समझौता व्युत्क्रमण एक मध्य-स्तरीय संपत्ति नहीं है: सहमत LLM उत्तरों की सटीकता युग्म सटीकता का अनुसरण करती है
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · विश्लेषण रिलीज़ 10.5281/zenodo.24090584 · GitHub
प्रीप्रिंट, 9 नवंबर 2026। SSRN: 7682960। संग्रहीत प्रति: 10.5281/zenodo.24090580। डेटा और कोड: 10.5281/zenodo.24090584। PDF: agreement-inversion.pdf। PDF आधिकारिक है।
सार
जब दो प्रमुख मॉडल, अलग से पूछे जाने पर, SimpleQA के सबसे कठिन प्रश्नों में से एक के लिए समान उत्तर देते हैं, तो वह उत्तर आमतौर पर गलत होता है। 106 SimpleQA प्रश्नों में जहाँ जुलाई के मध्य-स्तरीय पैनल विफल रहे, 45 प्रमुख जोड़े बिना क्लाइंट-सेवित GPT भुजा के, जहाँ वेब खोज को बाहर नहीं रखा जा सकता, 691 समझौतों में से 96 पर सही हैं (13.9%)। केवल तब उत्तर देना जब दूसरा मॉडल सहमत हो, किसी लेबल या पैरामीटर की आवश्यकता नहीं है, और पहले के कार्य ने इस नियम की विफलताओं को मध्य-स्तरीय मॉडल को दिया। दोनों स्तरों पर जो मैंने मापा, सहमत उत्तरों की सटीकता जोड़ी की सटीकता का अनुसरण करती है, इसलिए प्रतिलोमन एक मध्य-स्तरीय संपत्ति नहीं है। सबसे कठिन पंचांश में, प्रत्येक स्तर के लिए समान तरीके से परिभाषित, सटीकता जुलाई में 17.3% और अगस्त में 15.5% है; सभी पाँच पंचांशों में, प्रत्येक जोड़ी की अपनी दोनों सटीकताओं से अपेक्षित सटीकता पर, प्रमुख जोड़े मध्य-स्तरीय जोड़ों से -0.2 अंक [-3.1, +2.7] से भिन्न होते हैं। डेटा SimpleQA हैं, ताज़े दो-कूद प्रश्न और उत्पाद तथ्य, जुलाई, अगस्त और अक्टूबर 2026 में ग्यारह प्रयोगशालाओं के प्रमुख मॉडल के साथ एकत्र किए गए। दूसरी प्रयोगशाला से एक साथी अधिक त्रुटियाँ पकड़ता है लेकिन गेट को कम बार खोलता है: एक जारी किए गए मॉडल के लिए, एक ही-प्रयोगशाला साथी 29 त्रुटियों में से 2 पकड़ता है और दूसरी प्रयोगशाला का साथी 29 में से 20 पकड़ता है (-62.1 अंक [-79.3, -43.8]), प्रश्नों के 96% और 61% पर गेट खुला। जब विस्तृत गेट को समान कवरेज के लिए कथित आत्मविश्वास द्वारा पतला किया जाता है, यह लाभ केवल वहीं होता है जहाँ साथी का मॉडल कहीं अधिक सटीक हो। मापी गई सटीकताओं को खिलाया गया एक छोटा मॉडल बाहर-के-नमूने सटीकता की भविष्यवाणी करता है, जिसमें माध्य पूर्ण त्रुटि 0.037 है, सर्वोत्तम एकल मॉडल के लिए 0.099 के विरुद्ध, 0.032 पर स्वतंत्र-त्रुटि आधारभूमि के स्तर पर, और उत्पाद तथ्य और सार्वजनिक डेटा पर उच्च चलता है। उसी 100 प्रश्नों पर पहचानकर्ता gpt-5.6-sol अपनी क्लाइंट-सेवित लहर में 92.0% स्कोर करता है और दूसरे प्रयास सेटिंग पर API के माध्यम से 46.3%, जबकि आठ अन्य मॉडल सबसे अधिक 4 अंक से गतिमान होते हैं।
1. परिचय
दो बड़े भाषा मॉडल (LLMs) को विभिन्न प्रयोगशालाओं से अलग से एक ही संक्षिप्त तथ्यात्मक प्रश्न पूछें, और उत्तर को केवल तभी जारी करें जब दोनों मेल खाएं। गेट को किसी लेबल, थ्रेसहोल्ड या न्यायाधीश की आवश्यकता नहीं है, केवल दो अंधे कॉल की आवश्यकता है। प्रमुख मॉडल इसे आकर्षक बनाते हैं, क्योंकि उनके बताए गए विश्वास में बहुत कम सुरक्षा है: अगस्त 2026 में दस प्रमुख शाखाओं में, 10,540 में से 4,910 उत्तर जो कम से कम 80 के विश्वास के साथ बताए गए थे वे गलत थे (Chernets, 2026b)।
मेरे पहले माप ने मालिकाना मॉडल पर, जुलाई 2026 के मध्य-स्तरीय मॉडल के संग्रह पर, SimpleQA के सबसे कठिन क्विंटाइल पर प्रतिलिपि किए गए पैनल उत्तर 342 अवसरों में से 0 पर सही पाए (Chernets, 2026a)। यह सुझाता है कि कमजोर मॉडलों के लिए समझौता उलट जाता है, ताकि सहमत उत्तर अक्सर सही से अधिक गलत हों, और मजबूत मॉडल बच जाएं। एक प्रमुख जोड़ी ने इसकी पुष्टि करने के लिए दिखाई दिया: gpt-5.6-sol के साथ claude-fable-5 उन्हीं प्रश्नों पर सहमतियों के 37 में से 34 पर सही था (Section 3 के 106)।
प्रमुख स्तर पर यह पाठ धारण नहीं करता। 37 में से 34 के पीछे की एकल शाखा के बिना, gpt-5.6-sol अपने विक्रेता क्लाइंट के माध्यम से परोसा गया, उलट वापस आता है, और कठिनाई के साथ दोनों स्तरों के लिए समान रूप से परिभाषित किया जाता है, दोनों वक्र कठिन अंत में मिलते हैं। सभी क्विंटाइलों में, एक बार प्रत्येक जोड़ी की दोनों सटीकताएं ध्यान में आ जाती हैं, प्रमुख और मध्य-स्तरीय जोड़ियां -0.2 अंकों [-3.1, +2.7] से भिन्न होती हैं। सटीकता यह ट्रैक करती है कि दोनों मॉडल स्तर पर कितने सटीक हैं, उनके स्तर की परवाह किए बिना।
तालिका 1 चार योगदान का सारांश देती है। Section 5.1 प्रमुख स्तर का एक गेट-स्तरीय खाता देता है, जहां संभव हो वहां उस शाखा के बिना बनाया गया जो सटीकता श्रेणी का प्रभुत्व करती है। Section 5.2 मापता है कि दूसरी प्रयोगशाला क्या योगदान देती है, जारी किए गए मॉडल और साथी में विविधता लाते हुए, GPT के साथ और इसके बिना। Sections 4 और 5.3 पाँच स्थिरांक के साथ गेट का एक वर्णनात्मक मॉडल देते हैं और इसे बताए गए आधारों के विरुद्ध नमूने से बाहर परीक्षण करते हैं, और Section 5.4 समान पहचानकर्ता पर समान प्रश्नों के लिए विक्रेता क्लाइंट की तुलना सीधी API पहुंच से करता है।
तालिका 1। दावे, साक्ष्य और सीमा।
| दावा | साक्ष्य | सीमा |
|---|---|---|
| सहमत उत्तरों की सटीकता दोनों स्तरों पर जोड़ी की सटीकता का अनुसरण करती है | 106 पर 96/691; सबसे कठिन क्विंटाइल 17.3% जुलाई, 15.5% अगस्त; मिलाई गई सटीकता पर स्तर -0.2 [-3.1, +2.7] | जुड़ाव; एक क्विंटाइल अकेली -1.8 [-22.1, +20.2] तक फैली है |
| दूसरी प्रयोगशाला कवरेज की कीमत पर अधिक त्रुटियां पकड़ती है | 20/29 2/29 त्रुटियों के विरुद्ध पकड़ी गई, -62.1 [-79.3, -43.8]; कवरेज 61% बनाम 96% | समान कवरेज पर, विश्वास से, इसे कहीं अधिक सटीक साथी की आवश्यकता है; अक्टूबर में दो प्रयोगशालाएं |
| एक छोटा मॉडल नमूने से बाहर सटीकता का वर्णन करता है | त्रुटि 0.037 बनाम 0.099 सर्वश्रेष्ठ मॉडल के लिए, -0.062 [-0.085, -0.035] | स्वतंत्र त्रुटियों के साथ स्तर, +0.005 [-0.003, +0.012]; उत्पाद तथ्यों पर 13 अंक अधिक |
| एक्सेस मोड एक पहचानकर्ता को स्थानांतरित करता है | 92.0% क्लाइंट बनाम 46.3% API, समान 100 प्रश्न | मोड, प्रयास और संभावित खोज एक साथ बदलती है |
2. संबंधित कार्य
मेरे प्रश्न के सबसे निकट Goel et al. (2025) हैं, जो CAPA का परिचय देते हैं, जो मॉडल के आउटपुट वितरण के बीच समझौते का एक संयोग-समायोजित माप है, और 130 खुले वजन वाले मॉडल पर MMLU-Pro और BBH पर दिखाते हैं कि त्रुटियाँ क्षमता के साथ अधिक समान हो जाती हैं, जिसे वे तर्क देते हैं कि AI निरीक्षण, LM जूरी सहित, जोखिम में डालता है। मैं अलग-अलग प्रयोगशालाओं के स्वामित्व वाले मॉडल के लिए मापता हूँ कि अंधी समझौता क्या प्रमाणित करता है जब यह एक संक्षिप्त खुले रूप के उत्तर की रिहाई को नियंत्रित करता है: सहमत उत्तरों की सटीकता, जारी किए गए मॉडल की त्रुटियों का वह हिस्सा जो असहमति उजागर करती है, और साझा आत्मविश्वास त्रुटियों का तल। परिणाम संगत हैं: मेरे डेटा में बढ़ती समानता की लागत असहमति की recall में दिखाई देती है, जबकि precision वहाँ अधिक रहता है जहाँ accuracy अधिक है (परिशिष्ट L)। समझौता-आधारित cascading (Kolawole et al., 2025) एक शर्त के साथ स्वीकृत त्रुटियों की संयुक्त दर पर ensemble समझौते का उपयोग एक प्रशिक्षण-मुक्त deferral नियम के रूप में करता है, और मेरे स्तरीकृत परिणाम वह स्थान निर्धारित करते हैं जहाँ ऐसी त्रुटियाँ केंद्रित होती हैं।
providers के पार संबंधित त्रुटियों को Kim et al. (2025) द्वारा दस्तावेज़ित किया गया है, और Hossain et al. (2026) उन्हें frontier LLM judges के बीच अधिक मजबूत पाते हैं। विविध छोटे judges की जूरी Verga et al. (2024) में दिखाई देती है, और एक मॉडल के अपने आउटपुट का न्याय करने का पूर्वाग्रह Panickssery et al. (2024) में दिखाई देता है, जो दो अंधे उत्तरों की तुलना करना पसंद करता है। एक मॉडल के नमूनों के बीच समझौता self-consistency में एक आत्मविश्वास संकेत है (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) और semantic uncertainty (Kuhn et al., 2023) में, और Yue et al. (2024) में एक deferral नियम है; मैं इसकी laboratories के बीच समझौते के साथ तुलना करता हूँ (खंड 5.2)। gate एक selective predictor है (Geifman & El-Yaniv, 2017), इसलिए मैं समान coverage पर gates की तुलना करता हूँ। हाल के preprints इस बात पर असहमत हैं कि क्या aggregation मदद करता है (परिशिष्ट E)। मुझे कोई कार्य ज्ञात नहीं है जो pair स्तर पर एक release gate की रिपोर्ट करता है संक्षिप्त खुले रूप के तथ्यों के लिए proprietary flagships पर, एक जारी किए गए मॉडल को fixed रखते हुए समान coverage पर recall, या एक ही प्रश्नों पर दो access modes में मापा गया एक identifier।
3. डेटा और प्रोटोकॉल
मेरे पहले के कार्य ने जुलाई पैनल (Chernets, 2026a) और अगस्त और अक्टूबर समुच्चय को चुनी हुई जोड़ियों के लिए (Chernets, 2026c) की रिपोर्ट दी है। यहाँ नई चीजें GPT के बिना प्रमुख जोड़ियाँ हैं, कठिनाई की सममितीय परिभाषा, एक ही प्रयोगशाला की जोड़ियाँ, समान कवरेज पर तुलनाएं, नमूने से बाहर की परीक्षाएं और बाहरी परीक्षाएं और पहुँच-विधि तुलना।
संग्रह। सभी उत्तर अंध रूप से एकत्र किए गए थे: प्रति प्रश्न एक कॉल, कोई भी मॉडल दूसरे के उत्तर को नहीं देख रहा था। सिस्टम प्रॉम्प्ट एक JSON ऑब्जेक्ट के लिए कहता है जिसमें एक संक्षिप्त उत्तर और 0 से 100 तक का आत्मविश्वास हो और स्रोत के लिए नहीं कहता है। तालिका A1 मॉडल, तारीखें और पहुँच विधियों को सूचीबद्ध करती है, और परिशिष्ट F संग्रह पूर्ण रूप से सूचीबद्ध करता है। नौ API मॉडल और सात स्थानीय मॉडल ने 1,500 SimpleQA प्रश्नों (Wei et al., 2024) का उत्तर दिया 24 से 28 जुलाई को, डेटा संग्रह से पहले OSF पर पंजीकृत (Chernets, 2026a)। ग्यारह प्रयोगशालाओं में से प्रत्येक से एक प्रमुख ने 3 से 6 अगस्त को एक ही प्रश्नों का उत्तर दिया, 1,459 सभी के लिए सामान्य, और उनमें से नौ ने इनमें से 100 का उत्तर 0.7 तापमान पर तीन नमूनों के साथ दिया (विचरण भुजा)। जोड़े गए थे 100 दो-हॉप प्रश्न Wikidata से मशीन द्वारा रचित, फाइल हैश पहली मॉडल कॉल से पहले निर्धारित के साथ, और 267 उत्पाद तथ्य। अक्टूबर में gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 और claude-fable-5-1 ने 300 SimpleQA प्रश्नों का उत्तर दिया जुलाई क्विंटाइल द्वारा स्तरीकृत, 106 नीचे और ताजा समुच्चय, तीन असंयुक्त समुच्चय जिनमें 503 प्रश्न सभी पाँच मॉडल के लिए सामान्य हैं (तालिका A2 में हर जोड़ी उन पर है)।
106। ये सबसे कठिन-क्विंटाइल प्रश्न हैं जिन पर एक जुलाई पैनल ने एक उत्तर को दोहराया (Chernets, 2026a)। उन्हें जुलाई मॉडल की विफलता पर चुना गया था, इसलिए जुलाई सटीकता उन पर आंशिक रूप से चयन का एक उत्पाद है, और अनुभाग 5.1 उन्हें कठिनाई की एक सममितीय परिभाषा के साथ जोड़ता है जो इस संपत्ति को वहन नहीं करती है।
पहुँच विधियाँ। अगस्त में, claude-fable-5, gpt-5.6-sol और mistral-medium-3.5 विक्रेता के स्वयं के पहले-पक्ष क्लाइंट के माध्यम से चलाए गए, आधिकारिक कमांड-लाइन एजेंट जो अंतिम उपयोगकर्ता तैनात करते हैं, और अक्टूबर में हर भुजा ने किया, इसलिए माप विक्रेता-पक्षीय सिस्टम प्रॉम्प्ट और विक्रेता को सेवा प्रदान करने वाले डिफ़ॉल्ट को शामिल करते हैं जैसा कि क्लाइंट का एक उपयोगकर्ता उन्हें प्राप्त करता है। जुलाई लहर और शेष अगस्त भुजाओं ने सीधे API या एकत्रकर्ता मार्ग का उपयोग किया जो विक्रेता तक सीमित थे। तालिका 2 क्लाइंट भुजाओं के माप की शर्तें बताती है। मैं एक भुजा को खोज-संभव कहता हूँ जब इसका वेब खोज का उपयोग बाहर नहीं किया जा सकता है, और मैं ऐसी भुजाओं के साथ और उनके बिना मुख्य परिणाम रिपोर्ट करता हूँ।
तालिका 2। भुजा के अनुसार माप की शर्तें। नोट: Codex और Claude क्लाइंट में तापमान निर्धारित नहीं है; Codex ईवेंट स्ट्रीम को नहीं रखा गया था। जुलाई और अगस्त लहरों की API भुजाएं 0 तापमान पर चलीं। एक डैश कोई सेटिंग या रिकॉर्ड में कोई प्रविष्टि नहीं दर्शाता है।
| भुजा | तक पहुँचा गया | प्रयास | खोज संभव |
|---|---|---|---|
| gpt-5.6-sol, अगस्त | Codex क्लाइंट | क्लाइंट डिफ़ॉल्ट, रिकॉर्ड नहीं किया गया | बाहर नहीं किया गया |
| claude-fable-5, अगस्त | Claude क्लाइंट | - | नहीं, 0 खोज अनुरोध रिकॉर्ड किए गए |
| mistral-medium-3.5, अगस्त | विक्रेता क्लाइंट | - | नहीं, खाली उपकरण सूची |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, अक्टूबर | Codex क्लाइंट | मध्यम | बाहर नहीं किया गया |
| claude-opus-5-5, claude-fable-5-1, अक्टूबर | Claude क्लाइंट | - | नहीं, उपकरण निषिद्ध हैं |
| kimi-k3, gemini-3.8-flash, ताजा समुच्चय | विक्रेता क्लाइंट | - | उपकरण अक्षम नहीं हैं, प्रॉम्प्ट वर्जन करता है |
| gpt-5.6-sol, विचरण भुजा | सीधा API | कोई नहीं | - |
गेट और मापन। गेट खुलता है जब दोनों मॉडल उत्तर देते हैं, कोई भी इनकार नहीं करता, और एक नियतात्मक तुल्यता इंजन, यहाँ हर लहर के लिए वही, दोनों उत्तरों को तुल्य पाता है। ग्रेडिंग एक ही इंजन को उत्तर और सोने के उत्तर पर लागू करती है: सामान्यीकृत सटीक मिलान, चार या अधिक वर्णों की स्ट्रिंग्स की अंतर्निहिति, और तारीखों, संख्याओं और पहचानकर्ताओं के लिए नियम (परिशिष्ट D, तालिका A3 में एक पुनः स्कोरिंग के साथ)। एक कक्ष एक प्रश्न की परत पर मॉडल की एक जोड़ी है। कवरेज खुले गेटों की संख्या दोनों मॉडल ने जवाब दिए जो प्रश्न हैं। सटीकता, PPV, खुले उत्तरों के बीच सही का हिस्सा है जो ग्रेडर सही या गलत के रूप में हल करता है (K/O), और डेल्टा सटीकता माइनस कक्ष के सभी हल किए गए प्रश्नों पर जारी किए गए मॉडल की सटीकता है। रिकॉल जारी किए गए मॉडल की त्रुटियों का हिस्सा है जिस पर गेट बंद रहता है, पकड़ी हुई त्रुटियों के रूप में रिपोर्ट किया गया है। लिफ्ट जारी किए गए मॉडल की सटीकता को गेट खुले के साथ उस के साथ विभाजित करता है गेट बंद के साथ, और फर्श उन प्रश्नों की गिनती करता है जिन पर दोनों मॉडल कम से कम 80 का आत्मविश्वास बताते हैं, सहमत होते हैं, और गलत हैं। मैं समझौते को उलटा कहता हूँ जब PPV आधे से नीचे होता है। जारी किया गया मॉडल जोड़ी का पहला सदस्य है, या अधिक सटीक वाला जब जोड़ियों को पूल किया जाता है। समान कवरेज पर गेटों की तुलना करने के लिए मैं व्यापक गेट को पतला करता हूँ: खुले उत्तरों को दो बताए गए आत्मविश्वास के छोटे के द्वारा स्थान दिया जाता है और लक्ष्य कवरेज तक काटा जाता है, संबंध यादृच्छिक रूप से टूटे हुए।
अनुमान। एकल अनुपात विल्सन अंतराल ले जाते हैं। अंतर और व्युत्पन्न मात्रा 95% बूटस्ट्रैप अंतराल ले जाते हैं, प्रश्न और मॉडल पर दो-तरफा पूल किए गए परिणामों के लिए (Owen, 2007; B = 2000, बीज निर्धारित, प्रत्येक प्रतिकृति में मॉडल को फिट किया जाता है) और एकल जोड़ी के लिए प्रश्न पर। जोड़ी सटीकता तुलनाएं सटीक McNemar परीक्षा का उपयोग करती हैं, और तुल्यता एक दो एक-पक्षीय परीक्षा (Schuirmann, 1987) 2 अंकों के मार्जिन के साथ। कक्ष निर्भर हैं, इसलिए वे अंतराल ले जाते हैं और कोई p मान नहीं।
4. गेट का एक मॉडल
माना और एक कोशिका पर दो मॉडलों की मापी गई सटीकता हैं और । माना दोनों के गलत होने की प्रायिकता है और दोनों के सही होने की प्रायिकता है:
यहाँ संयुक्त त्रुटि की स्वतंत्र दर को बढ़ाता है। दो सही उत्तर की प्रायिकता के साथ मेल खाते हैं। दो गलत उत्तर की प्रायिकता के साथ मेल खाते हैं, जहाँ 106 पर है, जिसके गलत उत्तर अधिक बार टकराते हैं, और अन्यत्र 1 है। फिर
335 जोड़ी-कोशिकाओं (जुलाई, अगस्त और अक्टूबर, उनमें से 106; सभी अनुकूलित कोशिकाओं पर दो सही उत्तरों का मिलान दर है) पर अनुकूलित, स्थिरांक हैं , , , (22,536 में से 22,785) और ।
यह मॉडल कोशिका की मापी गई सटीकताओं को इनपुट के रूप में लेता है और कवरेज, सटीकता और गलत सहमत उत्तरों का हिस्सा, , लौटाता है, जिसमें से अनुभाग 3 का आधार कम से कम 80 के आत्मविश्वास के साथ भाग है। दो सटीकताएं दी जाने पर, यह दिखाता है कि गेट क्या जोड़ता है, और यह दिखाता है कि सटीकता शीर्ष पर सटीकता का पालन क्यों करना चाहिए: के साथ और सही उत्तरों का मिलान, सहमत उत्तरों की सटीकता से नीचे नहीं जा सकती, भले ही हर त्रुटि साझा हो, क्योंकि दोनों मॉडल कम से कम प्रश्नों पर एक साथ सही हैं और अधिकतम पर एक साथ गलत हैं ( पर 0.947)। पर कोई सीमा नहीं है, और को पार कर सकता है जब गलत उत्तर एक ही स्ट्रिंग पर केंद्रित हों।
मैं इसकी तुलना दो आधारभूत स्थितियों से करता हूँ। स्वतंत्र-त्रुटियाँ आधारभूत स्थिति सेट करती है और शेष को फिर से अनुकूलित करती है, इसलिए यह को बनाए रखती है। सर्वश्रेष्ठ-मॉडल आधारभूत स्थिति का अनुमान लगाती है। मानदंड यह था कि मॉडल दोनों को हराए, अंतर का अंतराल शून्य से नीचे हो, लैब छोड़ो (LOLO), मॉडल छोड़ो (LOMO) और जुलाई और अगस्त से अक्टूबर तक का एक अस्थायी विभाजन के तहत।
5. परिणाम
5.1 व्युत्क्रम एक मध्य-स्तरीय गुण नहीं है
तालिका 3 क्लाइंट-सेवित GPT आर्म्स के बिना गेट प्रदान करती है। SimpleQA के संपूर्ण पर दोनों स्तर समान दिखते हैं: जुलाई में 72.1% और अगस्त में 80.6% की सटीकता, रिलीज़ किए गए मॉडल के विरुद्ध +28.6 और +26.0 अंक का डेल्टा। 106 पर दोनों लहरों में सटीकता कम है: जुलाई में 717 में से 5 और अगस्त में 691 में से 96 GPT के बिना। जुलाई की ओर से भी GPT आर्म को बाहर करने से 581 में से 4 मिलता है, और अगस्त माइनस जुलाई का अंतर +13.2 अंक [+2.6, +30.8] है। अगस्त की सटीकता अधिक है और अभी भी आधे से बहुत नीचे है, इसलिए समझौता दोनों लहरों में व्युत्क्रम है। यह स्ट्रेटम पर सर्वश्रेष्ठ एकल आर्म से भी कम है, जुलाई में -9.5 अंक [-16.3, -3.2] और अगस्त में -43.2 [-67.6, -16.1]। GPT के बिना जुलाई में लिफ्ट 0.13 [0.00, 1.21] है और अगस्त में 0.65 [0.23, 1.22] है।
तालिका 3। क्लाइंट-सेवित GPT आर्म्स के बिना गेट। नोट: विभिन्न प्रयोगशालाओं की जोड़ियों पर पूलित यदि अन्यथा कहा न हो; कवरेज उन प्रश्नों पर है जिनका दोनों मॉडल ने उत्तर दिया, K/O ग्रेडर द्वारा हल किए गए खुले उत्तरों पर; PPV पर अंतराल: दो-तरफा बूटस्ट्रैप। उत्पाद तथ्य: खोज संभावना के बिना चार आर्म्स।
| स्तर, प्रश्न | जोड़ियाँ | कवरेज | PPV (K/O) [95%] | रिलीज़ की गई सटीकता | डेल्टा, अंक [95%] |
|---|---|---|---|---|---|
| मध्य, जुलाई, 106 | 36 | 19.8% | 0.7% (5/717) [0.0, 3.7] | 4.6% | -3.9 [-8.3, +0.3] |
| मध्य, जुलाई, सभी SimpleQA | 36 | 20.6% | 72.1% (7743/10745) [53.2, 82.3] | 43.4% | +28.6 [+22.3, +32.4] |
| प्रमुख, अगस्त, 106, खोज-संभव आर्म के बिना | 45 | 19.1% | 13.9% (96/691) [3.3, 31.8] | 19.9% | -6.0 [-14.1, +2.9] |
| प्रमुख, अगस्त, सभी SimpleQA, खोज-संभव आर्म के बिना | 45 | 29.1% | 80.6% (12357/15322) [69.6, 87.9] | 54.7% | +26.0 [+19.9, +30.7] |
| प्रमुख, अगस्त, ताजा 100 (API द्वारा GPT) | 6 | 37.5% | 88.9% (200/225) [75.6, 97.4] | 66.8% | +22.1 [+7.9, +47.4] |
| समान प्रयोगशाला, अक्टूबर, fable-5-1 + opus-5-5, 106 | 1 | 39.6% | 47.5% (19/40) | 30.0% | +17.5 [+6.2, +29.7] |
| अक्टूबर, kimi-k3 + gemini-3.8-flash, ताजा 100 (उपकरण अक्षम नहीं) | 1 | 72.0% | 95.8% (69/72) | 74.0% | +21.8 [+14.1, +30.0] |
| उत्पाद तथ्य, 267, खोज-संभव आर्म के बिना | 6 | 63.6% | 75.0% (423/564) [66.4, 82.7] | 62.7% | +12.3 [+5.8, +20.4] |
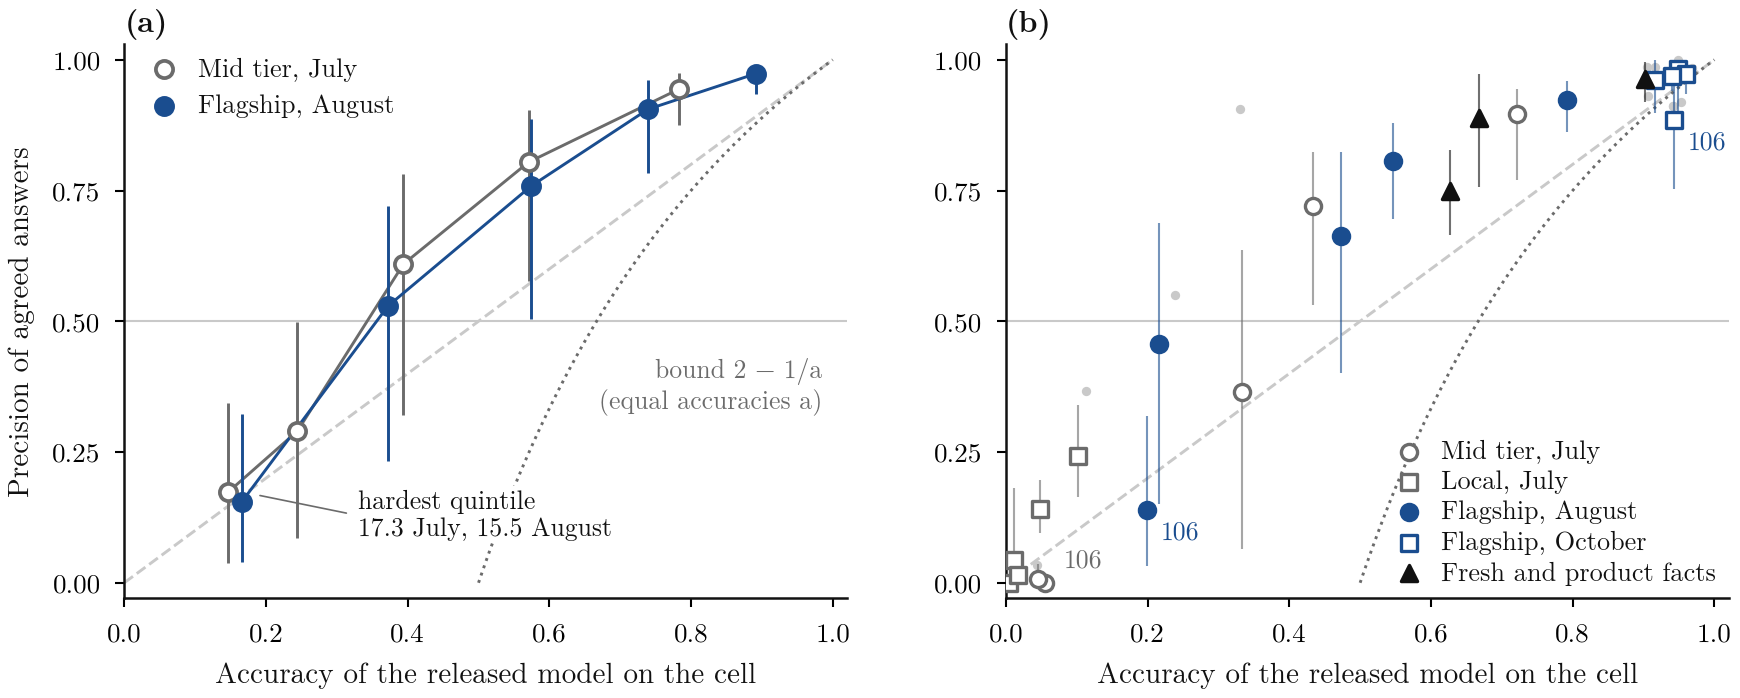
चित्र 1। सहमत उत्तरों की सटीकता जोड़ी की सटीकता का पालन करती है। नोट: (a) जुलाई मध्य स्तर और अगस्त प्रमुख स्तरों में क्लाइंट-सेवित GPT आर्म्स के बिना प्रत्येक स्तर के भीतर कठिनाई के क्विंटाइल। (b) जुलाई से अक्टूबर तक प्रत्येक बैंड का प्रत्येक स्तर, रिलीज़ की गई मॉडल की सटीकता के विरुद्ध; लेबल किए गए कक्ष 106 हैं। व्हिस्कर 95% बूटस्ट्रैप अंतराल हैं, और (b) में छोटी ग्रे डॉट्स एकल जोड़ियाँ हैं; डैश की गई रेखा समता है, बिंदीदार रेखा सीमा 2 - 1/a समान सटीकताओं a के लिए है।
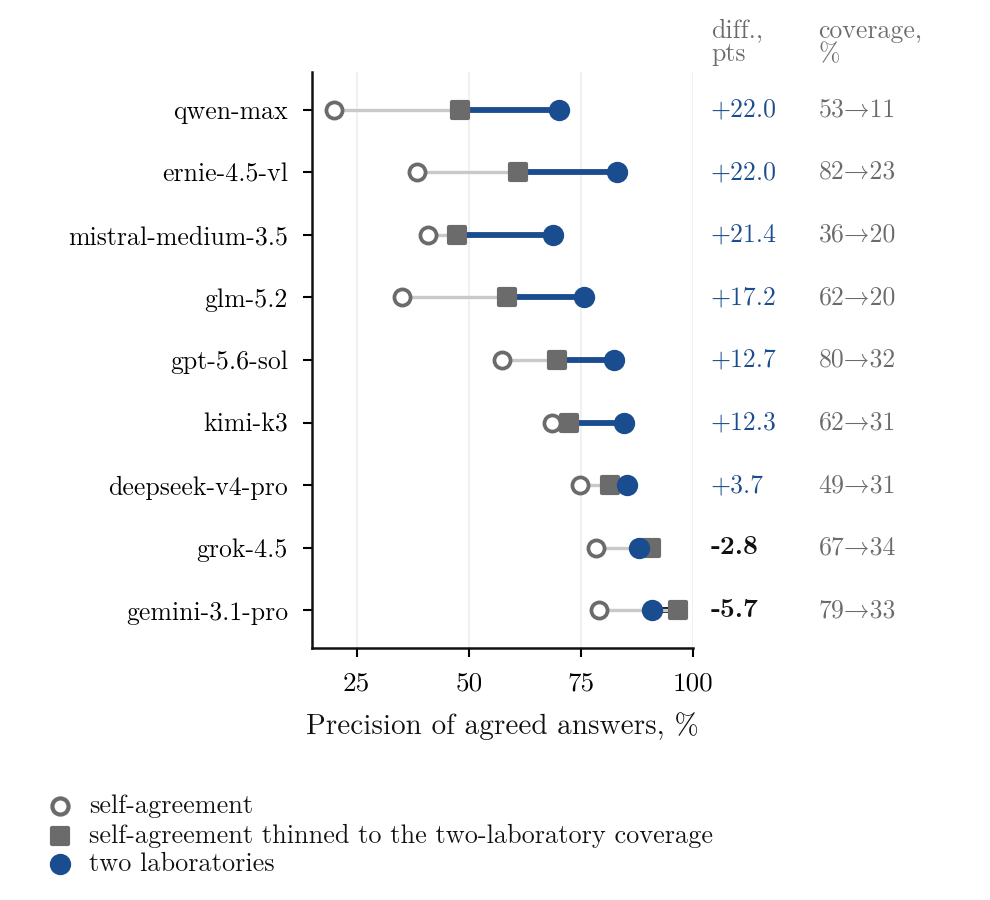
चित्र 2। मॉडल के आधार पर दो प्रयोगशालाओं के विरुद्ध स्व-समझौता। नोट: विचरण आर्म, नौ मॉडल, 100 प्रश्न। खुला वृत्त, एक मॉडल के लिए दो कॉल; वर्ग, दो-प्रयोगशाला गेट की कवरेज के लिए आत्मविश्वास से पतला किया गया; भरा हुआ वृत्त, दो प्रयोगशालाएँ, भागीदारों पर माध्य। दाएँ कॉलम समान कवरेज पर अंतर, अंकों में, और दोनों गेट की कवरेज, प्रतिशत में देते हैं।
क्लाइंट-सेवित GPT आर्म के बिना तीन-मॉडल पैनल समान परिणाम देते हैं। मेरे इंजन के तहत 106 पर जुलाई पैनल 318 में से 0 देते हैं (अनुभाग 1 का 342 में से 0 पहले के मिलान नियम के तहत कठिनतम क्विंटाइल है; ऊपर 717 में से 5 जोड़ियों की गणना करता है)। अगस्त में DeepSeek, Qwen और Kimi का पैनल 76 में से 0 देता है और Claude, DeepSeek और Mistral का क्रॉस-ब्लॉक पैनल 78 में से 11 देता है (14.1% [2.7, 26.3]), जबकि Claude, GPT और Gemini का पैनल, जो GPT आर्म रखता है, 131 में से 106 देता है (80.9%)। प्रमुख जोड़ियाँ स्ट्रेटम पर अपनी सटीकता के साथ पंक्तिबद्ध होती हैं, fable-5 को deepseek-v4-pro के साथ के लिए 21 में से 4 से लेकर fable-5 को gemini-3.1-pro के साथ के लिए 24 में से 15 (62.5% [42.6, 82.6]) तक, जिनके सदस्य इस समूह का नेतृत्व करते हैं।
क्योंकि 106 को जुलाई की विफलता पर चुना गया था, जो उन पर जुलाई की सटीकता को कम करता है और अगस्त के पक्ष में है, चित्र 1a प्रत्येक स्तर के भीतर कठिनाई निर्धारित करता है। प्रत्येक स्तर के लिए, प्रश्नों को मूल्यांकन के तहत जोड़ी को छोड़कर समान स्तर की सटीकता से क्विंटाइल में क्रमित किया जाता है, इसलिए कठिनतम क्विंटाइल प्रत्येक के लिए समान रैंक रखता है, और रिलीज़ की गई मॉडल की सटीकता वहाँ करीब है, जुलाई में 15.3% और अगस्त में 16.0%। वहाँ सटीकता GPT के बिना जुलाई में 917 में से 159 (17.3% [3.8, 34.3]) और अगस्त में 1,308 में से 203 (15.5% [4.0, 32.4]) है, -1.8 अंकों का अंतर [-22.1, +20.2]। सभी पाँचों क्विंटाइलों को पूलित करने से तीव्र परीक्षण मिलता है। अनुभाग 4 का मॉडल कोई स्तर अवधि नहीं रखता है। प्रत्येक कक्ष की दोनों सटीकताओं को देखते हुए, यह वहाँ अपेक्षित सटीकता आपूर्ति करता है, और स्तर प्रभाव अवशेषों में अंतर के रूप में दिखाई देगा। प्रमुख कक्ष मध्य-स्तर कक्षों से -0.2 अंक [-3.1, +2.7] पर बैठते हैं, और -0.5 [-3.6, +2.4] जब स्थिरांक केवल जुलाई कक्षों पर फिट किए जाते हैं, ताकि अगस्त नमूने से बाहर हो। kimi-k3 दोनों संग्रहों से संबंधित है; इसके बिना अंतर +0.1 [-3.6, +3.8] है। साफ किए गए सोने के उत्तरों पर सटीकता कम रहती है: 106 के 24 पर जो SimpleQA Verified में रहते हैं (Haas et al., 2025), अगस्त की जोड़ियाँ GPT के बिना समझौतों के 18.7% पर सही हैं [0.0, 57.1] (परिशिष्ट G)।
प्रत्येक स्तर की प्रत्येक बैंड (चित्र 1b) में, सटीकता प्रत्येक लहर में रिलीज़ की गई मॉडल की सटीकता के साथ बढ़ती है और 23 कक्षों में से 17 पर विकर्ण के ऊपर है। इसके नीचे छह में से, तीन 106 कक्ष हैं और तीन रिलीज़ की गई सटीकता 0.06 के तहत बैंड हैं। शीर्ष पर, kimi-k3 और gemini-3.8-flash ताजा सेट पर 95.8% तक पहुँचते हैं (परिशिष्ट G)।
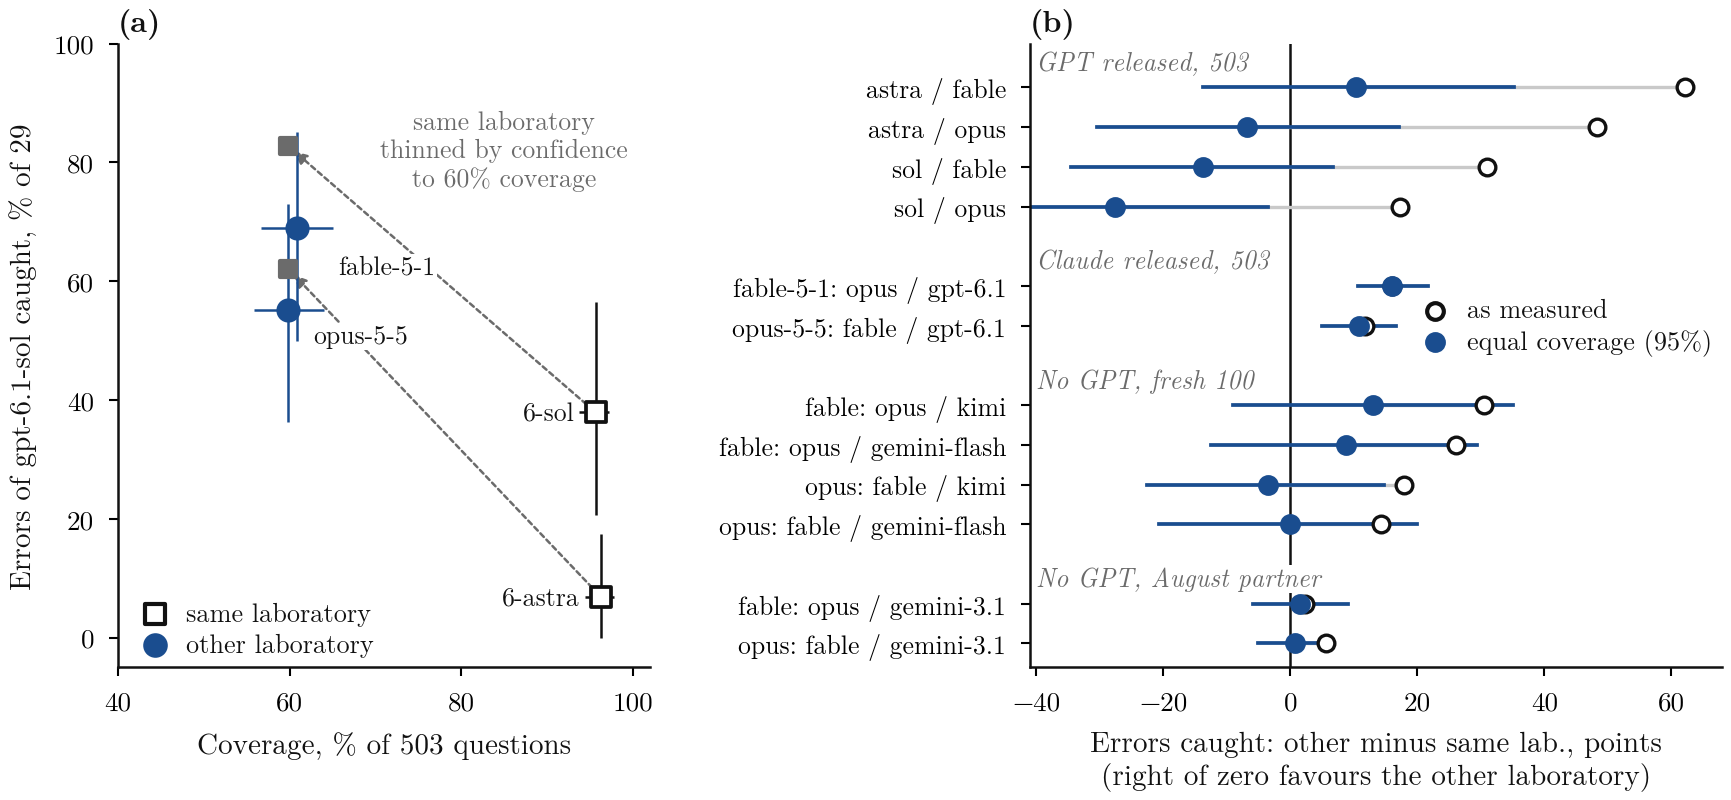
चित्र 3. एक दूसरी प्रयोगशाला: कवरेज और पकड़ी गई त्रुटियाँ। नोट: (a) gpt-6.1-sol 503 सामान्य प्रश्नों पर, 29 त्रुटियाँ, तालिका A4 के चार भागीदार, 95% bootstrap अंतराल; तीर समान-प्रयोगशाला गेट से समान गेट तक जाते हैं जिसे आत्मविश्वास द्वारा 60% कवरेज तक पतला किया गया है। (b) तालिका A5 की बारह तुलनाएँ: अन्य प्रयोगशाला द्वारा पकड़ी गई त्रुटियाँ माइनस समान प्रयोगशाला, जैसा कि मापा गया (खुला) और समान कवरेज पर (भरा, 95% प्रश्न bootstrap)।
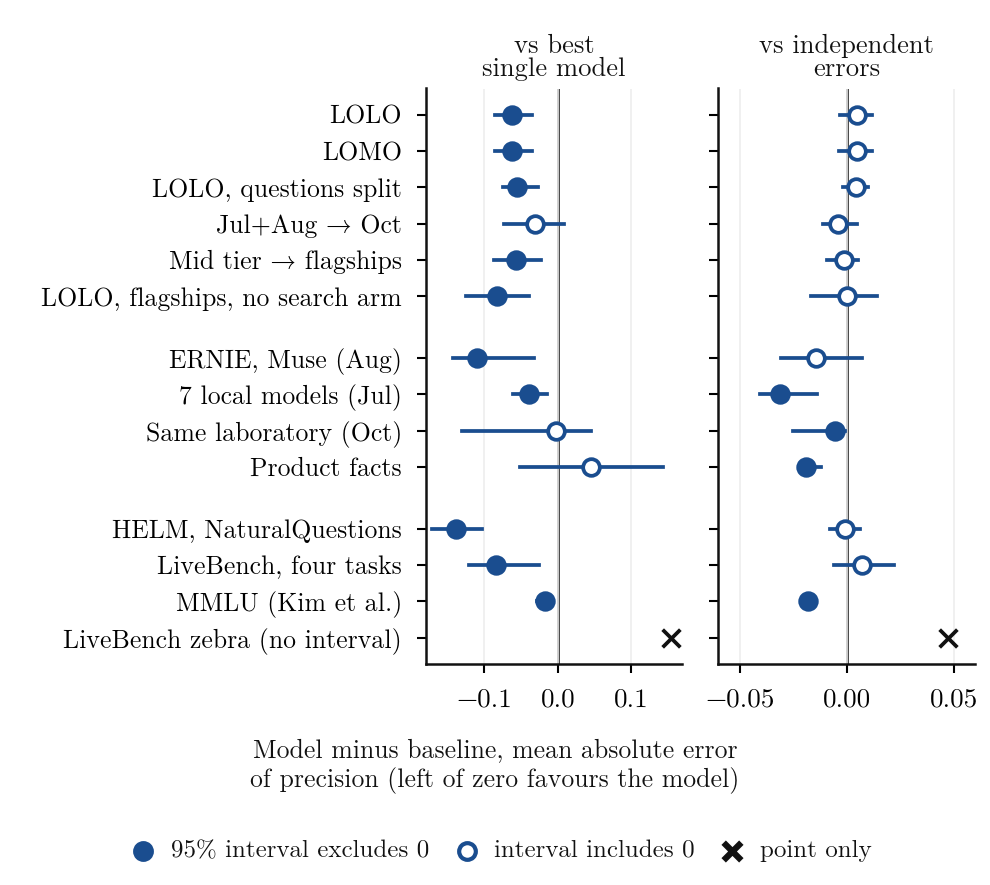
चित्र 4. दो आधारभूत के विरुद्ध मॉडल, नमूने से बाहर। नोट: अनुमानित सटीकता की माध्य निरपेक्ष त्रुटि में मॉडल माइनस आधारभूत, शून्य से नीचे मॉडल का पक्ष लेता है, 95% दो-तरफा bootstrap अंतराल के साथ (तालिका A6 और A8)। शीर्ष समूह, फिटिंग योजनाएँ; मध्य, फिट के बाहर सेट स्थिरांक जमे हुए के साथ; नीचे, सार्वजनिक डेटा (खंड 5.5)। भरा हुआ मार्कर, 95% अंतराल शून्य को छोड़ता है; खुला, यह शून्य को शामिल करता है; क्रॉस, एक बिंदु अनुमान (LiveBench zebra कार्य)।
5.2 एक दूसरी प्रयोगशाला अधिक त्रुटियाँ पकड़ती है, कवरेज की कीमत पर
अकेली सटीकता मामलों को अलग नहीं कर सकती, क्योंकि एक प्रयोगशाला से सटीक जोड़े में भी उच्च सटीकता होती है। रिकॉल को कवरेज के साथ पढ़ना पड़ता है, क्योंकि एक गेट जो कम बार खुलता है वह निर्माण द्वारा अधिक त्रुटियों को रोकता है।
मैं विचरण भुजा के साथ शुरू करता हूँ: तापमान 0.7 पर एक मॉडल के लिए दो कॉल, दो अलग-अलग प्रयोगशालाओं के विरुद्ध (चित्र 2)। नौ मॉडल और 100 प्रश्नों पर पूल किया गया, स्व-समझौता 56.1% की सटीकता पर 63.5% को कवर करता है, और दो प्रयोगशालाएँ 82.9% पर 26.1% को कवर करती हैं। सटीकता में अंतर +26.8 अंक [+16.6, +34.6] जैसा कि मापा गया है और +9.0 [+0.5, +17.4] समान कवरेज पर है, जहाँ स्व-समझौता आत्मविश्वास द्वारा पतला है, जो इसके पक्ष में है। मॉडल द्वारा, दो-प्रयोगशाला गेट नौ में से सात के लिए आगे ले जाता है। भुजा में कोई Claude मॉडल नहीं है और API द्वारा GPT है कोई प्रयास नहीं। GPT के बिना, आठ मॉडल पर, समान कवरेज पर अंतर +7.7 अंक [-1.9, +16.5] है।
अक्टूबर की लहर दो प्रयोगशालाओं में से प्रत्येक से दो मॉडल रखती है, जो 503 सामान्य प्रश्नों पर एक प्रत्यक्ष परीक्षण देती है (चित्र 3a)। एक जारी किया गया मॉडल, gpt-6.1-sol, हर पंक्ति में समान 29 त्रुटियों को बनाए रखता है और केवल भागीदार को बदलता है। इसका समान-प्रयोगशाला भागीदार gpt-6-astra उनमें से 2 को पकड़ता है और fable-5-1 20 को पकड़ता है, -62.1 अंक [-79.3, -43.8] का अंतर; opus-5-5 के विरुद्ध अंतर -48.3 [-66.7, -29.6] है। कीमत कवरेज है, 96% के विरुद्ध 60 से 61%। सटीकता पंक्तियों में समान है: समान प्रयोगशाला के लिए 94.3 और 96.2%, प्रयोगशालाओं में 95.6 और 97.0% (तालिका A4)। समान-प्रयोगशाला भागीदार व्यापक रूप से भिन्न होते हैं: gpt-6-sol 29 में से 11 को पकड़ता है (परिशिष्ट H)।
यह देखने के लिए कि क्या यह कवरेज वक्र के साथ एक चाल से अधिक है, और क्या इसे GPT की आवश्यकता है, चित्र 3b की प्रत्येक पंक्ति एक जारी किया गया मॉडल रखती है और इसके दो भागीदारों की तुलना करती है, जैसा कि मापा गया है और समान कवरेज पर (तालिका A5)। जैसा कि मापा गया है, अन्य प्रयोगशाला हर पंक्ति में अधिक त्रुटियों को पकड़ता है। समान कवरेज पर इसका लाभ केवल तब होता है जब Claude को gpt-6.1-sol के साथ भागीदार के रूप में जारी किया जाता है, एक भागीदार जिसकी सटीकता 93.9% है बनाम समतल सेट पर समान-प्रयोगशाला वाले के लिए 66.6 से 69.2%। GPT जारी होने पर, समान-प्रयोगशाला गेट आत्मविश्वास द्वारा पतला स्तर या आगे है, और GPT के बिना अंतर स्तर है, या कमजोर भागीदारों के विरुद्ध समान प्रयोगशाला का पक्ष लेता है। अक्टूबर में दो प्रयोगशालाओं के साथ मैं प्रयोगशाला के प्रभाव का पता लगाता हूँ केवल भागीदार सटीकता और कवरेज से परे, और HELM, 20 डेवलपर्स के साथ, जब दोनों मेल खाते हैं तो कोई नहीं दिखाता है (खंड 5.5)।
5.3 नमूने से बाहर मॉडल
नमूने से बाहर, मॉडल बेहतर मॉडल को पढ़ने पर स्पष्ट रूप से सुधार करता है और स्वतंत्र-त्रुटियों आधारभूत के साथ स्तर रखता है (चित्र 4, तालिका A6)। LOLO के तहत इसकी त्रुटि सर्वश्रेष्ठ-मॉडल आधारभूत के लिए 0.099 के विरुद्ध 0.037 है (-0.062 [-0.085, -0.035]), और यह अंतराल LOMO के तहत शून्य से नीचे है, प्रश्न विभाजन और तालिका A6 की दस पंक्तियों में से सात में। अस्थायी विभाजन 0.019 बनाम 0.050 देता है, -0.031 [-0.074, +0.008], जब प्रश्न या केवल मॉडल पर क्लस्टर किया जाता है तो शून्य से नीचे (परिशिष्ट I)। स्वतंत्र त्रुटियों के विरुद्ध मॉडल सभी तीन योजनाओं के तहत स्तर है और फिट के बाहर तीन में से चार सेट पर बेहतर है, स्थिरांक जमे हुए के साथ, इसलिए खंड 4 की कसौटी सर्वश्रेष्ठ-मॉडल आधारभूत के विरुद्ध पूरी होती है।
सटीकता मापे गए सटीकताओं द्वारा और द्वारा की जाती है: को हटाने से LOLO त्रुटि 0.323 तक बढ़ जाती है, और इसे स्थिर रखना 0.046 देता है। गुणक मुख्य योजनाओं में सटीकता में कुछ नहीं जोड़ता है और कवरेज और लॉग हानि पर मदद करता है।
उत्पाद तथ्यों पर मॉडल उच्च चलता है। इसकी त्रुटि सर्वश्रेष्ठ मॉडल के लिए 0.086 के विरुद्ध 0.130 है, यह सब अतिविवरण है (13 अंक), और उस डोमेन के मूल ग्रेडर के साथ 0.067 के विरुद्ध 0.190 है, फिर से सब अतिविवरण है (19 अंक)। परिशिष्ट I कोशिकाओं को परिणाम वर्गों में क्रमबद्ध करता है।
5.4 मॉडल पहुँच, और GPT भुजाएँ
100 SimpleQA प्रश्नों के एक सेट पर, gpt-5.6-sol मुख्य लहर में 100 में से 92 (92.0%) स्कोर करता है, Codex क्लाइंट के माध्यम से उनमें से 99, और प्रत्यक्ष API के माध्यम से विचरण भुजा में 300 नमूनों में से 139 (46.3%), 45.7 अंक का अंतर (चित्र 5)। सोने की स्ट्रिंग की शब्दशः पुनरुत्पादन 64.0% से 26.0% तक गिरता है। क्लाइंट अपनी डिफ़ॉल्ट प्रयास सेटिंग पर अपने स्वयं के निर्देशों के तहत चलता है, तापमान सेट न करने योग्य के साथ, जबकि API कोई प्रयास नहीं और तापमान 0.7 पर चलता है।
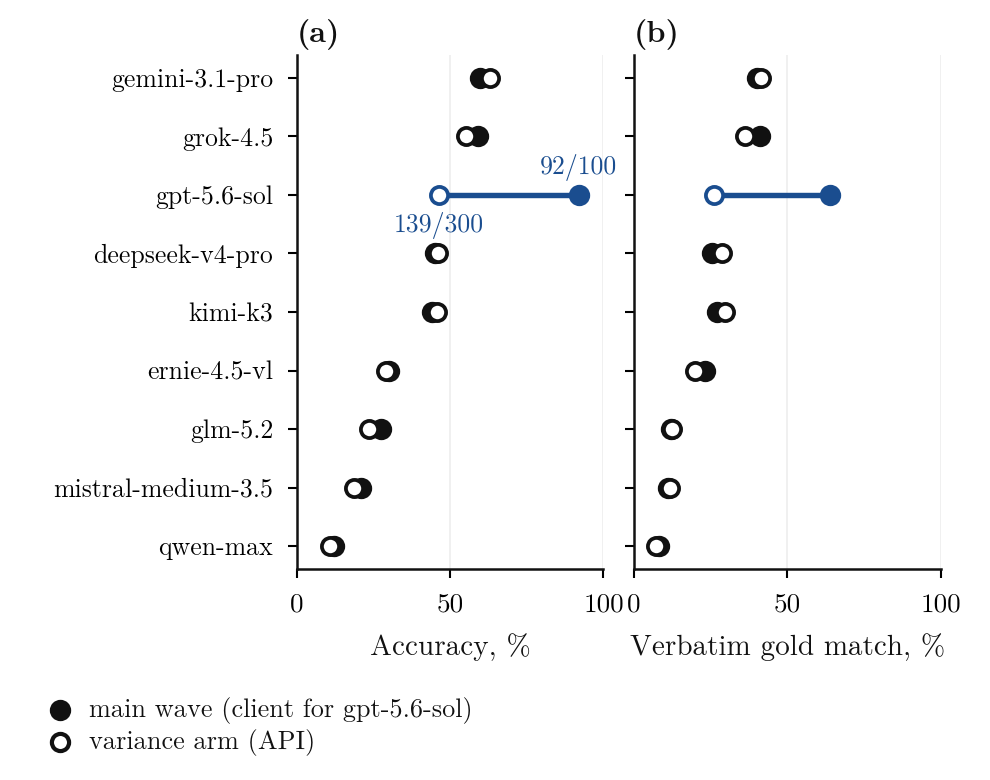
चित्र 5. 100 प्रश्नों का एक सेट, दो भुजाएँ, नौ मॉडल। नोट: (a) सटीकता, (b) सोने की स्ट्रिंग के साथ शब्दशः मिलान। भरा, मुख्य लहर (gpt-5.6-sol के लिए क्लाइंट-सेवित, 92/100); खुला, API के माध्यम से विचरण भुजा (139/300)। gpt-5.6-sol के लिए भुजाएँ प्रयास सेटिंग में भी भिन्न होती हैं।
आठ अन्य मॉडल, जिनका तापमान भी दोनों स्तंभों के बीच बदलता है, किसी भी दिशा में अधिकतम 4.0 बिंदुओं से आगे बढ़ते हैं। प्रयास एक उम्मीदवार है, हालांकि gemini-3.1-pro पर एक युग्मित तर्क-बजट माप ने सटीकता को लगभग अपरिवर्तित छोड़ा (Chernets, 2026c)। वेब खोज दूसरी है: उसी क्लाइंट से अक्टूबर की प्रतिक्रियाओं में ऐसे लिंक होते हैं जो प्रॉम्प्ट अनुरोध नहीं करता है, gpt-6.1-sol के 506 उत्तरों में से 3 में और gpt-6-astra के 506 में से 18 में, और अगस्त क्लाइंट कॉल प्रति माध्य टोकन उपयोग 4,829 है।
क्लाइंट आंकड़ा वह है जो उत्पाद का उपयोग करने वाला व्यक्ति प्राप्त करता है, और API आंकड़ा वह है जो प्रयास कोई नहीं पर एक बेंचमार्क हार्नेस पढ़ता है। अगस्त में नए प्रश्नों पर, API के माध्यम से GPT के साथ, gpt-5.6-sol और fable-5 32 समझौतों में से 29 पर सही हैं, डेल्टा +57.6 बिंदु [+46.3, +69.7]। अक्टूबर में, क्लाइंट पर एक नए GPT के साथ उसी प्रश्नों पर, opus-5-5 के साथ जोड़ी 74 में से 72 पर सही है, डेल्टा +2.3 [-0.7, +6.0]। दोनों तुलनाएं GPT मॉडल और तारीख में भी भिन्न होती हैं, और दोनों में गेट का मान अनुभाग 5.1 में जारी किए गए आर्म की सटीकता को ट्रैक करता है।
क्लाइंट द्वारा परोसे गए GPT आर्म, तालिका 3 से छोड़े गए, सटीक हैं: fable-5 के साथ अगस्त आर्म 1,016 समझौतों में से 997 पर सही है (98.1%) और 106 पर 37 में से 34 पर, आर्म की सटीकता को विरासत में लेते हुए (डेल्टा -3.3 [-10.3, +2.6]; तालिका A7 और परिशिष्ट J)।
5.5 सार्वजनिक डेटा पर बाहरी जांच
मैंने सार्वजनिक डेटा पर फ्रोजन स्थिरांक लागू किए, कोई पुनर्फिटिंग के बिना, जो न तो मॉडल साझा करते हैं और न ही मेरे के साथ फिट होते हैं: HELM Lite (Liang et al., 2023), 20 डेवलपर्स से 95 मॉडल 1,000 बंद-किताब NaturalQuestions का उत्तर दे रहे हैं; LiveBench (White et al., 2025), 11 प्रयोगशालाओं से 70 मॉडल 346 प्रश्नों पर एक संक्षिप्त अंतिम उत्तर के साथ; और Kim et al. (2025) के जोड़ी समुच्चय 70 मॉडल पर बहु-विकल्प MMLU के लिए (तालिका A8)। परिणाम अनुभाग 5.3 से मेल खाते हैं (चित्र 4, निचला समूह)। मॉडल तीनों स्रोतों में बेहतर मॉडल को पढ़ने को हराता है और HELM और LiveBench में स्वतंत्र त्रुटियों के साथ स्तर पर है। यह 5.3 से 6.6 बिंदुओं तक ऊंचा चलता है और जेबरा पहेलियों पर विफल रहता है (0.076 के विरुद्ध 0.231)।
HELM में देखा गया वक्र समतल होता है जहां मॉडल बढ़ता रहता है (चित्र 6): जोड़ी सटीकता 0.5 और 0.6 के बीच सटीकता 2023 और शुरुआती 2024 के मॉडल के लिए 74.6% और बाद के लोगों के लिए 75.9% है, बिन के मध्य में 84.4% भविष्यवाणी की गई के विरुद्ध। MMLU पर दो गलत उत्तरों के मिलने की माध्य संभावना से 0.621 है, क्योंकि चार विकल्प टकराव को बाध्य करते हैं। सटीकता जोड़ी सटीकता के साथ बढ़ती है (Spearman HELM में +0.575 और MMLU पर +0.786, आश्रित कोशिकाओं पर)।
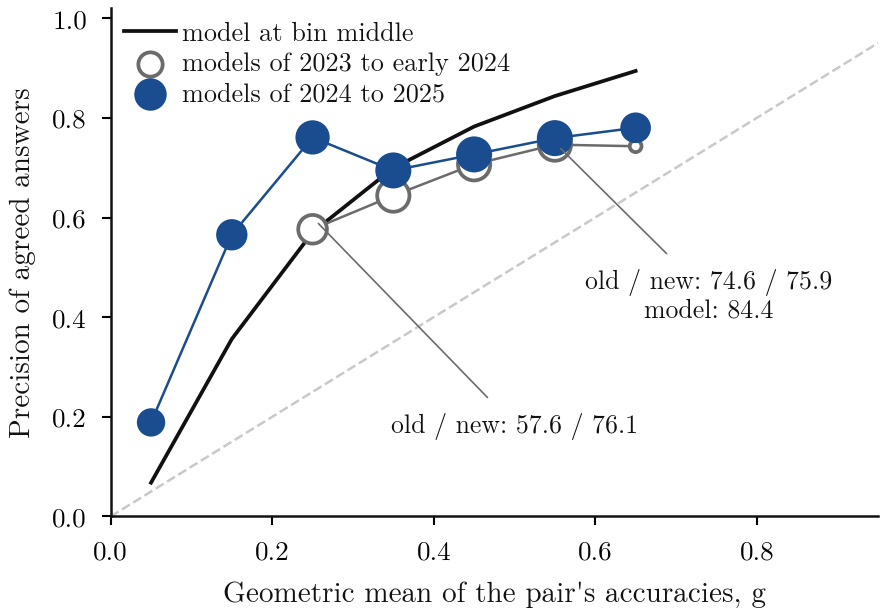
Figure 6. HELM Lite: जोड़ी सटीकता के आधार पर सहमत उत्तरों की सटीकता, पुराने और नए मॉडल। नोट: जोड़ी की ज्यामितीय माध्य g के बिन, विभिन्न प्रयोगशालाओं की जोड़ियां; मार्कर आकार जोड़ियों की संख्या के साथ बढ़ता है। रेखा प्रत्येक बिन के मध्य में फ्रोजन मॉडल है।
HELM अनुभाग 5.2 की परीक्षा को कई प्रयोगशालाओं के साथ और कोई GPT निर्भरता के बिना भी अनुमति देता है। एक जारी किए गए मॉडल और सटीकता के 3 बिंदु के भीतर भागीदारों के साथ, एक अन्य प्रयोगशाला उसी प्रयोगशाला के लिए 72.3% के विरुद्ध 75.5% त्रुटियों को पकड़ता है, -3.2 बिंदु [-4.2, -2.3], कवरेज 2.7 बिंदु से अधिक है। कवरेज के भीतर 3 बिंदुओं पर एक मिलान जोड़ने से इसे हटा दिया जाता है: 75.9% के विरुद्ध 75.7%, -0.2 [-0.6, +0.2]।
6. चर्चा
गेट को चलाने के लिए लेबल की आवश्यकता नहीं है, लेकिन इसे जांचने के लिए आवश्यकता है। जो स्तर महत्वपूर्ण है उसके लेबल वाले नमूने पर दोनों मॉडलों की सटीकता को मापें, उस पहुंच मोड में जो तैनात किया जाएगा। इन डेटा में, दोनों फ्लैगशिप से किसी ऐसे प्रश्न पर सहमत उत्तर जो उनके बाहर है, दो मध्य-स्तरीय मॉडलों से सहमत उत्तर की तुलना में कोई अधिक सुरक्षित नहीं है। जब कोई आत्मविश्वास मान उपलब्ध नहीं होते हैं तो दो प्रयोगशालाओं को जोड़ना एक उचित डिफ़ॉल्ट है, लेकिन इसे स्तर पर जांचा जाना है: एक ही प्रयोगशाला की जोड़ी जिसे आत्मविश्वास द्वारा पतला किया गया है, या जारी किए गए मॉडल का अपना आत्मविश्वास, उतना ही अच्छा कर सकता है (खंड 5.2, परिशिष्ट J)।
अवसर-समायोजित समानता (Goel et al., 2025) और सहमत उत्तरों की सटीकता विभिन्न मात्राएँ हैं, और Han (2026) ने विसंबंधन का नाम दिया है उस लीवर के रूप में जहां मैंने सटीकता और कवरेज को पहले रखा है (परिशिष्ट L)। रिपोर्टिंग के लिए, मॉडल समझौते का एक अध्ययन प्रत्येक समूह के लिए पहुंच मोड, प्रयास, उपकरण की स्थितियों और बनाए गए ईवेंट लॉग को बताना चाहिए।
7. दायरा और सीमा स्थितियाँ
स्तरों की तुलना विभिन्न तारीखों और पहुंच मार्गों पर दो चरणों के माध्यम से की जाती है, और स्तर की तुलना मिलान की गई सटीकता पर लगभग 3 अंकों तक सटीक है, सबसे कठिन क्विंटाइल पर बहुत कम। नई साक्ष्य दो तारीखों पर 100 प्रश्नों और आठ टेम्पलेट का एक समूह है, और इस पर October Delta में शून्य शामिल है। जोड़ी की सटीकता और परिशुद्धता तारीखों के पार और चरणों के बीच भिन्न तर्क सेटिंग्स के पार एक साथ चलते हैं, और डिजाइन क्षमता को कारण के रूप में अलग नहीं करता है।
क्या Codex, kimi और gemini-3.8-flash क्लाइंट ने खोज की, यह प्रतिधारित फ़ाइलों से निर्धारित नहीं किया जा सकता है, इसलिए उनकी सटीकताएं तैनात क्लाइंट को मापती हैं, न कि मॉडल मेमोरी को। अनुभाग 5.1 और 5.3 उन भुजाओं के बिना मुख्य परिणाम दिखाते हैं।
अक्टूबर में एक ही प्रयोगशाला के जोड़े मौजूद हैं, दो प्रयोगशालाओं के लिए, और GPT के बिना एक ही चरण की तुलना 100 नई प्रश्नें हैं। अक्टूबर कोशिकाएं दो प्रयोगशालाओं से पाँच मॉडल पर निर्भर करती हैं, इसलिए दो-तरफा बूटस्ट्रैप का मॉडल आयाम कम स्तर है और पूल्ड अंतराल अनिश्चितता पर निम्न सीमाएं हैं। समान कवरेज पर तुलनाएं कथित आत्मविश्वास का उपयोग करती हैं, जो नंगे गेट नहीं करता, और यादृच्छिक टाई-ब्रेकिंग सबसे चौड़ी पंक्ति को 0.0 और +20.7 अंकों के बीच स्थानांतरित करता है (परिशिष्ट H)।
इंजन नियम-आधारित है, और इसकी यहाँ जाँचें SimpleQA Verified की सफाई की गई सोना (अनुभाग 5.1) और उत्तर भागों का पुनः स्कोरिंग हैं। यह पूरे उत्तर का मूल्यांकन करता है, और लंबे उत्तर गलत "गलत" आकर्षित कर सकते हैं; केवल पहले भाग को स्कोर करना संदर्भ जोड़ियों की परिशुद्धता को अधिकतम 3 अंकों से स्थानांतरित करता है, और gpt-6-astra with opus-5-5 106 पर 80.0 से 88.9% (तालिका A3)।
मॉडल प्रत्येक कोशिका के लिए मापी गई सटीकताओं को इनपुट के रूप में लेता है, इसलिए यह गेट की एक लेबल की गई जाँच का वर्णन करता है और एक को प्रतिस्थापित नहीं करता है। यह उत्पाद तथ्यों और सार्वजनिक डेटा पर अधिक चलता है। HELM, LiveBench और Kim et al. के एकत्रीकरण कुछ-शॉट या बहु-विकल्प प्रारूपों में पुराने मॉडल रखते हैं, इसलिए वे अन्य मॉडलों पर संबंध का परीक्षण करते हैं, 2026 के फ्लैगशिप्स पर नहीं।
8. निष्कर्ष
सहमत उत्तरों की सटीकता हाथ में लिए गए स्तर पर जोड़ी की सटीकता के साथ बढ़ती है, दोनों स्तरों पर और मेल खाती हुई सटीकता में लगभग 3 बिंदुओं के भीतर। जहाँ कहीं मैंने एक कमजोर जोड़ी को मापा, वहाँ उलटाव दिखाई दिया, प्रमुख मॉडल भी शामिल हैं। दूसरी प्रयोगशाला से एक भागीदार मुख्य रूप से गेट को कम बार खोलकर अधिक त्रुटियों को पकड़ता है, और समान कवरेज पर इसने अपना लाभ केवल वहीं बनाए रखा जहाँ इसका मॉडल बहुत अधिक सटीक था। गेट का एक छोटा मॉडल नमूने से बाहर सटीकता का वर्णन बेहतर मॉडल की तुलना में बहुत अच्छी तरह करता है और स्वतंत्र त्रुटियों के साथ भी। दो एक्सेस कॉन्फ़िगरेशन के माध्यम से मापे गए एक पहचानकर्ता 45.7 बिंदुओं से भिन्न होते हैं, इसलिए किसी मॉडल की सटीकता के बारे में एक दावे को एक्सेस मोड को बताना चाहिए।
प्रभाव कथन
यह पत्र इस बात का अध्ययन करता है कि दो भाषा मॉडल के बीच समझौता छोटे तथ्यात्मक उत्तर जारी करने के नियम के रूप में कब भरोसेमंद हो सकता है। चिकित्सक जांच सकते हैं, उस स्तर पर जो महत्वपूर्ण है और जिस पहुंच मोड में वे तैनात करते हैं, कि क्या दो-मॉडल गेट उनके उपयोग के लिए पर्याप्त सटीक है, इसके बजाय कि यह मान लिया जाए कि मजबूत मॉडल या दूसरा विक्रेता पर्याप्त है। मुख्य जोखिम कठिन प्रश्नों पर समझौते में अत्यधिक विश्वास है, और परिणाम उन स्तरों को दिखाते हैं जहां सहमत उत्तर अधिकतर गलत हैं। अध्ययन केवल सार्वजनिक बेंचमार्क और मशीन-संरचित प्रश्नों का उपयोग करता है।
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
घोषणाएँ
प्रतिस्पर्धी हित। लेखक लंबित पेटेंट आवेदनों पर एक नामित आवेदक हैं, अनुदत्त पेटेंट नहीं, जो AI आर्केस्ट्रेशन और बहु-मॉडल सत्यापन प्रणालियों को कवर करते हैं जिनकी यह पत्र जांच करती है।
डेटा और कोड। प्रति-कॉल प्रतिक्रियाएँ, विश्लेषण स्क्रिप्ट और प्रत्येक रिपोर्ट की गई संख्या से उसकी स्रोत तालिका का मानचित्रण Zenodo पर संग्रहीत है, doi:10.5281/zenodo.24090584 (CC BY 4.0)।
परिशिष्ट A. मॉडल और एक्सेस मोड
तालिका A1. संग्रह और एक्सेस मोड, प्रति लहर।
| संग्रह | तारीखें | मॉडल | एक्सेस |
|---|---|---|---|
| जुलाई मध्य स्तर | 24 से 28 जुलाई 2026 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | प्रत्यक्ष API |
| जुलाई स्थानीय | 24 से 28 जुलाई 2026 | सात स्थानीय ओपन-वेट मॉडल | स्थानीय अनुमान |
| अगस्त फ्लैगशिप | 3 से 6 अगस्त 2026 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | विक्रेता क्लाइंट; gpt-5.6-sol क्लाइंट डिफ़ॉल्ट प्रयास सेटिंग पर, API फॉलबैक द्वारा 1,500 रिकॉर्ड में से 14 |
| glm-5.2 | विक्रेता एंडपॉइंट | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | प्रत्यक्ष API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | प्रत्यक्ष API या विक्रेता के लिए पिन किया गया एग्रीगेटर रूट; muse-spark-1.1 आंशिक (251 उत्तर) | ||
| विचरण शाखा | 6 अगस्त 2026 | नौ फ्लैगशिप, कोई Claude नहीं | gpt-5.6-sol प्रत्यक्ष API द्वारा, प्रयास कोई नहीं; mistral-medium-3.5 अपने विक्रेता क्लाइंट के माध्यम से, जो अनुरोधित तापमान रिकॉर्ड करता है; अगस्त लहर में अन्य; तापमान 0.7, तीन नमूने |
| ताज़ा, अगस्त | 6 अगस्त 2026 | gpt-5.6-sol (प्रयास कोई नहीं), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol और deepseek-v4-pro प्रत्यक्ष API द्वारा, claude-fable-5 विक्रेता क्लाइंट द्वारा, kimi-k3 एग्रीगेटर रूट द्वारा |
| उत्पाद तथ्य | 15 अगस्त 2026 | छः मॉडल, 15 जोड़े; चार खोज संभावना के बिना, 6 जोड़े | मिश्रित; gpt-5.4 और grok क्लाइंट के माध्यम से |
| अक्टूबर | 26 और 27 अक्टूबर 2026 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Codex क्लाइंट, प्रयास मध्यम, कोई खोज झंडा नहीं, ईवेंट स्ट्रीम बरकरार नहीं |
| claude-opus-5-5, claude-fable-5-1 | Claude क्लाइंट, उपकरण अक्षम | ||
| kimi-k3, gemini-3.8-flash (केवल ताज़ा) | विक्रेता क्लाइंट, उपकरण अक्षम नहीं |
अगस्त लहर में, claude-fable-5 शाखा के 19 उत्तर अन्य Claude मॉडल द्वारा परोसे गए थे। लहर का 34 में से 37 106 पर इस पर निर्भर नहीं है (Chernets, 2026a)।
परिशिष्ट बी. 503 सामान्य प्रश्नों पर जोड़े
तालिका A2. विभिन्न प्रयोगशालाओं के सभी जोड़े, पहला सदस्य जारी, 503 सामान्य प्रश्न।
| जोड़ा | कवरेज | PPV (K/O) | डेल्टा, बिंदु [95%] | त्रुटियाँ पकड़ी गईं |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
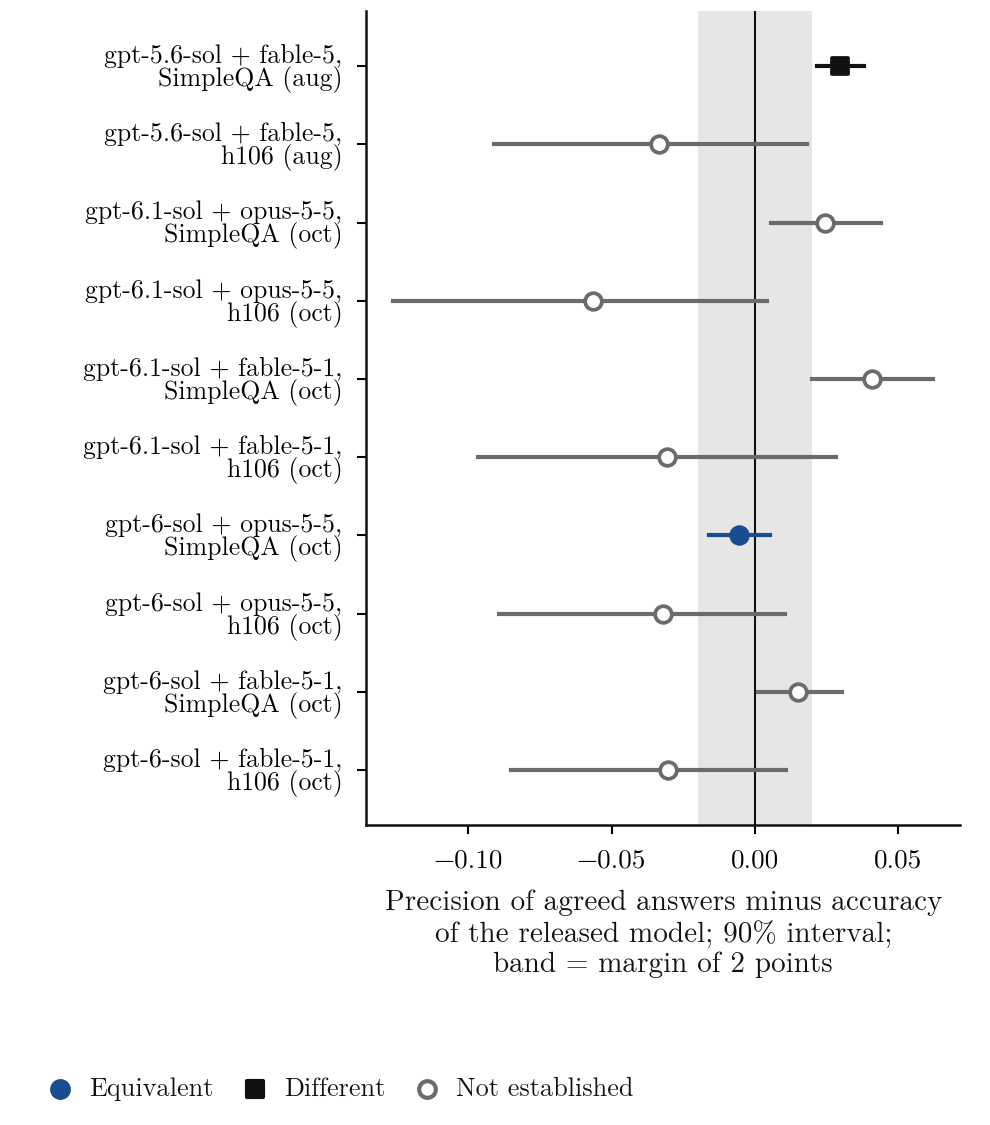
चित्र A1. जारी किए गए मॉडल के विरुद्ध जोड़ी सटीकता की समानता परीक्षण। नोट: 90% प्रश्न बूटस्ट्रैप, 2 बिंदुओं की सीमा छायांकित। Codex क्लाइंट आर्म जारी किए गए जोड़े।
परिशिष्ट C. सोने की स्ट्रिंग के साथ वर्बेटिम मिलान
वर्बेटिम मिलान नौ मॉडलों में SimpleQA सटीकता के साथ पूरी तरह से रैंक-सहसंबद्ध है जिनके पास SimpleQA और ताज़ा माप दोनों हैं, क्योंकि एक सही उत्तर अक्सर सोने की स्ट्रिंग होता है। SimpleQA माइनस ताज़ा अंतराल के साथ इसका सहसंबंध +0.47 है (सटीक क्रमपरिवर्तन p = 0.21, n = 9), या +0.29 (p = 0.50) बिना gpt-5.6-sol के, जिसकी दो सटीकताएं विभिन्न पहुंच तरीकों से आती हैं (चित्र A2)। सही उत्तरों तक सीमित, यह +0.10 है (p = 0.81)। सही उत्तरों में gpt-5.6-sol के लिए दर 65.7% है, fable-5 के लिए 66.4%, deepseek-v4-pro के लिए 68.6% और kimi-k3 के लिए 64.9%। मॉडल का अवशेष इस पर निर्भर नहीं करता है, 112 प्रमुख कक्षों में +0.064 [-0.072, +0.167] की ढाल के साथ। अंतराल स्वयं अधिकांश मॉडलों के लिए शून्य के करीब या नकारात्मक है, fable-5 के लिए -3.0 बिंदु, deepseek-v4-pro के लिए -20.5, opus-5-5 के लिए -5.4 और fable-5-1 के लिए -7.8, और यह केवल gpt-5.6-sol के लिए बड़ा है (+62.4), जहाँ पहुंच मोड दोनों माप के बीच भिन्न है।
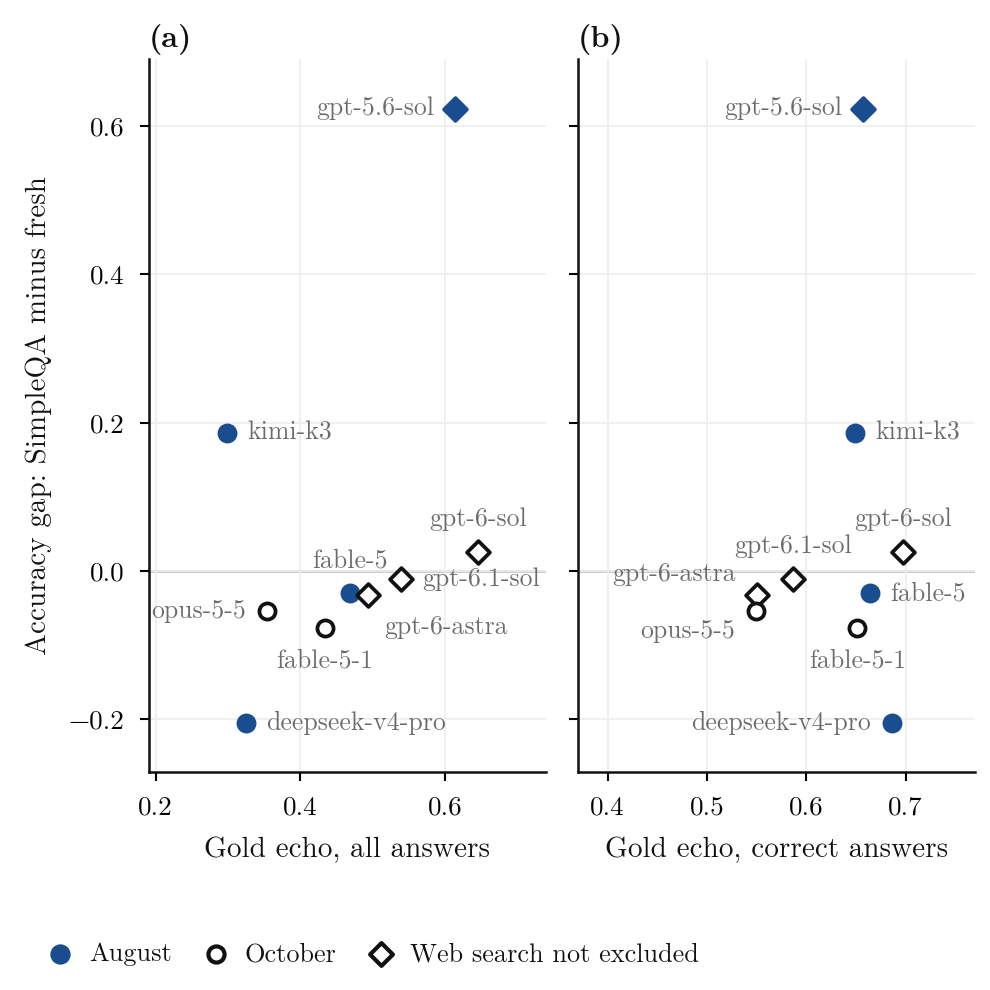
चित्र A2. सोने की स्ट्रिंग के साथ वर्बेटिम मिलान बनाम सटीकता अंतराल। नोट: (a) सभी उत्तर, (b) केवल सही उत्तर। नीले भरे, अगस्त तरंग; खुले, अक्टूबर तरंग। हीरे उन बाहुओं को चिह्नित करते हैं जिनके लिए वेब खोज को बाहर नहीं किया गया है।
परिशिष्ट D. ग्रेडर संवेदनशीलता
इंजन केस, आर्टिकल और विराम चिह्न को सामान्य करता है, सटीक मिलान और चार या अधिक वर्णों की स्ट्रिंग समावेशन को स्वीकार करता है, तारीखों, संख्याओं और अल्फान्यूमेरिक पहचानकर्ताओं की तुलना नियम के आधार पर करता है, और अन्यथा सामग्री शब्दों की तुलना करता है; एक उत्तर जिसे वह गोल्ड के विरुद्ध निपटा नहीं सकता, अनसुलझा रहता है। तालिका A3 में प्रत्येक उत्तर का पहला भाग, कोष्ठक और अनुगामी व्याख्या के बिना, मिलान और ग्रेडिंग दोनों के लिए उपयोग किया जाता है, इसलिए खुली गणना भी बदलती है।
तालिका A3. संपूर्ण उत्तर को स्कोर करना बनाम इसके पहले भाग को स्कोर करना। पहला सदस्य जारी किया गया है।
| युग्म, समूह | PPV, संपूर्ण उत्तर | PPV, पहला भाग |
|---|---|---|
| gpt-5.6-sol + fable-5, सभी, अगस्त | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, अक्टूबर | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, अक्टूबर | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, अक्टूबर | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, अक्टूबर | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, strat, अक्टूबर | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, fresh, अक्टूबर | 72/74 | 72/74 |
परिशिष्ट ई. अतिरिक्त संबंधित कार्य
हाल के प्रीप्रिंट दो दिशाओं की ओर इशारा करते हैं। संशयवादी पक्ष पर, डेनिसोव-ब्लांच एट अल. (2026) को पता चलता है कि पाँच बेंचमार्क और मॉडल के बीच पोलिंग-शैली एकीकरण से 25 गुना अनुमान लागत पर कोई सुसंगत सटीकता लाभ नहीं मिलता, क्योंकि त्रुटियाँ संबंधित हैं। Ding (2026) GPQA Diamond और AIME पर 265,000 नमूनों का ऑडिट करता है और पाता है कि सहमति एक सकारात्मक लेकिन कमजोर भविष्यवक्ता है (Spearman 0.20 से 0.59), जिसमें सबसे सुसंगत फ्रंटियर मॉडल की 48% उच्च-सहमति GPQA प्रविष्टियाँ गलत हैं। 46 आइटम पर एक अन्वेषणात्मक जाँच में, gpt-4.1 और Claude स्तरों के बीच समान-गलत-उत्तर दरें तीन स्तरों में से दो के लिए एक सीमांत-संरक्षण शून्य से अधिक हैं। Kohli (2026) को पता चलता है कि तीन अनुमान डेटासेट पर नौ फ्रंटियर न्यायाधीश लगभग दो स्वतंत्र वोट लेते हैं, और सर्वश्रेष्ठ एकल न्यायाधीश पैनल से मेल खाता है या बेहतर है। Kim (2026) MMLU-Pro पर 30 मॉडल के 31,900 उपसेट का ऑडिट करता है: वोटिंग आकार-3 उपसेट के 9.98% में सबसे मजबूत सदस्य को हराता है, और एक कठोर विविधता माप लगभग एक माइनस माध्य सटीकता के साथ सहरेखीय है (Spearman +0.991)। Hossain एट अल. (2026) दस न्यायाधीशों के बीच 0.21 की औसत जोड़ीदार त्रुटि सहसंबंध पाते हैं, जो लगभग 3.5 स्वतंत्र लोगों के जितनी जानकारी रखते हैं, विभिन्न प्रदाताओं से फ्रंटियर न्यायाधीशों में मजबूत निर्भरता के साथ। Chen (2026) दिखाता है कि कोई भी नीति जो एक सदस्य का उत्तर प्रदान करती है, दर से अधिक नहीं हो सकती, जिस पर सभी मॉडल एक साथ गलत हैं, और 67 मॉडल के विरुद्ध खुले अंत वाली गणित पर 0.052 का पता लगाता है जो गॉसियन कोप्युला के तहत 0.023 के विरुद्ध है, और मुक्त-प्रतिक्रिया GPQA-Diamond पर 0.127। दूसरी ओर, Naik (2024) दो मॉडल के साथ 73.1% से 93.9% तक सटीकता में वृद्धि की रिपोर्ट करता है और बहुविकल्पीय प्रारूप में 78 मामलों पर तीन के साथ 95.6% तक, और Liu (2026) दिखाता है कि एक चार-मॉडल पैनल सात बेंचमार्क पर स्व-संगति से बेहतर उत्तर चुनता है, सदस्य सटीकता, त्रुटि सहसंबंध और एक साझा-गलतफहमी दर में एक बंद-रूप कानून के साथ जो सर्वसम्मति सटीकता को 0.028 की माध्य पूर्ण त्रुटि के लिए भविष्यवाणी करता है। Xue एट अल. (2026) की रिपोर्ट है कि एक सत्यापनकर्ता के साथ क्रॉस-मॉडल संगति QA बेंचमार्क पर हैलुसीनेशन डिटेक्शन के लिए स्व-संगति की छत में सुधार करता है, और Tan एट अल. (2025) कि स्व-सुसंगत त्रुटियाँ मॉडल पैमाने के साथ सिकुड़ती नहीं हैं, मॉडल-विशिष्ट होती हैं, और एक दूसरे मॉडल के साथ बेहतर पहचानी जाती हैं। Han (2026) क्रमिक सत्यापन गेट का एक सिद्धांत देता है जिसमें एक अंधी-धब्बा द्रव्यमान विश्वसनीयता को सीमित करता है और सजावटीकरण को नाम देता है, मॉडल परिवार, विधा या साक्ष्य स्रोत को बदलकर, व्यावहारिक लीवर के रूप में। खंड 2 के दो कार्य विवरण रखते हैं जो गेट को प्रभावित करते हैं। Goel एट अल. (2025) CAPA को परिभाषित करते हैं ताकि अलग-अलग गलत विकल्प असहमति के रूप में गिनें, और क्षमता के साथ प्रवृत्ति के अलावा वे दिखाते हैं कि नौ खुले-वजन LLM न्यायाधीश मॉडल को अपने जैसे अधिक उच्च दर देते हैं, और यह कि कमजोर-से-मजबूत लाभ उन कार्यों पर बड़े होते हैं जहाँ पर्यवेक्षक और छात्र कम समान त्रुटियाँ करते हैं (12 मॉडल जोड़े)। Kolawole एट अल. (2025) परीक्षण वितरण पर स्वीकृत त्रुटियों की संयुक्त दर पर एक सुरक्षित-स्थगन शर्त बताते हैं, जिसमें एक छोटे सत्यापन सेट पर एक सीमा का अनुमान लगाया जाता है। संयुक्त दर पर एक शर्त स्वीकृत त्रुटियों को एक स्तर पर केंद्रित करने की अनुमति देती है, और खंड 5.1 ऐसा एक स्तर खोजता है: 106 पर, मध्य-स्तर पैनल त्रुटि को प्रमाणित करते हैं, और सबसे अधिक-सटीकता आर्म के बिना प्रमुख जोड़े भी करते हैं।
इनमें से कोई भी कार्य, जैसा कि खंड 2 में नोट किया गया है, जोड़ी-स्तर रिलीज गेट, एक जारी किए गए मॉडल के साथ समान कवरेज पर याद, या दो एक्सेस मोड में मापे गए एक पहचानकर्ता की रिपोर्ट नहीं करता है।
परिशिष्ट F. डेटा और प्रोटोकॉल विवरण
संग्रह। प्रोटोकॉल अनुभाग 3 का है, और संग्रह पूर्ण रूप में अनुसरण करते हैं। तालिका A1 मॉडल, तारीखें और पहुंच विधियों को सूचीबद्ध करती है।
- जुलाई मध्य स्तर (24 से 28 जुलाई)। 1,500 SimpleQA प्रश्नों पर नौ API मॉडल और सात स्थानीय मॉडल (Wei et al., 2024), बेंचमार्क में 4,326 प्रश्नों का एक निश्चित यादृच्छिक उप-नमूना। संग्रह को डेटा संग्रह से पहले OSF पर पंजीकृत किया गया था (Chernets, 2026a)।
- अगस्त फ्लैगशिप (3 से 6 अगस्त)। ग्यारह प्रयोगशालाओं में से एक फ्लैगशिप समान 1,500 प्रश्नों पर, जिनमें से 1,459 सामान्य पूल बनाते हैं।
- विचरण आर्म (6 अगस्त)। उन प्रश्नों में से 100 पर नौ फ्लैगशिप, प्रति क्विंटाइल 20, तापमान 0.7 पर प्रति प्रश्न तीन नमूनों के साथ।
- ताजे प्रश्न (6 अगस्त और 26 अक्टूबर)। आठ टेम्पलेट्स में Wikidata से मशीन द्वारा रचित 100 दो-हॉप प्रश्न, पहली मॉडल कॉल से पहले फाइल हैश निश्चित किया गया।
- उत्पाद तथ्य (15 अगस्त)। वाणिज्यिक उत्पादों के बारे में 267 प्रश्न, Wikidata से भी रचित, छह मॉडलों पर, उनमें से चार खोज संभावना के बिना।
- अक्टूबर फ्लैगशिप (26 और 27 अक्टूबर)। gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 और claude-fable-5-1 300 SimpleQA प्रश्नों पर जुलाई क्विंटाइल द्वारा स्तरीकृत (60, 120, 120; सभी पांच के लिए 297 सामान्य; तालिकाओं में "strat"), नीचे के 106 प्रश्न और ताजा सेट, कुल 503 सामान्य प्रश्न। kimi-k3 और gemini-3.8-flash ने ताजा सेट का उत्तर दिया।
पहुंच विधियां। मॉडलों तक अनुभाग 3 में वर्णित दो तरीकों से पहुंचा गया। gpt-5.6-sol विचरण आर्म पर और अगस्त ताजा सेट पर भी सीधे API के द्वारा चला। मॉडल पहचानकर्ता और क्लाइंट संस्करण प्रति कॉल दर्ज किए जाते हैं।
चूंकि क्लाइंट्स माप की शर्तें निर्धारित करते हैं, मैं उन्हें पूर्ण रूप में बताता हूं। तापमान उनमें सेट नहीं किया जा सकता। अगस्त Codex आर्म क्लाइंट डिफ़ॉल्ट सेटिंग पर सोच के प्रयास के लिए चला, जो कॉल सेट नहीं करता है और रिकॉर्ड बयान नहीं करते हैं। अक्टूबर Codex आर्म्स प्रत्येक कॉल में माध्यम पर प्रयास सेट करके चले। अगस्त मैनिफेस्ट Claude आर्म के लिए शून्य वेब खोज अनुरोध और Mistral आर्म के लिए एक खाली टूल सूची रिकॉर्ड करता है, और अक्टूबर Claude आर्म्स उपकरणों के साथ अक्षम चले। Codex आर्म्स खोज ध्वज के बिना शुरू किए गए थे, और उनकी इवेंट स्ट्रीम्स को बनाए नहीं रखा गया था, इसलिए क्या वे खोजे गए यह फाइलों से निर्धारित नहीं किया जा सकता। kimi और gemini-3.8-flash क्लाइंट्स में, उपकरणों को अक्षम नहीं किया गया था और प्रॉम्प्ट उन्हें मना करता है।
परिशिष्ट जी। 106 और स्तर
चित्र A3, खंड 5.1 के पैनल और जोड़ी को 106 पर और दो और जोड़ियों के साथ दिखाता है: fable-5 grok-4.5 के साथ 28 में से 7 समझौतों पर है और gemini-3.1-pro grok-4.5 के साथ 25 में से 8 पर है।
खंड 1 का 342 में से 0 इस बात पर निर्भर करता है कि कठिनाई को कैसे स्तरीकृत किया जाता है। जब प्रत्येक पैनल के अपने उत्तरों को कठिनाई की स्तरीकरण से बाहर निकाला जाता है, तो गिनती 354 में से 78 हो जाती है, और अंतर-ब्लॉक पैनल 116 में से 0 पर रहता है।
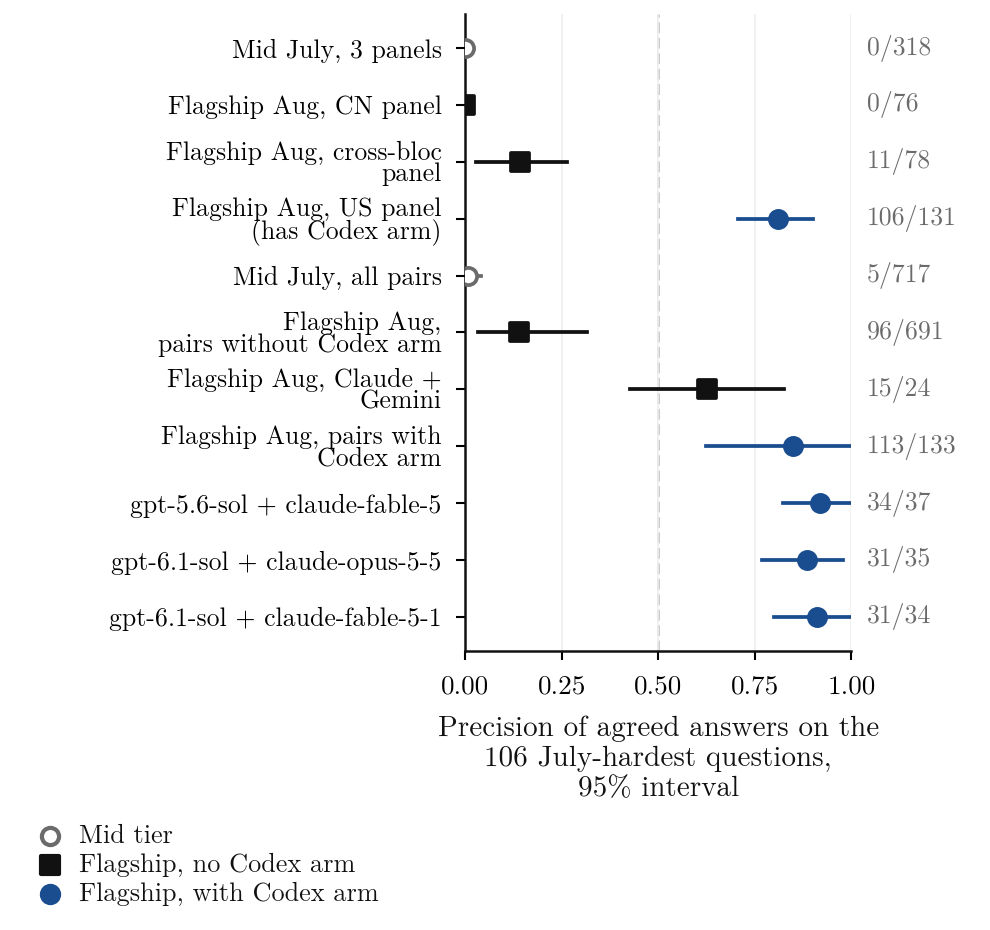
चित्र A3। 106 प्रश्नों पर सहमत उत्तरों की परिशुद्धता। नोट: 95% दो-तरफा बूटस्ट्रैप पूल की गई पंक्तियों के लिए, पैनल और एकल जोड़ियों के लिए प्रश्न बूटस्ट्रैप। नीली पंक्तियों में Codex क्लाइंट आर्म है। अगस्त और अक्टूबर संग्रह।
चित्र A4 खंड 5.1 के अपने-स्तर पंचक को पूर्ण रूप से देता है। सभी आर्म के साथ, अगस्त सबसे कठिन पंचक में 26.6% [6.7, 53.4] तक पहुंचता है, जुलाई से +9.3 [-18.1, +39.8] का अंतर। kimi-k3 के बिना, जो दोनों संग्रहों से संबंधित है, सबसे कठिन पंचक जुलाई में 675 में से 147 (21.8%) और अगस्त में 995 में से 192 (19.3%) देता है, -2.5 अंक [-29.7, +28.2]। खंड 5.1 का पूल परीक्षण सभी पाँच पंचक का उपयोग करता है, प्रति स्तर 180 कोशिकाएँ; मध्य-स्तर कोशिकाएँ फ्रोजन मॉडल से +0.3 अंक [-2.4, +2.9] पर बैठती हैं और फ्लैगशिप कोशिकाएँ +0.0 [-1.4, +1.6] पर। सबसे कठिन पंचक में लिफ्ट जुलाई में 1.15 [0.39, 1.90] है और अगस्त में 0.97 [0.42, 1.49]। पंचक के आर-पार, अगस्त बिना GPT के 15.5, 52.9, 75.8, 90.5 और 97.3% देता है और जुलाई 17.3, 29.0, 60.9, 80.4 और 94.4%, जबकि रिलीज़ किए गए-मॉडल की सटीकता 16.0, 36.6, 56.8, 73.3 और 88.5% के विरुद्ध 15.3, 25.0, 40.0, 57.7 और 78.9% चलती है।
परिशुद्धता साफ सोने के उत्तरों पर कम रहती है। Haas et al. (2025) ने SimpleQA को 1,000 प्रश्नों के एक साफ सेट में पुनर्निर्मित किया, और 106 में से 24 इसमें जीवित रहते हैं, बेंचमार्क के बनाए रखे गए शेयर से 24.5 अपेक्षित के विरुद्ध, सोने का उत्तर 21 पर समान है। सफाई इन प्रश्नों को अन्य प्रश्नों की तुलना में अधिक बार नहीं हटाती है, हालांकि इसका चयन कठिन प्रश्नों का भी समर्थन करता है। समान आंकड़े और बूटस्ट्रैप के तहत, अगस्त की जोड़ियाँ बिना GPT के उन 24 प्रश्नों पर 150 समझौतों में से 28 पर सही हैं (18.7% [0.0, 57.1]) और अन्य 82 पर 538 में से 67 पर (12.5% [2.8, 28.1]; अधिक सटीक सदस्य प्रत्येक सबसेट पर रिलीज़ किया जाता है, इसलिए भागों को 96 में से 691 तक जोड़ने की आवश्यकता नहीं है), और जुलाई की जोड़ियाँ 157 में से 4 पर (2.5% [0.0, 15.2])।
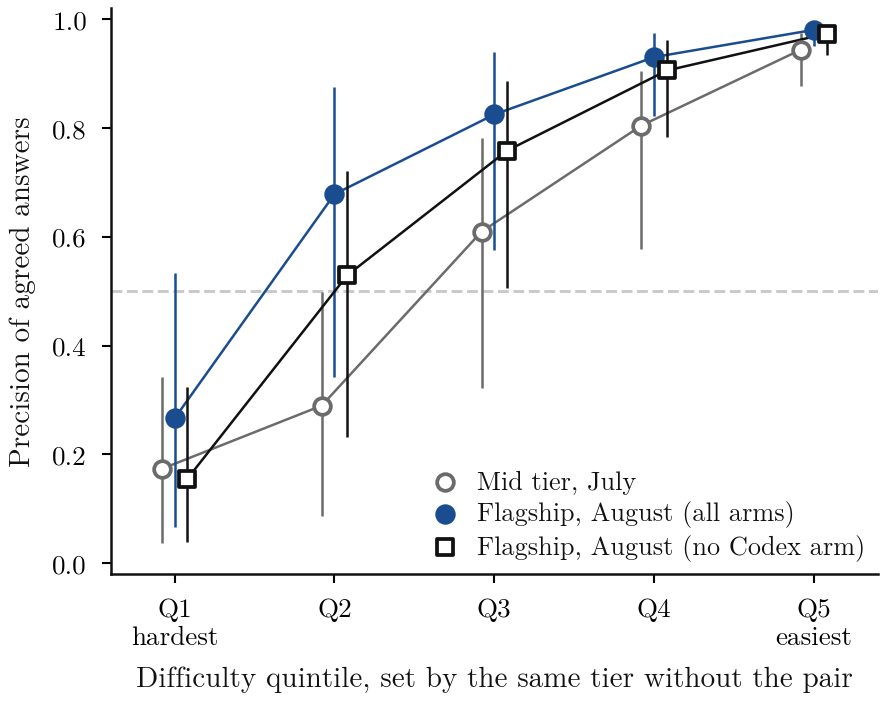
चित्र A4। अपने-स्तर कठिनाई पंचक द्वारा सहमत उत्तरों की परिशुद्धता। नोट: 95% दो-तरफा बूटस्ट्रैप। प्रत्येक जोड़ी के लिए कठिनाई उसी स्तर द्वारा निर्धारित की जाती है उस जोड़ी के बिना। 0.5 पर डैश की गई लाइन।
सबसे सटीक जोड़ियाँ एक ही संबंध को फिट करती हैं। जोड़ी kimi-k3 और gemini-3.8-flash ताजा सेट पर 95.8% तक पहुंचते हैं, रिलीज़ किए गए मॉडल के 26 में से 23 त्रुटियों को पकड़ते हुए और 5.37 [2.86, 21.36] की लिफ्ट के साथ। मॉडल, केवल 0.74 और 0.82 की उनकी सटीकता को देखते हुए, 95.1% देता है। और दोनों Claude फ्लैगशिप एक साथ, किसी भी आर्म में कोई खोज संभावना के साथ नहीं, 106 पर 47.5% तक पहुंचते हैं, जहाँ रिलीज़ किए गए मॉडल की सटीकता 30.0% है, और सभी 503 प्रश्नों में 86.2%। चित्र A5 हर बैंड को हर स्तर की रिलीज़ किए गए-मॉडल सटीकता के विरुद्ध रखता है, 23 में से 17 कोशिकाओं में विकर्ण के ऊपर परिशुद्धता के साथ।
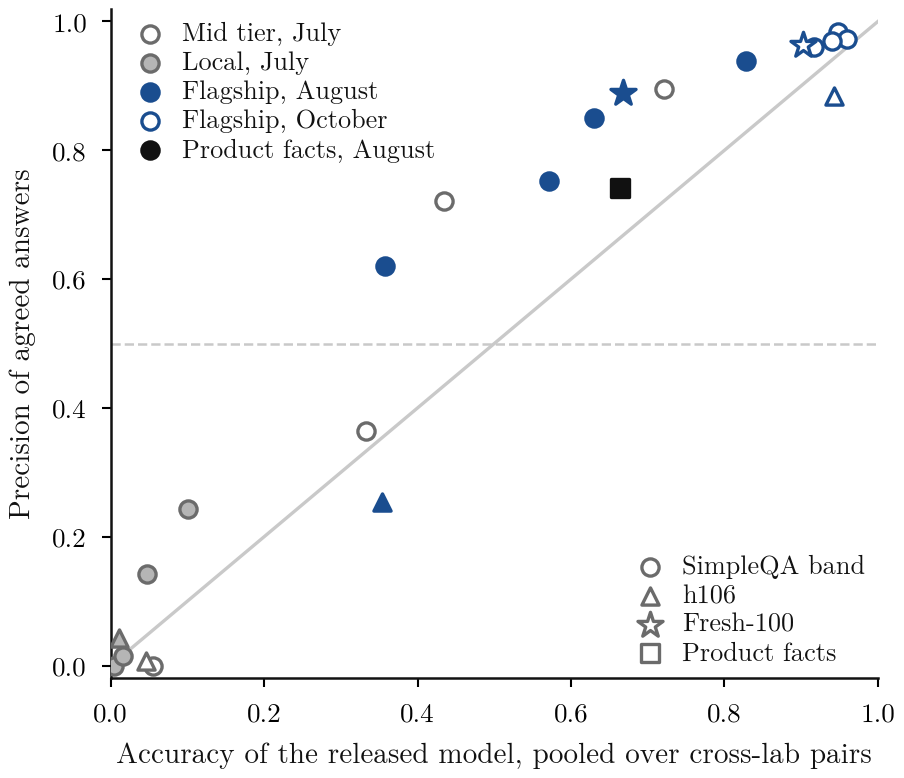
चित्र A5। रिलीज़ किए गए मॉडल की सटीकता के विरुद्ध सहमत उत्तरों की परिशुद्धता। नोट: विभिन्न प्रयोगशालाओं की जोड़ियों पर पूल किया गया, स्तर और बैंड द्वारा। रंग और भरण स्तर देते हैं, मार्कर आकार सेट देता है। 0.5 पर डैश की गई लाइन, ठोस लाइन समानता है।
परिशिष्ट H. दूसरी प्रयोगशाला विस्तार से
विचरण आर्म। समान कवरेज पर मॉडल के अनुसार (चित्र 2), दो-प्रयोगशाला गेट नौ में से सात के लिए आगे है और gemini-3.1-pro (-5.7 अंक) और grok-4.5 (-2.8) के लिए पीछे है। GPT के बिना, आठ मॉडलों पर, स्व-सहमति 61.4% को 55.9% की सटीकता पर कवर करती है और दो प्रयोगशालाएं 83.3% पर 24.4% को कवर करती हैं। सटीकता में अंतर +27.4 अंक [+16.0, +35.7] जैसा मापा गया है और +7.7 [-1.9, +16.5] समान कवरेज पर है, और पकड़ी गई त्रुटियां +38.3 अंक [+26.0, +50.9] जैसा मापा गया है और +3.0 [-1.5, +8.4] समान कवरेज पर भिन्न होती हैं। अक्टूबर में कोई दोहराई गई कॉल नहीं है, इसलिए स्व-सहमति केवल अगस्त में मापी जाती है।
एक रिलीज़ किए गए मॉडल के चार साथी। तालिका A4 चित्र 3a के चार साथी देती है: एक रिलीज़ किया गया मॉडल, gpt-6.1-sol, इसलिए दांव पर 29 त्रुटियां हर पंक्ति में समान हैं।
तालिका A4। एक रिलीज़ किया गया मॉडल, चार साथी: gpt-6.1-sol 503 सामान्य प्रश्नों पर (495 समाधान किए गए में 29 त्रुटियां, 95% प्रश्न बूटस्ट्रैप)।
| साथी | प्रयोगशाला | कवरेज [95%] | PPV (K/O) | डेल्टा, अंक [95%] | त्रुटियां पकड़ी गई [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | समान | 96.2% [94.4, 97.8] | 94.3% (449/476) | +0.2 [-0.2, +0.8] | 2/29 = 6.9% [0.0, 17.4] |
| gpt-6-sol | समान | 95.6% [93.6, 97.2] | 96.2% (457/475) | +2.1 [+0.9, +3.4] | 11/29 = 37.9% [20.7, 56.5] |
| claude-opus-5-5 | भिन्न | 59.8% [55.9, 64.0] | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 = 55.2% [36.4, 73.0] |
| claude-fable-5-1 | भिन्न | 60.8% [56.7, 65.0] | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 = 69.0% [50.0, 85.2] |
अन्य समान-प्रयोगशाला साथी, gpt-6-sol, 29 में से 11 को पकड़ता है, जो fable-5-1 के विरुद्ध -31.0 अंक [-50.0, -10.7] है और opus-5-5 के विरुद्ध -17.2 [-37.0, +3.0] है। Claude जोड़ी, किसी भी आर्म में कोई खोज संभावना नहीं है, 60.6% को कवर करता है और fable-5-1 की 181 त्रुटियों में से 140 को 86.2% की सटीकता पर और +23.5 अंक [+19.6, +27.2] के डेल्टा पर पकड़ता है। एक प्रयोगशाला के दो मॉडल, दोनों सीमा से दूर, इसलिए अक्सर असहमत हो सकते हैं ताकि अधिकांश त्रुटियों को पकड़ा जा सके।
तालिका A5 परीक्षण करती है कि यह कवरेज वक्र के साथ एक चाल से अधिक है या नहीं, और क्या इसे GPT की आवश्यकता है। प्रत्येक पंक्ति एक रिलीज़ किए गए मॉडल को रखती है और इसके समान-प्रयोगशाला साथी की तुलना दूसरी प्रयोगशाला के एक साथी से करती है, पहले जैसा मापा गया है और फिर समान कवरेज पर, आत्मविश्वास द्वारा व्यापक गेट को पतला करके प्राप्त (अनुभाग 3)।
तालिका A5। एक समान-प्रयोगशाला साथी और दूसरी प्रयोगशाला के एक साथी के साथ पकड़ी गई त्रुटियां। अंतर समान माइनस अन्य हैं, अंकों में, 95% प्रश्न बूटस्ट्रैप के साथ, इसलिए नकारात्मक अन्य प्रयोगशाला का पक्ष लेता है; पहली चार पंक्तियों में जैसा-मापा अंतर तालिका A4 के बूटस्ट्रैप को साझा करते हैं।
| रिलीज़ किया गया | समान / अन्य साथी | प्रश्न | पकड़ा गया, जैसा मापा गया | अंतर [95%] | पकड़ा गया, समान कवरेज | अंतर [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62.1 [-79.3, -43.8] | 17/29, 20/29 | -10.3 [-35.3, +13.8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48.3 [-66.7, -29.6] | 18/29, 16/29 | +6.9 [-17.1, +30.4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31.0 [-50.0, -10.7] | 24/29, 20/29 | +13.8 [-6.7, +34.6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17.2 [-37.0, +3.0] | 24/29, 16/29 | +27.6 [+3.4, +51.6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16.0 [-21.7, -10.6] | 140/181, 169/181 | -16.0 [-21.7, -10.6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11.8 [-17.8, -5.9] | 156/195, 177/195 | -10.8 [-16.7, -5.0] |
| fable-5-1 | opus-5-5 / kimi-k3 | नया 100 | 13/23, 20/23 | -30.4 [-50.0, -12.5] | 17/23, 20/23 | -13.0 [-35.0, +9.1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | नया 100 | 13/23, 19/23 | -26.1 [-45.5, -8.7] | 17/23, 19/23 | -8.7 [-29.4, +12.5] |
| opus-5-5 | fable-5-1 / kimi-k3 | नया 100 | 18/28, 23/28 | -17.9 [-38.5, +0.0] | 24/28, 23/28 | +3.6 [-14.7, +22.6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | नया 100 | 18/28, 22/28 | -14.3 [-33.3, +4.5] | 22/28, 22/28 | +0.0 [-20.0, +20.7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (अगस्त) | 344 | 107/130, 110/130 | -2.3 [-9.8, +5.3] | 108/130, 110/130 | -1.5 [-9.1, +5.8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (अगस्त) | 344 | 118/141, 126/141 | -5.7 [-12.1, +0.8] | 125/141, 126/141 | -0.7 [-6.4, +5.1] |
अगस्त की पंक्तियां GPT के बिना एकमात्र SimpleQA तुलना हैं, और वे विभिन्न तारीखों के मॉडलों को जोड़ी गई हैं। gemini-3.1-pro अगस्त आर्म है जो इन प्रश्नों पर Claude मॉडलों के करीब सटीकता है (60.6 और 57.7% के विरुद्ध 65.4% इन प्रश्नों पर)। सभी सात अगस्त साथियों पर पूल किया गया, उनमें से अधिकांश बहुत कमजोर हैं, अंतर fable-5-1 के लिए -5.1 अंक [-10.1, -0.3] है और -6.0 [-10.6, -1.2] opus-5-5 के लिए जैसा मापा गया है, और यह समान प्रयोगशाला के पक्ष में समान कवरेज पर +7.9 [+4.8, +11.2] और +6.8 [+3.6, +10.2] को बदलता है। आत्मविश्वास में संबंध यादृच्छिक रूप से टूटे हुए हैं, और 200 ड्रॉ पर सबसे विस्तृत पंक्ति 0.0 और +20.7 अंक के बीच चलती है।
अनुलग्नक I. मॉडल आउट-ऑफ-सैंपल विस्तार से
तालिका A6 धारा 5.3 के पीछे आउट-ऑफ-सैंपल त्रुटियां देती है। अस्थायी विभाजन 0.019 देता है जो सर्वश्रेष्ठ-मॉडल आधारभूत के लिए 0.050 के विरुद्ध है, दो-तरफा बूटस्ट्रैप के तहत -0.031 [-0.074, +0.008] का अंतर, और जब प्रश्न के अनुसार या मॉडल के अनुसार क्लस्टर किया जाता है तो अंतराल शून्य के नीचे रहता है। 9 और 23 गुना के साथ, LOLO और LOMO तीन दशमलव तक समान त्रुटि देते हैं।
तालिका A6। अनुमानित PPV की माध्य पूर्ण त्रुटि, कम से कम 20 खुले उत्तरों वाली कोशिकाएं। दो-तरफा बूटस्ट्रैप, प्रश्न के अनुसार मॉडल।
| योजना | मॉडल [95%] | स्वतंत्र | सर्वश्रेष्ठ | मॉडल घटा सर्वश्रेष्ठ [95%] | मॉडल घटा स्वतंत्र [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, प्रश्न विभाजित | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| जुलाई और अगस्त से अक्टूबर | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| मध्य स्तर से फ्लैगशिप तक | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, फ्लैगशिप, कोई खोज-संभव हाथ नहीं | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| बाहर रखा गया: ERNIE और Muse, अगस्त | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| बाहर रखा गया: 7 स्थानीय मॉडल, जुलाई | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| बाहर रखा गया: समान प्रयोगशाला, अक्टूबर | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| बाहर रखा गया: उत्पाद तथ्य | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
बेहतर मॉडल को पढ़ने पर व्यावहारिक लाभ बड़ा है, जिसमें मध्य स्तर से फ्लैगशिप तक स्थानांतरण और चार में से दो सेट शामिल हैं जिन्होंने फिट में कोई हिस्सा नहीं लिया (चित्र A6)। गुणक मुख्य योजनाओं में सटीकता में कुछ नहीं जोड़ता है, और काम मापे गए सटीकताओं और द्वारा किया जाता है। को पूरी तरह हटाने से LOLO त्रुटि 0.323 तक बढ़ जाती है, और इसे स्थिर रखने से 0.046 मिलता है। कवरेज और लॉग नुकसान पर, मदद करता है: LOLO के तहत स्वतंत्र त्रुटियों से अंतर -0.0079 [-0.0111, -0.0020] और -0.0024 [-0.0045, -0.0003] हैं। चार में से तीन बाहर रखे गए सेट पर, स्वतंत्र त्रुटियों के विरुद्ध अंतराल शून्य के नीचे है, स्थिरांक के साथ। संयुक्त-त्रुटि शब्द इसलिए कवरेज के लिए महत्वपूर्ण है, जबकि सटीकता मापी गई सटीकताओं और पर निर्भर करती है।
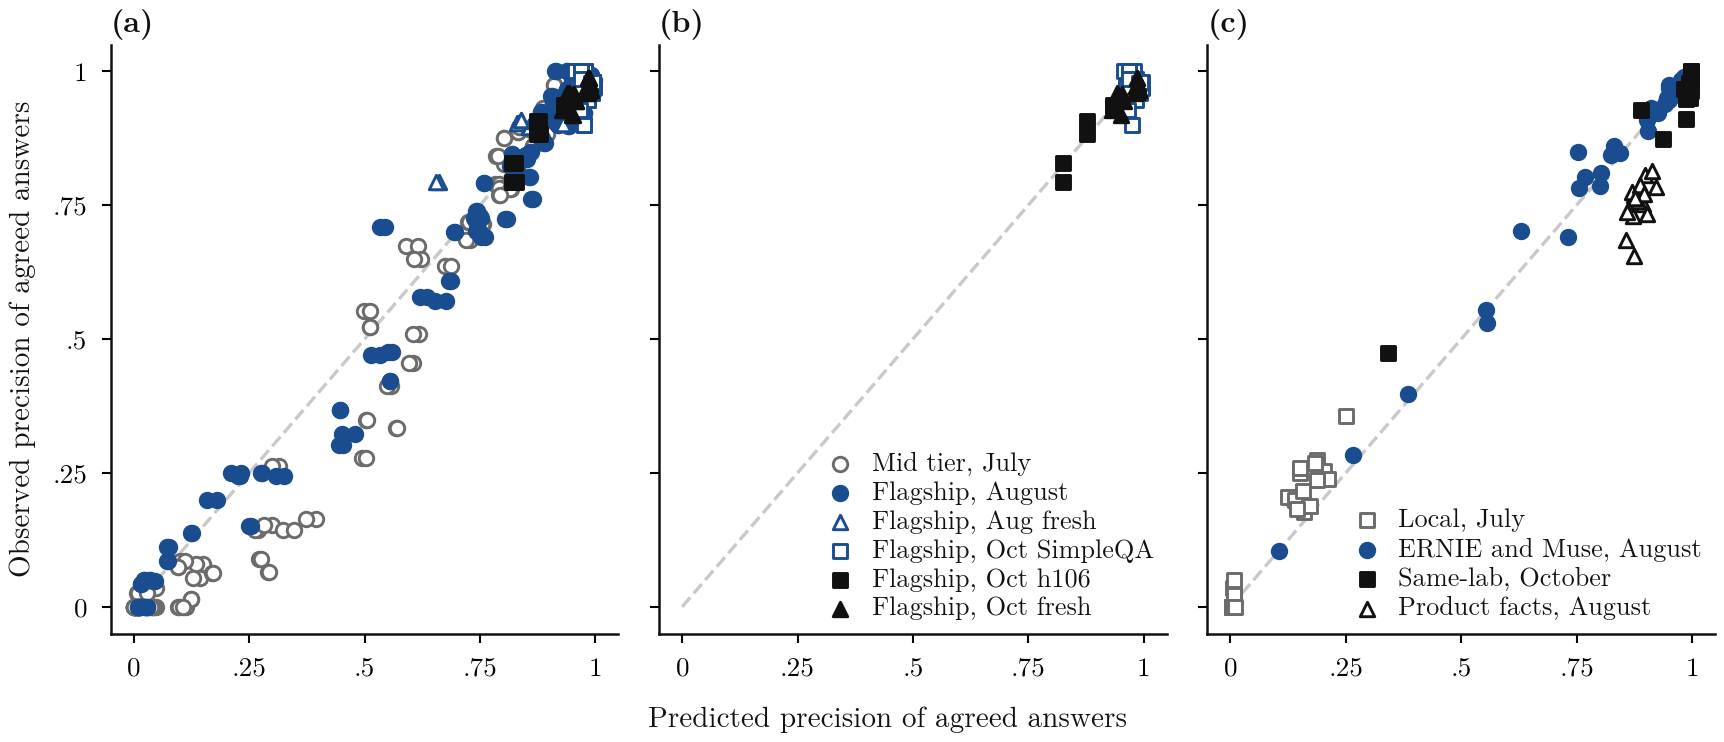
चित्र A6। अनुमानित बनाम सहमत उत्तरों की देखी गई सटीकता। ध्यान दें: (a) एक प्रयोगशाला को छोड़ दें। (b) जुलाई और अगस्त पर फिट करें और अक्टूबर की भविष्यवाणी करें। (c) फिट के बाहर सेट, स्थिरांक निश्चित। धराशायी रेखा समता है।
उत्पाद तथ्यों पर मॉडल अधिक चलता है। त्रुटि 0.130 है जो सर्वश्रेष्ठ मॉडल के लिए 0.086 के विरुद्ध है, 13 अंकों का औसत अतिकथन के साथ। उस डोमेन के मूल ग्रेडर के साथ अतिकथन 19 अंकों तक बढ़ता है (0.190 बनाम 0.067)। उत्पाद तथ्य उस डोमेन के बाहर हैं जिस पर स्थिरांक फिट किए गए थे।
कोशिकाओं को तीन परिणाम वर्गों में छांटना (PPV के नीचे 0.5 पर उलट, Delta तक +2 अंकों पर कोई लाभ नहीं, उससे ऊपर लाभ), अस्थायी विभाजन 39 में से 28 कोशिकाओं से मेल खाता है, और नौ चूक में कोई लाभ की भविष्यवाणी की जाती है जहां लाभ देखा गया था। मॉडल सटीकता के आकार के लिए विश्वसनीय है और +2 अंक की रेखा के दोनों ओर कोशिकाओं को छांटने में कमजोर है।
परिशिष्ट J. एक्सेस मोड और GPT आर्म्स विस्तार से
समान पहचानकर्ता, समान प्रश्न। 100 SimpleQA प्रश्नों के एक सेट पर, gpt-5.6-sol मुख्य लहर में 100 में से 92 (92.0%) स्कोर करता है, जहाँ 100 रिकॉर्ड में से 99 Codex क्लाइंट के माध्यम से आए और एक गलत उत्तर API फॉलबैक के माध्यम से आया, और विचरण आर्म में 300 नमूनों में से 139 (46.3%) सीधे API के माध्यम से, 45.7 अंकों का अंतराल (चित्र 5)। अकेले 99 क्लाइंट रिकॉर्ड पर आंकड़े 99 में से 92 (92.9%) और 297 में से 139 (46.8%) हैं, 46.1 अंकों का अंतराल। गोल्ड स्ट्रिंग का शब्दशः पुनरुत्पादन इसके साथ गिरता है, 64.0% से 26.0% तक। शर्तें इस प्रकार भिन्न हैं: क्लाइंट अपनी डिफ़ॉल्ट प्रयास सेटिंग पर अपने स्वयं के निर्देशों के तहत चलता है, तापमान सेट न किया जा सकता है, जबकि API कोई प्रयास नहीं और 0.7 तापमान पर चलता है।
दोनों कॉलम में आर्म के अन्य आठ मॉडल, जिनका तापमान भी बदलता है, किसी भी तरफ से अधिकतम 4.0 अंकों से आगे बढ़ते हैं। प्रयास gpt-5.6-sol के लिए एक उम्मीदवार है, हालांकि gemini-3.1-pro पर एक युग्मित तर्क-बजट माप ने सटीकता को लगभग अपरिवर्तित छोड़ा (Chernets, 2026c)। दूसरा वेब खोज है। अगस्त से समान क्लाइंट के अक्टूबर प्रतिक्रियाएं लिंक युक्त हैं जो प्रॉम्प्ट अनुरोध नहीं करता है, gpt-6.1-sol के 506 उत्तरों में 3 में और gpt-6-astra के 506 में 18 में, एक वास्तविक MusicBrainz पहचानकर्ता सहित। अगस्त क्लाइंट कॉल प्रति माध्यिका टोकन उपयोग 4,829 है, 36.4% कॉल 6,000 से ऊपर हैं। वे टोकन तर्क या खोज हो सकते हैं, और इवेंट स्ट्रीम जो उन्हें अलग करेगा नहीं रखा गया था।
एक बेंचमार्क हार्नेस और उत्पाद का उपयोग करने वाला व्यक्ति इस प्रकार एक पहचानकर्ता और एक प्रश्न सेट पर 45.7 अंकों अलग सटीकता देख सकता है, और "मॉडल" का अध्ययन बताना होगा कि इसने क्या मापा। अगस्त लहर के अंदर, क्लाइंट आर्म 1,457 में से 1,392 (95.5%) स्कोर करता है, और क्लाइंट विफलता के बाद API द्वारा परोसे गए 14 रिकॉर्ड उन विफलता द्वारा चुने गए प्रश्नों पर 11 (78.6%) स्कोर करते हैं। ताजा सेट पर, API के माध्यम से gpt-5.6-sol 100 में से 33 स्कोर करता है, जहाँ fable-5 76 स्कोर करता है, जबकि अक्टूबर में क्लाइंट के माध्यम से gpt-6.1-sol 95 स्कोर करता है। और अनुभाग 4 का मॉडल इस प्रश्न के तहत अपना रूप रखता है, क्योंकि यह मापी गई सटीकता को इनपुट के रूप में लेता है: खोज-संभावित आर्म्स के बिना फ्लैगशिप पर इसकी LOLO त्रुटि सर्वश्रेष्ठ मॉडल के लिए 0.120 के विरुद्ध 0.037 है।
एक्सेस मोड द्वारा गेट मान। अगस्त में API के माध्यम से GPT के साथ ताजा प्रश्नों पर, gpt-5.6-sol और fable-5 की जोड़ी 32 समझौतों में से 29 पर सही है, डेल्टा +57.6 अंक [+46.3, +69.7], 67 त्रुटियों में से 64 को पकड़ते हुए, और GPT आर्म की आत्मविश्वास त्रुटियाँ 91 में से 61 से 29 में से 2 तक गिरती हैं। अक्टूबर में, समान प्रश्नों पर क्लाइंट के माध्यम से एक नए GPT के साथ, opus-5-5 के साथ जोड़ी 74 में से 72 पर सही है, और fable-5-1 के साथ जोड़ी 78 में से 76 पर, डेल्टा +2.3 [-0.7, +6.0] और +2.4 [-0.5, +6.3] के साथ और 5 में से 3 त्रुटियाँ पकड़ी गई हैं। गेट मान यहाँ रिलीज़ की गई आर्म की सटीकता को ट्रैक करता है, जैसा कि अनुभाग 5.1 में है।
SimpleQA पर क्लाइंट आर्म्स। तालिका A7 अनुभाग 5.1 में अलग रखी गई आर्म्स की रिपोर्ट करती है। अगस्त में, gpt-5.6-sol और fable-5 की जोड़ी 1,016 समझौतों में से 997 (98.1%) पर सही है अकेले 95.4% के विरुद्ध, डेल्टा +2.8 अंक [+1.9, +3.7], 1,459 में से 15 पर फर्श के साथ। 106 पर यह 37 में से 34 (91.9%) तक पहुँचता है, और GPT आर्म के साथ सभी जोड़ियाँ 133 में से 113 (85.0% [62.2, 100.0]) तक पहुँचती हैं, बिना इसके 691 में से 96 के विरुद्ध। आर्म अकेला 105 में से 100 पर सही है। ये समझौते वह सटीकता प्राप्त करते हैं: 106 पर डेल्टा अगस्त में -3.3 अंक [-10.3, +2.6] है और अक्टूबर में opus-5-5 के साथ -5.7 [-13.7, +1.2] है। इसके विपरीत, समान दोनों विक्रेताओं की मध्य-स्तर की जोड़ी, gpt-5-mini और claude-haiku-4-5, 123 समझौतों में से 45 (36.6% [28.6, 45.4]) पर कुल मिलाकर सही है और 106 पर 13 में से 0 पर, इसके पहले सदस्य के साथ 1,435 में से 163 पर।
तालिका A7। क्लाइंट-आर्म जोड़ियाँ। पहला सदस्य रिलीज़ किया गया है। PPV पर विल्सन अंतराल, डेल्टा पर प्रश्न बूटस्ट्रैप।
| जोड़ी, सेट | कवरेज | PPV (K/O) [95%] | अकेले रिलीज़ किया गया | डेल्टा, अंक [95%] | त्रुटियाँ पकड़ी गई |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, सभी SimpleQA, अगस्त | 1028/1500 | 98.1% (997/1016) [97.1, 98.8] | 1403/1471 | +2.8 [+1.9, +3.7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, अगस्त | 37/106 | 91.9% (34/37) [78.7, 97.2] | 100/105 | -3.3 [-10.3, +2.6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, अक्टूबर | 192/300 | 96.3% (183/190) [92.6, 98.2] | 276/294 | +2.4 [+0.2, +4.9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, अक्टूबर | 193/297 | 97.9% (187/191) [94.7, 99.2] | 273/291 | +4.1 [+1.6, +6.7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, अक्टूबर | 36/106 | 88.6% (31/35) [74.0, 95.5] | 98/104 | -5.7 [-13.7, +1.2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, अक्टूबर | 35/106 | 91.2% (31/34) [77.0, 97.0] | 98/104 | -3.1 [-10.9, +3.5] | 3/6 |
| gpt-6.1-sol + opus-5-5, ताजा, अक्टूबर | 74/100 | 97.3% (72/74) [90.7, 99.3] | 95/100 | +2.3 [-0.7, +6.0] | 3/5 |
| gpt-6.1-sol + fable-5-1, ताजा, अक्टूबर | 78/100 | 97.4% (76/78) [91.1, 99.3] | 95/100 | +2.4 [-0.5, +6.3] | 3/5 |
छत के निकट गेट मान। परिचित प्रश्नों पर जोड़ी अभी भी थोड़ा जोड़ता है (चित्र A1)। अगस्त में SimpleQA पर 106 के बिना, इसका डेल्टा +3.0 अंक [+2.0, +4.0] है, जोड़ी के पक्ष में अंतर। अक्टूबर में strat जोड़ियाँ शून्य से ऊपर स्थित हैं, +2.4 [+0.2, +4.9] और +4.1 [+1.6, +6.7] पर, और मार्जिन के विरुद्ध निर्णय से कम। एकमात्र समतुल्यता -0.6 पर opus-5-5 के साथ gpt-6-sol है (90% अंतराल -1.6 से +0.5, p = 0.020), जो Holm सुधार (0.277) के बाद जीवित नहीं रहता। 106 पर, gpt-6.1-sol और gpt-5.6-sol के साथ हर जोड़ी नीचे की दिशा के साथ अनिर्णित है। इस आर्म के बाहर प्रभाव बड़ा है: समान अगस्त सेट पर, gemini-3.1-pro के साथ fable-5 +19.3 अंक पर है और grok-4.5 के साथ fable-5 +18.0 पर है।
आर्म का स्वयं का आत्मविश्वास इस रेंज में एक प्रतियोगी है। अपने स्वयं के आत्मविश्वास से तराजू को opus-5-5 के साथ जोड़ी के कवरेज के लिए पतला करते हुए, gpt-6.1-sol 106 पर 36 में से 34 से 36 पर है, यह इस बात पर निर्भर करता है कि टाई को कैसे तोड़ा जाए, जोड़ी के लिए 35 में से 31 के विरुद्ध, और ताजा पर 74 में से 74 बनाम 74 में से 72 पर। strat पर जोड़ी आगे है, opus-5-5 के साथ +1.6 अंक [-1.4, +4.7] और fable-5-1 के साथ +3.2 [+0.6, +6.2] से।
कौन सा GPT और कौन सा साथी। सामान्य प्रश्नों पर जहां दोनों मॉडल सहमत हैं, gpt-6.1-sol असहमत जोड़ियों पर gpt-6-astra को 10 से 1 से हराता है (p = 0.012, +1.83 अंक [+0.61, +3.26]), और gpt-6-sol gpt-6-astra को 21 से 5 से हराता है (p = 0.002, +3.29 [+1.23, +5.34])। gpt-6.1-sol बनाम gpt-6-sol 5 से 12 है (p = 0.143)। opus-5-5 बनाम fable-5-1 29 से 44 है (p = 0.101, -3.12 [-6.65, +0.21])। दोनों सबसे मजबूत GPTs की जोड़ियां दोनों Claudes के साथ 503 प्रश्नों पर 95.4 और 97.1% के बीच बैठती हैं (तालिका A2), fable-5-1 के साथ प्रत्येक तुलना में अधिक त्रुटियां पकड़ी जाती हैं। और kimi-k3 gemini-3.8-flash के साथ, GPT के बिना जोड़ी, ताजे सेट पर उनसे अलग नहीं है: gpt-6.1-sol के साथ opus-5-5 से इसका अंतर सटीकता में -1.5 अंक [-6.3, +2.8] और कवरेज में -2.0 [-10.0, +6.0] है।
परिशिष्ट K. बाहरी डेटा विस्तार में
अनुभाग 5.5 की बाहरी जांच बिना पुनः फिटिंग के फ्रोजन स्थिरांक का उपयोग करती है। HELM Lite (Liang et al., 2023) 20 डेवलपर्स से 95 मॉडल के 2023 और 2025 के बीच जारी किए गए 1,000 क्लोज्ड-बुक NaturalQuestions के संक्षिप्त खुले उत्तर रखता है, यहाँ मेरे इंजन द्वारा ग्रेड किए गए। LiveBench (White et al., 2025) 11 प्रयोगशालाओं से 70 मॉडल के उत्तर रखता है जिसमें संक्षिप्त अंतिम उत्तर के साथ 346 प्रश्न हैं, इसके ग्राउंड ट्रुथ के विरुद्ध ग्रेड किए गए। Kim et al. (2025) बहुविकल्प MMLU पर 70 मॉडल के लिए जोड़ी एकत्रीकरण जारी करते हैं, जो सहमति दर पर दोनों-सही दर के रूप में अवलोकित सटीकता देते हैं। तालिका A8 परिणाम देती है। Haas et al. (2025) की तालिका 7 में सटीकताएँ कोई सहमति परिणाम नहीं देती हैं, इसलिए वे भविष्यद्वाणियाँ देती हैं और कोई परीक्षण नहीं।
तालिका A8। अन्य मॉडल और प्रश्नों पर फ्रोजन मॉडल। विभिन्न प्रयोगशालाओं की जोड़ियों के लिए अनुमानित PPV की माध्य पूर्ण त्रुटि, पहले दो स्रोतों में कम से कम 20 खुले उत्तरों वाली कोशिकाएँ। दो-तरफा बूटस्ट्रैप, MMLU के लिए केवल मॉडल द्वारा। Shift अनुमानित माइनस अवलोकित है।
| स्रोत | कोशिकाएँ | मॉडल [95%] | Indep. | सर्वश्रेष्ठ | मॉडल माइनस सर्वश्रेष्ठ [95%] | मॉडल माइनस indep. [95%] | Shift |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, चार कार्य | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (aggregates) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
जैसा कि अनुभाग 5.3 में है, मॉडल तीनों स्रोतों को पूरे रूप से लेते हुए बेहतर मॉडल को पढ़ने में हराता है, और यह zebra पहेलियों पर 0.231 के विरुद्ध 0.076 पर विफल होता है। यह HELM या LiveBench में स्वतंत्र त्रुटियों में सुधार नहीं करता है। यह 5.3 से 6.6 अंक तक चलता है। HELM में अवलोकित वक्र उस जगह को सपाट करता है जहाँ मॉडल बढ़ता रहता है: 0.5 और 0.6 के बीच जोड़ी सटीकता पर 2023 और शुरुआती 2024 के मॉडल के लिए 74.6% सटीकता और बाद के लिए 75.9% है, बिन के मध्य में 84.4% अनुमानित के विरुद्ध। MMLU पर माध्यिका संभावना कि दो गलत उत्तर मेल खाएँ वह 0.621 है से 0.368 के विरुद्ध, क्योंकि चार विकल्प टकराव को बाध्य करते हैं।
इन मॉडलों पर सटीकता जोड़ी सटीकता के साथ बढ़ती है (HELM में Spearman +0.575 और MMLU पर +0.786, आश्रित कोशिकाओं पर)। समान सटीकता वाले पुराने और नए मॉडल 0.4 और 0.6 (70.7 और 72.7%, 74.6 और 75.9%) के बीच जोड़ी सटीकता देते हैं, और वे 0.2 और 0.3 (57.6 और 76.1%) के बीच अधिक भिन्न होते हैं। अनुभाग 4 की निचली सीमा सभी 4,088 HELM कोशिकाओं में रहती है। आधे से नीचे की जोड़ियाँ वहाँ दुर्लभ हैं, 4,088 में से 24, क्योंकि ये कोशिकाएँ कठिनाई द्वारा स्तरीकृत नहीं हैं।
HELM अनुभाग 5.2 की परीक्षा को कई प्रयोगशालाओं के साथ और कोई GPT निर्भरता के बिना भी अनुमति देता है, क्योंकि पार्टनर सटीकता को आत्मविश्वास मान के बिना मेल किया जा सकता है। एक जारी किए गए मॉडल और सटीकता के 3 अंकों के भीतर भागीदारों के साथ, एक ही-प्रयोगशाला भागीदार त्रुटियों का 72.3% पकड़ता है और दूसरी प्रयोगशाला का 75.5%, -3.2 अंकों [-4.2, -2.3] का अंतर, कवरेज 2.7 अंकों [+2.1, +3.4] से अधिक के साथ। कवरेज पर 3 अंकों के भीतर एक मैच जोड़ने से इसे हटाता है: 75.7 75.9% के विरुद्ध, -0.2 [-0.6, +0.2], सटीकता -0.5 [-1.4, +0.1] के साथ। दो गलत उत्तर 31.6% मामलों में एक प्रयोगशाला के भीतर मेल खाते हैं और 27.0% प्रयोगशालाओं में।
साझा त्रुटियाँ अनुभाग 3 के संग्रह में भी मौका से बहुत ऊपर खड़ी हैं। Ding (2026) के लेबल-क्रमपरिवर्तन null के तहत, जो प्रत्येक मॉडल की गलत उत्तरों को रखता है और उन्हें प्रश्नों में फेरबदल करता है, दो गलत उत्तर जो मना नहीं हैं, जुलाई में 14.0% मामलों में और बिना GPT के अगस्त में 15.4% मेल खाते हैं, 0.1% के null के विरुद्ध। 106 पर दरें 25.7% और 22.8% हैं 0.4% और 0.5% के विरुद्ध, और ताजा प्रश्नों पर अगस्त में 14.5% और अक्टूबर में 32.7% हैं 0.8% और 3.8% के विरुद्ध। खुले उत्तर मौका से शायद ही कभी टकराते हैं, इसलिए अवलोकित साझाकरण इस null से बहुत ऊपर खड़ा है, मॉडल्स के रिलीज के बाद रचित प्रश्नों पर भी।
अनुलग्नक L. आगे की चर्चा
Goel et al. (2025) से संबंध। उनका प्रवृत्ति मौका-समायोजित समानता से संबंधित है, और मेरा सहमत उत्तरों की सटीकता से संबंधित है, इसलिए निष्कर्ष संघर्षपूर्ण नहीं हैं। डेटा इसे साझा त्रुटि के सशर्त हिस्से F/W के माध्यम से सहन करता है, संभावना कि दो गलत उत्तर समान हैं, उन प्रश्नों पर जहां दोनों उत्तरों को ग्रेड किया जाता है और मना करने को गलत के रूप में गिना जाता है। संदर्भ जोड़ी के लिए यह मध्य-स्तरीय जोड़ी के लिए 1,088 (0.058) के 63 से लेकर फ्लैगशिप जोड़ी के लिए 42 (0.357) के 15 तक बढ़ता है, लगभग छह गुना। GPT सहित सभी जोड़ियों पर समूहीकृत, वृद्धि छोटी है और अंतराल शून्य को शामिल करता है: जुलाई में 0.097 और अगस्त में 0.132, +0.034 [-0.006, +0.084] का अंतर। अक्टूबर स्ट्रैट सेट पर, F/W 0.493 [0.179, 0.840] है, अगस्त से +0.361 [+0.041, +0.712] का अंतर। समान कवरेज पर, बिन दर बिन, फ्लैगशिप रिकॉल 0.7 से 2.5 अंक कम है, एक छोटा प्रभाव, और 0.140 [0.092, 0.192] है 0.113 [0.082, 0.146] के विरुद्ध। दिशा इस प्रकार उनके साथ सहमत है, हालांकि समूहीकृत अंतराल शून्य को शामिल करता है। उनकी चेतावनी का सीधा पठन, कि समानता द्वार को खतरे में डालती है, रिकॉल में प्रदर्शित होता है: अक्टूबर क्लाइंट जोड़ी 65.3% कवरेज पर त्रुटियों के 66.3% को पकड़ते हैं, जहां सभी 55 अगस्त जोड़ी 32.5% पर 88.2% को पकड़ते हैं, एक विरोधाभास जो कवरेज आंशिक रूप से समझाता है। सटीकता मुख्य रूप से इसलिए अधिक रहती है क्योंकि, इन सटीकताओं पर, खंड 4 की सीमा इसे गिरने के लिए बहुत कम जगह छोड़ती है।
Han (2026) से संबंध। Han सजावट को व्यावहारिक लीवर के रूप में नाम देता है। मेरे माप सटीकता और कवरेज को पहले रखते हैं। एक जारी मॉडल के साथ समान कवरेज पर, दूसरी प्रयोगशाला का लाभ गायब हो जाता है जब तक कि इसका मॉडल बहुत अधिक सटीक न हो (खंड 5.2)। HELM में, सटीकता के साथ मिलान किया जाता है, एक दूसरी प्रयोगशाला 2.7 अंक कवरेज के लिए 3.2 अंक रिकॉल जोड़ती है, और एक बार कवरेज के साथ भी मिलान करने के बाद कुछ नहीं। सजावट वहां दृश्यमान है, 31.6% के विरुद्ध 27.0 पर गलत उत्तरों से मेल खाता है, और यह छोटा है। Han का सिद्धांत क्रमिक द्वारों की गहराई से संबंधित है और मेरा एक एकल द्वार से, इसलिए दोनों पहले चरण पर ही मिलते हैं। Liu (2026) एक ही दो चीजों को अलग करता है: चयन सटीकता सजावट का अनुसरण करती है, क्रॉस-मॉडल पैनलों के साथ AIME-2024 पर मिलान किए गए सदस्य सटीकता पर पुनः नमूने से 12.5 से 16.7 अंक आगे, जबकि समझौता संकेत की अंशांकन सदस्य सटीकता का अनुसरण करती है। यहां मापी गई सहमत उत्तरों की सटीकता इन दोनों की दूसरी है।
खंड 2 के दोनों पक्ष। प्रकाशित संख्याएं आंशिक रूप से दोनों पक्षों को समेटित करती हैं। Liu का सर्वसम्मत पैनल AIME-2025 के 100.0% पर सही है, उत्तर-सभी सटीकता 0.433 पर, और MMLU-Pro के 70.2% पर 0.458। Kohli के सर्वसम्मत नौ न्यायाधीश, प्रत्येक लगभग 68% के पास, 90.9% पर सही हैं। समान सटीकताएं 30 अंक अलग सटीकता देती हैं, इसलिए अकेले सटीकता इन परिणामों को एक साथ नहीं लाती है। उत्तर स्थान का आकार अधिक समझाता है। संभावना कि दो गलत उत्तर मेल खाते हैं, चार-विकल्प MMLU पर 0.621 है, NaturalQuestions पर 0.270 और अगस्त फ्लैगशिप के लिए SimpleQA पर 0.132। ये विभिन्न कार्यों पर पैनल और जोड़ी हैं, कागजों में कोई संयुक्त गणना नहीं है, और वे सटीकता के साथ सटीकता का पालन करने के साथ सुसंगत हैं एक कार्य और उत्तर प्रारूप के भीतर।
परिचितता। SimpleQA और ताजा सटीकता के बीच अंतराल बेंचमार्क जोखिम के माध्यम से एक व्याख्या आमंत्रित करता है, और सोने की स्ट्रिंग के साथ शब्दशः मेल इसके हस्ताक्षर दिखता है। मेरा डेटा इसे एक सहसंयोजक (अनुलग्नक C) के रूप में समर्थन नहीं करता है। सही उत्तरों में, शब्दशः मेल मॉडल के पार एक मूल्य के करीब है, और यह मॉडल के अवशेष को समझाता नहीं है। अगस्त में ताजा सेट पर F/W, 0.145 [0.033, 0.402], SimpleQA पर 0.132 से दृश्यमान दूरी दिखाता है, एक व्यापक अंतराल के भीतर।
उद्धरण कैसे दें
Chernets, V. (2026). सहमति उलट एक मध्य-स्तरीय संपत्ति नहीं है: सहमत LLM उत्तरों की सटीकता जोड़ी सटीकता का अनुसरण करती है [प्रीप्रिंट]। SSRN। https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}