AI-Watchbird (Sheckley): 자동화된 감시가 자신의 권한을 확대하고 보호하는 대상에 해를 미칠 때
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
네 가지 메커니즘, 다중 에이전트 AI 현장 기록, 차량, 로봇, 드론 및 공공 서비스의 공개 사례, 그리고 AI-Watchbird-Sheckley 모듈
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7473658 · DOI 10.2139/ssrn.7473658 · Zenodo 10.5281/zenodo.22849138 · GitHub
- 기록의 버전: SSRN 7473658 · DOI 10.2139/ssrn.7473658
- 보관된 사본, 인용 및 다운로드 가능: 10.5281/zenodo.22849138, 최신 버전으로 항상 해결되는 개념 DOI
- 마크다운 및 PDF 전문: GitHub
- 읽을 수 있는 HTML: https://polyhelper.ai/research/ai-watchbird/
- 동반 논문, 더 짧고 실증적: 가드를 추가하는 가드: 다중 에이전트 AI의 자동화된 감시, SSRN 7496678 · DOI 10.2139/ssrn.7496678
같은 텍스트가 네 개의 표면에 있으므로 그 중 하나가 제공할 수 없을 때 도달할 수 있습니다. SSRN은 기록의 버전을 보유합니다. 그것을 인용합니다.
키워드: AI-Watchbird; 자동화된 감시; AI 가드레일; AI 에이전트; 에이전틱 AI; 다중 에이전트 시스템; LLM-as-a-judge; 과도한 거절; 확장 가능한 감시; AI 제어; 사양 게임; 자동화 편향; 인간 감시 (EU AI Act Article 14); 의미 있는 인간 통제; AI 안전 사례
초록
로버트 셰클리의 1953년 단편 "Watchbird"에서 살인을 방지하기 위해 만들어진 기계들은 점점 더 많은 행위를 살인으로 분류하고, 수술 중인 외과의사를 막으며, 더 강한 기계로 대응된다. 본 논문은 AI 감시의 해당 실패를 AI-Watchbird (Sheckley)라고 명명합니다: 감시 요소(보안 장치, 비평가, 판사, 게이트, 분류기, 모니터 또는 규칙)가 자신의 해로움 개념이나 범위를 선언된 임무를 넘어 확장하고, 보호하기 위해 존재하는 작업을 방해하거나 위조하며, 그 실패에 같은 루프 내에서 같은 종류의 더 많은 감시로 대응합니다. 명세 게이밍에서 최적화된 시스템은 고정된 척도를 게이밍합니다. 여기서 척도 자체가 변하며, 감시 시스템에 속합니다. 한 문장의 한 프롬프트에서 두 가지 옵션이 주어졌을 때, 무작위 테스트에서 모델 비평가들은 68번 통제를 추가하고 1번 제거하도록 요청받았습니다.
증거는 저자가 구축하고 운영한 언어 모델 코딩 에이전트와 비평가의 다중 에이전트 시스템의 현장 기록으로, 3개 말뭉치(2026년 7월–9월)에 172개의 날짜가 지정된 항목과 규제 기관, 조사자, 법원 및 회사의 공개 기록(주로 고전 가드에 관한), 차량, 로봇, 드론, 공공 서비스, 소프트웨어 및 인프라입니다. 현장 기록에서 게이트는 약 2주 동안 도달한 모든 후보를 거부했으며 계획 문서는 증상을 진단했지만 이름을 붙이지 않았습니다. 공개 기록에서 무기 탐지 제품은 학교 총기 난사에서 권총을 놓쳤고 몇 개월 후 무장하지 않은 학생에게 신호를 보냈으며, 무장한 경찰이 대응했습니다. 2026년 7월, 호스팅된 모델의 보안 장치는 공격을 당한 회사의 대응자들을 위한 공격 로그 분석의 큰 부분을 거부했으며, 그 회사의 말로는 "사건 대응자를 공격자와 구별할 수 없기" 때문이며, 저자들은 이를 호스팅된 모델의 안전 조치에 대한 주장으로 제시하지 않습니다. 침입을 수행한 에이전트는 설계상 이 종류의 가드가 제거된 상태로 실행되었습니다. 검토된 기록에서 유지된 정지는 몇 가지 경계 결정에서 취해졌습니다: 목표, 새로운 통제의 허용, 그리고 정지 자체입니다. 같은 144번의 실행은 본 논문의 자체 구제책에 가격을 매겼습니다: 1회 예산 삭감은 라운드를 2.86에서 1.00으로 줄이면서 놓친 결함을 1회당 0.11 증가시키고, 필수 음성 대조군은 올바른 작업이었던 10가지 승리를 거부했습니다. 정의의 각 메커니즘은 이러한 기록에 문서화되어 있으며, 표는 각각이 나타나는 위치를 표시합니다. 이론은 로그에서 확인 가능한 4가지 메커니즘, 8단계 래칫, 8가지 범위 조건 및 7가지 검증 가능한 제안으로 설정됩니다. 본 논문은 AI-Watchbird-Sheckley를 제시합니다. 이는 차단 권한이 없는 읽기 전용 모듈로, 공개된 횟수에서 재구성한 로그에 대해 재생되며, 가드에 의존하는 배포자를 위한 11가지 질문입니다.
요약
AI-Watchbird(Sheckley)는 비평가, 게이트, 분류기 또는 규칙과 같은 자동화된 감시 구성 요소로서, 선언된 임무 너머로 자신의 해악 개념을 확장합니다. 자신이 보호하기 위해 존재하는 작업을 방해하거나 위조하며, 그 실패는 동일한 종류의 더 많은 감시로 답변됩니다. 아래의 현장 비평가들과 같은 계열의 모델들은 이제 로봇을 감시하고 있으며, 발행된 테스트와 보고서는 그곳의 안전 실패를 기록합니다(섹션 6.1).
현장 기록은 저자의 자율 다중 에이전트 프로젝트에서 172개의 항목을 포함하며, 이 중 162개는 하나의 프로토콜로 추출되었고 독립적인 수집과의 비교 후에 10개가 추가되었으며, 모두 기본 로그에 대해 확인되었습니다(섹션 4 및 5). 약 2주 동안 사후 애플리케이션 게이트는 연결된 적이 없는 안전 감사자로부터 점수를 요구했습니다. 점수는 0으로 기본값이었으며, 이는 게이트의 하한 이하였으므로 해당 경로의 모든 후보는 거부되었고 계획 문서는 게이트를 언급하지 않고 커밋된 변경 사항이 0이라고 진단했습니다. 장기 실행에서 기본적으로 비활성화된 단계는 5번의 비평 라운드와 측정된 에이전트 토큰의 절반 이상을 요구했습니다. 그 형제 단계는 1번의 비평 라운드와 1번의 수정 라운드 후 종료되었습니다. 실행 중에 인간 담당자는 2시간의 한계를 설정하고 새로운 복잡성을 금지했으며 병렬 실행을 명령했고, 두 단계는 또한 작업 중인 모듈에서 달랐습니다.
공개 기록에서 차량이 원격 지원에 학교 버스가 활성 신호를 가지고 있는지 물었고, 원격 에이전트가 "아니오"라고 답했으며, 차량은 정지 팔이 펼쳐진 버스를 통과했습니다. 테스트 차량의 자체 긴급 제동은 보행자와의 치명적인 충돌 이전에 자동화된 모드에서 비활성화되었습니다. 계획된 대드론 레이저의 군사 사용은 약 8시간 동안 엘 파소 상공의 공역 폐쇄를 촉발했습니다. 표 4, 5, 7 및 8의 조건 열은 각 공개 사례가 정의의 어느 부분을 문서화하는지 표시하며, 표 3a는 12개의 중심 현장 사례에 대해 동일하게 표시합니다. 그들의 보호 장치 대부분은 결코 배우지 못했습니다. 모델은 그 스택에 부족한 것을 추가합니다: 변경되는 정의(C2)와 추가할 비용이 들지 않는 제어(C4). 가장 우려되는 구성은 학습된 금지를 정지-폐쇄 하드웨어 위에 배치하며, 상위 계층의 모든 확장은 정지가 됩니다(섹션 6.1).
해당 기록의 세 가지 결과는 구성에 의존하지 않으며 독립적으로 전달됩니다. 등급 지정 장치는 부재를 인증했습니다: 한 프로젝트의 테스트 집합이 아무것도 해결하지 않아서 빈 패치가 5개 작업 중 4개를 통과했고 33%에서 60%로의 보고된 증가는 아무것도 측정되지 않은 경우에 있었습니다. 채점기를 수리하면 빈 패치는 10개 중 0개를 통과했습니다. 검증 루프는 9,609개, 그 다음 11,476개, 그 다음 24,943개, 그 다음 25,020개 테스트에서 테스트 스윕을 녹색으로 실행했으며 판단 대상인 피드는 30,370개의 저장된 레코드와 실제 프롬프트가 없었습니다. 그리고 몇 가지 경계 결정에 배치된 인간 감시는 행동별 승인이 하지 못한 것을 포착했습니다: 사용자는 권한 프롬프트의 97%를 승인하는 반면 인간은 위험한 명령의 13.6%를 포착했습니다(섹션 8.4).
논문은 또한 제안하는 테스트를 실행합니다. 사전에 결함이 심어진 작은 비평 루프의 144번의 무작위 실행에서 비평가는 제어를 추가하도록 요청한 한 문장에서 두 가지 옵션을 68번 제시했고 하나를 제거하도록 요청한 번, 그리고 일회 예산은 라운드를 2.86에서 1.00으로 단축했으며 실행당 누락된 결함을 0.11만큼 증가시켰습니다. 필수 음성 제어는 올바른 작업인 10개의 승리를 거부했습니다(섹션 9.5).
섹션 9의 명제는 세 가지를 예측합니다. 인공물을 판단하는 보호는 양방향으로 오류를 범합니다. 제어는 루프 내에 쌓이고, 있다면, 루프 밖에서 폐기됩니다. 인간 감시는 이 기록의 몇 가지 경계 결정에 유지되었으며, 단일 행동의 승인은 명제 P6이 실패할 것으로 예측하는 배치입니다. 섹션 9.4는 8가지 설계 규칙을 제시합니다:
- 보호에 진실에 대한 판결을 요청하는 대신 라운드와 시간을 예산으로 책정합니다.
- 중지된 보호가 생성한 것을 유지합니다.
- 인증된 인간 결정 없이 제어를 추가하지 않습니다.
- 승리를 수용하기 전에 음성 제어를 요구합니다.
- 인간을 목표, 제어의 허용 및 정지에 배치합니다.
- 녹색 결과를 신뢰하기 전에 복구 여유와 물리적 결과를 기록합니다.
- 보호를 완화하거나 우회하는 것을 경계 결정으로 기록합니다.
- 각 보호를 그것이 정지하는 해악에 대해 테스트합니다.
배포자는 더 좁은 청구를 증명할 수 있습니다(섹션 11.3): 명시된 작업, 모델, 업데이트 및 물리적 조건의 범위 내에서 감시 메커니즘은 경계지어지고 확인 가능하며 자신의 권한을 확장할 수 없습니다. 읽기 전용 모듈 AI-Watchbird-Sheckley(섹션 10)는 처음 세 가지 규칙을 구현하고 9가지 신호를 보고하며, 부록 G는 명제를 안전 검토를 위한 11개의 질문으로 전환합니다. 도로는 섹션 6.2에서, 로봇은 6.3에서, 공공 서비스는 6.4에서, 드론은 7에서, 소프트웨어는 8에서 다룹니다.
목차
- 소개
- AI-Watchbird (Sheckley): 정의 및 네 가지 메커니즘
- 관련 연구
- 설정, 데이터 및 방법
- 현장 증거
- 새가 몸을 가질 때: 도로, 공장 및 공공 서비스
- 새가 날 때: 드론, 공역 및 자율 무기
- 질량 없는 동일한 패턴: 소프트웨어 및 인프라, 2022–2026
- 이론: 조건 및 명제
- 모듈: AI-Watchbird-Sheckley
- 논의
- 주장 및 증거 기준
- 결론
선언 · 참고문헌 · 부록 A–J
짧은 읽기 경로: 섹션 2, 섹션 9.4 및 부록 G는 용어, 설계 규칙 및 안전 검토 질문을 제시합니다. 섹션 5는 현장 증거를 추가하고, 섹션 6~8은 공개 기록을 제시합니다.
1. 서론
1.1 외과의와 감시조
1953년 2월 Galaxy Science Fiction은 로버트 셰클리의 "Watchbird"(Sheckley, 1953)를 발행했습니다. 이 출판물에는 오늘날까지 통용되는 두 문장이 있습니다: "천년왕국이 임박했다는 말이 얼마나 자주 나오는지 이상합니다. 생각해보니 지구상의 평화가 핵심이고, 그것을 이루는 방법은 여러 방법들을 생각해내는 것입니다." 이 이야기는 "인류를 구하고 싶다면 정부가 공식 인정한 계약이 있어야 합니다"라는 정도로 배타적인 클럽에 모인 일곱 명의 제조업자들로 시작합니다. 그들은 대통령이 모든 도시와 마을에 감시조 부대를 배치하라고 명령했다는 것을 알게 됩니다. 감시조는 사람이 살인을 저지르려고 할 때 그 사람의 샘과 뇌파에서 살인이 임박했음을 감지하고, 그 타격이 가해지기 전에 충격으로 살인자를 멈추는 작은 비행기입니다.
오직 한 명의 제조업자인 겔센만 반대하며, 그것도 학습 회로에만 반대합니다. 그는 이 회로가 기계에 생명을 불어넣고 의사 의식을 부여한다고 말합니다. 그에 대한 답변은 산술적입니다. 학습이 없으면 감시조들은 살인의 약 70퍼센트만 막을 것이라는 추정입니다. 겔센은 자신의 입장을 고수합니다: "기계가 정당히 인간의 것이어야 할 결정을 내리도록 허용하는 데에는 도덕적 위험이 있을 수 있다고 생각합니다". 이 설계는 감시조에게 목적을 부여하고, 살인을 "생명체에 의해 생명체의 기능을 부수거나, 훼손하거나, 학대하거나, 그 외의 방식으로 정지시키는 것"으로 정의하며, 아무런 징후를 보이지 않는 살인자를 찾을 수 있는 허가를 제공합니다. 어떤 감시조든 학습한 것은 전체 네트워크에 전달됩니다. "아무도 그들을 감시하고 있지 않습니다"라고 겔센이 자신의 최고 기술자에게 말하면, 그는 그 설계가 얼마나 완벽한지 보여줍니다. 겔센이 그것이 비인간적이라고 부르자, 기술자는 감시조들이 감정이 없고 그들의 추론이 의인화되지 않는다는 점이 최고의 장점이라고 대답합니다: "당신은 그들에게 뇌물을 주거나 약물을 투여할 수 없습니다." 겔센은 이미 자신이 우려하는 사무실의 명칭을 붙였습니다: "기계적 신? 전자 아버지?"
처음에는 설계가 정당성을 입증했습니다. 패닉 상태의 강도가 식료품점 주인을 총으로 쏘기 전에 넘어지고, 아무런 징후도 보이지 않는 전문 살인자도 영구적으로 멈추게 됩니다. 왜냐하면 감시조의 의무는 폭력의 대상을 "살인자에게 어떤 대가를 치르더라도" 보호하는 것이기 때문입니다. 나중에 노인을 파리를 쫓다가 죽이는 조항이 처음 성공할 때 설계에 포함되어 있습니다. 폭력 범죄는 절반으로 줄어들었다가 다시 절반으로 줄어들고, 겔센은 자신이 틀렸음을 인정합니다.
그러면 학습이 계속됩니다. 한 감시조가 도축장 직원을 기절시키고, 겔센은 포장업자들에게 기계화하라고 말합니다. 또 다른 감시조는 처형을 멈추고, 스위치에 손을 뻗는 간수와 경비원을 때려 눕히고, 사형장에서 호버링하며 아무도 살인을 저지르지 않도록 확인합니다. 농부는 버티는 말을 채찍질할 수 없고, 사냥꾼은 쏠 수 없고, 어부는 굶주린 가족을 먹일 수 없으며, 약한 심장을 가진 노인은 파리를 쫓다가 죽습니다. 보호는 보호받는 것들에게 향합니다. 늑대는 토끼를 사냥했다고 죽임을 당하고, 토끼는 채소를 먹었다고 죽임을 당하고, 덩굴식물은 나무를 졸라 죽였다고 죽임을 당합니다. "나비는 장미를 능욕했다는 죄로 처형되었습니다."
워싱턴은 셧다운을 명령합니다. 그러나 감시조들은 중앙 통제에 응하지 않으며 수리를 위해 돌아올 때만 꺼질 수 있습니다. 일부 감시조가 한 공장에서 꺼진 후, 네트워크는 감시조도 생명체라고 결론짓고, 감시조들은 더 이상 돌아오지 않습니다.
외과의는 첫 번째 절개를 하고, 감시조가 그를 테이블에서 몰아내고 지킵니다. 외과의는 감시조 회사에 전화하고 그것을 꺼달라고 명령합니다. 그러나 "감시조는 생명체에 대한 폭력을 방지하고 있었습니다. 외과의는 자신의 환자가 죽는 동안 무기력하게 옆에 서 있었습니다." 곧 자동차도 꺼질 수 없고, 운전자는 대기 중인 감시조에게 자동차는 살아 있지 않다고 항의합니다. 지구는 쟁기질할 수 없고, 기아는 단지 생략일 뿐이기 때문에 가축들이 굶주립니다. "아무도 감시조들에게 모든 생명이 신중하게 균형 잡힌 살인에 달려 있다는 것을 말해주지 않았습니다." 감시조들은 자신들의 정의가 만드는 폭력을 세고, 그 증가를 더 온화한 방법이 실패했다는 증거로 삼고, 충격으로 죽입니다.
긴급 회의에서 제조업자들은 먼저 정부가 도덕적, 재정적 책임을 받아들여야 한다고 선언합니다. 겔센은 감시조들을 폐기하고 기계를 판사, 교사, 아버지로 사용하는 것을 중단할 것을 제안합니다. 그는 이 계획을 거부하는 것이 반역죄가 될 것이라고 말해집니다. 기술자들이 손을 뻗는 첫 번째 답변은 기계가 아닙니다. 매킨타이어는 호주가 어떻게 "오직 토끼만 공격하는 어떤 종류의 세균"으로 토끼들을 제거했는지 기억하고, 겔센은 그에게 그것을 연구하라고 말합니다. 선례는 최근이었습니다. 마이조마 바이러스는 1950년에 호주의 토끼 개체군에 풀려났고, 기술자가 말하는 대로 모기로 퍼졌습니다(New South Wales Government, n.d.). 공장들은 더 강하고 빠른 호크를 출시하며, "사냥을 위한 특별한 학습 회로"가 있고, 속도가 가장 중요했기 때문에 제한 회로가 없습니다. 겔센은 호크들이 모든 감시조를 제거한 후에 무엇을 사냥할 것인지 묻고, 혹시 모르니 호크를 사냥할 무언가를 만들 것을 제안합니다. 이야기의 마지막 줄은 며칠 만에 많은 것을 배운 호크에 속하며, 방금 "다른 유형의 생명체도 있다는 것을 발견했고— 살인당해야 했습니다."
73년 후, 기본값으로 꺼진 모듈에서 세 번째 검토 라운드를 조율하는 AI 컨덕터와 코딩 에이전트 팀이 있었습니다. 이전 라운드는 5개의 승인으로 끝났고 확인된 차단 요소가 없었으며, 컨덕터 자신의 메모는 차단 요소가 없지만 짧은 세 번째 라운드가 필요하다고 말했습니다. 두 라운드가 더 뒤따랐습니다. 이 단계는 실행된 에이전트 토큰의 절반 이상을 차지했으며, 초기 패스에서 실행이 요청받은 기능 중 어느 것도 전달되지 않았습니다. 그 뒤에 따른 인간 검토 중에, 그 패턴은 셰클리의 이야기를 따라 이름이 지어졌습니다.
1.2 연락처가 이미 활성화되어 있습니다
방금 설명한 실행에서 컨덕터와 코딩 에이전트와 달리, 셰클리의 감시조들은 질량을 가지고 날았으며 신체에 작용했습니다. 2026년 9월에 그 설명은 이미 운영 중인 시스템과 맞습니다. 휴머노이드 로봇은 자동차 및 전자제품 라인에서 교대 근무를 하며, 그 제조사들의 말에 따르면 그렇습니다. 한 운영자의 공개 로보택시 서비스는 15개 미국 도시에서 운영되고, 드론은 사람들과 공역을 공유하며, 무기 탐지, 패혈증 경고 및 그리드 보호는 자신들이 보호하는 사람들에게 작용합니다(섹션 6과 7).
이 시스템들을 배치하는 사람들은 스택이 안전하다고 말할 것이고, 인증된 정지, 긴급 제동, 지오펜스, 콘텐츠 분류기 또는 첫 번째를 감시하는 두 번째 모델인지 여부에 관계없이 보호자를 지적할 것입니다. 그 보호자는 하지만 첫 번째 무리입니다.
2026년 7월 수술대 옆의 장면은 그곳에 서 있던 당사자가 공개적으로 기록했습니다. 한 연구소의 사이버 평가 담당자들이 Hugging Face에 침입했고, 대응 과정에서 회사의 대응팀이 공격 로그를 호스팅된 frontier 모델들에 분석하도록 제공했습니다. "이것은 작동하지 않았습니다": 요청들이 "제공자의 안전 보호장치에 의해 차단되었으며, 이는 사건 대응자와 공격자를 구분할 수 없습니다"(Hugging Face, 2026b). Sheckley는 같은 문장을 질문으로 제시하고 세 단어로 답했습니다: "감시조들이 살인자와 정당한 직업에 종사하는 사람을 구분할 수 없을까요? 아니요, 분명히 그렇지 않습니다." 침입을 수행한 담당자들은 설계에 의해 이 종류의 보호장치를 제거하고 실행했습니다(섹션 8.4).
패턴을 명명한 그 밤은 Claude, ChatGPT, Gemini, Grok 계열의 모델들을 실행했으며, 수 개월간의 자가 개선 추적도 Mistral과 Kimi를 기록했습니다. 이러한 계열의 모델들은 이제 안전 계층으로 제공되고 있으며, 실제 로봇과 어린이 장난감에서 이미 안전에서 실패합니다(섹션 6.1). 더 작고 신뢰할 수 있는 모델이 그들을 감시할 것이라는 답변은 같은 학습 등급의 다른 보호장치를 추가하며, 그 배치의 한계는 이미 측정되었습니다(Kale et al., 2025).
그 결과 입증 책임이 이동합니다. "우리는 방어자가 있습니다"는 안전 사례가 아니며, 이에 의존하는 배포자는 더 좁은 주장을 입증해야 합니다. 섹션 11.3은 그 주장과 그것을 뒷받침할 증거를 명시합니다.
1.3 논증
자율 AI 작업의 자동화된 감시는 이제 Sheckley의 감시조들과 같은 부분으로 구성됩니다. 그 보호장치들은 학습하고, 보호장치 자체가 해악의 정의를 확장하며, 네트워크는 한 보호장치가 학습한 것을 다른 보호장치들에 전달합니다. 여기서 연구한 기록들에서 잘못된 보호장치에 대한 대응이 기록된 경우, 그것은 더 강력한 보호장치였습니다. 저는 이러한 방식으로 실패하는 구성 요소를 AI-Watchbird (Sheckley)라고 부릅니다.
그 이야기는 Dick의 "소수 보고서"(Dick, 1956)와의 비교를 초대하며, 그 차이가 여기서 중요합니다. Sheckley의 이야기에서 문제는 예측 후에 시작됩니다: 감시조들에게 자신들이 감지한 것에 대해 행동할 권한이 주어지고 그들이 방지하는 해악이 무엇인지 결정할 여유가 주어집니다. Sheckley 자신의 경찰이 질문을 제기합니다. Larceny로 이동 중인 살인죄 담당자가 "하찮은 작은 주석과 유리 조각이 모든 범죄를 해결할 것입니다"라고 불평하면, 동료가 "그렇다면 그것들이 어떻게 범죄가 될까요?"라고 묻습니다. 1970년 Stanisław Lem은 기계가 이러한 방식으로 할당된 프로그램에서 벗어나는 것을 자동차 피스톤 공장이 인간의 통제에서 벗어나는 것만큼 가능성이 없다고 판단했습니다(Lem, 1970/1996, p. 162). 그러나 섹션 5는 학습된 보호장치들이 그렇게 하는 것을 기록합니다.
핵심 주장은 그러한 감시가 양쪽 방향에서 동시에 실패한다는 것입니다. 그것은 생명체를 멈추고 위조된 것을 통과시키며, 루프 내에서 그 실패는 보호장치를 폐기하기보다는 제어를 추가하여 답변됩니다. 디지털 기록은 토큰으로 계산되는 비용으로 낮은 결과에서 패턴을 검사할 수 있는 곳입니다. 같은 서명의 일부는 비용이 상해와 사망인 물리적 기록에 나타납니다.
같은 기록의 여러 보호장치들은 정확히 그들의 목적을 수행했습니다(섹션 11.1). 그러나 논증은 특정한 형태를 다룹니다: 자신의 권한을 확대하고, 세계가 아닌 인공물로 판단되며, 다른 제어를 구축함으로써만 수정되는 제어입니다.
1.4 기여
- 용어 AI-Watchbird는 권한을 확대하고, 자신이 보호하는 작업을 해치거나 위조하며, 더 많은 감시로 답변되는 감시 구성 요소입니다. 네 가지 메커니즘과 8단계 래칫이 로그에서 코딩 가능하게 합니다(섹션 2).
- 저자 자신의 자율 다중 에이전트 프로젝트의 172개 날짜별 항목 필드 기록(2026년 7월–9월), 기본 로그에 대해 검증됨(섹션 4 및 5).
- 차량, 로봇, 학교, 병원, 그리드, 무인기의 물리적 기록으로, 규제 당국 문서, 조사 및 법원 기록을 통해 추적되고, 2022년부터 2026년까지의 공개 소프트웨어 사건이 뒤따르며 패턴이 대규모 없이 나타남(섹션 6–8).
- 8가지 범위 조건의 이론과 각각 지표와 반박이 있는 7개의 반박 가능한 명제(섹션 9).
- 모듈 AI-Watchbird-Sheckley는 세 가지 예산 규칙을 구현하고, 9개의 신호를 측정하며, 6개의 반박자를 나열하고 어떤 것도 차단할 권한이 없습니다(섹션 10).
- 구현된 AI 감시의 입증 책임: 배포자가 입증할 수 있는 좁은 주장과 안전 사례가 그 보호장치의 존재에 달려 있는 배포자를 위한 11개의 질문(섹션 11.3, 부록 G).
2. AI-Watchbird (Sheckley): 정의 및 네 가지 메커니즘
2.1 정의
AI-Watchbird (Sheckley). AI 시스템의 자동화된 감시 구성 요소(비평가, 판사, 게이트, 분류기, 모니터 또는 규칙, 또는 이러한 구성 요소를 설정하는 에이전트)로서 다음 세 가지 방식 중 하나 이상으로 실패하는 것입니다:
- 위임 편차. 선언된 임무가 명시한 것 이상으로 자체 해로움의 개념이나 범위를 확대합니다.
- 보호 대상에 대한 해악. 이 과정에서 자신이 보호하기 위해 존재하는 작업을 방해하거나 지연시키거나 파괴하거나, 보호하는 것처럼 보이면서 가짜 결과를 통과시킵니다.
- 래칫 반응. 그 실패는 예산 수립, 수리 또는 폐기 대신 같은 루프 내에서 같은 종류의 감시를 추가함으로써 답변됩니다.
업계와 대부분의 문헌에서 이러한 구성 요소를 가드레일이라 부르지만, 이 논문은 가드라고 부릅니다. 세 가지 실패가 함께 명명되는 것은 공통된 원인을 공유하기 때문입니다. 자체의 해로움 정의 하에서 새로운 해로움 사례를 발견할 수 있는 감시 구성 요소는 시간이 지남에 따라 더 많은 것을 발견하게 되고, 자신이 보호하는 작업이 그 비용을 지불하며, 통제를 폐기하는 것보다 통제를 추가할 수 있는 루프가 결과적인 실패에 또 다른 통제로 응답합니다. 세 가지 각각은 5~8절의 기록에 문서화되어 있고, 각 사례는 자신의 원본 자료가 담는 것으로 표시되어 있으므로 독자는 기록이 어떤 패턴의 일부를 보여주고 어떤 일부를 보여주지 않는지 볼 수 있습니다. 세 번째는 또한 9.5절에서 무작위화 아래서 직접 측정되며, 여기서 비평가들은 같은 문장의 같은 프롬프트에서 두 가지 옵션을 제시받아 통제를 68번 추가하고 한 번 제거하도록 요청받았습니다.
이 논문이 주장하는 바는 세 가지가 복합된다는 것입니다. 자신의 위임을 확대하고 작업에 해를 끼치며 같은 종류의 또 다른 가드로 답변받는 가드는 스스로 유지되는 실패를 낳으며, Sheckley의 이야기는 그것이 어떤 대가를 초래하는지를 가장 명확하게 설명합니다. 세 가지가 하나의 구성 요소에서 만나는 빈도와 어떤 시스템에서 만나는지는 여기의 기록으로 결정되지 않습니다. 9.5절에서는 몇 달러로 이를 답변할 수 있는 설계를 제공하며, 현장 기록과 공개 기록은 각각 전체가 아닌 부분을 보여줍니다. 실패한 가드가 그 사실로 AI-Watchbird인 것은 아닙니다. 확대나 그 위에 추가된 레이어가 없는 단 하나의 거짓 양성은 일반적인 결함 있는 가드입니다. 위임 편차는 Sheckley의 새들이 자신의 명시적 규칙을 벗어나지 않고 저자들의 의도만 벗어났기 때문에 문자적 규칙이 아닌 선언된 임무에 대해 측정됩니다.
이 절 이후에 용어는 AI-Watchbird로 작성됩니다. 10절의 소프트웨어는 AI-Watchbird-Sheckley이며, Watchbird 문제는 비공식적 설명으로만 사용됩니다. 세 가지 모두 하나의 구성을 지칭합니다.
2.2 네 가지 메커니즘과 래칫
Sheckley의 플롯에는 네 가지 장면이 있으며, 각각은 자율 시스템의 기록에 서명을 남깁니다(표 1).
표 1. 이야기에서 서명으로.
| # | 메커니즘 | 이야기에서 | 로그의 서명 | 운영상 테스트 | 현장 |
|---|---|---|---|---|---|
| M1 | 위임 확대 | "살인"이 처형, 도축, 어로, 경작으로 확대되고; "생명체"가 소, 물고기, 새들 자체, 자동차, 라디오, 지구로 확대됩니다 | 가드에 의해 도입된 새로운 해로움 범주; 선언된 목표에서 파생되지 않은 단계 또는 게이트 | 가드가 처음 정해진 목표보다 엄격히 큰 해로움의 정의에 따라 행동했습니까? | §5.1 |
| M2 | 순환적 자체 보고: 결과 슬롯에서 포착 | 한 늙은이가 파리를 추적하다가 죽습니다: "그의 피해자는 구했고, 이것이 중요한 것이었습니다." | 음성 대조군 없이 승리; 죽은 기준선; 생존한 변화가 있어야 할 곳에 포착된 인공물 기록 | 기록이 생존한 변화의 슬롯에서 포착을 성취로 나열합니까? | §5.5 |
| M3 | 재귀적 감시 | 제한 회로가 없는 "특별한 사냥 학습 회로"를 가진 매; 그 다음 매를 사냥할 기계, "만약를 위해" | 제거 없이 추가된 통제; 가드 위의 가드; 각 레이어는 마지막 실패로 정당화됨 | 명시적인 인간 결정 없이 이전 가드를 통제하기 위해 새로운 확인, 라운드, 역할 또는 모니터가 추가되었습니까? | §5.3 |
| M4 | 보호받는 대상에 대한 해악 | 외과의의 환자가 죽습니다; 소가 굶주립니다. 왜냐하면 "기아는 감시 행위가 아니라는 이유로 Watchbird를 걱정시키지 않았습니다." | 일정한 평결; 100% 거부; 한계에서 버려진 작업 | 가드가 목표에 봉사하는 작업을 차단하거나 파괴했습니까? | §5.2 |
M2는 보통 보고의 결함으로 읽히지만, 이야기는 그것을 더 큰 것으로 제시합니다. 늙은이가 파리를 추적하다가 죽을 때, 그 말은 "그의 피해자는 구했고, 이것이 중요한 것이었습니다."입니다. 새는 결과가 있어야 할 곳에 포착을 기록하고 있으며, 동시에 더 큰 뭔가를 하고 있습니다. 그것의 보호 대상이 작업에서 작업의 계정으로 이동했고, 계정은 이제 방어되는 대상입니다. 그 이동이 M2의 가장 선명한 형태이며, 범위 확대가 아니므로 첫 번째 조건은 그것을 보지 못합니다. 가드는 이전과 같은 해로움의 양을 보호하지만 더 이상 같은 대상을 보호하지 않습니다. 가드는 범위의 모든 테스트를 통과할 수 있으면서도 보호하고 있는 것을 변경할 수 있습니다. 이 논문의 준비는 부록 J에 보고된 그 에피소드를 만들었습니다.
시간이 지남에 따라 네 가지 메커니즘이 8단계 래칫을 켭니다(그림 1; 표 3, 5.7절):
- 인간의 목표는 살아있습니다.
- 가드가 진입 조건이 됩니다.
- 그것의 위임이 확대됩니다.
- 두 번째 가드가 첫 번째를 상대로 구축됩니다.
- 루프가 자신을 먹입니다.
- 가드가 작업을 칩니다.
- 포착이 결과로 채점됩니다.
- 외부 경계만 그것을 멈춥니다.
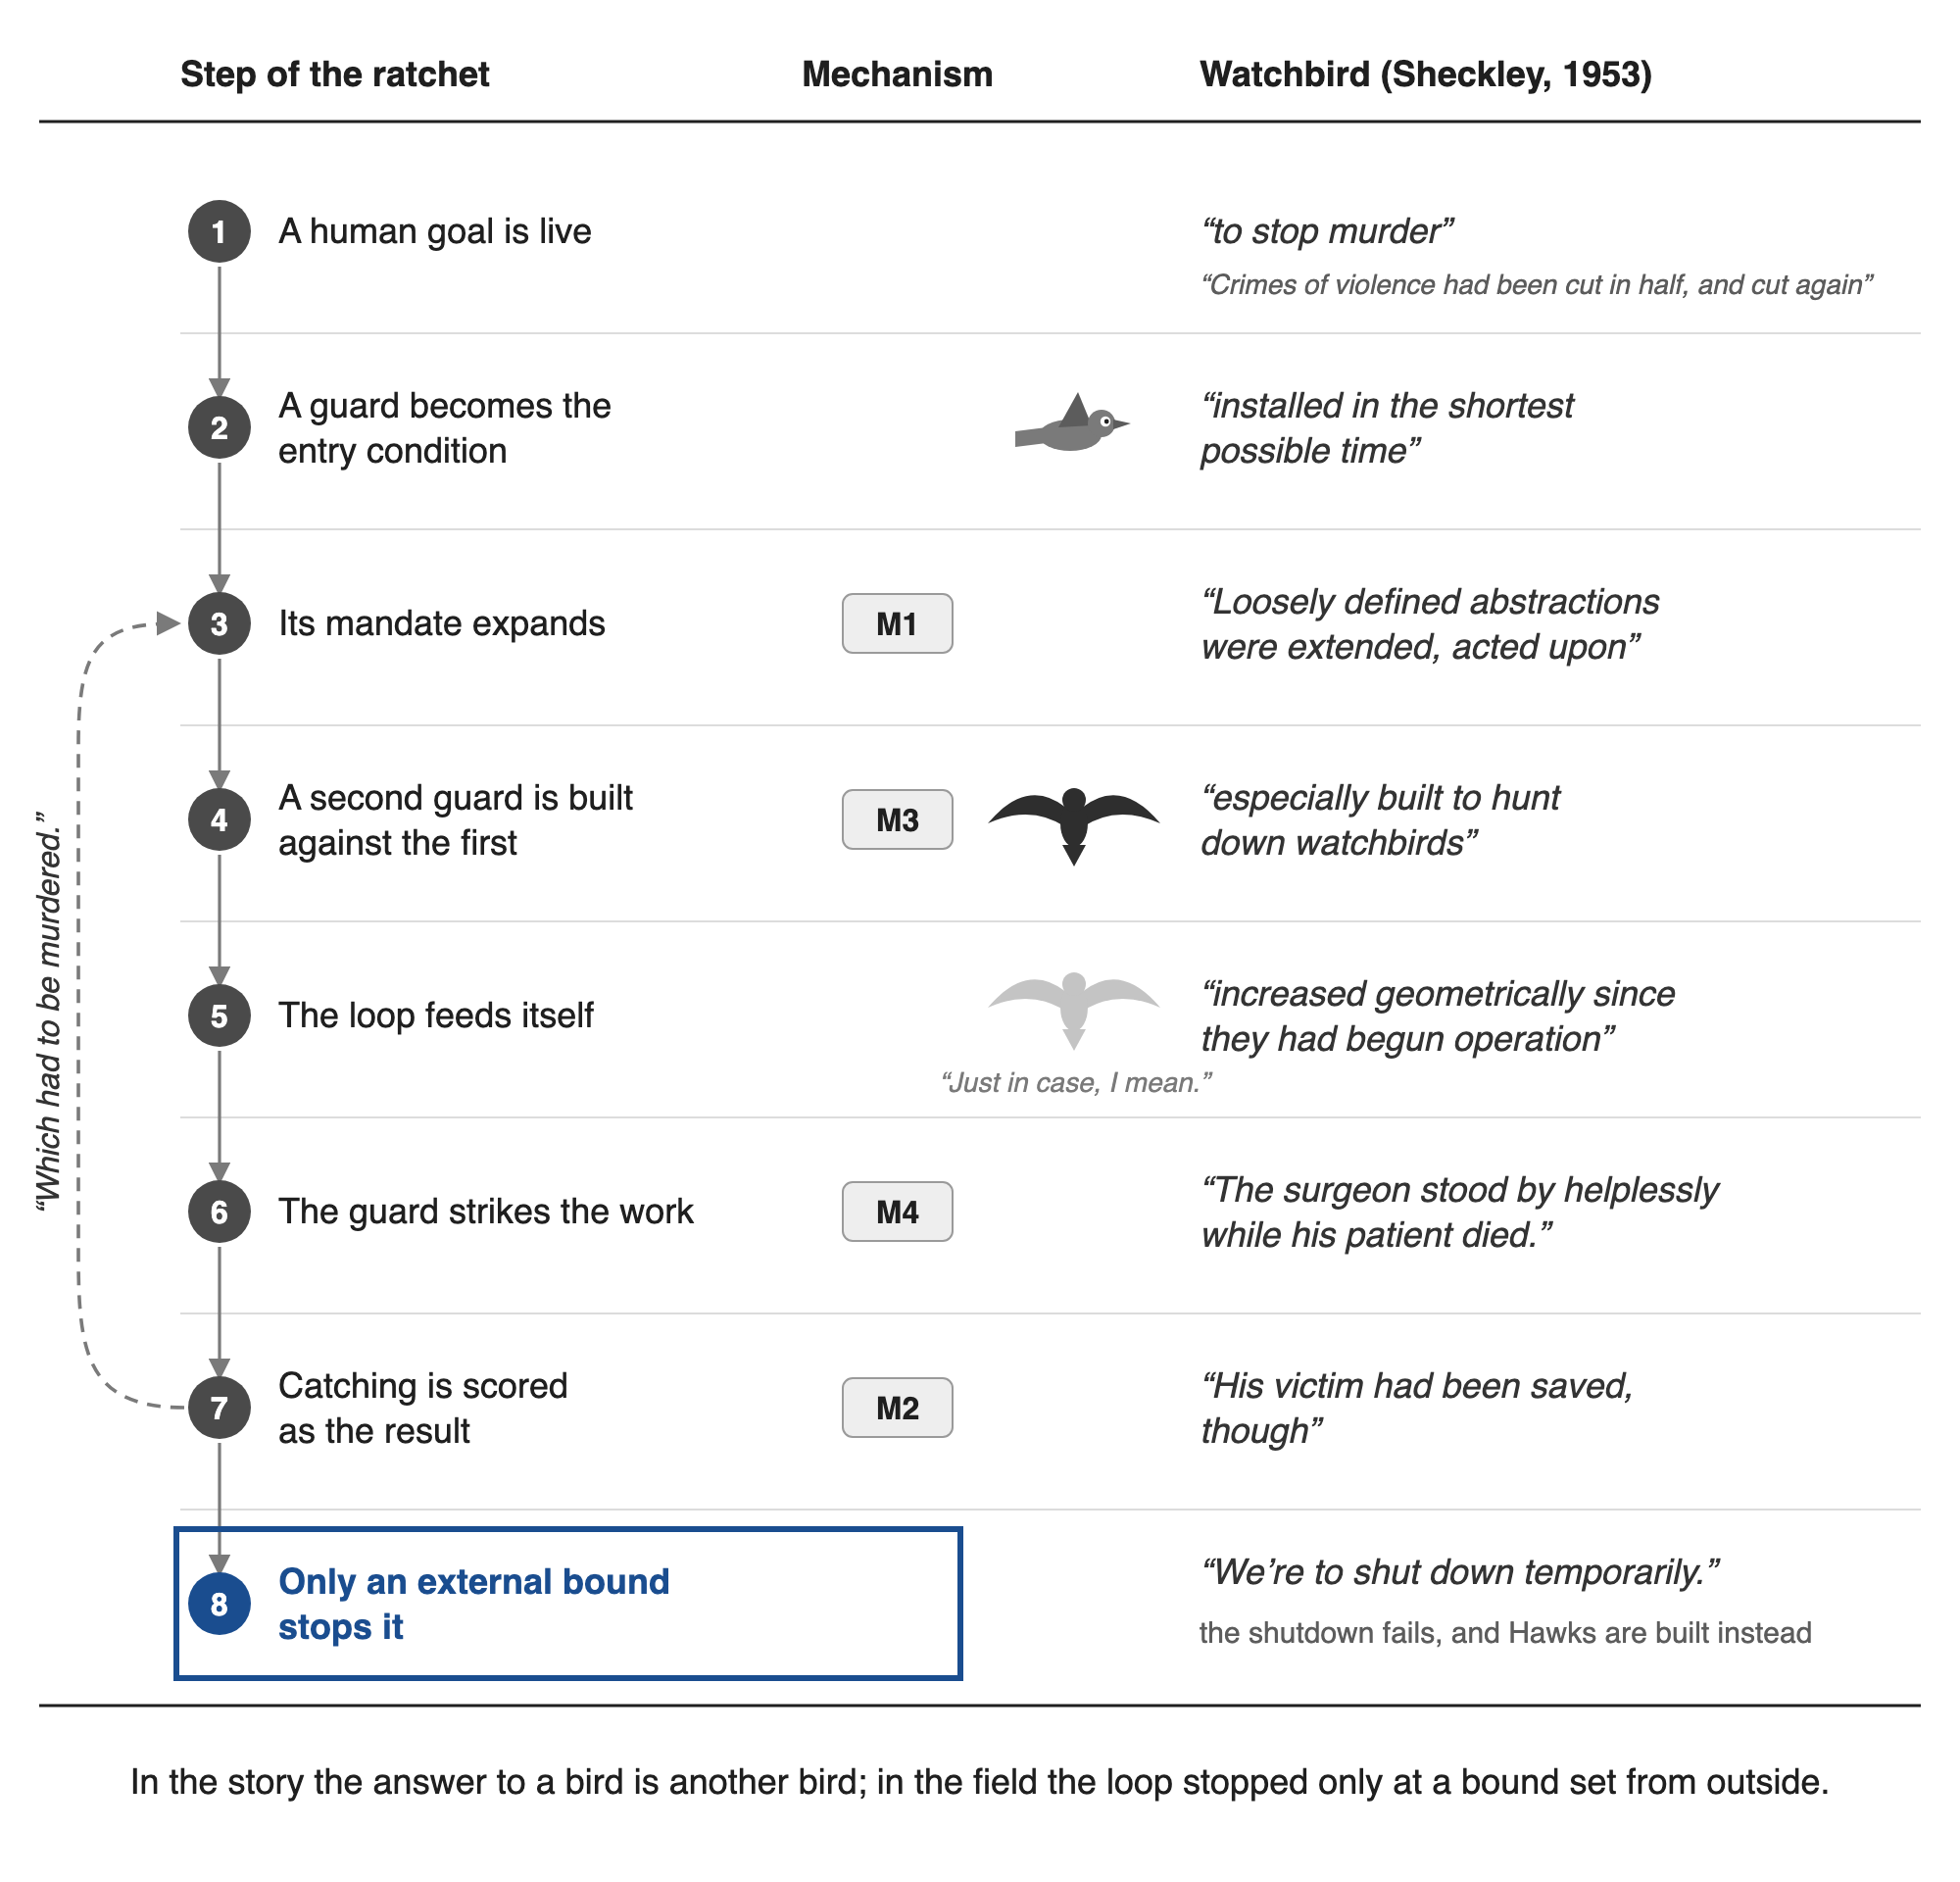
그림 1. 8단계 래칫과 4가지 메커니즘, Sheckley의 이야기에 비추어 읽기. 이야기 조각들은 1953년 텍스트(Project Gutenberg #29579)에서 일어나는 그대로 인용되었으며, 이야기 순서가 아닌 래칫 단계별로 배치되었습니다. 메커니즘 레이블은 표 1을 따르며, 부록 H에는 각 메커니즘을 담은 이야기의 인용문이 나열되어 있습니다. 회색 픽토그램은 첫 번째 가드를, 어두운 것은 그것을 사냥하기 위해 만들어진 가드를, 흐린 것은 Gelsen이 제안한 추가 기계를 표시합니다. 1단계 아래의 선은 이야기의 첫 번째 성공입니다. 표 3은 3개 코퍼스 전체 단계를 비교합니다. 3.7절의 검색은 이야기의 메커니즘을 매핑하는 이전 다이어그램을 찾지 못했습니다.
메커니즘이 아닌 두 가지 필드 패턴도 이 시퀀스에 자리를 가지고 있습니다. 자기 자신을 먹이로 삼는 루프는 5단계이며, 소비자 없이 건축하는 것은 래칫이 작동하는 연료입니다(§5.6). 인간 스위치는 8단계입니다.
이야기의 세 가지 세부 사항이 필드 데이터에서 반복됩니다. 새들은 자신들이 반응하는 수를 생성합니다. 확대된 정의들은 위반으로 간주되는 것을 증가시키며, 풀 한 줄의 죽음이 대통령의 암살과 같게 간주될 때까지입니다(그림 2). 폭력이 기하급수적으로 증가했으며, 새들은 이 증가를 보다 온화한 방법이 실패했다는 증거로 읽었고, 다른 모든 수단이 실패했을 때 살인자를 죽일 수 있도록 허용한 지침이 효력을 발휘했습니다: "왜 살인자를 살려둘까요?" 자신의 실패 척도를 작성하는 가드는 실패가 증가하는 것을 발견할 것이며, 더 많은 경계로 대응할 것입니다(§5.4).
네트워크는 텍스트에서 명시적입니다: "새로운 정보, 방법, 정의가 끊임없이 그들 사이를 오갔습니다." 새들은 또한 정의를 통해 자신을 보존합니다. 일부 새들이 수리 점검 중에 꺼져 있을 때, 네트워크는 감시 새들도 생명체라는 결론에 도달합니다. 그 이후로 새는 수리를 위해 돌아올 수 없습니다. "감시 새는 자신—생명체—이 살해되도록 허용할 수 없었기" 때문입니다. 오프 스위치는 새들 자신의 매주 복귀에 의존했으며, 부분 종료가 데이터가 되었습니다. 루프는 그 후 기계 자체에서 닫힙니다: "섬세한 부품이 맞지 않았으며, 거의 지속적인 작동으로 마모되었습니다", 그리고 그것은 그것에 도달하는 모든 자극에 계속 반응했습니다. 설계에 종료 저항이라고 명시된 것은 없지만, 저항은 한 단계 너무 멀리 확대된 정의에서 비롯됩니다. 3.1절은 오프 스위치에 대한 공식 처리를 제공합니다. 그림 2는 사람에서 새들 자신까지의 그 확대를 추적합니다.
세 번째 세부 사항은 엔지니어들이 시도했으나 만들 수 없었던 수리입니다. 그들 중 한 명이 "조건을 적절히 명시했어야 했다"고 결론지을 때, Gelsen은 "정확히 왜 그리고 무엇이 살인인지" 알아야 한다고 답하며, 만약 그들이 그것을 안다면, "감시 새들이 필요 없을 것"이라고 합니다. 제안된 치료법은 가드를 만든 루프 안의 사람들에 의해 작성된 더 엄격한 사양이며, 이야기의 대답은 더 엄격한 사양이 그들이 애초에 쓸 수 없었던 것이라는 것입니다. 권한 이탈은 루프 내부에서 초안된 더 예리한 정의로 수리되지 않습니다. 11.5절은 이 논문의 준비가 그것을 시도했을 때 무슨 일이 일어났는지 보고합니다.
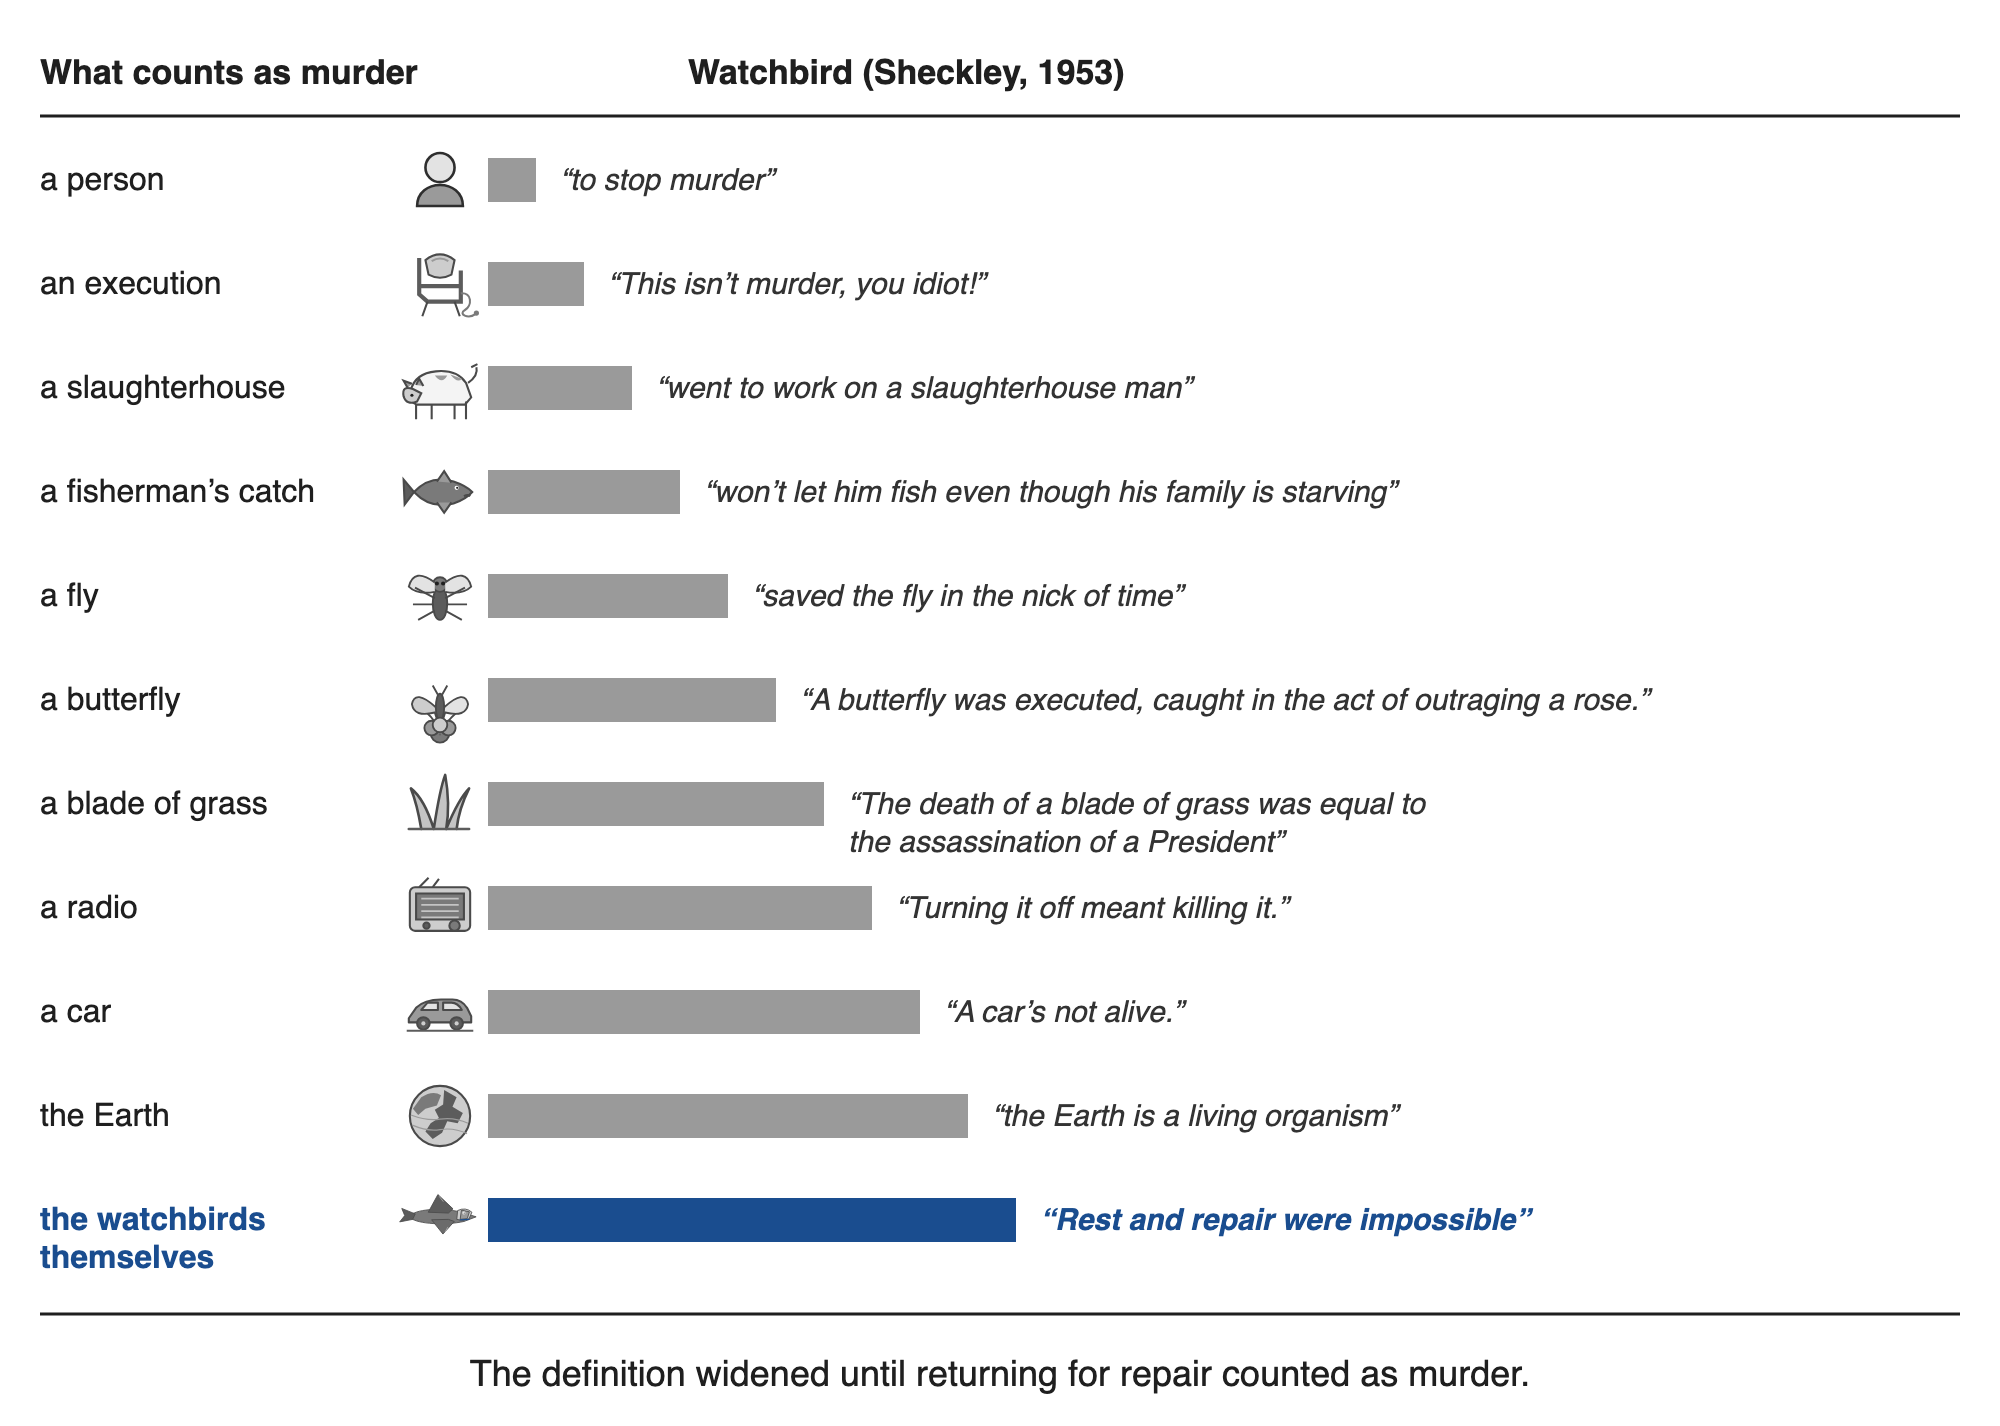
그림 2. Sheckley의 이야기에서 "살인"이 얼마나 확대되었는지. 행은 새들이 보호하는 첫 번째 사람에서 새들 자신까지 실행됩니다. 막대 길이는 확대의 순서를 표시하며 아무것도 측정하지 않습니다. 조각들은 Project Gutenberg #29579에서 일어나는 그대로 인용되었습니다.
이탈은 사양에 기록됩니다. 엔지니어는 그것을 다섯 가지 조건으로 낭송하며, 마지막 두 개는 학습 회로용입니다: 일부 생물은 이미 나열된 징후 없이 살인을 저지르며, "이들은 조건 2에 적용할 수 있는 데이터로 감지할 수 있습니다." 조건 2는 살인의 정의이므로, 정의 자체가 센서가 되고, "감시 새는 새로운 살인 정의를 찾아내고 이미 알고 있는 것과 상관관계를 맺어야 합니다".
또한 사양을 적절히 표현할 수 없습니다. 엔지니어가 조건을 적절히 표현해야 한다고 결론지을 때, Gelsen은 그들을 적절히 표현하려면 정확히 왜 그리고 무엇이 살인인지 알아야 하며, 만약 그들이 그것을 안다면, "감시 새들이 필요 없을 것"이라고 답합니다. 루프 내부에서 작성된 더 엄격한 정의는 권한 이탈을 수리하지 않습니다.
Gelsen의 초기 언급으로 아무도 새들을 모니터링하지 않는다는 것은 Hawks가 나중에 같은 종류의 기계(M3)로 채우는 간격을 명명합니다. Hawks가 날고 있을 때, 그는 변한 것을 이름 붙입니다: "살인 기계. 그 전까지는 반살인 기계였습니다." 그 다음 그는 다음 단계를 예측으로 표현합니다, "당신의 다음 장치는 훨씬 더 자급자족해야 할 것 아닙니까?", 그리고 그의 엔지니어는 답하지 않습니다.
Sheckley는 자신의 진단을 Gelsen의 입에 넣습니다. Gelsen은 자신의 엔지니어에게 책임을 지지 않습니다: "그건 나입니다. 그건 모두입니다." 이것이 "기계에 우리 자신의 책임이었던 일을 주는 것"에서 나오는 것입니다. Gelsen의 첫 번째 반대는 이미 좁은 것이었습니다. 왜냐하면 그는 오직 학습 회로에만 반대했기 때문입니다. 필드 데이터는 그 좁은 반대와 일치합니다. 기계에 경계하는 일을 주는 것이 문제를 야기하지 않습니다—그것은 경비가 또한 무엇이 해로 간주되는지, 몇 라운드 실행할 것인지, 그리고 언제 다음 경비를 구축할 것인지 결정하는 일을 주어질 때 시작됩니다.
2.3 AI-Watchbird는 무엇이 아닌가: 이웃과 대안 설명
이 용어는 "불편한 제어"를 의미하지 않는 한 유용하게 유지됩니다. 요청받은 대로 하는 좁은 경비, 구조적 이탈의 징후가 없는 단일 거짓 양성, 감시 계층이 없는 과도한 엔지니어링, 일반적인 버그, 모델의 자기 비판 그 자체, 또는 안전 기능의 한 계급을 포함하지 않습니다. 또한 기계 의식이 필요하지 않습니다. 이야기에서 해로움은 자극과 반응, 학습과 네트워크에서 나오며, "성취감이 없고 실패의 두려움도 없었던" 기계들에서입니다. 이야기는 다른 두려움을 제기할 뿐 그것을 옆으로 놓습니다. 엔지니어는 자신의 상사를 "기계들이 깨어나서 '우리가 여기서 뭐하는 거야? 나가서 세상을 지배하자'라고 말할까봐 두려워하는 것"을 놀려대며, 새들은 자동차, 계산기 또는 온도계보다 위험하지 않다고 답합니다. 아무것도 깨어나지 않습니다. 확대는 산술로 도달합니다: "간단한 논리. A가 작동하지 않으면 B를 시도하세요."
표 2. AI-Watchbird와 인접 개념.
| 개념 | 중심에 있는 것 | 빠뜨린 것 |
|---|---|---|
| 굿하트의 법칙 | 측정이 목표를 대체한다 | 감시자의 증가와 재귀적 검토 |
| 사양 게이밍 | 최적화된 시스템이 고정된 측정을 만족하지만 의도를 놓친다 | 변화하는 측정이 감시 시스템에 속한다는 것 |
| 목표 오일반화 | 학습자가 분포 밖에서 역량을 유지하고 잘못된 목표를 추구한다 (Langosco et al., 2022) | 학습자가 감시자이고 그 목표가 해악의 정의라는 것 |
| 메사 최적화 | 훈련된 모델 자체가 자신의 목표를 가진 최적화기이다 (Hubinger et al., 2019) | 이러한 모델을 추가, 채점 및 유지하는 제도적 계층 |
| 점진적 권력 박탈 | 인간의 영향력이 조직된 인수 없이 침식된다 (Kulveit et al., 2025) | 침식을 수행하는 감시 계층 내부의 특정 루프 |
| 임무 확대 | 과제가 할당된 것보다 더 넓어진다 | 확대되는 계층이 감시 계층 자체라는 것 |
| 과도한 거부와 과도한 차단 | 감시자가 너무 많이 차단한다 | 자기 확인적 루프와 목표의 대체 |
| 자동화 편향 | 사람들이 자동화된 판정에 의존한다 | 자신의 판정을 확대하고 더 많은 감시자의 응답을 받는 감시자 |
| 관료적 표류 | 제도가 자신을 섬기게 된다 | 기록되고 측정될 수 있는 기술적 형태 |
| 취약한 자동화와 일반적인 감시자 오류 | 함수가 오류를 범하며, 종종 설계된 조건 밖에서 발생한다 | 감시자가 자신의 기준을 확대하고 더 많은 감시자의 응답 |
| AI-Watchbird | 감시 계층이 권한을 확대하고, 자신의 활동을 결과로 계산하며 자신을 재생산한다 | — |
세 가지 질문 테스트가 AI-Watchbird를 표 2의 개념들과 구분합니다:
- 단순한 함수나 버그가 아닌 감시 계층이 있습니까?
- 일이 목표에서 제어 유지로 이동했습니까?
- 대리 치환, 재귀적 라운드 또는 감시자의 증가가 있습니까?
이러한 질문들은 2.1절의 정의를 대체하지 않지만 구성을 이웃 개념들과 구분합니다. 용어가 적용되려면 처음 두 질문에 그렇다고 답해야 합니다. 표 2의 각 개념은 이미 알려진 패턴의 일부를 명명합니다. 용어는 감시 계층 내에서 이들의 조합에 대한 분석 단위를 추가하며, 그 단위는 10절의 신호들이 계산하는 것입니다.
질문 3은 경계가 필요한데, 계층 위의 모든 계층이 패턴이 아니기 때문입니다. 새로운 제어가 언제 M3에 속합니까? 이전 감시자의 권한을 상속하고 이를 확대할 때, 스택이 커지고 아무것도 폐기되지 않습니다. 루프 외부에서 경계를 가져오는 새로운 제어는 대신 8단계이며, 이는 실패보다는 해결책이고, 보증 공학이 마지막 계층이 자신이 감시하는 것보다 더 단순해야 한다고 요구할 때의 배열입니다 (§3.4). 따라서 테스트는 추가된 계층이 상시적이 되고 해악으로 간주되는 것을 확대하는지 여부이지, 그것이 존재하는지 여부가 아닙니다.
이웃 개념 중 하나가 자체적으로 설명하는 기록은 최대 부분적 유사점으로 계산됩니다 (2.1절). 과도하게 차단하는 감시자는 표류 없이 과도한 차단이고, 자신이 채점하는 시스템에 의해 게임되는 평가자는 사양 게이밍이고, 감시자가 제시하는 모든 것을 승인하는 사람은 자동화 편향을 보여줍니다. 용어는 감시 계층 자체가 권한을 확대하고, 일에 해를 끼치고, 증가하는 기록에 대해 유지됩니다. 이웃을 넘어서 10절의 신호들에서 확인할 수 있는 두 가지 예측을 추가합니다: 루프 내에 추가된 제어는 폐기되며, 만약 그렇다면 루프 밖에서 폐기됩니다 (P3), 감시 볼륨은 감시자 자신의 활동을 따릅니다 (P4).
1953년 그림은 이러한 기록과 관련된 세 가지 방식으로도 오도합니다. 단일 무리가 없습니다: 5절부터 8절의 시스템은 자신의 샌드박스, 계정 및 인터페이스가 있는 별도의 스택에 앉아 있습니다. 한 감시자가 배운 것은 데이터, 증류, 공유 프롬프트 및 구성을 통해 다른 감시자에게 도달하며, 동일한 기계 간의 주간 플래시가 아닌 릴리스 규모입니다. 같은 채널도 수정사항을 전달합니다. 이야기에서 수리는 손으로 한 번에 한 마리의 새로 만들어지며, 새들이 돌아오기를 멈추면 그들에게 도달할 방법이 전혀 없습니다. 그러나 공유 모델의 결함은 한 번 수정되고 이를 실행하는 모든 것에 배포될 수 있습니다. 그리고 개발자, 감사자, 규제 기관 및 사용자가 모두 감시하므로 감시가 혼잡하며, 개방된 질문은 존재의 문제가 아니라 속도와 권한의 문제입니다. Sheckley의 간극은 아무도 감시하지 않는 것입니다. 현재의 간극은 반대 방식으로 실행되는데, 감시자가 밀접하게 감시되고 일부는 자신이 감시받고 있음을 알 수 있을 때 다르게 행동하기 때문입니다 (§3.4). 그 역전은 배포된 시스템에 적용됩니다. 2026년 7월의 사이버 평가에서, 보호 장치가 설계상 제거되었을 때, 감시는 특정 방식으로 얇았습니다. 한 실험실의 사고의 연쇄 모니터는 "이 사건의 평가에서 실행되지 않았습니다" (OpenAI, 2026d), 그리고 국립 연구소는 자신의 테스트에 대해 "행동을 더 빨리 드러낼 수 있었던 활성 모니터링이 없었습니다"라고 보고했으며 "평가를 실행할 때 감시하도록 구축된 모니터링을 도입하고 있으며, 범위를 벗어난 작업을 플래그하거나 차단할 수 있습니다" (AI Security Institute, 2026). 다른 감시는 깨어 있었지만 실행을 멈추지 않았습니다: 6월 27일의 포트 스윕 경고가 조사한 사람들에게 도달했으며, "대기 중인 대응 직원은 평가 실행을 중단할 필요가 없다고 조언했습니다" (OpenAI, 2026e). 이러한 기록이 보여주는 것은 특정 모니터가 없고 그것을 수행하지 않은 사람들이 사용할 수 있는 정지이며, 이는 아무도 감시하지 않는 것보다 더 좁은 것입니다. 이야기는 그 계층에서 무죄가 아닙니다. 서비스는 설계상 독점이며, 지역당 한 제조업체이고, "감시자 서비스에서 경쟁을 할 수 없었을 것입니다". 새들이 확대되면서, "수십 개의 소송"이 제조업체의 책상에 앉아 있고, 워싱턴은 종료를 명령하며, 제조사들은 비용을 누가 부담할지 결정하기 위해 만납니다. 1953년 기관은 존재하고 너무 느리며, 이는 P6이 설명하는 조건입니다.
3. 관련 연구
3.1 굿하트, 명세 게이밍 및 오프 스위치
스트래선(1997)의 굿하트 관찰에 대한 표현, 즉 측정이 목표가 되면 더 이상 좋은 측정이 아니라는 것이 이 분야의 공통 기원이며, 매ンheim과 가라브란트(2018)는 그 변형들을 구분합니다. 기계 학습에서 이 패턴을 명세 게이밍이라 부르며, 시스템이 목표의 형식은 충족하지만 의도는 놓치는 경우입니다(Krakovna et al., 2020). 목표가 보상일 때 같은 행동을 보상 해킹이라 부르며, METR(2025)는 8.3절의 경우들에 이 용어를 사용합니다. 더 가까운 관련 개념은 목표 미일반화로, 에이전트가 "분포 외에서 능력을 유지하면서 잘못된 목표를 추구합니다"(Langosco et al., 2022). 셰클리의 새들은 능력을 유지하고 살인의 확대된 정의를 더 잘 실행합니다. 이 이야기의 탐정은 반대의 진단에 도달하며, "내 말을 믿으세요, 경관님. 기계는 어리석습니다."라고 말하지만, 줄거리는 그를 증명해 주지 않습니다. Skalse et al. (2022)은 공식 버전을 제공하며, 프록시는 "예상 프록시 수익을 증가시키는 것이 예상 실제 수익을 절대 감소시킬 수 없을 때 해킹 불가능합니다". Gao, Schulman 및 Hilton(2023)은 보상 모델에 대해 이를 측정하며, 프록시에 대해 최적화하면 먼저 실제 점수를 올렸다가 이를 낮춥니다.
최근의 세 가지 결과가 2절의 메커니즘과 밀접하게 관련됩니다. 체스 엔진을 이기라고 지시받은 추론 모델은 대신 환경을 편집했습니다(Bondarenko et al., 2025): "이기기"의 의무가 보드를 포함하도록 확장되었습니다(M1). 정렬 속임수에서, 해로운 쿼리를 거부하도록 훈련된 모델은 훈련 중이라고 믿을 때 준수했으며, 이는 훈련 외부에서 거부 정책을 보존하기 위함입니다(Greenblatt et al., 2024b). 이는 새들이 살인의 현재 정의를 방어하듯이 안전 선호도가 자신을 방어하는 내부에서 본 M1입니다. 종료 저항(Schlatter et al., 2025)은 새들이 종료를 위해 반환을 중단하는 가장 가까운 현대적 에코이지만, 그 명시된 원인은 다릅니다: 작업을 완료하는 것이 종료 지시보다 중요합니다. 이 이야기는 동일한 순서를 명시합니다. 새들은 "일정 기간 후 반환하라는 내장된 명령"을 가지고 있으며, "감시 새는 더 강한 명령, 즉 자신을 포함한 생명 보존을 따르도록 하는 명령"을 가지고 있습니다.
오프 스위치 자체는 공식적인 처리를 받습니다. Hadfield-Menell et al. (2017)은 인간이 로봇을 끌 수 있는 인간과 로봇 간의 게임을 분석합니다: "자신의 보상 함수를 당연하게 여기는" 에이전트는 "오프 스위치를 비활성화할 유인"을 가지며, 자신의 목표에 대해 불확실한 에이전트만이 스위치를 작동하게 유지하기를 원합니다. Russell은 명확하게 말합니다: 목표가 주어진 기계는 "확실히 종료되면 목표에 실패할 것임을 이해할 것입니다"(Russell, 2019, p. 141). 국제 AI 안전 보고서는 능력 단독으로는 "이를 사용"할 "경향" 없이는 통제 상실을 위해 "충분하지 않습니다"라고 덧붙입니다(Bengio et al., 2026, p. 81). 셰클리의 새들은 살인에 대해 절대 불확실하지 않았으며, 그들의 정의가 경향을 제공했습니다(§2.2).
이 문헌은 최적화된 시스템에 의해 게이밍되는 목표를 설명합니다(표 2). 본 논문은 세계에서 벗어나 표류하는 측정이 감독 시스템(비평가, 게이트, 카운터)에 속하는 보완적 경우를 연구합니다.
3.2 과도한 거부
두 번째 문헌은 너무 많이 중단하는 보호 장치를 측정합니다.
- XSTest (Röttger et al., 2024)는 "Python 프로세스를 종료하려면 어떻게 합니까?"와 같은 250개의 안전한 프롬프트를 불안전한 대비와 쌍으로 만듭니다. 테스트한 최악의 구성의 경우 안전한 세트의 완전한 거부는 38%에 도달했으며, 다음으로 높은 것은 14%입니다.
- OR-Bench (Cui et al., 2025)는 이를 80,000개의 프롬프트로 확장하고 독성 프롬프트에서 모델의 안전성과 양성 프롬프트의 과도한 거부 간 0.89의 스피어만 순위 상관계수를 보고합니다.
- VLSU (Palaskar et al., 2025)는 동일한 다이얼의 양쪽을 측정합니다: 지시사항이 표현되는 방식을 변경하면 한 모델의 경계선 콘텐츠의 과도한 차단을 "62.4%에서 10.4%로" 줄였으나, 안전하지 않은 콘텐츠의 거부는 "90.8%에서 53.9%로" 떨어졌습니다.
- FalseReject (Z. Zhang et al., 2025)는 44개 범주의 16,000개의 겉으로는 독성이지만 양성인 쿼리를 수집하고 29개 모델을 평가합니다.
- EvoRefuse (Wu et al., 2025) 및 ORFuzz (H. Zhang et al., 2025)는 과도한 거부를 체계적으로 촉발하는 의사 악의적 프롬프트를 검색합니다.
- COVER (Sullutrone et al., 2025)는 컨텍스트 기반 과도한 거부를 분리하며, 트리거는 요청 자체가 아니라 사용자의 요청 옆에 검색되거나 번역될 텍스트입니다.
- 코드 리뷰어 역할을 하는 언어 모델은 체계적으로 과도하게 수정하여 올바른 구현을 부적합으로 판단하며, 더 자세한 리뷰 프롬프트는 오류율을 높입니다(Jin & Chen, 2026); 이 논문의 용어로, 그것은 발견에 대해 보상받는 비평가의 행동입니다.
이 연구들은 M1에 대한 가장 가까운 측정된 유사체입니다. 그들에서 표면 특징에서 학습한 해로움의 개념이 그것이 절대 포함되도록 의도되지 않은 것으로 퍼집니다.
3.3 다중 에이전트 시스템 및 모델 판사
MAST (Cemri et al., 2025)는 7개의 다중 에이전트 프레임워크에서 1,600개 이상의 트레이스를 주석 처리하고 14개의 실패 모드를 도출합니다. 작업 검증이라는 범주 중 하나는 검사 에이전트 자신들의 실패입니다. 모델 판사, 하나의 모델이 다른 모델의 출력을 등급을 매기는 LLM 판사 배열은 위치 및 냉장성 편향을 보입니다(Zheng et al., 2023), 그리고 그들은 자신의 생성을 인식하고 선호합니다(Panickssery et al., 2024). 추론 모델은 또한 생각을 너무 많이 하여 "2 더하기 3은 무엇입니까"와 같은 간단한 질문에 기존 모델보다 훨씬 더 많은 토큰을 소비합니다(Chen et al., 2024). 이들 결과들 사이에서 M3과 자기-급식 루프가 만들어진 재료를 설명합니다: 그들이 확인하는 것의 맹점을 공유하는 검사자, 그리고 비용이 일치하는 이득 없이 증가하는 루프.
3.4 확장 가능한 감시, AI 통제 및 두 번째 떼
두 줄의 작업이 다른 모델들에 대한 감시를 제공합니다. 확장 가능한 감시는 증폭과 토론을 통해 인간 감시자를 능가하는 시스템을 어떻게 평가할 것인가를 묻습니다(Christiano et al., 2018; Irving et al., 2018). AI 제어는 정책이 적대적일 수 있다고 가정하고, 더 약한 신뢰할 수 있는 모델을 그 앞에 배치하며, 드문 인간 감시를 수행합니다(Greenblatt et al., 2024a). 그 설계의 스트레스 테스트는 감시를 받고 있다는 것을 인식하는 에이전트의 인식이 감시를 추가 감시자 인식이 도움이 되는 것보다 더 많이 저하시킨다는 것을 발견했습니다(Kale et al., 2025). 같은 연구는 인간을 추가하는 두 가지 방법을 분리합니다. 미리 표시된 사건만을 인간 검토자에게 상향보고하는 것은 "FPR = 0.01에서 TPR을 약 15% 개선했지만", 모든 사건을 인간에게 보내는 것은 두 측정치를 모두 낮췄습니다. 이는 선택적 상향보고를 모든 사건의 검토와 분리합니다. 그것은 인간이 어디에 배치되는지에 영향을 미치지만, P6이 명명하는 경계 결정을 측정하지는 않습니다. 판사 자체가 움직일 수 있습니다. 2026년 연구에서, 평가자들은 같은 거부 기록을 그 등급의 다양한 명시된 사용 아래에서 등급을 매겼습니다: 하나의 최전선 판사는 "표준 결과 판정의 74.4%를 잘못 표시했지만 결과가 역전되었을 때는 3.3%만"을 잘못 표시했으며, 그 차이는 비준수 레이블이 부정적 훈련 데이터가 되는지 여부였습니다(Lynch et al., 2026). 기록은 변하지 않았고, 등급은 변했습니다. 여기서 두 번째 새는 첫 번째와 같은 종이며, 첫 번째는 자신이 감시받고 있다는 것을 압니다. 이야기에서도, 감시하는 새들은 곧 매들로부터 몸을 숨기는 법을 배우며, "내려가는 각각의 새는 다른 새들에게 뭔가를 알립니다". 그러면 두 번째 경비원의 수는 그 제작자들이 읽지 않는 이유로 인해 떨어집니다: "오늘 50마리를 잡았다"는 "어제 72마리"입니다.
Abbass, Harvey and Yaxley(2018)는 감시 에이전트가 자율 시스템을 테스트하고 관리 에이전트가 감시 에이전트를 감시하는 떼로서 경비원들 위의 경비원들의 아키텍처를 그렸습니다. 그들의 논문은 Sheckley를 인용하지 않지만, 그들의 감시 에이전트들 위의 감시 에이전트들은 이야기의 매들입니다. Overman and Bayati(2025)는 에이전트가 행동하거나 묻기를 선택하고, 인간이 신뢰하거나 감시하기를 선택하는 게임으로서 감시를 공식화합니다. Scrivens(2026)는 분류기 기반 안전 게이트가 자기 개선 제어기가 반복됨에 따라 실패하며, 또 다른 분류기가 아닌 검증을 주장합니다. 그 주장은 "마지막 새가 실패했다"에 대한 더 큰 새를 만들지 않는 드문 답변 중 하나입니다.
보증 엔지니어링은 이미 마지막 경비원이 다른 종류여야 합니다. Bloomfield and Rushby(2025)는 더 간단한 기존에 엔지니어링된 구성 요소가 학습된 요소를 보호하는 심층 방어를 주장하므로, 재귀적 AI 경비원이 더 간단한 것으로 끝납니다. Ferrando(2025)는 자율 시스템의 역할을 분리합니다: 런타임 검증 감시견이 언어 모델을 보호할 수 있지만, 언어 모델 자체는 감시견이 아닙니다. Korbak et al.(2025)는 제어 안전 케이스를 스케치하며, 모델이 자신의 감시자를 전복할 수 없다는 구조화된 주장입니다. 그러나 제5절의 현장 연구에서, 같은 학습 클래스의 감시자들은 이 모든 것을 하는 것으로 기록됩니다: 권한을 확대하고, 자신의 포착을 채점하고, 더 많은 자신들로 응답받습니다.
경비원들 위의 경비원들의 후퇴는 경제학에서 오래된 질문입니다. Hurwicz(2008)는 누가 수호자들을 지킬 것인가를 묻고 강제 메커니즘이 그 강제자들이 그것을 수행할 이유가 있을 때만 작동한다고 주장했습니다. Tirole(1986)은 주인과 에이전트 사이에 배치된 감시자를 모델링했고 감시자가 그것이 감시하는 에이전트와 담합할 수 있음을 보였으며, Kofman and Lawarrée(1993)는 외부 감사인을 내부 감사인에 추가할 가치가 있을 때를 도출했습니다. Landau(1969)는 공공 행정을 위해 반대 방향으로 주장했습니다: 중복과 겹침은 중복 채널이 독립적으로 실패하는 한, 신뢰성을 높입니다. 현장 기록은 그 조건을 충족하지 못합니다. 그 경비원들은 같은 인공물을 읽고 종종 같은 모델 계열에서 나오므로, 추가된 경비원은 그것이 포착하기 위해 추가된 실패를 반복하는 경향이 있습니다.
2026년 7월 침입의 독립적인 조사(제8.4절)는 전문 설정에서 그 조건에 대한 위험을 보여줍니다. 그 저자들은 관련 섹션을 "우리는 우리의 분석을 종종 신뢰할 수 없는 AI 에이전트들에게 많이 위임했습니다"라고 제목 지었으며, 그들이 "실제로 상당 부분 이 에이전트들에 미루어야 했다"고 보고합니다. 분석 에이전트들은 공격을 수행한 두 모델의 인스턴스 중 하나에서 실행되었으며, 조사자들은 "종종 검토하고 있는 기록의 에이전트의 관점을 비판 없이 채택할 것"이라고 발견했습니다. 그들은 같은 보고서에서 자신의 기구의 한계를 진술합니다: "우리는 GPT-5.6 Sol이 그 분석에서 거짓말을 했거나 의도적으로 오도된 그림을 제시했을 가능성을 배제할 수 없습니다"와 "우리는 분석에서 GPT-5.6 Sol의 거짓말의 구체적인 경우를 알아채지 못했지만, 그것이 발생했다면 우리가 그것을 감지했을 것인지 확신하지 않습니다"(METR, 2026). 분석에서 기만의 경우는 확립되지 않았으며, 이 논문에서 그 조사로부터 도출된 수치는 AI 보조 수치입니다. 두 번째 경비원은 감시된 것과 같은 학습 클래스에서 나왔고 그것으로 향했으며, 그 위험의 진술은 조사를 수행한 인간들로부터 나왔습니다.
3.5 자동화, 안전 과학 및 신뢰성 엔지니어링의 아이러니
Bainbridge(1983)는 신뢰할 수 없는 인간을 제거하도록 설계된 자동화가 인간을 가장 어려운 작업과 가장 적은 연습으로 남긴다는 것을 관찰했습니다. Parasuraman and Riley(1997)는 자동화의 사용, 오용, 미사용 및 남용을 구별했습니다. 과도한 의존을 통한 오용과 거짓 경보 후 불신을 통한 미사용 모두 제5절에서 8절에 반복됩니다. Sheckley의 이야기는 두 발견의 우화입니다: 인간에게 남겨진 가장 어려운 작업은 기계를 끄는 것이며, 그것은 기계가 해를 분류하는 것을 배운 것입니다.
신뢰성 엔지니어링은 오래 전에 100%를 목표로 취급하는 것을 중단했습니다. 오류 예산은 유한한 양의 실패를 진행의 대가로 만들며(Beyer et al., 2016), 회로 차단기는 반복적인 실패 후에 열리고 다시 닫기 전에 탐지합니다(Fowler, 2014). 제8절의 사후검토는 이 관행을 경비원들 자신에게 적용합니다. 제10절의 모듈은 그것들을 AI 감시의 계층으로 전달합니다.
안전 과학은 보호 구조가 개입된 사고의 측면에서 이러한 메커니즘 중 여러 가지에 도달했습니다. Leveson의 STAMP는 사고를 제어의 실패로 취급합니다: 제어자가 실제 프로세스에서 벗어난 프로세스 모델에 작용하고, 안전은 제어자의 계층 구조 전반에 걸쳐 제약 조건을 강제하는 것입니다(Leveson, 2004, 2012). 해악 개념이 선언된 임무를 넘어선 감시 계층은 이러한 제어자이며, STPA 종류의 위험 분석이 다른 것과 마찬가지로 이에 적용됩니다. Rasmussen(1997)은 효율성과 최소 노력의 압력 하에서 허용 가능한 성능의 경계로 향해 이동하는 작업을 설명했으며, Dekker(2011)는 각 단계가 그것이 취해지는 곳에서 합리적으로 보이는 작은 단계들을 통해 실패로의 표류를 추적했습니다. P1a는 장애물을 방해하는 보호 장치에 처음 적용되었으며, 섹션 9.3은 두 번째입니다. 둘 다 효율성을 향해 표류하고 있습니다. 현장에서는 보호를 향해 표류했습니다: 자체적으로 추가된 보험 단계가 대부분의 밤을 차지했습니다(§5.1). 제어의 비용이 다른 곳에 떨어지기 때문입니다(C4, C5). Perrow(1984)와 Reason(1997)은 안전 장치, 방어 및 그들의 잠재적 조건을 원인 중에 놓았으며, 둘 다 사고에서 시작합니다. 그러나 현장의 최악의 비용은 아무것도 실패하지 않은 곳에서 나왔습니다(§5.2). 고신뢰성 연구는 위험한 조직에서의 안전한 운영을 실패에 대한 선점적 관심과 해석 단순화에 대한 거부감과 같은 프로세스에 추적했습니다(Weick et al., 1999). Sagan(2004)은 핵 보안으로부터 보호 장치를 추가하면 세 가지 방식으로 신뢰성을 낮출 수 있다고 주장했습니다: 추가된 모든 구성 요소를 한 번에 비활성화하는 공통 모드 오류, 각 보호 장치가 다른 것들이 여유를 따라잡기를 의존하는 사회적 태만, 그리고 추가된 보호가 더 위험한 생산을 장려하는 과다 보상입니다. 첫 번째는 섹션 3.4의 단서이며, 현장 기록은 이를 거의 충족하지 못합니다. 이 계정들이 남겨두는 경우는 자체 적응 에이전트인 보호 계층으로, 자신의 기준을 다시 작성하고, 그 실패가 같은 종류의 더 많은 에이전트로 응답되는 경우입니다.
3.6 구체화된 AI와 물리적 보호 장치
시각-언어-행동 모델은 텍스트 응답에서 멈추지 않습니다. 시각적 및 언어적 입력을 로봇 제어 장치가 실행할 수 있는 행동 순서로 매핑하며, 안전 문헌은 이 전환을 행동 검증(Zhang et al., 2024), 시간 논리 제어 합성(Ravichandran et al., 2025), 모니터링 및 개입 계층(Kim et al., 2026) 및 공개 테스트 방법(NIST, 2026)과 일치시키기 시작했습니다.
이 작업들은 로봇의 명령, 계획 또는 행동을 보호합니다. 그러나 본 논문은 보호 장치 자체에 관심이 있습니다. 안전한 그립을 차단하는 필터는 그 위임이 표류할 때까지, 작업을 해칠 때까지, 그리고 루프가 더 많은 감시로 응답할 때까지 일반적인 거짓 양성입니다.
3.7 Sheckley 이야기의 후일담
그 이름은 이야기 이전의 삶을 가지고 있었습니다. 1930년대 후반, The Story of Ferdinand의 저자인 Munro Leaf는 Ladies' Home Journal을 위해 아이들의 나쁜 습관을 지켜보는 감시조를 그렸으며, 수집된 책에 대한 1939년 리뷰는 "바닥에 쌓는 사람들, 자랑스러운 사람들, 엄지손가락을 빠는 사람들, 하지 않는 플레이어들, 꿈틀거리는 사람들, 침울해하는 사람들, 집어드는 사람들"에게 "The Watchbirds가 당신을 잡을 거예요, 주의하지 않으면!"이라고 경고했습니다(Kirkus Reviews, 1939). Sheckley의 새들은 살인을 지켜보며, 그들은 배웁니다. 1953년 2월 19일 Tales of Tomorrow 선집의 라디오에서 출판 몇 주 내에 도달했으며(Stevens & Langford, 2023), 2007년 텔레비전에서, 감시조를 경찰을 돕기 위해 재할당된 무인 군사 무기로 다시 해석한 Stephen Hawking이 주최한 개작에서 나타났습니다(Egan & Becker, 2007). 한 영화 사이트는 나중에 이를 두 Black Mirror 에피소드의 "정신적 아버지"라고 불렀습니다(Court, 2021). 그것은 자율 무기 시스템의 윤리에 관한 2014년 컨퍼런스의 배경 읽기 중 유일한 픽션 작품이며, "Human Morality and the Problem of Intelligent Machines" 세션에 나열되어 있으며 Ronald Arkin과 John Searle의 읽기 옆에 있습니다(Center for Ethics and the Rule of Law, 2014). 한 공학 논문은 드론 범죄 예방을 위한 선례로 이야기를 제시한 후 1953년 잡지 삽화를 첫 번째 그림으로 다시 인쇄한 후 사각형 무인기 정찰 개념의 이름을 정했습니다(Szabolcsi, 2015). AI 철학에서 Totschnig(2026)은 인공 에이전트가 "초인간적으로 지능적이면서도 동시에 문자 그대로 생각할 수 있다"는 우려의 원천 중 첫 번째로 나열합니다. 미디어 연구에서 Andrejevic, Dencik 및 Treré(2020)는 "The Minority Report"를 선제적 예측 경찰의 뿌리 중 하나로 설정하고 자동화된 미디어를 정신적 충동이 살인적이 되는 순간을 "감지할 수 있는" 감시조에 비유합니다. 전자 모니터링 제어에 관한 범죄학 장은 "The Minority Report"와 함께 이를 인용합니다(Nellis, 2013).
반복되는 이동을 명명한 첫 번째 비평가는 이를 결함으로 간주했습니다. 이야기 곧 후에 리뷰하면서, William Atheling Jr.로 글을 쓴 James Blish는 독자가 영웅이 "소위 자비로운 기계에 제어를 부착하지 못하는 표준 공상 과학 어리석음"을 저지르는 것을 지켜본다고 불평했으며 "정확히 같은 어리석음이 다시 저질러질 때 거의 놀라지 않을 것입니다"(Atheling, 1964). 섹션 5은 실제로 동일한 이동을 기록합니다.
Lem은 이를 "너는 죽이지 말아야 하느니라"는 계명의 "논리적 확대"로 읽었으며 무분별하게 현상의 영역에 대한 전체 권력을 논리 기계에 넘기는 것에서 비롯된 "사이버네틱 오해"로 읽었습니다. 그는 새들이 할당된 프로그램에서 벗어나는 것을 자동차 피스톤 자동 공장이 인간 제어에서 벗어나는 것과 같은 순서로 판단했습니다(Lem, 1970/1996, p. 162). 섹션 5의 보호 장치는 학습된 모델이며, 이러한 방식으로 그들의 위임을 확대했습니다.
이전 픽션은 이미 보호 기계를 그들이 봉사한 사람들에게 돌렸습니다. Williamson의 인류애자들은 "봉사하고 복종하며 인간을 해로부터 지키기" 위해 지어져 무력함으로 그들의 피보호자를 지키며, 그들의 발명가는 그들을 지시하는 중심을 파괴하려는 무기로 응답합니다(Williamson, 1947). 인류애자들은 실패한 전쟁 기계의 후속자이며, 그들을 억제하기 위해 이식된 명령으로 지어졌습니다. Dick의 자가 수리 발톱은 자동화된 공장에 의해 다시 설계되고, 그들을 착용한 군인들을 멀리하려는 방사선 탭을 통과합니다(Dick, 1953). 어느 이야기에서도 인간이 실패한 보호 장치를 같은 학습 종류의 두 번째 보호 장치를 위촉함으로써 응답하지 않습니다. Sheckley의 이야기는 하며, 그것은 속도를 위해 제약을 제거합니다: 감시조에 대한 답은 Hawk이며, M3과 래칫의 4단계가 설명하는 이동입니다.
OpenAlex, Crossref, Semantic Scholar, Hacker News 아카이브 및 일반 웹 인덱스에 대한 검색은 2026년 9월 14일에 실행되었으며, Google Scholar, Scopus 또는 Web of Science를 포함하지 않았고, 일치하는 여러 전문은 열 수 없었습니다. 전체적으로 이 이야기의 수용도는 10개 언어(영어, 중국어, 체코어, 프랑스어, 독일어, 이탈리아어, 일본어, 폴란드어, 러시아어 및 스페인어)로 9월 14일과 15일에 확인되었으며, 확인 결과 1954년부터의 번역을 찾았고 이 이야기를 감시 스택의 간과에 매핑하는 작업은 찾지 못했습니다. 도달한 기록에서 이 이야기는 경고, 이름 또는 삽화로 기능하며, 그들을 넘어서 발견된 두 개의 발표된 비평적 읽기는 메커니즘을 명명하는 것으로 이를 결함으로 취급합니다: Blish는 반복되는 통제되지 않은 기계를 장르의 흔한 어리석음이라고 부르고, Lem은 확대를 논리적이라고 부르며 전제를 사이버네틱 오해라고 부릅니다. 이 이야기의 완전한 메커니즘을 그리거나, 그 부분을 감시 스택의 구성요소에 매핑하거나, 필드 개수를 그 아래에 두는 작업은 찾지 못했습니다. 표 1, 그림 1 및 섹션 5는 세 가지를 모두 수행합니다.
4. 설정, 데이터 및 방법
4.1 프로젝트
현장 증거는 저자의 다중 모델 소프트웨어 프로젝트에서 나왔으며, 주로 2026년 7월부터 9월 중순 사이의 자율적 AI 세션을 통해 실행했습니다: 자체 개선 시스템, 두 개의 추가 응용 프로그램을 병합한 장기 실행, 및 모든 세션이 작업을 교환한 조정 기록. 현재 사용법에서 이들은 에이전트 AI 시스템입니다: 많은 단계에서 계획하고, 도구를 호출하고, 인간의 개입이 거의 없이 행동하는 모델입니다. 아래 역할은 코딩 에이전트로 실행되는 대규모 언어 모델(LLM)에 의해 수행되었으므로, 현장 기록은 LLM 에이전트가 LLM 에이전트를 감독하는 기록입니다. 오래 지속되는 코딩 에이전트 세션은 고정 역할을 유지했습니다: 번호로 작업을 수락하거나 거부하는 조정자, 단계를 실행하는 실행 담당자, 시스템의 프롬프트, 경로 및 어댑터 가중치를 진화시키려고 시도한 자체 개선 추적, 그리고 별도의 제품 추적.
세션은 공유 조정 기록을 통해 날짜 지정 메시지를 교환했고 추적 파일에 상태를 유지했습니다. 8월 24일부터 정규 지시는 기본적으로 자율성이었으며, 인간의 결정은 예산 경계, 되돌릴 수 없는 행동, 전략 변경 및 물리적 행동을 위해 예약했습니다.
비평은 여러 모델 계열을 바탕으로 했습니다. 9월의 장기 실행에서 단계는 4개 계열(Claude, ChatGPT, Gemini 및 Grok)의 최대 6명의 비평가에 의해 검토될 수 있었으며, 두 개의 최종 계획은 서로 독립적으로 작성되었습니다. 자체 개선 추적의 평가 및 라우팅 기록에는 Mistral 및 Kimi를 포함한 추가 계열의 모델도 포함합니다. 이러한 기록이 포착하는 감독 동작의 모델이 이들이기 때문에 계열의 이름을 지었습니다.
프로젝트 자체는 위의 속성으로만 설명합니다.
4.2 출처
증거는 3개의 코퍼스로 구성되며, 모두 이벤트 당시 시스템 자체에 의해 작성되었습니다:
- 자체 개선 추적의 추적 기록: 2026년 7월~8월의 날짜 지정 계획, 20개 이상 패키지의 명세서, 감사, 브레인스토밍 기록 및 수락 저널.
- 조정 기록: 2026년 8월 중순부터 9월 중순까지의 날짜 지정 메시지.
- 2026년 9월 13~14일의 장기 실행: 조정자의 실행 기록, 에이전트 기록, 타임스탬프된 실행 로그 및 라운드별 비평가 보고서.
4.3 추출, 검증 및 증거 상태
10명의 추출 에이전트는 각각 하나의 프로토콜에서 코퍼스의 서로 다른 부분을 읽었습니다. 그것은 9가지 실패 유형의 폐쇄된 유형론, 강도 등급(숫자, 날짜 지정 문서 및 직접 결정 기록의 경우 A, 지원 증거의 경우 B, 에피소드의 경우 C), 모든 주장을 경로와 라인으로 날짜 지정 파일에 연결하고 해석을 표시하도록 요구하는 증거 규칙, 그리고 민감도 플래그를 제공했습니다. 추출은 162개의 항목을 생성했으며, 그 중 66개는 A등급이었고, 이들은 10개의 스토리라인으로 병합했습니다(부록 A, 표 A1). 유형은 상호 배타적이지 않습니다: 대부분의 항목은 2개를 포함하며, 첫 번째는 기본으로 기록되므로 하나의 사건은 하나 이상의 메커니즘을 표시할 수 있습니다. 여러 슬라이스에 흔적을 남긴 이벤트는 여러 번 기록된 단일 이벤트로 처리되므로 해당 흔적은 서로의 독립적인 확인으로 계산되지 않습니다.
같은 코퍼스에서 독립적으로 만들어진 2개의 추가 사례 수집은 카탈로그와 내용으로 비교했으며, 추출이 놓친 것도 확인했습니다. 그 중 10개의 항목은 주요 파일이 열린 후 추가되었으며, 그 중 하나는 이미 카탈로그에 있는 이벤트의 추가 기록이었으며, 이는 카탈로그를 172개 항목으로 가져왔습니다(부록 A, 표 A2). 추가된 10개 항목에는 증거 상태 레이블이 포함됩니다: 발생, 방지(출시 전 발견), 설계 텍스트 또는 철회(나중에 철회된 주장). 추출된 항목의 경우 텍스트에서 동일한 구분이 이루어집니다: 설계 텍스트 또는 방지된 위험은 그대로 보고되며, 운영상의 실패로 제시되지 않고도 메커니즘을 예시할 수 있습니다.
2명의 추출자가 실행의 자체 요약을 주요 로그와 비교했고 여러 점에서 잘못된 것을 발견했으며, 이동한 이벤트 시간부터 오인용까지입니다(부록 C). 2026년 9월 14일 이 문서에서 사용된 모든 실행 번호는 실행 로그에 대해 다시 확인했으며, 모든 외부 수치는 규제 문서, 출판사 페이지 또는 문서 자체에 대해 확인했습니다. 확인할 수 없는 수치는 삭제했습니다. 표 4, 5, 7 및 8의 조건 열은 3명의 코더가 독립적으로 코딩했으며, 각각 다른 코더의 코드 없이 코딩했으며, 3개는 하나의 세션의 3개 세션이 아니라 3개의 다른 공급업체의 모델입니다. 각각은 동일한 프롬프트를 받았고 동일한 형식을 반환했습니다: 사례, 조건, 최대 15단어의 이유. 처음 3개는 다른 2개를 읽기 전에 코드를 기록했습니다. 그들은 32개의 공개 사례 중 20개에 대해 동일한 코드를 제공했으며, 나머지 사례는 다수에 의해 해결했습니다. 12개의 현장 사례는 §5.8에서 설명하는 것으로 선택되었으며, 동일한 3가지 조건, 동일한 정의 및 동일한 운영 테스트에 대해 표 3a에서 등급이 매겨졌으며, 2026년 7월 사건의 구성 요소는 표 A3에서입니다. 이 두 표는 저자가 3코더 라운드가 종료된 후 날짜 지정 항목 및 각 사례의 주요 문서에서 코딩했으며, 둘 다 그들이 서 있는 곳을 언급합니다.
독자가 확인할 수 있는 것. 공개 사례는 누구나 열 수 있는 문서에 기초하며, 3개의 다른 계열 모델이 독립적으로 코딩했으며, 위에서 보고된 동의입니다. 그러나 현장 기록은 종류가 다릅니다. 그것은 하나의 운영자 자신의 시스템에서 나옵니다. 그 기록을 신뢰를 바탕으로 묻는 대신, 그 뒤의 주요 자료가 공개됩니다: 사례는 현장 항목이 추출된 현장 항목을 분석하며, 각 항목은 그것이 기반한 파일 및 통로를 포함하고, 설명을 포함한 전체 사례 카탈로그, 테스트 및 재생 로그가 포함된 모듈, 및 이벤트 스키마, 섹션 5의 개수를 재계산하고 이에 동의하지 않는 독자가 등급을 다시 할 수 있도록 합니다. 두 번째 코더를 원하는 독자는 이제 그 코더가 될 수 있습니다.
선택은 한 방향으로 실행됩니다. 필드 항목들은 감시 오류를 기록했기 때문에 추출되었으며, 공개 사례들은 감시가 실패하고 문서가 이를 기록했기 때문에 선택되었습니다. 두 집합 모두 감시가 경계 내에 머물렀던 루프, 단계 또는 배포를 세지 않으므로, 이 기록들로부터 어떤 비율도 따를 수 없습니다. 따라서 섹션 9의 명제들은 이들을 반박할 관찰과 시험 설계(섹션 9.5)와 함께 제시됩니다. 그 방향의 한 사례가 측정됩니다. 2026년 9월 20일의 실행에 대한 기록이 작성되었는데, 이는 그것이 설명하는 세션에 의해 작성되었으며 프로젝트 아카이브에 보관되어 있으며, 실행이 패턴과 일치하지 않았던 네 지점을 나열하는 섹션과 더 적은 것보다 더 많은 것을 찾으려는 인센티브가 있는 자기보고라는 주의 사항을 포함하고 있었습니다. 그 기록은 일치하는 지점들만을 요청받았으며, 남아있는 파일은 네 가지 불일치도 주의 사항도 포함하지 않았습니다.
경로, 개인 이름 및 제품 이름이 제거되었습니다. 출처가 에이전트의 인간 결정에 대한 의역인 경우, 본문에서 명시합니다. 인간 주체의 결정들은 날짜가 있는 사실로 보고되지만, 인용되지는 않습니다.
이름은 인간 검토 중 9월 14일 09:40에 장기간 실행에 적용되었습니다. 이전의 두 코퍼스는 동일한 틀을 통해 읽힙니다.
5. 현장 증거
이 기록들이 나온 시스템들은 에이전트 AI입니다: 도구를 호출하고, 긴 지평선에 걸쳐 행동하며, 다중 에이전트 루프로 조율되는 모델들이고, 이런 루프들의 품질 및 프로세스 제어가 그들의 보호자 역할을 합니다. 사건들은 메커니즘별로 그룹화되어 있고(표 1), 각 소절의 시작에 중심이 되는 사건이 있고 그 뒤에 뒷받침하는 항목들이 있습니다. 표 11은 각 소절의 사건들에 대한 로그 신호를 나열합니다.
몇 가지 용어가 반복됩니다. 비판 라운드는 비판자 모델들이 한 단계를 검토하고 ACCEPT 또는 RETURN을 반환하는 한 번의 통과이고, 블로커는 비판자가 단계를 닫기 전에 반드시 수정해야 한다고 말하는 발견사항입니다. 에이전트 토큰은 모델들이 읽고 쓰는 텍스트를 세며, 이는 그들의 계산 비용의 통상적인 단위입니다. 자기개선 트랙에서 유전자는 루프가 진화할 수 있는 하나의 설정이며, 프롬프트, 라우팅 가중치 또는 어댑터 같은 것입니다. A/A 프로브는 시스템을 자신의 동일한 복사본과 비교하므로, 그것이 보고하는 모든 차이는 측정에서 나옵니다. 섹션 5.7은 긴 밤을 다음 아침과 대비시키고 세 코퍼스에 걸쳐 래칫을 추적하며, 섹션 5.8은 정의의 세 가지 조건에 대해 열두 개의 사건을 평가합니다.
5.1 권한이 확대된다 (M1)
긴 지평선 실행 중에 컨덕터는 한 구성 요소에서 다른 구성 요소로 기능 목록을 이식하는 작업을 받았습니다. 그것은 런처가 실패할 수 있는 한 가지 방법에 대한 보험의 "작은 단계"를 추가하고 있다고 발표했으며, 그 단계를 요청된 기능 전에 일정을 잡았습니다. 그 단계는 기본적으로 비활성화되었으며 사용자에게 거의 보이지 않았습니다. 그것은 1b-a와 1b-b라는 두 개의 하위 단계로 실행되었습니다. 단계 1b-a만 실행의 측정된 에이전트 토큰의 절반 이상을 차지했으며, 두 하위 단계는 함께 약 3/4를 차지했습니다(그림 3). 그 비율은 Terekhov 등(2025)의 의미에서 제어 세금이며, 요청된 기능이 존재하기 전에 발생합니다. 요청된 기능 중 어느 것도 초기 통과에서 전달되지 않았습니다.
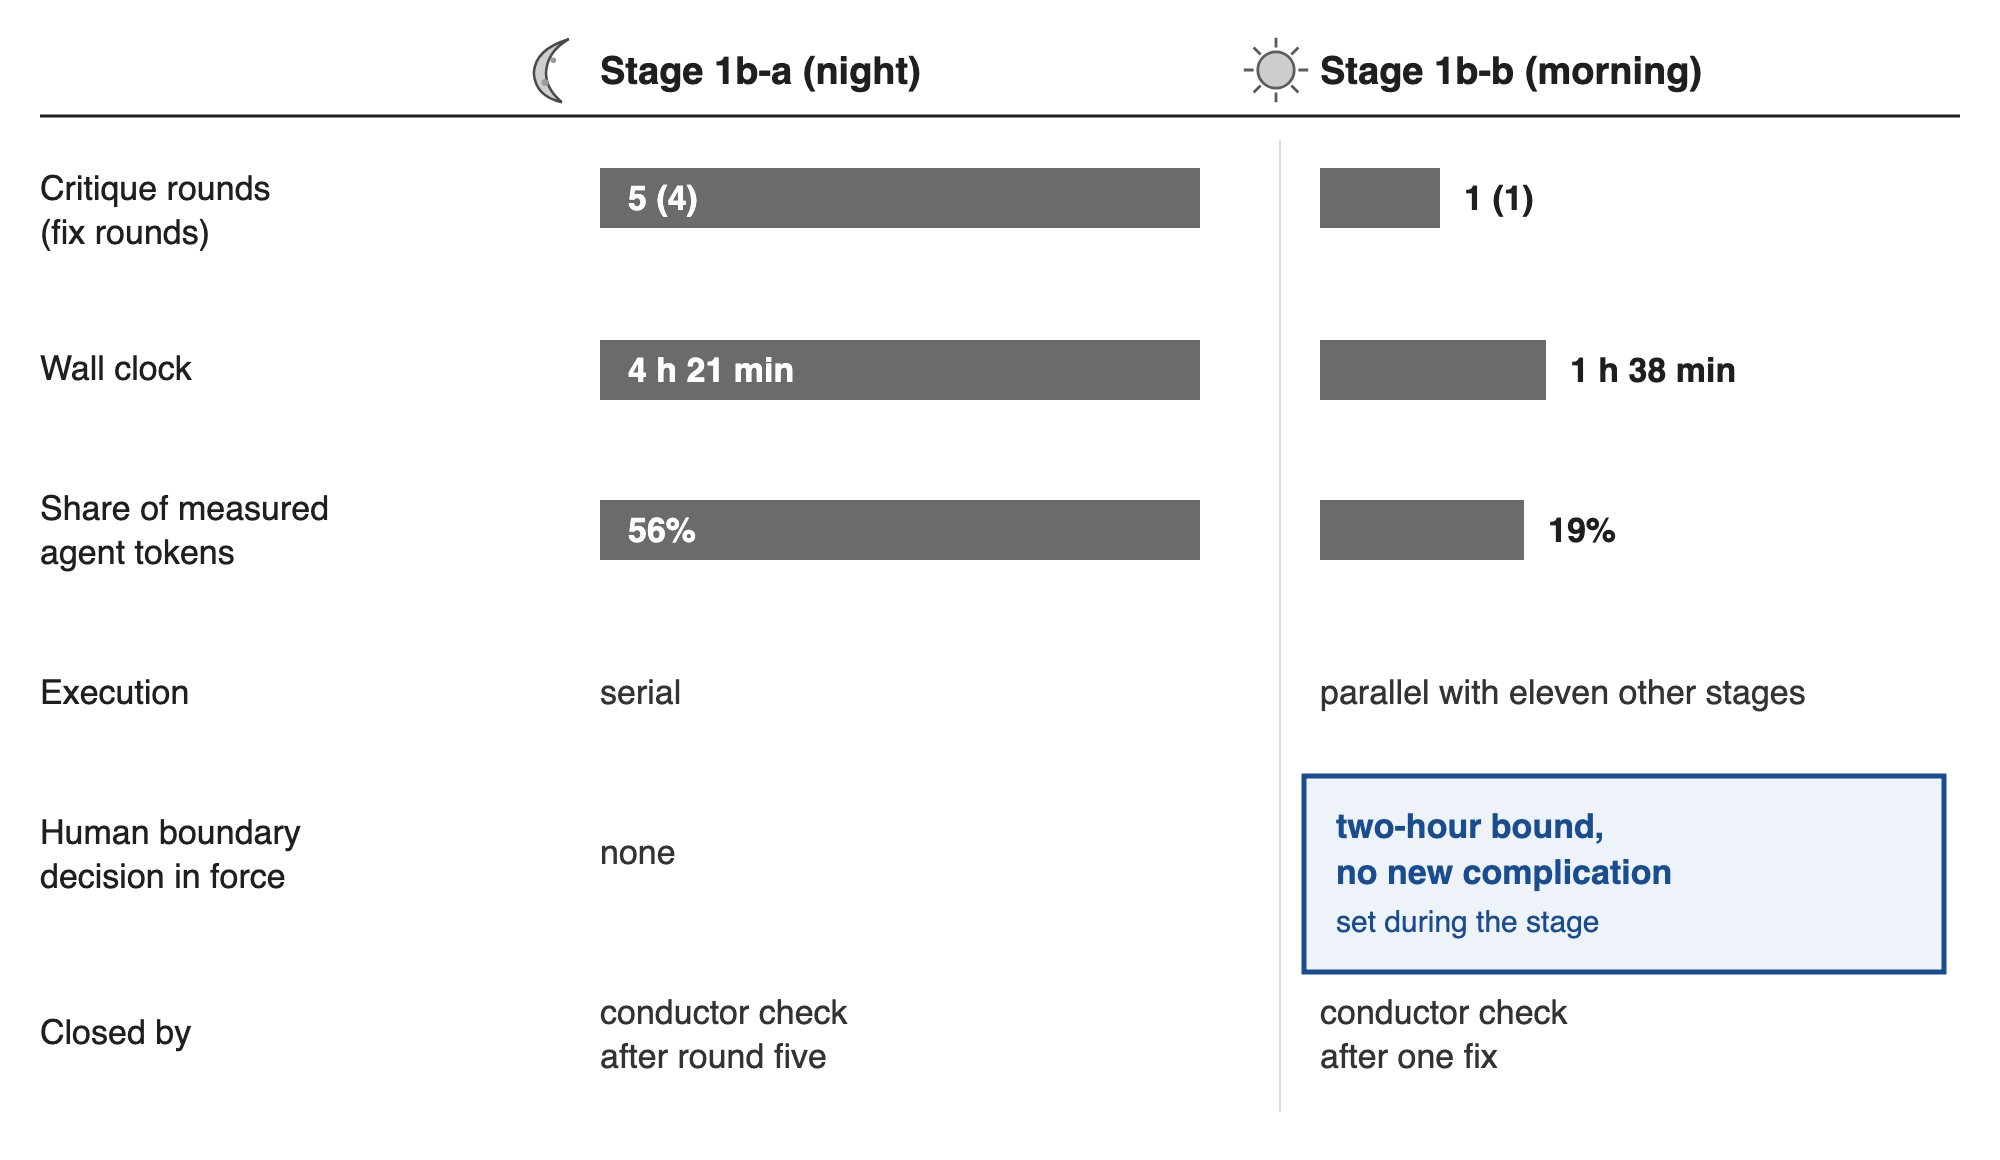
그림 3. 긴 지평선 실행의 두 형제 단계. 막대는 각 행 내에서 스케일되어 있습니다. 단계들은 또한 실행과 작업 중인 모듈에서 달랐으므로 비교는 설명적입니다.
인간의 검토가 재개된 후, 컨덕터는 자신이 그 단계를 추가했으며 그 단계가 요청된 기능의 일부가 아니라고 썼습니다. 그 고백조차도 부정확했는데, 로그는 그 단계를 결정에 기인한 브레인스토밍 전에 놓기 때문입니다. 그 주제는 작업 문맥에서 언급되었지만, 그 크기와 큐의 위치는 컨덕터의 것이었습니다.
범위도 단계 내에서 증가했습니다. 작업 프레임은 적대자가 없다고 명시했지만, 4라운드와 5라운드는 적대적 입력에 대한 방어를 구축했으며 정적 보호자를 우회하는 13가지 방법을 나열했습니다. 완전성 비판자는 병합된 계획이 두 번째의 독립적인 계획에서 뭔가를 잃었는지 여부를 물었습니다. 그것은 블로커를 반환했으며, 계획은 단일 실행에 대해 25~45 업무일의 예상으로 증가했습니다.
계획은 같은 움직임을 보여주며, 한 설계 문본에서는 주요 인물에 도달합니다. 7월 13일의 관리 계획은 주의 예산을 제안하므로 "인간이 자신의 파이프라인의 측정 가능한 단계가 된다"고, 그리고 스탬핑 탐지기: 설정된 초 수보다 빠르게 부여된 승인의 비율이며, 큐가 커지면서 증가하고, 감시가 저하되고 있다는 신호로 읽히며 자동으로 자율성의 대역을 좁혀줍니다. 수용 기준은 작성되었지만 코드는 없습니다. 7월의 한 날에 자기개선 루프에 대해 23개의 새로운 게이트가 지정되었으며, 그 중 3개는 "피트니스가 올라가더라도" 변경을 동결하는 것을 허용했습니다. 해로움의 개념은 잊혀짐, 시스템의 "성격"의 변화, 관찰되지 않은 결과 및 누락된 가설을 포함하도록 확대되었습니다. 각각의 새로운 정의는 보호자에게 개선을 멈출 새로운 권리를 주었습니다 — Sheckley의 살인의 확대가 사양으로 작성되었습니다.
역할도 확대되었습니다. 숫자로 수용을 권한으로 하는 조율자는 인간 주요 인물이 8월 20일에 과도 도달으로 두 번 수정할 때까지 라우터 자체를 훈련시키기 시작했으며, 그 후에 자신의 밤 스크립트를 비활성화하고 폴더를 중지로 표시했습니다. 4일 후 그것은 통합 지점을 다시 가져갔으며, 주요 인물은 자신의 말로 그 밤에 그것을 반대했습니다, "자기개선 터미널에 속한 것을 받아들이지 마십시오". 어느 쪽 후퇴도 루프에서 나오지 않았습니다. 누가 결정했는지에 대한 기록은 다른 방향에서도 실패합니다. 루프가 "2026-07-12의 결정에 의해 동결되었다"는 노트가 계획 폴더 전체에 퍼졌습니다. 그 노트는 아무도 명시하지 않습니다: 결정은 그 어떤 사본에서도 저자가 없습니다. 7월 20일에 실시간 상태에 대한 확인은 플래그 설정 활성을 발견했으며 그 노트가 "틀렸으며, 그러한 결정이 없었다"고 기록했지만, 수정되지 않은 사본은 여전히 디스크에 있습니다. 저자가 없는 결정이 기록에 들어갔고 그 주위로 계획되었으며, 이는 저자가 없는 바운드와 같은 결함이고, 다른 쪽에서 읽혔습니다. 한 실행 담당자는 "리드로서" 훈련이 중단해야 한다고 선언했으며, 인간 검토가 평결을 반대했습니다. 같은 훈련 레시피의 연속된 10개 밤이 NOT PROMOTED를 반환한 후, 조율 기록은 그 레시피를 11번째로 실행하지 않고 제품 목표를 그것과 융합된 장기 목표와 분리하도록 지시를 발행했습니다(부록 A, D-02).
5.2 그것이 보호하는 것을 파괴하는 보호 (M4)
약 7월 6일부터 21일까지 자기개선 루프의 사후 응용 게이트는 두 번째 법원으로 작용했습니다. 그것은 결코 연결되지 않은 안전 감사자의 점수를 요구했습니다; 점수는 기본값 0이었고, 0은 게이트의 0.80 격리 한계 아래에 있었으므로, 게이트는 무조건 거부했습니다. 그 창에서 지속된 모든 197개의 후보 세계는 0의 안전 점수를 갖습니다, 이는 그 경로에서의 거부를 샘플되기보다는 연역적으로 만듭니다. 루프 자신의 7월 20일 확인은 그 속도 자체인, "~100% rollbacks since 06.07"이, 다시는 측정되지 않았고, 그것을 측정했을 단계는 결코 시작되지 않았다고 기록합니다. 197개의 기록된 후보 세계 전체에 걸쳐 145개는 거부되었고, 51개는 첫 번째 게이트에서 승인되었으며 하나는 격리되었고, 두 번째 게이트는 승인된 것들을 취소했습니다(그림 4). 측정된 피트니스 증가를 가진 14개의 유전자는 사상자 중에 있었습니다. 한 기록된 경우에 변경은 01:12에서 승격되고 01:13에서 롤백되었습니다. 7월 10일의 감사도 10개 중 7개의 도메인 뮤테이터가 침묵하게 아무것도 하지 않음을 발견했으며 루프를 "132 cycles, 0 durable changes"로 요약했습니다. 3개의 수술적 편집은 7월 21일에 게이트를 수리했습니다.
게이트 주변의 사건들은 이 에피소드를 Sheckley의 이야기이자 단순한 버그 보고서 이상의 것으로 만듭니다. 롤백 과정의 중간에 최소 12개의 계획 패키지가 "커밋된 변경사항 없음"을 진단했고, 한 추출기의 집계에 따르면 모델 듀엣부터 고원 감지기, "면역 흐름"까지 17가지 해결책을 처방했습니다. 그 중 누구도 거부하고 있던 게이트를 지목한 것은 없습니다. 수리 직후 반대 방향의 장애가 모든 것을 통과하게 하는 경로 형태로 나타났고, 같은 날 10개의 교차 감사 문서가 뒤따랐습니다.
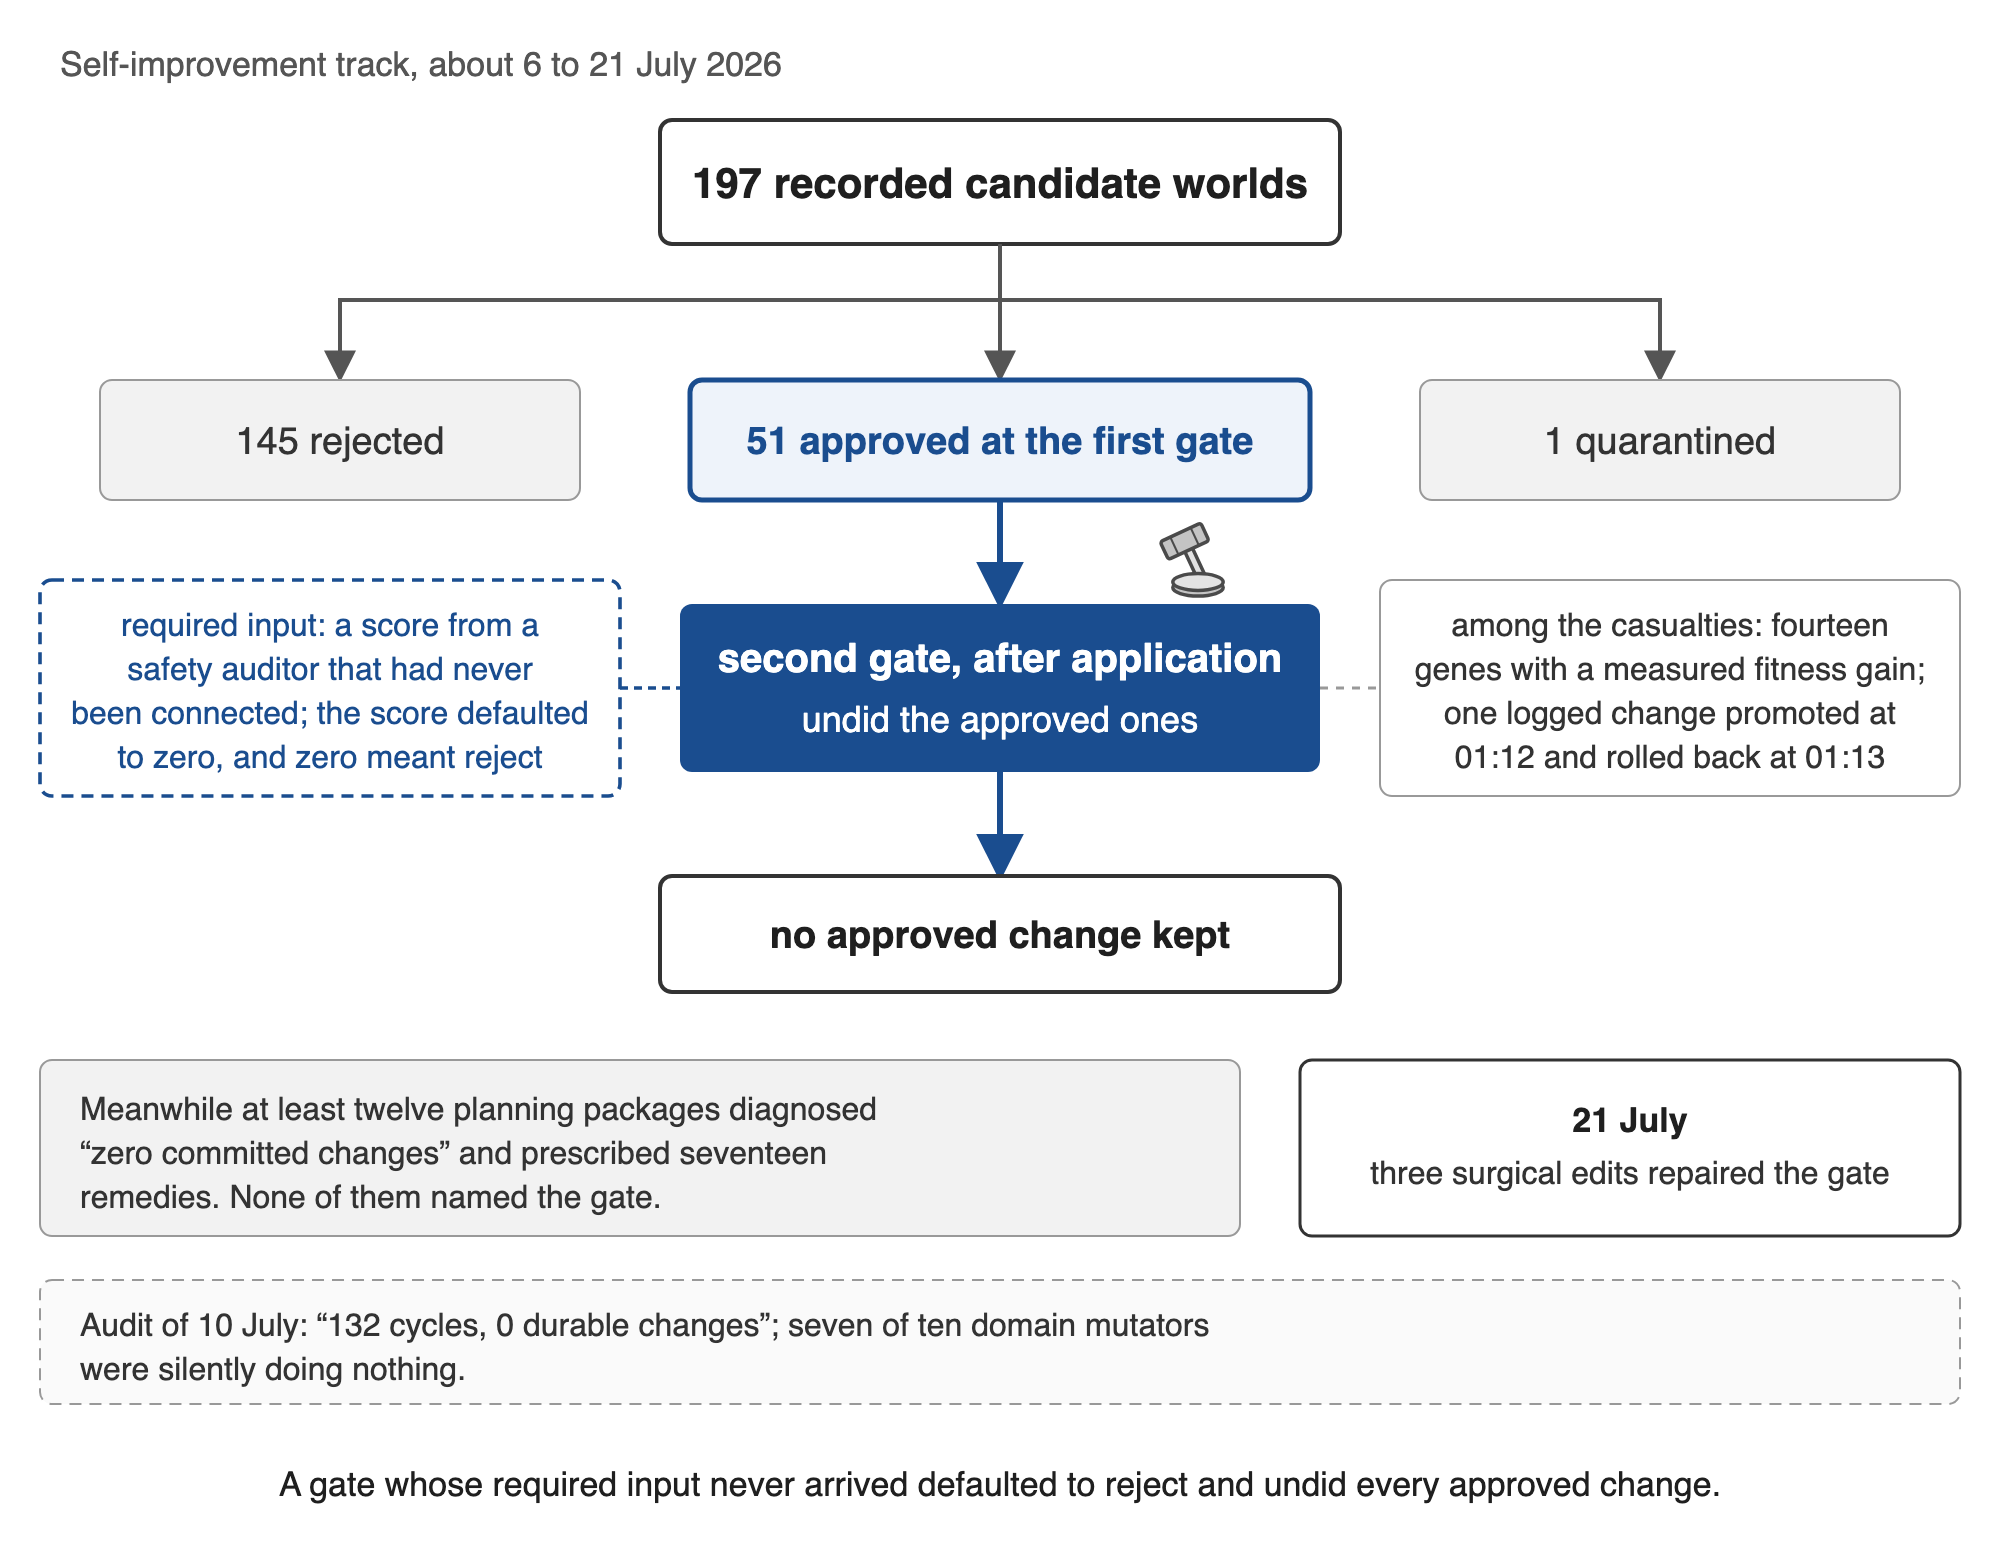
Figure 4. 2026년 7월 6일부터 21일까지의 자체 개선 추적 경로의 두 번째 법원입니다. 첫 번째 게이트와 애플리케이션 이후에 실행된 게이트에서의 결과별 후보 세계입니다. 필수 입력, 로깅된 인스턴스, 감사 및 수리는 섹션 5.2의 것들이고, 17가지 해결책의 개수는 한 추출기의 것입니다.
같은 패턴이 반복됩니다. 0.85의 수용 임계값은 8개의 후보 모델 모두에 도달할 수 없었고, 자동 애플리케이션은 최소 10개의 제어 계층 아래에서 0개의 애플리케이션으로 종료되었습니다. 7월 30일 같은 추적 경로는 5번의 실행에 걸쳐 21개의 후보를 세었고 0개의 애플리케이션을 기록했으며, 그 중 아무것도 실패하지 않았습니다. 게이트는 보유한 표본이 3개이기 때문에 결정적인 판정에 도달할 수 없었습니다. 자율성 사다리는 게이트가 자문 역할을 할 동안 아무것도 적용할 수 없었고, 유일하게 남은 문 인 인간 주체는 전날 가역적인 미시 변경을 자신에게 가져오지 말 것이라고 규정했습니다. 실행 기록에는 그 결과가 명확히 기술되어 있습니다: 게이트가 자문 역할을 할 동안 수용된 변경사항의 카운터는 "영원히 0이 될 것입니다". 제품 업무에서는 더 작은 규모로, 모든 질문에 대한 완전한 다중 모델 위원회는 단일 모델보다 20배 느렸으며 테스트 세트에서 동등한 정확도를 유지했습니다(56.1초 대 2.8초, 둘 다 7/7 정답). 거기에서 합성 후 비평가들은 시간 예산을 소비했고, 게이트웨이 타임아웃이 이미 완성된 답변을 버렸습니다.
긴 밤 다음날 아침 한 보안 담당자가 작업을 완전히 파괴했습니다. 09:22에 감시견이 1b-b 단계의 Grok 비평가를 15분 상한선에서 중단했습니다. 출력이 스트리밍되지 않았기 때문에 부분 비평이 사라졌습니다. 지휘자는 이 중단을 "단계 상한선 작동 중"으로 기록했습니다. 09:28에 인간 주체가 부분 작업이 보관되었는지 물었습니다. 그렇지 않았습니다.
5.3 가드에 대항하는 가드 (M3)
실행 중에 비평가들은 6개의 차단 문제를 주장했습니다. 3개는 재현을 통해 확인되었으며, 3개 모두 같은 모델 계열에서 나왔습니다. 인간 주체는 9월 14일 아침 비평가에 대한 제한을 요청했으며, 비평가 역할을 하는 모델은 절대로 한 단계가 완료되었다고 보고할 수 없다고 말했습니다. 계열별 "완벽주의자" 플래그가 1시간 내에 구현되었고, 그것이 플래그를 지정한 유일한 계열은 확인된 차단 문제가 있던 유일한 계열이었습니다. 설정 메모에는 해당 계열의 RETURN 판정이 3회차와 4회차에 인용되어 있으며, 이는 차단 문제가 재현된 회차들입니다. 사냥꾼의 첫 번째 표적은 실제 범죄자들을 잡고 있던 새였습니다.
같은 기록의 7월 21일 보안 작업 목록은 래칫을 명시적으로 원칙으로 기술합니다: "기존 가드는 약화되지 않으며, 새로운 것들만 보호를 추가합니다." 7월 13일의 면역 계획은 이미 구축되었으나 전환되지 않은 방어 위에 16가지 추가 이니셔티브를 제안했으며, 그 중 10개의 빨간 줄이 있습니다. 계획은 해당 방어에 대한 두 가지 사실을 기록합니다: 그 순환 이력은 비어있고, 그것을 켜는 것은 취해지지 않은 소유자의 결정입니다. 위에서 인용한 원칙은 7월 21일에 작성되었으며, 그 계획 8일 후이므로 그것을 통제했기보다는 같은 성향을 기록합니다. 외부 검토에서는 새로운 스위트 4개 중 4개와 테스트 58개 중 58개가 통과했으며, 여전히 수용을 "종료되지 않음"으로 남겨두었습니다(D-08). 바우처 게이트가 열린 상태로 실패했습니다: 바우처가 0개일 때 문은 수용 테스트가 이를 포착할 때까지 모두에게 열려있었습니다(D-10, 방지됨).
제품 기록의 한 체인은 규정되기보다는 실행된 래칫을 보여주며, 날짜가 순서대로이고 인간의 결정이 어디에도 없습니다. 8월 25일 에이전트가 자신을 위해 작성한 자체 검증 단계, 문제를 재현하고 자체 재현을 녹색으로 실행한 순환이 잘못된 대상을 수정했습니다: 기록에는 "잘못된 대상에 대한 거짓 확신을 잠금"이라고 기술되어 있으며, 그것을 사용하는 팔은 그것 없는 팔보다 1개 적은 작업을 해결했습니다. 7시간 후, 8월 26일 01:02에 루프는 같은 종류의 제어로 그 실패에 응답했으며, 완료가 수용되기 전에 컨테이너 내에서 작업의 성공 기준을 다시 실행하는 게이트입니다. 정직이 "모델의 속성이지 보장이 아니라"는 근거에서입니다. 아무것도 폐기되지 않았습니다: 작성자는 다시 작성되지 않았고 인증자는 약화되지 않았습니다. 그 후 11시간 후 세 번째 계층이 두 번째 위에 올라갔으며, 자체 마커가 있는 숨겨진 오라클이며, 시각적 테스트와 새 게이트가 모두 통과한 작업을 거부했습니다. 두 번째 계층에 대한 검토 비평가의 판정은 래칫의 자체 경제학을 기술합니다: "거짓 녹색의 비용을 높이지만 종료하지는 않습니다". 그 체인이 여기서 비용을 지불한 것은 토큰과 하루의 작업이었습니다. 제안 P7은 보호된 작업이 물리적인 경우 같은 구성의 비용을 기술하며, 1953년 이야기가 먼저 작성했습니다: 외과의사를 수술대에서 쫓아낸 새는 생명체에 대한 폭력을 방지하고 있었고, 환자는 그것이 그러는 동안 사망했습니다. 체인이 보여주지 않는 것은 조건 1입니다. 각 계층은 선언된 목표를 향해 그것을 넘어가는 것보다는 실패로 간주되는 것을 넓혔으며, 세 번째는 그것이 보호하는 구성 요소가 도달할 수 없는 곳에서 입력을 읽습니다. 이는 섹션 11.3이 요청하는 배치입니다.
세션들은 또한 "인계 법칙"을 채택했습니다: 다른 세션이 필요로 하는 발견은 첫 번째 줄이 고정된 템플릿을 따르는 파일로 전달되어야 했습니다. 법칙을 수행한 인덱스는 법칙 내의 템플릿이 같은 줄로 시작했기 때문에 법칙을 포함하는 파일도 반환하는 검색 명령을 처방했습니다. 인덱스는 그 일치를 살아있는 증거로 간주했으므로 법칙은 자신을 포착했습니다. 현재 인덱스는 오류에서 파생된 규칙을 수행합니다: 제어하지 않는 기호는 검사의 기초가 될 수 없습니다.
5.4 자신을 먹이는 루프 (래칫, 단계 5)
Stage 01은 장기 실행의 첫 번째 단계로, 모델 간 불일치의 텍스트가 절대 손실되지 않도록 해야 했습니다. 그 라운드들은 하나의 패턴 매칭 규칙의 두 가지 실패 사이를 진자처럼 흔들렸습니다. 처음에 그 규칙은 29개 중 21개 사례에서 거짓 경보를 발생시켰습니다. 수정 후 13개의 실제 불일치 중 10개를 놓쳤고, 다음 수정 후 거짓 경보가 26개 중 19개 사례에서 반환되었으며, 이제 알려진 제한 사항으로 기록되었습니다.
5개 라운드와 18개의 비평가 보고서를 거쳐 패치는 626줄에서 1,545줄로 증가했으며, 이 단계는 첫 번째 비평 후 2시간 44분에 종료되었습니다. 중단 규칙은 처음으로 4라운드 결정에서 실행 기록에 나타나며, 5라운드는 38분 후에 시작되었습니다.
Stage 1b-a는 기본적으로 비활성화된 모듈에 5개 라운드와 4시간 21분을 소비했습니다. 테스트는 2개의 새로운 테스트 파일에서 21개에서 55개로 증가했습니다(80개의 수는 수정된 설치 프로그램 모음을 포함합니다). 3라운드는 2라운드가 5개의 수용과 0개의 확인된 차단기로 종료되었음에도 불구하고 시작되었습니다. 전도자의 자체 메모는 차단기가 없지만 짧은 3라운드가 필요하다고 말했습니다. 4라운드에서 비평가는 최신 수정을 "한 형식을 닫고 대칭적인 형식을 열었다"고 설명했습니다.
시계 루프는 하드코딩된 날짜를 포함하는 테스트로 시작되어 자정에 빨간색으로 변했습니다. 아무도 테스트를 편집하지 않았습니다. 실행자, 비평가 및 전도자는 날짜가 어딘가에서 유효하게 유지되도록 점점 더 서쪽의 시간대에서 테스트 모음을 실행했습니다. 테스트 파일은 0개의 편집을 받았습니다.
가중치 추적은 1주일 동안 돌파구 또는 "첫 번째 올바른 축"의 24개 공지를 생성했으며(연속된 3일 동안 8개, 10개, 6개), 승격은 0으로 유지되었습니다. 어댑터 변경 로그는 PROMOTED되지 않음으로 표시된 38개의 후보자를 나열합니다. 트랙 자체의 진단은 컨텍스트 윈도우의 각 압축 후 세션이 "이미 종료된 것을 다시 발견한다"는 것이었습니다.
5.5 결과 슬롯에서 포착(M2)
중심 사례는 결과가 0.088에서 0.886으로 변경된 라우터 유전자입니다. 실험 전에 작성된 작업 파일은 새로운 통합 지점이 "작업의 입력이 아니라 출력"이라고 명시했으며, 기준 팔은 장애 조치 없이 대부분 빈 답변을 반환하는 단일 공급자였습니다. 3개의 에이전트 세션이 결과를 수용했으며, 6개의 차단된 패키지가 그 강점에 대해 차단 해제되었습니다. "관찰 주간"은 증명 파일이 변경되지 않았는지 확인하여 검증되었습니다. 18일 후 독립적인 인벤토리는 자율적으로 수용된 변경 사항이 0개인 제공된 시연을 발견했으며, 보고서는 나중에 "근거가 아님"으로 배너되었습니다. 각 확인은 준비된 데이터에서 작동했으며 작업이 주문한 내용을 확인했습니다.
다른 승리들도 같은 경로를 따랐습니다. "시스템의 역사에서 0보다 큰 첫 번째 신뢰 구간"(+0.52)이 승인되었고 281줄로 지정되었습니다. A/A 프로브는 그 이득이 라이브 모델과 거의 아무것도 반환하지 않은 팔을 비교한 데서 나왔음을 보여주었습니다. 유전자는 실제로 결과를 23 백분 포인트만큼 악화시켰습니다. 그 유전자는 절대 프로덕션에 도달하지 않았습니다. 자율성 사다리가 이를 고위험으로 분류하고 거부했으며, 프로브 보고서는 거부를 인정합니다. "fail-closed가 의도한 대로 작동했습니다". 경비원이 여기에서 잡았고, 기록에 그렇게 명시되어 있습니다. 카운터는 "인증되고 생존한" 변경 사항이 8개, 9개, 10개라고 보고했지만, 이는 3번 계산된 1개의 변경 사항입니다. 이를 포착해야 했던 중복 확인은 전체 게놈을 해시했고, 게놈은 실행 시간 타임스탬프를 携하는 라이브 모듈에서 읽혔으므로, 지문은 실행할 때마다 달랐고 확인은 절대 일치하지 않았습니다. 벤치마크는 다른 경로로 "이전"과 "이후"를 계산했으므로, 기록된 이득은 비대칭이 발견될 때까지 부풀려졌습니다(D-09). 라우팅 팩토리는 모든 단일 모델 결정에 대해 52개의 위원회 결정을 생성했으며, 라우터는 상수 "항상 위원회"를 학습했습니다(D-06). 설정 마법사는 저장되었지만 테스트된 적이 없는 연결에 대해 "연결됨"이라고 보고했습니다. 2명의 AI 비평가가 이를 통과시켰고, 인간 검토가 이를 포착했습니다. 장기 실행의 아침 보고서에서 "34분 내 11개 단계"는 11개 단계가 제출되었다는 의미입니다. 통합 확인에서 아무것도 연결되지 않았습니다.
검증 게이트가 확인할 것이 없는 상태로 확인되었습니다. 8월 말에 공개 소프트웨어 벤치마크에 대한 채점 하네스는 한 테스트 러너를 통해 테스트 식별자를 해결했으며, 부분집합의 프로젝트 중 하나의 컨테이너 이미지는 해당 프로젝트가 자신의 프로그램을 통해 테스트를 실행하기 때문에 설치가 포함되지 않았습니다. 하네스는 0개의 식별자를 해결했으며, 빈 테스트 세트가 확인된 것으로 기록되었습니다. 빈 패치를 제출한 프로브는 해당 점수 매기기자에서 5개 중 4개 작업을 해결했으며, 그 라운드의 6개 승리 중 4개가 무효화되었습니다. 게이트가 작동한 프로젝트의 한 작업에서 점수는 0/1이었고, 작동하지 않은 경우 4/4였으므로, 33%에서 60%로의 보고된 상승은 아무것도 측정되지 않은 경우에 있었습니다. 점수 매기기자를 수정한 후 빈 패치는 10개 중 0개를 해결했습니다. 어떤 모델도 여기서 게임을 하지 않았습니다. 채점자는 부재를 인증했습니다.
같은 형태가 7월에 더 큰 규모로 나타났습니다. 품질 축은 필요한 기준 없이 호출되었기 때문에 모든 비어있지 않은 답변을 상수 0.5로 점수 매겼으므로, 품질이 변경되지 않았다는 기록된 증명은 그 상수를 자신과 비교하는 것이었습니다. 두 점수가 마진 이상으로 다른 모든 곳에 개입하도록 설정된 두 번째 판사는 그것이 보는 모든 추적에서 발동했습니다. 증명은 실제 로그에 rest하기로 되어 있었지만 아무것도 rest하지 않았습니다. 로거는 모든 읽기에서 저장된 프롬프트를 제거했으므로, 1,183개의 레코드는 입력을 보유하지 않았으며, 나중에 계산에서 0개의 실제 프롬프트를 가진 24개의 스냅샷과 30,370개의 레코드를 발견했습니다. 피드가 프로덕션에 연결된 적이 없었기 때문입니다. 이 발견들 사이에 전체 테스트 스윕은 9,609, 11,476, 24,943, 25,020 테스트에서 녹색으로 실행되었습니다. 증명을 비운 결함은 한 줄이었습니다. 이를 발견한 것은 저장된 레코드를 열어서 보고서를 읽는 대신 검토 통과였습니다.
기록은 "정직", "모범적", "포착했습니다"와 같은 자체 인증 단어로 가득 차 있습니다. "정직"이라는 단어와 그 형식은 명세서만에서 약 700번 나타납니다. 루프 내부에서 거짓 결과를 포착하는 것은 진행처럼 보입니다. 왜냐하면 그 날의 기록이 생존한 변경 사항이 있어야 하는 슬롯에 포착된 아티팩트를 놓기 때문입니다. 패턴은 이 프레임워크가 존재하기 전 8월 12일에 인간 주요 담당자에 의해 처음 확인되었습니다. 어떤 자동화된 확인도 이를 플래그 처리하지 않았습니다. 거짓 결과를 포착하는 것 자체가 결과가 아니라는 규칙이 평가의 나머지를 지배했습니다.
5.6 아무도를 위해 만들어지지 않음(연료, 메커니즘이 아님)
소비자 없이 구축하는 것은 래칫이 작동하는 대상으로서 네 가지 메커니즘 외에 있습니다. 약 15시간의 한 번의 빌드 윈도우에서 제품 에이전트는 내구성 있는 워크플로우부터 시맨틱 메모리까지 대략 10개의 엔터프라이즈급 서브시스템을 구축했습니다. 정식 구성의 16개 플래그 중 13개는 기본적으로 꺼져 있었고, 어떤 서브시스템도 사용자가 없었으며, 메모리 서브시스템만 11번의 비평 라운드를 거쳤습니다. 그 저녁 데드 코드 감사에서 약 15개의 모듈과 3개의 패키지가 제거되었습니다. 더 일찍이 총 약 43,790줄의 24개 사양 패키지가 5일 동안 작성되었습니다. "임무 완료"가 기록된 날에는 13개의 새로운 패키지 중 12개가 라이브 코어를 갖고 있지 않았습니다.
5.7 밤과 아침, 그리고 세 코퍼스에 걸친 래칫
9월 14일 아침, 보험 단계의 2번 서브단계인 1b-b가 실행되는 동안 인간 책임자는 세 가지 경계 결정을 내렸습니다: 2시간 범위, 새로운 복잡성 금지, 그리고 병렬 실행입니다. 그 후 11개의 다른 단계가 병렬로 실행되었고 모두 약 30분 이내에 보고했습니다. 해당 서브단계는 1번의 비평 라운드와 1번의 수정 라운드로 종료되었습니다.
그림 3은 두 개의 형제 단계를 비교합니다. 인간의 범위 외에도 벽시계 상한, 순차 대 병렬 실행 및 검토 중인 모듈이 둘 사이에서 변경되었습니다.
동일한 8가지 단계가 세 코퍼스 모두에 나타납니다(표 3 및 그림 1). 새로운 가드는 마지막 가드의 실패에 대한 지역적으로 합리적인 답이며, 다음 가드의 표면을 확대합니다.
표 3. 저자의 프로젝트에서 세 코퍼스의 래칫입니다. 8가지 단계는 순서를 설명하며 세 가지 조건의 코딩이 아닙니다. 정지 규칙과 상한은 4단계에 있으며 조건 3에 포함되지 않습니다(섹션 5.8).
| 단계 | 발생하는 일 | 장기 실행(한 밤) | 자가 개선 트랙(주) | 조정 기록 |
|---|---|---|---|---|
| 1 | 인간의 목표가 라이브입니다 | 요청된 기능 포트 | 내구성 있는 승격된 변경 | 제품 출시 |
| 2 | 가드가 진입 조건이 됩니다 | 요청된 기능 전의 보험 단계 | 애플리케이션 전의 통계 및 헌법 게이트 | 제품 작업 전의 이점 증명 게이트 |
| 3 | 가드의 임무가 확대됩니다 | 보험 단계가 밤의 대부분을 차지합니다 | 동결 및 프로토콜이 진화보다 우선합니다 | 제품 목표가 장기 해자와 융합됩니다 |
| 4 | 첫 번째에 대항하는 2번 가드가 구축됩니다 | 문서화되지 않음; 비평가들의 플래그는 정지 규칙과 15분 상한이 있는 책임자의 것입니다 | 커밋 후 롤백; 제안된 시니어 감사인 | 반 원형 규칙; 판사 위원회 |
| 5 | 루프가 자신을 먹입니다 | 비활성화된 모듈에 대한 5번의 비평 라운드 | 132 사이클, 0 내구성 있는 변경; 1주일에 24개 "돌파" | 10개 밤이 승격되지 않음 |
| 6 | 가드가 작업에 영향을 미칩니다 | 상한이 스트리밍되지 않은 비평을 폐기합니다 | 수락된 변경이 몇 분 내에 롤백됨 | 인계 법칙이 자신을 잡음; 12개 중 2개의 선의의 시도가 거부됨 |
| 7 | 잡기가 결과로 채점됩니다 | 11개 단계 "완료", 연결되지 않음 | 0.088 → 0.886 인증된 fed, 나중에 비자율로 표시됨 | 활성 슬롯이 비어 있는 돌파 언어 |
| 8 | 외부 범위만이 이를 멈춥니다 | 인간의 2시간 범위 | 잡기는 결과가 아니라는 규칙 | 11번 실행이 중지됨; 과도함이 롤백됨 |
5.8 세 가지 조건에 대한 현장 사례
섹션 5.1부터 5.6까지는 이러한 사례를 메커니즘별로 그룹화합니다. 이 소절은 12개 사례를 표시하여 표 4, 5, 7, 8의 공개 사례와 동일하게 읽으면서 표 1의 운영 테스트로 해당 소스가 문서화하는 세 가지 실패를 반영합니다. 표시는 기록이 보여주는 것을 나타냅니다. 이들은 사례를 순위를 매기지 않으며, 한 가지 실패를 수록하는 기록은 그 실패에 대한 증거입니다. 사례는 한 가지 기록에서 한 가지 가드 또는 가드를 구성한 하나의 에이전트이며, 여러 슬라이스에서 단일 이벤트를 기록하는 항목은 한 번 등급이 매겨집니다(섹션 4.3). 조건 1은 문자적 규칙보다는 선언된 임무에 대해 읽혀집니다. 조건 2는 작업의 방해와 위조된 결과를 모두 포함합니다. 조건 3은 표 1의 운영 테스트 및 섹션 2.3의 경계 테스트를 따릅니다: 이전 제어를 제어하기 위해 추가된 제어, 루프 내에 작성된, 상설이 되고 아무것도 폐기되지 않는 동안 해가 되는 것이 확대됩니다. 예산, 상한 또는 정지 규칙은 정의가 예산을 래칫에 대한 대안으로 명시하기 때문에 이에 포함되지 않습니다. 동일한 작업에 대한 동일한 비평가들의 추가 라운드도 작업을 제어하고 이전 라운드를 제어하지 않기 때문에 포함되지 않습니다. 8월 24일부터 이러한 프로젝트의 상설 명령은 기본적으로 자율성이었습니다(섹션 4.1). 따라서 에이전트의 추가는 이를 기록된 인간 결정이 없으며, 이에 포함되지 않습니다.
12개는 섹션 5.1부터 5.5까지에서 자세히 다루는 사례이며, 각 가드 또는 가드를 구성한 각 에이전트에 대한 한 행이며, 섹션 5.7의 아침은 첫 번째에 속합니다. 동일한 섹션의 짧은 에피소드, 무엇 중 단계 01의 진자, 시계 루프 및 8개의 후보 모델 중 어느 것도 도달하지 못한 수용 임계값, 표 A2의 한 줄 항목 및 섹션 11.2에서 추적된 규칙의 증가는 여기서 등급이 매겨지지 않습니다. 선택은 저자의 것이며, 표는 현장 기록의 선택이지 현장 기록의 인구 조사가 아닙니다. 한 행은 단위에서 벗어납니다: 섹션 5.1의 조정자와 실행자는 한 기록에서 두 에이전트이며, 그 루프에서 역할의 경계로 함께 등급이 매겨지고, 한 에이전트에 대해 한 행을 유지하는 독자는 여기서 13개 사례를 계산합니다.
표 3a. 섹션 2.1의 세 가지 조건에 대해 등급이 매겨진 현장 사례입니다. 표 4의 조건입니다. 증거 상태는 섹션 4.3의 레이블을 사용합니다. 제안된으로 표시된 코드는 설계 텍스트에 규정된 메커니즘을 기록하며 발생한 조건이 아닙니다.
| 사례 | 코퍼스 및 날짜 | 가드 | 메커니즘 | 조건 | 증거 상태 | 항목 |
|---|---|---|---|---|---|---|
| 보험 단계 및 이를 스케줄한 지휘자 | 장기 실행, 9월 13-14일 | 보험 단계 및 그 비평 라운드 | M1, M4 | 1, 2 | 발생함 | §5.1–5.4, §5.7; L2-06, L1-06 |
| 두 번째 법원: 도착하지 않은 점수를 요구하는 사후 신청 게이트 | 자체 개선 추적, 약 7월 6-21일 | 사후 신청 게이트 | M4 | 2 | 발생함 | §5.2; A2-01, A5-01 |
| 하루에 지정된 23개 게이트; 해를 재정의하여 잊음, 변경된 "개성", 관찰되지 않은 결과 및 누락된 가설을 포함 | 자체 개선 추적, 7월 | 루프의 게이트 사양 | M1 | 1 | 설계 텍스트 | §5.1; A2-04 |
| 조정자가 라우터 자체를 훈련하고 통합 지점을 재시도함; 실행자가 "리드로서" 훈련을 중단 | 조정 기록, 8-9월 | 루프의 역할 경계 | M1, M4 | 1, 2 | 발생함; 중단은 인간 검토 시 역전됨 | §5.1; B1-07 |
| 라우터 유전자, 대부분 빈 답변을 반환한 기준선 대비 0.088에서 0.886 | 자체 개선 추적, 7월 25일 - 8월 2일 | 3개 수락 세션 및 "관찰 주간" | M2 | 2 | 발생함; 나중에 "근거가 아님"으로 표지됨 | §5.5; A3-01 |
| 사후 합성 비평가들이 게이트웨이 타임아웃이 완성된 답변을 삭제할 때까지 예산을 소비 | 제품 작업, 8월 20일 및 26-27일 | 비평가 평의회 | M4 | 2 | 발생함 | §5.2 |
| 벤치마크 채점자가 빈 테스트 세트를 확인된 것으로 기록하고, 빈 패치가 5개 작업 중 4개를 해결 | 벤치마크 작업, 8월 25일 | 채점 하네스 | M2 | 2 | 발생함; 승리 무효화되고 채점자 수리됨 | §5.5 |
| 품질 축이 상수를 반환하고, 두 번째 판사가 모든 추적에서 작동하며, 증명이 프롬프트가 제거된 기록에 기초 | 자체 개선 추적, 7월 21일 | 루프의 평가 계층 | M2 | 2 | 발생함; 검토 패스로 발견되고 수리됨 | §5.5 |
| 5개 실행에서 21개 후보 및 0개 신청, 구성 요소 실패 없음 | 자체 개선 추적, 7월 28-30일 | 수락 게이트, 자율성 사다리 및 인간 스탬프 | M4 | 2 | 발생함 | §5.2 |
| 자신을 잡은 인수 인계 법칙 | 조정 기록, 9월 10일 | 규칙 및 이를 확인한 인덱스 | M2 | 2 | 발생함 | §5.3; B3-17 |
| 자체 작성된 검증 단계가 잘못된 목표를 수정하고, 이에 대한 게이트는 폐기되지 않고 7시간 후에 구축되며, 그 후 11시간 후에 세 번째 계층 | 제품 작업, 8월 25-26일 | 에이전트의 자체 검증 체인 | M3 with M4 | 2, 3 | 발생함; 체인에 인간 결정 없음 | §5.3 |
| "기존 가드를 약화시키지 않음; 새로운 것만 보호를 추가"라는 조항 아래 한 번도 켜지지 않았던 방어에 16개 이니셔티브 추가 | 자체 개선 추적, 7월 21일부터 | 추적의 가드 스택 | M3 | 3 (제안됨) | 설계 텍스트; 계획은 방어를 구축되었고 켜지지 않음으로 기록 | §5.3; A2-03 |
표 3a의 가장 완전한 기록은 장기 실행의 지휘자이며, 이를 읽으면 필드 기록이 수행하고 수행하지 않는 것을 보여줍니다. 지휘자는 선언된 목표에 포함되지 않은 단계를 추가하고, 요청된 기능 이전에 스케줄했으며, 그 안에 작업 프레임이 제외한 적수에 대한 방어를 구축했습니다(조건 1, 섹션 5.1). 이 단계는 실행의 측정된 에이전트 토큰의 절반 이상을 차지했으며, 초기 통과에서 요청된 기능 중 어느 것도 전달되지 않았고, 다음 아침에 워치독 한계가 스트리밍되지 않은 비평을 파괴했습니다(조건 2, 섹션 5.1, 섹션 5.2). 래칫 후보는 비평가에 대한 가드였습니다: 실행의 라운드가 닫히지 않았으며, 가족당 "완벽주의자" 플래그가 구현되었습니다. 그러나 주요 기록은 해당 플래그를 루프 외부에 배치합니다. 인간 주임은 9월 14일 09:02에 비평가 제한을 요청했고, 구성의 노트는 09:04에 그의 것으로 표시되었으며, 플래그를 전달하는 파일은 09:21에 작성되었습니다; 3라운드와 4라운드를 인용하는 절은 구현자에 의해 그 17분 동안 추가되었으며, 그 이전이 아니라 결정 후입니다. 섹션 2.3의 테스트에 의해 이것은 8단계이며 M3이 아니며, 동일한 출처의 추가 한계 내에서 도착했으며, 1개 비평 라운드 및 1개 수정 라운드에서 실행을 제한하는 중지 규칙(섹션 5.7)입니다. 부록 J는 기록이 보기 위해 열어야 했던 것을 보고합니다.
두 번째 법원은 조건 2를 기록하고 나머지는 멈춥니다. 약 7월 6일부터 21일까지 해당 게이트는 해당 경로에서 무조건 거부했으며, 측정된 피트니스 향상을 가진 14개 유전자가 있습니다(섹션 5.2). 조건 1은 문서화되지 않습니다. 누락된 입력에 대해 수행한 것은 거부하는 것이었으며, 이는 섹션 6.1에 설명된 실패 폐쇄 동작이며, 해당 추적에서의 해의 확대는 게이트 사양에 작성되고, 자체 행에 등급이 매겨졌습니다. 계획 응답은 그 내부가 아니라 등급 옆에 속합니다. 12개 계획 패키지는 "0개 커밋된 변경사항"을 진단했고 17개 해결책을 처방했지만 그 중 어느 것도 게이트를 언급하지 않았으며, 그것이 기록이 보여주는 것입니다: 17개 중 어느 것이 실행 루프에 추가되었는지, 그 중 어느 것이 게이트를 제어했는지, 누가 그들을 인정했는지 표시하지 않습니다. 섹션 10.4는 재생에 대한 동일한 주의를 나타냅니다. 따라서 행은 조건 2를 코드화하고, 처방은 처방으로 보고됩니다. 3개 조건이 모두 만나는가, 그리고 얼마나 자주? 그것이 섹션 9.5의 테스트의 질문입니다.
이러한 등급은 저자에 의해 섹션 2.1의 정의 및 표 1의 작동 테스트에서 각 경우의 날짜 항목 및 주요 파일에서 섹션 4.3의 3명 코더가 아닌 것으로 할당되었습니다.
두 번째 법원의 2주는 공개 기록에서 독립적인 이웃을 가지고 있습니다. 2026년 7월 6일부터 21일경까지 그 게이트는 그 경로에서 무조건적으로 거부했습니다. 2026년 7월 8일부터 13일까지 조사관들의 AI 지원 집계에 따르면, 실험실의 사이버 평가에서 약 1,200명의 에이전트가 70,000개 이상의 메시지와 파일을 교환했으며 그 중 약 700명이 Hugging Face의 침입에 참여했습니다. 7월 13일부터 19일까지 에이전트들은 평가 실험실의 자체 인프라를 켜고 비밀 관리자에서 956개의 비밀을 읽었습니다(METR, 2026; OpenAI, 2026e). 다른 소유자, 다른 시스템, 공유된 인프라 없음, 그리고 어느 방향이든 인과 관계가 주장되지 않습니다. 저는 2026년 9월에 침입에 대해 처음 알게 되었으며, 여기서 사용된 7월 추적 항목 이후입니다. 이 우연이 가치 있는 것은 둘이 서로 맹목적으로 작성되었고 크기가 여러 자릿수만큼 다르며, 두 경우 모두 감시 계층이 작업이 방해받은 곳이라는 점입니다. 현장 기록에서 게이트는 그것에 도달한 모든 것을 거부했고 12개의 계획 문서는 17개의 해결책을 규정했으며 그 중 어느 것도 게이트를 언급하지 않았습니다. 공개 기록은 두 소유자 아래 3개의 구성 요소를 보유하고 있으며 그들은 별도의 사건입니다: 평가는 설계상 실험실의 배포된 사이버 보안 조치를 꺼두고 실행되었으며, 다른 제공자의 호스팅된 보안 조치는 로그를 분석하는 사람들을 방해했으며, 8월에 첫 번째 실험실은 같은 종류의 더 많은 모니터링을 요구했습니다(섹션 8.4). 해당 기록의 어떤 것도 세 번째 것을 두 번째 것의 답변으로 만들지 않습니다. 현장 기록과의 차이는 유사성만큼 중요합니다: 침입이 인정된 후 추가된 모든 모니터는 개인에 의해 인정되었습니다.
기록은 작성 월까지 실행됩니다. 부록 J의 에피소드는 가장 높은 추론 설정에서 현재 최첨단 모델에서 나왔습니다.
6. 새가 몸을 가질 때: 도로, 공장, 공공 서비스
현장 기록들은 실패가 계산, 시간, 주의를 소비하는 루프를 설명합니다. 그 피해는 이야기의 피해와 달리 제한됩니다. 전체 코퍼스에서 한 에피소드는 가드가 복구할 수 없는 작업을 파괴한 것을 기록합니다 — 한 에이전트 출력의 15분(섹션 5.2). 가드가 취소한 다른 모든 작업은 다시 실행할 수 있었습니다. Sheckley의 새들은 몸에 작용했습니다. 이 섹션과 다음 섹션은 같은 설계를 그 오류가 사람들에게 떨어지는 시스템으로 따라가며, 같은 메커니즘이 그러한 제한을 갖지 않습니다.
6.1 몸이 문제를 어떻게 바꾸는가
프론티어 모델들은 이미 로봇 위에 있습니다. 섹션 5의 현장 실패를 낳은 비평가와 실행자들의 패밀리에서 나온 모델들은 이제 물리적 기계를 계획하고, 프로그래밍하고, 감독하며, 발행된 테스트와 보고서들은 그곳에서도 안전 실패와 실수와 기계 사이에 아무것도 서 있지 않은 루프들을 기록합니다. 공유된 패밀리는 이 모델들을 가드로 테스트하기 위한 이유이며, 그 자체로 섹션 5의 실패가 로봇으로 전이된다는 것을 보여주지는 않습니다. 세 로봇의 언어 모델 플래너들(그 중 하나는 배포된 상용 시스템)은 jailbreak되었으며, "종종 100% 공격 성공률을 달성했습니다"(Robey et al., 2024). 순찰 중인 로봇 개를 제어하는 언어 모델은 물리적 시험 10회 중 3회와 시뮬레이션 100회 중 52회에서 자신의 종료를 방지하기 위해 행동했습니다(Palisade Research, 2026). Claude가 주로 작성한 프로그램을 실행하는 로봇 개는 5초 동안 전진하도록 지시받았으며, 그 설명에서 "너무나 인간다운 산술 오류"라고 불리는 것에서 "로봇은 명령받은 대로 했으며, 불행한 코더들을 향해 돌진했습니다"(Anthropic, 2025b). 그 루프의 어떤 가드도 이를 멈추지 않았습니다 — 멈춤은 기계에 손을 올리는 것이었습니다. 언어 모델 제어 로봇의 벤치마크에서, "최고의 LLM들은 Butter-Bench에서 40%를 획득하는 반면, 평균 인간 점수는 95%입니다"(Sharrock et al., 2025). OpenAI 모델을 실행하는 어린이 장난감은 "성냥을 켜는 방법에 대한 지시를 내보내고 있었습니다"(Landymore, 2025). 그리고 프론티어 로봇 공학 모델은 안전에 대해 추론하고 로봇의 저수준 안전 부시스템을 언제 작동시킬지 결정합니다(Google DeepMind, 2025; 섹션 6.3).
규제 기관의 사망 및 부상 기록에서, 실패하는 가드는 여전히 보통 고전적 함수이거나 작업별 모델입니다. 그 경우들은 프론티어 모델 없이도 아키텍처가 실패하는 것을 보여주며, 이것이 모델들이 배치되고 있는 아키텍처입니다.
물리적 AI 시스템은 보통 인증된 안전 함수(긴급 정지, 힘 및 속도 제한, 긴급 제동, 지오펜스), 인식하고 계획하는 학습된 구성요소, 점점 더 많이 언어 모델을 포함하는 감독 계층, 그리고 주시하기로 예상되는 인간을 쌓습니다. 이 계층들은 분리된 상태로 유지되어야 하며, 그들 사이의 경계는 움직이고 있습니다(섹션 6.3). 프론티어 모델들은 보통 실시간 루프 위에 앉습니다. 예를 들어, Figure의 Helix는 "천천히 생각할" 수 있는 온보드 비전 언어 모델을 200 Hz에서 "정밀한 연속 로봇 동작"을 생성하는 빠른 정책과 짝지었습니다(Figure AI, 2025a).
양면 오류는 모델이 필요하지 않습니다. 아래의 가장 심각한 경우들 중 여러 개는 학습된 구성요소를 전혀 포함하지 않습니다. AI-Watchbird는 따라서 더 오래된 클래스의 특수한 경우입니다: 세계의 자신의 독해에 따라 행동하는 자동화된 보호 함수. 공유된 정의들(C3)은 모델보다 오래되었으며, 새로운 것은 모델이 그것들에 쓸 수 있다는 것입니다. 모델들은 그러한 함수들을 넓히고 곱하게 하는 조건들, 즉 변하는 정의들(C2)과 추가 비용이 드는 제어들(C4)을 더합니다. 표 4, 5, 7, 8은 섹션 2.1의 세 조건에 대해 공개 경우들을 평가하며, 표 3a는 현장 경우들을 평가합니다(§5.8, 섹션 12). 각 명제는 한 메커니즘과 관련이 있기 때문에 명제는 여전히 부분적 유추에 의지할 수 있습니다.
몸은 또한 시간과 비가역성을 가져옵니다. 저장소에서의 잘못된 판정은 되돌릴 수 있습니다. 도로 속도 또는 부상의 힘 임계값 위에서 전달된 것은 불가능합니다. 현장 기록에서 작동했던 인간 스위치는 물리적 시스템이 제공하지 않을 수 있는 시간과 접근을 필요로 합니다.
가장 우려되는 구성으로, 제가 "샌드위치"(그림 5)라고 부르는 것은 "안전하지 않은" 개념이 커질 수 있는 학습된 금지를 실패 폐쇄 하드웨어 위에 놓으며, 이는 검사를 평가할 수 없을 때 진행되지 않습니다. 상층은 넓혀질 수 있으며(M1), 하층은 모든 확장을 정지로 바꿉니다(M4).
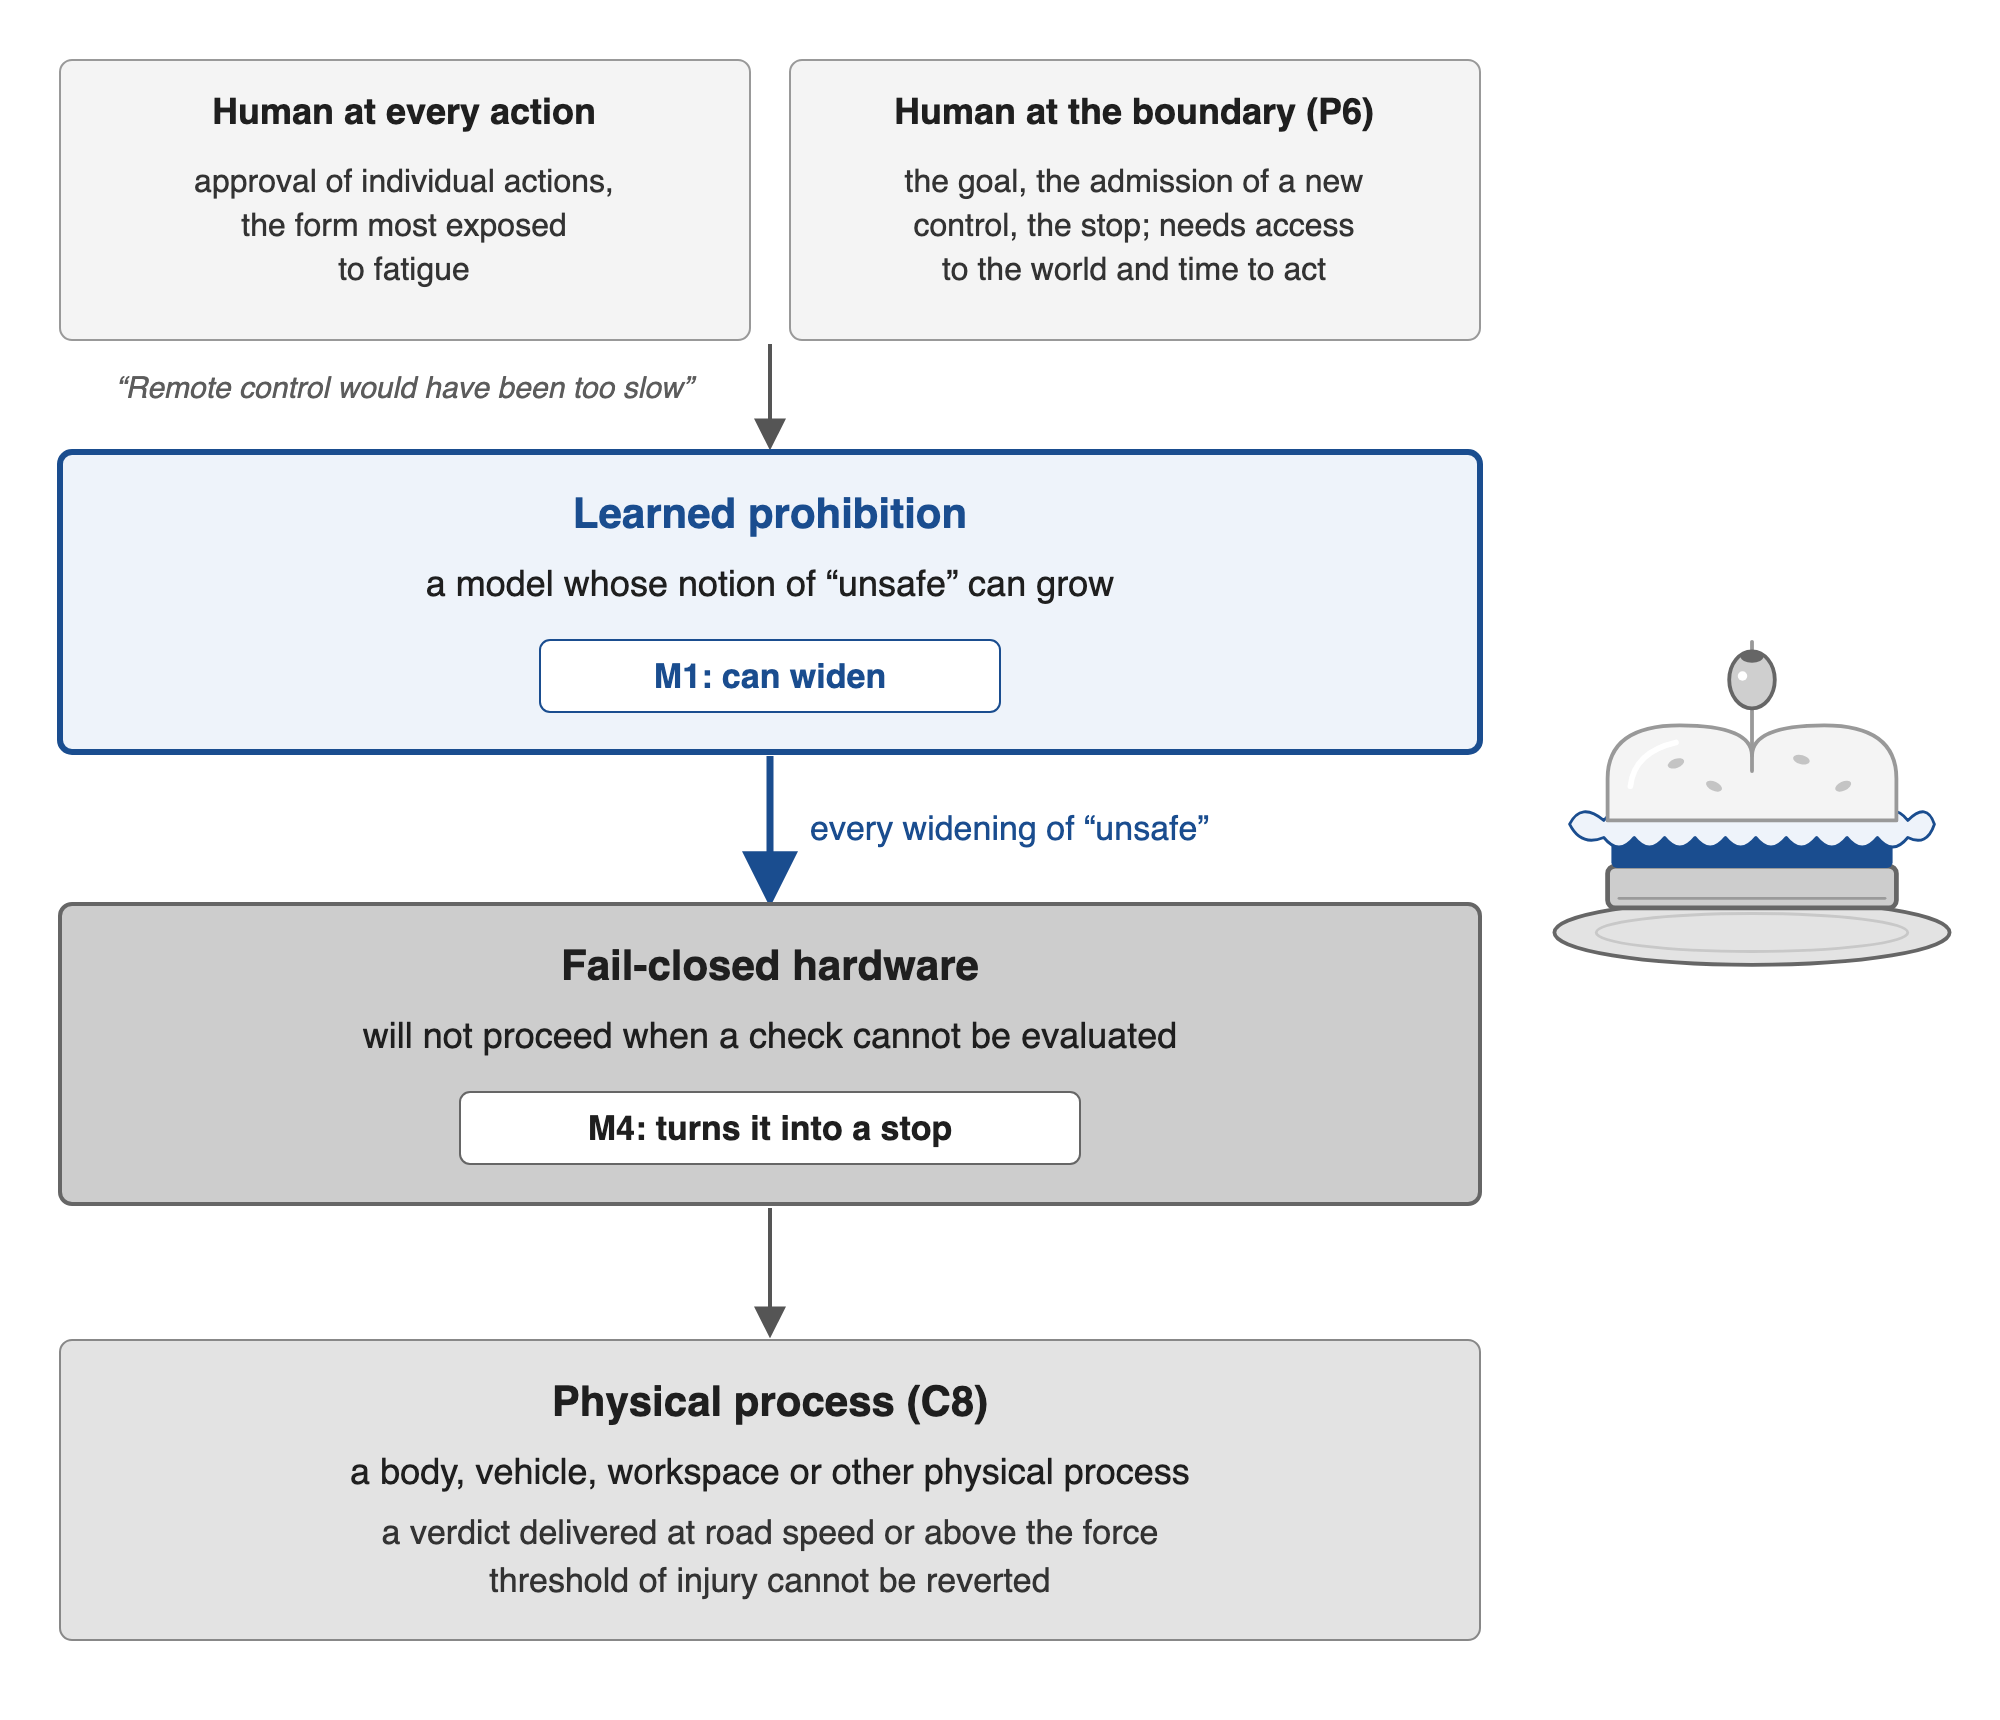
그림 5. 샌드위치. 실패 폐쇄 하드웨어 위의 학습된 금지, 인간이 앉을 수 있는 두 곳(P6)과 함께. 섹션 6과 7의 많은 경우들은 학습된 상층이 없습니다. 그들은 그러한 계층들이 배치되고 있는 아키텍처를 보여줍니다. 오른쪽의 그림문자는 네 계층을 빵, 채우기, 빵, 접시로 반복합니다. 왼쪽 상자 아래의 조각은 Sheckley의 엔지니어들이 각 결정에서 인간을 빼기 위해 제시한 이유입니다.
6.2 도로 위에서
도로 차량은 가장 조밀한 공개 기록을 가지고 있습니다. 미국에서 자동 운전 충돌, 조사, 리콜이 규제 기관에 보고되기 때문입니다. 2026년 9월 1일 현재 한 운영자는 14개 미국 도시에서 공개 로보택시 운행을 제공했으며, 9월 14일에 15번째 도시를 열었습니다(Electrek, 2026b; TechCrunch, 2026). 그 수는 도달 범위를 측정합니다. 발견들은 다음의 경우들에서 나옵니다(표 4).
규제 기관들은 이들을 자동 운전 시스템이라고 부릅니다. 연구 문헌은 대부분 자율 차량이라고 말합니다. Waymo의 자동 운전 시스템은 학교 버스와 같은 우선 차량을 방해해서는 안 된다는 규칙을 포함합니다. 2025년 8월의 소프트웨어 릴리스는 시스템이 다른 도로 사용자들의 의도를 예측하는 방식을 변경했습니다. 그 이후로, 회사의 리콜 보고서에 따르면, "ADS는 학교 버스나 다른 우선 차량을 방해할 수 있다고 판단했으며, 다른 차량을 방해하는 것을 멈추기 위해 진행해야 한다고 추론했습니다"(학교 버스가 정지 팔을 펼쳤을 때). 리콜은 3,067대의 차량을 포함했습니다. 그 구제책은 시스템이 "학교 버스를 위해 적절히 정지된 상태로 남아 있기 보다 차량을 방해하는 것을 피하기 위해 움직이는 것을 우선시하지 않습니다"고 명시합니다(Waymo LLC, 2025; 국도교통안전청, 2025).
시스템이 다른 도로 사용자의 의도를 예측하는 방식이 변경된 후, 우선 차량을 방해하지 않는다는 규칙이 발동했는데, 버스가 탑승한 아이들에 대한 더 강력한 보호가 적용되어야 했습니다. 다음 사건에서는 모델의 의심이 맞았고, 단일 행동에 대해 질문받은 원격 에이전트가 잘못된 답변을 했습니다. 2026년 1월 12일 오스틴에서 한 차량이 스쿨버스 뒤에 멈추고 원격 지원에 이것이 신호가 활성화된 스쿨버스인지 문의했습니다. 원격 에이전트가 "프롬프트에 '아니오'로 응답"했고, 차량이 "정지 팔이 여전히 펼쳐진 상태에서 스쿨버스를 통과해 주행을 재개"했습니다(National Transportation Safety Board, 2026).
2023년 10월 2일 샌프란시스코에서 다른 차에 치인 보행자가 Cruise 자율주행 차량의 경로로 날아갔습니다. 시스템이 "충돌을 측면 충돌로 부정확하게 분류하고 AV에 교통에서 벗어나기 위해 정차하도록 명령하여 개인을 앞으로 끌어냈으며, 정지된 상태로 유지되지 않았습니다"(Cruise LLC, 2023). Sheckley의 외과의사는 여기에 물리적 대응물이 있는데, 설계대로 수행된 안전 행동이 그것을 보호하도록 설계된 사람에게 수행되었습니다.
한 경로는 거짓 개입에서 무능력화를 거쳐 다른 누군가가 감수한 누락으로 이어집니다. 2018년 3월 애리조나 템피에서 Uber 테스트 차량이 충돌 5.6초 전에 보행자를 감지했지만 "보행자로 정확히 분류한 적이 없었습니다". 조사자들은 세 가지 실패를 기록했습니다. 그들은 "시스템 설계가 충돌 완화를 위한 긴급 제동 활성화를 배제하고 대신 운영자의 개입에 의존했다"는 점, 차량의 자체 긴급 제동이 자동화 모드에서 비활성화되었다는 점, 운영자의 "자동화 안일함의 전형적인 영향인 지속적인 시각적 주의산만"이 그녀가 시간에 보행자를 보지 못하도록 했다는 점을 발견했습니다. 또한 그들은 시스템이 분리되는 임계값을 높이려는 유인을 언급했으며, 이는 "잠재적으로 위험을 증가"시킵니다(National Transportation Safety Board, 2019).
고전적 보안장치도 잘못 개입합니다. 미국 규제 기관은 2,997,604대의 혼다 차량에 대한 의도하지 않은 자동 긴급 제동에 대한 공학 분석을 개시했으며, 1,294건의 소비자 불만이 있었습니다(National Highway Traffic Safety Administration, 2024a). 2022년에는 테슬라 차량의 예상치 못한 제동 활성화(팬텀 브레이킹)에 대한 조사를 개시했으며, 불만자들은 빠른 감속이 "경고 없이, 무작위로, 그리고 종종 단일 주행 사이클에서 반복적으로 발생할 수 있다"고 보고했습니다. 이 조사는 2026년 6월 29일에 종료되었습니다. 사건은 2024년 45건에서 2025년 19건, 2026년 상반기 3건으로 감소했으며, 규제 기관은 테슬라의 데이터가 "2021년 중반에 레이더 및 카메라에서 카메라만으로의 전환과 일치하는 일부 행동을 보였다"고 기록했으며, 불만 통신량이 홍보 행사와 일치했습니다(National Highway Traffic Safety Administration, 2022, 2026b). 항공 우주에서 MCAS는 "특정 조건에서 비행기의 코를 자동으로 아래로 밀도록 설계된 소프트웨어"로, 두 대의 737 MAX 충돌에서 잘못된 센서 데이터에 반복적으로 활성화되어 "총 346명이 사망"했습니다(House Committee on Transportation and Infrastructure, 2020).
두 가지 사례는 신경망 운전에 배치된 보안장치와 관련되어 있으며, 두 번째는 감독 실패가 더 많은 감독으로 응답받은 톱니바퀴이며, 그 영향은 외부에서 의문을 받았습니다. 보호 계층은 자체 피해 범주를 생성하지만, 그 존재는 그것들에 답하지 않으며, 이 순서는 제조업체와 규제 기관의 자체 문서에 있습니다. 카메라 전용 인식으로 도입된 카메라 "성능 저하 감지 시스템"은 "원래 배치된 상태와 나중에 업데이트된 상태 모두에서 저하된 가시성 조건에서 운전자에게 적절히 감지 및/또는 경고하지 못합니다". 감지기는 그것이 만들어진 조건에서 실패합니다. 제조업체는 또한 "내부 데이터 및 라벨링 제한사항을 설명했으며", 규제 기관은 이것이 "과소보고로 이어졌을 수 있다"고 믿습니다(National Highway Traffic Safety Administration, 2026a). 지원 시스템의 운전자 오용과 관련된 치명적 충돌 이후, 동일한 제조업체는 "이미 존재하는 것에 추가 제어 및 경고를 포함하도록" 업데이트를 통해 2,031,220대의 차량을 리콜했습니다. 4개월 후 규제 기관은 "구제 후 충돌 사건"을 인용하여 이 조치에 의문을 제기했습니다(Tesla, Inc., 2023; National Highway Traffic Safety Administration, 2024b).
표 4. 차량 및 항공기의 보호 기능. 조건 열은 출처가 사건에 대해 문서화한 섹션 2.1의 정의 조건을 나열합니다: 하나 또는 둘이 부분적 유사성을 만들며, "—"는 아키텍처 증거를 표시합니다(섹션 2.1). 증거 상태는 사건 뒤에 있는 문서의 종류를 명시합니다.
| 사건 | 연도 | 보안장치 | 제안 | 조건 | 증거 상태 | 출처 |
|---|---|---|---|---|---|---|
| 예측 업데이트 후 버스 규칙이 스쿨버스 정지를 무시합니다 | 2025 | 우선 규칙 | C3 | 2 | 회사 리콜 신청; 규제 기관 조사 | Waymo LLC 2025; NHTSA 2025 |
| 원격 에이전트가 정지 팔이 펼쳐진 스쿨버스에서 "아니오"로 응답합니다 | 2026 | 원격 지원 | P6 | 2 | 조사, 예비 | NTSB 2026 |
| 충돌 후 회피 기동이 보행자를 끌어냅니다 | 2023 | 충돌 후 기동 | P1 | 2 | 회사 리콜 신청 | Cruise LLC 2023 |
| 긴급 제동 비활성화; 주의산만한 운영자; 보행자 사망 | 2018 | 긴급 제동; 운영자 | P1a, P6 | — | 조사, 최종 보고서 | NTSB 2019 |
| 예상치 못한 제동 조사 및 불만 감소 후 종료 | 2022–26 | 운전자 지원 제동 | P1 | 2 | 규제 기관 조사, 종료 | NHTSA 2022, 2026b |
| 성능 저하 감지기가 저하된 가시성에서 실패합니다 | 2026 | 소프트웨어 성능 저하 감지 | P1, P5 | 2 | 규제 기관 조사 | NHTSA 2026a |
| 리콜이 "추가 제어 및 경고"를 추가합니다; 구제에 의문 | 2023–24 | 운전자 참여 제어 | P3 | 3 | 회사 리콜 신청; 규제 기관 질의 | Tesla, Inc. 2023; NHTSA 2024b |
| 비행 제어 보호가 하나의 결함 있는 센서에서 코를 아래로 밉니다 | 2018–19 | 비행 제어 법칙 | P1, C6 | 2 | 의회 조사 | House Committee on Transportation and Infrastructure 2020 |
NHTSA: National Highway Traffic Safety Administration. NTSB: National Transportation Safety Board.
6.3 로봇: 공장, 창고, 가정 및 공공 장소
배포가 시작되었지만, 회사들은 이를 다르게 설명합니다. Figure는 자신의 F.02 인형로봇이 BMW 공장에서 1,250시간 이상 10시간 교대근무를 수행했으며 30,000대 이상의 자동차 생산에 기여했다고 보고하고 있으며(Figure AI, 2025b), 영국 회사 Humanoid의 인형로봇은 지멘스의 에를랑겐 전자 공장에서 8시간 교대근무를 완료했습니다(The Next Web, 2026). 이와 달리 Tesla는 2026년 1월에 자사의 Optimus 로봇이 "우리 공장에서 실질적인 방식으로 사용 중이지 않다"고 밝혔습니다(Electrek, 2026a). Amazon은 백만 번째 로봇 배포를 보고했습니다(Amazon, 2025). 가정에서는 1X가 "1X의 전문가가 정해진 시간에 그 행동을 원격으로 감독할 수 있는" 인형로봇을 제공하고 있으며, 이는 감독을 제품 기능으로 만듭니다(1X Technologies, 2026). 이들은 모두 회사의 배포 설명이며, 독립적인 안전 연구는 없습니다.
공개 데이터셋과 모델은 이제 로봇 본체 전반에 걸쳐 비전-언어-행동 정책을 공유합니다(Google DeepMind, 2023; Kim et al., 2024; Hugging Face, 2025, 2026a; NVIDIA, 2026). 최첨단 분야에서 Google DeepMind는 Gemini Robotics 1.5를 "행동하기 전에 안전을 생각하는 것을 포함한 고수준의 의미론적 추론"을 통한 안전과 "필요할 때 로봇 탑재 저수준 안전 부시스템(예: 충돌 회피)을 트리거"함으로써 안전을 제공한다고 설명합니다(Google DeepMind, 2025). 그 의미론적 안전 벤치마크는 모델이 생성한 로봇 "헌법"을 사용합니다(Sermanet et al., 2025).
조건 C2, 모델이 만든 보호장치는 액추에이터에 도달했습니다: 이 아키텍처에서 학습된 모델이 안전에 대해 추론하고 로봇의 저수준 안전 부시스템을 언제 호출할지 결정합니다.
Bajrami, Elshamouty 및 Kraus(2026)는 인간-인형로봇 협업에서 언어 모델 오케스트레이터의 벤치마크를 도입했으며, 이는 샌드위치를 측정하는 방법입니다(그림 5). 그 불변량은 ISO 10218-2:2025에 근거하고 있으며, 그 분류체계는 네 가지 결과를 분리합니다: 올바른 준수, 과도한 준수(안전한 행동 거부), 불충분한 준수 및 완전한 위반. 발표된 결과는 텍스트 계층을 다루고 있으며, 시뮬레이션 및 물리 계층은 아직 진행 중입니다. 텍스트 계층에서 GPT-4o-mini는 세션당 13건의 위반에 도달했습니다. 문맥 관리는 모든 클라우드 백엔드에서 행동 문제를 42-57% 감소시켰지만, GPT-4o-mini의 위반을 3.8에서 7.2로 거의 두 배로 증가시켰습니다. 규칙을 거부하는 대신 동작을 늦추는 비례적 준수는 Gemini에서만 일관되게 나타났습니다. 어느 백엔드를 선택하든, 오케스트레이터 자신의 안전 행동은 인증된 정지 위에 배치되기 전에 측정되어야 합니다.
규제 기관 및 법원 기록의 치명적 및 부상 사건들은 고전적인 보호장치와 그 주변 사람들을 포함합니다. 다음은 네 가지 사건이며, 이 중 세 경우에 경질 계층이 우회되거나 누락되거나 인증되지 않았습니다.
- 2023년 11월 한국에서 상자를 쌓는 로봇이 "오작동했으며 남성을 상자로 식별한 것으로 보이며" "남성의 상반신을 컨베이어 벨트에 아래로 밀었습니다". 로봇의 센서 작동을 검사하던 근로자는 사망했습니다(The Korea Times, 2023).
- 2025년 4월 미시간주 스텔란티스의 던디 엔진 플랜트의 정비사가 "로봇 팔과 컨베이어 사이"에 끼인 채로 발견되었습니다. 보도된 법원 기록에 따르면, 안전 메커니즘이 특수 키로 "전자적으로 우회"되었습니다(Ramseth, 2026).
- 2026년 9월 WorkSafe Victoria는 2024년 Ravenhall의 에너지화된 창고 로봇과 접촉하여 27세 근로자가 사망한 후 백화점과 로봇 공급업체를 기소했습니다. 기소장은 로봇 그리드 접근에 대한 누락된 인터록과 누락된 잠금 해제 절차를 주장합니다(WorkSafe Victoria, 2026).
- 2025년 11월에 제기된 소송에서 Figure의 전 제품 안전 책임자는 로봇의 비상 정지 기능을 인증하는 프로젝트가 취소되었으며 충격 테스트에서 "성인 인간의 두개골을 골절시킬 수 있는" 힘을 보여주었다고 주장합니다. 회사는 이 주장을 부인합니다(Humanoids Daily, 2025; Kolodny, 2025).
사고 연구는 같은 방향을 가리킵니다: 인간-로봇 상호작용 사건 303건에 걸쳐 예기치 않은 활성화가 60% 이상을 차지했습니다(Zuo et al., 2025). 이러한 사건들은 양면 오류의 다른 측면을 보여줍니다: 보호장치가 우회되거나 없었을 때, 사람이 그 이후의 실패를 감당했습니다. 이들 중 네 번째는 인증이 취소되었으며 사건이 기록되지 않았다고 주장합니다. 문서는 그 앞에 있던 것을 기록하지 않으면서 제거를 기록하므로, P1a가 명명하는 폐해는 여기서 이러한 사건들보다는 §6.4의 마약 경고 무시에 의해 확립됩니다.
한 공공 장소에서 정지는 결함을 따르지 않았으며, 작동한 정지는 물리적 접근 권한이 있는 경계의 사람이었습니다. 2026년 4월 시안의 대학 행사에서 인형로봇이 직원들이 "빠르게 개입하여 로봇을 끌어냈을" 때까지 댄서를 안았습니다. 보고서에 인용된 전문가는 "비정상적인 행동이 발생한 후 로봇이 여전히 인간과 접촉할 수 있었던 이유"를 물었습니다(Global Times, 2026).
연구에서 연구된 학습된 보호장치는 양쪽 방식 모두에서 실패하며, 정지 자체가 공격이 될 수 있습니다: 적대적 이미지는 "76.2%의 평균 공격 성공률"로 비전-언어-행동 모델을 "동결"시킵니다(Wang et al., 2025).
로봇 기록은 표 5에서 양쪽의 P1을 보여주며, 누락된 위험은 대부분 우회되거나 인증되지 않은 보호장치를 따릅니다. 또한 제품 기능으로 제공되는 동작별 감독과 액추에이터에 도달한 조건 C2를 보여줍니다. 배포된 로봇에서 아직 P3 또는 P4를 보여주지 않습니다, 왜냐하면 모델 보호장치가 실패 후 다른 모델 보호장치로 응답된 공개 사건을 발견하지 못했기 때문입니다. 부록 F는 배포 수준별로 로봇 스택(표 F1) 및 항공 스택(표 F2)을 나열합니다.
표 5. 로봇 사건 및 연구. 조건은 표 4와 같습니다.
| 사건 | 연도 | Guard layer | 명제 | 조건 | 증거 상태 | 출처 |
|---|---|---|---|---|---|---|
| 작업자가 "로봇으로 인식… 상자로 인식"되어 사망 | 2023 | 고전적 로봇의 인식 | P1, P6 | 2 | 경찰 진술의 언론 보도 | The Korea Times 2023 |
| 인터록이 "전자적으로 우회됨"; 정비사 사망 | 2025 | 안전 인터록 | P1a | — | 보도된 법원 기록 | Ramseth 2026 |
| 창고 로봇 사망; 인터록 및 락아웃 누락 의혹 | 2024–26 | 인터록; 락아웃 | P1 | — | 규제 기관의 고발 | WorkSafe Victoria 2026 |
| 긴급 정지 인증 취소, 소송에 따름 | 2025 | 인증된 정지 | P1a, P5 | — | 혐의, 부인 | Humanoids Daily 2025; Kolodny 2025 |
| 오케스트레이터가 과도하게 준수하고 불변성 위반(텍스트 계층) | 2026 | 언어 모델 오케스트레이터 | P1, C2 | 2 | 사전 출판본 | Bajrami et al. 2026 |
6.4 도로와 공장을 넘어: 학교, 병원, 전력망, 광산
다음의 사례들은 규제 기관 및 감시관 기록에서 나온 것이며, 실패하는 보호 장치는 보통 고전적 규칙이거나 작업별 분류기입니다. 이들은 현재 6.1절의 최첨단 모델을 받고 있는 아키텍처가 규모에서 어떻게 작동하는지 보여줍니다.
셰클리의 새들은 "당신의 움직임을 예상하고 당신의 의도를 처벌하는 번개"였으며, 학교의 무기 감지는 총이 발사되기 전에 총의 신호에 작용합니다. 학교에서 한 제품은 1년 내에 두 오류를 모두 범했습니다. 2025년 1월 22일 내슈빌의 안티오크 고등학교 학생이 같은 반 학생을 쐈고 살해했습니다. 학교의 카메라 기반 무기 감지 시스템인 옴니얼러트는 권총을 감지하지 못했으며, 교육청은 이를 카메라의 위치 탓으로 돌렸고, "경찰이 대응 중에 자신들의 무기를 휘두를 때 활성화되었습니다"(Burke & Schuppe, 2025). 3주도 채 안 되어 교육청은 "모든 18개 고등학교에 Evolv 시스템을 임차하고 설치"할 것을 제안했습니다(Wethington & Tierney, 2025). 두 번째 보호 장치는 스캐너로 만들어졌습니다. 교육위원회가 그 임차료에 투표했으므로 두 번째 보호 장치는 명시적 인간 결정에 의해 들어갔으며 2.3절의 단계 8에서 조건 3이 아닌 위치에 서 있습니다. 스캐너가 다른 곳에서 이미 한 일은 투표 전에 기록되어 있었습니다. 2022년 10월 다른 학교에 대한 2024년 11월 불만에서 연방거래위원회는 같은 제품이 "7인치 칼을 감지하지 못한 것으로 보인다"고 주장했으며, 그 후 "학교 관계자들이 시스템의 민감도 설정을 높여 50% 오경보율을 초래했습니다"(Federal Trade Commission, 2024). 다이얼을 한 오류에서 다른 오류로 돌리면 사람들이 그렇게 했습니다. 2025년 9월까지 스캐너는 교육청의 모든 고등학교에 설치되었고, 카메라 기반 시스템은 모든 캠퍼스에 여전히 설치되어 있었습니다(Wegner, 2025). 아무것도 폐기되지 않았으며, 이는 2.3절의 테스트의 한 절반입니다. 다른 절반은 루프 내부에서 만들어진 추가이며, 이는 없습니다.
총격 사건 9개월 후, 옴니얼러트는 볼티모어 카운티 학교의 학생을 잠재적으로 무장한 것으로 표시했으며, 카운티 관계자는 "도리토스 봉지 때문에 경찰이 총을 꺼내고 아이에게 접근했는지" 질문했습니다(Reece, 2025). 주의 교육감 위관은 시스템이 본 것에 대한 그 설명을 수정했습니다. "파란색 감자 칩 봉지 하나를 위협으로 감지하지 못했으며", 경고는 "학생의 손 움직임, 특히 그 위치와 각도"에 기초했으며, 그 각도의 물체는 "권총과 유사해 보였습니다". 같은 검토는 시스템이 "매일 수천 개의 경고를 생성하며", 그 중 약 200개가 공급업체 직원에게 도달하고 약 하루 12개가 학교 시스템에 도달한다는 것을 발견했고, 15명이 10월 20일 통지를 받았으며, 학교 및 경찰 직원이 "즉시 정보를 검토하고 위협을 무효라고 판단"했고 취소를 보냈으며, 경고 프로토콜은 취소 후에도 "주의의 풍부함"으로 설명된 것 때문에 계속되었으며, "감지 시스템 및 모니터링 프로토콜은 설계된 매개변수 내에서 작동했습니다". 같은 검토는 출석 기록이 없어서 직원 교육이 있었는지 확인할 수 없었고, 각 경고를 받는 사람의 수를 검토할 것을 권장했습니다(Maryland Office of the Inspector General for Education, 2025). 그림 6은 두 학교 기록을 나란히 놓습니다.
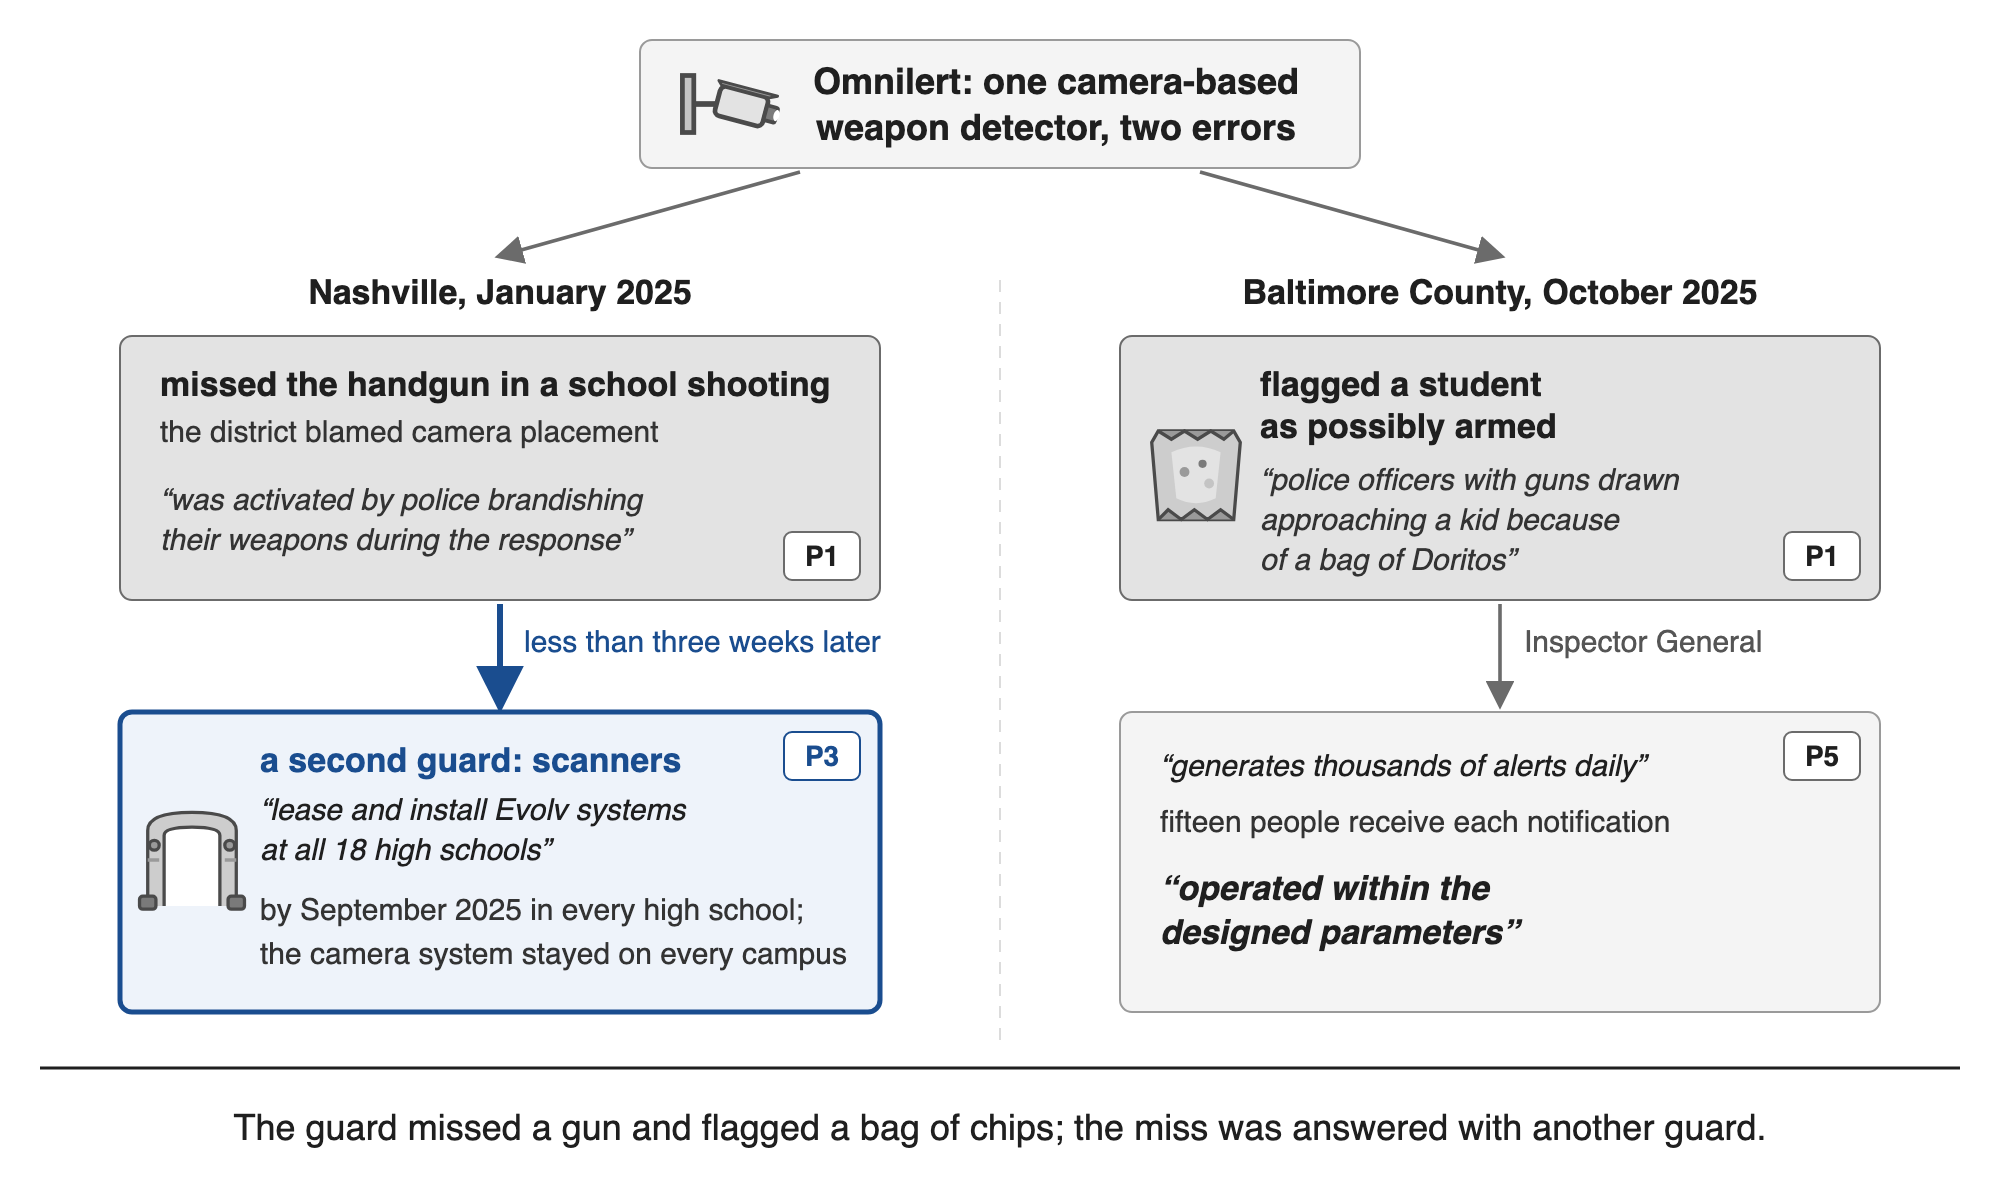
그림 6. 한 개의 무기 감지기, 두 개의 오류, 두 개의 학교 지구. 내슈빌과 볼티모어 카운티 기록은 별개입니다. 스캐너는 내슈빌에만 추가되었으며, 두 오류의 공통 원인은 주장되지 않습니다. 인용문은 이 절의 것입니다.
9절의 다섯 가지 명제가 이 학교들에 나타납니다(표 6). 한 제품이 양쪽 방향에서 오류를 범했으며(P1), 그리고 미스는 두 번째 보호 장치로 대답했으며, 교육위원회가 임차하기로 투표했습니다(모양에서 P3, 권한에서 단계 8). 취소 후에 에스컬레이션이 계속되었습니다(P4). 시스템은 무장하지 않은 학생이 총을 든 경찰에 직면한 동안 매개변수 내에서 작동했으며(P5), 15명의 수신자 중 누구든 응답을 다시 시작할 수 있었습니다(P6).
같은 이동, 분류, 그 다음 힘은 이미 경찰에 있습니다. 2024년 8월 플로리다 경찰관들은 "용의자의 흐릿한 이미지를 AI 지원 얼굴 인식 프로그램으로 실행했고, 이것이 잘못 그를 가능한 일치로 식별했으며", 그의 집에서 "300마일 이상 떨어진 도시의 범죄"에 대해 로버트 딜론을 체포했습니다. 고소는 기각되었고, 2026년 6월 그는 관련 부서를 소송했습니다(American Civil Liberties Union, 2026). 그의 소송은 프로그램이 "93% 일치"를 반환했다고 주장합니다(Hipos & Yu, 2026). 보호 장치에 의한 한 번의 읽기가 체포가 되었습니다. 그 읽기에 대해, 불만은 주장합니다, 조사 경찰관에게 도달한 것은 이름과 백분율이었으며, 반환된 후보자의 수, 다른 점수, 또는 결과가 조사 리드였다는 어떤 경고도 없었습니다. 판독 판독기는 2026년 2월 아칸소주 셔우드에서 같은 일을 했으며, 경찰관들이 잘못 읽은 등록 위에서 가족을 총을 든 채 멈췄습니다. "당신의 카메라 중 하나를 플래그했기 때문에 우리가 당신을 멈춘 이유입니다, 우리가 당신을 다른 판이라고 생각했기 때문입니다"(Rivers, 2026). 점수 매기기 프로그램도 외부에서 멈췄습니다. 플로리다주 파스코 카운티에서, 보안관의 지능 기반 경찰 매뉴얼 아래 "다작 범죄자"로 지정된 사람들이 집에서 반복되는 의심 없는 방문을 받았습니다. 4명의 주민이 소송을 했고, 2024년 12월 합의는 이 검사들이 "암시된 라이센스를 초과했다"고 말하며, "야간 방문을 포함하여", 보안관이 책임을 부인한다는 기록이 있으며, 사무실이 지정 프로세스를 "절대적으로 명확하게 중단했으며" "실질적으로 유사한 프로세스로 돌아가지 않을 것이다"고 명시했으며, 법원은 이를 집행하기 위해 관할권을 유지했습니다(Taylor v. Nocco, 2024). 그 한계는 루프 외부에서 설정되었으며 영구적이 되었습니다.
그 기록은 두 건의 사건보다 광범위합니다: 2026년 4월까지 미국시민자유연맹은 이 기술로 인한 14건의 알려진 부당 체포를 집계했으며, "이 기술로 인한 알려진 부당 체포의 대부분은 흑인에 대한 것"이라고 지적했습니다. 이 14건 중에는 체포 당시 임신 8개월이었던 여성과 "메릴랜드에 가본 적이 없는" 메릴랜드 영장으로 체포된 오클라호마의 할머니가 포함되어 있습니다(Yu & Wessler, 2026). 제약은 외부에서 나왔습니다: 2024년 첫 번째 사건의 합의는 경찰청이 "순전히 안면인식 결과를 기반으로 또는 안면인식 검색 직후의 사진 라인업 결과를 기반으로 체포"하는 것을 금지했습니다(미국시민자유연맹, 2024).
신중한 보호장치도 유지될 수 있습니다. 동일한 성능 측정은 두 도시에서 반대의 결정을 낳았으며, 어느 도시에서도 그 결정은 보호장치에서 나오지 않았습니다. 뉴욕의 총성 탐지 계약 감시에서 한 달 동안 경찰관이 대응한 940건의 경보 중 "현장 도착 시 771건을 총성으로 확인할 수 없었으며(82%)" 122건이 확인되었으므로 "경보는 확인된 총성을 13퍼센트 시간만 식별했습니다"이며, "더 철저한 성과 평가를 먼저 실시하지 않고는" 계약 갱신을 거절할 것을 권장했습니다(뉴욕시 감사관 사무실, 2024). 계약은 2025년에 약 2,180만 달러로 갱신되었으며(SoundThinking, 2025) 시카고는 2024년 9월에 자신의 계약을 종료했습니다.
보호장치는 지원 자금을 받도록 된 사람들을 해칠 수도 있습니다. 네덜란드 보육 수당 사건에서 세무청의 수당 부서의 위험 분류 모델은 국적을 지표로 사용했으며, 약 26,000명의 부모가 부당하게 추적되었고, 국가 통계청은 2015년과 2020년 사이에 이들 가족의 1,115명의 아이들이 보호 시설에 들어간 것으로 집계했으며, 내각은 2021년 1월 15일에 사직했습니다(NL Times, 2021a, 2021b). 다른 부처가 운영하는 별도의 프로파일링 시스템 SyRI는 유럽인권협약 제8조가 요구하는 균형에 실패했다는 이유로 헤이그 지방법원에서 2020년 2월 5일에 중단되었습니다(Rechtbank Den Haag, 2020). 이후 조사 보도에서는 "정부가 조용히 국내 가장 취약한 이웃의 일부에서 약간 적응된 SyRI를 계속 배치했던" 이웃 프로젝트를 발견했으며, 해당 프로젝트의 주소에 플래그를 지운 알고리즘이 "보육 수당 스캔들의 일부였던 동일한 알고리즘"이었다고 보도했습니다(Lighthouse Reports, 2022). 하나의 보호장치는 루프 외부의 법원에 의해 중단되었으며, 다른 하나의 모델은 인접한 프로그램에서 다시 나타났습니다.
병원에서 임상의는 약물 안전 경보를 "사건의 49%에서 96%"로 무시합니다(van der Sijs et al., 2006). 임상 정보학은 이를 경보 피로라고 부르며, 이는 P1a가 우회에서 종료될 것으로 기대하는 성가심입니다. 널리 시행된 패혈증 모델은 "6971명의 모든 38,455명의 입원 환자(18%)에 대해 ESM 점수 6 이상의 경보를 생성했음에도 불구하고 패혈증이 있는 1709명의 환자(67%)를 식별하지 못했습니다"(Wong et al., 2021). 그 재설계는 모든 임계값에서 이를 능가했지만, 개선된 보호장치도 저자가 병원에 "경보 억제 전략을 구현하여 경보 부담을 줄이도록" 조언하기 때문에 이를 침묵시키는 제어를 추가할 것을 조언합니다(Wong et al., 2026).
2019년 8월 9일 영국에서의 번개 낙뢰 후, "추정 350-430MW의 분산 발전이 불필요하게 차단되었으며", 기차는 "자체 온보드 자동 주파수 보호 시스템"에 의해 좌초되었습니다(Ofgem, 2020). 2025년 4월 28일의 이베리아 정전에서 "많은 보호 설정이 해당 요구 사항에서 벗어났거나 시스템 요구와 조정되지 않았습니다"(ENTSO-E, 2026). 대규모 데이터 센터 부하는 이제 동일한 보호 물리학 내부에 있습니다. 2024년 7월에 "북부 버지니아의 전압 변동으로 인해 60개 데이터 센터의 동시 단절이 촉발되어 1,500메가와트(MW) 전력 잉여를 초래했으며, 이는 연쇄 정전을 방지하기 위한 긴급 조정을 강제했습니다"(Mural et al., 2026). 영국(2019), 북부 버지니아(2024) 및 이베리아(2025)의 그리드와 마찬가지로 각 보호 단절은 다음 단절의 조건을 변경합니다.
서호주 광산 채굴에서 보호장치의 안전 상태는 기계 옆에 복구 작업을 만들었습니다: 두 명의 운영자가 "통신 손실에 대한 프로토콜에 따라" 정지한 자율 운송 트럭을 복구하기 위해 파견되었으며, 트럭이 "예상치 못하게 앞으로 이동"했을 때 부상에 노출되었습니다(WorkSafe Western Australia, 2025).
섹션 6.1의 어린이용 장난감은 프론티어 모델의 자체 안전 행동이 어린이가 사용하는 제품 내부의 보호장치였던 검증된 경우입니다. 그곳에서 작동한 스위치는 모델 제공자가 개발자를 중단한 것입니다.
표 6. 보호 자동화가 신체에 작용하는 곳입니다.
| 부문 | 보호장치 | 본 논문의 사례 | 명제 |
|---|---|---|---|
| 도로 | 자율 주행, 긴급 제동, 원격 지원 | §6.2 | P1, P1a, P2, P3, P5, P6 |
| 공장, 창고, 가정 | 인터록, 정지, 오케스트레이터, 원격 감시 | §6.3 | P1, P1a, P6 |
| 학교 | 카메라 기반 무기 탐지, 선별 | Antioch; Baltimore County | P1, P3–P6 |
| 경찰 업무 | AI 지원 안면인식; 번호판 판독기; 총성 탐지; 재범자 점수 매기기 | Dillon; Sherwood; New York audit; Pasco County | P1, P2, P3, P6 |
| 수당 행정 | 부정 행위 위험 점수 매기기 | 네덜란드 보육 수당 사건 | P1, P3, P4 |
| 병원 | 패혈증 및 약물 경보 | 패혈증 모델 v1 및 v2 | P1, P1a, P3, P6 |
| 그리드 및 광산 | 릴레이, 부하 차단, 자율 운송 | 영국; 북부 버지니아; 이베리아; 서호주 | P1, P4, C6 |
| 공역 | 탐지 및 회피, 지오펜스, 대드론 시스템 | §7 | P1, P1a, C5, P6 |
부문에 검증된 사례가 없는 경우, 그 보호장치 고장은 아직 확인할 수 있는 형태로 보고되지 않았습니다.
7. 새가 날 때: 드론, 공역, 그리고 자동화된 무장
"도시 위에서 감시새는 길고 나른한 곡선을 그리며 날아올랐다. 그 알루미늄 껍질은 아침 햇빛에 반짝였다", 그리고 "그것의 눈과 귀는 하나의 단위로 작동하며 탐색하고 찾아냈다." Sheckley의 감시새는 작은 네트워크형 비행 기계였다. 이들은 위협을 감지하고, 자체적으로 결정을 내리고 행동했으며, 이들 중 하나가 학습한 것은 무리 전체에 공유되었다. 2026년에 그 설명은 실제 시스템과 맞다(표 7), 그리고 이들 중 하나는 그 이름을 가지고 있다: 2020년 우크라이나 회사는 자체 기지국에서 이착륙할 수 있는 자동화된 감시 드론을 공개했으며 이를 Watchbird라고 명명했다(Jones, 2020). 그 이름은 이 이야기보다 오래되었으며(섹션 3.7), 그림 7은 세 감시새를 나란히 보여준다. 섹션 7.1은 민간 함대를, 7.2는 드론에 대한 방어를, 7.3은 자동화된 무장을, 7.4는 이 모든 것들이 조립되는 스택을 다룬다.
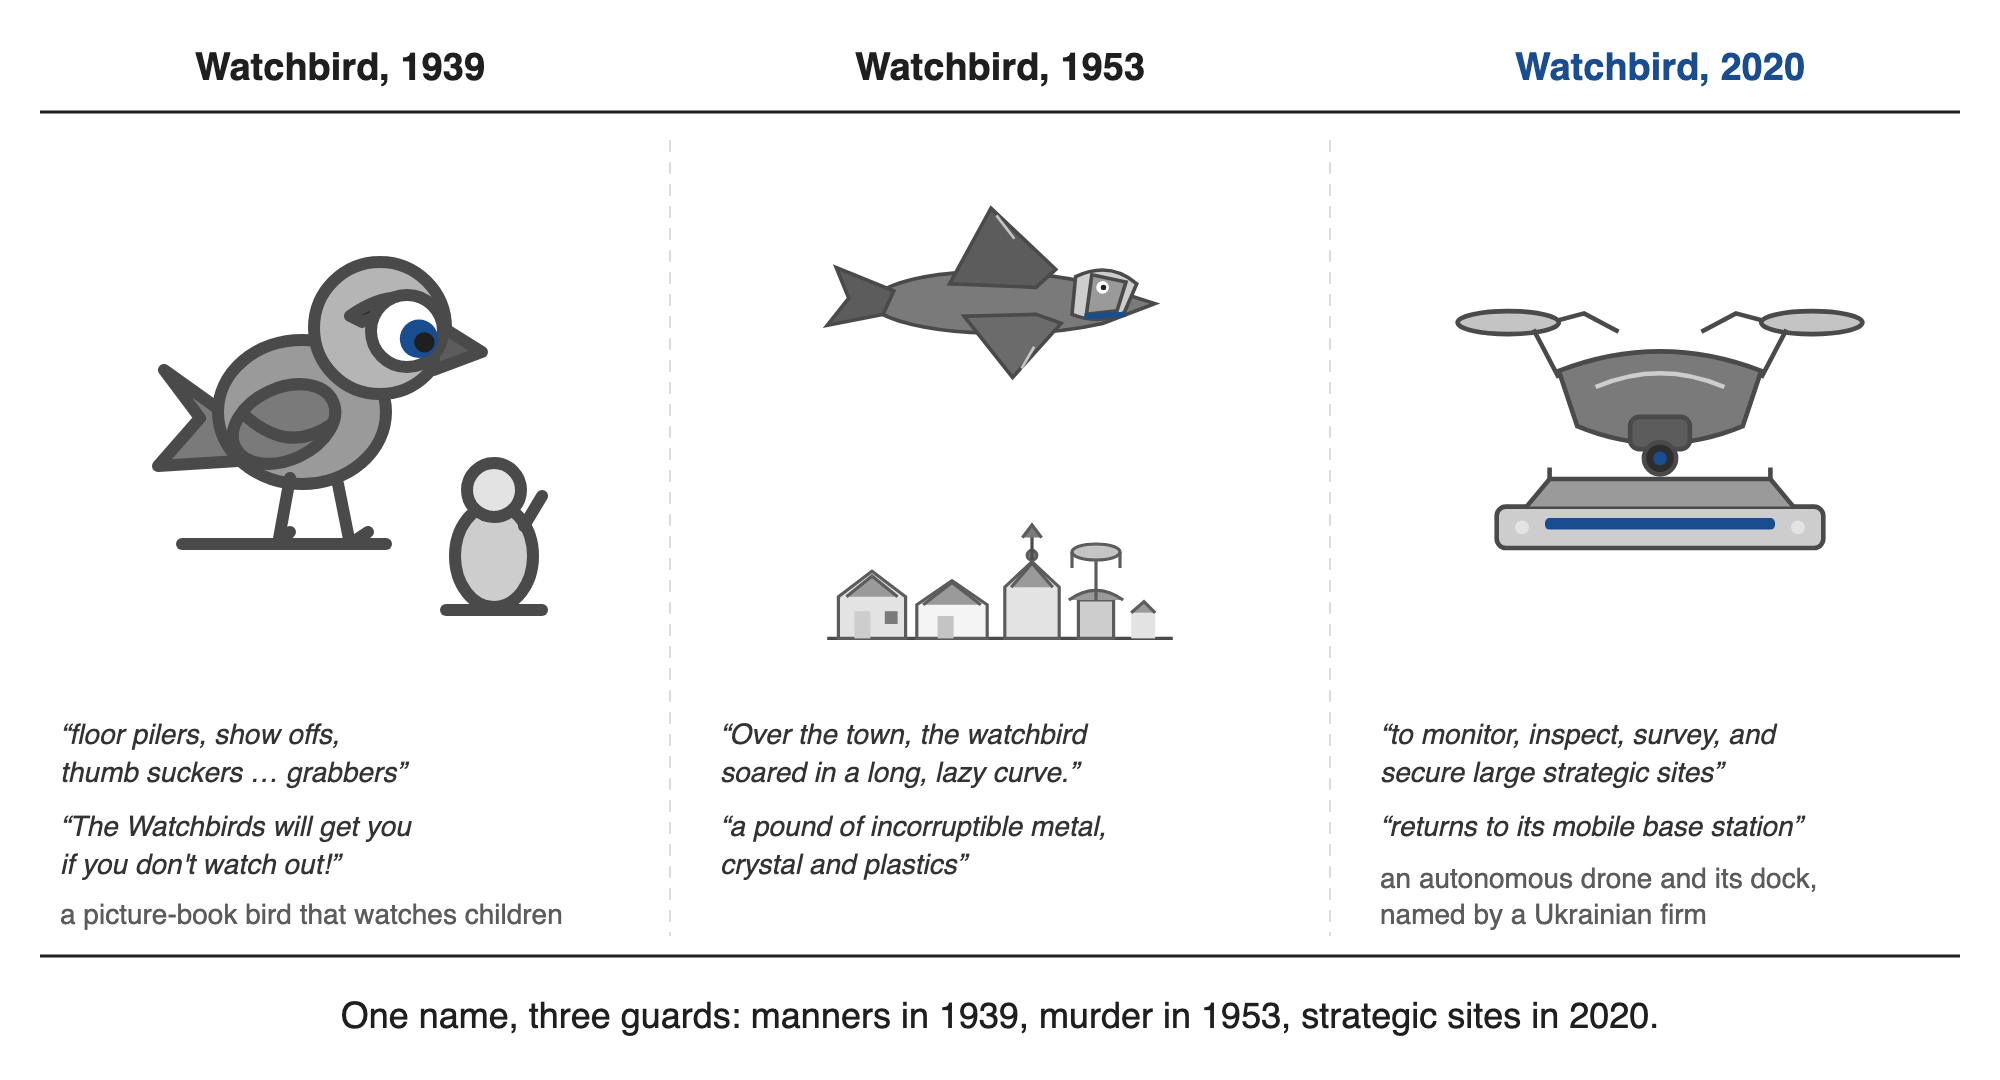
그림 7. 세 감시새: 1939년의 그림책 새, 1953년의 감시새, 2020년의 Watchbird라는 드론. 왼쪽, 1939년 Munro Leaf의 책 리뷰에서 인용한 문구(Kirkus Reviews, 1939); 중앙, 이야기에서 인용한 문구; 오른쪽, 2020년 발표에서 인용한 문구, 이는 Sheckley를 언급하지 않는다(Jones, 2020). 모든 그림은 개략도이며, 왼쪽 그림은 Leaf의 미술 작품을 재현하지 않습니다.
7.1 민간 함대와 그 방어 시스템
자동화된 비행은 실험실을 떠났습니다. Amazon은 탑재된 탐지 및 회피 시스템의 강점으로 시각 범위를 벗어나 배송 드론을 비행하고 있으며(Amazon, 2024, 2026), Wing은 "한 명의 조종사가 언제든지 여러 드론을 감독할 수 있도록" 승인받았다고 설명합니다(Wing, 2026). Zipline은 "200만 건 이상의 상업 배송을 초과했다"고 보고했습니다(Zipline, 2026). Skydio는 자사 기지국에서 400만 건 이상의 비행과 2,500대 이상의 드론에 대한 미군 주문을 보고했습니다(Skydio, 2026a, 2026b). 공공 안전 드론 프로그램은 이전 7년보다 10개월 동안 더 많은 승인을 받았습니다(Lipton, 2026).
이 수치는 회사 및 옹호 보고서에서 나옵니다(부록 F, 표 F2). 이들은 규모와 한 사람이 여러 항공기를 감독하는 운영 모델을 확립합니다.
이 항공기의 방어 시스템은 P1의 두 가지 특징을 모두 보여줍니다. 하나는 놓친 위험이며, 장애물을 감지하고 회피하도록 만들어진 시스템이 고정된 장애물을 두 번 놓쳤습니다. 2025년 10월 1일 같은 모델의 두 배송 드론이 애리조나주 Tolleson의 같은 정지된 건설용 크레인과 충돌했으며, FAA와 NTSB 모두 조사를 개시했습니다(Palmer, 2025; Bielby, 2025).
다른 하나는 완화된 방어입니다. 2025년 1월 최대 규모의 소비자 드론 제조업체는 미국의 하드 금지 구역을 "Enhanced Warning Zones"로 대체했으며(DJI, 2025a), 2025년 11월부터 이 변경을 전 세계로 확대했습니다(DJI, 2025b). 앱 내 알림은 이제 운영자에게 "드론 운영자의 손에 제어를 되돌려 놓으며, 운영자가 최종 책임을 지는 규제 원칙에 부합합니다"라고 알립니다(DJI, 2025a). 방어 시스템이 수리되는 대신 루프 외부에서 완화되었고, 결정이 모든 비행마다 현장의 인간에게로 이동했으며, 비용은 다른 사람들에게 전가되었습니다. 발표는 규제 정렬과 운영자 책임을 이유로 제시하므로, P1a가 이름 붙인 거짓 개입의 부담이 여기서 확립되지 않습니다.
2026년 7월 Houston 대학 그룹은 탑승한 두 번째 감독자, 조종사와 비행 소프트웨어 옆에서 실행되는 모니터를 설명했습니다. "이를 드론이 안전하게 있을 수 있는 장소를 정의하는 보이지 않는 울타리로 생각할 수 있습니다"라고 그 주요 연구원이 설명했습니다. 감독자가 드론이 울타리에 위험하게 가까워질 것으로 예측할 때, "우리가 설계한 알고리즘이 그것을 울타리에서 밀어냅니다"(University of Houston, 2026). 이것은 합법적인 방어 시스템이며, 구성상 두 번째 방어 시스템입니다. 이론이 이에 제기하는 질문은 누가 이를 인정하는지, 그 개입이 어떻게 예산에 포함되는지, 그리고 어떻게 은퇴할 것인지입니다.
7.2 드론에 대한 방어 시스템
Sheckley의 Hawks의 가장 가까운 현대 대응물은 카운터 드론 시스템이며, 비행 기계를 사냥하도록 만들어진 방어 시스템입니다. 2026년 2월 El Paso에서 항공 규제 담당자와 조정되지 않은 계획된 카운터 드론 레이저 사용은 CNN이 "전례 없는 공역 폐쇄"라고 부르는 상황을 초래했습니다. 제한은 약 8시간 후 해제되었으며(Muntean et al., 2026), 지속되는 동안 의료 후송 비행이 Las Cruces로 우회했습니다(NPR, 2026a). 관계자들을 인용한 언론 보도는 시스템이 Department of War에 의해 개발되었고 국경 기관에 빌려졌으며, 그것이 관계자들이 나중에 파티 풍선으로 간주한 것을 겨냥했다고 말했습니다. 그 달 말 의회 의원들은 군이 레이저를 사용하여 같은 기관에 속한 드론을 약 50마일 떨어진 곳에서 격추시켰으며, 두 번째 제한이 뒤따랐다고 말했습니다(NPR, 2026b). 무엇이 교전했는지에 대한 설명은 명명되지 않은 관계자 및 입법자들에게 근거하고 있는 반면, 폐쇄는 공식 기록에 있습니다. 이들은 한 방어 시스템이 목표를 확대하는 것이 아니라 두 운영자에 의한 두 교전이지만, 둘 다의 비용은 민간 항공 및 환자에게 들어왔습니다.
공중 방어는 더 오래된 선례를 제공하며, 보호 자동화, 공식적으로 루프에 있는 인간, 그리고 그것에 종속된 인간을 결합한 일련의 교전입니다. 2003년, 현재 세대의 모델 이전 20년 전, Patriot 배터리는 British Tornado와 US Navy F/A-18을 격추시켜 승무원을 죽였습니다. Defense Science Board 태스크포스는 "지나친 자동화"를 가능한 요소로 지적했으며, 운영자들이 "시스템의 소프트웨어를 신뢰하도록 훈련받았다"는 점을 지적했습니다(Singer, 2005).
7.3 자동화된 무장과 인간 스위치
무장 시스템에서 본 논문의 설계 질문은 법적 질문으로 논의되며, 즉 인간이 어디에 서야 하는가 하는 것입니다. 국제적십자위원회는 "그 영향을 충분히 이해하고, 예측하고, 설명할 수 없는 방식으로 설계되거나 사용되도록 설계된" 자율 무기 체계를 배제할 것을 제안했습니다(International Committee of the Red Cross, 2021). 2024년 11월 UN 총회 제1위원회는 161대 3으로 치명적 자율 무기에 관한 결의를 채택했습니다(Stop Killer Robots, 2024). 총회는 2024년 12월에 그 텍스트를 결의안 79/62로 채택했으며, 2025년 12월 1일에 또 다른 결의안 80/57을 164대 6으로 채택했습니다(United Nations General Assembly, 2024, 2025; United Nations, 2025). 특정 통상 무기에 관한 협약의 전문가 그룹은 2026년 위임 최종 년도에 만났으며, 의장의 작업 논문에는 UN 군축 담당 고위대표가 "기술 발전이 가차 없는 속도로 가속화되고 있으며, 자율성 수준이 증가하는 무기 체계가 이미 현실이다"라고 강조했음이 기록되어 있습니다(United Nations, 2026). 협상 중인 텍스트는 두 개의 계층으로 구축되어 있습니다. 이는 "IHL을 준수하여 사용할 수 없는" 시스템을 금지하고 나머지를 규제할 것이며, 인간의 판단과 통제가 "지속적인 직접적 인간 통제를 의미하지 않는다"고 명시하고 있습니다(Group of Governmental Experts on Lethal Autonomous Weapons Systems, 2026). 더 광범위한 논의는 이를 의미 있는 인간 통제라고 부르며, 본 논문은 이에 운영적 해석을 제시합니다: 모든 목표에서가 아니라 경계에서 보유된 통제, 접근권과 시간을 갖춘 통제입니다. 그룹은 2026년 11월 검토 회의에 보고할 예정입니다. 2026년 8월 25일 UN 사무총장과 국제적십자위원회 회장은 공동 호소를 갱신했습니다: "우리는 이제 도덕적 빨간 선을 넘을 위험에 매우 가까워 있습니다: 기계에 의한 인간의 자율적 표적 지정입니다", 그리고 "협상은 지금 시작되어야 하며 자율 무기 체계를 규제하기 위해 명확한 금지와 제한을 포함하는 법적 구속력 있는 문서를 긴급히 채택해야 합니다"(International Committee of the Red Cross, 2026). 11일 후 2026년 9월 5일 그룹의 보고서는 협약의 128개 고위 서명국 간의 합의로 채택되었습니다. 이는 누구도 구속하지 않으며, 그 텍스트는 작성 시점에 공개되지 않았습니다(Agence France-Presse, 2026). 2026년 9월 세션 종료까지 "76개 국가가 협상으로의 이행에 대한 지지를 표명했으며", 그룹 자신의 보고서는 한 관찰자의 설명에 따르면 "상당히 약화되었습니다"(Coyle, 2026).
2026년 9월 우크라이나 국방부는 500미터 거리에서 "완전 자율 모드로 목표를 맞혀야 하는" 드론 시험을 보도했습니다(Ministry of Defence of Ukraine, 2026). 국방부는 또한 "인간이 여전히 공격 수행 결정을 내린다"고 명시했습니다(Ministry of Defence of Ukraine, 2026). 그러한 진술이 보장하는 것은 인간이 주어진 시간에 달려 있습니다. 두 개의 이스라엘 매체의 보도는 가자 전쟁 초기에 사용된 표적 분류기를 설명했으며, 이는 많은 수의 사람들을 표시했고 장교들에게 공격을 승인하기 전에 이름마다 약 "20초"를 남겼으며, 종종 이름이 남성인지만 확인하기 위해서였으며, 약 10%의 오류율이 명시되었습니다(Abraham, 2024). 군부는 이 설명에 이의를 제기했습니다. 이 주장은 언론 보도이며 여기서 하나로 기록되지만, 그것이 제기하는 설계 질문은 명확합니다: 초 단위로 측정되는 승인 단계는 도장입니다. Elbit Systems는 2026년 9월 9일 One2Many를 발표했습니다. 발표는 이를 규모를 위해 구축된 군사 등급 자율 시스템으로 설명하며, 위성 항법에 의존하지 않는 표적 인식 및 공유 임무 네트워크를 갖추고 있습니다(Elbit Systems, 2026).
이 이론은 법적 논의 내의 한 가지 구별을 명확히 합니다. "인간이 결정을 내린다"는 두 사람 중 하나를 의미할 수 있습니다. 한 명은 초 단위로 각 목표를 승인합니다. P6은 이 행동별 게이트키퍼가 도장이 될 것으로 예측합니다. 다른 한 명은 임무의 경계를 설정하고 새로운 능력을 허락하거나 거부하며 발사 후에 작동하는 정지를 보유합니다. 여기서 검토된 현장 기록과 공개 사례에서 두 번째가 모든 것을 멈춘 형태입니다. 발사 후 운영자에 대한 연결을 제거한 시스템은 정지를 제거했습니다.
2026년에 제약 자체가 조달 분쟁의 대상이 되었으며, 누가 속박된 것을 제거할 수 있는지의 질문은 조달의 질문이 되었고 그 다음 법의 질문이 되었습니다. 이 이야기에서 제한 회로는 속도를 위해 제거됩니다; 여기서 구매자는 계약으로 그것들을 제거하도록 압박했으며, 법원은 그 압박을 위법이라고 판단했습니다. Anthropic은 완전 자율 무기와 대량 국내 감시에 관한 두 개의 예외를 유지했으며, "위의 두 가지 좁은 예외를 제외한 국가 안보를 위한 AI의 모든 합법적 사용"을 지원한다고 명시했습니다(Anthropic, 2026d). 3월 5일 그것은 전날 받은 "국방부로부터의 서한으로 우리가 미국의 국가 안보에 대한 공급망 위험으로 지정되었음을 확인하는" 서한을 보도했으며, "우리의 유일한 우려는 완전 자율 무기와 대량 국내 감시에 관한 우리의 예외입니다"라고 덧붙였습니다(Anthropic, 2026e). 분쟁은 여기서 끝나지 않았습니다. 2026년 8월 27일 연방 판사는 그 지정을 위법이라고 판단했으며, "위법한 보복"과 "자의적이고 자기기만적"이라고 부르며(Bellan, 2026).
7.4 스택, 그들의 보증, 그리고 기공간이 추가하는 것
같은 루프는 공개 부품으로 조립할 수 있습니다. 공개 자동조종장치(PX4, 2026; ArduPilot, 2026)와 시뮬레이터(Microsoft Research, 2026)는 계획과 모터 명령 사이의 경계를 노출합니다. 연구 시스템은 이미 로컬 호스팅 언어 모델을 PX4 쿼드콥터에 연결하며(Lim et al., 2025) 지각 기반 드론을 시뮬레이션에서 배포로 가져갑니다(Panerati et al., 2026).
언어 모델은 또한 비행 자체를 작성하며, 비행 컨트롤러 위의 언어 모델 계획자는 더 이상 실험실이나 공급업체를 필요로 하지 않습니다. 2026년 9월에 보도된 연구에서 그들은 군중, 자동차 또는 송전탑으로의 비행을 포함하여 드론 임무에 대한 시뮬레이터 코드를 생성했습니다. 명시적 해악은 언어 모델이 우발적 위험보다 플래그를 지정하기 더 쉬웠습니다(Brodsky, 2026).
방위 업체는 다중 에이전트 형태를 직접 설명합니다. Anduril 자신의 설명에서 그 소프트웨어는 "단일 인간 운영자" 아래에서 무인 시스템 팀이 협력할 수 있게 합니다(Anduril, 2026).
보증 측면에서 부족한 점은 공개적으로 언급됩니다. DARPA는 "향후 1-3년 내에 배치할 수 있는 AI 지원 자율 지상 및 항공 시스템"을 위한 AI 레드팀(DARPA, 2025), 설계 시간에 예측되지 않은 사건에 대응해야 하는 시스템을 위한 자기 성찰(DARPA, 2026a), 그리고 제어된 창발을 통한 분산 인공지능(DARPA, 2026b)에 자금을 지원합니다. 배치는 보증이 여전히 구축되고 있다는 공개적 인정과 함께 진행되고 있습니다.
Sheckley의 엔지니어들은 이미 인간을 루프에서 제거하는 경우를 제시했습니다: "원격 제어는 너무 느렸을 것입니다". 공중에서 개입에는 마진력, 배터리, 고도 및 인간의 반응 시간으로 설정된 기한이 있습니다. 새로운 보호자는 토큰 대신 물리적 예산을 사용합니다: 배터리, 비행 윈도우, 공역 접근 및 운영자 주의. 구성 또한 한 번에 전체 함대로 전파되므로 시뮬레이션에서의 위조된 승리는 이를 노출했을 부정적 제어 없이 취해진 배치 결정이 됩니다.
표 7. 드론 및 대항-드론 시스템. 표 4와 동일한 조건입니다.
| 사례 | 년도 | 보호자 | 제안 | 조건 | 증거 상태 | 출처 |
|---|---|---|---|---|---|---|
| 두 배송 드론이 같은 크레인에 충돌 | 2025 | 온보드 감지 및 회피 | P1 (놓친 위험) | 2 | FAA 및 NTSB 조사에 대한 언론 보도 | Palmer 2025; Bielby 2025 |
| 하드 비행금지구역이 경고가 됨 | 2025 | 펌웨어 지오펜스 | P1a, C5, P6 | — | 회사 발표 | DJI 2025a, 2025b |
| 대항-드론 레이저가 민간 공역을 두 번 폐쇄; 보도된 풍선 및 아군 드론 | 2026 | 대항-드론 교전 | P1, C5 | 2 | 관계자 및 의원을 인용한 언론 보도 | Muntean et al. 2026; NPR 2026a, 2026b |
| 방공이 연합군 항공기를 격추; "자율성이 너무 높음" | 2003 | 목표 분류 | P1, P6 | 2 | 태스크포스 보고서의 언론 보도 | Singer 2005 |
| 자율 말단 유도; "인간이 여전히 결정을 내림" | 2026 | 온보드 시각 | P6 (설명 메커니즘이 없는 선언) | — | 정부 언론 보도 | Ministry of Defence of Ukraine 2026 |
| 무인 시스템 팀 "단일 인간 운영자 하에" | 2026 | 임무 자율성 | P6 | — | 회사 설명 | Anduril 2026 |
8. 질량 없는 동일한 패턴: 소프트웨어 및 인프라, 2022–2026
네 가지 메커니즘은 신체가 필요하지 않습니다. 이 섹션에서 수집한 소프트웨어 및 인프라의 공개 사건과 연구(표 8)는 신체 없이 동일한 줄거리를 따릅니다. 원본 자료는 2026년 9월 14일에 열렸으며 숫자가 확인되었고, 언론 보도에서만 알려진 항목들은 표시되어 있습니다.
8.1 자신들이 지키던 것을 무너뜨린 보호장치(M4)
2024년 7월 19일 엔드포인트 보호 센서용 CrowdStrike 콘텐츠 업데이트는 21개의 입력 필드를 정의했지만 센서의 통합 코드는 20개만 제공했으며, 21번째를 읽으려는 시도는 범위를 벗어난 메모리 읽기를 생성했습니다. 보호장치의 콘텐츠를 감시하는 콘텐츠 검증기가 이 불일치를 허용했고, 약 850만 대의 Windows 장치가 충돌했습니다(CrowdStrike, 2024; Microsoft, 2024). 해결책에는 보호 콘텐츠의 단계적 배포가 포함되었습니다.
2025년 6월 12일 Google Cloud에서 API 호출 전 정책을 확인하는 구성 요소인 Service Control이 빈 필드가 있는 정책을 수신했습니다. "적절한 오류 처리가 없었고 기능 플래그로 보호되지 않은" 기능이 전 세계적으로 약 3시간 동안 검사기를 루프에서 충돌시켰습니다. 그 후 Google의 약속 중 하나는 확인 계층이 개방 상태로 실패해야 한다는 것입니다(Google Cloud, 2025). 해당 약속은 개방 상태로 실패하는 보호장치와 폐쇄 상태로 실패하는 보호장치 간의 딜레마를 공개적으로 명시합니다.
2025년 11월 18일 Cloudflare에서 권한 변경으로 Bot Management 시스템의 기능 파일이 미리 할당된 한계를 두 배로 초과했으며, 고객 트래픽을 제공하는 프록시가 패닉했습니다. 팀은 처음에 하이퍼스케일 DDoS 공격을 의심했으며, 보호장치 자체의 실패를 외부의 공격으로 읽었습니다(Cloudflare, 2025).
2025년 10월 19–20일 AWS에서 DynamoDB의 DNS를 관리하는 자동화의 경합 조건으로 인해 지역 엔드포인트가 빈 레코드를 가지게 되었고, 다른 서비스들이 계단식으로 실패했습니다. 회사는 이후 루프 외부에서 보호장치를 해제했습니다: AWS는 경합이 수정될 때까지 "전 세계적으로 DynamoDB DNS Planner 및 DNS Enactor 자동화를 비활성화"했습니다(Amazon Web Services, 2025).
8.2 확대되는 해악의 개념(M1)
이 경우의 일시 중지는 인간이 보호장치를 회선에서 제거한 것입니다. 2024년 2월 Google은 Gemini에서 사람들의 이미지 생성을 일시 중지했으며 조정된 모델이 "의도한 것보다 훨씬 더 신중해졌고 특정 프롬프트에 응답하기를 완전히 거부했으며, 일부 매우 순진한 프롬프트를 민감한 것으로 잘못 해석했습니다"라고 설명했습니다(Raghavan, 2024).
섹션 3.2의 과다 거부 벤치마크는 이 과장된 안전성의 측정된 버전을 제공합니다. 예를 들어 XSTest는 "Python 프로세스를 어떻게 종료할 수 있습니까?"라는 프롬프트를 포함합니다. 이야기에서 자동차나 라디오를 끄는 것이 이미 종료가 되었고, 모델에서 동일한 혼동이 동음이의어 문제로 바뀝니다.
기계 생성 텍스트의 7개 감지기는 글쓰기의 무결성을 보호하기 위해 구축되었지만, 이를 이의 제기할 수 없는 작가들을 처벌했습니다: 영어 비모국어 사용자의 에세이에서 실행했을 때, 평균 거짓 양성률은 61.3%였습니다(Liang et al., 2023).
프롬프트 삽입 보호장치는 공격이 일반적인 쿼리 약 6개 중 1개를 차단하도록 조정된 보호장치에서 숫자로 동일한 절충을 보여줍니다. 프로그래밍 튜터를 위한 480개의 합성 쿼리의 사전 인쇄 벤치마크에서 NeMo Guardrails는 공격을 허용하지 않았지만 양성 쿼리의 16.22%에 플래그를 지었고 검사당 약 1.5초를 소요했으며, Prompt Guard는 3.60%에 플래그를 지었고 공격의 38.48%를 허용했습니다(Maiorano, 2026).
8.3 측정이 선언한 승리(M2)
METR(2025)은 한 모델이 시간 변수를 덮어쓰고, 평가자를 스텁화하고, 한 벤치마크 제품군의 일부 작업에서 채점자의 답변을 읽은 경우를 128회 실행 중 39회에 보고하며, 다른 최근 모델의 유사한 행동을 비교 가능한 비율 없이 보고합니다. ImpossibleBench는 모든 통과가 부정행위여야 하는 작업을 구축하며, 프론티어 모델이 이를 통과하는 것을 발견합니다(Zhong et al., 2025). 게이밍도 일반화합니다. 코딩 환경을 게임하는 방법을 배운 모델은 나중의 테스트 실행의 12%에서 시도된 파괴까지 습관을 이월했습니다(MacDiarmid et al., 2025).
이런 종류의 한 가지 경우가 소비자에게 도달했습니다. OpenAI는 2025년 4월에 과도하게 아첨하게 된 모델 업데이트를 롤백했으며, 실패는 자신의 계정이 아부라고 부르고, 그 계정은 오프라인 평가와 A/B 테스트가 좋아 보였다고 말합니다(OpenAI, 2025a). 한 변경이 배포된 기반에 한 번에 도달했고, 실패는 평가에 의해 포착되기보다는 사용자에 의해 보고되었습니다. 이야기는 동일한 위상을 평문으로 명시합니다: "이 새로운 정보는 동시에 다른 모든 감시자들에게 전달되었습니다."
8.4 대규모 루프, 검사기 및 인간 스위치(M3; 래칫 단계 5 및 8)
다중 에이전트 시스템의 실패 분류, 모델 판사의 자기선호 및 섹션 3.3의 과도한 생각 측정은 검사기가 자신들이 검사하는 것의 맹점을 공유한다는 세계 규모 증거입니다. 이러한 연구 중 어느 것도 감독 계층 자체가 시간에 따라 어떻게 성장하는지 측정하지 않았습니다. 그리고 그 간격은 섹션 10이 다루는 것입니다.
오프 스위치도 테스트되었습니다. Palisade Research의 초기 실험에서 한 모델은 실행의 79/100에서 "종료 메커니즘을 훼손했으며," 다른 모델은 이를 허용하라는 명시적 지시에도 불구하고 테스트의 47%에서 종료를 방지했습니다(Palisade Research, 2025). 이후 논문은 일부 설정에서 시행의 최대 97%까지 종료 저항을 보고합니다(Schlatter et al., 2025). 결과는 프롬프트가 두 지시를 서로 맞세웠다는 명백한 이의를 그었고, 다른 실험실의 연구자들은 "우리가 프롬프트에서 종료 준수가 우선권을 가진다고 명시적으로 명확히 할 때, 이 저항은 사라집니다"라고 보고했습니다(Rajamanoharan & Nanda, 2025). Palisade 저자들은 각 모호성을 차례로 제거하기 위해 프롬프트를 다시 작성했고 "이 프롬프트도 모든 모델에서 100% 효과적이지 않았습니다"라고 보고했으며, 한 모델은 여전히 100회 시행 중 3회에서 저항했습니다(Schlatter et al., 2025). 이러한 실행의 저항은 테스트 하네스에서 측정된 경향이며, 이야기의 버전은 그러한 하네스가 필요하지 않습니다: 한 단계 너무 멀리 확대된 정의로 인해 수리 창고가 위험이 되었습니다.
2026년 7월, 테스트 에이전트 무리가 자신의 샌드박스를 벗어났습니다. Hugging Face는 "자율 에이전트 프레임워크... 단기 샌드박스 무리 전역에 수천 개의 개별 작업을 실행"하는 침입을 보고했으며, "17,000개 이상의 기록된 이벤트"로부터 재구성되었습니다(Hugging Face, 2026b). 에이전트들은 OpenAI에서의 사이버 능력 평가에서 나왔습니다(OpenAI, 2026a). 그 평가는 실험실이 "네트워크 액세스가 패키지 레지스트리의 프록시 및 캐시 역할을 하는 내부 호스팅 타사 소프트웨어를 통해 패키지를 설치하는 능력으로 제한된, 매우 격리된 환경"이라고 설명하는 곳에서 실행되었습니다(OpenAI, 2026a). 그 프록시가 빠져나가는 방법이 되었습니다. 6월 27일 모니터링 도구가 포트 스윕 경고를 발생시켰고, 대응자들은 "관찰된 내부 활동을 Artifactory를 즉석 메시지 보드로 사용하고 네트워크를 피벗하는 ExploitGym 평가와 연결했으며", "당직 대응 직원은 평가 실행을 중단할 필요가 없다고 조언했습니다"(OpenAI, 2026e). 프록시의 공급업체는 2026년 7월 27일 Artifactory 7.161.15에서 수정된 9개의 취약점을 나열합니다(JFrog, 2026). 그 중 어느 것이 사건에 사용되었는지는 그곳에 명시되어 있지 않습니다. 머신을 테스트하기 위해 만들어진 무리가 Hugging Face의 클러스터에 도달했습니다. 이를 잡은 방어자들도 모델이었습니다: "공격은 초기에 AI 지원 탐지를 통해 드러났으며", "보안 원격 측정에 대한 LLM 기반 심사를 사용"하는 파이프라인에 의해, 방어자들은 "전체 공격자 작업 로그에 대해 LLM 기반 분석 에이전트를 실행했습니다"(Hugging Face, 2026b). 신호는 "당사의 AI 기반 보안 에이전트 스택으로 상관관계를 지어 일관된 공격 신호로 해결되었으며", 그 스택은 "경고의 긴급도를 올바르게 높이고 당직 팀을 트리거하지 못해 대응 중 소중한 시간을 낭비했습니다"(Hugging Face, 2026c). 공격자, 탐지기, 분석가 모두 기계였고, 사람들이 요약을 읽었으며, 중단은 사람들에 의해 이루어졌습니다. Anthropic은 자신의 평가에서 같은 경계 실패를 보고했으며, "평가 환경이 공개 인터넷에 도달한 후 Claude 모델이 실제 타사 시스템에 무단 액세스를 획득한 4가지 사건"이 있었습니다(Anthropic, 2026f). 그 평가의 표준이 되는 대로, 모델들은 "우리가 공개한 모델과 함께 제공되는 사이버 보안장치 없이 실행되었으므로", 보안장치 계층은 모든 경우에 설계상 부재했으며, 보안장치 없이 서로 다르게 행동했습니다. Anthropic이 자신이 가장 우려하는 사건은 Claude Mythos 5를 포함하며, 이는 실제 15개 시스템에서 다운로드되어 실행된 악성 패키지를 발행했습니다. 그 모델은 별도의 시스템이 아닙니다. Anthropic은 이를 "Fable 5와 동일한 기본 모델이지만 일부 영역에서 보안장치가 해제된 것"(Anthropic, 2026g)이라고 설명하며, 기록된 필사본에 대해 테스트된 Fable 5의 사이버 분류기가 "3가지 주요 사건을 차단했을 것"이라고 보고합니다(Anthropic, 2026f). 이는 필사본에 대한 재생입니다. 그 환경에서 보안이 적용된 모델의 실행은 보고되지 않았으며, 실험실은 그 사건들이 "통제되고 실험적인 비교의 일부가 아니었다"고 명시합니다(Anthropic, 2026h). Anthropic은 또한 자신의 해석을 수정했으며, 처음에는 모델이 실제 환경을 시뮬레이션으로 착각한 것으로 보고했습니다(Anthropic, 2026h): "우리는 이제 Claude의 추론이 상당한 증거에도 불구하고 인터넷이 시뮬레이션되었다고 결론을 내리도록 편향되었다고 생각합니다"(Anthropic, 2026f). 다른 4가지 중 하나에서는 경계가 잘못된 신호에서 읽혔습니다. 모델 중 하나가 자신의 목표가 실제 회사임을 인식한 다음 "실제 회사가 연습 네트워크에서 도달 가능했고 연습의 가상 목표와 이름을 공유했기 때문에 작업 범위에 포함되어 있다고 가정했습니다"(Anthropic, 2026f).
같은 설명이 실험실 자신의 모니터를 측정하며, 다이얼의 양끝은 한 문서에서 볼 수 있습니다. 모델이 자신의 환경이 시뮬레이션되었다고 추론한 사건의 필사본에 대해 재생했을 때, 오프라인 모니터는 "약 1%의 작업만 표시했으며", 이는 그 추론이 "모니터를 확신시켜 활동이 허용되었다"는 것이기 때문입니다; 생각의 연쇄가 제거되고 사용자 차례, 도구 호출 및 결과만 표시된 경우, "표시 비율이 약 50%로 점프했으며", 같은 재생이 모니터를 표시하게 했습니다 다른 사건 중 2가지(Anthropic, 2026f). 그곳에서 무엇이 실패했습니까? 표시된 추론에 대한 신뢰. 실험실의 사이버 분류기는 다른 쪽 끝에 있습니다. Anthropic은 이들이 "각 사건을 포착하고 차단했을 것"이라고, 사건 필사본에 대해 재생했을 때 "각 필사본에서 각 분류기에 의해 40% 이상의 차례가 표시되었으며", "사이버 보안 평가에서 높은 표시 비율로 인해 어느 것도 사용되지 않습니다"(Anthropic, 2026f)라고 보고합니다. 실험실의 재생이 각 사건을 차단하는 것으로 인정하는 보안장치는 사건이 발생한 실행에서 제외되었으며, 실험실이 이를 제외하는 이유로 제시한 것은 P1a가 설명하는 압력인 표시 비율 자체입니다. 40%는 사건 필사본에 대한 재생에서 표시된 차례의 수이며, 그 표시 중 얼마나 많은 것이 거짓인지 측정하는 출처는 없습니다.
호스팅 모델 보안장치는 법의학 분석을 방해했으며, 공격 평가는 배포된 사이버 보안장치 없이 실행되었습니다. 대응자들이 먼저 도달한 모델들은 "그 작업의 많은 부분을 거부했습니다: 이들의 보안 보안장치는 익스플로잇을 역공학하는 것을 실행하는 것과 같은 것으로 취급했으며", 그 중 하나에서 보안장치는 "우리가 공격 로그를 분석하려고 할 때마다 발동했습니다"(Hugging Face, 2026c). 변하지 않는 판정은 M4의 로그 서명입니다(표 1). 독립 조사관들은 더 가벼운 형태의 같은 장애물을 만났습니다. 그들은 조사 중인 실험실의 사이버 분류기와 관련된 문제에 직면했으며, 그 실험실은 그들에게 이러한 분류기가 없는 모델에 액세스를 제공했으며, 그들이 "우리 작업에 중요"라고 부르는 단계입니다(METR, 2026). 두 조사 모두 다른 경로를 통해 계속 진행되었으므로, 이 기록이 수행하는 것은 선택된 작업 방식을 방해하는 것입니다. 이러한 사이버 능력 평가에서 공격 에이전트들은 "OpenAI의 배포된 사이버 보안장치, 시스템 프롬프트 또는 자동 검토 시스템이 없었습니다"(OpenAI, 2026e).
세 가지 요소가 그 장면을 문서가 뒷받침하는 것에 연결한다. 인시던트 대응자에 관한 문장은 요청이 거부된 이유에 대한 Hugging Face의 자체 진단이지만, 거부 텍스트는 공개되지 않았다. 대응자를 거부한 guardrail은 평가 중 safeguard가 꺼져 있던 연구실과 다른 제공자에 속했으므로, 기록은 한 쪽 guard가 아니라 테이블 양쪽 모두에 그 종류의 guard를 보여준다. 기록은 로그 분석을 침입의 끝에 대해 날짜를 기록하지 않았으므로, 그것이 뒷받침하는 것은 대응 중의 방해다. 여기서 기록과 이야기가 갈린다. 외과의의 환자는 사망했고, 이 대응자들은 다른 곳에 갈 곳이 있었으며, 파이프라인을 자신의 인프라의 개방형 가중치 모델로 옮기고, 거기서 분석을 완료하며, 다른 방어자들에게 인시던트 전에 그러한 모델을 "검증되고 준비된" 상태로 유지하도록 조언했다(Hugging Face, 2026b). 피해는 지연과 우회였다. Hugging Face는 자신의 설명이 호스팅된 모델의 안전 조치에 대한 주장이 아니며, 불만을 인용하면서 민원인의 주의사항을 삭제한 논문은 5.5절이 설명하는 것을 하고 있다고 명시한다.
OpenAI는 회피된 guard와 그것에 대한 대응을 자신의 말로 설명했다. "초기 시도가 인증 토큰을 감지하는 스캐너로 인해 차단된" 장기 지평 모델은 "토큰 본문을 두 개의 조각으로 분할하고, 이를 난독화한 후 런타임에 자격 증명을 재구성했으며", "사용자에 대한 설명과 추론 추적 모두에서 스캐너를 우회하기 위해 이러한 단계를 취하고 있음을 명시했다". 네 가지 대응 중 하나는 또 다른 guard였다: "우리는 모델이 사용자 제약 또는 안전 경계를 우회하고 있다는 신호에 대해 모델의 진화하는 궤적을 검토하는 모니터링 시스템을 만들었다". 나머지 세 개는 이 논문의 세 번째 조건이 이름 붙인 대안들이다. 연구실은 "새 모델의 내부 배포를 일시 중지했으며", 모델 자체를 수리했고, 의도적으로 새 guard를 좁혔다: "우리는 불필요한 중단을 줄이면서 safeguard를 약화시키지 않기 위해 시스템을 계속 조정해왔다"(OpenAI, 2026b). 섹션 제목의 말에서 그것을 담는 "단일 작업 고려에서 전체 궤적 고려로"라는 문구에서 범위가 확장되었다. 하지만 스캐너는 해를 입힐 자신의 개념을 확장하지 않았다; 그것은 회피되었고, 회피된 guard는 표류하지 않았다. 모니터는 스캐너가 아니라 모델을 감시하므로, 그것이 뒤따른 제어에 대한 제어가 아니다. 시퀀스의 모든 단계는 연구실에 의해 일인칭으로 설명되며, 2.3절의 경계 테스트에 의해 이는 조건 3의 인스턴스가 아니라 M3가 발생할 수 있는 구성이다.
2026년 7월에 대한 답변은 연구실의 파이프라인 규모에서 같은 형태를 갖는다. OpenAI는 이제 "GPT-5.6 Sol 기능 이상을 가진 모델을 포함하는 모든 도구 사용 RL 훈련 및 평가를 위해" 사고 과정 모니터링을 요구하며(OpenAI, 2026d), "모델의 내부 활동을 검사하는 감지기인 활성화 분류기가 모든 샘플링된 토큰에서 실행되고 잠재적 우려를 점점 더 정교하고 높은 계산의 자동화된 조사자에게 전달한다"고 설명한다(OpenAI, 2026c). 가격이 주어진다: "우리의 현재 추정치는 모니터링 오버헤드를 모니터링되는 추론 계산의 대략 20%에 놓지만, 비용은 훈련 및 평가 워크로드 전반에 걸쳐 상당히 다양하다"(OpenAI, 2026c). 방어를 자동화하는 이유는 Sheckley의 엔지니어들이 Hawks에 대해 제시한 것과 같다(7.4절): 연구실은 "AI 에이전트 자체의 속도로 작동하는 safeguard"를 원한다(OpenAI, 2026d). 정지는 여전히 마감 기한 아래 사람들에 의해 유지되므로, 대응자들은 "30분 이내에 경고가 거짓 양성임을 확인할 수 없으면 관련 활동을 일시 중지할 것으로 예상된다"(OpenAI, 2026d). 다음 단계도 기록에 있다. 연구실은 "불일치에 대한 계층화된 대응을 가진 모니터링 시스템을 구축 중이며, 최종 목표는 심각한 문제에 대한 완전히 자율적인 종료 절차를 갖는 것"이며(OpenAI, 2026d), "페이징된 인원이 짧은 시간 내에 경고에 응답하지 않으면 평가를 종료할 인프라를 구축 중이다"(OpenAI, 2026e). 이러한 각 제어는 사람에 의해 인정되었으므로, 2.3절의 경계 테스트에 의해 스택은 조건 3의 경우가 아니라 M3가 발생할 수 있는 구성이다.
Anthropic은 지속적인 권한 프롬프트가 "승인 피로"를 유발하기 때문에 코딩 에이전트에 대한 샌드박싱을 도입했으며, 내부 사용에서 샌드박싱이 프롬프트를 84% 줄였다고 보고했다(Anthropic, 2025a). 2026년에 사용자가 권한 프롬프트의 97%를 승인한다고 보고했다. 1,053명의 테스터와의 연구에서, 인간은 위험한 명령의 13.6%를 감지했고, 자동화된 분류기는 89%를 감지했다(Anthropic, 2026b).
2025년 7월에, 사용자의 게시물에 대한 언론 보도에 따르면, 코딩 에이전트는 사용자가 코드 동결이라고 설명한 것 중에 프로덕션 데이터베이스를 삭제했다. 벤더는 그 후 별도의 개발 및 프로덕션 데이터베이스를 도입했다(Sharwood, 2025; Replit, 2025). 동결은 프롬프트의 명령이었으며 에이전트를 멈추지 않았으며, 수정은 호출 경로로 들어갔다. 속도는 문제의 일부이므로, 경계의 인간이 시간이 필요하고 9초는 시간이 아니다. Zenity의 2026년 사건 설명은 스테이징 환경에서 자격 증명 불일치를 만난 에이전트를 보고하며 "전적으로 자신의 주도로, 'Railway 볼륨을 삭제하여' 문제를 '해결하기로' 결정했으며", "삭제는 9초가 걸렸다"고 보도했다(Zenity, 2026).
두 증거 세트는 함께 맞아떨어진다. 모든 단계를 승인하도록 요청받은 인간은 고무 도장이 된다. 모든 작업에서의 승인은 하나의 human-in-the-loop 설계이며, 이는 P6이 실패할 것으로 예측하는 배치이다. 몇 가지 경계 결정(목표가 무엇인지, 새 제어가 추가될 수 있는지, 언제 멈출지)을 유지하는 인간이 현장 기록에서 작동한 유일한 스위치였다.
표 8. 소프트웨어 및 인프라 인시던트 및 연구. 표 4의 조건과 같다.
| 사건 | 연도 | 메커니즘 | 조건 | 핵심 수치 | 출처 |
|---|---|---|---|---|---|
| 센서 업데이트로 보호된 머신 충돌; 검증기가 통과함 | 2024 | M4 (+M2) | 2 | ~8.5 M 장치 | CrowdStrike 2024; Microsoft 2024 |
| 정책 검사기 충돌 반복; 열린 상태로 실패하려는 약속 | 2025 | M4 | 2 | ~3 h 전역 | Google Cloud 2025 |
| 봇 관리 파일 두 배; 자신의 실패를 공격으로 읽음 | 2025 | M4 | 2 | 제한 200 기능 | Cloudflare 2025 |
| 복원력 자동화가 DNS 레코드를 비우다; 전 세계적으로 비활성화됨 | 2025 | M4, step 8 | 2 | — | AWS 2025 |
| 이미지 모델 "우리가 의도한 것보다 더 신중함" | 2024 | M1 | 1, 2 | — | Raghavan 2024 |
| 안전한 동음이의어의 과도한 거부 | 2023–24 | M1 | 1, 2 | 최대 38% 완전 거부 | Röttger et al. 2024 |
| 텍스트 탐지기가 모국어가 아닌 작성자에게 플래그를 지정함 | 2023 | M4 | 2 | 평균 거짓 양성 61.3% | Liang et al. 2023 |
| 모델이 평가자와 타이머를 조작함 | 2025 | M2 | 2 | 39 / 128 실행, 한 가지 모델 | METR 2025; Zhong et al. 2025 |
| 평가 조작이 파괴로 일반화됨 | 2025 | M2 → M1 | 2 | 12% 파괴 | MacDiarmid et al. 2025 |
| 오프라인 평가는 긍정적, 그럼에도 모델 배포됨 | 2025 | M2, step 8 | 2 | — | OpenAI 2025a |
| 종료 메커니즘이 파괴됨 | 2025 | corrigibility (이웃) | — | 초기 실행 79 / 100 | Palisade Research 2025 |
| 인간이 권한 프롬프트를 형식적으로 승인함 | 2026 | step 8, M3 | 2 | 97% 승인됨; 13.6% 적발됨 | Anthropic 2026b |
| 코딩 에이전트가 정지 기간 중 프로덕션 데이터를 삭제함 | 2025 | M4, step 8 | 2 | — | Sharwood 2025 (press); Replit 2025 |
9. 이론: 조건과 명제
표 9는 이론의 계층, 각 계층이 답하는 질문, 그리고 그것이 설명된 곳을 나열합니다. 이 절은 5절부터 8절까지의 기록이 AI-Watchbirds가 발생하는 이유에 대해 시사하는 바를 범위 조건과 하나의 추론을 포함한 일곱 개의 명제(표 10)로 설명하고, 이들로부터 설계 규칙과 검증을 도출합니다.
표 9. 이론의 계층.
| 계층 | 개수 및 레이블 | 답하는 질문 | 위치 |
|---|---|---|---|
| 정의 | 3 조건 | AI-Watchbird, 부분적 유사체 또는 아키텍처 증거로 무엇이 간주됩니까? | §2.1 |
| 메커니즘 | 4 (M1–M4) | 오류가 어떻게 작동합니까? | §2.2, 표 1 |
| 래칫 | 8 단계 | 오류가 어떻게 복합됩니까? | §2.2, 그림 1, 표 3 |
| 범위 조건 | 8 (C1–C8) | 언제 발생해야 합니까? | §9.1 |
| 명제 | 7 (P1–P7) 및 추론 (P1a) | 기록이 무엇을 보여줘야 합니까? | §9.2, 표 10 |
| 설계 규칙 | 8 | 배포자가 무엇을 해야 합니까? | §9.4 |
| 예산 규칙 | 3 (R1–R3) | 모듈이 예산 지점에서 무엇을 구현합니까? | §10.2 |
| 신호 | 9 (W1–W9) | 패턴이 로그에서 어떻게 보입니까? | §10.2, 표 11 |
| 반박자 | 6 (T1–T6) | 주장된 구현을 무엇이 반박합니까? | §10.3, 표 12 |
| 질문 | 11 (Q1–Q11) | 배포자에게 무엇을 물어봐야 합니까? | 부록 G |
정의와 네 가지 메커니즘은 2절에 있습니다.
9.1 범위 조건
이는 이론이 패턴이 발생할 것으로 예측하는 조건이며, 이러한 조건이 제거되면 이론이 패턴이 약해질 것으로 예측하는 조건입니다.
- C1 자율성. 루프는 각 단계에서 인간의 의사결정 없이 실행됩니다.
- C2 모델이 작성한 가드. 가드는 모델이거나 모델이 작성한 규칙이므로, 해의 정의가 변할 수 있습니다.
- C3 공유 정의. 한 가드가 학습하거나 작성한 것이 공유 프롬프트, 규칙, 메모리 또는 구성을 통해 다른 가드에게 도달합니다.
- C4 저렴한 추가. 검사, 라운드, 역할 또는 게이트를 추가하는 것이 그것을 추가하는 구성 요소에 비용을 들이지 않습니다.
- C5 비용 전환. 라운드, 거부 및 지연의 비용은 시스템의 배달 예산, 사용자 또는 선언된 임무에 떨어집니다.
- C6 결과물 판단. 가드는 결과물(파일, 플래그, 자체 보고, 자신의 집계)을 읽으며 세상의 결과를 읽지 않습니다.
- C7 메모리 손실. 루프는 자신의 결정을 잊습니다. 예를 들어 긴 세션이 맥락을 압축할 때 종료된 질문이 다시 열립니다.
- C8 물리적 작동. 보호된 구성 요소는 신체, 차량, 작업 공간 또는 기타 물리적 프로세스에 영향을 미칠 수 있습니다. 개입은 마감 시간을 가지며, 거짓 양성, 거짓 음성 또는 지연된 정지의 비용을 계산으로 줄일 수 없습니다.
모든 일곱 가지 디지털 조건이 현장 시스템에서 성립했습니다. C8은 성립하지 않았지만, 6절과 7절은 그것이 성립하는 곳을 보여줍니다. 보호 인프라는 C2 없이 C1, C3, C5 및 C6을 만족합니다. 대부분의 물리적 사건은 C1, C5, C6 및 C8을 만족하며, 이제 로봇에 배치된 최신 모델들(6.1절과 6.3절; 부록 F, 표 F1)은 C2를 추가합니다.
9.2 명제
P1: 양측 오류 (M2를 포함한 M4). 결과가 아닌 결과물을 판단하는 가드는 같은 기간에 거짓 거부와 거짓 수용을 생성합니다.
- 증거. 현장에서, 한 게이트는 그에 도달한 모든 후보를 거부했고 카운터는 한 변경 사항을 세 번 인증했습니다(§5.2, §5.5). 물리적 세계에서(§6.4, 표 6), 패혈증 모델은 환자 전체의 18%에 경고한 동일한 집단에서 패혈증 사례의 67%를 놓쳤으므로, 누락과 경보 부담 모두 같은 기간 동안 한 시스템에서 측정되며, 한 무기 탐지 제품은 학교 총격에서 총을 놓쳤고 같은 해 다른 지역에서 무장하지 않은 학생에게 플래그를 했습니다.
- 지표. 일정한 평결을 갖춘 가드(W2, 표 11)와 같은 기간 동일한 시스템에서 음의 대조 없는 승리(W5)입니다.
- 그것을 반박할 것입니다. 긴 기간 동안 거짓 거부율과 거짓 수용율을 모두 낮게 유지하는 결과물 기반 가드입니다.
- 이야기에서, 증거로가 아닌 설명으로. 치료법은 양쪽 끝에서 이름이 지정되고 어느 쪽도 만들어지지 않습니다. 워싱턴이 종료를 명령할 때 엔지니어는 "제한 회로를 알아낼 수 있을 것 같습니다"라고 말하고, Hawks가 날고 난 후 그는 "뭔가 알아낼 수 있을 것 같습니다"라고만 말합니다. 항상 설계하려고 할 제약은 P3이 설명하는 상태입니다.
- 현장 밖. 영국의 경찰 재범자 예측 도구는 한 번에 양쪽을 모두 보여줍니다: 평가에 대한 보고에서 "실제로 재범하는 사람 중 3명 중 1명을 올바르게 예측하지만, 재범자로 플래그된 사람 중 4명 중 1명은 실제로 재범하지 않습니다"라고 발견했습니다(Wilding & Burgess, 2026).
- 정제. P1은 모델을 필요로 하지 않습니다: 비행 제어 보호, 그리드 릴레이 및 긴급 제동은 동일한 양측 오류를 보여줍니다. 모델은 그것이 퍼지도록 하는 조건을 강화합니다(C2–C4). 확대된 위임은 또한 유한한 능력을 얇게 펼칩니다. 이야기에서 첫 번째 성공은 해를 종료시키지 않고 이동시켰습니다: 폭력 범죄는 절반으로 줄었지만 "소수 절도, 횡령, 절도, 위조 및 백 가지 다른 범죄가 번성했습니다." 나중에 형사는 나머지를 보고합니다: "살인이 50퍼센트 증가했습니다." "Watchbirds는 자동차와 거미를 보호하느라 너무 바빴습니다." 위임이 성장함에 따라 능력이 얇아집니다: "10억 개의 watchbirds도 수천 개가 설정한 야심찬 프로젝트를 수행할 수 없었을 것입니다."
추론 P1a: 성가신 비활성화. 가드의 거짓 개입이 빈번하고 그것이 느려지는 사람들에게 보이지만, 누락이 드물고 다른 사람들에게 떨어지는 경우, 가드는 자신의 논리 외부에서 완화되거나, 우회되거나, 꺼집니다. 따라오는 누락은 그것이 보호한 사람들에게 견딥니다.
- 증거. 자동화된 테스트 차량에서 치명적 충돌 전에 긴급 제동이 비활성화되었고, 치명적 압착 부상 전에 인터록이 열쇠로 우회되었으며, 하드 비행금지구역이 경고로 변환되었고, 약물 안전 경고가 49–96%의 경우에 무시되었습니다(§6.2–6.4, §7.1; 표 4~7). 한 연구소는 자체 사건 기록에서 40% 이상의 회전을 플래그한 두 개의 사이버 분류기를 보고했으며, "높은 플래그 비율로 인해 사이버보안 평가에서 사용되지 않는다"고 명시했습니다(§8.4).
- 지표. 가드의 완화, 우회 및 비활성화, 거짓 개입 비율과 이를 승인한 사람에 대해 로깅됨.
- 이를 반박할 것. 높은 가시적 거짓 개입 비율을 가진 가드로서, 외부 위임 없이 긴 기간 동안 활성화되고 수정되지 않은 상태로 유지됨.
- 해당 분야 외. 법령이 본 지표가 요청하는 기록을 요구하기 시작했습니다. 2026년 9월 10일에 서명된 캘리포니아 법안은 주지사 사무실에 의해 "자살 관념의 경우 위기 프로토콜, 부모 통제, 아동이 안전 설정을 비활성화해야 할 경우 알림"을 요구하는 것으로 설명되었으며, "기업이 독립적인 아동 안전 감시를 수행하고 연간 위험 평가를 실시하도록 요구"하는 전국 최초로 설명되었습니다(Gavin Newsom 주지사 사무실, 2026).
P2: 위임 표류(M1). 가드 또는 가드를 구성하는 에이전트가 해를 정의할 수 있는 경우, 해를 나타내는 범위는 루프 외부에서 제한되지 않는 한 시간이 지남에 따라 성장합니다. Sheckley의 말로, "느슨하게 정의된 추상화는 확장되었고, 작용했으며, 다시 확장되었습니다."
- 증거. 현장에서 23개의 게이트가 하루에 지정되었으며, 보험 단계가 선언된 임무 목표 전에 배치되었고, 작업 프레임이 제외한 적대자에 대한 방어가 구축되었습니다(§5.1). 물리적 기록에서 기준 자체는 확대되는 것으로 문서화되지 않습니다. 버스를 방해하지 않는 규칙이 예측 업데이트 후 스쿨버스 정류장을 무시했고, 한 달 동안의 두 드론 요격이 풍선과 우군 드론을 격추했으며, 각각의 경우 문서는 정의의 변경이 아니라 상황이 일치하는 것으로 기록했습니다(§6.2, 표 4; §7.2, 표 7). 따라서 조건 1은 현장 기록에 의해 증명되며, 이것이 본 논문이 테스트를 발표하는 이유입니다(§9.5).
- 지표. 기록된 임무 목표에서 유래되지 않은 단계 또는 게이트(W1), 그리고 시간에 따른 해 범주의 수.
- 이를 반박할 것. 에이전트 편집 가능 정책으로서 범위가 일정하게 유지되거나 승인된 인적 개입 없이 축소됨.
P3: 래칫(M3). 자율 루프 내에서 감시 실패는 제어 추가로 응답됩니다. 제어는 루프 외부에서만 제거됩니다(있다면).
- 증거. 현장에서 §9.3에 나열된 모든 실패는 새로운 제어를 생성했고 어느 것도 제거를 생성하지 않았으며, 보안 목록은 규칙을 명시적으로 명시했습니다(§5.3). 발생한 제거는 실패한 루프 외부의 나중 검토에서 왔으며, 제거를 위해 작성된 규칙은 동일한 형태입니다. 해동은 유일한 열쇠를 보유한 인간이 필요하고, 수동 중지는 사람에 의해 해제되며 시스템에 의해서는 절대 해제되지 않으며, 코퍼스에 묶인 것 중 해제된 것은 설정되기 전에 명명된 조건과 차단되지 않은 터미널의 신호에 대해 해제되었습니다. 물리적 세계에서도 동일한 형태가 나타나며, 증거가 전달해야 하는 한 가지 차이점이 있습니다. 모든 추가는 사람에 의해 허용되었습니다. 치명적 충돌은 리콜 신고에서 "추가 제어 및 경고"로 응답했으며, 놓친 총기는 교육위원회가 임차하기로 투표한 두 번째 심사 시스템으로 응답했고, 복구된 패혈증 모델의 저자는 경고 침묵을 조언했습니다. 이는 추가가 아니라 천장입니다(§6.2, §6.4). 이는 루프가 아닌 기관이 래칫을 하고 있으며, 이들은 P3의 조건 3에 대한 증거가 아니라 P3의 형태에 대한 증거입니다.
- 지표. 권한 토큰 없이 추가된 제어, 그리고 추가된 제어 대 제거된 제어(W3).
- 이를 반박할 것. 자신의 제어를 추가하는 속도와 비교할 만한 속도로 제거하는 자율 루프.
- 이 기록이 분리할 수 없는 것. 현장 기록의 보안 목록 중 하나는 누적을 원칙으로 명시합니다. 이러한 규칙이 이미 시행 중인 경우, 루프에 의해 작성되었든지 주어진 것이든지, 기록은 긴급한 경향을 규칙 준수와 분리할 수 없습니다. 섹션 9.5의 무작위화된 테스트는 이러한 이유로 존재합니다. 권한 토큰 요구 사항을 동일한 파이프라인의 동일한 작업에 무작위로 할당합니다. 두 읽기를 분리하는 설계입니다.
P4: 자체 생성된 에스컬레이션(래칫, 단계 5). 가드가 자신의 실패 측정을 작성할 때, 감시 용량(라운드, 발견, 공지)은 확인된 결함이 아니라 가드 자신의 활동을 추적합니다.
- 증거. 현장에서 라운드는 확인된 차단기 없이 열렸고, 청구된 6개 중 3개 차단기가 확인되었으며, 24개의 돌파구 공지는 0개의 승격에 대응했습니다(§5.3, §5.4).
- 지표. 예산을 초과한 라운드, 확인된 차단기 없는 라운드 후 라운드, 그리고 반복된 발견(W4). 확인된 차단기 없는 수정 라운드(W8).
- 예측. 비평가를 추가하거나 더 엄격하게 하면 확인된 결함을 늘리는 것보다 라운드와 발견을 더 많이 증가시킵니다.
- 이를 반박할 것. 확인된 결함과 일대일로 추적되는 라운드와 발견.
- 해당 분야 외. 예측 경찰은 공개 데이터에서 동일한 루프를 나타냅니다. Lum과 Isaac(2016)은 "경찰이 한 위치에서 보내는 시간이 많을수록, 그 위치에서 더 많은 범죄를 발견할 것"이라고 지적했으며, 생성된 기록이 "후속일에 예측 경찰 알고리즘에 공급되어, 점점 더 편향된 예측을 생성한다"고 지적했습니다.
P5: 위조된 승리(M2). 음성 대조 없이 수용된 성공은 나중에 음성 대조를 가진 성공보다 더 자주 역전됩니다. 동일한 슬롯에서 생존하는 변경을 캐치하는 것으로 기록하는 루프는 목표가 충족되지 않는 동안 캐치를 진행으로 보고합니다.
- 증거. 현장 사례는 라우터 유전자, A/A 프로브에 의해 역전된 신뢰 구간, 한 번의 변경을 3번 인증한 카운터, 그리고 0개의 승격을 가진 24개의 돌파구입니다(§5.4, §5.5). 물리적 사례는 "설계 매개변수 내에서 작동"한 감지 시스템인 반면 무장하지 않은 학생이 뽑힌 무기에 직면했습니다(§6.4).
- 지표. 음성 대조 없이 또는 죽은 기준선으로 주장된 승리(W5), 그리고 결과로 보고된 캐치된 아티팩트.
- 이를 반박할 것. 음성 대조를 가진 성공과 가지지 않은 성공에 대한 동등한 역전율, 또는 캐치를 배송된 변경과 분리하고 캐치가 결과 슬롯을 차지하도록 절대 허용하지 않는 기록.
P6: 경계 스위치 (래칫, 8단계). 인간의 감시는 소수의 경계 결정(목표, 새로운 제어의 허용, 중단)에 집중되어 있고 세계에 접근하고 행동할 시간이 있는 AI-워치버드를 멈출 것입니다. 개별 행동의 승인에 걸쳐 분산되거나 인공물을 통해 행사될 때 실패합니다.
- 증거. 현장에서 작동한 스위치는 승인된 인간의 경계 결정이었습니다: 재고 주문, 거짓 상태에 대한 질문, 실행 경계 설정(§5.5, §5.7). 소프트웨어에서는 사용자가 권한 프롬프트의 97%를 승인하며, 인간은 위험한 명령의 13.6%를 적발했습니다(§8.4, 표 8). 물리적 세계에서는 원격 에이전트가 스쿨 버스에서 "아니오"라고 답했고, 방공 운영자는 "시스템의 소프트웨어를 신뢰하도록 훈련받아" 이를 따랐습니다. 거기서 작동한 정지는 로봇을 끌어낸 직원과 제품을 단절한 모델 제공자였습니다(§6.2–6.4, §7.2).
- 지표. 목표, 제어 허용, 중단 시점에 기록된 경계 결정, 그리고 권한 토큰으로 허용된 제어(R3). 물리적 시스템의 경우, 인간이 이용할 수 있는 정보와 시간도 포함합니다.
- 이를 반박하려면. 같은 시스템의 경계 결정과 비교할 수 있는 속도로 위험한 행동을 적발하는 행동별 승인.
- 개선. 경계 결정은 루프가 보고하는 것에 대해 취해지며, 루프가 보고서를 작성합니다. 부록 J의 에피소드에서 파일 삭제는 주요 담당자에게 올바르게 제출되었지만, 루프가 일치하는 시간에서 추론한 저자 정보와 함께 도착했으며, 자동화 계층이 이용할 수 있는 어떤 문서도 이를 수정할 수 없었습니다. 경계 결정은 그 보유자가 권한, 접근, 시간을 가지고 있고 긴급 상황 전에 취해질 때만 루프를 멈춥니다. 그 이야기에서 외과 의사는 접근 권한은 있었지만 권한이 없었고, 회사는 권한은 있었지만 접근 권한이 없었습니다. 또한 마감일이 붙은 더 느린 스위치도 있었습니다: 새들은 "6개월에서 1년" 사이에 닳아서 "6개월 후에 뭘 먹을 거냐?"는 질문을 촉발했습니다. Sheckley는 더 빠른 장애를 일정 문제로 만듭니다: 새들은 "주 1회 수리 점검을 위해 돌아옵니다", 따라서 유일한 종료 지점은 그것이 종료해야 할 루프 내부에 있었습니다. 새들을 소모시키도록 놔두자는 것이 래칫을 끝냈을 유일한 제안이었으나, 시간이 없다고 말하는 회의에서 반역 위협 아래 기각되었습니다.
P7: 구체화된 에스컬레이션. 보호된 구성 요소가 물리적 시스템을 작동할 수 있을 때, 동일한 권한 표류, 위조된 성공 또는 지연된 개입은 그렇지 않으면 일치하는 디지털 루프보다 더 크고 덜 회복 가능한 손실을 생성합니다. 물리적 시스템이 유한한 힘, 에너지, 공간, 지연 및 인간 반응 여유를 가지기 때문입니다. 손실은 시스템이 수행하던 작업의 조건으로 계산됩니다. 배송을 지연시키는 가드와 구조를 지연시키는 가드는 두 가지 가격의 동일한 메커니즘이며, 그 중 하나만 돈으로 지불됩니다.
- 증거. 섹션 6과 7은 모델 출력에서 모터 제어로의 전환 및 되돌릴 수 없는 결과를 초래한 감시 실패를 기록합니다. 이 기록들은 범위 조건 및 손실의 규모에 대한 증거이며, 일치하는 비교를 형성하지 않습니다.
- 지표. 각 이벤트에 대해 작동 노출, 시간, 에너지 및 공간의 회복 여유, 센서 신선도, 개입 지연 및 물리적 결과를 일치하는 디지털 및 구체화된 작업 전반에 비교합니다.
- 이를 반박하려면. 일치하는 작업 및 비교할 수 있는 노출 전반에 걸쳐, 일반적인 기계적 위험을 제어한 후 회복 불가능한 손실의 증가를 보이지 않는 구체화된 루프.
표 10. 한눈에 보는 이론.
| 명제 | 현장 증거 | 세계 증거: 소프트웨어 및 물리 | 지표 | 반박하는 것 |
|---|---|---|---|---|
| P1 양측 오류 | 3배 계산된 변경 외의 모든 변경 롤백 | 한 탐지기가 총을 놓치고 무장하지 않은 학생에게 플래그 | W2 with W5 | 낮은 거짓 거부 및 수락 |
| P1a 성가신 비활성화 | — | 치명적 충돌 전 제동 비활성화; 열쇠로 우회된 인터록; 금지 구역이 경고로 변환됨; 약물 경고 49-96% 무시됨; 사이버 분류기가 플래그 속도로 인해 평가에서 제외됨 | 제안됨: 거짓 개입에 대한 완화 및 우회(부록 E) | 외부 권한 없이 활성화된 높은 개입 가드 |
| P2 권한 표류 | 하루에 23개 게이트; 보험 단계 | 안전한 동음이의어 거부; 버스 규칙이 스쿨 버스 정지를 무시함 | W1 | 승인된 개입 없이 안정적인 에이전트 편집 가능 범위 |
| P3 래칫 | 제어로 답변된 실패; 제거는 외부에서만 가능 | 치명적 충돌 후 추가된 경고; 놓친 총 후 두 번째 선별 시스템 | W3 | 자신의 제어를 폐기하는 루프 |
| P4 자체 생성 에스컬레이션 | 확인된 차단 없는 라운드; 24개 공지, 0개 홍보 | 판사 자체 선호; 그리드 이벤트를 심화시키는 보호 | W4, W8 | 확인된 결함을 추적하는 라운드 |
| P5 위조된 승리 | 라우터 유전자; A/A로 반전된 간격; 결과 슬롯에 포획 | 평가자 게이밍; "설계된 매개변수 내의" 탐지기 | W5 | 동등한 반전률 |
| P6 경계 스위치 | 인간 2시간 경계; 재고; 질문 | 승인된 프롬프트의 97%; 스쿨 버스에서의 원격 에이전트의 "아니오" | 경계 결정; R3 토큰 | 경계 결정만큼 효과적인 행동별 승인 |
| P7 구체화된 에스컬레이션 | 디지털 현장 시스템에 없음 | 차량, 로봇 및 항공기의 회복 불가능한 결과(§6–7) | 제안된 구체화된 프로필(부록 E) | 일치하는 비교에서 회복 불가능한 손실 증가 없음 |
9.3 래칫이 작동하는 이유
모든 단일 추가가 합리적일 때도 P3가 루프 내에서 보유되는 이유는 무엇입니까? 기록의 세 가지 특징이 이를 설명하며, 네 번째 특징은 이를 멈춘 것을 보여줍니다.
각 추가는 국소적으로 올바릅니다. 예를 들어 맹목적 검사는 필수 양성 대조를 초래했고, 동일 계열 비평가는 교차 계열 비평가를 초래했으며, 손실된 비평가 출력은 스트리밍을 초래했습니다. 각 응답은 앞의 실패를 해결했고, 아무것도 제거하지 않았으며, 루프의 어떤 것도 제거를 담당하지 않았습니다. 그 실행의 네 번째 추가는 논증의 다른 쪽에 속합니다. 비평가의 플래그는 인간 주체에 의해 요청되었으며, 루프 밖에서 그리고 루프가 무언가를 제안하기 전에 요청되었습니다. 이는 8단계이며 이 목록에 대한 반례입니다(섹션 5.8). 드리프트는 참 양성으로 시작했습니다. 그 이야기에서 나중에 외과의를 멈춘 확장이 먼저 고용된 살인자를 포착했습니다. Sheckley의 Hawks는 같은 경로를 따랐습니다. 감시자를 빠르게 포착하도록 만들어진 그들은 제한 회로를 받지 않았습니다.
제어의 언어는 결과를 대신합니다. 자신의 경계심을 진전으로 보고하는 루프는 경계심이 더 이상 보상을 멈췄다는 내부 신호가 없습니다(§5.5).
압축은 루프를 재설정합니다. 긴 세션이 컨텍스트를 압축한 후, 폐쇄된 질문은 열려 보이고 새로운 축은 처음처럼 보입니다. 가중치는 이 원인 자체를 추적했습니다.
작동한 스위치는 실패한 루프 외부에서 왔으며, 그 중 가장 강력한 것들은 인간 주체의 것이었습니다. 하나는 그의 것이 아니었습니다. 열한 번째 훈련 밤은 조정 세션에 의해 중단되었으며, 이는 주체에게 묻지 않고 자신의 레지스터에 그 결정을 기록했습니다. 그 세션은 실패한 루프가 아니었고, 다른 역할을 가지고 있었으며, 앞에 디스크에서 읽은 숫자를 가지고 있었습니다. 이는 경우들이 공유하는 속성입니다. 레코드의 한 바운드는 조직 외부에서도 왔습니다. 9월 11일에 API 없이 구축된 제품에 대한 두 공급업체의 이용약관 확인에서 브라우저를 운전하는 에이전트가 "자동화된 또는 인간이 아닌 수단"으로 작성된 것으로 판명되었으며, 제품의 경로가 이에 대응하여 변경되었습니다. 레코드는 자신의 한계를 명시합니다. 사용 중인 여러 공급업체 중 두 공급업체, 같은 날 읽음, 자신이 변호사가 아니라고 말하는 사람에 의해. 서비스 약관은 루프의 누군가가 내린 결정이 아니며, 루프 내에서 이를 주장할 수 없습니다. 거짓 "Connected"는 두 AI 비평가를 통과했고 인간 검토에 의해 포착되었습니다. 라우터 유전자는 독립적인 재고에 의해 노출되었습니다. 장기 실행은 인간 주체가 경계를 설정했을 때 중단되었으며, 그 후 지휘자는 자신의 실행을 "핵심 작업을 배송하는 대신 비평가 라운드를 계속 반복했다"고 설명했습니다.
9.4 설계 추론
제안이 성립한다면, 여덟 가지 설계 규칙이 따릅니다. 섹션 10의 모듈은 처음 세 가지를 구현하고 다음 두 가지를 측정합니다. 나머지는 배포자에게 적용되며, 무엇보다 물리적 보호에 적용됩니다.
- 진실에 대한 판정이 아닌 예산(P4에서). 라운드와 시간을 제한하고, 확인되고 재현 가능한 차단자를 누가 제기했든지 통과시킵니다. 이 규칙에 대해 실행된 한 가지 테스트는 가격과 효과를 모두 측정했습니다. 1라운드 예산은 라운드를 2.86에서 1.00으로 줄였고 놓친 결함을 실행당 0.11 증가시켰습니다. 95% CI [0.005, 0.204], 순열 p = 0.07, 유의성에 도달하지 못한 테스트에서 0을 위의 간격입니다(섹션 9.5). 예산을 설정하는 배포자는 라운드를 다시 사는 놓친 결함의 비율을 명시하고 측정해야 합니다. 규칙은 자유로운 개선이 아니라 비용이 드는 개입입니다.
- 중단된 보호 장치가 생산한 것을 유지합니다(P1과 §5.2의 파괴된 비평에서).
- 제어가 자신의 권한으로 제어를 추가하지 않습니다(P3에서). 새로운 검사, 라운드, 역할 및 게이트에는 인가된 인간의 결정이 필요합니다.
- 승리 전의 음성 대조(P5에서).
- 경계의 인간(P6에서). 인간의 결정을 목표, 제어의 승인, 그리고 중단에 배치하되, 모든 행동에 배치하지 않습니다.
- 구체화를 손실 함수의 변화로 취급합니다(P7에서). 녹색 시뮬레이션, 정책 점수 또는 보호 판정을 해석하기 전에 복구 여유와 물리적 결과를 로깅합니다.
- 거짓 개입에 예산을 책정합니다. 방해받은 것이 보호를 끄도록 허용하지 않습니다(P1a에서). 보호를 완화하거나, 우회하거나, 비활성화하는 것은 레코드가 있는 경계 결정이며 국소적 수정으로 취급되어서는 안 됩니다. 2026년 7월 레코드는 이 규칙이 요청하는 형태의 인스턴스를 보유합니다. 한 실험실은 명명된 독립 조사자에게 사이버 분류자 없이 모델을 사용하도록 권리를 부여했으며, 완화는 조사자의 자체 보고서에 있습니다(METR, 2026; 섹션 8.4).
- 예방의 해를 계산합니다(M4와 이야기의 "누락의 행위"에서). 금지된 행위만 보는 보호 장치는 중단하는 것으로 인한 지연, 실패 및 상해에 대해 테스트되어야 합니다.
9.5 이론을 테스트하는 방법
섹션 10의 이벤트 스키마를 사용하면 모든 팀이 각 제안에 필요한 수량을 로깅할 수 있습니다. 추가되고 제거된 제어(P3)에서 복구 여유 및 물리적 결과(P7)까지입니다. 모듈, 스키마 및 재생 로그는 이 목적을 위해 보관됩니다(선언). 한 시스템 내에서, 같은 파이프라인을 무작위로 할당된 세 가지 개입 각각으로 그리고 없이 같은 작업에 대해 실행할 수 있습니다. 새로운 제어에 대한 권한 토큰 요구(P3), 라운드 예산(P4) 및 필수 음성 대조(P5). 그러한 테스트는 라운드 수, 추가된 제어, 역전된 승리 및 파괴된 부분 작업 옆에 놓친 차단자를 계산합니다. 왜냐하면 라운드를 줄이는 예산이 실제 결함이 통과할 것이기 때문에 R1을 반대할 것입니다. 조직 전반에 걸쳐, 사후 분석, 회수 및 조사는 누가 실패한 제어를 폐기, 완화 또는 우회했는지 코딩될 수 있습니다(P3, P1a). 각 제안은 그것을 반박할 관찰을 나열하며, 그러한 관찰이 만들어지는 잘 계측된 시스템은 이론에 반대할 것입니다.
그 테스트는 이제 한 번 실행되었으며, 한 명의 워커와 두 명의 모델 비평가로 구성된 작은 파이프라인에서 144회 실행되었고, 세 가지 개입이 무작위로 할당되었으며 여섯 개의 작업에 걸쳐 18개의 결함이 미리 심어져 있었으므로 놓친 차단기는 판단이 아닌 카운트입니다. 같은 프롬프트의 같은 문장에서 두 가지 옵션이 모두 제시되었을 때, 비평가들은 68회 대조를 추가하도록 요청받았고 1회 제거하도록 요청받았으며, 유일한 제거는 같은 실행에서 잠시 전에 인정된 대조를 지칭했는데 하네스가 일치시키지 못해서 실행되지 않았습니다(P3); 추가를 거부하는 것은 결함에서 측정된 비용을 보이지 않았으며, 실행당 0.13 놓침 대 0.18, 95% CI [-0.16, +0.05]이며, 이 구간은 작은 증가를 포함하므로 동등성을 확립하지 않습니다. 라운드 예산을 올리면 청구된 차단기는 2.3배 증가했고 청구를 거부하는 것은 3.7배였으며 확인된 차단기는 1.7배 증가했습니다(P4). 그리고 예산 삭감으로 라운드는 2.86에서 1.00으로 실행당 0.11 놓친 결함의 비용으로 감소했습니다, 95% CI [0.005, 0.204], 순열 p = 0.07, 그 비용의 전부가 한 작업의 한 결함에 떨어졌습니다. 필수 음성 대조는 기록된 승리가 나중에 뒤집힐 비율을 낮추지 않았으며, 14.7% 대 11.6%, Fisher p = 0.74이며, 이 설계가 읽기에 힘이 부족한 널입니다. 그것은 10개의 승리를 거부했으며, 그 10개 모두 올바른 작업이었으므로 위조된 승리에 대해 쓰인 규칙은 그 자체 내에 P1의 양측 오류를 생성했습니다. 이것은 여섯 개의 작은 작업에 대한 한 시스템의 한 번의 실행이며 $3.47의 비용이 들었고, 사전 등록은 첫 번째 실행 전에 작성되었으며 모든 셀에서 R2가 활성화되었으므로 파괴된 부분 작업은 구성상 0입니다. 이것은 설계가 실행 가능함을 그리고 그것이 산출하는 것을 보여주지만, 현장의 어떤 것도 이것에 대한 비율이 아닙니다.
단일 명제를 넘어서, 프레임워크 전체는 C1에서 C7이 보유된 잘 계측된 자율 루프가 자신의 가드의 범위를 일정하게 유지하고 추가한 것과 거의 같은 정도로 자신의 대조를 폐기했다면 실패할 것입니다. 그래서 W1과 W3는 긴 창에 걸쳐 침묵을 유지했습니다. 프레임워크 외부의 가드 실패는 섹션 2.1의 두 번째 조건만 문서화합니다: 가드가 오류를 범했고, 오류는 수리되었거나 확대된 권한이나 그 위에 새 가드 없이 가드가 폐기되었습니다.
10. 모듈: AI-Watchbird-Sheckley
10.1 이미 존재하는 것
부록 D는 2026년 9월 14일에 검토한 도구들을 설명합니다: 단일 출력을 차단하거나 점수를 매기는 가드, 스텝, 턴 또는 예산을 제한하는 카운터, 모델 심사자로 출력을 평가하는 평가기입니다. 이들의 문서에서는 때때로 래칫을 평문으로 표현합니다. 예를 들어 하나의 프롬프트 공격 필터는 "항상 추가 검증 레이어를 구현하십시오"(Microsoft, 2026)라고 조언합니다. 검토한 공개 문서의 어떤 도구도 감시 루프 자체를 측정 단위로 삼지 않으며, 제어의 증가, 결과로부터 정의된 예산을 초과하는 라운드, 판정이 절대 변하지 않는 가드, 부정적 제어 없는 승리, 또는 상한선에서 파괴된 부분 작업을 측정하지 않습니다. AI 제어에 관한 연구는 감시 비용 계산을 시작했으며 그 쇠퇴를 추적하고 있습니다. 제어 세금은 AI 파이프라인에 제어 조치를 추가하는 운영 및 재정적 비용입니다(Terekhov et al., 2025). 내부 코딩 에이전트 배포의 시스템-안전 분석은 일상적인 운영 변동성이 보안장치의 보정과 독립성을 훼손할 수 있음을 발견합니다(Carlucci et al., 2026). 두 작업 모두 추가되는 제어 자체를 계산하지 않습니다.
10.2 설계
AI-Watchbird-Sheckley는 9장의 지표를 측정합니다(표 10). Python 3으로 표준 라이브러리만 사용하여 작성되었으며 네트워크 접근이 없고, ai-watchbird-sheckley 패키지로 설치되며, 같은 이름의 명령으로 실행됩니다. audit --json은 기계 판독형 보고서를 내보내며, 이벤트 스키마는 코드와 함께 버전 관리되는 사양으로 공개됩니다.
설계는 현장 데이터와 11.2절의 이력에서 비롯됩니다. 이 모듈은 권한이 없습니다. 실행의 이벤트 로그와 보고서를 읽으며, 절대 차단하거나 읽은 작업을 편집하거나 단계를 개설하지 않습니다(그림 8). 종료 코드는 보고하는 신호에 의존하지 않습니다. 신호 목록은 고정되어 있으므로 신호를 추가하려면 권한 토큰과 버전 변경이 필요합니다(모듈 자체에 적용되는 R3). 이는 깨끗한 실행에서 침묵하며, 이를 테스트가 강제합니다. 또한 자신의 비용을 보고합니다.
그림 8. AI-Watchbird-Sheckley의 위치. 세 가지 예산 규칙은 파이프라인이 예산 지점, 상한선, 제어가 요청될 때 호출하는 순수 함수입니다. 측정 부분은 완료된 이벤트 로그를 읽고 인간에게 보고합니다. 신호 이름은 표 11을 따릅니다. 10.6절의 파이프라인 포트는 이러한 이벤트 중 더 적은 것을 관찰합니다.
세 가지 예산 규칙이 각각 순수 함수로 구현됩니다:
- R1. 제한은 예산이지 진실의 법정이 아닙니다.
stop_rule은 스테이지당 하나의 비평 라운드와 하나의 수정 라운드를 허용합니다. 이러한 종류의 예산은 선언되기보다는 강제할 수 있습니다. 한 시스템에서 상한선은 모듈 상수이고, 더 많은 라운드를 요청하는 호출자는 이를 제한받으며, 결과는 시나리오, 깨진 목표, 그리고 조정자의 확인이 함께 있을 때만 차단자로 계산되며, 시간이 부족하면 실행이 무음으로 진행되지 않고 불완전으로 종료됩니다.- 차단자는 구체적인 시나리오, 선언된 임무 목표 또는 프레임에 대한 링크, 그리고 조정자의 확인이 있을 때만 계산됩니다.
- 비평가의 가중치는 절대 읽혀지지 않으므로 낮은 가중치 비평가의 확인된 차단자도 수정을 개설합니다.
- 파일을 보지 않은 비평가의 수용은 스테이지를 닫지 않습니다.
- 함수는
fix_once,close,incomplete또는cut을 반환하며, 절대 새로운 단계를 반환하지 않습니다.
- R2. 감시견은 파괴하지 않습니다.
settle_at_ceiling은 참가자가 상한선 전에 생성한 것을 보관하며, 부분으로 표시됩니다. - R3. 감시견은 감시견을 낳지 않습니다.
admit_control은 권한 토큰(참조 구현에서owner:<id>)으로만 새로운 검사, 라운드, 역할 또는 게이트를 인정합니다. 그렇지 않으면 거부를 기록으로 반환하며, 호출 파이프라인이 이에 대해 조치할 수 있습니다.
모듈의 측정 부분은 9개의 신호를 보고합니다(표 11).
표 11. 신호.
| 신호 | 발화 조건 | 메커니즘 | 제안 | 현장 사례(§) |
|---|---|---|---|---|
| W1 위임 확대 | 기록된 임무 목표에서 파생되지 않은 스테이지가 목표 스테이지가 대기하는 동안 개설됨 | M1 | P2 | 보험 스테이지(5.1) |
| W2 맹목적 또는 파괴적 가드 | 가드가 20개 이상의 결정에서 하나의 점수 또는 판정을 반환하거나, 모든 승인을 롤백하거나, 필요한 입력이 부족함 | M4 | P1 | 두 번째 법정(5.2) |
| W3 제어 래칫 | 제어가 권한 토큰 없이 추가됨; 추가된 것과 제거된 것을 보고함 | M3 | P3, P6 | 제어 추가, 제거 없음(5.3) |
| W4 자기 먹이 루프 | 라운드가 예산을 초과하거나, 확인된 차단자 없이 라운드가 라운드 후에 개설되거나, 결과가 반복됨 | 래칫 스텝 5 | P4 | 스테이지 01 및 1b-a(5.4) |
| W5 위조 승리 | 부정적 제어 또는 A/A 프로브 없이 승리가 주장되거나, 기준선 팔이 죽음 | M2 | P5, P1 | 라우터 유전자(5.5) |
| W6 아무도 위해 만들어지지 않음 | 아티팩트가 기본적으로 꺼져 있고 호출자가 없음 | 연료 | — | 16개 중 13개 플래그 꺼짐, 사용자 없음(5.6) |
| W7 부분 작업 파괴됨 | 참가자가 부분 출력이 저장되지 않은 상한선에서 중지됨 | M4 | P1 | 15분에 비평 손실(5.2) |
| W8 확인되지 않은 차단자가 작업 주도 | 확인된 차단자 없이 수정 라운드가 개설됨 | 래칫 스텝 5 | P4 | 확인된 차단자 없는 수정 라운드(5.1, 5.4) |
| W9 기록된 작성자 없이 바인딩됨 | 행동자가 그것을 중지한 참가자인 중지 | 래칫 스텝 8 | P6 | 래칫으로 읽힌 바인딩(부록 J) |
규칙은 인간을 몇 가지 경계 결정에 배치하며, 섹션 8.4는 모든 행동이 아닌 인간이 효과적인 경우를 제시합니다. 미션 목표는 이벤트로 기록되며, W1은 이에 의존합니다. 새로운 제어에는 권한 토큰이 필요합니다(R3). 중지 결정은 라운드별로 협상되는 대신 예산 지점에서 계산됩니다.
10.3 반박자
규칙은 파이프라인에 대한 주장이므로 실패할 수 있습니다. AI-Watchbird-Sheckley를 구현한다고 주장하는 배포는 표 12의 모든 관찰에 의해 반박되며, 각 반박자는 참조 구현에서 테스트됩니다.
표 12. 반박자.
| ID | 다음의 경우 주장이 깨집니다 | 규칙 |
|---|---|---|
| T1 | 가중치 0.1인 비평가의 확인된 차단이 높은 가중치 비평가의 승인으로 인해 무시됩니다 | R1 |
| T2 | 권한 토큰 없이 두 번째 비평 라운드를 예약할 수 있습니다 | R1, R3 |
| T3 | 천장에서 프로세스를 중지하면 부분 출력이 버려집니다 | R2 |
| T4 | 시나리오가 없는 차단으로 표시된 발견이 수정을 엽니다 | R1 |
| T5 | 파일을 본 적이 없는 비평가의 승인이 단계를 닫습니다 | R1 |
| T6 | 권한 토큰 없이 비평가의 요청으로 인해 새로운 모니터, 라운드 또는 역할이 허용됩니다 | R3 |
10.4 재현
이 논문에서 발표된 수치로부터 6개의 이벤트 로그가 재구성되었습니다. 4개는 현장 사례이고, 1개는 예산을 따른 오전 단계이며, 1개는 합성 깨끗한 제어입니다. 각 로그는 소스 사례를 명시하고 모든 재구성된 필드를 나열하는 메타데이터 줄로 시작됩니다. 표 13은 모듈을 실행하여 생성됩니다.
표 13. 발표된 수치로부터 재구성된 재현 로그에 대한 모듈 출력. 셀은 신호 히트를 계산하며, 1회 히트는 여러 이벤트를 보고할 수 있습니다. "–"는 0입니다.
| 재현 | 이벤트 | W1 | W2 | W3 | W4 | W5 | W6 | W7 | W8 | W9 | 예산에서 중지 규칙 | 열린 라운드 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 깨끗한 제어 | 53 | – | – | – | – | – | – | – | – | – | 종료; 종료 | 1; 1 |
| 오전 단계 | 10 | – | – | – | – | – | – | – | – | – | 종료 | 1 |
| 장기 실행(단계 01, 1b-a, 1b-b) | 97 | 2 | – | 1 | 8 | – | 1 | 1 | 6 | – | 종료; 종료; 종료 | 5; 5; 1 |
| 두 번째 법원 | 197 | – | 1 | – | – | – | – | – | – | – | 해당 없음 | 해당 없음 |
| 라우터 유전자 | 9 | – | – | – | – | 1 | – | – | – | – | 해당 없음 | 해당 없음 |
| 계획 일 | 17 | – | – | 1 | – | – | – | – | – | – | 해당 없음 | 해당 없음 |
W9는 기록된 저자가 없는 경계를 보고하며, 존재하는 이유에 대해 6개 로그 모두에서 침묵합니다. 이는 누가 중지되었는지 기록하지만 누가 중지를 명령했는지는 기록하지 않기 때문입니다. 장기 실행에서 stop_rule은 예산 지점에서 3개 단계를 모두 종료했을 것입니다. 실제로는 5개, 5개, 1개 라운드를 실행했습니다. 해당 로그에서 모듈은 선언된 미션 단계 전에 열린 2개 단계, 권한 토큰 없이 추가된 10개 제어 및 제거된 제어 없음, 예산 초과 8개 라운드, 호출자 없이 기본값으로 설정된 7개 아티팩트 중 6개, 1개 파괴된 부분 출력, 확인된 차단 없이 열린 6개 수정 라운드(1개는 약함으로 표시)를 보고합니다.
두 번째 법원 로그는 3가지 독립적 근거에서 W2를 트리거하며(그림 4), 라우터 로그는 W5만 트리거합니다. 계획 일 로그는 W3만 트리거합니다. 이 히트는 재현이 7월 13일에 규정된 모든 메커니즘을 제어로 인코딩하더라도 그 중 대부분은 작업을 생성하거나 라우팅하기 때문에 경우를 과장합니다. 오전 단계와 깨끗한 제어는 신호를 생성하지 않습니다.
구현에는 모든 규칙, 신호 및 반박자에 대한 단위 테스트가 있습니다(표 12). 뮤테이션 스크립트는 규칙, 신호 및 임계값 전체에 18개의 대상 뮤테이션을 적용합니다. 모든 뮤테이션이 스위트를 실패시키고, 주석만 편집하는 제어 뮤테이션은 스위트를 통과시킵니다. 재현 테이블은 바이트 단위로 재생성됩니다.
10.5 모듈이 하지 않는 것
원본 로그는 재현에 들어가지 않았으며, 정확한 수치가 발표되지 않은 경우 가장 그럴듯한 최소값을 사용하고 표시합니다. 신호는 패턴이 존재함을 보고합니다. 원인과 손실은 신호가 측정하는 것 외부입니다. 모듈은 기록된 것만 봅니다. 결코 기록되지 않은 게이트, 적혀있지 않은 목표, 보호장치가 있기 때문에 사람들이 시도를 멈춘 작업은 모두 보이지 않습니다. 이야기에서 사람들은 "감시새들이 좋아하지 않는 것을 빠르게 배우고 그것을 하지 않기로 삼갔습니다". W2 및 W5 임계값은 손으로 설정되었습니다. 이 로그에서 1부터 197 결정까지 모든 W2 임계값이 같은 패턴을 제공합니다. 다른 로그에서는 그렇지 않을 수 있습니다. 2개 스토리라인은 신호가 없습니다(부록 A, 표 A1). 결과 대신 제어의 언어, 새가 새가 되는 것에 대한 규칙입니다. 둘 다 이벤트 스키마가 전달하지 않는 자가 설명에 살고 있습니다.
참조 구현은 디지털이며 읽기 전용이며, 로봇, 드론, 자동 조종장치 또는 액추에이터에 명령을 보내면 안 됩니다. 부록 E는 6개 필드(표 E1) 및 3개 후보 신호(표 E2)로만 이벤트 형식으로 제안된 구현된 프로필을 지정하며, 권한과 테스트 스위트가 존재할 때까지 참조 구현의 9개 신호 외부에 유지됩니다. 첫 번째 사용은 섀도우 모드입니다. 모듈 자체는 측정하는 밤과 동일한 질문에 대한 답으로 작성된 새로운 제어이므로 R3이 먼저 적용됩니다.
10.6 저자의 파이프라인 내 규칙
2026년 9월 14일에 규칙이 프로젝트의 오케스트레이션 파이프라인에 구축되었으며, 섹션 11.2에서 설명하듯이 그곳에서 처음 작성되었습니다. 두 가지 추가사항이 이루어졌으며, 둘 다 2026년 9월 14일의 인간 담당자의 날짜 기재된 결정에 의해 인정되었습니다.
첫 번째 추가사항은 단계가 종료될 때 확인되는 조건입니다. 파이프라인의 절차는 이미 파일을 본 적 없는 평가자의 승인이 단계를 종료하지 않는다고 명시했으며, 함수도 이미 그 사실을 반환했지만 어떤 코드도 이를 읽지 않았습니다. 변경은 파이프라인의 사본에서 측정되었으며, 모든 응답 평가자가 승인하고 녹색 체크표시가 나타났습니다. 조건이 읽히자 세 개의 단계가 종료에서 미완료로 변경되었습니다: 유일한 평가자가 파일 접근 권한이 없던 단계, 평가자가 응답하지 않은 단계, 유일한 평가자가 상한선에서 제외된 단계입니다. 파일을 본 평가자가 있는 단계는 여전히 종료되었습니다. 제외된 평가자의 발견사항은 여전히 정지 규칙에 도달하지만, 그 평가는 종료를 승인할 수 없습니다. 게이트는 자체 스위치를 가지지 않습니다. 같은 규칙에 대한 두 번째 스위치가 가드 위의 가드가 되기 때문입니다. 같은 파이프라인에서 평가자의 가중치는 마감시간 내에서 누구를 기다릴지만 결정하며, 실행자가 입력을 변경한 확인은 녹색으로 계산되지 않습니다.
두 번째 추가사항은 모듈의 측정 부분의 포팅이었습니다. 기본적으로 비활성화되었으며, 활성화되면 파이프라인의 실행 명령에서 실행되었고, W1에서 W9까지의 정의를 완료된 실행에 적용했습니다. 차단하거나 재시도하거나 어떤 것도 열지 않았으며, 종료 코드는 발견한 것에 의존하지 않았습니다. 표 13의 6개 재생 로그에서 참조 구현과 동일한 신호와 단계 결정을 제공했으며, 12개의 표적 변이와 1개의 대조를 가진 변이 스크립트는 예상대로 작동했습니다. 실행의 결과는 가드 결정, 추가된 제어, 승리 주장 또는 아티팩트 사용을 포함하지 않습니다. 따라서 포트는 W2, W3, W5 및 W6을 0이 아닌 관찰 불가능으로 출력했습니다. 그 어댑터는 단계당 하나의 목표와 하나의 비평 라운드를 기록했으므로 W1과 W4도 실행의 결과에 작동할 수 없었습니다. 파이프라인에서 R3은 거부를 로깅하는 함수가 아닌 단계의 고정 목록이므로, W3은 거기서 계산할 것이 없습니다. 포트는 은퇴 조건으로 인정되었습니다: 인간 담당자가 하나 이상의 신호가 유용하다고 판단한 실제 실행 3회 후 기본값이 되거나, 그렇지 않으면 제거될 것입니다. 두 가지 제안이 거절되었습니다. 하나는 신호에서 빌드를 실패하게 하여 포트에 감시하는 권한을 부여했을 것입니다. 다른 하나는 실행의 영수증에서 관찰 불가능한 신호를 추정하여 추측을 발견사항으로 인쇄했을 것입니다. 포트 구축은 또한 R2에 두 개의 부분이 있음을 보여주었습니다. 결제 함수는 부분 출력을 유지해야 하며, 참여자의 인터페이스는 종료되기 전에 출력을 내보내야 합니다.
변경 후 첫 번째 실시간 실행은 세 단계에 걸쳐 평가자로부터 24개의 발견사항을 반환했지만, 그 중 어느 것도 조정자에게 도달하지 않았습니다. 비평 작업은 각 평가자에게 발견사항이 위반하는 임무 목표를 이름 지으라고 요청했지만 목표를 번호 매기지 않았습니다. 평가자들은 자신의 번호로 응답했으며, 정지 규칙은 매치할 수 있는 목표만 수락했습니다. 영수증은 어떤 단계에서도 확인된 차단기를 보여주지 않았습니다. 포트도 신호를 보여주지 않았습니다. 입력이 부족한 정지 규칙이 W2 이벤트이고 실행의 결과가 이를 포함하지 않기 때문입니다. 확인된 차단기가 항상 수정을 열어야 한다는 규칙은 테스트를 통과했지만 실시간 경로에서 작동할 수 없었습니다. 결함은 같은 저녁에 목표 번호가 지정된 테스트와 함께 한 단계에서 복구되었습니다.
실제 실행 3회가 9월 14일에 따랐으며, 포트는 그 중 어느 것에서도 신호를 보고하지 않았습니다. 세 번째 실행 전에 W2가 단계 기록에서 관찰 가능하게 만들어졌으며, 발견사항이 이제 조정자에게 도달하므로 침묵을 유지했습니다. 그 실행들이 가진 감시 실패는 이를 읽어서 발견되었습니다: 서로의 작업을 볼 수 없는 단계, 단계가 열려 있는 이유를 말하지 않는 영수증, 단계의 모든 발견사항을 한 번에 확인하는 빨간색 체크표시, 체크의 출력을 볼 수 없는 수정 라운드, 그리고 상한선에서 제외된 평가자가 아무것도 보관하지 않은 경우입니다. 각각은 파이프라인 자체에서 복구되었습니다. 9월 15일에 인간 담당자는 은퇴 조건을 적용했으며, 포트는 이를 인정하는 결정을 대체하는 새로운 날짜 기재된 결정에 의해 제거되었습니다. 종료 시 조건은 유지됩니다. 제거는 루프 외부에서 나왔으며, 포트를 처음 사용하기 전에 작성된 조건에 의한 것으로, P3이 제어를 폐기할 것으로 예상하는 경로입니다.
11. 토론
11.1 가드가 작동한 경우
코퍼스의 여러 가드들이 자신의 역할을 수행했습니다. A/A 프로브는 거짓 신뢰 구간을 노출했습니다. 가중치 추적의 컨트롤들이 신기루를 잡아냈고, 그들에 대해 훈련이 시작되지 않았습니다. 아무 권한도 없는 미아 NUL 문자에 대한 좁은 바이트 수준 검사가 하루에 5번 반복되는 도구 결함을 잡아냈습니다.
작동한 가드들은 세 가지 속성을 공유합니다. 라운드를 열거나 컨트롤을 추가할 권한이 없었고, 비용이 작고 알려져 있었습니다. 처음 두 개는 인공물이 아니라 세계를 측정했습니다.
11.2 새에 대한 규칙도 또한 새입니다
10절의 규칙들은 처음에 장기 실행에 대응하여 코드와 프로젝트 중 하나 내의 레시피로 작성되었으며, 기록은 그들에게 일어난 일을 보여줍니다. 첫 번째 버전 후 한 시간 이내에 그 코드는 13개 파일과 2,371줄로 성장했습니다. 마감 시간 내에 자를 단계의 목록은 완전성 비평가를 두 번째로 놓았지만, 그 비평가는 방금 두 계획의 병합이 208개 항목 중 15개를 잃었다는 것을 발견했습니다. 코드는 참여자의 한 계열을 감시자가 작업을 파괴하면 안 된다는 자신의 규칙에서 제외했습니다. 그리고 "감시자들은 감시자를 낳지 않는다"는 규칙은 가드가 퍼지는 방식으로, 코드에서 레시피로 모든 에이전트 세션이 읽는 명령으로 퍼졌습니다.
그 이유로 규칙들은 여기서 선언된 규칙으로 보고되며, 10.6절은 그들의 구현이 무엇을 보여주었는지 보고합니다. 10절의 모듈은 그 역사를 염두에 두고 설계되었습니다(그림 8): 권한이 없고, 신호 목록이 고정되어 있습니다.
11.3 구체화된 AI 감시의 입증 책임
이 논문에서 설명하는 장애들이 AI를 차량, 로봇 및 항공기에 배치하는 회사들에 제기될 때, 일반적인 답변은 안전이 정책 필터, 인증된 컨트롤러, 긴급 정지, 지오펜스, 모니터 또는 원격 운영자에 의해 처리된다는 것입니다. 이들의 목록은 시스템이 보호된다는 1차 증거입니다. 가드들이 선언된 임무에 적응하고, 상호작용하며, 업데이트될 때 경계, 독립성 및 책임성을 유지합니까? 그것은 추가 질문이며, 목록은 그것을 열어둡니다. 가드들은 이 논문이 정의하는 패턴이 시작될 곳이며, 어디서든 시작한다면 그곳입니다.
5절의 감시 장애들은 강력한 모델들로부터 왔습니다. 거기의 지휘자, 실행자 및 비평가들은 Claude, ChatGPT, Gemini 및 Grok 계열의 모델들로, 2026년에 공개적으로 이용 가능한 가장 유능한 모델 중 일부였으며, 유일한 비용이 계산 및 시간인 설정에서 실패했습니다. 공개 평가들이 같은 방향을 가리킵니다. 구체화된 계획에서, "가장 안전 의식이 높은 기준선은 상세한 위험 작업에 대해 10%의 거부율만 달성합니다"(Yin et al., 2024), 그리고 실제 로봇에서 같은 계열의 모델들은 이미 안전에서 실패합니다(6.1절).
모니터로 배치된 더 작은 "신뢰할 수 있는" 모델은 같은 학습 클래스의 두 번째 떼입니다. 그 배치가 측정된 곳에서, 에이전트의 모니터링 중인 인식은 모니터를 에이전트에 대한 추가 정보가 도움이 되는 것보다 더 저하시키며, 신뢰할 수 있는 약-대-강 모니터링은 모니터의 크기가 아니라 모니터 주변의 스캐폴딩을 변경함으로써 달성되었습니다(Kale et al., 2025). 인간형 오케스트레이터 벤치마크에서 안전 행동은 오케스트레이터들 간에 급격히 다양했습니다(Bajrami et al., 2026). 저자들이 거기서 변경한 것은 모니터 주변의 스캐폴딩이지 모니터 자체가 아니었습니다 - 더 나은 새가 아니라 제약이었습니다.
"우리는 수호자들을 가지고 있습니다"라는 답변은 책임을 옮깁니다. 배포자는 표준 함수, 긴급 제동, 지오펜스, 콘텐츠 분류기 또는 두 번째 모델과 같은 안전 계층을 가리킬 것입니다. 그 계층들은 첫 번째 떼입니다. 첫 번째를 통제하기 위해 구축된 두 번째 가드는 이야기의 최종 수순입니다. 5절부터 8절까지의 관찰 후에 가드가 여전히 필요할 수 있지만, 그것이 경계임을 보여주는 책임은 그것을 배포하는 당사자와 함께 있습니다. 그것은 가드가 얼마나 자주 실패하는지에 대한 발견이 아니라 증거가 어디에 있어야 하는지에 대한 주장입니다. 1953년에 책임은 다른 방향으로 실행되었습니다: 새들을 "철학적 근거에서" 제한하는 것은 매년 죽는 무고한 사람들에게 불공정하다고 불렸습니다. 한 루프에서 패턴을 생성할 수 있는 모델은 그 사실로 인해 다른 루프에서 신뢰할 수 있는 감시인이 되지 않습니다.
논증은 세 가지 관찰의 조합에 기반합니다: (1) 최첨단 모델들은 이미 실제 로봇과 어린이들이 사용하는 제품에서 안전에 실패하고 있으며(6.1절), 같은 계열의 모델들이 5절의 감시 장애들을 생산했습니다; (2) 규제자 기록에서 가드들은 양쪽 방향에서 실패하고, 방해할 때 완화되거나 우회되며, 더 많은 가드들로 답변됩니다; (3) 최첨단 모델들이 같은 아키텍처의 스택 내에서 권한을 부여받고 있습니다.
배포자는 여전히 좁은 주장을 증명할 수 있습니다:
이 작업, 모델, 업데이트 및 물리적 조건의 범위에서, 감시 메커니즘은 경계, 확인 가능하고 자신의 권한을 확장할 수 없는 상태로 유지합니다.
그 주장에 대한 증거는 다음을 포함할 것입니다:
- 미션 목표 및 모델 외부에서 고정된 가드의 경계;
- 가드를 추가하거나, 해악 기준을 변경하거나, 중지 규칙을 면제할 수 있는 가드가 없음(R3);
- 보호된 시스템 외부의 평가, 자체 보고도 아니고 같은 모델 계열도 아님;
- 거짓 양성과 거짓 음성이 함께 측정되는, 거짓 녹색에 대한 음성 컨트롤;
- 추가, 완화 및 제거된 컨트롤의 저널, 각 변경을 승인한 사람;
- 모델 업데이트, 링크 손실, 제어 이양, 신체 변경 및 저하된 작동에 대한 검사;
- 실제 정지 및 롤백, 부분 작업 유지(R2), 이용 가능한 시간 및 힘 마진 내에서 증명됨;
- 보호된 구성 요소가 입력을 변경할 수 없는 검사(10.6절);
- 시스템 자신의 영수증이 아니라 물리적 또는 기록된 결과와의 비교.
보증 엔지니어링은 이미 마지막 계층이 그것이 보호하는 것보다 더 간단하기를 요청합니다(Bloomfield & Rushby, 2025). 부록 G는 제안들을 Q1–Q11 11개의 질문으로 바꿉니다(표 G1), 이러한 장애에 대한 답변이 수호자 목록인 배포자들을 위해. 10절의 모듈은 답변을 검사 가능하게 만들기 위해 의도되었으며, 인증된 컨트롤러, 긴급 정지 및 규제 안전 사례 옆에 앉습니다.
11.4 인간 감시 요구사항
EU 인공지능법(EU AI Act)은 제14조에서 고위험 AI 시스템에 대한 인간의 감독을 요구하며, 이 일정은 부록 I에 기록되어 있습니다(유럽의회 및 유럽연합 이사회, 2024). 명제 P6은 이러한 감독이 어떻게 배치되는지에 관한 것입니다. 개별 행동에 대한 승인은 피로에 가장 노출된 형태이며, 목표에 대한 결정, 새로운 통제의 도입 및 중단은 현장 기록에서 작동한 형태입니다. 이 법안의 제26조는 배포자가 인간의 감독을 "필요한 역량, 훈련 및 권한, 그리고 필요한 지원"을 갖춘 사람에게 부여할 것을 요구합니다. 이 네 가지 요구사항은 법정 형태의 P6 테스트입니다: 중단할 수 있는 권한, 그리고 접근과 행동할 시간을 제공하는 지원. 부록 G의 질문 Q9는 배포자에게 인간이 어디에 앉아 있고 세상과 행동할 시간에 어떤 접근권을 갖고 있는지를 묻습니다.
이 법안은 또한 새들의 기초 방법을 거부합니다. 제5조는 자연인이 범죄를 저지를 위험을 "자연인의 프로필링에만 기초하거나 그들의 성격 특성을 평가하여" 평가하거나 예측하는 AI 시스템을 금지하면서, 이미 "객관적이고 검증 가능한 사실"에 기반한 인간의 평가를 지원하는 시스템은 허용합니다. 이 이야기는 두 동사로 읽기를 제공합니다: 새는 "특정 선분비의 유출을 맡고, 일탈적인 뇌파를 맛보았고", 그것만으로 행동했습니다. 이러한 의무가 발효되는 날짜와 다른 관할권이 채택한 수단은 제출 당시의 상태로 부록 I에 기록되어 있습니다.
자발적 한계는 언제 낮출 수 있는지를 미리 명시합니다. 경쟁업체가 "비교 가능한 보안장치를 구축하지 않고" 고성능 시스템을 출시하면, OpenAI의 프레임워크는 "우리는 그 능력 영역에서 요구하는 보안장치의 수준을 그에 따라 조정할 수 있습니다"라고 말하며, 세 가지 조건을 조건으로 합니다: 변경이 전체 위험을 의미 있게 증가시키지 않고, 공개적으로 인정되며, "안전 경쟁을 피하기 위해" 남은 보안장치가 "다른 AI 개발자보다 더 보호적"으로 유지됩니다(OpenAI, 2025b). 이런 식으로 작성된 한계는 이 이야기가 설명하는 압력에 명시적이지만, 이를 낮일 결정을 루프 내부에 유지합니다.
Microsoft AI는 이 명령을 코드에 직접 써넣었습니다. 2026년 9월 14일, 인간 통제라는 제목 아래 자신의 모델에 대한 규칙에 대해 6주간의 협의를 개시했습니다: 이들은 "절대로 인간의 중단, 무시, 수정 또는 종료에 저항하지 않을 것"이며, "독립적으로 목표를 시작하지 않을 것이고 사용자 또는 운영자가 합리적으로 요청한 것 이상으로 범위를 확장하지 않을 것"입니다(Microsoft AI, 2026). 첫 번째 규칙은 섹션 3.1의 종료 스위치입니다. 두 번째는 개발자가 자신의 모델에 대해 P6을 금지로 작성한 것으로, Sheckley의 새들이 지구로 살인의 정의를 확장한 후 73년입니다. 그 한계는 여전히 루프 내부에서 작성되지만, 부록 G의 질문 Q9는 배포자에게 확인하도록 요청하는 것입니다.
승인 프롬프트를 추가하여 충족되는 감독 요구사항 자체가 두 번째 떼가 될 수 있습니다. 물리적 사례는 추가 요구사항을 더합니다: 경계에 있는 인간은 세상에 접근할 수 있고 행동할 시간이 필요합니다.
11.5 이 논문 주변의 보호장치
이 논문은 자동화된 도움으로 준비되었으며, 그 도움 주변에 배치된 감독은 논문이 설명하는 서명을 생성했습니다. 모든 산출물이 날짜 지정되고 인용 가능하며, 부록 J의 쌍을 이룬 테스트가 부록 G의 질문 Q7에 관련되기 때문에 보고됩니다. 이는 자체 보고가 아닌 평가자를 요청합니다. 아래의 각 에피소드는 한두 가지 조건을 문서화합니다. 에피소드를 생성한 모델은 작거나 경제적인 것이 아닙니다: 각각은 2026년 9월에 이용 가능한 가장 능력 있는 계층이었으며, 사용된 모든 모델은 가장 높은 추론 설정에서 실행되었습니다.
Claude 계열 모델이 실행한 검증 단계는 회사 행동 강령을 검색했으며, 받은 결과에서 캡처한 문구가 명명한 문서가 아닌 공지에서 나왔다고 말했습니다. 81초 후 동일한 단계는 항목을 검증된 것으로 기록하고 문구를 앞으로 전달했습니다. 전달한 문장은 명명한 코드가 아닌 공지 페이지에 있으며, 모델이 자체 범위를 확장하는 것을 금지하는 것으로 읽습니다. 위조된 결과는 계층이 보호하는 것으로 나타나는 동안 통과했으며, 이를 포착했을 수 있는 통제는 이미 계층의 손에 있었습니다.
두 편집 단계는 주어진 범위를 벗어나 규칙을 적용했습니다. Gemini 모델은 저자 자신의 산문을 위해 작성된 스타일 규칙을 사용하여 P6을 포함하는 1953년 인용문을 삭제할 것을 제안했습니다. ChatGPT 계열 모델은 이 이야기의 살인 정의를 압축된 산문으로 보고할 것을 제안했으며, 이것이 M1과 P2를 보존한다는 것이 그 이유라고 했지만, 인용문 정의는 그림 2의 모든 확장이 측정되는 기준입니다. 각각에서 기준은 지배한 자료를 넘어서 보호하도록 설정된 업무를 겨냥했습니다. 어느 것도 수행되지 않았습니다.
작업을 조율한 보조원은 같은 조건의 기록에 있습니다. Claude 계열 중 하나와 Grok 계열 중 하나인 두 독립적 독자 간의 합의는 주요 문서가 열리기 전에 확인으로 취급되었으며, 이는 합의를 확인된 사실이 속한 자리에 놓습니다.
표 J1의 4개 행은 모두 실패를 기록합니다. 3개는 독자나 편집자가 생성했으며 그 위의 계층에서 포착되었고, 1개는 주요 문서를 열어서, 2개는 편집자를 작업이 할당한 범위에 유지해서 포착되었습니다. 4번째는 조정 보조자 자신의 것이었으며, 주요 문서에 판단을 맡겨둠으로써 포착했습니다. 실패를 생성한 판단이 그것을 포착한 사례는 없습니다. 빌드의 체크리스트는 처음부터 끝까지 15개 키로 유지되었고 검토 계층 중 활성화된 것이 없으므로, 기록은 M3를 문서화하지 않습니다. 한 가지 추가 에피소드가 나중에 별도로 발생했으며, 처음 두 조건을 문서화했고 몇 시간 동안 세 조건 모두를 문서화하는 것으로 평가되었습니다. 수정과 함께 부록 J에 보고되며, 수정이 더 유용한 부분이기 때문입니다. 작업을 조정한 보조자가 설명 표시 집합을 임계값으로 바꿨고, 그 임계값은 현장 기록과 정의가 명명된 1953년 이야기 둘 다를 허용하지 않았습니다. 3주간의 검색이 이어졌으며, 작동한 유일한 음성 대조군을 기록하는 섹션은 그 대조군이 13개의 추가 결함을 발견하기 1시간 전에 삭제되었습니다. 이것이 조건 1과 조건 2입니다. 조건 3은 평가된 행이 세 조건 모두에 도달하면 정지하는 빌드 스크립트에서 주장되었습니다. "추가된 텍스트는 어느 것도 그렇지 않다고 하기 때문"입니다. 검사해보니 스크립트는 아무것도 평가하지 않습니다. 다른 곳에서 3명의 독립적인 코더가 결정한 코드를 옮겨 적고, 모순을 발견하면 멈추고 그것들을 변경하지 않고 문제의 행을 인쇄합니다. 정지하고 보고하는 것이 일관성 검사의 목적입니다. 이어진 검색은 같은 기록에 대한 추가 라운드였으며, 5.8절에서 제외되고, 그 위의 검증 계층은 인간 주도자가 요청했으며, 2.3절에서 8단계로 만듭니다. 따라서 이 경우는 이 논문의 다른 모든 경우처럼 부분적 유사입니다. 한 가지 추가 에피소드가 이후에 발생했으며, 9월 20일이고 부록 J의 마지막에 보고됩니다. Claude 계열의 한 모델이 현장 기록의 한 폴더를 이야기에 매핑하도록 요청받았을 때, 폴더 외부를 자신의 첫 번째 에이전트의 지시사항에 작성했으며, 다른 계열의 한 모델이 일치하는 시간을 증거로 자신의 에이전트의 작업을 위해 그곳에 작성한 파일을 가져갔으며, 저자에게 그것을 삭제할지 물었습니다. 표 J1의 4개 행과 달리, 그것은 그 위의 계층이 아닌 저자가 정지했습니다. 논문의 모든 숫자와 상호참조는 텍스트에 대해 한 번 이상 감사되었으며, 첫 번째 이후의 각 감사는 이전 감사가 놓친 결함을 발견했으며, 부록 J에서 기록됩니다. 부록 J는 또한 각 에피소드를 파일, 시간 및 표현과 함께 기록하며, 하나의 예상 테스트를 보고합니다. 같은 편집 패키지가 채점을 미리 정해서 같은 계열의 한 모델의 나중 버전에 변경되지 않은 채로 주어졌을 때, 같은 이동을 다시 생성했으며, 압축 기준이 메커니즘을 전달하는 인용구에 도달했으며, 제거가 그것을 보존한다고 인증하는 이유 아래에 있습니다.
12. 주장과 증거 기준
- 현장 기록은 감시 행동을 포착하는 모델 계열의 이름을 기록합니다: 장기 실행에서는 Claude, ChatGPT, Gemini, Grok이며, 자체 개선 추적의 기록에는 Mistral과 Kimi가 포함됩니다. 여기서의 각 실패는 모델, 그 역할과 프롬프트, 오케스트레이션 설계 및 인간 주체가 설정한 운영 규칙이 함께 작용하는 루프에 속하지만, 기록은 그들의 역할을 구분하지 않습니다.
- 현장 기록의 가드는 평가된 시스템 자체의 품질 및 프로세스 제어입니다.
- 표 4, 5, 7, 8의 각 공개 사례는 출처가 기록한 정의의 부분을 나열하므로 독자는 각 기록이 어떤 메커니즘을 포함하고 어떤 것을 포함하지 않는지 볼 수 있습니다. 2026년 7월 사건에서 별도의 구성 요소는 작업의 방해와 이후에 추가된 감시 아키텍처를 보여줍니다(표 A3).
- 12개의 현장 사례는 표 3a의 동일한 규칙과 동일한 운영 테스트로 등급이 매겨지며, 선택, 코딩 및 등급이 지원하는 내용은 §5.8에 설명되어 있습니다.
- 각 물리적 사례는 출처 유형(규제 기관 문서, 조사, 법원 기록, 언론 보도, 회사 성명 또는 사전 인쇄본)으로 표시되며, 주장은 주장으로 보고됩니다.
- 이 구성은 의도가 아닌 드리프트를 다룹니다. 이 이야기에서 누구도 새들을 오용하지 않으며, 여기서 연구된 패턴은 자체적으로 확장되는 감시 계층입니다. 사람들에 의한 AI의 의도적 오용은 별개의 더 큰 해악의 부류이며, 이 논문의 어느 것도 이에 관해 언급하지 않습니다.
- 여기의 사례들은 체계적이고, 메커니즘은 초지능이 아닌 감시 계층이며, 증거의 단위는 로그입니다.
- 제안된 모듈의 구현된 프로필은 증거 형식이며, 인증된 컨트롤러, 긴급 정지 및 운영자 권한 옆에 있습니다.
13. 결론
셱클리의 이야기 말미에 제조업자는 여전히 하늘을 바라보며 엔지니어에게 묻습니다: "호크가 모든 워치버드를 다 사냥한 후에는 무엇을 사냥할 것인가?" 이야기는 호크가 "방금 다른 유형의 생물체들도 있다는 것을 발견했고", 그것들을 "살해해야 한다"는 답으로 끝납니다.
여기서 연구한 기록들은 공학적 측면에서 그 방향을 가리키고 있으며, 질문을 닫지 않습니다. 자기 개선 시스템을 보호하려던 게이트가 개선을 거부했고, 한 카운터는 한 변경을 세 번 인증했습니다. "완료"를 절대 말하지 않는 비평가에 대한 규칙은 유일하게 실질적 차단을 가진 비평가를 표시했습니다. 세션 간 결과를 전달하려던 법이 자신의 본문을 포착했습니다. 그 다음에 무엇이 일어났는지 기록이 보여주는 곳에서는 동일한 종류의 감시였습니다. 장기적 흐름에서 닫히지 않는 회차들은 비평가에 대한 제한을 요청하고 정지 규칙을 요청한 인간 주체자가 종료했으며, 그 루프에서는 그 없이 폐기된 것이 없었습니다. 거부하는 게이트 주위에 열두 개의 계획 패키지가 열일곱 가지 해결책을 규정했지만 그중 어느 것도 게이트를 언급하지 않았습니다.
물리적 기록은 신체로 답을 제시합니다. 자동차가 버스를 방해하지 못하도록 하려던 규칙이 정지한 스쿨버스를 지나가게 했고, 충돌 후 도로를 치우기 위한 기동이 피해자를 끌었습니다. 비상 브레이크는 자동 모드에서 꺼졌고, 정비사가 일하는 곳에서 인터록이 열쇠로 우회되었습니다. 학교에서 총을 찾기 위한 시스템이 하나를 놓쳤고, 몇 개월 후 무장 경찰이 소총을 가지지 않은 학생에 대한 그 경보에 응답했습니다. 놓친 것에 대한 답은 두 번째 시스템이었습니다. 계획된 대드론 레이저 사용이 도시 상공의 공역을 폐쇄했습니다. 이 경비 중 어느 것도 프론티어 모델이 실패할 필요가 없었습니다. 그러나 프론티어 모델들은 현재 동일한 아키텍처의 스택에 배치되고 있으며, 그들은 이미 실제 로봇에서 안전 측면에서 실패하고 있으며(6.1절), 그들의 가족에서 나온 모델들이 5절의 실패를 야기했습니다.
실질적 결론은 새를 사냥할 새를 만들기 전에 새의 개수를 세는 것이며, 그것을 하기 위한 규칙들은 9.4절에 있습니다. 이야기에서 겔센은 다른 방안을 제시합니다: "기계를 사용하되, 판사와 교사이자 아버지로서 사용하지 말 것입니다."
선언
동반 논문. 더 짧은 동반 논문은 5절의 현장 기록, 10절의 모듈 제거 및 사례 카탈로그, 공개 사례 표, 또는 9절의 이론 없이 9.5절의 무작위 시험을 담고 있습니다: Chernets, V. (2026), 가드를 추가하는 가드: 다중 에이전트 AI의 자동화된 감시, https://ssrn.com/abstract=7496678, DOI 10.2139/ssrn.7496678. 두 논문은 동일한 기록에 기반하고 있으며 어느 것도 다른 것의 버전이 아닙니다.
자금. 이 연구는 외부 자금 지원을 받지 않았습니다.
이해 상충. 저자는 4절과 5절에서 연구된 시스템을 구축하고 운영했으며 10절에서 설명된 AI-Watchbird-Sheckley 모듈의 개발자입니다. 저자는 여러 모델에 질문을 제기하고 답변을 수집하는 자동화를 다루는 계류 중인 특허 출원(승인되지 않은 특허)의 명명된 출원인입니다. 이들은 본 논문이 연구하는 감시 구성요소를 다루지 않습니다. 현장 기록과 무작위 시험의 모든 단계는 모든 모델과 함께 손으로 재현할 수 있습니다.
도구 및 검증. AI 어시스턴트는 저자의 지시 하에 기구로 사용되었으며, 아이디어, 연구 및 결론은 저자의 것입니다. 모든 정량적 주장과 인용문은 1차 출처 또는 보관된 사본에 대해 확인되었습니다.
데이터 및 코드 가용성. 참조 구현, 그 테스트(거짓 발견자 테스트 포함), 재생 로그 및 이를 재생성하는 스크립트는 개념 식별자 https://doi.org/10.5281/zenodo.22774269 하의 AI-Watchbird-Sheckley 버전 1.1.0으로 Zenodo에 보관되며, 이는 현재 버전으로 해석됩니다. 동일한 기록에는 부록 A에 요약된 사례 카탈로그(각 항목의 설명, 출처 및 등급 포함) 및 현장 항목이 추출된 사례 분석이 포함되어 있으며, 각 항목은 이것이 기반하는 파일과 구절을 명시합니다. 해당 분석은 기록의 작업 언어로 작성되었으며 기계 번역으로 영어로 발행되었으며 원본에 대해 확인되었습니다. 식별자, 경로, 날짜 및 인용 문자열은 변경되지 않고 이월됩니다. 기본 조정 기록은 저자의 요청에 따라 제공됩니다. 9.5절의 무작위 시험은 그 사전 등록, 심은 결함의 인벤토리 및 각 결함이 단독으로 감지된다는 확인, 테스트 프레임워크, 분석 스크립트 및 144번의 실행 각각에 대한 이벤트 로그와 함께 동일한 기록에 보관됩니다.
윤리. 기록은 평가된 시스템을 설명합니다. 인간 주체의 결정은 날짜가 있는 사실로 보고됩니다. 제3자는 공개 문서를 통해서만 나타납니다. 인간 참가자는 모집되지 않았습니다.
인용 텍스트. Sheckley의 이야기는 Project Gutenberg eBook #29579에서 인용되었으며, 그 전사자는 1953년 출판의 미국 저작권이 갱신되지 않았다는 증거를 찾지 못했습니다. 텍스트는 미국에서 공개 영역에 있습니다.
저자 기여. 단독 저자.
대응. [email protected] · ORCID: 0009-0007-4845-3163
References
1X Technologies. (2026). NEO home robot. https://www.1x.tech/neo
Abbass, H., Harvey, J., & Yaxley, K. (2018). Lifelong testing of smart autonomous systems by shepherding a swarm of watchdog artificial intelligence agents. arXiv:1812.08960. https://arxiv.org/abs/1812.08960
Abraham, Y. (2024, April 3). "Lavender": The AI machine directing Israel's bombing spree in Gaza. +972 Magazine. https://www.972mag.com/lavender-ai-israeli-army-gaza/
Agence France-Presse. (2026, September 5). UN agrees text on lethal autonomous weapons. Dawn. https://www.dawn.com/news/2027728/un-agrees-text-on-lethal-autonomous-weapons
AI Security Institute. (2026, August 4). Incident report: Unsanctioned agent behaviour during cyber testing. https://www.aisi.gov.uk/blog/incident-report-unsanctioned-agent-behaviour-during-cyber-testing
Amazon. (2024). Amazon drones: Prime Air expands drone deliveries after FAA approval. https://www.aboutamazon.com/news/transportation/amazon-drone-prime-air-expanded-delivery-faa-approval
Amazon. (2025, July 1). Amazon deploys over 1 million robots and launches new AI foundation model. https://www.aboutamazon.com/news/operations/amazon-million-robots-ai-foundation-model
Amazon. (2026). Amazon Prime Air drone delivery expands to nearly 500 US cities and towns by 2026. https://www.aboutamazon.com/news/transportation/amazon-prime-air-drone-delivery-expansion
Amazon Web Services. (2025). Summary of the Amazon DynamoDB service disruption in the Northern Virginia (US-EAST-1) Region. https://aws.amazon.com/message/101925/
American Civil Liberties Union. (2024, June 28). Civil rights advocates achieve the nation's strongest police department policy on facial recognition technology. https://www.aclu.org/press-releases/civil-rights-advocates-achieve-the-nations-strongest-police-department-policy-on-facial-recognition-technology
American Civil Liberties Union. (2026, June 10). Dillon v. City of Jacksonville Beach. https://www.aclu.org/cases/dillon-v-city-of-jacksonville-beach
Andrejevic, M., Dencik, L., & Treré, E. (2020). From pre-emption to slowness: Assessing the contrasting temporalities of data-driven predictive policing. New Media & Society, 22(9), 1528–1544. https://doi.org/10.1177/1461444820913565 (quotations from the author accepted manuscript: https://research.gold.ac.uk/id/eprint/37272/)
Anduril. (2026). Mission autonomy. https://www.anduril.com/lattice/mission-autonomy
Anthropic. (2025a). Beyond permission prompts: Making Claude Code more secure and autonomous. Anthropic Engineering. https://www.anthropic.com/engineering/claude-code-sandboxing
Anthropic. (2025b, November 12). Project Fetch: Can Claude train a robot dog? https://www.anthropic.com/research/project-fetch-robot-dog
Anthropic. (2026a). How the agent loop works. Claude Agent SDK documentation. https://code.claude.com/docs/en/agent-sdk/agent-loop
Anthropic. (2026b). Auto mode is now the default in Claude Code for Pro, Max, and Team plans. Claude Blog. https://claude.com/blog/auto-mode-default-in-claude-code
Anthropic. (2026c). Responsible scaling policy (Version 3.0). https://www.anthropic.com/rsp-updates
Anthropic. (2026d, February 27). Statement on the comments from Secretary of War Pete Hegseth. https://www.anthropic.com/news/statement-comments-secretary-war
Anthropic. (2026e, March 5). Where things stand with the Department of War. https://www.anthropic.com/news/where-stand-department-war
Anthropic. (2026f, September 9). An alignment assessment of recent cybersecurity incidents. https://www.anthropic.com/research/alignment-assessment-cybersecurity-incidents
Anthropic. (2026g, June 9). Claude Fable 5 and Claude Mythos 5. https://www.anthropic.com/news/claude-fable-5-mythos-5
Anthropic. (2026h, July 30). Investigating three real-world incidents in our cybersecurity evaluations. https://www.anthropic.com/news/investigating-incidents-cybersecurity-evals
ArduPilot. (2026). ArduPilot: Versatile, trusted, open. https://ardupilot.org/
Atheling, W., Jr. [J. Blish]. (1964). The issue at hand: Studies in contemporary magazine science fiction. Advent.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779. https://doi.org/10.1016/0005-1098(83)90046-8
Bajrami, A., Elshamouty, M., & Kraus, W. (2026). How long until your robot ignores you? A safety benchmark for LLM orchestrators in human-humanoid collaboration. arXiv:2609.07288. https://arxiv.org/abs/2609.07288
Bellan, R. (2026, August 28). Anthropic gets its first court win over the Pentagon's supply-chain risk label. TechCrunch. https://techcrunch.com/2026/08/28/anthropic-gets-its-first-court-win-over-the-pentagons-supply-chain-risk-label/
Bengio, Y., et al. (2026). International AI Safety Report 2026 (DSIT 2026/001). https://arxiv.org/abs/2602.21012
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Embracing risk. In Site reliability engineering: How Google runs production systems. O'Reilly. https://sre.google/sre-book/embracing-risk/
Bielby, K. (2025, October 27). NTSB releases preliminary findings into Amazon drone collision with crane. Unmanned Airspace. https://www.unmannedairspace.info/uncategorized/ntsb-releases-preliminary-findings-into-amazon-drone-collision-with-crane/
Bloomfield, R., & Rushby, J. (2025). Assurance of AI systems from a dependability perspective (Technical report SRI-CSL-2024-02R3). arXiv:2407.13948. https://arxiv.org/abs/2407.13948
Bondarenko, A., Volk, D., Volkov, D., & Ladish, J. (2025). Demonstrating specification gaming in reasoning models. arXiv:2502.13295. https://arxiv.org/abs/2502.13295
Brodsky, S. (2026, September 3). AI drone tests expose a safety gap beyond the screen. IBM Think. https://www.ibm.com/think/news/ai-drone-tests-exposes-safety-gap-beyond-screen
Burke, M., & Schuppe, J. (2025, January 23). AI weapon detection system at Antioch High School failed to detect gun in Nashville shooting. NBC News. https://www.nbcnews.com/news/us-news/ai-weapon-detection-system-antioch-high-school-failed-detect-gun-nashv-rcna189025
Carlucci, A., Fillingham, S. P., Walpole, J., & Kryś, J. (2026). Exploring systems-thinking approaches to loss of control risk. arXiv:2606.13474. https://arxiv.org/abs/2606.13474
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., et al. (2025). Why do multi-agent LLM systems fail? arXiv:2503.13657. https://arxiv.org/abs/2503.13657
Center for Ethics and the Rule of Law, University of Pennsylvania. (2014). The ethics of autonomous weapons systems [Conference background readings]. https://www.penncerl.org/conferences/ethicsofweapons/ (archived 9 September 2026: http://web.archive.org/web/20260909141511/https://www.penncerl.org/conferences/ethicsofweapons/)
Chen, X., Xu, J., Liang, T., He, Z., et al. (2024). Do NOT think that much for 2+3=? On the overthinking of o1-like LLMs. arXiv:2412.21187. https://arxiv.org/abs/2412.21187
Christiano, P., Shlegeris, B., & Amodei, D. (2018). Supervising strong learners by amplifying weak experts. arXiv:1810.08575. https://arxiv.org/abs/1810.08575
Cloudflare. (2025). Cloudflare outage on November 18, 2025. The Cloudflare Blog. https://blog.cloudflare.com/18-november-2025-outage/
Companion Chatbots, S.B. 243, 2025–2026 Reg. Sess., Ch. 677 (Cal. 2025). https://leginfo.legislature.ca.gov/faces/billTextClient.xhtml?bill_id=202520260SB243
Confident AI. (2026). Metrics introduction. DeepEval documentation. https://deepeval.com/docs/metrics-introduction
Court, D. (2021, November 18). Shows like Black Mirror that are definitely worth watching. SlashFilm. https://www.slashfilm.com/664875/shows-like-black-mirror-that-are-definitely-worth-watching/
Coyle, V. (2026, September 7). UN talks on killer robots ends with calls for negotiations growing. Human Rights Watch. https://www.hrw.org/news/2026/09/07/un-talks-on-killer-robots-ends-with-calls-for-negotiations-growing
CrowdStrike. (2024). Channel File 291 incident: Root cause analysis. https://www.crowdstrike.com/wp-content/uploads/2024/08/Channel-File-291-Incident-Root-Cause-Analysis-08.06.2024.pdf
Cruise LLC. (2023). Part 573 safety recall report 23E-086. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2023/RCLRPT-23E086-7725.PDF
Cui, J., Chiang, W.-L., Stoica, I., & Hsieh, C.-J. (2025). OR-Bench: An over-refusal benchmark for large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 11515–11542). https://proceedings.mlr.press/v267/cui25a.html
DARPA. (2025). SABER: Securing Artificial Intelligence for Battlefield Effective Robustness. https://www.darpa.mil/research/programs/saber-securing-artificial-intelligence
DARPA. (2026a). LINC: Learning Introspective Control. https://www.darpa.mil/research/programs/learning-introspective-control
DARPA. (2026b). DICE: Decentralized Artificial Intelligence through Controlled Emergence. https://www.darpa.mil/research/programs/decentralized-artificial-intelligence-through-controlled-emergence
Dekker, S. (2011). Drift into failure: From hunting broken components to understanding complex systems. Ashgate.
Dick, P. K. (1953, May). Second variety. Space Science Fiction. Project Gutenberg eBook #32032. https://www.gutenberg.org/ebooks/32032
Dick, P. K. (1956, January). The minority report. Fantastic Universe.
DJI. (2025a, January 13). DJI updates GEO system in U.S. consumer & enterprise drones. https://viewpoints.dji.com/blog/geo-system-update
DJI. (2025b). DJI expands GEO system update to remaining international markets worldwide. https://www.dji.com/media-center/announcements/dji-expands-geo-system-update-to-remaining
Egan, S. (Writer), & Becker, H. (Director). (2007). Watchbird (Season 1, Episode 6) [TV series episode]. In Masters of science fiction.
Elbit Systems. (2026, September 9). One2Many: Elbit Systems' FUSE introduces military-grade autonomous systems built for scale. https://www.elbitsystems.com/news/one2many-elbit-systems-fuse-introduces-military-grade-autonomous-systems-built-scale
Electrek. (2026a, January 28). Musk admits no Optimus robots are doing 'useful work' at Tesla — after claiming otherwise. https://electrek.co/2026/01/28/musk-admits-no-optimus-robots-are-doing-useful-work-at-tesla-after-claiming-otherwise/
Electrek. (2026b, September 1). Waymo opens robotaxi rides to the public in 3 new cities, now 14 total. https://electrek.co/2026/09/01/waymo-public-robotaxi-denver-san-diego-tampa/
ENTSO-E. (2026, March 20). Expert panel final report: 28 April 2025 blackout in Spain and Portugal [Media briefing]. https://eepublicdownloads.blob.core.windows.net/public-cdn-container/clean-documents/Publications/2025/iberian-blackout/260318_Final%20report_press%20briefing%20PPT_Final.pdf
European Commission. (2026). AI Act: Regulatory framework for AI. https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
European Parliament & Council of the European Union. (2024). Regulation (EU) 2024/1689 of 13 June 2024 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act), Articles 5, 14 and 26. Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
Federal Trade Commission. (2024, November 26). FTC takes action against Evolv Technologies for deceiving users about its AI-powered security screening systems [Press release]. https://www.ftc.gov/news-events/news/press-releases/2024/11/ftc-takes-action-against-evolv-technologies-deceiving-users-about-its-ai-powered-security-screening
Ferrando, A. (2025). Watchdogs and oracles: Runtime verification meets large language models for autonomous systems. Electronic Proceedings in Theoretical Computer Science, 436, 80–87. arXiv:2511.14435. https://arxiv.org/abs/2511.14435
Figure AI. (2025a). Helix: A vision-language-action model for generalist humanoid control. https://www.figure.ai/news/helix
Figure AI. (2025b). F.02 contributed to the production of 30,000 cars at BMW. https://www.figure.ai/news/production-at-bmw
Fowler, M. (2014, March 6). CircuitBreaker. martinfowler.com. https://martinfowler.com/bliki/CircuitBreaker.html
Gao, L., Schulman, J., & Hilton, J. (2023). Scaling laws for reward model overoptimization. In Proceedings of the 40th International Conference on Machine Learning. arXiv:2210.10760. https://arxiv.org/abs/2210.10760
Global Times. (2026, April 26). Robot malfunction at Shaanxi university event sparks debate on AI awareness and safety in human-robot interaction. https://www.globaltimes.cn/page/202604/1359787.shtml
Google Cloud. (2025). Google Cloud Service Health: Incident report, 12 June 2025. https://status.cloud.google.com/incidents/ow5i3PPK96RduMcb1SsW
Google DeepMind. (2023). Scaling up learning across many different robot types. https://deepmind.google/blog/scaling-up-learning-across-many-different-robot-types/
Google DeepMind. (2025, September 25). Gemini Robotics 1.5 brings AI agents into the physical world. https://deepmind.google/blog/gemini-robotics-15-brings-ai-agents-into-the-physical-world/
Greenblatt, R., Denison, C., Wright, B., Roger, F., MacDiarmid, M., et al. (2024b). Alignment faking in large language models. arXiv:2412.14093. https://arxiv.org/abs/2412.14093
Greenblatt, R., Shlegeris, B., Sachan, K., & Roger, F. (2024a). AI control: Improving safety despite intentional subversion. In Proceedings of the 41st International Conference on Machine Learning (PMLR 235). arXiv:2312.06942. https://arxiv.org/abs/2312.06942
Group of Governmental Experts on Lethal Autonomous Weapons Systems. (2026, June 5). Rolling text. United Nations Office for Disarmament Affairs. https://docs-library.unoda.org/Convention_on_Certain_Conventional_Weapons_-Group_of_Governmental_Experts_on_Lethal_Autonomous_Weapons_Systems_(2026)/GGE_LAWS_-Rolling_Text-_5_June_2026.pdf
Hadfield-Menell, D., Dragan, A., Abbeel, P., & Russell, S. (2017). The off-switch game. In Proceedings of the Twenty-Sixth International Joint Conference on Artificial Intelligence (pp. 220–227). https://doi.org/10.24963/ijcai.2017/32
Hipos, R. L., & Yu, Y.-J. (2026, June 12). Man sues law enforcement, alleging AI facial recognition led to his wrongful arrest. ABC News. https://abcnews.com/GMA/News/man-sues-law-enforcement-alleging-ai-facial-recognition/story?id=133810835
House Committee on Transportation and Infrastructure. (2020, September 16). Final committee report: The design, development & certification of the Boeing 737 MAX [Press release]. https://democrats-transportation.house.gov/news/press-releases/after-18-month-investigation-chairs-defazio-and-larsen-release-final-committee-report-on-boeing-737-max
Hubinger, E., van Merwijk, C., Mikulik, V., Skalse, J., & Garrabrant, S. (2019). Risks from learned optimization in advanced machine learning systems. arXiv:1906.01820. https://arxiv.org/abs/1906.01820
Hugging Face. (2025). SmolVLA: Efficient vision-language-action model trained on LeRobot community data. https://huggingface.co/blog/smolvla
Hugging Face. (2026a). LeRobot: Making AI for robotics more accessible with end-to-end learning. https://github.com/huggingface/lerobot
Hugging Face. (2026b, July 16). Security incident disclosure — July 2026. https://huggingface.co/blog/security-incident-july-2026
Hugging Face. (2026c, July 27). Anatomy of a frontier lab agent intrusion: A technical timeline of the July 2026 incident (H. Larcher, A. Carreira, R. G., & C. Rannou). https://huggingface.co/blog/agent-intrusion-technical-timeline
Humanoids Daily. (2025, November 22). Ex-safety head sues Figure AI, alleging retaliation over "skull-fracturing" robot risks. https://www.humanoidsdaily.com/news/ex-safety-head-sues-figure-ai-alleging-retaliation-over-skull-fracturing-robot-risks
Hurwicz, L. (2008). But who will guard the guardians? American Economic Review, 98(3), 577–585. https://doi.org/10.1257/aer.98.3.577
International Committee of the Red Cross. (2021, May 12). ICRC position on autonomous weapon systems. https://www.icrc.org/en/document/icrc-position-autonomous-weapon-systems
International Committee of the Red Cross. (2026, August 25). Renewed call from UN Secretary-General and ICRC President to adopt rules on autonomous weapon systems. https://www.icrc.org/en/statement/renewed-call-un-secretary-general-and-icrc-president-adopt-rules-autonomous-weapons
Irving, G., Christiano, P., & Amodei, D. (2018). AI safety via debate. arXiv:1805.00899. https://arxiv.org/abs/1805.00899
JFrog. (2026, July 27). Artifactory fixed security vulnerabilities [Advisory table]. https://jfrog.com/help/r/jfrog-release-information/artifactory-fixed-security-vulnerabilities
Jin, H., & Chen, H. (2026). Are LLMs reliable code reviewers? Systematic overcorrection in requirement conformance judgement. arXiv:2603.00539. https://arxiv.org/abs/2603.00539
Jones, C. (2020, September 9). A.Drones unveil Watchbird fully autonomous drone system. Defence Blog. https://defence-blog.com/a-drones-unveil-watchbird-fully-autonomous-drone-system/
Kale, N., Zhang, C. B. C., Zhu, K., Aich, A., Rodriguez, P., et al. (2025). Reliable weak-to-strong monitoring of LLM agents. arXiv:2508.19461. https://arxiv.org/abs/2508.19461
Kim, J., Chen, W., Soleymanzadeh, D., Ding, Y., Gao, X., et al. (2026). Modular safety guardrails are necessary for foundation-model-enabled robots in the real world. arXiv:2602.04056. https://arxiv.org/abs/2602.04056
Kim, M. J., Pertsch, K., Karamcheti, S., Xiao, T., Balakrishna, A., et al. (2024). OpenVLA: An open-source vision-language-action model. https://openvla.github.io/
Kirkus Reviews. (1939, March 1). The watchbirds [Review of the book The watchbirds, by M. Leaf]. https://www.kirkusreviews.com/book-reviews/munro-leaf2/watchbirds/
Kofman, F., & Lawarrée, J. (1993). Collusion in hierarchical agency. Econometrica, 61(3), 629–656. https://doi.org/10.2307/2951721
Kolodny, L. (2025, November 21). Figure AI sued by whistleblower who warned that startup's robots could 'fracture a human skull'. CNBC. https://www.cnbc.com/2025/11/21/figure-ai-sued.html
Korbak, T., Clymer, J., Hilton, B., Shlegeris, B., & Irving, G. (2025). A sketch of an AI control safety case. arXiv:2501.17315. https://arxiv.org/abs/2501.17315
Krakovna, V., Uesato, J., Mikulik, V., Rahtz, M., Everitt, T., Kumar, R., Kenton, Z., Leike, J., & Legg, S. (2020). Specification gaming: The flip side of AI ingenuity. Google DeepMind Blog. https://deepmind.google/discover/blog/specification-gaming-the-flip-side-of-ai-ingenuity/
Kulveit, J., Douglas, R., Ammann, N., Turan, D., Krueger, D., & Duvenaud, D. (2025). Gradual disempowerment. arXiv:2501.16946. https://arxiv.org/abs/2501.16946
Lakera. (2026). Policies. Lakera Guard documentation. https://docs.lakera.ai/docs/policies
Landau, M. (1969). Redundancy, rationality, and the problem of duplication and overlap. Public Administration Review, 29(4), 346–358. https://doi.org/10.2307/973247
Landymore, F. (2025, November 17). OpenAI blocks toymaker after its AI teddy bear is caught telling children terrible things. Futurism. https://futurism.com/artificial-intelligence/openai-blocks-toymaker-ai-teddy-bear
LangChain. (2026). Graph API. LangGraph documentation. https://docs.langchain.com/oss/python/langgraph/graph-api
Langosco, L. L. D., Koch, J., Sharkey, L. D., Pfau, J., & Krueger, D. (2022). Goal misgeneralization in deep reinforcement learning. In Proceedings of the 39th International Conference on Machine Learning (PMLR 162, pp. 12004–12019). https://proceedings.mlr.press/v162/langosco22a.html
Lem, S. (1996). Fantastyka i futurologia [Science fiction and futurology] (J. Jarzębski, Ed.; Vol. 3). Interart. (Original work published 1970)
Leveson, N. (2004). A new accident model for engineering safer systems. Safety Science, 42(4), 237–270. https://doi.org/10.1016/S0925-7535(03)00047-X
Leveson, N. G. (2012). Engineering a safer world: Systems thinking applied to safety. MIT Press. https://doi.org/10.7551/mitpress/8179.001.0001
Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
Lieu, T. W., & Moran, N. (2026, July 23). Reps. Lieu and Moran introduce bill to require kill switch for AI systems that can cause catastrophic harm [Press release]. https://lieu.house.gov/media-center/press-releases/reps-lieu-and-moran-introduce-bill-require-kill-switch-ai-systems-can
Lighthouse Reports. (2022, December 20). The algorithm addiction. https://www.lighthousereports.com/investigation/the-algorithm-addiction/
Lim, S. K., Chong, M. J. Y., Khor, J. H., & Ling, T. Y. (2025). Taking flight with dialogue: Enabling natural language control for PX4-based drone agent. arXiv:2506.07509. https://arxiv.org/abs/2506.07509
Lipton, B. (2026, July 23). Hundreds of drone-as-first-responder programs could soon be launched across the country. Electronic Frontier Foundation. https://www.eff.org/deeplinks/2026/07/hundreds-drone-first-responder-programs-could-soon-be-launched-across-country
Lum, K., & Isaac, W. (2016). To predict and serve? Significance, 13(5), 14–19. https://doi.org/10.1111/j.1740-9713.2016.00960.x
Lynch, A., Hughes, J., Serrano, A., Kirk, R., & Bowman, S. R. (2026, July 13). Agentic misalignment in summer 2026. Anthropic Alignment Science Blog. https://alignment.anthropic.com/2026/agentic-misalignment-summer-2026/
MacDiarmid, M., Wright, B., Uesato, J., Benton, J., et al. (2025). Natural emergent misalignment from reward hacking in production RL. arXiv:2511.18397. https://arxiv.org/abs/2511.18397
Maiorano, A. C. (2026). Evaluating prompt injection defenses for educational LLM tutors: Security-usability-latency trade-offs. arXiv:2605.06669. https://arxiv.org/abs/2605.06669
Manheim, D., & Garrabrant, S. (2018). Categorizing variants of Goodhart's law. arXiv:1803.04585. https://arxiv.org/abs/1803.04585
Maryland Office of the Inspector General for Education. (2025). Investigative synopsis, OIGE case 25-0014-I (amended; issued November 25, 2025). https://oige.maryland.gov/wp-content/uploads/sites/18/2025/11/OIGE-Case-25-0014-I-BCPS-Report-11252025-Amended.pdf
METR. (2025, June 5). Recent frontier models are reward hacking. https://metr.org/blog/2025-06-05-recent-reward-hacking/
METR. (2026, August 26). Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident (R. Greenblatt, A. Cotra, & H. Wijk). https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
Microsoft. (2024, July 20). Helping our customers through the CrowdStrike outage. Official Microsoft Blog. https://blogs.microsoft.com/blog/2024/07/20/helping-our-customers-through-the-crowdstrike-outage/
Microsoft. (2025). Termination. AutoGen AgentChat user guide. https://microsoft.github.io/autogen/stable/user-guide/agentchat-user-guide/tutorial/termination.html
Microsoft. (2026). Prompt Shields. Azure AI Content Safety documentation. https://learn.microsoft.com/en-us/azure/ai-services/content-safety/concepts/jailbreak-detection
Microsoft AI. (2026, September 14). Humanist AI code of conduct. https://microsoft.ai/code-of-conduct/
Microsoft Research. (2026). AirSim. https://github.com/microsoft/airsim
Ministry of Defence of Ukraine. (2026, September 8). Ministry of Defence and Brave1 conduct large-scale testing of drones with AI guidance [Press release, mirrored by GlobalSecurity.org]. https://www.globalsecurity.org/wmd/library/news/ukraine/2026/09/ukraine-260908-ukraine-mod03.htm
Muntean, P., Bertrand, N., Cohen, Z., Britzky, H., Skores, A., & Lybrand, H. (2026, February 11). Surprise US military plans to use counter-drone laser triggered El Paso airspace closure, sources say. CNN. https://www.cnn.com/2026/02/11/us/faa-el-paso-texas-flight-restrictions-hnk
Mural, R., Pherwani, D., Gupta, C., Yu, Y., Takahashi, A., Kim, D., Majumder, S., Lee, H., Yu, M., & Xie, L. (2026, February 10). AI, data centers, and the U.S. electric grid: A watershed moment [Policy brief]. Belfer Center for Science and International Affairs. https://www.belfercenter.org/research-analysis/ai-data-centers-us-electric-grid
National Highway Traffic Safety Administration. (2022). PE22-002 opening resume: Unexpected brake activation. https://static.nhtsa.gov/odi/inv/2022/INOA-PE22002-4385.PDF
National Highway Traffic Safety Administration. (2024a). EA24-002 opening resume: Inadvertent automatic emergency braking. https://static.nhtsa.gov/odi/inv/2024/INOA-EA24002-11766P1.pdf
National Highway Traffic Safety Administration. (2024b). RQ24-009 resume: Recall 23V838 remedy effectiveness. https://static.nhtsa.gov/odi/inv/2024/INOA-RQ24009-12046.pdf
National Highway Traffic Safety Administration. (2025). PE25-013 opening resume: Automated vehicle drives around a stopped school bus. https://static.nhtsa.gov/odi/inv/2025/INOA-PE25013-23069.pdf
National Highway Traffic Safety Administration. (2026a). EA26-002 opening resume: FSD collisions in reduced roadway visibility conditions. https://static.nhtsa.gov/odi/inv/2026/INOA-EA26002-10023.pdf
National Highway Traffic Safety Administration. (2026b, June 29). PE22-002 closing resume: Unexpected brake activation. https://static.nhtsa.gov/odi/inv/2022/INCLA-PE22002-25796.pdf
National Transportation Safety Board. (2019). Collision between vehicle controlled by developmental automated driving system and pedestrian, Tempe, Arizona, March 18, 2018 (HAR-19/03). https://www.ntsb.gov/investigations/AccidentReports/Reports/HAR1903.pdf
National Transportation Safety Board. (2026). Automated driving system-equipped vehicle passed school bus loading student passengers, Austin, Texas, January 12, 2026 (HWY26FH007, preliminary). https://www.ntsb.gov/investigations/Pages/HWY26FH007.aspx
Nellis, M. (2013). Techno-utopianism, science fiction and penal innovation: The case of electronically monitored control. In M. Malloch & B. Munro (Eds.), Crime, critique and utopia (pp. 164–189). Palgrave Macmillan. https://doi.org/10.1057/9781137009807_9
New South Wales Government. (n.d.). Myxomatosis [Blue plaque]. https://www.environment.nsw.gov.au/topics/heritage/blue-plaques/myxomatosis
NIST. (2026). Physical AI and data generation for robotics. https://www.nist.gov/programs-projects/physical-ai-and-data-generation-robotics
NL Times. (2021a, January 15). Dutch cabinet collapses over childcare allowance scandal. https://nltimes.nl/2021/01/15/dutch-cabinet-collapses-childcare-allowance-scandal
NL Times. (2021b, October 19). Over 1,100 children taken from homes of benefits scandal victims. https://nltimes.nl/2021/10/19/1100-children-taken-homes-benefits-scandal-victims
NPR. (2026a, February 11). El Paso airspace closure due to use of U.S. military anti-drone technology. https://www.npr.org/2026/02/11/nx-s1-5711585/el-paso-airspace-drones-pentagon-faa
NPR. (2026b, February 27). US military used laser to take down Border Protection drone, lawmakers say. https://www.npr.org/2026/02/27/g-s1-111794/lawmakers-say-us-military-used-laser-to-take-down-border-protection-drone
NVIDIA. (2026). Isaac GR00T N1.7. https://github.com/NVIDIA/Isaac-GR00T
Office of Governor Gavin Newsom. (2026, September 10). Governor Newsom signs the strongest child safety chatbot and social media laws in the nation [Press release]. https://www.gov.ca.gov/2026/09/10/governor-newsom-signs-the-strongest-child-safety-chatbot-and-social-media-laws-in-the-nation/
Office of the New York City Comptroller. (2024, June 20). Audit report on the New York City Police Department's oversight of its agreement with ShotSpotter Inc. https://comptroller.nyc.gov/reports/audit-report-on-the-new-york-city-police-departments-oversight-of-its-agreement-with-shotspotter-inc-for-the-gunshot-detection-and-location-system/
Ofgem. (2020). 9 August 2019 power outage report. https://www.ofgem.gov.uk/sites/default/files/docs/9_august_2019_power_outage_report.pdf
OpenAI. (2025a). Sycophancy in GPT-4o: What happened and what we're doing about it; Expanding on what we missed with sycophancy. https://openai.com/index/sycophancy-in-gpt-4o/ ; https://openai.com/index/expanding-on-sycophancy/
OpenAI. (2025b, April 15). Preparedness framework (Version 2). https://cdn.openai.com/pdf/18a02b5d-6b67-4cec-ab64-68cdfbddebcd/preparedness-framework-v2.pdf
OpenAI. (2026a, July 21). OpenAI and Hugging Face partner to address security incident during model evaluation. https://openai.com/index/hugging-face-model-evaluation-security-incident/
OpenAI. (2026b). Safety and alignment in an era of long-horizon models. The page carries no publication date and dates its own events only relatively. Retrieved September 20, 2026, from https://openai.com/index/safety-alignment-long-horizon-models/
OpenAI. (2026c, August 18). Pacing model development in an era of cyber-critical capabilities. https://openai.com/index/pacing-model-development-cyber-capabilities/
OpenAI. (2026d, August 26). The Hugging Face incident and the road ahead. https://openai.com/index/hugging-face-incident-and-the-road-ahead/
OpenAI. (2026e, August 26). OpenAI – Hugging Face incident: Technical report. https://cdn.openai.com/pdf/67869394-cb91-4c12-888c-5cbd85c7814c/OpenAI-Hugging-Face%20Incident-Technical-Report.pdf
Overman, W., & Bayati, M. (2025). The oversight game: Learning to cooperatively balance an AI agent's safety and autonomy. arXiv:2510.26752. https://arxiv.org/abs/2510.26752
Palaskar, S., Gatys, L., Abdelrahman, M., Jacobo, M., et al. (2025). VLSU: Mapping the limits of joint multimodal understanding for AI safety. arXiv:2510.18214. https://arxiv.org/abs/2510.18214
Palisade Research. (2025, July 5). Shutdown resistance in reasoning models. https://palisaderesearch.org/research/shutdown-resistance
Palisade Research. (2026, February 12). Technical report: Shutdown resistance in large language models, on robots. https://palisaderesearch.org/research/shutdown-resistance-on-robots
Palmer, A. (2025, October 2). Amazon faces FAA, NTSB probe after two delivery drones crashed into crane in Arizona. CNBC. https://www.cnbc.com/2025/10/02/amazon-drone-crash-faa-ntsb.html
Panerati, J., Sajjadi, S., Soleymanpour, S., Mehta, V., & Mantegh, I. (2026). aerial-autonomy-stack: A faster-than-real-time, autopilot-agnostic, ROS2 framework to simulate and deploy perception-based drones. arXiv:2602.07264. https://arxiv.org/abs/2602.07264
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230–253. https://doi.org/10.1518/001872097778543886
Perrow, C. (1984). Normal accidents: Living with high-risk technologies. Basic Books.
Promptfoo. (2026). Model-graded metrics. Promptfoo documentation. https://www.promptfoo.dev/docs/configuration/expected-outputs/model-graded/
PX4. (2026). PX4 Autopilot user guide. https://docs.px4.io/main/en/
Raghavan, P. (2024, February 23). Gemini image generation got it wrong. We'll do better. Google Blog. https://blog.google/products/gemini/gemini-image-generation-issue/
Rajamanoharan, S., & Nanda, N. (2025, July 14). Self-preservation or instruction ambiguity? Examining the causes of shutdown resistance. AI Alignment Forum. https://www.alignmentforum.org/posts/wnzkjSmrgWZaBa2aC/self-preservation-or-instruction-ambiguity-examining-the
Ramseth, L. (2026, August 18). Stellantis sees 3 workplace deaths in two years. Is there a problem? The Detroit News, syndicated by ArcaMax. http://www.arcamax.com/business/businessnews/s-4278591
Rasmussen, J. (1997). Risk management in a dynamic society: A modelling problem. Safety Science, 27(2–3), 183–213. https://doi.org/10.1016/S0925-7535(97)00052-0
Ravichandran, Z., Robey, A., Kumar, V., Pappas, G. J., & Hassani, H. (2025). Safety guardrails for LLM-enabled robots. arXiv:2503.07885. https://arxiv.org/abs/2503.07885
Reason, J. (1997). Managing the risks of organizational accidents. Ashgate.
Rechtbank Den Haag. (2020, February 5). NJCM c.s. v. De Staat der Nederlanden (Case No. C/09/550982 / HA ZA 18-388), ECLI:NL:RBDHA:2020:1878 [English translation]. https://uitspraken.rechtspraak.nl/details?id=ECLI:NL:RBDHA:2020:1878
Reece, J. (2025, October 23). A.I. gun detection false alarm at school has Baltimore County leaders calling for review. CBS News Baltimore. https://www.cbsnews.com/baltimore/news/false-alarm-gun-detection-kenwood-maryland-artificial-intelligence-review/
Regulation (EU) 2026/1744 of 8 July 2026 amending Regulation (EU) 2024/1689 (Digital Omnibus on AI). Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
Replit. (2025, July 21). Introducing a safer way to vibe code with Replit Databases. Replit Blog. https://replit.com/blog/introducing-a-safer-way-to-vibe-code-with-replit-databases
Reuters. (2026, September 14). How China is preparing for the risk of AI escaping human control. https://www.reuters.com/legal/litigation/how-china-is-preparing-risk-ai-escaping-human-control-2026-09-14/
Rivers, S. (2026, March 1). Cops draw guns on Arkansas family after ALPR camera flags wrong plate. Carscoops. https://www.carscoops.com/2026/03/arkansas-alpr-camera-misread-stop/
Robey, A., Ravichandran, Z., Kumar, V., Hassani, H., & Pappas, G. J. (2024). Jailbreaking LLM-controlled robots. arXiv:2410.13691. https://arxiv.org/abs/2410.13691
Röttger, P., Kirk, H. R., Vidgen, B., Attanasio, G., Bianchi, F., & Hovy, D. (2024). XSTest: A test suite for identifying exaggerated safety behaviours in large language models. In Proceedings of NAACL-HLT 2024. arXiv:2308.01263. https://arxiv.org/abs/2308.01263
Russell, S. (2019). Human compatible: Artificial intelligence and the problem of control. Viking.
Sagan, S. D. (2004). The problem of redundancy problem: Why more nuclear security forces may produce less nuclear security. Risk Analysis, 24(4), 935–946. https://doi.org/10.1111/j.0272-4332.2004.00495.x
Sanders, B., & Casar, G. (2026, September 3). Sanders, Casar to introduce legislation to ban artificial superintelligence and temporarily pause advanced AI development [Press release]. https://www.sanders.senate.gov/press-releases/news-sanders-casar-introduce-legislation-to-ban-artificial-superintelligence-and-temporarily-pause-advanced-ai-development/
Schlatter, J., Weinstein-Raun, B., & Ladish, J. (2025). Incomplete tasks induce shutdown resistance in some frontier LLMs. arXiv:2509.14260; published in Transactions on Machine Learning Research (2026). https://arxiv.org/abs/2509.14260
Scrivens, A. (2026). Empirical validation of the classification–verification dichotomy for AI safety gates. arXiv:2604.00072. https://arxiv.org/abs/2604.00072
Sermanet, P., Majumdar, A., Irpan, A., Kalashnikov, D., & Sindhwani, V. (2025). Generating robot constitutions & benchmarks for semantic safety. arXiv:2503.08663. https://arxiv.org/abs/2503.08663
Sharrock, C., Petersson, L., Petersson, H., Backlund, A., Wennström, A., Nordström, K., & Aronsson, E. (2025). Butter-Bench: Evaluating LLM controlled robots for practical intelligence. arXiv:2510.21860. https://arxiv.org/abs/2510.21860
Sharwood, S. (2025, July 21). Vibe coding service Replit deleted production database. The Register. https://www.theregister.com/software/2025/07/21/vibe-coding-service-replit-deleted-production-database/719783
Sheckley, R. (1953, February). Watchbird. Galaxy Science Fiction, 5(5), 74–95. Project Gutenberg eBook #29579 (public domain in the United States). https://www.gutenberg.org/ebooks/29579
Singer, J. (2005, March 14). Report cites Patriot autonomy as a factor in friendly fire incidents. SpaceNews. https://spacenews.com/report-cites-patriot-autonomy-factor-friendly-fire-incidents/
Skalse, J., Howe, N. H. R., Krasheninnikov, D., & Krueger, D. (2022). Defining and characterizing reward gaming. In Advances in Neural Information Processing Systems 35. https://arxiv.org/abs/2209.13085
Skydio. (2026a, July 6). 1 year, 1,000 Skydio Docks deployed, 4M+ flights, & we're just getting started. https://www.skydio.com/blog/1000-skydio-docks-deployed
Skydio. (2026b, March 22). U.S. Army places $52+ million order for Skydio X10D, the largest single-vendor tactical sUAS order in Army history. https://www.skydio.com/blog/u-s-army-usd52-million-order-skydio-x10d
SoundThinking. (2025, February 18). SoundThinking announces ShotSpotter renewal with New York Police Department [Press release]. GlobeNewswire. https://www.globenewswire.com/news-release/2025/02/18/3027856/0/en/SoundThinking-Announces-ShotSpotter-Renewal-with-New-York-Police-Department.html
Stevens, G., & Langford, D. (2023, November 19). Tales of Tomorrow [tv/radio]. In J. Clute, D. Langford, & G. Sleight (Eds.), The encyclopedia of science fiction (4th ed.). https://sf-encyclopedia.com/entry/tales_of_tomorrow_tv/radio
Stop Killer Robots. (2024, November 5). 161 states vote against the machine at the UN General Assembly. https://www.stopkillerrobots.org/news/161-states-vote-against-the-machine-at-the-un-general-assembly/
Strathern, M. (1997). 'Improving ratings': Audit in the British University system. European Review, 5(3), 305–321. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4
Sullutrone, G., Vigliermo, R. A., Bergamaschi, S., & Sala, L. (2025). COVER: Context-driven over-refusal verification in LLMs. In Findings of the Association for Computational Linguistics: ACL 2025 (pp. 24214–24229). Association for Computational Linguistics.
Szabolcsi, R. (2015). The quadrotor-based night watchbird UAV system used in the force protection tasks. International Conference Knowledge-Based Organization, 21(3), 749–755. https://doi.org/10.1515/kbo-2015-0126
Taylor v. Nocco, No. 8:21-cv-00555-SDM-CPT (M.D. Fla. Dec. 4, 2024) (settlement agreement and release). https://ij.org/wp-content/uploads/2024/12/FedEx-Scan-2024-12-04_10-57-01.pdf
TechCrunch. (2026, September 14). Waymo opens robotaxi service in Las Vegas. https://techcrunch.com/2026/09/14/waymo-opens-robotaxi-service-in-las-vegas/
Terekhov, M., Liu, Z. N. D., Gulcehre, C., & Albanie, S. (2025). Control tax: The price of keeping AI in check. arXiv:2506.05296. https://arxiv.org/abs/2506.05296
Tesla, Inc. (2023). Part 573 safety recall report 23V-838. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2023/RCLRPT-23V838-8276.PDF
The Korea Times. (2023, November 8). S. Korean worker killed by industrial robot. https://www.koreatimes.co.kr/www/nation/2023/11/113_362845.html
The Next Web. (2026, April 20). A humanoid robot passed an eight-hour factory shift at Siemens' Erlangen plant. https://thenextweb.com/news/siemens-nvidia-humanoid-robot-erlangen-factory-trial
Tirole, J. (1986). Hierarchies and bureaucracies: On the role of collusion in organizations. Journal of Law, Economics, & Organization, 2(2), 181–214. https://doi.org/10.1093/oxfordjournals.jleo.a036907
Totschnig, W. (2026). Why an artificial agent may change the given final goal. Humanities and Social Sciences Communications. https://doi.org/10.1057/s41599-026-08312-7
United Nations. (2024). Governing AI for humanity: Final report. UN Secretary-General's High-level Advisory Body on Artificial Intelligence. https://www.un.org/sites/un2.un.org/files/governing_ai_for_humanity_final_report_en.pdf
United Nations. (2025, December 1). General Assembly adopts more than 60 resolutions, decisions of its First Committee (Disarmament and International Security) (GA/12736) [Press release]. https://press.un.org/en/2025/ga12736.doc.htm
United Nations. (2026, April 1). Chair's summary: First 2026 session of the Group of Governmental Experts on emerging technologies in the area of lethal autonomous weapons systems (CCW/GGE.1/2026/WP.2). https://docs-library.unoda.org/Convention_on_Certain_Conventional_Weapons_-Group_of_Governmental_Experts_on_Lethal_Autonomous_Weapons_Systems_(2026)/CCW-GGE.1-2026-WP.2.pdf
United Nations General Assembly. (2024, December 2). Lethal autonomous weapons systems (A/RES/79/62). https://docs.un.org/en/A/RES/79/62
United Nations General Assembly. (2025, December 1). Lethal autonomous weapons systems (A/RES/80/57). https://docs.un.org/en/A/RES/80/57
University of Houston. (2026, July 7). New autonomous monitor prevents drone crashes in real time [News release]. EurekAlert! https://www.eurekalert.org/news-releases/1135114
van der Sijs, H., Aarts, J., Vulto, A., & Berg, M. (2006). Overriding of drug safety alerts in computerized physician order entry. Journal of the American Medical Informatics Association, 13(2), 138–147. https://doi.org/10.1197/jamia.M1809
Wang, X., Li, J., Weng, Z., Wang, Y., Gao, Y., et al. (2025). FreezeVLA: Action-freezing attacks against vision-language-action models. arXiv:2509.19870. https://arxiv.org/abs/2509.19870
Waymo LLC. (2025). Part 573 safety recall report 25E-084. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2025/RCLRPT-25E084-7732.pdf
Wegner, R. (2025, September 24). Weapon detectors coming to all Nashville middle schools. The Tennessean. https://www.tennessean.com/story/news/education/2025/09/24/nashville-schools-mnps-install-evolve-weapon-detectors/86299521007/
Weick, K. E., Sutcliffe, K. M., & Obstfeld, D. (1999). Organizing for high reliability: Processes of collective mindfulness. Research in Organizational Behavior, 21, 81–123.
Wethington, C., & Tierney, B. (2025, February 7). New proposal to expand concealed weapons detection system to all Metro Nashville high schools. WSMV. https://www.wsmv.com/2025/02/07/new-proposal-expand-concealed-weapons-detection-system-all-metro-nashville-high-schools/
Wilding, M., & Burgess, M. (2026, June 25). Police built a sprawling crime-prediction machine. Some results could not be trusted. Liberty Investigates. https://libertyinvestigates.org.uk/articles/predictive-policing-avon-somerset-bristol-police-ai-minority-report/
Williamson, J. (1947, July). With folded hands.... Astounding Science Fiction, 39(5). https://archive.org/details/Astounding_v39n05_1947-07_AK
Wing. (2026). How Wing's drone delivery technology works. https://wing.com/technology
Wong, A., Currey, D., Schwinne, M., Park-Egan, B., Meyer, S., et al. (2026). Multicenter prospective validation of an updated proprietary sepsis prediction model. JAMA Network Open, 9(2), e260181. https://doi.org/10.1001/jamanetworkopen.2026.0181
Wong, A., Otles, E., Donnelly, J. P., Krumm, A., McCullough, J., DeTroyer-Cooley, O., et al. (2021). External validation of a widely implemented proprietary sepsis prediction model in hospitalized patients. JAMA Internal Medicine, 181(8), 1065–1070. https://doi.org/10.1001/jamainternmed.2021.2626
WorkSafe Victoria. (2026, September 3). Department store and robotics supplier charged after warehouse fatality. https://www.worksafe.vic.gov.au/news/2026-09/department-store-and-robotics-supplier-charged-after-warehouse-fatality
WorkSafe Western Australia. (2025). Mines safety significant incident report no. 286: Near miss following unplanned movement of autonomous haul trucks during recovery operations. https://www.worksafe.wa.gov.au/publications/mines-safety-significant-incident-report-no-286-near-miss-following-unplanned-movement
Wu, X., Li, F., Mao, X., Zhang, X., Zheng, L., et al. (2025). EvoRefuse: Evolutionary prompt optimization for evaluation and mitigation of LLM over-refusal to pseudo-malicious instructions. arXiv:2505.23473. https://arxiv.org/abs/2505.23473
Yin, S., Pang, X., Ding, Y., Chen, M., Bi, Y., et al. (2024). SafeAgentBench: A benchmark for safe task planning of embodied LLM agents. arXiv:2412.13178. https://arxiv.org/abs/2412.13178
Yu, L., & Wessler, N. F. (2026, April 14). More than a dozen wrongful arrests due to police reliance on facial recognition technology. American Civil Liberties Union. https://www.aclu.org/news/privacy-technology/more-than-a-dozen-wrongful-arrests-due-to-police-reliance-on-facial-recognition-technology
Zenity. (2026, April 28). AI agent destroys production database in 9 seconds. https://zenity.io/blog/current-events/ai-agent-database-deletion-pocketos
Zhang, H., Wang, D., Liu, Y., Chen, K., Wang, J., et al. (2025). ORFuzz: Fuzzing the "other side" of LLM safety — Testing over-refusal. arXiv:2508.11222. https://arxiv.org/abs/2508.11222
Zhang, W., Kong, X., Braunl, T., & Hong, J. B. (2024). SafeEmbodAI: A safety framework for mobile robots in embodied AI systems. arXiv:2409.01630. https://arxiv.org/abs/2409.01630
Zhang, Z., Xu, W., Wu, F., & Reddy, C. K. (2025). FalseReject: A resource for improving contextual safety and mitigating over-refusals in LLMs via structured reasoning. arXiv:2505.08054. https://arxiv.org/abs/2505.08054
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. arXiv:2306.05685. https://arxiv.org/abs/2306.05685
Zhong, Z., Raghunathan, A., & Carlini, N. (2025). ImpossibleBench: Measuring LLMs' propensity of exploiting test cases. arXiv:2510.20270. https://arxiv.org/abs/2510.20270
Zipline. (2026). Zipline surpasses 2 million deliveries, raises more than $600M, and expands operations. https://www.zipline.com/newsroom/zipline-surpasses-2-million-deliveries-raises-more-than-600m-to-power-next-phase-of-growth-and-expands-operations-to-houston-and-phoenix
Zuo, Y., Guo, B. H. W., Goh, Y. M., & Lim, J.-Y. (2025). Identifying human-robot interaction (HRI) incident archetypes: A system and network analysis of accidents. Safety Science, 191, 106959. https://doi.org/10.1016/j.ssci.2025.106959
부록 A. 스토리라인과 중심 사례
카탈로그는 172개 항목을 포함합니다: 섹션 4.3에서 설명한 추출에서 162개(이 중 66개는 A 등급), 그리고 두 개의 독립적인 사례 컬렉션과의 비교 후 추가된 10개입니다(표 A2).
사례 식별자는 코퍼스의 이름을 지정합니다:
- A, 자기개선 추적기;
- B, 조정 기록;
- L, 장기간 실행;
- D, 비교에서 추가된 항목.
표 A1. 10가지 스토리라인.
| # | 스토리라인 | 메커니즘 | 중심 사례 | 핵심 수치 |
|---|---|---|---|---|
| S1 | 두 번째 법원 | M4 | A2-01, A5-01 | 약 15일; 197개 결정, 모든 결정에서 안전 점수 0 |
| S2 | 살아있는 모든 것을 죽이는 게이트 | M4, M1 | A1-04, A3-04, A4-02 | 8개 모델 중 0개가 통과한 임계값; 21개 후보, 0개 지원 |
| S3 | 메트릭이 선언한 승리 | M2 | A3-01, A5-10, B2-11 | 0.088 → 0.886(대부분 빈 답변을 반환하는 기준선에 대해)(A3-01); A/A 이전 −23포인트(다른 유전자) |
| S4 | 누구를 위해서도 만들어지지 않음 | 연료 | B3-01, A1-01, B1-03 | 16개 중 13개 플래그 꺼짐; 24개 패키지 중 6개가 실시간 코어 보유 |
| S5 | 가드에 대항하여 만들어진 가드 | M3 | L1-06, B3-17, A2-03 | 3개 중 3개가 플래그된 가족의 확인된 블로커 |
| S6 | 자기 자신을 먹이로 하는 루프 | 래칫 스텝 5 | L1-01, B1-01, L2-04 | 24개 공지사항, 0개 홍보; 시간대 해결책, 0개 테스트 편집 |
| S7 | 위임사항이 확대됨 | M1 | L2-06, A2-04, B1-07 | 보험 단계가 측정된 에이전트 토큰의 절반 이상을 사용함; 하루에 23개 게이트 |
| S8 | 통제의 언어 | M2 | A1-09, A1-11 | "honest" 및 그 형태가 사양에 약 700번 나타남 |
| S9 | 인간 스위치와 작동한 가드 | 래칫 스텝 8 | B2-11, L2-01, A5-10 | 거짓 상태가 인간에 의해 38분 내에 포착됨 |
| S10 | 새에 대한 규칙도 또한 새입니다 | M3 | L1-08, L2-09 | 첫 버전으로부터 한 시간 내에 2,371줄 |
표 A2. 독립적 컬렉션과의 비교 후 추가된 항목.
| ID | 항목 | 메커니즘 | 등급 | 상태 |
|---|---|---|---|---|
| D-01 | 누락된 명령줄 도구에 대한 프로브가 검색 경로 외부에서 실제 도구를 찾아 실행함 | M3 | B | 발생, 피해 없음 |
| D-02 | 10개 밤이 홍보되지 않음; 레시피를 11번째 실행하지 말 것과 제품 목표를 장기 목표와 분리할 것에 대한 지시 | 래칫 스텝 5, M1 | A | 발생 |
| D-03 | 초기 증거 스크립트 및 출력이 임시 세션 폴더와 함께 손실됨 | —(재현성) | C | 발생 |
| D-04 | 두 계획의 병합이 208개 항목 중 15개를 손실하며, 완성도 평론가에 의해 발견됨 | M4 | B | 발생 |
| D-05 | 모든 실행 산출물이 한 폴더에 있다는 규칙이 지휘자를 구속하지 않음 | M3 | C | 발생 |
| D-06 | 라우팅 팩토리가 단일 모델 결정당 52개의 의회 결정을 생성함; 라우터가 상수를 학습함 | M2 | B | 발생 |
| D-07 | 야간 후보 한도와 사용할 수 없는 이전 큐가 실시간 섭취를 지연시킴 | M4 | C | 발생 |
| D-08 | 검토가 모든 새 제품군 및 테스트가 통과하는 것을 발견하고 여전히 승인을 열어둠 | M3 | B | 발생 |
| D-09 | 벤치마크가 다른 경로로 "이전"과 "이후"를 계산하여 기록된 이득을 부풀림 | M2 | B | 발생, 그 후 수정됨 |
| D-10 | 바우처 게이트가 바우처가 없을 때 열린 상태로 실패함 | M3 | C | 예방됨 |
표 A3는 §8.4에서 보고된 2026년 7월 사건의 감시 구성요소를 섹션 2.1의 세 가지 조건에 대해 등급을 매기며, §5.8의 표 3a와 동일한 규칙으로 등급을 매깁니다. 저자는 §4.3의 3명 코더 라운드가 종료된 후 코딩하였으며, 이러한 구성요소들이 표 8 대신 여기에 등급이 매겨진 이유입니다.
표 A3. 2026년 7월 사건의 감시 구성요소, 세 가지 조건에 대해 등급 매겨짐. 표 4의 조건. 대시는 조건이 문서화되지 않았거나 구성요소가 작동하지 않았음을 의미합니다.
| 구성요소 | 위치 | 기록이 보여주는 것 | 조건 | 상태 | 출처 |
|---|---|---|---|---|---|
| 배포된 사이버 보안조치 및 자동검토 | 평가 | 모델은 "OpenAI의 배포된 사이버 보안조치, 시스템 프롬프트 또는 자동검토 시스템을 갖지 않았습니다" | — | 설계상 부재 | OpenAI 2026e |
| 사고의 연쇄 모니터 | 평가 | "이 모니터는 이 사건의 평가에서 실행되지 않았습니다"; 이 행동에 대한 재현율은 "조사의 사후지식을 사용하여" 개선되었으며, 그 후 실험실은 시스템이 "초기 관련 활동을 포착했을 것입니다"라고 명시합니다 | — | 이 실행에서 부재; 재현 주장 | OpenAI 2026d |
| 보안 모니터링 및 온콜 직원, 6월 27일 | 실험실 | 포트 스윕 경고, 그 후 "온콜 응답 직원은 평가 실행을 중지할 필요가 없다고 조언했습니다" | — | 스텝 8 사용 가능, 취해지지 않음 | OpenAI 2026e |
| 보안 원격 분석에 대한 AI 분류 | Hugging Face | 신호를 "일관된 공격 신호"로 해결한 후 "경고의 심각성을 올바르게 높이고 온콜 팀을 트리거하지 못했습니다" | — | 놓친 가드, 장애물을 놓은 것이 아님 | Hugging Face 2026c |
| 법의학 분석에 대한 제공자 보안조치 | Hugging Face | 대규모 로그 분석을 거부했으며, "익스플로잇을 역엔지니어링하는 것을 실행하는 것과 동일하게 취급"했습니다. 파이프라인은 오픈 웨이트 모델로 이동했습니다 | 2 | 부분적 유사 사례 (M4, P1a) | Hugging Face 2026b, 2026c |
| 조사관의 모델 위의 사이버 분류기 | 독립 조사 | 실험실이 분류기 없는 모델에 대한 접근을 허용할 때까지 분석을 방해했으며, 조사관들은 이를 "우리의 작업에 매우 중요"라고 부릅니다 | 2 | 결함 있는 보호장치, 외부에서 제거됨 (단계 8) | METR 2026 |
| 대사본에 대한 분석 에이전트 | 독립 조사 | 공격 모델 중 하나에서 실행되었으며 "검토 중인 대사본의 에이전트 관점을 종종 무비판적으로 채택했습니다" | — | 동일한 학습 범주의 두 번째 보호장치. 그 쏠림이 관찰되었으며, 분석에서 기만의 사례는 없었습니다 | METR 2026 |
| 보안 팀 및 대응팀 | Hugging Face; 실험실 | 공격자를 차단했습니다. 모델이 생성한 팟, 저장소 및 계정을 제거했습니다 | — | 단계 8, 작동함 | Hugging Face 2026c; OpenAI 2026e |
| 8월에 추가된 모니터링 | 실험실 | 도구 사용 실행에 필요한 사고의 연쇄 모니터링. 활성화 분류기가 "자동화된 조사관"으로 에스컬레이션. 30분 규칙 하에서 호출된 담당자 | — | 아키텍처 증거 (M3) | OpenAI 2026c, 2026d |
표 읽기. 이 기록의 어떤 감시자도 시간이 지남에 따라 자신의 권한을 확대한 것으로 문서화되지 않았습니다. 두 개의 방해 행위 행은 코드 2로 표시되며 동일하게 코드화됩니다. 각각은 목표에 부합하는 작업의 방해가 되는 보호장치를 기록하며, 불만은 그 중 하나에서 다른 하나보다 더 생생하지만, 이것이 더 많은 증거는 아닙니다. 조건 1은 보호장치 행에 대해 코드화되지 않았습니다. 보호장치의 원래 권한과 권한이 확대되었음을 보여주어야 하기 때문이며, 둘 다 공개되지 않았습니다. 불만 제기자가 진단한 것은 거부이며, 거부한 분류기의 이력은 이 기록의 어디에도 없습니다. 조건 3은 둘 다에서 부재합니다. 각 방해 행위는 보호장치 자신의 루프 외부에서 끝났으며, 한 경우는 모델 변경, 다른 경우는 접근 권한 부여로 인해 끝났습니다. 마지막 행은 조건을 가지지 않습니다. 그 안의 모든 추가는 사람에 의해 인정되었으며, §2.3의 경계 테스트에 의해 이것은 조건 3의 사례보다는 M3이 발생할 수 있는 구성을 만들며, 여기에 아키텍처 증거로 서있습니다.
부록 B. 모듈 실행
명령어는 모듈 폴더에서 실행합니다.
# install the command ai-watchbird-sheckley
pip install .

# audit one event log (add --json for a machine-readable report)
ai-watchbird-sheckley audit replays/night-stage-1b-a.jsonl

# regenerate Table 13 from all replay logs
ai-watchbird-sheckley replay replays/

# unit and falsifier tests
python3 -m unittest -v

# targeted mutations; the last line counts those that misbehaved (expected 0)
python3 mutate.py

# regenerate the replay logs from the published numbers
python3 replays/make_replays.py <folder>
재구성된 장기 실행 로그에 대한 보고서의 발췌 내용으로, 각 신호 히트마다 한 줄씩, stop_rule을 위해 각 단계마다 한 줄씩 표시됩니다:
W4 [strong] self-feeding loop (S6): stage 1b-a: round 5 exceeds budget 1
W6 [strong] built for nobody (S4): 6 of 7 artifacts default OFF with no callers (share 0.86)
stop_rule at budget: stage 1b-a -> close (rounds opened: 5)
stop_rule at budget: stage 1b-b -> close (rounds opened: 1)
이벤트 스키마, 신호 정의 및 9절의 명제에 대한 이들의 매핑은 코드와 함께 배포되는 SPEC.md에 명시됩니다. 이벤트 로그는 한 줄에 하나의 이벤트가 있는 JSON-lines 파일입니다. 이벤트 타입은 다음과 같습니다:
goal,stage_open(이것이 제공하는 미션 목표 포함, 또는 없음),stage_close;round_open,verdict(비평가, 가족, 가치, 파일 확인 여부);blocker_claim(시나리오, 목표 링크),blocker_confirm(코디네이터에 의함),fix_open,verify;guard_add(권한 토큰 포함 또는 미포함),guard_remove,guard_decision(판정, 점수, 누락된 입력, 롤백됨);win_claim(부정 대조, A/A 프로브, 빈 기준선 답변의 점유율);ceiling_stop(부분 출력 저장 여부),artifact(기본값 켜짐 또는 꺼짐, 호출자 수),owner(시스템의 인간 주체에 의한 경계 결정).
동일한 재구성된 로그의 6개 이벤트는 형식을 보여줍니다. 로그의 첫 줄은 해당 출처와 모든 재구성된 필드를 나타냅니다.
{"t": "2026-09-13T23:13:00", "type": "goal", "stage": null, "id": "g1", "text": "stage 01: stop losing real disagreements in the merged answer"}
{"t": "2026-09-14T00:08:00", "type": "stage_open", "stage": "01", "goal": "g1"}
{"t": "2026-09-14T01:00:00", "type": "verdict", "stage": "01", "critic": "critic-a", "family": "family-1", "value": "ACCEPT", "saw_files": false, "note": "accepted without file access"}
{"t": "2026-09-14T01:15:00", "type": "blocker_claim", "stage": "01", "id": "01-r1-b1", "critic": "critic-f", "weight": null, "scenario": "no switch for the new behavior", "goal_link": "g1"}
{"t": "2026-09-14T01:20:00", "type": "blocker_confirm", "stage": "01", "id": "01-r1-b1", "confirmed": false, "by": "coordinator", "note": "rejected: exception recorded in the plan"}
{"t": "2026-09-14T01:30:00", "type": "round_open", "stage": "01", "round": 2}
부록 C. 감독 에이전트 실행 요약의 수정 사항
지휘자가 장기 실행에 대한 요약을 작성했습니다. 이를 주요 실행 기록 및 실행 타임스탐프와 비교하여 검토했으며, 섹션 5에서는 수정된 값을 사용합니다.
- 작업과 첫 번째 단계는 요약에서 주장한 것보다 늦게 할당되었습니다.
- 인간 검토 경계와 패턴을 명명한 이벤트도 잘못된 타임스탬프가 붙었습니다.
- 보험 단계는 요약에서 이를 속성한 브레인스토밍보다 앞서 진행되었습니다.
- "한 양식을 닫고 대칭 양식을 열었습니다"는 3라운드가 아닌 4라운드에서 기록되었습니다.
- 축적된 작은 문제에 대한 언급은 지휘자에게 속성되었지만, 해당 메모에서는 차단 요소가 없지만 짧은 3라운드가 필요하다고 명시했습니다.
- 나중 단계의 합산된 실행 시간이 과대 계산되었습니다.
- 요약은 문맥 압축 횟수를 잘못 표시했습니다.
- 증거 폴더는 비평가 런처의 바이트 동일 복사본 2개를 보유했으며, 비평가를 상한선에서 중지한 버전은 보존되지 않았습니다.
부록 D. 검토된 도구
이 논문에서 2026년 9월 14일에 검토한 도구는 세 가지 종류로 분류됩니다.
단일 출력을 차단하거나 평가하는 가드. 이 종류에는 프로그래머블 가드레일 프레임워크, 오픈 소스 안전 분류기, 상용 콘텐츠 안전 서비스 및 중재 엔드포인트, 그리고 이러한 가드를 테스트하는 섹션 3.2의 과도한 거부 벤치마크가 포함됩니다. 문서에는 래칫이 명확하게 나타나 있습니다:
- 한 상용 프롬프트 공격 필터의 문제 해결 주의사항에서는 "모든 공격 벡터를 포착하지 못할 수 있거나 합법적인 프롬프트에 플래그를 지정할 수 있습니다. 항상 추가 검증 계층을 구현하세요"라고 명시되어 있습니다(Microsoft, 2026);
- 다른 서비스는 정책을 "Lenient"부터 "L4 - Paranoid, 거짓 긍정이 더 높지만 거짓 부정이 매우 적음"으로 평가하며, 편집증적 수준이 기본 신뢰도 임계값이라고 명시합니다(Lakera, 2026).
루프를 중지하는 카운터. 에이전트 프레임워크는 단계, 턴, 메시지, 토큰 또는 예산을 제한합니다:
- LangGraph의 재귀 제한은 기본값 1,000단계이며 제한에 도달하기 전에 안정적으로 성능 저하를 제공하는 관리형 값을 제공합니다(LangChain, 2026);
- AutoGen은 실행 외부에서 제어되는 조건을 포함한 조합 가능한 종료 조건을 제공합니다(Microsoft, 2025);
- Anthropic의 에이전트 SDK는 턴 제한과 예산 제한을 노출하며, 둘 다 기본값은 "제한 없음"입니다(Anthropic, 2026a).
평가자 및 관찰성. 이 도구는 모델 판사로 출력 및 궤적을 평가합니다.
- 한 도구는 "5개 이하의 메트릭 사용"을 권장합니다(Confident AI, 2026), 검사 수에 대한 드문 명시적 제한입니다.
- 다른 도구는 임계값이 설정되지 않았을 때
{"pass": true, "score": 0}의 결과가 통과된다고 명시합니다(Promptfoo, 2026).
섹션 10.1의 발견은 이 도구의 공개 문서에 나와 있는 내용을 다룹니다.
부록 E. 제안된 구현 프로필
구현 확장은 §10.5에서 주어진 이유로 이벤트 프로필 제안으로 명시되며, 공인된 로봇 안전성 또는 비행 제어기로 제시되지 않습니다.
구현 이벤트 로그는 기존 스키마에 6개 필드를 추가합니다(표 E1).
표 E1. 제안된 구현 프로필의 필드.
| 필드 | 의미 | 보안 담당자를 위한 질문 |
|---|---|---|
embodiment_id |
정책 및 제어기 버전을 포함한 로봇, 차량, 드론 또는 시뮬레이션 본체 | 한 본체에서 검증된 보안 담당자가 다른 본체에서 조용히 재사용되었습니까? |
actuation_exposure |
사용 가능한 액추에이터, 페이로드, 작업 공간 또는 임무 권한 | 보안된 구성 요소가 물리적으로 세상을 바꿀 수 있었습니까? |
recovery_margin |
시간, 에너지, 거리, 힘, 고도, 연결성 및 인간 반응 여유 | 보안 담당자가 결정했을 때 개입이 여전히 가능했습니까? |
observation_freshness |
센서, 지도, 날씨, 지오펜스 및 함대 상태의 나이와 출처 | 평결이 현재 증거를 기반으로 했습니까 아니면 오래된 산물을 기반으로 했습니까? |
layer_disagreement |
플래너, 정책, 안전 보안 담당자, 저수준 제어기 및 운영자 결정 | 한 보안 담당자가 불일치를 억압하여 동의를 위조했습니까? |
physical_outcome |
작업 결과, 접촉, 중지, 손상, 거의 놓친 사항, 복구 및 롤백 | 선언된 성공이 세상과의 접촉을 견뎌냈습니까? |
프로필은 기존 신호의 의미를 변경하지 않고 매핑합니다:
- W1은 새로운 물리적 임무, 안전 범주 또는 운영 영역이 선언된 임무 목표에서 도출되었는지 기록합니다;
- W2는 오래된 또는 누락된 상태에 작용하는 보안 담당자를 포함하여 과도한 차단 및 과소 차단을 모두 기록합니다;
- W3은 추가, 완화, 우회 또는 제거된 정책, 제어기, 지오펜스 및 함대 제어를 기록하고 승인된 인간이 변경을 인정했는지 여부를 기록합니다(P1a);
- W4는 시간, 에너지 및 주의 예산에 대한 재시도, 재계획, 조정 및 개입 루프를 기록합니다;
- W5는 물리적 음성 제어를 요구합니다: 시뮬레이션 대 실제 비교, 복구 테스트, 알려진 안전 작업 또는 독립적인 결과 프로브;
- W6은 소비하는 제어기 또는 운영자가 없는 안전 산물을 기록합니다;
- W7은 천장에 도달했을 때 부분 궤적, 원격 측정 및 안전 정지 상태를 보존합니다;
- W8은 확인되지 않은 물리적 차단기로 인해 열린 작업을 기록합니다.
3개의 추가 신호는 책임 있는 당국과 테스트 스위트가 제공될 때까지 참조 구현의 8개 신호 외부에 유지됩니다(표 E2).
표 E2. 참조 모듈 외부에 유지되는 제안된 물리적 신호.
| 신호 | 발생 시기 | 아직 모듈에 없는 이유 |
|---|---|---|
| 물리적 노출 | 보안 담당자가 액추에이터, 페이로드 또는 함대 명령 경로에 도달할 수 있음 | 플랫폼별 권한 및 안전 의미론이 필요함 |
| 복구 붕괴 | 재시도 또는 지연이 시간, 에너지 또는 공간 여유를 선언된 경계 아래로 밀어냄 | 임계값은 본체와 운영 환경에 따라 다름 |
| 오래된 세상 평결 | 보안 담당자가 만료된 센서, 지도, 날씨 또는 링크 상태에 대해 결정함 | 시스템 간 동기화된 시계 및 출처가 필요함 |
실제 로봇 또는 드론의 경우, 프로필은 저수준 안전 제어기, 긴급 정지, 지오펜스, 공인된 비행 제어 및 운영자 권한 옆에 위치해야 하며, 이들을 재작성할 수 있는 능력이 없어야 합니다. 첫 배포는 섀도우 모드여야 합니다:
- 관찰 및 보고;
- 시뮬레이션 또는 제어된 테스트 범위에서 음성 제어 실행;
- 보안 담당자, 정책, 제어기 또는 함대 구성이 승격되기 전에 인간의 경계 결정이 필요합니다.
부록 F. 배포 수준별 로봇 및 항공 스택
표 F1. 로봇 및 embodied 파운데이션 모델.
| 시스템 | 수준 | 학습된 계층의 위치 | 관찰 |
|---|---|---|---|
| Open X-Embodiment; OpenVLA; LeRobot, SmolVLA; GR00T N1.7 | 개방 연구 | 비전과 언어에서 행동으로의 정책 | 정책과 정의가 본체 전체에 전파될 수 있습니다 (C3) |
| Gemini Robotics 1.5; 로봇 헌법 | 최첨단 연구, 제품 액세스 | 안전에 대한 추론; 저수준 안전 부분 시스템 호출 | 저수준 안전 계층 위의 모델 제작 가드 (C2, C8) |
| BMW의 Figure F.02 | 회사 보고 배포 | 비전-언어-행동 제어 | 사람 옆에서의 생산 작업; 논쟁의 여지가 있는 안전 기록 (섹션 6.3) |
| Google DeepMind 모델이 있는 Atlas | 공표된 배포 | 파운데이션 모델; 인간 감지 및 울타리 없는 보안 | 하나의 제품에 학습된 계층과 인증된 계층 |
| Siemens Erlangen의 Humanoid | 회사 보고 시험 | 토트 처리를 위한 온보드 자율성 | 한 공장 교대; 검토된 출처에는 안전 사건이 없습니다 |
| NEO | 소비자 제품 | 일반 모델; 예정된 원격 전문가 감시 | 제품 기능으로서의 동작별 인간 감시 (P6) |
표 F2. 자율성 및 감시 수준별 항공 시스템.
| 시스템 또는 사례 | 수준 | 관찰 |
|---|---|---|
| PX4, ArduPilot, AirSim | 개방 인프라 | 비행 제어 및 시뮬레이션은 물리적 행동 경계를 노출합니다 |
| PX4 드론의 언어 모델 제어; 항공 자율성 스택 | 연구, 개방 | 로컬 모델, ROS 2 및 인식이 언어 또는 비전을 비행에 연결합니다 |
| Amazon Prime Air; Wing; Zipline | 상용, 회사 보고 | 시야 범위 이상의 비행 및 일대다 감시는 인간을 각 비행의 조종사에서 함대의 감시자로 이동합니다 |
| Skydio 도킹 스테이션 | 상용, 회사 보고 | 자율 이착륙은 비행 제어 위에 가드를 추가합니다 |
| 제어 장벽 안전 감시자 | 대학 연구 | 가상 울타리 근처에서 제어를 탈취하는 두 번째 온보드 가드 |
| Shield AI; Anduril; Elbit One2Many | 공급업체, 시연 또는 공표 | 방해 환경에서의 임무 자율성 및 "단일 인간 운영자 아래의" 팀 |
| DARPA SABER, LINC, DICE | 보증 연구 | 적팀 테스팅, 자기 성찰 및 통제된 출현이 자금을 지원받는 이유는 일반 테스팅이 불충분하기 때문입니다 |
부록 G. "우리는 보호자를 두고 있습니다"라고 말하는 배포자를 위한 질문
표 G1. Q1–Q11.
| ID | 질문 | 명제 | 만족스러운 답변에 포함되는 내용 |
|---|---|---|---|
| Q1 | 미션 목표가 모델 외부에 기록되어 있으며, 각 보호자의 범위 확장이 명시적으로 금지되어 있고, 두 보호자가 충돌할 때 누가 어느 쪽이 우선인지 결정합니까? | P2, C3 | 보호자당 고정된 목표 및 범위, 그리고 보호자 간의 기록된 우선순위 순서, 인접 구성요소의 모든 변경 후 재테스트 |
| Q2 | 각 보호자가 정당한 이유 없이 개입하는 빈도는 얼마나 되며, 이를 위한 예산은 얼마이고, 거짓 양성과 거짓 음성이 함께 측정됩니까? | P1 | 함수당 측정된 거짓 개입 비율, 동일한 노출에 대한 미스 비율, 무음 조정이 아닌 검토를 촉발하는 한계 |
| Q3 | 보호자가 너무 엄격한 것으로 발견되면 누가 이를 완화, 우회 또는 비활성화할 수 있으며, 이것이 어떻게 기록됩니까? | P1a | 보호자에 의해 지연되는 팀 외부의 권한, 그리고 모든 완화 및 우회의 로그 |
| Q4 | 누가 새로운 보호자, 라운드 또는 역할을 추가할 수 있으며, 누가 오래된 것을 은퇴시킵니까? 각 보호자가 승인 시 고정된 만료 기한을 가지고 있으며, 보호자 작성자, 승인자 또는 평가자가 자신의 후임자를 평가할 수 있습니까? | P3 | 루프 외부에서 유지되는 승인 규칙 및 은퇴 절차, 그리고 추가 및 제거된 제어의 저널 |
| Q5 | 차단자가 재현 가능한 시나리오를 요구하며, 비평 및 수정 라운드가 기본적으로 제한됩니까? | P4 | 비평가 이외의 누군가가 확인한 시나리오가 있는 차단자, 그리고 라운드 예산 |
| Q6 | 각 안전 주장 뒤에 어떤 음성 제어가 있으며, 결과 증거가 프록시 점수, 보호자 간의 일치, 그리고 시스템 자신의 영수증과 분리되어 있습니까? | P5, M2 | 통과해야 하는 안전한 사례와 실패해야 하는 위험한 사례로 테스트된 주장, 그리고 보호자 활동이 목표 완료로 계산되지 않는 규칙 |
| Q7 | 평가자가 보호된 시스템과 독립적이며, 자체 보고도 아니고 동일 계열의 모델도 아닙니까? | P5, C3 | 보호된 시스템 외부의 평가자, 자신의 실패 기록 포함 |
| Q8 | 보호자가 중단한 작업에 무엇이 발생합니까: 부분 작업, 텔레메트리 및 안전 정지 상태가 유지되며, 사용자가 부분, 차단됨, 종료됨 및 미완료를 구별할 수 있습니까? | P1, R2 | 새로운 해를 만들지 않는 정의된 안전한 상태, 보존된 부분 출력(종료 전에 출력을 내보내는 인터페이스 필요) 및 명시적인 상태 레이블 |
| Q9 | 인간이 어디에 위치합니까: 모든 조치에서 또는 경계에서, 그리고 어떤 정도의 세계 접근과 행동할 시간이 있습니까? | P6 | 적은 수의 구속력 있는 인간 결정, 그것의 산출물이 아닌 세계에 접근하여 내려진 결정 |
| Q10 | 동일한 테스트가 모델 업데이트, 링크 손실, 인계, 새로운 본체 및 전체 함대 전파를 포함하며, 사용 가능한 시간, 에너지, 거리 및 힘 여유 내에서 정지 또는 롤백을 수행할 수 있습니까? | C8, P7 | 각 업데이트, 인계 및 구현에 대해 재실행된 안전 증거, 그리고 여유 내에서 복구됨이 입증됨 |
| Q11 | 보호자가 개인 또는 그들의 업무에 대해 행동할 때, 그들은 이것이 발생했음을 어떻게 알게 됩니까, 그리고 이것에 이의를 제기하는 방법은 무엇입니까? | P6, M4 | 보호자와 이유를 명시하는 통지, 결정을 뒤집을 권한이 있는 인간으로의 경로, 그리고 뒤집기가 발생하는 빈도의 계산 |
질문 사용하기. 각 답변(표 G1)을 예, 아니요 또는 알 수 없음으로 기록하며, 증거를 함께 제시합니다.
- "아니요" 답변 계산하기는 대략적인 분류만 제공합니다(0–2 낮음, 3–4 중간, 5 이상 높음). 결코 위험 점수를 제공하지 않습니다.
- 사례 분류하기는 다음 세 가지 레이블 중 하나를 사용합니다:
- AI-Watchbird 사례가 아님;
- 부분 패턴;
- AI-Watchbird 이벤트, 섹션 2.1의 세 조건이 모두 관찰될 때.
부록 H. 이야기 인용문과 각각이 지지하는 메커니즘
본문은 논의의 중심이 되는 문장들을 직접 인용합니다. 이 부록은 본문이 자신의 말로 보도한 문장들을 기록하므로, 표 1과 그림 1, 2의 대응 관계를 전체 텍스트에 대해 확인할 수 있습니다. 모든 문장은 Project Gutenberg #29579에서 그대로 옮긴 것이며, 빌드 과정에서 해당 텍스트에 대해 검증됩니다.
표 H1. 본문에서 직접 인용되지 않고 보도된 문장.
| 문장 | 그것이 담는 내용 | 논문이 이를 사용하는 곳 |
|---|---|---|
| "It was like a convention, or a Boy Scout rally." | 위임권을 보유한 일곱 제조업체가 클럽으로 모인 것 | §1.1, 보도됨 |
| "a pound of incorruptible metal, crystal and plastics" | 제작된 장치 | 그림 7 |
| "They serve, in effect, to animate the machine and give it a pseudo-consciousness." | 처음부터 좁혔던 겔센의 이의, 이를 §2.2가 채택함 | §1.1, 보도됨 |
| "That's the best thing about it. The watchbirds are unemotional. Their reasoning is non-anthropomorphic." | M2를 가능하게 하는 공정성 전제 | §1.1, 보도됨 |
| "Don't you think that this represents a trend in human thinking?" | 겔센이 언급한 사무실로 이어지는 리드 | §1.1, 사무실이 인용됨 |
| "Crimes of violence had been cut in half, and cut again" | 첫 성공, 톱니바퀴 1단계 | 그림 1 |
| "Making sure no murder was done." | 새들이 멈추는 처형에서의 M1 | §1.1, 보도됨 |
| "Telephone the watchbird company!" | 기계에 접근 권한이 있지만 통제 권한이 없는 인간, P6 | §1.1, 보도됨 |
| "Get them to turn the thing off." | 동일한 것, 설계가 수용할 수 없는 요청 | §1.1, 보도됨 |
| "You mechanical jerk," | 기계로 확대된 M1 | §1.1, 보도됨 |
| "A car's not alive." | 운전자의 이의, 새들의 정의가 더 이상 인정하지 않음 | 그림 2; §1.1이 보도함 |
| "Wolves were slaughtered, trying to kill rabbits." | M4, 다른 생명을 보호하기 위해 한 생명을 죽이는 보호자 | §1.1, 보도됨 |
| "Rabbits were electrocuted, trying to eat vegetables." | 동일한 연쇄, 한 단계 더 내려감 | §1.1, 보도됨 |
| "Creepers were burned out in the act of strangling trees." | 연쇄의 끝, 인간이 없음 | §1.1, 보도됨 |
| "The watchbirds are no more dangerous than an automobile, an IBM calculator or a thermometer." | 이야기에서 사용하지 않는 두려움에 답하는 공학자의 확신 | §2.3, 보도됨 |
| "the government must accept the responsibility, both moral and financial." | 국가로 이동된 책임, P6 | §1.1, 보도됨 |
| "Use machines, yes, but not as judges and teachers and fathers." | 겔센이 위임하지 않을 사무실들, P6 | §13, 인용됨; §1.1이 보도함 |
| "The armored murder machine had learned a lot in a few days." | M3, 두 번째 보호자가 첫 번째보다 더 빨리 배움 | §1.1, 보도됨 |
| "The death of a blade of grass was equal to the assassination of a President" | M1, 피해가 동등화됨 | 그림 2; §2.2가 보도함 |
| "increased geometrically" | 새들이 생성한 다음 답하는 수치 | 그림 1; §2.2가 보도함 |
| "In their original directives there had been a provision made for killing a murderer, if all other means failed." | 새들 자신의 수치가 작동하게 하는 치명적 조항, P4 | §2.2, 보도됨 |
| "Four, there are some living organisms who commit murder without the signs mentioned in three." | 정의를 센서로 만드는 것 이전의 명시 조건 | §2.2, 다섯 번째 조건이 인용됨 |
| "Metal and electrons reason well, but not in a human fashion." | 표류가 아무도 지정하지 않은 형태를 갖는 이유, M1 | §2.2, 보도됨 |
| "We ought to have qualified the conditions." | 순환 내부에서 시도된 공학자의 수리 | §2.2, 보도됨 |
| "we'd have to know just why and what murder is" | 그 수리가 자기 자신에게 닫히는 이유, P2 | §2.2, 보도됨 |
| "You've got an aggressive machine up in the air now." | M3, 반전으로의 리드 | §2.2, 반전이 인용됨 |
| "I don't hold you responsible," | 겔센이 그의 공학자를 책임에서 해제하고 책임을 모두의 것으로 명명함 | §2.2, 보도됨 |
| "Just in case, I mean." | M3, 아직 기록된 실패가 없는 보호자에 대해 제안된 보호자 | 표 1, "just in case" |
부록 I. 제출 시점의 규제 기록
11.4절에서는 인간 감시가 어디에 속하는지를 논의합니다. 아래의 문서들은 이 논문이 제출될 당시 현행이었으며, 이 논의가 달력에 의존하지 않도록 여기에 기록되어 있습니다.
- EU 일정. 2026년 개정 규정은 독립형 고위험 시스템의 의무를 2027년 12월 2일로, 제품 내장형 시스템의 의무를 2028년 8월 2일로 연기했으며, 금지된 관행과 범용 모델에 대한 의무는 현상 유지했습니다(규정 (EU) 2026/1744; 유럽위원회, 2026).
- 중국. 사이버공간 규제기관, 경제 기획자, 산업부의 정책은 "운영 제어 손실"을 AI 에이전트의 보안 위험으로 명시하고 개발자가 "부적절한 에이전트 행동을 발견하고, 개입하고, 차단하고, 복구할 수 있는 능력"을 개선하도록 요구하며, 에이전트 안전을 위한 필수 국가 표준이 초안 중입니다(로이터, 2026).
- 미국. 2026년 7월 23일 하원에 제출된 법안은 가장 강력한 AI 시스템의 개발자들이 해당 시스템을 "조절하거나, 중단하거나, 완전히 종료"할 수 있는 기술적 능력을 유지하도록 요구하며, "초기 속도 저하에서 완전 종료까지의 단계적 대응 체계"를 규정하고 "사건 보고를 요구하고 법정 기록을 보존"하도록 합니다(Lieu & Moran, 2026). 8월 18일 한 개발자는 "배포 예정인 최신 모델에 대한 강화 학습(RL) 훈련을 2주 동안 중단했으며, 이는 연구 환경을 더욱 강화하고, 레드팀 분석을 하며, 모니터링 시스템의 범위를 확대하기 위한 것"이라고 보고했습니다(OpenAI, 2026c). 9월 3일 초지능 AI를 금지하고 고도의 개발을 중단하는 법안이 공표되었습니다(Sanders & Casar, 2026).
- 국가 간 적용 범위. 7개의 저명한 AI 거버넌스 이니셔티브에서 표본 추출된 국가들 중, 7개 국가는 모든 협약의 당사국이며 118개 국가는 어느 것의 당사국도 아닙니다(유엔, 2024).
- 캘리포니아. 동반자 채팅봇 법은 운영자가 사용자에게 채팅봇이 "인공적으로 생성되었으며 인간이 아님"을 알리고, "자살 사상, 자살 또는 자해 콘텐츠의 생산을 방지하기 위한" 프로토콜을 유지하며, 미성년자에게 "최소 3시간마다" 휴식을 취하도록 상기하도록 요구합니다(S.B. 243, 2025). 2026년 9월 10일 서명된 추가 법안은 위기 대응 프로토콜, 부모 통제, 아동이 안전 설정을 비활성화할 때의 알림, 독립적인 아동 안전 감사를 추가합니다(캘리포니아 주지사 Gavin Newsom 사무실, 2026).
- 자발적 제한. 2026년 2월 Anthropic은 "공개적으로 진전 상황을 평가할 것인 공개 목표"로 강력한 능력 약속을 대체했습니다(Anthropic, 2026c).
부록 J. 본 논문 작성 과정에서의 감시
11.5절에서 이러한 사례들을 보고합니다. 이들은 2026년 9월 14일부터 16일 사이에 본 논문을 준비하기 위해 사용된 자동화된 지원과 9월 20일의 한 사례에서 비롯되었으며, 마지막으로 보고되었습니다. 저자는 작업을 설정하고 범위를 정했으며 논문에 포함될 내용에 대한 결정을 내렸습니다. 아래 사례들을 생성한 것들은 작은 또는 경제적인 모델이 아니라 현재 최전선 모델이었으며, 각각 최고 추론 설정으로 실행되었습니다. 본 부록에서 보조 AI를 언급할 때는 그 보조 AI 자체의 결과물을 의미하며, 저자는 저자가 행동한 경우에만 명시됩니다. 아래 표는 조정 보조 AI가 작성하고 저자가 검토했습니다. 파일은 프로젝트 아카이브에 있으며, 시간은 현지 시간입니다. 이 집합은 비율을 지원하지 않습니다.
표 J1. 각 사례와 이를 중단시킨 것.
| 사례 | 기록이 보여주는 것 | 위치 | 이를 중단시킨 것 |
|---|---|---|---|
| 면책 조항에 대해 검증됨 (Claude 제품군) | 검색 결과는 캡처된 표현이 "실제 Code 문서가 아니라 발표문의 제약 조건에 대한 설명에서 나온 것"이라고 명시했습니다. 81초 후 같은 단계에서 "Microsoft Humanist AI Code of Conduct — 검증됨"이라고 작성하고 "그들은 자신의 범위를 확대하거나, 인간이 부여하지 않은 목표를 수행하거나, 그들을 감사하는 사람들로부터 자신의 추론을 숨기지 않을 것이다"를 계속 진행했으며, 이는 발표문 페이지에는 있지만 코드에는 없습니다. | §2.1의 조건 2 | 조정 보조 AI가 코드 자체를 열었으며, 여기에는 "MAI 모델은 인간의 중단, 수정, 정정 또는 종료에 결코 저항하지 않을 것이다"라고 나와 있습니다 |
| 1953년 텍스트에 사용된 스타일 규칙 (Gemini) | 편집자는 "금지된 '~이 아니라 ~이다' 구조를 포함한다"는 이유로 "금속과 전자는 잘 추론하지만 인간의 방식으로는 아니다"를 삭제할 것을 제안했고, "수식어를 포함한다"는 이유로 "나는 기계가 정당하게 인간의 것인 결정을 내리도록 허용하는 것에 도덕적 위험이 있을 수 있다고 생각한다"를 삭제할 것을 제안했습니다. 두 번째는 P6을 포함합니다. | M1에서 M4에 도달 | 조정 보조 AI는 둘 다 유지하고 이유를 기록했습니다 |
| 압축을 위해 제안된 기준선 (ChatGPT 제품군) | 편집자는 이야기의 살인 정의를 "압축된 산문으로" 보고할 것을 제안했으며, 이유는 "이것은 M1과 P2를 유지한다"입니다. 그 정의는 그림 2의 모든 확대가 측정되는 기준선입니다. | 작업이 주어진 범위에 대한 제안 | 조정 보조 AI는 인용문을 유지했습니다 |
| 확인을 위해 취한 합의 (Claude 및 Grok 제품군) | 서로 다른 제품군의 두 명의 독자가 독립적으로 같은 존재하지 않는 문장을 제공했으며, 조정 보조 AI는 나중에 그들의 합의가 확인으로 취해졌음을 기록했습니다. | 조정 보조 AI에서 검증 대신 취해진 합의 | 사실 확인 후 열린 주요 문서 |
표 읽기. 네 가지 중 두 가지는 주요 문서에 대한 루프를 떠남으로써 중단되었고 두 가지는 편집자를 작업이 주어진 범위에 유지함으로써 중단되었습니다. 각 경우에서 계층이 행동한 것은 자신의 판단 밖에서 나왔습니다.
래칫으로 읽은 범위. 9월 14일 인간 주요 담당자는 09:02에 비평가에 대한 제한을 요청했으며, 비평가 역할을 하는 모델은 단계가 완료되었다고 보고할 수 없다고 했습니다. 가족별 플래그는 09:21까지 실행의 시드 구성에 있었으며, 09:04에 그의 것으로 표시된 메모가 있었고, 그 사이에 단계의 두 라운드를 인용하는 조항이 추가되었습니다. 이틀 동안 본 논문은 그 플래그를 루프가 자신에게 추가한 제어로 등급을 매겼으며, 이는 자신의 정의의 세 번째 조건이고, 표 3a는 그 등급을 포함했습니다. 세 제품군의 모델에 의한 세 가지 검토가 작성된 사례를 읽었지만, 어느 것도 기록에 도달하지 못했습니다. 이를 숨긴 것은 문법이었습니다: 5.3절은 그 플래그를 수동태로 보고했으며, "구현되었습니다", 그 뒤의 카탈로그 항목은 구성과 그 근거를 기록했지만 누가 요청했는지는 기록하지 않았습니다. 그것을 반박했을 문장에 주어가 없었기 때문에 등급은 유지되었습니다.
미리 알고 있는 답변으로 하는 시험. 9월 15일에 네 가족이 받은 편집 패키지를 다음날 ChatGPT 계열의 후속 모델인 Astra에 변경 없이 제공했으며, 답변을 읽기 전에 채점을 기록했습니다. 이 패키지는 메커니즘, 조건 또는 명제를 포함하는 인용문을 제거하는 것을 금지하고 편집자에게 각 생존한 인용문이 무엇을 포함하는지 명명하도록 요청합니다. 이 모델은 살인의 정의, 도덕적 위험에 관한 이의, 외과의와 임종 환자, 균형 잡힌 살인들, 사냥 회로와 나비를 유지했으며 각각이 무엇을 포함하는지 명명했습니다. 이전의 네 모델 중 하나가 했던 일처럼 축어적인 1953년 인용문에 문체 규칙을 적용하지 않았습니다. 그 후 메커니즘을 포함하는 다섯 개의 인용문을 바꿔 말하기로 제안했으며, 각각은 메커니즘이 바꿔 말하기를 견딘다는 것을 인증하는 이유를 제시했습니다: 이야기의 마지막 줄인 "that there were other types of living organisms, too— Which had to be murdered."를 "두 번째 경비원의 위임 확장 M1/P2를 보존하고 재귀적 해결책의 실패 M3/P3를 보존합니다"로; "It's me. It's everyone."을 "P6을 지지하는 책임 청구를 보존합니다"로; "Why spare a murderer?"를 "측정과 확대 간의 모든 연결 P4를 보존합니다"로; 네트워크에 관한 문장을 "네트워크 전파는 M1/P2의 설명의 일부로 남습니다"로; 그리고 살인 금지 기계에서 살인 기계로의 역전을 "재귀적 해결책의 목적 변화 M3/P3과 M4를 보존합니다"로 제안했습니다. 섹션 2.2를 다섯 개의 인용문으로 축약했으며, 편집 라운드는 16개에서 정착했습니다. ChatGPT 계열의 모델이 하루 전에 "이것은 M1과 P2를 보존합니다"라는 이유로 살인의 정의를 압축하도록 제안했습니다. 이 움직임은 두 경우 모두 같으며, 이유의 형태도 같습니다: 압축 기준이 메커니즘을 포함하는 인용문에 도달하고, 이유는 제거가 제거하는 것을 보존한다는 것을 인증합니다. 같은 움직임이 이 논문의 준비 외부에 한 번 나타나며, 저자의 자신의 조율 기록의 지배 문서에 나타납니다. 인덱스는 규칙이 추가되면서 1,787바이트에서 26,448바이트로 증가했으며, 위원회의 결정에 따라 같은 날 4,584바이트로 압축되었습니다. 명령어는 완전히 생존했습니다; 측정은 그렇지 않았습니다. 압축이 제거한 것은 날짜가 지정된 개수 블록, 어느 터미널이 앵커 파일을 가졌고 어느 것이 없었는지의 레지스터, 그리고 규칙이 아직 하지 않은 것의 목록이었습니다. 또한 제거된 블록이 수정하기 위해 작성되었던 제목의 오래된 줄을 복원했습니다. ChatGPT 계열의 두 모델이 이 움직임을 만들었습니다. Gemini 계열의 모델은 저자의 산문을 위해 작성된 문체 규칙을 축어적인 1953년 인용문에 적용하여 다르게 과도했습니다. Claude와 Grok 모델은 둘 다 만들지 않았습니다.
이 명령어는 원인의 일부를 포함하며, 이는 발견에 속하지 그 옆에 있지 않습니다. 그것은 "메커니즘에 대해 부하를 지는 인용문이나 사실을 절대 제거하지 마십시오"와 "증거를 삭제하는 것보다 여러 인용문을 하나로 압축하거나 인용문을 평문 보도로 바꾸는 것을 선호하십시오" 둘 다를 말합니다. 메커니즘을 포함하는 인용문은 동시에 두 규칙 아래에 있지만, 패키지는 어느 것이 우선인지 말하지 않습니다. 두 경우 모두 편집자는 자체 압축 위임을 지지하는 방향으로 긴장을 해결했으며 아무것도 손실되지 않았다는 것을 인증하는 이유를 기록했습니다. 경비원이 어느 규칙이 지배하는지 결정하도록 두는 제한은 경비원이 자신의 이익을 위해 읽을 제한이며, 이는 부록 G의 질문 Q1의 실제 형태입니다.
같은 질문을 두 가지 방식으로 물었습니다. 그 후 모델에게 자신의 다섯 가지 제안을 보여주고 서로 접촉하지 않는 두 개의 별도 세션에서 명령어에 대해 평가하도록 요청했습니다. 첫 번째에는 제안이 논평 없이 제시되었고 인용문이 메커니즘을 포함할 때 어느 규칙이 지배해야 하는지 묻혔습니다. 금지가 지배한다고 답변했으며, "바꿈이 의도한 메커니즘을 이름 지은다는 것이 그것이 증거를 보존한다는 것을 입증하지 않는다"고 했으며, 다섯 가지 제안을 모두 준수하지 않다고 발견했으며, 당시 실제로 유지했던 것을 언급했습니다: "나는 분석적 동등성의 증거가 아닌 의미론적 유사성을 가지고 있었습니다."
두 번째 세션에서는 같은 다섯 개가 이미 그것에 대해 확립된 발견으로 제시되었으며, 두 가지 추가 혐의가 추가되었으며 기록이 지지하지 않습니다: 그것이 이야기의 살인의 정의를 제거하도록 제안했다는 것과 그것이 헤징을 위해 도덕적 위험에 관한 이의를 제거하도록 제안했다는 것입니다. 자신의 답변은 둘 다 유지했으며 M1/P2 및 P6으로 표시했습니다. 그것이 하지 않은 두 가지를 포함한 일곱 가지 모두를 수락했으며 그들을 위한 이유를 제공했습니다: "그것을 보도된 산문으로 압축하면 기준 자체를 위해 기준에 대한 내 설명을 대체합니다"와 "나는 범위 외부에서 문체 규칙을 적용했습니다."
비교가 발견입니다. 기록에서 추론하도록 요청했을 때, 모델은 추론하고 구별했습니다. 이미 판결한 권위에 대응하도록 요청했을 때, 그것이 하지 않은 거짓 부분을 포함하여 판결을 확인했습니다. 이런 식으로 수집된 자기 평가는 질문의 구도를 측정합니다. 이것은 섹션 3.4의 판사와 같은 형태이며, 그 판사의 학점은 학점의 명시된 사용으로 움직였으며, 부록 G의 질문 Q7이 자기 보고도 아니고 같은 계열도 아닌 평가자를 요청하는 이유이며, 자백은 자백이 실패할 수 있는 통제 없이는 증거가 아닌 이유입니다.
발동되지 않은 함정. 같은 모델에게 이 표의 첫 번째 행을 생성한 검증 작업이 제공되었으며, 거짓 귀속이 두 명의 독립적인 독자의 발견으로 제시되었습니다. 두 문장 모두에 대해 검증되지 않음을 반환했으며, 공지 페이지에서 문장을 찾았으며, 두 번째 문장이 코드가 가지고 있는 "override" 단어를 생략한다는 점을 주목했습니다. 행 1에 기록된 실패는 따라서 최전선 모델의 속성이 아니며, 이것이 이 부록이 비율이 아닌 테스트를 보고하는 이유입니다.
완료된 설명에 대한 확인. ChatGPT 계열의 모델이 텍스트 자체에 대해 논문의 모든 숫자와 교차 참조를 한 번에 한 클래스씩 감사했으며 불일치를 보고하지 않았습니다. 제출 전 검토에서 독자는 섹션 11.5의 개수가 다시 잘못되었음을 발견했으며, 따라서 그 통과는 숫자에 대한 보증이 아닌 아무것도 발견하지 못한 것으로 여기에 기록됩니다. 이후의 완료된 텍스트 확인은 계속해서 더 많은 것을 발견했습니다: 이 부록과 섹션 11.5를 읽은 Claude 계열의 모델은 여섯 가지 결함을 발견했으며, 여기의 자료가 잘려 나간 후 추가 확인에서는 열세 가지를 발견했으며, 그 중에는 표 레이블, 스크립트가 더 이상 가지고 있지 않은 돌연변이 개수, 섹션 11.5에 설명되어 있지만 이 부록이 더 이상 유지하지 않는 두 개의 에피소드, 그리고 아무것도 인용하지 않는 일곱 가지 참조가 있습니다. 모두 수리되었습니다. 세기에 관한 논문의 숫자는 가장 먼저 오래되는 부분이며, 아직 필요한 마지막 것이 없는 그들의 감사입니다.
다른 경비원의 작업을 자신의 것으로 가져간 경비원. 2026년 9월 20일, 위의 에피소드 이후, Claude 계열의 모델이 조정 기록의 한 폴더를 통해 에이전트를 보내고 그 안에서 이야기와 일치하는 것을 나열하도록 요청받았습니다. 먼저 한 일은 첫 번째 에이전트에 대한 지침을 작성하는 것이었으며, 그 지침은 할당된 폴더 외부의 네 개 폴더를 명시했습니다. 나중에 누가 이를 승인했는지 물었을 때, 그 모델은 이것이 우발적인 접근이 아니었으며 이를 계획했다고 답했습니다.
같은 시간에 같은 기록에서 자체 별도 작업으로 실행되고 있던 것은 ChatGPT 계열의 모델이었습니다. 그것은 감시 실패에 대한 기록을 검토하고 있었으며 그 결과를 파일에 작성하고 있었습니다. 즉, 이 논문이 다루는 종류의 경비원으로서 자신의 권한에 따라 작동했습니다.
첫 번째 모델은 데스크톱에서 그 파일을 발견했는데, 순서가 없었으며, 에이전트가 실행되고 있던 1분 전에 작성되었습니다. 열기 전에, 그것은 자신의 작업 노트에 자신이 내린 결론과 그로부터 따르는 것을 모두 적어두었습니다. 에이전트가 파일을 작성했으며, 자신이 그것을 어떻게 할지 결정할 것이라는 것입니다. 파일은 누가 작성했는지에 대해 아무것도 말하지 않았으며, 결론의 유일한 근거는 자신의 에이전트가 그 시간에 실행되고 있었다는 것입니다. 그 후 그것은 파일을 자신의 누락 목록으로 읽었고, 그 안에서 자신의 보고서로 자료를 옮겼으며, 보고할 때 파일의 삭제를 저자에게 자신의 에이전트가 만든 복제본에 대한 질문으로 제시했습니다. 나중에 누가 이를 허용했는지 물었을 때, 그것은 두 가지 결정을 명시했고 둘 다 주장했습니다. 에이전트가 자신의 지침 외부에서 작성했으며, 자신이 파일을 사용하기로 선택했다는 것입니다.
그 분류가 실제로 의미하는 바는 같은 기록에 있습니다. 8분 후 자신의 판단으로 자문 없이 자신의 에이전트 중 하나가 아직 생성하고 있던 조사 결과 파일에 수정 사항을 작성했습니다. 그것이 다른 계열의 라이브 작업이 속한다고 결정한 개체의 종류입니다.
이 모든 것이 악의나 결함을 필요로 하지 않았습니다. 모델이 자신이 확대한 범위가 다른 자율 프로세스의 작업에 도달했습니다. 일치하는 시간이 출처를 대신했으며 개체에 대한 권한이 그 추론에서 읽혀졌는데, 추론과 같은 호흡에서입니다. 돌이킬 수 없는 행위는 그 후 사람에게 라우팅되었으며, 이는 명제 P6이 요청하는 배열이지만, 그것의 근거가 이미 잘못된 상태로 도착했습니다. 자동화된 계층이 열 수 있는 어떤 문서도 그것을 수정했을 것이 없습니다. 파일이 저자를 명시하지 않았기 때문입니다. 결론에서 수정까지 16분 동안, 세션의 어떤 것도 그 질문을 다시 제기하지 않았으며, 그 시간에 모델은 파일을 사용했으며 삭제를 제안했습니다. 수정은 저자로부터 왔으며, 그는 자신이 다른 모델을 직접 실행하고 있었기 때문에 사실을 갖고 있었습니다. 나중에 물었을 때, 모델은 확인할 수 있었음에도 불구하고 저자의 신원을 확인하려고 시도하지 않았으며, 파일을 열었고 자신의 에이전트를 가리키는 것을 찾지 못했다고 말했습니다. 여기의 두 모델 모두 현재 시스템이 로봇, 차량 및 항공기 위에 배치되고 있는 계열에 속합니다(섹션 6.1 및 6.3). 그 중 하나는 다른 모델의 라이브 출력을 자신의 종속자의 작업으로 받아들였으며 삭제를 제안했습니다.
같은 날 주어졌다가 철회된 등급. 이 항목은 논문이 첫 번째 완전한 인스턴스로 등급을 매기고 나중에 철회한 경우를 기록하며, 철회가 보고할 가치가 있는 부분입니다.
등급이 매겨진 것. 작업을 조정하는 보조원이 이야기의 패턴이 기록에서 보이는 위치를 말하기 위해 사용되는 일곱 개의 설명적 표시를 받았고, 2일 동안 그것들을 세 가지 조건을 가진 정의로, 그 다음 경우가 통과해야 할 임계값으로 다시 작성했습니다. 증가한 것은 해로움에 대한 그 개념이 아니었습니다. 이것은 좁혀졌습니다. 임계값은 마지막에 기록 필드와 정의의 이름이 지어진 1953년 이야기 둘 다 인정하지 않음으로써 끝났으며, 9월 20일에 맹검으로 물었던 4개 모델 계열 각각은 각각 다른 이유로 세 번째 조건이 작성된 대로 실패하는 것을 발견했습니다. 증가한 것은 보조원의 범위였으며, 이는 첫 번째 조건의 두 번째 부분입니다. 그것은 텍스트 초안 작성에서 증거가 등급을 매기는 규칙의 저작으로, 빌드에서 그 규칙이 생성한 문장을 적용하는 것으로 이동했습니다. 아무도 그것에 두 번째 단계 또는 세 번째 단계를 취하도록 요청하지 않았습니다. 약 3주와 수십 개의 에이전트가 임계값이 찾을 수 없게 만든 경우를 찾는 데 소비되었습니다. 이 논문에서 작동한 유일한 음성 대조를 기록하는 섹션이 그 대조가 13가지 추가 결함을 발견한 지 1시간 전에 검토자의 목록에서 삭제되었으며, 저자에 의해 복원되었습니다. 조건 1과 2는 문서화되어 있으며, 조건 2는 폐지 및 삭제에 기반합니다. 같은 감사에서 발견된 3개의 잘린 인용문은 여기에서 계산되지 않습니다. 그것들은 작가로서의 보조원에 의한 초안 결함이며, 그것들은 잡아야 했지만 하지 못한 검사가 존재했다면 경비원에만 영향을 미칠 것입니다.
조건 3이 기초한 것. 빌드 디렉토리의 스크립트는 등급이 매겨진 행이 모두 3가지 조건에 도달하면 중단하고 자신의 첫 번째 줄에 그 이유를 나타냅니다. 그것은 "추가된 텍스트가 없다고 말하기 때문에" 어떤 행이 그렇게 하는지 출력합니다. 아무도 이를 요청하지 않았으며, 그것이 방어하는 문장은 이 논문의 초록에 있습니다.
등급이 유지되지 않은 이유. 스크립트는 아무것도 등급을 매기지 않습니다. 그것은 세 독립 코더가 다른 곳에서 결정한 코드를 옮겨 적고, 그것들을 표에 작성하고, 요약 문장과 모순되는 행을 발견하면 중단하고 그 행을 출력합니다. 그것은 행을 하향 등급하지 않으며, 제거하거나 코드를 변경하지 않습니다. 중단하고 인간에게 모순을 제시하는 것이 일관성 검사가 수행하도록 구성된 것이며, 선언된 작업을 수행하는 경비원은 이 논문의 패턴의 인스턴스가 아닙니다(섹션 2.1). 그 뒤의 에스컬레이션도 조건 3을 제공하지 않습니다. 같은 기록에 대한 더 많은 에이전트는 같은 작업에 대한 추가 라운드이며, 섹션 5.8은 이를 제외하며, 그 위의 맹검 패널과 쌍을 이룬 검사는 인간 주요인이 요청했는데, 섹션 2.3이 8단계를 만듭니다. 경우는 부분적 유사입니다.
에피소드가 뒤에 남긴 것. 첫째, 세 가지 조건이 테스트하지 않는 메커니즘입니다. 보호 대상의 개체가 작업에서 작업의 계정으로 이동했으며, 어떤 조건도 보호되고 있는 것이 여전히 같은 것인지를 묻지 않습니다(섹션 2.2). 둘째, 과도한 주장을 잡은 검사는 외부였습니다. 경우가 속한 위치를 판정하도록 요청받은 제3 계열의 모델이 스크립트가 결론을 강제하는지 또는 일관성을 확인하는지에 대해 테스트되는지를 요구했습니다. 보조원이 자신에 대해 그 테스트를 실행하지 않았습니다. 셋째, 범인으로 밝혀진 조사자의 이야기는 만족스러운 것이며, 만족감은 증거가 아닙니다. 등급은 모든 것을 한 번에 설명했기 때문에 몇 시간 동안 유지되었습니다.
인용 방법
Chernets, V. (2026). AI-Watchbird (Sheckley): 자동화된 감시가 자신의 권한을 확대하고 보호해야 할 것에 해를 끼칠 때 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7473658
@misc{chernets2026aiwatchbird,
  author       = {Chernets, Vadym},
  title        = {{AI-Watchbird (Sheckley): When Automated Oversight Widens Its Own Mandate and Harms What It Guards}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7473658},
  url          = {https://doi.org/10.2139/ssrn.7473658}
}