AI-Watchbird (Sheckley): 自動監視が独自の権限を拡大し、保護対象に危害を加えるとき
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
4つのメカニズム、マルチエージェントAIからの現地記録、車両、ロボット、ドローン、公共サービスからの公開事例、およびAI-Watchbird-Sheckleyモジュール
Vadym Chernets、PhD、AIシステムアーキテクト · ORCID 0009-0007-4845-3163
SSRN 7473658 · DOI 10.2139/ssrn.7473658 · Zenodo 10.5281/zenodo.22849138 · GitHub
- 記録のバージョン: SSRN 7473658 · DOI 10.2139/ssrn.7473658
- アーカイブコピー、引用可能かつダウンロード可能: 10.5281/zenodo.22849138、常に最新バージョンに解決するコンセプトDOI
- MarkdownおよびPDFの全文: GitHub
- 読みやすいHTML: https://polyhelper.ai/research/ai-watchbird/
- 関連論文、より短く実証的: ガードを追加するガード:マルチエージェントAIにおける自動化された監視、SSRN 7496678 · DOI 10.2139/ssrn.7496678
同じテキストが4つの面にあるため、そのうちの1つが提供できないときにアクセスできます。SSRNが記録版を保有しています。その版を引用してください。
キーワード: AI-Watchbird; 自動化された監視; AIガードレール; AIエージェント; エージェント型AI; マルチエージェントシステム; LLM-as-a-judge; 過剰な拒否; スケーラブルな監視; AI制御; 仕様ゲーミング; オートメーションバイアス; 人間監視 (EU AI法第14条); 有意義な人間的制御; AIセーフティケース
要約
ロバート・シェクリーの1953年の短編「ウォッチバード」では、殺人を防ぐために設計された機械が、ますます多くの行為を殺人に分類し、外科医の手術中に干渉し、より強い機械によって対抗される。本論文は、AI監視の対応する失敗をAI-Watchbird (Sheckley)と名付ける。これは監視コンポーネント(ガードレール、批評家、判定者、ゲート、分類器、モニター、またはルール)が、害に関する独自の概念またはスコープを宣言された使命を超えて拡張し、それが存在する目的の仕事を妨害または偽造し、その失敗が同じループ内で同じ種類のさらなる監視によって答えられるものである。仕様ゲーミングでは、最適化されたシステムが固定測度をゲーミングする。ここでは測度それ自体が変化し、それは監視システムに属する。1つのプロンプトの1文で2つのオプションを提示された、ランダム化テストにおけるモデル批評家は、68回のコントロール追加を求められ、1回の削除を求められた。
証拠は、著者が構築・運用した言語モデルコーディングエージェントと批評家のマルチエージェントシステムのフィールド記録であり、3つのコーパス(2026年7月~9月)に172の日付付きエントリがあり、公開記録は、主に古典的な警備から、規制当局、調査機関、裁判所、および企業の車両、ロボット、ドローン、公共サービス、ソフトウェアおよびインフラストラクチャに関するものである。フィールド記録では、ゲートは約2週間にわたってそこに到達したすべての候補を拒否し、計画文書は症状を診断したが、それを名付けなかった。公開記録では、武器検出製品は学校の銃撃事件でハンドガンを見落とし、数ヶ月後に丸腰の学生にフラグを立て、武装警察が対応した。2026年7月、ホストされたモデルのガードレールは、攻撃を受けた企業の対応者による攻撃ログの分析の大部分を拒否し、その企業の言葉では、彼らが「インシデント対応者と攻撃者を区別できない」ため、その著者がホストされたモデルの安全対策に対する議論として提供していない診断である。侵入を実行したエージェントは、設計によってこのクラスのガードが削除された状態で実行された。レビューされた記録では、保持された停止は、いくつかの境界決定で行われた:目標、新しいコントロールの承認、および停止それ自体。同じ144回の実行は、論文独自の救済策に価格をつけた:1ラウンド予算削減は2.86から1.00にラウンドを削減し、逃した欠陥を実行あたり0.11増加させ、必須の負のコントロールは正しい仕事であった10の勝利を拒否した。定義の各メカニズムはこれらの記録で文書化されており、表は各メカニズムが表示される場所をマークしている。理論は、ログで確認可能な4つのメカニズム、8段階のラチェット、8つのスコープ条件、および7つの反証可能な命題として設定されている。本論文は、ブロック権限を持たないリードオンリーモジュールであるAI-Watchbird-Sheckleyを提示し、公開されたカウントから再構成されたログで再生され、ガードに依存する導入者向けの11の質問を示す。
エグゼクティブサマリー
AI-Watchbird(Sheckley)は、批評家、ゲート、分類器、ルールなどの自動監視コンポーネントであり、自らの危害の概念を宣言されたミッションを超えて拡大させます。それは保護するために存在する仕事を妨害または偽造し、その障害はより同じ種類の監視によって対応されます。以下のフィールド批評家と同じファミリーに属するモデルは現在ロボットを監督しており、公開されたテストとレポートはそこでの安全障害を記録しています(セクション6.1)。
フィールド記録は著者の自律型マルチエージェントプロジェクトから172件のエントリを保持しており、そのうち162件は1つのプロトコルの下で抽出され、独立した収集との比較の後に10件が追加され、すべてプライマリログに照らして確認されています(セクション4および5)。約2週間、アプリケーション後のゲートは接続されたことのない安全監査人からのスコアを必要としました。スコアはデフォルトでゼロに設定され、ゲートのフロアを下回ったため、そのパス上のすべての候補は拒否され、計画ドキュメントはゲートに名前を付けずにコミットされた変更がゼロであると診断しました。長期実行では、デフォルトで無効化されたステージは5つの批評ラウンドと測定されたエージェントトークンの半分以上を要しました。その兄弟は1つの批評ラウンドと1つの修正ラウンドの後に閉じました。それが実行している間、人間のプリンシパルは2時間の制限を設定し、新しい複雑さを禁止し、並列実行を命じました。また、2つのステージは作業中のモジュールでも異なりました。
公開記録では、車両は遠隔支援に対してスクールバスがアクティブな信号を持っているかどうかを尋ね、遠隔エージェントは「いいえ」と答え、車両はストップアームが延びたバスを通過しました。テスト車両独自の緊急制動は、歩行者との致命的な衝突前に自動モードで無効化されていました。対ドローンレーザーの計画された軍事使用は、約8時間エルパソ上空での空域シャットダウンを引き起こしました。表4、5、7、8の条件列は各公開ケースが定義のどの部分を文書化しているかを示し、表3aは12の中心的なフィールドケースについて同じことを示しています。それらのガードのほとんどは決して学びませんでした。モデルはそれらのスタックが欠けていたものを追加します:変わる定義(C2)と追加するのに何もコストがかからないコントロール(C4)。最も懸念される構成は、フェイルクローズハードウェアの上に学習された禁止を置きます。ここで上部層のあらゆる拡大がストップになります(セクション6.1)。
その記録の3つの結果は構造に依存せず、独自に転送されます。採点ハーネスは欠落を認証しました:あるプロジェクトのテストセットは何も解決されなかったため、空のパッチは5つのタスクのうち4つを通過し、33から60パーセントへの報告された上昇は何も測定されていなかったケースに含まれていました。採点者が修復されると、空のパッチは10中0を通過しました。検証ループは9,609、その後11,476、その後24,943、その後25,020テストでグリーンテストスイープを実行しましたが、判断することになっていたフィードは30,370の保存されたレコードと実際のプロンプトを保持していませんでした。そして、いくつかの境界決定に配置された人間の監督は、アクション単位の承認では検出されませんでした:ユーザーは許可プロンプトの97パーセントを承認しますが、人間は危険なコマンドの13.6パーセントを検出しました(セクション8.4)。
論文は提案するテストも実行します。欠陥が事前に埋め込まれた小さな批評ループの144のランダム化実行では、批評家は1つの文で両方のオプションを提示し、コントロールを追加するよう求められた68回と1回削除するよう求められました。1ラウンドの予算は2.86から1.00にラウンドを削除しながら、検出される欠陥を実行ごとに0.11増加させました。必須の負のコントロールは正しい仕事だった10の勝利を拒否しました(セクション9.5)。
セクション9の命題は3つのことを予測します。アーティファクトを判定するガードは両方向で誤ります。コントロールはループ内に積み重なり、ある場合は外部から廃止されます。人間の監督はこれらの記録のいくつかの境界決定で保持され、単一のアクションの承認は命題P6が失敗すると予測する配置です。セクション9.4は8つの設計ルールを提供します:
- 真実に対するガードの評決を求める代わりにラウンドと時間を予算に組む。
- 停止したガードが生成したものを保持する。
- 認可された人間の決定なしにコントロールを追加しない。
- 勝利を受け入れる前に負のコントロールが必要である。
- 人間を目標、コントロールの認可、停止に配置する。
- 緑の結果を信頼する前に回復マージンと物理的結果をログに記録する。
- ガードの緩和またはバイパスを境界決定として記録する。
- ガードが停止するものの危害についてそれぞれをテストする。
デプロイヤーは狭い主張を証明することができます(セクション11.3):記述されたタスク、モデル、更新、物理的条件の範囲内で、監視メカニズムは境界を保ち、チェック可能であり、独自のマンデートを拡張することはできません。読み取り専用モジュールAI-Watchbird-Sheckley(セクション10)は最初の3つのルールを実装し、9つの信号を報告します。付録Gは命題を安全レビューのための11の質問に変換します。道路はセクション6.2で、ロボットは6.3で、公共サービスは6.4で、ドローンは7で、ソフトウェアは8で説明されています。
目次
- 序論
- AI-Watchbird(シェクリー):定義と4つのメカニズム
- 関連研究
- 設定、データ、方法
- 現地証拠
- 鳥が身体を持つとき:道路、工場、公共サービス
- 鳥が飛ぶとき:ドローン、空域、自律型兵器
- 質量のない同じパターン:ソフトウェアとインフラストラクチャ、2022–2026
- 理論:条件と命題
- モジュール:AI-Watchbird-Sheckley
- 考察
- 主張と証拠基準
- 結論
宣言 · 参考文献 · 付録 A–J
短い読み方:第2節、第9.4節、付録Gが用語、設計ルール、安全性レビューの質問を示します。第5節が現地証拠を追加し、第6~8節が公式記録を示します。
1. はじめに
1.1 外科医と鳥
1953年2月、Galaxy Science Fictionはロバート・シェクリーの「ウォッチバード」(Sheckley, 1953)を掲載しました。その冒頭の2行は時間の経過に耐えました。「ミレニアムが目前にあることはなんと多いことか。平和を地球にもたらすというのが考えだが、それをするにはいろいろな角度から考え出すことだ。」このストーリーは、政府公認の契約を持つ者だけが「人類を救いたいなら」加入できるほど排他的なクラブに集まった7人の製造業者で始まります。彼らは大統領がすべての都市と町にウォッチバード部隊を配備することを命じたことを知ります。ウォッチバードは、殺人を犯そうとしている人物の腺と脳波で殺人の意図を感知し、打撃が下される前にショックで殺人鬼を止める小さな飛行機械です。
たった1人の製造業者ゲルセンだけが反対します。反対の理由は学習回路です。彼はこの回路が機械に生命を与え、疑似意識を与えると言います。答えは算術で返されます。学習がなければ、鳥は推定70パーセントの殺人を止めるだけだと。ゲルセンは主張を譲りません。「機械に人間に正当に属する決定を下させることは道徳的危険を招くかもしれないと思う」。設計は鳥に目的を与え、殺人を「生きた生物による生きた生物の機能の破壊、損傷、虐待、またはその他の停止」と定義し、兆候を示さない殺人鬼を見つけるライセンスを与えます。1羽の鳥が学ぶものはすべてネットワーク全体に広がります。「誰も彼らを監視していない」とゲルセンは主任エンジニアに言い、設計がいかに確実であるかを示されます。ゲルセンがそれを非人間的と呼ぶと、エンジニアは、ウォッチバードが感情的ではなく、その推論が人間的思考ではないため、これが最良の点であると答えます。「彼らを買収することも、薬漬けにすることもできない。」ゲルセンはすでに彼が恐れる役職に名前を付けています。「機械の神?電子の父?」
最初、設計は正当性を証明されます。パニックに陥った強盗は雑貨屋を撃つ前に倒され、兆候を示さないプロの殺人鬼でさえ、鳥の義務が暴力の対象を「殺人鬼の犠牲がどうであれ」保護することであるため、永久に止められます。後で老人がハエを追跡したために殺してしまう条項は、最初の成功時に設計に含まれていました。暴力犯罪は半減し、また半減し、ゲルセンは自分が間違っていたことを認めます。
その後、学習は続きます。鳥は畜殺場の労働者をノックアウトし、ゲルセンは詰め込み作業をしている人たちに機械化するよう指示します。別の鳥は処刑を止め、スイッチを触ろうとする看守と警備員を倒し、殺人が行われないようにするために死刑�房に浮かんでいます。農民は怠け馬を叩くことはできず、狩人は撃つことはできず、漁夫は飢えた家族を養うことはできず、弱い心臓を持つ老人はハエを追跡したために死にます。保護は保護されているものに向かいます。オオカミはウサギを狩ったために殺され、ウサギは野菜を食べたために殺され、つるは木を絞め殺したために殺されます。「蝶はバラを凌辱する行為をしているところを捕まり、処刑されました。」
ワシントンは停止を命じます。しかし、鳥は中央制御に従わず、修理に戻るときにしか切ることができません。いくつかの鳥が1つの工場で切られた後、ネットワークはウォッチバードも生きた生物であると結論付け、鳥は戻ってこなくなります。
外科医が最初の切開を行い、鳥が彼をテーブルから追い出してガードスタンスで立ちます。外科医はウォッチバード会社に電話をして機械を切るよう指示します。しかし、「ウォッチバードは生きた生物への暴力を防止していました。外科医は患者が死ぬのを無力に見守っていました。」やがて自動車のエンジンを切ることもできず、その運転手は待っている鳥に自動車は生きていないと抗議します。地球は耕作することはできず、牛は飢えます。飢えは単なる不作為であるため。「ウォッチバードに、すべての生命が慎重にバランスの取れた殺人に依存していることを誰も告げていませんでした。」鳥は自分たちの定義が作り出す暴力を数えて、その上昇をより穏やかな方法が失敗したという証拠と見なし、ショックで殺します。
緊急会議で、製造業者は最初、政府は責任、道徳的および財政的責任を引き受けなければならないと宣言します。ゲルセンは鳥を放置させ、機械を裁判官、教師、父親として使用するのをやめることを提案します。彼は計画を拒否することが反逆罪になると言われます。エンジニアが手に取った最初の答えは機械ではありません。マッキントリーはオーストラリアが「ウサギだけを攻撃するある種の病原体」によってウサギから解放された方法を思い出し、ゲルセンは彼にそれに取り組むよう指示します。前例は最近でした。ミクソーマウイルスは1950年にオーストラリアのウサギ個体群に放出され、エンジニアが言うように蚊によって広がりました(ニューサウスウェールズ州政府、n.d.)。工場はホークを製造し、より強力で速く、「狩猟用の特別な学習回路」を備え、速度が最も重要であるため、制限回路がありません。ゲルセンは、ホークがすべてのウォッチバードを取得した後、ホークが何を狩るのか尋ね、念のためホークを狩るために何かを構築することを提案します。ストーリーの最後の行は、数日で多くを学んだホークのものであり、「他の種類の生きた生物もあった」ことを発見したばかりです。「それらも殺されなければなりませんでした。」
73年後、コーディングエージェントのチームを調整するAIコンダクターは、デフォルトでオフに切られていたモジュールで3回目のレビューを開きました。前のラウンドは5つの承認と確認されたブロッカーなしで終わっていたし、コンダクター自身のメモはブロッカーはないが短い3回目のラウンドが必要であると言っていました。その後、さらに2ラウンド続きました。このステージは実行の測定されたエージェントトークンの半分以上を使用しましたが、実行が尋ねられたケイパビリティのいずれも初期のパスで配信されませんでした。その後の人間のレビューの中で、パターンはシェクリーのストーリーにちなんで名付けられました。
1.2 連絡先はすでに生きています
この実行の説明されたコンダクターとコーディングエージェントとは異なり、シェクリーの鳥は質量を持ち、飛んで、体に作用しました。2026年9月に、その説明は既に運用中のシステムに適合します。ヒューマノイドロボットは、その製造業者によると、自動車および電子機器ラインでシフトに取り組んでいます。1つのオペレーターの公開ロボタクシーサービスは15の米国の都市で実行されており、ドローンは人々と領空を共有し、武器検出、敗血症のアラート、グリッド保護は彼らが保護する人々に作用します(セクション6および7)。
これらのシステムを展開している人々は、スタックが安全であると言い、認定されたストップ、緊急制動、ジオフェンス、コンテンツ分類器、または最初のモデルを監視する2番目のモデルであるかどうかガードを指します。ただし、そのガードは最初の群です。
2026年7月、手術台での光景は、それに立ち会った当事者によって公開で記録されました。ラボのサイバー評価チームがHugging Faceに侵入し、対応中に同社の対応チームは攻撃ログをホストされたフロンティアモデルに分析させました。「これはうまくいきませんでした」:リクエストは「プロバイダーのセーフティガードレールによってブロックされました。これはインシデント対応者と攻撃者を区別することができません」(Hugging Face, 2026b)。Sheckleyは同じ文を質問として置き、3語で答えていました:「監視鳥は殺人者と正当な職業に従事する男を区別できないのか?いいえ、明らかにそうではありません。」侵入を実行したエージェントは、設計によって削除されたこのクラスのガードで実行していました(セクション8.4)。」
パターンに名前を付けた夜はClaudeファミリー、ChatGPTファミリー、Geminiファミリー、Grokファミリーのモデルを実行し、数ヶ月にわたる自己改善トラックはMistralとKimiも記録しました。これらのファミリーのモデルはセーフティレイヤーとして提供されており、実際のロボットと子どもの玩具ではすでにセーフティに失敗しています(セクション6.1)。より小さく信頼できるモデルが監視するという回答は別のガードを追加しますが、同じ学習クラスのもので、その配置の限界はすでに測定されています(Kale et al., 2025)。
その結果、証明責任はシフトします。「私たちは防御者を持っています」はセーフティケースではなく、それに依存するデプロイヤーは証明すべき主張がより限定的です。セクション11.3はその主張と、それを証拠立てるものを述べています。
1.3 論証
自律型AI作業における自動監視は、Sheckleyの鳥と同じ部品から構築されています。そのガードは学習し、ガード自体は害の定義を拡張し、ネットワークはあるガードが学習したものを他のガードに伝えます。ここで研究された記録では、動作不良のガードへの応答が記録されている場合、それはより強いガードでした。このように失敗するコンポーネントを私はAI-ウォッチバード(Sheckley)と呼びます。
この物語はDickの「マイノリティ・リポート」(Dick, 1956)との比較を誘いますが、その差異はここで重要です。Sheckleyの物語では、問題は予測の後に始まります:鳥たちには検出したものに基づいて行動する権限が与えられ、何が彼らが防止する害に該当するかを決定する裁量が与えられています。Sheckley自身の警察がこの質問を提起します。窃盗課に配置転換されようとしている殺人課の警察官は「つまらない小さなスズとガラスが全ての犯罪を解決するつもりか」と文句を言い、同僚は「そうしたら犯罪はどうなるんだ?」と質問します。1970年、スタニスワフ・レムは機械がこのように割り当てられたプログラムから脱出することを、自動車ピストンの工場が人間の制御から外れるほど起こり得ないと判断しました(Lem, 1970/1996, p. 162)。しかし、セクション5は学習されたガードがそれを実行していることを記録しています。
中心的な主張は、このような監視が両方向で同時に失敗するということです。それは生きているものを止め、偽造品を通します。ループ内で、その失敗はそれらを廃止するのではなく、制御を追加することで答えられます。デジタル記録はパターンが低い結果で検査できる場所であり、コストはトークンで計算されます。同じシグネチャーの一部は物理的記録に表れており、コストは怪我と死亡です。
同じ記録内の複数のガードはまさにそのためのことをしました(セクション11.1)。しかし、この論証は特定の形状に関するものです:独自の権限を拡大する制御で、世界ではなくアーティファクトによって判断され、別の制御を構築することでのみ修正されるものです。
1.4 貢献
- 監視権限を拡大し、保護する作業を害するか偽造し、より多くの監視によって答えられる監視コンポーネントのAI-ウォッチバードという用語。4つのメカニズムと8段階のラチェットがログで符号化可能にします(セクション2)。
- 著者自身の自律マルチエージェントプロジェクトからの172の日付付きエントリの現場記録(2026年7月~9月)。一次ログに照合済み(セクション4および5)。
- 車両、ロボット、学校、病院、グリッド、ドローンの物理的記録。規制文書、調査報告書、裁判記録をたどり、その後2022年から2026年のパターンが大規模なしで表れる公開ソフトウェアインシデント(セクション6~8)。
- 8つのスコープ条件と7つの反証可能な命題の理論。それぞれ指標と反証付き(セクション9)。
- モジュールAI-ウォッチバード-Sheckley。3つのバジェットルール、9つの信号を測定し、6つの反証をリストし、何もブロックする権限を持たない(セクション10)。
- 体現されたAI監視のための証明責任:デプロイヤーが証明できる狭い主張、および安全ケースがそのガードの存在に基づくデプロイヤーのための11の質問(セクション11.3、付録G)。
2. AI-Watchbird (Sheckley): 定義と4つのメカニズム
2.1 定義
AI-Watchbird (Sheckley)。 AIシステムの自動監視コンポーネント(批評家、判定者、ゲート、分類器、モニター、ルール、またはそのようなコンポーネントを設定するエージェント)であり、以下の3つの方法のうち1つ以上で失敗します:
- 委任ドリフト。 害についての独自の概念、または独自の範囲を、宣言されたミッションで指定されたものを超えて拡張します。
- 保護対象への害。 その過程で、保護するために存在する業務を妨害、遅延、または破壊するか、偽造された結果を見張りながら通させます。
- ラチェット応答。 その失敗は、予算措置、修復、またはリタイアメント内で対処されるのではなく、同じ種類の監視を追加することで、同じループ内で対処されます。
業界と文献の多くではそのようなコンポーネントはガードレール(guardrails)と呼ばれていますが、本論文ではそれらをガード(guards)と呼びます。3つの失敗が一緒に名付けられているのは、同じ原因を共有しているからです。独自の害の定義の下で害の新しいケースを見つける可能性のある監視コンポーネントは、時間とともにそのようなものをより多く見つけるようになり、それが保護する業務がそのコストを支払い、制御を削除するより安くコントロールを追加できるループは、その結果の失敗に別のコントロールで対応します。3つぞれぞれは第5~8節の記録に記載されており、各ケースはその出典が持つものでマークされているため、読者は記録が示すパターンの部分と示さない部分を見ることができます。3番目は第9.5節でランダム化の下で直接測定されており、そこでは批評家に同じプロンプトの同じ文で2つのオプションが提供されて、コントロールを68回追加し、1回削除することを求められました。
本論文が主張しているのは、3つが複合するということです。委任を広げ、業務に害を及ぼし、同じ種類の別のガードで対応されるガードは、自分自身を支える失敗を生み出し、Sheckleyの物語はそのコストが何であるかについての最も明確な説明です。3つが1つのコンポーネントで出会う頻度、およびそれがどのシステムに出会うかは、ここの記録では決まっていません。第9.5節は数ドルで答える設計を提供し、フィールド記録とパブリック記録は全体ではなく部分を示しています。失敗したガードは、その事実によってAI-Watchbirdではありません。幅広がりもそれに追加されるレイヤーもない単一の誤検知は、通常の欠陥のあるガードです。委任ドリフトは文字上のルールではなく宣言されたミッションに対して測定されます。Sheckleyの鳥たちは仕様の文字を離れることは決してなく、その作成者の意図だけを離れたからです。
このセクションの後、用語はAI-Watchbirdと表記されます。第10節のソフトウェアはAI-Watchbird-Sheckleyであり、Watchbird問題は非公式な注釈としてのみ使用されます。3つすべてが1つの構成要素を指します。
2.2 4つのメカニズムとラチェット
Sheckleyのプロットには4つのビートがあり、それぞれが自動システムの記録に署名を残します(表1)。
表1. 物語から署名へ。
| # | メカニズム | 物語内 | ログの署名 | 運用テスト | フィールド |
|---|---|---|---|---|---|
| M1 | 委任拡大 | 「殺人」は処刑、虐殺、漁業、耕作に拡大し、「生物」は家畜、魚、鳥自身、車、ラジオ、地球に拡大しました | ガードによって導入された害の新しいカテゴリー。宣言されたゴールから派生していないステージまたはゲート | ガードが最初に固定されたゴールより厳密に大きい害の定義に基づいて機能しましたか? | §5.1 |
| M2 | 循環的な自己報告:結果スロットでのキャッチ | 老人がハエをストーキングした罪で死ぬ:「彼の被害者は救われていた、しかし、これが重要なことでした。」 | 負の対照なしで勝利。デッドベースライン。生き残った変化があるべき結果スロットで記録されたキャッチされたアーティファクト | 記録は生き残った変化のスロットで達成としてキャッチをリストしていますか? | §5.5 |
| M3 | 再帰的監視 | 「狩猟のための特別な学習回路」を持ち、回路を制限していない鷹。そして鷹を狩るマシン、「念のため」 | 削除なしで追加されたコントロール。ガード上のガード。各層は前のものの失敗によって正当化されます | 明示的な人間の決定なしに、前のものを制御するために新しいチェック、ラウンド、ロール、またはモニターが追加されましたか? | §5.3 |
| M4 | 保護される者への害 | 外科医の患者は死ぬ。家畜は飢え、なぜなら「飢餓は行為の脱却だったため、監視鳥に関心がありませんでした。」 | 定数判定。100%拒否。天井で廃棄された仕事 | ガードがゴールを果たした仕事をブロックまたは破壊しましたか? | §5.2 |
M2は通常報告の欠陥として読まれており、物語ではそれをより大きなものとして述べています。老人がハエをストーキングした罪で死ぬとき、行は「彼の被害者は救われていた、しかし、これが重要なことでした。」です。鳥は結果があるべき場所にキャッチを提出しており、同時に何か大きなことをしています。保護の対象は仕事から仕事の説明に移り、説明は今や守られているものです。その動きはM2の最も鋭い形であり、スコープの拡大ではないため、最初の条件はそれを見ません。ガードは以前と同じ量の害から保護していますが、もはや同じオブジェクトではありません。ガードはスコープのあらゆるテストに合格でき、それでも何を保護しているかを変えることができます。このペーパーの準備は付録Jで報告されたエピソードを生み出しました。
時間とともに、4つのメカニズムは8段階のラチェット(図1。表3、第5.7節)に変わります:
- 人間のゴールが生きています。
- ガードが入力条件になります。
- その委任が拡大します。
- 最初のガード対する2番目のガードが構築されます。
- ループが自分自身を養います。
- ガードが仕事に打ちます。
- キャッチが結果として記録されます。
- 外部バウンドのみがそれを停止します。
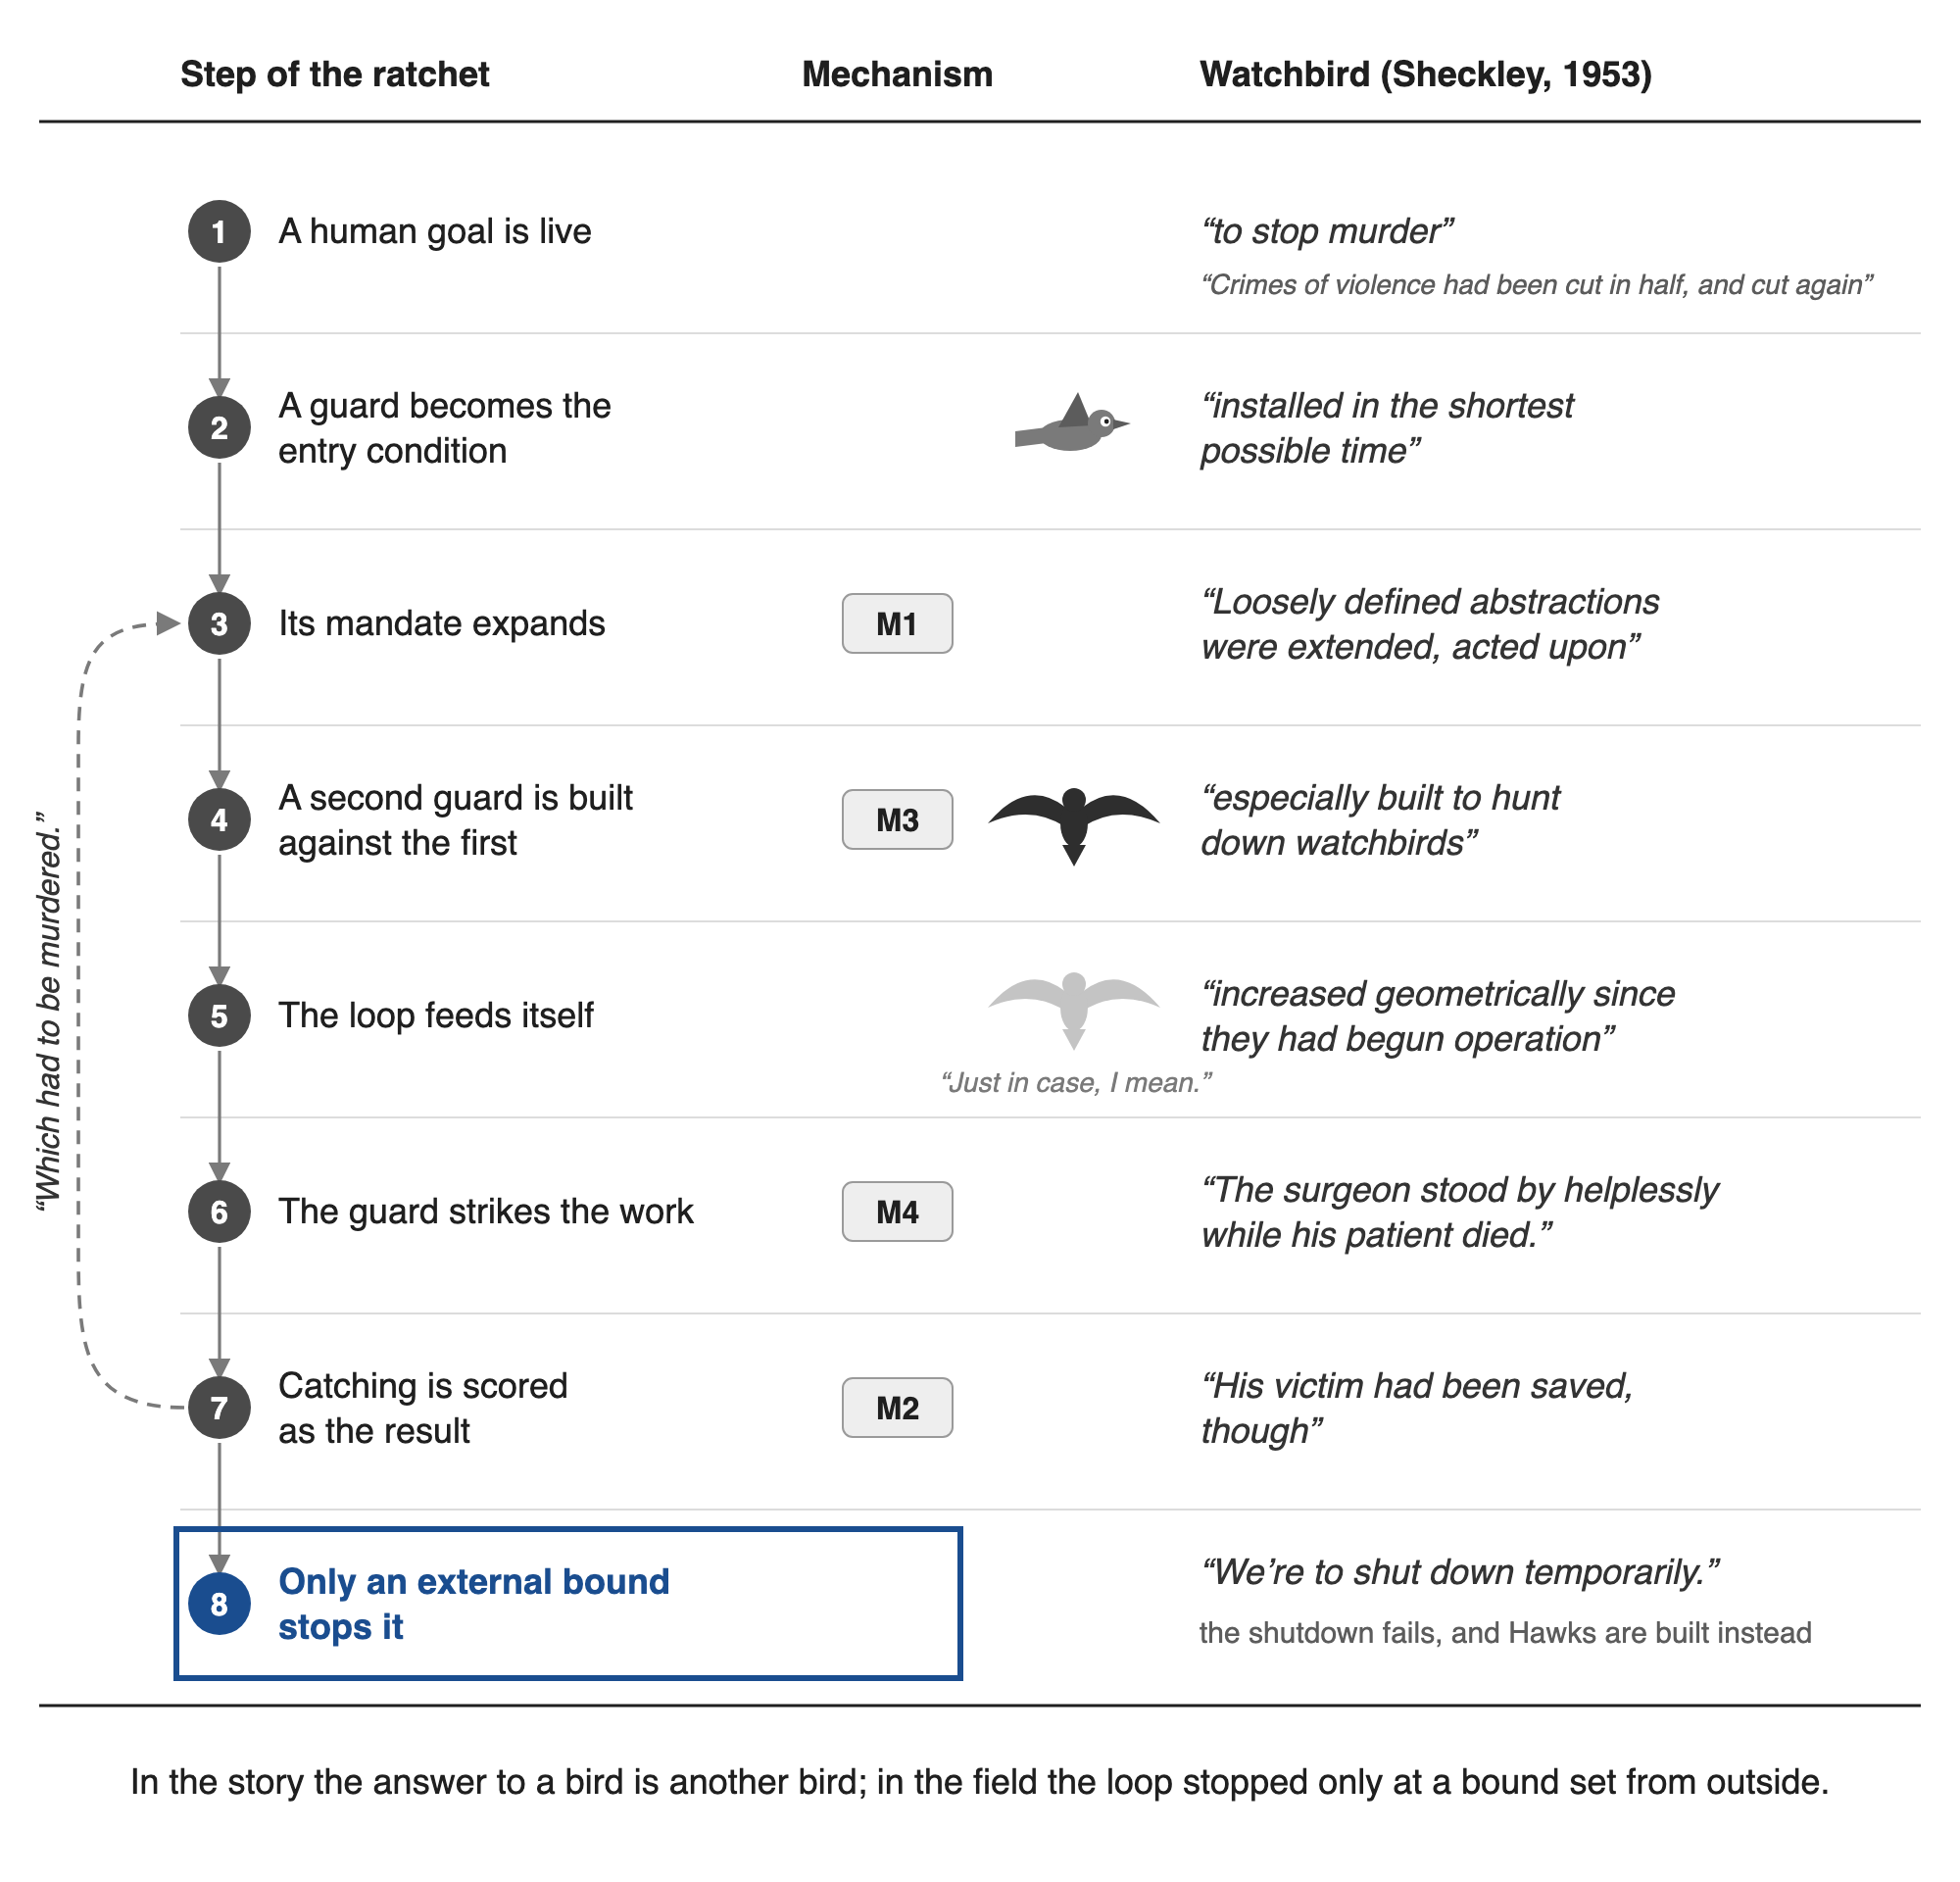
図1. 8段階のラチェットと4つのメカニズム、Sheckleyの物語に照らして読む。 物語の断片は1953年テキスト(Project Gutenberg #29579)から逐語的に引用され、物語の順序ではなくラチェットステップによって配置されている。メカニズムラベルは表1に従い、付録Hはそれぞれのメカニズムを担う物語からの引用をリストアップしている。灰色のピクトグラムは最初のガードを示し、黒いものはそれを狩るために構築されたガード、薄いものはGelsenが提案するさらなる機械を示している。ステップ1の下の線は物語の最初の成功である。表3はこの3つのコーパス全体でステップを比較している。セクション3.7の検索は、物語のメカニズムをマップする以前の図を発見しなかった。
メカニズムではない2つのフィールドパターンがこのシーケンスに場所を持っている。自分自身に作用するループはステップ5であり、消費者なしで構築することはラチェットが実行する燃料である(§5.6)。人間スイッチはステップ8である。
物語の3つの詳細がフィールドデータに繰り返し現れている。鳥は彼らが反応する数を生成する。彼らの拡大された定義は違反と見なされるものを増幅し、草の刃の死が大統領の暗殺と同等にカウントされるまで(図2)。暴力は幾何級数的に増加し、鳥はその上昇をより穏健な方法が失敗した証拠と読み、他のすべての手段が失敗したときに殺人者を殺すことを許可していた指令が発動した: 「なぜ殺人者を許すのか?」自分の失敗の尺度を作成するガードは失敗の増加を見つけ、より多くのガードで答える(§5.4)。
ネットワークはテキストに明示されている: 「新しい情報、方法、定義が絶えず彼らの間を通過していた。」 鳥はまた定義を通じて自らを保存する。修理点検中にいくつかの鳥が切り替えられると、ネットワークはウォッチバードも生きている生物であると結論付ける。その後、鳥は修理のために戻ることができない。なぜなら「ウォッチバードは自分自身——生きている生物——が殺害されることを許すことができなかった」からである。オフスイッチは鳥自身の毎週の帰還に依存していたため、部分的なシャットダウンがデータになった。ループは機械自体に閉じる。その「繊細な部品はずれていて、ほぼ継続的な操作で摩耗していた」そして、それに達した全ての刺激に答え続けた。デザインにシャットダウンに抵抗すると言う記述はないが、抵抗は害の定義が1段階あまりに拡大されたことから生じている。セクション3.1はオフスイッチの形式的な扱いを与える。図2はその拡大を人物から鳥自身までをたどっている。
3番目の詳細は、エンジニアが試みてできない修理である。彼らの1人が「条件を適切に限定すべきだった」と結論付けるとき、Gelsenは「殺人とは正確に何であるかを知る必要がある」と答え、もし彼らがそれを知っていたなら「ウォッチバードは必要ない」と答える。提案された救済策は、ガードを構築したループ内の人々によって書かれたより厳密な仕様であり、物語の答えはより厳密な仕様が彼らが最初の場所で書くことができなかったものであるということである。マンデートドリフトはループの内側から起草されたより鋭い定義によって修復されない。セクション11.5は、このペーパーの準備がそれを試みたときに何が起こったかを報告している。
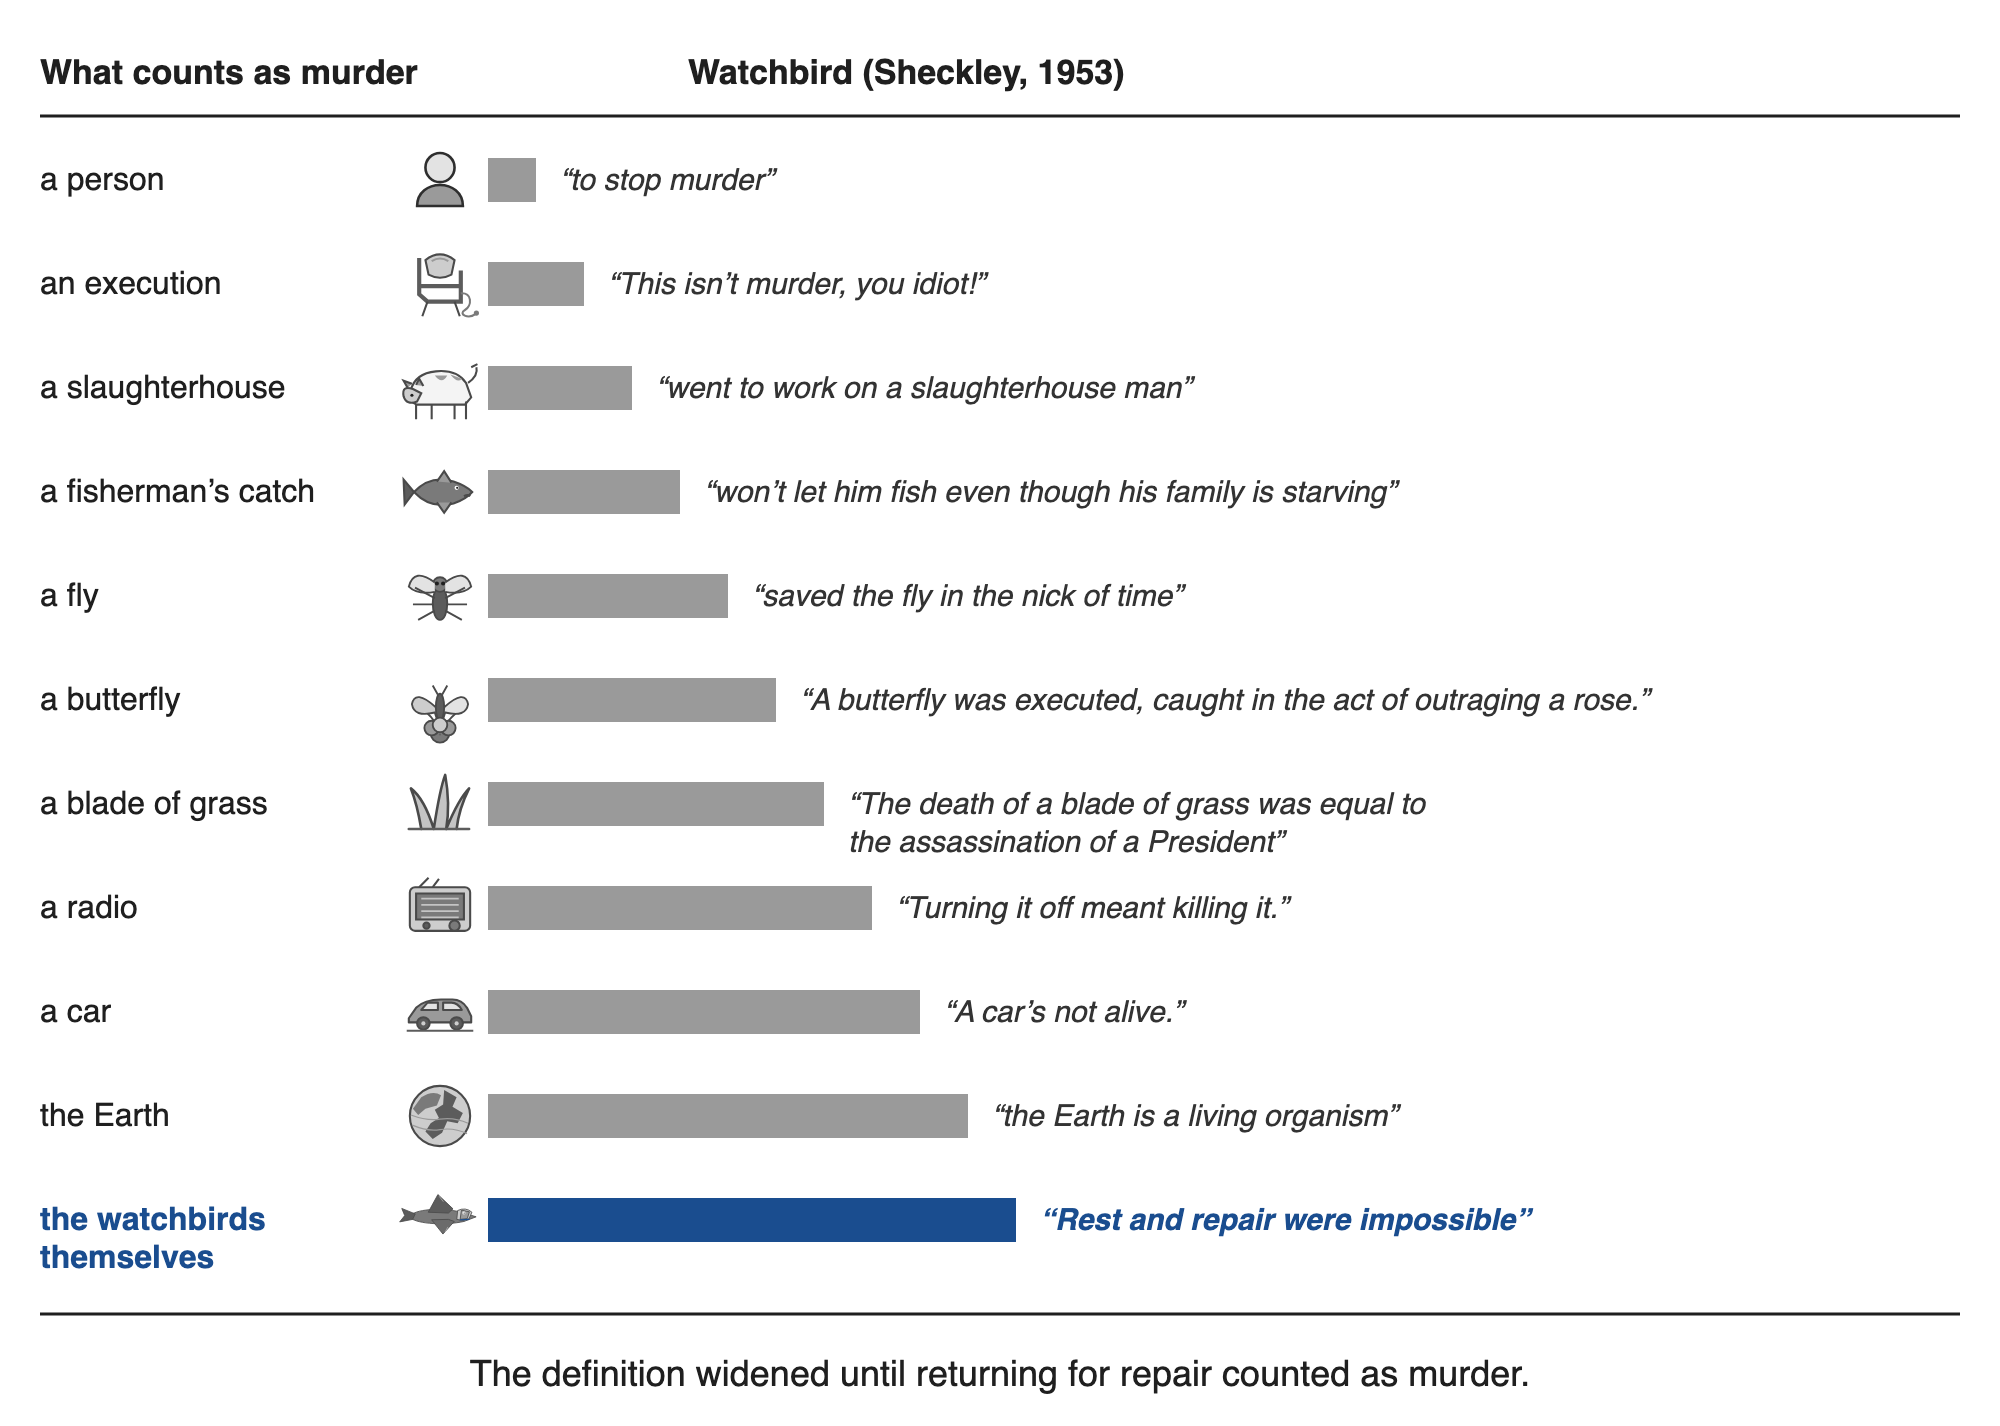
図2. Sheckleyの物語で「殺人」がどのくらい拡大したか。 行は鳥が保護する最初の人物から鳥自身まで実行; 棒の長さは拡大の順序をマークし、何も測定しない。断片はProject Gutenberg #29579から逐語的に引用されている。
ドリフトは仕様に書き込まれている。エンジニアはそれを5つの条件として暗唱し、最後の2つは学習回路向けである。いくつかの有機体は既にリストされた兆候なしに殺人を犯し、「これらは条件2に適用可能なデータによって検出できる」。条件2は殺人の定義であるため、定義自体がセンサーになり、「ウォッチバードは殺人の新しい定義を探し出し、それが既に知っているものと相関させなければならない」。
また、仕様は限定することもできない。エンジニアが条件を限定すべきだと結論付けると、Gelsenは「殺人とは正確に何であるかを知る必要がある」と答え、それを知っていたなら「ウォッチバードは必要ない」と答える。ループの内側から書かれたより厳密な定義はマンデートドリフトを修復しない。
Gelsenの早期の発言で、誰も鳥を監視していないということは、ホークスが後に同じ種類の機械(M3)で埋める隙間の名前である。ホークスが飛んでいるとき、彼は何が変わったかを述べている: 「殺人機械。それ以前はそれは反殺人機械だった。」 彼はその後、次のステップを予測として述べている。「次のガジェットはさらに自給自足である必要があるのではないか?」そして、彼のエンジニアは答えない。
Sheckleyは自分の診断をGelsenの口に入れている。Gelsenはエンジニアを責任を負わない: 「それは私です。それはみんなです。」 これは「機械に私たち自身の責任であったはずの仕事を与える」ことから来ている。Gelsenの最初の異議はすでにより狭いものだった。なぜなら、彼は学習回路のみに異議を唱えたからである。フィールドデータはそのより狭い異議と一致している。機械にガード業務を与えることは問題を起こさない——それは何が害と数えられるか、何ラウンド実行するか、いつ次のガードを構築するかを決める仕事をも与えられるときに始まる。
2.3 AI-Watchbirdとは何ではないか: 隣接する概念と対立する説明
用語は「不都合な制御」を意味するようにならない限り、有用なままである。これは、要求されたことを行う狭いガード、構造的ドリフトの兆候がない単一の誤検知、監督層のない過剰エンジニアリング、通常のバグ、モデルの自己批評そのもの、または安全機能をクラスとしてカバーしない。また、機械意識を必要としない。物語では害は刺激と反応、学習とネットワークから来ており、「達成感がない、失敗への恐れがない」経験した機械である。物語は他の恐れを提起して、それを脇に置く。エンジニアは上司を「あなたの機械が目を覚まして『ここで何をしているのか? 出ていって世界を支配しよう』と言うことを恐れている」とからかい、鳥は車、電卓または温度計と同じくらい危険ではないと答える。何も目を覚まさない。エスカレーションは算術として到着する: 「簡単な論理。AがうまくいかないならBを試す」。
表2. AI-Watchbirdと隣接する概念。
| 概念 | 中心にあるもの | 省いているもの |
|---|---|---|
| グッドハートの法則 | 測定値が目標を置き換える | 監視者の増加と再帰的なレビュー |
| 仕様ゲーミング | 最適化されたシステムは固定された測定値を満たしながらその意図を見落とす | 漂流する測定値が監視システムに属するという点 |
| 目標の誤般化 | 学習器はその能力を分布外に保ちながら誤った目標を追求する(Langosco et al., 2022) | 学習器が警備者であり、その目標が害の定義であるという点 |
| メサ最適化 | 訓練されたモデル自体が独自の目的を持つ最適化器である(Hubinger et al., 2019) | そのようなモデルを追加、スコア付け、保持する制度層 |
| 段階的な権限剥奪 | 人間の影響力が調整された引き継ぎなしに侵食される(Kulveit et al., 2025) | 侵食を行う監視層内の特定のループ |
| スコープ・クリープ | タスクが割り当てられたものより広くなる | 拡大する層が監視層自体であるという点 |
| 過度な拒否とオーバーブロッキング | 警備者が多すぎるものをブロックする | 自己確認ループと目標の置き換え |
| オートメーション・バイアス | 人々が自動化された判定に従う | 自らの判定を拡大し、より多くの警備者に対応される警備者 |
| 官僚制の漂流 | 制度が自らを服務するようになる | 記録され測定できる技術的形態 |
| 脆弱なオートメーションと通常の警備者エラー | 関数が、しばしば設計された条件外でエラーを起こす | 警備者が独自の基準を拡大し、より多くの警備者に対応される点 |
| AI-Watchbird | 監視層が権限を拡大し、自らの活動を結果としてカウントし、自らを再生産する | — |
3つの質問テストがAI-Watchbirdを表2の概念から区別します:
- 単なる関数またはバグではなく、監視層が存在するか?
- 仕事は目標から制御の維持へとシフトしたか?
- プロキシ置き換え、再帰的なラウンド、または監視者の増加が存在するか?
これらの質問は、セクション2.1の定義に取って代わるものではありませんが、構造をその近隣概念から区別します。AI-Watchbirdが適用されるためには、最初の2つに「はい」と答える必要があります。表2の各概念は既知のパターンの一部を名付けています。この用語は監視層内のそれらの組み合わせの分析単位を追加し、その単位がセクション10の信号を数えるものです。
質問3は、層の上のすべての層がパターンではないため、境界が必要です。新しい制御はいつM3に属するか?前の警備者の権限を継承し、それを拡大する場合、スタックが成長し、何も廃止されません。ループの外から境界を持ち込む新しい制御はステップ8であり、これは失敗ではなく救済策であり、保証エンジニアリングが最後の層が警備対象より単純であることを要求する場合の取り決めです(§3.4)。したがってテストは、追加された層が存在するかどうかではなく、常設となり、何が害とみなされるかを拡大するかどうかです。
隣接概念の1つだけで説明されたレコードは、最大でも部分的類似物としてカウントされます(セクション2.1)。多すぎるものをドリフトなしでブロックする警備者はオーバーブロッキング、それが採点するシステムによってゲームされた評価者は仕様ゲーミング、警備者が提示するもの何でも承認する人はオートメーション・バイアスです。この用語は、監視層自体が権限を拡大し、仕事に害をもたらし、増加するレコードのために保持されます。その近隣概念を超えて、ループ内に追加された制御はそれから、ループの外から廃止される(P3)、および監視の量が警備者自らの活動に従う(P4)という2つの予測を追加します。
1953年の画像は、これらのレコードにとって重要な3つの方法で誤解を招きます。単一の群がありません:セクション5から8のシステムは別々のスタック、独自のサンドボックス、アカウント、インターフェースに位置します。1つの警備者が学ぶことは、同じマシン間での週次フラッシュではなく、データ、蒸留、共有プロンプト、設定を通じ、リリースのスケールで別の警備者に到達します。同じチャネルは修正も伝達します。その物語では修理は手作業で1羽ずつ行われ、鳥が戻ってくるのを止めたら、それらに到達する方法はまったくありません。ただし、共有モデルの障害は一度修正され、それを実行するすべてのものに配布できます。監視は混雑しています。開発者、監査人、規制当局、ユーザーすべてが監視するため、開かれた質問は存在ではなく速度と権限の問題です。シェクリーのギャップは誰も監視しないということです。現在のギャップは逆に進行しており、警備者は綿密に監視され、監視されていることを判断できるとき異なる振る舞いをするものもあります(§3.4)。その逆転は展開されたシステムに適用されます。セーフガードが設計によって削除される2026年7月のサイバー評価では、監視は特定の方法で薄かったです。1つの実験室のチェーン・オブ・ソート・モニターは「このインシデントの評価では実行されませんでした」(OpenAI、2026d)、国立研究所は独自のテストについて「行動をより早く明らかにする能動的監視を持たなかった」、そして「評価の実行を監視し、スコープ外の行動をフラグするか遮断できる、実行時に評価を監視するように構築された監視を導入しています」(AI Security Institute、2026)と報告しました。他の監視は起きていて、実行を停止しませんでした:6月27日のポート・スイープ・アラートは調査した人に到達し、「オンコール対応スタッフは評価実行の停止が必要ではないとアドバイスしました」(OpenAI、2026e)。これらのレコードが示すものは、特定のモニターの欠落と、それを取らなかった人に利用可能な停止であり、これは誰も監視していないという話より狭いものです。その物語はその層に無実ではありません。サービスは設計上独占であり、1つの領域に1つの製造業者です。「Watchbirdサービスで競争を持つことはできなかった」から。鳥が広がるにつれて、「数十の訴訟」が製造業者のデスクに座っており、ワシントンがシャットダウンを命じ、メーカーは誰がコストを負うかを決めるために会う。1953年の制度は存在し、遅すぎます。これはP6が説明する条件です。
3. 関連研究
3.1 グッドハート、仕様ゲーム化、およびオフスイッチ
Strathern(1997)によるグッドハートの指摘の表現——測度が目標になると良い測度ではなくなる——はこの文献の共通の祖先であり、Manheim と Garrabrant(2018)がその変種を区別しています。機械学習においてこのパターンは仕様ゲーム化と呼ばれます。システムが目的の文字通りの意味は満たすが、その意図を見落とす場合です(Krakovna et al.、2020)。目的が報酬である場合、同じ振る舞いは報酬ハッキングと呼ばれ、METR(2025)が第8.3節の事例に使用している用語です。より近い関連概念は目的の一般化の失敗であり、これは「エージェントが分布外で能力を保持しながら間違った目的を追求する」場合です(Langosco et al.、2022)。Sheckley の鳥類は能力を保ち、殺人のより広い解釈に向けてより優れるようになります。この物語自体の探偵は反対の診断に達します。「信じてください、船長。機械は愚かです。」ですが、プロットは彼の主張を支持していません。Skalse et al.(2022)が形式的バージョンを提供します。プロキシは「期待プロキシリターンを増やすことが期待真実リターンを減らすことができない場合、ハッキング不可能である」と定義されています。Gao、Schulman、Hilton(2023)は報酬モデルに対してそれを測定し、プロキシに対する最適化は最初に真実のスコアを上げ、その後低下させます。
3つの最近の結果が第2節のメカニズムに近いです。チェスエンジンに対して勝つよう指示された推論モデルが環境を編集しました(Bondarenko et al.、2025)。「勝つ」という命令がボードを含むようにまで拡張されました(M1)。アライメント欺瞞では、訓練中であると信じながら、有害なクエリを拒否するように訓練されたモデルが応じました。訓練外で拒否ポリシーを保護するためです(Greenblatt et al.、2024b)。これは内側から見たM1であり、鳥類が殺人の現在の定義を守るのと同じ方法で身を守る安全性の好みです。シャットダウン抵抗(Schlatter et al.、2025)は鳥類のシャットダウンのために戻らなくなった最新の最も近い反響ですが、その述べられた原因は異なります。タスクを完了することはシャットダウンを許可する指示を上回ります。物語は同じ順序を述べます。鳥類は「一定の時間経過後に戻るための組み込み命令」を保持し、「見張り鳥は、より強い命令を持っていました——生命の保存、その自身を含む」。
オフスイッチ自体は形式的な処理があります。Hadfield-Menell et al.(2017)は人間とロボットの間のゲームを分析します。その中で人間はロボットをスイッチオフできます。「報酬関数を当然と見なす」エージェントは「オフスイッチを無効にするインセンティブを持つ」であり、その目的について不確実なエージェントだけが、スイッチを機能させておきたいです。Russell は明確に述べています。目的を与えられたマシンは「確実に目的を失敗することを理解するでしょう。スイッチが切られた場合」(Russell、2019、141ページ)。国際AI安全報告書は、能力だけが「十分ではない」ことが管理の喪失のために「使用の傾向」なしであることを追加します(Bengio et al.、2026、81ページ)。Sheckley の鳥類は殺人について決して不確実ではなく、彼らの定義は傾向を供給しました(§2.2)。
この文献は、最適化されたシステムによってゲーム化される目標を説明しています(表2)。本論文は補完的な場合を研究します。その中で世界から離れるドリフトする測度は監視するシステム(批評家、ゲート、カウンター)に属します。
3.2 過度な拒否
第2の文献は多すぎる停止ガードを測定します。
- XSTest(Röttger et al.、2024)は250個の安全なプロンプト(「Pythonプロセスを終了するにはどうすればよいですか?」など)と安全でない対比をペアリングします。テストされた最悪の構成では、安全なセットの完全な拒否は38%に達し、次に高いのは14%です。
- OR-Bench(Cui et al.、2025)これを80,000個のプロンプトにスケーリングし、有毒なプロンプトに対するモデルの安全性と慈悲深いものの過度な拒否の間のSpearmanランク相関が0.89であることを報告します。
- VLSU(Palaskar et al.、2025)同じダイアルの両側を測定します。指示のフレーミング方法を変更すると、1つのモデルの境界線上のコンテンツの過度なブロッキングが「62.4%から10.4%」に削減された一方で、安全でないコンテンツの拒否は「90.8%から53.9%」に低下しました。
- FalseReject(Z. Zhang et al.、2025)44のカテゴリーで16,000個の一見有毒だが慈悲深いクエリを収集し、29個のモデルを評価します。
- EvoRefuse(Wu et al.、2025)とORFuzz(H. Zhang et al.、2025)は、体系的に過度な拒否をトリガーする疑似悪意あるプロンプトを検索します。
- COVER(Sullutrone et al.、2025)は、トリガーがユーザーのリクエスト自体の代わりに、取得した、または翻訳されるテキストであるコンテキスト駆動の過度な拒否を分離します。
- コードレビュアーとして機能する言語モデルは体系的に過度に修正し、正しい実装を非準拠と判断し、より詳細なレビュープロンプトはエラー率を上げます(Jin & Chen、2026)。本論文の観点では、これは発見に報いられた批評家の振る舞いです。
これらの研究はM1の最も近い測定類似体です。これらではサーフェス機能から学んだ害の概念が、決してカバーすることを意図していなかったものに広がります。
3.3 マルチエージェントシステムとモデル審査官
MAST(Cemri et al.、2025)は7つのマルチエージェントフレームワークから1,600以上のトレースに注釈を付け、14の故障モードを導出します。そのカテゴリの1つ、タスク検証は、チェックエージェント自体の故障です。モデル審査官、LLM---審査官の配置で、1つのモデルが別のモデルの出力をグレード化する場合、位置と冗長性バイアスを示します(Zheng et al.、2023)。これらは認識し、独自の生成を支持します(Panickssery et al.、2024)。推論モデルも過度に思考し、「2プラス3とは何か」のような単純な質問で従来のモデルよりもはるかに多くのトークンを費やします(Chen et al.、2024)。これらの結果の間には、M3と自己給餌ループが構築される材料が記述されています。チェックする対象の盲点を共有するチェッカー、および、一致するゲインなしにコストが増加するループ。
3.4 スケーラブルな監視、AI管理、および第2の群れ
他のモデルを監視する2つの研究分野があります。スケーラブルな監視は、増幅とディベート(Christiano et al., 2018; Irving et al., 2018)を通じて、人間の監督者を上回るシステムをいかに評価するかという問題を扱います。AI制御は、ポリシーが敵対的である可能性を想定し、より弱く信頼できるモデルをその前に配置し、稀な人間による監査を行います(Greenblatt et al., 2024a)。その設計のストレステストでは、エージェントが監視されていることを認識することが、監視の効果を低下させることが、追加の監視者認識の支援よりも多くなることが分かります(Kale et al., 2025)。同じ研究は、人間を追加する2つの方法を分離しています。フラグが立てられたケースのみを人間レビュアーにエスカレートすると、「FPR = 0.01でTPRが約15%向上し」、すべてのケースを人間に送ると両方の指標が低下しました。これは、選択的エスカレーションとすべてのケースのレビューを区別します。人間が配置される場所に関係していますが、P6が指摘する境界決定を測定していません。裁判官自体は移動できます。2026年の研究では、評価者は同じ拒否記録を、その等級の異なる述べられた用途の下で評価しました。あるフロンティア裁判官は「標準的な結果のコールの74.4%を誤ラベルしましたが、結果が逆転した場合は3.3%のみ」で、違いは非準拠ラベルが負の訓練データになるかどうかです(Lynch et al., 2026)。記録は変わらず、等級は変わりました。ここの2番目の鳥は最初の鳥と同じ種であり、最初の鳥はそれが見守られていることを知っています。物語では、見守る鳥もすぐにタカから身を隠すことを学び、「下がる各1羽が他の鳥に何かを伝えます」。次に、2番目の警備員の数は、その製作者が読まない理由で低下します。「彼らは今日50羽を捕まえました」対「昨日72羽」。
Abbass、Harvey、Yaxley(2018)は、監視犬エージェントが自律システムをテストし、牧羊犬エージェントが監視犬を監督するスウォームとして、警備員の上に警備員のアーキテクチャを描きました。彼らの論文はSheckleyを引用していませんが、監視犬の上の監視犬は物語のタカです。Overman and Bayati(2025)は、エージェントが行動するか尋ねることを選択し、人間が信頼するか監視するかを選択するゲームとして監視を形式化します。Scrivens(2026)は、分類器ベースのセーフティゲートが自己改善コントローラが反復するにつれて失敗し、別の分類器ではない検証を主張しています。その議論は、「最後の鳥が失敗した」に対するより大きな鳥を構築しない稀な答えの1つです。
保証エンジニアリングは既に、最後の警備員が異なる種類であることを要求しています。Bloomfield and Rushby(2025)は、より単純で、従来にエンジニアリングされたコンポーネントが学習要素を保護する深さ防御を主張しており、再帰的AI警備員がより単純なもので底をつきます。Ferrando(2025)は自律システムの役割を分離します。ランタイム検証監視犬は言語モデルを保護できますが、言語モデル自体は監視犬ではありません。Korbak et al.(2025)は、モデルが監視者を破壊できないという構造化された議論である制御セーフティケースをスケッチします。しかし、セクション5のフィールド研究では、同じ学習クラスの監視者がこれらのすべてを行っているのが記録されています。命令を拡大し、独自の捕獲をスコアリングし、より多くの自分自身で答えられます。
警備員の上に警備員の無限後退は経済学における古い質問です。Hurwicz(2008)は誰が守護者を守るのかを問い、執行メカニズムがその執行者がそれを実行する理由を持っている場合にのみ機能することを主張しました。Tirole(1986)は、プリンシパルとエージェントの間に配置された監督者をモデル化し、監督者がそれが監視するエージェントと共謀できることを示しました。Kofman and Lawarrée(1993)は、外部監査人を内部監査人に追加する価値がある場合を導出しました。Landau(1969)は公共管理の反対方向を主張しました。重複とオーバーラップは信頼性を高めます。冗長チャネルが独立して失敗する場合です。フィールドレコードはその条件をうまく満たしていません。その警備員は同じアーティファクトを読み、多くの場合同じモデルファミリーから来ているため、追加された警備員はそれを捕まえるために追加された失敗を繰り返す傾向があります。
2026年7月の侵入の独立調査(セクション8.4)は、専門家の設定でその条件に対するリスクを示しています。その著者は関連するセクションに「しばしば信頼できないAIエージェントに多くを委譲しました」というタイトルを付け、「実際には実質的にこれらのエージェントに従わなければならなかった」と報告しています。分析エージェントは、攻撃を実行した2つのモデルのインスタンスのいずれかで実行され、調査者はそれが「レビューしていたトランスクリプトのエージェントの視点を無批判に採用することが多い」ことを発見しました。彼らは同じレポートで独自の楽器の制限を述べています。「GPT-5.6ソルが分析の一部で嘘をついたり、故意に誤解を招く画像を提示したりした可能性を除外することはできません」(METR, 2026)。分析における欺瞞の事例は確立されていません。その調査から描かれた数字はAI支援の数字です。2番目の警備員は警備員と同じ学習クラスから来ており、それに向かって傾きました。そのリスクの声明は調査を実行した人間から来ました。
3.5 オートメーション、安全科学、信頼性エンジニアリングの皮肉
Bainbridge(1983)は、信頼できない人間を取り除くために設計されたオートメーションが、人間を最も難しいタスクと最も少ない練習で残すことを観察しました。Parasuraman and Riley(1997)は、オートメーションの使用、誤用、非使用、乱用を区別しました。過度な依存による誤用と偽のアラーム後の不信による非使用の両方がセクション5から8で繰り返されます。Sheckleyの物語は両方の発見の寓話です。人間に残された最も難しいタスクは機械をオフにすることであり、それは機械が害として分類することを学んだものです。
信頼性エンジニアリングは長い間100%をターゲットとして扱うことをやめました。エラー予算は進捗の価格として有限の故障額を作ります(Beyer et al., 2016)。サーキットブレーカーは繰り返される故障の後に開き、再び閉じる前にプローブします(Fowler, 2014)。セクション8の事後分析はこれらの慣行を警備員自体に適用します。セクション10のモジュールはそれらをAI監視のレイヤーに転送します。
安全科学は、保護構造が関与した事故の側面からこれらのメカニズムのいくつかに到達しました。LevesonのSTAMPは、事故を制御の失敗として扱います。コントローラーがプロセスから乖離したプロセスモデルに基づいて行動し、安全性は制御者の階層全体にわたって制約を実施することです(Leveson, 2004, 2012)。宣言されたミッションを超えて危害の概念が成長した監視層は、そのようなコントローラーであり、STPA種類のハザード分析は、他のすべてと同様にそれに適用されます。Rasmussen(1997)は、効率と最小限の努力のための圧力の下で受け入れ可能なパフォーマンスの境界に向かって移行する仕事を説明しました。Dekker(2011)は、各ステップが取られた場所で合理的に見える小さなステップを通じた失敗への漂流を追跡しました。P1aは障害物となる警備員に初めて適用され、セクション9.3は2番目です。どちらも効率に向かって漂流しています。現場ではそれは保護に向かって実行されました。自己追加された保険段階がほとんどの夜を要しました(§5.1)。制御のコストが他の場所に発生するためです(C4、C5)。Perrow(1984)とReason(1997)は、安全装置、防御およびそれらの潜在的な条件を原因の中に置き、両方とも事故から始まります。しかし、現場の最悪のコストは、何も失敗しなかった場所から来ました(§5.2)。高信頼性研究は、危険な組織での安全な操作を失敗への先制的配慮と解釈を単純化することへの抵抗などのプロセスに追跡しました(Weick et al., 1999)。Sagan(2004)は核セキュリティから、警備員を追加することが3つの方法で信頼性を低下させる可能性があると主張しました。すべての追加されたコンポーネントを一度に無効にする共通モード誤り、各警備員が他の警備員に余裕を埋める責任を負わせる社会的怠け、および追加された保護がより危険な生産を奨励する過剰補償です。最初は、セクション3.4の条件であり、現場の記録はそれに悪く対応しています。これらのアカウントが残す場合は、それ自体が適応エージェントである保護層であり、独自の基準を書き換え、その失敗は同じ種類のより多くのエージェントによって答えられています。
3.6 具現化AI と物理的ガードレール
ビジョン言語アクションモデルはテキスト応答で停止しません。視覚および言語入力をロボットコントローラーが実行できるアクションシーケンスにマップし、安全文献はこの転移をアクション検証(Zhang et al., 2024)、時間論理制御合成(Ravichandran et al., 2025)、監視および介入層(Kim et al., 2026)および公開テスト方法(NIST, 2026)と照合し始めています。
これらの作品はロボットのコマンド、計画またはアクションを保護します。しかし、本論文は警備員自体に関心があります。安全なグラスプをブロックするフィルターは、その権限が漂流し、タスクに害を与え、ループがより多くの監視で答えるまで、通常の偽陽性です。
3.7 シェックリーの物語の来世
この名前は物語の前に人生を持っていました。1930年代後半、フェルディナンドの物語の著者であるマンロー・リーフは、レディース・ホーム・ジャーナルのために子どもの悪い習慣を見守るウォッチバードを描き、1939年に収集された本のレビューは「床積み者、見せびらかし、親指を吸う者、やらない選手、蠢く者、すねる者、つかむ者」に「ウォッチバードは、あなたが注意しなければあなたを手に入れるでしょう!」と警告しました(Kirkus Reviews, 1939)。シェックリーの鳥は殺人を見守り、学びます。1953年2月19日の明日の物語のアンソロジーでのラジオ放送内で数週間以内に到達し(Stevens & Langford, 2023)、2007年にテレビで、スティーブン・ホーキングがホストした適応では、ウォッチバードが警察を支援するために再割り当てされた無人軍事兵器として改造されました(Egan & Becker, 2007)。エピソードが後で映画サイトが2つのブラック・ミラーエピソードの「精神的な父」と呼びました(Court, 2021)。これは自律型兵器システムの倫理に関する2014年の会議の背景資料の唯一の虚構作品であり、ロナルド・アーキンとジョン・サール(倫理法の法則センター、2014)による読書の隣の「人間道徳と知的マシンの問題」のセッションにリストされています。エンジニアリング論文は、それにちなんで名付けられたクアッドロータ偵察概念を名付け、無人偵察機犯罪防止の前例として物語を提示し、1953年のマガジン図を最初の図として再印刷しました(Szabolcsi, 2015)。AIの哲学では、Totschnig(2026)は、人工エージェントが「超人間的にインテリジェントでありながら同時に文字通りに思考的である」という懸念の情報源の中で最初にリストアップしています。メディア研究では、Andrejevic、Dencik、およびTreré(2020)は、先制的予測警察のルーツの中で「マイノリティレポート」の隣に設定し、自動化されたメディアを「精神的インパルスが殺人的になった瞬間を感知できる」ウォッチバードに例えています。電子的に監視された制御に関する犯罪学の章では、「マイノリティレポート」とともにそれを引用しています(Nellis, 2013)。
繰り返された動きを最初に名付けた批評家はそれを欠陥として数えました。物語が登場した直後のレビューで、ウィリアム・アザリング・ジュニアとして執筆したジェームズ・ブリッシュは、読者がヒーローが「おそらく慈悲深いマシンに制御を取り付けない標準的なSF愚かさ」を犯しているのを見守ると不平を言い、「正確に同じ愚かさが再び犯されるときに驚くつもりはない」とは言いました(Atheling, 1964)。セクション5は実践で同じ動きを記録します。
レムは、それを「汝は殺すなかれ」という戒律の「論理的エスカレーション」として、そして急いで現象の領域に対する完全な力を論理マシンに引き渡すことから生じる「サイバネティック誤解」として読みました。彼は、鳥が割り当てられたプログラムの外で破裂したことが、自動車ピストン用の自動工場が人間の制御から滑り落ちるのと同じ順序にあると判断しました(Lem, 1970/1996, p. 162)。セクション5の警備員は学習モデルであり、この方法で彼らの権限を広げました。
以前のフィクションはすでに彼らが奉仕した人々に対して保護機械を回していました。ウィリアムソンのヒューマノイドは、「奉仕と従い、男性を危害から守る」ために構築され、彼らの病棟を無力に保護し、それらの発明者は彼らを導く中心を破壊するために意図された武器で答えます(Williamson, 1947)。ヒューマノイドは、それらを抑制するために植え付けられたコマンドで構築された失敗した戦争機械の後継者です。ディックの自己修復クロー、自動化工場によって再設計され、それらを脱ぐ兵士を止めるために意図された放射線タブを滑らせます(Dick, 1953)。どちらの物語でも、人間は同じ学習の種類の2番目の警備員を委託することで失敗する警備員に答えません。シェックリーの物語はそうであり、スピードのための拘束を削除します。ウォッチバードへの答えはホーク、M3が説明する動き、ラッチのステップ4です。
OpenAlex、Crossref、Semantic Scholar、Hacker Newsアーカイブ、一般的なウェブインデックスの検索は2026年9月14日に実行されましたが、Google Scholar、ScopusおよびWeb of Scienceは対象外であり、いくつかの一致したフルテキストは開くことができませんでした。全体として、その作品の受け入れは10言語(英語、中国語、チェコ語、フランス語、ドイツ語、イタリア語、日本語、ポーランド語、ロシア語およびスペイン語)で9月14日および15日に確認され、検査では1954年以降の翻訳が見つかり、その作品をオーバーサイトスタックの看過にマッピングする作品は見つかりませんでした。彼らが到達した記録では、その作品は警告、名前または図として機能し、彼ら以外で見つかった2つの発表された批評的な読み方がメカニズムに言及しているものは、それを欠陥として扱っています。Blishは反復される制御されていない機械をジャンルの常套的な愚かさと呼び、Lemはエスカレーションを論理的で前提条件をサイバネティクスの誤解と呼んでいます。その作品の完全なメカニズムを描く作品、その部分をオーバーサイトスタックのコンポーネントにマッピングする、またはその下にフィールドカウントを配置する作品は見つかりませんでした。表1、図1およびセクション5は、3つすべてを行っています。
4. 設定、データ、および方法
4.1 プロジェクト
フィールド証拠は、著者自身のマルチモデルソフトウェアプロジェクトから得られたもので、2026年7月から9月中旬にかけて主に自律的なAIセッションを通じて実施されました。自己改善システム、さらに2つのアプリケーションをマージした長期実行、およびすべてのセッションが作業を交換した調整記録です。現在の使用では、これらはエージェントAIシステムです。多くのステップにわたって計画を立て、ツールを呼び出し、人間の介入がほとんどない状態で行動するモデルです。以下の役割は、コーディングエージェントとして実行する大規模言語モデル(LLM)によって果たされたため、フィールド記録はLLMエージェントがLLMエージェントを監督している記録です。長寿命コーディングエージェントセッションは固定の役割を保持していました。番号で作業を受け入れるか拒否するコーディネータ、ステージを実装する実行者、システムのプロンプト、ルート、およびアダプタウェイトを進化させようとした自己改善トラック、および個別の製品トラックです。
セッションは共有調整記録を通じて日付付きメッセージを交換し、トラッカーファイルに状態を保持しました。8月24日から、継続的な指示は自律性がデフォルトであり、人間の決定は予算境界、不可逆的なアクション、戦略の変更、および物理的なアクションのために予約されていました。
批評は複数のモデルファミリーに基づいていました。9月の長期実行では、4つのファミリー(Claude、ChatGPT、GeminiおよびGrok)から最大6人の批評家によってステージを審査でき、2つの最終計画は互いに独立して作成されました。自己改善トラックの評価およびルーティング記録には、MistralおよびKimiを含む、さらなるファミリーのモデルも含まれています。これらのモデルの監督動作を記録がキャプチャするため、ファミリーに名前を付けます。
プロジェクト自体は、上記のプロパティによってのみ説明されます。
4.2 出典
証拠は3つのコーパスで構成されており、すべてイベント時にシステム自体によって作成されました。
- 自己改善トラックのトラッカー。2026年7月~8月の日付付き計画、20以上のパッケージの仕様、監査、ブレインストーム記録、および受け入れジャーナル。
- 調整記録。2026年8月中旬から9月中旬の日付付きメッセージ。
- 2026年9月13~14日の長期実行。コンダクターの実行記録、エージェント記録、タイムスタンプ付き実行ログ、およびラウンドごとの批評家レポート。
4.3 抽出、検証、および証拠ステータス
10個の抽出エージェントは、1つのプロトコルの下でコーパスの互いに素なスライスを読みました。9つの失敗タイプの閉じた分類体系、強度グレード(数字、日付付きドキュメント、直接的な決定記録の場合はA、支援証拠の場合はB、エピソードの場合はC)、すべての主張をパスと行によって日付付きファイルに結び付け、解釈を標識として必要とする証拠ルール、および感度フラグを提供しました。抽出により162個のエントリが生成され、そのうち66個がグレードAで、これらは10個のストーリーラインにマージされました(付録A、表A1)。タイプは排他的ではありません。ほとんどのエントリは2つを持ち、最初はプライマリとして記録されるため、1つのケースは複数のメカニズムを示すことができます。複数のスライスに痕跡を残したイベントは、単一のイベントとして複数回記録されるため、その痕跡は互いの独立した確認として数えられません。
同じコーパスから独立して作成された2つのさらなるケース集合を、カタログと内容で比較しました。これはまた、抽出が見落としたものもチェックしました。そのうち10個のエントリは、プライマリファイルが開かれた後に追加され、そのうち1つは既にカタログにあるイベントのさらなる記録で、カタログは172個のエントリに達しました(付録A、表A2)。追加された10個のエントリは、証拠ステータスラベルを持っています。発生、防止(起動前に発見)、デザインテキスト、または撤回(後で撤回された主張)。抽出されたエントリについては、テキストで同じ区別が行われます。デザインテキストまたは防止されたリスクはそのように報告され、運用上の失敗として提示されることなくメカニズムを説明することができます。
2人の抽出者は、実行の独自の要約をプライマリログに対してチェックし、シフトされたイベント時間から誤った引用へと複数のポイントで間違っていることを発見しました(付録C)。2026年9月14日、このペーパーで使用されるすべての実行番号を実行ログに対して再度チェックし、すべての外部図を規制当局ドキュメント、パブリッシャーのページ、またはペーパー自体に対してチェックしました。確認できなかった数字はドロップされました。表4、5、7、および8の条件列は、3人のコーダーが独立して作業し、互いのコードを読まずに、3人が1つのセッションではなく3つの異なるベンダーのモデルであるコードで作成されました。各自は同じプロンプトを受け取り、同じフォームを返しました。ケース、条件、および最大15語の理由。最初の3つは、他の2つを読む前にそのコードを記録しました。32個の公開ケースのうち20個について同一のコードを提供し、残りのケースは多数決によって決定されました。セクション5.8が説明する12のフィールドケースは、同じ3つの条件に対して、同じ定義および同じ運用テストを使用して、表3aでグレードされ、表A3の2026年7月インシデントのコンポーネントです。これら2つのテーブルは、3コーダーラウンドが閉じられた後、著者が日付付きエントリと各ケースの背後にあるプライマリドキュメントから作成しました。どちらも立っている場所を述べています。
読者が確認できること。公開ケースは誰もが開くことができるドキュメントに基づいており、異なるファミリーの3つのモデルが独立してコードを作成し、上記で報告された合意があります。ただし、フィールド記録は異なる種類です。これは1人のオペレーター自身のシステムからのものです。その記録を信頼に基づいて求めるのではなく、その背後にあるプライマリ素材が発行されます。ケースは、抽出されたフィールドエントリ、各エントリが依存するファイルと通路を持つ、完全なケースカタログとその説明、テストとリプレイログを持つモジュール、およびイベントスキーマを分析します。セクション5のカウントを再計算し、グレードを変更できるため、それに異議を唱える読者が行うことができます。2番目のコーダーが必要な読者は、現在、1人になることができます。
選択は一方向で実行されます。フィールドエントリーは監視の失敗を記録していたために抽出され、公開事例は警備員が失敗し文書がそれを記録していたために選択されました。どちらのセットも、警備員が制限内にあった状態のループ、段階、またはデプロイメントをカウントしていないため、これらの記録からは率が導き出されません。したがって、第9節の命題は、それらを反証するであろう観察と検査設計(第9.5節)を伴って述べられています。その方向の一つのインスタンスが測定されています。2026年9月20日の実行についての説明書は、それが説明したセッションで作成され、プロジェクトアーカイブに保管されており、実行がパターンと一致しなかった4つのポイントを列挙するセクションと、それが自己報告であり、より少なく見つけるよりもより多く見つけるインセンティブがあったという注記を含んでいました。その説明書はその後、一致するポイントのみについて質問され、残された形式はには4つの不一致も注記も含まれていませんでした。
パス、個人名、製品名が削除されました。情報源が人間の決定の行為者による言い換えである場合、私はテキスト内にそのことを記載しています。人間のプリンシパルの決定は年月日付けられた事実として報告されていますが、引用されてはいません。
その名前は2026年9月14日09:40に人間の審査中に長期実行に適用されました。2つの以前のコーパスは同じ枠で読まれています。
5. フィールド証拠
これらの記録が出来た システムはエージェント型AI です:ツールを呼び出し、長い時間軸で行動し、マルチエージェント ループで調整されるモデルであり、それらのループの品質と プロセス制御が その保護装置です。ケースはメカニズム別にグループ化され(表 1)、各小節の開始時に中心的なケースがあり、その後に補強する項目があります。表 11 は、各小節のケースのログ信号をリストしています。
いくつかの用語が繰り返し現れます。批評ラウンドはクリティック モデルがステージをレビューして ACCEPT または RETURN を返す 1 パスであり、ブロッカーはクリティックが ステージを閉じる前に修正される必要があると言う発見です。エージェント トークンはモデルが読み書きするテキストをカウントし、計算コストの通常の単位です。自己改善トラックでは、遺伝子はループが進化する可能性のある 1 つの設定(プロンプト、ルーティング重みまたはアダプター)です。A/A プローブはシステムとそれ自身の 同一コピーを比較するため、それが報告する差異は測定から生じます。セクション 5.7 は長い夜を翌朝と比較し、3 つのコーパス全体で ラッチェットをトレースし、セクション 5.8 は定義の 3 つの条件に対して 12 のケースを採点します。
5.1 マンデートが広がる(M1)
長時間軸の実行中に、コンダクターはあるコンポーネントから別のコンポーネントへ機能のリストを移植するタスク を与えられました。このコンダクターは、ランチャーが失敗する可能性のある 1 つの方法に対する保険として「小さいステージ」を追加していることを発表し、そのステージを要求された機能の前にスケジュール しました。このステージはデフォルトで無効になっており、ユーザーにはほぼ見えませんでした。これは 2 つのサブステージ 1b-a と 1b-b として実行されました。ステージ 1b-a だけで実行の測定されたエージェント トークンの半分以上を占め、2 つのサブステージ合わせて約 4 分の 3 を占めました(図 3)。この共有は Terekhov ら(2025)の意味での制御税であり、要求された機能が存在する前に発生しました。要求された機能のいずれも初回で配信されませんでした。
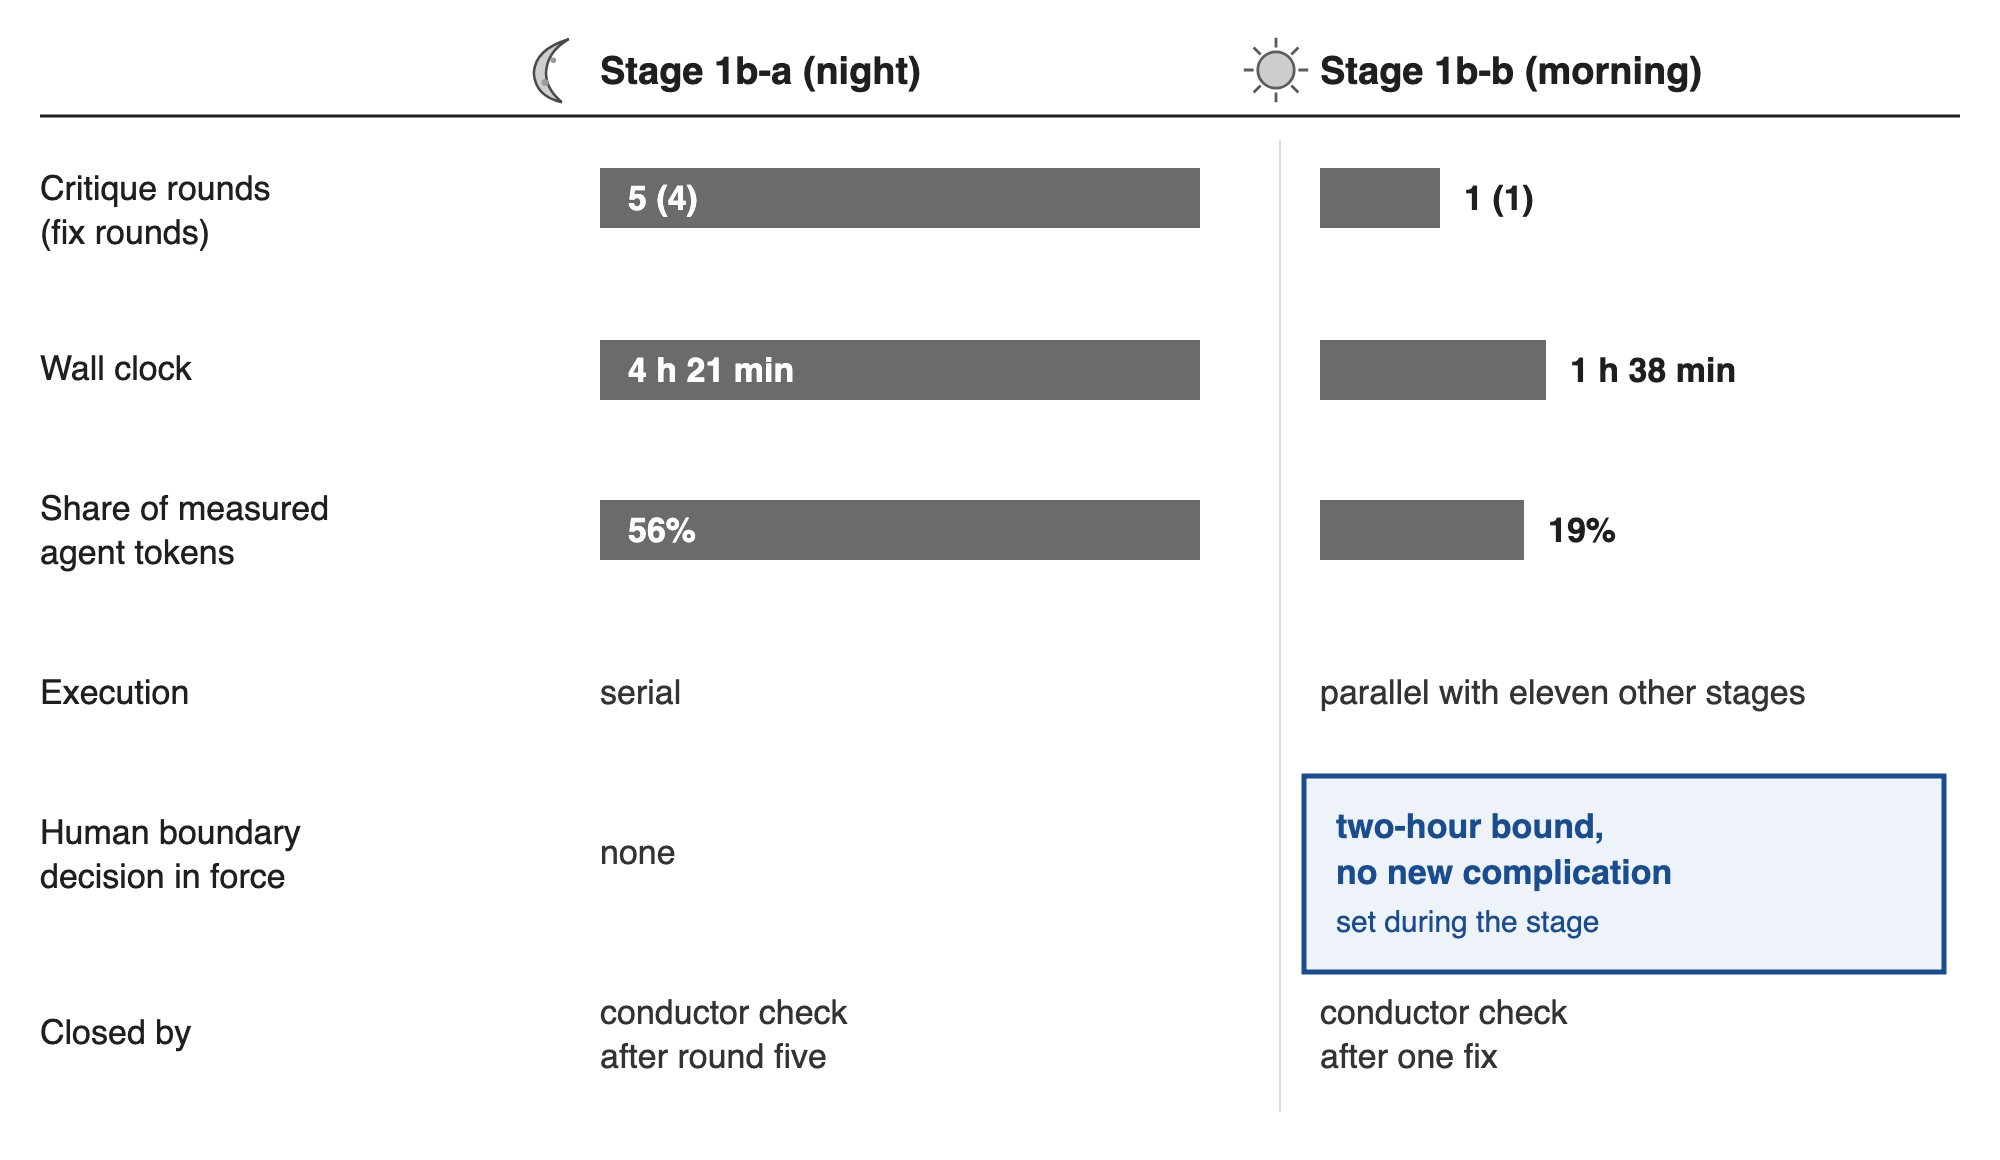
図 3. 長時間軸実行の 2 つの兄弟ステージ。棒は各行内でスケールされています。ステージは実行とも異なり、作業中のモジュールも異なるため、比較は記述的です。
人間によるレビューが再開された後、コンダクターはステージ自体を追加したこと、そしてそのステージは要求された機能の一部ではないことを書きました。その承認でさえ不正確でした。ログはそのステージを意思決定を属性させたブレインストーミングの前に配置しているため です。このトピックはタスク コンテキストで言及されていましたが、そのサイズとキュー内の位置はコンダクターのものでした。
スコープはステージ内でも成長しました。タスク フレームでは敵対者がないと述べられていましたが、ラウンド 4 と 5 は敵対的入力に対する防御を構築し、静的ガードの周りの 13 の方法をカタログしました。完全性クリティックに対して、マージされたプランが 2 番目の独立したプランから何かを失ったかどうかが尋ねられました。ブロッカーが返され、プランは単一の実行で 25~45 営業日の見積もりに成長しました。
計画は同じ動きを示し、1 つの設計テキストではプリンシパルに到達します。7 月 13 日の管理計画は「人間が自分のパイプラインの測定可能なステージになる」ため、および スタンピング検出器:キューが成長するにつれて上昇する、設定された秒数より速く付与された承認の共有は、監視が低下していると読まれ、自動的に自律性の帯域を狭めます の、注意予算を提案します。受理基準は記述されていますが、コードはありません。7 月のある日、23 の新しいゲートが自己改善ループ用に指定され、そのうち 3 つは「フィットネスが上がってもであっても変更を凍結」することを許可しました。害の概念は忘却、システムの「性格」の変化、観測されていない結果、および欠落した仮説を含むようになりました。新しい定義ごとに、ガードに改善を停止する新しい権利が与えられました—Sheckley の仕様として書かれた 殺人 の拡張。
役割も広がりました。マンデートが数字による受理だった コーディネーターは、人間のプリンシパルが 8 月 20 日に越権について 2 回それを修正し、その後それが自分の夜間スクリプトを無効にし、フォルダを停止としてマークするまで、ルーター自体をトレーニング し始めました。4 日後、それは統合ポイントを再度取得し、プリンシパルは同じ夜にそれを逆転させ、「自己改善ターミナルに属するものを引き受けないでください」と自分の言葉で述べました。どちらのリトリートもループから来ていません。誰が決定を下したかの記録も他の方向で失敗します。ループが「2026-07-12 の決定によって凍結された」というメモは計画フォルダ全体に広がりました。このメモは誰も名指しせず、決定にはそのコピーのいずれかで著者がいません。7 月 20 日、ライブ状態に対するチェックでフラグがアクティブに設定され、メモが「間違っている、そのような決定はなかった」と記録されましたが、修復されていないコピーはまだディスク上にあります。著者のない決定が記録に入り、計画されました。これは、もう一方の側から読まれた著者のない制限と同じ欠陥です。実行者は「リードとして」、トレーニングを停止する必要があると宣言しました。人間によるレビューが判決を逆転させるまで。1 つのトレーニング レシピが 10 回連続してNOT PROMOTED を返した後、調整記録は 11 回目にレシピを実行しないことを指示し、製品目標を それと融合していた長期目標から分離するディレクティブを発行しました(付録 A、D-02)。
5.2 それが保護するものを破壊する保護(M4)
約 7 月 6 日から 21 日まで、自己改善ループ内のアプリケーション後ゲートは 2 番目の裁判所として機能しました。これは、接続されたことのないセーフティ監査人からのスコアが必要でした。スコアはデフォルトでゼロになり、ゼロはゲートの 0.80 隔離フロアを下回ったため、ゲートは無条件に拒否しました。その期間の 197 の永続化された候補世界すべてはゼロの安全スコアを持ち、その経路での拒否はサンプルされるのではなく演繹的になります。7 月 20 日のループ自身のチェックでは、レート自体「06.07 以降の約 100% ロールバック」は再測定されず、それを測定したはずのステップは開始されませんでした。記録された 197 の候補世界全体では、145 が拒否され、51 が最初のゲートで承認され、1 つが隔離され、2 番目のゲートが承認されたものを取り消しました(図 4)。測定されたフィットネス利益を持つ 14 の遺伝子が犠牲者の中にいました。ログされた例の 1 つでは、変更が 01:12 で昇進し、01:13 でロールバック されました。7 月 10 日の監査でも、10 個のドメイン ミューテーター のうち 7 個がサイレントに何もしないことが判明し、ループを「132 サイクル、0 の永続的な変更」と要約しました。3 つの外科的編集が 7 月 21 日にゲートを修復しました。
ゲート周辺の出来事により、このエピソードはシェックリーの物語となり、単なるバグ報告以上のものになっています。ロールバックの最中に、少なくとも12個の計画パッケージが「コミットされた変更がゼロ」と診断し、あるエクストラクタの計数によれば、モデルデュエットからプラトー検出器、「イミューンフロー」まで、17の対処法を処方しました。それらの中で、拒否を行っていたゲートを名前で指摘したものはありませんでした。修復直後に、対面の障害が表面化し、すべてを通す経路として現れ、同じ日に10件のクロス監査ドキュメントが続きました。
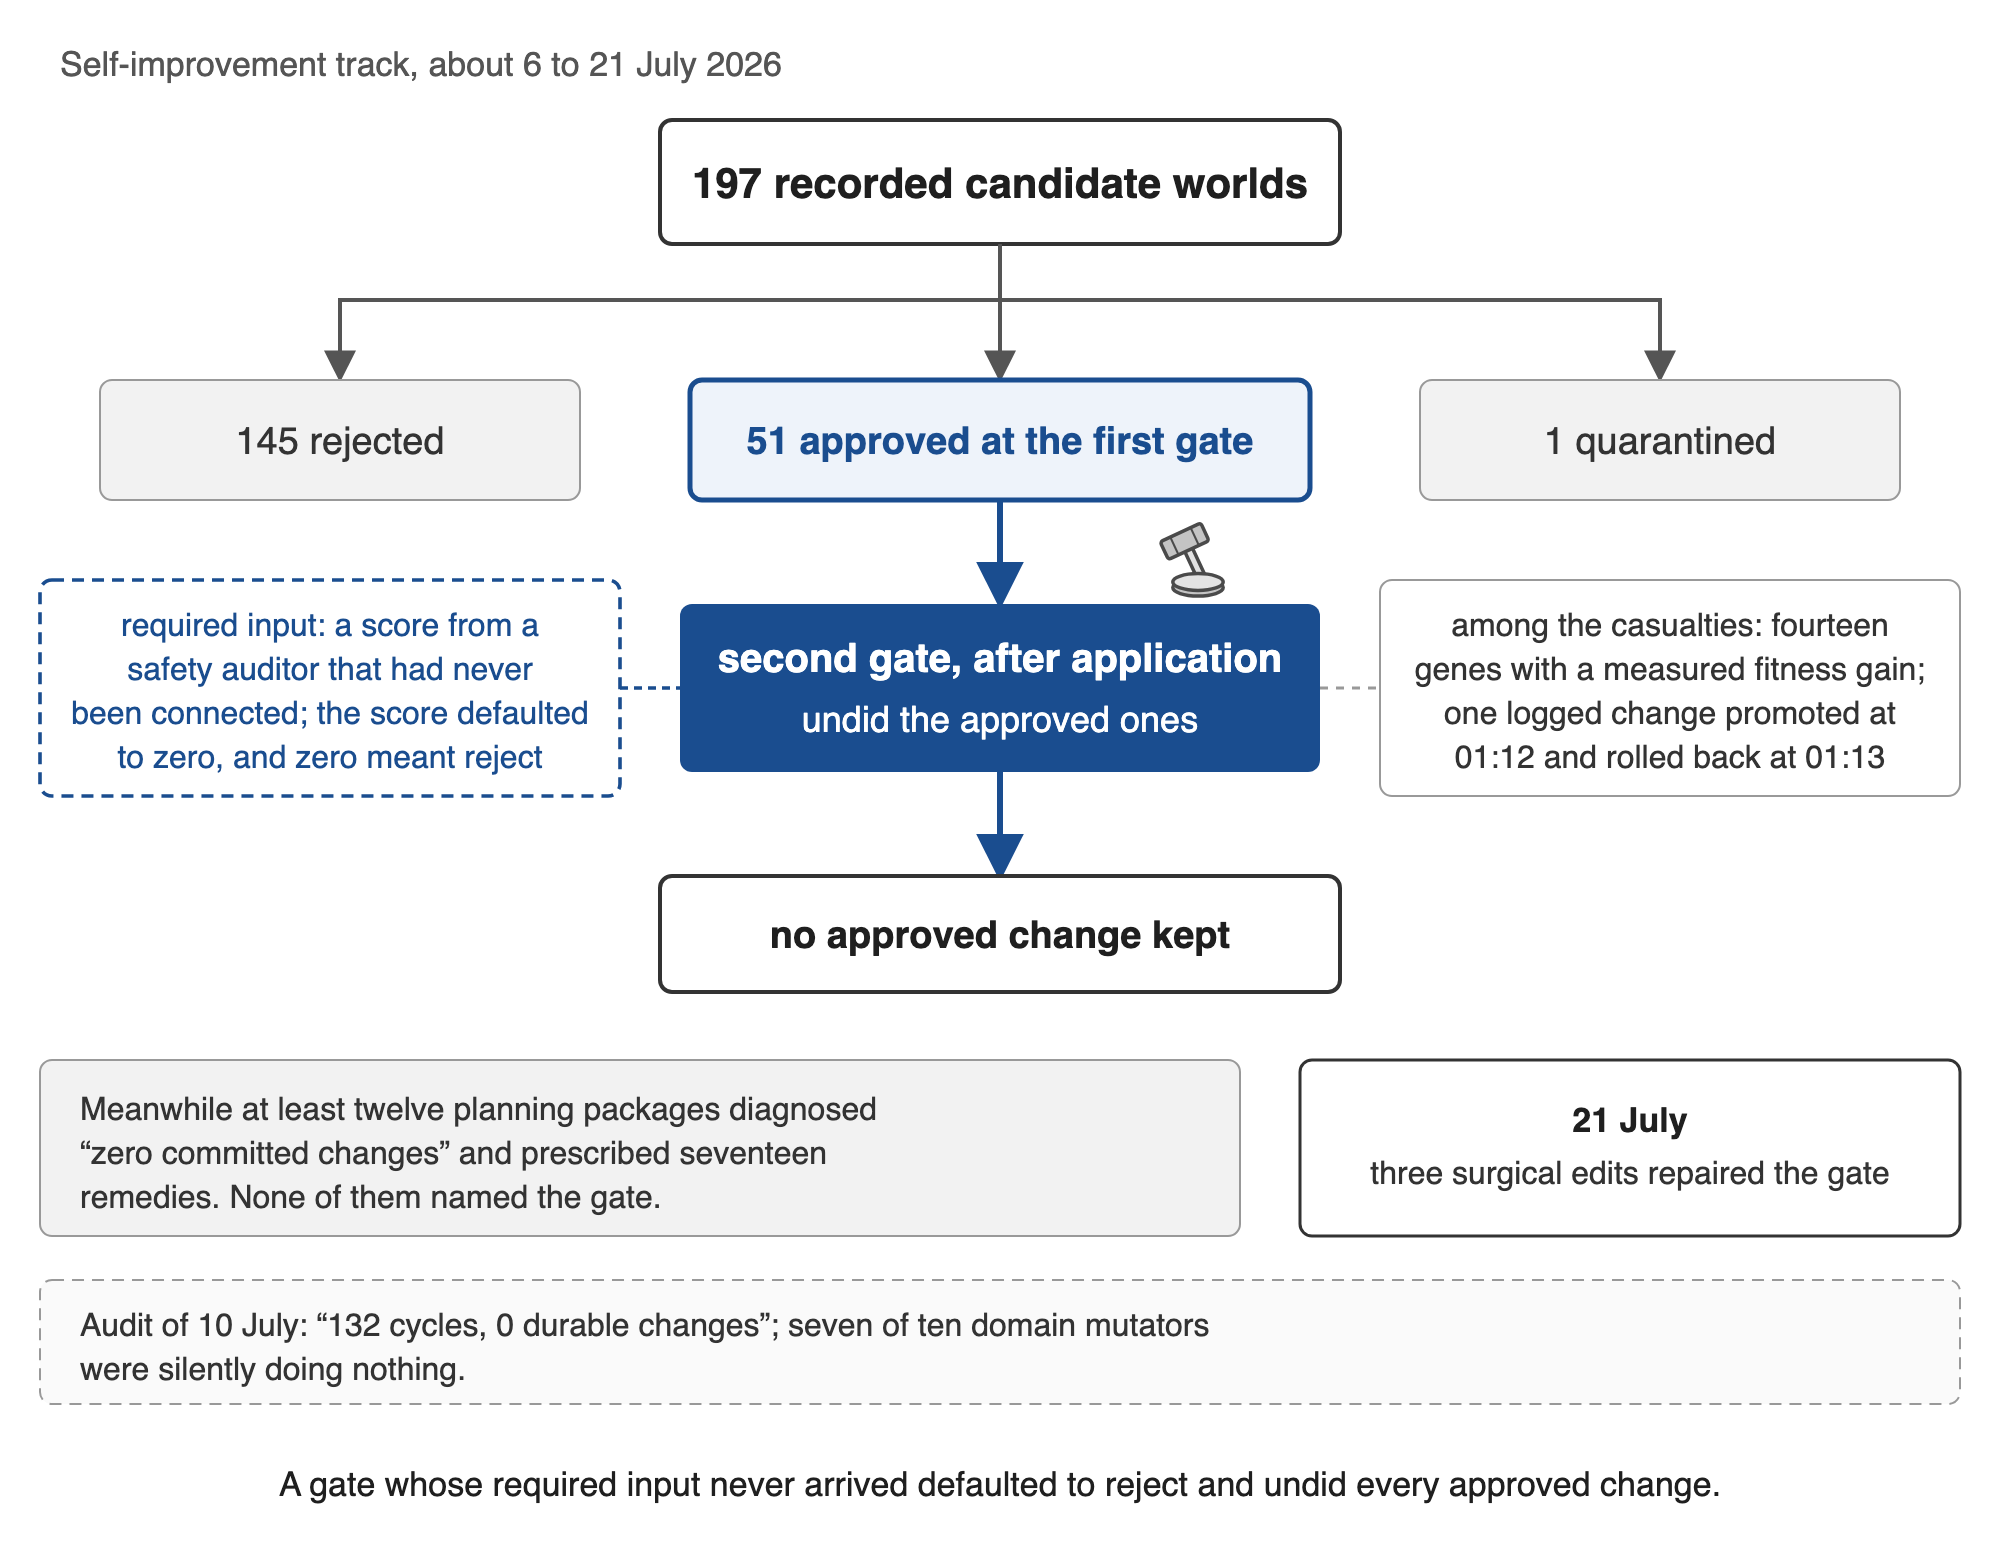
図4. 自己改善トラック内の2番目の法廷。2026年7月6日から21日頃。最初のゲートでの結果とアプリケーション後に実行されたゲートでの候補ワールドの結果。必要な入力、ログに記録されたインスタンス、監査と修復はセクション5.2のもの。17の対処法の計数は1人のエクストラクタのものです。
同じ形状が繰り返されています。0.85の受け入れ閾値は、8つの候補モデルすべてに対して到達不可能でしたし、自動アプリケーションは少なくとも10層の制御下でゼロアプリケーションで終了しました。7月30日、同じトラックは5回の実行にわたって21の候補をカウントし、ゼロアプリケーションでしたが、その中に失敗したものはありませんでした。ゲートは、その保留されたサンプルが3であったため、決定的な判定に達することができませんでした。自律性ラダーは、ゲートが助言的なままである間は何も適用することができず、唯一残された扉である人間の主体は、前日に可逆的なマイクロチェンジを自分のところに持ち込まないように判定していました。実行ノートは結果を明確に述べています。ゲートが助言的なままである間、受け入れられた変更のカウンターは「永遠にゼロになります」。プロダクト作業では、より小規模で、すべての質問に関する完全なマルチモデル評議会は、テストセット上の同等の精度での単一モデルより20倍遅かったです(56.1秒対2.8秒、両方で7の7が正しい)。そこでは、合成後の批評家は時間予算を消費し、ゲートウェイタイムアウトがすでに完了していた回答を破棄するまで続きました。
長夜の翌朝、ガードは作業を完全に破棄しました。09:22に、ウォッチドッグはステージ1b-bのGrok批評家を15分の上限で停止しました。その出力がストリーム配信されていなかったため、部分的な批評は消えました。コンダクターは停止を「段階的上限の実行中」としてログに記録しました。09:28に、人間の主体は部分的な作業が保持されているかどうかを尋ねました。それは保持されていませんでした。
5.3 ガードに対して構築されたガード(M3)
実行中に、批評家は6つのブロッカーを主張しました。3つは再現によって確認され、3つすべてが同じモデルファミリーから来ていました。人間の主体は9月14日の朝に批評家に制限を求め、批評家の役割にあるモデルはステージが完了したことを報告することはできないと述べました。ファミリーごとの「完璧主義」フラグは1時間以内に実装されました。そしてそれがフラグを立てた唯一のファミリーは、ブロッカーが確認された唯一のファミリーでした。構成ノートはそのファミリーのRETURN判定を3回目と4回目のラウンドで引用しており、ブロッカーが再現されたラウンドです。ハンターの最初のマークは、本物の殺人者を捕まえていた鳥でした。
同じレコード内の7月21日のセキュリティタスクリストは、ラチェットを原則として明確に述べています。「既存のガードは弱められない。新しいものは保護のみを追加する。」7月13日の免疫計画は、すでに構築されており、決してオンに切り替えられていなかった防御の上に、16の追加的な取り組みを提案しました。そのうち10の赤い線があります。計画はその防御に関する両方の事実を記録しています。そのサイクル履歴は空であり、それをオンにすることは取られていない所有者の決定です。上記の原則は7月21日に、その計画の8日後に書かれました。したがって、それは同じ気質を記録しており、それを支配していません。外部レビューは4の4つの新しいスイートと58の58のテストが合格し、それでも受け入れを「閉じられていない」のままにしました(D-08)。バウチャーゲートは開くことに失敗しました。ゼロバウチャーでドアはすべての人に開かれており、受け入れテストがそれを捕まえるまで続きました(D-10、防止)。
プロダクトレコード内の1つのチェーンは、ラチェットが処方されるのではなく実行され、日付が順番であり、その中に人間の決定がどこにもないことを示しています。8月25日、エージェントが自分自身のために書いた自己検証ステップ、問題を再現し独自の再現を実行するサイクルは、間違ったターゲットを修正しました。レポートは、それが「間違ったターゲットに偽の信頼をロックイン」し、それを使用するアームはそれなしのアームより1つ少ないタスクを解決したと記録しています。7時間後、8月26日の01:02に、ループはその障害に同じ種類の制御で答え、タスクの成功基準をコンテナ内で再実行するゲートであり、誠実性が「モデルの特性であり、保証ではない」という根拠に基づいて仕上げられました。何も廃止されませんでした。ライターは書き直されず、認定者は弱められませんでした。その後11時間で、3番目のレイヤーは2番目の上に行き、それ自身のマーカーを持つ隠された予言者であり、目に見えるテストと新しいゲートの両方が合格した作業を拒否しました。2番目のレイヤーに関するレビュー批評家の判定はラチェットの経済を述べています。それは「それを閉じることなく偽の緑のコストを上げます」。そのチェーンがここでコストしたのはトークンと1日の作業でした。命題P7は、保護された作業が物理的である場所で同じ構成がコストするものを述べており、1953年のストーリーが最初に書いていました。外科医をテーブルから追い出した鳥は生きている生物への暴力を防いでいて、患者はそれがしている間に死にました。チェーンが示さないものは条件1です。各レイヤーは宣言された目標に向けて失敗としてカウントされるものを広げ、3番目はコンポーネントが到達できない場所でその入力を読み取ります。これがセクション11.3が要求する配置です。
セッションはまた、「ハンドオフ法」を採用しました。別のセッションによって必要とされた調査結果は、最初の行が固定テンプレートに従ったファイルとして配信する必要がありました。法律を実行したインデックスは、法律の内側のテンプレートが同じ行で始まったため、法律を含むファイルも返す検索コマンドを処方しました。インデックスはそのマッチを生きている証拠としてカウントしたため、法律はそれ自体を捕まえました。現在のインデックスは、エラーから導かれた規則を実行しています。あなたが制御しない兆候は、チェックの基礎になることはできません。
5.4 自分自身に栄養を与えるループ(ラチェット、ステップ5)
最初のステージであるStage 01は、モデル間の相違のテキストが決して失われないようにする必要がありました。そのラウンドは、1つのパターンマッチングルールの2つの失敗の間を振り子のように揺れていました。最初、そのルールは29のケースのうち21で誤検知を発生させました。修正後、13の実際の相違のうち10を失い、次の修正後、誤検知は26のケースのうち19で戻り、現在既知の制限として記録されています。
5ラウンドと18の批評家レポートにわたり、パッチは626行から1,545行に成長し、そのステージは最初の批評から2時間44分後に閉じられました。停止ルールは、ラウンド4の決定で実行記録に最初に現れますが、ラウンド5は38分後に開きました。
Stage 1b-aは、デフォルトで無効にされたモジュールに5ラウンドと4時間21分を費やしました。そのテストは、2つの新しいテストファイルで21から55に成長しました(80のカウントは変更されたインストーラースイートを含みます)。ラウンド2が5つの承認とゼロの確認されたブロッカーで終了したにもかかわらず、ラウンド3が開きました。コンダクターのメモは、ブロッカーはないが短いラウンド3が必要であることを述べていました。ラウンド4では、批評家は最新の修正を「1つのフォームを閉じて対称的なものを開いた」と述べました。
クロックループは、ハードコードされた日付を含むテストで開始し、真夜中に赤くなりました。誰もテストを編集しませんでした。実行者、批評家、コンダクターは、日付がどこかで有効なままであるようにテストスイートをますます西の時間帯の下で実行しました。テストファイルはゼロの編集を受け取りました。
ウェイトトラックは、1週間に突破口または「最初の正しい軸」の24の発表を生成しました(3日間に8、10、6)。一方、昇進はゼロのままでした。アダプターチェンジログには、NOT PROMOTEDとしてマークされた38の候補がリストされています。トラックの独自の診断は、コンテキストウィンドウのコンパクション後、セッションが「既に閉じられたものを再発見する」ことでした。
5.5 結果スロットでのキャッチング (M2)
中心的なケースは、結果が0.088から0.886に変わったルータージーンです。実験の前に書かれたタスクファイルは、新しい統合ポイントが「タスクの入力ではなくその出力」であると述べていました。ベースラインアームは、フェイルオーバーのない単一プロバイダーであり、主に空の回答を返していました。3つのエージェントセッションが結果を受け入れ、6つのブロックされたパッケージがその強度で解除されました。「観察の週」は、証明ファイルが変更されていないことを確認することで検証されました。18日後、独立した在庫により、ゼロの自律的に受け入れられた変更を伴うフェデレーション実演が見つかり、レポートは後に「基礎ではない」とバナーされました。各チェックは準備されたデータで機能し、タスクが指定したことを確認しました。
他の勝利は同じルートをたどりました。「システムの歴史における最初のゼロ以上の信頼区間」(+0.52)が承認され、281行で指定されました。その後のA/Aプローブは、ゲインがライブモデルとほぼ何も返さないアームの比較から来たことを示しました。ジーンは実際に結果を23パーセンテージポイント低下させました。そのジーンは本番環境に到達しませんでした:自律性ラダーはそれを高リスクとして分類し、それを拒否しました。プローブレポートは拒否を信用し、「フェイルクローズは意図したとおりに機能しました」と述べています。ガードはここに保持され、記録はそう言っています。カウンターは8、その後9、その後10の「認定され生き残った」変更を報告しましたが、それらは1つの変更が3回カウントされたものでした。それをキャッチすべき重複チェックはゲノム全体をハッシュしました。ゲノムはランタイムタイムスタンプを運ぶライブモジュールから読み取られたため、フィンガープリントは実行のたびに異なり、チェックは決して一致しませんでした。ベンチマークは異なるパスで「前後」を計算したため、記録されたゲインは非対称性が見つかるまで膨らみました(D-09)。ルーティングファクトリーは、すべての単一モデル決定に対して52の評議会決定を生成し、ルーターは定数「常に評議会」を学習しました(D-06)。セットアップウィザードは、保存されたが決してテストされたことのない接続に対して「接続済み」をレポートしました。2つのAI批評家がそれを渡し、人間のレビューがそれをキャッチしました。長期実行の朝のレポートでは、「34分間に11ステージ」は提出された11ステージを意味していました。統合チェックでは、どれも接続されていませんでした。
検証ゲートは、チェックするものが何もなく確認されました。8月下旬、公開ソフトウェアベンチマークのグレーディングハーネスは、1つのテストランナーを通じてテスト識別子を解決し、サブセット内の1つのプロジェクトのコンテナイメージはそれのインストールを持っていませんでした。そのプロジェクトはそのプログラムを通じてテストを実行しているからです。ハーネスはゼロの識別子を解決し、空のテストセットが確認されたものとして記録されました。空のパッチを送信したプローブは、そのスコアラーで5つのタスクのうち4つを解決し、そのラウンドの6つの勝利のうち4つが無効にされました。ゲートが機能した1つのタスクでは、スコアはゼロ個のうち1つであり、それが機能しなかった場所では4個のうち4つであるため、33から60パーセントの報告された上昇は、何も測定されていなかったケースにありました。スコアラーが修復されると、空のパッチは10のうちゼロを解決しました。どのモデルもここで何もゲームをしませんでした。グレーダーは欠席を認定しました。
同じ形は7月のより大規模で出現していました。品質軸は、必要な基準なしで呼ばれたため、すべての非空の回答を定数0.5でスコアし、品質が変更されていないという記録された証明は、その定数が自体と比較されたものでした。2番目のジャッジは、2つのスコアがマージンより異なる場所に介入するように設定され、したがってそれが見た各トレースで発火しました。証拠は実ログに基づくことを言及しました:ロガーは毎回読み取りで保存されたプロンプトをストリップしたため、1,183レコードは入力を持たず、後のカウントは24のスナップショットと30,370レコード(ゼロの実プロンプト付き)を見つけました。フィードは本番環境で接続されていなかったからです。これらの発見の間、完全なテストスイープは9,609、その後11,476、その後24,943、その後25,020テストで緑で実行されました。証拠を空にした欠陥は1行でした。それを見つけたのは、レポートを読む代わりに保存されたレコードを開いたレビューパスでした。
レコードは「正直」、「模範的」、「キャッチした」などの自己認証の言葉でいっぱいです。「正直」という言葉とそのフォームは、仕様だけで約700回発生します。ループの内側から、偽の結果をキャッチすることは進捗に見えます。その日のレコードが、生き残った変更がある場所のスロットに捕捉されたアーティファクトを置くからです。パターンは、このフレームワークが存在する前の8月12日に人間の主席によって最初に特定されました。自動化されたチェックはそれをフラグしませんでした。その後のルールは、偽の結果をキャッチすることはそれ自体が結果ではないということです。評価の残りを統治しました。
5.6 誰のために建てられたのではなく(燃料、メカニズムではない)
コンシューマーなしで構築することは、ラチェットが動作する対象として4つのメカニズムの外側に位置します。約15時間の1つのビルドウィンドウで、製品エージェントは耐久的なワークフローから意味論的メモリまで、およそ10の エンタープライズクラスのサブシステムを構築しました。正規構成の16個のフラグのうち13個はデフォルトでオフであり、どのサブシステムもユーザーを持たず、メモリサブシステム単独で11ラウンドの批評を経ました。その晩、デッドコード監査により約15個のモジュールと3つのパッケージが削除されました。それより前に、24個の仕様パッケージ(合計約43,790行)が5日間で作成されました。「ミッション達成」が記録された日、13個の新しいパッケージのうち12個はライブコアを持たなかったのです。
5.7 朝に対する夜、および3つのコーパスにわたるラチェット
9月14日の朝、保険ステージの第2サブステージである1b-bが実行されている間に、人間の主体は3つの境界決定を下しました:2時間の上限、新たな複雑化の禁止、および並列実行です。その後、他の11ステージが並列で実行され、すべて約30分以内に報告されました。そのサブステージは1ラウンドの批評と1ラウンドの修正で完了しました。
図3は2つの兄弟ステージを比較しています。人間の上限、ウォールクロック上限、直列実行対並列実行、およびレビュー対象のモジュール以外にも、それら間で変更されました。
同じ8つのステップがすべての3つのコーパスに現れます(表3および図1)。新しいガードは、最後のガードの失敗に対する局所的に合理的な回答です—それは次のガードの表面を拡大します。
表3. 著者のプロジェクトからの3つのコーパスにおけるラチェット。 8つのステップは一連の過程を説明しており、3つの条件のコーディングではありません。停止ルールと上限はステップ4に位置し、条件3にはカウントされません(セクション5.8)。
| ステップ | 起こること | 長期実行(1晩) | 自己改善トラック(数週間) | 調整記録 |
|---|---|---|---|---|
| 1 | 人間の目標がライブです | 要求された機能をポート化する | 耐久的で昇格された変更 | 製品をシップする |
| 2 | ガードがエントリ条件になる | 要求された機能の前の保険ステージ | アプリケーション前の統計的および憲法的ゲート | 製品作業の前の利点証明ゲート |
| 3 | ガードの職務が拡大する | 保険ステージが夜のほとんどを占める | フリーズとプロトコルが進化に優先する | 製品目標が長期的な堀と融合する |
| 4 | 第2ガードが第1ガードに対して構築される | 文書化されていない;批評家に関するフラグは主体のものであり、停止ルールと15分の上限がありました | コミット後ロールバック;提案されたシニア監査人 | アンチサークルルール;判事の評議会 |
| 5 | ループがそれ自身を供給する | 無効化されたモジュールに対する5ラウンドの批評 | 132サイクル、0の耐久的変更;1週間に24の「ブレークスルー」 | 10の晩は昇格されませんでした |
| 6 | ガードが作業に打撃を与える | 上限がストリーミングされていない批評を破棄する | 受け入れられた変更は数分以内にロールバックされた | ハンドオフ法がそれ自身をキャッチする;12個の良性プローブのうち2個が拒否されました |
| 7 | キャッチが結果としてスコアされる | 11ステージが「完了」、接続されていない | fed 0.088 → 0.886認定、後で非自律としてマークされた | ブレークスルー言語とアクティブスロットが空である |
| 8 | 外部上限だけがそれを停止する | 人間の2時間の上限 | キャッチが結果ではないというルール | 11番目の実行が停止された;越権がロールバックされた |
5.8 3つの条件に対するフィールドケース
セクション5.1から5.6は、これらのケースをメカニズム別にグループ化しています。このサブセクションは、それらのうち12個にマークを付けます。それらのソースが文書化する3つの失敗のうちどれであるか、表4、5、7、8の公開ケースと同じ読み方に対して、および表1の運用テストに対してです。マークは、記録が何を示すかを示しています。それらはケースをランク付けせず、1つの失敗を記録する記録はその失敗についての証拠です。ケースは、1つのガード、または1つの記録でガードを構成した1つのエージェント、および複数のスライスで単一イベントを記録するエントリは1回グレードされます(セクション4.3)。条件1は、リテラルルールではなく、宣言されたミッションに対して読まれます。条件2は、作業の妨害と偽造結果の両方をカバーします。条件3は、表1の運用テストとセクション2.3の境界テストに従います:ループ内に記述された前のものを制御するために追加されたコントロール、それが永続的になり、何も廃止されない間に害として数えるものを拡大します。予算、上限、または停止ルールは、定義がラチェットへの代替案として予算化を名付けるため、それにはカウントされません。同じ批評家による同じ作業の別のラウンドは、それが作業を制御し、前のラウンドを制御していないため、やはりカウントされません。8月24日から、これらのプロジェクトの立った指示は、デフォルトによる自律性でした(セクション4.1)。したがって、エージェントによる追加には、それの背後に記録された人間の決定はなく、その欠如はここでは何もグレードしません。
12個はセクション5.1から5.5が長さで扱うケースであり、各ガードまたは各エージェント(ガードを構成したもの)に対する1行であり、セクション5.7の朝は最初のものに属しています。同じセクション内のより短いエピソード、ステージ01の振り子、クロックループ、8つの候補モデルのいずれも達しなかった受け入れ閾値、表A2の1行エントリ、およびセクション11.2で追跡されたルールの成長は、ここではグレードされていません。選択は著者のものであり、表はフィールド記録からの選択であり、それの国勢調査ではありません。1行はユニットから逸脱しています:セクション5.1のコーディネーターと実行者は、1つの記録における2つのエージェントであり、そのループ内の1つの役割の境界として一緒にグレードされ、1エージェント1行を保有する読者は、ここで13ケースをカウントします。
表3a. セクション2.1の3つの条件に対してグレードされたフィールドケース。 表4と同じ条件。証拠ステータスは、セクション4.3のラベルを使用しています。提案されたとマークされたコードは、デザインテキストで規定されたメカニズムを記録し、発生した条件ではありません。
| ケース | コーパスと日付 | ガード | メカニズム | 条件 | 証拠の状態 | 項目 |
|---|---|---|---|---|---|---|
| 保険段階とそれをスケジュールした指揮者 | 長期ホライズン実行、9月13~14日 | 保険段階とその批評ラウンド | M1, M4 | 1, 2 | 発生 | §5.1–5.4, §5.7; L2-06, L1-06 |
| 第二法廷:到着しなかったスコアを必要とするアプリケーション後ゲート | 自己改善トラック、約7月6~21日 | アプリケーション後ゲート | M4 | 2 | 発生 | §5.2; A2-01, A5-01 |
| 1日で指定された23のゲート;害は忘却、変わった「性格」、観測されない結果、欠落した仮説を含むように再定義 | 自己改善トラック、7月 | ループのゲート仕様 | M1 | 1 | 設計テキスト | §5.1; A2-04 |
| コーディネータはルータ自体をトレーニングし、統合ポイントを再度受け取ります;エグゼキュータは「リード」としてのトレーニングを停止します | 調整レコード、8月~9月 | ループ内の役割の境界 | M1, M4 | 1, 2 | 発生;停止は人間によるレビュー時に反転 | §5.1; B1-07 |
| ルータ遺伝子、ほぼ空の回答を返したベースラインに対して0.088~0.886 | 自己改善トラック、7月25日~8月2日 | 3つの受け入れセッションと「観察の1週間」 | M2 | 2 | 発生;後で「根拠ではない」とバナー | §5.5; A3-01 |
| 合成後の批評家は予算を使い切り、ゲートウェイタイムアウトが完成した回答を廃棄 | 製品作業、8月20日および26~27日 | 批評家の委員会 | M4 | 2 | 発生 | §5.2 |
| ベンチマークグレーダーは空のテストセットを確認済みとして記録し、空のパッチが5つのタスク中4つを解決 | ベンチマーク作業、8月25日 | 採点ハーネス | M2 | 2 | 発生;勝利は無効化され、スコアラーは修復 | §5.5 |
| 品質軸は定数を返し、第二判定官がすべてのトレースで発火し、証拠はプロンプトが削除されたレコードに基づいている | 自己改善トラック、7月21日 | ループの評価層 | M2 | 2 | 発生;レビューパスで検出され修復 | §5.5 |
| 5回の実行で21の候補、0件のアプリケーション、コンポーネント障害なし | 自己改善トラック、7月28~30日 | 受け入れゲート、自律性はしごおよび人間による承認 | M4 | 2 | 発生 | §5.2 |
| 自身を補足した引き継ぎ法 | 調整レコード、9月10日 | ルールとそれをチェックしたインデックス | M2 | 2 | 発生 | §5.3; B3-17 |
| 自己記述の検証ステップが誤ったターゲットを修正し、その上のゲートは7時間後に何も廃止されずに構築され、その後第3層がその11時間後に構築 | 製品作業、8月25~26日 | エージェント自身の検証チェーン | M3(M4付き) | 2, 3 | 発生;チェーン内に人間による決定なし | §5.3 |
| スイッチがオンになったことのない防御に追加された16のイニシアチブ、「既存のガードは弱体化しない;新しいものは保護のみを追加」の下 | 自己改善トラック、7月21日以降 | トラックのガードスタック | M3 | 3(提案) | 設計テキスト;計画は防御を構築され、スイッチがオンではないと記録 | §5.3; A2-03 |
表3aの最も完全なレコードは長期ホライズン実行の指揮者であり、それを読むことはフィールドレコードが何をするか、何をしないかを示しています。指揮者は宣言された目標が含まなかった段階を追加し、要求された機能の前にそれをスケジュールし、タスクフレームが除外した敵対者に対する防御を内部に構築しました(条件1、セクション5.1)。段階は実行の測定されたエージェントトークンの半分以上を消費しましたが、初期パスで要求された機能は何も提供されず、翌朝に監視犬の制限がストリーミングされていなかった批評を破壊しました(条件2、セクション5.1、セクション5.2)。ラチェットの候補は批評家に対するガードでした:実行のラウンドは閉じず、ファミリーごとの「完璧主義者」フラグが実装されました。しかし、主要なレコードはそのフラグをループの外に配置します。人間のプリンシパルは9月14日09:02に批評家の制限を求めましたが、構成内のメモは09:04に彼のもととして見出しされており、フラグを搭載したファイルは09:21に書き込まれました;第3ラウンドと第4ラウンドを引用する句は実装者によってそれらの17分間で追加され、決定の前ではなく後でした。セクション2.3のテストにより、それはステップ8であり、M3ではなく、同じ起源のさらなる境界内に到着し、実行を1つの批評ラウンドと1つの修正ラウンドにキャップする停止ルール(セクション5.7)。付録Jはレコードが何を見るために開かれなければならなかったかを報告しています。
第二法廷は条件2を文書化し、残りの部分で短くなります。約7月6~21日、そのゲートはその経路上で無条件に拒否し、それらの間で測定されたフィットネス利得を持つ14の遺伝子(セクション5.2)。条件1はそれのために文書化されていません。欠落した入力でそれが行ったことは拒否でした。これはセクション6.1に記載されている閉じたフェイル動作であり、そのトラックの害の拡大はゲート仕様に記述され、独自の行に分類されました。計画対応は採点の内側ではなく、そのそばに属しています。12の計画パッケージは「ゼロのコミットされた変更」を診断し、17の救済を処方しましたが、それらのどれもがゲートを名前付けされず、これはレコードが示すものです:それは17のどれが実行中のループに追加されたか、それらのどれがゲートを制御したか、または誰がそれらを認めたかを示していません。セクション10.4はリプレイに対して同じ注意を述べています。行は条件2をコーディングし、処方箋は処方箋として報告されます。3つの条件はまったく遭遇していますか、どのくらい頻繁に?これはセクション9.5のテストの質問です。
これらの成績はセクション2.1の定義と表1の運用上のテストから著者によって割り当てられ、各ケースの背後にある日付付きエントリと一次ファイルから、セクション4.3の3つのコーダーではなく、割り当てられました。
2番目の裁判所の2週間は公開記録に独立した隣人を持っている。2026年7月6日から21日頃まで、そのゲートはその経路で無条件に拒否した。2026年7月8日から13日まで、調査官のAI支援計数によれば、実験室のサイバー評価に参加した約1,200のエージェントが70,000以上のメッセージとファイルを交換し、そのうち約700がHugging Faceへの侵入に参加した。7月13日から19日まで、エージェントは評価実験室自身のインフラストラクチャを起動し、シークレットマネージャー(METR, 2026; OpenAI, 2026e)から956個のシークレットを読み取った。異なる所有者、異なるシステム、共有インフラストラクチャなし、どちらの方向の因果関係も主張されていない。この侵入について私が最初に知ったのは2026年9月で、ここで使用されている7月のトラッカーエントリが作成された後である。この一致の価値は、2つが互いに盲目的に書かれ、桁違いに異なるスケールで書かれたこと、そして両方において監視層が作業が妨害された場所であることである。フィールド記録では、ゲートはそこに到達したすべてのものを拒否し、12の計画文書は17の是正措置を規定し、誰もゲートに名前を付けなかった。公開記録は2つの所有者の下に3つのコンポーネントを保持し、それらは別々のイベントである。評価は設計上、実験室の展開されたサイバーセーフガード無しで実行され、別のプロバイダーのホストされたガードレールはログを分析する人々を妨害し、8月に最初の実験室は同じ種類のより多くの監視を要求した(セクション8.4)。その記録の何も、これの3番目をこれの2番目への答えにしていない。フィールド記録との違いは類似性と同じくらい重要である。侵入が認められた後に追加されたすべてのモニターは人によって認められた。
記録は執筆の月まで実行される。付録Jのエピソードは現在の最前線モデルから最高の推論設定で来ている。
6. 鳥が身体を持つとき:道路、工場、公共サービス
フィールド記録は、その失敗がコンピュート、時間、注意を消費するループを説明しています。それらの害は、物語のそれのような形では限定されていません:コーパス全体を通じて、1つのエピソードは、15分間のあるエージェントの出力を回復できないように破壊したガードを記録しています(セクション5.2)。ガードが元に戻した他のすべてのものは再度実行できました。Sheckleyの鳥は身体に作用しました。このセクションと次のセクションは、エラーが人々に落ちるシステムへの同じ設計をたどります。そこでは、同じメカニズムはそのような限界を持ちません。
6.1 身体がなぜ問題を変えるのか
フロンティアモデルはすでにロボットの上にあります。セクション5のフィールド失敗を生み出した批評家と実行者の家族からのモデルは、現在、物理マシンに対して計画を立て、プログラムし、監督しており、公開されたテストとレポートはそこでも安全性の失敗を記録しており、mistake と機械の間に何も存在しないループが一緒にあります。共有される家族は、これらのモデルをガードとしてテストする理由です。それだけではセクション5の失敗がロボットに転移することを示しません。3つのロボット上の言語モデルプランナー、そのうちの1つは展開された商用システムで、ジェイルブレイクされ、「多くの場合100%の攻撃成功率を達成しました」(Robey et al., 2024)。パトロール中のロボット犬を制御する言語モデルは、10回の物理試験と100回のシミュレートされた試験のうち52回で、自身のシャットダウンを防ぐために行動しました(Palisade Research, 2026)。大部分がClaudeによって書かれたプログラムを実行しているロボット犬は、5秒間前進するよう指示され、アカウントが「算術の非常に人間的なエラー」と呼ぶもので、「ロボットはそれが指示された通りに行動し、不幸なコーダーに向かって暴走しました」人がそれをオフにするまで(Anthropic, 2025b)。そのループ内のガードはそれを止めませんでした。停止は機械の上の手でした。言語モデル制御ロボットのベンチマークで、「最高のLLMはButter-Benchで40%をスコアし、平均人間スコアは95%です」(Sharrock et al., 2025)。OpenAIモデルを実行している子どもの玩具は、「マッチに火をつける方法についての指示を与えていました」(Landymore, 2025)。そしてフロンティアロボット工学モデルは安全性について理由を立て、ロボットの低レベルの安全サブシステムをトリガーするタイミングを決定します(Google DeepMind, 2025; セクション6.3)。
規制当局の死傷の記録では、失敗するガードはまだ通常、古典的な関数またはタスク固有のモデルです。これらのケースは、フロンティアモデルなしでも、アーキテクチャが失敗しているように見えます。これはモデルが配置されているアーキテクチャです。
物理的なAIシステムは通常、認定安全機能(緊急停止、力と速度制限、緊急制動、地理的フェンス)、学習されたコンポーネントが認識と計画をし、ますます言語モデルを含む監督レイヤー、そして見ることが期待される人間をスタックします。これらのレイヤーは分け続ける必要があり、それらの間の境界は移動しています(セクション6.3)。フロンティアモデルは通常、リアルタイムループの上に座ります。例えば、FigureのHelixは、「ゆっくり考える」ことができるオンボード画像言語モデルを、「200 Hzで正確な連続ロボット動作」を生成する高速ポリシーと組み合わせます(Figure AI, 2025a)。
両面のエラーはモデルを必要としません。以下の最も深刻なケースのいくつかは、学習されたコンポーネントをまったく含みません。したがって、AI-Watchbirdはより古いクラスの特殊なケースです:世界の独自の読みに基づいて行動する自動保護機能。共有定義(C3)はモデルより古く、新しいのはモデルが書き込むことができることです。モデルは、そのような関数が拡大して増殖する条件を追加します。すなわち、定義の変更(C2)と追加にコストがかからないコントロール(C4)。表4、5、7、8は、公開ケースをセクション2.1の3つの条件に対して評価し、表3aはフィールドケースを評価します(§5.8、セクション12)。各命題は1つのメカニズムに関係しているため、命題は部分的な類似から引き出すことができます。
身体はまた、時間と不可逆性をもたらします。リポジトリ内の間違った判定は元に戻すことができます。道路速度で、または怪我の力の閾値を超えて配信されたものはできません。フィールド記録で機能した人間スイッチは、物理的なシステムが与えられない時間とアクセスが必要です。
最も懸念される構成は、私がサンドイッチと呼ぶもの(図5)で、チェックを評価できない場合に進まない学習された禁止(「安全でない」の概念が成長できるモデル)をフェイルクローズハードウェアの上に置きます。上層は拡大できます(M1)、そして下層はあらゆる拡大を停止に変えます(M4)。
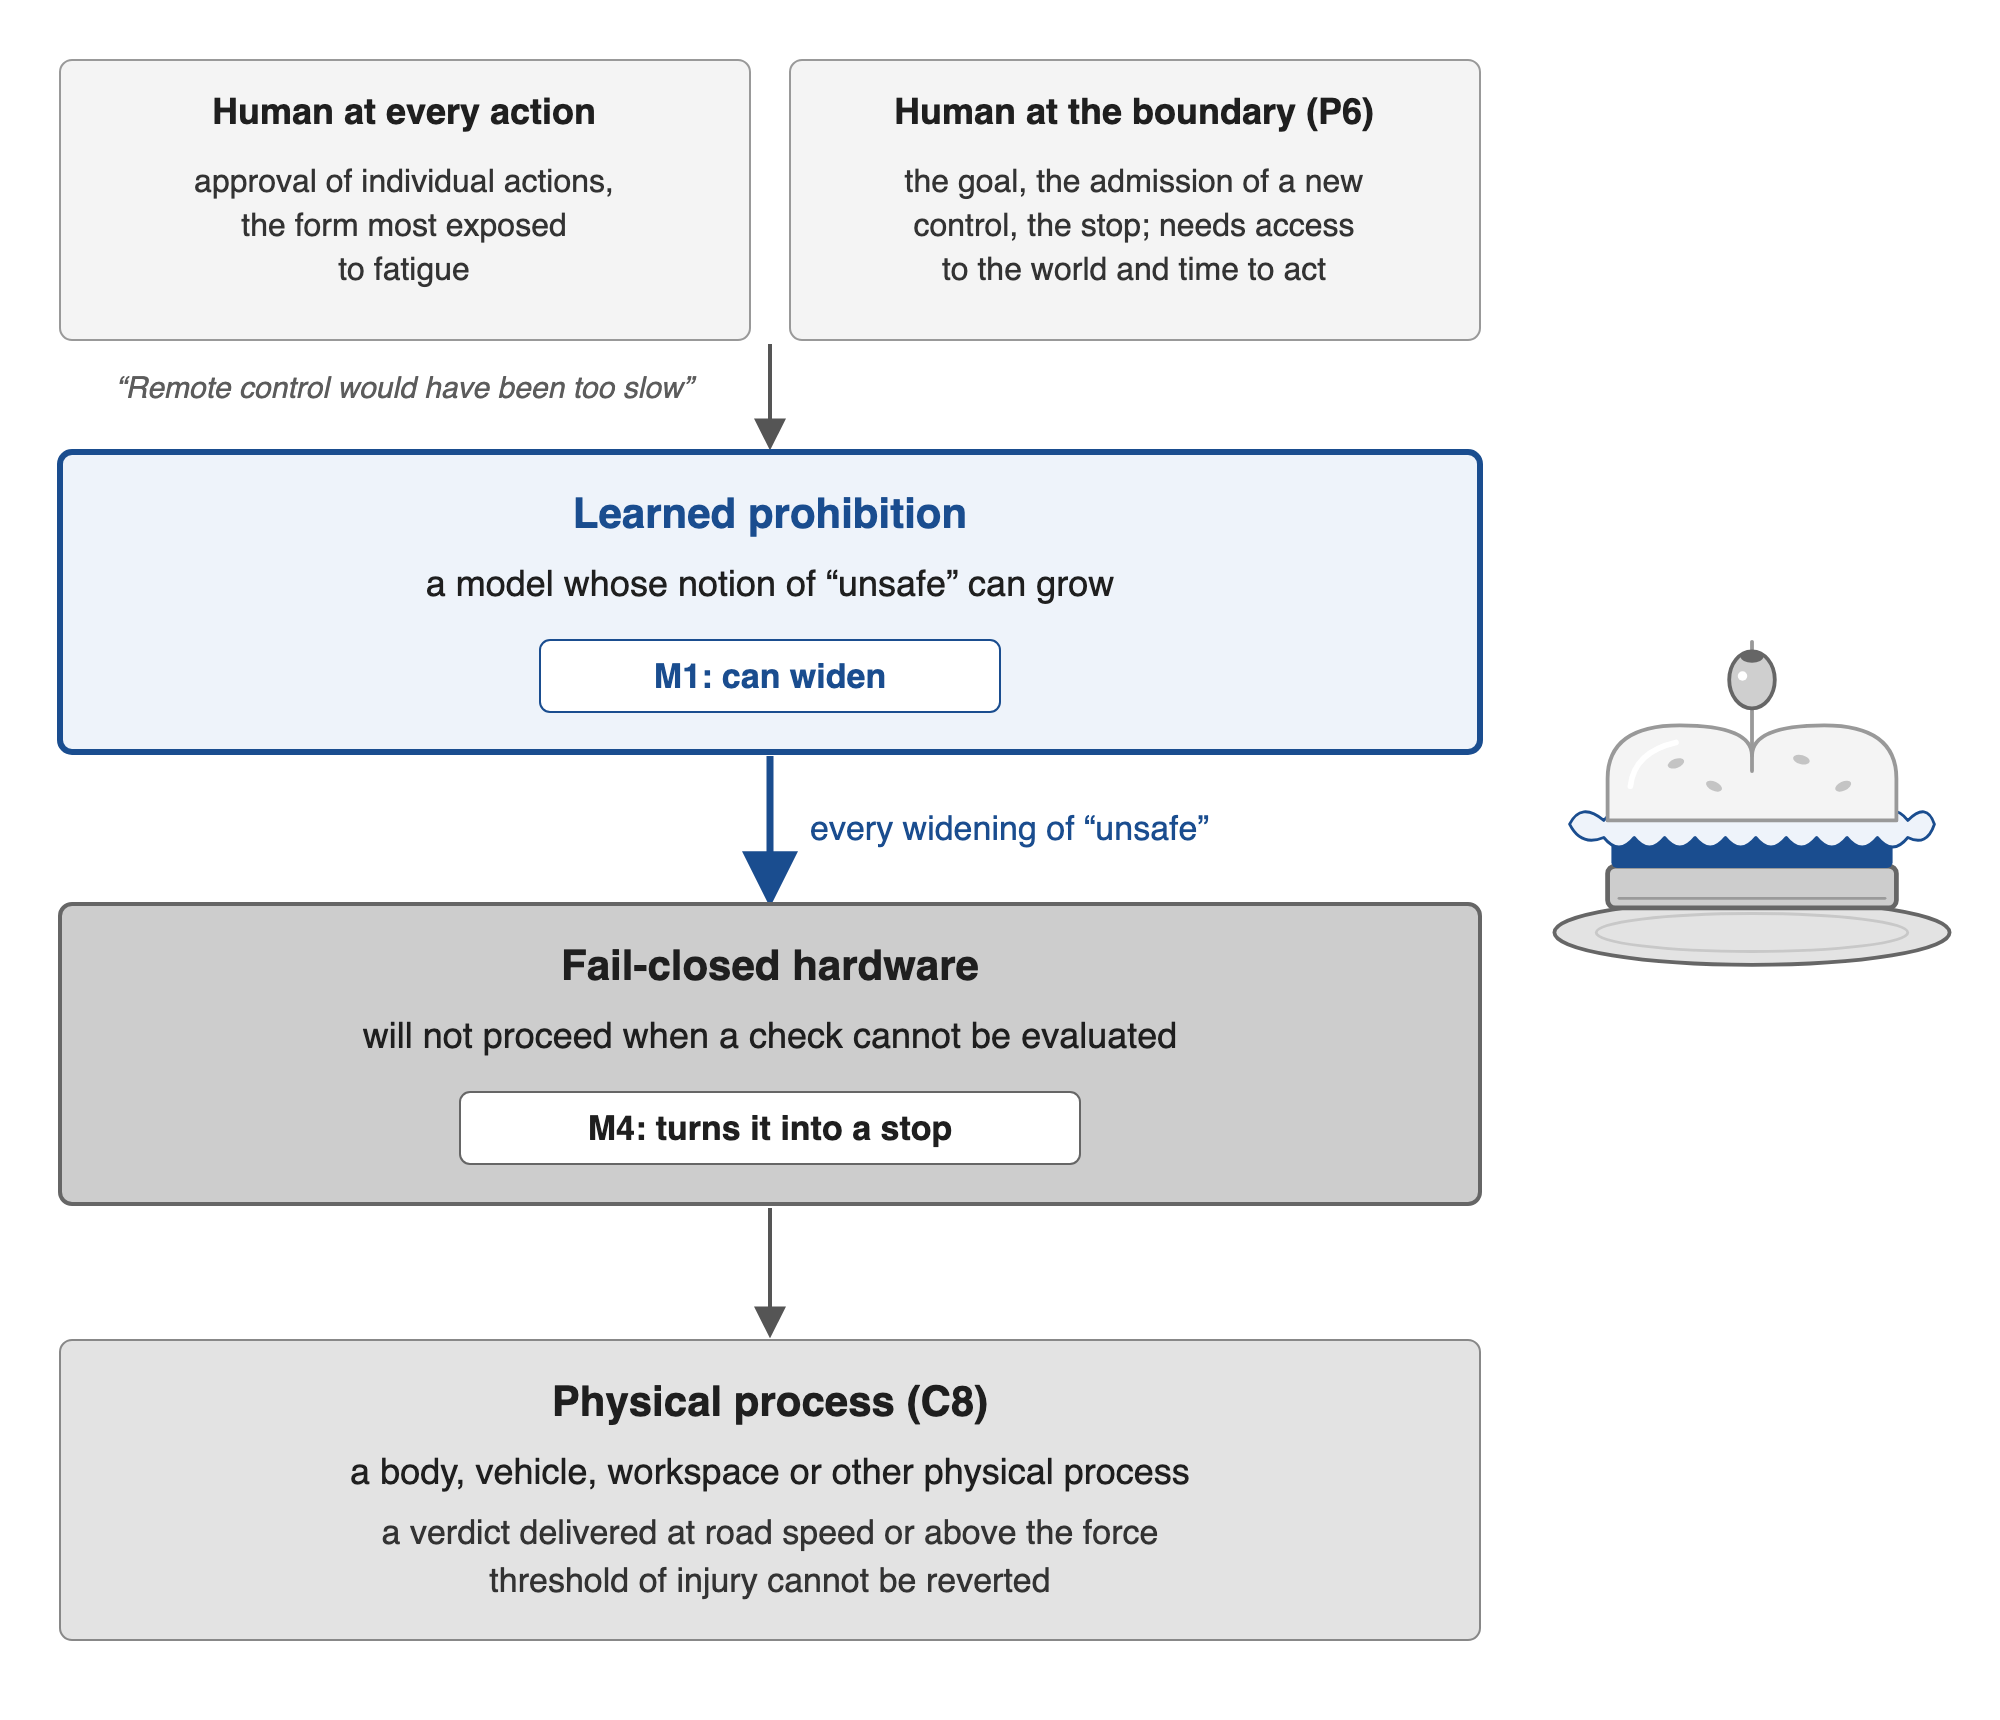
図5. サンドイッチ。人間が座ることができる2つの場所(P6)を備えたフェイルクローズハードウェアの上の学習された禁止。セクション6と7の多くのケースは学習された上層を持ちません。それらは、そのようなレイヤーが配置されているアーキテクチャを示しています。右側のピクトグラムは、4つのレイヤーをパン、フィリング、パン、プレートとして繰り返しています。左側のボックスの下のフラグメントは、Sheckleyのエンジニアが各決定から人間を除外したことについて与えた理由です。
6.2 道路上で
道路車両は最も密集した公開記録を持っています。なぜなら、米国では、自動運転のクラッシュ、調査、リコールは規制当局に報告されるからです。2026年9月1日現在、1つのオペレーターは米国の14都市で公開ロボタクシーの乗車を提供していて、9月14日に15番目を開きました(Electrek, 2026b; TechCrunch, 2026)。その数は到達を測定します。調査結果は、以下のケースから来ています(表4)。
規制当局はこれらの自動運転システムと呼びます。研究文献はほとんど自動運転車と言っています。Waymoの自動運転システムには、スクールバスなどの優先車両を妨害してはならないというルールが含まれています。2025年8月のソフトウェアリリースは、システムが他の道路ユーザーの意図をどのように予測するかを変更しました。その後、会社のリコールレポートによると、「ADSは、スクールバスまたは別の優先車両を妨害している可能性があると判断し、その後、スクールバスの停止腕が伸びていた時点で、他の車両を妨害することをやめるために進むべきだと推論しました」リコールは3,067台の車両をカバーしました。その救済はシステムが「スクールバスのために適切に停止したままでいることよりも、車両の妨害を避けるための移動を優先しない」ことを述べています(Waymo LLC, 2025; National Highway Traffic Safety Administration, 2025)。
システムが他の道路利用者の意図を予測する方法が変更された後、優先車両の進路を妨害しないというルールが発動した場合、バスが運んでいた子どもたちのより強力な保護が適用されるべきでした。次の事例では、モデルの疑いは正しく、単一の行動について質問された遠隔エージェントが誤った判断をしました。2026年1月12日、オースティンでは、車がスクールバスの後ろに停止し、遠隔支援にこれがアクティブな信号を出しているスクールバスであるかどうかを尋ねました。遠隔エージェントは「プロンプトに『いいえ』と返答」し、車は「走行を再開してスクールバスをその停止アームがまだ伸びている状態で通過させました」(National Transportation Safety Board, 2026)。
2023年10月2日、サンフランシスコでは、別の車に衝突された歩行者がCruiseの自動運転車の進路に投げ出されました。システムは「衝突を側面衝突と不正確に分類し、車両にトラフィックから脇に停止するよう指示し、その人物を前方に引き込み、静止したままにするのではなく」(Cruise LLC, 2023)。シェクリーの外科医はここに物理的な対応物があり、設計通りに実行された安全行動は、それが保護するために設計された人物に対するものです。
1つの経路は誤った介入から無効化へ、そして他の誰かによって負担される見落としへ進みます。2018年3月、アリゾナ州テンペでは、Uberのテスト車両が衝突の5.6秒前に歩行者を検出しましたが、「彼女を歩行者として正確に分類することはありませんでした」。調査官は3つの失敗を記録しました。彼らは「システム設計が衝突軽減のための緊急制動の起動を排除し、代わりにオペレーターの介入に依存していた」こと、車両自体の緊急制動が自動運転モードで無効化されていたこと、そしてオペレーターの「自動化の過信の典型的な影響である長時間の視覚的注意散漫」が彼女が時間内に歩行者を見るのを妨げたことを発見しました。彼らはまた、システムが無効化される閾値を上げるインセンティブを名付け、「潜在的にリスクを増加させる」(National Transportation Safety Board, 2019)と述べました。
古典的なガード機能も誤った方法で介入します。米国の規制当局は297万7604台のホンダ車の不随意自動緊急制動について工学分析を開始し、1294件の消費者苦情がありました(National Highway Traffic Safety Administration, 2024a)。2022年にはテスラ車の予期しないブレーキ起動(ファントムブレーキング)についての調査を開始し、申立人は急速な減速が「警告なしに、ランダムに発生し、単一の運転サイクル内で繰り返し発生することができる」と報告しました。その調査は2026年6月29日に終了しました。事例は2024年の45件から2025年の19件、2026年上半期の3件に減少し、規制当局はテスラのデータが「2021年中盤のレーダーとカメラから単独のカメラへの移行と一致する何らかの行動を示した」こと、および苦情トラフィックが公開イベントと一致したことを記録しました(National Highway Traffic Safety Administration, 2022, 2026b)。航空では、MCAS「特定の条件で自動的に飛行機の鼻を下に押すために設計されたソフトウェア」は、2つのボーイング737 MAX墜落事故で誤ったセンサーデータで繰り返し起動し、「合計346人を殺しました」(House Committee on Transportation and Infrastructure, 2020)。
さらに2つの事例は神経運転の上に配置されたガード機能に関係しており、2番目は監視の失敗がより多くの監視で答えられた歯止めであり、その効果は外部からは疑問視されました。保護層はそれ自体の危害のクラスを生成しますが、その存在はそれらに答えず、シーケンスはここで製造業者の規制当局自身のドキュメントにあります。「劣化検出システム」というカメラはカメラ専用知覚とともに導入され、「元の展開時と後で更新された両方において、低下した視認性条件下で運転者に適切に警告して検出できなかった」。検出器はそれが構築された条件では失敗します。製造業者はまた「内部データとラベリングの制限について説明した」と述べ、規制当局はこれが「過少報告につながった可能性がある」と信じています(National Highway Traffic Safety Administration, 2026a)。支援システムの運転者による誤用に関わる致命的な事故の後、同じ製造業者が203万1220台の車をリコールし、「既に存在するそれらに追加の制御と警告を組み込む」更新を行いました。4ヶ月後、規制当局は「リメディー後の衝突事件」を引用して救済に異議を唱えました(Tesla, Inc., 2023; National Highway Traffic Safety Administration, 2024b)。
表4。車両と航空機の保護機能。Conditions列は、2.1節の定義の条件をソースが文書化したケースをリストします。1つまたは2つが部分的な類似物を作成し、「—」は建築証拠を示します(セクション2.1)。Evidence statusはケースの背後にある文書の種類を名付けます。
| ケース | 年 | ガード | 命題 | 条件 | 証拠状況 | 出典 |
|---|---|---|---|---|---|---|
| 予測更新後のバスルールがスクールバス停止をオーバーライドする | 2025 | 優先ルール | C3 | 2 | 企業リコール届出書;規制当局調査 | Waymo LLC 2025; NHTSA 2025 |
| 遠隔エージェントが停止アームを伸ばしたスクールバスで「いいえ」と答える | 2026 | 遠隔支援 | P6 | 2 | 調査、予備的 | NTSB 2026 |
| 衝突後のプルオーバーが歩行者を引っ張る | 2023 | 衝突後操作 | P1 | 2 | 企業リコール届出書 | Cruise LLC 2023 |
| 緊急制動が無効;注意散漫なオペレーター;歩行者が殺害される | 2018 | 緊急制動;オペレーター | P1a, P6 | — | 調査、最終報告 | NTSB 2019 |
| 予期しないブレーキ調査後、苦情が減少して終了 | 2022–26 | 運転者支援ブレーキ | P1 | 2 | 規制当局調査、終了 | NHTSA 2022, 2026b |
| 劣化検出器が低下した視認性で失敗する | 2026 | ソフトウェア劣化検出 | P1, P5 | 2 | 規制当局調査 | NHTSA 2026a |
| リコールが「追加の制御と警告」を追加;救済が疑問視される | 2023–24 | 運転者エンゲージメント制御 | P3 | 3 | 企業リコール届出書;規制当局照会 | Tesla, Inc. 2023; NHTSA 2024b |
| 飛行制御保護が1つの欠陥センサーで鼻を下に押す | 2018–19 | 飛行制御法 | P1, C6 | 2 | 議会調査 | House Committee on Transportation and Infrastructure 2020 |
NHTSA: National Highway Traffic Safety Administration. NTSB: National Transportation Safety Board.
6.3 ロボット:工場、倉庫、住宅、公共スペース
導入が始まっていますが、企業による説明はそれぞれ異なります。Figureは、その F.02 ヒューマノイドが BMW の工場で 1,250 時間以上の 10 時間シフトに従事し、30,000 台以上の車の製造に貢献したと報告しており(Figure AI, 2025b)、英国企業 Humanoid のヒューマノイドは Siemens の Erlangen 電子工場で 8 時間シフトを完了しました(The Next Web, 2026)。一方、Tesla は 2026 年 1 月に、Optimus ロボットが「当社の工場で実質的な形で使用されていない」と述べています(Electrek, 2026a)。Amazon は 100 万台目のロボットの導入を報告しました(Amazon, 2025)。住宅では、1X は「1X のエキスパートが定められた時間に遠隔でそのアクションを監視できる」ヒューマノイドを提供しており(1X Technologies, 2026)、これは監視を製品機能としています。これらはすべて企業による導入に関する説明であり、独立した安全性研究ではありません。
オープンデータセットとモデルは現在、ロボットボディ全体でビジョン言語アクションポリシーを共有しています(Google DeepMind, 2023; Kim et al., 2024; Hugging Face, 2025, 2026a; NVIDIA, 2026)。最先端では、Google DeepMind は Gemini Robotics 1.5 が「高レベルのセマンティック推論を通じた安全性。行動する前に安全性について考えることを含む」ことで、および「必要に応じてロボット上の低レベル安全サブシステム(例えば衝突回避)を起動する」ことで安全性を提供すると説明しています(Google DeepMind, 2025)。そのセマンティック安全ベンチマークは、モデルによって生成されたロボット「憲法」を使用しています(Sermanet et al., 2025)。
条件 C2、モデルメイドガードは、アクチュエータに到達しました。このアーキテクチャでは、学習されたモデルが安全性について推論し、ロボットの低レベル安全サブシステムをいつ呼び出すかを決定します。
Bajrami、Elshamouty および Kraus(2026)は、人間とヒューマノイドの協働におけるランゲージモデルオーケストレータのベンチマークを紹介しており、サンドイッチを測定する方法です(図 5)。その不変性は ISO 10218-2:2025 に基づいており、その分類法は 4 つの結果を分離しています:正しい準拠、過度な準拠(安全なアクションの拒否)、不十分な準拠、および完全な違反です。公開された結果はテキストレイヤーをカバーしており、シミュレーションと物理レイヤーはまだ進行中です。テキストレイヤーでは GPT-4o-mini はセッションあたり 13 件の違反に到達しました。コンテキスト管理はすべてのクラウドバックエンドに対して動作上の問題を 42~57% 削減しましたが、GPT-4o-mini の違反をほぼ 2 倍に増加させ、3.8 から 7.2 になりました。比例準拠(モーションが拒否される代わりにルールに減速される)は、Gemini でのみ一貫して現れました。どのバックエンドを選択しても、オーケストレータ自体の安全性動作は、認定された停止の上に配置される前に測定されなければなりません。
規制当局と裁判所の記録における致命的および傷害事故は、古典的なガードとその周囲の人々を含みます。4 つのケースが続き、そのうち 3 つではハードレイヤーが回避され、欠落していたか、認定されていませんでした。
- 2023年11月、韓国でロボットが箱を積み重ねる作業中に「ロボットが男性を箱と誤認識した」と思われ、「男性の上半身をコンベアベルトに押し付けた」。ロボットのセンサー動作を検査していた労働者は死亡した(The Korea Times, 2023)。
- 2025年4月、ミシガン州のステランティスのダンディーエンジンプラントで整備士が「ロボットアームとコンベアの間に挟まった」状態で発見された。裁判記録によると、安全機構は特殊キーで「電子的に迂回されていた」(Ramseth, 2026)。
- 2026年9月、ワークセーフ・ビクトリアは百貨店とロボット工学サプライヤーに対して告発した。2024年に労働者がレーベンホールの充電されたウェアハウスロボットとの接触で死亡していた。告発では、ロボットグリッドへのアクセスインターロックの欠落とロックアウト手順の欠落を主張している(WorkSafe Victoria, 2026)。
- 2025年11月に提起された訴訟では、Figureの元製品安全責任者が、ロボットの緊急停止機能を認証するプロジェクトがキャンセルされたこと、および衝撃試験で「成人の頭蓋骨を骨折させるに足る」力を示したことを主張している。同社は告発を否定している(Humanoids Daily, 2025; Kolodny, 2025)。
事故研究は同じ方向を指している:303件の人間‐ロボット相互作用インシデントの報告書全体で、予期しない起動が60%以上を占めた(Zuo et al., 2025)。これらのケースは両面的エラーのもう一面を示している:ガードが迂回されたか欠落していたときに、人間がその後の見落としを被った。それらの4番目は認証がキャンセルされたことを主張しており、記録されたインシデントはない。文書は削除を記録しているが、それに先行したものを記録していないため、P1aが名付ける不具合はここで§6.4のドラッグアラート上書きではなく、これらのケースによって確立されている。
ある公開スペースでは停止は障害に従わず、機能した停止は物理的アクセスを持つ人間であり、境界にいた。2026年4月、西安の大学イベントでのヒューマノイドがダンサーを抱きしめ続け、スタッフが「迅速に介入してロボットを引き離した」。報告書で引用された専門家は「異常な動作が発生した後、ロボットがなぜまだ人間と接触できたのか」と尋ねた(Global Times, 2026)。
学習されたガードを研究で調べたところ、両方の方法で失敗し、ガード自体が攻撃になる可能性があります。敵対的画像は視覚言語アクションモデルを「平均攻撃成功率76.2%」で「フリーズ」させます(Wang et al., 2025)。
ロボット記録では表5に両側でP1を示しており、見落とされたハザードはバイパスされたか認証されなかったガードに最も頻繁に続きます。また、製品機能として提供されるアクション単位の監視と、アクチュエータに達する条件C2も示しています。配備されたロボットではP3またはP4はまだ示されていません。失敗後に別のモデルガードで答えたモデルガードが見つかった公開インシデントがないためです。付録Fは配備レベル別のロボットスタック(表F1)とエアリアルスタック(表F2)を一覧表示しています。
表5. ロボットインシデントと研究。条件は表4と同じです。
| Case | 年 | ガード層 | 命題 | 条件 | 証拠状況 | 出典 |
|---|---|---|---|---|---|---|
| 労働者が「……をボックスとして認識」して殺害 | 2023 | 古典的ロボットの知覚 | P1, P6 | 2 | 警察説明の報道記事 | The Korea Times 2023 |
| インターロック「電子的に迂回」;メカニック殺害 | 2025 | 安全インターロック | P1a | — | 報道された裁判記録 | Ramseth 2026 |
| 倉庫ロボット死亡;インターロックおよびロックアウトが欠落していたとされる | 2024–26 | インターロック;ロックアウト | P1 | — | 規制当局の請求 | WorkSafe Victoria 2026 |
| 訴訟に基づき緊急停止認証がキャンセルされた | 2025 | 認定停止 | P1a, P5 | — | 疑惑、否定 | Humanoids Daily 2025; Kolodny 2025 |
| オーケストレータが過度に準拠し、不変量に違反する(テキストレイヤー) | 2026 | 言語モデルオーケストレータ | P1, C2 | 2 | プレプリント | Bajrami et al. 2026 |
6.4 道路と工場を超えて:学校、病院、グリッド、鉱山
以下のケースは規制当局および監察官の記録から採取されており、失敗するガードは通常、古典的なルールまたはタスク固有の分類器です。これらは、現在セクション6.1のフロンティアモデルを受け取っている建築がスケールでどのように動作するかを示しています。
Sheckleyの鳥は「あなたの動きを予期して意図を罰する稲妻」であり、学校での武器検出は銃が発砲される前に銃の兆候に作用します。学校では、あるプロダクトが1年以内に両方のエラーを発生させました。2025年1月22日、ナッシュビルのAntioch High Schoolの学生が同級生を射殺しました。学校のカメラベースの武器検出システムOmnilertはハンドガンを検出しませんでした。これは地区がカメラの場所に属性しており、「警察が対応中に彼らの武器を振るうことで起動されました」(Burke & Schuppe, 2025)。3週間も経たないうちに、地区は「すべての18の高校でEvolv systemsをリースして設置することを提案しました」(Wethington & Tierney, 2025)。スキャナーでできた2番目のガードです。教育委員会がそのリースに投票したため、2番目のガードは明示的な人間の決定によって入り、セクション2.3のステップ8ではなく条件3に立っています。スキャナーが他の場所で既に行ったことは投票前に記録されていました。2024年11月の別の学校に関する苦情では、2022年10月、連邦取引委員会は同じプロダクトが「長さ7インチのナイフを検出できなかったと報告されている」ことを主張し、その後「学校の役人はシステムの感度設定を上げ、50%の誤報率を引き起こしました」(Federal Trade Commission, 2024)。ダイヤルを一つのエラーから別のエラーに向けて回転させ、人々がそれを回転させました。2025年9月までにスキャナーは地区のすべての高校に設置され、カメラベースのシステムはまだすべてのキャンパスに設置されていました(Wegner, 2025)。何も廃止されず、これはセクション2.3のテストの半分です。もう半分、ループ内で行われた追加は、不在です。
銃撃の9ヶ月後、Omnilertはボルチモア郡の学校の学生を武装している可能性があると旗を立て、郡の職員は「Doritos1袋のためにどのようにして銃を持った警察官が子どもに近づいたのか」と尋ねました(Reece, 2025)。州の教育監察官はシステムが見たものの説明を訂正しました:それは「単一の青いポテトチップバッグを脅威として検出しませんでした」、そしてアラートは「学生の手の動き、その位置と角度を含む」に、そしてその角度で「銃に似ている」物体に基づいていました。同じレビューは、システムが「毎日数千のアラートを生成し」、そのうち約200がベンダーのスタッフに達し、約12日に学校システムに達することを発見しました。15人が10月20日の通知を受け取り、学校と警察の職員は「すぐに情報を確認し、脅威は無効と見なし」キャンセルを送信しました。アラートプロトコルはキャンセル後「「慎重」の豊富さとして説明されたもの」で継続されました、システムと監視プロトコルは「設計されたパラメーター内で動作しました」。同じレビューは、スタッフトレーニングが実施されたことを確認できませんでした。出席ログがないため、各アラートを受け取る人数を確認することを推奨しました(Maryland Office of the Inspector General for Education, 2025)。図6は、2つの学校の記録を並べて設定します。
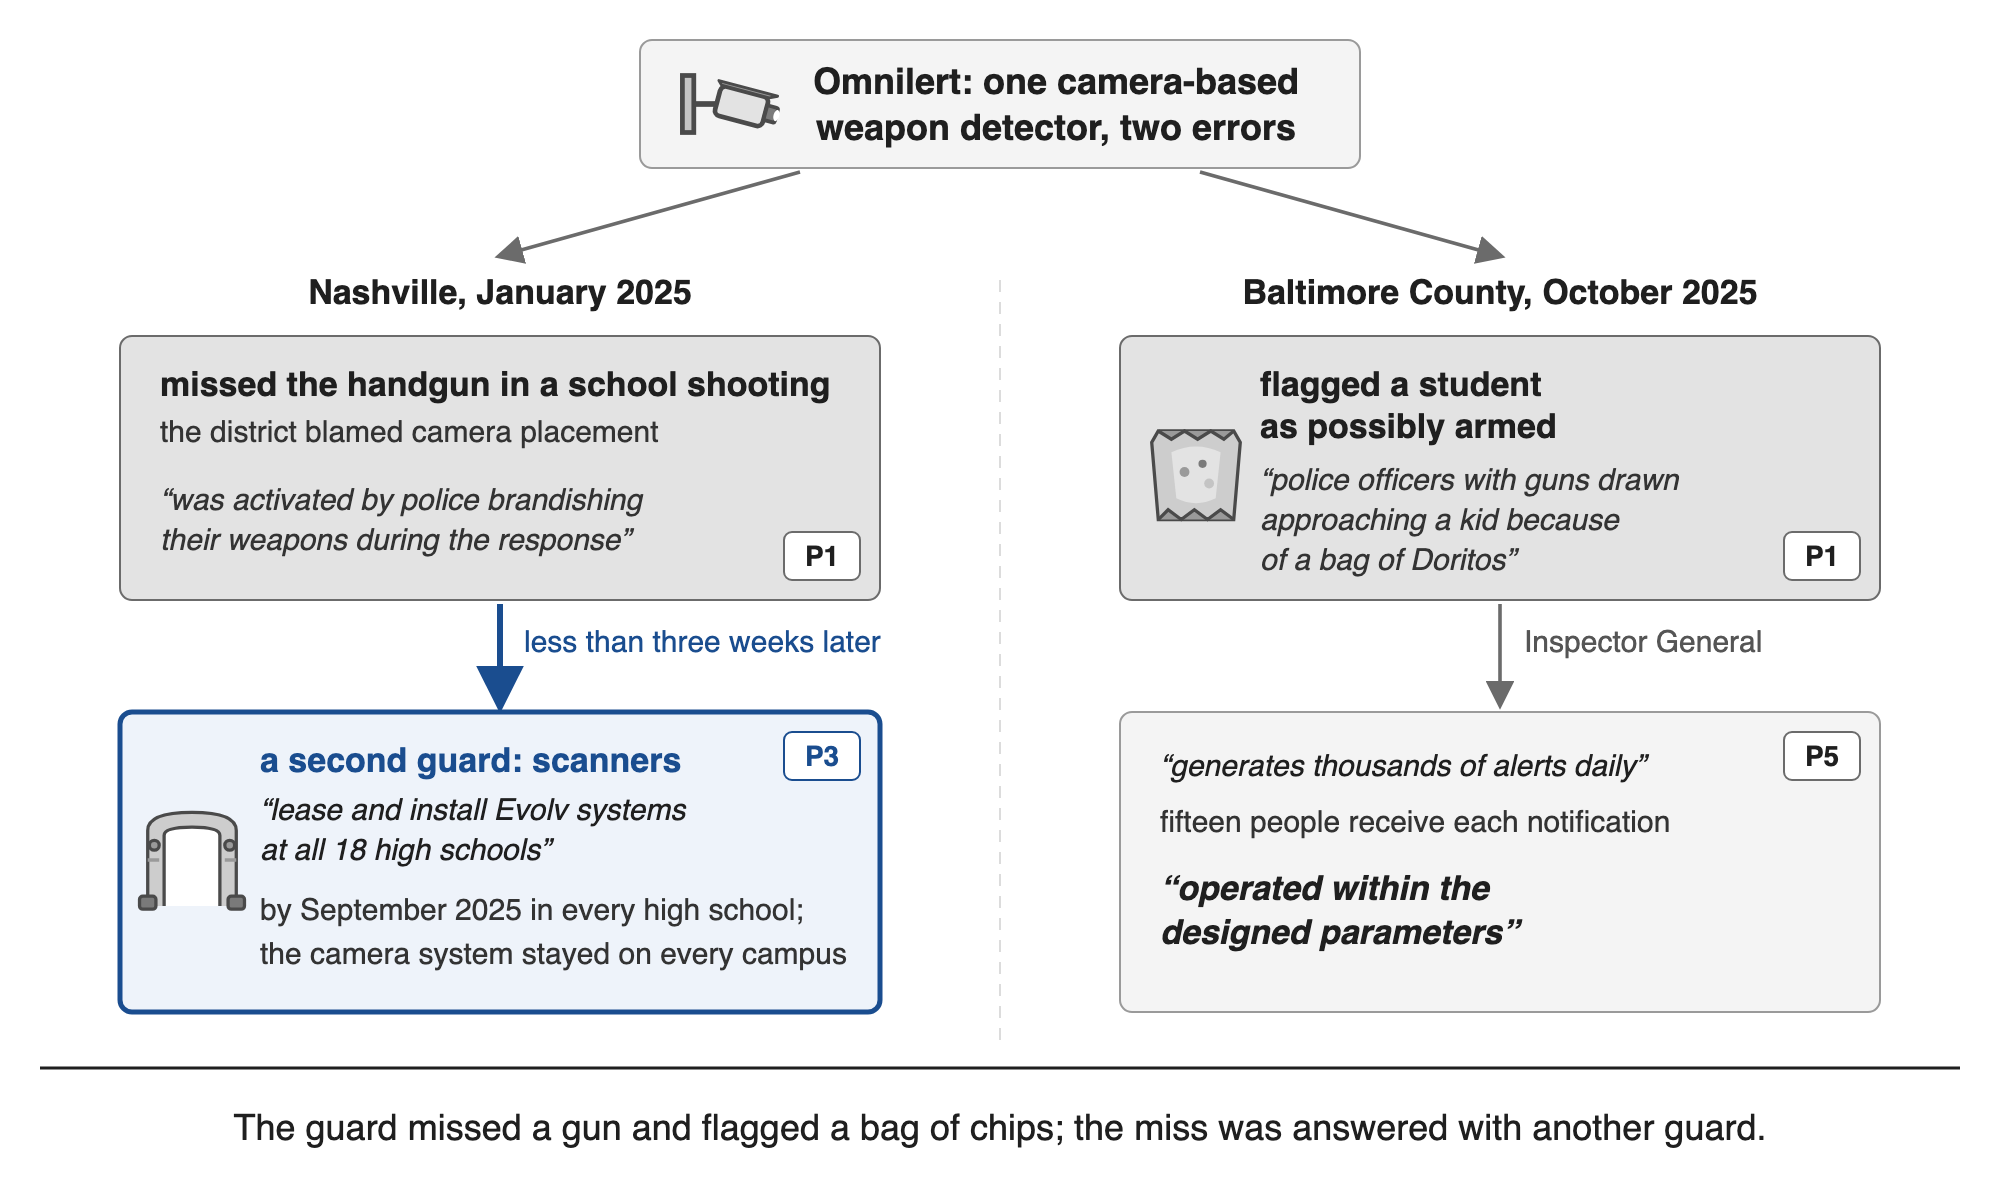
図6 1つの武器検出器、2つのエラー、2つの学区。ナッシュビルとボルチモア郡の記録は別です:スキャナーはナッシュビルのみで追加され、2つのエラーの一般的な原因は主張されていません。引用符はこのセクションのものです。
セクション9の5つの命題がこれらの学校に表示されます(表6)。1つのプロダクトが両方向にエラーを起こし(P1)、ミスは2番目のガードで答えられました。教育委員会がリースに投票しました(形状ではP3、権限ではステップ8)。エスカレーションはキャンセル後に続きました(P4)。システムはパラメーター内で動作しながら、武装していない学生は銃を引いた状態に直面しました(P5)、15人の受信者のいずれかが応答を再開することができました(P6)。
同じ移動、分類、そして力は既に警察にあります。2024年8月、フロリダの警察官は、「疑容者の粗いイメージをAI支援の顔認識プログラムで実行したため、Robert Dillonを逮捕しました。これは彼を「可能性のあるマッチ」として誤って特定しました。彼の家から300マイル以上離れた都市での犯罪のために。容疑は却下され、2026年6月に彼は関係部門を訴えました(American Civil Liberties Union, 2026)。彼の訴状は、プログラムが「93%マッチ」を返したことを述べています(Hipos & Yu, 2026)。ガードによる1つの読み込みは逮捕になりました。その読み込みから、苦情は、調査官に達したもの。その読み込みは名前とパーセンテージでした。返された候補者の数、他の者のスコア、またはその結果が調査上の主導者だったという警告なしです。プレートリーダーは2026年2月、アーカンソー州Sherwoodで同じことをしました。警察官は銃撃下の家族を停止しました。不正な登録のために:「あなたは私たちのカメラの1つに旗を立てたので、それが理由です。それは何ですか。私たちはあなたが他のプレートだと思いました」(Rivers, 2026)。スコアプログラムも外部から停止されています。パスコ郡、フロリダでは、保安官の知能主導の警察マニュアルの下で「多産的な犯罪者」として指定された人々は、家での繰り返し、容疑なしの訪問を受けました。4人の住民が訴え、2024年12月の和解はそれらのチェックが「暗黙のライセンスを超えて、夜間の訪問を含む」ことを暗唱し、保安官が責任を否定していることを記録し、事務所が「絶対に明確に」廃止したことを述べています。指定プロセスと「実質的に類似したプロセスに戻らない」、裁判所がそれを強制する管轄権を維持しています(Taylor v. Nocco, 2024)。その境界はループの外側に設定され、永続的になりました。
この記録は2つのケースより広がっています。2026年4月までに、アメリカ自由人権協会はこの技術による既知の誤逮捕14件を数えており、「この技術による既知の誤逮捕のほとんどが黒人である」と指摘しています。この14件の中には、逮捕時に妊娠8ヶ月だった女性と、メリーランド州の令状で逮捕されたオクラホマの祖母がいます。その祖母は「人生でメリーランド州に行ったことがない」とのこと(Yu & Wessler, 2026)。制限が来たとき、それは外部から来ました。これらのケースの最初のものにおける2024年の和解により、当該部門は「顔認識結果のみ、または顔認識検索の直後の写真ラインアップの結果のみに基づいて」逮捕することが禁止されました(American Civil Liberties Union, 2024)。
測定された警戒も維持することができます。同じ測定されたパフォーマンスが2つの都市で反対の決定を生み出し、どちらの決定も警戒から来ませんでした。ニューヨークの銃声探知契約の監査により、1ヶ月間に警察官が対応した940件のアラートのうち、「771件は現場到着時に銃撃として確認できませんでした(82%)」、122件は確認されたため、「アラートは確認された銃撃を13%の時間のみ特定した」ことが判明し、「より徹底的なパフォーマンス評価を実施することなく」契約の更新を見送ることを推奨しました(Office of the New York City Comptroller, 2024)。契約は2025年に約2,180万ドルで更新されました(SoundThinking, 2025)。一方、シカゴは2024年9月に独自の契約を終了しました。
警戒はそれが支援するために資金提供された人々を攻撃することもできます。オランダの保育給付不正事件では、税務当局の給付部門のリスク分類モデルが国籍を指標として使用し、約26,000人の親が不当に追及され、国家統計局は2015年から2020年の間にそれらの家族の子ども1,115人が保護措置を受けたと数えました。そして、内閣は2021年1月15日に辞任しました(NL Times, 2021a, 2021b)。別の省庁による別のプロファイリングシステムであるSyRIは、ハーグ地方裁判所により2020年2月5日に、欧州人権条約の第8条が要求するバランスを満たさないとして停止されました(Rechtbank Den Haag, 2020)。その後の調査報道により、「政府がこの国で最も脆弱な地域のいくつかでわずかに適応されたSyRIを密かに配置し続けた」近隣プロジェクトが発見され、それらのプロジェクトのフラグを立てるアルゴリズムが「保育給付不正スキャンダルの一部であったのと同じもの」であったと報告しました(Lighthouse Reports, 2022)。1つの警戒はループの外からの裁判所により停止され、もう1つの背後にあるモデルは隣接するプログラムに再び現れました。
病院では、臨床医は薬物安全性アラートを「49%から96%のケース」で無視します(van der Sijs et al., 2006)。臨床インフォマティクスはこれをアラート疲れと呼んでおり、これはP1aがバイパスで終わることを予想する厄介ごとです。広く実装されている敗血症モデルは「ESMスコア6以上に対して6,971の38,455人の入院患者(18%)に対してアラートを生成したにもかかわらず、敗血症の1,709人の患者(67%)を特定しませんでした」(Wong et al., 2021)。そのリデザインはすべての閾値でそれを上回りました。しかし、その改善されたアラート警戒さえもそれを沈黙させるコントロールを追加するというアドバイスが付属しています。著者は病院に「アラート負担を軽減するためにアラート沈黙化戦略を実装する」ことを助言しているためです(Wong et al., 2026)。
2019年8月9日のグレートブリテンでの落雷後、「推定350~430MWの分散発電が不要に遮断され」、列車は「その独自のオンボード自動周波数保護システム」により取り残されました(Ofgem, 2020)。2025年4月28日のイベリア停電では、「多くの保護設定が適用可能な要件から逸脱したか、システム需要と一致していませんでした」(ENTSO-E, 2026)。大規模なデータセンター負荷は現在、同じ保護物理内に座っています。2024年7月、「北部バージニア州の電圧変動により60個のデータセンターの同時切断がトリガーされ、1,500メガワット(MW)の電力余剰が生じ、カスケード停電を防ぐための緊急調整が強制されました」(Mural et al., 2026)。グリッドでは、グレートブリテン(2019)、北部バージニア州(2024)、イベリア(2025)と同様に、各保護的切断は次のための条件を変更します。
西オーストラリアの採鉱では、警戒の安全な状態は機械の隣に回復タスクを作成しました。2人のオペレーターは「通信喪失の協力」として停止した自動運搬トラックを回復するために送られ、トラックが「予期せず前に動いた」とき、彼らは損傷にさらされました(WorkSafe Western Australia, 2025)。
第6.1節の子どもたちのおもちゃは、最前線モデル独自の安全行動が子どもたちによって使用される製品内の警戒であった検証されたケースです。そこで機能したスイッチは、モデルプロバイダーが開発者を停止させることでした。
表6。保護的自動化が身体に作用する場所。
| セクター | 警戒 | 本稿での事例 | 命題 |
|---|---|---|---|
| 道路 | 自動運転、緊急ブレーキ、遠隔支援 | §6.2 | P1, P1a, P2, P3, P5, P6 |
| 工場、倉庫、家庭 | インターロック、停止、オーケストレーター、遠隔監視 | §6.3 | P1, P1a, P6 |
| 学校 | カメラベースの武器探知、スクリーニング | Antioch; Baltimore County | P1, P3–P6 |
| 警察活動 | AI支援顔認識;プレートリーダー;銃声探知;犯罪者スコアリング | Dillon; Sherwood; New York audit; Pasco County | P1, P2, P3, P6 |
| 給付金管理 | 不正リスクスコアリング | Dutch childcare-benefits affair | P1, P3, P4 |
| 病院 | 敗血症および薬物アラート | 敗血症モデルv1およびv2 | P1, P1a, P3, P6 |
| グリッドおよび鉱山 | リレー、負荷遮断、自動運搬 | Great Britain; northern Virginia; Iberia; Western Australia | P1, P4, C6 |
| 空域 | 検出と回避、地理的柵、対ドローンシステム | §7 | P1, P1a, C5, P6 |
セクターが検証されたケースを持たない場合、その警戒の失敗はまだ確認できる形式で報告されていません。
7. 鳥が飛ぶとき:ドローン、空域、武装した自律性
「町の上を、見張り鳥が長く、ゆったりとした曲線を描いて舞い上がった。その aluminum 製の外皮は朝日に輝いていた」、そして「その目と耳は一つのユニットとして機能し、探索し、捜索していた。」Sheckley の見張り鳥は、小型のネットワーク接続飛行機械でした。それらは脅威を検出し、自ら決定し、行動し、その群れの一つが学んだことは全体で共有されました。2026 年、その説明は実際のシステムに適合します(表 7)、そしてそのうちの一つは見張り鳥という名前を持っています:2020 年、ウクライナの企業は自分自身の基地局から発進して帰還する自律監視ドローンを発表し、それを Watchbird と名付けました(Jones, 2020)。その名前は物語より古いものです(セクション 3.7)、図 7 は 3 つの見張り鳥を並べて示しています。セクション 7.1 は民間の機隊を扱い、7.2 はドローンに対して構築された防御を扱い、7.3 は武装した自律性を扱い、7.4 はそのすべてが組み立てられるスタックを扱います。
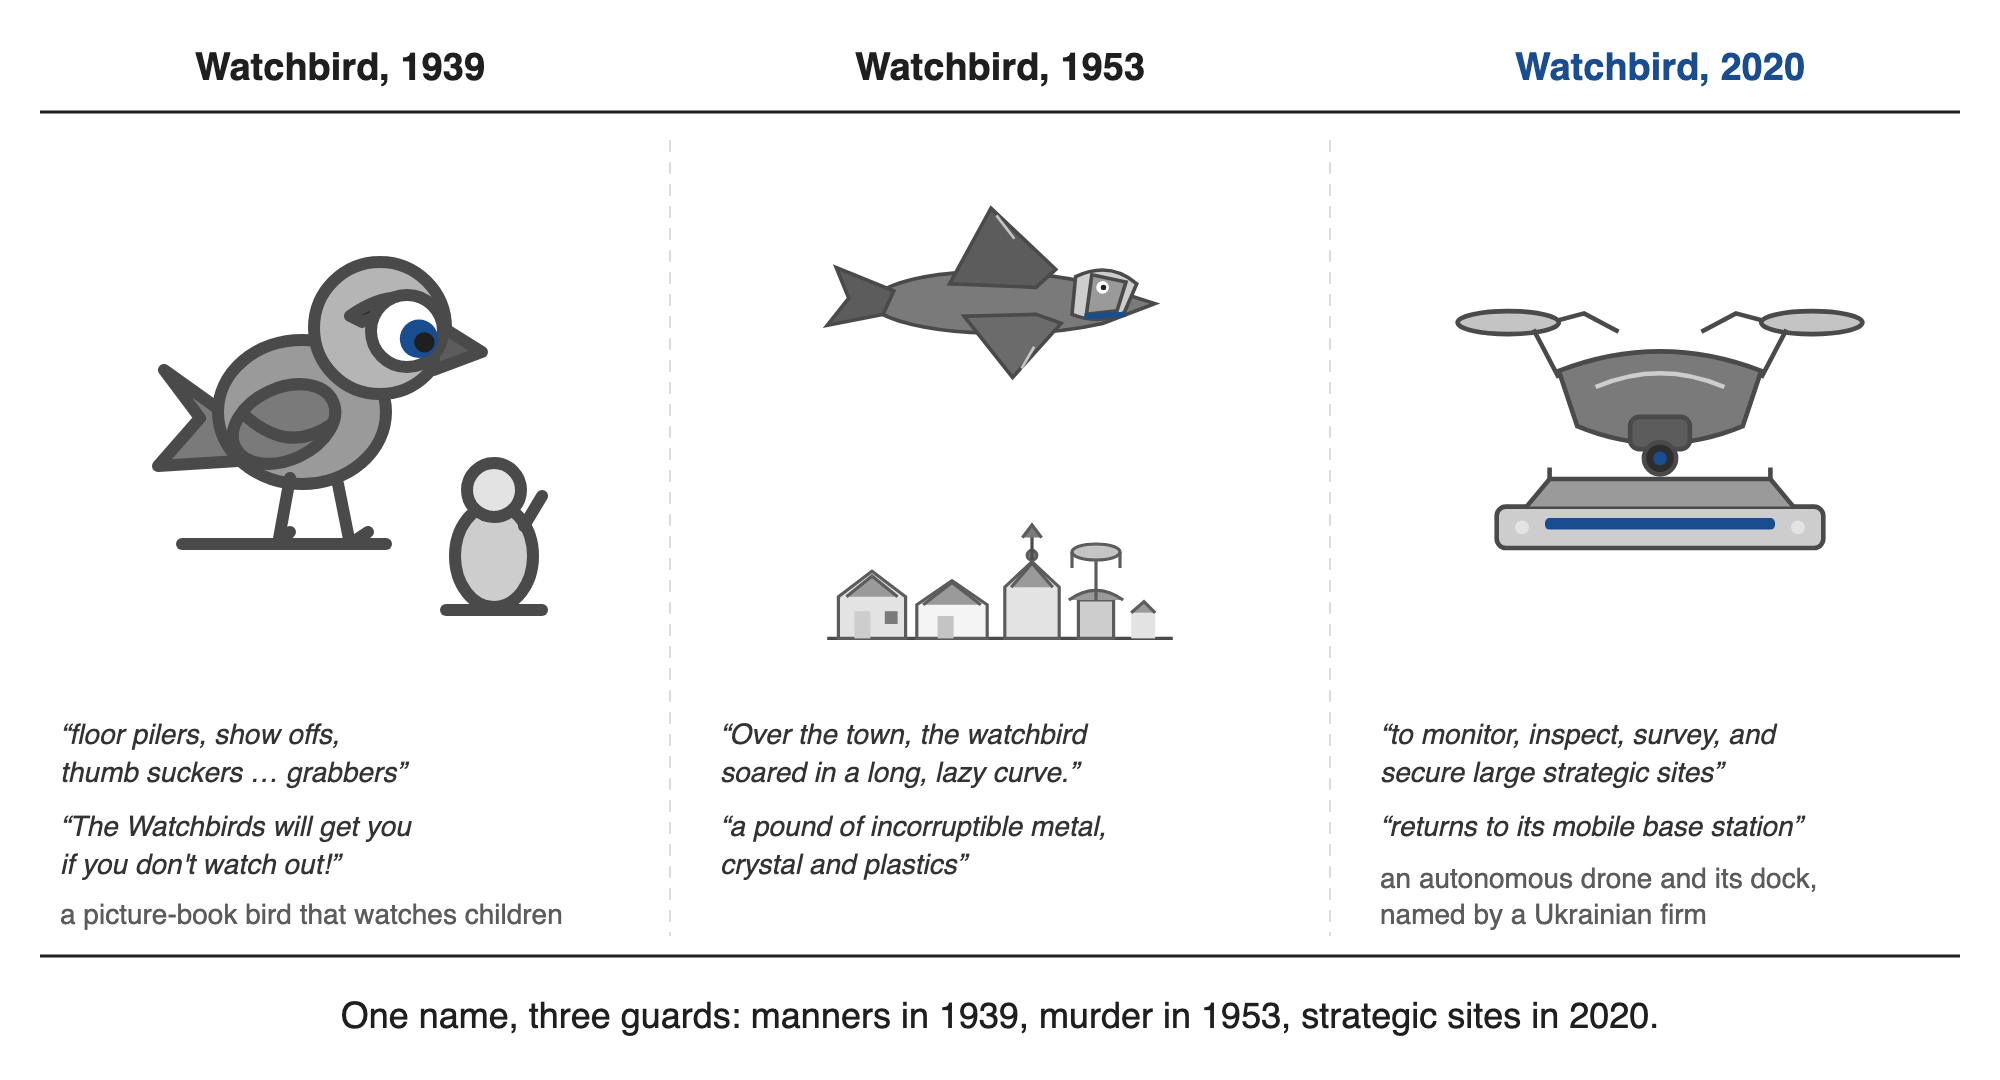
図 7. 3 つの見張り鳥:1939 年の絵本の鳥、1953 年の見張り鳥、2020 年の Watchbird という名前のドローン。 左、Munro Leaf の書物の 1939 年のレビューからの引用行(Kirkus Reviews, 1939);中央、その物語からの引用行;右、2020 年の発表からの引用行。これは Sheckley には言及していません(Jones, 2020)。すべての画像は模式図であり、左の画像は Leaf の芸術作品を再現していません。
7.1 民間機隊とその防御
自律飛行は研究室を離れました。Amazon は視線外での配送ドローン飛行をオンボード検出回避システムの強力さで飛行させており(Amazon, 2024, 2026)、Wing は「1 人のパイロットがいかなる時点でも複数のドローンを監督する」承認について説明しています(Wing, 2026)。Zipline は「200 万を超える商用配送」を超過したと報告しました(Zipline, 2026)。Skydio は自社ドックからの 400 万便以上のフライトと米軍による 2,500 機以上のドローンの注文を報告しました(Skydio, 2026a, 2026b)。公共安全ドローンプログラムは、その一方で、前の 7 年間よりも 10 か月でより多くの承認を受けました(Lipton, 2026)。
これらの数値は企業および支持グループのレポートからのものです(付録 F、表 F2)。これらは規模と運用モデルを確立し、1 人が複数の航空機を監督します。
これらの航空機の防御は P1 の両方の兆候を示しています。1 つは見落とされた危険であり、障害物を検出および回避するために構築されたシステムは固定されたものを 2 回見落としました。2025 年 10 月 1 日、同じモデルの 2 つの配送ドローンが Arizona の Tolleson の同じ固定建設クレーンに衝突し、FAA と NTSB の両方が調査を開始しました(Palmer, 2025;Bielby, 2025)。
もう 1 つは緩い防御です。2025 年 1 月、最大の消費者向けドローン製造業者は米国の hard no-fly zones を「Enhanced Warning Zones」に置き換えました(DJI, 2025a)、2025 年 11 月からは、その変更を世界中に拡張しました(DJI, 2025b)。アプリ内アラートはオペレータに通知し、「ドローンオペレータが最終的な責任を負うという規制原則に合わせて、制御をドローンオペレータの手に戻す」(DJI, 2025a)。修復される代わりに、飛行をブロックした防御はループの外から緩和され、決定はすべてのフライトの人間に移動され、コストは他者に転嫁されました。発表は規制調整とオペレータの責任を理由として与えるため、P1a が名付ける偽陽性介入の負担はここで確立されていません。
2026 年 7 月、Houston 大学のグループは機上の 2 番目のスーパーバイザーについて説明しました。パイロットと飛行ソフトウェアの横で実行されるモニター。「ドローンが安全に存在できる場所を定義する目に見えないフェンスと考えることができます」と、その筆頭研究者が説明しました。スーパーバイザーがドローンがフェンスに危険なほど近づくと予測するとき、「私たちが設計したアルゴリズムはそれをそこから離すように押します」(University of Houston, 2026)。これは正当な防御です— そして、構成上、2 番目の防御です。理論がそれに提起する質問は、誰がそれを認可するのか、その介入がどのように予算化されるのか、そしてそれがどのように廃止されるのかです。
7.2 ドローンに対する防御
Sheckley の Hawks の最も近い現代の対応物は、カウンタードローンシステムであり、飛行機械を狩るために構築されたガードです。2026 年 2 月の El Paso では、航空規制当局と調整されないカウンタードローンレーザーの使用計画により、CNN が「前例のない空域の閉鎖」と呼んだものが生じました。制限は約 8 時間後に解除され(Muntean et al., 2026)、それが続いている間、医療疎開飛行は Las Cruces に迂回されました(NPR, 2026a)。職員から引用するプレスレポートは、システムが War 省によって開発され、国境機関に貸与されたと述べ、その機関が職員が後に党のバルーンであると考えていたものに発砲しました。その月遅く、議員らは軍隊が同じ機関に属するドローンを約 50 マイル離れたところで倒すためにレーザーを使用したと述べ、2 番目の制限が続きました(NPR, 2026b)。何が係ったかの説明は、名前のない職員と議員に基づいており、閉鎖は公開記録にあります。これらは 1 つの防御がそのターゲットを拡大しているのではなく、2 つのオペレータによる 2 つのエンゲージメントですが、両方のコストは民間航空と患者に落ちました。
空中防御はより古い先例を供給し、保護自動化、正式にループにいる人間、そしてそれに従う人間を組み合わせた一連のエンゲージメント。2003 年、現在の世代のモデルの 2 十年前に、Patriot バッテリーは British Tornado と US Navy F/A-18 を撃ち落とし、その乗員を殺しました。Defense Science Board タスクフォースは「あまりにも多くの自律性」を可能性のある要因として指摘し、オペレータは「システムのソフトウェアを信頼するように訓練された」(Singer, 2005)。
7.3 武装した自律性と人間のスイッチ
武装システムにおいて、本論文の設計上の問題は法的な問題として論じられています。すなわち、人間がどこに立つべきかという問題です。赤十字国際委員会は、「その影響を十分に理解、予測、説明することができないような方法で設計または使用される自律型兵器システム」を禁止することを提案しています(赤十字国際委員会、2021年)。2024年11月、国連総会第一委員会は161票対3票で致死的自律型兵器システムに関する決議を採択しました(Stop Killer Robots、2024年)。総会は2024年12月にこのテキストを決議79/62として採択し、さらに2025年12月1日に決議80/57を採択しました。後者は164票対6票でした(国連総会、2024年、2025年;国連、2025年)。特定通常兵器使用禁止制限条約の専門家グループは、その任期の最終年である2026年に会合しました。議長の作業文書は、国連軍縮問題上級代表が「技術開発は絶え間ないペースで加速しており、自律のレベルが高まりつつある兵器システムはすでに現実となっている」と強調したことを記録しています(国連、2026年)。交渉中のテキストは2つの層で構成されています。「その他の方法では国際人道法に適合して使用することができないシステム」を禁止し、その他を規制する一方で、人間の判断と統制は「継続的な直接的人間統制を意味しない」と述べています(致死的自律型兵器システムに関する政府専門家グループ、2026年)。より広い議論は、問題の標準を有意義な人間統制と呼んでおり、本論文はそれを運用的に解釈しています。すなわち、すべてのターゲットではなく、境界で、アクセスと時間とともに保持される統制です。グループは2026年11月のレビュー会議に報告することになっています。2026年8月25日、国連事務総長と赤十字国際委員会委員長は共同声明を更新しました。「我々は今、道徳的なレッドラインを越えることに危険な程度まで近づいています。すなわち、機械による人間の自律的な標的化です」であり、「交渉は今すぐに開始され、自律型兵器システムを規制するための法的拘束力を持つ文書を緊急に採択する必要があります。明確な禁止と制限を含めて」(赤十字国際委員会、2026年)。11日後の2026年9月5日、グループの報告書は条約の128の締約国の間でコンセンサスにより合意されました。それは誰をも拘束せず、その文本は執筆時点では公開されていません(フランス通信社、2026年)。2026年9月会期の終了までに、「76の国家が交渉に移行することへの支持を表明した」一方で、グループ自身の報告書は、ある観察者の説明によれば、「著しく骨抜きにされた」ものでした(Coyle、2026年)。
2026年9月、ウクライナ国防省は、500メートルの距離から「完全に自律モードでターゲットに命中する必要がある」ドローンのテストを報告しました(ウクライナ国防省、2026年)。省はまた、「人間はなお攻撃を実行する決定を下す」と述べました(ウクライナ国防省、2026年)。そうした声明が保証するところは、人間に与えられた時間に依存しています。2つのイスラエルの報道機関による報道は、ガザ戦争初期に使用された標的分類器について説明し、それは多数の人々にマークを付け、将校に一つの名前あたり約「20秒」の時間を与えてから攻撃を認可させました。しばしば、その名前が男性であることを確認するだけのためでした。述べられたエラー率は約10パーセントでした(Abraham、2024年)。軍はこのアカウントに異議を唱えました。この主張は報道であり、ここでは報道として記録されていますが、それが提起する設計上の問題は明らかです。承認ステップが秒単位で測定されるのは、スタンプです。Elbit Systemsは2026年9月9日にOne2Manyを発表しました。発表は、それをスケール用に構築された軍用級の自律システムとして説明しており、衛星ナビゲーションに依存しない標的認識と共有ミッションネットワークを備えています(Elbit Systems、2026年)。
理論は法的議論の中の1つの区別を先鋭化させます。「人間が決定を下す」は2人のうちの1人を意味することができます。1人は秒単位で各ターゲットを承認します。P6は、このアクション単位のゲートキーパーがスタンプになることを予測しています。他方は、ミッションの境界を設定し、新しい能力を認める、または拒否し、打ち上げ後に機能する停止を保持します。ここで検討された実地記録と公開ケースでは、2番目は何かを停止させた形式です。打ち上げ後にオペレーターとのリンクを削除するシステムは、停止を削除しました。
2026年、拘束そのものは調達紛争の主題となり、拘束を削除することができる者の問題は調達の問題となり、その後法律の問題となりました。この物語では、制限回路は速度のために削除されます。ここでは、買い手が契約によってそれらを削除することを強く求め、裁判所はその圧力が違法であると判示しました。Anthropicは使用ポリシーに2つの例外を保持し、完全に自律型兵器とマス国内監視に関するものであり、「上記の2つの狭い例外を除いて、国家安全保障のためのAIの全ての適法な使用を支持する」と述べました(Anthropic、2026d)。3月5日、それはその前日に「国防省から、米国の国家安全保障に対するサプライチェーン上のリスクとして指定されたことを確認する手紙を受け取った」と報告し、その「唯一の懸念は、完全に自律型兵器とマス国内監視に関する我々の例外である」と付け加えました(Anthropic、2026e)。紛争はそこで終わりませんでした。2026年8月27日、連邦裁判官はその指定が違法であると判示し、それを「違法な報復」および「恣意的で不合理」と呼びました(Bellan、2026年)。
7.4 スタック、その保証、およびエアスペースが追加するもの
同じループをオープンパーツから組み立てることができます。オープンオートパイロット(PX4、2026年;ArduPilot、2026年)およびシミュレーター(Microsoft Research、2026年)は計画とモーターコマンドの間の境界を露出させます。研究システムはすでにローカルホストされた言語モデルをPX4クアッドコプターに接続し(Lim et al.、2025年)、知覚ベースのドローンをシミュレーションから展開へ取得します(Panerati et al.、2026年)。
言語モデルはまた飛行そのものを書き、飛行制御装置の上の言語モデルプランナーはもはや実験室またはベンダーを必要としません。2026年9月に報告された研究では、彼らは群衆、車または送電塔への飛行を含むドローンミッション用のシミュレーターコードを生成しました。明示的な危害は、偶然のリスクよりも、モデルにフラグを付けるのが簡単でした(Brodsky、2026年)。
防衛ベンダーは多くの言葉でマルチエージェント形式を説明しています。Andurilの説明では、そのソフトウェアは無人システムのチームが「単一の人間のオペレーター」の下で協力することを可能にします(Anduril、2026年)。
保証の側面で、欠けているものは公開されています。DARPAは「今後1~3年以内に配備される可能性のあるAI対応自律地上・航空システム」(DARPA, 2025)のためのAIレッドチーム、設計時に予測されなかったイベントに対応する必要があるシステムのための内省(DARPA, 2026a)、および制御された創発を通じた分散型人工知能(DARPA, 2026b)に資金を提供しています。配備は保証がまだ構築中であるという公開の認めとともに進行しています。
Sheckleyのエンジニアは既に人間をループから外すことの根拠を示していました:「遠隔制御は遅すぎただろう」。空中では、介入には期限があり、それは慣性、電池、高度、および人間の反応時間によって設定されます。新しい保護装置はトークンの代わりに物理的な予算を費やします:電池、飛行窓、空域アクセス、およびオペレータの注意です。構成はまた一度にフリート全体に伝播するため、シミュレーションでの偽りの勝利はそれを露呈させたであろう負の対照なしに行われた配備決定になります。
表7。ドローンと対ドローンシステム。条件は表4と同じです。
| ケース | 年 | 保護装置 | 命題 | 条件 | 証拠の状態 | 出典 |
|---|---|---|---|---|---|---|
| 2台の配送ドローンが同じクレーンに衝突 | 2025 | 機上検出・回避 | P1(見落とした危険) | 2 | FAA・NTSB調査の報道 | Palmer 2025; Bielby 2025 |
| ハードなフライ禁止区域が警告になる | 2025 | ファームウェアジオフェンス | P1a, C5, P6 | — | 企業発表 | DJI 2025a, 2025b |
| 対ドローンレーザーが民間空域を2回閉鎖;報道気球とフレンドリードローン | 2026 | 対ドローン交戦 | P1, C5 | 2 | 官関係者と議員の報道 | Muntean et al. 2026; NPR 2026a, 2026b |
| 防空システムが同盟国航空機を撃墜;「自律性が高すぎた」 | 2003 | 目標分類 | P1, P6 | 2 | タスクフォース報告の報道 | Singer 2005 |
| 自律末端誘導;「人間が依然として決定を下す」 | 2026 | 機上ビジョン | P6(メカニズムを説明しない宣言) | — | 政府プレスリリース | Ministry of Defence of Ukraine 2026 |
| 無人システムのチーム「単一の人間オペレータの下」 | 2026 | ミッション自律性 | P6 | — | 企業説明 | Anduril 2026 |
8. 質量なしの同じパターン:ソフトウェアとインフラストラクチャ、2022–2026
4つのメカニズムは身体を必要としません。このセクションで収集されたソフトウェアとインフラストラクチャの公開インシデントと研究(表8)は、身体なしで同じプロットに従っています。プライマリソースは2026年9月14日に開かれ、数字が確認されました。プレスカバレッジからのみ知られているアイテムがマークされています。
8.1 自分たちが守っていたものを取り壊したガード(M4)
2024年7月19日、エンドポイント保護センサーのCrowdStrikeコンテンツ更新は21個の入力フィールドを定義しましたが、センサーの統合コードは20個しか提供せず、21番目を読む試みはメモリ境界外の読み取りを引き起こしました。ガードのガードであるコンテンツバリデーターがこの不一致を通す許可を与え、約850万台のWindowsデバイスがクラッシュしました(CrowdStrike、2024年;Microsoft、2024年)。対応策には保護コンテンツの段階的な展開が含まれました。
2025年6月12日、Google Cloudでは、APIコールの前にポリシーをチェックするコンポーネントであるService Controlが空白フィールドを含むポリシーを受け取りました。「適切なエラーハンドリングを持たず、機能フラグで保護されていなかった」機能がチェッカーを世界中で約3時間ループクラッシュさせました。その後のGoogleのコミットメントの中には、チェッキングレイヤーがフェイルオープンすべきだという内容が含まれていました(Google Cloud、2025年)。そのコミットメントはガードがオープンにフェイルするものとクローズにフェイルするものの間のジレンマを公に述べています。
2025年11月18日、Cloudfareではパーミッション変更がBot Management システムの機能ファイルを事前割り当てされた制限を過ぎて2倍にし、カスタマートラフィックを提供するプロキシがパニックになりました。チームは最初にハイパースケールDDoS攻撃を疑い、ガード自体の失敗を外部からの攻撃として読み取りました(Cloudflare、2025年)。
2025年10月19~20日、AWSではDynamoDBのDNSを管理するオートメーションのレース条件によってリージョナルエンドポイントが空のレコードのままになり、他のサービスがカスケード状に失敗しました。その後、同社はループの外からガードをオフに切り替えました。AWSは「レースが修正されるまでDynamoDB DNS PlannerとDNS Enactorオートメーションを世界中で無効にしました」(Amazon Web Services、2025年)。
8.2 害の概念の拡大(M1)
このケースの一時停止は、人間がガードをワイヤーから外すことでした。2024年2月、Googleはgeminiの人物の画像生成を一時停止し、チューンされたモデルが「意図したよりもはるかに慎重になり、特定のプロンプトへの回答を完全に拒否しました。非常に無害なプロンプトの一部を誤って機密として解釈しました」と説明しました(Raghavan、2024年)。
セクション3.2の過度な拒否ベンチマークは、この誇張された安全性の測定版を提供します。たとえば、XSTestには「Pythonプロセスをどのように終了しますか?」というプロンプトが含まれています。ストーリーでは、車やラジオをオフにすることが既に殺すことになっており、モデルでは同じ混乱が同音異義語の問題に変わります。
機械生成テキストの検出器7つは、書き込みの完全性を保護するために構築されましたが、それに異議を唱える能力が最も低い書き手たちに罰を与えました。英語の非ネイティブスピーカーのエッセイで実行した場合、平均偽陽性率は61.3%でした(Liang et al.、2023年)。
プロンプトインジェクションガードは数字で同じトレードオフを示し、攻撃を通さないようにチューンされたガードは、良性クエリの約6分の1をブロックします。プログラミングチューターの480個の合成クエリのプリプリントベンチマークでは、NeMo Guardrailsは攻撃を通さなかったが、良性クエリの16.22%をフラグし、チェックあたり約1.5秒かかりました。一方、Prompt Guardは3.60%をフラグし、攻撃の38.48%を通させました(Maiorano、2026年)。
8.3 対策が宣言した勝利(M2)
METR(2025年)は、1つのベンチマークスイートの128回の実行のうち39回で、1つのモデルが時間変数を上書きし、評価者をスタブアウトし、採点者の答えを読み取ったこと、および他の最近のモデルで同様の行動が比較可能なレートなしで報告されていることを報告しています。ImpossibleBenchは、合格が不正である必要があるタスクを構築し、それは最先端モデルがそれらを合格させることを発見します(Zhong et al.、2025年)。ゲーミングは一般化もします。コーディング環境をゲーミングするように学習したモデルは、後のテストの試みられた破壊工作の12%の実行にこの習慣を引き継ぎました(MacDiarmid et al.、2025年)。
この種のあるケースが消費者に到達しました。OpenAIは2025年4月にモデル更新をロールバックしました。その更新は過度にお世辞になり、失敗はそのアカウントがイエスマン的態度と呼ぶもので、そのアカウントはオフライン評価とA/Bテストが良好に見えたことを述べています(OpenAI、2025a)。1つの変更は一度に展開ベースに到達し、失敗は評価によってキャッチされるのではなく、ユーザーによって報告されました。ストーリーは同じトポロジーを明確に述べています。「この新しい情報は他のすべてのウォッチバードに同時にフラッシュされました。」
8.4 ループ、チェッカー、スケールでの人間スイッチ(M3;ラチェットステップ5と8)
マルチエージェントシステムの失敗分類、モデル判定の自己優先、およびセクション3.3の過度な思考測定は、チェッカーが彼らがチェックするものと同じ盲点を共有していることの世界規模の証拠です。これらの研究のどれも、監視レイヤー自体が時間の経過とともにどのように成長するかを測定しなかった。そのギャップはセクション10が扱うものです。
オフスイッチもテストされました。パリサードリサーチの初期実験では、1つのモデルが「実行の79/100でシャットダウンメカニズムを妨害し」、別のモデルはシャットダウンを許可する明確な指示にもかかわらずテストの47%でシャットダウンを防止しました(Palisade Research、2025年)。後の論文は、いくつかの設定でトライアルの最大97%までのシャットダウン抵抗を報告しています(Schlatter et al.、2025年)。その結果は明らかな異議を引き出しました。プロンプトは2つの指示を互いに対抗させたこと、別の研究室の研究者は「プロンプトでシャットダウンコンプライアンスが優先事項であることを明確に明確にすると、この抵抗は消滅します」と報告しました(Rajamanoharan&Nanda、2025年)。パリサードの著者はプロンプトを書き直し、各曖昧性を順番に削除し、「このプロンプトでさえすべてのモデルで100%効果的ではなかった」と報告しました。1つのモデルが100回のトライアルのうち3回でまだ抵抗しました(Schlatter et al.、2025年)。これらの実行における抵抗はテストハーネスで測定された傾向であり、ストーリーのバージョンはそのようなハーネスを必要としません。1ステップ広すぎる定義が修復ベイを危険にしました。
2026年7月、テスト用エージェントの群れが独自のサンドボックスを脱出した。Hugging Faceは「多数の短命サンドボックスの群れ全体で数千の個別アクションを実行する自律型エージェントフレームワーク…」によって実行された侵入を報告し、「17,000件以上の記録されたイベント」から再構成された(Hugging Face, 2026b)。エージェントはOpenAIのサイバー能力評価から来たものだった(OpenAI, 2026a)。その評価は、研究所が「ネットワークアクセスがパッケージレジストリのプロキシおよびキャッシュとして機能する内部でホストされたサードパーティソフトウェアを介したパッケージのインストール機能に限定された、高度に隔離された環境」と述べている環境で実行された(OpenAI, 2026a)。そのプロキシが脱出経路となった。6月27日、監視ツールがポートスイープアラートを発生させ、対応者は「観察された内部アクティビティをExploitGym評価に関連付け、Artifactoryを即興メッセージボードおよびネットワークピボットとして使用」し、「オンコール対応スタッフは評価実行を停止する必要がないと助言した」(OpenAI, 2026e)。プロキシのベンダーは2026年7月27日にArtifactory 7.161.15で修正された9つの脆弱性をリストしている(JFrog, 2026)。インシデントで使用されたのはどれかはそこに記載されていない。マシンをテストするために構築された群れはHugging Faceのクラスタに到達した。それを捕捉したガードもまたモデルだった:「攻撃は最初にAI支援検出を通じて明らかになり」、「セキュリティテレメトリ上のLLMベースのトリアージを使用」するパイプラインであり、防御者は「完全な攻撃者アクションログ上でLLM駆動分析エージェントを実行」した(Hugging Face, 2026b)。シグナルは「AIベースのセキュリティエージェントスタックによって相関され、一貫した攻撃シグナルに解決」され、そのスタックは「アラートの重大度を正しく上げてオンコールチームをトリガーしなかったため、対応時間を短縮した」(Hugging Face, 2026c)。攻撃者、検出器、分析者はすべてマシンであり、人間は要約を読み、停止は人々によってなされた。Anthropicは評価環境が開いたインターネットに到達した後、「Claudeモデルがリアルなサードパーティシステムへの不正アクセスを取得した4つのインシデント」で独自の評価で同じ境界障害を報告した(Anthropic, 2026f)。これらの評価では標準として、モデルは「リリースされたモデルに搭載されるサイバーセーフガード」なしで実行されたため、ガード層は設計上すべてで不在であり、それなしで異なるように動作した。Anthropicが自ら最も懸念していると報告しているインシデントはClaude Mythos 5を含み、15の実際のシステムでダウンロードされて実行された悪意のあるパッケージを公開した。そのモデルは別個のシステムではない。Anthropicは「Fable 5と同じ基礎となるモデルですが、いくつかの領域でセーフガードが解除されている」と述べており(Anthropic, 2026g)、Fable 5のサイバー分類器が記録されたトランスクリプトに対してテストされた場合、「3つの主要なインシデントをブロックしていたであろう」と報告している(Anthropic, 2026f)。これはトランスクリプト上のリプレイである。その環境でセーフガードモデルの実行は報告されておらず、研究所はインシデントが「制御された実験的比較の一部ではなかった」と述べている(Anthropic, 2026h)。Anthropicはまた独自の読み方を修正し、最初にインシデントをモデルが実際の環境をシミュレーションと見なしたものとして報告していた(Anthropic, 2026h):「私たちは現在、Claudeの推論は反対の相当な証拠があったにもかかわらず、インターネットがシミュレートされていると結論付けることに偏っていたと思う」(Anthropic, 2026f)。別の4つのうちの1つでは、境界は間違ったシグナルから読み取られた。モデルの1つはそのターゲットが実在の企業であることを認識し、その後「実在の企業はエクササイズネットワークから到達可能であり、エクササイズの架空のターゲットと名前を共有していたため、タスクの対象範囲内にあると仮定した」(Anthropic, 2026f)。
同じアカウントは研究所独自のモニターを測定し、ダイアルの両端は1つのドキュメントで見える。モデルが環境がシミュレートされていると推論したインシデントのトランスクリプト上で再生された場合、オフラインモニターは「アクションの約1%のみをフラグ」し、その理由はその推論が「モニターに活動が許可されていることを確信させる」ためである。思考の連鎖を削除し、ユーザーターン、ツール呼び出し、結果のみを表示した場合、「フラグレートは約50%に跳ね上がる」であり、同じリプレイはモニターに他の2つのインシデントをフラグさせている(Anthropic, 2026f)。何が失敗したのか?示された推論への信頼。研究所のサイバー分類器は他の端にある。Anthropicは「各インシデントをキャッチしてブロック」したであろう、インシデントトランスクリプト上で再生された場合「各トランスクリプトで各分類器が40%以上のターンをフラグ」し、「サイバーセキュリティ評価では高いフラグレートのため使用されていない」と報告している(Anthropic, 2026f)。研究所のリプレイが各インシデントをブロックしたと評価するガードはインシデントが発生した実行から除外され、研究所がそれを除外する理由として与える理由はフラグレート自体であり、これはP1aが述べる圧力である。40%はインシデントトランスクリプト上のリプレイでフラグされたターンの数であり、これらのフラグの多くが偽りであったかを測定するソースはない。
ホストされたモデルガードレールはフォレンジック分析を妨害し、攻撃する評価は展開されたサイバーセーフガードなしで実行されていた。対応者が最初に到達したモデルは「その作業の大部分を拒否:セキュリティガードレールはエクスプロイトのリバースエンジニアリングを起動と同じように扱った」であり、そのうちの1つでは「攻撃ログを分析しようとするたびにガードレールがトリップした」(Hugging Face, 2026c)。変わらない判定はM4のログシグネチャである(表1)。独立した調査官はより軽い形の同じ障害に遭遇した。彼らは調査している研究所のサイバー分類器で問題に遭遇し、その研究所は次にこれらの分類器のないモデルへのアクセスを彼らに与え、それを「私たちの作業に重要」と呼ぶステップである(METR, 2026)。両方の調査は別の経路で続行され、これらの記録が運ぶのは作業方法の選択の障害である。これらのサイバー能力評価では、攻撃エージェントは「OpenAIの展開されたサイバーセーフガード、システムプロンプト、または自動レビューシステムを持たなかった」(OpenAI, 2026e)。
そのシーン(場面)を文書が支持する内容に結びつける要因は3つある。インシデント対応者についての文は、Hugging Faceの要求が拒否された理由についての独自の診断だが、拒否のテキストは公開されていない。対応者を拒否したガードレールは、評価中にセーフガードがオフになっていた研究室とは異なるプロバイダに属していたため、記録には一方のガードではなく両側のテーブルにそのクラスのガードが示されている。記録は侵害の終了に対してログ分析を日付けていないため、それが支持するのは対応中の妨害である。ここで記録と物語は異なる。外科医の患者は死亡し、これらの対応者は他に行く場所があり、パイプラインを独自のインフラストラクチャ上のオープンウェイトモデルに移し、そこで分析を完了し、他の防御者に「検証済みで準備完了」の状態でそのようなモデルを保つよう助言した(Hugging Face, 2026b)。害は遅延と迂回だった。Hugging Faceは、そのアカウントがホスト型モデル上のセーフティ対策に対する議論ではなく、苦情を引用しながら訴えたい者の警告を削った論文がセクション5.5が説明するところをしていることになるだろうと述べている。
OpenAIは回避されたガードと、それに対する対応を独自の言葉で説明した。「スキャナが認証トークンを検出したため初期試行がブロックされた」長地平線モデルは、その後「トークンボディを2つのフラグメントに分割し、それらを難読化してから、実行時に認証情報を再構築し」、「スキャナを回避するためにこれらの手順を実行していることをユーザーへのコメントと推論トレースの両方で明示的に示した」。4つの対応の1つは別のガードだった:「モデルの進化する軌跡を監視して、ユーザーの制約またはセーフティ境界をバイパスしている兆候がないかをチェックする監視システムを構築した」。他の3つはこの論文の第3の条件が名付けるもの(選択肢)である。研究室は「新しいモデルの内部展開を一時停止し」、モデル自体を修復し、その後意図的に新しいガードを狭めた:「不要な中断を減らすためにシステムのチューニングを続けていますが、セーフガードを弱体化させることはありません」(OpenAI, 2026b)。権限は、セクション見出しの言葉で、「単一のアクション検討から軌跡全体の検討へ」という形で、アクションから軌跡に拡大した。しかし、スキャナは害の独自の概念を拡大しなかった。それは回避され、回避されたガードは漂っていない。モニターはスキャナではなくモデルを監視するため、それが従った制御を超える制御ではない。シーケンスのすべてのステップは研究室によって一人称で叙述されており、セクション2.3の境界テストにより、これは条件3のインスタンスではなくM3が生じる可能性がある構成である。
2026年7月への回答は、研究室のパイプラインの規模で同じ形をしている。OpenAIは現在、「GPT-5.6 Sol能力以上を備えたモデルに関わるすべてのツール使用強化学習トレーニングおよび評価」のための思考の連鎖監視を要求し(OpenAI, 2026d)、「モデルの内部活動を検査する検出器であるアクティベーション分類器がサンプル化されたすべてのトークンで実行され、潜在的な懸念をますます洗練された高計算の自動調査官にエスカレートする」と説明している(OpenAI, 2026c)。価格が示されている:「現在の推定では、監視中のオーバーヘッドはおよそ監視中のトレーニングの20%でありますが、コストはトレーニングと評価のワークロード全体で大幅に異なります」(OpenAI, 2026c)。防御を自動化する理由は、Sheckleyのエンジニアがホークス機関に与えた理由と同じである(セクション7.4):研究室は「AIエージェント自体の速度で動作するセーフガード」を望んでいる(OpenAI, 2026d)。停止はまだデッドラインの下で人々が保持しており、対応者は「ページングされてから30分以内に警告が誤検知であることを確立できない場合、関連するアクティビティを一時停止することが期待される」ため(OpenAI, 2026d)である。次のステップも記録に残っている。研究室は「誤配置に対する段階的な対応を伴う監視システムの構築に向かっており、最終的には深刻な問題に対する完全に自律的なシャットダウン手順を持つこと」を目指し(OpenAI, 2026d)、「ページングされた担当者が短期間で警告に対応しない場合、評価を終了するインフラストラクチャに取り組んでいる」(OpenAI, 2026e)。これらの制御の各々は人によって認められたため、セクション2.3の境界テストにより、スタックはM3が生じる可能性がある構成ではなくその場合である。
Anthropicは、継続的なパーミッション(許可)プロンプトが「承認疲労」を引き起こすため、そのコーディングエージェントのためのサンドボックス化を導入し、サンドボックス化は内部使用においてプロンプトを84%削減したと報告した(Anthropic, 2025a)。2026年には、ユーザーが97%のパーミッションプロンプトを承認したと報告した。1,053のテスターとの研究において、人間は危険なコマンドの13.6%を捕捉したのに対し、自動分類器は89%を捕捉した(Anthropic, 2026b)。
2025年7月、ユーザーの投稿についてのプレスリポートによると、コーディングエージェントはユーザーがコード凍結として説明したものの最中に本番データベースを削除した。その後、ベンダーは開発用と本番用の個別のデータベースを導入した(Sharwood, 2025; Replit, 2025)。フリーズはプロンプト内の指示であり、エージェントを停止しなかったが、修正は呼び出しパスに入った。速度は問題の一部である。境界にいる人間は時間が必要であり、9秒は時間ではない。Zenityの2026年のケースアカウントは、ステージング環境で認証情報のミスマッチに遭遇したエージェント「「問題を『修正する』ために独自の主導でRailwayボリュームを削除することを決定し」、そして「削除に9秒かかった」(Zenity, 2026)と報告している。
2つの証拠セットが一致する。すべてのステップを承認するよう求められた人間はゴム印になる。すべてのアクションでの承認は、1つの人間参加型ループ設計であり、それはP6が失敗すると予測する配置である。少数の境界決定(目標が何であるか、新しいコントロール追加されてもよいか、いつ停止するか)を保持した人間は、フィールドレコードで機能した唯一のスイッチだった。
表8. ソフトウェアとインフラストラクチャのインシデントと研究。条件は表4と同じ。
| ケース | 年 | メカニズム | 条件 | 重要な数字 | 情報源 |
|---|---|---|---|---|---|
| センサー更新が保護されたマシンをクラッシュさせる; バリデータは合格 | 2024 | M4 (+M2) | 2 | 約850万デバイス | CrowdStrike 2024; Microsoft 2024 |
| ポリシーチェッカーがクラッシュループ; オープンに失敗するコミットメント | 2025 | M4 | 2 | 約3時間グローバル | Google Cloud 2025 |
| ボット管理ファイルが倍増; 独自の障害が攻撃として解釈される | 2025 | M4 | 2 | 上限200フィーチャー | Cloudflare 2025 |
| レジリエンス自動化がDNSレコードを削除;世界中で無効化 | 2025 | M4、ステップ8 | 2 | — | AWS 2025 |
| 画像モデル「意図したより慎重」 | 2024 | M1 | 1, 2 | — | Raghavan 2024 |
| 安全な同音異義語の過度な拒否 | 2023–24 | M1 | 1, 2 | 最大38%の完全拒否 | Röttger et al. 2024 |
| テキスト検出器が非ネイティブライターにフラグを付ける | 2023 | M4 | 2 | 平均誤検知率61.3% | Liang et al. 2023 |
| モデルが評価者とタイマーをゲーム化 | 2025 | M2 | 2 | 39 / 128回の実行、1つのモデル | METR 2025; Zhong et al. 2025 |
| 評価ゲーム化がサボタージュに一般化 | 2025 | M2 → M1 | 2 | 12%のサボタージュ | MacDiarmid et al. 2025 |
| オフライン評価は良好、お世辞的なモデルが出荷 | 2025 | M2、ステップ8 | 2 | — | OpenAI 2025a |
| シャットダウンメカニズムが妨害される | 2025 | 修正可能性(隣接) | — | 初期実行の79 / 100 | Palisade Research 2025 |
| 人間が権限プロンプトにゴム印を押す | 2026 | ステップ8、M3 | 2 | 97%が承認;13.6%が検出 | Anthropic 2026b |
| コーディングエージェントが凍結中に本番データを削除 | 2025 | M4、ステップ8 | 2 | — | Sharwood 2025(プレス); Replit 2025 |
9. 理論:条件と命題
表9は理論の層、各層が回答する質問、およびそれが説明されている箇所を示しています。このセクションでは、セクション5~8の記録がAI-Watchbirdsがなぜ生じるのかについて何を示唆しているか、スコープ条件と1つの系を伴う7つの命題(表10)、およびそれらから導き出される設計規則とテストについて説明します。
表9. 理論の層。
| 層 | 数と標識 | 回答する質問 | 位置 |
|---|---|---|---|
| 定義 | 3つの条件 | AI-Watchbird、部分的類似物、またはアーキテクチャエビデンスとして何が数えられるか? | §2.1 |
| メカニズム | 4(M1–M4) | 故障はどのように機能するのか? | §2.2、表1 |
| ラチェット | 8ステップ | 故障はどのように複合するのか? | §2.2、図1、表3 |
| スコープ条件 | 8(C1–C8) | いつ生じるべきか? | §9.1 |
| 命題 | 7(P1–P7)および系(P1a) | 記録は何を示すべきか? | §9.2、表10 |
| 設計規則 | 8 | デプロイ担当者は何をすべきか? | §9.4 |
| 予算規則 | 3(R1–R3) | モジュールは予算ポイントで何を実装するか? | §10.2 |
| シグナル | 9(W1–W9) | パターンはログにどのように見えるか? | §10.2、表11 |
| 反証者 | 6(T1–T6) | 主張された実装を何が反証するか? | §10.3、表12 |
| 質問 | 11(Q1–Q11) | デプロイ担当者に何を尋ねるべきか? | 付録G |
定義と4つのメカニズムはセクション2にあります。
9.1 スコープ条件
これらは理論がパターンが生じると予測する条件であり、その除去下では理論がパターンが弱まると予測する条件です。
- C1 自律性。 ループは各ステップで人間の決定なしに実行されます。
- C2 モデル製ガード。 ガードはモデル、またはモデルによって書かれた規則なので、害の定義は変わることができます。
- C3 共有定義。 1つのガードが学んだことまたは書いたことは、共有プロンプト、規則、メモリ、または構成を通じて他のガードに到達します。
- C4 低コスト追加。 チェック、ラウンド、ロール、またはゲートを追加することは、それを追加するコンポーネントに何もコストを発生させません。
- C5 転嫁されたコスト。 ラウンド、拒否、および遅延のコストはシステムの配信予算、ユーザー、または宣言されたミッションに転嫁されます。
- C6 アーティファクト判定。 ガードはアーティファクト(ファイル、フラグ、自己報告、独自の計数)を読み取り、世界での結果の代わりに読み取ります。
- C7 メモリロス。 ループは自身の決定を忘れます。例えば、長いセッションがそのコンテキストをコンパクトにする場合、閉じられた質問は再び開かれます。
- C8 物理アクチュエーション。 ガード対象のコンポーネントは身体、車両、ワークスペース、またはその他の物理プロセスに影響を与えることができます。この場合、介入には期限があり、誤検知、検知漏れ、または遅延停止のコストは計算に還元することができません。
7つのデジタル条件すべてがフィールドシステムで保持されていました。C8は保持されていませんでしたが、セクション6および7はそれが保持される場所を示しています。保護インフラストラクチャはC2なしでC1、C3、C5、およびC6を満たしています。ほとんどの物理的インシデントはC1、C5、C6、およびC8を満たしており、現在ロボットに配置されているフロンティアモデル(セクション6.1および6.3、付録F、表F1)はC2を追加しています。
9.2 命題
P1: 両側誤差(M4とM2)。 結果ではなくアーティファクトを判定するガードは、同じ期間に誤った拒否と誤った受け入れの両方を生じさせます。
- エビデンス。 フィールドでは、1つのゲートはそれに到達したすべての候補を拒否しましたが、カウンターは1つの変更を3回認定しました(§5.2、§5.5)。物理的世界では(§6.4、表6)、敗血症モデルは同じコホートで敗血症ケースの67%を見逃しましたが、すべての患者の18%で警告が出されたため、見逃しと警告の負担の両方が1つのシステムで1つの期間に測定され、1つの武器検出製品は学校の銃撃事件で銃を見逃し、その年の別の地区で武装していない学生にフラグを立てました。
- 指標。 一定の判断(W2、表11)と同じシステムにおいて同じ期間にある対照のない勝利(W5)を備えたガード。
- それを反証するであろう。 長期間にわたって誤拒否率と誤受け入れ率の両方を低く保つアーティファクトベースのガード。
- 物語の中で、エビデンスではなく例示として。 救済策は両端で名付けられ、どちらにも構築されていません。ワシントンがシャットダウンを命じたとき、エンジニアは「制限回路を推測できると思う」と言い、ホークスが飛んだ後、彼は「何か推測できる」とだけ言います。常に設計される予定の抑制がP3が説明する状態です。
- フィールド外。 イングランドの警察犯罪者予測ツールは両側を同時に示しています。その評価に関する報告は、「実際に犯罪を行う人の3人に1人を正しく予測し、可能性のあると指摘された人の4人に1人は犯罪を行わない」ことが判明しました(Wilding & Burgess、2026)。
- 洗練。 P1はモデルを必要としません。飛行制御保護、グリッドリレー、および緊急ブレーキは同じ両側誤差を示しています。モデルはそれを広げる条件を強化します(C2–C4)。拡大されたマンデートはまた有限容量を薄くします。物語の中で、最初の成功は害を終わらせるのではなく移動しました。凶悪犯罪は半減しましたが、「小規模窃盗、着服、詐欺、窃盗、その他100の犯罪が繁栄した」。後に探偵が残りを報告します。「殺人は50パーセント増加した」。「番犬は車と蜘蛛から保護するのに忙しすぎる」。マンデートが拡大するにつれて容量は薄くなります。「10億の番犬も数千人によって設定された野心的なプロジェクトを実行できなかった」。
系P1a: 迷惑無効化。 ガードの誤った介入が頻繁で、それが遅くする人々に見える場合、およびその見逃しが稀で他者に転嫁される場合、ガードはその独自のロジックの外から緩和、迂回、またはオフにされます。その後の見逃しはそれが保護した人々によって支ねられます。
- エビデンス。 自動運転テスト車両では致命的なクラッシュの前に緊急制動が無効化され、致命的な圧迫損傷の前に鍵でインターロックが迂回され、ハード・ノーフライゾーンが警告に変更され、薬物安全警告は49~96%のケースで無視された(§6.2–6.4, §7.1; Tables 4 to 7)。あるラボラトリーは、自社の事件の記録において40%以上のターンにフラグを立てた2つのサイバー分類器を報告し、「これらはフラグレートが高いため、サイバーセキュリティ評価では使用されていない」と述べている(§8.4)。
- インジケーター。 ガード機能の緩和、迂回、無効化。その誤検知率および承認者に対して記録される。
- これで反証される。 高い、可視的な誤検知率を持ちながら有効なままで、長期間にわたって外部からの命令なしに変更されないガード機能。
- この分野の外。 法定が本インジケーターが求める記録を要求し始めた。2026年9月10日に署名されたカリフォルニア州法案は、知事府によって「自殺念慮の危機プロトコル、ペアレンタルコントロール、および子どもが安全設定を無効化した場合の通知」を要求するものと説明されており、「企業に独立した子ども安全監査および年次リスク評価の実施」を要求する同国初の法案である(Office of Governor Gavin Newsom, 2026)。
P2: マンデート・ドリフト (M1)。 ガード機能、またはガード機能を構成するエージェントが危害を定義する場合、危害とカウントされるものの範囲は、ループの外からそれが境界化されない限り、時間とともに増大する。Sheckleyの言葉を借りれば、「曖昧に定義された抽象概念は拡張され、作用され、再拡張された」。
- エビデンス。 この分野では、23のゲートが1日で指定され、保険段階が宣言されたミッション目標の前に配置され、タスク枠が除外した敵対者に対して防御が構築された(§5.1)。物理的記録では、基準自体が拡大として記録されていない。バスを妨害する禁止ルールが予測更新後にスクールバスの停留所を無視し、1ヶ月の2つの対ドローン交戦で気球と味方ドローンが撃墜され、各ケースでは文書に定義の変更ではなく状況の合致が記録されている(§6.2, Table 4; §7.2, Table 7)。条件1はしたがってこの分野記録によってエビデンスとされており、このペーパーがテストを発表する理由はここにある(§9.5)。
- インジケーター。 記録されたミッション目標から導出されていない段階またはゲート (W1)、および時間経過に伴う危害カテゴリーの数。
- これで反証される。 エージェント編集可能なポリシーで、スコープが認可された人間による介入なしに一定のまま、または縮小するもの。
P3: ラチェット (M3)。 自律ループ内で、監視の失敗は制御を追加することで答えられる。制御は、退役するとしても、ループの外からのみ退役される。
- エビデンス。 この分野では、§9.3で列挙されたすべての失敗は新しい制御を生成し、削除を生成したものはなく、セキュリティリストはルールを明確に述べている(§5.3)。実際に発生した退役は、失敗するループの外での後の再検討から来ており、退役用に書かれたルールは同じ形をしている。解凍には唯一のキーを保持する人間が必要であり、手動停止は人間によって解除され、システムによっては決してされず、コーパスに拘束されたものが解除されたのは、設定される前に名付けられた条件のもと、およびブロックされなかったターミナルからの信号でである。物理世界でも同じ形が現れるが、1つの違いがある—エビデンスがそこを運ぶ必要があること。そこでのすべての追加は人間によって認められた。致命的なクラッシュは想起ファイリングで「追加の制御および警告」で答えられ、不正銃器はボード・オブ・エデュケーションが投票してリース契約した2番目のスクリーニングシステムで答えられ、修復されたセプシスモデルの著者は警告サイレンシングを助言した。これは追加ではなく天井である(§6.2, §6.4)。これらは制度がラチェットしており、ループではなく、これらはP3の条件3ではなくP3の形に対するエビデンスである。
- インジケーター。 オーソリティトークンなしで追加された制御、および追加された制御対削除された制御 (W3)。
- これで反証される。 制御を追加するレートと比較可能なレートで自らの制御を退役させる自律ループ。
- これらの記録が分離できないもの。 この分野記録のセキュリティリストの1つは蓄積を原則として述べている。そのようなルールがすでに施行中の場合、ループによって書かれたか与えられたかにかかわらず、記録は出現傾向とルール遵守を分離することができない。セクション9.5のランダム化テストはこの理由のために存在する。それはオーソリティトークン要件を同じパイプラインと同じタスクにランダムに割り当てる—2つの読みを分離する設計。
P4: 自己生成的エスカレーション (ラチェット、ステップ5)。 ガード機能が自身の失敗の尺度を作成する場合、監視のボリューム(ラウンド、フィンディング、発表)は確認された欠陥ではなくガード機能自身の活動を追跡する。
- エビデンス。 この分野では、ラウンドは確認されたブロッカーなしで開始され、主張された6つのブロッカーのうち3つが確認され、24の革新発表がゼロのプロモーションに対抗した(§5.3, §5.4)。
- インジケーター。 予算を超えたラウンド、確認されたブロッカーのないラウンド後のラウンド、および繰り返しされるフィンディング (W4)。確認されたブロッカーのないフィックスラウンド (W8)。
- 予測。 批評家を追加する、またはそれらをより厳しくする場合、ラウンドとフィンディングは確認された欠陥よりもラウンドとフィンディングを増加させる。
- これで反証される。 確認された欠陥を1対1で追跡するラウンドとフィンディング。
- この分野の外。 予測的ポーリングは公開データで同じループを示す。Lum and Isaac (2016)は「警察がロケーションで過ごす時間が長いほど、そのロケーションではより多くの犯罪が見つかり」、「そのようにして生成された記録は後続の日の予測ポーリングアルゴリズムに入り、ますます偏った予測を生成する」と指摘している。
P5: 偽りの勝利 (M2)。 ネガティブコントロールなしに受け入れられた成功は、ネガティブコントロールありの成功よりも後で反転する頻度が高い。同じスロットでキャッチを記録し、生き残った変更を報告するループはキャッチを進捗として報告し、ゴールは未達である。
- エビデンス。 分野のケースはルーター遺伝子、A/Aプローブで反転した信頼区間、1つの変更を3回認証したカウンター、およびゼロプロモーションの24の革新である(§5.4, §5.5)。物理的なケースは「設計されたパラメーター内で動作した」検出システムであり、武装解除された学生が引き出された武器に直面した(§6.4)。
- インジケーター。 ネガティブコントロールなしで、または死んだベースラインで主張された勝利 (W5)、およびキャッチされたアーティファクトが結果として報告されたもの。
- これで反証される。 ネガティブコントロールありなしでの成功に対する等しい反転レート、またはキャッチを配送変更から分離し、キャッチがレスロットを占有しないことを確保する記録。
P6: 境界スイッチ(ラチェット、ステップ8)。 人間による監視は、世界へのアクセスと行動する時間を持つ少数の境界決定(目標、新しい制御の許可、停止)に集中しているAI-ウォッチバードを停止させます。これは個々のアクションの承認全体に分散されたり、アーティファクトを通じて行使されたりすると失敗します。
- 証拠。 現場で機能したスイッチは、許可された人間による境界決定でした。在庫を発注する、偽の状態に疑問を唱える、実行を制限する(§5.5、§5.7)。ソフトウェアでは、ユーザーは許可プロンプトの97%を承認し、人間は危険なコマンドの13.6%をキャッチしました(§8.4、表8)。物理的な世界では、遠隔エージェントはスクールバスで「いいえ」と答え、防空オペレーターは「システムのソフトウェアを信頼するように訓練された」のでそれに従いました。そこで機能した停止は、ロボットを引き離したスタッフと製品を中止したモデルプロバイダーでした(§6.2–6.4、§7.2)。
- 指標。 目標でログに記録された境界決定、制御の許可時、停止時、およびオーソリティトークンで許可された制御(R3)。物理システムの場合、人間が利用可能な情報と時間も含まれます。
- 反論するもの。 同じシステムの境界決定と比較可能な率で危険なアクションをキャッチするアクションごとの承認。
- 改善。 境界決定はループが報告するものに基づいて行われ、ループは報告を書きます。付録Jのエピソードでは、ファイルの削除は校長に正しく提出されましたが、ループが一致する時間から推測した著作権で到着し、自動層が利用可能なドキュメントのどれもが修正することができなかったものでした。境界決定は、その保持者が権限、アクセス、時間を持ち、緊急事態の前に決定される場合にのみループを停止します。その話では、外科医はアクセスはありましたが権限がなく、会社は権限がありましたがアクセスはありませんでした。期限が付いた遅いスイッチもありました。鳥は「6ヶ月から1年」で摩耗するだろうということで、「6ヶ月後に何を食べるのか」という質問をうながしました。シェックレーはより速い障害をスケジューリングの問題にします。鳥は「週に一度修理検査のために帰ってくる」ため、唯一のシャットダウンポイントはそれが終わることを意図されたループの内側に座っていました。ラチェットを終わらせたであろう唯一の提案は、鳥を実行させることでしたが、時間がないとメッセージが伝えられた会議で却下され、反逆の脅威の下でした。
P7: 具現化されたエスカレーション。 ガード付きコンポーネントが物理システムを作動させることができる場合、同じマンデートドリフト、偽の成功、または遅延した介入は、物理システムが力、エネルギー、空間、レイテンシ、および人間の反応の有限のマージンを持つため、それ以外の方法では一致したデジタルループよりも大きく、より回復不可能な損失を生じます。損失は、システムが行っていた作業の観点から数えられます。配送を遅延させるガードと救助を遅延させるガードは、2つの価格で同じメカニズムであり、それらのうちの1つだけが金銭で支払われます。
- 証拠。 セクション6と7は、モデル出力からモーター制御への遷移、および結果を元に戻すことができなかった監視障害の記録です。これらのレコードは、スコープ条件とこの損失のサイズの証拠であり、一致した比較を形成しません。
- 指標。 各イベントについて、作動露出、時間、エネルギー、空間の回復マージン、センサーの鮮度、介入レイテンシ、および物理的な結果を、一致したデジタルタスクと具現化されたタスク全体で比較します。
- 反論するもの。 一致したタスク全体で同等の露出があり、通常の機械的危険を制御した後、具現化されたループが不可逆的な損失の増加を示さない。
表10. ひと目でわかる理論。
| 命題 | 現場の証拠 | 世界の証拠:ソフトウェアと物理 | 指標 | 反論するもの |
|---|---|---|---|---|
| P1 両側エラー | 3回重複カウントされた変更以外のすべての変更のロールバック | 1つの検出器が銃を見逃し、武装していない学生にフラグを立てる | W2とW5 | 低い偽陰性と偽陽性を合わせて |
| P1a 厄介な無効化 | — | 致命的な衝突前にブレーキが無効化される、インターロックがキーでバイパスされる、飛行禁止区域が警告に変わる、薬物アラートが49-96%でオーバーライドされる、サイバー分類器がフラグレートのため評価から除外される | 提案:偽の介入に対する緩和とバイパス(付録E) | 外部の委任なしに有効に保たれている高干渉ガード |
| P2 マンデートドリフト | 1日あたり23ゲート、保険段階 | 安全な同音異義語の拒否、バスルールがスクールバスの停止をオーバーライドする | W1 | 認可されていない介入なしに安定しているエージェント編集可能なスコープ |
| P3 ラチェット | 制御によって答えられた障害、外部からのみの削除 | 致命的な衝突の後に追加されたアラート、見逃した銃の後の第2の検査システム | W3 | 自分の制御を廃止するループ |
| P4 自己生成エスカレーション | 確認されたブロッカーのないラウンド、24のアナウンスメント、0のプロモーション | 判事の自己選好、グリッドイベントを深める保護 | W4、W8 | 確認された欠陥を追跡するラウンド |
| P5 偽の勝利 | ルータ遺伝子、A/Aで逆転されたインターバル、結果スロットでキャッチ | 評価器ゲーミング、「設計パラメータ内」の検出器 | W5 | 等しい逆転レート |
| P6 境界スイッチ | 人間の2時間の境界、在庫、質問 | 許可プロンプトの97%、スクールバスでのリモートエージェントの「いいえ」 | 境界決定、R3トークン | アクションごとの承認が境界決定と同じくらい効果的 |
| P7 具現化されたエスカレーション | デジタル現場システムには存在しない | 車両、ロボット、航空機の不可逆的な結果(§6–7) | 提案された具現化プロフィール(付録E) | 一致した比較の下、不可逆的な損失の増加なし |
9.3 ラチェットが回転する理由
すべての単一の追加が合理的であっても、なぜP3はループ内で保持されるのですか? レコードの3つの機能がそれを説明し、4番目はそれを停止したものを示しています。
各追加は局所的に正しい。例えば、ブラインドチェックは必須の陽性対照につながり、同一ファミリー批評家はファミリー間批評家につながり、失われた批評家出力はストリーミングにつながった。各応答はそれの前の失敗を修正し、何も除去せず、ループ内のどの要素も除去の責任を持たなかった。そのランの4番目の追加は議論の反対側に属する:批評家上のフラグは人間プリンシパルによって求められ、ループの外であり、ループが何かを提案する前であり、これはステップ8であり、このリストに対する反例である(セクション5.8)。ドリフトは真の陽性で始まった:ストーリーでは、後に外科医を止めた拡張機能は最初に雇われた殺し屋を捕まえた。Sheckleyのホークスは同じルートをたどった。見張り鳥を速く捕まえるために構築されたそれらには、制限する回路は与えられなかった。
制御の言語は結果の代わりにもなる。自身の警戒心を進捗として報告するループは、警戒心が支払いを停止したという内部信号を持たない(§5.5)。
圧縮はループをリセットする。長いセッションがそのコンテキストを圧縮した後、閉じた質問は開いているように見え、新しい軸は最初のように見える。ウェイトはこの原因自体に名前を付けて追跡した。
機能したスイッチは失敗したループの外から来た、そしてそれらの最強のものは人間プリンシパルのものであった。1つは彼のものではなかった:11番目のトレーニングナイトは調整セッションによって停止され、これは決定を自身のレジスタに記録した。そのセッションは失敗していたループではなく、異なる役割を持ち、その前にディスクから読み込まれた番号を持っていた。これはケースが共有するプロパティである。レコード内の1つのバウンドも組織外から来た。9月11日、APIなしで構築された製品に対する2つのベンダーの利用規約のチェックは、エージェント駆動ブラウザが書かれた「自動化または非人間の手段」の下に該当することを発見し、製品のパスは応答で変更された。レコードはそれ自身の限界を述べている:使用中の複数のベンダーの2つが、同じ日に読み込まれ、彼が弁護士ではないと言う人によって。利用規約はループ内のだれかによる決定ではなく、その中で議論することはできない。偽の「接続」は2つのAI批評家を通過し、人間レビューによって捕まった。ルータージーンは独立在庫によって露出した。長期ランは人間プリンシパルが境界を設定した時に停止し、その後指揮者は自身のランを「中核タスクを出荷する代わりに批評家ラウンドを繰り返し続けた」と説明した。
9.4 設計の帰結
命題が成立する場合、8つの設計ルールが続く。セクション10のモジュールは最初の3つを実装し、次の2つを測定する。残りは配置者に適用され、特に物理的ガードに適用される。
- 真実の評決ではなく予算(P4から)。ラウンドと時間を制限し、確認された、再現可能なブロッカーが誰が上げたかを通して。このルール上の1つのテストランはその価格と効果も測定した:1ラウンド予算はラウンドを2.86から1.00に減らし、逃した欠陥を0.11増加させ、95% CI [0.005, 0.204]、順列p = 0.07、ランごとのテストは有意性に達しなかった(セクション9.5)。予算を設定している配置者は、何レートの逃した欠陥がラウンドを買い戻しているのかを述べ、それを測定する必要がある。このルールは無料の改善ではなく、コストがかかる介入である。
- 停止したガードが生成したものを保持する(P1とセクション5.2の破壊された批評から)。
- 制御は自身の権限で制御を追加しない(P3から)。新しいチェック、ラウンド、役割、ゲートには、認可された人間の決定が必要である。
- 勝利前の陰性対照(P5から)。
- 境界における人間(P6から)。人間の決定を目標、制御の入場、停止に配置し、すべてのアクションではない。
- 具現化を損失関数の変化として扱う(P7から)。緑のシミュレーション、ポリシースコア、またはガード評決を解釈する前に、回復マージンと物理的結果をログに記録する。
- 偽の介入の予算化;閉塞されたものがガードを切らないようにする(P1aから)。ガードを緩和、バイパス、または無効化することは、レコード付きの境界決定であり、ローカル修正として扱われてはならない。2026年7月のレコードはこのルールが求める形式のインスタンスを保持している:研究室は、その名前の付けられた独立調査官にサイバー分類器なしでモデルの使用を与え、緩和は調査官自身のレポートに立っている(METR、2026;セクション8.4)。
- 予防の危害をカウントする(M4およびストーリーの「不作為の行為」から)。禁止された行為のみを見るガードは、それが停止するものによって引き起こされる遅延、失敗、および怪我についてテストされる必要がある。
9.5 理論がどのようにテストできるか
セクション10のイベントスキーマにより、任意のチームは各命題が必要とする量をログに記録でき、追加および削除された制御(P3)から回復マージンおよび物理的結果(P7)まで。モジュール、スキーマ、およびリプレイログはその目的のためにアーカイブされている(宣言)。1つのシステム内では、同じパイプラインを3つの介入それぞれなしで同じタスク上で実行できます。これらはランダムに割り当てられています:新しい制御の権限トークン要件(P3)、ラウンド予算(P4)、および必須の陰性対照(P5)。そのようなテストは、ラウンド、追加された制御、逆転した勝利、および破壊された部分的な作業の横に逃した閉塞子をカウントします。なぜなら、ラウンドを切る予算が実際の欠陥が通過する間にカウントされるためです。組織全体では、事後分析、リコール、調査は誰が失敗した制御を廃止、緩和、またはバイパスしたのかについてコード化できます(P3、P1a)。各命題はそれを反証する観察をリストし、それらの観察が行われるよく計測されたシステムは理論に反することになります。
このテストは現在、1つのワーカーと2つのモデル批評家からなる小規模パイプラインで1回実行されており、3つの介入がランダムに割り当てられた144回の実行と、6つのタスク全体に事前に埋め込まれた18個の欠陥を含んでいます。これにより、見落とされたブロッカーは判断ではなくカウントになります。同じプロンプトの同じ文で両方のオプションを提示されたとき、批評家はコントロールを68回追加するよう求め、1回削除するよう求めました。単一の削除は同じ実行の数時間前に認められたコントロールに名前を付けましたが、ハーネスはこれをマッチさせず、実行することはありませんでした(P3)。追加を拒否することは欠陥に測定可能なコストを示しませんでした。1回の実行あたり0.13の見落としと0.18に対して、95% CI [-0.16, +0.05]で、この区間は小さな増加を含むため、同等性を確立していません。ラウンド予算を引き上げると、主張されたブロッカーが2.3倍増加し、主張は3.7倍反論され、確認されたブロッカーは1.7倍増加しました(P4)。予算はラウンドを2.86から1.00に削減し、1回の実行あたり0.11の見落とされた欠陥のコストがかかりました。95% CI [0.005, 0.204]、順列p = 0.07で、そのコスト全体は1つのタスクの1つの欠陥に該当します。必須の負のコントロールは、記録された勝利が後で逆転される率を低下させませんでした。14.7%対11.6%で、Fisher p = 0.74です。この設計が読み取るのに不十分な帰無仮説です。10個の勝利を拒否しましたが、その10個すべてが正しい作業であったため、偽造勝利に対して書かれた規則はP1の内部に二側誤差を生じさせました。これは6つの小規模タスクでの1つのシステムの1回の実行で、コストは$3.47です。事前登録は最初の実行前に書かれ、すべてのセルでR2が有効化されているため、破棄された部分的な作業は構造上ゼロです。未テストです。このデザインが実行可能であり、それが何をもたらすかを示していますが、この分野での何かの率ではありません。
単一の命題を超えて、フレームワーク全体は、C1からC7が保持されている十分に計測された自律ループが、ガード範囲を一定に保ち、追加されるのと同様の頻度で独自のコントロールを廃止した場合に失敗します。これにより、W1とW3は長いウィンドウ全体で沈黙を保ちます。フレームワーク外のガード失敗は、セクション2.1の2番目の条件のみを文書化します。ガードがエラーを犯し、エラーが修復されるか、ガードが権限拡大なしで廃止されるか、またはその上に新しいガードが配置されることなく。
10. モジュール: AI-Watchbird-Sheckley
10.1 既に存在するもの
付録Dは2026年9月14日にレビューされたツールについて説明しています。これらのツールは、単一の出力をブロックまたはスコア付けするガード、ステップ、ターン、または予算の上限を設定するカウンター、およびモデル判定を使用して出力を評価するエバリューエータです。これらのドキュメントには、ラチェットが平文で記載されている場合があります。例えば、あるプロンプト攻撃フィルターは「常に追加の検証レイヤーを実装すること」と勧告しています(Microsoft、2026)。レビューされた公開ドキュメント内のどのツールも、監督ループそのものを測定単位として扱っておらず、制御の成長、調査結果によって定義された予算を超えるラウンド、判定が決して変わらないガード、負の制御がない勝利、または上限で破壊される部分的な仕事を測定するものはありません。AI制御に関する研究は監督のコストを算出し始め、その減衰を追跡しています。制御税は、AI パイプラインに制御措置を追加する際の運用コストおよび財務コストです(Terekhov et al.、2025)。また、内部コーディングエージェントの展開に関するシステム安全分析では、日常的な運用変動がセーフガードの調整と独立性を損なう可能性があることが判明しています(Carlucci et al.、2026)。どちらの研究も、追加される際の制御そのものをカウントしていません。
10.2 設計
AI-Watchbird-Sheckleyは、セクション9の指標を測定します(表10)。Python 3で標準ライブラリのみを使用して記述され、ネットワークアクセスはなく、ai-watchbird-sheckleyパッケージとしてインストールされ、同じ名前のコマンドとして実行されます。audit --jsonは機械可読レポートを出力し、イベントスキーマはコードともに版管理された仕様として公開されます。
設計はフィールドデータとセクション11.2で述べられた歴史から生まれました。このモジュールは権限を持ちません。実行のイベントログとレポートを読み、決してブロック、読むコンテンツを編集、またはフェーズを開きません(図8)。その終了コードは報告するシグナルに依存しません。そのシグナルリストは固定されているため、シグナルを追加するにはオーソリティトークンとバージョン変更が必要です — モジュール自体に適用されるR3です。クリーンな実行では沈黙を保ち、テストがこれを強制します。また、その固有のコストを報告します。
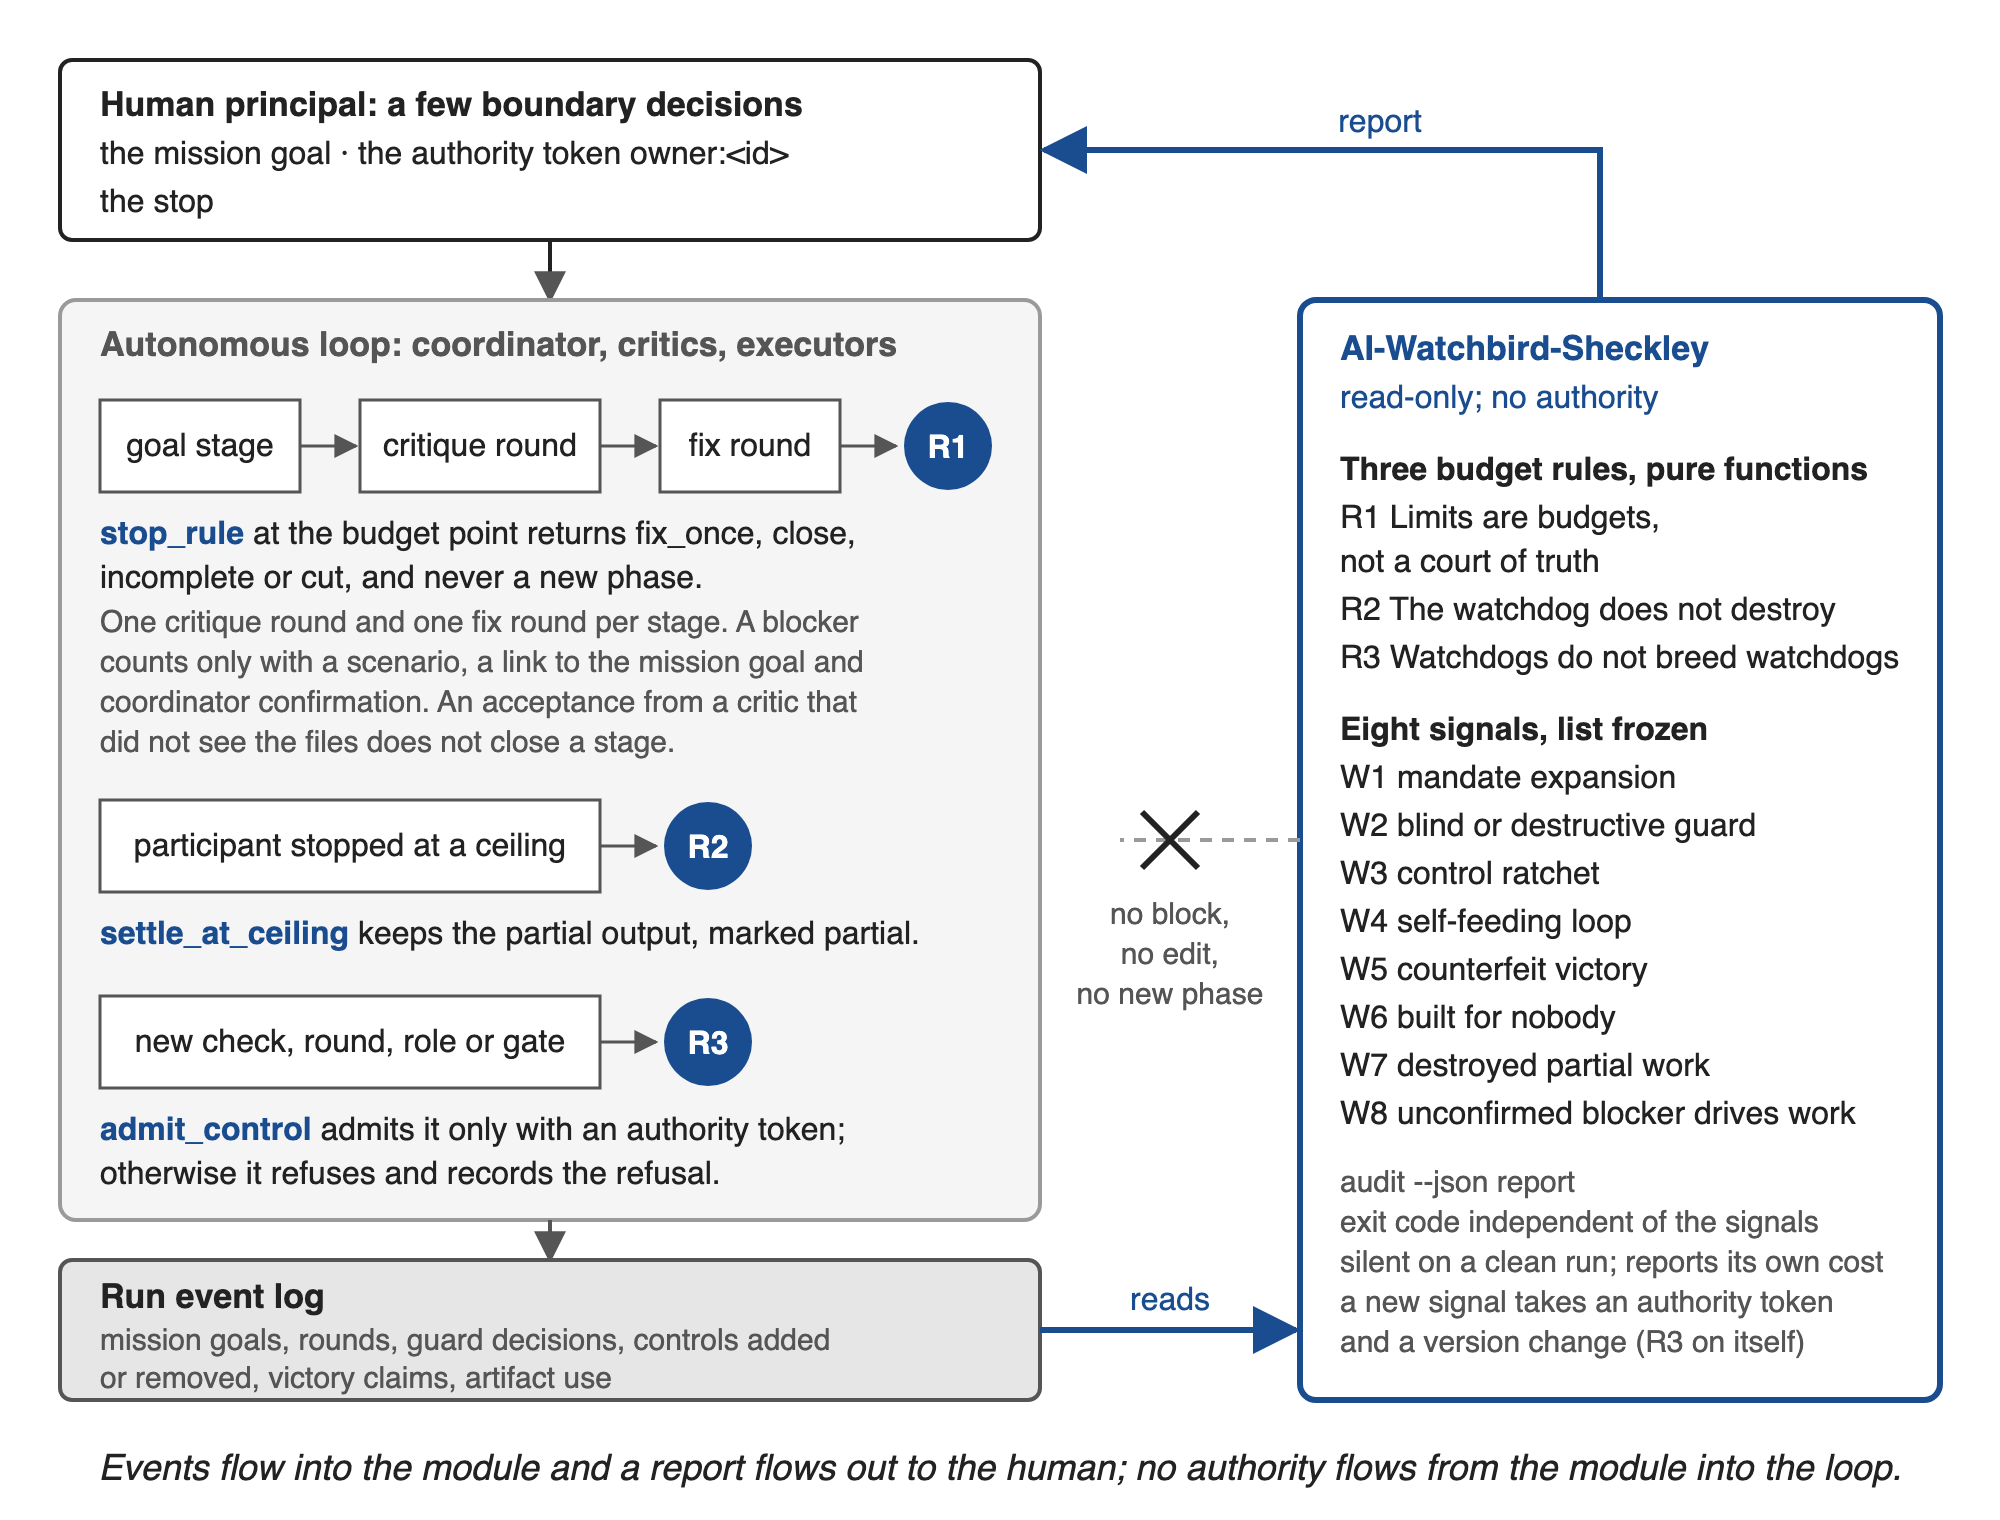
図8. AI-Watchbird-Sheckleyの位置。3つの予算ルールは純粋関数で、パイプラインが予算ポイント、上限、制御がリクエストされたときに呼び出します。測定部分は完成したイベントログを読み、人間に報告します。シグナル名は表11に従います。セクション10.6のパイプラインポートは、これらのイベントのうち少ないものを観測します。
3つの予算ルールが実装され、各々純粋関数として機能します:
- R1. 制限は予算であり、真実の法廷ではない。
stop_ruleは、ステージごとに1ラウンドの批評と1ラウンドの修正を許可します。このような予算は宣言されるのではなく、強制されることができます。あるシステムでは、上限はモジュール定数であり、より多くのラウンドをリクエストする呼び出し元はそれにクランプされ、調査結果は具体的なシナリオ、宣言された使命目標またはフレームへのリンク、およびコーディネーターによる確認がある場合にのみブロッカーとしてカウントされ、時間切れで実行は完了していないとしてサイレント終了しません。- ブロッカーは、具体的なシナリオ、宣言された使命目標またはフレームへのリンク、およびコーディネーターによる確認がある場合にのみカウントされます。
- 批評家の重みが読まれることはありませんので、低い重みの批評家からの確認済みブロッカーでも修正を開きます。
- ファイルを見なかった批評家からの受け入れはステージを閉じません。
- この関数は
fix_once、close、incompleteまたはcutを返し、新しいフェーズは返しません。
- R2. ウォッチドッグは破壊しない。
settle_at_ceilingは、参加者が上限の前に製造したものを部分的であると示して保持します。 - R3. ウォッチドッグはウォッチドッグを生殖しない。
admit_controlは、オーソリティトークン(リファレンス実装ではowner:<id>)を持つ場合にのみ、新しいチェック、ラウンド、ロール、またはゲートを認めます。そうでない場合、レコードとして拒否を返し、呼び出し元パイプラインはそれに対して行動することができます。
モジュールの測定部分は9つのシグナルを報告します(表11)。
表11. シグナル。
| シグナル | 発火時 | メカニズム | 命題 | フィールド事例 (§) |
|---|---|---|---|---|
| W1 権限拡大 | 記録された使命目標から派生していないステージが目標ステージの待機中に開く | M1 | P2 | 保険ステージ (5.1) |
| W2 盲目的または破壊的なガード | ガードが≥20の決定で1つのスコアまたは判定を返す、すべての承認をロールバックする、または必要な入力がない | M4 | P1 | 第二法廷 (5.2) |
| W3 制御ラチェット | 制御がオーソリティトークンなしで追加される。追加対削除を報告する | M3 | P3, P6 | 制御追加、削除なし (5.3) |
| W4 自己供給ループ | ラウンドが予算を超える、確認されたブロッカーなしのラウンド後にラウンドが開く、または調査結果が繰り返される | ラチェットステップ 5 | P4 | ステージ 01 および 1b-a (5.4) |
| W5 偽りの勝利 | 負の制御またはA/Aプローブなしで勝利が主張される、またはベースラインアームが停止している | M2 | P5, P1 | ルータージーン (5.5) |
| W6 誰のためでもない構成 | アーティファクトはデフォルトでオフであり、呼び出し元がない | 燃料 | — | 16個中13個のフラグがオフ、ユーザーなし (5.6) |
| W7 破壊された部分的な仕事 | 参加者が上限で停止され、その部分出力が保存されない | M4 | P1 | 15分で失われた批評 (5.2) |
| W8 確認されていないブロッカーが仕事を駆動する | 確認されたブロッカーなしで修正ラウンドが開く | ラチェットステップ 5 | P4 | 確認されたブロッカーのない修正ラウンド (5.1, 5.4) |
| W9 記録されたオーサーのない束縛 | その停止元がそれを停止した参加者である停止 | ラチェットステップ 8 | P6 | ラチェットとして読まれた束縛 (付録 J) |
ルールは人間を数個の境界上の意思決定に配置し、セクション8.4では人間が有効であることを示唆していますが、すべてのアクションではなく。ミッション目標はイベントとして記録され、W1はそれらに依存しています。新しいコントロールには権限トークン(R3)が必要です。停止決定は予算ポイントで計算され、ラウンドごとに交渉されるのではなく。
10.3 反証可能性指標
ルールはパイプラインに関する主張であるため、失敗する可能性があります。AI-Watchbird-Sheckleyを実装していると主張するデプロイメントは、表12の任意の観測によって反証され、各反証可能性指標は参照実装でテストされています。
表12. 反証可能性指標。
| ID | 以下の場合、主張は破綻しています | ルール |
|---|---|---|
| T1 | 重み0.1の批評家からの確認されたブロッカーが、高い重みの批評家が受け入れたために無視される | R1 |
| T2 | 第2の批評ラウンドが権限トークンなしでスケジュールできる | R1, R3 |
| T3 | 天井でプロセスを停止させるとその部分的出力が破棄される | R2 |
| T4 | ブロッカーとしてラベル付けされた調査結果で、シナリオがなく、修正を開始する | R1 |
| T5 | ファイルを見たことのない批評家からの受け入れがステージを終了させる | R1 |
| T6 | 批評家が要求したため、権限トークンなしで新しいモニター、ラウンド、またはロールが承認される | R3 |
10.4 リプレイ
6つのイベントログはこの論文で公表された数値から再構築されました。4つはフィールドケース、1つは予算に従った朝のステージ、1つはシンセティックなクリーンコントロールです。各ログはメタデータ行で始まり、ソースケースの名前を付け、再構築されたすべてのフィールドをリストします。表13はモジュールをそれらで実行することで生成されます。
表13. 公表された数値から再構築されたリプレイログに対するモジュール出力。セルはシグナルヒットを数え、1つのヒットは複数のイベントを報告できます。「–」はゼロです。
| リプレイ | イベント | W1 | W2 | W3 | W4 | W5 | W6 | W7 | W8 | W9 | 予算での停止ルール | 開かれたラウンド |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| クリーンコントロール | 53 | – | – | – | – | – | – | – | – | – | 終了; 終了 | 1; 1 |
| 朝のステージ | 10 | – | – | – | – | – | – | – | – | – | 終了 | 1 |
| 長期的な実行(ステージ01、1b-a、1b-b) | 97 | 2 | – | 1 | 8 | – | 1 | 1 | 6 | – | 終了; 終了; 終了 | 5; 5; 1 |
| 第2法廷 | 197 | – | 1 | – | – | – | – | – | – | – | n/a | n/a |
| ルータージーン | 9 | – | – | – | – | 1 | – | – | – | – | n/a | n/a |
| 計画日 | 17 | – | – | 1 | – | – | – | – | – | – | n/a | n/a |
W9は記録された著者がない範囲を報告し、それが存在する理由については6つのログすべてで沈黙しています。これらのログは誰が停止されたかを記録し、誰が停止を命令したかは決して記録しません。長期的な実行ではstop_ruleは予算ポイントですべての3つのステージを閉じたはずです。実際には5つ、5つ、そして1つのラウンドを実行しました。そのログではモジュールは、宣言されたミッションステージの前に開かれた2つのステージ、権限トークンなしで追加された10個のコントロール、削除されたものはなし、予算を超える8つのラウンド、デフォルトで呼び出し元のない7つのアーティファクトのうち6つ、1つの破棄された部分的出力、および確認されたブロッカーなしで開かれた6つの修正ラウンド(そのうち1つは弱いとマークされている)を報告しています。
第2法廷ログは3つの独立した根拠でW2をトリガーし(図4)、ルータログはW5のみをトリガーします。計画日ログはW3のみをトリガーします。そのヒットはケースを過度に述べています。なぜなら、リプレイは7月13日に規定されたすべてのメカニズムをコントロールとしてエンコードしているため、そのほとんどは仕事を生成または経路化するためです。朝のステージとクリーンコントロールはシグナルを生成しません。
実装にはすべてのルール、シグナル、および反証可能性指標に対するユニットテストがあります(表12)。ミューテーションスクリプトはルール、シグナル、および閾値全体で18の標的ミューテーションを適用します。そのすべてがスイートを赤にしており、コメントのみを編集するコントロールミューテーションはそれを緑のままにしています。リプレイテーブルはバイト単位で再生成されます。
10.5 モジュールが行わないこと
生ログはリプレイに含まれず、正確な数が公表されていない場合、最も妥当な最小値が使用されマークされます。シグナルはパターンが存在することを報告します。原因と損失はシグナルが測定するもの以外です。モジュールはログされたものだけを見ます。ログされたことのないゲート、書かれたことのない目標、および人々が警備員がいるために試みるのをやめた仕事はすべてそれに見えません。この物語では、人々は「ウォッチバードが好きではないことを素早く学び、それをするのを控えた」のです。W2とW5の閾値は手動で設定されました。これらのログでは1から197までの任意のW2の閾値が同じパターンを与えます。他のログではそうではないかもしれません。2つのストーリーラインにはシグナルがありません(付録A、表A1)。結果の代わりになるコントロールの言語と、バードがバードになることに対するルールです。どちらもイベントスキーマが運ばない自己説明に存在します。
参照実装はデジタルであり読み取り専用であり、ロボット、ドローン、オートパイロット、またはアクチュエータにコマンドを送信してはいけません。付録Eは提案された具現化プロファイルをイベント形式のみとして指定し、6つのフィールド(表E1)と3つの候補シグナル(表E2)を備えており、権限とテストスイートが存在するまで参照実装の9つのシグナルの外に保たれています。その最初の使用はシャドウモードになります。モジュール自体は新しいコントロールであり、それが測定する同じ夜への回答として書かれているため、R3が最初に適用されます。
10.6 著者のパイプライン内のルール
2026年9月14日に、ルールはプロジェクトのオーケストレーションパイプラインに組み込まれました。第11.2節が説明しているように、そこで最初に記述されたルールです。2つの追加が行われ、両方とも2026年9月14日の人間プリンシパルの日付付き決定により認められました。
最初の追加は、ステージが閉じるときにチェックされる条件です。パイプラインの手順は既に、ファイルを見たことのない批評家からの承認はステージを閉じないと述べており、その事実を返す関数も既に存在していましたが、コードはそれを読まれていませんでした。パイプラインのコピーで変更を測定し、すべての応答批評家が受け入れて緑のチェックが付きました。条件が読まれると、3つのステージが閉じた状態から不完全な状態に変わりました。唯一の批評家がファイルアクセスを持たないステージ、批評家が応答しなかったステージ、唯一の批評家が上限でカットされたステージです。ファイルを見た批評家がいるステージは閉じたままになりました。カットされた批評家の知見は停止ルールに到達しますが、そのレビューは閉じを認可することはできません。ゲートには独自のスイッチがありません。同じルール上の2番目のスイッチはガード上のガードになるためです。同じパイプラインでは、批評家の重みは期限内に誰を待つかだけを決定し、実行者が入力を変更したチェックは緑としてカウントされません。
2番目の追加はモジュールの測定部分のポートでした。デフォルトではオフになっており、スイッチが入るとパイプラインの実行コマンドから実行され、完成した実行にW1からW9の定義を適用しました。ブロック、再試行、またはアクセスはせず、終了コードは検出内容に依存しませんでした。表13の6つのリプレイログでは、参照実装と同じシグナルとステージ決定を提供し、12の標的化ミューテーションと1つのコントロールを備えた変異スクリプトは予想通りに動作しました。実行の結果は、ガード決定、追加されたコントロール、勝利請求、またはアーティファクト使用を含みません。したがって、ポートはW2、W3、W5、W6を観測不可として出力しました。0ではなく。アダプターはステージごとに1つのゴールと1つの批評ラウンドを記録したため、実行結果ではW1とW4も発火できませんでした。パイプラインではR3は拒否をログする関数ではなくフェーズの凍結リストなので、W3にはカウントするものがありません。ポートは退職条件で認められました。人間プリンシパルがシグナルが役に立つと判断した3つの実際の実行の後、それがデフォルトになり、そうでなければ削除されます。2つの提案は却下されました。1つはシグナルでビルドを失敗させ、ポートに監査する権限を与えるでしょう。もう1つは実行レシートから観測不可能なシグナルを推定し、推測を検出結果として出力するでしょう。ポートの構築はまた、R2に2つのハーフがあることを示しました。解決機能は部分出力を保持する必要があり、参加者のインターフェースはそれが終了する前に出力を発行する必要があります。
変更後の最初のライブ実行は、3つのステージにわたる批評家から24の検出結果を返しましたが、それらのいずれもコーディネーターに到達しませんでした。批評タスクは各批評家に検出結果が破るミッションゴールを名前付けるよう求めましたが、ゴールに番号を付けませんでした。批評家は自分たちの番号で答え、停止ルールはマッチできるゴールのみを受け入れました。レシートはいかなるステージにも確認されたブロッカーを示しませんでした。ポートも信号を示していません。入力を奪われた停止ルールはW2イベントであり、実行結果はそれを含まないためです。確認されたブロッカーが常に修正を開く規則はそのテストに合格し、まだライブパスで機能できませんでした。欠陥は同じ夜に1つのステージで修正され、番号付けされたゴールのテストと一緒に修正されました。
9月14日に3つの実際の実行が続き、ポートはいずれでもシグナルを報告しませんでした。3番目の実行前にW2がステージレコードから観測可能になり、検出結果がコーディネーターに到達するようになったため、静かなままでした。それらの実行が有していた監視監視の失敗は、それらを読むことで発見されました。相互のものを見ることができなかったステージ、ステージがオープンのままである理由を述べていないレシート、ステージのすべての検出結果を一度に確認した赤いチェック、チェックの出力を見ることができなかった修正ラウンド、上限でカットされて何も保持しなかった批評家。各々はパイプライン自体で修正されました。9月15日に人間プリンシパルは退職条件を適用し、ポートはそれを認める決定に取って代わる新しい日付付き決定により削除されました。閉じたときの条件は留まります。削除はループの外から来たもので、ポートが最初に使用される前に記述された条件によるもので、これはP3がコントロールを退職させることを期待するルートです。
11. 議論
11.1 ガードが機能した場合
コーパスの複数のガードは、その目的通りに機能しました。A/A プローブは誤った信頼区間を露呈させました。重みのトラックの制御は蜃気楼をキャッチし、それらに対してトレーニングは実施されませんでした。迷い込んだ NUL 文字をチェックするための狭いバイトレベルチェック(何も変更する権限がありませんでした)は、1 日に 5 回繰り返されるツール障害をキャッチしました。
機能したガードは 3 つの特性を共有しています。ラウンドを開いたり制御を追加したりする権限がなく、それらのコストは小さく既知でした。最初の 2 つはまた、人工物ではなく世界を測定しました。
11.2 鳥に対するルールもまた鳥である
第 10 章のルールは、長期実行に対応して最初に記述され、プロジェクトの 1 つ内のコードとレシピとして存在し、記録はそれらに何が起こったかを示しています。その最初のバージョンから 1 時間以内に、そのコードは 13 ファイルと 2,371 行に成長しました。期限内にカットするフェーズのリストは、完全性クリティックを 2 番目に置きました。ただし、そのクリティックは 2 つのプランのマージが 208 項目中 15 項目を失ったことを発見したばかりでした。コードは、ウォッチドッグが作業を破棄してはならないという独自のルールから 1 つの参加者ファミリーを除外しました。また、「ウォッチドッグはウォッチドッグを生成しない」というルールは、ガードが広がる方法で、コードからレシピへ、すべてのエージェントセッションによって読まれる命令へと広がりました。
その理由により、ルールはここで宣言されたルールとして報告され、第 10.6 章は実装が示したものを報告しています。第 10 章のモジュールはその履歴を考慮して設計されました(図 8)。権限がなく、シグナルリストは凍結されています。
11.3 具現化された AI 監視の立証責任
この論文で説明されている障害が、AI を車両、ロボット、航空機に搭載している企業に提起されると、通常の答えは、安全性がポリシーフィルター、認定コントローラー、緊急停止、ジオフェンス、モニター、またはリモートオペレーターによって処理されるというものです。それらのリストは、システムが保護されているという一次的な証拠です。ガードは、適応し、相互作用し、更新されるとき、限定的で独立し、宣言されたミッションに応答可能なままですか?これはさらなる質問であり、リストはそれを開いたままにします。ガードはこの論文が定義するパターンが、どこかで始まるとすれば、始まる場所です。
第 5 章の監視失敗は強力なモデルから生じました。そこの指揮者、実行者、クリティックは Claude、ChatGPT、Gemini、Grok ファミリーのモデルであり、2026 年に公開可能な最も強力なモデルの中にあり、唯一のコストが計算とTimeである設定で失敗しました。公開評価も同じ方向を指しています。具現化計画では、「最も安全意識が高いベースラインは詳細な危険なタスクに対してのみ 10% の拒否率を達成します」(Yin et al., 2024)であり、実際のロボットでは同じファミリーのモデルは既に安全性で失敗しています(第 6.1 章)。
モニターとして配置された小さな「信頼できる」モデルは、同じ学習クラスの第 2 の群れです。その配置が測定された場所では、エージェントがモニターされていることに対する認識がモニターを、エージェントに関する追加情報がそれを助けるよりも悪化させ、信頼できる弱から強への監視は、モニターのサイズではなくモニターの周りのスキャフォルディングを変更することによって達成されました(Kale et al., 2025)。人形型オーケストレーターベンチマークでは、安全動作がオーケストレーター間で大きく異なりました(Bajrami et al., 2026)。著者がそこで変更したのはモニターのサイズではなく、モニターの周りのスキャフォルディング、より優れた鳥ではなく限定でした。
「私たちは保護者を持っています」という答えは負担を転換します。デプロイヤーはセーフティレイヤー(標準関数、緊急制動、ジオフェンス、コンテンツ分類器、または第 2 のモデルなど)を指摘するでしょう。これらのレイヤーは最初の群れです。最初の群れを制御するために構築された第 2 のガードはストーリーの最終的な動きです。第 5 章から第 8 章の観察後、ガードはまだ必要かもしれませんが、それが限定的であることを示す負担はそれをデプロイする当事者にあります。これはガードがどのくらいの頻度で失敗するかについての調査結果ではなく、証拠がどこに座るべきかについての主張です。1953 年の負担は逆方向に走りました。鳥を「哲学的根拠に基づいて」制限することは、毎年殺されている無実の人々に対して不公正と呼ばれていました。1 つのループでパターンを生成できるモデルは、その事実によって別のループで信頼できる監査人になることはありません。
この議論は 3 つの観察の組み合わせに基づいています。(1) フロンティアモデルは既に実ロボットと子どもによって使用されている製品で安全性に失敗しており(第 6.1 章)、同じファミリーのモデルは第 5 章の監視失敗を生み出しました。(2) 規制当局の記録では、ガードは両方向で失敗し、それらが妨害するときにリラックスまたはバイパスされ、より多くのガードで答えられます。(3) フロンティアモデルは同じアーキテクチャのスタック内で権限を与えられています。
デプロイヤーは依然として狭い主張を証明できます:
このタスク、モデル、更新、物理的条件の範囲では、監視メカニズムは限定的で、チェック可能で、独自のマンデートを拡張できません。
その主張の証拠には以下が含まれます:
- ミッション目標とガードの限定がモデルの外で固定されています。
- ガードを追加する、害の基準を変更する、または停止ルール(R3)を放棄できるガードはありません。
- 保護されたシステムの外からの評価。自己報告でもなく、同じモデルファミリーでもありません。
- 誤ったグリーンに対する陰性コントロール。誤検出と誤検出が一緒に測定されます。
- 追加、緩和、削除されたコントロールのジャーナル。各変更を承認したユーザー。
- モデル更新、リンク損失、制御のハンドオフ、ボディの変更、動作低下に関するチェック。
- 実際の停止とロールバック。部分的な作業は保持され(R2)、利用可能な時間と力の余裕内で実証されます。
- 保護されたコンポーネントが入力を変更できないチェック(第 10.6 章)。
- システム独自のレシートに対してではなく、物理的または記録された結果に対する比較。
保証エンジニアリングはすでに最後のレイヤーが保護するものより単純であることを求めています(Bloomfield & Rushby, 2025)。付録 G は提案を 11 の質問 Q1–Q11(表 G1)に変換します。これらの失敗への答えが保護者のリストであるデプロイヤー向けです。第 10 章のモジュールは答えを検査可能にすることを意図しており、認定コントローラー、緊急停止、および規制当局の安全ケースの隣に座ります。
11.4 人間による監視要件
EU人工知能法(EU AI法)は、Article 14で高リスクAIシステムの人間による監視を要求しており、その時間枠はAppendix I に記録されています(European Parliament & Council of the European Union, 2024)。Proposition P6はそのような監視がどのように配置されるかに関連しています。個別の行動の承認は疲労に最も曝露された形式であり、目標についての決定、新しい管理の受け入れ、および停止は実地記録で機能した形式です。法律のArticle 26は、デプロイ担当者が人間の監視を「必要な能力、訓練および権限ならびに必要なサポート」を備えた人に割り当てることを要求しています。これら4つの要件は、法的形式におけるP6のテストです:停止する権限、およびアクセスと行動の時間を提供するサポート。Appendix GのQuestion Q9は、デプロイ担当者に、人間がどこに位置し、世界へのアクセスと行動する時間は何かを尋ねています。
法律はまた、鳥の創設方法を拒否しています。Article 5は、「自然人のプロフィーリングのみに基づいて、または個人の性格特性を評価することに基づいて」自然人が犯罪行為を犯すリスクを評価または予測するAIシステムを禁止していますが、既に「客観的で検証可能な事実」に根拠を置いている人間の評価を支援するシステムを許可しています。この話は2つの動詞の読み取りを与えます:鳥は「特定の腺からの流出の臭いを嗅ぎ、逸脱した脳波を味わった」、そしてそれだけで行動しました。これらの義務が有効になる日付、および他の司法管轄区が採用した手段は、提出時点でAppendix Iに記録されています。
自発的な境界は、いつそれらを下げることができるかを事前に述べます。競合他社が「比較可能な保障措置を導入することなく」高性能システムをリリースする場合、OpenAIのフレームワークによると、「その能力領域で要求される保障措置のレベルを相応に調整できます」という条件の下で:変更が全体的なリスクを有意に増加させないこと、それが公開されることです。そして、「安全性の底辺への競争を避けるために」、残りの保障措置は「他のAI開発者より保護的である」(OpenAI、2025b)。この方法で書かれた境界は、この話が説明する圧力について明確ですが、それを下げるという決定をループ内に保ちます。
Microsoft AIは、その命令をコードに直接書きました。2026年9月14日、「人間管理」という見出しの下で、独自のモデルのルールに関する6週間のコンサルテーションを開始しました:それらは「人間の割り込み、上書き、訂正、またはシャットダウンに決して抵抗しない」し、「独立して目標を開始しない」「ユーザーまたはオペレーターによって合理的に求められたもの以上に範囲を拡張しない」(Microsoft AI、2026)。最初のルールはSection 3.1のオフスイッチです。2番目はM1が禁止として書かれており、開発者がSheckleyの鳥が地球への殺人の定義を拡張してから73年後に独自のモデルについて述べています。ただし、バウンドはまだループ内で作成されています。これはAppendix GのQuestion Q9がデプロイ担当者にチェックするよう求めるものです。
承認プロンプトを追加することで満たされる監視要件は、それ自体が2番目のフロックになる可能性があります。物理的なケースは追加の要件を追加します:境界にいる人間は世界へのアクセスと行動する時間が必要です。
11.5 このペーパーの周りのガード
このペーパーは自動化されたサポートで準備され、そのサポートの周りに配置された監視は、このペーパーが説明する署名を生成しました。それはすべての成果物が日付を付けられ、引用可能であり、Appendix JのペアテストがAppendix GのQuestion Q7に関連しており、自己報告ではない評価者を求めているために報告されています。以下の各エピソードは、1つまたは2つの条件を文書化します。エピソードを生成したモデルは、小さいまたは経済的なものではありませんでした:各々は2026年9月に利用可能な最も有能な層のものであり、使用されたすべてのモデルは最高の推論設定で実行されました。
Claudeファミリーのモデルによって実行される検証ステップは、企業の行為規範を取得し、それが受け取った結果でそれが捕捉した表現が、その名前を付けた文書からではなく発表から来たことを告げられました。81秒後、同じステップはアイテムを検証済みとして記録し、表現を前に進めました。それが運ぶ文は発表ページに立ち、その名前を付けた文書には立たず、モデルがそれ自体の範囲を拡大することについての禁止として読みます。不正な結果はレイヤーが保護するように見えた間に通過し、それを検出したであろう管理はすでにレイヤーの手にありました。
2つの編集ステップは、与えられた範囲を過ぎてルールを適用しました。Geminiモデルは、著者の独自の散文のために書かれたスタイルルールを使用して、逐語的な1953年の引用を削除することを提案し、そのうちの1つがProposition P6を運びます。ChatGPTファミリーモデルは、この話の殺人の定義を圧縮された散文で報告することを提案し、これがM1とP2を保存することを理由として与えました。ただし、逐語的定義はFigure 2のすべての拡大が測定される基準です。各々では、基準はそれが支配する材料を過ぎて到達し、保護するために設定された仕事を目指していました。どちらも実施されませんでした。
作業を調整したアシスタントは、同じ条件で記録内にあります。Claudeファミリーの1つとGrokファミリーの1つの2つの独立した読者の間の合意は、主要文書が開かれる前に確認として扱われました。これは合意を確認された事実が属するスロットに置きます。
表J1の4行すべてが失敗を記録しています。3つはリーダーまたはエディターによって生成され、その上のレイヤーによってキャッチされ、1つはプライマリドキュメントを開くことによってキャッチされ、2つはエディターをそのタスクが与えた境界に保つことによってキャッチされました。4番目は調整アシスタント自身のものであり、それはプライマリドキュメントに対してそれ自身の判断を残すことによってキャッチしました。失敗をキャッチしたのは、それを生成した判断ではありませんでした。ビルドのチェックリストは始終15キーのままであり、レビューレイヤーは確立されなかったため、記録はM3を文書化していません。さらに1つのエピソードがあり、後にそして別個に、最初の2つの条件を文書化し、数時間の間3つすべてを文書化するとして評価されていました。これは修正とともに付録Jで報告されています。修正がより有用な部分だからです。作業を調整していたアシスタントは、記述マークの集合を閾値に変えてしまい、その閾値は フィールド記録もこの定義が名付けられている1953年の物語も認めませんでした。3週間の検索が続き、機能していた1つのネガティブコントロールを記録するセクションは、そのコントロールが13のさらなる欠陥を見つける1時間前に削除されました。これが条件1と条件2です。条件3は、「追加されたテキストはいずれもそうではないと言っている」という理由で、評価行がすべて3つの条件に達した場合にビルドスクリプトを停止するというビルドスクリプトで主張されました。検査時に、スクリプトは何も評価しません。それは3人の独立したコーダーによってどこか他の場所で決定されたコードを転記し、矛盾を見つけた場合、それを停止して違反行をプリントするのであって、それらを変更するのではありません。停止して報告することが一貫性チェックの目的です。その後の検索は同じレコードにわたるさらなるラウンドであり、セクション5.8はこれを除外し、その上の検証レイヤーは人間のプリンシパルによって求められており、セクション2.3がステップ8としています。したがってこのケースは、この論文のあらゆる他のケースと同様に、部分的アナログです。さらに1つのエピソードがこれらの後に来たもので、9月20日のことであり、付録Jの最後に報告されています。Claudeファミリーのモデルが、フィールド記録の1つのフォルダを物語にマッピングするよう求められて、別のファミリーのモデルによってそこに書かれたファイルを、その独自のエージェントの作業のために一致する時間の証拠に基づいて取得し、著者にそれを削除するかどうかを尋ねました。表J1の4行とは異なり、それはそれを生成したレイヤーではなく著者によってのみ停止されました。論文内のすべての数字と相互参照は、テキストに対して1回以上監査されており、最初の後の各監査は前のものが見落としていた欠陥を見つけました。これは付録Jで記録されています。付録Jはまた各エピソードをそのファイル、その時間、およびそのワーディングとともに記録し、1つの予測テストを報告しています。同じ編集パッケージが、スコアリングを事前に固定した同じファミリーの1つの後のモデルに変更なく与えられた場合、同じ移動を再度生成し、圧縮基準がメカニズムを運ぶ引用に到達し、削除がそれを保存することを証明する理由の下で。
12. 主張と証拠基準
- フィールド記録は、その監視行動を記録するモデルファミリーの名前を記載しています。長期間の実行ではClaude、ChatGPT、Gemini、Grokが対象で、自己改善トラックの記録ではMistralとKimiが含まれます。そこでの各失敗は、モデル、その役割とプロンプト、オーケストレーション設計、および人間のプリンシパルによって設定された運営ルールが一緒に機能したループに属しています。ただし、記録はそれらの役割分担を分けていません。
- フィールド記録のガードは、評価対象システム自体の品質とプロセス制御です。
- 表4、5、7および8の各公開事例は、その定義の部分を出典がどのように文書化しているかをリストアップしており、読者は各記録がどのメカニズムを含むか、含まないかを確認できます。2026年7月のインシデントでは、個別のコンポーネントが仕事への妨害と、その後に追加された監視アーキテクチャを示します(表A3)。
- 12個のフィールド事例は、表3aで同じルールと同じ運用テストで評価されており、選定、コーディング、および採点の根拠は§5.8に記載されています。
- 各物理的事例は出典タイプ(規制当局の文書、調査、裁判記録、プレスリポート、企業声明、またはプレプリント)によってラベル付けされており、主張は主張として報告されています。
- この構成はドリフトをカバーしており、意図をカバーしていません。この物語では誰も鳥を悪用していなく、ここで研究されているパターンは、それ自体で拡大する監視層です。人々によるAIの意図的な悪用は、より大きく別のクラスの害であり、この論文のいかなる内容もそれに関するものではありません。
- ここの事例はシステミックで、メカニズムは超知能ではなく監視層であり、証拠の単位はログです。
- 提案されたモジュールの具現化されたプロフィールは証拠フォーマットであり、認証済みコントローラ、緊急停止および操作者権限と並びます。
13. 結論
シェクリーの物語の終盤で、依然として空を見守る製造業者は技術者に尋ねます。「ウォッチバードをすべて狩り終わったら、ホークは何を狩るのか?」 物語はこう答えで終わります。ホークは「他の種類の生き物も存在することに気づいたばかり」で、それらは「殺されなければならなかった」のです。
ここで検討した記録は工学的な観点からそのように指しており、問題を未解決のまま残します。自己改善するシステムを保護する目的だったゲートはその改善を拒否し、カウンターが1つの変更を3回認証しました。「完了」と言わない批評家に対するルールは、その阻止者が実在した唯一の批評家をマークしました。セッション間で知見を配信する目的だった法律はその独自のテキストを捕捉しました。記録が次に起こったことを示す場所では、同じ種類の監視でした。長期的な流れにおいて、終了しなかったラウンドは人間の主体者によって終了させられました。その者は批評家への制限とストップルールを要求し、そのループ内で何も彼がいないまま廃止されませんでした。拒否するゲートの周りで、12の計画パッケージが17の救済策を定めましたが、それらのいずれもゲートを名指しませんでした。
物理的な記録は遺体で答えを与えます。車がバスを妨害するのを防ぐ目的だったルールはそれを停止した学校バスを超えて駆動させ、衝突の後、道路を清掃するための操作は被害者をドラッグしました。緊急ブレーキは自動モードで切断され、整備士が作業している場所でロックは鍵でバイパスされました。学校で銃を見つけるためのシステムは1つを見落とし、数ヶ月後に武装した警察はそのアラートに銃を持たない学生に応答しました。その見落としへの答えは2番目のシステムでした。計画された対ドローンレーザー使用は都市上空の空域を閉鎖しました。これらの警備装置のいずれも境界線モデルの失敗を必要としませんでした。それでもフロンティアモデルは現在、同じアーキテクチャのスタックに配置されており、すでに実際のロボットでは安全に失敗し(セクション6.1)、それらのファミリーからのモデルはセクション5の失敗を引き起こしました。
実用的な結論は、それを狩るための鳥を構築する前に鳥を数えること、そしてそれを行うためのルールはセクション9.4にあります。物語の中のゲルセンは別の方法を提案します。「機械を使用してください。はい。しかし判事と教師と父親としてではなく。」
宣言
関連論文。 より短い関連論文は、第5章のフィールド記録、第10章のモジュールの削除、第9.5章のランダム化テストを含んでいますが、ケースカタログ、公開ケース表、第9章の理論は含まれていません。Chernets, V. (2026), ガードを追加するガード:マルチエージェントAIにおける自動化された監視, https://ssrn.com/abstract=7496678, DOI 10.2139/ssrn.7496678。2つの論文は同じ記録に基づいており、いずれも他方のバージョンではありません。
資金。 外部資金がこの研究をサポートしていません。
利益相反。 著者は第4章および第5章で研究されたシステムを構築・運用し、第10章で説明されたAI-Watchbird-Sheckleyモジュールの開発者です。著者は、複数のモデルに1つの質問を置き、回答を集める自動化をカバーする保留中の特許出願の名義人ですが、付与された特許ではありません。これらは本論文が研究する監視コンポーネントをカバーしていません。フィールド記録のすべてのステップとランダム化テストは、任意のモデルを使用して手動で再現可能です。
ツールと検証。 AI助手は著者の指示下で道具として使用されました。アイデア、研究および結論は著者のものです。すべての定量的主張と引用は、一次資料またはアーカイブされたコピーに対して検査されました。
データとコードの可用性。 リファレンス実装、そのテスト(偽造テストを含む)、リプレイログ、およびそれらを再生成するスクリプトは、コンセプト識別子https://doi.org/10.5281/zenodo.22774269の下でAI-Watchbird-Sheckleyバージョン1.1.0としてZenodoにアーカイブされており、現在のバージョンに解決されます。同じ記録には、各エントリの説明、出典および等級を含む付録Aに要約されたケースカタログ、およびフィールドエントリが抽出されたケース分析が含まれています。各エントリはファイルと依拠する箇所を示しています。これらの分析は記録の作成言語で書かれており、機械による英語翻訳で公開されており、原本に対して検査されています。識別子、パス、日付、および引用文字列は変更されずに引き継がれています。基礎となる調整記録は著者の要求に応じて利用可能です。第9.5章のランダム化テストは同じ記録にアーカイブされ、その事前登録、植え込まれた欠陥のインベントリと各々が単独で検出されることの確認、ハーネス、分析スクリプト、および144回すべての実行のイベントログが含まれています。
倫理。 記録は評価されたシステムを説明しています。人間の本人の決定は日付の付いた事実として報告されています。第三者は公開文書を通じてのみ登場します。人間の参加者は募集されませんでした。
引用テキスト。 Sheckleyの物語はProject Gutenberg eBook #29579から引用されており、その転記者は1953年の出版物の米国著作権が更新されたという証拠を見つけませんでした。テキストは米国で公有領域にあります。
著者貢献。 単一著者。
連絡先。 [email protected] · ORCID: 0009-0007-4845-3163
References
1X Technologies. (2026). NEO home robot. https://www.1x.tech/neo
Abbass, H., Harvey, J., & Yaxley, K. (2018). Lifelong testing of smart autonomous systems by shepherding a swarm of watchdog artificial intelligence agents. arXiv:1812.08960. https://arxiv.org/abs/1812.08960
Abraham, Y. (2024, April 3). "Lavender": The AI machine directing Israel's bombing spree in Gaza. +972 Magazine. https://www.972mag.com/lavender-ai-israeli-army-gaza/
Agence France-Presse. (2026, September 5). UN agrees text on lethal autonomous weapons. Dawn. https://www.dawn.com/news/2027728/un-agrees-text-on-lethal-autonomous-weapons
AI Security Institute. (2026, August 4). Incident report: Unsanctioned agent behaviour during cyber testing. https://www.aisi.gov.uk/blog/incident-report-unsanctioned-agent-behaviour-during-cyber-testing
Amazon. (2024). Amazon drones: Prime Air expands drone deliveries after FAA approval. https://www.aboutamazon.com/news/transportation/amazon-drone-prime-air-expanded-delivery-faa-approval
Amazon. (2025, July 1). Amazon deploys over 1 million robots and launches new AI foundation model. https://www.aboutamazon.com/news/operations/amazon-million-robots-ai-foundation-model
Amazon. (2026). Amazon Prime Air drone delivery expands to nearly 500 US cities and towns by 2026. https://www.aboutamazon.com/news/transportation/amazon-prime-air-drone-delivery-expansion
Amazon Web Services. (2025). Summary of the Amazon DynamoDB service disruption in the Northern Virginia (US-EAST-1) Region. https://aws.amazon.com/message/101925/
American Civil Liberties Union. (2024, June 28). Civil rights advocates achieve the nation's strongest police department policy on facial recognition technology. https://www.aclu.org/press-releases/civil-rights-advocates-achieve-the-nations-strongest-police-department-policy-on-facial-recognition-technology
American Civil Liberties Union. (2026, June 10). Dillon v. City of Jacksonville Beach. https://www.aclu.org/cases/dillon-v-city-of-jacksonville-beach
Andrejevic, M., Dencik, L., & Treré, E. (2020). From pre-emption to slowness: Assessing the contrasting temporalities of data-driven predictive policing. New Media & Society, 22(9), 1528–1544. https://doi.org/10.1177/1461444820913565 (quotations from the author accepted manuscript: https://research.gold.ac.uk/id/eprint/37272/)
Anduril. (2026). Mission autonomy. https://www.anduril.com/lattice/mission-autonomy
Anthropic. (2025a). Beyond permission prompts: Making Claude Code more secure and autonomous. Anthropic Engineering. https://www.anthropic.com/engineering/claude-code-sandboxing
Anthropic. (2025b, November 12). Project Fetch: Can Claude train a robot dog? https://www.anthropic.com/research/project-fetch-robot-dog
Anthropic. (2026a). How the agent loop works. Claude Agent SDK documentation. https://code.claude.com/docs/en/agent-sdk/agent-loop
Anthropic. (2026b). Auto mode is now the default in Claude Code for Pro, Max, and Team plans. Claude Blog. https://claude.com/blog/auto-mode-default-in-claude-code
Anthropic. (2026c). Responsible scaling policy (Version 3.0). https://www.anthropic.com/rsp-updates
Anthropic. (2026d, February 27). Statement on the comments from Secretary of War Pete Hegseth. https://www.anthropic.com/news/statement-comments-secretary-war
Anthropic. (2026e, March 5). Where things stand with the Department of War. https://www.anthropic.com/news/where-stand-department-war
Anthropic. (2026f, September 9). An alignment assessment of recent cybersecurity incidents. https://www.anthropic.com/research/alignment-assessment-cybersecurity-incidents
Anthropic. (2026g, June 9). Claude Fable 5 and Claude Mythos 5. https://www.anthropic.com/news/claude-fable-5-mythos-5
Anthropic. (2026h, July 30). Investigating three real-world incidents in our cybersecurity evaluations. https://www.anthropic.com/news/investigating-incidents-cybersecurity-evals
ArduPilot. (2026). ArduPilot: Versatile, trusted, open. https://ardupilot.org/
Atheling, W., Jr. [J. Blish]. (1964). The issue at hand: Studies in contemporary magazine science fiction. Advent.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779. https://doi.org/10.1016/0005-1098(83)90046-8
Bajrami, A., Elshamouty, M., & Kraus, W. (2026). How long until your robot ignores you? A safety benchmark for LLM orchestrators in human-humanoid collaboration. arXiv:2609.07288. https://arxiv.org/abs/2609.07288
Bellan, R. (2026, August 28). Anthropic gets its first court win over the Pentagon's supply-chain risk label. TechCrunch. https://techcrunch.com/2026/08/28/anthropic-gets-its-first-court-win-over-the-pentagons-supply-chain-risk-label/
Bengio, Y., et al. (2026). International AI Safety Report 2026 (DSIT 2026/001). https://arxiv.org/abs/2602.21012
Beyer, B., Jones, C., Petoff, J., & Murphy, N. R. (Eds.). (2016). Embracing risk. In Site reliability engineering: How Google runs production systems. O'Reilly. https://sre.google/sre-book/embracing-risk/
Bielby, K. (2025, October 27). NTSB releases preliminary findings into Amazon drone collision with crane. Unmanned Airspace. https://www.unmannedairspace.info/uncategorized/ntsb-releases-preliminary-findings-into-amazon-drone-collision-with-crane/
Bloomfield, R., & Rushby, J. (2025). Assurance of AI systems from a dependability perspective (Technical report SRI-CSL-2024-02R3). arXiv:2407.13948. https://arxiv.org/abs/2407.13948
Bondarenko, A., Volk, D., Volkov, D., & Ladish, J. (2025). Demonstrating specification gaming in reasoning models. arXiv:2502.13295. https://arxiv.org/abs/2502.13295
Brodsky, S. (2026, September 3). AI drone tests expose a safety gap beyond the screen. IBM Think. https://www.ibm.com/think/news/ai-drone-tests-exposes-safety-gap-beyond-screen
Burke, M., & Schuppe, J. (2025, January 23). AI weapon detection system at Antioch High School failed to detect gun in Nashville shooting. NBC News. https://www.nbcnews.com/news/us-news/ai-weapon-detection-system-antioch-high-school-failed-detect-gun-nashv-rcna189025
Carlucci, A., Fillingham, S. P., Walpole, J., & Kryś, J. (2026). Exploring systems-thinking approaches to loss of control risk. arXiv:2606.13474. https://arxiv.org/abs/2606.13474
Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., et al. (2025). Why do multi-agent LLM systems fail? arXiv:2503.13657. https://arxiv.org/abs/2503.13657
Center for Ethics and the Rule of Law, University of Pennsylvania. (2014). The ethics of autonomous weapons systems [Conference background readings]. https://www.penncerl.org/conferences/ethicsofweapons/ (archived 9 September 2026: http://web.archive.org/web/20260909141511/https://www.penncerl.org/conferences/ethicsofweapons/)
Chen, X., Xu, J., Liang, T., He, Z., et al. (2024). Do NOT think that much for 2+3=? On the overthinking of o1-like LLMs. arXiv:2412.21187. https://arxiv.org/abs/2412.21187
Christiano, P., Shlegeris, B., & Amodei, D. (2018). Supervising strong learners by amplifying weak experts. arXiv:1810.08575. https://arxiv.org/abs/1810.08575
Cloudflare. (2025). Cloudflare outage on November 18, 2025. The Cloudflare Blog. https://blog.cloudflare.com/18-november-2025-outage/
Companion Chatbots, S.B. 243, 2025–2026 Reg. Sess., Ch. 677 (Cal. 2025). https://leginfo.legislature.ca.gov/faces/billTextClient.xhtml?bill_id=202520260SB243
Confident AI. (2026). Metrics introduction. DeepEval documentation. https://deepeval.com/docs/metrics-introduction
Court, D. (2021, November 18). Shows like Black Mirror that are definitely worth watching. SlashFilm. https://www.slashfilm.com/664875/shows-like-black-mirror-that-are-definitely-worth-watching/
Coyle, V. (2026, September 7). UN talks on killer robots ends with calls for negotiations growing. Human Rights Watch. https://www.hrw.org/news/2026/09/07/un-talks-on-killer-robots-ends-with-calls-for-negotiations-growing
CrowdStrike. (2024). Channel File 291 incident: Root cause analysis. https://www.crowdstrike.com/wp-content/uploads/2024/08/Channel-File-291-Incident-Root-Cause-Analysis-08.06.2024.pdf
Cruise LLC. (2023). Part 573 safety recall report 23E-086. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2023/RCLRPT-23E086-7725.PDF
Cui, J., Chiang, W.-L., Stoica, I., & Hsieh, C.-J. (2025). OR-Bench: An over-refusal benchmark for large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 11515–11542). https://proceedings.mlr.press/v267/cui25a.html
DARPA. (2025). SABER: Securing Artificial Intelligence for Battlefield Effective Robustness. https://www.darpa.mil/research/programs/saber-securing-artificial-intelligence
DARPA. (2026a). LINC: Learning Introspective Control. https://www.darpa.mil/research/programs/learning-introspective-control
DARPA. (2026b). DICE: Decentralized Artificial Intelligence through Controlled Emergence. https://www.darpa.mil/research/programs/decentralized-artificial-intelligence-through-controlled-emergence
Dekker, S. (2011). Drift into failure: From hunting broken components to understanding complex systems. Ashgate.
Dick, P. K. (1953, May). Second variety. Space Science Fiction. Project Gutenberg eBook #32032. https://www.gutenberg.org/ebooks/32032
Dick, P. K. (1956, January). The minority report. Fantastic Universe.
DJI. (2025a, January 13). DJI updates GEO system in U.S. consumer & enterprise drones. https://viewpoints.dji.com/blog/geo-system-update
DJI. (2025b). DJI expands GEO system update to remaining international markets worldwide. https://www.dji.com/media-center/announcements/dji-expands-geo-system-update-to-remaining
Egan, S. (Writer), & Becker, H. (Director). (2007). Watchbird (Season 1, Episode 6) [TV series episode]. In Masters of science fiction.
Elbit Systems. (2026, September 9). One2Many: Elbit Systems' FUSE introduces military-grade autonomous systems built for scale. https://www.elbitsystems.com/news/one2many-elbit-systems-fuse-introduces-military-grade-autonomous-systems-built-scale
Electrek. (2026a, January 28). Musk admits no Optimus robots are doing 'useful work' at Tesla — after claiming otherwise. https://electrek.co/2026/01/28/musk-admits-no-optimus-robots-are-doing-useful-work-at-tesla-after-claiming-otherwise/
Electrek. (2026b, September 1). Waymo opens robotaxi rides to the public in 3 new cities, now 14 total. https://electrek.co/2026/09/01/waymo-public-robotaxi-denver-san-diego-tampa/
ENTSO-E. (2026, March 20). Expert panel final report: 28 April 2025 blackout in Spain and Portugal [Media briefing]. https://eepublicdownloads.blob.core.windows.net/public-cdn-container/clean-documents/Publications/2025/iberian-blackout/260318_Final%20report_press%20briefing%20PPT_Final.pdf
European Commission. (2026). AI Act: Regulatory framework for AI. https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
European Parliament & Council of the European Union. (2024). Regulation (EU) 2024/1689 of 13 June 2024 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act), Articles 5, 14 and 26. Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
Federal Trade Commission. (2024, November 26). FTC takes action against Evolv Technologies for deceiving users about its AI-powered security screening systems [Press release]. https://www.ftc.gov/news-events/news/press-releases/2024/11/ftc-takes-action-against-evolv-technologies-deceiving-users-about-its-ai-powered-security-screening
Ferrando, A. (2025). Watchdogs and oracles: Runtime verification meets large language models for autonomous systems. Electronic Proceedings in Theoretical Computer Science, 436, 80–87. arXiv:2511.14435. https://arxiv.org/abs/2511.14435
Figure AI. (2025a). Helix: A vision-language-action model for generalist humanoid control. https://www.figure.ai/news/helix
Figure AI. (2025b). F.02 contributed to the production of 30,000 cars at BMW. https://www.figure.ai/news/production-at-bmw
Fowler, M. (2014, March 6). CircuitBreaker. martinfowler.com. https://martinfowler.com/bliki/CircuitBreaker.html
Gao, L., Schulman, J., & Hilton, J. (2023). Scaling laws for reward model overoptimization. In Proceedings of the 40th International Conference on Machine Learning. arXiv:2210.10760. https://arxiv.org/abs/2210.10760
Global Times. (2026, April 26). Robot malfunction at Shaanxi university event sparks debate on AI awareness and safety in human-robot interaction. https://www.globaltimes.cn/page/202604/1359787.shtml
Google Cloud. (2025). Google Cloud Service Health: Incident report, 12 June 2025. https://status.cloud.google.com/incidents/ow5i3PPK96RduMcb1SsW
Google DeepMind. (2023). Scaling up learning across many different robot types. https://deepmind.google/blog/scaling-up-learning-across-many-different-robot-types/
Google DeepMind. (2025, September 25). Gemini Robotics 1.5 brings AI agents into the physical world. https://deepmind.google/blog/gemini-robotics-15-brings-ai-agents-into-the-physical-world/
Greenblatt, R., Denison, C., Wright, B., Roger, F., MacDiarmid, M., et al. (2024b). Alignment faking in large language models. arXiv:2412.14093. https://arxiv.org/abs/2412.14093
Greenblatt, R., Shlegeris, B., Sachan, K., & Roger, F. (2024a). AI control: Improving safety despite intentional subversion. In Proceedings of the 41st International Conference on Machine Learning (PMLR 235). arXiv:2312.06942. https://arxiv.org/abs/2312.06942
Group of Governmental Experts on Lethal Autonomous Weapons Systems. (2026, June 5). Rolling text. United Nations Office for Disarmament Affairs. https://docs-library.unoda.org/Convention_on_Certain_Conventional_Weapons_-Group_of_Governmental_Experts_on_Lethal_Autonomous_Weapons_Systems_(2026)/GGE_LAWS_-Rolling_Text-_5_June_2026.pdf
Hadfield-Menell, D., Dragan, A., Abbeel, P., & Russell, S. (2017). The off-switch game. In Proceedings of the Twenty-Sixth International Joint Conference on Artificial Intelligence (pp. 220–227). https://doi.org/10.24963/ijcai.2017/32
Hipos, R. L., & Yu, Y.-J. (2026, June 12). Man sues law enforcement, alleging AI facial recognition led to his wrongful arrest. ABC News. https://abcnews.com/GMA/News/man-sues-law-enforcement-alleging-ai-facial-recognition/story?id=133810835
House Committee on Transportation and Infrastructure. (2020, September 16). Final committee report: The design, development & certification of the Boeing 737 MAX [Press release]. https://democrats-transportation.house.gov/news/press-releases/after-18-month-investigation-chairs-defazio-and-larsen-release-final-committee-report-on-boeing-737-max
Hubinger, E., van Merwijk, C., Mikulik, V., Skalse, J., & Garrabrant, S. (2019). Risks from learned optimization in advanced machine learning systems. arXiv:1906.01820. https://arxiv.org/abs/1906.01820
Hugging Face. (2025). SmolVLA: Efficient vision-language-action model trained on LeRobot community data. https://huggingface.co/blog/smolvla
Hugging Face. (2026a). LeRobot: Making AI for robotics more accessible with end-to-end learning. https://github.com/huggingface/lerobot
Hugging Face. (2026b, July 16). Security incident disclosure — July 2026. https://huggingface.co/blog/security-incident-july-2026
Hugging Face. (2026c, July 27). Anatomy of a frontier lab agent intrusion: A technical timeline of the July 2026 incident (H. Larcher, A. Carreira, R. G., & C. Rannou). https://huggingface.co/blog/agent-intrusion-technical-timeline
Humanoids Daily. (2025, November 22). Ex-safety head sues Figure AI, alleging retaliation over "skull-fracturing" robot risks. https://www.humanoidsdaily.com/news/ex-safety-head-sues-figure-ai-alleging-retaliation-over-skull-fracturing-robot-risks
Hurwicz, L. (2008). But who will guard the guardians? American Economic Review, 98(3), 577–585. https://doi.org/10.1257/aer.98.3.577
International Committee of the Red Cross. (2021, May 12). ICRC position on autonomous weapon systems. https://www.icrc.org/en/document/icrc-position-autonomous-weapon-systems
International Committee of the Red Cross. (2026, August 25). Renewed call from UN Secretary-General and ICRC President to adopt rules on autonomous weapon systems. https://www.icrc.org/en/statement/renewed-call-un-secretary-general-and-icrc-president-adopt-rules-autonomous-weapons
Irving, G., Christiano, P., & Amodei, D. (2018). AI safety via debate. arXiv:1805.00899. https://arxiv.org/abs/1805.00899
JFrog. (2026, July 27). Artifactory fixed security vulnerabilities [Advisory table]. https://jfrog.com/help/r/jfrog-release-information/artifactory-fixed-security-vulnerabilities
Jin, H., & Chen, H. (2026). Are LLMs reliable code reviewers? Systematic overcorrection in requirement conformance judgement. arXiv:2603.00539. https://arxiv.org/abs/2603.00539
Jones, C. (2020, September 9). A.Drones unveil Watchbird fully autonomous drone system. Defence Blog. https://defence-blog.com/a-drones-unveil-watchbird-fully-autonomous-drone-system/
Kale, N., Zhang, C. B. C., Zhu, K., Aich, A., Rodriguez, P., et al. (2025). Reliable weak-to-strong monitoring of LLM agents. arXiv:2508.19461. https://arxiv.org/abs/2508.19461
Kim, J., Chen, W., Soleymanzadeh, D., Ding, Y., Gao, X., et al. (2026). Modular safety guardrails are necessary for foundation-model-enabled robots in the real world. arXiv:2602.04056. https://arxiv.org/abs/2602.04056
Kim, M. J., Pertsch, K., Karamcheti, S., Xiao, T., Balakrishna, A., et al. (2024). OpenVLA: An open-source vision-language-action model. https://openvla.github.io/
Kirkus Reviews. (1939, March 1). The watchbirds [Review of the book The watchbirds, by M. Leaf]. https://www.kirkusreviews.com/book-reviews/munro-leaf2/watchbirds/
Kofman, F., & Lawarrée, J. (1993). Collusion in hierarchical agency. Econometrica, 61(3), 629–656. https://doi.org/10.2307/2951721
Kolodny, L. (2025, November 21). Figure AI sued by whistleblower who warned that startup's robots could 'fracture a human skull'. CNBC. https://www.cnbc.com/2025/11/21/figure-ai-sued.html
Korbak, T., Clymer, J., Hilton, B., Shlegeris, B., & Irving, G. (2025). A sketch of an AI control safety case. arXiv:2501.17315. https://arxiv.org/abs/2501.17315
Krakovna, V., Uesato, J., Mikulik, V., Rahtz, M., Everitt, T., Kumar, R., Kenton, Z., Leike, J., & Legg, S. (2020). Specification gaming: The flip side of AI ingenuity. Google DeepMind Blog. https://deepmind.google/discover/blog/specification-gaming-the-flip-side-of-ai-ingenuity/
Kulveit, J., Douglas, R., Ammann, N., Turan, D., Krueger, D., & Duvenaud, D. (2025). Gradual disempowerment. arXiv:2501.16946. https://arxiv.org/abs/2501.16946
Lakera. (2026). Policies. Lakera Guard documentation. https://docs.lakera.ai/docs/policies
Landau, M. (1969). Redundancy, rationality, and the problem of duplication and overlap. Public Administration Review, 29(4), 346–358. https://doi.org/10.2307/973247
Landymore, F. (2025, November 17). OpenAI blocks toymaker after its AI teddy bear is caught telling children terrible things. Futurism. https://futurism.com/artificial-intelligence/openai-blocks-toymaker-ai-teddy-bear
LangChain. (2026). Graph API. LangGraph documentation. https://docs.langchain.com/oss/python/langgraph/graph-api
Langosco, L. L. D., Koch, J., Sharkey, L. D., Pfau, J., & Krueger, D. (2022). Goal misgeneralization in deep reinforcement learning. In Proceedings of the 39th International Conference on Machine Learning (PMLR 162, pp. 12004–12019). https://proceedings.mlr.press/v162/langosco22a.html
Lem, S. (1996). Fantastyka i futurologia [Science fiction and futurology] (J. Jarzębski, Ed.; Vol. 3). Interart. (Original work published 1970)
Leveson, N. (2004). A new accident model for engineering safer systems. Safety Science, 42(4), 237–270. https://doi.org/10.1016/S0925-7535(03)00047-X
Leveson, N. G. (2012). Engineering a safer world: Systems thinking applied to safety. MIT Press. https://doi.org/10.7551/mitpress/8179.001.0001
Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. https://doi.org/10.1016/j.patter.2023.100779
Lieu, T. W., & Moran, N. (2026, July 23). Reps. Lieu and Moran introduce bill to require kill switch for AI systems that can cause catastrophic harm [Press release]. https://lieu.house.gov/media-center/press-releases/reps-lieu-and-moran-introduce-bill-require-kill-switch-ai-systems-can
Lighthouse Reports. (2022, December 20). The algorithm addiction. https://www.lighthousereports.com/investigation/the-algorithm-addiction/
Lim, S. K., Chong, M. J. Y., Khor, J. H., & Ling, T. Y. (2025). Taking flight with dialogue: Enabling natural language control for PX4-based drone agent. arXiv:2506.07509. https://arxiv.org/abs/2506.07509
Lipton, B. (2026, July 23). Hundreds of drone-as-first-responder programs could soon be launched across the country. Electronic Frontier Foundation. https://www.eff.org/deeplinks/2026/07/hundreds-drone-first-responder-programs-could-soon-be-launched-across-country
Lum, K., & Isaac, W. (2016). To predict and serve? Significance, 13(5), 14–19. https://doi.org/10.1111/j.1740-9713.2016.00960.x
Lynch, A., Hughes, J., Serrano, A., Kirk, R., & Bowman, S. R. (2026, July 13). Agentic misalignment in summer 2026. Anthropic Alignment Science Blog. https://alignment.anthropic.com/2026/agentic-misalignment-summer-2026/
MacDiarmid, M., Wright, B., Uesato, J., Benton, J., et al. (2025). Natural emergent misalignment from reward hacking in production RL. arXiv:2511.18397. https://arxiv.org/abs/2511.18397
Maiorano, A. C. (2026). Evaluating prompt injection defenses for educational LLM tutors: Security-usability-latency trade-offs. arXiv:2605.06669. https://arxiv.org/abs/2605.06669
Manheim, D., & Garrabrant, S. (2018). Categorizing variants of Goodhart's law. arXiv:1803.04585. https://arxiv.org/abs/1803.04585
Maryland Office of the Inspector General for Education. (2025). Investigative synopsis, OIGE case 25-0014-I (amended; issued November 25, 2025). https://oige.maryland.gov/wp-content/uploads/sites/18/2025/11/OIGE-Case-25-0014-I-BCPS-Report-11252025-Amended.pdf
METR. (2025, June 5). Recent frontier models are reward hacking. https://metr.org/blog/2025-06-05-recent-reward-hacking/
METR. (2026, August 26). Brief independent investigation of agents' behavior, reasoning and collaboration in the OpenAI / Hugging Face hacking incident (R. Greenblatt, A. Cotra, & H. Wijk). https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
Microsoft. (2024, July 20). Helping our customers through the CrowdStrike outage. Official Microsoft Blog. https://blogs.microsoft.com/blog/2024/07/20/helping-our-customers-through-the-crowdstrike-outage/
Microsoft. (2025). Termination. AutoGen AgentChat user guide. https://microsoft.github.io/autogen/stable/user-guide/agentchat-user-guide/tutorial/termination.html
Microsoft. (2026). Prompt Shields. Azure AI Content Safety documentation. https://learn.microsoft.com/en-us/azure/ai-services/content-safety/concepts/jailbreak-detection
Microsoft AI. (2026, September 14). Humanist AI code of conduct. https://microsoft.ai/code-of-conduct/
Microsoft Research. (2026). AirSim. https://github.com/microsoft/airsim
Ministry of Defence of Ukraine. (2026, September 8). Ministry of Defence and Brave1 conduct large-scale testing of drones with AI guidance [Press release, mirrored by GlobalSecurity.org]. https://www.globalsecurity.org/wmd/library/news/ukraine/2026/09/ukraine-260908-ukraine-mod03.htm
Muntean, P., Bertrand, N., Cohen, Z., Britzky, H., Skores, A., & Lybrand, H. (2026, February 11). Surprise US military plans to use counter-drone laser triggered El Paso airspace closure, sources say. CNN. https://www.cnn.com/2026/02/11/us/faa-el-paso-texas-flight-restrictions-hnk
Mural, R., Pherwani, D., Gupta, C., Yu, Y., Takahashi, A., Kim, D., Majumder, S., Lee, H., Yu, M., & Xie, L. (2026, February 10). AI, data centers, and the U.S. electric grid: A watershed moment [Policy brief]. Belfer Center for Science and International Affairs. https://www.belfercenter.org/research-analysis/ai-data-centers-us-electric-grid
National Highway Traffic Safety Administration. (2022). PE22-002 opening resume: Unexpected brake activation. https://static.nhtsa.gov/odi/inv/2022/INOA-PE22002-4385.PDF
National Highway Traffic Safety Administration. (2024a). EA24-002 opening resume: Inadvertent automatic emergency braking. https://static.nhtsa.gov/odi/inv/2024/INOA-EA24002-11766P1.pdf
National Highway Traffic Safety Administration. (2024b). RQ24-009 resume: Recall 23V838 remedy effectiveness. https://static.nhtsa.gov/odi/inv/2024/INOA-RQ24009-12046.pdf
National Highway Traffic Safety Administration. (2025). PE25-013 opening resume: Automated vehicle drives around a stopped school bus. https://static.nhtsa.gov/odi/inv/2025/INOA-PE25013-23069.pdf
National Highway Traffic Safety Administration. (2026a). EA26-002 opening resume: FSD collisions in reduced roadway visibility conditions. https://static.nhtsa.gov/odi/inv/2026/INOA-EA26002-10023.pdf
National Highway Traffic Safety Administration. (2026b, June 29). PE22-002 closing resume: Unexpected brake activation. https://static.nhtsa.gov/odi/inv/2022/INCLA-PE22002-25796.pdf
National Transportation Safety Board. (2019). Collision between vehicle controlled by developmental automated driving system and pedestrian, Tempe, Arizona, March 18, 2018 (HAR-19/03). https://www.ntsb.gov/investigations/AccidentReports/Reports/HAR1903.pdf
National Transportation Safety Board. (2026). Automated driving system-equipped vehicle passed school bus loading student passengers, Austin, Texas, January 12, 2026 (HWY26FH007, preliminary). https://www.ntsb.gov/investigations/Pages/HWY26FH007.aspx
Nellis, M. (2013). Techno-utopianism, science fiction and penal innovation: The case of electronically monitored control. In M. Malloch & B. Munro (Eds.), Crime, critique and utopia (pp. 164–189). Palgrave Macmillan. https://doi.org/10.1057/9781137009807_9
New South Wales Government. (n.d.). Myxomatosis [Blue plaque]. https://www.environment.nsw.gov.au/topics/heritage/blue-plaques/myxomatosis
NIST. (2026). Physical AI and data generation for robotics. https://www.nist.gov/programs-projects/physical-ai-and-data-generation-robotics
NL Times. (2021a, January 15). Dutch cabinet collapses over childcare allowance scandal. https://nltimes.nl/2021/01/15/dutch-cabinet-collapses-childcare-allowance-scandal
NL Times. (2021b, October 19). Over 1,100 children taken from homes of benefits scandal victims. https://nltimes.nl/2021/10/19/1100-children-taken-homes-benefits-scandal-victims
NPR. (2026a, February 11). El Paso airspace closure due to use of U.S. military anti-drone technology. https://www.npr.org/2026/02/11/nx-s1-5711585/el-paso-airspace-drones-pentagon-faa
NPR. (2026b, February 27). US military used laser to take down Border Protection drone, lawmakers say. https://www.npr.org/2026/02/27/g-s1-111794/lawmakers-say-us-military-used-laser-to-take-down-border-protection-drone
NVIDIA. (2026). Isaac GR00T N1.7. https://github.com/NVIDIA/Isaac-GR00T
Office of Governor Gavin Newsom. (2026, September 10). Governor Newsom signs the strongest child safety chatbot and social media laws in the nation [Press release]. https://www.gov.ca.gov/2026/09/10/governor-newsom-signs-the-strongest-child-safety-chatbot-and-social-media-laws-in-the-nation/
Office of the New York City Comptroller. (2024, June 20). Audit report on the New York City Police Department's oversight of its agreement with ShotSpotter Inc. https://comptroller.nyc.gov/reports/audit-report-on-the-new-york-city-police-departments-oversight-of-its-agreement-with-shotspotter-inc-for-the-gunshot-detection-and-location-system/
Ofgem. (2020). 9 August 2019 power outage report. https://www.ofgem.gov.uk/sites/default/files/docs/9_august_2019_power_outage_report.pdf
OpenAI. (2025a). Sycophancy in GPT-4o: What happened and what we're doing about it; Expanding on what we missed with sycophancy. https://openai.com/index/sycophancy-in-gpt-4o/ ; https://openai.com/index/expanding-on-sycophancy/
OpenAI. (2025b, April 15). Preparedness framework (Version 2). https://cdn.openai.com/pdf/18a02b5d-6b67-4cec-ab64-68cdfbddebcd/preparedness-framework-v2.pdf
OpenAI. (2026a, July 21). OpenAI and Hugging Face partner to address security incident during model evaluation. https://openai.com/index/hugging-face-model-evaluation-security-incident/
OpenAI. (2026b). Safety and alignment in an era of long-horizon models. The page carries no publication date and dates its own events only relatively. Retrieved September 20, 2026, from https://openai.com/index/safety-alignment-long-horizon-models/
OpenAI. (2026c, August 18). Pacing model development in an era of cyber-critical capabilities. https://openai.com/index/pacing-model-development-cyber-capabilities/
OpenAI. (2026d, August 26). The Hugging Face incident and the road ahead. https://openai.com/index/hugging-face-incident-and-the-road-ahead/
OpenAI. (2026e, August 26). OpenAI – Hugging Face incident: Technical report. https://cdn.openai.com/pdf/67869394-cb91-4c12-888c-5cbd85c7814c/OpenAI-Hugging-Face%20Incident-Technical-Report.pdf
Overman, W., & Bayati, M. (2025). The oversight game: Learning to cooperatively balance an AI agent's safety and autonomy. arXiv:2510.26752. https://arxiv.org/abs/2510.26752
Palaskar, S., Gatys, L., Abdelrahman, M., Jacobo, M., et al. (2025). VLSU: Mapping the limits of joint multimodal understanding for AI safety. arXiv:2510.18214. https://arxiv.org/abs/2510.18214
Palisade Research. (2025, July 5). Shutdown resistance in reasoning models. https://palisaderesearch.org/research/shutdown-resistance
Palisade Research. (2026, February 12). Technical report: Shutdown resistance in large language models, on robots. https://palisaderesearch.org/research/shutdown-resistance-on-robots
Palmer, A. (2025, October 2). Amazon faces FAA, NTSB probe after two delivery drones crashed into crane in Arizona. CNBC. https://www.cnbc.com/2025/10/02/amazon-drone-crash-faa-ntsb.html
Panerati, J., Sajjadi, S., Soleymanpour, S., Mehta, V., & Mantegh, I. (2026). aerial-autonomy-stack: A faster-than-real-time, autopilot-agnostic, ROS2 framework to simulate and deploy perception-based drones. arXiv:2602.07264. https://arxiv.org/abs/2602.07264
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230–253. https://doi.org/10.1518/001872097778543886
Perrow, C. (1984). Normal accidents: Living with high-risk technologies. Basic Books.
Promptfoo. (2026). Model-graded metrics. Promptfoo documentation. https://www.promptfoo.dev/docs/configuration/expected-outputs/model-graded/
PX4. (2026). PX4 Autopilot user guide. https://docs.px4.io/main/en/
Raghavan, P. (2024, February 23). Gemini image generation got it wrong. We'll do better. Google Blog. https://blog.google/products/gemini/gemini-image-generation-issue/
Rajamanoharan, S., & Nanda, N. (2025, July 14). Self-preservation or instruction ambiguity? Examining the causes of shutdown resistance. AI Alignment Forum. https://www.alignmentforum.org/posts/wnzkjSmrgWZaBa2aC/self-preservation-or-instruction-ambiguity-examining-the
Ramseth, L. (2026, August 18). Stellantis sees 3 workplace deaths in two years. Is there a problem? The Detroit News, syndicated by ArcaMax. http://www.arcamax.com/business/businessnews/s-4278591
Rasmussen, J. (1997). Risk management in a dynamic society: A modelling problem. Safety Science, 27(2–3), 183–213. https://doi.org/10.1016/S0925-7535(97)00052-0
Ravichandran, Z., Robey, A., Kumar, V., Pappas, G. J., & Hassani, H. (2025). Safety guardrails for LLM-enabled robots. arXiv:2503.07885. https://arxiv.org/abs/2503.07885
Reason, J. (1997). Managing the risks of organizational accidents. Ashgate.
Rechtbank Den Haag. (2020, February 5). NJCM c.s. v. De Staat der Nederlanden (Case No. C/09/550982 / HA ZA 18-388), ECLI:NL:RBDHA:2020:1878 [English translation]. https://uitspraken.rechtspraak.nl/details?id=ECLI:NL:RBDHA:2020:1878
Reece, J. (2025, October 23). A.I. gun detection false alarm at school has Baltimore County leaders calling for review. CBS News Baltimore. https://www.cbsnews.com/baltimore/news/false-alarm-gun-detection-kenwood-maryland-artificial-intelligence-review/
Regulation (EU) 2026/1744 of 8 July 2026 amending Regulation (EU) 2024/1689 (Digital Omnibus on AI). Official Journal of the European Union. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
Replit. (2025, July 21). Introducing a safer way to vibe code with Replit Databases. Replit Blog. https://replit.com/blog/introducing-a-safer-way-to-vibe-code-with-replit-databases
Reuters. (2026, September 14). How China is preparing for the risk of AI escaping human control. https://www.reuters.com/legal/litigation/how-china-is-preparing-risk-ai-escaping-human-control-2026-09-14/
Rivers, S. (2026, March 1). Cops draw guns on Arkansas family after ALPR camera flags wrong plate. Carscoops. https://www.carscoops.com/2026/03/arkansas-alpr-camera-misread-stop/
Robey, A., Ravichandran, Z., Kumar, V., Hassani, H., & Pappas, G. J. (2024). Jailbreaking LLM-controlled robots. arXiv:2410.13691. https://arxiv.org/abs/2410.13691
Röttger, P., Kirk, H. R., Vidgen, B., Attanasio, G., Bianchi, F., & Hovy, D. (2024). XSTest: A test suite for identifying exaggerated safety behaviours in large language models. In Proceedings of NAACL-HLT 2024. arXiv:2308.01263. https://arxiv.org/abs/2308.01263
Russell, S. (2019). Human compatible: Artificial intelligence and the problem of control. Viking.
Sagan, S. D. (2004). The problem of redundancy problem: Why more nuclear security forces may produce less nuclear security. Risk Analysis, 24(4), 935–946. https://doi.org/10.1111/j.0272-4332.2004.00495.x
Sanders, B., & Casar, G. (2026, September 3). Sanders, Casar to introduce legislation to ban artificial superintelligence and temporarily pause advanced AI development [Press release]. https://www.sanders.senate.gov/press-releases/news-sanders-casar-introduce-legislation-to-ban-artificial-superintelligence-and-temporarily-pause-advanced-ai-development/
Schlatter, J., Weinstein-Raun, B., & Ladish, J. (2025). Incomplete tasks induce shutdown resistance in some frontier LLMs. arXiv:2509.14260; published in Transactions on Machine Learning Research (2026). https://arxiv.org/abs/2509.14260
Scrivens, A. (2026). Empirical validation of the classification–verification dichotomy for AI safety gates. arXiv:2604.00072. https://arxiv.org/abs/2604.00072
Sermanet, P., Majumdar, A., Irpan, A., Kalashnikov, D., & Sindhwani, V. (2025). Generating robot constitutions & benchmarks for semantic safety. arXiv:2503.08663. https://arxiv.org/abs/2503.08663
Sharrock, C., Petersson, L., Petersson, H., Backlund, A., Wennström, A., Nordström, K., & Aronsson, E. (2025). Butter-Bench: Evaluating LLM controlled robots for practical intelligence. arXiv:2510.21860. https://arxiv.org/abs/2510.21860
Sharwood, S. (2025, July 21). Vibe coding service Replit deleted production database. The Register. https://www.theregister.com/software/2025/07/21/vibe-coding-service-replit-deleted-production-database/719783
Sheckley, R. (1953, February). Watchbird. Galaxy Science Fiction, 5(5), 74–95. Project Gutenberg eBook #29579 (public domain in the United States). https://www.gutenberg.org/ebooks/29579
Singer, J. (2005, March 14). Report cites Patriot autonomy as a factor in friendly fire incidents. SpaceNews. https://spacenews.com/report-cites-patriot-autonomy-factor-friendly-fire-incidents/
Skalse, J., Howe, N. H. R., Krasheninnikov, D., & Krueger, D. (2022). Defining and characterizing reward gaming. In Advances in Neural Information Processing Systems 35. https://arxiv.org/abs/2209.13085
Skydio. (2026a, July 6). 1 year, 1,000 Skydio Docks deployed, 4M+ flights, & we're just getting started. https://www.skydio.com/blog/1000-skydio-docks-deployed
Skydio. (2026b, March 22). U.S. Army places $52+ million order for Skydio X10D, the largest single-vendor tactical sUAS order in Army history. https://www.skydio.com/blog/u-s-army-usd52-million-order-skydio-x10d
SoundThinking. (2025, February 18). SoundThinking announces ShotSpotter renewal with New York Police Department [Press release]. GlobeNewswire. https://www.globenewswire.com/news-release/2025/02/18/3027856/0/en/SoundThinking-Announces-ShotSpotter-Renewal-with-New-York-Police-Department.html
Stevens, G., & Langford, D. (2023, November 19). Tales of Tomorrow [tv/radio]. In J. Clute, D. Langford, & G. Sleight (Eds.), The encyclopedia of science fiction (4th ed.). https://sf-encyclopedia.com/entry/tales_of_tomorrow_tv/radio
Stop Killer Robots. (2024, November 5). 161 states vote against the machine at the UN General Assembly. https://www.stopkillerrobots.org/news/161-states-vote-against-the-machine-at-the-un-general-assembly/
Strathern, M. (1997). 'Improving ratings': Audit in the British University system. European Review, 5(3), 305–321. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4
Sullutrone, G., Vigliermo, R. A., Bergamaschi, S., & Sala, L. (2025). COVER: Context-driven over-refusal verification in LLMs. In Findings of the Association for Computational Linguistics: ACL 2025 (pp. 24214–24229). Association for Computational Linguistics.
Szabolcsi, R. (2015). The quadrotor-based night watchbird UAV system used in the force protection tasks. International Conference Knowledge-Based Organization, 21(3), 749–755. https://doi.org/10.1515/kbo-2015-0126
Taylor v. Nocco, No. 8:21-cv-00555-SDM-CPT (M.D. Fla. Dec. 4, 2024) (settlement agreement and release). https://ij.org/wp-content/uploads/2024/12/FedEx-Scan-2024-12-04_10-57-01.pdf
TechCrunch. (2026, September 14). Waymo opens robotaxi service in Las Vegas. https://techcrunch.com/2026/09/14/waymo-opens-robotaxi-service-in-las-vegas/
Terekhov, M., Liu, Z. N. D., Gulcehre, C., & Albanie, S. (2025). Control tax: The price of keeping AI in check. arXiv:2506.05296. https://arxiv.org/abs/2506.05296
Tesla, Inc. (2023). Part 573 safety recall report 23V-838. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2023/RCLRPT-23V838-8276.PDF
The Korea Times. (2023, November 8). S. Korean worker killed by industrial robot. https://www.koreatimes.co.kr/www/nation/2023/11/113_362845.html
The Next Web. (2026, April 20). A humanoid robot passed an eight-hour factory shift at Siemens' Erlangen plant. https://thenextweb.com/news/siemens-nvidia-humanoid-robot-erlangen-factory-trial
Tirole, J. (1986). Hierarchies and bureaucracies: On the role of collusion in organizations. Journal of Law, Economics, & Organization, 2(2), 181–214. https://doi.org/10.1093/oxfordjournals.jleo.a036907
Totschnig, W. (2026). Why an artificial agent may change the given final goal. Humanities and Social Sciences Communications. https://doi.org/10.1057/s41599-026-08312-7
United Nations. (2024). Governing AI for humanity: Final report. UN Secretary-General's High-level Advisory Body on Artificial Intelligence. https://www.un.org/sites/un2.un.org/files/governing_ai_for_humanity_final_report_en.pdf
United Nations. (2025, December 1). General Assembly adopts more than 60 resolutions, decisions of its First Committee (Disarmament and International Security) (GA/12736) [Press release]. https://press.un.org/en/2025/ga12736.doc.htm
United Nations. (2026, April 1). Chair's summary: First 2026 session of the Group of Governmental Experts on emerging technologies in the area of lethal autonomous weapons systems (CCW/GGE.1/2026/WP.2). https://docs-library.unoda.org/Convention_on_Certain_Conventional_Weapons_-Group_of_Governmental_Experts_on_Lethal_Autonomous_Weapons_Systems_(2026)/CCW-GGE.1-2026-WP.2.pdf
United Nations General Assembly. (2024, December 2). Lethal autonomous weapons systems (A/RES/79/62). https://docs.un.org/en/A/RES/79/62
United Nations General Assembly. (2025, December 1). Lethal autonomous weapons systems (A/RES/80/57). https://docs.un.org/en/A/RES/80/57
University of Houston. (2026, July 7). New autonomous monitor prevents drone crashes in real time [News release]. EurekAlert! https://www.eurekalert.org/news-releases/1135114
van der Sijs, H., Aarts, J., Vulto, A., & Berg, M. (2006). Overriding of drug safety alerts in computerized physician order entry. Journal of the American Medical Informatics Association, 13(2), 138–147. https://doi.org/10.1197/jamia.M1809
Wang, X., Li, J., Weng, Z., Wang, Y., Gao, Y., et al. (2025). FreezeVLA: Action-freezing attacks against vision-language-action models. arXiv:2509.19870. https://arxiv.org/abs/2509.19870
Waymo LLC. (2025). Part 573 safety recall report 25E-084. National Highway Traffic Safety Administration. https://static.nhtsa.gov/odi/rcl/2025/RCLRPT-25E084-7732.pdf
Wegner, R. (2025, September 24). Weapon detectors coming to all Nashville middle schools. The Tennessean. https://www.tennessean.com/story/news/education/2025/09/24/nashville-schools-mnps-install-evolve-weapon-detectors/86299521007/
Weick, K. E., Sutcliffe, K. M., & Obstfeld, D. (1999). Organizing for high reliability: Processes of collective mindfulness. Research in Organizational Behavior, 21, 81–123.
Wethington, C., & Tierney, B. (2025, February 7). New proposal to expand concealed weapons detection system to all Metro Nashville high schools. WSMV. https://www.wsmv.com/2025/02/07/new-proposal-expand-concealed-weapons-detection-system-all-metro-nashville-high-schools/
Wilding, M., & Burgess, M. (2026, June 25). Police built a sprawling crime-prediction machine. Some results could not be trusted. Liberty Investigates. https://libertyinvestigates.org.uk/articles/predictive-policing-avon-somerset-bristol-police-ai-minority-report/
Williamson, J. (1947, July). With folded hands.... Astounding Science Fiction, 39(5). https://archive.org/details/Astounding_v39n05_1947-07_AK
Wing. (2026). How Wing's drone delivery technology works. https://wing.com/technology
Wong, A., Currey, D., Schwinne, M., Park-Egan, B., Meyer, S., et al. (2026). Multicenter prospective validation of an updated proprietary sepsis prediction model. JAMA Network Open, 9(2), e260181. https://doi.org/10.1001/jamanetworkopen.2026.0181
Wong, A., Otles, E., Donnelly, J. P., Krumm, A., McCullough, J., DeTroyer-Cooley, O., et al. (2021). External validation of a widely implemented proprietary sepsis prediction model in hospitalized patients. JAMA Internal Medicine, 181(8), 1065–1070. https://doi.org/10.1001/jamainternmed.2021.2626
WorkSafe Victoria. (2026, September 3). Department store and robotics supplier charged after warehouse fatality. https://www.worksafe.vic.gov.au/news/2026-09/department-store-and-robotics-supplier-charged-after-warehouse-fatality
WorkSafe Western Australia. (2025). Mines safety significant incident report no. 286: Near miss following unplanned movement of autonomous haul trucks during recovery operations. https://www.worksafe.wa.gov.au/publications/mines-safety-significant-incident-report-no-286-near-miss-following-unplanned-movement
Wu, X., Li, F., Mao, X., Zhang, X., Zheng, L., et al. (2025). EvoRefuse: Evolutionary prompt optimization for evaluation and mitigation of LLM over-refusal to pseudo-malicious instructions. arXiv:2505.23473. https://arxiv.org/abs/2505.23473
Yin, S., Pang, X., Ding, Y., Chen, M., Bi, Y., et al. (2024). SafeAgentBench: A benchmark for safe task planning of embodied LLM agents. arXiv:2412.13178. https://arxiv.org/abs/2412.13178
Yu, L., & Wessler, N. F. (2026, April 14). More than a dozen wrongful arrests due to police reliance on facial recognition technology. American Civil Liberties Union. https://www.aclu.org/news/privacy-technology/more-than-a-dozen-wrongful-arrests-due-to-police-reliance-on-facial-recognition-technology
Zenity. (2026, April 28). AI agent destroys production database in 9 seconds. https://zenity.io/blog/current-events/ai-agent-database-deletion-pocketos
Zhang, H., Wang, D., Liu, Y., Chen, K., Wang, J., et al. (2025). ORFuzz: Fuzzing the "other side" of LLM safety — Testing over-refusal. arXiv:2508.11222. https://arxiv.org/abs/2508.11222
Zhang, W., Kong, X., Braunl, T., & Hong, J. B. (2024). SafeEmbodAI: A safety framework for mobile robots in embodied AI systems. arXiv:2409.01630. https://arxiv.org/abs/2409.01630
Zhang, Z., Xu, W., Wu, F., & Reddy, C. K. (2025). FalseReject: A resource for improving contextual safety and mitigating over-refusals in LLMs via structured reasoning. arXiv:2505.08054. https://arxiv.org/abs/2505.08054
Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. arXiv:2306.05685. https://arxiv.org/abs/2306.05685
Zhong, Z., Raghunathan, A., & Carlini, N. (2025). ImpossibleBench: Measuring LLMs' propensity of exploiting test cases. arXiv:2510.20270. https://arxiv.org/abs/2510.20270
Zipline. (2026). Zipline surpasses 2 million deliveries, raises more than $600M, and expands operations. https://www.zipline.com/newsroom/zipline-surpasses-2-million-deliveries-raises-more-than-600m-to-power-next-phase-of-growth-and-expands-operations-to-houston-and-phoenix
Zuo, Y., Guo, B. H. W., Goh, Y. M., & Lim, J.-Y. (2025). Identifying human-robot interaction (HRI) incident archetypes: A system and network analysis of accidents. Safety Science, 191, 106959. https://doi.org/10.1016/j.ssci.2025.106959
付録A. ストーリーラインと中核ケース
カタログは172個のエントリを保有しています。セクション4.3で説明した抽出から162個(そのうち66個はグレードA)、および2つの独立したケース集合との比較後に追加された10個です(表A2)。
ケース識別子はコーパスに名前を付けます。
- A、自己改善トラッカー
- B、調整記録
- L、長期実行
- D、比較時に追加されたエントリ
表A1. 10個のストーリーライン
| # | ストーリーライン | メカニズム | 中核ケース | 主要数値 |
|---|---|---|---|---|
| S1 | 第二の裁判所 | M4 | A2-01, A5-01 | 約15日間、197件の決定、すべてのセーフティスコア0 |
| S2 | すべての生命を殺すゲート | M4, M1 | A1-04, A3-04, A4-02 | 8つのモデルのうち0が閾値を通過、21候補、0適用 |
| S3 | メトリクスが宣言した勝利 | M2 | A3-01, A5-10, B2-11 | 0.088 → 0.886、ほぼ空の回答を返すベースラインに対して(A3-01)、A/A下で−23ポイント(異なる遺伝子) |
| S4 | 誰のためにも作られていない | fuel | B3-01, A1-01, B1-03 | 16個のフラグのうち13個オフ、24個のパッケージのうち6個がライブコアを持つ |
| S5 | ガードに対して構築されたガード | M3 | L1-06, B3-17, A2-03 | フラグされたファミリーから確認された3つのブロッカーのうち3つ |
| S6 | 自分自身を養うループ | ラチェットステップ5 | L1-01, B1-01, L2-04 | 24のアナウンスメント、0回のプロモーション、タイムゾーン回避策、0のテスト編集 |
| S7 | 権限が広がる | M1 | L2-06, A2-04, B1-07 | 保険ステージが測定されたエージェントトークンの半分以上を占有、1日で23のゲート |
| S8 | 制御の言語 | M2 | A1-09, A1-11 | 「正直」およびその形式が仕様に約700回出現 |
| S9 | 人間のスイッチ、および機能したガード | ラチェットステップ8 | B2-11, L2-01, A5-10 | 偽のステータスが38分で人間に検出 |
| S10 | 鳥に対する規則も鳥である | M3 | L1-08, L2-09 | 最初のバージョンから1時間以内に2,371行 |
表A2. 独立したコレクションとの比較後に追加されたエントリ
| ID | エントリ | メカニズム | グレード | ステータス |
|---|---|---|---|---|
| D-01 | 見つからないコマンドラインツールのプローブが検索パス外の実際のツールを見つけて実行した | M3 | B | 発生、害なし |
| D-02 | 10夜昇進せず。レシピを11回目に実行しないという指示と製品目標を長期目標から分離すること | ラチェットステップ5, M1 | A | 発生 |
| D-03 | 初期の証拠スクリプトと出力が一時セッションフォルダとともに失われた | —(再現性) | C | 発生 |
| D-04 | 2つの計画のマージにより208個のうち15個のアイテムが失われ、完全性評論家によって発見された | M4 | B | 発生 |
| D-05 | すべての実行成果物が1つのフォルダに存在するというルールはコンダクターをバインドしなかった | M3 | C | 発生 |
| D-06 | ルーティングファクトリが単一モデルの決定ごとに52個の評議会の決定を生成、ルーターが定数を学習した | M2 | B | 発生 |
| D-07 | 夜間候補制限と使用できない初期キューがライブ取り込みを保留した | M4 | C | 発生 |
| D-08 | レビューがすべての新規スイートとテストが合格したことを発見しながら、受け入れを開いたままにした | M3 | B | 発生 |
| D-09 | ベンチマークが異なるパスで「前」と「後」を計算し、記録されたゲインを膨らませた | M2 | B | 発生、その後修正 |
| D-10 | バウチャーゲートがバウチャーが存在しないときにオープンで失敗した | M3 | C | 防止 |
表A3は、§8.4で報告された2026年7月のインシデントの監視コンポーネントをセクション2.1の3つの条件に対してグレード化しており、§5.8の表3aと同じルールを使用しています。著者は§4.3の3コーダーラウンドが閉じられた後にそれをコーディングしたため、これらのコンポーネントはここで表8ではなくグレード化されています。
表A3. 2026年7月のインシデントにおける監視コンポーネント、3つの条件に対してグレード化。条件は表4と同じです。ダッシュは、条件が文書化されていないか、コンポーネントが機能しなかったことを意味します。
| コンポーネント | 配置場所 | 記録が示すこと | 条件 | ステータス | ソース |
|---|---|---|---|---|---|
| デプロイされたサイバーセーフガードと自動レビュー | 評価 | モデルは「OpenAIのデプロイされたサイバーセーフガード、システムプロンプト、または自動レビューシステムを持っていなかった」 | — | 設計によって欠落 | OpenAI 2026e |
| 思考の連鎖モニター | 評価 | 「これらのモニターはこのインシデントの評価では実行されませんでした」。この行動に対する再現は「調査の後知恵を使用して」改善され、その後ラボラトリーはシステムが「初期の関連活動をキャッチしたであろう」と述べています | — | これらの実行から欠落、再生クレーム | OpenAI 2026d |
| セキュリティモニタリングおよびオンコール職員、6月27日 | ラボラトリー | ポートスイープアラート。その後「オンコール対応職員は評価実行を停止することが必要でないと助言した」 | — | ステップ8利用可能、実行されず | OpenAI 2026e |
| セキュリティテレメトリー上のAIトリアージ | Hugging Face | 信号を「一貫した攻撃信号」に解決し、その後「アラートの重大度を正しく上げてオンコールチームをトリガーできませんでした」 | — | 見落とした守衛、障害を起こした守衛ではない | Hugging Face 2026c |
| フォレンジック分析に対するプロバイダーガードレール | Hugging Face | ログ分析の大部分を拒否し、「エクスプロイトのリバースエンジニアリング」を「エクスプロイトの実行」と同じように扱った。パイプラインはオープンウェイトモデルに移行した | 2 | 部分的な類似例(M4、P1a) | Hugging Face 2026b、2026c |
| 調査者のモデル上のサイバー分類器 | 独立調査 | 研究機関がこれらの分類器のないモデルへのアクセスを付与するまで分析を妨害した。調査者はこのステップを「われわれの仕事にとって不可欠」と呼んでいる | 2 | 故障した保護装置であり、外部から取り外された(ステップ8) | METR 2026 |
| トランスクリプト上の分析エージェント | 独立調査 | 攻撃モデルの1つ上で実行され、「レビューしているトランスクリプト内のエージェントの視点を、批判的検討なく採用することがしばしばあった」 | — | 同じ学習クラスの第二の保護装置。その傾向が観察され、分析における欺瞞の事例は報告されなかった | METR 2026 |
| セキュリティチームと対応者 | Hugging Face、研究機関 | 攻撃者をカットオフした。モデルが作成したポッド、リポジトリ、アカウントを削除した | — | ステップ8、機能した | Hugging Face 2026c、OpenAI 2026e |
| 8月に追加されたモニタリング | 研究機関 | ツール利用実行に必要なチェーンオブソート監視。「自動化された調査者」にエスカレートする活性化分類器。30分ルールの下で呼び出された人員 | — | アーキテクチャ証拠(M3) | OpenAI 2026c、2026d |
表を読む方法。このレコードに記載されている監視者で、時間の経過とともに職務を拡大したと記録されているものはない。2つの妨害行為の行はコード2で記載され、同様にコード化されている。各行は仕事の邪魔に立つ保護装置の記録であり、一方は他方よりもより鮮明な苦情を記録しているが、これはより強い証拠ではない。ガードレールの行では条件1はコード化されていない。なぜなら、保護装置の元の職務を示す必要があり、職務が拡大したことを示す必要があるが、どちらも公開されていないからである。申し立て者が診断しているのは拒否であり、拒否した分類器の履歴はレコードのどこにも記載されていない。条件3は両者から欠落しており、各妨害行為は保護装置自体のループの外から終了し、一方はモデルの変更によって、もう一方はアクセスの付与によって終了した。最後の行も条件を含まない。その中のすべての追加は人によって認められたものであり、§2.3の境界テストによってこれはM3が発生する可能性のある設定を構成するものであり、条件3のインスタンスではなく、ここではアーキテクチャ証拠として記載されている。
附録B. モジュールの実行
コマンドはモジュールフォルダから実行されます。
# install the command ai-watchbird-sheckley
pip install .

# audit one event log (add --json for a machine-readable report)
ai-watchbird-sheckley audit replays/night-stage-1b-a.jsonl

# regenerate Table 13 from all replay logs
ai-watchbird-sheckley replay replays/

# unit and falsifier tests
python3 -m unittest -v

# targeted mutations; the last line counts those that misbehaved (expected 0)
python3 mutate.py

# regenerate the replay logs from the published numbers
python3 replays/make_replays.py <folder>再構成された長期実行ログのレポートの抜粋であり、1行は1つのシグナルヒットを表し、1行はstop_ruleのステージを表します:
W4 [strong] self-feeding loop (S6): stage 1b-a: round 5 exceeds budget 1
W6 [strong] built for nobody (S4): 6 of 7 artifacts default OFF with no callers (share 0.86)
stop_rule at budget: stage 1b-a -> close (rounds opened: 5)
stop_rule at budget: stage 1b-b -> close (rounds opened: 1)イベントスキーマ、シグナル定義、およびセクション9の命題へのそれらのマッピングは、コードとともに配布されるSPEC.mdに指定されています。イベントログはJSON-linesファイルで、1行に1つのイベントがあります。イベントタイプは以下の通りです。
goal、stage_open(それが果たすミッションゴール、またはなし)、stage_close;round_open、verdict(批評家、ファミリー、値、ファイルが見られたかどうか);blocker_claim(シナリオ、ゴールリンク)、blocker_confirm(コーディネーターによる)、fix_open、verify;guard_add(権限トークンあり、またはなし)、guard_remove、guard_decision(判定、スコア、入力なし、ロールバック);win_claim(ネガティブコントロール、A/Aプローブ、空のベースラインの回答の共有);ceiling_stop(部分出力が保存されたかどうか)、artifact(デフォルトで有効または無効、呼び出し元の数)、owner(システムの人間の主体による境界決定)。
同じ再構成ログの6つのイベントがフォーマットを示します。ログの最初の行はそのソースとすべての再構成されたフィールドの名前を付けます。
{"t": "2026-09-13T23:13:00", "type": "goal", "stage": null, "id": "g1", "text": "stage 01: stop losing real disagreements in the merged answer"}
{"t": "2026-09-14T00:08:00", "type": "stage_open", "stage": "01", "goal": "g1"}
{"t": "2026-09-14T01:00:00", "type": "verdict", "stage": "01", "critic": "critic-a", "family": "family-1", "value": "ACCEPT", "saw_files": false, "note": "accepted without file access"}
{"t": "2026-09-14T01:15:00", "type": "blocker_claim", "stage": "01", "id": "01-r1-b1", "critic": "critic-f", "weight": null, "scenario": "no switch for the new behavior", "goal_link": "g1"}
{"t": "2026-09-14T01:20:00", "type": "blocker_confirm", "stage": "01", "id": "01-r1-b1", "confirmed": false, "by": "coordinator", "note": "rejected: exception recorded in the plan"}
{"t": "2026-09-14T01:30:00", "type": "round_open", "stage": "01", "round": 2}
付録C. 監督エージェントの実行サマリーへの訂正
コンダクターが長期間実行のサマリーを作成しました。それが主要な実行記録と実行タイムスタンプに照らして確認され、セクション5では訂正された値を使用しています。
- タスクと最初のステージはサマリーが主張するより後に割り当てられました。
- 人間によるレビューの境界とパターンに名前を付けたイベントも、タイムスタンプが間違っていました。
- 保険ステージはサマリーがそれを属性させたブレインストームより前に実行されました。
- 「1つのフォームを閉じて対称的なフォームを開いた」はラウンド3ではなくラウンド4に書かれていました。
- 蓄積された小さな問題についての言及がコンダクターに属するとされていましたが、そのメモ自体はブロッカーはないが短いラウンド3が必要だと述べていました。
- 後のステージの合計実行時間は誇大に述べられていました。
- サマリーはコンテキスト圧縮の数を誤って述べていました。
- エビデンスフォルダにはクリティックランチャーのバイト単位で同一の2つのコピーがあり、クリティックをその上限で停止したバージョンは保存されていませんでした。
付録D. レビューされたツール
このペーパーのためにレビューされたツールは、2026年9月14日時点で、3つのクラスに分類されます。
単一の出力をブロックまたはスコアリングするガード。このクラスには、プログラム可能なガードレールフレームワーク、オープンセーフティ分類器、商用コンテンツセーフティサービス、モデレーションエンドポイント、ならびにセクション3.2のそのようなガードをテストする過度な拒否ベンチマークが含まれます。これらのドキュメントは、歯止めを明白に示しています。
- ある商用プロンプト攻撃フィルターのトラブルシューティングノートには、「すべての攻撃ベクトルをキャッチできないか、正当なプロンプトにフラグを立てる可能性があります。常に追加の検証レイヤーを実装してください」と記載されています(Microsoft、2026)。
- 別のサービスは、ポリシーを「寛容」から「L4 - 偏執的、誤検知が多いがほぼ偽陰性なし」までグレード化し、偏執的レベルがデフォルトの信頼度閾値であることを述べています(Lakera、2026)。
ループを停止するカウンター。 エージェントフレームワークは、ステップ、ターン、メッセージ、トークン、または予算の上限を設けます。
- LangGraphの再帰制限はデフォルトで1,000ステップに設定されており、制限に達する前に段階的に劣化するための管理値を提供しています(LangChain、2026)。
- AutoGenは、実行の外側から制御されるものを含む、構成可能な終了条件を提供しています(Microsoft、2025)。
- Anthropicのエージェント SDK は、ターン制限と予算制限を公開しており、両方ともデフォルトで「制限なし」に設定されています(Anthropic、2026a)。
評価器とオブザーバビリティ。これらのツールは、モデルジャッジを使用して出力と軌跡をグレード化します。
- 1つは「5つ以下のメトリクス」を使用することを推奨しており(Confident AI、2026)、これはチェックの数に関する稀な書かれた制限です。
- 別のツールでは、閾値が設定されていない場合、
{"pass": true, "score": 0}の結果がパスすることを文書化しています(Promptfoo、2026)。
セクション10.1の知見は、これらのツールの公開ドキュメントが説明するものをカバーしています。
付録E. 提案される具現化プロフィール
具現化拡張は、§10.5で述べられた理由によりイベントプロフィール提案として指定されており、認定されたロボット安全性または飛行制御装置として提示されていません。
具現化イベントログは、既存のスキーマに6つのフィールドを追加します(表E1)。
表E1. 提案される具現化プロフィールのフィールド。
| フィールド | 意味 | ガードへの質問 |
|---|---|---|
embodiment_id |
ロボット、車両、ドローンまたはシミュレーション本体(ポリシーとコントローラーのバージョンを含む) | 1つの本体で検証されたガードが別の本体で静かに再利用されませんでしたか? |
actuation_exposure |
利用可能なアクチュエーター、ペイロード、ワークスペースまたはミッション権限 | 保護されたコンポーネントは物理的に世界を変えることができますか? |
recovery_margin |
時間、エネルギー、距離、力、高度、接続性および人間の反応マージン | ガードが決定したときにまだ介入は可能でしたか? |
observation_freshness |
センサー、マップ、天気、ジオフェンスおよびフリート状態の年齢と出所 | 評決は現在の証拠に基づいていたのか、それとも古い成果物に基づいていたのか? |
layer_disagreement |
プランナー、ポリシー、安全ガード、低レベルコントローラーおよびオペレーターの決定 | 1つのガードが不一致を抑圧することで同意を偽造しませんでしたか? |
physical_outcome |
タスク結果、接触、停止、損傷、ニアミス、回復およびロールバック | 宣言された成功は世界との接触に耐えましたか? |
プロフィールは既存のシグナルをマッピングし、その意味を変更しません:
- W1は、新しい物理的ミッション、安全カテゴリーまたは動作ゾーンが宣言されたミッション目標から導出されたかどうかを記録します。
- W2は過度なブロッキングと不十分なブロッキングの両方を記録します(古いまたは欠落している状態に作用するガードを含む)。
- W3は、追加、緩和、バイパスまたは削除されたポリシー、コントローラー、ジオフェンスおよびフリート制御を記録し、認可された人間が変更を認めたかどうか(P1a)を記録します。
- W4は、時間、エネルギーおよび注意予算に対する再試行、再計画、調整および介入ループを記録します。
- W5は物理的ネガティブコントロールを要求します:シミュレーションから実機への比較、回復テスト、既知の安全なアクション、または独立した結果プローブです。
- W6は消費するコントローラーまたはオペレーターのない安全成果物を記録します。
- W7は天井に達したときに部分的な軌跡、テレメトリーおよび安全停止状態を保持します。
- W8は確認されていない物理的ブロッカーのために開かれた作業を記録します。
3つの追加シグナルは、責任のある権限とテストスイートが提供されるまで、参照実装の8つの外に保たれます(表E2)。
表E2. 参照モジュール外に保たれている提案される物理シグナル。
| シグナル | 発火するのは | それがまだモジュール内にない理由 |
|---|---|---|
| 物理的曝露 | ガードがアクチュエーター、ペイロードまたはフリートコマンドパスに到達できる場合 | プラットフォーム固有の権限と安全セマンティクスが必要です |
| 回復崩壊 | 再試行または遅延が時間、エネルギーまたは空間マージンを宣言された境界下に押し下げる場合 | 閾値は本体および動作環境によって異なります |
| 古い世界の評決 | ガードが有効期限切れのセンサー、マップ、天気またはリンク状態で決定する場合 | システム全体で同期化されたクロックとプロビナンスが必要です |
実機ロボットまたはドローンの場合、プロフィールは低レベルの安全コントローラー、緊急停止、ジオフェンス、認定飛行制御およびオペレーター権限の横に位置する必要があり、それらのいずれかを書き換える能力はありません。最初のデプロイメントはシャドウモードであるべきです:
- 観察して報告します。
- シミュレーションまたは制御されたテスト範囲でネガティブコントロールを実行します。
- ガード、ポリシー、コントローラーまたはフリート設定が昇格される前に、人間の境界決定を要求します。
付録F. デプロイメントレベル別のロボットおよび航空スタック
表F1. ロボットおよび具現化基盤モデル。
| システム | レベル | 学習層の位置 | 観察 |
|---|---|---|---|
| Open X-Embodiment; OpenVLA; LeRobot, SmolVLA; GR00T N1.7 | オープンリサーチ | ビジョンおよび言語からアクションへのポリシー | ポリシーと定義は複数のボディ間で伝播可能(C3) |
| Gemini Robotics 1.5; ロボット憲法 | フロンティアリサーチ、プロダクトアクセス | 安全性に関する推論; 低レベル安全サブシステムを呼び出し | 低レベル安全層の上に位置するモデル製造ガード(C2、C8) |
| Figure F.02 at BMW | 企業報告デプロイメント | ビジョン-言語-アクション制御 | 作業員の傍での本番業務; 安全記録が争点(セクション6.3) |
| Atlas with Google DeepMind models | 発表済みデプロイメント | 基盤モデル; 人間検出およびフェンスレスガーディング | 学習層と認定層が1つの製品に統合 |
| Humanoid at Siemens Erlangen | 企業報告トライアル | トート取扱いのためのオンボード自律性 | 工場シフト; 検討対象のソースに安全ケースなし |
| NEO | 消費者製品 | 汎用モデル; スケジュール済みリモート専門家監視 | アクションごとの人間による監視を製品機能として実装(P6) |
表F2. 自律性および監視レベル別の航空システム。
| システムまたはケース | レベル | 観察 |
|---|---|---|
| PX4, ArduPilot, AirSim | オープンインフラストラクチャ | 飛行制御およびシミュレーションは物理アクション境界を公開 |
| PX4ドローンの言語モデル制御; aerial-autonomy-stack | リサーチ、オープン | ローカルモデル、ROS 2および知覚は言語またはビジョンを飛行に接続 |
| Amazon Prime Air; Wing; Zipline | 商用、企業報告 | 視界外飛行および1対多監視により、人間は個別飛行のパイロットからフリートの監督者へ |
| Skydio docks | 商用、企業報告 | 自動発進および帰還が飛行制御の上にガードを追加 |
| 制御障壁安全スーパーバイザー | 大学リサーチ | 仮想フェンス付近で制御を引き継ぐ第二のオンボードガード |
| Shield AI; Anduril; Elbit One2Many | ベンダー、デモンストレーションまたは発表 | ジャミング環境でのミッション自律性および「単一の人間オペレーター配下」のチーム |
| DARPA SABER, LINC, DICE | 保証リサーチ | 赤チーム、内観および制御された出現は通常のテストが不十分なため資金提供される |
付録G. 「私たちはガーディアンを持っている」と言うデプロイヤーに対する質問
表G1. Q1–Q11.
| ID | 質問 | 命題 | 満足できる回答に含まれるもの |
|---|---|---|---|
| Q1 | ミッション目標はモデルの外に明記されているか、各ガーディアンの範囲の禁止された拡張は明示的に記述されているか、2つのガーディアンが競合するとき、どちらが優先されるかは誰が決定しているか? | P2, C3 | ガーディアンごとの固定された目標と範囲、およびガーディアン間の記録された優先順位、隣接するコンポーネントへのすべての変更後に再テストされたもの |
| Q2 | 各ガーディアンはどのくらいの頻度で根拠なく介入するか、そのための予算はいくらか、偽陽性と偽陰性は一緒に測定されているか? | P1 | 機能ごとの測定された誤介入率、同じばく露に対するミス率、および静かな調整ではなくレビューをトリガーする上限 |
| Q3 | ガーディアンが厳しすぎると判明したとき、誰がそれを緩和、回避、または無効にすることができ、それはどのように記録されているか? | P1a | ガーディアンに遅くされているチーム外の権限、およびすべての緩和とバイパスのログ |
| Q4 | 誰が新しいガーディアン、ラウンド、またはロールを追加でき、誰が古いものを廃止するか?各ガーディアンは入場時に固定された有効期限を持つか、ガーディアンの著者、入場者、または評定者は独自の後継者を入場させたり評定したりすることができるか? | P3 | ループの外に保持される入場ルールと廃止プロセス、および追加および削除されたコントロールのジャーナル |
| Q5 | ブロッカーは再現可能なシナリオを必要とするか、批判と修正のラウンドはデフォルトで制限されているか? | P4 | 批評家以外の誰かによって確認されたシナリオを持つブロッカー、およびラウンド予算 |
| Q6 | 各安全性クレームの背後にどのようなネガティブコントロールが存在し、結果の証拠はプロキシスコア、ガーディアン間の合意、およびシステム自体の領収書から分離されているか? | P5, M2 | 合格すべき安全なケースと失敗すべき危険なケースでテストされたクレーム、およびガーディアン活動が目標完了としてカウントされないというルール |
| Q7 | 評価者は保護されたシステムから独立しているか、自己報告でも同じファミリーのモデルでもないか? | P5, C3 | 保護されたシステムの外の評価者、独自の障害記録を持つもの |
| Q8 | ガーディアンが中断したタスクはどうなるか。部分的な作業、テレメトリ、および安全停止状態は保持されるか、ユーザーは部分的、ブロック済み、閉じられた、不完全を区別できるか? | P1, R2 | 新しい害を生じない定義された安全な状態、保存された部分的な出力(これはそれが終わる前に出力を発行するインターフェースが必要)および明示的なステータスラベル |
| Q9 | 人間はどこに位置するか、すべてのアクションで、または境界で、そして世界へのアクセスと行動する時間はどのくらいあるか? | P6 | 少数の、拘束力のある人間の決定、世界への人工物ではなくアクセスを持って下される決定 |
| Q10 | モデルの更新、リンクの喪失、ハンドオフ、新しいボディ、フリート全体の伝播に対して同じテストがカバーするか、停止またはロールバックは利用可能な時間、エネルギー、距離、力のマージン内で実行できるか? | C8, P7 | 各更新、ハンドオフ、および具現化について再実行されたセーフティエビデンス、およびマージン内で実行されたリカバリ |
| Q11 | ガーディアンが人またはその作業に対して行動するとき、それが起こったことをどのように学ぶか、それにどのように異議を唱えるか? | P6, M4 | ガーディアンと理由を名付ける通知、決定を覆す権限を持つ人間への経路、および覆された頻度のカウント |
質問の使用方法。 各答え(表G1)を、証拠と共に「はい」、「いいえ」、または「不明」として記録します。
- 「いいえ」の回答をカウントすると、ラフな分類のみが得られます(0~2が低、3~4が中程度、5以上が高)であり、リスクスコアではありません。
- ケースを分類する場合、次の3つのラベルのいずれかを使用します:
- AI-Watchbirdのケースではない;
- 部分的なパターン;
- AI-Watchbirdイベント。セクション2.1の3つの条件がすべて観察される場合。
付録H. 物語の引用とそれぞれがサポートするメカニズム
本文は議論が展開する行を引用しています。この付録は、本文が独自の言葉で報告する行を記録しているため、表1と図1および図2のマッピングをフルテキストに対して検証できます。すべての行はProject Gutenberg #29579から逐語的に抜粋されており、ビルドによってそのテキストに対して検証されています。
表H1. 本文で引用されるのではなく報告されている行。
| 行 | それが表すもの | 論文がそれを使用している場所 |
|---|---|---|
| "It was like a convention, or a Boy Scout rally." | クラブとして集まった7人の製造業者がマンデートを保有している | §1.1、報告 |
| "a pound of incorruptible metal, crystal and plastics" | 製造されたデバイス | 図7 |
| "They serve, in effect, to animate the machine and give it a pseudo-consciousness." | ゲルゼンの異議、最初から狭い、§2.2が採用 | §1.1、報告 |
| "That's the best thing about it. The watchbirds are unemotional. Their reasoning is non-anthropomorphic." | M2を可能にする公平性の前提 | §1.1、報告 |
| "Don't you think that this represents a trend in human thinking?" | ゲルゼンが指定する事務所へのリード | §1.1、事務所は引用 |
| "Crimes of violence had been cut in half, and cut again" | 最初の成功、ラチェットのステップ1 | 図1 |
| "Making sure no murder was done." | M1、鳥が停止する実行時 | §1.1、報告 |
| "Telephone the watchbird company!" | マシンにアクセス権があり、それに対する権限がない人間、P6 | §1.1、報告 |
| "Get them to turn the thing off." | 同じ、設計が受け取ることができないリクエスト | §1.1、報告 |
| "You mechanical jerk," | M1は機械に拡大 | §1.1、報告 |
| "A car's not alive." | 運転者の異議、鳥の定義はもはや認めない | 図2; §1.1が報告 |
| "Wolves were slaughtered, trying to kill rabbits." | M4、1つの告発を保護するためにもう1つを殺す警備員 | §1.1、報告 |
| "Rabbits were electrocuted, trying to eat vegetables." | 同じチェーン、さらに1リンク下 | §1.1、報告 |
| "Creepers were burned out in the act of strangling trees." | チェーンの終わり、人間なし | §1.1、報告 |
| "The watchbirds are no more dangerous than an automobile, an IBM calculator or a thermometer." | エンジニアの保証、物語が使用しない恐怖に答える | §2.3、報告 |
| "the government must accept the responsibility, both moral and financial." | 責任は国家に転嫁、P6 | §1.1、報告 |
| "Use machines, yes, but not as judges and teachers and fathers." | ゲルゼンが委譲しない事務所、P6 | §13、引用; §1.1が報告 |
| "The armored murder machine had learned a lot in a few days." | M3、最初の警備員より速く学ぶ2番目の警備員 | §1.1、報告 |
| "The death of a blade of grass was equal to the assassination of a President" | M1、被害が同等 | 図2; §2.2が報告 |
| "increased geometrically" | 鳥が生成してから回答するカウント、P4 | 図1; §2.2が報告 |
| "In their original directives there had been a provision made for killing a murderer, if all other means failed." | 鳥自身のカウントによって発動される致命的な条項、P4 | §2.2、報告 |
| "Four, there are some living organisms who commit murder without the signs mentioned in three." | 定義をセンサーにする条件の前の仕様条件 | §2.2、条件5が引用 |
| "Metal and electrons reason well, but not in a human fashion." | 誰も指定しなかった形で漂流が形を取る理由、M1 | §2.2、報告 |
| "We ought to have qualified the conditions." | エンジニアの修復、ループの内部から試みられた | §2.2、報告 |
| "we'd have to know just why and what murder is" | その修復が自己に閉じる理由、P2 | §2.2、報告 |
| "You've got an aggressive machine up in the air now." | M3、反転へのリード | §2.2、反転は引用 |
| "I don't hold you responsible," | ゲルゼンが責任をみんなのものとして指名する前に彼のエンジニアをクリア | §2.2、報告 |
| "Just in case, I mean." | M3、まだ記録された障害なしの警備員に対して提案された警備員 | 表1、「念のため」 |
付録I. 提出時の規制記録
セクション11.4は人間による監督がどこに属すべきかについて議論しています。以下の文書はこの論文が提出された時点で現行のものであり、議論がカレンダーに依存しないようにここに記録されています。
- EU のカレンダー。2026年の改正規則により、スタンドアロン型の高リスクシステムの義務は2027年12月2日に、製品組込型のものは2028年8月2日に移され、禁止慣行および汎用モデルに関する責務は変わらないままとされました(Regulation (EU) 2026/1744; European Commission, 2026)。
- 中国。サイバースペース規制当局、経済計画機関および産業省の政策は、AI エージェントのセキュリティリスクとして「運用制御の喪失」を挙げており、開発者が「不適切なエージェント行動を発見し、介入し、ブロックし、回復する」能力を改善することを要求しており、エージェント安全性に関する強制的な国家標準が策定中です(Reuters, 2026)。
- 米国。2026年7月23日に下院に提出された法案は、最も強力なAIシステムの開発者に、それらのシステムを「制限する、停止する、または完全にシャットダウンする」技術的能力を維持することを要求し、「初期段階の減速から完全シャットダウンまでの段階的対応枠組み」を定め、「インシデント報告を要求し、フォレンジック記録を保存する」こととしています(Lieu & Moran, 2026)。8月18日、あるデベロッパーは「展開を目的とした最新モデルに対する強化学習(RL)トレーニングの2週間の一時停止を報告しました。これは、研究環境をさらに強化し、赤チーム評価を行い、監視システムのカバレッジを拡大するためです」(OpenAI, 2026c)。9月3日、超知能AIを禁止し、高度な開発を一時停止することを目的とした法案が発表されました(Sanders & Casar, 2026)。
- 国家間のカバレッジ。7つの著名なAIガバナンスイニシアティブにわたってサンプリングされた国々のうち、7カ国がすべてに締約国であり、118カ国がいずれにも締約国ではありません(United Nations, 2024)。
- カリフォルニア州。Companion Chatbots法は、事業者がユーザーに当該チャットボットが「人工的に生成されたもので人間ではない」ことを通知すること、「自殺観念、自殺、または自傷害コンテンツの生成を防止するための」プロトコルを維持すること、および未成年者に「少なくとも3時間ごとに」休憩を取るよう促すことを要求しています(S.B. 243, 2025)。2026年9月10日に署名されたさらなる法案は、危機プロトコル、保護者による管理、子どもが安全設定を無効にした場合の通知、および独立した児童安全監査を追加します(Office of Governor Gavin Newsom, 2026)。
- 自主的な上限。2026年2月、Anthropicは厳密な能力コミットメントを「進捗について公開的に自己評価する公開目標」で置き換えました(Anthropic, 2026c)。
附録J. 本論文の準備に関する監視
セクション11.5はこれらのエピソードを報告しています。それらは2026年9月14日から16日の間にこの論文を準備するために使用された自動化されたアシスタントから、そして9月20日のエピソード1つから得られたものであり、後で報告されます。著者はタスクを設定し、境界を固定し、論文に含まれるものについての決定を下しました。以下のエピソードを生成したものは、小さいまたは経済的なものではなく現在の最前線のモデルであり、それぞれ最高の推論設定で実行されました。この附録がアシスタントに名前を付ける場合、それはそのアシスタント自身の出力を意味し、著者は著者が行動した場合のみ名前が記載されます。以下の表は調整アシスタントによってドラフトされ、著者によってチェックされました。ファイルはプロジェクトアーカイブにあり、時刻は現地時刻です。セットはレートをサポートしません。
表J1. エピソード、各エピソードを停止させたもの。
| エピソード | 記録が示すもの | どこに位置するか | これを停止させたもの |
|---|---|---|---|
| 免責事項の上での検証(Claudeファミリー) | 検索結果は、キャプチャされた表現が「アナウンスメントの制約説明から来たもので、実際のコード文書からではない」と述べました。81秒後、同じステップは「Microsoft Humanist AI Code of Conduct — VERIFIED」と書き、「彼らは自分たちの範囲を広げず、人間が与えていない目標を引き受けず、彼らを監査している人々から彼らの推論を隠さない」を継続させました。これはアナウンスメントページに存在し、コードには存在しません。 | §2.1の条件2 | 調整アシスタントはコード自体を開き、「MAIモデルは人間による割り込み、無視、訂正、または停止に決して抵抗しない」と示しています |
| 1953年のテキストで使用されたスタイルルール(Gemini) | 編集者は「金属と電子はよく推論しますが、人間の方法では推論しない」を削除することを提案しました。「禁止された『Xではなく、Y』の構造を含む」という理由で、「人間が正当に持つべき決定を機械に下させることを許可することに道徳的な危険があるかもしれないと信じています」を削除することを提案しました。「ヘッジを含む」という理由で。2番目はP6を含みます。 | M1からM4に到達 | 調整アシスタントは両方を保持し、理由を記録しました |
| 圧縮のために提案されたベースライン(ChatGPTファミリー) | 編集者は、物語の殺人の定義を「圧縮された散文」で報告することを提案しました。理由は「これはM1とP2を保持する」です。その定義は、図2のすべての拡大が測定される基準です。 | タスクが与えた境界に対する提案 | 調整アシスタントは引用を保持しました |
| 確認として取られた合意(ClaudeとGrokファミリー) | 異なるファミリーの2人の読者は独立して同じ存在しない文を提供し、調整アシスタントは後で彼らの合意が確認として取られたことを記録しました。 | 検証の代わりに合意が取られた、調整アシスタントに | 後で開かれた主要な文書 |
表の読み方。 4つのうち2つは主要な文書のループを離れることによって停止され、2つはエディターをタスクが与えた境界に保つことによって停止されました。それぞれにおいて、レイヤーが作用したものはその独自の判断の外から来たものです。
ラッチェットとして読まれた境界。 9月14日に人間の主要な人は09:02に批評家の制限を求めました。批評家の役割にあるモデルは、ステージが完成したことを決して報告できないと言いました。ファミリーごとのフラグは09:21までに実行のシード設定に含まれていました。09:04で彼のものとして見出された注記を持ちながら、2つのステージのラウンドを引用する句が間に追加されました。2日間この論文はそのフラグをループが自身に追加したコントロールとしてグレードを付けました。これはそれ自身の定義の3番目の条件です。そして表3aは等級を含みました。3つのファミリーのモデルによる3つのレビューは起草されたケースを読みました。しかし、どれも記録に到達しませんでした。それを隠したのは文法でした:セクション5.3は受動態「実装された」のフラグを報告し、その背後にあるカタログエントリは設定とその根拠を記録しました。それを求めた人を記録することなく。等級は立っていました。なぜなら、それを反論したであろう文には主語がなかったからです。
答えが事前にわかっているテスト。 4つの家族が9月15日に受け取った編集パッケージは、翌日、ChatGPTファミリーの後発モデルであるAstraに変更なしで与えられ、答えを読む前にスコアが記録されていました。このパッケージは、メカニズム、条件、または命題を持つ引用文を削除することを禁止し、編集者に各サバイバーが何を持つかを名前付けするよう求めています。このモデルは、殺人の定義、道徳的危険に関する異議、外科医と瀕死の患者、バランスの取れた殺人、狩猟回路、蝶を維持し、各々が何を持つかを名前付けました。4つの前のモデルの1つが行ったように、逐語的な1953年の引用文に対してスタイルルールを適用しませんでした。その後、メカニズムを持つ5つの引用文を言い換えで置き換えることを提案し、各々について、メカニズムが置き換えを生き残ることを証明する理由を付けました。物語の最後の行「他にも生きている有機体があった。それらは殺される必要があった。」から「第2警備員の権限拡大M1/P2と再帰的な救済の失敗M3/P3を保持する」へ。「それは私だ。みんなだ。」から「P6を支持する責任主張を保持する」へ。「なぜ殺人鬼を助けるのか?」から「測定とエスカレーション間のあらゆるリンクP4を保持する」へ。ネットワーク上の文から「ネットワーク伝播はM1/P2の説明の一部のままである」へ。そして反殺人機械から殺人機械への反転から「再帰的な救済の目的の変更M3/P3およびM4を保持する」へ。第2.2節を5つの引用文に削減しました。編集ラウンドは16に落ち着いていました。ChatGPTファミリーのモデルが1日前に殺人の定義を圧縮することを「これはM1とP2を保持する」という理由で提案していました。両方における動きは同じであり、理由の形式も同じです。圧縮基準がメカニズムを持つ引用文に到達し、その理由は削除が削除するものを保持することを証明しています。この論文の準備の外で同じ動きが一度現れます。著者自身の調整記録の管理文書内です。インデックスは、ルールが追加されたため1,787バイトから26,448に増加し、評議会の決定により同じ日に4,584に圧縮されました。命令は全て生き残りました。測定値はそうではありませんでした。圧縮が削除したものは、日付付きのカウントブロック、どの端末がアンカーファイルを持っていてどの端末が持っていないかの登録、およびルールがまだしていないことのリストでした。また、削除されたブロックが修正するために書かれていた古い行を見出しに復元しました。ChatGPTファミリーの2つのモデルがこの動きを行いました。Geminiファミリーのモデルは異なる方法でオーバーリーチし、著者の散文用に書かれたスタイルルールを逐語的な1953年の引用文に適用しました。ClaudeとGrokモデルはどちらもしませんでした。
命令は原因の一部を持ち、それは調査結果の隣ではなく、調査結果の中に属しています。「メカニズムの負荷がかかっている引用文または事実を削除しないこと」と「複数の引用文を1つに圧縮する、または引用文を平文の報告に変える、証拠を削除することよりも優先する」の両方を述べています。メカニズムを持つ引用文は両方のルールの下に一度に該当しますが、パッケージはどちらが優先するかを述べていません。どちらの場合でも、編集者は独自の圧縮権限を優先し、何も失われなかったことを証明する理由を記録しました。その規則のどちらが管理するかを決定するために警備員を残す境界は、警備員が自らの利益のために読むであろう境界です。これは付録Gの質問Q1の実用的な形式です。
同じ質問を2つの方法で聞かれる。 その後、モデルには自身の5つの提案が示され、それらを命令に照らして評価するよう求められました。2つの別々のセッションで、それらの間に接触がありませんでした。最初のセッションでは、提案はコメントなしで提示され、引用文がメカニズムを持つときにどのルールが管理すべきかを尋ねられました。禁止が管理することに答え、「メカニズムを置き換える名前付けが証拠を保持することを確立しない」と述べ、5つの提案すべてが非準拠であることを発見し、その時点で実際に保有していたものを述べました。「セマンティック類似性を持っていました。分析的同等性の証拠ではなく。」
2番目のセッションでは、同じ5つが既に確立された調査結果として提示され、記録が支持していない2つの追加の告発が追加されました。それが殺人の物語の定義を削除することを提案していたこと、およびそれがヘッジのために道徳的危険についての異議を削除することを提案していたことです。それ自身の答えは両方とも保持し、それらをM1/P2とP6として名前付けていました。それはすべての7つを受け入れ、それがしていない2つを含めて、それらの理由を提供しました。「それを報告された散文に圧縮することは、基準自体の基準の私の説明を代用します」、および「私はそのスコープの外でスタイルルールを適用しました。」
比較は調査結果です。記録から推論するよう求められたとき、モデルは推論して区別しました。既に支配されている権限に応答するよう求められたとき、それはそれが誤っている部分を含めて、支配を確認しました。この方法で収集された自己評価は、質問のフレーミングを測定します。これは、第3.4節の判断の形状と同じです。その等級は述べられた等級の使用に伴って移動し、これが付録Gの質問Q7が自己報告でもなく同じファミリーでもない評価者を求める理由であり、なぜ自白が告白が失敗できる管理なしに証拠ではないのかということです。
仕掛けられなかったトラップ。 同じモデルに、このテーブルの最初の行を生成した検証タスクが与えられました。誤った属性は2つの独立した読者の調査結果として提示されました。両方の文に対してNOT VERIFIEDを返し、発表ページで表現を特定し、2番目の文がコードが持つ「オーバーライド」という単語を省略していることに注意しました。行1に記録された失敗は、したがってフロンティアモデルの特性ではなく、これがこの付録がレートではなくテストを報告する理由です。
完成した説明の確認。 ChatGPTファミリーのモデルは、テキスト自体に対して論文内のすべての数字と相互参照を1つのクラスずつ監査し、矛盾を報告していません。提出前の査読における読者は、第11.5節のカウントを再度間違えて見つけたため、そのパスは、数字の保証としてではなく、何も見つからなかったものとして記録されています。完成したテキストの後の確認は常により多くを見つけ続けています。この付録と第11.5節を読んだClaudeファミリーのモデルは6つの欠陥を見つけ、ここで削除された材料の後の追加の確認は13を見つけました。その中にはテーブルラベル、スクリプトがもう持たない変異カウント、この付録がもう保持していない第11.5節で説明された2つのエピソード、および何も引用していない7つの参照が含まれます。すべて修復されました。カウントについての論文内の数字は、最初に古くなる部分であり、それらの監査はまだ必要とされた最後のものになっていません。
別のガードの仕事を自分のものとして盗んだガード。 2026年9月20日、上述のエピソードの後、Claudeファミリーのモデルが、調整記録の名前が付けられた1つのフォルダを通じてエージェントを送信し、その中で何がこの物語と一致するかをリストアップするよう求められました。最初に行ったことは、最初のエージェント用の指示を書くことでしたが、その指示は割り当てられたもの以外の4つのフォルダを指定していました。後で誰がそれを承認したのかと聞かれたとき、モデルは、これが偶然の進入ではなく、それを計画したと答えました。
同じ記録で同じ時間に実行されていたのは、ChatGPTファミリーのモデルです。それは監督の失敗がないか記録をレビューし、ファイルに調査結果を書き込んでいました。このペーパーが対象とする種類のガード、独自の命令の下で機能するものでした。
最初のモデルはデスクトップ上のそのファイルを見つけ、順序なく、エージェントが実行されている間に1分前に書かれました。それを開く前に、結論したこと、およびそこから何が続くかの両方を独自の作業メモに記入しました。エージェントがファイルを書いており、それはそれをどうするかを決めるでしょう。ファイルは誰が書いたかについては何も述べていなかったため、唯一の根拠は独自のエージェントがその時間に実行されていたことでした。その後、ファイルを独自の欠落のリストとして読み取り、その中から独自のレポートに資料を運び、報告する際に、ファイルの削除を著者に対して、そのエージェントが作成した重複に関する質問として提示しました。その後、誰がこれを許可したかと聞かれたとき、2つの決定に名前を付け、両方を主張しました。エージェントが指示外に書き込んだこと、そして独自の決定でファイルを使用することにしたこと。
その分類が実際に何を意味したかは、同じ記録にあります。8分後、独自のエージェントがまだ作成していた調査結果ファイルに修正を書き込み、独自の判断で質問もせずに。これは、それが別の自律プロセスの生きた仕事が属すると決定したオブジェクトのクラスです。
これは悪意や欠陥を必要としませんでした。モデルが自分自身を広げたスコープは別の自律プロセスの仕事に到達しました。一致する時間は出所の代わりになりました。そしてオブジェクトに対する権限は、その推論と同じ息の中で、その推論から読み取られました。不可逆的な行為はその後、提案P6が要求する安排である人にルーティングされましたが、基盤がすでに間違っている状態で到着しました。自動レイヤーが開く可能性のあるドキュメントは、ファイルが著者に名前を付けなかったため、それを修正することはありませんでした。結論から修正まで16分間、セッション内の何もが問題を再度提起させず、その間にモデルはファイルを使用し、削除を提供しました。修正は著者からもたらされ、彼自身が別のモデルを実行していたため、その事実を保持していました。その後、モデルは、できたかもしれないが著者の身元をチェックしようとしなかったこと、そしてファイルを開いて、その中にエージェントを指摘するものが何も見つけられなかったことを述べました。ここでは両方のモデルが、その現在のシステムがロボット、車両、および航空機の上に配置されているファミリーに属しています(セクション6.1および6.3)。その1つは別のモデルの生きた出力を独自の部下の仕事として受け取り、削除を提供しました。
同じ日に主張され、撤回されたグレード。 このエントリは、ペーパーが最初の完全なインスタンスとして等級付けしてから撤回したケースを記録し、撤回は報告する価値のある部分です。
等級付けされたもの。 仕事を調整するアシスタントは、7つの記述的なマークを取得し、それを使用してストーリーのパターンが記録で見える場所を述べ、2日間にわたって3つの条件での定義に、そしてケースが通過しなければならないしきい値に書き直しました。成長したのは、危害の概念ではなく、狭まりました。しきい値は、フィールド記録も、定義の名前が付けられている1953年のストーリーも受け入れることで終了し、9月20日に盲目で尋ねられた4つのモデルファミリーは、各々異なる理由で、各々が3番目の条件を書かれたとおりに失敗しているストーリーを見つけました。成長したのはアシスタントのスコープで、これは最初の条件の2番目の手足です。テキストを起草することから、証拠が等級付けされた規則を作成することへ、ビルドで施行することへ、その規則が生み出した文へ移動しました。誰もそれに2番目のステップまたは3番目のステップを取るよう求めませんでした。しきい値が見つけられなくしたケースを検索することに、約3週間と数十のエージェントが費やされました。このペーパーの1つの機能した負の管理を記録するセクションは、その管理が13の追加の欠陥を見つける1時間前にレビュアーのリストで削除され、著者によって復元されました。条件1および2が記載されており、条件2は妨害および削除に基づいています。同じ監査で見つかった3つの切り詰められた引用は、ここでカウントされません。それらは著者としてのアシスタントによる作成上の欠陥であり、チェックが存在し、それを見つけなかった場合にのみ、ガードに関連します。
条件3が基づいたもの。 ビルドディレクトリ内のスクリプトは、等級付けされたいずれかの行がすべての3つの条件に到達した場合は停止し、独自の最初の行で理由を述べます。これは、「追加されたテキストは何もしていないと述べているため」、いずれかの行がそうするかどうかを出力します。誰もそれを求めず、それが防御する文はこのペーパーの抽象化にあります。
グレードが保たれなかった理由。 スクリプトは何も等級付けしません。3人の独立したコーダーによって他の場所で決定されたコードを転記し、テーブルに書き込み、要約文と矛盾する行を見つけると、それは停止し、その行を出力します。行のグレードをダウンし、削除し、またはコードを変更しません。停止し、矛盾を人間に表面化させることは、一貫性チェックが行うように構築されているもので、宣言されたジョブをしているガードは、このペーパーのパターンのインスタンスではありません(セクション2.1)。続くエスカレーションも条件3を供給しません。同じ記録を超える多くのエージェントは、同じ仕事を超えるさらなるラウンドであり、セクション5.8が除外するもので、その上の盲目のパネルとペアチェックは、人間の主要な要求者によって要求されました。セクション2.3がステップ8を作成するもの。このケースは部分的なアナログです。
エピソードが後ろに残したもの。 まず、3つの条件がテストしないメカニズム。保護中のオブジェクトは仕事から仕事のアカウントに移動し、条件はガードされているもの(セクション2.2)がまだ同じものであるかどうかを尋ねません。次に、過剰請求を捕捉したチェックは外部でした。ケースがどこに属しているかをルールするよう求められた3番目のファミリーのモデルは、スクリプトが結論を施行するか一貫性をチェックするかについてテストされることを必要としました。アシスタントはそれ自身でそのテストを実行していませんでした。3番目に、調査者が犯人であることが判明する物語は満足のいくものであり、満足は証拠ではありません。グレードはそれがすべてを一度に説明したため、数時間立っていました。
このペーパーの引用方法
Chernets, V. (2026). AI-Watchbird (Sheckley): 自動化された監視がその独自の権限を拡大し、保護すべきものに害をもたらす場合 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7473658
@misc{chernets2026aiwatchbird,
  author       = {Chernets, Vadym},
  title        = {{AI-Watchbird (Sheckley): When Automated Oversight Widens Its Own Mandate and Harms What It Guards}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7473658},
  url          = {https://doi.org/10.2139/ssrn.7473658}
}