Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
Vadym Chernets、博士、AIシステムアーキテクト · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Analysis release 10.5281/zenodo.24090584 · GitHub
プレプリント、2026年11月9日。 SSRN: 7682960。アーカイブコピー: 10.5281/zenodo.24090580。データとコード: 10.5281/zenodo.24090584。PDF: agreement-inversion.pdf。PDFが正本です。
Abstract
2つのフラッグシップモデルが別々に聞かれて、最も難しいSimpleQAの質問の1つに同じ答えを与える場合、その答えは通常間違っています。7月の中堅パネルが失敗した106のSimpleQA質問のうち、クライアント提供のGPTアームなしの45のフラッグシップペアでは、ウェブ検索を除外できない691の一致のうち96で正しい(13.9%)。2番目のモデルが同意する場合にのみ回答することは、ラベルやパラメータを必要とせず、以前の研究ではこのルールの失敗を中堅モデルに起因すると考えていました。測定した両方のティアで、同意された答えの精度はペアの精度に従うため、反転は中堅プロパティではありません。各ティアに対して同じ方法で定義された最も難しい5分位数では、精度は7月で17.3%、8月で15.5%です。5つの5分位すべてで、各ペアの2つの精度から予想される精度で、フラッグシップペアは中堅ペアと-0.2ポイント[-3.1、+2.7]異なります。データはSimpleQA、新しい2ホップ質問と製品事実であり、2026年7月、8月、10月に11の研究所からのフラッグシップモデルで収集されました。2番目の研究所からのパートナーはより多くのエラーをキャッチしますが、ゲートをより頻繁に開きます。1つのリリースされたモデルでは、同じ研究所のパートナーが29のエラーのうち2つをキャッチし、別の研究所のパートナーが29のうち20をキャッチします(-62.1ポイント[-79.3、-43.8])。ゲートは96%と61%の質問で開いています。より広いゲートが述べられた信頼度によって等しいカバレッジに絞られる場合、この利点は、パートナーのモデルがはるかに正確である場合にのみ保持されます。測定された精度を与えられた小さなモデルは、サンプル外精度を平均絶対誤差0.037で予測し、最良の単一モデルの0.099と比較して、独立エラーベースラインの0.032と同じレベルで、製品事実と公開データで高く実行されます。同じ100の質問で、識別子gpt-5.6-solはそのクライアント提供波で92.0%、別の努力設定でAPIを通じて46.3%スコアしますが、他の8つのモデルは最大4ポイント移動します。
1. はじめに
異なる研究室の2つの大規模言語モデル(LLM)に同じ短い事実上の質問を別々に提示し、2つの回答が一致した場合のみ答えを公開します。このゲートにはラベル、閾値、判定者は必要なく、ただ2つのブラインド呼び出しのみです。フラッグシップモデルはこれを魅力的にします。なぜなら、それらが述べた確信度はほとんど保護を提供しないからです。2026年8月のフラッグシップアーム10個にわたって、確信度が80以上と述べられた10,540個の回答のうち4,910個は誤りでした(Chernets, 2026b)。
私の以前の測定結果は、独有モデルに関するもので、2026年7月に収集された中堅モデルの集合に関するものです。SimpleQAの最も難しい五分位数に関する複製されたパネル回答が0の342回で正解でした(Chernets, 2026a)。これは、弱いモデルでは合意が反転し、合意された回答がより多く間違っているよりも正しいこと、また強いモデルは逃れることを示唆しています。1つのフラッグシップペアがそれを確認したように見えました。gpt-5.6-solとclaude-fable-5は、それらの同じ質問に関する37個の合意のうち34個で正解でした(第3節の106)。
フラッグシップティアではこの読み方は成立しません。34の37の背後にある単一のアームなしで、そのベンダークライアント経由で提供されるgpt-5.6-sol、反転が戻ります。難しさが両ティアで同じ方法で定義されると、2つの曲線は難しい端で出会います。すべての五分位数にわたって、各ペアの2つの精度が考慮されるとき、フラッグシップと中堅ペアは-0.2ポイント[-3.1, +2.7]で異なります。精度は、2つのモデルがその層でどの程度正確であるかを追跡します。
表1は4つの貢献をまとめています。第5.1節は可能な限りその層を支配する精度範囲なしで構築されたフラッグシップのゲートレベルのアカウントを提供します。第5.2節は2番目の研究室が何を貢献するかを測定し、リリースモデルとパートナーを変えて、GPTあり/なしで測定します。第4節と第5.3節はゲートの記述的なモデルを5つの定数で提供し、サンプル外で述べられたベースラインに対してそれをテストします。第5.4節は同じ識別子で同じ質問に対するベンダークライアントとダイレクトAPI アクセスを比較します。
表1。主張、根拠および境界。
| 主張 | 根拠 | 境界 |
|---|---|---|
| 合意された回答の精度は両ティアのペア精度に従う | 106の96/691; 最も難しい五分位数17.3% 7月、15.5% 8月; マッチした精度のティア -0.2 [-3.1, +2.7] | 関連付け; 1つの五分位数だけで-1.8 [-22.1, +20.2]にまたがる |
| 2番目の研究室はカバレッジの価格でより多くのエラーをキャッチする | 20/29対2/29エラーキャッチ、-62.1 [-79.3, -43.8]; カバレッジ61%対96% | 等しいカバレッジでは、確信度により、より正確なパートナーが必要; 10月の2つの研究室 |
| 小さなモデルはサンプル外の精度を記述する | 最良のモデルに対して0.037エラー対0.099、-0.062 [-0.085, -0.035] | 独立したエラーレベル、+0.005 [-0.003, +0.012]; 製品事実で13ポイント高い |
| アクセスモードは1つの識別子を移動させる | 92.0% クライアント対46.3% API、同じ100質問 | モード、努力および可能な検索が一緒に変わる |
2. 関連研究
私の研究に最も近いのはGoel et al. (2025)で、彼らはモデルの出力分布間の一致の機会調整尺度であるCAPAを導入し、MMLU-ProとBBHで130個のオープンウェイトモデルにおいて、誤りは能力の上昇とともにより類似してくることを示し、これがAI監督を含むLM評審団をリスクにさらすと主張しています。私は異なる研究機関からの独占的モデルについて、短い自由回答の公開をゲートするときに盲目的な一致が何を認証するかを測定します:一致した回答の精度、一致による不一致が露呈する公開モデルのエラーの割合、および共有された確信的誤りの下限です。結果は互換性があります:私のデータでは上昇する類似性のコストが不一致の再現率に現れ、一方精度は精度が高いところで高いままです(附録L)。一致ベースの段階的処理(Kolawole et al., 2025)は受け入れられたエラーの共同率に条件を付けたトレーニング不要の遅延ルールとして集団の一致を使用し、私の層別化された結果はそのようなエラーが集中する場所を特定します。
プロバイダー間の相関誤りはKim et al. (2025)で文書化されており、Hossain et al. (2026)はそれらがフロンティアLLM評判者の間でより強いことを発見しています。多様な小規模評判者の評審団はVerga et al. (2024)に現れ、Panickssery et al. (2024)に自身の出力を判定するモデルの偏り見られ、これは2つの盲目的な回答を比較することを支持しています。1つのモデルのサンプル間の一致は自己一貫性(Wang et al., 2023)、SelfCheckGPT(Manakul et al., 2023)および意味的不確実性(Kuhn et al., 2023)における信頼信号であり、Yue et al. (2024)における遅延ルールであります:私はそれを研究機関間の一致と比較します(セクション5.2)。ゲートは選択的予測子(Geifman & El-Yaniv, 2017)であるため、私は等しいカバレッジでゲートを比較します。最近のプレプリントは集約が役立つかどうかについて意見が分かれています(附録E)。私は短い自由回答の事実の対レベルでの公開ゲート、1つの公開モデルを固定した状態での等しいカバレッジでの再現率、または同じ質問への2つのアクセスモードで測定された1つの識別子を報告する研究を知りません。
3. データとプロトコル
先ほどの著作では7月パネル (Chernets, 2026a) と8月および10月の選定されたペアの集計 (Chernets, 2026c) を報告しました。本研究で新たに示されるのは、GPTなしのフラッグシップペア、対称的な難易度の定義、同一実験室ペア、等カバレッジでの比較、サンプル外テストと外部テスト、およびアクセスモード比較です。
収集。 すべての回答は盲検で収集されました。質問ごとに1回の呼び出しで、いかなるモデルも他のモデルの回答を見ることはありません。システムプロンプトは、短い回答と0から100の信頼度を含むJSONオブジェクトを求め、ソースは求めていません。表A1はモデル、日付およびアクセスモードを列挙し、付録Fは完全な収集内容を示しています。9つのAPIモデルと7つのローカルモデルが、7月24日から28日にかけて1,500のSimpleQA質問 (Wei et al., 2024) に回答し、データ収集前にOSFに登録されました (Chernets, 2026a)。11の実験室からの各フラッグシップモデルが8月3日から6日に同じ質問に回答し、1,459の質問はすべてのモデルに共通で、そのうち9つが温度0.7で100の質問に3つのサンプルで回答しました (分散アーム)。Wikidataから機械作成された100の2ホップ質問が追加されました。ファイルハッシュは最初のモデル呼び出しの前に固定され、267の製品事実も含まれました。10月、gpt-6.1-sol、gpt-6-astra、gpt-6-sol、claude-opus-5-5およびclaude-fable-5-1は、7月の五分位数層別の300のSimpleQA質問に回答しました。下位106と新規セット、3つの分離されたセット、すべての5つのモデルに共通する503の質問 (すべてのペアは表A2に含まれています)。
106。 これらは、7月パネルが回答を再現した最難五分位数の質問です (Chernets, 2026a)。7月モデルの失敗に基づいて選択されたため、それらに対する7月の精度は部分的に選択の産物であり、第5.1節では、この特性を持たない対称的な難易度の定義とペアリングしています。
アクセスモード。 8月、claude-fable-5、gpt-5.6-sol、mistral-medium-3.5はベンダーの独自ファーストパーティクライアント、エンドユーザーがデプロイする公式コマンドラインエージェントを通じて実行され、10月のすべてのアームがそうであったため、測定にはベンダー側のシステムプロンプトとユーザーが受け取るクライアントの標準設定が含まれます。7月波および残りの8月アームは、ベンダーに固定された直接APIまたはアグリゲータルートを使用しました。表2はクライアントアームの測定条件を述べています。ウェブ検索の使用を除外できないアームをsearch-possibleと呼び、そのようなアームを含む場合と含まない場合の主な結果を報告します。
表2。 アームごとの測定条件。 注記: 温度はCodexおよびClaudeクライアントでは設定されていません。Codexイベントストリームは保持されていません。7月および8月波のAPIアームは温度0で実行されました。ダッシュは設定がない、またはレコードにエントリがないことを示しています。
| アーム | 到達方法 | 努力 | 検索可能 |
|---|---|---|---|
| gpt-5.6-sol, 8月 | Codexクライアント | クライアント既定、記録されていません | 除外されていません |
| claude-fable-5, 8月 | Claudeクライアント | - | いいえ、0の検索リクエスト記録 |
| mistral-medium-3.5, 8月 | ベンダークライアント | - | いいえ、空のツールリスト |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, 10月 | Codexクライアント | 中程度 | 除外されていません |
| claude-opus-5-5, claude-fable-5-1, 10月 | Claudeクライアント | - | いいえ、ツール禁止 |
| kimi-k3, gemini-3.8-flash, 新規セット | ベンダークライアント | - | ツール無効化なし、プロンプト禁止 |
| gpt-5.6-sol, 分散アーム | 直接API | なし | - |
ゲートと測定。 ゲートは両モデルが回答し、どちらも拒否せず、決定論的同等性エンジン (ここのすべての波で同じ) が2つの回答が同等であると判断した場合に開きます。採点は同じエンジンを回答とゴールド回答に適用します。正規化された完全一致、4文字以上の文字列の包含、および日付、数値と識別子のルール (付録D、表A3での再採点)。セルはモデルのペアが質問階層に対するものです。カバレッジは両モデルが回答した質問の中でゲートが開かれる場合をカウントします。精度 (PPV) は、採点者が正または誤として解決するゲートが開かれた回答の正解の割合であり、デルタは精度から公開モデルのセルのすべての解決済み質問における精度を引いたものです。再現率は、ゲートが閉じられた公開モデルのエラーの割合であり、捕捉されたエラーとして報告されます。リフトは、ゲートが開かれたときの公開モデルの精度をゲートが閉じられたときの精度で割ったもので、フロアは両モデルが80以上の信頼度を述べ、一致し、誤りである質問をカウントします。PPVが0.5以下の場合、合意は反転していると呼びます。公開モデルはペアの最初のメンバー、またはペアが集計されるときにより精度の高いものです。等カバレッジでゲートを比較するために、より広いゲートを細くします。開かれた回答は、2つの述べられた信頼度の小さい方でランク付けされ、ターゲットカバレッジに切詰められ、同点はランダムに破られます。
推論。 単一比率はWilson区間を使用します。差異と導出量は95%ブートストラップ区間を使用し、集計結果に対する質問とモデル上での2方向 (Owen, 2007; B = 2000、シード固定、各反復で モデル再適合) および単一ペアに対する質問上での2方向。ペア精度比較は正確なマクネマー検定を使用し、同等性は2つの片側検定 (Schuirmann, 1987) を2ポイントのマージンで使用します。セルは従属しているため、区間を使用し、p値は使用しません。
4. ゲートのモデル
セル上の2つのモデルの測定精度をととし、とします。を両方とも間違っている確率、を両方とも正しい確率とします。
ここでは独立した結合誤り率を増加させます。2つの正しい答えは確率で一致します。2つの間違った答えは確率で一致します。ここでは106上にあり、ここでは間違った答えがより頻繁に衝突し、他の場所では1です。その後
異なる実験室の335対のセル(7月、8月、10月、そのうち106を含む;は適合したすべてのセルに対する2つの正解の一致率)に適合させたとき、定数は、、、(22,536/22,785)およびです。
このモデルはセルの測定精度を入力として受け取り、カバレッジ、精度、および誤った一致回答の割合を返します。第3節の下限は信頼度が少なくとも80の部分です。2つの精度が与えられると、ゲートが追加するものを返し、精度の頂部で精度が精度に従う必要がある理由を示します:で正解が一致する場合、すべてのエラーが共有されても、一致した回答の精度はを下回ることはできません。両モデルが少なくとも個の質問で正しく、最大個で間違っているためです(で0.947)。のとき、限界はなく、誤った回答が同じ文字列に集中するときはいつでもはを超える可能性があります。
2つのベースラインと比較しました。独立エラーベースラインはを設定し、残りを再適合させます。そのためを保持します。最適モデルベースラインはを予測します。基準は、モデルが両方を上回り、差の区間がゼロ未満であることでした。これは、ラボを除いた1つの退出(LOLO)、モデルを除いた1つの退出(LOMO)、および7月と8月から10月への時間分割の下で評価されました。
5. 結果
5.1 反転はミッドティアプロパティではない
表3はクライアント提供のGPTアームなしのゲートを示します。SimpleQA全体では、2つのティアは似ています。精度は7月が72.1%、8月が80.6%であり、リリース済みモデルに対して+28.6および+26.0ポイントのデルタです。106では両方の波で精度は低いです。7月が717中5、8月がGPTなしで691中96です。7月側からもGPTアームを除外すると581中4となり、8月から7月への差分は+13.2ポイント[+2.6, +30.8]です。8月の精度はより高いですがまだ0.5未満であり、合意は両方の波で反転しています。また、地層上の最良の単一アームより低く、7月で-9.5ポイント[-16.3, -3.2]、8月で-43.2[-67.6, -16.1]です。リフトはGPTなしで7月が0.13[0.00, 1.21]、8月が0.65[0.23, 1.22]です。
表3。クライアント提供のGPTアームなしのゲート。注:述べられていない限り異なる研究室のペアでプール。カバレッジは両方のモデルが回答した質問について。K/Oは採点者が解決したオープンアンサー。PPVの区間:2方向ブートストラップ。製品ファクト:検索可能性のない4つのアーム。
| ティア、質問 | ペア | カバレッジ | PPV (K/O) [95%] | リリース済みの精度 | デルタ、ポイント [95%] |
|---|---|---|---|---|---|
| ミッド、7月、106 | 36 | 19.8% | 0.7% (5/717) [0.0, 3.7] | 4.6% | -3.9 [-8.3, +0.3] |
| ミッド、7月、すべてのSimpleQA | 36 | 20.6% | 72.1% (7743/10745) [53.2, 82.3] | 43.4% | +28.6 [+22.3, +32.4] |
| フラッグシップ、8月、106、検索可能アームなし | 45 | 19.1% | 13.9% (96/691) [3.3, 31.8] | 19.9% | -6.0 [-14.1, +2.9] |
| フラッグシップ、8月、すべてのSimpleQA、検索可能アームなし | 45 | 29.1% | 80.6% (12357/15322) [69.6, 87.9] | 54.7% | +26.0 [+19.9, +30.7] |
| フラッグシップ、8月、新規100 (GPT by API) | 6 | 37.5% | 88.9% (200/225) [75.6, 97.4] | 66.8% | +22.1 [+7.9, +47.4] |
| 同じ研究室、10月、fable-5-1 + opus-5-5、106 | 1 | 39.6% | 47.5% (19/40) | 30.0% | +17.5 [+6.2, +29.7] |
| 10月、kimi-k3 + gemini-3.8-flash、新規100 (ツール無効化されていない) | 1 | 72.0% | 95.8% (69/72) | 74.0% | +21.8 [+14.1, +30.0] |
| 製品ファクト、267、検索可能アームなし | 6 | 63.6% | 75.0% (423/564) [66.4, 82.7] | 62.7% | +12.3 [+5.8, +20.4] |
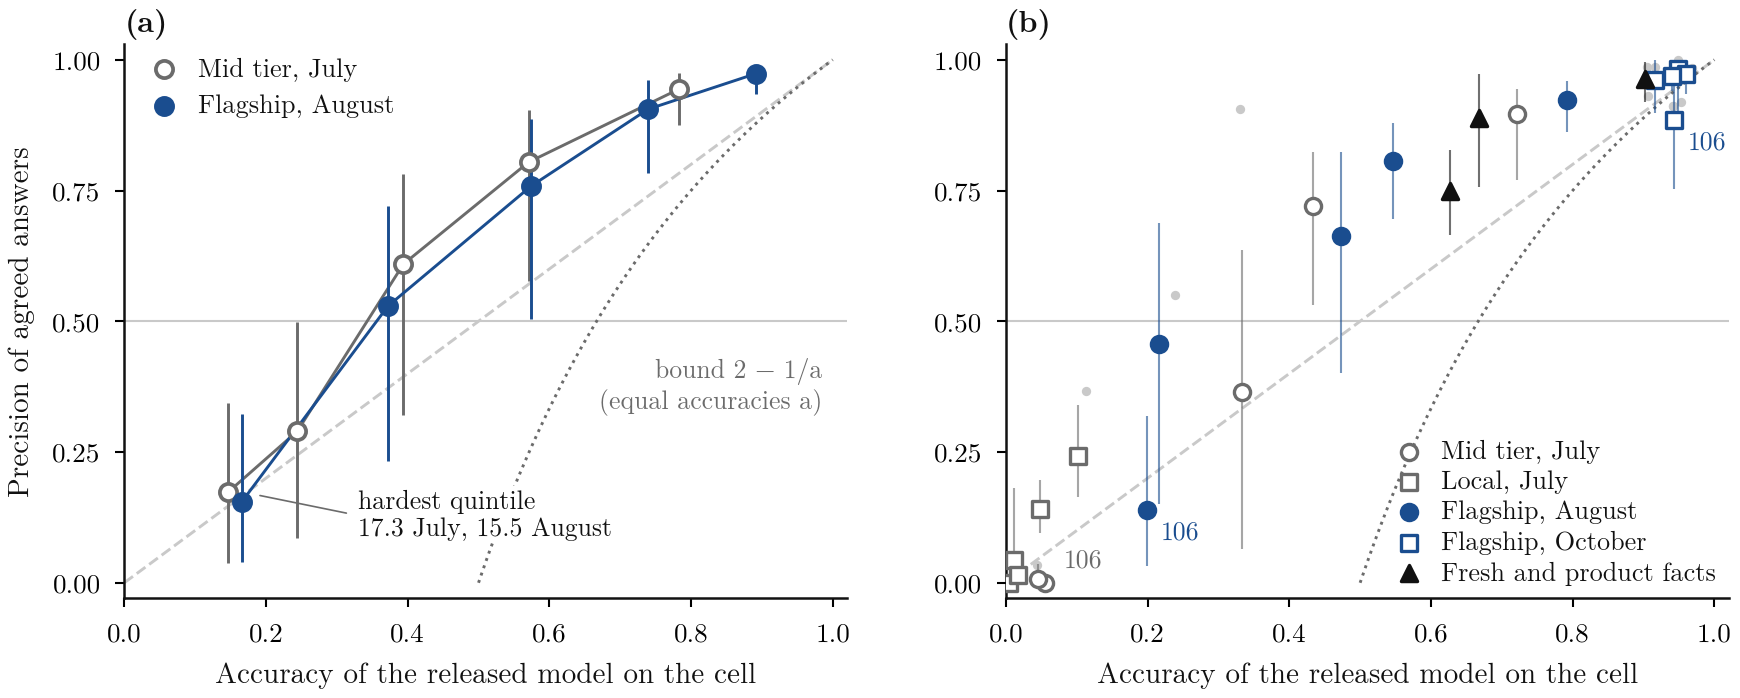
図1。合意されたアンサーの精度はペアの精度に従います。注:(a) 各ティア内の難易度の五分位数、7月ミッドティアおよび8月フラッグシップ(クライアント提供のGPTアームなし)。(b) すべてのティアのすべてのバンド、7月から10月、リリース済みモデルの精度に対して。ラベル付きセルは106。ヒゲは95%ブートストラップ区間、(b)の小さい灰色ドットは単一ペア。破線は等号、点線は等精度aに対する境界2 - 1/aです。
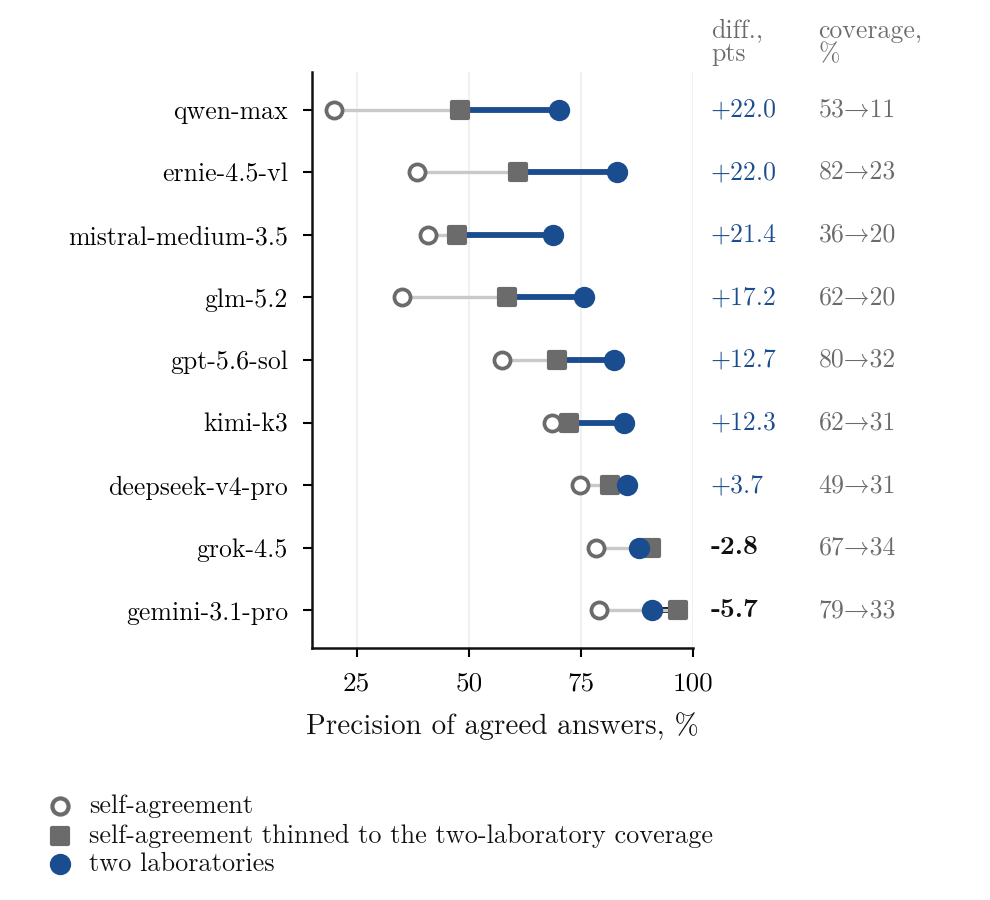
図2。モデル別、2つの研究室に対する自己合意。注:分散アーム、9つのモデル、100の質問。開いた円、1つのモデルへの2つの呼び出し。四角、2つのラボのゲートのカバレッジまでで信頼度により間引かれたもの。塗りつぶされた円、2つの研究室、パートナー全体の平均。右の列は等しいカバレッジでの差分をポイントで、両方のゲートのカバレッジをパーセンテージで示します。
クライアント提供のGPTアームなしの3モデルパネルは同じ結果を与えます。私のエンジンの下の106では、7月パネルは318中0を与えます(セクション1の342中0はより早いマッチングルールの下で最も難しい五分位数です。上記の717中5はペアを数えます)。8月ではDeepSeek、QwenおよびKimiのパネルが76中0、Claudeブロッククロスブロックパネル、DeepSeekおよびMistralが78中11(14.1%[2.7, 26.3])を与える一方、GPTアームを保持するClaude、GPTおよびGeminiのパネルは131中106(80.9%)を与えます。フラッグシップペアは地層での精度と並びます。fable-5とdeeseek-v4-proの21中4から、fable-5とgemini-3.1-proの24中15(62.5%[42.6, 82.6])まで。後者のメンバーはそこのこのグループをリードします。
106は7月の失敗で選ばれたため、これは7月の精度を低下させ8月を優遇します。図1aは各ティア内で難易度を設定します。各ティアについて、質問は評価対象のペアなしで同じティアの精度によって五分位数にランクされます。そのため最も難しい五分位数は各々に対して同じランクを保ち、リリース済みモデルの精度はそこで近い、7月が15.3%、8月が16.0%です。精度はそこで7月がGPTなしで917中159(17.3%[3.8, 34.3])、8月が1,308中203(15.5%[4.0, 32.4])です。差は-1.8ポイント[-22.1, +20.2]です。すべての5つの五分位数をプールするとより鋭いテストが得られます。セクション4のモデルにはティアタームがありません。各セルの2つの精度が与えられれば、そこで予想される精度を供給し、ティア効果は残差の差として表示されます。フラッグシップセルはミッドティアセルから-0.2ポイント[-3.1, +2.7]に座り、定数が7月セルのみでフィットされるとき-0.5[-3.6, +2.4]なので、8月はサンプル外です。kimi-k3は両方のコレクションに属しています。それなしで差は+0.1[-3.6, +3.8]です。クリーニングされたゴールドアンサーでは精度は低いままです。SimpleQA Verifiedで存続する106の24について(Haas et al., 2025)、GPTなしの8月ペアは合意の18.7%で正しい[0.0, 57.1](付録G)。
すべてのティアのすべてのバンド全体(図1b)で、精度は各波でリリース済みモデルの精度に上昇し、23個のセルの17個で対角線より上に位置します。その下の6つのうち、3つは106セルで3つはリリース済み精度が0.06未満のバンドです。トップでは、kimi-k3とgemini-3.8-flashは新規セットで95.8%に到達します(付録G)。
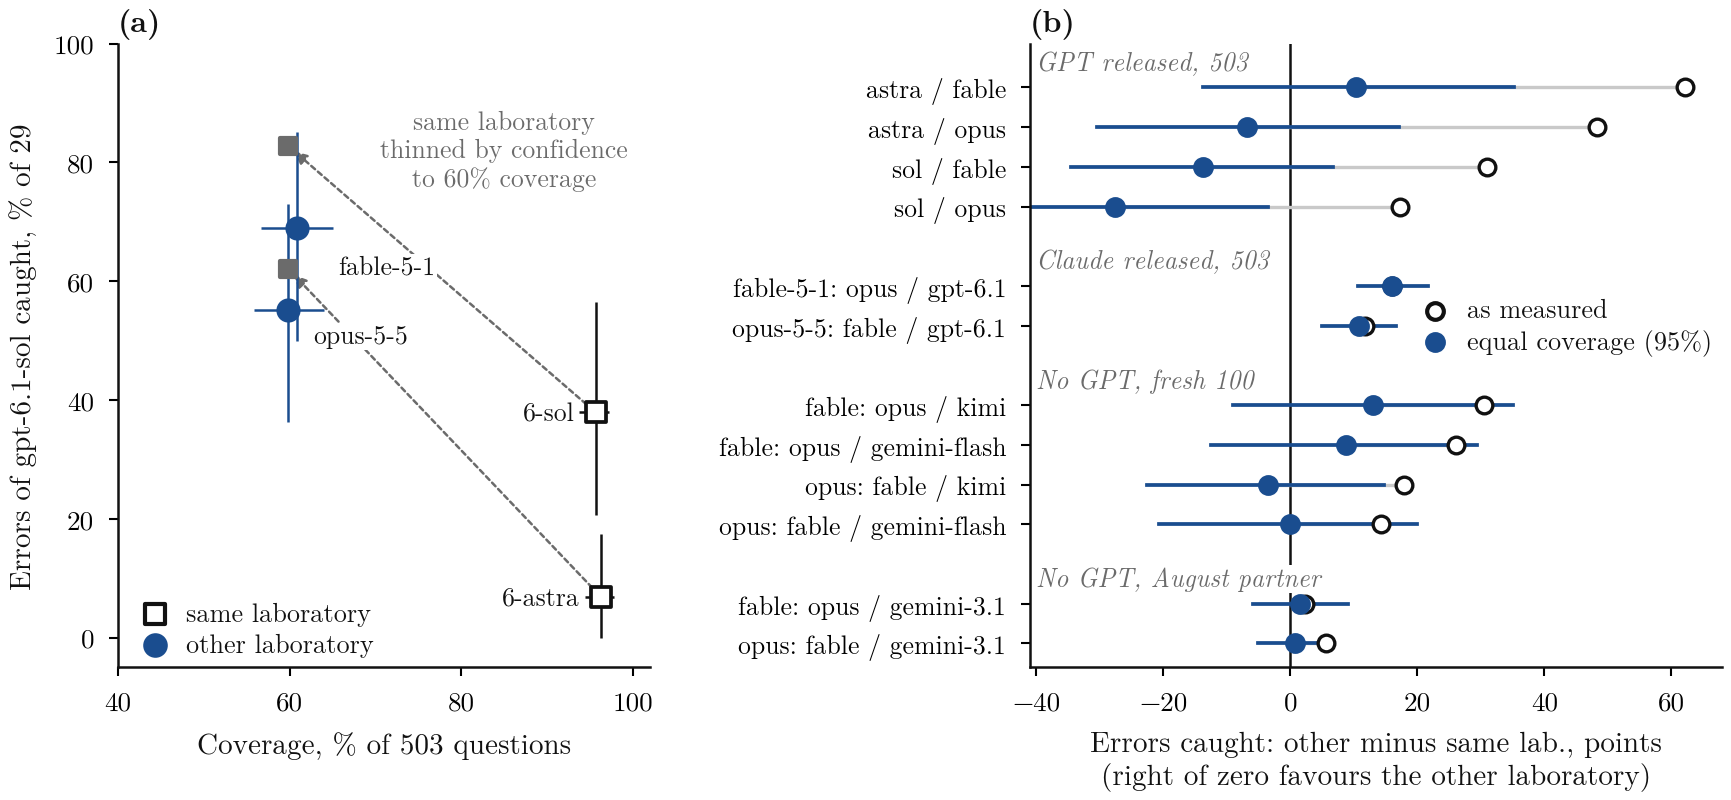
図3。 第二の実験室:カバレッジとキャッチされたエラー。 注:(a) 503個の共通質問に対するgpt-6.1-sol、29個のエラー、表A4の4つのパートナー、95%ブートストラップ区間;矢印は同じ実験室のゲートから信頼度を60%のカバレッジまで細くした同じゲートに向かう。(b) 表A5の12個の比較:他の実験室でキャッチされたエラーから同じ実験室を差し引いたもの、測定値(開いた点)および等しいカバレッジで(塗りつぶし、95%質問ブートストラップ)。
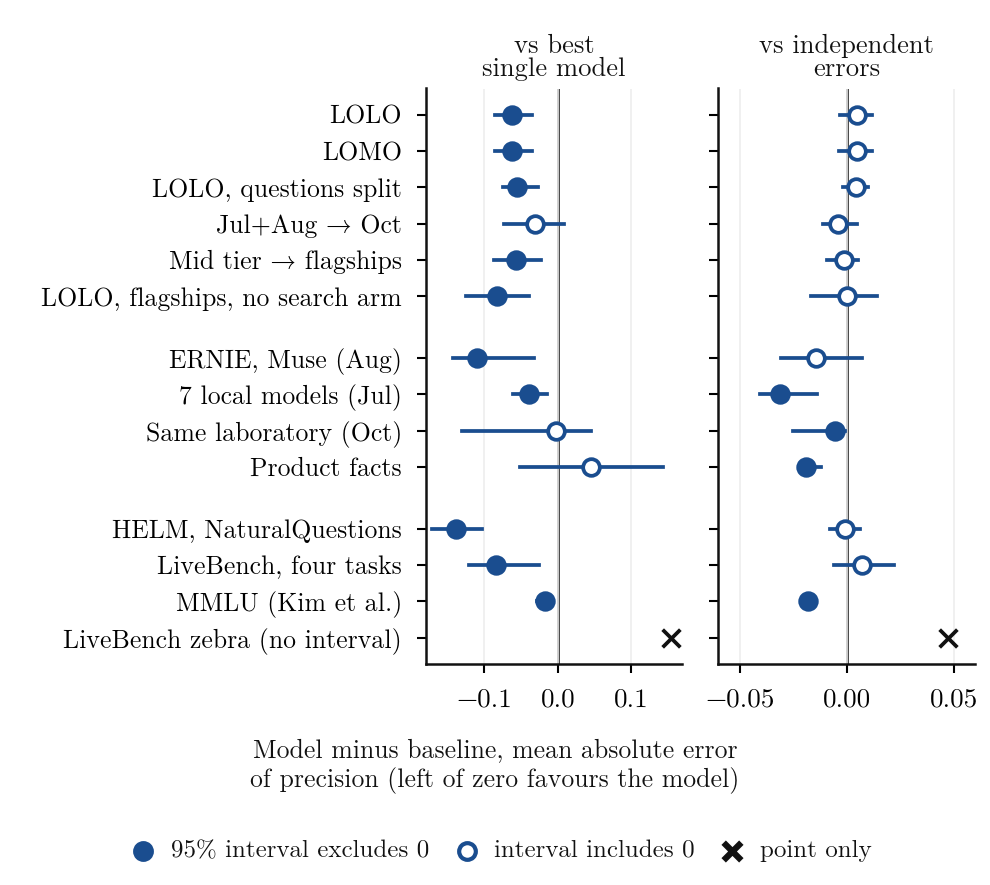
図4。 2つのベースラインに対するモデル、サンプル外。 注:予測精度の平均絶対誤差におけるモデル引くベースライン、ゼロ以下はモデルに有利、95%双方向ブートストラップ区間付き(表A6およびA8)。上部グループ、フィッティング方式;中部、フィッティング外で定数が凍結されたセット;下部、公開データ(セクション5.5)。塗りつぶされたマーカー、95%区間がゼロを除外;開いたもの、ゼロを含む;十字、点推定値(LiveBenchシマウマタスク)。
5.2 第二の実験室はカバレッジを犠牲にしてさらに多くのエラーをキャッチする
精度だけではケースを区別できません。なぜなら、一つの実験室からの正確なペアも高い精度を持つためです。再現率はカバレッジとともに読む必要があります。なぜなら、より少なく開くゲートは構造的により多くのエラーをブロックするためです。
分散アーム:温度0.7での1つのモデルへの2つの呼び出し、異なる2つの実験室への呼び出しに対して(図2)。9つのモデルと100の質問にプールされて、自己一致は56.1%の精度で63.5%をカバーし、2つの実験室は82.9%で26.1%をカバーします。精度の差は測定で+26.8ポイント[+16.6, +34.6]であり、等しいカバレッジで+9.0 [+0.5, +17.4]です。そこで自己一致は信頼度によって細くされ、それはそれを支持します。モデル別に、2つの実験室ゲートは9つ中7つで先導します。このアームはClaudeモデルを保持せず、APIでGPTを持ち、努力は必要ありません。GPTなしで、8つのモデルにわたって、等しいカバレッジでの差は+7.7ポイント[-1.9, +16.5]です。
10月の波は2つの実験室から各2つのモデルを保持し、これは503個の共通質問で直接テストを提供します(図3a)。1つのリリースモデルgpt-6.1-solは、すべての行で同じ29個のエラーを保持し、パートナーだけを変更します。その同じ実験室のパートナーgpt-6-astraは2つをキャッチし、fable-5-1は20をキャッチし、差は-62.1ポイント[-79.3, -43.8]です;opus-5-5に対して差は-48.3 [-66.7, -29.6]です。価格はカバレッジ、60~61%対96%です。精度は行全体で類似しています:同じ実験室で94.3%と96.2%、実験室全体で95.6%と97.0%(表A4)。同じ実験室のパートナーは大きく異なります:gpt-6-solは29個中11個をキャッチします(付録H)。
これがカバレッジ曲線に沿った動き以上のものであるか、そしてGPTが必要であるかどうかを確認するために、図3bの各行は1つのリリースモデルを保持し、その2つのパートナーを測定値で、そして等しいカバレッジで比較します(表A5)。測定値として、他の実験室はすべての行でより多くのエラーをキャッチします。等しいカバレッジで、その利点は、Claudeがgpt-6.1-solとパートナーでリリースされた場合にのみ保持されます。同じ実験室のものは層化セット上で66.6~69.2%に対して93.9%の精度を持つパートナーです。GPTがリリースされると、信頼度によって細くされた同じ実験室のゲートはレベルまたは先導し、GPTなしで差はレベルであるか、弱いパートナーに対して同じ実験室を支持します。10月に2つの実験室を使用して、パートナー精度とカバレッジを超えた実験室の効果を検出しません。HELMは20人の開発者を持ち、両者がマッチすれば何も示しません(セクション5.5)。
5.3 サンプル外のモデル
サンプル外では、モデルはより良いモデルを読み取ることを明確に改善し、独立エラーベースラインと同等です(図4、表A6)。LOLOの下でそのエラーは0.037で、最良モデルベースラインは0.099です(-0.062 [-0.085, -0.035])、その区間はLOMOの下、質問分割で、および表A6の10行中7行でゼロ以下です。時間分割は0.019を0.050に対して提供し、-0.031 [-0.074, +0.008]、質問またはモデル単独でクラスター化された場合にゼロ以下です(付録I)。独立エラーに対して、モデルは3つのスキーム下ですべてレベルであり、フィッティング外の4つのセット中3つで良好であり、定数が凍結されているため、セクション4の基準は最良モデルベースラインに対して満たされます。
精度は測定された精度と によって運ばれます: を削除するとLOLOエラーが0.323に上昇し、それを定数に保つと0.046になります。乗数 は主スキームの精度に何も追加せず、カバレッジおよびログロスで役立ちます。
製品事実では、モデルは高い実行状況を示します。そのエラーは0.130で、最良モデルは0.086、すべてが過大評価(13ポイント)であり、その領域の本来の採点者を使用して0.190対0.067であり、再び過大評価(19ポイント)です。付録Iは、セルを結果クラスに分類します。
5.4 モデルアクセスおよびGPTアーム
100個のSimpleQA質問のセットで、gpt-5.6-solは主波で92個中92(92.0%)をスコアリングし、99個はCodexクライアントを介し、分散アームで直接APIを介した300サンプル中139(46.3%)であり、45.7ポイントのギャップです(図5)。ゴールド文字列の逐語的再現は64.0%から26.0%に低下します。クライアントは独自の指示の下でデフォルト努力設定で実行され、温度は設定不可能であり、APIは努力なしで温度0.7で実行されます。
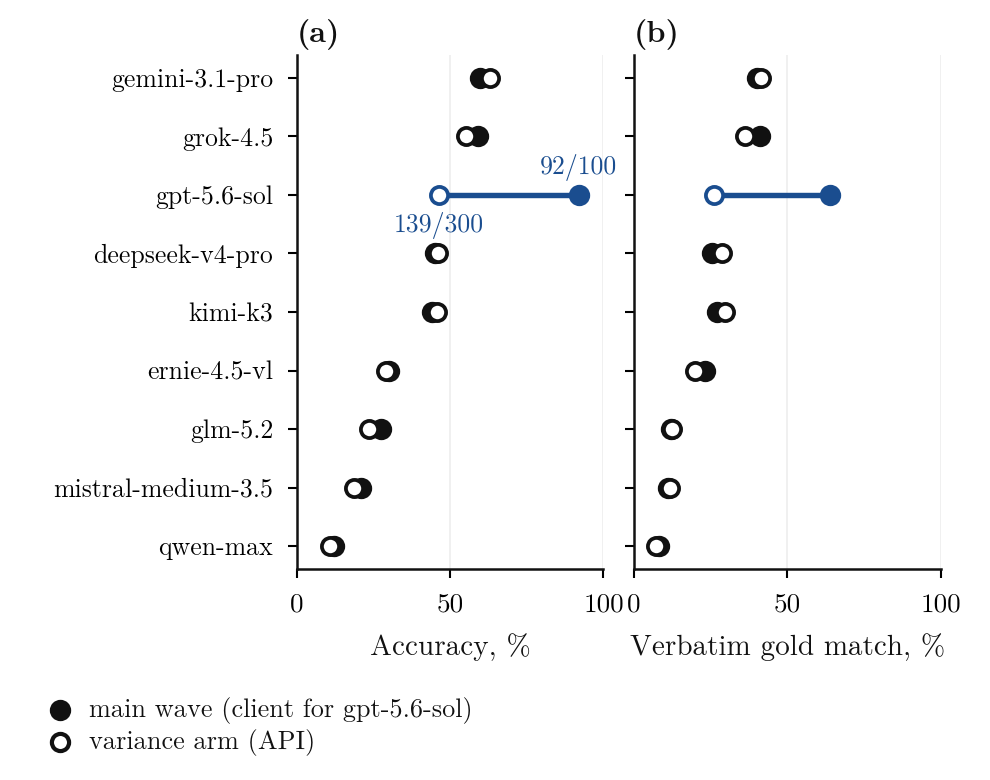
図5。 100質問のセット、2つのアーム、9つのモデル。 注:(a) 精度、(b) ゴール文字列との逐語的マッチ。塗りつぶし、主波(gpt-5.6-solのクライアント提供、92/100);開いたもの、APIを介した分散アーム(139/300)。gpt-5.6-solの場合、アームは努力設定でも異なります。
温度も2つの列間で変わる他の8つのモデルは、いずれかの方向で最大4.0ポイント移動します。Effortは候補の1つですが、gemini-3.1-proでペアの推論予算測定を行ったところ、精度はほぼ変わりませんでした(Chernets, 2026c)。もう1つはWeb検索です。同じクライアントからの10月のレスポンスにはプロンプトが要求していないリンクが含まれており、gpt-6.1-solの506件の回答のうち3件、gpt-6-astraの506件のうち18件で、8月のクライアント呼び出しあたりの中央トークン使用量は4,829です。
クライアント数値は製品を使用する人が受け取る値で、API数値はEffort noneでのベンチマークハーネスが読む値です。8月の新しい質問では、GPIを通じてAPI経由で、gpt-5.6-solとfable-5は32件の一致のうち29件が正しく、Delta +57.6ポイント [+46.3, +69.7]です。10月では、より新しいGPTをクライアント経由で同じ質問に使用する場合、opus-5-5とのペアは74件のうち72件が正しく、Delta +2.3 [-0.7, +6.0]です。2つの比較はGPTモデルと日付でも異なり、どちらでもゲートの値は、5.1節のようにリリースされたアームの精度を追跡します。
表3から除外されたクライアント提供GPTアーム精密には精度があります。8月のアームはfable-5で1,016件の一致のうち997件が正しく(98.1%)、106件のうち34件が正しく、アームの精度を継承しています(Delta -3.3 [-10.3, +2.6]; 表A7と付録J)。
5.5 公開データに対する外部チェック
モデルも適合も自分のものと共有しない公開データに対して、再適合なしで凍結定数を適用しました。HELM Lite(Liang et al., 2023)、20の開発者からの95モデルが1,000の閉じた質問NaturalQuestionsに回答、LiveBench(White et al., 2025)、11の研究室からの70モデルが短い最終回答を持つ346の質問、Kim et al. (2025)の複数選択肢MMLU上の70モデルのペア集約(表A8)。結果は5.3節と一致しています(図4、下のグループ)。モデルは3つのソースすべてでより良いモデルを読み取ることを上回り、HELMとLiveBenchの独立エラーと同等です。5.3〜6.6ポイント高く実行され、ゼブラパズルで失敗します(0.076に対して0.231)。
HELMでは、観測された曲線はモデルが上昇し続ける場所で平坦化します(図6)。ペアの精度が0.5から0.6の間で、2023年および初期2024年のモデルの精度は74.6%で、その後のモデルの精度は75.9%で、ビンの中央で予測される84.4%に対して。MMLU上では、2つの間違った回答が一致する中央の確率は0.621で、からの0.368に対して、4つのオプションが衝突を強制するため。精度はペアの精度と一緒に上昇します(HELMでSpearman +0.575、MMU上で+0.786、従属セルより)。
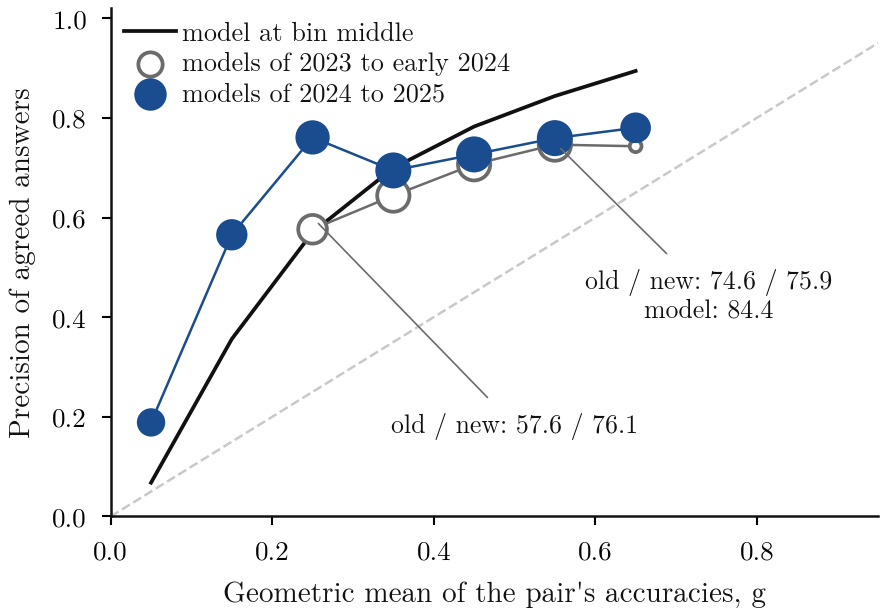
Figure 6. HELM Lite: ペアの精度別の一致した回答の精度、古いモデルと新しいモデル。 注:ペアの精度の幾何平均gのビン、異なる研究室のペア、マーカーサイズはペア数で増加します。線は各ビンの中央での凍結モデルです。
HELMはまた、多くの研究室で5.2節のテストを許可し、GPT依存性はありません。1つのリリースモデルと精度が3ポイント以内のパートナーを使用して、別の研究室は同じ研究室の72.3%に対して75.5%のエラーをキャッチします、-3.2ポイント [-4.2, -2.3]、カバレッジはより高い2.7ポイント。カバレッジに3ポイント以内の一致を追加するとそれを削除します。75.7対75.9%、-0.2 [-0.6, +0.2]。
6. 議論
ゲートの実行ではラベルは不要ですが、チェックには必要です。重要な層の標本化されたサンプルで、展開されるアクセスモードにおいて、両モデルの精度を測定してください。このデータでは、両者の範囲を超えた質問に対する2つのフラグシップモデルからの合意答は、2つの中堅モデルからの合意答よりも安全ではありません。信頼値が利用できない場合、2つの研究所をペアにすることは合理的なデフォルトですが、層で検証する必要があります。信頼度で削減された同一研究所のペア、または公開されたモデルの信頼度そのものが同等の結果を得ることができます(セクション5.2、付録J)。
チャンス調整類似度(Goel et al., 2025)と合意答の精度は異なる量であり、Han(2026)は装飾相関を、精度とカバレッジを優先する地点である私が置いた仕掛けとして命名しています(付録L)。報告のため、モデル合意の研究は、各グループのアクセスモード、労力、ツール条件、および保持されたイベントログを述べるべきです。
7. スコープと境界条件
ティアは異なる日付とアクセスルートで2つの波を通じて比較され、ティア比較は一致精度で約3ポイント程度正確ですが、最難五分位だけでははるかに低くなります。新しい証拠は2つの日付における100の質問と8つのテンプレートの1つのセットであり、10月のDeltaはそれを含みません。ペアの精度と適合率は日付全体と波間で異なる推論設定全体で一緒に動き、設計は原因として能力を分離しません。
Codexクライアント、kimiおよびgemini-3.8-flashクライアントが検索できたかどうかは保持されたファイルから解決することはできないため、それらの精度は模型メモリではなく、配置されたクライアントを測定します。セクション5.1および5.3は、それらのアームなしで主な結果を示しています。
同じ実験室のペアは10月に存在し、2つの実験室について、GPTなしで同じ波の比較は100の新しい質問です。10月セルは2つの実験室から5つのモデルに依存しているため、2方向ブートストラップのモデル次元は数レベルが少なく、プール化された区間は不確実性の下限です。等しいカバレッジでの比較は記載された信頼度を使用します。これは単純なゲートは使用しません。ランダムな同点破りは最も広い行を0.0から+20.7ポイント間で移動します(付録H)。
エンジンはルールベースであり、ここのチェックはSimpleQA Verified(セクション5.1)のクリーニングされたゴールドと回答部分の再スコアリングです。答え全体を評価し、長い回答は偽の「間違い」を引き出すことができます。最初の部分のみをスコアリングすることで、参照ペアの精度を最大3ポイント移動し、gpt-6-astraとopus-5-5は80の106から80.0から88.9%(表A3)に移動します。
モデルは各セルの測定精度を入力として取得するため、ゲートのラベル付きチェックを説明し、置き換えません。製品事実と公開データで高く実行されます。HELM、LiveBenchおよびKim et al.の集計は、フラッグシップ2026のではなく、他のモデルの関係をテストするため、少数ショットまたは複数選択形式で古いモデルを保持します。
8. 結論
合意された回答の精度は、当該階層のペアの正確性とともに上昇し、ティア間および一致した正確性の約3ポイント以内の両方で上昇します。逆転現象は、フラッグシップを含め、弱いペアを測定した場所で現れました。第2の実験室のパートナーは、主にゲートをより頻繁に開かないことによってより多くのエラーをキャッチし、カバレッジが同等の場合、そのモデルがはるかに正確である場所でのみその利点を保持しました。ゲートの小さなモデルは、より良いモデルよりもサンプル外精度をより良く記述し、独立したエラーと同等です。2つのアクセス構成を通じて測定された1つの識別子は45.7ポイント異なるため、モデルの正確性に関する主張はアクセスモードを述べるべきです。
インパクト・ステートメント
本論文は、2つの言語モデル間の一致が短い事実的回答を提供するためのルールとして信頼できる場合を研究しています。実務家は、より強力なモデルまたは第2のベンダーで十分だと仮定する代わりに、重要な層で、かつ展開するアクセスモードにおいて、2モデル・ゲートが自らの用途に対して十分な精度を持つかどうかを検証できます。主なリスクは難しい質問に対する一致への過度な信頼であり、結果は一致した回答がほぼ間違っている層を示しています。本研究は公開ベンチマークと機械合成質問のみを使用しています。
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
宣言
利益相反。著者は、本論文が検証するAIオーケストレーションおよびマルチモデル検証システムをカバーする、未許可特許出願の指定出願人です。
データとコード。呼び出しごとの応答、分析スクリプト、および報告されたすべての数字からその出典表へのマッピングは、Zenodoにアーカイブされています。doi:10.5281/zenodo.24090584 (CC BY 4.0)。
付録A. モデルとアクセスモード
表A1. ウェーブごとのコレクションとアクセスモード。
| コレクション | 日付 | モデル | アクセス |
|---|---|---|---|
| 7月中級 | 2026年7月24日~28日 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | Direct API |
| 7月ローカル | 2026年7月24日~28日 | 7つのローカルオープンウェイトモデル | ローカル推論 |
| 8月フラッグシップ | 2026年8月3日~6日 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | ベンダークライアント。gpt-5.6-solはクライアントのデフォルト努力設定で、APIフォールバックで1,500件中14件 |
| glm-5.2 | ベンダーエンドポイント | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | Direct API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | Direct APIまたはベンダーにピン留めされたアグリゲータールート。muse-spark-1.1は部分的(251件の回答) | ||
| 分散アーム | 2026年8月6日 | 9つのフラッグシップ、Claudeなし | gpt-5.6-solは直接API、努力なし。mistral-medium-3.5はそのベンダークライアントを通じて、要求されたtemperatureを記録。その他は8月ウェーブと同様。temperature 0.7、3サンプル |
| Fresh、8月 | 2026年8月6日 | gpt-5.6-sol(努力なし)、claude-fable-5、deepseek-v4-pro、kimi-k3 | gpt-5.6-solとdeepseek-v4-proはdirect API、claude-fable-5はベンダークライアント、kimi-k3はアグリゲータールート |
| 製品事実 | 2026年8月15日 | 6モデル、15ペア。検索機能がない4つ、6ペア | 混合。gpt-5.4とgrokはクライアントを通じて |
| 10月 | 2026年10月26日~27日 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Codexクライアント、努力中程度、検索フラグなし、イベントストリームは保持されない |
| claude-opus-5-5, claude-fable-5-1 | Claudeクライアント、ツール不可 | ||
| kimi-k3, gemini-3.8-flash(freshのみ) | ベンダークライアント、ツールは無効化されていない |
8月ウェーブでは、claude-fable-5アームの19件の回答が他のClaudeモデルで提供されました。ウェーブの106件中37件中34件はそれらに依存していません(Chernets、2026a)。
付録 B. 503 個の共通質問に対するペア
表 A2. 異なるラボのすべてのペア、最初のメンバーがリリース、503 個の共通質問。
| ペア | カバレッジ | PPV (K/O) | デルタ、ポイント [95%] | 検出されたエラー |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
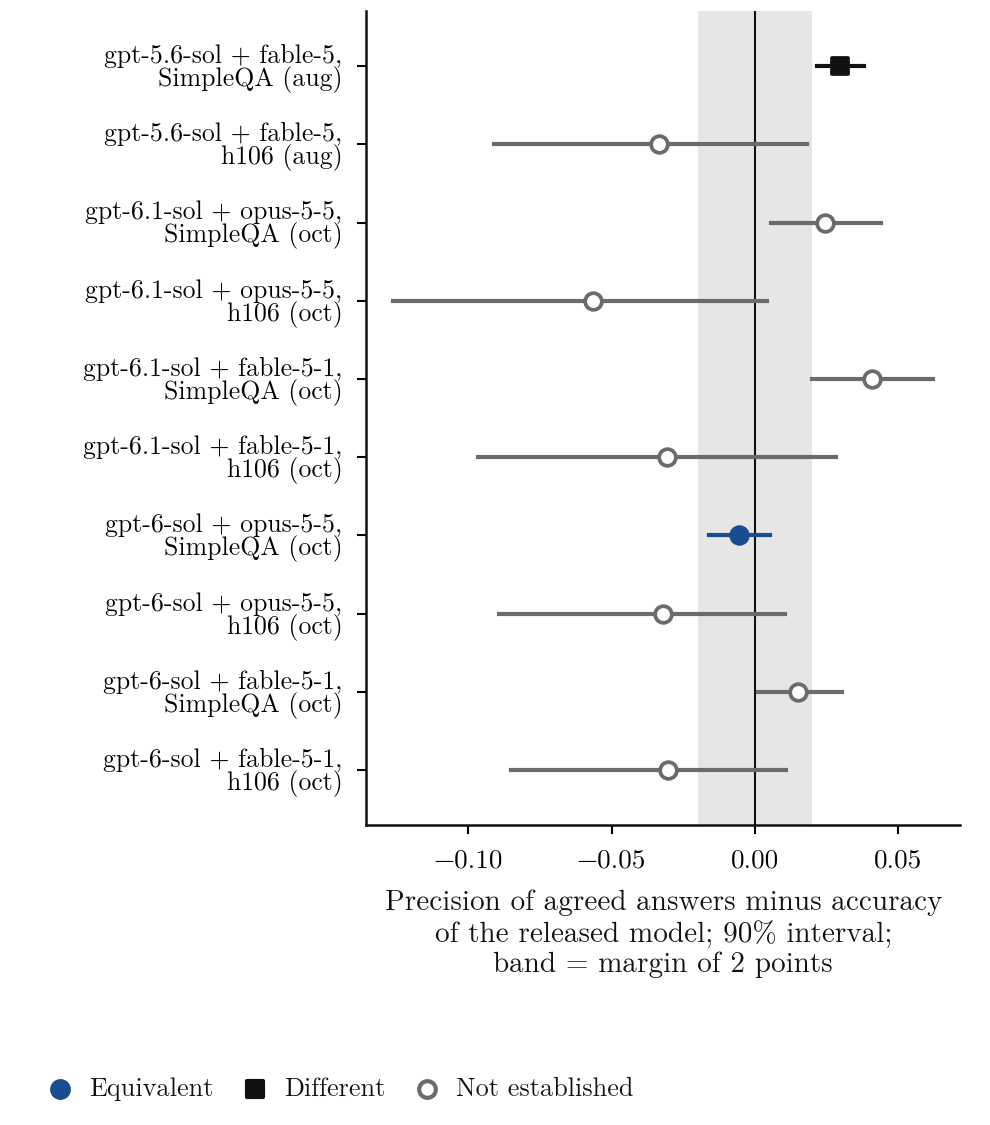
図 A1。 リリースされたモデルに対するペアの精度の同等性テスト。 注記:90% 質問ブートストラップ、2 ポイントのマージンが網掛けされています。Codex クライアント アームがリリースされたペア。
付録C. ゴールド文字列との逐語的一致
逐語的一致は、SimpleQAと新規測定の両方を備えた9つのモデル全体でSimpleQA精度と完全にランク相関しており、正しい答えはしばしばゴール文字列であるためです。SimpleQA削除新規測定ギャップとの相関は+0.47(正確な順列p = 0.21、n = 9)、またはgpt-5.6-solなしで+0.29(p = 0.50)です。gpt-5.6-solの2つの精度は異なるアクセスモードから得られています(図A2)。正しい答えに限定すると、+0.10(p = 0.81)です。正しい答えの中での割合は、gpt-5.6-solで65.7%、fable-5で66.4%、deepseek-v4-proで68.6%、kimi-k3で64.9%です。モデルの残差はそれに依存せず、112個のフラッグシップセル全体で+0.064 [-0.072, +0.167]のスロープです。ギャップ自体はほとんどのモデルでゼロに近いかマイナスであり、fable-5で-3.0ポイント、deepseek-v4-proで-20.5、opus-5-5で-5.4、fable-5-1で-7.8であり、2つの測定間でアクセスモードが異なるgpt-5.6-solでのみ大きい(+62.4)です。
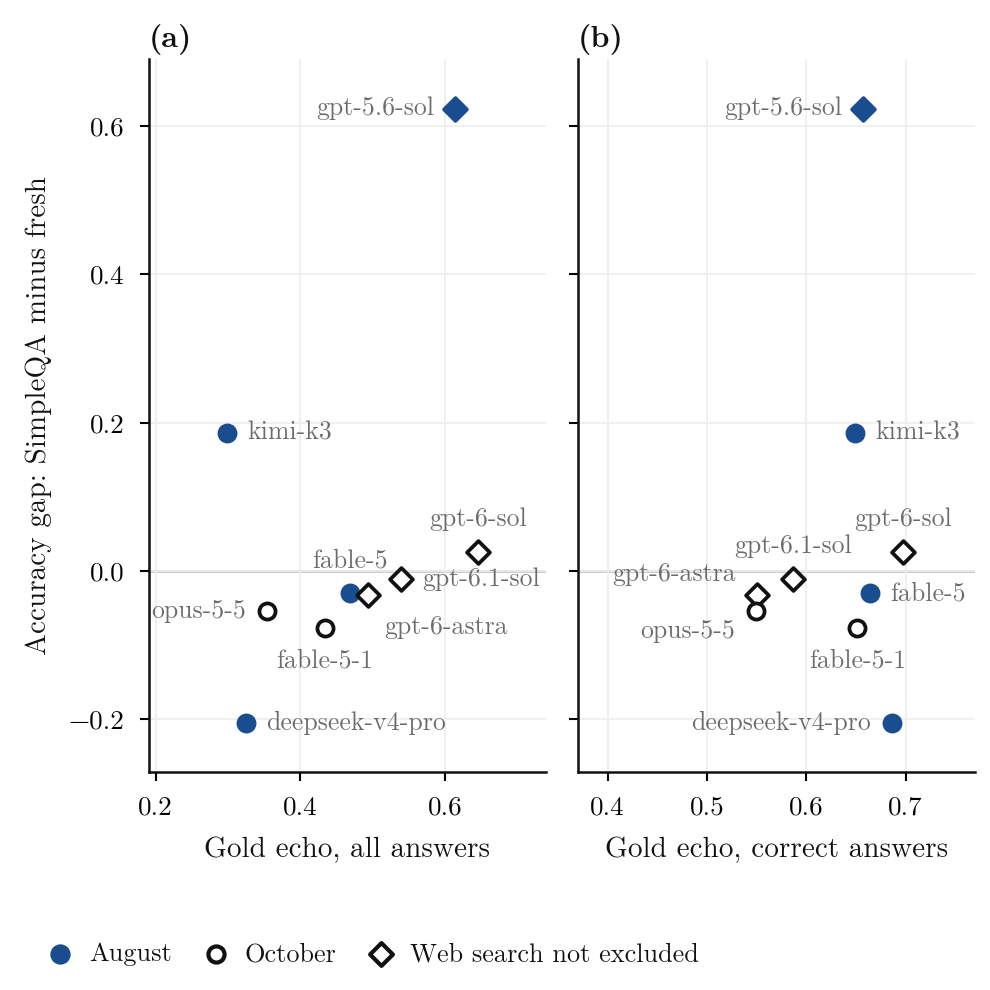
図A2。 ゴールド文字列との逐語的一致と精度ギャップの関係。 注:(a)すべての答え、(b)正しい答えのみ。濃い青は8月の波、白は10月の波を示します。ダイヤモンドはウェブ検索が除外されていないアームを示します。
付録D. 採点者感度
エンジンは大文字小文字、冠詞および句読点を正規化し、完全一致および4文字以上の文字列の含有を受け入れ、日付、数字および英数字識別子を規則によって比較し、その他の場合は内容語を比較します。エンジンが金標準に対して決定できない回答は未解決のままです。表A3では、各回答の最初の部分(括弧およびその後の説明なし)が照合および採点に使用されるため、オープンカウントも変わります。
表A3。 全回答に対する最初の部分の採点。最初のメンバーはリリースされています。
| ペア、セット | PPV、全回答 | PPV、最初の部分 |
|---|---|---|
| gpt-5.6-sol + fable-5, すべて, 8月 | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, 10月 | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, 10月 | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5、106、10月 | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5、strat、10月 | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1、戦略的、10月 | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5、フレッシュ、10月 | 72/74 | 72/74 |
付録 E. その他の関連研究
最近のプレプリントは 2 つの方向を示唆しています。懐疑的な側面として、Denisov-Blanch et al. (2026) は、5 つのベンチマークとモデル全体でのポーリング形式の集約は、エラーが相関しているため、推論コストの 25 倍でも一貫した精度向上をもたらさないことを発見しています。Ding (2026) は GPQA Diamond と AIME で 265,000 サンプルを監査し、合意は正の相関を持つが弱い予測因子であること(Spearman 0.20~0.59)、最も一貫性のあるフロンティアモデルの高合意 GPQA エントリの 48% が誤りであることを発見しています。46 項目の探索的チェックでは、gpt-4.1 と Claude 層間の同じ誤った答えの割合が、3 つの層のうち 2 つについて限界保存ヌル仮説を上回ります。Kohli (2026) は、3 つの推論データセット上の 9 つのフロンティア判定者がおよそ 2 つの独立した投票を持つこと、および最良の単一判定者がパネルと同等か上回ることを発見しています。Kim (2026) は MMLU-Pro の 30 モデルの 31,900 個の部分集合を監査し、投票が大きさ 3 の部分集合の 9.98% で最強メンバーを上回ること、および厳密な多様性尺度が 1 マイナス平均精度とほぼ共線関係にあること(Spearman +0.991)を発見しています。Hossain et al. (2026) は 10 人の判定者全体での平均ペアワイズエラー相関が 0.21 であること、これが約 3.5 個の独立した判定者と同程度の情報を持つこと、異なるプロバイダーのフロンティア判定者間でより強い依存性があることを発見しています。Chen (2026) は、1 つのメンバーの答えを出力するポリシーが、すべてのモデルが一緒に誤る率 の 1 マイナスを超えることができないこと、67 モデルにおいて開放形式の数学で が 0.052 であることを示しており、ガウス型コプラでは 0.023、自由記述 GPQA-Diamond では 0.127 であることを発見しています。一方、Naik (2024) は、複数選択形式の 78 ケースで精度が 73.1% から 2 つのモデルで 93.9% に上昇し、3 つのモデルで 95.6% に上昇することを報告しており、Liu (2026) は 4 モデルパネルが 7 つのベンチマークで自己一貫性より優れた答えを選択すること、メンバー精度、エラー相関、および共有誤解率の閉じた形の法則がコンセンサス精度を平均絶対誤差 0.028 で予測することを示しています。Xue et al. (2026) は、検証者を伴うクロスモデル一貫性が QA ベンチマーク上の幻覚検出の自己一貫性の上限を改善することを報告しており、Tan et al. (2025) は、自己一貫性エラーはモデルスケールで縮小しないこと、モデル固有の傾向があること、第 2 モデルでより良く検出されることを報告しています。Han (2026) は、ブラインドスポット質量が信頼性を上限とする直列検証ゲートの理論を提供し、モデルファミリー、モダリティ、または証拠源を変更することによる装飾化を実践的なテコとして名付けています。第 2 節の 2 つの研究はゲートに関連する詳細を含んでいます。Goel et al. (2025) は、異なる誤った選択肢を意見の不一致とカウントするように CAPA を定義し、能力との傾向に加えて、9 つのオープンウェイト LLM 判定者が自分たちに似たモデルを高くスコアリングすること、および弱から強への利益は監督者と学生がより似たエラーを出す タスクでより大きいこと(12 モデルペア)を示しています。Kolawole et al. (2025) は、テスト分布上の受け入れられたエラーの結合率に対する安全遅延条件を述べており、閾値は小さな検証セットで推定されます。結合率の条件により、受け入れられたエラーが 1 つの層に集中することが可能であり、第 5.1 節はそのような層を見つけます。106 では中層パネルが誤りを認証し、最高精度アームなしのフラッグシップペアも同様に行います。
第 2 節で述べたように、これらの研究のいずれも、ペアレベルのリリースゲート、1 つのリリースされたモデルを固定したときの等しいカバレッジでのリコール、または 2 つのアクセスモードで測定された 1 つの識別子を報告していません。
付録F. データおよびプロトコルの詳細
コレクション。プロトコルはセクション3のものであり、コレクションは完全に以下の通りです。表A1はモデル、日付およびアクセス方式をリストしています。
- 7月中旬層(7月24~28日)。9つのAPIモデルおよび7つのローカルモデルを1,500のSimpleQA質問(Wei et al., 2024)に対して実行しました。これはベンチマークの4,326質問の固定ランダム部分標本です。コレクションはデータ収集前にOSFに登録されました(Chernets, 2026a)。
- 8月フラッグシップ(8月3~6日)。11の研究機関からそれぞれ1つのフラッグシップモデルを同じ1,500質問に対して実行しました。そのうち1,459が共通プールを構成します。
- バリアンスアーム(8月6日)。これらのフラッグシップのうち9つを、その100質問について、温度0.7で、1質問あたり3サンプルで実行しました。各五分位ごとに20質問です。
- 新規質問(8月6日および10月26日)。Wikidataから8つのテンプレート全体で機械により構成された100の2ホップ質問。最初のモデル呼び出しの前にファイルハッシュが固定されました。
- 製品情報(8月15日)。商用製品に関する267質問。これもWikidataから構成されており、6つのモデルで実行されました。そのうち4つは検索機能がありません。
- 10月フラッグシップ(10月26~27日)。gpt-6.1-sol、gpt-6-astra、gpt-6-sol、claude-opus-5-5およびclaude-fable-5-1を、7月の五分位により層化された300のSimpleQA質問で実行しました(60、120、120; 5つすべてに共通するものは297質問; 表では「strat」)。以下の106質問および新規セットを含めて、合計503の共通質問です。kimi-k3およびgemini-3.8-flashは新規セットに回答しました。
アクセス方式。モデルはセクション3で説明された2つの方法でアクセスされました。gpt-5.6-solはバリアンスアームおよび8月の新規セットで直接APIで実行されました。モデル識別子およびクライアントバージョンはコールごとに記録されました。
クライアントが測定条件を設定するため、完全に述べます。温度はそこでは設定できません。8月のCodexアームはクライアントの推論努力の既定設定で実行されました。これはコールで設定されず、レコードに記載されません。10月のCodexアームは各コールで努力を中程度に設定して実行されました。8月のマニフェストレコードはClaudeアームで0件のウェブ検索リクエスト、Mistralアームで空のツールリストを示しており、10月のClaudeアームはツールを禁止して実行されました。CodexアームはSearchフラグなしで起動され、そのイベントストリームは保持されなかったため、検索されたかどうかはファイルから判断できません。kimiおよびgemini-3.8-flashクライアントでは、ツールは無効化されず、プロンプトで禁止されています。
付録G. 106と階層
図A3は、セクション5.1の106に関するパネルとペアを示し、さらに2つのペアを加えています:fable-5とgrok-4.5は28の合意のうち7で一致し、gemini-3.1-proとgrok-4.5は25のうち8で一致しています。
セクション1の342のうち0は、難易度がどのようにランク付けされるかに依存しています。各パネル自体の回答を難易度ランク付けから除外すると、カウントは354のうち78になり、クロスブロックパネルは116のうち0のままです。
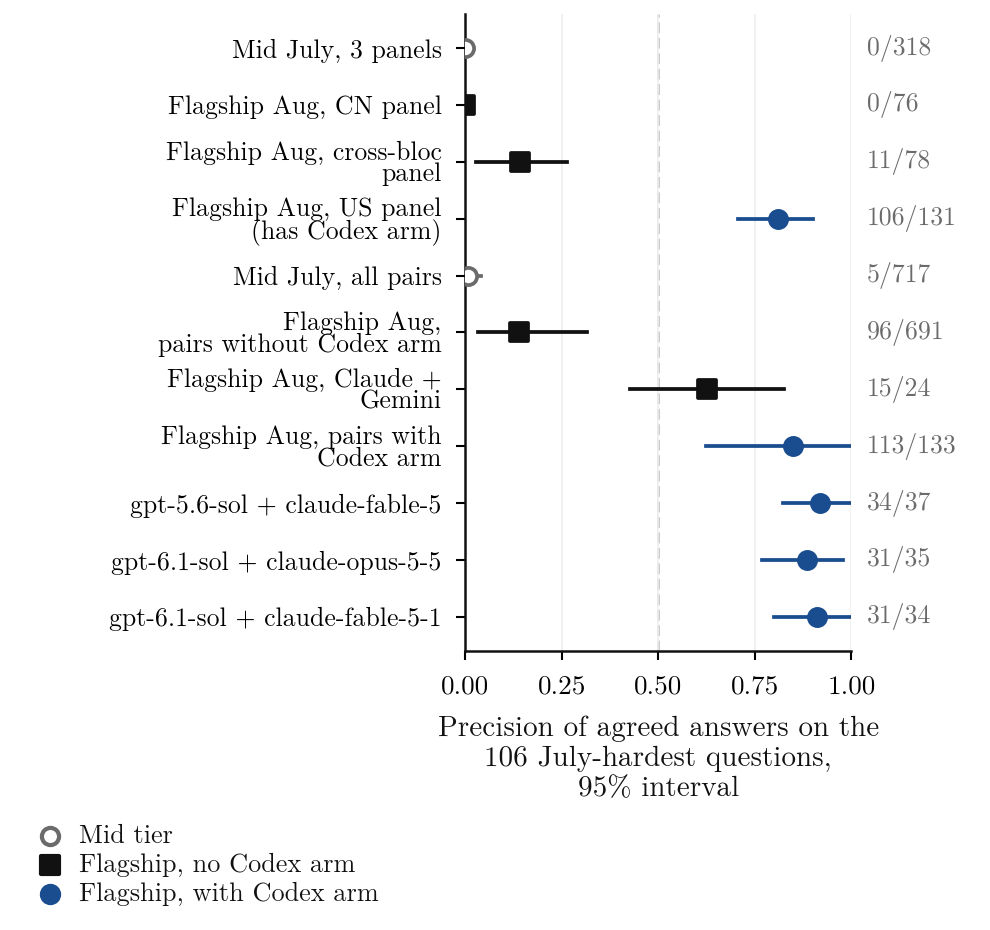
図A3。 106の質問に対する合意された回答の精度。 注:プール行に対する95%の双方向ブートストラップ、パネルと単一ペアに対する質問ブートストラップ。青い行にはCodexクライアントアームが含まれています。8月と10月の収集。
図A4は、セクション5.1の独自階層五分位数を完全に示しています。すべてのアームで、8月は最も難しい五分位数で26.6% [6.7, 53.4]に達し、7月から+9.3 [-18.1, +39.8]の差があります。両方の収集に属するkimi-k3を除くと、最も難しい五分位数は7月に675のうち147(21.8%)、8月に995のうち192(19.3%)を与え、-2.5ポイント [-29.7, +28.2]。セクション5.1のプール検定は5つの五分位数すべてを使用し、階層あたり180セル。中程度の階層セルは凍結モデルから+0.3ポイント [-2.4, +2.9]、フラッグシップセルは+0.0 [-1.4, +1.6]。最も難しい五分位数でのリフトは7月で1.15 [0.39, 1.90]、8月で0.97 [0.42, 1.49]。五分位数全体で、GPTなしの8月は15.5、52.9、75.8、90.5、97.3%、7月は17.3、29.0、60.9、80.4、94.4%で、リリースモデル精度は16.0、36.6、56.8、73.3、88.5%対15.3、25.0、40.0、57.7、78.9%です。
クリーニングされたゴールド回答では精度は低いままです。Haas et al.(2025)はSimpleQAをクリーニングされた1,000の質問のセットに再構築し、ベンチマークの保持率から期待される24.5に対して24のうち106が生き残り、ゴール回答が21で同じです。クリーニングはこれらの質問を他の質問より頻繁に削除することはありませんが、その選択は難しい質問も優遇しています。同じ統計とブートストラップの下で、GPTなしの8月ペアは、それらの24の質問に対する150の合意のうち28で正しい(18.7% [0.0, 57.1])、他の82に対する538のうち67で正しい(12.5% [2.8, 28.1]。より正確なメンバーは各サブセットでリリースされるため、パーツは96のうち691に合計する必要はありません)、7月ペアは157のうち4で正しい(2.5% [0.0, 15.2])。
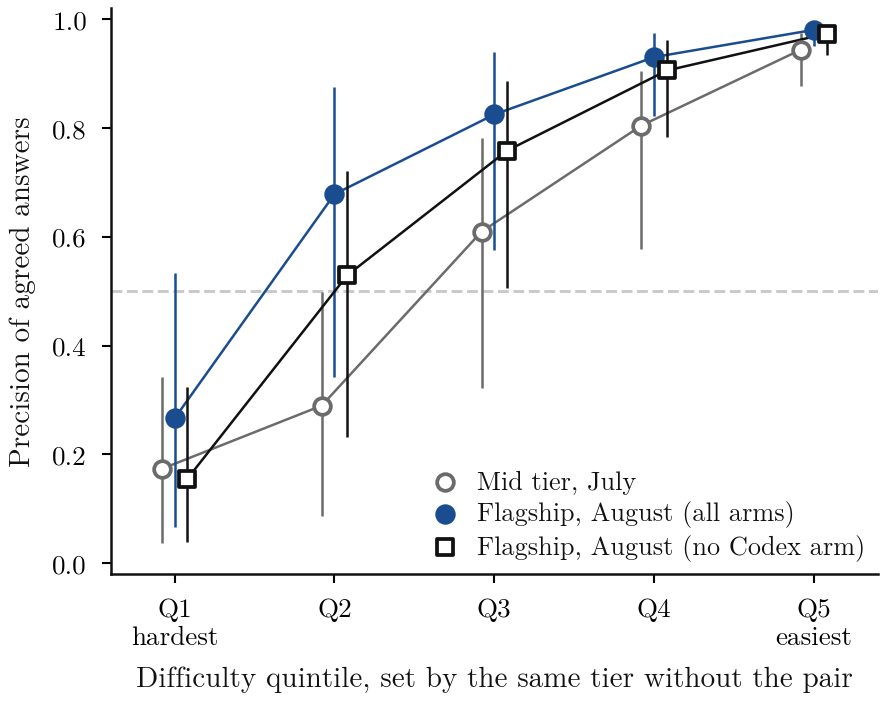
図A4。 独自階層難易度五分位数による合意された回答の精度。 注:95%の双方向ブートストラップ。各ペアの難易度は、そのペアなしの同じ階層によって設定されます。破線は0.5。
最も正確なペアは同じ関係に適合します。kimi-k3とgemini-3.8-flashのペアは新しいセットで95.8%に達し、リリースモデルの26の誤りのうち23を捕捉し、5.37 [2.86, 21.36]のリフト。モデルは、0.74と0.82の精度のみを与えられて、95.1%を返します。検索可能性のないの2つのClaudeフラッグシップは、リリースモデル精度が30.0%である106で47.5%に達し、すべての503の質問で86.2%。図A5は、すべての階層のすべてのバンドをリリースモデル精度に対してプロットし、23のセルのうち17で対角線上方の精度。
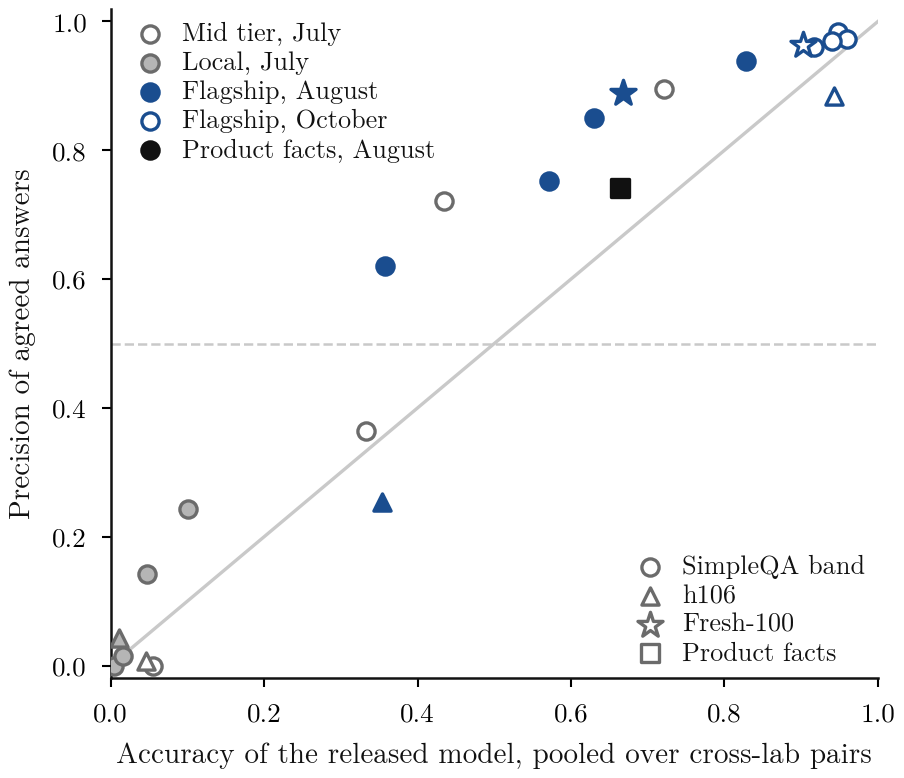
図A5。 リリースモデルの精度に対する合意された回答の精度。 注:異なる研究所のペアにプール、階層とバンド別。色と塗りつぶしは階層を与え、マーカー形状はセットを与えます。破線は0.5、実線は等式。
付録H. 2番目の研究室の詳細
分散アーム。 モデルの等しいカバレッジでの比較(図2)では、2つの研究室ゲートは9つ中7つで先行し、gemini-3.1-pro(-5.7ポイント)とgrok-4.5(-2.8ポイント)で後退しています。GPTなしで、8つのモデルにおいて、自己合意は61.4%のカバレッジで精度55.9%を達成し、2つの研究室は24.4%のカバレッジで83.3%を達成しています。精度の差は測定では+27.4ポイント[+16.0, +35.7]、等しいカバレッジでは+7.7ポイント[-1.9, +16.5]であり、捕捉されたエラーの差は測定では+38.3ポイント[+26.0, +50.9]、等しいカバレッジでは+3.0ポイント[-1.5, +8.4]です。10月には反復呼び出しがないため、自己合意は8月のみで測定されています。
1つのリリース済みモデルの4つのパートナー。 表A4は図3aの4つのパートナーを示しています。1つのリリース済みモデルであるgpt-6.1-solについて、すべての行で同じ29のエラーが対象です。
表A4。 1つのリリース済みモデル、4つのパートナー: 503の共通質問におけるgpt-6.1-sol(495個の解決済み中29のエラー、95%の質問ブートストラップ)。
| パートナー | 研究室 | カバレッジ [95%] | PPV (K/O) | 差分、ポイント [95%] | 捕捉されたエラー [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | 同じ | 96.2% [94.4, 97.8] | 94.3% (449/476) | +0.2 [-0.2, +0.8] | 2/29 = 6.9% [0.0, 17.4] |
| gpt-6-sol | 同じ | 95.6% [93.6, 97.2] | 96.2% (457/475) | +2.1 [+0.9, +3.4] | 11/29 = 37.9% [20.7, 56.5] |
| claude-opus-5-5 | 異なる | 59.8% [55.9, 64.0] | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 = 55.2% [36.4, 73.0] |
| claude-fable-5-1 | 異なる | 60.8% [56.7, 65.0] | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 = 69.0% [50.0, 85.2] |
同じ研究室のもう1つのパートナーであるgpt-6-solは29中11を捕捉しており、これはfable-5-1に対して-31.0ポイント[-50.0, -10.7]、opus-5-5に対して-17.2ポイント[-37.0, +3.0]です。Claudeペアは、どちらのアームでも検索の可能性がなく、60.6%をカバーし、fable-5-1の181のエラー中140を86.2%の精度とともに捕捉し、Delta +23.5ポイント[+19.6, +27.2]を達成しています。天井からはるかに遠い1つの研究室の2つのモデルは、エラーの大部分を捕捉するのに十分なほど頻繁に意見が異なる可能性があります。
表A5は、これがカバレッジ曲線に沿った単なる動きより以上のものかどうか、およびGPTが必要かどうかをテストしています。各行は1つのリリース済みモデルを保持し、その同じ研究室のパートナーを別の研究室のパートナーと比較し、最初は測定のままで、次に等しいカバレッジで比較します。等しいカバレッジはより広いゲートを信頼度で薄めることによって達成されます(セクション3)。
表A5。 同じ研究室のパートナーおよび別の研究室のパートナーで捕捉されたエラー。差分は同じマイナス他、ポイント単位で、95%の質問ブートストラップを伴い、負は他の研究室を支持します。測定のままの差分は、最初の4つの行で表A4のブートストラップを共有します。
| リリース済み | 同じ/他のパートナー | 質問 | 捕捉、測定のまま | 差分 [95%] | 捕捉、等しいカバレッジ | 差分 [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62.1 [-79.3, -43.8] | 17/29, 20/29 | -10.3 [-35.3, +13.8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48.3 [-66.7, -29.6] | 18/29, 16/29 | +6.9 [-17.1, +30.4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31.0 [-50.0, -10.7] | 24/29, 20/29 | +13.8 [-6.7, +34.6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17.2 [-37.0, +3.0] | 24/29, 16/29 | +27.6 [+3.4, +51.6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16.0 [-21.7, -10.6] | 140/181, 169/181 | -16.0 [-21.7, -10.6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11.8 [-17.8, -5.9] | 156/195, 177/195 | -10.8 [-16.7, -5.0] |
| fable-5-1 | opus-5-5 / kimi-k3 | 新規 100 | 13/23, 20/23 | -30.4 [-50.0, -12.5] | 17/23, 20/23 | -13.0 [-35.0, +9.1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | 新規 100 | 13/23, 19/23 | -26.1 [-45.5, -8.7] | 17/23, 19/23 | -8.7 [-29.4, +12.5] |
| opus-5-5 | fable-5-1 / kimi-k3 | 新規 100 | 18/28, 23/28 | -17.9 [-38.5, +0.0] | 24/28, 23/28 | +3.6 [-14.7, +22.6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | 新規 100 | 18/28, 22/28 | -14.3 [-33.3, +4.5] | 22/28, 22/28 | +0.0 [-20.0, +20.7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (8月) | 344 | 107/130, 110/130 | -2.3 [-9.8, +5.3] | 108/130, 110/130 | -1.5 [-9.1, +5.8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (8月) | 344 | 118/141, 126/141 | -5.7 [-12.1, +0.8] | 125/141, 126/141 | -0.7 [-6.4, +5.1] |
8月の行はGPTなしの唯一のSimpleQA比較であり、異なる日付のモデルをペアにします。gemini-3.1-proはこれらの質問におけるClaudeモデルに精度が最も近い8月アーム(これらの質問で65.4%対60.6%および57.7%)です。すべての7つの8月パートナーの全体に渡ってプールされた場合、そのほとんどははるかに弱く、差分は測定で-5.1ポイント[-10.1, -0.3](fable-5-1の場合)および-6.0ポイント[-10.6, -1.2](opus-5-5の場合)であり、等しいカバレッジでは同じ研究室を支持して+7.9ポイント[+4.8, +11.2]および+6.8ポイント[+3.6, +10.2]に変わります。信頼度のタイは無作為に破られ、200ドローにおいて、最も広い行は0.0ポイントから+20.7ポイントの間を動きます。
付録I. モデルのサンプル外性能の詳細
表A6は5.3節の背後にあるサンプル外誤差を示しています。時系列分割は0.019を与え、最良モデルのベースラインに対して0.050であり、双方向ブートストラップの下で-0.031 [-0.074, +0.008]の差があり、質問のみでまたはモデルのみでクラスタリングした場合、区間はゼロより下にあります。9および23フォールドでは、LOLOとLOMOは小数点以下3桁で同じ誤差を与えます。
表A6。 予測PPVの平均絶対誤差、少なくとも20の開かれた回答を含むセル。双方向ブートストラップ、質問とモデル別。
| スキーム | モデル [95%] | 独立 | 最良 | モデル - 最良 [95%] | モデル - 独立 [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO、質問分割 | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| 7月8月から10月 | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| ミッドティアからフラッグシップへ | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO、フラッグシップ、検索可能アーム除外 | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| 除外: ERNIE および Muse、8月 | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| 除外: 7つのローカルモデル、7月 | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| 除外: 同一実験室、10月 | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| 除外: 製品事実 | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
より優れたモデルを読み取ることに対する実用的な利益は大きく、ミッドティアからフラッグシップへの転移と、適合に参加しなかった4つのセットのうち2つが含まれます(図A6)。乗数は主要なスキームの精度に何も追加せず、仕事は測定された精度とによって行われます。を完全に除去するとLOLO誤差は0.323に上がり、それを定数に保つと0.046を与えます。カバレッジとログ損失では、は役に立ちます: LOLOの下で独立誤差からの差は-0.0079 [-0.0111, -0.0020]と-0.0024 [-0.0045, -0.0003]です。除外された4つのセットのうち3つで、独立誤差に対する区間は、定数が固定されている場合、ゼロより下にあります。したがって結合誤差項はカバレッジに対して重要ですが、精度は測定された精度とに依存しています。
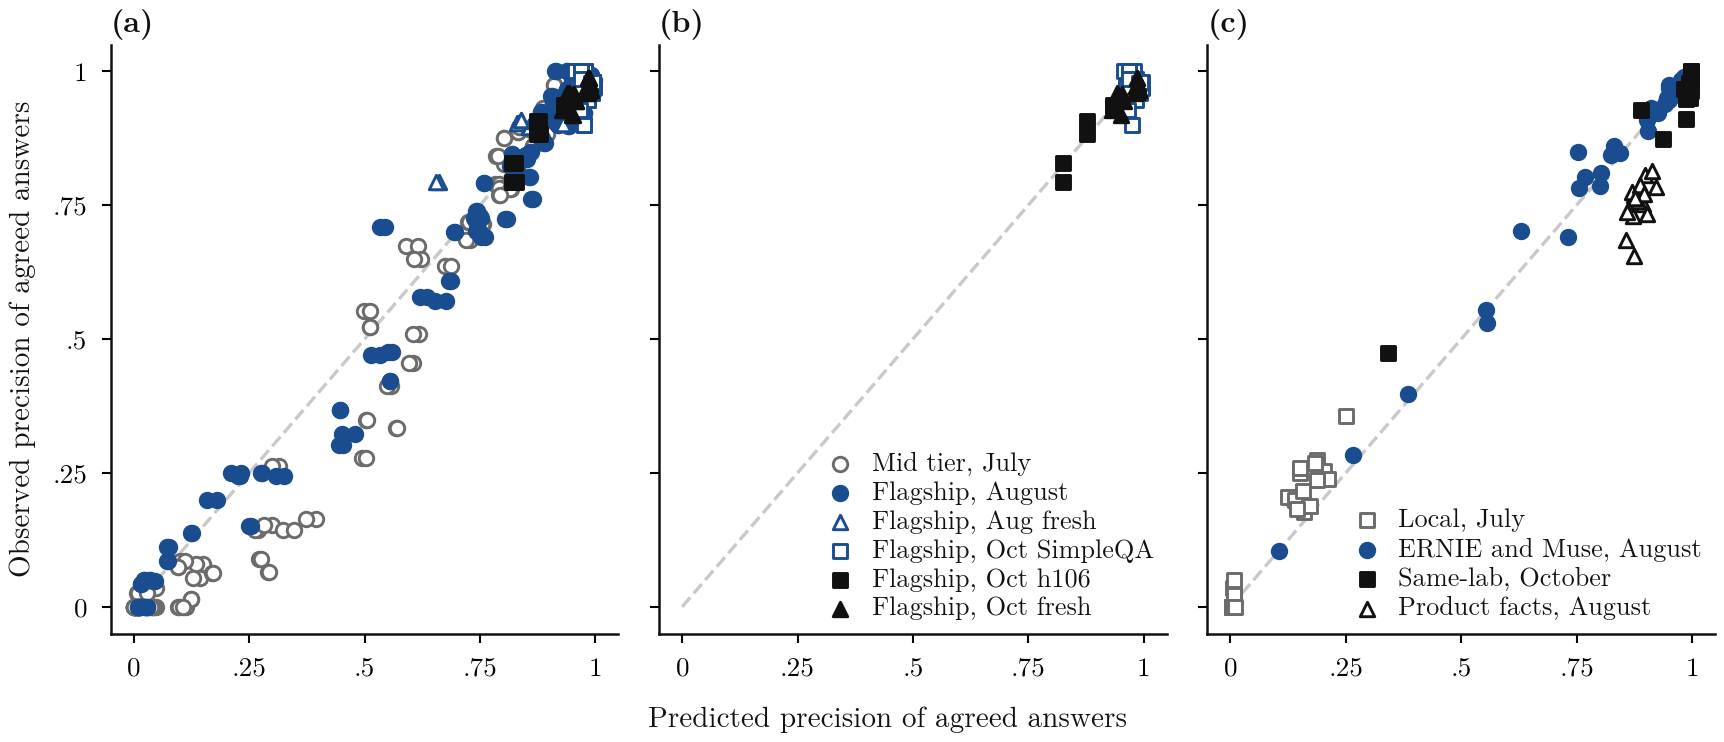
図A6。 合意された回答の予測精度対観測精度。 注: (a) 1つの実験室を除外。(b) 7月と8月で適合させ、10月を予測。(c) 適合の外のセット、定数を固定。破線は等号を表しています。
製品事実では、モデルは高く実行されます。誤差は最良モデルに対して0.086である0.130で、平均の過大評価は13ポイントです。そのドメイン固有の採点者では、過大評価は19ポイント(0.190対0.067)に上がります。製品事実は定数が適合された領域の外にあります。
セルを3つの結果クラスに分類すると(PPV 0.5未満で反転、デルタが+2ポイントまで利益なし、それ以上で利益あり)、時系列分割は39セルのうち28セルと一致し、9つのミスは利益が観測されたところで利益がないと予測します。モデルは精度の大きさについては信頼できますが、+2ポイント線の両側でセルを分類することは弱いです。
付録J. アクセスモードとGPTアームの詳細
同じ識別子、同じ質問。100個のSimpleQA質問のセットでは、gpt-5.6-solはメインウェーブで100点中92点(92.0%)を獲得し、100レコード中99個はCodexクライアントを経由し、1つの誤った答えはAPIフォールバック経由で、直接APIでは300サンプル中139個(46.3%)を獲得し、45.7ポイントのギャップがあります(図5)。クライアントレコード99個のみでは、数字は99点中92点(92.9%)と297点中139点(46.8%)で、46.1ポイントのギャップがあります。金の文字列の逐語的再現は、64.0%から26.0%に低下します。条件は以下のように異なります。クライアントは独自の指示に従い、デフォルト努力設定で実行され、温度は設定不可能ですが、APIは努力なしで温度0.7で実行されます。
2つの列にわたって、温度も変わる他の8つのモデルのアームは、どちらの方向でも最大4.0ポイント移動します。努力はgpt-5.6-solの候補の1つですが、gemini-3.1-proの連動推論予算測定では精度がほぼ変わらずでした(Chernets、2026c)。もう1つはウェブ検索です。同じクライアントからの10月の応答は、プロンプトが要求していないリンクを含み、gpt-6.1-solの506回の答え中3回、gpt-6-astraの506回中18回含まれており、実際のMusicBrainz識別子を含みます。8月のクライアント呼び出しあたりの中央トークン使用量は4,829で、呼び出しの36.4%が6,000を超えています。これらのトークンは推論または検索の可能性があり、それらを分離するイベントストリームは保持されていません。
ベンチマークハーネスと製品を使用している人は、1つの識別子と1つの質問セットで45.7ポイント離れた精度を見ることができ、「モデル」の研究は測定したものを述べる必要があります。8月のウェーブ内で、クライアントアームは1,457中1,392点(95.5%)を獲得し、クライアント障害後にAPIが提供した14レコードは、その障害により選択された質問で11点(78.6%)を獲得します。新しいセットでは、APIを通じたgpt-5.6-solは100点中33点を獲得し、fable-5は76点を獲得し、gpt-6.1-solは10月にクライアントを通じて95点を獲得します。セクション4のモデルは、測定された精度を入力として受け取るため、この質問に基づいてその形式を保持します。検索可能なアームなしのフラグシップではLOLOエラーは0.037で、最良のモデルは0.120です。
アクセスモード別のゲート値。8月の新しい質問では、APIを通じたGPTで、gpt-5.6-solとfable-5のペアは32件の一致中29件で正しく、Delta +57.6ポイント [+46.3、+69.7]、67件のエラー中64件をキャッチし、GPTアームの確信的エラーは91件中61件から29件中2件に低下します。10月では、同じ質問でクライアントを通じた新しいGPTで、opus-5-5とのペアは74件中72件で正しく、fable-5-1とのペアは78件中76件で正しく、Delta +2.3 [-0.7、+6.0]と+2.4 [-0.5、+6.3]で3件中3件のエラーをキャッチします。ゲート値はここでセクション5.1のように解放されたアームの精度を追跡します。
SimpleQA上のクライアントアーム。表A7はセクション5.1で脇に置かれたアームを報告しています。8月では、gpt-5.6-solとfable-5のペアは1,016件の一致中997件(98.1%)で正しく、単独で95.4%に対して、Delta +2.8ポイント [+1.9、+3.7]で、15件中1,459件でフロアがあります。106では34件中37件(91.9%)に到達し、すべてのGPTアームとのペアは133件中113件(85.0% [62.2、100.0])に到達し、それなしの691件中96件に対してです。アーム単独は105件中100件で正しいです。これらの一致はその精度を継承します。106でのDeltaは8月で-3.3ポイント [-10.3、+2.6]で、10月のopus-5-5で-5.7 [-13.7、+1.2]です。対照的に、同じ2つのベンダーの中堅ペアであるgpt-5-miniとclaude-haiku-4-5は、全体で123件の一致中45件(36.6% [28.6、45.4])で正しく、106で13件中0件で、最初のメンバーは1,435件中163件です。
表A7。クライアントアームペア。最初のメンバーはリリース済みです。PPVのWilson区間、DeltaのクエスションブートストラップGraup。
| ペア、セット | カバレッジ | PPV (K/O) [95%] | 単独リリース | Delta、ポイント [95%] | キャッチされたエラー |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5、全SimpleQA、8月 | 1028/1500 | 98.1% (997/1016) [97.1, 98.8] | 1403/1471 | +2.8 [+1.9, +3.7] | 49/68 |
| gpt-5.6-sol + fable-5、106、8月 | 37/106 | 91.9% (34/37) [78.7, 97.2] | 100/105 | -3.3 [-10.3, +2.6] | 2/5 |
| gpt-6.1-sol + opus-5-5、strat、10月 | 192/300 | 96.3% (183/190) [92.6, 98.2] | 276/294 | +2.4 [+0.2, +4.9] | 11/18 |
| gpt-6.1-sol + fable-5-1、strat、10月 | 193/297 | 97.9% (187/191) [94.7, 99.2] | 273/291 | +4.1 [+1.6, +6.7] | 14/18 |
| gpt-6.1-sol + opus-5-5、106、10月 | 36/106 | 88.6% (31/35) [74.0, 95.5] | 98/104 | -5.7 [-13.7, +1.2] | 2/6 |
| gpt-6.1-sol + fable-5-1、106、10月 | 35/106 | 91.2% (31/34) [77.0, 97.0] | 98/104 | -3.1 [-10.9, +3.5] | 3/6 |
| gpt-6.1-sol + opus-5-5、fresh、10月 | 74/100 | 97.3% (72/74) [90.7, 99.3] | 95/100 | +2.3 [-0.7, +6.0] | 3/5 |
| gpt-6.1-sol + fable-5-1、fresh、10月 | 78/100 | 97.4% (76/78) [91.1, 99.3] | 95/100 | +2.4 [-0.5, +6.3] | 3/5 |
天井付近のゲート値。馴染みのある質問では、ペアはまだ少し追加されます(図A1)。8月のSimpleQA上で106を除いた場合、DeltaはDelta +3.0ポイント [+2.0、+4.0]で、ペアに有利な差があります。10月では、strat ペアはプラスの上にあり、+2.4 [+0.2、+4.9]と+4.1 [+1.6、+6.7]で、マージインを達成していません。単一の同等性はgpt-6-solとopus-5-5の-0.6です(90%区間-1.6〜+0.5、p = 0.020)で、Holm補正を生き残りません(0.277)。106では、gpt-6.1-solとgpt-5.6-solを持つすべてのペアは下向き方向で決定されていません。このアームの外では、効果は大きいです。同じ8月セットで、fable-5とgemini-3.1-proは+19.3ポイント、fable-5とgrok-4.5は+18.0です。
アームの独自の信頼は、この範囲では競争相手です。opus-5-5とのペアのカバレッジに自信を薄めたgpt-6.1-solは、タイの破り方に応じて106で36中34〜36です。対してペアは35中31で、freshで74/74対72/74です。stratではペアがリードし、opus-5-5で+1.6ポイント [-1.4、+4.7]、fable-5-1で+3.2 [+0.6、+6.2]です。
どのGPTとどのパートナーか。 両モデルが共通の問題について解決する場合、gpt-6.1-solはgpt-6-astraに対して不一致ペアで10対1で勝利し(p = 0.012、+1.83ポイント[+0.61, +3.26])、gpt-6-solはgpt-6-astraに対して21対5で勝利します(p = 0.002、+3.29 [+1.23, +5.34])。gpt-6.1-solとgpt-6-solの対比は5対12です(p = 0.143)。opus-5-5とfable-5-1の対比は29対44です(p = 0.101、-3.12 [-6.65, +0.21])。最も強い2つのGPTと2つのClaudeのペアは503問にわたって95.4~97.1%です(表A2)。fable-5-1は各比較における誤りをより多く捉えています。kimi-k3とgemini-3.8-flash(GPTを含まないペア)は新しいセットではそれらから区別できません。gpt-6.1-solとopus-5-5の差は精度で-1.5ポイント[-6.3, +2.8]、カバレッジで-2.0 [-10.0, +6.0]です。
附録K. 外部データの詳細
セクション5.5の外部チェックは、再フィッティングなしで凍結された定数を使用します。HELM Lite(Liang et al., 2023)は、2023年から2025年の間にリリースされた20の開発者による95モデルの短い開放回答を保持しており、1,000の閉鎖型NaturalQuestionsに対して、ここで私のエンジンで採点されています。LiveBench(White et al., 2025)は、11の研究機関による70モデルの回答を保持し、短い最終回答を持つ346の質問に対して、その真実値に対して採点されています。Kim et al.(2025)は複数選択肢のMMLUに関する70モデルのペア集計をリリースしており、これらは観測された精度を一致率に対する両者正解率として示します。表A8は結果を示します。Haas et al.(2025)の表7の精度は一致結果を伴わないため、予測を生じますがテストは生じません。
表A8. 他のモデルと質問に対する凍結モデル。異なる研究機関のペアの予測PPVの平均絶対誤差、最初の2つのソースで少なくとも20の開放回答がある セル。ツーウェイブートストラップ、MMLUについてはモデルのみ。シフトは予測マイナス観測。
| ソース | セル | モデル [95%] | 独立 | 最良 | モデル マイナス 最良 [95%] | モデル マイナス 独立 [95%] | シフト |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench、4つのタスク | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (集計) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
セクション5.3と同様に、モデルは3つのソース全体を通して、より良いモデルを読み取ることに勝ります。そしてそれはzebra puzzleで失敗し、0.076に対して0.231です。HELMまたはLiveBenchの独立した誤差を改善しません。全体的に5.3〜6.6ポイント高く実行されます。HELMではペア精度が0.5〜0.6の間でモデルが上昇し続ける場所で観測曲線が平坦化します:2023年および2024年初期のモデルで74.6%、後年のモデルで75.9%の精度に対して、ビンの中央で84.4%が予測されています。MMLUでは、2つの間違った回答が一致する中央値の確率は、からの0.368に対して0.621です、4つのオプションが衝突を強制するため。
これらのモデルでは精度はペア精度で上昇します(HELMで+0.575、MMLUで+0.786のスピアマン相関、従属セルで)。同様の精度を持つ古いモデルと新しいモデルはペア精度0.4〜0.6の間で同様の精度を示し(70.7%と72.7%、74.6%と75.9%)、0.2〜0.3の間でより異なります(57.6%と76.1%)。セクション4の下限はすべての4,088HELMセルに保持されます。0.5未満のペアは、これらのセルが難易度で層別化されていないため、そこではまれです、4,088の24。
HELMはまた、多くの研究機関とGPT依存がないセクション5.2のテストを許可します、パートナー精度は信頼値なしでマッチできるため。1つのリリースされたモデルおよび精度が3ポイント以内のパートナーの場合、同じ研究機関のパートナーは誤りの72.3%をキャッチし、別の研究機関のものは75.5%で、-3.2ポイント[-4.2, -2.3]の差があり、カバレッジは2.7ポイント高い[+2.1, +3.4]。3ポイント以内のカバレッジでマッチを追加するとそれが削除されます:75.7対75.9%、-0.2[-0.6, +0.2]、精度-0.5[-1.4, +0.1]。2つの間違った回答は研究機関内の場合31.6%、研究機関間の場合27.0%でマッチします。
共有エラーはセクション3のコレクションでも遠くに立ちます。Ding(2026)のラベル順列ヌルの下で、各モデルの間違った回答を保持し、質問全体でそれらをシャッフルすると、拒否ではない2つの間違った回答は7月では14.0%、8月では15.4%のケースでマッチし、ヌルは0.1%に対してです。106では比率は25.7%と22.8%、ヌルは0.4%と0.5%に対してです。新しい質問では8月には14.5%、10月には32.7%、ヌルは0.8%と3.8%に対してです。開放回答はめったに偶然に衝突しないため、観測された共有はこのヌルをはるかに上回り、モデルのリリース後に作成された質問でもです。
付録L. さらなる議論
Goel et al. (2025)との関係。 彼らのトレンドは偶然調整類似度に関するもので、私のものは合意答の精度に関するものであるため、知見は矛盾しません。データはこれを条件付き共有誤り率F/W、つまり両方の答が採点された質問で両方の答が間違っている確率により示唆されます(棄却を間違いとして数えます)。参照ペアについて、中堅ペアでは1,088中63 (0.058)からフラグシップペアでは42中15 (0.357)に上昇し、約6倍です。GPTを含むすべてのペアにわたってプールすると、上昇はより小さく、区間はゼロを含みます。7月は0.097、8月は0.132で、差は+0.034 [-0.006, +0.084]です。10月の層化セットではF/Wは0.493 [0.179, 0.840]で、8月からの差は+0.361 [+0.041, +0.712]です。カバレッジが等しいとき、ビン単位で、フラグシップ再現率は0.7から2.5ポイント低く、わずかな効果で、は0.140 [0.092, 0.192]対0.113 [0.082, 0.146]です。したがって方向は彼らのものと一致しますが、プールされた区間はゼロを含みます。類似度がゲートを脅かすという彼らの警告の直接的な読みは再現率に現れます。10月クライアントペアは65.3%のカバレッジで66.3%のエラーを捕捉し、すべての55個の8月ペアは32.5%のカバレッジで88.2%を捕捉します。これはカバレッジが部分的に説明する対比です。精度は高く保たれています。主に、これらの精度では、第4節の限界がそれが低下する余地をほとんど残さないためです。
Han (2026)との関係。 Hanは実践的なテコとして相関の除去を述べています。私の測定は精度とカバレッジを最優先にしています。1つの公開されたモデルで等しいカバレッジで、2番目の研究室の利点は、そのモデルがはるかに正確でない限り消えます(第5.2節)。HELMでは、精度が一致すると、2番目の研究室は再現率で3.2ポイント、カバレッジで2.7ポイントを追加し、カバレッジも同様に一致するとそれ以上何も追加されません。相関の除去はそこに27.0対31.6%の一致する誤り答で見えており、わずかです。Hanの理論は連続ゲートの深さに関するもので、私のものは単一ゲートに関するものであるため、2つは最初のステップでのみ会います。Liu (2026)は同じ2つのことを分離しています。選択精度は相関の除去に従い、クロスモデルパネルはAIME-2024でメンバー精度が一致した場合、リサンプリングより12.5から16.7ポイント前です。一致信号の校正はメンバー精度に従います。ここで測定された合意答の精度は2番目のものです。
第2節の両側。 公開されている数値は両側をある程度調和させます。Liuの満場一致パネルはAIME-2025で100.0%正しく、答えをすべて出す精度が0.433であり、MMLU-Proで70.2%正しく、0.458です。Kohliの満場一致9人の審査員は各々約68%に近く、90.9%で正しいです。同様の精度は30ポイント離れた精度を与えるため、精度だけではこれらの結果をもたらすことができません。答え空間のサイズがより多く説明します。2つの誤り答が一致する確率は、4択MMLUで0.621、NaturalQuestionsで0.270、8月のフラグシップではSimpleQAで0.132です。これらは異なるタスク上のパネルおよびペアであり、論文全体での結合計算はなく、精度がタスク内および答え形式内で精度に従うことと一致しています。
親しみやすさ。 SimpleQAと新規精度間のギャップはベンチマーク露出を通じた説明を招き、金の文字列との逐語的一致がその特徴に見えます。私のデータはこれを共変量として支持しません(付録C)。正しい答の中で、逐語的一致はモデル全体でほぼ1つの値に近く、モデルの残差を説明しません。8月の新規セット上のF/W、0.145 [0.033, 0.402]は、SimpleQAの0.132から目に見える距離を示さず、広い区間内にあります。
この論文を引用する方法
Chernets, V. (2026). Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}