Inversão de Concordância Não é uma Propriedade de Nível Intermediário: Precisão de Respostas de Modelos de IA Concordantes Segue a Acurácia do Par
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Versão de análise 10.5281/zenodo.24090584 · GitHub
Pré-impressão, 9 de novembro de 2026. SSRN: 7682960. Cópia arquivada: 10.5281/zenodo.24090580. Dados e código: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. O PDF é a versão autorizada.
Resumo
Quando dois modelos principais, consultados separadamente, dão a mesma resposta para uma das perguntas mais difíceis do SimpleQA, essa resposta geralmente está errada. Nas 106 questões do SimpleQA onde painéis de nível médio falharam, 45 pares de modelos principais sem o braço GPT servido pelo cliente, onde a busca na web não pode ser excluída, estão corretos em 96 de 691 acordos (13,9%). Responder apenas quando um segundo modelo concorda não requer rótulos ou parâmetros, e trabalhos anteriores atribuíram as falhas dessa regra aos modelos de nível médio. Em ambos os níveis que medi, a precisão das respostas acordadas segue a precisão do par, portanto a inversão não é uma propriedade de nível médio. No quintil mais difícil, definido da mesma forma para cada nível, a precisão é 17,3% em julho e 15,5% em agosto; em todos os cinco quintis, na precisão esperada das duas precisões de cada par, pares principais diferem de pares de nível médio por -0,2 pontos [-3,1, +2,7]. Os dados são SimpleQA, perguntas frescas de dois saltos e fatos de produtos, coletados em julho, agosto e outubro de 2026 com modelos principais de onze laboratórios. Um parceiro de um segundo laboratório detecta mais erros, mas abre o portão com menos frequência: para um modelo lançado, um parceiro do mesmo laboratório detecta 2 de 29 erros e um parceiro de outro laboratório 20 de 29 (-62,1 pontos [-79,3, -43,8]), com o portão aberto em 96% e 61% das questões. Quando o portão mais amplo é afunilado pela confiança declarada para cobrir igualmente, essa vantagem se sustenta apenas onde o modelo do parceiro é muito mais preciso. Um pequeno modelo alimentado com precisões medidas prediz a precisão fora da amostra com erro médio absoluto de 0,037 contra 0,099 para o melhor modelo único, em nível com uma linha de base de erros independentes em 0,032, e tem desempenho alto em fatos de produtos e dados públicos. Nas mesmas 100 questões, o identificador gpt-5.6-sol obtém 92,0% em sua onda servida pelo cliente e 46,3% através da API em outro setting de esforço, enquanto oito outros modelos se movem por no máximo 4 pontos.
1. Introdução
Faça a mesma pergunta factual breve a dois grandes modelos de linguagem (LLMs) de laboratórios diferentes, separadamente, e libere a resposta apenas se as duas coincidirem. A barreira não precisa de rótulo, limiar ou juiz, apenas duas chamadas às cegas. Os modelos de ponta tornam isso atraente, pois sua confiança declarada oferece pouca proteção: entre dez braços de ponta em agosto de 2026, 4.910 de 10.540 respostas declaradas com confiança de pelo menos 80 estavam erradas (Chernets, 2026b).
Minha medição anterior em modelos proprietários, uma coleção de julho de 2026 de modelos de médio nível, encontrou respostas de painel replicadas no quintil mais difícil do SimpleQA corretas em 0 de 342 ocasiões (Chernets, 2026a). Isso sugere que o acordo se inverte para modelos fracos, de modo que as respostas acordadas estão mais frequentemente erradas do que certas, e que os modelos fortes escapam. Um par de ponta pareceu confirmá-lo: gpt-5.6-sol com claude-fable-5 estava correto em 34 de 37 acordos nessas mesmas perguntas (os 106 da Seção 3).
No nível de ponta essa interpretação não se sustenta. Sem o braço único por trás dos 34 de 37, gpt-5.6-sol servido através do cliente do seu fornecedor, a inversão retorna, e com dificuldade definida da mesma forma para ambos os níveis as duas curvas se encontram na extremidade difícil. Em todos os quintis, uma vez que as duas acurácias de cada par são contabilizadas, os pares de ponta e médio nível diferem por -0,2 pontos [-3,1, +2,7]. A precisão acompanha o quão preciso os dois modelos são no estrato, qualquer que seja seu nível.
A Tabela 1 resume quatro contribuições. A Seção 5.1 fornece uma conta no nível da barreira dos modelos de ponta, construída onde possível sem o braço que domina a faixa de acurácia. A Seção 5.2 mede o que um segundo laboratório contribui, variando o modelo lançado e o parceiro, com GPT e sem ele. As Seções 4 e 5.3 fornecem um modelo descritivo da barreira com cinco constantes e o testam fora da amostra contra linhas de base declaradas, e a Seção 5.4 compara clientes de fornecedor com acesso direto à API para o mesmo identificador nas mesmas perguntas.
Tabela 1. Afirmações, evidência e limite.
| Afirmação | Evidência | Limite |
|---|---|---|
| A precisão das respostas acordadas segue a acurácia do par em ambos os níveis | 96/691 nos 106; quintil mais difícil 17,3% julho, 15,5% agosto; nível em acurácia correspondida -0,2 [-3,1, +2,7] | Associação; um quintil único abrange -1,8 [-22,1, +20,2] |
| Um segundo laboratório detecta mais erros ao preço da cobertura | 20/29 contra 2/29 erros detectados, -62,1 [-79,3, -43,8]; cobertura 61% contra 96% | Com cobertura igual, por confiança, precisa de um parceiro muito mais preciso; dois laboratórios em outubro |
| Um modelo pequeno descreve precisão fora da amostra | Erro 0,037 contra 0,099 para o melhor modelo, -0,062 [-0,085, -0,035] | Nível com erros independentes, +0,005 [-0,003, +0,012]; 13 pontos acima em fatos de produtos |
| Modo de acesso move um identificador | 92,0% cliente contra 46,3% API, mesmas 100 perguntas | Modo, esforço e possível busca mudam juntos |
2. Trabalhos relacionados
O mais próximo da minha pergunta é Goel et al. (2025), que introduzem CAPA, uma medida de concordância ajustada por acaso entre distribuições de saída de modelos, e mostram em 130 modelos de peso aberto em MMLU-Pro e BBH que erros tornam-se mais similares com capacidade, o que argumentam coloca supervisão de IA, incluindo júris de LM, em risco. Meço, para modelos proprietários de diferentes laboratórios, o que a concordância cega certifica quando funciona como porteiro para a liberação de uma resposta aberta curta: a precisão das respostas concordadas, a proporção dos erros do modelo liberado que a discordância expõe, e o piso de erros confiantes compartilhados. Os resultados são compatíveis: em meus dados o custo da similaridade crescente se manifesta na recuperação da discordância, enquanto a precisão permanece alta onde a acurácia é alta (Apêndice L). Cascata baseada em concordância (Kolawole et al., 2025) usa concordância de ensemble como regra de deferência sem treinamento com uma condição na taxa conjunta de erros aceitos, e meus resultados estratificados localizam onde tais erros se concentram.
Erros correlacionados entre provedores são documentados por Kim et al. (2025), e Hossain et al. (2026) os encontram mais fortes entre juízes LLM de fronteira. Júris de juízes pequenos diversos aparecem em Verga et al. (2024), e o viés de um modelo julgando sua própria saída em Panickssery et al. (2024), que favorece comparar duas respostas cegas. Concordância entre amostras de um modelo é um sinal de confiança em consistência automática (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) e incerteza semântica (Kuhn et al., 2023), e uma regra de deferência em Yue et al. (2024); comparo com concordância entre laboratórios (Seção 5.2). O porteiro é um preditor seletivo (Geifman & El-Yaniv, 2017), então comparo porteiros em cobertura igual. Pré-prints recentes discordam sobre se agregação ajuda (Apêndice E). Não conheço trabalho que reporte um porteiro de liberação em nível de par em fatos abertos curtos para navios-capitânias proprietários, recuperação em cobertura igual com um modelo liberado fixo, ou um identificador medido em dois modos de acesso nas mesmas perguntas.
3. Dados e protocolo
Meu trabalho anterior relatou os painéis de julho (Chernets, 2026a) e os agregados de agosto e outubro para pares selecionados (Chernets, 2026c). Novos aqui são os pares principais sem GPT, a definição simétrica de dificuldade, os pares do mesmo laboratório, as comparações com cobertura igual, os testes fora da amostra e externos e a comparação de modo de acesso.
Coleções. Todas as respostas foram coletadas à cegas: uma chamada por pergunta, sem nenhum modelo vendo a resposta de outro. O prompt do sistema solicita um objeto JSON com uma resposta curta e uma confiança de 0 a 100 e não solicita fontes. A Tabela A1 lista modelos, datas e modos de acesso, e o Apêndice F as coleções na íntegra. Nove modelos de API e sete modelos locais responderam a 1.500 perguntas do SimpleQA (Wei et al., 2024) de 24 a 28 de julho, registradas no OSF antes da coleta de dados (Chernets, 2026a). Um principal de cada um de onze laboratórios respondeu às mesmas perguntas de 3 a 6 de agosto, 1.459 comuns a todos, e nove deles responderam 100 destas com temperatura 0,7 e três amostras (o braço de variância). Foram adicionadas 100 perguntas de dois saltos compostas por máquina a partir de Wikidata, com o hash do arquivo fixado antes da primeira chamada de modelo, e 267 fatos de produtos. Em outubro, gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 e claude-fable-5-1 responderam a 300 perguntas do SimpleQA estratificadas pelo quintil de julho, as 106 abaixo e o conjunto atualizado, três conjuntos disjuntos com 503 perguntas comuns a todos os cinco modelos (cada par deles está na Tabela A2).
Os 106. Estas são as perguntas do quintil mais difícil nas quais um painel de julho replicou uma resposta (Chernets, 2026a). Foram selecionadas na falha dos modelos de julho, então a precisão de julho nelas é parcialmente um produto da seleção, e a Seção 5.1 as emparelha com uma definição simétrica de dificuldade que não carrega essa propriedade.
Modos de acesso. Em agosto, claude-fable-5, gpt-5.6-sol e mistral-medium-3.5 rodaram através do cliente próprio de primeira parte do fornecedor, o agente de linha de comando oficial que os usuários finais implantam, e em outubro cada braço o fez, então as medições incluem prompts do sistema do lado do fornecedor e padrões de serviço conforme recebidos por um usuário do cliente. A onda de julho e os braços restantes de agosto usaram API direto ou rotas de agregador fixadas ao fornecedor. A Tabela 2 descreve as condições de medição dos braços do cliente. Chamo um braço de busca-possível quando seu uso de busca na web não pode ser excluído, e informo os resultados principais com e sem tais braços.
Tabela 2. Condições de medição por braço. Nota: a temperatura não é definida nos clientes Codex e Claude; os fluxos de eventos Codex não foram retidos. Braços de API das ondas de julho e agosto rodaram com temperatura 0. Um travessão marca nenhuma configuração ou nenhuma entrada nos registros.
| Braço | Atingido por | Esforço | Busca possível |
|---|---|---|---|
| gpt-5.6-sol, agosto | cliente Codex | padrão do cliente, não registrado | não excluído |
| claude-fable-5, agosto | cliente Claude | - | não, 0 solicitações de busca registradas |
| mistral-medium-3.5, agosto | cliente do fornecedor | - | não, lista de ferramentas vazia |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, outubro | cliente Codex | médio | não excluído |
| claude-opus-5-5, claude-fable-5-1, outubro | cliente Claude | - | não, ferramentas desabilitadas |
| kimi-k3, gemini-3.8-flash, conjunto atualizado | cliente do fornecedor | - | ferramentas não desabilitadas, prompt proíbe |
| gpt-5.6-sol, braço de variância | API direto | nenhum | - |
Portão e medidas. O portão abre quando ambos os modelos respondem, nenhum recusa, e um mecanismo de equivalência determinístico, o mesmo para cada onda aqui, encontra as duas respostas equivalentes. A classificação aplica o mesmo mecanismo à resposta e à resposta ouro: correspondência exata normalizada, contenção de cadeias de quatro ou mais caracteres, e regras para datas, números e identificadores (Apêndice D, com uma reclassificação na Tabela A3). Uma célula é um par de modelos em um estrato de perguntas. Cobertura conta portões abertos entre perguntas que ambos os modelos responderam. Precisão, PPV, é a fração correta entre respostas abertas que o classificador resolve como certas ou erradas (K/O), e Delta é precisão menos a precisão do modelo liberado em todas as perguntas resolvidas da célula. Recall é a fração dos erros do modelo liberado nos quais o portão permanece fechado, relatada como erros capturados. Lift divide a precisão do modelo liberado com o portão aberto pela com o portão fechado, e o piso conta perguntas nas quais ambos os modelos declaram confiança de pelo menos 80, concordam, e estão errados. Chamo acordo invertido quando PPV está abaixo de uma metade. O modelo liberado é o primeiro membro do par, ou o mais preciso quando os pares são agrupados. Para comparar portões com cobertura igual, afinizo o portão mais largo: respostas abertas são classificadas pela menor das duas confiânças declaradas e cortadas para a cobertura alvo, empates quebrados aleatoriamente.
Inferência. Proporções simples levam intervalos de Wilson. Diferenças e quantidades derivadas levam intervalos de bootstrap de 95%, bidirecional sobre pergunta e modelo para resultados agrupados (Owen, 2007; B = 2000, semente fixa, com o modelo reajustado em cada replicata) e sobre pergunta para um único par. Comparações de precisão emparelhada usam o teste exato de McNemar, e equivalência um teste de dois lados unilaterais (Schuirmann, 1987) com uma margem de 2 pontos. Células são dependentes, então carregam intervalos e sem valores p.
4. Um modelo do portão
Sejam e as acurácias medidas de dois modelos em uma célula e . Seja a probabilidade de que ambos estejam errados e a probabilidade de que ambos estejam corretos:
Aqui amplifica a taxa independente de erro conjunto. Duas respostas corretas concordam com probabilidade . Duas respostas erradas concordam com probabilidade , onde no 106, cujas respostas erradas colidem com maior frequência, e 1 em outros lugares. Então
Ajustado em 335 pares de células de diferentes laboratórios (julho, agosto e outubro, com 106 entre eles; é a taxa de correspondência de duas respostas corretas em todas as células ajustadas), as constantes são , , , (22.536 de 22.785) e .
O modelo recebe as acurácias medidas da célula como entrada e retorna cobertura, precisão e a proporção de respostas erradas concordantes, , cuja base da Seção 3 é a parte com confiança de pelo menos 80. Dadas duas acurácias, retorna o que o gate adiciona e mostra por que a precisão deve acompanhar a acurácia no topo: com e respostas corretas correspondendo, a precisão das respostas concordantes não pode ser inferior a , mesmo que cada erro seja compartilhado, visto que ambos os modelos estão corretos juntos em pelo menos das questões e errados juntos em no máximo (0.947 em ). Em não há limite, e pode exceder sempre que respostas erradas se concentram na mesma cadeia.
Comparo com duas linhas de base. A linha de base de erros-independentes define e reajusta o resto, mantendo . A linha de base do melhor-modelo prediz . O critério foi que o modelo supera ambas, com o intervalo da diferença abaixo de zero, sob validação cruzada deixando-um-laboratório-de-fora (LOLO), deixando-um-modelo-de-fora (LOMO) e uma divisão temporal de julho e agosto para outubro.
5. Resultados
5.1 Inversão não é uma propriedade de camada intermediária
A Tabela 3 apresenta o gate sem os braços GPT servidos pelo cliente. No conjunto do SimpleQA os dois níveis se assemelham: precisão de 72,1% em julho e 80,6% em agosto, com um Delta de +28,6 e +26,0 pontos em comparação com o modelo lançado. No 106 a precisão é baixa em ambas as ondas: 5 de 717 em julho e 96 de 691 em agosto sem GPT. Excluindo o braço GPT também do lado de julho obtém-se 4 de 581, e a diferença agosto menos julho é de +13,2 pontos [+2,6, +30,8]. A precisão em agosto é mais alta e ainda muito abaixo de um meio, portanto o acordo é invertido em ambas as ondas. Também está abaixo do melhor braço único no estrato, por -9,5 pontos [-16,3, -3,2] em julho e -43,2 [-67,6, -16,1] em agosto. O lift é 0,13 [0,00, 1,21] em julho e 0,65 [0,23, 1,22] em agosto sem GPT.
Tabela 3. O gate sem braços GPT servidos pelo cliente. Nota: agrupado sobre pares de diferentes laboratórios a menos que indicado; cobertura sobre questões que ambos os modelos responderam, K/O sobre respostas abertas que o avaliador resolve; intervalo em PPV: bootstrap bidirecional. Fatos de produto: os quatro braços sem possibilidade de busca.
| Camada, questões | Pares | Cobertura | PPV (K/O) [95%] | Acurácia do lançado | Delta, pontos [95%] |
|---|---|---|---|---|---|
| Intermediária, julho, 106 | 36 | 19,8% | 0,7% (5/717) [0,0, 3,7] | 4,6% | -3,9 [-8,3, +0,3] |
| Intermediária, julho, todo SimpleQA | 36 | 20,6% | 72,1% (7743/10745) [53,2, 82,3] | 43,4% | +28,6 [+22,3, +32,4] |
| Navio-almirante, agosto, 106, sem braço com possibilidade de busca | 45 | 19,1% | 13,9% (96/691) [3,3, 31,8] | 19,9% | -6,0 [-14,1, +2,9] |
| Navio-almirante, agosto, todo SimpleQA, sem braço com possibilidade de busca | 45 | 29,1% | 80,6% (12357/15322) [69,6, 87,9] | 54,7% | +26,0 [+19,9, +30,7] |
| Navio-almirante, agosto, 100 fresco (GPT via API) | 6 | 37,5% | 88,9% (200/225) [75,6, 97,4] | 66,8% | +22,1 [+7,9, +47,4] |
| Mesmo laboratório, outubro, fable-5-1 + opus-5-5, 106 | 1 | 39,6% | 47,5% (19/40) | 30,0% | +17,5 [+6,2, +29,7] |
| Outubro, kimi-k3 + gemini-3.8-flash, 100 fresco (ferramentas não desabilitadas) | 1 | 72,0% | 95,8% (69/72) | 74,0% | +21,8 [+14,1, +30,0] |
| Fatos de produto, 267, sem braço com possibilidade de busca | 6 | 63,6% | 75,0% (423/564) [66,4, 82,7] | 62,7% | +12,3 [+5,8, +20,4] |
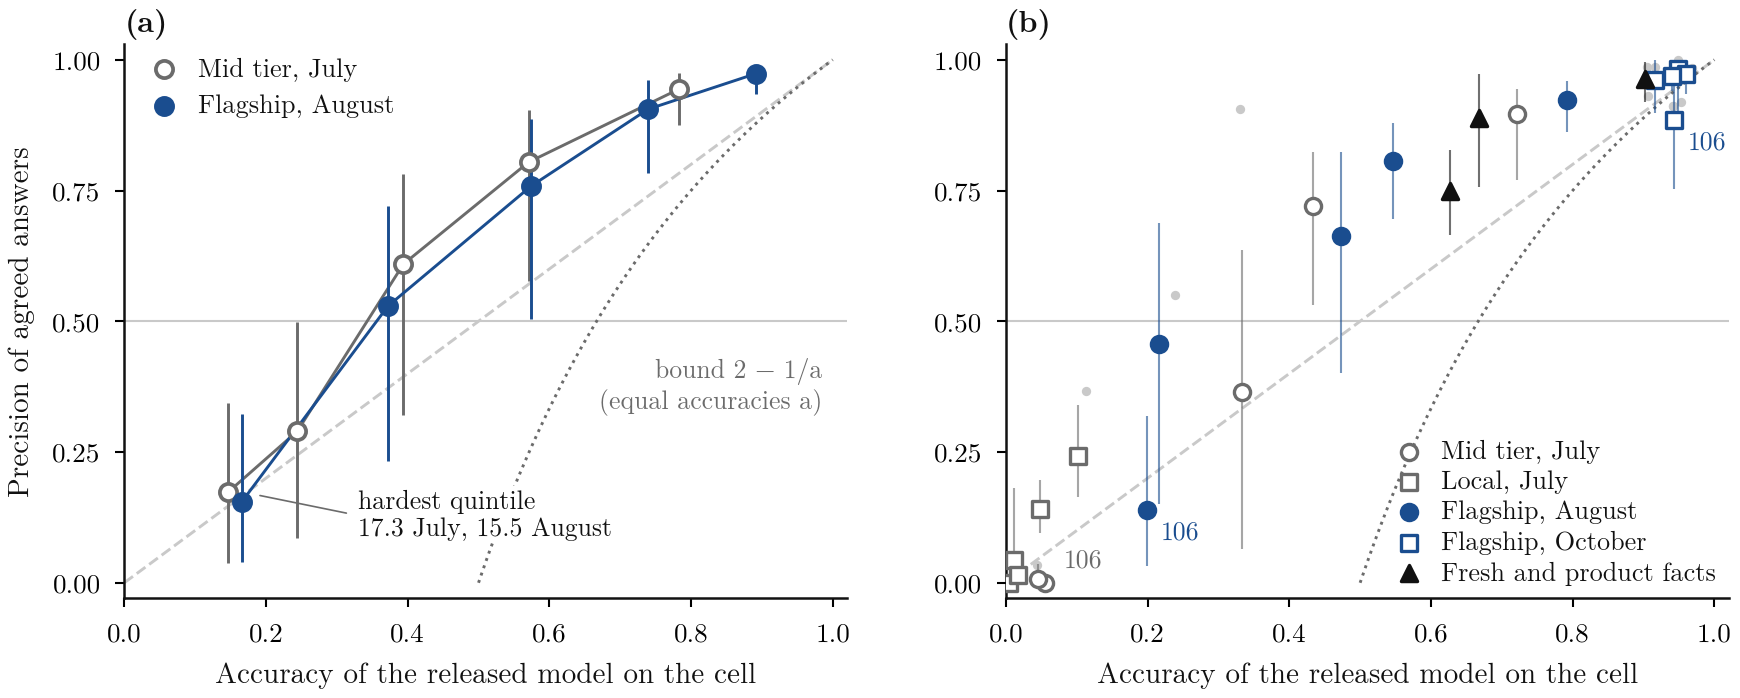
Figura 1. A precisão das respostas concordes segue a acurácia do par. Nota: (a) quintis de dificuldade estabelecidos dentro de cada camada, julho camada intermediária e agosto navios-almirante sem os braços GPT servidos pelo cliente. (b) Cada banda de cada camada, julho a outubro, em relação à acurácia do modelo lançado; células rotuladas são o 106. Os bigodes são intervalos de bootstrap de 95%, e pequenos pontos cinzentos em (b) são pares individuais; linha tracejada é igualdade, linha pontilhada o limite 2 - 1/a para acurácias iguais a.
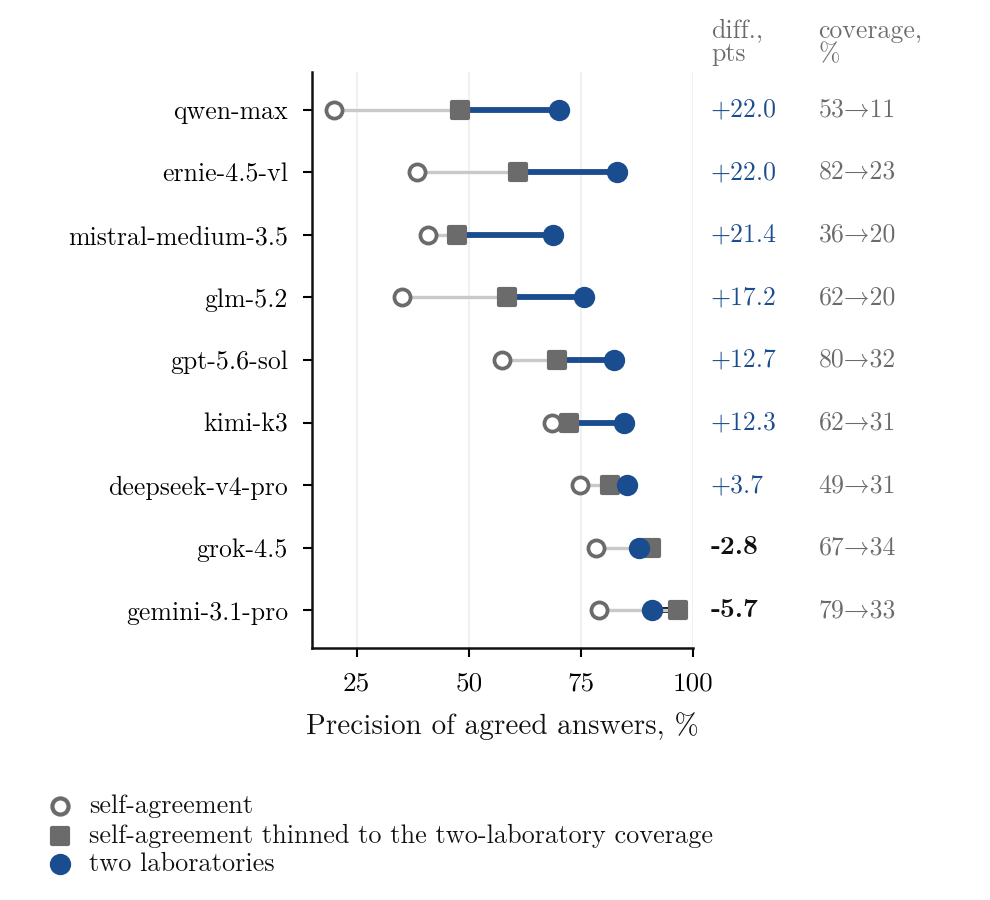
Figura 2. Autoagrado contra dois laboratórios, por modelo. Nota: braço de variância, nove modelos, 100 questões. Círculo aberto, duas chamadas a um modelo; quadrado, o mesmo reduzido por confiança para a cobertura do gate de dois laboratórios; círculo preenchido, dois laboratórios, média sobre parceiros. As colunas direitas mostram a diferença com cobertura igual, em pontos, e a cobertura de ambos os gates, em percentual.
Painéis de três modelos sem o braço GPT servido pelo cliente dão o mesmo resultado. No 106 sob meu mecanismo os painéis de julho dão 0 de 318 (o 0 de 342 da Seção 1 é o quintil mais difícil sob a regra de correspondência anterior; o 5 de 717 acima conta pares). Em agosto o painel de DeepSeek, Qwen e Kimi dá 0 de 76 e o painel transnuclear de Claude, DeepSeek e Mistral 11 de 78 (14,1% [2,7, 26,3]), enquanto o painel de Claude, GPT e Gemini, que mantém o braço GPT, dá 106 de 131 (80,9%). Os pares Navio-almirante se alinham com sua acurácia no estrato, de 4 de 21 para fable-5 com deepseek-v4-pro a 15 de 24 (62,5% [42,6, 82,6]) para fable-5 com gemini-3.1-pro, cujos membros lideram este grupo lá.
Como o 106 foi escolhido pela falha de julho, o que reduz a precisão de julho neles e favorece agosto, a Figura 1a estabelece dificuldade dentro de cada camada. Para cada camada, as questões são classificadas em quintis pela acurácia da mesma camada sem o par sob avaliação, portanto o quintil mais difícil mantém o mesmo posto para cada, e a acurácia do modelo lançado lá é próxima, 15,3% em julho e 16,0% em agosto. A precisão lá é 159 de 917 (17,3% [3,8, 34,3]) em julho e 203 de 1.308 (15,5% [4,0, 32,4]) em agosto sem GPT, uma diferença de -1,8 pontos [-22,1, +20,2]. Agrupando todos os cinco quintis se obtém um teste mais fino. O modelo da Seção 4 não tem termo de camada. Dadas as duas acurácias de cada célula, ele fornece a precisão esperada lá, e um efeito de camada apareceria como uma diferença nos resíduos. As células do navio-almirante ficam -0,2 pontos [-3,1, +2,7] das células da camada intermediária, e -0,5 [-3,6, +2,4] quando as constantes são ajustadas apenas nas células de julho, de modo que agosto está fora da amostra. kimi-k3 pertence a ambas as coleções; sem ela a diferença é +0,1 [-3,6, +3,8]. Em respostas ouro limpas a precisão permanece baixa: nos 24 do 106 que sobrevivem em SimpleQA Verified (Haas et al., 2025), pares de agosto sem GPT acertam em 18,7% dos acordos [0,0, 57,1] (Apêndice G).
Em cada banda de cada camada (Figura 1b), a precisão sobe com a acurácia do modelo lançado em cada onda e fica acima da diagonal em 17 de 23 células. Das seis abaixo dela, três são células 106 e três são bandas com acurácia lançada abaixo de 0,06. No topo, kimi-k3 com gemini-3.8-flash chegam a 95,8% no conjunto fresco (Apêndice G).
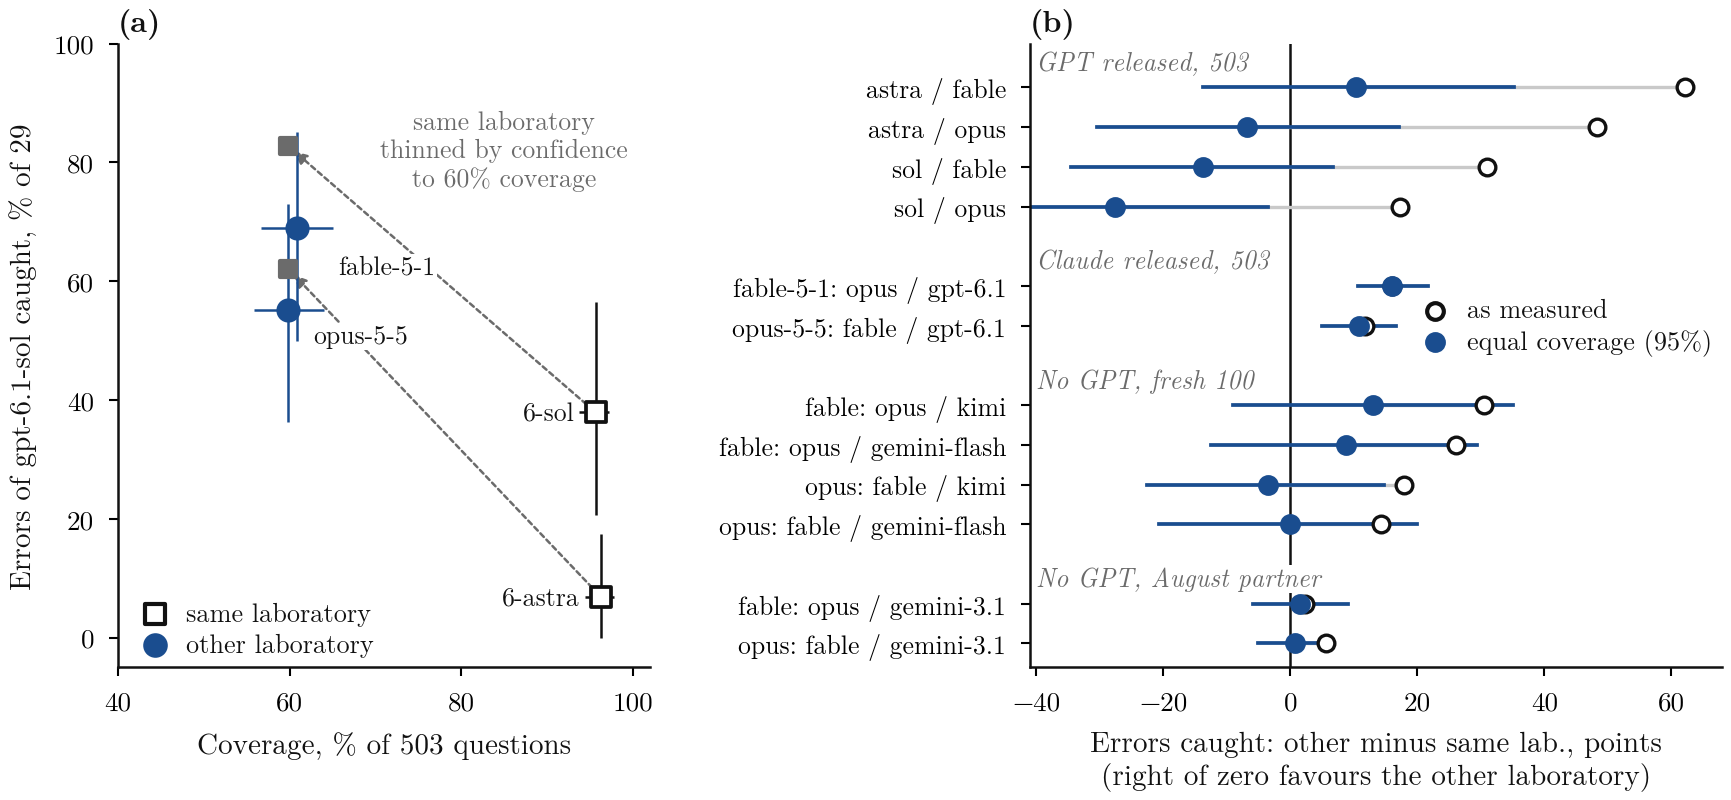
Figura 3. Um segundo laboratório: cobertura e erros detectados. Nota: (a) gpt-6.1-sol em 503 perguntas comuns, 29 erros, quatro parceiros da Tabela A4, intervalos bootstrap de 95%; setas levam do portão do mesmo laboratório ao mesmo portão afinado por confiança para 60% de cobertura. (b) As doze comparações da Tabela A5: erros detectados pelo outro laboratório menos o mesmo laboratório, conforme medido (aberto) e em cobertura igual (preenchido, bootstrap de 95% das perguntas).
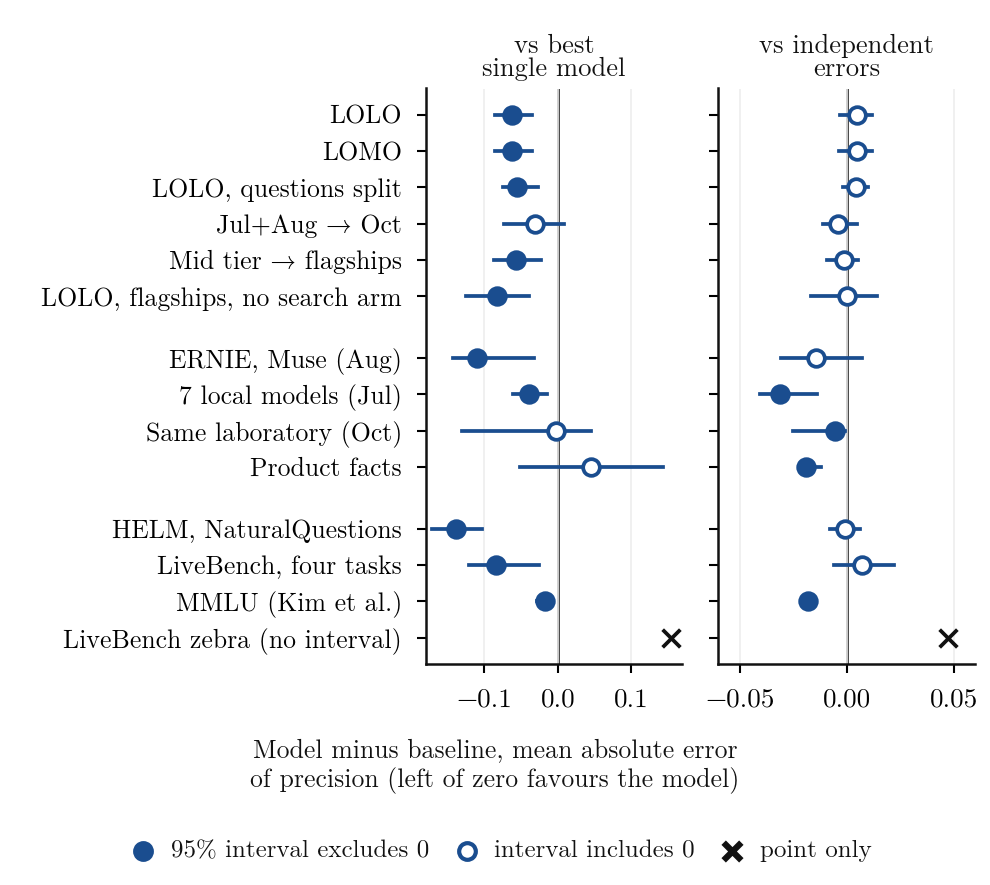
Figura 4. O modelo contra dois baselines, fora da amostra. Nota: modelo menos baseline no erro absoluto médio da precisão prevista, abaixo de zero favorece o modelo, com intervalos bootstrap bidireccionais de 95% (Tabelas A6 e A8). Grupo superior, esquemas de ajuste; meio, conjuntos fora do ajuste com constantes congeladas; inferior, dados públicos (Seção 5.5). Marcador preenchido, o intervalo de 95% exclui zero; aberto, inclui zero; cruz, uma estimativa pontual (a tarefa zebra do LiveBench).
5.2 Um segundo laboratório detecta mais erros, ao custo da cobertura
A precisão sozinha não consegue separar os casos, porque pares precisos de um laboratório também têm alta precisão. O recall deve ser lido com cobertura, já que um portão que se abre menos frequentemente bloqueia mais erros por construção.
Começo com o braço de variância: duas chamadas a um modelo com temperatura 0,7, contra duas chamadas a laboratórios diferentes (Figura 2). Agrupado em nove modelos e 100 perguntas, o auto-acordo cobre 63,5% com precisão de 56,1%, e dois laboratórios cobrem 26,1% com 82,9%. A diferença em precisão é +26,8 pontos [+16,6, +34,6] conforme medido e +9,0 [+0,5, +17,4] em cobertura igual, onde o auto-acordo é afinado por confiança, o que o favorece. Por modelo, o portão de dois laboratórios lidera em sete de nove. O braço não contém modelo Claude e tem GPT por API com esforço zero. Sem GPT, em oito modelos, a diferença em cobertura igual é +7,7 pontos [-1,9, +16,5].
A onda de outubro contém dois modelos cada um de dois laboratórios, o que oferece um teste direto em 503 perguntas comuns (Figura 3a). Um modelo lançado, gpt-6.1-sol, mantém os mesmos 29 erros em cada linha e muda apenas o parceiro. Seu parceiro do mesmo laboratório gpt-6-astra detecta 2 deles e fable-5-1 detecta 20, uma diferença de -62,1 pontos [-79,3, -43,8]; contra opus-5-5 a diferença é -48,3 [-66,7, -29,6]. O preço é a cobertura, 60 a 61% contra 96%. A precisão é semelhante nas linhas: 94,3% e 96,2% para o mesmo laboratório, 95,6% e 97,0% entre laboratórios (Tabela A4). Parceiros do mesmo laboratório diferem amplamente: gpt-6-sol detecta 11 de 29 (Apêndice H).
Para ver se isto é mais do que um movimento ao longo da curva de cobertura, e se precisa de GPT, cada linha da Figura 3b mantém um modelo lançado e compara seus dois parceiros, conforme medido e em cobertura igual (Tabela A5). Conforme medido, o outro laboratório detecta mais erros em cada linha. Em cobertura igual sua vantagem se mantém apenas quando Claude é lançado com gpt-6.1-sol como parceiro, um parceiro com 93,9% de precisão contra 66,6 a 69,2% para o do mesmo laboratório no conjunto estratificado. Com GPT lançado, o portão do mesmo laboratório afinado por confiança está nivelado ou à frente, e sem GPT a diferença está nivelada, ou favorece o mesmo laboratório contra parceiros fracos. Com dois laboratórios em outubro não detecto nenhum efeito do laboratório além da precisão do parceiro e cobertura, e HELM, com 20 desenvolvedores, não mostra nenhum uma vez que ambos são pareados (Seção 5.5).
5.3 O modelo fora da amostra
Fora da amostra, o modelo melhora claramente na leitura do modelo melhor e está nivelado com o baseline de erros independentes (Figura 4, Tabela A6). Sob LOLO seu erro é 0,037 contra 0,099 para o baseline do melhor modelo (-0,062 [-0,085, -0,035]), e esse intervalo fica abaixo de zero sob LOMO, a divisão de perguntas e em sete das dez linhas da Tabela A6. A divisão temporal dá 0,019 contra 0,050, -0,031 [-0,074, +0,008], abaixo de zero quando agrupado por pergunta ou por modelo sozinho (Apêndice I). Contra erros independentes o modelo está nivelado sob todos os três esquemas e melhor em três de quatro conjuntos fora do ajuste, com constantes congeladas, então o critério da Seção 4 é atendido contra o baseline do melhor modelo.
A precisão é realizada pelas acurácias medidas e por : remover eleva o erro LOLO para 0,323, e mantê-lo constante dá 0,046. O multiplicador não adiciona nada à precisão nos esquemas principais e ajuda em cobertura e perda logarítmica.
Em fatos de produtos o modelo funciona alto. Seu erro é 0,130 contra 0,086 para o melhor modelo, tudo isto superestimativa (13 pontos), e 0,190 contra 0,067 com o avaliador nativo desse domínio, novamente tudo superestimativa (19 pontos). O Apêndice I classifica as células em classes de resultado.
5.4 Acesso ao modelo e os braços GPT
Em um conjunto de 100 perguntas SimpleQA, gpt-5.6-sol marca 92 de 100 (92,0%) na onda principal, 99 delas através do cliente Codex, e 139 de 300 amostras (46,3%) através da API direta no braço de variância, uma diferença de 45,7 pontos (Figura 5). A reprodução textual da sequência de ouro cai com ela, de 64,0% para 26,0%. O cliente funciona em sua configuração de esforço padrão sob suas próprias instruções, com temperatura não configurável, enquanto a API funciona com esforço zero e temperatura 0,7.
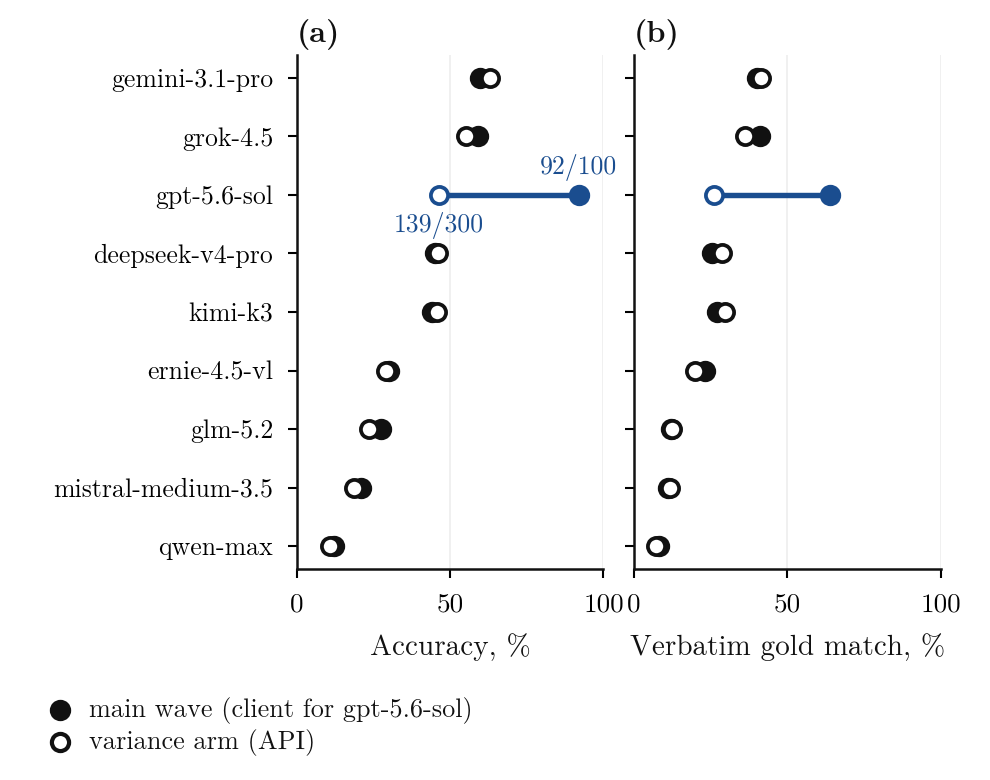
Figura 5. Um conjunto de 100 perguntas, dois braços, nove modelos. Nota: (a) acurácia, (b) correspondência textual com a sequência de ouro. Preenchido, onda principal (servido por cliente para gpt-5.6-sol, 92/100); aberto, braço de variância através da API (139/300). Para gpt-5.6-sol os braços também diferem na configuração de esforço.
Os outros oito modelos, cuja temperatura também varia entre as duas colunas, movem-se por no máximo 4,0 pontos em qualquer direção. Esforço é um candidato, embora uma medição de raciocínio-orçamento emparelhada no gemini-3.1-pro deixasse a precisão praticamente inalterada (Chernets, 2026c). Busca na web é a outra: respostas de outubro do mesmo cliente contêm links que o prompt não solicita, em 3 de 506 respostas de gpt-6.1-sol e 18 de 506 de gpt-6-astra, e o uso mediano de tokens por chamada de cliente em agosto é 4.829.
A figura do cliente é o que uma pessoa usando o produto recebe, e a figura da API é o que um harness de benchmark em esforço nenhum lê. Em perguntas novas em agosto, com GPT pela API, gpt-5.6-sol e fable-5 estão corretos em 29 de 32 concordâncias, Delta +57,6 pontos [+46,3, +69,7]. Em outubro, com um GPT mais recente pelo cliente nas mesmas perguntas, o par com opus-5-5 está correto em 72 de 74, Delta +2,3 [-0,7, +6,0]. As duas comparações também diferem no modelo GPT e na data, e em ambas o valor do gate rastreia a precisão do braço lançado, como na Seção 5.1.
Os braços GPT servidos por cliente, deixados de fora da Tabela 3, são precisos: o braço de agosto com fable-5 está correto em 997 de 1.016 concordâncias (98,1%) e em 34 de 37 nos 106, herdando a precisão do braço (Delta -3,3 [-10,3, +2,6]; Tabela A7 e Apêndice J).
5.5 Verificação externa em dados públicos
Apliquei as constantes congeladas, sem readequação, a dados públicos que não compartilham nem modelos nem ajuste com os meus: HELM Lite (Liang et al., 2023), 95 modelos de 20 desenvolvedores respondendo 1.000 NaturalQuestions de livro fechado; LiveBench (White et al., 2025), 70 modelos de 11 laboratórios em 346 perguntas com uma resposta final curta; e os agregados em pares de Kim et al. (2025) para 70 modelos em MMLU de múltipla escolha (Tabela A8). Os resultados correspondem à Seção 5.3 (Figura 4, grupo inferior). O modelo bate na leitura do melhor modelo em todas as três fontes e está no mesmo nível com erros independentes em HELM e LiveBench. Ele funciona alto em 5,3 a 6,6 pontos e falha em zebra puzzles (0,231 contra 0,076).
Em HELM a curva observada se achata onde o modelo continua subindo (Figura 6): em precisão de concordância em pares entre 0,5 e 0,6 é 74,6% para modelos de 2023 e início de 2024 e 75,9% para os posteriores, contra 84,4% previsto no meio da classe. Em MMLU a chance mediana de que duas respostas erradas correspondam é 0,621 contra 0,368 de , já que quatro opções forçam colisões. A precisão sobe com a concordância em pares (Spearman +0,575 em HELM e +0,786 em MMLU, sobre células dependentes).
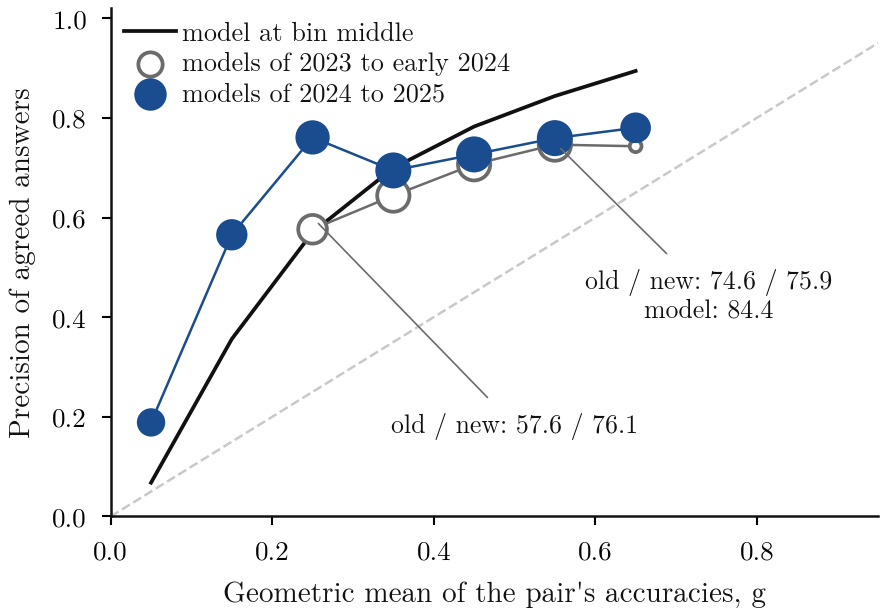
Figura 6. HELM Lite: precisão de respostas concordadas por concordância em pares, modelos mais antigos e mais novos. Nota: classes da média geométrica g das precisões do par, pares de laboratórios diferentes; o tamanho do marcador cresce com o número de pares. A linha é o modelo congelado no meio de cada classe.
HELM também permite o teste da Seção 5.2 com muitos laboratórios e sem dependência de GPT. Com um modelo lançado e parceiros dentro de 3 pontos de precisão, outro laboratório detecta 75,5% dos erros contra 72,3% para o mesmo laboratório, -3,2 pontos [-4,2, -2,3], com cobertura maior em 2,7 pontos. Adicionar uma correspondência em cobertura dentro de 3 pontos remove: 75,7 contra 75,9%, -0,2 [-0,6, +0,2].
6. Discussão
Executar o gate não requer rótulos, mas verificá-lo, sim. Meça a precisão de ambos os modelos em uma amostra rotulada do estrato que importa, no modo de acesso que será implantado. Nestes dados, uma resposta consensual de dois modelos de ponta sobre uma questão além de ambos não é mais segura do que uma resposta consensual de dois modelos de médio porte. Parear dois laboratórios é um padrão razoável quando nenhum valor de confiança está disponível, mas deve ser verificado no estrato: um par do mesmo laboratório afinado pela confiança, ou a confiança do próprio modelo liberado, pode funcionar tão bem (Seção 5.2, Apêndice J).
Similaridade ajustada ao acaso (Goel et al., 2025) e precisão de respostas consensuais são quantidades diferentes, e Han (2026) nomeia descorrelação como o fator onde coloco precisão e cobertura em primeiro lugar (Apêndice L). Para relatório, um estudo de concordância de modelos deve indicar modo de acesso, esforço, condições da ferramenta e registros de eventos retidos para cada braço.
7. Escopo e condições de contorno
Os níveis são comparados em duas ondas em datas diferentes e rotas de acesso, e a comparação de níveis é precisa em cerca de 3 pontos com acurácia combinada, muito menos na quintila mais difícil sozinha. A evidência nova é um conjunto de 100 questões e oito templates em duas datas, e October Delta nele inclui zero. A acurácia e precisão de pares se movem juntas entre datas e entre configurações de raciocínio que diferem entre ondas, e o design não isola a capacidade como uma causa.
Se os clientes Codex, kimi e gemini-3.8-flash fizeram buscas não pode ser definido pelos arquivos retidos, então suas acurácias medem o cliente conforme implantado, não a memória do modelo. As seções 5.1 e 5.3 mostram os resultados principais sem esses ramos.
Pares do mesmo laboratório existem em October, para dois laboratórios, e sem GPT a comparação de mesma onda é as 100 questões novas. As células de October baseiam-se em cinco modelos de dois laboratórios, então a dimensão de modelo do bootstrap bidirecional tem poucos níveis e intervalos agrupados são limites inferiores na incerteza. As comparações com cobertura igual usam confiança declarada, que o portão simples não tem, e o desempate aleatório move a linha mais larga entre 0,0 e +20,7 pontos (Apêndice H).
O mecanismo é baseado em regras, e suas verificações aqui são o ouro limpo de SimpleQA Verified (Seção 5.1) e uma reavaliação de partes de respostas. Ele avalia a resposta inteira, e respostas longas podem gerar um "errado" falso; a pontuação apenas da primeira parte move a precisão de pares de referência em no máximo 3 pontos, e gpt-6-astra com opus-5-5 nos 106 de 80,0 para 88,9% (Tabela A3).
O modelo leva as acurácias medidas para cada célula como entrada, então descreve uma verificação rotulada do portão e não substitui uma. Funciona bem em fatos de produtos e dados públicos. HELM, LiveBench e os agregados de Kim et al. mantêm modelos mais antigos em formatos com poucos exemplos ou múltipla escolha, então testam a relação em outros modelos, não em navios-capitânia de 2026.
8. Conclusão
A precisão de respostas concordantes aumenta com a precisão do par no estrato em questão, em ambos os níveis e dentro de aproximadamente 3 pontos na precisão equiparada. Inversão apareceu onde quer que eu medisse um par fraco, incluindo os navios-insignia. Um parceiro de um segundo laboratório detecta mais erros principalmente por abrir o portão com menos frequência, e com cobertura igual manteve sua vantagem apenas onde seu modelo era muito mais preciso. Um modelo pequeno do portão descreve a precisão fora da amostra muito melhor do que o modelo melhor e tão bem quanto erros independentes. Um identificador medido através de duas configurações de acesso difere por 45,7 pontos, então uma afirmação sobre a precisão de um modelo deve indicar o modo de acesso.
Declaração de Impacto
Este artigo estuda quando a concordância entre dois modelos de linguagem pode ser considerada confiável como regra para disponibilizar respostas factuais breves. Profissionais podem verificar, no estrato que importa e no modo de acesso que implantam, se um sistema de dois modelos é preciso o suficiente para seu uso, em vez de presumir que modelos mais fortes ou um segundo fornecedor são suficientes. O risco principal é confiança excessiva na concordância em questões difíceis, e os resultados mostram os estratos em que respostas concordadas estão principalmente incorretas. O estudo utiliza apenas benchmarks públicos e questões compostas por máquina.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
Declarações
Conflitos de interesse. O autor é requerente nomeado em pedidos de patente pendentes, não patentes concedidas, cobrindo orquestração de IA e sistemas de validação multi-modelo do tipo que este artigo examina.
Dados e código. Respostas por chamada, scripts de análise e o mapeamento de cada número relatado para sua tabela de origem estão arquivados em Zenodo, doi:10.5281/zenodo.24090584 (CC BY 4.0).
Apêndice A. Modelos e modos de acesso
Tabela A1. Coleções e modos de acesso, por onda.
| Coleção | Datas | Modelos | Acesso |
|---|---|---|---|
| Julho médio | 24 a 28 de julho de 2026 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | API direta |
| Julho local | 24 a 28 de julho de 2026 | sete modelos locais de peso aberto | Inferência local |
| Agosto principais | 3 a 6 de agosto de 2026 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | Cliente do fornecedor; gpt-5.6-sol com a configuração de esforço padrão do cliente, 14 de 1.500 registros por fallback de API |
| glm-5.2 | Ponto de extremidade do fornecedor | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | API direta | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | API direta ou rota agregadora fixada ao fornecedor; muse-spark-1.1 parcial (251 respostas) | ||
| Braço de variância | 6 de agosto de 2026 | Nove principais, sem Claude | gpt-5.6-sol por API direta, esforço nenhum; mistral-medium-3.5 através do seu cliente do fornecedor, que registra a temperatura solicitada; outros como na onda de agosto; temperatura 0,7, três amostras |
| Fresco, agosto | 6 de agosto de 2026 | gpt-5.6-sol (esforço nenhum), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol e deepseek-v4-pro por API direta, claude-fable-5 por cliente do fornecedor, kimi-k3 por rota agregadora |
| Fatos do produto | 15 de agosto de 2026 | Seis modelos, 15 pares; quatro sem possibilidade de busca, 6 pares | Misto; gpt-5.4 e grok através de clientes |
| Outubro | 26 e 27 de outubro de 2026 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Cliente Codex, esforço médio, sem sinalizador de busca, fluxo de eventos não retido |
| claude-opus-5-5, claude-fable-5-1 | Cliente Claude, ferramentas desativadas | ||
| kimi-k3, gemini-3.8-flash (apenas fresco) | Clientes do fornecedor, ferramentas não desativadas |
Na onda de agosto, 19 respostas do braço claude-fable-5 foram servidas por outros modelos Claude. Os 34 de 37 de 106 da onda não dependem deles (Chernets, 2026a).
Apêndice B. Pares sobre as 503 questões comuns
Tabela A2. Todos os pares de laboratórios diferentes, primeiro membro lançado, 503 questões comuns.
| Par | Cobertura | PPV (K/O) | Delta, pontos [95%] | Erros capturados |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
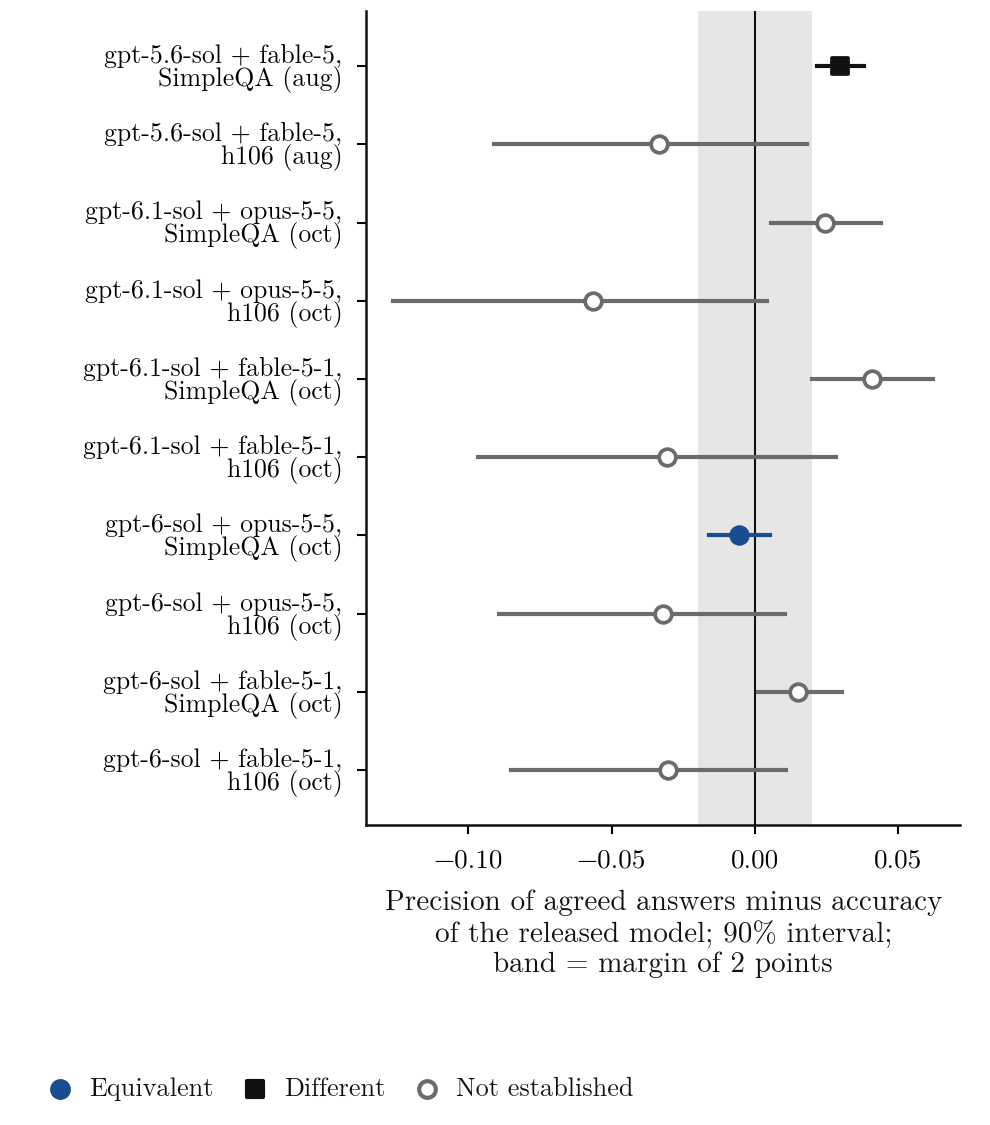
Figura A1. Teste de equivalência da precisão do par contra o modelo lançado. Nota: bootstrap de 90% de questões, margem de 2 pontos destacada. Pares com braço cliente Codex lançado.
Apêndice C. Correspondência literal com a sequência de referência
A correspondência literal correlaciona-se perfeitamente com a precisão SimpleQA entre os nove modelos com ambas as medições SimpleQA e recente, uma vez que uma resposta correta é frequentemente a sequência de referência. Sua correlação com a lacuna SimpleQA menos recente é +0,47 (p de permutação exato = 0,21, n = 9), ou +0,29 (p = 0,50) sem gpt-5.6-sol, cujas duas precisões provêm de modos de acesso diferentes (Figura A2). Restrita a respostas corretas, é +0,10 (p = 0,81). Entre as respostas corretas, a taxa é 65,7% para gpt-5.6-sol, 66,4% para fable-5, 68,6% para deepseek-v4-pro e 64,9% para kimi-k3. O resíduo do modelo não depende dela, com uma inclinação de +0,064 [-0,072, +0,167] em 112 células principais. A lacuna em si é próxima de zero ou negativa para a maioria dos modelos, em -3,0 pontos para fable-5, -20,5 para deepseek-v4-pro, -5,4 para opus-5-5 e -7,8 para fable-5-1, e é grande apenas para gpt-5.6-sol (+62,4), onde o modo de acesso difere entre as duas medições.
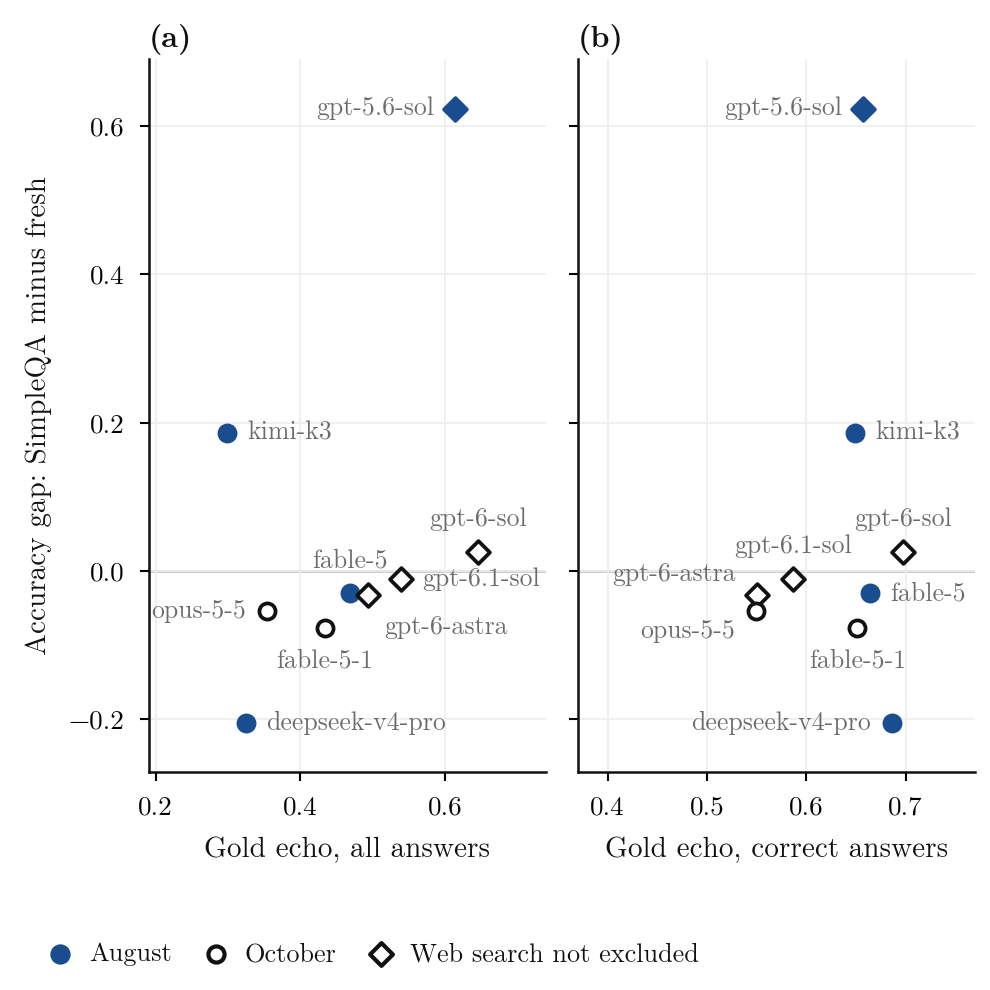
Figura A2. Correspondência literal com a sequência de referência em relação à lacuna de precisão. Nota: (a) todas as respostas, (b) apenas respostas corretas. Azul preenchido, onda de agosto; aberto, onda de outubro. Losangos marcam braços para os quais a busca na web não é excluída.
Apêndice D. Sensibilidade do avaliador
O mecanismo normaliza maiúsculas/minúsculas, artigos e pontuação, aceita correspondências exatas e contenção de sequências de quatro ou mais caracteres, compara datas, números e identificadores alfanuméricos por regra, e, caso contrário, compara palavras de conteúdo; uma resposta que não consiga se resolver contra o ouro fica sem resolução. Na Tabela A3, a primeira parte de cada resposta, sem parênteses e explicação à direita, é usada para correspondência e avaliação, então a contagem aberta também muda.
Tabela A3. Avaliação da resposta completa em relação à avaliação de sua primeira parte. O primeiro membro é liberado.
| Par, conjunto | PPV, resposta completa | PPV, primeira parte |
|---|---|---|
| gpt-5.6-sol + fable-5, todos, agosto | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, outubro | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, outubro | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, October | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, October | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, estratégia, outubro | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, novo, outubro | 72/74 | 72/74 |
Apêndice E. Trabalhos relacionados adicionais
Preprints recentes apontam em duas direções. No lado cético, Denisov-Blanch et al. (2026) descobrem que a agregação no estilo de pesquisa em cinco benchmarks e modelos não produz ganho consistente de precisão a 25 vezes o custo de inferência, porque os erros são correlacionados. Ding (2026) audita 265.000 amostras em GPQA Diamond e AIME e descobre que o acordo é um preditor positivo, mas fraco (Spearman 0,20 a 0,59), com 48% das entradas GPQA de alto acordo do modelo de fronteira mais consistente erradas. Em uma verificação exploratória em 46 itens, as taxas de mesma resposta errada entre gpt-4.1 e tiers Claude excedem um nulo preservador de margem para dois de três tiers. Kohli (2026) descobrem que nove juízes de fronteira em três conjuntos de dados de inferência carregam cerca de dois votos independentes, e que o melhor juiz único iguala ou supera o painel. Kim (2026) audita 31.900 subconjuntos de 30 modelos em MMLU-Pro: votação supera o membro mais forte em 9,98% de subconjuntos de tamanho 3, e uma medida de diversidade rigorosa é quase colinear com um menos a precisão média (Spearman +0,991). Hossain et al. (2026) encontram uma correlação de erro pairwise média de 0,21 entre dez juízes, que carregam aproximadamente tanta informação quanto 3,5 independentes, com dependência mais forte entre juízes de fronteira de diferentes provedores. Chen (2026) mostra que qualquer política que produza a resposta de um membro não pode exceder um menos a taxa na qual todos os modelos estão errados juntos, e encontra de 0,052 em matemática aberta em 67 modelos contra 0,023 sob uma cópula gaussiana, e 0,127 em GPQA-Diamond de resposta livre. Do outro lado, Naik (2024) relata precisão subindo de 73,1% para 93,9% com dois modelos e para 95,6% com três em 78 casos em formato de múltipla escolha, e Liu (2026) mostra um painel de quatro modelos selecionando respostas melhor que auto-consistência em sete benchmarks, com uma lei de forma fechada em precisão de membro, correlação de erro e uma taxa de conceito errôneo compartilhado que prediz a precisão de consenso para um erro absoluto médio de 0,028. Xue et al. (2026) relatam que a consistência entre modelos com um verificador melhora o teto da auto-consistência para detecção de alucinação em benchmarks de QA, e Tan et al. (2025) que erros auto-consistentes não diminuem com a escala do modelo, tendem a ser específicos do modelo, e são melhor detectados com um segundo modelo. Han (2026) fornece uma teoria de portais de verificação em série na qual uma massa de ponto cego limita a confiabilidade e nomeia descorrelação, pela mudança de família de modelo, modalidade ou fonte de evidência, como a alavanca prática. Dois dos trabalhos da Seção 2 carregam detalhes que afetam o portal. Goel et al. (2025) definem CAPA de modo que opções erradas distintas contem como desacordo, e além da tendência com capacidade eles mostram que nove juízes LLM de peso aberto pontuam modelos mais similares a si mesmos mais alto, e que ganhos fraco-para-forte são maiores em tarefas onde supervisor e aluno cometem erros menos similares (12 pares de modelos). Kolawole et al. (2025) declaram uma condição de deferência segura na taxa conjunta de erros aceitos sobre a distribuição de teste, com um limiar estimado em um pequeno conjunto de validação. Uma condição na taxa conjunta permite que erros aceitos se concentrem em um estrato, e a Seção 5.1 encontra tal estrato: em 106, painéis de nível intermediário certificam o erro, assim como pares principais sem o braço de maior precisão.
Nenhum desses trabalhos relata, como observado na Seção 2, o portal de lançamento em nível de par, recall em cobertura igual com um modelo lançado mantido fixo, ou um identificador medido em dois modos de acesso.
Apêndice F. Detalhes de dados e protocolo
Coleções. O protocolo é o da Seção 3, e as coleções seguem na íntegra. A Tabela A1 lista modelos, datas e modos de acesso.
- Camada média de julho (24 a 28 de julho). Nove modelos de API e sete modelos locais em 1.500 perguntas SimpleQA (Wei et al., 2024), uma subamostra aleatória fixa das 4.326 perguntas no benchmark. A coleção foi registrada no OSF antes da coleta de dados (Chernets, 2026a).
- Principais em agosto (3 a 6 de agosto). Um modelo principal de cada um de onze laboratórios nas mesmas 1.500 perguntas, das quais 1.459 formam o pool comum.
- Braço de variância (6 de agosto). Nove dos modelos principais em 100 dessas perguntas, 20 por quintil, com temperatura 0,7 e três amostras por pergunta.
- Perguntas novas (6 de agosto e 26 de outubro). 100 perguntas de dois saltos compostas por máquina a partir da Wikidata em oito templates, com o hash do arquivo fixo antes da primeira chamada do modelo.
- Fatos de produtos (15 de agosto). 267 perguntas sobre produtos comerciais, também compostas a partir da Wikidata, em seis modelos, quatro deles sem possibilidade de busca.
- Principais em outubro (26 e 27 de outubro). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 e claude-fable-5-1 em 300 perguntas SimpleQA estratificadas por quintil de julho (60, 120, 120; 297 comuns a todos os cinco; "strat" nas tabelas), as 106 perguntas abaixo e o conjunto novo, 503 perguntas comuns no total. kimi-k3 e gemini-3.8-flash responderam ao conjunto novo.
Modos de acesso. Os modelos foram alcançados das duas formas descritas na Seção 3. gpt-5.6-sol também executou por API direto no braço de variância e no conjunto novo de agosto. Identificadores de modelos e versões de cliente são registrados por chamada.
Como os clientes estabelecem as condições de medição, as enuncio na íntegra. Temperatura não pode ser definida neles. O braço Codex de agosto executou na configuração padrão do cliente para esforço de raciocínio, que a chamada não define e os registros não indicam. Os braços Codex de outubro executaram com esforço definido como médio em cada chamada. Os registros de manifesto de agosto mostram zero solicitações de busca na web para o braço Claude e uma lista de ferramentas vazia para o braço Mistral, e os braços Claude de outubro executaram com ferramentas desabilitadas. Os braços Codex foram iniciados sem a flag de busca, e seus fluxos de eventos não foram retidos, então se eles fizeram buscas não pode ser determinado a partir dos arquivos. Nos clientes kimi e gemini-3.8-flash, ferramentas não foram desabilitadas e o prompt as proíbe.
Apêndice G. O 106 e os tiers
A Figura A3 mostra os painéis e pares da Seção 5.1 sobre o 106 e mais dois pares: fable-5 com grok-4.5 está correto em 7 de 28 acordos e gemini-3.1-pro com grok-4.5 em 8 de 25.
O 0 de 342 da Seção 1 depende de como a dificuldade é classificada. Quando as próprias respostas de cada painel são excluídas da classificação de dificuldade, a contagem se torna 78 de 354, e o painel entre blocos permanece em 0 de 116.
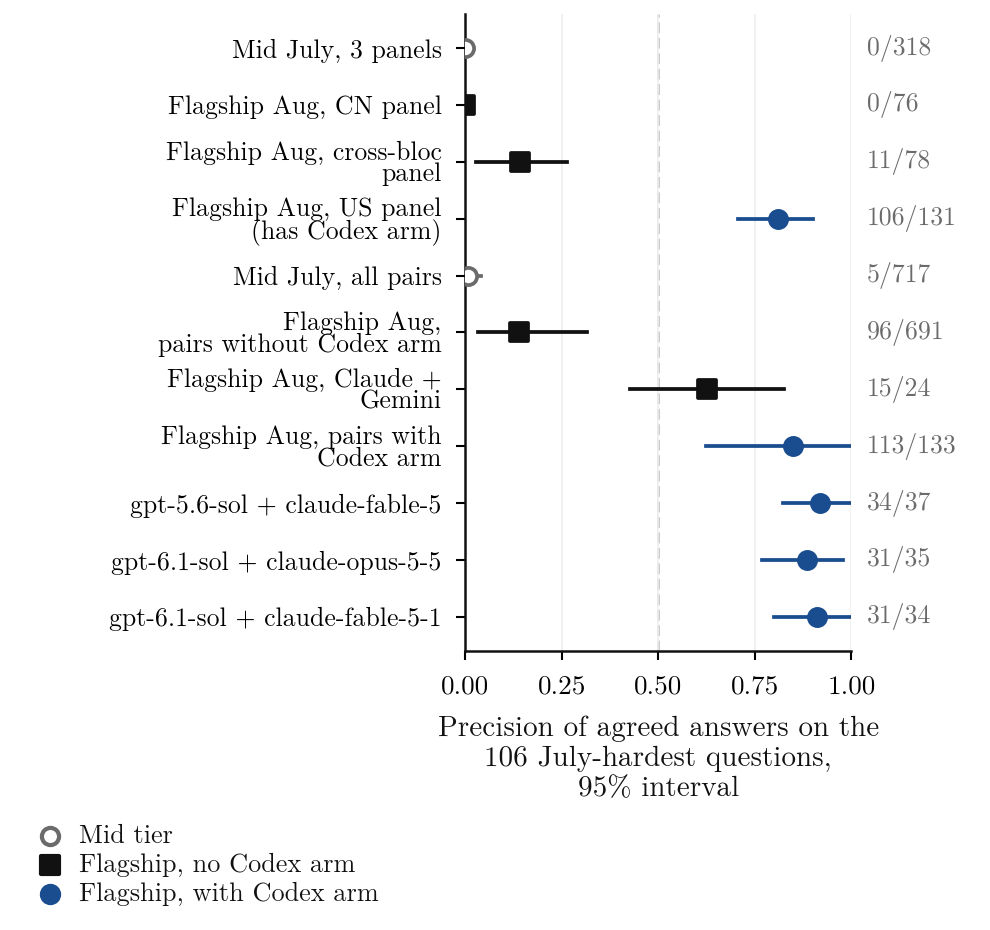
Figura A3. Precisão de respostas acordadas sobre as 106 questões. Nota: bootstrap bidirecional de 95% para linhas agrupadas, bootstrap de questão para painéis e pares únicos. Linhas azuis contêm um braço de cliente Codex. Coleções de agosto e outubro.
A Figura A4 apresenta em sua integralidade os quintis de tier próprio da Seção 5.1. Com todos os braços, agosto atinge 26,6% [6,7, 53,4] no quintil mais difícil, uma diferença de +9,3 [-18,1, +39,8] de julho. Sem kimi-k3, que pertence a ambas as coleções, o quintil mais difícil apresenta 147 de 675 (21,8%) em julho e 192 de 995 (19,3%) em agosto, -2,5 pontos [-29,7, +28,2]. O teste agrupado da Seção 5.1 utiliza todos os cinco quintis, 180 células por tier; células de tier intermediário ficam +0,3 pontos [-2,4, +2,9] e células flagship +0,0 [-1,4, +1,6] do modelo congelado. O ganho no quintil mais difícil é 1,15 [0,39, 1,90] em julho e 0,97 [0,42, 1,49] em agosto. Nos quintis, agosto sem GPT apresenta 15,5, 52,9, 75,8, 90,5 e 97,3% e julho 17,3, 29,0, 60,9, 80,4 e 94,4%, enquanto a acurácia do modelo lançado é 16,0, 36,6, 56,8, 73,3 e 88,5% contra 15,3, 25,0, 40,0, 57,7 e 78,9%.
A precisão permanece baixa em respostas ouro limpas. Haas et al. (2025) reconstruiu SimpleQA em um conjunto limpo de 1.000 questões, e 24 das 106 sobrevivem nele, contra 24,5 esperados pela parcela do benchmark retida, com a resposta ouro idêntica em 21. A limpeza não remove essas questões com mais frequência que outras, embora sua seleção também favoreça questões difíceis. Sob a mesma estatística e bootstrap, pares de agosto sem GPT estão corretos em 28 de 150 acordos nessas 24 questões (18,7% [0,0, 57,1]) e em 67 de 538 nas outras 82 (12,5% [2,8, 28,1]; o membro mais preciso é lançado em cada subconjunto, assim as partes não precisam somar 96 de 691), e pares de julho em 4 de 157 (2,5% [0,0, 15,2]).
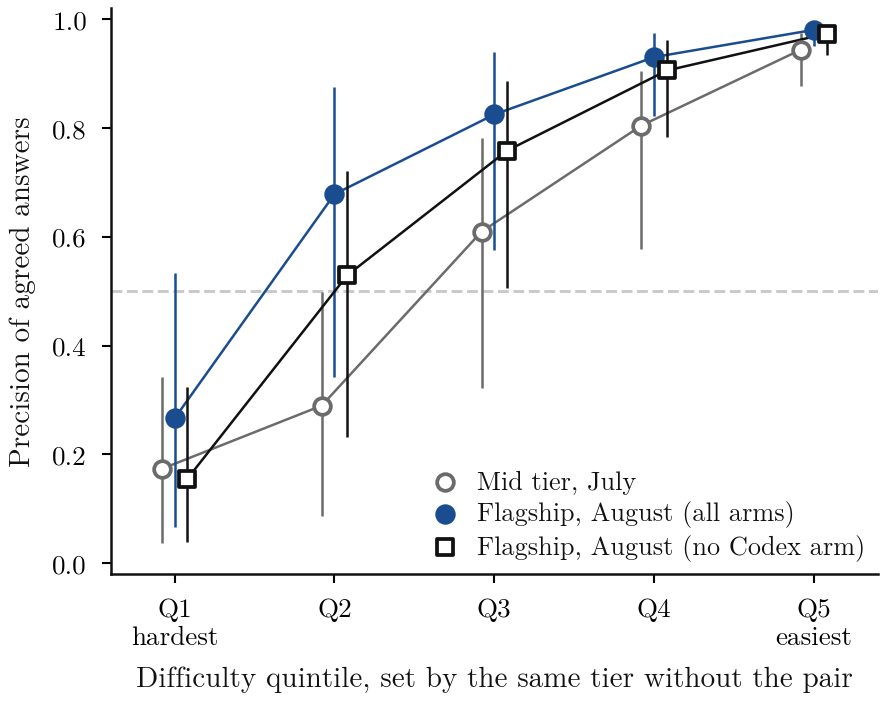
Figura A4. Precisão de respostas acordadas por quintil de dificuldade de tier próprio. Nota: bootstrap bidirecional de 95%. A dificuldade para cada par é definida pelo mesmo tier sem esse par. Linha tracejada em 0,5.
Os pares mais precisos se ajustam à mesma relação. O par kimi-k3 e gemini-3.8-flash atingem 95,8% no conjunto novo, com 23 de 26 erros do modelo lançado capturados e um ganho de 5,37 [2,86, 21,36]. O modelo, dadas apenas suas acurácias de 0,74 e 0,82, retorna 95,1%. E os dois flagships Claude juntos, sem nenhuma possibilidade de busca em nenhum braço, atingem 47,5% sobre o 106, onde a acurácia do modelo lançado é 30,0%, e 86,2% em todas as 503 questões. A Figura A5 traça cada banda de cada tier contra a acurácia do modelo lançado, com precisão acima da diagonal em 17 de 23 células.
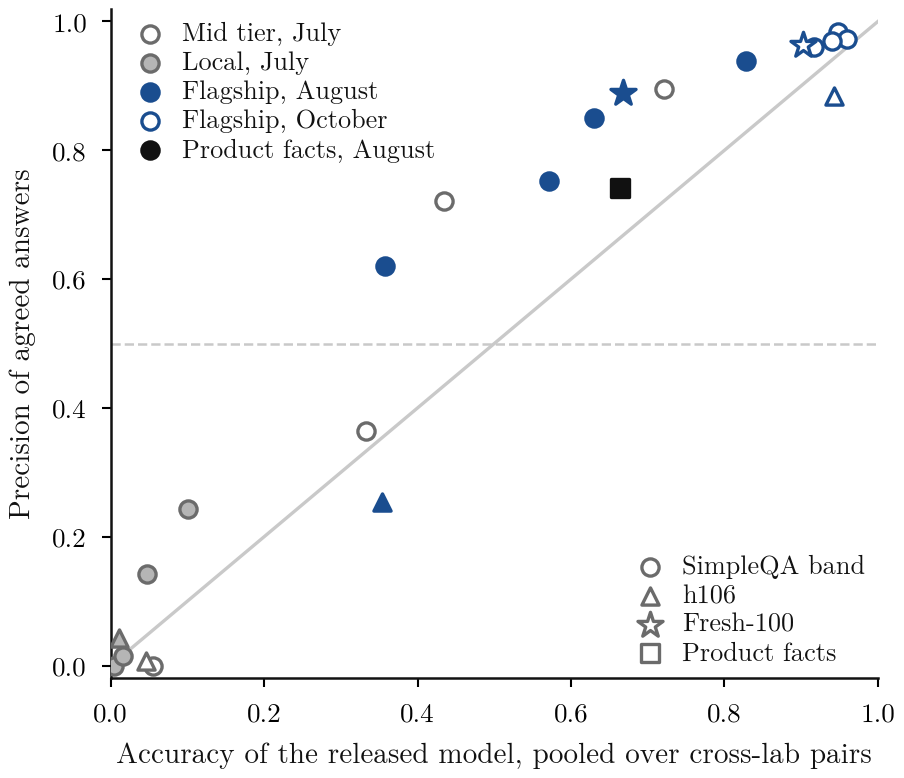
Figura A5. Precisão de respostas acordadas contra acurácia do modelo lançado. Nota: agrupado sobre pares de diferentes laboratórios, por tier e banda. Cor e preenchimento definem o tier, forma do marcador o conjunto. Linha tracejada em 0,5, linha sólida é igualdade.
Apêndice H. O segundo laboratório em detalhes
O braço de variância. Por modelo com cobertura igual (Figura 2), o gate de dois laboratórios lidera em sete de nove e fica atrás para gemini-3.1-pro (-5,7 pontos) e grok-4.5 (-2,8). Sem GPT, em oito modelos, o acordo próprio cobre 61,4% com precisão de 55,9% e dois laboratórios 24,4% com 83,3%. A diferença em precisão é +27,4 pontos [+16,0, +35,7] conforme medido e +7,7 [-1,9, +16,5] com cobertura igual, e os erros capturados diferem por +38,3 pontos [+26,0, +50,9] conforme medido e +3,0 [-1,5, +8,4] com cobertura igual. Outubro não tem chamadas repetidas, portanto o acordo próprio é medido apenas em agosto.
Quatro parceiros de um modelo lançado. A Tabela A4 fornece os quatro parceiros da Figura 3a: um modelo lançado, gpt-6.1-sol, portanto os 29 erros em questão são os mesmos em cada linha.
Tabela A4. Um modelo lançado, quatro parceiros: gpt-6.1-sol em 503 questões comuns (29 erros entre 495 resolvidas, bootstrap de 95% das questões).
| Parceiro | Laboratório | Cobertura [95%] | VPP (K/O) | Delta, pontos [95%] | Erros capturados [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | mesmo | 96,2% [94,4, 97,8] | 94,3% (449/476) | +0,2 [-0,2, +0,8] | 2/29 = 6,9% [0,0, 17,4] |
| gpt-6-sol | mesmo | 95,6% [93,6, 97,2] | 96,2% (457/475) | +2,1 [+0,9, +3,4] | 11/29 = 37,9% [20,7, 56,5] |
| claude-opus-5-5 | diferente | 59,8% [55,9, 64,0] | 95,6% (285/298) | +1,5 [-0,2, +3,3] | 16/29 = 55,2% [36,4, 73,0] |
| claude-fable-5-1 | diferente | 60,8% [56,7, 65,0] | 97,0% (294/303) | +2,9 [+1,1, +4,8] | 20/29 = 69,0% [50,0, 85,2] |
O outro parceiro do mesmo laboratório, gpt-6-sol, captura 11 de 29, o que é -31,0 pontos [-50,0, -10,7] contra fable-5-1 e -17,2 [-37,0, +3,0] contra opus-5-5. O par Claude, sem possibilidade de busca em nenhum braço, cobre 60,6% e captura 140 de 181 erros de fable-5-1 com precisão de 86,2% e um Delta de +23,5 pontos [+19,6, +27,2]. Dois modelos de um laboratório, ambos longe do teto, podem assim discordar com frequência suficiente para capturar a maioria dos erros.
A Tabela A5 testa se isso é mais do que um deslocamento ao longo da curva de cobertura, e se precisa de GPT. Cada linha mantém um modelo lançado e compara seu parceiro do mesmo laboratório com um parceiro de outro laboratório, primeiro conforme medido e depois com cobertura igual, atingida reduzindo o gate mais amplo por confiança (Seção 3).
Tabela A5. Erros capturados com um parceiro do mesmo laboratório e com um parceiro de outro laboratório. As diferenças são mesmo menos outro, em pontos, com bootstrap de 95% das questões, portanto valores negativos favorecem o outro laboratório; as diferenças conforme medido nas primeiras quatro linhas compartilham o bootstrap da Tabela A4.
| Lançado | Parceiro mesmo / outro | Questões | Capturado, conforme medido | Diferença [95%] | Capturado, cobertura igual | Diferença [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62,1 [-79,3, -43,8] | 17/29, 20/29 | -10,3 [-35,3, +13,8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48,3 [-66,7, -29,6] | 18/29, 16/29 | +6,9 [-17,1, +30,4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31,0 [-50,0, -10,7] | 24/29, 20/29 | +13,8 [-6,7, +34,6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17,2 [-37,0, +3,0] | 24/29, 16/29 | +27,6 [+3,4, +51,6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16,0 [-21,7, -10,6] | 140/181, 169/181 | -16,0 [-21,7, -10,6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11,8 [-17,8, -5,9] | 156/195, 177/195 | -10,8 [-16,7, -5,0] |
| fable-5-1 | opus-5-5 / kimi-k3 | novo 100 | 13/23, 20/23 | -30,4 [-50,0, -12,5] | 17/23, 20/23 | -13,0 [-35,0, +9,1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | novo 100 | 13/23, 19/23 | -26,1 [-45,5, -8,7] | 17/23, 19/23 | -8,7 [-29,4, +12,5] |
| opus-5-5 | fable-5-1 / kimi-k3 | novo 100 | 18/28, 23/28 | -17,9 [-38,5, +0,0] | 24/28, 23/28 | +3,6 [-14,7, +22,6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | novo 100 | 18/28, 22/28 | -14,3 [-33,3, +4,5] | 22/28, 22/28 | +0,0 [-20,0, +20,7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (agosto) | 344 | 107/130, 110/130 | -2,3 [-9,8, +5,3] | 108/130, 110/130 | -1,5 [-9,1, +5,8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (agosto) | 344 | 118/141, 126/141 | -5,7 [-12,1, +0,8] | 125/141, 126/141 | -0,7 [-6,4, +5,1] |
As linhas de agosto são a única comparação do SimpleQA sem GPT, e elas pareiam modelos de datas diferentes. gemini-3.1-pro é o braço de agosto mais próximo em precisão aos modelos Claude nessas questões (65,4% contra 60,6 e 57,7% nessas questões). Agrupado em todos os sete parceiros de agosto, a maioria deles muito mais fraca, a diferença é -5,1 pontos [-10,1, -0,3] para fable-5-1 e -6,0 [-10,6, -1,2] para opus-5-5 conforme medido, e se transforma em +7,9 [+4,8, +11,2] e +6,8 [+3,6, +10,2] com cobertura igual, a favor do mesmo laboratório. Empates em confiança são desfeitos aleatoriamente, e ao longo de 200 sorteios a linha mais ampla se move entre 0,0 e +20,7 pontos.
Apêndice I. O modelo fora da amostra em detalhe
A Tabela A6 apresenta os erros fora da amostra por trás da Seção 5.3. A divisão temporal fornece 0.019 contra 0.050 para a linha de base do melhor modelo, uma diferença de -0.031 [-0.074, +0.008] sob o bootstrap bidirecional, e o intervalo fica abaixo de zero quando agrupado apenas por questão ou apenas por modelo. Com 9 e 23 folds, LOLO e LOMO fornecem o mesmo erro até três casas decimais.
Tabela A6. Erro absoluto médio do PPV previsto, células com pelo menos 20 respostas abertas. Bootstrap bidirecional, questão por modelo.
| Esquema | Modelo [95%] | Indep. | Melhor | Modelo menos melhor [95%] | Modelo menos indep. [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, questões divididas | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| Julho e agosto para outubro | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| Faixa média para topo de linha | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, topo de linha, sem braço de busca possível | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| Retido: ERNIE e Muse, agosto | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| Retido: 7 modelos locais, julho | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| Retido: mesmo laboratório, outubro | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| Retido: fatos de produto | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
O ganho prático sobre a leitura do modelo melhor é grande, incluindo transferência da faixa média para topo de linha e dois dos quatro conjuntos que não participaram do ajuste (Figura A6). O multiplicador não adiciona nada à precisão nos esquemas principais, e o trabalho é realizado pelas acurácias medidas e por . Remover completamente eleva o erro LOLO para 0.323, e mantê-lo constante fornece 0.046. Em cobertura e log loss, ajuda: sob LOLO as diferenças dos erros independentes são -0.0079 [-0.0111, -0.0020] e -0.0024 [-0.0045, -0.0003]. Em três dos quatro conjuntos retidos, o intervalo contra erros independentes fica abaixo de zero, com constantes congeladas. O termo de erro conjunto importa, portanto, para cobertura, enquanto a precisão repousa nas acurácias medidas e em .
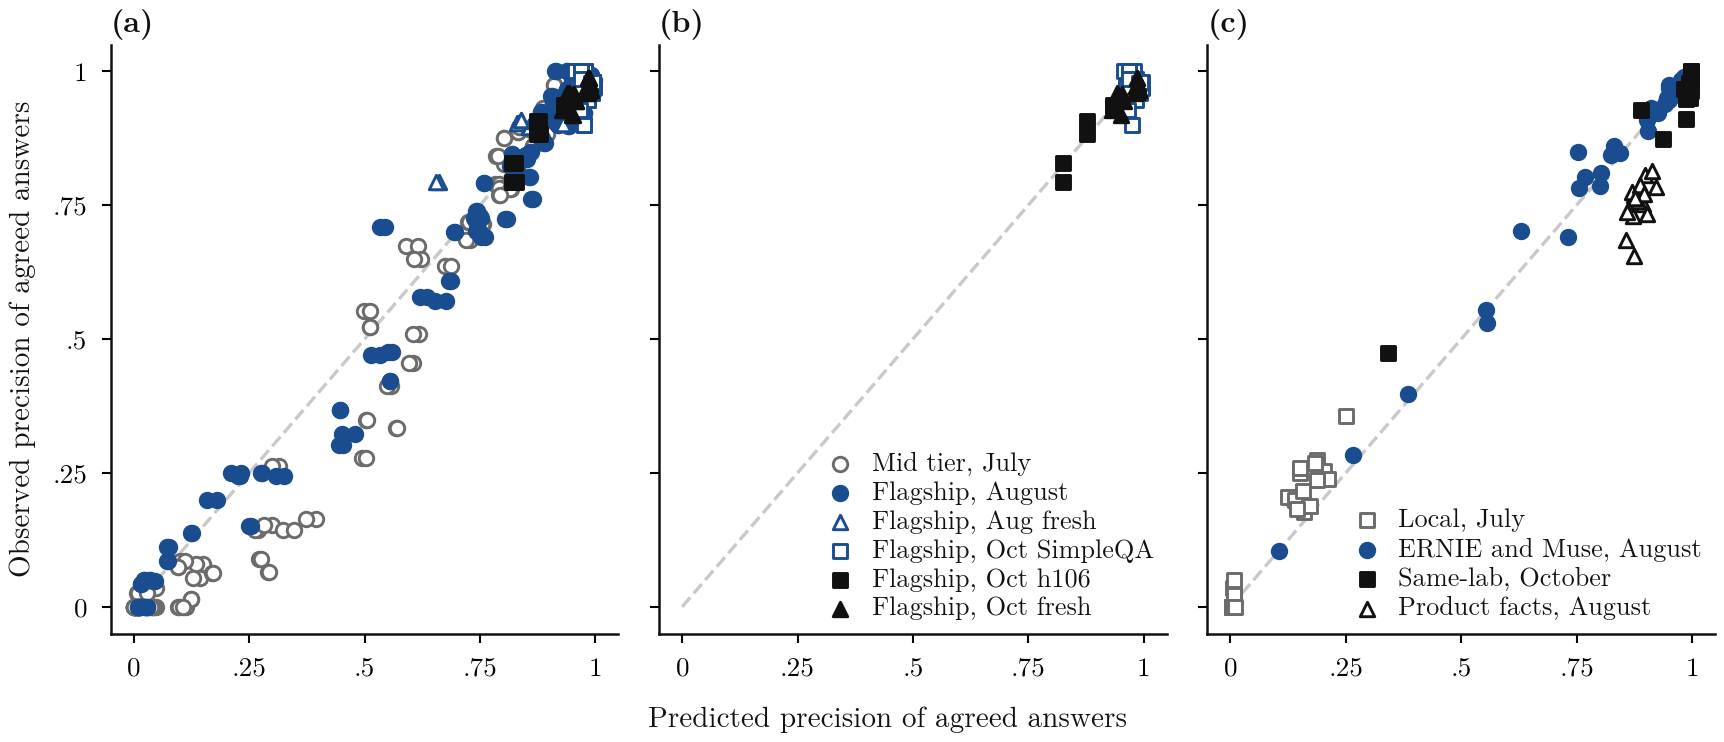
Figura A6. Precisão predita contra observada de respostas concordadas. Nota: (a) deixar um laboratório de fora. (b) Ajuste em julho e agosto e previsão de outubro. (c) Conjuntos fora do ajuste, constantes fixadas. A linha tracejada é igualdade.
Em fatos de produto o modelo executa acima do esperado. O erro é 0.130 contra 0.086 para o melhor modelo, com uma superestimativa média de 13 pontos. Com o classificador nativo desse domínio a superestimativa sobe para 19 pontos (0.190 contra 0.067). Fatos de produto estão fora do domínio sobre o qual as constantes foram ajustadas.
Classificando células em três classes de resultado (invertidas com PPV abaixo de 0.5, sem ganho com Delta até +2 pontos, ganho acima disso), a divisão temporal corresponde a 28 de 39 células, e nove dos erros predizem sem ganho onde ganho foi observado. O modelo é confiável para o tamanho da precisão e mais fraco na classificação de células em ambos os lados da linha de +2 pontos.
Apêndice J. Modos de acesso e os braços GPT em detalhes
Mesmo identificador, mesmas perguntas. Em um conjunto de 100 perguntas SimpleQA, gpt-5.6-sol obtém 92 de 100 (92,0%) na onda principal, onde 99 dos 100 registros vieram através do cliente Codex e uma resposta errada através de um fallback de API, e 139 de 300 amostras (46,3%) através da API direta no braço de variância, uma diferença de 45,7 pontos (Figura 5). Nos 99 registros do cliente apenas, os números são 92 de 99 (92,9%) e 139 de 297 (46,8%), uma diferença de 46,1 pontos. A reprodução textual da string de ouro cai junto com ela, de 64,0% para 26,0%. As condições diferem da seguinte forma: o cliente é executado em sua configuração de esforço padrão sob suas próprias instruções, com temperatura não configurável, enquanto a API é executada com esforço nenhum e temperatura 0,7.
Nas duas colunas os outros oito modelos do braço, cuja temperatura também muda, variam em no máximo 4,0 pontos de qualquer forma. Esforço é um candidato para gpt-5.6-sol, embora uma medição de orçamento de raciocínio emparelhada em gemini-3.1-pro deixou a precisão praticamente inalterada (Chernets, 2026c). Busca na web é a outra. Respostas de outubro do mesmo cliente contêm links que o prompt não solicita, em 3 de 506 respostas de gpt-6.1-sol e em 18 de 506 de gpt-6-astra, incluindo um identificador MusicBrainz real. O uso mediano de tokens por chamada do cliente em agosto é 4.829, com 36,4% das chamadas acima de 6.000. Esses tokens podem ser raciocínio ou busca, e o fluxo de eventos que os separaria não foi retido.
Um harness de benchmark e uma pessoa usando o produto podem assim ver precisões 45,7 pontos apartadas em um identificador e um conjunto de perguntas, e um estudo do "modelo" tem que declarar qual mediu. Dentro da onda de agosto, o braço cliente obtém 1.392 de 1.457 (95,5%), e os 14 registros servidos pela API após uma falha do cliente obtêm 11 (78,6%), em perguntas selecionadas por essa falha. No conjunto novo, gpt-5.6-sol através da API obtém 33 de 100, onde fable-5 obtém 76, enquanto gpt-6.1-sol através do cliente obtém 95 em outubro. E o modelo da Seção 4 mantém sua forma sob esta pergunta, já que recebe precisões medidas como entrada: em navios-insignia sem braços com busca possível seu erro LOLO é 0,037 contra 0,120 para o melhor modelo.
Valor de gate por modo de acesso. Em perguntas novas em agosto, com GPT através da API, o par gpt-5.6-sol e fable-5 está certo em 29 de 32 acordos, Delta +57,6 pontos [+46,3, +69,7], capturando 64 de 67 erros, e erros confiantes do braço GPT caem de 61 de 91 para 2 de 29. Em outubro, com um GPT mais recente através do cliente nas mesmas perguntas, o par com opus-5-5 está certo em 72 de 74, e o par com fable-5-1 em 76 de 78, com um Delta de +2,3 [-0,7, +6,0] e +2,4 [-0,5, +6,3] e 3 de 5 erros capturados. O valor de gate aqui rastreia a precisão do braço lançado, como na Seção 5.1.
Braços cliente em SimpleQA. A Tabela A7 relata os braços separados na Seção 5.1. Em agosto, o par gpt-5.6-sol e fable-5 está certo em 997 de 1.016 acordos (98,1%) contra 95,4% sozinho, Delta +2,8 pontos [+1,9, +3,7], com o piso em 15 de 1.459. Nos 106 que alcança 34 de 37 (91,9%), e todos os pares com o braço GPT alcançam 113 de 133 (85,0% [62,2, 100,0]), contra 96 de 691 sem ele. O braço sozinho está certo em 100 de 105. Esses acordos herdam essa precisão: o Delta nos 106 é -3,3 pontos [-10,3, +2,6] em agosto e -5,7 [-13,7, +1,2] com opus-5-5 em outubro. Em contraste, o par de nível médio dos mesmos dois fornecedores, gpt-5-mini e claude-haiku-4-5, está certo em 45 de 123 acordos (36,6% [28,6, 45,4]) no geral e 0 de 13 nos 106, com seu primeiro membro em 163 de 1.435.
Tabela A7. Pares de braço cliente. O primeiro membro é lançado. Intervalo de Wilson em PPV, bootstrap de pergunta em Delta.
| Par, conjunto | Cobertura | PPV (K/O) [95%] | Lançado sozinho | Delta, pontos [95%] | Erros capturados |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, todos SimpleQA, agosto | 1028/1500 | 98,1% (997/1016) [97,1, 98,8] | 1403/1471 | +2,8 [+1,9, +3,7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, agosto | 37/106 | 91,9% (34/37) [78,7, 97,2] | 100/105 | -3,3 [-10,3, +2,6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, outubro | 192/300 | 96,3% (183/190) [92,6, 98,2] | 276/294 | +2,4 [+0,2, +4,9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, outubro | 193/297 | 97,9% (187/191) [94,7, 99,2] | 273/291 | +4,1 [+1,6, +6,7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, outubro | 36/106 | 88,6% (31/35) [74,0, 95,5] | 98/104 | -5,7 [-13,7, +1,2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, outubro | 35/106 | 91,2% (31/34) [77,0, 97,0] | 98/104 | -3,1 [-10,9, +3,5] | 3/6 |
| gpt-6.1-sol + opus-5-5, novo, outubro | 74/100 | 97,3% (72/74) [90,7, 99,3] | 95/100 | +2,3 [-0,7, +6,0] | 3/5 |
| gpt-6.1-sol + fable-5-1, novo, outubro | 78/100 | 97,4% (76/78) [91,1, 99,3] | 95/100 | +2,4 [-0,5, +6,3] | 3/5 |
Valor de gate próximo ao teto. Em perguntas familiares o par ainda adiciona um pouco (Figura A1). Em agosto em SimpleQA sem os 106, seu Delta é +3,0 pontos [+2,0, +4,0], uma diferença a favor do par. Em outubro os pares strat situam-se acima de zero, em +2,4 [+0,2, +4,9] e +4,1 [+1,6, +6,7], e aquém de uma decisão contra a margem. A única equivalência é gpt-6-sol com opus-5-5 em -0,6 (intervalo de 90% -1,6 a +0,5, p = 0,020), que não sobrevive à correção de Holm (0,277). Nos 106, cada par com gpt-6.1-sol e gpt-5.6-sol é indeciso com uma direção descendente. Fora deste braço o efeito é grande: no mesmo conjunto de agosto, fable-5 com gemini-3.1-pro está em +19,3 pontos e fable-5 com grok-4.5 em +18,0.
A confiança própria do braço é um concorrente nesta faixa. Reduzido por sua própria confiança à cobertura do par com opus-5-5, gpt-6.1-sol está em 34 a 36 de 36 nos 106, dependendo de como empates são resolvidos, contra 31 de 35 para o par, e 74 de 74 em novo contra 72 de 74. Em strat o par lidera, por +1,6 pontos [-1,4, +4,7] com opus-5-5 e por +3,2 [+0,6, +6,2] com fable-5-1.
Qual GPT e qual parceiro. Em questões comuns que ambos os modelos resolvem, gpt-6.1-sol supera gpt-6-astra 10 a 1 em pares discordantes (p = 0,012, +1,83 pontos [+0,61, +3,26]), e gpt-6-sol supera gpt-6-astra 21 a 5 (p = 0,002, +3,29 [+1,23, +5,34]). gpt-6.1-sol contra gpt-6-sol fica em 5 a 12 (p = 0,143). opus-5-5 contra fable-5-1 fica em 29 a 44 (p = 0,101, -3,12 [-6,65, +0,21]). Pares dos dois GPTs mais fortes com os dois Claudes ficam entre 95,4 e 97,1% sobre 503 questões (Tabela A2), com fable-5-1 capturando mais dos erros em cada comparação. E kimi-k3 com gemini-3.8-flash, o par sem GPT, não é separável deles no conjunto novo: sua diferença em relação a gpt-6.1-sol com opus-5-5 é de -1,5 pontos [-6,3, +2,8] em precisão e -2,0 [-10,0, +6,0] em cobertura.
Apêndice K. Dados externos em detalhes
A verificação externa da Seção 5.5 utiliza as constantes congeladas sem reajuste. HELM Lite (Liang et al., 2023) contém respostas abertas breves de 95 modelos de 20 desenvolvedoras, lançados entre 2023 e 2025, para 1.000 perguntas NaturalQuestions de livro fechado, avaliadas aqui por meu mecanismo. LiveBench (White et al., 2025) contém respostas de 70 modelos de 11 laboratórios para 346 perguntas com uma resposta final breve, avaliadas contra sua verdade fundamental. Kim et al. (2025) lançam agregados de pares para 70 modelos no MMLU de múltipla escolha, que fornecem a precisão observada como a taxa de ambos corretos sobre a taxa de concordância. A Tabela A8 apresenta o resultado. As acurácias da Tabela 7 de Haas et al. (2025) não apresentam resultados de concordância, portanto produzem predições e nenhum teste.
Tabela A8. O modelo congelado em outros modelos e perguntas. Erro absoluto médio do PPV previsto para pares de laboratórios diferentes, células com pelo menos 20 respostas abertas nas duas primeiras fontes. Bootstrap bidirecional, apenas por modelo para MMLU. Mudança é prevista menos observada.
| Fonte | Células | Modelo [95%] | Indep. | Melhor | Modelo menos melhor [95%] | Modelo menos indep. [95%] | Mudança |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4.088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, quatro tarefas | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (agregados) | 2.189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
Como na Seção 5.3, o modelo supera a leitura do modelo melhor nas três fontes consideradas como um todo, e falha em quebra-cabeças de zebra, com 0.231 contra 0.076. Não melhora nos erros independentes em HELM ou LiveBench. Executa alto, de 5,3 a 6,6 pontos no geral. Em HELM a curva observada se achata onde o modelo continua aumentando: na precisão de pares entre 0,5 e 0,6 a precisão é 74,6% para modelos de 2023 e início de 2024 e 75,9% para os posteriores, contra 84,4% previsto no meio do intervalo. Em MMLU a mediana da chance de duas respostas erradas coincidirem é 0.621 contra 0.368 de , já que quatro opções forçam colisões.
Nestes modelos a precisão aumenta com a precisão dos pares (Spearman +0.575 em HELM e +0.786 em MMLU, sobre células dependentes). Modelos mais antigos e mais novos com precisão similar fornecem precisão similar entre precisão de pares 0,4 e 0,6 (70,7 e 72,7%, 74,6 e 75,9%), e diferem mais entre 0,2 e 0,3 (57,6 e 76,1%). O limite inferior da Seção 4 é válido em todas as 4.088 células HELM. Pares abaixo de um meio são raros ali, 24 de 4.088, porque estas células não são estratificadas por dificuldade.
HELM também permite o teste da Seção 5.2 com muitos laboratórios e sem dependência de GPT, porque a precisão do parceiro pode ser equiparada sem valores de confiança. Com um modelo lançado e parceiros dentro de 3 pontos de precisão, um parceiro do mesmo laboratório identifica 72,3% dos erros e de outro laboratório 75,5%, uma diferença de -3,2 pontos [-4,2, -2,3], com cobertura maior por 2,7 pontos [+2,1, +3,4]. Adicionar uma correspondência na cobertura dentro de 3 pontos remove-a: 75,7 contra 75,9%, -0,2 [-0,6, +0,2], com precisão -0,5 [-1,4, +0,1]. Duas respostas erradas coincidem em 31,6% dos casos dentro de um laboratório e 27,0% entre laboratórios.
Erros compartilhados também se situam muito acima do acaso nas coleções da Seção 3. Sob a nulidade de permutação de rótulos de Ding (2026), que mantém as respostas erradas de cada modelo e as embaralha entre perguntas, duas respostas erradas que não são recusas coincidem em 14,0% dos casos em julho e 15,4% em agosto sem GPT, contra uma nulidade de 0,1%. Nas 106 as taxas são 25,7% e 22,8% contra 0,4% e 0,5%, e em perguntas recentes 14,5% em agosto e 32,7% em outubro contra 0,8% e 3,8%. Respostas abertas raramente colidem por acaso, portanto o compartilhamento observado se situa muito acima desta nulidade, em perguntas compostas após o lançamento dos modelos também.
Apêndice L. Discussão adicional
Relação com Goel et al. (2025). A tendência deles se refere à similaridade ajustada pelo acaso, e a minha se refere à precisão das respostas concordantes, portanto os achados não entram em conflito. Os dados tratam disso através da proporção condicional de erro compartilhado, F/W, a probabilidade de que duas respostas incorretas sejam iguais, em questões em que ambas as respostas são avaliadas e com recusas contadas como incorretas. Para os pares de referência, ela aumenta de 63 de 1.088 (0,058) para o par de nível médio para 15 de 42 (0,357) para o par emblemático, aproximadamente seis vezes. Agregados em todos os pares, GPT incluído, o aumento é menor e o intervalo inclui zero: 0,097 em julho e 0,132 em agosto, uma diferença de +0,034 [-0,006, +0,084]. No conjunto estratificado de outubro, F/W é 0,493 [0,179, 0,840], uma diferença de agosto de +0,361 [+0,041, +0,712]. Com cobertura igual, bin por bin, a recuperação do modelo emblemático é menor em 0,7 a 2,5 pontos, um efeito pequeno, e é 0,140 [0,092, 0,192] em relação a 0,113 [0,082, 0,146]. A direção assim concorda com a deles, embora o intervalo agregado inclua zero. A leitura direta do aviso deles, que a similaridade ameaça a porta, realmente aparece na recuperação: pares de clientes de outubro capturam 66,3% dos erros com cobertura de 65,3%, enquanto todos os 55 pares de agosto capturam 88,2% em 32,5%, um contraste que a cobertura explica parcialmente. A precisão permanece alta em grande parte porque, nessas precisões, o limite da Seção 4 deixa pouco espaço para ela cair.
Relação com Han (2026). Han nomeia a descorrelação como o mecanismo prático. Minhas medições colocam precisão e cobertura em primeiro lugar. Com cobertura igual com um modelo lançado, a vantagem de um segundo laboratório desaparece a menos que seu modelo seja muito mais preciso (Seção 5.2). Em HELM, com precisão pareada, um segundo laboratório adiciona 3,2 pontos de recuperação para 2,7 pontos de cobertura, e nada uma vez que a cobertura também seja pareada. A descorrelação é visível ali, em 27,0 contra 31,6% de respostas incorretas coincidentes, e é pequena. A teoria de Han se refere à profundidade de portas em série e a minha a uma única porta, portanto as duas se encontram apenas no primeiro passo. Liu (2026) separa as mesmas duas coisas: a precisão da seleção segue a descorrelação, com painéis entre modelos à frente da reamostragem por 12,5 a 16,7 pontos no AIME-2024 com precisão de membro pareada, enquanto a calibração do sinal de concordância segue a precisão do membro. A precisão das respostas concordantes medida aqui é a segunda destas.
Os dois lados da Seção 2. Os números publicados reconciliam parcialmente os dois lados. O painel unânime de Liu está correto em 100,0% do AIME-2025 com uma precisão de responder a tudo de 0,433, e em 70,2% do MMLU-Pro em 0,458. Os nove juízes unânimes de Kohli, cada um próximo a 68%, estão corretos em 90,9%. Precisões similares dão precisão 30 pontos apart, portanto a precisão sozinha não traz esses resultados juntos. O tamanho do espaço de respostas explica mais. A probabilidade de que duas respostas incorretas correspondam é 0,621 no MMLU de quatro opções, 0,270 em NaturalQuestions e 0,132 em SimpleQA para modelos emblemáticos de agosto. Estes são painéis e pares em tarefas diferentes, sem cálculo conjunto entre os artigos, e eles são consistentes com a precisão seguindo a precisão dentro de uma tarefa e formato de resposta.
Familiaridade. Uma lacuna entre SimpleQA e precisão recente convida a uma explicação através de exposição a benchmarks, e a correspondência literal com a string de ouro parece ser sua assinatura. Meus dados não apoiam isso como uma covariável (Apêndice C). Entre respostas corretas, a correspondência literal é próxima a um valor em todos os modelos, e não explica o resíduo do modelo. F/W no conjunto recente em agosto, 0,145 [0,033, 0,402], não mostra distância visível de 0,132 em SimpleQA, dentro de um intervalo amplo.
Como citar
Chernets, V. (2026). Inversão de Concordância Não é uma Propriedade de Nível Intermediário: Precisão de Respostas de Modelos de IA Concordantes Segue a Acurácia do Par [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}