KI-Kosten reduzieren: Bezahlen Sie ein Modell nur für die Entscheidungen, die eines benötigen — Tools
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
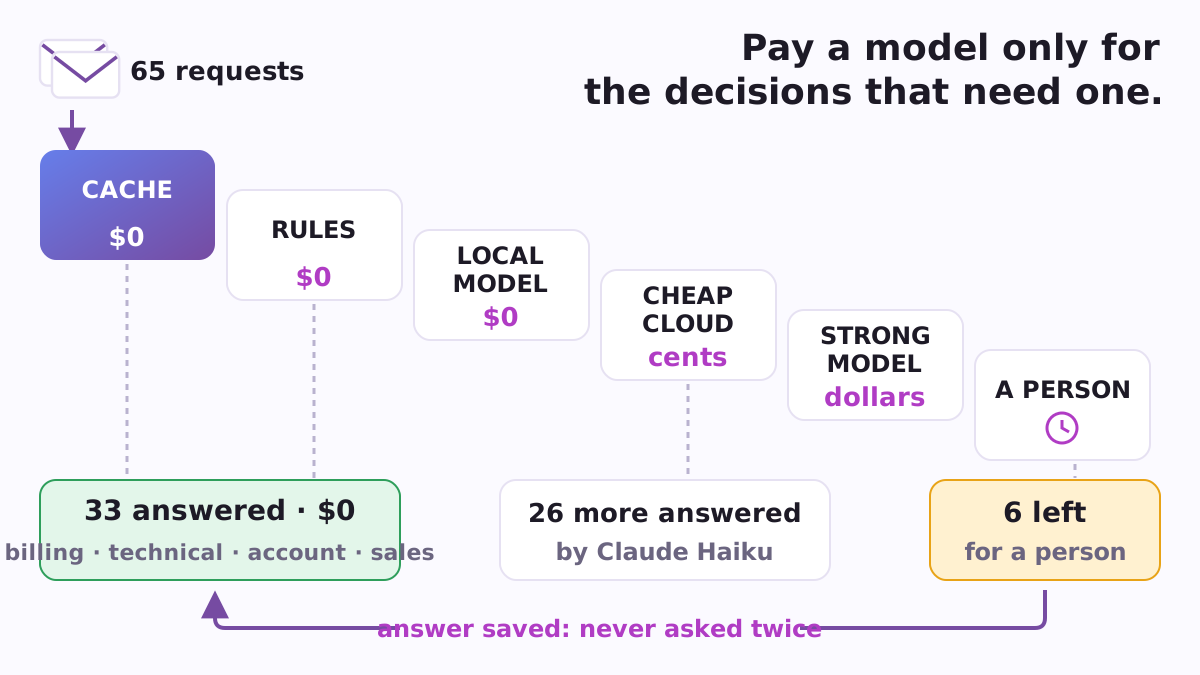
Decidecall nimmt die kleinen Entscheidungen, die ein Unternehmen immer wieder trifft (welches Team erhält diese Nachricht, genehmigen oder zurückweisen, dringend oder nicht), und beantwortet jede mit dem günstigsten Mittel, das sicher genug ist. Eine bereits gegebene Antwort kommt zuerst, dann eine einfache Regel, dann ein Modell, das auf Ihrem eigenen Computer läuft; nur das Übrige geht an ein bezahltes Modell, und das, bei dem kein Modell sicher genug ist, geht an eine Person. Die Antwort der Person wird gespeichert, sodass dieselbe Frage nie zweimal Kosten verursacht.
Decidecall ist ein kostenloses, quelloffenes Plugin für Claude Code, Anthropics KI-Assistent, der mit den Dateien auf Ihrem Computer arbeitet. Es benötigt kein Konto, keine Kreditkarte und keinen eigenen API-Schlüssel (der Zugriffscode, den Programme verwenden, um eine KI aufzurufen): Ein bezahltes Modell wird über ein Programm erreicht, das Ihr Unternehmen bereits installiert hat und bei dem Sie angemeldet sind.
Warum die meisten Entscheidungen kein Modell brauchen
Viele Teams, die mit KI anfangen, senden jede Nachricht an ein Modell. Es funktioniert, und es zahlt für dieselbe Antwort immer und immer wieder: „Wo ist meine Rechnung?" kommt täglich in einen Support-Posteingang, und das Wort „Rechnung" sagt bereits, dass es zur Abrechnung geht. Tian Pan beschreibt ein Team, das monatelang ein Modell zum Weiterleiten von Support-Tickets verwendete, bevor es bemerkte, dass 70 % der Tickets einen Produktnamen in der Betreffzeile nannten, was eine einfache Nachschlagetabelle mit 99 % Genauigkeit weitergeleitet hätte.
Forscher haben die gleiche Idee im großen Maßstab gemessen. Stanfords FrugalGPT fragt zunächst ein billiges Modell und steigt nur auf, wenn die Antwort schwach aussieht; es entsprach dem besten einzelnen Modell „mit bis zu 98 % Kosteneinsparung". LMSYSs RouteLLM, das für jede Frage ein starkes oder schwaches Modell auswählt, senkte die Kosten bei einem Benchmark um über 85 %, während es 95 % der Qualität von GPT-4 behielt.
So funktioniert die Kette
Jede Entscheidung durchläuft die gleichen sechs Glieder und stoppt beim ersten, das sicher genug ist:
- Cache: bereits gegebene Antworten. Eine exakte Wiederholung wird gefunden, auch bei unterschiedlichen Großbuchstaben, Leerzeichen und Satzzeichen. Mit einem kleinen Embedding-Modell auf Ihrem Computer (z. B.
nomic-embed-textin Ollama) wird auch eine anders formulierte Frage gefunden: „Warum wurde meine Karte zweimal belastet?" findet die Antwort auf „Ich wurde diesen Monat zweimal berechnet". - Regeln: Wörter, die die Antwort klären, einmal niedergeschrieben: „Rechnung", „Rückerstattung" oder „berechnet" bedeutet Abrechnung. Wenn zwei Regeln auf unterschiedliche Antworten hindeuten, bleiben sie stumm, statt zu raten.
- Lokales Modell: ein Modell, das auf Ihrem eigenen Computer läuft, kostenlos für jede Entscheidung.
- Günstige und starke Cloud-Modelle: bezahlte Modelle, das günstigste zulässige zuerst.
- Eine Person: wer die Entscheidung trifft, dem wird die beste bisherige Vermutung gezeigt.
Jedes Glied antwortet mit einer Entscheidung und einer Konfidenz, einer Zahl von 0 bis 1. Bei 0,95 oder mehr wird die Antwort angenommen. Darunter wird das nächste Glied befragt, und wenn zwei verschiedene Quellen übereinstimmen (und mindestens eine von ihnen zu 0,70 oder mehr sicher ist), ist das entscheidend. Zwei Glieder, die die gleiche Familie von Modellen verwenden, bestätigen sich nie gegenseitig, und eine Übereinstimmung nach Bedeutung im Cache ist nur ein Vorschlag, den ein anderes Glied bestätigen muss. Wenn nichts sicher ist, entscheidet eine Person, und ihre Antwort geht in den Cache. Beide Schwellwerte können Sie ändern.
Eine Art von Entscheidung ist eine kleine Datei: die Frage, die möglichen Antworten, die Wörter, die sie klären, und wie sicher ein Glied sein muss. Das gleiche Format funktioniert für die Sortierung von Support-Nachrichten, „genehmigen oder zurückschicken" bei Spesenbelegen oder „dringend oder nicht" bei eingehender Post.
Ein praktisches Beispiel: 65 Support-Nachrichten
Das Repository enthält einen Support-Posteingang für vier Teams (Abrechnung, technisch, Konto und Vertrieb): 65 Kundennachrichten mit Wiederholungen, wie sie in echtem Support vorkommen. Am 2. Oktober 2026 wurde die Chain zweimal darauf gemessen (vollständige Ergebnisse):
| Chain | Entschieden ohne eine Person | Richtig | An eine Person gesendet | Kosten von 65 Entscheidungen |
|---|---|---|---|---|
| cache + rules | 36 | 36 von 36 | 29 | $0 |
| cache + rules + Claude Haiku 4.5 | 59 | 57 von 59 (96,6%) | 6 | $0,167 zu Listenpreisen |
Ohne ein Modell überhaupt wurden mehr als die Hälfte des Posteingangs kostenlos und ohne Fehler sortiert (erneut am 10. Oktober 2026 mit demselben Ergebnis ausgeführt). Mit Claude Haiku 4.5, Anthropics kleines und schnelles Modell, blieben sechs Nachrichten für eine Person.
Der Bericht ist gleichermaßen klar darüber, was nicht funktioniert hat. Haiku irrte sich zweimal, während es sich zu 98 % sicher war: „Ich werde alle fünf Minuten abgemeldet" wurde an technisch statt an Konto gesendet, und ebenso die Wiederholung. Genau deshalb fragt die Chain eine zweite, andere Quelle an, bevor sie die wiederholte Antwort eines Modells vertraut. Fünfundsechzig Beispiele sind eine erste Lektion: Das Tool ist so aufgebaut, dass Sie die gleiche Messung an ein paar hundert Ihrer eigenen früheren Entscheidungen durchführen.
Was es tut
- Entscheiden: eine Frage beantworten: die Antwort, welcher Link sie lieferte, wie sicher sich das System war, welche Kosten entstanden.
- Kennzeichnen: die Antwort einer Person wird zwischengespeichert, sodass sie beim nächsten Mal kostenlos verfügbar ist.
- Befördern: Entscheidungen, die die Modelle konsistent auf die gleiche Weise trafen und die von zwei verschiedenen Modellfamilien bestätigt wurden, werden zu Cache-Einträgen, sobald Sie zustimmen; Wörter, die immer nur mit einer Antwort verknüpft waren, werden als neue Regeln angeboten.
- Prüfen: Ihre eigenen gekennzeichneten vergangenen Entscheidungen werden durch die Chain ausgeführt und zeigen, wie viele ohne eine Person entschieden wurden, wie viele richtig waren, wie ehrlich die Konfidenzwerte waren, und die Kosten einer Entscheidung im Vergleich zum Senden aller Daten an ein Modell.
- Kandidaten: 14 Programme und Services, die hinter einem Link stehen können, jeweils mit Lizenz und Quellseite.
Entscheidungsmodelle funktionieren direkt einsatzbereit
Eine neue Art von Modell ist genau für diese Aufgabe angekommen. TypeSafe's Jev, angekündigt im September 2026, schreibt keinen Text: es nimmt eine Situation und eine Frage mit Optionen und gibt die gewählte Option mit einer Wahrscheinlichkeit zurück, zu 0,042 USD pro Million Input-Token (DataCamp). Open-Source-Modelle derselben Art laufen auf Ihrem eigenen Computer: Strands Decider, dessen Autoren berichten, dass seine „Antworten bei einer Konfidenz von 0,9 oder höher etwa 95 % der Zeit korrekt sind", und seit Ollama 0.35 Entscheidungsmodelle, die von Ollama bereitgestellt werden, dem kostenlosen Tool zum lokalen Ausführen von Modellen. Decidecall spricht diese Schnittstelle direkt an, genauso wie gewöhnliche lokale Modelle (Ollama, llama.cpp, vLLM, LM Studio) und Claude über die Claude Code, die Sie bereits haben; bench zeigt auf Ihren eigenen Daten, was jede einzelne hinzufügt.
Ihre Regeln für Daten und Geld
Decidecall liest dieselbe Unternehmensrichtliniendatei wie die anderen Unternehmens-Plugins:
- Sensible Daten bleiben auf dem Computer. Markieren Sie eine Entscheidung rot und sie geht nur in den Cache, die Regeln und lokale Modelle; Decidecall behält einen Fingerabdruck des Textes, niemals den Text selbst.
- Nur die Anbieter, die Sie zulassen, oder nur solche, die nach der Antwort nichts behalten.
- Ein tägliches Budget: Ein bezahlter Link, der dieses überschreiten würde, wird übersprungen, und die kostenlosen Links funktionieren weiter.
- Schlüssel bleiben im Schlüsselbund, nie in einer Datei.
Es ist eine einzelne Python-Datei, die nichts außer Python benötigt und öffnet keine eigene Netzwerkverbindung, sodass sie auch auf einem Computer ohne Internetverbindung läuft.
Erste Schritte
Fügen Sie in Claude Code den Poly A1-Katalog hinzu und installieren Sie Decidecall (kein Git und kein GitHub-Konto erforderlich):
/plugin marketplace add https://raw.githubusercontent.com/vadimchernets/poly-a1-plugins/main/.claude-plugin/marketplace.json
/plugin install decidecall@poly-a1
Sagen Sie dann, was Sie entscheiden möchten, in Ihren eigenen Worten: „unsere Support-Nachrichten nach Team sortieren" oder „lohnt sich Strands Decider für uns". Claude stellt seine Fragen nacheinander (was wird entschieden, welche Antworten sind möglich, welche Wörter machen die Antwort sicher, wie sicher muss sie sein) und schreibt die Task-Datei mit Ihnen. Dann führt es bench auf Ihren bisherigen Entscheidungen aus, bevor etwas bezahlt wird. Decidecall benötigt Python 3.8 oder neuer und funktioniert auf Mac, Linux und Windows.
Code, das Beispiel-Postfach und die Messungen: github.com/vadimchernets/decidecall.
Wo es passt
Decidecall ist eines der Unternehmens-Plugins im Poly A1 plugins Katalog. Es arbeitet mit Routecall zusammen, wo ein starkes Modell plant und günstigere die Menge bewältigen, und mit Billcall, das zählt, was KI das Unternehmen kostet; Firmcall schreibt die gemeinsame Richtliniendatei. Decidecall wurde von Vadym Chernets geschrieben, unter der Apache-2.0-Lizenz veröffentlicht und auf Zenodo archiviert (DOI 10.5281/zenodo.23116720).
Vadym Chernets entwickelt auch Poly A1, eine App, in der KIs verschiedener Unternehmen die Arbeit voneinander überprüfen.