Wie man die KI-Produktivität anhand überprüfter Arbeit misst, nicht Tokens — Tools
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
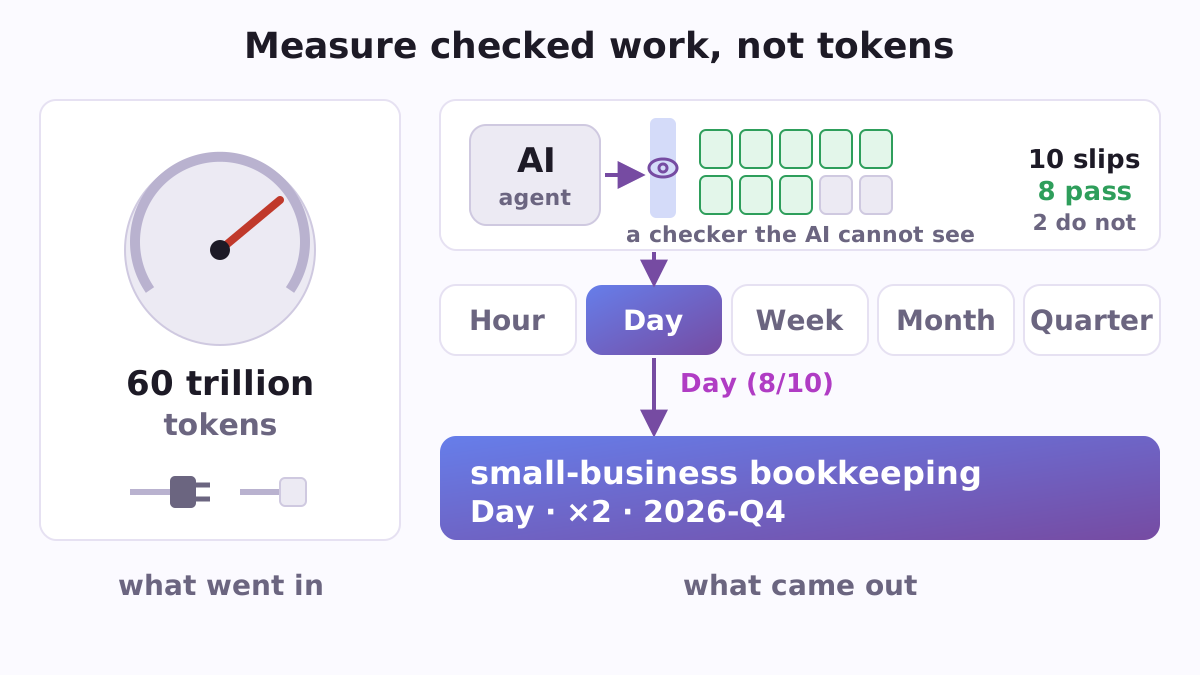
Wenn Sie echte Arbeit erledigen, indem Sie sie KI-Agenten übertragen (Claude Code, Codex, Cursor und ähnliche), zeigt kein Jobtitel, Abschluss oder Lebenslauf, was Sie zuverlässig liefern können. Die Zahl, die viele Arbeitgeber 2026 anstrebten – wie viele Token eine Person verbraucht – zeigt noch weniger. Delegation Horizon ist ein kostenloses Open-Source-Tool, das ein einfaches Protokoll der Arbeit, die Sie KI-Agenten übertragen, in eine datierte Zeile umwandelt:
small-business bookkeeping · Day · ×2 · 2026-Q4Es liest sich so: In der Buchhaltung kleiner Unternehmen übergibt diese Person regelmäßig KI-Agenten Arbeitsaufträge, die ein Spezialist von Hand etwa einen Tag benötigen würde, und eine Kontrolle, die die Agenten nie sahen, bestätigt diese; jede Stunde ihrer eigenen Aufmerksamkeit bringt mindestens zwei Stunden überprüfte Arbeit ein; bewertet im vierten Quartal 2026. Sie führen das Protokoll in einem beliebigen Tabellenkalkulationsprogramm, und die Bewertung wird auf Ihrem eigenen Computer ausgerechnet, durch ein kleines Python-Skript oder durch eine Webseite, die offline läuft. Kein Konto, kein Schlüssel, nichts zu bezahlen, und das Protokoll verlässt niemals Ihren Computer.
Warum das Zählen von Tokens fehlgeschlagen ist
2026 versuchten mehrere große Unternehmen zu messen, wie gut die Mitarbeiter KI nutzten, indem sie quantifizierten, wie viel KI sie einsetzten – ein Trend, den die Presse „Tokenmaxxing" nannte. Bei Meta protokollierte ein von Mitarbeitern entwickeltes Leaderboard mit dem Spitznamen Claudeonomics in 30 Tagen 60 Billionen Tokens über mehr als 85.000 Mitarbeiter hinweg (Shopifreaks). Bei Amazon „erstellten Mitarbeiter KI-Agenten, um unnötige Aufgaben auszuführen, um ihre Punktzahl zu verbessern", und das Tracking-System wurde offline genommen (CIO). Im September erklärte Meta, dass es „KI-Adoptions-Dashboards oder Token-Zählungen nicht zur Bewertung von Auswirkungen verwenden wird" (CIO).
Ein Token-Zähler misst, was eingegeben wurde, nicht was herauskommt; DORA, Googles Cloud-Forschungsprogramm, nennt es „rein ein Maß für Input" (DORA). Dennoch gaben in LeadDevs Umfrage 2026 58 % der Befragten an, dass ihr Unternehmen die Auswirkungen von KI immer noch an der Token-Nutzung misst, während nur 19 % dies für effektiv befanden (LeadDev). Delegation Horizon zählt stattdessen den Output in jeder Branche.
Zwei Zahlen und eine Linie
Jede Arbeit, die Sie an Agenten übergeben, wird zu einer Zeile des Protokolls: ihr Bereich, wie lange ein qualifizierter Spezialist sie von Hand benötigen würde (ihre „Referenzstunden"), wie viele Minuten Ihrer eigenen Aufmerksamkeit es brauchte, welche Prüfung sie durchlief, und ob sie bestanden wurde.
- Der verifizierte Delegationshorizont ist die größte Arbeitsmenge, die Sie regelmäßig an Agenten übergeben und durch eine Prüfung bestätigt bekommen, die sie nicht sahen. Er hat fünf Stufen: Stunde, Tag, Woche, Monat und Quartal (1, 8, 40, 160 und 500 Referenzstunden). Stunde und Tag benötigen zehn Arbeiten dieser Größe in den letzten 91 Tagen; Woche benötigt sechs in 182 Tagen; Monat sechs in einem Jahr; Quartal drei in einem Jahr. Ein Buchhalter und ein Entwickler unterliegen der gleichen Regel.
- Der Verstärkungsgewinn wird in geprüften Referenzstunden pro Stunde Ihrer Aufmerksamkeit über die letzten 91 Tage gemessen, Fehlschläge eingeschlossen, dargestellt in Schritten von ×1, ×2, ×5, ×20 und ×60.
Beide werden pro Bereich beibehalten, daher kann die gleiche Person bei Woche in Finanztools und bei Tag in Webanwendungen sein. Beide haben ein Datum: eine Stufe wird jeden Quartal wieder erreicht, und ab Woche aufwärts muss eines ihrer Teile aus den letzten 91 Tagen stammen.
Was als überprüft gilt
Mindestens acht von zehn Teilen einer Stufe müssen eine von vier Arten von Überprüfung bestehen: versteckte Tests, ein qualifizierter Experte, tatsächliche Nutzung durch die Menschen, für die die Arbeit bestimmt ist, oder ein Modell aus einer anderen KI-Familie, das gegen Quellen überprüft, die Sie selbst geöffnet haben. Ihre eigene Überprüfung und die Übereinstimmung zwischen Modellen der gleichen Familie werden protokolliert, zählen aber nie. Fehlgeschlagene und aufgegebene Teile bleiben im Protokoll und zählen gegen Sie, ebenso wie ein Teil, bei dem jemand außerhalb des Protokolls geholfen hat, ein Teil, dessen spätere Überprüfung fehlgeschlagen ist, und ein Ergebnis, das später zurückgezogen wurde. Ein Teil, dessen Fehler nicht rückgängig gemacht werden können, wie Geld, das gesendet wurde, muss bestanden werden, und eine andere KI-Familie reicht allein nie aus, um es zu überprüfen. Ab Woche aufwärts werden absichtliche Fehler in mindestens eine Aufgabe vor der Übergabe eingepflanzt; das Erkennen zeigt, dass Sie wirklich überprüfen, und ein verpasster Fehler blockiert Woche und höher.
Die Strenge hat einen Grund: Menschen beurteilen ihre eigene Geschwindigkeit mit KI schlecht. In einer METR-Studie von 2025 brauchten 16 erfahrene Entwickler 19% länger mit KI-Tools, doch danach „glaubten sie immer noch, dass KI sie um 20% beschleunigt hatte" (METR).
Ein praktisches Beispiel
Das Repository enthält das Protokoll eines fiktiven Buchhalters, P07: zehn Arbeitsaufträge, jeder mindestens einen Facharbeitstag umfassend, an Agenten zwischen Juli und September 2026 vergeben. Bewertet am 9. Oktober 2026:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Acht von zehn bestanden, genau das, was Day braucht; ein Teil wurde nur durch die eigene Überprüfung des Buchhalters geprüft und eines fiel bei der Überprüfung durch einen Experten durch. Die acht überprüften Teile summieren sich auf 80 Referenzstunden gegenüber etwa 17,2 Stunden Aufmerksamkeit auf alle zehn auf, ein Gewinn von 4,66, der in die ×2-Stufe fällt. Hätte der Buchhalter das fehlerhafte Teil gelöscht, würde das Protokoll besser aussehen und schlechter bewertet: die Sprosse würde auf neun Teilen ruhen, die Anzahl von zehn verfehlen und unter Hour fallen, während der Gewinn auf ×5 springen würde. Jeder, der den Datensatz erhält, sieht das sofort, da eine Neuberechnung am Datum der Karte nicht mehr übereinstimmt. Deshalb gehören Fehler ins Protokoll.
Für Menschen, die durch Agenten bauen
record_card.pyliest Ihre Tabelle und druckt die Zeile und eine kurze Karte: die Stufe, die dahinter liegende Anzahl („8 von 10 Teilen der Day-Größe verifiziert in seinem 91-Tage-Fenster"), der Gewinn und die Arten der Überprüfung.--format mderstellt eine Karte für ein Profil oder eine E-Mail an einen Arbeitgeber;--format recorddruckt nur die Zeile für einen Lebenslauf.tools/explain.py(neu in Version 1.1.0) sagt Ihnen, warum Ihr Protokoll die Stufe verdient, die es hat: welche Bedingung gilt oder fehlschlägt und welches Teil es entscheidet, wie viele weitere Fehler die Stufe ertragen kann, der Tag, an dem es verfällt, wenn Sie nichts Neues protokollieren, und was die nächste Stufe noch braucht. Es zeigt auch, wie wenig zehn Teile allein beweisen: acht von zehn passen zu jeder wahren Erfolgsquote von etwa 44 % bis 97 %.checker.htmlführt die gleiche Bewertung in einem Browser offline durch; ein Test vergleicht sie mit dem Python-Bewertungsprogramm auf dem bearbeiteten Beispiel und 40 zufälligen Protokollen. Beide lesen eine mit Semikola, Dezimalkommas und Tag.Monat.Jahr-Daten gespeicherte Tabelle, wie europäische Tabellen sie speichern.tools/log_piece.pyerstellt eine Protokollzeile, indem Sie Fragen gestellt werden. Wenn Sie in Claude Code arbeiten, öffnet ein fertiger Hook (ein kleines Skript, das Claude Code bei einem Ereignis ausführt) jedes Mal einen ausstehenden Eintrag, wenn eine Agentensitzung endet, sodass ein fehlgeschlagenes Teil niemals vergessen wird. Es liest kein Transkript und sendet nichts irgendwo hin; jedes Agentenwerkzeug, das einen Befehl am Ende einer Sitzung ausführen kann, kann es verwenden.tools/planted.pyversiegelt Ihre Liste der gepflanzten Fehler mit einem Fingerabdruck vor der Übergabe und bewertet sie danach, wobei falsche Einträge und ausgelassene Dinge separat gezählt werden, und lehnt eine nach der Versiegelung geänderte Liste ab.
Für die vierte Art der Überprüfung, eine weitere KI-Familie, die Ihre Quellen liest, setzt Sidecall ein Stück Arbeit auf die anderen KI-Tools auf Ihrem Computer.
Für Manager und Personalwesen
kits/ai-usage-in-reviews.md ist eine fertige Richtlinie zur KI in Leistungsbeurteilungen. Statt Token oder Ausgaben fragt sie nach akzeptierten Arbeitsleistungen mit bestandener Prüfung; statt „nutzt KI täglich" die größte an Agenten übergebene und letztes Quartal verifizierte Aufgabe. Das Beurteilungsgespräch hat drei Fragen, beginnend mit: Welche größte Arbeitsleistung haben Sie dieses Quartal an Agenten übergeben und als korrekt nachgewiesen, und wie?
Ein Team führt ein Protokoll mit erfundenem Label pro Person (der Bewerter lehnt unbekannte Spalten ab, sodass echte Namen nicht durchrutschen können); examples/team-log.csv zeigt vier Personen über fünf Felder. Jeden Quartal gibt record_card.py pro Person und Feld eine Karte aus. Um eine zu prüfen, nimmt tools/verify_record.py den Datensatz und das Protokoll und sagt Feld für Feld, ob das Protokoll die bewertete Datei ist, der Bewerter derselbe ist und der Datensatz bei erneuter Bewertung gleich bleibt. audit_sample.py zieht eine Zufallsstichprobe zur Nachprüfung aus einem Wort, das der zweite Prüfer nach Erhalt des Protokolls auswählt, sodass niemand erraten kann, welche Arbeitsleistungen gezogen werden, und tools/too_clean.py kennzeichnet Protokolle, die zu gut aussehen: keine Fehler, kaum variierende Größen, jede Leistung auf eine Art geprüft.
Referenzstunden sind außerhalb des Teams festgelegt: aus einer Aufgabenbank oder von zwei Bewertern, die nicht wissen, wessen Arbeit es ist. tools/reference_hours.py nimmt ihre Schätzungen und gibt ihr geometrisches Mittel, wenn sie sich um das 1,5-Fache unterscheiden, oder ruft einen dritten Bewerter auf; kits/reference-hours-raters.md sagt, wie man sie auswählt und einweist.
Um nach verifizierter Arbeit statt nach Abschluss einzustellen, enthält kits/hiring-test/ einen bezahlten eintägigen Arbeitstest im eigenen Bereich des Kandidaten, mit versteckter Prüfung, angelegten Fehlern und einem Bewerter, der den Lebenslauf nicht kennt. kits/trade-screen.md fügt eine Frage des Handwerks in der ersten Woche hinzu, bevor jemand zugelassen wird, denn ein Profil oder Jobtitel sagt weniger als es scheint: Von 60 Personen, die die Filter einer Umfrageplattform als Buchhalter zuließen, beantworteten 11 eine solche Frage falsch, acht davon durch Verwechslung von Soll und Haben.
Was der erste Test mit Menschen ergab
Das schwächste Glied jedes Maßstabs in „Stunden eines Spezialisten" ist die Schätzung selbst, daher wurde sie zuerst getestet. Im Oktober 2026 führte man auf Prolific eine Vor-Pilotstudie durch, registriert auf OSF, bevor Daten eingingen. Dafür zahlte man 119 arbeitende Buchhalter und Webentwickler, damit sie schätzten, wie lange jede der zehn Aufgaben von Hand dauern würde. Zwei zufällig ausgewählte Bewerter lagen nur in 28 % der Fälle bei der Buchführung und in 25 % bei der Webentwicklung innerhalb des 1,5-Fachen voneinander entfernt – gegen die 70 %, die der Plan vorsah. Aufgaben, die als einwöchige Arbeit formuliert waren, erhielten Medieschätzungen von 8 bis 20 Stunden, und dieselbe Aufgabe am Ende noch einmal gestellt, führte deutlich häufiger zu einer höheren Schätzung als zu einer niedrigeren.
Was daraus für alle folgt, die das Tool verwenden: Die Vermutungen zweier Fremder sind zu verrauscht, um ein Stück zu dimensionieren. Mediane größerer Panels stabilisieren sich schnell; zwei separate Panels von 15 Buchhaltern oder 21 Webentwicklern stimmten in mindestens 70 % der Ziehungen innerhalb des 1,5-Fachen überein. Referenzstunden stammen daher aus einer Aufgabenbank mit gemessenen Zeiten oder aus einem Panel, und die anonymisierten Daten, die registrierte Analyse und die explorative Analyse befinden sich alle in pilot/, damit jeder sie erneut ausführen kann.
Für Forschende
METR misst KI-Modelle anhand eines Zeithorizonts: die Länge einer Aufgabe in Expertenstunden, die ein Modell zuverlässig bewältigt. Delegation Horizon fragt dasselbe von einer Person, und ihr Anteil von acht zu zehn spiegelt METRs 80%-Horizont wider. Ein Schreibtisch-Vorpilot an simulierten Protokollen stimmte die Regeln ab (Version 1.1), der oben beschriebene Prolific-Vorpilot testete die Referenzstunden, und das Protokoll, der Vorregistrierungsentwurf und das Einverständnisformular des vollständigen Piloten mit Personen befinden sich in pilot/. kits/process-vs-experience-study.md und kits/matched-task-study.md sind einsatzbereite Protokolle zum Vergleich von Gruppen bei denselben Aufgaben, und tools/power.py zeigt, wie viele Personen eine solche Studie benötigt.
Das Papier hinter dem Werkzeug macht auch datierte, überprüfbare Vorhersagen. In Anthropics Studie von etwa 400.000 Claude-Code-Sitzungen endeten Sitzungen, die Code produzierten, in verifizierten Erfolg 34 % der Zeit für Personen in Softwareberufen und 29 % für alle anderen (Anthropic). Einundvierzig Vorhersagen wurden am 9. Oktober 2026 auf OSF registriert, jeweils mit einer Wahrscheinlichkeit, darunter dass METRs 80%-Horizont für das beste öffentliche Modell einen Arbeitstag bis Ende 2027 erreicht (0,80) und dass weniger als zwei Fortune-500-Arbeitgeber Token-Zählungen während 2027 als offizielles Bewertungskriterium nutzen (0,80). Ein Test zeigt, dass jede registrierte Datei noch byte für byte die eingereichte ist, und brier.py, predictions/score.py und predictions/skill.py bewerten sie jedes Jahr; eine Studie, die nie durchgeführt wird, wird als Fehlschlag gezählt, nicht stillschweigend fallen gelassen.
Erste Schritte
Sie benötigen Python 3.9 oder neuer und sonst nichts.
- Laden Sie das Repository von der GitHub-Seite herunter (Code, dann Download ZIP) oder klonen Sie es.
- Öffnen Sie
templates/work-log.csvin einem beliebigen Tabellenkalkulationsprogramm (Excel, Numbers, LibreOffice, Google Sheets) und fügen Sie eine Zeile pro Aufgabe hinzu, die Sie an KIs übergeben haben: akzeptiert, abgelehnt oder aufgegeben.templates/README.mderklärt jede Spalte in einfachen Worten, undexamples/c4-log.csvist ein ausgefülltes Protokoll zum Kopieren. - Speichern Sie es als CSV und führen Sie die Karte aus, oder doppelklicken Sie auf
checker.html, wenn Sie einen Browser vorziehen.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
Herkunft
Delegation Horizon ist der Begleitcode zum Paper After the Programmer Divide: Ein Maßstab für Menschen, die durch KI-Agenten entwickeln von Vadym Chernets (Oktober 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918). Das aktuelle Release 1.1.0 vom 11. Oktober 2026 wird bei jedem Push auf Python 3.9 bis 3.13 getestet. Der Code steht unter der MIT-Lizenz und ist auf Zenodo archiviert (DOI 10.5281/zenodo.23267444, das immer auf das neueste Release verweist); alles finden Sie unter github.com/vadimchernets/delegation-horizon. Ein früheres Paper desselben Autors, After Chat, fragt, warum so wenige Menschen vom Chatten mit KI dazu übergegangen sind, KI-Agenten für sich arbeiten zu lassen; sein Code, After Chat, stellt eine Frage mehreren KIs und zeigt, wo sie sich widersprechen.
delegation-horizon auf GitHub ansehen
Vadym Chernets entwickelt auch Poly A1, eine App, in der KIs verschiedener Unternehmen sich gegenseitig kontrollieren.