Comment réduire les coûts des IA : payez un modèle uniquement pour les décisions qui en ont besoin — Outils
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Decidecall traite les petites décisions qu'une entreprise prend régulièrement (quelle équipe reçoit ce message, approuver ou renvoyer, urgent ou non) et répond à chacune avec la solution la moins chère qui soit suffisamment fiable. Une réponse donnée précédemment vient d'abord, puis une règle simple, puis un modèle exécuté sur votre propre ordinateur ; seul ce qui reste va à un modèle payant, et ce dont aucun modèle n'est sûr va à une personne. La réponse de la personne est mémorisée, de sorte que la même question ne coûte jamais deux fois.
Decidecall est un plugin gratuit et open source pour Claude Code, l'assistant IA d'Anthropic qui fonctionne avec les fichiers de votre ordinateur. Il ne nécessite aucun compte, aucune carte bancaire ni aucune clé API propre (le code d'accès que les programmes utilisent pour appeler une IA) : un modèle payant est accessible via un programme que votre entreprise a déjà installé et auquel elle s'est connectée.
Pourquoi la plupart des décisions n'ont jamais besoin d'un modèle
De nombreuses équipes qui commencent avec l'IA envoient chaque message à un modèle. Cela fonctionne, et cela paie pour la même réponse encore et encore : « où est ma facture ? » arrive chaque jour dans une boîte de réception d'assistance, et le mot « facture » indique déjà qu'elle va à la facturation. Tian Pan décrit une équipe qui a exécuté un modèle pour router les tickets d'assistance pendant des mois avant de remarquer que 70 % des tickets nommaient un produit dans la ligne d'objet, qu'une simple table de lookup aurait routée avec 99 % de précision.
Les chercheurs ont mesuré la même idée à grande échelle. FrugalGPT de Stanford demande d'abord un modèle bon marché et ne progresse que lorsque la réponse semble faible ; il a égalé le meilleur modèle unique « avec une réduction de coût allant jusqu'à 98 % ». RouteLLM de LMSYS choisit un modèle fort ou faible pour chaque question et a réduit les coûts de plus de 85 % sur un repère tout en conservant 95 % de la qualité de GPT-4.
Comment fonctionne la chaîne
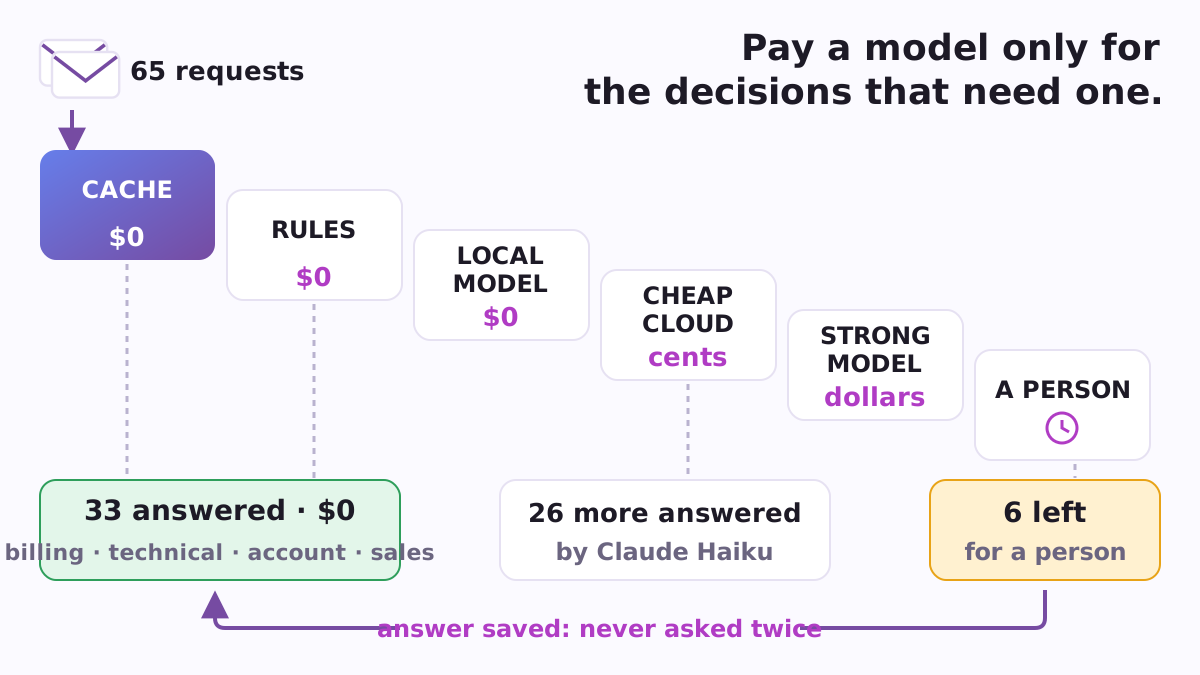
Chaque décision parcourt les mêmes six maillons et s'arrête au premier qui est suffisamment sûr :
- Cache : réponses déjà données. Une répétition exacte est trouvée même avec des majuscules, espaces et ponctuations différents. Avec un petit modèle d'embedding sur votre ordinateur (comme
nomic-embed-textdans Ollama), une question posée autrement est trouvée aussi : « Pourquoi ma carte a-t-elle été facturée deux fois ? » trouve la réponse à « J'ai été débité deux fois ce mois-ci ». - Règles : des mots qui règlent la réponse, écrits une fois : « facture », « remboursement » ou « débité » signifie facturation. Quand deux règles pointent vers des réponses différentes, elles restent silencieuses plutôt que de deviner.
- Modèle local : un modèle s'exécutant sur votre propre ordinateur, gratuit pour chaque décision.
- Modèles cloud bon marché et puissants : modèles payants, le moins cher autorisé d'abord.
- Une personne : celle qui possède la décision, à qui est montée la meilleure estimation jusqu'à présent.
Chaque maillon répond avec une décision et une confiance, un nombre de 0 à 1. À 0,95 ou plus, la réponse est acceptée. En dessous, le maillon suivant est interrogé, et quand deux sources différentes s'accordent (et qu'au moins l'une d'elles est sûre à 0,70 ou plus), cela le règle. Deux maillons exécutant la même famille de modèle ne se confirment jamais mutuellement, et une correspondance par le sens dans le cache n'est jamais qu'une suggestion qu'un autre maillon doit confirmer. Quand rien n'est certain, une personne décide, et sa réponse entre dans le cache. Les deux seuils sont les vôtres à modifier.
Un type de décision est un petit fichier : la question, les réponses possibles, les mots qui la règlent et le degré de certitude qu'un maillon doit avoir. Le même format fonctionne pour trier les messages d'assistance, « approuver ou renvoyer » sur les demandes de remboursement ou « urgent ou pas » sur les messages entrants.
Un exemple résolu : 65 messages d'assistance
Le dépôt contient une boîte de réception d'assistance pour quatre équipes (facturation, technique, compte et ventes) : 65 messages clients, avec des répétitions comme dans l'assistance réelle. Le 2 octobre 2026, la chaîne a été mesurée sur celle-ci deux fois (résultats complets) :
| Chaîne | Décidé sans une personne | Correct | Envoyé à une personne | Coût de 65 décisions |
|---|---|---|---|---|
| cache + règles | 36 | 36 sur 36 | 29 | 0 $ |
| cache + règles + Claude Haiku 4.5 | 59 | 57 sur 59 (96,6 %) | 6 | 0,167 $ au prix catalogue |
Sans aucun modèle, plus de la moitié de la boîte de réception a été triée gratuitement sans erreur (réexécuté le 10 octobre 2026 avec le même résultat). En ajoutant Claude Haiku 4.5, le modèle petit et rapide d'Anthropic, six messages restaient pour une personne.
Le rapport est tout aussi clair sur ce qui n'a pas fonctionné. Haiku s'est trompé deux fois en étant sûr à 98 % : « Je me déconnecte toutes les cinq minutes » a été envoyé à technique au lieu de compte, tout comme sa répétition. C'est exactement pour cela que la chaîne demande une deuxième source différente avant de faire confiance à la réponse répétée d'un modèle. Soixante-cinq exemples sont une première lecture : l'outil est conçu pour que vous exécutiez la même mesure sur quelques centaines de vos propres décisions passées.
Ce que cela fait
- Décider une question : la réponse, quel lien l'a trouvée, le niveau de certitude, le coût.
- Étiqueter : la réponse d'une personne va dans le cache, donc c'est gratuit la prochaine fois.
- Promouvoir : les décisions que les modèles ont continué à prendre de la même manière, confirmées par deux familles de modèles différentes, deviennent des entrées de cache une fois que vous dites oui ; les mots qui n'ont jamais eu qu'une seule réponse sont proposés comme nouvelles règles.
- Évaluer : vos propres décisions étiquetées du passé s'exécutent à travers la chaîne, montrant combien ont été décidées sans une personne, combien étaient justes, l'honnêteté des chiffres de confiance, et le coût d'une décision par rapport à l'envoi de tout à un modèle.
- Candidats : 14 programmes et services qui peuvent se placer derrière un lien, chacun avec sa licence et sa page source.
Les modèles de décision se branchent directement
Un nouveau type de modèle est arrivé pour faire exactement ce travail. Jev de TypeSafe, annoncé en septembre 2026, n'écrit aucun texte : il prend une situation et une question avec des options et retourne l'option choisie avec une probabilité, à 0,042 $ par million de tokens d'entrée (DataCamp). Les modèles ouverts du même type s'exécutent sur votre propre ordinateur : Strands Decider, dont les auteurs rapportent que ses « réponses avec une confiance de 0,9 ou plus sont correctes environ 95 % du temps », et, depuis Ollama 0.35, les modèles de décision servis par Ollama, l'outil gratuit pour exécuter des modèles localement. Decidecall parle directement cette interface, ainsi que les modèles locaux ordinaires (Ollama, llama.cpp, vLLM, LM Studio) et Claude via Claude Code que vous avez déjà ; bench montre sur vos propres données ce que chacun apporte.
Vos règles pour les données et l'argent
Decidecall lit le même fichier de politique d'entreprise que les autres plugins d'entreprise :
- Les données sensibles restent sur l'ordinateur. Marquez une décision en rouge et elle ne va que dans le cache, les règles et les modèles locaux ; Decidecall conserve une empreinte du texte, jamais le texte lui-même.
- Uniquement les fournisseurs que vous autorisez, ou uniquement ceux qui ne conservent rien après avoir répondu.
- Un budget quotidien : un lien payant qui le dépasserait est ignoré, et les liens gratuits continuent de fonctionner.
- Les clés restent dans le trousseau, jamais dans un fichier.
C'est un seul fichier Python qui n'a besoin de rien au-delà de Python et n'ouvre aucune connexion réseau de son propre chef, il s'exécute donc même sur un ordinateur déconnecté d'Internet.
Comment commencer
Dans Claude Code, ajoutez le catalogue Poly A1 et installez Decidecall (aucun git et aucun compte GitHub nécessaires) :
/plugin marketplace add https://raw.githubusercontent.com/vadimchernets/poly-a1-plugins/main/.claude-plugin/marketplace.json
/plugin install decidecall@poly-a1
Dites ensuite ce que vous voulez décider, dans vos propres termes : « trier nos messages d'assistance par équipe », ou « Strands Decider vaut-il le coup pour nous ». Claude pose ses questions une à une (ce qui est décidé, les réponses possibles, les mots qui rendent la réponse certaine, le degré de certitude requis) et rédige le fichier de tâche avec vous. Ensuite, il exécute bench sur vos décisions antérieures avant que quoi que ce soit ne soit payé. Decidecall nécessite Python 3.8 ou une version plus récente et fonctionne sur Mac, Linux et Windows.
Le code, la boîte de réception d'exemple et les mesures : github.com/vadimchernets/decidecall.
Où il s'intègre
Decidecall est l'un des plugins d'entreprise du catalogue Poly A1 plugins. Il fonctionne en tandem avec Routecall, où un modèle puissant planifie et les modèles moins coûteux traitent le volume, et avec Billcall, qui compte ce que les IA coûtent à l'entreprise ; Firmcall écrit le fichier de politique partagée. Decidecall a été écrit par Vadym Chernets, publié sous la licence Apache-2.0 et archivé sur Zenodo (DOI 10.5281/zenodo.23116720).
Vadym Chernets crée également Poly A1, une application dans laquelle les IA de différentes entreprises vérifient le travail les unes des autres.