KI für Gerichtsdokumente: Gefälschte Zitate vor der Einreichung erkennen — Werkzeuge
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Wenn Sie ohne Anwalt vor Gericht gehen und ChatGPT, Claude oder Gemini für die Dokumentenvorbereitung nutzen, ist der teuerste Fehler nicht unbeholfen geschriebener Text. Es ist ein überzeugter Satz, der einen Fall zitiert, der nicht existiert. Docprep ist ein kostenloses Open-Source-Programm, das die Anordnung der KIs ändert, anstatt welche KI Sie verwenden. Mehrere KIs von verschiedenen Unternehmen schreiben jeweils einen vollständigen Entwurf desselben Dokuments, ohne sich gegenseitig zu sehen. Eine KI führt die Entwürfe zusammen, ohne zu wissen, welches Unternehmen welchen geschrieben hat. Zwei KIs prüfen dann den zusammengeführten Text, Zitate zuerst, und die letzte stammt von einem anderen Unternehmen als das, das ihn zusammengeführt hat. Sie erhalten das Dokument, beide Prüfberichte und einen Datensatz des Durchlaufs, und Sie entscheiden, welche Korrektionen Sie vornehmen.
Es läuft auf Ihrem eigenen Computer. Mit API-Schlüsseln (den Passwörtern, die einem Programm die direkte Kommunikation mit den Modellen eines KI-Unternehmens ermöglichen) läuft es von selbst. Ohne sie übergibt es Ihnen jeden Schritt als Datei zum Einfügen in die KI-Chat-Websites, die Sie bereits nutzen, und setzt dort an, wo Sie aufgehört haben. Es funktioniert für jedes Dokument, dessen Aussagen Quellen benötigen, wie einen Bericht, einen Versicherungsbeschwerde oder eine Beschwerde bei einer Behörde, und seine Beispielaufgabe ist ein Antrag, den ein Selbstvertreter benötigen könnte.
Warum eine KI nicht ausreicht für eine Gerichtseinreichung
Erfundene Zitate sind keine seltenen Unfälle. Am 10. Oktober 2026 listete die von dem Forscher Damien Charlotin gepflegte AI Hallucination Cases database 2.184 Gerichtsentscheidungen auf, die sich mit von KI erstelltem Inhalt wie gefälschten Zitaten befassten; in 1.259 davon war die Partei eine Person, die sich selbst vertrat. Im August 2026 ordnete ein kalifornisches Berufungsgericht einen Ehemann und eine Ehefrau, die ohne Anwalt Berufung eingelegt hatten, dazu an, die Anwaltsgebühren der anderen Seite für die Berufung zu zahlen, weil sie sich auf nicht vorhandene Behörden und erfundene Zitate gestützt hatten (California Courts Newsroom). Das Bundesgericht für den Middle District of Georgia teilt Parteien, die sich selbst vertreten, unmissverständlich mit, dass „KI eine Partei nicht von ihrer Verantwortung entbindet, sicherzustellen, dass alle in Gerichtseinreichungen zitierten Fakten und Rechtsmittel korrekt sind" (M.D. Ga.).
Mehr Menschen stehen vor dieser Aufgabe: Der Anteil der bei US-Bundesgerichten eingereichten zivilrechtlichen Fälle ohne Anwalt stieg von einem langjährigen Durchschnitt von 11 % auf 16,8 % im Geschäftsjahr 2025 (Shah and Levy, via beSpacific). Neuere Modelle beheben das Problem nicht allein. Princeton-Forscher überprüften über 8.000 Zitate aus acht Generationen kostenloser ChatGPT-Modelle und stellten fest, dass GPT-5.1 zu 6,57 % halluziniert, „eine statistisch signifikante Verschlechterung". Die gleiche Studie weist auf das Mittel hin, um das Docprep konzipiert ist: Eine KI-Prüfung, der erlaubt ist, in Rechtsdatenbanken und im offenen Web zu suchen, erwischte jeden nicht vorhandenen Zitation im Test (Princeton CITP).
Wie es funktioniert
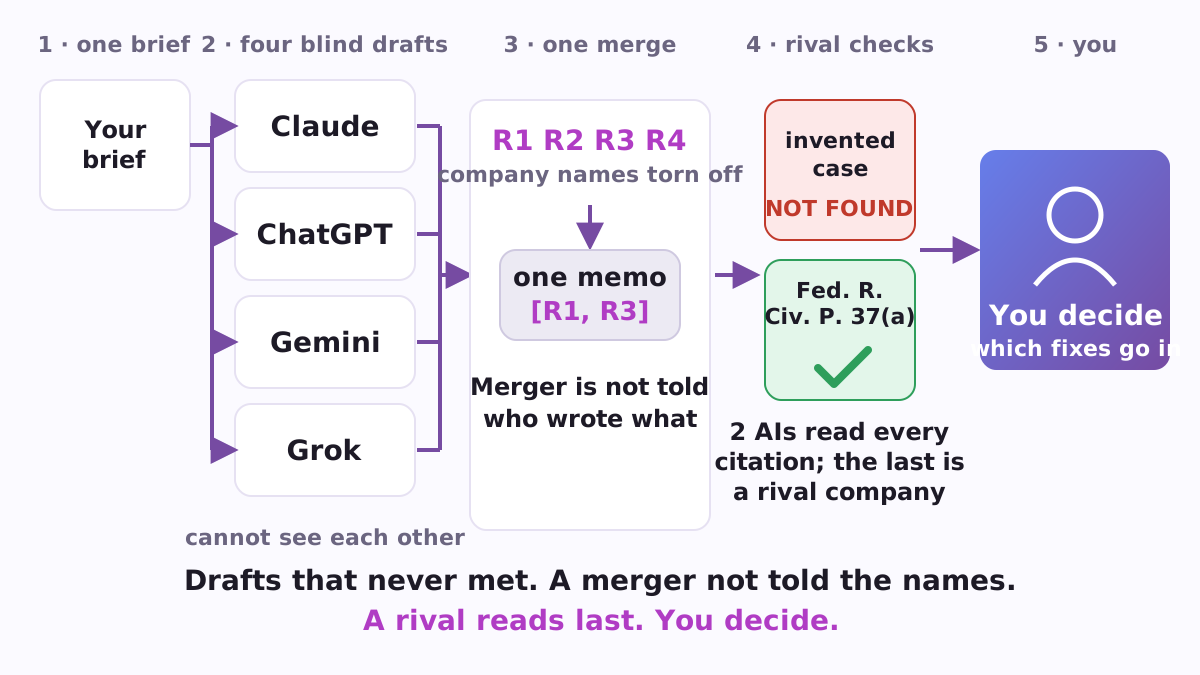
Docprep führt eine geschriebene Aufgabe durch fünf Schritte, und jeder Schritt ist dadurch definiert, was die KI darin sehen darf.
- Ein Briefing. Sie schreiben die Aufgabe einmal: was Sie benötigen, die Gerichtsbarkeit, das Format, was als Quelle zählt. Das Beispiel fragt nach einem Memorandum, ob ein Prozessführer ohne Anwalt vor Bundesgericht einen Antrag stellen darf, um Ermittlungsantworten zu erzwingen, die nur mit Standard-Einwände beantwortet wurden.
- Separate Entwürfe. Mindestens drei KIs von mindestens drei Unternehmen verfassen jeweils einen vollständigen Entwurf mit Websuche, sofern verfügbar. Keine sieht den Entwurf einer anderen. Jede muss jede Aussage mit einer Quelle belegen, das markieren, was sie nicht überprüfen konnte, als „unverified", und darf nicht „zu einer mittleren Position tendieren", damit Meinungsverschiedenheiten sichtbar werden.
- Ein blindes Zusammenführen. Eine KI erhält die Entwürfe als R1, R2, R3 in zufälliger Reihenfolge; ein Entwurf, der seinen Urheber nennt, wird mit dieser Phrase durch „[Anbieter entfernt]" ersetzt. Die Zusammenführung kennzeichnet jeden Anspruch mit den dahinter stehenden Entwürfen, wie in [R1, R3], und schreibt ein Protokoll darüber, worüber die Entwürfe sich einigten, wo sie uneinig waren und wie jeder Konflikt gelöst wurde. Eine Zusammenführung ohne dieses Protokoll stoppt den Lauf.
- Eine interne Überprüfung. Eine KI aus dem Unternehmen der Zusammenführung liest das Ergebnis in einer neuen Sitzung, überprüft, dass jede Quelle existiert und sagt, was behauptet wird, ordnet Befunde als Critical, Major und Minor ein und gibt ein Urteil ab.
- Eine externe Überprüfung. Eine KI eines anderen Unternehmens liest das Dokument und den ersten Bericht, bestätigt oder bestreitet jeden Befund, fügt eigene hinzu und gibt das abschließende Urteil.
Alles landet in einem Ordner: das Briefing, alle Prompts und Entwürfe, das zusammengeführte Dokument, das Zusammenführungsprotokoll, beide Berichte und ein manifest.json-Datensatz. Keine Korrektur eines Kritikers wird auf Ihren Text automatisch angewendet; Sie entscheiden. Genaue Seitenzahlen verdienen Ihre genaue Betrachtung, denn das ist der Ort, an dem selbst Such-KIs am schwächsten sind (der Princeton-Agent fing nur 18,2 % falscher Pincites), und das Öffnen des Falls auf der zitierten Seite klärt es.
Warum diese Regeln
- Die Entwürfe treffen sich nie. In KI-Debatten wechseln Modelle oft von einer korrekten Antwort zu einer falschen, wenn ein Peer überzeugend argumentiert (Wynn, Satija and Hadfield, 2025).
- Der Merger wird nicht informiert, wer was geschrieben hat. KI-Schiedsrichter neigen dazu, ihre eigene Ausgabe höher zu bewerten, und können sie erkennen (Panickssery, Bowman and Feng, 2024). Der Schlüssel zu den Bezeichnungen geht nur in die Unterlagen, damit Sie später zählen können, wie oft ein Merger sein eigenes Unternehmen bevorzugte.
- Der letzte Leser kommt aus einem anderen Unternehmen. In einer Studie von mehr als 350 Modellen gaben zwei, wenn beide falsch waren, etwa 60 % der Zeit die gleiche falsche Antwort auf einem Leaderboard (Kim et al., ICML 2025). Ein anderswo trainierter Kritiker ist der direkteste Weg zu gemeinsamen blinden Flecken.
- Jeder Kritiker muss suchen können. Docprep weigert sich zu starten, wenn ein Kritiker kein Suchwerkzeug hat.
- Die Regeln sind Code.
python3 docprep.py checkweigert sich, ein Setup zu akzeptieren, das sie bricht, beispielsweise eines, bei dem der abschließende Kritiker aus dem Unternehmen des Mergers stammt oder die Entwürfe weniger als drei Unternehmen umfassen.
Was der Datensatz Ihnen bietet
Das Manifest zeichnet für jeden Schritt das Modell auf, ob es über eine API oder manuell ausgeführt wurde, Fingerabdrücke der Eingabeaufforderung und der Antwort, die Zeit, den Schlüssel zu den Beschriftungen und beide Urteile. Es zeichnet sogar auf, ob ein Suchwerkzeug wirklich an jede Anfrage angehängt war. Einige Gerichte fragen nach der Nutzung von KI: Der Northern District of Texas verlangt, dass eine mit generativer KI erstellte Schrift „diese Tatsache auf der ersten Seite offenlegt" (LR 7.2(f)). Ein Docprep-Ausführungsordner enthält genau das Material für einen solchen Hinweis. Es spart auch Geld: resume führt nur die Schritte aus, für die noch keine Datei vorhanden ist, sodass ein fehlgeschlagener Aufruf niemals einen bezahlten Aufruf wiederholt.
Zwei Möglichkeiten, es auszuführen
Von Hand, in den Chat-Seiten, ohne API-Schlüssel. Die manuelle Formel schreibt für jeden Schritt eine Datei MANUAL-<role>.md mit dem Prompt und dem zu verwendenden Modell. Sie fügen es in einen neuen Chat ein, fügen die Antwort unter der Markierungslinie ein und führen resume aus. Ein vollständiger Durchlauf umfasst sieben Einfügungen: vier Entwürfe (Claude, ChatGPT, Gemini und Grok), die Zusammenführung und zwei Überprüfungen. Die Regeln berücksichtigen, von welchem Unternehmen ein Modell stammt, nicht welchen Plan Sie bezahlen, und dieser Weg ermöglicht es Ihnen auch, die Deep-Research-Modi der Chat-Seiten zu nutzen.
Mit API-Schlüsseln, automatisch. Legen Sie Schlüssel für Anthropic, OpenAI und Google fest, und Docprep ruft die Modelle selbst auf, jeweils mit dem Suchwerkzeug des eigenen Unternehmens; Grok und ein Llama-Modell können als zusätzliche Entwurfsverfasser hinzukommen. Die Beispielkonfiguration enthält eine grundlegende Formel für Routinedokumente und eine erweiterte für alles, das vor Gericht verwendet wird, basierend auf Modellen, die im September 2026 verfügbar waren; jede Kombination aus verschiedenen Unternehmen, die die Regeln einhält, ist möglich.
Das Protokoll nennt sich selbst eine Rampe: „Es wurde für jemanden gebaut, der die Treppen nicht nehmen kann: der nicht fünf Schnittstellen gleichzeitig offen halten, sie gegeneinander abwägen und die Antwort zurückbringen kann." Docprep übernimmt das Zurückbringen.
Unterschiede zu einem LLM-Rat
Docprep gehört zur Familie der LLM-Räte, Multi-Agent-Debatten und LLM-als-Richter. Andrej Karpathys beliebtes llm-council lässt Modelle einander bewerten, wobei die Namen verborgen sind, dann schreibt ein „Vorsitzender"-Modell eine abschließende Antwort. Docprep unterscheidet sich auf vier Wegen, alle durch Code durchgesetzt: Die Verfasser lesen sich nie gegenseitig, dem Merger wird nicht mitgeteilt, wer was geschrieben hat, das abschließende Urteil kommt von einem anderen Unternehmen als dem Merger, und jeder Schritt hinterlässt einen Datensatz. Es stoppt auch vor einem abschließenden Neuschreiben: Sie erhalten das Dokument und die Berichte, nicht einen Text, der still für Sie korrigiert wurde.
Wie man anfängt
Sie benötigen Python 3 und den Code von der GitHub-Seite.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
Geben Sie bei API-Schlüsseln die Modellnamen Ihrer Konten in config.yaml ein, führen Sie dann python3 docprep.py check und python3 docprep.py run --brief briefs/my-brief.md --formula enhanced aus. Die Offline-Tests (python3 -m pytest tests/test_offline.py, fünf Tests) führen die gesamte Pipeline ohne Schlüssel oder Netzwerk aus.
Woher es kommt
Docprep ist die Referenzimplementierung des Protokolls aus dem Paper Die fehlende Variable in der KI-gestützten Rechtspraxis: Architektur und die Qualität des Pro-Se-Zugangs zur Justiz von Vadym Chernets (SSRN 7120940, DOI 10.2139/ssrn.7120940). Das Paper argumentiert, dass die Art und Weise, wie KI-Hilfe organisiert ist – ein Modell einmal abgefragt oder mehrere Modelle verschiedener Unternehmen, die sich gegenseitig überprüfen – eine Variable für die Qualität dessen ist, was sich selbst vertretende Prozessparteien einreichen, und es basiert auf einem Bundesfall, in dem der Autor ohne Anwalt Kläger war. Der Code ist eine Python-Datei unter der MIT-Lizenz, der Protokolltext PROTOCOL.md steht unter CC BY 4.0, und alles finden Sie unter github.com/vadimchernets/docprep. Um eine Frage an die KI-Tools auf Ihrem Computer zu stellen, siehe After Chat und Sidecall; um die KI-Chat-Seiten über Ihren eigenen Browser zu nutzen, siehe Roundcall.
Vadym Chernets entwickelt auch Poly A1, eine App, in der KIs verschiedener Unternehmen die Arbeit der jeweils anderen überprüfen.