IA pour documents judiciaires : détectez les fausses citations avant de déposer — Outils
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
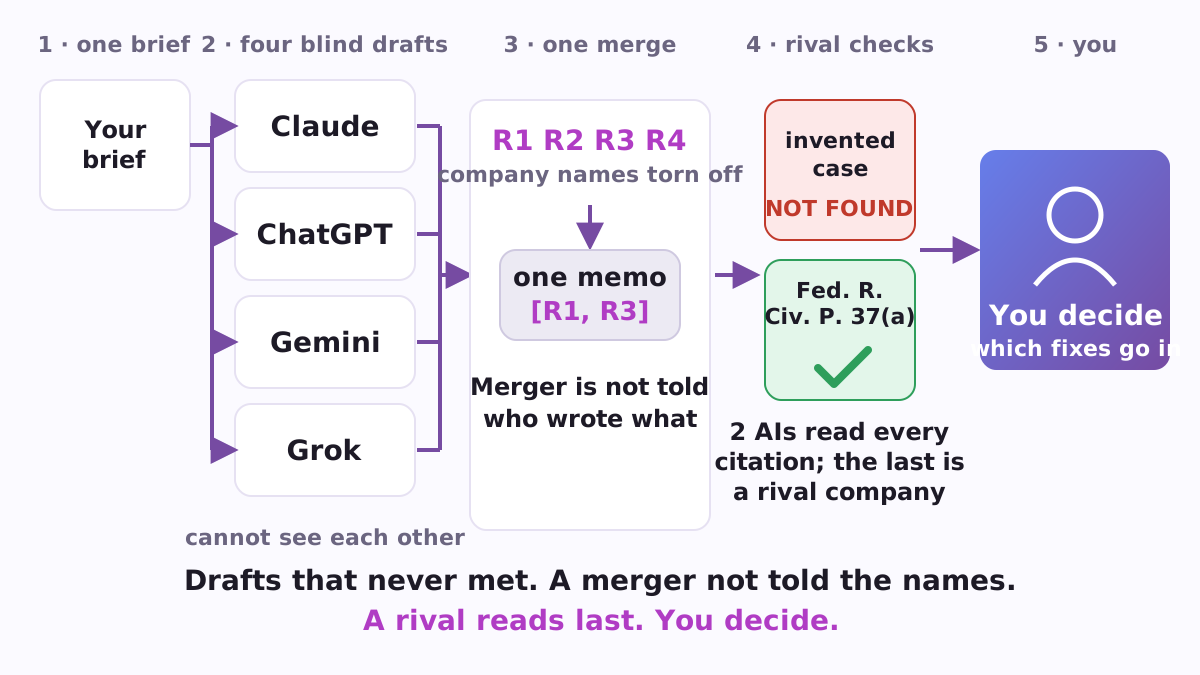
Si vous allez en justice sans avocat et utilisez ChatGPT, Claude ou Gemini pour vous aider à préparer les documents, l'erreur la plus coûteuse n'est pas une écriture maladroite. C'est une phrase confiante qui cite un arrêt qui n'existe pas. Docprep est un programme gratuit et open source qui change la façon dont les IA sont organisées plutôt que celle de choisir quelle IA utiliser. Plusieurs IA de sociétés différentes rédigent chacune un brouillon complet du même document sans se voir. Une IA fusionne les brouillons sans être informée de l'IA qui a écrit quel brouillon. Deux IA vérifient ensuite le texte fusionné, en commençant par les citations, et la dernière provient d'une société différente de celle qui a effectué la fusion. Vous obtenez le document, les deux rapports de vérification et un enregistrement de l'exécution, et vous décidez quelles corrections y intégrer.
Il s'exécute sur votre propre ordinateur. Avec des clés API (les mots de passe qui permettent à un programme de communiquer directement avec les modèles d'une société d'IA), il s'exécute de lui-même. Sans elles, il vous remet chaque étape sous forme de fichier à coller dans les sites de chat IA que vous utilisez déjà, et reprend là où vous vous êtes arrêté. Il fonctionne pour tout document dont les affirmations ont besoin de sources, comme un rapport, un appel d'assurance ou une plainte auprès d'un organisme de réglementation, et sa tâche d'exemple est une motion qu'un justiciable non représenté pourrait avoir besoin de préparer.
Pourquoi une seule IA ne suffit pas pour un dossier judiciaire
Les citations fictives ne sont pas des accidents rares. Le 10 octobre 2026, la base de données AI Hallucination Cases tenue par le chercheur Damien Charlotin recensait 2 184 décisions judiciaires traitant de contenu produit par l'IA comme les fausses citations ; dans 1 259 d'entre elles, la partie était une personne se représentant elle-même. En août 2026, une cour d'appel californienne a ordonné à un mari et sa femme qui avaient interjeté appel sans avocat de payer les honoraires des avocats de l'autre partie en appel, parce qu'ils s'étaient fiés à des autorités inexistantes et à des citations fabriquées (California Courts Newsroom). La cour fédérale du district du centre de la Géorgie dit clairement aux parties se représentant elles-mêmes que « l'IA n'allège pas la responsabilité d'une partie de s'assurer que tous les faits et autorités juridiques cités dans les dossiers judiciaires sont exacts » (M.D. Ga.).
Plus de personnes font face à cette tâche : la part des cas civils fédéraux américains déposés sans avocat est passée d'une moyenne à long terme de 11 % à 16,8 % en exercice fiscal 2025 (Shah et Levy, via beSpacific). Les modèles plus récents ne la résolvent pas à eux seuls. Des chercheurs de Princeton ont vérifié plus de 8 000 citations provenant de huit générations de modèles ChatGPT gratuits et ont trouvé que GPT-5.1 hallucine à 6,57 %, « une régression statistiquement significative ». La même étude pointe vers le remède autour duquel Docprep est construit : un vérificateur IA autorisé à fouiller les bases de données juridiques et le web ouvert a détecté chaque citation inexistante dans le test (Princeton CITP).
Comment ça marche
Docprep fait passer une tâche écrite par cinq étapes, chacune définie par ce que l'IA qui s'en charge est autorisée à voir.
- Un seul énoncé. Vous écrivez la tâche une seule fois : ce que vous avez besoin, la juridiction, le format, ce qui compte comme source. L'exemple demande un mémorandum sur la question de savoir si une partie non représentée par un avocat devant une cour fédérale peut demander la communication de réponses à une demande de production données uniquement avec des objections stéréotypées.
- Projets distincts. Au moins trois IA d'au moins trois entreprises différentes rédigent chacune un projet complet, avec recherche sur le web là où elle est disponible. Aucune ne voit le projet d'une autre. Chacune doit citer une source pour chaque affirmation, marquer ce qu'elle n'a pas pu vérifier comme « non vérifié », et ne pas « pencher vers une position médiane », pour que les désaccords ressortent.
- Une fusion en aveugle. Une IA reçoit les projets sous le nom R1, R2, R3 dans un ordre aléatoire ; un projet qui mentionne son créateur voit cette phrase remplacée par « [nom du fournisseur supprimé] ». La fusion étiquète chaque affirmation avec les projets qui la soutiennent, par exemple [R1, R3], et rédige un journal de ce sur lequel les projets s'accordaient, où ils divergeaient et comment chaque conflit a été résolu. Une fusion sans ce journal arrête le traitement.
- Une vérification interne. Une IA de la même entreprise que la fusion lit le résultat dans une nouvelle session, vérifie que chaque source existe et dit ce qui est affirmé, classe les conclusions Critique, Majeure et Mineure, et donne un verdict.
- Une vérification externe. Une IA d'une autre entreprise lit le document et le premier rapport, confirme ou conteste chaque conclusion, en ajoute d'autres et donne le verdict final.
Tout aboutit dans un même dossier : l'énoncé, chaque invite et projet, le document fusionné, le journal de fusion, les deux rapports et un enregistrement manifest.json. Aucune correction d'un évaluateur n'est appliquée automatiquement à votre texte ; vous choisissez. Les numéros de page précis méritent votre attention la plus soutenue, car c'est là que même les vérificateurs IA qui font des recherches sont les plus faibles (l'agent de Princeton n'a détecté que 18,2 % des mauvaises citations paginées), et l'ouverture de l'affaire à la page citée résout la question.
Pourquoi ces règles
- Les brouillons ne se rencontrent jamais. Dans les débats sur les IA, les modèles passent souvent d'une réponse correcte à une mauvaise lorsqu'un pair argue de manière convaincante (Wynn, Satija et Hadfield, 2025).
- Le fusionneur n'est pas informé de qui a écrit quoi. Les juges IA ont tendance à évaluer leur propre résultat plus favorablement et peuvent le reconnaître (Panickssery, Bowman et Feng, 2024). La clé des étiquettes n'existe que dans le dossier, ce qui vous permet de compter ultérieurement à quelle fréquence un fusionneur a favorisé sa propre entreprise.
- Le dernier lecteur provient d'une autre entreprise. Dans une étude portant sur plus de 350 modèles, lorsque deux avaient tous deux tort, ils donnaient la même mauvaise réponse environ 60 % du temps sur un classement (Kim et al., ICML 2025). Un critique formé ailleurs est le chemin le plus direct vers les angles morts partagés.
- Chaque critique doit pouvoir effectuer des recherches. Docprep refuse de démarrer si un critique n'a pas d'outil de recherche.
- Les règles sont du code.
python3 docprep.py checkrefuse une configuration qui les viole, par exemple une où le critique final provient de l'entreprise du fusionneur ou où les rédacteurs s'étendent sur moins de trois entreprises.
Ce que l'enregistrement vous offre
Le manifeste enregistre, pour chaque étape, le modèle, qu'il ait fonctionné via une API ou manuellement, les empreintes de la requête et de la réponse, l'heure, la clé des étiquettes et les deux verdicts. Il enregistre même si un outil de recherche était réellement attaché à chaque demande. Certains tribunaux s'enquièrent de l'utilisation de l'IA : le tribunal de district nord du Texas exige qu'un mémoire préparé avec une IA générative « divulgue ce fait sur la première page » (LR 7.2(f)). Un dossier d'exécution Docprep contient exactement le matériel nécessaire pour un tel avis. Cela permet aussi d'économiser de l'argent : resume exécute uniquement les étapes pour lesquelles aucun fichier n'existe encore, de sorte qu'un appel échoué ne répète jamais un appel payant.
Deux façons de l'exécuter
À la main, sur les sites de chat, sans clé API. La formule manuelle écrit un fichier MANUAL-<role>.md pour chaque étape avec l'invite et le modèle à utiliser. Vous le collez dans un nouveau chat, collez la réponse sous la ligne de marquage et exécutez resume. Une exécution complète comporte sept collages : quatre brouillons (Claude, ChatGPT, Gemini et Grok), la fusion et deux vérifications. Les règles se soucient de quelle entreprise provient un modèle, non du forfait que vous payez, et ce chemin vous permet aussi d'utiliser les modes de recherche approfondie des sites de chat.
Avec des clés API, automatiquement. Définissez les clés pour Anthropic, OpenAI et Google, et Docprep appelle les modèles lui-même, chacun avec l'outil de recherche de sa propre entreprise ; Grok et un modèle Llama peuvent se joindre en tant que rédacteurs supplémentaires. La configuration d'exemple comporte une formule basique pour les documents routiniers et une formule améliorée pour tout ce qu'une cour lira, construite à partir de modèles disponibles en septembre 2026 ; tout ensemble provenant d'entreprises différentes qui respecte les règles fera l'affaire.
Le protocole s'appelle lui-même une rampe : « Il a été construit pour quelqu'un qui ne peut pas prendre l'escalier : qui ne peut pas tenir cinq interfaces ouvertes à la fois, les lire les unes contre les autres et ramener la réponse. » Docprep fait le transport.
Comment cela diffère d'un conseil d'IA
Docprep appartient à la famille des conseils d'IA, débats multi-agents et IA-comme-juge. Le populaire llm-council d'Andrej Karpathy fait classer les modèles les uns par rapport aux autres avec les noms cachés, puis un modèle « Président » rédige une réponse finale unique. Docprep diffère de quatre façons, toutes appliquées par le code : les rédacteurs ne se lisent jamais, le fusionneur ne sait pas qui a écrit quoi, le verdict final provient d'une entreprise différente de celle du fusionneur, et chaque étape laisse une trace. Il s'arrête également avant toute réécriture finale : vous obtenez le document et les rapports, non un texte corrigé discrètement pour vous.
Comment commencer
Vous avez besoin de Python 3 et du code de la page GitHub.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
Avec les clés API, mettez les noms de modèles que vos comptes offrent dans config.yaml, puis exécutez python3 docprep.py check et python3 docprep.py run --brief briefs/my-brief.md --formula enhanced. Les tests hors ligne (python3 -m pytest tests/test_offline.py, cinq tests) exécutent l'ensemble du pipeline sans clés ni réseau.
D'où cela provient
Docprep est l'implémentation de référence du protocole décrit dans l'article La variable manquante dans le contentieux assisté par l'IA : Architecture et la qualité de l'accès à la justice pour les personnes sans avocat de Vadym Chernets (SSRN 7120940, DOI 10.2139/ssrn.7120940). L'article soutient que la manière dont l'aide de l'IA est organisée — un modèle interrogé une seule fois ou plusieurs modèles de différentes entreprises se vérifiant mutuellement — est une variable dans la qualité de ce que déposent les justiciables non représentés, et il s'appuie sur une affaire fédérale dans laquelle l'auteur était le demandeur sans avocat. Le code est un fichier Python unique sous la licence MIT, le texte du protocole PROTOCOL.md est sous CC BY 4.0, et tout est disponible à github.com/vadimchernets/docprep. Pour poser une question aux outils d'IA sur votre ordinateur, consultez After Chat et Sidecall ; pour interroger les sites de discussion d'IA via votre propre navigateur, consultez Roundcall.
Vadym Chernets développe aussi Poly A1, une application dans laquelle les IA de différentes entreprises se vérifient mutuellement.