Comment mesurer la productivité de l'IA par le travail vérifié, non par les tokens — Outils
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
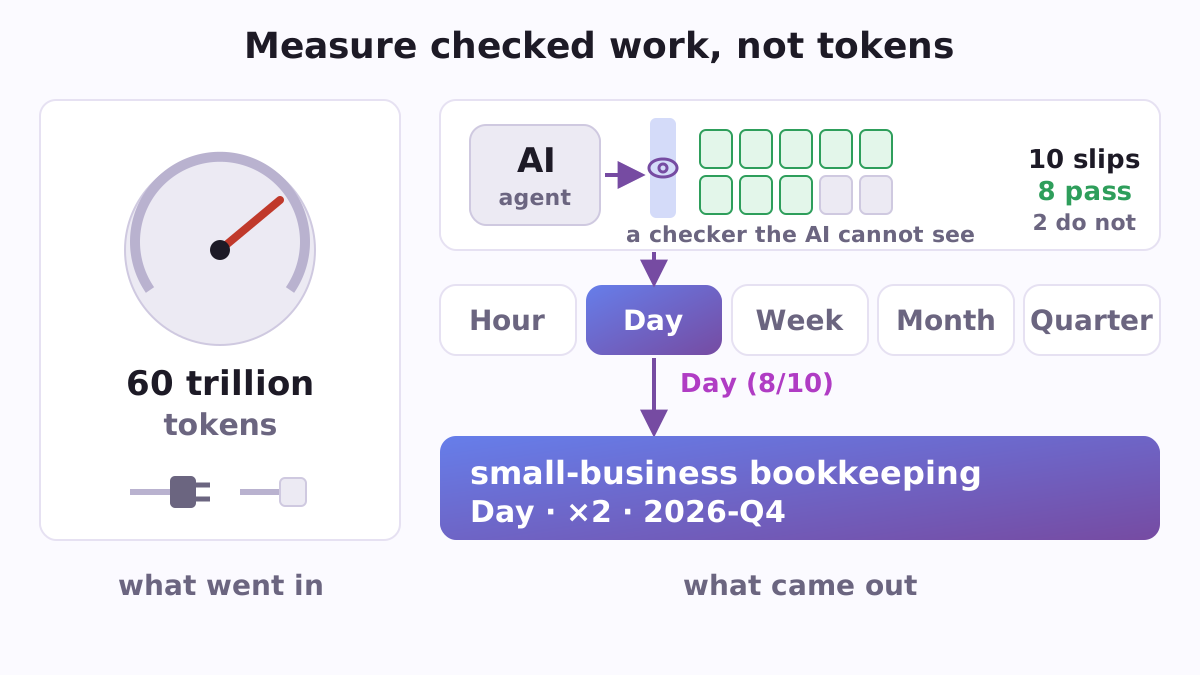
Si vous accomplissez du travail réel en le confiant à des agents IA (Claude Code, Codex, Cursor et similaires), aucun titre, diplôme ou ligne de CV ne montre ce que vous pouvez être en mesure de livrer. Le nombre auquel de nombreux employeurs ont eu recours en 2026, combien de jetons une personne utilise, en montre encore moins. Delegation Horizon est un outil gratuit et open source qui transforme un simple journal du travail que vous confiez aux agents IA en une ligne datée :
small-business bookkeeping · Day · ×2 · 2026-Q4Cela se lit ainsi : dans la comptabilité des petites entreprises, cette personne confie régulièrement aux agents IA des tâches qui prendraient environ une journée à un spécialiste en travail manuel, et une vérification que les agents n'ont jamais vue les confirme ; chaque heure de leur propre attention génère au moins deux heures de travail vérifié ; noté au quatrième trimestre 2026. Vous conservez le journal dans n'importe quel tableur, et le score est calculé sur votre propre ordinateur, par un petit script Python ou par une page web qui s'exécute hors ligne. Pas de compte, pas de clé, rien à payer, et le journal ne quitte jamais votre ordinateur.
Pourquoi le décompte des tokens a échoué
En 2026, plusieurs grandes entreprises ont tenté de mesurer l'utilisation de l'IA par les employés en fonction de la quantité d'IA utilisée, une tendance que la presse a baptisée tokenmaxxing. Chez Meta, un tableau de bord construit par les employés, surnommé Claudeonomics, a enregistré 60 billions de tokens en 30 jours sur plus de 85 000 employés (Shopifreaks). Chez Amazon, « les employés créaient des agents IA pour accomplir des tâches inutiles dans le but d'améliorer leurs scores », et le suivi a été désactivé (CIO). En septembre, Meta a déclaré qu'elle « n'utiliserait pas les tableaux de bord d'adoption de l'IA ou les décomptes de tokens pour évaluer l'impact » (CIO).
Un décompte de tokens mesure ce qui entre, non ce qui sort ; DORA, le programme de recherche de Google Cloud, le qualifie de « mesure purement d'entrée » (DORA). Pourtant, selon l'enquête 2026 de LeadDev, 58 % des répondants ont déclaré que leur organisation mesure toujours l'impact de l'IA par l'utilisation des tokens, tandis que seulement 19 % l'ont jugée efficace (LeadDev). Delegation Horizon compte plutôt la sortie, dans n'importe quelle profession.
Deux nombres et une ligne
Chaque travail que vous confiez aux agents devient une ligne du journal : son domaine, le temps qu'un spécialiste qualifié lui consacrerait manuellement (ses « heures de référence »), le nombre de minutes de votre propre attention qu'il a fallu, quel contrôle il a suivi, et s'il l'a réussi.
- L'horizon de délégation vérifié est la taille maximale de travail que vous confiez régulièrement aux agents et que vous faites confirmer par un contrôle qu'ils n'ont pas vu. Il compte cinq échelons : Heure, Jour, Semaine, Mois et Trimestre (1, 8, 40, 160 et 500 heures de référence). Heure et Jour exigent dix travaux de cette taille au cours des 91 derniers jours ; Semaine en exige six en 182 jours ; Mois six en un an ; Trimestre trois en un an. Un comptable et un développeur font face à la même règle.
- Le gain d'amplification est les heures de référence vérifiées par heure de votre attention au cours des 91 derniers jours, les échecs compris, affiché par étapes de ×1, ×2, ×5, ×20 et ×60.
Les deux sont conservés par domaine, de sorte que la même personne peut être à Semaine dans les outils financiers et à Jour dans les applications web. Les deux portent une date : un échelon est obtenu à nouveau chaque trimestre, et à partir de Semaine vers le haut, l'une de ses pièces doit provenir des 91 derniers jours.
Ce qui compte comme vérifié
Au moins huit pièces sur dix de la taille d'un échelon doivent passer l'un des quatre types de vérification : tests cachés, expert qualifié, utilisation réelle par les personnes pour lesquelles le travail est destiné, ou un modèle d'une autre famille d'IA vérifiant par rapport à des sources que vous avez ouvertes vous-même. Votre propre examen et l'accord entre modèles de la même famille sont enregistrés mais ne comptent jamais. Les pièces échouées et abandonnées restent dans le journal et comptent contre vous, tout comme une pièce sur laquelle quelqu'un vous a aidé en dehors du journal, une pièce dont l'audit ultérieur a échoué et un résultat qui a été retiré plus tard. Une pièce dont les erreurs ne peuvent pas être rectifiées, comme l'argent envoyé, doit passer, et une autre famille d'IA n'est jamais suffisante à elle seule pour la vérifier. À partir de la Semaine, des erreurs délibérées sont plantées dans au moins une tâche avant la remise ; les attraper montre que vous vérifiez vraiment, et en rater une bloque la Semaine et au-delà.
La rigueur a une raison : les gens jugent mal leur propre vitesse avec l'IA. Dans une étude METR de 2025, 16 développeurs expérimentés ont pris 19 % plus de temps avec les outils d'IA, pourtant après « ils croyaient toujours que l'IA les avait accélérés de 20 % » (METR).
Un exemple travaillé
Le dépôt inclut le journal d'un comptable fictif, P07 : dix pièces de travail, chacune représentant une journée de spécialiste ou plus, confiées à des agents entre juillet et septembre 2026. Évaluées le 9 octobre 2026 :
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Huit sur dix ont réussi, exactement ce dont Day a besoin ; une pièce n'a été vérifiée que par l'examen propre du teneur de livres et une a échoué à la vérification d'un expert. Les huit pièces vérifiées totalisent 80 heures de référence contre environ 17,2 heures d'attention sur les dix, un gain de 4,66, qui se situe à l'étape ×2. Si le teneur de livres avait supprimé la pièce défaillante, le journal aurait meilleure apparence et un score plus faible : l'échelon reposerait sur neuf pièces, manquerait le décompte de dix et chuterait en dessous d'Hour, tandis que le gain bondirait à ×5. Quiconque reçoit le dossier le voit immédiatement, car un recalcul à la date de la carte ne correspond plus. C'est pourquoi les défaillances doivent figurer dans le dossier.
Pour les personnes qui construisent par des agents
record_card.pylit votre feuille de calcul et imprime la ligne et une courte carte : l'échelon, le nombre qui la soutient (« 8 sur 10 pièces de taille Day vérifiées dans sa fenêtre de 91 jours »), le gain et les types de vérification.--format mdcrée une carte pour un profil ou un e-mail à un employeur ;--format recordimprime seulement la ligne pour un CV.tools/explain.py(nouveau dans la version 1.1.0) vous dit pourquoi votre journal obtient l'échelon qu'il obtient : quelle condition tient ou échoue et quelle pièce la décide, combien d'échecs supplémentaires l'échelon peut supporter, le jour où il expire si vous ne consignez rien de nouveau, et ce que l'échelon suivant a encore besoin. Il montre aussi à quel point dix pièces prouvent peu d'elles-mêmes : huit sur dix conviennent à tout taux de réussite vrai d'environ 44 % à 97 %.checker.htmlfait le même calcul de score dans un navigateur, hors ligne ; un test le compare avec le calcul Python sur l'exemple travaillé et 40 journaux aléatoires. Les deux lisent une feuille de calcul enregistrée avec des points-virgules, des virgules décimales et des dates jour.mois.année, comme les feuilles de calcul européennes les enregistrent.tools/log_piece.pyconstruit une ligne de journal en vous posant des questions. Si vous travaillez dans Claude Code, un crochet prêt à l'emploi (un petit script que Claude Code exécute lors d'un événement) ouvre une entrée en attente chaque fois qu'une session d'agent se termine, de sorte qu'une pièce échouée n'est jamais oubliée. Il ne lit aucune transcription et n'envoie rien nulle part ; tout outil d'agent capable d'exécuter une commande à la fin d'une session peut l'utiliser.tools/planted.pyscelle votre liste d'erreurs plantées avec une empreinte digitale avant le transfert et la note ensuite, les entrées erronées et les choses omises comptées à part, et refuse une liste modifiée après le scellement.
Pour le quatrième type de vérification, une autre famille d'IA lisant vos sources, Sidecall confie une pièce de travail aux autres outils d'IA sur votre ordinateur.
Pour les responsables et les RH
kits/ai-usage-in-reviews.md est une politique prête à l'emploi pour les IA dans les évaluations de performance. Au lieu de jetons ou de dépenses, elle demande des pièces de travail acceptées avec une vérification pour chacune ; au lieu de « utilise les IA quotidiennement », la plus grande pièce confiée aux agents et vérifiée le trimestre dernier. Sa conversation d'évaluation compte trois questions, commençant par : quelle est la plus grande pièce de travail que vous avez confiée aux agents ce trimestre et que vous avez montrée juste, et comment ?
Une équipe tient un journal avec un libellé fictif par personne (l'évaluateur refuse les colonnes inconnues, les vrais noms ne peuvent donc pas se glisser) ; examples/team-log.csv montre quatre personnes sur cinq champs. Chaque trimestre record_card.py imprime une fiche par personne et par champ. Pour en vérifier une, tools/verify_record.py prend l'enregistrement et le journal et dit, champ par champ, si le journal est le fichier qui a été évalué, si l'évaluateur est le même, et si l'enregistrement est identique lors d'une nouvelle évaluation. audit_sample.py tire un échantillon aléatoire pour re-vérifier à partir d'un mot que le deuxième vérificateur choisit après avoir reçu le journal, de sorte que personne ne peut deviner quelles pièces seront tirées, et tools/too_clean.py signale les journaux qui semblent trop bons : pas d'échecs, des tailles qui varient à peine, chaque pièce vérifiée d'une seule façon.
Les heures de référence sont fixées en dehors de l'équipe : à partir d'une banque de tâches, ou par deux évaluateurs qui ne savent pas de qui il s'agit. tools/reference_hours.py prend leurs estimations et donne leur moyenne géométrique quand elles sont à moins de 1,5 fois l'une de l'autre, ou fait appel à un troisième évaluateur ; kits/reference-hours-raters.md dit comment les choisir et les informer.
Pour recruter sur du travail vérifié plutôt que sur un diplôme, kits/hiring-test/ contient un test de travail payé d'une journée dans le domaine propre du candidat, avec une vérification cachée, des erreurs plantées et un évaluateur qui n'a pas vu le CV. kits/trade-screen.md ajoute une question du métier de la première semaine avant que quiconque soit admis, puisqu'un profil ou un titre de poste dit moins qu'il n'y paraît : sur 60 personnes que les filtres d'une plateforme d'enquête admises comme comptables, 11 se sont trompées sur une telle question, huit d'entre elles en inversant débit et crédit.
Ce que le premier test auprès de personnes a révélé
Le point faible de toute mesure en « heures de spécialiste » est l'estimation elle-même, c'est pourquoi elle a été testée en premier. En octobre 2026, une pré-étude pilote sur Prolific, enregistrée sur OSF avant l'arrivée de données, a rémunéré 119 comptables et développeurs web pour estimer la durée de chacune de dix tâches à faire manuellement. Deux évaluateurs choisis au hasard se situaient à moins de 1,5 fois l'un de l'autre seulement dans 28 % des cas en comptabilité et dans 25 % dans le travail web, contre les 70 % prévus par le plan. Les tâches conçues pour représenter une semaine de travail ont obtenu des estimations médianes de 8 à 20 heures, et la même tâche posée à nouveau en fin de test a donné une estimation plus élevée bien plus souvent qu'une estimation inférieure.
Ce qui en découle pour quiconque utilise l'outil : les estimations de deux étrangers sont trop bruitées pour dimensionner une tâche. Les médianes de panels plus grands se stabilisent rapidement ; deux panels distincts de 15 comptables, ou de 21 développeurs web, se sont accordés à moins de 1,5 fois dans au moins 70 % des cas. Les heures de référence proviennent donc d'une banque de tâches avec des temps mesurés, ou d'un panel, et les données anonymisées, l'analyse enregistrée et l'analyse exploratoire se trouvent toutes dans pilot/ pour que quiconque puisse les réexécuter.
Pour les chercheurs
METR mesure les modèles IA selon un horizon temporel : la durée de tâche, en heures d'expert, qu'un modèle termine de manière fiable. Delegation Horizon pose la même question à une personne, et sa part de huit sur dix reflète l'horizon de 80 % de METR. Un pré-pilote de bureau sur des journaux simulés a ajusté les règles (version 1.1), le pré-pilote Prolific ci-dessus a testé les heures de référence, et le protocole, le brouillon de préenregistrement et le formulaire de consentement du pilote complet avec des personnes se trouvent dans pilot/. kits/process-vs-experience-study.md et kits/matched-task-study.md sont des protocoles prêts pour comparer des groupes sur les mêmes tâches, et tools/power.py indique le nombre de personnes qu'une telle étude nécessite.
L'article derrière l'outil formule également des paris datés et vérifiables. Dans l'étude d'Anthropic portant sur environ 400 000 sessions Claude Code, les sessions qui ont produit du code ont abouti à un succès vérifié 34 % du temps pour les personnes exerçant des métiers de l'informatique et 29 % pour tout le monde (Anthropic). Quarante et un prédictions ont été enregistrées sur OSF le 9 octobre 2026, chacune avec une probabilité, notamment que l'horizon de 80 % de METR pour le meilleur modèle public atteigne une journée de travail d'ici la fin de 2027 (0,80) et que moins de deux employeurs du Fortune 500 utilisent les décomptes de tokens comme critère d'évaluation officiel au cours de 2027 (0,80). Un test montre que chaque fichier enregistré est toujours identique octet pour octet à celui déposé, et brier.py, predictions/score.py et predictions/skill.py les évaluent chaque année ; une étude qui n'est jamais menée est comptée comme un échec, non pas discrètement abandonnée.
Comment démarrer
Vous avez besoin de Python 3.9 ou plus récent et rien d'autre.
- Téléchargez le référentiel à partir de la page GitHub (Code, puis Download ZIP) ou clonez-le.
- Ouvrez
templates/work-log.csvdans n'importe quel tableur (Excel, Numbers, LibreOffice, Google Sheets) et ajoutez une ligne par travail que vous avez confié à des agents : accepté, rejeté ou abandonné.templates/README.mdexplique chaque colonne en termes clairs, etexamples/c4-log.csvest un journal rempli dont vous pouvez vous inspirer. - Enregistrez-le en CSV et exécutez la carte, ou double-cliquez sur
checker.htmlsi vous préférez un navigateur.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
D'où cela vient
Delegation Horizon est le code compagnon de l'article Au-delà de la division des programmeurs : une mesure pour les personnes qui construisent par le biais d'agents IA de Vadym Chernets (octobre 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918). La version actuelle, 1.1.0 du 11 octobre 2026, est testée à chaque envoi sur Python 3.9 à 3.13. Le code est sous licence MIT et archivé sur Zenodo (DOI 10.5281/zenodo.23267444, qui pointe toujours vers la dernière version) ; tout se trouve sur github.com/vadimchernets/delegation-horizon. Un article antérieur du même auteur, After Chat, s'interroge sur les raisons pour lesquelles si peu de personnes sont passées de la discussion avec des IA à la délégation du travail à des agents ; son code, After Chat, pose une même question à plusieurs IA et montre où elles divergent.
Voir delegation-horizon sur GitHub
Vadym Chernets développe aussi Poly A1, une application dans laquelle les IA de différentes entreprises vérifient mutuellement leur travail.