AI 지원 소송에서 누락된 변수: 아키텍처와 프로 세 접근성의 품질
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, PhD, AI 시스템 아키텍트 · ORCID 0009-0007-4845-3163
SSRN 7120940 · DOI 10.2139/ssrn.7120940 · Zenodo 10.5281/zenodo.22168724 · GitHub
- 기록 버전: SSRN 7120940 · DOI 10.2139/ssrn.7120940
- 보관된 사본, 인용 가능하고 다운로드 가능: 10.5281/zenodo.22168724 — 개념 DOI, 항상 최신 버전으로 해석됩니다
- 마크다운 및 PDF 형식의 전체 텍스트: GitHub
- 읽을 수 있는 HTML: https://polyhelper.ai/research/missing-variable/
동일한 텍스트가 네 가지 서식으로 제공되므로 그 중 하나를 사용할 수 없을 때도 접근할 수 있습니다. SSRN에 기록 버전이 있으므로 그것을 인용합니다.
AI 지원 소송에서 누락된 변수
아키텍처와 자신의 변호인 사법 접근의 질
Vadym Chernets, PhD1
2026년 7월 최초 게시; 이 버전은 2026년 9월
저자 공개 성명
이 기사에 대한 저자의 관심은 세 가지이며 각각 중요합니다. 첫째, 저자는 사건 연구로 제시되는 소송인 Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.)의 원고입니다. 둘째, 저자는 여기서 사용이 검토되는 다중 모델 오케스트레이션 시스템의 개발자이며, III부에서 설명한 특허 계열 내의 국제 출원에 명명된 출원인입니다. 따라서 저자는 이 기사가 분석하는 방법에 관심이 있습니다. 셋째, 저자는 분석가입니다. IV부에 설정된 방법론적 제약은 분석을 지배합니다: 공개 소송 기록에만 의존, 합의 동기에 대한 추론 금지, 및 시스템의 자체 보고 성능 지표의 비증거 처리. VII부는 한계를 나열합니다.
두 단락, 하나는 II부에 하나는 부록에 있으며, 저자가 시스템을 구축한 이유와 왜 소송을 제기했는지에 대한 저자 자신의 말입니다. 그들은 그의 것으로 표시되어 있으며, 어떤 발견도 그들에 기초하지 않습니다. 그 외에 이 기사는 공개 연방 소송 기록 및 공개되어 있는 출처에서만 도출됩니다. 합의하지 않은 피고인을 상대로 계속 진행 중인 청구와 관련하여 특권이 있는 소송 전략을 공개하지 않습니다. 저자는 변호사가 아닙니다. AI 어시스턴트는 저자의 지시에 따라 도구로 사용되었으며, 아이디어, 연구 및 결론은 저자의 것입니다.
요약
거의 모든 소송 관련 AI 기사는 명시되지 않은 가정에 기반합니다: AI 보조는 하나의 것이라는 것입니다. 그 가정이 낳는 논쟁은 규모와 위조에 관한 것입니다: 연방 본인소송 청구인 비율이 11%에서 거의 17%로 상승, 법원이 "실존적 위협"을 설명, 위조된 인용에 대한 제재 결정의 증가하는 동향. 집계 연구가 아직 보여줄 수 없는 것은 AI 보조의 어떤 구성이든 자력으로 소송을 진행하는 사람들이 하는 일의 질을 변화시키는지 여부입니다. 여기서 사용된 기록은 하나의 연방 사건의 공개 소송 기록이며, 규모와 환각 설명이 예측하지 못하는 패턴을 담고 있습니다. 어떤 종류의 변호사도 없는 자력 소송인으로서, 저자의 설명에 따르면 다중 모델 조율 시스템(병렬로 쿼리된 독립 모델, 평균화되지 않고 표면화된 불일치, 외부 출처에 대해 검증된 인용)을 사용하여, 4일 이내에 6개의 조정된 사전 소장 편지에 대응하고, 기한보다 6주 앞서 실질적인 이의 신청을 제출했으며, 선도 법률회사의 변호사로 대리된 7명의 피고인을 위해 제출된 약식 판결 신청에서 검증 가능한 법정 인용 오류를 식별했습니다. 해당 사건에는 13개의 기술 피고인이 이름을 올렸습니다. 이 세 가지 중 마지막 것은 문헌을 지배하는 실패 양식의 역입니다. 본 논문은 아키텍처 의존성 가설을 제안합니다: AI 보조의 아키텍처, 즉 단일 모델 프롬프팅과 다중 모델 조율은 자력 소송의 질에 있어 그 자체로 경험적 변수이며, 구현 세부사항이 아니고 AI의 이용 가능성과 같은 것이 아닙니다. 여기서 다루는 법리적 결과는 연방 법원이 2026년 초에 나누어진 작업물 특권과 무단 실행 프레임워크에 관한 것입니다. 이 사건은 검증 가능한 존재 증명과 연구 의제로 제시됩니다; 저자는 피고인, 시스템 개발자, 그리고 분석가입니다.
키워드: pro se 소송; 자력 소송인; 사법 접근성; AI 보조 소송; 생성형 AI; 다중 에이전트 토론; 다중 모델 조율; 위조된 인용; 인용 검증; 작업물 특권; 공개; 상시 명령; Rule 11; 법적 무단 실행; Title III; 아키텍처 의존성 가설. JEL 분류: K41 (소송 절차); K10 (법의 기본 영역, 일반); O33 (기술 변화: 선택 및 결과). # 목차
I. 서론 4
II. 사법 접근성 격차와 Pro Se AI 전환 6
III. 단일 모델 프롬프팅에서 조율로: 인지 외골격 11
IV. 방법 및 증거 기초 15
V. 결과 18
A. 초기 결함 있는 제출 이후 법적 틀 재구성 19
B. 조정된 사전 소장 관행에 대한 대응 20
C. 통합된 항변에 대한 적시 대응 21
D. 항변 약식 판결 신청에서 법정 인용 오류 식별 22
E. 초기 합의 23
VI. 법리적 영향 25
A. 자력 소송인과 작업물 특권 25
B. 법적 무단 실행 27
C. 재구성, 해결 아님 29
VII. 제한사항 및 향후 과제 29
VIII. 결론 32
부록. 실행될 수 있도록 명시된 하나의 보조 아키텍처 34
선택된 참고자료 및 권위 42
I. 서론
한 명의 소송인, 13개의 AI 회사: 여기서 검토된 사건은 본 논문이 문헌에 제기하는 질문을 하나의 소송 기록으로 압축합니다. 미국인의 민사 법률 수요와 이를 충족하기 위해 이용 가능한 자원 사이의 격차는 U.S. 사법 제도에서 가장 지속적인 문제 중 하나입니다. 법률 서비스 공사의 가장 최근 전국 조사에 따르면 저소득 미국인은 그들에게 실질적으로 영향을 미친 민사 법률 문제의 92%에 대해 도움을 받지 못했거나 부족한 도움을 받았으며, 저소득 가구의 거의 3분의 3이 단 1년 동안 최소한 하나의 그러한 문제를 경험했습니다.2 대부분의 자력 소송인에게 장벽은 소송 수수료가 아니라 그 이후의 모든 것입니다: 올바른 법원 찾기, 유효한 청구권 식별, 법인 피고인에 대한 소송 이행, 경험 많은 변호사가 압박된 기한 하에서 작성한 소장에 대한 대응.
생성형 AI가 널리 사용 가능해진 이후 그 인구는 빠르게 증가했습니다. 최근 대규모 경험적 연구에 따르면 20년 동안 11% 근처에서 안정적이었던 연방 민사 본인소송 청구인 비율이 회계연도 2025년에 16.8%로 상승했으며, 2019년에 사실상 0에서 2026년 초까지 18% 이상으로 올라갔다고 보고합니다. AI 생성 텍스트의 마커를 나타내는 샘플링된 연방 민사 소장의 비율입니다. 이 샘플은 RECAP 아카이브에서 가져온 소장(pro se와 함께 변호사로 제출된 것 모두)에 기반하며, 저자들은 변호사 없이 제출된 제출을 과소 표현한다고 주의합니다.3
법원과 평론가들은 대부분 우려로 반응했습니다. 당시 연방 지방 법원의 수석 판사는 전체 문제를 "연방 법원에 대한 실존적 위협"이라고 설명했습니다.4 변호사협회는 소비자 챗봇이 법적 무단 실행으로 교차할 수 있음을 경고하며, 대리인이 있거나 없는 소송인이 존재하지 않는 사건을 인용하는 약식 판결 신청을 제출하는 증가하는 제재 결정 본문이 있습니다.
이 우려는 근거가 있지만, AI 사용의 특정 양식을 설명합니다. 그 양식에 집중함으로써 기존 경험적 연구는 암묵적으로 AI 보조를 동질적인 것으로 취급하며, 본 논문은 이 가정이 더 이상 방어할 수 없다고 주장합니다. 문서화된 실패(환각된 권위, 의존적 일치, 미분화된 규모)는 단일 모델 프롬프팅의 특징입니다: 소송인이 하나의 범용 모델에 질문을 제기하고 결과를 제출합니다. pro se AI 사용의 거의 전체 경험적 그림은 그 양식에 기반합니다.
여기서 검토하는 아키텍처는 다른 것이며, 그 차이가 중요한지가 문제입니다. 다중 모델 오케스트레이션에서 쿼리는 여러 독립적인 모델에 동시에 발송되고, 그들의 출력이 비교됩니다. 동의와 불일치가 명시되며, 가능한 오류를 표시하는 소수 신호를 포함한 발산은 평균화되기보다는 보존됩니다. 여기서 주장하는 것은 좁지만, 옳다면 중요한 결과를 낳습니다. 단일 모델 실패 모드는 현재의 우려를 야기하지만 AI 보조 소송에 고유한 것이 아닐 수 있으며, 오케스트레이션 아키텍처는 AI 사용을 양의 원천에서 품질의 수단으로 전환할 수 있습니다. 기여는 방법론적입니다. 본 논문은 AI 보조의 아키텍처를 구현 세부 사항이 아닌 별개의 경험적 변수로 취급할 것을 제안하며, 다음의 사례는 그 제안을 동기 부여하는 하나의 문서화된 사례로 제시됩니다. 네 단어로 표현된 주장: 아키텍처, 이용 가능성이 아닙니다.
이 주장은 단일 사례 연구인 Chernets v. Google LLC et al.을 통해 전개되며, 이는 한 명의 자기 대리 소송 당사자가 (그의 설명에 따르면) 다중 모델 오케스트레이션 시스템을 사용하여 수많은 로펌의 변호사로 대리된 기술 피고인 그룹을 상대로 제기한 연방 소송입니다. 분석은 공개 기록에 전적으로 의존합니다. 제출, 날짜, 그리고 모든 독자가 검증할 수 있는 문서 번호들입니다. 그 기록은 지배적인 양 및 환각 설명이 설명하지 않는 행동과 AI 보조 제출에 대한 집계 연구가 감지하도록 설계되지 않은 행동을 보여줍니다. 협력적 방어에 맞서 지속된 전체 소장 작성 주기, 6개의 협력적 사전 동의 서한이 4일 이내에 회신되고 실질적 반박이 기한 몇 주 전에 제출되었으며, 방어 연합의 소장에서 검증 가능한 법령 인용 오류가 식별되었습니다. 4명의 피고인이 조기에 합의했습니다 (기밀 조건으로, Part V.E 참조). 사건은 계속 진행 중이며, 이를 검토하는 목적은 검증 가능한 기록을 사용하여 지배적 설명에서는 존재할 것으로 예상되지 않는 현상을 분리하고 문헌이 아직 면밀히 검토하지 않은 현상을 사용하는 것입니다.
당사자가 작성한 단일 사례는 현상이 발생했음을 입증할 수 있지만, 얼마나 자주 발생하는지 또는 일반화되는지는 입증할 수 없습니다. Part VII은 제한을 명시합니다. 이 논증은 AI 보조의 아키텍처가 AI 보조 소송 연구에서 독립 변수이며, 이용 가능성과 양에 초점을 맞춘 현재의 틀이 분리하지 않는 변수라는 것입니다. 이것이 아키텍처 의존성 가설이며, Part IV가 공식적으로 명시합니다.
본 논문은 다음과 같이 진행됩니다. Part II는 본 연구를 접근 정의 문헌과 자기 대리 AI 사용에 관한 신흥 학문 내에 위치시킵니다. Part III는 단일 모델 프롬프팅을 오케스트레이션과 구별하고 메커니즘을 명시합니다. Part IV는 사례 연구 방법과 공개 기록에서의 증거 기초를 제시합니다. Part V는 발견을 제시합니다. Part VI는 작업 생성물 교의와 무허가 법률 실무 체계에 대한 함의를 검토합니다. Part VII은 제한과 향후 작업을 다룹니다. Part VIII는 결론을 내립니다.
II. 접근 정의의 간극과 자기 대리 AI의 전환
정의의 간극은 미국 민사 제도의 주변적 특징이 아니라 구조적 특징입니다. 저소득 및 중산층 미국인의 상당한 비율이 그들의 민사 문제에 대해 의미 있는 법적 도움을 받지 못하며, 많은 사건 범주에서 자기 대리는 예외가 아닌 규범입니다 (Carpenter, Shanahan, Steinberg & Mark 2022). 1970년대의 비교 접근 정의 운동 (Cappelletti & Garth 1978)이후, 학자들은 그 문제를 배분의 문제로 틀지어 왔습니다. 법적 전문성은 희소 자원이며 불균등하게 배분되며, 변호사를 받을 여유가 없는 소송 당사자는 종종 가장 많이 걸려 있는 사람들입니다 (Sandefur 2019). 그 문헌은 정의에 대한 접근이 무엇에 대한 접근인지를 묻습니다. 여기서 추구하는 질문은 그 무언가의 품질입니다.
그 배경에 비해 생성 AI는 모호한 발전으로 나타났습니다. 한 관점에서, 그것은 법적 능력을 민주화하여 대리되지 않은 소송 당사자들에게 변호사가 제공하는 연구, 초안 작성, 분석의 모조를 제공할 것을 약속했습니다. 그 약속은 프론티어 모델이 통일 변호사 시험에 합격했을 때 구체적인 형태를 취했습니다 (Katz, Bommarito, Gao & Arredondo 2024). 그러나 그러한 성능 벤치마크는 아키텍처 차이를 분리하지 않으면서 능력에 대한 기대를 변화시켰습니다. Simshaw는 AI가 대신 두 계층 제도를 뿌리내릴 수 있다고 일찍 경고했으며, 자원이 풍부한 사람들은 전문 인적 판단을 받는 반면 다른 모든 사람들은 자동화된 근사치를 받습니다.5 그 이후 나타난 경험적 그림은 더 구체적입니다. 수백만 건의 연방 제출 건을 분석하면서, 최근 작업은 생성 AI의 공개 출시 이후 자기 대리 소송 당사자의 비율이 급격히 상승했음을 문서화하고 불만 자체에서 AI 일관성 초안의 지표를 개발합니다. 그 집계 기록은 아직 이것이 자기 대리 소송 당사자를 더 나은 위치에 두는지 여부를 보여줄 수 없습니다. 그 연구의 가장 신중한 독자들이 관찰하는 바와 같이, 새로운 소송 당사자를 법원 입구를 지나 얻는 것은 그들이 안에 있을 때 도움을 주는 것과는 같지 않습니다 (Engstrom & Caspi 2026).
그림 1. 생성 AI의 광범위한 이용 가능성 이후 연방 민사 자기 대리 소송 당사자의 증가.
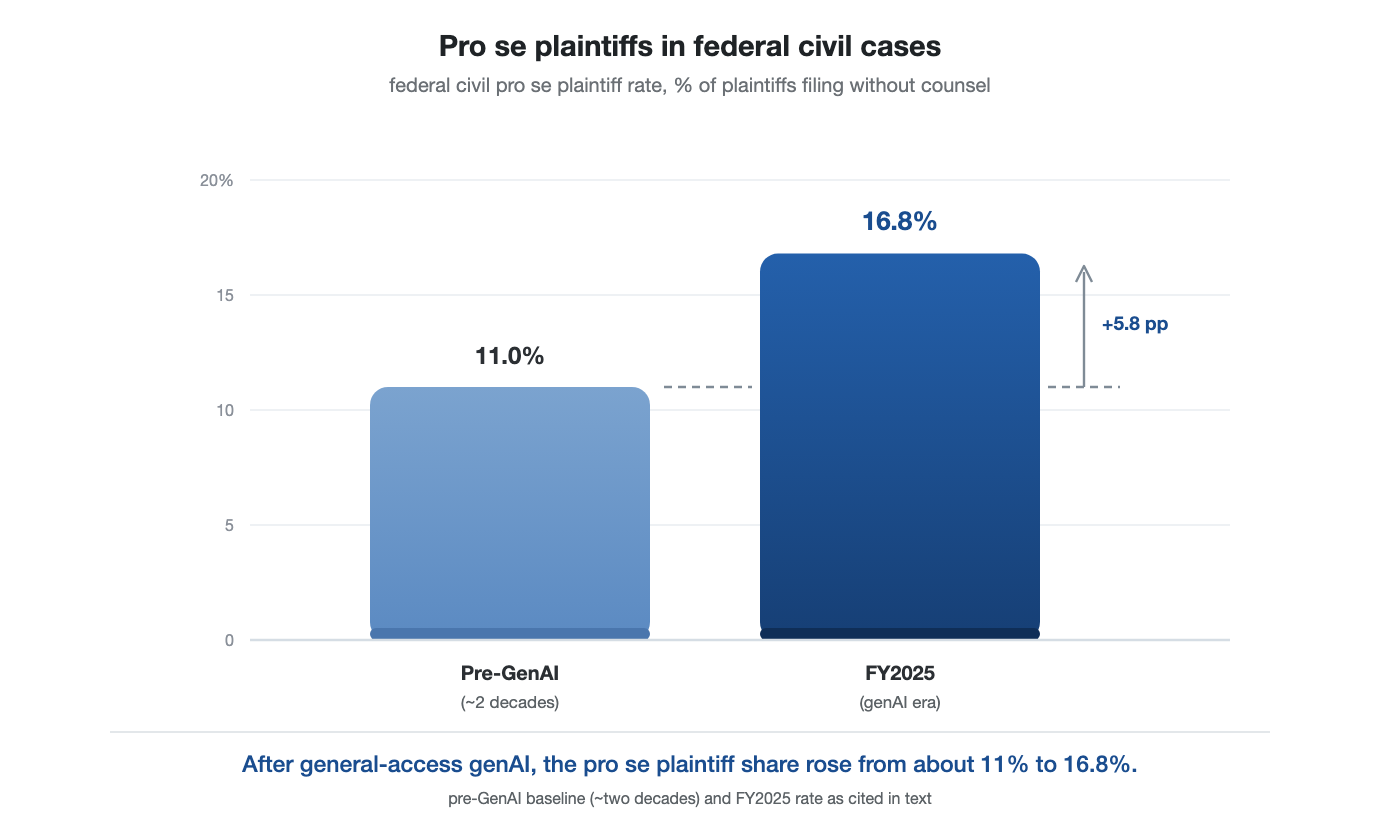
출처: Shah & Levy (2026)에서 개작, 수치는 반올림됨.
법원과 현직 변호사들의 반응은 주로 신중한 입장이었으며, 우려 사항들은 위조, 무단 실행, 그리고 규모 문제에 집중되어 있습니다. 위조에 관해서는, 현재 상당한 판례들이 존재하지 않는 판례를 인용하는 소장을 제출한 소송당사자와 변호사들에게 제재를 가합니다.6 이는 그럴듯하지만 허위인 판례를 생성하는 생성형 모델에서 직접 추적되는 실패 모드입니다. 이 실패 모드는 법원이 발견했거나 확립된 것으로 간주한 AI 위조 자료에 의존하는 소장의 판례 기록을 생성했습니다: 2026년 9월까지 전 세계적으로 2,000건 이상(Charlotin 2026)이며, 여기에는 월스트리트의 가장 저명한 회사 중 하나가 부정확한 인용과 기타 오류(일부는 AI "환각")를 포함하는 긴급 소장으로 연방 파산 법원에 사과한 널리 보도된 사건이 포함됩니다.7 그 판례 기록의 구성 자체가 교시적입니다: 압도적으로 자력 변론 현상으로 시작된 것이 그것으로 남지 않았습니다. 2026년 중반까지 정식 변호사가 기록된 사건의 약 3분의 2를 차지했으며, 새로 기록된 판단에서의 그들의 비중이 증가하고 있었습니다.8 변호사회와 평론가들은 또한 소비자 챗봇이 법률 지도를 제공하면서 정식 변호사에게 예약된 법률 실행의 범위를 넘는지 여부와 그들을 운영하는 단체가 책임을 질 수 있는지 여부에 대해 질문하면서 무단 실행에 대해 우려합니다.9 규모에 관해서는, 판사들이 AI 보조 자력 변론 소장의 유입을 사법부 자원에 대한 부담으로 설명했으며, 가장 강한 표현으로는 연방 법원에 대한 실존적 위협입니다.
사법부 대응은 더 나아가 드러나는 형태를 취했습니다. 2023년 중반 이후, 개별 연방 및 주 판사들은 자신의 법정에서 생성형 AI를 다루는 상시 명령을 발부했으며(공개 추적기는 이제 수백 개를 나열하고 있으며, 두 개가 같지 않음), 당사자들에게 AI가 작성에 사용되었는지 공시하거나, 인용이 검증되었는지 또는 둘 다를 증명하도록 요구합니다.10 상시 명령은 설계를 공유합니다(표 1): AI 사용의 사실과 그 결과의 검증을 규제합니다. 아키텍처, 지원이 단일 모델 또는 통합, 자체 검증 또는 그렇지 않은지 여부는 여기서 격리된 변수이며, 저자가 찾은 상시 명령 중 어느 것에도 나타나지 않습니다. 이 상시 명령을 여기서 연구한 사건에 적용하는 법원은 AI가 사용되었다는 사실만 기록합니다. 공시 체계와 실증 문헌 모두 현재 어떻게 하는지에 대한 어휘를 갖추고 있지 않으며, 이 부재는 위에서 설명한 동일한 균질성 가정과 같으며, 규제 형태입니다.
표 1. 새로운 AI 공시 체계: 상시 명령이 요구하는 것과 그렇지 않은 것.
| 상시 명령이 요구하는 것 | 체계에서의 존재 |
| 생성형 AI가 작성에 사용되었는가? | 일상적으로 요구됨 |
| 인용 및 인용문이 검증되었는가? | 일상적으로 요구됨 |
| 어느 도구 또는 모델이 사용되었는가? | 때때로 요구됨 |
| 지원이 단일 모델인가 아니면 통합(아키텍처)인가? | 찾은 상시 명령 중 어느 것에도 없음 |
| 모델 간 불일치가 표면화되고 해결되었는가? | 찾은 상시 명령 중 어느 것에도 없음 |
출처: AI에 관한 사법부 상시 명령의 공개 추적기(Law360 Pulse; Legal AI Governance), 2026년 7월 기준; 주 9 참조. 범위에 대한 특성화는 저자의 것입니다.
그림 2. 누락된 변수: 기존 실증 연구는 AI 지원의 가용성을 변화시키며, 그 아키텍처는 측정되지 않습니다.
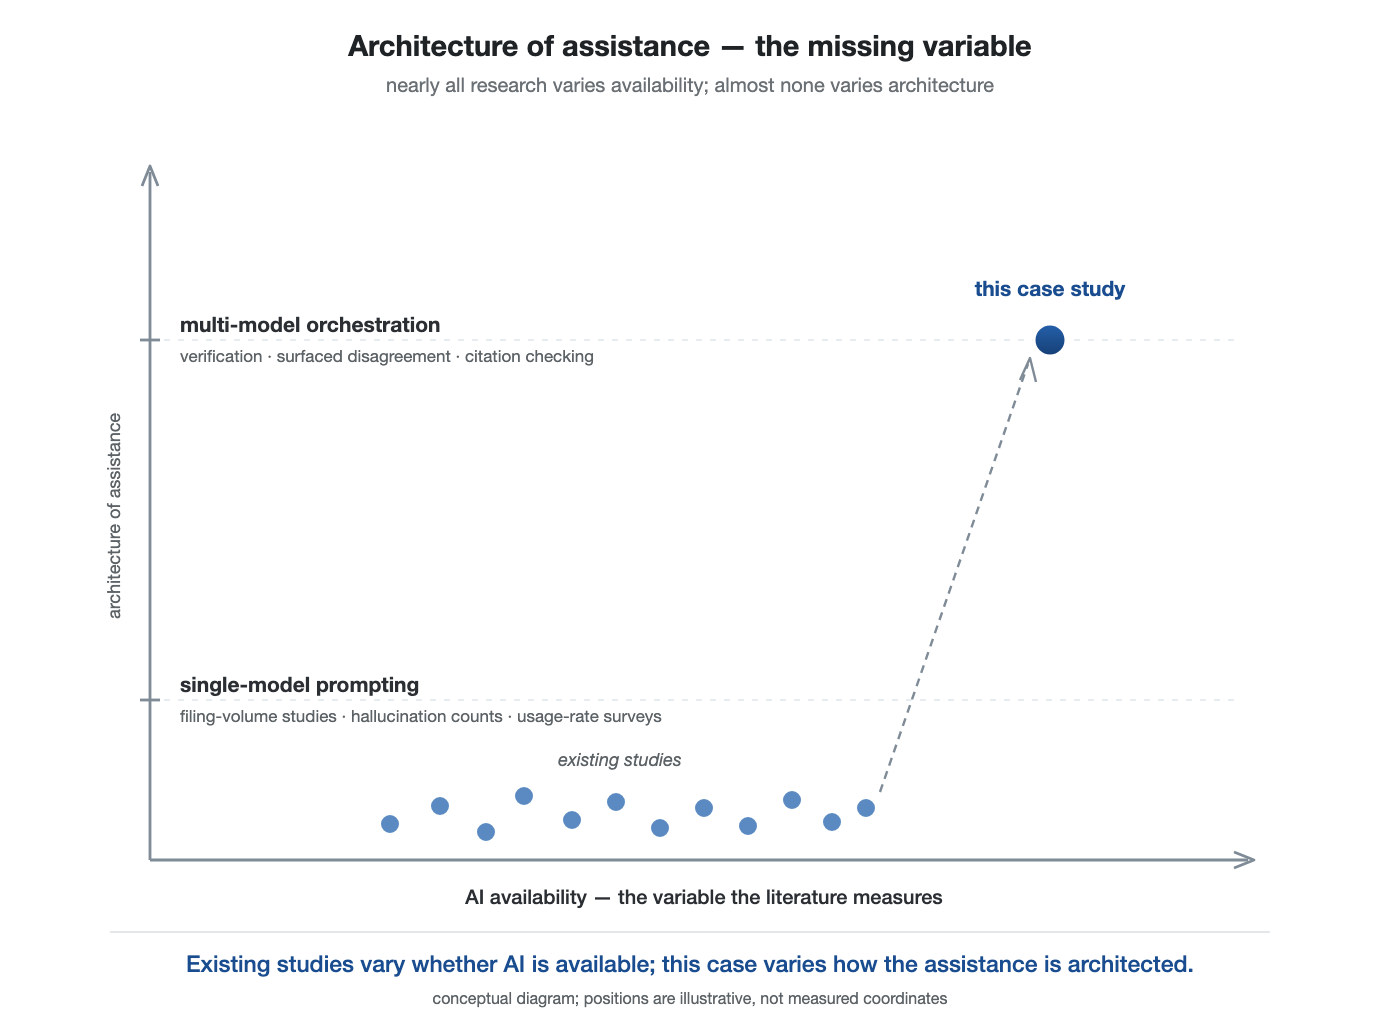
출처: 이 부분에서 논의된 실증 문헌의 저자 개요.
두 발전이 여기서 추구되는 질문에서 만납니다. 정의 간격은 자력 변론이 중요한 이유를 설명합니다: 대부분의 소송당사자에게 자력 변론의 대안은 전혀 대리인이 없는 것입니다. 최근 자력 변론의 증가, 생성형 AI의 광범위한 가용성과 동시에, AI 지원의 아키텍처가 부수적인 세부 사항이 아니라 중요한 연구 질문이 되었음을 설명합니다. 미표시 소송당사자가 이제 규모있게 AI를 통해 행동하고 있다면,11 그 AI가 어떻게 구성되어 있는지는 법원에 도달하는 것의 질을 형성할 수 있으며, 원칙적으로 개인과 직면하는 기관 간의 문제 해결 능력의 간격을 좁힐 수 있습니다.
통합이 무엇을 위한 것으로 이해되는지 변경하는 추가 프레이밍이 있습니다. 운동, 척추, 또는 시각 장애가 있어 한 번에 여러 브라우저 인터페이스를 작동할 수 없는 사용자의 경우, 건강한 사용자가 지루하다고 여기는 수동 워크플로우(각 제공자 열기, 쿼리 붙여넣기, 읽기, 비교)는 지루하지 않지만 불가능합니다. 통합 다중 모델 접근은 생산성 선호가 아니라 합리적인 수정 질문입니다(cf. Blanck 2014, 인지 장애가 있는 사람들을 위한 웹 접근성에 관해; 운동, 척추 및 시각 장애에 대한 확장은 저자 자신의 것입니다). 사람이 수동으로 수행할 수 있는 워크플로우의 보조 자동화를 차단하면 구조상 수동으로 수행할 수 없는 사용자에게 가장 무겁게 떨어지는 부담을 부과하며, 그 사용자의 경우 아키텍처는 무단 실행에 관한 논쟁을 합리적인 수정 질문으로 전환합니다.12
저는 손으로 할 수 없는 가족의 누군가를 위해 만들었습니다 --- 브라우저 탭 사이를 기어 다닐 수 없는 누군가를 위해. 지팡이, 안내견: 뭔가는 사람이 할 수 없는 부분을 합니다. 한 번 말하면, 완료됩니다. 이것이 이 사건이 다루는 것입니다.
이러한 우려들이 공유하는 것과 본 논문이 가시화하려는 것은 자기소송 당사자가 AI를 어떻게 사용하는지에 대한 암묵적 모델입니다. 즉, 한 사람, 하나의 범용 모델, 최소한의 검증, 최대한의 산출입니다. 다만 이것이 유일한 구조는 아니며, 실증 문헌(그림 2)은 다른 구조를 기반으로 구축된 사례들을 아직 검토하지 않았습니다. 학문은 AI 보조 자기소송의 수량과 그 가장 일반적 형태의 신뢰성을 측정했으나, 다른 구조의 지원이 다른 수준의 소송 행위를 산출하는지는 대체로 묻지 않았습니다. 이 격차는 집계 연구가 분리하지 못한 사용 양식에 대한 밀착 기록된 사례를 제공함으로써 해소됩니다.
III. 단일 모델 프롬프팅에서 오케스트레이션으로: 인지적 외골격
"인지적 외골격"이라는 용어는 법률-AI 논쟁이 붕괴시키기 쉬운 구별을 표시합니다. 외골격은 그 안의 사람을 증대시킵니다. 그것은 그 사람을 대신하여 행동하지 않으며, 그 사람이 없으면 무용지물입니다. 증강과 대체 사이의 이러한 구별이 제VI부에서 다루어지는 법리적 질문 양쪽을 관통합니다. 작업 산물 보호는 보호되는 전략이 여전히 소송 당사자 자신의 것이기 때문에 증강에 자연스럽게 부착되며, 대체에는 어색합니다. 비인가 실행 프레임워크는 대체(누군가를 대신하여 법률을 실행하는 개체)를 목표로 하며, 누군가가 자신을 위해 실행하는 도구에는 약하게 작동합니다. 주어진 시스템이 어느 쪽인지는 레이블이 아닌 구조와 사용의 문제입니다. 제II부에서 검토한 우려들은 암묵적 구조를 공유합니다. 전형적인 문제 사례에서, 자기 대리 소송 당사자는 단일 범용 모델에 질문을 제시하고 그 산출물을 제출합니다. 뒤이은 병리들은 상당 부분 그 단일-모델 구성의 특성입니다. 즉, 위조된 인용, 법률에 대한 자신감 있는 오류 진술, 사용자의 전제에 대한 아첨적 동의(Sharma et al. 2024)입니다. 홀로인 모델은 내부적 대안자가 없으며, 그에 모순하도록 위치한 파이프라인의 아무것도 없습니다. 그 오류들은 아무리 자신감 있어도 이의 제기 없이 통과합니다. 문헌을 지배하는 단일-모델 실패 양식은 이러한 의미에서 인공지능의 특성이 아닙니다. 그것들은 하나의 구성의 특성입니다.
수십 년 동안, AI-법률 연구는 법률 추론을 규칙과 사례 기반 모델로 인코딩하는 명시적 지식 공학을 통해 신뢰성을 추구했으며(Ashley 2017), 기계학습 전환이 규칙 인코딩의 문제를 패턴 학습으로 전환하기 전이었습니다(Surden 2014). 컴퓨터 과학의 별개 연구 본체는 이 구성이 이용 가능한 유일한 것이 아니며, 그 실패 양식들이 부분적으로 내재적이기보다 구조적임을 시사합니다. 다중-에이전트 토론이라고 흔히 칭하는 접근에서, 여러 모델 인스턴스는 독립적으로 답변을 생성한 후 연속 라운드에 걸쳐 서로의 추론을 비판한 후 하나의 응답으로 수렴합니다. 기초 연구는 이 "마음의 사회" 절차가 사실적 타당성을 개선하고 단일 모델이 경향이 있는 궤변적 답변과 환각을 감소시킨다고 보고합니다.13 후속 연구는 구조화된 불일치가 수학, 논리, 질문-답변 벤치마크에 걸쳐 환각을 감소시키며, 동시에 소수의 에이전트와 라운드를 넘어 수익 감소, 최종 답변뿐 아닌 중간 주장의 품질 평가 필요성 같은 한계를 식별한다고 보고하면서 발견을 확장하고 수정했습니다.14 벤치마크 도메인이 여기서 중요합니다. 그 문헌은 검증 가능한 답변을 가진 도메인인 수학, 논리, 질문-답변 벤치마크에서 주로 구조화된 불일치를 검증합니다. 많은 질문이 단일의 검증 가능한 답변을 결여하고 모델이 공유 오류에 대해 정중히 수렴할 수 있는 법률 논증에 그 이득이 전이되는지는 미검증이며, 전이는 여기서 검토된 설계의 가정이지 입증된 결과가 아닙니다.
현 분석을 위해, 중요한 메커니즘의 부분은 신뢰성 이득이 어디에서 발생하는지입니다. 가설은 이득이 어떤 단일 모델이 더 유능하기보다는 모델들 간의 관계에서 나오며, 불일치가 억압되기보다는 표면화되고 판정된다는 것입니다. 오케스트레이션의 가치는 더 많은 답변이 아니라 더 잘 지지된 것입니다. 한 모델이 주장하고 다른 모델이 이의를 제기하는 사실은 정밀 검사가 가장 필요한 사실이며, 논쟁 절차는 그것에 주의를 유도하는 반면, 단일-모델 프롬프팅은 할 수 없습니다. 이 메커니즘은 다른 분야(기계학습의 앙상블 방법, 정보 이론의 오류 정정 코드, 그룹 숙고의 과학에서의 구조화된 불동의)에서 인식할 수 있는 친척들을 가지고 있으며, 이는 그것이 어떤 하나의 제품의 유물이 아닌 중복, 불일치-보존 시스템의 일반적 특성임을 시사합니다.
표 2. 설계 특성별 단일-모델 프롬프팅 대 다중-모델 오케스트레이션
| 특성 | 단일-모델 프롬프팅 | 다중-모델 오케스트레이션 |
| 내부 대안자 | 없음. 산출 이의 제기 없음 | 모델들이 서로 반대 심문함 |
| 인용의 출처 | 모델 가중치에서 생성됨 | 외부 데이터베이스에 대해 검증됨 |
| 불일치 처리 | 표면화되지 않음 | 보존됨. 검토 촉발 가능 |
| 특성적 실패 양식 | 위조, 아첨 | 축소된 위조(토론 문헌에 따름) |
출처: 다중-에이전트 토론 문헌(예: Du et al. 2024; Liang et al. 2024; Chan et al. 2023)의 설계 특성 및 오케스트레이션 열의 경우 시스템 문서
본 판례는 저자의 지식으로는 다른 어떤 소송도 공유하지 않는 반사적 구조를 가지고 있습니다. 즉, 분쟁의 대상이 되는 기술이 분쟁이 진행되는 기술이라는 점입니다. 여러 피고인이 이러한 종류의 시스템이 쿼리하는 모델을 개발하고, 문제의 오케스트레이션 시스템은 동일한 공개적으로 이용 가능한 모델들을 조율하며, V부에서 검토된 소송 진행은 그 조율이 사용 중인 상태에서 발생했습니다. 여기서 제시된 가설에 따르면, 어떤 단일 모델도 그 능력을 제공하지 않았습니다. 각각은 위에서 설명한 단일 모델 장애 모드를 가지고 있으며, 구성 요소 모델을 개발한 각 피고인은 구조상 최대 자신의 구성 요소 모델에만 접근할 수 있었습니다. 중요했던 구성은 관계적 구성입니다. 적대적 제공자로부터의 이질적 모델들이 병렬로 쿼리되고, 서로를 검증합니다. 반사성은 구성 요소 기술을 일정하게 유지하기 때문에 분석적 작업을 수행합니다. 기록이 드러내는 어떤 차이도 소송인이 피고인들보다 더 나은 구성 요소 모델에 접근했다는 점만으로는 설명할 수 없습니다. 여러 구성 요소 모델이 피고인들 자신의 모델이었기 때문입니다. 구성, 접근, 그리고 운영자 기술이 설명 가능성으로 남아 있습니다. 이 연구 방향은 또한 피고인들에게 외부적이지 않습니다. 주요 AI 연구소들은 단일 모델에 비한 다중 에이전트 및 앙상블 구성의 장점에 대해 직접 출판했으며, 연구 기간 동안 자신들의 제품에서 교차 모델 검증을 상용화하기 위해 이동했습니다.15 문제의 아키텍처는 업계 자체가 점점 더 지지하는 것입니다.
오케스트레이션은 다중 에이전트 토론을 운영 시스템으로 일반화합니다(그림 3). 토론이 일반적으로 하나의 모델의 여러 인스턴스를 실행하는 반면, 오케스트레이션은 서로 다른 제공자로부터의 이질적 모델들에 걸쳐 쿼리를 전달하고, 그들의 출력을 정규화하며, 합의를 계산하고, 중요하게도, 단일 답변으로 평균화하기보다는 발산을 일급 신호로 보존합니다. 사례 연구에서 사용된 오케스트레이션 시스템은 이 패턴의 한 구현입니다. 기술 문서에 따르면, 이질적 모델 쿼리, 합의 형성, 발산 보존, 그리고 외부 소스에 대한 인용 검증을 통합합니다.16
문제의 오케스트레이션 아키텍처는 명시된, 공학적 설계입니다. 이는 2025년과 2026년에 특허협력조약에 따라 제출된 여러 국제 출원을 포함하여 계류 중인 특허 출원 계열의 대상입니다.17
두 가지 구성은 여러 설계 축을 따라 다릅니다(표 2에 요약됨). 이들 약정 중 두 가지가 분석적으로 중요합니다. 하나는 외부 소스에 대한 인용 검증입니다. 소송에서의 지배적 단일 모델 장애인 환각 케이스는 모델이 검색하기보다는 학습된 패턴으로부터 인용을 생성하기 때문에 발생하며, 각 인용을 라이브 데이터베이스에 대해 검증하고, 확인할 수 없는 것을 포함시키기보다는 플래그를 지정하는 아키텍처는 그 장애를 그 근원에서 목표로 합니다. 다른 하나는 발산의 보존입니다. 모델들이 법적 해석에 대해 불동의할 때, 오케스트레이션 시스템은 불동의를 보수주의와 인간 검토의 트리거로 취급하도록 구성될 수 있으며, 다수결로 해결되어야 할 노이즈로서가 아닙니다. 고위험 영역에서, 독립적 시스템 간의 불동의는 그 자체로 행동 가능한 정보를 구성할 수 있으며, 통계적 노이즈는 아닙니다. 가능한 오류를 나타내는 소수 신호는 보존되고 상향 상정됩니다. 버려지지 않습니다.
그림 3. 오케스트레이션 원칙: 병렬 쿼리, 비교, 그리고 발산의 보존.
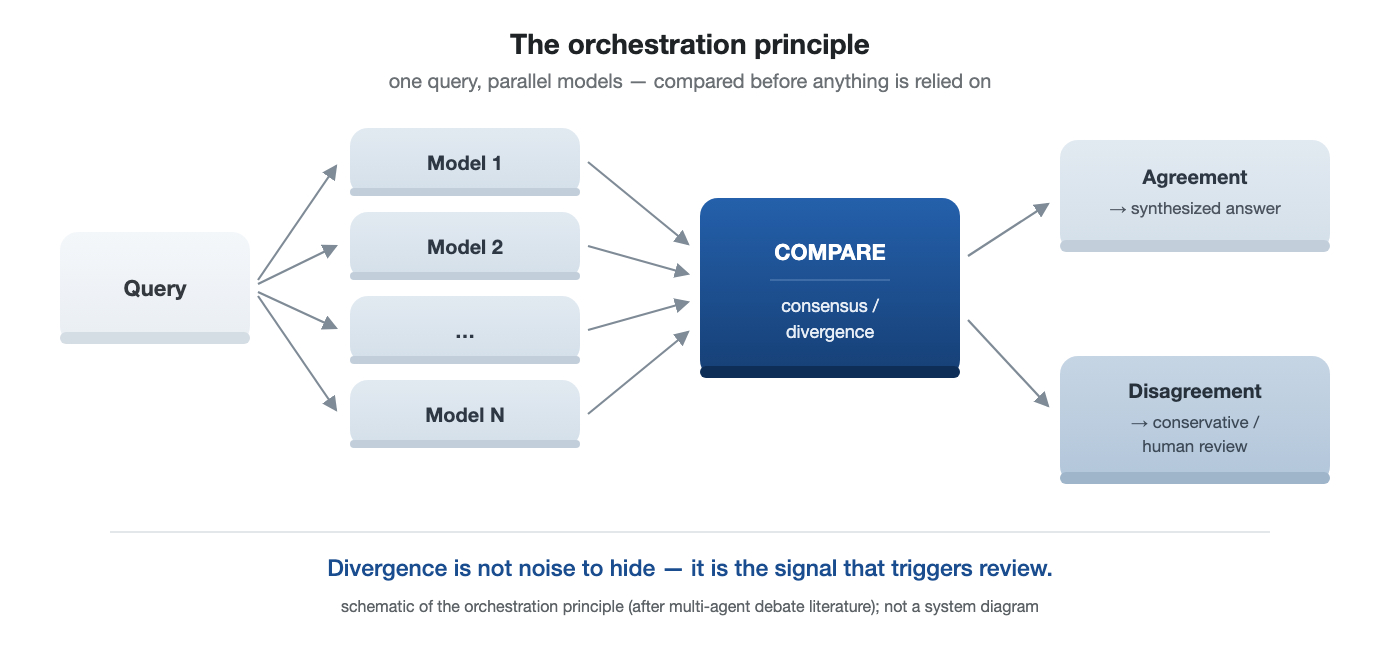
출처: 다중 에이전트 토론 문헌 이후의 일반 원칙의 개략도이며, 특정 제품 아키텍처의 다이어그램이 아닙니다.
구조적 지점은 법원이 비인 AI 사용에 대해 주의하게 만든 특정 병증이 단일 모델 프롬프팅의 특성이며, 오케스트레이션 아키텍처가 이러한 병증을 목표로 한다는 점입니다. 문서화된 장애는 구성의 속성입니다. 이들은 AI 지원 자체의 속성이 아닙니다. 이 의미에서 아키텍처는 신뢰성의 근원을 고립된 모델에서 모델 간의 관계로 이동합니다. 고립된 지능에서 조율된 지능으로 이동합니다. 오케스트레이션도 특이하지 않습니다. 상용 라우팅 및 다중 모델 제품들은 점점 더 동일한 설계 속성을 노출하고 있으며, 이는 경험적 법률 문헌에서 아키텍처의 부재를 더욱 두드러지게 만듭니다. 그 아키텍처 차이가 관찰 가능한 소송 진행의 차이를 만드는지는 경험적 질문이며, 기사의 나머지 부분은 검증 가능한 기록에 대해 그것을 검토할 수 있는 한 가지 상황으로 전환합니다.
IV. 방법 및 증거 기초
이 설계는 단일 사례 연구이며, 현상의 성질을 반영한 선택입니다. 다중 모델 오케스트레이션은 현재 실시간 연방 소송에서 드물며, 여기서의 목표는 그 빈도를 추정하는 것이 아니라 검증 가능한 기록에 대해 특정 행동 패턴이 발생했음을 확립하고 그것을 특성화하는 것입니다. 질이라고 사용된 것은 기록부에서 검증 가능한 관찰 가능한 소송 진행을 나타냅니다. 기한 준수, 인용 정확성, 절차적 정확성, 기록에 대한 응답성, 그리고 제출 주장의 일관성입니다. 이것은 결과를 나타내지 않으며, 단일 사건은 보증할 수 없습니다. 이러한 종류의 사건은 주의할 가치가 있습니다. 기한, 상대방, 결과가 있는 실제 적대적 소송은 실험실 평가만으로는 AI 지원 인간 추론을 관찰하기 위한 더욱 의미 있는 설정을 제공할 수 있습니다. VII부는 이 제한으로 돌아갑니다. 이들 차원 중에서, V부의 발견은 주로 기한 준수, 절차적 정확성, 인용 정확성에 관한 것입니다. 제출 주장의 일관성은 기록부에서 독립적으로 점수를 매기기보다는 문서화되며, 어떤 발견도 계류 중인 어떤 이의 결과에 의존하지 않습니다.
증거의 기초는 독립적으로 검색 가능합니다. 본 문서에 인용된 모든 제출물은 ECF 번호로 식별되며, 저자에 대한 의존 없이 아래의 사건 번호에 따라 PACER에서 직접 임의의 독자가 취득할 수 있습니다. 여기에는 Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.)의 공개 연방 소송 기록과 다른 피고인을 대상으로 했던 이전 소송인 No. 1:25-cv-07770 (S.D.N.Y.)의 소송 기록이 포함됩니다. 사건의 구조는 수치로 표현될 수 있으며, 모두 소송 기록 검증 가능합니다. 13명의 명시된 피고인 중 10명이 출석했고, 7명이 합동으로 기각 신청에 참여했으며, 4명이 합의하여 편견으로 기각되었고, 6명이 2026년 6월 현재 계속 소송을 진행 중입니다(표 3). 13명 중 3명은 나타나지 않았으며, 기록에는 해당 피고인들에 대한 송달 및 법인 식별의 어려움이 나타나 있습니다. 이들이 출석하지 않은 이유는 확립되지 않았습니다. 한 명의 외국 피고인은 헤이그 송달협약에 따라 중국의 중앙 기관을 통해 송달을 위해 이송되었습니다. 아무것도 돌아오지 않았습니다. 확인도, 거부도 없었습니다. 한 명의 국내 피고인은 소장이 등록된 대리인에게 도달하기까지 여러 주에서 4번의 시도가 필요했으며, 이는 서명 집행자가 선서 하에 확인했습니다. 출석은 이어지지 않았습니다. 세 번째 피고인은 자신의 법인 구조를 이용하여 어느 법인이 명시되었는지에 대해 이의를 제기했습니다. 법인 구조 및 국경 간 절차는 실제로 절차적 보호막으로 작동할 수 있으며, 이를 처리하는 것은 대리 당사자가 일반적으로 전문 변호사 또는 벤더에게 맡기는 업무인데, 여기서 자신을 대리한 피고인은 13명 모두에 대해 직접 처리했습니다. 제V부의 소송 행위에 관한 모든 사실적 주장은 제출된 서면으로부터 도출되며, 이는 소송 번호와 날짜로 식별되고 임의의 독자가 독립적으로 검색할 수 있습니다. 다만 소송 당사자의 AI 지원 방식은 예외이며, 이는 소송 기록에 기재되지 않습니다. 본 문서가 법원에서 한 진술을 언급할 때에는 공식 기록에 의존하고, 당사자들의 주장을 언급할 때에는 당사자의 특성화가 아닌 제출물 자체(피고인들의 합동 기각 신청 및 보조 의견서, 그리고 피고인의 반박)에 의존합니다.18
저자의 역할에서 초반에 공개된 세 가지 방법론적 제약이 따릅니다. 첫째, 분석은 공개 기록에 한정되며 소송 전략에 관한 저자의 특권적 지식을 활용하지 않으며, 합의하지 않은 피고인들에 대해 계속 진행 중인 청구에 관한 작업 산물을 공개하지 않습니다. 둘째, 본 문서는 소송 기록이 확립하는 것(날짜, 제출물, 판결, 서면의 문본)과 확립하지 않는 것(당사자들의 주관적 동기, 특히 모든 합의의 이유. 합의 조건은 기밀)을 전체에서 구별합니다. 셋째, 오케스트레이션 시스템의 자체 문서에 의해 제시된 성능에 관한 주장은 자체 보고로 취급되며 효능의 증거로서 의존하지 않습니다. 결론은 기록에 보이는 소송 행위에 근거하며, 시스템의 자체 설명에 근거하지 않습니다.
증거의 기초에서 한 가지 비대칭성이 앞서 설명한 방법을 제한합니다. 본 연구의 종속변수인 소송 행위는 소송 기록으로 완전히 검증 가능합니다. 제V부에서 분석된 모든 제출물, 날짜, 문서는 임의의 독자가 검색할 수 있습니다. 독립변수는 그런 방식으로 검색될 수 없습니다. 공개 기록은 오케스트레이션 시스템이 존재함을 확립하고 그 구조를 문서화합니다. 현재의 청구는 시스템을 특성화하고, 특허 출원은 설계를 명시하며, 반박 당사자의 기술 증거는 그 오케스트레이션 특징을 설명합니다. 소송 기록이 보여줄 수 없는 것은 어느 AI 지원 방식이 특정 제출물을 생성했는지, 또는 소송 당사자의 작업 방식이 언제 변경되었는지입니다. 이러한 사실은 저자 자신의 프로세스 설명에 근거하며, 본 문서는 나타나는 곳에서 이를 표시합니다. 따라서 이 연구는 검증 가능한 산출물 기록을 자체 보고된 입력 기록과 쌍을 이루며, 제VII부에서 제안된 통제된 설계는 보고가 아닌 아키텍처 변수가 관찰되도록 구성됩니다. 부록은 이 목적을 위한 실행 매니페스트를 명시합니다.
소송 기록은 오케스트레이션 시스템을 사용하는 자신을 대리한 소송 당사자가 특정 일정에 따라 특정 제출물을 생성했음을 확립합니다. 시스템이 아닌 소송 당사자의 자체 역량이 관찰된 특징을 생성했다는 것을 확립할 수 없습니다. 따라서 본 문서는 행위 및 그 아키텍처 맥락을 설명하고 인과 질문을 미해결로 취급하여 제VII부에서 제안된 통제된 연구에 의해 해결되도록 합니다.
공식적으로 표현하면, 여기서 제시하는 가설은 다음과 같습니다.
아키텍처 의존 가설. 생성형 AI의 가용성을 일정하게 유지하면서, AI 지원의 아키텍처(단일 모델 프롬프팅 대 다중 모델 오케스트레이션)는 서로 다른 경험적 변수로 기능합니다(그림 4). 지원 방식은 기한 준수, 인용 정확성, 절차적 정확성, 기록에 대한 반응성을 포함한 관찰 가능한 소송 행위의 측정 가능한 차이와 연관됩니다. 이 가설은 거짓임을 증명할 수 있습니다. 지원 방식으로 코딩된 자신을 대리한 제출물의 체계적 비교가 그러한 연관성을 발견하지 못한다면 이를 반박합니다.
그림 4. 아키텍처 의존 가설을 주장의 연쇄로 보여줍니다. 각 연결은 발견이 아닌 테스트할 주장입니다.
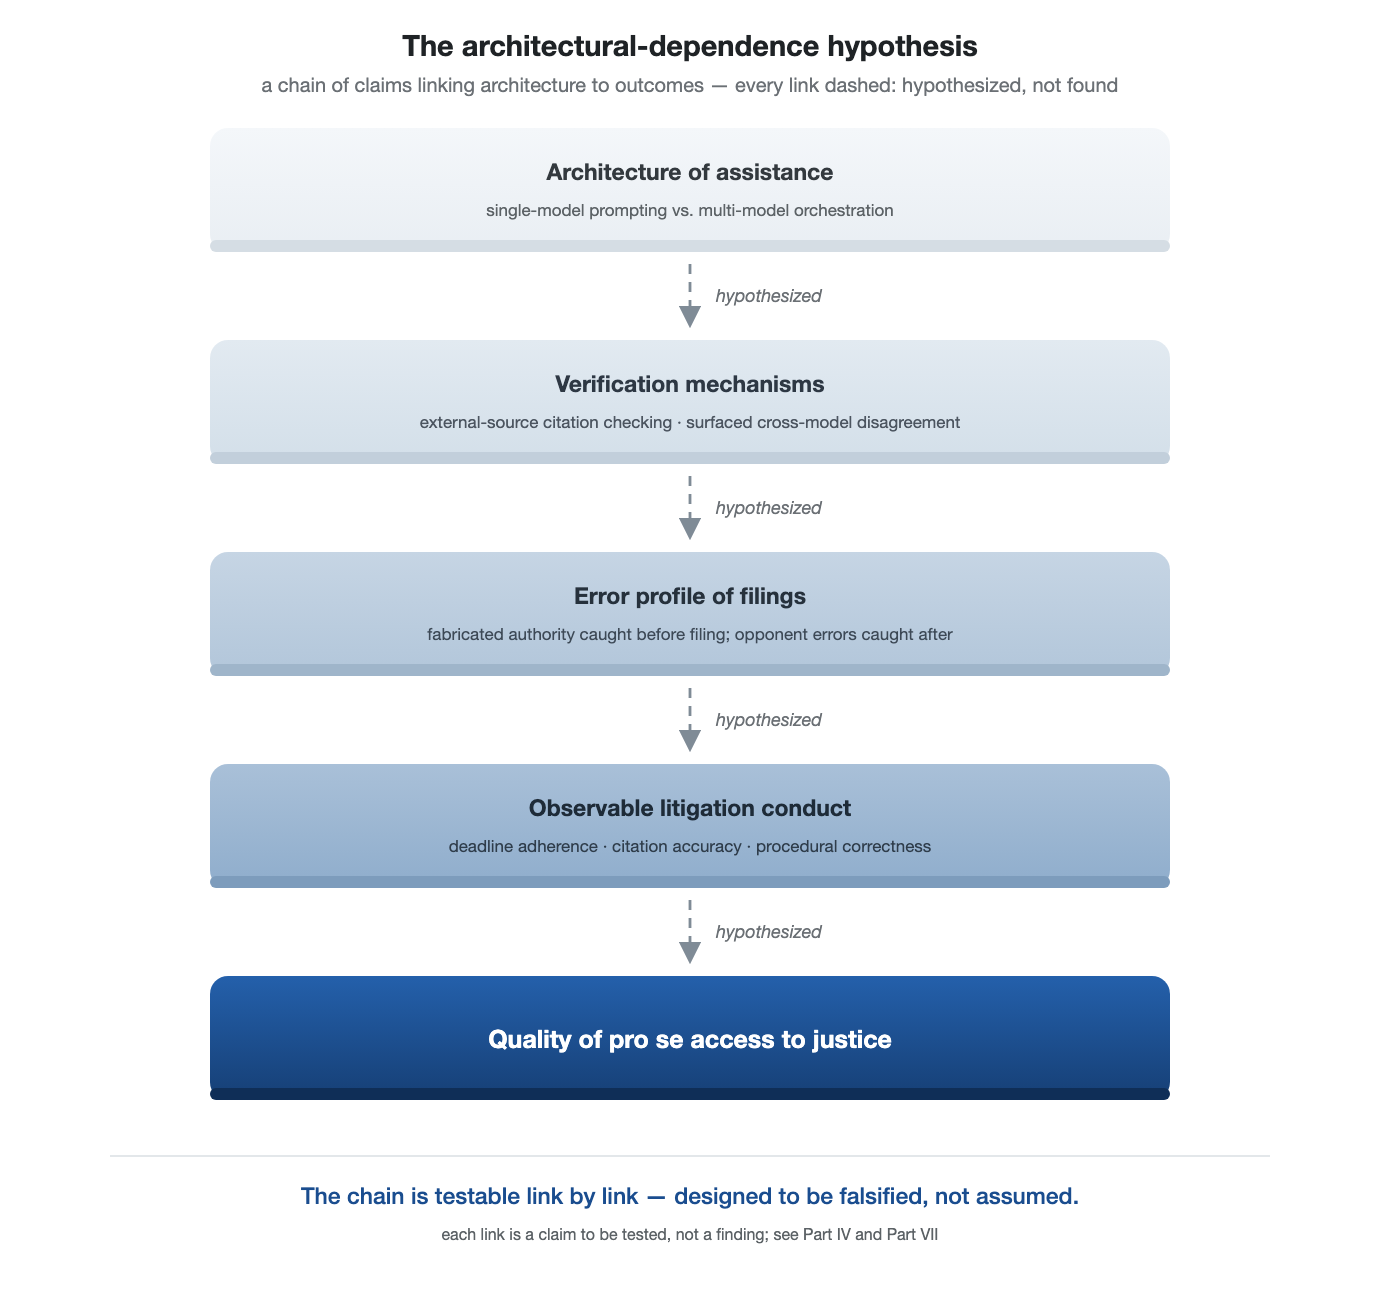
출처: 본문에 진술된 가설에 대한 저자의 개략도입니다. 점선 화살표는 가설화된 미테스트 연결을 표시합니다.
V. 발견
소송의 여러 특징이 여기서 제시된 질문과 관련되며, 그림 5는 이들을 순서대로 배치합니다.
이 사건에서 법적 자원의 불균형은 연구에 우연이 아닙니다. 이는 연구에 중요성을 부여하는 조건입니다. 한쪽에는 법률 교육이 없고 어떤 종류의 변호사도 없는, 심지어 제한된 범위의 변호사도 없는 단 한 명의 자신을 대리한 소송 당사자가 있었습니다. 다른 쪽에는 수많은 주요 법률사무소의 변호사들이 공동 전선으로 결합되어 7명의 피고인을 대리하여 합동으로 기각 신청을 제출하고 상호 간에 제출물을 조율하는 방어진이 있었습니다. 대리되지 않은 한 명의 개인이 그 정렬에 대해 전체 문답 주기를 진행하면서 모든 기한을 충족하고, 본안 관련 주장을 제시하며, 정렬된 법무팀이 발견하지 못한 오류를 식별하는 구성은 사법 접근성 문헌이 일어나지 않는 것으로 취급하는 것에 가깝습니다. 본 문서의 나머지 부분은 공개 소송 기록에 이를 문서화합니다. 이를 설명할 수 있는 것이 전체적으로 본 문서가 추구하는 질문입니다.
그림 5. 사건의 절차적 연대.
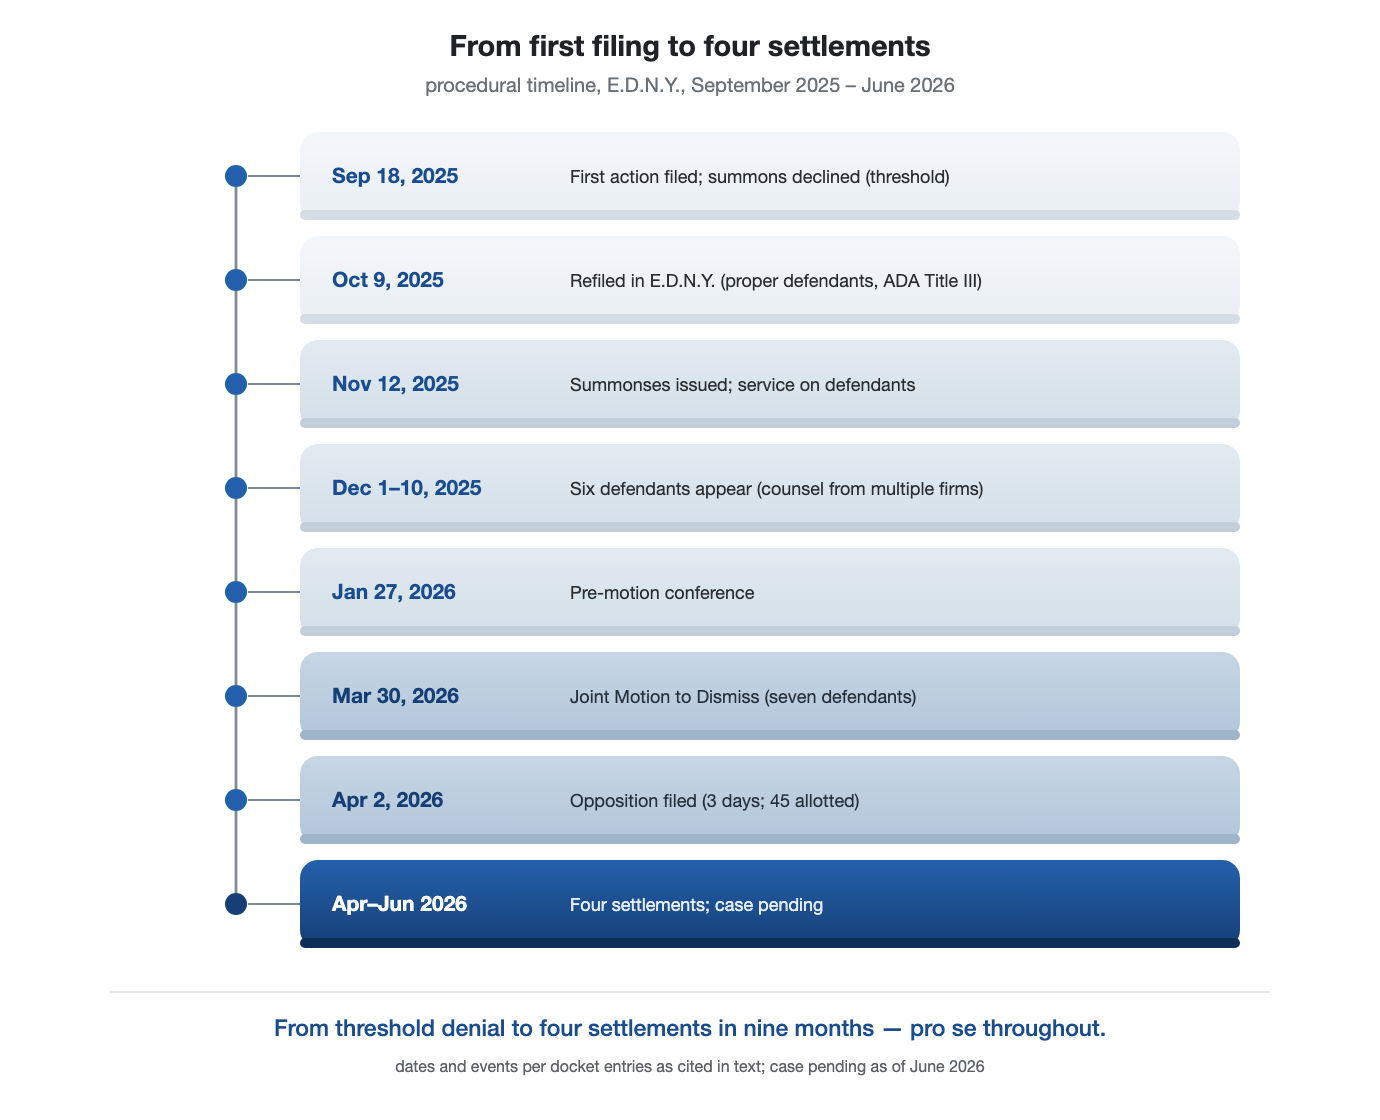
출처: Public docket, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), and the related earlier action.
A. 초기 결함 있는 소장 제출 이후의 법적 틀의 재구성.
2025년 9월에 제출되어 공개 기록이 된 소송인의 첫 번째 소장은 여러 독립적인 측면에서 절차적으로 결함이 있었습니다. 그것은 변호사 없이 진행할 수 없는 유한책임회사의 이름으로 제기되었으며, 잘못된 피고를 상대로, 잘못된 지역에서, 그리고 ADA의 잘못된 명목 아래에서 제기되었습니다. 법원은 소장을 각하하고 소장장을 발부하지 않았습니다. 약 3주 후에 개인적으로 그리고 올바른 지역에서 제출된 두 번째 소장은 법령의 적절한 조항에 따라 청구권을 재구성하고, 적절한 피고들의 이름을 명시했으며, 상당히 확대된 증거 제출을 동반했습니다. 정정을 수반하는 한 가지 방법의 변화가 있었습니다. 저자 자신의 설명에 따르면, 첫 번째 소장을 통해 소송인은 소비자 기기에서 단일 모델을 사용하며 작업했으며, 재구성은 직접 모델 접근을 통한 전체 다중 모델 오케스트레이션의 첫 사용과 일치했습니다. 송무 기록은 그 순서를 확인할 수 없으며, 이것이 원인으로 제시되지는 않습니다. 송무 기록이 보여주는 것은 정정 자체, 즉 본 논문이 검토하는 첫 번째 사례입니다. 기록은 각하된 소장에서 소장장이 발부되고 복수의 소송대리인이 선임된 피고들의 출석을 야기한 소장으로의 빠른 전환을 반영합니다. 이 재구성은 포럼, 소송원인, 그리고 소장 기준에 대해 여러 모델을 조회하는 오케스트레이션 워크플로우가 지원하도록 설계된 광범위하고 교차 검증된 법적 틀의 개정과 같은 종류입니다.
B. 조율된 소장 전 절차에 대한 응답.
2026년 1월 12일 하루 저녁, 여섯 명의 피고인들이 약 4시간 반의 간격으로 여섯 개의 소장 전 편지를 제출했으며, 이들은 함께 제출할 수 있도록 연장을 요청하기 위해 공동으로 신청했습니다.19 법원의 개별 관행에 따르면, 각 편지는 청구인으로부터 5영업일 내에 응답이 필요했습니다. 각각 특정 피고인의 주장을 다루는 여섯 개의 응답 의견서가 4일 내에 제출되었습니다.20 이 사건은 속도보다 더 많은 것을 보여줍니다. 조율된 다각적 소장에 대한 응답은 미리 최종화될 수 없습니다. 왜냐하면 그 응답의 방향은 소장이 제출된 저녁까지 존재하지 않았던 여섯 개의 문서에 의해 결정되기 때문입니다. 그러나 이러한 유형의 소송에서 피고인들이 사용할 수 있는 주장들은 예측 가능한 범주에서 나옵니다. 즉, 소송적격, 디지털 서비스에 대한 제3편의 적용 가능성, 청구 원인 부재입니다. 성실한 당사자는 예상되는 주장에 대한 모듈식 응답을 준비하고 편지가 도착하면 이를 조정할 수 있습니다. 따라서 선제적 초안 작성은 이 사건에 의해 배제되지는 않고 제한됩니다. 4일의 간격이 확립하는 것은 여섯 개의 별개 제출에 대해 개별적으로 작성된 여섯 개의 의견서를 조립, 조정 및 제출하는 것입니다. 그것이 확립할 수 없는 것은 그 내용의 얼마나 많은 부분이 편지보다 먼저 존재했는지입니다.
C. 통합 방어에 대한 시의적절한 답변.
법원이 중복적인 소장을 줄이도록 피고인들을 초대한 사전 동의 회의 이후, 사전 동의 서한을 제출한 6명을 포함한 7명의 피고인이 지원 메모와 함께 기각 신청을 공동으로 제출했습니다. 법원의 일정에 따라, 고소인의 반박은 약 45일 후에 제출되어야 했습니다. 반박은 2026년 4월 2일자(신청서의 3월 30일 제출 3일 후)이며 다음날 법정 기록에 기록되어, 5월 14일 응답 기한보다 약 6주 앞서 제출되었습니다. 선언서와 방대한 증거 자료가 동반된 28페이지 메모였습니다. Figure 6은 양쪽 소장 라운드 모두에 대해 방어의 준비 기간에 대한 응답 기간을 설정합니다. 관찰은 복수 변호사 사무소의 변호인이 대리하는 조직적 방어에 대해 자력 소송인이 제출한 실질적이고 시의적절하며 균형잡힌 답변의 사실이며, 그 장단점이 아닙니다. 관련 요점은 개인적이기보다는 건축학적입니다: 여러 개의 서로 다른 소장에 대해 한 번에 실질적으로 응답하는 것은 문헌이 가정하는 단일 스레드 프롬프팅과 대조적으로, 다중 모델 워크플로우가 배포하도록 구조화된 일종의 병렬, 다중 스레드 작업입니다. 타이밍은 준수 이외의 다른 것에 중요합니다: 공개 법정 기록에 완전한 응답 기간 동안 답변되지 않은 상태로 있는 신청서는 그 기간 동안 기록을 읽는 누구에게든 신청자들의 계정만을 제시합니다. 며칠 내에 제출된 반박은 그 기간을 축소시킵니다. 그러한 종류의 비대칭은 일반적으로 자력 소송인에게 불리하게 작용하는데, 자력 소송인은 보통 그 기간을 압축할 수 없습니다.
Figure 6. 소장 라운드별 준비 및 응답 기간.
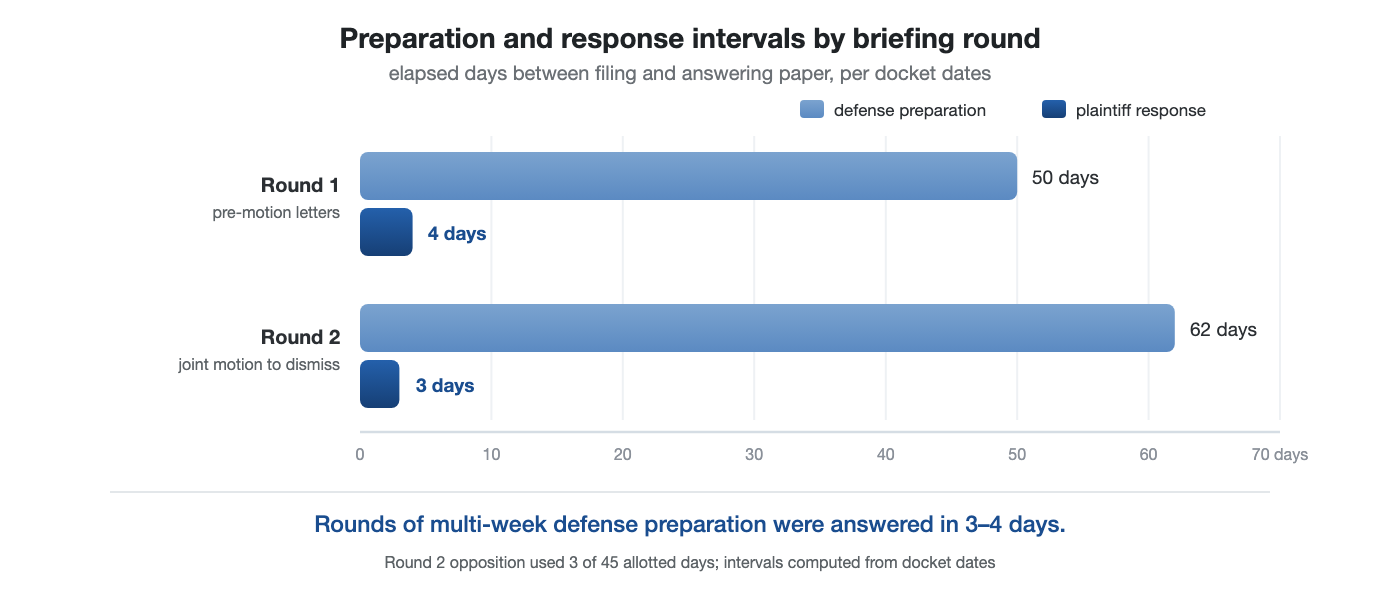
출처: 공개 법정 기록; 각 라운드에서 관련 제출과 응답 제출 날짜 사이의 경과 일수(문서 날짜; 법정 기록은 1일 늦을 수 있음). 첫 번째 라운드의 방어 기간은 서비스 완료(2025년 11월)에서 2026년 1월 12일의 조정된 사전 동의 서한까지 측정됩니다. 경과 기간은 준비 시간을 위에서 제한하며, 초안 작성 시간을 전략적 타이밍과 구별하지 않습니다.
D. 변론서의 법정 인용 오류 식별
원고의 반박에서 공동 신청의 법적 근거로 인용된 오류를 식별했습니다. "완전하고 동등한 향유" 요소를 다루면서 변론 측 간선은 42 U.S.C. § 12184(ECF No. 69-1, 15면)를 인용했습니다. 이는 버스, 택시, 리무진 같은 민간 단체가 제공하는 특정 공중 교통을 규율하는 조항인데, 청구는 공중 편의시설 조항인 42 U.S.C. § 12182에 따라 발생합니다(원고의 반박, ECF No. 76, 17면).21 AI 비전문가 사용에 대한 전형적 우려는 제작된 인용입니다. 즉, 모델이 생성하고 소송인이 제출한 존재하지 않는 법적 근거입니다. 여기서 검증 가능한 인용 오류는 변호사가 제출한 제출물에 나타났으며, 외부 출처에 대한 인용 검증을 포함한 기록된 설계를 가진 오케스트레이션 시스템을 사용하는 자기대리 소송인의 제출물에서 식별되었습니다. III부에서 정의된 오케스트레이션은 교차 모델 불일치와 외부 출처에 대한 검증이라는 두 가지 메커니즘을 묶으며, 전치된 절 번호는 두 번째가 포착하도록 구축된 종류의 결함입니다. 다중 모델 토론은 이를 위해 필요하지 않습니다. 저자의 설명에 따르면 오류는 소송인이 아닌 워크플로우에 의해 드러났습니다. 한 모델이 인용된 절과 청구가 발생한 조항 간의 불일치를 표시했고, 통합 모델이 이를 확인했으며, 비평가가 다시 확인했습니다. 소송인은 변호사가 아니며 오류를 찾거나 스스로 수정을 검증할 수 없었습니다. 관련된 재산은 전체 번들이 아닌 검증 구성요소입니다. 수정의 방향은 문헌이 예상하도록 유도하는 패턴과 반대로 진행되며, 신청의 처분에서의 무게는 법원을 위한 것입니다. 오류는 모든 독자가 독립적으로 검증할 수 있습니다. 두 조항은 미국법전의 같은 소장 내에서 두 절 떨어져 있으며, 변론 측 메모의 § 12184 인용은 페이지 표면에 보입니다. 두 조항은 평행한 운영 언어를 담고 있으며, 각각 자신의 영역 내에서 "완전하고 동등한 향유"를 보장합니다. 따라서 치환은 독자가 읽기 속도에서 알아채지 못하고 모든 인용을 출처에 대해 확인할 때 놓칠 수 없는 종류입니다. 이들을 구분하는 것은 범위입니다. § 12184는 민간 단체가 제공하는 특정 공중 교통을 규율하며, 공중 편의시설이 아닙니다. 원고의 반박은 잘못된 인용을 메모의 처분적 요소 처리에 나타났기 때문에 "단순 절차상이 아닌" 것으로 제시했습니다. 전치된 절 번호는 제작된 법적 근거가 아닙니다. 상대방 간선에서 잘못된 법정 인용을 탐지하는 것은 비전문가 AI 사용에 대한 문헌이 지배하는 실패 모드, 즉 자신의 간선에서 잘못된 인용을 생성하는 것의 역입니다.
귀속은 오류 자체와는 별개 문제입니다. 문헌의 암묵적 규칙은 AI 보조 비전문가 소송인의 오류를 범주에 할당합니다. 기술이 하는 일의 증거로서, 그리고 변호사의 오류를 개인에게 할당합니다. 그렇지 않으면 신뢰할 수 있는 관행에서의 감시 오류로서입니다. 여기에 기록된 에피소드는 그 규칙을 테스트하며, 질문으로 가장 잘 표현됩니다. 생성형 AI를 사용하는 자기대리 소송인이 공중 편의시설 조항 대신 ADA의 교통 조항을 인용했다면, 처분적 요소에서, 오류는 고립된 감시 오류로 읽혔을까, 아니면 평신도가 챗봇으로 소송할 때 일어나는 일의 카탈로그에 하나 더 들어갔을까요? 두 가지 해석은 일치할 가능성이 낮으며, 오류 자체가 아닌 이 귀속의 비대칭성이 아키텍처 의존성 가설이 문헌에 검토하도록 요청하는 것의 일부입니다. 행동이 생산 방식이 아닌 생산 방식으로 코딩되고 있는지 여부입니다. 더욱이 비대칭성은 이동하는 기준선에 대해 지속됩니다. II부가 기록하므로, 기록된 환각 사건은 더 이상 주로 자기대리 현상이 아니며, 그러나 체계적 위협의 프레임은 명부의 자기대리 쪽에 부착되어 있습니다.
E. 초기 합의.
그림 7. 네 건의 합의 순서.
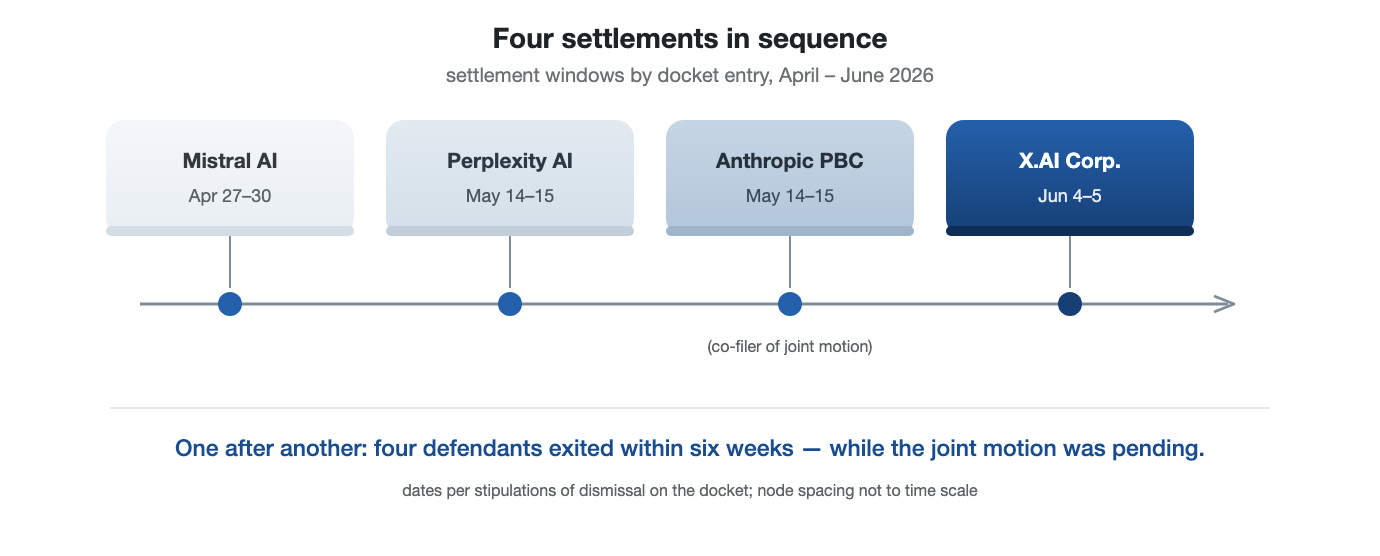
출처: 공개 도켓, ECF 번호 83-86 및 94 (기각 합의; ECF 번호 83 및 84는 Mistral 합의의 같은 날짜에 제출된 두 건이며, 기각 명령은 번호 84를 인용함).
소송에 진입했던 네 명의 피고인이 청구인과의 분쟁을 해결하였으며, 압축된 기간 내에 기각되었습니다 (그림 7). 표준적이듯이, 공개 도켓에는 기각 합의서만 나타나고, 합의 조건은 기밀이며, 사유는 기록에 없으며, 원인을 추론하지 않습니다. 본 소절은 기록에 통상적으로 보이지 않는 합의 순서를 기재하며, 이를 통해 검증 가능하게 합니다.
순서의 두 가지 특징은 공개 도켓에 보이므로 언급할 가치가 있습니다. 적어도 두 경우에 조정된 방어에 맞춘 피고인이 기각 합의로 그 방어를 떠났으며, 한 건은 반박 제출 후 연합의 재반박 전에 합의했고, 다른 한 건은 먼저 연합의 공동 메모를 자신의 신청에 포함한 후 합의했습니다. 시간적 패턴은 공개 제출의 문제입니다: 공동 전선에 진입했던 피고인들이 일대일씩 그것을 떠났으며, 그들이 가입했던 신청은 계류 중이었습니다.
다른 특징은 법인 피고인과 자신을 변론하는 소송인 간의 합의가 통상적으로 기밀이며 공개 기록에 거의 흔적을 남기지 않는다는 것입니다. 여기서 기각 합의는 그 자체로 도켓 항목이며, 이는 순서를 통상적으로 더 명확하게 해석할 수 있도록 합니다; 그 기록의 증거적 가치는 그것의 검증 가능성에 있습니다.
표 3. 13명의 명시된 피고인 현황 (2026년 6월 기준).
| 현황 | 피고인 |
| 출석하지 않음 | Samsung; DeepSeek; OpenAI |
| 합의 및 기각 | Mistral AI; Perplexity AI; Anthropic PBC; X.AI Corp. |
| 진행 중 | Microsoft; Apple; Google; Meta; Amazon; Alibaba Cloud |
출처: 공개 도켓, 2026년 6월 기준.
그림 8은 2026년 6월 4일의 일일 도켓 순서를 1차 기록으로 재현합니다. 읽는 사람이 시간을 직접 검토할 수 있도록 포함되었습니다. 어떤 AI 보조 소송의 구성이 이러한 형태의 기록을 생성하며, 얼마나 자주 생성합니까? 그 질문은 제7부가 제안하는 체계적 연구에 속합니다.
그림 8. 2026년 6월 4일 도켓 순서.
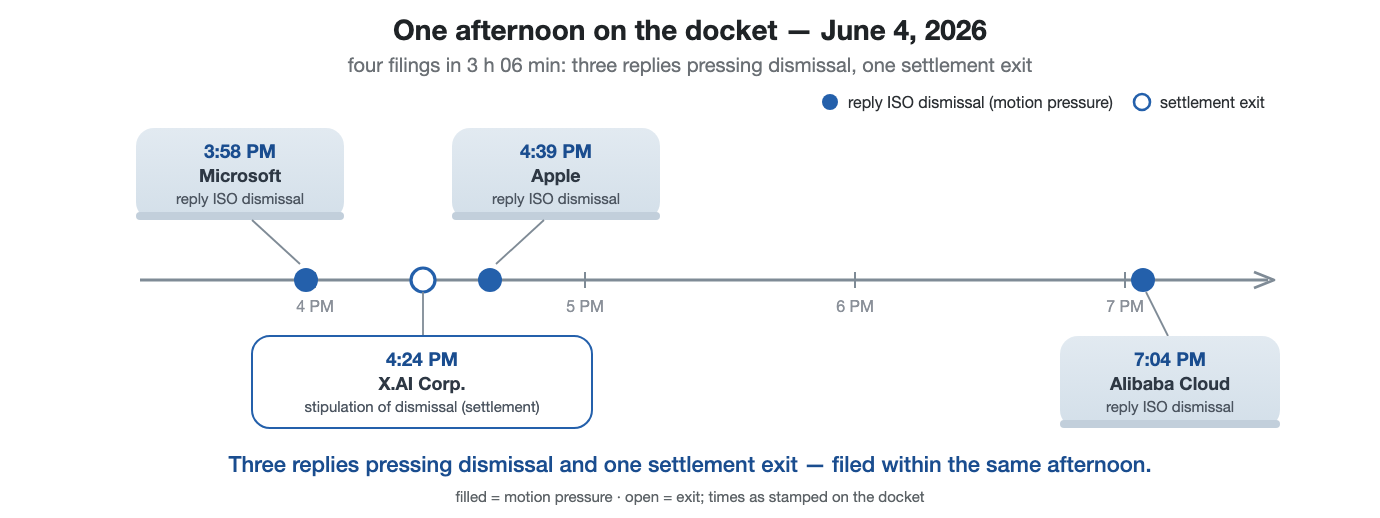
출처: 공개 도켓; 단일 날짜 제출 시간, ECF 번호 93-96.
이러한 특징들은 함께 자신을 변론하는 소송인이 완전한 소장 검토 순환을 통해 다당사 연방 소송을 유지하고, 기한을 충족하며, 비례적으로 대응하고, 조정된 변론된 방어에 맞서 상대방의 오류를 식별하는 패턴을 설명합니다. 이는 지배적 설명이 설명하는 패턴이 아닙니다. 차별화되지 않은 규모와 신뢰할 수 없는 결과의 그 설명은 분포를 특징짓고, 단일 사건은 분포와 모순될 수 없습니다; 그러나 여기서 기록된 패턴은 집계 연구가 측정하는 것 밖에 있으며, 이것이 그것이 그들에게 보이지 않은 이유입니다. 조직화 아키텍처가 패턴에 책임이 있는지, 그리고 패턴이 사건들 간에 재발하는지는 다음 부분이 체계적 조사를 위해 설정하는 질문입니다.
VI. 교의적 함의
더 어려운 질문들은 교의적이며, 그들 중 두 가지는 현재 연방 법원을 통해 진행 중입니다. 목표는 pro se AI 사용의 조직화 기반, 품질 지향 설명이 각각을 어떻게 다시 설정하는지를 보여주는 것입니다. 법원은 이미 증거로서 AI 결과를 평가하기 위한 발전된 프레임워크를 보유하고 있습니다 (Grimm, Grossman & Cormack 2021). 여기의 질문들은 인접한 것들입니다: 그들은 기계 결과가 허용 가능한지에 관한 것이 아닙니다; 둘 다 결과를 생성한 프로세스를 누가 소유하는지 그리고 그 프로세스가 법을 실행하는지에 관한 것입니다.
A. 작업 산물과 비전문 소송인.
소송인의 AI 시스템과의 상호작용이 작업 산물로서 증거개시로부터 보호받는지 여부는 새롭게 논쟁의 대상이 되고 있습니다. 2026년 초 7주 동안 세 개의 연방법원이 AI 사용과 작업 산물 보호의 교점에 도달했으며, 이들은 한 목소리를 내지 않았습니다.22 Warner v. Gilbarco, Inc.에서 판사보는 비전문 고용 소송 피고인이 생성형 AI 질의문과 그 응답을 제출하도록 강제하는 결정을 거부했으며, 당해 자료들이 연방민사소송규칙 26(b)(3)에 따른 작업 산물임을 판단했습니다. 자기 소송인은 자신의 변호인으로 행동하며, 자료는 그의 정신적 인상과 준비 과정을 반영했고, 생성형 AI 시스템(개인이 아닌 도구)에 대한 공개는 포기가 요구하는 상대방에 대한 공개가 아니었다는 이유입니다. 본 판단은 교리의 가장 오래된 층위에 있습니다. Hickman v. Taylor가 가장 강력하게 보호한 것은 변호인의 정신적 인상, 결론, 이론이었기 때문입니다. 이는 법원이 거의 절대적으로 취급하는 작업 산물 계층입니다(Hickman v. Taylor, 329 U.S. 495, 510--11 (1947)). 소송인이 작성한 질의문, 그가 반복 수정한 초안, 그가 버린 주장들이 그 계층의 비전문 소송인 유사물입니다. 1주일 후 United States v. Heppner에서 법원은 반대 결론에 도달했습니다. 피고인 대리인의 개입 없이 자신의 주도로 공개 AI 보조기를 사용했으며, 법원은 결과물 파일의 제출을 명령했습니다. 피고인이 변호인의 지시 없이 행동했고 플랫폼의 소비자 약관이 제공자에게 그의 입력값을 보유 및 사용할 권리를 허용했다는 점을 강조했습니다. Morgan v. V2X, Inc.는 세 번째이자 가장 상세한 판단으로, Warner의 핵심 판단을 확대하여 비전문 소송인의 소송 준비 과정에서의 AI 사용이 "규칙 26(b)(3)이 보호하기 위해 고안한 종류의 비밀유지, 전략 중심의 반복적 작업 산물과 밀접하게 유사하다"고 결론지었습니다. 그러나 같은 결정에서 소송인은 상대방이 비밀유지를 지정한 자료와 관련하여 사용한 AI 도구의 명칭을 공개하도록 요구했으며, 보호 명령을 수정하여 그러한 자료에 대한 주류 AI 서비스 사용을 제한했습니다.23 법원이 그은 구별은 분석적으로 중요합니다. Warner와 Heppner가 충돌하지 않는 이유를 설명하기 때문입니다. 변론인을 우회하는 대리인 소송인은 당사자와 대리인 사이의 간격을 만들고, 이 간격이 Heppner에서 결정적이었던 반면, 비전문 소송인은 "동시에 당사자이면서 대리인"이므로 그러한 간격이 존재하지 않습니다. 보호는 무제한이 아니었습니다. 법원은 AI 도구의 정체성 자체가 보호되지 않는다고 판단했으며, 비밀 증거개시 자료에 대한 AI 사용을 훈련, 보유, 제3자 공개에 대한 계약상 안전장치를 조건으로 했습니다. 따라서 세 판단은 AI를 교리에서 제외하기보다는 AI에 전통적 교리를 적용하는 데 수렴하지만, 누가 보호를 주장할 수 있는지, 무엇이 포기에 해당하는지에서는 상이합니다. 이들이 그은 선은 건축학적인 선입니다. 비록 어휘는 본 논문의 것입니다. 법원의 의견은 대리, 비밀유지, 포기에 대해 언급합니다. Heppner 청구를 좌절시킨 것은 AI 사용이 아니라 사용된 구성입니다. 보유 및 훈련을 허용하는 약관을 가진 소비자 도구였습니다. 대조적으로 Morgan은 훈련, 보유, 제3자 공개로부터 계약상으로 금지된 구성을 조건으로 보호를 제한합니다. 비밀유지 상황은 검증과 마찬가지로 AI 자체가 아니라 지원 아키텍처의 속성입니다. 본 논문의 변수는 교리 자체 내에 나타납니다(표 4).
표 4. 2026년 초 작업 산물 3부작, 구성별.
| 사건 | 소송인 | 대리 간격 있음? | 도구 구성 | 판단 |
| Warner | 비전문 청구인 | 없음 --- 당사자와 대리인은 동일 | 자신의 준비 도구로 사용된 생성형 AI | 작업 산물로 보호됨 |
| Heppner | 변론인 없이 행동하는 변론인 대리 피고인 | 있음 --- 당사자가 대리인을 우회 | 소비자 도구; 약관이 제공자의 보유 및 훈련 허용 | 제출 명령 |
| Morgan | 비전문 청구인 | 없음 --- "동시에 당사자이면서 대리인" | 비밀 자료에 대한 사용이 계약상 제한 조건: 훈련, 보유, 제3자 공개 없음 | 조건부로 보호됨; 도구 정체성은 보호되지 않음 |
출처: Warner, 2026 WL 373043; Heppner, 2026 WL 436479; Morgan, 2026 WL 864223. 판단들은 전통적 교리 적용에 수렴하고 구성 사실에서 상이합니다. 마지막 두 열의 건축학적 해석은 본 논문의 것이지, 법원의 것이 아닙니다 --- 아키텍처는 법이 아니라 법이 고려하는 사실을 변경합니다.
Morgan은 2026년 3월 30일에 판단되었으며, 이는 본 논문에서 연구한 사건의 기각 공동 신청서가 제출된 날입니다. 교리가 형성되는 동안 사건이 준비되고 있었습니다.
2026년 초 결정들을 함께 읽으면, 도구의 아키텍처는 점점 더 결정적이 됩니다: 누가 이를 지시했는지, 무엇을 했는지, 그 기록이 어떻게 유지되었는지입니다. 오케스트레이션 계정은 그 선에서 무엇이 위험에 처해 있는지를 명확히 합니다. AI가 자신을 대리하는 소송 당사자에 대한 지원이 단순한 기계적 텍스트 생성일 뿐이라면, 이를 보호된 전략으로 취급할 경우가 약할 것입니다. 소송 당사자가 질문을 구성하고, 상이한 모델 출력을 비교 검토하며, 주장을 향해 반복하는 오케스트레이션 워크플로우는 기능상 변호사의 손에서 항상 보호해온 전략으로 가득한 반복적 과정과 구별하기 어렵습니다. 상이한 분석 엔진 패널을 지시하는 소송 당사자는 주임 변호사가 주니어 어소시에이트 팀을 지시하는 것과 정확히 닮았습니다. 한 당사자가 다른 당사자의 소송 준비에 무임승차하는 것을 방지하려는 교리의 기저 목적은, 그 준비가 어소시에이트에 의해 수행되든 소송 당사자가 다중 모델 시스템을 통해 수행하든 동등한 힘으로 적용됩니다. Morgan은 이 방향을 가리키고 있으며, 오케스트레이션 프레이밍은 기능적 근거를 제공합니다.
업무 물건 보호는 비밀성에 달려 있으며, 자발적 공개 공시에 의해 포기될 수 있습니다. 최소한 공개된 내용에 대해서는 말입니다. 따라서 자신의 계류 중인 사건에 대한 계정을 공표하면 Morgan이 인정하는 보호를 공개한 내용과 관련하여 포기할 위험이 있습니다.
B. 법률 무단 실행.
자력 소송 맥락에서의 UPL 우려는 검토해보면 기이하게 구성되어 있습니다. 무단 법률 실행 규칙은 타인의 부적격 대리로부터 대중을 보호하기 위해 법률 실행을 면허받은 변호사에게 한정합니다.24 이러한 규칙은 주법의 산물이며, 법률 실행에 대한 정의는 관할권마다 다릅니다. 다음은 특정 주의 경계보다는 프레임워크의 공유된 논리에 관한 것입니다. 소비자 법률 AI로 인해 제기되는 진정한 UPL 질문은 도구 또는 그것을 운영하는 회사가 의뢰인에게 조언함으로써 무단 법률 실행에 종사하는지 여부입니다. 그 질문은 실질적으로 조언의 신뢰성에 달려 있습니다. UPL 규칙이 방지하려는 무능한 실행처럼 보이는 신빙성 있게 허위 권위를 만들어내는 도구입니다.
그러나 자력 소송 의뢰인은 자신 외에는 아무도 대리하지 않습니다. 그들은 이를 행할 법정 권리가 있으며(28 U.S.C. § 1654), 결함 있는 제출에 대한 제재는 의뢰인이 아닌 본인에게 떨어집니다. 이러한 의뢰인이 AI 시스템을 사용할 때, UPL 프레임워크는 "법률 실행"을 어디에나 찾아야 합니다. 도구에서, 그 개발자에서, 또는 어디에도, 그리고 이러한 각 답변은 어색합니다. 실제로 우려를 촉발하는 것은 인가가 아니라 신뢰성입니다. 즉, 면허받지 않은, 책임 있는 시스템이 검증할 능력이 없는 사람에게 신빙성 있게 잘못된 법을 제공할 두려움입니다. 신뢰성이 전부는 아닙니다. 왜냐하면 법원은 역량만큼 책임성을 통해 법률 실행을 감시하기 때문입니다. 면허받은 변호사는 제재받거나, 정지되거나, 자격이 박탈될 수 있지만, AI 시스템은 이 중 어느 것도 될 수 없습니다. 책임성의 격차는 실제이며, 조직 계정은 신뢰성을 다루지만 책임성은 다루지 않습니다. 조직화된 시스템이 체계적으로 오류를 범했다면, 책임은 세 곳 중 한 곳에 떨어질 수 있습니다. 제출에 서명하는 운영자(현재 규칙 11이 도달하는 유일한 행위자), 아키텍처의 제공자, 또는 아무도. 법이 선택하는 세 곳 중 어느 곳이 책임성의 격차를 좁히거나 단순히 재배치할지 결정합니다.
여기서 단일 모델/조직화 구별은 실질적인 작업을 수행합니다. UPL 우려를 촉발하는 신뢰성 적자는 단일 모델 구성의 특징이며, 교차 모델 검증 및 인용 유효성 검사 주위에 구축된 아키텍처는 그 적자를 목표로 합니다. 매우 신뢰할 수 있는 도구가 여전히 "법률을 실행한다"고 말할 수 있으므로 이것이 UPL 질문을 해결하지는 않습니다. 그것이 하는 일은 논쟁이 병합하는 경향이 있는 두 가지를 분리하는 것입니다. 신뢰성과 인가는 분석적으로 구별되는 질문이며, 그것들을 혼동하면 건축 수정이 인가에 접근하지 않고도 첫 번째 것을 해결할 수 있다는 사실을 모호하게 합니다. 신뢰성이 진정한 우려라면, 건축이 인가만으로가 아니라 분석의 일부가 되며, 단일 답변을 주장하기보다는 불일치를 드러내고 해결하도록 설계된 시스템은 자체 조건에서 우려를 해결합니다. 신뢰성이 건축적이라면, 그것은 또한 설계 가능하고 인증 가능하며, 법률 서비스 규제를 재창조하는 제안이 의존하는 대상입니다(Hadfield 2017). 검증할 수 없는 것을 방출하지 않고, 축약할 수 없는 불확실성을 인간에게 전달하는 아키텍처는 무단 조언자가 아니라 설계에 따른 준수로 기능하기 시작합니다.
C. 해결이 아닌 재구성
두 법리 영역 모두 여전히 미해결 상태입니다. pro se AI 사용에 관한 지배적인 양과 환각 설명이 이러한 법리 논쟁을 형성했으며, 품질 중심의 오케스트레이션 기반 설명이 이를 재구성합니다. AI 사용이 기계적 산출이 아닌 반복적 전략으로 이해될 때 작업생산물 특권이 더 일관성 있게 보이며, 신뢰성이 본질적 결함이 아닌 구조적 변수로 취급될 때 UPL 논쟁이 다르게 보입니다.
VII. 한계 및 향후 연구
네 가지 한계가 설계를 제한합니다. 첫째, 가장 근본적으로, 이것은 단일 사례(n = 1)이며 그 당사자에 의해 저술되었습니다. V부의 발견들은 분포도 주장이 아닌 존재 주장입니다. 이러한 사례가 할 수 있는 것은 정성적 방법론이 극단적이거나 계시적 사례에 대해 오랫동안 인정해온 것입니다. 즉, 표준 설계가 아직 도달하지 못한 현상을 드러내고 체계적 연구가 검증해야 할 가설을 생성하는 것입니다.
둘째, 저자는 소송당사자, 개발자 및 분석가입니다. IV부의 제약들은 이 때문에 존재합니다.
셋째, 인과관계를 분리할 수 없습니다. 기록은 구조의 기여를 소송당사자 자신의 능력, 사전 준비, 청구하지 않은 당사자의 인센티브, 또는 다른 교란요인들로부터 분리할 수 없습니다. III부의 구조 논의는 입증된 메커니즘이 아닌 그럴듯한 메커니즘을 제공합니다.
여러 대안적 설명이 여전히 그럴듯합니다. 소송당사자는 단순히 능력이 있을 수 있습니다. 교육받고, 동기부여되고, 청구되지 않은 pro se 당사자는 변호사가 수십 시간 동안 진행할 사건에 수백 시간을 투자할 수 있습니다. 3일 반박은 처리가 아닌 준비를 측정할 수 있습니다(V.B부). 선택은 두 수준에서 작동합니다. 사건 수준에서, 이 사건은 기록이 호의적이기 때문에 논문의 주제이며, 오케스트레이션 보조를 받은 소송당사자가 실패하는 사건들은 어떤 논문도 생성하지 않습니다. 에피소드 수준에서 선택은 저자 자신의 것입니다. 판결문에는 이 논문이 설명하는 5개 사건보다 더 많은 사건이 포함되어 있으며, 저자는 어느 것을 제시할지 선택했습니다. 그 선택에 대항하여, 완전성 진술은 판결문 검증 가능합니다. 2026년 6월 현재, 기록에는 소송인을 제재하는 명령이 없고, 그의 제출물을 각하하는 명령이 없으며, 그가 놓친 기한이 없습니다. 기록이 부정적 절차 언급에 가장 가까운 곳은 사건의 개시에 있으며, 법원이 소송인의 빈곤 인정 절차로 진행 신청을 거부했으나(청구 수수료는 허용된 시간 내에 납부됨) 소장이 발행될 수 없다는 점을 언급했고 송달 주소가 공급될 때까지 그렇게 되었습니다. 진술은 PACER 접근권이 있는 누구든지 반박할 수 있습니다. 에피소드 수준 선택이 여전히 숨길 수 있는 것은 부정적인 판결이 아닌 강조입니다. 아래 제안된 연구는 이러한 대안적 설명들 사이를 중재하도록 설계되었습니다.
한 가지 추가 한계는 타당성이 아닌 범위에 관한 것입니다. II부는 정의 격차를 법률서비스공사가 연구하는 저소득층 미국인들의 관점에서 틀지었으나, 여기서 소송당사자는 자신의 설계 시스템을 운영하는 박사급 AI 시스템 건축가이며, 기술 능력 분포의 먼 꼬리에서 추출한 자기 대리 소송인입니다. 존재 증명은 그 사실에 의해 약화되지 않지만, 그 범위는 II부가 중심을 두는 인구보다 더 좁습니다. 이 사건은 오케스트레이션 보조 소송이 그 인구에 실질적으로 이용 가능하다는 것을 보여주지 않으며, 비용, 디지털 접근, 기술적 유창함이 그 자체로 장벽입니다. 구조의 이점이 전문가 운영자에서 일반적인 자기 대리 소송인으로의 이전을 견딜 수 있는지는 경험적 질문이며, II부의 보조 틀에 대해 그것은 아마도 결정적인 질문입니다. 아래 제안된 연구의 장애인 부문은 이에 도달하도록 설계되었습니다. 이전은 단순한 기술적 설정의 문제가 아닙니다. 오케스트레이션은 운영자의 인지적 부담을 초안 작성에서 중재로 재배치합니다. 경쟁하는 산출물 읽기, 표면화된 불동의 평가, 어느 문장이 살아남을지 결정. 중재는 그 자체로 요구하는 기술입니다. 그 부담이 운영자 전문성이 아닌 인터페이스 설계에 의해 수행될 수 있는지, 그리고 인지, 시각 또는 교육적 장벽이 있는 소송인들에게 어떤 비용으로 수행될 수 있는지는 경험적 질문만큼 설계 질문이기도 합니다.
넷째, 사건은 진행 중입니다. 여기서의 어떤 발견도 어떻게 종료될지에 달려 있지 않습니다.
이 사건이 제시하는 가설은 오케스트레이션 아키텍처가 단일 모델 프롬프팅보다 더 높은 수준의 소송 대리인 없는 소송 진행을 수반한다는 것이며, 이는 검증 가능합니다. 체계적인 연구는 AI 지원 모드별로 코드화된 소송 대리인 없는 소장 표본을 통해 소송 진행(기한 준수, 인용 정확성, 소송 결과)을 비교할 수 있으며, 경험적 문헌이 개발하기 시작한 AI 일관성 초안 지표와 법적 추론을 위해 공동으로 구축된 벤치마크인 LegalBench를 사용합니다(Guha et al. 2023). 제5부에서 직접 나오는 한 과제 군집인 시드된 오류 탐지는 검증 가능한 결함이 있는 테스트 소장으로, 거기에서 문서화된 종류의 결함들입니다: 전치된 법령 조항, 오류 인용된 권위, 위조된 인용. 탐지율은 단일 모델 프롬프팅에서 오케스트레이션된 검증까지 지원 모드 전반에서 비교되며, 변호사 및 비변호사 운영자를 별도 집단으로 합니다. 아키텍처의 구성 요소(외부 자료 검증 및 교차 모델 불일치)는 각각 절제되므로, 각 메커니즘의 기여가 번들 전체에 귀속되기보다는 파악됩니다(표 5). 이러한 설계는 이해 관계 없는 연구자들이 많은 사건에서 수행할 경우, 여기서 주장한 존재 주장을 분포 주장으로 전환하거나 이를 반박할 수 있습니다. 더 강력한 설계가 가능하며 선호되어야 합니다: 사전 등록된 프로토콜, 공개 자료, 그리고 시스템의 인용 검증율을 포함한 자신의 주장에 대한 블라인드 세트 검증으로 동일한 법적 과제에 대한 단일 모델 및 오케스트레이션된 지원의 통제된 비교; 다중 모델 도구의 공개 가능성을 중심으로 한 차분-차분 설계 같은 준실험적 식별; 그리고 제2부의 보조 틀이 가설이 아닌 운동 장애, 시각 장애, 또는 인지 장애가 있는 참가자를 위한 전담 집단입니다. 법적 지원의 무작위 평가는 선례가 있습니다: 사법 접근성 문헌은 대리 제공 및 분리된 지원 제안에 대한 무작위 연구를 실행했으며(Greiner, Pattanayak & Hennessy 2013), 여기서 제안한 지원 모드 비교는 해당 설계 전통을 아키텍처 변수로 확장합니다. 더 광범위하게, 이 가설은 분야가 아직 채택하지 않은 기준을 제시합니다: AI 시스템이 그 출력의 품질뿐만 아니라 그 추론 아키텍처의 품질로도 평가되어야 한다는 것입니다. 법에 특화된 것은 없습니다: 의학, 공학, 금융에서 결과적인 작업이 생성형 시스템에 위임되는 곳이면 어디든, 같은 질문이 발생하고 같은 변수가 측정되지 않습니다. 또한 사법 접근성 분석이 오랫동안 고정된 것으로 취급해온 변수를 재구성합니다. 소추자의 진입 비용은 405달러 제출 수수료였고, 변호사의 공식적 진입 비용은 200달러 pro hac vice 수수료였습니다(ECF Nos. 19, 52, 60). 둘 다 수백 달러 정도이며, 효과적으로 극복할 수 없었던 자원 격차의 양 끝에 서 있습니다; 비교는 공식적 진입 수수료에만 관련되며, 대리 비용은 아닙니다. 변경된 것은 법정 입장의 가격이 아니라 그곳에 남아있기 위해 필요한 소송 능력의 한계 비용일 수 있습니다. 그 비용이 실제로 감소했는지, 그리고 얼마나 감소했는지는 제안한 연구의 경험적 질문입니다; 그것이 상수보다는 변수가 되었다는 것 자체가 검증할 가치가 있는 가설입니다.
표 5. 제안한 연구, 집단별.
| 집단 | 구성 | 격리되는 것 |
| 1 | 인간만, AI 없음(대조) | 지원 없이 기본 탐지 |
| 2 | 단일 모델 프롬프팅 | 문헌이 문서화하는 모드 |
| 3 | 오케스트레이션, 완전 | 배포된 번들 |
| 4 | 외부 자료 검증 없는 오케스트레이션 | 인용 확인의 기여 |
| 5 | 교차 모델 불일치 없는 오케스트레이션 | 표면화된 차이의 기여 |
주: 각 집단은 변호사 및 비변호사 운영자를 별도 집단으로 실행되며, 별도의 장애 집단은 다섯 개 번호 집단 외에서 실행되며, 운동 장애, 시각 장애, 또는 인지 장애가 있는 참가자를 위한 것이며, 결과 측정은 세션 전에 사전 등록됩니다; 본문 참조.
VIII. 결론
소송 대리인 없는 소송에서 인공지능에 관한 일반적인 설명은 규모와 신뢰성에 관한 이야기입니다: 더 많은 소송자들이 더 빠르게 제출하며, 위조된 권위의 위험이 높아집니다. 명시되지는 않지만, AI 지원은 한 소송자가 하나의 범용 모델에 프롬프트를 주는 것을 의미한다고 가정하며, 그 가정은 더 이상 유지되지 않습니다.
여기서 검토된 사건은 저자의 설명에 따라 다른 아키텍처를 기반으로 구축되었습니다: 여러 독립적인 모델이 병렬로 쿼리되었고, 그들의 불일치가 표면화되고 해결되었으며 억압되지 않았습니다. 소송 진행의 설명은 전적으로 검증 가능한 공개 기록에 기반하며; 그 기록은 규모와 환각 설명이 설명하지도 예측하지도 않는 진행을 포함합니다: 결함 있는 소장의 신속한 재구성, 기한보다 훨씬 앞서 제출된 실질적인 이의, 그리고 조율된 방어 소장에서 법령 인용 오류의 식별입니다. 그 다음 본 논문은 AI 지원을 오케스트레이션으로, 그리고 품질의 문제로 이해하는 것이 연방 법원 앞의 두 교의적 논쟁을 어떻게 재구성하는지 보여주었습니다. 소송이 요구하는 속도로 타이핑하거나, 보거나, 조직할 수 없는 소송자들에게, 아키텍처 차이는 효율성의 문제가 아니라 미국 장애인법의 의미에서 사실상 완전하고 동등한 향유에 관한 접근성의 문제입니다: AI 지원이 구성되는 방식이 소송 대리인 없는 자기 대리를 가능하게 하는 것입니다.
AI 지원의 아키텍처는 가용성뿐만 아니라 자기대리소송인(self-represented litigants)이 현재 할 수 있는 것에 대한 분석에 속한다는 주장입니다. 기초 모델들이 원시적 능력에서 수렴하면서 이 주장은 더욱 시급해집니다. 모델 자체들의 차이가 줄어들 때, 그들이 결합되는 방식의 차이는 더 커질 것이기 때문입니다. 아키텍처 의존성 가설은 아키텍처가 구현의 세부사항이 아니라는 것입니다. 그것은 사람과 법원이 할 수 있는 것의 질을 결정하는 요소입니다. AI가 법률 업무에 참여하는지 여부는 더 이상 의문의 여지가 없습니다. 남은 문제는 어떤 아키텍처가 무엇을 하는지입니다. 이 관점에서 pro se AI 문제는 지능 문제가 아닌 설계 문제이며, 설계 문제에는 설계 답변이 있습니다. 앞으로 해야 할 일은 더 나은 개별 모델을 기다리는 대신 특정 아키텍처를 명시하고 서로를 테스트하는 것입니다. 부록은 그러한 아키텍처 하나를 실행되고 비판될 수 있을 정도로 정확하게 명시하며, 참조 구현이 함께 공개됩니다.
부록. 실행될 수 있도록 명시된 하나의 지원 아키텍처
이 논문의 주장은 "AI 지원"이 서로 다른 실패 특성을 가진 아키텍처 계열을 나타낸다는 것입니다. 이 주장은 적어도 하나의 아키텍처가 실행되고 비판될 수 있을 정도로 정확하게 명시되면 더 쉽게 테스트할 수 있습니다. 아래 프로토콜이 그러한 명시입니다. 이것을 여기서 맹검 통합 프로토콜25이라 부르는데, 모델들이 서로를 읽는 다중 에이전트 토론과 가장 명백하게 구분되는 단계의 이름을 따랐습니다.26 이것은 공개 모델만 사용하며, 세 개의 공급업체에 대한 소비자 또는 API 접근 권한이 있는 모든 사람이 이를 재현할 수 있습니다.
아래 프로토콜은 아키텍처 수준에서 제3부에서 설명된 계열을 명시합니다. 즉, 고립되어 쿼리된 이질적 모델들, 명시적 규칙 아래에 형성되고 평균화되기보다는 불일치가 보존된 합의, 그리고 모든 인용이 그 출처에 대해 검증됨입니다. 이것은 제3부에서 설명된 시스템과 마지막 검사가 어떻게 수행되는지에서 다릅니다. 거기서는 생성된 데이터베이스에 대해 검증하는 구성 요소이고, 여기서는 검색 가능 모델 다음에 사람이고, 아래 제약 조건 3은 모델의 승인이 검사가 아니라는 것을 명확하게 명시합니다. 이것은 증거로서가 아닌 명시로서 명시되어 있습니다. 논문은 사건 연구의 결과로서 제출을 제공하지 않으며 이로부터 추론을 도출하지 않습니다(보류된 것: 주석 24). 프로토콜이 논증에 기여하는 것은 실행 매니페스트입니다. 이 논문의 아키텍처 변수는 자기 보고식입니다(제4부). 매니페스트는 바깥쪽 독자가 그 이상이 될 수 있기 전에 필요한 것입니다. 제5부의 제출은 아무것도 포함하지 않습니다.
이것이 해결하는 문제.
본인소송 당사자는 무료 소비자 티어를 통해 여러 최첨단 모델에 접근할 수 있으며, 비용, 디지털 접근성, 기술적 이해도가 장벽으로 남아 있습니다(제7부): 아래의 고위험 칼럼은 유료 API 접근이며, 나중에 설정된 기밀유지 조건은 가장 보호가 필요한 자료에 대해 대부분의 무료 티어를 제외합니다. 일반적인 관행은 하나에 질문하고, 답변을 읽고 이를 제출하는 것입니다. 문서화된 실패는 존재하지 않는 인용을 생성하는 확신 있는 모델이며, 이를 포착하기 위해 프로세스에 배치된 것이 없습니다. 이 프로토콜은 단일 질문을 공통 작업 명세서와 이를 따르는 4단계로 대체합니다. 각 모델을 정확히 원래대로 유지하며, 여러 모델을 배열하여 한 시스템의 오류가 다른 조직에서 훈련한 시스템과의 접촉을 견뎌내야 하고, 각각이 말한 것을 기록합니다.
역할.
프로토콜은 각 역할이 무엇을 볼 수 있는지에 의해 정의됩니다. 네 가지 규칙이 이를 규정합니다:
1. 생성자는 과제 진술문만 보고 다른 것은 보지 않습니다. 누구도 다른 생성자의 초안을 보지 않습니다.
2. 통합자는 무작위 순서로 중립적 레이블 R1부터 Rn 아래의 모든 초안을 봅니다. 어느 벤더가 어떤 초안을 만들었는지 절대 알아내지 않습니다.
3. 첫 번째 비평가는 통합자 자신의 패밀리 내에서 새로운 맥락 속에서 읽습니다. 과제 진술문과 통합 문서를 보지만, 이를 만든 통합 과정은 보지 않습니다.
4. 마지막 독자는 통합자와 다른 벤더의 비평가입니다. 과제 진술문, 통합 문서, 그리고 첫 번째 비평가의 보고서를 보며, 그 판정이 실행을 종료합니다.
네 가지 규칙을 만족하는 다양한 벤더의 최신 모델 집합이면 프로토콜을 실행할 수 있습니다. 예시로, 다음은 2026년 9월에 사용 가능했던 공개 모델로 역할을 채울 수 있는 것들입니다:
표 6. 네 가지 역할을 채울 수 있는 2026년 9월에 사용 가능한 공개 모델.
| 역할 | 일상적 문서 | 고위험 문서 |
|---|---|---|
| 생성자, 격리됨 | claude-sonnet-5 with search; gpt-5.6-terra with search; gemini-3.1-pro-high with search; an open-weight model | claude-opus-5 with search; gpt-6-astra with search; gemini-3.1-pro-high with search; Grok (xAI); an open-weight model |
| 통합자, 맹목적 | claude-sonnet-5 | claude-fable-5-1 |
| 비평가 1, 통합자의 패밀리, 새로운 맥락 | claude-sonnet-5 | claude-fable-5-1 |
| 비평가 2, 다른 벤더, 마지막에 읽음 | gpt-5.6-terra | gpt-6-astra |
출처: 2026년 9월 기준 벤더 문서. 역할에 대한 모델의 배치는 저자의 것이며, 식별자가 아니라 역할이 프로토콜을 정의합니다.
표는 사용 가능했던 것을 보여주는 예시이며, 식별자는 변경될 것입니다. 역할은 변경되지 않을 것입니다. Grok은 벤더로 명명되고 오픈 웨이트 모델은 클래스로 명명됩니다. 호스팅된 식별자가 호스트마다 다르기 때문이며, gemini-3.1-pro-high는 벤더의 API 문서에 있는 모델 코드가 아니라 호스팅된 인터페이스의 별칭입니다. 고위험 열은 다섯 번째 생성자를 추가하며, 그 통합자는 초안을 작성하지 않은 모델이므로 레이블 아래에서 자신의 텍스트를 절대 판단하지 않습니다. 그림 9는 역할별로 프로토콜을 그립니다.
역할에 패밀리를 배치하는 것은 측정이 아니라 저자의 사용에 기반합니다. 2025년과 2026년에 이 시스템들과 약 2,000시간의 작업을 거쳐, 맹목적 비평가로서 새로운 맥락에 배치된 모델은 통합자와 같은 패밀리에서 온 경우 가장 엄격하고 가장 유용한 검증을 반환했으며, 검토 중인 텍스트가 그 패밀리에 의해 생성된 경우에도 그렇게 했습니다. 다른 벤더의 비평가들이 더 약한 독자는 아니었습니다. 그들은 다른 것들을 발견했으며, 이것이 프로토콜이 그들 중 하나를 유지하고 마지막 판정을 부여하는 이유입니다. 네 가지 규칙은 각 역할이 무엇을 볼 수 있는지에 관한 것이지 어느 벤더가 그것을 채우는지에 관한 것이 아니며, 통합자 또는 첫 번째 비평가에서 다른 패밀리를 선호하는 독자는 하나를 대체하고 여전히 프로토콜을 실행할 수 있습니다.
그림 9. 역할별 맹목적 통합 프로토콜: 격리된 생성, 맹목적 통합, 그리고 두 가지 검증.
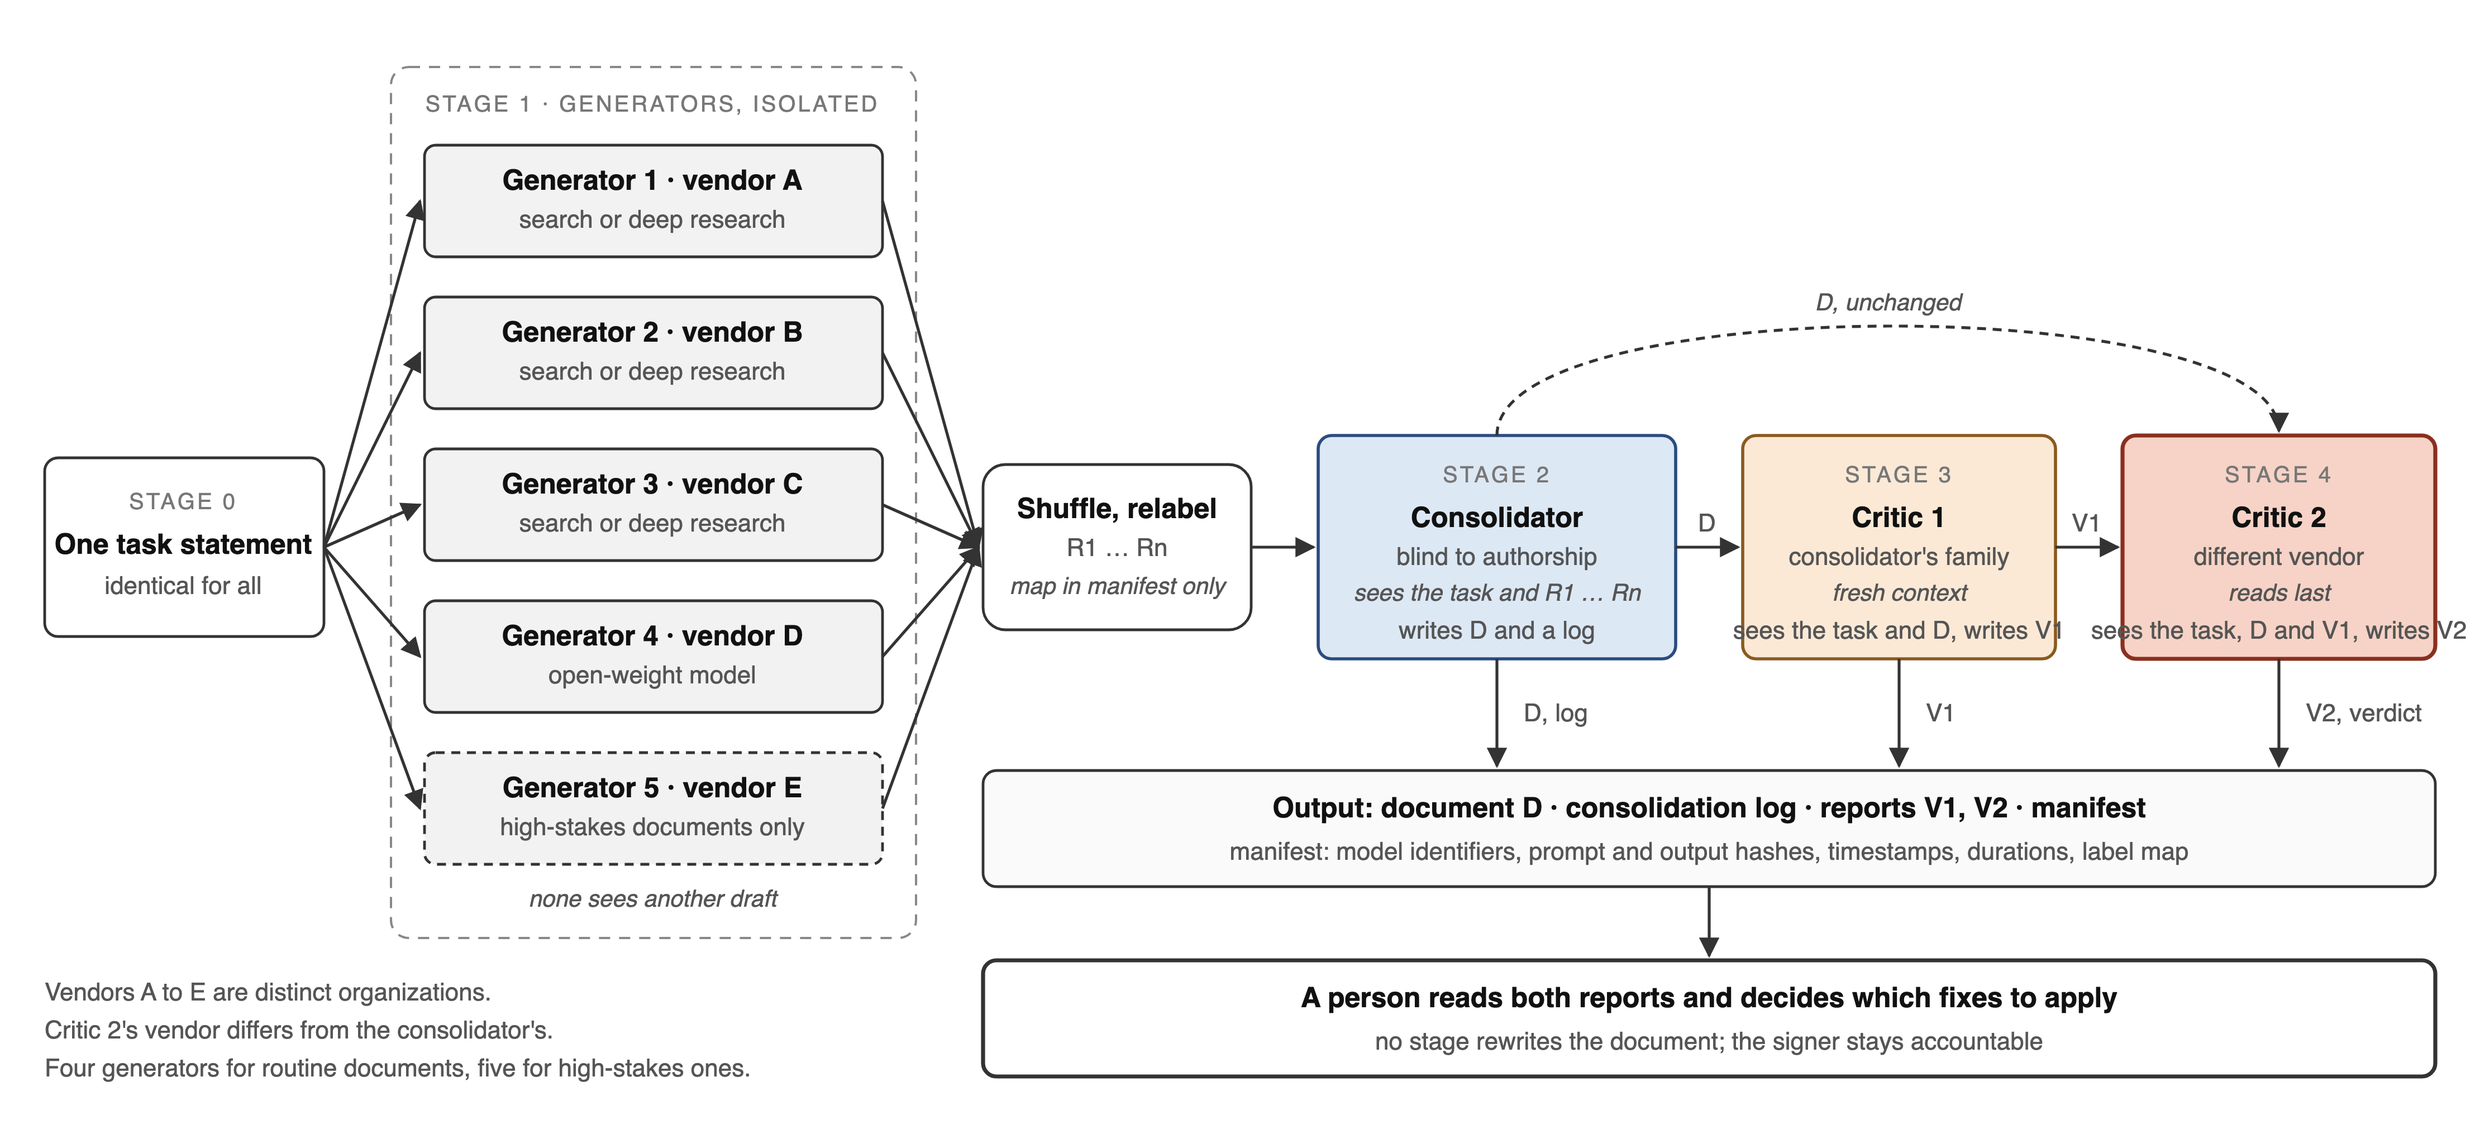
출처: 이 부록에서 규정된 프로토콜에 대한 저자의 다이어그램.
이것은 램프입니다. 계단을 이용할 수 없는 사람을 위해 만들어졌습니다. 다섯 개의 인터페이스를 동시에 열고, 서로를 읽고, 답을 돌려줄 수 없는 사람을 위해 말입니다. 램프는 그것이 만들어진 사람뿐만 아니라 문을 통과하는 모든 사람에게 사용됩니다. 위의 공식은 누구나 그것을 가져갈 수 있도록 기록되어 있습니다.
단계.
단계 0. 하나의 과제 진술서. 단일 서면 진술서는 목표, 관할권, 요구되는 형식, 출처로 인정되는 것, 그리고 검증할 수 없는 주장에 대해 수행할 작업을 설정합니다. 모든 모델이 동일하게 받으므로 초안 간의 차이는 모델에서 비롯됩니다.
단계 1. 격리된 생성. 각 생성기는 인터페이스나 API에서 웹 검색이 지원되는 곳에서 병렬로 완전한 초안을 생성하며, 과제에서 깊이 있는 조사가 요구되는 경우 깊이 있는 조사를 수행합니다. 이러한 공급업체의 소비자 인터페이스는 기본적으로 검색합니다. 일부 프로그래밍 방식 엔드포인트는 검색 도구를 제공하지 않으며, 이러한 엔드포인트에서 실행되는 생성기는 가중치에서 초안을 작성하고 있으며, 이는 실행 기록에 표시되어야 합니다. 각 생성기는 모든 사실적 및 법적 주장에 대해 검증 가능한 출처를 인용하고, 검증할 수 없는 것을 검증되지 않은 것으로 표시하며, 공개된 질문으로 마무리해야 합니다. 격리가 메커니즘입니다. 다른 조직에서 만들어지고 다른 말뭉치에 기반한 모델은 다른 것들을 발명하며, 여러 모델이 독립적으로 생성하는 주장은 각각 자신의 인용을 가지고 있으며, 이는 그들 중 하나만 단독으로 생성한 주장과는 다른 증거적 지위에 있습니다. 다른 초안을 본 초안 작성자는 그 주장이 사실인지 여부와 무관한 이유로 그것과 동의합니다.
단계 2. 맹검 통합. 한 모델이 R1에서 Rn까지의 초안을 무작위로 선택된 순서로 받으며 실행 매니페스트에만 기록되며, 명시적 규칙에 따라 병합합니다. 여러 초안이나 검증 가능한 인용으로 지원되는 주장이 포함되도록 선호되며, 이는 초안에 들어가는 것에 대한 규칙이지 그것이 사실이라는 발견이 아닙니다. 단일 초안에서 발견된 자료는 검증 가능한 인용을 포함할 때 유지됩니다. 갈등은 증거로 해결되거나 텍스트에 표시됩니다. 초안 간의 동의는 동의로 기록되며 절대 증명으로 승격되지 않습니다. 새 자료는 통합자가 직접 검증하는 경우에만 입력되며 추가된 것으로 표시됩니다. 각 실질적 주장은 그것을 지원하는 초안의 이름을 지정하는 태그를 포함합니다. 통합자는 또한 로그를 작성합니다. 초안이 동의한 것, 동의하지 않은 것과 각 갈등이 어떻게 해결되었는지, 그리고 무엇이 삭제되었고 왜 삭제되었는지입니다. 로그는 불일치가 남아 있는 곳입니다. 레이블 맵이 유지되므로 나중의 독자는 태그를 이에 대해 설정하고 통합자가 자신의 공급업체 초안을 선호한 빈도를 측정할 수 있습니다.
단계 3. 내부 검증. 통합자의 계열에서 온 비평가가 합병된 문서를 새로운 맥락에서 읽으며, 통합에 대한 기억이 없습니다. 이것의 과제는 검증이며 개선된 문서를 반환하지 않습니다. 모든 인용의 존재와 정확성을 확인하고, 추론의 공백과 과장을 검사하며, 과제 진술서가 충족되었는지 확인하고, 중대, 주요, 경미로 순위가 지정된 결과를 보고합니다. 판정: 승인, 수정하여 승인, 또는 거절.
단계 4. 공급업체 간 검증. 다른 공급업체에서 온 비평가가 동일한 문서와 첫 번째 보고서를 읽습니다. 각 발견을 확인, 이의 또는 확장하고, 자신의 것을 추가하며, 최종 판정을 제시합니다. 이 단계는 앞의 두 단계의 약점 때문에 존재합니다. 자신의 계열에 의해 검증된 통합자는 그 계열의 맹점을 공유하며, 다른 곳에서 훈련받은 독자가 가장 직접적인 경로입니다.
파이프라인에서 나가는 것.
산출물은 통합된 문서, 통합 로그, 두 가지 검증 보고서, 그리고 매니페스트입니다. 어느 단계도 비평가의 출력으로 문서를 덮어쓰지 않습니다. 한 사람이 보고서를 읽고 어떤 수정을 적용할지 결정합니다. 소송에서는 제출물에 서명하는 사람이 그 내용에 대해 책임이 있으며, 텍스트를 자동으로 수정하는 파이프라인은 누가 무엇을 결정했는지 불명확하게 만들 것입니다.
매니페스트는 모든 단계에 대해 모델 식별자, 프롬프트 해시, 출력 해시, 시작 시간 및 소요 시간과 레이블 맵을 기록합니다. 이것이 없으면, 이런 방식으로 준비된 문서는 단일 모델에게 두 번 질문하여 생성된 문서와 구별할 수 없습니다. 이것이 있으면, 현장에 있지 않던 독자가 운영자의 실행 기록을 감사할 수 있습니다: 어떤 식별자가 어떤 역할로 구성되었는지, 초안에 어떤 순서로 레이블이 붙여졌는지, 각 단계가 무엇을 받고 반환했는지를 말입니다. 이것은 증거가 아닌 구조화된 자가 보고입니다. 식별자는 인증된 응답이 아닌 구성에서 나오며, 손으로 실행한 단계는 인터페이스에서 무엇이 일어났는지에 대한 운영자의 말을 포함하고, 검색 도구가 제공되었다는 기록은 출처가 확인되었다는 기록이 아닙니다. 관찰된 변수를 보고된 것보다는 것으로 만드는 것은 실행에 대한 제3자 보관을 취하는 것이며, 이는 VII부의 설계가 제공하는 것이고 파일 형식이 할 수 없는 것입니다.
참고 구현.
참고 구현인 docprep은 개방형 라이선스(주석 25)로 공개되어 있습니다. 표 6의 구성, 매니페스트 형식, 그리고 계정이나 키 없이 실행되는 오프라인 테스트를 포함하는 한 파일의 약 500줄 파이썬 코드입니다.
구현은 강제하는 것과 요청하는 것을 분리합니다. 네 가지 역할 규칙은 강제됩니다. 생성기의 프롬프트는 작업 설명만으로 조립되며, 초안은 순서를 섞고 재레이블하여 통합자에게 도달하고, 맵은 매니페스트에만 기록됩니다. 첫 번째 평가자가 통합자의 제품군 밖에 있거나 마지막 평가자가 제품군 안에 있는 구성은 모델이 호출되기 전에 거부됩니다(그림 10). 2단계의 병합 규칙은 요청일 뿐입니다. 이는 통합자의 프롬프트의 지시사항이며, 모델은 이를 어길 수 있습니다. 로그 없이 반환된 통합이 실행을 중단하므로 하나는 나중에 확인됩니다.
그림 10. 실행의 사전조건으로서의 역할 규칙: 종료 평가자에 대한 확인 및 그것이 인쇄하는 거부.
home = family(cfg, cons) # the consolidator's vendor family
. . .
if critics and family(cfg, critics[-1]) == home:
problems.append(f"{critics[-1]['name']} is from the consolidator's family "
f"({home}); the last reader must come from another vendor")
. . .
if problems and enforce:
sys.exit(f"formula '{formula_name}' breaks the protocol:\n - "
+ "\n - ".join(problems))
$ python3 docprep.py run --formula manual
formula 'manual' breaks the protocol:
- critic_cross is from the consolidator's family (anthropic);
the last reader must come from another vendor
출처: docprep, docprep.py, validate() 함수, 버전 v1.0.0(주석 25); 생략 표시. 코드 아래는 종료 평가자가 통합자의 제품군으로 재할당된 예시 구성에서 실행된 명령의 출력입니다. 저장소의 오프라인 테스트는 동일한 거부를 주장합니다.
강제는 매니페스트가 가지는 한계를 가집니다. 역할의 제품군은 구성에서 선언되며, 인증되지 않습니다. 수동으로 실행된 단계는 운영자의 말에 맹목적이고 새롭습니다. 재레이블은 이름을 제거하지만 스타일은 제거하지 않습니다. 그리고 거부는 꺼질 수 있으며, 이 경우 매니페스트는 그것이 되었으며 위반된 규칙을 나열하도록 기록합니다. 규칙은 운영자의 실수에 대해 강제되며, 운영자에 대해서는 아닙니다.
법적 범위.
오류 상관관계를 낮추기 위해 공급업체를 추가하는 아키텍처는 동시에 자료가 나가는 장소의 수를 증가시킵니다. 미국 법원에서 자신을 대리하는 소송 당사자에게 그 거래는 추상적이지 않습니다.
2026년 9월 현재 미국의 입장은 세 부분으로 나뉩니다: 제출자가 공개해야 할 사항, 공급업체에 보낼 수 있는 것, 그리고 그 업무가 작업 산물로 존속하는지 여부입니다. 제2부와 표 1은 공개 체계를 담고 있으며, 제VI.A부는 작업 산물 분석 및 그 근거를 담고 있습니다. AI 사용을 공개하거나 모델 이름을 밝혀야 하는 일반적으로 적용 가능한 연방 절차 규칙은 없습니다. 2026년 4월 민사 규칙 자문 위원회는 허위 판례 인용을 다루는 두 가지 제안을 의제에서 제외했으며, 당시 규칙 제정이 적절하지 않다고 합의했습니다.27 지역 규칙과 개별 상거 명령은 이를 요구하며, 그들은 다릅니다. 텍사스 북부 지구는 소장의 첫 페이지에 AI 사용 사실을 요구하지만 어떤 모델인지는 묻지 않습니다. 국제 무역 법원의 Vaden 판사는 사용된 프로그램, 그것이 생성한 텍스트의 구체적인 부분, 그리고 해당 사용이 비인가 당사자에게 기밀 정보나 영업상 비밀 정보를 공개하지 않았음을 인증할 것을 요구합니다.28
2026년 봄의 두 가지 규칙 제정 조치는 혼동하기 쉬우며, 그 혼동은 답변을 바꿉니다. 민사 규칙 자문 위원회는 존재하지 않는 판례를 인용하는 것을 다루기 위해 규칙 11을 수정하는 두 가지 제안을 검토했으며, 당시 규칙 제정이 적절하지 않다고 합의했고, 2026년 4월 14일에 항목을 제외했습니다. 3주 후 증거 규칙 자문 위원회는 AI 사용의 공개가 아니라 기계 생성 증거의 허용 가능성을 다루는 연방 증거 규칙 707을 검토했으며, 초안을 개정하고 계속 검토하기로 하여 이를 진행하지 않았습니다. 첫 번째 조치는 제출자가 인증하는 것에 관한 것이고, 두 번째는 법원이 허용할 수 있는 것에 관한 것이며, 어느 쪽도 공개 의무를 만들지 않습니다. 이 둘은 기록 자체에서 연결되어 있으며, 이것이 그들이 하나로 읽히는 이유입니다. 4월 민사 규칙 위원회 결의서는 규칙 707의 초안을 인용하고 있으며, 그 회의록은 증거 규칙 위원회가 해당 규칙을 검토 중이었음을 언급합니다.
상대방이 기밀로 지정한 자료가 더 어려운 경우이며, 이는 이 아키텍처에 직접 도달합니다. Morgan 사건에서 법원은 자신을 대리하는 피고인이 공급업체가 계약상 입력 내용을 저장하거나 모델 훈련 또는 개선에 사용하지 않고, 서비스 제공에 필수인 경우를 제외하고 제3자에게 공개하지 않으며 수령자가 동등한 보호로 구속되고, 요청 시 이를 제거하거나 삭제하도록 계약상 구속되는 경우에만 그러한 자료를 AI 서비스에 넣도록 허용했습니다. 법원은 제출자가 해당 자료와 관련하여 사용된 모든 도구를 밝히고 이러한 보호 조치를 서면으로 기록하도록 요구했습니다. 법원은 그 조건이 대부분의 주류 저비용 또는 무료 AI를 배제한다고 지적했습니다. 이것들은 국가 규칙이 아니라 하나의 보호 명령의 조건이며, 저자가 찾은 가장 제한적인 것입니다. 이 프로토콜은 이들을 자신의 설계 정책으로 채택합니다.
세 가지 제약이 따릅니다. 이들은 이 프로토콜의 설계 규칙이며, 소송 당사자에게 법이 요구하는 것에 대한 진술이 아닙니다.
1. 공개 제출물과 운영자가 전송할 자유가 있는 자료는 모델로 갈 수 있습니다. 봉인된 자료, 보호 명령 대상 자료, 그리고 상대방의 기밀 발견 자료는 명령이 허용하고 공급업체 약관이 Morgan이 부과한 조건을 충족하지 않는 한 그렇지 않습니다. 제한은 발생기뿐 아니라 모든 단계와 모든 수령자를 포함합니다: 통합자와 두 비평가 모두 병합된 초안을 받으며, 유지된 아티팩트는 이를 따라 이동합니다. 문서의 소유권이 그에 첨부된 기밀 유지 의무를 자동으로 해제하지는 않습니다. 명백한 내용은 노출을 감시할 수 있게 합니다. 이것이 그것을 합법적으로 만드는 것은 아닙니다.
2. 명백한 내용은 공개를 지원합니다. 이것이 공개 자체는 아닙니다. 어떤 모델 식별자가 어떤 아티팩트를 생성했고 언제인지 기록하며, 이는 프로그램 사용을 요청하는 법원이 원할 자료이며, 담당 판사가 요청하든 아니든 유지할 가치가 있습니다. 상거 명령이 요구하는 통지를 제출하지 않으며, Judge Vaden의 규칙과 같은 규칙이 도달하는 최종 문서의 부분을 식별하거나, 어떤 인증도 제공하지 않습니다.
3. 모든 인용의 출처에 대한 검증은 사람이 수행합니다. 규칙 11(b)은 그 조건에 따라 미표현 당사자에게 도달하며, 그 기준은 특정 절차가 아니라 상황에 따른 합리적 조사입니다. 제2부는 기조된 인용 기록이 보여주는 것을 설정합니다. 모델 간의 합의와 두 비평가의 승인은 검증이 아닙니다.
요건은 지구와 판사에 따라 다르며, 담당 판사의 상거 명령이 적용됩니다.
한계.
소비자 인터페이스의 심층 연구 모드는 공급업체 API에서 정확한 동등물이 없습니다. 이를 필요로 하는 단계는 수동으로 실행됩니다. 프롬프트는 파일에 작성되고, 운영자가 인터페이스에서 실행한 후 답변을 다시 붙여넣으며, 매니페스트에서 해당 단계가 그렇게 실행되었음을 기록합니다. 그 폴백은 수동이며, Part II에서는 여러 인터페이스 전반에 걸친 수동 워크플로우가 운동 또는 시각 장애가 있는 소송당사자에게 단순히 더 느린 것만이 아닌 이유를 설명합니다. 이에 의존하는 프로토콜은 그 한계를 상속합니다.
모델 간의 일치는 진실만큼이나 상관관계의 증거입니다. 겹치는 말뭉치에서 학습된 모델들은 오류를 공유하며, 만장일치의 초안 집합은 함께 틀릴 수 있습니다. 프로토콜은 도달할 수 있는 상관관계를 낮추고 나머지를 기록합니다.
프로토콜은 단일 모델 프롬프팅과 비교되지 않았습니다. 그 가치를 결정할 비교는 맹검 평가입니다. 동일한 작업이 두 가지 방식으로 준비되고, 결과 문서가 어느 것이 어느 것인지 알지 못하는 독자들에 의해 인용 정확도, 작업 설명에 대한 완전성, 법원이 주목할 오류에 대해 채점됩니다. 프로토콜이 여기에 명시되어 있으므로 이 비교를 실행할 수 있습니다.
위에 명명된 저장소는 파이프라인, 구성 및 오프라인 테스트를 포함합니다.
선택된 참고문헌 및 권위
ABA Model Rules of Professional Conduct r. 5.5.
Americans with Disabilities Act, 42 U.S.C. §§ 12181--12188.
Ashley, Kevin D., Artificial Intelligence and Legal Analytics: New Tools for Law Practice in the Digital Age (Cambridge Univ. Press 2017).
Avery, Joseph J., Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).
Blanck, Peter, eQuality: The Struggle for Web Accessibility by Persons with Cognitive Disabilities (Cambridge Univ. Press 2014).
Cappelletti, Mauro & Bryant Garth, Access to Justice: The Newest Wave in the Worldwide Movement to Make Rights Effective, 27 Buff. L. Rev. 181 (1978).
Carpenter, Anna E., Colleen F. Shanahan, Jessica K. Steinberg & Alyx Mark, Judges in Lawyerless Courts, 110 Geo. L.J. 509 (2022).
Centers for Disease Control and Prevention, 장애는 우리 모두에게 영향을 미칩니다 (2022 BRFSS data).
Chan, Chi-Min, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu & Zhiyuan Liu, ChatEval: Towards Better LLM-Based Evaluators Through Multi-Agent Debate, arXiv:2308.07201 (2023).
Charlotin, Damien, AI 환각 사례 데이터베이스, https://www.damiencharlotin.com/hallucinations/ (2026년 9월 마지막 방문).
Chernets, Vadym, docprep: A Reference Implementation of the Blind-Consolidation Protocol, release v1.0.0 (2026), https://github.com/vadimchernets/docprep (MIT license; the protocol specified in the Appendix, and the code that runs it).
Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) (공개 도킷); PolyHelper.AI LLC v. United States of America, No. 1:25-cv-07770 (S.D.N.Y. 2025) (이전 소송, 다른 피고).
Cohen-Sasson, Or, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (2026년 근간).
Du, Yilun, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.
Engstrom, Nora Freeman & Aviv Caspi, Opening the Courthouse Door---or Just Lowering the Threshold?, JOTWELL: Legal Profession (2026년 7월 3일).
Fed. R. Civ. P. 26(b)(3).
Greiner, D. James, Cassandra Wolos Pattanayak & Jonathan Hennessy, The Limits of Unbundled Legal Assistance: A Randomized Study in a Massachusetts District Court and Prospects for the Future, 126 Harv. L. Rev. 901 (2013).
Grimm, Paul W., Maura R. Grossman & Gordon V. Cormack, Artificial Intelligence as Evidence, 19 Nw. J. Tech. & Intell. Prop. 9 (2021).
Guha, Neel 등, LegalBench: 대규모 언어 모델의 법적 추론 능력을 측정하기 위한 협력 기반 벤치마크, Advances in Neural Information Processing Systems 36 (2023).
Hadfield, Gillian K., Rules for a Flat World: Why Humans Invented Law and How to Reinvent It for a Complex Global Economy (Oxford Univ. Press 2017).
Hannaford-Agor, Paula, Scott Graves & Shelley Spacek Miller, 주(State) 법원의 민사 소송 현황 (National Center for State Courts 2015).
Hickman v. Taylor, 329 U.S. 495 (1947).
Katz, Daniel Martin, Michael James Bommarito, Shang Gao & Pablo Arredondo, GPT-4 Passes the Bar Exam, 382 Phil. Trans. R. Soc. A 20230254 (2024).
Legal Services Corporation, The Justice Gap: 저소득층 미국인의 충족되지 않은 민사 법률 서비스 필요 (2022).
Liang, Tian, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (2024).
Magesh, Varun, Faiz Surani, Matthew Dahl, Mirac Suzgun, Christopher D. Manning & Daniel E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford HAI (2024).
Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).
뉴욕주 변호사협회, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026).
Park v. Kim, 91 F.4th 610 (2d Cir. 2024).
Sandefur, Rebecca L., Access to What?, 148 Daedalus 49 (2019).
Shah, Anand V. & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859.
Sharma, Mrinank, et al., Towards Understanding Sycophancy in Language Models, ICLR (2024).
Simshaw, Drew, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).
Surden, Harry, Machine Learning and Law, 89 Wash. L. Rev. 87 (2014).
저자와 함께 보유 중인 시스템 문서입니다.
U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (2026년 3월 3일).
United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. 2026년 2월 17일).
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. 2026년 2월 10일).
* AI 시스템 아키텍트입니다. 저자의 역할(소송 당사자, 시스템 개발자 및 분석가)은 아래의 저자 공개 성명에 기재되어 있습니다. 의견을 환영합니다: [email protected].↩︎
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022), https://justicegap.lsc.gov. 일반적인 자력 구제의 규모에 관해서는, 선도적인 다중 관할권 연구에서 민사 사건의 3분의 2 이상에서 최소 한 당사자가 자력으로 대리되었습니다. See Paula Hannaford-Agor, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts iv (National Center for State Courts 2015).↩︎
Anand V. Shah & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859 (450만 건 이상의 비수감자 연방 민사 사건, 2005회계년도–2026회계년도 및 4,600만 건의 매칭된 PACER 도킷 항목 분석); 참고 Or Cohen-Sasson, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).↩︎
Chief Judge Patrick J. Schiltz (D. Minn.), quoted in Mattathias Schwartz & Zach Montague, Artificial Intelligence Floods Court Dockets with Home-Brewed Lawsuits, N.Y. Times (May 25, 2026).↩︎
Drew Simshaw, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).↩︎
See, e.g., Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023); Park v. Kim, 91 F.4th 610 (2d Cir. 2024).↩︎
Letter from Andrew J. Dietderich, Sullivan & Cromwell LLP, to Chief Judge Martin Glenn, U.S. Bankruptcy Court, S.D.N.Y. (Apr. 18, 2026) (일부 AI "환각"을 포함한 "부정확한 인용 및 기타 오류"에 대해 사과하며, 이는 Prince Global Holdings Ltd.의 15장 절차에서 4월 9일 긴급 신청에 포함되었습니다.); see Sullivan & Cromwell Apologizes to Judge for AI Hallucinations, Bloomberg Law (Apr. 21, 2026).↩︎
AI Hallucination Cases Database (Damien Charlotin), https://www.damiencharlotin.com/hallucinations/ (2026년 7월 2일 스냅샷): 전 세계적으로 문서화된 1,668건의 사건 중 975건은 자력으로 대리된 소송당사자와 관련이 있었고 653건은 대리인과 관련이 있었습니다. 2023년에는 약 10명 중 7명이 자력으로 대리된 소송당사자와 관련이 있었으며, 새로 문서화된 조사 결과에 대한 대리인의 점유율은 2025–2026년에 걸쳐 꾸준히 상승했습니다.↩︎
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026); 2026년 Georgetown Journal of Legal Ethics의 AI 및 무허가 법률 실무에 대한 해설도 참고하시기 바랍니다.↩︎
See Law360 Pulse, Tracking Federal Judge Orders on Artificial Intelligence (last visited July 2026); Legal AI Governance, Federal and State Court Orders on AI, https://legalaigovernance.com/tracker/court-orders/ (last visited July 2026).↩︎
See How Courts Are Coping with a Flood of AI-Generated Lawsuits, MIT Technology Review (June 4, 2026) (2022년 이전에는 대략 연간 45건, 2024년에는 1,100건 이상으로 증가한 Vermont의 자력으로 대리된 당사자의 소장 제출에 관해, 특히 보고함).↩︎
이 사건 연구의 소장에서 시스템을 이러한 용어로 특성화합니다. 프레이밍은 원고의 법적 이론으로 주목되며, 실질적인 판단이 아닙니다. 영향을 받는 인구의 규모에서 미국 성인 4명 중 1명 이상(7,000만 명 이상)이 2022년에 장애를 보고했습니다. CDC, Disability Impacts All of Us (2022 BRFSS data), 그리고 2025년 장애인의 고용–인구 비율은 22.8%였으며, 장애가 없는 사람의 경우 65.2%였습니다. U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics — 2025, USDL-26-0364 (Mar. 3, 2026).↩︎
Yilun Du, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.↩︎
See, e.g., Tian Liang, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP 2024) 17889; Chi-Min Chan et al., ChatEval: Towards Better LLM-Based Evaluators through Multi-Agent Debate, arXiv:2308.07201 (2023).↩︎
원고의 이의 제출이 이러한 개발 중 하나를 기록에 제출했으며, 한 피고인이 공개적으로 발표한 교차 제공자, 다중 모델 합의 기능을 주목했습니다. See Plaintiff's Opposition, ECF No. 76.↩︎
시스템 기술 문서(설계 목적으로만 인용).↩︎
이 아키텍처는 저자가 명명된 신청자인 국제 특허 출원 제품군의 주제입니다. 이 제품군은 소송의 공개 기록에 문서화되어 있으며(Plaintiff's Opposition, Ex. 3 참고), 그 식별자는 분석과 무관하므로 여기에서 생략됩니다.↩︎
Joint Motion to Dismiss and Memorandum in Support, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), ECF Nos. 69, 69-1; Plaintiff's Memorandum of Law in Opposition, ECF No. 76 (Apr. 2, 2026); Transcript of Pre-Motion Conference, ECF No. 55 (Jan. 27, 2026).↩︎
ECF Nos. 28 (동의 신청), 30, 32--34, 36--37 (2026년 1월 12일). 이 문서들은 서로 조정되었으며, 한 피고는 공동 피고인들의 사전 신청 문서에 제시된 근거와 주장을 명시적으로 채택했습니다.↩︎
ECF Nos. 39--44 (2026년 1월 15--16일).↩︎
공동 기각 신청 지지 의견서, ECF No. 69-1과 피고인의 반박 의견서, ECF No. 76, 17쪽을 비교 참조.↩︎
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026) (Patti, M.J.); United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026) (Rakoff, J.); Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).↩︎
Morgan v. V2X, Inc., 2026 WL 864223, at *3 (D. Colo. Mar. 30, 2026).↩︎
ABA 변호사 윤리 모범 규칙 r. 5.5; Joseph J. Avery, Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024) 참조.↩︎
이 논문은 공개적으로 제출된 문서와 이미 피고인과 공중에 공개된 건축학적 특징만을 설명합니다. 사용된 프롬프트, 특정 질문에 대한 시스템의 의사결정 논리, 그리고 모든 초안 작업 산출물은 제외합니다.↩︎
docprep, 블라인드 통합 프로토콜의 참조 구현, https://github.com/vadimchernets/docprep (MIT 라이선스); 여기서 설명하는 버전은 릴리스 v1.0.0입니다. 저장소는 한 파일의 실행 가능한 파이프라인, 표 6의 구성, 매니페스트 형식, 계정이나 키 없이 실행되는 오프라인 테스트를 보유하고 있으며, 이 부록을 CC BY 4.0 하의 독립형 명세서로 포함합니다. 모델 식별자와 접근은 운영자의 자체 계정에 맞게 구성되어야 합니다.↩︎
민사규칙자문위원회, 2026년 4월 14일 회의 초안 회의록, 18쪽, 민사소송규칙위원회, 의제서 383 (2026년 6월 3--4일)에 재인쇄됨 (항목 17, "인공지능 환각"); 민사규칙자문위원회, 의제서 438--50 (2026년 4월 14일) (제안 25-CV-S 및 25-CV-V, 둘 다 규칙 11에 관한 것) 참조; 민사규칙자문위원회 보고서 60쪽 (2026년 5월 6일), 의제서, 위의 364쪽 참조 (의제에서 제외된 사항). 회의록은 위원회의 2026년 가을 회의에서의 승인 대기 중 초안 상태입니다. 공개가 아닌 기계 생성 증거의 허용성을 규율하는 제안 연방증거규칙 707은 별개 사항입니다: 증거규칙자문위원회는 2026년 5월 7일에 이를 수정했으며 진척시키지 않고 계속 검토 중입니다.↩︎
N.D. Tex. Civ. R. 7.2(f) (작성 의견서의 첫 페이지에 생성형 인공지능 사용 공개, 담당 판사가 지시하는 경우 이를 통해 작성된 부분의 추가 공개 포함); 인공지능 명령, 국제무역법원 (Vaden, J.) (2023년 6월 8일) (사용된 프로그램의 식별, 이를 통해 생성된 텍스트의 특정 부분의 식별, 그리고 사용이 권한 없는 당사자에게 기밀 또는 사업상 독점 정보를 공개하지 않았음을 인증하도록 요구).↩︎
인용 방법
Chernets, V. (2026). 인공지능 보조 소송에서 누락된 변수: 아키텍처와 준소송인 사건 접근의 정의 품질 [전인쇄본]. SSRN. https://doi.org/10.2139/ssrn.7120940
@misc{chernets2026missingvariable,
  author       = {Chernets, Vadym},
  title        = {{The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7120940},
  url          = {https://doi.org/10.2139/ssrn.7120940}
}