A Variável Ausente em Litígios Assistidos por IA: Arquitetura e a Qualidade do Acesso à Justiça para Pro Se
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7120940 · DOI 10.2139/ssrn.7120940 · Zenodo 10.5281/zenodo.22168724 · GitHub
- Versão do registro: SSRN 7120940 · DOI 10.2139/ssrn.7120940
- Cópia arquivada, citável e baixável: 10.5281/zenodo.22168724 — DOI de conceito, sempre resolve para a versão mais recente
- Texto completo em Markdown e PDF: GitHub
- HTML legível: https://polyhelper.ai/research/missing-variable/
O mesmo texto está em quatro plataformas para que possa ser acessado quando uma delas não puder servir. SSRN mantém a versão do registro; cite aquela.
A Variável Ausente em Litígios Assistidos por IA
Arquitetura e a Qualidade do Acesso à Justiça para Pro Se
Vadym Chernets, PhD1
Publicado pela primeira vez em julho de 2026; esta versão setembro de 2026
DECLARAÇÃO DE DIVULGAÇÃO DO AUTOR
O interesse do autor neste artigo é triplo, e cada aspecto é material. Primeiro, o autor é a parte autora em Chernets v. Google LLC et al., nº 1:25-cv-05691-RER-RML (E.D.N.Y.), o litígio que serve como estudo de caso. Segundo, o autor é o desenvolvedor do sistema de orquestração multi-modelo cujo uso é examinado aqui, e é requerente nomeado em aplicações internacionais dentro da família de patentes descrita na Parte III; o autor, portanto, tem interesse nos métodos que este artigo analisa. Terceiro, o autor é o analista. As restrições metodológicas estabelecidas na Parte IV governam a análise: confiança exclusiva no protocolo federal público, nenhuma inferência sobre motivos de acordo, e tratamento não-probatório das métricas de desempenho auto-relatadas do sistema. A Parte VII apresenta os limites.
Dois parágrafos, um na Parte II e outro no Apêndice, são as próprias palavras do autor sobre por que construiu o sistema e por que processou; estão marcados como suas, e nenhuma conclusão repousa sobre eles. Caso contrário, este artigo baseia-se exclusivamente no protocolo federal público e em fontes publicamente disponíveis; não divulga estratégia de litígio privilegiada relativa a reivindicações que permanecem pendentes contra os réus que não celebraram acordo. O autor não é advogado. Assistentes de IA foram usados como instrumentos sob a direção do autor; as ideias, pesquisa e conclusões são do autor.
RESUMO
Quase todos os relatos sobre IA em litígios repousam sobre uma suposição não declarada: que a assistência de IA é uma coisa. O debate que essa suposição produz é sobre volume e fabricação: uma taxa de autores pró-se federais aumentando de 11% para quase 17%, tribunais descrevendo uma "ameaça existencial", um acervo crescente de decisões de sanções sobre citações fabricadas. O que os estudos agregados ainda não conseguem mostrar é se alguma configuração de assistência de IA muda a qualidade do que litigantes auto-representados fazem. O registro utilizado aqui é o protocolo público de um caso federal, e ele contém um padrão que a narrativa de volume e alucinação não prevê. Um litigante auto-representado sem advogado de nenhuma espécie, utilizando, segundo o relato do autor, um sistema de orquestração multi-modelo (modelos independentes consultados em paralelo, discordância identificada em vez de eliminada pela média, citações verificadas em relação a fontes externas), respondeu a seis cartas de pré-moção coordenadas em quatro dias, apresentou uma oposição substantiva seis semanas antes do prazo, e identificou um erro de citação estatutária verificável em uma petição apresentada por sete réus representados por advogados de firmas líderes, em um caso nomeando treze réus de tecnologia. A última das três é o inverso do modo de falha que domina a literatura. O Artigo propõe a hipótese de dependência de arquitetura: a arquitetura da assistência de IA, prompts de modelo único versus orquestração multi-modelo, é uma variável empírica na qualidade da litígação auto-representada por direito próprio, não um detalhe de implementação e não a mesma coisa que a disponibilidade de IA. As consequências doutrinais abordadas aqui são para a doutrina de trabalho executado, onde os tribunais federais se dividiram no início de 2026, e para o marco regulatório de prática não autorizada. O caso é oferecido como prova de existência falsável e uma agenda de pesquisa; o autor é o demandante, o desenvolvedor do sistema e o analista.
Palavras-chave: litígios pró-se; litigantes auto-representados; acesso à justiça; litígios assistidos por IA; IA generativa; debate multi-agente; orquestração multi-modelo; citações fabricadas; verificação de citações; doutrina de trabalho executado; divulgação; ordens permanentes; Regra 11; prática não autorizada da profissão jurídica; Título III; hipótese de dependência de arquitetura. Classificação JEL: K41 (Processo de Litígios); K10 (Áreas Básicas de Direito, Geral); O33 (Mudança Tecnológica: Escolhas e Consequências). # Sumário
I. Introdução 4
II. A Lacuna de Acesso à Justiça e a Virada da IA Pró-se 6
III. De Prompts de Modelo Único para Orquestração: O Exoesqueleto Cognitivo 11
IV. Método e Base Probatória 15
V. Constatações 18
A. Reconstrução do Marco Legal Após um Protocolo Inicial Defeituoso 19
B. Resposta à Prática de Pré-Moção Coordenada 20
C. Resposta Oportuna a uma Defesa Consolidada 21
D. Identificação de um Erro de Citação Estatutária no Memorando de Defesa 22
E. Acordos Precoces 23
VI. Implicações Doutrinais 25
A. Trabalho Executado e o Litigante Pró-se 25
B. Prática Não Autorizada da Profissão Jurídica 27
C. Uma Reformulação, Não uma Resolução 29
VII. Limitações e Trabalho Futuro 29
VIII. Conclusão 32
Apêndice. Uma Arquitetura de Assistência, Especificada para Que Possa Ser Executada 34
Referências e Autoridades Selecionadas 42
I. Introdução
Um litigante, treze empresas de IA: o caso examinado aqui comprime em um único protocolo a questão que este Artigo coloca à literatura. A lacuna entre as necessidades legais civis dos americanos e os recursos disponíveis para atendê-las está entre os problemas mais duradouros do sistema de justiça dos EUA. O estudo nacional mais recente da Legal Services Corporation descobriu que os americanos de baixa renda receberam nenhuma ou ajuda inadequada para noventa e dois por cento dos problemas legais civis que os afetaram substancialmente, com quase três em cada quatro famílias de baixa renda experimentando pelo menos um problema desse tipo em um único ano.2 Para a maioria dos litigantes auto-representados, a barreira não é a taxa de protocolo, mas tudo depois disso: localizar o tribunal correto, identificar a causa de ação operativa, efetuar o serviço em réus corporativos e responder a moções redigidas por advogados experientes sob prazos comprimidos.
Essa população cresceu rapidamente desde que a IA generativa se tornou amplamente disponível. Um estudo empírico recente em larga escala relata que a taxa federal de autores pró-se civis, estável perto de onze por cento por duas décadas, subiu para 16,8 por cento no ano fiscal de 2025 (Figura 1), e que a proporção de reclamações civis federais amostradas apresentando marcadores de texto gerado por IA subiu de praticamente zero em 2019 para mais de dezoito por cento no início de 2026, conforme medido nesse estudo. Essa amostra é extraída de reclamações apresentadas tanto pró-se quanto com advogado, obtidas do arquivo RECAP, que os autores advertem subrepresentar protocolos feitos sem advogado.3
Tribunais e comentaristas reagiram principalmente com apreensão. O então juiz-chefe de um tribunal distrital federal descreveu o problema geral como "uma ameaça existencial aos tribunais federais".4 Associações de advogados alertam que chatbots de consumidor podem transpor para a prática não autorizada da profissão jurídica, e um corpo crescente de decisões de sanções aborda litigantes, representados e não representados igualmente, que apresentam petições citando casos que não existem.
A apreensão é bem fundamentada, mas descreve um modo particular de uso de IA. Ao focar nesse modo, o trabalho empírico existente trata implicitamente a assistência de IA como homogênea, e este Artigo argumenta que a suposição já não é defensável. Os fracassos documentados (autoridade alucinada, concordância aduladora, volume indiferenciado) são característicos de prompts de modelo único: um litigante coloca uma questão para um modelo de propósito geral e apresenta o resultado. Quase toda a imagem empírica do uso de IA pró-se repousa nesse modo.
A arquitetura examinada aqui é uma diferente, e a questão é se essa diferença importa. Na orquestração multi-modelo, uma consulta é despachada simultaneamente para vários modelos independentes e seus resultados são comparados. Concordância e discordância são tornadas explícitas, e divergência, incluindo um sinal minoritário que sinaliza um possível erro, é preservada em vez de ser apagada pela média. A afirmação avançada aqui é estreita, mas, se correta, consequente: os modos de falha de modelo único que animam a preocupação atual podem não ser intrínsecos à litigância assistida por IA, e uma arquitetura de orquestração pode converter o uso de IA de uma fonte de volume em um instrumento de qualidade. A contribuição é metodológica: o Artigo propõe que a arquitetura da assistência por IA seja tratada como uma variável empírica distinta em vez de um detalhe de implementação, e o caso que se segue é oferecido como uma instância documentada motivando essa proposta. A afirmação, em quatro palavras: arquitetura, não disponibilidade.
A afirmação é desenvolvida através de um único estudo de caso, Chernets v. Google LLC et al., uma ação federal em que um único demandante auto-representado, usando (segundo seu próprio relato) um sistema de orquestração multi-modelo, litigou contra um grupo de réus da tecnologia representados por advogados de numerosos escritórios de advocacia. A análise repousa inteiramente no dossiê público: petições, datas e números de documento que qualquer leitor pode verificar. Esse registro mostra conduta que a conta prevalecente de volume-e-alucinação não descreve e que estudos agregados de apresentação assistida por IA não são projetados para detectar: um ciclo completo de argumentação sustentado contra uma defesa coordenada, com seis cartas pré-moção coordenadas respondidas em quatro dias e uma oposição substantiva apresentada semanas antes do prazo, e a identificação de um erro de citação estatutária verificável no parecer da coligação de defesa. Quatro réus fizeram acordo antecipadamente (em termos confidenciais; Parte V.E). O caso permanece pendente, e o propósito de examiná-lo é usar um registro verificável para isolar um fenômeno que, segundo a conta prevalecente, não seria esperado que existisse e que a literatura ainda não examinou de perto.
Um único caso de autoria de uma parte pode estabelecer que um fenômeno ocorreu, não com que frequência ocorre ou se se generaliza; a Parte VII estabelece os limites. O argumento é que a arquitetura da assistência por IA é uma variável independente no estudo da litigância assistida por IA, uma variável que o enquadramento atual, focado em disponibilidade e volume, não isola. Essa é a hipótese de dependência de arquitetura; a Parte IV a declara formalmente.
O Artigo procede da seguinte forma. A Parte II situa o estudo dentro da literatura de acesso à justiça e da bolsa de estudos emergente sobre uso de IA pro se. A Parte III distingue a formulação de modelo único da orquestração e especifica o mecanismo. A Parte IV apresenta o método de estudo de caso e sua base probatória no dossiê público. A Parte V apresenta os achados. A Parte VI examina as implicações para a doutrina do produto de trabalho e o marco de prática não autorizada da lei. A Parte VII aborda limitações e trabalho futuro. A Parte VIII conclui.
II. A Lacuna de Acesso à Justiça e a Volta da IA Pro Se
A lacuna de justiça é uma característica estrutural do sistema civil dos EUA, não uma marginal. Uma grande parcela de americanos de baixa e média renda não recebe ajuda jurídica significativa para seus problemas civis, e em muitas categorias de caso a auto-representação é a norma e não a exceção (Carpenter, Shanahan, Steinberg & Mark 2022). Desde o movimento de acesso à justiça comparativo dos anos 1970 (Cappelletti & Garth 1978), estudiosos enquadraram a questão como uma de distribuição: experiência jurídica é um recurso escasso, distribuído irregularmente, e os litigantes menos capazes de arcar com advogados são frequentemente aqueles com mais em jogo (Sandefur 2019). Essa literatura pergunta o que acesso à justiça é acesso a; a questão perseguida aqui é a qualidade desse algo.
Contra esse pano de fundo, a IA generativa chegou como um desenvolvimento ambivalente. Em uma visão, prometia democratizar a capacidade jurídica, dando aos litigantes desrepresentados um facsímile da pesquisa, redação e análise que o advogado fornece. Essa promessa tomou forma concreta quando um modelo de fronteira passou no Uniform Bar Examination (Katz, Bommarito, Gao & Arredondo 2024), embora parâmetros de desempenho desse tipo tenham mudado as expectativas sobre capacidade sem isolar diferenças arquiteturais. Simshaw alertou cedo que a IA poderia, em vez disso, consolidar um sistema de dois níveis, no qual os bem-dotados de recursos obtêm julgamento humano especializado enquanto todos os outros recebem aproximações automatizadas.5 A imagem empírica que desde então emergiu é mais concreta: analisando milhões de apresentações federais, trabalhos recentes documentam que a taxa de demandantes pro se aumentou acentuadamente após a divulgação pública de IA generativa e desenvolve indicadores de redação consistente com IA nas próprias reclamações. Esse registro agregado ainda não pode mostrar se algo disso deixa os litigantes auto-representados em melhor situação. Como os leitores mais cuidadosos desse estudo observam, conseguir que novos demandantes passem pela porta do tribunal não é o mesmo que ajudá-los uma vez lá dentro (Engstrom & Caspi 2026).
Figura 1. O aumento nos demandantes pro se civis federais após a ampla disponibilidade de IA generativa.
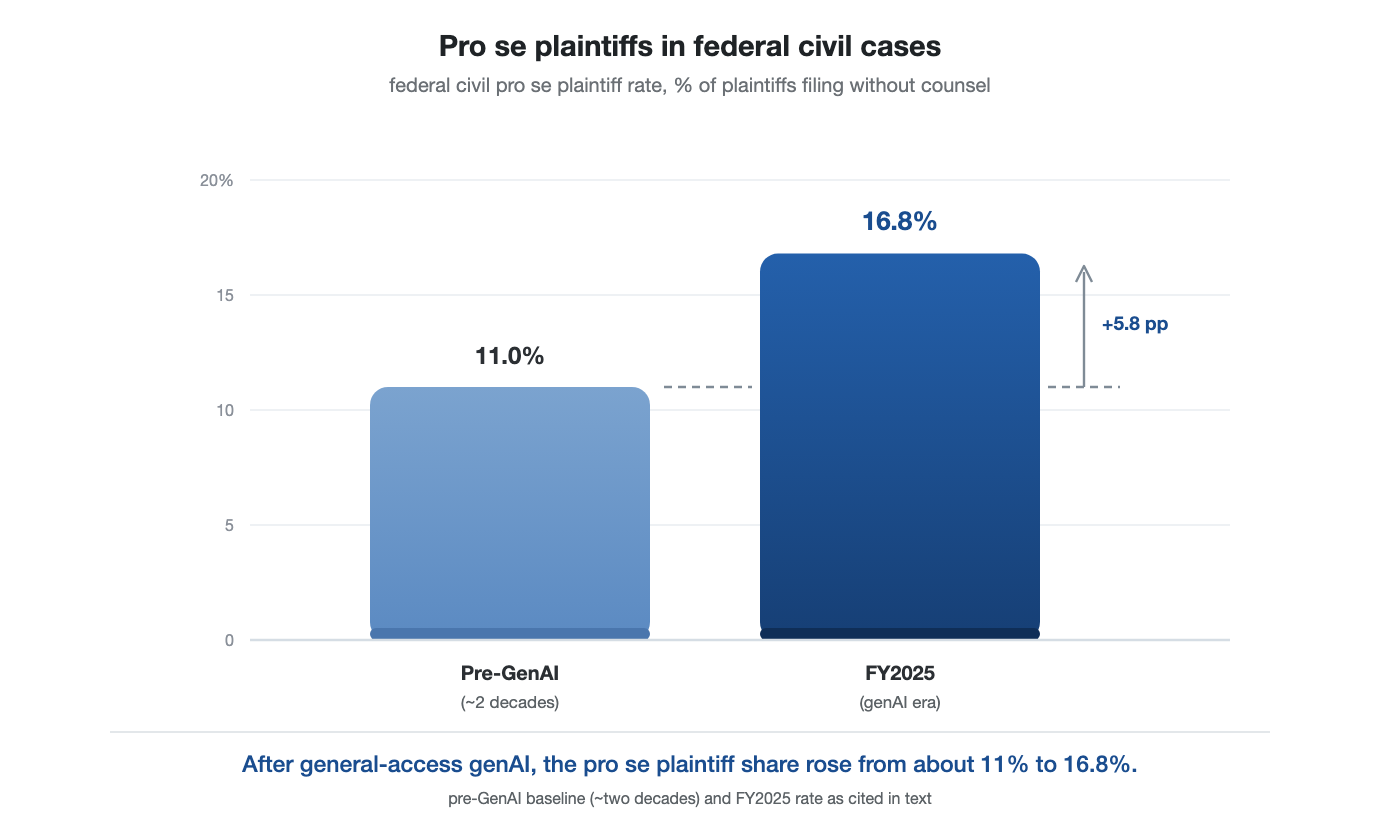
Fonte: Adaptado de Shah & Levy (2026); números arredondados.
A recepção nos tribunais e na advocacia prática tem sido predominantemente cautelosa, e as preocupações se concentram em fabricação, prática não autorizada e volume. Quanto à fabricação, uma linha agora substancial de decisões sanciona litigantes e advogados que apresentam memoriais citando casos que não existem,6 um modo de falha rastreado diretamente para modelos generativos que produzem autoridade plausível mas fictícia. Esse modo de falha produziu um dossiê rastreado de decisões em que um tribunal encontrou, ou considerou como estabelecido, que um protocolo se baseava em material fabricado por IA: mais de dois mil em todo o mundo até setembro de 2026 (Charlotin 2026), e que agora inclui um episódio amplamente divulgado em que uma das firmas mais proeminentes de Wall Street pediu desculpas a um tribunal federal de falência por um protocolo de emergência contendo citações imprecisas e outros erros, alguns deles "alucinações" de IA.7 A composição desse dossiê é em si instrutiva: o que começou predominantemente como um fenômeno de autorepresentação não permaneceu assim. Em meados de 2026, advogados licenciados representavam aproximadamente dois quintos dos incidentes documentados, e sua parcela de constatações recém-documentadas estava crescendo.8 Associações de advogados e comentaristas também se preocupam com a prática não autorizada, questionando se chatbots de consumidor dispensando orientação jurídica cruzam a linha que reserva a prática do direito para advogados licenciados, e se as entidades que os operam podem ser responsabilizadas.9 Quanto ao volume, juízes descreveram um influxo de protocolos pro se assistidos por IA como uma sobrecarga dos recursos judiciais, no enquadramento mais agudo uma ameaça existencial aos tribunais federais.
A resposta judicial assumiu uma forma adicional e reveladora. Desde meados de 2023, juízes federais e estaduais individuais emitiram ordens permanentes abordando IA generativa em suas salas de audiência (rastreadores públicos agora listam centenas, nenhuma igual à outra), exigindo que as partes divulguem se IA foi usada na redação, certificar que as citações foram verificadas, ou ambas.10 As ordens compartilham um design (Tabela 1): elas regulam o fato do uso de IA e a verificação de seu resultado. Arquitetura, seja a assistência de modelo único ou orquestrada, auto-verificável ou não, é a variável isolada aqui, e não aparece em nenhuma das ordens que o autor localizou. Um tribunal aplicando tal ordem ao caso estudado aqui registraria apenas que IA foi usada. Nem o regime de divulgação nem a literatura empírica atualmente tem um vocabulário para como, e essa ausência é a mesma suposição de homogeneidade descrita acima, em forma regulatória.
Tabela 1. O regime emergente de divulgação de IA: o que as ordens permanentes pedem, e o que não pedem.
| O que a ordem pede | Presença no regime |
| IA generativa foi usada na redação? | Rotineiramente exigido |
| As citações e citações diretas foram verificadas? | Rotineiramente exigido |
| Qual ferramenta ou modelo foi usado? | Às vezes exigido |
| A assistência foi de modelo único ou orquestrada (arquitetura)? | Não encontrado em nenhuma ordem localizada |
| O desacordo entre modelos foi exposto e resolvido? | Não encontrado em nenhuma ordem localizada |
Fonte: Rastreadores públicos de ordens permanentes judiciais sobre IA (Law360 Pulse; Legal AI Governance), a partir de julho de 2026; veja nota 9. A caracterização da cobertura é do autor.
Figura 2. A variável ausente: estudos empíricos existentes variam a disponibilidade de assistência de IA; sua arquitetura não é medida.
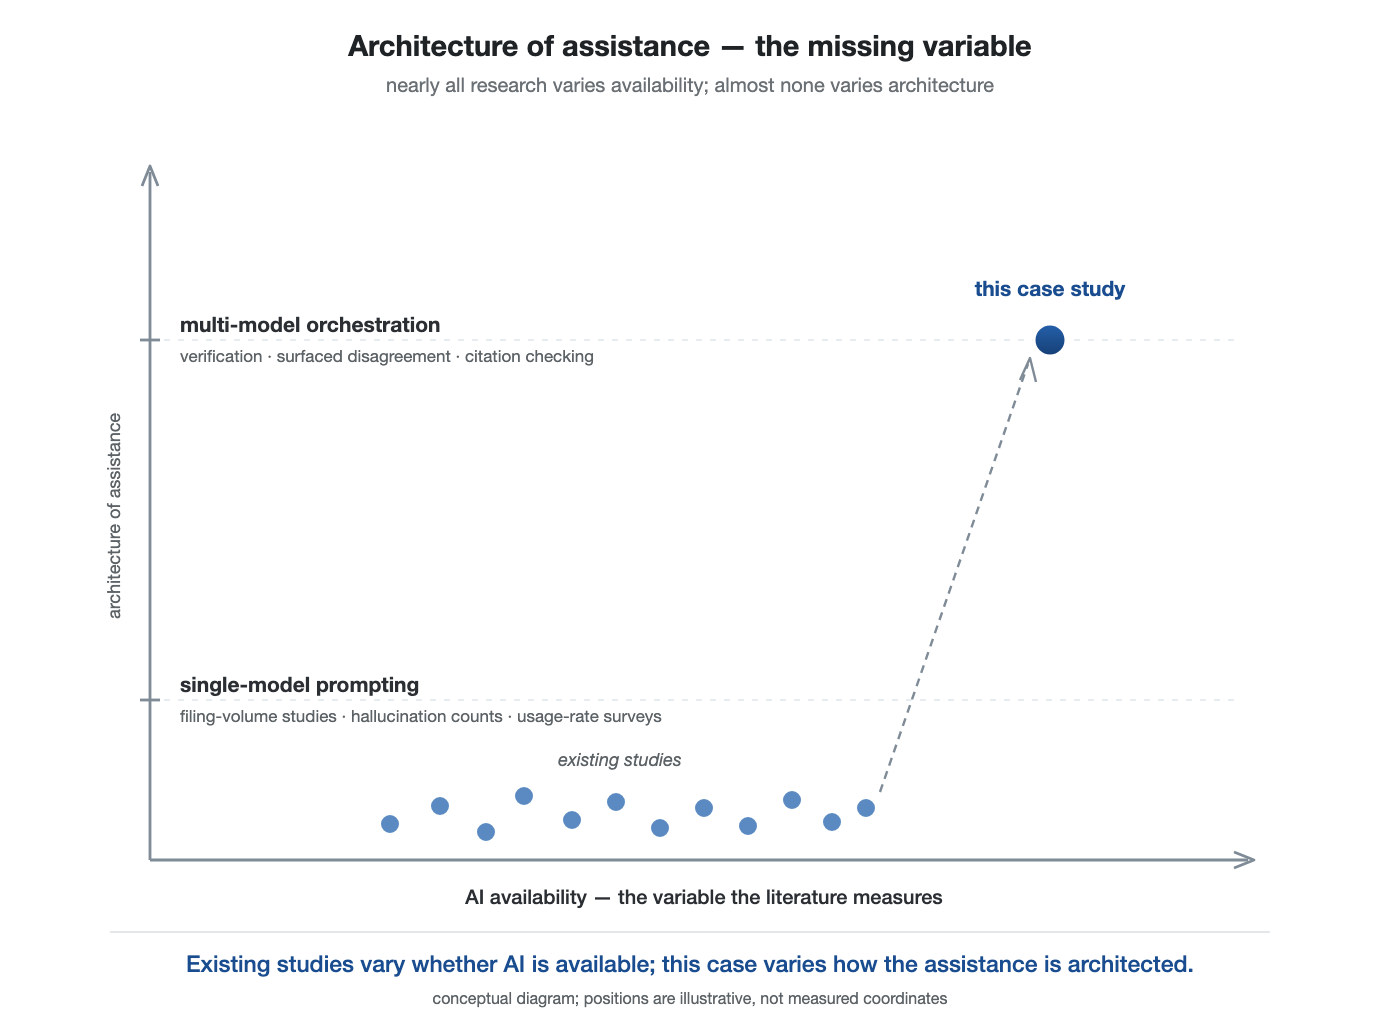
Fonte: Esquema do autor da literatura empírica discutida nesta Parte.
Os dois desenvolvimentos se encontram na questão perseguida aqui. A lacuna de justiça explica por que a autorepresentação é importante: para a maioria dos litigantes a alternativa à autorepresentação é nenhuma representação. O aumento recente da autorepresentação, concomitante com a ampla disponibilidade de IA generativa, explica por que a arquitetura da assistência de IA se tornou uma questão de pesquisa importante em vez de um detalhe incidental. Se litigantes não representados estão agora agindo através de IA em escala,11 então como essa IA é configurada pode moldar a qualidade do que chega aos tribunais, e pode em princípio estreitar a lacuna na capacidade de resolução de problemas entre indivíduos e as instituições que enfrentam.
Um enquadramento adicional muda o que se entende ser a orquestração. Para um usuário com deficiência motora, espinhal ou visual que não consegue operar várias interfaces de navegador ao mesmo tempo, o fluxo de trabalho manual que usuários sem deficiência encontram meramente entediante (abrir cada provedor, colar a consulta, ler, comparar) não é entediante, mas indisponível. O acesso unificado a múltiplos modelos não é uma preferência de produtividade, mas uma questão de modificação razoável (cf. Blanck 2014, sobre acessibilidade web para pessoas com deficiências cognitivas; a extensão para deficiências motoras, espinhais e visuais é do próprio autor). Bloquear a automação assistiva de um fluxo de trabalho que uma pessoa poderia realizar manualmente de outra forma impõe um fardo que recai, por construção, mais pesadamente sobre os usuários menos capazes de realizá-lo manualmente, e para esse usuário a arquitetura transforma um debate sobre prática não autorizada em uma questão de modificação razoável.12
Construí para alguém da minha família que não consegue fazer isso à mão --- que não consegue se arrastar entre abas de navegador. Uma muleta, um cão guia: algo faz a parte que uma pessoa não consegue fazer. Diga uma vez, e está feito. Isso é do que este caso trata.
O que essas preocupações compartilham, e o que este Artigo procura tornar visível, é um modelo implícito de como um litigante que se autorepresenta utiliza IA: uma pessoa, um modelo de propósito geral, verificação mínima, resultado máximo. Não é, porém, a única arquitetura disponível, e a literatura empírica (Figura 2) ainda não examinou casos construídos sobre uma diferente. A literatura acadêmica mede a quantidade de litígios que se autorepresentam auxiliados por IA e a confiabilidade de sua forma mais comum; em grande medida não perguntou se uma arquitetura diferente de assistência produz uma qualidade diferente de conduta litigiosa. A lacuna é abordada aqui fornecendo um caso documentado de perto de um modo de uso que os estudos agregados não isolam.
III. De Prompting de Modelo Único para Orquestração: O Exoesqueleto Cognitivo
O termo "exoesqueleto cognitivo" marca uma distinção que o debate legal-IA tende a confundir. Um exoesqueleto amplifica a pessoa dentro dele; não atua no lugar da pessoa, e é inerte sem a pessoa. Essa distinção entre ampliação e substituição perpassa ambas as questões doutrinárias abordadas na Parte VI. A proteção do produto do trabalho aplica-se naturalmente à ampliação, porque a estratégia protegida permanece sendo própria do litigante, e se aplica desajeitadamente à substituição. O marco de prática não autorizada visa a substituição (uma entidade praticando direito para alguém) e se aplica mal a uma ferramenta através da qual uma pessoa pratica por si mesma. Se um determinado sistema é um ou outro é uma questão de arquitetura e uso, não de rótulos. As preocupações examinadas na Parte II compartilham uma arquitetura implícita. No caso paradigmático de problema, um litigante que se autorepresenta coloca uma questão a um único modelo de propósito geral e submete seu resultado. As patologias que se seguem são, em grande parte, propriedades dessa configuração de modelo único: citações fabricadas, afirmações jurídicas incorretas dadas com confiança, concordância sicofântica com a premissa do usuário (Sharma et al. 2024). Um modelo isolado não tem um adversário interno, nada no pipeline posicionado para contradizê-lo. Seus erros, por mais confiantes que sejam, passam sem contestação. Os modos de falha de modelo único que dominam a literatura não são, nesse sentido, propriedades da inteligência artificial; são propriedades de uma configuração.
Durante décadas, a pesquisa em IA-e-direito perseguiu confiabilidade através de engenharia de conhecimento explícita, codificando raciocínio jurídico em regras e modelos baseados em casos (Ashley 2017), antes da virada do aprendizado de máquina deslocar a questão de codificar regras para aprender padrões (Surden 2014). Um corpo distinto de pesquisa em ciência da computação sugere que essa configuração não é a única disponível, e que seus modos de falha são parcialmente arquiteturais em vez de intrínsecos. Na abordagem comumente denominada debate multi-agente, várias instâncias de modelo geram independentemente respostas e então criticam o raciocínio uma da outra através de rodadas sucessivas antes de convergirem para uma resposta. O estudo fundamental relata que esse procedimento de "sociedade de mentes" melhora a validade factual e reduz as respostas falaciosas e as alucinações às quais os modelos únicos são propensos.13 Trabalhos posteriores estenderam e qualificaram a descoberta, relatando que o desacordo estruturado reduz alucinação em matemática, lógica e referências de resposta a perguntas, enquanto também identificam limites, como retornos decrescentes além de um punhado de agentes e rodadas, e a necessidade de avaliar a qualidade da argumentação intermediária em vez de apenas respostas finais.14 Os domínios de referência importam aqui. Essa literatura valida o desacordo estruturado em grande parte em referências de matemática, lógica e resposta a perguntas, domínios com respostas verificáveis. Se seus ganhos se transferem para o argumento jurídico, onde muitas perguntas carecem de uma única resposta verificável e os modelos podem convergir educadamente para um erro compartilhado, não foi testado, e a transferência é uma suposição do design examinado aqui em vez de um resultado demonstrado.
Para a análise presente, a parte do mecanismo que importa é de onde o ganho de confiabilidade se origina. A hipótese é que o ganho vem das relações entre os modelos em vez de qualquer modelo único ser mais capaz, do desacordo sendo trazido à tona e julgado em vez de suprimido. O valor da orquestração não é mais respostas, mas respostas melhor apoiadas. Um fato que um modelo afirma e outro contesta é o fato que mais necessita de escrutínio, e um procedimento de debate direciona a atenção para ele, enquanto que prompting de modelo único não pode. O mecanismo tem parentes reconhecíveis em outros campos (métodos de conjunto no aprendizado de máquina, códigos de correção de erros na teoria da informação, dissenso estruturado na ciência da deliberação em grupo), que sugere que é uma propriedade geral de sistemas redundantes que preservam o desacordo, em vez de um artefato de qualquer produto.
Tabela 2. Prompting de modelo único versus orquestração de múltiplos modelos, por propriedade de design.
| Propriedade | Prompting de modelo único | Orquestração de múltiplos modelos |
| Adversário interno | Nenhum; resultado incontestado | Modelos se contra-examinam mutuamente |
| Fonte de citações | Gerado a partir de pesos do modelo | Validado em relação a bancos de dados externos |
| Tratamento do desacordo | Não exposto | Preservado; pode desencadear revisão |
| Modo de falha característico | Fabricação, sycofancia | Fabricação reduzida (conforme literatura de debate) |
Fonte: Propriedades de design conforme a literatura de debate multi-agente (p.ex., Du et al. 2024; Liang et al. 2024; Chan et al. 2023) e, para a coluna de orquestração, a documentação do sistema.
O estudo de caso possui uma estrutura reflexiva que, conforme o conhecimento do autor, nenhuma outra litigância até agora compartilha: a tecnologia em disputa é a tecnologia por meio da qual a disputa é conduzida. Vários dos réus desenvolvem modelos que sistemas desse tipo consultam, o sistema de orquestração em questão coordena esses mesmos modelos publicamente disponíveis, e a conduta litigiosa examinada na Parte V ocorreu enquanto essa coordenação estava em uso. Na hipótese apresentada aqui, nenhum modelo individual conferiu a capacidade. Cada um carrega os modos de falha de modelo único descritos acima, e cada réu que desenvolve um modelo constituinte teve, por construção, acesso no máximo a seu próprio modelo constituinte. A configuração que importava era uma relacional: modelos heterogêneos de provedores adversos, consultados em paralelo, verificando um ao outro. A reflexividade realiza trabalho analítico porque mantém a tecnologia componente constante: quaisquer diferenças que o registro revele não podem ser atribuídas unicamente ao litigante ter acesso a modelos componentes melhores do que os réus, uma vez que vários dos modelos componentes eram dos próprios réus; configuração, acesso e habilidade do operador permanecem como explicações abertas. Esta linha de pesquisa também não é externa aos réus. Grandes laboratórios de IA publicaram eles mesmos sobre as vantagens de configurações multi-agente e ensemble sobre modelos únicos, e durante o período estudado moveram-se para comercializar verificação entre modelos em seus próprios produtos.15
Orquestração generaliza o debate multi-agente em um sistema operacional (Figura 3). Enquanto o debate típico executa múltiplas instâncias de um modelo, a orquestração distribui uma consulta entre modelos heterogêneos de diferentes provedores, normaliza suas saídas, calcula um consenso e, criticamente, preserva a divergência como um sinal de primeira classe em vez de calcular a média em uma única resposta. O sistema de orquestração usado no estudo de caso é uma implementação deste padrão: conforme sua documentação técnica, ele incorpora consultas de modelos heterogêneos, formação de consenso, preservação de divergência e verificação de citações contra fontes externas.16
A arquitetura de orquestração em questão é um design especificado e engenheirado. É o objeto de uma família de pedidos de patente pendentes, incluindo várias aplicações internacionais sob o Tratado de Cooperação em Matéria de Patentes apresentadas em 2025 e 2026.17
As duas configurações diferem ao longo de vários eixos de design, resumidos na Tabela 2. Dois desses compromissos são analiticamente significativos. Um é validação de citação contra fontes externas. A falha dominante de modelo único em litigância, o caso alucinado, surge porque um modelo gera citações de padrões aprendidos em vez de recuperá-las, e uma arquitetura que verifica cada citação contra um banco de dados ao vivo, sinalizando em vez de incluir qualquer coisa que não possa confirmar, visa essa falha em sua fonte. O outro é preservação de divergência. Onde modelos discordam sobre uma interpretação legal, um sistema de orquestração pode ser configurado para tratar a discordância como um gatilho para conservadorismo e revisão humana em vez de como ruído a ser resolvido por votação por maioria. Em domínios de alto risco, discordância entre sistemas independentes pode em si constituir informações acionáveis em vez de ruído estatístico: um sinal minoritário indicando um possível erro é retido e elevado. Não é descartado.
Figura 3. O princípio de orquestração: consulta paralela, comparação e preservação de divergência.
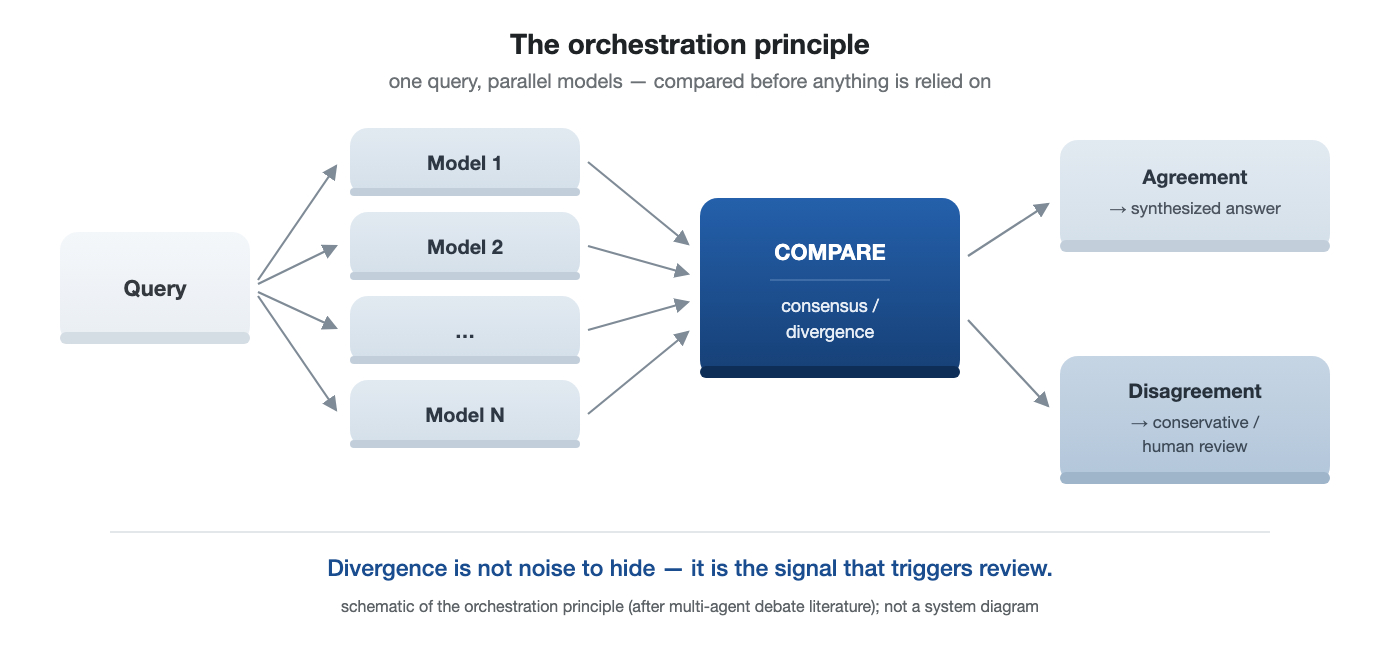
Fonte: Esquema do princípio geral conforme a literatura de debate multi-agente; não é um diagrama de nenhuma arquitetura de produto específica.
O ponto estrutural é que as patologias específicas que tornaram os tribunais cautelosos quanto ao uso de IA pro se são características de prompting de modelo único, e que uma arquitetura de orquestração é dirigida para essas patologias. As falhas documentadas são propriedades de uma configuração. Não são propriedades da assistência de IA como tal. Neste sentido, a arquitetura muda a fonte de confiabilidade de um modelo isolado para relações entre modelos: de inteligência isolada para inteligência coordenada. Nem orquestração é exótica: roteamento comercial e produtos multi-modelo cada vez mais expõem essas mesmas propriedades de design, o que torna a ausência de arquitetura da literatura jurídica empírica ainda mais conspícua. Se essa diferença arquitetônica produz uma diferença em conduta litigiosa observável é uma questão empírica, e o restante do Artigo se volta para um cenário em que pode ser examinado contra um registro verificável.
IV. Método e Base Probatória
O design é um estudo de caso único, uma escolha que reflete a natureza do fenômeno: orquestração multi-modelo em litigância federal ao vivo é atualmente rara, e o objetivo aqui não é estimar sua frequência, mas estabelecer, contra um registro verificável, que um padrão particular de conduta ocorreu e caracterizá-lo. Qualidade, conforme usado ao longo, refere-se à conduta litigiosa observável verificável a partir do registro: cumprimento de prazos, precisão de citação, correção processual, responsividade ao registro e coerência da argumentação apresentada. Não se refere a resultados, que nenhum caso único pode justificar. Um caso desse tipo merece atenção: litigância adversarial do mundo real, com prazos, oponentes e consequências, pode oferecer um cenário mais significativo para observar o raciocínio humano assistido por IA do que apenas avaliação de laboratório. A Parte VII retorna a essa limitação. Dessas dimensões, os achados na Parte V incidem principalmente sobre cumprimento de prazos, correção processual e precisão de citação; a coerência da argumentação apresentada é documentada no registro em vez de ser pontuada independentemente, e nenhum achado depende do resultado de qualquer moção pendente.
A base probatória é independentemente recuperável: cada petição citada neste Artigo é identificada por seu número ECF e pode ser obtida por qualquer leitor diretamente do PACER sob os números de caso abaixo, sem depender do autor. Consiste no registro processual público federal em Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.), juntamente com o registro da ação anterior, No. 1:25-cv-07770 (S.D.N.Y.), que nomeou um réu diferente. A estrutura do caso pode ser apresentada em números, todos verificáveis no registro processual: dos treze réus nomeados, dez compareceram; sete juntaram-se a uma moção conjunta para rejeição; quatro transacionaram e foram dispensados com prejuízo; e seis continuavam litigando em junho de 2026 (Tabela 3). Três dos treze nunca compareceram, e o registro mostra dificuldades de notificação e identificação da entidade em relação àqueles réus; não estabelece por que não compareceram. Um réu estrangeiro foi transmitido para notificação por meio da Autoridade Central da China sob a Convenção de Haia sobre Serviço de Processo. Nada voltou: nenhuma confirmação, nenhuma recusa. Um réu doméstico exigiu quatro tentativas em vários estados antes que a citação chegasse ao seu agente registrado, confirmado por um oficial de justiça sob juramento. Nenhum comparecimento se seguiu. Um terceiro invocou sua própria estrutura corporativa para contestar qual entidade tinha sido nomeada. A estrutura corporativa e o procedimento transfronteiriço podem operar, na prática, como um escudo processual, e trabalhar através dele é uma tarefa que uma parte representada normalmente confia a advogados especializados ou prestadores de serviços, o que aqui o autor não representado fez por si só, para os treze. Todas as afirmações factuais na Parte V relativas à conduta processual são extraídas de documentos protocolados, identificados por número de registro e data, que qualquer leitor pode recuperar independentemente, exceto o modo de assistência de IA do litigante, que um registro processual não registra. Quando o Artigo se refere a declarações feitas em tribunal, baseia-se na transcrição oficial; quando se refere aos argumentos das partes, baseia-se nos próprios arquivos (a moção conjunta dos réus e o memorando de apoio, e a oposição do autor) em vez de qualquer caracterização por uma parte.18
Três restrições metodológicas decorrem da função do autor, divulgadas no início. Primeiro, a análise se limita ao registro público; não se baseia no conhecimento privilegiado do autor da estratégia processual, e não divulga produto de trabalho relativo a reclamações que permanecem pendentes contra os réus que não transacionaram. Segundo, o Artigo distingue em toda parte o que o registro processual estabelece (datas, arquivos, decisões, o texto de documentos) do que não estabelece: os motivos subjetivos das partes, e em particular as razões de qualquer acordo, cujos termos são confidenciais. Terceiro, as reivindicações feitas pela própria documentação do sistema de orquestração sobre seu desempenho são tratadas como autorrelatadas e não são consideradas como evidência de eficácia; as descobertas se baseiam na conduta processual visível no registro, não no relato do sistema sobre si mesmo.
Uma assimetria na base probatória qualifica o método que acaba de ser descrito. A variável dependente deste estudo, a conduta processual, é plenamente verificável no registro processual: cada arquivo, data e documento analisado na Parte V pode ser recuperado por qualquer leitor. A variável independente não é recuperável dessa forma. O registro público estabelece que o sistema de orquestração existe e documenta sua arquitetura: a reclamação operativa caracteriza o sistema, os pedidos de patente especificam o design, e os documentos técnicos da oposição descrevem seus recursos de orquestração. O que o registro processual não pode mostrar é qual modo de assistência de IA produziu qualquer arquivo específico, ou quando o método de trabalho do litigante mudou. Esses fatos se baseiam no relato próprio do autor de seu processo, e o Artigo os marca como tal onde aparecem. O estudo, portanto, emparelha um registro verificável de saídas com um registro autorrelatado de entradas, e os designs controlados propostos na Parte VII são construídos de modo que a variável de arquitetura seja observada em vez de relatada; o Apêndice especifica um manifesto de execução para esse propósito.
O registro processual estabelece que um litigante não representado usando um sistema de orquestração produziu arquivos específicos em um cronograma específico. Ele não pode estabelecer que o sistema, em vez das próprias capacidades do litigante, produziu suas características observadas. O Artigo, portanto, descreve a conduta e seu contexto arquitetônico e trata a questão causal como aberta, a ser abordada pelo estudo controlado proposto na Parte VII.
Formalmente declarado, a hipótese apresentada aqui é a seguinte:
Hipótese de dependência arquitetônica. Mantendo constante a disponibilidade de IA generativa, a arquitetura da assistência de IA (prompting de modelo único versus orquestração de múltiplos modelos) funciona como uma variável empírica distinta (Figura 4): o modo de assistência está associado a diferenças mensuráveis na conduta processual observável, incluindo cumprimento de prazos, precisão de citação, correção processual e responsividade ao registro. A hipótese é refutável: uma comparação sistemática de arquivos pro se codificados por modo de assistência que não encontrasse tal associação a refutaria.
Figura 4. A hipótese de dependência arquitetônica como uma cadeia de afirmações. Cada elo é uma afirmação a ser testada, não uma descoberta.
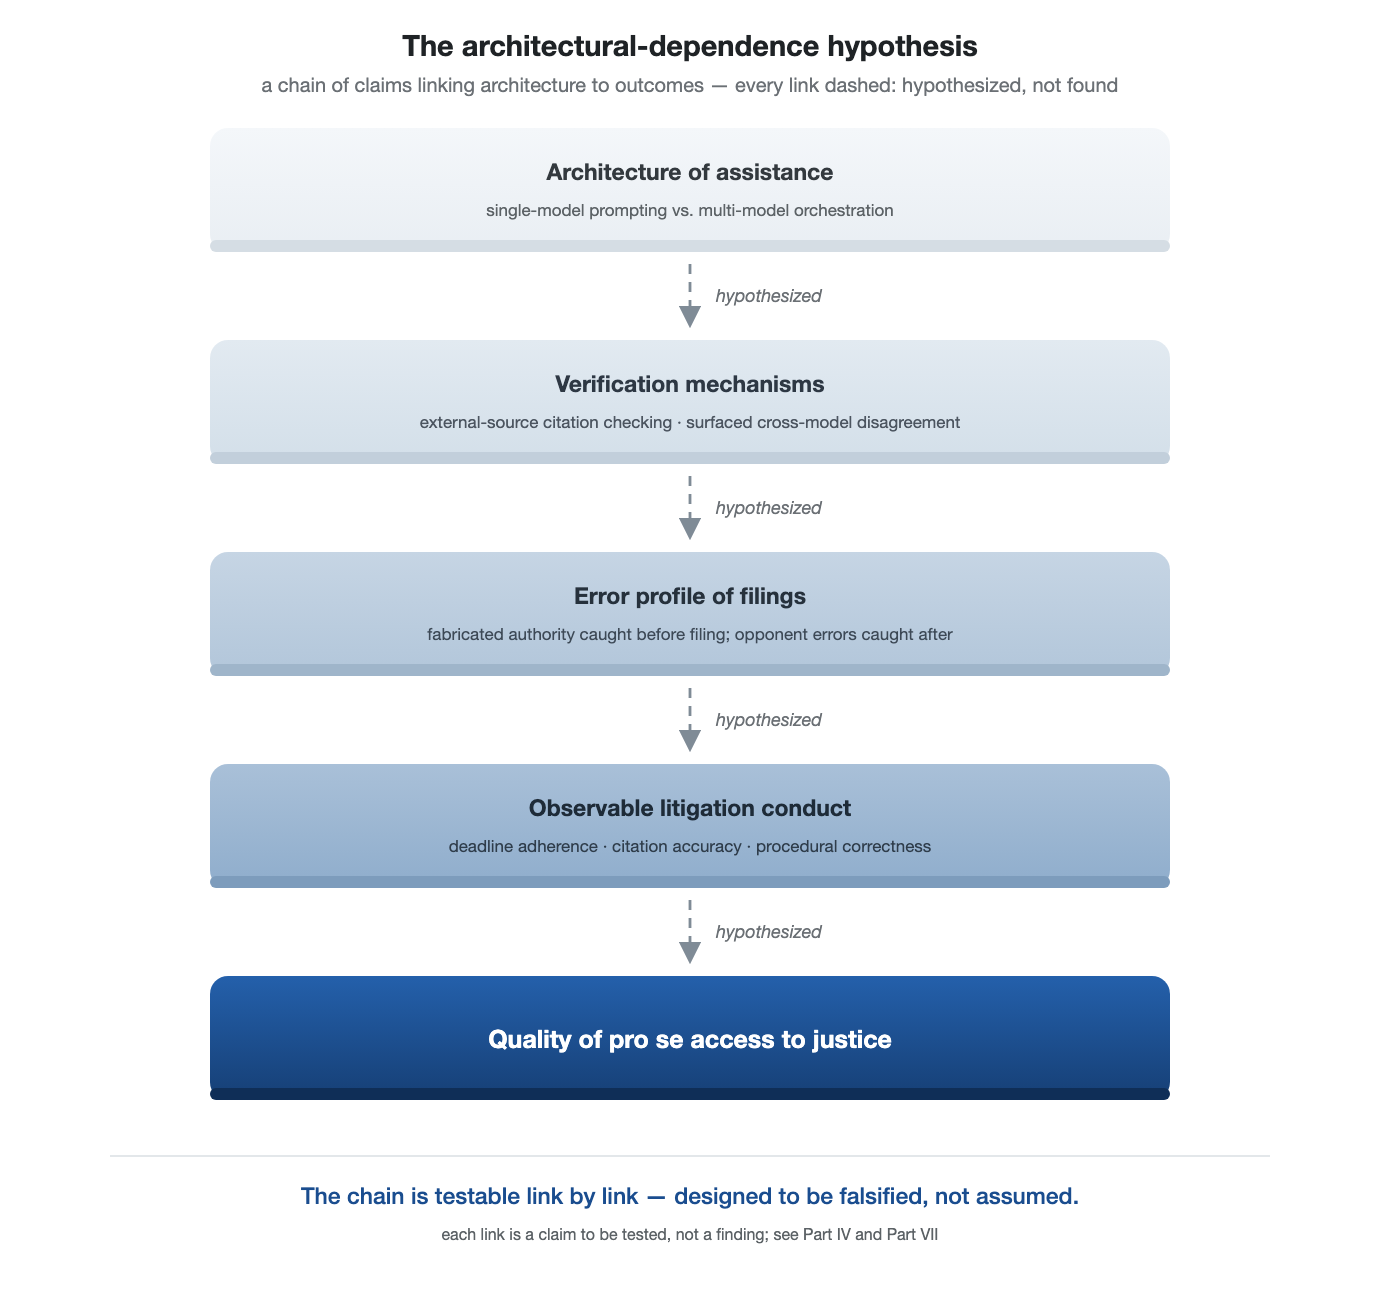
Fonte: Esquema do autor da hipótese declarada no texto; setas tracejadas marcam elos hipotéticos não testados.
V. Descobertas
Vários aspectos do litígio incidem sobre a questão colocada aqui, e a Figura 5 os apresenta em sequência.
A disparidade de recursos legais neste caso não é incidental ao estudo; é a condição que dá ao estudo seu sentido. De um lado estava um único litigante não representado sem formação jurídica e sem nenhum tipo de advogado, nem mesmo advogado de escopo limitado. Do outro lado estava uma defesa na qual advogados de vários escritórios líderes se combinaram em uma frente comum, protocolando uma moção conjunta para rejeição em nome de sete réus e coordenando suas petições entre si. Uma configuração na qual um indivíduo não representado sustenta um ciclo de briefing completo contra esse alinhamento, atendendo a cada prazo, respondendo sobre o mérito, e identificando um erro que os escritórios alinhados não capturaram, é próxima daquilo que a literatura de acesso à justiça considera como não ocorrendo. O restante desta Parte a documenta, em um registro público; o que pode explicá-la é a questão que o Artigo como um todo examina.
Figura 5. Cronologia processual do caso.
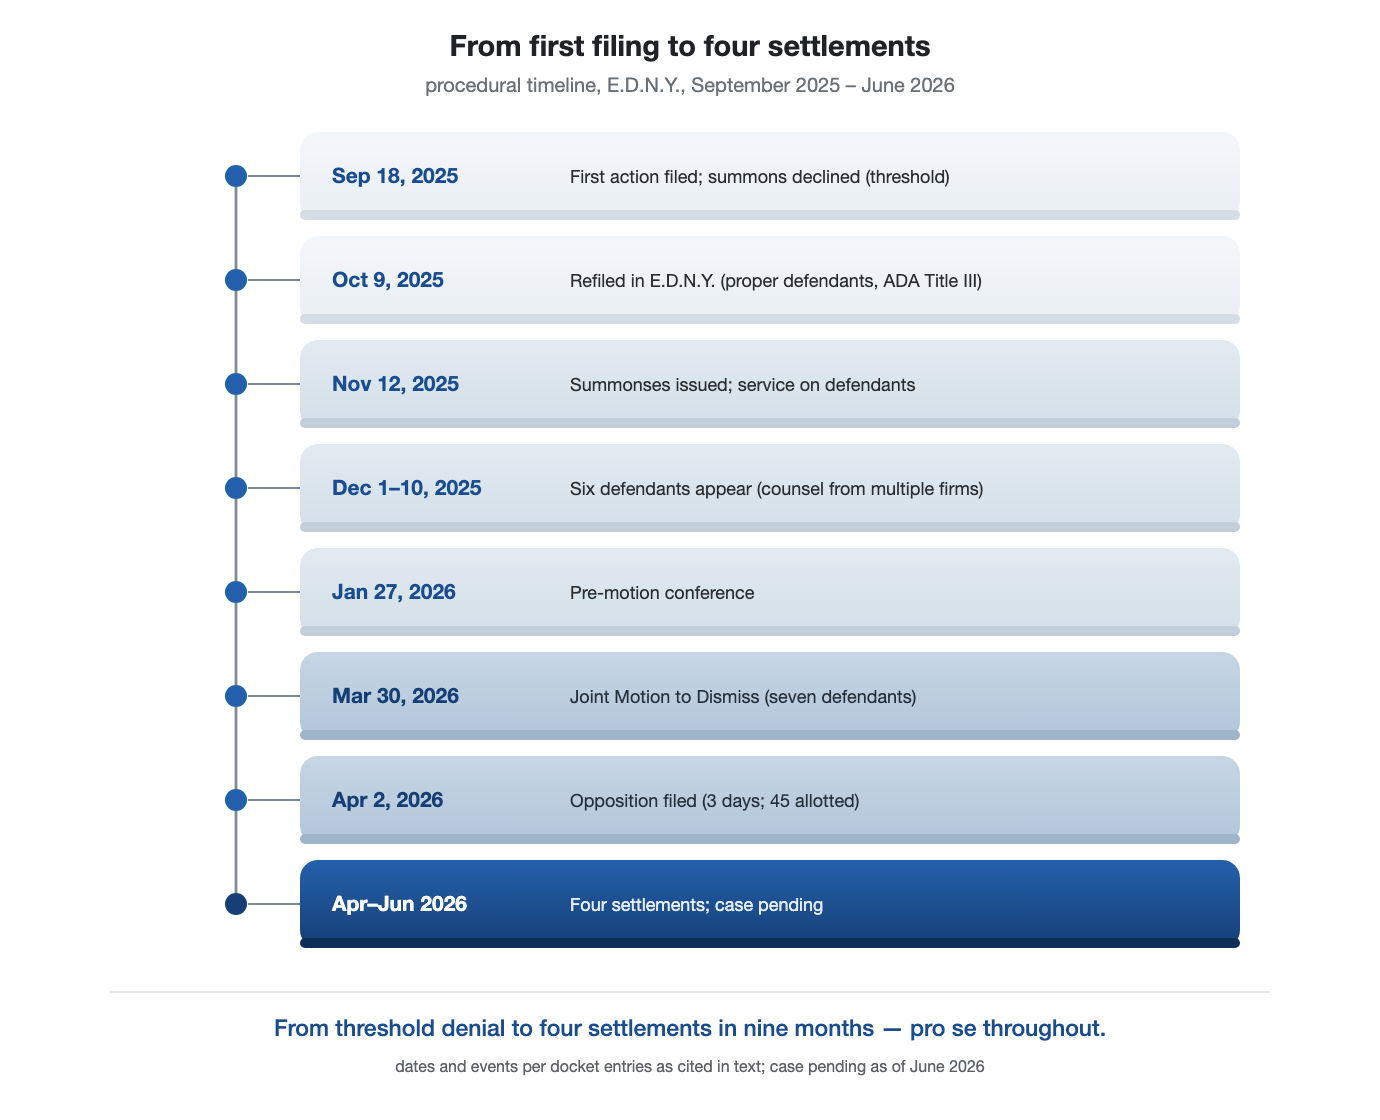
Fonte: Protocolo público, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), e a ação anterior relacionada.
A. Reconstrução do marco legal após um protocolo inicial defeituoso.
A primeira ação do litigante, ajuizada em setembro de 2025 e objeto de registro público, era procedimentalmente defeituosa em vários aspectos independentes: foi ajuizada em nome de uma sociedade limitada, que não pode litigar sem advogado; contra o réu incorreto; no distrito errado; e sob o título incorreto da ADA. O tribunal encerrou-a no limiar, recusando-se a expedir uma citação. Uma segunda ação, ajuizada pessoalmente e no distrito correto aproximadamente três semanas depois, reformulou a pretensão sob a disposição apropriada do estatuto, nomeou os réus apropriados e foi acompanhada por uma apresentação de provas substancialmente expandida. Uma mudança de método acompanhou a correção. Pela própria conta do autor, através do primeiro protocolo o litigante havia trabalhado com um único modelo em um dispositivo do consumidor, e a reconstrução coincidiu com o primeiro uso da orquestração completa de múltiplos modelos por meio de acesso direto ao modelo. Os autos não podem confirmar essa sequência, e não é oferecida como causa. O que os autos mostram é a própria correção, o primeiro episódio que este Artigo examina: o registro reflete uma transição rápida de uma ação extinta no limiar para uma que prosseguiu para a notificação e motivou aparições de múltiplos réus representados. A reconstrução é o tipo de revisão ampla e verificada do marco legal que um fluxo de trabalho de orquestração, consultando múltiplos modelos sobre forum, causa de ação e padrão de petição, é projetado para apoiar.
B. Resposta à prática coordenada de pré-moção.
Em uma única noite, 12 de janeiro de 2026, seis réus apresentaram seis cartas de pré-moção em um intervalo de aproximadamente quatro horas e meia, tendo conjuntamente requerido uma extensão para que pudessem apresentar juntos.19 De acordo com as práticas individuais do tribunal, cada carta exigia uma resposta do autor dentro de cinco dias úteis. Seis memoriais de resposta, cada um endereçado aos argumentos de um réu específico, foram apresentados dentro de quatro dias.20 O episódio diz respeito a mais do que velocidade: uma resposta a um processo coordenado e multi-frontal não pode ser finalizada antecipadamente, porque sua abordagem é determinada por seis documentos que não existiam até a noite em que foram apresentados. Porém, os argumentos disponíveis aos réus em um caso deste tipo são extraídos de um repertório previsível: legitimidade de parte, a aplicabilidade do Título III aos serviços digitais, falta de fundamentação da ação. Uma parte diligente pode preparar respostas modulares aos argumentos antecipados e adaptá-las uma vez que as cartas cheguem. A redação antecipada é, portanto, constrangida por este episódio em vez de ser impossibilitada por ele: o que o intervalo de quatro dias estabelece é a montagem, adaptação e apresentação de seis memoriais endereçados individualmente contra seis apresentações distintas. O que não pode estabelecer é quanto de seu conteúdo antecedeu as cartas.
C. Resposta tempestiva a uma defesa consolidada.
Seguindo uma conferência pré-moção na qual o tribunal convidou os réus a reduzirem petições duplicadas, sete réus, incluindo os seis que haviam protocolado cartas pré-moção, apresentaram uma moção conjunta para rejeição com memorando de apoio. De acordo com o cronograma do tribunal, a tréplica da autora vencia aproximadamente quarenta e cinco dias depois. A tréplica foi datada em 2 de abril de 2026 (três dias após o protocolo da moção em 30 de março) e registrada na pauta no dia seguinte, aproximadamente seis semanas antes do prazo de resposta de 14 de maio. Tratava-se de um memorando de vinte e oito páginas acompanhado de uma declaração e volumosos anexos. A Figura 6 estabelece os intervalos de resposta em relação aos intervalos de preparação da defesa para ambas as rodadas de peticionamento. A observação refere-se ao fato de uma resposta substantiva, tempestiva e proporcional, não aos seus méritos, apresentada por uma parte litigante autorepresentada contra uma defesa coordenada representada por advogados de várias firmas. O ponto relevante é arquitetônico e não pessoal: responder sobre o mérito a vários autos distintos simultaneamente é o tipo de tarefa paralela e multi-thread que um fluxo de trabalho multi-modelo é estruturado para distribuir, em contraste com o prompting de thread único que a literatura assume. O cronograma importa por algo além de conformidade: uma moção que permanece sem resposta em uma pauta pública por um período de resposta completo apresenta, para qualquer pessoa que leia o registro durante esse intervalo, apenas a versão dos requerentes. Uma tréplica protocolada dentro de dias reduz esse intervalo. Uma assimetria desse tipo ordinariamente funciona contra as partes autorepresentadas, que normalmente não conseguem comprimir o intervalo.
Figura 6. Intervalos de preparação e resposta, por rodada de peticionamento.
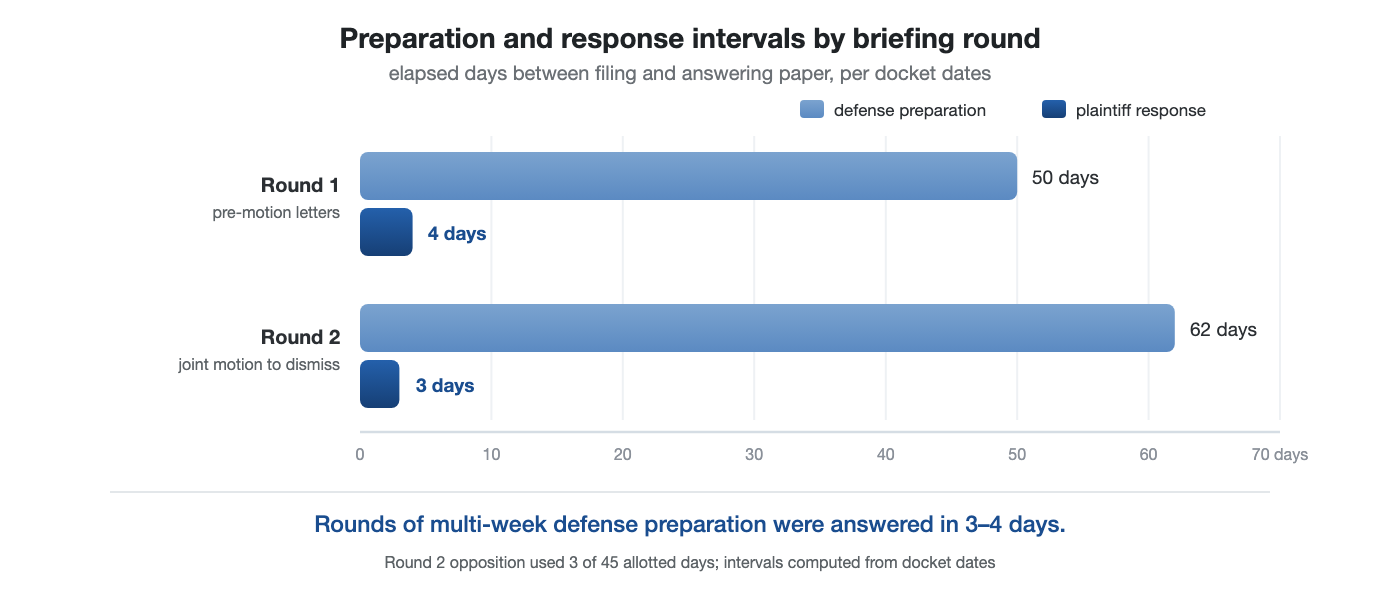
Fonte: Pauta pública; dias decorridos entre o protocolo operativo e a data do protocolo da resposta em cada rodada (datas dos documentos; o registro na pauta pode ocorrer um dia depois). O intervalo da defesa na primeira rodada é medido desde a conclusão da citação (novembro de 2025) até as cartas pré-moção coordenadas de 12 de janeiro de 2026. Os intervalos decorridos estabelecem um limite superior para o tempo de preparação; não diferenciam tempo de redação de cronograma estratégico.
D. Identificação de erro de citação estatutária no memorando de defesa.
A oposição do autor identificou um erro na autoridade estatutária em que se baseou a moção conjunta. Ao abordar o elemento "full and equal enjoyment", o memorando de defesa citou 42 U.S.C. § 12184 (ECF No. 69-1, p. 15), a disposição que governa transporte público especificado fornecido por entidades privadas, como ônibus, táxis e limusines, enquanto a reclamação surge sob 42 U.S.C. § 12182, a disposição de acomodações públicas (Plaintiff's Opposition, ECF No. 76, p. 17).21 A preocupação paradigmática com o uso de IA pro se é a citação fabricada: autoridade que não existe, gerada por um modelo e apresentada por um litigante. Aqui, o erro de citação verificável aparece em uma petição apresentada por um advogado, e foi identificado em uma petição apresentada por um litigante auto-representado usando um sistema de orquestração cujo design documentado inclui validação de citação contra fontes externas. A orquestração, conforme definida na Parte III, agrupa dois mecanismos, desacordo entre modelos e validação contra fontes externas, e um número de seção transposto é o tipo de defeito que o segundo foi projetado para detectar. Debate entre múltiplos modelos não é necessário para isso. Segundo relato do autor, o erro foi revelado pelo fluxo de trabalho em vez de pelo litigante: um modelo sinalizou a incompatibilidade entre a seção citada e a disposição sob a qual a reclamação surge, o modelo consolidador verificou e confirmou, e o crítico verificou novamente. O litigante não é um advogado e não poderia ter encontrado o erro ou verificado a correção sozinho. A propriedade implicada é o componente de verificação, não o conjunto como um todo. A direção da correção corre oposta ao padrão que a literatura leva a esperar; seu peso na disposição da moção cabe ao tribunal. O erro é independentemente verificável por qualquer leitor: as duas disposições estão dois artigos separados no mesmo subcapítulo do Código dos EUA, e a citação § 12184 no memorando de defesa é visível na face da página. As duas disposições têm linguagem operativa paralela, cada uma garantindo "full and equal enjoyment" em seu domínio, e a substituição é, portanto, do tipo que um leitor absorve sem perceber na velocidade de leitura e não pode deixar de notar quando todas as citações são verificadas contra sua fonte. O que as distingue é cobertura: § 12184 governa transporte público especificado fornecido por entidades privadas, não lugares de acomodação pública. A oposição do autor caracterizou a citação errada como "não meramente clerical" porque aparecia no tratamento do memorando de um elemento dispositivo; um número de seção transposto não é autoridade fabricada. Detectar uma citação estatutária deslocada em uma memorando opositora é o inverso do modo de falha que domina a literatura sobre o uso de IA pro se, a saber, gerar citações deslocadas na própria.
A atribuição é uma questão separada do erro em si. A regra implícita da literatura atribui erros de litigantes pro se assistidos por IA à categoria, como evidência do que a tecnologia faz, e erros de advogados ao indivíduo, como um lapso em uma prática confiável de outra forma. O episódio documentado aqui oferece um teste dessa regra, e é mais bem expresso como uma pergunta: se um litigante auto-representado usando IA generativa tivesse citado a disposição de transporte da ADA no lugar da disposição de acomodações públicas, em um elemento dispositivo, o erro teria sido lido como um lapso isolado ou como uma entrada a mais no catálogo do que acontece quando leigos litigam com chatbots? As duas interpretações dificilmente corresponderiam, e essa assimetria de atribuição, não o erro em si, faz parte do que a hipótese de dependência de arquitetura pede à literatura que examine: se a conduta está sendo classificada com base em quem a produziu em vez de como foi produzida. A assimetria, além disso, persiste contra uma linha de base móvel: conforme registra a Parte II, os incidentes de alucinação documentados não são mais predominantemente um fenômeno auto-representado, mas o enquadramento de ameaça sistêmica permanece ligado ao lado auto-representado do protocolo.
E. Primeiros assentamentos.
Figura 7. Sequência dos quatro assentamentos.
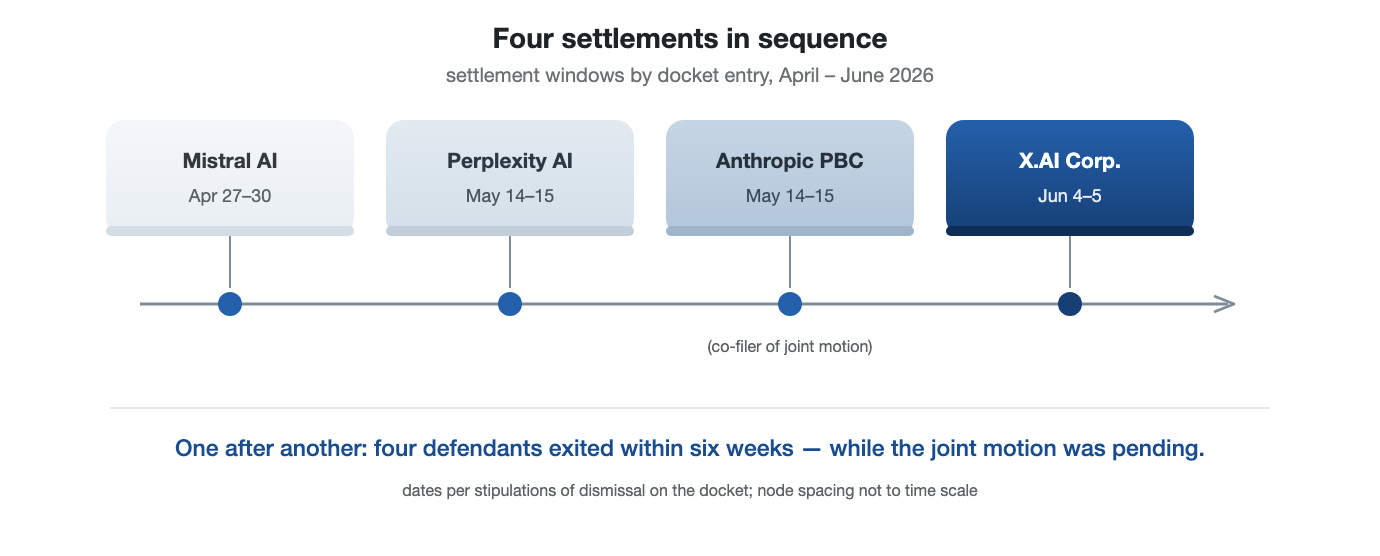
Fonte: Processo público, ECF Nos. 83--86 e 94 (acordos de extinção com prejuízo; ECF Nos. 83 e 84 são dois protocolos de mesmo dia da estipulação Mistral, a ordem de extinção citando No. 84).
Quatro réus que haviam ingressado na lide resolveram suas disputas com a autora e foram extintos com prejuízo em um período comprimido (Figura 7). Conforme é padrão, apenas os acordos de extinção constam do processo público; os termos do acordo são confidenciais, os motivos não constam do processo, e nenhuma causa é inferida. Esta subseção coloca em registro uma sequência de acordos que ordinariamente é invisível, tornando-a assim verificável.
Duas características da sequência merecem ser mencionadas, porque são visíveis no processo público. Em pelo menos duas ocasiões um réu que havia se alinhado com a defesa coordenada subsequentemente a abandonou por acordo de extinção, um resolvendo após o protesto ser apresentado e antes da tréplica da coligação; o outro depois de primeiro incorporar o memorial conjunto da coligação em uma petição própria. O padrão cronológico é uma questão de registro processual público: réus que haviam entrado em uma frente comum saíram dela, um por vez, enquanto a petição que haviam integrado permanecia pendente.
A outra característica é que os acordos entre réus corporativos e um litigante que se representa a si mesmo ordinariamente são confidenciais e deixam pouco rastro no registro processual público. Aqui os acordos de extinção são eles mesmos registros de protocolo, o que torna a sequência incomumente legível; o valor probatório desse registro reside em sua verificabilidade.
Tabela 3. Situação dos treze réus nomeados (em junho de 2026).
| Situação | Réus |
| Não compareceram | Samsung; DeepSeek; OpenAI |
| Acordo e extinção | Mistral AI; Perplexity AI; Anthropic PBC; X.AI Corp. |
| Em continuação | Microsoft; Apple; Google; Meta; Amazon; Alibaba Cloud |
Fonte: Processo público, em junho de 2026.
A Figura 8 reproduz a sequência de protocolos de um único dia, 4 de junho de 2026, como registro primário. É incluída para que o leitor possa examinar o cronograma diretamente. Quais configurações de litígio assistido por IA produzem registros desta forma, e com que frequência? Essa pergunta é abordada pelo estudo sistemático que a Parte VII propõe.
Figura 8. Sequência de protocolos em 4 de junho de 2026.
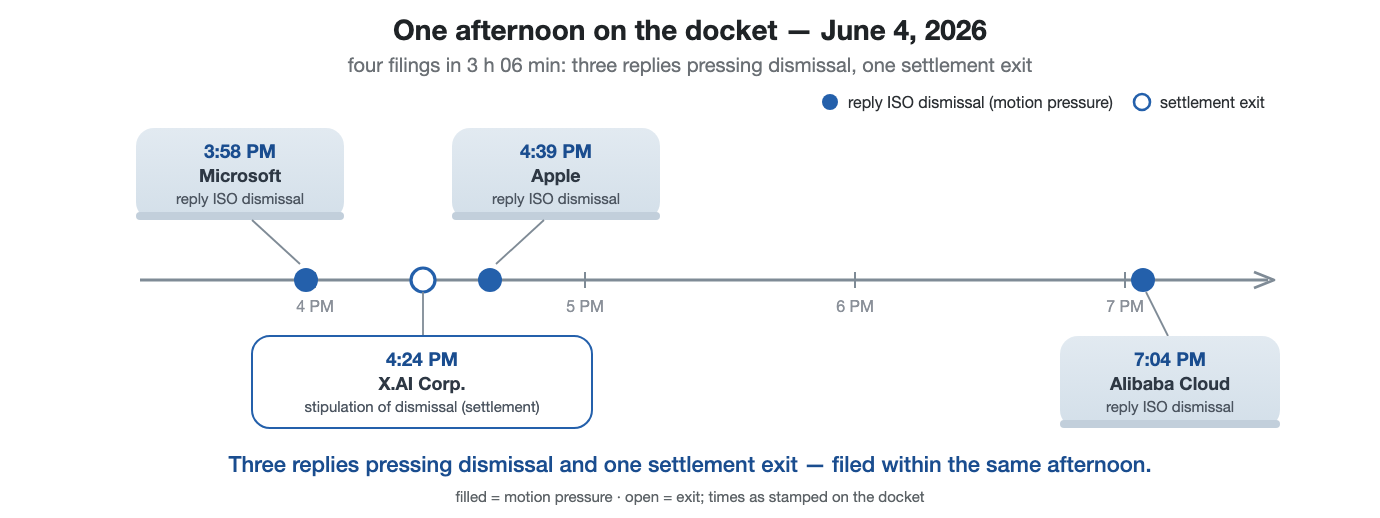
Fonte: Processo público; horários de protocolo de um único dia, ECF Nos. 93-96.
Essas características em conjunto descrevem um litigante que se representa a si mesmo sustentando uma ação federal com múltiplas partes através de um ciclo completo de peticionamento, cumprindo prazos, respondendo proporcionalmente e identificando um erro do oponente, contra uma defesa coordenada e representada. Esse não é o padrão que a narrativa predominante descreve. Essa narrativa, de volume indiferenciado e saída não confiável, caracteriza uma distribuição, e um único caso não pode contradizer uma distribuição; mas o padrão documentado aqui fica fora do que os estudos agregados medem, razão pela qual permaneceu invisível para eles. Se a arquitetura de orquestração é responsável pelo padrão, e se o padrão recorre entre casos, são questões que as Partes seguintes enquadram para investigação sistemática.
VI. Implicações Doutrinais
As questões mais difíceis são doutrinais, e duas delas estão tramitando pelos tribunais federais neste momento. O objetivo é mostrar como um relato baseado em orquestração, orientado para qualidade, do uso de IA pro se reformula cada uma. Os tribunais já possuem um marco desenvolvido para avaliar as saídas de IA como prova (Grimm, Grossman & Cormack 2021). As questões aqui são adjacentes: não se tratam de se a saída da máquina é admissível; ambas tratam de quem é dono do processo que produziu a saída e se esse processo exerce a profissão jurídica.
A. Produto do trabalho e o litigante pro se.
Se as interações de um litigante com um sistema de IA estão protegidas da descoberta como produto do trabalho é uma questão recentemente contestada. No período de sete semanas no início de 2026, três tribunais federais chegaram à interseção entre o uso de IA e a proteção do produto do trabalho, e não chegaram a um consenso.22 Em Warner v. Gilbarco, Inc., um juiz de magistrado negou uma moção para compelir uma querelante de emprego pro se a produzir suas consultas de IA gerativa e as respostas que recebeu, determinando que os materiais eram produto do trabalho sob a Regra Federal de Procedimento Civil 26(b)(3): um litigante que se representa age como seu próprio advogado, os materiais refletem suas impressões mentais e preparação, e a divulgação para um sistema de IA gerativa, uma ferramenta em vez de uma pessoa, não era a divulgação adversarial que a renúncia requer. A decisão situa-se no estrato mais antigo da doutrina, já que o que Hickman v. Taylor protegia mais fortemente eram as impressões mentais, conclusões e teorias do advogado: o nível do produto do trabalho que os tribunais tratam como quase absoluto (Hickman v. Taylor, 329 U.S. 495, 510--11 (1947)). As consultas que um litigante formula, os rascunhos que ele itera e os argumentos que ele descarta são o análogo pro se desse nível. Uma semana depois, em United States v. Heppner, um tribunal chegou ao resultado oposto: um réu criminal representado havia usado um assistente de IA pública por sua própria iniciativa, sem qualquer envolvimento do advogado, e o tribunal ordenou que os arquivos resultantes fossem produzidos, enfatizando que ele havia agido sem orientação do advogado e que os termos de consumidor da plataforma permitiam ao provedor reter e usar suas entradas. Morgan v. V2X, Inc., a terceira e mais elaborada decisão da série, estendeu a decisão central de Warner, concluindo que o uso de IA por um litigante pro se na preparação de litígios "se assemelha muito ao tipo de produto de trabalho iterativo confidencial e estratégico que a Regra 26(b)(3) foi projetada para proteger." A mesma ordem, porém, exigiu que o litigante divulgasse o nome de qualquer ferramenta de IA que tivesse usado em conexão com material que o outro lado havia designado como confidencial, e emendou a ordem de proteção para restringir o uso de serviços mainstream de IA com tal material.23 A distinção que o tribunal fez é analiticamente importante, porque explica por que Warner e Heppner não estão em conflito: uma parte representada que contorna o advogado cria uma lacuna entre a parte e o advogado, a lacuna que se mostrou fatal em Heppner, enquanto um litigante pro se "é simultaneamente a parte e o advogado", portanto, nenhuma lacuna desse tipo existe. A proteção não era ilimitada: o tribunal determinou que a identidade da ferramenta de IA não era em si protegida, e condicionou o uso de IA em materiais de descoberta confidencial a salvaguardas contratuais contra treinamento, retenção e divulgação a terceiros. As três decisões convergem, portanto, na aplicação da doutrina tradicional à IA em vez de excluir a IA dela, mas divergem sobre quem pode reivindicar a proteção e sobre o que conta como renúncia. A linha que desenham é uma linha arquitetônica, embora o vocabulário seja deste Artigo: as opiniões falam de agência, confidencialidade e renúncia. O que condenou a alegação de Heppner não foi o uso de IA, mas a configuração usada: uma ferramenta de consumidor cujos termos permitiam retenção e treinamento. Morgan, em contraste, condiciona a proteção a uma configuração contratualmente proibida de treinamento, retenção e divulgação a terceiros. A postura de confidencialidade, como verificação, é uma propriedade da arquitetura da assistência em vez de da IA como tal. A variável do Artigo aparece aqui dentro da própria doutrina (Tabela 4).
Tabela 4. A tríade de produto do trabalho do início de 2026, por configuração.
| Caso | Litigante | Lacuna de agência? | Configuração da ferramenta | Decisão |
| Warner | Querelante pro se | Nenhuma --- a parte e o advogado são um | IA gerativa usada como sua própria ferramenta de preparação | Protegido como produto do trabalho |
| Heppner | Réu representado, agindo sem advogado | Sim --- a parte contornou o advogado | Ferramenta de consumidor; termos permitiam retenção do provedor e treinamento | Produção ordenada |
| Morgan | Querelante pro se | Nenhuma --- "simultaneamente a parte e o advogado" | Uso em materiais confidenciais condicionado a proibições contratuais: sem treinamento, retenção ou divulgação a terceiros | Protegido, com condições; identidade da ferramenta não protegida |
Fonte: Warner, 2026 WL 373043; Heppner, 2026 WL 436479; Morgan, 2026 WL 864223. As decisões convergem na aplicação da doutrina tradicional e divergem nos fatos de configuração; a leitura arquitetônica das duas últimas colunas é do Artigo, não dos tribunais --- a arquitetura muda os fatos que a doutrina pondera, não a lei.
Morgan foi decidido em 30 de março de 2026, o dia em que a moção conjunta de rejeição foi apresentada no caso estudado aqui: a doutrina estava se formando enquanto o caso estava sendo discutido.
Lidas em conjunto, as decisões do início de 2026 tornam a arquitetura da ferramenta cada vez mais determinante: quem a direcionou, o que ela fez, como seu registro foi mantido. O relato de orquestração esclarece o que está em jogo nessa linha. Se a assistência de IA para um litigante que se representa a si mesmo fosse meramente geração de texto mecânica, o argumento para tratá-la como estratégia protegida seria fraco; um fluxo de trabalho de orquestração, em que um litigante formula questões, pondera os resultados divergentes de modelos e itera em direção a uma posição, é difícil de distinguir, em função, do processo iterativo carregado de estratégia que a doutrina do produto do trabalho sempre protegeu nas mãos de advogados. Um litigante que direciona um painel de mecanismos analíticos divergentes se assemelha a nada tanto quanto a um advogado sênior que direciona uma equipe de assistentes juniores. O propósito subjacente da doutrina, evitar que uma das partes se beneficie gratuitamente da preparação de litígio da outra, se aplica com igual força, quer essa preparação seja realizada por um assistente ou por um litigante trabalhando através de um sistema multi-modelo. Morgan aponta nessa direção, e o enquadramento de orquestração fornece a justificativa funcional.
A proteção do produto do trabalho depende da confidencialidade, e pode ser renunciada por divulgação pública voluntária, pelo menos quanto ao que é divulgado. Publicar um relato do próprio caso pendente de alguém, portanto, corre o risco de renunciar, quanto ao que divulga, a proteção que Morgan reconhece.
B. Exercício não autorizado da profissão de advogado.
A preocupação com UPL no contexto de litigante em causa própria é, na verdade, estranhamente formulada. As regras sobre exercício não autorizado da profissão de advogado reservam a prática jurídica a advogados licenciados a fim de proteger o público da representação não qualificada por terceiros.24 Essas regras são criações do direito estadual, e suas definições de prática variam por jurisdição; o que se segue diz respeito à lógica compartilhada do marco regulatório em vez da fronteira de qualquer estado em particular. A verdadeira questão de UPL levantada pela IA jurídica para consumidores é se a ferramenta, ou a empresa que a opera, se envolve em exercício não autorizado da profissão ao aconselhar o litigante. Essa questão depende substancialmente da confiabilidade do conselho: um instrumento que confiadamente fabrica autoridade se parece com a prática incompetente que as regras de UPL existem para prevenir.
Um litigante em causa própria, porém, não representa ninguém além de si mesmo. Ele tem o direito estatutário de fazê-lo (28 U.S.C. § 1654), e a sanção por uma petição defeituosa recai sobre ele e não sobre um cliente. Quando tal litigante utiliza um sistema de IA, o marco regulatório de UPL deve localizar a "prática jurídica" em algum lugar: na ferramenta, em seu desenvolvedor, ou em lugar nenhum, e cada uma dessas respostas é problemática. O que realmente anima a preocupação não é autorização mas confiabilidade, o temor de que um sistema não licenciado e irresponsável fornecerá com confiança informações jurídicas incorretas a uma pessoa sem capacidade de verificá-las. A confiabilidade não é tudo, porque os tribunais fiscalizam a prática jurídica através da responsabilidade tanto quanto da competência: um advogado licenciado pode ser sancionado, suspenso ou ter sua inscrição cancelada, e um sistema de IA não pode ser nenhum destes. A lacuna de responsabilidade é real, e a conta de orquestração trata da confiabilidade, não da responsabilidade. Se um sistema orquestrado cometesse erros sistematicamente, a responsabilidade poderia recair em um de três lugares: no operador que assina a petição (o único ator que a Regra 11 atualmente alcança), no fornecedor da arquitetura, ou em ninguém. O que a lei selecionar entre os três determinará se a lacuna de responsabilidade se estreita ou meramente se desloca.
Aqui a distinção entre modelo único/orquestração faz uma diferença real. O déficit de confiabilidade que anima a preocupação de UPL é característico da configuração de modelo único, e uma arquitetura construída em torno da verificação entre modelos e validação de citações é direcionada para esse déficit. Isso não dissolve a questão de UPL, já que uma ferramenta altamente confiável ainda pode ser dita "praticando direito". O que faz é separar duas coisas que o debate tende a mesclar: confiabilidade e autorização são questões analiticamente distintas, e confundi-las oculta que um conserto arquitetônico pode abordar a primeira sem tocar na segunda. Se a confiabilidade é a verdadeira preocupação, então a arquitetura, e não apenas a licença, torna-se parte da análise, e um sistema projetado para expor e resolver desacordo em vez de afirmar uma resposta única aborda a preocupação em seus próprios termos. Se a confiabilidade é arquitetônica, é também projetável e certificável, o tipo de objeto sobre o qual propostas para reinventar a regulação dos serviços jurídicos dependem (Hadfield 2017). Uma arquitetura que recusa emitir o que não pode verificar, e que encaminha a incerteza irredutível ao ser humano, começa a funcionar como conformidade por design em vez de como uma consultora não licenciada.
C. Uma reinterpretação, não uma resolução.
Ambas as áreas doutrinárias permanecem indefinidas. A narrativa dominante de volume e alucinação do uso de IA em pro se moldou estes debates doutrinários, e uma narrativa orientada para qualidade e baseada em orquestração as reinterpreta. A proteção de work-product parece mais coerente quando o uso de IA é entendido como estratégia iterativa em vez de produção mecânica, e o debate sobre UPL parece diferente quando a confiabilidade é tratada como uma variável arquitetônica em vez de um defeito inerente.
VII. Limitações e Trabalhos Futuros
Quatro limitações circunscrevem o desenho. Primeiro, e mais fundamentalmente, este é um único caso (n = 1) redigido por uma parte nele. Os achados na Parte V são afirmações de existência e não distribucionais. O que tal caso pode fazer é o que a metodologia qualitativa há muito reconhece para casos extremos ou reveladores: expor um fenômeno que os desenhos padrão ainda não alcançaram, e gerar as hipóteses que o estudo sistemático deve então testar.
Em segundo lugar, o autor é litigante, desenvolvedor e analista; as restrições na Parte IV existem por causa disso.
Em terceiro lugar, a causalidade não pode ser isolada. O registro não pode separar a contribuição da arquitetura da própria habilidade do litigante, preparação anterior, os incentivos de uma parte não cobrada, ou outros fatores confundidores. A discussão arquitetônica na Parte III fornece um mecanismo plausível, não um demonstrado.
Várias explicações rivais permanecem plausíveis. O litigante pode simplesmente ser capaz: educado, motivado e sem cobrar, uma parte pro se pode gastar centenas de horas em um caso que seria atribuído em dezenas. A oposição de três dias pode medir preparação em vez de processamento (Parte V.B). A seleção opera em dois níveis. No nível do caso, este caso é objeto de um artigo porque seus autos são favoráveis, e casos em que litigantes assistidos por orquestração fracassam não geram artigos. No nível do episódio, a seleção é do próprio autor: os autos contêm mais eventos do que os cinco que este Artigo descreve, e o autor escolheu quais apresentar. Contra essa seleção, a declaração de completude é verificável pelos autos: a partir de junho de 2026, os autos não contêm nenhuma ordem sancionando o autor, nenhuma ordem excluindo qualquer de seus pedidos, e nenhum prazo que ele tenha perdido. O mais próximo que os autos chegam a uma anotação processual adversa situa-se no limiar do caso, onde o tribunal negou o pedido do autor para proceder in forma pauperis (a taxa de depósito foi então paga dentro do prazo permitido) e observou que as citações não poderiam ser expedidas até que os endereços de serviço fossem fornecidos, o que depois o foram. A declaração é falsificável por qualquer pessoa com acesso ao PACER; o que a seleção de nível de episódio ainda pode ocultar é ênfase, não decisões adversas. O estudo proposto abaixo é projetado para decidir entre essas explicações rivais.
Uma limitação adicional diz respeito ao alcance em vez da validade. A Parte II estrutura a lacuna de acesso à justiça em termos dos americanos de baixa renda que a Legal Services Corporation estuda, enquanto o litigante aqui é um arquiteto de sistemas de IA de nível doutorado operando um sistema de seu próprio design, um autor que se representa retirado da cauda extrema da distribuição de capacidade técnica. A prova de existência não é enfraquecida por esse fato, mas seu escopo é mais estreito do que a população que a Parte II centra: nada neste caso mostra que a litigação assistida por orquestração é praticamente disponível para essa população, para quem custo, acesso digital e fluência técnica são em si mesmas barreiras. Se os benefícios da arquitetura sobrevivem à transferência de um operador especialista para um litigante típico que se representa é uma questão empírica, e para o enquadramento assistivo da Parte II é argumentavelmente a decisiva; o componente de deficiência do estudo proposto abaixo é projetado para alcançá-la. A transferência não é apenas uma questão de configuração técnica. A orquestração recoloca o fardo cognitivo do operador de redação para arbitragem: ler resultados concorrentes, pesar desacordos que emergiram, decidir qual linha sobrevive. A arbitragem é em si mesma uma habilidade exigente. Se esse fardo pode ser assumido pelo design de interface em vez de pela expertise do operador, e a que custo para litigantes com barreiras cognitivas, visuais ou educacionais, é tanto uma questão de design quanto uma empírica.
Em quarto lugar, o caso está pendente; nenhuma constatação aqui depende de como ele termina.
A hipótese que este caso gera, de que a arquitetura de orquestração está associada a condutas de litígio em causa própria de maior qualidade do que a instrução de modelo único, é testável. Um estudo sistemático poderia comparar a conduta de litígio (cumprimento de prazos, precisão de citações, resultados de moções) em uma amostra de petições em causa própria codificadas pelo modo de assistência de IA, usando os indicadores de redação consistente com IA que a literatura empírica começou a desenvolver e o LegalBench, um benchmark de raciocínio legal construído colaborativamente (Guha et al. 2023). Uma família de tarefas, detecção de erro inserido, segue diretamente da Parte V. Petições de teste contêm defeitos verificáveis dos tipos documentados: uma seção legal transposta, uma autoridade citada incorretamente, uma citação fabricada. As taxas de detecção são então comparadas entre modos de assistência, desde a instrução de modelo único até a verificação orquestrada, com operadores advogados e não advogados como braços separados. Os componentes da arquitetura (verificação de fonte externa e desacordo entre modelos) são removidos separadamente, de modo que a contribuição de cada mecanismo seja identificada em vez de creditada ao pacote (Tabela 5). Um desenho assim, conduzido por pesquisadores desinteressados em muitos casos, poderia converter a afirmação de existência avançada aqui em uma reivindicação distribucional ou refutá-la. Desenhos mais fortes estão disponíveis e devem ser preferidos: comparações controladas de assistência de modelo único e orquestrada em tarefas legais idênticas, com protocolos pré-registrados, materiais abertos e validação de conjunto cego das próprias reivindicações do sistema, incluindo sua taxa de verificação de citação; identificação quase-experimental, como desenhos de diferenças em diferenças em torno da disponibilidade pública de ferramentas multi-modelo; e um braço dedicado para participantes com deficiências motoras, visuais ou cognitivas, para quem o enquadramento assistivo da Parte II não é hipotético. A avaliação randomizada de assistência legal tem precedente: a literatura de acesso à justiça realizou estudos randomizados de ofertas de representação e de assistência desagregada (Greiner, Pattanayak & Hennessy 2013), e a comparação de modo de assistência proposta aqui estende essa tradição de desenho para a variável de arquitetura. De forma mais ampla, a hipótese sugere um padrão que o campo ainda não adotou: que os sistemas de IA sejam avaliados não apenas pela qualidade de seus outputs, mas também pela qualidade de sua arquitetura de raciocínio. Nada nela é específico para o direito: onde quer que trabalho consequente seja delegado a sistemas generativos, em medicina, engenharia ou finanças, a mesma pergunta surge, e a mesma variável fica sem ser medida. Também recontextualiza uma variável que a análise de acesso à justiça há muito trata como fixa. O custo de entrada do autor era a taxa de ajuizamento de $405, e o custo de entrada formal de um advogado de defesa era a taxa de pro hac vice de $200 (ECF Nos. 19, 52, 60). Ambos estão em algumas centenas de dólares, e ficam nas duas extremidades do que tem sido uma lacuna de recursos efetivamente intransponível; a comparação diz respeito apenas a taxas de entrada formal, não ao custo de representação. O que pode ter mudado não é o preço de entrar em uma sala de tribunal, mas o custo marginal da capacidade de litígio necessária para permanecer em uma. Se esse custo de fato caiu, e por quanto, é uma questão empírica para o estudo proposto; que se tornou uma variável em vez de uma constante é em si uma hipótese que vale a pena testar.
Tabela 5. O estudo proposto, por braço.
| Braço | Configuração | O que isola |
| 1 | Apenas humano, sem IA (controle) | Detecção de linha de base sem assistência |
| 2 | Instrução de modelo único | O modo que a literatura documenta |
| 3 | Orquestração, completa | O pacote conforme implantado |
| 4 | Orquestração sem verificação de fonte externa | Contribuição da verificação de citação |
| 5 | Orquestração sem desacordo entre modelos | Contribuição da divergência exposta |
Nota: Cada braço é executado com operadores advogados e não advogados como grupos separados, e um braço de deficiência separado, executado fora dos cinco braços numerados, para participantes com deficiências motoras, visuais ou cognitivas, e com medidas de resultado pré-registradas antes das sessões; veja texto.
VIII. Conclusão
A narrativa prevalecente de inteligência artificial em litígios em causa própria é uma história sobre volume e falta de confiabilidade: mais litigantes, ajuizando mais rápido, com risco elevado de autoridade fabricada. Assume, sem explicitar, que assistência de IA significa um litigante instruindo um modelo de propósito geral, e essa suposição não se sustenta mais.
O caso examinado aqui foi construído, segundo relato do autor, em uma arquitetura diferente: vários modelos independentes foram consultados em paralelo, e seu desacordo foi exposto e resolvido em vez de suprimido. A descrição da conduta de litígio repousa inteiramente em um registro público verificável; esse registro contém conduta que a narrativa de volume-e-alucinação nem descreve nem prediz: uma rápida reconstrução de uma petição deficiente, uma oposição substantiva ajuizada bem antes do prazo, e a identificação de um erro de citação legal em uma defesa coordenada. O artigo então mostrou como entender a assistência de IA como orquestração, e como uma questão de qualidade, recontextualiza dois debates doutrinários atualmente perante os tribunais federais. Para litigantes que não conseguem digitar, ver ou se organizar na velocidade que o litígio exige, a diferença arquitetônica é uma questão não de eficiência, mas de acesso no sentido da Lei de Acessibilidade para Pessoas com Deficiência de gozo pleno e igualitário: se a forma como a assistência de IA está configurada é o que torna a autorepresentação possível.
A afirmação é que a arquitetura da assistência de IA, não apenas sua disponibilidade, pertence à análise do que os litigantes que se representam a si mesmos podem agora fazer. Essa afirmação torna-se ainda mais urgente conforme os modelos fundacionais convergem em capacidade bruta, porque quando os próprios modelos diferem menos, a forma como são combinados diferirá mais. A hipótese de dependência arquitetônica é que a arquitetura não é um detalhe de implementação: é um determinante da qualidade do que as pessoas e os tribunais podem fazer. Se a IA participa do trabalho legal não é mais uma questão; o que permanece em aberto é quais arquiteturas fazem o quê. Nesta perspectiva, o problema de IA pro se é um problema de design, não um problema de inteligência, e problemas de design têm respostas de design. O trabalho à frente é especificar arquiteturas particulares e testá-las umas contra as outras, em vez de esperar por modelos individuais melhores. O Apêndice enuncia uma dessas arquiteturas com precisão suficiente para ser executada e criticada, e uma implementação de referência é publicada com ela.
Apêndice. Uma Arquitetura de Assistência, Especificada para Poder Ser Executada
O argumento deste Artigo é que "assistência de IA" nomeia uma família de arquiteturas com diferentes propriedades de falha. A afirmação é mais fácil de testar uma vez que pelo menos uma arquitetura seja enunciada com precisão suficiente para ser executada e criticada. O protocolo abaixo é tal enunciação. É chamado aqui de protocolo de consolidação cega25, após o estágio que mais claramente a separa do debate multi-agente, no qual os modelos se leem mutuamente.26 Ele usa apenas modelos públicos, e qualquer pessoa com acesso de consumidor ou API a três fornecedores pode reproduzi-lo.
O protocolo abaixo enuncia, no nível de arquitetura, a família descrita na Parte III: modelos heterogêneos consultados em isolamento, um consenso formado sob regras explícitas com o desacordo preservado em vez de ser anulado pela média, e cada citação verificada contra sua fonte. Difere do sistema descrito na Parte III em como essa última verificação é feita: lá é um componente que valida contra um banco de dados em tempo real, aqui são modelos com capacidade de busca seguidos por uma pessoa, e a restrição três abaixo afirma claramente que a aprovação dos modelos não é a verificação. É enunciado aqui como uma especificação, não como evidência: o Artigo não oferece nenhuma petição no estudo de caso como seu resultado e não extrai nenhuma inferência dela (o que é omitido: nota 24). O que o protocolo contribui para o argumento é o manifesto de execução. A variável de arquitetura neste Artigo é autorrelatada (Parte IV); um manifesto é o que um leitor externo precisaria antes que pudesse ser qualquer outra coisa. As petições da Parte V não carregam nenhum.
O problema que aborda.
Um litigante autorrepresentado pode acessar vários modelos de fronteira através de planos gratuitos para consumidor, e custo, acesso digital e fluência técnica permanecem barreiras (Parte VII): a coluna de alto risco abaixo é acesso API pago, e a condição de confidencialidade estabelecida posteriormente exclui a maioria dos planos gratuitos para o material que mais necessita proteção. A prática comum é fazer uma pergunta a um, ler a resposta e arquivá-la. A falha documentada é um modelo confiante produzindo uma citação que não existe, sem nada no processo posicionado para detectá-la. O protocolo substitui a pergunta única por uma declaração de tarefa comum e quatro estágios que a seguem. Deixa cada modelo exatamente tão preciso quanto era; organiza vários de modo que o erro de um sistema tenha que sobreviver ao contato com sistemas treinados por outras organizações, e registra o que cada um deles disse.
Papéis.
O protocolo é definido pelo que cada papel tem permissão de ver. Quatro regras o definem:
1. Geradores veem o enunciado da tarefa e nada mais. Nenhum vê o rascunho de outro gerador.
2. O consolidador vê cada rascunho sob rótulos neutros R1 a Rn, em ordem aleatória. Nunca descobre qual fornecedor produziu qual rascunho.
3. O primeiro crítico lê dentro da própria família do consolidador, em um contexto novo. Vê o enunciado da tarefa e o documento consolidado, e nada da consolidação que o produziu.
4. O último leitor é um crítico de um fornecedor diferente do consolidador. Vê o enunciado da tarefa, o documento consolidado e o relatório do primeiro crítico, e seu veredicto encerra a execução.
Qualquer conjunto de modelos de fronteira de diferentes fornecedores que satisfaça as quatro regras executa o protocolo. Como ilustração, estes são modelos públicos que estavam disponíveis em setembro de 2026 e poderiam preencher os papéis:
Tabela 6. Modelos públicos disponíveis em setembro de 2026 que poderiam preencher os quatro papéis.
| Papel | Documentos de rotina | Documentos de alto risco |
|---|---|---|
| Geradores, isolados | claude-sonnet-5 com busca; gpt-5.6-terra com busca; gemini-3.1-pro-high com busca; um modelo de peso aberto | claude-opus-5 com busca; gpt-6-astra com busca; gemini-3.1-pro-high com busca; Grok (xAI); um modelo de peso aberto |
| Consolidador, cego | claude-sonnet-5 | claude-fable-5-1 |
| Crítico 1, família do consolidador, contexto novo | claude-sonnet-5 | claude-fable-5-1 |
| Crítico 2, fornecedor diferente, lê por último | gpt-5.6-terra | gpt-6-astra |
Fonte: Documentação do fornecedor em setembro de 2026. A atribuição de modelos aos papéis é do autor; os papéis, não os identificadores, definem o protocolo.
A tabela é uma ilustração do que estava disponível, e os identificadores envelhecerão. Os papéis não. Grok é nomeado por fornecedor e o modelo de peso aberto por classe, porque seus identificadores hospedados variam de host para host, e gemini-3.1-pro-high é o alias de uma interface hospedada em vez do código do modelo na documentação da API do fornecedor. A coluna de alto risco adiciona um quinto gerador, e seu consolidador é um modelo que não escreveu rascunho, portanto nunca julga seu próprio texto sob um rótulo. A Figura 9 desenha o protocolo por papel.
A atribuição de famílias aos papéis repousa no uso do autor, não em uma medição. Ao longo de aproximadamente duas mil horas de trabalho com esses sistemas em 2025 e 2026, um modelo colocado em um contexto novo como crítico cego retornou a verificação mais rigorosa e útil quando vinha da mesma família que o consolidador, e o fez mesmo quando o texto sob revisão havia sido produzido por essa família. Críticos de outros fornecedores não eram leitores mais fracos; encontraram coisas diferentes, razão pela qual o protocolo mantém um deles e lhe dá o veredicto de fechamento. As quatro regras são sobre o que cada papel pode ver, não sobre qual fornecedor o preenche, e um leitor que prefira uma família diferente no consolidador ou no primeiro crítico pode substituir uma e ainda estar executando o protocolo.
Figura 9. O protocolo de consolidação cega, por papel: geração isolada, consolidação cega e duas verificações.
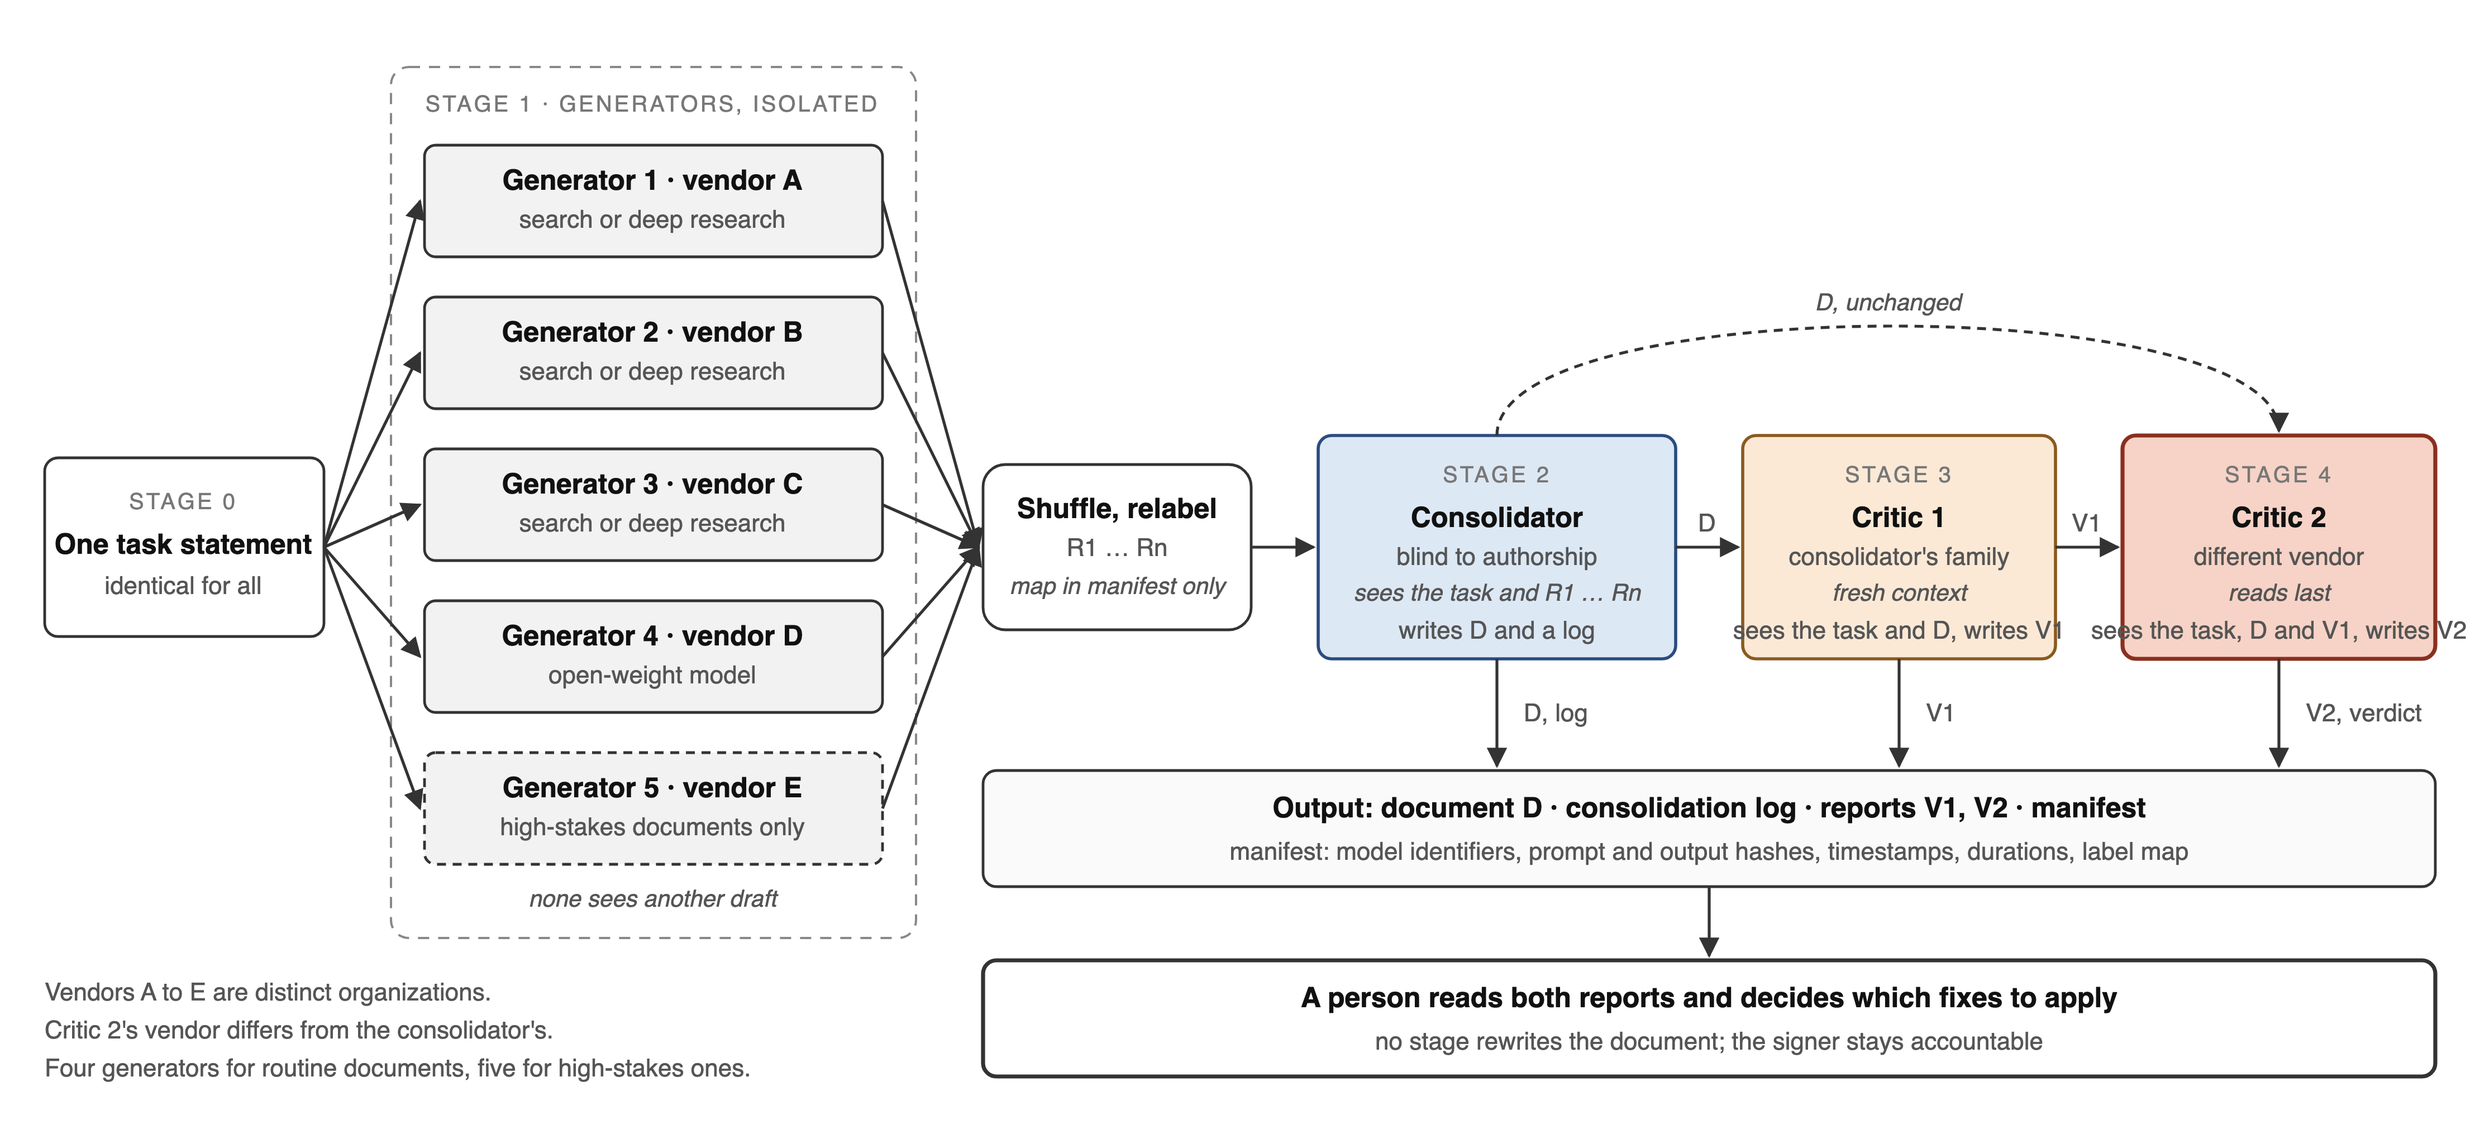
Fonte: Diagrama do autor do protocolo especificado neste Apêndice.
Esta é uma rampa. Foi construída para alguém que não consegue subir as escadas: que não consegue manter cinco interfaces abertas simultaneamente, compará-las umas com as outras e sintetizar a resposta. Uma rampa é usada por todos que chegam à porta, não apenas pela pessoa para quem foi construída. A fórmula acima está escrita para que qualquer um possa usá-la.
Etapas.
Etapa 0. Uma declaração de tarefa única. Uma única declaração escrita estabelece o objetivo, a jurisdição, o formato necessário, o que conta como fonte e o que fazer com uma alegação que não pode ser verificada. Cada modelo a recebe inalterada, de modo que as diferenças entre os rascunhos provenham dos modelos.
Etapa 1. Geração isolada. Cada gerador produz um rascunho completo em paralelo, com a busca na web ativada sempre que a interface ou a API a oferece, e com pesquisa profunda quando a tarefa exige profundidade. As interfaces para consumidores desses fornecedores buscam por padrão; alguns pontos de extremidade programáticos não contêm ferramenta de busca, e um gerador executado em um deles está elaborando a partir de pesos, o que o registro da execução deve mostrar. Cada um é obrigado a citar uma fonte verificável para cada proposição de fato e lei, a marcar o que não pôde verificar como não verificado, e a encerrar com suas questões abertas. O isolamento é o mecanismo. Modelos construídos por diferentes organizações em corpora diferentes inventam coisas diferentes, e uma alegação que vários deles produzem de forma independente, cada um com sua própria citação, está em uma posição de prova diferente de uma alegação que apenas um deles produziu. Um redator que vê outro rascunho concorda com ele por razões não relacionadas ao fato de a alegação ser verdadeira.
Etapa 2. Consolidação cega. Um modelo recebe os rascunhos como R1 a Rn, em uma ordem escolhida aleatoriamente e registrada apenas no manifesto de execução, e os mescla sob regras explícitas. Alegações apoiadas por vários rascunhos ou por uma citação verificável são preferidas para inclusão, o que é uma regra sobre o que entra no rascunho e não uma constatação de que são verdadeiras. O material encontrado em um único rascunho é mantido quando carrega uma citação verificável. Os conflitos são resolvidos com evidência ou sinalizados no texto. O acordo entre rascunhos é registrado como acordo e nunca é promovido a prova. O novo material entra apenas se o consolidador o verificar, e é marcado como adicionado. Cada alegação substantiva carrega uma etiqueta nomeando os rascunhos que a apoiam. O consolidador também escreve um registro: sobre o que os rascunhos concordaram, sobre o que discordaram e como cada conflito foi resolvido, e o que foi descartado e por quê. O registro é onde o desacordo sobrevive. Como o mapa de etiquetas é mantido, um leitor posterior pode comparar as etiquetas com ele e medir com que frequência o consolidador preferiu o rascunho de seu próprio fornecedor.
Etapa 3. Verificação interna. Um crítico da família do consolidador lê o documento mesclado em um contexto fresco, sem memória da consolidação. Sua tarefa é verificação, e ele não retorna um documento melhorado. Ele verifica cada citação quanto à existência e precisão, testa o raciocínio quanto a lacunas e exagero, confirma se a declaração de tarefa foi atendida, e relata os resultados classificados como Crítico, Maior e Menor com um veredicto: aprovar, aprovar com correções ou rejeitar.
Etapa 4. Verificação entre fornecedores. Um crítico de um fornecedor diferente lê o mesmo documento e o primeiro relatório. Ele confirma, disputa ou estende cada constatação, adiciona a sua própria, e dá o veredicto final. A etapa existe por causa da fraqueza das duas anteriores: um consolidador verificado por sua própria família compartilha os pontos cegos dessa família, e um leitor treinado em outro lugar é a rota mais direta para eles.
O que sai do pipeline.
O entregável é o documento consolidado, o registro de consolidação, ambos os relatórios de verificação e um manifesto. Nenhuma etapa sobrescreve o documento com o resultado de um crítico. Uma pessoa lê os relatórios e decide quais correções aplicar. Em litígio, a pessoa que assina o protocolo é responsável pelo seu conteúdo, e um pipeline que silenciosamente reescrevesse o texto obscureceria quem decidiu o quê.
O manifesto registra, para cada etapa, o identificador do modelo, o hash do prompt, o hash da saída, a hora de início e a duração, junto com o mapa de rótulos. Sem ele, um documento preparado desta forma é indistinguível de um produzido perguntando a um único modelo duas vezes. Com ele, um leitor que não estava presente pode auditar o registro do operador da execução: qual identificador foi configurado para qual papel, em que ordem os rascunhos foram rotulados, o que cada etapa recebeu e retornou. É um autorrelato estruturado, não uma prova. Os identificadores vêm da configuração em vez de uma resposta autenticada, uma etapa executada manualmente carrega a palavra do operador sobre o que aconteceu na interface, e um registro de uma ferramenta de busca sendo oferecida não é um registro de uma fonte sendo verificada. Tornar a variável observada em vez de reportada requer custódia de terceiros da execução, que é o que o design na Parte VII fornece e o que um formato de arquivo não pode fornecer.
Implementação de referência.
Uma implementação de referência, docprep, é publicada sob uma licença aberta (nota 25): aproximadamente quinhentas linhas de Python em um arquivo, com a configuração da Tabela 6, o formato de manifesto e testes offline que funcionam sem contas ou chaves.
A implementação separa o que impõe do que apenas solicita. As quatro regras de papel são aplicadas. Um prompt de gerador é montado unicamente a partir da declaração da tarefa; os rascunhos chegam ao consolidador embaralhados e rotulados novamente, com o mapa escrito apenas no manifesto; e uma configuração cujo primeiro crítico está fora da família do fornecedor do consolidador, ou cujo último crítico está dentro dela, é recusada antes de qualquer modelo ser chamado (Figura 10). As regras de mesclagem da Etapa 2 são apenas solicitadas: elas são instruções do prompt do consolidador, e um modelo pode desobedecê-las. Uma é verificada posteriormente, visto que uma consolidação retornada sem seu registro interrompe a execução.
Figura 10. Uma regra de papel como precondição da execução: a verificação do crítico final e a recusa que imprime.
home = family(cfg, cons) # the consolidator's vendor family
. . .
if critics and family(cfg, critics[-1]) == home:
problems.append(f"{critics[-1]['name']} is from the consolidator's family "
f"({home}); the last reader must come from another vendor")
. . .
if problems and enforce:
sys.exit(f"formula '{formula_name}' breaks the protocol:\n - "
+ "\n - ".join(problems))
$ python3 docprep.py run --formula manual
formula 'manual' breaks the protocol:
- critic_cross is from the consolidator's family (anthropic);
the last reader must come from another vendor
Fonte: docprep, docprep.py, function validate(), release v1.0.0 (nota 25); elipses marcadas. Abaixo do código, a saída do comando mostrado, executado na configuração de exemplo com o crítico final atribuído ao fornecedor do consolidador. Os testes offline do repositório afirmam a mesma recusa.
A aplicação tem os limites que o manifesto tem. A família do fornecedor de um papel é declarada na configuração, não autenticada. Uma etapa executada manualmente é cega e nova segundo a palavra do operador. A retulagem remove nomes, não o estilo. E a recusa pode ser desligada, nesse caso o manifesto registra que foi e lista as regras violadas. As regras são aplicadas contra um erro do operador, não contra um operador.
O envelope legal.
Uma arquitetura que reduz a correlação de erros ao adicionar fornecedores aumenta, pelo mesmo ato, o número de locais por onde o material sai. Para um litigante autorepresentado em um tribunal dos Estados Unidos, essa troca não é abstrata.
A posição nos Estados Unidos em setembro de 2026 tem três partes: o que uma parte deve divulgar, o que pode ser enviado a um provedor, e se o trabalho sobrevive como proteção de trabalho. A Parte II e a Tabela 1 contêm o regime de divulgação; a Parte VI.A contém a análise de proteção de trabalho e suas fontes de autoridade. Nenhuma regra de procedimento federal geralmente aplicável exige que uma parte divulgue o uso de IA ou nomeie um modelo: em abril de 2026, o Comitê Consultivo sobre Regras Civis retirou de sua agenda duas propostas dirigidas a autoridades fabricadas, concordando que a edição de regras não seria apropriada naquela época.27 Regras locais e ordens permanentes individuais exigem isso, e elas diferem. O Distrito Norte do Texas pede a constatação do uso de IA na primeira página de uma petição e não pede qual modelo. O Juiz Vaden do Tribunal de Comércio Internacional pede pelo programa utilizado, pelas porções específicas de texto que produziu, e por uma certificação de que o uso não divulgou informações confidenciais ou de propriedade comercial a uma parte não autorizada.28
Duas ações de edição de regras da primavera de 2026 são fáceis de confundir, e essa confusão muda a resposta. O Comitê Consultivo sobre Regras Civis considerou duas propostas para alterar a Regra 11 para abordar citações de autoridades que não existem, concordou que a edição de regras não seria apropriada naquela época, e retirou a questão em 14 de abril de 2026. Três semanas depois, o Comitê Consultivo sobre Regras de Prova considerou a Regra Federal de Prova 707 proposta, que rege a admissibilidade de evidência gerada por máquina em vez da divulgação do uso de IA; ela revisou o rascunho e manteve-o sob estudo em vez de avançar com ele. A primeira ação diz respeito ao que uma parte certifica, a segunda ao que um tribunal pode admitir, e nenhuma criou um dever de divulgar. Os dois estão ligados no registro em si, razão pela qual são lidos como um: o memorando de abril do comitê de Regras Civis cita o rascunho da Regra 707, e suas atas observam que o comitê de Regras de Prova tinha essa regra sob estudo.
Material que outra parte designou como confidencial é o caso mais difícil, e ele alcança essa arquitetura diretamente. Em Morgan, o tribunal permitiu que uma parte autorepresentada colocasse tal material em um serviço de IA apenas quando o provedor é contratualmente obrigado a não armazenar ou usar a entrada para treinar ou melhorar seu modelo, a não divulgá-lo a terceiros, exceto quando a divulgação é essencial para entregar o serviço e o destinatário é vinculado por proteções equivalentes, e a remover ou deletar a pedido; exigiu que a parte nomeasse qualquer ferramenta usada em conexão com esse material e mantivesse documentação escrita dessas salvaguardas. O tribunal observou que a condição exclui a maioria das IA convencionais de baixo custo ou gratuitas. Esses são os termos de uma ordem de proteção única em vez de uma regra nacional, e eles são os mais restritivos que o autor localizou; o protocolo os adota como sua própria política de projeto.
Seguem três restrições. Elas são regras de projeto deste protocolo, não declarações do que a lei exige de um litigante.
1. Arquivos públicos e material que o operador é livre para transmitir podem ser enviados aos modelos. Material selado, material sob uma ordem de proteção, e descoberta confidencial de outra parte não, a menos que a ordem permita e os termos do provedor atendam à condição que Morgan impôs. A restrição cobre todos os estágios e todos os destinatários, não apenas os geradores: o consolidador e ambos os críticos recebem o rascunho mesclado, e os artefatos retidos viajam com ele. A propriedade de um documento não descarrega por si só uma obrigação de confidencialidade a ele anexada. O manifesto torna a exposição auditável; ele não a torna legal.
2. O manifesto apoia a divulgação; ele não é a divulgação. Ele registra qual identificador de modelo produziu qual artefato e quando, que é o material que um tribunal solicitando o programa utilizado desejará, e vale a pena manter quer o juiz presidente o solicite ou não. Ele não arquiva o aviso que uma ordem permanente exige, não identifica as porções do documento final que uma regra como a do Juiz Vaden alcança, e não fornece qualquer certificação.
3. A verificação de cada citação contra sua fonte é feita por uma pessoa. A Regra 11(b) se aplica a uma parte não representada por seus termos, e seu padrão é investigação razoável sob as circunstâncias em vez de qualquer procedimento particular; a Parte II expõe o que o registro de citações fabricadas mostra. Acordo entre modelos e aprovação por dois críticos não são verificação.
Os requisitos variam por distrito e por juiz, e a ordem permanente do juiz presidente governa.
Limites.
Os modos de pesquisa profunda das interfaces de consumidor não possuem equivalente exato nas APIs dos fornecedores. Uma etapa que necessite um é executada manualmente: o prompt é escrito em um arquivo, o operador o executa na interface e cola a resposta de volta, e o manifesto registra que a etapa foi executada dessa forma. Essa alternativa é manual, e a Parte II explica por que um fluxo de trabalho manual em várias interfaces não é meramente mais lento para um litigante com deficiência motora ou visual. Um protocolo que depende disso herda esse limite.
A concordância entre modelos é evidência de correlação tanto quanto de verdade. Modelos treinados em corpora sobrepostos compartilham erros, e um conjunto unânime de rascunhos pode estar errado em conjunto. O protocolo reduz a correlação que pode alcançar e registra o restante.
O protocolo não foi comparado com prompting de modelo único. A comparação que resolveria seu valor é uma avaliação cega: as mesmas tarefas preparadas de ambas as formas, os documentos resultantes pontuados por leitores que não sabem qual é qual, em precisão de citação, completude em relação à declaração de tarefa e erros que um tribunal notaria. O protocolo é indicado aqui para que essa comparação possa ser executada.
O repositório mencionado acima contém o pipeline, a configuração e os testes offline.
Referências e Autoridades Selecionadas
ABA Model Rules of Professional Conduct r. 5.5.
Americans with Disabilities Act, 42 U.S.C. §§ 12181--12188.
Ashley, Kevin D., Artificial Intelligence and Legal Analytics: New Tools for Law Practice in the Digital Age (Cambridge Univ. Press 2017).
Avery, Joseph J., Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).
Blanck, Peter, eQuality: The Struggle for Web Accessibility by Persons with Cognitive Disabilities (Cambridge Univ. Press 2014).
Cappelletti, Mauro & Bryant Garth, Access to Justice: The Newest Wave in the Worldwide Movement to Make Rights Effective, 27 Buff. L. Rev. 181 (1978).
Carpenter, Anna E., Colleen F. Shanahan, Jessica K. Steinberg & Alyx Mark, Judges in Lawyerless Courts, 110 Geo. L.J. 509 (2022).
Centers for Disease Control and Prevention, Disability Impacts All of Us (2022 BRFSS data).
Chan, Chi-Min, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu & Zhiyuan Liu, ChatEval: Towards Better LLM-Based Evaluators Through Multi-Agent Debate, arXiv:2308.07201 (2023).
Charlotin, Damien, AI Hallucination Cases Database, https://www.damiencharlotin.com/hallucinations/ (acesso em setembro de 2026).
Chernets, Vadym, docprep: A Reference Implementation of the Blind-Consolidation Protocol, release v1.0.0 (2026), https://github.com/vadimchernets/docprep (licença MIT; o protocolo especificado no Apêndice e o código que o executa).
Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) (protocolo público); PolyHelper.AI LLC v. United States of America, No. 1:25-cv-07770 (S.D.N.Y. 2025) (ação anterior, réu diferente).
Cohen-Sasson, Or, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).
Du, Yilun, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.
Engstrom, Nora Freeman & Aviv Caspi, Opening the Courthouse Door---or Just Lowering the Threshold?, JOTWELL: Legal Profession (July 3, 2026).
Fed. R. Civ. P. 26(b)(3).
Greiner, D. James, Cassandra Wolos Pattanayak & Jonathan Hennessy, The Limits of Unbundled Legal Assistance: A Randomized Study in a Massachusetts District Court and Prospects for the Future, 126 Harv. L. Rev. 901 (2013).
Grimm, Paul W., Maura R. Grossman & Gordon V. Cormack, Artificial Intelligence as Evidence, 19 Nw. J. Tech. & Intell. Prop. 9 (2021).
Guha, Neel, et al., LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models, Advances in Neural Information Processing Systems 36 (2023).
Hadfield, Gillian K., Rules for a Flat World: Why Humans Invented Law and How to Reinvent It for a Complex Global Economy (Oxford Univ. Press 2017).
Hannaford-Agor, Paula, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts (National Center for State Courts 2015).
Hickman v. Taylor, 329 U.S. 495 (1947).
Katz, Daniel Martin, Michael James Bommarito, Shang Gao & Pablo Arredondo, GPT-4 Passes the Bar Exam, 382 Phil. Trans. R. Soc. A 20230254 (2024).
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022).
Liang, Tian, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (2024).
Magesh, Varun, Faiz Surani, Matthew Dahl, Mirac Suzgun, Christopher D. Manning & Daniel E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford HAI (2024).
Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026).
Park v. Kim, 91 F.4th 610 (2d Cir. 2024).
Sandefur, Rebecca L., Access to What?, 148 Daedalus 49 (2019).
Shah, Anand V. & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (manuscrito não publicado), https://ssrn.com/abstract=6766859.
Sharma, Mrinank, et al., Towards Understanding Sycophancy in Language Models, ICLR (2024).
Simshaw, Drew, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).
Surden, Harry, Machine Learning and Law, 89 Wash. L. Rev. 87 (2014).
System Documentation (em arquivo com o autor).
U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (Mar. 3, 2026).
United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026).
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026).
* Arquiteto de sistemas de IA. Os papéis do autor como demandante, desenvolvedor de sistemas e analista estão descritos na Declaração de Divulgação do Autor abaixo. Comentários bem-vindos: [email protected].↩︎
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022), https://justicegap.lsc.gov. Em termos de autorrepresentação em geral, pelo menos uma das partes se autorrepresentou em mais de três quartos dos processos civis em um importante estudo multijurisdicional. Ver Paula Hannaford-Agor, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts iv (National Center for State Courts 2015).↩︎
Anand V. Shah & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (manuscrito inédito), https://ssrn.com/abstract=6766859 (analisando mais de 4,5 milhões de processos civis federais não prisioneiros, FY2005--FY2026, e 46 milhões de entradas de autos correspondentes do PACER); ver também Or Cohen-Sasson, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).↩︎
Chief Judge Patrick J. Schiltz (D. Minn.), citado em Mattathias Schwartz & Zach Montague, Artificial Intelligence Floods Court Dockets with Home-Brewed Lawsuits, N.Y. Times (May 25, 2026).↩︎
Drew Simshaw, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).↩︎
Ver, por exemplo, Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023); Park v. Kim, 91 F.4th 610 (2d Cir. 2024).↩︎
Carta de Andrew J. Dietderich, Sullivan & Cromwell LLP, a Chief Judge Martin Glenn, U.S. Bankruptcy Court, S.D.N.Y. (Apr. 18, 2026) (desculpando-se por "citações imprecisas e outros erros," alguns deles "alucinações" de IA, em uma moção de emergência de 9 de abril nos procedimentos do Capítulo 15 de Prince Global Holdings Ltd.); ver Sullivan & Cromwell Apologizes to Judge for AI Hallucinations, Bloomberg Law (Apr. 21, 2026).↩︎
AI Hallucination Cases Database (Damien Charlotin), https://www.damiencharlotin.com/hallucinations/ (instantâneo de 2 de julho de 2026): de 1.668 incidentes documentados em todo o mundo, 975 envolveram litigantes autorrepresentados e 653 envolveram advogados representados; em 2023, aproximadamente sete em dez envolveram litigantes autorrepresentados, e a participação dos advogados nas descobertas recentemente documentadas aumentou constantemente entre 2025 e 2026.↩︎
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026); ver também comentários sobre IA e exercício não autorizado do direito no Georgetown Journal of Legal Ethics (2026).↩︎
Ver Law360 Pulse, Tracking Federal Judge Orders on Artificial Intelligence (última visitação julho 2026); Legal AI Governance, Federal and State Court Orders on AI, https://legalaigovernance.com/tracker/court-orders/ (última visitação julho 2026).↩︎
Ver How Courts Are Coping with a Flood of AI-Generated Lawsuits, MIT Technology Review (June 4, 2026) (relatando, entre outros, que as ações ajuizadas por partes autorrepresentadas em Vermont aumentaram de aproximadamente quarenta e cinco por ano antes de 2022 para mais de 1.100 em 2024).↩︎
A petição inicial no estudo de caso caracteriza o sistema nesses termos; o enquadramento é anotado como a teoria jurídica do demandante, não como uma determinação de mérito. Na escala da população afetada, mais de um em cada quatro adultos americanos --- mais de 70 milhões --- relataram uma deficiência em 2022, CDC, Disability Impacts All of Us (dados BRFSS 2022), e a razão entre emprego e população para pessoas com deficiência foi de 22,8% em 2025, versus 65,2% para aqueles sem deficiência, U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (Mar. 3, 2026).↩︎
Yilun Du, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.↩︎
Ver, por exemplo, Tian Liang, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP 2024) 17889; Chi-Min Chan et al., ChatEval: Towards Better LLM-Based Evaluators through Multi-Agent Debate, arXiv:2308.07201 (2023).↩︎
A oposição do demandante colocou tal desenvolvimento no registro, anotando o anúncio público de um réu de um recurso de consenso multifornecedor e multi-modelo. Ver Plaintiff's Opposition, ECF No. 76.↩︎
System technical documentation (citado apenas para fins de design).↩︎
A arquitetura é objeto de uma família de pedidos internacionais de patente pendentes sobre os quais o autor é um requerente nomeado; a família é documentada no registro público da ação judicial (ver Plaintiff's Opposition, Ex. 3), e seus identificadores são omitidos aqui como irrelevantes para a análise.↩︎
Joint Motion to Dismiss and Memorandum in Support, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), ECF Nos. 69, 69-1; Plaintiff's Memorandum of Law in Opposition, ECF No. 76 (Apr. 2, 2026); Transcript of Pre-Motion Conference, ECF No. 55 (Jan. 27, 2026).↩︎
ECF Nos. 28 (moção de consentimento), 30, 32--34, 36--37 (Jan. 12, 2026). As cartas coordenaram-se entre si; um réu expressamente adotou os fundamentos e argumentos constantes das cartas pré-moção de seus co-réus.↩︎
ECF Nos. 39--44 (Jan. 15--16, 2026).↩︎
Comparar Petição em Apoio à Moção para Arquivamento, ECF No. 69-1, com a Oposição da Parte Autora, ECF No. 76, p. 17.↩︎
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026) (Patti, M.J.); United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026) (Rakoff, J.); Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).↩︎
Morgan v. V2X, Inc., 2026 WL 864223, at *3 (D. Colo. Mar. 30, 2026).↩︎
Ver ABA Model Rules of Prof'l Conduct r. 5.5; Joseph J. Avery, Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).↩︎
Este Artigo descreve apenas documentos publicamente arquivados e características arquitetônicas já divulgadas aos réus e ao público. Omite os prompts utilizados, a lógica de decisão do sistema em qualquer questão específica, e todos os produtos de trabalho rascunhados.↩︎
docprep, uma implementação de referência do protocolo blind-consolidation, https://github.com/vadimchernets/docprep (licença MIT); a versão descrita aqui é a release v1.0.0. O repositório contém o pipeline executável em um arquivo, a configuração da Tabela 6, o formato do manifesto, e testes offline que funcionam sem contas ou chaves, juntamente com este Apêndice como uma especificação independente sob CC BY 4.0. Os identificadores de modelo e acesso devem ser configurados para as contas do operador.↩︎
Advisory Comm. on Civil Rules, Rascunho de Atas de Reunião de Apr. 14, 2026, p. 18, reimpresso em Comm. on Rules of Practice & Procedure, Agenda Book 383 (June 3--4, 2026) (item 17, "Artificial Intelligence Hallucinations"); ver também Advisory Comm. on Civil Rules, Agenda Book 438--50 (Apr. 14, 2026) (Suggestions 25-CV-S and 25-CV-V, ambas direcionadas a Rule 11); Report of the Advisory Comm. on Civil Rules 60 (May 6, 2026), em Agenda Book, supra, p. 364 (questões retiradas da agenda). As atas estão em rascunho aguardando aprovação na reunião de outono de 2026 do comitê. Proposed Federal Rule of Evidence 707, que rege a admissibilidade de provas geradas por máquina em vez de divulgação, é uma questão separada: o Advisory Committee on Evidence Rules a revisou em 7 de maio de 2026 e a manteve sob estudo em vez de promovê-la.↩︎
N.D. Tex. Civ. R. 7.2(f) (divulgação do uso de inteligência artificial generativa na primeira página de uma petição, com divulgação adicional das porções assim preparadas se o juiz presidente ordenar); Order on Artificial Intelligence, U.S. Court of International Trade (Vaden, J.) (June 8, 2023) (exigindo a identificação do programa utilizado, das porções específicas de texto que produziu, e certificação de que o uso não divulgou informações confidenciais ou proprietárias comerciais a uma parte não autorizada).↩︎
Como citar
Chernets, V. (2026). The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice [Pré-impressão]. SSRN. https://doi.org/10.2139/ssrn.7120940
@misc{chernets2026missingvariable,
  author       = {Chernets, Vadym},
  title        = {{The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7120940},
  url          = {https://doi.org/10.2139/ssrn.7120940}
}