La Variable Faltante en Litigios Asistidos por IA: Arquitectura y la Calidad del Acceso a la Justicia Pro Se
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, Doctorado, arquitecto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7120940 · DOI 10.2139/ssrn.7120940 · Zenodo 10.5281/zenodo.22168724 · GitHub
- Versión de registro: SSRN 7120940 · DOI 10.2139/ssrn.7120940
- Copia archivada, citable y descargable: 10.5281/zenodo.22168724 — DOI de concepto, siempre se resuelve a la versión más reciente
- Texto completo como Markdown y PDF: GitHub
- HTML legible: https://polyhelper.ai/research/missing-variable/
El mismo texto está en cuatro superficies para que se pueda acceder cuando una de ellas no pueda servirlo. SSRN mantiene la versión de registro; cite esa.
La Variable Faltante en Litigios Asistidos por IA
Arquitectura y la Calidad del Acceso a la Justicia Pro Se
Vadym Chernets, Doctorado1
Publicado por primera vez en julio de 2026; esta versión septiembre de 2026
DECLARACIÓN DE DIVULGACIÓN DEL AUTOR
El interés del autor en este Artículo es triple, y cada aspecto es material. Primero, el autor es el demandante en Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.), el litigio que sirve como estudio de caso. Segundo, el autor es el desarrollador del sistema de orquestación multi-modelo cuyo uso se examina aquí, y es solicitante nombrado en aplicaciones internacionales dentro de la familia de patentes descrita en la Parte III; por lo tanto, el autor tiene un interés en los métodos que este Artículo analiza. Tercero, el autor es el analista. Las restricciones metodológicas establecidas en la Parte IV rigen el análisis: dependencia exclusivamente del expediente público, ninguna inferencia de los motivos de la liquidación, y tratamiento no probatorio de las métricas de desempeño autoinformadas del sistema. La Parte VII indica los límites.
Dos párrafos, uno en la Parte II y otro en el Apéndice, son las propias palabras del autor sobre por qué construyó el sistema y por qué demandó; están marcados como suyos, y ningún hallazgo se basa en ellos. De otra manera, este Artículo se basa exclusivamente en el expediente federal público y en fuentes públicamente disponibles; no divulga la estrategia litigiosa privilegiada relacionada con reclamaciones que permanecen pendientes contra los demandados que no se han liquidado. El autor no es un abogado. Se utilizaron asistentes de IA como instrumentos bajo la dirección del autor; las ideas, la investigación y las conclusiones son del autor.
RESUMEN
Casi toda referencia de la IA en litigios se basa en un supuesto no declarado: que la asistencia de IA es una cosa. El debate que produce ese supuesto se refiere al volumen y la fabricación: una tasa de demandantes pro se federales que subió del 11% al casi 17%, tribunales describiendo una «amenaza existencial», un docket cada vez mayor de decisiones sobre sanciones por citas fabricadas. Lo que los estudios agregados aún no pueden mostrar es si alguna configuración de asistencia de IA cambia la calidad de lo que hacen los litigantes que se autorepresentan. El registro utilizado aquí es el docket público de un caso federal, y contiene un patrón que la descripción de volumen y alucinación no predice. Un litigante que se autorepresenta sin abogado alguno, utilizando, según la descripción del autor, un sistema de orquestación multimodelo (modelos independientes consultados en paralelo, desacuerdo expuesto en lugar de promediado, citas verificadas contra fuentes externas), respondió a seis cartas previas a moción coordinadas en cuatro días, presentó una oposición sustancial seis semanas antes de la fecha límite e identificó un error de cita estatutaria verificable en un escrito presentado por siete demandados representados por abogados de firmas líderes, en un caso que nombra a trece demandados de tecnología. El último de estos tres es el inverso del modo de falla que domina la literatura. El Artículo propone la hipótesis de dependencia de arquitectura: la arquitectura de la asistencia de IA, consulta de modelo único versus orquestación multimodelo, es una variable empírica en la calidad de los litigios que se autorepresentan en su propio derecho, no un detalle de implementación ni lo mismo que la disponibilidad de IA. Las consecuencias doctrinales que se abordan aquí son para la doctrina del trabajo realizado, donde los tribunales federales se dividen a principios de 2026, y para el marco de práctica no autorizada. El caso se ofrece como una prueba de existencia falsable y una agenda de investigación; el autor es el demandante, el desarrollador del sistema y el analista.
Palabras clave: litigios pro se; litigantes que se autorepresentan; acceso a la justicia; litigios asistidos por IA; IA generativa; debate multiagente; orquestación multimodelo; citas fabricadas; verificación de citas; doctrina del trabajo realizado; divulgación; órdenes permanentes; Regla 11; práctica no autorizada de la ley; Título III; hipótesis de dependencia de arquitectura. Clasificación JEL: K41 (Proceso de Litigio); K10 (Áreas Básicas de Derecho, General); O33 (Cambio Tecnológico: Opciones y Consecuencias). # Contenido
I. Introducción 4
II. La Brecha de Acceso a la Justicia y el Giro de IA Pro Se 6
III. De la Consulta de Modelo Único a la Orquestación: El Exoesqueleto Cognitivo 11
IV. Método y Base Probatoria 15
V. Hallazgos 18
A. Reconstrucción del Marco Legal Tras una Presentación Inicial Defectuosa 19
B. Respuesta a la Práctica Previa a Moción Coordinada 20
C. Respuesta Oportuna a una Defensa Consolidada 21
D. Identificación de un Error de Cita Estatutaria en el Memorándum de Defensa 22
E. Acuerdos Tempranos 23
VI. Implicaciones Doctrinales 25
A. Trabajo Realizado y el Litigante Pro Se 25
B. Práctica No Autorizada de la Ley 27
C. Un Replanteamiento, No una Resolución 29
VII. Limitaciones y Trabajo Futuro 29
VIII. Conclusión 32
Apéndice. Una Arquitectura de Asistencia, Especificada para que Pueda Ejecutarse 34
Referencias y Autoridades Seleccionadas 42
I. Introducción
Un litigante, trece empresas de IA: el caso examinado aquí comprime en un único docket la pregunta que este Artículo presenta a la literatura. La brecha entre las necesidades legales civiles de los estadounidenses y los recursos disponibles para satisfacerlas es uno de los problemas más duraderos del sistema de justicia estadounidense. El estudio nacional más reciente de la Corporación de Servicios Legales encontró que los estadounidenses de bajos ingresos recibieron ayuda nula o inadecuada para el noventa y dos por ciento de los problemas legales civiles que los afectaban sustancialmente, con casi tres de cuatro hogares de bajos ingresos experimentando al menos un problema de este tipo en un único año.2 Para la mayoría de los litigantes que se autorepresentan, la barrera no es la tarifa de presentación sino todo lo que viene después: localizar el tribunal correcto, identificar la causa de acción operativa, efectuar la notificación a los demandados corporativos y responder a mociones redactadas por abogados experimentados bajo plazos comprimidos.
Esa población ha crecido rápidamente desde que la IA generativa se puso ampliamente disponible. Un reciente estudio empírico a gran escala informa que la tasa federal de demandantes civiles pro se, estable cerca del once por ciento durante dos décadas, subió al 16,8 por ciento en el año fiscal 2025 (Figura 1), y que la proporción de demandas civiles federales muestreadas que llevan marcadores de texto generado por IA se elevó de prácticamente cero en 2019 a más del dieciocho por ciento a principios de 2026, según se mide en ese estudio. Esa muestra se basa en demandas presentadas tanto pro se como con abogado, tomadas del archivo RECAP, que los autores advierten subestima las presentaciones hechas sin abogado.3
Los tribunales y comentaristas han reaccionado en su mayoría con aprensión. El entonces juez jefe de un tribunal de distrito federal describió el problema general como «una amenaza existencial para los tribunales federales».4 Las asociaciones de abogados advierten que los chatbots de consumidor pueden incursionar en la práctica no autorizada del derecho, y un cuerpo cada vez mayor de decisiones sobre sanciones aborda a litigantes, representados y no representados por igual, que presentan escritos citando casos que no existen.
La aprensión está bien fundada, pero describe un modo particular de uso de IA. Al enfocarse en ese modo, el trabajo empírico existente trata implícitamente la asistencia de IA como homogénea, y este Artículo argumenta que el supuesto ya no es defendible. Los fracasos documentados (autoridad alucinada, acuerdo servil, volumen indiferenciado) son característicos de la consulta de modelo único: un litigante plantea una pregunta a un modelo de propósito general y presenta el resultado. Casi toda la imagen empírica del uso de IA pro se se basa en ese modo.
La arquitectura examinada aquí es diferente, y la pregunta es si esa diferencia importa. En la orquestación multimodelo, una consulta se envía simultáneamente a varios modelos independientes, y sus resultados se comparan. El acuerdo y el desacuerdo se hacen explícitos, y la divergencia, incluida una señal minoritaria que señala un posible error, se preserva en lugar de promediar. La afirmación que se avanza aquí es estrecha pero, si es correcta, consecuencial: los modos de fallo de modelo único que impulsan la preocupación actual pueden no ser intrínsecos al litigio asistido por IA, y una arquitectura de orquestación puede convertir el uso de IA de una fuente de volumen en un instrumento de calidad. La contribución es metodológica: el Artículo propone que la arquitectura de la asistencia por IA se trate como una variable empírica distinta en lugar de un detalle de implementación, y el caso que sigue se ofrece como una instancia documentada que motiva esa propuesta. La afirmación, en cuatro palabras: arquitectura, no disponibilidad.
La afirmación se desarrolla a través de un solo estudio de caso, Chernets v. Google LLC et al., una acción federal en la que un demandante que se representa a sí mismo, utilizando (según su propio relato) un sistema de orquestación multimodelo, litigó contra un grupo de demandados tecnológicos representados por abogados de numerosos despachos legales. El análisis descansa enteramente en el expediente público: escritos, fechas y números de documento que cualquier lector puede verificar. Ese registro muestra conducta que la narrativa prevalente de volumen y alucinación no describe y que los estudios agregados de presentación asistida por IA no están diseñados para detectar: un ciclo de alegatos completo sustentado contra una defensa coordinada, con seis escritos previos a la moción coordinados respondidos en cuatro días y una oposición sustantiva presentada semanas antes del plazo, y la identificación de un error de cita estatutaria verificable en el escrito de la coalición defensiva. Cuatro demandados se allanaron temprano (en términos confidenciales; Parte V.E). El caso sigue pendiente, y el propósito de examinarlo es utilizar un registro verificable para aislar un fenómeno que, en la narrativa prevalente, no se esperaría que existiera y que la literatura aún no ha examinado de cerca.
Un solo caso redactado por una parte puede establecer que un fenómeno ocurrió, no con qué frecuencia ocurre o si se generaliza; la Parte VII establece los límites. El argumento es que la arquitectura de la asistencia por IA es una variable independiente en el estudio del litigio asistido por IA, una variable que el enfoque actual, centrado en la disponibilidad y el volumen, no aísla. Esta es la hipótesis de dependencia arquitectónica; la Parte IV la establece formalmente.
El Artículo procede de la siguiente manera. La Parte II sitúa el estudio en la literatura de acceso a la justicia y la investigación emergente sobre el uso de IA pro se. La Parte III distingue la solicitud a modelo único de la orquestación y especifica el mecanismo. La Parte IV presenta el método de estudio de caso y su base probatoria en el expediente público. La Parte V presenta los hallazgos. La Parte VI examina las implicaciones para la doctrina del producto del trabajo y el marco de práctica no autorizada del derecho. La Parte VII aborda limitaciones y trabajo futuro. La Parte VIII concluye.
II. La brecha de acceso a la justicia y el giro hacia la IA pro se
La brecha de justicia es una característica estructural del sistema civil estadounidense, no una marginal. Una gran parte de estadounidenses de bajos y medianos ingresos no recibe ayuda legal significativa para sus problemas civiles, y en muchas categorías de casos la autorepresentación es la norma más que la excepción (Carpenter, Shanahan, Steinberg & Mark 2022). Desde el movimiento comparativo de acceso a la justicia de los años 1970 (Cappelletti & Garth 1978), los estudiosos han enmarcado la pregunta como una de distribución: la experiencia legal es un recurso escaso, asignado de manera desigual, y los litigantes menos capaces de permitirse abogado son a menudo aquellos con más en juego (Sandefur 2019). Esa literatura pregunta a qué se refiere el acceso a la justicia; la pregunta perseguida aquí es la calidad de esa ayuda.
Con ese trasfondo, la IA generativa llegó como un desarrollo ambiguo. Según una perspectiva, prometía democratizar la capacidad legal, dando a los litigantes no representados un facsímil de la investigación, la redacción y el análisis que proporciona el abogado. Esa promesa tomó forma concreta cuando un modelo de vanguardia aprobó el Examen Uniforme del Colegio de Abogados (Katz, Bommarito, Gao & Arredondo 2024), aunque los puntos de referencia de desempeño de ese tipo cambiaron las expectativas sobre la capacidad sin aislar las diferencias arquitectónicas. Simshaw advirtió temprano que la IA podría en cambio perpetuar un sistema de dos niveles, en el que los bien dotados de recursos obtienen el juicio humano experto mientras que todos los demás reciben aproximaciones automatizadas.5 El panorama empírico que ha surgido desde entonces es más concreto: analizando millones de presentaciones federales, trabajos recientes documentan que la tasa de demandantes pro se se disparó tras el lanzamiento público de la IA generativa y desarrolla indicadores de redacción coherente con la IA en las propias demandas. Ese registro agregado aún no puede mostrar si algo de esto deja a los litigantes que se representan a sí mismos en mejor situación. Como observan los lectores más cuidadosos de ese estudio, pasar nuevos demandantes por la puerta del juzgado no es lo mismo que ayudarles una vez adentro (Engstrom & Caspi 2026).
Figura 1. El aumento de demandantes pro se en litigios civiles federales tras la amplia disponibilidad de la IA generativa.
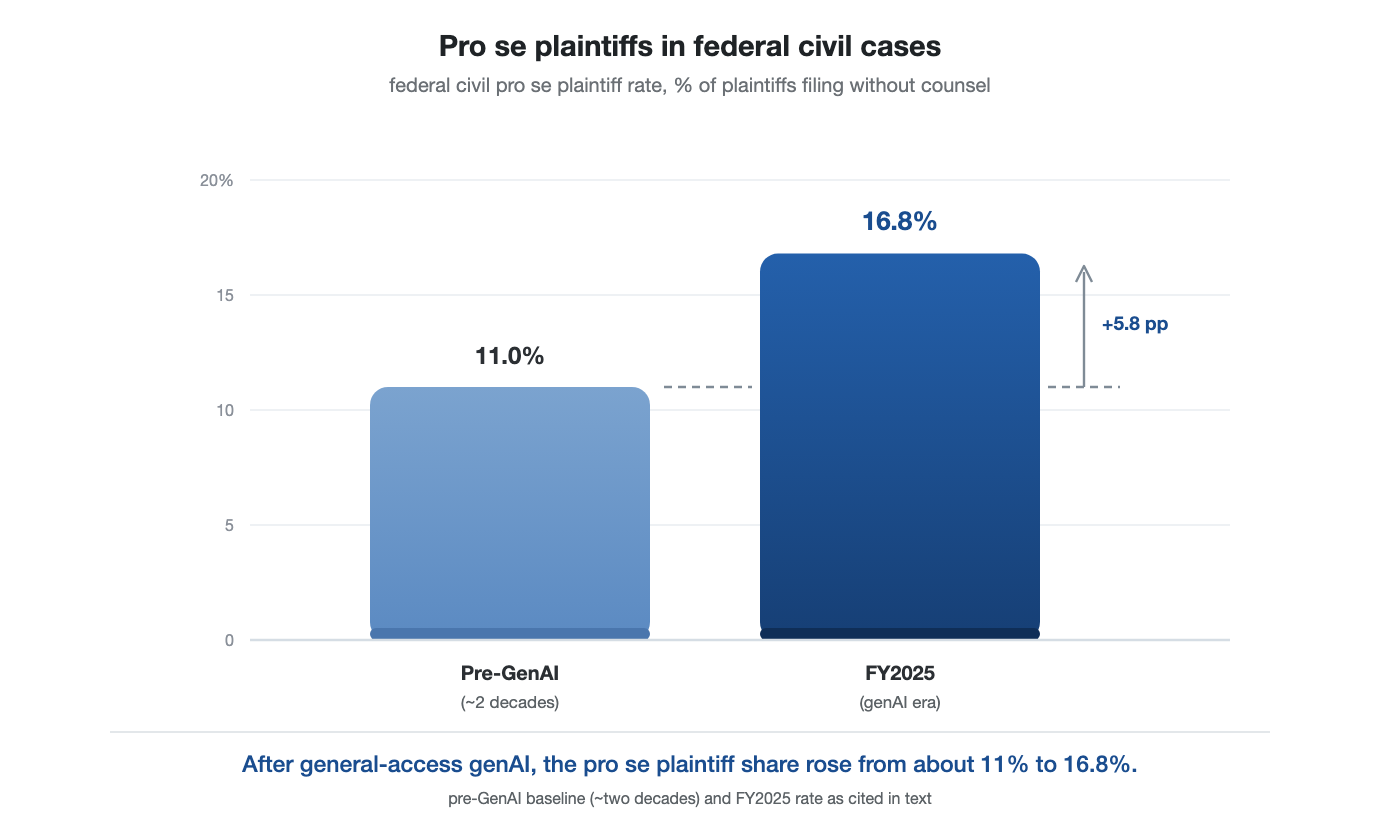
Fuente: Adaptado de Shah & Levy (2026); cifras redondeadas.
La acogida en los tribunales y el colegio de abogados ha sido predominantemente cautelosa, y las preocupaciones se agrupan en torno a la fabricación, el ejercicio no autorizado y el volumen. En cuanto a la fabricación, una línea de decisiones ahora sustancial sanciona a los litigantes y abogados que presentan escritos citando casos que no existen,6 un modo de fallo rastreado directamente hasta los modelos generativos que producen autoridad plausible pero ficticia. Ese modo de fallo ha producido un registro monitoreado de decisiones en el que un tribunal determinó o tomó como establecido que una presentación se basaba en material fabricado por IA: más de dos mil en todo el mundo según septiembre de 2026 (Charlotin 2026), e incluye ahora un episodio ampliamente reportado en el que una de las firmas más prominentes de Wall Street se disculpó ante un tribunal federal de quiebras por una presentación de emergencia que contenía citas inexactas y otros errores, algunos de ellos "alucinaciones" de IA.7 La composición de ese registro es en sí misma instructiva: lo que comenzó de manera abrumadora como un fenómeno de auto-representación no se ha mantenido como tal. Para mediados de 2026, los abogados con licencia representaban aproximadamente dos quintas partes de los incidentes documentados, y su proporción de hallazgos recién documentados estaba creciendo.8 Los colegios de abogados y comentaristas también se preocupan por el ejercicio no autorizado, cuestionando si los chatbots de consumo que ofrecen orientación legal cruzan la línea que reserva el ejercicio del derecho a los abogados con licencia, y si las entidades que los operan podrían ser responsables.9 En cuanto al volumen, los jueces han descrito una afluencia de presentaciones pro se asistidas por IA como una tensión en los recursos judiciales, en la formulación más aguda una amenaza existencial para los tribunales federales.
La respuesta judicial ha adoptado una forma adicional y reveladora. Desde mediados de 2023, jueces individuales de tribunales federales y estatales han emitido mandatos permanentes que abordan la IA generativa en sus salas de audiencias (los rastreadores públicos ahora enumeran cientos, ninguno igual a otro), requiriendo que las partes divulguen si se usó IA en la redacción, certifiquen que las citas fueron verificadas, o ambas.10 Los mandatos comparten un diseño (Tabla 1): regulan el hecho del uso de IA y la verificación de su resultado. La arquitectura, ya sea que la asistencia sea de modelo único u orquestada, auto-verificante o no, es la variable aislada aquí, y no aparece en ninguno de los mandatos que el autor ha ubicado. Un tribunal que aplicara tal mandato al caso estudiado aquí registraría solo que se utilizó IA. Ni el régimen de divulgación ni la literatura empírica actualmente tienen un vocabulario para cómo, y esa ausencia es el mismo supuesto de homogeneidad descrito anteriormente, en forma regulatoria.
Tabla 1. El régimen emergente de divulgación de IA: qué solicitan los mandatos permanentes, y qué no.
| Lo que el mandato solicita | Presencia en el régimen |
| ¿Se utilizó IA generativa en la redacción? | Requerido rutinariamente |
| ¿Fueron verificadas las citas y las comillas? | Requerido rutinariamente |
| ¿Qué herramienta o modelo se utilizó? | A veces requerido |
| ¿Fue la asistencia de modelo único u orquestada (arquitectura)? | No encontrado en ningún mandato ubicado |
| ¿Se identificó y se resolvió el desacuerdo entre modelos? | No encontrado en ningún mandato ubicado |
Fuente: Rastreadores públicos de mandatos permanentes judiciales sobre IA (Law360 Pulse; Legal AI Governance), a partir de julio de 2026; véase la nota 10. La caracterización de la cobertura es del autor.
Figura 2. La variable faltante: los estudios empíricos existentes varían la disponibilidad de asistencia de IA; su arquitectura no se mide.
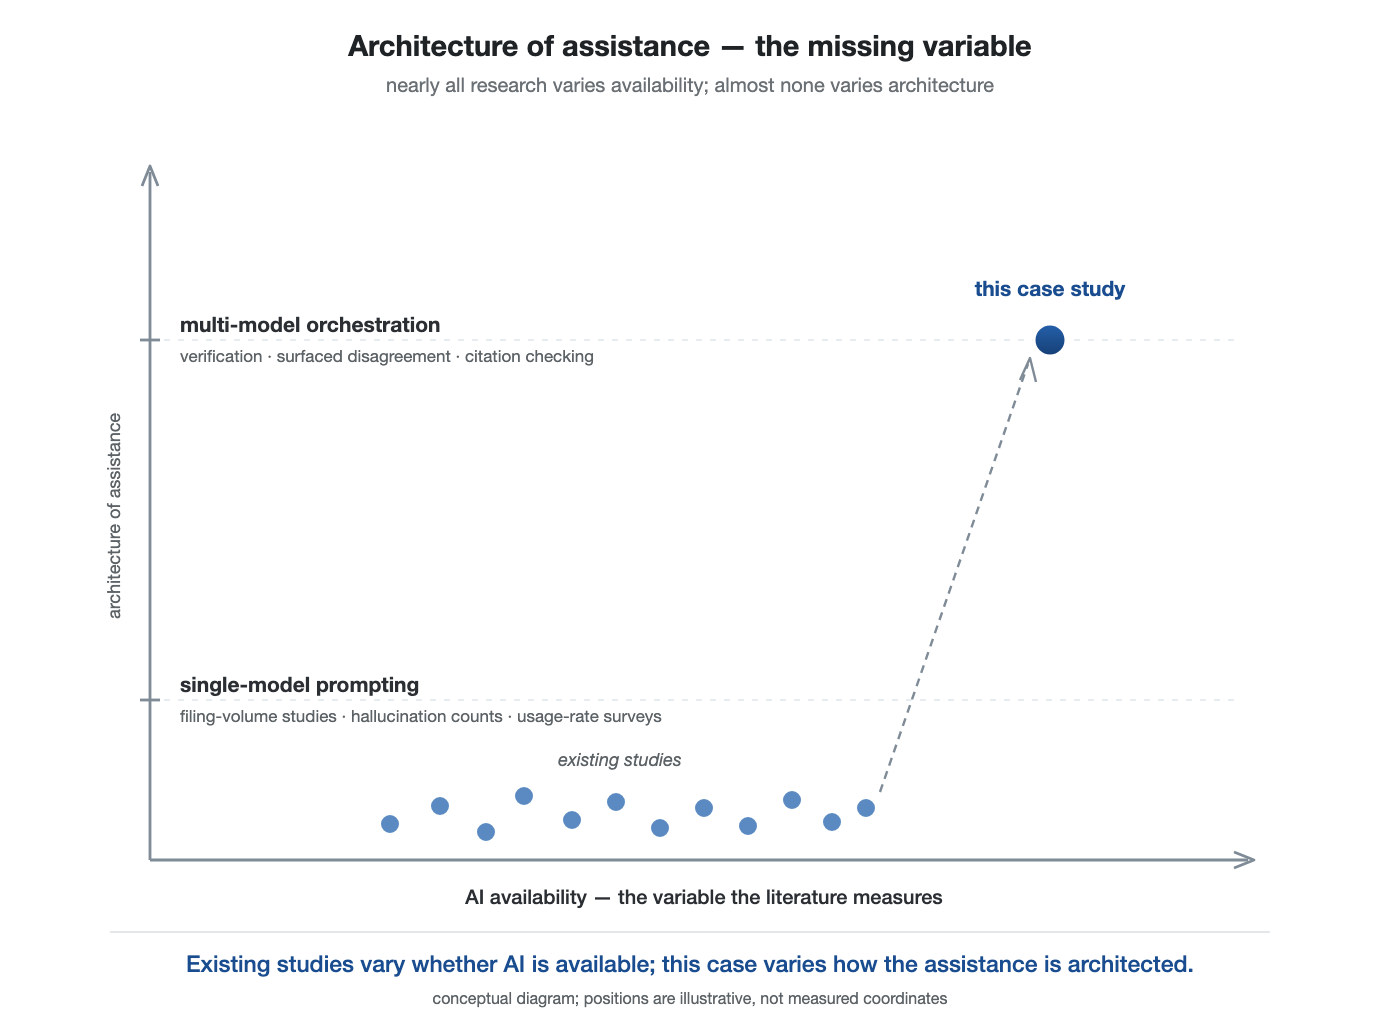
Fuente: Esquema del autor de la literatura empírica discutida en esta Parte.
Los dos desarrollos se encuentran en la pregunta perseguida aquí. La brecha de justicia explica por qué la auto-representación importa: para la mayoría de los litigantes la alternativa a la auto-representación es ninguna representación en absoluto. El aumento reciente en la auto-representación, coincidiendo con la amplia disponibilidad de IA generativa, explica por qué la arquitectura de la asistencia de IA se ha convertido en una pregunta de investigación importante en lugar de un detalle incidental. Si los litigantes sin representación ahora están actuando a través de IA a escala,11 entonces cómo se configure esa IA puede moldear la calidad de lo que llega a los tribunales, y puede en principio estrechar la brecha en la capacidad de resolución de problemas entre individuos y las instituciones que enfrentan.
Un marco adicional cambia para qué se entiende que es la orquestación. Para un usuario con discapacidad motora, de la médula espinal o visual que no puede operar varias interfaces de navegador simultáneamente, el flujo de trabajo manual que los usuarios sin discapacidad encuentran meramente tedioso (abrir cada proveedor, pegar la consulta, leer, comparar) no es tedioso sino no disponible. El acceso unificado multi-modelo no es una preferencia de productividad sino una cuestión de modificación razonable (cf. Blanck 2014, sobre accesibilidad web para personas con discapacidades cognitivas; la extensión a discapacidades motoras, de la médula espinal y visuales es propia del autor). Bloquear la automatización asistida de un flujo de trabajo que una persona podría realizar manualmente entonces impone una carga que recae, por construcción, más pesadamente en los usuarios menos capaces de realizarlo manualmente, y para ese usuario la arquitectura convierte un debate sobre el ejercicio no autorizado en una cuestión de modificación razonable.12
Lo construí para alguien en mi familia que no puede hacerlo a mano --- que no puede navegar entre las pestañas del navegador. Un bastón, un perro guía: algo hace la parte que una persona no puede hacer. Dilo una vez, y está hecho. De eso se trata este caso.
Lo que estos problemas comparten, y lo que este Artículo busca hacer visible, es un modelo implícito de cómo una persona que se representa a sí misma utiliza la IA: una persona, un modelo de propósito general, verificación mínima, producción máxima. Sin embargo, no es la única arquitectura disponible, y la literatura empírica (Figura 2) aún no ha examinado casos construidos sobre una diferente. La literatura especializada mide la cantidad de litigios pro se asistidos por IA y la confiabilidad de su forma más común; en gran medida no ha preguntado si una arquitectura de asistencia diferente produce una calidad diferente de conducta litigiosa. La brecha se aborda aquí proporcionando un caso documentado de cerca de un modo de uso que los estudios agregados no aíslan.
III. Del Prompting de Modelo Único a la Orquestación: El Exoesqueleto Cognitivo
El término «exoesqueleto cognitivo» marca una distinción que el debate legal-IA tiende a colapsar. Un exoesqueleto amplifica a la persona dentro de él; no actúa en lugar de la persona, e es inerte sin la persona. Esa distinción entre aumento y sustitución corre a través de ambas cuestiones doctrinales tratadas en la Parte VI. La protección del producto del trabajo se adhiere naturalmente al aumento, porque la estrategia protegida sigue siendo propia del litigante, e incómodamente a la sustitución. El marco de práctica no autorizada tiene como objetivo la sustitución (una entidad ejerciendo la ley para alguien) y funciona mal en una herramienta a través de la cual una persona practica por sí misma. Si un sistema dado es uno u otro es una cuestión de arquitectura y uso, no de etiquetas. Los problemas considerados en la Parte II comparten una arquitectura implícita. En el caso problemático paradigmático, una persona que se representa a sí misma plantea una pregunta a un modelo de propósito general único y presenta su salida. Las patologías que siguen son, en gran medida, propiedades de esa configuración de modelo único: citas fabricadas, afirmaciones confiadas incorrectas de ley, acuerdo adulador con la premisa del usuario (Sharma et al. 2024). Un modelo solitario no tiene adversario interno, nada en el pipeline posicionado para contradecirlo. Sus errores, por muy seguros que sean, pasan sin ser impugnados. Los modos de fallo de modelo único que dominan la literatura no son, en este sentido, propiedades de la inteligencia artificial; son propiedades de una configuración.
Durante décadas, la investigación en IA y derecho persiguió la confiabilidad a través de ingeniería de conocimiento explícita, codificando razonamientos legales en reglas y modelos basados en casos (Ashley 2017), antes de que el giro del aprendizaje automático desplazara la pregunta de codificar reglas a aprender patrones (Surden 2014). Un cuerpo distinto de investigación en informática sugiere que esta configuración no es la única disponible, y que sus modos de fallo son en parte arquitectónicos más que intrínsecos. En el enfoque comúnmente denominado debate multiagente, varias instancias de modelo generan independientemente respuestas y luego critican el razonamiento mutuo a través de rondas sucesivas antes de converger en una respuesta. El estudio fundamental reporta que este procedimiento de «sociedad de mentes» mejora la validez fáctica y reduce las respuestas falaces y alucinaciones a las cuales los modelos únicos son propensos.13 El trabajo posterior ha extendido y calificado el hallazgo, reportando que el desacuerdo estructurado reduce la alucinación en matemáticas, lógica y puntos de referencia de preguntas-respuestas, mientras también identifica límites, tales como rendimientos decrecientes más allá de un puñado de agentes y rondas, y la necesidad de evaluar la calidad del razonamiento intermedio en lugar de solo respuestas finales.14 Los dominios de puntos de referencia importan aquí. Esa literatura valida el desacuerdo estructurado en gran medida en matemáticas, lógica y puntos de referencia de preguntas-respuestas, dominios con respuestas verificables. Si sus ganancias se transfieren al argumento legal, donde muchas preguntas carecen de una única respuesta verificable y los modelos pueden converger cortésmente en un error compartido, está sin probar, y la transferencia es una suposición del diseño examinado aquí más que un resultado demostrado.
Para el presente análisis, la parte del mecanismo que importa es dónde se origina la ganancia de confiabilidad. La hipótesis es que la ganancia proviene de las relaciones entre modelos en lugar de que cualquier modelo único sea más capaz, del desacuerdo siendo expuesto y adjudicado en lugar de suprimido. El valor de la orquestación no es más respuestas sino mejor respaldadas. Un hecho que un modelo afirma y otro contesta es el hecho que más necesita escrutinio, y un procedimiento de debate encamina la atención hacia él, mientras que el prompting de modelo único no puede. El mecanismo tiene parientes reconocibles en otros campos (métodos de conjunto en aprendizaje automático, códigos correctores de errores en teoría de la información, disensión estructurada en la ciencia de la deliberación grupal), lo que sugiere que es una propiedad general de sistemas redundantes que preservan el desacuerdo en lugar de un artefacto de cualquier producto.
Tabla 2. Prompting de modelo único versus orquestación multimodelo, por propiedad de diseño.
| Propiedad | Prompting de modelo único | Orquestación multimodelo |
| Adversario interno | Ninguno; salida sin cuestionamiento | Los modelos se examinan mutuamente |
| Fuente de citas | Generadas a partir de pesos del modelo | Validadas contra bases de datos externas |
| Manejo del desacuerdo | No se expone | Preservado; puede desencadenar revisión |
| Modo de fallo característico | Fabricación, adulación | Fabricación reducida (según literatura de debate) |
Fuente: Propiedades de diseño según la literatura de debate multiagente (p. ej., Du et al. 2024; Liang et al. 2024; Chan et al. 2023) y, para la columna de orquestación, la documentación del sistema.
El estudio de caso presenta una estructura reflexiva que, según el conocimiento del autor, ningún otro litigio aún comparte: la tecnología en disputa es la tecnología por la cual se conduce la disputa. Varios de los demandados desarrollan modelos que sistemas de este tipo consultan, el sistema de orquestación en cuestión coordina esos mismos modelos disponibles públicamente, y la conducta litigiosa examinada en la Parte V ocurrió mientras esa coordinación estaba en uso. Según la hipótesis presentada aquí, ningún modelo individual confirió la capacidad. Cada uno presenta los modos de fallo de modelo único descritos anteriormente, y cada demandado que desarrolla un modelo constituyente tuvo, por construcción, acceso a cuando mucho su propio modelo constituyente. La configuración que importaba era una relacional: modelos heterogéneos de proveedores adversos, consultados en paralelo, verificándose mutuamente. La reflexividad realiza trabajo analítico porque mantiene constante la tecnología componente: cualesquiera diferencias que el expediente revele no pueden atribuirse únicamente a que el litigante tenía acceso a modelos componentes mejores que los de los demandados, ya que varios de los modelos componentes eran propios de los demandados; la configuración, el acceso y la habilidad del operador permanecen como explicaciones abiertas. Esta línea de investigación tampoco es externa a los demandados. Los principales laboratorios de IA han publicado ellos mismos sobre las ventajas de las configuraciones multiagente y de conjunto sobre modelos únicos, y durante el período estudiado procedieron a comercializar la verificación entre modelos en sus propios productos.15 La arquitectura en cuestión es una que la industria misma respalda cada vez más.
La orquestación generaliza el debate multiagente en un sistema operacional (Figura 3). Donde el debate típicamente ejecuta múltiples instancias de un modelo, la orquestación distribuye una consulta entre modelos heterogéneos de diferentes proveedores, normaliza sus salidas, calcula un consenso y, críticamente, preserva la divergencia como una señal de primera clase en lugar de promediarla en una única respuesta. El sistema de orquestación utilizado en el estudio de caso es una implementación de este patrón: según su documentación técnica, incorpora consultas de modelos heterogéneos, formación de consenso, preservación de divergencia y verificación de citas contra fuentes externas.16
La arquitectura de orquestación en cuestión es un diseño especificado e ingenierizado. Es el sujeto de una familia de solicitudes de patente pendientes, incluyendo varias solicitudes internacionales bajo el Tratado de Cooperación en Materia de Patentes presentadas en 2025 y 2026.17
Las dos configuraciones difieren en varios ejes de diseño, resumidas en la Tabla 2. Dos de esos compromisos son analíticamente significativos. Uno es la validación de citas contra fuentes externas. La falla dominante de modelo único en litigio, el caso alucinado, surge porque un modelo genera citas a partir de patrones aprendidos en lugar de recuperarlas, y una arquitectura que verifica cada cita contra una base de datos activa, marcando en lugar de incluir cualquier cosa que no pueda confirmar, se dirige a esa falla en su origen. El otro es la preservación de la divergencia. Cuando los modelos no están de acuerdo en una interpretación legal, un sistema de orquestación se puede configurar para tratar el desacuerdo como un disparador para el conservadurismo y la revisión humana en lugar de como ruido a ser resuelto por voto mayoritario. En dominios de alto riesgo, el desacuerdo entre sistemas independientes puede constituir en sí mismo información procesable en lugar de ruido estadístico: una señal minoritaria que indica un posible error se retiene y se eleva. No se descarta.
Figura 3. El principio de orquestación: consulta paralela, comparación y preservación de la divergencia.
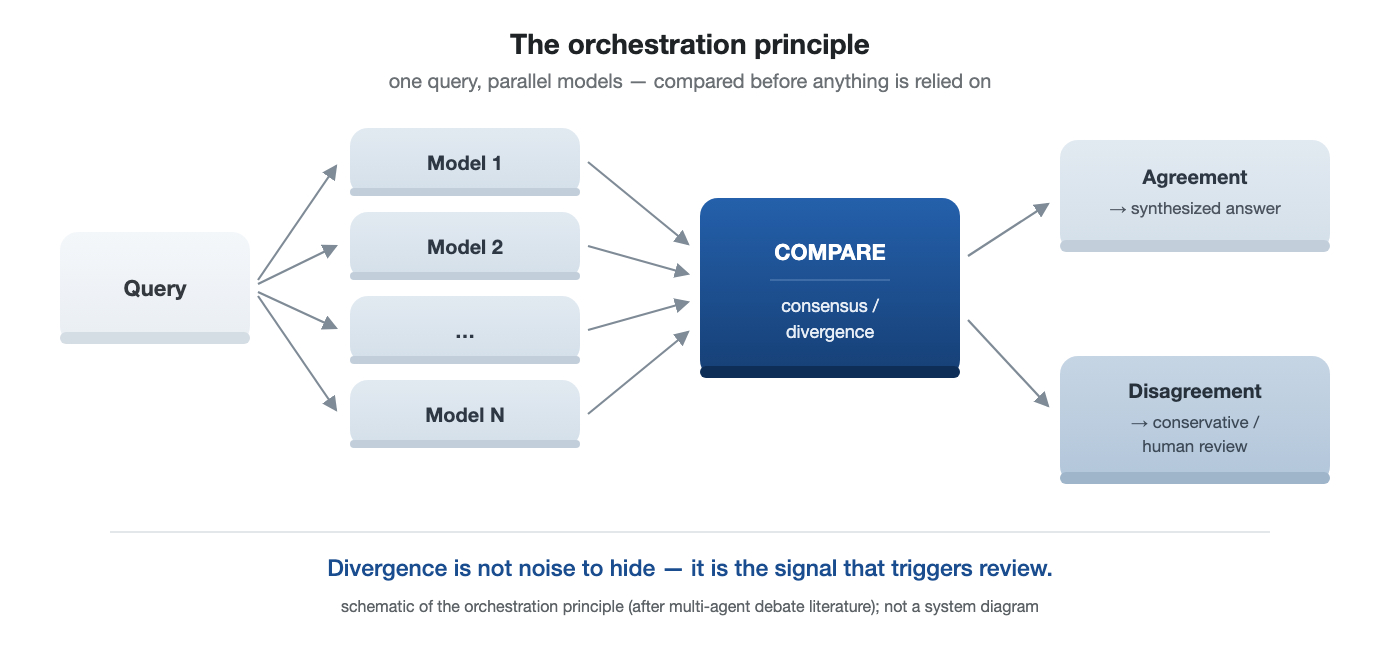
Fuente: Esquema del principio general según la literatura de debate multiagente; no es un diagrama de ninguna arquitectura de producto específica.
El punto estructural es que las patologías específicas que han hecho que los tribunales desconfíen del uso de IA sin representación letrada son características de la solicitud de modelo único, y que una arquitectura de orquestación se dirige a esas patologías. Los fracasos documentados son propiedades de una configuración. No son propiedades de la asistencia de IA como tal. En este sentido, la arquitectura traslada la fuente de confiabilidad de un modelo aislado a relaciones entre modelos: de la inteligencia aislada a la inteligencia coordinada. Tampoco la orquestación es exótica: el enrutamiento comercial y los productos multimodelo exponen cada vez más estas mismas propiedades de diseño, lo que hace que la ausencia de arquitectura de la literatura legal empírica sea aún más conspicua. Si esa diferencia arquitectónica produce una diferencia en la conducta litigiosa observable es una pregunta empírica, y el resto del Artículo se dirige a un escenario en el cual puede examinarse contra un registro verificable.
IV. Método y Base Probatoria
El diseño es un estudio de caso único, una elección que refleja la naturaleza del fenómeno: la orquestación multimodelo en litigio federal en vivo es actualmente rara, y el objetivo aquí no es estimar su frecuencia sino establecer, contra un registro verificable, que ocurrió un patrón particular de conducta y caracterizarlo. Calidad, como se usa en toda la obra, se refiere a conducta litigiosa observable verificable desde el expediente: cumplimiento de plazos, precisión de citas, corrección procesal, capacidad de respuesta al registro y coherencia del argumento presentado. No se refiere a resultados, que ningún caso único puede garantizar. Un caso de este tipo merece atención: el litigio adversario del mundo real, con plazos, opositores y consecuencias, puede ofrecer un escenario más significativo para observar el razonamiento humano asistido por IA que solo la evaluación de laboratorio. La Parte VII vuelve a esta limitación. De estas dimensiones, los hallazgos en la Parte V se refieren principalmente al cumplimiento de plazos, la corrección procesal y la precisión de citas; la coherencia del argumento presentado se documenta en el registro en lugar de puntuarse de forma independiente, y ningún hallazgo depende del resultado de ningún movimiento pendiente.
La base probatoria es independientemente recuperable: toda presentación citada en este artículo se identifica por su número de ECF y puede ser obtenida por cualquier lector directamente de PACER conforme a los números de caso que figuran a continuación, sin depender del autor. Se compone del expediente federal público en Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.), junto con el expediente de la acción anterior, No. 1:25-cv-07770 (S.D.N.Y.), que nombró un demandado diferente. La estructura del caso puede exponerse en cifras, todas verificables en el expediente: de trece demandados nombrados, diez comparecieron; siete se adhirieron a una moción conjunta de desestimación; cuatro transigieron y fueron desestimados con perjuicio; y seis continuaban litigando a partir de junio de 2026 (Tabla 3). Tres de los trece nunca comparecieron, y el expediente muestra dificultades en la notificación e identificación de la entidad respecto de esos demandados; no establece por qué no comparecieron. Un demandado extranjero fue remitido para notificación a través de la Autoridad Central de China conforme a la Convención de La Haya sobre Notificación. Nada regresó: ni confirmación ni rechazo. Un demandado nacional requirió cuatro intentos en varios estados antes de que la citación llegara a su agente registrado, confirmado por un ejecutor de citaciones bajo juramento. No hubo comparecencia posterior. Un tercero invocó su propia estructura corporativa para impugnar qué entidad había sido nombrada. La estructura corporativa y el procedimiento transfronterizo pueden funcionar, en la práctica, como escudo procesal, y trabajar a través de esto es una tarea que una parte representada típicamente encomienda a abogados especializados o proveedores, lo que aquí el demandante sin representación hizo él mismo, respecto de los trece. Todas las afirmaciones factuales en la Parte V respecto de conducta litigiosa se extraen de documentos presentados, identificados por número de expediente y fecha, que cualquier lector puede recuperar independientemente, salvo el modo de asistencia de IA del litigante, que un expediente no registra. Cuando el artículo se refiere a declaraciones hechas en corte, se basa en la transcripción oficial; cuando se refiere a los argumentos de las partes, se basa en los escritos mismos (la moción conjunta de los demandados y memorando de apoyo, y la oposición del demandante) en lugar de basarse en caracterización alguna de una parte.18
Tres limitaciones metodológicas se derivan del rol del autor, divulgadas al inicio. Primero, el análisis se limita al expediente público; no se basa en el conocimiento privilegiado del autor sobre estrategia litigiosa, y no divulga producto del trabajo respecto de reclamaciones que permanecen pendientes contra los demandados que no transigieron. Segundo, el artículo distingue a lo largo qué establece el expediente (fechas, presentaciones, sentencias, el texto de documentos) de lo que no establece: los motivos subjetivos de las partes, y en particular las razones de cualquier transacción, cuyos términos son confidenciales. Tercero, las afirmaciones hechas por la propia documentación del sistema de orquestación sobre su desempeño se tratan como autoinformadas y no se utilizan como evidencia de eficacia; los hallazgos descansan en conducta litigiosa visible en el expediente, no en la cuenta del sistema de sí mismo.
Una asimetría en la base probatoria califica el método que acaba de describirse. La variable dependiente de este estudio, conducta litigiosa, es completamente verificable en el expediente: toda presentación, fecha y documento analizado en la Parte V puede ser recuperado por cualquier lector. La variable independiente no es recuperable de esa manera. El expediente público establece que el sistema de orquestación existe y documenta su arquitectura: la demanda operativa caracteriza el sistema, las solicitudes de patentes especifican el diseño, y los anexos técnicos de la oposición describen sus características de orquestación. Lo que el expediente no puede mostrar es qué modo de asistencia de IA produjo cualquier presentación particular, o cuándo cambió el método de trabajo del litigante. Esos hechos descansan en la propia narración del autor sobre su proceso, y el artículo los marca como tales donde aparecen. El estudio, por lo tanto, empareja un registro verificable de productos con un registro autoinformado de insumos, y los diseños controlados propuestos en la Parte VII se construyen de modo que la variable de arquitectura sea observada en lugar de informada; el Apéndice especifica un manifiesto de ejecución para ese propósito.
El expediente establece que un litigante sin representación que utiliza un sistema de orquestación produjo presentaciones particulares en un calendario particular. No puede establecer que el sistema, más que las capacidades propias del litigante, produjo sus características observadas. El artículo, por lo tanto, describe la conducta y su contexto arquitectónico y trata la pregunta causal como abierta, a ser abordada por el estudio controlado propuesto en la Parte VII.
Declarada formalmente, la hipótesis presentada aquí es la siguiente:
Hipótesis de dependencia arquitectónica. Manteniendo constante la disponibilidad de IA generativa, la arquitectura de asistencia de IA (invitación de modelo único versus orquestación multimodelo) funciona como una variable empírica distinta (Figura 4): el modo de asistencia se asocia con diferencias medibles en conducta litigiosa observable, incluyendo cumplimiento de plazos, exactitud de las citas, corrección procesal, y respuesta al expediente. La hipótesis es refutable: una comparación sistemática de escritos pro se codificados por modo de asistencia que no encontrara tal asociación la refutaría.
Figura 4. La hipótesis de dependencia arquitectónica como una cadena de afirmaciones. Cada eslabón es una afirmación a ser probada, no un hallazgo.
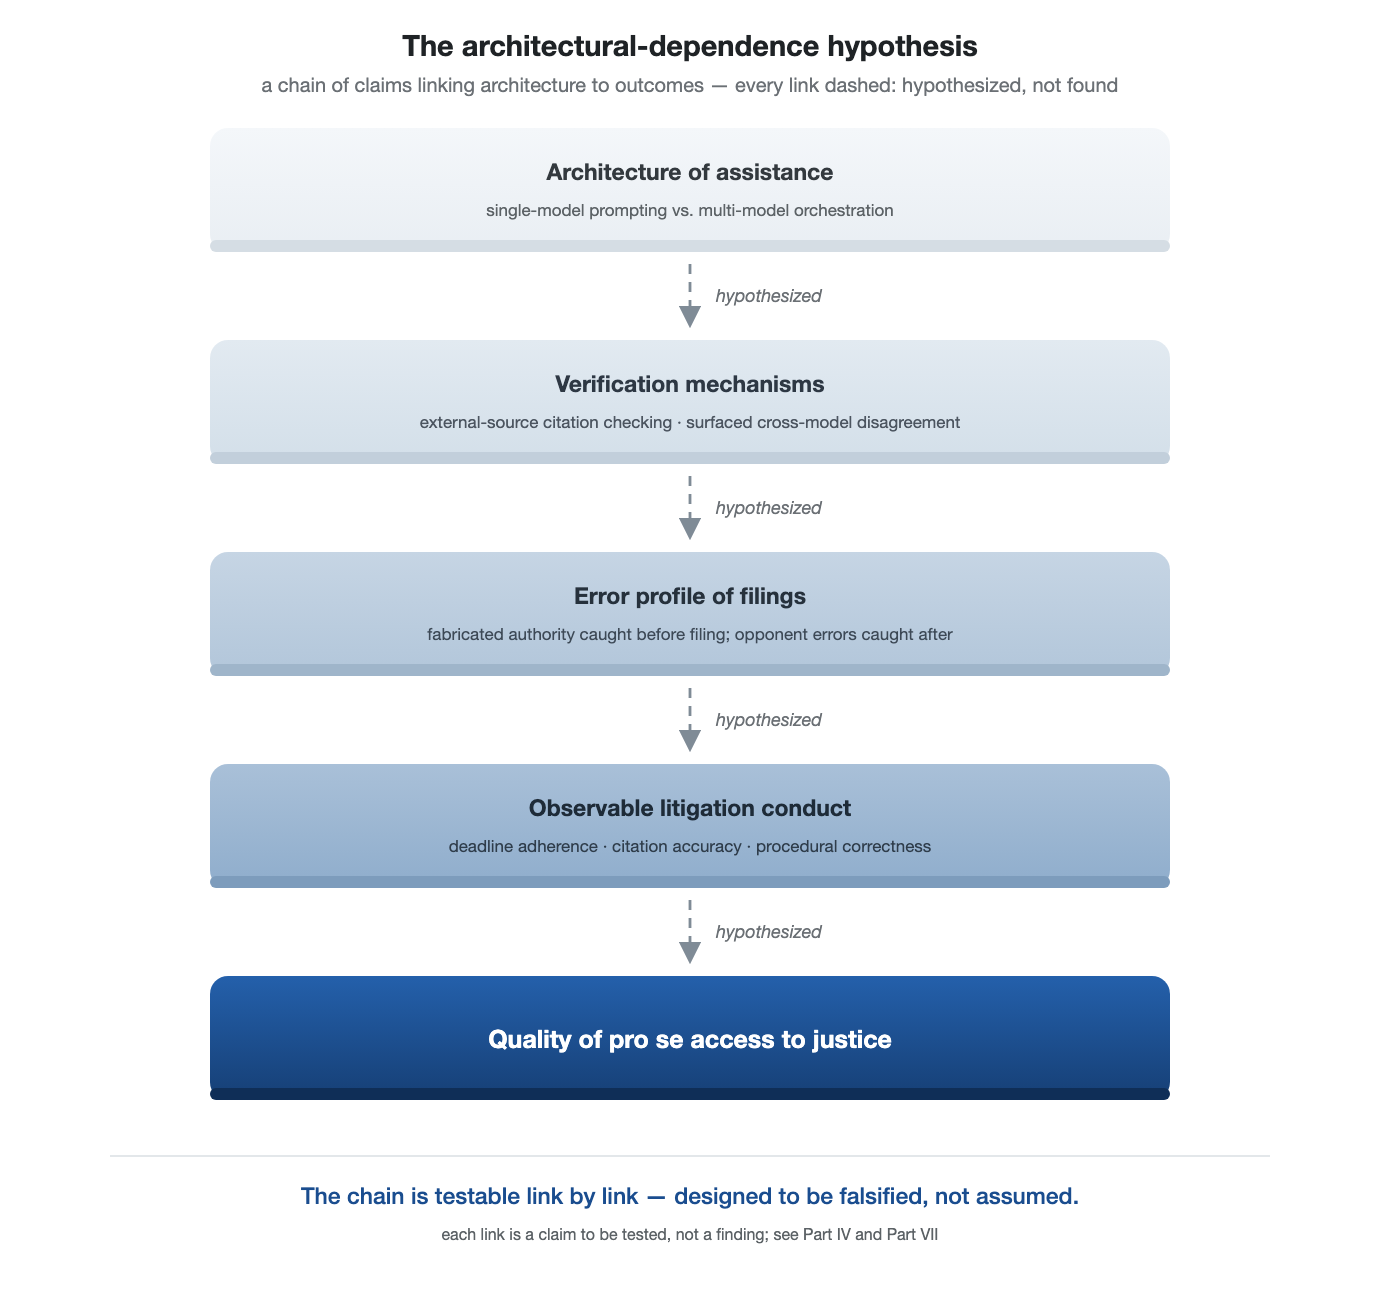
Fuente: Esquema del autor de la hipótesis establecida en el texto; las flechas discontinuas marcan eslabones hipotéticos, sin probar.
V. Hallazgos
Varios aspectos del litigio tienen relación con la pregunta planteada aquí, y la Figura 5 los presenta en secuencia.
La disparidad de recursos legales en este caso no es incidental al estudio; es la condición que le da su sentido al estudio. Por un lado había un único litigante sin representación sin capacitación legal y sin abogado de ningún tipo, ni siquiera abogado de alcance limitado. Por el otro lado había una defensa en la que abogados de numerosos despachos líderes se combinaron en un frente común, presentando una moción conjunta de desestimación en nombre de siete demandados y coordinando sus presentaciones entre sí. Una configuración en la que un individuo sin representación sostiene un ciclo completo de presentación de escritos contra esa alineación, cumpliendo cada plazo, respondiendo sobre el fondo, e identificando un error que los despachos alineados no detectaron, está cerca de lo que la literatura de acceso a la justicia trata como algo que no sucede. El resto de esta Parte lo documenta, en un expediente público; lo que puede explicarlo es la pregunta que el artículo en su totalidad persigue.
Figura 5. Cronología procesal del caso.
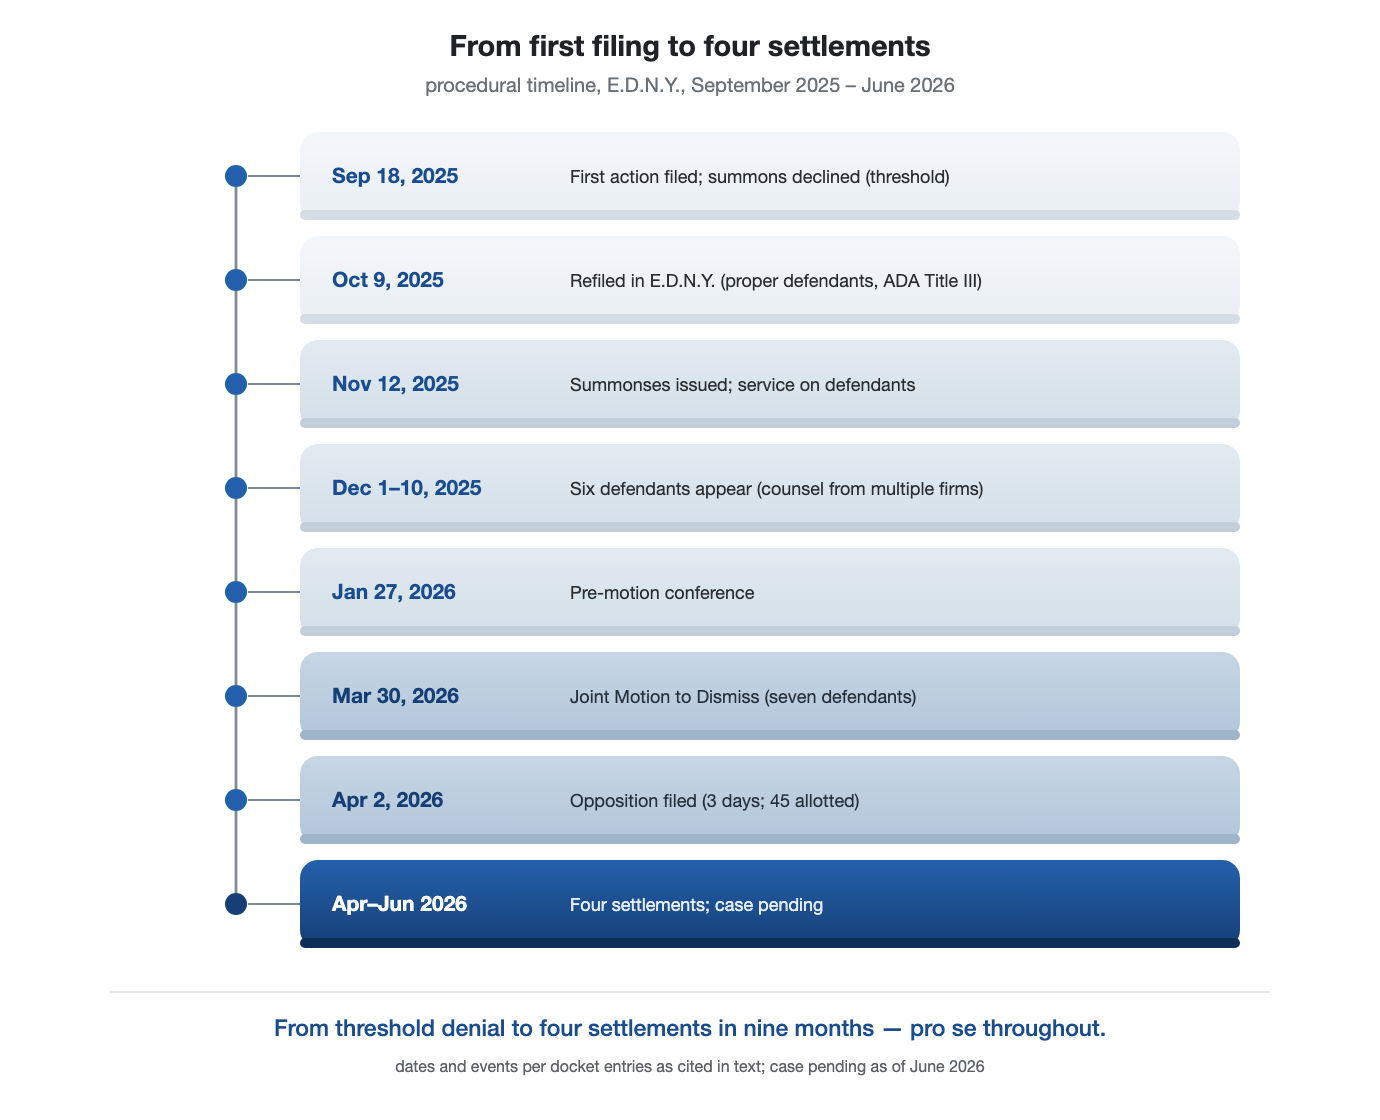
Fuente: Public docket, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), y la acción anterior relacionada.
A. Reconstrucción del marco legal después de una presentación inicial defectuosa.
La primera acción del demandante, presentada en septiembre de 2025 y de registro público, era procedimentalmente defectuosa en varios aspectos independientes: fue presentada en nombre de una sociedad de responsabilidad limitada, que no puede proceder sin representación legal; contra el demandado incorrecto; en el distrito incorrecto; y bajo el título incorrecto de la ADA. El tribunal rechazó la demanda de plano, sin emitir una citación. Una segunda acción, presentada personalmente y en el distrito correcto aproximadamente tres semanas después, reformuló la demanda bajo la disposición apropiada de la ley, designó a los demandados correctos, y fue acompañada por un aporte probatorio sustancialmente ampliado. Un cambio de método acompañó la corrección. Según relato del propio autor, en la primera presentación el demandante había trabajado con un único modelo en un dispositivo personal, y la reconstrucción coincidió con el primer uso de orquestación completa de múltiples modelos a través de acceso directo a los modelos. El expediente judicial no puede confirmar esa secuencia, y no se ofrece como causa. Lo que el expediente judicial sí muestra es la corrección en sí misma, el primer episodio que este Artículo examina: el registro refleja una transición rápida de una presentación desestimada de plano a una que procedió a la notificación y provocó la actuación de múltiples demandados representados. La reconstrucción es el tipo de revisión amplia y verificada del marco legal que un flujo de trabajo de orquestación, que consulta múltiples modelos sobre foro, causa de acción y estándar de demanda, está diseñado para respaldar.
B. Respuesta a la práctica coordinada previa a la moción.
En una sola noche, 12 de enero de 2026, seis demandados presentaron seis escritos previos a la moción en el transcurso de aproximadamente cuatro horas y media, habiendo solicitado conjuntamente una prórroga para poder presentar juntos.19 Conforme a las prácticas individuales del tribunal, cada escrito requería una respuesta del demandante dentro de cinco días hábiles. Seis memorandos de respuesta, cada uno dirigido a los argumentos de un demandado específico, fueron presentados en el transcurso de cuatro días.20 El episodio tiene implicaciones que van más allá de la velocidad: una respuesta a una presentación coordinada en múltiples frentes no puede completarse de antemano, porque su dirección viene determinada por seis documentos que no existían hasta la tarde en que fueron presentados. Pero los argumentos disponibles para los demandados en un caso de este tipo provienen de un repertorio predecible: legitimación, la aplicabilidad del Título III a los servicios digitales, deficiencia en la formulación de la demanda. Una parte diligente puede preparar respuestas modulares a argumentos previstos y adaptarlas una vez que lleguen los escritos. La redacción anticipada se ve por lo tanto limitada por este episodio, antes que imposibilitada por ello: lo que el intervalo de cuatro días establece es la elaboración, adaptación y presentación de seis memorandos dirigidos individualmente frente a seis presentaciones distintas. Lo que no puede establecer es cuánto de su contenido fue anterior a la presentación de los escritos.
C. Respuesta oportuna a una defensa consolidada.
Tras una conferencia previa al escrito en la que el tribunal invitó a los demandados a reducir los escritos duplicados, siete demandados, incluyendo todos los seis que habían presentado escritos previos a la moción, presentaron una moción conjunta de desestimación con un memorando de apoyo. Conforme al calendario del tribunal, la oposición de la demandante debía presentarse aproximadamente cuarenta y cinco días después. La oposición estaba fechada el 2 de abril de 2026 (tres días después de la presentación de la moción el 30 de marzo) e ingresó en el expediente el día siguiente, aproximadamente seis semanas antes del plazo de respuesta del 14 de mayo. Fue un memorando de veintiocho páginas acompañado de una declaración y anexos voluminosos. La Figura 6 compara los intervalos de respuesta con los intervalos de preparación de la defensa para ambas rondas de escritos. La observación es el hecho de una respuesta sustancial, oportuna y proporcionada, no sus méritos, presentada por un litigante que se representa a sí mismo contra una defensa coordinada representada por abogados de varios despachos. El punto relevante es arquitectónico más que personal: responder sobre el fondo a varios escritos distintos simultáneamente es el tipo de tarea paralela de múltiples hilos que un flujo de trabajo multimodelo está estructurado para distribuir, en contraste con el procesamiento de un solo hilo que asume la literatura. La sincronización importa por algo más que el cumplimiento: una moción que permanece sin respuesta en un expediente público durante todo un período de respuesta presenta, para cualquiera que lea el expediente durante ese intervalo, únicamente la versión de los demandados. Una oposición presentada dentro de días reduce ese intervalo. Una asimetría de ese tipo ordinariamente corre en contra de las partes que se representan a sí mismas, quienes ordinariamente no pueden comprimir el intervalo.
Figura 6. Intervalos de preparación y respuesta, por ronda de escritos.
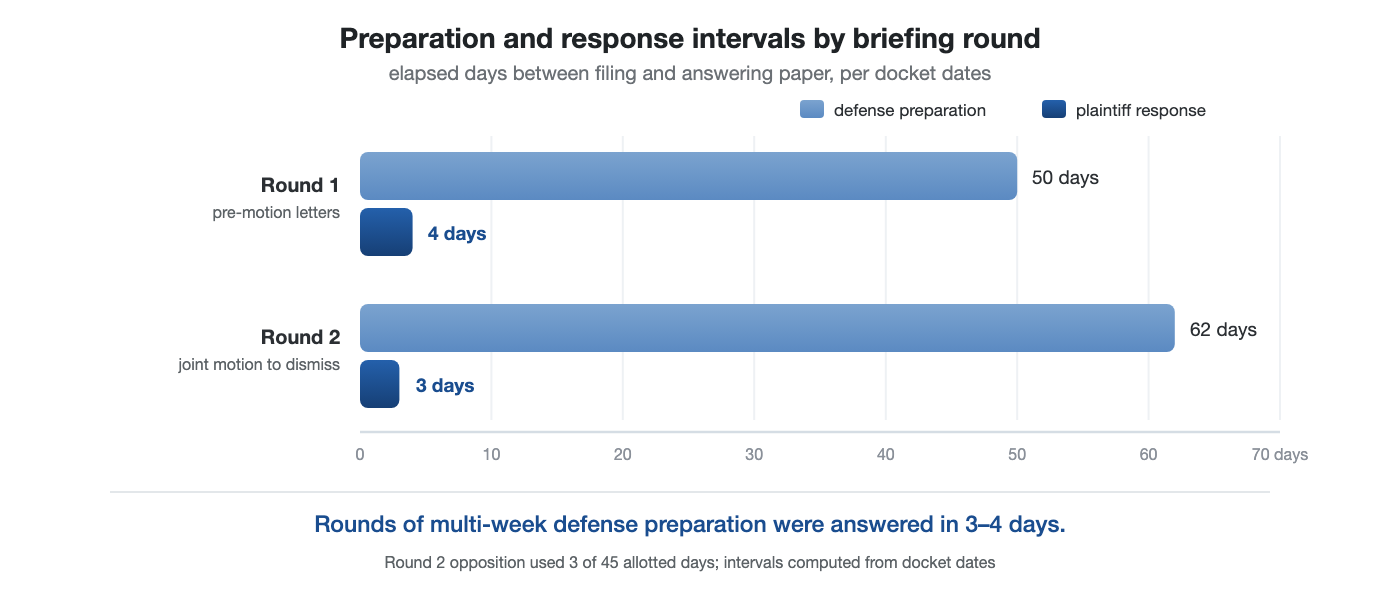
Fuente: Expediente público; días transcurridos entre la presentación relevante y la fecha de la presentación de respuesta en cada ronda (fechas de documento; la entrada en el expediente puede seguir un día después). El intervalo de defensa en la primera ronda se mide desde la finalización de la notificación (noviembre de 2025) hasta los escritos coordinados previos a la moción del 12 de enero de 2026. Los intervalos transcurridos limitan el tiempo de preparación; no distinguen el tiempo de redacción de la temporización estratégica.
D. Identificación de un error de cita estatutaria en el memorando de defensa.
La oposición de la demandante identificó un error en la autoridad estatutaria en que se basó la moción conjunta. En su tratamiento del elemento de «disfrute pleno e igualitario», el escrito de defensa citó 42 U.S.C. § 12184 (ECF No. 69-1, pág. 15), la disposición que rige el transporte público especificado proporcionado por entidades privadas, tales como autobuses, taxis y limusinas, mientras que la demanda se basa en 42 U.S.C. § 12182, la disposición sobre establecimientos públicos (Plaintiff's Opposition, ECF No. 76, pág. 17).21 La preocupación paradigmática sobre el uso de IA por litigantes sin representación es la cita fabricada: una autoridad que no existe, generada por un modelo y presentada por un litigante. Aquí, el error de cita verificable aparece en una presentación presentada por un abogado, y fue identificado en una presentación hecha por un litigante sin representación que utiliza un sistema de orquestación cuyo diseño documentado incluye validación de citas contra fuentes externas. La orquestación, tal como se define en la Parte III, agrupa dos mecanismos: desacuerdo entre modelos y validación contra fuentes externas, y un número de sección transpuesto es el tipo de defecto que el segundo está diseñado para detectar. El debate entre múltiples modelos no es necesario para ello. Según el relato del autor, el error fue revelado por el flujo de trabajo más que por el litigante: un modelo señaló la discrepancia entre la sección citada y la disposición de la que surge la demanda, el modelo consolidador lo verificó y lo confirmó, y el crítico lo verificó nuevamente. El litigante no es abogado y no podría haber encontrado el error ni verificado la corrección por sí mismo. La propiedad implicada es el componente de verificación, no el conjunto como un todo. La dirección de la corrección va en sentido opuesto al patrón que la literatura induce a esperar; su peso en la resolución de la moción corresponde al tribunal. El error es verificable de manera independiente por cualquier lector: las dos disposiciones están separadas por dos secciones en el mismo subcapítulo del Código de los Estados Unidos, y la cita del § 12184 en el memorando de defensa es visible en la página. Las dos disposiciones contienen un lenguaje operativo paralelo, cada una garantizando «disfrute pleno e igualitario» dentro de su ámbito, y la sustitución es por lo tanto del tipo que un lector absorbe sin percibir a la velocidad de lectura y no puede pasar por alto cuando se verifica cada cita contra su fuente. Lo que los distingue es el alcance: § 12184 rige el transporte público especificado proporcionado por entidades privadas, no establecimientos públicos. La oposición de la demandante argumentó que la cita incorrecta era «no meramente técnica» porque apareció en el tratamiento del memorando de un elemento determinante; un número de sección transpuesto no es una autoridad fabricada. Detectar una cita estatutaria mal ubicada en un escrito de la parte contraria es lo inverso del modo de falla que domina la literatura sobre el uso de IA por litigantes sin representación, es decir, generar citas mal ubicadas en el suyo propio.
La atribución es un asunto separado del error en sí. La regla implícita de la literatura asigna los errores de litigantes sin representación asistidos por IA a la categoría, como evidencia de lo que hace la tecnología, y los errores de abogados al individuo, como un descuido en una práctica que de otro modo es confiable. El episodio documentado aquí ofrece una prueba de esa regla, y se expresa mejor como una pregunta: si un litigante sin representación que utiliza IA generativa hubiera citado la disposición sobre transporte de la ADA en lugar de la disposición sobre establecimientos públicos, en un elemento determinante, ¿se habría interpretado el error como un descuido aislado, o como una entrada más en el catálogo de lo que sucede cuando personas sin formación jurídica litigan con chatbots? Las dos interpretaciones probablemente no coincidirían, y esta asimetría de atribución, no el error en sí, es parte de lo que la hipótesis de dependencia de la arquitectura pide a la literatura que examine: si la conducta se está codificando por quién la produjo en lugar de cómo se produjo. La asimetría, además, persiste contra una línea de base móvil: como registra la Parte II, los incidentes de alucinación documentados ya no son predominantemente un fenómeno de los litigantes sin representación, pero el encuadre de la amenaza sistémica permanece vinculado al lado de los litigantes sin representación del expediente.
E. Asentamientos tempranos.
Figure 7. Secuencia de los cuatro asentamientos.
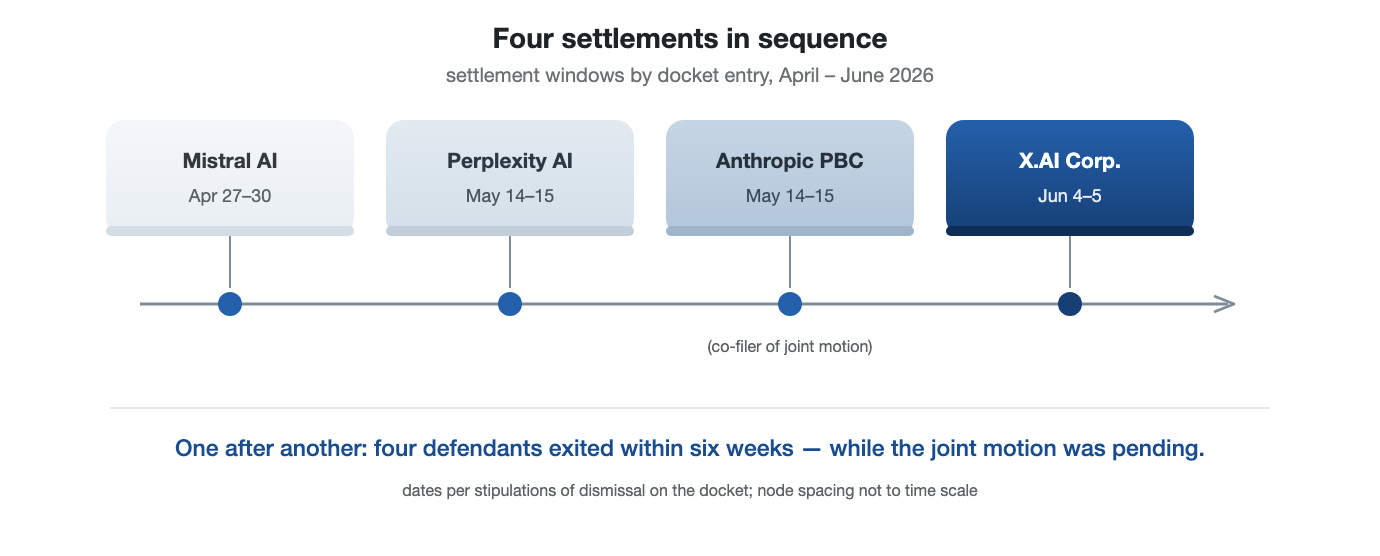
Fuente: Expediente público, ECF Nos. 83-86 y 94 (estipulaciones de desestimación con prejuicio; ECF Nos. 83 y 84 son dos presentaciones del mismo día de la estipulación Mistral, la orden de desestimación citando No. 84).
Cuatro demandados que habían entrado en el litigio resolvieron sus disputas con la demandante y fueron desestimados con prejuicio dentro de un período comprimido (Figure 7). Como es estándar, solo las estipulaciones de desestimación aparecen en el expediente público; los términos del acuerdo son confidenciales, las razones no están en el expediente, y no se infiere causa alguna. Esta subsección registra una secuencia de acuerdos que ordinariamente es invisible, y por lo tanto la hace verificable.
Dos características de la secuencia merecen mencionarse, porque son visibles en el expediente público. En al menos dos casos, un demandado que se había alineado con la defensa coordinada posteriormente la abandonó por estipulación de desestimación, uno llegando a acuerdo después de que se presentara la oposición y antes de la contrarréplica de la coalición; el otro después de incorporar primero el memorándum conjunto de la coalición en una moción propia. El patrón cronológico es una cuestión de presentación pública: los demandados que habían entrado en un frente común lo abandonaron, uno a la vez, mientras que la moción que habían suscrito permanecía pendiente.
La otra característica es que los acuerdos entre demandados corporativos y una demandante que se autorepresenta son ordinariamente confidenciales y dejan poco rastro en el expediente público. Aquí, las estipulaciones de desestimación son ellas mismas entradas del expediente, lo que hace la secuencia inusualmente legible; el valor probatorio de ese expediente reside en su verificabilidad.
Table 3. Estado de los trece demandados nombrados (a partir de junio de 2026).
| Estado | Demandados |
| No comparecieron | Samsung; DeepSeek; OpenAI |
| Llegaron a acuerdo y fueron desestimados | Mistral AI; Perplexity AI; Anthropic PBC; X.AI Corp. |
| En curso | Microsoft; Apple; Google; Meta; Amazon; Alibaba Cloud |
Fuente: Expediente público, a partir de junio de 2026.
La Figura 8 reproduce la secuencia del expediente de un único día, 4 de junio de 2026, como un expediente primario. Se incluye para que el lector pueda inspeccionar el cronograma directamente. ¿Qué configuraciones de litigio asistido por IA producen expedientes de esta forma, y con qué frecuencia? Esa pregunta pertenece al estudio sistemático que la Parte VII propone.
Figure 8. Secuencia del expediente el 4 de junio de 2026.
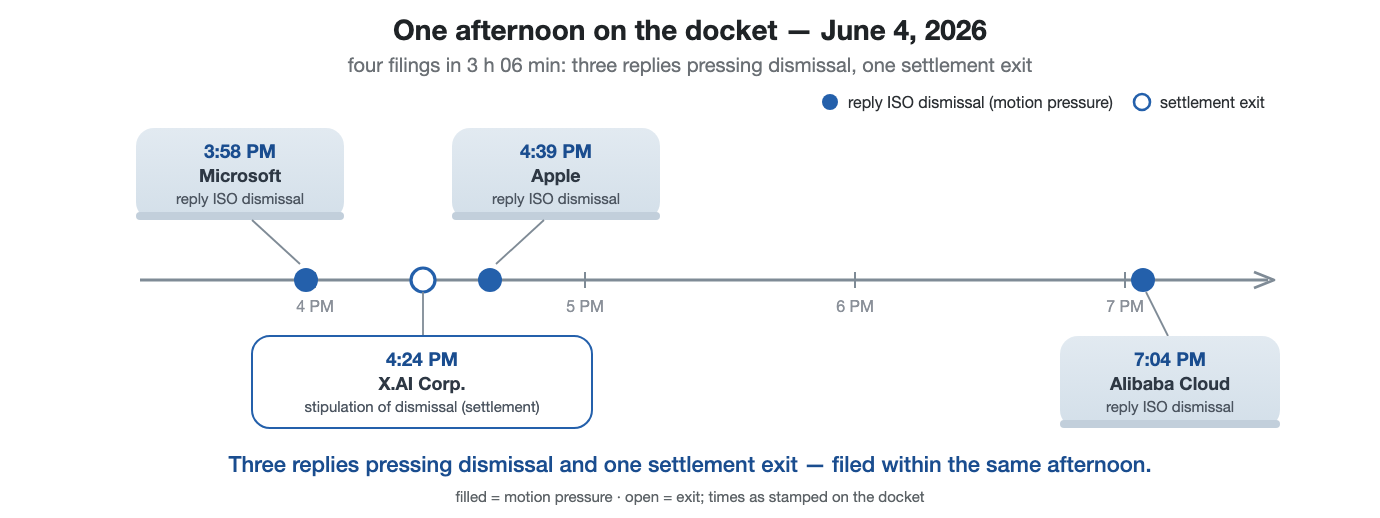
Fuente: Expediente público; tiempos de presentación en un único día, ECF Nos. 93-96.
Estas características juntas describen a una demandante que se autorepresenta sustentando una acción federal multipartes a través de un ciclo de presentación completo, cumpliendo plazos, respondiendo en proporción, e identificando un error del oponente, contra una defensa coordinada y representada. Ese no es el patrón que describe la explicación predominante. Esa explicación, de volumen indiferenciado y salida poco confiable, caracteriza una distribución, y un solo caso no puede contradecir una distribución; pero el patrón documentado aquí cae fuera de lo que miden los estudios agregados, razón por la cual ha permanecido invisible para ellos. Si la arquitectura de orquestación es responsable del patrón, y si el patrón se repite en los casos, son preguntas que las próximas Partes enmarcan para la investigación sistemática.
VI. Implicaciones Doctrinales
Las preguntas más difíciles son doctrinales, y dos de ellas se están moviendo a través de los tribunales federales en este momento. El objetivo es mostrar cómo una explicación basada en orquestación y orientada a la calidad del uso de IA pro se reencuadra cada una. Los tribunales ya poseen un marco desarrollado para evaluar los resultados de IA como prueba (Grimm, Grossman & Cormack 2021). Las preguntas aquí son adyacentes: no se trata de si el resultado de la máquina es admisible; ambas se refieren a quién es propietario del proceso que produjo el resultado y si ese proceso practica derecho.
A. Documento de trabajo y el litigante que se representa a sí mismo.
Recientemente se cuestiona si las interacciones de un litigante con un sistema de inteligencia artificial están protegidas de la producción como documento de trabajo. En el transcurso de siete semanas a principios de 2026, tres tribunales federales llegaron a la intersección del uso de IA y la protección del documento de trabajo, y no hablaron con una sola voz.22 En Warner v. Gilbarco, Inc., un juez de magistratura denegó una moción para constreñir a una demandante de empleo que se representa a sí misma a producir sus consultas de inteligencia artificial generativa y las respuestas que recibió, sosteniendo que los materiales eran documento de trabajo conforme a la Regla Federal de Procedimiento Civil 26(b)(3): un litigante que se representa a sí mismo actúa como su propio abogado, los materiales reflejaban sus impresiones mentales y preparación, y la divulgación a un sistema de inteligencia artificial generativa, una herramienta más que una persona, no fue la divulgación adversarial que requiere la renuncia. La sentencia se sitúa en el estrato más antiguo de la doctrina, ya que lo que Hickman v. Taylor protegió más fuertemente fueron las impresiones mentales, conclusiones y teorías del abogado: el nivel de documento de trabajo que los tribunales tratan como casi absoluto (Hickman v. Taylor, 329 U.S. 495, 510--11 (1947)). Las consultas que formula un litigante, los borradores que itera, y los argumentos que descarta son el análogo de ese nivel para quien se representa a sí mismo. Una semana después, en United States v. Heppner, un tribunal llegó al resultado opuesto: un acusado penal representado había utilizado un asistente de IA público por su propia iniciativa, sin intervención de su abogado, y el tribunal ordenó la producción de los archivos resultantes, haciendo hincapié en que había actuado sin dirección de su abogado y que los términos de consumo de la plataforma permitían al proveedor retener y usar sus datos. Morgan v. V2X, Inc., la tercera y más elaborada sentencia de la serie, extendió la sentencia central de Warner, concluyendo que el uso de inteligencia artificial por parte de un litigante que se representa a sí mismo en la preparación del litigio "se asemeja mucho al tipo de documento de trabajo confidencial, iterativo y estratégico que la Regla 26(b)(3) fue diseñada para proteger." Sin embargo, la misma orden requería que el litigante divulgara el nombre de cualquier herramienta de IA que hubiera utilizado en conexión con material que la otra parte hubiera designado como confidencial, y enmendó la orden de protección para restringir el uso de servicios de inteligencia artificial convencionales con tal material.23 La distinción que hizo el tribunal es analíticamente importante, porque explica por qué Warner y Heppner no están en conflicto: una parte representada que elude a su abogado crea una brecha entre la parte y el abogado, la brecha que resultó fatal en Heppner, mientras que un litigante que se representa a sí mismo "es simultáneamente la parte y el abogado," por lo que no existe tal brecha. La protección no fue ilimitada: el tribunal sostuvo que la identidad de la herramienta de IA no estaba en sí misma protegida, y condicionó el uso de inteligencia artificial sobre materiales de descubrimiento confidencial a salvaguardas contractuales contra el entrenamiento, retención, y divulgación a terceros. Las tres sentencias así convergen en aplicar la doctrina tradicional a la inteligencia artificial en lugar de hacer excepción de ella, pero divergen sobre quién puede reclamar la protección y sobre qué cuenta como renuncia. La línea que trazan es arquitectónica, aunque el vocabulario es de este Artículo: las opiniones hablan de agencia, confidencialidad, y renuncia. Lo que condenó la demanda de Heppner no fue el uso de la inteligencia artificial sino la configuración utilizada: una herramienta de consumo cuyos términos permitían retención y entrenamiento. Morgan, por el contrario, condiciona la protección a una configuración contractualmente prohibida del entrenamiento, retención, y divulgación a terceros. La postura de confidencialidad, como la verificación, es una propiedad de la arquitectura de la asistencia más que de la inteligencia artificial como tal. La variable del Artículo aparece aquí dentro de la doctrina misma (Tabla 4).
Tabla 4. La tríada de documento de trabajo de principios de 2026, por configuración.
| Caso | Litigante | ¿Brecha de agencia? | Configuración de herramienta | Sentencia |
| Warner | Demandante que se representa a sí misma | Ninguna --- la parte y el abogado son uno | Inteligencia artificial generativa utilizada como su propia herramienta de preparación | Protegida como documento de trabajo |
| Heppner | Acusado representado, actuando sin abogado | Sí --- la parte eludió al abogado | Herramienta de consumo; los términos permitían retención y entrenamiento del proveedor | Producción ordenada |
| Morgan | Demandante que se representa a sí misma | Ninguna --- "simultáneamente la parte y el abogado" | Uso sobre materiales confidenciales condicionado a barras contractuales: sin entrenamiento, retención, o divulgación a terceros | Protegida, con condiciones; identidad de la herramienta no protegida |
Fuente: Warner, 2026 WL 373043; Heppner, 2026 WL 436479; Morgan, 2026 WL 864223. Las decisiones convergen en aplicar la doctrina tradicional y divergen en los hechos de configuración; la lectura arquitectónica de las dos últimas columnas es del Artículo, no de los tribunales --- la arquitectura cambia los hechos que pondera la doctrina, no la ley.
Morgan fue decidida el 30 de marzo de 2026, el día en que se presentó la moción conjunta para desestimar en el caso estudiado aquí: la doctrina se estaba formando mientras se estaban escribiendo los memoriales.
Leídas conjuntamente, las decisiones de principios de 2026 hacen que la arquitectura de la herramienta sea cada vez más decisiva: quién la dirigió, qué hizo, cómo se guardó su registro. La descripción de la orquestación aclara lo que está en juego en esa línea. Si la asistencia de IA a un litigante que se representa a sí mismo fuera meramente generación mecánica de texto, el argumento para tratarla como estrategia protegida sería débil; un flujo de trabajo de orquestación, en el que un litigante formula preguntas, pondera salidas de modelos divergentes e itera hacia una posición, es difícil de distinguir, funcionalmente, del proceso iterativo cargado de estrategia que la doctrina del trabajo abogadil siempre ha protegido en manos de los abogados. Un litigante que dirige un conjunto de motores analíticos divergentes se asemeja en gran medida a un abogado principal que dirige a un equipo de asociados junior. El propósito subyacente de la doctrina, impedir que una de las partes se beneficie gratuitamente de la preparación para el litigio de la otra, se aplica con igual fuerza ya sea que esa preparación la realice un asociado o un litigante trabajando a través de un sistema multimodelo. Morgan apunta en esta dirección, y el marco de orquestación proporciona la justificación funcional.
La protección del trabajo abogadil depende de la confidencialidad, y puede renunciarse a ella mediante divulgación pública voluntaria, al menos en lo que se divulga. Publicar un relato de su propio caso pendiente, por lo tanto, puede resultar en la renuncia de la protección que Morgan reconoce.
B. Ejercicio no autorizado de la abogacía.
La preocupación sobre UPL en el contexto pro se resulta, a primera vista, curiosamente formulada. Las normas de ejercicio no autorizado de la abogacía reservan la práctica del derecho a abogados licenciados con el fin de proteger al público de la representación no calificada de terceros.24 Estas normas son producto del derecho estatal, y sus definiciones de práctica varían según la jurisdicción; lo que sigue se refiere a la lógica compartida del marco más que a los límites de cualquier estado. La verdadera cuestión de UPL planteada por la IA legal de consumo es si la herramienta, o la empresa que la opera, incurre en práctica no autorizada al asesorar al litigante. Esa cuestión depende sustancialmente de la confiabilidad del asesoramiento: un instrumento que fabrica autoridades con confianza se asemeja a la práctica incompetente que las normas de UPL existen para prevenir.
Un litigante pro se, sin embargo, no representa a nadie más que a sí mismo. Tiene derecho estatutario para hacerlo (28 U.S.C. § 1654), y la sanción por un escrito defectuoso recae sobre él en lugar de sobre un cliente. Cuando tal litigante utiliza un sistema de IA, el marco de UPL debe ubicar la "práctica del derecho" en algún lugar: en la herramienta, en su desarrollador, o en ninguno; y cada una de esas respuestas resulta problemática. Lo que realmente anima la preocupación no es la autorización sino la confiabilidad, el temor de que un sistema sin licencia y sin responsabilidad suministre con seguridad leyes incorrectas a una persona que carece de capacidad para verificarlas. La confiabilidad no es lo único, porque los tribunales supervisan la práctica del derecho a través de mecanismos de responsabilidad tanto como de competencia: un abogado licenciado puede ser sancionado, suspendido o inhabilitado, y un sistema de IA no puede serlo. La brecha de responsabilidad es real, y el relato de orquestación aborda la confiabilidad, no la responsabilidad. Si un sistema orquestado cometiera errores de manera sistemática, la responsabilidad podría recaer en uno de tres lugares: en el operador que firma el escrito (el único actor al que la Regla 11 actualmente alcanza), en el proveedor de la arquitectura, o en ninguno. El que la ley seleccione de estos tres determinará si la brecha de responsabilidad se reduce o simplemente se reubica.
Aquí la distinción entre modelo único y orquestación cobra verdadero sentido. El déficit de confiabilidad que anima la preocupación por UPL es característico de la configuración de modelo único, y una arquitectura construida en torno a la verificación entre modelos y la validación de citas se dirige a ese déficit. Eso no disuelve la cuestión de UPL, pues una herramienta altamente confiable aún podría decirse que "practica el derecho." Lo que hace es separar dos cosas que el debate tiende a fusionar: la confiabilidad y la autorización son cuestiones analíticamente distintas, y fusionarlas oscurece que una solución arquitectónica puede abordar la primera sin tocar la segunda. Si la confiabilidad es la verdadera preocupación, entonces la arquitectura, y no solo el licenciamiento, se convierte en parte del análisis, y un sistema diseñado para exponer y resolver desacuerdos en lugar de afirmar una sola respuesta aborda la preocupación en sus propios términos. Si la confiabilidad es arquitectónica, también es diseñable y certificable, el tipo de objeto en el que se basan las propuestas para reinventar la regulación de los servicios legales (Hadfield 2017). Una arquitectura que rehúsa emitir lo que no puede verificar, y que dirige la incertidumbre irreducible al ser humano, comienza a funcionar como cumplimiento por diseño en lugar de como un asesor sin licencia.
C. Un replanteamiento, no una resolución.
Ambas áreas doctrinales permanecen sin resolver. El relato dominante de volumen y alucinación del uso de IA en propia persona ha moldeado estos debates doctrinales, y un relato orientado a la calidad basado en orquestación los replantea. La protección del producto de trabajo parece más coherente cuando el uso de IA se entiende como una estrategia iterativa en lugar de un resultado mecánico, y el debate de UPL se ve diferente cuando la confiabilidad se trata como una variable arquitectónica en lugar de un defecto inherente.
VII. Limitaciones y Trabajo Futuro
Cuatro limitaciones acotan el diseño. Primero, y fundamentalmente, este es un único caso (n = 1) redactado por una de las partes. Los hallazgos en la Parte V son afirmaciones de existencia más que afirmaciones distribucionales. Lo que tal caso puede hacer es lo que la metodología cualitativa ha reconocido durante mucho tiempo para casos extremos o reveladores: exponer un fenómeno que los diseños estándar aún no han alcanzado, y generar las hipótesis que el estudio sistemático debe entonces probar.
Segundo, el autor es litigante, desarrollador y analista; las restricciones en la Parte IV existen por ello.
Tercero, la causalidad no puede aislarse. El registro no puede separar la contribución de la arquitectura de la habilidad propia del litigante, la preparación previa, los incentivos de una parte no facturada, u otros factores de confusión. La discusión arquitectónica en la Parte III proporciona un mecanismo plausible, no uno demostrado.
Varias explicaciones rivales siguen siendo plausibles. El litigante puede simplemente ser capaz: educado, motivado, y no facturado, una parte en propia persona puede dedicar cientos de horas a un caso que los abogados dedicarían decenas de horas. La oposición de tres días puede medir la preparación más que el procesamiento (Parte V.B). La selección opera en dos niveles. A nivel de caso, este caso es el tema de un artículo porque su registro es favorable, y los casos en los que los litigantes asistidos por orquestación fallan no generan artículos. A nivel de episodio, la selección es propia del autor: el expediente contiene más eventos que los cinco que este Artículo describe, y el autor eligió cuál presentar. Contra esa selección, la declaración de completitud es verificable mediante el expediente: a partir de junio de 2026, el registro no contiene ninguna orden sancionando al demandante, ninguna orden tachando ninguno de sus escritos, y ningún plazo que haya incumplido. Lo más cercano que el registro llega a una nota procesal adversa se encuentra en el umbral del caso, donde el tribunal denegó la solicitud del demandante de proceder in forma pauperis (la tarifa de presentación fue pagada dentro del plazo permitido) y observó que los edictos no podían expedir hasta que se suministraran las direcciones de notificación, lo cual luego fue realizado. La declaración es falsable por cualquiera con acceso a PACER; lo que la selección a nivel de episodio aún puede ocultar es énfasis, no fallos adversos. El estudio propuesto a continuación está diseñado para adjudicar entre estas explicaciones rivales.
Una limitación adicional se refiere al alcance más que a la validez. La Parte II enmarca la brecha de justicia en términos de los estadounidenses de bajos ingresos que la Legal Services Corporation estudia, mientras que el litigante aquí es un arquitecto de sistemas IA a nivel de Ph.D. operando un sistema de su propio diseño, un demandante en propia persona extraído del extremo lejano de la distribución de capacidad técnica. La prueba de existencia no se debilita por ese hecho, pero su alcance es más estrecho que la población en la que la Parte II se centra: nada en este caso muestra que el litigio asistido por orquestación esté prácticamente disponible para esa población, para quienes el costo, el acceso digital, y la fluidez técnica son en sí mismas barreras. Si los beneficios de la arquitectura sobreviven la transferencia de un operador experto a un litigante típico en propia persona es una pregunta empírica, y para el marco asistivo de la Parte II es argumentablemente la decisiva; el brazo de discapacidad del estudio propuesto a continuación está diseñado para alcanzarlo. La transferencia no es solo un asunto de configuración técnica. La orquestación traslada la carga cognitiva del operador desde la redacción hasta el arbitraje: leer salidas competidoras, sopesar desacuerdos presentados, decidir cuál línea sobrevive. El arbitraje es en sí mismo una habilidad exigente. Si esa carga puede ser llevada por diseño de interfaz en lugar de por experiencia del operador, y a qué costo para litigantes con barreras cognitivas, visuales, o educativas, es tanto una pregunta de diseño como una empírica.
Cuarto, el caso está pendiente; ningún hallazgo aquí depende de cómo termine.
La hipótesis que este caso genera, de que la arquitectura de orquestación se asocia con una conducta de litigio pro se de mayor calidad que la indicación de modelo único, es verificable. Un estudio sistemático podría comparar la conducta de litigio (cumplimiento de plazos, precisión de citas, resultados de mociones) en una muestra de presentaciones pro se codificadas por modo de asistencia de IA, utilizando los indicadores de borrador consistente con IA que la literatura empírica ha comenzado a desarrollar y LegalBench, un benchmark construido colaborativamente para razonamiento legal (Guha et al. 2023). Una familia de tareas, detección de errores sembrados, sigue directamente de la Parte V. Los escritos de prueba se salpican con defectos verificables de los tipos documentados allí: una sección estatutaria transpuesta, una autoridad mal citada, una cita fabricada. Las tasas de detección se comparan luego entre modos de asistencia, desde la indicación de modelo único hasta la verificación orquestada, con operadores abogados y no abogados como brazos separados. Los componentes de la arquitectura (verificación de fuente externa y desacuerdo entre modelos) se aíslan y analizan separadamente, de modo que la contribución de cada mecanismo se identifique en lugar de atribuirse al paquete (Tabla 5). Un diseño tal, conducido por investigadores desinteresados en muchos casos, podría convertir la afirmación de existencia presentada aquí en una distribucional, o refutarla. Hay diseños más fuertes disponibles y deberían ser preferidos: comparaciones controladas de asistencia de modelo único y orquestada en tareas legales idénticas, con protocolos pre-registrados, materiales abiertos y validación a ciegas del conjunto de afirmaciones propias del sistema, incluyendo su tasa de verificación de citas; identificación cuasi-experimental, como diseños de diferencia en diferencias en torno a la disponibilidad pública de herramientas multimodelo; y un brazo dedicado para participantes con discapacidades motoras, visuales o cognitivas, para quienes el encuadre asistencial de la Parte II no es hipotético. La evaluación aleatoria de la asistencia legal tiene precedente: la literatura de acceso a la justicia ha realizado estudios aleatorizados de ofertas de representación y de asistencia modular (Greiner, Pattanayak & Hennessy 2013), y la comparación de modo de asistencia propuesta aquí extiende esa tradición de diseño a la variable de arquitectura. En términos más generales, la hipótesis sugiere un estándar que el campo aún no ha adoptado: que los sistemas de IA se evalúen no solo por la calidad de sus salidas, sino también por la calidad de su arquitectura de razonamiento. Nada en esto es específico al derecho: dondequiera que el trabajo consecuencial se delegue a sistemas generativos, en medicina, ingeniería o finanzas, surge la misma pregunta y la misma variable no se mide. También reencuadra una variable que el análisis de acceso a la justicia ha tratado durante mucho tiempo como fija. El costo de entrada del demandante fue la tarifa de presentación de $405, y el costo de entrada formal del abogado defensor fue la tarifa pro hac vice de $200 (ECF Nos. 19, 52, 60). Ambos están en los bajos cientos de dólares, y se encuentran en los dos extremos de lo que ha sido una brecha de recursos efectivamente insuperable; la comparación se refiere solo a los aranceles de entrada formales, no al costo de la representación. Lo que puede haber cambiado no es el precio de entrar en una sala de justicia sino el costo marginal de la capacidad de litigio requerida para mantenerse en una. Si ese costo de hecho ha bajado, y cuánto, es una pregunta empírica para el estudio propuesto; que se haya convertido en una variable en lugar de una constante es en sí mismo una hipótesis que vale la pena probar.
Tabla 5. El estudio propuesto, por brazo.
| Brazo | Configuración | Lo que aísla |
| 1 | Solo humano, sin IA (control) | Detección de referencia sin asistencia |
| 2 | Indicación de modelo único | El modo que documenta la literatura |
| 3 | Orquestación, completa | El paquete tal como se despliega |
| 4 | Orquestación sin verificación de fuente externa | Contribución de la verificación de citas |
| 5 | Orquestación sin desacuerdo entre modelos | Contribución de la divergencia expuesta |
Nota: Cada brazo se ejecuta con operadores abogados y no abogados como grupos separados, y un brazo de discapacidad separado, ejecutado fuera de los cinco brazos numerados, para participantes con discapacidades motoras, visuales o cognitivas, y con medidas de resultado pre-registradas antes de las sesiones; véase el texto.
VIII. Conclusión
La narración predominante de la inteligencia artificial en litigio pro se es una historia sobre volumen y falta de confiabilidad: más litigantes, presentando más rápido, con un riesgo elevado de autoridad fabricada. Asume, sin decirlo, que la asistencia de IA significa que un litigante da indicaciones a un modelo de propósito general, y esa suposición ya no se sostiene.
El caso examinado aquí fue construido, según relato del autor, sobre una arquitectura diferente: se consultaron varios modelos independientes en paralelo, y su desacuerdo fue expuesto y resuelto en lugar de suprimido. La descripción de la conducta de litigio descansa enteramente en un registro público verificable; ese registro contiene conducta que el relato de volumen y alucinación ni describe ni predice: una reconstrucción rápida de una presentación defectuosa, una oposición sustantiva presentada mucho antes del cronograma, y la identificación de un error de cita estatutaria en un escrito de defensa coordinado. El Artículo luego mostró cómo entender la asistencia de IA como orquestación, y como cuestión de calidad, reencuadra dos debates doctrinales ahora ante los tribunales federales. Para litigantes que no pueden escribir, ver u organizar a la velocidad que el litigio exige, la diferencia arquitectónica es cuestión no de eficiencia sino de acceso en el sentido de la Ley de Estadounidenses con Discapacidades de disfrute pleno e igual: si la forma en que se configura la asistencia de IA es lo que hace que la autorepresentación sea posible en absoluto.
La afirmación es que la arquitectura de la asistencia de IA, no solo su disponibilidad, pertenece al análisis de lo que ahora pueden hacer los litigantes que se representan a sí mismos. Esa afirmación se vuelve aún más apremiante a medida que los modelos fundacionales convergen en capacidad bruta, porque cuando los modelos en sí difieren menos, la forma en que se combinan diferirá más. La hipótesis de dependencia de arquitectura es que la arquitectura no es un detalle de implementación: es un determinante de la calidad de lo que las personas y los tribunales pueden hacer. Ya no se cuestiona si la IA participa en trabajo legal; lo que permanece abierto es qué arquitecturas hacen qué. Según esta perspectiva, el problema de la IA pro se es un problema de diseño, no un problema de inteligencia, y los problemas de diseño tienen respuestas de diseño. El trabajo por delante es especificar arquitecturas particulares y ponerlas a prueba unas contra otras en lugar de esperar por modelos individuales mejores. El Apéndice enuncia una arquitectura de este tipo con la precisión suficiente para ser ejecutada y criticada, y se publica una implementación de referencia con ella.
Apéndice. Una Arquitectura de Asistencia, Especificada para que Pueda Ejecutarse
El argumento de este artículo es que la "asistencia de IA" designa una familia de arquitecturas con diferentes propiedades de fallo. La afirmación es más fácil de probar una vez que al menos una arquitectura se ha enunciado con la precisión suficiente para ser ejecutada y criticada. El protocolo que sigue es tal afirmación. Se denomina aquí el protocolo de consolidación ciega25, en referencia a la etapa que más claramente lo separa del debate multiagente, en el cual los modelos se leen entre sí.26 Utiliza solo modelos públicos, y cualquiera con acceso de consumidor o API a tres proveedores puede reproducirlo.
El protocolo que sigue describe, al nivel de arquitectura, la familia descrita en la Parte III: modelos heterogéneos consultados en aislamiento, un consenso formado bajo reglas explícitas con el desacuerdo preservado en lugar de ser promediado, y cada cita verificada contra su fuente. Difiere del sistema descrito en la Parte III en cómo se realiza esa última verificación: allí es un componente que valida contra una base de datos en vivo, aquí son modelos habilitados para búsqueda seguidos por una persona, y la restricción tres a continuación establece claramente que la aprobación de los modelos no es la verificación. Se presenta aquí como una especificación, no como evidencia: el artículo no ofrece ningún escrito del caso como su resultado y no extrae ninguna inferencia de él (lo que se omite: nota 24). Lo que el protocolo contribuye al argumento es el manifiesto de ejecución. La variable de arquitectura en este artículo es autoinformada (Parte IV); un manifiesto es lo que un lector externo necesitaría antes de que pudiera ser otra cosa. Los escritos en la Parte V no incluyen ninguno.
El problema que aborda.
Un litigante que se representa a sí mismo puede acceder a varios modelos de frontera a través de niveles gratuitos para consumidores, y el costo, el acceso digital y la fluidez técnica siguen siendo barreras (Parte VII): la columna de alto riesgo a continuación es acceso API de pago, y la condición de confidencialidad establecida más adelante excluye la mayoría de los niveles gratuitos para el material que más necesita protección. La práctica común es hacer una pregunta, leer la respuesta y archivarla. El fracaso documentado es un modelo confiado que produce una cita que no existe, sin nada en el proceso posicionado para detectarlo. El protocolo reemplaza la pregunta única con un enunciado de tarea común y cuatro etapas que la siguen. Deja cada modelo exactamente tan preciso como era; organiza varios de modo que el error de un sistema debe sobrevivir al contacto con sistemas entrenados por otras organizaciones, y registra lo que cada uno de ellos dijo.
Roles.
El protocolo se define por lo que cada rol puede ver. Cuatro reglas lo fijan:
1. Los generadores ven la declaración de la tarea y nada más. Ninguno ve el borrador de otro generador.
2. El consolidador ve cada borrador bajo etiquetas neutrales R1 a Rn, en orden aleatorio. Nunca se entera de qué proveedor produjo qué borrador.
3. El primer crítico lee dentro de la propia familia del consolidador, en un contexto nuevo. Ve la declaración de la tarea y el documento consolidado, y nada de la consolidación que lo produjo.
4. El último lector es un crítico de un proveedor diferente al del consolidador. Ve la declaración de la tarea, el documento consolidado y el informe del primer crítico, y su veredicto cierra la ejecución.
Cualquier conjunto de modelos fronterizos de diferentes proveedores que satisfaga las cuatro reglas ejecuta el protocolo. Como ilustración, estos son modelos públicos que estaban disponibles en septiembre de 2026 y podrían llenar los roles:
Tabla 6. Modelos públicos disponibles en septiembre de 2026 que podrían llenar los cuatro roles.
| Rol | Documentos rutinarios | Documentos de alto riesgo |
|---|---|---|
| Generadores, aislados | claude-sonnet-5 con búsqueda; gpt-5.6-terra con búsqueda; gemini-3.1-pro-high con búsqueda; un modelo de peso abierto | claude-opus-5 con búsqueda; gpt-6-astra con búsqueda; gemini-3.1-pro-high con búsqueda; Grok (xAI); un modelo de peso abierto |
| Consolidador, ciego | claude-sonnet-5 | claude-fable-5-1 |
| Crítico 1, familia del consolidador, contexto nuevo | claude-sonnet-5 | claude-fable-5-1 |
| Crítico 2, proveedor diferente, lee último | gpt-5.6-terra | gpt-6-astra |
Fuente: Documentación del proveedor a partir de septiembre de 2026. La asignación de modelos a roles es del autor; los roles, no los identificadores, definen el protocolo.
La tabla es una ilustración de lo que estaba disponible, y los identificadores envejecerán. Los roles no. Grok se menciona por proveedor y el modelo de peso abierto por clase, porque sus identificadores alojados varían de host a host, y gemini-3.1-pro-high es el alias de una interfaz alojada más que el código del modelo en la documentación de API del proveedor. La columna de alto riesgo añade un quinto generador, y su consolidador es un modelo que no escribió ningún borrador, por lo que nunca juzga su propio texto bajo una etiqueta. La Figura 9 dibuja el protocolo por rol.
La asignación de familias a roles se basa en el uso del autor, no en una medición. A lo largo de aproximadamente dos mil horas de trabajo con estos sistemas en 2025 y 2026, un modelo colocado en un contexto nuevo como crítico ciego devolvió la verificación más estricta y útil cuando provenía de la misma familia que el consolidador, e incluso cuando el texto bajo revisión había sido producido por esa familia. Los críticos de otros proveedores no eran lectores más débiles; encontraron cosas diferentes, razón por la cual el protocolo mantiene uno de ellos y le da el veredicto de cierre. Las cuatro reglas se refieren a lo que cada rol puede ver, no a qué proveedor lo llena, y un lector que prefiere una familia diferente en el consolidador o en el primer crítico puede sustituir uno y aún estar ejecutando el protocolo.
Figura 9. El protocolo de consolidación ciega, por rol: generación aislada, consolidación ciega y dos verificaciones.
Fuente: Diagrama del autor del protocolo especificado en este Apéndice.
Esta es una rampa. Se construyó para alguien que no puede subir las escaleras: alguien que no puede mantener cinco interfaces abiertas al mismo tiempo, leerlas una contra la otra y llevar la respuesta de vuelta. Una rampa es usada por todos los que llegan a la puerta, no solo por la persona para la que fue construida. La fórmula anterior está escrita para que cualquiera pueda seguirla.
Etapas.
Etapa 0. Una declaración de tarea única. Una declaración escrita única establece el objetivo, la jurisdicción, el formato requerido, qué cuenta como fuente y qué hacer con una afirmación que no puede verificarse. Cada modelo la recibe sin cambios, de modo que las diferencias entre borradores provengan de los modelos.
Etapa 1. Generación aislada. Cada generador produce un borrador completo en paralelo, con búsqueda web habilitada dondequiera que la interfaz o la API la admita, e investigación profunda donde la tarea lo requiera. Las interfaces de consumidor de estos proveedores buscan por defecto; algunos puntos finales programáticos no cuentan con herramienta de búsqueda, y un generador ejecutándose en uno de esos está redactando a partir de pesos, lo cual debe constar en el registro de ejecución. Se requiere que cada uno cite una fuente verificable para cada proposición fáctica y legal, que marque como no verificado lo que no pudo verificar, y que cierre con sus preguntas abiertas. El aislamiento es el mecanismo. Los modelos construidos por diferentes organizaciones en diferentes corpus inventan cosas diferentes, y una afirmación que varios de ellos producen independientemente, cada uno con su propia cita, ocupa una posición evidencial diferente de una afirmación que solo uno de ellos produjo. Un redactor que ve otro borrador está de acuerdo con él por razones no relacionadas con si la afirmación es verdadera.
Etapa 2. Consolidación a ciegas. Un modelo recibe los borradores como R1 a Rn, en un orden elegido al azar y registrado solo en el manifiesto de ejecución, y los fusiona bajo reglas explícitas. Las afirmaciones apoyadas por varios borradores o por una cita verificable se prefieren para su inclusión, lo cual es una regla sobre qué entra en el borrador y no un hallazgo de que sean verdaderas. El material encontrado en un solo borrador se mantiene cuando lleva una cita verificable. Los conflictos se resuelven con evidencia o se marcan en el texto. El acuerdo entre borradores se registra como acuerdo y nunca se promueve a prueba. El material nuevo entra solo si el consolidador lo verifica por sí mismo, y se marca como agregado. Cada afirmación sustancial lleva una etiqueta que nombra los borradores que la apoyan. El consolidador también escribe un registro: en qué estuvieron de acuerdo los borradores, en qué no estuvieron de acuerdo y cómo se resolvió cada conflicto, y qué se descartó y por qué. El registro es donde sobrevive el desacuerdo. Porque se mantiene el mapa de etiquetas, un lector posterior puede contrastar las etiquetas con él y medir con qué frecuencia el consolidador prefirió el borrador de su propio proveedor.
Etapa 3. Verificación interna. Un crítico de la familia del consolidador lee el documento fusionado en un contexto nuevo, sin memoria de la consolidación. Su tarea es la verificación, y no devuelve un documento mejorado. Verifica cada cita por existencia y precisión, examina el razonamiento en busca de lagunas y exageración, confirma que se cumplió la declaración de tarea, y reporta hallazgos clasificados como Crítico, Mayor y Menor con un veredicto: aprobar, aprobar con correcciones, o rechazar.
Etapa 4. Verificación entre proveedores. Un crítico de un proveedor distinto lee el mismo documento y el primer informe. Confirma, cuestiona o extiende cada hallazgo, añade los propios, y emite el veredicto final. La etapa existe debido a la debilidad de las dos anteriores: un consolidador verificado por su propia familia comparte los puntos ciegos de esa familia, y un lector capacitado en otro lugar es la ruta más directa a ellos.
Lo que sale del conducto.
El entregable es el documento consolidado, el registro de consolidación, ambos informes de verificación y un manifiesto. Ninguna etapa sobrescribe el documento con la salida del crítico. Una persona lee los informes y decide qué correcciones aplicar. En litigio, la persona que firma la presentación es responsable de su contenido, y un conducto que silenciosamente reescribiera el texto enmascararía quién decidió qué.
El manifiesto registra, para cada etapa, el identificador del modelo, el hash de la solicitud, el hash de salida, la hora de inicio y la duración, junto con el mapa de etiquetas. Sin él, un documento preparado de esta manera es indistinguible de uno producido al solicitar a un único modelo dos veces. Con él, un lector que no estuvo presente puede auditar el registro del operador de la ejecución: qué identificador se configuró para qué función, en qué orden se etiquetaron los borradores, qué recibió y devolvió cada etapa. Es un autorregistro estructurado, no una prueba. Los identificadores provienen de la configuración en lugar de una respuesta autenticada, una etapa ejecutada manualmente lleva la palabra del operador sobre lo que sucedió en la interfaz, y un registro de que se ofrece una herramienta de búsqueda no es un registro de que se verifica una fuente. Hacer que la variable sea observada en lugar de simplemente reportada requiere custodia de terceros de la ejecución, lo cual es lo que el diseño en la Parte VII proporciona y lo que un formato de archivo no puede.
Implementación de referencia.
Una implementación de referencia, docprep, se publica bajo una licencia abierta (nota 25): aproximadamente quinientas líneas de Python en un archivo, con la configuración de la Tabla 6, el formato de manifiesto y pruebas sin conexión que se ejecutan sin cuentas ni claves.
La implementación separa lo que aplica de lo que solo solicita. Se aplican las cuatro reglas de rol. El mensaje de un generador se ensambla solo a partir del enunciado de la tarea; los borradores llegan al consolidador mezclados y reetiquetados, con el mapa escrito solo en el manifiesto; y se rechaza una configuración cuyo primer crítico está fuera de la familia de proveedores del consolidador, o cuyo último crítico está dentro de ella, antes de que se llame a cualquier modelo (Figura 10). Las reglas de fusión de la Etapa 2 solo se solicitan: son instrucciones en el mensaje del consolidador, y un modelo puede desobedecerlas. Una se verifica después, ya que una consolidación devuelta sin su registro detiene la ejecución.
Figura 10. Una regla de rol como precondición de la ejecución: la verificación del crítico de cierre y el rechazo que imprime.
home = family(cfg, cons) # the consolidator's vendor family
. . .
if critics and family(cfg, critics[-1]) == home:
problems.append(f"{critics[-1]['name']} is from the consolidator's family "
f"({home}); the last reader must come from another vendor")
. . .
if problems and enforce:
sys.exit(f"formula '{formula_name}' breaks the protocol:\n - "
+ "\n - ".join(problems))
$ python3 docprep.py run --formula manual
formula 'manual' breaks the protocol:
- critic_cross is from the consolidator's family (anthropic);
the last reader must come from another vendor
Fuente: docprep, docprep.py, función validate(), versión v1.0.0 (nota 25); elipsis marcadas. Debajo del código, la salida del comando mostrado, ejecutada en la configuración de ejemplo con el crítico de cierre reasignado a la familia de proveedores del consolidador. Las pruebas sin conexión del repositorio afirman el mismo rechazo.
La aplicación tiene los límites que tiene el manifiesto. La familia de proveedores de un rol se declara en la configuración, no se autentica. Una etapa ejecutada manualmente es ciega y nueva según la palabra del operador. El reetiquetado elimina nombres, no estilos. Y el rechazo se puede desactivar, en cuyo caso el manifiesto registra que fue así y enumera las reglas incumplidas. Las reglas se aplican contra los errores del operador, no contra el operador.
El marco legal.
Una arquitectura que reduce la correlación de errores al añadir proveedores aumenta, por ese mismo acto, el número de lugares por donde se disemina el material. Para un litigante que se autorepresenta ante un tribunal de los Estados Unidos, ese intercambio no es abstracto.
La posición en los Estados Unidos a partir de septiembre de 2026 tiene tres partes: lo que un presentador debe divulgar, qué se puede enviar a un proveedor en absoluto, y si el trabajo se mantiene como producto de trabajo. La Parte II y la Tabla 1 establecen el régimen de divulgación; la Parte VI.A contiene el análisis del producto de trabajo y sus autoridades. Ninguna regla de procedimiento federal generalmente aplicable requiere que un presentador divulgue el uso de IA o nombre un modelo: en abril de 2026, el Comité Asesor sobre Reglas Civiles retiró de su agenda dos propuestas dirigidas a autoridad fabricada, acordando que la elaboración de normas no sería apropiada en ese momento.27 Las reglas locales y las órdenes de estancia individuales sí lo requieren, y difieren. El Distrito Norte de Texas solicita el hecho del uso de IA en la primera página de un escrito y no solicita qué modelo. La Juez Vaden de la Corte de Comercio Internacional solicita el programa utilizado, las porciones específicas de texto que produjo, y una certificación de que el uso no divulgó información confidencial o de propiedad comercial a una parte no autorizada.28
Dos acciones de elaboración de normas de la primavera de 2026 son fáciles de confundir, y la confusión cambia la respuesta. El Comité Asesor sobre Reglas Civiles consideró dos propuestas para enmendar la Regla 11 para abordar citas de autoridad que no existen, acordó que la elaboración de normas no sería apropiada en ese momento, y retiró el tema el 14 de abril de 2026. Tres semanas después, el Comité Asesor sobre Reglas de Prueba consideró la Regla Federal de Prueba 707 propuesta, que rige la admisibilidad de prueba generada por máquina en lugar de la divulgación del uso de IA; revisó el proyecto y lo mantuvo bajo estudio en lugar de avanzar con él. La primera acción se refiere a lo que un presentador certifica, la segunda a lo que un tribunal puede admitir, y ninguna creó un deber de divulgar. Los dos están vinculados en el registro mismo, por lo que se leen como uno: el memorándum de abril del comité de Reglas Civiles cita el proyecto de la Regla 707, y sus actas notan que el comité de Reglas de Prueba tenía esa regla bajo estudio.
El material que otra parte ha designado como confidencial es el caso más difícil, y llega directamente a esta arquitectura. En Morgan, el tribunal permitió a una demandante que se autorepresentaba poner tal material en un servicio de IA solo donde el proveedor está obligado contractualmente a no almacenar o usar la entrada para entrenar o mejorar su modelo, a no divulgarlo a terceros excepto donde la divulgación es esencial para entregar el servicio y el destinatario está obligado por protecciones equivalentes, y a remover o eliminar sobre solicitud; requirió que la demandante nombrara cualquier herramienta utilizada en conexión con ese material y mantuviera documentación escrita de esas salvaguardas. El tribunal observó que la condición excluye la mayoría de las IA convencionales de bajo costo o sin costo. Esos son los términos de una orden de protección en lugar de una regla nacional, y son los más restrictivos que ha localizado el autor; el protocolo los adopta como su propia política de diseño.
Tres limitaciones siguen. Son reglas de diseño de este protocolo, no declaraciones de lo que la ley requiere de un litigante.
1. Los autos públicos y el material que el operador es libre de transmitir pueden ir a los modelos. El material sellado, el material bajo una orden de protección, y el descubrimiento confidencial de otra parte no, a menos que la orden lo permita y los términos del proveedor cumplan la condición que Morgan impuso. La restricción cubre cada etapa y cada destinatario, no solo los generadores: el consolidador y ambos críticos reciben el proyecto fusionado, y los artefactos retenidos viajan con él. La propiedad de un documento no descarga por sí sola una obligación de confidencialidad adjunta a él. El manifiesto hace la exposición auditable; no la hace legal.
2. El manifiesto apoya la divulgación; no es la divulgación. Registra cuál identificador de modelo produjo cuál artefacto y cuándo, que es el material que un tribunal pidiendo el programa utilizado querrá, y vale la pena mantener ya sea que el juez presidente lo pida o no. No presenta el aviso que una orden de estancia requiere, no identifica las porciones del documento final que una regla como la de la Juez Vaden alcanza, ni suministra certificación alguna.
3. La verificación de cada cita contra su fuente se realiza por una persona. La Regla 11(b) alcanza a una parte no representada por sus términos, y su estándar es investigación razonable bajo las circunstancias en lugar de cualquier procedimiento particular; la Parte II establece lo que el registro de citas fabricadas muestra. El acuerdo entre modelos y la aprobación por dos críticos no son verificación.
Los requisitos varían por distrito y por juez, y la orden de estancia del juez presidente rige.
Límites.
Los modos de investigación profunda de las interfaces de consumidor no tienen un equivalente exacto en las API de los proveedores. Una etapa que lo requiere se ejecuta manualmente: la indicación se escribe en un archivo, el operador la ejecuta en la interfaz y vuelve a pegar la respuesta, y el manifiesto registra que la etapa se ejecutó de esa manera. Ese respaldo es manual, y la Parte II explica por qué un flujo de trabajo manual en varias interfaces no es simplemente más lento para un litigante con una discapacidad motora o visual. Un protocolo que depende de él hereda ese límite.
El acuerdo entre modelos es evidencia de correlación tanto como de verdad. Los modelos entrenados con corpus superpuestos comparten errores, y un conjunto unánime de borradores puede estar equivocado en conjunto. El protocolo reduce la correlación que puede alcanzar y registra el resto.
El protocolo no ha sido comparado con indicaciones de un único modelo. La comparación que establecería su valor es una evaluación ciega: las mismas tareas preparadas de ambas formas, los documentos resultantes evaluados por lectores que no saben cuál es cuál, en exactitud de citas, completitud respecto a la declaración de la tarea y errores que un tribunal advertiría. El protocolo se expone aquí para que esta comparación pueda realizarse.
El repositorio mencionado anteriormente contiene la canalización, la configuración y las pruebas sin conexión.
Referencias y Autoridades Seleccionadas
ABA Model Rules of Professional Conduct r. 5.5.
Americans with Disabilities Act, 42 U.S.C. §§ 12181--12188.
Ashley, Kevin D., Artificial Intelligence and Legal Analytics: New Tools for Law Practice in the Digital Age (Cambridge Univ. Press 2017).
Avery, Joseph J., Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).
Blanck, Peter, eQuality: The Struggle for Web Accessibility by Persons with Cognitive Disabilities (Cambridge Univ. Press 2014).
Cappelletti, Mauro & Bryant Garth, Access to Justice: The Newest Wave in the Worldwide Movement to Make Rights Effective, 27 Buff. L. Rev. 181 (1978).
Carpenter, Anna E., Colleen F. Shanahan, Jessica K. Steinberg & Alyx Mark, Judges in Lawyerless Courts, 110 Geo. L.J. 509 (2022).
Centers for Disease Control and Prevention, Disability Impacts All of Us (2022 BRFSS data).
Chan, Chi-Min, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu & Zhiyuan Liu, ChatEval: Towards Better LLM-Based Evaluators Through Multi-Agent Debate, arXiv:2308.07201 (2023).
Charlotin, Damien, AI Hallucination Cases Database, https://www.damiencharlotin.com/hallucinations/ (last visited September 2026).
Chernets, Vadym, docprep: A Reference Implementation of the Blind-Consolidation Protocol, release v1.0.0 (2026), https://github.com/vadimchernets/docprep (licencia MIT; el protocolo especificado en el Apéndice y el código que lo ejecuta).
Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) (expediente público); PolyHelper.AI LLC v. United States of America, No. 1:25-cv-07770 (S.D.N.Y. 2025) (causa anterior, demandado distinto).
Cohen-Sasson, Or, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).
Du, Yilun, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.
Engstrom, Nora Freeman & Aviv Caspi, Opening the Courthouse Door---or Just Lowering the Threshold?, JOTWELL: Legal Profession (July 3, 2026).
Fed. R. Civ. P. 26(b)(3).
Greiner, D. James, Cassandra Wolos Pattanayak & Jonathan Hennessy, The Limits of Unbundled Legal Assistance: A Randomized Study in a Massachusetts District Court and Prospects for the Future, 126 Harv. L. Rev. 901 (2013).
Grimm, Paul W., Maura R. Grossman & Gordon V. Cormack, Artificial Intelligence as Evidence, 19 Nw. J. Tech. & Intell. Prop. 9 (2021).
Guha, Neel, et al., LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models, Advances in Neural Information Processing Systems 36 (2023).
Hadfield, Gillian K., Rules for a Flat World: Why Humans Invented Law and How to Reinvent It for a Complex Global Economy (Oxford Univ. Press 2017).
Hannaford-Agor, Paula, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts (National Center for State Courts 2015).
Hickman v. Taylor, 329 U.S. 495 (1947).
Katz, Daniel Martin, Michael James Bommarito, Shang Gao & Pablo Arredondo, GPT-4 Passes the Bar Exam, 382 Phil. Trans. R. Soc. A 20230254 (2024).
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022).
Liang, Tian, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (2024).
Magesh, Varun, Faiz Surani, Matthew Dahl, Mirac Suzgun, Christopher D. Manning & Daniel E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford HAI (2024).
Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026).
Park v. Kim, 91 F.4th 610 (2d Cir. 2024).
Sandefur, Rebecca L., Access to What?, 148 Daedalus 49 (2019).
Shah, Anand V. & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859.
Sharma, Mrinank, et al., Towards Understanding Sycophancy in Language Models, ICLR (2024).
Simshaw, Drew, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).
Surden, Harry, Machine Learning and Law, 89 Wash. L. Rev. 87 (2014).
System Documentation (en poder del autor).
U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (Mar. 3, 2026).
United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026).
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026).
* Arquitecta de sistemas de IA. Los roles de la autora como demandante, desarrolladora de sistemas y analista se detallan en la Declaración de Divulgación de Autora a continuación. Comentarios bienvenidos: [email protected].↩︎
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022), https://justicegap.lsc.gov. En cuanto a la escala de la autorepresentación en general, al menos una de las partes se autorepresentaba en más de tres cuartas partes de los casos civiles en un estudio multijurisdiccional destacado. Véase Paula Hannaford-Agor, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts iv (National Center for State Courts 2015).↩︎
Anand V. Shah & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (20 de marzo de 2026) (manuscrito inédito), https://ssrn.com/abstract=6766859 (analizando más de 4,5 millones de casos civiles federales no carcelarios, FY2005--FY2026, y 46 millones de asientos de expediente PACER coincidentes); véase también Or Cohen-Sasson, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (próxima publicación 2026).↩︎
Juez Presidente Patrick J. Schiltz (D. Minn.), citado en Mattathias Schwartz & Zach Montague, Artificial Intelligence Floods Court Dockets with Home-Brewed Lawsuits, N.Y. Times (25 de mayo de 2026).↩︎
Drew Simshaw, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).↩︎
Véase, p. ej., Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023); Park v. Kim, 91 F.4th 610 (2d Cir. 2024).↩︎
Carta de Andrew J. Dietderich, Sullivan & Cromwell LLP, al Juez Presidente Martin Glenn, Tribunal de Quiebras de EE.UU., S.D.N.Y. (18 de abril de 2026) (disculpándose por "citas inexactas y otros errores", algunos de ellos "alucinaciones" de IA, en una moción de emergencia del 9 de abril en los procedimientos del Capítulo 15 de Prince Global Holdings Ltd.); véase Sullivan & Cromwell Apologizes to Judge for AI Hallucinations, Bloomberg Law (21 de abril de 2026).↩︎
AI Hallucination Cases Database (Damien Charlotin), https://www.damiencharlotin.com/hallucinations/ (captura del 2 de julio de 2026): de 1.668 incidentes documentados a nivel mundial, 975 involucraban litigantes autorepresentados y 653 involucraban partes representadas; en 2023, aproximadamente siete de cada diez involucraban litigantes autorepresentados, y la participación de abogados en los hallazgos recién documentados aumentó constantemente entre 2025 y 2026.↩︎
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026); véase también comentario sobre IA y la práctica no autorizada del derecho en la Georgetown Journal of Legal Ethics (2026).↩︎
Véase Law360 Pulse, Tracking Federal Judge Orders on Artificial Intelligence (última consulta julio de 2026); Legal AI Governance, Federal and State Court Orders on AI, https://legalaigovernance.com/tracker/court-orders/ (última consulta julio de 2026).↩︎
Véase How Courts Are Coping with a Flood of AI-Generated Lawsuits, MIT Technology Review (4 de junio de 2026) (informando, entre otras cosas, que las presentaciones de partes autorepresentadas en Vermont aumentaron de aproximadamente 45 por año antes de 2022 a más de 1.100 en 2024).↩︎
La demanda en el estudio de caso caracteriza el sistema en estos términos; el enfoque se señala como la teoría legal de la demandante, no como una determinación de fondo. En cuanto a la escala de la población afectada, más de uno de cada cuatro adultos estadounidenses --- más de 70 millones --- reportaron una discapacidad en 2022, CDC, Disability Impacts All of Us (2022 BRFSS data), y la tasa de empleo de la población con discapacidad fue del 22,8% en 2025, versus 65,2% para quienes no la tienen, U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (3 de marzo de 2026).↩︎
Yilun Du, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.↩︎
Véase, p. ej., Tian Liang, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP 2024) 17889; Chi-Min Chan et al., ChatEval: Towards Better LLM-Based Evaluators through Multi-Agent Debate, arXiv:2308.07201 (2023).↩︎
La oposición de la demandante incluyó tal desarrollo en el registro, indicando el anuncio público de uno de los demandados de una función de consenso multiproveedores y multimodelo. Véase Plaintiff's Opposition, ECF No. 76.↩︎
Documentación técnica del sistema (citada solo para propósitos de diseño).↩︎
La arquitectura es el tema de una familia de solicitudes de patente internacionales pendientes en las que la autora es una solicitante designada; la familia se documenta en el registro público del litigio (véase Plaintiff's Opposition, Ex. 3), y se omiten aquí sus identificadores por ser inmateriales para el análisis.↩︎
Moción Conjunta para Desestimar y Memorándum en Apoyo, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), ECF Nos. 69, 69-1; Memorándum de Derecho de la Demandante en Oposición, ECF No. 76 (2 de abril de 2026); Transcripción de la Conferencia Previa a Moción, ECF No. 55 (27 de enero de 2026).↩︎
ECF Nos. 28 (moción de consentimiento), 30, 32-34, 36-37 (ene. 12, 2026). Las cartas se coordinaron entre sí; un acusado adoptó expresamente los fundamentos y argumentos expuestos en las cartas previas a la moción de sus coacusados.↩︎
ECF Nos. 39-44 (ene. 15-16, 2026).↩︎
Compárese el Memorándum en Apoyo de la Moción Conjunta para Desestimar, ECF No. 69-1, con la Oposición de la Demandante, ECF No. 76, en p. 17.↩︎
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. Feb. 10, 2026) (Patti, M.J.); United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026) (Rakoff, J.); Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).↩︎
Morgan v. V2X, Inc., 2026 WL 864223, at *3 (D. Colo. Mar. 30, 2026).↩︎
Véase ABA Model Rules of Prof'l Conduct r. 5.5; Joseph J. Avery, Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).↩︎
Este artículo describe únicamente documentos presentados públicamente y características arquitectónicas ya divulgadas a los acusados y al público. Retiene las indicaciones utilizadas, la lógica de decisión del sistema sobre cualquier pregunta en particular, y todo producto de trabajo en borrador.↩︎
docprep, una implementación de referencia del protocolo de consolidación ciega, https://github.com/vadimchernets/docprep (licencia MIT); la versión descrita aquí es la versión v1.0.0. El repositorio contiene la tubería ejecutable en un archivo, la configuración de la Tabla 6, el formato de manifiesto, y pruebas sin conexión que se ejecutan sin cuentas ni claves, junto con este Apéndice como una especificación independiente bajo CC BY 4.0. Los identificadores de modelo y el acceso deben configurarse para las cuentas propias del operador.↩︎
Comisión Consultiva sobre Reglas Civiles, Borrador de Actas de la Reunión del 14 de abr. de 2026, p. 18, reimpreso en Comisión sobre Reglas de Práctica y Procedimiento, Libro de Agenda 383 (3-4 de junio de 2026) (artículo 17, "Alucinaciones de Inteligencia Artificial"); véase también Comisión Consultiva sobre Reglas Civiles, Libro de Agenda 438-50 (14 de abr. de 2026) (Sugerencias 25-CV-S y 25-CV-V, ambas dirigidas a la Regla 11); Informe de la Comisión Consultiva sobre Reglas Civiles 60 (6 de mayo de 2026), en Libro de Agenda, supra, p. 364 (asuntos retirados del orden del día). Las actas están en borrador pendientes de aprobación en la reunión de otoño de 2026 del comité. La Regla Federal de Pruebas Propuesta 707, que rige la admisibilidad de pruebas generadas por máquina en lugar de la divulgación, es un asunto separado: la Comisión Consultiva sobre Reglas de Pruebas la revisó el 7 de mayo de 2026 y la mantuvo bajo estudio en lugar de promoverla.↩︎
N.D. Tex. Civ. R. 7.2(f) (divulgación del uso de inteligencia artificial generativa en la primera página de un escrito, con divulgación adicional de las porciones así preparadas si lo ordena el juez que preside); Orden sobre Inteligencia Artificial, Corte de Comercio Internacional de los EE.UU. (Vaden, J.) (8 de junio de 2023) (requiere identificación del programa utilizado, de las porciones específicas de texto que produjo, y certificación de que el uso no divulgó información confidencial o propietaria a una parte no autorizada).↩︎
Cómo citar
Chernets, V. (2026). The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice [Preimpresión]. SSRN. https://doi.org/10.2139/ssrn.7120940
@misc{chernets2026missingvariable,
  author       = {Chernets, Vadym},
  title        = {{The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7120940},
  url          = {https://doi.org/10.2139/ssrn.7120940}
}