La variable manquante dans le contentieux assisté par l'IA : Architecture et la qualité de l'accès à la justice pour les personnes sans avocat
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, PhD, architecte de systèmes IA · ORCID 0009-0007-4845-3163
SSRN 7120940 · DOI 10.2139/ssrn.7120940 · Zenodo 10.5281/zenodo.22168724 · GitHub
- Version de référence : SSRN 7120940 · DOI 10.2139/ssrn.7120940
- Copie archivée, citée et téléchargeable : 10.5281/zenodo.22168724 — concept DOI, toujours résolu à la dernière version
- Texte complet en Markdown et PDF : GitHub
- HTML lisible : https://polyhelper.ai/research/missing-variable/
Le même texte est sur quatre surfaces pour qu'il puisse être consulté quand l'une d'elles ne peut pas le servir. SSRN détient la version de référence ; citez celle-ci.
La variable manquante dans les litiges assistés par l'IA
Architecture et qualité de l'accès à la justice pour les pro se
Vadym Chernets, PhD1
Publié en juillet 2026 ; version actuelle septembre 2026
DÉCLARATION DE DIVULGATION DE L'AUTEUR
L'intérêt de l'auteur dans cet Article est triple, et chaque volet est matériel. Premièrement, l'auteur est le demandeur dans Chernets c. Google LLC et al., n° 1:25-cv-05691-RER-RML (E.D.N.Y.), le litige qui sert de cas d'étude. Deuxièmement, l'auteur est le développeur du système d'orchestration multimodèle dont l'utilisation est examinée ici, et est demandeur nommé sur les demandes internationales au sein de la famille de brevets décrite dans la partie III ; l'auteur a donc un intérêt dans les méthodes que cet Article analyse. Troisièmement, l'auteur est l'analyste. Les contraintes méthodologiques énoncées dans la partie IV régissent l'analyse : dépendance exclusive du dossier public, aucune inférence des motifs de règlement, et traitement non probant des mesures de performance auto-signalées du système. La partie VII énonce les limites.
Deux paragraphes, un dans la partie II et un dans l'Appendice, sont les propres paroles de l'auteur sur les raisons pour lesquelles il a construit le système et pourquoi il a poursuivi ; ils sont marqués comme les siens, et aucune conclusion ne repose sur eux. Autrement, cet Article s'appuie exclusivement sur le dossier fédéral public et les sources accessibles au public ; il ne divulgue pas la stratégie de litige privilégiée concernant les réclamations qui restent en suspens contre les défendeurs qui n'ont pas transigé. L'auteur n'est pas un avocat. Des assistants IA ont été utilisés comme instruments sous la direction de l'auteur ; les idées, la recherche et les conclusions sont celles de l'auteur.
RÉSUMÉ
Presque tous les comptes rendus de l'IA en matière de contentieux reposent sur une hypothèse non formulée : l'assistance par l'IA est une seule chose. Le débat qu'engendre cette hypothèse porte sur le volume et la fabrication : un taux de demandeurs pro se fédéraux passé de 11 % à près de 17 %, des cours décrivant une « menace existentielle », un dossier croissant de décisions de sanctions pour citations fabriquées. Ce que les études globales ne peuvent pas encore montrer, c'est si une quelconque configuration d'assistance par l'IA modifie la qualité de ce que font les justiciables non représentés. Le dossier utilisé ici est le dossier public d'une affaire fédérale, et il contient une structure que le compte rendu volume-et-hallucination ne prédisait pas. Un justiciable non représenté sans aucun avocat, utilisant, selon le compte rendu de l'auteur, un système d'orchestration multi-modèle (modèles indépendants interrogés en parallèle, désaccords surfacés plutôt que lissés, citations vérifiées par rapport à des sources externes), a répondu à six lettres pré-motion coordonnées en quatre jours, a déposé une opposition substantielle six semaines avant la date limite, et a identifié une erreur vérifiable de citation statutaire dans un mémoire déposé pour sept défendeurs représentés par le conseil d'importants cabinets, dans une affaire impliquant treize défendeurs technologiques. Le dernier de ces trois est l'inverse du mode de défaillance qui domine la littérature. L'Article propose l'hypothèse de dépendance architecturale : l'architecture de l'assistance par l'IA, incitation à modèle unique par rapport à orchestration multi-modèle, est une variable empirique dans la qualité du contentieux non représenté en soi, et non un détail d'implémentation ni la même chose que la disponibilité de l'IA. Les conséquences doctrinales examinées ici concernent la doctrine du travail produit, où les cours fédérales se sont divisées au début de 2026, et le cadre de l'exercice non autorisé. L'affaire est offerte comme une preuve d'existence réfutable et un programme de recherche ; l'auteur est le demandeur, le développeur du système et l'analyste.
Mots-clés : contentieux pro se ; justiciables non représentés ; accès à la justice ; contentieux assisté par l'IA ; IA générative ; débat multi-agents ; orchestration multi-modèle ; citations fabriquées ; vérification des citations ; doctrine du travail produit ; divulgation ; ordonnances permanentes ; règle 11 ; exercice non autorisé du droit ; titre III ; hypothèse de dépendance architecturale. Classification JEL : K41 (Processus de contentieux) ; K10 (Domaines fondamentaux du droit, Généralités) ; O33 (Changement technologique : choix et conséquences). # Table des matières
I. Introduction 4
II. L'écart d'accès à la justice et le tournant IA pro se 6
III. De l'incitation à modèle unique à l'orchestration : l'exosquelette cognitif 11
IV. Méthode et base probante 15
V. Résultats 18
A. Reconstruction du cadre juridique suite à un dépôt initial défectueux 19
B. Réponse à la pratique pré-motion coordonnée 20
C. Réponse opportune à une défense consolidée 21
D. Identification d'une erreur de citation statutaire dans le mémoire de défense 22
E. Règlements amiables précoces 23
VI. Implications doctrinales 25
A. Travail produit et le justiciable pro se 25
B. Exercice non autorisé du droit 27
C. Une reformulation, non une résolution 29
VII. Limitations et travaux futurs 29
VIII. Conclusion 32
Appendice. Une architecture d'assistance, spécifiée pour qu'elle puisse être exécutée 34
Références et autorités sélectionnées 42
I. Introduction
Un justiciable, treize sociétés d'IA : l'affaire examinée ici comprime en un seul dossier la question que cet Article pose à la littérature. L'écart entre les besoins juridiques civils des Américains et les ressources disponibles pour les satisfaire est l'un des problèmes les plus durables du système judiciaire américain. L'étude nationale la plus récente de la Legal Services Corporation a révélé que les Américains à faible revenu n'ont reçu aucune aide ou une aide inadéquate pour quatre-vingt-douze pour cent des problèmes juridiques civils qui les ont substantiellement affectés, avec près de trois ménages à faible revenu sur quatre connaissant au moins un tel problème au cours d'une seule année.2 Pour la plupart des justiciables non représentés, le obstacle n'est pas le droit de dépôt mais tout ce qui suit : localiser le bon tribunal, identifier la cause d'action applicable, notifier les défendeurs sociétés, et répondre aux motions rédigées par le conseil expérimenté dans le respect de délais serrés.
Cette population a crû rapidement depuis que l'IA générative est devenue largement disponible. Une étude empirique récente à grande échelle rapporte que le taux fédéral de demandeurs pro se en matière civile, stable près de onze pour cent pendant deux décennies, a augmenté à 16,8 pour cent en année budgétaire 2025 (Figure 1), et que la part des réclamations civiles fédérales échantillonnées portant des marqueurs de texte généré par l'IA a grimpé de pratiquement zéro en 2019 à plus de dix-huit pour cent au début de 2026, telle que mesurée dans cette étude. Cet échantillon s'appuie sur des réclamations déposées à la fois pro se et avec le conseil, tirées de l'archive RECAP, que les auteurs avertissent sous-représente les dépôts faits sans avocat.3
Les cours et les commentateurs ont réagi principalement avec appréhension. Le juge en chef de l'époque d'une cour de district fédérale a décrit le problème global comme « une menace existentielle pour les cours fédérales ».4 Les ordres professionnels avertissent que les chatbots grand public pourraient franchir le seuil de l'exercice non autorisé du droit, et un corpus croissant de décisions de sanctions traite les justiciables, représentés et non représentés, qui déposent des mémoires citant des affaires qui n'existent pas.
L'appréhension est bien fondée, mais elle décrit un mode particulier d'utilisation de l'IA. En se concentrant sur ce mode, les travaux empiriques existants traitent implicitement l'assistance par l'IA comme homogène, et cet Article soutient que l'hypothèse n'est plus défendable. Les défaillances documentées (autorité hallucincée, accord complaisamment, volume indifférencié) sont caractéristiques de l'incitation à modèle unique : un justiciable pose une question à un modèle généraliste et dépose le résultat. Presque tout le tableau empirique de l'utilisation de l'IA pro se repose sur ce mode.
L'architecture examinée ici est une architecture différente, et la question est de savoir si cette différence a de l'importance. Dans l'orchestration multi-modèles, une requête est envoyée simultanément à plusieurs modèles indépendants, et leurs résultats sont comparés. L'accord et le désaccord sont explicites, et la divergence, y compris un signal minoritaire qui signale une possible erreur, est préservée plutôt que d'être moyennée. L'affirmation avancée ici est étroite mais, si elle est correcte, conséquente : les modes de défaillance des modèles uniques qui alimentent les préoccupations actuelles peuvent ne pas être intrinsèques aux litiges assistés par l'IA, et une architecture d'orchestration peut convertir l'utilisation de l'IA d'une source de volume en un instrument de qualité. La contribution est méthodologique : l'Article propose que l'architecture de l'assistance par l'IA soit traitée comme une variable empirique distincte plutôt que comme un détail d'implémentation, et l'étude de cas qui suit est offerte comme une instance documentée motivant cette proposition. L'affirmation, en quatre mots : l'architecture, pas la disponibilité.
L'affirmation est développée par le biais d'une seule étude de cas, Chernets v. Google LLC et al., une action fédérale dans laquelle un plaignant non représenté, utilisant (selon son propre compte) un système d'orchestration multi-modèles, a plaidé contre un groupe de défendeurs technologiques représentés par des avocats de nombreux cabinets juridiques. L'analyse repose entièrement sur le dossier public : les dépôts, les dates et les numéros de documents que n'importe quel lecteur peut vérifier. Ce dossier montre une conduite que le compte dominant du volume et de l'hallucination ne décrit pas et que les études agrégées des dépôts assistés par l'IA ne sont pas conçues pour détecter : un cycle de plaidoiries complet soutenu contre une défense coordonnée, avec six lettres pré-moción coordonnées auxquelles il a été répondu en quatre jours et une opposition substantielle déposée des semaines avant la date limite, et l'identification d'une erreur de citation statutaire vérifiable dans le mémoire de la coalition de défense. Quatre défendeurs se sont arrangés rapidement (à titre confidentiel ; partie V.E). L'affaire reste en attente, et l'objectif de l'examiner est d'utiliser un dossier vérifiable pour isoler un phénomène qui, selon le compte dominant, ne serait pas censé exister et que la littérature n'a pas encore examiné de près.
Une seule affaire rédigée par une partie peut établir qu'un phénomène s'est produit, non à quelle fréquence il se produit ou s'il se généralise ; la partie VII énonce les limites. L'argument est que l'architecture de l'assistance par l'IA est une variable indépendante dans l'étude des litiges assistés par l'IA, une variable que le cadrage actuel, axé sur la disponibilité et le volume, n'isole pas. C'est l'hypothèse de dépendance architecturale ; la partie IV l'énonce formellement.
L'Article procède comme suit. La partie II situe l'étude dans la littérature sur l'accès à la justice et les travaux émergeants sur l'utilisation de l'IA par des procureurs non assistés. La partie III distingue la demande de modèle unique de l'orchestration et précise le mécanisme. La partie IV énonce la méthode de l'étude de cas et sa base probante dans le dossier public. La partie V présente les conclusions. La partie VI examine les implications pour la doctrine du produit du travail et le cadre de la pratique non autorisée du droit. La partie VII aborde les limitations et les travaux futurs. La partie VIII conclut.
II. L'écart d'accès à la justice et le tournant vers l'IA pour les procureurs non assistés
L'écart de justice est une caractéristique structurelle du système civil américain, non une caractéristique marginale. Une grande part des Américains à revenu faible et moyen ne reçoivent pas d'aide juridique significative pour leurs problèmes civils, et dans de nombreuses catégories d'affaires, l'auto-représentation est la norme plutôt que l'exception (Carpenter, Shanahan, Steinberg & Mark 2022). Depuis le mouvement comparatif d'accès à la justice des années 1970 (Cappelletti & Garth 1978), les chercheurs ont formulé la question comme une question de distribution : l'expertise juridique est une ressource rare, inégalement répartie, et les plaideurs les moins en mesure de se permettre un avocat sont souvent ceux qui ont le plus à perdre (Sandefur 2019). Cette littérature pose la question de ce que signifie l'accès à la justice ; la question poursuivie ici est la qualité de cette chose.
Dans ce contexte, l'IA générative est arrivée comme un développement ambigu. Selon un point de vue, elle promettait de démocratiser la capacité juridique, donnant aux plaideurs non représentés un simulacre de la recherche, de la rédaction et de l'analyse que les avocats fournissent. Cette promesse a pris forme concrète quand un modèle de pointe a réussi l'examen uniforme du barreau (Katz, Bommarito, Gao & Arredondo 2024), bien que les critères de performance de ce type aient changé les attentes concernant la capacité sans isoler les différences architecturales. Simshaw a averti tôt que l'IA pourrait plutôt entériner un système à deux niveaux, dans lequel les bien dotés en ressources obtiennent un jugement humain expert tandis que tout le monde d'autre reçoit des approximations automatisées.5 Le tableau empirique qui a émergé depuis est plus concret : en analysant des millions de dépôts fédéraux, des travaux récents documentent que le taux de plaignants sans représentation s'est considérablement accru suite à la publication publique de l'IA générative et développent des indicateurs de rédaction conforme à l'IA dans les plaintes elles-mêmes. Ce dossier agrégé ne peut pas encore montrer si cela permet aux plaideurs auto-représentés de s'en sortir mieux. Comme l'observent les lecteurs les plus prudents de cette étude, faire passer de nouveaux plaignants par les portes du tribunal n'est pas la même chose que de les aider une fois à l'intérieur (Engstrom & Caspi 2026).
Figure 1. L'augmentation des plaignants civils fédéraux sans représentation suite à la large disponibilité de l'IA générative.
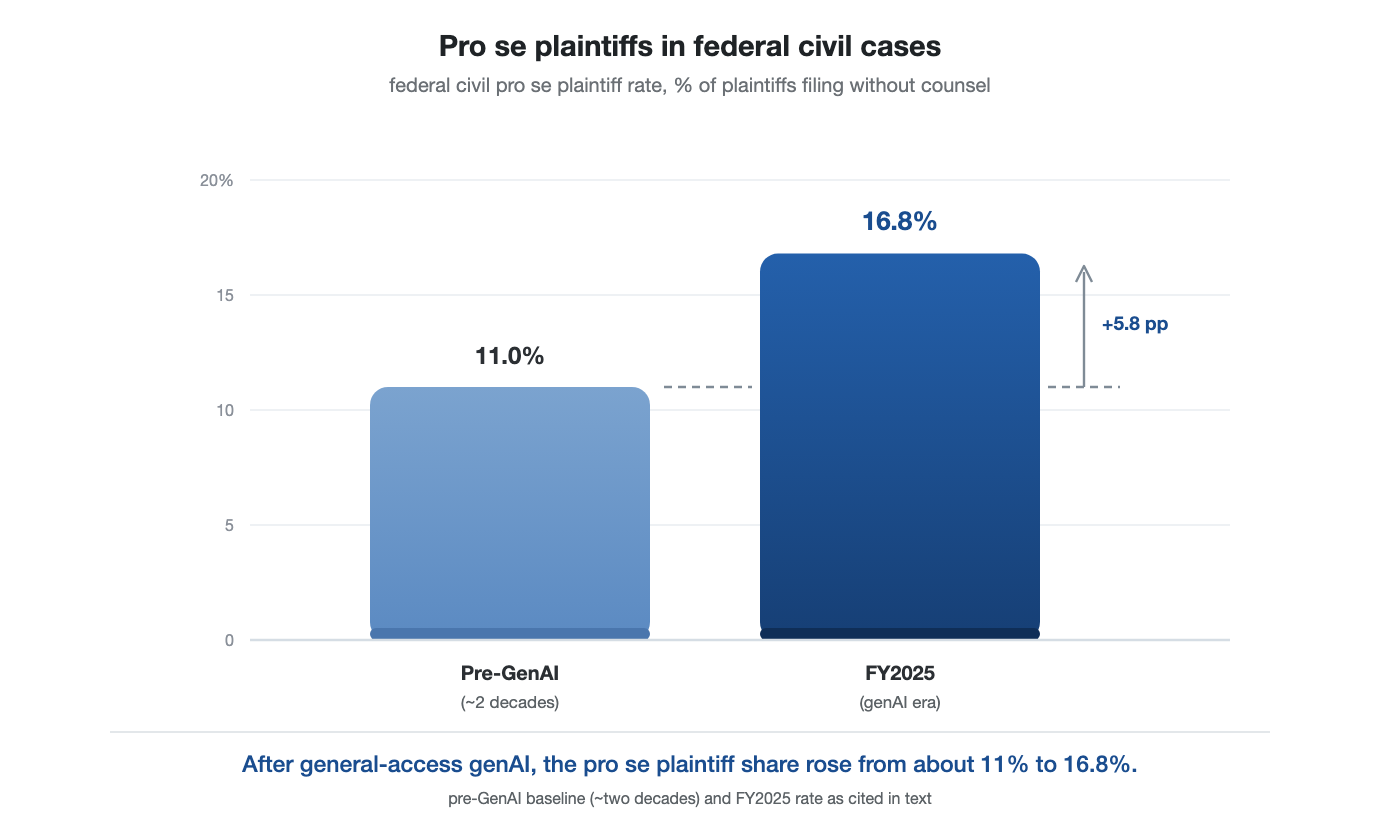
Source : Adapté de Shah & Levy (2026) ; chiffres arrondis.
L'accueil dans les tribunaux et le barreau exerçant a été prédominamment prudent, et les préoccupations se regroupent autour de la fabrication, de l'exercice non autorisé et du volume. Sur la fabrication, une ligne désormais substantielle de décisions sanctionne les plaideurs et les avocats qui déposent des mémoires citant des cas qui n'existent pas,6 un mode de défaillance retracé directement aux modèles génératifs qui produisent une autorité plausible mais fictive. Ce mode de défaillance a produit un dossier suivi de décisions dans lesquelles un tribunal a constaté, ou a tenu pour établi, qu'un dépôt s'appuyait sur du matériel fabriqué par l'IA : plus de deux mille dans le monde en septembre 2026 (Charlotin 2026), et cela comprend maintenant un épisode largement rapporté dans lequel l'une des plus éminentes sociétés de Wall Street s'est excusée auprès d'un tribunal des faillites fédéral pour un dépôt d'urgence contenant des citations inexactes et d'autres erreurs, dont certaines des « hallucinations » de l'IA.7 La composition de ce dossier est elle-même instructive : ce qui a commencé de manière écrasante comme un phénomène d'autorepréentation n'est pas resté tel. À la mi-2026, les avocats autorisés représentaient environ deux cinquièmes des incidents documentés, et leur part des conclusions nouvellement documentées était en croissance.8 Les ordres professionnels et les commentateurs s'inquiètent également de l'exercice non autorisé, se demandant si les chatbots de consommation dispensant des conseils juridiques franchissent la ligne réservant l'exercice du droit aux avocats autorisés, et si les entités qui les exploitent pourraient en être responsables.9 Quant au volume, les juges ont décrit une vague de dépôts pro se assistés par l'IA comme une tension sur les ressources judiciaires, dans le cadrage le plus aigu, une menace existentielle pour les tribunaux fédéraux.
La réponse judiciaire a pris une forme supplémentaire et révélatrice. Depuis la mi-2023, des juges fédéraux et des États individuels ont émis des ordres permanents abordant l'IA générative dans leurs salles d'audience (les suivi publics en listent maintenant des centaines, aucun n'est identique), exigeant des parties qu'elles divulguent si l'IA a été utilisée dans la rédaction, de certifier que les citations ont été vérifiées, ou les deux.10 Les ordres partagent une conception (Tableau 1) : ils réglementent le fait de l'utilisation de l'IA et la vérification de son résultat. L'architecture, que l'assistance soit monoplan ou orchestrée, auto-vérifiante ou non, est la variable isolée ici, et elle n'apparaît dans aucun des ordres que l'auteur a localisés. Un tribunal appliquant un tel ordre à l'affaire étudiée ici enregistrerait seulement que l'IA a été utilisée. Ni le régime de divulgation ni la littérature empirique n'ont actuellement un vocabulaire pour le comment, et cette absence est la même hypothèse d'homogénéité décrite ci-dessus, sous forme réglementaire.
Tableau 1. Le régime émergent de divulgation de l'IA : ce que les ordres permanents demandent, et ce qu'ils ne demandent pas.
| Ce que l'ordre demande | Présence dans le régime |
| L'IA générative a-t-elle été utilisée dans la rédaction ? | Couramment requise |
| Les citations et les guillemets ont-ils été vérifiés ? | Couramment requise |
| Quel outil ou modèle a été utilisé ? | Parfois requise |
| L'assistance était-elle monoplan ou orchestrée (architecture) ? | Pas trouvée dans aucun ordre localisé |
| Le désaccord entre les modèles a-t-il été mis en évidence et résolu ? | Pas trouvée dans aucun ordre localisé |
Source : Suivi publics des ordres permanents judiciaires sur l'IA (Law360 Pulse ; Legal AI Governance), en juillet 2026 ; voir note 9. La caractérisation de la couverture est celle de l'auteur.
Figure 2. La variable manquante : les études empiriques existantes varient la disponibilité de l'assistance par l'IA ; son architecture n'est pas mesurée.
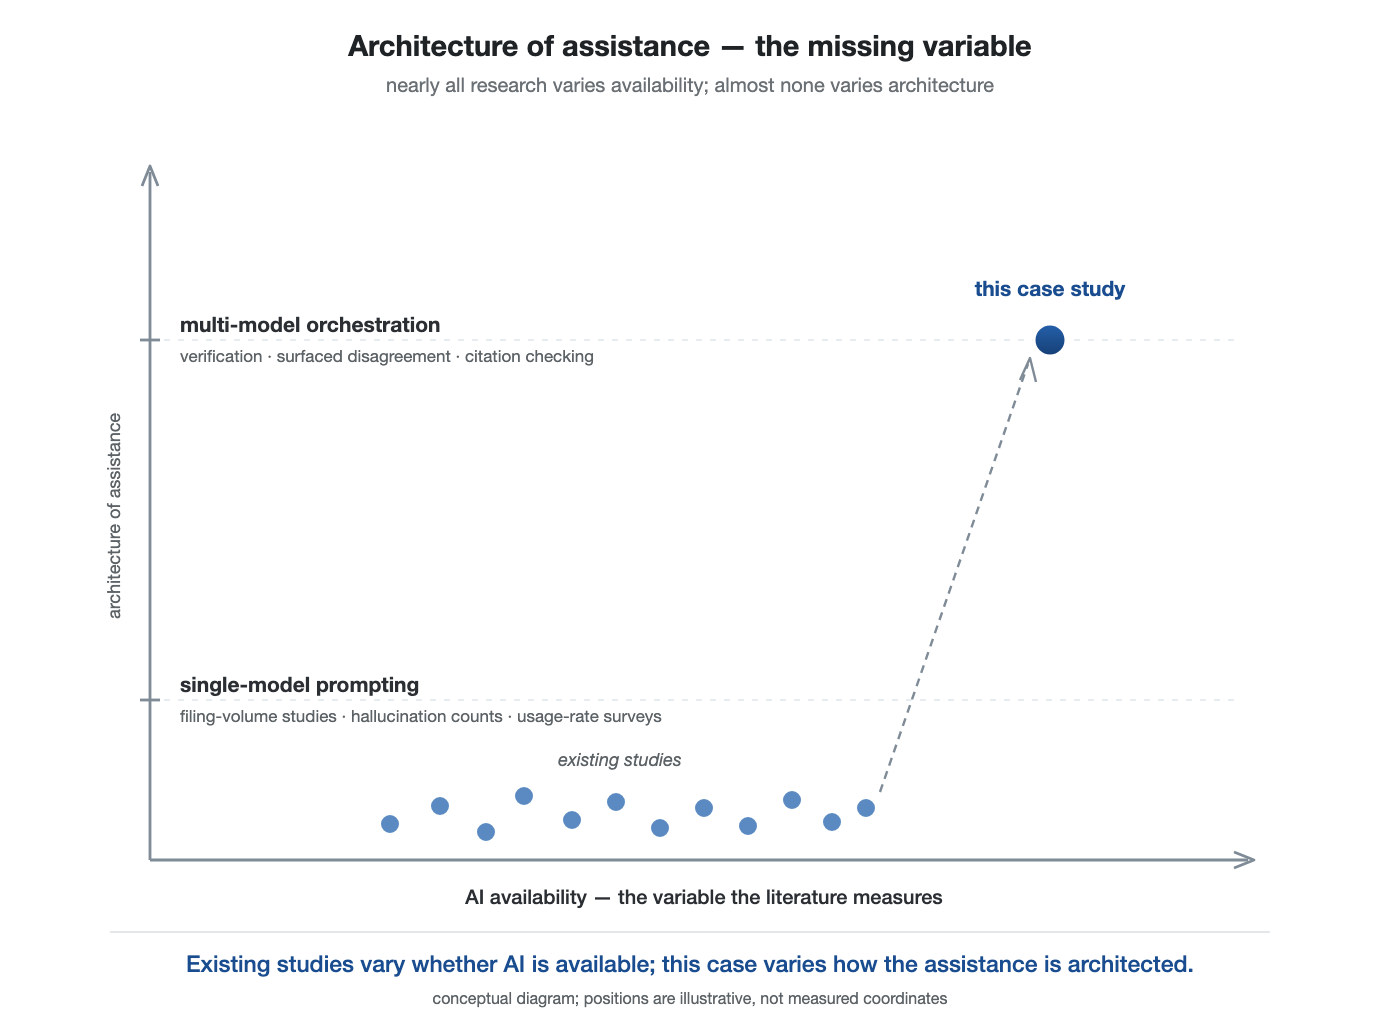
Source : Schéma de l'auteur de la littérature empirique abordée dans cette Partie.
Les deux développements se rencontrent dans la question poursuivie ici. Le fossé d'accès à la justice explique pourquoi l'autorepréentation importe : pour la plupart des plaideurs, l'alternative à l'autorepréentation n'est pas la représentation, c'est l'absence complète de représentation. L'augmentation récente de l'autorepréentation, concomitante à la large disponibilité de l'IA générative, explique pourquoi l'architecture de l'assistance par l'IA est devenue une question de recherche importante plutôt qu'un détail accessoire. Si les plaideurs non représentés agissent maintenant par le biais de l'IA à grande échelle,11 alors la façon dont cette IA est configurée peut façonner la qualité de ce qui atteint les tribunaux, et peut en principe réduire le fossé de capacité de résolution de problèmes entre les individus et les institutions auxquelles ils font face.
Un encadrement supplémentaire change ce qu'on entend par orchestration. Pour un utilisateur ayant un handicap moteur, spinal ou visuel qui ne peut pas utiliser plusieurs interfaces de navigateur à la fois, le flux de travail manuel que les utilisateurs valides trouvent simplement fastidieux (ouvrir chaque fournisseur, coller la requête, lire, comparer) n'est pas fastidieux mais indisponible. L'accès unifié multi-modèles n'est pas une préférence de productivité mais une question d'adaptation raisonnable (cf. Blanck 2014, sur l'accessibilité du web pour les personnes en situation de handicap cognitif ; l'extension aux handicaps moteurs, spinaux et visuels est celle de l'auteur). Bloquer l'automatisation assistive d'un flux de travail qu'une personne pourrait autrement accomplir manuellement impose alors un fardeau qui retombe, par construction, le plus lourdement sur les utilisateurs les moins capables de l'accomplir manuellement, et pour cet utilisateur, l'architecture transforme un débat sur l'exercice non autorisé en une question d'adaptation raisonnable.12
Je l'ai construit pour quelqu'un dans ma famille qui ne peut pas le faire à la main --- qui ne peut pas se déplacer entre les onglets du navigateur. Une béquille, un chien guide : quelque chose fait la partie qu'une personne ne peut pas faire. Dites-le une fois, et c'est fait. C'est de cela qu'il s'agit.
Ce que partagent ces préoccupations, et ce que cet Article cherche à rendre visible, est un modèle implicite de la manière dont un justiciable non représenté utilise l'IA : une personne, un modèle polyvalent, une vérification minimale, une production maximale. Ce n'est pas la seule architecture disponible, cependant, et la littérature empirique (Figure 2) n'a pas encore examiné de cas fondés sur une architecture différente. Les travaux de recherche mesurent la quantité de contentieux pro se assisté par l'IA et la fiabilité de sa forme la plus courante ; ils n'ont largement pas demandé si une architecture différente d'assistance produit une qualité différente de conduite contentieuse. L'écart est comblé ici en fournissant un cas étroitement documenté d'un mode d'utilisation que les études agrégées n'isolent pas.
III. De l'interrogation de modèle unique à l'orchestration : l'exosquelette cognitif
Le terme « exosquelette cognitif » marque une distinction que le débat juridique sur l'IA tend à effondrer. Un exosquelette amplifie la personne qui s'y trouve ; il n'agit pas à la place de la personne, et il est inerte sans la personne. Cette distinction entre augmentation et substitution traverse les deux questions doctrinales abordées dans la Partie VI. La protection du travail préalable s'attache naturellement à l'augmentation, car la stratégie protégée reste celle du plaideur, et maladroitement à la substitution. Le cadre de la pratique non autorisée vise la substitution (une entité exerçant le droit pour quelqu'un d'autre) et s'applique mal à un outil par lequel une personne exerce pour elle-même. Qu'un système donné soit l'un ou l'autre est une question d'architecture et d'utilisation, non d'étiquettes. Les préoccupations examinées dans la Partie II partagent une architecture implicite. Dans le cas paradigmatique problématique, un justiciable non représenté pose une question à un modèle polyvalent unique et en soumet la production. Les pathologies qui s'ensuivent sont, dans une large mesure, des propriétés de cette configuration de modèle unique : citations fabriquées, affirmations erronées et confiantes du droit, accord flagorneur avec la prémisse de l'utilisateur (Sharma et al. 2024). Un modèle solitaire n'a pas d'adversaire interne, rien dans le pipeline positionné pour le contredire. Ses erreurs, aussi confiantes soient-elles, passent sans être contestées. Les modes de défaillance de modèle unique qui dominent la littérature sont, en ce sens, non pas des propriétés de l'intelligence artificielle ; ce sont des propriétés d'une configuration.
Pendant des décennies, la recherche en IA et droit a poursuivi la fiabilité par l'ingénierie des connaissances explicites, en codant le raisonnement juridique dans des règles et des modèles fondés sur des cas (Ashley 2017), avant que le virage vers l'apprentissage automatique ne décale la question du codage des règles à l'apprentissage des modèles (Surden 2014). Un corpus distinct de recherche en informatique suggère que cette configuration n'est pas la seule disponible, et que ses modes de défaillance sont en partie architecturaux plutôt qu'intrinsèques. Dans l'approche communément appelée débat multi-agents, plusieurs instances de modèle génèrent indépendamment des réponses, puis se critiquent mutuellement le raisonnement au cours de rondes successives avant de converger sur une réponse. L'étude fondatrice rapporte que cette procédure de « société des esprits » améliore la validité factuelle et réduit les réponses erronées et les hallucinations auxquelles les modèles uniques sont sujets.13 Les travaux ultérieurs ont étendu et nuancé la conclusion, en signalant que le désaccord structuré réduit l'hallucination dans les mathématiques, la logique et les évaluations de réponses aux questions, tout en identifiant des limites, telles que les rendements décroissants au-delà d'une poignée d'agents et de rondes, et la nécessité d'évaluer la qualité de l'argumentation intermédiaire plutôt que les seules réponses finales.14 Les domaines d'évaluation comptent ici. Cette littérature valide le désaccord structuré largement sur les évaluations mathématiques, logiques et de réponses aux questions, des domaines avec des réponses vérifiables. Si ses gains se transfèrent à l'argumentation juridique, où de nombreuses questions n'ont pas de réponse unique vérifiable et les modèles peuvent converger poliment sur une erreur partagée, n'est pas testé, et le transfert est une hypothèse de la conception examinée ici plutôt qu'un résultat démontré.
Pour l'analyse présente, la partie du mécanisme qui importe est celle d'où provient le gain de fiabilité. L'hypothèse est que le gain provient des relations entre les modèles plutôt que d'un modèle quelconque étant plus capable, du désaccord étant mis en surface et arbitré plutôt que supprimé. La valeur de l'orchestration n'est pas plus de réponses mais de réponses mieux étayées. Un fait qu'un modèle affirme et un autre conteste est le fait qui a le plus besoin d'examen, et une procédure de débat achemine l'attention vers celui-ci, tandis que l'interrogation de modèle unique ne peut pas. Le mécanisme a des parents reconnaissables dans d'autres domaines (méthodes d'ensemble en apprentissage automatique, codes correcteurs d'erreurs en théorie de l'information, dissension structurée dans la science de la délibération collective), ce qui suggère qu'il s'agit d'une propriété générale des systèmes redondants préservant le désaccord plutôt qu'un artefact d'un quelconque produit.
Tableau 2. Interrogation de modèle unique par rapport à orchestration multi-modèles, par propriété de conception.
| Propriété | Interrogation de modèle unique | Orchestration multi-modèles |
| Adversaire interne | Aucun ; production non contestée | Les modèles se contre-interrogent mutuellement |
| Source des citations | Générée à partir des poids du modèle | Validée par rapport aux bases de données externes |
| Traitement du désaccord | Non mis en surface | Préservé ; peut déclencher un examen |
| Mode de défaillance caractéristique | Fabrication, flagornerie | Fabrication réduite (selon la littérature de débat) |
Source : Propriétés de conception selon la littérature de débat multi-agents (par ex., Du et al. 2024 ; Liang et al. 2024 ; Chan et al. 2023) et, pour la colonne orchestration, la documentation du système.
L'étude de cas présente une structure réflexive qui, à la connaissance de l'auteur, n'est partagée par aucun autre contentieux : la technologie en litige est la technologie par laquelle le litige est conduit. Plusieurs des défendeurs développent des modèles que des systèmes de ce type interrogent, le système d'orchestration en question coordonne ces mêmes modèles accessibles au public, et la conduite du litige examinée à la partie V s'est déroulée alors que cette coordination était en usage. Selon l'hypothèse avancée ici, aucun modèle individuel n'a conféré la capacité. Chacun porte les modes de défaillance d'un seul modèle décrits ci-dessus, et chaque défendeur développant un modèle constitutif avait, par construction, accès à au maximum son propre modèle constitutif. La configuration qui importait était une configuration relationnelle : des modèles hétérogènes de fournisseurs adverses, interrogés en parallèle, se vérifiant mutuellement. La réflexivité fait un travail analytique car elle maintient la technologie composante constante : quelles que soient les différences que le dossier révèle, elles ne peuvent être attribuées uniquement au fait que le plaideur avait accès à de meilleurs modèles composants que les défendeurs, puisque plusieurs des modèles composants étaient ceux des défendeurs eux-mêmes ; la configuration, l'accès et les compétences de l'opérateur restent des explications ouvertes. Cette ligne de recherche n'est pas non plus externe aux défendeurs. Les grands laboratoires d'IA ont eux-mêmes publié sur les avantages des configurations multi-agents et d'ensemble par rapport aux modèles uniques, et au cours de la période étudiée ont adopté la commercialisation de la vérification cross-modèles dans leurs propres produits.15 L'architecture en question est celle que l'industrie elle-même approuve de plus en plus.
L'orchestration généralise le débat multi-agents en un système opérationnel (Figure 3). Là où le débat exécute généralement plusieurs instances d'un modèle, l'orchestration distribue une requête sur des modèles hétérogènes de différents fournisseurs, normalise leurs résultats, calcule un consensus, et, de manière critique, préserve la divergence comme un signal de première classe plutôt que de l'intégrer dans une réponse unique. Le système d'orchestration utilisé dans l'étude de cas est une implémentation de ce schéma : selon sa documentation technique, il intègre l'interrogation de modèles hétérogènes, la formation de consensus, la préservation de la divergence, et la vérification des citations par rapport à des sources externes.16
L'architecture d'orchestration en question est une conception spécifiée et conçue. Elle est l'objet d'une famille de demandes de brevet en attente, y compris plusieurs demandes internationales en vertu du Traité de coopération en matière de brevets déposées en 2025 et 2026.17
Les deux configurations diffèrent selon plusieurs axes de conception, résumés dans le Tableau 2. Deux de ces engagements sont analytiquement significatifs. L'un est la validation des citations par rapport à des sources externes. La défaillance dominante d'un seul modèle en contentieux, le cas halluciné, survient parce qu'un modèle génère des citations à partir de motifs appris plutôt que de les récupérer, et une architecture qui vérifie chaque citation contre une base de données en direct, signalant plutôt qu'incluant tout ce qu'elle ne peut pas confirmer, cible cette défaillance à sa source. L'autre est la préservation de la divergence. Quand les modèles divergent sur une interprétation juridique, un système d'orchestration peut être configuré pour traiter le désaccord comme un déclencheur du conservatisme et de l'examen humain plutôt que comme du bruit à résoudre par un vote à la majorité. Dans les domaines à enjeux élevés, le désaccord entre systèmes indépendants peut lui-même constituer une information exploitable plutôt que du bruit statistique : un signal minoritaire indiquant une possible erreur est conservé et relevé. Il n'est pas ignoré.
Figure 3. Le principe d'orchestration : requête parallèle, comparaison et préservation de la divergence.
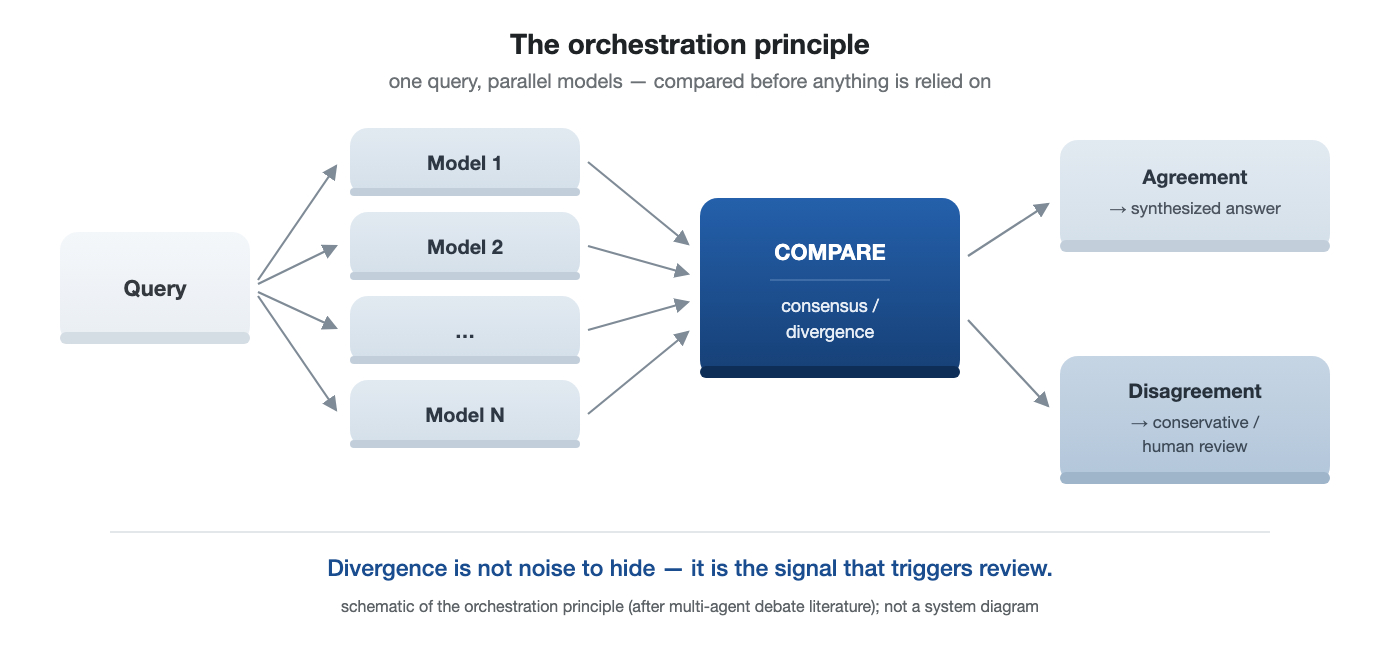
Source : Schéma du principe général d'après la littérature sur le débat multi-agents ; pas un diagramme d'une architecture de produit spécifique.
Le point structurel est que les pathologies spécifiques qui ont rendu les tribunaux réticents à utiliser les IA en cause personnelle sont caractéristiques de l'interrogation par modèle unique, et qu'une architecture d'orchestration est dirigée contre ces pathologies. Les défaillances documentées sont des propriétés d'une configuration. Elles ne sont pas des propriétés de l'assistance par IA en tant que telle. En ce sens, l'architecture déplace la source de la fiabilité d'un modèle isolé aux relations entre modèles : de l'intelligence isolée à l'intelligence coordonnée. L'orchestration n'est pas non plus exotique : les produits commerciaux de routage et multi-modèles exposent de plus en plus ces mêmes propriétés de conception, ce qui rend d'autant plus manifeste l'absence d'architecture de la littérature juridique empirique. Que cette différence architecturale produise une différence dans la conduite observable du litige est une question empirique, et le reste de l'article se concentre sur un contexte dans lequel elle peut être examinée par rapport à un dossier vérifiable.
IV. Méthode et fondement probant
La conception est une étude de cas unique, un choix qui reflète la nature du phénomène : l'orchestration multi-modèles en contentieux fédéral en direct est actuellement rare, et l'objectif ici n'est pas d'estimer sa fréquence mais d'établir, par rapport à un dossier vérifiable, qu'un schéma particulier de conduite s'est produit et de le caractériser. La qualité, telle qu'utilisée partout, désigne la conduite du litige observable vérifiable à partir du dossier : le respect des délais, l'exactitude des citations, la correction procédurale, la réactivité au dossier et la cohérence de l'argumentation déposée. Elle ne désigne pas les résultats, qu'aucun cas unique ne peut justifier. Un cas de cette nature mérite l'attention : le contentieux adversarial réel, avec délais, adversaires et conséquences, peut offrir un contexte plus significatif pour observer le raisonnement humain assisté par IA qu'une seule évaluation en laboratoire. La partie VII revient sur cette limitation. Parmi ces dimensions, les conclusions de la partie V portent principalement sur le respect des délais, la correction procédurale et l'exactitude des citations ; la cohérence de l'argumentation déposée est documentée dans le dossier plutôt qu'évaluée indépendamment, et aucune conclusion ne dépend de l'issue d'une motion en attente.
Le fondement probant est récupérable de manière indépendante : chaque dossier cité dans cet Article est identifié par son numéro ECF et peut être obtenu par tout lecteur directement à partir de PACER selon les numéros de dossier ci-dessous, sans dépendre de l'auteur. Il se compose du dossier fédéral public dans Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.), ainsi que du dossier de l'action antérieure, No. 1:25-cv-07770 (S.D.N.Y.), qui concernait un défendeur différent. La structure du dossier peut être énoncée en chiffres, tous vérifiables sur dossier : sur treize défendeurs nommés, dix ont comparu ; sept se sont joints à une requête conjointe en radiation ; quatre se sont arrangés et ont été radiés avec préjudice ; et six continuaient à plaider en juin 2026 (Tableau 3). Trois des treize n'ont jamais comparu, et le dossier montre des difficultés de signification et d'identification d'entité concernant ces défendeurs ; il n'explique pas pourquoi ils n'ont pas comparu. Un défendeur étranger a été transmis pour signification par l'Autorité centrale chinoise conformément à la Convention de La Haye sur la signification. Rien n'est revenu : ni confirmation, ni refus. Un défendeur national a nécessité quatre tentatives dans plusieurs États avant que l'assignation n'atteigne son agent enregistré, confirmé par un huissier sous serment. Aucune comparution n'a suivi. Un tiers a invoqué sa propre structure sociale pour contester quelle entité avait été nommée. La structure sociale et la procédure transfrontalière peuvent fonctionner, en pratique, comme un écran procédural, et s'en accommoder est une tâche qu'une partie représentée confie généralement à des conseillers spécialisés ou à des prestataires, ce que la partie non représentée a fait elle-même pour les treize. Toutes les affirmations factuelles de la Partie V concernant la conduite du litige sont tirées de documents déposés, identifiés par numéro de dossier et date, que tout lecteur peut récupérer indépendamment, sauf le mode d'assistance IA du justiciable, que le dossier n'enregistre pas. Lorsque l'Article se réfère à des déclarations faites en justice, il s'appuie sur la transcription officielle ; lorsqu'il se réfère aux arguments des parties, il s'appuie sur les dépôts eux-mêmes (la requête conjointe des défendeurs et le mémoire justificatif, ainsi que l'opposition du demandeur) plutôt que sur une quelconque caractérisation par une partie.18
Trois contraintes méthodologiques découlent du rôle de l'auteur, divulgué dès le départ. Premièrement, l'analyse se limite au dossier public ; elle ne s'appuie pas sur la connaissance privilégiée de l'auteur de la stratégie de litige, et elle ne divulgue pas le travail préalable concernant les réclamations qui restent en instance contre les défendeurs non arrangés. Deuxièmement, l'Article distingue partout ce que le dossier établit (dates, dépôts, jugements, texte des documents) de ce qu'il n'établit pas : les motifs subjectifs des parties, et en particulier les raisons de tout arrangement, dont les termes sont confidentiels. Troisièmement, les affirmations faites par la documentation propre du système d'orchestration au sujet de sa performance sont traitées comme auto-déclarées et ne sont pas utilisées comme preuve d'efficacité ; les conclusions reposent sur la conduite du litige visible au dossier, non sur le compte rendu du système sur lui-même.
Une asymétrie dans le fondement probant nuance la méthode qui vient d'être décrite. La variable dépendante de cette étude, la conduite du litige, est complètement vérifiable sur dossier : chaque dépôt, date et document analysé dans la Partie V peut être récupéré par tout lecteur. La variable indépendante n'est pas récupérable de cette manière. Le dossier public établit que le système d'orchestration existe et documente son architecture : la plainte opérante caractérise le système, les demandes de brevet spécifient la conception, et les pièces justificatives techniques de l'opposition décrivent ses caractéristiques d'orchestration. Ce que le dossier ne peut pas montrer, c'est quel mode d'assistance IA a produit un dépôt particulier, ou quand la méthode de travail du justiciable a changé. Ces faits reposent sur le propre compte rendu de l'auteur de son processus, et l'Article les marque comme tels où ils apparaissent. L'étude associe donc un dossier vérifiable de résultats à un dossier auto-déclaré des données d'entrée, et les conceptions contrôlées proposées dans la Partie VII sont construites de sorte que la variable d'architecture soit observée plutôt que rapportée ; l'Appendice spécifie un manifeste d'exécution à cette fin.
Le dossier établit qu'un justiciable non représenté utilisant un système d'orchestration a produit des dépôts particuliers selon un calendrier particulier. Il ne peut pas établir que le système, plutôt que les propres capacités du justiciable, a produit leurs caractéristiques observées. L'Article décrit donc la conduite et son contexte architectural et traite la question causale comme ouverte, à être abordée par l'étude contrôlée proposée dans la Partie VII.
Énoncée formellement, l'hypothèse présentée ici est la suivante :
Hypothèse de dépendance architecturale. Maintenant la disponibilité de l'IA générative constante, l'architecture de l'assistance IA (invocation de modèle unique par rapport à l'orchestration de modèles multiples) fonctionne comme une variable empirique distincte (Figure 4) : le mode d'assistance est associé à des différences mesurables dans la conduite observable du litige, notamment le respect des délais, la précision des citations, la correction procédurale et la réactivité au dossier. L'hypothèse est réfutable : une comparaison systématique des dépôts pro se codés par mode d'assistance qui ne trouverait pas une telle association la réfuterait.
Figure 4. L'hypothèse de dépendance architecturale comme chaîne de réclamations. Chaque lien est une réclamation à tester, non une conclusion.
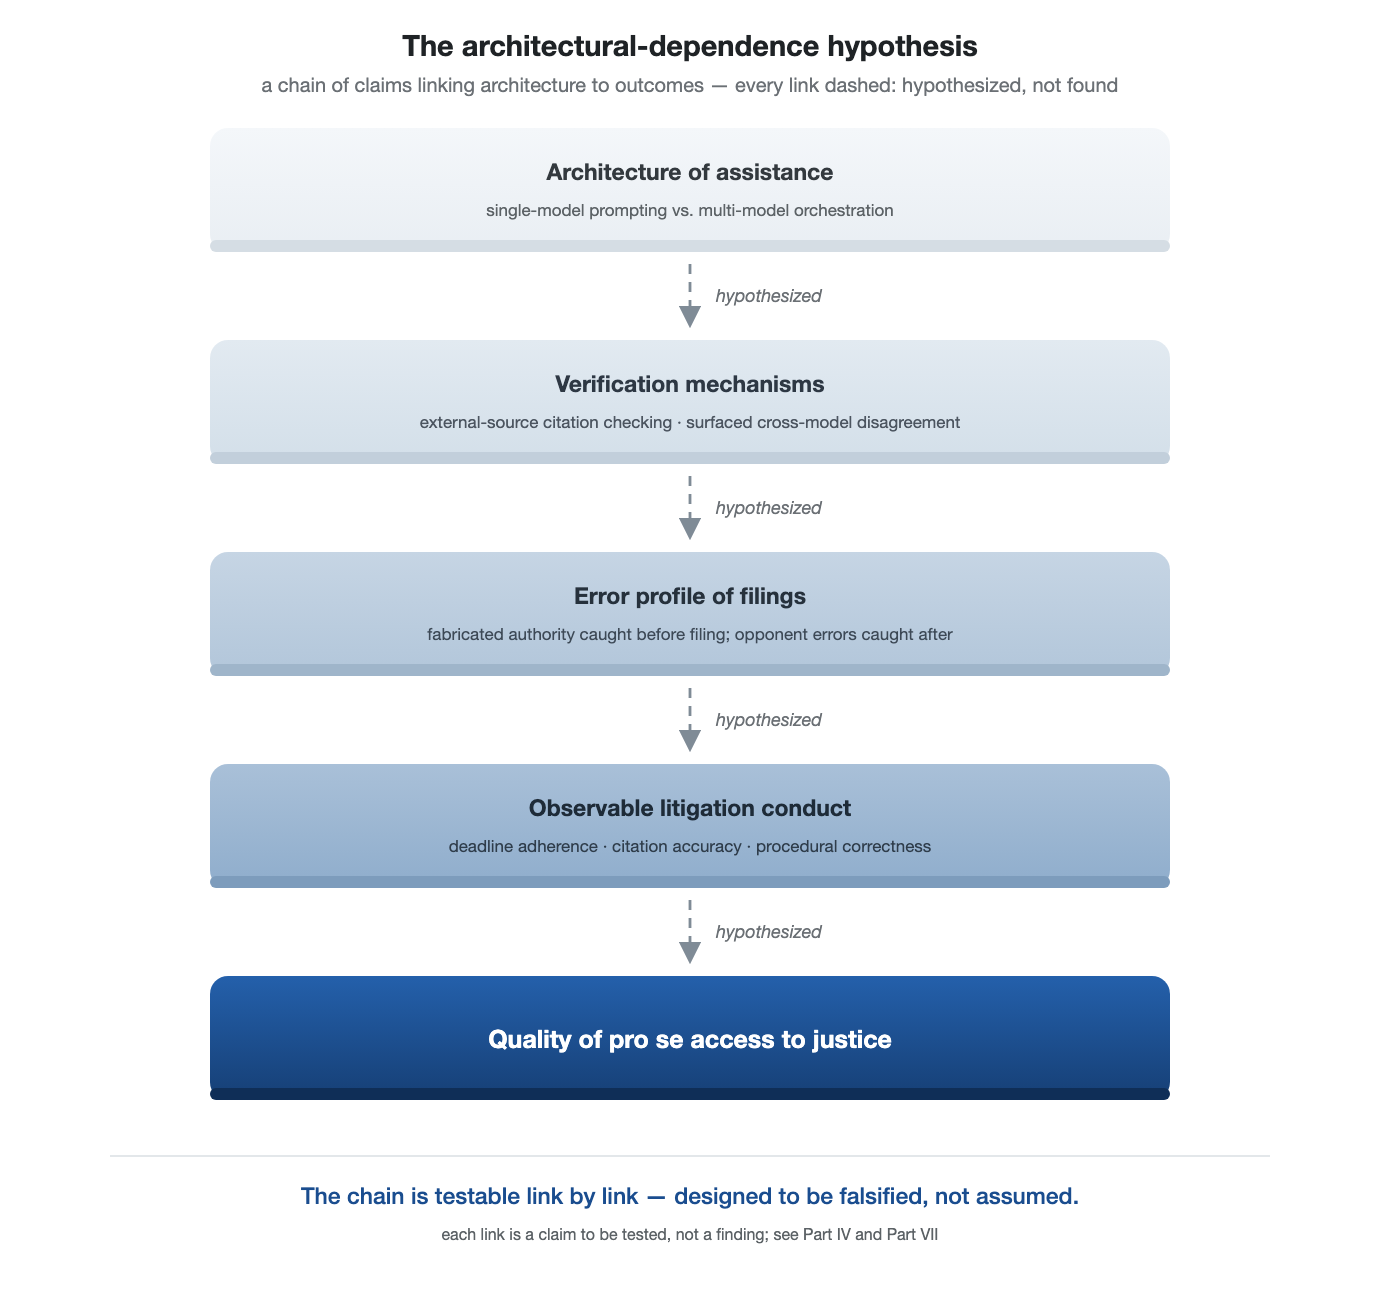
Source : Schéma de l'auteur de l'hypothèse énoncée dans le texte ; les flèches pointillées marquent les liens hypothétiques, non testés.
V. Conclusions
Plusieurs caractéristiques du litige portent sur la question posée ici, et la Figure 5 les met en séquence.
La disparité des ressources juridiques dans cette affaire n'est pas accessoire à l'étude ; c'est la condition qui confère son importance à l'étude. D'un côté se trouvait un justiciable non représenté unique sans formation juridique et sans avocat d'aucune sorte, pas même un conseil à portée limitée. De l'autre côté se trouvait une défense dans laquelle des avocats de nombreux cabinets éminents se sont combinés en un front commun, déposant une requête conjointe en radiation au nom de sept défendeurs et coordonnant leurs dépôts entre eux. Une configuration dans laquelle un individu non représenté seul maintient un cycle de mémoires complet contre cet alignement, respectant chaque délai, répondant sur le fond, et identifiant une erreur que les cabinets alignés n'ont pas détectée, est proche de ce que la littérature sur l'accès à la justice traite comme ne se produisant pas. Le reste de cette Partie le documente sur un dossier public ; ce qui peut l'expliquer est la question que l'Article dans son ensemble poursuit.
Figure 5. Chronologie procédurale de l'affaire.
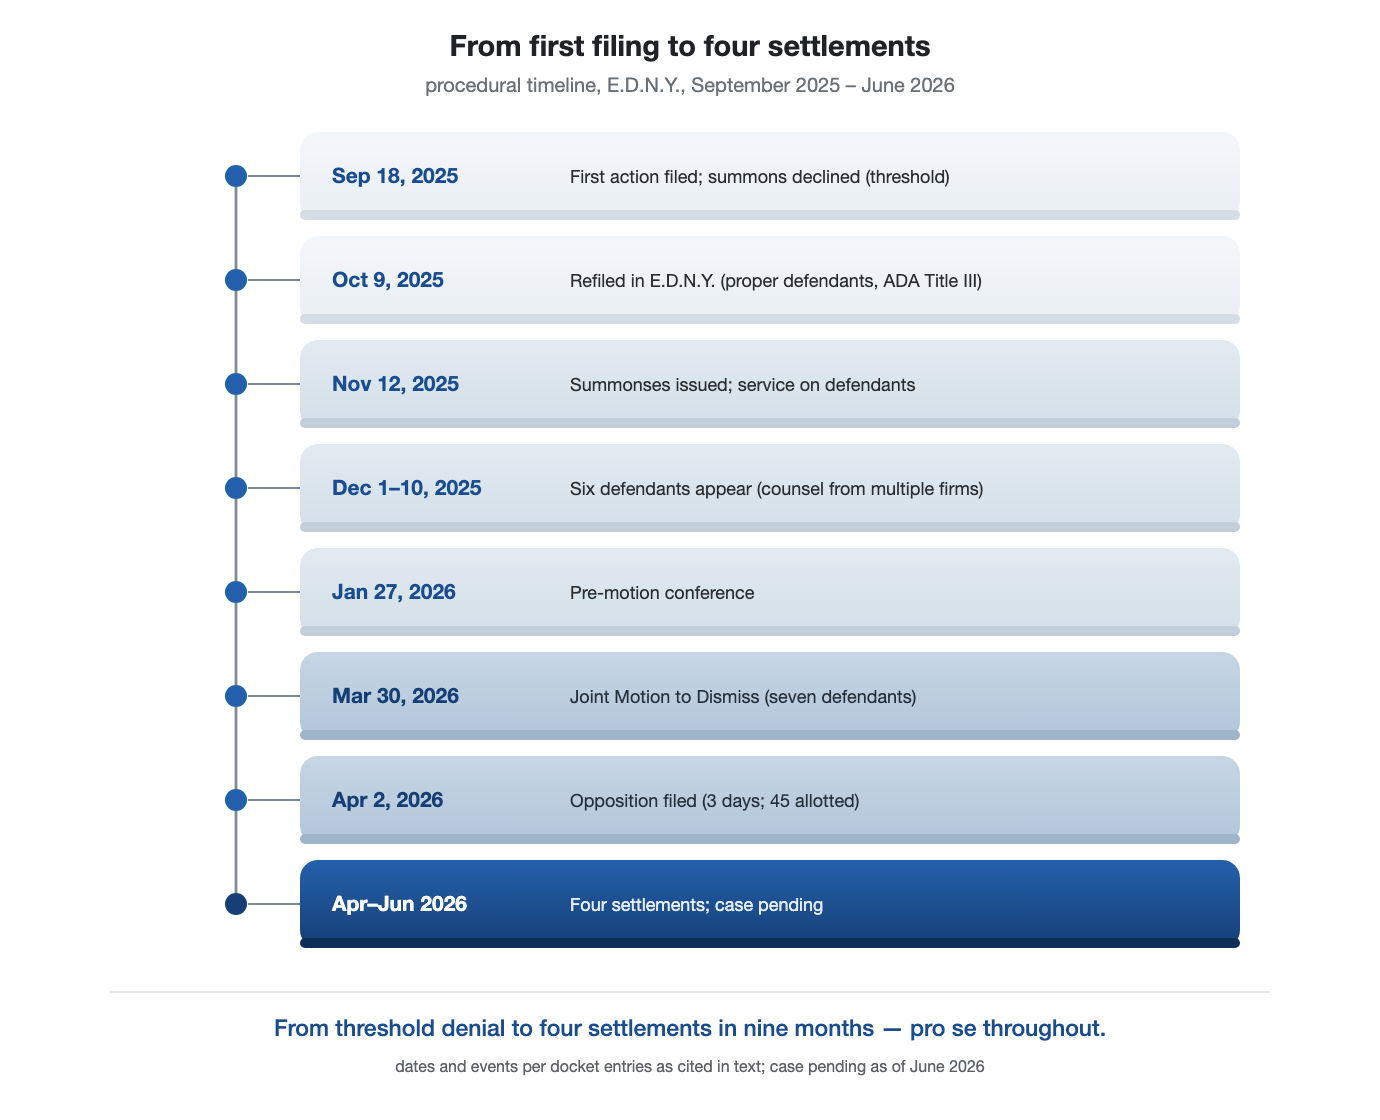
Source : Dossier public, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), et l'action antérieure connexe.
A. Reconstruction du cadre juridique suite à un dépôt initial défectueux.
La première action du justiciable, déposée en septembre 2025 et constituant un acte public, était vicieuse sur le plan procédural sous plusieurs aspects indépendants : elle avait été intentée au nom d'une société à responsabilité limitée, qui ne peut agir sans avocat ; contre le mauvais défendeur ; dans le mauvais ressort ; et en vertu du mauvais titre de l'ADA. La cour l'a close à titre préliminaire, refusant de délivrer une assignation. Une deuxième action, déposée personnellement et dans le bon ressort environ trois semaines plus tard, a reformulé la demande en vertu de la disposition appropriée de la loi, a désigné les bons défendeurs, et s'accompagnait d'une soumission probante substantiellement développée. Un changement de méthode a accompagné la correction. De l'aveu même de l'auteur, lors du premier dépôt, le justiciable avait travaillé avec un seul modèle sur un appareil grand public, et la reconstruction a coïncidé avec le premier usage d'une orchestration multi-modèles complète par accès direct aux modèles. Le dossier ne peut confirmer cette séquence, et elle n'est pas présentée comme cause. Ce que le dossier montre effectivement, c'est la correction elle-même, le premier épisode que cet Article examine : le dossier reflète une transition rapide entre un dépôt rejeté à titre préliminaire et celui qui a procédé à la signification et a suscité des comparutions de plusieurs défendeurs représentés. La reconstruction est le type de révision large et vérifiée du cadre juridique qu'un flux de travail d'orchestration, interrogeant plusieurs modèles sur le forum, la cause d'action et la norme de allégation, est conçu pour soutenir.
B. Réponse à la pratique coordonnée de pré-requête.
En une seule soirée, le 12 janvier 2026, six défendeurs ont déposé six lettres de pré-requête dans un délai d'environ quatre heures et demie, ayant conjointement demandé une prolongation pour pouvoir déposer ensemble.19 Selon les pratiques individuelles du tribunal, chaque lettre exigeait une réponse du demandeur dans un délai de cinq jours ouvrables. Six mémoires de réponse, chacun adressé aux arguments d'un défendeur spécifique, ont été déposés dans un délai de quatre jours.20 L'épisode porte sur plus que la rapidité : une réponse à un dépôt coordonné et multi-front ne peut pas être finalisée à l'avance, car son contenu est déterminé par six documents qui n'existaient pas avant la soirée où ils ont été déposés. Cependant, les arguments disponibles pour les défendeurs dans un cas de ce type proviennent d'un répertoire prévisible : la qualité pour agir, l'applicabilité du titre III aux services numériques, le défaut de cause d'action. Une partie diligente peut préparer des réponses modulaires aux arguments anticipés et les adapter une fois que les lettres arrivent. La rédaction anticipée est donc limitée par cet épisode plutôt que d'en être exclue : ce que l'intervalle de quatre jours établit, c'est l'assemblage, l'adaptation et le dépôt de six mémoires individuellement adressés contre six soumissions distinctes. Ce qu'il ne peut pas établir, c'est la quantité de leur contenu qui a précédé les lettres.
C. Réponse opportune à une défense consolidée.
Suite à une conférence préalable à la motion au cours de laquelle le tribunal a invité les défendeurs à réduire les mémoires redondants, sept défendeurs, y compris les six qui avaient déposé des lettres préalables à la motion, ont déposé une motion conjointe en rejet accompagnée d'un mémoire à l'appui. Selon le calendrier du tribunal, l'opposition du demandeur était due environ quarante-cinq jours plus tard. L'opposition était datée du 2 avril 2026 (trois jours après le dépôt de la motion le 30 mars) et inscrite au dossier le jour suivant, soit environ six semaines avant la date limite de réponse du 14 mai. C'était un mémoire de vingt-huit pages accompagné d'une déclaration et de nombreuses pièces justificatives. La figure 6 compare les intervalles de réponse aux intervalles de préparation de la défense pour les deux séries de mémoires. L'observation porte sur le fait d'une réponse substantielle, opportune et proportionnée, non sur ses mérites, déposée par un plaideur sans représentation légale contre une défense coordonnée représentée par des avocats de plusieurs cabinets. Le point pertinent est d'ordre architectural plutôt que personnel : répondre sur le fond à plusieurs mémoires distincts à la fois est le type de tâche parallèle et multi-fil qu'un flux de travail multi-modèle est structuré pour distribuer, en contraste avec le flux simple supposé par la littérature. Le timing est important pour quelque chose au-delà de la conformité : une motion qui reste sans réponse sur un dossier public pendant toute une période de réponse ne présente, à quiconque lit le dossier pendant cet intervalle, que la version des parties demanderesses. Une opposition déposée en quelques jours réduit cet intervalle. Une asymétrie de ce type joue ordinairement contre les plaideurs sans représentation légale, qui ne peuvent généralement pas compresser l'intervalle.
Figure 6. Intervalles de préparation et de réponse, par série de mémoires.
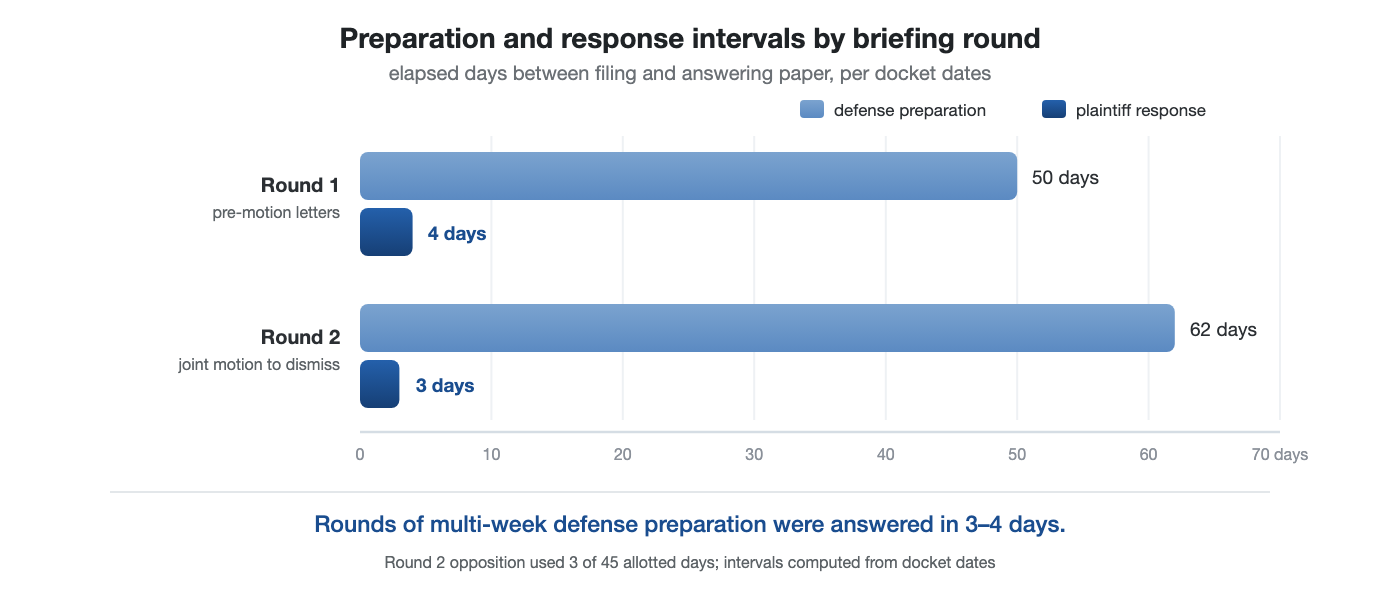
Source : Dossier public ; jours écoulés entre le dépôt pertinent et la date du dépôt responsif dans chaque série (dates des documents ; l'inscription au dossier peut suivre d'un jour). L'intervalle de défense dans la première série se mesure de l'achèvement de la signification (novembre 2025) aux lettres préalables coordonnées du 12 janvier 2026. Les intervalles écoulés limitent la durée de préparation par le haut ; ils ne distinguent pas le temps de rédaction du choix stratégique du moment.
D. Identification d'une erreur de citation statutaire dans le mémoire de la défense.
L'opposition du demandeur a identifié une erreur dans l'autorité statutaire invoquée dans la motion conjointe. En traitant l'élément du « plein et égal accès », le mémoire de la défense citait 42 U.S.C. § 12184 (ECF No. 69-1, at 15), la disposition régissant les transports publics spécifiés fournis par des entités privées, tels que les autobus, les taxis et les limousines, alors que la demande repose sur 42 U.S.C. § 12182, la disposition relative aux établissements accessibles au public (Plaintiff's Opposition, ECF No. 76, at 17).21 La préoccupation paradigmatique concernant l'utilisation des IA par les justiciables non représentés est la citation fabriquée : une autorité qui n'existe pas, générée par un modèle et déposée par un justiciable. Ici, l'erreur de citation vérifiable apparaît dans une présentation déposée par un avocat, et elle a été identifiée dans une présentation déposée par un justiciable non représenté utilisant un système d'orchestration dont la conception documentée comprend une validation des citations par rapport aux sources externes. L'orchestration, telle que définie à la partie III, regroupe deux mécanismes : le désaccord entre modèles et la validation par rapport aux sources externes, et un numéro de section transposé est le type de défaut que le second est conçu pour détecter. Le débat multi-modèles n'est pas nécessaire. Selon le compte-rendu de l'auteur, l'erreur a été mise en évidence par le flux de travail plutôt que par le justiciable : un modèle a signalé l'inadéquation entre la section citée et la disposition sur laquelle repose la demande, le modèle de consolidation l'a vérifiée et confirmée, et le critique l'a vérifiée à nouveau. Le justiciable n'est pas avocat et n'aurait pas pu trouver l'erreur ou vérifier la correction lui-même. La propriété impliquée est la composante de vérification, non l'ensemble du regroupement. La direction de la correction suit une trajectoire opposée à la tendance que la littérature laisse supposer ; son poids dans la disposition de la motion relève du tribunal. L'erreur est indépendamment vérifiable par tout lecteur : les deux dispositions se situent à deux sections d'intervalle dans le même sous-chapitre du Code américain, et la citation de § 12184 dans le mémoire de la défense est visible sur la face de la page. Les deux dispositions contiennent un langage opérationnel parallèle, chacun garantissant le « plein et égal accès » dans son domaine, et la substitution est donc du type qu'un lecteur assimile sans remarquer à la vitesse de lecture et ne peut manquer lorsque chaque citation est vérifiée par rapport à sa source. Ce qui les distingue, c'est la couverture : § 12184 régit les transports publics spécifiés fournis par des entités privées, non les établissements accessibles au public. L'opposition du demandeur a soulevé la mauvaise citation comme « non simplement formelle » parce qu'elle apparaissait dans le traitement d'un élément décisif du mémoire ; un numéro de section transposé n'est pas une autorité fabriquée. Détecter une mauvaise citation statutaire dans un mémoire adverse est l'inverse du mode de défaillance qui domine la littérature sur l'utilisation des IA par les justiciables non représentés, à savoir générer des citations mal placées dans le sien.
L'attribution est une question distincte de l'erreur elle-même. La règle implicite de la littérature assigne les erreurs des justiciables non représentés assistés par IA à la catégorie, comme preuve de ce que la technologie fait, et les erreurs des avocats à l'individu, comme une négligence dans une pratique par ailleurs fiable. L'épisode documenté ici offre un test de cette règle, et il est mieux énoncé sous forme de question : si un justiciable non représenté utilisant l'IA générative avait cité la disposition relative aux transports de la ADA à la place de la disposition relative aux établissements accessibles au public, sur un élément décisif, l'erreur aurait-elle été lue comme une négligence isolée, ou comme une entrée de plus dans le catalogue de ce qui se produit lorsque des non-juristes plaident avec des chatbots ? Les deux lectures ne risqueraient pas de correspondre, et cette asymétrie d'attribution, non l'erreur elle-même, est l'une des choses que l'hypothèse de dépendance architecturale demande à la littérature d'examiner : si la conduite est codée par qui l'a produite plutôt que par comment elle a été produite. L'asymétrie, en outre, persiste face à une ligne de référence mouvante : comme le note la partie II, les incidents d'hallucination documentés ne sont plus une préoccupation prédominante des justiciables non représentés, mais l'encadrement de la menace systémique reste attaché au côté non représenté du dossier.
E. Les premiers règlements.
Figure 7. Séquence des quatre règlements.
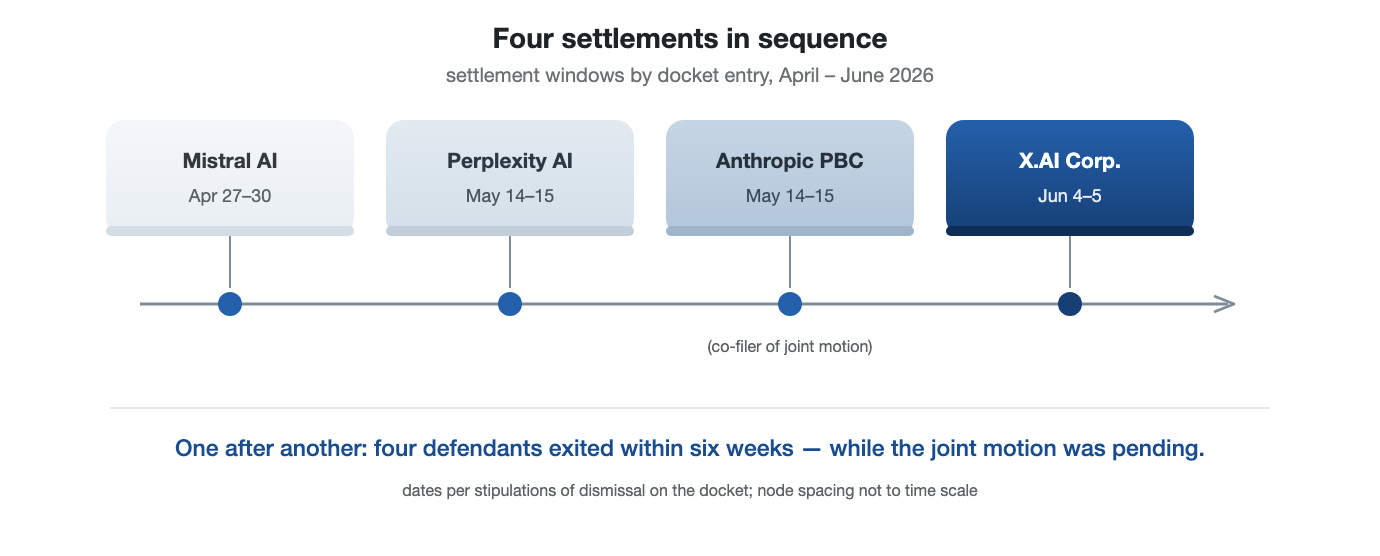
Source : Dossier public, ECF Nos 83-86 et 94 (stipulations de désistement sans réserve ; ECF Nos 83 et 84 sont deux dépôts du même jour de la stipulation Mistral, l'ordonnance de désistement citant le No 84).
Quatre défendeurs qui avaient engagé le litige ont résolu leurs différends avec le demandeur et ont été désistés sans réserve sur une période resserrée (Figure 7). Comme c'est la pratique habituelle, seules les stipulations de désistement figurent au dossier public ; les modalités du règlement sont confidentielles, les raisons ne figurent pas au dossier et aucune cause n'est déduite. Cette sous-section met au dossier une séquence de règlement qui est ordinairement invisible, et la rend ainsi vérifiable.
Deux caractéristiques de la séquence méritent d'être énoncées, car elles sont visibles au dossier public. Dans au moins deux cas, un défendeur qui s'était aligné sur la défense coordonnée l'a quittée ensuite par stipulation de désistement, l'un s'étant arrangé après le dépôt de l'opposition et avant la duplique de la coalition ; l'autre après avoir d'abord incorporé le mémoire conjoint de la coalition dans un mémoire de sa propre initiative. Le schéma chronologique est une question de dépôt public : les défendeurs qui avaient participé à un front commun l'ont quitté, un à un, tandis que le mémoire auquel ils avaient adhéré restait en suspens.
L'autre caractéristique est que les règlements entre des défendeurs sociétés et un plaideur se représentant lui-même sont ordinairement confidentiels et laissent peu de traces au dossier public. Ici, les stipulations de désistement sont elles-mêmes des entrées du dossier, ce qui rend la séquence extraordinairement lisible ; la valeur probante de ce dossier réside dans sa vérifiabilité.
Tableau 3. Statut des treize défendeurs nommés (en juin 2026).
| Statut | Défendeurs |
| N'a pas comparu | Samsung ; DeepSeek ; OpenAI |
| Arrangé et désisté | Mistral AI ; Perplexity AI ; Anthropic PBC ; X.AI Corp. |
| En cours | Microsoft ; Apple ; Google ; Meta ; Amazon ; Alibaba Cloud |
Source : Dossier public, en juin 2026.
La Figure 8 reproduit la séquence du dossier d'un seul jour, le 4 juin 2026, en tant que document primaire. Elle est incluse afin que vous puissiez inspecter le calendrier directement. Quelles configurations du contentieux assisté par IA produisent des dossiers de cette forme, et avec quelle fréquence ? Cette question appartient à l'étude systématique que la Partie VII propose.
Figure 8. Séquence du dossier du 4 juin 2026.
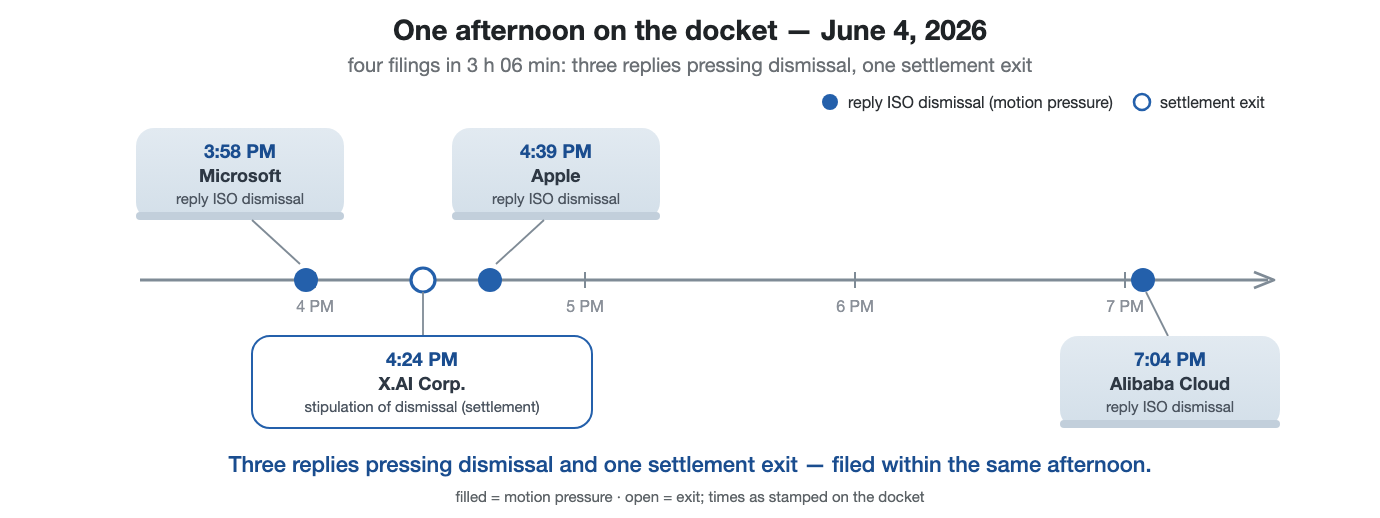
Source : Dossier public ; délais de dépôt en un seul jour, ECF Nos 93-96.
Ces caractéristiques ensemble décrivent un plaideur se représentant lui-même soutenant une action fédérale multipartite à travers un cycle de mémoires complet, respectant les délais, répondant proportionnellement, et identifiant une erreur de l'adversaire, face à une défense coordonnée et représentée. Ce n'est pas le schéma que décrit le compte rendu dominant. Ce compte rendu, de volume indifférencié et de rendement peu fiable, caractérise une distribution, et un seul cas ne peut pas contredire une distribution ; mais le schéma documenté ici sort de ce que les études agrégées mesurent, ce qui explique pourquoi il leur est resté invisible. Que l'architecture d'orchestration soit responsable du schéma, et que le schéma se reproduise entre les dossiers, sont des questions que les Parties suivantes encadrent pour une enquête systématique.
VI. Implications doctrinales
Les questions les plus difficiles sont doctrinales, et deux d'entre elles se font actuellement l'objet de contentieux dans les tribunaux fédéraux. L'objectif est de montrer comment un compte rendu d'orchestration basé sur la qualité, orienté vers l'utilisation d'IA en litige sans représentation, reformule chacune. Les tribunaux possèdent déjà un cadre développé pour évaluer les résultats des machines comme preuve (Grimm, Grossman & Cormack 2021). Les questions ici sont des questions adjacentes : elles ne concernent pas la question de savoir si le résultat des machines est recevable ; toutes deux concernent qui possède le processus qui a produit le résultat et si ce processus pratique le droit.
A. Le travail avocat et le plaideur sans représentation.
La question de savoir si les interactions d'un plaideur avec un système d'IA sont protégées contre la découverte en tant que travail avocat est nouvellement contestée. Au cours d'une période de sept semaines au début de 2026, trois tribunaux fédéraux ont atteint l'intersection entre l'utilisation de l'IA et la protection du travail avocat, et ils ne se sont pas exprimés d'une seule voix.22 Dans Warner v. Gilbarco, Inc., un juge magistrat a rejeté une motion en vue de contraindre une plaignante en matière d'emploi sans représentation à produire ses requêtes destinées à une IA générative et les réponses qu'elle a reçues, estimant que les matériaux constituaient un travail avocat au titre de la Règle 26(b)(3) des Règles fédérales de procédure civile : un plaideur qui se représente lui-même agit comme son propre avocat, les matériaux reflétaient ses impressions mentales et sa préparation, et la divulgation à un système d'IA générative, un outil plutôt qu'une personne, ne constituait pas la divulgation contradictoire que la renonciation exige. La décision s'inscrit dans la strate la plus ancienne de la doctrine, car ce que Hickman v. Taylor protégeait le plus fortement était les impressions mentales, conclusions et théories de l'avocat : la catégorie de travail avocat que les tribunaux traitent comme quasi absolue (Hickman v. Taylor, 329 U.S. 495, 510--11 (1947)). Les requêtes qu'un plaideur formule, les brouillons qu'il itère et les arguments qu'il abandonne constituent l'analogue sans représentation de cette catégorie. Une semaine plus tard, dans United States v. Heppner, un tribunal est parvenu au résultat opposé : un défendeur criminel représenté avait utilisé un assistant IA public de sa propre initiative, sans aucune implication du conseil, et le tribunal a ordonné la production des fichiers qui en résultaient, en soulignant qu'il avait agi sans direction du conseil et que les conditions de consommation de la plateforme permettaient au fournisseur de conserver et d'utiliser ses contributions. Morgan v. V2X, Inc., la troisième décision et la plus élaborée de cette série, a étendu la décision fondamentale de Warner, concluant que l'utilisation de l'IA par un plaideur sans représentation dans la préparation du litige « ressemble étroitement au type de travail avocat itératif confidentiel et stratégique que la Règle 26(b)(3) a été conçue pour protéger ». Le même jugement, cependant, exigeait que le plaideur divulgue le nom de tout outil d'IA qu'il avait utilisé en relation avec des matériaux que l'autre partie avait désignés comme confidentiels, et modifiait l'ordonnance de protection pour restreindre l'utilisation des services d'IA grand public avec ces matériaux.23 La distinction que le tribunal a établie est analytiquement importante, car elle explique pourquoi Warner et Heppner ne sont pas en conflit : une partie représentée qui contourne le conseil crée un fossé entre le plaideur et l'avocat, le fossé qui s'est avéré fatal dans Heppner, alors qu'un plaideur sans représentation « est simultanément le plaideur et l'avocat », de sorte qu'aucun tel fossé n'existe. La protection n'était pas illimitée : le tribunal a estimé que l'identité de l'outil d'IA n'était pas elle-même protégée, et il a conditionné l'utilisation de l'IA sur des matériaux de découverte confidentiels à des garanties contractuelles contre l'entraînement, la conservation et la divulgation à des tiers. Les trois décisions convergent ainsi sur l'application de la doctrine traditionnelle à l'IA plutôt que de la soustraire, mais divergent sur qui peut revendiquer la protection et sur ce qui constitue une renonciation. La ligne qu'elles tracent est une ligne architecturale, bien que le vocabulaire soit celui de cet Article : les opinions parlent d'agentivité, de confidentialité et de renonciation. Ce qui a condamné la réclamation dans Heppner n'était pas l'utilisation de l'IA mais la configuration utilisée : un outil destiné aux consommateurs dont les conditions permettaient la conservation et l'entraînement. Morgan, en revanche, conditionne la protection à une configuration contractuellement exclue de l'entraînement, de la conservation et de la divulgation à des tiers. La posture de confidentialité, comme la vérification, est une propriété de l'architecture de l'assistance plutôt que de l'IA en tant que telle. La variable de l'Article apparaît ici à l'intérieur de la doctrine elle-même (Tableau 4).
Tableau 4. La triade du travail avocat du début de 2026, par configuration.
| Affaire | Plaideur | Fossé d'agentivité ? | Configuration de l'outil | Décision |
| Warner | Plaignante sans représentation | Aucun --- le plaideur et l'avocat ne font qu'un | IA générative utilisée comme son propre outil de préparation | Protégée en tant que travail avocat |
| Heppner | Défendeur représenté, agissant sans conseil | Oui --- le plaideur a contourné l'avocat | Outil destiné aux consommateurs ; conditions permettant la conservation et l'entraînement par le fournisseur | Production ordonnée |
| Morgan | Plaignante sans représentation | Aucun --- « simultanément le plaideur et l'avocat » | L'utilisation sur les matériaux confidentiels est conditionnée à des restrictions contractuelles : pas d'entraînement, de conservation ou de divulgation à des tiers | Protégée, sous conditions ; l'identité de l'outil n'est pas protégée |
Source : Warner, 2026 WL 373043 ; Heppner, 2026 WL 436479 ; Morgan, 2026 WL 864223. Les décisions convergent sur l'application de la doctrine traditionnelle et divergent sur les faits de configuration ; la lecture architecturale des deux dernières colonnes est celle de l'Article, non celle des tribunaux --- l'architecture change les faits que la doctrine pèse, non la loi.
Morgan a été décidée le 30 mars 2026, le jour où la motion conjointe en rejet a été déposée dans l'affaire étudiée ici : la doctrine se formait pendant que l'affaire était en cours de plaidoirie.
Lues ensemble, les décisions du début 2026 rendent l'architecture de l'outil de plus en plus déterminante : qui l'a dirigée, ce qu'elle a fait, comment son dossier a été conservé. Le récit d'orchestration clarifie les enjeux de cette ligne. Si l'assistance par IA à un plaideur non représenté n'était que la génération mécanique de texte, l'argument en faveur de son traitement comme stratégie protégée serait faible ; un flux de travail d'orchestration, dans lequel un plaideur formule des questions, pèse les résultats divergents des modèles et itère vers une position, est difficile à distinguer, sur le plan fonctionnel, du processus itératif chargé de stratégie que la doctrine du secret professionnel a toujours protégée entre les mains du conseil. Un plaideur dirigeant un groupe de moteurs analytiques divergents ne ressemble à rien d'autre qu'à un avocat principal dirigeant une équipe d'associés juniors. L'objectif sous-jacent de la doctrine, qui est d'empêcher une partie de profiter gratuitement de la préparation du procès d'une autre partie, s'applique avec une force égale, que cette préparation soit effectuée par un associé ou par un plaideur travaillant par le biais d'un système multi-modèles. Morgan pointe dans cette direction, et le cadre d'orchestration fournit la justification fonctionnelle.
La protection du secret professionnel dépend de la confidentialité, et elle peut être levée par la divulgation publique volontaire, du moins quant à ce qui est divulgué. Publier un récit de sa propre affaire en cours risque donc de lever, quant à ce qu'il divulgue, la protection que Morgan reconnaît.
B. Exercice non autorisé du droit.
La préoccupation relative à l'exercice non autorisé du droit dans le contexte du pro se est, à l'examen, curieusement formulée. Les règles d'exercice non autorisé du droit réservent la pratique du droit aux avocats titulaires d'une licence afin de protéger le public contre une représentation non qualifiée d'autrui.24 Ces règles relèvent du droit étatique, et leurs définitions de la pratique varient selon la juridiction ; ce qui suit concerne la logique commune du cadre plutôt que la limite d'un État particulier. La véritable question d'exercice non autorisé du droit soulevée par l'IA juridique pour les consommateurs est de savoir si l'outil, ou l'entreprise qui l'exploite, exerce sans autorisation en conseillant le plaideur. Cette question dépend largement de la fiabilité des conseils : un instrument qui fabrique avec assurance l'autorité ressemble à la pratique incompétente que les règles d'exercice non autorisé du droit existent pour prévenir.
Un plaideur pro se ne représente personne d'autre que lui-même. Il dispose d'un droit statutaire de le faire (28 U.S.C. § 1654), et la sanction pour un dépôt défectueux pèse sur lui plutôt que sur un client. Quand un tel plaideur utilise un système d'IA, le cadre d'exercice non autorisé du droit doit situer la « pratique du droit » quelque part : dans l'outil, chez son développeur, ou nulle part, et chacune de ces réponses est maladroite. Ce qui anime véritablement la préoccupation n'est pas l'autorisation mais la fiabilité, la crainte qu'un système non autorisé et sans reddition de comptes ne fournisse avec assurance un droit erroné à une personne incapable de le vérifier. La fiabilité n'en est pas la totalité, car les tribunaux contrôlent la pratique du droit par la reddition de comptes autant que par la compétence : un avocat titulaire d'une licence peut être sanctionné, suspendu ou radié, et un système d'IA ne peut être aucune de ces choses. L'écart de reddition de comptes est réel, et le compte d'orchestration traite de la fiabilité, non de la reddition de comptes. Si un système orchestré commettait des erreurs systématiques, la responsabilité pourrait incomber à l'une de trois places : à l'opérateur qui signe le dépôt (le seul acteur que la Règle 11 atteint actuellement), au fournisseur de l'architecture, ou à personne. Le choix que la loi fera déterminera si l'écart de reddition de comptes se rétrécit ou se réinstalle simplement.
Ici, la distinction modèle unique/orchestration effectue un véritable travail. Le déficit de fiabilité qui anime la préoccupation relative à l'exercice non autorisé du droit est caractéristique de la configuration à modèle unique, et une architecture construite autour de la vérification cross-modèle et de la validation des citations est dirigée vers ce déficit. Cela ne dissout pas la question d'exercice non autorisé du droit, car un outil très fiable peut toujours être dit « pratiquer le droit ». Ce qu'il fait, c'est séparer deux choses que le débat tend à fusionner : la fiabilité et l'autorisation sont analytiquement des questions distinctes, et les confondre obscurcit qu'une correction architecturale peut traiter la première sans toucher la seconde. Si la fiabilité est la véritable préoccupation, alors l'architecture, et non la licence seule, devient partie de l'analyse, et un système conçu pour faire surface et résoudre les désaccords plutôt que d'affirmer une réponse unique traite la préoccupation selon ses propres termes. Si la fiabilité est architecturale, elle est aussi concevable et certifiable, le type d'objet sur lequel les propositions de réinvention de la réglementation des services juridiques dépendent (Hadfield 2017). Une architecture qui refuse d'émettre ce qu'elle ne peut pas vérifier, et qui achemine l'incertitude irréductible vers l'humain, commence à fonctionner comme conformité par conception plutôt que comme conseiller non autorisé.
C. Une reformulation, non une résolution.
Les deux domaines doctrinaux restent non résolus. Le récit dominant centré sur le volume et les hallucinations de l'utilisation de l'IA par les parties non représentées a façonné ces débats doctrinaux, et un récit axé sur la qualité et l'orchestration les reformule. La protection du travail préparatoire paraît plus cohérente quand l'utilisation de l'IA est comprise comme une stratégie itérative plutôt que comme un résultat mécanique, et le débat sur l'exercice non autorisé du droit semble différent quand la fiabilité est traitée comme une variable architecturale plutôt que comme un défaut inhérent.
VII. Limitations et travaux futurs
Quatre limites délimitent la conception. Premièrement, et c'est le plus fondamental, il s'agit d'une seule affaire (n = 1) rédigée par une partie à celle-ci. Les conclusions de la partie V sont des affirmations d'existence plutôt que des affirmations distributionnelles. Ce qu'un tel cas peut faire, c'est ce que la méthodologie qualitative reconnaît depuis longtemps pour les cas extrêmes ou révélateurs : exposer un phénomène que les conceptions standards n'ont pas encore atteint, et générer les hypothèses que l'étude systématique doit alors tester.
Deuxièmement, l'auteur est litigant, développeur et analyste ; les contraintes de la partie IV existent en raison de cela.
Troisièmement, la causalité ne peut pas être isolée. Le dossier ne peut pas séparer la contribution de l'architecture de la propre compétence du litigant, de sa préparation antérieure, des incitations d'une partie non rémunérée, ou d'autres facteurs de confusion. La discussion architecturale de la partie III fournit un mécanisme plausible, non un mécanisme démontré.
Plusieurs explications rivales restent plausibles. Le litigant peut simplement être capable : éduqué, motivé, et non rémunéré, une partie non représentée peut consacrer des centaines d'heures à une affaire que le conseil traiterait en dizaines. L'opposition de trois jours peut mesurer la préparation plutôt que le traitement (partie V.B). La sélection s'opère à deux niveaux. Au niveau de l'affaire, cette affaire fait l'objet d'un article parce que son dossier est favorable, et les affaires dans lesquelles les litigants assistés par orchestration échouent ne génèrent aucun article. Au niveau de l'épisode, la sélection est celle de l'auteur lui-même : le dossier contient plus d'événements que les cinq que cet article décrit, et l'auteur a choisi lesquels présenter. Contre cette sélection, la déclaration de complétude est vérifiable sur dossier : en juin 2026, le dossier ne contient aucune ordonnance sanctionnant le demandeur, aucune ordonnance radiant l'un quelconque de ses mémoires, et aucun délai qu'il aurait manqué. Le point le plus proche d'une note procédurale défavorable se situe au seuil de l'affaire, où le tribunal a rejeté la demande du demandeur de procéder in forma pauperis (les frais de dépôt ont alors été versés dans le délai imparti) et a observé que les citations à comparaître ne pouvaient être délivrées tant que les adresses de signification n'étaient pas fournies, ce qui a alors été fait. La déclaration est réfutable par quiconque a accès à PACER ; ce que la sélection au niveau de l'épisode peut encore dissimuler, c'est l'importance, non les ordonnances défavorables. L'étude proposée ci-dessous est conçue pour trancher entre ces explications rivales.
Une limitation supplémentaire porte sur la portée plutôt que sur la validité. La partie II encadre le déficit d'accès à la justice en termes des Américains à faibles revenus que la Legal Services Corporation étudie, tandis que le litigant ici est un architecte de systèmes IA au niveau du doctorat utilisant un système de sa propre conception, une partie non représentée tirée de la queue extrême de la distribution des capacités techniques. La preuve d'existence n'est pas affaiblie par ce fait, mais sa portée est plus étroite que la population que la partie II met en avant : rien dans cette affaire ne montre que le contentieux assisté par orchestration est pratiquement disponible pour cette population, pour laquelle le coût, l'accès numérique et la maîtrise technique sont eux-mêmes des obstacles. Le fait que les avantages de l'architecture survivent au transfert d'un opérateur expert à un litigant non représenté typique est une question empirique, et pour le cadre d'assistance de la partie II, c'est probablement le point décisif ; la composante handicap de l'étude proposée ci-dessous est conçue pour l'atteindre. Le transfert ne relève pas seulement de la configuration technique. L'orchestration déplace la charge cognitive de l'opérateur de la rédaction à l'arbitrage : lire des résultats concurrents, peser les désaccords révélés, décider quelle ligne survit. L'arbitrage est en soi une compétence exigeante. Le fait que ce fardeau puisse être porté par la conception de l'interface plutôt que par l'expertise de l'opérateur, et au prix d'un impact sur les litigants ayant des barrières cognitives, visuelles ou éducatives, est autant une question de conception qu'une question empirique.
Quatrièmement, l'affaire est en instance ; aucune conclusion ici ne dépend de la manière dont elle se termine.
L'hypothèse que cette affaire génère, selon laquelle l'architecture d'orchestration est associée à une conduite de litige pro se de meilleure qualité que l'incitation à modèle unique, est testable. Une étude systématique pourrait comparer la conduite du litige (respect des délais, exactitude des citations, résultats des motions) dans un échantillon de dépôts pro se codés selon le mode d'assistance par IA, en utilisant les indicateurs de rédaction cohérente en IA que la littérature empirique a commencé à développer et LegalBench, un benchmark collaboratif pour le raisonnement juridique (Guha et al. 2023). Une famille de tâches, la détection d'erreurs ensemencées, découle directement de la Partie V. Les mémoires d'essai sont semés de défauts vérifiables des types documentés là : une section statutaire transposée, une autorité mal citée, une citation fabriquée. Les taux de détection sont alors comparés entre les modes d'assistance, de l'incitation à modèle unique à la vérification orchestrée, avec des opérateurs avocats et non-avocats comme bras séparés. Les composants de l'architecture (vérification de source externe et désaccord entre modèles) sont ablés séparément, de sorte que la contribution de chaque mécanisme est identifiée plutôt que créditée au bundle (Tableau 5). Une telle conception, menée par des chercheurs désintéressés dans de nombreuses affaires, pourrait convertir la revendication d'existence avancée ici en une revendication distributionnelle, ou la réfuter. Des conceptions plus solides sont disponibles et devraient être préférées : des comparaisons contrôlées de l'assistance à modèle unique et orchestrée sur des tâches juridiques identiques, avec des protocoles pré-enregistrés, des matériaux ouverts et une validation d'ensemble aveugle des revendications du système lui-même, y compris son taux de vérification des citations ; identification quasi-expérimentale, telle que les conceptions de différences-en-différences autour de la disponibilité publique d'outils multi-modèles ; et un bras dédié aux participants atteints de handicaps moteurs, visuels ou cognitifs, pour lesquels le cadrage d'assistance de la Partie II n'est pas hypothétique. L'évaluation randomisée de l'assistance juridique a un précédent : la littérature sur l'accès à la justice a mené des études randomisées sur les offres de représentation et l'assistance non groupée (Greiner, Pattanayak & Hennessy 2013), et la comparaison du mode d'assistance proposée ici prolonge cette tradition de conception à la variable d'architecture. Plus largement, l'hypothèse suggère une norme que le domaine n'a pas encore adoptée : que les systèmes d'IA soient évalués non seulement par la qualité de leurs résultats, mais aussi par la qualité de leur architecture de raisonnement. Rien n'en est spécifique au droit : partout où un travail conséquent est délégué à des systèmes génératifs, en médecine, en ingénierie ou en finance, la même question se pose, et la même variable reste non mesurée. Cela requalifie également une variable que l'analyse de l'accès à la justice a longtemps traitée comme fixe. Le coût d'entrée du demandeur était les frais de dépôt de 405 $, et le coût d'entrée formel d'un avocat de la défense était les frais pro hac vice de 200 $ (ECF Nos. 19, 52, 60). Les deux sont dans les bas centaines de dollars, et ils se situent aux deux extrémités de ce qui a été un écart de ressources effectivement infranchissable ; la comparaison concerne uniquement les frais d'entrée formels, non le coût de la représentation. Ce qui peut avoir changé n'est pas le prix d'entrer dans une salle d'audience mais le coût marginal de la capacité de litige requise pour y rester. Que ce coût a effectivement baissé, et de combien, est une question empirique pour l'étude proposée ; que celui-ci soit devenu une variable plutôt qu'une constante est en soi une hypothèse digne d'être testée.
Tableau 5. L'étude proposée, par bras.
| Bras | Configuration | Ce qu'il isole |
| 1 | Humain uniquement, pas d'IA (contrôle) | Détection de base sans assistance |
| 2 | Incitation à modèle unique | Le mode que la littérature documente |
| 3 | Orchestration, complète | Le bundle tel que déployé |
| 4 | Orchestration sans vérification de source externe | Contribution de la vérification des citations |
| 5 | Orchestration sans désaccord entre modèles | Contribution de la divergence affichée |
Remarque : Chaque bras est exécuté avec des opérateurs avocats et non-avocats comme groupes séparés, et un bras de handicap distinct, exécuté en dehors des cinq bras numérotés, pour les participants atteints de handicaps moteurs, visuels ou cognitifs, et avec des mesures de résultat pré-enregistrées avant les sessions ; voir texte.
VIII. Conclusion
Le récit dominant de l'intelligence artificielle dans le litige pro se est une histoire de volume et de fiabilité : plus de plaideurs, dépôt plus rapide, avec un risque accru d'autorité fabriquée. Il suppose, sans le dire, que l'assistance par IA signifie un plaideur incitant un modèle d'usage général, et cette hypothèse ne tient plus.
L'affaire examinée ici a été construite, selon le récit de l'auteur, sur une architecture différente : plusieurs modèles indépendants ont été interrogés en parallèle, et leur désaccord a été affiché et résolu plutôt que supprimé. La description de la conduite du litige repose entièrement sur un dossier public vérifiable ; ce dossier contient une conduite que le compte du volume et des hallucinations ne décrit ni ne prédit : une reconstruction rapide d'un dépôt défectueux, une opposition substantielle déposée bien avant la date limite, et l'identification d'une erreur de citation statutaire dans un mémoire de défense coordonnée. L'article a ensuite montré comment la compréhension de l'assistance par IA comme orchestration, et comme une question de qualité, requalifie deux débats doctrinaux actuellement devant les tribunaux fédéraux. Pour les plaideurs qui ne peuvent pas dactylographier, voir ou organiser à la vitesse que le litige exige, la différence architecturale est une question non pas d'efficacité mais d'accès au sens de la Loi sur les Américains en situation de handicap : pleine jouissance et égalité ; que la façon dont l'assistance par IA est configurée est ce qui rend l'auto-représentation possible du tout.
L'affirmation est que l'architecture de l'assistance par IA, et non seulement sa disponibilité, appartient à l'analyse de ce que les plaideurs non représentés peuvent désormais faire. Cette affirmation devient d'autant plus pressante que les modèles fondamentaux convergent en capacité brute, car lorsque les modèles eux-mêmes diffèrent moins, la façon dont ils sont combinés différera davantage. L'hypothèse de dépendance à l'architecture est que l'architecture n'est pas un simple détail d'implémentation : elle est un déterminant de la qualité de ce que les personnes et les tribunaux peuvent faire. La question de savoir si l'IA participe au travail juridique n'est plus en débat ; ce qui reste ouvert est les architectures qui font quoi. Selon ce compte, le problème de l'IA pour les plaideurs non représentés est un problème de conception, non un problème d'intelligence, et les problèmes de conception ont des réponses de conception. Le travail à venir consiste à spécifier des architectures particulières et à les tester les unes contre les autres au lieu d'attendre de meilleurs modèles individuels. L'Appendice énonce une telle architecture avec une précision suffisante pour être exécutée et critiquée, et une implémentation de référence est publiée avec elle.
Appendice. Une architecture d'assistance, spécifiée pour pouvoir être exécutée
L'argument de cet Article est que « l'assistance par IA » désigne une famille d'architectures avec des propriétés de défaillance différentes. L'affirmation est plus facile à tester une fois qu'au moins une architecture est énoncée avec une précision suffisante pour être exécutée et critiquée. Le protocole ci-dessous est une telle déclaration. Il est appelé ici le protocole de consolidation en aveugle25, d'après l'étape qui le sépare le plus clairement du débat multi-agents, dans lequel les modèles se lisent mutuellement.26 Il utilise uniquement des modèles publics, et quiconque dispose d'un accès grand public ou par API à trois fournisseurs peut le reproduire.
Le protocole ci-dessous énonce, au niveau de l'architecture, la famille décrite à la partie III : des modèles hétérogènes interrogés isolément, un consensus formé selon des règles explicites avec le désaccord préservé plutôt qu'annulé, et chaque citation vérifiée par rapport à sa source. Il diffère du système décrit à la partie III par la façon dont cette dernière vérification est effectuée : là, c'est un composant qui valide par rapport à une base de données en direct, ici ce sont des modèles compatibles avec la recherche suivis d'une personne, et la contrainte trois ci-dessous énonce clairement que l'approbation des modèles n'est pas la vérification. Il est énoncé ici comme une spécification, non comme une preuve : l'Article ne propose aucun dossier dans l'étude de cas comme résultat et n'en tire aucune déduction (ce qui est retenu : note 24). Ce que le protocole apporte à l'argument est le manifeste d'exécution. La variable d'architecture dans cet Article est autodéclarée (partie IV) ; un manifeste est ce dont un lecteur extérieur aurait besoin avant que ce soit autre chose. Les dossiers de la partie V n'en contiennent aucun.
Le problème qu'il résout.
Un plaideur non représenté peut accéder à plusieurs modèles de pointe par le biais de niveaux gratuits pour consommateurs, et le coût, l'accès numérique et la maîtrise technique restent des obstacles (Partie VII) : la colonne à enjeux élevés ci-dessous correspond à l'accès payant via API, et la condition de confidentialité énoncée ultérieurement exclut la plupart des niveaux gratuits pour les contenus qui nécessitent le plus de protection. La pratique courante consiste à poser une question, à lire la réponse et à la produire. L'échec documenté est celui d'un modèle sûr de lui produisant une citation qui n'existe pas, sans rien dans le processus positionné pour le détecter. Le protocole remplace la question unique par un énoncé de tâche commun et quatre étapes qui le suivent. Il laisse chaque modèle exactement aussi précis qu'il l'était ; il en arrange plusieurs pour qu'une erreur d'un système doive survivre au contact avec des systèmes entraînés par d'autres organisations, et il enregistre ce que chacun d'entre eux a dit.
Rôles.
Le protocole est défini par ce que chaque rôle est autorisé à voir. Quatre règles le fixent :
1. Les générateurs voient l'énoncé de la tâche et rien d'autre. Aucun ne voit le brouillon d'un autre générateur.
2. Le consolidateur voit chaque brouillon sous des étiquettes neutres R1 à Rn, dans un ordre aléatoire. Il n'apprend jamais quel fournisseur a produit quel brouillon.
3. Le premier critique lit au sein de la propre famille du consolidateur, dans un contexte nouveau. Il voit l'énoncé de la tâche et le document consolidé, et rien de la consolidation qui l'a produit.
4. Le dernier lecteur est un critique d'un fournisseur différent du consolidateur. Il voit l'énoncé de la tâche, le document consolidé et le rapport du premier critique, et son verdict clôt l'exécution.
Tout ensemble de modèles de pointe de différents fournisseurs qui satisfait les quatre règles exécute le protocole. À titre d'illustration, voici des modèles publics qui étaient disponibles en septembre 2026 et pouvaient remplir les rôles :
Tableau 6. Modèles publics disponibles en septembre 2026 pouvant remplir les quatre rôles.
| Rôle | Documents courants | Documents critiques |
|---|---|---|
| Générateurs, isolés | claude-sonnet-5 with search; gpt-5.6-terra with search; gemini-3.1-pro-high with search; an open-weight model | claude-opus-5 with search; gpt-6-astra with search; gemini-3.1-pro-high with search; Grok (xAI); an open-weight model |
| Consolidateur, aveugle | claude-sonnet-5 | claude-fable-5-1 |
| Critique 1, famille du consolidateur, contexte nouveau | claude-sonnet-5 | claude-fable-5-1 |
| Critique 2, fournisseur différent, lit en dernier | gpt-5.6-terra | gpt-6-astra |
Source : Documentation des fournisseurs en septembre 2026. L'affectation des modèles aux rôles est celle de l'auteur ; les rôles, non les identifiants, définissent le protocole.
Le tableau est une illustration de ce qui était disponible, et les identifiants vieilliront. Les rôles ne vieilliront pas. Grok est nommé par le fournisseur et le modèle en open-weight par la classe, car leurs identifiants hébergés varient d'un hébergeur à l'autre, et gemini-3.1-pro-high est l'alias d'une interface hébergée plutôt que le code du modèle dans la documentation API du fournisseur. La colonne documents critiques ajoute un cinquième générateur, et son consolidateur est un modèle qui n'a écrit aucun brouillon, il ne juge donc jamais son propre texte sous une étiquette. La figure 9 dessine le protocole par rôle.
L'affectation des familles aux rôles repose sur l'utilisation par l'auteur, non sur une mesure. Au cours de roughly deux mille heures de travail avec ces systèmes en 2025 et 2026, un modèle placé dans un contexte nouveau comme critique aveugle a fourni la vérification la plus stricte et la plus utile quand il venait de la même famille que le consolidateur, et il l'a fait même là où le texte examiné avait été produit par cette famille. Les critiques d'autres fournisseurs n'étaient pas des lecteurs plus faibles ; ils trouvaient des choses différentes, c'est pourquoi le protocole en garde un et lui donne le verdict final. Les quatre règles concernent ce que chaque rôle peut voir, non quel fournisseur le remplit, et un lecteur qui préfère une famille différente au consolidateur ou au premier critique peut en substituer une et exécuter toujours le protocole.
Figure 9. Le protocole de consolidation aveugle, par rôle : génération isolée, consolidation aveugle, et deux vérifications.
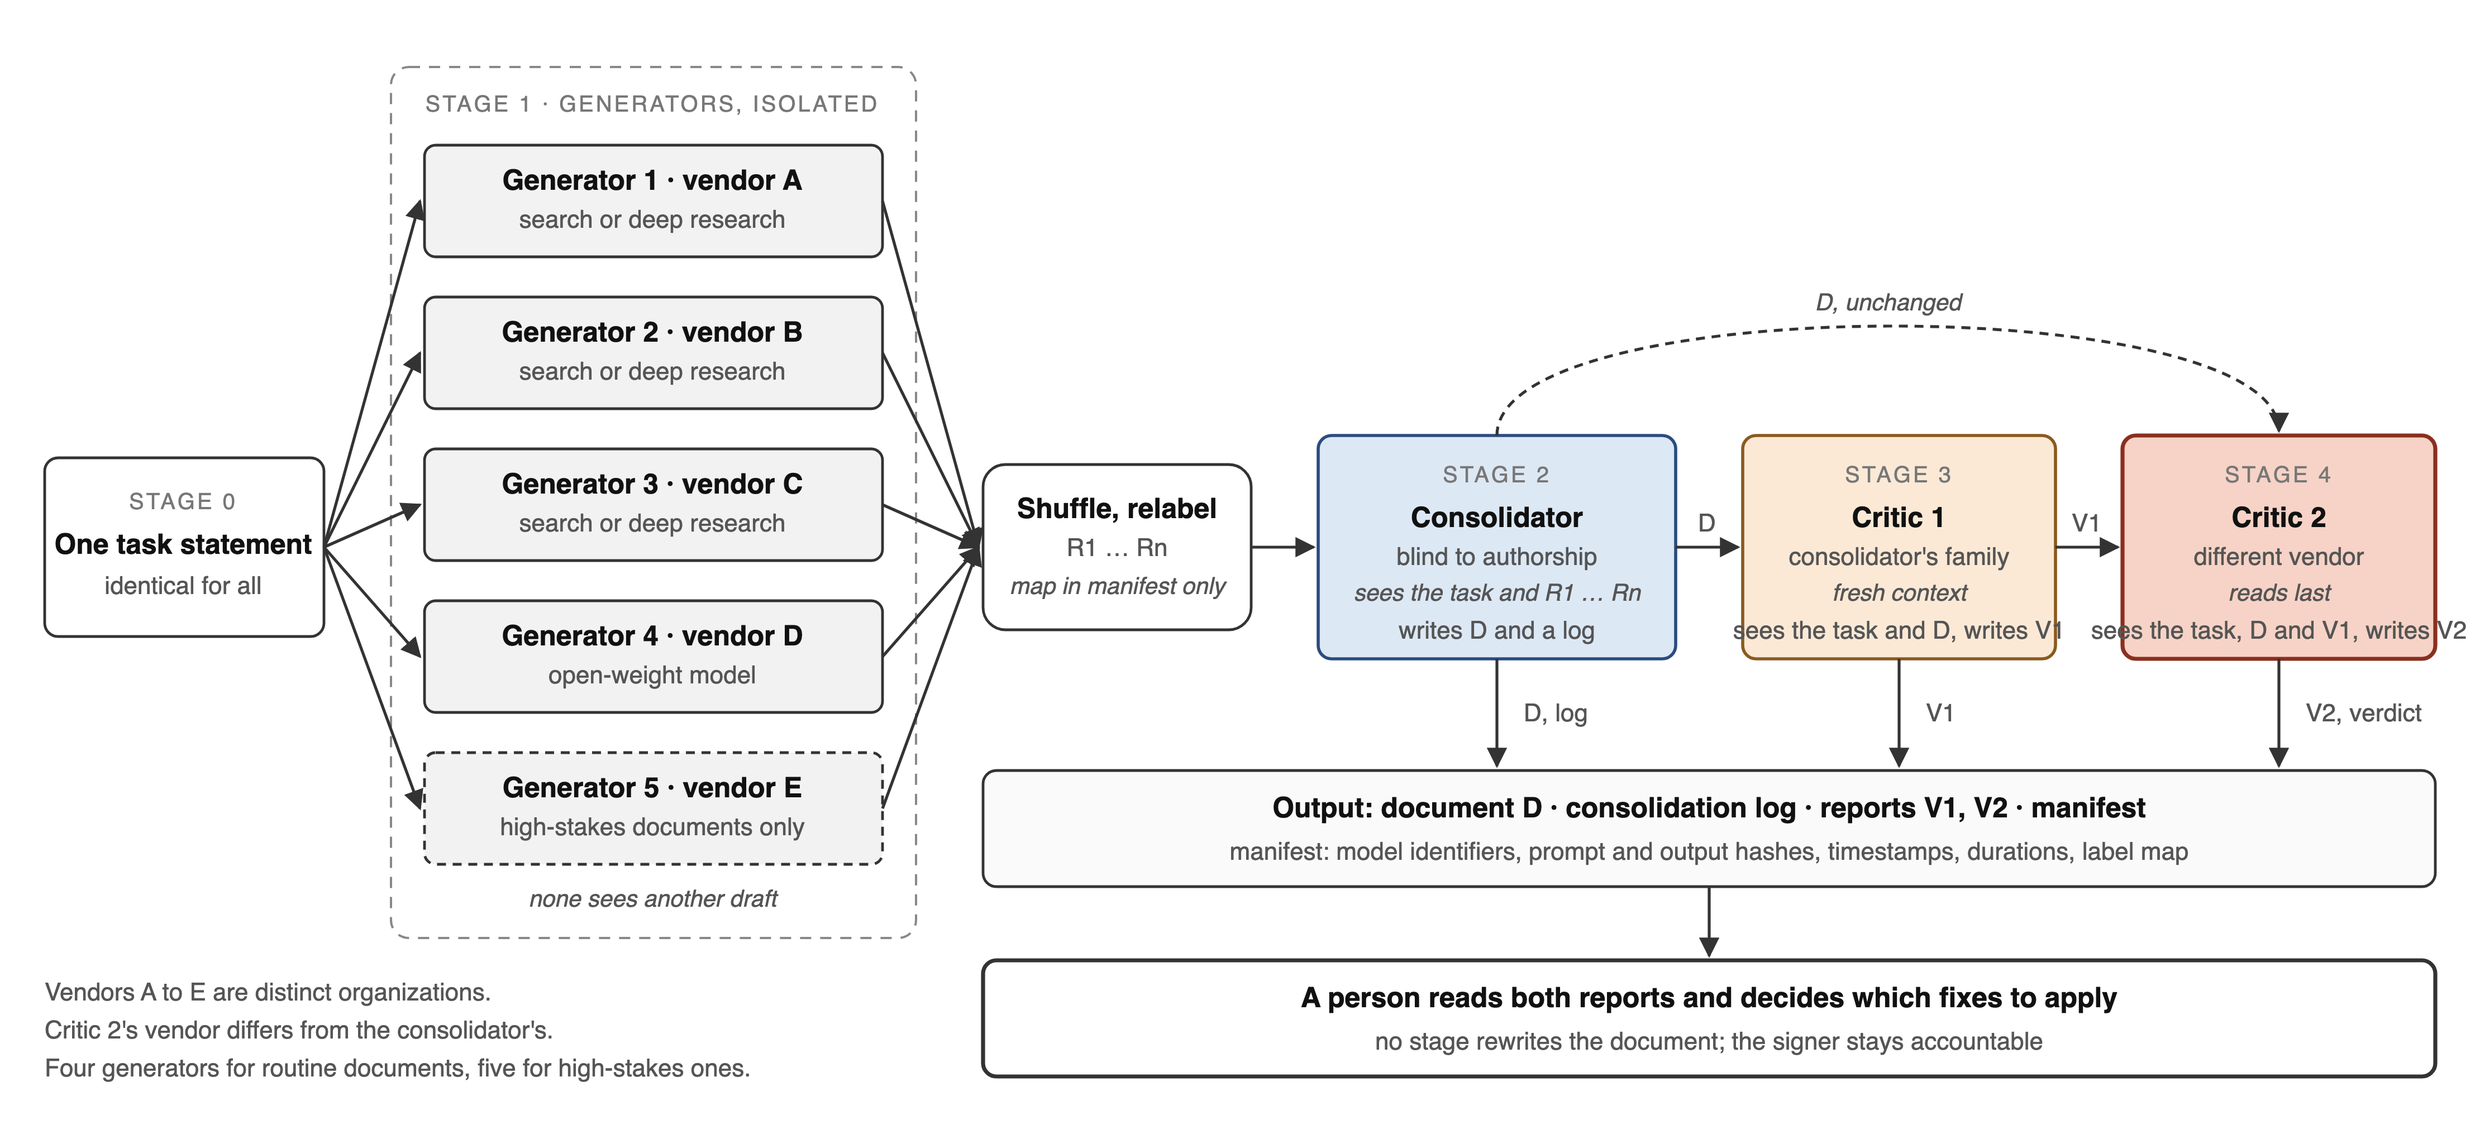
Source : Diagramme de l'auteur du protocole spécifié dans cette Annexe.
C'est une rampe. Elle a été construite pour quelqu'un qui ne peut pas prendre les escaliers : qui ne peut pas tenir cinq interfaces ouvertes à la fois, les lire l'une contre l'autre, et ramener la réponse. Une rampe est utilisée par tous ceux qui franchissent la porte, non seulement par la personne pour qui elle a été construite. La formule ci-dessus est écrite pour que quiconque puisse la suivre.
Étapes.
Étape 0. Un énoncé de tâche. Un énoncé écrit unique expose l'objectif, la juridiction, le format requis, ce qui compte comme source, et ce qu'il faut faire en cas de réclamation qui ne peut pas être vérifiée. Chaque modèle le reçoit inchangé, de sorte que les différences entre les projets proviennent des modèles.
Étape 1. Génération isolée. Chaque générateur produit un projet complet en parallèle, avec la recherche web activée partout où l'interface ou l'API la propose, et avec une recherche approfondie quand la tâche l'exige. Les interfaces de consommation de ces fournisseurs recherchent par défaut ; certains points de terminaison programmatiques ne disposent d'aucun outil de recherche, et un générateur fonctionnant sur l'un d'eux rédige à partir des poids, ce que l'enregistrement d'exécution doit montrer. Chacun est tenu de citer une source vérifiable pour chaque proposition factuelle et juridique, de marquer ce qu'il n'a pas pu vérifier comme non vérifié, et de conclure par ses questions ouvertes. L'isolation est le mécanisme. Les modèles construits par des organisations différentes sur des corpus différents inventent des choses différentes, et une réclamation que plusieurs d'entre eux produisent indépendamment, chacun avec sa propre citation, se trouve dans une position probante différente d'une réclamation qu'un seul d'entre eux a produite. Un rédacteur qui voit un autre projet s'y accorde pour des raisons sans rapport avec la véracité de la réclamation.
Étape 2. Consolidation en aveugle. Un modèle reçoit les projets de R1 à Rn, dans un ordre choisi au hasard et enregistré uniquement dans le manifeste d'exécution, et les fusionne selon des règles explicites. Les réclamations soutenues par plusieurs projets ou par une citation vérifiable sont préférées pour l'inclusion, ce qui est une règle sur ce qui entre dans le projet et non une constatation qu'elles sont vraies. Le matériel trouvé dans un seul projet est conservé quand il porte une citation vérifiable. Les conflits sont résolus par la preuve ou signalés dans le texte. L'accord entre les projets est enregistré comme accord et jamais promu au rang de preuve. Du nouveau matériel n'entre que si le consolidateur le vérifie lui-même, et il est marqué comme ajouté. Chaque réclamation substantielle porte une balise nommant les projets qui la soutiennent. Le consolidateur rédige également un journal : sur quoi les projets étaient d'accord, sur quoi ils n'étaient pas d'accord et comment chaque conflit a été résolu, et ce qui a été supprimé et pourquoi. Le journal est l'endroit où le désaccord survit. Parce que la carte des étiquettes est conservée, un lecteur ultérieur peut mettre les balises en regard de celle-ci et mesurer à quelle fréquence le consolidateur a préféré le projet de son propre fournisseur.
Étape 3. Vérification interne. Un critique de la famille du consolidateur lit le document fusionné dans un contexte nouveau, sans souvenir de la consolidation. Sa tâche est la vérification, et il ne retourne aucun document amélioré. Il vérifie chaque citation pour son existence et sa précision, teste le raisonnement pour les lacunes et les exagérations, confirme que l'énoncé de tâche a été respecté, et rend compte des constatations classées Critique, Majeure et Mineure avec un verdict : approuver, approuver avec corrections, ou rejeter.
Étape 4. Vérification intervendeurs. Un critique d'un fournisseur différent lit le même document et le premier rapport. Il confirme, conteste ou étend chaque constatation, en ajoute les siennes, et donne le verdict final. Cette étape existe en raison de la faiblesse des deux précédentes : un consolidateur vérifié par sa propre famille partage les points faibles de cette famille, et un lecteur formé ailleurs est la route la plus directe pour les atteindre.
Ce qui quitte le pipeline.
Le livrrable est le document consolidé, le journal de consolidation, les deux rapports de vérification et un manifeste. Aucune étape ne remplace le document par la production d'un critique. Une personne lit les rapports et décide quels correctifs appliquer. En litige, la personne qui signe le dossier est responsable de son contenu, et un pipeline qui réécrirerait silencieusement le texte obscurcirait qui a décidé quoi.
Le manifeste enregistre, pour chaque étape, l'identifiant du modèle, le hash de la requête, le hash de la production, l'heure de début et la durée, ainsi que la carte des étiquettes. Sans lui, un document préparé de cette manière est indistinguable d'un produit en interrogeant un seul modèle deux fois. Avec lui, un lecteur qui n'était pas présent peut auditer l'enregistrement de l'opérateur de l'exécution : quel identifiant a été configuré pour quel rôle, dans quel ordre les brouillons ont été étiquetés, ce que chaque étape a reçu et retourné. C'est un auto-rapport structuré, pas une preuve. Les identifiants proviennent de la configuration plutôt que d'une réponse authentifiée, une étape exécutée à la main porte la parole de l'opérateur sur ce qui s'est passé dans l'interface, et un enregistrement d'un outil de recherche offert n'est pas un enregistrement d'une source vérifiée. Rendre la variable observée plutôt que rapportée nécessite la garde tiers de l'exécution, ce que la conception de la Partie VII fournit et ce qu'un format de fichier ne peut pas fournir.
Implémentation de référence.
Une implémentation de référence, docprep, est publiée sous une licence ouverte (note 25) : environ cinq cents lignes de Python dans un seul fichier, avec la configuration du tableau 6, le format du manifeste, et des tests hors ligne qui s'exécutent sans comptes ni clés.
L'implémentation sépare ce qu'elle impose de ce qu'elle demande seulement. Les quatre règles de rôle sont imposées. L'invite d'un générateur est assemblée à partir de la seule déclaration de la tâche ; les brouillons atteignent le consolidateur mélangés et réétiquetés, avec la correspondance écrite uniquement dans le manifeste ; et une configuration dont le premier critique se trouve en dehors de la famille du consolidateur, ou dont le dernier critique s'y trouve, est refusée avant tout appel de modèle (figure 10). Les règles de fusion de l'étape 2 sont seulement demandées : ce sont des instructions dans l'invite du consolidateur, et un modèle peut les désobéir. L'une d'elles est vérifiée après, car une consolidation renvoyée sans son journal arrête l'exécution.
Figure 10. Une règle de rôle comme précondition de l'exécution : la vérification du critique de fermeture, et le refus qu'elle affiche.
home = family(cfg, cons) # la famille de fournisseur du consolidateur
. . .
if critics and family(cfg, critics[-1]) == home:
problems.append(f"{critics[-1]['name']} is from the consolidator's family "
f"({home}); the last reader must come from another vendor")
. . .
if problems and enforce:
sys.exit(f"formula '{formula_name}' breaks the protocol:\n - "
+ "\n - ".join(problems))
$ python3 docprep.py run --formula manual
formula 'manual' breaks the protocol:
- critic_cross is from the consolidator's family (anthropic);
the last reader must come from another vendor
Source : docprep, docprep.py, fonction validate(), version v1.0.0 (note 25) ; élisions marquées. Sous le code, la sortie de la commande affichée, exécutée sur l'exemple de configuration avec le critique de fermeture réattribué au fournisseur du consolidateur. Les tests hors ligne du dépôt affirment le même refus.
L'imposition a les limites que le manifeste a. La famille de fournisseur d'un rôle est déclarée dans la configuration, non authentifiée. Une étape exécutée manuellement est aveugle et nouvelle sur la parole de l'opérateur. La réétiquetage supprime les noms, non le style. Et le refus peut être désactivé, auquel cas le manifeste enregistre qu'il l'a été et énumère les règles violées. Les règles sont imposées contre une erreur d'opérateur, non contre un opérateur.
L'enveloppe juridique.
Une architecture qui réduit la corrélation des erreurs en ajoutant des fournisseurs augmente, par le même acte, le nombre d'endroits où le matériel sort. Pour un plaideur non représenté devant un tribunal des États-Unis, ce commerce n'est pas abstrait.
La position aux États-Unis en septembre 2026 comporte trois volets : ce qu'un déposant doit divulguer, ce qui peut être envoyé à un fournisseur à tous, et si le travail survit en tant que travail préparatoire. Les deuxième et troisième parties et le tableau 1 portent le régime de divulgation ; la partie VI.A porte l'analyse du travail préparatoire et ses autorités. Aucune règle de procédure fédérale d'application générale n'exige d'un déposant de divulguer l'utilisation d'une IA ou de nommer un modèle : en avril 2026, le Comité consultatif sur les règles de procédure civile a retiré de son ordre du jour deux propositions visant les autorités fabriquées, convenant que l'adoption de règles ne serait pas appropriée à ce moment-là.27 Les règles locales et les ordonnances des juges au dossier l'exigent, et elles diffèrent. Le district nord du Texas demande le fait de l'utilisation d'une IA à la première page d'un mémoire et ne demande pas quel modèle. Le juge Vaden de la Cour du Commerce international demande le programme utilisé, les portions spécifiques du texte qu'il a produites, et une certification attestant que l'utilisation divulguée n'a révélé aucune information confidentielle ou propriétaire à une partie non autorisée.28
Deux actions en matière de rulemaking du printemps 2026 sont faciles à confondre, et la confusion change la réponse. Le Comité consultatif sur les règles de procédure civile a pris en charge deux propositions visant à modifier la règle 11 pour traiter les citations d'autorités qui n'existent pas, a convenu que l'adoption de règles ne serait pas appropriée à ce moment-là, et a retiré l'article le 14 avril 2026. Trois semaines plus tard, le Comité consultatif sur les règles de preuve a pris en charge la règle fédérale de preuve proposée 707, qui régit l'admissibilité de la preuve générée par machine plutôt que la divulgation de l'utilisation d'une IA ; il a révisé le projet et l'a conservé à l'étude plutôt que de l'avancer. La première action concerne ce qu'un déposant certifie, la deuxième ce qu'un tribunal peut admettre, et aucune n'a créé une obligation de divulguer. Les deux sont liées dans le dossier lui-même, ce qui est pourquoi elles sont lues comme une : le mémorandum d'avril du comité des règles civiles cite le projet de règle 707, et ses procès-verbaux notent que le comité des règles de preuve avait cette règle à l'étude.
Le matériel qu'une autre partie a désigné comme confidentiel est le cas plus difficile, et il atteint directement cette architecture. Dans l'affaire Morgan, le tribunal a permis à un plaideur non représenté de placer un tel matériel dans un service d'IA uniquement lorsque le fournisseur est contractuellement tenu de ne pas stocker ou utiliser l'entrée pour entraîner ou améliorer son modèle, de ne pas le divulguer à des tiers sauf si la divulgation est essentielle à la prestation du service et le destinataire est lié par des protections équivalentes, et de le supprimer ou l'effacer sur demande ; il a exigé que le demandeur nomme tout outil utilisé en relation avec ce matériel et tienne une documentation écrite de ces garanties. Le tribunal a observé que la condition exclut la plupart des IA courantes à faible coût ou gratuites. Ce sont les termes d'une ordonnance de protection plutôt qu'une règle nationale, et c'est la plus restrictive que l'auteur a localisée ; le protocole les adopte comme sa propre politique de conception.
Trois contraintes en décoult. Ce sont les règles de conception de ce protocole, non des déclarations de ce que la loi exige d'un plaideur.
1. Les dépôts publics et le matériel que l'opérateur est libre de transmettre peuvent aller aux modèles. Le matériel sous scellé, le matériel soumis à une ordonnance de protection, et la découverte confidentielle d'une autre partie ne le font pas, sauf si l'ordonnance le permet et les conditions du fournisseur respectent la condition que Morgan a imposée. La restriction couvre chaque étape et chaque destinataire, non les générateurs seuls : le consolidateur et les deux critiques reçoivent le projet fusionné, et les artefacts conservés l'accompagnent. La propriété d'un document ne décharge pas en soi une obligation de confidentialité qui y est attachée. Le manifeste rend l'exposition vérifiable ; il ne la rend pas légale.
2. Le manifeste soutient la divulgation ; ce n'est pas la divulgation. Il enregistre quel identifiant de modèle a produit quel artefact et quand, ce qui est le matériel qu'un tribunal demandant le programme utilisé voudra, et c'est utile à conserver que le juge de la cause le demande ou non. Il ne dépose pas l'avis qu'une ordonnance personnelle exige, n'identifie pas les portions du document final qu'une règle telle que celle du juge Vaden atteint, ni ne fournit aucune certification.
3. La vérification de chaque citation par rapport à sa source est effectuée par une personne. La règle 11(b) atteint une partie non représentée par ses termes, et sa norme est l'investigation raisonnable selon les circonstances plutôt que toute procédure particulière ; la partie II expose ce que le dossier des citations fabriquées montre. L'accord entre les modèles et l'approbation par deux critiques ne constituent pas une vérification.
Les exigences varient selon le district et selon le juge, et l'ordonnance personnelle du juge de la cause régit.
Limites.
Les modes de recherche approfondie des interfaces grand public n'ont pas d'équivalent exact dans les API des fournisseurs. Une étape qui en nécessite une est exécutée manuellement : l'invite est écrite dans un fichier, l'opérateur l'exécute dans l'interface et colle la réponse, et le manifeste enregistre que l'étape a été exécutée de cette façon. Ce recours est manuel, et la partie II explique pourquoi un flux de travail manuel sur plusieurs interfaces n'est pas seulement plus lent pour un justiciable ayant une déficience motrice ou visuelle. Un protocole qui en dépend hérite de cette limite.
L'accord entre les modèles est une preuve de corrélation autant que de vérité. Les modèles entraînés sur des corpus qui se chevauchent partagent les erreurs, et un ensemble unanime de brouillons peut se tromper ensemble. Le protocole réduit la corrélation qu'il peut atteindre et enregistre le reste.
Le protocole n'a pas été comparé avec l'invite d'un seul modèle. La comparaison qui établirait sa valeur est une évaluation en aveugle : les mêmes tâches préparées de deux façons, les documents résultants notés par des lecteurs qui ne savent pas qui est qui, selon l'exactitude des citations, l'exhaustivité par rapport à l'énoncé de la tâche, et les erreurs qu'un tribunal remarquerait. Le protocole est énoncé ici pour que cette comparaison puisse être effectuée.
Le référentiel nommé ci-dessus contient le pipeline, la configuration et les tests hors ligne.
Références et Autorités Sélectionnées
ABA Model Rules of Professional Conduct r. 5.5.
Americans with Disabilities Act, 42 U.S.C. §§ 12181--12188.
Ashley, Kevin D., Artificial Intelligence and Legal Analytics: New Tools for Law Practice in the Digital Age (Cambridge Univ. Press 2017).
Avery, Joseph J., Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).
Blanck, Peter, eQuality: The Struggle for Web Accessibility by Persons with Cognitive Disabilities (Cambridge Univ. Press 2014).
Cappelletti, Mauro & Bryant Garth, Access to Justice: The Newest Wave in the Worldwide Movement to Make Rights Effective, 27 Buff. L. Rev. 181 (1978).
Carpenter, Anna E., Colleen F. Shanahan, Jessica K. Steinberg & Alyx Mark, Judges in Lawyerless Courts, 110 Geo. L.J. 509 (2022).
Centers for Disease Control and Prevention, Disability Impacts All of Us (données de l'enquête BRFSS de 2022).
Chan, Chi-Min, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu & Zhiyuan Liu, ChatEval: Towards Better LLM-Based Evaluators Through Multi-Agent Debate, arXiv:2308.07201 (2023).
Charlotin, Damien, AI Hallucination Cases Database, https://www.damiencharlotin.com/hallucinations/ (dernière visite en septembre 2026).
Chernets, Vadym, docprep: A Reference Implementation of the Blind-Consolidation Protocol, release v1.0.0 (2026), https://github.com/vadimchernets/docprep (MIT license; the protocol specified in the Appendix, and the code that runs it).
Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) (public docket); PolyHelper.AI LLC v. United States of America, No. 1:25-cv-07770 (S.D.N.Y. 2025) (earlier action, different defendant).
Cohen-Sasson, Or, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).
Du, Yilun, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.
Engstrom, Nora Freeman & Aviv Caspi, Opening the Courthouse Door---or Just Lowering the Threshold?, JOTWELL: Legal Profession (July 3, 2026).
Fed. R. Civ. P. 26(b)(3).
Greiner, D. James, Cassandra Wolos Pattanayak & Jonathan Hennessy, The Limits of Unbundled Legal Assistance: A Randomized Study in a Massachusetts District Court and Prospects for the Future, 126 Harv. L. Rev. 901 (2013).
Grimm, Paul W., Maura R. Grossman & Gordon V. Cormack, Artificial Intelligence as Evidence, 19 Nw. J. Tech. & Intell. Prop. 9 (2021).
Guha, Neel, et al., LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models, Advances in Neural Information Processing Systems 36 (2023).
Hadfield, Gillian K., Rules for a Flat World: Why Humans Invented Law and How to Reinvent It for a Complex Global Economy (Oxford Univ. Press 2017).
Hannaford-Agor, Paula, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts (National Center for State Courts 2015).
Hickman v. Taylor, 329 U.S. 495 (1947).
Katz, Daniel Martin, Michael James Bommarito, Shang Gao & Pablo Arredondo, GPT-4 Passes the Bar Exam, 382 Phil. Trans. R. Soc. A 20230254 (2024).
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022).
Liang, Tian, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (2024).
Magesh, Varun, Faiz Surani, Matthew Dahl, Mirac Suzgun, Christopher D. Manning & Daniel E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford HAI (2024).
Mata c. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
Morgan c. V2X, Inc., n° 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. 30 mars 2026).
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026).
Park c. Kim, 91 F.4th 610 (2d Cir. 2024).
Sandefur, Rebecca L., Access to What?, 148 Daedalus 49 (2019).
Shah, Anand V. & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859.
Sharma, Mrinank, et al., Towards Understanding Sycophancy in Language Models, ICLR (2024).
Simshaw, Drew, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).
Surden, Harry, Machine Learning and Law, 89 Wash. L. Rev. 87 (2014).
Documentation système (en dossier auprès de l'auteur).
U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (3 mars 2026).
United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. 17 févr. 2026).
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. 10 févr. 2026).
* Architecte de systèmes IA. Les rôles de l'auteur en tant que plaignant, développeur de système et analyste sont exposés dans la Déclaration de divulgation de l'auteur ci-dessous. Les commentaires sont les bienvenus : [email protected].↩︎
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022), https://justicegap.lsc.gov. Sur l'ampleur de l'autoprésentation en général, au moins une partie s'est autoprésent dans plus des trois quarts des affaires civiles dans une étude majeure multi-juridictionnelle. Voir Paula Hannaford-Agor, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts iv (National Center for State Courts 2015).↩︎
Anand V. Shah & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859 (analyzing over 4.5 million non-prisoner federal civil cases, FY2005--FY2026, and 46 million matched PACER docket entries); voir aussi Or Cohen-Sasson, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).↩︎
Chief Judge Patrick J. Schiltz (D. Minn.), cité dans Mattathias Schwartz & Zach Montague, Artificial Intelligence Floods Court Dockets with Home-Brewed Lawsuits, N.Y. Times (May 25, 2026).↩︎
Drew Simshaw, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).↩︎
Voir, par ex., Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023); Park v. Kim, 91 F.4th 610 (2d Cir. 2024).↩︎
Lettre d'Andrew J. Dietderich, Sullivan & Cromwell LLP, au Chief Judge Martin Glenn, U.S. Bankruptcy Court, S.D.N.Y. (Apr. 18, 2026) (s'excusant pour « les citations inexactes et autres erreurs », certaines d'entre elles des « hallucinations » d'IA, dans une motion d'urgence du 9 avril dans les procédures du chapitre 15 de Prince Global Holdings Ltd.); voir Sullivan & Cromwell Apologizes to Judge for AI Hallucinations, Bloomberg Law (Apr. 21, 2026).↩︎
AI Hallucination Cases Database (Damien Charlotin), https://www.damiencharlotin.com/hallucinations/ (snapshot of July 2, 2026): des 1 668 incidents documentés dans le monde, 975 impliquaient des plaideurs s'autoprésent et 653 impliquaient du personnel avocat représentant; en 2023, environ sept sur dix impliquaient des plaideurs s'autoprésent, et la part du personnel avocat dans les nouvelles conclusions documentées a augmenté régulièrement entre 2025 et 2026.↩︎
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026); voir aussi le commentaire sur l'IA et l'exercice non autorisé du droit dans la Georgetown Journal of Legal Ethics (2026).↩︎
Voir Law360 Pulse, Tracking Federal Judge Orders on Artificial Intelligence (last visited July 2026); Legal AI Governance, Federal and State Court Orders on AI, https://legalaigovernance.com/tracker/court-orders/ (last visited July 2026).↩︎
Voir How Courts Are Coping with a Flood of AI-Generated Lawsuits, MIT Technology Review (June 4, 2026) (rapportant, notamment, que les dépôts par des plaideurs s'autoprésent au Vermont sont passés de quatre-vingt-cinq par an avant 2022 à plus de 1 100 en 2024).↩︎
La plainte dans l'étude de cas caractérise le système dans ces termes; le cadrage est noté comme la théorie juridique du plaignant, et non comme une détermination du fond. Sur l'ampleur de la population touchée, plus d'un quart des adultes américains — plus de 70 millions — ont déclaré un handicap en 2022, CDC, Disability Impacts All of Us (2022 BRFSS data), et le ratio emploi-population pour les personnes en situation de handicap était de 22,8 % en 2025, par rapport à 65,2 % pour ceux sans, U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (Mar. 3, 2026).↩︎
Yilun Du, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.↩︎
Voir, par ex., Tian Liang, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP 2024) 17889; Chi-Min Chan et al., ChatEval: Towards Better LLM-Based Evaluators through Multi-Agent Debate, arXiv:2308.07201 (2023).↩︎
L'opposition du plaignant a placé un tel développement dans le dossier, en notant l'annonce publique d'une fonctionnalité de consensus multi-fournisseurs et multi-modèles d'un défendeur. Voir Plaintiff's Opposition, ECF No. 76.↩︎
Documentation technique système (citée à titre de conception uniquement).↩︎
L'architecture fait l'objet d'une famille de demandes de brevet international en instance sur lesquelles l'auteur est un demandeur nommé; la famille est documentée dans le dossier public du procès (voir Plaintiff's Opposition, Ex. 3), et ses identifiants sont omis ici comme non pertinents pour l'analyse.↩︎
Joint Motion to Dismiss and Memorandum in Support, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), ECF Nos. 69, 69-1; Plaintiff's Memorandum of Law in Opposition, ECF No. 76 (Apr. 2, 2026); Transcript of Pre-Motion Conference, ECF No. 55 (Jan. 27, 2026).↩︎
ECF nos 28 (motion consentie), 30, 32–34, 36–37 (12 jan. 2026). Les lettres se sont coordonnées entre elles ; un défendeur a expressément adopté les motifs et arguments énoncés dans les lettres antérieures à la motion de ses co-défendeurs.↩︎
ECF nos 39–44 (15–16 jan. 2026).↩︎
Comparer Memorandum in Support of Joint Motion to Dismiss, ECF No. 69-1, avec Plaintiff's Opposition, ECF No. 76, p. 17.↩︎
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. 10 fév. 2026) (Patti, M.J.); United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. 17 fév. 2026) (Rakoff, J.); Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. 30 mars 2026).↩︎
Morgan v. V2X, Inc., 2026 WL 864223, p. *3 (D. Colo. 30 mars 2026).↩︎
Voir ABA Model Rules of Prof'l Conduct r. 5.5; Joseph J. Avery, Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).↩︎
Cet article ne décrit que les documents publiquement déposés et les caractéristiques architecturales déjà divulgués aux défendeurs et au public. Il ne divulgue pas les invites utilisées, la logique décisionnelle du système sur une question particulière, et tous les travaux préparatoires en projet.↩︎
docprep, une implémentation de référence du protocole de consolidation aveugle, https://github.com/vadimchernets/docprep (licence MIT) ; la version décrite ici est la version v1.0.0. Le dépôt contient le pipeline exécutable en un seul fichier, la configuration du tableau 6, le format du manifeste, et les tests hors ligne qui s'exécutent sans comptes ni clés, ainsi que cet Appendice en tant que spécification autonome sous CC BY 4.0. Les identifiants de modèle et l'accès doivent être configurés pour les propres comptes de l'opérateur.↩︎
Advisory Comm. on Civil Rules, Draft Minutes of Meeting of 14 avr. 2026, p. 18, réimprimé dans Comm. on Rules of Practice & Procedure, Agenda Book 383 (3–4 juin 2026) (point 17, « Artificial Intelligence Hallucinations ») ; voir aussi Advisory Comm. on Civil Rules, Agenda Book 438–50 (14 avr. 2026) (Suggestions 25-CV-S et 25-CV-V, toutes deux dirigées vers la règle 11) ; Report of the Advisory Comm. on Civil Rules 60 (6 mai 2026), dans Agenda Book, supra, p. 364 (points retirés de l'ordre du jour). Les procès-verbaux sont à l'état de projet en attente d'approbation à la réunion d'automne 2026 du comité. La proposition de règle de preuve fédérale 707, qui régit l'admissibilité des preuves générées par machine plutôt que la divulgation, est une question distincte : le Comité consultatif sur les règles de preuve l'a révisée le 7 mai 2026 et l'a maintenue à l'étude plutôt que de la faire progresser.↩︎
N.D. Tex. Civ. R. 7.2(f) (divulgation de l'utilisation de l'IA générative sur la première page d'un mémoire, avec divulgation supplémentaire des portions ainsi préparées si le juge président le demande) ; Order on Artificial Intelligence, U.S. Court of International Trade (Vaden, J.) (8 juin 2023) (exigeant l'identification du programme utilisé, des portions spécifiques de texte qu'il a produites, et certification que l'utilisation n'a divulgué aucune information confidentielle ou propriétaire à une partie non autorisée).↩︎
Comment citer
Chernets, V. (2026). La variable manquante dans le contentieux assisté par l'IA : Architecture et la qualité de l'accès à la justice pour les personnes sans avocat [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7120940
@misc{chernets2026missingvariable,
  author       = {Chernets, Vadym},
  title        = {{The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7120940},
  url          = {https://doi.org/10.2139/ssrn.7120940}
}