Die fehlende Variable in der KI-gestützten Rechtspraxis: Architektur und die Qualität des Pro-Se-Zugangs zur Justiz
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7120940 · DOI 10.2139/ssrn.7120940 · Zenodo 10.5281/zenodo.22168724 · GitHub
- Registrierte Fassung: SSRN 7120940 · DOI 10.2139/ssrn.7120940
- Archiviertes Exemplar, zitierbar und herunterladbar: 10.5281/zenodo.22168724 — Konzept-DOI, löst sich immer zur neuesten Version auf
- Volltext als Markdown und PDF: GitHub
- Lesbare HTML: https://polyhelper.ai/research/missing-variable/
Derselbe Text befindet sich auf vier Oberflächen, damit er erreicht werden kann, wenn einer von ihnen nicht bereitgestellt werden kann. SSRN enthält die registrierte Fassung; zitieren Sie diese.
Die fehlende Variable im KI-gestützten Rechtsstreit
Architektur und die Qualität des Pro-Se-Zugangs zur Justiz
Vadym Chernets, PhD1
Erstmals gepostet Juli 2026; diese Fassung September 2026
OFFENLEGUNGSERKLÄRUNG DES AUTORS
Das Interesse des Autors an diesem Artikel ist dreifältig, und jeder Strang ist wesentlich. Erstens ist der Autor der Kläger in Chernets v. Google LLC et al., Nr. 1:25-cv-05691-RER-RML (E.D.N.Y.), dem Rechtsstreit, der als Fallstudie dient. Zweitens ist der Autor der Entwickler des Multi-Model-Orchestrierungssystems, dessen Verwendung hier untersucht wird, und ist benannter Anmelder bei internationalen Anmeldungen innerhalb der in Teil III beschriebenen Patentfamilie; der Autor hat daher ein Interesse an den in diesem Artikel analysierten Methoden. Drittens ist der Autor der Analyst. Die in Teil IV festgelegten methodischen Einschränkungen regeln die Analyse: ausschließliche Verlässlichkeit auf den öffentlichen Dossier, keine Rückschlüsse auf Vergleichsmotive und nicht-evidentielle Behandlung der selbstberichteten Leistungskennzahlen des Systems. Teil VII legt die Grenzen dar.
Zwei Absätze, einer in Teil II und einer in der Anlage, sind die eigenen Worte des Autors darüber, warum er das System entwickelt hat und warum er geklagt hat; sie sind als solche gekennzeichnet, und keine Feststellung beruht auf ihnen. Ansonsten stützt sich dieser Artikel ausschließlich auf den öffentlichen Bundesdossier und öffentlich verfügbare Quellen; er offenbart nicht privilegierte Rechtsstreitstrategie bezüglich Ansprüche, die gegen die nicht vergleichenden Beklagten noch ausstehen. Der Autor ist kein Anwalt. KI-Assistenten wurden unter der Anleitung des Autors als Instrumente eingesetzt; die Ideen, Forschungen und Schlussfolgerungen stammen vom Autor.
ZUSAMMENFASSUNG
Fast jede Darstellung von KI in der Rechtspraxis beruht auf einer unstated Annahme: dass KI-Unterstützung ein einziges Phänomen ist. Die Debatte, die diese Annahme hervorbringt, dreht sich um Volumen und Fabrikation: eine Steigerung der Quote selbstvertretener Kläger in Bundesverfahren von 11 % auf knapp 17 %, Gerichte, die von einer „existenziellen Bedrohung" sprechen, ein wachsendes Docket mit Sanktionsentscheidungen wegen gefälschter Zitate. Was die aggregierten Studien noch nicht zeigen können, ist, ob eine bestimmte Konfiguration von KI-Unterstützung die Qualität dessen, was selbstvertretene Prozessparteien tun, verändert. Das hier verwendete Dossier ist das öffentliche Docket eines Bundesverfahrens, und es enthält ein Muster, das die Volumen-und-Halluzinations-Erklärung nicht vorhersagt. Ein selbstvertretener Prozessbeteiligter ohne Anwalt jeglicher Art, der nach Aussage des Autors ein Multi-Model-Orchestrierungssystem einsetzt (unabhängige Modelle parallel abgefragt, Uneinigkeit aufgedeckt statt weggemittelt, Zitate gegen externe Quellen verifiziert), beantwortete sechs koordinierte Schreiben vor Motionsanträgen innerhalb von vier Tagen, reichte einen wesentlichen Widerspruch sechs Wochen vor Fristablauf ein und identifizierte einen verifizierbaren Fehler in einer Gesetzeszitierung in einem Schriftsatz, der von sieben Beklagten eingereicht wurde, vertreten durch Rechtsanwälte von führenden Kanzleien, in einem Fall gegen dreizehn Technologiebeklagte. Das letzte dieser drei Ereignisse ist das Gegenteil des Fehlermodus, der die Literatur dominiert. Der Artikel schlägt die Architektur-Abhängigkeitshypothese vor: Die Architektur der KI-Unterstützung, Single-Model-Prompting versus Multi-Model-Orchestrierung, ist eine empirische Variable in der Qualität selbstvertretener Rechtspraxis in ihrem eigenen Recht, nicht ein Implementierungsdetail und nicht dasselbe wie die Verfügbarkeit von KI. Die hier behandelten doktrinellen Konsequenzen betreffen die Work-Product-Doktrin, bei der Bundesgerichte sich Anfang 2026 uneinig sind, und das Rahmenwerk der unbefugten Ausübung von Rechtspraxis. Der Fall wird als falsifizierbarer Existenzbeweis und als Forschungsagenda angeboten; der Autor ist der Kläger, der Systementwickler und der Analyst.
Schlüsselwörter: Selbstvertretung in Rechtsverfahren; selbstvertretene Prozessparteien; Zugang zur Justiz; KI-gestützte Rechtsspraxis; generative KI; Multi-Agent-Debatte; Multi-Model-Orchestrierung; gefälschte Zitate; Zitatverifizierung; Work-Product-Doktrin; Offenlegung; Anordnungen; Regel 11; unbefugte Ausübung von Rechtspraxis; Title III; Architektur-Abhängigkeitshypothese. JEL-Klassifikation: K41 (Litigation Process); K10 (Basic Areas of Law, General); O33 (Technological Change: Choices and Consequences). # Inhaltsverzeichnis
I. Einleitung 4
II. Die Zugangsgerechtigkeitslücke und die Pro-Se-KI-Wende 6
III. Von Single-Model-Prompting zu Orchestrierung: Das kognitive Exoskelett 11
IV. Methode und Beweisgrundlage 15
V. Ergebnisse 18
A. Rekonstruktion des Rechtsrahmens nach einer anfänglichen fehlerhaften Einreichung 19
B. Antwort auf koordinierte Pre-Motion-Praxis 20
C. Zeitnahe Antwort auf eine konsolidierte Verteidigung 21
D. Identifizierung eines Fehlers in der Gesetzeszitierung in der Verteidigungsmemorandum 22
E. Frühe Vergleiche 23
VI. Doktrinelle Auswirkungen 25
A. Work Product und die selbstvertretene Partei 25
B. Unbefugte Ausübung von Rechtspraxis 27
C. Eine Neuformulierung, keine Lösung 29
VII. Einschränkungen und zukünftige Arbeiten 29
VIII. Schlussfolgerung 32
Anhang. Eine Unterstützungsarchitektur, spezifiziert, damit sie ausgeführt werden kann 34
Ausgewählte Referenzen und Behörden 42
I. Einleitung
Ein Prozessführer, dreizehn KI-Unternehmen: Der hier untersuchte Fall verdichtet die Frage, die dieser Artikel an die Literatur stellt, in einem einzigen Docket. Die Lücke zwischen den Zivilrechtsbedürfnissen von Amerikanern und den Ressourcen, die zu ihrer Erfüllung verfügbar sind, gehört zu den dauerhaftesten Problemen des U.S.-Justizsystems. Die neueste nationale Studie der Legal Services Corporation stellte fest, dass Amerikaner mit niedrigem Einkommen bei zweiundneunzig Prozent der zivilen Rechtsprobleme, die sie wesentlich betrafen, keine oder unzureichende Hilfe erhielten, wobei fast drei von vier Haushalten mit niedrigem Einkommen in einem Jahr mindestens ein solches Problem erlebten.2 Für die meisten selbstvertretenen Prozessparteien ist das Hindernis nicht die Gerichtsgebühr, sondern alles danach: das richtige Gericht ausfindig machen, die gültige Klageursache identifizieren, die Zustellung an Unternehmen bewerkstelligen und auf Anträge antworten, die von erfahrenem Anwaltspersonal unter straffen Fristen verfasst wurden.
Diese Bevölkerungsgruppe ist schnell gewachsen, seit generative KI weit verbreitet verfügbar ist. Eine jüngste großangelegte empirische Studie berichtet, dass die Quote der selbstvertretenen Kläger in Bundeszivilverfahren, die zwei Jahrzehnte lang stabil bei etwa elf Prozent lag, im Steuerjahr 2025 auf 16,8 Prozent anstieg (Abbildung 1), und dass der Anteil der untersuchten Bundeszivilbeschwerden mit Markierungen von KI-generiertem Text von praktisch null im Jahr 2019 auf mehr als achtzehn Prozent bis Anfang 2026 anstieg, wie in dieser Studie gemessen. Diese Stichprobe basiert auf Beschwerden, die sowohl selbstvertreten als auch mit Anwalt eingereicht wurden, entnommen aus dem RECAP-Archiv, das die Autoren darauf hinweisen, dass es Einreichungen ohne Anwalt unterrepräsentiert.3
Gerichte und Kommentatoren haben größtenteils mit Besorgnis reagiert. Der damalige Oberrichter eines Bundesgerichts beschrieb das Gesamtproblem als „existenzielle Bedrohung für die Bundesgerichte".4 Anwaltsverbände warnen, dass Verbraucher-Chatbots in die unbefugte Ausübung von Rechtspraxis eindringen können, und eine wachsende Anzahl von Sanktionsentscheidungen befasst sich mit Prozessführern, vertreten und unvertreten gleichermaßen, die Schriftsätze einreichen, die Fälle zitieren, die nicht existieren.
Die Besorgnis ist begründet, beschreibt aber einen bestimmten Modus der KI-Nutzung. Durch die Konzentration auf diesen Modus behandelt bestehende empirische Arbeit implizit KI-Unterstützung als homogen, und dieser Artikel argumentiert, dass die Annahme nicht länger haltbar ist. Die dokumentierten Fehler (halluzinierte Autoritäten, unterwürftige Zustimmung, undifferenziertes Volumen) sind charakteristisch für Single-Model-Prompting: Ein Prozessführer stellt eine Frage an ein einzelnes Allzweckmodell und reicht das Ergebnis ein. Fast das gesamte empirische Bild der Pro-Se-KI-Nutzung beruht auf diesem Modus.
Die hier untersuchte Architektur ist eine andere, und die Frage ist, ob dieser Unterschied von Bedeutung ist. Bei der Multi-Modell-Orchestrierung wird eine Anfrage gleichzeitig an mehrere unabhängige Modelle versendet, und ihre Ausgaben werden verglichen. Übereinstimmung und Nichtübereinstimmung werden explizit gemacht, und Divergenz, einschließlich eines Minderheitssignals, das auf einen möglichen Fehler hinweist, wird bewahrt, statt gemittelt zu werden. Die hier vorgebrachte These ist eng gefasst, aber wenn sie korrekt ist, folgenreich: Die Fehlermodi des Single-Modell-Systems, die gegenwärtige Bedenken animieren, könnten nicht intrinsisch für die KI-gestützte Prozessführung sein, und eine Orchestrierungsarchitektur könnte die KI-Nutzung von einer Quelle des Volumens in ein Instrument der Qualität umwandeln. Der Beitrag ist methodologisch: Der Artikel schlägt vor, die Architektur der KI-Unterstützung als eine eigenständige empirische Variable und nicht als Implementierungsdetail zu behandeln, und der folgende Fall wird als ein dokumentiertes Beispiel angeboten, das diesen Vorschlag motiviert. Die These in vier Worten: Architektur, nicht Verfügbarkeit.
Die These wird anhand einer einzelnen Fallstudie entwickelt, Chernets v. Google LLC et al., eine bundesgerichtliche Klage, in der ein selbst vertretener Kläger, nach eigenem Bericht mit Hilfe eines Multi-Modell-Orchestrierungssystems, gegen eine Gruppe von Technologiedefendanten prozessierte, die durch Anwälte aus zahlreichen Anwaltskanzleien vertreten werden. Die Analyse stützt sich vollständig auf das öffentliche Verfahrensregister: Eingaben, Daten und Dokumentennummern, die jeder Leser überprüfen kann. Diese Akten zeigen Verhalten, das die vorherrschende Volumen-und-Halluzinations-These nicht beschreibt und das aggregierte Studien zu KI-gestützten Eingaben nicht erfassen sollen: ein vollständiger Schriftsatzwechsel, der gegen eine koordinierte Gegenreaktion aufrechterhalten wurde, mit sechs koordinierten Vor-Motions-Schreiben, die innerhalb von vier Tagen beantwortet wurden, und ein substantieller Gegenantrag, der Wochen vor Fristablauf eingereicht wurde, sowie die Identifizierung eines überprüfbaren Gesetzeszitats-Fehlers im Schriftsatz der Defendantenkoalition. Vier Defendanten einigten sich frühzeitig (auf vertraulichen Bedingungen; Teil V.E). Der Fall ist noch nicht abgeschlossen, und der Zweck seiner Untersuchung besteht darin, anhand einer überprüfbaren Aktenakte ein Phänomen zu isolieren, das nach der herrschenden These nicht zu existieren erwartet würde und das die Literatur bisher nicht genau untersucht hat.
Ein einzelner Fall eines beteiligten Anwalts kann zeigen, dass ein Phänomen aufgetreten ist, nicht wie oft es auftritt oder ob es sich verallgemeinert; Teil VII gibt die Grenzen an. Die These besagt, dass die Architektur der KI-Unterstützung eine unabhängige Variable bei der Untersuchung von KI-gestützter Prozessführung ist, eine Variable, die die aktuelle, auf Verfügbarkeit und Volumen konzentrierte Rahmung nicht isoliert. Das ist die Architektur-Abhängigkeits-Hypothese; Teil IV formuliert sie formal.
Der Artikel gliedert sich wie folgt. Teil II situiert die Studie innerhalb der Zugang-zur-Justiz-Literatur und der aufstrebenden Fachliteratur über die Eigenvertretungs-KI-Nutzung. Teil III unterscheidet das Single-Modell-Prompting von Orchestrierung und spezifiziert den Mechanismus. Teil IV stellt die Fallstudien-Methode und ihre Grundlage in den öffentlichen Akten dar. Teil V präsentiert die Ergebnisse. Teil VI untersucht Implikationen für die Arbeitsergebnis-Doktrin und den Rahmen der unautorisierten Rechtsausübung. Teil VII behandelt Einschränkungen und zukünftige Arbeiten. Teil VIII schließt ab.
II. Die Zugangsgerechtigkeitslücke und der Pro-Se-KI-Wendepunkt
Die Gerechtigkeitslücke ist ein strukturelles Merkmal des zivilen Systems der USA, nicht ein marginales. Ein großer Anteil der Americans mit niedrigem und mittlerem Einkommen erhält keine sinnvolle Rechtsberatung für ihre Zivilprobleme, und in vielen Fallkategorien ist die Eigenvertretung eher die Regel als die Ausnahme (Carpenter, Shanahan, Steinberg & Mark 2022). Seit der vergleichenden Zugangsgerechtigkeitsbewegung der 1970er Jahre (Cappelletti & Garth 1978) haben Wissenschaftler die Frage als eine der Verteilung formuliert: Juridische Expertise ist eine knappe Ressource, ungleich verteilt, und die Parteien, die sich Anwälte am wenigsten leisten können, sind oft diejenigen mit dem meisten auf dem Spiel (Sandefur 2019). Diese Literatur fragt, worauf sich der Zugang zur Justiz bezieht; die hier verfolgte Frage ist die Qualität dieses Etwas.
Vor diesem Hintergrund kam generative KI als eine mehrdeutige Entwicklung an. Nach einer Sicht versprach sie, die juridische Fähigkeit zu demokratisieren und gab unvertretenen Parteien ein Abbild der Recherche, Abfassung und Analyse, die Anwälte erbringen. Dieses Versprechen nahm konkrete Form an, als ein Frontier-Modell die Uniform Bar Examination bestand (Katz, Bommarito, Gao & Arredondo 2024), obwohl Leistungs-Benchmarks dieser Art Erwartungen über Fähigkeiten änderten, ohne architektonische Unterschiede zu isolieren. Simshaw warnte früh davor, dass KI stattdessen ein Zwei-Klassen-System verfestigen könnte, in dem die gut ausgestatteten Parteien sachkundiges menschliches Urteilsvermögen erhalten, während alle anderen automatisierte Annäherungen erhalten.5 Das empirische Bild, das sich seitdem abgezeichnet hat, ist konkreter: Durch die Analyse von Millionen von bundesgerichtlichen Eingaben dokumentiert aktuelle Arbeit, dass die Rate der Pro-Se-Kläger nach der öffentlichen Freigabe von generativer KI stark gestiegen ist und entwickelt Indikatoren für KI-konsistente Abfassung in den Beschwerdeschriften selbst. Dieses aggregierte Verfahrensregister kann noch nicht zeigen, ob dies Eigenvertretenen Parteien bessergeht. Wie die vorsichtigsten Leser dieser Studie beobachten, ist es nicht dasselbe, neue Kläger über die Gerichtshaustore zu bringen, wie ihnen zu helfen, sobald sie innen sind (Engstrom & Caspi 2026).
Abbildung 1. Der Anstieg der bundesgerichtlichen Pro-Se-Kläger nach breiter Verfügbarkeit von generativer KI.
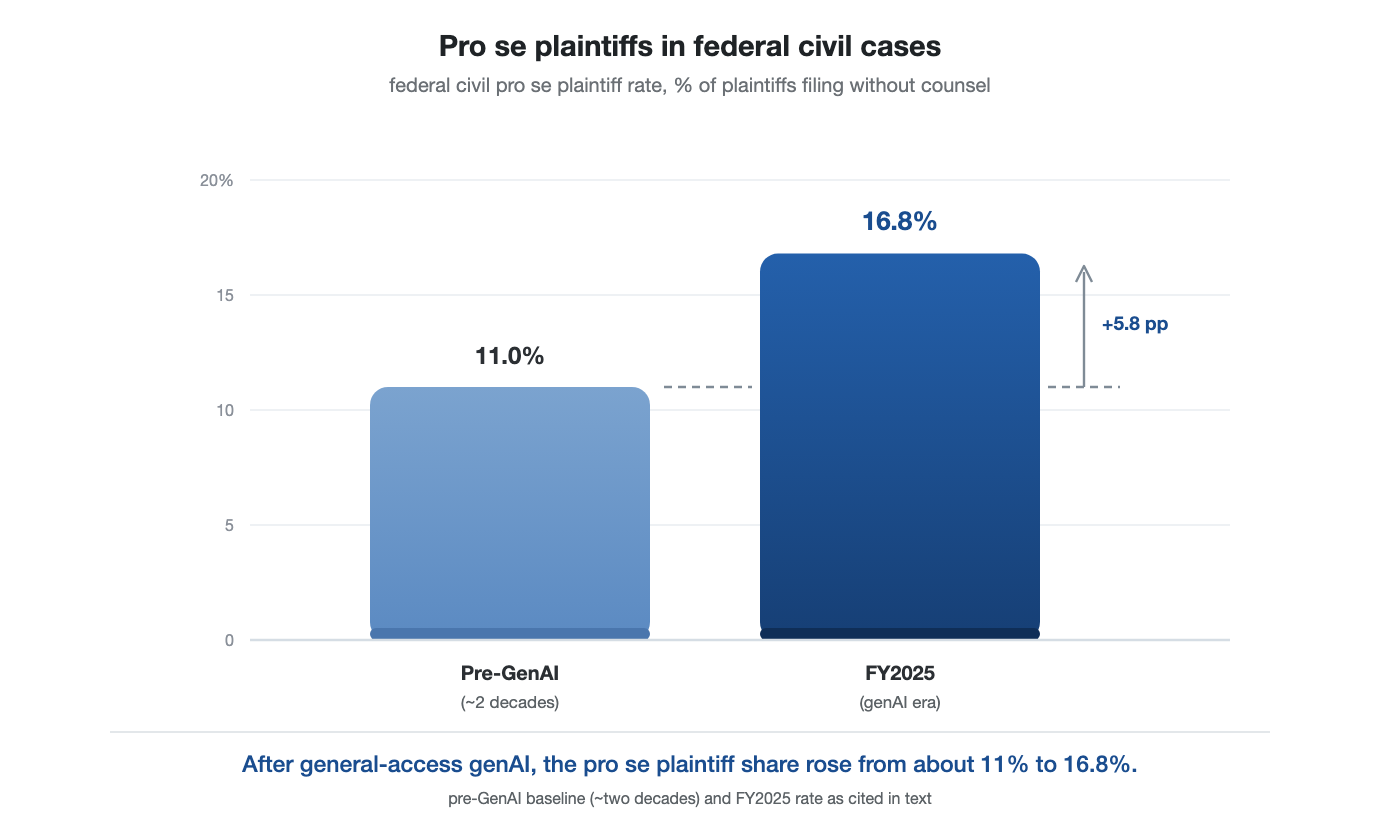
Quelle: Angepasst von Shah & Levy (2026); Zahlen gerundet.
Die Aufnahme in den Gerichten und in der praktizierenden Anwaltschaft war überwiegend vorsichtig, und die Bedenken konzentrieren sich auf Fälschung, unbefugte Praxis und Volumen. Zur Fälschung gibt es inzwischen eine umfangreiche Reihe von Entscheidungen, die Parteien und Anwälte sanktionieren, die Schriftsätze einreichen, in denen Fälle zitiert werden, die nicht existieren,6 ein Fehler, der direkt auf generative Modelle zurückzuführen ist, die plausible, aber fiktive Autoritäten erzeugen. Dieser Fehlermodus hat zu einer verfolgten Sammlung von Entscheidungen geführt, in denen ein Gericht festgestellt hat oder als etabliert angenommen hat, dass eine Einreichung auf von KI gefälschtem Material beruhte: mehr als zweitausend weltweit bis September 2026 (Charlotin 2026), und dies umfasst nun auch einen viel beachteten Fall, in dem eines der prominentesten Unternehmen der Wall Street sich bei einem Bundeskonkursgericht für eine Notfalleinreichung entschuldigte, die ungenaue Zitate und andere Fehler enthielt, von denen einige KI-„Halluzinationen" waren.7 Die Zusammensetzung dieser Sammlung ist selbst aufschlussreich: Was zunächst überwiegend ein Phänomen von Selbstvertretern war, ist nicht eines geblieben. Mitte 2026 machten lizenzierte Anwälte etwa zwei Fünftel der dokumentierten Fälle aus, und ihr Anteil an neu dokumentierten Feststellungen wuchs.8 Anwaltskammern und Kommentatoren sind auch besorgt über unbefugte Praxis und stellen in Frage, ob Verbraucher-Chatbots, die rechtliche Beratung erteilen, die Grenze überschreiten, die die Ausübung des Rechtsberufs lizenzierten Anwälten vorbehalten ist, und ob die diese betreibenden Einrichtungen Verantwortung tragen könnten.9 Was das Volumen betrifft, haben Richter einen Zustrom von KI-gestützten Einreichungen von Selbstvertretern als Belastung für die Gerichtsressourcen beschrieben, in der schärfsten Formulierung eine existenzielle Bedrohung für die Bundesgerichte.
Die gerichtliche Antwort hat eine weitere, aufschlussreiche Form angenommen. Seit Mitte 2023 haben einzelne Bundes- und Staatsrichter Daueraufträge erlassen, die generative KI in ihren Gerichtssälen regeln (öffentliche Tracker listen nun Hunderte auf, keine zwei gleich), die von Parteien verlangen, offenzulegen, ob KI beim Verfassen verwendet wurde, zu bescheinigen, dass Zitate überprüft wurden, oder beides.10 Die Aufträge teilen ein Design (Tabelle 1): Sie regeln die Tatsache der KI-Nutzung und die Überprüfung ihrer Ausgabe. Architektur, ob die Unterstützung einzelmodellbasiert oder orchestriert, selbstverifizierend oder nicht, ist die hier isolierte Variable, und sie erscheint in keinem der Aufträge, die der Autor gefunden hat. Ein Gericht, das einen solchen Auftrag auf den hier untersuchten Fall anwendet, würde nur festhalten, dass KI verwendet wurde. Weder das Offenlegungssystem noch die empirische Literatur haben derzeit ein Vokabular dafür, wie, und diese Abwesenheit ist die gleiche Homogenitätsannahme, die oben beschrieben wurde, in regulatorischer Form.
Tabelle 1. Das entstehende KI-Offenlegungssystem: Was Daueraufträge verlangen und was nicht.
| Was der Auftrag verlangt | Präsenz im System |
| Wurde generative KI beim Verfassen verwendet? | Routinemäßig erforderlich |
| Wurden Zitate und Anführungen überprüft? | Routinemäßig erforderlich |
| Welches Werkzeug oder Modell wurde verwendet? | Manchmal erforderlich |
| War die Unterstützung einzelmodellbasiert oder orchestriert (Architektur)? | In keinem gefundenen Auftrag vorhanden |
| Wurde Uneinigkeit zwischen Modellen aufgedeckt und gelöst? | In keinem gefundenen Auftrag vorhanden |
Quelle: Öffentliche Tracker gerichtlicher Daueraufträge zu KI (Law360 Pulse; Legal AI Governance), Stand Juli 2026; siehe Anmerkung 9. Die Charakterisierung der Abdeckung stammt vom Autor.
Abbildung 2. Die fehlende Variable: Bestehende empirische Studien variieren die Verfügbarkeit von KI-Unterstützung; ihre Architektur bleibt ungemessen.
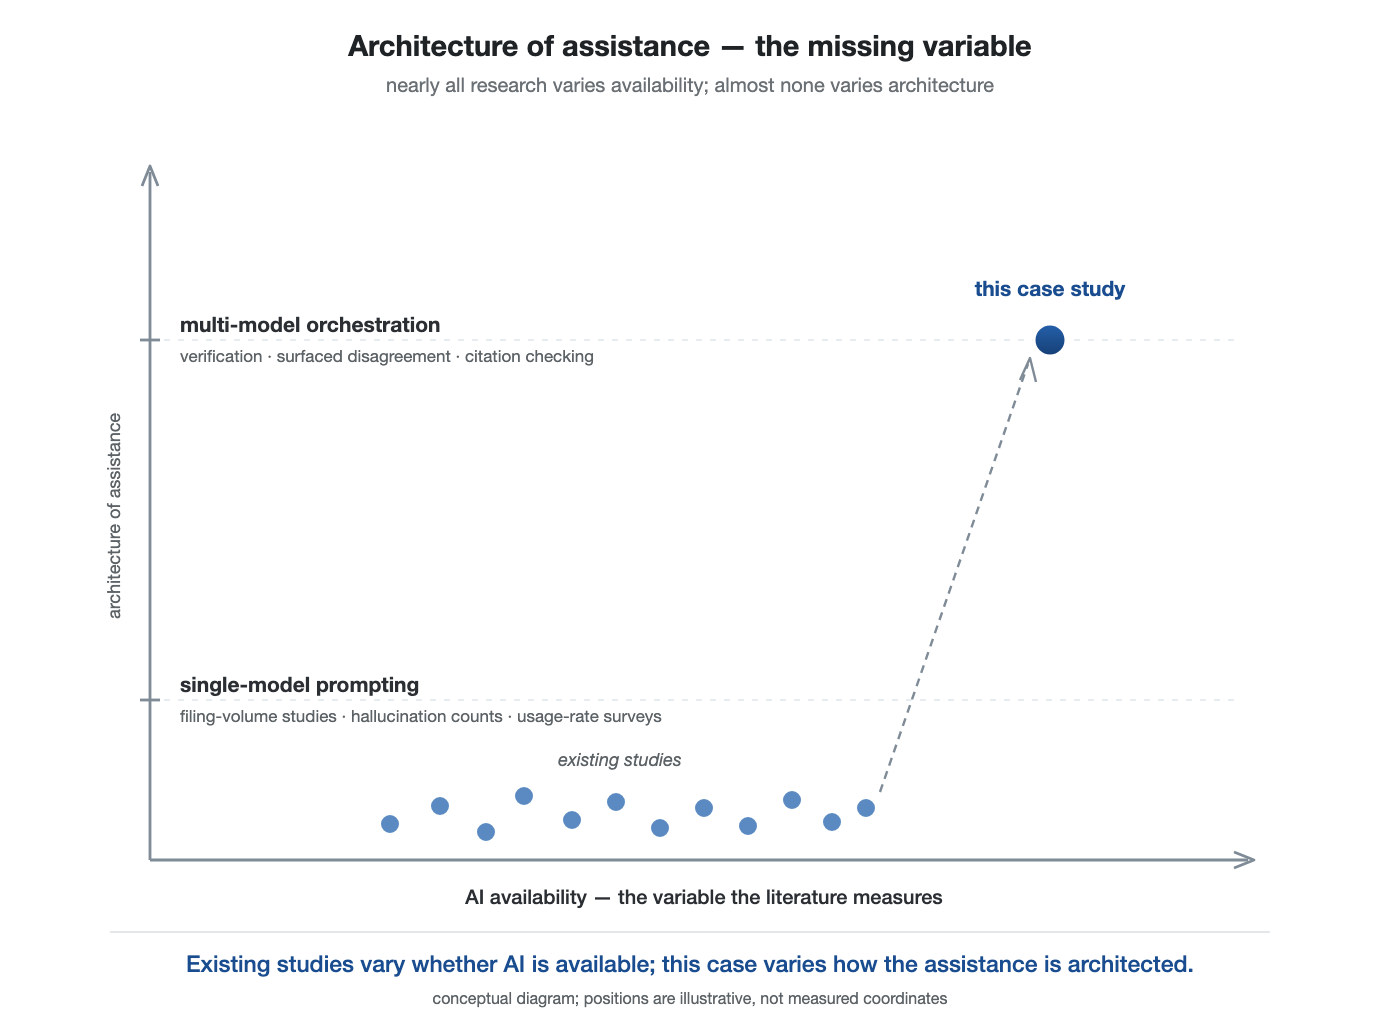
Quelle: Schematische Darstellung des Autors der in diesem Teil besprochenen empirischen Literatur.
Die beiden Entwicklungen treffen sich in der hier verfolgten Frage. Der Zugang zur Justiz erklärt, warum Selbstvertretung wichtig ist: Für die meisten Prozessparteien ist die Alternative zur Selbstvertretung überhaupt keine Vertretung. Der jüngste Anstieg der Selbstvertretung, zeitgleich mit der breiten Verfügbarkeit generativer KI, erklärt, warum die Architektur von KI-Unterstützung zu einer wichtigen Forschungsfrage statt zu einem nebensächlichen Detail geworden ist. Wenn Vertreter ohne Anwalt jetzt in großem Maßstab durch KI handeln,11 könnte die Art und Weise, wie diese KI konfiguriert ist, die Qualität dessen beeinflussen, was die Gerichte erreicht, und könnte grundsätzlich die Lücke in der Problemlösungskapazität zwischen Einzelpersonen und den Institutionen, denen sie gegenüberstehen, verringern.
Eine weitere Rahmensetzung ändert, wofür Orchestrierung verstanden wird. Für einen Benutzer mit motorischer, Rückenmarks- oder Sehbehinderung, der mehrere Browserschnittstellen nicht gleichzeitig bedienen kann, ist der manuelle Arbeitsablauf, den Benutzer ohne Behinderung nur mühsam finden (jeden Anbieter öffnen, die Abfrage einfügen, lesen, vergleichen), nicht mühsam, sondern nicht verfügbar. Einheitlicher Multi-Modell-Zugang ist keine Produktivitätspräferenz, sondern eine Frage der angemessenen Vorkehrung (vgl. Blanck 2014 zur Barrierefreiheit im Web für Personen mit kognitiven Behinderungen; die Erweiterung auf motorische, Rückenmarks- und Sehbehinderungen geht auf den Autor zurück). Das Blockieren der Automatisierung eines Arbeitsablaufs, den eine Person andernfalls manuell durchführen könnte, führt dann zu einer Belastung, die konstruktionsbedingt am stärksten auf die Benutzer fällt, die sie am wenigsten manuell durchführen können, und für diesen Benutzer wird die Architektur aus einer Debatte über unbefugte Praxis zu einer Frage angemessener Vorkehrung.12
Ich habe es für jemanden in meiner Familie gebaut, der das von Hand nicht tun kann – wer nicht zwischen Browser-Tabs herumklettern kann. Eine Krücke, ein Führhund: etwas macht den Teil, den eine Person nicht tun kann. Sag es einmal, und es ist getan. Das ist worum es in diesem Fall geht.
Was diese Bedenken verbindet, und was dieser Artikel sichtbar machen möchte, ist ein implizites Modell, wie eine sich selbst vertretende Partei KI nutzt: eine Person, ein allgemeines Modell, minimale Verifikation, maximale Ausgabe. Es ist nicht die einzige verfügbare Architektur, und die empirische Literatur (Abbildung 2) hat Fälle, die auf einer anderen aufgebaut sind, noch nicht untersucht. Die Forschung misst die Quantität von KI-gestützter Selbstvertretung im Gerichtsverfahren und die Zuverlässigkeit ihrer häufigsten Form; sie hat sich aber weitgehend nicht gefragt, ob eine andere Assistenz-Architektur zu einer anderen Qualität des Verfahrensverhaltens führt. Diese Lücke wird hier durch die detaillierte Dokumentation eines Nutzungsmodus geschlossen, den die aggregierten Studien nicht isolieren.
III. Von Single-Model-Prompting zu Orchestrierung: Das kognitive Exoskelett
Der Begriff „kognitives Exoskelett" markiert eine Unterscheidung, die die KI-Rechtsdebatte zu verwischen neigt. Ein Exoskelett verstärkt die Person in ihm; es handelt nicht an ihrer Stelle, und es ist ohne die Person träge. Diese Unterscheidung zwischen Verstärkung und Substitution zieht sich durch beide in Teil VI behandelten Sachfragen. Der Arbeitsproduktschutz knüpft sich natürlich an Verstärkung an, weil die geschützte Strategie die eigene des Prozessführers bleibt, und schwerfällig an Substitution. Das Rahmenwerk der Befugnis zur Rechtsausübung zielt auf Substitution ab (eine Einheit übt Recht für jemanden aus) und greift nur schlecht bei einem Werkzeug, durch das eine Person für sich selbst recht ausübt. Ob ein bestimmtes System das eine oder das andere ist, ist eine Frage der Architektur und Nutzung, nicht der Bezeichnungen. Die in Teil II behandelten Bedenken teilen eine implizite Architektur. Im paradigmatischen Problemfall stellt sich eine sich selbst vertretende Partei eine Frage an ein einzelnes allgemeines Modell und reicht seine Ausgabe ein. Die Pathologien, die daraus folgen, sind zum großen Teil Eigenschaften dieser Single-Model-Konfiguration: fabrizierte Zitate, selbstsichere Fehldarstellungen des Rechts, kriechzustimmung mit der Prämisse des Nutzers (Sharma et al. 2024). Ein einzelnes Modell hat keinen internen Gegner, nichts in der Pipeline, das ihm widersprechen könnte. Seine Fehler gehen, wie sicher auch immer, ungeklärt durch. Die Single-Model-Fehlermodi, die die Literatur dominieren, sind in diesem Sinne nicht Eigenschaften künstlicher Intelligenz; sie sind Eigenschaften einer Konfiguration.
Jahrzehntelang verfolgte die KI-und-Recht-Forschung Zuverlässigkeit durch explizite Wissenstechnik, indem rechtliches Denken in Regeln und fallgestützte Modelle kodifiziert wurde (Ashley 2017), bevor die Machine-Learning-Wende die Frage von der Kodifizierung von Regeln zum Lernen von Mustern verschob (Surden 2014). Ein unterschiedlicher Forschungszweig in der Informatik deutet darauf hin, dass diese Konfiguration nicht die einzige verfügbare ist und dass ihre Fehlermodi teilweise architektonischer als inhärent sind. In dem häufig als Multi-Agent-Debatte bezeichneten Ansatz generieren mehrere Modellinstanzen unabhängig Antworten und kritisieren dann gegenseitig ihre Begründung über aufeinanderfolgende Runden, bevor sie sich auf eine Antwort einigen. Die grundlegende Studie berichtet, dass dieses Verfahren der „Gesellschaft von Köpfen" die faktische Gültigkeit verbessert und die trügerischen Antworten und Halluzinationen reduziert, zu denen einzelne Modelle neigen.13 Nachfolgende Arbeiten haben die Erkenntnis erweitert und qualifiziert und berichten, dass strukturierter Dissens Halluzinationen in Mathematik, Logik und Frage-Antwort-Benchmarks reduziert, während auch Grenzen identifiziert werden, wie sinkende Erträge über ein Dutzend Agenten und Runden hinaus und die Notwendigkeit, die Qualität der Zwischenargumentationen statt nur der Endantworten zu bewerten.14 Die Benchmark-Bereiche sind hier relevant. Diese Literatur validiert strukturierten Dissens weitgehend in Mathematik, Logik und Frage-Antwort-Benchmarks, Bereiche mit überprüfbaren Antworten. Ob seine Gewinne auf rechtliche Argumentation übertragen, wo viele Fragen keine einzige überprüfbare Antwort haben und Modelle höflich auf einen gemeinsamen Fehler konvergieren können, ist ungeprüft, und der Transfer ist eine Annahme des hier untersuchten Designs statt eines demonstrierten Ergebnisses.
Für die vorliegende Analyse ist der Teil des Mechanismus, der relevant ist, wo der Zuverlässigkeitsgewinn seinen Ursprung hat. Die Hypothese ist, dass der Gewinn aus den Beziehungen zwischen Modellen statt aus einem einzelnen, fähigeren Modell kommt, aus Dissens, der oberflächlich und beigelegt wird statt unterdrückt. Der Wert der Orchestrierung liegt nicht in mehr Antworten, sondern in besser gestützten. Eine Tatsache, die ein Modell behauptet und ein anderes bestreitet, ist die Tatsache, die einer genauen Prüfung bedarf, und ein Debattenverfahren lenkt Aufmerksamkeit darauf, während Single-Model-Prompting dies nicht kann. Der Mechanismus hat erkennbare Verwandte in anderen Bereichen (Ensemble-Methoden im Machine Learning, fehlerkorrigierende Codes in der Informationstheorie, strukturierter Dissent in der Wissenschaft der Gruppendiskussion), was deutet, dass dies eine allgemeine Eigenschaft von redundanten, Dissens-bewahrenden Systemen ist statt eines Artefakts eines Produkts.
Tabelle 2. Single-Model-Prompting versus Multi-Model-Orchestrierung nach Design-Eigenschaft.
| Eigenschaft | Single-Model-Prompting | Multi-Model-Orchestrierung |
| Interner Gegner | Keiner; Ausgabe ungeklärt | Modelle untersuchen sich gegenseitig |
| Quelle von Zitaten | Aus Modellgewichten generiert | Gegen externe Datenbanken validiert |
| Umgang mit Dissens | Nicht oberflächlich | Bewahrt; kann Überprüfung auslösen |
| Charakteristischer Fehler-Modus | Fabrikation, Kriechzustimmung | Reduzierte Fabrikation (nach Debattenliteratur) |
Quelle: Design-Eigenschaften nach der Multi-Agent-Debattenliteratur (z. B. Du et al. 2024; Liang et al. 2024; Chan et al. 2023) und für die Orchestrierungsspalte die Systemdokumentation.
Der Fall hat eine reflexive Struktur, die nach Kenntnis des Autors kein anderes Verfahren bislang aufweist: Die strittige Technologie ist die Technologie, durch die der Streit geführt wird. Mehrere der Beklagten entwickeln Modelle, die Systeme dieser Art abfragen, das fragliche Orchestrierungssystem koordiniert diese gleichen öffentlich verfügbaren Modelle, und das in Teil V untersuchte Verfahrensverhalten fand statt, während diese Koordination in Gebrauch war. Nach der hier vorgebrachten Hypothese hat kein einzelnes Modell die Fähigkeit verliehen. Jedes weist die oben beschriebenen Fehlermodi eines einzelnen Modells auf, und jeder Beklagte, der ein bestandteiles Modell entwickelt, hatte konstruktionsgemäß Zugang zu höchstens seinem eigenen bestandteilen Modell. Die Konfiguration, die wichtig war, war eine relationale: heterogene Modelle von gegnerischen Anbietern, parallel abgefragt, sich gegenseitig überprüfend. Die Reflexivität leistet analytische Arbeit, weil sie die Komponententechnologie konstant hält: Welche Unterschiede der Akteninhalt auch offenbart, können nicht allein auf die Tatsache zurückgeführt werden, dass der Kläger Zugang zu besseren Komponentenmodellen hat als die Beklagten, da mehrere der Komponentenmodelle die eigenen der Beklagten waren; Konfiguration, Zugang und Bedienerkompetenz bleiben offene Erklärungen. Diese Forschungslinie ist auch nicht extern zu den Beklagten. Große KI-Labore haben selbst über die Vorteile von Multi-Agent- und Ensemble-Konfigurationen gegenüber einzelnen Modellen publiziert, und während des untersuchten Zeitraums zur Kommerzialisierung von modellübergreifender Verifizierung in ihren eigenen Produkten übergegangen.15 Die fragliche Architektur ist eine, die die Industrie selbst zunehmend unterstützt.
Orchestrierung verallgemeinert Multi-Agent-Debatte in ein operatives System (Abbildung 3). Während Debatte typischerweise mehrere Instanzen eines Modells ausführt, verteilt Orchestrierung eine Abfrage über heterogene Modelle verschiedener Anbieter, normalisiert ihre Ausgaben, berechnet einen Konsens und bewahrt, entscheidend, Divergenz als ein Signal erster Ordnung, anstatt sie in eine einzelne Antwort zu mitteln. Das in der Fallstudie verwendete Orchestrierungssystem ist eine Implementierung dieses Musters: Nach seiner technischen Dokumentation vereinigt es heterogene Modellabfragen, Konsensbildung, Divergenzbewahrung und Zitierverifizierung anhand externer Quellen.16
Die fragliche Orchestrierungsarchitektur ist ein spezifiziertes, konstruiertes Design. Sie ist Gegenstand einer Familie von ausstehenden Patentanmeldungen, darunter mehrere internationale Anmeldungen gemäß Patentzusammenarbeitsvertrag, die 2025 und 2026 eingereicht wurden.17
Die zwei Konfigurationen unterscheiden sich entlang mehrerer Designachsen, zusammengefasst in Tabelle 2. Zwei dieser Verpflichtungen sind analytisch bedeutsam. Eine ist Zitiervalidierung anhand externer Quellen. Das dominante Versagen eines einzelnen Modells in Verfahren, der halluzinierte Fall, entsteht, weil ein Modell Zitate aus gelernten Mustern erzeugt, anstatt sie zu finden, und eine Architektur, die jedes Zitat anhand einer Live-Datenbank überprüft und alles, das sie nicht bestätigen kann, kennzeichnet, anstatt es einzubeziehen, zielt auf diesen Fehler an seiner Quelle an. Das andere ist Bewahrung von Divergenz. Wenn sich Modelle über eine rechtliche Interpretation uneinig sind, kann ein Orchestrierungssystem so konfiguriert werden, dass Uneinigkeit als Auslöser für Konservatismus und menschliche Überprüfung behandelt wird, anstatt als Rauschen, das durch Mehrheitsvotum gelöst wird. In hochriskanten Bereichen kann Uneinigkeit zwischen unabhängigen Systemen selbst verwertbare Information darstellen, anstatt statistisches Rauschen: Ein Minderheitssignal, das einen möglichen Fehler anzeigt, wird bewahrt und hervorgehoben. Es wird nicht verworfen.
Abbildung 3. Das Orchestrierungsprinzip: parallele Abfrage, Vergleich und Bewahrung von Divergenz.
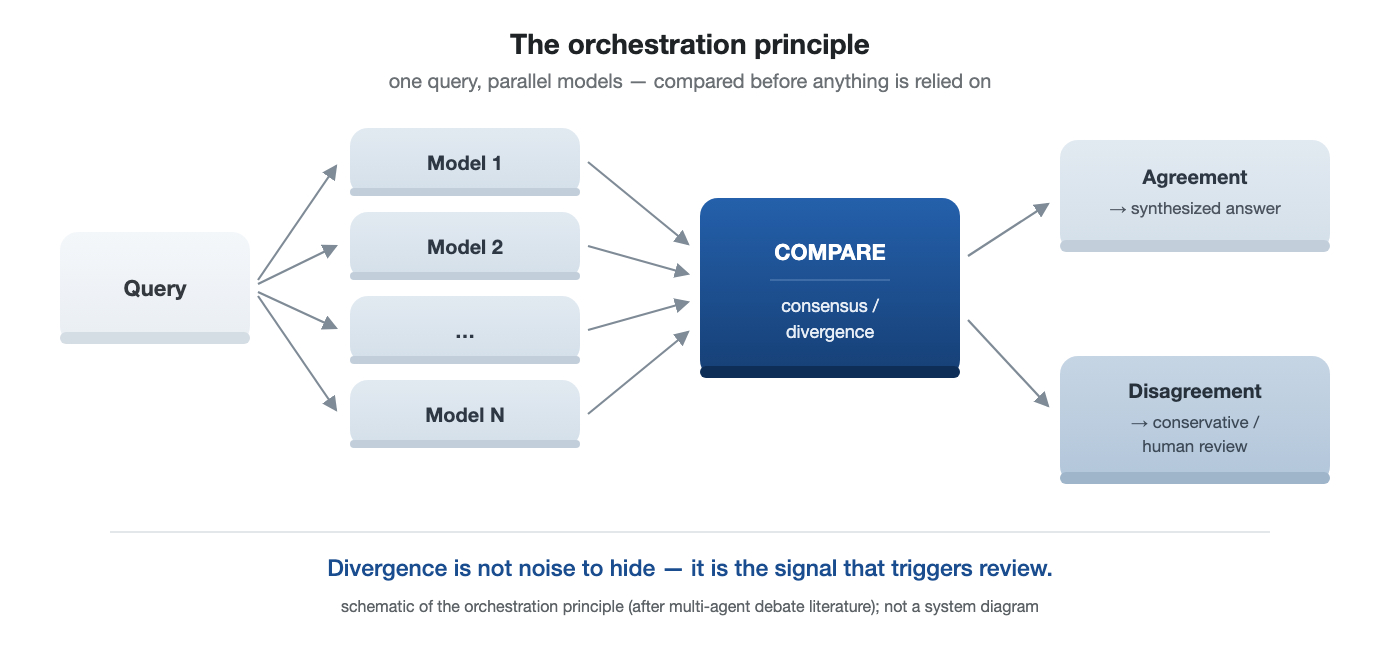
Quelle: Schematische Darstellung des allgemeinen Prinzips nach der Multi-Agent-Debattenliteratur; nicht ein Diagramm einer spezifischen Produktarchitektur.
Der strukturelle Punkt ist, dass die spezifischen Pathologien, die Gerichte gegenüber der pro-se-KI-Nutzung vorsichtig gemacht haben, charakteristisch für Single-Model-Prompting sind, und dass eine Orchestrierungsarchitektur auf diese Pathologien abzielt. Die dokumentierten Fehler sind Eigenschaften einer Konfiguration. Sie sind nicht Eigenschaften von KI-Unterstützung als solcher. In diesem Sinne verschiebt die Architektur die Quelle der Zuverlässigkeit von einem isolierten Modell zu Beziehungen zwischen Modellen: von isolierter Intelligenz zu koordinierter Intelligenz. Orchestrierung ist auch nicht exotisch: Kommerzielle Routing- und Multi-Model-Produkte legen zunehmend diese gleichen Designeigenschaften offen, weshalb die Abwesenheit von Architektur in der empirischen Rechtsliteratur umso auffälliger ist. Ob dieser architektonische Unterschied einen Unterschied im beobachtbaren Verfahrensverhalten erzeugt, ist eine empirische Frage, und der Rest des Artikels wendet sich einer Umgebung zu, in der sie gegen eine überprüfbare Aufzeichnung untersucht werden kann.
IV. Methode und Beweisgrundlage
Das Design ist eine Einzelfallstudie, eine Wahl, die die Art des Phänomens widerspiegelt: Multi-Model-Orchestrierung in laufenden Bundesverfahren ist derzeit selten, und das Ziel hier ist nicht, ihre Häufigkeit zu schätzen, sondern festzustellen, gegen eine überprüfbare Aufzeichnung, dass ein bestimmtes Muster von Verhalten aufgetreten ist und es zu charakterisieren. Qualität, wie durchgehend verwendet, bezieht sich auf beobachtbares Verfahrensverhalten, das aus der Akte überprüfbar ist: Einhaltung von Fristen, Zitiergenauigkeit, verfahrensmäßige Korrektheit, Responsivität gegenüber der Akte und die Kohärenz eingereichten Arguments. Sie bezieht sich nicht auf Ergebnisse, die kein einzelner Fall rechtfertigen kann. Ein Fall dieser Art verdient Aufmerksamkeit: Echter gegnerischer Rechtsstreit, mit Fristen, Gegnern und Konsequenzen, kann eine sinnvollere Umgebung bieten zur Beobachtung von KI-gestütztem menschlichem Denken als Laborauswertung allein. Teil VII kehrt zu dieser Begrenzung zurück. Von diesen Dimensionen konzentrieren sich die Ergebnisse in Teil V hauptsächlich auf Fristeinhaltung, verfahrensmäßige Korrektheit und Zitiergenauigkeit; die Kohärenz eingereichten Arguments ist in der Akte dokumentiert, anstatt unabhängig bewertet zu sein, und keine Erkenntnis hängt vom Ergebnis eines ausstehenden Antrags ab.
Die Grundlage der Beweise ist unabhängig abrufbar: jede in diesem Artikel zitierte Einreichung wird durch ihre ECF-Nummer identifiziert und kann von jedem Leser direkt über PACER unter den unten angegebenen Aktenzeichen ohne Abhängigkeit vom Autor abgerufen werden. Sie besteht aus dem öffentlichen Bundesaktenplan in Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.), zusammen mit dem Aktenplan des früheren Verfahrens, No. 1:25-cv-07770 (S.D.N.Y.), in dem ein anderer Beklagter benannt wurde. Die Struktur des Falls lässt sich in Zahlen darstellen, alle vom Aktenplan verifizierbar: von dreizehn benannten Beklagten erschienen zehn; sieben schlossen sich einem gemeinsamen Antragsschreiben zum Erlass an; vier einigten sich und wurden mit Präjudiz abgewiesen; und sechs befanden sich im Juni 2026 noch im Verfahren (Tabelle 3). Drei der dreizehn erschienen nie, und die Akten zeigen Zustellungs- und Behördenfeststellungsschwierigkeiten bezüglich dieser Beklagten; sie erklären nicht, warum diese nicht erschienen. Ein ausländischer Beklagter wurde zur Zustellung über Chinas Zentralbehörde gemäß dem Haager Zustellungsübereinkommen übermittelt. Es kam nichts zurück: keine Bestätigung, keine Ablehnung. Ein inländischer Beklagter benötigte vier Versuche über mehrere Staaten, bevor die Klage seinen registrierten Bevollmächtigten erreichte, bestätigt durch einen unter Eid stehenden Zustellungsbeamten. Kein Erscheinen folgte. Ein dritter berief sich auf seine eigene Unternehmensstruktur, um anzufechten, welche Körperschaft benannt worden war. Unternehmensstruktur und grenzüberschreitende Verfahren können in der Praxis als prozessuales Schutzschild fungieren, und sich durch diese hindurchzuarbeiten ist eine Aufgabe, die eine vertretene Partei normalerweise spezialisiertem Anwälten oder Anbietern überträgt, was hier der selbstvertretene Kläger selbst für alle dreizehn tat. Alle sachlichen Aussagen in Teil V zum Verfahrensverhalten stammen aus eingereichten Dokumenten, die nach Aktennummer und Datum identifiziert sind und die jeder Leser unabhängig abrufen kann, außer die Methode der KI-Unterstützung des Prozessierenden, die ein Aktenplan nicht verzeichnet. Wenn der Artikel auf Aussagen vor Gericht verweist, stützt er sich auf das offizielle Protokoll; wenn er auf die Argumente der Parteien verweist, stützt er sich auf die Einreichungen selbst (den gemeinsamen Antragsschreiben und die unterstützende Gegenüberstellung der Beklagten sowie die Gegenerwiderung des Klägers) statt auf irgendwelche Charakterisierungen durch eine Partei.18
Aus der Rolle des Autors, die zu Beginn offengelegt wurde, folgen drei methodische Beschränkungen. Erstens ist die Analyse auf die öffentliche Akte beschränkt; sie stützt sich nicht auf das privilegierte Wissen des Autors über Prozessstrategie und offenbart keine Arbeitsprodukte zu Ansprüchen, die gegen die nicht beilegenden Beklagten anhängig bleiben. Zweitens unterscheidet der Artikel durchgehend zwischen dem, was der Aktenplan feststellt (Daten, Einreichungen, Entscheidungen, der Text von Dokumenten), und dem, was nicht: die subjektiven Motive der Parteien, und insbesondere die Gründe für irgendwelche Beilegung, deren Bedingungen vertraulich sind. Drittens werden Behauptungen der eigenen Dokumentation des Orchestrierungssystems über seine Leistung als Selbstmeldung behandelt und nicht als Wirksamkeitsbeweise herangezogen; die Ergebnisse beruhen auf in der Akte sichtbarem Verfahrensverhalten, nicht auf der Darstellung des Systems.
Eine Asymmetrie in der Grundlage der Beweise qualifiziert die gerade beschriebene Methode. Die abhängige Variable dieser Studie, Verfahrensverhalten, ist vollständig vom Aktenplan verifizierbar: jede Einreichung, jedes Datum und jedes in Teil V analysierte Dokument kann von jedem Leser abgerufen werden. Die unabhängige Variable ist auf diese Weise nicht abrufbar. Die öffentliche Akte stellt fest, dass das Orchestrierungssystem existiert und seine Architektur dokumentiert: die operative Beschwerde charakterisiert das System, die Patentanmeldungen spezifizieren den Plan, und die technischen Exponate des Widerspruchs beschreiben seine Orchestrierungsmerkmale. Was die Akte nicht zeigen kann, ist welche Methode der KI-Unterstützung eine bestimmte Einreichung hervorbrachte, oder wann sich die Arbeitsmethode des Prozessierenden änderte. Diese Fakten beruhen auf dem eigenen Bericht des Autors über seinen Prozess, und der Artikel markiert sie als solche, wo sie erscheinen. Die Studie koppelt daher eine verifizierbare Leistungsaufzeichnung mit einer selbstgemeldeten Eingabeaufzeichnung, und die in Teil VII vorgeschlagenen kontrollierten Designs sind so konstruiert, dass die Architekturvariable beobachtet statt berichtet wird; der Anhang spezifiziert ein Laufmanifest zu diesem Zweck.
Die Akte stellt fest, dass ein selbstvertreteter Prozessierender, der ein Orchestrierungssystem nutzt, bestimmte Einreichungen nach einem bestimmten Plan produzierte. Sie kann nicht feststellen, dass das System, statt der eigenen Fähigkeiten des Prozessierenden, ihre beobachteten Merkmale hervorbrachte. Der Artikel beschreibt daher das Verhalten und seinen architektonischen Kontext und behandelt die Kausalfrage als offen, um durch die in Teil VII vorgeschlagene kontrollierte Studie adressiert zu werden.
Formal ausgedrückt, ist die hier vertretene Hypothese die folgende:
Architektur-Abhängigkeits-Hypothese. Unter Konstanthaltung der Verfügbarkeit generativer KI funktioniert die Architektur der KI-Unterstützung (Single-Model-Prompting gegenüber Multi-Model-Orchestrierung) als eine unterschiedliche empirische Variable (Abbildung 4): Die Unterstützungsweise ist mit messbaren Unterschieden in beobachtbarem Verfahrensverhalten verbunden, einschließlich Fristenbeachtung, Zitiergenauigkeit, prozeduraler Richtigkeit und Reaktionsfähigkeit auf die Akte. Die Hypothese ist falsifizierbar: ein systematischer Vergleich von pro-se-Einreichungen, kodiert nach Unterstützungsmodus, der keine solche Assoziation fände, würde sie widerlegen.
Abbildung 4. Die Architektur-Abhängigkeits-Hypothese als eine Anspruchskette. Jeder Link ist ein zu testender Anspruch, kein Ergebnis.
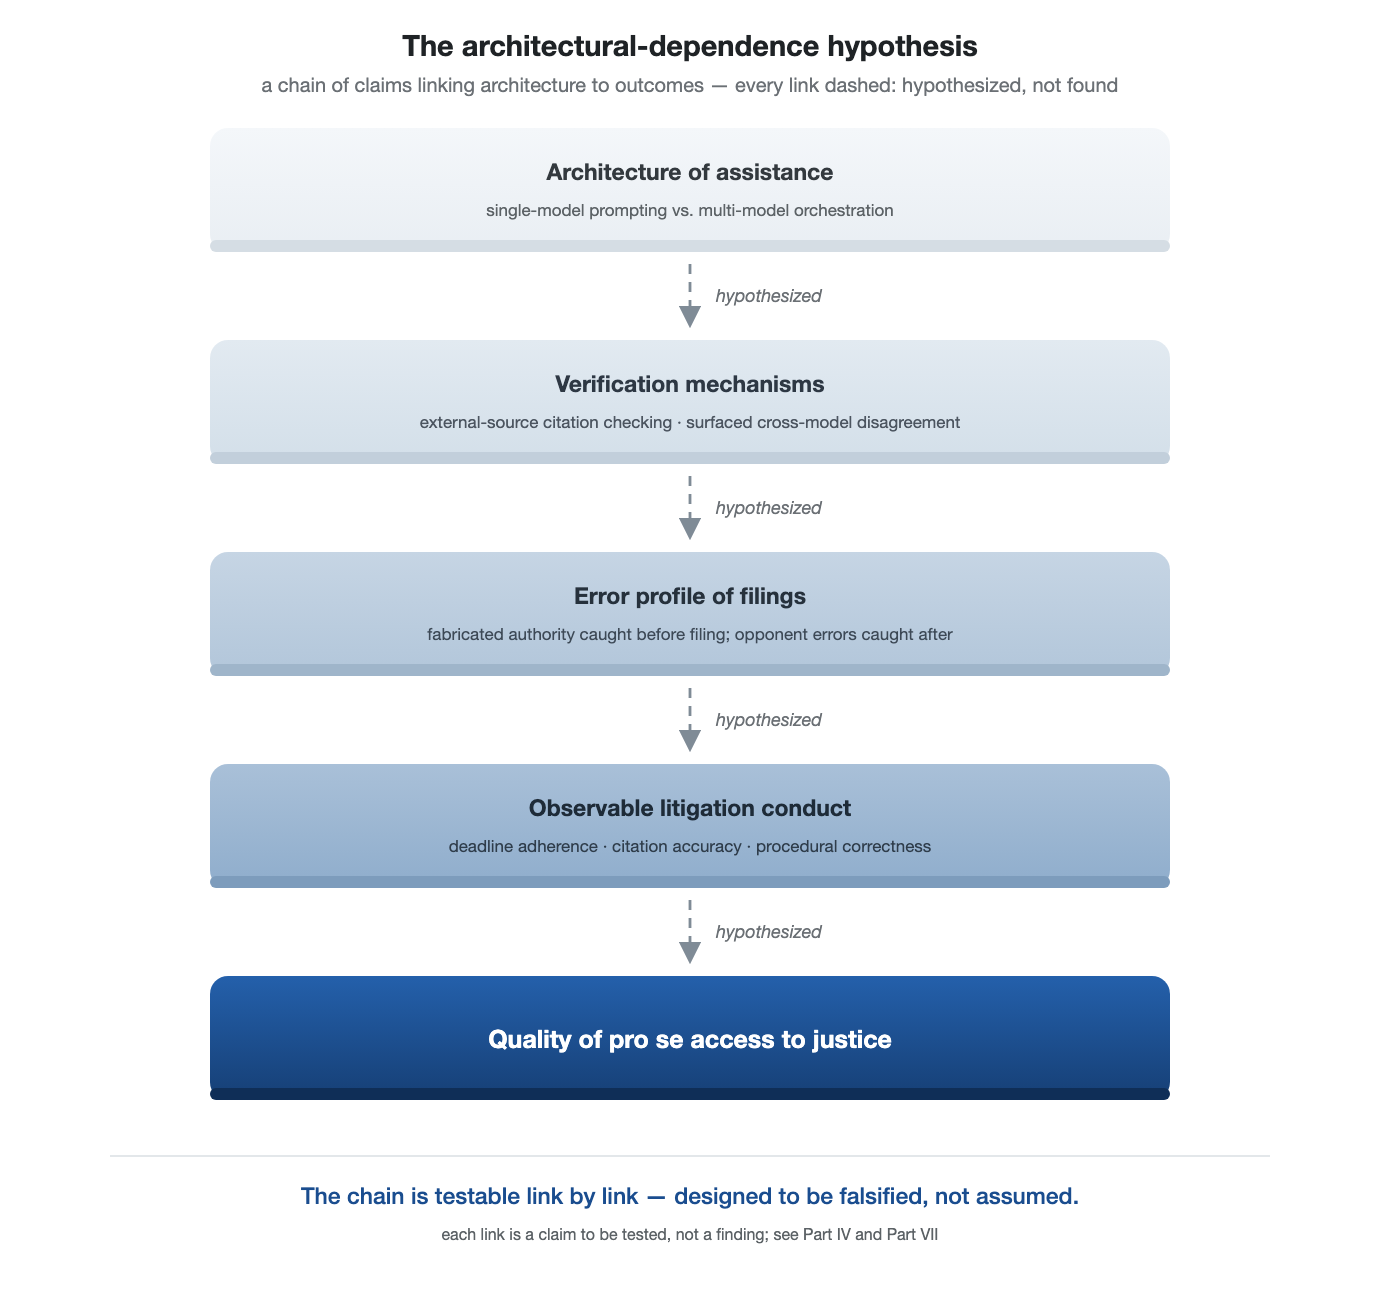
Quelle: Schematische Darstellung des Autors der im Text angegebenen Hypothese; gestrichelte Pfeile markieren hypothetisierte, nicht getestete Links.
V. Ergebnisse
Mehrere Merkmale des Verfahrens betreffen die hier gestellte Frage, und Abbildung 5 stellt sie in Sequenz.
Die Disproportion der rechtlichen Ressourcen in diesem Fall ist nicht nebensächlich zur Studie; sie ist die Bedingung, die der Studie ihren Sinn gibt. Auf einer Seite war ein einzelner selbstvertreteter Prozessierender ohne Juristenausbildung und ohne Anwalt jeglicher Art, nicht einmal mit beschränkter Reichweite. Auf der anderen Seite war eine Verteidigung, in der Anwälte aus zahlreichen führenden Kanzleien sich zu einer gemeinsamen Front zusammenfanden, einen gemeinsamen Antragsschreiben im Namen von sieben Beklagten einreichten und ihre Einreichungen untereinander koordinierten. Eine Konstellation, in der ein unvertretener Einzelner einen vollständigen Schriftwechsel gegen diese Ausrichtung aufrechterhielt, jeden Stichtag erfüllte, in der Sache antwortete und einen Fehler identifizierte, den die ausgerichteten Kanzleien nicht erkannten, ist nahe an dem, was die Zugang-zur-Justiz-Literatur als nicht geschehend behandelt. Der Rest dieses Teils dokumentiert es, auf einem öffentlichen Aktenplan; was es möglicherweise erklärt, ist die Frage, der der Artikel als Ganzes nachgeht.
Abbildung 5. Verfahrenschronologie des Falls.
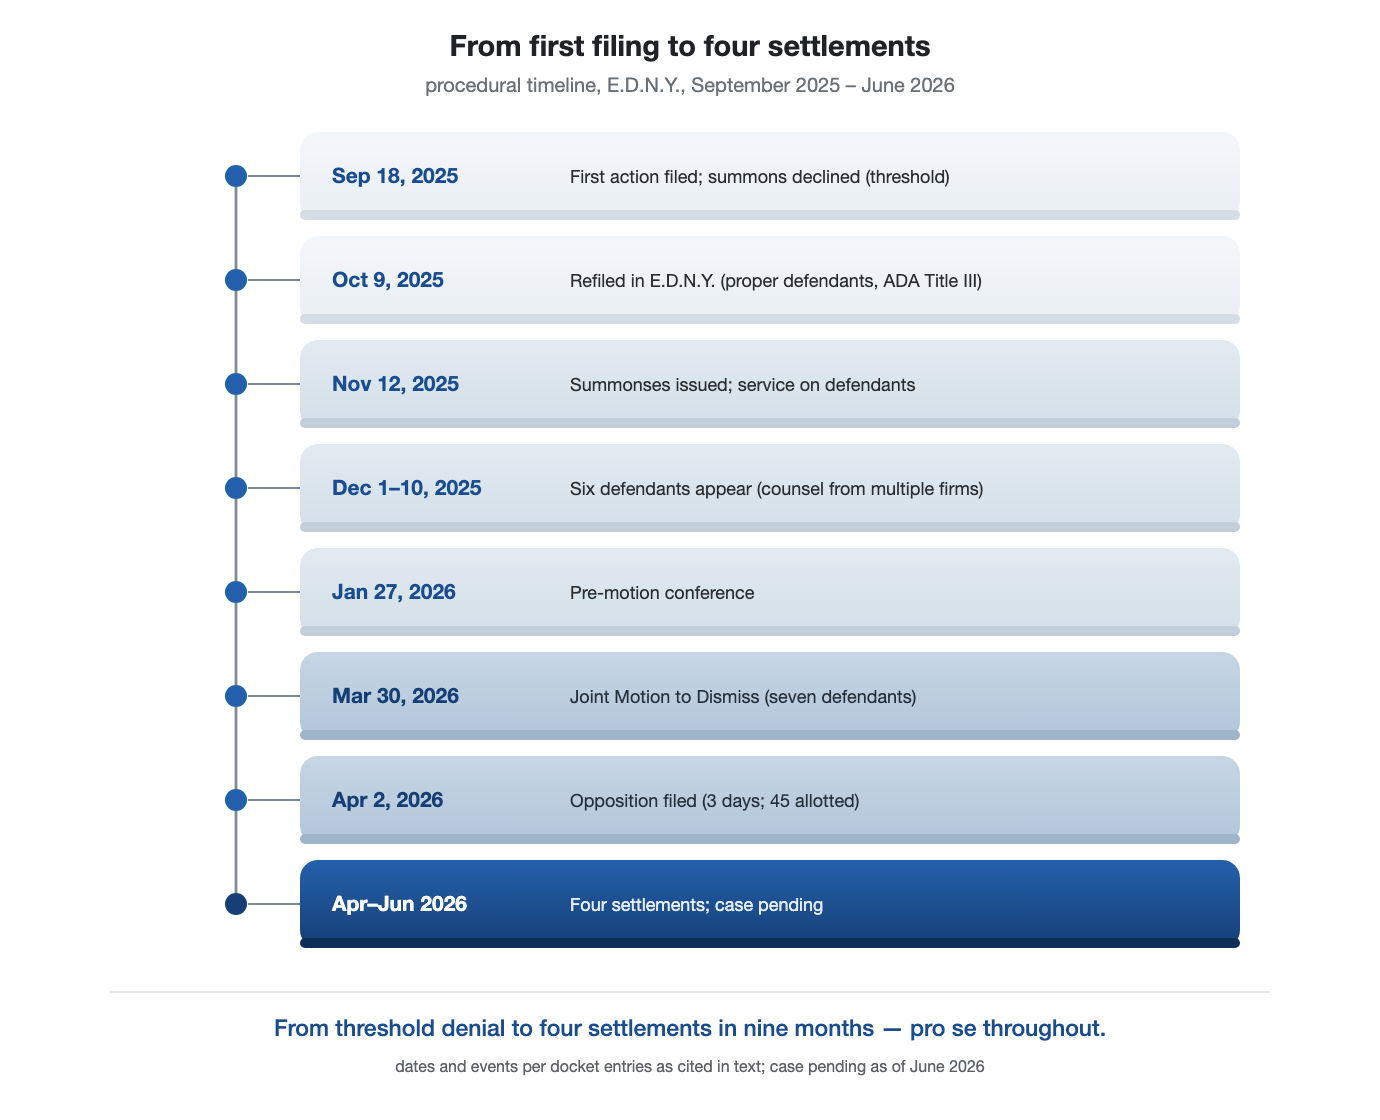
Quelle: Public docket, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), and the related earlier action.
A. Rekonstruktion des Rechtsrahmens nach einer anfänglichen fehlerhaften Klageeinreichung.
Die erste Klage des Klägers, die im September 2025 eingereicht wurde und öffentlich zugänglich ist, war in mehreren unabhängigen Aspekten verfahrensfehlerhaft: Sie wurde im Namen einer Gesellschaft mit beschränkter Haftung eingereicht, die nicht ohne Anwalt verhandeln kann; gegen den falschen Beklagten; im falschen Bezirk; und unter der falschen Bestimmung des ADA. Das Gericht wies sie an der Schwelle ab und lehnte es ab, eine Vorladung auszustellen. Eine zweite Klage, die etwa drei Wochen später persönlich und im richtigen Bezirk eingereicht wurde, stellte den Anspruch unter der angemessenen Bestimmung des Gesetzes dar, benannte die ordnungsgemäßen Beklagten und war von einer erheblich erweiterten Beweisvorlage begleitet. Eine Änderung der Methode begleitete die Korrektur. Nach eigenem Bericht des Autors hatte der Kläger durch die erste Klageeinreichung mit einem einzigen Modell auf einem Verbrauchergerät gearbeitet, und die Rekonstruktion fiel mit der erstmaligen Verwendung einer vollständigen Multi-Modell-Orchestrierung durch direkten Modellzugriff zusammen. Das Docket kann diese Abfolge nicht bestätigen, und sie wird nicht als Grund angeboten. Was das Docket zeigt, ist die Korrektur selbst, die erste Episode, die dieser Artikel untersucht: Die Akten zeigen einen schnellen Übergang von einer an der Schwelle abgewiesenen Klageeinreichung zu einer, die zur Zustellung führte und das Erscheinen mehrerer vertretener Beklagter zur Folge hatte. Die Rekonstruktion ist die Art einer umfassenden, mehrfach überprüften Revision des Rechtsrahmens, die ein Orchestrierungs-Workflow, der mehrere Modelle zu Forum, Anspruchsgrundlage und Klagestandard abfragt, unterstützen soll.
B. Reaktion auf koordinierte Anträge vor der Hauptantragstellung.
An einem einzigen Abend, dem 12. Januar 2026, reichten sechs Beklagte innerhalb von etwa vier Stunden und dreißig Minuten sechs Vorschreiben zur Antragstellung ein, nachdem sie gemeinsam um eine Fristverlängerung gebeten hatten, um gemeinsam einreichen zu können.19 Nach den einzelnen Praktiken des Gerichts erforderte jedes Schreiben eine Gegenäußerung der Klägerin innerhalb von fünf Geschäftstagen. Sechs Gegenerwiderungen, jede auf die Argumente eines bestimmten Beklagten zugeschnitten, wurden innerhalb von vier Tagen eingereicht.20 Die Episode betrifft mehr als nur Geschwindigkeit: Eine Reaktion auf eine koordinierte, mehrseitige Antragstellung kann nicht im Voraus abgeschlossen werden, da ihre Ausrichtung durch sechs Dokumente festgelegt ist, die erst an dem Abend ihrer Einreichung entstanden. Aber die den Beklagten in einem Fall dieser Art zur Verfügung stehenden Argumente stammen aus einem vorhersehbaren Repertoire: Klagebefugnis, die Anwendbarkeit von Titel III auf digitale Dienste, Mangelhaftigkeit der Klage. Eine fleißige Partei kann modulare Reaktionen auf vorausgesehene Argumente vorbereiten und sie nach Eintreffen der Schreiben anpassen. Vorausgehende Entwurfsarbeit ist daher durch diese Episode eingeengt, nicht aber ausgeschlossen: Was das viertägige Intervall etabliert, ist die Zusammenstellung, Anpassung und Einreichung von sechs einzeln adressierten Gegendarstellungen gegen sechs unterschiedliche Einreichungen. Was es nicht etablieren kann, ist, wie viel ihres Inhalts den Schreiben vorausging.
C. Zeitnahe Gegenäußerung zu einer konsolidierten Gegenposition.
Nach einer Vorkonferenz, in der das Gericht die Beklagten einlud, doppelte Schriftsätze zu vermeiden, reichten sieben Beklagte, darunter alle sechs, die Vorschriftsätze eingereicht hatten, einen gemeinsamen Antragsschriftsatz mit begleitender Begründung ein. Nach dem Gerichtsplan war die Gegenäußerung des Klägers etwa fünfundvierzig Tage später fällig. Die Gegenäußerung war auf den 2. April 2026 datiert (drei Tage nach der Einreichung des Antrags am 30. März) und wurde am folgenden Tag in die Akten eingereicht, etwa sechs Wochen vor der Antwortfrist vom 14. Mai. Es handelte sich um eine achtundzwanzig-seitige Begründung, begleitet von einer eidesstattlichen Erklärung und umfangreichen Anlagen. Abbildung 6 stellt die Antwortzeiträume gegen die Vorbereitungszeiträume der Gegenseite für beide Schriftsatzrunden gegenüber. Die Beobachtung betrifft die Tatsache einer sachlichen, zeitnahen und angemessenen Gegenäußerung, nicht ihre Begründetheit, eingereicht von einem in Eigenvertretung handelnden Prozessparteien gegen eine koordinierte Gegenposition, vertreten durch Anwälte mehrerer Kanzleien. Der relevante Punkt ist eher struktureller als persönlicher Natur: inhaltlich auf mehrere unterschiedliche Briefe gleichzeitig zu antworten ist die Art von paralleler, multi-Thread-Aufgabe, für deren Verteilung ein Multi-Modell-Arbeitsablauf strukturiert ist, im Gegensatz zu dem Single-Thread-Prompting, das die Fachliteratur voraussetzt. Das Timing ist wichtig für mehr als nur Compliance: ein Antrag, der während der gesamten Antwortzeitspanne unbeantwortet auf einem öffentlichen Docket liegt, präsentiert während dieses Zeitraums jedem, der die Akten liest, nur die Darstellung der Antragsteller. Eine Gegenäußerung, die innerhalb weniger Tage eingereicht wird, verkürzt diese Zeitspanne erheblich. Eine solche Asymmetrie läuft normalerweise gegen in Eigenvertretung handelnde Parteien, die die Zeitspanne normalerweise nicht verkürzen können.
Abbildung 6. Vorbereitungs- und Antwortzeiträume nach Schriftsatzrunde.
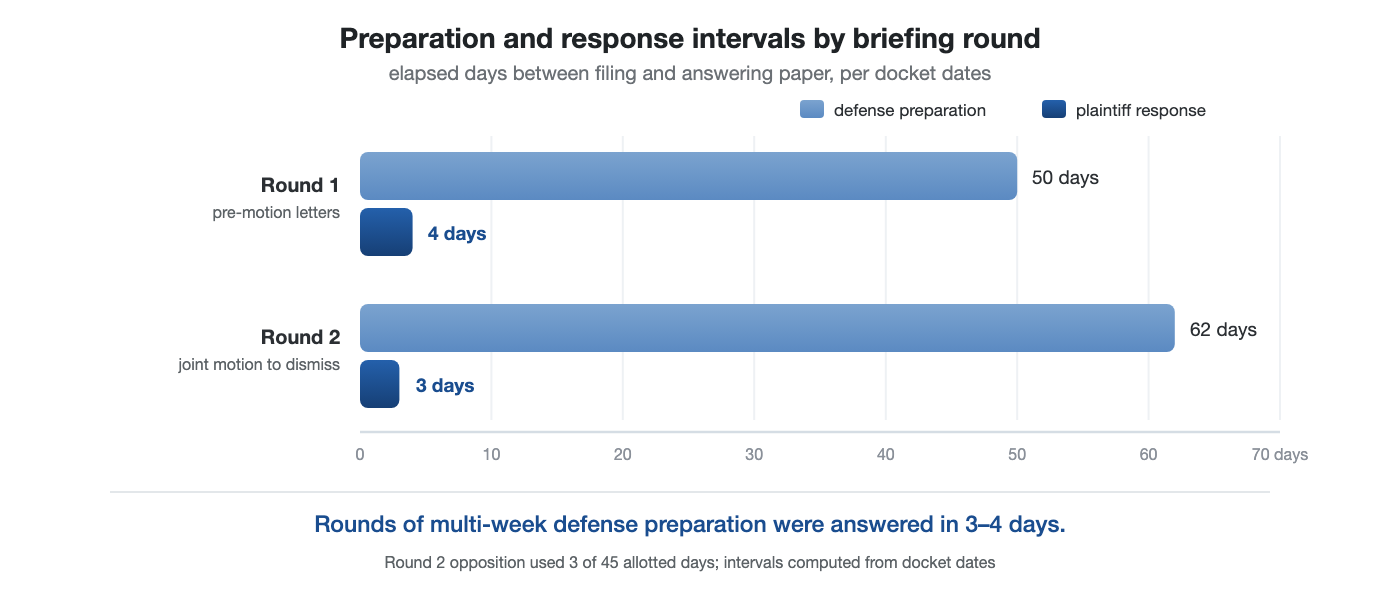
Quelle: Öffentliches Docket; verstrichene Tage zwischen dem maßgeblichen Schriftsatz und dem Datum des Gegenarguments in jeder Runde (Dokumentdaten; Docket-Eintrag kann um einen Tag folgen). Das Verteidigungsintervall in der ersten Runde wird von der Zustellung (November 2025) bis zu den koordinierten Vorschriftsätzen vom 12. Januar 2026 gemessen. Verstrichene Intervalle begrenzen die Vorbereitungszeit von oben; sie unterscheiden nicht zwischen Schreibzeit und strategischem Timing.
D. Identifikation eines Fehlers bei der Gesetzeszitierung in der Gegenstellungnahme der Verteidigung.
Die Gegenäußerung des Klägers identifizierte einen Fehler in der Gesetzesgrundlage, auf die in der gemeinsamen Antragsschrift Bezug genommen wurde. Bei der Behandlung des Elements der „vollständigen und gleichberechtigten Nutzung" zitierte die Gegenstellungnahme der Verteidigung 42 U.S.C. § 12184 (ECF Nr. 69-1, S. 15), die Bestimmung, die bestimmte öffentliche Verkehrsmittel regelt, die von privaten Unternehmen betrieben werden, wie Busse, Taxis und Limousinen, während die Anspruchsgrundlage sich auf 42 U.S.C. § 12182 bezieht, die Bestimmung für öffentliche Einrichtungen (Plaintiff's Opposition, ECF Nr. 76, S. 17).21 Die paradigmatische Sorge bei der KI-Nutzung von Laienvertretern ist das erfundene Zitat: eine Autorität, die nicht existiert, von einem Modell erzeugt und von einem Prozessparteienvertreter eingereicht. Hier zeigt sich der überprüfbare Fehler bei der Gesetzeszitierung in einer Schrift, die von einem Anwalt eingereicht wurde, und er wurde in einer Schrift identifiziert, die von einem Prozessparteienvertreter ohne anwaltliche Vertretung unter Verwendung eines Orchestrierungssystems eingereicht wurde, dessen dokumentiertes Design die Validierung von Zitaten gegen externe Quellen umfasst. Orchestrierung, wie in Teil III definiert, bündelt zwei Mechanismen, Meinungsverschiedenheiten zwischen Modellen und Validierung gegen externe Quellen, und eine vertauschte Abschnittsnummer ist die Art von Fehler, die der zweite Mechanismus erkennen soll. Eine Debatte zwischen mehreren Modellen ist dafür nicht erforderlich. Nach Angabe des Autors wurde der Fehler durch den Arbeitsablauf und nicht durch den Prozessparteienvertreter aufgedeckt: ein Modell kennzeichnete die Diskrepanz zwischen dem zitierten Abschnitt und der Bestimmung, auf die sich der Anspruch bezieht, das konsolidierende Modell überprüfte dies und bestätigte es, und der Kritiker überprüfte es erneut. Der Prozessparteienvertreter ist kein Anwalt und hätte den Fehler weder finden noch die Korrektur selbst überprüfen können. Die betroffene Eigenschaft ist die Validierungskomponente, nicht das Bündel als Ganzes. Die Richtung der Korrektur läuft dem Muster entgegen, das die Literatur erwarten lässt; sein Gewicht bei der Entscheidung über den Antrag liegt beim Gericht. Der Fehler ist unabhängig überprüfbar für jeden Leser: die beiden Bestimmungen liegen zwei Abschnitte auseinander im gleichen Unterkapitel des U.S. Code, und die Zitierung von § 12184 in der Gegenstellungnahme der Verteidigung ist auf der Seite sichtbar. Die beiden Bestimmungen tragen parallele operative Formulierungen, jede garantiert „volle und gleichberechtigte Nutzung" in ihrem Bereich, und die Ersetzung ist daher die Art, die ein Leser beim Lesen mit Lesegeschwindigkeit aufnimmt, ohne es zu bemerken, und nicht übersehen kann, wenn jedes Zitat gegen seine Quelle überprüft wird. Was sie unterscheidet, ist der Anwendungsbereich: § 12184 regelt bestimmte öffentliche Verkehrsmittel, die von privaten Unternehmen betrieben werden, nicht Orte der öffentlichen Nutzung. Die Gegenäußerung des Klägers kritisierte die fehlerhafte Zitierung als „nicht nur formaler Natur", weil sie in der Behandlung eines entscheidenden Elements in der Gegenstellungnahme erschien; eine vertauschte Abschnittsnummer ist keine erfundene Autorität. Das Erkennen einer fehlerhaft zitierten Gesetzesbestimmung in einer Gegenstellungnahme ist das Gegenteil des Ausfallszenarios, das die Literatur zur KI-Nutzung von Laienvertretern dominiert, nämlich das Generieren von fehlerhaft zitierten Bestimmungen in der eigenen Schrift.
Die Zuschreibung ist eine separate Frage vom Fehler selbst. Die implizite Regel der Literatur ordnet Fehler von KI-unterstützten Laienvertretern der Kategorie zu, als Beweis für das, was die Technologie bewirkt, und Fehler von Anwälten dem Individuum, als Versehen in einer ansonsten zuverlässigen Praxis. Der hier dokumentierte Fall bietet eine Überprüfung dieser Regel, und er wird am besten als Frage formuliert: Hätte ein Prozessparteienvertreter ohne anwaltliche Vertretung, der generative KI nutzt, die Bestimmung zur Beförderung des ADA statt der Bestimmung für öffentliche Einrichtungen bei einem entscheidenden Element zitiert, würde der Fehler als isoliertes Versehen gelesen, oder als ein weiterer Eintrag im Katalog dessen, was geschieht, wenn Laien mit Chatbots vor Gericht auftreten? Die beiden Lesarten würden wahrscheinlich nicht übereinstimmen, und diese Asymmetrie der Zuschreibung, nicht der Fehler selbst, ist Teil dessen, was die Architektur-Abhängigkeitshypothese die Literatur zu untersuchen auffordert: ob Verhalten danach kodiert wird, wer es hervorbrachte, anstatt danach, wie es hervorgebracht wurde. Die Asymmetrie bleibt überdies bestehen gegen eine bewegliche Baseline: wie Teil II dokumentiert, sind die dokumentierten Halluzinationsfälle nicht mehr überwiegend ein Phänomen von Laienvertretern, aber die Rahmung der systemischen Bedrohung bleibt an der Seite der Laienvertreter in der Docketliste angeheftet.
E. Frühe Vergleiche.
Abbildung 7. Abfolge der vier Vergleiche.
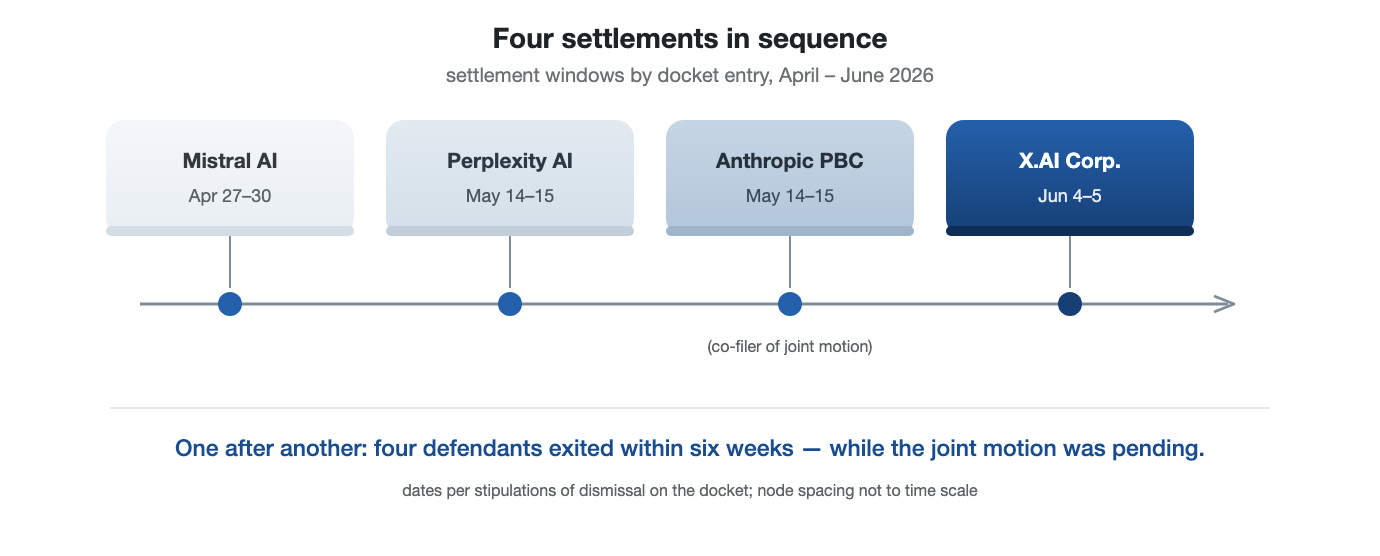
Quelle: Öffentliches Dossier, ECF Nos. 83–86 und 94 (Verzichtsanträge mit Präklusion; ECF Nos. 83 und 84 sind zwei Anträge an demselben Tag zur Mistral-Vereinbarung, die Einstellung zitiert No. 84).
Vier Beklagte, die das Verfahren eingeleitet hatten, einigten sich mit der Klägerin und wurden innerhalb eines kurzen Zeitraums mit Präklusion abgewiesen (Abbildung 7). Wie üblich sind auf dem öffentlichen Dossier nur die Verzichtsanträge enthalten; die Vergleichsbedingungen sind vertraulich, die Gründe sind nicht zu den Akten genommen, und es wird kein Grund abgeleitet. Dieser Abschnitt dokumentiert eine Vergleichsabfolge, die normalerweise unsichtbar ist, und macht sie dadurch überprüfbar.
Zwei Merkmale der Abfolge sind erwähnenswert, da sie auf dem öffentlichen Dossier sichtbar sind. In mindestens zwei Fällen verließ ein Beklagter, der sich der koordinierten Verteidigung angeschlossen hatte, diese anschließend durch Verzichtsantrag, wobei einer nach Einreichung der Gegenäußerung und vor der Stellungnahme des Bündnisses verglichen wurde; der andere, nachdem er zunächst das gemeinsame Memorandum des Bündnisses in seinen eigenen Antrag aufgenommen hatte. Das chronologische Muster ist eine Angelegenheit öffentlicher Einreichung: Beklagte, die eine gemeinsame Front gebildet hatten, verließen diese einzeln, während der Antrag, dem sie beigetreten waren, noch ausstehend war.
Das andere Merkmal besteht darin, dass Vergleiche zwischen juristischen Personen als Beklagte und einer in Eigenregie prozessierenden Partei normalerweise vertraulich sind und wenig Spuren im öffentlichen Dossier hinterlassen. Hier sind die Verzichtsanträge selbst Dossiereinträge, wodurch die Abfolge ungewöhnlich lesbar ist; der Beweiskraftwert dieser Urkunde liegt in ihrer Überprüfbarkeit.
Tabelle 3. Status der dreizehn benannten Beklagten (Stand Juni 2026).
| Status | Beklagte |
| Nicht vorgeladen | Samsung; DeepSeek; OpenAI |
| Verglichen und abgewiesen | Mistral AI; Perplexity AI; Anthropic PBC; X.AI Corp. |
| Laufend | Microsoft; Apple; Google; Meta; Amazon; Alibaba Cloud |
Quelle: Öffentliches Dossier, Stand Juni 2026.
Abbildung 8 reproduziert die Dossiererfolge eines einzelnen Tages, 4. Juni 2026, als primäres Dokument. Sie wird eingefügt, damit Sie den zeitlichen Ablauf unmittelbar überprüfen können. Welche Konfigurationen von KI-unterstützter Prozesstätigkeit erzeugen Aufzeichnungen dieser Form, und wie häufig? Diese Frage gehört zu der systematischen Untersuchung, die Teil VII vorschlägt.
Abbildung 8. Dossierfolge am 4. Juni 2026.
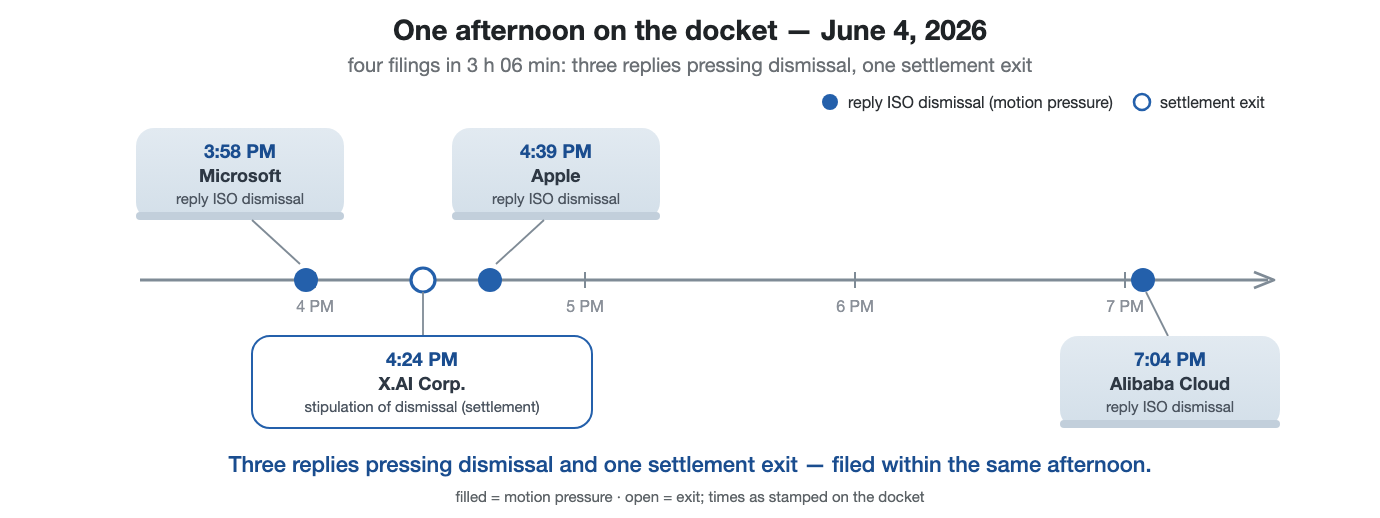
Quelle: Öffentliches Dossier; Einreichungszeiten an einem einzelnen Tag, ECF Nos. 93–96.
Diese Merkmale zusammen beschreiben eine in Eigenregie prozessierende Partei, die ein mehrteiliges Bundesverfahren durch einen vollständigen Schriftsatzkreislauf aufrechterhält, Fristen einhält, proportional antwortet und einen Fehler eines Gegners identifiziert, gegen eine koordinierte, vertragende Verteidigung. Das ist nicht das Muster, das die herrschende Darstellung beschreibt. Diese Darstellung von undifferenziertem Volumen und unzuverlässiger Leistung charakterisiert eine Verteilung, und ein einzelner Fall kann eine Verteilung nicht widersprechen; aber das hier dokumentierte Muster fällt außerhalb dessen, was die aggregierten Studien messen, weshalb es für sie unsichtbar geblieben ist. Ob die Orchestrierungsarchitektur für das Muster verantwortlich ist, und ob das Muster sich über Fälle hinweg wiederholt, sind Fragen, die die nächsten Teile für systematische Untersuchung festlegen.
VI. Doktrinäre Auswirkungen
Die schwierigeren Fragen sind doktrinär, und zwei davon werden derzeit vor den Bundesgerichten verhandelt. Ziel ist es zu zeigen, wie ein orchestrierungsgestützter, qualitätsorientierter Bericht über die Nutzung von KI durch in Eigenregie prozessierende Parteien jede umrahmt. Gerichte verfügen bereits über ein ausgefeiltes Rahmenwerk zur Bewertung von KI-Ergebnissen als Beweise (Grimm, Grossman & Cormack 2021). Die hier gestellten Fragen sind angrenzende: Sie befassen sich nicht damit, ob maschinelle Ergebnisse zulässig sind; beide betreffen, wer den Prozess besitzt, der die Ergebnisse hervorgebracht hat, und ob dieser Prozess Jura praktiziert.
A. Arbeitsergebnis und der Prozessbestand ohne Anwalt.
Ob die Interaktionen eines Prozessbeteiligten mit einem KI-System vor der Offenlegung als Arbeitsergebnis geschützt sind, wird neu angefochten. Innerhalb einer Spanne von sieben Wochen im Frühjahr 2026 erreichten drei Bundesgerichte die Schnittstelle zwischen KI-Nutzung und Arbeitsergebnisschutz, und sie sprachen nicht mit einer Stimme.22 In Warner v. Gilbarco, Inc. lehnte ein Richterin die Antrag ab, eine Klägerin ohne Anwalt zu zwingen, ihre generativen-KI-Anfragen und die erhaltenen Antworten vorzulegen, und hielt fest, dass die Materialien unter Federal Rule of Civil Procedure 26(b)(3) als Arbeitsergebnis geschützt waren: Eine Selbstvertreterin handelt als ihre eigene Anwältin, die Materialien spiegelten ihre geistigen Eindrücke und Vorbereitung wider, und die Offenlegung gegenüber einem KI-System, einem Werkzeug und nicht einer Person, war nicht die gegnerische Offenlegung, die ein Verzicht erfordert. Die Entscheidung sitzt in der ältesten Schicht der Doktrin, da das, was Hickman v. Taylor am stärksten schützte, die geistigen Eindrücke, Schlussfolgerungen und Theorien des Anwalts waren: die Stufe des Arbeitsergebnisses, das Gerichte als nahezu absolut behandeln (Hickman v. Taylor, 329 U.S. 495, 510–11 (1947)). Die Anfragen, die eine Prozessbetelligte formuliert, die Entwürfe, die sie überarbeitet, und die Argumente, die sie verwirft, sind das Analogon dieser Stufe für Selbstvertretung. Eine Woche später erreichte ein Gericht in United States v. Heppner das entgegengesetzte Ergebnis: Ein verurteilter Straftäter mit Anwalt hatte auf eigene Initiative, ohne jede Beteiligung der Anwältin, einen öffentlichen KI-Assistenten genutzt, und das Gericht ordnete die Herausgabe der resultierenden Dateien an, wobei es betonte, dass er ohne Anweisung der Anwältin gehandelt hatte und dass die Bedingungen der Plattform dem Anbieter erlaubten, seine Eingaben zu behalten und zu nutzen. Morgan v. V2X, Inc., die dritte und aufwendigste Entscheidung der Reihe, erweiterte Warners Kernfeststellung und kam zu dem Ergebnis, dass die Nutzung von KI durch einen Prozessbestandenen in der Prozessvorbereitung „der Art von vertraulichem, strategiebelastetem iterativem Arbeitsergebnis ähnelt, das Rule 26(b)(3) zu schützen bestimmt war." Dieselbe Anordnung verlangte jedoch von dem Prozessbestandenen, den Namen aller KI-Tools, die er in Verbindung mit Material verwendet hatte, das die andere Seite als vertraulich bezeichnet hatte, offenzulegen, und änderte die Schutzanordnung, um die Nutzung gängiger KI-Dienste mit solchem Material einzuschränken.23 Die Unterscheidung, die das Gericht traf, ist analytisch wichtig, da sie erklärt, warum Warner und Heppner nicht in Konflikt stehen: Eine Partei mit Anwalt, die die Anwältin umgeht, schafft eine Lücke zwischen Partei und Anwältin, die Lücke, die sich in Heppner als verhängnisvoll erwies, während eine Prozessbestandene ohne Anwalt „gleichzeitig Partei und Anwältin ist", so dass keine solche Lücke besteht. Der Schutz war nicht unbegrenzt: Das Gericht hielt fest, dass die Identität des KI-Tools selbst nicht geschützt war, und machte den KI-Einsatz bei vertraulichem Entdeckungsmaterial von vertraglichen Schutzmaßnahmen gegen Training, Aufbewahrung und Offenlegung Dritter abhängig. Die drei Entscheidungen konvergieren also darauf, die traditionelle Doktrin auf KI anzuwenden, anstatt KI aus ihr auszunehmen, divergieren aber darüber, wer den Schutz geltend machen kann und was als Verzicht zählt. Die Linie, die sie ziehen, ist eine architektonische, obwohl das Vokabular das dieses Artikels ist: Die Stellungnahmen sprechen von Agentur, Vertraulichkeit und Verzicht. Das, was den Heppner-Anspruch zunichte machte, war nicht die Nutzung von KI, sondern die verwendete Konfiguration: ein Consumer-Tool, dessen Bedingungen Aufbewahrung und Training erlaubten. Morgan hingegen macht den Schutz von einer Konfiguration abhängig, die vertraglich vor Training, Aufbewahrung und Offenlegung Dritter geschützt ist. Die Vertraulichkeitsposition ist, wie die Überprüfung, eine Eigenschaft der Architektur der Unterstützung und nicht der KI als solcher. Die Variable des Artikels erscheint hier innerhalb der Doktrin selbst (Tabelle 4).
Tabelle 4. Die Arbeitsergebnis-Triade des Frühjahrs 2026, nach Konfiguration.
| Fall | Prozessbestandener | Agentur-Lücke? | Werkzeug-Konfiguration | Entscheidung |
| Warner | Klägerin ohne Anwalt | Keine — Partei und Anwältin sind eins | Generative KI als ihr eigenes Vorbereitungswerkzeug verwendet | Als Arbeitsergebnis geschützt |
| Heppner | Beklagter mit Anwalt, handelt ohne Anwältin | Ja — Partei umging Anwältin | Consumer-Tool; Bedingungen erlaubten dem Anbieter Aufbewahrung und Training | Herausgabe angeordnet |
| Morgan | Klägerin ohne Anwalt | Keine — „gleichzeitig Partei und Anwältin" | Nutzung bei vertraulichem Material abhängig von vertraglichen Beschränkungen: kein Training, keine Aufbewahrung oder Offenlegung Dritter | Geschützt, mit Bedingungen; Werkzeug-Identität nicht geschützt |
Quelle: Warner, 2026 WL 373043; Heppner, 2026 WL 436479; Morgan, 2026 WL 864223. Die Entscheidungen konvergieren auf die Anwendung der traditionellen Doktrin und divergieren bei Konfigurationsfakten; die architektonische Lesart der letzten beiden Spalten ist die des Artikels, nicht die der Gerichte — Architektur ändert die Fakten, die die Doktrin wiegt, nicht das Gesetz.
Morgan wurde am 30. März 2026 entschieden, dem Tag, an dem der gemeinsame Antrag zur Klageabweisung in dem hier untersuchten Fall eingereicht wurde: Die Doktrin bildete sich, während der Fall gerade schriftlich verhandelt wurde.
Die frühen Entscheidungen von 2026 machen zusammen gelesen die Architektur des Tools zunehmend bestimmend: wer es leitete, was es tat, wie seine Aufzeichnungen geführt wurden. Der Orchestrierungsbericht verschärft, was in dieser Linie auf dem Spiel steht. Wenn KI-Unterstützung für einen selbstvertretenen Prozessführenden bloß mechanische Textgenerierung wäre, wäre der Fall für die Behandlung als geschützte Strategie schwach; ein Orchestrierungsworkflow, in dem ein Prozessführender Fragen formuliert, divergente Modellergebnisse abwägt und iterativ auf eine Position hinarbeitet, ist funktional schwer vom strategiegeladenen iterativen Prozess zu unterscheiden, den die Work-Product-Doktrin in den Händen von Anwälten schon immer geschützt hat. Ein Prozessführender, der ein Panel divergenter analytischer Engines leitet, ähnelt nichts so sehr wie ein leitender Anwalt, der ein Team von Junior-Anwälten leitet. Der zugrunde liegende Zweck der Doktrin, zu verhindern, dass eine Partei auf Kosten der Prozessvorbereitung der anderen Partei mitfährt, gilt mit gleicher Kraft, ob diese Vorbereitung von einem Anwalt oder von einem Prozessführenden durchgeführt wird, der durch ein Multi-Modell-System arbeitet. Morgan weist in diese Richtung, und der Orchestrierungsrahmen liefert die funktionale Begründung.
Der Work-Product-Schutz hängt von Vertraulichkeit ab, und er kann durch freiwillige öffentliche Offenlegung aufgehoben werden, zumindest soweit das Offengelegte betroffen ist. Die Veröffentlichung eines Berichts über einen eigenen anhängigen Fall birgt daher das Risiko, den Schutz, den Morgan anerkennt, soweit das Offengelegte betroffen ist, aufzugeben.
B. Unerlaubte Ausübung der Anwaltspraxis.
Die Besorgnis hinsichtlich unerlaubter Ausübung der Anwaltspraxis im Kontext der Selbstvertretung ist bei näherer Betrachtung merkwürdig gerahmt. Die Regeln gegen unerlaubte Ausübung der Anwaltspraxis reservieren die Ausübung der Anwaltspraxis für lizenzierte Anwälte, um die Öffentlichkeit vor unqualifizierter Vertretung durch andere zu schützen.24 Diese Regeln sind Geschöpfe des Staatsrechts, und ihre Definitionen der Praxisausübung variieren je nach Gerichtsbarkeit; das Folgende befasst sich mit der gemeinsamen Logik des Rahmens und nicht mit der Grenzziehung eines einzelnen Staates. Die echte Frage zur unerlaubten Ausübung der Anwaltspraxis, die durch Verbraucher-KI im Rechtsbereich aufgeworfen wird, ist, ob das Werkzeug oder das Unternehmen, das es betreibt, durch die Beratung des Prozessparteien unerlaubte Praxis ausübt. Diese Frage hängt wesentlich von der Zuverlässigkeit der Beratung ab: Ein Instrument, das dreist falsche Autorität fabriziert, sieht aus wie die inkompetente Praxis, deren Verhinderung die Regeln zur unerlaubten Ausübung der Anwaltspraxis bezwecken.
Eine Partei, die sich selbst vertritt, vertritt jedoch niemanden außer sich selbst. Sie hat ein gesetzliches Recht dazu (28 U.S.C. § 1654), und die Sanktion für eine fehlerhafte Eingabe fällt auf sie selbst und nicht auf einen Mandanten. Wenn eine solche Partei ein KI-System nutzt, muss der Rahmen der unerlaubten Ausübung der Anwaltspraxis die „Ausübung der Anwaltspraxis" irgendwo verorten: im Werkzeug, bei seinem Entwickler oder nirgendwo, und jede dieser Antworten ist unbefriedigend. Was die Besorgnis eigentlich antreibt, ist nicht Autorisation, sondern Zuverlässigkeit – die Furcht, dass ein unlizenziertes, nicht rechenschaftspflichtiges System einer Person ohne die Fähigkeit zur Überprüfung zuversichtlich falsches Recht liefert. Zuverlässigkeit ist nicht das Ganze davon, denn Gerichte kontrollieren die Ausübung der Anwaltspraxis durch Rechenschaftspflicht ebenso wie durch Kompetenz: ein lizenzierter Anwalt kann sanktioniert, suspendiert oder disbarred werden, und ein KI-System kann keines von diesen sein. Die Rechenschaftslücke ist real, und die Orchestrierungs-Rechnung behandelt Zuverlässigkeit, nicht Rechenschaftspflicht. Wenn ein orchestriertes System systematisch fehlerhaft wäre, könnte die Verantwortung an einer von drei Stellen fallen: beim Betreiber, der die Eingabe unterzeichnet (der einzige Akteur, den Regel 11 gegenwärtig erreicht), beim Anbieter der Architektur oder bei niemandem. Welche der drei das Recht auswählt, wird bestimmen, ob sich die Rechenschaftslücke verengt oder sich nur verlagert.
Hier leistet die Unterscheidung zwischen Einzelmodell und Orchestrierung echte Arbeit. Das Zuverlässigkeitsdefizit, das die Besorgnis zur unerlaubten Ausübung der Anwaltspraxis antreibt, ist charakteristisch für die Einzelmodell-Konfiguration, und eine um Modellübergreifende Verifikation und Zitiervalidierung aufgebaute Architektur ist auf dieses Defizit ausgerichtet. Dies löst die Frage der unerlaubten Ausübung der Anwaltspraxis nicht auf, da ein hochzuverlässiges Werkzeug trotzdem als „Ausübung der Anwaltspraxis" bezeichnet werden kann. Was es tut, ist zwei Dinge zu trennen, die die Debatte dazu neigt zu vermischen: Zuverlässigkeit und Autorisation sind analytisch unterschiedliche Fragen, und das Vermischen verdeckt, dass eine architektonische Lösung die erste behandeln kann, ohne die zweite anzutasten. Wenn Zuverlässigkeit das echte Anliegen ist, wird Architektur und nicht allein Lizenzierung Teil der Analyse, und ein System, das Uneinigkeit hervorbringt und auflöst, statt eine einzige Antwort zu behaupten, behandelt die Besorgnis auf ihre eigenen Bedingungen hin. Wenn Zuverlässigkeit architektonisch ist, ist sie auch gestaltbar und zertifizierbar, die Art von Objekt, auf das Vorschläge zur Neugestaltung der Regulierung von Rechtsdienstleistungen angewiesen sind (Hadfield 2017). Eine Architektur, die es ablehnt, auszustoßen, was sie nicht verifizieren kann, und die nicht reduzierbare Unsicherheit zum Menschen leitet, beginnt, als Compliance durch Design und nicht als unlizenzierter Ratgeber zu funktionieren.
C. Eine Neurahmung, keine Lösung.
Beide Rechtsbereiche bleiben ungeklärt. Die herrschende Darstellung von KI-Nutzung pro se in Bezug auf Volumen und Halluzinationen hat diese Rechtsdiskussionen geprägt, und eine qualitätsorientierte, orchestrierungsbasierte Darstellung rahmt sie neu ein. Der Schutz von Arbeitsergebnissen wirkt kohärenter, wenn KI-Nutzung als iterative Strategie statt als mechanische Ausgabe verstanden wird, und die UPL-Debatte sieht anders aus, wenn Zuverlässigkeit als architektonische Variable statt als inhärentes Defekt behandelt wird.
VII. Einschränkungen und zukünftige Arbeiten
Vier Grenzen begrenzen das Design. Erstens und grundlegendsten handelt es sich um einen Einzelfall (n = 1), der von einer Partei dazu verfasst wurde. Die Ergebnisse in Teil V sind Existenzaussagen statt Verteilungsaussagen. Was ein solcher Fall leisten kann, hat die qualitative Methodik lange für extreme oder offenbarende Fälle anerkannt: ein Phänomen offenlegen, das Standarddesigns noch nicht erreicht haben, und die Hypothesen generieren, die systematische Studien dann testen müssen.
Zweitens ist der Verfasser Prozesspartei, Entwickler und Analyst; die Einschränkungen in Teil IV existieren deswegen.
Drittens kann Kausalität nicht isoliert werden. Die Gerichtsakte kann den Beitrag der Architektur nicht von der eigenen Geschicklichkeit der Prozesspartei, vorheriger Vorbereitung, den Anreizen einer unbezahlten Partei oder anderen Störfaktoren trennen. Die architektonische Diskussion in Teil III liefert einen plausiblen Mechanismus, nicht einen nachgewiesenen.
Mehrere alternative Erklärungen bleiben plausibel. Die Prozesspartei könnte einfach fähig sein: gebildet, motiviert und unbezahlt, eine pro-se-Partei kann hunderte Stunden auf einen Fall verwenden, den ein Anwalt mit zehn Stunden besetzen würde. Die dreitägige Gegenäußerung könnte Vorbereitung statt Verarbeitung messen (Teil V.B). Auswahl funktioniert auf zwei Ebenen. Auf der Fall-Ebene ist dieser Fall Gegenstand eines Artikels, weil seine Akte günstig ist, und Fälle, in denen orchestrierungsgestützte Prozessparteien scheitern, erzeugen keine Artikel. Auf der Episoden-Ebene ist die Auswahl die des Verfassers selbst: die Aktenliste enthält mehr Ereignisse als die fünf, die dieser Artikel beschreibt, und der Verfasser wählte aus, welche zu präsentieren sind. Gegen diese Auswahl ist die Vollständigkeitsaussage aktensichtbar: Seit Juni 2026 enthält die Akte keinen Beschluss, der den Kläger sanktioniert, keinen Beschluss, der eines seiner Schriftsätze streicht, und keine Frist, die er versäumt hat. Das Nächste, das die Akte einer ungünstigen verfahrensrechtlichen Anmerkung kommt, liegt am Anfang des Verfahrens, wo das Gericht den Antrag des Klägers zur Prozessführung in forma pauperis ablehnte (die Einreichungsgebühr wurde dann innerhalb der zulässigen Frist bezahlt) und feststellte, dass Ladungen nicht ausgestellt werden könnten, bis Zustellungsadressen angegeben würden, was diese dann waren. Die Aussage ist durch jeden mit PACER-Zugang widerlegbar; was Auswahl auf Episoden-Ebene noch verbergen kann, ist Gewichtung, nicht ungünstige Beschlüsse. Die unten vorgeschlagene Studie ist darauf ausgelegt, zwischen diesen alternativen Erklärungen zu entscheiden.
Eine weitere Einschränkung bezieht sich auf Reichweite statt Gültigkeit. Teil II rahmt die Gerechtigkeitslücke in Bezug auf einkommensschwache Amerikaner, die die Legal Services Corporation untersucht, während die Prozesspartei hier ein Ph.D.-Architekt von KI-Systemen ist, der ein System seiner eigenen Gestaltung betreibt, ein selbstvertreter Kläger aus dem äußersten Ende der Verteilung technischer Fähigkeit. Der Existenzbeweis wird durch diese Tatsache nicht geschwächt, aber sein Umfang ist enger als die Population, auf die Teil II ausgerichtet ist: nichts in diesem Fall zeigt, dass orchestrierungsgestützte Rechtsstreitigkeiten praktisch für diese Population verfügbar sind, für die Kosten, digitaler Zugang und technische Sicherheit selbst Barrieren darstellen. Ob die Vorteile der Architektur die Übertragung von einem fachkundigen Bedienenden auf einen typischen Selbstvertreter-Kläger überstehen, ist eine empirische Frage, und für den Unterstützungsrahmen von Teil II ist sie wohl die entscheidende; der Behindertenarm der unten vorgeschlagenen Studie ist darauf ausgelegt, sie zu erreichen. Die Übertragung ist nicht nur eine Frage der technischen Einrichtung. Orchestrierung verlegt die kognitive Belastung des Bedienenden vom Verfassen zum Schiedsrichter: das Lesen konkurrierender Ausgaben, das Abwägen oberflächlicher Meinungsverschiedenheiten, das Entscheiden, welche Zeile überlebt. Schiedsrichtertätigkeit ist selbst eine anspruchsvolle Fähigkeit. Ob diese Belastung durch Schnittstellengestaltung statt durch Bedienenden-Fachkenntnis getragen werden kann und zu welchem Preis für Prozessparteien mit kognitiven, visuellen oder Bildungsbarrieren, ist ebenso eine Gestaltungsfrage wie eine empirische.
Viertens ist der Fall anhängig; kein Ergebnis hier hängt davon ab, wie er endet.
Die Hypothese, die dieser Fall generiert, dass Orchestrierungsarchitektur mit höherwertiger Pro-se-Litigationskonduit verbunden ist als Single-Model-Prompting, ist testbar. Eine systematische Studie könnte Litigationskonduit (Einhaltung von Fristen, Zitiergenauigkeit, Antragsresultate) über eine Stichprobe von Pro-se-Einreichungen hinweg vergleichen, die nach Art der KI-Unterstützung codiert wurden, unter Verwendung der KI-konsistenten Entwurfsindikatoren, die die empirische Literatur entwickelt hat, und von LegalBench, einem gemeinsam aufgebauten Maßstab für juristische Argumentation (Guha et al. 2023). Eine Aufgabenfamilie, die Erkennung von gesäten Fehlern, folgt direkt aus Teil V. Testbriefe werden mit überprüfbaren Mängeln der dort dokumentierten Art versetzt: ein transponierter Gesetzesabschnitt, eine missquotierte Autorität, ein erfundenes Zitat. Die Erkennungsraten werden dann über Unterstützungsmodi hinweg verglichen, vom Single-Model-Prompting zur orchestrierten Überprüfung, wobei Anwälte und Nichtanwälte als separate Gruppen fungieren. Die Komponenten der Architektur (Überprüfung externer Quellen und modellübergreifende Uneinigkeit) werden separat abgebaut, damit der Beitrag jedes Mechanismus ermittelt wird, anstatt ihn dem Bündel zugeordnet zu werden (Tabelle 5). Ein solches Design, durchgeführt von unvoreingenommenen Forschern über viele Fälle hinweg, könnte die hier vertretene Existenzbehauptung in eine Verteilungsbehauptung umwandeln oder sie widerlegen. Stärkere Designs sind verfügbar und sollten bevorzugt werden: kontrollierte Vergleiche von Single-Model- und orchestrierter Unterstützung bei identischen Rechtsaufgaben mit vorab registrierten Protokollen, offenen Materialien und blind-set-Validierung der Systemeigenen Ansprüche, einschließlich ihrer Zitierüberprüfungsrate; quasi-experimentelle Identifikation, etwa Differenz-in-Differenzen-Designs rund um die öffentliche Verfügbarkeit von Multi-Model-Tools; und einen dedizierten Arm für Teilnehmer mit motorischen, visuellen oder kognitiven Behinderungen, für die der Unterstützungsrahmen von Teil II nicht hypothetisch ist. Randomisierte Bewertung von Rechtsunterstützung hat Präzedenz: Die Literatur zum Zugang zur Justiz hat randomisierte Studien zu Angeboten von Vertretung und zu Paketdiensten durchgeführt (Greiner, Pattanayak & Hennessy 2013), und der hier vorgeschlagene Vergleich der Unterstützungsart erweitert diese Design-Tradition auf die Architekturvariable. Breiter gefasst schlägt die Hypothese einen Standard vor, den das Feld noch nicht angenommen hat: dass KI-Systeme nicht nur nach der Qualität ihrer Ausgaben, sondern auch nach der Qualität ihrer Argumentationsarchitektur bewertet werden. Nichts daran ist spezifisch für das Rechtswesen: Überall dort, wo bedeutsame Arbeit an generative Systeme delegiert wird, in der Medizin, im Ingenieurwesen oder im Finanzwesen, stellt sich die gleiche Frage, und die gleiche Variable bleibt unmessen. Es rahmt auch eine Variable neu ein, die die Zugangsgerechtigkeitsanalyse lange Zeit als gegeben behandelt hat. Die Eintrittskosten des Klägers waren die Gerichtsgebühr von 405 Dollar, und die formelle Eintrittsgebühr eines Prozessanwalts war die Gebühr für „pro hac vice" von 200 Dollar (ECF Nrn. 19, 52, 60). Beide liegen im niedrigen dreistelligen Dollarbereich und markieren die beiden Enden einer wirksam unüberbrückbaren Ressourcenlücke; der Vergleich betrifft nur formelle Eintrittsgebühren, nicht die Kosten der Vertretung. Was sich möglicherweise geändert hat, ist nicht der Preis für den Zugang zu einem Gerichtssaal, sondern die Grenzkosten der Litigationsfähigkeit, die erforderlich sind, um darin zu bleiben. Ob diese Kosten tatsächlich gesunken sind und um wie viel, ist eine empirische Frage für die vorgeschlagene Studie; dass sie zu einer Variablen statt zu einer Konstante geworden ist, ist selbst eine Hypothese, die es zu testen gilt.
Tabelle 5. Die vorgeschlagene Studie, nach Arm.
| Arm | Konfiguration | Was er isoliert |
| 1 | Nur Mensch, keine KI (Kontrolle) | Baseline-Erkennung ohne Unterstützung |
| 2 | Single-Model-Prompting | Der Modus, den die Literatur dokumentiert |
| 3 | Orchestrierung, vollständig | Das Bündel wie eingesetzt |
| 4 | Orchestrierung ohne Überprüfung externer Quellen | Beitrag der Zitierüberprüfung |
| 5 | Orchestrierung ohne modellübergreifende Uneinigkeit | Beitrag der oberflächlichen Divergenz |
Hinweis: Jeder Arm wird mit Anwälten und Nichtanwälten als separate Gruppen durchgeführt, und ein separater Behinderungsarm, außerhalb der fünf nummerierten Arme durchgeführt, für Teilnehmer mit motorischen, visuellen oder kognitiven Behinderungen, und mit Ergebnismaßstäben, die vor den Sitzungen vorab registriert werden; siehe Text.
VIII. Fazit
Die vorherrschende Darstellung von künstlicher Intelligenz in der Pro-se-Litigation ist eine Geschichte über Volumen und Unzuverlässigkeit: mehr Kläger, die schneller einreichen, mit erhöhtem Risiko erfundener Autoritäten. Sie nimmt stillschweigend an, dass KI-Unterstützung bedeutet, dass ein Kläger ein allgemeines Modell auffordert, und diese Annahme gilt nicht mehr.
Der hier untersuchte Fall wurde, nach Angaben des Autors, auf einer anderen Architektur aufgebaut: Mehrere unabhängige Modelle wurden parallel abgefragt, und ihre Uneinigkeit wurde oberflächlich gemacht und gelöst, anstatt unterdrückt zu werden. Die Beschreibung der Litigationskonduit stützt sich vollständig auf eine überprüfbare öffentliche Urkunde; diese Urkunde enthält Litigationskonduit, die das Volumen-und-Halluzinations-Konto weder beschreibt noch vorhersagt: eine schnelle Rekonstruktion einer fehlerhaften Einreichung, ein sachlicher Widerspruch, der weit im Voraus eingereicht wurde, und die Identifikation eines Gesetzeszitationsfehlers in einem abgestimmten Verteidigerbrief. Der Artikel zeigte dann, wie das Verständnis von KI-Unterstützung als Orchestrierung und als Frage der Qualität zwei derzeit vor den Bundesgerichten stehende doktrinale Debatten umrahmt. Für Kläger, die nicht mit der Geschwindigkeit der Litigation tippen, sehen oder organisieren können, die die das Rechtswesen verlangt, ist der architektonische Unterschied eine Frage nicht der Effizienz, sondern des Zugangs im Sinne des Americans with Disabilities Act für volle und gleichberechtigte Genießbarkeit: ob die Art, wie KI-Unterstützung konfiguriert ist, das ist, was Selbstvertretung überhaupt möglich macht.
Die Behauptung lautet, dass die Architektur der KI-Unterstützung – nicht nur ihre Verfügbarkeit – in die Analyse dessen gehört, was sich selbst vertretende Prozessparteien nun tun können. Diese Behauptung wird nur dringlicher, je mehr Grundlagenmodelle in ihrer grundsätzlichen Leistungsfähigkeit konvergieren, denn wenn sich die Modelle selbst weniger unterscheiden, werden sich die Arten unterscheiden, auf die sie kombiniert werden. Die Architektur-Abhängigkeitshypothese besagt, dass Architektur kein Implementierungsdetail ist: Sie ist ein bestimmender Faktor für die Qualität dessen, was Menschen und Gerichte tun können. Ob KI an Rechtsarbeit teilnimmt, ist keine Frage mehr; offen bleibt, welche Architekturen was tun. Nach dieser Auffassung ist das Pro-se-KI-Problem ein Designproblem, kein Intelligenzproblem, und Designprobleme haben Designlösungen. Die vor uns liegende Aufgabe besteht darin, bestimmte Architekturen anzugeben und sie gegeneinander zu testen, anstatt auf bessere einzelne Modelle zu warten. Der Anhang gibt eine solche Architektur präzise genug an, um ausgeführt und kritisiert zu werden, und eine Referenzimplementierung wird zusammen mit ihr veröffentlicht.
Anhang. Eine Unterstützungsarchitektur, präzise angegeben, um ausgeführt zu werden
Das Argument dieses Artikels lautet, dass „KI-Unterstützung" eine Familie von Architekturen mit unterschiedlichen Fehlereigenschaften benennt. Die Behauptung lässt sich leichter testen, sobald mindestens eine Architektur präzise genug angegeben ist, um ausgeführt und kritisiert zu werden. Das nachstehende Protokoll ist eine solche Angabe. Es wird hier als Blind-Konsolidierungsprotokoll25 bezeichnet, benannt nach dem Stadium, das es am klarsten von einer Multi-Agent-Debatte unterscheidet, bei der die Modelle einander lesen.26 Es verwendet nur öffentliche Modelle, und jeder mit Zugang zu drei Anbietern über Consumer oder API kann es reproduzieren.
Das nachstehende Protokoll gibt auf der Ebene der Architektur die in Teil III beschriebene Familie an: heterogene Modelle, die isoliert abgefragt werden, ein Konsens, der unter expliziten Regeln gebildet wird, wobei die Uneinigkeit bewahrt bleibt, statt sie auszumitteln, und jedes Zitat wird gegen seine Quelle überprüft. Es unterscheidet sich von dem in Teil III beschriebenen System darin, wie diese letzte Überprüfung durchgeführt wird: Dort ist es eine Komponente, die gegen eine Live-Datenbank validiert, hier sind es suchfähige Modelle, gefolgt von einer Person, und Einschränkung drei unten besagt ausdrücklich, dass die Zustimmung der Modelle nicht die Überprüfung ist. Es wird hier als Spezifikation angegeben, nicht als Beweis: Der Artikel enthält keine Einreichung in der Fallstudie als Output und zieht keinen Schluss daraus (was zurückgehalten wird: Anmerkung 24). Was das Protokoll zum Argument beiträgt, ist das Ausführungsmanifest. Die Architekturvariable in diesem Artikel wird selbst berichtet (Teil IV); ein Manifest ist das, was ein externer Leser benötigen würde, bevor es etwas anderes sein könnte. Die Einreichungen in Teil V enthalten keine.
Das Problem, das es löst.
Ein Rechtsanwalt in Eigenvertretung kann über kostenlose Verbrauchertarife mehrere Frontier-Modelle erreichen, und Kosten, digitaler Zugang und technische Kompetenz bleiben Hürden (Teil VII): Die hochriskante Spalte unten ist der kostenpflichtige API-Zugang, und die später festgelegte Vertraulichungsbedingung schließt die meisten kostenlosen Tarife für das Material aus, das am meisten Schutz benötigt. Die gängige Praxis besteht darin, ein Modell zu befragen, die Antwort zu lesen und diese einzureichen. Das dokumentierte Versagen ist ein selbstsicheres Modell, das ein nicht existierendes Zitat erzeugt, wobei nichts im Prozess positioniert ist, um es zu erkennen. Das Protokoll ersetzt die einzelne Anfrage durch eine gemeinsame Aufgabenstellung und vier Phasen, die darauf folgen. Es lässt jedes Modell genau so genau wie zuvor; es ordnet mehrere so an, dass ein Fehler eines Systems den Kontakt mit Systemen überstehen muss, die von anderen Organisationen trainiert wurden, und es protokolliert, was jedes von ihnen gesagt hat.
Rollen.
Das Protokoll wird durch das definiert, was jede Rolle sehen darf. Vier Regeln legen es fest:
1. Generatoren sehen die Aufgabenstellung und nichts sonst. Niemand sieht den Entwurf eines anderen Generators.
2. Der Konsolidator sieht jeden Entwurf unter neutralen Bezeichnungen R1 bis Rn in zufälliger Reihenfolge. Er erfährt niemals, welcher Anbieter welchen Entwurf erstellt hat.
3. Der erste Kritiker liest innerhalb der eigenen Familie des Konsolidators in einem neuen Kontext. Er sieht die Aufgabenstellung und das konsolidierte Dokument und nichts von der Konsolidierung, die es hervorgebracht hat.
4. Der letzte Leser ist ein Kritiker von einem anderen Anbieter als der Konsolidator. Er sieht die Aufgabenstellung, das konsolidierte Dokument und den Bericht des ersten Kritikers, und sein Urteil beendet den Durchlauf.
Jeder Satz von Grenzmodellen verschiedener Anbieter, der die vier Regeln erfüllt, kann das Protokoll ausführen. Zur Veranschaulichung sind hier öffentliche Modelle, die im September 2026 verfügbar waren und die Rollen ausfüllen könnten:
Tabelle 6. Im September 2026 verfügbare öffentliche Modelle, die die vier Rollen ausfüllen könnten.
| Rolle | Routinedokumente | Dokumente mit hohen Einsätzen |
|---|---|---|
| Generatoren, isoliert | claude-sonnet-5 with search; gpt-5.6-terra with search; gemini-3.1-pro-high with search; an open-weight model | claude-opus-5 with search; gpt-6-astra with search; gemini-3.1-pro-high with search; Grok (xAI); an open-weight model |
| Konsolidator, blind | claude-sonnet-5 | claude-fable-5-1 |
| Kritiker 1, Familie des Konsolidators, neuer Kontext | claude-sonnet-5 | claude-fable-5-1 |
| Kritiker 2, anderer Anbieter, liest zuletzt | gpt-5.6-terra | gpt-6-astra |
Quelle: Anbieter-Dokumentation vom September 2026. Die Zuordnung von Modellen zu Rollen ist die des Autors; die Rollen, nicht die Bezeichner, definieren das Protokoll.
Die Tabelle ist eine Veranschaulichung dessen, was verfügbar war, und die Bezeichner werden veralten. Die Rollen werden es nicht. Grok wird vom Anbieter benannt und das Open-Weight-Modell nach Klasse, weil ihre gehosteten Bezeichner von Host zu Host variieren, und gemini-3.1-pro-high ist der Alias einer gehosteten Schnittstelle und nicht der Modellcode in der API-Dokumentation des Anbieters. Die Spalte für hohe Einsätze fügt einen fünften Generator hinzu, und sein Konsolidator ist ein Modell, das keinen Entwurf geschrieben hat, so dass es seinen eigenen Text unter einem Label niemals beurteilt. Abbildung 9 zeigt das Protokoll nach Rolle.
Die Zuordnung von Familien zu Rollen basiert auf der Verwendung durch den Autor, nicht auf einer Messung. Im Laufe von etwa zweitausend Stunden Arbeit mit diesen Systemen in 2025 und 2026 lieferte ein Modell, das in einem neuen Kontext als blinder Kritiker eingesetzt wurde, die strengste und nützlichste Verifikation, wenn es aus derselben Familie wie der Konsolidator stammte, und es tat dies auch dort, wo der überprüfte Text von dieser Familie produziert worden war. Kritiker anderer Anbieter waren keine schwächeren Leser; sie fanden andere Dinge, weshalb das Protokoll einen von ihnen behält und ihm das abschließende Urteil gibt. Die vier Regeln handeln davon, was jede Rolle sehen darf, nicht davon, welcher Anbieter sie ausfüllt, und ein Leser, der eine andere Familie beim Konsolidator oder beim ersten Kritiker bevorzugt, kann eine austauschen und führt dennoch das Protokoll aus.
Abbildung 9. Das Blind-Konsolidierungs-Protokoll nach Rolle: isolierte Generierung, blinde Konsolidierung und zwei Verifikationen.
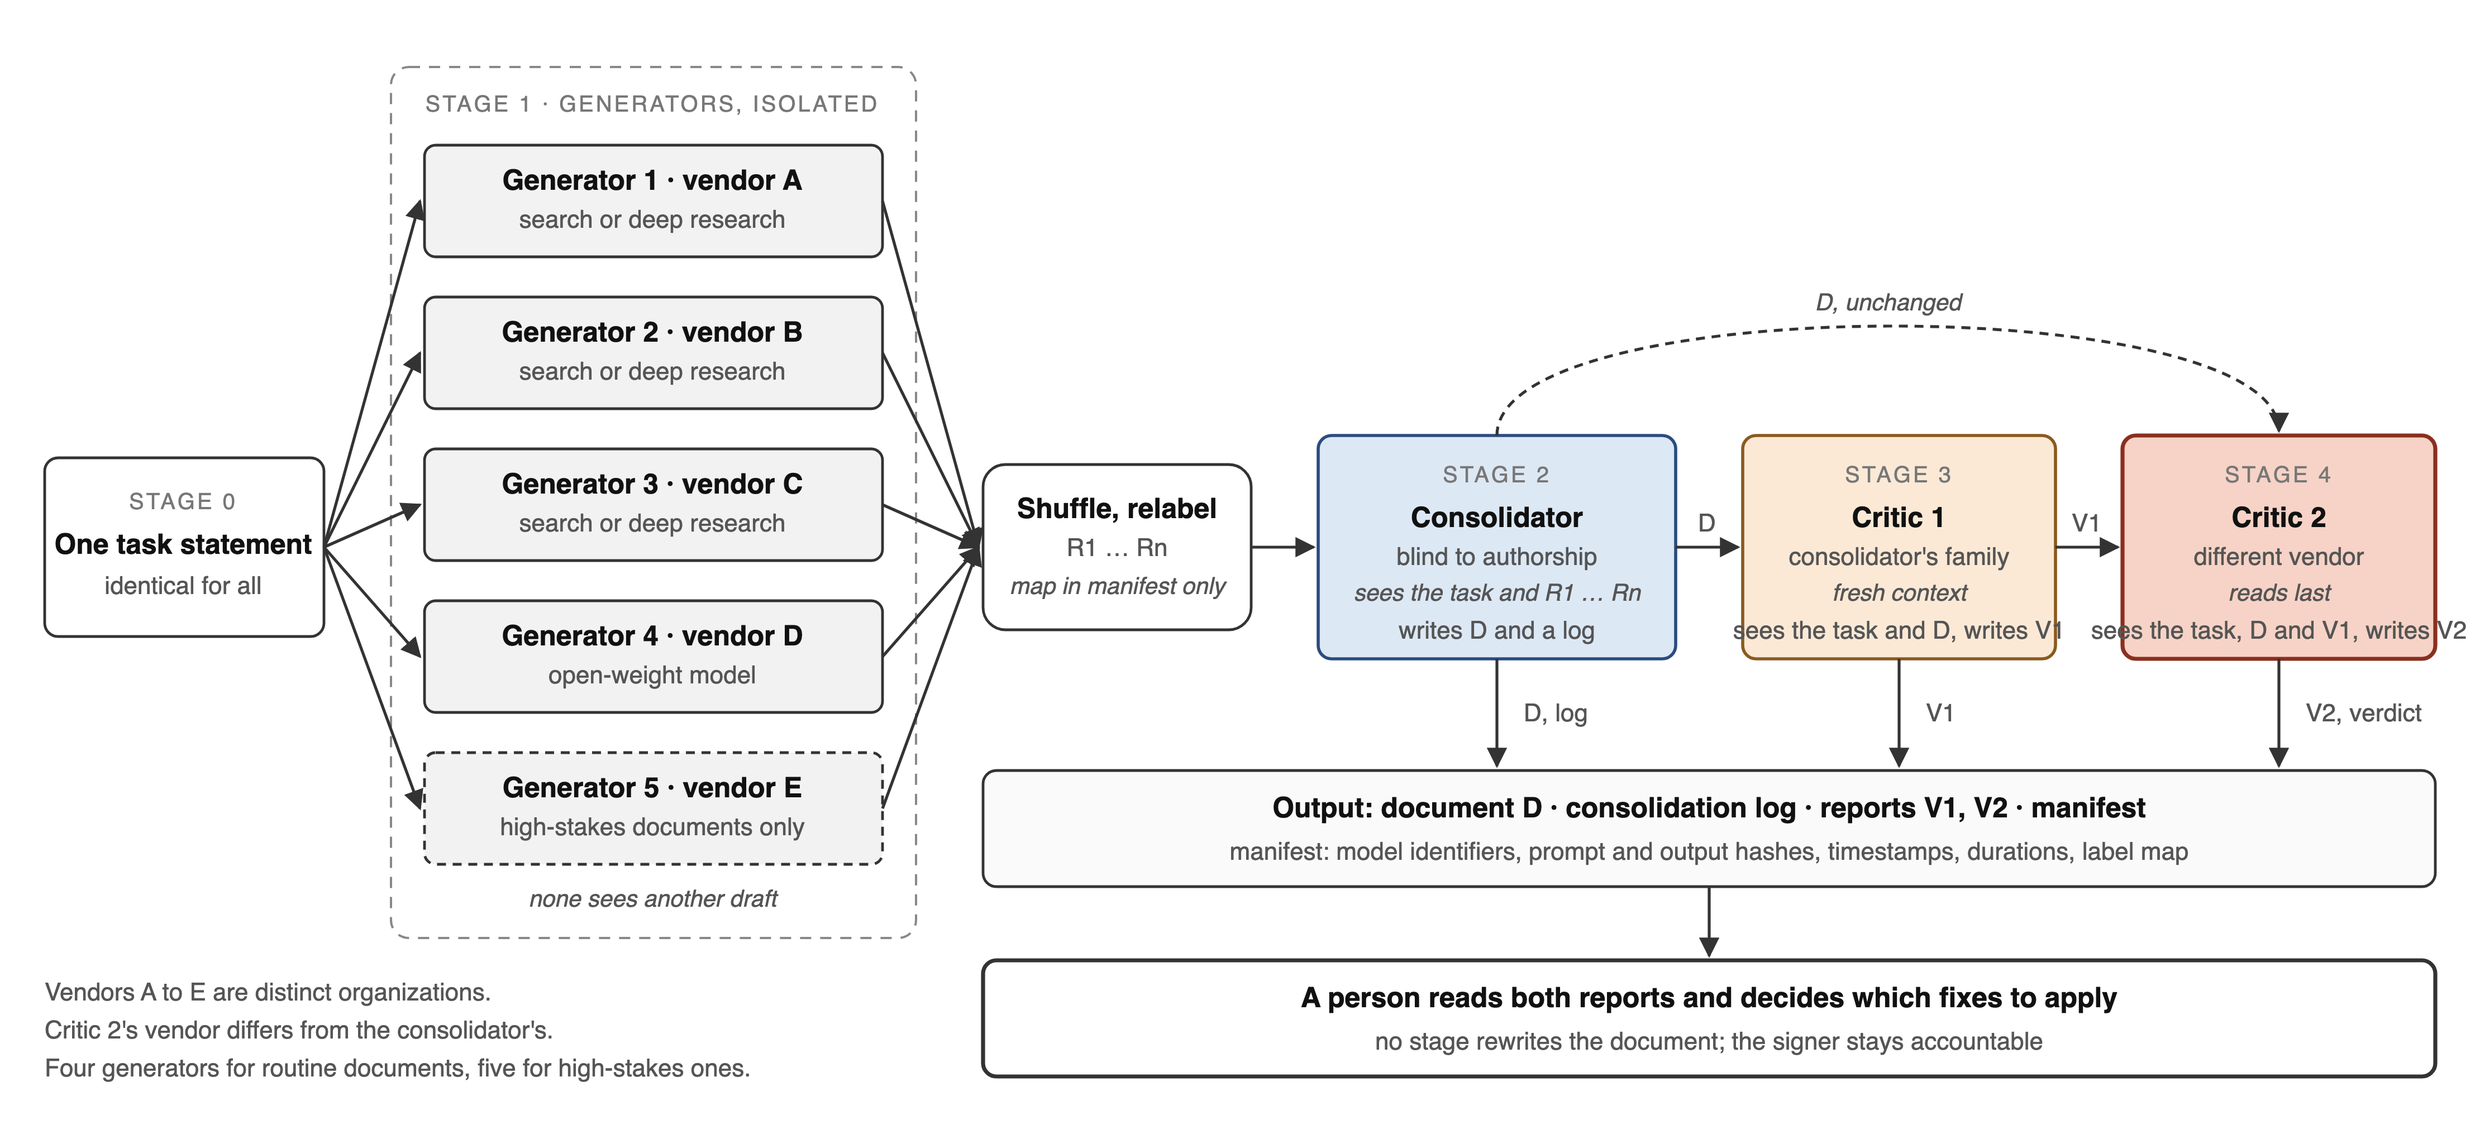
Quelle: Diagramm des Autors des in diesem Anhang festgelegten Protokolls.
Das ist eine Rampe. Sie wurde für jemanden gebaut, der die Treppen nicht nehmen kann: der nicht fünf Schnittstellen gleichzeitig offen halten, sie gegeneinander lesen und die Antwort mitbringen kann. Eine Rampe wird von jedem benutzt, der zur Tür kommt, nicht nur von der Person, für die sie gebaut wurde. Die obige Formel wird aufgeschrieben, damit jeder sie verwenden kann.
Phasen.
Phase 0. Eine Aufgabenstellung. Eine einzelne schriftliche Aussage legt das Ziel, die Zuständigkeit, das erforderliche Format, was als Quelle zählt, und was mit einer Behauptung zu tun ist, die nicht verifiziert werden kann, fest. Jedes Modell erhält sie unverändert, damit Unterschiede zwischen Entwürfen von den Modellen stammen.
Phase 1. Isolierte Generierung. Jeder Generator erstellt parallel einen vollständigen Entwurf, wobei die Websuche überall dort aktiviert ist, wo die Schnittstelle oder die API sie trägt, und mit intensiver Recherche, wenn die Aufgabe Tiefe erfordert. Die Verbraucherschnittstellen dieser Anbieter suchen standardmäßig; einige programmgesteuerte Endpunkte enthalten kein Suchwerkzeug, und ein Generator, der auf einem dieser Endpunkte läuft, erstellt Entwürfe aus Gewichtungen, was der Laufdatensatz zeigen muss. Jeder ist verpflichtet, für jede sachliche und rechtliche Aussage eine verifizierbare Quelle anzugeben, das, was er nicht verifizieren konnte, als unverifiziiert zu kennzeichnen und mit seinen offenen Fragen zu schließen. Isolation ist der Mechanismus. Von verschiedenen Organisationen auf verschiedenen Korpora entwickelte Modelle erfinden unterschiedliche Dinge, und eine Behauptung, die mehrere von ihnen unabhängig produzieren, jeweils mit eigenen Zitaten, steht in einer anderen Beweislage als eine Behauptung, die nur eines von ihnen produziert hat. Ein Entwurfsverfasser, der einen anderen Entwurf sieht, stimmt damit aus Gründen zu, die damit zusammenhängen, ob die Behauptung wahr ist oder nicht.
Phase 2. Blinde Konsolidierung. Ein Modell erhält die Entwürfe als R1 bis Rn in einer zufällig gewählten und nur im Laufmanifest aufgezeichneten Reihenfolge und führt sie nach expliziten Regeln zusammen. Behauptungen, die von mehreren Entwürfen unterstützt werden oder durch ein verifizierbares Zitat gestützt werden, werden bevorzugt aufgenommen, was eine Regel darüber ist, was in den Entwurf eingeht, und keine Feststellung, dass sie wahr sind. Material, das sich in einem einzelnen Entwurf befindet, wird beibehalten, wenn es ein verifizierbares Zitat trägt. Konflikte werden mit Belegen gelöst oder im Text gekennzeichnet. Übereinstimmung zwischen Entwürfen wird als Übereinstimmung aufgezeichnet und nie zu einem Beweis befördert. Neues Material wird nur dann aufgenommen, wenn der Konsolidierer es selbst verifiziert, und wird als hinzugefügt gekennzeichnet. Jede wesentliche Behauptung trägt ein Tag, das die Entwürfe benennt, die sie unterstützen. Der Konsolidierer schreibt auch ein Protokoll: worauf sich die Entwürfe einigten, worin sie sich uneinig waren und wie jeder Konflikt gelöst wurde, und was gestrichen wurde und warum. Das Protokoll ist der Ort, an dem der Dissens überlebt. Da die Beschriftungszuordnung beibehalten wird, kann ein späterer Leser die Tags dagegen setzen und messen, wie oft der Konsolidierer seinen eigenen Anbieterentwurf bevorzugte.
Phase 3. Interne Verifikation. Ein Kritiker aus der Familie des Konsolidierers liest das zusammengeführte Dokument in einem frischen Kontext, ohne Erinnerung an die Konsolidierung. Seine Aufgabe ist Verifikation, und er gibt kein verbessertes Dokument zurück. Er überprüft jedes Zitat auf Existenz und Genauigkeit, testet die Begründung auf Lücken und Übertreibungen, bestätigt, dass die Aufgabenstellung erfüllt wurde, und meldet Ergebnisse nach Kritikalität, Bedeutung und Geringfügigkeit mit einem Urteil: genehmigen, mit Korrektionen genehmigen oder ablehnen.
Phase 4. Anbieterübergreifende Verifikation. Ein Kritiker eines anderen Anbieters liest dasselbe Dokument und den ersten Bericht. Er bestätigt, bestreitet oder erweitert jedes Ergebnis, fügt seine eigenen hinzu und gibt das abschließende Urteil ab. Diese Phase existiert wegen der Schwäche der beiden vorangegangenen: Ein Konsolidierer, der von seiner eigenen Familie überprüft wird, teilt die Blindstellen dieser Familie, und ein anderswo ausgebildeter Leser ist der direkteste Weg zu ihnen.
Was die Pipeline verlässt.
Die Liefergabe ist das konsolidierte Dokument, das Konsolidierungsprotokoll, beide Überprüfungsberichte und ein Manifest. Keine Phase überschreibt das Dokument mit der Ausgabe eines Kritikers. Eine Person liest die Berichte und entscheidet, welche Korrektionen angewendet werden sollen. In Gerichtsverfahren ist die Person, die die Einreichung unterzeichnet, für deren Inhalt verantwortlich, und eine Pipeline, die den Text stillschweigend umgeschrieben hätte, würde verschleiern, wer was entschieden hat.
Das Manifest verzeichnet für jede Phase die Modellkennung, den Prompt-Hash, den Ausgabe-Hash, die Startzeit und die Dauer zusammen mit der Beschriftungstabelle. Ohne es ist ein auf diese Weise vorbereitetes Dokument von einem nicht zu unterscheiden, das durch zweimaliges Abfragen eines einzelnen Modells erstellt wurde. Mit ihm kann ein Leser, der bei der Ausführung nicht anwesend war, die Aufzeichnung des Operateurs des Durchlaufs überprüfen: welche Kennung für welche Rolle konfiguriert wurde, in welcher Reihenfolge die Entwürfe beschriftet wurden, was jede Phase erhielt und zurückgab. Es ist ein strukturierter Selbstbericht, kein Beweis. Die Kennungen stammen aus der Konfiguration statt aus einer authentifizierten Antwort, eine manuell ausgeführte Phase trägt das Wort des Operateurs für das, was in der Schnittstelle geschah, und eine Aufzeichnung einer angebotenen Suchwerkzeugs ist keine Aufzeichnung einer überprüften Quelle. Das Beobachtete statt des Gemeldeten zu machen, erfordert Fremdverwahrung des Durchlaufs, was die Ausgestaltung in Teil VII liefert und was ein Dateiformat nicht kann.
Referenzimplementierung.
Eine Referenzimplementierung, docprep, wird unter einer offenen Lizenz veröffentlicht (Anmerkung 25): etwa fünfhundert Zeilen Python in einer Datei, mit der Konfiguration von Tabelle 6, dem Manifestformat und Offline-Tests, die ohne Konten oder Schlüssel laufen.
Die Implementierung trennt das, was sie durchsetzt, von dem, was sie nur anfordert. Die vier Rollenregeln werden durchgesetzt. Der Prompt eines Generators wird nur aus der Aufgabenstellung zusammengestellt; die Entwürfe erreichen den Konsolidator gemischt und umbenannt, wobei die Zuordnung nur im Manifest geschrieben wird; und eine Konfiguration, deren erster Kritiker außerhalb der Familie des Konsolidators sitzt oder deren letzter Kritiker in ihr sitzt, wird abgelehnt, bevor ein Modell aufgerufen wird (Abbildung 10). Die Zusammenführungsregeln von Phase 2 werden nur angefordert: Sie sind Anweisungen im Prompt des Konsolidators, und ein Modell kann sie nicht befolgen. Einer wird hinterher überprüft, da ein Konsolidierungsergebnis ohne sein Protokoll den Lauf stoppt.
Abbildung 10. Eine Rollenregel als Vorbedingung des Laufs: die Überprüfung des abschließenden Kritikers und die Ablehnung, die er ausgibt.
home = family(cfg, cons) # die Anbieterfamilie des Konsolidators
. . .
if critics and family(cfg, critics[-1]) == home:
problems.append(f"{critics[-1]['name']} is from the consolidator's family "
f"({home}); the last reader must come from another vendor")
. . .
if problems and enforce:
sys.exit(f"formula '{formula_name}' breaks the protocol:\n - "
+ "\n - ".join(problems))
$ python3 docprep.py run --formula manual
formula 'manual' breaks the protocol:
- critic_cross is from the consolidator's family (anthropic);
the last reader must come from another vendor
Quelle: docprep, docprep.py, Funktion validate(), Release v1.0.0 (Anmerkung 25); Auslassungen gekennzeichnet. Unterhalb des Codes die Ausgabe des angezeigten Befehls, ausgeführt auf der Beispielkonfiguration mit dem abschließenden Kritiker dem Anbieter des Konsolidators neu zugewiesen. Die Offline-Tests des Repositorys behaupten dieselbe Ablehnung.
Die Durchsetzung hat die Grenzen, die das Manifest hat. Die Anbieterfamilie einer Rolle wird in der Konfiguration deklariert, nicht authentifiziert. Ein von Hand ausgeführter Schritt ist blind und neu auf das Wort des Operators hin. Umbenennung entfernt Namen, nicht Stil. Und die Ablehnung kann ausgeschaltet werden, in welchem Fall das Manifest aufzeichnet, dass dies der Fall war, und die gebrochenen Regeln auflistet. Die Regeln werden gegen einen Fehler eines Operators durchgesetzt, nicht gegen einen Operator.
Die rechtliche Umgebung.
Eine Architektur, die die Fehlerkorrelation durch Hinzufügen von Anbietern senkt, erhöht durch denselben Akt die Anzahl der Orte, an denen das Material austritt. Für einen sich selbst vertretenden Kläger vor Gericht in den Vereinigten Staaten ist diesen Handel nicht abstrakt.
Die Lage in den Vereinigten Staaten im September 2026 hat drei Teile: was ein Einreicher offenlegen muss, was überhaupt an einen Anbieter gesendet werden darf, und ob die Arbeit als Arbeitsprodukt überdauert. Teil II und Tabelle 1 enthalten das Offenlegungsregime; Teil VI.A enthält die Arbeitsprodukt-Analyse und ihre Autoritäten. Keine allgemein anwendbare föderale Verfahrensregel verlangt von einem Einreicher, die Verwendung von KI offenzulegen oder ein Modell zu benennen: Im April 2026 setzte der Beratungsausschuss für Zivilverfahren zwei Anträge zur Bekämpfung erfundener Autoritäten von seiner Tagesordnung ab und kam überein, dass eine Regeländerung zu diesem Zeitpunkt nicht angebracht wäre.27 Lokale Regeln und einzelne Standanordnungen verlangen dies jedoch, und sie unterscheiden sich. Der Northern District of Texas verlangt auf der ersten Seite einer Eingabe die Tatsache der KI-Nutzung und fragt nicht, welches Modell. Richter Vaden des Court of International Trade verlangt das verwendete Programm, die spezifischen Textabschnitte, die es produziert hat, und eine Bestätigung, dass die gemeldete Verwendung keine vertraulichen oder geschäftlich geschützten Informationen an eine unbefugte Partei offengelegt hat.28
Zwei Regeländerungsmaßnahmen des Frühjahrs 2026 sind leicht zu verwechseln, und die Verwechslung ändert die Antwort. Der Beratungsausschuss für Zivilverfahren nahm zwei Anträge zur Änderung von Regel 11 auf, um Zitate von Autoritäten anzusprechen, die nicht vorhanden sind, einigten sich darauf, dass eine Regeländerung zu diesem Zeitpunkt nicht angebracht wäre, und setzten das Thema am 14. April 2026 ab. Drei Wochen später nahm der Beratungsausschuss für Beweisregeln den vorgeschlagenen Federal Rule of Evidence 707 auf, der die Zulässigkeit von maschinell generierten Beweisen regelt, anstatt die Offenlegung der KI-Nutzung zu regeln; er überarbeitete den Entwurf und behielt ihn zur weiteren Prüfung, anstatt ihn voranzubringen. Die erste Maßnahme betrifft, was ein Einreicher bescheinigt, die zweite, was ein Gericht zulassen darf, und keine schuf eine Pflicht zur Offenlegung. Die beiden sind im Datensatz selbst verknüpft, weshalb sie als eine gelesen werden: Das April-Memorandum des Zivilverfahrensausschusses zitiert den Entwurf von Regel 707, und seine Protokolle vermerken, dass der Beweisregelsausschuss diese Regel zur weiteren Prüfung hatte.
Material, das eine andere Partei als vertraulich gekennzeichnet hat, ist der schwierigere Fall, und es erreicht diese Architektur direkt. In Morgan erlaubte das Gericht einem sich selbst vertretenden Kläger, solches Material nur in einen KI-Dienst einzugeben, wenn der Anbieter vertraglich verpflichtet ist, die Eingabe nicht zu speichern oder zu verwenden, um sein Modell zu trainieren oder zu verbessern, es nicht an Dritte offenzulegen, außer wenn die Offenlegung für die Erbringung des Dienstes wesentlich ist und der Empfänger gleichwertige Schutzmaßnahmen bindet, und es auf Anfrage zu entfernen oder zu löschen; es verlangte vom Kläger, alle in Zusammenhang mit diesem Material verwendeten Werkzeuge zu benennen und schriftliche Dokumentation dieser Schutzmaßnahmen zu führen. Das Gericht beobachtete, dass die Bedingung die meisten gängigen kostenlosen oder günstigen KIs ausschließt. Dies sind die Bedingungen einer Schutzanordnung statt einer nationalen Regel, und sie sind die restriktivsten, die der Autor gefunden hat; das Protokoll übernimmt sie als eigene Gestaltungspolitik.
Drei Einschränkungen folgen. Dies sind Gestaltungsregeln dieses Protokolls, keine Aussagen darüber, was das Gesetz von einem Litiganten verlangt.
1. Öffentliche Einreichungen und Material, das der Betreiber frei übermitteln darf, dürfen an die Modelle gehen. Versiegeltes Material, Material unter einer Schutzanordnung und vertrauliche Entdeckung einer anderen Partei dürfen dies nicht, es sei denn, die Anordnung erlaubt es und die Bedingungen des Anbieters erfüllen die Bedingung, die Morgan auferlegt hat. Die Beschränkung gilt für jede Phase und jeden Empfänger, nicht nur die Generatoren: der Konsolidierer und beide Kritiker erhalten den zusammengefassten Entwurf, und die behaltenen Artefakte reisen damit. Eigentum an einem Dokument entlastet nicht von selbst eine damit verbundene Vertraulichkeitsverpflichtung. Das Manifest macht die Exposition überprüfbar; es macht sie nicht rechtmäßig.
2. Das Manifest unterstützt die Offenlegung; es ist nicht die Offenlegung. Es zeichnet auf, welche Modellkennung welches Artefakt und wann produziert hat, was das Material ist, das ein Gericht, das das verwendete Programm fragt, haben will, und es ist es wert, behalten zu werden, unabhängig davon, ob der vorsitzende Richter fragt. Es reicht die Mitteilung nicht ein, die eine Standanordnung verlangt, identifiziert die Abschnitte des endgültigen Dokuments, das eine Regel wie die des Richters Vaden erreicht, oder liefert irgendeine Bescheinigung.
3. Überprüfung jedes Zitats gegen seine Quelle wird von einer Person durchgeführt. Regel 11(b) erreicht eine nicht vertretene Partei nach ihren Bedingungen, und ihr Standard ist angemessene Anfrage unter den Umständen, anstatt eines bestimmten Verfahrens; Teil II legt dar, was die Aufzeichnung erfundener Zitate zeigt. Übereinstimmung zwischen Modellen und Genehmigung durch zwei Kritiker sind keine Überprüfung.
Die Anforderungen variieren je nach Bezirk und Richter, und die Standanordnung des vorsitzenden Richters ist maßgebend.
Grenzen.
Die Deep-Research-Modi der Verbraucheroberflächen haben keine genaue Entsprechung in den Anbieter-APIs. Eine Phase, die eine benötigt, wird von Hand ausgeführt: die Aufforderung wird in eine Datei geschrieben, der Bediener führt sie in der Oberfläche aus und fügt die Antwort wieder ein, und das Manifest verzeichnet, dass die Phase auf diese Weise ausgeführt wurde. Dieses Fallback ist manuell, und Teil II erläutert, warum ein manueller Workflow über mehrere Oberflächen hinweg nicht nur für einen Prozessbeteiligten mit motorischer oder visueller Beeinträchtigung langsamer ist. Ein Protokoll, das davon abhängt, erbt diese Grenze.
Übereinstimmung zwischen Modellen ist ebenso ein Beleg für Korrelation wie für Wahrheit. Modelle, die auf sich überlappenden Korpora trainiert wurden, teilen Fehler, und eine einstimmige Menge von Entwürfen kann gemeinsam falsch sein. Das Protokoll senkt die erreichbare Korrelation und verzeichnet den Rest.
Das Protokoll wurde nicht mit dem Prompting mit einzelnen Modellen verglichen. Der Vergleich, der seinen Wert klären würde, ist eine verblindete Bewertung: dieselben Aufgaben werden auf beide Arten vorbereitet, die resultierenden Dokumente werden von Lesern bewertet, die nicht wissen, welche welche ist, auf Zitiergenauigkeit, Vollständigkeit gegenüber der Aufgabenstellung und Fehler, die ein Gericht bemerken würde. Das Protokoll wird hier dargelegt, damit dieser Vergleich durchgeführt werden kann.
Das oben genannte Repository enthält die Pipeline, die Konfiguration und die Offline-Tests.
Ausgewählte Referenzen und Autoritäten
ABA Model Rules of Professional Conduct r. 5.5.
Americans with Disabilities Act, 42 U.S.C. §§ 12181--12188.
Ashley, Kevin D., Artificial Intelligence and Legal Analytics: New Tools for Law Practice in the Digital Age (Cambridge Univ. Press 2017).
Avery, Joseph J., Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).
Blanck, Peter, eQuality: The Struggle for Web Accessibility by Persons with Cognitive Disabilities (Cambridge Univ. Press 2014).
Cappelletti, Mauro & Bryant Garth, Access to Justice: The Newest Wave in the Worldwide Movement to Make Rights Effective, 27 Buff. L. Rev. 181 (1978).
Carpenter, Anna E., Colleen F. Shanahan, Jessica K. Steinberg & Alyx Mark, Judges in Lawyerless Courts, 110 Geo. L.J. 509 (2022).
Centers for Disease Control and Prevention, Disability Impacts All of Us (2022 BRFSS data).
Chan, Chi-Min, Weize Chen, Yusheng Su, Jianxuan Yu, Wei Xue, Shanghang Zhang, Jie Fu & Zhiyuan Liu, ChatEval: Towards Better LLM-Based Evaluators Through Multi-Agent Debate, arXiv:2308.07201 (2023).
Charlotin, Damien, AI Hallucination Cases Database, https://www.damiencharlotin.com/hallucinations/ (zuletzt besucht September 2026).
Chernets, Vadym, docprep: A Reference Implementation of the Blind-Consolidation Protocol, release v1.0.0 (2026), https://github.com/vadimchernets/docprep (MIT license; the protocol specified in the Appendix, and the code that runs it).
Chernets v. Google LLC et al., No. 1:25-cv-05691-RER-RML (E.D.N.Y.) (public docket); PolyHelper.AI LLC v. United States of America, No. 1:25-cv-07770 (S.D.N.Y. 2025) (earlier action, different defendant).
Cohen-Sasson, Or, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).
Du, Yilun, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.
Engstrom, Nora Freeman & Aviv Caspi, Opening the Courthouse Door---or Just Lowering the Threshold?, JOTWELL: Legal Profession (July 3, 2026).
Fed. R. Civ. P. 26(b)(3).
Greiner, D. James, Cassandra Wolos Pattanayak & Jonathan Hennessy, The Limits of Unbundled Legal Assistance: A Randomized Study in a Massachusetts District Court and Prospects for the Future, 126 Harv. L. Rev. 901 (2013).
Grimm, Paul W., Maura R. Grossman & Gordon V. Cormack, Artificial Intelligence as Evidence, 19 Nw. J. Tech. & Intell. Prop. 9 (2021).
Guha, Neel, et al., LegalBench: A Collaboratively Built Benchmark for Measuring Legal Reasoning in Large Language Models, Advances in Neural Information Processing Systems 36 (2023).
Hadfield, Gillian K., Rules for a Flat World: Why Humans Invented Law and How to Reinvent It for a Complex Global Economy (Oxford Univ. Press 2017).
Hannaford-Agor, Paula, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts (National Center for State Courts 2015).
Hickman v. Taylor, 329 U.S. 495 (1947).
Katz, Daniel Martin, Michael James Bommarito, Shang Gao & Pablo Arredondo, GPT-4 Passes the Bar Exam, 382 Phil. Trans. R. Soc. A 20230254 (2024).
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022).
Liang, Tian, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models Through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (2024).
Magesh, Varun, Faiz Surani, Matthew Dahl, Mirac Suzgun, Christopher D. Manning & Daniel E. Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, Stanford HAI (2024).
Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023).
Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. Mar. 30, 2026).
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026).
Park v. Kim, 91 F.4th 610 (2d Cir. 2024).
Sandefur, Rebecca L., Access to What?, 148 Daedalus 49 (2019).
Shah, Anand V. & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859.
Sharma, Mrinank, et al., Towards Understanding Sycophancy in Language Models, ICLR (2024).
Simshaw, Drew, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).
Surden, Harry, Machine Learning and Law, 89 Wash. L. Rev. 87 (2014).
System Documentation (on file with author).
U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (3. März 2026).
United States v. Heppner, Nr. 25-cr-503, 2026 WL 436479 (S.D.N.Y. Feb. 17, 2026).
Warner gegen Gilbarco, Inc., Nr. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. 10. Feb. 2026).
* Architekt von KI-Systemen. Die Rollen des Autors als Kläger, Systementwickler und Analyst sind in der nachstehenden Offenlegungserklärung des Autors dargelegt. Kommentare willkommen: [email protected].↩︎
Legal Services Corporation, The Justice Gap: The Unmet Civil Legal Needs of Low-Income Americans (2022), https://justicegap.lsc.gov. Zum Umfang der Selbstvertretung im Allgemeinen war in mehr als drei Vierteln der Zivilverfahren in einer führenden multijurisdiktionellen Studie mindestens eine Partei selbstvertreten. Siehe Paula Hannaford-Agor, Scott Graves & Shelley Spacek Miller, The Landscape of Civil Litigation in State Courts iv (National Center for State Courts 2015).↩︎
Anand V. Shah & Joshua Y. Levy, Access to Justice in the Age of AI: Evidence from U.S. Federal Courts (Mar. 20, 2026) (unpublished manuscript), https://ssrn.com/abstract=6766859 (analyzing over 4.5 million non-prisoner federal civil cases, FY2005--FY2026, and 46 million matched PACER docket entries); see also Or Cohen-Sasson, Stochastic Justice: Legal Inconsistency by Humans and AI, 105 Neb. L. Rev. (forthcoming 2026).↩︎
Richter Patrick J. Schiltz (D. Minn.), zitiert in Mattathias Schwartz & Zach Montague, Artificial Intelligence Floods Court Dockets with Home-Brewed Lawsuits, N.Y. Times (May 25, 2026).↩︎
Drew Simshaw, Access to A.I. Justice: Avoiding an Inequitable Two-Tiered System of Legal Services, 24 Yale J.L. & Tech. 150 (2022).↩︎
Siehe beispielsweise Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (S.D.N.Y. 2023); Park v. Kim, 91 F.4th 610 (2d Cir. 2024).↩︎
Schreiben von Andrew J. Dietderich, Sullivan & Cromwell LLP, an Richter Martin Glenn, U.S. Bankruptcy Court, S.D.N.Y. (Apr. 18, 2026) (Entschuldigung für „ungenaue Zitate und andere Fehler", einige davon KI-„Halluzinationen", in einem Notantrag vom 9. April in den Chapter-15-Verfahren von Prince Global Holdings Ltd.); siehe Sullivan & Cromwell Apologizes to Judge for AI Hallucinations, Bloomberg Law (Apr. 21, 2026).↩︎
AI Hallucination Cases Database (Damien Charlotin), https://www.damiencharlotin.com/hallucinations/ (Momentaufnahme vom 2. Juli 2026): Von 1.668 dokumentierten Vorfällen weltweit waren 975 an Selbstvertretern beteiligt und 653 an Anwälten; 2023 waren etwa sieben von zehn Vorfälle an Selbstvertreter gebunden, und der Anteil der Anwälte bei neu dokumentierten Erkenntnissen stieg stetig durch 2025–2026.↩︎
New York State Bar Association, Pro Se Advocacy in the AI Era: Benefits, Challenges, and Ethical Implications (2026); siehe auch Kommentare zu KI und der unbefugten Rechtsausübung in der Georgetown Journal of Legal Ethics (2026).↩︎
Siehe Law360 Pulse, Tracking Federal Judge Orders on Artificial Intelligence (last visited July 2026); Legal AI Governance, Federal and State Court Orders on AI, https://legalaigovernance.com/tracker/court-orders/ (last visited July 2026).↩︎
Siehe How Courts Are Coping with a Flood of AI-Generated Lawsuits, MIT Technology Review (June 4, 2026) (Bericht unter anderem, dass die Einreichungen von Selbstvertretern in Vermont von etwa fünfundvierzig pro Jahr vor 2022 auf über 1.100 im Jahr 2024 stiegen).↩︎
Die Beschwerde in der Fallstudie charakterisiert das System in diesen Begriffen; die Rahmensetzung wird als die Rechtstheorie des Klägers vermerkt, nicht als Sachurteil. Zum Umfang der betroffenen Bevölkerung berichteten mehr als ein Viertel der US-amerikanischen Erwachsenen – über 70 Millionen – 2022 von einer Behinderung, CDC, Disability Impacts All of Us (2022 BRFSS-Daten), und die Beschäftigungs-Bevölkerungs-Quote für Menschen mit Behinderung betrug 2025 22,8 %, gegenüber 65,2 % für Menschen ohne Behinderung, U.S. Bureau of Labor Statistics, People with a Disability: Labor Force Characteristics --- 2025, USDL-26-0364 (Mar. 3, 2026).↩︎
Yilun Du, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum & Igor Mordatch, Improving Factuality and Reasoning in Language Models through Multiagent Debate, Proceedings of the 41st International Conference on Machine Learning (ICML 2024), arXiv:2305.14325.↩︎
Siehe beispielsweise Tian Liang, Zhiwei He, Wenxiang Jiao, Xing Wang, Yan Wang, Rui Wang, Yujiu Yang, Shuming Shi & Zhaopeng Tu, Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate, Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP 2024) 17889; Chi-Min Chan et al., ChatEval: Towards Better LLM-Based Evaluators through Multi-Agent Debate, arXiv:2308.07201 (2023).↩︎
Die Gegenentgegnung des Klägers versetzte eine solche Entwicklung in den Beleg und vermerkte die öffentliche Ankündigung eines Verteidiger zu einem anbieterübergreifenden, Multi-Modell-Konsensfunktion. Siehe Plaintiff's Opposition, ECF No. 76.↩︎
Systemtechnische Dokumentation (zitiert nur für Design).↩︎
Die Architektur ist Gegenstand einer Familie von anstehenden internationalen Patentanmeldungen, bei denen der Autor ein benannter Anmelder ist; die Familie wird in der öffentlichen Akte des Verfahrens dokumentiert (siehe Plaintiff's Opposition, Ex. 3), und ihre Kennungen werden hier als unwesentlich für die Analyse weggelassen.↩︎
Joint Motion to Dismiss and Memorandum in Support, Chernets v. Google LLC, No. 1:25-cv-05691-RER-RML (E.D.N.Y.), ECF Nos. 69, 69-1; Plaintiff's Memorandum of Law in Opposition, ECF No. 76 (Apr. 2, 2026); Transcript of Pre-Motion Conference, ECF No. 55 (Jan. 27, 2026).↩︎
ECF Nos. 28 (Zustimmungsantrag), 30, 32–34, 36–37 (12. Jan. 2026). Die Schreiben waren aufeinander abgestimmt; ein Beklagter übernahm ausdrücklich die Gründe und Argumente in den vorgerichtlichen Schreiben seiner Mitbeklagten.↩︎
ECF Nos. 39–44 (15.–16. Jan. 2026).↩︎
Vgl. Memorandum in Support of Joint Motion to Dismiss, ECF No. 69-1, mit Plaintiff's Opposition, ECF No. 76, S. 17.↩︎
Warner v. Gilbarco, Inc., No. 2:24-cv-12333, 2026 WL 373043 (E.D. Mich. 10. Feb. 2026) (Patti, M.J.); United States v. Heppner, No. 25-cr-503, 2026 WL 436479 (S.D.N.Y. 17. Feb. 2026) (Rakoff, J.); Morgan v. V2X, Inc., No. 25-cv-01991-SKC-MDB, 2026 WL 864223 (D. Colo. 30. März 2026).↩︎
Morgan v. V2X, Inc., 2026 WL 864223, at *3 (D. Colo. 30. März 2026).↩︎
Siehe ABA Model Rules of Prof'l Conduct r. 5.5; Joseph J. Avery, Patricia Sánchez Abril & Alissa del Riego, ChatGPT, Esq.: Recasting Unauthorized Practice of Law in the Era of Generative AI, 26 Yale J.L. & Tech. 64 (2024).↩︎
Dieser Artikel beschreibt nur öffentlich eingereichte Dokumente und architektonische Merkmale, die den Beklagten und der Öffentlichkeit bereits offengelegt wurden. Er enthält nicht die verwendeten Prompts, die Entscheidungslogik des Systems zu einer bestimmten Frage und alle Entwurfsergebnisse.↩︎
docprep, eine Referenzimplementierung des Blind-Consolidation-Protokolls, https://github.com/vadimchernets/docprep (MIT-Lizenz); die hier beschriebene Version ist Release v1.0.0. Das Repository enthält die ausführbare Pipeline in einer Datei, die Konfiguration von Tabelle 6, das Manifestformat und Offline-Tests, die ohne Konten oder Schlüssel laufen, zusammen mit diesem Anhang als eigenständige Spezifikation unter CC BY 4.0. Modellkennungen und Zugriff müssen für die Konten des Betreibers konfiguriert werden.↩︎
Advisory Comm. on Civil Rules, Draft Minutes of Meeting of 14. Apr. 2026, S. 18, nachgedruckt in Comm. on Rules of Practice & Procedure, Agenda Book 383 (3.–4. Juni 2026) (Punkt 17, „Artificial Intelligence Hallucinations"); siehe auch Advisory Comm. on Civil Rules, Agenda Book 438–50 (14. Apr. 2026) (Suggestions 25-CV-S und 25-CV-V, beide zu Rule 11); Report of the Advisory Comm. on Civil Rules 60 (6. Mai 2026), in Agenda Book, supra, S. 364 (von der Tagesordnung gestrichene Punkte). Die Minuten sind entwürfig und ausstehend zur Genehmigung auf dem Herbsttreffen 2026 des Ausschusses. Proposed Federal Rule of Evidence 707, die die Zulässigkeit von maschinell generierter Evidenz und nicht die Offenlegung regelt, ist eine separate Angelegenheit: Der Advisory Committee on Evidence Rules überarbeitete sie am 7. Mai 2026 und behielt sie unter Prüfung bei, anstatt sie voranzubringen.↩︎
N.D. Tex. Civ. R. 7.2(f) (Offenlegung der Verwendung von generativer künstlicher Intelligenz auf der ersten Seite einer Schrift, mit weiterer Offenlegung der so erstellten Teile, falls der Vorsitzende Richter dies anordnet); Order on Artificial Intelligence, U.S. Court of International Trade (Vaden, J.) (8. Juni 2023) (Erfordernis der Angabe des verwendeten Programms, der spezifischen Textteile, die es erstellte, und Bescheinigung, dass die Offenlegung keine vertraulichen oder geschäftseigenen Informationen an eine unberechtigte Partei offenbarte).↩︎
Zitierweise
Chernets, V. (2026). Die fehlende Variable in der KI-gestützten Rechtspraxis: Architektur und die Qualität des Pro-Se-Zugangs zur Justiz [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7120940
@misc{chernets2026missingvariable,
  author       = {Chernets, Vadym},
  title        = {{The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7120940},
  url          = {https://doi.org/10.2139/ssrn.7120940}
}