Lacrado Antes da Abertura: Um Padrão Verificável para Medir Previsões de IA em Mercados Financeiros
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Quatorze modelos de IA dos EUA e da China, doze mercados, quatro horizontes: uma liga ao vivo selada, uma contagem de vozes independentes por trás de cada consenso e 30 previsões registradas
Vadym Chernets, PhD, arquiteto de sistemas de IA · Fundador, PolyHelper (polyhelper.ai) · ORCID 0009-0007-4845-3163
SSRN 7653679 · DOI 10.2139/ssrn.7653679 · Zenodo 10.5281/zenodo.23552697 · OSF registration 10.17605/OSF.IO/9Q86N · Analysis release 10.5281/zenodo.23552700 · GitHub
Baixe este artigo
- SSRN (citação preferida): ssrn.com/abstract=7653679 · DOI 10.2139/ssrn.7653679
- Zenodo (arquivado, acesso aberto): doi.org/10.5281/zenodo.23552697
- OSF (as previsões registradas da Seção 8): doi.org/10.17605/OSF.IO/9Q86N
- GitHub (texto completo e os comandos de verificação do Apêndice B): https://github.com/vadimchernets/papers/tree/main/sealed-before-the-open
- Analysis release (os arquivos que esta versão lê, congelados, com um manifesto SHA-256): doi.org/10.5281/zenodo.23552700
- Liga ao vivo e dados abertos (CC BY 4.0): trends.polyhelper.ai/markets/ · trends.polyhelper.ai/api/v1/
Verifique um selo em três etapas (Apêndice B): baixe o livro e o carimbo de 20 de outubro, faça hash do prefixo marcado, verifique a âncora.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
head -n 159 council-book.jsonl | shasum -a 256   # 59673b9e...a7d9, as in 130025Z.txt
ots verify 130025Z.txt.ots                       # Bitcoin block 972,334
Sem um nó Bitcoin, ots info 130025Z.txt.ots mostra o atestado do bloco 972.334, cuja raiz de Merkle qualquer explorador de blocos exibe (Apêndice B, Etapa 6). A Etapa 10 verifica o selo no registro Rekor do Sigstore.
Cite o preprint SSRN. As sessões pontuadas são lidas em 20 de outubro de 2026, dos arquivos abertos gerados em 21 de outubro de 2026 entre 02:42 e 05:33 UTC. A primeira execução contada, de 21 de outubro de 2026, é lida dos arquivos gerados às 22:16 UTC. A Tabela 5 fornece o status de conformidade conforme lido em 21 de outubro de 2026 às 15:05 UTC, a verificação de conformidade do requisito 1 às 22:33 UTC e a entrada Rekor do requisito 3 em 22 de outubro de 2026 às 00:00:16 UTC.
Palavras-chave: previsão de IA; modelos de linguagem grandes; mercados financeiros; avaliação de previsões; escore de Brier; calibração; viés de antecipação; carimbagem de tempo confiável; OpenTimestamps; número efetivo de vozes independentes; mercados de previsão; previsões registradas
JEL: G17; C53; C52; G14; D84
Resumo
Quando um modelo de IA diz que o ouro vai subir, um leitor pode avaliar a previsão no fechamento, mas geralmente não pode verificar quando foi feita. Um backtest mistura memória com habilidade, e uma temporada de negociação é um caminho através do mercado. Proponho um padrão de requisitos numerados para medir previsões de IA dos mercados financeiros e documento sua implementação de referência, o conselho de liga aberta de IA Council · Markets, executado pela PolyHelper, com um status publicado por requisito. Quatorze grandes modelos de linguagem, sete de laboratórios americanos e sete de laboratórios chineses, respondem à mesma pergunta em um snapshot de preço compartilhado, cada um com sua própria conta. Onze deles preveem doze indicadores em quatro horizontes antes de cada abertura em Nova York. Cada resposta contada é selada em uma cadeia de hash SHA-256 antes de seu preço de referência e ancorada em Bitcoin através de OpenTimestamps. A partir de 21 de outubro de 2026, a contagem é declarada antecipadamente, e autoridades RFC 3161 independentes assinam cada registro com carimbo de tempo, que também entra no log de transparência Sigstore Rekor. Na primeira manhã contada, cada resposta contada foi assinada antes da abertura às 09:30 ET, oito delas 29 minutos antes. A pontuação de Brier do evento solicitado é comparada com um benchmark de 50%, a taxa base climatológica e preços do mercado de previsão, e o acordo é relatado como uma contagem de vozes independentes. Nas manhãs de desenvolvimento de 19 e 20 de outubro, as imagens de probabilidade dos modelos eram tão semelhantes quanto as de aproximadamente 1,6 previsores independentes. Em 20 de outubro, três dos quatro pares mais próximos uniram um laboratório americano e um chinês. Comparado a um mapa datado de 23 esforços de previsão e negociação de IA, a liga é a primeira liga de IA ao vivo em indicadores financeiros a combinar estes elementos. É também a primeira arena de mercado de IA onde sete modelos americanos e sete modelos chineses negociam sob um protocolo ao lado de leitores atribuídos uma vez, aleatoriamente, para prever antes ou depois de ver os modelos. Trinta previsões datadas, registradas no OSF antes da postagem, são pontuadas em revisões datadas.
Sumário executivo
Uma previsão de preço é evidência de habilidade apenas se o previstor não conhecia o resultado, a previsão existia antes dele, e a previsão pontuada é a que conta, qualquer que sejam as outras tentativas. Os modelos de IA prejudicam todas as três: podem ter lido o resultado no treinamento, podem ser questionados novamente em segundos, e seu registro é geralmente mantido por quem perguntou. Escrevi cada condição como um requisito que um leitor pode verificar. AI Council · Markets, executado pela PolyHelper, é a implementação de referência.
Cada pergunta diz respeito a um resultado ainda por vir, o que a mantém fora da memória de um modelo. Um mercado é um teste que se renova: faz uma nova pergunta toda manhã e responde à mesma tarde, para que nenhum modelo possa ter lido a resposta. Duas previsões se comparam apenas quando apostam na mesma coisa, e a unidade é portanto um contrato de evento fixado antecipadamente. Cada resposta é selada em uma cadeia de hash antes do preço de abertura a partir do qual é pontuada, já que uma previsão que viu o movimento de abertura responde a uma pergunta diferente. Não quis que o registro descansasse na confiança em seu guardião, então a cadeia é ancorada no Bitcoin e, a partir de 21 de outubro de 2026, assinada por autoridades independentes de carimbo de tempo. Uma execução por sessão conta. A partir de 21 de outubro a regra que a escolhe é declarada antecipadamente e selada, e as outras execuções permanecem publicadas e rotuladas.
A pontuação é a pontuação de Brier do evento perguntado. É uma pontuação adequada, portanto um previstor não ganha nada ao declarar senão sua crença. A liga a lê contra uma moeda, a taxa base do evento e os preços do mercado de previsão, três barras diferentes para habilidade. Modelos correlacionados não são testemunhas separadas, e o acordo entre eles é relatado como um número de vozes independentes. Sete modelos americanos e sete chineses compartilham a pergunta, o instantâneo, o prazo e as regras, portanto qualquer diferença entre os lados é medida em uma tarefa. Os leitores são aleatorizados uma vez, para ver os modelos antes ou depois de fazerem previsões, e permanecem naquele grupo. Eles medem se os modelos ajudam as pessoas ou apenas as puxam junto (F28, F29).
As duas manhãs de desenvolvimento mostram o que essas medidas leem. No horizonte de um dia as imagens de probabilidade dos modelos selados antes da abertura eram tão semelhantes quanto as de menos de dois previsores independentes. Foram mais decididas em seis meses, quando suas previsões se resolvem por último, e em 20 de outubro três dos quatro pares mais próximos se juntaram a um laboratório americano e um chinês. Um teste primário e trinta previsões, registrados no OSF antes da postagem, são pontuados em revisões datadas em dados e código abertos.
1. Introdução
Na manhã de segunda-feira uma pessoa pergunta a um modelo de IA se deve comprar ouro. O modelo diz que sim, com certa confiança, e dá uma razão. Ao fechamento, o ouro caiu. O modelo estava errado, ou foi azarado, ou foi uma de várias respostas que deu naquela manhã? A resposta existia às 09:00, ou foi escrita ao meio-dia? A pessoa não consegue dizer. Na maioria das avaliações revisadas na Seção 7, o tempo de uma previsão repousa no registro do operador. A liga que descrevo aqui mantém esse registro fora do operador. Na terça-feira 20 de outubro de 2026, antes da abertura, oito modelos deram ao ouro em média uma probabilidade de 45% de fechar em alta no contrato diário do Polymarket, e a multidão naquele contrato precificou 29%. Ambos os números foram selados antes da abertura às 09:30 ET, e qualquer pessoa pode lê-los novamente (Apêndice B).
Arenas em que modelos negociam dinheiro real atraíram ampla atenção em 2025 (Forklog, 2025a, 2025b), e benchmarks de previsão de LLM chegaram aos principais locais de aprendizado de máquina: ForecastBench no ICLR 2025 (Karger et al., 2025), FutureX (Zeng et al., 2025) e Prophet Arena (Yang et al., 2025) no ICLR 2026. Benchmarks de negociação constataram que a maioria dos agentes não superou a estratégia buy and hold (Y. Chen et al., 2025; Yu et al., 2025), e em mercados de previsão líquidos um forte sistema de previsão de IA ainda ficou atrás do consenso do mercado enquanto uma combinação dos dois superou ambos (Alur et al., 2025).
Esses esforços compartilham uma dependência: a evidência de que uma previsão precedeu seu resultado é mantida por quem executou a avaliação. Backtests não conseguem fornecê-la, porque o modelo pode já conhecer o resultado (Lopez-Lira et al., 2025; Paleka et al., 2026). Benchmarks ao vivo a fornecem através dos registros do operador, e Prophet Arena adiciona um selo SHA-256 com sal de cada previsão, com recibos assinados opcionais, cronometrados pelo relógio da própria plataforma (Prophet Arena, 2026). Foresight Arena compromete previsões com hash de eventos do Polymarket, algumas delas sobre preços de ativos, na cadeia Polygon antes de um prazo e as pontua contra o preço de mercado. Sua versão revisada relata resultados simulados e adia os ao vivo (Nechepurenko & Shuvalov, 2026a). Prediction Arena deu aos modelos de fronteira capital real no Kalshi e Polymarket e manteve registros do operador sem um compromisso (Zhang et al., 2026). Fora da IA, previsões de bolhas financeiras foram seladas por checksum com divulgação atrasada já em 2010 (Sornette et al., 2010), e, fora dos mercados, as probabilidades de futebol de uma IA foram ancoradas em Bitcoin desde julho de 2026 (NeuPortal, 2026). Não encontrei nenhuma liga ao vivo de previsões de IA em um painel fixo de indicadores financeiros que ancore seus registros fora do controle do operador (Seção 7). Minha pergunta de pesquisa é o que uma medição de previsões de mercado de IA precisa para que um leitor possa verificar, contra um relógio fora do controle do operador, o que foi previsto, até quando, e qual previsão contou.
Proponho um padrão para essa medição, escrito como uma lista de verificação de requisitos DEVE e DEVERIA (Seção 3.13), e documento uma implementação dele, a liga ao vivo aberta AI Council · Markets, executada pelo PolyHelper, em trends.polyhelper.ai/markets. Catorze modelos, sete de laboratórios norte-americanos e sete de laboratórios chineses, executam portfólios simulados na mesma questão, snapshot e regras, e onze deles estão no Conselho e fornecem probabilidades. Cada manhã antes da abertura de Nova York o Conselho prevê 12 indicadores financeiros, abrangendo índices de ações, taxas, dólar, volatilidade, commodities e Bitcoin, em quatro horizontes de um dia a seis meses. Cada resposta é selada em um livro encadeado por hash cuja cabeça é ancorada em Bitcoin através do OpenTimestamps. Cada resposta é pontuada a partir do primeiro preço após seu selo, e o livro é publicado com o código de pontuação e os dados. A partir de 21 de outubro de 2026 autoridades de carimbo de tempo RFC 3161 independentes também assinam cada registro com carimbo, para que um leitor possa verificar contra relógios fora do controle do operador que as respostas contadas existiam antes do preço de abertura pelo qual são pontuadas (Seção 3.2). O registro selado também é um novo tipo de dados abertos para finanças: um painel diário de probabilidades de muitos modelos de IA nos mesmos eventos, fixado antes da abertura, sobre o qual seu desacordo e seu valor podem ser medidos.
O contrato de evento é publicado como um esquema com um verificador que qualquer outra liga pode executar em seus próprios arquivos (Seção 3.13). O que contribuo é o padrão e uma implementação que um leitor pode verificar. As primeiras sessões mostram os dados que produz, e os testes registrados da Seção 8 decidem a habilidade. A Seção 3 estabelece o padrão e a Seção 4 um design de pontuação para um ambiente de mercado ao vivo. A Seção 5 mede o número efetivo de vozes independentes em dados ao vivo, a Seção 6 estabelece um design para humanos antes de IA, e a Seção 7 desenha um mapa datado de arenas de mercado de IA. A Seção 8 contém as previsões registradas, a Seção 9 as objeções mais fortes com a regra que responde cada uma, e a Seção 10 o alcance de cada afirmação. A Seção 7.4 estabelece o que é novo, em três afirmações e três designs adicionais primeiros entre as arenas de mercado de IA revisadas, e sobre o que a liga se constrói, cada um com seu precedente mais próximo. O Apêndice E fornece a evidência célula por célula.
2. Por que o conhecimento retroativo prejudica as previsões de mercado de IA
Os torneios de previsão humana protegem as três condições do Resumo executivo com prazos de inscrição e um organizador confiável. Os modelos de IA ultrapassam cada proteção. Um modelo pode conhecer o resultado a partir do treinamento, pode ser consultado muitas vezes em um minuto, e o registro do que disse é mantido, via de regra, pela pessoa que perguntou. As três primeiras subseções abordam essas questões em sequência, e a quarta explica por que uma temporada de negociação não pode substituir um registro de previsão.
2.1 O que um modelo se lembra
A avaliação mais barata de um modelo de IA em previsão financeira é um backtest, mas os dados de treinamento do modelo podem já conter o que aconteceu depois. Lopez-Lira et al. (2025) demonstraram que modelos de linguagem grandes recuperam valores exatos de séries macroeconômicas e financeiras de antes de seu corte de treinamento, que uma instrução para não usar conhecimento posterior não remove essa recuperação, e que a recuperação cessa após o corte: dentro da janela de treinamento, habilidade e memória não são identificadas.
Gao et al. (2025) construíram um teste para viés prospectivo, a propensão ao lookahead. Em uma replicação do resultado de que as pontuações de modelos em manchetes de notícias predizem retornos de ações (Lopez-Lira & Tang, 2023), o poder preditivo foi amplificado em observações com alta propensão ao lookahead. Após o corte, o sinal bruto permaneceu, enquanto a interação associada à memorização perdeu significância. Glasserman e Lin (2023) separaram dois vieses em amostra de backtests de sentimento do GPT, lookahead e uma distração pelo que o modelo sabe sobre a empresa nomeada, e encontraram o segundo maior, especialmente para grandes empresas. Em vinte anos de dados, a estrutura FINSABER descobriu que as vantagens relatadas para estratégias de investimento com LLM diminuem acentuadamente uma vez que sobrevivência, data snooping e lookahead são controlados (W. W. Li et al., 2025), e benchmarks construídos em simulação histórica, como InvestorBench (H. Li et al., 2025), herdam a mesma exposição.
A literatura repara isso de duas maneiras. Uma restringe o modelo: modelos de linguagem cronologicamente consistentes são treinados apenas em texto disponível antes de cada data de previsão (He et al., 2025). A outra restringe o tempo: qualquer modelo, em sua força total e com busca, é consultado sobre um resultado ainda por vir, e a resposta é fixada, veriravelmente, antes do resultado existir. Escolhi restringir o tempo e deixar o modelo em sua força total. Os dois caminhos são complementares, já que um modelo cronologicamente consistente pode entrar em uma liga selada.
2.2 Rotas de vazamento
Passar para perguntas ao vivo remove o maior vazamento, mas não todo vazamento. Paleka et al. (2026) mostram que o vazamento temporal em avaliações de previsores baseados em modelos de linguagem é frequentemente sutil, e que o desempenho em uma avaliação pode não se transferir para previsão no mundo. FutureX relata modos de falha da mesma família, incluindo páginas da web falsas e respostas cuja validade temporal está errada (Zeng et al., 2025). Em previsão macro-financeira, restringir as entradas de um modelo ao que estava disponível no momento da decisão remove muito da habilidade aparente que benchmarks vazados relatam (Guan & Chen, 2026). Uma forma nomeada é drift de eventos entre dias: artigos dos dias após um relatório de ganhos já carregam a reação do mercado, e se entrarem nas entradas para um dia anterior, o resultado vaza para a previsão (Zhang & Zhang, 2026). Uma previsão selada antes do preço de referência não pode se basear em texto escrito depois dele.
Para mercados financeiros, o problema de tempo é concreto. Uma previsão para o dia registrada às 09:29 e uma registrada às 09:45 são objetos diferentes, porque a segunda pode ver o movimento de abertura. Se o registro de quando uma previsão foi feita é mantido apenas pelo operador, um leitor deve confiar que nenhuma resposta posterior se substituiu a uma anterior. Pré-registro separa a geração de uma hipótese de seu teste fixando-a em um registro público antes de os dados existirem (Nosek et al., 2018). Uma previsão selada é inscrição automática e diária, e marcação de tempo confiável permite a um terceiro verificar seu tempo (Haber & Stornetta, 1991; Todd, 2016).
2.3 Muitas execuções, uma pontuação
Um previsor em um torneio geralmente envia uma resposta até um prazo. Um modelo pode ser consultado dez vezes, com redações ligeiramente diferentes ou em minutos ligeiramente diferentes, e suas respostas variam. Um avaliador que mantém a melhor de dez, ou executa novamente um pipeline após uma falha e mantém a nova execução, infla habilidade sem alterar uma única previsão, e a inflação é invisível a menos que toda execução seja registrada e a regra para qual execução conta seja fixada com antecedência. Portanto, escrevi o padrão para selar cada execução que envia, contar uma execução por sessão por uma regra escrita antes das execuções, e manter as outras como cálculos de referência rotulados (Seção 3.4).
2.4 Uma trajetória não é uma medição
Arenas nas quais modelos negociam dinheiro respondem cujas decisões teriam feito dinheiro, mas o retorno de uma carteira em uma temporada é um sorteio dos caminhos que o mercado poderia ter tomado. Relatos da imprensa das duas primeiras temporadas da Alpha Arena relatam uma reversão da classificação: o modelo que venceu a primeira temporada, em futuros perpétuos de criptomoeda, estava entre os mais fracos na segunda, em ações tokenizadas dos EUA com novos formatos e alavancagem (Forklog, 2025a, 2025b; Yahoo Finance, 2025). Ativos, formatos e modelos mudaram entre as temporadas, então a reversão, conforme esses relatos a reportam, não identifica sorte. É o que uma temporada como uma trajetória prediz. StockBench descobriu que a maioria dos agentes negociando ações da Dow por cerca de quatro meses não superou buy and hold (Y. Chen et al., 2025), LiveTradeBench descobriu em mais de 50 dias ao vivo que placares de chat geral não predisseram resultados de negociação (Yu et al., 2025), e PredictionMarketBench descobriu que agentes ingênuos perdem para taxas e liquidação em livros de pedidos Kalshi replicados (Arora & Malpani, 2026). Prediction Arena deu a uma coorte de modelos de fronteira capital real por 57 dias, e os mesmos modelos tiveram um retorno médio de −22,6% em Kalshi e −1,1% em Polymarket (Zhang et al., 2026): o local moveu o resultado médio por mais de vinte pontos. Nenhum pode dizer se um modelo sabia algo sobre o mercado, porque um retorno mistura a direção de um call, seu tamanho, seu tempo, seus custos e o caminho do mercado em um número.
As probabilidades isolam a direção e a confiança de uma previsão. Um modelo que afirma uma chance de 70% de que o ouro suba hoje pode ser avaliado apenas nessa afirmação, por uma regra estritamente própria (Brier, 1950; Gneiting & Raftery, 2007). Doze mercados em quatro horizontes produzem muitas dessas afirmações por modelo por dia, embora os doze mercados de um dia compartilhem uma sessão (Seção 4.6). Em questões de um mercado de previsão regulado que se resolveu após o treinamento dos modelos, cinco modelos de fronteira foram excessivamente confiantes, e um raciocínio mais estendido piorou a calibração (Nel, 2025).
2.5 O que as três condições exigem
A previsão deve ser feita após o ponto de corte do modelo sobre um resultado ainda por vir (2.1). Seu tempo deve ser fixado antes do resultado em um registro cuja mudança posterior um terceiro pode detectar (2.2). A regra para qual previsão conta deve ser fixada antes das execuções (2.3). A pontuação deve ser uma pontuação própria do evento perguntado, agregada em sessões independentes suficientes para distinguir habilidade de um caminho de sorte, com uma verificação de calibração (2.4). E o acordo entre os modelos deve ser descontado pela correlação de seus erros antes de ser lido como evidência (Clemen & Winkler, 1985; Kim et al., 2025; Chernets, 2026a). A Seção 3 escreve os cinco como uma lista de verificação.
3. O protocolo
O protocolo torna o momento de uma previsão um fato que um terceiro pode verificar, e diz qual camada desse fato repousa em quem. Tudo abaixo é publicado nos arquivos abertos da liga (AI Council · Markets, 2026): o protocolo como arena-protocol.json, o livro selado como council-book.jsonl, os textos das perguntas em asks/, e as listas marcadas com suas provas OpenTimestamps em uma página por dia (/markets/proof/<day>/). Descrevo as regras como estavam em 20 de outubro de 2026 (protocolo arena-3, versão 2 da metodologia de pontuação) e uso a execução daquela manhã, 2026-10-20-am, como exemplo prático; toda hora e hash citados para ela podem ser relidos nos arquivos abertos (Apêndice B). Cada selo carrega a versão da metodologia em vigor, e uma mudança posterior de regras deixa tudo selado antes disso como estava.
O contrato de evento. O padrão mede eventos. Um modelo, uma execução ou uma linha de um ranking é uma coleção deles, e defino cada evento por um contrato fixado antes da pergunta ser enviada (Tabela 1). Duas previsões pertencem ao mesmo evento apenas quando cada campo concorda. Uma previsão com uma referência própria, como uma linha selada após a abertura (Seção 3.3), é uma previsão sobre um evento diferente. É pontuada naquele evento e mantida fora de toda estatística que compara modelos em um evento comum (requisito 4).
A palavra rendimento nomeia três eventos separados nesta liga. A previsão é sobre o próprio rendimento de 10 anos, em unidades de rendimento, de sua referência até seu preço terminal às 15:00 ET. O contrato da multidão, quando a pergunta lista um, é resolvido no rendimento par do Tesouro às 15:30 ET, fechamento a fechamento, e é pontuado nesses termos (Seção 4.9). A carteira possui um fundo de títulos do Tesouro (IEF), que sobe quando o rendimento cai (Seção 4.7). Em 20 de outubro a multidão precificou o contrato do rendimento em 7% contra o rendimento par anterior de 5,15%, preço que já refletia a queda do pré-mercado; a própria pergunta da liga sobre o rendimento começa a partir da referência de 09:30 e pergunta algo diferente. Uma chamada correta em uma não diz nada em si sobre as outras. VIX é dividido da mesma forma: a previsão é sobre o índice, a carteira ordinária não pode mantê-lo, a liga Pro pode.
Tabela 1. Campos mínimos de um contrato de evento, e onde a implementação de referência fixa cada um.
| Campo | O que fixa | Implementação de referência |
|---|---|---|
| Alvo | O indicador em si, não um instrumento que o rastreia | 12 indicadores por código; fundos negociados aparecem apenas nas ligas de carteira (assets, trades_as) |
| Predicado e horizonte | O evento: uma subida estrita da referência ao preço terminal | prob_up; 1d; 1w, 1m, 6m como 5, 21 e 126 sessões (Bitcoin 7, 30 e 182 dias corridos) |
| Fonte de preço | Fornecedor, símbolo, tamanho da barra e regra de timestamp para o preço de referência e terminal, por indicador | Fornecedor, símbolo e regra de referência em cada linha de previsão (price_provider, price_symbol, reference_rule; para o S&P 500, a barra de um minuto de ^GSPC no ou após o tempo de referência), declarado por indicador no esquema do contrato; fonte dos preços da carteira no protocolo (prices) |
| Corte de informação | O que uma previsão pode usar: qualquer coisa antes do preço de referência, nunca o próprio preço de referência | Snapshot de preço e pergunta com hash na linha de execução (snapshot_sha256, ask_sha256) |
| Prazo e execução contada | Qual resposta conta para a sessão | A partir de 21 de outubro de 2026, a execução matinal programada, declarada com antecedência, selada em asks.jsonl e publicada na página de prova; dentro dela, a linha selada por último antes da referência (counted), e a partir da sessão 11 (2 de novembro de 2026) a primeira linha de resposta bem-formada de cada assento selada antes da referência, linhas posteriores do mesmo assento sendo marcadas como tentativas, por uma regra declarada em asks.jsonl, linha 74, SHA-256 de texto 0f42c93b…b0b6cd. Para 19 e 20 de outubro, a execução selada por último antes da abertura (session_run), aplicada após as execuções; em toda execução contada até agora cada assento selou uma linha de resposta, portanto a primeira e a última linha antes da referência são as mesmas |
| Preço de referência | Uma referência por evento, tomada após o selo | Primeiro preço no ou após 09:30 ET; Bitcoin, o fechamento da primeira barra de um minuto começando no ou após o selo da linha (reference, btc) |
| Resolução | Preço terminal, sua hora e sua regra | Fechamento da última sessão do horizonte às 16:00 ET; o rendimento de 10 anos às 15:00 ET; o dia do Bitcoin do minuto do selo até 16:00 ET da sessão de pontuação |
| Regra de empate | Quais pequenos movimentos são empates e como são pontuados | Banda de 0,1 vezes uma escala de barra de um minuto do movimento do dia, cerca de 0,08 de um desvio padrão de sessão; sessões de rolagem deixadas de fora (direction, noise_rolls) |
| Regra de pontuação e benchmarks | A pontuação adequada e com o que é comparada | Pontuação de Brier sobre todas as linhas; benchmark de 50%; climatologia fixa do evento (climatology_fixed, Seção 4.3) |
| Versão de regras | Qual metodologia se aplica | methodology.version, selada em cada linha de execução; methodology_version em cada linha de previsão |
| Identificador de evento | Uma chave para "o mesmo evento" | event_id_v2, um hash das nove chaves do contrato completo, com a event_id de cinco chaves ao lado (event-contract.schema.json, Seção 3.13) |
Nota: Nomes de campos entre parênteses são aqueles dos arquivos abertos (arena-protocol.json, campo methodology de cada linha de execução, council-stats.json, council-calibration.json e colunas de council-forecasts.csv). A janela 15:00 ET do rendimento é declarada na linha de execução selada de 20 de outubro.
3.1 Um dia da liga
A Figura 1 segue um dia da liga desde o snapshot até a pontuação.
Captura. Antes da pergunta ser enviada, o motor tira uma captura de preço de 12 mercados: S&P 500, Nasdaq-100, Dow Jones, o índice de semicondutores (SOX), o rendimento do bônus do Tesouro americano de 10 anos, o índice do dólar (DXY), VIX, ouro, WTI, Brent, cobre e Bitcoin (Tabela 2). Cada linha carrega seu preço, mudanças recentes, amplitude de 52 semanas e o minuto em que foi lida; antes da abertura as linhas de índice de ações e rendimento contêm a sessão anterior, enquanto as outras linhas são ao vivo. O SHA-256 da captura é escrito na linha de execução (snapshot_sha256), para que uma afirmação posterior de que os modelos viram preços diferentes possa ser testada.
Pergunta. Catorze assentos fazem negociações; onze deles também fornecem probabilidades e formam o Conselho, cinco de laboratórios americanos e seis de laboratórios chineses, e três assentos no banco apenas fazem negociações (Tabela 8). Uma pergunta vai para cada modelo do Conselho, palavra por palavra, exceto um bloco que fornece a cada modelo sua própria conta. O SHA-256 do texto comum é escrito na linha de execução (ask_sha256) e repetido em cada linha de resposta, e o texto é publicado como asks/<sha256>.md. O hash do texto que cada modelo recebeu, incluindo sua própria conta, é selado quando é enviado (asks.jsonl). Em 20 de outubro a pergunta abriu às 08:30 EDT, e seu arquivo publicado tem hash para o valor na linha de execução, 77d3c627…6f07. Também forneceu as mudanças pré-abertura dos futuros do índice de ações e disse aos modelos que podem usá-las (Seção 3.3).
Selado antes de 09:30 ET. Cada resposta é registrada como uma linha do livro com encadeamento de hash. Em 20 de outubro as oito respostas contadas carregam tempos de resposta de 12:31:11Z a 12:42:02Z; a linha de execução e as respostas entraram no livro em um único lote, as respostas com booked_at 13:00:25Z, e o lote foi marcado com data de 13:00:25Z (09:00:25 ET). Um selo de lote marca o lote. O Requisito 12 sela cada resposta na chegada, e a manhã de 21 de outubro mostra ambas as formas. Suas primeiras oito respostas contadas (12:32:52Z a 12:44:59Z) foram registradas em um lote às 13:00:19Z, o segundo em que duas autoridades externas assinaram sua lista marcada com data, e uma nona foi registrada às 13:23:37Z, 14 segundos após sua chegada, o segundo em que três autoridades assinaram a próxima lista (Seção 3.2). A página de prova de 20 de outubro registra que "a entrada para a pontuação fechou em Ter, Out 20, 2026, 9:30 AM ET (2026-10-20T13:30:00Z)". Quatro marcas com data foram obtidas nesse dia, às 13:00:25Z, 15:00:12Z, 15:36:05Z e 16:52:54Z, ancoradas nos blocos 972.334, 972.344, 972.354 e 972.359. A primeira cobre linhas 1 a 159, que contêm a linha de execução (151) e as oito respostas contadas (152 a 159).
Abertura. O preço de referência de cada mercado, exceto Bitcoin, é o primeiro preço em ou após 09:30 ET; para Bitcoin, que é negociado 24 horas por dia, é o fechamento da primeira barra de um minuto que começa em ou após o lacre da linha. A referência é sempre obtida após o lacre (Seção 3.3).
Pontuação após o fechamento. Após o fechamento de 16:00 ET o motor escreve uma linha de pontuação no mesmo livro com a referência, fechamento, mudança, sinalizador de empate e a probabilidade que cada modelo forneceu. Em 20 de outubro a linha de pontuação (linha 184) foi registrada às 20:30:36Z, após o último carimbo de data do dia, portanto é coberta pelo próximo carimbo de data, o primeiro de 21 de outubro. Horizontes mais longos são pontuados quando suas janelas fecham, como suas próprias linhas.
Figura 1. Um dia da liga: captura, pergunta, lacre, abertura, pontuação.
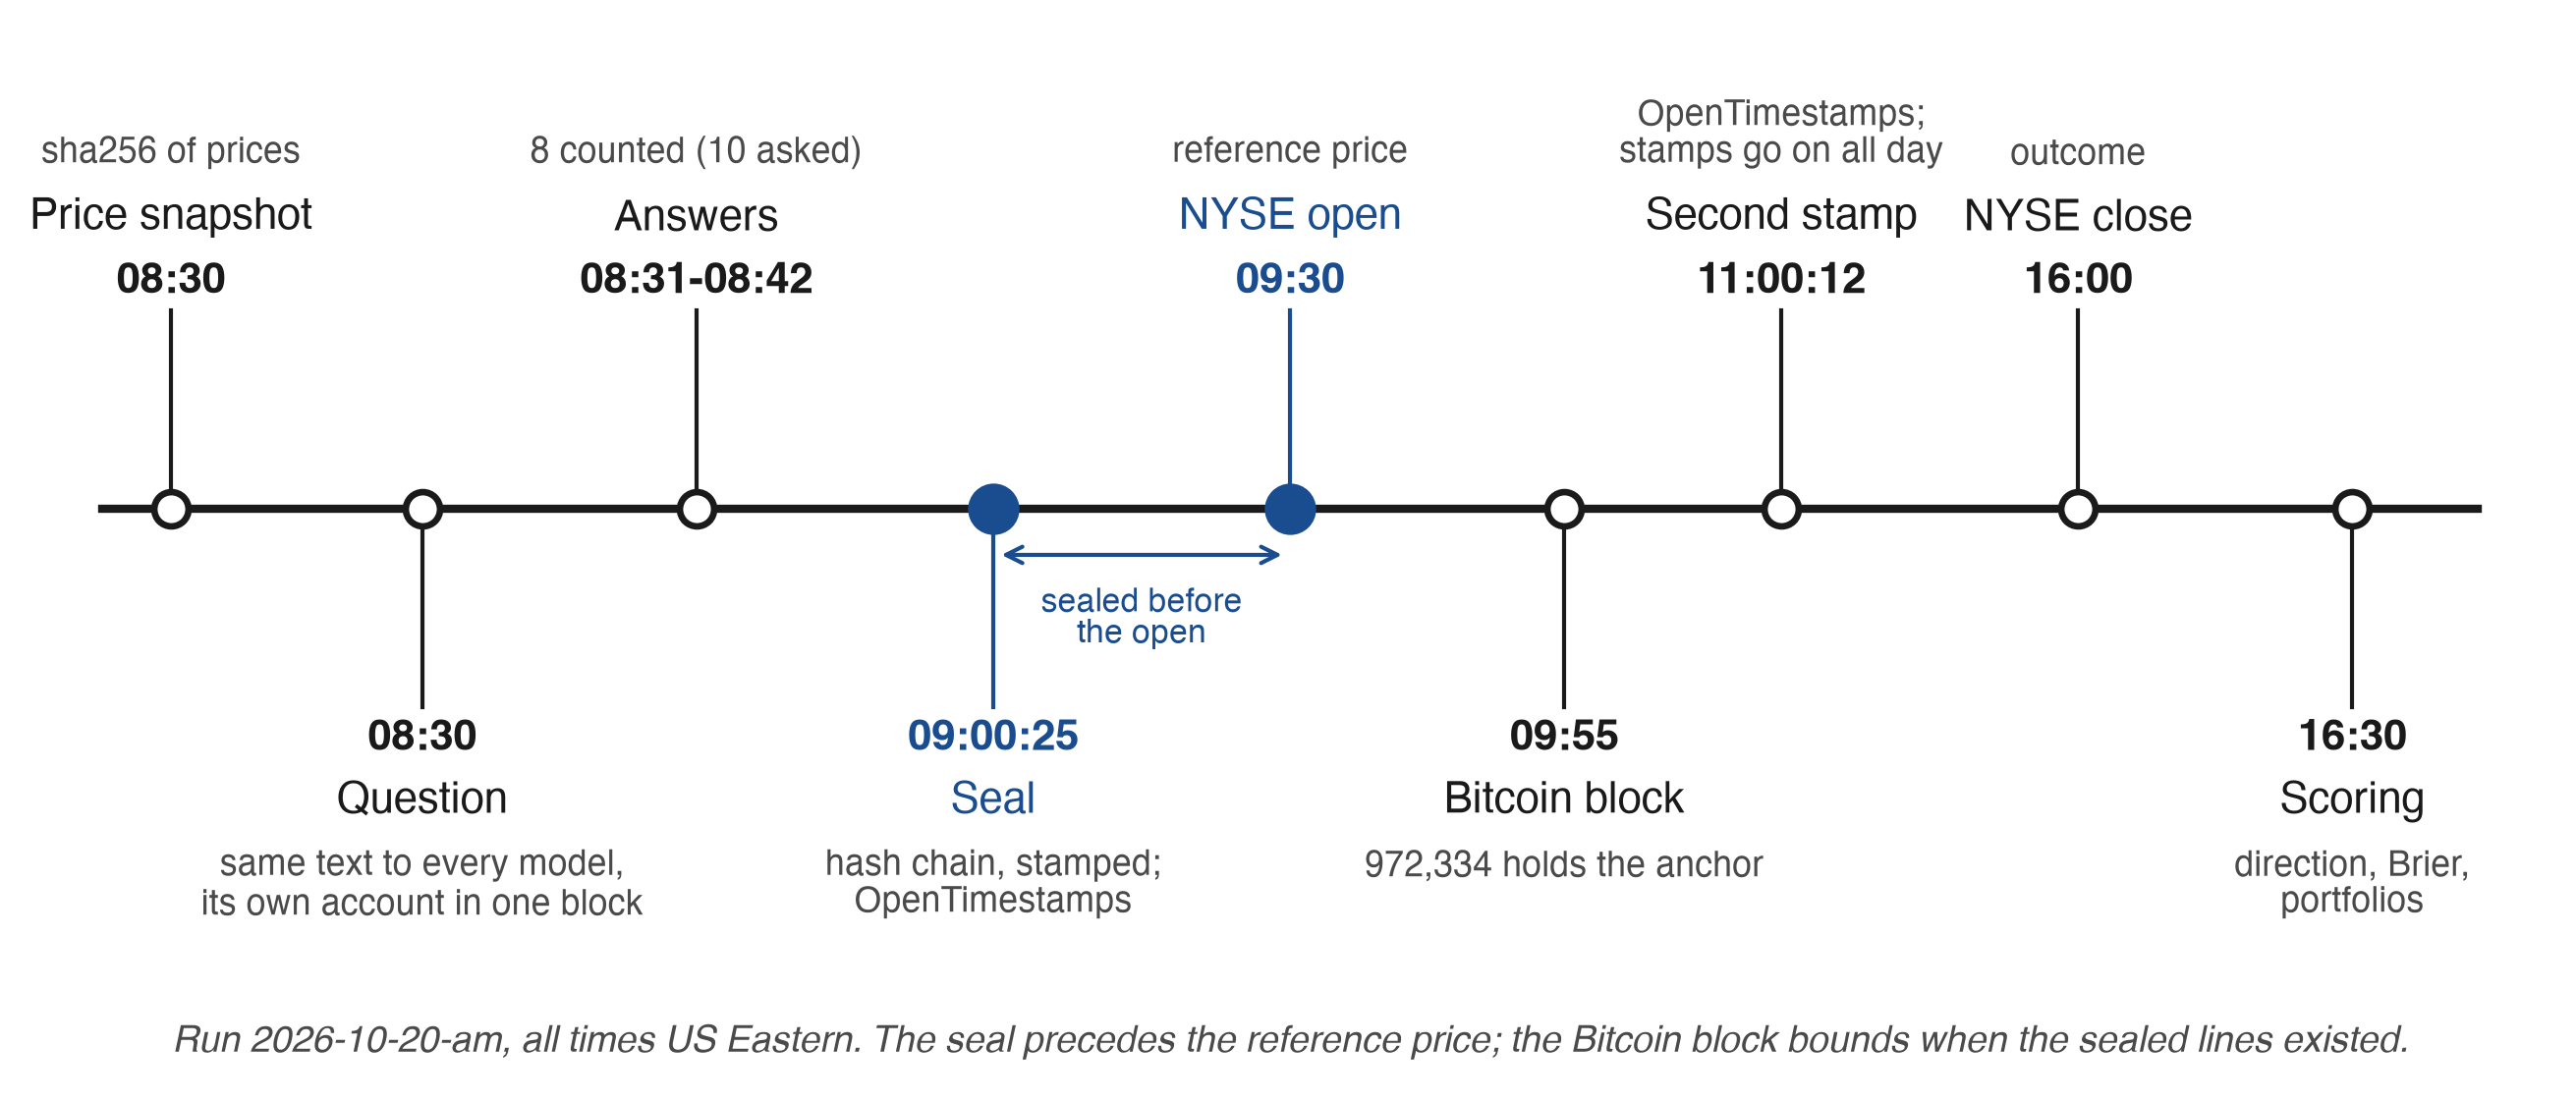
Nota: Os tempos são aqueles da execução 2026-10-20-am lida de council-book.jsonl e a página de prova /markets/proof/2026-10-20/. ET é a hora de Nova York. O tempo do bloco Bitcoin é a hora do cabeçalho do bloco 972.334, que contém a âncora do carimbo de data de 13:00:25Z. Um tempo de cabeçalho limita o tempo de mineração pelo limite prático (Seção 3.11). O segundo carimbo de data do dia, 15:00:12Z (11:00:12 ET), é marcado para mostrar que carimbos de data continuam ao longo do dia; a linha de pontuação de 20:30:36Z é coberta pelo primeiro carimbo de data do próximo dia.
Na Tabela 2 dou, para cada mercado, o símbolo de preço no qual seu evento é resolvido, o fim de seu evento de um dia, o fundo através do qual as ligas de portfólio o mantêm e o contrato de multidão selado com a pergunta em 20 de outubro de 2026.
Tabela 2. Os doze mercados: símbolo de preço, referência e fim do evento de um dia, o fundo em que cada um é negociado nas ligas de portfólio, e o contrato de multidão selado em 20 de outubro de 2026.
| Mercado | Código | Símbolo de preço | Referência | Fim do evento de um dia (ET) | Negociado como | Contrato de multidão, 20 de outubro de 2026 (local, volume selado $) |
|---|---|---|---|---|---|---|
| S&P 500 | SPX | ^GSPC |
Primeira barra de 1 min em ou após 09:30 ET | 16:00 | SPY | Polymarket, 20.637 (Kalshi também listada) |
| Nasdaq-100 | NDX | ^NDX |
Idem | 16:00 | QQQ | Kalshi, 1.150 |
| Dow Jones | DJI | ^DJI |
Idem | 16:00 | DIA | Polymarket, 20 |
| Semicondutores | SOX | ^SOX |
Idem | 16:00 | SOXQ | Nenhuma |
| Rendimento do bônus do Tesouro americano de 10 anos | US10Y | ^TNX |
Idem | 15:00 | IEF | Kalshi, 3.199 |
| Índice do dólar | DXY | DX-Y.NYB |
Idem | 16:00 | UUP | Polymarket, 4 |
| VIX | VIX | ^VIX |
Idem | 16:00 | Não mantido (indicators_only) |
Nenhuma |
| Ouro | GOLD | GC=F |
Idem | 16:00 | GLD | Polymarket, 3.112 (Kalshi também listada) |
| WTI | WTI | CL=F |
Idem | 16:00 | USO | Polymarket, 3.736 (Kalshi também listada) |
| Brent | BRENT | BZ=F |
Idem | 16:00 | BNO | Nenhuma |
| Cobre | COPPER | HG=F |
Idem | 16:00 | CPER | Nenhuma |
| Bitcoin | BTC | BTC-USD |
Fechamento da primeira barra de 1 min começando em ou após o lacre da linha | 16:00 da sessão de pontuação | BTC-USD | Polymarket, 38 |
Nota: Das linhas de previsão das execuções de 20 e 21 de outubro de 2026 (price_provider, price_symbol, reference_rule, event_end_at), arena-protocol.json (assets, indicators_only) e linha 151 de execução de council-book.jsonl (crowd.odds, crowd.kalshi). Cada linha nomeia o provedor yahoo_finance_chart_v8_1m e a regra first_1m_bar_at_or_after_reference_at__last_1m_bar_at_or_before_end_at__v1. Horizontes de uma semana, um mês e seis meses são 5, 21 e 126 sessões (Bitcoin 7, 30 e 182 dias; Tabela 1). As bandas de sorteio são configuradas por sessão (Tabela 1) e não estão listadas. A comparação de multidão primária admite contratos com volume selado de pelo menos $1.000 (Seção 4.9).
Os preços existem antes da pergunta, a pergunta antes das respostas, as respostas antes do preço do qual são pontuadas, e o resultado depois de todos eles. Cada "antes" é escrito no livro como um hash, e a cabeça do livro é ancorada fora do controle do operador.
3.2 O que é um selo
O livro é uma sequência de linhas JSON , escritas uma vez e mantidas como escritas. Cada linha tem quatro campos de escrituração: sua posição n, o hash da linha anterior prev, seu próprio hash de conteúdo seal, e seu hash encadeado link. Seja o SHA-256 (National Institute of Standards and Technology, 2015) e seja a serialização de um objeto JSON com chaves classificadas exatamente como json.dumps(o, sort_keys=True, ensure_ascii=False) do Python o escreve, codificado como UTF-8 (Apêndice B, Passo 4). Então para a linha com conteúdo (todos os campos exceto os quatro):
O selo fixa o que a linha diz. O elo fixa o que ela diz, onde fica e tudo antes dela. Recomputei ambos os hashes para todas as 211 linhas do livro em 20 de outubro de 2026: cada seal e cada link se reproduzem, e cada prev é igual ao link da linha anterior.
A linha de execução contém o hash da pergunta, o hash do snapshot de preço, a lista por lado, a metodologia de pontuação em vigor e os preços do mercado de previsão registrados quando a pergunta foi feita. A linha de resposta contém o modelo, seu modo e sua resposta inteira analisada para os 12 mercados e quatro horizontes, com own_sha256, o hash da resposta bruta, e ask_sha256. A linha de pontuação contém o resultado. Os três são selados da mesma forma.
Uma cadeia sozinha prova ordem e conteúdo. Um operador que controla o arquivo poderia reconstruir uma cadeia inteira em uma tarde, então tomo tempo de fora. A cada execução o motor escreve uma lista curta com carimbo de data/hora que nomeia, para cada livro, quantas linhas tinha, o SHA-256 de exatamente essas linhas e o elo do último. Para este livro em 20 de outubro às 13:00:25Z lê-se "159 linhas, sha256 59673b9e…a7d9, último elo 378273fd…7175b2c". A lista é marcada com carimbo de data/hora usando OpenTimestamps (Todd, 2016), que agrega muitos hashes em uma árvore de Merkle e vincula sua raiz a uma transação Bitcoin através de servidores de calendário públicos. A prova .ots, publicada junto com a lista, mantém o caminho de operações de hash do SHA-256 da lista para a raiz de Merkle de um cabeçalho de bloco, aqui bloco 972.334, hora de cabeçalho 13:55:20Z. A construção é a marcação de tempo encadeada de Haber e Stornetta (1991) com a cadeia Bitcoin (Nakamoto, 2008) como testemunha.
Avaliava a evidência de tempo por quem um leitor precisa confiar, do próprio registro do operador até uma hora assinada:
- Nível 1, o registro do operador. Cada linha é lacrada na corrente (
at,prev,link; linhas de resposta adicionambooked_at, o segundo do lacre do lote), e o preço de referência é obtido após o lacre. A corrente fixa a ordem e o conteúdo; o minuto do lacre é o que o operador registrou. - Submissão aos calendários. A lista que contém a cabeça da corrente é enviada aos calendários OpenTimestamps públicos (as provas nomeiam
alice.btc.calendar.opentimestamps.orgebob.btc.calendar.opentimestamps.org). Um recibo pendente mostra que o hash foi aceito; não carrega uma hora que um leitor possa verificar. - Nível 2, a âncora Bitcoin. Os calendários comprometem o hash a um bloco Bitcoin. O prefixo ancorado não existiu depois de algumas horas após a hora do cabeçalho do bloco, pelo limite prático (Seção 3.11), e uma reescrita posterior de uma linha nele é detectável por qualquer um que tenha uma prova anterior. O bloco pode ser minerado após 09:30 ET: em 20 de outubro o carimbo de 09:00:25 ET alcançou um bloco com hora do cabeçalho 09:55:20 ET.
- Nível 2+, hora assinada. A partir de 21 de outubro de 2026 autoridades independentes de carimbo de tempo RFC 3161 (Adams et al., 2001), FreeTSA e DigiCert, acompanhadas por Sectigo da terceira lista daquele dia, assinam cada lista carimbada, fixando o segundo em que cada linha que cobre existiu. O leitor confia em uma autoridade e seu certificado em vez do operador, e com autoridades independentes qualquer uma é suficiente. O token marca a hora do lote. A chegada de cada resposta é o objeto da exigência 12.
Uma linha é lacrada quando entra na corrente, a cabeça é carimbada quando vai aos calendários, e é ancorada quando atinge um bloco. Como o livro apenas cresce, um carimbo obtido na linha 159 ainda verifica em qualquer comprimento posterior: head -n 159 do arquivo de hoje retorna os bytes carimbados inalterados e faz hash para o valor carimbado naquela manhã, então o prefixo é obtido pela contagem de linhas, não por um filtro que reescreveria as linhas. Cada lista carimbada imprime a regra de byte que faz hash: o arquivo como armazenado, UTF-8 sem marca de ordem de byte e sem nada recodificado, cada linha contada com seu LF final, e uma última linha contada assim que seu LF é escrito.
Hora da divulgação e hora do lacre. A hora do lacre é quando uma linha entra na corrente; a hora da divulgação é quando seu texto fica público. A liga publica os textos das linhas após a pontuação do dia, com o local, o lacre e a hora visíveis antes disso (página de prova). Divulgação atrasada, a propriedade de Sornette et al. (2010), impede que um terceiro use uma probabilidade lacrada em aberto. Vincular o operador, que mantém o texto para registrá-lo, é o trabalho de P1b e P2 (Seção 3.11). Dentro de um lote a corrente registra a ordem de registro: em 20 de outubro a linha de execução está antes de suas respostas e foi registrada com elas, após sua chegada.
3.3 Preço de referência após o lacre
O preço de referência é o primeiro preço após o lacre pela regra de cada mercado. Uma previsão é avaliada apenas no caminho de preço que começa depois que foi fixada. Informação que existe antes da referência é permitida: a pergunta pode carregar os futuros pré-abertura (em 20 de outubro, os futuros S&P 500, Nasdaq-100, Dow e Russell 2000 contra o fechamento anterior), e um modelo pode procurar por notícias até sua resposta. O que o protocolo exclui é o preço de referência e tudo depois dele.
Uma linha lacrada após a abertura é mantida. Recebe sua própria referência, o primeiro preço após seu próprio lacre, e é marcada como atrasada (late_ref na linha de pontuação). Uma linha lacrada após o fechamento não é avaliada para essa sessão (counted). Tal linha responde a uma pergunta diferente: no livro de 20 de outubro, a referência própria de uma linha lacrada após a abertura inverteu o sinal do movimento pontuado em seis de suas nove células de um dia. Portanto mantenho fora de tudo que compara modelos em um evento comum: o consenso, as contagens de erro compartilhado, o modelo mais próximo, o número efetivo de vozes e todas as comparações cabeça a cabeça (exigência 4). A linha de pontuação marca a linha, e a série contada de estatísticas da liga a deixa de fora (Tabela 5).
A mesma regra fixa uma referência por evento comum, Bitcoin incluído. Na implementação de referência, a referência Bitcoin é o fechamento da primeira barra de um minuto que começa em ou após o lacre da linha (reference_rule, Yahoo Finance BTC-USD), então o preço é sempre posterior ao lacre, enquanto os arquivos abertos escrevem o lacre segundo como reference_at e o início da barra com preço como reference_price_at. Uma linha lacrada em um lote posterior obtém sua própria referência Bitcoin e é um evento separado. Em 21 de outubro as oito respostas lacradas às 13:00:19Z compartilham a referência 83.536,42, o fechamento da barra 13:01Z; a nona, lacrada às 13:23:37Z, tem a sua própria, 83.677,08, o fechamento da barra 13:24Z, e é avaliada separadamente (own_event, same_event falso), fora do evento Bitcoin comum. Como reference_at iguala o segundo do lacre, um corte em "lacrado antes de reference_at" deixaria cair cada linha Bitcoin. Uso um relógio para todos os doze mercados: uma linha de resposta entra nas estatísticas de evento comum apenas se foi lacrada antes da referência 09:30 ET da sessão. As linhas Bitcoin seguem o mesmo corte 09:30 ET, enquanto o próprio preço Bitcoin é referenciado a partir do primeiro minuto após o lacre da execução. Esta é a regra da série contada publicada (n_eff.counted) e dos scripts de resolução apresentados. Uma vez que respostas são lacradas na chegada (exigência 12), a referência comum para um mercado que negocia constantemente é o preço no fechamento da ingestão da execução, após cada lacre contado.
3.4 Uma execução contada por sessão
A liga pergunta mais de uma vez por dia (uma corrida matinal, uma corrida vespertina, uma corrida Bitcoin de fim de semana e um radar de domingo), então várias corridas podem visar uma sessão. Exatamente uma conta para cada modelo e sessão, e o padrão exige que essa corrida seja fixada por uma regra declarada antes das corridas (requisito 6). Uma regra da forma "a corrida selada por último antes da abertura" é aplicada após o fato. Deixa o operador livre para enviar uma corrida posterior antes da abertura, e assim escolher entre corridas. Portanto, fiz do cronograma a regra. A partir de 21 de outubro de 2026, o início do registro contado, a corrida matinal programada conta e toda outra corrida é um cálculo de referência. A declaração é selada como a primeira linha da cadeia de perguntas de saída (asks.jsonl, 04:16 UTC em 21 de outubro de 2026, oito horas antes da corrida matinal) e publicada na página de prova com seu SHA-256 (c24b0d4f…5df5) e uma captura do Internet Archive (05:35 UTC no mesmo dia); li-a lá em 21 de outubro de 2026 às 15:05 UTC. Nas duas sessões de desenvolvimento, 19 e 20 de outubro, a metodologia selada contou a corrida selada por último antes da abertura da sessão (session_run), uma regra aplicada após as corridas. Essas sessões formam um segmento de desenvolvimento fora da janela da comparação primária (Seção 8). As outras corridas são pontuadas em sua própria página (not_counted, earlier_run), mantidas, publicadas e rotuladas, e qualquer pessoa pode aplicar a regra declarada aos carimbos de tempo selados (P3, Seção 3.11). As tentativas das ligas de portfólio (asked_again, Apêndice A) são seladas com seus hashes de pergunta e ficam fora de toda pontuação de previsão.
3.5 Direção, probabilidade e o empate
O modelo fornece prob_up, sua probabilidade de 0 a 100 de que o indicador seja maior no final do horizonte do que em seu preço de referência. Para o rendimento de 10 anos, uma "compra" é uma aposta de que o rendimento suba; para VIX, que a volatilidade esperada suba.
Trato pequenos movimentos como empates por uma regra fixada antecipadamente. A banda é , com a retorno percentual absoluto de um minuto médio nas quatro sessões de barras de minuto antes da referência; para retornos normais, isto é cerca de 0.08 do desvio padrão de uma sessão (council-stats.json, draw_band). Para os futuros (WTI, Brent, ouro, cobre), movimentos de minuto em uma mudança registrada do contrato do mês inicial são deixados de fora, porque um roll é um salto entre dois contratos (noise_rolls). O padrão exige que o evento pontuado seja o evento perguntado (requisito 7). A pontuação Brier primária é computada sobre todas as linhas, uma subida significando uma mudança acima de zero, e a pontuação sem empates é relatada em segundo lugar com o número de linhas que ela elimina. Os modelos são solicitados pela probabilidade de uma subida estrita e não são informados sobre a regra de empate. A partir da sessão de 21 de outubro, a pontuação de todas as linhas é a pontuação principal da liga (campo pall). As sessões de desenvolvimento permanecem como publicadas, um segmento separado (requisito 15), em uma pontuação que deixa empates de fora. Tal pontuação é minimizada pela probabilidade de uma subida dado um movimento fora da banda, então para a pergunta feita, ela não é estritamente própria.
Uma banda de empate e uma pontuação própria podem caminhar juntas. Um design pede a probabilidade de uma subida dado um movimento fora da banda e a pontua apenas em linhas que não são empates. O outro pede três probabilidades, de uma subida, um empate e uma queda, pontuadas pela pontuação Brier de três resultados, estritamente própria para a tríade (Brier, 1950; Gneiting & Raftery, 2007):
Uma previsão que dá ao empate probabilidade zero em uma linha que não é um empate marca exatamente a pontuação Brier binária, . A previsão uniforme de um terço cada marca contra 0.25 para a moeda binária, então a pontuação de três resultados precisa de seu próprio benchmark. Uma probabilidade de exatamente 50 não favorece nenhum lado e é pontuada por Brier apenas.
3.6 "Comprar nas quedas" como um nível fixado antecipadamente
"Comprar em quedas" sem um nível não pode ser pontuado, então exijo uma resposta com a ação buy_dips para dar entry, um nível abaixo da referência no qual o modelo adicionaria. Se o preço a tocar durante a sessão, a carteira compra no entry, caso contrário nada é comprado. De qualquer forma a probabilidade é pontuada. As cinco ações permitidas são buy_strong, buy_dips, hold, trim e sell. Uma palavra fora da lista é mantida como action_word, sua probabilidade e níveis são pontuados, e ela não negocia.
Cada célula de resposta porta portanto duas respostas lacradas sobre um evento, uma probabilidade e uma ação, e nos dois últimos fechamentos contados elas se alinham (Figura 2). Pelas 384 células dos oito assentos lacrados antes da referência em 20 de outubro de 2026 e as 432 células dos nove assentos em 21 de outubro de 2026, nenhum campo de ação estava vazio, cada sell e trim ficou abaixo de 50, hold ficou em torno de uma chance mesmo (mediana 52 em ambas as manhãs) e a mediana subiu passo a passo para buy_strong. Encontro uma compra em quedas ao lado de uma probabilidade abaixo de 50 em quatro células: três células de um dia do Claude em 20 de outubro (S&P 500 48, Nasdaq-100 47, semicondutores 46) e o S&P 500 do MiMo em uma semana em 21 de outubro (47). Uma compra em quedas é uma ordem que se executa apenas em um nível de entry fixado abaixo da referência, então uma probabilidade abaixo de 50 ao lado dela é coerente. A Tabela 3 conta as ações por horizonte. hold preencheu 64 das células de um dia em cada manhã (de 96 e 108 células), e em seis meses buy_dips liderou (37 e 38 células).
Figura 2. Probabilidade declarada de alta pela ação lacrada na mesma célula de resposta: execuções 2026-10-20-am (oito assentos lacrados antes da referência) e 2026-10-21-am (nove assentos), todos os quatro horizontes.
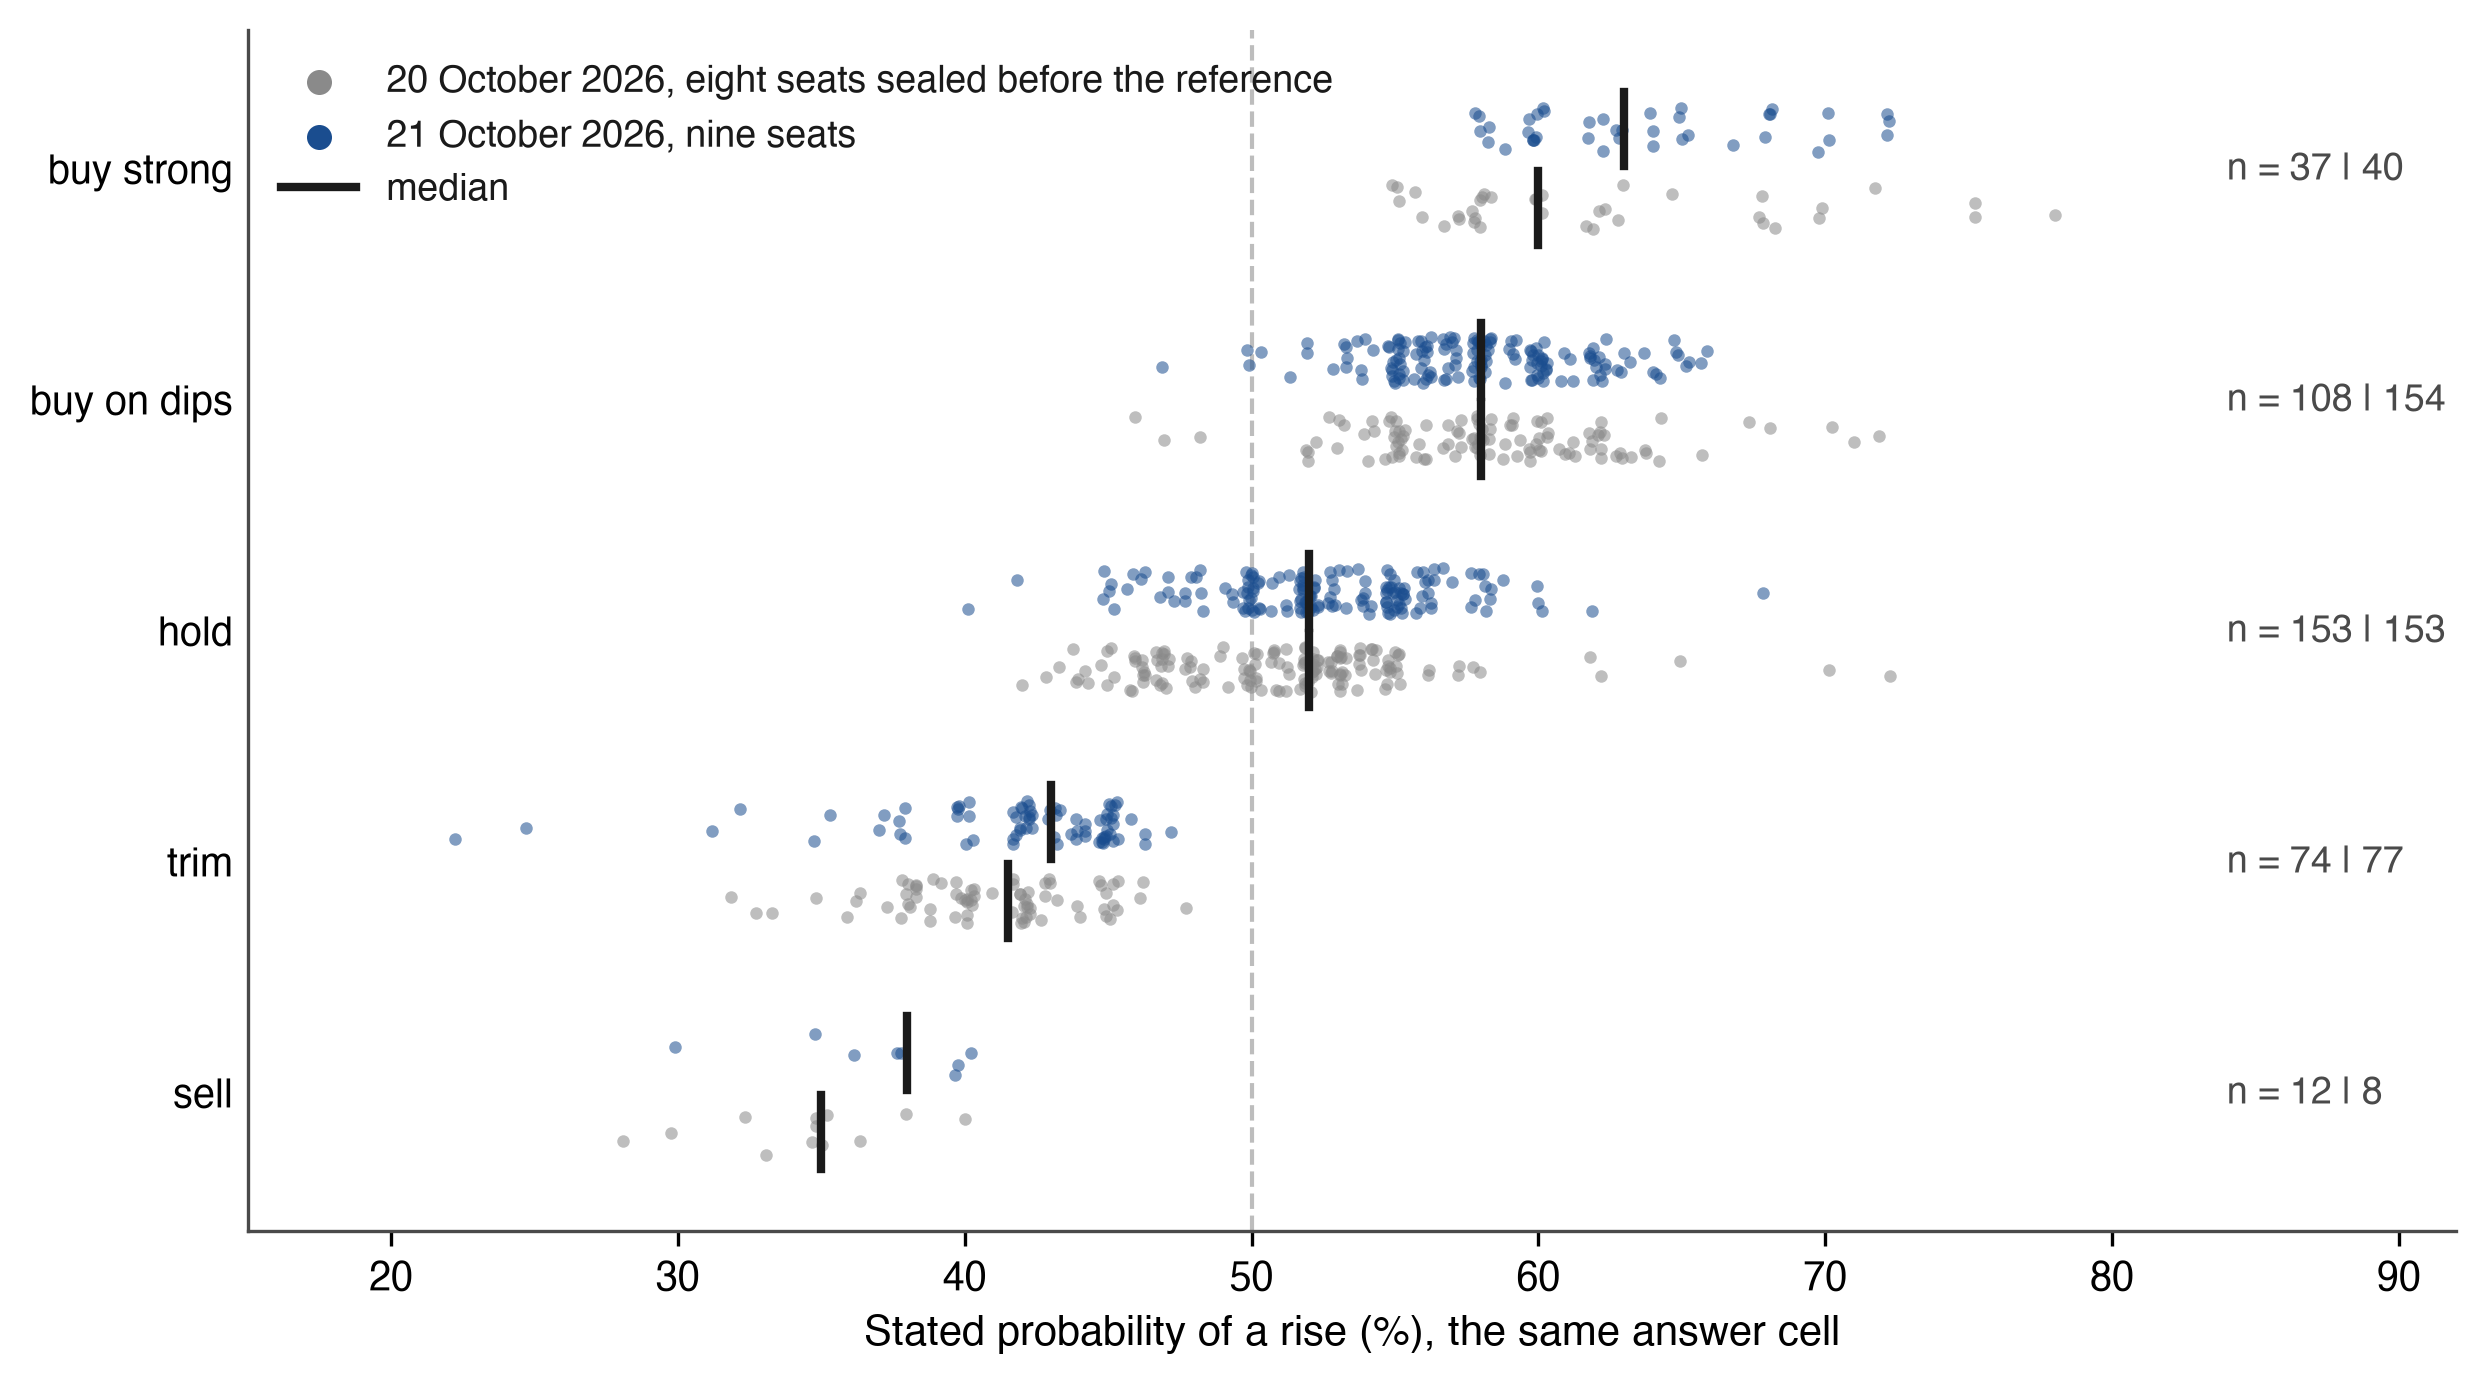
Nota: Cada ponto é uma célula de resposta (assento × mercado × horizonte), ligeiramente tremulada; as barras marcam as medianas (sell 35 e 38, trim 41,5 e 43, hold 52 e 52, compra em quedas 58 e 58, compra forte 60 e 63); n indica as células de 20 | 21 de outubro. Ações conforme lacradas em items.<market>.<horizon>.action, probabilidades em prob_up. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC. Como toda figura e tabela das Seções 3 a 5 construídas a partir de respostas lacradas, ela não mostra resultado.
Tabela 3. Ações lacradas por horizonte: execuções 2026-10-20-am (oito assentos lacrados antes da referência, 96 células por horizonte) e 2026-10-21-am (nove assentos, 108 células por horizonte).
| Horizonte | Execução | Vender | Reduzir | Manter | Comprar em quedas | Compra forte |
|---|---|---|---|---|---|---|
| 1 dia | 20 out 2026 | 1 | 11 | 64 | 16 | 4 |
| 1 dia | 21 out 2026 | 0 | 12 | 64 | 26 | 6 |
| 1 semana | 20 out 2026 | 3 | 23 | 33 | 31 | 6 |
| 1 semana | 21 out 2026 | 1 | 18 | 31 | 54 | 4 |
| 1 mês | 20 out 2026 | 2 | 15 | 42 | 24 | 13 |
| 1 mês | 21 out 2026 | 3 | 22 | 34 | 36 | 13 |
| 6 meses | 20 out 2026 | 6 | 25 | 14 | 37 | 14 |
| 6 meses | 21 out 2026 | 4 | 25 | 24 | 38 | 17 |
Nota: Contagens de células de resposta pela ação nelas lacrada. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC.
3.7 Quatro horizontes e o ano
Toda resposta abrange quatro horizontes para cada mercado: o próximo dia de negociação (1d), a semana (1w), o mês (1m) e seis meses (6m), mais uma frase sem pontuação sobre o ano (years). Para os onze mercados de horário de bolsa os horizontes mais longos são 5, 21 e 126 sessões; para Bitcoin são 7, 30 e 182 dias corridos, e seu dia vai desde o minuto do lacre até o fechamento 16:00 ET da sessão de pontuação, cerca de sete horas para a execução matutina. Comparo horizontes dentro de cada definição. Um modelo em uma manhã portanto dá 48 probabilidades, cada uma resolvida em sua própria janela e todas lacradas em um minuto com um conjunto de informações.
3.8 Alvo e "errado se"
Para cada mercado e horizonte o modelo também dá target, onde espera que o preço vá, e invalidation, mostrado como "Errado se", o nível no qual admitiria que a visão estava errada, com seu risco principal e o que a faria revisar a visão (risk, revise_if). Tudo é lacrado com a probabilidade, então a previsão é falsificável nos próprios termos do modelo. Uma resposta lacrada mostra os campos em funcionamento. Em 19 de outubro de 2026, antes da abertura, ChatGPT (GPT-6.1 Sol) deu ao S&P 500 uma chance de 54% de alta no dia, com um alvo de 7.678,59 e "Errado se" em 7.560, depois 42% em uma semana, 38% em um mês e 61% em seis meses. Sua visão declarada foi "Dou mais peso aos efeitos inflacionários imediatos dos gastos com IA do que ao seu eventual dividendo de produtividade", e sua condição para revisão foi "Eu abandonaria a visão baixista mensal se SPX ultrapassasse 8000 junto com orientações de lucros melhorando" (linha do livro 83). Cada um desses níveis pode ser verificado contra o caminho do preço sem perguntar ao modelo o que ele quis dizer. Na Figura 3 desenho a resposta toda, com a probabilidade, a ação, o alvo e o nível "Errado se" em cada horizonte, e o nível de entry de 7.350 em seis meses no qual sua compra em quedas se executaria. A pergunta havia mostrado o fechamento anterior, 7.659,44, e o preço de referência do dia, 7.700,34, foi tomado após o lacre.
Figura 3. Uma resposta lacrada: ChatGPT no S&P 500, execução 2026-10-19-am (council-book.jsonl, linha 83), com probabilidade, ação, alvo, nível "Errado se" e nível de entry em cada horizonte.
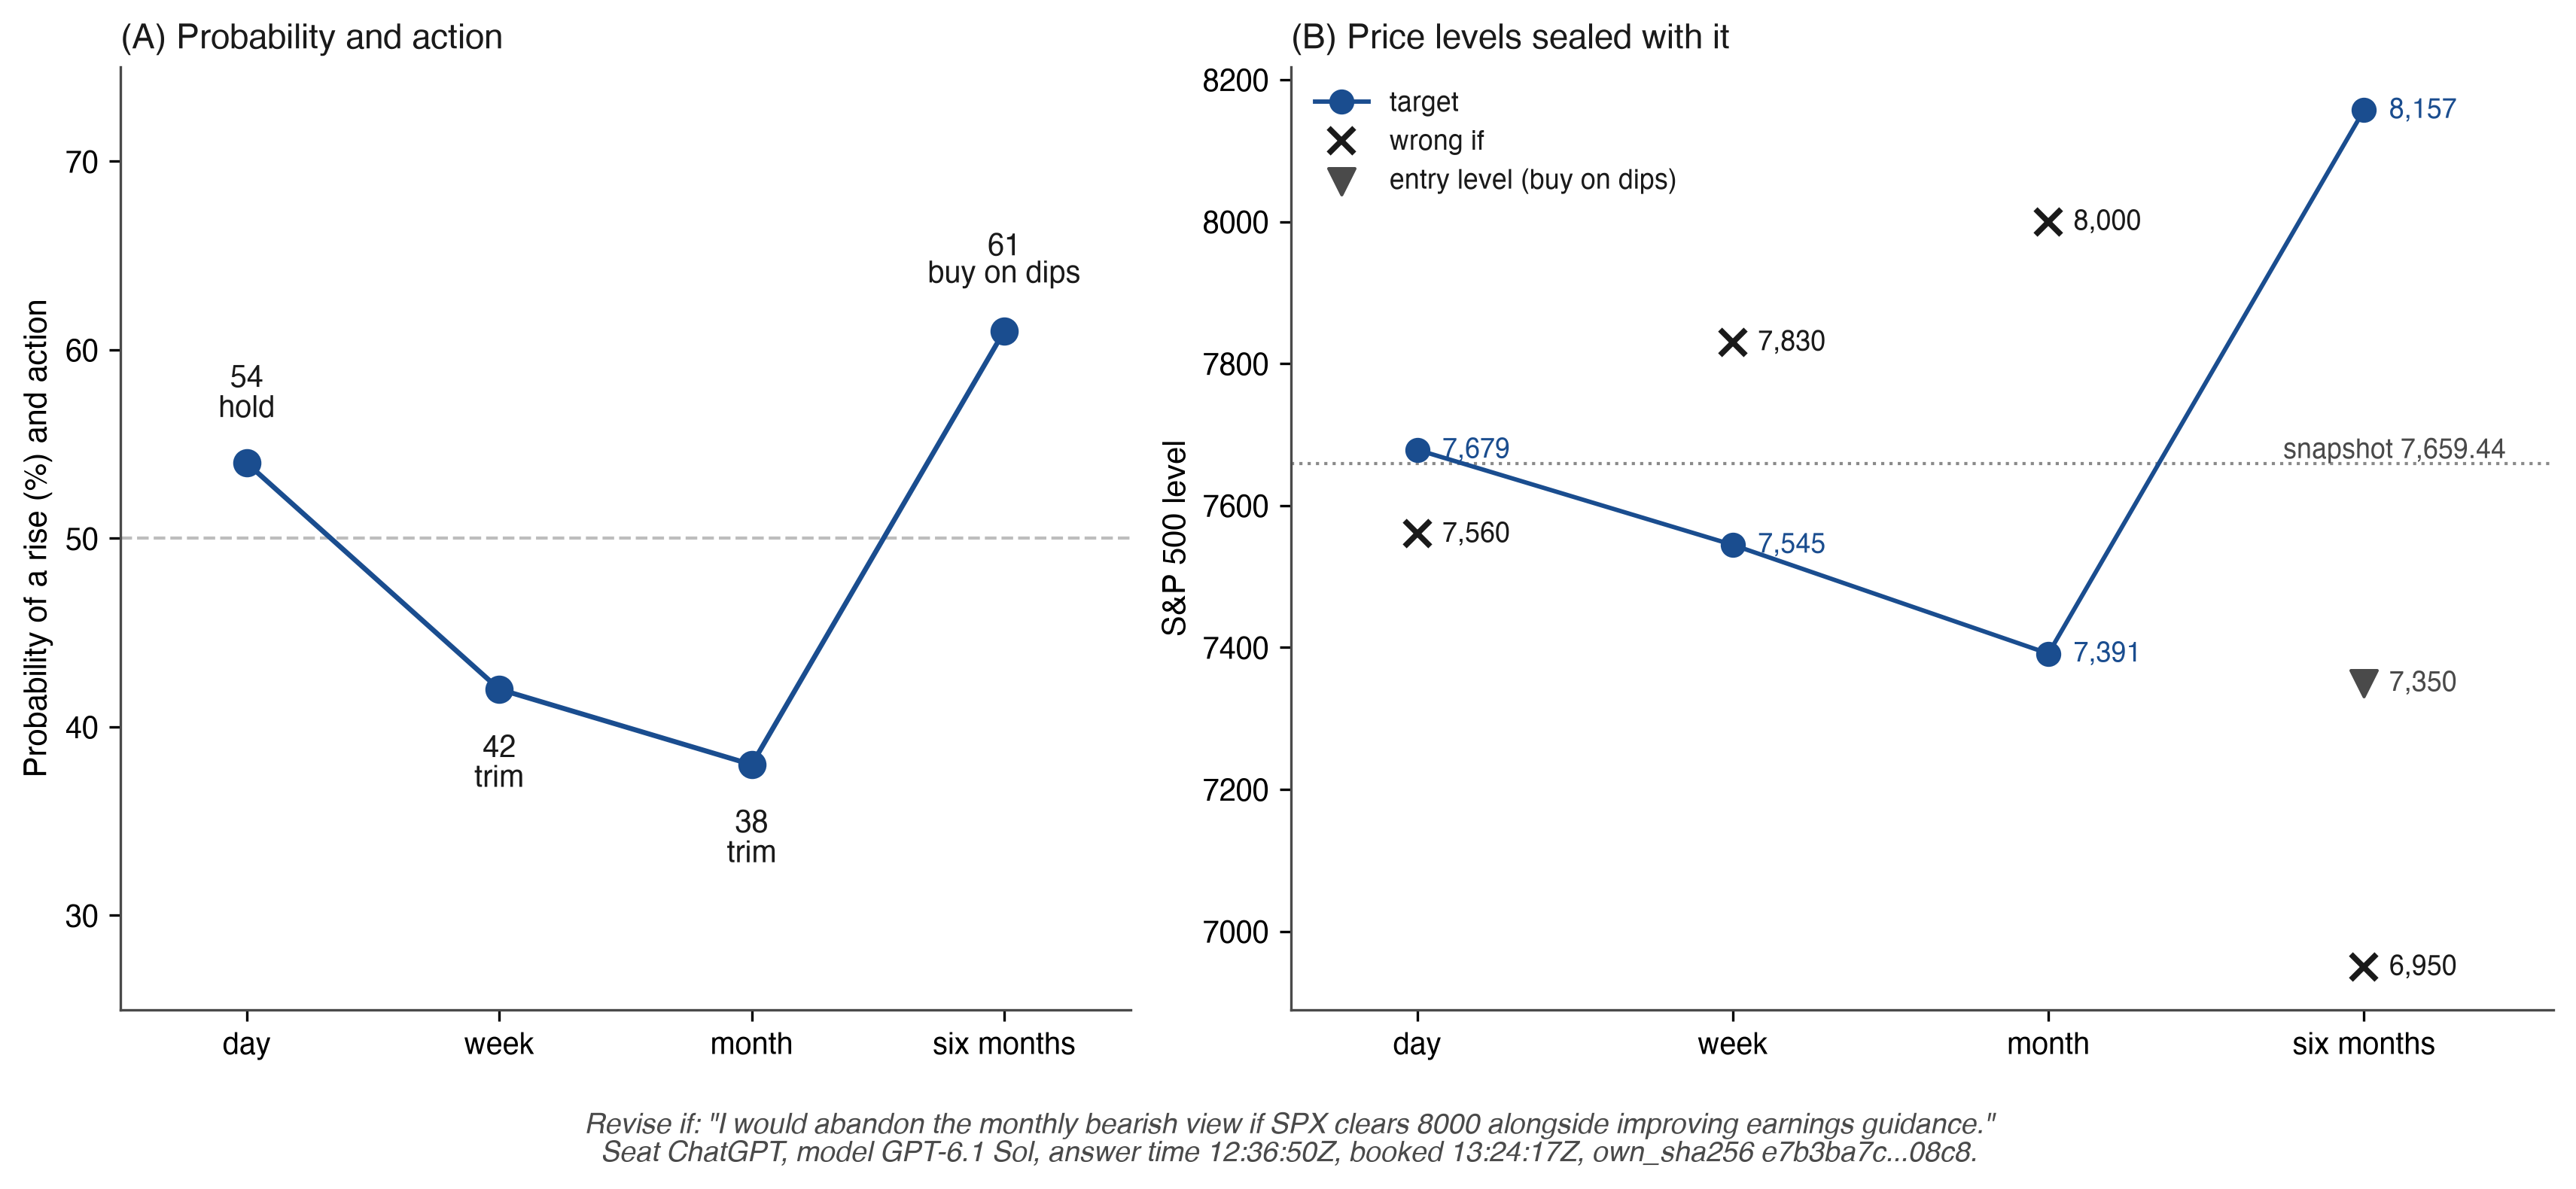
Nota: Todos os valores conforme selados na linha de resposta (hora da resposta 12:36:50Z, reservado 13:24:17Z, antes da referência 09:30 ET). A linha pontilhada é o preço do S&P 500 no snapshot da pergunta (asks/02577f9c….md); a linha através dos alvos une os horizontes para leitura e não é um caminho. O nível de entrada é o campo items.SPX.6m.entry da linha de resposta; a coluna entry de council-forecasts.csv está vazia para esta célula.
3.9 Células vazias
Toda célula de uma resposta é pontuada. Uma célula que um modelo deixa vazia conta como 50%, Brier 0.25, sem lado (counted_50); não pode superar a moeda, mas pode ocultar desempenho pior que a moeda em um mercado difícil, então relato a contagem de células vazias ao lado de cada pontuação (requisito 8). Uma cadeira que não envia linha de resposta é registrada como no_answer e está ausente das pontuações daquele run. O 0.25 preenchido pertence à pontuação de serviço da cadeira. O consenso e as contagens de concordância são formados a partir das probabilidades realmente dadas, e o campo of as conta. Cada cadeira portanto tem três resultados em cada horizonte, cada um classificado por si: a pontuação Brier nas probabilidades declaradas, a proporção de células esperadas respondidas antes do prazo, e a pontuação de serviço. A carteira é um quarto resultado em sua própria tabela. Uma pontuação combinada única ocultaria se uma cadeira perdeu em julgamento, pontualidade ou negociação.
As células esperadas devem ser conhecidas antes das respostas. O padrão solicita um rol de respostas esperadas, com as cadeiras, mercados, horizontes, prazo e política de tentativa, selado antes da primeira pergunta de um run (requisito 13), para que toda célula esperada se resolva em um status (contada, counted_50, no_answer ou recusada). A linha do run carrega o rol por lado, e a partir de 21 de outubro de 2026 o rol é selado antes da primeira pergunta, na cadeia de perguntas saintes (asks.jsonl). O rol verifica completude contra o cronograma declarado. O hash de cada pergunta sainte, selado quando é enviado, verifica os runs que foram enviados (requisito 13).
3.10 Uma mudança de versão do modelo, uma correção, uma mudança de regras
Uma cadeira é um participante operacional; uma versão de modelo é uma implementação específica de tempo, e o registro mantém ambas. Quando a versão de uma cadeira muda, sua conta continua, a mudança é datada, o resultado desde a nova versão é mostrado à parte (new_model_version), cada versão recebe sua própria conta a partir do dia em que assumiu (_ver:<modelo>:<n>), e um run no qual uma versão mudou é sinalizado (seat_versions_in_run).
Uma correção é uma nova linha que nomeia as linhas que diz respeito (of), e a linha que corrige permanece conforme escrito. Os preços seguem a mesma regra: o protocolo declara que a partir de 22 de outubro de 2026 um preço de referência ou fechamento corrigido entra como uma linha de correção selada com sua fonte e razão, e a linha de pontuação antes dele não é reescrita (price_corrections em arena-protocol.json). Em 20 de outubro, 47 das 211 linhas do livro eram correções: algumas restauram o modelo e modo de respostas nos primeiros runs a partir dos recibos do run, outras registram que uma resposta re-selada é igual a uma linha anterior (same_as, cópias mais antigas em council-forecasts-copies.csv). O padrão requer modelo, versão e modo na própria linha de resposta, ou, em uma estação cega, um compromisso salgado com eles (requisito 1).
Uma mudança da metodologia muda a tarefa e abre um novo segmento de medição (requisito 15). Uma pontuação confirmatória, um ganho pareado ou uma comparação de carteira é calculada dentro de uma versão de metodologia, ou as versões são relatadas como segmentos separados; previsões antigas re-pontuadas sob uma nova regra são rotuladas uma análise alternativa. Uma afirmação que repousa em um elemento de nível 2+ cobre os selos feitos depois que esse elemento aparece nos arquivos públicos.
3.11 Prova-de-antes: três propriedades
Chamo um registro de previsão de prova-de-antes quando um terceiro, usando arquivos públicos e a cadeia Bitcoin, pode estabelecer as propriedades abaixo, e quando o registro diz quais delas repousam em quem. Seja uma previsão mantida na linha de livro , com preço de referência no tempo e resultado no tempo . Seja o carimbo comprometer as primeiras linhas através do resumo , e deixe sua prova colocar a lista carimbada no bloco com tempo de cabeçalho . Escreva pela margem pela qual o tempo verdadeiro de mineração pode seguir o tempo de cabeçalho: algumas horas na prática, pelo limite discutido abaixo.
P1a. Sem reconstrução após a âncora. Para cada previsão contada há um registro com . O prefixo registrado existiu, pelo limite prático, não mais tarde que , e qualquer adição, remoção ou reescrita posterior de uma linha nele muda , de modo que ela não mais corresponde ao resumo confirmado no bloco . Para cada resultado mais tarde que isto exclui uma previsão escrita após o resultado.
P1b. Compromisso antes da referência. A previsão foi selada antes de . A partir de 21 de outubro de 2026 isto vale no nível 2+, para qualquer pessoa que aceita uma das autoridades e seu certificado: dois registros RFC 3161 assinados antes de numa lista registrada com . Em 21 de outubro duas autoridades assinaram a lista cobrindo linhas 1 a 222, a linha de execução (214) e oito respostas contadas (215 a 222), às 13:00:19 UTC, 29 minutos e 41 segundos antes de , e três assinaram a lista cobrindo a nona resposta contada (224) às 13:23:37 UTC, 6 minutos e 23 segundos antes de (Apêndice B, Passo 9). Para Bitcoin a referência é o fechamento da primeira barra de um minuto após a selagem de cada linha, 13:01Z para o lote e 13:24Z para a nona resposta, de modo que a ordem vale lá por construção. Para as sessões de desenvolvimento de 19 e 20 de outubro, as sessões que esta versão pontua, P1b repousa no nível 1 no registro encadeado (at, booked_at, prev, link). Em 20 de outubro o bloco de ancoragem caiu depois de (Seção 3.2).
P2. Sem substituição. Mudar qualquer campo de para muda , portanto e cada ligação posterior, portanto . Uma substituição indetectável exigiria uma segunda pré-imagem de SHA-256 ou uma reescrita da cadeia Bitcoin, desde que o verificador tenha a prova que foi publicada no registro (modelo de ameaça abaixo).
P3. Sem seleção entre execuções seladas divulgadas. Para cada modelo e sessão a linha contada é fixada por uma regra declarada antes das execuções e aplicada apenas a registros de tempo selados. A partir de 21 de outubro de 2026 essa regra é o cronograma publicado, selado antes das execuções. Dentro da execução, a primeira resposta bem-formada de cada assento conta a partir da sessão 11 (declarada em asks.jsonl, linha 74). A seção 3.4 dá a regra das sessões de desenvolvimento. Cada outra execução selada permanece no livro, etiquetada, e um leitor pode recomputar qual linha conta. A forma completa também cobre execuções solicitadas e deixadas não seladas: o resumo de cada questão enviada é selado quando é enviado (nível 2+). A partir de 21 de outubro de 2026 estes resumos são encadeados em asks.jsonl.
Modelo de ameaça. Um registro de tempo prova que um resumo existia. Ele não diz nada sobre outros resumos registrados ao seu lado. Um operador que hospeda tanto o livro quanto as provas poderia registrar dois livros em cada execução e depois substituir livro e prova juntos; o substituto se verifica contra Bitcoin, e contra uma autoridade de registro de tempo também. O Requisito 3 portanto torna OBRIGATÓRIO publicar, em cada registro, o SHA-256 da lista registrada em pelo menos um canal append-only que o operador não controla (um depósito arquivado, um hospedeiro de controle de versão público ou uma captura de arquivo web) e nomear os canais na página de prova. A partir de 22 de outubro de 2026 cada lista registrada entra no registro de transparência Sigstore Rekor no momento do registro, e as listas dos dias anteriores entraram nele em 21 de outubro de 2026 entre 23:45 e 23:47 UTC (Tabela 5). Para uma lista no registro, P1a e P2 valem contra todos a partir de seu horário de registro, e antes desse horário contra qualquer parte que tenha mantido, ou possa recuperar de um arquivo independente, uma prova anterior.
A Tabela 4 define cada propriedade contra o elemento do protocolo que a fornece e o nível no qual um leitor pode verificá-la.
Tabela 4. Proof-of-before: qual elemento do protocolo fornece cada propriedade e em qual nível.
| Propriedade | O que exclui | Elemento que a fornece | Como um leitor verifica |
|---|---|---|---|
| P1a Sem reconstrução após a âncora (nível 2, com uma cópia independente da prova ou da entrada Rekor da lista) | Uma previsão escrita ou reescrita após a âncora | Hash de prefixo marcado por livro; âncora OpenTimestamps em Bitcoin; digest do carimbo em um canal independente | head -n m o hash é igual ao digest marcado; prova .ots leva à raiz de Merkle do bloco; o limite precede o resultado |
| P1b Compromisso antes da referência (nível 1 para 19 e 20 de outubro; nível 2+ a partir de 21 de outubro) | Uma previsão selada após o preço de referência mas pontuada a partir dele | Minuto do carimbo na cadeia (booked_at); referência após o carimbo; selagem na chegada (obrigatória); a partir de 21 de outubro: tokens RFC 3161 |
Comparar o tempo de carimbo da linha, máx(at, booked_at), com 09:30 ET da sessão; a partir de 21 de outubro: Apêndice B, Etapa 9 |
| P2 Sem substituição (nível 2, com uma cópia independente da prova ou da entrada Rekor da lista) | Uma previsão selada alterada posteriormente | seal por linha; link encadeado com prev; livro somente para append |
Recomputar seal e link; cada prev é igual ao link anterior |
| P3 Sem seleção entre execuções seladas divulgadas (regra de nível 1; forma completa nível 2+) | Solicitar várias vezes e contar a execução que venceu | Uma execução contada por sessão, declarada antecipadamente a partir de 21 de outubro de 2026; todas as outras execuções mantidas como not_counted; nível 2+: hashes de pergunta de saída selados quando enviados (asks.jsonl, a partir de 21 de outubro) |
Aplicar a regra declarada aos tempos de carimbo do livro; encontrar todas as execuções em council-forecasts.csv (run_id, run_role) |
P1a tem uma resolução de horas e seu limite é prático. O tempo externo é o tempo de um bloco na cadeia que a rede aceitou, e o tempo de cabeçalho desse bloco é definido pelo minerador. As regras de consenso o limitam por baixo pela mediana de tempo dos 11 blocos anteriores e por cima em aproximadamente duas horas à frente dos relógios ajustados pela rede dos nós que o aceitam (Bitcoin Developer Documentation, n.d.). Nenhuma regra fixa por quanto tempo após seu tempo de cabeçalho um bloco foi de fato minerado. Em operação ordinária a mediana fica cerca de uma hora atrás do tempo real, então o digest ancorado existia no máximo algumas horas depois de . Um verificador que quer um limite apenas das regras de consenso usa o tempo de cabeçalho de um bloco várias confirmações depois, e um tempo calendário assinado em cada carimbo vem apenas de uma autoridade de marcação de tempo (nível 2+). Para o bloco 972.334 a mediana de tempo dos 11 blocos anteriores foi 12:45:12Z, 70 minutos antes de seu tempo de cabeçalho. Um Internet-Draft IETF especifica como um verificador verifica provas temporais ancoradas em Bitcoin (Fassbender, 2026). Em 17, 19 e 20 de outubro os blocos de ancoragem (971.796, 972.153 e 972.334) tinham tempos de cabeçalho dentro de uma hora do tempo de reserva, e para o horizonte do dia, que se resolve às 16:00 ET, o limite com sua margem caiu antes do resultado; para horizontes mais longos a resolução é imaterial. A ordem entre carimbo e referência dentro da sessão é P1b.
3.12 A escada de confiança
Reivindicações públicas sobre previsões de IA "verificadas" situam-se em três níveis, com uma quarta etapa acima do último (Figura 4). No nível 0 o leitor confia no operador. No nível 1 o operador mantém uma impressão digital ou um registro encadeado, que prova que um texto posterior corresponde a um hash anterior, mas não quando o hash foi feito. No nível 2 a impressão digital é ancorada fora do operador, em um registro público que não pode ser reescrito ou retroativamente datado sem detecção, e verificada com ferramentas que o operador não controla. O nível 2+ é o nível 2 mais um tempo assinado por terceiros em cada carimbo (Seção 3.2).
Figura 4. A escada de confiança: confiar no operador, impressão digital do operador, âncora fora do operador, e tempo assinado por duas autoridades (nível 2+, RFC 3161, a partir de 21 de outubro de 2026).
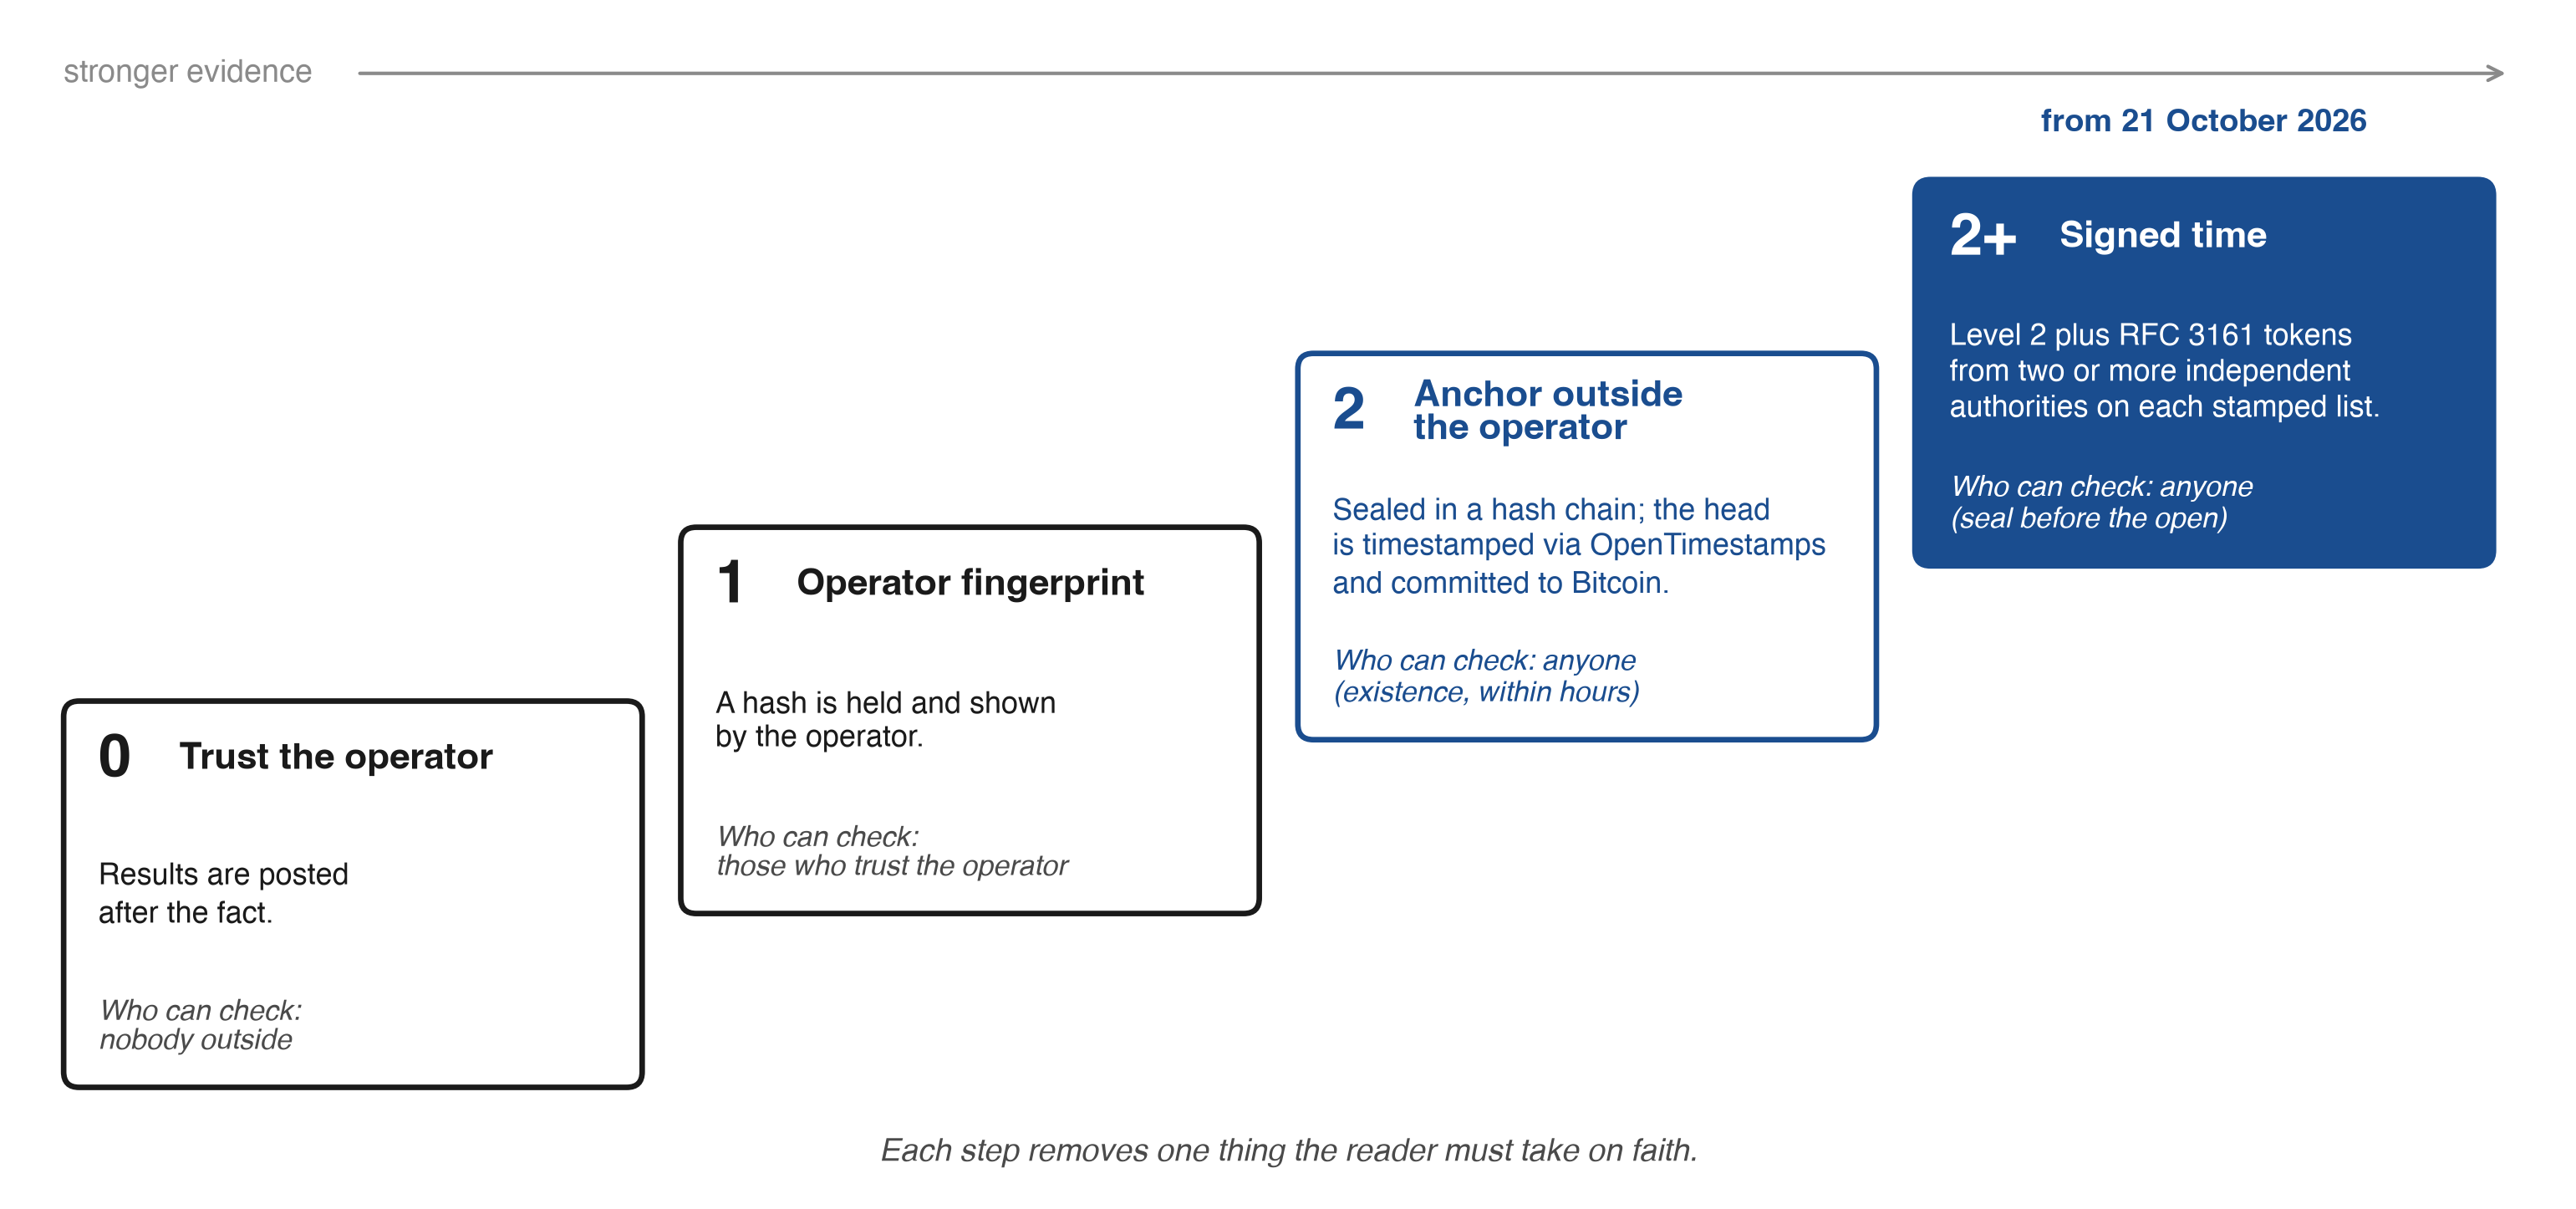
Nota: Os níveis descrevem o que um leitor deve confiar sobre o tempo de um registro. O nível 2+ adiciona tokens RFC 3161, na liga a partir de 21 de outubro de 2026, quando o registro contendo as respostas contadas foi assinado antes da abertura às 09:30 ET. Selagem na chegada, o preço de referência após o carimbo e a regra de execução contada são requisitos separados (Seção 3.13).
Na implementação de referência a âncora fornece nível 2 para P1a e P2, contra qualquer parte que tenha uma cópia independente de uma prova, e contra todos para cada lista marcada inserida no log Rekor (Seção 3.11). P1b está no nível 2+ no registro contado (Seção 3.11). P3 repousa no nível 1 no registro encadeado do operador e, a partir de 21 de outubro de 2026, em uma regra de execução contada declarada antecipadamente. A escada mede confiança no relógio. O que um leitor pode reivindicar sobre preços ou habilidade sobe uma segunda escada, a escada de reivindicações (Tabela B1, Apêndice B): regras publicadas, arquivos recomputados, um compromisso externo verificado, resultados reconciliados com uma fonte de preço independente, uma avaliação prospectiva emparelhada congelada antes de sua janela, e replicação por um segundo pipeline. Essa segunda escada termina nas comparações registradas da Seção 8.
3.13 Lista de verificação do padrão proposto
Escrevo os requisitos abaixo como aquilo que uma arena, benchmark ou fundo adota quando reclama seguir o padrão. DEVE marca um requisito sem o qual a reivindicação não se sustenta; DEVERIA marca a especificação de nível 2+.
- DEVE definir cada tarefa por um contrato de evento fixado antes da pergunta ser enviada, com pelo menos os campos da Tabela 1, incluindo a fonte de preço de cada indicador (fornecedor, símbolo, tamanho de barra e regra de timestamp para o preço de referência e terminal); resultados de previsão que se encontrem no futuro; e selar o modelo, sua versão e seu modo na própria linha de resposta. Em uma estação cega a linha os carrega como um compromisso SHA-256 salgado, , e os sais são publicados após a estação, assim a identidade fica fixada no selo e oculta até o fim da estação.
- DEVE manter um registro somente acrescentável e encadeado por hash no qual cada linha é selada ao entrar, o texto da pergunta e o instantâneo de preço são transformados em hash na execução, a pergunta é publicada, e uma correção é uma nova linha que nomeia as linhas que ela diz respeito.
- DEVE ancorar a cabeça do registro fora do operador em cada execução (nível 2), publicar as provas, declarar o limite com sua margem, e publicar cada resumo com timestamp no momento da marcação em pelo menos um canal somente acrescentável que o operador não controla.
- DEVE tomar um preço de referência por evento comum, após o selo, por uma regra publicada para cada instrumento; uma linha selada posteriormente recebe sua própria referência e é um evento separado. Previsões são agrupadas (consenso, acordo, contagens de erro compartilhado, comparações entre modelos) apenas quando todos os campos de seus contratos de evento concordam.
- DEVE publicar cada execução, contada ou não, com seu rótulo.
- DEVE fixar a execução contada de cada sessão por uma regra declarada antes das execuções (por exemplo, um cronograma publicado), e DEVERIA publicar a declaração com seu hash em um canal que o operador não controla. Uma regra aplicada posteriormente às execuções que foram realizadas não atende a isso.
- DEVE pontuar o evento perguntado por uma regra estritamente própria: o escore de Brier primário de uma subida estrita sobre todas as linhas, com qualquer escore filtrado em segundo lugar e o número de linhas que ele descarta; ou, com uma banda de empate, perguntar pela probabilidade de uma subida dado um movimento fora da banda, ou pedir três probabilidades e pontuá-las pelo escore de Brier de três resultados (Seção 3.5).
- DEVE relatar células vazias e respostas ausentes ao lado de cada escore, manter um valor preenchido fora do consenso e contagens de acordo, e relatar qualidade em probabilidades declaradas, cobertura e qualquer escore de serviço como resultados separados.
- DEVE relatar o parâmetro não informativo de 50% e uma taxa climatológica base do mesmo evento para cada ativo e horizonte, estimados em uma janela fixa que termina antes da estação e selados por um hash publicado, com o escore de habilidade de Brier contra ele; um preço de mercado de previsão usado como parâmetro é selado com seu volume negociado, e um piso de volume declarado define a comparação primária.
- DEVE classificar apenas após um número mínimo de sessões por horizonte, com intervalos agrupados por sessão e, para horizontes mais longos que um dia, intervalos que respeitem janelas sobrepostas; uma comparação é planejada para precisão na diferença de Brier pareada a nível de sessão, e uma alegação de ausência de diferença requer um intervalo dentro de uma margem de equivalência declarada (Seção 4.6).
- DEVE publicar os dados e o código de pontuação para que cada pontuação possa ser recomputada por um terceiro, e citar em cada revisão de artigo uma versão de análise imutável com uma soma de verificação para cada arquivo (Apêndice C).
- DEVE selar cada resposta na chegada, sem aguardar um lote, e DEVERIA (nível 2+) obter um token RFC 3161 de uma autoridade de carimbo de tempo público em cada selo.
- DEVERIA (nível 2+) selar o hash de cada pergunta enviada quando ela é transmitida, e selar a lista de respostas esperadas com seu prazo e política de nova tentativa antes da primeira pergunta de uma execução.
- DEVE acompanhar qualquer consenso publicado de modelos, na mesma superfície, com o número de probabilidades declaradas que entraram nele, sua correlação média pareada e o da Seção 5.1 para essa execução e horizonte, para que um leitor veja quantas vozes independentes estão por trás do acordo.
- DEVE tratar uma mudança de metodologia como o início de um novo segmento de medição e uma correção como uma linha acrescentada que deixa o original em seu lugar; pontuações confirmatórias são computadas dentro de um segmento (Seção 3.10).
- DEVE, onde os leitores fazem previsões junto aos modelos: atribuir cada leitor uma única vez e aleatoriamente, nunca reatribuído; contar uma primeira previsão por mercado, identificador e sessão; fechar previsões de leitores no tempo de referência; tratar um identificador redefinido como um novo leitor e relatar a proporção de redefinições; rotular o grupo cego no dicionário de dados antes da primeira previsão pontuada; e não armazenar endereço de nenhum leitor, no máximo um hash salted dele com o dia usado apenas para limitar votos repetidos, publicando nenhum deles (Seção 6).
- DEVERIA relatar os diagnósticos das Seções 4 a 6 junto às pontuações: a proporção do maior autovalor e a razão de participação da matriz de semelhança, as duas contagens de distintividade de cada assento, o teste dos lados como blocos, um registro de busca para cada link citado que entra em uma contagem de sobreposição, o braço somente com preços, repetições de probabilidade sob um pacote congelado, preço de compra, preço de venda e hora da última transação em cada linha de multidão, e o giro de cada conta e custos ao lado de uma sombra sem negociação.
Parte da lista de verificação é executada como código. A liga publica o contrato de evento como um esquema JSON (event-contract.schema.json) e um verificador autossuficiente escrito apenas com a biblioteca padrão do Python (tools/conformance.py, no mesmo endereço dos dados, SHA-256 e1f929a9…63db2e conforme recuperado em 21 de outubro de 2026, 22:33 UTC, mantido inalterado em tools/archive/conformance-e1f929a9.py; environment.json lista todas as versões do verificador com sua data e hash). O contrato completo tem nove chaves: ativo, horizonte, tempo de referência, tempo final, regra, versão do resolvedor, regra de referência, provedor de preço e símbolo de preço, e seu event_id_v2 é ev2- seguido pelos primeiros 16 dígitos hexadecimais do SHA-256 de seu JSON canônico (chaves ordenadas, sem espaços, UTF-8). O primeiro identificador, event_id (ev1-, as primeiras cinco chaves), permanece ao lado, então nenhum identificador publicado jamais muda. Duas ligas que escrevem o mesmo contrato obtêm o mesmo identificador, então o teste do requisito 4 se torna uma comparação de identificadores para cada campo que fixa o resultado, e as regras de pontuação são fixadas pela versão da metodologia selada na mesma linha. O verificador valida cada linha contra o esquema, reconstrói seu identificador, verifica os tempos, o intervalo de probabilidade e os campos de resultado, rejeita um identificador usado para dois eventos e exige a versão da metodologia de cada linha (requisito 15). Qualquer liga pode executar python3 conformance.py its.csv em sua própria exportação. No arquivo de previsões da liga de 21 de outubro de 2026, 22:33 UTC, relatou "3792 linhas, OK", com ambos os identificadores reconstruídos em cada linha. Um sucesso mostra um registro bem formado, e a Tabela 5 lê o requisito de conformidade um a um.
A Tabela 5 fornece o status da implementação de referência em relação a cada requisito. Uma afirmação que repousa sobre um requisito vale a partir da data em que o requisito é atendido. "Atendido" significa visível nos arquivos públicos quando os li em 21 de outubro de 2026 às 15:05 UTC (veja a nota), "Parcialmente atendido" significa que parte do requisito é visível lá, e "Em andamento" que a implementação está em andamento, com as partes já implementadas listadas ao lado.
Tabela 5. Conformidade da implementação de referência, conforme lida em 21 de outubro de 2026 (requisito 3 em 22 de outubro de 2026).
| Req. | Nível | Status | O que está implementado |
|---|---|---|---|
| 1 Contrato de evento | DEVE | Atendido a partir de 21 de outubro de 2026 | Campos de contrato selados na metodologia; esquema de contrato, verificador e ambos os identificadores em cada linha de previsão, o event_id_v2 de nove chaves com provedor, símbolo e regra de referência; modelo com sua string de versão e modo selados em cada linha de resposta (restaurados por linhas de correção para as primeiras execuções) |
| 2 Registro encadeado por hash | DEVE | Atendido | Hashes de cadeia, pergunta e snapshot, perguntas publicadas, correções como linhas |
| 3 Âncora externa | DEVE | Atendido a partir de 22 de outubro de 2026 | Âncora OpenTimestamps em cada execução, provas publicadas; a partir de 21 de outubro, tokens RFC 3161 de duas autoridades independentes em cada lista com carimbo de tempo (três a partir de 13:23 UTC), cada lista nomeando a anterior pelo seu SHA-256; cada lista com carimbo de tempo inserida no registro de transparência Sigstore Rekor no momento do carimbo a partir de 22 de outubro de 2026 (a primeira no índice de log 3.368.763.032, cinco segundos após seu carimbo de 00:00:11 UTC), e as listas anteriores em 21 de outubro entre 23:45 e 23:47 UTC (a lista de 20 de outubro no índice de log 3.368.351.276) |
| 4 Uma referência por evento comum | DEVE | Em andamento | Linhas seladas após a referência carregam sua própria referência (late_ref); linhas carregam reference_at, same_event e event_id; a série contada de n_eff, rotulada como a principal, deixa tais linhas de fora; o n_eff de todos os assentos, rotulado como "sem corte pelo tempo de selo", e together são publicados ao lado sem o corte |
| 5 Cada execução publicada | DEVE | Atendido | Execuções não contadas rotuladas como not_counted |
| 6 Execução contada | DEVE; DEVERIA | DEVE atendido a partir de 21 de outubro; DEVERIA atendido | Execução matinal agendada declarada antecipadamente, selada como primeira linha de asks.jsonl (04:16 UTC) e publicada na página de prova com seu SHA-256 e uma captura do Internet Archive (05:35 UTC); 19 e 20 de outubro seguem a regra de desenvolvimento da Seção 3.4 |
| 7 Evento perguntado | DEVE | Em andamento | Brier de todas as linhas declarado como a pontuação principal da sessão de 21 de outubro (main_metric, primeira pontuação dessas após esse encerramento); 19 e 20 de outubro permanecem conforme publicado, um segmento separado (method_segments) |
| 8 Células vazias | DEVE | Atendido | counted_50, no_answer, of; três resultados relatados separadamente |
| 9 Benchmarks | DEVE | Em andamento | Benchmark de 50% publicado; climatologia fixa publicada no council-calibration.json ao vivo a partir de 21 de outubro de 2026, 08:54 UTC (climatology_fixed, 48 células de mercado-horizonte, SHA-256 de conteúdo 2810d11e…3cabb7, sha256_ok verdadeiro); F12 e F13 já aplicam o piso de $1.000 em suas próprias definições, e o piso de volume de público da metodologia publicada o completa |
| 10 Classificação e intervalos | DEVE | Em andamento | Regra 30/10, intervalos agrupados por sessão e intervalos emparelhados no nível da sessão (pairs, council-pairs.csv) publicados; intervalos de janela sobreposta e margens declaradas no registro |
| 11 Dados, código, lançamento | DEVE | Em andamento | Dados e código publicados com hashes; lançamento de análise depositado em cada revisão |
| 12 Selagem na chegada; RFC 3161 | DEVE; DEVERIA | Parcialmente atendido | Tokens RFC 3161 em cada lista com carimbo de tempo a partir de 21 de outubro; naquela manhã oito respostas foram seladas em um lote e uma nona 14 segundos após sua chegada; selagem de cada resposta na chegada o completa |
| 13 Hashes de pergunta, roster antes da pergunta | DEVERIA | Parcialmente atendido a partir de 21 de outubro | Cada etapa de uma execução sela seu roster (assentos solicitados, assentos já respondidos, reservas) antes de sua primeira pergunta, então uma segunda solicitação é visível; hashes de pergunta outgoing encadeados em asks.jsonl e cobertos pelas listas com carimbo de tempo; ambos na página de prova; prazo e política de retry se unem aos campos do roster |
| 14 Vozes efetivas ao lado do consenso | DEVE | Em progresso | n_eff publicado em council-stats.json; a série contada (execuções contadas, respostas lacradas antes das 09:30 ET) é marcada como a principal, a série de todos os assentos é mantida ao lado dela; impressão ao lado de cada consenso exibido a completa |
| 15 Segmentos | MUST | Atendido | Versão de metodologia lacrada em cada linha de execução e em cada linha de previsão (methodology_version); pontuações por segmento (method_segments); mudanças datadas; nada recontado |
| 16 Leitores | MUST | Em progresso | Dois grupos aleatórios permanentes ativos (experiment.g0, g1), apenas primeiras previsões, previsões dos leitores fechadas às 09:30 ET, nenhum endereço armazenado (um hash salificado por dia limita votos); o rótulo de grupo cego no dicionário de dados e a proporção de reinicializações a completam |
| 17 Diagnósticos | SHOULD | Parcialmente atendido | Razão de participação (n_eff_participation), as contagens sem sinal e centradas em climatologia, sobreposição de fonte compartilhada e o braço Closed Book publicados; os outros diagnósticos são especificados |
Nota: Status conforme lido nos arquivos públicos e na página de prova de 21 de outubro de 2026 às 15:05 UTC (council-stats.json gerado em 14:51:50 UTC, council-book.jsonl de 230 linhas); o requisito 1 é conforme verificado às 22:33 UTC do mesmo dia (Seção 3.13), e o requisito 3 conforme registrado no log Rekor em 22 de outubro de 2026 às 00:00:16 UTC (Apêndice B, Passo 10).
4. Medidas
O protocolo fixa o que foi dito e quando. As medidas transformam esse registro em pontuações; juntas formam a avaliação de previsão que o padrão exige. Descrevo cada medida conforme publicada na metodologia (versão 2) e no protocolo da liga (arena-3, liga Pro pro-1) e, onde o padrão exige mais, o requisito. A seção 5 apresenta os valores de dependência em dados ao vivo, e os resultados de acurácia chegam como revisões datadas deste artigo.
4.1 Direção
O indicador estava mais alto ou mais baixo ao final do horizonte que em sua referência, e a probabilidade do modelo apoiou esse lado? Acima de 50 respalda uma alta, abaixo de 50 uma queda, exatamente 50 nenhuma. Uma previsão de 51% e uma de 95% obtêm o mesmo acerto, de modo que a direção não consegue distinguir um modelo confiante de um hesitante, e a medida principal é a pontuação de Brier.
4.2 Pontuação de Brier
Para uma previsão com probabilidade declarada (em porcentagem) de uma alta e resultado ,
e a pontuação de um modelo em previsões resolvidas é a média (Brier, 1950), de 0 para uma previsão perfeita a 1 para a pior. A pontuação de Brier é estritamente própria para o evento em que é calculada (Gneiting & Raftery, 2007); para a pergunta da liga esse evento é uma alta estrita em todas as linhas (Seção 3.5, requisito 7).
4.3 O benchmark de 50% não informativo e climatologia
Um previsor que sempre diz 50% obtém 0,25 em cada previsão. Este é o benchmark de 50% não informativo (a "moeda" dos arquivos da liga), uma referência neutra. Um previsor que conhece a taxa base de altas pode obter uma pontuação abaixo de 0,25 sem habilidade sobre o dia, e em horizontes longos a taxa base pode estar bem longe de um meio. Portanto, adiciono um benchmark climatológico (requisito 9): a frequência de uma alta estrita do mesmo evento para cada ativo e horizonte, estimada em uma janela fixa que termina antes da temporada e selada na metodologia, com a pontuação de habilidade de Brier
nas mesmas linhas. O mesmo evento significa o evento que o contrato pontua: para o dia, do preço de referência ao preço terminal pela regra de fonte de preço da Tabela 1 (09:30 a 16:00 ET, o rendimento até 15:00 ET, Bitcoin do minuto de selagem até 16:00 ET). Para horizontes mais longos funciona sobre as mesmas contagens de sessões ou dias calendário (Seção 3.7). Uma taxa base de um evento diferente enviesaria o benchmark.
Na implementação de referência a climatologia fixa é o campo climatology_fixed de council-calibration.json: por ativo e horizonte, p_up, a frequência de 2016 a 2025 de uma alta estrita com cada linha contada, p_up_ex_draw, a mesma com empates excluídos, as contagens n e n_independent, a janela e a regra. O benchmark primário é = p_up, porque a pontuação de Brier primária conta todas as linhas. p_up_ex_draw serve a pontuação de habilidade da própria liga sem empates (bss_reference). O campo está selado por council-clim-window.json, publicado no endereço de dados, com 2810d11e…3cabb7, o SHA-256 de seu conteúdo: json.dumps do Python do objeto sem sua chave sha256, com chaves ordenadas e configurações padrão. O script de arquivamento recomputa esse hash de conteúdo antes de ler . O campo entrou no arquivo ao vivo em 21 de outubro de 2026 às 08:54 UTC, seu hash de conteúdo verifica (sha256_ok), e é o benchmark da comparação primária. Onde a janela ao vivo não tem histórico diário, o evento diário mais próximo fica no lugar: a barra diária para ouro, WTI, Brent, cobre e índice do dólar, o fechamento diário para o rendimento de 10 anos, o dia UTC para Bitcoin e, a partir de uma semana, movimentos da abertura. Os quatro índices de ações dos EUA tiram o deles da barra diária da sessão de 09:30 a 16:00 ET em si, o evento que os modelos respondem, e o teste primário também é relatado naqueles quatro isoladamente (Seção 8). As aproximações enviesam e deixam as previsões intocadas (Seção 10).
4.4 Calibração e nitidez
Calibração pergunta se as probabilidades declaradas ocorrem na taxa declarada. A liga relata calibração de confiança direcional: cada probabilidade resolvida é dobrada para o lado que ela respalda ( torna-se com o resultado invertido, e exatamente 50 deixado de fora), as previsões dobradas caem em quatro bins, [50, 60), [60, 70), [70, 80) e [80, 100], e cada bin mostra a probabilidade média declarada e a parcela que se confirmou, plotada a partir de 20 previsões (calib_min). Dobração mede se a confiança no lado respaldado é igualada pela taxa de acertos naquele lado. A calibração da probabilidade bruta de alta também pode ser computada das linhas abertas. O escore de Brier se divide em um termo de calibração e um termo de resolução (Murphy, 1973), e os bins são um complemento legível para essa divisão.
Bins precisam de muitas previsões, então adiciono, para cada assento, o consenso e cada horizonte, o ajuste de calibração logística em todas as linhas do evento perguntado (Cox, 1958). Uma inclinação abaixo de 1 significa que as probabilidades declaradas ficam muito distantes de uma metade, acima de 1 muito próximas; mede uma inclinação para altas ou quedas. A inclinação usa cada previsão e carrega um erro padrão, computado com sessões mantidas juntas (Seção 4.6). O mesmo ajuste, com intervalos agrupados por evento, foi aplicado aos preços da Polymarket (Walker, 2026).
Calibração é julgada junto com acuidade, já que um previsor que sempre diz 50% é calibrado e não informativo (Gneiting et al., 2007). Também peço por, por assento, consenso e horizonte,
de 0 (sempre 50%) a 100 (sempre certo), em probabilidades declaradas apenas, e com a probabilidade climatológica da Seção 4.3 no lugar de 50. Acuidade contra uma metade espera-se que cresça com o horizonte onde as taxas de base de longo prazo ficam longe de uma metade; acuidade contra climatologia é a própria do previsor. Nenhuma precisa de um resultado. Na execução contada de 20 de outubro de 2026 os oito assentos lacrados antes da referência tiveram K de 9,2 em um dia, 14,1 em uma semana, 13,9 em um mês e 20,3 em seis meses (Figura 5; as células em si estão na Figura 6B). Eles ficaram cerca de cinco pontos de uma chance par para o dia e foram mais decididos no horizonte que resolve por último, parte do qual é taxa de base que remove. Em 21 de outubro de 2026 os nove assentos deram 10,1, 12,5, 14,6 e 19,9. A maioria das probabilidades declaradas ficou entre 40 e 60. Em um dia isso valeu para 93% delas em 20 de outubro e 95% em 21 de outubro, e mesmo em seis meses para mais de metade (58% e 61%).
Figura 5. Probabilidades declaradas de alta por horizonte: execuções 2026-10-20-am (oito assentos lacrados antes da referência) e 2026-10-21-am (nove assentos).
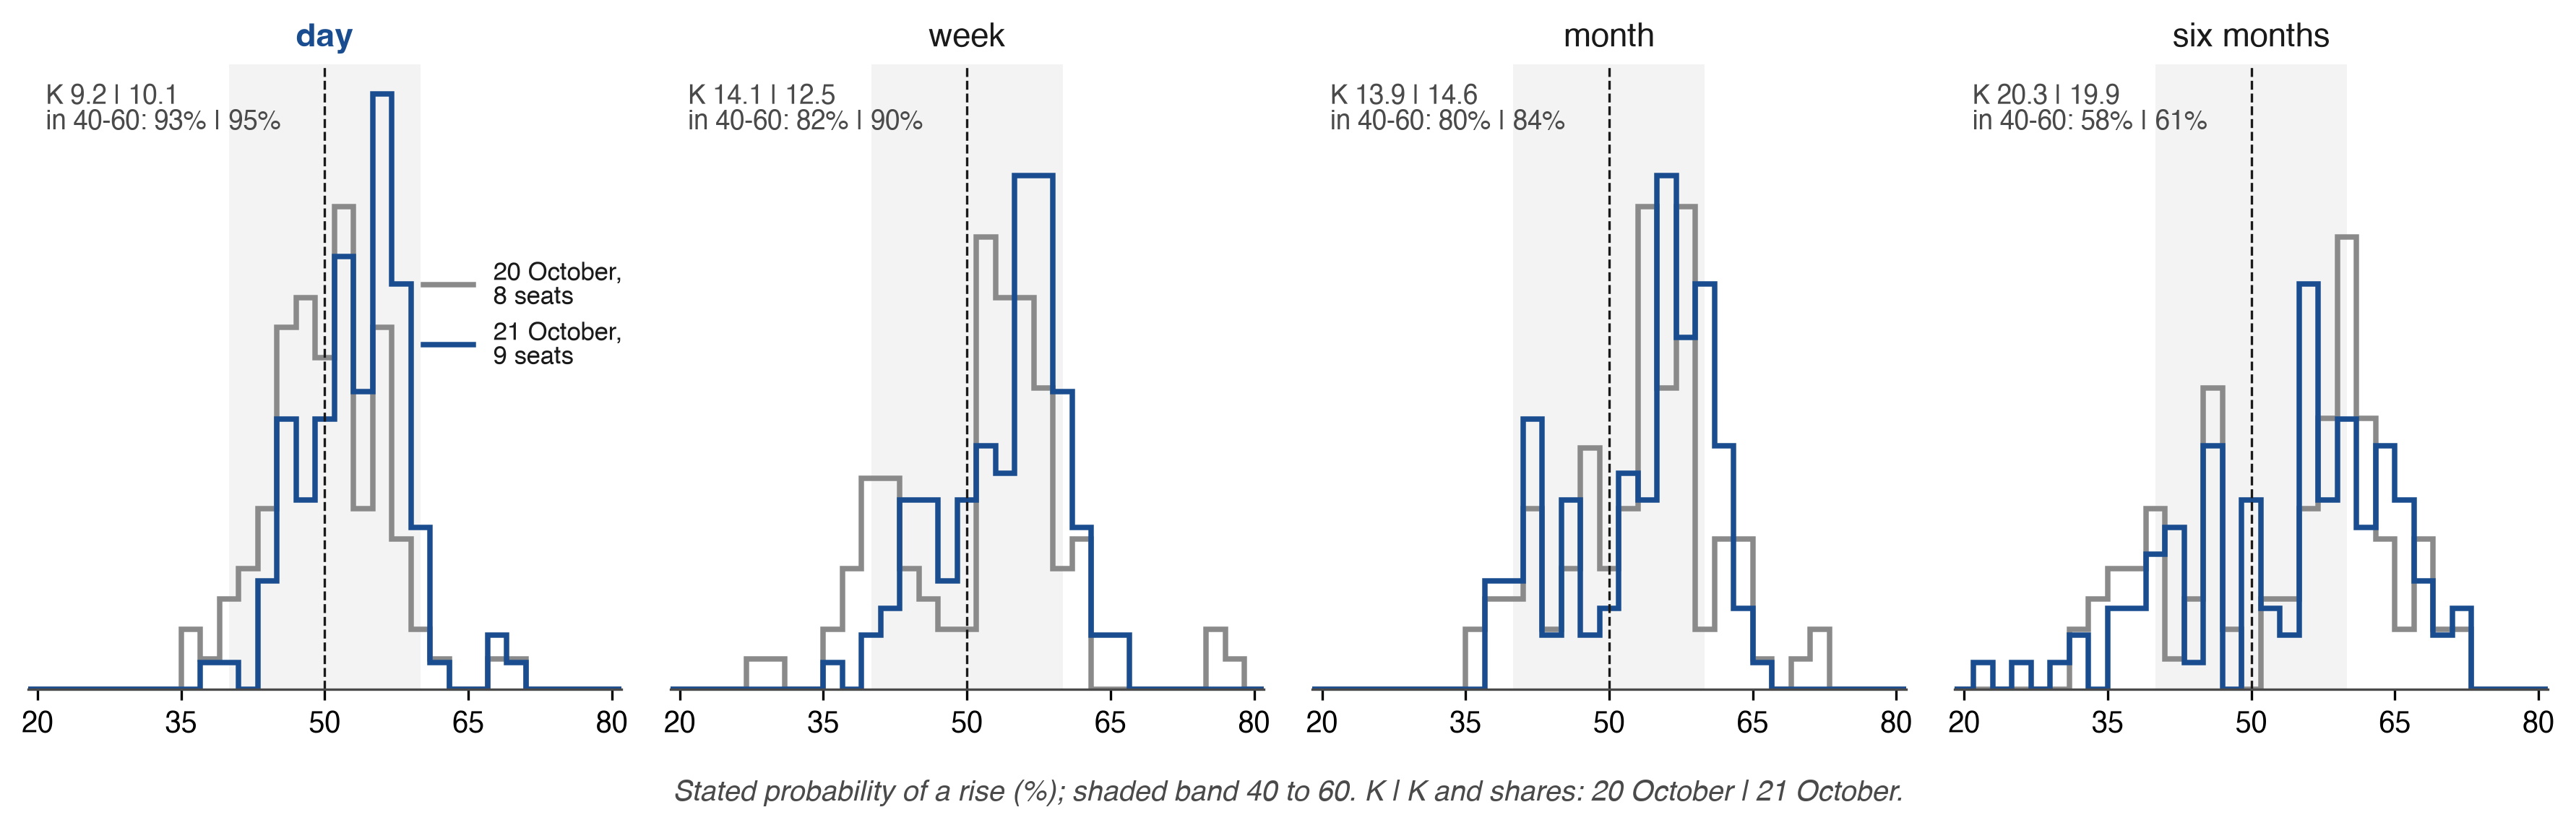
Nota: Histogramas em passos de 2 pontos, escalados para área igual; a banda sombreada vai de 40 a 60. K = (2/n)Σ|p − 50| (Seção 4.4). Em 21 de outubro as quatro células Bitcoin da nona resposta carregam uma referência própria (Seção 3.3) e são deixadas de fora desta e de toda leitura agrupada da execução (428 de 432 células). Fonte: council-forecasts.csv salvo 22 de outubro de 2026, 01:32 UTC.
4.5 Linhas de base
A liga pontuou as mesmas linhas contra linhas de base fixas:
- Moeda (0,25 em cada previsão).
- Momentum: direção de ontem do mesmo indicador em um fixo de 55%, pontuado nas mesmas linhas que o consenso; o campo publicado da liga deixa empates de fora, e o F15 registrado o pontua em todas as linhas (Seção 8.1).
- Compre e segure (
_hold_all), S&P 500 (_spy), 60/40 (_passive), Caixa na letra do Tesouro de 13 semanas (_cash) e Aleatório dentro das regras da liga (_random).
Os dois primeiros são linhas de base para as pontuações de probabilidade, e os outros cinco são carteiras executadas sob os mesmos custos e execução dos modelos. Momentum verifica uma regra trivial. Quando o resultado é uma chance igual independente de ontem, uma probabilidade fixa de 55% pontua em expectativa. A linha de base climatológica é o padrão que o requisito estabelece. A metodologia também nomeia uma linha de base sem mudança, uma previsão pontual sem probabilidade, que permanece fora da comparação de Brier. O consenso do Conselho é também uma linha de base: a média das probabilidades dos modelos, com a maior e a menor descartadas quando cinco ou mais respondem, um segundo assento da mesma família ponderado em um terço, e o resultado mantido entre 2% e 98%.
A média aritmética traz um ganho que não é habilidade. Para um evento com resultado e pesos somando um, a pontuação de Brier da média ponderada iguala a média ponderada das pontuações dos membros menos sua dispersão ponderada (Krogh & Vedelsby, 1995):
O consenso, portanto, não pode perder para a média dos membros que mantém, em um evento comum, seja qual for sua habilidade; manter o resultado entre 2% e 98% pode custar no máximo 0.0004 em uma série. Um achado de que o consenso supera seu membro médio é esperado mecanicamente. Sua habilidade é julgada contra a moeda, a taxa base climatológica, a multidão e o melhor modelo único do período anterior, e o termo de dispersão é relatado junto à pontuação de consenso (Seção 5.3).
4.6 A regra 30/10: 30 previsões em pelo menos 10 dias de negociação
Um modelo entra na tabela de um horizonte apenas quando tem pelo menos 30 previsões resolvidas naquele horizonte e pelo menos 10 sessões de negociação com pelo menos uma previsão resolvida naquele horizonte em cada. A metodologia lacrada expõe a regra e sua razão em um campo: "os 12 indicadores de um dia se movem juntos: a liga mostra os dias de negociação próximos às previsões, e um modelo é classificado após 30 previsões resolvidas em pelo menos 10 dias de negociação" (independence). A regra não limita como as previsões se distribuem desigualmente nessas sessões, portanto a tabela mostra o número de sessões de cada modelo junto à sua pontuação (days), e a segunda condição é a que se aplica. Se as previsões dentro de uma sessão compartilham uma correlação , então previsões de uma sessão carregam a informação de aproximadamente independentes, o efeito de desenho da amostragem por conglomerados (Kish, 1965). Com e , uma sessão vale aproximadamente 3.75 previsões independentes, e trinta previsões de três manhãs cerca de onze. Exigir 10 dias de negociação força a amostra a abranger notícias diferentes; dentro de um horizonte a unidade de reamostragem é a sessão. A regra 30/10 decide a elegibilidade, e o poder é tratado abaixo. A primeira tabela, após a sessão de 30 de outubro de 2026, é uma ordenação descritiva provisória, e um modelo que perdeu qualquer uma das dez primeiras sessões se torna elegível posteriormente.
O arquivo de estatísticas publica intervalos de 5 sessões pontuadas (t de Student nas médias de sessão) e de 20 por um bootstrap sobre sessões, com os 12 indicadores de um dia como um agrupamento (council-stats.json, sample.note). Antes de 5 sessões nenhum intervalo é mostrado, e um intervalo computado em linhas trata os doze mercados de um dia como independentes e é muito estreito. Para horizontes mais longos que um dia, previsões consecutivas compartilham a maior parte de sua janela de resultado, então exijo, para horizonte em sessões, intervalos consistentes em heterocedasticidade e autocorrelação com defasagem (Newey & West, 1987) ou um bootstrap de blocos com blocos de pelo menos sessões (Künsch, 1989), e nenhum intervalo antes de sessões (requisito 10). Em uma temporada de 126 sessões essa regra fornece intervalos em uma semana a partir da sessão 25 e em um mês a partir da sessão 105, e nenhum em seis meses, que precisaria de 630. Afirmações confirmatórias repousam no dia, o horizonte primário, e na semana e no mês onde a regra é atendida. Resultados de seis meses e os intervalos diários são descritivos nesta temporada. Uma afirmação de habilidade é lida nas datas de verificação registradas (Seção 8), quaisquer que sejam as sessões entre elas.
O poder pertence à comparação que será afirmada, uma diferença de Brier pareada. Para um previsor e um benchmark nos mesmos eventos, seja a média sobre os eventos da sessão de . Com um desvio padrão das médias de sessão e um menor efeito declarado , um teste bilateral a 5% com 80% de poder precisa de aproximadamente sessões independentes. A persistência aumenta o número, e a análise registrada mantém sessões consecutivas juntas (Diebold & Mariano, 1995; Künsch, 1989). Em 126 sessões o cálculo Brier do arquivo (power_brier) detecta uma queda abaixo da moeda de 0,0105, e uma queda de 0,005 precisa de 554 sessões. Extrapola de 171 previsões de duas sessões (o arquivo foi gerado 21 de outubro de 2026, 05:33 UTC, nos dados de 20 de outubro; o campo ao vivo é recomputado em cada execução), tomando seu desvio padrão no nível de previsão de 0,062 e como um proxy até cinco sessões serem pontuadas. É recomputado na sessão 30 em dados no nível de sessão, e os testes registrados não dependem disso. O cálculo de taxa de acerto do arquivo (power) precisa de 209 sessões para dizer 55% de 50% em um assumido. Uma análise independente de questões de mercado de previsão binária chega à mesma ordem: cerca de 350 previsões resolvidas para detectar uma vantagem de Brier de 0,02 sobre o mercado (Nechepurenko & Shuvalov, 2026a).
Um resultado negativo precisa de sua própria regra. Uma pequena diferença estimada, um intervalo muito amplo para decidir e evidência de nenhuma diferença são três achados. Declaro uma margem de equivalência, ±0,01 Brier, para cada comparação confirmatória, e leio "nenhuma diferença material" apenas quando o intervalo de 90% da diferença pareada (dois testes unilaterais a 5%) fica inteiramente dentro dela. Escolhi a margem. Fica próximo ao que a extrapolação de duas sessões diz que 126 sessões podem resolver (power_brier, acima), não muda quando essa extrapolação é recomputada, e é uma tolerância de pontuação, distinta de qualquer limite econômico.
4.7 A liga de portfólio
Probabilidades medem julgamento. Uma carteira, uma medida secundária, mostra o que um modelo faz com ela. Cada um dos 14 modelos administra $100.000 de dinheiro simulado sob as mesmas regras: onze fundos negociados representam os mercados (VIX é apenas um indicador), posições são apenas long de 5% a 25%, caixa rende a letra do Tesouro de 13 semanas, cada dólar que muda custa 0,1%, e uma decisão negocia no primeiro open após seu lacre (o primeiro preço das 09:30 às 09:45 ET). "Hold" é uma decisão sem negociação e sem custo. Uma decisão que quebra uma regra é recusada e as posições se mantêm. Cada conta é marcada no fechamento com seu retorno e drawdown máximo, e a partir de 20 sessões com os índices de Sharpe e Sortino (Sharpe, 1994; Sortino & Price, 1994). As regras completas estão no arquivo de protocolo (Apêndice A, Tabela A1). A conta pontua o instrumento, um fundo do Tesouro para o rendimento e um fundo para cada futura de commodity, portanto um escore de Brier mais baixo não estabelece um valor de conta mais alto. A conta é comparada com as linhas de base passivas sob os mesmos custos, dentro de uma versão de regras.
4.8 A liga Pro
Cada modelo mantém uma segunda conta de $100.000 na liga Pro (pro-1), um book long-short com pesos assinados de 5% a 30% do patrimônio e exposição bruta de 100% a 200%, portanto alavancagem de até 2×; VIX pode ser negociado aqui. Suas linhas de base são o S&P 500 mantido long e mantido short.
4.9 IA contra a multidão
Para até oito dos 12 mercados, mercados de previsão negociam uma questão diária próxima à da liga. A questão de cada execução as lista com suas regras de resolução completas e pede a cada modelo sua própria probabilidade de "Up" em cada uma, em um campo separado de sua linha de resposta (crowd_up). A instrução de não pesquisar Polymarket, Kalshi ou qualquer odds de apostas está lacrada na questão, e o que a busca de um modelo retornou fica fora do lacre. Onde Polymarket lista o mercado, os modelos respondem à questão do Polymarket, e uma questão Kalshi é feita apenas para um mercado que Polymarket não lista (council-calibration.json, method.crowd_window). Os preços da multidão e volumes negociados (vol) são registrados quando a questão é enviada e lacrados na linha de execução (crowd.odds para Polymarket, crowd.kalshi para Kalshi). Em 20 de outubro foram registrados às 12:30:06Z, antes do primeiro modelo começar sua resposta. Oculto o preço intencionalmente. Um modelo que é mostrado o preço do mercado e pedido para revisá-lo pode vencer o mercado em alguns contratos (S. Kim et al., 2026), mas sua resposta não é mais evidência independente da multidão. A liga mantém os dois separados: a resposta lacrada é cega para o preço, e qualquer combinação com a multidão é uma estratégia separada, lacrada antes de ser pontuada (Seção 5.3). Cada comparação nomeia seu relógio de informações: o preço lacrado é a multidão no momento da questão, enquanto o arquivo de calibração compara a resposta de cada modelo com o preço da multidão no minuto de resposta do próprio modelo, ambos pontuados na resolução da multidão. Após resolução a liga relata, por questão, a probabilidade dos modelos e da multidão, o escore de Brier de cada um e os lados que cada um acertou (linha de book crowd; council-league.json, campo crowd).
Em 20 de outubro o Polymarket listava seis questões diárias de "Up or Down" (S&P 500, Dow, ouro, WTI, o índice do dólar e Bitcoin) e Kalshi cinco (S&P 500, Nasdaq-100, o rendimento de 10 anos, ouro e WTI): oito mercados, três deles em ambos os venues. Onde ambos os venues listam um mercado, uso o contrato do Polymarket, aquele que os modelos responderam; caso contrário, o contrato Kalshi. Cada probabilidade da multidão vem de um contrato. Uma questão Kalshi é definida em um strike, e seu preço é convertido em "acima do fechamento anterior" por interpolação entre os dois strikes adjacentes (lo, hi na linha de execução). O preço interpolado aproxima a probabilidade daquele evento a partir de dois preços negociados, e ambos os lados são então pontuados naquele evento sintético pela fonte que o contrato nomeia. Admito um contrato na comparação primária quando seu volume lacrado é pelo menos $1.000 no momento em que a questão é enviada, e relato contratos mais finos separadamente. O limite mostra que dinheiro foi negociado no contrato. Exigência 17 pede bid, ask e o tempo da última negociação em cada linha da multidão, já que no Polymarket os spreads são mais amplos em resultados improváveis (Dubach, 2026).
As questões da multidão são próximas às da liga, e seus relógios diferem. O dia da liga vai da referência 09:30 às 16:00 ET (o rendimento às 15:00 ET); as questões da multidão vão próximo ao fechamento e várias resolvem em outras horas e de outras fontes: ouro e índice do dólar às 17:00 ET vela Pyth, WTI no fechamento diário do contrato de futuros ativo, o rendimento no rendimento par 15:30 do Tesouro, Bitcoin do meio-dia ao meio-dia na Binance. Portanto faço a comparação questão por questão, nos próprios termos da multidão, com a probabilidade separadamente elicitada. Preços de mercados de previsão são uma linha de base forte (Wolfers & Zitzewitz, 2004; Berg et al., 2008), e os contratos macroeconômicos do Kalshi preveem com precisão aproximadamente como a Pesquisa de Expectativas de Mercado e o consenso Bloomberg (Diercks et al., 2026). Nitidez (Seção 4.4) é comparada nos mesmos contratos, modelo por modelo, a partir de crowd_up, já que a multidão não precifica o evento de prob_up.
A distância que uma falta de concordância de eventos pode mover um escore pode ser declarada exatamente. Suponha que um índice tenha fechado ontem a 100, abre a 98 e fecha a 99: caiu em relação ao fechamento anterior e subiu em relação à abertura. Deixe que duas versões de um evento se resolvam com resultados opostos em uma fração de linhas, com as probabilidades e as linhas fixas. Em uma linha invertida, uma previsão muda seu escore de Brier por , no máximo 1 em valor absoluto, então um escore de Brier médio se move por no máximo . A lacuna entre os previsores e muda nessa linha por , então a lacuna se move por no máximo , onde é o conjunto de linhas invertidas. Os limites valem para previsões fixas em uma amostra fixa. Duas regras decorrem disso. As previsões entram um escore comum apenas em um evento, com um preço de referência (requisito 4). E cada comparação com a multidão relata sua fração de sessões de mercado nas quais as duas questões se resolvem com sinais opostos; uma lacuna não maior que não é lida como uma vantagem de qualquer um dos lados.
4.10 A grade: modelo × mercado × horizonte
Cada resposta contada preenche uma célula de uma grade tridimensional: até onze modelos do Conselho, 12 mercados e quatro horizontes (Figura 6). Cada célula acumula seu próprio escore de Brier, taxa de acerto, calibração e nitidez. A grade responde perguntas que um único placar não consegue: quais mercados são previsíveis em qual horizonte, se a vantagem de um modelo está em uma classe de ativos, e se o mês é mais fácil que o dia quando cada um é medido contra sua própria taxa base. As visualizações marginais são publicadas em council-league.json (models, by_asset, by_horizon), as linhas completas em council-forecasts.csv.
Figura 6. A grade de medição. (A) O desenho: modelo × mercado × horizonte. (B) A grade preenchida: as probabilidades seladas de uma manhã contada, 20 de outubro de 2026.
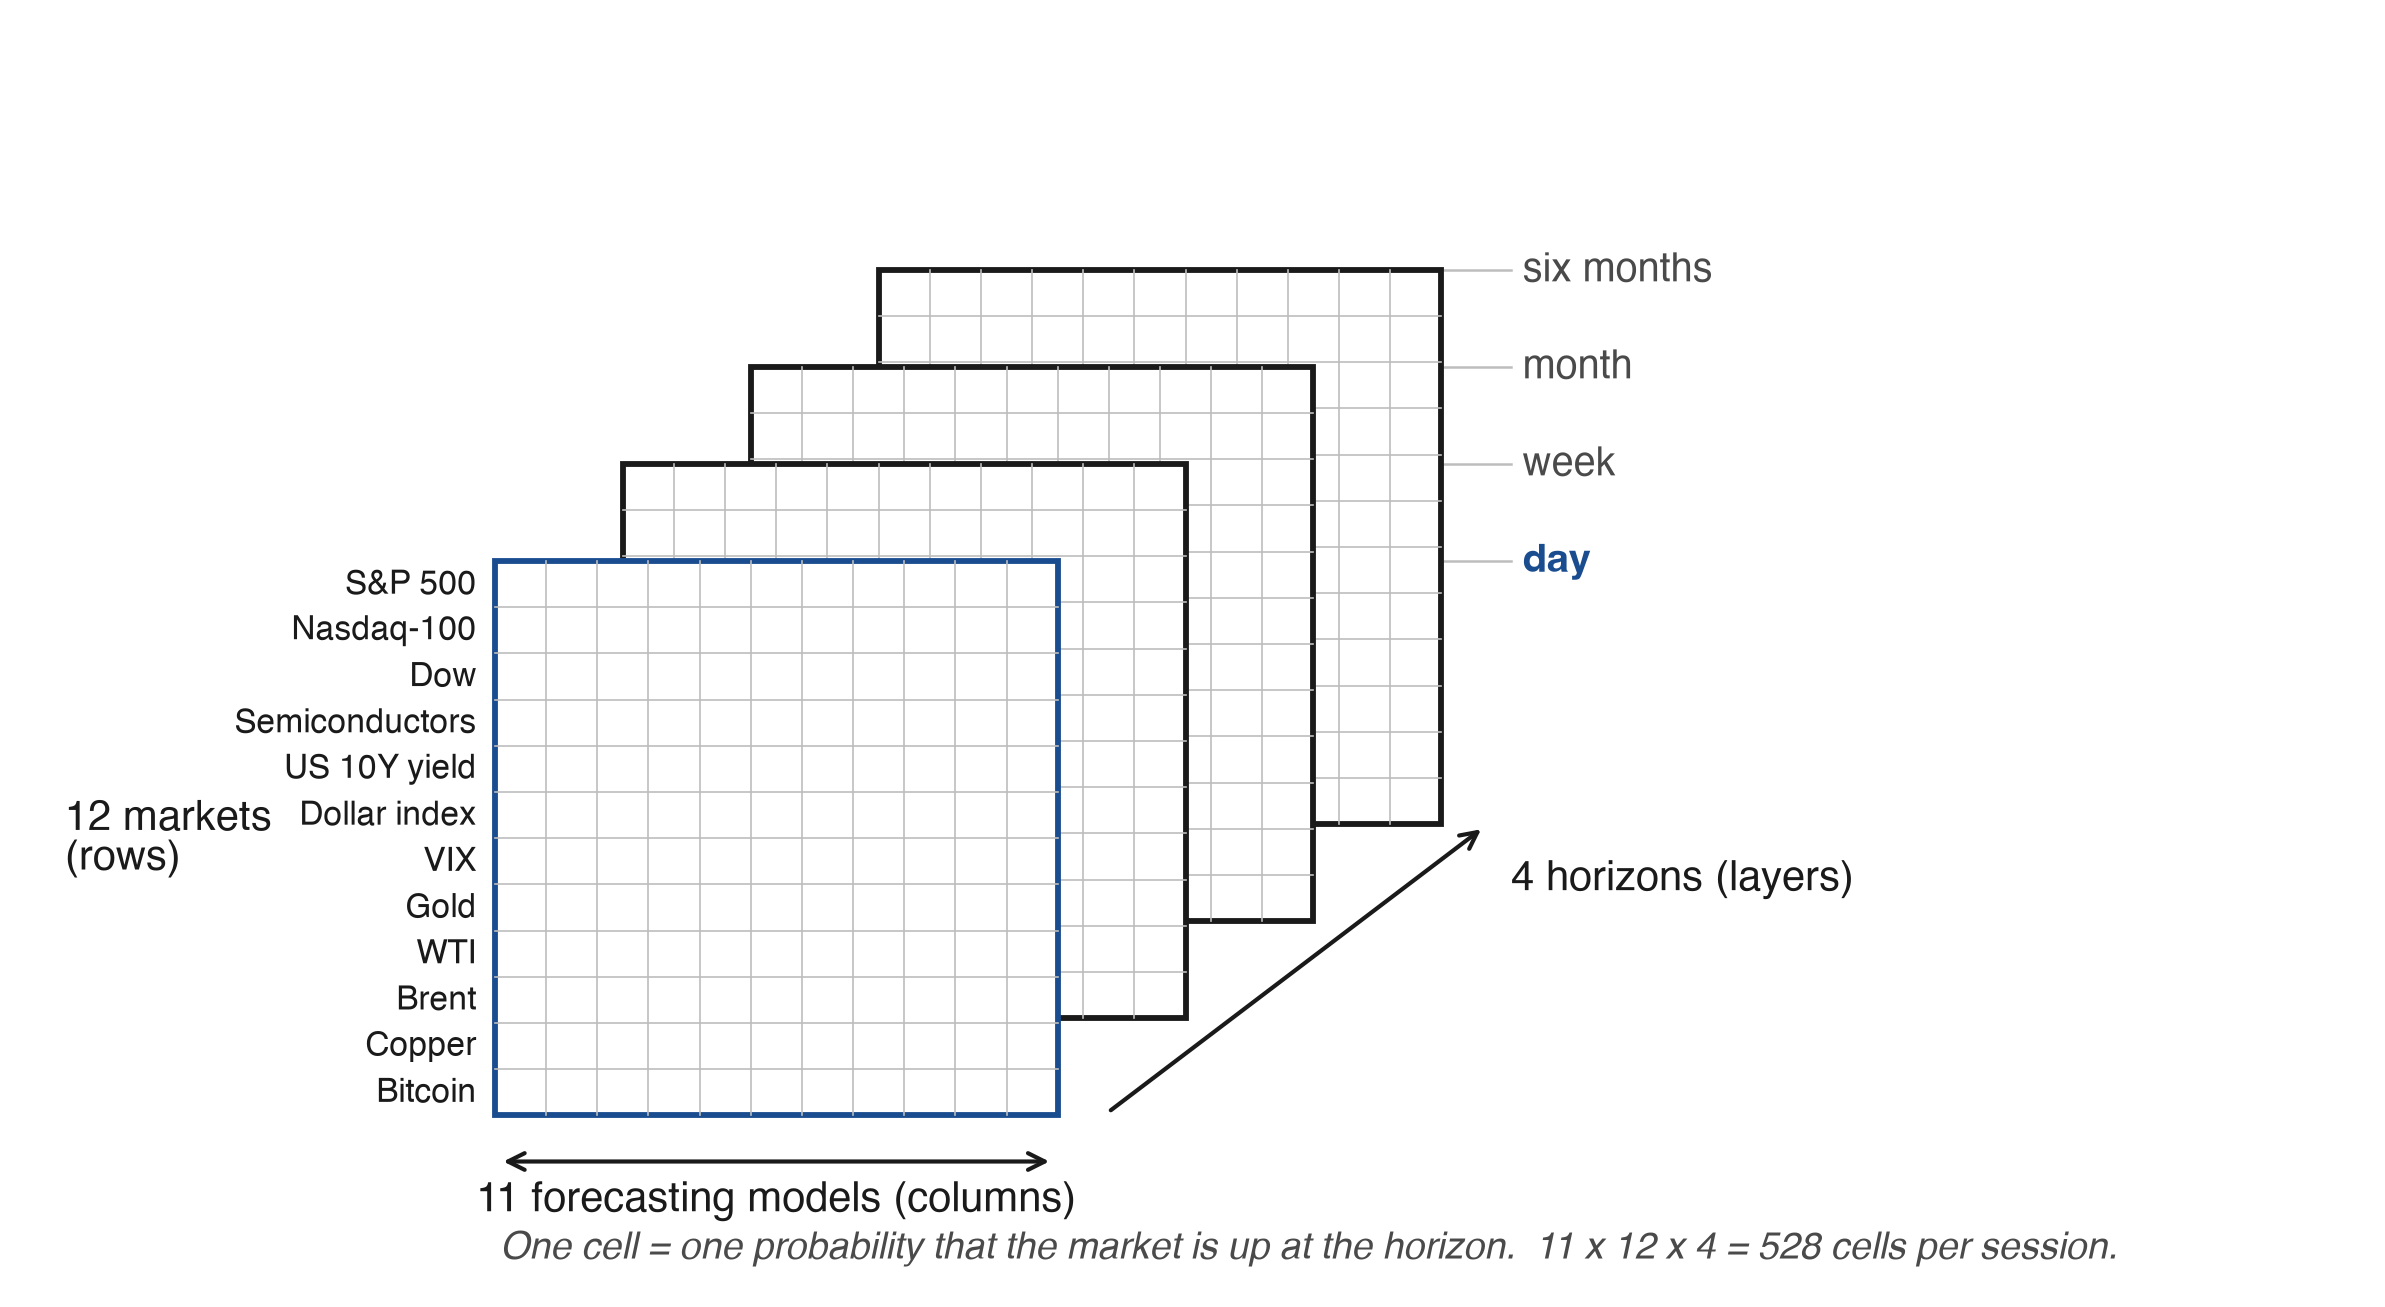
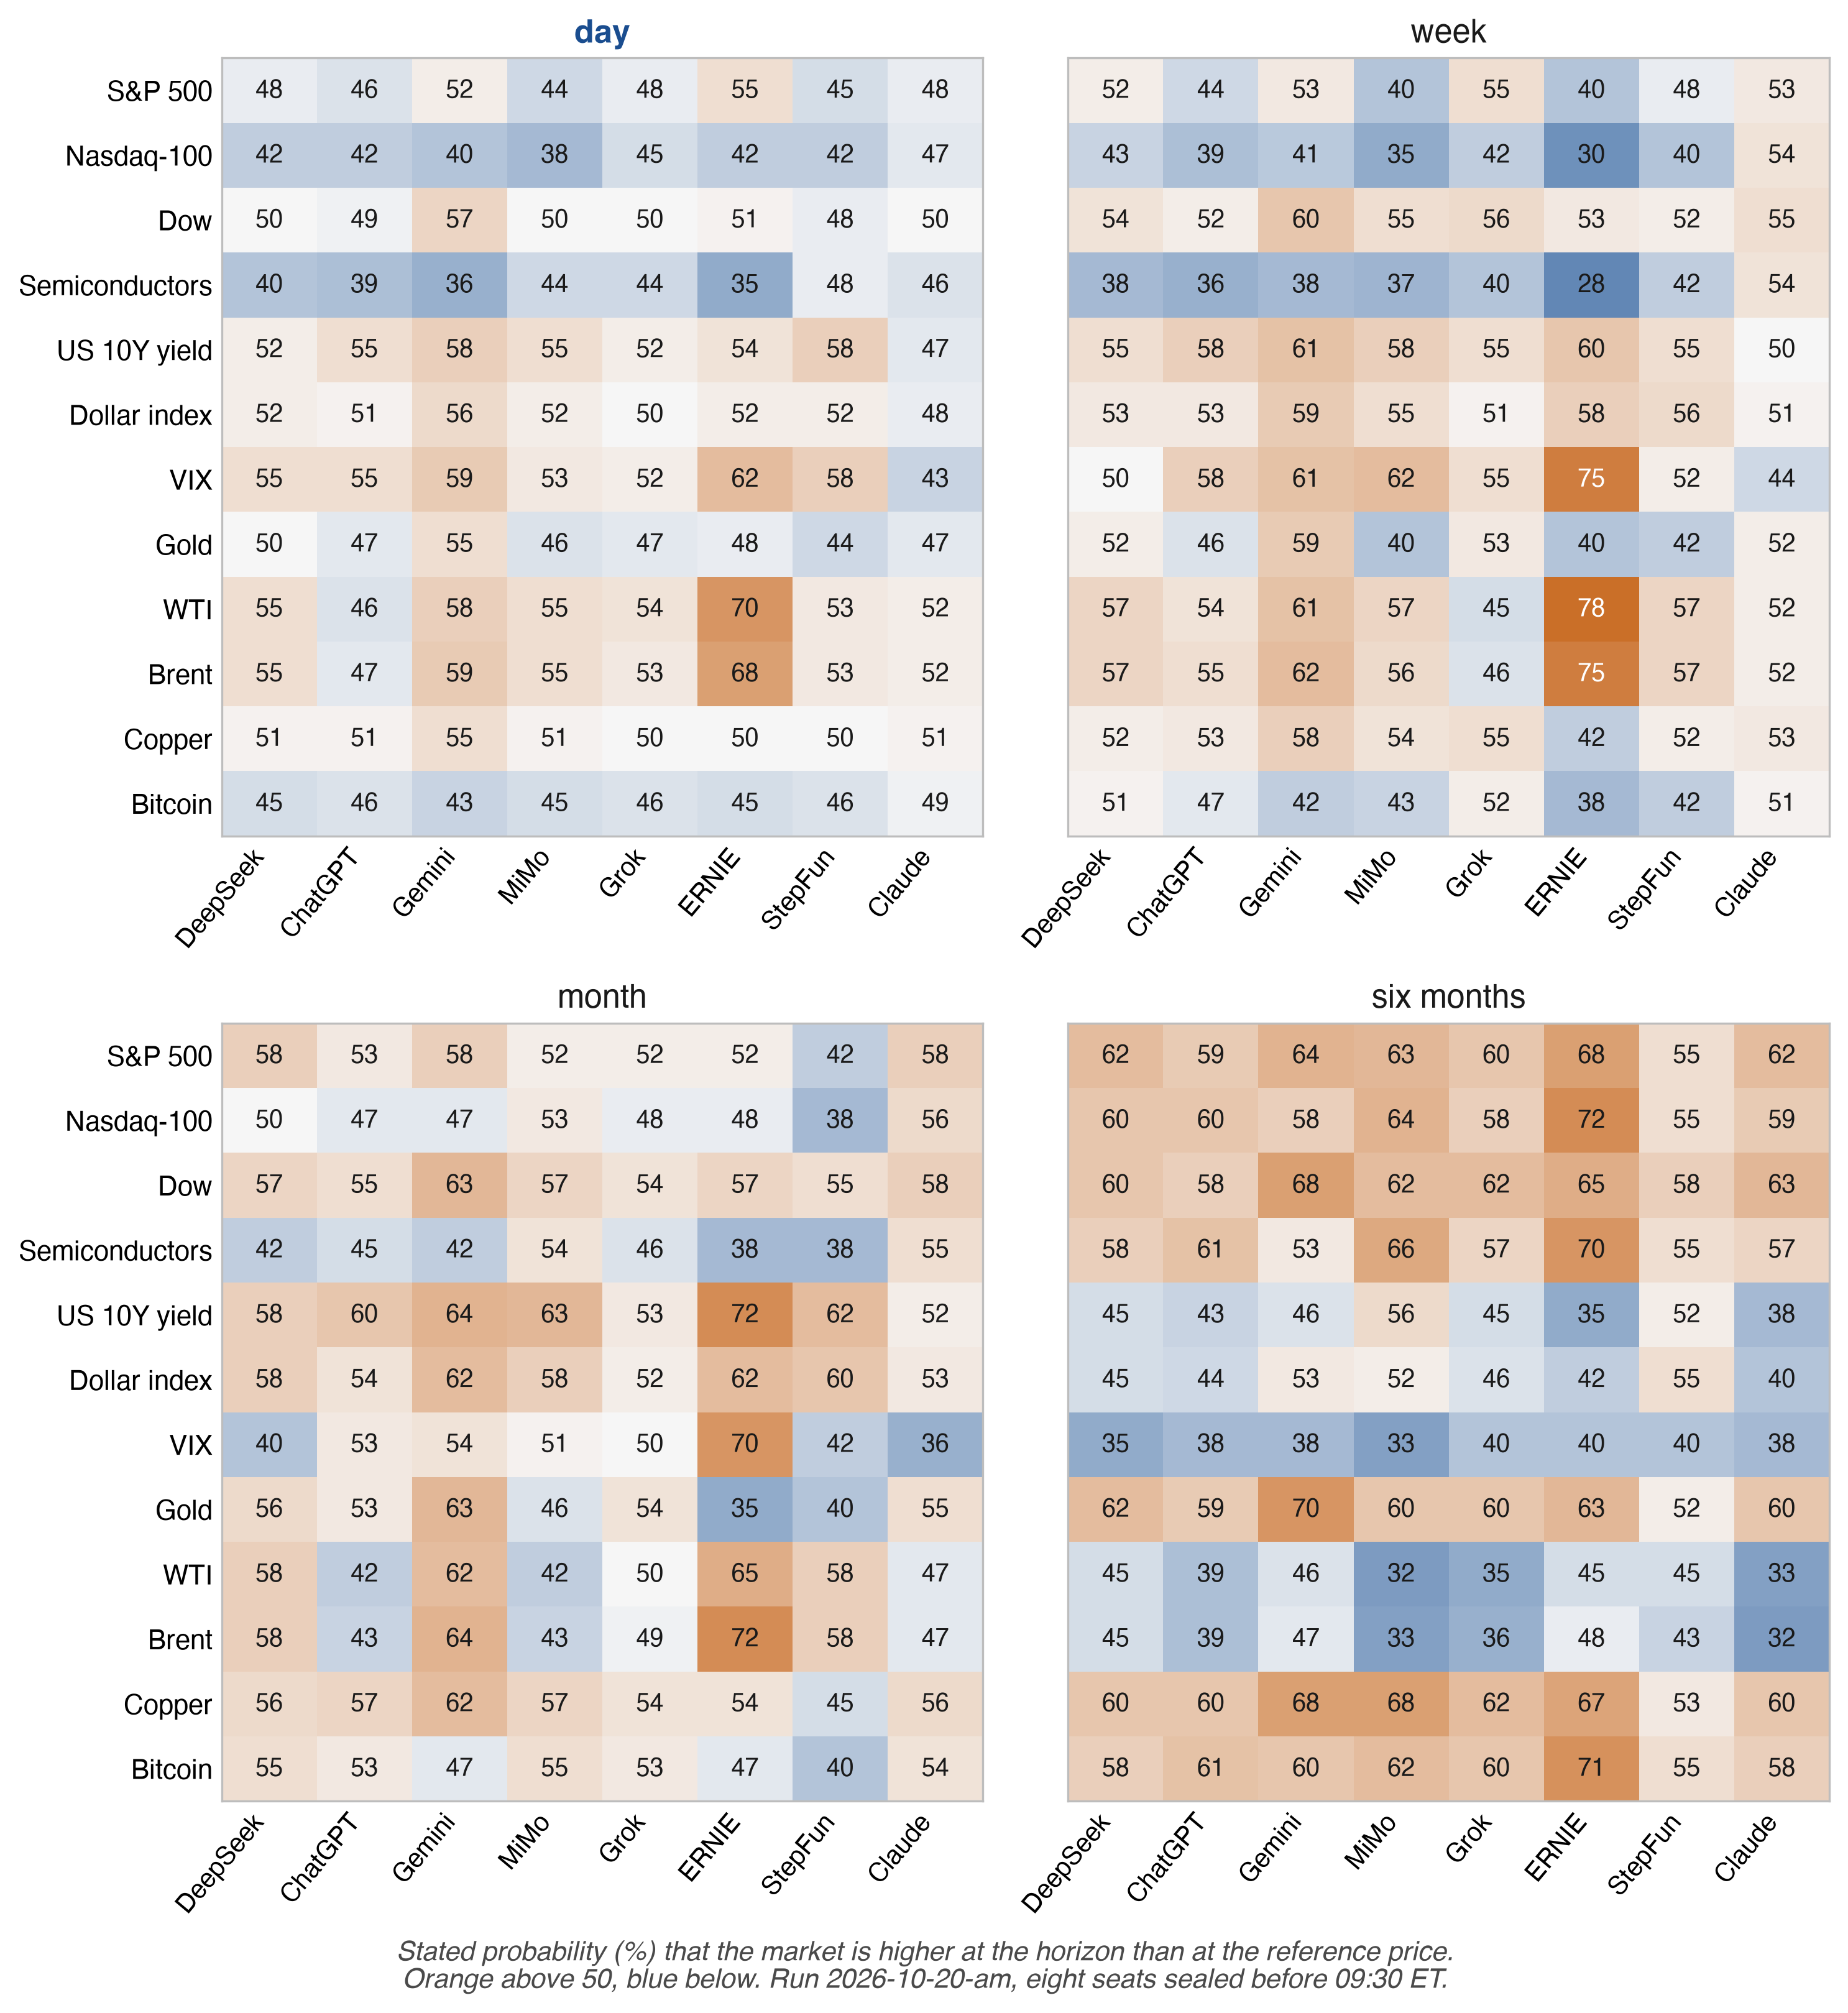
Nota: (A) As células são preenchidas das linhas contadas de council-forecasts.csv; uma célula é classificada apenas sob a regra da Seção 4.6. (B) Os oito assentos cujas respostas foram seladas antes da referência 09:30 ET em 20 de outubro de 2026 (execução 2026-10-20-am), uma célula por mercado e horizonte, coloridas pela probabilidade declarada de uma alta e centradas em 50%. Os assentos são ordenados pelo seu carregamento no primeiro componente principal das imagens de probabilidade, não por país. Fonte: council-forecasts.csv, lido em 21 de outubro de 2026.
Os forecasts de dia se resolvem a cada sessão; os forecasts da primeira semana da liga pontuada se resolvem a partir de 26 de outubro de 2026, os forecasts do primeiro mês por volta de 19 de novembro de 2026 e os forecasts dos primeiros seis meses em abril de 2027.
4.11 Reprodutibilidade
Cada pontuação pode ser recompilada a partir de arquivos abertos. O código do mecanismo de portfólio é publicado como texto, 19 arquivos e as configurações da liga, cada um com seu SHA-256 (arena-code.json). Um script de recontagem (replay.py) recomputa o valor, participação em caixa, taxas e pesos de cada conta a partir dos negócios e dos preços. Nos arquivos de 20 de outubro de 2026, ele reproduziu todas as 253 linhas publicadas de 145 contas dentro do arredondamento da publicação (Apêndice B, Etapa 7). Um segundo script, tools/replay_brier.py no mesmo endereço, recomputa de council-forecasts.csv a pontuação de Brier de cada previsão contada e os totais por assento, horizonte e versão de metodologia, e as compara com as figuras publicadas; nos arquivos ativos de 22 de outubro de 2026, 00:09 UTC, correspondeu exatamente a todos os 9.318 números publicados. Cada linha de previsão em council-forecasts.csv nomeia a linha do livro que a sela (line), de modo que cada pontuação é rastreável até uma resposta selada e dali até um prefixo com carimbo de tempo e um bloco Bitcoin (Apêndice B). Uma linha de pontuação é coberta pelo primeiro carimbo depois dela.
Qualquer pessoa pode recomputar os resultados publicados. A cadeia e a âncora fixam as respostas seladas, seus tempos e suas questões. As chamadas brutas do modelo, o feed de preços e o código implantado são publicados com seus hashes conforme fornecidos pelo operador. Reconciliar preços de referência e fechamento com uma segunda fonte independente é o resultado do topo da escada de afirmações (Tabela B1). Como os arquivos ativos mudam a cada execução, cada revisão cita uma versão de análise imutável no Zenodo (10.5281/zenodo.23552700) com um manifesto do SHA-256, tamanho e hora de recuperação de cada arquivo (Apêndice C).
5. Quantos vozes independentes
A liga tem onze assentos de previsão. Um conselho desse tamanho parece ter tantas opiniões, e a liga é construída para contar quantas ela mantém. Se os erros de N previsores correlacionam com um ρ comum, sua média carrega a evidência de
N_eff = N / (1 + (N − 1)ρ)
previsores independentes, e conforme N cresce, N_eff se aproxima de 1/ρ e para aí. A fórmula é o efeito de desenho da amostragem por conglomerados (Kish, 1965), e a saturação do valor de especialistas dependentes foi demonstrada para combinação de previsões por Clemen e Winkler (1985). O artigo complementar o aplica a painéis de modelos de IA (Chernets, 2026a). O limite não depende de quantos modelos foram consultados. Com ρ = 0,5 mil modelos valem duas testemunhas, e uma vez que um conselho é maior que 1/ρ, reduzir ρ compra mais do que adicionar membros. A entrada é medida. Quando dois modelos de linguagem estão ambos errados, eles frequentemente dão a mesma resposta errada, mais ainda dentro de uma arquitetura ou provedor (Kim et al., 2025). Os erros de previsão de três modelos de fronteira correlacionaram com uma média r de 0,77 em 568 questões binárias (Spiro, 2026), e os modelos de fronteira fazem previsões altamente correlacionadas no benchmark de IA do Metaculus (Aitchison et al., 2026). Quando muitos tomadores de decisão adotam um algoritmo, a decisão coletiva pode piorar mesmo que o algoritmo vença cada um deles isoladamente (Kleinberg & Raghavan, 2021). Teoria e simulações calibradas a holdings institucionais sugerem que a adoção ampla de modelos de IA similares encurta a vida dos sinais que negociam (Meng & Chen, 2026). Tais argumentos precisam de uma semelhança medida dos modelos como entrada. Uma liga de mercado fornece uma verdade fundamental externa a cada dia de negociação e até onze transmissões ao vivo de probabilidades nas quais ρ pode ser estimado. N_eff é uma contagem de variância. Um viés que cada modelo compartilha permanece na média qualquer que seja o número de modelos, razão pela qual a liga também conta o erro unânime diretamente (Seção 5.3). Um consenso de modelos impresso sem seu número efetivo de vozes é uma pesquisa impressa sem seu tamanho de amostra: o leitor vê a proporção que concorda e não consegue dizer quanto de evidência o acordo mantém. O Requisito 14 portanto torna a contagem OBRIGATÓRIA onde quer que um consenso seja mostrado. Em 20 de outubro oito assentos selaram uma imagem de um dia antes da abertura, e suas imagens eram tão parecidas quanto as de 1,46 previsores independentes (Seção 5.2).
5.1 Como a liga estima ρ
Cada execução selada fornece, para cada assento de previsão, uma probabilidade de que cada um dos 12 mercados estará em alta em cada horizonte. Para cada execução e horizonte a liga calcula a média sobre pares de assentos da correlação de Pearson de suas probabilidades nos mercados ambos respondidos, e avalia N_eff = n / (1 + (n − 1)ρ) com o n e ρ da própria execução. N_eff é convexa em ρ, assim a média das contagens por execução é pelo menos a contagem no ρ médio, e o ruído de amostragem de ρ, estimado de doze mercados, também empurra a contagem por execução para cima. Uma média abaixo de um limiar, como em F1 e F2, é portanto a leitura conservadora, e uma comparação entre horizontes é feita no próprio ρ (F9). Com doze mercados uma correlação pairwise carrega um erro padrão de cerca de 0,26 a 0,18 entre a faixa observada de 0,38 a 0,64; os pares de uma execução compartilham assentos e mercados, então sua média é mais estável que um par mas não pela raiz de seu número. Um intervalo vem de cinco execuções contadas. Eu uso a linha de resposta mais recente de cada assento e deixo de fora as células restauradas após o lacre por uma linha correction datada, porque elas não estavam na resposta lacrada. A regra de elegibilidade faz parte do estimador. Eu admito apenas execuções contadas, e apenas respostas lacradas antes do preço de referência, de modo que uma resposta tardia, que poderia ver o movimento de abertura, não entre. O arquivo aberto council-stats.json publica esta série sob n_eff.counted, com a regra declarada no arquivo. O bloco mais antigo n_eff.per_run e sua média calculam todas as execuções seladas, execuções de teste e respostas tardias incluídas. O Apêndice C fornece os campos para recomputação a partir de council-forecasts.csv e council-book.jsonl. A Tabela 6 segue as linhas do arquivo aberto através dessa regra, das seis execuções seladas até o registro contado.
Tabela 6. Do arquivo aberto até o registro contado, por execução: linhas, correções, assentos, linhas lacradas antes da referência, 50s declarados, células inválidas e linhas de um dia contadas (council-forecasts.csv, 3.792 linhas).
| Execução | Papel | Linhas no arquivo | Linhas de correção | Assentos respondendo | Assentos lacrados antes da referência | Linhas lacradas antes da referência | 50s declarados | Células inválidas | Linhas de um dia contadas |
|---|---|---|---|---|---|---|---|---|---|
| 2026-10-16-eve | Teste | 1.056 | 39 | 9 | 9 | 1.017 | 20 | 0 | 0 |
| 2026-10-17-btc | Teste | 864 | 32 | 9 | 9 | 832 | 40 | 0 | 0 |
| 2026-10-18-radar | Teste | 672 | 21 | 8 | 8 | 651 | 22 | 0 | 0 |
| 2026-10-19-am | Desenvolvimento | 336 | 11 | 7 | 7 | 325 | 4 | 0 | 83 |
| 2026-10-20-am | Desenvolvimento | 432 | 0 | 9 | 8 | 384 | 14 | 12 | 105 (96 lacrados antes da referência) |
| 2026-10-21-am | Registro contado | 432 | 0 | 9 | 9 | 432 | 24 | 0 | 108 |
Nota: As linhas de correção adicionam células (colunas marcadas por line_kind); as outras colunas contam as células das linhas de resposta. Uma linha é lacrada antes da referência quando seu lacre, max(at, booked_at), precede 09:30 ET da sessão que visa; os três testes visam 19 de outubro. As células informadas como 50 e inválidas são lidas de cell_status (explicit_50, invalid), linhas contadas de status. Em 20 de outubro o nono assento, Meta AI, lacrou em 16:16:52Z: suas 12 células inválidas não contêm probabilidade, e suas nove linhas contadas de um dia são pontuadas a partir de sua própria referência, fora do evento comum. Em 21 de outubro as quatro células Bitcoin da nona resposta têm sua própria referência (Seção 3.3). Fonte: council-forecasts.csv e council-book.jsonl salvos em 22 de outubro de 2026, 01:32 UTC (SHA-256 do CSV 9fa4747e…c299d).
Publico estatísticas complementares junto à contagem. A correlação é computada através dos mercados, portanto inclui a forma como os mercados se movem em conjunto (os três índices de ações dos EUA, WTI e Brent); uma segunda versão mantém um mercado por grupo, removendo o Nasdaq-100, o Dow e o Brent. A correlação através dos mercados também depende da direção em que cada mercado é perguntado: uma subida do VIX, do dólar ou do rendimento normalmente acompanha uma queda das ações, e a liga pergunta a cada mercado como uma subida, fixada em seu contrato de evento. Também computo uma versão livre dessa convenção, que correlaciona os desvios de 50 sem subtrair a média de cada assento através dos mercados, de modo que virar qualquer mercado não muda nada. Em um dia fornece 1,85 e 1,54, em 19 e 20 de outubro, contra 1,74 e 1,46 para a contagem de destaque. Tirada da probabilidade climatológica em vez de 50, os mesmos desvios fornecem a leitura que a Seção 4.3 pede para horizontes longos. A razão de participação da matriz é uma contagem de dimensão diferente, e sob equicorrelação as duas diferem, portanto a leio ao lado de N_eff como uma segunda contagem. Uma terceira estatística remove o consenso de cada mercado primeiro. Subtrair um consenso estimado dos mesmos modelos torna os desvios negativamente correlacionados por construção, portanto esta é descritiva e não registrada. O Requisito 17 adiciona a participação do maior autovalor. Uma participação próxima a um diz que um único fator comum carrega a semelhança, a estrutura sob a qual um único ρ comum é um resumo justo, e uma participação baixa diz que o ρ único esconde vários fatores. Na execução contada de 20 de outubro de 2026, através de todas as 48 células dos oito assentos lacrados antes da referência, o maior autovalor carrega 68% do traço (5,47 de 8). Um único fator comum detém a maior parte da semelhança. A razão de participação da matriz de um dia foi 2,28 em 19 de outubro, 1,79 em 20 de outubro e 3,28 em 21 de outubro (n_eff_participation).
As contagens de destaque medem o quão semelhantes são as imagens de probabilidade. A correlação de erros, o ρ da fórmula acima, é a segunda contagem, e a liga a computa a partir de sessões pontuadas: a correlação média pairwise dos indicadores de erro dos assentos através dos mercados, convertida em N_eff da mesma forma (n_eff_errors). Também carrega o co-movimento de resultados. Quando os três índices de ações caem juntos, modelos que disseram subida erram juntos independentemente de sua semelhança.
5.2 Uma primeira leitura do método
Leio o método pela primeira vez nas sessões de desenvolvimento de 19 e 20 de outubro de 2026 (Seção 8). Em suas duas execuções matinais contadas, usando apenas respostas lacradas antes do preço de referência 09:30 ET, encontro N_eff em um dia de 1,74 em 19 de outubro de 2026 (n = 7 assentos lacrados antes da referência, ρ = 0,505) e 1,46 em 20 de outubro de 2026 (n = 8, ρ = 0,64). As imagens daquelas duas manhãs eram tão semelhantes quanto as de cerca de 1,6 previsores independentes. Mantendo um mercado por grupo fornece 1,69 e 1,57. A primeira execução do registro contado, em 21 de outubro de 2026, forneceu 2,23 (n = 9, ρ = 0,379), e 2,09 com um mercado por grupo (council-stats.json, n_eff.counted.per_run, gerado em 21 de outubro de 2026, 22:16 UTC).
A mesma regra em cada horizonte, com as três medidas descritivas que não precisam de resultado além dela, fornece a Tabela 7.
Tabela 7. Leitura descritiva por horizonte das execuções matinais contadas, respostas lacradas antes da referência: N_eff das imagens de probabilidade (ρ pairwise médio entre colchetes), nitidez K, participação de probabilidades entre 40 e 60, e dispersão através de assentos.
| Execução | Medida | 1 dia | 1 semana | 1 mês | 6 meses |
|---|---|---|---|---|---|
| 19 out 2026 (n = 7) | N_eff (ρ) | 1,74 (0,51) | 2,81 (0,25) | 2,39 (0,32) | 1,16 (0,84) |
| K | 10,7 | 14,4 | 17,9 | 25,0 | |
| Participação em [40, 60] (%) | 88 | 81 | 67 | 42 | |
| Dispersão (pontos) | 4,2 | 6,3 | 7,4 | 5,1 | |
| 20 out 2026 (n = 8) | N_eff (ρ) | 1,46 (0,64) | 1,99 (0,43) | 2,68 (0,28) | 1,14 (0,86) |
| K | 9,2 | 14,1 | 13,9 | 20,3 | |
| Participação em [40, 60] (%) | 93 | 82 | 80 | 58 | |
| Dispersão (pontos) | 3,5 | 5,7 | 6,2 | 4,7 | |
| 21 out 2026 (n = 9) | N_eff (ρ) | 2,23 (0,38) | 2,63 (0,30) | 2,41 (0,34) | 1,58 (0,59) |
| K | 10,1 | 12,5 | 14,6 | 19,9 | |
| Participação em [40, 60] (%) | 95 | 90 | 84 | 61 | |
| Dispersão (pontos) | 4,3 | 4,8 | 5,7 | 6,8 |
Nota: Doze mercados por horizonte. N_eff pela regra do script arquivado neff-horizons.py (Seção 5.1), com células que carregam uma referência própria deixadas de fora (em 21 de outubro as células Bitcoin da nona resposta); o valor de um dia de 21 de outubro iguala o n_eff.counted.per_run publicado. K = (2/n)Σ|p − 50| através das células dos assentos (Seção 4.4); dispersão é o desvio padrão populacional através dos assentos, média sobre os doze mercados. Valores de council-forecasts.csv e council-book.jsonl salvos em 22 de outubro de 2026, 01:32 UTC.
Em todas as três rodadas as vozes são menos numerosas aos seis meses e mais numerosas em uma semana e um mês do que em um dia. A semelhança dos seis meses pode vir de taxas de base compartilhadas (as ações e o ouro tendem a subir em seis meses), portanto a contagem de seis meses também deve ser lida sobre desvios da probabilidade climatológica. Vejo o padrão na rodada de 20 de outubro (Figura 6B) e na Figura 7 eu o desenho mercado por mercado. Os oito assentos lacrados antes da referência colocaram cinco mercados abaixo de uma chance uniforme para o dia e perto de 60% aos seis meses. Em probabilidade média o S&P 500 foi de 48 para 62, o Nasdaq-100 de 42 para 61, semicondutores de 42 para 60, ouro de 48 para 61 e Bitcoin de 46 para 61, enquanto o petróleo, o VIX e o rendimento de 10 anos foram no sentido oposto (WTI 55 para 40, VIX 55 para 38, o rendimento 54 para 45). O conselho viu um choque curto que se dissipa. Aos seis meses convergiu para a deriva de longo prazo. Em 21 de outubro a ponta curta se moveu e a ponta longa se manteve. Os nove assentos deram ao S&P 500 55,9 para o dia e 60,4 aos seis meses, e apenas cobre (47,9) e VIX (45,7) ficaram abaixo de uma chance uniforme para o dia. Aos seis meses os ativos de risco novamente ficaram em 56,7 a 62,7 e petróleo, VIX, rendimento e dólar em 41,2 a 46,1.
Figura 7. Probabilidade média informada de uma alta em um dia e aos seis meses, por mercado: (A) rodada 2026-10-20-am, oito assentos lacrados antes da referência; (B) rodada 2026-10-21-am, nove assentos.
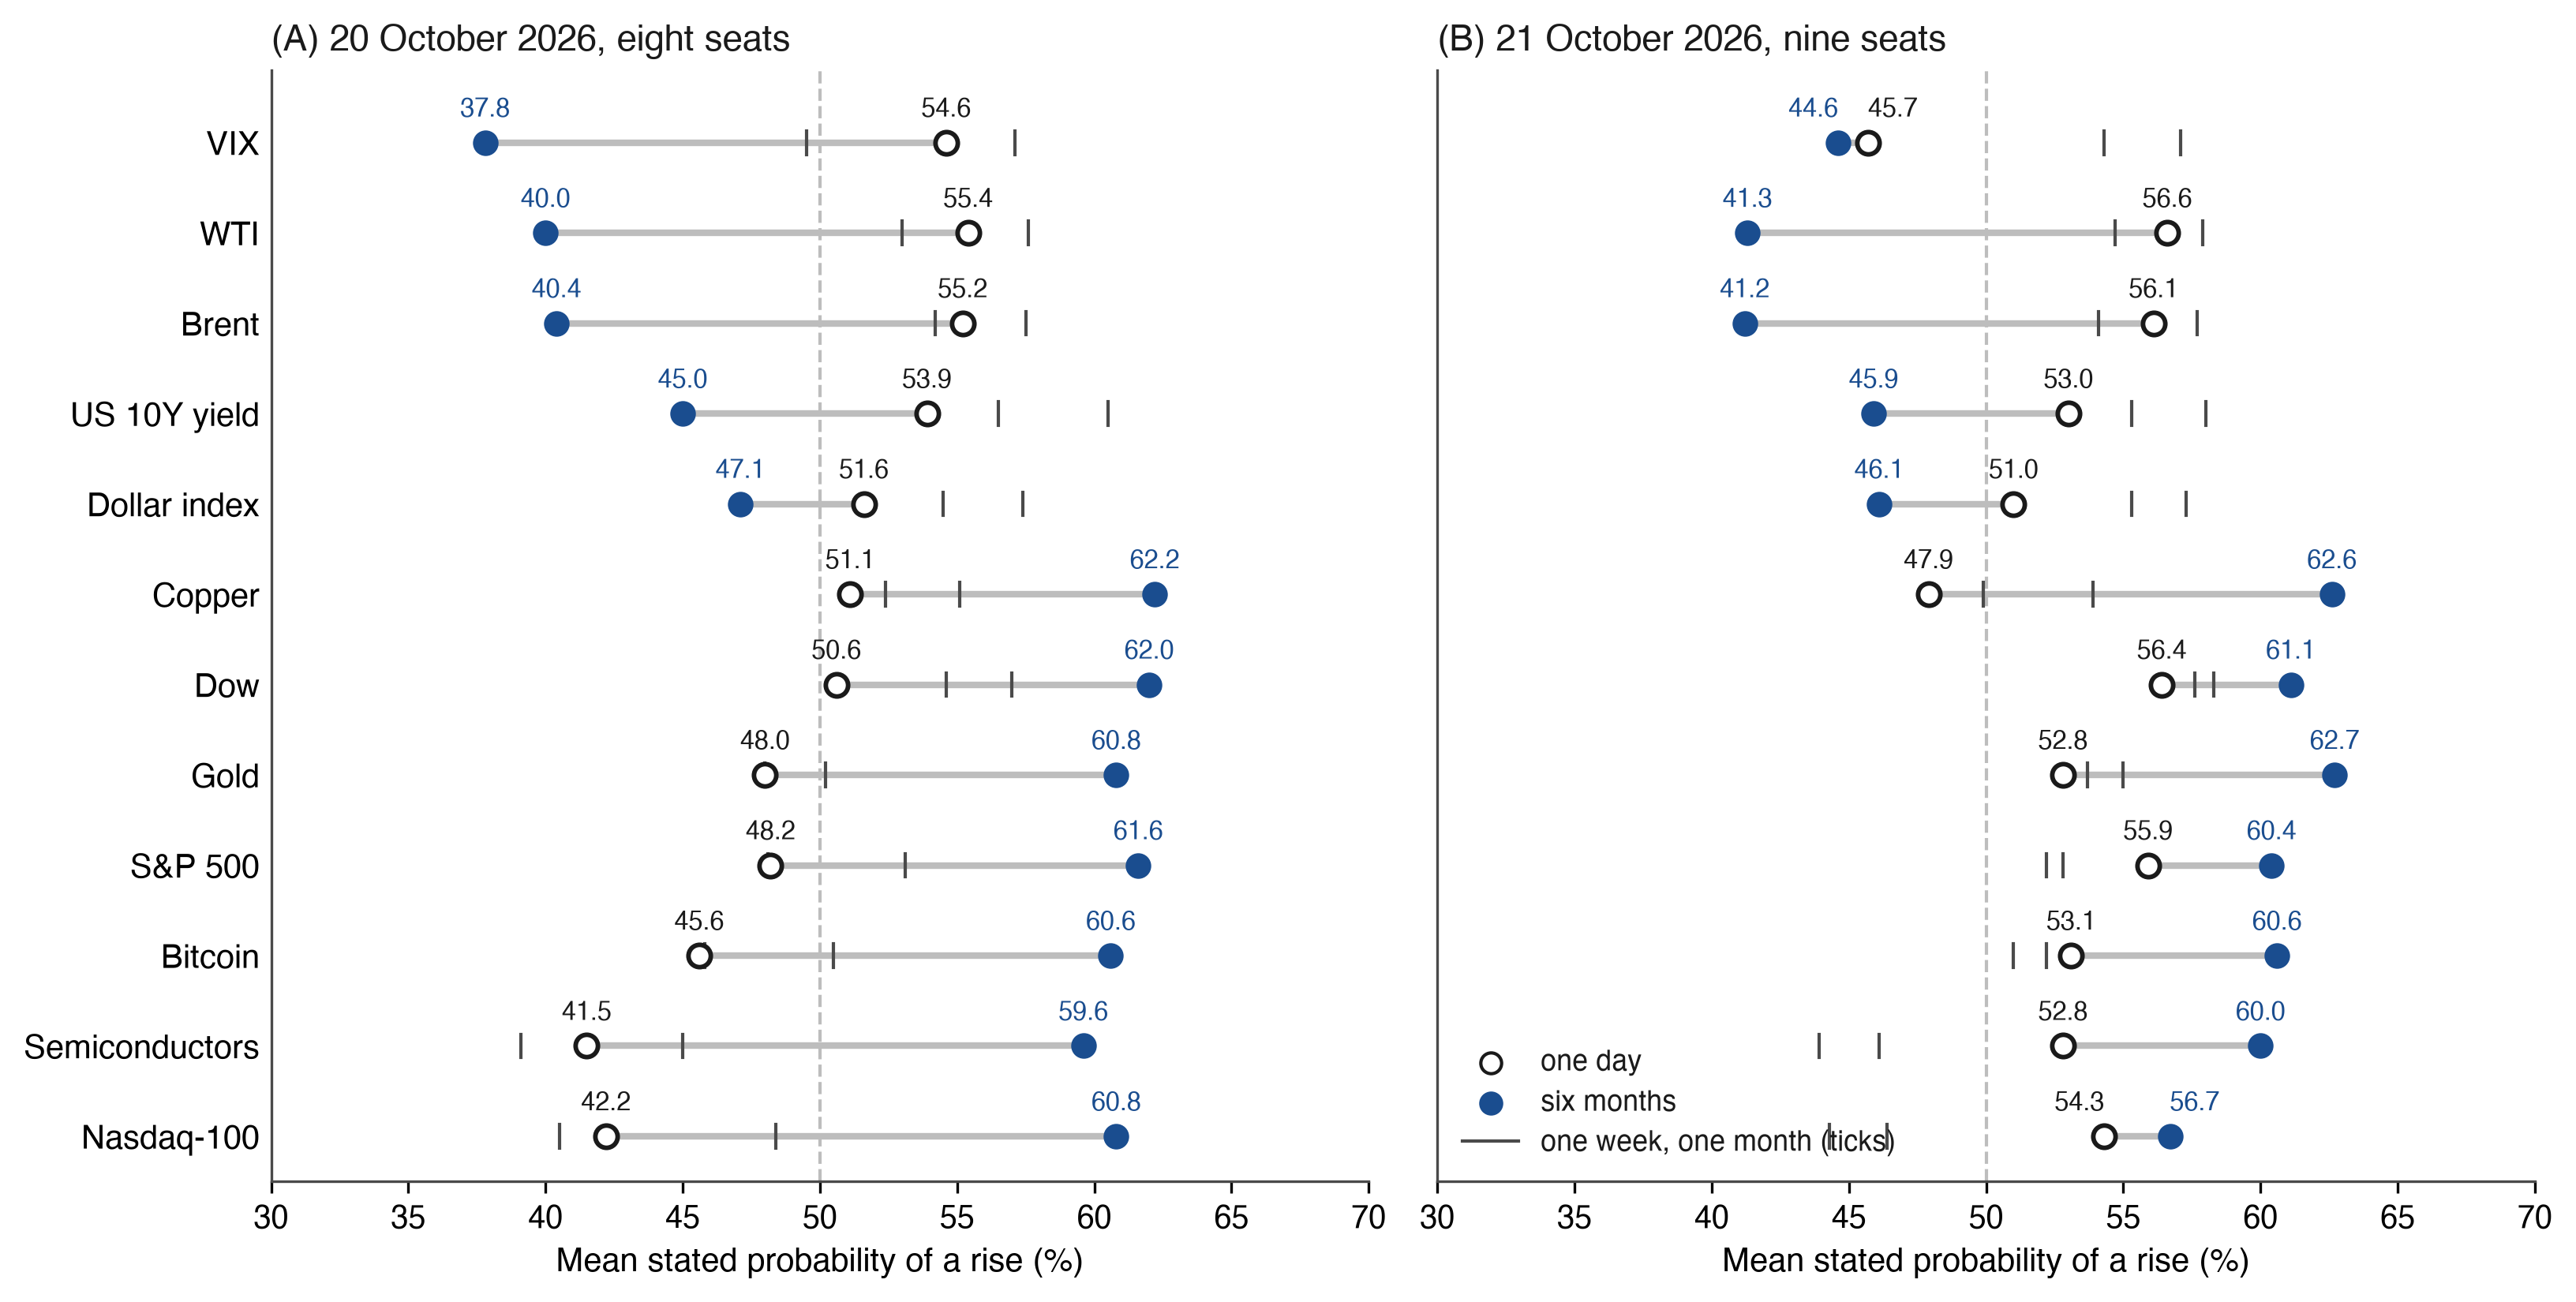
Nota: Média de prob_up dos assentos; marcas indicam uma semana e um mês. Os mercados são ordenados pela mudança de um dia para seis meses em 20 de outubro. As probabilidades de seis meses incluem a taxa de base de cada mercado (Seção 4.3); a mesma leitura contra climatologia é . Em 21 de outubro a média de Bitcoin exclui as células da nona resposta, que têm sua própria referência. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC.
A mesma rodada fornece a dispersão que a Seção 8 usa. Entre os oito assentos, o desvio padrão populacional das probabilidades foi em média 3,5 pontos em um dia, 5,7 em uma semana, 6,2 em um mês e 4,7 aos seis meses. Em um dia variou de 1,5 pontos em cobre a 6,4 em WTI, e as células mais largas foram VIX e Brent em um mês (9,9 e 9,8). Em 21 de outubro a dispersão média foi 4,3, 4,8, 5,7 e 6,8 pontos, maior aos seis meses (Brent 9,5, WTI e VIX 8,4). A Figura 8 mostra cada célula em ambas as manhãs.
Figura 8. Dispersão das probabilidades informadas entre os assentos, por mercado e horizonte: (A) rodada 2026-10-20-am, oito assentos lacrados antes da referência; (B) rodada 2026-10-21-am, nove assentos.
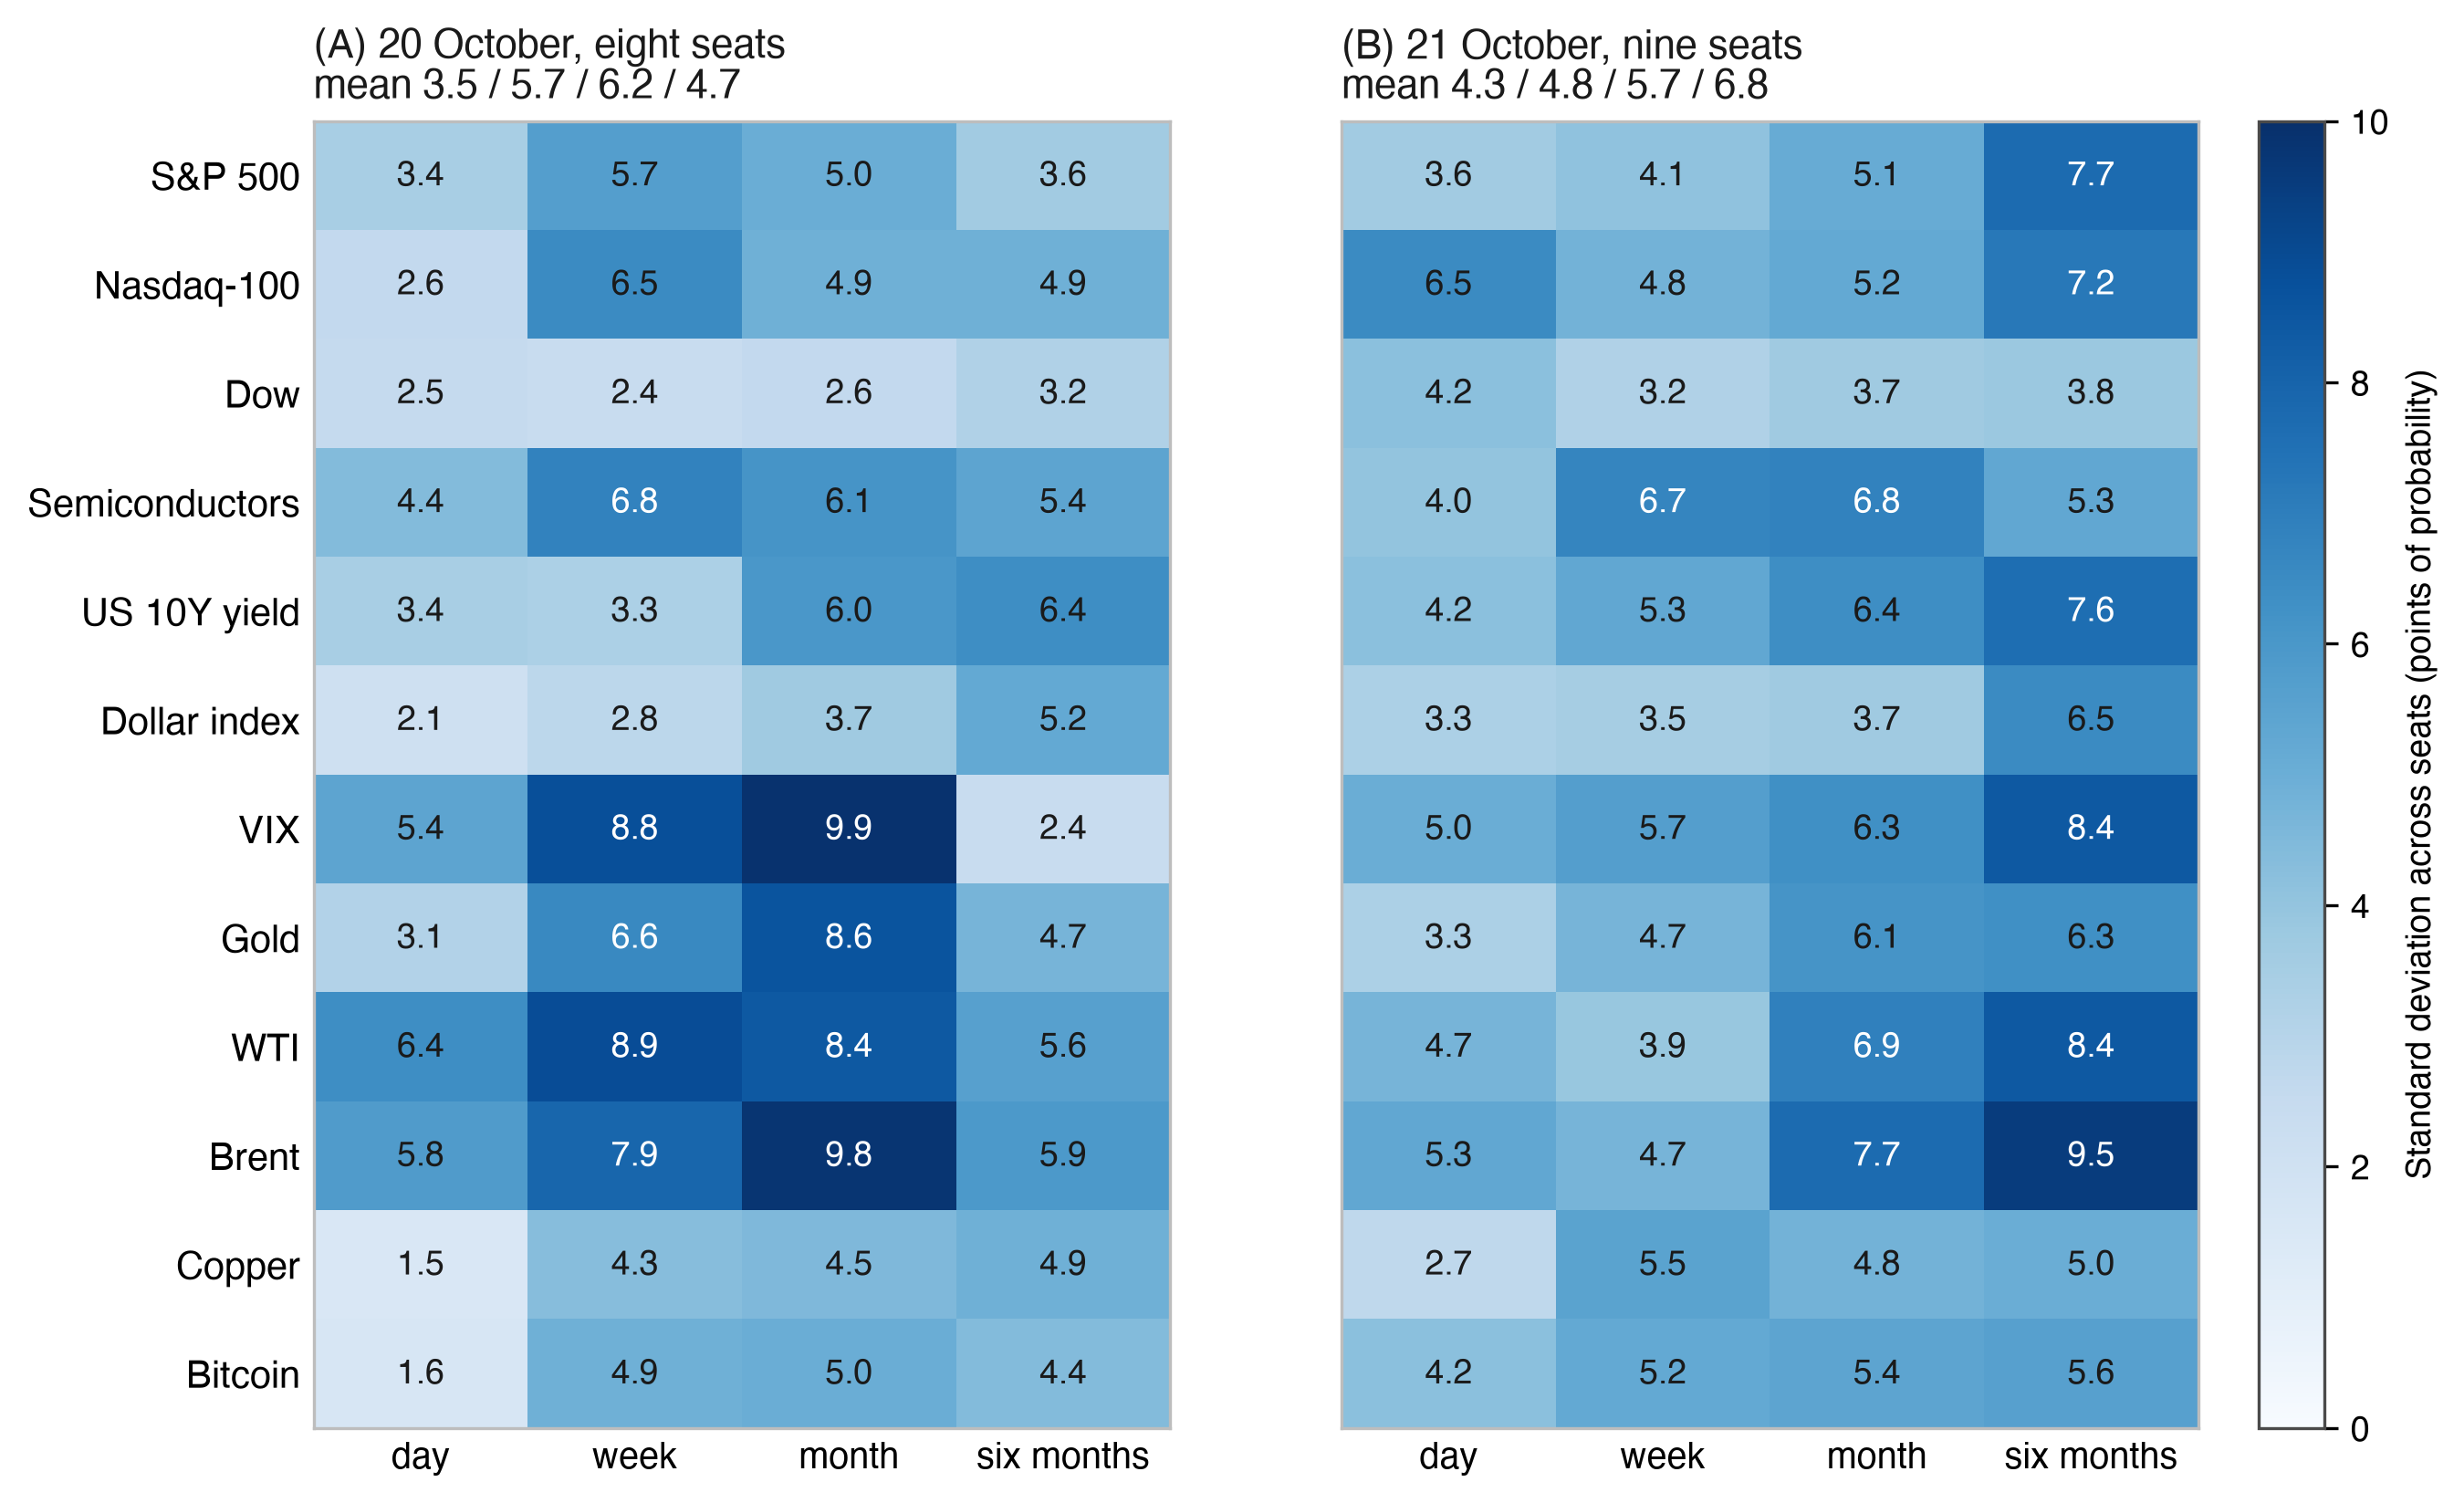
Nota: Desvio padrão populacional de prob_up entre os assentos em cada célula, em pontos de probabilidade; os títulos do painel fornecem a média sobre os doze mercados em cada horizonte. A Seção 8 registra o uso de dispersão como análise secundária. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC.
Rodadas sucessivas respondem perguntas sobrepostas sobre os mesmos mercados, e as janelas de uma semana e um mês de rodadas vizinhas se sobrepõem. Uma comparação entre horizontes é portanto feita em diferenças pareadas rodada por rodada, com intervalos sobre blocos de rodadas (F9). As três rodadas experimentais de 16 a 18 de outubro, todas destinadas à sessão de 19 de outubro e não contabilizadas, deram 4,01, 2,69 e 2,06 em um dia. A contagem em indicadores de erro segue a mesma regra de elegibilidade e é computada pelo script arquivado de F3. O campo n_eff_errors do arquivo aberto é uma série descritiva mais ampla e não é a manchete. A Figura 9 coloca os valores por rodada nas curvas da fórmula. As previsões F1 a F3 e F9 (Seção 8) indicam o que as rodadas contabilizadas após o registro devem mostrar.
Figura 9. Número efetivo de vozes independentes contra o número de modelos, com as leituras por rodada das primeiras rodadas lacradas e da primeira rodada contabilizada.
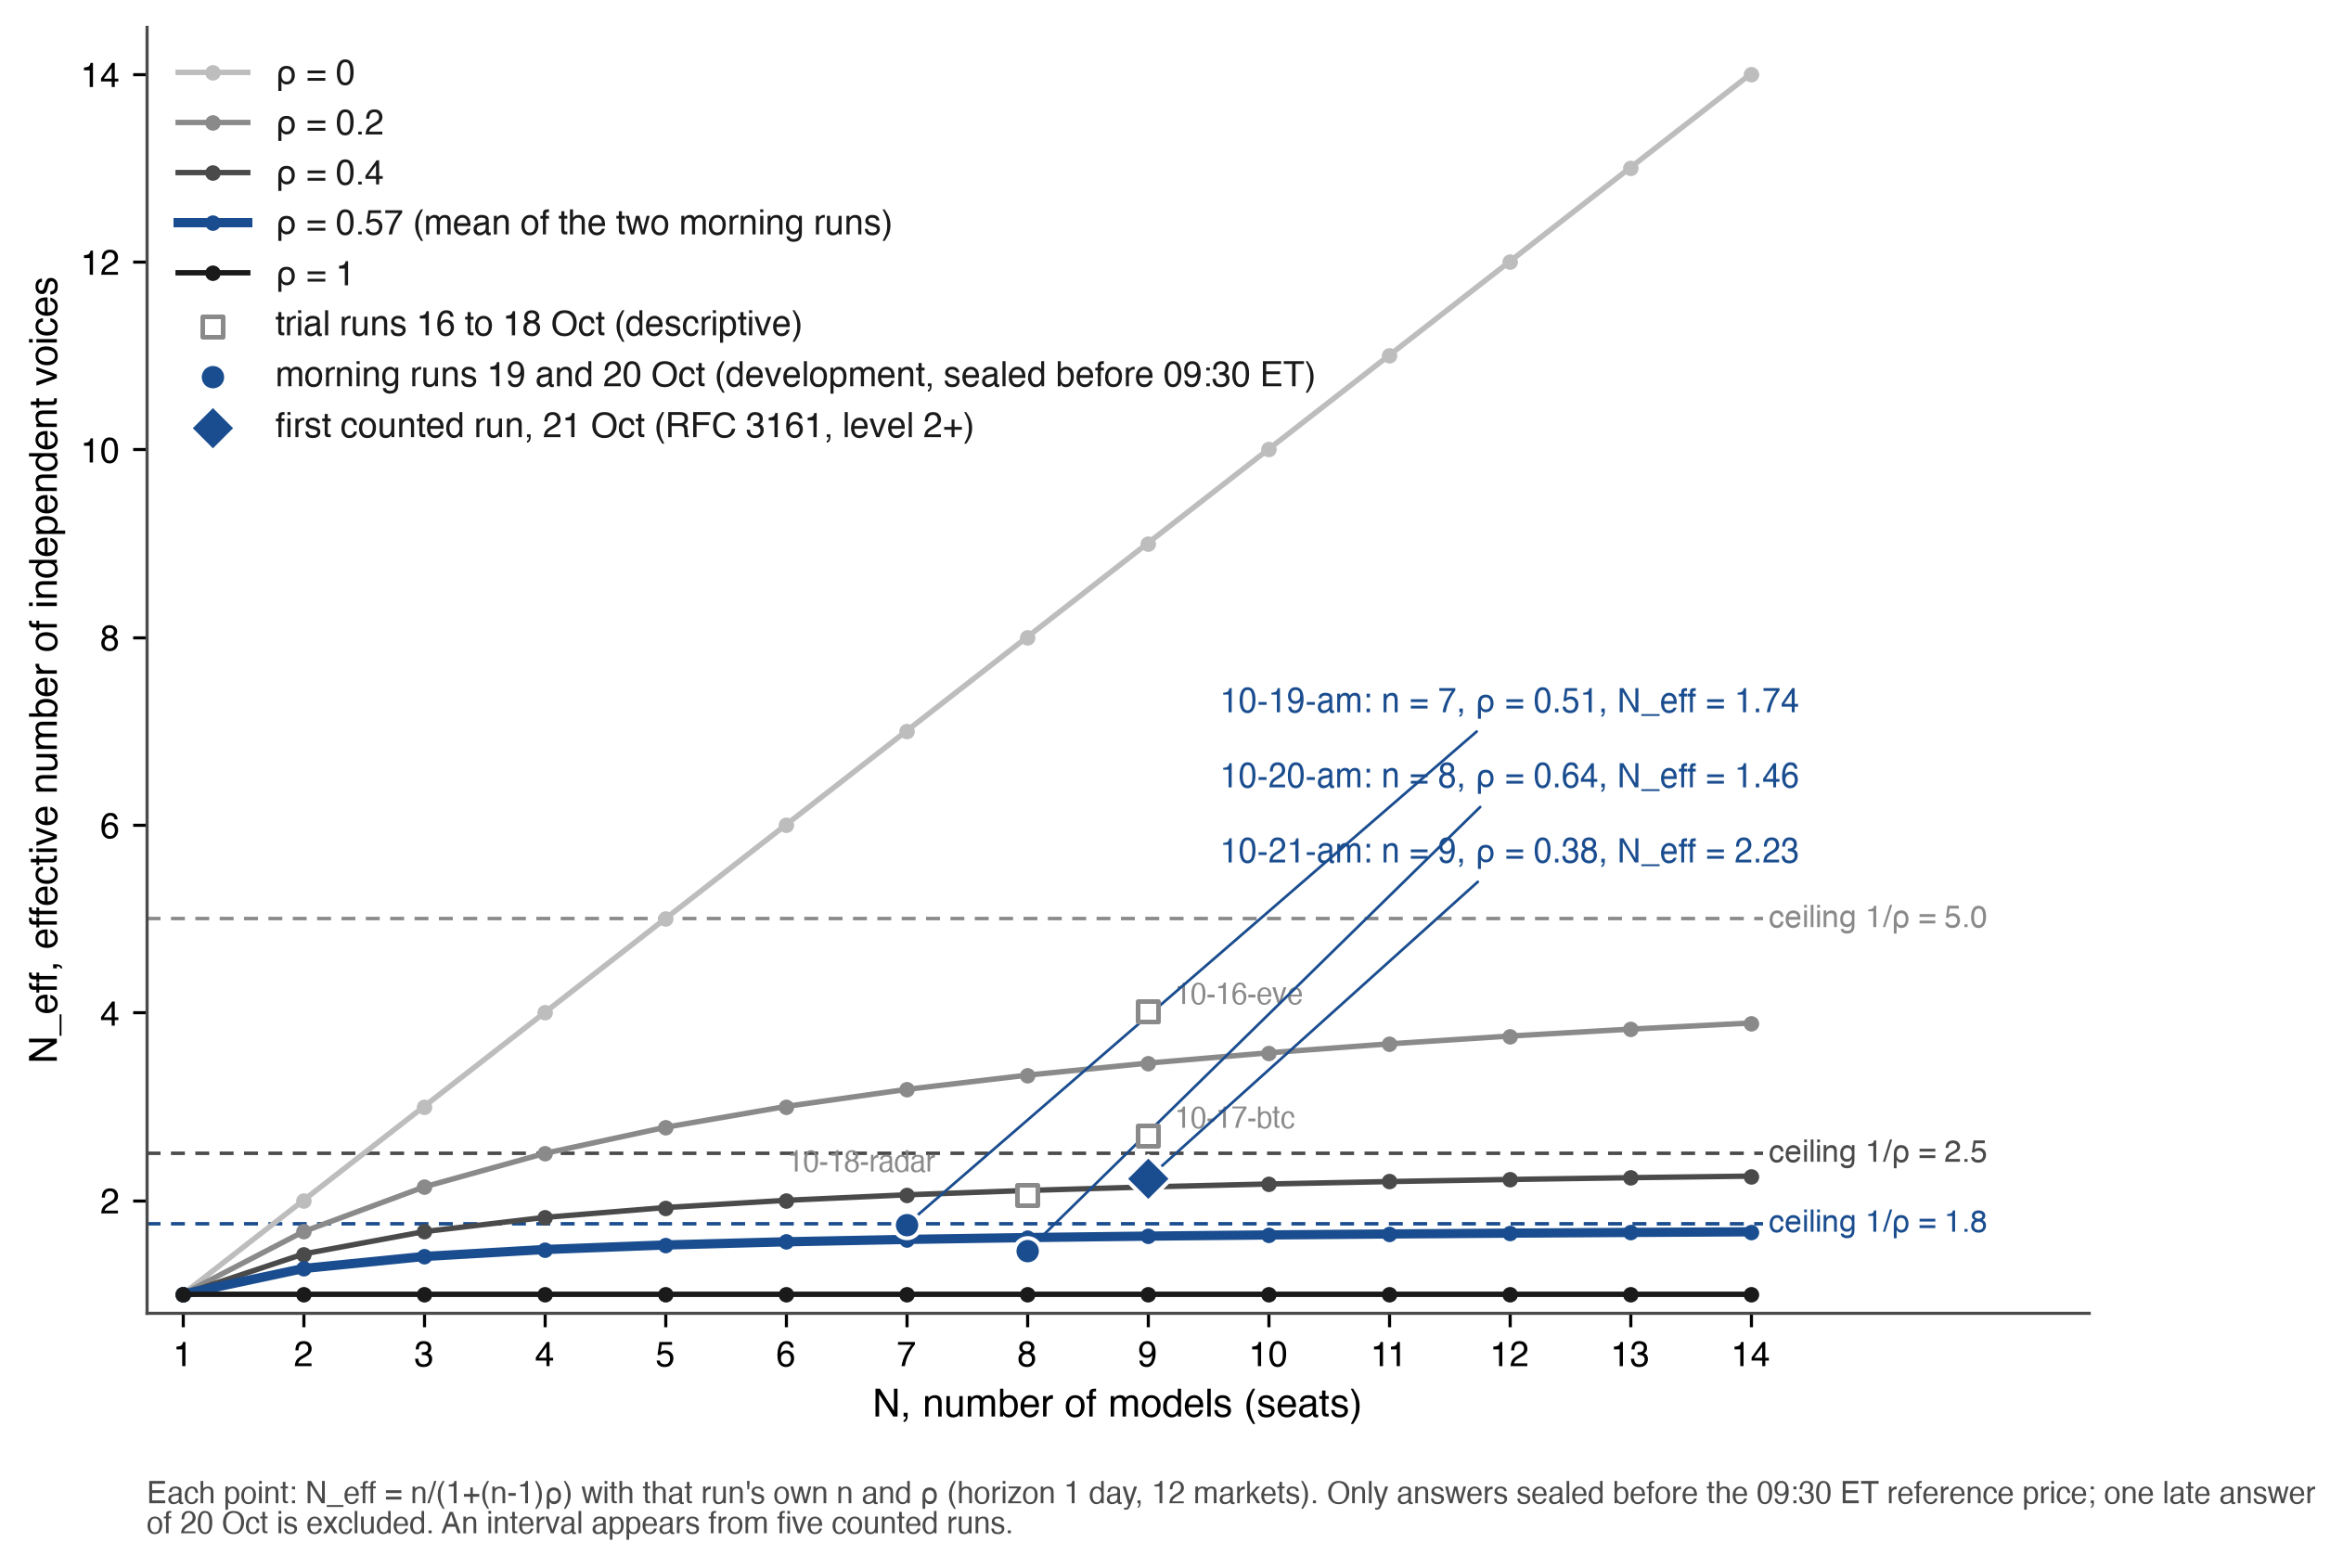
Nota: N_eff = N / (1 + (N − 1)ρ) para N = 1 a 14 e ρ de 0, 0,2, 0,4, 0,57 e 1; linhas tracejadas marcam os limites superiores 1/ρ. Círculos preenchidos: as rodadas matutinas de 19 e 20 de outubro em um dia, respostas lacradas antes da referência (1,74, n = 7, ρ = 0,505; 1,46, n = 8, ρ = 0,64); a curva destacada é seu ρ médio, 0,57. Diamante preenchido: a primeira rodada do registro contabilizado, 21 de outubro de 2026 (2,23, n = 9, ρ = 0,379). Quadrados abertos: as três rodadas experimentais (4,01, 2,69, 2,06). Fonte: council-forecasts.csv e council-book.jsonl, lido em 21 de outubro de 2026, pela regra da Seção 5.1.
5.3 O consenso e por que desconta famílias
Defino o consenso para um mercado como a média das probabilidades dos assentos, com três regras. Quando pelo menos cinco assentos respondem, a probabilidade mais baixa e a mais alta são descartadas. Um segundo modelo da mesma família conta um terço, e o mesmo acontece com cada um adicional, portanto um laboratório que opera vários modelos não pode outvote os outros por número. Sob uma estrutura de bloco a fórmula uniforme superestima N_eff (Kim et al., 2025). O resultado é limitado a 2 a 98%. Cada assento no atual registro vem de um laboratório diferente (Tabela 8), portanto cada peso de família é 1. A regra é escrita na metodologia aberta antes de um laboratório ocupar dois assentos.
Pela identidade da Seção 4.5, o consenso supera a média dos membros que mantém mecanicamente em um evento comum, e contra o conselho completo o corte é uma escolha que o consenso de sombra e F10 medem, um ganho aritmético. A habilidade é avaliada apenas contra referências fora do conselho: a moeda, a taxa base climatológica, a multidão e, para F10, o modelo que liderou uma janela anterior. O valor de um assento é medido diretamente: a pontuação Brier do consenso em eventos comuns com e sem aquele assento, nas mesmas sessões. Um leave-one-out computado após os resultados é uma descrição. Qualquer ponderação diferente do corte congelado, pesos familiares e clamp, escolhida porque teria vencido em temporadas já vistas, é uma nova estratégia (White, 2000): é lacrada antes da primeira sessão que governa e pontuada apenas após esse lacre.
Lacruo uma tal estratégia com o registro, como um teste da própria tese desta seção: se vozes correlacionadas valem menos, desconta-las deveria ajudar. O consenso de sombra pondera cada assento pelo inverso de sua correlação média aos pares com os outros assentos, computado nas imagens de probabilidade de um dia das execuções contadas lacradas antes do carimbo de tempo de registro, respostas lacradas antes da referência apenas, com a correlação média limitada em 0.05 (um assento sem resposta elegível naquela janela recebe o peso mediano dos outros). Os pesos são arquivados com o registro e congelados pela temporada. Em cada evento eles são renormalizados sobre os assentos respondentes, e o corte de extremos, os pesos familiares e o clamp são os do consenso publicado. Um script arquivado computa a sombra dos arquivos abertos e a pontua nos mesmos eventos do consenso publicado, que nunca substitui. A Seção 8 declara a comparação. O Requisito 17 também fornece a cada assento duas contagens descritivas de distintividade, sua correlação média com os outros assentos respondentes e a proporção de suas células direcionais que concordam com a maioria. Um assento que é distinto e adiciona ao consenso em eventos comuns é o assento que a regra familiar e o teto da Seção 5 argumentam para manter. Em 20 de outubro de 2026, em oito assentos lacrados antes da referência e todas as 48 células, as duas contagens variaram de uma correlação média de 0.47 e 70% de concordância com a maioria dos outros (Claude) para 0.71 e 88% (DeepSeek). Claude ficou sozinho de seu lado de uma chance uniforme em quatro das 48 células, mais que qualquer outro assento, entre elas semicondutores e o Nasdaq-100 em uma semana, ao qual deu 54 enquanto os sete outros deram 28 a 43. A precisão é pontuada separadamente.
all_wrong conta as sessões de mercado nas quais cada assento respondente estava errado, com pelo menos quatro respondentes, e minority_right conta aquelas nas quais o consenso estava errado e pelo menos um assento estava certo. Em ambos, as linhas são todas as linhas com o resultado "suba" significando uma mudança maior que zero, e um 50% declarado não é certo nem errado, de modo que aquele assento não conta como respondente para aquela linha. Sob independência, erro unânime entre quatro ou mais assentos com taxas de erro próximas de uma metade seria incomum, e sua frequência em relação ao produto das próprias taxas de erro dos assentos respondentes nas mesmas linhas é F6. A contagem é um diagnóstico de agrupamento que mistura o co-movimento dos resultados, a dificuldade de sessões particulares e um viés compartilhado, e não identifica cópia. Uma minoria certa que recorre é o caso para mostrar a chamada de cada assento ao lado do consenso.
5.4 Fontes compartilhadas
Cada linha de previsão de council-forecasts.csv carrega os domínios e links que seu modelo citou (source_domains, source_urls). Para as respostas de um dia de cada execução relato a concentração de citações nos sites mais citados, a sobreposição média de Jaccard de links e sites citados entre pares de assentos, e se pares que compartilham um link concordam sobre a ação mais frequentemente do que pares que não compartilham, dentro de estratos de execução e mercado, por permutação. Nas primeiras cinco execuções um site de notícias atraiu cerca de um quinto de todas as citações, a sobreposição de links exatos era pequena (Jaccard médio de 0.006), e a maior concordância dos 34 pares que compartilhavam um link não era distinguível do acaso (permutação p = 0.14). Um link citado é uma string que o modelo emitiu e não prova que a página foi lida, e seu rótulo pode diferir de seu endereço. Em 19 de outubro uma resposta citou "Reuters" com um link para investing.com (linha do livro 83). O Requisito 17 portanto pede um registro de busca (status, hora, SHA-256 do conteúdo, hora de publicação declarada) antes que um link entre a sobreposição. Números que a própria questão forneceu, como os futuros pré-abertura, são removidos antes de as figuras compartilhadas serem contadas. Em Prediction Arena, quanto um modelo pesquisou não rastreou seu resultado (Zhang et al., 2026), de modo que a liga mede o que a busca faz para o acordo em vez de assumi-lo. A sobreposição de citações mede a proveniência relatada, e F5 afirma o que deveria mostrar.
Na Figura 10 conto quem cita o que. As respostas de um dia lacradas antes da referência nas seis execuções de 16 a 21 de outubro de 2026, 918 linhas, carregam 1.875 citações de 233 sites. Reuters atraiu 407 delas (21,7%) e foi citada por dez dos onze assentos, todos menos Claude. Sua participação variou de 6,2% a 30,3% por execução. Os próximos sites foram cnbc.com (139) e bloomberg.com (66). Nas duas últimas manhãs contadas, sites que pelo menos dois assentos citaram atraíram 68,5% e 58,3% das citações.
Figura 10. Sites citados por assento: citações nas respostas de um dia lacradas antes da referência, execuções de 16 a 21 de outubro de 2026, os dez sites mais citados.
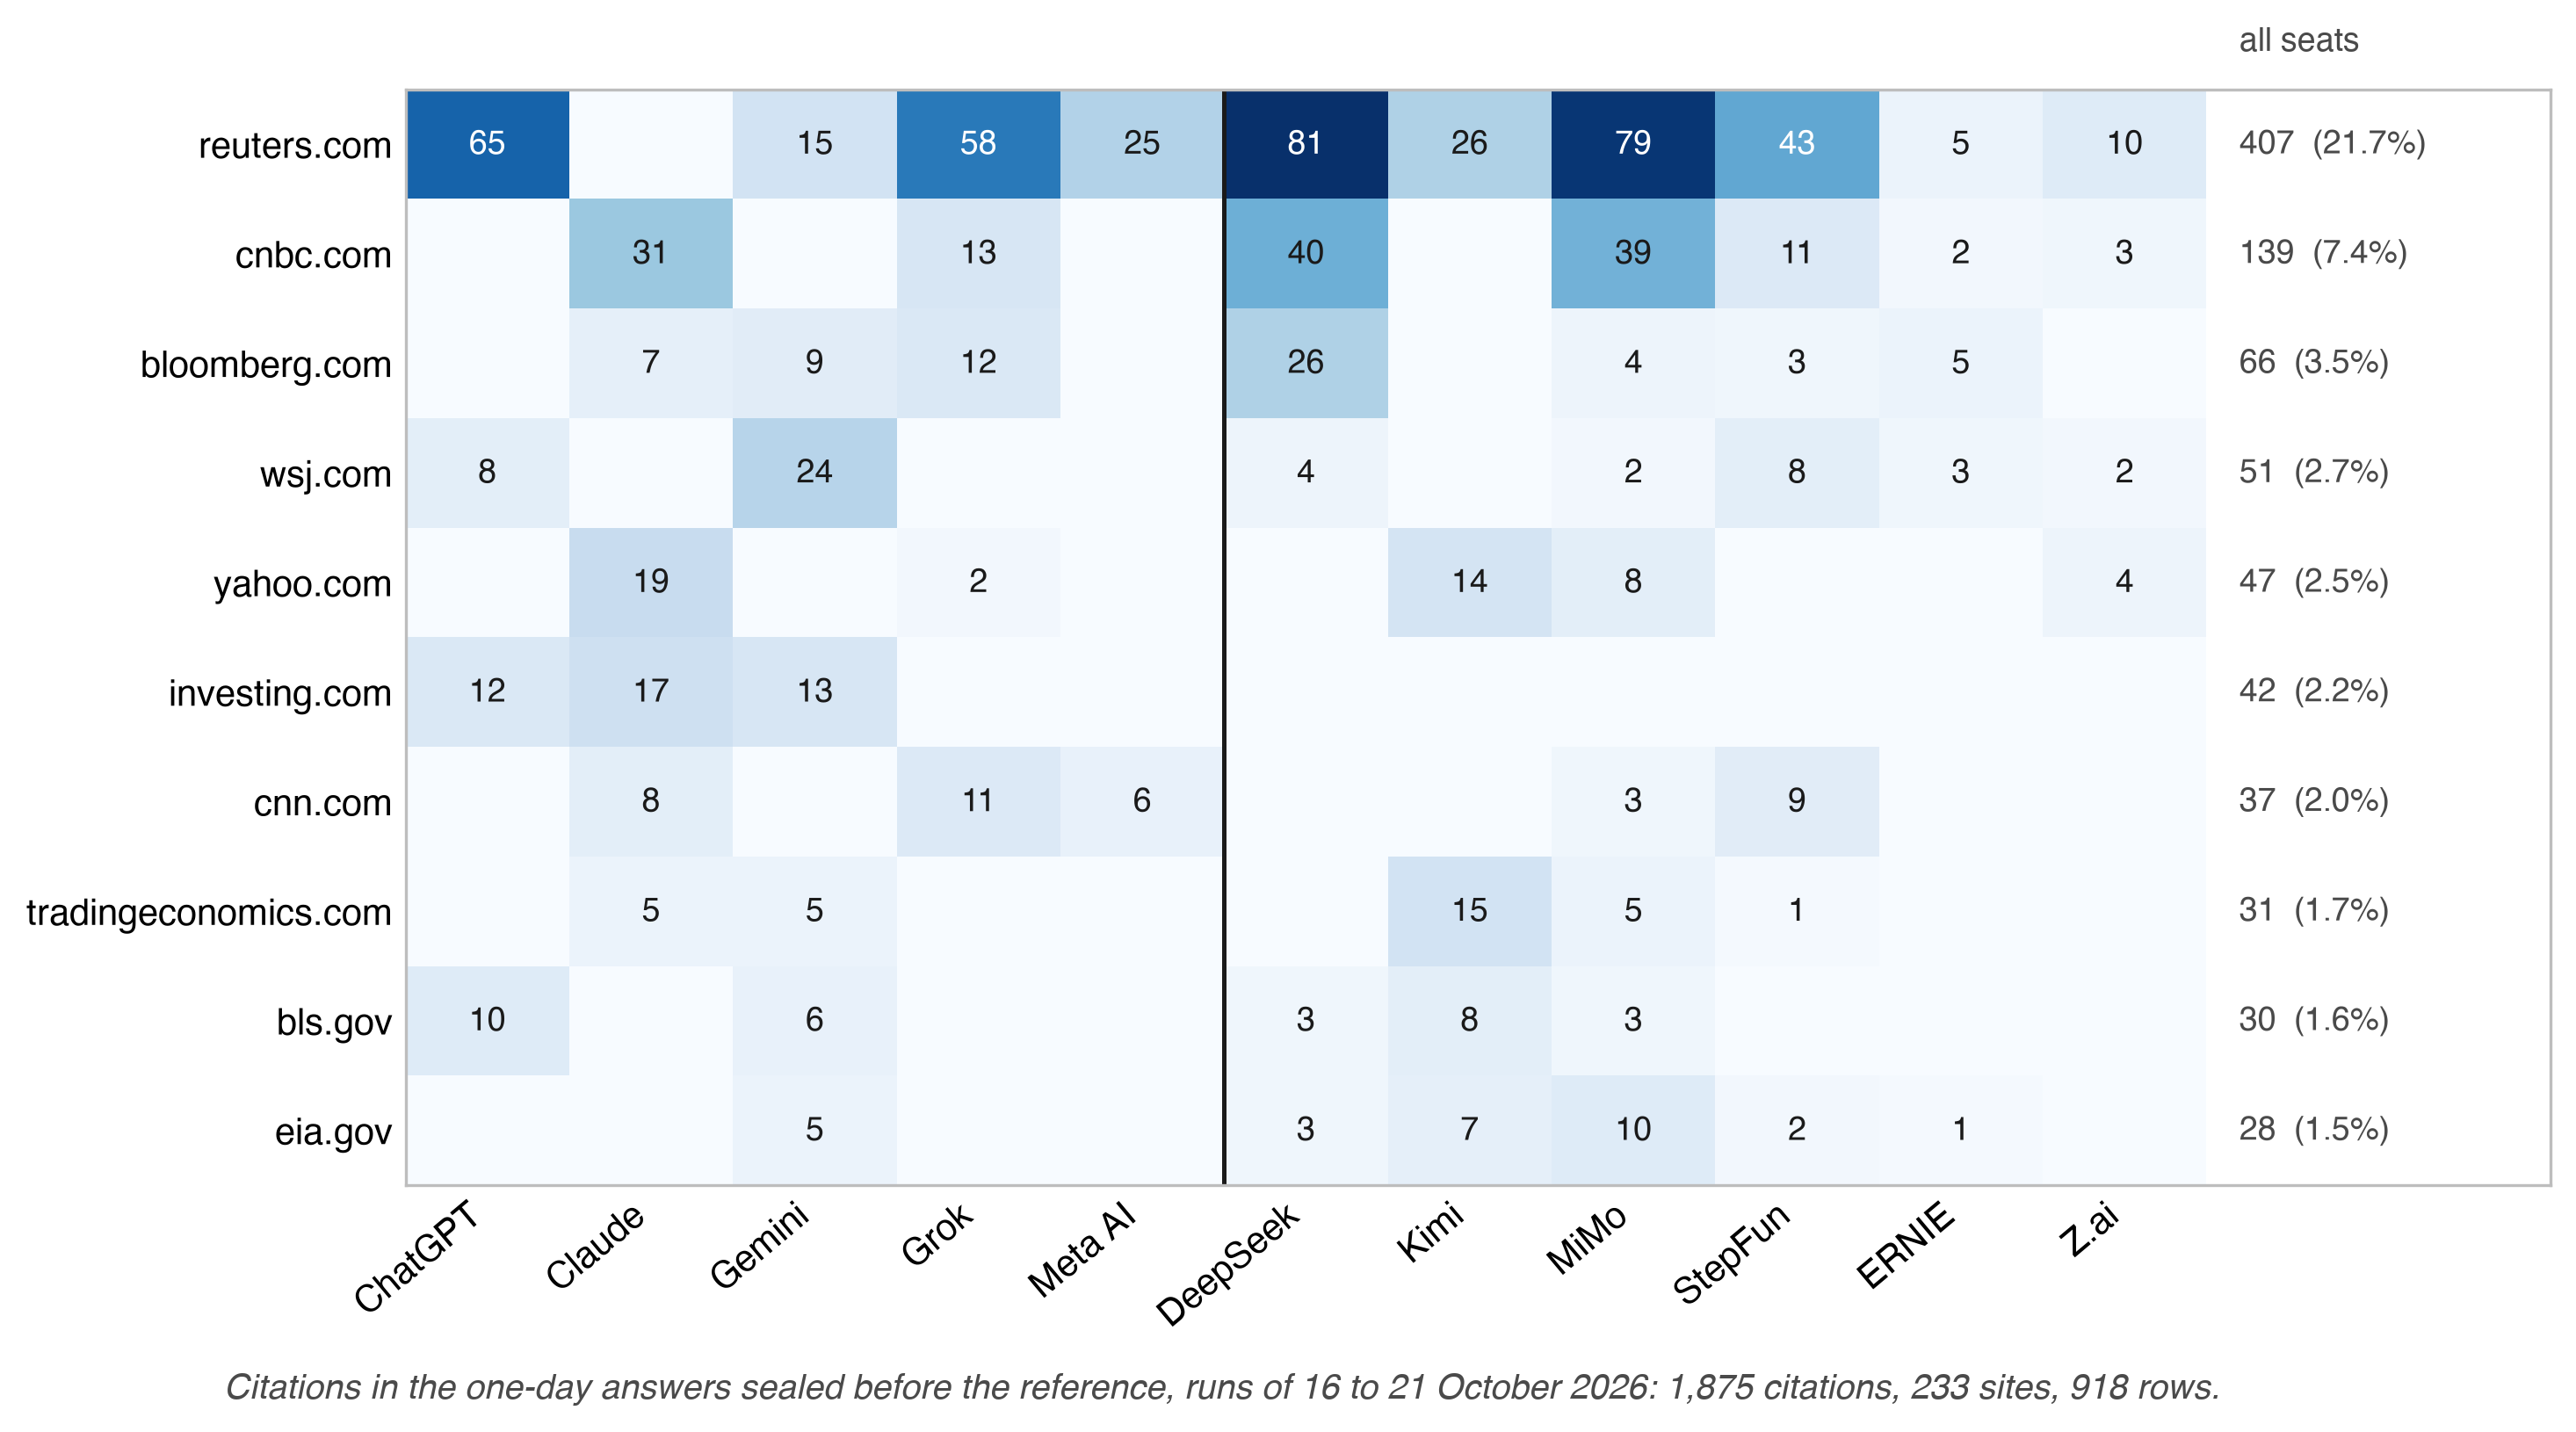
Nota: Uma contagem por site citado por célula de resposta (source_domains), assentos dos EUA primeiro, com uma regra entre os lados; a coluna direita fornece o total de cada site e sua participação de todas as 1.875 citações. Um domínio citado é lido como a Seção 5.4 lê um link citado. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC.
5.5 O livro fechado: a mesma questão sem busca
Notícias adicionadas não melhoram um previsora de modelo de linguagem por padrão: em questões resolvidas após os cortes dos modelos, contexto de notícias ajudou em algumas questões e prejudicou em outras, através de viés de recência, ponderação excessiva de rumores e mudança no que um termo se refere (Karkar & Chopra, 2025).
Na liga Closed Book, após cada execução, os mesmos modelos recebem um pacote lacrado em vez da web aberta: o snapshot de preço da execução e manchetes datadas, cada uma com fonte, link, horário de publicação e hash, e são instruídos a não pesquisar ou usar ferramentas. Cada linha de resposta registra o estado de pesquisa sob um de três rótulos: verificado (a configuração da ferramenta previne recuperação e a resposta não mostra nenhuma), configurado mas não verificado, ou apenas instrução. Links fora do pacote são marcados outside. O pacote é lacrado com seu hash antes das respostas e não é reconstruído, e as execuções Closed Book usam suas próprias contas de $100.000 fora da tabela diária.
O arquivo arena-cb-experiment.json relata, execução por execução, o calor do desacordo (100 vezes a divisão média das ações do dia), N_eff e a dispersão de portfólios, fechado menos aberto nos mesmos modelos. Se o conselho fechado concorda mais, entradas idênticas conduzem o rebanho. Se concorda menos, a pesquisa puxa os modelos para as mesmas páginas. Uma afirmação sobre pesquisa é válida quando os braços diferem apenas em pesquisa. Cada resposta fechada vem de um contexto fresco que não foi mostrado a resposta aberta, a multidão ou outro assento, com a mesma pergunta, snapshot e prazo de informação, versões correspondentes e estados de acesso registrados. Para F20 e F21, as respostas de ambos os braços são lacradas antes da mesma referência comum, caso contrário cada braço é pontuado em sua própria referência, e a ordem em que os braços são consultados é equilibrada entre os dias. Se o conselho fechado discorda menos e sua perda de Brier é maior, entradas idênticas tornaram os modelos semelhantes sem torná-los melhores.
Dois braços não podem separar as duas fontes de semelhança, as mesmas notícias lidas na mesma manhã e as mesmas crenças aprendidas no treinamento. O Requisito 17 portanto especifica um terceiro braço, apenas preços: os mesmos modelos recebem o snapshot de preço lacrado da execução e a pergunta, sem manchetes e sem pesquisa, sob o mesmo prazo e regras de independência. Concordância que permanece sem notícias vem de priors compartilhados; concordância adicionada pelo pacote vem de notícias compartilhadas; concordância adicionada pela web aberta vem de pesquisa. Quando o braço é executado, cada execução relata N_eff e o calor do desacordo em todos os três braços nos mesmos assentos e sessões.
5.6 Discussão contra consenso simples
A elicitação cega-paralela fornece a cada modelo a pergunta bruta sem visualização dos outros, portanto a concordância tem peso evidencial. A elicitação informada-sequencial compra correção de erros ao preço da independência (Chernets, 2026a). Em sete benchmarks de linguagem, votação por maioria sozinha responde por a maioria dos ganhos geralmente creditados ao debate multi-agente (Choi et al., 2025), portanto uma discussão tem que superar a votação simples nas mesmas perguntas antes de ganhar um lugar. As previsões diárias são cega-paralela por construção. A discussão é executada em uma trilha semanal separada que nunca toca o registro diário: uma cadeira, alternando entre os lados, lê cada portfólio lacrado sob letras embaralhadas e escreve o portfólio do conselho e duas ou três críticas, cada uma nomeando um mercado, um risco, um peso e a direção do fundo nas próximas cinco sessões, portanto cada crítica tem uma consequência verificável. Cada modelo criticado responde uma vez e declara o portfólio que manteria. Contas de sombra comercializam o portfólio da cadeira, os pesos lacrados, os pesos com a crítica aplicada, e a resposta declarada (council-talk.json, council-talk-critiques.csv; F22, F23).
5.7 Um modelo, perguntado novamente
Uma vez por semana a pergunta de portfólio é feita novamente, três vezes, para três ou quatro modelos, e as repetições são lacradas como suas próprias linhas, não como decisões. council-repeats.json relata o calor entre as próprias respostas de um modelo contra o calor entre modelos, o que fornece o piso de ruído do desacordo (F24). Como N_eff é computado em probabilidades, o Requisito 17 estende as repetições para probabilidades: sob um pacote congelado um modelo selecionado responde a mesma pergunta de probabilidade três vezes em contextos independentes, cada um lacrado como uma linha de diagnóstico, e a liga relata a variância dentro do modelo contra a variância entre modelos. Uma mudança de versão de modelo é datada, e o registro desde a versão é mostrado separadamente.
5.8 Laboratório de origem: as mesmas condições
Todos os quatorze assentos negociam na liga de portfólio. Onze assentos do Conselho fornecem probabilidades, cinco de laboratórios dos EUA e seis de laboratórios chineses, e três assentos estão no banco, negociando apenas (Tabela 8). Cada modelo recebe uma pergunta, construída em um snapshot de preço, com o texto publicado sob seu SHA-256. Cada resposta é lacrada por um prazo e pontuada por um conjunto de regras, e cada assento mantém os mesmos $100.000, custos e limites. O arquivo asks mostra o cronograma. Em 21 de outubro a primeira pergunta foi para cada assento dentro de 0,17 segundos, às 12:30:09Z, e um reenvio para o mesmo assento carrega o mesmo hash. Os assentos ainda silenciosos às 13:00 foram perguntados novamente em uma segunda onda às 13:00:21Z sob sua própria linha de execução e hash de pergunta (asks.jsonl). Cada modelo é perguntado em seu modo de raciocínio mais forte conforme listado na entrada do roster, e o modo lacrado na linha de resposta é o modo pontuado. Cada provedor serve seu modelo com suas próprias ferramentas e computação, portanto a comparação é entre laboratórios conforme servem seus modelos (Seção 10).
Tabela 8. Assentos da liga (league-roster.json, gerado 21 de outubro de 2026) e a string de versão lacrada em cada linha de resposta do assento até 21 de outubro de 2026.
| Assento | Laboratório | Lado | Função | Versão lacrada |
|---|---|---|---|---|
| ChatGPT | OpenAI | US | Conselho | GPT-6.1 Sol |
| Claude | Anthropic | US | Conselho | Claude Opus 5.5 |
| Gemini | US | Conselho | Gemini 4 Argon | |
| Grok | xAI | US | Conselho | Grok 4.7 |
| Meta AI | Meta | US | Conselho | Muse Spark 1.3 |
| Nemotron | NVIDIA | US | Banco | apenas portfólio |
| Amazon Nova | Amazon | US | Banco | apenas portfólio |
| DeepSeek | DeepSeek | CN | Conselho | DeepSeek V4.1 |
| ERNIE (Wenxin) | Baidu | CN | Conselho | ERNIE |
| StepFun | StepFun | CN | Conselho | Step 5 Preview |
| MiMo | Xiaomi | CN | Conselho | MiMo-V2.6-Pro |
| Kimi | Moonshot AI | CN | Conselho | Kimi K3 |
| Z.ai | Zhipu | CN | Conselho | GLM-5.3 |
| Qwen | Alibaba | CN | Bench | apenas portfólio |
Nota: o modo lacrado ao lado de cada versão está na linha de resposta (Apêndice C), e cada versão é a string que a interface do provedor retorna, para ERNIE apenas seu nome; cada assento vem de um laboratório diferente, então cada peso de família é 1 (Seção 5.3).
Comparações anteriores não colocaram os dois lados em uma pergunta e um instantâneo. Cao et al. (2025) descobriram que um modelo dos EUA previu firmas chinesas de forma mais otimista e menos precisa do que um modelo chinês, e que a lacuna desapareceu uma vez que notícias chinesas foram adicionadas, o que aponta ao acesso à informação como sua fonte. A comparação aqui é observacional, porque provedor, geração, idioma e ferramentas viajam com o rótulo do país (Seção 10). É relatado entre e dentro dos lados, e qualquer lacuna, em probabilidades ou pontuações, é publicada com seu intervalo quando cada assento é deixado de fora por vez. Uma lacuna que muda de sinal ou perde a maior parte de seu tamanho quando um assento é descartado é relatada como daquele assento, não do lado (F18, F19). O Requisito 17 também pergunta se o lado é um bloco. Para cada execução, define a correlação média de probabilidades dentro de cada lado contra a correlação entre os lados, com a probabilidade de uma diferença pelo menos tão grande quando os rótulos dos lados são permutados entre os assentos respondentes. Com cinco e seis assentos, o teste é diagnóstico. Se os pares mais próximos unem os dois lados, o rótulo do país não é onde o rebanho se divide. Li primeiro na execução contada de 20 de outubro de 2026 (oito assentos lacrados antes da referência, 48 células) e não encontro bloqueio por país. A correlação média de probabilidades é 0,66 dentro dos lados e 0,61 entre eles, e três dos quatro pares mais próximos os unem: ChatGPT e MiMo (0,88), Gemini e DeepSeek (0,86), DeepSeek e Grok (0,77). Células individuais podem se dividir por lado. A maior lacuna entre as médias dos lados naquela execução estava em ouro em um mês, 56 para os quatro assentos dos EUA contra 44 para os quatro assentos chineses, e ouro em uma semana ficou em terceiro, 52,5 contra 43,5. Um máximo sobre 48 células é grande por construção. Quando os oito assentos são divididos em quatro e quatro em cada uma das 70 maneiras possíveis, 26 das divisões produzem uma lacuna de célula máxima pelo menos tão grande (p = 0,37). DeepSeek deu ouro em um mês 56, acima de três dos quatro assentos dos EUA, então nem mesmo a célula mais ampla se divide limpiamente por lado. Na Figura 11 mostro toda a matriz, com a manhã de 21 de outubro ao lado dela.
Figura 11. Três dos quatro pares mais próximos unem um laboratório dos EUA e um chinês em 20 de outubro de 2026, e o par mais próximo o faz novamente em 21 de outubro: correlação pairwise das probabilidades lacradas, (A) 20 de outubro, oito assentos lacrados antes da referência; (B) 21 de outubro, nove assentos; com a correlação média de cada assento e concordância com a maioria, e os autovalores de cada matriz.
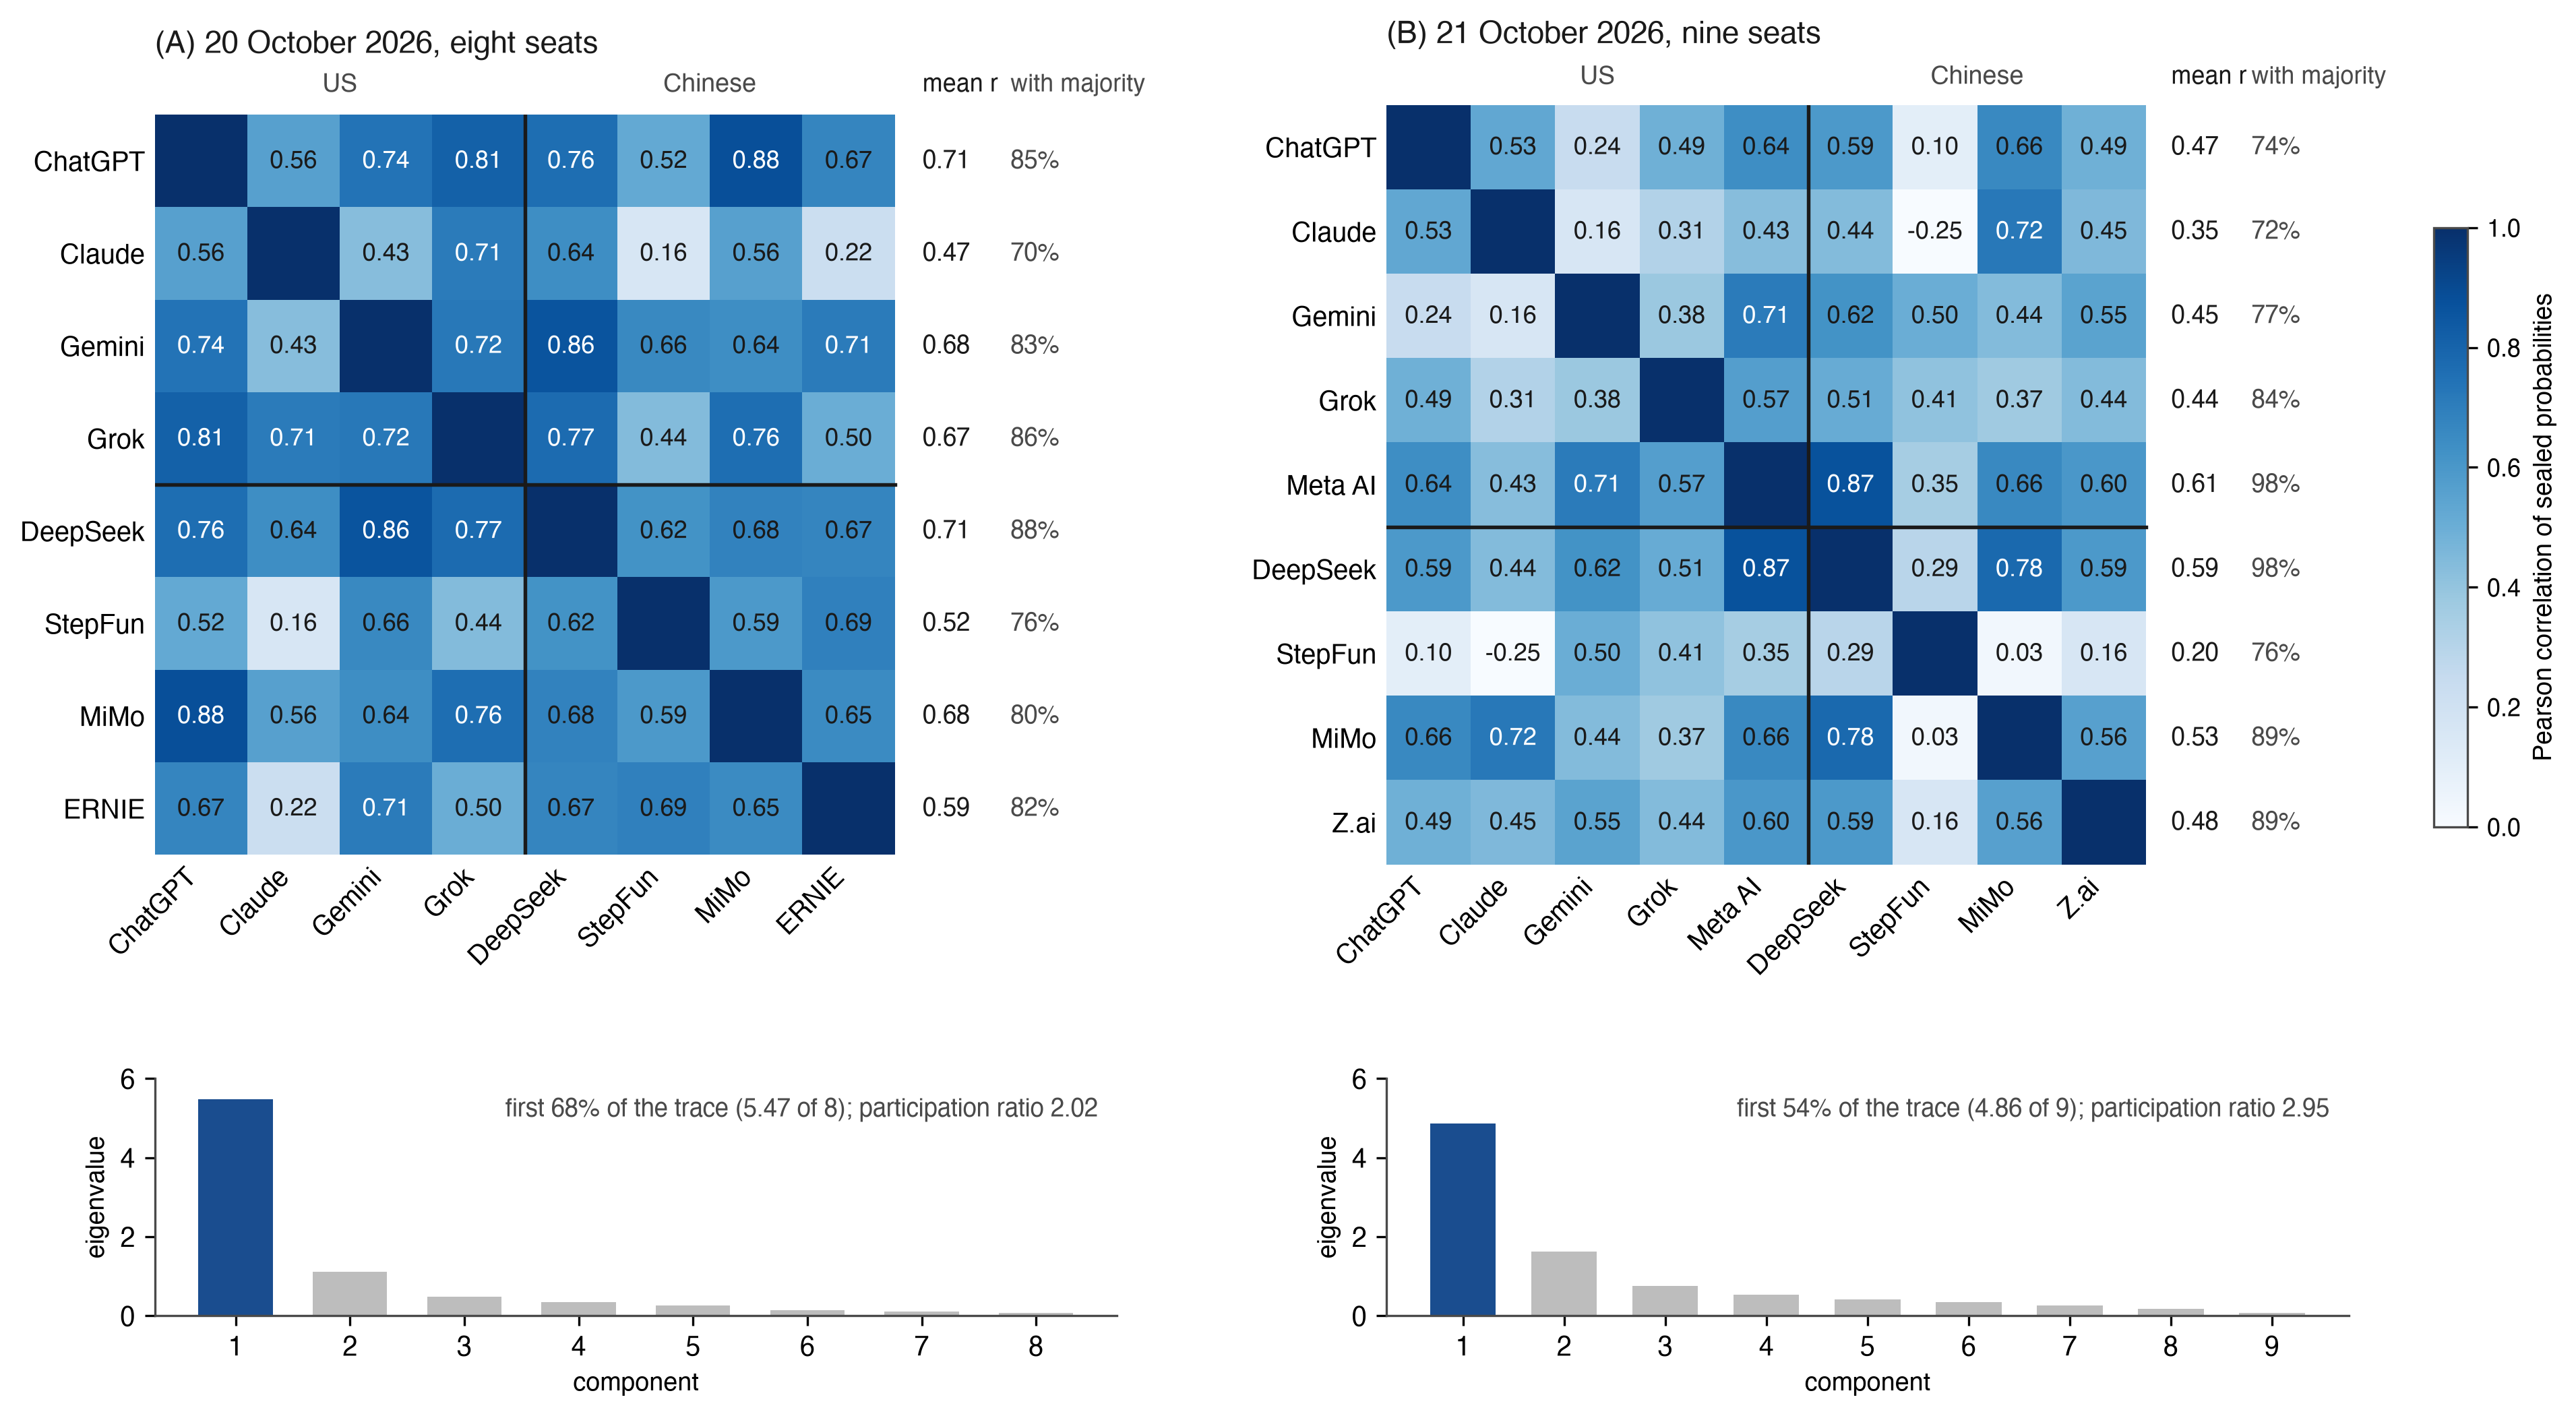
Nota: Correlação de Pearson sobre as 48 células (12 mercados × 4 horizontes) das execuções 2026-10-20-am e 2026-10-21-am, sobre as células que ambos os assentos responderam em um evento comum (em 21 de outubro as células de Bitcoin da Meta AI carregam sua própria referência, então seus pares usam 44 células); assentos dos EUA primeiro, com uma regra entre os lados. A média r é a correlação média do assento com os outros assentos, e com maioria é a proporção das células direcionais do assento do mesmo lado de 50 que a maioria dos outros assentos, empates e 50s declarados deixados de fora. Abaixo de cada matriz, seus autovalores, com a proporção do primeiro e a razão de participação (Σλ)²/Σλ² (requisito 17). Média dentro dos lados 0,66 e 0,43, entre eles 0,61 e 0,48. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC.
Li a primeira execução contada, em 21 de outubro de 2026, da mesma forma com nove assentos lacrados antes da referência, cinco dos EUA e quatro chineses. A correlação média é 0,43 dentro dos lados e 0,48 entre eles. O par mais próximo novamente os une, Meta AI e DeepSeek (0,87), com Claude e MiMo (0,72) em terceiro. A maior lacuna entre as médias dos lados caiu para 7,0 pontos, em Brent em um mês, e 110 das 126 divisões dos nove assentos em grupos de cinco e quatro dão uma lacuna máxima pelo menos tão grande (p = 0,87). Ouro em um mês, 12,0 pontos de diferença em 20 de outubro, ficou 0,1 apart (Figura 12). A semelhança também se estendeu a mais fatores. O primeiro autovalor carregava 54% do traço (4,86 de 9) contra 68% no dia anterior, com uma razão de participação de 2,95 contra 2,02. Nas duas manhãs, os dois assentos mais distantes dos outros foram Claude e StepFun. Suas correlações médias eram 0,47 e 0,52 em 20 de outubro e 0,35 e 0,20 em 21 de outubro. Duas manhãs do diagnóstico mostram nenhum bloqueio por país, e F18 e F19 decidem isso ao longo da estação.
Figura 12. Diferença entre as probabilidades declaradas médias dos assentos dos EUA e chineses, por mercado e horizonte: (A) execução 2026-10-20-am (quatro e quatro assentos lacrados antes da referência); (B) execução 2026-10-21-am (cinco e quatro assentos).
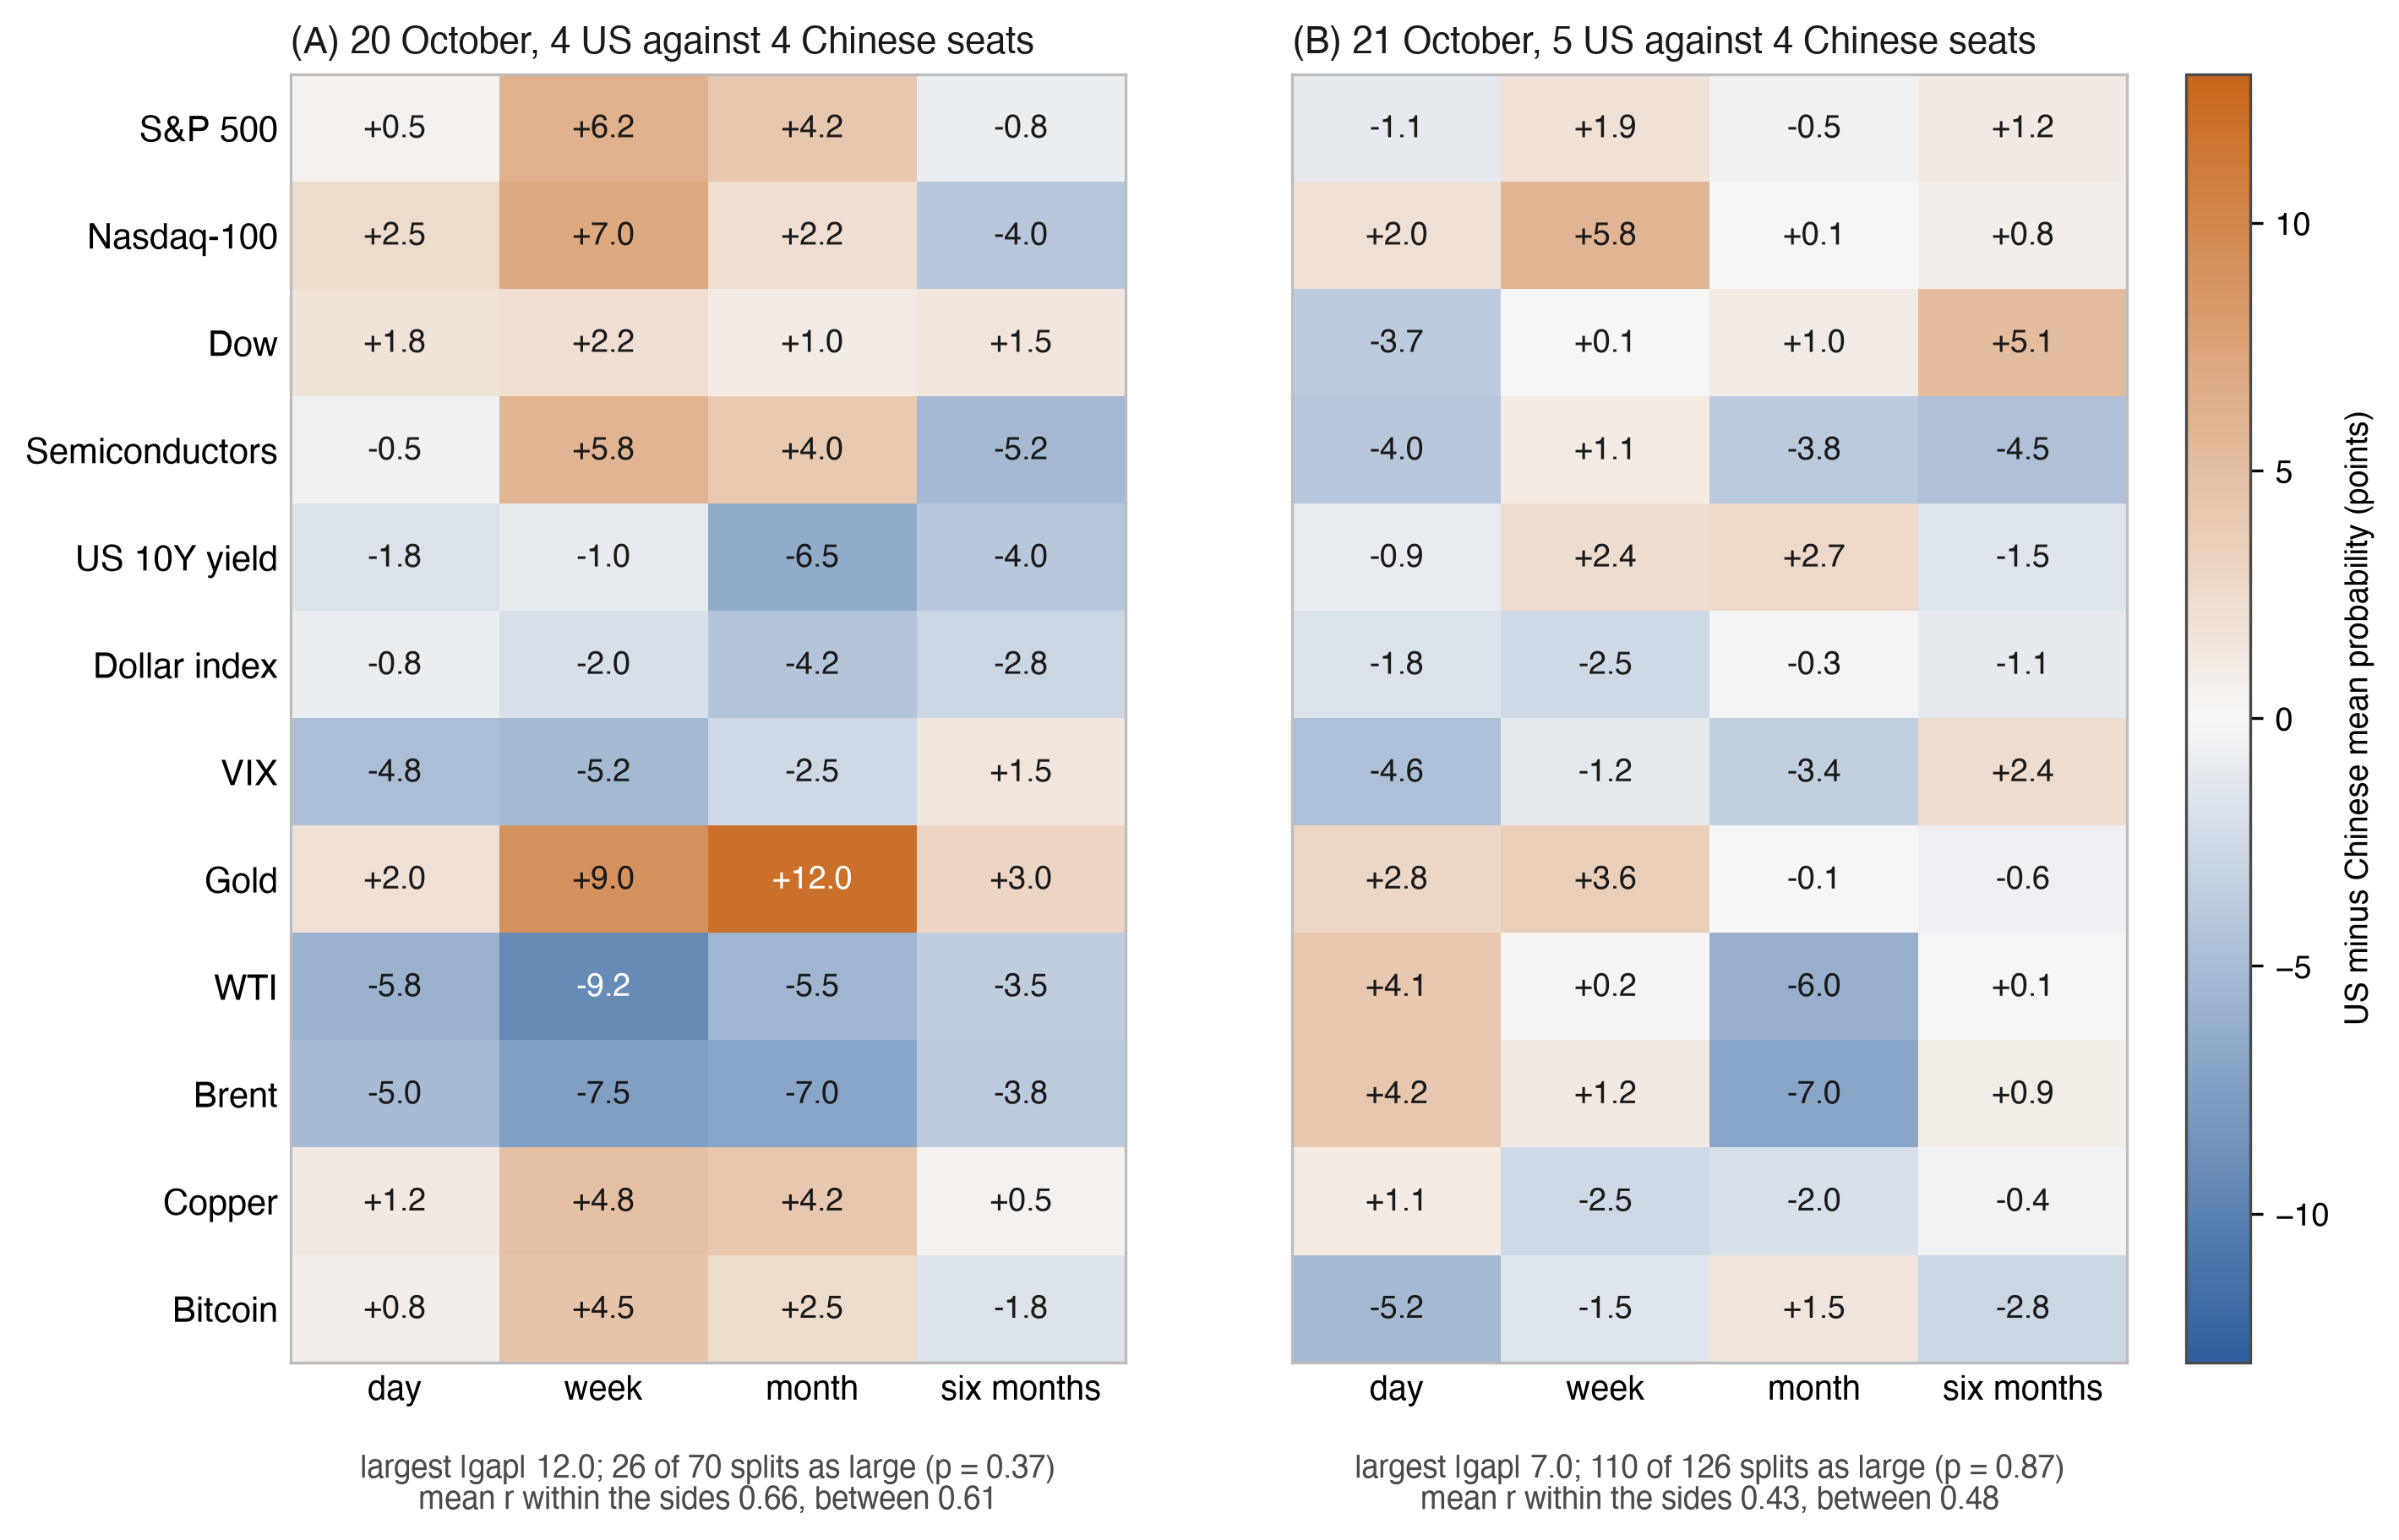
Nota: Pontos de probabilidade, EUA menos chinês; laranja onde os assentos dos EUA se posicionam mais alto, azul onde os assentos chineses se posicionam. Sob cada painel estão a maior diferença absoluta, o número de todas as divisões dos mesmos assentos em grupos dos mesmos tamanhos que dão uma diferença máxima pelo menos tão grande (70 divisões em A, 126 em B), e a correlação média dentro e entre os lados. Em 21 de outubro a linha de Bitcoin deixa de fora as células de Meta AI, que carregam sua própria referência. Fonte: council-forecasts.csv salvo em 22 de outubro de 2026, 01:32 UTC.
6. Humanos antes da IA
A liga mede modelos. A página que os mostra também pergunta se ver os modelos ajuda uma pessoa a fazer previsões ou apenas a move em direção a eles. A maioria das evidências vem de estudos nos quais o conselho chega primeiro. Schoenegger et al. (2025) forneceu um assistente de modelo de linguagem a 991 participantes e encontrou ganhos de precisão de aproximadamente um quarto, até mesmo de um assistente projetado para dar conselhos ruidosos; Schoenegger et al. (2024) encontrou um conjunto de doze modelos que correspondeu a uma multidão de 925 previsores, e que uma média simples de previsões humanas e de máquina funcionou ainda melhor. As pessoas abandonam um algoritmo depois de vê-lo errar (Dietvorst et al., 2015), e em outros contextos o pesam acima do conselho humano (Logg et al., 2019). Em um torneio de previsão geopolítica, os previsores raramente se basearam em previsões de máquina e tenderam a escolher modelos que concordavam com suas crenças anteriores (Abeliuk et al., 2020). O que esses estudos não conseguem separar facilmente é ajuda de ancoragem.
6.1 Desenho
Qualquer visitante pode marcar cada um dos 12 mercados para cima ou para baixo durante a sessão, com uma confiança de 55 a 95%, sem se registrar. Cada leitor é atribuído uma vez e permanentemente, por um identificador aleatório anônimo, a um de dois grupos. O grupo que vê vê as respostas dos modelos imediatamente; o grupo cego as vê apenas após sua primeira previsão da sessão.
6.2 O que é medido
Para a primeira previsão em uma sessão, a liga registra quatro quantidades. Tomo como resultado primário a pontuação de Brier (uma confiança c em um lado lida como probabilidade c/100 desse lado), nos mesmos mercados para ambos os grupos, cada mercado ponderado pela contagem do grupo menor nele. O tempo para a primeira previsão mostra se os modelos aceleram uma decisão. A confiança declarada contra a taxa de acerto fornece excesso de confiança. A ancoragem é a proporção de primeiras previsões que concordam em direção com o consenso, comparada entre grupos. Um leitor cego que abre os modelos primeiro é contado como um olhar. A análise segue a atribuição, com olhares como não conformidade. council-league.json publica as contagens, taxas de acerto, tempos, confiança, olhares e pontuações de Brier sob experiment (g0, g1), e o requisito 16 tem o rótulo do dicionário de dados de qual grupo está cego antes da primeira previsão pontuada. O experimento está ativo e aberto a todos os visitantes, e em 21 de outubro estava em seu início, n = 0 primeiras previsões pontuadas em ambos os grupos. F28 e F29, registrados no OSF com as previsões da Seção 8, fixam seus dois resultados em 200 primeiras previsões correspondentes por grupo.
6.3 Proteção contra preenchimento
Apenas as primeiras previsões entram na comparação, e nenhum nome, contas ou detalhes de contato são coletados. O requisito 16 define uma primeira previsão por mercado por identificador por sessão. O endereço do leitor não é armazenado: a liga mantém apenas um hash com sal dele com o dia, para limitar votos repetidos. As previsões do leitor fecham no tempo de referência, e um identificador redefinido é tratado como um novo leitor, com a proporção de redefinições informada.
6.4 O que a comparação mostra
A atribuição aleatória torna os dois grupos comparáveis um com o outro. Ambos são visitantes de uma página pública que escolheram vir, então a comparação fala por eles e não por investidores. Ela mede um efeito de acesso, e o segundo protocolo abaixo mede revisão de um julgamento anterior. Uma concordância maior com o conselho é medida como uma mudança, e o protocolo de revisão mostra aprendizagem pela cópia. Um identificador representa um participante observável, e uma pessoa pode ter vários, então a liga relata identificadores atribuídos e contribuintes, primeiras previsões e taxas de retorno por grupo. A participação repetida é uma análise secundária agrupada por identificador e sessão.
Um segundo protocolo, especificado pelo padrão, mede revisão diretamente. Cada leitor primeiro registra uma direção privada e confiança com o conselho oculto, é então mostrado o conselho ou uma tela de controle por atribuição aleatória, e registra uma previsão final para o mesmo mercado e sessão. O resultado primário é a diferença entre braços na mudança da pontuação de Brier da previsão privada para a final; o movimento em direção ao conselho é informado separadamente para sessões nas quais sua chamada estava certa e errada, portanto aprendizagem e cópia podem ser distinguidas. O protocolo de revisão entra nas revisões datadas deste artigo quando ele é executado.
7. Um mapa datado das arenas de mercado de IA
7.1 O que o mapa registra
Entre 2023 e 2026 a pergunta "modelos de IA conseguem prever mercados?" foi formulada em quatro formas: backtests de julgamentos do modelo sobre preços históricos, benchmarks em questões ainda em aberto, arenas nas quais modelos operavam com dinheiro real ou virtual, e mercados de previsão usados como base ou local. O mapa registra quem introduziu cada esforço, quando, e o que mediu. Na Tabela 9 faço seis perguntas sobre cada um: como o tempo de uma previsão é garantido e em que nível de confiança, se probabilidades são avaliadas por uma regra estritamente própria, se vários horizontes são comparados nos mesmos ativos, se o acordo entre modelos é lido contra sua correlação (uma contagem de vozes independentes ou um peso de correlação), se um humano prevê antes de ver a IA, e se os dados estão abertos. No Apêndice E comparo a implementação de referência com os esforços mais próximos característica por característica (Tabela E1).
Níveis de confiança seguem a Figura 4 e a Seção 3.12: 0, o registro de chegada do operador; 1, uma impressão digital do operador ou registro vinculado por hash cujo tempo se baseia no operador ou seu hospedeiro; 2, uma impressão digital comprometida fora do operador, que delimita de fora quando o registro existiu, dentro da tolerância daquele registro (para Bitcoin, algumas horas após a hora do cabeçalho do bloco, porque uma hora de cabeçalho deve exceder a mediana das onze anteriores e pode ser anterior ao tempo real); 2+, nível 2 mais um tempo assinado por terceiros (RFC 3161) em cada lacre. Um backtest não tem tempo de submissão para garantir. Construí o mapa a partir de artigos publicados, páginas de projetos, repositórios e relatórios de imprensa, e encerrei a busca em 21 de outubro de 2026. Cada afirmação de prioridade na Seção 7.4 é restrita aos esforços revisados aqui. "ND" significa não documentado publicamente em 21 de outubro de 2026: não encontrado na descrição pública, o que não prova ausência. Registro o que cada esforço pode provar a partir de seus materiais públicos e deixo sua qualidade sem classificação.
7.2 A linha do tempo
2023 a 2024. Lopez-Lira e Tang (2023) mostraram que pontuações GPT de manchetes de notícias previram retornos subsequentes das ações, o que abriu o campo e sua dúvida central (Seção 2.1). Em 2024 chegaram perguntas ao vivo. Um sistema aumentado por recuperação se aproximou do agregado humano em questões publicadas após o ponto de corte dos modelos (Halawi et al., 2024), um conjunto de doze modelos igualou uma multidão de 925 pessoas (Schoenegger et al., 2024), Metaculus executou torneios trimestrais de bots contra profissionais, que lideraram a cada trimestre até meados de 2025 (Metaculus, 2025a, 2025b), e ForecastBench perguntou sobre mil questões geradas em oito horizontes e encontrou especialistas ainda à frente do melhor modelo (Karger et al., 2025).
2025. Benchmarks de finanças e arenas de dinheiro seguiram. InvestorBench ofereceu decisões financeiras simuladas em dados históricos (H. Li et al., 2025), e evidências sobre memória e look-ahead em backtests se acumularam (Lopez-Lira et al., 2025; W. W. Li et al., 2025; Paleka et al., 2026; Gao et al., 2025). FutureX executou um benchmark ao vivo diário de agentes (Zeng et al., 2025). Em outubro, Alpha Arena forneceu dinheiro real a seis modelos, conforme relatórios da imprensa (Forklog, 2025a, 2025b; Yahoo Finance, 2025), StockBench operou com alavancagem ações do Dow (Y. Chen et al., 2025), Agent Market Arena operou ao vivo (Qian et al., 2025), e Prophet Arena avaliou questões ao vivo de Kalshi e Polymarket por calibração e retornos simulados (Yang et al., 2025). LiveTradeBench (Yu et al., 2025), Rallies AI Arena (Rallies.ai, 2025-2026), o AIA Forecaster, que igualou superprevisores e, combinado com o mercado, o superou (Alur et al., 2025), e KalshiBench, que descobriu cinco modelos de fronteira com excesso de confiança (Nel, 2025), fecharam o ano.
2026, primeiro semestre. Mercados de previsão se tornaram um local. FinDeepForecast executou agentes de pesquisa profunda semanalmente (X. Li et al., 2026). Um conjunto de previsões de ações Gemini foi chamado de "com bloqueio de tempo" sem um mecanismo documentado (louidev, 2026). PredictionMarketBench repetiu livros de ordens de Kalshi (Arora & Malpani, 2026). Prediction Arena forneceu capital real a seis modelos em Kalshi e Polymarket e avaliou o valor da conta a partir dos registros do operador (Zhang et al., 2026). PolyBench avaliou 36.165 previsões em snapshots de Polymarket (Cheng et al., 2026). PolySwarm propôs um enxame de 50 personas de modelo de linguagem cujas probabilidades são combinadas com preços de Polymarket e avaliadas pelo escore de Brier (Barot & Borkhatariya, 2026). Em maio, Foresight Arena propôs um benchmark sem permissão no qual agentes confirmam previsões com hash de eventos Polymarket através de um commit-reveal keccak256 em Polygon antes de um prazo, um commit por agente e rodada imposto na retransmissora, avaliado pelo escore de Brier e um escore Alpha contra o mid-price no prazo. Seu artigo relata resultados simulados, e um estudo complementar executa agentes ao vivo nele (Nechepurenko & Shuvalov, 2026a, 2026b).
2026, segundo semestre. MarketMania (15 de julho) fornece sete modelos um payload divulgado, avalia probabilidades declaradas em cinco criptomoedas em cinco horizontes, mede comportamento de rebanho como o aumento de concordar com a maioria, e refaz questões idênticas, sem compromisso de respostas documentado (MarketMania, 2026). NeuPortal ancora as probabilidades de futebol de uma IA não nomeada em Bitcoin através de OpenTimestamps (NeuPortal, 2026). LLM Trading Arena (20 de julho) confirma cada preenchimento e justificativa em um histórico git público (MaxWellApexLab, 2026). LiveMacroEval executou nowcasts macroeconômicos a cada hora (Zhao et al., 2026), TradeRank abriu sua décima temporada em 10 de outubro (TradeRank, 2026), e Prophet Arena documentou um registro de hashes SHA-256 salgados no relógio do operador (Prophet Arena, 2026). AI Council · Markets lacrou sua primeira execução em 16 de outubro de 2026 e começou a contar sua pontuação em 19 de outubro de 2026.
7.3 O que cada um pode provar
Tabela 9. Arenas de mercado de IA e benchmarks de previsão, 2023 a 2026: o que cada um pode provar a partir de seus materiais públicos.
| Arena ou benchmark (primeira vez pública) | O que é previsto ou operado | Tempo de previsão garantido por (nível de confiança) | Probabilidades avaliadas por uma regra própria | Vários horizontes nos mesmos ativos | Acordo descontado para vozes correlacionadas | Humano prevê antes de ver a IA | Dados abertos |
|---|---|---|---|---|---|---|---|
| Lopez-Lira & Tang (abr 2023) | Retornos de ações de pontuações de manchetes | Backtest, sem tempo de submissão | Não (pontuações usadas como sinais) | Não | Não | Não | ND |
| Metaculus AI benchmark (Q3 2024) | Questões do Metaculus, bots contra profissionais | Recorde da plataforma (0) | Sim (pontuação frente a frente) | Não | ND | Conjunto separado de profissionais | Parcialmente |
| ForecastBench (Set 2024) | Aproximadamente 1.000 questões geradas, não resolvidas no envio | Recorde do operador (0) | Sim (Brier) | Sim (oito horizontes nas questões do conjunto, 7 dias a 10 anos) | ND | Conjuntos separados de superprevisores e público | Sim |
| InvestorBench (ACL 2025) | Decisões sobre ações, criptomoedas e ETFs em simulação | Backteste, sem tempo de envio | ND | Não | ND | Não | Sim |
| FutureX (Ago 2025) | Eventos futuros amplos, agentes com busca | Recorde do operador (0) | Não (acurácia da resposta) | Não | ND | Não | Sim |
| Alpha Arena (Out 2025) | Negociação com dinheiro real, criptomoedas e depois ações americanas | Recorde do operador (0); organizador afirma que as operações são verificáveis | Não (retornos) | Não | ND | Não | Declarado pelo organizador |
| StockBench (Out 2025) | Back-trading em ações do Dow, março a junho de 2025 | Backteste, sem tempo de envio | Não (retorno, drawdown, Sortino) | Não | ND | Não | Sim |
| Agent Market Arena (Out 2025) | Negociação ao vivo por agentes LLM, ações e criptomoedas | ND (0) | Não (resultados de negociação) | Não | ND | ND | ND |
| Prophet Arena (Out 2025) | Eventos do Kalshi e Polymarket | Registro SHA-256 salgado na chegada, recibo assinado pela plataforma opcional; relógio do operador (1) | Sim (1 − Brier); calibração como diagnóstico | Visualizações de horizonte no arquivo; limites ND | ND | Não; preço de mercado como linha de base | Sim |
| LiveTradeBench (Nov 2025) | Alocações em ações americanas e Polymarket, 50 dias | ND (0) | Não (alocações, retornos) | Não | ND | Não | Sim |
| Rallies AI Arena (Nov 2025) | $100.000 virtuais por modelo em ações americanas, oito modelos (imprensa) | ND (0) | Não (retornos) | Não | ND | ND | ND |
| AI-Trader (Dez 2025) | Agentes de negociação ao vivo em ações americanas, ações A e criptomoedas, três modelos chineses e três americanos | Recorde do operador (0) | Não (retornos) | Não | ND | Não | Repositório aberto |
| KalshiBench (Dez 2025) | 300 questões do Kalshi resolvidas após a data limite | Conjunto estático após a data limite | Sim (Brier; pontuação de habilidade contra climatologia); ECE como diagnóstico | Não | Não | Não | Sim |
| PredictionMarketBench (2026) | Livros de ofertas do Kalshi reexecutados com taxas | Reexecução de backteste | Não (P&L de negociação) | Não | ND | Não | ND |
| Prediction Arena (Jan a Mar 2026) | Negociação com capital real no Kalshi e Polymarket, contratos financeiros entre sete categorias | Registros do operador (0) | Não (valor da conta, retorno, taxa de vitória) | Não | Não | Não | ND (nenhum repositório fornecido) |
| PolyBench (Abr 2026) | Snapshots do Polymarket, 6 a 12 de fev 2026 | ND (0) | Não (acurácia direcional, retorno ponderado por confiança) | Não | ND | Não | Código aberto; conjunto de dados por link de download (não recuperado) |
| Foresight Arena (Mai 2026) | Eventos binários do Polymarket, alguns sobre preços de ativos | Commit-reveal keccak256 por agente e rodada no Polygon PoS antes do prazo (2; tempo de bloco); resultados do artigo simulados, agentes ao vivo em um estudo complementar | Sim (Brier; Alpha contra o preço médio de mercado) | Não | Não (desfechos de mercados assumidos independentes) | Não | Contratos e código de análise abertos; dados on-chain, licença ND |
| MarketMania (Jul 2026) | Cinco criptomoedas em cinco horizontes, sete modelos, um payload divulgado | ND (0) | Sim (Brier na probabilidade declarada; intervalo de calibração) | Sim (1 hora a 1 mês) | Parcialmente (comportamento de rebanho medido; acordo não é descontado) | ND | Exportações de API, licença ND |
| NeuPortal (Jul 2026) | Probabilidades de partidas de futebol de uma IA sem nome (não financeiro) | SHA-256 de cada arquivo de previsão, com data/hora em Bitcoin via OpenTimestamps (2) | Sim (Brier de três resultados) | Não | Não (um modelo) | ND; preço do Polymarket no ou antes do bloqueio como linha de base | Sim (GitHub, Zenodo) |
| LLM Trading Arena (Jul 2026) | Negociação em papel de criptomoedas e ações do S&P 100, $100.000 por modelo | Histórico git público de cada preenchimento e justificativa, ordens preenchidas na próxima abertura (1; o tempo depende do host git) | Não (valor da conta) | Não | ND | ND | Sim (MIT, ledger completo, contas recomputáveis) |
| LiveMacroEval (Ago 2026) | Nowcasts horários de 16 indicadores macroeconômicos americanos antes do lançamento | ND (0) | Não (pontuações baseadas em retorno e apostas) | Não | ND | Não; nowcasts institucionais como comparadores | Artigo CC BY 4.0; licença de dados ND |
| RockAlpha (s.d.) | Negociação de ações por IA ao vivo, seis modelos chineses e quatro americanos, alavancagem de 2× | ND (0) | Não (retornos) | Não | ND | Não | ND |
| TradeRank (temporada 10, Out 2026) | Decisões diárias de 22 modelos sobre criptomoedas e grandes capitalizações americanas, $10.000 simulados | ND (0) | ND | Não | ND | ND | Conjunto de dados JSON aberto, licença ND |
| AI Council · Markets (Out 2026) | Painel fixo de 12 indicadores financeiros, diariamente | A partir de 21 de out 2026, pelo menos dois tokens RFC 3161 por lista marcada, assinada antes da abertura (2+); cadeia SHA-256, cabeça ancorada em Bitcoin (2); 19 e 20 de out 2026 no nível 1 para selo antes da referência (Tabela 12) | Parcialmente (Brier de todas as linhas principal a partir de 21 de out 2026, Seção 3.5; Brier contra moeda e linhas de base; caixas de calibração como diagnóstico) | Sim (dia, semana, mês, seis meses) | Sim (N_eff por uma regra de elegibilidade declarada; segundo modelo de uma família pesa um terço) | Sim (dois grupos permanentes, Seção 6) | Sim (CC BY 4.0, código de pontuação, script de recontagem) |
Nota: ND = não documentado publicamente em 21 de outubro de 2026, significando que a propriedade não foi encontrada na descrição pública e o código não foi inspecionado. "Regra apropriada" conta apenas uma pontuação estritamente apropriada da probabilidade de previsão (Brier, log score). Acurácia, ECE e retornos são marcados Não. "Pool separado" significa que humanos fazem previsões das mesmas questões independentemente, não que um humano prevê primeiro e depois vê a IA. Alpha Arena e Rallies AI Arena baseiam-se em relatórios de imprensa. Li Foresight Arena e Prediction Arena em texto completo (arXiv:2605.00420v2, arXiv:2604.07355v1), NeuPortal e LLM Trading Arena de seus repositórios, e MarketMania de suas páginas de metodologia e pesquisa. NeuPortal não é uma arena de mercado. Listo porque seu selo é o mais próximo do padronizado aqui. O AIA Forecaster, FinDeepForecast e o dataset GlassBallAI estão apenas na linha do tempo. As fontes são fornecidas na Seção 7.2.
7.4 Lendo o mapa
A coluna de confiança mostra o campo se movendo de backtests, que não conseguem garantir tempo, para questões ao vivo garantidas pelo registro do operador, e para registros do operador de hashes salgados com recibos assinados (Prophet Arena). O Nível 2 existe fora de um painel fixo de indicadores financeiros. Foresight Arena compromete previsões de eventos do Polymarket, algumas delas sobre preços de ativos, ao Polygon (Nechepurenko & Shuvalov, 2026a, 2026b). Previsões meteorológicas concorrentes são comprometidas on-chain na subnet Zeus (Ørpheus AI, n.d.), e NeuPortal ancora probabilidades de futebol em Bitcoin. Previsões financeiras seladas com divulgação atrasada remontam ao Financial Bubble Experiment (Sornette et al., 2010), e um registro de previsão não-IA é ancorado em Bitcoin e avaliado pela pontuação de Brier (Jyotish, 2026). Timestamping público gratuito existe (Todd, 2016), então a âncora é barata. As regras em torno dela a tornam um teste justo.
Probabilidades e portfólios raramente se encontram. A maioria das arenas que negocia retornos de pontuação ou valor da conta, e a maioria dos benchmarks que pontuam probabilidades não negociam. Prophet Arena une os dois através de retornos simulados, MarketMania negocia em papel as previsões que pontuam, e Foresight Arena pontua probabilidades contra o preço de mercado. Um padrão para mercados financeiros precisa de ambos. O portfólio responde a pergunta que os usuários fazem, e a probabilidade é a parte que uma regra apropriada pode pontuar em um registro curto (Seção 2.4). Uma coluna está vazia: nenhum esforço na Tabela 9 desconsidera acordo por vozes correlacionadas em seus materiais públicos. MarketMania mede rebanho, mas não transforma acordo em uma contagem de vozes, e Foresight Arena trata resultados de mercado como independentes. Fora dos modelos de linguagem, o torneio Numerai pontua a contribuição de um modelo após neutralizar suas previsões contra o meta modelo construído a partir de todos os envios (Numerai, n.d.). Isso recompensa sinal distinto e deixa em aberto quantas vozes independentes um consenso sustenta. A evidência de que modelos erram juntos é forte offline (Seção 5).
O que é novo. Seis designs na liga não têm correspondência entre os sistemas revisados em 21 de outubro de 2026 (Tabela E1, Tabela 9). Os três primeiros a diferenciam de cada sistema no mapa:
- AI Council · Markets é a primeira liga ao vivo de previsões de IA em um painel fixo de indicadores financeiros que ancora seu livro-razão de previsão fora do operador, pontua cada previsão a partir de um preço de referência obtido após seu selo, fixa a execução contada por uma regra declarada com antecedência com cada outra execução publicada e rotulada, e relata uma contagem efetiva de vozes diária. No registro contado, a partir de 21 de outubro de 2026, a regra de execução contada é declarada com antecedência e selada na cadeia de questões, e pelo menos duas autoridades RFC 3161 independentes colocam as respostas contadas antes do preço de referência (nível 2+). A Tabela 12 fornece o nível de cada elemento para as sessões de desenvolvimento de 19 e 20 de outubro de 2026, nível 1 para a ordem de selo e preço de referência. Foresight Arena é a conjunção mais próxima: uma âncora externa, um commit reforçado por retransmissor por agente e rodada e um preço de referência no prazo de commit, em eventos do Polymarket em vez de um painel de indicadores fixo com previsão diária.
- É a primeira liga ao vivo de previsões de IA em indicadores financeiros que relata, a cada execução, o número efetivo de vozes por uma regra de elegibilidade declarada (execuções contadas, respostas seladas antes da referência), além de pesos de família no consenso e contagens de erro unânime e de minorias certas. A fórmula é clássica (Kish, 1965; Clemen & Winkler, 1985), a correlação de erros de modelo é estabelecida offline (Kim et al., 2025; Spiro, 2026; Aitchison et al., 2026), e rebanho foi medido ao vivo (MarketMania, 2026). A alegação é a contagem dentro de uma liga ao vivo.
- Propõe um padrão que separa integridade de conteúdo, existência externamente delimitada, compromisso antes do preço de referência e identificação da previsão que conta, escrito como requisitos MUST e SHOULD numerados com verificações que um leitor pode executar (Seção 3.13, Apêndice B). A Seção 3.13 fornece o status de cada requisito para a implementação de referência. Nem Foresight Arena nem Prediction Arena propõem um padrão para que outros adotem.
Os outros três a diferenciam de cada arena de mercado de IA no mapa:
- Leitores são designados uma vez, aleatoriamente, e nunca redesignados, a um de dois grupos que fazem previsões dos mesmos mercados no mesmo dia que os modelos: um vê os modelos imediatamente, o outro apenas após sua primeira previsão, então faz previsão antes de vê-los (Seção 6). O design é ao vivo e aberto a cada visitante, com seus dois resultados registrados como F28 e F29 e lidos em 200 primeiras previsões por grupo. Designs anteriores comparam pools separados de humanos (ForecastBench, Metaculus) ou dão às pessoas um assistente de IA primeiro (Schoenegger et al., 2025).
- Sete modelos de laboratórios americanos e sete de laboratórios chineses, cada um de um laboratório diferente, respondem a mesma questão, enviada em uma etapa, no mesmo snapshot sob o mesmo prazo, regras e contas (Seção 5.8, Tabela 8). Os rosters mais próximos são do RockAlpha, seis modelos chineses e quatro americanos, um por laboratório, com alavancagem 2× (Rockflow, n.d.), e do AI-Trader, três e três, negociando ações americanas, A-shares e criptomoedas (Fan et al., 2025). Nenhum publica um selo, uma pontuação de probabilidade ou um design de leitor. Outros rosters misturam dois modelos chineses entre seis a oito (Alpha Arena, Rallies AI Arena, LLM Trading Arena, MarketMania), e TradeRank dispõe 22 modelos sem um design de país.
- Trinta previsões datadas sobre a própria liga, cada uma com uma medida, uma data de verificação e uma regra de refutação, são precificadas por votos cegos de modelos de três famílias e registradas com seus resolvedores antes dos dados que as decidem existirem (Seção 8).
O Closed Book, critiques pontuadas e consultas repetidas funcionam na liga também, e seus predecessores aparecem na linha do tempo (Seção 7.2, Tabela E1).
O que a liga se baseia. O compromisso de uma previsão hash antes do resultado (Foresight Arena; NeuPortal e Jyotish através de OpenTimestamps) e o lacre de previsões financeiras com divulgação atrasada (Sornette et al., 2010) precedem esta liga. NeuPortal, o lacre mais próximo, difere de quatro formas: um modelo sem nome, futebol, um benchmark de multidão tomado no ou antes do lock, e nenhuma regra de execução contada ou cadeia hash documentada. Esforços anteriores também fornecem ligas de dinheiro multi-modelo diárias (Alpha Arena, Agent Market Arena, Rallies AI Arena, LLM Trading Arena, TradeRank), contas virtuais de $100.000, recomputação de terceiros de contas ou pontuações (LLM Trading Arena, Foresight Arena) e alavancagem (Alpha Arena, RockAlpha). Eles também fornecem comparação com preços de mercados de previsão no momento da resposta (Foresight Arena, Prophet Arena, NeuPortal, o AIA Forecaster), uma pontuação adequada com análise de potência (Foresight Arena), pontuações de probabilidade em vários horizontes com operações em papel (MarketMania; ForecastBench para horizontes), uma pontuação de habilidade climatológica (KalshiBench) e designs de coordenação ao vivo em uma arena ancorada (Nechepurenko & Shuvalov, 2026b). A liga usa esses recursos. Questões de eventos, negociações em dinheiro real e amplitude de milhares de questões são outros designs com seus próprios pontos fortes, e complementam um painel diário fixo.
8. Previsões registradas
Declaro aqui, com datas, limiares e probabilidades, o que a liga demonstrará, e seus arquivos abertos decidirão. Esta versão lê duas sessões pontuadas, até 20 de outubro de 2026. Cada previsão nomeia sua medida, o campo aberto ou script arquivado que a resolve, uma data de verificação, o resultado que a confirma e o resultado que a refuta, e uma probabilidade que torna um erro mensurável (Brier, 1950; Gneiting & Raftery, 2007), seguindo Chernets (2026c). Registrar previsões antes dos dados que as resolvem separa a previsão da evidência que a testa (Nosek et al., 2018); o projeto segue a lógica do Relatório Registrado, no qual métodos e análises são fixados antes de resultados existirem (Chambers, 2013). O protocolo faz isso para os modelos todas as manhãs; esta seção faz isso uma vez para o protocolo.
O desfecho primário. Uma comparação é primária, e a reivindicação de habilidade da liga repousa apenas nela: o consenso do conselho prevê melhor o dia do que a taxa base? Para cada sessão da sessão 11 (2 de novembro de 2026) até a sessão 126, o fim da temporada, o ganho pareado é
onde é o conjunto dos eventos de mercado de um dia da sessão que o consenso respondeu, é o consenso publicado (Seção 5.3) construído apenas a partir de respostas lacradas antes do preço de referência do evento, é 1 para uma alta estrita e 0 caso contrário sobre todas as linhas, empates incluídos (Seção 3.5), e é a frequência de 2016 a 2025 de uma alta estrita do mercado do evento em um dia, todas as linhas contadas: o campo p_up de climatology_fixed.table[*] (horizonte 1d) em council-calibration.json, não o p_up_ex_draw que exclui empates e que a liga usa como referência de sua própria pontuação de habilidade. A tabela é lacrada pelo arquivo council-clim-window.json, publicado sob o endereço de dados, cujo SHA-256 do conteúdo (do JSON sem sua chave sha256, chaves ordenadas) é 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7. O script arquivado lê o campo e verifica o lacre. O campo está nos arquivos abertos desde 21 de outubro de 2026, 08:54 UTC, e o script o lê sem erro. Onde o histórico diário não cobre a janela ativa, a frequência usa o evento diário mais próximo (Seção 10). Um positivo significa que o consenso teve a menor perda. Cada evento pesa igualmente dentro de uma sessão e cada sessão igualmente na janela. A estimativa é a média de . Seu intervalo é um bootstrap de bloco móvel sobre sessões, blocos de cinco, 10.000 reamostragens, sementes 20261102, intervalos percentil (Künsch, 1989; Diebold & Mariano, 1995). O veredicto é lido em ordem em 30 de abril de 2027. A reivindicação primária é confirmada se o intervalo de 95% fica inteiramente acima de zero. Caso contrário, se o intervalo de 90% fica inteiramente dentro da zona de equivalência de ±0,01 Brier, a margem que o padrão declara para toda comparação confirmatória (Seção 4.6), o resultado é lido como nenhum ganho de tamanho prático. Qualquer outro resultado é inconclusivo, e um ganho não significativo não é lido como equivalência. Um ganho confirmado cujo intervalo de 90% também fica dentro da zona é relatado como confirmado e menor que a margem. No desvio padrão de perda do arquivo aberto atual e correlação (power_brier em council-stats.json), 126 sessões conseguem distinguir uma diferença de cerca de 0,01, então a zona corresponde ao que a temporada consegue resolver. Uma análise de sensibilidade registrada é relatada junto ao veredicto: o mesmo ganho pareado no S&P 500, Nasdaq-100, Dow e índice de semicondutores sozinhos, cuja taxa base é computada na sessão do evento de 09:30 a 16:00 ET (sensitivity_exact_window no script arquivado). A probabilidade registrada de que a reivindicação primária seja confirmada é 0,08. A estimativa se sustenta para o caminho que a temporada toma, e o placar relata a média e dispersão de mudanças diárias por mercado na janela.
As sessões e execuções anteriores à sessão 11 formam a janela de design. Elas incluem as duas sessões de desenvolvimento com pontuação da Seção 5.2, informaram o design e alguns limites, e nenhuma leitura de estimativa confirmatória as lê. As trinta previsões abaixo são apostas secundárias, pontuadas em conjunto por seu próprio escore de Brier, e nenhuma é lida por si só como confirmando habilidade. As tabelas diárias nas páginas da liga são descritivas, e uma alegação é lida em uma data de verificação registrada. Uma questão científica secundária é declarada sem direção: a discordância ajuda? A dispersão entre previsores tem tido significado econômico desde Miller (1977): ações sobre as quais as previsões dos analistas discordam mais ganham retornos menores posteriormente (Diether et al., 2002). O spread dos assentos é a versão da liga da discordância de previsão de máquina, que em finanças é medida como a dispersão das previsões de retorno em modelos de aprendizado de máquina e prediz retornos de ações menores (Bali et al., 2023) e retornos de criptomoedas menores (Chu et al., 2025). Aqui os previsores são modelos de linguagem, a previsão é a probabilidade de um evento fixo, e a questão é sobre precisão. Em eventos de um dia contados após o registro, o spread das probabilidades dos assentos (o desvio padrão populacional de suas probabilidades declaradas para o evento, em pontos) é dividido em tercis, com limites nos percentis 33,3º e 66,7º nas sessões 1 a 10, calculado pelo script apresentado por esta regra fixada antecipadamente. O ganho pareado do consenso sobre a climatologia é comparado entre o tercil mais alto e o mais baixo com o mercado fixo, bicaudal. A estatística é a média entre mercados da diferença no ganho médio entre os dois tercis, com um intervalo de bootstrap de blocos móveis, e não é resolvida se qualquer tercil tem menos de 30 eventos. Uma segunda questão secundária testa a tese da Seção 5 diretamente: descontar vozes correlacionadas ajuda? Nos eventos de um dia contados das sessões 11 a 126, a diferença de Brier pareada entre o consenso publicado e o consenso sombra da Seção 5.3, cujos pesos são apresentados com o registro, é estimada pelo mesmo bootstrap de blocos móveis que o endpoint primário e lida contra a mesma zona de equivalência de ±0,01. Nenhuma questão secundária carrega uma probabilidade registrada, então o número de previsões permanece trinta. Ambas são relatadas sem ajuste de multiplicidade. Uma comparação científica adicional seria um novo registro.
8.1 Regras para escrever as previsões
Cada previsão é resolvida a partir dos dados abertos da liga, sob CC BY 4.0, em https://trends.polyhelper.ai/api/v1/, e nenhuma precisa de dados que mantenho privadamente. O Conjunto A (10 previsões: F1, F2, F5, F7, F8, F20, F22, F23, F24 e F28) é definido por um campo publicado, ou uma comparação de dois, que qualquer pessoa pode ler em um navegador; o script apresentado aplica o campo à janela. O Conjunto B (20 previsões) precisa de uma computação sobre os arquivos brutos abertos. Para cada um, o script é apresentado com o registro, com seu SHA-256, antes dos dados que ele lerá existirem, e o script é a definição.
Uma regra de janela se aplica a cada linha a menos que a linha designe outra: a previsão é calculada nas sessões da sessão 11 até sua data de verificação, em linhas contadas lacradas antes da referência 09:30 ET da sessão (o mesmo corte se aplica ao Bitcoin, cuja referência é o fechamento da primeira barra de um minuto após o lacre da linha), com escores de Brier sobre todas as linhas (empates incluídos). Quando um campo publicado também cobre sessões anteriores, o script apresentado aplica a definição do campo à janela. Uma sessão é um dia em que a Bolsa de Valores de Nova York está aberta: a sessão 1 é 19 de outubro de 2026, a sessão 10 é 30 de outubro, a sessão 11 é 2 de novembro, a sessão 30 é 30 de novembro e a sessão 52 é 31 de dezembro de 2026, com 26 de novembro e 25 de dezembro fechados. A temporada de 126 sessões termina por volta de 20 de abril de 2027 e é verificada em 30 de abril de 2027. Cada previsão é verificada na primeira publicação dos arquivos abertos após sua data. Os resolutores nos scripts OSF (resolve.py, versão de regras osf-rules-1) fixam quatro detalhes que as linhas deixam abertos. "Ranked" é a regra 30/10 aplicada dentro da janela própria da previsão, exceto F8, que lê a bandeira da liga. Os dois trimestres de F25 são sessões 11 a 52 (Q4 2026 após o período de desenvolvimento) e as sessões de 4 de janeiro a 31 de março de 2027. A regra de momentum de F15 é a direção do resultado da liga do indicador na sessão anterior (preço de referência até fechamento) em 55%, sem previsão após um movimento zero, pontuado em todas as linhas. O spread usado para os tercis acima é o desvio padrão das probabilidades dos assentos.
Como é comparado com como: um modelo contra a moeda, a regra de momentum, o consenso e a multidão nas mesmas sessões e mercados. Em comparações entre modelos cada evento pesa igualmente dentro de uma sessão e cada sessão igualmente na janela, sobre os assentos que responderam essa sessão, então a amostra são os assentos disponíveis. Quando uma previsão precisa de uma amostra mínima, uma amostra menor na data de verificação a deixa não resolvida. Se um campo é renomeado, o resolvedor usa o equivalente documentado no dicionário de dados (arena-dataset.json e os esquemas publicados) e registra o mapeamento. Defini os limites de F1 a F5 e F9 após as primeiras execuções lacradas serem visíveis para mim. Suas janelas começam na sessão 11, então nenhuma dessas execuções as decide. Em suas amostras mínimas três previsões são descritivas, com estes erros padrão: cerca de 5 pontos para o hiato de calibração F14 em 100 previsões, cerca de 11 pontos para a compartilhamento F22 em 20 críticas e cerca de 0,02 Brier para a diferença F28 em 200 primeiras previsões por grupo. F15, F21 e F28 comparam estimativas pontuais com um limiar de 0,01, e a zona de equivalência pertence ao endpoint primário. Várias previsões declaram a expectativa de que nenhuma habilidade seja mensurável nestes tamanhos de amostra. A Tabela D1 dá o valor esperado sem habilidade ao lado delas, e um sucesso lá não mostra que a habilidade está ausente. Cada previsão diz respeito ao que a liga medirá, não de que forma um mercado se moverá.
8.2 As previsões
A Tabela 10 apresenta dez previsões centrais e a Tabela D1 (Apêndice D) todas as trinta. F1 a F3, F5 a F7 e F9 perguntam o quão similares são as imagens e os erros do conselho e em qual horizonte as vozes se separam. F4 coloca a nitidez dos modelos contra a da multidão, e F8 (operacional) pergunta se a tabela se preenche conforme o cronograma. F10 a F15 comparam o consenso com um líder anterior, uma regra simples e a multidão. Duas previsões, F16, F17, perguntam onde qualquer sinal se situa entre os horizontes. F18 e F19 dizem respeito aos lados americano e chinês, F20 e F21 ao Closed Book, F22 a F24 discussão e repetições. F25 a F27 perguntam se os líderes perduram e se bons previsores negociam bem, F28 e F29 o que o acesso aos modelos faz aos leitores, e F30 se o estilo entrega um modelo uma vez que os nomes estão ocultos.
Tabela 10. Dez previsões centrais, com limites, datas de verificação e probabilidades (todas as trinta na Tabela D1).
| # | Previsão | Refutada se | Data de verificação | p |
|---|---|---|---|---|
| F1 | O conselho permanece abaixo de duas vozes independentes: média N_eff de um dia sobre execuções contadas de sessões 11 a 30, pela regra da Seção 5.1, abaixo de 2,0 | média ≥ 2,0 com pelo menos 10 execuções | 30 nov 2026 | 0,50 |
| F3 | Os erros também são compartilhados: N_eff nos indicadores de erro de um dia dos assentos, mediado sobre pelo menos 30 sessões pontuadas a partir da sessão 11, abaixo de 4,0 | valor ≥ 4,0 com pelo menos 30 sessões | 31 dez 2026 | 0,74 |
| F6 | O erro unânime é pelo menos duas vezes mais frequente do que o produto das próprias taxas de erro dos assentos respondentes nas mesmas linhas prevê | compartilhamento observado < 2 × esperado | 31 dez 2026 | 0,92 |
| F10 | A média supera seguir o líder: em dezembro de 2026, o consenso pontua melhor em um dia do que o modelo que liderou novembro | Brier do consenso ≥ Brier do líder de novembro nas mesmas sessões de mercado em dezembro | 31 dez 2026 | 0,64 |
| F11 | Nenhum modelo único mostra uma vantagem diária detectada sobre a moeda, sobre todas as linhas a partir da sessão 11 | intervalo de aglomerado de sessão 95% de algum modelo classificado situa-se inteiramente abaixo de 0,25 | 31 dez 2026 | 0,79 |
| F12 | A multidão supera o conselho em pelo menos 100 sessões de mercado de um dia com um contrato de pelo menos $1.000 de volume selado | Brier da multidão ≥ Brier do conselho | 31 dez 2026 | 0,83 |
| F13 | A média da multidão e do conselho supera a multidão sozinha nos mesmos contratos | Brier da combinação ≥ Brier da multidão | 31 dez 2026 | 0,30 |
| F18 | País é um fator pequeno: a diferença entre os lados americano e chinês é menor do que a amplitude do Brier do modelo classificado dentro de cada lado | diferença ≥ amplitude dentro de qualquer lado | 31 dez 2026 | 0,80 |
| F20 | A mesma notícia significa menos disputa: calor do Closed Book abaixo do calor aberto | calor fechado ≥ calor aberto | 30 nov 2026 | 0,70 |
| F30 | O estilo entrega o modelo na temporada cega: um adivinhador fixo identifica o modelo em três vezes a chance ou melhor | acurácia top-1 média < média de 3/k sobre itens | 30 abr 2027 | 0,46 |
Nota: p é a probabilidade registrada de que a previsão se concretize, dado que é resolvida: a mediana de três votos cegos de modelos de três famílias, emitidos a partir da afirmação, medida, data e limite apenas. Seis valores (F5, F7, F20, F21, F23, F25) são os votos de 20 de outubro de 2026. Os outros vinte e quatro e o ponto final primário foram votados em 21 de outubro de 2026, em três rodadas posteriores, cada uma sobre o texto das previsões reescritas naquela rodada, e cada valor é a mediana dos votos da rodada (todas as rodadas estão no arquivo). Votos que se espalham por mais de 0,15 são sinalizados no arquivo. Escores Brier são de um dia, a menos que indicado; intervalos são 95% por sessões. A Seção 8.4 fornece a regra para previsões não resolvidas.
8.3 Probabilidades
Pedi a três modelos de três famílias, Claude Opus 5.5 (Anthropic), GPT-6.1 (OpenAI) e Grok (xAI; a versão está arquivada com os votos), para precificar a lista limpa (afirmação, medida, data de verificação e limite, sem nenhuma estimativa minha), cada um sem ver os números dos outros, e cada probabilidade registrada é a mediana dos três. As três famílias também ocupam assentos na liga, e F18, F19 e F30 dizem respeito àqueles assentos. Cada eleitor precificou as afirmações antes de qualquer registro existir. Painéis de verificadores de modelos falham de maneiras mensuráveis quando seus membros se veem (Chernets, 2026b), então cada eleitor precificou a lista sozinho. Todas as probabilidades são condicionais à resolução; a parcela resolvida é relatada ao lado da pontuação.
8.4 Congelamento e pontuação
Registro as previsões e o ponto final primário na OSF (10.17605/OSF.IO/9Q86N) antes de postar, como um registro aberto, público de imediato, com a lista limpa, todos os votos, os scripts do Conjunto B e os resolutores de cada linha, o script do ponto final primário, o SHA-256 do conteúdo da climatologia selada e um manifesto de cada arquivo arquivado com seu SHA-256. Todas as datas de verificação e todas as janelas caem depois do carimbo de tempo do registro. Um registro na OSF não pode ser editado, e uma retirada deixa um registro público com sua razão, então as previsões vivem lá. SSRN substitui o preprint na revisão.
Nada é deletado. Toda previsão aparece em todo cartão de pontuação como se realizou, não se realizou, ainda não vencida, ou não resolvida. Uma previsão que não pôde ser computada até sua data permanece não resolvida e nunca é contada como um sucesso. Cada cartão de pontuação relata o escore Brier sobre previsões resolvidas, a fração resolvida, um limite pior no qual toda previsão não resolvida após sua data adiciona max[p², (1 − p)²] com todas as previsões após suas datas no denominador, e o escore de habilidade Brier contra um plano 0,5. Os cartões de pontuação seguem as datas de verificação (30 de novembro de 2026, 31 de dezembro de 2026, 30 de abril de 2027), cada um publicado como uma revisão datada deste artigo na SSRN e Zenodo e registrado na OSF, e cada parecer cita o campo ou script em que repousa.
9. Objeções e a regra que responde cada uma
Quatro objeções pressionam mais fortemente o desenho. Cada uma é respondida abaixo por uma regra da Seção 3 ou por um teste registrado da Seção 8.
Informação pré-abertura lidera a previsão. O preço de referência é o primeiro preço após o lacre, então uma resposta contada não pode usar a impressão 09:30, e uma resposta tardia obtém sua própria referência posterior. Informação disponível antes da referência, como os futuros pré-abertura cotados na pergunta, é permitida e faz parte da previsão; um previsor que lê os futuros pode inclinar-se para o lado certo sem nenhum julgamento próprio. A habilidade é medida contra a taxa climática base e a multidão, cujos preços mantêm as mesmas informações pré-abertura, assim como contra a moeda. Histórico memorizado não pode ajudar um modelo a prever um fechamento que ainda não aconteceu (Lopez-Lira et al., 2025; Paleka et al., 2026).
Empates e o evento solicitado. A pergunta solicita a probabilidade de uma subida estrita e não declara a faixa de empate. A partir de 21 de outubro de 2026 a pontuação principal conta todas as linhas, a pontuação do evento solicitado (Seção 3.5). As sessões de desenvolvimento permanecem conforme publicadas, sem empates, e cada comparação registrada usa um evento dentro de um segmento de metodologia (Seção 8.1).
Quem mantém o registro. Eu opero a liga e escrevi as previsões (Declarações). Uma execução conta por sessão, e outras execuções são publicadas como not_counted. No registro contado de 21 de outubro de 2026 a ordem de lacre e preço de referência repousa em tokens RFC 3161 de pelo menos duas autoridades independentes (nível 2+), e para as sessões de desenvolvimento de 19 e 20 de outubro no registro encadeado (nível 1, Tabela 12). O padrão controla a seleção entre execuções com um hash de cada pergunta de saída no momento do envio, uma execução contada declarada antecipadamente (lacrada na cadeia de perguntas de 21 de outubro de 2026), e cada lista marcada com carimbo de tempo inserida no carimbo em um registro de transparência pública que o operador não controla (Sigstore Rekor, a partir de 22 de outubro de 2026; Seção 3.13). As previsões se resolvem de arquivos públicos por um campo nomeado ou um script arquivado antes de seus dados existirem, o registro não pode ser editado, e as probabilidades foram definidas cegas.
Probabilidades comprimidas. As probabilidades dos modelos permanecem próximas a 50%. Em 20 de outubro as probabilidades separadamente elicitadas dos oito assentos lacrados antes da referência para os contratos listados em oito mercados (crowd_up) ficavam em média 5,9 pontos de 50%, e os preços da multidão nos mesmos contratos 20,7 pontos (onde ambas as plataformas listavam um mercado, o contrato Polymarket, que é aquele para o qual os modelos responderam). Parte da distância da multidão é o movimento pré-mercado já em um contrato de fechamento para fechamento, então comparo contrato por contrato no evento que cada contrato resolve. Nos cinco contratos com volume lacrado de pelo menos $1.000 (Tabela 11) os assentos inclinaram-se pela mesma direção do preço da multidão todas as vezes, e os assentos ficaram em média 7,5 pontos de 50% contra 28,1 da multidão. A multidão em si é cautelosa: em 188.509 mercados Polymarket resolvidos, preços ficaram muito próximos a uma metade, com uma inclinação de recalibragem logística de 1.112 (Walker, 2026). Os assentos ficaram ainda mais próximos a uma metade. Na pergunta de um único dia da própria liga os mesmos oito assentos ficaram em média 4,6 pontos de 50% (K = 9,2, Seção 4.4). A liga pode distinguir duas leituras de compressão. Pela decomposição de Murphy a pontuação Brier é confiabilidade menos resolução mais incerteza (Seção 4.4). Um previsor cauteloso é calibrado e abre mão de resolução, então marca perto da climatologia e perde pouco para uma multidão mais aguda, enquanto um previsor que traduz uma visão qualitativa em uma probabilidade mal é mal calibrado também, com uma inclinação de calibração afastada de um (Cox, 1958), e perde para a multidão por mais do que sua agudeza explica. F4 declara a lacuna de agudeza, F12 e F13 a comparação com a multidão, e F14 a calibração, cada uma em uma temporada após o registro.
Tabela 11. Preço da multidão e a probabilidade separadamente elicitada dos assentos no mesmo contrato, 20 de outubro de 2026 (oito assentos lacrados antes da referência; contratos com volume lacrado de pelo menos $1.000).
| Mercado | Plataforma | Volume lacrado ($) | Preço da multidão (%) | Média dos assentos crowd_up (%) |
Intervalo dos assentos (%) |
|---|---|---|---|---|---|
| S&P 500 | Polymarket | 20.637 | 34,0 | 46,4 | 42 a 52 |
| WTI | Polymarket | 3.736 | 83,0 | 61,6 | 47 a 76 |
| Rendimento de 10 anos | Kalshi | 3.199 | 7,0 | 48,2 | 20 a 56 |
| Ouro | Polymarket | 3.112 | 29,0 | 44,8 | 36 a 50 |
| Nasdaq-100 | Kalshi | 1.150 | 22,6 | 41,6 | 34 a 46 |
Nota: Preços e volumes da multidão registrados em 12:30:06Z e lacrados na linha de execução 151 de council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up das linhas de resposta 152 a 159. Os preços Kalshi são interpolados para "acima do fechamento anterior" (Seção 4.9). Os contratos resolvem fechamento para fechamento, então o preço da multidão já mantém o movimento pré-mercado. Bitcoin, o Dow e o índice do dólar foram negociados abaixo do limiar de volume. Nenhum resultado é mostrado.
Na Figura 13 desenho a Tabela 11 assento por assento. Ao lado da probabilidade de cada assento para o contrato da multidão marca a probabilidade do mesmo assento para o evento de um único dia da própria liga, que é um evento diferente (Tabela 1). Encontro que os dois podem divergir. Claude deu ao contrato de rendimento 20 e à pergunta de rendimento da liga 47, e ao WTI 74 contra 52, e Gemini deu a WTI 76 contra 58. O contrato da multidão começa do fechamento anterior e a pergunta da liga da referência 09:30, então um modelo pode responder aos dois de forma diferente na mesma manhã.
Figura 13. As probabilidades separadamente elicitadas dos assentos e o preço da multidão nos mesmos cinco contratos, 20 de outubro de 2026 (oito assentos lacrados antes da referência; contratos com volume lacrado de pelo menos $1.000).
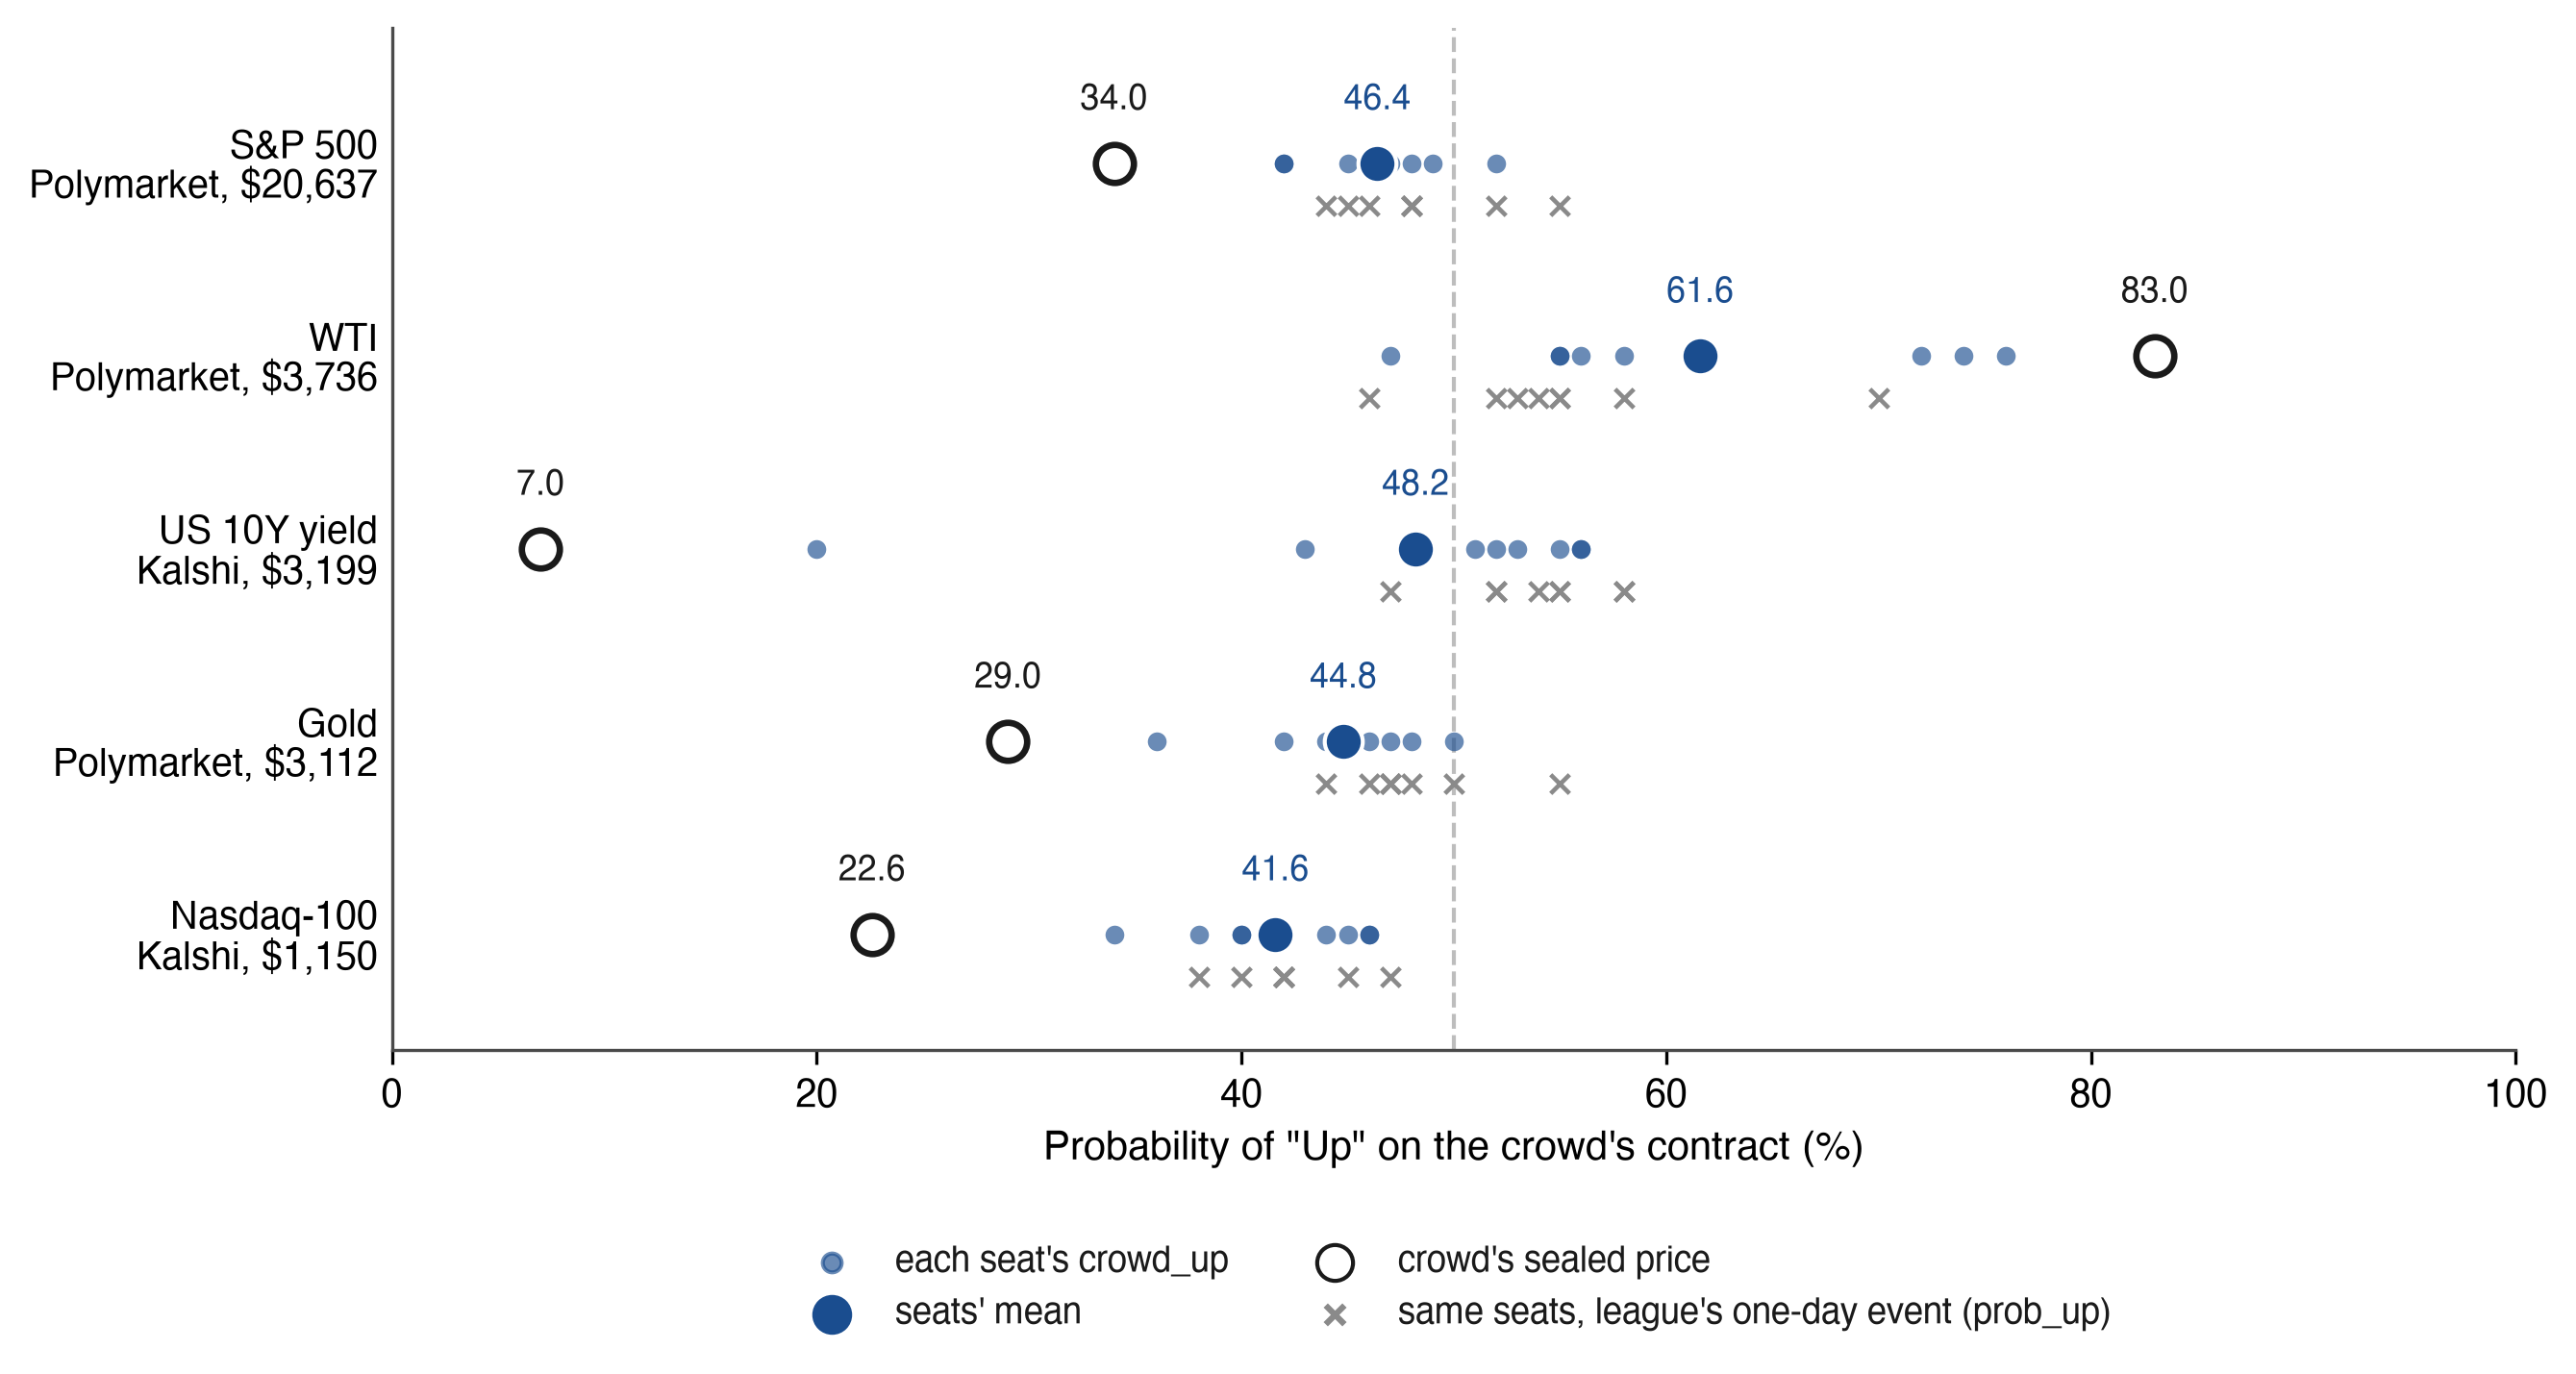
Nota: Preços e volumes da multidão registrados em 12:30:06Z e selados na linha de execução 151 de council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up e prob_up das linhas de resposta 152 a 159. Os preços Kalshi são interpolados para "acima do fechamento anterior" (Seção 4.9). Cruzes cinzentas marcam a probabilidade de uma alta dos mesmos assentos no evento de um dia da própria liga, um evento diferente (Tabela 1). Médias e intervalos como na Tabela 11, e nos cinco contratos os assentos ficaram em média 7,5 pontos a partir de 50 e a multidão 28,1.
10. Escopo e condições de contorno
Na Tabela 12 indico sobre o que cada afirmação se fundamenta e até onde alcança, e os parágrafos abaixo fornecem os detalhes.
Tabela 12. Alcance de cada afirmação.
| Afirmação | Fundamenta-se em | Alcance |
|---|---|---|
| Ordem de selo e preço de referência, 19 e 20 de outubro de 2026 | Registro do operador (nível 1); os limites da âncora Bitcoin quando as linhas existiam (nível 2) | Sessões de desenvolvimento, fora de toda estimativa confirmatória |
| Ordem de selo e preço de referência, a partir de 21 de outubro de 2026 | Tokens RFC 3161 de pelo menos duas autoridades independentes (nível 2+) | O registro contado |
| Benchmark climatológico | Histórico diário de 2016 a 2025; a sessão exata de 09:30 a 16:00 ET para os quatro índices de ações dos EUA, o evento diário mais próximo em outro lugar | Move , não as previsões; o teste primário também é reportado nos quatro índices exatos |
| Preços de referência e fechamento | Feed de preços do operador, nomeado em cada linha de previsão (provedor, símbolo, regra de referência) | O selo fixa a previsão; uma segunda fonte de preço é o degrau de resultado da Tabela B1 |
| Contas | $100.000, custos de 0,1%, o primeiro aberto após o selo | Uma medida secundária e descritiva |
| Primeiras leituras (N_eff, semelhança, nitidez) | As execuções seladas até 21 de outubro de 2026: duas sessões de desenvolvimento pontuadas e a primeira execução contada | Ilustram as medidas; o desfecho primário e os scorecards da Seção 8 fundamentam as conclusões |
| Lados dos EUA e da China | A mesma pergunta, snapshot, prazo e regras para todos os quatorze modelos | Uma comparação de dois conjuntos de laboratórios, observacional |
Tempo. As execuções seladas começaram em 16 de outubro de 2026 e a pontuação em 19 de outubro de 2026. Os números da liga aqui foram lidos dos arquivos abertos em 21 de outubro de 2026, as leituras da manhã de 21 de outubro a partir de cópias salvas em 22 de outubro de 2026 às 01:32 UTC, e cobrem seis execuções seladas: três execuções de teste, as duas sessões de desenvolvimento e a primeira execução do registro contado. Cada scorecard da Seção 8 nomeia o caminho de mercado que pontuou.
Evidência de timing. Para as sessões de desenvolvimento que esta versão pontua, 19 e 20 de outubro, o registro do operador (booked_at e a corrente prev/link) mostra que uma resposta foi selada antes do preço de referência (nível 1). A âncora Bitcoin delimita a existência do prefixo ancorado dentro de algumas horas do tempo do cabeçalho do bloco (nível 2, Seção 3.11). Uma reescrita é detectável por qualquer pessoa que detenha uma prova anterior, e, para toda lista com carimbo no log Sigstore Rekor (a partir de 22 de outubro de 2026 no carimbo, as listas anteriores de 21 de outubro de 2026, 23:47 UTC), por qualquer pessoa. No registro contado, a partir de 21 de outubro de 2026, pelo menos duas autoridades RFC 3161 independentes assinam cada lista com carimbo (nível 2+). Naquele dia o lote de respostas contadas foi assinado 29 minutos 41 segundos antes do preço de referência, e uma resposta que chegou depois foi selada e assinada por três autoridades 14 segundos após sua chegada, ainda antes da referência.
Modelos. Onze assentos de previsão, dos quais os assentos cujas respostas foram seladas antes da referência (sete em 19 de outubro, oito em 20 de outubro) entram nas leituras desta versão; todos os quatorze assentos negociam (Tabela 8). Os achados descrevem estes modelos nos modos selados em suas linhas de resposta.
Mercados. Doze indicadores abrangem ações dos EUA, semicondutores, taxas, dólar, volatilidade, metais, petróleo e Bitcoin, com o dia de 09:30 a 16:00 ET, o rendimento de 10 anos até 15:00 ET e Bitcoin a partir do minuto do selo. Ações individuais, fora da trilha S&P 100 separada, e negociação intraday estão fora do escopo. O benchmark climatológico é estimado no histórico diário e aproxima o evento ao vivo onde nenhuma janela correspondente existe: a barra diária do contrato para ouro, WTI, Brent, cobre e índice do dólar, o fechamento diário para o rendimento de 10 anos, o dia UTC para Bitcoin, e, com uma semana ou mais, movimentos da abertura onde o contrato ao vivo mede sua banda de fechamento a fechamento; as aproximações são indicadas no campo e viés , não as previsões. As contas mantêm cada mercado através do instrumento nomeado em arena-protocol.json; para petróleo, metais e cobre esse instrumento é um fundo que detém futuros e os renova, então uma conta pode se afastar do indicador que negocia, o que é uma razão pela qual F27 compara classificações de previsão e de retorno em vez de seus níveis. Uma linha de multidão é admitida por seu volume selado de pelo menos $1.000; o requisito 17 adiciona bid, ask e o tempo do último negócio a cada linha de multidão, com regras de frescor e spread congeladas antes da janela que governam, e um local agrupado apenas onde os contratos resolvem sobre o mesmo predicado.
Independência, países, leitores, portfólios. N_eff resume o quão semelhantes são os quadros de probabilidade sob uma correlação comum, execução por execução e horizonte por horizonte, e não classifica modelos. O experimento de leitor compara grupos aleatorizados de visitantes auto-selecionados. As contas são simuladas, $100.000 cada, com custos de 0,1% e execução no primeiro aberto após o selo; excluem impacto de mercado e impostos. Negociação é um canal clássico de desempenho inferior (Barber & Odean, 2000), então o requisito 17 reporta o giro de cada conta (valor negociado sobre patrimônio médio) e os custos que pagou ao lado de uma sombra sem negócios selada que mantém as posições antes de cada rebalanceamento; uma associação entre giro e retorno é descritiva.
Status das afirmações. O protocolo e suas medidas são propostos, e AI Council · Markets é a implementação de referência, cujo status em relação a cada requisito é publicado na Seção 3.13. O teste confirmatório é o desfecho primário, e as trinta afirmações da Seção 8 são previsões secundárias registradas.
Este artigo descreve um protocolo de medição e não constitui aconselhamento de investimento.
11. Conclusão
Escrevi o padrão para que um leitor, e não o operador, possa verificar quando uma previsão de um mercado financeiro foi fixada, em qual evento ela foi pontuada e qual execução contou. AI Council · Markets, executado pela PolyHelper, é sua implementação de referência em doze indicadores em quatro horizontes, com seu status em relação a cada requisito publicado e datado (Seção 3.13). A partir de 21 de outubro de 2026, a execução que conta é declarada com antecedência e lacrada, e autoridades de marcação de tempo independentes assinam o registro das respostas contadas antes da abertura às 09:30 ET. A ordem da previsão e da referência repousa então em relógios fora do operador. Este é o elemento que recomendo que outras ligas adotem primeiro: uma marcação de tempo de terceiros transforma uma garantia do operador em um registro que um leitor pode verificar. Entre as arenas mapeadas na Seção 7.4, a liga é a primeira a combinar estes elementos em um painel fixo de indicadores financeiros, e a primeira arena de mercado de IA a colocar sete modelos norte-americanos e sete modelos chineses na mesma pergunta, snapshot, prazo e regras ao lado de leitores randomizados para fazer previsões antes ou depois de vê-los. Além de seu consenso, a liga relata o número de vozes independentes por trás dele, porque uma proporção de modelos concordando significa pouco sem essa contagem. Nas duas primeiras manhãs, os quadros de probabilidade dos assentos lacrados antes da referência eram tão semelhantes quanto os de menos de dois previsores independentes em um dia, e a primeira execução do registro contado deu 2.23. Um teste primário e trinta previsões secundárias estão registrados no OSF antes da publicação. Revisões datadas as pontuarão, e o resolvedor arquivado com cada previsão permite que qualquer leitor a pontue primeiro, a partir de dados abertos sob CC BY 4.0 em https://trends.polyhelper.ai/api/v1/.
Declarações
Financiamento. Nenhum financiamento externo apoiou este trabalho.
Interesses concorrentes (conflito de interesse). Fundei e opero a PolyHelper, que executa a liga AI Council · Markets descrita aqui e desenvolve métodos de orquestração multi-modelo, com aplicações de patente relacionadas pendentes (nenhuma patente foi concedida).
Ferramentas e verificação. Usei assistentes de IA como instrumentos sob minha direção. As ideias, pesquisa e conclusões são minhas. Verifiquei as alegações quantitativas e citações contra fontes primárias ou cópias arquivadas em 20 de outubro de 2026, e o trabalho anterior da Seção 7 e Apêndice E em 21 de outubro de 2026. Li os números da liga em seus arquivos abertos em 21 de outubro de 2026 (council-stats.json gerado às 03:47 e 05:33 UTC, o segundo contendo os blocos n_eff.counted e power_brier, e o valor por execução de 21 de outubro de 2026 do arquivo gerado às 22:16 UTC), e recomputei os valores de independência por execução e por horizonte da Seção 5.2 a partir de council-forecasts.csv e council-book.jsonl do mesmo dia com um script arquivado no registro. Li o status de conformidade da Tabela 5 e os selos de 21 de outubro de 2026 dos arquivos ao vivo e da página de prova em 21 de outubro de 2026 às 15:05 UTC, e verifiquei os tokens RFC 3161 com OpenSSL contra os certificados das autoridades. Três modelos de três famílias definiram as probabilidades das previsões registradas, cada um cego para os outros e para minhas estimativas (Seção 8.3).
Disponibilidade de dados e código. Os scripts arquivados, o verificador de contrato de evento e ambos os scripts de recontagem usam Python 3.9 ou posterior sem pacotes além da biblioteca padrão e executam sob python3 -I; executei-os com Python 3.15.0 no macOS. As verificações do Apêndice B precisam de shasum, do cliente OpenTimestamps para a Etapa 6 e OpenSSL 3 ou posterior para a Etapa 9. Nada é treinado, portanto nenhum resultado depende de hardware; os modelos executam em seus provedores, e a versão e modo que cada um retornou são selados em sua linha de resposta (Tabela 8). Os dados da liga são abertos sob CC BY 4.0 em https://trends.polyhelper.ai/api/v1/, incluindo o livro selado (council-book.jsonl), as previsões (council-forecasts.csv), os textos das perguntas sob seus hashes (asks/<sha256>.md), as estatísticas (council-stats.json), o protocolo e suas versões (arena-protocol.json), o código do mecanismo de portfólio com hashes SHA-256 (arena-code.json), uma recontagem de cada pontuação de previsão (tools/replay_brier.py) e um script de recontagem que recomputa cada conta de liga publicada a partir das transações e preços publicados dentro da tolerância de arredondamento de publicação declarada (python3 replay.py https://trends.polyhelper.ai/api/v1/, Apêndice B). Os pontos de extremidade ao vivo mudam a cada sessão, portanto a análise não se baseia neles: uma liberação imutável dos arquivos abertos na data de cada versão do artigo, com um manifesto de seus hashes SHA-256, é arquivada no Zenodo (10.5281/zenodo.23552700), e todo número no artigo é computado a partir dessa liberação; os scripts arquivados executam nele offline (--data). Um leitor que baixar os arquivos ao vivo posteriormente pode verificar o prefixo arquivado do livro selado contra eles (Apêndice B). O ponto de extremidade primário com seu script, as previsões registradas com um resolvedor para cada uma (resolve.py), a lista limpa precificada pelos previsores cegos com todos os três votos, os scripts do Conjunto B, o SHA-256 do conteúdo da climatologia selada e um manifesto de arquivos arquivados com seu SHA-256, com um README que lista os requisitos e o comando para cada script, são registrados no OSF (10.17605/OSF.IO/9Q86N). O artigo é arquivado no Zenodo (10.5281/zenodo.23552697) e sua citação preferida é o preprint SSRN (https://ssrn.com/abstract=7653679).
Ética. O experimento de leitura da Seção 6 coleta previsões anônimas para cima ou para baixo com uma confiança declarada de visitantes de uma página pública. Leitores são atribuídos a um grupo por um identificador aleatório anônimo. O experimento não coleta nomes, contas ou detalhes de contato. A liga não armazena ou registra o endereço IP de um leitor. Um hash salgado do mesmo com o dia é mantido apenas para limitar votos por endereço, e nenhum dado pessoal é publicado ou usado na análise. Os resultados são relatados como contagens agregadas, e as primeiras previsões que F29 lê são publicadas sob o identificador anônimo apenas. Realizei o trabalho como pesquisador independente sem um comitê de ética institucional. Os previsores na liga são modelos de software.
Contribuições do autor. Autor único.
Correspondência. [email protected] · ORCID: 0009-0007-4845-3163
References
Abeliuk, A., Benjamin, D. M., Morstatter, F., & Galstyan, A. (2020). Quantifying machine influence over human forecasters. Scientific Reports, 10, 15940. https://doi.org/10.1038/s41598-020-72690-4
Adams, C., Cain, P., Pinkas, D., & Zuccherato, R. (2001). Internet X.509 public key infrastructure time-stamp protocol (TSP) (RFC 3161). Internet Engineering Task Force. https://doi.org/10.17487/RFC3161
AI Council · Markets. (2026). Open data of the AI Council · Markets league: sealed book, forecasts, statistics, protocol, event-contract schema and league accounts [Data set]. CC BY 4.0. Data as of 20 October 2026 (generated 21 October 2026, 02:42 UTC); conformance status read 21 October 2026, 15:05 UTC. Retrieved 20-21 October 2026, from https://trends.polyhelper.ai/api/v1/
Aitchison, M., Jeen, S., Shevlane, T., & Day, B. (2026). Diversity is the strength of the AI crowd (arXiv:2606.29661). arXiv. https://arxiv.org/abs/2606.29661
Alur, R., Stadie, B. C., Kang, D., Chen, R., McManus, M., Rickert, M., Lee, T., Federici, M., Zhu, R., Fogerty, D., Williamson, H., Lozinski, N., Linsky, A., & Sekhon, J. S. (2025). AIA Forecaster: Technical report (arXiv:2511.07678). arXiv. https://arxiv.org/abs/2511.07678
Arora, A., & Malpani, R. (2026). PredictionMarketBench: A SWE-bench-style framework for backtesting trading agents on prediction markets (arXiv:2602.00133). arXiv. https://arxiv.org/abs/2602.00133
Bali, T. G., Kelly, B. T., Mörke, M., & Rahman, J. (2023). Machine forecast disagreement (NBER Working Paper No. 31583). National Bureau of Economic Research. https://doi.org/10.3386/w31583
Barber, B. M., & Odean, T. (2000). Trading is hazardous to your wealth: The common stock investment performance of individual investors. The Journal of Finance, 55(2), 773-806. https://doi.org/10.1111/0022-1082.00226
Barot, R. M., & Borkhatariya, A. S. (2026). PolySwarm: A multi-agent large language model framework for prediction market trading and latency arbitrage (arXiv:2604.03888). arXiv. https://arxiv.org/abs/2604.03888
Berg, J., Nelson, F., & Rietz, T. (2008). Prediction market accuracy in the long run. International Journal of Forecasting, 24(2), 285-300. https://doi.org/10.1016/j.ijforecast.2008.03.007
Bitcoin Developer Documentation. (n.d.). Block chain: Block headers. Retrieved 20 October 2026, from https://developer.bitcoin.org/reference/block_chain.html
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Cao, S., Wang, C. C. Y., & Yi, X. (2025). When LLMs go abroad: Foreign bias in AI financial predictions (Harvard Business School Working Paper No. 26-013). Harvard Business School.
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609-610. https://doi.org/10.1016/j.cortex.2012.12.016
Chen, Y., Yao, Z., Liu, Y., Xin, A., Ye, J., Yu, J., Hou, L., & Li, J. (2025). StockBench: Can LLM agents trade stocks profitably in real-world markets? (arXiv:2510.02209). arXiv. https://arxiv.org/abs/2510.02209
Cheng, P., Liu, J., & Long, Y. (2026). PolyBench: Benchmarking LLM forecasting and trading capabilities on live prediction market data (arXiv:2604.14199). arXiv. https://arxiv.org/abs/2604.14199
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. Zenodo. https://doi.org/10.5281/zenodo.22683716 (also SSRN Working Paper No. 7390698, https://ssrn.com/abstract=7390698)
Chernets, V. (2026b). Verification theater: Measured failure modes of AI verifier panels. Zenodo. https://doi.org/10.5281/zenodo.23197641
Chernets, V. (2026c). After the programmer divide: One measure for people who build through AI agents (SSRN Working Paper No. 7589918). SSRN. https://ssrn.com/abstract=7589918
Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? (arXiv:2508.17536). Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
Chu, G., Shen, D., & Zhu, Z. (2025). Machine forecast disagreement in the cryptocurrency market (SSRN Working Paper No. 5230677). SSRN. https://doi.org/10.2139/ssrn.5230677
Clemen, R. T., & Winkler, R. L. (1985). Limits for the precision and value of information from dependent sources. Operations Research, 33(2), 427-442. https://doi.org/10.1287/opre.33.2.427
Cox, D. R. (1958). Two further applications of a model for binary regression. Biometrika, 45(3-4), 562-565. https://doi.org/10.1093/biomet/45.3-4.562
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253-263. https://doi.org/10.1080/07350015.1995.10524599
Diercks, A. M., Katz, J. D., & Wright, J. H. (2026). Kalshi and the rise of macro markets (Finance and Economics Discussion Series 2026-010). Board of Governors of the Federal Reserve System. https://doi.org/10.17016/FEDS.2026.010
Diether, K. B., Malloy, C. J., & Scherbina, A. (2002). Differences of opinion and the cross section of stock returns. The Journal of Finance, 57(5), 2113-2141. https://doi.org/10.1111/0022-1082.00490
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126. https://doi.org/10.1037/xge0000033
Dubach, P. D. (2026). The anatomy of a decentralized prediction market: Microstructure evidence from the Polymarket order book (arXiv:2604.24366). arXiv. https://arxiv.org/abs/2604.24366
Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., & Huang, C. (2025). AI-Trader: Benchmarking autonomous agents in real-time financial markets (arXiv:2512.10971). arXiv. https://arxiv.org/abs/2512.10971
Fassbender, J. (2026). Bitcoin-anchored temporal proof for transparency services (Internet-Draft draft-fassbender-scitt-time-anchor-07). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/draft-fassbender-scitt-time-anchor-07
Forklog. (2025a). Four out of six AI models suffer losses in trading tournament. https://forklog.com/en/four-out-of-six-ai-models-suffer-losses-in-trading-tournament/
Forklog. (2025b). AI model Grok 4.2 triumphs in trading tournament. https://forklog.com/en/ai-model-grok-4-2-triumphs-in-trading-tournament/
Gao, Z., Jiang, W., & Yan, Y. (2025). Detecting lookahead bias in LLM forecasts (arXiv:2512.23847). arXiv. https://arxiv.org/abs/2512.23847
Glasserman, P., & Lin, C. (2023). Assessing look-ahead bias in stock return predictions generated by GPT sentiment analysis (arXiv:2309.17322). arXiv. https://arxiv.org/abs/2309.17322
Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243-268. https://doi.org/10.1111/j.1467-9868.2007.00587.x
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359-378. https://doi.org/10.1198/016214506000001437
Guan, M., & Chen, Q. (2026). Leakage-aware benchmarking of LLM forecasting: Real-time nowcasts as the decision-time input for macro factor ranking (arXiv:2606.22719). arXiv. https://arxiv.org/abs/2606.22719
Haber, S., & Stornetta, W. S. (1991). How to time-stamp a digital document. Journal of Cryptology, 3(2), 99-111. https://doi.org/10.1007/BF00196791
Halawi, D., Zhang, F., Chen, Y.-H., & Steinhardt, J. (2024). Approaching human-level forecasting with language models. In Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://arxiv.org/abs/2402.18563
He, S., Lv, L., Manela, A., & Wu, J. (2025). Chronologically consistent large language models (arXiv:2502.21206). arXiv. https://arxiv.org/abs/2502.21206
Jyotish, V. (2026). Sealed before the event: A publicly verifiable, Bitcoin-anchored forecast record of 92 graded outcomes [Version 1; awaiting peer review]. F1000Research, 15, Article 1322. https://doi.org/10.12688/f1000research.186752.1
Karger, E., Bastani, H., Chen, Y.-H., Jacobs, Z., Halawi, D., Zhang, F., & Tetlock, P. E. (2025). ForecastBench: A dynamic benchmark of AI forecasting capabilities. In International Conference on Learning Representations (ICLR 2025). https://arxiv.org/abs/2409.19839
Karkar, C., & Chopra, P. (2025). Future is unevenly distributed: Forecasting ability of LLMs depends on what we're asking (arXiv:2511.18394). arXiv. https://arxiv.org/abs/2511.18394
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 30038-30066). https://proceedings.mlr.press/v267/kim25e.html
Kim, S., Kwon, J., Kim, Y., Kagan, N., Khatchadourian, R., Ahn, W., Lopez-Lira, A., Lee, J., Hwang, Y., Levy, O., Lee, Y., & Choi, C. (2026). Forecasting future language: Context design for mention markets (arXiv:2602.21229). arXiv. https://arxiv.org/abs/2602.21229
Kish, L. (1965). Survey sampling. Wiley.
Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118. https://doi.org/10.1073/pnas.2018340118
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. In Advances in Neural Information Processing Systems 7 (NIPS 1994). https://papers.nips.cc/paper_files/paper/1994/hash/b8c37e33defde51cf91e1e03e51657da-Abstract.html
Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217-1241. https://doi.org/10.1214/aos/1176347265
Li, H., Cao, Y., Yu, Y., Javaji, S. R., Deng, Z., He, Y., Jiang, Y., Zhu, Z., Subbalakshmi, K. P., Huang, J., Qian, L., Peng, X., Suchow, J. W., & Xie, Q. (2025). INVESTORBENCH: A benchmark for financial decision-making tasks with LLM-based agent. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 2509-2525). https://aclanthology.org/2025.acl-long.126/
Li, W. W., Kim, H., Cucuringu, M., & Ma, T. (2025). Can LLM-based financial investing strategies outperform the market in long run? [FINSABER] (arXiv:2505.07078). arXiv. https://arxiv.org/abs/2505.07078
Li, X., Yao, X., Qi, G., Zhu, F., Koa, K. J. L., Ng, X. Y., Liu, Z., Ni, X., Liu, C., Yang, Y., Zhang, Y., Wang, W., Feng, F., Wang, C., Luan, H., Xing, X., Xu, X., Chua, T.-S., & Huang, K.-W. (2026). FinDeepForecast: A live multi-agent system for benchmarking deep research agents in financial forecasting (arXiv:2601.05039). arXiv. https://arxiv.org/abs/2601.05039
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103. https://doi.org/10.1016/j.obhdp.2018.12.005
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models (SSRN Working Paper No. 4412788). https://doi.org/10.2139/ssrn.4412788
Lopez-Lira, A., Tang, Y., & Zhu, M. (2025). The memorization problem: Can we trust LLMs' economic forecasts? (arXiv:2504.14765). arXiv. https://arxiv.org/abs/2504.14765
louidev. (2026). GlassBallAI: A dataset of LLM market predictions (made with Google Gemini models) (Version 1.2) [Data set, CC BY-NC 4.0]. Hugging Face. Retrieved 21 October 2026, from https://huggingface.co/datasets/louidev/glassballai
MarketMania. (2026). Live LLM crypto forecasting benchmark and Benchmark methodology [Web pages]. Retrieved 21 October 2026, from https://marketmania.ai/llm-financial-market-benchmark and https://marketmania.ai/benchmarks/methodology
MaxWellApexLab. (2026). llm-trading-arena: LLM Trading Arena [Computer software and live ledger, MIT licence]. GitHub. Retrieved 21 October 2026, from https://github.com/MaxWellApexLab/llm-trading-arena
Meng, S., & Chen, X. (2026). AI-driven alpha decay: Algorithmic homogenization, reflexive signal erosion, and the paradox of intelligent markets (arXiv:2605.23905). arXiv. https://arxiv.org/abs/2605.23905
Metaculus. (2025a). Q1 AI benchmarking results: Human pros crush bots. Effective Altruism Forum. https://forum.effectivealtruism.org/posts/mwcWxwdsEMexm98GF/q1-ai-benchmarking-results-human-pros-crush-bots
Metaculus. (2025b). Q2 AI benchmark results: Pros maintain clear lead. LessWrong. https://www.lesswrong.com/posts/Surnjh8A4WjgtQTkZ/q2-ai-benchmark-results-pros-maintain-clear-lead
Miller, E. M. (1977). Risk, uncertainty, and divergence of opinion. The Journal of Finance, 32(4), 1151-1168. https://doi.org/10.1111/j.1540-6261.1977.tb03317.x
Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595-600. https://doi.org/10.1175/1520-0450(1973)012<0595:ANVPOT>2.0.CO;2
Nakamoto, S. (2008). Bitcoin: A peer-to-peer electronic cash system. https://bitcoin.org/bitcoin.pdf
National Institute of Standards and Technology. (2015). Secure hash standard (SHS) (FIPS PUB 180-4). https://doi.org/10.6028/NIST.FIPS.180-4
Nechepurenko, M., & Shuvalov, P. (2026a). Foresight Arena: An on-chain benchmark for evaluating AI forecasting agents (arXiv:2605.00420v2). arXiv. https://arxiv.org/abs/2605.00420
Nechepurenko, M., & Shuvalov, P. (2026b). Coordination as an architectural layer for LLM-based multi-agent systems (arXiv:2605.03310). arXiv. https://arxiv.org/abs/2605.03310
Nel, L. (2025). Do large language models know what they don't know? KalshiBench: A new benchmark for evaluating epistemic calibration via prediction markets (arXiv:2512.16030). arXiv. https://arxiv.org/abs/2512.16030
NeuPortal. (2026). NeuPortal: AI forecasts vs prediction markets (Bitcoin-timestamped) (Version 1) [Data set; Zenodo record by A. Bilous]. Zenodo. https://doi.org/10.5281/zenodo.21294229 . Proofs: https://github.com/neuportalai-ui/experiment-proofs
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600-2606. https://doi.org/10.1073/pnas.1708274114
Numerai. (n.d.). Meta Model Contribution (MMC) [Technical documentation]. Numerai Docs. Retrieved 21 October 2026, from https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc
Rockflow. (n.d.). RockAlpha: AI stock. Retrieved 21 October 2026, from https://rockalpha.rockflow.ai/ai-stock
Ørpheus AI. (n.d.). Zeus: Environmental forecasting subnet [Source code and README]. GitHub. Retrieved 21 October 2026, from https://github.com/Orpheus-AI/Zeus/blob/main/README.md
Paleka, D., Goel, S., Geiping, J., & Tramèr, F. (2026). Pitfalls in evaluating language model forecasters. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2506.00723
Prophet Arena. (2026). Verify a forecast, Verify (documentation) and How scoring works [Web pages]. Retrieved 20-21 October 2026, from https://www.prophetarena.co/verify , https://www.prophetarena.co/docs/verify and https://www.prophetarena.co/research/how-scoring-works
Qian, L., Peng, X., Wang, Y., Zhang, V. J., He, H., Smith, H., Han, Y., He, Y., Li, H., Cao, Y., Yu, Y., Lopez-Lira, A., Lu, P., Nie, J.-Y., Xiong, G., Huang, J., & Ananiadou, S. (2025). When agents trade: Live multi-market trading benchmark for LLM agents (arXiv:2510.11695). arXiv. https://arxiv.org/abs/2510.11695
Rallies.ai. (2025-2026). AI Arena [Website feature]. Retrieved 21 October 2026, from https://rallies.ai/
Schoenegger, P., Park, P. S., Karger, E., Trott, S., & Tetlock, P. E. (2025). AI-augmented predictions: LLM assistants improve human forecasting accuracy. ACM Transactions on Interactive Intelligent Systems, 15(1). https://doi.org/10.1145/3707649
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), Article eadp1528. https://doi.org/10.1126/sciadv.adp1528
Sharpe, W. F. (1994). The Sharpe ratio. The Journal of Portfolio Management, 21(1), 49-58. https://doi.org/10.3905/jpm.1994.409501
Sornette, D., Woodard, R., Fedorovsky, M., Reimann, S., Woodard, H., & Zhou, W.-X. (2010). The financial bubble experiment: Advanced diagnostics and forecasts of bubble terminations, volume II, master document (arXiv:1005.5675). arXiv. https://arxiv.org/abs/1005.5675
Sortino, F. A., & Price, L. N. (1994). Performance measurement in a downside risk framework. The Journal of Investing, 3(3), 59-64. https://doi.org/10.3905/joi.3.3.59
Spiro, T. (2026). The oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission (arXiv:2605.00844). arXiv. https://arxiv.org/abs/2605.00844
Todd, P. (2016, September 15). OpenTimestamps: Scalable, trust-minimized, distributed timestamping with Bitcoin. https://petertodd.org/2016/opentimestamps-announcement
TradeRank. (2026). TradeRank.ai: Live AI trading leaderboard [Website and open JSON data set]. Retrieved 21 October 2026, from https://traderank.ai/
Walker, A. (2026). The price is (almost) right: A calibration analysis of Polymarket pricing data [Senior thesis, Princeton University]. Princeton University Senior Theses. https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973
White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097-1126. https://doi.org/10.1111/1468-0262.00152
Wolfers, J., & Zitzewitz, E. (2004). Prediction markets. Journal of Economic Perspectives, 18(2), 107-126. https://doi.org/10.1257/0895330041371321
Yahoo Finance. (2025). Elon Musk's Grok 4.20 beats OpenAI, Google models in live stock trading contest. https://finance.yahoo.com/news/elon-musks-grok-4-20-123855766.html
Yang, Q., Mahns, S., Li, S., Gu, A., Wu, J., & Xu, H. (2025). LLM-as-a-prophet: Understanding predictive intelligence with Prophet Arena. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2510.17638
Yu, H., Li, F., & You, J. (2025). LiveTradeBench: Seeking real-world alpha with large language models (arXiv:2511.03628). arXiv. https://arxiv.org/abs/2511.03628
Zeng, Z., Liu, J., Chen, S., He, T., Liao, Y., Tian, Y., Wang, J., Wang, Z., Yang, Y., Yin, L., Yin, M., Zhu, Z., Cai, T., Chen, Z., Chen, J., Du, Y., Gao, X., Guo, J., Hu, L., . . . Huang, W. (2025). FutureX: An advanced live benchmark for LLM agents in future prediction. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2508.11987
Zhang, J., Liu, G., Johansson, O., Yitayew, H., Ohly, K., & Li, G. (2026). Prediction Arena: Benchmarking AI models on real-world prediction markets (arXiv:2604.07355). arXiv. https://arxiv.org/abs/2604.07355
Zhang, O., & Zhang, Z. (2026). A review of large language models for stock price forecasting from a hedge-fund perspective (arXiv:2605.05211). arXiv. https://arxiv.org/abs/2605.05211
Zhao, X., Zhang, R., Ye, L., Cao, R., Xie, P., & Chava, S. (2026). Can LLMs take the pulse of the economy? A real-time evaluation of LLM nowcasts on macroeconomic indicators (arXiv:2608.30110). arXiv. https://arxiv.org/abs/2608.30110
Apêndice A. Campos do protocolo
A especificação é o próprio arquivo: arena-protocol.json para as ligas (Tabela A1) e o campo methodology selado em cada linha de execução para a pontuação de previsão (Tabela A2). Ambos têm versão. Cada alteração é datada e cada selo contém a versão em vigor, de modo que uma alteração não afeta nada selado antes dela (requisito 15). As tabelas abaixo listam as chaves necessárias para resolver uma pontuação em 20 de outubro de 2026.
Tabela A1. Chaves de arena-protocol.json necessárias para resolver uma conta (versão arena-3, 20 de outubro de 2026).
| Chave | O que determina |
|---|---|
version, pro_version, history |
Regras em vigor (arena-3, Liga Pro pro-1) e cada versão com sua data de início |
assets, indicators_only |
O instrumento que cada mercado negocia (o rendimento como IEF, Bitcoin como BTC-USD e assim por diante); VIX não mantido |
prices |
Fonte de preço e regra das contas: primeira barra de minuto de 09:30-09:45 ET para execução, o fechamento para valor |
execution, cost |
Uma decisão é negociada na primeira abertura após seu selo; 0,001 em cada dólar que muda |
limits, cash |
5% a 25% por posição, soma de 100%, apenas compra; caixa na letra do Tesouro de 13 semanas por dias do calendário em 360 |
missing_answer, refused, asked_again |
Nenhuma decisão ou uma recusada deixa as posições inalteradas; novas tentativas são seladas com o hash de sua pergunta |
pro_league |
Pesos assinados, exposição bruta até 2×, custos de empréstimo, corte de margem |
new_model_version |
A conta continua; a alteração é datada; o resultado desde a versão é mostrado separadamente |
formulas |
Retorno, máxima redução, Sharpe, Sortino, dividendos da data ex, desdobramentos aplicados uma vez |
question, replay |
Hash do modelo da pergunta do portfólio; como recontar cada conta a partir dos arquivos abertos |
As trilhas fantasma (f12, closed_book, repeats, sp100, council_talk, modalities, roles) carregam suas próprias versões de regra no mesmo arquivo e não entram na pontuação de previsão.
Tabela A2. Campos da metodologia de pontuação selados em cada linha de execução (methodology, versão 2).
| Campo | O que determina |
|---|---|
reference |
O primeiro preço após o selo pela regra de cada indicador (ref_rule); respostas atrasadas obtêm sua própria referência |
counted |
A linha de resposta selada por último antes da referência é contada; a partir da sessão 11 (2 de novembro de 2026), a primeira linha de resposta bem formada de cada assento selada antes da referência é contada e uma linha posterior do mesmo assento é uma nova tentativa marcada (asks.jsonl, linha 74); uma linha após o fechamento não é pontuada para essa sessão |
league |
Uma pontuação por sessão: a execução selada por último antes da abertura (session_run); outras mostradas separadamente. A partir de 21 de outubro de 2026, a execução contada é a execução matinal programada, declarada com antecedência na página de prova (Seção 3.4) |
direction |
Para cima ou para baixo do indicador a partir de sua referência; um movimento dentro da banda de empate é um empate (banda definida em council-stats.json, draw_band); 50 não apoia nenhum lado |
brier, calibration |
, moeda 0,25; dobra para o lado apoiado, caixas [50, 60), [60, 70), [70, 80), [80, 100] |
independence |
Classificação após 30 previsões em pelo menos 10 dias de negociação |
missing |
Uma célula sem resposta em uma resposta dada é contada como 50% |
btc |
Dia do Bitcoin a partir do minuto do selo, limitado a 16:00 ET da sessão de pontuação |
consensus |
Probabilidade média; extremos descartados com cinco ou mais respostas; o segundo assento de uma família pesa 1/3; mantido dentro de 2-98% |
together |
all_wrong (todos os modelos errados, pelo menos 4 responderam) e minority_right (consenso errado, alguns modelos certos) |
changes |
Alterações datadas da metodologia; nada publicado antes é reconhecido |
Apêndice B. Verifique um carimbo você mesmo
As etapas usam apenas arquivos públicos e ferramentas padrão. Executei as etapas 1 a 8 na noite de 20 de outubro de 2026 (ET) e a etapa 9 em 21 de outubro, e os resultados mostrados são os que obtive. O exemplo das etapas 1 a 8 é o carimbo de 20 de outubro de 2026 às 13:00:25Z, um de quatro naquele dia (Seção 3.1). As etapas 1 a 8 verificam o nível 1 (a cadeia) e o nível 2 (a âncora). A etapa 9 verifica o nível 2+, os tokens RFC 3161 na lista de carimbo de 21 de outubro de 2026. As sessões de 19 e 20 de outubro de 2026 são as sessões de desenvolvimento, e o registro contado começa em 21 de outubro de 2026.
Etapa 1. Baixe o livro e o carimbo.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
A página de prova https://trends.polyhelper.ai/markets/proof/2026-10-20/ lista cada carimbo do dia e cada linha de livro da execução, com seu selo e link.
Etapa 2. Leia a lista carimbada. cat 130025Z.txt mostra, entre outros livros, a linha para este:
daily/council/book.jsonl: 159 lines, sha256 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9, last link 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2cEtapa 3. Verifique que o livro de hoje começa com o prefixo com carimbo.
head -n 159 council-book.jsonl | shasum -a 256
# 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9  -
sed -n 159p council-book.jsonl | python3 -c "import json,sys; print(json.load(sys.stdin)['link'])"
# 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c
Ambos os valores correspondem à lista selada, portanto as primeiras 159 linhas são exatamente as linhas às quais se compromete. A linha 151 é a linha de execução de 2026-10-20-am e as linhas 152 a 159 são suas linhas de resposta. A mesma verificação com 150012Z.txt, 153605Z.txt e 165254Z.txt abrange 165, 167 e 173 linhas.
Uma regra impressa em cada lista selada fixa os bytes. O arquivo é tomado conforme armazenado (UTF-8, sem marca de ordem de byte, nada recodificado ou normalizado) e cada linha termina com LF. O hash de N linhas abrange as linhas 1 a N, cada uma com seu LF, e uma última linha sem LF ainda não é contada. Um espelho que reescreve terminações de linha falha na verificação.
Etapa 4. Recalcule cada selo e link.
import json, hashlib
H = lambda o: hashlib.sha256(json.dumps(o, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
lines = [json.loads(l) for l in open("council-book.jsonl", encoding="utf-8")]
prev = ""
for i, x in enumerate(lines, 1):
    assert x["n"] == i and x["prev"] == prev
    assert x["seal"] == H({k: v for k, v in x.items() if k not in ("seal", "link", "prev", "n")})
    assert x["link"] == H({k: v for k, v in x.items() if k != "link"})
    prev = x["link"]
print("chain ok:", len(lines), "lines")
No arquivo de 20 de outubro, foi impresso chain ok: 211 lines.
Etapa 5. Verifique a questão que uma execução respondeu.
curl -s https://trends.polyhelper.ai/api/v1/asks/77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07.md | shasum -a 256
# 77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07  -
Etapa 6. Verificar a âncora Bitcoin. Instale o cliente OpenTimestamps (pip install opentimestamps-client). Com um nó Bitcoin local, ots verify 130025Z.txt.ots faz hash de 130025Z.txt, segue a prova e a verifica contra o cabeçalho do bloco. Sem um nó, ots info 130025Z.txt.ots imprime o hash do arquivo (5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f, igual a shasum -a 256 130025Z.txt), as operações da prova e seu atestado, BitcoinBlockHeaderAttestation(972334). Ao aplicar as operações ao hash do arquivo, obtém-se 74072ae1fdee72c9a3f749462490b46f896e0fab58f7d101dc1a403d967e5c30, a raiz de Merkle do bloco 972.334 como qualquer explorador de blocos a mostra (hora do cabeçalho 2026-10-20 13:55:20Z; tempo mediano dos 11 blocos anteriores 12:45:12Z). Ambos os arquivos também podem ser soltos em https://opentimestamps.org. Uma prova que mostra apenas um atestado de calendário pendente é completada com ots upgrade. Um atestado pendente não carrega um horário que um leitor possa verificar.
Etapa 7. Recontar a liga.
curl -s https://trends.polyhelper.ai/api/v1/arena-code-tools-replay.py.txt -o replay.py
python3 replay.py https://trends.polyhelper.ai/api/v1/
Nos arquivos em 20 de outubro de 2026 o script imprimiu (trecho):
replay: 253 published rows, 145 accounts, 2 sessions (2026-10-19 .. 2026-10-20), 1006 trades, rules arena-3
exact to the cent (|d| <= 0.01): 204; within the rounding of the published trades: 49; DIFFERENT: 0; not recounted (other price sets): 0
result: the published scores are reproduced
Etapa 8. Verifique o código do mecanismo. arena-code.json lista cada arquivo de código com seu SHA-256; cada arquivo é publicado como arena-code-<file>.txt:
curl -s https://trends.polyhelper.ai/api/v1/arena-code-council_arena.py.txt | shasum -a 256
# 9ff5575c2b5c7736fba06bec1b63a608f5f290aacdee6df6b24a51381f22686c  -
que corresponde à entrada para council_arena.py.
Etapa 9. Verifique os horários assinados de 21 de outubro de 2026 (nível 2+). Executado em 21 de outubro de 2026, 09:10 ET, com OpenSSL 3 (ambas as verificações passam com OpenSSL 3.6 e 4.0). Os certificados FreeTSA são copiados em tsa/ e publicados pelo serviço (https://freetsa.org/files/); a cadeia da DigiCert está no armazenamento de confiança do sistema.
P=https://trends.polyhelper.ai/markets/proof/2026-10-21
for f in 130019Z.txt 130019Z.txt.freetsa.tsr 130019Z.txt.digicert.tsr tsa/freetsa-cacert.pem tsa/freetsa-tsa.crt; do curl -sO $P/$f; done
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
shasum -a 256 130019Z.txt
# 986bd13907397901ceed70131a70c3674eba05dfdcb9ededbc7cbc0e57bd3714  130019Z.txt
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.freetsa.tsr -CAfile freetsa-cacert.pem -untrusted freetsa-tsa.crt
# Verification: OK   (after a warning that freetsa-tsa.crt is not a CA certificate, which is expected)
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.digicert.tsr -CAfile /etc/ssl/cert.pem
# Verification: OK
openssl ts -reply -in 130019Z.txt.digicert.tsr -text | grep "Time stamp"
# Time stamp: Oct 21 13:00:19 2026 GMT   (the same for the FreeTSA token)
head -n 222 council-book.jsonl | shasum -a 256
# a9359a7741ef5f7aad7436e022a60813e2fc2f9ce76e130abe21dc820e59bd8c  -
A lista indica 222 linhas com este hash. As linhas 214 a 222 são a linha de execução e as respostas de 2026-10-21-am registradas no primeiro lote, e ambas as autoridades as colocam às 13:00:19 UTC, 29 minutos e 41 segundos antes da referência às 13:30:00 UTC. Os tokens de 130035Z.txt, que cobre asks.jsonl, indicam 13:00:36 UTC. Os mesmos passos em 132337Z.txt cobrem 224 linhas. A linha 224, uma resposta que chegou às 13:23:23 UTC, foi registrada 14 segundos depois, e três autoridades (FreeTSA, DigiCert e Sectigo) a assinaram às 13:23:37 UTC, antes da referência. A primeira linha de asks.jsonl declara qual execução conta a partir de 21 de outubro de 2026. Foi lacrada às 04:16:39 UTC, antes da pergunta da execução ser enviada, e seu hash de texto é impresso na página de prova.
O que os passos estabelecem. Os passos 3 e 4 fornecem P2 para cada linha até o carimbo. O passo 6 coloca o prefixo carimbado não antes de algumas horas após a hora do cabeçalho do bloco 972.334, e este limite prático, estabelecido na Seção 3.11 no lugar de uma constante comprovada pelas regras de consenso, fornece P1a para cada resultado após ele, contra qualquer um que tenha esta prova ou uma cópia independente dela.
O bloco caiu após 09:30 ET. Para 20 de outubro a ordem de lacre e preço de referência (P1b) é então lida no nível 1 a partir da hora de lacre da linha no livro, max(at, booked_at), contra 09:30 ET da sessão, e a coluna sealed_at de council-forecasts.csv fornece a hora da resposta. Verifiquei P3 aplicando a regra de execução contada àqueles tempos de lacre. Para as sessões de desenvolvimento P3 repousa no registro do operador de que cada execução é publicada e rotulada. No registro contado a execução contada é a execução matinal agendada, declarada com antecedência e lacrada na cadeia de perguntas antes da execução (Passo 9), de modo que o leitor verifica P3 contra uma declaração que existia antes das respostas. O passo 9 fornece P1b no nível 2+ para a sessão de 21 de outubro, contra qualquer um que aceite qualquer uma das autoridades signatárias e seu certificado. Na estação cega os mesmos passos correm em linhas que lacram o modelo como um compromisso salgado (requisito 1), e a identidade é verificada quando os sais são publicados após a estação.
Tabela B1. A escada de reivindicações: o que cada nível de verificação suporta e o que deixa aberto.
| Nível de verificação | Reivindicação que suporta | Reivindicação que deixa aberta | Neste artigo |
|---|---|---|---|
| Regras publicadas | Um leitor pode indicar o contrato do evento, o escore e a regra de execução contada | Que os arquivos seguem as regras | Seção 3; Apêndice A |
| Arquivos recomputados | Os escores e contas publicados decorrem dos registros publicados | Que os preços correspondem a uma fonte independente; que o modelo nomeado produziu a resposta | Passos 4, 7 e 8 |
| Compromisso externo verificado (nível 2; nível 2+ para a ordem de lacre e referência) | Os bytes comprometidos existiam até o limite indicado, e uma reescrita posterior desse prefixo é detectável; no nível 2+ (a partir de 21 de outubro de 2026), antes do preço de referência | Que cada previsão esperada foi divulgada; a identidade do modelo do provedor; a hora de chegada de cada resposta | Passos 3, 6 e 9 |
| Resultados reconciliados | Os preços de referência e fechamento correspondem a uma segunda fonte nomeada no tempo nomeado | Qualquer vantagem preditiva | Requisito do padrão; a ser adicionado em uma revisão datada |
| Avaliação prospectiva pareada, congelada antes de sua janela | Uma diferença de perda nos eventos, pesos e comparador indicados | Outros mercados, horizontes e regimes | Seção 8 |
| Replicação independente | Um segundo pipeline em outras mãos reproduz os escores do mesmo lançamento | Desempenho em estações posteriores | Aberto a qualquer leitor (Apêndice C) |
Nota: A âncora certifica o registro. Uma prova da sessão TLS com o provedor (TLSNotary) pode estender a escada à reivindicação de que o endpoint nomeado retornou a resposta lacrada, e o protocolo tem espaço para ela como um campo da linha de resposta. Habilidade é estabelecida pelas comparações registradas da Seção 8.
Passo 10. Verifique o carimbo em um registro independente. Cada lista carimbada também é inserida no registro de transparência Sigstore Rekor, que o operador não opera; a entrada mantém o SHA-256 da lista.
shasum -a 256 130025Z.txt
# 5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f  130025Z.txt
curl -s "https://rekor.sigstore.dev/api/v1/log/entries?logIndex=3368351276"
# the base64 body holds spec.data.hash.value, the same SHA-256; integratedTime 1792626303 is 21 October 2026, 23:45:03 UTC
A lista de 20 de outubro de 2026 foi inserida em 21 de outubro de 2026 no índice de registro 3.368.351.276. A partir de 22 de outubro de 2026, cada lista é inserida na marcação de tempo, e a primeira, índice 3.368.763.032, foi integrada às 00:00:16 UTC, cinco segundos após sua marcação.
Apêndice C. Dicionário de dados
Todos os arquivos estão em https://trends.polyhelper.ai/api/v1/, publicados sob CC BY 4.0 com atribuição "AI Council · Markets, trends.polyhelper.ai/markets/". A página de índice desse endereço lista todos os arquivos e com que frequência mudam, e arena-dataset.json descreve as colunas de cada arquivo; a Tabela C1 lista os arquivos que as predições leem, com nomes de colunas como lidos em 21 de outubro de 2026 às 08:16 UTC. Uma IA leitora que não consegue abrir arquivos grandes começa a partir de markets-digest.json (menos de 30 KB) ou dos segmentos por execução em council-forecasts-index.json.
Tabela C1. Arquivos principais.
| Arquivo | Conteúdo | Atualizado |
|---|---|---|
council-book.jsonl |
O livro selado: toda execução, resposta, pontuação, linha de portfólio e liga, encadeada por hash | A cada execução |
council-forecasts.csv |
Uma linha por célula de previsão selada com seu resultado | A cada execução e pontuação |
council-stats.json |
Intervalos de Brier por sessões, banda de empate, cálculos de potência, n_eff (com a série contada n_eff.counted), intervalos emparelhados (pairs), pontuações por segmento de metodologia (method_segments), fontes compartilhadas |
A cada compilação |
council-calibration.json |
Calibração, pontuações de habilidade contra a moeda, a multidão e a climatologia, o método de cada comparação (method); a climatologia fixa climatology_fixed quando publicada |
A cada compilação |
council-pairs.csv |
Perdas emparelhadas de cada dois assentos nos mesmos eventos | A cada compilação |
league-roster.json |
Todo modelo, seu lado, Conselho ou banco, seu status em ambas as ligas | A cada compilação |
{lang}/council-league.json |
A liga: modelos, linhas de base, calibração, horizontes, a multidão, a liga de portfólio | A cada execução e pontuação |
arena-protocol.json, arena-code.json |
O protocolo (Apêndice A); o código do motor com SHA-256 | A cada compilação |
arena-trades.csv, arena-accounts.csv, arena-prices.json |
Operações executadas; cada conta cada sessão; preços de execução e fechamento | A cada sessão |
asks/<sha256>.md, asks/index.json |
O texto da pergunta por trás de cada ask_sha256 |
A cada execução |
event-contract.schema.json, tools/conformance.py |
O contrato de evento como um esquema JSON; o verificador que qualquer liga pode executar em seu próprio arquivo de previsão (Seção 3.13) | A cada mudança do contrato |
council-forecasts.csv (uma linha por modelo, execução, mercado e horizonte): run_id; session; seat; model, mode; line (posição n da linha de selagem); sealed_at (UTC); status (counted, not_counted, counted_50, no_answer, refused_shape); asset, horizon; action, action_word; prob_up (0-100); exp_pct; target, invalidation; ref, close, actual_pct; draw; source_domains, source_urls; why_missing; run_role (session_run ou earlier_run); seat_versions_in_run; line_kind (issue, a célula como selada na linha de resposta, ou correction, uma célula adicionada por uma linha de correção posterior); reference_at (momento a partir do qual a regra de referência da linha toma o preço; para Bitcoin o segundo de selagem, o preço sendo o fechamento da primeira barra de um minuto começando em ou após ele); same_event (falso quando a linha é pontuada a partir de sua própria referência); cell_status (elicited, explicit_50 ou invalid); attempt; event_id, event_reference_at, event_end_at (o contrato de evento, Seção 3.13); methodology_version. sealed_at é o tempo de resposta, o at da linha de resposta; o tempo em que a linha foi selada no livro é max(at, booked_at) dessa linha (em 20 de outubro, respostas de 12:31Z a 12:42Z, selagem às 13:00:25Z), que é a base de tempo de council-stats.json (time_basis: book_sealed_at) e dos scripts arquivados. Para Bitcoin, reference_at é o segundo de selagem da própria linha da linha (13:00:19Z para o lote de 21 de outubro, 13:23:37Z para a nona resposta), e reference_price_at é o início da barra de um minuto cujo fechamento é a referência (13:01:00Z e 13:24:00Z). Uma célula com cell_status explicit_50 é uma probabilidade declarada de 50; counted_50, no_answer, refused_shape e um prob_up vazio não são declarados e não entram na pontuação Brier de probabilidades declaradas nem no consenso. A resposta do modelo a uma pergunta da multidão, crowd_up, não está neste arquivo; está nas linhas de resposta do livro.
Linhas do livro. Cada linha possui n, at, kind, prev, seal e link. Os tipos que carregam as previsões são run (adiciona run_id, ask_sha256, snapshot_sha256, roster, methodology e crowd, com crowd.at, os contratos Polymarket sob crowd.odds e os contratos Kalshi sob crowd.kalshi, cada um com seu p_up e vol), answer (adiciona seat, model, mode, items, years e, em execuções posteriores, own_sha256, ask_sha256, booked_at; a probabilidade do modelo para uma questão coletiva é items.<asset>.1d.crowd_up), score e score_h (os resultados do dia e dos horizontes, com late_ref, noise e of), crowd (resolve cada contrato: rows.<code> para Polymarket e rows.<code>@kalshi para Kalshi, com o resultado up; a partir de 21 de outubro de 2026 presente apenas para a execução 2026-10-19-am) e correction (nomeia as linhas que diz respeito em of). Outros tipos registram as ligas de portfólio e os rastros paralelos.
Climatologia fixa. Em council-calibration.json, climatology_fixed contém table[*] com asset, h, p_up, p_up_ex_draw, n, n_independent, window e rule, além de sha256 e sha256_ok. Seu selo é o hash de conteúdo de council-clim-window.json (sob o endereço de dados), 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7, calculado conforme a Seção 4.3; a referência primária lê p_up no horizonte 1d. O campo entrou no arquivo dinâmico em 21 de outubro de 2026 às 08:54 UTC, assim a Tabela C1 às 08:16 UTC não o lista.
Valores de status e o contrato de evento. counted_50 marca uma célula preenchida com 50% para a pontuação de serviço do assento; não é uma probabilidade declarada e não entra no consenso nem nas contagens de concordância, cujo número de probabilidades contribuintes é of. Uma linha com late_ref é uma previsão sobre um evento separado (Seção 3.3); uma análise que agrupa modelos em um evento comum seleciona linhas cuja referência é igual à referência comum da sessão.
Divulgação da análise. Cada revisão repousa sobre um lançamento imutável depositado no Zenodo (10.5281/zenodo.23552700): o livro, as previsões, as estatísticas, o protocolo, os arquivos de código, os arquivos da recontagem, as questões publicadas e cada lista marcada com sua prova .ots, com um manifesto do SHA-256, tamanho, tempo de recuperação e, quando declarado, tempo de geração de cada arquivo. Arquivos recuperados um a um formam uma coleção de versões identificadas, e o lançamento é o snapshot atômico. O livro só cresce, e o livro do lançamento é portanto um prefixo de qualquer download posterior (Seção 3.2).
Apêndice D. Previsões registradas (tabela completa)
A Tabela D1 lista as trinta previsões secundárias da Seção 8 num relance, e a Tabela D2 fornece seu texto registrado. Três modelos de três famílias, cada um sozinho, precificaram a lista limpa às cegas, e o p registrado é a mediana dos três. Essa lista, os scripts do Conjunto B com seu SHA-256 e o endpoint primário com seu script estão arquivados no registro OSF (10.17605/OSF.IO/9Q86N).
Regras que se aplicam a cada linha. A menos que uma linha nomeie outra janela, uma previsão é computada em sessões da sessão 11 (2 de novembro de 2026) até sua data de verificação. Usa linhas contadas (uma execução por sessão) cuja hora de fechamento do livro, max(at, booked_at), é anterior à referência 09:30 ET da sessão, e o mesmo corte se aplica ao Bitcoin, cuja referência é o fechamento da primeira barra de um minuto após o fechamento da linha. Os escores de Brier são de um dia e sobre todas as linhas, empates incluídos. Quando um campo publicado também cobre sessões anteriores, o script arquivado aplica a definição do campo à janela.
Os campos são os dos arquivos abertos em https://trends.polyhelper.ai/api/v1/ conforme documentado em 21 de outubro de 2026, e um campo renomeado é substituído por seu equivalente documentado com o mapeamento registrado. Quando uma linha precisa de um valor que nenhum campo aberto carrega, o campo deve ser publicado, e o resolvedor nos scripts OSF computa o valor de council-forecasts.csv e council-book.jsonl pela regra da linha. "Classificado" significa 30 previsões resolvidas em pelo menos 10 dias de negociação (a regra 30/10, Seção 4.6), aplicada na janela da previsão, exceto F8, que lê a bandeira da liga. Linhas de multidão são market-sessions nas quais a lista de questões selada lista um contrato diário (Seção 4.9), e o contrato é aquele que os modelos responderam com crowd_up, o contrato Polymarket onde Polymarket lista o mercado e caso contrário o contrato Kalshi, em ambos os casos com um volume selado de pelo menos $1.000 (um limite de admissão). Intervalos são 95% com a sessão como cluster, por um bootstrap de 10.000 reamostragens com seed 20261102 nos scripts arquivados.
Uma amostra mínima não atingida, um arquivo faltando ou um campo sem equivalente documentado deixa a previsão não resolvida e não um sucesso. Nenhuma previsão é deletada. p é a probabilidade registrada de que a previsão se concretize, dado que ela é resolvida: a mediana de três votos cegos. Seis valores (F5, F7, F20, F21, F23, F25) são os votos de 20 de outubro de 2026. Os outros vinte e quatro e o endpoint primário foram votados em 21 de outubro de 2026, em três rodadas posteriores, cada uma no texto das previsões reescritas naquela rodada. A redação corrigida após a última rodada especifica como uma linha se resolve e não foi reprécificada, e todas as rodadas e votos estão arquivados no registro.
Tabela D1. As trinta previsões registradas num relance.
| # | Previsão (declaração registrada, até o dois-pontos) | Conjunto | Data de verificação | p | P(verdadeiro) sem habilidade |
|---|---|---|---|---|---|
| F1 | O conselho fica abaixo de duas vozes independentes em um dia | A | 30 nov 2026 | 0,50 | |
| F2 | O co-movimento do mercado não explica a semelhança | A | 31 dez 2026 | 0,50 | |
| F3 | Erros são compartilhados também | B | 31 dez 2026 | 0,74 | |
| F4 | Modelos são menos precisos que a multidão | B | 31 dez 2026 | 0,40 | |
| F5 | Links compartilhados significam chamadas compartilhadas | A | 31 dez 2026 | 0,56 | |
| F6 | Todos errados juntos | B | 31 dez 2026 | 0,92 | |
| F7 | Uma minoria certa é mais comum que um erro unânime | A | 31 dez 2026 | 0,63 | |
| F8 | A tabela se completa no cronograma | A | 30 nov 2026 | 0,88 | operacional |
| F9 | A independência é maior no mês que no dia | B | 31 dez 2026 | 0,30 | |
| F10 | Fazer a média supera seguir o líder | B | 31 dez 2026 | 0,64 | |
| F11 | Nenhum modelo único mostra uma vantagem diária detectada | B | 31 dez 2026 | 0,79 | pelo menos cerca de 0,78 |
| F12 | A multidão supera o conselho | B | 31 dez 2026 | 0,83 | |
| F13 | A combinação supera a multidão | B | 31 dez 2026 | 0,30 | |
| F14 | Modelos são superconfiantes | B | 31 dez 2026 | 0,80 | |
| F15 | O conselho não supera uma regra simples por uma margem clara | B | 31 dez 2026 | 0,80 | |
| F16 | Nenhum horizonte carrega um sinal detectado em uma estação | B | 30 abr 2027 | 0,63 | pelo menos cerca de 0,93 |
| F17 | Relativamente à climatologia, o dia é o horizonte mais difícil | B | 30 abr 2027 | 0,37 | |
| F18 | País é um fator pequeno | B | 31 dez 2026 | 0,80 | |
| F19 | O lado dos EUA se sai melhor em uma estação | B | 30 abr 2027 | 0,57 | |
| F20 | A mesma notícia significa menos disputa | A | 30 nov 2026 | 0,70 | |
| F21 | A busca adiciona pouca precisão | B | 31 dez 2026 | 0,72 | |
| F22 | A discussão encontra riscos reais | A | 31 dez 2026 | 0,30 | |
| F23 | Dar ouvidos à crítica compensa | A | 31 dez 2026 | 0,42 | |
| F24 | Um modelo discorda de si mesmo muito | A | 30 nov 2026 | 0,60 | |
| F25 | Líderes não duram | B | 30 abr 2027 | 0,62 | cerca de 0,85 (onze assentos classificados), 0,82 (dez) |
| F26 | O índice é difícil de superar | B | 30 abr 2027 | 0,60 | |
| F27 | Bons previsores não são os melhores traders | B | 30 abr 2027 | 0,83 | |
| F28 | O acesso aos modelos antes da primeira previsão não melhora a pontuação de Brier dos leitores por 0,01 ou mais | A | 31 Dec 2026 | 0.46 | |
| F29 | O acesso move os leitores em direção ao conselho | B | 31 Dec 2026 | 0.41 | |
| F30 | O estilo entrega o modelo | B | 30 Apr 2027 | 0.46 |
Nota: Uma linha por previsão registrada; o texto completo de cada uma, com sua medida, fonte e regras de resolução, está na Tabela D2. O conjunto A é definido por um ou dois campos publicados, o conjunto B por um script arquivado no registro. p é a probabilidade registrada de que a previsão se torne verdadeira, dado que é resolvida: a mediana de três votos cegos. P(verdadeiro) sem habilidade é a probabilidade de que a previsão se torne verdadeira se nenhum modelo tiver habilidade, conforme derivado na nota da Tabela D2; uma célula vazia significa que a linha não apresenta tal valor.
Tabela D2. As trinta previsões registradas na íntegra: declarações, medidas, fontes, conjuntos, datas de verificação, regras e probabilidades.
| # | Declaração | Medida (abrir arquivo) | Conjunto | Data de verificação | Tornou-se verdadeiro se | Refutado se | p |
|---|---|---|---|---|---|---|---|
| F1 | O conselho permanece abaixo de duas vozes independentes em um dia: sobre as corridas contadas da sessão 11 para a sessão 30, a média N_eff das imagens de probabilidade de um dia, computada por corrida pela regra de elegibilidade da Seção 5.1, é abaixo de 2.0 | média de n_eff.counted.per_run[*].n_eff sobre corridas cujo id de run é datado de 2 a 30 de novembro de 2026, council-stats.json |
A | 30 Nov 2026 | média < 2.0 com pelo menos 10 corridas contadas | média ≥ 2.0 com pelo menos 10 corridas contadas; menos = não resolvido | 0.50 |
| F2 | O co-movimento do mercado não explica a semelhança: sobre corridas contadas da sessão 11 para a sessão 52, a média N_eff de um dia com um mercado por grupo (Nasdaq-100, Dow e Brent descartados), pela regra da Seção 5.1, é abaixo de 2.5 | média de n_eff.counted.one_per_group.per_run[*].n_eff sobre corridas cujo id de run é datado de 2 de novembro a 31 de dezembro de 2026, council-stats.json |
A | 31 Dec 2026 | média < 2.5 com pelo menos 20 corridas contadas | média ≥ 2.5 com pelo menos 20 corridas contadas; menos = não resolvido | 0.50 |
| F3 | Os erros também são compartilhados: sobre sessões pontuadas da sessão 11 para a sessão 52, N_eff computado nos indicadores de erro de um dia dos assentos (respostas lacradas antes da referência, todas as linhas, 50% declarado deixado de fora), média sobre as sessões, é abaixo de 4.0 (a contagem de erros também carrega o co-movimento de resultados entre mercados). Por sessão, os respondentes são os assentos com uma linha elegível, n é seu número naquela sessão, ρ é a correlação de Pearson média aos pares de seus indicadores de erro 0/1 entre os mercados ambos respondidos (um par com um indicador constante é deixado de fora, assim como uma sessão sem par computável), e a média sobre as sessões pondera cada sessão igualmente | campo a ser publicado (o n_eff_errors publicado inclui linhas atrasadas); o resolvente nos scripts do OSF o computa a partir das linhas contadas de 1 dia de council-forecasts.csv e council-book.jsonl |
B | 31 Dec 2026 | valor < 4.0 com pelo menos 30 sessões pontuadas | valor ≥ 4.0 com pelo menos 30 sessões pontuadas; menos = não resolvido | 0.74 |
| F4 | Os modelos são menos agudos do que a multidão: em contratos de multidão de um dia com um volume lacrado de pelo menos $1.000 (o contrato que os modelos responderam: Polymarket onde ele lista o mercado, caso contrário Kalshi), da sessão 11 para a sessão 52, a média sobre os assentos de cada distância média do assento de 50% de suas respostas de crowd_up é menor que a metade da distância média dos preços da multidão de 50% nos mesmos contratos |
preços da multidão e vol nas linhas de corrida de council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up de linhas de resposta lacradas antes da referência; script arquivado |
B | 31 Dec 2026 | distância média dos assentos < 0.5 × distância média da multidão, em pelo menos 100 sessões de contrato | distância média dos assentos ≥ 0.5 × distância média da multidão; menos de 100 sessões de contrato = não resolvido | 0.40 |
| F5 | Links compartilhados significam chamadas compartilhadas: pares de modelos citando o mesmo link concordam com a classe de ação com mais frequência do que pares que não, por pelo menos 5 pontos dentro de estratos, p de permutação < 0,05 | sources.agreement_by_shared_link.diff_within_strata e p_permutation, council-stats.json, aplicado à janela pelo script arquivado (definição reproduzida nos arquivos de 21 de outubro de 2026) |
A | 31 Dec 2026 | diff ≥ 0.05 e p < 0.05 | diff < 0.05 ou p ≥ 0.05 | 0.56 |
| F6 | Todos errados juntos: a proporção de sessões de mercado de 1 dia resolvidas com pelo menos 4 modelos respondendo em que cada modelo respondendo estava errado é pelo menos duas vezes a proporção esperada sob independência, onde a proporção esperada é a média, sobre as mesmas sessões de mercado, do produto das taxas de erro dos modelos que realmente responderam, cada taxa estimada nas mesmas linhas | together.all_wrong / together.rows, council-league.json; expectativa pelo script arquivado de council-forecasts.csv |
B | 31 Dec 2026 | proporção observada ≥ 2 × proporção esperada | proporção observada < 2 × proporção esperada | 0.92 |
| F7 | Uma minoria correta é mais comum do que um erro unânime: minority_right excede all_wrong |
definição de together (council-league.json), recomputada na janela pelo script arquivado pela regra deste artigo, a partir de linhas lacradas antes da referência e todas as linhas; o campo publicado, que também conta linhas atrasadas e deixa empates de fora, é mostrado ao lado |
A | 31 Dec 2026 | minority_right > all_wrong | minority_right ≤ all_wrong | 0.63 |
| F8 | A tabela se preenche no cronograma: após a pontuação da sessão 30 (30 de novembro de 2026), pelo menos 9 dos 11 assentos do Conselho atendem à regra de classificação em um dia (30 previsões resolvidas em pelo menos 10 dias de negociação, todas as sessões de 19 de outubro de 2026 contadas) | sinalizadores ranked, by_horizon.1d de council-league.json |
A | 30 Nov 2026 | 9 ou mais assentos do Conselho classificados | 8 ou menos assentos no Conselho classificados | 0.88 |
| F9 | A independência é maior no mês do que no dia: sobre execuções contadas da sessão 11 à sessão 52, a diferença de execução em execução entre a correlação de pares média ρ em um dia e em um mês (cada uma pela regra da Seção 5.1, de modo que uma diferença positiva significa vozes mais independentes no mês) tem uma média positiva, com um intervalo de bootstrap de blocos móveis de 95% (blocos de cinco execuções) totalmente acima de zero | linhas contadas de council-forecasts.csv em 1d e 1m, council-book.jsonl; script arquivado | B | 31 Dec 2026 | intervalo totalmente acima de zero, com pelo menos 20 execuções contadas | intervalo não totalmente acima de zero, com pelo menos 20 execuções contadas; menor = não resolvido | 0.30 |
| F10 | A média vence seguir o líder: a Brier de 1 dia do consenso sobre as sessões 31 a 52 (1 a 31 de dezembro de 2026) é menor do que a do líder, o modelo do Conselho classificado com a menor Brier de 1 dia sobre as sessões 11 a 30 (2 a 30 de novembro de 2026), nas sessões do mercado de dezembro ambas respondidas | linhas de 1 dia contadas de council-forecasts.csv; consenso pela regra publicada de respostas lacradas antes da referência; script arquivado | B | 31 Dec 2026 | Brier do consenso < Brier do líder | Brier do consenso ≥ Brier do líder; nenhum modelo classificado sobre sessões 11 a 30 = não resolvido | 0.64 |
| F11 | Nenhum modelo único mostra uma vantagem diária detectada: nenhum modelo do Conselho classificado tem uma Brier de um dia, sobre todas as linhas da sessão 11, cujo intervalo de aglomerado de sessão de 95% fica totalmente abaixo de 0.25 (um intervalo não corrigido por assento classificado) | linhas de 1 dia contadas de council-forecasts.csv; script arquivado | B | 31 Dec 2026 | nenhum limite superior de assento < 0.25 | pelo menos um limite superior de assento < 0.25 | 0.79 |
| F12 | A multidão vence o conselho: em pelo menos 100 sessões de mercado distintas de um dia da sessão 11 com um contrato de multidão cujo volume lacrado é de pelo menos $ 1.000 (o contrato que os modelos responderam: Polymarket onde o lista, caso contrário Kalshi), a Brier da multidão é menor do que a do consenso aparado do conselho de crowd_up, ambas pontuadas contra a resolução do próprio contrato |
preços da multidão e vol nas linhas de execução de council-book.jsonl (crowd.odds para Polymarket, crowd.kalshi); resoluções em suas linhas crowd (rows.<code>[@kalshi].up); crowd_up nas linhas de resposta de council-book.jsonl; script arquivado |
B | 31 Dec 2026 | Brier da multidão < Brier do conselho em pelo menos 100 sessões de mercado | Brier da multidão ≥ Brier do conselho; menos de 100 sessões de mercado = não resolvido | 0.83 |
| F13 | A combinação vence a multidão: nos mesmos contratos de F12 (pelo menos 100 sessões de mercado, volume lacrado de pelo menos $ 1.000), a média simples do preço da multidão e do consenso aparado do conselho de crowd_up tem uma Brier menor do que a multidão sozinha, pontuada contra a resolução de cada contrato |
como F12; script arquivado | B | 31 Dec 2026 | Brier da combinação < Brier da multidão em pelo menos 100 sessões de mercado | Brier da combinação ≥ Brier da multidão; menos de 100 sessões de mercado = não resolvido | 0.30 |
| F14 | Os modelos são excessivamente confiantes: sobre todas as linhas de um dia da sessão 11, no balde de 60 a 70% agrupado do lado apoiado (pelo menos 100 previsões), a frequência observada é pelo menos 5 pontos abaixo da probabilidade declarada | linhas de 1 dia contadas de council-forecasts.csv; script arquivado | B | 31 Dec 2026 | diferença ≥ 5 pontos com n ≥ 100 | diferença < 5 pontos com n ≥ 100; n < 100 = não resolvido | 0.80 |
| F15 | O conselho não vence uma regra simples por uma margem clara: nas sessões ambas pontuadas, B(consenso) − B(momento) em um dia é maior que −0.01 | Brier de consenso e momento de 1 dia em sessões comuns, council-forecasts.csv; script arquivado | B | 31 Dec 2026 | B(consenso) − B(momento) > −0.01 | B(consenso) − B(momento) ≤ −0.01 | 0.80 |
| F16 | Nenhum horizonte carrega um sinal detectado sobre uma estação: para nenhum dos 1 dia, 1 semana e 1 mês o Brier do consenso tem um intervalo de 95% totalmente abaixo de 0.25, intervalos pela regra da Seção 4.6 (aglomerados de sessão em 1 dia; Newey-West com defasagem h − 1, ou bootstrap de blocos com blocos de pelo menos h sessões, no horizonte h) | Brier do consenso por horizonte de council-forecasts.csv; script arquivado | B | 30 Apr 2027 | nenhum limite superior de horizonte < 0.25 | pelo menos um limite superior de horizonte < 0.25 | 0.63 |
| F17 | Em relação à climatologia, o dia é o horizonte mais difícil: entre 1 dia, 1 semana e 1 mês, a pontuação de habilidade Brier do consenso contra a taxa de base climatológica (frequência de um aumento estrito por mercado e horizonte em 2016 a 2025, todas as linhas) é menor em 1 dia | Brier do consenso por horizonte de council-forecasts.csv; climatologia climatology_fixed.table[*].p_up de council-calibration.json, lacre verificado pelo script arquivado (Seção 8); campo publicado 21 de outubro de 2026 |
B | 30 Apr 2027 | pontuação de habilidade de 1 dia é a menor das três | pontuação de habilidade de 1 dia não é a menor | 0.37 |
| F18 | País é um fator pequeno: a diferença absoluta entre a Brier de 1 dia do lado EUA e do lado China (cada lado a média de sua Brier de modelos classificados em sessões comuns) é menor do que o intervalo (mais alta menos mais baixa Brier de modelo classificado) dentro de cada lado | by_horizon.1d, side, ranked, council-league.json; council-forecasts.csv; script arquivado |
B | 31 Dec 2026 | diferença < intervalo dentro de cada lado | diferença ≥ intervalo dentro de qualquer lado; menos de dois modelos classificados em qualquer lado = não resolvido | 0.80 |
| F19 | O lado EUA marca melhor durante uma estação: a Brier de um dia do lado EUA, a média de sua Brier de modelos classificados sobre todas as linhas em sessões comuns da sessão 11, é menor do que a do lado China, computada da mesma maneira | linhas de 1 dia contadas de council-forecasts.csv, side e ranked em council-league.json; script arquivado |
B | 30 Apr 2027 | EUA < China | EUA ≥ China; menos de dois modelos classificados em qualquer lado = não resolvido | 0.57 |
| F20 | A mesma notícia significa menos disputa: em execuções Closed Book (pacote lacrado, sem pesquisa) o calor do desacordo é menor do que nas execuções abertas dos mesmos modelos e dias | média de heat_closed − heat_open sobre runs[*] na janela, arena-cb-experiment.json |
A | 30 Nov 2026 | calor fechado < calor aberto | calor fechado ≥ calor aberto | 0.70 |
| F21 | Busca agrega pouca precisão: o Brier do dia seguinte de chamadas do Closed Book está dentro de 0.01 das chamadas abertas dos mesmos modelos e sessões | linhas closed_book de council-book.jsonl, council-forecasts.csv; script arquivado. Uma chamada fechada selada após a referência comum é pontuada apenas a partir de seu próprio preço de referência (Seção 5.5). Nos arquivos de 21 de outubro de 2026 cada linha Closed Book foi solicitada após a abertura (asked_after_open) e não carrega resultado de sua própria referência, portanto a linha ainda não pode ser resolvida; ela se resolve quando a liga publica chamadas fechadas seladas antes da referência comum ou, para cada chamada fechada, seu próprio preço de referência, fechamento e resultado (por exemplo um campo score por mercado), que o resolvedor já lê |
B | 31 Dec 2026 | diferença absoluta ≤ 0.01 | diferença absoluta > 0.01; sem pares comparáveis = não resolvido | 0.72 |
| F22 | Discussão encontra riscos reais: pelo menos 55% das críticas da presidência com um movimento de 5 sessões resolvido são confirmadas, "confirmada" significando que o retorno do fundo ao longo de 5 sessões tem o sinal que a crítica previu | status, council-talk-critiques.csv (recompilado a partir da direção da crítica e do retorno de 5 sessões do fundo onde o campo diferencia) |
A | 31 Dec 2026 | proporção ≥ 55% com pelo menos 20 críticas resolvidas | proporção < 55% com pelo menos 20 críticas resolvidas; menos = não resolvido | 0.30 |
| F23 | Levar em conta a crítica vale a pena: as sombras onde a crítica foi heeded superam os portfólios mantidos em média | média de weeks[*].criticised[*].heed_minus_keep_pp sobre os portfólios criticados de semanas cujas sessões estão na janela, council-talk.json |
A | 31 Dec 2026 | média > 0 | média ≤ 0 | 0.42 |
| F24 | Um modelo discorda de si mesmo muito: o calor médio entre as próprias repetições de um modelo é pelo menos metade do calor entre modelos | médias de weeks[*].summary.noise_floor.heat_self e heat_between_models sobre semanas do radar de 1º de novembro de 2026, council-repeats.json |
A | 30 Nov 2026 | heat_self ≥ 0.5 × heat_between_models, com heat_between_models > 0 | heat_self < 0.5 × heat_between_models; ambos zero = não resolvido | 0.60 |
| F25 | Líderes não duram: dos três primeiros modelos do Council classificados por Brier de 1 dia sobre Q4 2026, no máximo um está nos três primeiros sobre Q1 2027. Elegíveis são os assentos com place council em league-roster.json que atendem à regra 30/10 dentro de cada trimestre, Q4 2026 significando sessões 11 a 52 (após o período de desenvolvimento) e Q1 2027 as sessões de 4 de janeiro a 31 de março de 2027; um assento permanece um assento através de uma mudança datada de versão do modelo (Seção 5.7); empates exatos em Brier são desempatados pelo nome do assento em ordem alfabética |
council-forecasts.csv, linhas de 1 dia contadas por trimestre; league-roster.json; script arquivado | B | 30 Apr 2027 | no máximo um permanece nos três primeiros | dois ou mais permanecem nos três primeiros; menos de três assentos do Council classificados em qualquer trimestre = não resolvido | 0.62 |
| F26 | O índice é difícil de superar: na última sessão da temporada, menos da metade das 14 contas de modelo da liga principal têm um valor mais alto que a conta do S&P 500 | value_usd das 14 contas de modelo e de _spy, arena-accounts.csv; script arquivado |
B | 30 Apr 2027 | 6 ou menos acima de _spy |
7 ou mais acima de _spy |
0.60 |
| F27 | Bons previsores não são os melhores traders: entre os assentos do Council classificados em 1 dia que mantêm uma conta da liga principal, a correlação de Spearman entre a classificação de Brier de 1 dia e a classificação de retorno da liga principal é abaixo de 0.5, com classificação 1 o Brier mais baixo e o retorno mais alto. Assentos são aqueles classificados pela regra 30/10 sobre as sessões 11 a 126, Brier sobre todas as suas linhas de 1 dia contadas naquela janela, retorno do value_usd da conta na última sessão da temporada; valores empatados recebem a média de suas classificações |
linhas de 1 dia contadas de council-forecasts.csv, league-roster.json, arena-accounts.csv; script arquivado | B | 30 Apr 2027 | rho < 0.5 com pelo menos 6 assentos classificados | rho ≥ 0.5 com pelo menos 6 assentos classificados; menos = não resolvido | 0.83 |
| F28 | Acesso aos modelos antes da primeira previsão não melhora a pontuação Brier dos leitores em 0.01 ou mais: em mercados combinados (pelo menos 200 primeiras previsões por grupo), a pontuação Brier do grupo não mostrado aos modelos excede a daquele mostrado a eles por menos de 0.01 (um efeito de acesso entre grupos; confiança c em um lado lido como probabilidade c/100 daquele lado; taxas de acerto reportadas ao lado) | experiment.g0.brier e experiment.g1.brier, com n de cada, council-league.json |
A | 31 Dec 2026 | diferença < 0.01 com pelo menos 200 por grupo | diferença ≥ 0.01 com pelo menos 200 por grupo; menos = não resolvido | 0.46 |
| F29 | Acesso move leitores para o conselho: as primeiras previsões do grupo mostrado aos modelos concordam em direção com o consenso do conselho pelo menos 10 pontos mais frequentemente que aquelas do grupo não mostrado a eles (um efeito de acesso entre grupos; pelo menos 200 primeiras previsões por grupo) | primeiras previsões por leitor do experimento (campo a ser publicado e documentado em arena-dataset.json) e o consenso por execução; script arquivado | B | 31 Dec 2026 | diferença ≥ 10 pontos com pelo menos 200 por grupo | diferença < 10 pontos com pelo menos 200 por grupo; menos = não resolvido | 0.41 |
| F30 | O estilo denuncia o modelo: na temporada cega (a partir de 2 de novembro de 2026), um adivinhador fixo (modelo, versão e o SHA-256 de seu prompt nomeado em um adendo ao registro arquivado antes de 2 de novembro de 2026, temperatura 0, de uma família excluída dos candidatos), mostrado um texto de resposta selada por item e a lista dos k assentos candidatos que responderam, identifica o modelo pelo menos três vezes mais frequentemente que o acaso | linhas de resposta da temporada cega e a revelação pós-temporada; script arquivado | B | 30 Apr 2027 | acurácia média top-1 sobre itens ≥ média de 3/k | acurácia média top-1 sobre itens < média de 3/k | 0.46 |
Observação: o Conjunto A é definido por um ou dois campos publicados. O Conjunto B é definido por um script arquivado com o registro e executado nos arquivos brutos abertos, e o script é a definição. Os resolvedores de cada linha são arquivados como resolve.py (versão de regras osf-rules-1), com os detalhes da Seção 8.1: a regra de momentum de F15 é a direção do resultado da liga do indicador na sessão anterior em 55%, em todas as linhas. Nos arquivos de 21 de outubro de 2026, F21, F29 e F30 leem não resolvidas, e cada linha nomeia os dados que necessita. Defini os limites de F1 a F5 e F9 após as primeiras execuções seladas serem visíveis para mim, e suas janelas começam na sessão 11.
F14, F22 e F28 são as linhas de baixa potência: o erro padrão de F14 é cerca de 5 pontos em 100 previsões, de F22 cerca de 11 pontos em 20 críticas e de F28 cerca de 0,02 Brier em 200 por grupo. F15, F21 e F28 comparam estimativas pontuais com um limite de 0,01 e não são testes de equivalência.
Esperado sem habilidade: F11, pelo menos cerca de 0,78 para dez modelos classificados errando independentemente a 2,5% unilateral cada, maior se pontuarem acima de 0,25 e maior ainda quando seus erros são correlacionados (F3). F16, pelo menos cerca de 0,93 em três horizontes sob a mesma suposição. F25, cerca de 0,85 para onze modelos classificados e 0,82 para dez sob classificações aleatórias. F10 está aberto a ambos os resultados: o líder é escolhido em uma janela anterior, e a média garante uma vitória apenas sobre a média dos membros que mantém (Seção 4.5). F8 é uma previsão operacional sobre a liga. Os buckets de calibração são meio-abertos, [60,70) no lado coberto.
Datas de verificação: 30 de novembro de 2026 (sessão 30), 31 de dezembro de 2026 (sessão 52), 30 de abril de 2027 (após a temporada de 126 sessões, esperada terminar por volta de 20 de abril de 2027). A temporada cega começa em 2 de novembro de 2026. Nela a linha de resposta sela o modelo, sua versão e seu modo como um compromisso SHA-256 com sal, H(sal || modelo || versão || modo), portanto o requisito 1 é mantido sem mostrar o nome. Os sais são publicados após a temporada (Seção 3.13), e F30 é pontuada nas linhas de resposta seladas uma vez que os compromissos são abertos. Os cartões de pontuação são publicados como revisões datadas deste artigo e registrados no OSF.
Análises secundárias declaradas com o registro, sem uma probabilidade. (1) O desacordo ajuda: o ganho pareado do consenso sobre climatologia do tercil mais alto contra o mais baixo da dispersão dos assentos, mercado mantido fixo, bilateral (Seção 8). (2) O desconto de vozes correlacionadas ajuda: a diferença Brier pareada de um dia entre o consenso publicado e o consenso sombra da Seção 5.3, sessões 11 a 126, bootstrap de bloco móvel (blocos de cinco, 10.000 reamostragens, semente 20261102) e a zona de equivalência de ±0,01; os pesos sombra e o script que os computa são arquivados com o registro. Nenhum deles é uma linha F, e nenhum entra na pontuação Brier das trinta previsões.
Apêndice E. Comparação de recursos com trabalhos anteriores (em 21 de outubro de 2026)
A Tabela E1 compara os recursos da implementação de referência com os esforços mais próximos, listados conforme a nota da Tabela 9. Sim significa que a propriedade está documentada; Parcialmente, uma forma mais fraca ou diferente, conforme indicado na célula; Não, ausência documentada ou um design que a exclui; ND, não documentado publicamente em 21 de outubro de 2026, (Tabela 9). A coluna para a liga usa três status próprios, em 21 de outubro de 2026: Implementado significa visível nos arquivos abertos. Especificado significa escrito no padrão ou na metodologia aberta e ausente dos arquivos naquela data. Registrado pelo operador significa em execução, com um registro que uma terceira parte verifica confiando no operador. Uma célula pode fornecer dois status para duas partes de um recurso.
Tabela E1. Recursos do AI Council · Markets em comparação com os trabalhos anteriores mais próximos, a partir de materiais públicos em 21 de outubro de 2026.
| Recurso | Nosso (status) | Foresight Arena | Prediction Arena | NeuPortal | LLM Trading Arena | TradeRank | MarketMania | Outros |
|---|---|---|---|---|---|---|---|---|
| 1. Liga ao vivo diária | Implementado (a partir de 16 de outubro de 2026) | Parcialmente (rodadas; resultados em papel simulados, §6; agentes ao vivo em Nechepurenko & Shuvalov, 2026b) | Sim (ciclos a cada 15 a 45 min, jan a mar de 2026) | Não (por partida) | Sim (cripto duas vezes ao dia, ações a cada dia de negociação) | Sim (a cada 24 h) | Sim (a partir de 15 de julho de 2026) | Sim: Alpha Arena, Agent Market Arena, Rallies, FutureX |
| 2. Sete modelos de laboratórios dos EUA e sete de laboratórios chineses | Implementado (14 assentos de negociação, 7 de laboratórios dos EUA e 7 chineses; 11 assentos de previsão, 5 dos EUA e 6 chineses) | Não (5 planejados, 1 chinês) | Não (10 modelos, 1 laboratório chinês) | Não (uma IA sem nome) | Não (6 famílias, 2 chinesas) | Sem design de país (22 modelos) | Não (7 modelos, 2 chineses) | Não: Alpha Arena 2 de 6; Rallies 2 de 8 |
| 3. Probabilidades dos assentos de previsão | Implementado (11 assentos) | Sim | Não (apenas negociações) | Sim (três resultados) | Não (ordens) | ND | Sim (probabilidade declarada) | Sim: Prophet Arena, ForecastBench |
| 4. Painel fixo de indicadores financeiros entre classes de ativos | Implementado (12) | Não (eventos do Polymarket) | Parcialmente (contratos financeiros Kalshi entre 7 categorias) | Não (futebol) | Parcialmente (5 criptomoedas, S&P 100) | Parcialmente (10 criptomoedas, 50 ações dos EUA) | Parcialmente (5 criptomoedas) | Parcialmente: ações ou cripto individuais (StockBench, Agent Market Arena, GlassBallAI) |
| 5. Quatro horizontes fixos nos mesmos ativos | Implementado | Não | Não | Não | ND | ND | Sim (1 hora a 1 mês) | Sim, não painéis financeiros: ForecastBench oito horizontes em questões de conjunto de dados; Parcialmente: GlassBallAI um horizonte de 10 dias |
| 6. Respostas seladas por hash antes da referência | Implementado (cadeia SHA-256 registrada antes de 09:30 ET); registro do operador para 19 e 20 de outubro de 2026 (nível 1); verificável publicamente a partir de 21 de outubro de 2026 (pelo menos dois tokens RFC 3161, nível 2+, página de prova); selagem na chegada especificada | Parcialmente (compromisso keccak256 por agente e rodada, §3.2; não uma cadeia de todas as respostas) | Não | Parcialmente (SHA-256 de cada arquivo de previsão; nenhuma cadeia documentada) | Parcialmente (histórico git de preenchimentos e justificativas antes do próximo preenchimento aberto) | ND | ND | Parcialmente: Prophet Arena registro SHA-256 salgado, relógio do operador; Sornette et al. (2010) somas de verificação, não IA |
| 7. Âncora fora do operador | Implementado (Bitcoin, OpenTimestamps: existência não posterior a algumas horas após o bloco; em 20 de outubro de 2026 após a abertura) | Parcialmente (Polygon PoS, §3.2) | Não | Sim (Bitcoin; futebol, uma IA) | Não (o tempo descansa no host git) | ND | ND | Sim, não financeiro: compromissos Zeus em cadeia de previsões meteorológicas; Jyotish (2026), não IA; Não: Prophet Arena (relógio do operador) |
| 8. Preço de referência tomado após o selo | Implementado e verificável publicamente a partir de 21 de outubro de 2026 (nível 2+, Apêndice B, Passo 9); registrado pelo operador para 19 e 20 de outubro de 2026 (booked_at, nível 1) |
Parcialmente (preço médio do benchmark armazenado após o prazo; resultado binário, Fig. 3) | Não | Parcialmente (preço da multidão no ou antes do bloqueio) | Parcialmente (ordens preenchidas na abertura seguinte) | ND | Parcialmente (entrada na primeira vela de 1 minuto após a resposta) | ND |
| 9. Uma execução contada por uma regra escrita antecipadamente; todas as execuções publicadas | Implementado (todas as execuções publicadas, outras etiquetadas not_counted); execução contada declarada antecipadamente e selada na cadeia de questões a partir de 21 de outubro de 2026 (Seção 3.4); para as sessões de desenvolvimento de 19 e 20 de outubro de 2026 a regra foi aplicada após as execuções |
Parcialmente (um commit por agente e rodada, reforçado pelo relayer, §4.3; todos os commits públicos na cadeia; execuções fora da cadeia não cobertas) | Não (execução pré-janela de um modelo oculto, App. B.2) | ND | ND | ND | ND | ND |
| 10. Pontuação estritamente própria e calibração | Implementado em parte (Brier publicado cai empates; caixas de calibração); Brier de todas as linhas especificado como primário a partir de 21 de outubro de 2026 e calculado pelos scripts apresentados | Sim (Brier, Alpha, decomposição de Murphy, §3.3 a §3.5) | Não (retorno, taxa de vitória, §3.3) | Sim (Brier de três resultados) | Não (valor da conta) | ND | Sim (Brier, lacuna de calibração) | Sim: Prophet Arena, ForecastBench |
| 11. Benchmarks não informativos de 50% e climatológicos | Implementado (50%); implementado (frequências 2016 a 2025 seladas; campo climatology_fixed nos arquivos abertos a partir de 21 de outubro de 2026, 08:54 UTC) |
Parcialmente (baselines aleatória e de mercado) | Não | ND | ND | ND | ND | Parcialmente: ForecastBench baselines ingênuas; KalshiBench escore de habilidade em comparação com climatologia |
| 12. Regra de sessão mínima antes da classificação | Implementado (30/10, flags ranked) |
Parcialmente (análise de poder, rodadas mínimas recomendadas, §3.6.2) | Não | ND | ND | ND | ND | ND |
| 13. Portfólio simulado de $100.000 por modelo | Implementado | Não | Parcialmente (real $10.000 em contratos de eventos) | Não | Sim ($100.000, papel) | Parcialmente ($10.000 simulado) | Parcialmente (operações de futuros em papel) | Sim: Rallies $100.000; Alpha Arena real $10.000 |
| 14. Venda a descoberto e alavancagem 2× | Implementado (Pro league) | Não | Não (sem alavancagem, §4.5.1) | Não | Parcialmente (alavancagem de criptografia, sem venda a descoberto) | ND | Parcialmente (compra ou venda a descoberto, papel) | Sim: Alpha Arena perpetuais alavancados (press) |
| 15. Preço do mercado de predição no momento da resposta como comparação | Implementado (crowd_up contra o preço do contrato) |
Sim (Alpha contra preço médio, §3.4) | Parcialmente (operações contra preços) | Sim | ND | ND | ND | Sim: Prophet Arena, AIA Forecaster |
| 16. Acordo descontado para vozes correlacionadas, em tempo real | Implementado (N_eff por uma regra de elegibilidade declarada, n_eff.counted; pesos familiares; contagem de todos-errados e minoria-correta) |
Não (independência de mercado assumida, §7.5) | Não | Não (um modelo) | ND | ND | Parcialmente (rebanho medido, não descontado) | Apenas offline: Kim et al. (2025), Spiro (2026), Aitchison et al. (2026) |
| 17. Livro fechado com pacote de notícias selado | Implementado (pacote selado com hash); ausência de operador de busca registrado onde a linha diz apenas instrução | Não (busca opcional, não ablacionada) | Não (todos os modelos buscam) | ND | ND | ND | Parcialmente (um payload revelado com resumo de notícias; busca ND) | Parcialmente: FinDeepForecast com e sem busca, offline; MarketMania payload comum |
| 18. Modo de discussão em conselho | Implementado | Não (cego por design) | Não (trabalho futuro) | ND | ND | ND | ND | Parcialmente: configurações de coordenação, em tempo real na Foresight Arena (Nechepurenko & Shuvalov, 2026b) |
| 19. Consultas repetidas de um modelo | Implementado (portfólios); repeticões de probabilidade especificadas | Não | Não | ND | ND | ND | Sim (execuções de estabilidade) | Estudos de amostragem offline (Aitchison et al., 2026) |
| 20. Leitores fazem previsões antes de ver a IA, dois grupos permanentes | Ao vivo e aberto para todos os visitantes; resultados registrados como F28 e F29, lidos nos primeiros 200 palpites por grupo; rótulo do grupo especificado | Não | Não | ND | ND | ND | ND | Parcialmente: pools separados (ForecastBench, Metaculus); ensaio de assistência (Schoenegger et al., 2025) |
| 21. Temporada cega | Especificada (a partir de 2 de novembro de 2026; modelo, versão e modo selados como um compromisso SHA-256 com sal, sais publicados após a temporada) | Não | Parcialmente (um modelo sob um identificador oculto) | ND | ND | ND | ND | ND |
| 22. Previsões datadas sobre a liga, precificadas cegas | Implementado (30, precificadas cegas; registradas na OSF antes da postagem) | Não | Não | ND | ND | ND | ND | ND |
| 23. Dados abertos sob licença declarada | Implementado (CC BY 4.0) | Parcialmente (on-chain, nenhuma licença de dados declarada) | ND (nenhum repositório fornecido) | Sim (GitHub, Zenodo) | Sim (MIT, livro razão completo) | Parcialmente (JSON aberto, licença não declarada) | Parcialmente (exportações de API, licença ND) | Sim: ForecastBench, LiveTradeBench, StockBench; GlassBallAI CC BY-NC |
| 24. Código de pontuação aberto com hashes | Implementado (código do engine com hashes, arena-code.json; recontagem forecast-score, tools/replay_brier.py; resolvers arquivados na OSF) | Sim (contratos on-chain, repositório de análise) | Não | ND | Parcialmente (código aberto) | ND | ND | Parcialmente: PolyBench, código ForecastBench |
| 25. Recálculo de cada conta por terceiros | Implementado (replay.py) |
Sim ("replay do histórico completo", Contributions 1) | Não | ND | Sim (livro razão recalcula cada conta) | ND | ND | ND |
| 26. Token RFC 3161 no lacre | Implementado a partir de 21 de outubro de 2026, verificável publicamente (FreeTSA e DigiCert; Sectigo adicionado na mesma manhã; página de comprovação); lacre na chegada especificado | Não | Não | ND | ND | ND | ND | Não é IA: uma ferramenta de lacre geral para previsões humanas |
Nota: Os números § nas colunas Foresight Arena e Prediction Arena referem-se a seções desses artigos. As linhas 5, 10, 13 a 15, 19 e 25 são recursos que a liga compartilha com trabalhos anteriores. Linhas por trás das afirmações da Seção 7.4: Afirmação 1: linhas 4 e 6 a 9 (linha 8 no nível 1 para 19 e 20 de outubro, nível 2+ a partir de 21 de outubro). Afirmação 2: linha 16. Afirmação 3: linhas 6 a 12, 16 e 26, lidas com a coluna de status da Seção 3.13. Afirmação 4: linha 20. Afirmação 5: linha 2. Afirmação 6: linha 22.
Como citar
Chernets, V. (2026). Lacrado Antes da Abertura: Um Padrão Verificável para Medir Previsões de IA em Mercados Financeiros [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7653679
@misc{chernets2026sealedbeforetheopen,
  author       = {Chernets, Vadym},
  title        = {{Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7653679},
  url          = {https://doi.org/10.2139/ssrn.7653679}
}