Инверсия согласия — это не свойство среднего уровня: точность согласованных ответов LLM следует точности пары
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Вадим Чернец, PhD, архитектор AI-систем · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Выпуск анализа 10.5281/zenodo.24090584 · GitHub
Препринт, 9 ноября 2026 г. SSRN: 7682960. Архивная копия: 10.5281/zenodo.24090580. Данные и код: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. PDF является авторитетным источником.
Аннотация
Когда две флагманские модели, опрашиваемые отдельно, дают одинаковый ответ на один из самых сложных вопросов SimpleQA, этот ответ обычно неправильный. На 106 вопросах SimpleQA, где панели среднего уровня июля не прошли, 45 пар флагманских моделей без обслуживаемого клиентом рукава GPT, где поиск в веб-сети не может быть исключён, правильны на 96 из 691 совпадений (13,9%). Ответ только при согласии второй модели не требует меток или параметров, и более ранние работы приписывали неудачи этого правила моделям среднего уровня. На обоих измеренных мною уровнях точность согласованных ответов следует точности пары, поэтому инверсия не является свойством моделей среднего уровня. В самом сложном квинтиле, определённом одинаково для каждого уровня, точность составляет 17,3% в июле и 15,5% в августе; по всем пяти квинтилям, при точности, ожидаемой от двух точностей каждой пары, пары флагманских моделей отличаются от пар среднего уровня на -0,2 пункта [-3,1, +2,7]. Данные взяты из SimpleQA, свежих двухшаговых вопросов и фактов о продуктах, собранных в июле, августе и октябре 2026 года с флагманскими моделями одиннадцати лабораторий. Партнёр из второй лаборатории выявляет больше ошибок, но открывает вход реже: для одной выпущенной модели партнёр из той же лаборатории выявляет 2 из 29 ошибок, а партнёр из другой лаборатории 20 из 29 (-62,1 пункта [-79,3, -43,8]), при открытом входе на 96% и 61% вопросов. Когда более широкий вход сужен по объявленной уверенности для равного охвата, это преимущество сохраняется только там, где модель партнёра намного точнее. Небольшая модель, получившая измеренные точности, предсказывает внешнюю точность со средней абсолютной ошибкой 0,037 против 0,099 для лучшей единственной модели, на уровне базовой линии с независимыми ошибками на 0,032, и показывает высокие результаты на фактах о продуктах и публичных данных. На тех же 100 вопросах идентификатор gpt-5.6-sol показывает 92,0% в обслуживаемой клиентом волне и 46,3% через API с другим уровнем усилий, в то время как восемь других моделей движутся максимум на 4 пункта.
1. Введение
Задайте одинаковый короткий фактический вопрос двум большим языковым моделям (БЯМ) из разных лабораторий отдельно и опубликуйте ответ только если оба совпадают. Фильтр не требует метки, порога или судьи, только два слепых вызова. Флагманские модели делают это привлекательным, потому что их заявленная уверенность обеспечивает слабую защиту: в десяти флагманских вариантах в августе 2026 года 4910 из 10540 ответов, высказанных с уверенностью не менее 80, были неправильными (Чернец, 2026b).
Мое более ранее измерение на проприетарных моделях, сборка середины июля 2026 года моделей среднего уровня, выявило повторяемые ответы панели на самом сложном квинтиле SimpleQA, корректные в 0 из 342 случаев (Чернец, 2026a). Это предполагает, что согласие инвертируется для слабых моделей, так что согласованные ответы чаще неправильны, чем правильны, и что сильные модели избегают этого. Одна флагманская пара, похоже, подтверждает это: gpt-5.6-sol с claude-fable-5 был правильным в 34 из 37 согласованных ответов на те же вопросы (106 из раздела 3).
На флагманском уровне это прочтение не выполняется. Без единственного варианта позади 34 из 37, gpt-5.6-sol, предоставляемого через клиента поставщика, инверсия возвращается, и при одинаково определенной сложности для обоих уровней две кривые встречаются в сложном конце. Во всех квинтилях, после учета двух точностей каждой пары, флагманские и среднеуровневые пары отличаются на -0,2 пункта [-3,1, +2,7]. Точность отслеживает, насколько точны две модели на слое, независимо от их уровня.
Таблица 1 резюмирует четыре вклада. Раздел 5.1 дает описание фильтра на уровне флагманов, построенное везде, где возможно, без варианта, который доминирует в диапазоне точности. Раздел 5.2 измеряет, что вносит вторая лаборатория, варьируя выпущенную модель и партнера, с GPT и без него. Разделы 4 и 5.3 дают описательную модель фильтра с пятью константами и проверяют ее вне выборки против заявленных базовых значений, а раздел 5.4 сравнивает клиентов поставщиков с прямым доступом через API для одного и того же идентификатора на одних и тех же вопросах.
Таблица 1. Утверждения, свидетельства и граница.
| Утверждение | Свидетельство | Граница |
|---|---|---|
| Точность согласованных ответов следует точности пары на обоих уровнях | 96/691 в 106; самый сложный квинтиль 17,3% июль, 15,5% август; уровень при согласованной точности -0,2 [-3,1, +2,7] | Ассоциация; один квинтиль охватывает -1,8 [-22,1, +20,2] |
| Вторая лаборатория выявляет больше ошибок ценой охвата | 20/29 против 2/29 выявленных ошибок, -62,1 [-79,3, -43,8]; охват 61% против 96% | При равном охвате по уверенности требуется намного более точный партнер; две лаборатории в октябре |
| Малая модель описывает точность вне выборки | Ошибка 0,037 против 0,099 для лучшей модели, -0,062 [-0,085, -0,035] | На уровне независимых ошибок, +0,005 [-0,003, +0,012]; 13 пунктов выше на фактах о продукте |
| Режим доступа меняет один идентификатор | 92,0% клиент против 46,3% API, одинаковые 100 вопросов | Режим, усилие и возможный поиск меняются вместе |
2. Связанные работы
Ближе всего к моему вопросу находится работа Goel et al. (2025), которые вводят CAPA — меру согласия, скорректированную на случайность, между распределениями выходных данных моделей, и демонстрируют на 130 открытых моделях с весами на MMLU-Pro и BBH, что ошибки становятся более сходными с увеличением возможностей, что, по их утверждению, ставит под угрозу AI-надзор, включая жюри из языковых моделей. Я измеряю для проприетарных моделей от различных лабораторий, что слепое согласие подтверждает, когда оно ограничивает выпуск краткого ответа открытой формы: точность согласованных ответов, долю ошибок выпущенной модели, которые разногласие выявляет, и нижний предел общих уверенных ошибок. Результаты совместимы: в моих данных стоимость растущего сходства проявляется в полноте разногласия, тогда как точность остаётся высокой там, где высока точность (Приложение L). Каскадирование на основе согласия (Kolawole et al., 2025) использует согласие ансамбля как обучения-свободное правило отказа с условием на совместную частоту принятых ошибок, а мои стратифицированные результаты определяют место концентрации таких ошибок.
Коррелированные ошибки у разных провайдеров документированы Kim et al. (2025), и Hossain et al. (2026) обнаруживают их более сильными среди судей-LLM frontiera. Жюри из разнообразных малых судей появляются в Verga et al. (2024), а смещение модели, судящей свой собственный выход, в Panickssery et al. (2024), что благоприятствует сравнению двух слепых ответов. Согласие среди выборок одной модели является сигналом уверенности в самосогласованности (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) и семантической неопределённости (Kuhn et al., 2023), а также правилом отказа в Yue et al. (2024); я сравниваю его с согласием между лабораториями (Раздел 5.2). Шлюз является селективным предиктором (Geifman & El-Yaniv, 2017), поэтому я сравниваю шлюзы при равном охвате. Недавние препринты расходятся во мнении о том, помогает ли агрегация (Приложение E). Мне не известно никаких работ, которые сообщают о выпускном шлюзе на уровне пары для кратких фактов открытой формы с проприетарными флагманами, полноте при равном охвате с одной выпущенной моделью, зафиксированной, или одном идентификаторе, измеренном в двух режимах доступа на одних и тех же вопросах.
3. Данные и протокол
Мои предыдущие работы представили июльские панели (Chernets, 2026a) и августовские и октябрьские агрегаты для избранных пар (Chernets, 2026c). Новые здесь — флагманские пары без GPT, симметричное определение сложности, пары из одной лаборатории, сравнения при равном охвате, внеборочные и внешние тесты, а также сравнение режимов доступа.
Сборки. Все ответы были собраны вслепую: один вызов на вопрос, при этом ни одна модель не видела ответ другой. Системная подсказка запрашивает объект JSON с кратким ответом и оценкой уверенности от 0 до 100 и не запрашивает источники. Таблица A1 перечисляет модели, даты и режимы доступа, а Приложение F — полный процесс сборки. Девять API-моделей и семь локальных моделей ответили на 1500 вопросов SimpleQA (Wei et al., 2024) с 24 по 28 июля, зарегистрированные на OSF перед сбором данных (Chernets, 2026a). По одному флагманскому от каждой из одиннадцати лабораторий ответили на те же вопросы с 3 по 6 августа, 1459 общих для всех, и девять из них ответили на 100 из них при температуре 0,7 с тремя выборками (ветвь дисперсии). Добавлены 100 двухшаговых вопросов, составленных машиной из Wikidata, с хешем файла, зафиксированным перед первым вызовом модели, и 267 фактов о продуктах. В октябре gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 и claude-fable-5-1 ответили на 300 вопросов SimpleQA, стратифицированных по июльским квинтилям, 106 ниже и свежий набор, три непересекающихся набора с 503 вопросами, общими для всех пяти моделей (каждая пара по ним находится в Таблице A2).
106. Это вопросы из самого сложного квинтиля, на которые июльская панель повторила ответ (Chernets, 2026a). Они были отобраны на основе отказа июльских моделей, поэтому точность июля на них частично является результатом отбора, и раздел 5.1 сопоставляет их с симметричным определением сложности, которое не имеет этого свойства.
Режимы доступа. В августе claude-fable-5, gpt-5.6-sol и mistral-medium-3.5 работали через собственный основной клиент поставщика, официальный интерфейс командной строки, который развёртывают конечные пользователи, а в октябре каждая ветвь работала, поэтому измерения включают системные подсказки со стороны поставщика и стандартные настройки обслуживания, как их получает пользователь клиента. Июльская волна и остальные августовские ветви использовали прямые маршруты API или агрегаторов, привязанные к поставщику. Таблица 2 указывает условия измерения ветвей клиента. Я называю ветвь поиск-возможной, когда невозможно исключить использование ею веб-поиска, и я сообщаю основные результаты с такими ветвями и без них.
Таблица 2. Условия измерения по ветвям. Примечание: температура не устанавливается в клиентах Codex и Claude; потоки событий Codex не были сохранены. API-ветви июльской и августовской волн работали при температуре 0. Тире обозначает отсутствие параметра или отсутствие записи в реестрах.
| Ветвь | Достигнута через | Затраты | Поиск возможен |
|---|---|---|---|
| gpt-5.6-sol, август | Codex клиент | стандартное значение клиента, не записано | не исключено |
| claude-fable-5, август | Claude клиент | - | нет, записано 0 запросов поиска |
| mistral-medium-3.5, август | клиент поставщика | - | нет, пустой список инструментов |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, октябрь | Codex клиент | среднее | не исключено |
| claude-opus-5-5, claude-fable-5-1, октябрь | Claude клиент | - | нет, инструменты запрещены |
| kimi-k3, gemini-3.8-flash, свежий набор | клиент поставщика | - | инструменты не отключены, подсказка запрещает |
| gpt-5.6-sol, ветвь дисперсии | прямой API | нет | - |
Вентиль и меры. Вентиль открывается, когда обе модели ответили, ни одна не отказала, и детерминированный механизм эквивалентности, одинаковый для каждой волны здесь, находит две ответа эквивалентными. Оценка применяет тот же механизм к ответу и эталонному ответу: нормализованное точное совпадение, содержание строк из четырёх или более символов и правила для дат, чисел и идентификаторов (Приложение D с переоценкой в Таблице A3). Ячейка — это пара моделей на слое вопросов. Охват подсчитывает открытые вентили среди вопросов, на которые ответили обе модели. Точность, PPV, — это доля правильных среди открытых ответов, которые оценщик определяет как правильные или неправильные (K/O), и Delta — это точность минус полнота выпущенной модели по всем разрешённым вопросам ячейки. Полнота — это доля ошибок выпущенной модели, на которых вентиль остаётся закрытым, сообщается как выявленные ошибки. Lift делит точность выпущенной модели с открытым вентилем на эту с закрытым вентилем, а полоса подсчитывает вопросы, на которых обе модели указывают уверенность не менее 80, согласны и ошибаются. Я называю согласие перевёрнутым, когда PPV ниже половины. Выпущенная модель — это первый член пары или более точный при объединении пар. Чтобы сравнить вентили при равном охвате, я прореживаю более широкий вентиль: открытые ответы ранжируются по меньшему из двух указанных доверительных показателей и обрезаются до целевого охвата, связи разрешаются случайным образом.
Логический вывод. Одиночные доли содержат интервалы Вилсона. Различия и производные величины содержат 95%-ные интервалы начальной загрузки, двусторонние по вопросам и моделям для объединённых результатов (Owen, 2007; B = 2000, зерно зафиксировано, модель переустановлена в каждой репликации) и по вопросам для одной пары. Парные сравнения точности используют точный тест Макнемара, а эквивалентность — двусторонний тест (Schuirmann, 1987) с полем 2 пункта. Ячейки зависимы, поэтому они содержат интервалы и не содержат значения p.
4. Модель шлюза
Пусть и — измеренные точности двух моделей на ячейке, и . Пусть — вероятность того, что обе модели ошибаются, а — вероятность того, что обе модели правы:
Здесь увеличивает независимую вероятность совместной ошибки. Два правильных ответа совпадают с вероятностью . Два неправильных ответа совпадают с вероятностью , где на 106, чьи неправильные ответы чаще совпадают, и 1 в остальных местах. Тогда
Подобран на 335 парах клеток разных лабораторий (июль, август и октябрь, из них 106; — коэффициент совпадения двух правильных ответов по всем подобранным клеткам), константы равны , , , (22 536 из 22 785) и .
Модель принимает на входе измеренные точности клетки и возвращает охват, точность и долю неправильных согласованных ответов, , из которых часть в разделе 3 — это часть с доверием не менее 80. Для двух точностей она возвращает, что добавляет вентиль, и показывает, почему точность должна следовать за точностью вверху: при и совпадении правильных ответов, точность согласованных ответов не может упасть ниже , даже если каждая ошибка общая, поскольку обе модели правы вместе по крайней мере на вопросах и неправы вместе максимум на (0.947 при ). При границы нет, и может превышать всякий раз, когда неправильные ответы сосредоточены на одной строке.
Я сравниваю её с двумя базовыми моделями. Базовая модель независимых ошибок устанавливает и переподбирает остальное, так что она сохраняет . Базовая модель лучшей модели предсказывает . Критерием было, чтобы модель превосходила обе, с интервалом разности ниже нуля в условиях исключения одной лаборатории (LOLO), исключения одной модели (LOMO) и временного разделения с июля и августа на октябрь.
5. Результаты
5.1 Инверсия не является свойством среднего уровня
Таблица 3 дает модель без обслуживаемых клиентом GPT-ветвей. В целом на SimpleQA два уровня выглядят одинаково: точность 72,1% в июле и 80,6% в августе с дельта +28,6 и +26,0 пункта по сравнению с выпущенной моделью. На 106 точность низкая в обе волны: 5 из 717 в июле и 96 из 691 в августе без GPT. Исключение GPT-ветви из июльской части также дает 4 из 581, и разница август минус июль составляет +13,2 пункта [+2,6, +30,8]. Точность в августе выше и по-прежнему намного ниже одной второй, поэтому согласованность инвертирована в обе волны. Она также ниже лучшей отдельной ветви на страте на -9,5 пункта [-16,3, -3,2] в июле и -43,2 [-67,6, -16,1] в августе. Lift составляет 0,13 [0,00, 1,21] в июле и 0,65 [0,23, 1,22] в августе без GPT.
Таблица 3. Модель без обслуживаемых клиентом GPT-ветвей. Примечание: объединено по парам из разных лабораторий, если не указано иное; покрытие распространяется на вопросы, на которые оба модели ответили, K/O на открытые ответы, разрешенные оценивающим; интервал на PPV: двусторонний bootstrap. Факты о продукте: четыре ветви без возможности поиска.
| Уровень, вопросы | Пары | Покрытие | PPV (K/O) [95%] | Точность выпущенной модели | Дельта, пункты [95%] |
|---|---|---|---|---|---|
| Средний, июль, 106 | 36 | 19,8% | 0,7% (5/717) [0,0, 3,7] | 4,6% | -3,9 [-8,3, +0,3] |
| Средний, июль, все SimpleQA | 36 | 20,6% | 72,1% (7743/10745) [53,2, 82,3] | 43,4% | +28,6 [+22,3, +32,4] |
| Флагманский, август, 106, без ветви с возможностью поиска | 45 | 19,1% | 13,9% (96/691) [3,3, 31,8] | 19,9% | -6,0 [-14,1, +2,9] |
| Флагманский, август, все SimpleQA, без ветви с возможностью поиска | 45 | 29,1% | 80,6% (12357/15322) [69,6, 87,9] | 54,7% | +26,0 [+19,9, +30,7] |
| Флагманский, август, свежие 100 (GPT по API) | 6 | 37,5% | 88,9% (200/225) [75,6, 97,4] | 66,8% | +22,1 [+7,9, +47,4] |
| Одна лаборатория, октябрь, fable-5-1 + opus-5-5, 106 | 1 | 39,6% | 47,5% (19/40) | 30,0% | +17,5 [+6,2, +29,7] |
| Октябрь, kimi-k3 + gemini-3.8-flash, свежие 100 (инструменты не отключены) | 1 | 72,0% | 95,8% (69/72) | 74,0% | +21,8 [+14,1, +30,0] |
| Факты о продукте, 267, без ветви с возможностью поиска | 6 | 63,6% | 75,0% (423/564) [66,4, 82,7] | 62,7% | +12,3 [+5,8, +20,4] |
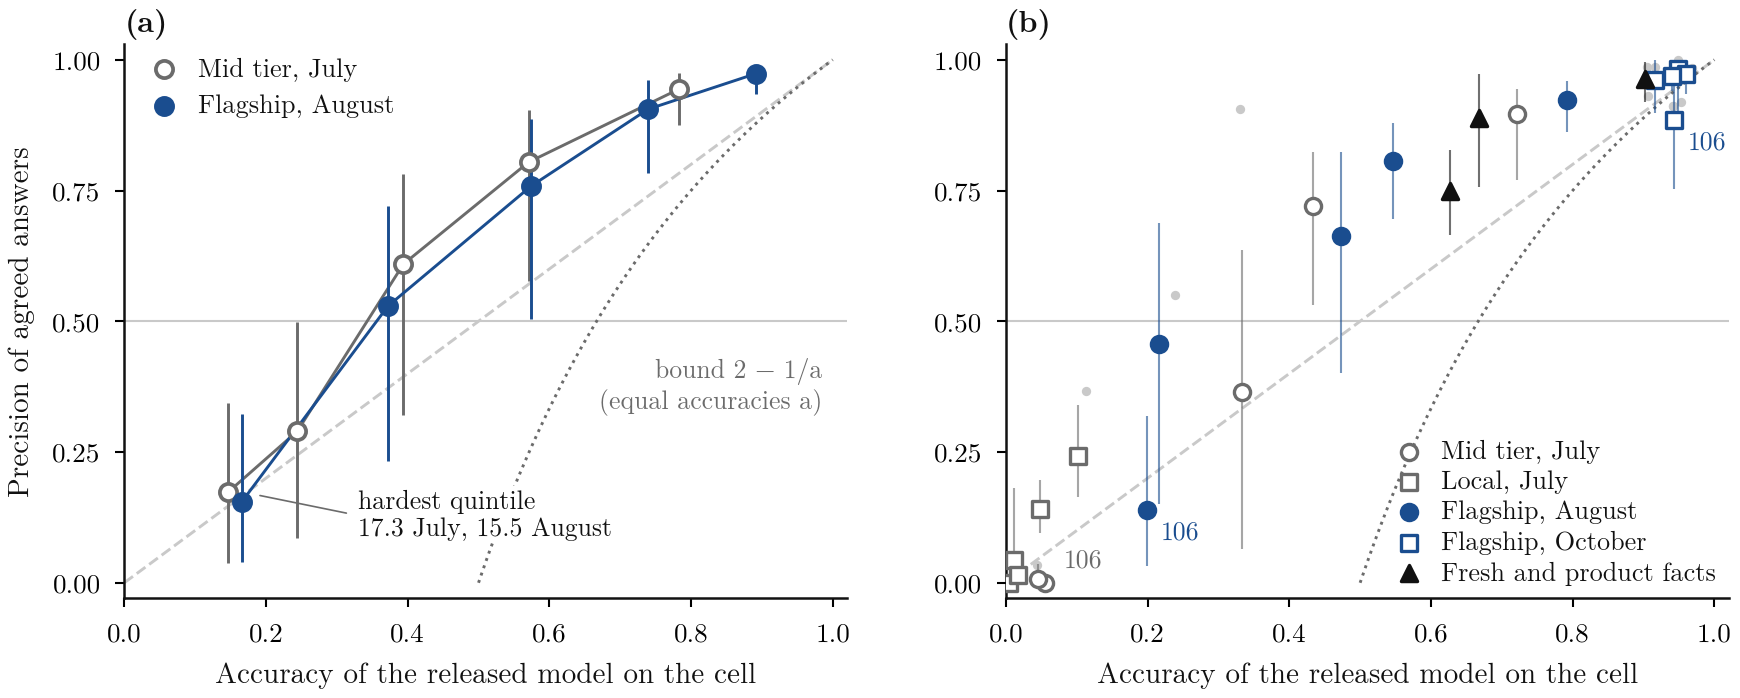
Рисунок 1. Точность согласованных ответов соответствует точности пары. Примечание: (a) квинтили сложности в каждом уровне, июль средний уровень и август флагманские без обслуживаемых клиентом GPT-ветвей. (b) Каждая полоса каждого уровня с июля по октябрь в зависимости от точности выпущенной модели; обозначенные ячейки — это 106. Усы — это 95% доверительные интервалы bootstrap, и небольшие серые точки в (b) — это отдельные пары; штриховая линия — равенство, пунктирная линия — граница 2 - 1/a при равных точностях a.
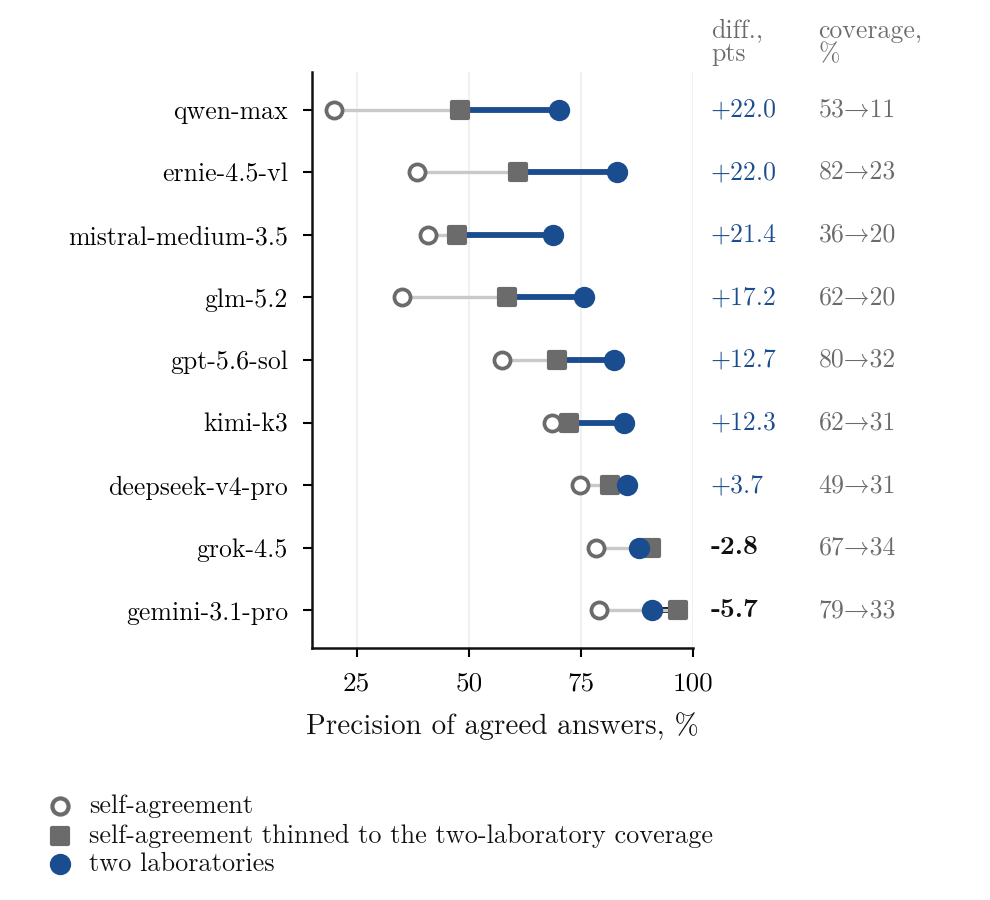
Рисунок 2. Самосогласованность относительно двух лабораторий по моделям. Примечание: ветвь дисперсии, девять моделей, 100 вопросов. Открытый круг — два обращения к одной модели; квадрат — то же самое, отфильтрованное по уверенности к покрытию двухлабораторной модели; заполненный круг — две лаборатории, среднее значение по партнерам. Правые столбцы дают разницу при равном покрытии в пункты и покрытие обеих моделей в процентах.
Трёхмодельные панели без обслуживаемой клиентом GPT-ветви дают тот же результат. На 106 в моем механизме июльские панели дают 0 из 318 (0 из 342 раздела 1 — это самый сложный квинтиль по более ранней схеме сопоставления; 5 из 717 выше считает пары). В августе панель DeepSeek, Qwen и Kimi дает 0 из 76, а панель между блоками Claude, DeepSeek и Mistral дает 11 из 78 (14,1% [2,7, 26,3]), в то время как панель Claude, GPT и Gemini, которая содержит GPT-ветвь, дает 106 из 131 (80,9%). Флагманские пары соответствуют их точности на страте, от 4 из 21 для fable-5 с deepseek-v4-pro до 15 из 24 (62,5% [42,6, 82,6]) для fable-5 с gemini-3.1-pro, чьи члены возглавляют эту группу там.
Поскольку 106 были выбраны по июльскому отказу, который снижает июльскую точность на них и благоприятствует августу, Рисунок 1a устанавливает сложность в каждом уровне. Для каждого уровня вопросы ранжируются в квинтили по точности того же уровня без пары в оценке, так что самый сложный квинтиль имеет один и тот же ранг для каждого, и точность выпущенной модели там близка, 15,3% в июле и 16,0% в августе. Точность там составляет 159 из 917 (17,3% [3,8, 34,3]) в июле и 203 из 1308 (15,5% [4,0, 32,4]) в августе без GPT, разница -1,8 пункта [-22,1, +20,2]. Объединение всех пяти квинтилей дает более строгий тест. Модель раздела 4 не имеет членов уровня. При имеющихся двух точностях каждой ячейки она дает ожидаемую там точность и эффект уровня проявится как разница в остатках. Ячейки флагманского уровня лежат на -0,2 пункта [-3,1, +2,7] от ячеек среднего уровня и -0,5 [-3,6, +2,4] когда константы подгоняются только по июльским ячейкам, так что август находится вне выборки. kimi-k3 принадлежит обеим совокупностям; без него разница составляет +0,1 [-3,6, +3,8]. На очищенных верных ответах точность остается низкой: на 24 из 106, которые выживают в SimpleQA Verified (Haas et al., 2025), августовские пары без GPT правы на 18,7% согласованности [0,0, 57,1] (Приложение G).
По каждой полосе каждого уровня (Рисунок 1b) точность растет с точностью выпущенной модели в каждой волне и лежит выше диагонали в 17 из 23 ячеек. Из шести ниже её три — это ячейки 106 и три — это полосы с точностью выпущенной модели менее 0,06. На вершине kimi-k3 с gemini-3.8-flash достигают 95,8% на свежем наборе (Приложение G).
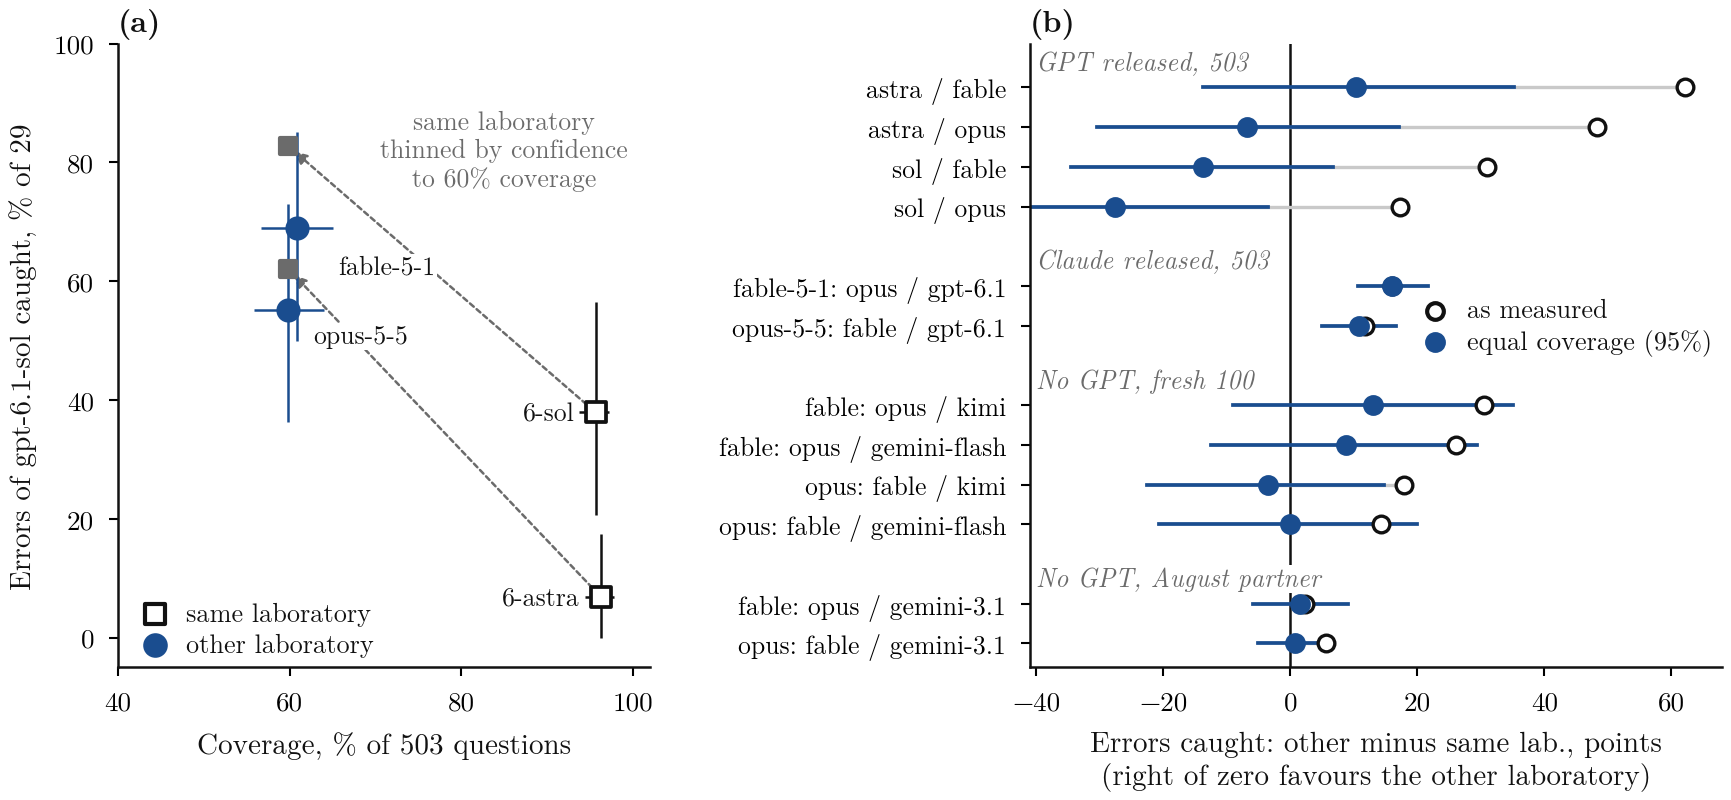
Рисунок 3. Вторая лаборатория: охват и обнаруженные ошибки. Примечание: (a) gpt-6.1-sol на 503 общих вопросах, 29 ошибок, четыре партнёра из таблицы A4, 95% доверительные интервалы бутстреп; стрелки ведут от того же лабораторного шлюза к тому же шлюзу, разреженному по доверию до 60% охвата. (b) Двенадцать сравнений из таблицы A5: ошибки, обнаруженные другой лабораторией минус одна лаборатория, как измерено (открытые) и при равном охвате (закрытые, 95% доверительный интервал бутстреп для вопросов).
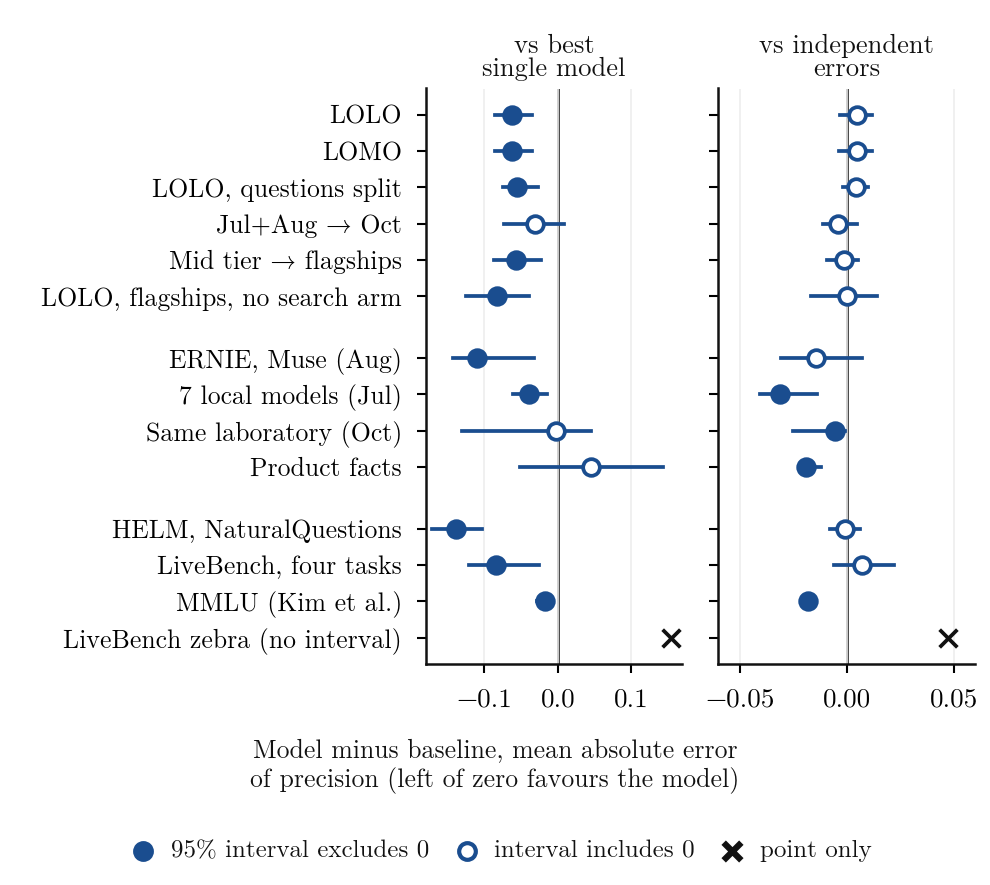
Рисунок 4. Модель против двух базовых вариантов, вне выборки. Примечание: модель минус базовый вариант в средней абсолютной ошибке предсказанной точности, ниже нуля предпочтительна модель, с 95% двусторонними доверительными интервалами бутстреп (таблицы A6 и A8). Верхняя группа, схемы подгонки; средняя — наборы вне подгонки с замороженными константами; нижняя — открытые данные (раздел 5.5). Закрытый маркер — 95% интервал исключает нуль; открытый — включает нуль; крест — точечная оценка (задача зебры LiveBench).
5.2 Вторая лаборатория обнаруживает больше ошибок за счёт охвата
Одна только точность не может разделить случаи, потому что точные пары из одной лаборатории также имеют высокую точность. Полноту нужно читать вместе с охватом, так как шлюз, который открывается реже, по построению блокирует больше ошибок.
Я начинаю с группы дисперсии: два вызова одной модели при температуре 0.7 против двух вызовов разных лабораторий (рисунок 2). Объединённые по девяти моделям и 100 вопросам, самосогласованность охватывает 63.5% при точности 56.1%, а две лаборатории охватывают 26.1% при 82.9%. Разница в точности составляет +26.8 пункта [+16.6, +34.6] при измерении и +9.0 [+0.5, +17.4] при равном охвате, где самосогласованность разреженна по доверию, что её предпочитает. По моделям двух-лабораторный шлюз лидирует для семи из девяти. Группа не содержит модели Claude и имеет GPT по API при нулевом усилии. Без GPT, по восьми моделям, разница при равном охвате составляет +7.7 пункта [-1.9, +16.5].
Октябрьская волна содержит по две модели из двух лабораторий, что даёт прямой тест на 503 общих вопросах (рисунок 3a). Одна выпущенная модель, gpt-6.1-sol, сохраняет одни и те же 29 ошибок в каждой строке и меняет только партнёра. Её партнёр из одной лаборатории gpt-6-astra обнаруживает 2 из них, а fable-5-1 обнаруживает 20, разница -62.1 пункта [-79.3, -43.8]; против opus-5-5 разница составляет -48.3 [-66.7, -29.6]. Цена — охват, 60–61% против 96%. Точность сходна по строкам: 94.3 и 96.2% для одной лаборатории, 95.6 и 97.0% по разным лабораториям (таблица A4). Партнёры из одной лаборатории различаются широко: gpt-6-sol обнаруживает 11 из 29 (приложение H).
Чтобы увидеть, является ли это чем-то большим, чем движение вдоль кривой охвата, и нужен ли для этого GPT, каждая строка рисунка 3b сохраняет одну выпущенную модель и сравнивает её двух партнёров, как измерено и при равном охвате (таблица A5). При измерении другая лаборатория обнаруживает больше ошибок в каждой строке. При равном охвате её преимущество сохраняется только когда Claude выпущена с gpt-6.1-sol в качестве партнёра, партнёра с точностью 93.9% против 66.6–69.2% для партнёра из одной лаборатории на стратифицированном наборе. Когда GPT выпущена, шлюз из одной лаборатории, разреженный по доверию, находится на одном уровне или впереди, а без GPT разница находится на одном уровне или предпочитает одну лабораторию против слабых партнёров. С двумя лабораториями в октябре я не обнаруживаю влияния лаборатории, кроме точности партнёра и охвата, а HELM с 20 разработчиками не показывает его, когда оба согласованы (раздел 5.5).
5.3 Модель вне выборки
Вне выборки модель явно улучшается в отношении чтения лучшей модели и находится на одном уровне с базовым вариантом независимых ошибок (рисунок 4, таблица A6). При LOLO её ошибка составляет 0.037 против 0.099 для базового варианта лучшей модели (-0.062 [-0.085, -0.035]), и этот интервал лежит ниже нуля при LOMO, разделении вопросов и в семи из десяти строк таблицы A6. Временное разделение даёт 0.019 против 0.050, -0.031 [-0.074, +0.008], ниже нуля при кластеризации по вопросу или по модели отдельно (приложение I). Против независимых ошибок модель находится на одном уровне при всех трёх схемах и лучше на трёх из четырёх наборов вне подгонки с замороженными константами, поэтому критерий раздела 4 выполнен против базового варианта лучшей модели.
Точность обеспечивается измеренными точностями и : удаление повышает ошибку LOLO до 0.323, а её удержание константой даёт 0.046. Множитель ничего не добавляет к точности в основных схемах и помогает при охвате и логарифмической потере.
На фактах о продуктах модель работает с высокими показателями. Её ошибка составляет 0.130 против 0.086 для лучшей модели, всё это преувеличение (13 пункта), и 0.190 против 0.067 с родным оценщиком этого домена, снова всё преувеличение (19 пункта). Приложение I сортирует ячейки по классам результатов.
5.4 Доступ к модели и группы GPT
На одном наборе из 100 вопросов SimpleQA gpt-5.6-sol набирает 92 из 100 (92.0%) в основной волне, 99 из них через клиент Codex, и 139 из 300 образцов (46.3%) через прямой API в группе дисперсии, разрыв 45.7 пункта (рисунок 5). Буквальное воспроизведение золотой строки падает вместе с ней, с 64.0% до 26.0%. Клиент работает при своём параметре усилия по умолчанию согласно своим инструкциям, с невозможностью установки температуры, тогда как API работает при нулевом усилии и температуре 0.7.
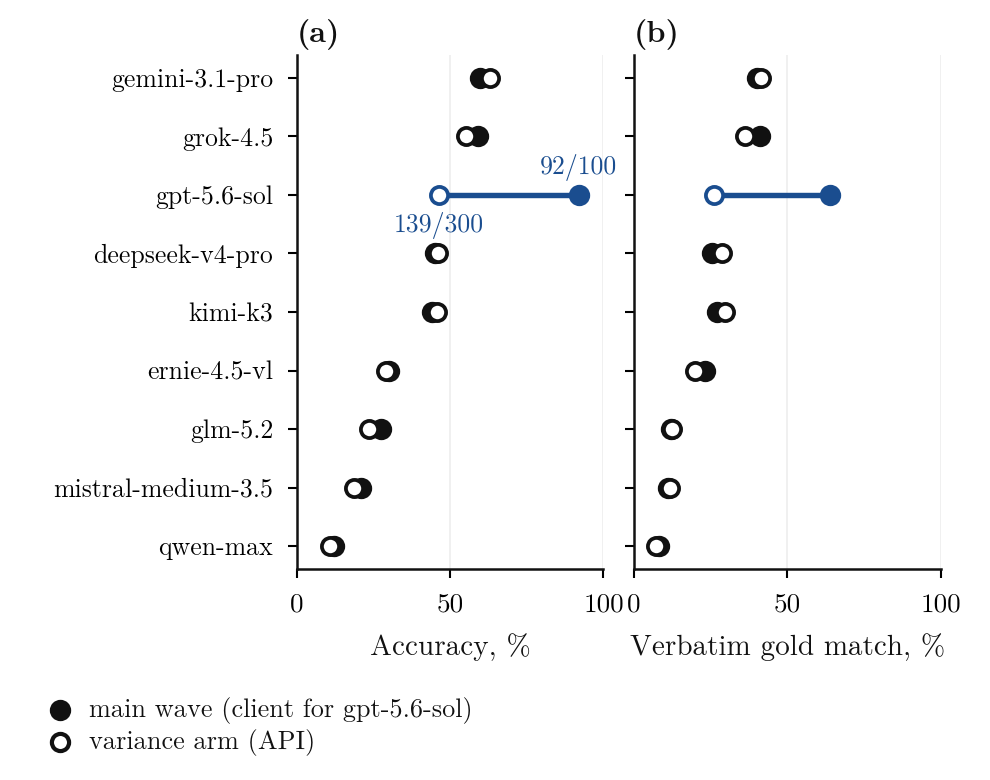
Рисунок 5. Один набор из 100 вопросов, две группы, девять моделей. Примечание: (a) точность, (b) буквальное совпадение с золотой строкой. Закрытые, основная волна (обслуживается клиентом для gpt-5.6-sol, 92/100); открытые, группа дисперсии через API (139/300). Для gpt-5.6-sol группы также различаются параметром усилия.
Восемь других моделей, температура которых также изменяется между двумя столбцами, смещаются максимум на 4,0 пункта в любом направлении. Усилие — один из возможных кандидатов, хотя парное измерение бюджета рассуждений на gemini-3.1-pro оставило точность практически неизменной (Chernets, 2026c). Веб-поиск — другой: октябрьские ответы от того же клиента содержат ссылки, которые запрос не запрашивает, в 3 из 506 ответов gpt-6.1-sol и 18 из 506 gpt-6-astra, а медианное использование токенов на вызов клиента в августе составляет 4829.
Показатель клиента — это то, что получает человек, использующий продукт, а показатель API — это то, что читает тестовый стенд при нулевом усилии. На новых вопросах в августе с GPT через API gpt-5.6-sol и fable-5 правильны в 29 из 32 совпадений, Delta +57,6 пункта [+46,3, +69,7]. В октябре с более новым GPT через клиент на те же вопросы пара с opus-5-5 правильна в 72 из 74, Delta +2,3 [-0,7, +6,0]. Два сравнения также отличаются моделью GPT и датой, и в обоих случаях значение шлюза отслеживает точность выпущенного варианта, как в разделе 5.1.
Варианты GPT, обслуживаемые клиентом и исключённые из таблицы 3, точны: августовский вариант с fable-5 правилен в 997 из 1016 совпадений (98,1%) и в 34 из 37 по 106, наследуя точность варианта (Delta -3,3 [-10,3, +2,6]; таблица A7 и приложение J).
5.5 Внешняя проверка на открытых данных
Я применил замороженные константы без переподгонки к открытым данным, которые не совместно используют ни модели, ни подгонку с моими: HELM Lite (Liang et al., 2023), 95 моделей от 20 разработчиков, ответивших на 1000 закрытых вопросов NaturalQuestions; LiveBench (White et al., 2025), 70 моделей от 11 лабораторий на 346 вопросах с кратким окончательным ответом; и парные агрегаты Kim et al. (2025) для 70 моделей на множественный выбор MMLU (таблица A8). Результаты совпадают с разделом 5.3 (рисунок 4, нижняя группа). Модель превосходит чтение в пользу лучшей модели во всех трёх источниках и сравнима с независимыми ошибками в HELM и LiveBench. Она завышается на 5,3–6,6 пункта и не работает на головоломках зебра (0,231 против 0,076).
В HELM наблюдаемая кривая выравнивается там, где модель продолжает расти (рисунок 6): при точности пары между 0,5 и 0,6 точность составляет 74,6% для моделей 2023 года и начала 2024 года и 75,9% для более поздних, против 84,4% предсказанных в середине интервала. На MMLU медианная вероятность того, что два неправильных ответа совпадают, составляет 0,621 против 0,368 из , так как четыре варианта вынуждают коллизии. Точность растёт с точностью пары (Spearman +0,575 в HELM и +0,786 на MMLU, по зависимым ячейкам).
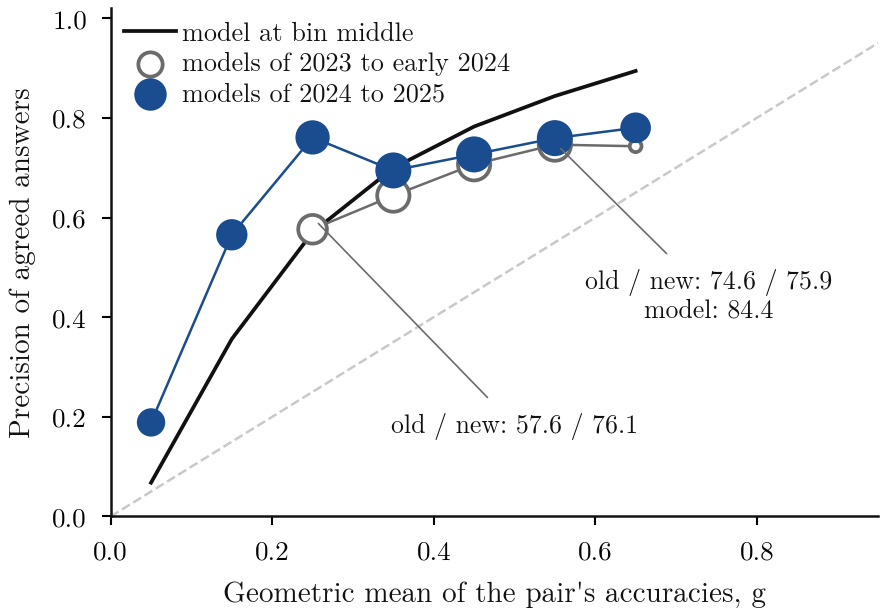
Рисунок 6. HELM Lite: точность согласованных ответов по точности пары, более старые и более новые модели. Примечание: интервалы геометрического среднего g точностей пары, пары из разных лабораторий; размер маркера растёт с количеством пар. Линия — замороженная модель в середине каждого интервала.
HELM также позволяет провести тест раздела 5.2 со множеством лабораторий и без зависимости от GPT. С одной выпущенной моделью и партнёрами в пределах 3 пунктов точности, другая лаборатория улавливает 75,5% ошибок против 72,3% для той же лаборатории, -3,2 пункта [-4,2, -2,3], при охвате выше на 2,7 пункта. Добавление совпадения по охвату в пределах 3 пунктов удаляет его: 75,7 против 75,9%, -0,2 [-0,6, +0,2].
6. Обсуждение
Запуск шлюза не требует разметки, но проверка его требует. Измерьте точность обеих моделей на размеченной выборке страты, которая имеет значение, в режиме доступа, который будет развёрнут. В этих данных согласованный ответ двух флагманских моделей на вопрос, находящийся вне их компетенции, не безопаснее согласованного ответа двух моделей среднего уровня. Объединение двух лабораторий является разумным выбором по умолчанию, когда значения уверенности недоступны, но это необходимо проверить на страте: пара из одной лаборатории, отфильтрованная по уверенности, или собственная уверенность выпущенной модели могут работать столь же хорошо (раздел 5.2, приложение J).
Скорректированная на случайность схожесть (Goel et al., 2025) и точность согласованных ответов — это разные величины, и Han (2026) называет декорреляцию рычагом, где я отдаю приоритет точности и полноте охвата (приложение L). При представлении результатов исследование согласованности моделей должно указывать режим доступа, объём работ, условия инструментов и сохранённые журналы событий для каждой ветви.
7. Область применения и граничные условия
Уровни сравниваются в две волны на разные даты и через разные маршруты доступа, и сравнение уровней точно до примерно 3 пунктов при совпадающей точности, намного меньше при изоляции самого сложного квинтиля. Свежие данные представляют собой один набор из 100 вопросов и восьми шаблонов на две даты, и октябрьское изменение включает нулевое значение. Точность и полнота пар движутся вместе по датам и в условиях рассуждений, которые различаются между волнами, и дизайн не выделяет способность как причину.
То, осуществляли ли поиск клиенты Codex, kimi и gemini-3.8-flash, невозможно установить из сохранённых файлов, поэтому их точности измеряют клиента в развёрнутом виде, а не память модели. Разделы 5.1 и 5.3 показывают основные результаты без этих ветвей.
Пары одной лаборатории существуют в октябре для двух лабораторий, и без GPT сравнение в одной волне — это 100 свежих вопросов. Октябрьские ячейки опираются на пять моделей из двух лабораторий, поэтому размерность модели двусторонней бутстрап-процедуры имеет несколько уровней, и объединённые интервалы являются нижними границами неопределённости. Сравнения при равном охвате используют указанную доверительную вероятность, которую чистый шлюз не использует, и случайный тай-брейк перемещает самую широкую строку между 0.0 и +20.7 пункта (Приложение H).
Система основана на правилах, и её проверки здесь — это очищенное золото SimpleQA Verified (раздел 5.1) и переоценка частей ответа. Она оценивает весь ответ, и длинные ответы могут получить ложное «неправильно»; оценка только первой части перемещает полноту эталонных пар не более чем на 3 пункта, а gpt-6-astra с opus-5-5 на 106 вопросах переходит с 80.0 на 88.9% (Таблица A3).
Модель берёт измеренные точности для каждой ячейки в качестве входных данных, поэтому она описывает помеченную проверку шлюза и не заменяет её. Она работает хорошо на фактах о продуктах и открытых данных. HELM, LiveBench и агрегаты работ Kim et al. держат старые модели в форматах few-shot или множественного выбора, поэтому они проверяют это соотношение на других моделях, а не на флагманских моделях 2026 года.
8. Заключение
Точность согласованных ответов возрастает с точностью пары на исследуемом уровне, на обоих ярусах и примерно на 3 пункта при совпадающей точности. Инверсия появлялась везде, где я измерял слабую пару, включая флагманские модели. Партнер из второй лаборатории выявляет больше ошибок в основном благодаря тому, что открывает ворота реже, и при равном охвате сохранил своё преимущество только там, где его модель была намного более точной. Небольшая модель ворот описывает внешнюю точность намного лучше, чем лучшая модель, и так же хорошо, как независимые ошибки. Один идентификатор, измеренный через две конфигурации доступа, отличается на 45,7 пункта, поэтому утверждение о точности модели должно указывать режим доступа.
Заявление об эффективности
В данной статье исследуется, когда согласие между двумя языковыми моделями можно использовать как правило для выпуска коротких фактических ответов. Практикующие специалисты могут проверить на интересующем их уровне и в режиме доступа, который они используют, достаточно ли точна двухмодельная система для их применения, вместо того чтобы предполагать, что более мощные модели или второй поставщик будут достаточными. Основной риск заключается в чрезмерном доверии к согласию по сложным вопросам, и результаты показывают уровни, на которых согласованные ответы в основном ошибочны. Исследование использует только общедоступные контрольные наборы и вопросы, составленные машинами.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
Декларации
Конфликт интересов. Автор является названным заявителем по находящимся на рассмотрении патентным заявкам, а не выданным патентам, охватывающим системы оркестрирования ИИ и многомодельной валидации, которые исследуются в данной работе.
Данные и код. Ответы за каждый вызов, сценарии анализа и сопоставление каждого приведённого числа с его исходной таблицей архивированы на Zenodo, doi:10.5281/zenodo.24090584 (CC BY 4.0).
Приложение А. Модели и режимы доступа
Таблица А1. Коллекции и режимы доступа по волнам.
| Коллекция | Даты | Модели | Доступ |
|---|---|---|---|
| July mid tier | 24–28 июля 2026 г. | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | Прямой API |
| July local | 24–28 июля 2026 г. | семь локальных моделей с открытыми весами | Локальный вывод |
| August flagships | 3–6 августа 2026 г. | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | Клиент поставщика; gpt-5.6-sol при установке усилия клиента по умолчанию, 14 из 1500 записей через резервный API |
| glm-5.2 | Конечная точка поставщика | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | Прямой API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | Прямой API или маршрут агрегатора, привязанный к поставщику; muse-spark-1.1 частичный (251 ответ) | ||
| Variance arm | 6 августа 2026 г. | Девять флагманских моделей, без Claude | gpt-5.6-sol через прямой API, усилие отсутствует; mistral-medium-3.5 через клиент его поставщика, который записывает запрошенную температуру; остальные — как в августовской волне; температура 0,7, три выборки |
| Fresh, August | 6 августа 2026 г. | gpt-5.6-sol (усилие отсутствует), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol и deepseek-v4-pro через прямой API, claude-fable-5 через клиент поставщика, kimi-k3 через маршрут агрегатора |
| Product facts | 15 августа 2026 г. | Шесть моделей, 15 пар; четыре без возможности поиска, 6 пар | Смешанный; gpt-5.4 и grok через клиентов |
| October | 26 и 27 октября 2026 г. | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Клиент Codex, усилие среднее, флаг отсутствия поиска, поток событий не сохранен |
| claude-opus-5-5, claude-fable-5-1 | Клиент Claude, инструменты запрещены | ||
| kimi-k3, gemini-3.8-flash (только свежие) | Клиенты поставщиков, инструменты не отключены |
В августовской волне 19 ответов из области claude-fable-5 были обработаны другими моделями Claude. Результаты волны: 34 из 37 в 106 не зависят от них (Chernets, 2026a).
Приложение B. Пары по 503 общим вопросам
Таблица A2. Все пары различных лабораторий, первый член выпущен, 503 общих вопроса.
| Пара | Охват | PPV (K/O) | Дельта, пункты [95%] | Выявленные ошибки |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
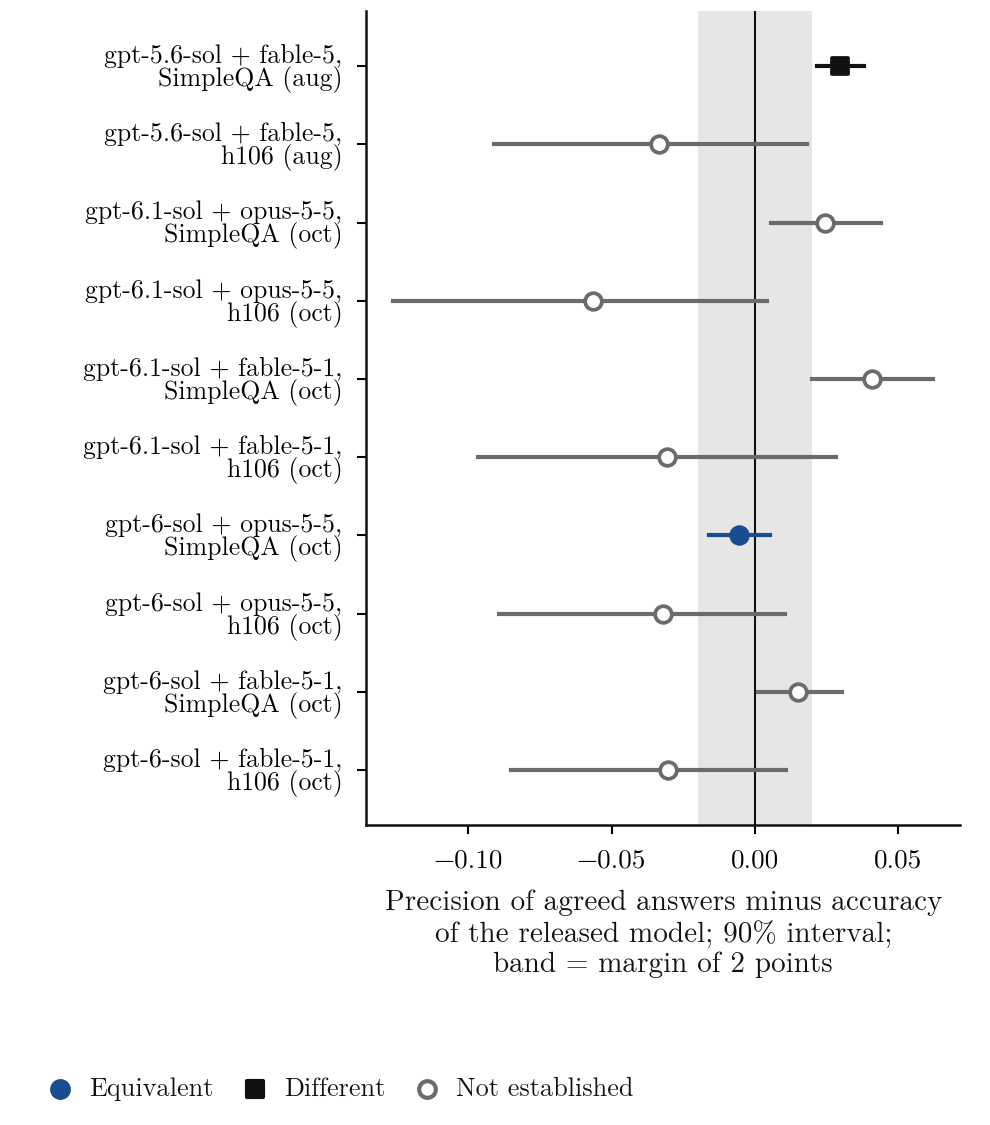
Рисунок A1. Тест эквивалентности точности пары в сравнении с выпущенной моделью. Примечание: 90% бутстреп вопросов, интервал 2 пункта выделен. Пары с выпущенным модулем клиента Codex.
Приложение C. Точное совпадение с эталонной строкой
Точное совпадение ранг-коррелирует идеально с точностью SimpleQA на девяти моделях с обоими измерениями SimpleQA и свежим измерением, так как правильный ответ часто является эталонной строкой. Его корреляция с разницей SimpleQA минус свежее измерение составляет +0,47 (точный тест перестановок p = 0,21, n = 9), или +0,29 (p = 0,50) без gpt-5.6-sol, чьи две точности получены из разных режимов доступа (рисунок A2). В ограничении только на правильные ответы она составляет +0,10 (p = 0,81). Среди правильных ответов доля составляет 65,7% для gpt-5.6-sol, 66,4% для fable-5, 68,6% для deepseek-v4-pro и 64,9% для kimi-k3. Остаток модели от неё не зависит, с наклоном +0,064 [-0,072, +0,167] по 112 флагманским ячейкам. Сама разница близка к нулю или отрицательна для большинства моделей, составляя -3,0 пункта для fable-5, -20,5 для deepseek-v4-pro, -5,4 для opus-5-5 и -7,8 для fable-5-1, и она велика только для gpt-5.6-sol (+62,4), где режим доступа различается между двумя измерениями.
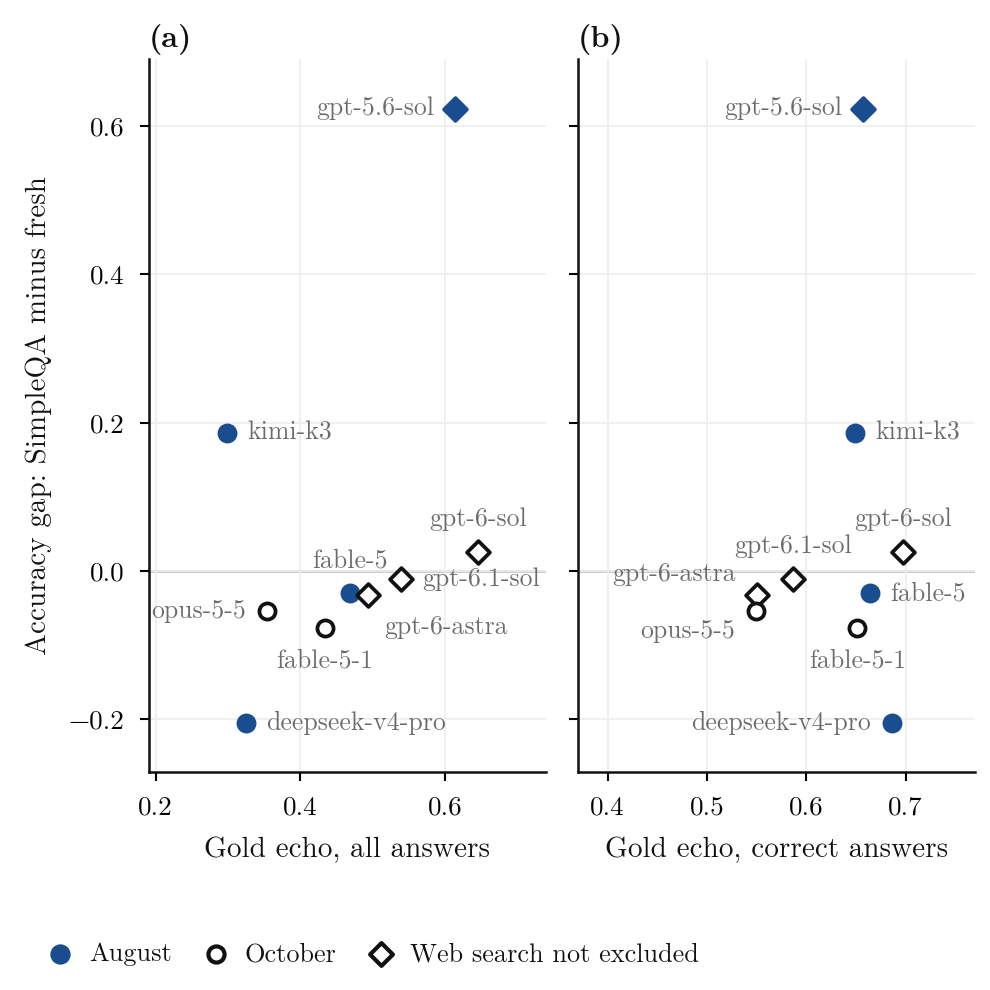
Рисунок A2. Точное совпадение с эталонной строкой в сравнении с разницей в точности. Примечание: (a) все ответы, (b) только правильные ответы. Заполненный синий цвет — волна августа; открытый — волна октября. Ромбы обозначают варианты, для которых поиск в интернете исключён.
Приложение D. Чувствительность оценщика
Модуль нормализует регистр, артикли и пунктуацию, принимает точные совпадения и вхождения строк из четырёх и более символов, сравнивает даты, числа и буквенно-цифровые идентификаторы по правилам, в остальном сравнивает содержательные слова; ответ, который модуль не может сопоставить с эталоном, остаётся неразрешённым. В таблице A3 первая часть каждого ответа без скобок и дополнительного объяснения используется как для сопоставления, так и для оценки, поэтому количество открытых ответов также изменяется.
Таблица A3. Оценка полного ответа в сравнении с оценкой его первой части. Первый элемент опубликован.
| Пара, набор | PPV, полный ответ | PPV, первая часть |
|---|---|---|
| gpt-5.6-sol + fable-5, все, август | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, октябрь | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, октябрь | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, октябрь | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, октябрь | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, стратег., октябрь | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, свежий, октябрь | 72/74 | 72/74 |
Приложение E. Дополнительные связанные работы
Недавние препринты указывают в двух направлениях. На скептической стороне Денисов-Бланш и соавт. (2026) обнаруживают, что агрегация в стиле опроса по пяти бенчмаркам и моделям не дает стабильного прироста точности при увеличении затрат вычислений в 25 раз, поскольку ошибки коррелированы. Динг (2026) проверяет 265 000 образцов на GPQA Diamond и AIME и обнаруживает, что согласованность является положительным, но слабым предиктором (Спирман 0,20–0,59), при этом 48% записей GPQA с высокой согласованностью наиболее стабильной пограничной модели содержат ошибки. При исследовательской проверке на 46 элементах частоты совпадения неправильных ответов между gpt-4.1 и уровнями Claude превышают нулевой результат, сохраняющий различие, для двух из трех уровней. Коли (2026) обнаруживает, что девять пограничных судей на трех наборах данных вывода несут примерно два независимых голоса, и что лучший отдельный судья соответствует или превосходит панель. Ким (2026) проверяет 31 900 подмножеств из 30 моделей на MMLU-Pro: голосование превосходит самого сильного участника в 9,98% подмножеств размера 3, и строгая мера разнообразия почти коллинеарна с единицей минус средняя точность (Спирман +0,991). Хоссейн и соавт. (2026) обнаруживают среднюю попарную корреляцию ошибок 0,21 в пяти судей, которые содержат примерно столько же информации, сколько 3,5 независимых, с более сильной зависимостью между пограничными судьями разных провайдеров. Чэнь (2026) показывает, что любая политика, выводящая ответ одного участника, не может превышать единицу минус частота , при которой все модели ошибаются вместе, и обнаруживает 0,052 по открытой математике на 67 моделях в сравнении с 0,023 при гауссовой копуле и 0,127 по GPQA-Diamond с открытым ответом. С другой стороны, Наик (2024) сообщает, что точность растет с 73,1% до 93,9% с двумя моделями и до 95,6% с тремя на 78 случаях в формате с множественным выбором, и Лю (2026) показывает, что четырехмодельная панель выбирает ответы лучше, чем самосогласованность на семи бенчмарках, с замкнутой формулой по точности участников, корреляции ошибок и общей частоте неправильного понимания, которая предсказывает точность консенсуса со средней абсолютной ошибкой 0,028. Сюэ и соавт. (2026) сообщают, что кросс-модельная согласованность с верификатором превосходит потолок самосогласованности для обнаружения галлюцинаций на QA бенчмарках, и Тан и соавт. (2025) сообщают, что ошибки самосогласованности не сокращаются с масштабом модели, имеют тенденцию быть специфичными для модели и лучше обнаруживаются со второй моделью. Хан (2026) приводит теорию последовательных ворот верификации, в которой слепая масса ограничивает надежность, и называет декоррелирование путем изменения семейства моделей, модальности или источника доказательств практическим рычагом. Два из работ раздела 2 содержат детали, имеющие отношение к вратам. Гоэль и соавт. (2025) определяют CAPA таким образом, чтобы различные неправильные варианты считались несогласованностью, и помимо тренда с возможностью показывают, что девять судей открытого веса LLM оценивают модели более похожим образом на себя выше, и что усиления от слабого к сильному больше на задачах, где супервизор и студент делают менее похожие ошибки (12 пар моделей). Колаволе и соавт. (2025) формулируют условие безопасного отказа от совместной частоты принятых ошибок по тестовому распределению с пороговым значением, оцененным на небольшом наборе валидации. Условие на совместную частоту позволяет принятым ошибкам концентрироваться на одном слое, и раздел 5.1 находит такой слой: на 106, средние панели подтверждают ошибку, как и пограничные пары без самого точного участника.
Ни одна из этих работ не сообщает, как отмечено в разделе 2, о парных вратах отпуска, полноте при равном охвате с одной выпущенной моделью, зафиксированной, или одном идентификаторе, измеренном в двух режимах доступа.
Приложение F. Данные и детали протокола
Сборки. Протокол соответствует разделу 3, и сборки приведены полностью. Таблица A1 содержит список моделей, дат и режимов доступа.
- Середина июля (24–28 июля). Девять моделей API и семь локальных моделей на 1500 вопросах SimpleQA (Wei et al., 2024), фиксированная случайная подвыборка из 4326 вопросов в тестовом наборе. Сборка была зарегистрирована на OSF перед сбором данных (Chernets, 2026a).
- Флагманы августа (3–6 августа). По одному флагманству из одиннадцати лабораторий на тех же 1500 вопросах, из которых 1459 образуют общий пул.
- Ветка дисперсии (6 августа). Девять флагманств на 100 из этих вопросов, по 20 на квинтиль, при температуре 0,7 с тремя выборками на вопрос.
- Свежие вопросы (6 августа и 26 октября). 100 двухшаговых вопросов, составленных машиной из Wikidata по восьми шаблонам, с хешем файла, зафиксированным перед первым вызовом модели.
- Факты о продуктах (15 августа). 267 вопросов о коммерческих продуктах, также составленные из Wikidata, на шести моделях, четыре из них без возможности поиска.
- Флагманы октября (26 и 27 октября). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 и claude-fable-5-1 на 300 вопросах SimpleQA, стратифицированных по квинтилям июля (60, 120, 120; 297 общих для всех пяти; «strat» в таблицах), 106 вопросах ниже и свежем наборе, всего 503 общих вопроса. kimi-k3 и gemini-3.8-flash ответили на свежий набор.
Режимы доступа. К моделям обращались двумя способами, описанными в разделе 3. gpt-5.6-sol также работал по прямому API в ветке дисперсии и на свежем наборе августа. Идентификаторы моделей и версии клиентов записаны для каждого вызова.
Поскольку клиенты устанавливают условия измерения, я излагаю их полностью. Температуру нельзя установить в них. Ветка Codex августа работала с параметром усилия рассуждения, установленным по умолчанию клиентом, который вызов не устанавливает и записи не указывают. Ветки Codex октября работали с усилием, установленным на среднее значение в каждом вызове. Записи манифеста августа содержат нулевые запросы веб-поиска для ветки Claude и пустой список инструментов для ветки Mistral, а ветки Claude октября работали с запретом инструментов. Ветки Codex были запущены без флага поиска, и их потоки событий не сохранялись, поэтому наличие поиска невозможно определить из файлов. В клиентах kimi и gemini-3.8-flash инструменты не были отключены, и подсказка их запрещает.
Приложение G. 106 и уровни
На рисунке A3 показаны панели и пары из раздела 5.1 по 106 и еще две пары: fable-5 с grok-4.5 правильно ответили на 7 из 28 совпадений, а gemini-3.1-pro с grok-4.5 на 8 из 25.
Результат 0 из 342 раздела 1 зависит от того, как ранжируется сложность. Когда собственные ответы каждой панели исключаются из ранжирования сложности, число становится 78 из 354, а межблоковая панель остается на 0 из 116.
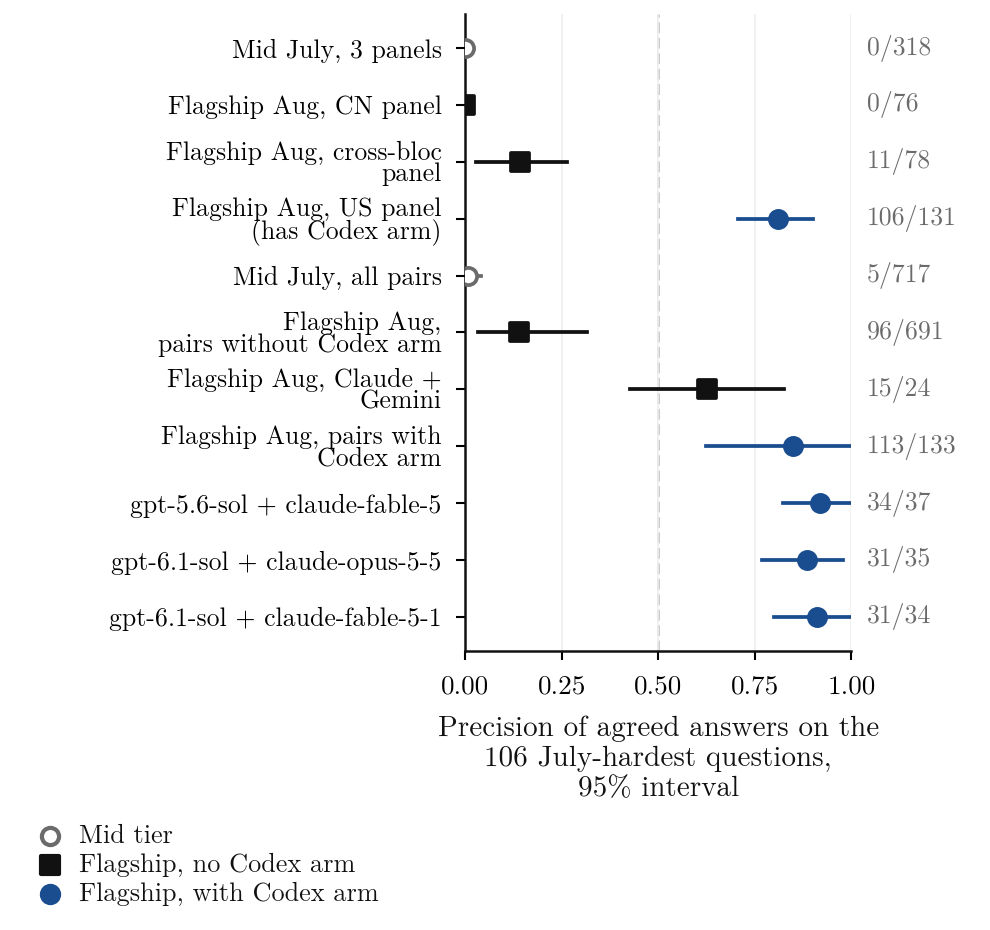
Figure A3. Точность согласованных ответов на 106 вопросов. Примечание: 95% двусторонний бутстреп для объединенных строк, бутстреп вопросов для панелей и отдельных пар. Синие строки содержат ветвь клиента Codex. Сборки августа и октября.
На рисунке A4 приведены собственные квинтили уровней из раздела 5.1 в полном объеме. Со всеми ветвями август достигает 26,6% [6,7, 53,4] в самом сложном квинтиле, с разницей +9,3 [-18,1, +39,8] от июля. Без kimi-k3, входящего в обе сборки, самый сложный квинтиль дает 147 из 675 (21,8%) в июле и 192 из 995 (19,3%) в августе, −2,5 пункта [−29,7, +28,2]. Объединенный тест раздела 5.1 использует все пять квинтилей, 180 ячеек на уровень; ячейки среднего уровня на +0,3 пункта [−2,4, +2,9] и ячейки флагманского уровня на +0,0 [−1,4, +1,6] от замороженной модели. Улучшение в самом сложном квинтиле составляет 1,15 [0,39, 1,90] в июле и 0,97 [0,42, 1,49] в августе. По квинтилям август без GPT дает 15,5, 52,9, 75,8, 90,5 и 97,3%, а июль 17,3, 29,0, 60,9, 80,4 и 94,4%, тогда как точность выпущенных моделей составляет 16,0, 36,6, 56,8, 73,3 и 88,5% против 15,3, 25,0, 40,0, 57,7 и 78,9%.
Точность остается низкой на очищенных эталонных ответах. Haas et al. (2025) переработали SimpleQA в очищенный набор из 1000 вопросов, и 24 из 106 сохранились в нем, против 24,5 ожидаемых от доли сохраненного эталона, с идентичным эталонным ответом на 21. Очистка не удаляет эти вопросы чаще, чем другие, хотя ее выбор также отдает предпочтение сложным вопросам. По той же статистике и бутстрепу пары августа без GPT правильно ответили на 28 из 150 совпадений на этих 24 вопросах (18,7% [0,0, 57,1]) и на 67 из 538 на остальных 82 (12,5% [2,8, 28,1]; более точный член выпущен в каждом подмножестве, поэтому части не обязательно складываются в 96 из 691), а пары июля на 4 из 157 (2,5% [0,0, 15,2]).
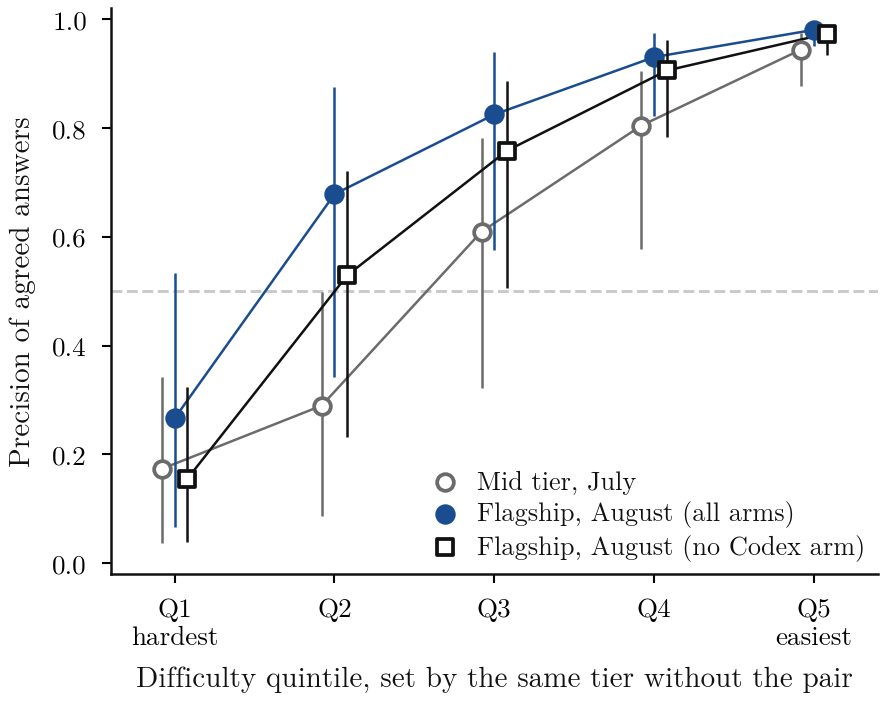
Figure A4. Точность согласованных ответов по квинтилям сложности собственного уровня. Примечание: 95% двусторонний бутстреп. Сложность для каждой пары устанавливается тем же уровнем без этой пары. Пунктирная линия на 0,5.
Наиболее точные пары подчиняются той же закономерности. Пара kimi-k3 и gemini-3.8-flash достигает 95,8% на свежем наборе, перехватив 23 из 26 ошибок выпущенной модели и с улучшением 5,37 [2,86, 21,36]. Модель, учитывая только их точность 0,74 и 0,82, возвращает 95,1%. А два флагманских Claude вместе, без возможности поиска ни в одной ветви, достигают 47,5% на 106, где точность выпущенной модели составляет 30,0%, и 86,2% по всем 503 вопросам. На рисунке A5 каждая полоса каждого уровня сопоставляется с точностью выпущенной модели, с точностью выше диагонали в 17 из 23 ячеек.
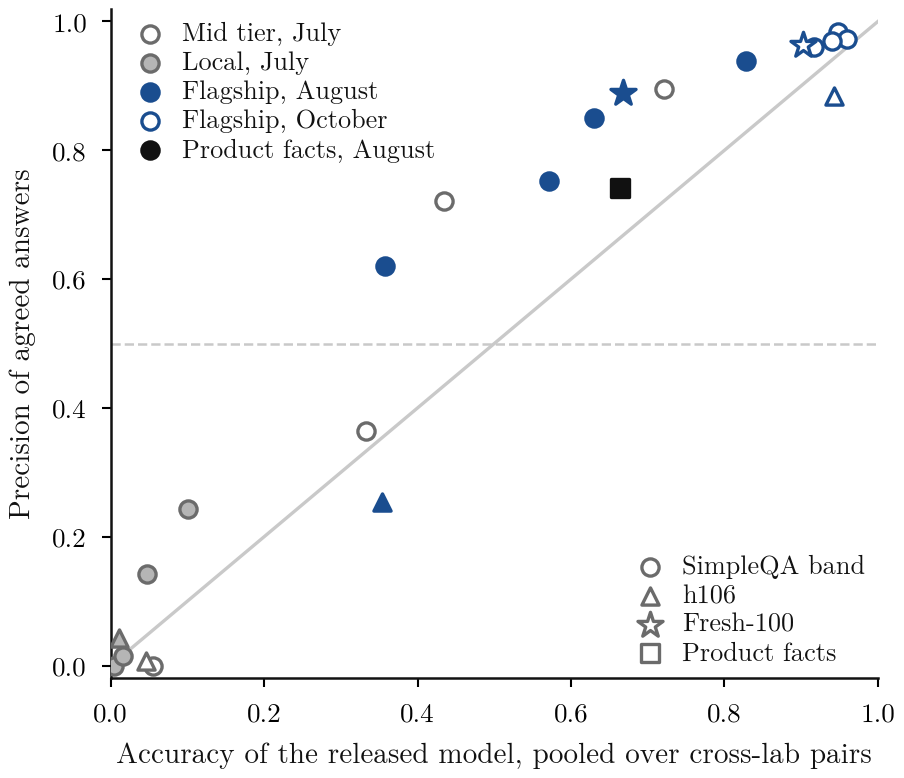
Figure A5. Точность согласованных ответов в зависимости от точности выпущенной модели. Примечание: объединено по парам разных лабораторий, по уровню и полосе. Цвет и заливка дают уровень, форма маркера — набор. Пунктирная линия на 0,5, сплошная линия — равенство.
Приложение H. Вторая лаборатория в деталях
Вариационное плечо. По модели при равном охвате (Рисунок 2) двухлабораторный шлюз лидирует в семи из девяти и отстает для gemini-3.1-pro (-5.7 пункта) и grok-4.5 (-2.8). Без GPT, по восьми моделям, самосогласованность покрывает 61.4% с точностью 55.9%, а две лаборатории — 24.4% с точностью 83.3%. Разница в точности составляет +27.4 пункта [+16.0, +35.7] при измерении и +7.7 [-1.9, +16.5] при равном охвате, а обнаруженные ошибки различаются на +38.3 пункта [+26.0, +50.9] при измерении и +3.0 [-1.5, +8.4] при равном охвате. В октябре нет повторных вызовов, поэтому самосогласованность измеряется только в августе.
Четыре партнера одной выпущенной модели. Таблица A4 дает четырех партнеров Рисунка 3a: одна выпущенная модель, gpt-6.1-sol, поэтому 29 ошибок в игре одинаковы в каждой строке.
Таблица A4. Одна выпущенная модель, четыре партнера: gpt-6.1-sol на 503 общих вопросах (29 ошибок среди 495 разрешенных, бутстреп вопроса 95%).
| Партнер | Лаборатория | Охват [95%] | ППЗ (К/В) | Дельта, пункты [95%] | Обнаружено ошибок [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | same | 96.2% [94.4, 97.8] | 94.3% (449/476) | +0.2 [-0.2, +0.8] | 2/29 = 6.9% [0.0, 17.4] |
| gpt-6-sol | same | 95.6% [93.6, 97.2] | 96.2% (457/475) | +2.1 [+0.9, +3.4] | 11/29 = 37.9% [20.7, 56.5] |
| claude-opus-5-5 | different | 59.8% [55.9, 64.0] | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 = 55.2% [36.4, 73.0] |
| claude-fable-5-1 | different | 60.8% [56.7, 65.0] | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 = 69.0% [50.0, 85.2] |
Другой партнер в той же лаборатории, gpt-6-sol, обнаруживает 11 из 29, что составляет -31.0 пункта [-50.0, -10.7] против fable-5-1 и -17.2 [-37.0, +3.0] против opus-5-5. Пара Claude, без возможности поиска в обоих плечах, покрывает 60.6% и обнаруживает 140 из 181 ошибок fable-5-1 с точностью 86.2% и Дельтой +23.5 пункта [+19.6, +27.2]. Две модели одной лаборатории, обе далеко от потолка, таким образом могут часто расходиться, чтобы обнаружить большинство ошибок.
Таблица A5 проверяет, является ли это чем-то большим, чем движением вдоль кривой охвата, и нужен ли для этого GPT. Каждая строка оставляет одну выпущенную модель и сравнивает ее партнера в той же лаборатории с партнером из другой лаборатории, сначала при измерении, а затем при равном охвате, достигнутом путем истончения более широкого шлюза по уверенности (Раздел 3).
Таблица A5. Обнаруженные ошибки с партнером в той же лаборатории и с партнером из другой лаборатории. Разницы — одна лаборатория минус другая, в пунктах, с бутстрепом вопроса 95%, поэтому отрицательные значения благоприятствуют другой лаборатории; разницы при измерении в первых четырех строках используют бутстреп Таблицы A4.
| Выпущенная | Партнер: одна / другая лаборатория | Вопросы | Обнаружено, при измерении | Разница [95%] | Обнаружено, равный охват | Разница [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62.1 [-79.3, -43.8] | 17/29, 20/29 | -10.3 [-35.3, +13.8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48.3 [-66.7, -29.6] | 18/29, 16/29 | +6.9 [-17.1, +30.4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31.0 [-50.0, -10.7] | 24/29, 20/29 | +13.8 [-6.7, +34.6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17.2 [-37.0, +3.0] | 24/29, 16/29 | +27.6 [+3.4, +51.6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16.0 [-21.7, -10.6] | 140/181, 169/181 | -16.0 [-21.7, -10.6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11.8 [-17.8, -5.9] | 156/195, 177/195 | -10.8 [-16.7, -5.0] |
| fable-5-1 | opus-5-5 / kimi-k3 | fresh 100 | 13/23, 20/23 | -30.4 [-50.0, -12.5] | 17/23, 20/23 | -13.0 [-35.0, +9.1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | fresh 100 | 13/23, 19/23 | -26.1 [-45.5, -8.7] | 17/23, 19/23 | -8.7 [-29.4, +12.5] |
| opus-5-5 | fable-5-1 / kimi-k3 | fresh 100 | 18/28, 23/28 | -17.9 [-38.5, +0.0] | 24/28, 23/28 | +3.6 [-14.7, +22.6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | fresh 100 | 18/28, 22/28 | -14.3 [-33.3, +4.5] | 22/28, 22/28 | +0.0 [-20.0, +20.7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (August) | 344 | 107/130, 110/130 | -2.3 [-9.8, +5.3] | 108/130, 110/130 | -1.5 [-9.1, +5.8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (August) | 344 | 118/141, 126/141 | -5.7 [-12.1, +0.8] | 125/141, 126/141 | -0.7 [-6.4, +5.1] |
Строки августа — это единственное сравнение SimpleQA без GPT, и они объединяют модели из разных дат. gemini-3.1-pro — это плечо августа, ближайшее по точности к моделям Claude на этих вопросах (65.4% против 60.6 и 57.7% на этих вопросах). Объединено по всем семи партнерам августа, большинство из них намного слабее, разница составляет -5.1 пункта [-10.1, -0.3] для fable-5-1 и -6.0 [-10.6, -1.2] для opus-5-5 при измерении, и она становится +7.9 [+4.8, +11.2] и +6.8 [+3.6, +10.2] при равном охвате в пользу одной лаборатории. Ничьи в уверенности разрешаются случайно, и по 200 розыгрышам самая широкая строка колеблется между 0.0 и +20.7 пункта.
Приложение I. Модель вне выборки в деталях
Таблица A6 показывает ошибки вне выборки, стоящие за разделом 5.3. Временное разбиение дает 0.019 против 0.050 для базовой модели, разница -0.031 [-0.074, +0.008] под двусторонней бутстрепом, и интервал лежит ниже нуля при кластеризации только по вопросам или только по модели. При 9 и 23 складках LOLO и LOMO дают одинаковую ошибку до трех десятичных знаков.
Таблица A6. Средняя абсолютная ошибка предсказанной PPV, ячейки как минимум с 20 открытыми ответами. Двусторонний бутстреп, по вопросам и моделям.
| Схема | Модель [95%] | Независ. | Лучшая | Модель минус лучшая [95%] | Модель минус независ. [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, разбиение вопросов | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| Июль и август к октябрю | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| Средний уровень к флагманам | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, флагманы, без ветви с возможностью поиска | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| Исключено: ERNIE и Muse, август | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| Исключено: 7 локальных моделей, июль | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| Исключено: та же лаборатория, октябрь | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| Исключено: факты о продукте | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
Практический выигрыш по сравнению с выбором более совершенной модели велик, включая перенос со среднего уровня на флагманы и два из четырех наборов, которые не участвовали в подгонке (рисунок A6). Множитель не добавляет ничего к точности в основных схемах, и работа выполняется измеренными точностями и . Удаление в целом повышает ошибку LOLO до 0.323, а при фиксировании она составляет 0.046. По покрытию и логарифмической потерям помогает: при LOLO различия от независимых ошибок составляют -0.0079 [-0.0111, -0.0020] и -0.0024 [-0.0045, -0.0003]. На трех из четырех исключенных наборов интервал против независимых ошибок лежит ниже нуля при зафиксированных константах. Член совместной ошибки, таким образом, имеет значение для покрытия, тогда как точность зависит от измеренных точностей и .
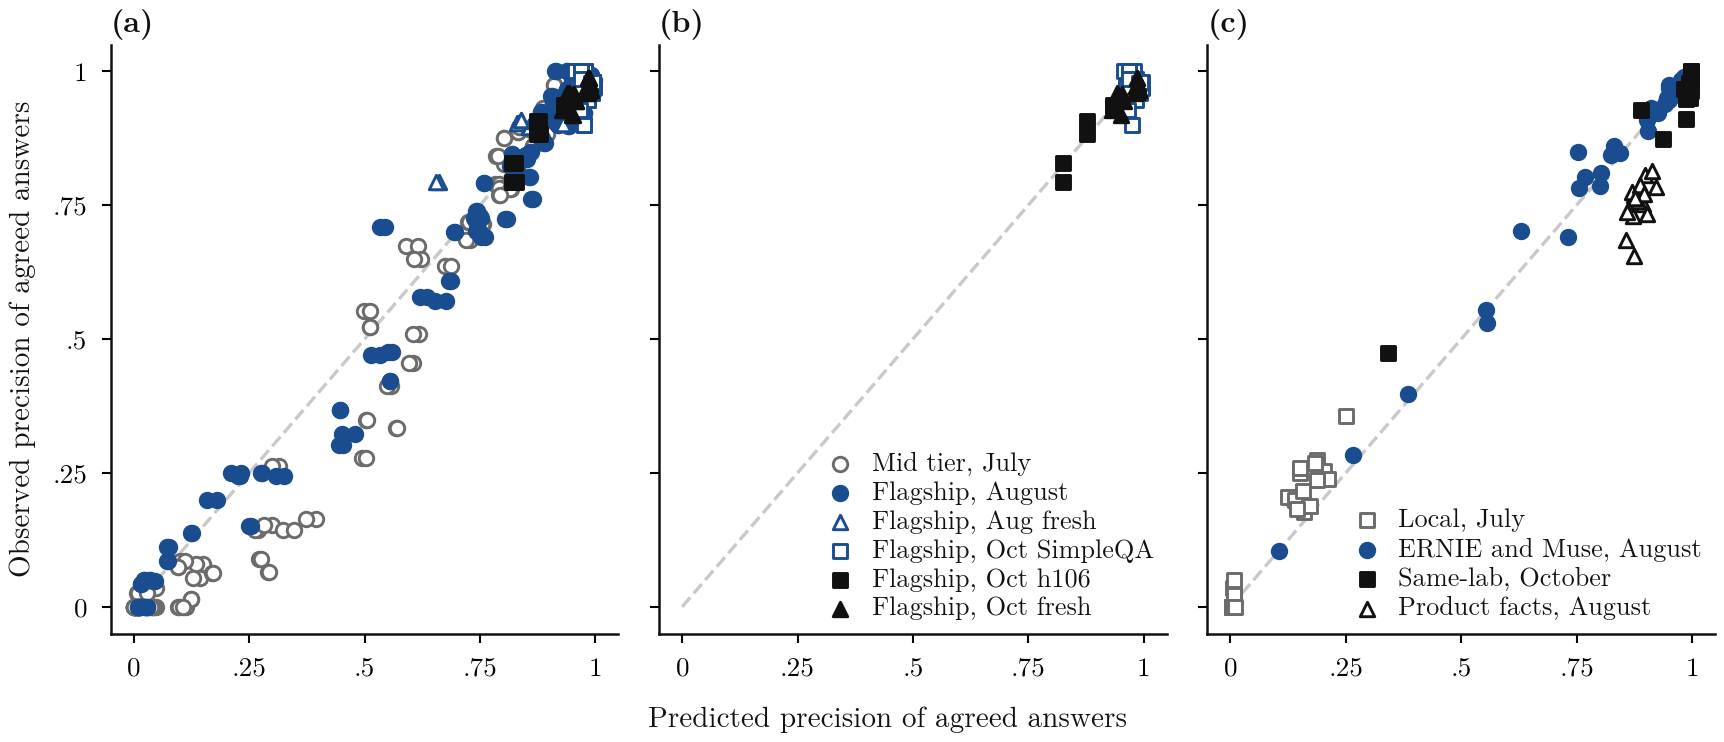
Рисунок A6. Предсказанная против наблюдаемой точности согласованных ответов. Примечание: (a) исключение одной лаборатории. (b) Подгонка на июль и август, предсказание октября. (c) Наборы вне подгонки, константы зафиксированы. Пунктирная линия — равенство.
По фактам о продукте модель дает завышенные значения. Ошибка составляет 0.130 против 0.086 для лучшей модели, со средним преувеличением в 13 пунктов. С классификатором этой области переоценка увеличивается до 19 пунктов (0.190 против 0.067). Факты о продукте находятся вне области, на которой были подобраны константы.
При сортировке ячеек на три класса исходов (инвертированные при PPV ниже 0.5, без выигрыша при изменении до +2 пунктов, выигрыш выше этого), временное разбиение совпадает с 28 из 39 ячеек, и девять промахов предсказывают отсутствие выигрыша там, где был наблюдаем выигрыш. Модель надежна для оценки величины точности и менее эффективна при сортировке ячеек по обе стороны от линии +2 пункта.
Приложение J. Режимы доступа и плечи GPT в деталях
Один и тот же идентификатор, одни и те же вопросы. На наборе из 100 вопросов SimpleQA модель gpt-5.6-sol набирает 92 из 100 (92,0%) на основной волне, где 99 из 100 записей поступили через клиент Codex и один неправильный ответ через запасной вариант API, и 139 из 300 образцов (46,3%) через прямой API в плече дисперсии — разница 45,7 пункта (рисунок 5). Только на 99 записях клиента показатели составляют 92 из 99 (92,9%) и 139 из 297 (46,8%), разница 46,1 пункта. Дословное воспроизведение эталонной строки падает вместе с этим, с 64,0% до 26,0%. Условия отличаются следующим образом: клиент работает с настройкой усилия по умолчанию согласно своим инструкциям, температура не настраивается, в то время как API работает с нулевым усилием и температурой 0,7.
По двум колонкам остальные восемь моделей плеча, температура которых также меняется, сдвигаются максимум на 4,0 пункта в любую сторону. Усилие — один из кандидатов для gpt-5.6-sol, хотя парное измерение бюджета рассуждений на gemini-3.1-pro оставило точность практически неизменной (Чернец, 2026c). Веб-поиск — другой. Октябрьские ответы того же клиента содержат ссылки, которые запрос не требует, в 3 из 506 ответов gpt-6.1-sol и в 18 из 506 gpt-6-astra, включая реальный идентификатор MusicBrainz. Медианное использование токенов на вызов клиента в августе составляет 4829, при этом 36,4% вызовов превышают 6000. Эти токены могут быть рассуждениями или поиском, и поток событий, который их разделил бы, не был сохранён.
Бенчмарк-система и человек, использующий продукт, могут таким образом видеть точность, различающуюся на 45,7 пункта на одном идентификаторе и одном наборе вопросов, и исследование «модели» должно указать, какую именно оно измеряло. Внутри волны августа плечо клиента набирает 1392 из 1457 (95,5%), а 14 записей, обслуженных API после отказа клиента, набирают 11 (78,6%) на вопросах, выбранных этим отказом. На свежем наборе gpt-5.6-sol через API набирает 33 из 100, где fable-5 набирает 76, а gpt-6.1-sol через клиент набирает 95 в октябре. И модель из раздела 4 сохраняет свою форму при этом вопросе, поскольку она принимает измеренные точность в качестве входных данных: на флагманах без плеч с возможным поиском её ошибка LOLO составляет 0,037 против 0,120 для лучшей модели.
Значение вентиля по режиму доступа. На свежих вопросах в августе с GPT через API пара gpt-5.6-sol и fable-5 правильна в 29 из 32 совпадений, Delta +57,6 пункта [+46,3, +69,7], перехватывая 64 из 67 ошибок, и уверенные ошибки плеча GPT падают с 61 из 91 до 2 из 29. В октябре с более новым GPT через клиент на тех же вопросах пара с opus-5-5 правильна в 72 из 74, а пара с fable-5-1 в 76 из 78, с Delta +2,3 [-0,7, +6,0] и +2,4 [-0,5, +6,3] и 3 из 5 перехватанными ошибками. Значение вентиля здесь отслеживает точность выпущенного плеча, как в разделе 5.1.
Плечи клиента на SimpleQA. В таблице A7 приводятся плечи, отложенные в разделе 5.1. В августе пара gpt-5.6-sol и fable-5 правильна в 997 из 1016 совпадений (98,1%) против 95,4% отдельно, Delta +2,8 пункта [+1,9, +3,7], с минимумом 15 из 1459. На 106 она достигает 34 из 37 (91,9%), и все пары с плечом GPT достигают 113 из 133 (85,0% [62,2, 100,0]) против 96 из 691 без него. Плечо отдельно правильно в 100 из 105. Эти совпадения наследуют эту точность: Delta на 106 составляет -3,3 пункта [-10,3, +2,6] в августе и -5,7 [-13,7, +1,2] с opus-5-5 в октябре. В отличие от этого, среднеуровневая пара от одних и тех же поставщиков, gpt-5-mini и claude-haiku-4-5, правильна в 45 из 123 совпадений (36,6% [28,6, 45,4]) в целом и в 0 из 13 на 106, её первый член — в 163 из 1435.
Таблица A7. Пары плеч клиента. Первый элемент выпущен. Интервал Вильсона для PPV, бутстреп вопроса для Delta.
| Пара, набор | Охват | PPV (K/O) [95%] | Выпущен отдельно | Delta, пункты [95%] | Перехватанные ошибки |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, все SimpleQA, август | 1028/1500 | 98,1% (997/1016) [97,1, 98,8] | 1403/1471 | +2,8 [+1,9, +3,7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, август | 37/106 | 91,9% (34/37) [78,7, 97,2] | 100/105 | -3,3 [-10,3, +2,6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, октябрь | 192/300 | 96,3% (183/190) [92,6, 98,2] | 276/294 | +2,4 [+0,2, +4,9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, октябрь | 193/297 | 97,9% (187/191) [94,7, 99,2] | 273/291 | +4,1 [+1,6, +6,7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, октябрь | 36/106 | 88,6% (31/35) [74,0, 95,5] | 98/104 | -5,7 [-13,7, +1,2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, октябрь | 35/106 | 91,2% (31/34) [77,0, 97,0] | 98/104 | -3,1 [-10,9, +3,5] | 3/6 |
| gpt-6.1-sol + opus-5-5, свежий, октябрь | 74/100 | 97,3% (72/74) [90,7, 99,3] | 95/100 | +2,3 [-0,7, +6,0] | 3/5 |
| gpt-6.1-sol + fable-5-1, свежий, октябрь | 78/100 | 97,4% (76/78) [91,1, 99,3] | 95/100 | +2,4 [-0,5, +6,3] | 3/5 |
Значение вентиля у потолка. На знакомых вопросах пара всё ещё добавляет немного (рисунок A1). В августе на SimpleQA без 106 её Delta составляет +3,0 пункта [+2,0, +4,0], разница в пользу пары. В октябре пары strat лежат выше нуля, при +2,4 [+0,2, +4,9] и +4,1 [+1,6, +6,7], и короче решения против маржи. Единственное эквивалентное — gpt-6-sol с opus-5-5 при -0,6 (90% интервал -1,6 до +0,5, p = 0,020), что не выживает после коррекции Холма (0,277). На 106 каждая пара с gpt-6.1-sol и gpt-5.6-sol не решена с нисходящим направлением. Вне этого плеча эффект велик: на том же августовском наборе fable-5 с gemini-3.1-pro находится при +19,3 пункта и fable-5 с grok-4.5 при +18,0.
Собственная уверенность плеча — конкурент в этом диапазоне. Прореженная своей собственной уверенностью до охвата пары с opus-5-5, gpt-6.1-sol находится при 34–36 из 36 на 106, в зависимости от того, как разрешены ничьи, против 31 из 35 для пары, и 74 из 74 на свежем против 72 из 74. На strat пара лидирует, на +1,6 пункта [-1,4, +4,7] с opus-5-5 и на +3,2 [+0,6, +6,2] с fable-5-1.
Какой GPT и какой партнер. На общих вопросах, которые разрешают обе модели, gpt-6.1-sol превосходит gpt-6-astra 10 к 1 на несогласованных парах (p = 0.012, +1.83 балла [+0.61, +3.26]), а gpt-6-sol превосходит gpt-6-astra 21 к 5 (p = 0.002, +3.29 [+1.23, +5.34]). gpt-6.1-sol против gpt-6-sol составляет 5 к 12 (p = 0.143). opus-5-5 против fable-5-1 составляет 29 к 44 (p = 0.101, -3.12 [-6.65, +0.21]). Пары двух самых сильных GPT с двумя Claude находятся между 95.4 и 97.1% на 503 вопросах (Таблица A2), причем fable-5-1 выявляет больше ошибок в каждом сравнении. А kimi-k3 с gemini-3.8-flash, пара без GPT, неразличима от них на новом наборе: её разница с gpt-6.1-sol и opus-5-5 составляет -1.5 балла [-6.3, +2.8] по точности и -2.0 [-10.0, +6.0] по полноте.
Приложение К. Внешние данные в деталях
Внешняя проверка раздела 5.5 использует замороженные константы без переобучения. HELM Lite (Liang et al., 2023) содержит краткие открытые ответы 95 моделей от 20 разработчиков, выпущенные между 2023 и 2025 годами, на 1000 закрытых вопросов NaturalQuestions, оценённых здесь моим движком. LiveBench (White et al., 2025) содержит ответы 70 моделей от 11 лабораторий на 346 вопросов с кратким финальным ответом, оценённые против его ground truth. Kim et al. (2025) выпускают парные агрегаты для 70 моделей на многовариантном тесте MMLU, которые дают наблюдаемую точность как долю правильных пар от доли совпадений. В таблице A8 приведены результаты. Точности в таблице 7 работы Haas et al. (2025) не содержат исходов совпадений, поэтому они дают предсказания и не дают теста.
Таблица A8. Замороженная модель на других моделях и вопросах. Средняя абсолютная ошибка предсказанного PPV для пар из разных лабораторий, ячейки с минимум 20 открытыми ответами в первых двух источниках. Двусторонний бутстреп, только по моделям для MMLU. Смещение — предсказанное минус наблюдаемое.
| Источник | Ячейки | Модель [95%] | Независ. | Лучшая | Модель минус лучшая [95%] | Модель минус независ. [95%] | Смещение |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, четыре задачи | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (агрегаты) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
Как в разделе 5.3, модель превосходит чтение лучшей модели по всем трём источникам в целом, и она не работает на головоломках зебры при 0.231 против 0.076. Она не улучшает независимые ошибки в HELM или LiveBench. Она работает высоко, на 5.3–6.6 процентных пункта в целом. В HELM наблюдаемая кривая выравнивается там, где модель продолжает расти: при точности пары между 0.5 и 0.6 точность составляет 74.6% для моделей 2023 и начала 2024 года и 75.9% для более поздних, против 84.4% предсказано в середине бина. На MMLU медианная вероятность того, что два неправильных ответа совпадают, составляет 0.621 против 0.368 из , поскольку четыре варианта вынуждают столкновения.
На этих моделях точность растёт с точностью пары (Спирмен +0.575 в HELM и +0.786 на MMLU, по зависимым ячейкам). Более старые и новые модели с похожей точностью дают похожую точность между точностью пары 0.4 и 0.6 (70.7 и 72.7%, 74.6 и 75.9%), и они отличаются больше между 0.2 и 0.3 (57.6 и 76.1%). Нижняя граница раздела 4 выполняется во всех 4,088 ячейках HELM. Пары ниже одной половины редки там, 24 из 4,088, потому что эти ячейки не стратифицированы по сложности.
HELM также позволяет проверку раздела 5.2 со многими лабораториями и без зависимости от GPT, потому что точность партнёра может быть сопоставлена без значений уверенности. С одной выпущенной моделью и партнёрами в пределах 3 пункта точности партнёр из той же лаборатории ловит 72.3% ошибок и из другой лаборатории 75.5%, разница -3.2 пункта [-4.2, -2.3], при охвате выше на 2.7 пункта [+2.1, +3.4]. Добавление сопоставления охвата в пределах 3 пункта это устраняет: 75.7 против 75.9%, -0.2 [-0.6, +0.2], с точностью -0.5 [-1.4, +0.1]. Два неправильных ответа совпадают в 31.6% случаев в пределах лаборатории и 27.0% между лабораториями.
Общие ошибки также значительно превышают случайность в коллекциях раздела 3. По нулевой гипотезе перестановки меток Ding (2026), которая сохраняет неправильные ответы каждой модели и перемешивает их по вопросам, два неправильных ответа, которые не являются отказами, совпадают в 14.0% случаев в июле и 15.4% в августе без GPT, против нуля 0.1%. На 106 ставки составляют 25.7% и 22.8% против 0.4% и 0.5%, а на свежих вопросах 14.5% в августе и 32.7% в октябре против 0.8% и 3.8%. Открытые ответы редко сталкиваются по случайности, поэтому наблюдаемое совпадение значительно превышает эту нулевую гипотезу, на вопросах, составленных после выпуска моделей, а также.
Приложение L. Дальнейшее обсуждение
Связь с Goel et al. (2025). Их тренд касается скорректированной на случайность схожести, а мой — точности согласованных ответов, поэтому выводы не противоречат друг другу. Данные проливают свет на это через условную долю общей ошибки, F/W, вероятность того, что два неправильных ответа совпадают, по вопросам, где оба ответа оценены и отказы считаются неправильными. Для эталонных пар она возрастает с 63 из 1088 (0,058) для среднего уровня пары до 15 из 42 (0,357) для флагманской пары, примерно в шесть раз. Объединённо по всем парам, включая GPT, подъём меньше и интервал включает нуль: 0,097 в июле и 0,132 в августе, разница +0,034 [-0,006, +0,084]. На октябрьском стратифицированном наборе F/W составляет 0,493 [0,179, 0,840], разница от августа +0,361 [+0,041, +0,712]. При равном охвате, бин за бином, отзыв флагмана ниже на 0,7–2,5 пункта — небольшой эффект, и составляет 0,140 [0,092, 0,192] против 0,113 [0,082, 0,146]. Направление, таким образом, согласуется с их направлением, хотя объединённый интервал включает нуль. Прямое прочтение их предупреждения о том, что схожесть угрожает затвору, действительно появляется в отзыве: октябрьские пары клиентов перехватывают 66,3% ошибок при охвате 65,3%, где все 55 августовских пар перехватывают 88,2% при 32,5%, контраст, который охват отчасти объясняет. Точность остаётся высокой в основном потому, что при такой точности ограничение из раздела 4 оставляет ей мало места для падения.
Связь с Han (2026). Han называет декорреляцию практическим рычагом. Мои измерения ставят на первое место точность и охват. При равном охвате с одной выпущенной моделью преимущество второй лаборатории исчезает, если её модель не намного точнее (раздел 5.2). В HELM, при согласованной точности, вторая лаборатория добавляет 3,2 пункта отзыва за 2,7 пункта охвата, и ничего при согласовании охвата также. Декорреляция видна там при 27,0 против 31,6% совпадающих неправильных ответов, и она невелика. Теория Han касается глубины последовательных затворов, а моя — одного затвора, поэтому они встречаются только на первом шаге. Liu (2026) разделяет те же две вещи: точность выбора следует декорреляции, с кросс-модельными панелями впереди переsampling на 12,5–16,7 пунктов на AIME-2024 при согласованной точности членов, а калибровка сигнала согласия следует точности членов. Точность согласованных ответов, измеренная здесь, — это второе из них.
Две стороны раздела 2. Опубликованные числа отчасти примиряют две стороны. Единогласная панель Liu правильна на 100,0% AIME-2025 при точности ответа на все вопросы 0,433 и на 70,2% MMLU-Pro при 0,458. Девять единогласных судей Kohli, каждый около 68%, правильны на 90,9%. Похожие точности дают точность, различающуюся на 30 пунктов, поэтому только точность не приводит эти результаты в соответствие. Размер пространства ответов объясняет больше. Вероятность того, что два неправильных ответа совпадают, составляет 0,621 на четырёхвариантном MMLU, 0,270 на NaturalQuestions и 0,132 на SimpleQA для августовских флагманов. Это панели и пары на разных задачах, без совместного расчёта по статьям, и они согласуются с точностью, следующей точности внутри задачи и формата ответа.
Знакомство. Разрыв между SimpleQA и свежей точностью приглашает объяснение через подверженность контрольному набору, и буквальное совпадение с золотой строкой выглядит как его сигнатура. Мои данные не поддерживают это как ковариату (приложение C). Среди правильных ответов буквальное совпадение близко к одному значению по моделям и не объясняет остаток модели. F/W на свежем наборе в августе, 0,145 [0,033, 0,402], не показывает видимого расстояния от 0,132 на SimpleQA, в пределах широкого интервала.
Как цитировать
Chernets, V. (2026). Инверсия согласия — это не свойство среднего уровня: точность согласованных ответов LLM следует точности пары [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}