法庭文件AI:在提交前捕捉虚假引用
这是译文。权威版本是英文原文,引用请以原文为准。
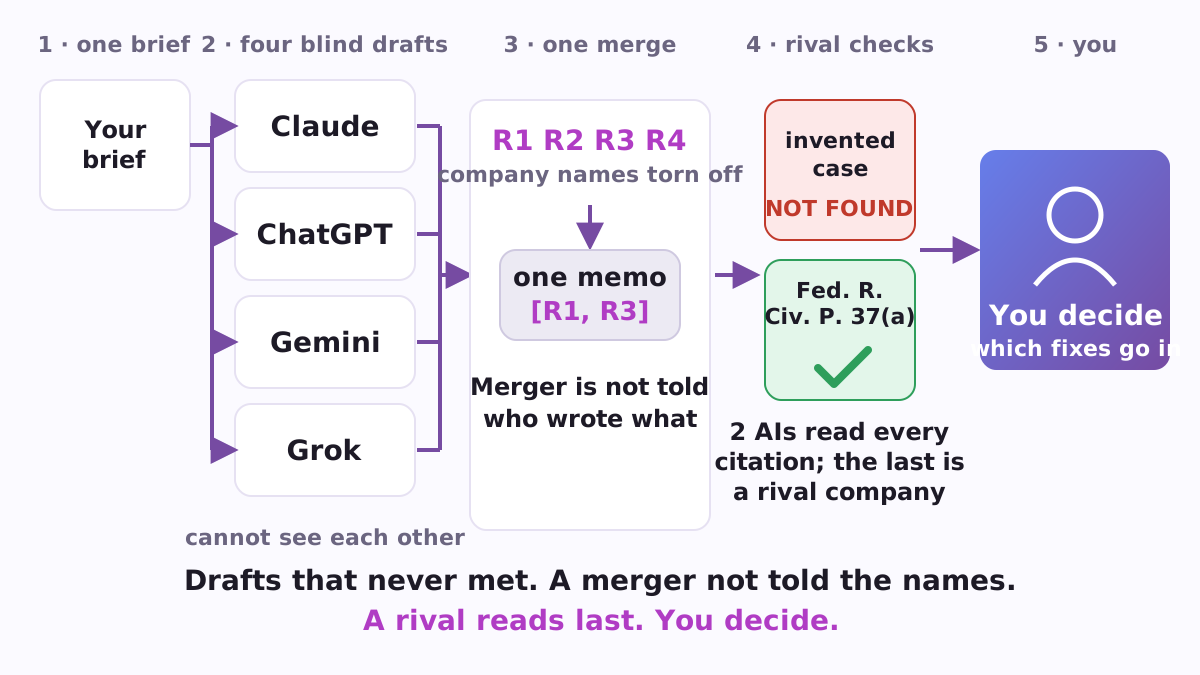
如果你要上法庭而没有律师,并使用 ChatGPT、Claude 或 Gemini 来帮助处理文件,最昂贵的错误不是笨拙的写作,而是一句引用不存在的案件的确定陈述。Docprep 是一个免费、开源的程序,它改变的是 AI 的安排方式,而不是你使用哪个 AI。来自不同公司的多个 AI 各自编写同一文档的完整草稿,而彼此看不到。一个 AI 合并这些草案,但不被告知哪个公司写了哪个。然后两个 AI 检查合并的文本,优先检查引用,其中最后一个来自与合并它的公司不同的公司。你获得文档、两份检查报告和运行记录,然后你决定包含哪些修复。
它在你自己的计算机上运行。使用 API 密钥(允许程序直接与 AI 公司的模型通话的密码),它可以自动运行。没有它们,它将每一步作为文件交给你,你可以粘贴到你已经使用的 AI 聊天网站中,并从你离开的地方继续。它适用于任何声明需要来源的文档,如报告、保险申诉或向监管机构的投诉,其示例任务是自诉当事人可能需要的动议。
为什么一个人工智能对法庭诉讼文件来说还不够
虚假引用并非罕见事故。2026年10月10日,由研究员Damien Charlotin维护的人工智能幻觉案例数据库列出了2184项涉及人工智能生成内容(如虚假引用)的法庭裁决;其中1259项中,当事人是自行代理人。2026年8月,加州上诉法院命令一对在没有律师情况下提出上诉的夫妇支付对方的上诉律师费,因为他们依赖了不存在的权威和虚构的引文(California Courts Newsroom)。格鲁吉亚州中区联邦法院明确告诉自行代理的当事人,"人工智能不能减轻当事人确保法庭诉讼文件中引用的所有事实和法律权威都准确无误的责任"(M.D. Ga.)。
更多人面临这项工作:美国联邦民事案件中无律师代理提交的比例从长期平均的11%上升到2025财年的16.8%(Shah and Levy, 通过beSpacific)。新型模型单独无法解决这一问题。普林斯顿研究人员检查了来自八代免费ChatGPT模型的8000多条引用,发现GPT-5.1的幻觉率为6.57%,"统计学意义上的显著衰退"。同一研究指出了Docprep所围绕的解决方案:一个可以搜索法律数据库和开放网络的人工智能检查工具在测试中识别了所有不存在的引用(Princeton CITP)。
工作原理
Docprep 通过五个步骤处理一个书面任务,每个步骤由该步骤中的人工智能被允许看到的信息定义。
- 一份简述。 你只需写一次任务:你需要什么、管辖权、格式、什么算作来源。该示例要求一份备忘录,说明自代诉讼人在联邦法院中是否可以对仅以模板异议回答的发现响应提出强制动议。
- 单独草稿。 至少来自三家不同公司的三个人工智能各自撰写一份完整的草稿,并进行网络搜索(如有)。没有人看到其他人的草稿。每一个都必须为每个陈述引用来源,将无法验证的内容标记为"未验证",并且不倾向于中间立场,这样分歧就显示出来了。
- 盲合并。 一个人工智能以随机顺序接收草稿(如 R1、R2、R3);命名其制作者的草稿将该短语替换为"[vendor name removed]"。合并器使用其背后的草稿标记每个声明,如 [R1, R3],并记录草稿同意的内容、意见不一致的地方以及如何解决每个冲突。没有该日志的合并会停止运行。
- 内部检查。 来自合并器所属公司的人工智能在新的会话中读取结果,检查每个来源是否存在并说明声称的内容,将发现等级分为"关键"、"主要"和"次要",并给出判决。
- 外部检查。 来自不同公司的人工智能阅读文件和第一份报告,确认或质疑每一项发现,添加自己的发现并给出最终判决。
所有内容都在一个文件夹中:简述、每个提示和草稿、合并的文件、合并日志、两份报告和一个 manifest.json 记录。评论者的修复不会自动应用于你的文本;由你选择。具体页码值得你最密切的关注,因为这正是搜索人工智能检查器最薄弱的地方(普林斯顿代理仅识别了 18.2% 的错误页码引文),在引用的页面打开案件即可解决问题。
这些规则为何必要
- 各份草稿互不相见。在人工智能辩论中,当同行进行有说服力的论证时,模型往往会从正确答案转向错误答案(Wynn, Satija and Hadfield, 2025)。
- 合并方不被告知谁撰写了什么。人工智能评判员倾向于给自己的输出打更高的分数,并且能够识别它(Panickssery, Bowman and Feng, 2024)。标签的密钥仅进入记录,因此您稍后可以统计合并方有利于自己公司的频率。
- 最后的读者来自另一家公司。在对超过350个模型的研究中,当两个模型都犯错时,它们在一个排行榜上约60%的时间给出相同的错误答案(Kim et al., ICML 2025)。在其他地方培训的批评者是发现共享盲点的最直接途径。
- 每位批评者都必须能够进行搜索。如果批评者没有搜索工具,Docprep拒绝启动。
- 规则即代码。
python3 docprep.py check拒绝违反这些规则的设置,例如结束批评者来自合并方所属的公司,或起草人员来自少于三个公司的情况。
记录为您提供的内容
该清单为每一步记录了以下内容:模型、是否通过API运行或手动运行、提示和答案的指纹、时间、标签的键和两项判决。它甚至记录了搜索工具是否真的附加到了每个请求。一些法院会询问AI的使用情况:Northern District of Texas要求用生成式AI准备的简报必须"在第一页披露此事实"(LR 7.2(f))。Docprep运行文件夹中包含了此类通知所需的确切材料。它还可以节省资金:resume仅运行尚无文件的步骤,因此不会重复已付费的调用。
两种运行方式
手动运行,在聊天网站中,无需 API 密钥。 manual 公式为每个步骤写入一个文件 MANUAL-<role>.md,其中包含提示词和要使用的模型。你将其粘贴到一个新的聊天中,将答案粘贴回标记线下方,然后运行 resume。完整运行需要七次粘贴:四份草稿(Claude、ChatGPT、Gemini 和 Grok)、合并和两次检查。规则关注的是模型来自哪家公司,而不是你支付的计划,这种方法也让你可以使用聊天网站的深度研究模式。
使用 API 密钥,自动运行。 为 Anthropic、OpenAI 和 Google 设置密钥,Docprep 自己调用这些模型,每个模型都使用其公司自己的搜索工具;Grok 和 Llama 模型可以作为额外的起草者加入。示例配置有一个用于常规文档的 basic 公式和一个用于法院将审阅的任何内容的 enhanced 公式,基于 2026 年 9 月可用的模型构建;来自不同公司但遵守规则的任何组合都可以。
该协议称自己为一个斜坡:"它是为无法上楼梯的人构建的:无法同时打开五个界面、相互对比阅读它们,并将答案携带回来的人。" Docprep 负责携带。
它与 LLM council 的区别
Docprep 属于 LLM council、多智能体辩论和 LLM-as-a-judge 这一类系统。Andrej Karpathy 著名的 llm-council 让多个模型在隐藏身份的情况下相互排名,然后由一个"主席"模型撰写最终答案。Docprep 在四个方面有所不同,这些都由代码强制执行:起草者彼此看不到对方的草稿,合并器不被告知谁写了什么,最终判决来自与合并器不同的公司,每一步都留下记录。它还在任何最终改写之前停止:你得到的是文档和报告,而不是为你悄悄修改的文本。
如何开始
您需要 Python 3 和来自 GitHub 页面 的代码。
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
使用 API 密钥,将你的账户提供的模型名称放入 config.yaml,然后运行 python3 docprep.py check 和 python3 docprep.py run --brief briefs/my-brief.md --formula enhanced。离线测试(python3 -m pytest tests/test_offline.py,五个测试)无需密钥或网络即可运行整个管道。
它的来源
Docprep是Vadym Chernets论文The Missing Variable in AI-Assisted Litigation: Architecture and the Quality of Pro Se Access to Justice中协议的参考实现(SSRN 7120940,DOI 10.2139/ssrn.7120940)。该论文主张,人工智能帮助的安排方式(询问一个模型一次或来自不同公司的多个模型相互检查)是自代理诉讼人提交文件质量的一个变量,并以作者作为无律师原告的一个联邦案件为基础。该代码是MIT许可证下的一个Python文件,协议文本PROTOCOL.md采用CC BY 4.0许可证,所有内容都在github.com/vadimchernets/docprep。要向您计算机上的人工智能工具提出一个问题,请参阅After Chat和Sidecall;要通过您自己的浏览器向人工智能聊天网站提问,请参阅Roundcall。
Vadym Chernets还开发Poly A1,一个来自不同公司的人工智能相互检查彼此工作的应用程序。