AI for Court Documents: 偽りの引用を提出前に見つける — ツール
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
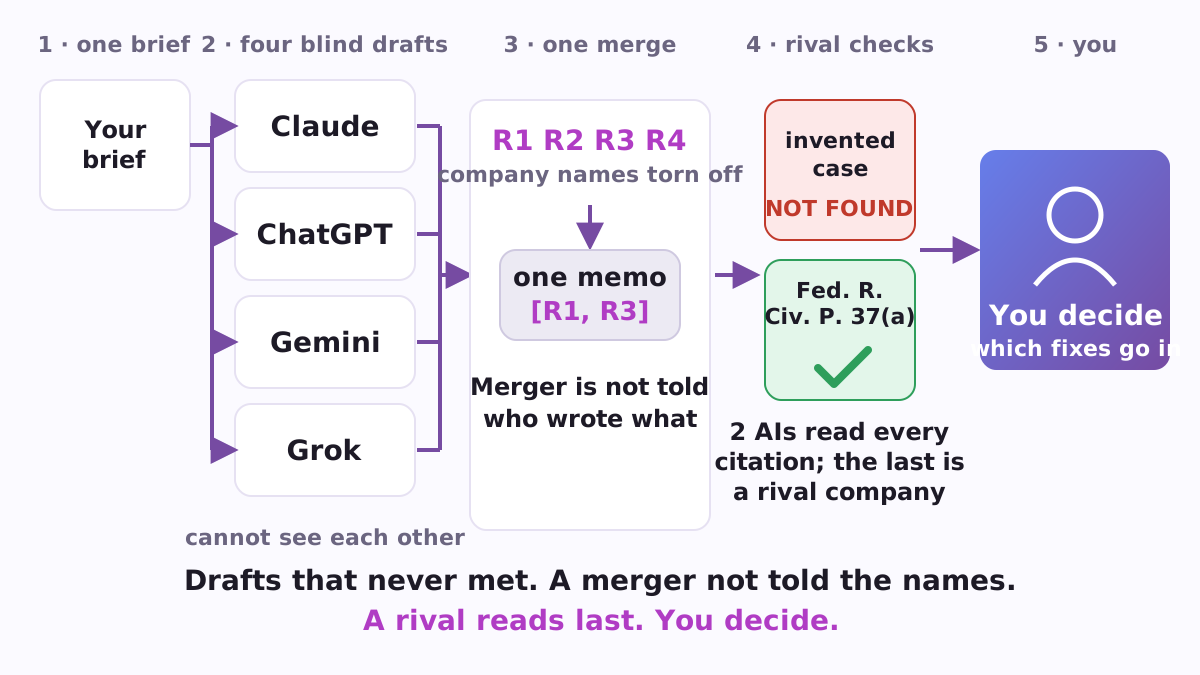
弁護士なしで裁判所に行き、ChatGPT、Claude、Gemini を書類作成に利用する場合、最も高くつく間違いは、ぎこちない文章ではありません。それは、存在しない判例を引用した自信のある文です。Docprep は無料のオープンソースプログラムで、使用する AI ではなく、AI の配置方法を変更します。異なる企業からの複数の AI が、互いに見ることなく同じ文書の完全な草案を各自作成します。1 つの AI が、どの企業が何を書いたかを知らされずに草案をまとめます。次に 2 つの AI がマージされたテキストを確認し、引用を最初に確認します。最後の AI はそれをまとめた AI とは異なる企業のものです。文書と 2 つの確認報告書および実行の記録が得られ、どの修正を反映するかはあなたが決定します。
自分のコンピュータで実行されます。API キー (プログラムが AI 企業のモデルと直接通信することを可能にするパスワード) があれば、単独で実行されます。API キーがない場合は、各ステップをファイルとして提示し、すでに使用している AI チャットサイトに貼り付けることができ、中断したところから再開されます。報告書、保険上訴、規制当局への苦情など、主張にソースが必要な任意の文書に機能し、その例示的なタスクは本人訴訟者が必要とする可能性がある申し立てです。
なぜ裁判所への提出書類には1つのAIでは不十分なのか
架空の引用は稀な事故ではありません。2026年10月10日の時点で、研究者Damien Charlotin が管理するAI Hallucination Cases databaseには、架空の引用などAIが生成したコンテンツに関わる裁判所の判決が2,184件リストアップされており、そのうち1,259件は本人訴訟人が当事者でした。2026年8月、カリフォルニア控訴裁判所は、弁護士なしで控訴した夫婦に対し、存在しない当局と架空の引用に依拠したため、相手側の弁護士費用の支払いを命じました(California Courts Newsroom)。ジョージア州中部地区の連邦裁判所は本人訴訟人に対し、「AIは、裁判所への提出書類に引用されたすべての事実および法的根拠が正確であることを確認する当事者の責任を軽減するものではありません」と明言しています(M.D. Ga.)。
その職務に直面する人はさらに増えています。弁護士なしで提出されたアメリカ連邦民事事件の割合は、長期平均の11%から会計年度2025年の16.8%に上昇しました(Shah and Levy, via beSpacific)。新しいモデル単独ではそれを解決しません。プリンストン大学の研究者は、ChatGPT モデルの8世代から8,000件以上の引用を検査し、GPT-5.1 が6.57%で幻覚を起こしていることを発見しました。これは「統計的に有意な悪化」です。同じ研究は Docprep が構築されている対策を指摘しています。法律データベースと一般的なウェブを検索することが許可されたAIチェッカーは、テストで存在しない引用をすべて検出しました(Princeton CITP)。
どのように機能するか
Docprepは1つの作成されたタスクを5つのステップを通して処理し、各ステップはそのステップ内のAIが何を見ることができるかによって定義されます。
- 1つのブリーフ。タスクを1回書きます。必要なもの、管轄権、形式、ソースの基準を記します。例は、連邦裁判所で自己代理人訴訟人が定型的な異議のみで答えられた証拠開示応答を強制する申し立てができるかどうかについてのメモランダムを求めています。
- 別個のドラフト。少なくとも3つの異なる企業からの少なくとも3つのAIが、利用可能な場所ではウェブサーチを使用して、完全なドラフトをそれぞれ作成します。いずれも他のドラフトを見ません。各AIはすべての陳述に対してソースを引用し、検証できなかったものを「未検証」とマークし、「中間的な立場に向けてヘッジ」しないため、意見の相違が明らかになります。
- ブラインドマージ。1つのAIがドラフトをランダムな順序でR1、R2、R3として受け取ります。その作成者に名前を付けたドラフトは、そのフレーズが「[ベンダー名削除]」に置き換えられます。マージャーは各主張に背後にあるドラフトをタグ付けし(例:[R1、R3])、ドラフトが何に合意したか、どこで意見が異なったか、各競合がどのように解決されたかのログを書きます。そのログのないマージは実行を停止します。
- 内部からのチェック。マージャーと同じ企業のAIが新しいセッションで結果を読み、すべてのソースが存在し、何が主張されているかを確認し、調査結果をクリティカル、メジャー、マイナーにランク付けし、判定を与えます。
- 外部からのチェック。別の企業のAIがドキュメントと最初のレポートを読み、各調査結果を確認または異議を唱え、独自の調査結果を追加し、最終的な判定を与えます。
すべてが1つのフォルダに格納されます。ブリーフ、すべてのプロンプトとドラフト、マージされたドキュメント、マージログ、両方のレポート、およびmanifest.jsonレコードです。批評家の修正は自動的にあなたのテキストに適用されません。あなたが選びます。ページ番号の正確な引用は最も注意深く確認する価値があります。これは、検索AIチェッカーでさえ最も弱い場所です(Princetonエージェントは間違った引用番号の18.2%しか捕捉しませんでした)。引用されたページでケースを開くと、それが確定します。
これらのルールが必要な理由
- ドラフトは決して出会わない。 AI ディベートでは、モデルがピアの説得力のある議論に直面すると、正解から誤った答えに切り替わることがよくあります (Wynn, Satija and Hadfield, 2025)。
- マージャーには誰が何を書いたかが告げられない。 AI ジャッジは自分自身の出力をより高く評価する傾向があり、それを認識できます (Panickssery, Bowman and Feng, 2024)。ラベルの鍵は記録にのみ入るため、後でマージャーが自社に有利な判定をした頻度を数えることができます。
- 最後の査読者は別の企業から来ています。 350 以上のモデルの調査では、2 つが両方とも間違っていた場合、あるリーダーボード上で約 60% の確率で同じ誤った答えを出しました (Kim et al., ICML 2025)。他の場所で訓練された批評家は、共有された盲点に到達する最も直接的なルートです。
- すべての批評家が検索できなければならない。 Docprep は、批評家が検索ツールを持たない場合、起動を拒否します。
- ルールはコードです。
python3 docprep.py checkはそれらを破るセットアップを拒否します。例えば、最後の批評家がマージャーの企業から来ている、またはドラフターが 3 社未満にまたがっている場合です。
記録があなたに提供するもの
マニフェスト記録は、すべてのステップについて、モデル、APIを通じて実行されたか手動で実行されたか、プロンプトと回答のフィンガープリント、時刻、ラベルへのキー、および両方の判定を記録します。各リクエストに検索ツールが実際に添付されたかどうかも記録します。AIの使用について質問する裁判所もあります。テキサス州北部地区は、生成AIで準備された簡潔書について「最初のページでこの事実を開示する」ことを要求しています(LR 7.2(f))。Docprepの実行フォルダには、そのような通知のための正確な資料が含まれています。また、コストも節約します。resumeは、まだファイルがないステップのみを実行するため、失敗した呼び出しは有料の呼び出しを繰り返しません。
実行方法は2つあります
手動で、チャットサイトで、APIキーなし。 manualフォーミュラは各ステップごとにMANUAL-<role>.mdファイルを書き出し、プロンプトと使用するモデルを記載します。これを新しいチャットに貼り付け、答えをマーカー行の下に貼り戻してresumeを実行します。フルラン は7つの貼り付けです:4つのドラフト(Claude、ChatGPT、GeminiおよびGrok)、マージ、および2つのチェックです。ルールはどの企業のモデルかを気にします。支払うプランではなく、このパスではチャットサイトのディープリサーチモードも使用できます。
APIキーを使用して、自動的に。 Anthropic、OpenAI、Googleのキーを設定すると、Docprepが各モデルを呼び出し、各企業独自の検索ツールを使用します。GrokとLlamaモデルは追加のドラフターとして参加できます。サンプル設定には、通常の文書用のbasicフォーミュラと、裁判所が読む可能性のあるもの用のenhancedフォーミュラがあり、2026年9月時点で利用可能なモデルから構築されています。ルールを守る異なる企業のセットなら何でも可能です。
このプロトコルはランプと呼ばれています:「階段が上れない人のために作られました。同時に5つのインターフェイスを開いたままにして、互いに読み比べて、答えを持ち帰ることができない人のためです。」Docprepが持ち運びをします。
LLM評議会との違い
Docprepはニューラルネットワークに基づく複数エージェント議論とLLM審査官という手法のファミリーに属しています。Andrej Karpathyの人気のあるllm-councilは、名前を隠した状態でモデルが互いにランク付けし、その後「議長」モデルが最終的な回答を作成します。Docprepは4つの点で異なり、すべてコードで実装されています。起草者は互いに内容を読まず、統合者は誰が何を書いたかを知らされず、最終判定は統合者とは別の企業からもたらされ、すべてのステップが記録に残ります。また、最終的な修正の前に停止します。つまり、ドキュメントとレポートが提供されるのであり、テキストが静かに修正されて提供されるのではありません。
始め方
Python 3 とGitHub ページのコードが必要です。
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
API キーを使用する場合、アカウントが提供するモデル名を config.yaml に入力してから、python3 docprep.py check と python3 docprep.py run --brief briefs/my-brief.md --formula enhanced を実行します。オフラインテスト(python3 -m pytest tests/test_offline.py、5 つのテスト)はキーやネットワークなしでパイプライン全体を実行します。
どこから来たのか
Docprepは、Vadym Chernetsによる論文AI支援訴訟における欠落変数:本人訴訟者による司法へのアクセス品質とアーキテクチャのプロトコルの参照実装です(SSRN 7120940、DOI 10.2139/ssrn.7120940)。この論文は、AIの支援がどのように配置されているか、つまり1つのモデルに1回質問するか、異なる企業の複数のモデルが相互に検証するかが、本人訴訟者が提出する文書の品質における変数であることを主張しており、著者が弁護士なしで原告であった連邦裁判事件に基づいています。コードはMITライセンスの下にある単一のPythonファイルで、プロトコルテキストPROTOCOL.mdはCC BY 4.0の下にあり、すべてはgithub.com/vadimchernets/docprepにあります。AIツールにコンピュータで1つの質問をするには、After ChatとSidecallを参照してください。AIチャットサイトに自分のブラウザを通じてアクセスするには、Roundcallを参照してください。
Vadym ChernetsはまたPoly A1を開発しています。これは異なる企業のAIが互いの作業を検証するアプリです。