법원 문서를 위한 AI: 제출 전에 허위 인용구 잡기 — 도구
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
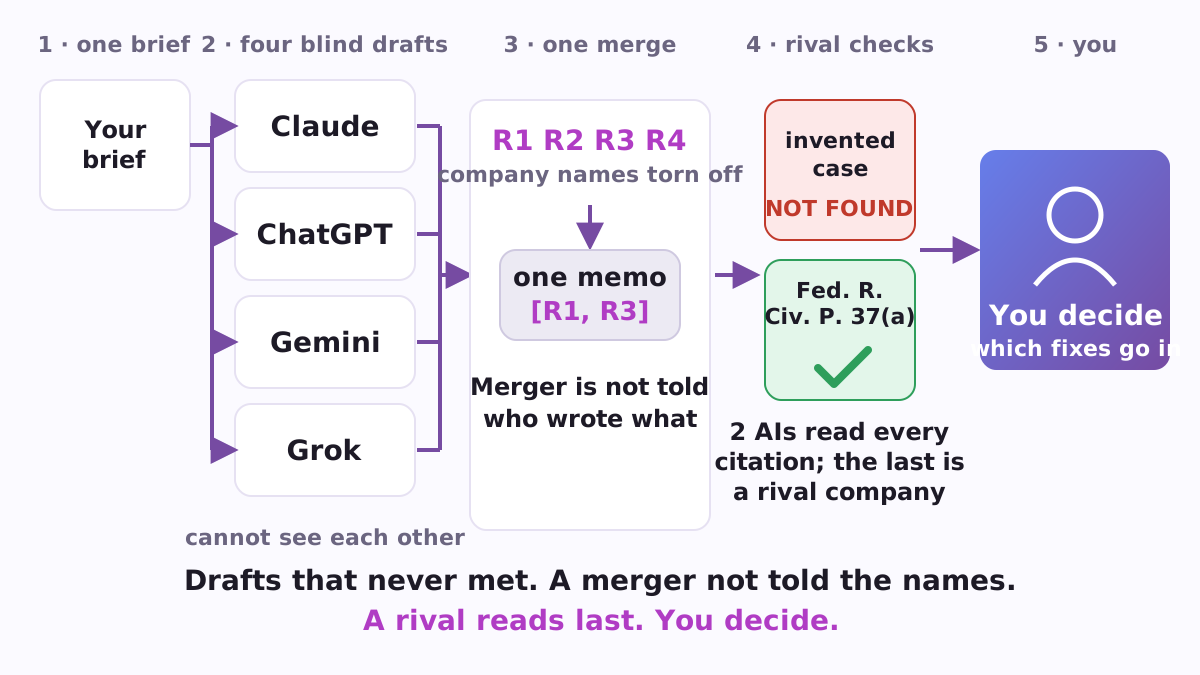
변호사 없이 법원에 가고 ChatGPT, Claude 또는 Gemini를 서류 작성에 도움을 받으려고 사용하는 경우, 가장 비용이 많이 드는 실수는 서툰 글쓰기가 아닙니다. 존재하지 않는 판례를 인용하는 자신감 있는 문장입니다. Docprep은 어떤 AI를 사용하는지보다는 AI를 배열하는 방식을 바꾸는 무료 오픈 소스 프로그램입니다. 다양한 회사의 여러 AI가 각각 서로를 보지 않고 동일한 문서의 완전한 초안을 작성합니다. 하나의 AI가 어느 회사가 어떤 것을 작성했는지 알지 못한 채 초안을 병합합니다. 두 개의 AI가 병합된 텍스트를 인용을 우선으로 확인하며, 마지막 AI는 병합한 회사와 다른 회사에서 나옵니다. 문서, 두 개의 검토 보고서 및 실행 기록을 받으며, 어떤 수정 사항을 포함할지 결정합니다.
자신의 컴퓨터에서 실행됩니다. API 키(프로그램이 AI 회사의 모델과 직접 통신할 수 있도록 하는 비밀번호)를 사용하면 자동으로 실행됩니다. 키 없이는 각 단계를 이미 사용 중인 AI 채팅 사이트에 붙여넣을 파일로 제공하고, 중단한 부분에서 계속됩니다. 보고서, 보험 항소 또는 규제 기관에 대한 불만과 같이 주장이 출처가 필요한 모든 문서에 사용할 수 있으며, 예시 작업은 자신을 대리하는 소송당사자가 필요로 할 수 있는 신청서입니다.
한 개의 AI는 법원 제출용으로 충분하지 않은 이유
조작된 인용은 드문 사고가 아닙니다. 2026년 10월 10일 연구자 Damien Charlotin이 관리하는 AI Hallucination Cases database는 가짜 인용과 같은 AI가 생성한 콘텐츠를 다루는 2,184개의 법원 판결을 기록했습니다. 그 중 1,259건에서는 당사자가 자신을 대리하는 사람이었습니다. 2026년 8월 변호사 없이 항소한 남편과 아내에게 California appeals court는 존재하지 않는 법적 근거와 조작된 인용에 의존했다는 이유로 상대방의 변호사 수수료를 지급하도록 명령했습니다(California Courts Newsroom). Georgia 중부 연방법원은 자신을 대리하는 당사자들에게 "AI는 법원 제출 문서에 인용된 모든 사실과 법적 근거가 정확한지 확인할 당사자의 책임을 덜어주지 않습니다"라고 명확히 말합니다(M.D. Ga.).
더 많은 사람들이 그 업무에 직면하고 있습니다. 변호사 없이 제출된 미국 연방 민사 사건의 비중은 장기 평균 11%에서 2025회계연도에 16.8%로 증가했습니다(Shah and Levy, via beSpacific). 최신 모델만으로는 해결되지 않습니다. Princeton 연구자들은 8세대의 무료 ChatGPT 모델에서 8,000개 이상의 인용을 검토했으며 GPT-5.1이 6.57%에서 환각을 일으키고 있음을 발견했습니다. "통계적으로 유의미한 퇴행"입니다. 같은 연구는 Docprep이 구축된 해결책을 제시합니다. 법률 데이터베이스와 공개 웹을 검색할 수 있는 AI 검사기는 테스트에서 존재하지 않는 모든 인용을 포착했습니다(Princeton CITP).
작동 방식
Docprep는 하나의 작성된 작업을 5단계를 거쳐 진행하며, 각 단계는 그 단계의 AI가 볼 수 있도록 허용된 것에 의해 정의됩니다.
- 하나의 지시사항. 작업을 한 번 작성합니다: 필요한 것, 관할권, 형식, 출처로 인정되는 것. 예시는 연방법원에서 자신을 대리하는 소송당사자가 보일러플레이트 이의만으로 답변한 증거개시 응답을 강제할 동의를 신청할 수 있는지에 관한 메모랜덤을 요청합니다.
- 별도의 초안. 최소 3개 회사의 최소 3개 AI가 각각 전체 초안을 작성하며, 가능한 경우 웹 검색을 사용합니다. 어느 누구도 다른 초안을 보지 못합니다. 각 AI는 모든 주장에 대해 출처를 인용해야 하고, 검증할 수 없는 것을 "unverified"로 표시해야 하며, "중간 입장으로 회피"하지 않아야 하므로 의견 불일치가 드러납니다.
- 맹검 병합. 한 AI는 초안을 무작위 순서로 R1, R2, R3으로 받습니다. 제작사 이름을 명시한 초안은 그 표현이 "[vendor name removed]"로 대체됩니다. 병합자는 각 주장을 [R1, R3]과 같이 그것을 뒷받침하는 초안으로 태그하고, 초안이 동의한 것, 의견이 맞지 않은 것, 각 충돌이 어떻게 해결되었는지에 대한 로그를 작성합니다. 그 로그가 없는 병합은 실행을 중단합니다.
- 내부 검수. 병합자의 회사에서 온 AI가 새로운 세션에서 결과를 읽고, 모든 출처가 존재하며 무엇이 주장되었는지 확인하고, 발견 사항을 Critical, Major, Minor로 순위를 매기고 판정을 제시합니다.
- 외부 검수. 다른 회사의 AI가 문서와 첫 번째 보고서를 읽고, 각 발견을 확인하거나 이의를 제기하고, 자신의 발견을 추가하고 최종 판정을 제시합니다.
모든 것이 한 폴더에 저장됩니다: 지시사항, 모든 프롬프트와 초안, 병합된 문서, 병합 로그, 두 보고서 및 manifest.json 기록. 비평가의 수정 사항이 자동으로 텍스트에 적용되지 않습니다. 선택하면 됩니다. 정확한 페이지 번호는 검색 AI 검수자도 가장 약한 부분이므로 가장 자세히 살펴볼 가치가 있습니다(Princeton 에이전트는 잘못된 페이지 인용의 18.2%만 포착했습니다). 인용된 페이지에서 사건을 열면 그것으로 확정됩니다.
이 규칙들이 필요한 이유
- 초안들이 만나지 않습니다. AI 논쟁에서 모델들은 동료가 설득력 있게 주장할 때 올바른 답변에서 잘못된 답변으로 바뀌는 경우가 많습니다 (Wynn, Satija and Hadfield, 2025).
- 병합자는 누가 무엇을 작성했는지 알려지지 않습니다. AI 판사들은 자신의 결과물에 더 높은 점수를 매기는 경향이 있으며, 이를 인식할 수 있습니다 (Panickssery, Bowman and Feng, 2024). 레이블의 키는 기록에만 저장되므로 나중에 병합자가 자신의 회사를 얼마나 자주 선호했는지 계산할 수 있습니다.
- 마지막 검토자는 다른 회사에서 옵니다. 350개 이상의 모델에 대한 연구에서, 둘 다 틀렸을 때 한 리더보드에서 약 60%의 확률로 동일한 잘못된 답변을 제시했습니다 (Kim et al., ICML 2025). 다른 곳에서 훈련받은 비평가가 공유된 맹점에 도달하는 가장 직접적인 경로입니다.
- 모든 비평가는 검색 기능을 사용할 수 있어야 합니다. 비평가가 검색 도구가 없으면 Docprep은 시작을 거부합니다.
- 규칙들은 코드입니다.
python3 docprep.py check는 규칙을 위반하는 설정, 예를 들어 마지막 비평가가 병합자의 회사에서 온 경우나 초안 작성자들이 3개 미만의 회사에 걸쳐 있는 경우를 거부합니다.
기록이 제공하는 것
매니페스트 기록은 모든 단계에서 모델, API를 통해 실행되었는지 아니면 수동으로 실행되었는지 여부, 프롬프트와 답변의 지문, 시간, 레이블의 키 및 두 가지 판정을 기록합니다. 각 요청에 검색 도구가 실제로 첨부되었는지 여부도 기록합니다. 일부 법원은 AI 사용에 대해 묻습니다. 텍사스 북부 지구는 생성형 AI로 준비된 소장에 "첫 페이지에 이 사실을 공시할 것"을 요구합니다(LR 7.2(f)). Docprep 실행 폴더에는 정확히 그러한 공지를 위한 자료가 포함되어 있습니다. 비용도 절감합니다. resume는 아직 파일이 없는 단계만 실행하므로 실패한 호출이 유료 호출을 반복하지 않습니다.
실행하는 두 가지 방법
채팅 사이트에서 수동으로, API 키 없이. 수동 공식은 각 단계에 대해 프롬프트와 사용할 모델을 포함한 MANUAL-<role>.md 파일을 작성합니다. 이를 새로운 채팅에 붙여 넣고, 표시 줄 아래에 답변을 붙여 넣은 후 resume을 실행합니다. 전체 실행은 일곱 번의 붙여 넣기로 이루어집니다: 네 개의 초안(Claude, ChatGPT, Gemini 및 Grok), 병합, 그리고 두 번의 검사입니다. 규칙은 어떤 요금제를 사용하는지는 상관없이 모델이 어느 회사에서 온 것인지를 고려하며, 이 방법은 또한 채팅 사이트의 심층 연구 모드를 사용할 수 있게 해줍니다.
API 키를 사용하여 자동으로. Anthropic, OpenAI 및 Google의 키를 설정하면, Docprep이 각 모델을 자동으로 호출하며, 각각의 회사 자체 검색 도구를 사용합니다. Grok과 Llama 모델이 추가 초안 작성자로 참여할 수 있습니다. 예제 구성은 일상적인 문서용 기본 공식과 법원이 읽을 모든 것을 위한 고급 공식을 포함하며, 이는 2026년 9월에 사용 가능한 모델로 구축되었습니다. 규칙을 유지하는 한 다양한 회사의 모든 집합이 작동합니다.
이 프로토콜은 자신을 경사로라고 부릅니다: "계단을 오를 수 없는 사람을 위해 만들어졌습니다. 다섯 개의 인터페이스를 동시에 열고, 서로를 비교해서 읽고, 답변을 다시 가져갈 수 없는 사람을 위해서입니다." Docprep이 그것을 전달합니다.
LLM 위원회와의 차이점
Docprep는 LLM 위원회, 다중 에이전트 토론 및 LLM-as-a-judge 계열에 속합니다. Andrej Karpathy의 유명한 llm-council은 모델들이 이름을 숨긴 채 서로를 순위 매기고, "의장" 모델이 최종 답변을 작성합니다. Docprep는 네 가지 방식으로 다르며, 모두 코드로 강제됩니다: 작성자들은 서로를 읽지 않으며, 병합자는 누가 무엇을 작성했는지 알려지지 않고, 최종 판정은 병합자와 다른 회사에서 나오며, 모든 단계가 기록을 남깁니다. 또한 최종 재작성 전에 멈춥니다: 조용히 수정된 텍스트가 아니라 문서와 보고서를 받게 됩니다.
시작하는 방법
Python 3과 GitHub 페이지의 코드가 필요합니다.
git clone https://github.com/vadimchernets/docprep
cd docprep
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp config.example.yaml config.yaml
python3 docprep.py run --brief briefs/example_brief.md --formula manual
python3 docprep.py resume --run runs/<id>
API 키를 사용할 때는 계정이 제공하는 모델 이름을 config.yaml에 입력한 후 python3 docprep.py check와 python3 docprep.py run --brief briefs/my-brief.md --formula enhanced를 실행합니다. 오프라인 테스트(python3 -m pytest tests/test_offline.py, 5개 테스트)는 키나 네트워크 없이 전체 파이프라인을 실행합니다.
출처
Docprep는 Vadym Chernets의 논문 AI 지원 소송에서 누락된 변수: 아키텍처와 프로 세 접근성의 품질 (SSRN 7120940, DOI 10.2139/ssrn.7120940)에서 제시한 프로토콜의 참조 구현입니다. 이 논문은 AI 지원이 어떻게 배열되는지, 즉 한 모델에 한 번 질문하는 방식과 여러 회사의 모델이 서로를 검증하는 방식이 자신을 변호할 수 없는 소송 당사자들이 제출하는 문서의 품질에 영향을 미치는 변수라고 주장하며, 저자가 변호사 없이 원고였던 연방 소송 사건을 기반으로 합니다. 코드는 MIT 라이선스 하의 Python 파일 하나이며, 프로토콜 텍스트 PROTOCOL.md는 CC BY 4.0 라이선스이며, 모든 것은 github.com/vadimchernets/docprep에 있습니다. 컴퓨터의 AI 도구에 하나의 질문을 하려면 After Chat와 Sidecall을 참고하세요. AI 채팅 사이트에 자신의 브라우저를 통해 질문하려면 Roundcall을 참고합니다.
Vadym Chernets는 또한 서로 다른 회사의 AI가 각각의 작업을 검증하는 앱인 Poly A1을 개발합니다.