जब एजेंट की मेमोरी विरल कोड में समेट दी जाए, तो क्या दो AI एक ही गलत जवाब पर सहमत होते हैं?
के साथ Mohan Bheemadolu · AI एजेंट डेवलपर · FlyHash for LLM agent memory के सह-लेखक
आधे मिनट में
Mohan Bheemadolu AI एजेंटों के लिए मेमोरी बनाते हैं। Dr. Chrisogonas O. Odhiambo के साथ उन्होंने FlyHash, जो हर याद को विरल कोड के रूप में रखता है, यानी एक लंबा वेक्टर जिसमें सिर्फ़ कुछ "सक्रिय बिट" चालू होते हैं, ठीक वैसे जैसे फल-मक्खी की नाक गंधों को अलग पहचानती है। सक्रिय बिटों की उतनी ही संख्या (32) पर, लेखकों के सिंथेटिक बेंचमार्क में, यह सही यादों को आम तरीके से लगभग 2.5 गुना बेहतर रैंक करता है (mAP 0.27 बनाम 0.11)। बराबर स्टोरेज पर लगभग चार गुना बिट वाला आम तरीका इसकी बराबरी कर लेता है या इससे आगे निकल जाता है, और असली बातचीतों में बढ़त छोटी है।
हमारा सवाल: एजेंट के जवाब को अक्सर एक दूसरा AI जाँचता है, मगर दोनों वही मेमोरी पढ़ते हैं। अगर उस मेमोरी में तथ्य छूट गया, तो क्या दोनों एक ही गलत जवाब पर सहमत होने लगते हैं?
हमारे पहले रन में, सादी कीवर्ड मेमोरी के साथ, ऐसा ही दिखा: जब मेमोरी में तथ्य छूट गया, तो दोनों AI के सहमत जवाबों में से 45% गलत थे, जबकि तथ्य मौजूद होने पर 3%। अब Mohan FlyHash को चार कोड-साइज़ पर चलाएँगे, और हम देखेंगे कि क्या कम सक्रिय बिट वाले कोड से यह और बिगड़ता है।
पेपर
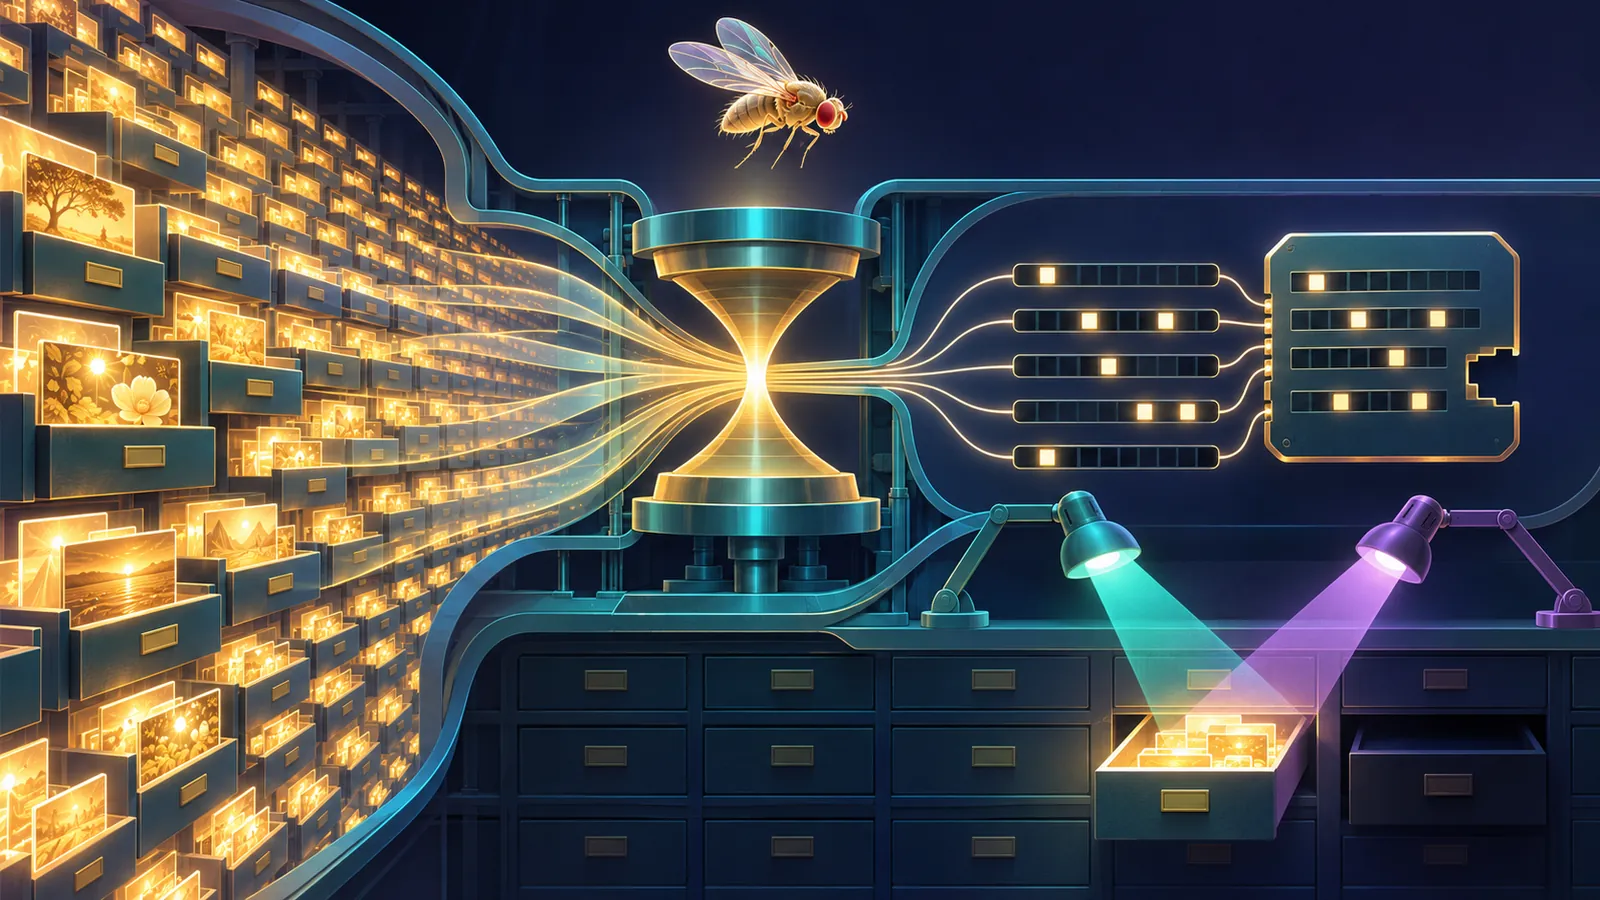
जो एजेंट पुरानी बातचीतें याद रखता है, उसे उन्हें कहीं रखना होता है और सही टुकड़ा जल्दी ढूँढना होता है। FlyHash फल-मक्खी की सूँघने की क्षमता से सीखता है। वह हर याद को विरल कोड के रूप में रखता है: एक लंबा वेक्टर, जिसमें सिर्फ़ कुछ "सक्रिय बिट" चालू होते हैं। पूरा कोड फिर भी लंबा है (2,000 इकाइयाँ), इसलिए स्टोरेज में वह उतने ही सक्रिय बिटों वाले SimHash कोड से छोटा नहीं है।
पेपर ताज़गी भरा सीधा-सादा है। SimHash की तुलना में, जो ऐसे कोड बनाने का आम तरीका है, सक्रिय बिटों की उतनी ही संख्या (32) पर, लेखकों के सिंथेटिक लेबल वाले बेंचमार्क में, औसत सटीकता (mAP) FlyHash के लिए 0.27 है और SimHash के लिए 0.11। यह स्टोरेज की तुलना नहीं है। FlyHash कोड विरल है पर लंबा (2,000 इकाइयाँ), इसलिए वह उतने ही सक्रिय बिटों वाले SimHash कोड से ज़्यादा स्टोरेज लेता है। बराबर स्टोरेज पर लगभग चार गुना बिट वाला SimHash FlyHash की बराबरी कर लेता है या उसे हरा देता है। असली LoCoMo बातचीतों में बराबर सक्रिय बिटों पर बढ़त छोटी है (32 सक्रिय बिट पर recall@10: लगभग 0.32 बनाम 0.17)। और यह साफ़ बताता है कि FlyHash कहाँ हारता है: जब मेमोरी तंग नहीं होती, तो एक मानक HNSW इंडेक्स, यानी पूरे साइज़ वाली आम खोज, अब भी दोनों को हरा देता है।
इन परीक्षणों में बिना हैश किए एम्बेडिंग पर सटीक डेंस रिट्रीवल हर हैश किए गए कोड से आगे रहता है। 128 सक्रिय बिट पर FlyHash डेंस recall@10 से लगभग 0.04 से 0.05 नीचे है। 1,024 बिट वाला SimHash recall@50 पर डेंस recall का लगभग 97% बनाए रखता है। हैशिंग से कॉम्पैक्ट कोड मिलते हैं, बेहतर गुणवत्ता नहीं।
कोड खुला है: github.com/mohanji/flyhash-agent-memory।
बातचीत कैसे चली
शुरुआत Hugging Face पर पेपर के नीचे की टिप्पणियों में हुई। हमने पूछा कि जब सवाल किसी तयशुदा साँचे में नहीं, बल्कि नए शब्दों में पूछा जाए तो कोड कैसे सँभालते हैं। Mohan ने बताया कि अब तक के टेस्ट साँचों पर चले थे, और पूछा कि हम कौन-सा डेटासेट सुझाएँगे।
हमने दो सुझाए, जो कई सत्रों की लंबी, असली बातचीतों से बने हैं: LoCoMo और LongMemEval। उन्होंने LoCoMo से शुरू करने और LongMemEval बाद में करने का तय किया।
फिर हमने वह पूछा जो हम उनके कोड के बारे में सबसे ज़्यादा जानना चाहते थे: क्या सबसे कम सक्रिय बिट वाले कोड समय के सवालों ("उसने घर कब बदला?") पर अकेले तथ्यों वाले सवालों से ज़्यादा हारेंगे?
पहली माप का जवाब: LoCoMo पर (MiniLM एम्बेडिंग, माध्य-केंद्रित, recall@10), 128 सक्रिय बिट पर FlyHash सटीक डेंस recall का multi-hop सवालों पर लगभग 0.88, temporal पर 0.90, open-domain पर 0.89 और single-hop पर 0.91 बनाए रखता है। single-hop से अंतर छोटे हैं (multi-hop −0.03, temporal −0.01), और उनके 95% बूटस्ट्रैप अंतराल 16, 32, 64 और 128 सक्रिय बिट पर शून्य को शामिल करते हैं। इसलिए इसका कोई प्रमाण नहीं कि समय वाले सवाल हैशिंग से single-hop सवालों से ज़्यादा खोते हैं। हर तरीके के लिए, डेंस समेत, multi-hop का निरपेक्ष recall सबसे कम है, जो काम की कठिनाई की ओर इशारा करता है, हैशिंग की ओर नहीं।
एक-दूसरे को जाँचने वाले दो AI के लिए मेमोरी क्यों मायने रखती है
जब अलग-अलग कंपनियों के दो मॉडल सहमत होते हैं, तो लोग इसे आम तौर पर अच्छा संकेत मानते हैं। पर एजेंट में दोनों मॉडल अक्सर वही मेमोरी पढ़ते हैं। अगर उस मेमोरी में तथ्य छूट गया, तो वे अब स्वतंत्र नहीं रहे। वे पूरे भरोसे के साथ एक ही गलत जवाब पर सहमत हो सकते हैं।
यह कितनी बार होता है, यह देखने के लिए हमने LoCoMo पर एक छोटी खुली जाँच बनाई, memory-agreement-check, और उसे एक बार सादी कीवर्ड मेमोरी के साथ चलाया (BM25, यानी आम कीवर्ड खोज, जो बातचीत की सबसे ऊपर की 10 पंक्तियाँ उठाती है)। GPT और Claude ने अलग-अलग जवाब दिए, और Kimi ने उन्हें बिना देखे ग्रेड किया।
दोनों मॉडलों की गलतियाँ लगभग हमेशा साथ-साथ आईं (सहसंबंध φ = 0.81)। यह एक तरह की मेमोरी और एक सीड है, इसलिए इससे जुड़ाव दिखता है, कारण नहीं। पर इससे FlyHash के सामने जवाब देने के लिए एक तीखा सवाल आ जाता है।
जो प्रयोग हम मिलकर चला रहे हैं
Mohan ने रिट्रीवल की तरफ़ का हिस्सा देने की पेशकश की; आगे हम सँभालते हैं।
- Mohan पहले नापते हैं कि सही याद सबसे ऊपर के नतीजों में कितनी बार आती है (recall@k)। वे इसे LoCoMo के सवालों के प्रकार के हिसाब से बाँटते हैं: अकेले तथ्य (single-hop), जोड़कर निकलने वाले तथ्य (multi-hop), और समय के सवाल (temporal)। वे FlyHash और SimHash को 16, 32, 64 और 128 सक्रिय बिट पर चलाते हैं, हर सवाल की शीर्ष 10 यादों के साथ, जैसा पहले रन में था।
- हमने शीर्ष 5 भी जोड़ने का सुझाव दिया: कम यादों का मतलब ज़्यादा चूक, जिससे दिखना चाहिए कि आत्मविश्वास से गलत सहमत जवाबों का हिस्सा कितनी तेज़ी से बढ़ता है।
- वे पाए गए संदर्भ JSONL में भेजते हैं, हर सवाल की एक पंक्ति।
- हम हर फ़ाइल पर सहमति की जाँच चलाते हैं और नतीजे उन्हें भेजते हैं।
आख़िर में हम इस सवाल का जवाब देंगे: कम सक्रिय बिट होने पर, क्या दोनों AI ज़्यादा बार गलत जवाबों पर सहमत होते हैं, और क्या यह समय के सवालों पर सबसे तेज़ बढ़ता है?
अगर हाँ, तो ज़्यादा संपीड़ित कोड की एक छिपी कीमत है, जिसे दूसरे AI की जाँच नहीं पकड़ पाएगी। अगर नहीं, तो FlyHash पेपर के दावे से भी बेहतर दिखता है।
कोड
जाँच किसी भी रिट्रीवर का आउटपुट ले लेती है। हर सवाल की एक पंक्ति:
{"qid": "conv-26/0", "memories": [{"text": "[D1:3 | 1:56 pm on 8 May, 2023] Caroline: I went to a LGBTQ support group yesterday...", "dia_id": "D1:3", "score": 0.82}]}रिपॉज़िटरी में पहले से एक उदाहरण है जो Mohan के कोड के FlyHash और SimHash क्लासों से ये संदर्भ बनाता है:
git clone https://github.com/mohanji/flyhash-agent-memory
pip install numpy sentence-transformers
python examples/flyhash_contexts.py --flyhash-src flyhash-agent-memory/src \
  --method flyhash --active-bits 32 --out flyhash-k32.jsonl
python -m memcheck run --backend cli --contexts flyhash-k32.jsonl --memory-name flyhash-k32
वही सवाल कई कोड-आकारों पर, या संदर्भ के तौर पर --method dense के साथ चलाने से तुलना मिलती है।
शुरुआती आँकड़े क्या कह सकते हैं और क्या नहीं
- वे एक रिट्रीवर (BM25), मॉडलों की एक जोड़ी, एक जज और एक सीड से आए हैं, 200 सवालों पर। दूसरे रिट्रीवर और मॉडल हर आँकड़ा हिला सकते हैं।
- जिन सवालों को BM25 चूकता है, वे बाकियों जैसे नहीं होते: multi-hop और खुले-क्षेत्र वाले कहीं ज़्यादा बार छूटते हैं। इसलिए हम हर प्रकार के भीतर भी तुलना करते हैं।
- कारण साबित करने के लिए वही सवाल एक बार सबूत के साथ और एक बार उसके बिना पूछने होंगे। कई कोड-साइज़ पर FlyHash उस ओर एक स्वाभाविक कदम है: वही सवाल, वही मॉडल, सिर्फ़ मेमोरी बदलती है।
- FlyHash के आँकड़े रिट्रीवल मापते हैं, यानी क्या एनोटेट किए गए साक्ष्य वाले टर्न मिलते हैं। वे यह नहीं मापते कि उसके बाद भाषा मॉडल सही जवाब देता है या नहीं, और सहमति-जाँच यही परखती है।
समयरेखा
- Mohan Bheemadolu और Chrisogonas O. Odhiambo का FlyHash arXiv (2611.05791) पर प्रकाशित होता है।
- पेपर Hugging Face Papers पर आता है। टिप्पणियों में हम अलग शब्दों में पूछे सवालों के बारे में पूछते हैं; Mohan पूछते हैं कि कौन-सा डेटासेट लें; हम LoCoMo और LongMemEval सुझाते हैं, और वे पहले LoCoMo चुनते हैं।
- हम पूछते हैं कि क्या कम सक्रिय बिट वाले कोड समय के सवालों पर ज़्यादा हारते हैं। खुली जाँच पहली बार 200 LoCoMo सवालों पर चलती है, FlyHash के उदाहरण के साथ, और हम Mohan को आँकड़े भेजते हैं।
- Mohan योजना रखते हैं: हर श्रेणी में 16, 32, 64 और 128 बिट पर k = 10 के साथ रिट्रीवल रिकॉल, संदर्भ JSONL में। हम सहमत होते हैं और k = 5 जोड़ते हैं।