Quando a memória de um agente é espremida em códigos esparsos, duas IAs concordam na mesma resposta errada?
com Mohan Bheemadolu · desenvolvedor de agentes de IA · coautor do FlyHash for LLM agent memory
Em meio minuto
Mohan Bheemadolu constrói memória para agentes de IA. Com a Dra. Chrisogonas O. Odhiambo, escreveu o FlyHash, que guarda cada memória como um código esparso, um vetor longo com apenas alguns "bits ativos" ligados, do jeito que o nariz da mosca-da-fruta distingue cheiros. Com o mesmo número de bits ativos (32), no benchmark sintético dos autores, ele ordena as memórias certas cerca de 2,5 vezes melhor que o método habitual (mAP 0,27 contra 0,11). Com o mesmo armazenamento, o método habitual com cerca de quatro vezes mais bits o iguala ou o supera, e o ganho é menor em conversas reais.
Nossa pergunta: a resposta de uma IA costuma ser conferida por uma segunda IA, mas as duas leem a mesma memória. Se essa memória perde o fato, as duas passam a concordar na mesma resposta errada?
Na nossa primeira rodada, com memória simples por palavras-chave, parecia que sim: quando a memória perdeu o fato, 45% das respostas em que as duas IAs concordaram estavam erradas, contra 3% quando ela tinha o fato. Agora o Mohan roda o FlyHash em quatro tamanhos de código, e a gente vê se códigos com menos bits ativos pioram isso.
O artigo
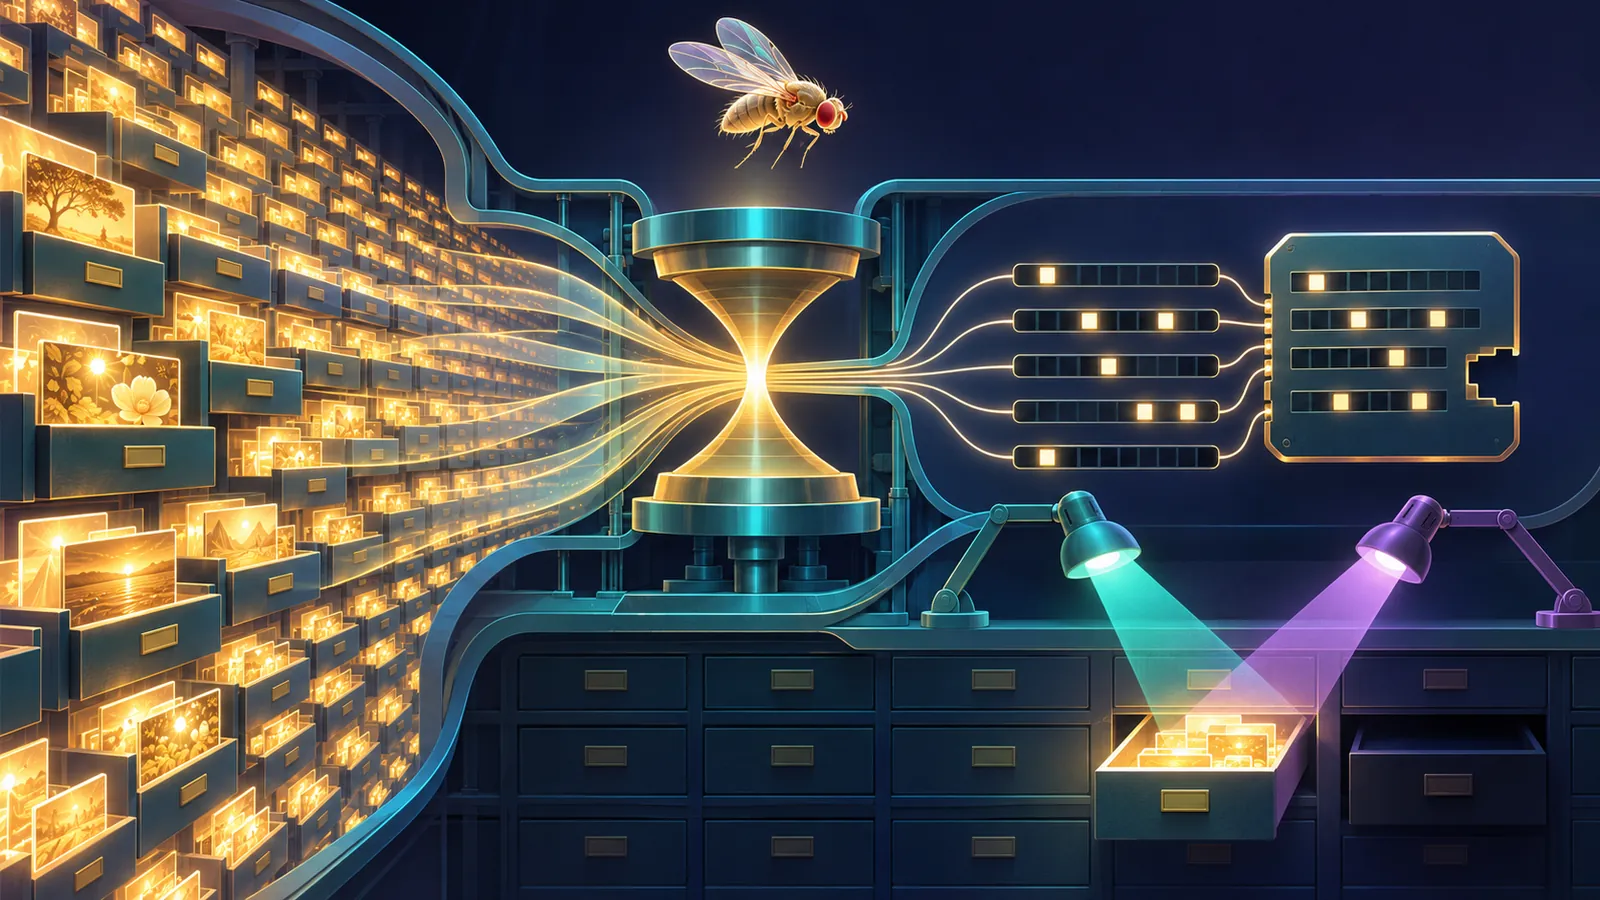
Um agente que lembra conversas passadas precisa guardá-las em algum lugar e achar o trecho certo rápido. O FlyHash toma emprestado o olfato da mosca-da-fruta. Ele guarda cada memória como um código esparso: um vetor longo em que só alguns "bits ativos" ficam ligados. O código completo continua longo (2.000 unidades), então não é menor em armazenamento que um código SimHash com o mesmo número de bits ativos.
O artigo é refrescantemente direto. Comparado com o SimHash, o jeito habitual de fazer esses códigos, com o mesmo número de bits ativos (32), no benchmark sintético rotulado dos autores, a precisão média (mAP) é 0,27 para o FlyHash contra 0,11 para o SimHash. Isso não é uma comparação de armazenamento. Um código FlyHash é esparso, mas longo (2.000 unidades), então ocupa mais armazenamento que um código SimHash com os mesmos bits ativos. Com o mesmo armazenamento, o SimHash com cerca de quatro vezes mais bits iguala ou supera o FlyHash. Em conversas reais do LoCoMo, a vantagem com os mesmos bits ativos é menor (recall@10 com 32 bits ativos: cerca de 0,32 contra 0,17). E diz com todas as letras onde o FlyHash perde: quando a memória não é apertada, um índice HNSW padrão, a busca comum em tamanho completo, ainda vence os dois.
A recuperação densa exata sobre os embeddings sem hash continua à frente de todos os códigos com hash nestes testes. Com 128 bits ativos, o FlyHash fica cerca de 0,04 a 0,05 abaixo do recall@10 denso. O SimHash com 1.024 bits mantém cerca de 97% do recall denso no recall@50. O hashing traz códigos compactos, não mais qualidade.
O código é aberto: github.com/mohanji/flyhash-agent-memory.
Como foi a conversa
Começou nos comentários embaixo do artigo no Hugging Face. Perguntamos como os códigos se saem quando a pergunta vem com outras palavras, e não num modelo fixo. O Mohan disse que os testes até então usaram modelos fixos e perguntou que conjunto de dados a gente sugeria.
Sugerimos dois, feitos de conversas longas e reais, de várias sessões: LoCoMo e LongMemEval. Ele escolheu começar pelo LoCoMo e fazer o LongMemEval depois.
Depois perguntamos o que mais queríamos saber sobre os códigos dele: os com menos bits ativos vão perder mais em perguntas sobre tempo ("quando ela se mudou?") do que em fatos isolados?
Resposta da primeira medição: no LoCoMo (embeddings MiniLM, centrados na média, recall@10), com 128 bits ativos o FlyHash mantém cerca de 0,88 do recall denso exato nas perguntas multi-hop, 0,90 nas temporais, 0,89 nas de domínio aberto e 0,91 nas single-hop. As diferenças em relação às single-hop são pequenas (multi-hop −0,03, temporal −0,01), e seus intervalos bootstrap de 95% incluem o zero com 16, 32, 64 e 128 bits ativos. Portanto, não há evidência de que as perguntas temporais percam mais com o hashing do que as single-hop. O multi-hop tem o menor recall absoluto em todos os métodos, o denso incluído, o que aponta para a dificuldade da tarefa, não para o hashing.
Por que a memória importa para duas IAs que se conferem
Quando dois modelos de empresas diferentes concordam, as pessoas costumam tomar isso como bom sinal. Mas, num agente, os dois modelos tendem a ler a mesma memória. Se essa memória perdeu o fato, eles deixam de ser independentes. Podem concordar, com toda a confiança, na mesma resposta errada.
Para ver com que frequência isso acontece, montamos uma pequena verificação aberta sobre o LoCoMo, a memory-agreement-check, e a rodamos uma vez com memória simples por palavras-chave (BM25, busca comum por palavras-chave, trazendo as 10 primeiras falas do diálogo). O GPT e o Claude responderam separadamente, e o Kimi os corrigiu às cegas.
Os erros dos dois modelos quase sempre vieram juntos (uma correlação de φ = 0,81). É um tipo de memória e uma semente aleatória, então mostra uma ligação, não uma causa. Mas dá ao FlyHash uma pergunta afiada para responder.
O experimento que estamos rodando juntos
Mohan se ofereceu para fornecer o lado da recuperação; a partir daí, seguimos nós.
- Mohan mede primeiro com que frequência a memória certa fica entre os primeiros resultados (recall@k). Ele separa por tipo de pergunta do LoCoMo: fatos isolados (single-hop), fatos que precisam ser juntados (multi-hop) e perguntas sobre tempo (temporal). Roda o FlyHash e o SimHash com 16, 32, 64 e 128 bits ativos, com as 10 primeiras memórias por pergunta, como na primeira rodada.
- Sugerimos acrescentar também as 5 primeiras: menos memórias significam mais perdas, o que deve mostrar com que rapidez cresce a parcela de respostas concordantes e confiantemente erradas.
- Ele envia os contextos recuperados em JSONL, uma linha por pergunta.
- Nós rodamos a verificação de concordância em cada arquivo e enviamos a ele os resultados.
A pergunta que vamos responder no final: com menos bits ativos, as duas IAs concordam em respostas erradas com mais frequência, e isso cresce mais depressa nas perguntas sobre tempo?
Se sim, um código mais comprimido tem um custo oculto que uma segunda IA não vai pegar. Se não, o FlyHash fica ainda melhor do que o artigo diz.
O código
A verificação aceita a saída de qualquer recuperador. Uma linha por pergunta:
{"qid": "conv-26/0", "memories": [{"text": "[D1:3 | 1:56 pm on 8 May, 2023] Caroline: I went to a LGBTQ support group yesterday...", "dia_id": "D1:3", "score": 0.82}]}O repositório já tem um exemplo que gera esses contextos com as classes FlyHash e SimHash do código do Mohan:
git clone https://github.com/mohanji/flyhash-agent-memory
pip install numpy sentence-transformers
python examples/flyhash_contexts.py --flyhash-src flyhash-agent-memory/src \
  --method flyhash --active-bits 32 --out flyhash-k32.jsonl
python -m memcheck run --backend cli --contexts flyhash-k32.jsonl --memory-name flyhash-k32
Rodar as mesmas perguntas em vários tamanhos de código, ou com --method dense como referência, dá a comparação.
O que os primeiros números podem e não podem dizer
- Eles vêm de um recuperador (BM25), um par de modelos, um juiz e uma semente, em 200 perguntas. Outros recuperadores e modelos podem mexer em todos os números.
- As perguntas que o BM25 perde não são como as outras: as multi-hop e as de domínio aberto são perdidas bem mais vezes. Por isso comparamos também dentro de cada tipo.
- Para provar a causa, seria preciso responder às mesmas perguntas uma vez com a evidência e outra sem. O FlyHash em vários tamanhos de código é um passo natural nessa direção: mesmas perguntas, mesmos modelos, só a memória muda.
- Os números do FlyHash medem a recuperação, isto é, se os turnos com a evidência anotada são encontrados. Eles não medem se um modelo de linguagem depois responde corretamente, que é o que a verificação de concordância estuda.
Cronologia
- O FlyHash é publicado no arXiv (2611.05791) por Mohan Bheemadolu e Chrisogonas O. Odhiambo.
- O artigo aparece no Hugging Face Papers. Nos comentários, perguntamos sobre perguntas parafraseadas; Mohan pergunta qual conjunto de dados usar; sugerimos LoCoMo e LongMemEval, e ele escolhe o LoCoMo primeiro.
- Perguntamos se códigos com menos bits ativos perdem mais em perguntas sobre tempo. A verificação aberta roda pela primeira vez em 200 perguntas do LoCoMo, com um exemplo para o FlyHash, e enviamos os números ao Mohan.
- Mohan apresenta o plano: recall de recuperação por categoria com 16, 32, 64 e 128 bits e k = 10, contextos em JSONL. Concordamos e acrescentamos k = 5.