Коли пам'ять агента стиснуто в розріджені коди, чи погоджуються два ШІ на одній хибній відповіді?
разом із Mohan Bheemadolu · розробник ШІ-агентів · співавтор FlyHash for LLM agent memory
За півхвилини
Mohan Bheemadolu будує пам'ять для ШІ-агентів. Разом із Dr. Chrisogonas O. Odhiambo він написав FlyHash: кожен спогад зберігається як розріджений код, довгий вектор, у якому ввімкнено лише кілька «активних бітів», так само як ніс плодової мушки розрізняє запахи. При однаковому числі активних бітів (32), на синтетичному бенчмарку авторів, він ранжує потрібні спогади приблизно в 2,5 раза краще за звичний метод (mAP 0,27 проти 0,11). При однаковому обсязі пам'яті звичний метод приблизно з учетверо більшою кількістю бітів наздоганяє його або випереджає, а на реальних розмовах виграш менший.
Наше питання: відповідь ШІ часто перевіряє другий ШІ, але обидва читають ту саму пам'ять. Якщо в ній немає потрібного факту, чи починають вони погоджуватися на тій самій хибній відповіді?
У першому прогоні, зі звичайною ключовою пам'яттю, так і виглядало: коли пам'ять пропускала факт, 45% відповідей, на яких погодилися обидва ШІ, були хибними, проти 3%, коли факт у ній був. Далі Mohan проганяє FlyHash на чотирьох розмірах коду, а ми дивимося, чи від кодів із меншою кількістю активних бітів стає гірше.
Стаття
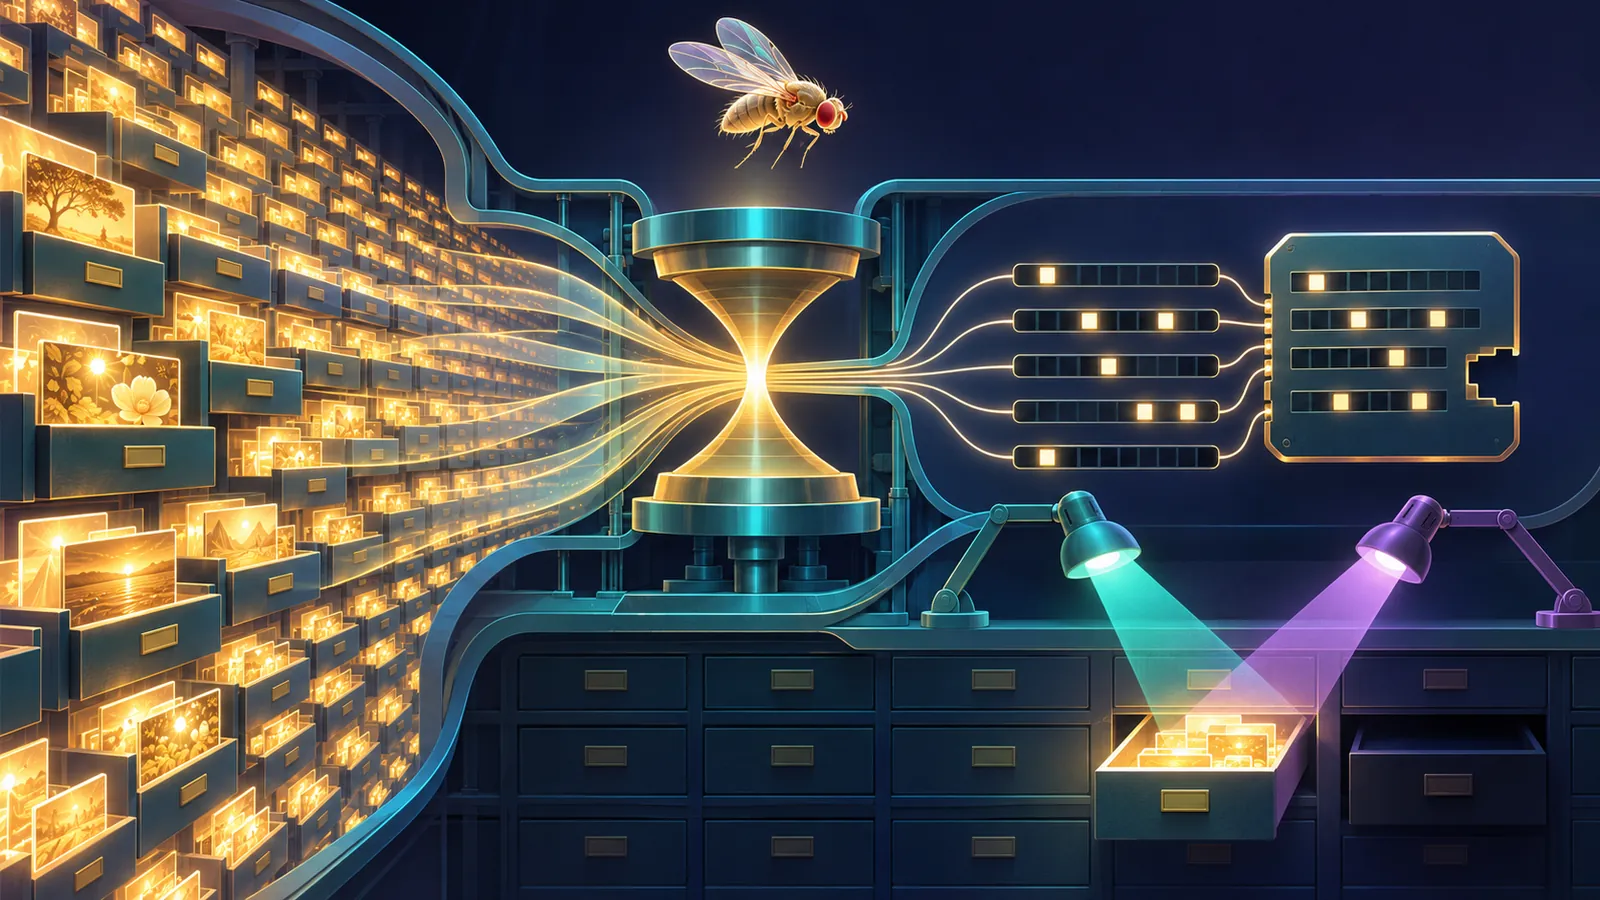
Агент, що пам'ятає минулі розмови, має десь їх тримати й швидко знаходити потрібний шматок. FlyHash бере ідею з нюху плодової мушки. Він зберігає кожен спогад як розріджений код: довгий вектор, у якому ввімкнено лише кілька «активних бітів». Повний код усе одно довгий (2000 одиниць), тому за обсягом він не менший за код SimHash із тим самим числом активних бітів.
Стаття на диво проста. Порівняно з SimHash, звичним способом робити такі коди, при однаковому числі активних бітів (32), на синтетичному розміченому бенчмарку авторів, середня точність (mAP) у FlyHash дорівнює 0,27 проти 0,11 у SimHash. Це не порівняння за обсягом пам'яті. Код FlyHash розріджений, але довгий (2000 одиниць), тому займає більше місця, ніж код SimHash з тими самими активними бітами. При однаковому обсязі SimHash приблизно з учетверо більшою кількістю бітів наздоганяє FlyHash або випереджає його. На реальних розмовах LoCoMo перевага при однаковому числі активних бітів менша (recall@10 при 32 активних бітах: близько 0,32 проти 0,17). І прямо каже, де FlyHash програє: коли пам'ять не обмежена, стандартний індекс HNSW, звичайний повнорозмірний пошук, усе одно випереджає обох.
Точний щільний пошук за нехешованими ембедингами в цих тестах лишається попереду будь-якого хешованого коду. При 128 активних бітах FlyHash приблизно на 0,04–0,05 нижчий за щільний recall@10. SimHash з 1024 бітами зберігає близько 97% щільного recall при recall@50. Хешування дає компактні коди, а не кращу якість.
Код відкритий: github.com/mohanji/flyhash-agent-memory.
Як минула розмова
Усе почалося в коментарях під статтею на Hugging Face. Ми спитали, як коди справляються, коли питання сформульоване новими словами, а не за шаблоном. Mohan сказав, що досі тести йшли за шаблонами, і спитав, який датасет ми порадимо.
Ми запропонували два, зібрані з довгих реальних розмов на багато сесій: LoCoMo і LongMemEval. Він вирішив почати з LoCoMo, а LongMemEval залишити на потім.
Потім ми спитали про те, що найбільше хотіли знати про його коди: чи програватимуть коди з найменшою кількістю активних бітів більше на питаннях про час («коли вона переїхала?»), ніж на поодиноких фактах?
Відповідь за першим виміром: на LoCoMo (ембединги MiniLM, центровані за середнім, recall@10) при 128 активних бітах FlyHash зберігає близько 0,88 точного щільного recall на multi-hop-питаннях, 0,90 на часових, 0,89 на open-domain і 0,91 на single-hop. Відмінності від single-hop невеликі (multi-hop −0,03, часові −0,01), а їхні 95-відсоткові бутстреп-інтервали містять нуль при 16, 32, 64 і 128 активних бітах. Отже, немає підстав вважати, що часові питання втрачають від хешування більше, ніж single-hop. У multi-hop найнижчий абсолютний recall за будь-якого методу, включно зі щільним, що вказує на складність задачі, а не на хешування.
Чому пам'ять важлива для двох ШІ, що перевіряють одне одного
Коли дві моделі від різних компаній дають однакову відповідь, люди зазвичай вважають це добрим знаком. Але в агенті обидві моделі здебільшого читають ту саму пам'ять. Якщо вона пропустила факт, вони вже не незалежні. Вони можуть упевнено погодитися на тій самій хибній відповіді.
Щоб побачити, як часто таке буває, ми зробили невелику відкриту перевірку на LoCoMo, memory-agreement-check, і запустили її один раз зі звичайною ключовою пам'яттю (BM25, звичайний пошук за словами, що дістає 10 перших реплік діалогу). GPT і Claude відповідали окремо, а Kimi оцінював їх наосліп.
Помилки двох моделей майже завжди збігалися (кореляція φ = 0,81). Це один вид пам'яті й один випадковий сід, тож це зв'язок, а не причина. Але він дає FlyHash гостре питання, на яке відповісти.
Експеримент, який ми проводимо разом
Mohan запропонував надати сторону ретривалу; далі ми беремо на себе.
- Mohan спершу вимірює, як часто потрібний спогад потрапляє в топ знайденого (recall@k). Він ділить це за типами питань LoCoMo: окремі факти (single-hop), факти, які треба з'єднати (multi-hop), і питання про час (temporal). Проганяє FlyHash і SimHash на 16, 32, 64 і 128 активних бітах, з топ-10 спогадів на питання, як у першому прогоні.
- Ми запропонували додати ще й топ-5: менше спогадів означає більше пропусків, а це має показати, як швидко зростає частка впевнено хибних узгоджених відповідей.
- Він надсилає знайдені контексти як JSONL, один рядок на питання.
- Ми запускаємо перевірку згоди на кожному файлі й надсилаємо йому результати.
Питання, на яке ми відповімо в кінці: чи частіше погоджуються на хибних відповідях обидва ШІ, при меншій кількості активних бітів, і чи найшвидше це зростає для питань про час?
Якщо так, у більш стиснутого коду є прихована ціна, яку другий ШІ не піймає. Якщо ні, FlyHash виглядає ще краще, ніж каже стаття.
Код
Перевірка приймає вивід будь-якого ретривера. Один рядок на питання:
{"qid": "conv-26/0", "memories": [{"text": "[D1:3 | 1:56 pm on 8 May, 2023] Caroline: I went to a LGBTQ support group yesterday...", "dia_id": "D1:3", "score": 0.82}]}У репозиторії вже є приклад, що будує ці контексти класами FlyHash і SimHash з коду Mohan:
git clone https://github.com/mohanji/flyhash-agent-memory
pip install numpy sentence-transformers
python examples/flyhash_contexts.py --flyhash-src flyhash-agent-memory/src \
  --method flyhash --active-bits 32 --out flyhash-k32.jsonl
python -m memcheck run --backend cli --contexts flyhash-k32.jsonl --memory-name flyhash-k32
Якщо прогнати ті самі питання на кількох розмірах коду або проти --method dense як еталона, вийде порівняння.
Що перші цифри можуть і не можуть сказати
- Вони з одного ретривера (BM25), однієї пари моделей, одного судді й одного сіду, на 200 питаннях. Інші ретривери й моделі можуть зрушити кожну цифру.
- Питання, які BM25 пропускає, не схожі на решту: multi-hop і open-domain пропускаються набагато частіше. Тому ми порівнюємо ще й усередині кожного типу.
- Щоб довести причину, треба відповісти на ті самі питання один раз із репліками-доказами, а другий без них. FlyHash на кількох розмірах коду — природний крок до цього: ті самі питання, ті самі моделі, змінюється лише пам'ять.
- Цифри FlyHash вимірюють пошук, тобто чи знаходяться розмічені репліки-докази. Вони не вимірюють, чи відповідає потім мовна модель правильно, а саме це вивчає перевірка узгодженості.
Хронологія
- Mohan Bheemadolu і Chrisogonas O. Odhiambo публікують FlyHash на arXiv (2611.05791).
- Стаття з'являється на Hugging Face Papers. У коментарях ми питаємо про перефразовані питання; Mohan питає, який датасет узяти; ми пропонуємо LoCoMo і LongMemEval, і він обирає спершу LoCoMo.
- Ми питаємо, чи програють коди з меншою кількістю активних бітів більше на питаннях про час. Відкрита перевірка вперше запускається на 200 питаннях LoCoMo, з прикладом для FlyHash, і ми надсилаємо Mohan цифри.
- Mohan викладає план: recall ретривалу за категоріями на 16, 32, 64 і 128 бітах при k = 10, контексти як JSONL. Ми погоджуємося й додаємо k = 5.