Quand la mémoire d'un agent est condensée en codes épars, deux IA s'accordent-elles sur la même mauvaise réponse ?
avec Mohan Bheemadolu · développeur d'agents IA · co-auteur de FlyHash for LLM agent memory
En trente secondes
Mohan Bheemadolu construit de la mémoire pour des agents IA. Avec le Dr Chrisogonas O. Odhiambo, il a écrit FlyHash, qui stocke chaque souvenir sous forme de code épars, un long vecteur où seuls quelques « bits actifs » sont allumés, un peu comme le nez d'une mouche du vinaigre distingue les odeurs. À nombre égal de bits actifs (32), sur le benchmark synthétique des auteurs, il classe les bons souvenirs environ 2,5 fois mieux que la méthode habituelle (mAP 0,27 contre 0,11). À stockage égal, la méthode habituelle avec environ quatre fois plus de bits l'égale ou le dépasse, et l'écart est plus faible sur de vraies conversations.
Notre question : la réponse d'une IA est souvent vérifiée par une seconde IA, mais toutes deux lisent la même mémoire. Si cette mémoire rate le fait, se mettent-elles à tomber d'accord sur la même mauvaise réponse ?
Dans notre première exécution, avec une simple mémoire par mots-clés, ça en avait l'air : quand la mémoire avait raté le fait, 45 % des réponses sur lesquelles les deux IA s'accordaient étaient fausses, contre 3 % quand elle l'avait. Prochaine étape : Mohan fait tourner FlyHash à quatre tailles de code, et nous regardons si des codes à moins de bits actifs aggravent la chose.
L'article
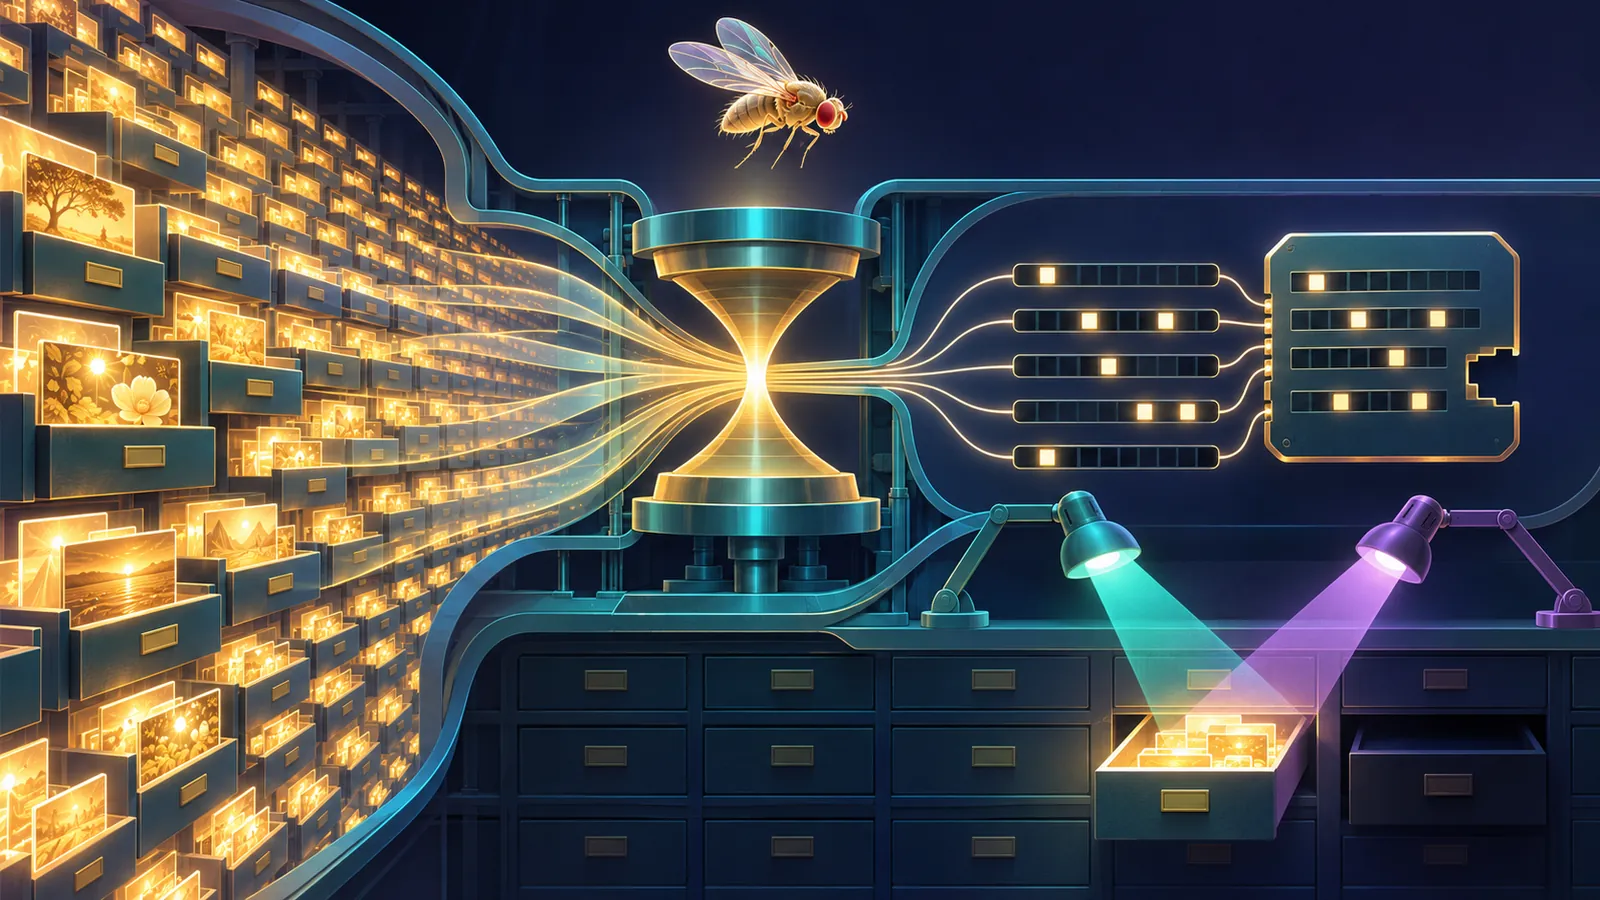
Un agent qui se souvient de conversations passées doit les garder quelque part et retrouver vite le bon morceau. FlyHash s'inspire de l'odorat de la mouche du vinaigre. Il stocke chaque souvenir sous forme de code épars : un long vecteur où seuls quelques « bits actifs » sont allumés. Le code complet reste long (2 000 unités), il n'est donc pas plus petit en stockage qu'un code SimHash avec le même nombre de bits actifs.
L'article est d'une simplicité rafraîchissante. Comparé à SimHash, la méthode habituelle pour fabriquer de tels codes, à nombre égal de bits actifs (32), sur le benchmark synthétique annoté des auteurs, la précision moyenne (mAP) est de 0,27 pour FlyHash contre 0,11 pour SimHash. Ce n'est pas une comparaison de stockage. Un code FlyHash est épars mais long (2 000 unités), il occupe donc plus de stockage qu'un code SimHash avec les mêmes bits actifs. À stockage égal, SimHash avec environ quatre fois plus de bits l'égale ou le dépasse. Sur de vraies conversations LoCoMo, l'avantage à bits actifs égaux est plus faible (recall@10 à 32 bits actifs : environ 0,32 contre 0,17). Et il dit franchement où FlyHash perd : quand la mémoire n'est pas serrée, un index HNSW standard, la recherche classique en taille réelle, fait encore mieux que les deux.
La recherche dense exacte sur les embeddings non hachés reste devant tous les codes hachés dans ces tests. À 128 bits actifs, FlyHash est environ 0,04 à 0,05 sous le recall@10 dense. SimHash avec 1 024 bits garde environ 97 % du recall dense à recall@50. Le hachage apporte des codes compacts, pas une meilleure qualité.
Le code est ouvert : github.com/mohanji/flyhash-agent-memory.
Comment la conversation s'est déroulée
Tout a commencé dans les commentaires sous l'article, sur Hugging Face. Nous avons demandé comment les codes s'en sortent quand une question est posée avec d'autres mots plutôt que sur un gabarit fixe. Mohan a répondu que les tests jusque-là utilisaient des gabarits et nous a demandé quel jeu de données nous suggérions.
Nous en avons proposé deux, construits à partir de longues conversations réelles réparties sur plusieurs sessions : LoCoMo et LongMemEval. Il a choisi de commencer par LoCoMo et de faire LongMemEval ensuite.
Puis nous avons posé ce qu'on voulait le plus savoir sur ses codes : les codes à moins de bits actifs perdront-ils davantage sur les questions de temps (« quand a-t-elle déménagé ? ») que sur les faits isolés ?
Réponse de la première mesure : sur LoCoMo (embeddings MiniLM, centrés sur la moyenne, recall@10), à 128 bits actifs, FlyHash garde environ 0,88 du recall dense exact sur les questions multi-hop, 0,90 sur les temporelles, 0,89 sur les questions ouvertes et 0,91 sur les single-hop. Les écarts avec single-hop sont faibles (multi-hop −0,03, temporel −0,01), et leurs intervalles de bootstrap à 95 % incluent zéro à 16, 32, 64 et 128 bits actifs. Rien n'indique donc que les questions temporelles perdent plus au hachage que les single-hop. Multi-hop a le recall absolu le plus bas pour toutes les méthodes, dense comprise, ce qui renvoie à la difficulté de la tâche, pas au hachage.
Pourquoi la mémoire compte pour deux IA qui se contrôlent mutuellement
Quand deux modèles de deux entreprises différentes s'accordent, on y voit en général un bon signe. Mais dans un agent, les deux modèles lisent le plus souvent la même mémoire. Si cette mémoire a raté le fait, ils ne sont plus indépendants. Ils peuvent s'accorder, avec aplomb, sur la même mauvaise réponse.
Pour voir à quelle fréquence ça arrive, nous avons monté un petit contrôle ouvert sur LoCoMo, memory-agreement-check, et l'avons lancé une fois avec une simple mémoire par mots-clés (BM25, la recherche par mots-clés classique, qui ramène les 10 premières lignes de dialogue). GPT et Claude ont répondu séparément, et Kimi les a notés à l'aveugle.
Les erreurs des deux modèles venaient presque toujours ensemble (une corrélation de φ = 0,81). C'est un seul type de mémoire et un seul tirage aléatoire : cela montre un lien, pas une cause. Mais cela pose à FlyHash une question bien nette.
L'expérience que nous menons ensemble
Mohan a proposé de fournir la partie récupération ; nous prenons le relais à partir de là.
- Mohan mesure d'abord à quelle fréquence le bon souvenir arrive parmi les premiers résultats (recall@k). Il le découpe par type de question LoCoMo : faits isolés (single-hop), faits à recouper (multi-hop) et questions de temps (temporal). Il fait tourner FlyHash et SimHash à 16, 32, 64 et 128 bits actifs, avec les 10 meilleurs souvenirs par question, comme dans la première exécution.
- Nous avons suggéré d'ajouter aussi le top 5 : moins de souvenirs, c'est plus de ratés, ce qui devrait montrer à quelle vitesse croît la part de réponses concordantes mais fausses données avec assurance.
- Il envoie les contextes récupérés en JSONL, une ligne par question.
- Nous exécutons le contrôle d'accord sur chaque fichier et lui envoyons les résultats.
La question à laquelle nous répondrons à la fin : avec moins de bits actifs, les deux IA s'accordent-elles plus souvent sur de mauvaises réponses, et est-ce que ça grimpe le plus vite pour les questions de temps ?
Si oui, un code plus comprimé a un coût caché qu'une seconde IA ne détectera pas. Sinon, FlyHash paraît encore meilleur que ne le dit l'article.
Le code
Le contrôle accepte la sortie de n'importe quel retriever. Une ligne par question :
{"qid": "conv-26/0", "memories": [{"text": "[D1:3 | 1:56 pm on 8 May, 2023] Caroline: I went to a LGBTQ support group yesterday...", "dia_id": "D1:3", "score": 0.82}]}Le dépôt contient déjà un exemple qui construit ces contextes avec les classes FlyHash et SimHash du code de Mohan :
git clone https://github.com/mohanji/flyhash-agent-memory
pip install numpy sentence-transformers
python examples/flyhash_contexts.py --flyhash-src flyhash-agent-memory/src \
  --method flyhash --active-bits 32 --out flyhash-k32.jsonl
python -m memcheck run --backend cli --contexts flyhash-k32.jsonl --memory-name flyhash-k32
Exécuter les mêmes questions à plusieurs tailles de code, ou avec --method dense comme référence, donne la comparaison.
Ce que les premiers chiffres peuvent dire, et ce qu'ils ne peuvent pas dire
- Ils viennent d'un seul retriever (BM25), d'une seule paire de modèles, d'un seul juge et d'un seul seed, sur 200 questions. D'autres retrievers et d'autres modèles peuvent faire bouger chaque chiffre.
- Les questions que BM25 rate ne ressemblent pas aux autres : les questions multi-hop et ouvertes sont ratées bien plus souvent. Nous comparons donc aussi au sein de chaque type.
- Pour prouver une cause, il faudrait répondre aux mêmes questions une fois avec les preuves et une fois sans. FlyHash à plusieurs tailles de code est une étape naturelle dans ce sens : mêmes questions, mêmes modèles, seule la mémoire change.
- Les chiffres de FlyHash mesurent la récupération, c'est-à-dire si les tours de parole annotés comme preuves sont retrouvés. Ils ne mesurent pas si un modèle de langage répond ensuite correctement, ce qu'étudie la vérification d'accord.
Chronologie
- FlyHash est publié sur arXiv (2611.05791) par Mohan Bheemadolu et Chrisogonas O. Odhiambo.
- L'article apparaît sur Hugging Face Papers. Dans les commentaires, nous posons la question des questions reformulées ; Mohan demande quel jeu de données utiliser ; nous suggérons LoCoMo et LongMemEval, et il choisit LoCoMo en premier.
- Nous demandons si les codes à moins de bits actifs perdent davantage sur les questions de temps. Le contrôle ouvert tourne pour la première fois sur 200 questions LoCoMo, avec un exemple pour FlyHash, et nous envoyons les chiffres à Mohan.
- Mohan expose le plan : rappel de récupération par catégorie à 16, 32, 64 et 128 bits avec k = 10, contextes en JSONL. Nous sommes d'accord et ajoutons k = 5.