エージェントのメモリを疎なコードに圧縮すると、二つのAIは同じ間違った答えで一致するのか?
共同: Mohan Bheemadolu · AIエージェント開発者 · FlyHash for LLM agent memory の共著者
30秒でわかる
Mohan Bheemadoluさんは、AIエージェント向けのメモリをつくっています。Dr. Chrisogonas O. Odhiamboさんと一緒に FlyHash。各記憶を疎なコード、つまり少数の「アクティブビット」だけがオンになった長いベクトルとして保存する方法で、ショウジョウバエの鼻が匂いを嗅ぎ分ける仕組みをまねています。アクティブビット数が同じ(32)条件で、著者たちの合成ベンチマークでは、よく使われる方法の約2.5倍うまく正しい記憶を上位に並べます(mAP 0.27対0.11)。同じ記憶容量で比べると、よく使われる方法は約4倍のビット数で並ぶか上回り、実際の会話では差は小さくなります。
私たちの問いはこうです。AIの答えはよく二つ目のAIにチェックされますが、二つとも同じメモリを読んでいます。そのメモリが事実を逃したら、二つは同じ間違った答えで一致しはじめるのでしょうか。
最初の実行では、素朴なキーワードメモリで、そう見えました。メモリが事実を逃したとき、二つのAIが一致した答えの45%が間違いでした。事実を持っていたときは3%です。次はMohanさんがFlyHashを4つのコードサイズで走らせ、アクティブビットが少ないほど悪くなるのかを私たちが確かめます。
論文
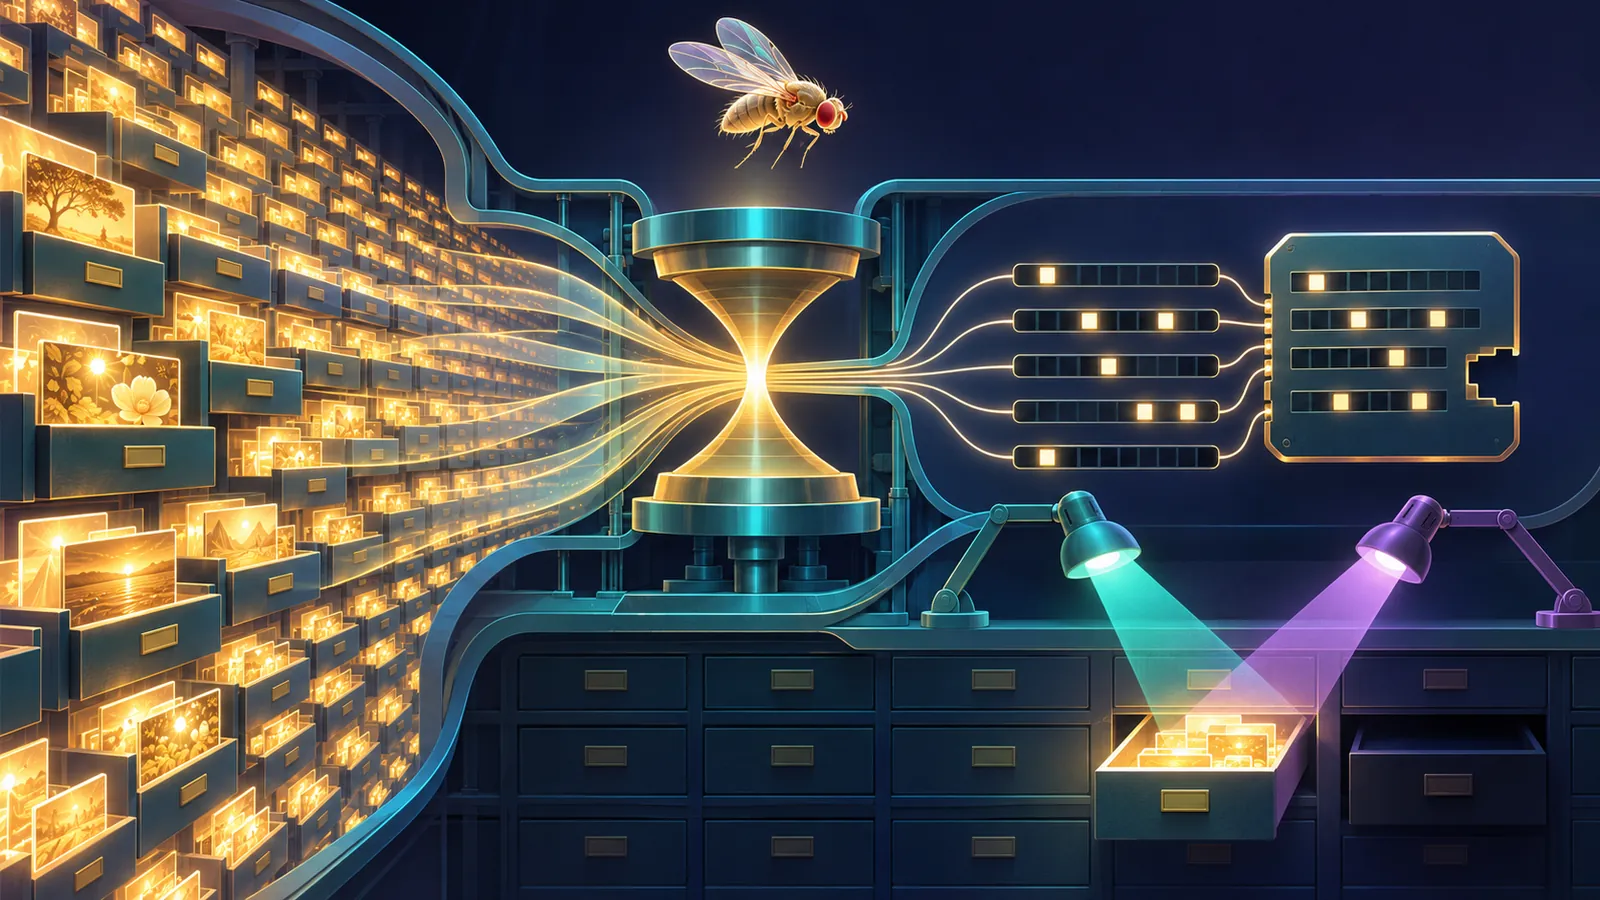
過去の会話を覚えているエージェントは、それをどこかにしまって、必要な部分をすぐ見つけなければなりません。FlyHashはショウジョウバエの嗅覚から借りた考え方です。各記憶を疎なコードとして保存します。少数の「アクティブビット」だけがオンになった、長いベクトルです。コード全体は依然として長い(2,000ユニット)ので、アクティブビット数が同じSimHashのコードより容量が小さいわけではありません。
論文は気持ちいいほど素直です。こうしたコードをつくる定番の方法であるSimHashと比べて、アクティブビット数が同じ(32)条件で、著者たちの合成ラベル付きベンチマークでは、平均適合率(mAP)はFlyHashが0.27、SimHashが0.11です。これは記憶容量の比較ではありません。FlyHashのコードは疎ですが長く(2,000ユニット)、アクティブビット数が同じSimHashのコードより多くの容量を使います。同じ記憶容量なら、約4倍のビット数を持つSimHashがFlyHashに並ぶか上回ります。実際のLoCoMoの会話では、アクティブビット数をそろえたときの優位は小さくなります(32アクティブビットでのrecall@10:約0.32対0.17)。しかも、FlyHashが負ける場面もはっきり書いています。メモリに余裕があるなら、標準的なHNSWインデックス(ふつうのフルサイズの検索)のほうが、両方を上回ります。
ハッシュ化していない埋め込みに対する厳密な密検索は、これらのテストでどのハッシュコードよりも上にとどまります。128アクティブビットで、FlyHashは密検索のrecall@10より約0.04〜0.05低くなります。1,024ビットのSimHashは、recall@50で密検索のrecallの約97%を保ちます。ハッシュ化で得られるのはコンパクトなコードであって、より良い品質ではありません。
コードは公開されています。github.com/mohanji/flyhash-agent-memory。
会話の経緯
きっかけは、Hugging Faceの論文の下のコメントでした。質問が決まったテンプレートではなく、新しい言い方で来たとき、このコードはどうなるのかを尋ねました。Mohanさんは、これまでのテストはテンプレートだったと答えて、どのデータセットがいいか聞き返してくれました。
私たちが挙げたのは、長くて本物の、複数セッションにわたる会話からつくられた二つ、LoCoMoとLongMemEvalです。彼はまずLoCoMoから始めて、LongMemEvalをあとにすることにしました。
そして、いちばん知りたかったことを聞きました。アクティブビットがいちばん少ないコードは、単一の事実についての質問より、時間についての質問(「彼女はいつ引っ越した?」)で多く落ちるのでしょうか。
最初の測定からの答え:LoCoMo(MiniLM埋め込み、平均中心化、recall@10)で、128アクティブビットのとき、FlyHashは厳密な密検索のrecallの、マルチホップ質問で約0.88、時間に関する質問で0.90、オープンドメインで0.89、シングルホップで0.91を保ちます。シングルホップとの差は小さく(マルチホップ −0.03、時間 −0.01)、95%ブートストラップ区間は16、32、64、128のどのアクティブビットでもゼロを含みます。したがって、時間に関する質問がシングルホップの質問よりハッシュ化で多く落ちるという証拠はありません。マルチホップは、密検索を含むどの方法でも絶対的なrecallが最も低く、これはハッシュ化ではなく課題の難しさを示しています。
互いを検証する二つのAIにとって、なぜメモリが重要か
別々の会社の二つのモデルが同じ答えになると、たいていはよい兆候だと受け取られます。でもエージェントの中では、二つのモデルは同じメモリを読んでいることが多いのです。そのメモリが事実を逃していたら、もう独立ではありません。自信たっぷりに、同じ間違った答えで一致することがあります。
それがどれくらい起きるかを見るために、LoCoMo上の小さな公開チェック memory-agreement-check をつくり、素朴なキーワードメモリ(BM25、ふつうのキーワード検索で、対話の上位10行を取る)で1回走らせました。GPTとClaudeが別々に答え、Kimiが何も知らされずに採点しました。
二つのモデルの間違いは、ほとんど一緒に起きました(相関はφ = 0.81)。これは1種類のメモリと1つのシードによる結果なので、示せるのは関連で、原因ではありません。それでも、FlyHashに答えてほしい、はっきりした問いが手に入りました。
一緒に走らせている実験
Mohanが取得の側を引き受けてくれ、そこから先は私たちが受け持ちます。
- Mohanがまず、正しい記憶が上位に入る割合(recall@k)を測ります。LoCoMoの質問の種類ごとに分けます。単一の事実(シングルホップ)、つなげて考える事実(マルチホップ)、時間についての質問(テンポラル)です。FlyHashとSimHashを、16、32、64、128のアクティブビットで走らせます。質問ごとに上位10件のメモリを使い、最初の実行と同じにします。
- 私たちは上位5件も加えることを提案しました。メモリが少なければ取りこぼしが増えるので、自信たっぷりに間違った一致の割合がどれだけ速く増えるかが見えるはずです。
- 彼は取得したコンテキストを、質問1つにつき1行のJSONLで送ります。
- 私たち が各ファイルに一致チェックを走らせ、結果を彼に送ります。
最後に答えたい問いは、こうです。アクティブビットが減るにつれて、二つのAIが一致して間違える割合は上がるのか。そして、いちばん速く上がるのは時間についての質問なのか。
もしそうなら、より圧縮されたコードには、二つ目のAIでは捕まえられない隠れたコストがあります。そうでなければ、FlyHashは論文が言う以上によく見えます。
コード
このチェックは、どんなリトリーバーの出力でも受け付けます。質問1つにつき1行です。
{"qid": "conv-26/0", "memories": [{"text": "[D1:3 | 1:56 pm on 8 May, 2023] Caroline: I went to a LGBTQ support group yesterday...", "dia_id": "D1:3", "score": 0.82}]}リポジトリには、Mohanのコードの FlyHash と SimHash のクラスを使ってこれらのコンテキストを作る例がすでにあります。
git clone https://github.com/mohanji/flyhash-agent-memory
pip install numpy sentence-transformers
python examples/flyhash_contexts.py --flyhash-src flyhash-agent-memory/src \
  --method flyhash --active-bits 32 --out flyhash-k32.jsonl
python -m memcheck run --backend cli --contexts flyhash-k32.jsonl --memory-name flyhash-k32
同じ質問を複数のコードサイズで、あるいは基準として --method dense に対して走らせると、比較ができます。
最初の数字が言えることと、言えないこと
- 数字は、1つのリトリーバー(BM25)、1組のモデル、1人の審査役、1つのシードによるもので、200問が対象です。別のリトリーバーやモデルなら、どの数字も動きえます。
- BM25が逃す質問は、ほかの質問とは違います。マルチホップやオープンドメインの質問は、ずっと頻繁に逃されます。なので、種類ごとにも比べます。
- 原因まで示すなら、同じ質問に、証拠があるときとないときで一度ずつ答えさせます。複数のコードサイズでのFlyHashは、そこへ向かう自然な一歩です。同じ質問、同じモデルで、変わるのはメモリだけです。
- FlyHashの数字は検索、つまり注釈付きの証拠となる発話ターンが見つかるかどうかを測っています。そのあと言語モデルが正しく答えるかどうかは測っておらず、それを調べるのが一致チェックです。
タイムライン
- Mohan BheemadoluとChrisogonas O. OdhiamboによるFlyHashが、arXiv(2611.05791)で公開されます。
- 論文がHugging Face Papersに載ります。コメント欄で私たちが言い換えられた質問について尋ね、Mohanがどのデータセットを使うか聞き返し、私たちがLoCoMoとLongMemEvalを挙げ、彼はまずLoCoMoを選びます。
- アクティブビットの少ないコードは時間についての質問でより多く落ちるのか、と尋ねます。公開チェックがLoCoMoの200問で初めて走り、FlyHash用の例もつけて、Mohanに数字を送ります。
- Mohanが計画を示します。k = 10で、16、32、64、128ビットのカテゴリ別の取得recall、コンテキストはJSONLで。私たちは同意し、k = 5を加えます。