Если память агента сжать в разреженные коды, сойдутся ли два ИИ на одном неверном ответе?
вместе с Mohan Bheemadolu · разработчик ИИ-агентов · соавтор FlyHash for LLM agent memory
За полминуты
Mohan Bheemadolu делает память для ИИ-агентов. Вместе с Dr. Chrisogonas O. Odhiambo он написал FlyHash: каждое воспоминание хранится как разреженный код, длинный вектор, в котором включено лишь несколько «активных битов», примерно так, как нос плодовой мушки различает запахи. При том же числе активных битов (32), на синтетическом бенчмарке авторов, он ранжирует нужные воспоминания примерно в 2,5 раза лучше обычного метода (mAP 0,27 против 0,11). При равном объёме памяти обычный метод примерно с вчетверо большим числом битов догоняет его или обгоняет, а на реальных разговорах выигрыш меньше.
Наш вопрос: ответ ИИ часто проверяет второй ИИ, но оба читают одну и ту же память. Если в ней нет нужного факта, начинают ли они сходиться на одном и том же неверном ответе?
В первом прогоне, с обычной памятью по ключевым словам, похоже на то: когда память упустила факт, 45% ответов, на которых сошлись оба ИИ, были неверными, а когда факт в ней был, только 3%. Дальше Mohan прогонит FlyHash при четырёх размерах кода, а мы проверим, делают ли коды с меньшим числом активных битов это хуже.
Статья
Агент, который помнит прошлые разговоры, должен где-то их хранить и быстро находить нужный фрагмент. FlyHash берёт идею у обоняния плодовой мушки. Он хранит каждое воспоминание как разреженный код: длинный вектор, в котором включено лишь несколько «активных битов». Полный код всё равно длинный (2000 единиц), поэтому по объёму он не меньше кода SimHash с тем же числом активных битов.
Статья освежающе простая. По сравнению с SimHash, обычным способом делать такие коды, при том же числе активных битов (32), на синтетическом размеченном бенчмарке авторов, средняя точность (mAP) у FlyHash равна 0,27 против 0,11 у SimHash. Это не сравнение по объёму памяти. Код FlyHash разреженный, но длинный (2000 единиц), поэтому занимает больше места, чем код SimHash с теми же активными битами. При равном объёме SimHash примерно с вчетверо большим числом битов догоняет FlyHash или обгоняет его. На реальных разговорах LoCoMo преимущество при одинаковом числе активных битов меньше (recall@10 при 32 активных битах: около 0,32 против 0,17). И прямо сказано, где FlyHash проигрывает: когда с памятью не тесно, стандартный индекс HNSW, то есть обычный поиск без сжатия, всё равно побеждает обоих. Статьи, где так честно сказано, в чём метод слабее, встречаются реже, чем следовало бы, и именно поэтому мы им написали.
Точный плотный поиск по нехешированным эмбеддингам в этих тестах остаётся впереди любого хешированного кода. При 128 активных битах FlyHash примерно на 0,04–0,05 ниже плотного recall@10. SimHash с 1024 битами сохраняет около 97% плотного recall при recall@50. Хеширование даёт компактные коды, а не лучшее качество.
Код открыт: github.com/mohanji/flyhash-agent-memory.
Как шёл разговор
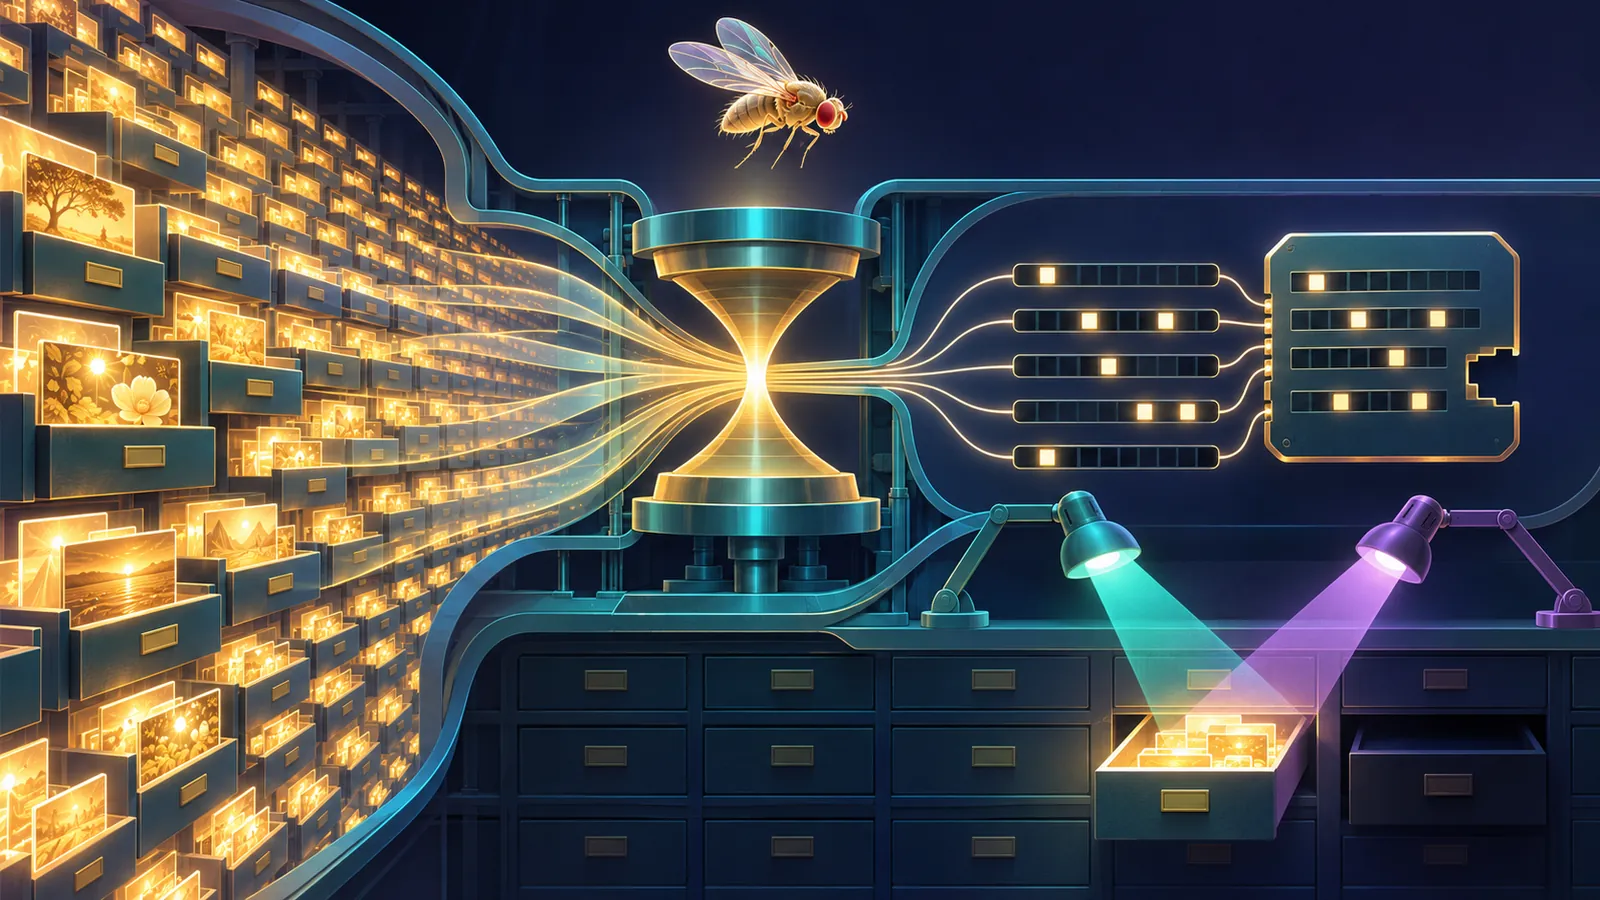
Всё началось с комментариев под статьёй на Hugging Face. Мы спросили, как коды справляются, когда вопрос задан другими словами, а не по шаблону. Mohan ответил, что пока тесты шли по шаблонам, и спросил, какой набор данных мы посоветуем.
Мы предложили два, собранные из длинных реальных диалогов на много сессий: LoCoMo и LongMemEval. Он решил начать с LoCoMo, а LongMemEval взять потом.
Потом мы спросили о том, что нам хотелось узнать больше всего: проиграют ли коды с наименьшим числом активных битов больше на вопросах о времени («когда она переехала?»), чем на отдельных фактах?
Ответ по первому измерению: на LoCoMo (эмбеддинги MiniLM, центрированные по среднему, recall@10) при 128 активных битах FlyHash сохраняет около 0,88 точного плотного recall на multi-hop-вопросах, 0,90 на временных, 0,89 на open-domain и 0,91 на single-hop. Отличия от single-hop невелики (multi-hop −0,03, временные −0,01), и их 95-процентные бутстрэп-интервалы включают ноль при 16, 32, 64 и 128 активных битах. Значит, нет оснований считать, что временные вопросы теряют от хеширования больше, чем single-hop. У multi-hop самый низкий абсолютный recall при любом методе, включая плотный, что указывает на сложность задачи, а не на хеширование.
Почему память важна для двух ИИ, проверяющих друг друга
Когда две модели от разных компаний сходятся на одном ответе, это обычно считают хорошим знаком. Но в агенте обе модели чаще всего читают одну и ту же память. Если в ней нет нужного факта, они уже не независимы. Они могут уверенно сойтись на одном и том же неверном ответе.
Чтобы увидеть, как часто так бывает, мы собрали небольшую открытую проверку на LoCoMo, memory-agreement-check, и прогнали её один раз на обычной памяти по ключевым словам (BM25, обычный поиск по словам, 10 лучших реплик диалога). GPT и Claude отвечали отдельно, а Kimi оценивал их вслепую.
Ошибки двух моделей почти всегда шли вместе (корреляция φ = 0,81). Это один вид памяти и одно зерно случайности, так что это связь, а не причина. Но у FlyHash теперь есть чёткий вопрос, на который нужно ответить.
Эксперимент, который мы ставим вместе
Mohan предложил взять на себя поиск; дальше работаем мы.
- Mohan сначала измеряет, как часто нужное воспоминание попадает в лучшие результаты (recall@k). Он делит это по типам вопросов LoCoMo: отдельные факты (один шаг), факты, которые надо сложить вместе (несколько шагов), и вопросы о времени. FlyHash и SimHash он гоняет при 16, 32, 64 и 128 активных битах, с 10 лучшими воспоминаниями на вопрос, как в первом прогоне.
- Мы предложили добавить ещё top 5: меньше воспоминаний значит больше промахов, и это покажет, как быстро растёт доля уверенно неверных согласованных ответов.
- Он присылает найденные контексты в JSONL, по строке на вопрос.
- Мы запускаем проверку согласия на каждом файле и отправляем ему результаты.
Вопрос, на который мы ответим в конце: при меньшем числе активных битов чаще ли оба ИИ сходятся на неверных ответах, и быстрее ли всего это растёт на вопросах о времени?
Если да, у более сжатого кода есть скрытая цена, которую второй ИИ не поймает. Если нет, FlyHash выглядит даже лучше, чем сказано в статье.
Код
Проверка принимает вывод любого поисковика. Одна строка на вопрос:
{"qid": "conv-26/0", "memories": [{"text": "[D1:3 | 1:56 pm on 8 May, 2023] Caroline: I went to a LGBTQ support group yesterday...", "dia_id": "D1:3", "score": 0.82}]}В репозитории уже есть пример, который строит такие контексты на классах FlyHash и SimHash из кода Mohan:
git clone https://github.com/mohanji/flyhash-agent-memory
pip install numpy sentence-transformers
python examples/flyhash_contexts.py --flyhash-src flyhash-agent-memory/src \
  --method flyhash --active-bits 32 --out flyhash-k32.jsonl
python -m memcheck run --backend cli --contexts flyhash-k32.jsonl --memory-name flyhash-k32
Если прогнать те же вопросы при нескольких размерах кода или с --method dense в качестве эталона, получится сравнение.
Что могут и чего не могут сказать первые цифры
- Они получены на одном поисковике (BM25), одной паре моделей, одном судье и одном зерне, на 200 вопросах. Другие поисковики и модели могут сдвинуть любую цифру.
- Вопросы, которые BM25 упускает, не похожи на остальные: вопросы с несколькими шагами и открытые упускаются гораздо чаще. Поэтому мы сравниваем ещё и внутри каждого типа.
- Чтобы доказать причину, нужно ответить на те же вопросы один раз с репликами-доказательствами и один раз без них. FlyHash при нескольких размерах кода — естественный шаг к этому: те же вопросы, те же модели, меняется только память.
- Цифры FlyHash измеряют поиск, то есть находятся ли размеченные реплики-доказательства. Они не измеряют, отвечает ли потом языковая модель верно, а именно это изучает проверка согласия.
Хронология
- Mohan Bheemadolu и Chrisogonas O. Odhiambo публикуют FlyHash на arXiv (2611.05791).
- Статья появляется на Hugging Face Papers. В комментариях мы спрашиваем про вопросы своими словами; Mohan спрашивает, какой набор данных взять; мы предлагаем LoCoMo и LongMemEval, и он выбирает сначала LoCoMo.
- Мы спрашиваем, не проигрывают ли коды с меньшим числом активных битов больше на вопросах о времени. Открытая проверка впервые идёт на 200 вопросах LoCoMo, с примером для FlyHash, и мы отправляем Mohan цифры.
- Mohan излагает план: полнота поиска по категориям при 16, 32, 64 и 128 битах с k = 10, контексты в JSONL. Мы соглашаемся и добавляем k = 5.