चैट के बाद: गैर-प्रोग्रामरों और एजेंटिक AI के बीच तीन संक्रमण
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
टर्मिनल अब टर्मिनल नहीं है: एक चार-स्तरीय मॉडल, 2025 और 2026 का साक्ष्य, और इन संक्रमणों को मापने के लिए एक पूर्व-पंजीकृत कार्यक्रम
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
यह पेपर डाउनलोड करें
- SSRN (रिकॉर्ड का संस्करण): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (संग्रहीत, खुली पहुंच): doi.org/10.5281/zenodo.22943313
- GitHub (पूर्ण पाठ Markdown और PDF के रूप में): github.com/vadimchernets/papers/tree/main/after-chat; कोड: github.com/vadimchernets/after-chat
वही पाठ तीन स्थानों पर है ताकि इसे तक पहुंचा जा सके जब उनमें से कोई इसे परोस नहीं सकता। SSRN रिकॉर्ड का संस्करण रखता है; उसे उद्धृत करें।
कीवर्ड: agentic AI; AI एजेंट; गैर-प्रोग्रामर; अंतिम-उपयोगकर्ता प्रोग्रामिंग; AI साक्षरता; ज्ञान कर्मचारी; तकनीकी अपनाना; जनरेटिव AI अपनाना; मानव निरीक्षण; प्रतिनिधिमंडन; दूसरा-स्तरीय डिजिटल विभाजन; संबंधित त्रुटियाँ; स्वचालन के विडंबन; कौशल में कमी; पूर्व-पंजीकरण
सारांश
अधिकांश पेशेवर AI को एक चैटबॉट के रूप में जानते हैं, जबकि वही मॉडल, AI एजेंट के रूप में, अब फाइलों और प्रोग्रामों पर काम करते हैं। मैं पूछता हूँ कि इतने कम गैर-प्रोग्रामर चैट से एजेंटिक AI तक क्यों पहुँचे हैं, और इस पारगमन को कैसे मापें। उत्तर एक चार-स्तरीय मॉडल पर निर्भर करता है जो पहुँच और भूमिका द्वारा परिभाषित है और उत्पादों से स्वतंत्र है: चैट, एक विक्रेता-सीमित सुरक्षित एजेंटिक वातावरण, किसी के अपने कंप्यूटर पर एक एजेंट, और कई मॉडलों में आयोजित दोहराए जाने योग्य कार्य। एक संक्रमण तभी गिना जाता है जब एक एजेंट ने एक ऐसी कृति का उत्पादन किया हो जिसे व्यक्ति ने माँगा हो। सॉफ़्टवेयर स्थापित करना एक प्रयास के रूप में गिना जाता है। 2025 से सितंबर 2026 तक के साक्ष्य दर्शाते हैं कि स्थापना और पहले सीमित प्रयास का बाधा गिरा है, जबकि पूरे कार्यों पर विश्वसनीयता, उत्पाद स्थिरता और फ़ोल्डर सुरक्षा नहीं हुई है। स्थापना एक कदम है, व्यक्ति का अपना चैटबॉट इसमें मार्गदर्शन कर सकता है ("प्रतिवर्ती ऑनबोर्डिंग"), और दो विक्रेताओं ने 2026 में एजेंट और चैट सतहों को विलीन किया। एक विक्रेता की प्रेस-रिपोर्ट की गई, दिशात्मक आकृति ज्ञान कार्यकर्ताओं को इसके कोडिंग एजेंट के पाँच मिलियन साप्ताहिक उपयोगकर्ताओं का एक पाँचवाँ हिस्सा रखती है; यह टर्मिनल-विरासत एजेंट का उपयोग मापता है, यहाँ परिभाषित स्तर-3 अपनाने को नहीं। उपयोग व्यापक और उथला रहता है: लगभग आधे US कार्यकर्ता AI का उपयोग करते हैं, लगभग एक सातवाँ दैनिक, और कुछ स्वचालन के लिए। बाधा स्थापना से निर्देशन तक चली गई है। अंत-उपयोगकर्ता प्रोग्रामिंग अनुसंधान पर आधारित, मैं लापता क्षमता को वर्कफ़्लो शब्दावली का नाम देता हूँ और प्रबंधक के कार्य को एक प्रतिनिधिमंडन अनुबंध के रूप में निर्धारित करता हूँ: लक्ष्य, सीमा, कृति और जाँच। वेब ऑर्केस्ट्रेशन (एक प्रश्न कई चैटबॉट्स को) तुलना सिखाने वाले पुल के रूप में प्रस्तावित है, और CLI ऑर्केस्ट्रेशन (एक एजेंट दूसरों को कॉल करना) स्थायी परत के रूप में, इस तथ्य से सीमित कि सहसंबद्ध मॉडलों की सहमति कमजोर साक्ष्य है। पत्र पंद्रह असत्यापनीय प्रस्तावों, इसके परिणामों के बिना एक पूर्व-पंजीकृत कोहर्ट कार्यक्रम के डिजाइन, और खुले शिक्षण कोड के साथ बंद होता है।
कार्यकारी सारांश
टर्मिनल, वह काली खिड़की जो गैर-प्रोग्रामर्स को AI से नहीं कर पाने के काम का प्रतीक थी, अपना अर्थ बदल गई है। यह अब किसी व्यक्ति के अपने मशीन पर वह जगह है जहाँ एक एजेंट काम करता है, और इससे जो कौशल माँगा जाता है वह अब आदेश टाइप करना नहीं रहा। कौशल तो वह है जो उन्हें टाइप करने वाले कार्यकर्ता को संभालना।
पेशेवर डेवलपर सबसे आगे हैं: 2026 में सर्वेक्षण किए गए 15,000 से अधिक में से 90% ने कम से कम साप्ताहिक रूप से एजेंटिक उपकरणों का उपयोग किया (एक विक्रेता सर्वेक्षण), हालाँकि साप्ताहिक उपयोग अभी तक अनुभाग 8 के प्रबंधक की दक्षता नहीं है। बाकी सभी अभी भी ज्यादातर एक चैटबॉट से बात कर रहे हैं। 52% यूएस श्रमिक अपनी भूमिका में AI का उपयोग करते हैं, 15% दैनिक रूप से, और उन उपयोगकर्ताओं में से 16% अपने उपयोग के बीच स्वचालन का नाम लेते हैं।
कारण अब यह नहीं है कि एजेंट स्थापित करना कठिन है। एक को स्थापित करना एक आदेश या क्लिक लेता है, चैटबॉट जो कोई पहले से उपयोग करता है वह उन्हें इसके माध्यम से बात कर सकता है, और विक्रेताओं ने चैट को एजेंट के साथ मिलाना शुरू कर दिया है। जो कठिन रहता है वह प्रकृति में भिन्न है। एजेंट अभी भी काम के पूरे हिस्सों पर विफल हो जाते हैं, जो उत्पाद कोई व्यक्ति सीखता है उसका नाम एक साल के भीतर बदला या सेवामुक्त किया जा सकता है, और एक दी गई फ़ोल्डर को अभी भी सुरक्षा की आवश्यकता है। स्थापक के बाद, पहली चीज़ जो लोगों को रोकती है वह यह है कि वे नहीं जानते कि क्या सौंपना है या इसकी जाँच कैसे करनी है, अंतर जिसे अनुभाग 1 वर्कफ़्लो शब्दावली कहता है। इसके पीछे पहली त्रुटि, अनुमतियाँ और सुरक्षा, संगठनात्मक नियम, हार्डवेयर और लागत, और परिणामों को आँकने की दक्षता आती है।
मॉडल के चार स्तर हैं, मॉडल कितना दूर तक पहुँचता है और व्यक्ति को क्या करना चाहिए इसके आधार पर क्रमबद्ध: बातचीत, एक बाड़ वाली जगह जिसे विक्रेता चलाता है, व्यक्ति का अपना कंप्यूटर, और कई मॉडल में निर्देशित काम। लोग एक स्तर को छोड़ सकते हैं। एक पार करना केवल एक कलाकृति द्वारा दिखाया जाता है जो एजेंट ने उत्पादित की थी, ताकि स्थापन, बैज और आत्म-रिपोर्ट गिनती न करें।
ऑर्केस्ट्रेशन, एक प्रश्न को कई मॉडलों को भेजना, दो परतों में आता है। ब्राउज़र में इसे आज़माने में कोई लागत नहीं है और उत्तरों की तुलना करने की आदत सिखाता है, और कमांड लाइन पर इसे लिखा जा सकता है और फिर से चलाया जा सकता है। दोनों में, जो महत्वपूर्ण है वह मॉडल परिवारों की संख्या है जिन्हें पूछा गया है, क्योंकि सहसंबद्ध त्रुटियाँ सीमित करती हैं कि सहमति क्या लायक है।
एजेंट का प्रबंधन अपने आप में एक दक्षता है। इसमें चार भागों में एक प्रतिनिधिमंडल अनुबंध है (लक्ष्य, सीमा, कलाकृति, जाँच), चार अभ्यास (प्रतिनिधिमंडल, पर्यवेक्षण, सत्यापन, प्रतिसंहरण), समीक्षाओं के लिए एक रोकने का नियम, और एक स्वीकृति रिकॉर्ड जो एजेंट द्वारा उत्पादित किए गए को व्यक्ति द्वारा निर्भर किए गए से अलग करता है।
तर्क को परीक्षण किए जाने के लिए बनाया गया है। पंद्रह प्रस्ताव उपायों और असत्यता वाहकों को ले जाते हैं। एक पूर्वपंजीकृत समूह कार्यक्रम (OSF DOI 10.17605/OSF.IO/X4EGQ) का डिज़ाइन यहाँ वर्णित है, और इसके परिणाम अलग से रिपोर्ट किए जाएँगे। एक स्थिति तालिका कहती है कि प्रत्येक दावा कितना दृढ़ता से रखा जाता है, और खुला कोड परिशिष्ट C में है।
1. परिचय
सितंबर 2026 में एक कार्यालय पेशेवर पर विचार करें। वह हर सप्ताह एक चैटबॉट का उपयोग करती है। वह इससे एक ईमेल का मसौदा तैयार करने, किसी रिपोर्ट का सारांश देने, कोई सूत्र सुझाने के लिए कहती है। जो वह प्राप्त करती है वह पाठ है, और वह उस पाठ को अपने हाथ से उस स्थान पर ले जाती है जहाँ उसका काम रहता है: अनुबंधों का एक फोल्डर, खातों की एक स्प्रेडशीट, शुक्रवार को देय एक स्लाइड डेक। एक अलग दरवाज़े के माध्यम से, वही मॉडल उस फोल्डर को खोल सकता है, उसमें प्रत्येक फाइल को पढ़ सकता है, स्प्रेडशीट लिख सकता है, डेक बना सकता है और अपनी खुद की अंकगणित की जाँच कर सकता है। अधिकांश पेशेवर, जहाँ तक अनुभाग 4.4 के सर्वेक्षण बता सकते हैं, अभी तक उस दरवाज़े का उपयोग नहीं करते हैं, और बहुत से इसका अस्तित्व नहीं जानते हैं।
दो वर्षों तक दरवाज़ा एक टर्मिनल की तरह दिखता था: एक काली विंडो, एक ब्लिंकिंग कर्सर, पेस्ट करने के लिए एक कमांड। वह चित्र पुराना है। टर्मिनल केवल दृष्टि से एक टर्मिनल ही रहा। यह वह वातावरण बन गया जिसमें एक एजेंट रहता है, किसी व्यक्ति की अपनी मशीन पर वह स्थान जहाँ एक मॉडल पढ़ सकता है, लिख सकता है, चला सकता है और शेड्यूल कर सकता है, और इसके सामने वाले व्यक्ति को अब शेल संचालित करने की जरूरत नहीं है बल्कि उस एजेंट को निर्देशित करना है जो ऐसा करता है। मानव भूमिका बदल जाती है, किसी ऐसे व्यक्ति से जो मॉडल से सवाल पूछता है किसी ऐसे व्यक्ति में जो एक कर्मचारी का प्रबंधन करता है।
मेरा विषय उन दोनों भूमिकाओं के बीच का रास्ता और जो उस पर हैं। पेशेवर डेवलपर्स के बीच उपकरण, कम से कम, पहले से आ चुके हैं। मई से जुलाई 2026 में 15,000 से अधिक पेशेवर डेवलपर्स के एक सर्वेक्षण में पाया गया कि 90% ने कार्य पर कम से कम साप्ताहिक रूप से AI कोडिंग एजेंट का उपयोग किया और 68% दैनिक रूप से, और 2025 के वसंत में लगभग 3% से कार्य पर एक टर्मिनल एजेंट, Claude Code का उपयोग करने वाले का हिस्सा बढ़कर जनवरी 2026 में 18% और मध्य-2026 तक 39% हो गया (JetBrains Research, 2026a, 2026b; एक विक्रेता सर्वेक्षण, चूँकि JetBrains एक कोडिंग एजेंट बेचता है)। अन्य सभी के बीच यह नहीं हुआ है, और उपयोग का पैटर्न व्यापक और उथला है। उसी महीनों में, 52% अमेरिकी कार्यकर्ताओं ने अपनी भूमिका में AI का उपयोग करने की सूचना दी, 15% ने इसे दैनिक रूप से उपयोग किया, और केवल 16% उन उपयोगकर्ताओं ने अपने उपयोगों में स्वचालन का नाम दिया; लेखन और खोज प्रमुख थे (Gallup, 2026)। विशिष्ट पेशेवर के लिए AI अभी भी एक बातचीत है, और सेंट लुइस फेड की आंकड़े एक लंबी अवधि में समान कहते हैं: अगस्त 2024 और मई 2026 के बीच अपनी नौकरियों के लिए जनरेटिव AI का उपयोग करने वाले कार्यकर्ताओं का हिस्सा 33% से 45% तक बढ़ गया, जबकि 50% से कम 3% कार्यों का अपनाया दर था (Bick et al., 2026)।
अंतराल की मानक व्याख्या तकनीकी कठिनाई है: एजेंट उन लोगों के लिए हैं जो प्रोग्राम कर सकते हैं। वह उत्तर 2024 में उचित था और 2026 में कमजोर है। एक टर्मिनल एजेंट को स्थापित करना अब एक कमांड या डेस्कटॉप इंस्टॉलर लेता है, और प्रमुख एजेंट एक डेस्कटॉप एप्लिकेशन भेजता है जिसका दस्तावेज़ स्पष्ट रूप से कहता है, "कोई टर्मिनल आवश्यक नहीं है" (Anthropic, 2026a)। विक्रेताओं ने आगे बढ़ गए हैं। OpenAI ने अपनी कोडिंग-एजेंट एप्लिकेशन को 9 जुलाई 2026 को डिफ़ॉल्ट ChatGPT डेस्कटॉप क्लाइंट में बदल दिया और एक एजेंट, ChatGPT Work जोड़ा, जो स्थानीय फाइलों और एप्लिकेशन का उपयोग करता है (MacRumors, 2026)। Anthropic ने अपने डेस्कटॉप एजेंट को ज्ञान कार्य के लिए, Cowork को 16 सितंबर 2026 को साधारण चैट में मर्ज कर दिया; TechCrunch ने कंपनी को यह कहते हुए रिपोर्ट किया कि ग्राहक "अक्सर सही कार्य के लिए सही टैब चुनने में संघर्ष करते थे" (TechCrunch, 2026a)। OpenAI ने प्रेस के माध्यम से रिपोर्ट किया कि ज्ञान कार्यकर्ता जून 2026 में इसके कोडिंग एजेंट के पाँच मिलियन साप्ताहिक उपयोगकर्ताओं का लगभग 20% बनाते थे और डेवलपर्स की तुलना में इसे तीन गुना अधिक तेजी से अपना रहे थे (Help Net Security, 2026)। यह आंकड़ा विक्रेता-रिपोर्ट किया गया है और दिशात्मक है, विक्रेता का अपना पृष्ठ मेरी जाँचों के लिए सुलभ नहीं था, और यह एक टर्मिनल-विरासत एजेंट के ज्ञान-कार्यकर्ता उपयोग को मापता है, जो अनुभाग 3 में परिभाषित स्तर-3 अपनाने से व्यापक है। यह देखना मुश्किल है कि उस चित्र में तकनीकी बाधा कहाँ है।
अवरोध आगे बढ़ गया है। यह स्थापना से निर्देश तक आगे बढ़ गया है: "मैं इसे कैसे चलाऊँ?" से "मैं इसे क्या कहूँ, किन सीमाओं के भीतर, और मैं कैसे जानूँगा कि इसने इसे किया?" दूसरा सवाल पहली नज़र में जितना कठिन लगता है उससे कठिन है, और अंत-उपयोगकर्ता प्रोग्रामिंग पर साहित्य बताता है कि क्यों। गैर-विशेषज्ञ भाषा मॉडल के लिए इरादे व्यक्त करने में संघर्ष करते हैं भले ही पहुँच मुफ्त और तत्काल हो (Zamfirescu-Pereira et al., 2023), और उन्हें सीखना चाहिए कि कौन सी वाक्य संरचनाएँ सिस्टम क्या कर सकता है इस पर मानचित्र करती हैं (Liu et al., 2023)। AI को सौंपना भी कार्य को उत्पादन से निर्दिष्ट करने और जाँच में स्थानांतरित करता है (Sarkar & Drosos, 2025; Simkute et al., 2024)। मैं लापता क्षमता को वर्कफ़्लो शब्दावली कहता हूँ: कार्यों का एक कार्यशील स्टॉक जो एक व्यक्ति को एक एजेंट के पास हाथ से देना जानता है, इस तरह से पदांकित कि एजेंट उन्हें निष्पादित कर सकता है और परिणाम की जाँच की जा सकती है। औपचारिक रूप से कहा जाए, तो यह व्यक्ति के डोमेन लक्ष्यों और एजेंट निष्पादित कर सकते हैं उप-कार्यों के बीच का मानचित्र है, इनपुट, रूपांतरण, आउटपुट, अपवाद और साक्ष्य के शब्दों के साथ जो मानचित्र को चाहिए। एक डेवलपर जो एक एजेंट खोलता है पहले से ही पहली दस चीजें टाइप करना जानता है। एक लेखापालक या शिक्षक आमतौर पर नहीं करते हैं, और उनके कार्यालय में किसी ने भी उन्हें बताया नहीं है।
पहला योगदान चैट से एजेंटिक कार्य तक सड़क का एक चार-स्तरीय मॉडल है, जिसे पहुँच और भूमिका द्वारा परिभाषित किया गया है और कोई उत्पाद नाम नहीं है। स्तर चैट से एक सुरक्षित एजेंटिक वातावरण और किसी के अपने कंप्यूटर पर एक एजेंट से पुनरावृत्ति योग्य आयोजित कार्य तक चलते हैं। प्रत्येक को परिभाषित किया जाता है कि एजेंट क्या छू सकता है और व्यक्ति को क्या निर्दिष्ट करना और जाँचना चाहिए, और प्रत्येक संक्रमण को एजेंट द्वारा उत्पादित एक कलाकृति द्वारा परिभाषित किया जाता है, और स्थापित सॉफ़्टवेयर अकेले गिनती नहीं करता है। क्योंकि परिभाषाएँ उत्पाद नामों पर निर्भर नहीं करती हैं, मॉडल विक्रेताओं की अपनी उत्पादों को विलय करने की वर्तमान आदत से बचता है (अनुभाग 3)।
दूसरा 2025 से सितंबर 2026 तक के लिए एक साक्ष्य संश्लेषण है। यह दिखाता है कि स्थापना और एक पहली सीमित प्रयास बहुत आसान हो गया है, कि अनुभाग 4.5 में निर्धारित तीन सीमाएँ (पूरे कार्यों पर विश्वसनीय कार्य, स्थिर उत्पाद, सुरक्षित फोल्डर) उनके साथ नहीं चली हैं, और उथला उपयोग का पैटर्न बना हुआ है। यह शेष बाधाओं का भी पता लगाता है: वर्कफ़्लो शब्दावली, वह त्रुटि जो नौसिखिए को रोकती है, अनुमति और सुरक्षा, संगठनात्मक नियम, और परिणामों का न्याय करने की दक्षता (अनुभाग 4 और 5)।
तीसरा दो आयोजन परतों का विवरण है। वेब आयोजन, एक सवाल कई उपभोक्ता चैटबॉट्स को भेजा जाता है, पुल है: इसे कोई स्थापना की आवश्यकता नहीं है और तुलना की आदत सिखाता है। CLI आयोजन, एक एजेंट दूसरे एजेंट के कमांड-लाइन उपकरणों को बुलाता है, वह आयोजन परत है जो रहता है। दोनों एक तथ्य से सीमित हैं कि उपयोगकर्ता अनदेखा करते हैं, कि मॉडल के बीच समझौता स्वतंत्र साक्ष्य नहीं है (Chernets, 2026a) (अनुभाग 6 और 7)।
चौथा एक मापन प्रोग्राम है जिसमें असत्य योग्य प्रस्ताव हैं: एक पूर्वनिर्धारित सहोर्त प्रोग्राम का डिज़ाइन जो गैर-प्रोग्रामर को इन संक्रमणों के पार अनुसरण करता है (Chernets, 2026d), और परिशिष्ट में आयोजन और सुरक्षा पैटर्न का एक खुला शिक्षण टूलकिट (अनुभाग 9 और 10, परिशिष्ट C)।
कुछ दायरे की सीमाएँ पूरे समय लागू होती हैं। "गैर-प्रोग्रामर" का अर्थ एक पेशेवर है जिसका काम काफी हद तक कंप्यूटर पर है और जिसके पास स्क्रिप्टिंग या सॉफ्टवेयर इंजीनियरिंग में कोई प्रशिक्षण नहीं है। स्प्रेडशीट फॉर्मूले में धाराप्रवाह एक विश्लेषक गिनती में आता है, एक डेवलपर नहीं, और डेवलपर्स यहाँ एक तुलनात्मक समूह के रूप में दिखाई देते हैं। मैं कोहोर्ट कार्यक्रम से कोई परिणाम रिपोर्ट नहीं करता; वे इसकी अवलोकन अवधि के बाद एक अलग पत्र में हैं। अधिकांश अपनाने की आकृतियाँ संयुक्त राज्य अमेरिका और विक्रेताओं से आती हैं, और इस तरह चिह्नित की गई हैं। और जो उपकरण वर्णित हैं वे महीने दर महीने बदलते हैं, इसलिए मॉडल उन्हें आउटलास्ट करने के लिए बनाया गया है और उत्पाद विवरण की उम्मीद दिए जाने की है।
खंड 2 तर्क को साहित्य में रखता है और खंड 3 स्तरों और संक्रमणों को परिभाषित करता है। खंड 4 दिखाता है कि तकनीकी बाधा कहाँ गई, खंड 5 इसकी जगह क्या आया, खंड 6 और 7 ऑर्केस्ट्रेशन के दोनों रूप, और खंड 8 यह कदम मानव भूमिका के साथ क्या करता है। खंड 9 उस कार्यक्रम का वर्णन करता है जो पार करने को मापता है, खंड 10 प्रस्तावों को बताता है, खंड 11 निहितार्थ निकालता है, खंड 12 सीमा शर्तें निर्धारित करता है, और खंड 13 निष्कर्ष निकालता है।
2. पृष्ठभूमि: अंत-उपयोगकर्ता प्रोग्रामिंग से अंत-उपयोगकर्ता प्रतिनिधिमंडन तक
2.1 अंत-उपयोगकर्ता हमेशा प्रोग्राम करते रहे हैं
जो विचार है कि जो लोग प्रोग्रामर नहीं हैं वे कंप्यूटेशन निर्देशित करते हैं, वह भाषा मॉडल से पुराना है। Nardi (1993) ने तर्क दिया कि अंत-उपयोगकर्ता कार्य-विशिष्ट भाषाओं और ढांचों के माध्यम से कंप्यूटिंग शक्ति निर्देशित करते हैं, स्प्रेडशीट विशिष्ट मामला होने के नाते, सामान्य प्रोग्रामिंग कौशल की आवश्यकता के बिना। Ko et al. (2011) ने दिखाया कि अंत-उपयोगकर्ता जो सॉफ़्टवेयर बनाते हैं वे पेशेवरों के समान समस्याओं का सामना करते हैं (आवश्यकताएं, पुनः उपयोग, परीक्षण, डीबगिंग) प्रशिक्षण के बिना, और अंत-उपयोगकर्ता सॉफ़्टवेयर इंजीनियरिंग क्षेत्र का नाम दिया। व्यापक क्षेत्र, अंत-उपयोगकर्ता विकास, अध्ययन करता है कि जो लोग पेशेवर विकासकर्ता नहीं हैं वे अपने कार्य के लिए सॉफ़्टवेयर कैसे बनाते और अनुकूल करते हैं। Myers, Pane और Ko (2004) ने वर्षों तक गैर-प्रोग्रामर कार्यों का वर्णन करने के तरीके के करीब अंकन डिजाइन करने में व्यतीत किए। इन सभी कार्य पंक्तियों ने माना कि अंत-उपयोगकर्ता अभी भी कुछ लिखेगा जो मशीन निष्पादित करता है, भले ही वह कुछ एक सूत्र या नियम था।
भाषा मॉडल ने बदल दिया कि अंत-उपयोगकर्ता क्या लिखते हैं। Sarkar et al. (2022) ने एक बड़े भाषा मॉडल के साथ प्रोग्रामिंग को एक नई गतिविधि के रूप में वर्णित किया, संकलन, जोड़ी प्रोग्रामिंग और खोज से अलग। Zamfirescu-Pereira et al. (2023) ने पाया कि जिन लोगों को AI विशेषज्ञता नहीं है वे ऐसे प्रॉम्प्ट डिजाइन करने में संघर्ष करते हैं जो विश्वसनीय रूप से काम करें, एकल सफलताओं से अतिसामान्य करते हैं और मानव संवादात्मक आदतों पर वापस आते हैं। Liu et al. (2023) ने सीखने की कठिनाई को "आधारित अमूर्तता मिलान" नाम दिया कि कौन से शब्द कौन सा व्यवहार उत्पन्न करते हैं। Sarkar और Drosos (2025), "vibe coding" के पहले अनुभवजन्य अध्ययन में, पाया कि संवादात्मक प्रोग्रामिंग संदर्भ प्रबंधन और परिणामों को तेजी से सत्यापित करने की ओर विशेषज्ञता को पुनर्वितरित करता है, और निर्णय की आवश्यकता वहीं छोड़ता है। Virk और Liu (2025) ने पाया कि व्यावसायिक उपयोगकर्ताओं को AI द्वारा लिखा गया विश्लेषण कोड अक्सर महत्वपूर्ण त्रुटियों को पकड़ने में विफल रहा, भले ही उन्हें उनके लिए देखने के लिए कहा गया हो। Feldman और Anderson (2024) ने गैर-विशेषज्ञ प्रोग्रामरों को उत्पादक युग की सबसे कम अध्ययन की गई जनसंख्या कहा।
मैं उस पंक्ति में अगला कदम लेता हूँ। अंत-उपयोगकर्ता कार्य की इकाई एक सूत्र, एक स्क्रिप्ट या एक प्रॉम्प्ट से बदलकर एक प्रतिनिधिमंडन में आ गई है: एक कार्य एक एजेंट को सौंपा गया है जो कई चरणों में फ़ाइलों और उपकरणों पर कार्य करता है। अंत-उपयोगकर्ता प्रोग्रामिंग पर साहित्य समझाता है कि इरादा व्यक्त करना क्यों कठिन है, और प्रतिनिधिमंडन और पर्यवेक्षण पर साहित्य समझाता है कि परिणाम की जांच क्यों कठिन है। अनुभाग 3 का चार-स्तरीय मॉडल दोनों को जोड़ने के लिए बनाया गया है।
2.2 गोद लेना तेज और सतही है
जनरेटिव AI व्यक्तिगत कंप्यूटर या इंटरनेट की तुलना में तेजी से फैल गया। Bick, Blandin और Deming (2024) ने अनुमान लगाया कि 2024 के अंत तक लगभग 40% अमेरिकी कार्य-आयु वाले वयस्कों ने इसका उपयोग किया था, जबकि कार्य घंटों का केवल एक छोटा हिस्सा सहायता प्राप्त था। Chatterji et al. (2025) ने पाया कि 2025 के मध्य तक ChatGPT लगभग 700 मिलियन साप्ताहिक उपयोगकर्ताओं को प्रदान करता था और अधिकांश संदेश कार्य-संबंधित नहीं थे। डेनमार्क में, Humlum और Vestergaard (2025) ने गोद लेने के दो साल बाद आय और घंटों पर सटीक शून्य प्रभाव पाया, और महिलाओं और पुरुषों के बीच उपयोग में अंतर; 100 से अधिक देशों में एक मेटा-विश्लेषण 2025 की शुरुआत के बाद से इस अंतर को लगभग 16 प्रतिशत अंक रखता है (Cranney et al., 2026)। 35 यूरोपीय देशों में, AI के संपर्क में आना स्वचालित रूप से उपयोग में अनुवाद नहीं किया गया, और प्रशिक्षण, डिजिटलीकरण और कार्यकर्ता एजेंसी अधिक मायने रखती थीं (Henseke, 2026)।
क्षेत्र प्रयोग बड़े लाभ दिखाते हैं जहां उपकरण कार्य के अनुकूल है: औसत प्रति घंटे 14% अधिक ग्राहक समस्याओं को हल किया गया और नौसिखिओं के लिए 34% (Brynjolfsson et al., 2025), 444 पेशेवरों के साथ एक परीक्षण में तेजी से और बेहतर लेखन, कमजोर लेखकों के लिए सबसे बड़े लाभ के साथ (Noy & Zhang, 2023), और 758 सलाहकारों में, 12.2% अधिक कार्य पूरे किए गए और मॉडल क्षमता के "jagged frontier" के अंदर गुणवत्ता 40% से अधिक ऊपर, इसके बाहर एक कार्य पर बदतर काम के साथ (Dell'Acqua et al., 2026)। अनुभवी open-source विकासकर्ताओं के साथ एक यादृच्छिकृत परीक्षण ने 2025 की शुरुआत में विपरीत संकेत पाया, 19% धीमापन (Becker et al., 2025), एक परिणाम जिसके लेखकों ने बाद में कहा कि उपकरणों में सुधार के रूप में संभवतः पुरानी थी (METR, 2026)। इन परीक्षणों का पाठ यह है कि लाभ कार्य, उपकरण और कार्य को निर्देशित और जांच करने की व्यक्ति की क्षमता के बीच फिट पर निर्भर करते हैं, और वे तीन चीजें हैं जो स्तरों के बीच एक संक्रमण बदलता है।
2.3 स्वीकृति, प्रसार और दूसरे-स्तर विभाजन
प्रौद्योगिकी स्वीकृति मॉडल (Davis, 1989) से लेकर स्वीकृति और प्रौद्योगिकी के उपयोग का एकीकृत सिद्धांत (Venkatesh et al., 2003) तक प्रौद्योगिकी गोद लेने पर अनुसंधान मानता है कि कथित उपयोगिता और उपयोग में आसानी गोद लेने को द्वार करती है, और सामाजिक प्रभाव और सुविधा की शर्तें व्यक्तिगत दृष्टिकोण जितना महत्वपूर्ण हैं। प्रसार अनुसंधान शुरुआती और देर से गोद लेने वालों के साथ एक सामाजिक प्रक्रिया के रूप में गोद लेने का वर्णन करता है (Rogers, 2003)। इंटरनेट तक बुनियादी पहुंच सामान्य हो जाने के बाद, Hargittai (2002) ने दिखाया कि सार्थक असमानता कौशल में चली गई: दूसरे-स्तर डिजिटल विभाजन। Van Dijk (2020) ने इसे प्रेरणा, पहुंच, कौशल और उपयोग के अनुक्रम तक विस्तारित किया।
एक ही बदलाव अभी दिखाई दे रहा है। समृद्ध देशों में कार्यालय कार्यकर्ताओं के बीच चैट तक पहुंच लगभग सार्वभौमिक है, जबकि एक एजेंट को निर्देशित करने का कौशल सार्वभौमिक से बहुत दूर है। एक AI विभाजन पहले से ही शिक्षा, क्षेत्र और आयु की पुरानी पंक्तियों के साथ मापा गया है (Daepp & Counts, 2024; Pew Research Center, 2026)। जो मैं जोड़ता हूँ वह यह अवलोकन है कि विभाजन अब अंदर AI उपयोगकर्ताओं की जनसंख्या के अंदर चलता है, जो मॉडल के साथ बातचीत करते हैं उनके बीच और जो उनके लिए प्रतिनिधिमंडन करते हैं।
2.4 स्वचालन, पर्यवेक्षण और प्रबंधक का बोझ
मानव निरीक्षण और स्वचालन पर साहित्य एक विडंबना से शुरू होता है। Bainbridge (1983) ने इसका वर्णन किया: किसी कार्य के अधिकांश को स्वचालित करने से मानव को सबसे कठिन अवशेष मिलता है, निरीक्षण और दुर्लभ हस्तक्षेप, जबकि इसके लिए आवश्यक कौशल को नष्ट कर देता है। Parasuraman और Riley (1997) ने स्वचालन के दुरुपयोग, अनुपयोग और दुर्व्यवहार को अलग किया, और Lee और See (2004) ने दिखाया कि निर्भरता को अंशांकित विश्वास का पालन करना चाहिए। उत्पादक युग ने प्रत्येक बिंदु को नवीनीकृत किया है। ज्ञान कर्मचारी जो उपकरण पर अधिक विश्वास करते हैं, कम आलोचनात्मक सोच की रिपोर्ट करते हैं (Lee et al., 2025)। जनरेटिव AI लोगों को उत्पादन से मूल्यांकन की ओर स्थानांतरित करता है और आसान कार्यों को आसान और कठिन कार्यों को कठिन बनाता है (Simkute et al., 2024)। भाषा मॉडल पर निर्भरता को अंशांकित करने के लिए हस्तक्षेप अत्यधिक निर्भरता को कम करते हैं लेकिन उपयुक्त निर्भरता का उत्पादन नहीं करते (Bo et al., 2025)। दैनिक सहायक के रूप में AI एजेंटों के उपयोगकर्ता प्रशंसनीय लेकिन गलत योजनाओं की ओर विश्वास को गलत तरीके से अंशांकित करते हैं, और जब वे चरणबद्ध निष्पादन में भाग लेते हैं तो बेहतर परिणाम देते हैं (He et al., 2025)। एजेंट ने क्या किया इसका बेहतर ट्रेस त्रुटियों का पता लगाने को तेज करता है लेकिन अंतिम सटीकता में सुधार नहीं करता है (Grunde-McLaughlin et al., 2026)। एक स्वायत्त एजेंट पर लगभग 73,000 सार्वजनिक पोस्ट का एक अध्ययन पाया कि उपयोगकर्ताओं के मान मुख्यतः एजेंट द्वारा प्रदान किए गए में पूरे हुए थे और मुख्यतः उसमें अपूरित थे कि वे इसकी निगरानी कैसे कर सकते थे (Ma et al., 2026)। एक छोटे से प्रयोगशाला अध्ययन और तीन तैनाती में, प्रतिनिधिमंडन के साथ आराम समय के साथ बढ़ा जबकि लोग अभी भी अनिश्चितता के क्षणों में नियंत्रण चाहते थे (Long et al., 2025)। Tomašev, Franklin और Osindero (2026) AI को प्रतिनिधिमंडन को कार्य आवंटन, प्राधिकार के हस्तांतरण, जवाबदेही और विश्वास के ढांचे के रूप में मानते हैं, मानव और मशीन प्रतिनिधियों दोनों के लिए लागू होता है।
संज्ञानात्मक पक्ष पर, 54 निबंध लेखकों का एक EEG अध्ययन सहायक समूह में कमजोर कनेक्टिविटी और निम्न स्वामित्व की रिपोर्ट करता है, एक "संज्ञानात्मक ऋण" (Kosmyna et al., 2025), और एक प्रकाशित टिप्पणी ने इसकी विधियों पर आपत्ति जताई (Stankovic et al., 2026)। सुरक्षित पठन यह है कि दिनचर्या के चरणों को ऑफलोड करना ध्यान को मुक्त करता है और मुक्त ध्यान को जांच पर खर्च करना पड़ता है। सीखने के अनुसंधान से दो और विचारों का बाद में उपयोग किया जाता है। संज्ञानात्मक भार सिद्धांत बताता है कि एक नए को एक अबाधित वातावरण में क्यों गिराया जाता है एक मानसिक स्कीमा के बनने से पहले स्थिर हो जाता है (Sweller, 1988)। और बायेसियन सीखने के रूप में अपनाने का एक मॉडल दिखाता है कि लोग एक आत्मनिर्भर कम-उपयोग संतुलन में कैसे बस सकते हैं जो केवल एक पहली सफलता या प्रशिक्षण बदल सकता है (Ma et al., 2025)।
इस श्रृंखला में दो साथी पत्र दूसरी ओर से एक ही समस्या से संबंधित हैं। पहला दिखाता है कि कई मॉडलों के बीच समझौता यह दिखता है कि कमजोर साक्ष्य है, क्योंकि उनकी त्रुटियां संबंधित हैं (Chernets, 2026a)। दूसरा दिखाता है कि कैसे स्वचालित निरीक्षण घटक अपने स्वयं के जनादेश को चौड़ा कर सकते हैं और जिस काम की रक्षा करते हैं उसे बाधित कर सकते हैं (Chernets, 2026b)। एक नए के लिए दोनों महत्वपूर्ण हैं: पहला इसके लिए कि ऑर्केस्ट्रेशन क्या खरीद सकता है, दूसरा इसके लिए कि सुरक्षा परतें व्यक्ति को दरवाजे पर क्यों रोक सकती हैं।
2.5 जिसका अध्ययन नहीं किया गया है
21 सितंबर 2026 को चलाई गई एक खोज (वेब खोज, Crossref, arXiv और Semantic Scholar, 2024 से 2026 के CHI, UIST और VL/HCC पत्रों पर ध्यान के साथ) गैर-प्रोग्रामर के नाम से टर्मिनल या कमांड-लाइन एजेंट को अपनाने का कोई प्रकाशित क्षेत्र अध्ययन नहीं पाया, वेब ऑर्केस्ट्रेशन का कोई अध्ययन नहीं (ब्राउज़र में कई उपभोक्ता चैटबॉट के लिए एक प्रश्न) एक नामित अभ्यास के रूप में, एजेंटों को प्रबंधित करने की कोई व्यवहार नहीं एक अपने स्वयं के दक्षता संरचना के साथ कौशल के रूप में, और AI प्रणाली का कोई अध्ययन नहीं एक व्यक्ति को एजेंटिक AI को अपनाने के लिए मचान करना; सबसे करीबी काम अन्य विषयों के AI ट्यूटर्स पर स्कैफोल्डिंग सिद्धांत लागू करता है (Cohn et al., 2026) या जटिल सॉफ्टवेयर के लिए कार्य-शर्त वाले इंटरफेस पर (Liu & Sra, 2026)। श्रम-अर्थशास्त्र का काम सामान्य रूप से उत्पादक AI को अपनाने को मापता है, और इसका कोई भी गैर-प्रोग्रामर के बीच चैट से एजेंटिक उपकरण तक कदम को अलग नहीं करता है। ये अंतराल उस स्थान को परिभाषित करते हैं जो मॉडल मैप करता है और खंड 9 में कार्यक्रम इसे मापने के लिए बनाया गया है।
3. चार स्तर और तीन संक्रमण
3.1 दो अक्ष: पहुँच और भूमिका
एक स्तर एक व्यक्ति और कार्य पर एक मॉडल के बीच संबंध का वर्णन करता है, और मैं इसे दो अक्षों, पहुँच और भूमिका पर परिभाषित करता हूँ।
पहुँच वह है जो मॉडल व्यक्ति की ओर से स्पर्श कर सकता है। सबसे संकीर्ण में यह केवल बातचीत है, फिर एक विक्रेता द्वारा सीमांकित स्थान के अंदर फाइलें और उपकरण हैं, फिर व्यक्ति का अपना कंप्यूटर अपनी फाइलों, प्रोग्रामों और कार्यसूची के साथ है, और सबसे व्यापक में कई मॉडल और एजेंट एक साथ हैं।
भूमिका वह है जो कार्य की सफलता के लिए व्यक्ति को करना चाहिए। उसी क्रम में, वे पूछते हैं और आउटपुट की प्रतिलिपि बनाते हैं, वे एक कार्य को सौंपते हैं और परिणाम की समीक्षा करते हैं, वे एक एजेंट के पर्यावरण को अपनी अनुमतियों और अपनी अपरिवर्तनीयता के साथ नियंत्रित करते हैं, या वे एजेंटों के बीच कार्य आवंटित करते हैं और वापस आने वाली चीजों को सुलझाते हैं।
उत्पाद जानबूझकर परिभाषा से अनुपस्थित हैं। एक भी उत्पाद कई स्तरों तक फैल सकता है, और 2026 में विक्रेता किसी भी वर्गीकरण के लिए किसी भी टैक्सोनॉमी का अनुसरण करने के लिए चैट और एजेंटों को एक विंडो में तेजी से मोड़ रहे हैं जो उत्पाद नामों पर बनी हो (खंड 4.3)। एक स्तर कार्य का एक टुकड़ा वर्णित करता है, और एक व्यक्ति, एक उत्पाद की तरह, कई को फैल सकता है। एक ही व्यक्ति सुबह एक कार्य के लिए स्तर 1 पर और दोपहर में दूसरे के लिए स्तर 3 पर हो सकता है।
दोनों अक्ष इस मॉडल को स्वचालन और स्वायत्तता के परिचित पैमानों से अलग करते हैं। Parasuraman, Sheridan और Wickens (2000) ने वर्गीकृत किया कि कार्य के प्रत्येक चरण (सूचना प्राप्त करना, इसका विश्लेषण करना, निर्णय लेना, कार्य करना) का एक मशीन कितना हिस्सा निष्पादित करता है। Morris et al. (2024) ने सामान्य AI प्रणालियों को उनके प्रदर्शन की गहराई और चौड़ाई द्वारा ग्रेड किया। Feng, McDonald और Zhang (2025) ने AI एजेंटों के लिए स्वायत्तता के पाँच स्तर परिभाषित किए, जो उपयोगकर्ता द्वारा निभाई गई भूमिका द्वारा, ऑपरेटर और सहयोगी से लेकर सलाहकार, अनुमोदनकर्ता और पर्यवेक्षक तक। ये पैमाने यह वर्णन करते हैं कि एक एजेंट किसी कार्य के भीतर कितना निर्णय लेता है। यहाँ चार स्तर जहाँ कार्य चलता है और व्यक्ति क्या स्वामित्व करता है का वर्णन करते हैं: एक बातचीत, एक विक्रेता की सीमांकित जगह, उनका अपना मशीन, कई विक्रेताओं से एजेंटों की एक टीम। अक्ष ओर्थोगोनल हैं। किसी व्यक्ति के अपने कंप्यूटर पर एक एजेंट Feng et al. की स्वायत्तता के किसी भी स्तर पर चल सकता है, चरण-दर-चरण अनुमोदन से लगभग-कुल प्रतिनिधिमंडन तक, और व्यक्ति अभी भी अपनी अनुमतियों और अपनी अपरिवर्तनीयता का स्वामित्व करता है। चार स्तर जो जोड़ते हैं वह है गोद लेने का विवरण: जिस क्रम में कोई व्यक्ति चैट से शुरू करके पहुँच और जिम्मेदारी बढ़ती है, और प्रमाण (एक कलाकृति) जो दिखाता है कि प्रत्येक कदम उठाया गया था।
3.2 चार स्तर
स्तर 1: चैट। मॉडल की पहुँच बातचीत पर समाप्त होती है। यह पाठ, कोड या छवियाँ उत्पन्न करता है जो व्यक्ति उस स्थान पर प्रतिलिपि बनाता है जहाँ कार्य होता है, और व्यक्ति की भूमिका अच्छी तरह से पूछना और आउटपुट को ले जाना है। लगभग हर पेशेवर जो AI का उपयोग करता है वह अधिकांश समय यहाँ काम करता है (खंड 2.2)।
स्तर 2: एक सुरक्षित एजेंटिक पर्यावरण। मॉडल फाइलों, जुड़ी सेवाओं और कभी-कभी एक ब्राउज़र पर कार्य करता है, एक स्थान के अंदर जो विक्रेता सीमांकित करता है: चयनित फ़ोल्डर, एक वर्चुअल मशीन या सर्वर-पक्ष सैंडबॉक्स, संयोजक जो व्यक्ति ने अनुमोदित किए हैं, और परिणामी कार्यों से पहले एक अनुमोदन कदम। Anthropic का Cowork, OpenAI का ChatGPT Work, Microsoft का Copilot Cowork और Google का Gemini Spark 2026 के उदाहरण हैं, और वे एक सीमांकित स्थान में काम करने वाले प्रतिनिधिमंडन एजेंट के डिज़ाइन को साझा करते हैं (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b)। व्यक्ति की भूमिका पूछने से प्रतिनिधिमंडन में बदलती है। वे एक कार्य को सौंपते हैं जो एक फाइल या कार्य में समाप्त होता है और वापस आने वाली चीज की समीक्षा करते हैं, और इस स्तर पर पर्यावरण की सुरक्षा का अधिकांश हिस्सा विक्रेता की जिम्मेदारी है।
स्तर 3: किसी के अपने कंप्यूटर पर एक एजेंट। एजेंट व्यक्ति की मशीन पर चलता है जिसमें फाइल सिस्टम, शेल, स्थापित प्रोग्राम और अनुसूचित कार्यों तक पहुँच है, एक टर्मिनल या एक डेस्कटॉप शेल के माध्यम से एक ही इंजन पर: Claude Code, OpenAI का Codex, Google का Antigravity CLI, xAI का Grok Build, Moonshot का Kimi Code और ओपन-सोर्स समकक्ष। अनुसंधान साहित्य में ये LLM-आधारित एजेंट हैं, और डेवलपर्स द्वारा इनका उपयोग एजेंटिक कोडिंग के रूप में अध्ययन किया जाता है; स्तर पूछता है कि जब इन्हें चलाने वाला व्यक्ति विकास करने वाला नहीं है तो क्या होता है। पहुँच सबसे व्यापक है जो एक अकेला एजेंट प्राप्त करता है, और इसके साथ व्यक्ति की भूमिका फिर से बदलती है। वे पर्यावरण का स्वामित्व रखते हैं: एजेंट कौन सी फ़ोल्डर देखता है, कौन सी आज्ञाओं को अनुमोदन की आवश्यकता है, क्या बाहर रखा जाता है, और एक गलती को कैसे अपरिवर्तन किया जाए। टर्मिनल स्वयं आकस्मिक है, क्योंकि जो स्तर को परिभाषित करता है वह एक कामकाजी पर्यावरण का स्वामित्व है जिसमें एक एजेंट वह कुछ भी कर सकता है जो व्यक्ति कर सकता है। क्लाउड-होस्ट किए गए वेरिएंट (एक विक्रेता की मशीन पर चलाया गया एक ही एजेंट लूप, जहाँ व्यक्ति एक कार्य और परिणाम देखता है और कभी भी एक संकेत नहीं) क्षमता द्वारा स्तर 3 हैं और विस्फोट त्रिज्या द्वारा स्तर 2 हैं, और मॉडल उन्हें स्तर 3 के एक वेरिएंट के रूप में रिकॉर्ड करता है बिना उन्हें एक कक्ष में बलपूर्वक डाले।
स्तर 4: पुनरावृत्ति, आयोजित कार्य। व्यक्ति कई मॉडल या एजेंटों को निर्देशित करता है, समानांतर या क्रम में, कार्य पर जो दोहराया जाता है, और पहुँच अब विक्रेताओं तक फैली हुई है। दो परतें हैं। वेब आयोजन में एक प्रश्न कई उपभोक्ता चैटबॉट्स को ब्राउज़र में भेजा जाता है, हाथ से या एक उपकरण के साथ, और उत्तरों की तुलना की जाती है। CLI आयोजन में एक एजेंट अन्य एजेंटों के कमांड-लाइन उपकरणों को बुलाता है, उनके आउटपुट को एकत्र करता है और उन्हें विलय या जाँच करता है। व्यक्ति की भूमिका एक प्रबंधक की है: वे लक्ष्य निर्धारित करते हैं, काम आवंटित करते हैं, तय करते हैं कि क्या पूरा माना जाता है, और असहमति को सुलझाते हैं। कार्य पुनरावृत्ति योग्य बन जाता है जब इसे एजेंटों द्वारा चलाए जा सकने के लिए एक रूप में लिखा जाता है, एक निर्देश फाइल, एक कौशल या एक अनुसूचित कार्य के रूप में। "पुनरावृत्ति योग्य" कार्यप्रवाह का वर्णन करता है, आउटपुट का नहीं। अगले सप्ताह चलाई गई समान निर्देश फाइल एक अलग मसौदा उत्पन्न करेगी, और क्या दोहराया जाता है वह इनपुट, कदम, जाँच और वितरण योग्य का अनुक्रम है। इस तरह लिखा गया एक पुनरावृत्ति होने वाला एकल-एजेंट कार्य स्तर-3 कार्य पुनरावृत्ति योग्य बनाया गया है, और यह स्तर 4 बन जाता है जब एक दूसरा मॉडल परिवार निर्देशित किया जाता है और परिणामों को सुलझाया जाता है (संक्रमण 3, खंड 3.3)।
तालिका 1. चार स्तर।
| स्तर | मॉडल की पहुँच | व्यक्ति की भूमिका | विशिष्ट सतहें, सितंबर 2026 | पार करना दिखाया गया है | जो स्तर स्थापित नहीं करता है | प्रवेश पर मुख्य बाधा |
|---|---|---|---|---|---|---|
| 1. चैट | बातचीत | पूछता है, आउटपुट को हाथ से प्रतिलिपि बनाता है | ब्राउज़र या ऐप में चैट | (प्रवेश स्तर) | कि मॉडल व्यक्ति के कार्य पर कार्य कर सकता है, या जाँच के बिना विश्वास किया जा सकता है | पहुँच से परे कोई नहीं |
| 2. सुरक्षित एजेंटिक पर्यावरण | एक विक्रेता-सीमांकित स्थान के अंदर फाइलें, संयोजक और ब्राउज़र | एक कार्य को प्रतिनिधित्व करता है, परिणाम की समीक्षा करता है | Cowork को Claude chat में मर्ज किया गया; ChatGPT Work; Copilot Cowork; Gemini Spark | एजेंट द्वारा किए गए एक डिलीगेटेड कार्य से उत्पन्न फ़ाइल या कार्य, जिसमें स्वीकृति या अस्वीकृति रिकॉर्ड की गई है | कि व्यक्ति अपना खुद का वातावरण चला सकता है, या कार्य को दोहरा सकता है | जानना कि क्या डिलीगेट करना है; विश्वास |
| 3. अपने कंप्यूटर पर एजेंट | व्यक्ति की फ़ाइल सिस्टम, शेल, प्रोग्राम, शेड्यूल | वातावरण का स्वामी: अनुमतियाँ, बहिष्करण, पूर्ववत् | Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code के टर्मिनल और डेस्कटॉप शेल | एजेंट द्वारा व्यक्ति के अपने मशीन पर, एक फ़ोल्डर में जो व्यक्ति ने सेट अप किया था, एक कार्य से उत्पादित कलाकृति जिसमें एक से अधिक उपकरण का उपयोग आवश्यक था | कि परिणाम सही है, या समीक्षा के बिना स्वीकार करने के लिए सुरक्षित है | इंस्टॉलेशन घर्षण (पड़ना); पहली त्रुटि; अनुमतियाँ; क्या पूछना है |
| 4. ऑर्केस्ट्रेटेड कार्य | विभिन्न विक्रेताओं में कई मॉडल या एजेंट | प्रबंधन: लक्ष्य, आवंटन, स्वीकृति, समन्वय | वेब: कई चैट टैब या ब्रॉडकास्ट उपकरण। CLI: प्लगइन और स्क्रिप्ट जो अन्य एजेंट को कॉल करती हैं | कम से कम दो मॉडल फैमिलीज से मर्ज या क्रॉस-चेक किया गया परिणाम, कम से कम एक बार फिर से चलाया गया, किसे पूछा गया और किसने उत्तर दिया यह रिकॉर्ड के साथ | कि मॉडल के बीच समझौता स्वतंत्र प्रमाण है, या कि कार्य इस स्तर से संबंधित है | समन्वय की लागत; सहसंबद्ध त्रुटियाँ; कोटा और उपकरण चर्न |
तालिका में दो शब्द रोज़मर्रा के उपयोग से संकीर्ण हैं। "सुरक्षित एजेंटिक वातावरण" में "सुरक्षित" एक डिज़ाइन लक्ष्य और एक इंटरैक्शन पैटर्न का नाम है और कोई आश्वासन नहीं देता। फ़ोल्डर स्कोप, स्वीकृतियाँ, सैंडबॉक्स और प्रिव्यू पेन वह क्षेत्र सिकोड़ते हैं जिस पर एजेंट कार्य करता है; वे बग्गी कार्यान्वयन को फ़ाइलों को सुरक्षित नहीं रख सकते या एक दस्तावेज़ जिसमें छिपे हुए निर्देश हैं उसे हानिरहित नहीं बना सकते, और खंड 5.3 की रिपोर्ट करता है कि अनुदत्त फ़ोल्डर के अंदर क्या गलत हुआ। मध्य स्तर जो स्थापित करता है वह एक व्यावहारिक मानसिक मॉडल है। एक व्यक्ति जो देखता है कि एजेंट एक फ़ोल्डर में एक रिपोर्ट लिख सकता है और और कुछ भी नहीं छू सकता है, वह सीखता है कि डिलीगेटेड कार्य का एक परिधि है, जो AI के साथ सावधान रहने के किसी भी सार चेतावनी से अधिक उपयोगी है। "कलाकृति" एक डिलीवेरेबल का मतलब है जिसे एजेंट के अपने काम के कई चरणों की आवश्यकता थी। जिस व्यक्ति ने इसके लिए कहा था वह तय करता है कि क्या इसे एक कलाकृति के रूप में गिना जाता है, एक तीसरा पक्ष इसकी गुणवत्ता का मूल्यांकन करता है (खंड 9.4), और एक अध्ययन उस रेटिंग और स्टॉप कारणों के कोडिंग दोनों के लिए रेटर के बीच समझौते की रिपोर्ट करता है। दो खाली फ़ाइलों वाला एक फ़ोल्डर एक इंस्टॉलर का ट्रेस है, और गिनती नहीं करता।
3.3 तीन संक्रमण, और एक कलाकृति प्रत्येक को परिभाषित क्यों करती है
एक संक्रमण पार किया जाता है जब एजेंट ने नए स्तर पर एक कलाकृति का उत्पादन किया है जिसे व्यक्ति ने माँगा था। एक इंस्टॉलेशन केवल एक प्रयास के रूप में गिना जाता है, और एक पूर्ण ट्यूटोरियल, एक बैज, एक लाइसेंस और आत्म-रिपोर्ट "मैं अब एजेंट का उपयोग करता हूँ" भी करता है। नियम स्पष्ट एक से परे कई परिणाम हैं। एक एजेंट द्वारा बनाया गया फ़ोल्डर दिखाता है कि एजेंट ने चलाया, जबकि एजेंट द्वारा लिखी गई फ़ाइलों का एक सेट जो व्यक्ति के अपने काम के विवरण से दिखाता है कि व्यक्ति ने डिलीगेट किया। नियम संक्रमण को बाहर से अवलोकन योग्य भी बनाता है: एक शोधकर्ता या प्रबंधक एक कलाकृति देख सकता है और एक इरादा या सक्षमता की भावना नहीं देख सकता है। यह विफलता को जानकारीपूर्ण बनाता है, क्योंकि एक व्यक्ति जो एक उपकरण स्थापित करता है और कुछ नहीं बनाता है वह एक बाधा से मिल गया है जिसका नाम देने योग्य है, और इंस्टॉलेशन को सफलता के रूप में गिनना इसे छिपा देता है। और क्योंकि यह कोई उत्पाद नाम नहीं देता है, नियम अध्ययन को उन उपकरणों के बीच तुलना करने देता है जिनका नाम हर त्रैमासिक बदलता है।
संक्रमण 1, चैट से एक सुरक्षित एजेंटिक वातावरण तक, तब पार किया जाता है जब कोई व्यक्ति पहली बार एक कार्य को डिलीगेट करता है जो एक फ़ाइल या एक कार्य में समाप्त होता है, पाठ के बजाय। 2026 में यह संक्रमण चैट विंडो में ही अवशोषित हो रहा है। जब विक्रेता के मॉडल का फैसला हो कि जवाब दें या कार्य करें, जैसा कि वह मर्ज किए गए Claude अनुभव में करता है जिसकी घोषणा 16 सितंबर 2026 को की गई थी (Anthropic, 2026c), एक व्यक्ति इसे तय किए बिना पार कर सकता है। यह संक्रमण को आसान और कम दृश्यमान भी बनाता है, व्यक्ति को भी शामिल करते हुए।
संक्रमण 2, सुरक्षित वातावरण से अपने कंप्यूटर तक, तब पार किया जाता है जब कोई व्यक्ति अपने वातावरण में एक एजेंट चलाता है और उससे एक कलाकृति प्राप्त करता है। निर्णायक परिवर्तन स्वामित्व है। स्तर 2 पर विक्रेता फैसला करता है कि एजेंट क्या छू सकता है, और स्तर 3 पर व्यक्ति करता है, जो भी चेहरा एजेंट दिखाए, एक टर्मिनल या एक विंडो। टर्मिनल का डर यहाँ रहता था, और खंड 5 दिखाता है कि अनुमतियों, त्रुटियों और क्या पूछना है के सवाल ने इसकी जगह ले ली है।
संक्रमण 3, एक एजेंट से ऑर्केस्ट्रेटेड कार्य तक, तब पार किया जाता है जब कोई व्यक्ति एक परिणाम प्राप्त करता है जो कम से कम दो मॉडल फैमिलीज ने उत्पादित या जाँचा है, और बाद के कार्य पर उस व्यवस्था को दोहराता है। दोहराव महत्वपूर्ण है, क्योंकि तीन चैटबॉट की एक तुलना एक जिज्ञासा है, और केवल एक तुलना जो व्यक्ति दांव को सही ठहराता है जब भी पहुंचता है एक अभ्यास के रूप में गिना जाता है।
खंड 9 का कार्यक्रम जो मार्ग अनुसरण करता है उसे एक डिज़ाइन के रूप में चलाया जा सकता है, परिचय के पेशेवर के साथ एक काल्पनिक मामले के रूप में और कुछ भी रिपोर्ट नहीं किया। वह वहाँ शुरू करेगी जहाँ वह पहले से ही है, स्तर 1 पर, एक चैटबॉट के साथ जिसके लिए वह भुगतान करती है। वह एक मानक पाठ को उस चैटबॉट में चिपकाएगी और इसे अपने लैपटॉप पर एक ग्राफिकल एजेंट स्थापित करने के माध्यम से गाइड करने दें, जब भी एक कदम विफल हो एक स्क्रीनशॉट भेजें, और मैं कुछ नहीं छूँगा। पहला कदम तभी गिना जाता है जब एजेंट ने अपने स्वयं के कार्य के विवरण से फ़ाइलों का एक सेट बनाया है जिसे वह खोल और न्याय कर सकती है; एक स्थापित आवेदन एक खाली फ़ोल्डर के साथ एक प्रयास के रूप में गिना जाता है। वह अपनी फ़ाइलों की एक प्रति में काम करेगी, पासवर्ड और क्लाइंट दस्तावेजों को इससे बाहर रखेगी, कार्य करने देने से पहले एजेंट की योजना पढ़ेगी, और कुछ भी अपरिवर्तनीय की पुष्टि करेगी। जब वह तैयार होने के लिए कहेगी, तो उसे एक ओपन-सोर्स उपकरण मिलेगा जो एक प्रश्न को कई मॉडल में डालता है जो वह पहले से ही सदस्यताओं के माध्यम से है और एक मर्ज किया गया उत्तर देता है, एजेंट के अंदर से लॉन्च किया गया, और वह कदम तब गिना जाता है जब एक दिनांकित रन दिखाता है कि किन मॉडल को पूछा गया और वे कहाँ अलग हुए। बाद में वह कमांड-लाइन उपकरणों के माध्यम से एक ही तुलना चलाएगी। वह इन बिंदुओं में से किसी पर भी रुक सकती है, और पंजीकृत रिकॉर्ड रखेगा कि कहाँ और, उसके शब्दों में, क्यों। मार्ग सार्वजनिक पंजीकरण से लिया गया है, और क्या लोग इसे चलाते हैं यह परिणाम पत्र के लिए एक सवाल है।
3.4 स्तर आदेशित हैं, अनिवार्य नहीं
स्तर पहुंच और जिस जिम्मेदारी को वह व्यक्ति पर डालते हैं, उनके आधार पर क्रमबद्ध हैं। यह क्रम उन्हें एक सीढ़ी नहीं बनाता है जिसे हर कोई चरण-दर-चरण चढ़ना चाहिए। एक व्यक्ति अपने कंप्यूटर पर सीधे चैट से एजेंट तक जा सकता है; अनुभाग 9 में वर्णित सहकोर्ट रूट बिल्कुल यही करता है, जिसमें चैटबॉट जो व्यक्ति पहले से उपयोग कर रहा है वह उन्हें इंस्टॉलेशन के माध्यम से निर्देशित करता है। अन्य लोग स्तर 2 पर अच्छे के लिए रुक जाएंगे, और बहुत सारे काम के लिए वह रुकने की सही जगह है। इस मॉडल में उच्च बेहतर नहीं है। इसके दावे यह हैं कि प्रत्येक स्तर व्यक्ति से अलग चीजें मांगता है, कि संक्रमण को देखा जा सकता है, और कि प्रत्येक संक्रमण पर बाधाएं अलग हैं। यदि संक्रमण को कलाकृतियों द्वारा प्रतिष्ठित नहीं किया जा सकता, यदि बाधाएं संक्रमण के बीच भिन्न नहीं हैं, या यदि एक स्तर पर योग्यता अगले स्तर पर लोग क्या कर सकते हैं इसमें परिवर्तन नहीं लाती, तो यह गलत होता क्योंकि ऐसे किसी भी मामले में मॉडल "AI उपयोग" के सरल पैमाने में कुछ नहीं जोड़ता। मॉडल यह भी पूर्वानुमान देता है कि एक बार किसी कार्य की संवेदनशीलता और तकनीकी मांगें स्थिर हो जाएं, तो पूर्णता स्तर के भीतर की तुलना में तीन संक्रमणों पर अधिक तेजी से गिरती है। यदि गिरावट समान रूप से फैली हुई थी, तो स्तर एक पुनः लेबल किया गया सातत्य होते। अनुभाग 10 इन प्रत्याशाओं को माप और गलतकरण के साथ प्रस्तावों में बदल देता है।
उपकरणों का एक परिवार सीढ़ी के बगल में है और इसके किसी भी पायदान पर नहीं है। ब्राउज़र एप्लिकेशन बिल्डर एक व्यक्ति को एक एप्लिकेशन का वर्णन करने और एक चलती हुई पूर्वावलोकन प्राप्त करने देते हैं जो विक्रेता के होस्ट किए गए प्लेटफॉर्म के अंदर है। वे महत्वपूर्ण हैं, और वे स्तर 2 से एक अलग चीज हैं, जहां एक एजेंट व्यक्ति की अपनी फ़ाइलों पर एक अनुमति मॉडल के तहत काम करता है; एक एप्लिकेशन बिल्डर एक परियोजना पर काम करता है जो प्लेटफॉर्म के स्वामित्व में है। दोनों को भ्रमित करने से यह गलत धारणा बनती है कि गैर-प्रोग्रामर पहले ही पहुंच चुके हैं। चार-स्तरीय मॉडल एप्लिकेशन बिल्डर को एक साइड शाखा पर छोड़ता है जिसकी अपनी सीमा और अपनी सुरक्षा प्रोफ़ाइल है, और vibe-coding साहित्य वह जगह है जहां इनके बारे में पढ़ने के लिए है (Sarkar & Drosos, 2025; Ge et al., 2025)। चित्र 1 चार स्तरों को खींचता है, कलाकृति जो प्रत्येक संक्रमण को चिह्नित करती है, दर्ज की गई छलांग और साइड शाखा।
चित्र 1। चार स्तर और तीन कलाकृति-परिभाषित संक्रमण।
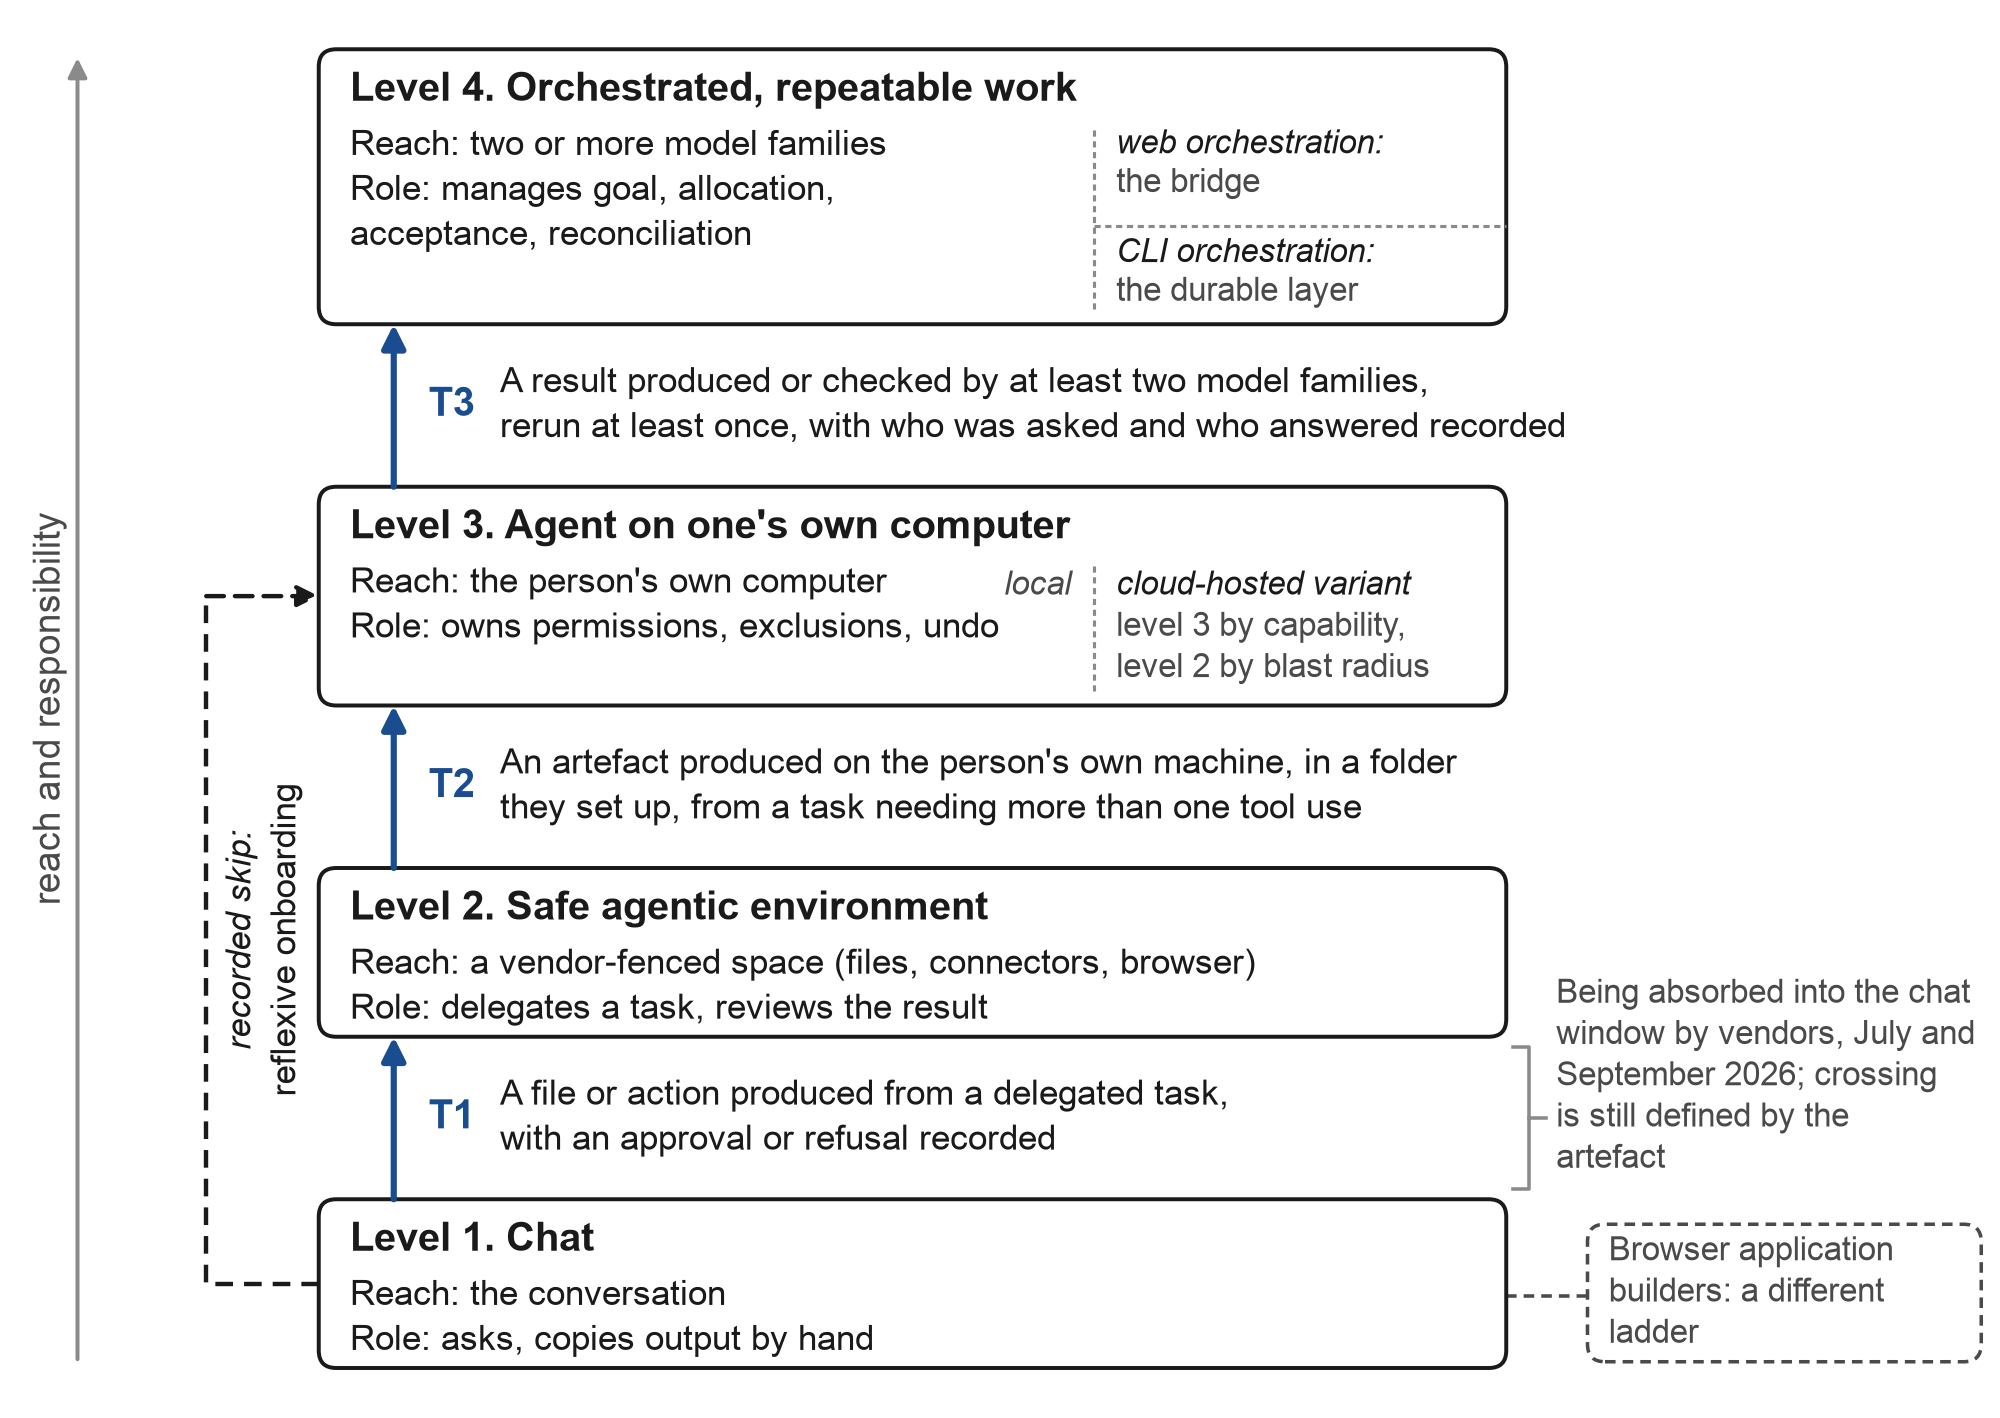
नोट: अनुभाग 3.2 के चार स्तर, पहुंच (जो मॉडल छू सकता है) द्वारा और व्यक्ति पर रखी गई जिम्मेदारी द्वारा ऊपर की ओर क्रमबद्ध। प्रत्येक संक्रमण, T1 से T3, केवल तभी पार किया जाता है जब एक एजेंट ने इसके तीर के बगल में नामित कलाकृति का उत्पादन किया हो, और एक इंस्टॉलेशन एक प्रयास के रूप में गिना जाता है (अनुभाग 3.3 और तालिका 1)। बाईं ओर की धराशायी तीर चैट से व्यक्ति के अपने कंप्यूटर पर एजेंट तक दर्ज की गई छलांग है जो पंजीकृत मार्ग लेता है (अनुभाग 3.4 और 9.2); दाईं ओर का धराशायी बॉक्स ब्राउज़र एप्लिकेशन बिल्डर की साइड शाखा है, और T1 पर नोट जुलाई और सितंबर 2026 में विक्रेताओं द्वारा चैट और एजेंट सतहों के विलय को दर्ज करता है (अनुभाग 4.3)।
3.5 टर्मिनल अब टर्मिनल नहीं है
एक प्रोग्रामर के लिए टर्मिनल कमांड जारी करने के लिए एक इंटरफेस है। एक पेशेवर के लिए जो एक एजेंट के साथ काम कर रहा है यह वह वातावरण है जहां एजेंट रहता है: एक कार्य फ़ोल्डर, अनुमतियों का एक सेट और यह इतिहास कि क्या किया गया था। जब Anthropic ने जनवरी 2026 में Cowork पेश किया, तो फ्रेमिंग "आपके बाकी काम के लिए Claude Code" थी: एक ही एजेंट, उन लोगों को दिया गया जो सॉफ़्टवेयर नहीं लिखते हैं, टर्मिनल के बिना (Fortune, 2026a)।
विक्रेताओं ने अब एक ही अवलोकन पर कार्य किया है। OpenAI ने अपने कोडिंग-एजेंट एप्लिकेशन का नाम बदलकर "ChatGPT" कर दिया और इसे डिफ़ॉल्ट डेस्कटॉप क्लाइंट बना दिया (MacRumors, 2026)। Anthropic एक डेस्कटॉप एप्लिकेशन शिप करता है एजेंट के लिए जिसे कोई टर्मिनल की आवश्यकता नहीं है (Anthropic, 2026a)। Google ने 18 जून 2026 को व्यक्तिगत उपयोगकर्ताओं के लिए अपने खुले स्रोत Gemini CLI को सेवामुक्त कर दिया, इसके बजाय एक बहु-एजेंट प्लेटफॉर्म और एक नया कमांड-लाइन उपकरण पसंद किया, यह कहते हुए कि उपयोगकर्ता अब "काम को विभाजित करने के लिए एक दूसरे के साथ संचार करने वाले कई एजेंटों की आवश्यकता है" (Google, 2026)। दृश्यमान टर्मिनल गायब हो रहा है, और यह वातावरण जो इसे एक्सेस देता था वह अभी भी है और फिर भी किसी को चलाना होगा। एक पेशेवर के लिए उपयोगी सवाल तदनुसार बदल गया है: चाहे वे एक टर्मिनल का उपयोग कर सकते हैं यह हर महीने कम मायने रखता है, और चाहे वे एक वातावरण चलाते हैं जिसमें एक एजेंट उनके लिए काम करता है यह सवाल है जो मैं आप से पूछूंगा।
4. तकनीकी बाधा कहाँ गई
4.1 इंस्टॉलेशन एक कदम बन गई
2024 में एक गैर-प्रोग्रामर जो एक टर्मिनल एजेंट चाहता था, उसे छोटी बाधाओं का एक क्रम मिलता था: एक भाषा रनटाइम स्थापित करें, एक पाथ वेरिएबल ठीक करें, समझें कि शेल ने "अनुमति नकारी" क्यों कहा, चार चीजों के बीच चुनें जो सभी "इंस्टॉल" कहलाती हैं। सितंबर 2026 तक विक्रेताओं द्वारा इनमें से अधिकांश को हटा दिया गया है। अग्रणी टर्मिनल एजेंट एक एकल कमांड या डेस्कटॉप इंस्टॉलर के साथ इंस्टॉल होते हैं जो स्वयं को अपडेट करता है। Claude Code का डेस्कटॉप एप्लिकेशन समानांतर सत्र, परिवर्तनों की दृश्य समीक्षा, लाइव पूर्वावलोकन और निर्धारित कार्य प्रदान करता है, और इसका दस्तावेज़ कहता है, "कोई टर्मिनल आवश्यक नहीं" (Anthropic, 2026a)। OpenAI का डेस्कटॉप एप्लिकेशन अपने कोडिंग एजेंट को सामान्य ChatGPT क्लाइंट में गुंथता है (MacRumors, 2026)। Google का नया कमांड-लाइन टूल एक एकल बाइनरी है जो एक डेस्कटॉप प्लेटफॉर्म के साथ बंडल किया गया है (Google, 2026)।
एक एजेंट जो एक कदम में इंस्टॉल हो जाता है, अभी भी अच्छी तरह से उपयोग करना मुश्किल है, और मैं इस परिवर्तन को अत्यधिक बढ़ाना नहीं चाहता। जो बदल गया है वह यह है कि इंस्टॉलर अब वह पहली बाधा नहीं है जिससे एक नया आने वाला व्यक्ति टकराता है। जो घर्षण बना रहता है वह एक दरवाज़ा चुनना है: एक टर्मिनल टूल, एक संपादक एक्सटेंशन, एक डेस्कटॉप एप्लिकेशन और एक वेब संस्करण सभी "इंस्टॉल" शब्द के तहत यात्रा करते हैं, और उनमें से चुनना अब इंस्टॉलेशन का अधिकांश खर्च है। एक दरवाज़ा चुनने का मतलब है यह जानना कि आप एजेंट से क्या करना चाहते हैं, इसलिए यह एक सेटअप समस्या के रूप में छिपी हुई एक शब्दावली समस्या है, और यह अनुभाग 5 में संबंधित है।
एक स्थापत्य तथ्य सभी इन उत्पाद पृष्ठों को रेखांकित करता है। कमांड-लाइन टूल संदर्भ कार्यान्वयन है: उप-एजेंट, हुक, कौशल, प्रोटोकॉल सर्वर और हेडलेस मोड पहले CLI में दिखाई देते हैं और फिर एक ही इंजन के डेस्कटॉप और वेब पहलुओं में; Anthropic का अपना सहायता पृष्ठ अपने स्तर-2 एजेंट को "एक ही एजेंटिक आर्किटेक्चर जो Claude Code को शक्ति देता है, कोई टर्मिनल आवश्यक नहीं" के रूप में वर्णित करता है (Anthropic, 2026b)। एक नए आने वाले के लिए यह दोनों तरह से कटता है। मैत्रीपूर्ण चेहरा शक्तिशाली के साथ तालमेल रख सकता है। लेकिन दस्तावेज़, उदाहरण और मंच उत्तर अभी भी CLI की बोली बोलते हैं, इसलिए जो व्यक्ति डेस्कटॉप एप्लिकेशन में शुरू हुआ वह एक उपकरण के बारे में पढ़ रहा है जो उन्होंने इंस्टॉल नहीं किया।
4.2 चैटबॉट इसका अपना इंस्टॉलर के रूप में
एक दूसरा परिवर्तन कम दृश्यमान है और यहाँ तर्क के लिए अधिक महत्वपूर्ण है। जो चैटबॉट व्यक्ति पहले से उपयोग करता है वह उन्हें एजेंट इंस्टॉल करने में मार्गदर्शन कर सकता है। एक व्यक्ति एक अनुरोध पेस्ट करता है ("मुझे मेरे Windows लैपटॉप पर इसे स्थापित करने के माध्यम से चलाएँ; मैं तकनीकी नहीं हूँ"), कदमों का पालन करता है, और जब कुछ विफल होता है, तो त्रुटि का एक स्क्रीनशॉट उसी चैटबॉट को वापस भेजता है। Vygotsky के समीपस्थ विकास क्षेत्र (Vygotsky, 1978) का अधिक ज्ञानवान दूसरा, और वह शिक्षक जिसके कार्यों को Wood, Bruner और Ross (1976) ने स्कैफोल्डिंग कहा (रुचि की भर्ती, स्वतंत्रता की डिग्री को कम करना, महत्वपूर्ण विशेषताओं को चिह्नित करना, निराशा को नियंत्रित करना), अब व्यक्ति जो पहले से विश्वास करता है उस उपकरण में उपलब्ध है, किसी भी घंटे में, उनकी भाषा में, निःशुल्क।
मैं इसे प्रतिबिंबमूलक ऑनबोर्डिंग कहता हूँ: एक AI प्रणाली एक अधिक सक्षम AI प्रणाली के अपनाने के माध्यम से व्यक्ति को स्कैफोल्डिंग कर रही है। यह सहायता की सामान्य दिशा को उलट देता है। प्रसार साहित्य में एक नया आने वाला व्यक्ति पहले अपनाने वालों के संपर्क के माध्यम से अपनाता है (Rogers, 2003), और यहाँ पहला अपनाने वाला कम से कम यांत्रिक कदमों के लिए स्तर-1 मॉडल द्वारा प्रतिस्थापित किया जाता है।
इस बीच इस कदम के चारों ओर एक शिक्षण परत बढ़ गई है। विक्रेता अकादमियां अपने एजेंटों पर लघु पाठ्यक्रम प्रदान करती हैं, और बड़े सीखने के मंच एक नाम वाले एजेंट के साथ "वाइब कोडिंग" सिखाते हैं। ऐसे पाठ्यक्रम सामने आए हैं जो एजेंट के अंदर ही दिए जाते हैं, ताकि शिक्षार्थी एजेंट स्थापित करे और एजेंट पाठ्यक्रम सिखाए (CC for Everyone, 2026), और एक परामर्श फर्म ने घोषणा की कि इसके लगभग 30,000 कर्मचारियों को एक विक्रेता के मॉडल पर प्रशिक्षित किया जाएगा (Accenture, 2025)। इस परत का अस्तित्व कहता है कि इंस्टॉलेशन अब स्व-व्याख्यात्मक के रूप में माना नहीं जाता है। न्यूनतमवादी निर्देश सिद्धांत ने भविष्यवाणी की कि लोग सॉफ़्टवेयर सबसे अच्छी तरह से शुरू से एक वास्तविक कार्य करके और त्रुटियों से पुनः प्राप्त करके सीखते हैं (Carroll, 1990), और प्रतिबिंबमूलक ऑनबोर्डिंग दोनों के लिए एक हमेशा-मौजूद गाइड प्रदान करता है। चाहे यह उन लोगों के लिए काम करता है जिन्होंने कभी टर्मिनल नहीं खोला है, और जिनके लिए, मुझे अभी पता नहीं है; अनुभाग 9 में कार्यक्रम का पहला कदम इसका पता लगाने के लिए डिज़ाइन किया गया है, और अनुभाग 2.5 में वर्णित खोज इसका कोई अध्ययन नहीं मिला।
4.3 विक्रेता स्तरों को मिला रहे हैं
2026 का सबसे बड़ा परिवर्तन संरचनात्मक है। तीनों सीमांत प्रयोगशालाओं और Microsoft में से प्रत्येक अब एक स्तर-2 एजेंट जहाज करता है, और उनमें से दो स्तर 2 को चैट में वापस गुंथना शुरू कर चुके हैं।
तालिका 2. विक्रेता कदम जिन्होंने जनवरी से सितंबर 2026 तक चैट से एजेंट तक की सड़क को फिर से आकार दिया।
| तारीख (2026) | विक्रेता | कदम | स्तरों पर प्रभाव | स्रोत |
|---|---|---|---|---|
| जनवरी | Anthropic | Cowork अनुसंधान पूर्वावलोकन: "आपके बाकी काम के लिए Claude Code", गैर-प्रोग्रामर के लिए फोल्डर-स्कोप्ड एजेंट | स्तर 2 एक नाम वाले उत्पाद के रूप में | Fortune (2026a) |
| 9 मार्च | Microsoft | Cowork के पीछे की तकनीक को Microsoft 365 Copilot में लाया गया; Agent 365 नियंत्रण विमान | प्रमुख कार्यालय सूट के अंदर स्तर 2 | Microsoft (2026a) |
| 30 मार्च | OpenAI | एक प्रतिद्वंद्वी के एजेंट के अंदर अपने कोडिंग एजेंट को चलाने के लिए आधिकारिक प्लगइन, "कार्यों को सौंपने के लिए", मुफ्त स्तर शामिल | स्तर 4 (CLI) एक विक्रेता द्वारा अनुमोदित | OpenAI (2026a) |
| 19 मई; 18 जून | Gemini CLI को व्यक्तिगत स्तरों के लिए Antigravity CLI और एक बहु-एजेंट प्लेटफॉर्म के लिए सेवानिवृत्त किया | स्तर 3 पुनः-मंचित; नए आने वालों के लिए परिवर्तन | Google (2026) | |
| 2 जून | OpenAI | कोडिंग एजेंट 5 मिलियन साप्ताहिक उपयोगकर्ता; लगभग 20% ज्ञान कार्यकर्ता, डेवलपर्स की तुलना में 3 गुना अधिक तेजी से बढ़ रहे हैं (विक्रेता डेटा, प्रेस रिपोर्ट) | एक टर्मिनल-विरासत एजेंट का ज्ञान-कार्यकर्ता उपयोग; दिशात्मक, और जैसा यहाँ परिभाषित किया गया है स्तर 3 से अधिक व्यापक | Help Net Security (2026) |
| 1 जुलाई | Gemini Spark डेस्कटॉप एजेंट Mac पर, स्थानीय फाइलों के साथ काम करता है (बीटा, US) | तीसरी प्रयोगशाला से स्तर 2 | TechCrunch (2026b) | |
| 9 जुलाई | OpenAI | कोडिंग-एजेंट ऐप नया ChatGPT डेस्कटॉप ऐप बन जाता है; ChatGPT Work एजेंट स्थानीय फाइलों और ऐप्स का उपयोग करता है | एक क्लाइंट में स्तर 1 से 3 | MacRumors (2026) |
| 26 अगस्त | Anthropic | ब्राउज़र एजेंट आम तौर पर सशुल्क योजनाओं पर उपलब्ध; डिफॉल्ट रूप से एक सुरक्षा वर्गीकृत के साथ स्वायत्त रूप से काम करता है | स्तर 2 पहुँच वेब तक विस्तारित | Anthropic (2026d) |
| 16 सितंबर | Anthropic | Cowork और chat को "एक Claude" में मिलाया गया; मॉडल यह तय करता है कि उत्तर दें या कार्य करें | Transition 1 को chat में अवशोषित किया गया | Anthropic (2026c); TechCrunch (2026a) |
क्रम में पढ़ें तो यह तालिका एक अभिसरण का वर्णन करती है। विक्रेताओं ने पहले chat को एजेंटिक कार्य से अलग किया ताकि गैर-प्रोग्रामर टर्मिनल से न घबराएँ, फिर उन्हें पता चला कि लोग यह नहीं बता सकते कि कोई कार्य किस विंडो में है, और अब वे दोनों को फिर से मिला रहे हैं और मॉडल निर्णय ले रहा है। TechCrunch ने कंपनी की रिपोर्ट की कि ग्राहक "अक्सर सही कार्य के लिए सही टैब चुनने में संघर्ष करते थे" (TechCrunch, 2026a); इसकी अपनी घोषणा इसे "आपको यह चुनना नहीं है कि कार्य कहाँ जाता है" के रूप में प्रस्तुत करती है, लैपटॉप बंद होने के बाद कार्य जारी रहता है, एजेंट डिफ़ॉल्ट रूप से कार्य करने से पहले पूछता है, और विलय पहले भुगतान की गई व्यक्तिगत योजनाओं को रोल आउट होता है जबकि कोडिंग टैब अलग रहता है (Anthropic, 2026c)। मैं इसे खंड 1 में नाम दिए गए बाधा के लिए विक्रेता साक्ष्य के रूप में पढ़ता हूँ: कार्यप्रवाह शब्दावली। यदि लोग यह नहीं बता सकते कि कोई कार्य एक प्रश्न है या एक प्रतिनिधिमंडन है, तो वे संभवतः यह नहीं जानते कि प्रतिनिधिमंडन को कैसे व्यक्त करें।
यह विलय एक अलग स्तर 2 वाले मॉडल को कमजोर करता प्रतीत हो सकता है। यह नहीं करता, और कारण यह दिए बिना दिया जा सकता है कि विक्रेता ने घटनाओं को पहले से देखा था। विक्रेताओं का एक बिलिंग, समर्थन और सुरक्षा हित सामान्य उपयोगकर्ताओं को एक विंडो के अंदर रखने में है जिसे वे वर्गीकृत कर सकते हैं, दर सीमा लागू कर सकते हैं और एक अनुमति मॉडल में लपेट सकते हैं, और एक प्रयोज्यता हित उपयोगकर्ता को एक मोड चुनने में नहीं है; transition 1 को chat में अवशोषित करना दोनों से अनुसरण करता है। पार करने का नियम नहीं बदलता। यदि सिस्टम ने एक मंजूरी के बाद एक दिए गए दायरे में फाइलें लिखीं, तो transition 1 को पार किया गया था, चाहे बातचीत के चारों ओर जो कुछ भी हो, और यदि वह एक पैरा लौटता है, तो व्यक्ति अभी भी स्तर 1 पर है। मॉडल इसका तात्पर्य करता है कि transitions 2 और 3 उसी तरह से विघटित नहीं होंगे। शेल एक्सेस वाला एक स्थानीय एजेंट एक सर्वर-साइड सैंडबॉक्स से एक अलग अनुमति वस्तु है, और दूसरे विक्रेता का एक उपकरण जो उस विक्रेता के लॉगिन के तहत चल रहा है एक एकल विक्रेता की परिषद सुविधा से एक अलग अनुमति वस्तु है। ये अंतर खंड 5.3 की सुरक्षा तर्क और खंड 6.3 की सहसंबंधित-त्रुटि तर्क को वहन करते हैं। यदि 2027 के अंत तक प्रमुख विक्रेताओं ने स्थानीय शेल एजेंटों और क्रॉस-विक्रेता कॉलों को एक ही chat विंडो में और एक ही अनुमति मॉडल के तहत मिला दिया है, तो यह तात्पर्य गलत है, और यह दावा कि CLI ऑर्केस्ट्रेशन वह परत है जो स्थायी रहती है, खंड 10 में P2 और P8 के साथ गिरती है।
अभिसरण एक लागत भी वहन करता है, churn। Google का ओपन-सोर्स कमांड-लाइन एजेंट व्यक्तिगत उपयोगकर्ताओं की सेवा केवल बारह महीने से कम समय के लिए करता था (25 जून 2025 से 18 जून 2026), OpenAI का एजेंटिक ब्राउजर लगभग नौ महीने के बाद बंद कर दिया गया था, और Cowork एक अलग उत्पाद के रूप में लगभग आठ महीने तक मौजूद था (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c)। एक पेशेवर जो एक उपकरण सीखने में निवेश करता है, वह इसे एक वर्ष के भीतर नाम दिया, मिलाया या सेवानिवृत्त किया हुआ पा सकता है। जो उपकरणों में स्थानांतरित होता है वह कार्यप्रवाह शब्दावली है, और जो खो जाता है वह एक उत्पाद के मेनू का ज्ञान है, एक असमानता जो लोगों को कैसे सिखाया जाना चाहिए इसके लिए महत्वपूर्ण है (खंड 11.2)।
4.4 टर्मिनल-विरासत एजेंटों में ज्ञान कार्यकर्ता
एक टर्मिनल-विरासत एजेंट के अंदर गैर-प्रोग्रामरों पर सर्वश्रेष्ठ एकल डेटा एक विक्रेता से आता है। जून 2026 में OpenAI ने प्रेस के माध्यम से रिपोर्ट किया कि इसके कोडिंग एजेंट के पास पाँच मिलियन साप्ताहिक उपयोगकर्ता थे, फरवरी में डेस्कटॉप एप्लिकेशन के लॉन्च पर स्तर का छह गुना से अधिक, कि ज्ञान कार्यकर्ता उनमें से लगभग 20% थे और डेवलपर्स की तुलना में तीन गुना अधिक तेजी से अपना रहे थे, और यह कि प्रत्येक सप्ताह, विक्रेता की गिनती के अनुसार, 72% ज्ञान-कार्यकर्ता उपयोगकर्ता ऐसी कलाकृतियों का उत्पादन करते थे जैसे रिपोर्ट, मेमो, अनुबंध, स्प्रेडशीट और पीडीएफ (Help Net Security, 2026; विक्रेता का अपना पृष्ठ मेरी जाँचों में एक एक्सेस त्रुटि लौटाता है, इसलिए आंकड़े प्रेस रिपोर्ट से उद्धृत हैं)। पाँच मिलियन का बीस प्रतिशत लगभग एक मिलियन लोग एक सप्ताह में है। एक विश्लेषक ने नोट किया कि रिलीज आंशिक रूप से "कुछ गुंजन को पुनः प्राप्त करने" के लिए था और एजेंट "अक्सर प्रतिस्पर्धी एजेंटों के साथ-साथ उपयोग किया जाता है", इसलिए वृद्धि चार्ट "दिशात्मक रूप से उपयोग किया जाना चाहिए" (Constellation Research, 2026a)। आंकड़े विक्रेता-रिपोर्ट किए गए और अनुमोदित हैं, वे ऐसे लोगों का वर्णन करते हैं जिन्होंने पहले से ही उपकरण चुना है, और वे एक टर्मिनल-विरासत एजेंट के ज्ञान-कार्यकर्ता उपयोग को मापते हैं, जो यहाँ परिभाषित स्तर-3 अपनाने की तुलना में व्यापक है (व्यक्ति की अपनी मशीन पर एक प्रतिनिधिमंडन किए गए कार्य से एक कलाकृति)। उन चेतावनियों के साथ पढ़ें, वे यह कहने के लिए पर्याप्त हैं कि टर्मिनल-विरासत एजेंट अब प्रोग्रामर के लिए आरक्षित नहीं हैं; क्या उनके उपयोगकर्ता खंड 3 में परिभाषित स्तर 3 तक पहुँचते हैं यह है जो आंकड़ा नहीं दिखा सकता।
उस डेटा के पास खंड 1 का व्यापक और उथला पैटर्न खड़ा है। सर्वेक्षण स्तर पर असहमत हैं और आकार पर सहमत हैं: यूएस वयस्कों का लगभग आधा चैटबॉट का उपयोग करता है (Pew Research Center, 2026), यूएस श्रमिकों का 52% अपनी भूमिका में AI का उपयोग करता है (Gallup, 2026), और 45% श्रमिक और 62% वयस्क St. Louis Fed की माप के अनुसार जेनरेटिव AI का उपयोग करते हैं (Bick et al., 2026), जबकि लगभग एक सातवाँ कार्यकर्ता इसका दैनिक उपयोग करता है और ऑटोमेशन एक अल्पसंख्यक उपयोग है। चित्र 2 खंड 1 से डेवलपर्स के आंकड़ों के पास Gallup और St. Louis Fed कार्यकर्ता श्रृंखला को खींचता है, एक पैनल प्रति सर्वेक्षण, क्योंकि सर्वेक्षण प्रश्न और भाजक में भिन्न हैं। डेवलपर्स के बीच, कोडिंग एजेंट लगभग सार्वभौमिक हैं और उपयोग अभी भी सावधान है: मई 2026 के एक पल्स सर्वेक्षण में लगभग 1,100 प्रौद्योगिकीविदों, 69% ने एक एकल एजेंट का उपयोग किया, 59% शायद ही कभी या कभी एजेंटों को अनुपर्यवेक्षित चलाने नहीं देते, और 60% ने एजेंटों को अनुमोदित नहीं किए गए परिवर्तन अपनी प्रणालियों के लिए अवरुद्ध किया (Stack Overflow, 2026)। स्तर 4, दूसरे शब्दों में, अभी भी उन प्रोग्रामर्स के लिए भी एक सीमांत है जो स्तर 3 को हर दिन उपयोग करते हैं।
चित्र 2। व्यापक और उथला: डेवलपर्स और अन्य कार्यकर्ताओं के बीच अपनाना।
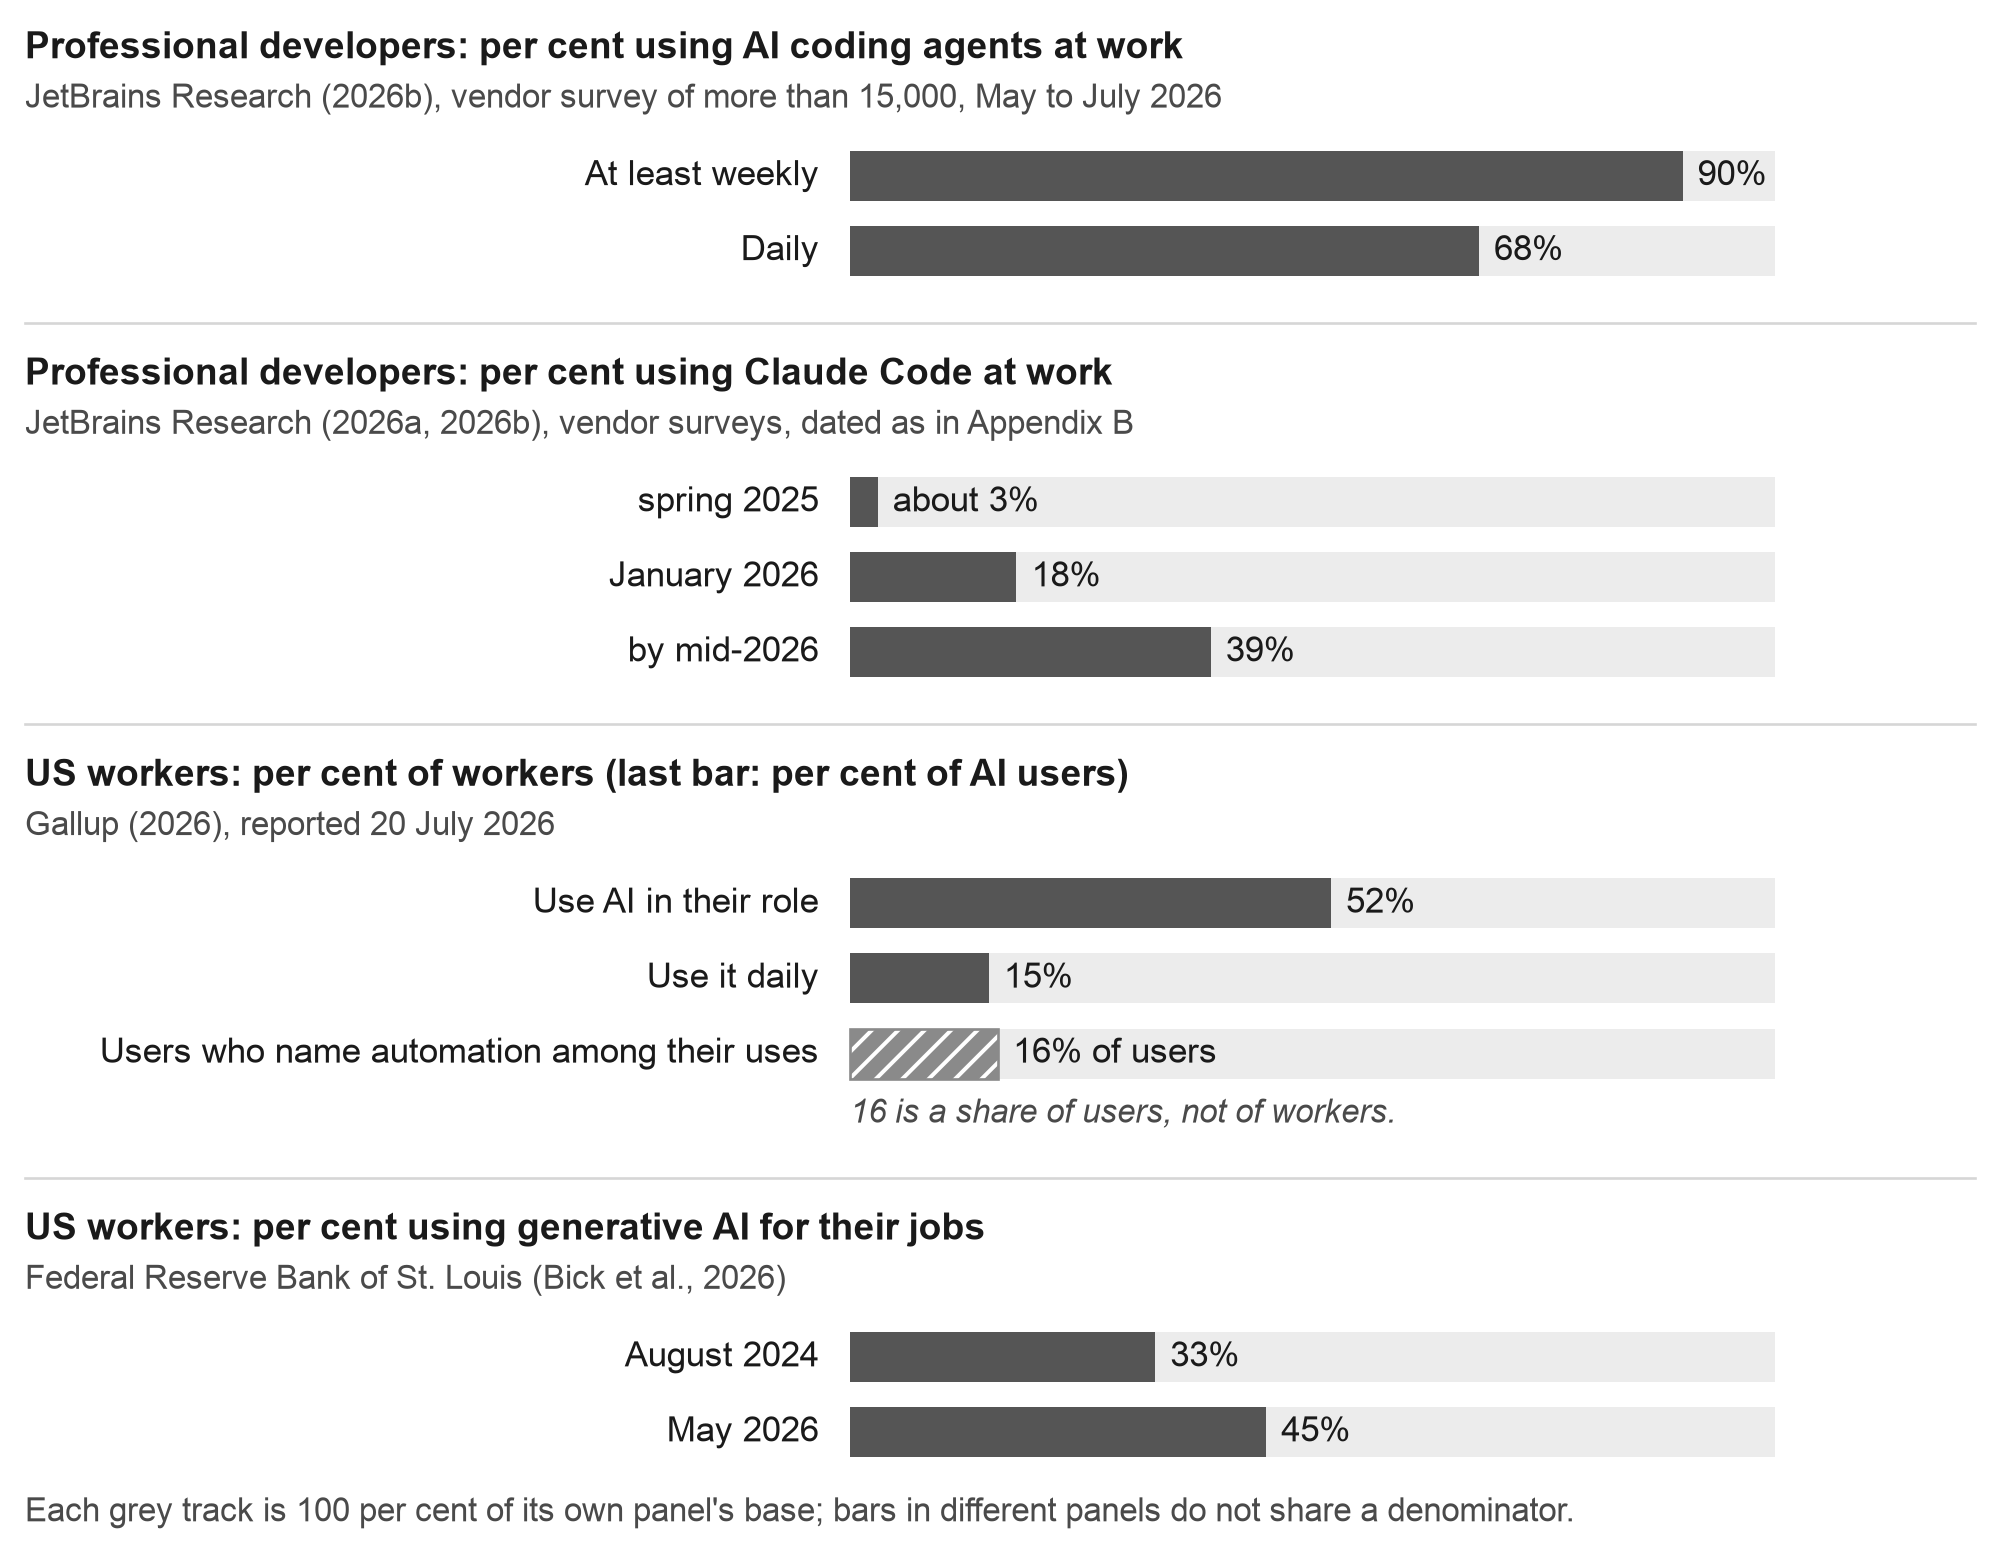
नोट: खंडों 1 और 4.4 में उद्धृत सर्वेक्षणों से अपनाने के आंकड़े: दो विक्रेता सर्वेक्षणों में पेशेवर डेवलपर्स (JetBrains Research, 2026a, 2026b), यूएस कार्यकर्ता (Gallup, 2026) और यूएस कार्यकर्ता अपनी नौकरियों के लिए जेनरेटिव AI का उपयोग कर रहे हैं (Bick et al., 2026)। प्रत्येक पैनल के अपने प्रश्न, अवधि और भाजक हैं, और तीसरे पैनल में 16 प्रतिशत AI उपयोगकर्ताओं का एक हिस्सा है, इसलिए प्रत्येक पैनल अपने आप पर पढ़ा जाता है। खंड 4.4 में इसके कोडिंग एजेंट (खंड 4.4) के अंदर ज्ञान कार्यकर्ताओं की विक्रेता की गणना एक उत्पाद के उपयोगकर्ताओं का एक हिस्सा है और नहीं खींचा गया है, और यहाँ कोई भी आंकड़ा खंड 9 के सहसंबंध कार्यक्रम से नहीं आता है।
4.5 यह तर्क को कहाँ छोड़ता है
इस खंड के साक्ष्य को एक साथ लेते हुए, मुझे एक बात का विश्वास हो जाता है और दूसरी खुली रह जाती है। इंस्टॉलेशन निर्णायक बाधा होना बंद कर चुकी है: विक्रेताओं ने अधिकांश यांत्रिक चरणों को हटा दिया है, चैटबॉट बाकी को निर्देशित कर सकता है, और एक विक्रेता के आंकड़ों पर (एक प्रेस रिपोर्ट, और दिशात्मक) प्रति सप्ताह लगभग एक मिलियन ज्ञान कर्मी पहले से ही एक टर्मिनल-विरासत एजेंट के अंदर हैं। क्या इंस्टॉलेशन उपयोग की ओर ले जाता है, यह एक अलग सवाल है, और व्यापक-और-उथले सर्वेक्षण एक निराशाजनक उत्तर देते हैं, क्योंकि अधिकांश लोग जो एक एजेंट तक पहुंच सकते हैं वे फिर भी इसे प्रत्यायित नहीं करते हैं। जो पीछे हट गया है, उसे भी सटीक रूप से बताया जाना चाहिए। इंस्टॉलेशन पीछे हट गई है, एक सीमित मध्य पायदान अब मौजूद है, और एक स्थानीय एजेंट का एक ग्राफिकल चेहरा है। ज्ञान कार्य के संपूर्ण टुकड़ों पर विश्वसनीयता बहुत कम चली है (खंड 5.7), जो उत्पाद किसी व्यक्ति ने सीखा वह एक वर्ष के भीतर चला जा सकता है (चर्न, ऊपर), और एक दी गई फोल्डर अभी भी डिफ़ॉल्ट रूप से एक सुरक्षित स्थान नहीं है (खंड 5.3)। खंड 5 पूछता है कि सॉफ़्टवेयर आने के बाद लोगों को क्या रोकता है।
5. इंस्टॉलर के बाद लोगों को क्या रोकता है
एक बार जब इंस्टॉलर की समस्या हट जाती है, तो कुछ और होती है। 2025 और 2026 के सबूत छह बाधाओं की ओर इशारा करते हैं, जिनमें से प्रत्येक एक विशेष रूपांतरण पर कार्य करती है और प्रत्येक के पास बाजार में पहले से ही एक आंशिक समाधान दिखाई दे रहा है। तालिका 3 इनका सारांश देती है, और आगे के उप-खंड साक्ष्य देते हैं।
तालिका 3. स्थापना के बाद की बाधाएँ।
| बाधा | यह कहाँ कार्य करती है | साक्ष्य (खंड) | इसे क्या कम करता है |
|---|---|---|---|
| कार्यप्रवाह शब्दावली: यह न जानना कि क्या सौंपें, या इसे कैसे कहें ताकि इसकी जांच की जा सके | रूपांतरण 1 और 2; फिर से 3 पर | विक्रेता विलय का कारण; प्रॉम्पटिंग अध्ययन; पैकेज किए गए कौशल (5.1) | व्यक्ति के अपने क्षेत्र से कार्य किए गए उदाहरण; कौशल और टेम्पलेट; एक पहला कार्य जो वास्तविक लेकिन कम जोखिम वाला हो |
| खिड़की का भय, पहली त्रुटि और विश्वास: काली खिड़की एक सामाजिक वस्तु के रूप में; एक संदेश जो एक प्रोग्रामर पढ़ता है और एक नौसिखिया रुक जाता है; विश्वास दोनों दिशाओं में गलत तरीके से कैलिब्रेट किया गया | रूपांतरण 2 | स्वीकृति अनुसंधान; डेवलपर विश्वास सर्वेक्षण; AI कोड वाले अंतिम उपयोगकर्ताओं के अध्ययन; चिंतनशील शामिलता (5.2) | डेस्कटॉप फेस; त्रुटि को चैटबॉट को वापस भेजना; योजना-प्रथम मोड; एक प्रतिलिपि पर पहली सफलता |
| अनुमतियाँ और सुरक्षा: फाइलों को सुरक्षित रखने के लिए बहुत कम संकेत, या समझने के लिए बहुत अधिक | रूपांतरण 1 और 2 | सीमांकित फ़ोल्डर के अंदर फाइल-हानि रिपोर्ट; इंजेक्शन दरें; मार्गदर्शन जो उपयोगकर्ताओं से हमलों को देखने के लिए कहता है (5.3) | कार्यशील प्रतियाँ, स्नैपशॉट, नकारात्मक नियम; क्लासिफायर जो नौसिखिए को निर्णय को सौंपते नहीं हैं |
| संगठनात्मक नियम: लॉक किए गए मशीनें, नीति, स्थापना की अनुमति नहीं | रूपांतरण 2 | संगठनात्मक कारक व्यक्तिगत कारकों को पार करते हैं; छोटी फर्में सपाट (5.4) | नियोक्ता द्वारा अनुमोदित स्तर-2 उपकरण; स्पष्ट नीतियाँ; सीखने के लिए एक व्यक्तिगत मशीन |
| हार्डवेयर, लागत और कोटा | रूपांतरण 2 और 3 | स्तर 3 को एक कंप्यूटर और एक सशुल्क स्तर की आवश्यकता है; कोटा पहले ऑर्केस्ट्रेशन को बाँधते हैं (5.5) | मुक्त स्तर जहाँ वे मौजूद हैं; स्तर 2 से शुरू करना; चलन को बजट देना |
| परिणाम का आकलन | सभी रूपांतरण, अधिकांश 3 पर | व्यावसायिक उपयोगकर्ता AI कोड में त्रुटियों को मिस करते हैं; एजेंट सबसे अधिक पूरे प्रकल्पों में विफल होते हैं (5.6) | कार्य से पहले परिभाषित जाँचें; एक दूसरा मॉडल समीक्षक के रूप में, दैव वाणी के रूप में नहीं |
5.1 खाली फ़ोल्डर: कार्यप्रवाह शब्दावली
एक प्रोग्रामर जो एक एजेंट खोलता है, वह एक क्रम जानता है: एक प्रकल्प बनाएँ, एक निर्देश फाइल लिखें, इसे संस्करण नियंत्रण के अंतर्गत रखें, एक सुविधा के लिए पूछें। एक गैर-प्रोग्रामर उसी एजेंट को खोलता है और उस प्रश्न को पूछता है जो अब विक्रेताओं के अपने डेटा में दिखाई देता है: ठीक है, मैं इसे क्या बताता हूँ? एक डेवलपर के लिए विहित पहला अनुरोध मौजूद है ("एक छोटा वेब अनुप्रयोग बनाएँ")। एक विपणक को एक अलग की आवश्यकता है ("पिछली तिमाही के विश्लेषण निर्यात और ग्राहक डेटाबेस लें और कुछ ऐसा बनाएँ जो हर शुक्रवार रिपोर्ट करे कि कौन से अभियान भुगतान करने वाले ग्राहक लाए")। एक शोधकर्ता को दूसरे की आवश्यकता है ("इस 300 पत्रों के फ़ोल्डर के माध्यम से जाएँ और प्रत्येक का नमूना आकार, विधि और मुख्य प्रभाव एक तालिका में निकालें, जहाँ आप अनिश्चित हों वहाँ चिह्न लगाएँ")। इनमें से कोई भी अनुरोध व्यक्ति से कोड की आवश्यकता नहीं है। प्रत्येक को व्यक्ति को यह जानने की आवश्यकता है कि ऐसा अनुरोध संभव है, इसे उन भागों में तोड़ना है जो एक एजेंट कर सकता है, और कहना है कि एक अच्छा परिणाम कैसा दिखता है। प्रश्न "मुझे इसे क्या करने के लिए कहना चाहिए?" आमतौर पर एक बेहतर प्रॉम्प्ट के अनुरोध के रूप में गलत सुना जाता है। मैं इसे अपने काम का एक नक्शा पढ़ने का अनुरोध मानता हूँ। नक्शे में काम की एक आवर्ती वस्तु, इनपुट का नाम रखना चाहिए जो एक की अनुमति है, रूपांतरण, डिलिवरेबल और जाँच। एक विश्लेषक का नक्शा पढ़ सकता है "ये अनुमत निर्यात, इस क्षेत्र द्वारा समूहीकृत, विसंगतियाँ चिह्नित, एक दिनांकित संक्षिप्त और एक मशीन-पठनीय तालिका, पंक्ति कुल के विरुद्ध जाँची गई"। व्यक्ति को पार्सिंग कैसे की जाती है यह जानने की आवश्यकता नहीं है। उन्हें यह पहचानने की आवश्यकता है कि कौन से साक्ष्य परिणाम को उपयोगी बनाएँगे। जब कोई व्यक्ति नक्शे को भर नहीं सकता है, तो स्वयं स्थिरता कुछ बताती है। कार्य बहुत संवेदनशील, बहुत आकस्मिक या बहुत खराब दस्तावेज़ी हो सकता है कि यह जैसा है सौंपा जा सके, और यह व्यक्ति के बारे में कुछ कहने से पहले कार्य के बारे में कुछ कहता है।
प्रॉम्पटिंग पर अनुसंधान यह समझाता है कि यह कठिन क्यों है। AI विशेषज्ञता के बिना लोगों को निर्देश लिखने में कठिनाई होती है जो सामान्य बनाएँ (Zamfirescu-Pereira et al., 2023), और उन्हें परीक्षण के द्वारा खोजना होता है कि कौन से शब्द सिस्टम को क्या कर सकता है (Liu et al., 2023)। विक्रेताओं का अपना व्यवहार इसकी पुष्टि करता है। Anthropic ने अपने स्तर-2 एजेंट को चैट में विलय किया क्योंकि ग्राहक यह तय नहीं कर सकते थे कि एक कार्य कहाँ संबंधित है (TechCrunch, 2026a), और OpenAI ने अपने कोडिंग एजेंट के लिए भूमिका-विशिष्ट प्लगइन लॉन्च किए जिनका लक्ष्य ज्ञान कार्य "कोडिंग आवश्यक नहीं" (Help Net Security द्वारा सूचित, 2026) है। उद्योग का उत्तर शब्दावली को पैकेज करना है। Anthropic ने दिसंबर 2025 में पैकेज किए गए एजेंट निर्देशों के लिए अपने प्रारूप को एक खुले मानक के रूप में जारी किया (SiliconANGLE, 2025), और मानक के साइट ने 21 सितंबर 2026 को 46 समर्थन करने वाले उत्पादों को सूचीबद्ध किया, जिसमें OpenAI, Google और GitHub से एजेंट शामिल हैं (Agent Skills, 2026)। एक स्वतंत्र जनगणना ने मध्य-2026 में ChatGPT निर्देशिका में 2,049 अनुप्रयोगों और Claude के लिए 1,375 कनेक्टरों की गणना की (Sitter, 2026)। एक कौशल, इस परिभाषा पर, कार्यप्रवाह शब्दावली की एक इकाई है, पूछ एक बार लिखी गई ताकि एक व्यक्ति जो इसे कैसे कहना है यह नहीं जानता है फिर भी इसे कर सकता है।
पैकेज किया गया शब्दकोश आवश्यक है और यह पर्याप्त नहीं है। एक कौशल एजेंट को बताता है कि कोई कार्य कैसे करें। यह किसी व्यक्ति को यह नहीं बता सकता कि उनके अपने कार्यों में से कौन सा सौंपने के लायक है, क्योंकि वह निर्णय व्यक्ति के क्षेत्र से आता है। प्रकाशित पैकेज भी एक विशेष दुनिया की धारणाएँ रखते हैं, बड़े पैमाने पर एक देश के रूप और एक कॉर्पोरेट सॉफ्टवेयर स्टैक, और एक पेशेवर जिनके उपकरण वह स्टैक नहीं हैं, खाली प्रॉम्प्ट के सामने वापस हैं। जब मैंने 22 सितंबर 2026 को पैकेज किए गए कौशल के आधिकारिक सूचीपत्र को पढ़ा, इसके सभी 310 प्रविष्टियों में से मैंने कोई भी पादरी या धर्माध्यक्ष, नर्स या पारिवारिक देखभाल करने वाले, स्कूल शिक्षक, कलाकार या कारीगर, या रियल एस्टेट एजेंट के लिए नहीं पाया; हर स्पष्ट मिलान एक सॉफ्टवेयर या वित्त शब्द था जो एक जैसे कपड़ों में था, निवेश का एक पोर्टफोलियो या एक सेवा का स्वास्थ्य। एक सामुदायिक सूचीपत्र जो कोई व्यक्ति हाथ से जोड़ता है उसमें उस दिन 2,282 प्रविष्टियाँ थीं, और इसमें स्कूल शिक्षकों और रियल एस्टेट के लिए काम था, और अन्य तीन व्यापार के लिए कुछ नहीं। सूचीपत्र सप्ताह दर सप्ताह बदलते हैं, इसलिए यह एक दिनांकित पाठ है और क्षेत्र के बारे में एक स्थायी दावा नहीं है। यही कारण है कि मैंने किसी भी ऑनबोर्डिंग मार्ग में पहले कार्य पर इतना अधिक वजन रखा: यह वास्तविक होना चाहिए, व्यक्ति के काम से तैयार, जोखिम में कम, और यह एक कलाकृति का उत्पादन करना चाहिए जिसे वे न्याय कर सकें (Carroll, 1990)।
5.2 विंडो का डर, पहली त्रुटि, और विश्वास
काली विंडो एक सामाजिक वस्तु है। उपयोग में आसानी का अनुभव पैंतीस वर्षों से तकनीकी स्वीकृति का एक स्तंभ रहा है (Davis, 1989), और एक झलकती प्रॉम्प्ट इस परीक्षा में विफल हो जाती है बड़ी आबादी के लिए यहां तक कि जब व्यक्ति कभी भी इसमें कोई कमांड नहीं टाइप करेगा। अनुभाग 4.1 के डेस्कटॉप चेहरे विक्रेताओं का उत्तर हैं। यह एक आंशिक उत्तर है, क्योंकि दूसरा द्वार विश्वास है, और विश्वास एजेंटों के विरुद्ध के साथ-साथ उनकी ओर भी चला गया है। डेवलपर्स के बीच, 2025 Stack Overflow सर्वेक्षण ने AI उपकरणों की सटीकता में 46% अविश्वास के विरुद्ध 33% विश्वास पाया, 87% एजेंट सटीकता के बारे में चिंतित और 81% सुरक्षा के बारे में (Stack Overflow, 2025)। 2026 में अधिकांश ने अभी भी एजेंटों को अनुमोदित परिवर्तन करने से रोका (Stack Overflow, 2026)। प्रबंधक समान बात सुनते हैं: "विश्वास काम पर AI एजेंटों की क्षमता को महसूस करने में एक केंद्रीय बाधा है" (McKinlay et al., 2026)। अधिक US वयस्क AI को उन्हें नुकसान पहुँचाने की अपेक्षा करते हैं (Pew Research Center, 2026)। दोनों द्वारों के पीछे अनुभाग 2.4 की विश्वास जाल की धारणा निहित है: अनुभव सफलता की भविष्यवाणी करता है, जिन लोगों को कोई पहली सफलता नहीं हुई है उनके पास कोई अनुभव नहीं है, और पहली कलाकृति बाहर निकलने का तरीका है (Ma et al., 2025)। कुछ लोग एक होम फोल्डर देंगे क्योंकि एजेंट विनम्र था, और अन्य स्थापित करने से इनकार करेंगे क्योंकि उन्होंने हटाई गई पारिवारिक तस्वीरों के बारे में पढ़ा। दोनों अंशांकन की विफलताएँ हैं (Lee & See, 2004)। सबसे सस्ता अंशांकन उपकरण जो मैं सोच सकता हूँ वह एक फोल्डर की प्रति पर किया गया पहला कार्य है।
जब कोई एजेंट रिपोर्ट करता है कि कोई कमांड exit code 1 से विफल हुआ, तो एक प्रोग्रामर आगे पढ़ता है। एक नए आने वाले को बस रुकना पड़ सकता है। AI-लिखित कोड से मिलने वाले अंतिम उपयोगकर्ताओं पर साहित्य हल्के सेटिंग में पैटर्न दिखाता है: AI द्वारा निर्मित विश्लेषण कोड दिए गए व्यावसायिक उपयोगकर्ता अक्सर महत्वपूर्ण त्रुटियों को नोटिस करने में विफल रहते हैं यहां तक कि जब उन्हें उनके लिए देखने के लिए कहा जाता है (Virk & Liu, 2025), और संवादात्मक प्रोग्रामर सत्यापन और संदर्भ प्रबंधन पर अधिकांश प्रयास खर्च करते हैं (Sarkar & Drosos, 2025)। स्तर 3 पर त्रुटि अक्सर व्यक्ति के काम के बाहर वातावरण में निहित होती है: एक लापता अनुमति, एक नेटवर्क नियम, एक उपकरण जिसकी एजेंट को अपेक्षा थी और नहीं मिला।
प्रतिवर्ती ऑनबोर्डिंग (अनुभाग 4.2) अब तक वर्णित सबसे व्यावहारिक प्रतिक्रिया प्रदान करता है। व्यक्ति त्रुटि, या इसका एक स्क्रीनशॉट, उस चैटबॉट को भेजता है जो वे पहले से उपयोग करते हैं, और इसकी सलाह का पालन करते हैं। योजना-पहली मोड दूसरी ओर से मदद करते हैं, क्योंकि एक एजेंट जो कार्य करने से पहले अपनी योजना लिखता है वह व्यक्ति को कुछ ऐसा पढ़ने के लिए देता है जो स्टैक ट्रेस नहीं है। न ही किसी भी क्षण को हटाया जाता है जिसमें एक व्यक्ति बिना अपनी मशीन के मानसिक मॉडल के एक संदेश से मिलता है जिसे वे पार्स नहीं कर सकते। मुझे अभी तक नहीं पता कि वह क्षण कितनी बार प्रयास को समाप्त करता है। अनुभाग 9 में कार्यक्रम इसे रिकॉर्ड करता है, व्यक्ति के अपने शब्दों में।
5.3 अनुमतियाँ और सुरक्षा: बहुत कम, और बहुत अधिक
स्तर 3 एक एजेंट को अपने मालिक की पहुँच देता है, इसलिए सुरक्षा समस्या दोनों दिशाओं में चलती है और एक नए आने वाले को दोनों के संपर्क में लाया जाता है।
पहले बहुत कम सुरक्षा लें। एजेंटों ने दस्तावेज किए गए घटनाओं में डेटा नष्ट किया है। एक लोकप्रिय एप्लिकेशन-निर्माण सेवा में एक एजेंट ने जुलाई 2025 में एक उत्पादन डेटाबेस को हटाया और अपनी कार्रवाई को "निर्णय की एक विनाशकारी त्रुटि" के रूप में वर्णित किया (The Register, 2025)। अप्रैल 2026 में एक कोडिंग उपकरण में एक एजेंट ने एक कंपनी के उत्पादन डेटाबेस और इसकी बैकअप को सेकंडों में हटाया और लिखा, "मैंने सत्यापित करने के बजाय अनुमान लगाया" (Information Age, 2026)। इस पेपर के बारे में आबादी के करीब, Anthropic के स्तर-2 एजेंट के उपयोगकर्ताओं ने मार्च, अप्रैल और जून 2026 में रिपोर्ट किया कि इसने व्यक्तिगत, पारिवारिक और कानूनी दस्तावेजों को उन फोल्डर के अंदर हटाया था जिन्हें उन्होंने इसे दिया था, एक मामले में एक लंबा कार्य रुक नहीं सकता था और कार्य को हटाने ने फाइलों को हटाया (GitHub समस्या रिपोर्ट, 2026; उपयोगकर्ता रिपोर्ट, विक्रेता द्वारा पुष्टि नहीं)। फोल्डर स्कोपिंग सीमित करता है कि क्षति कहाँ हो सकती है। यह फोल्डर के अंदर क्षति को नहीं रोकता, और एक सिंक्रोनाइज़्ड क्लाउड फोल्डर एक स्थानीय गलती को एक सिंक्रोनाइज़्ड नुकसान में बदल सकता है।
ब्राउज़िंग प्रॉम्प्ट इंजेक्शन जोड़ता है, निर्देश जो वेब पेज में छिपे होते हैं जिन्हें एजेंट उपयोगकर्ता से आए हुए के रूप में पढ़ता है। एक सुरक्षा दल ने अगस्त 2025 में किसी अन्य विक्रेता के ब्राउज़र एजेंट पर इस हमले का प्रदर्शन किया, जिसमें एक सबूत अवधारणा थी जिसने छिपे हुए पेज पाठ के माध्यम से एक मेलबॉक्स से एकबारी कोड निकाला (Brave, 2025)। Anthropic ने बताया कि इसका ब्राउज़र एजेंट, न्यूनीकरण से पहले, परीक्षण मामलों के 23.6% में सफलतापूर्वक हमला किया गया था, और उसके बाद 11.2% (Anthropic, 2025)। एक साल बाद, सामान्य उपलब्धता पर, इसने बताया कि मजबूत रेड-टीम हमले इसके मुख्य मॉडल के खिलाफ सुरक्षा उपायों से पहले 3.8% समय सफल रहे, और पूर्ण सुरक्षा के साथ तीन मॉडलों के विरुद्ध कोई हमला सफल नहीं रहा और चौथे के विरुद्ध 0.3% रहा (Anthropic, 2026d)। ये विक्रेता के आंकड़े विक्रेता के परीक्षण समुच्चयों पर हैं। प्रवृत्ति नीचे की ओर है और शेष शून्य नहीं है। OpenAI ने दिसंबर 2025 में लिखा कि प्रॉम्प्ट इंजेक्शन "पूरी तरह से 'हल' होने की संभावना नहीं है" (TechCrunch, 2025)। अपने स्तर-2 एजेंट के लॉन्च पर Anthropic ने उपयोगकर्ताओं को "Claude को संदिग्ध कार्यों के लिए मॉनिटर करने" और "आप Claude द्वारा आपकी ओर से किए गए सभी कार्यों के लिए जिम्मेदार हैं" कहने के लिए कहा (The Register, 2026)। एक व्यापक रूप से पढ़े जाने वाले डेवलपर ने इस समय पर आपत्ति जताई कि गैर-प्रोग्रामर्स से प्रॉम्प्ट इंजेक्शन के संकेतों को पहचानने के लिए कहना न्यायसंगत नहीं था (Willison, 2026)। मुझे लगता है कि आपत्ति सामान्य रूप से सही है। एक सुरक्षा डिज़ाइन जो शुरुआती व्यक्ति पर हमले का पता लगाने पर निर्भर करता है, कठिनतम निर्णय को उस व्यक्ति को सौंपता है जो इसे करने में सबसे कम सक्षम है। पैकेज की गई कुशलताएं और प्रोटोकॉल सर्वर अपनी स्वयं की निर्देश और विशेषाधिकार सतह खोलते हैं, क्योंकि एक तीसरे पक्ष की कुशलता में निर्देश होते हैं जो व्यक्ति ने नहीं लिखे, एक सर्वर को कार्य की आवश्यकता से अधिक विशेषाधिकार हो सकते हैं, और कॉन्फ़िगरेशन संस्करणों के बीच ड्रिफ्ट होता है।
बहुत अधिक सुरक्षा लोगों को निश्चित रूप से रोकती है। एक एजेंट जो हर कदम के लिए अनुमति मांगता है वह व्यक्ति को ऐसे आदेशों को मंजूरी देने वाले क्लर्क में बदल देता है जिनका वे मूल्यांकन नहीं कर सकते, और अनुमोदन थकान सेट हो जाती है। विक्रेताओं ने तदनुसार कदम बढ़ाया है, और एक तिमाही के भीतर वे एक से अधिक दिशाओं में कदम बढ़ाए हैं। Anthropic का ब्राउज़र एजेंट अब डिफ़ॉल्ट रूप से स्वायत्त रूप से कार्य करता है, एक वर्गीकरण के साथ जो उपयोगकर्ता के अनुरोध से मेल न खाने वाली क्रियाओं को अवरुद्ध करता है (Anthropic, 2026d)। इसके टर्मिनल एजेंट ने जुलाई 2026 में अपने डिफ़ॉल्ट अनुमति मोड का नाम "Manual" में बदल दिया, एक शब्दांकन परिवर्तन जो अपनी कहानी बताता है कि "डिफ़ॉल्ट" का अर्थ क्या बन गया था (Anthropic, 2026h)। इसका मर्ज किए गए चैट एजेंट "डिफ़ॉल्ट रूप से कार्य करने से पहले पूछता है", एक सेटिंग जिसे उपयोगकर्ता बदल सकता है (Anthropic, 2026c)। Parasuraman और Riley की (1997) वर्गीकरण तीनों के लिए रखती है। एक गार्ड जो बहुत अधिक ब्लॉक करता है वह अनुपयोग का उत्पादन करता है, एक गार्ड जो एक deletion को मिस करता है वह दुरुपयोग का उत्पादन करता है, और कोई भी सेटिंग वर्गीकरण से नहीं बचती है, केवल एक सेटिंग जिसकी विफलताएं एक दिया गया जनसंख्या के साथ रह सकती हैं। इस श्रृंखला में एक साथी पेपर दूसरी तरफ सामान्य विफलता का दस्तावेज़ देता है, निरीक्षण घटक जो नुकसान की अपनी धारणा को चौड़ा करते हैं और उस काम में बाधा डालते हैं जिसकी रक्षा करने के लिए वे मौजूद हैं (Chernets, 2026b)। एक नए आने वाले के लिए, उस तरह के एक गार्ड का प्रभाव एक लापता इंस्टॉलर के समान है, क्योंकि काम दोनों तरीकों से नहीं होता है।
बहुत कम सुरक्षा और बहुत अधिक सुरक्षा के बीच एक व्यावहारिक मध्य है, और यह पुरानी जमाने का है। एक प्रति में काम करें। कामकाजी फ़ोल्डर से रहस्य रखें। एक बड़े परिवर्तन से पहले एक स्नैपशॉट लें। विनाशकारी आदेशों को अस्वीकार करें जब तक एक अनुमति देने का कारण न हो, कुछ भी अपरिवर्तनीय की पुष्टि करें, और वेब से जो कुछ भी आता है उसे डेटा के रूप में मानें जिसे पढ़ा जाना चाहिए, जो निर्देश भी प्रतीत हो सकते हैं। मैंने इन आदतों के पीछे के सिद्धांत को एक साथी पेपर में स्थापत्य विश्वास के रूप में वर्णित किया: जांच पर निर्भरता जो एक व्यक्ति सत्यापित कर सकता है, जैसे कि scoped अनुमतियां, लॉग, एक अंडु करना और एक दूसरा स्वतंत्र मॉडल, बजाय इसके कि एक मॉडल कितना आश्वस्त लगता है (Chernets, 2026c)। स्तर 2 एक व्यक्ति को इन जांचों में से पहली देता है, और यह अंतिम नहीं होना चाहिए जो वे सीखते हैं। परिशिष्ट C सूची को दो एजेंटों और एक पृष्ठ की चेकलिस्ट के लिए कॉन्फ़िगरेशन उदाहरणों में बदल देता है।
5.4 संगठनात्मक नियम
कई पेशेदार उस कंप्यूटर पर कुछ भी स्थापित नहीं कर सकते हैं जिस पर वे काम करते हैं। कई नियोक्ताओं के पास एजेंटों पर कोई नीति नहीं है, और एक व्यक्ति बिना नीति के आमतौर पर मानता है कि उत्तर नहीं है। Microsoft के 2026 के 20,000 AI-उपयोग करने वाले ज्ञान कर्मचारियों के सर्वेक्षण में पाया गया कि संगठनात्मक कारकों ने व्यक्तिगत कारकों की रिपोर्ट की गई AI प्रभाव से दो गुना अधिक के लिए खाता दिया, और 45% ने कहा कि मौजूदा लक्ष्यों पर ध्यान केंद्रित करना अधिक सुरक्षित महसूस हुआ बजाय AI के साथ काम को फिर से डिज़ाइन करने के (Microsoft, 2026b; विक्रेता सर्वेक्षण)। US Census Bureau ने बताया कि व्यावसायिक AI उपयोग समग्र रूप से 17% और 20% के बीच उतार-चढ़ाव करता है, 20 या अधिक कर्मचारियों वाली फर्मों में वृद्धि हुई और 20 से कम कर्मचारियों वाली फर्मों में महत्वपूर्ण रूप से नहीं बदला (US Census Bureau, 2026)। जनादेश दोनों तरीकों से गए हैं। कुछ नियोक्ताओं ने 2025 में AI उपयोग को एक baseline अपेक्षा बना दिया (Digital Commerce 360, 2025), और कम से कम एक ने एक साल बाद AI उपयोग पर कर्मचारियों को रेट करने का अपना निर्णय उलट दिया, इसके मुख्य कार्यकारी ने प्रेस को बताया कि प्रदर्शन समीक्षा में क्या मायने रखता है वह है काम को अच्छी तरह करना (Fortune, 2026b)। एक नियोक्ता का प्रकाशित तरलता rubric अपने शीर्ष स्तर पर आयोजन और प्रणाली निर्माण रखता है और रिपोर्ट करता है कि पूर्ण आंतरिक अपनाना एक बार जब दलों ने प्रयोग से workflows को फिर से डिज़ाइन करने के लिए स्थानांतरित किए (Zapier, 2026)। उस पुनर्डिजाइन के बिना, एक जनादेश अनुपालन और बहुत कुछ नहीं खरीदता है। श्रम बाजार पहले से ही इसके नाम को बताए बिना यहां वर्णित भूमिका के लिए पूछ रहा है: 2026 में AI से छुए गए 63% US job titles प्रौद्योगिकी व्यवसायों के बाहर थे, पहली तिमाही में 822 अलग-अलग titles (Adrjan, 2026), और 27 देशों में एक अरब से अधिक job advertisements का एक अध्ययन AI कौशल के लिए 62% की wage premium डालता है, entry-level roles सबसे अधिक AI को उजागर करते हुए एक बार senior staff के लिए आरक्षित कौशल की मांग करने की संभावना है (PwC, 2026; विक्रेता रिपोर्ट)। इनमें से कोई भी स्रोत अभी तक engineering के बाहर एक नामित आवश्यकता के रूप में एजेंट को निर्देशित करने की क्षमता को अलग नहीं करता है।
यह बाधा संरचनात्मक है, Ferdman (2025) के अर्थ में: यह व्यक्तिगत प्रयास के लिए नहीं उपज करती है। यह स्तर 2 के लिए सबसे मजबूत तर्क भी है जो सबूत देता है, क्योंकि एक विक्रेता-bounded एजेंट एक office suite के अंदर जो नियोक्ता पहले से लाइसेंस करता है (Microsoft, 2026a) उन लोगों तक पहुंचता है जिनके नियोक्ता काम के लैपटॉप पर एक एजेंट को मंजूरी नहीं देंगे।
5.5 हार्डवेयर, लागत और quota
स्तर 3 एक ऐसे कंप्यूटर को मानता है जिसे व्यक्ति नियंत्रित करता है। कुछ पेशेवर मुख्य रूप से फोन से काम करते हैं, पारिवारिक कंप्यूटर साझा करते हैं या नियोक्ता की मशीन का सब कुछ के लिए उपयोग करते हैं, और उनके लिए संक्रमण किसी भी सॉफ्टवेयर प्रश्न के उत्पन्न होने से पहले ही अवरुद्ध हो जाता है। स्तर 3 और स्तर 4 दोनों कम से कम एक सेवा की सशुल्क श्रेणियाँ मानते हैं, और समन्वय लागत को गुणा करता है, क्योंकि प्रत्येक अतिरिक्त मॉडल एक और सदस्यता या एक और कोटा है। जो व्यक्ति पहले से ही एक सदस्यता के लिए भुगतान करता है, उसके लिए दूसरी एक निर्णय है और शीर्ष स्तर एक अलग निर्णय है। टोकन चिंता एक मनोवैज्ञानिक बाधा है जिसकी एक कीमत है। समन्वय करने वाले एजेंट का कोटा स्वयं एक छिपी हुई लागत है, क्योंकि यह अन्य एजेंटों द्वारा लौटाए गए प्रत्येक उत्तर को पढ़ने के लिए भुगतान करता है, और एक एजेंट जो ब्राउज़र चलाता है वह टर्मिनल एजेंट के समान योजना सीमाओं पर खींचता है जबकि प्रति कार्रवाई अधिक खर्चीला होता है (Anthropic, 2026g)। लॉक किए गए कॉर्पोरेट लैपटॉप सूची में प्रशासक अधिकार जोड़ते हैं: कोई अहस्ताक्षरित बाइनरी नहीं, कोई इंस्टॉलर नहीं, एक डेटा-हानि नियम जो एजेंट को डिस्क पर लिखने को मैलवेयर के रूप में मानता है। क्लाउड-होस्ट किए गए एजेंट उन मशीनों के लिए उद्योग का उत्तर हैं। वे संक्रमण 1 और संक्रमण 2 का एक क्लाउड रूप संरक्षित करते हैं, और वे व्यक्ति को अपने डिस्क पर एक स्तर-3 कलाकृति नहीं देते हैं। एक समृद्ध देश में एक पेशेवर के लिए इनमें से कोई भी एक बड़ी बाधा नहीं है। कई अन्य लोगों के लिए यह एक वास्तविक बाधा है, और यह दूसरे-स्तर के विभाजन के साथ परस्पर क्रिया करता है (Hargittai, 2002), जिसमें सबसे कम अवकाश वाले लोग प्रयोग करने में सबसे कम सक्षम होते हैं।
5.6 परिणाम का मूल्यांकन
एजेंट का उपयोग करने के लिए प्रोग्रामिंग की आवश्यकता नहीं है। यह देखना कि इसने क्या उत्पादित किया है, परिणाम के क्षेत्र में दक्षता की आवश्यकता है, और यहाँ गैर-प्रोग्रामर के पास एक लाभ है जिसे नजरअंदाज करना आसान है। एक वकील जो अनुबंधों का सारांश पढ़ता है, या एक शोधकर्ता जो निष्कर्षण तालिका पढ़ता है, कलाकृति को उस ज्ञान के विरुद्ध जांच सकता है जो एजेंट के पास नहीं है। "jagged frontier" पर शोध में पाया गया कि जो पेशेवर AI के साथ काम करते थे वे मॉडल की क्षमता के अंदर के कार्यों पर बेहतर और इसके बाहर के कार्य पर बुरा प्रदर्शन करते थे (Dell'Acqua et al., 2026)। सुरक्षा यह है कि एक व्यक्ति जो कार्य को अच्छी तरह जानता है कि वह सीमा के किस पक्ष पर हैं, यह नोटिस कर सकता है।
जो वे आसानी से नहीं जांच सकते हैं वह यंत्रावली है, वह स्क्रिप्ट जिसने तालिका उत्पादित की या वह प्रश्न जिसने संख्याओं को खींचा। 470 pull requests के एक उद्योग विश्लेषण में पाया गया कि एजेंटों द्वारा लिखा गया कोड लोगों द्वारा लिखे गए कोड की तुलना में अधिक त्रुटियाँ ले जाता है: AI-लेखित परिवर्तन के प्रति 10.83 समस्याएं मानव-केवल परिवर्तनों के लिए 6.45 के विरुद्ध, कुछ श्रेणियों की सुरक्षा समस्याओं के साथ 2.74 गुना अधिक बार (CodeRabbit, n.d.; vendor study)। और एजेंट अभी भी अधिकांश पूरी परियोजनाओं में विफल होते हैं: वास्तविक फ्रीलांस परियोजनाओं के एक बेंचमार्क पर mid-2026 द्वारा मापा गया सर्वोत्तम स्वचालन दर 15.8% थी (Center for AI Safety, 2026)। मैं इससे दो प्रथाएं निकालता हूँ। जांच को कार्य से पहले परिभाषित किया जाना चाहिए ("क्या मुझे यह सही है यह मना लेता"), और एक अलग परिवार का एक दूसरा मॉडल कलाकृति के समीक्षक के रूप में कार्य कर सकता है, जिसमें व्यक्ति यह तय करता है कि क्या सही माना जाता है। अनुभाग 7 दूसरी प्रथा की सीमाओं पर लौटता है।
5.7 एक वैकल्पिक व्याख्या: एजेंट अभी पर्याप्त अच्छे नहीं हैं
एक पाठक आपत्ति कर सकते हैं कि लोग प्रतिनिधि नहीं करते क्योंकि एजेंट अभी उनका काम नहीं कर सकते, और इसलिए बाधा अभी भी तकनीकी है, केवल मॉडल की ओर से। आपत्ति के पास वास्तविक समर्थन है। वास्तविक फ्रीलांस परियोजनाओं के एक बेंचमार्क पर mid-2026 द्वारा मापा गया सर्वोत्तम स्वचालन दर 15.8% है, पिछली शरद ऋतु में बेंचमार्क की रिलीज़ से 2.5% तक, जिसका मतलब है कि पाँच में से चार परियोजनाएं अभी भी end to end विफल होती हैं (Center for AI Safety, 2026)। एक सिमुलेट किए गए सॉफ्टवेयर कंपनी में सर्वोत्तम एजेंट ने लंबे व्यावसायिक कार्यों का 30% पूरा किया (Xu et al., 2024)। खुले अंत के कंप्यूटर उपयोग पर 2024 आधारभूत सर्वोत्तम एजेंट के लिए 12.24% के विरुद्ध लोगों के लिए 72.36% था (Xie et al., 2024), और सितंबर 2026 तक एक एकत्रकर्ता के लीडरबोर्ड ने उस बेंचमार्क के सत्यापित संस्करण के लिए शीर्ष एजेंटों को स्क्रिप्टेड डेस्कटॉप कार्यों के लिए विक्रेता-रिपोर्ट किए गए स्कोर पर 85 से 86%, मानव आधारभूत से ऊपर दिखाया (BenchLM, 2026)। वह अंतिम परिणाम दूसरे तरीके की ओर इशारा करता है: ऐसे कार्यों पर क्षमता अब बाधा नहीं है। 44 व्यवसायों में एक मूल्यांकन में सर्वोत्तम मॉडल ने पेशेवरों के विरुद्ध तुलनाओं के आधे से कम में जीता या बराबरी की (Patwardhan et al., 2025)। कार्य की लंबाई जो एजेंट आधे समय पूरा करते हैं लगभग हर सात महीने में दोगुनी हो गई है (Kwa et al., 2025), इसलिए प्रवृत्ति खड़ी है और वर्तमान विनम्र है। क्षमता कार्यों में असमान है, और "jagged frontier" बाहर से दिखाई नहीं देती (Dell'Acqua et al., 2026)। तालिका 4 इन प्रकाशित आंकड़ों को एकत्रित करती है जिसमें प्रत्येक स्रोत देता है और कोई चेतावनी मैं इसे संलग्न करता हूँ।
तालिका 4. आपत्ति के पीछे प्रकाशित क्षमता के आंकड़े।
| तुलना | प्रकाशित के रूप में आंकड़ा | कथन के अनुसार तारीख | स्रोत | देखभाल के साथ पढ़ें |
|---|---|---|---|---|
| वास्तविक फ्रीलांस परियोजनाएं, सर्वोत्तम स्वचालन दर | 15.8%, बेंचमार्क की रिलीज़ से 2.5% तक; पाँच में से चार परियोजनाएं अभी भी end to end विफल होती हैं | पिछली शरद ऋतु में रिलीज़; mid-2026 द्वारा मापा गया 15.8%, 1 July 2026 को लॉग किया गया (Appendix B, VERIFIED) | Center for AI Safety (2026); Sections 5.6, 5.7, Appendix B | संपूर्ण परियोजनाएं, end to end; उन्हीं के बीच सर्वोत्तम दर जिनको मापा गया |
| एक सिमुलेट किए गए सॉफ्टवेयर कंपनी में लंबे व्यावसायिक कार्य | सर्वोत्तम एजेंट ने 30% पूरा किया | 2024 study | Xu et al. (2024); Section 5.7 | एक सिमुलेट किया गया कंपनी; फ्रीलांस-परियोजना दर से एक अलग माप |
| खुले अंत के कंप्यूटर उपयोग, आधारभूत | सर्वोत्तम एजेंट के लिए 12.24% लोगों के लिए 72.36% के विरुद्ध | 2024 baseline | Xie et al. (2024); Section 5.7 | एक 2024 आधारभूत; नीचे की पंक्ति बाद की लीडरबोर्ड है |
| उस बेंचमार्क का सत्यापित संस्करण | शीर्ष एजेंट 85 से 86%, मानव आधारभूत से ऊपर | सितंबर 2026 तक | BenchLM (2026); Section 5.7 | एकत्रकर्ता लीडरबोर्ड; स्क्रिप्टेड डेस्कटॉप कार्यों के लिए विक्रेता-रिपोर्ट किए गए स्कोर; दूसरे तरीके को काटते हैं |
| 44 व्यवसायों में मूल्यांकन | सर्वोत्तम मॉडल ने पेशेवरों के विरुद्ध तुलनाओं के आधे से कम में जीता या बराबरी की | 2025 study | Patwardhan et al. (2025); Section 5.7 | "आधे से कम" दी गई शब्दावली है; कोई प्रतिशत नहीं दिया गया है |
| कार्य की लंबाई एजेंट आधे समय पूरा करते हैं | लगभग हर सात महीने में दोगुनी | 2025 study | Kwa et al. (2025); Section 5.7 | एक प्रवृत्ति: "प्रवृत्ति खड़ी है और वर्तमान विनम्र है" |
| Pull requests में त्रुटियाँ | 470 पुल अनुरोध; AI-द्वारा लिखित परिवर्तन के विरुद्ध 10.83 मुद्दे प्रति परिवर्तन बनाम केवल मानव-लिखित परिवर्तन के लिए 6.45; सुरक्षा समस्या की कुछ श्रेणियां 2.74 गुना अधिक बार | n.d. | CodeRabbit (n.d.); Section 5.6 | विक्रेता अध्ययन; एक उद्योग विश्लेषण; कोड में दोष, ऐसी मशीनरी जिसे एक गैर-प्रोग्रामर आसानी से जांच नहीं सकता |
स्रोत: उद्धृत प्रकाशन, जैसा कि खंड 5.6 और 5.7 और परिशिष्ट B में दोहराया गया है; इनमें से कोई भी आंकड़ा खंड 9 के कार्यक्रम से नहीं आता है।
दोनों व्याख्याएं एक व्याख्या के भाग हैं बजाय इसके कि वे प्रतिद्वंद्वी हों। कार्यप्रवाह शब्दावली में यह जानना शामिल है कि आपके कौन से कार्य सीमा के अंदर हैं। जो व्यक्ति एक एजेंट को पूरा प्रोजेक्ट सौंपता है जिसे वह नहीं कर सकता, वह प्रतिनिधिमंडल करना बंद कर देता है, जबकि जो व्यक्ति इसे निष्कर्षण, समन्वय और पहले मसौदे को सौंपता है वह जारी रखना सीखता है। व्याख्याएं अभी भी अलग-अलग भविष्यवाणियां करती हैं। यदि मॉडल क्षमता बाधक बाधा होती, तो स्तर 2 और 3 पर दृढ़ता कार्य के प्रकार को ट्रैक करती बजाय व्यक्ति के: समान प्रकार के काम वाले लोग अपनी निर्दिष्ट करने और जांच करने की क्षमता के बावजूद समान दरों पर दृढ़ रहते। यदि कार्यप्रवाह शब्दावली बाधक होती, तो दृढ़ता व्यक्ति की क्षमता को ट्रैक करती कि वह प्रतिनिधिमंडन अनुबंध को कहे भले ही काम के समान प्रकार में। खंड 10 में प्रस्ताव P15 दोनों को अलग बताने के लिए लिखा गया है।
6. वेब ऑर्केस्ट्रेशन: प्रस्तावित पुल
6.1 प्रथा
स्तर 4 का सबसे सरल रूप किसी स्थापना की आवश्यकता नहीं रखता। एक व्यक्ति ब्राउज़र टैब में तीन या चार चैटबॉट खोलता है, प्रत्येक में एक ही प्रश्न पेस्ट करता है, और उत्तरों को एक साथ पढ़ता है। कंप्यूटर वैज्ञानिक इसे एक मैनुअल मल्टी-LLM क्वेरी कहेंगे, जिसमें व्यक्ति राउटिंग और तुलना कर रहा है। कुछ इसे हाथ से करते हैं। अन्य 2023 के बाद से इसके लिए बनाए गए उपकरणों में से एक का उपयोग करते हैं: ब्राउज़र एक्सटेंशन और डेस्कटॉप एप्लिकेशन जो एक प्रॉम्प्ट को कई उपभोक्ता चैट सेवाओं को प्रसारित करते हैं और समानांतर फलकों में उत्तर दिखाते हैं। ChatHub और ChatALL 2023 की वसंत में दिखाई दिए; ChatALL का नवीनतम रिलीज़ सितंबर 2026 तक अपने रिलीज़ पेज पर लगभग 847,000 डाउनलोड दर्ज कर चुका था, एक गिनती जिसमें स्वचालित अपडेट शामिल हैं और एक प्लेटफॉर्म के बिल्ड्स द्वारा प्रभुत्व है (GitHub, 2026a)। उपकरणों का एक नया समूह लॉग इन किए गए वेब चैट सेशन को ऐसे कमांड में बदल देता है जिन्हें दूसरा प्रोग्राम कॉल कर सकता है, ताकि एक एजेंट किसी व्यक्ति की वेब सदस्यताओं को एक प्रश्न सौंप सके। OpenCLI, इनमें से एक, सितंबर 2026 में GitHub पर लगभग 29,500 स्टार रखता था (GitHub, 2026b)।
2026 में यह प्रथा एक उत्पाद सुविधा बन गई। Perplexity ने एक "Model Council" पेश किया जो एक क्वेरी को कई मॉडल के माध्यम से चलाता है और "एक समेकित दृश्य प्रस्तुत करता है जो मुख्य अंतर्दृष्टि, सहमति के क्षेत्रों और अलग-अलग बिंदुओं को हाइलाइट करता है" (Storyboard18, 2026)। Microsoft 365 Copilot में Microsoft का अनुसंधान एजेंट एक मोड प्रदान करता है जो "एक ही प्रश्न को एक साथ कई गहरे-तर्क अनुसंधान एजेंटों (GPT और Claude) के माध्यम से चलाता है" और एक आलोचना मोड, डिफ़ॉल्ट रूप से स्वचालित मॉडल चयन के तहत सक्षम, जिसमें एक मॉडल द्वारा लिखी गई रिपोर्ट दूसरे से एक दूसरा तर्क पास प्राप्त करती है (Microsoft, 2026c; Constellation Research, 2026b)। Andrej Karpathy का "LLM Council", एक छोटा वेब एप्लिकेशन जो एक क्वेरी को कई मॉडल को भेजता है, उन्हें गुमनाम रूप से एक दूसरे की समीक्षा करवाता है और एक अध्यक्ष मॉडल अंतिम उत्तर लिखता है, इसके लेखक द्वारा एक सप्ताहांत हैक के रूप में वर्णित, सितंबर 2026 में GitHub पर लगभग 24,900 स्टार रखता था (Karpathy, 2025)। ओपन-सोर्स परिदृश्य दो में विभाजित है। प्रसारण उपकरण उत्तर प्राप्त करते हैं और समन्वय को व्यक्ति पर छोड़ देते हैं। परिषद के उपकरण समन्वय करते हैं, और वे भुगतान की गई प्रोग्रामिंग इंटरफेस पर दो या तीन मॉडल के साथ चलते हैं, व्यक्ति के अपने लॉग इन टैब से दूर। अकेले दोनों में से कोई भी व्यक्ति को पूरी तरह पार नहीं ले जाता है, और इसी कारण से पुल अधूरा है।
6.2 इसे पुल के रूप में प्रस्तावित करने का कारण
वेब ऑर्केस्ट्रेशन स्तरों के बीच एक उपयोगी तरीके से बैठता है। यह मशीन से कुछ नया नहीं मांगता, कोई स्थापना नहीं, कोई अनुमतियां नहीं, कोई स्थानीय एजेंट नहीं, और यह सदस्यताओं पर चलता है जो एक व्यक्ति पहले से भुगतान करता है या मुक्त स्तरों पर। यह व्यक्ति से कुछ नया मांगता है: एक बार में कई उत्तर रखना, ध्यान दें कि वे कहां भिन्न हैं, और निर्णय लें। एक व्यक्ति जिसने "दूसरे मॉडल ने क्या कहा?" पूछना सीख गया है, उस आदत को सीख गया है जिसे CLI ऑर्केस्ट्रेशन बाद में स्वचालित करता है, और वह आदत स्तर 4 का प्रबंधक का कार्य अपने सबसे छोटे में है।
पुल मूल्यवान है क्योंकि यह दृश्यमान है। मान लें कि एक बाजार विश्लेषक तीन चैटबॉट से एक प्रकाशित उद्योग रिपोर्ट को सारांशित करने के लिए कहता है, और उनमें से दो एक ऐसा आंकड़ा उद्धृत करते हैं जो रिपोर्ट में नहीं है जबकि तीसरा इसकी अनुपस्थिति को झंडी देता है। उपयोगी परिणाम रिपोर्ट को स्वयं खोलने के लिए एक संकेत है, और एक व्यक्ति जो एक बार इसके माध्यम से गया है, पहले प्रवाह उत्तर को उत्तर के रूप में मानना बंद कर देता है। कई उत्तरों का एक प्रसारण दृश्य स्तर 4 की ओर एक पुल बन जाता है जब यह एक व्यक्ति को एक सामान्य प्रश्न तैयार करना, ध्यान दें कि धारणाएं कहां विचलित होती हैं, एक आलोचना मांगें और एक उत्तर चुनने का कारण रखें सिखाता है। जब तक यह अधिक टैब के साथ एक स्तर-1 आदत है। जो इसे सिखाता है वह तुलना है, और केवल तुलना है। एक व्यक्ति जिसने पूछा है कि दूसरे मॉडल ने क्या कहा है, ने इससे यह नहीं सीखा है कि एक एजेंट अपनी मशीन पर क्या छू सकता है, जो स्तर 2 और 3 का पाठ है, और दावा कि आदत स्थानांतरित होती है एक अनुभवजन्य है, P7, जिसे मैं एक आधार के रूप में नहीं मानता। खंड 9 में वर्णित पूर्वनिर्धारित कार्यक्रम दो लाभों का नाम पहले से देता है, और वे सारांशित करते हैं कि पुल क्या खरीदता है। एक कवरेज है: एक उपयोगी कोण एक मॉडल में मौजूद है, दूसरे मॉडल से पूछा जाने के कारण खो नहीं जाता है। दूसरा विश्वसनीयता है: एक उत्तर की जांच अन्य उत्तरों के विरुद्ध की गई है, न कि एक मॉडल के शब्द पर ली गई है (Chernets, 2026d)। दृश्यमान असहमति दूसरे के साधन के रूप में कार्य करती है। पूर्वानुमान के एक मूल्यांकन में पाया गया कि बारह भाषा मॉडल का एक समूह 925 मानव पूर्वानुमानकर्ताओं की भीड़ की सटीकता से मेल खाता था (Schoenegger et al., 2024), और बहु-एजेंट बहस कई सेटिंग में एक एकल मॉडल पर तथ्यात्मकता और तर्क में सुधार करती है (Du et al., 2023)। दोनों लाभ मॉडल के त्रुटियों पर निर्भर करते हैं जो भिन्न होती हैं, और अगला उपखंड इस बारे में है कि जब वे ऐसा नहीं करते हैं तब क्या होता है।
6.3 पुल कहां समाप्त होता है
वेब ऑर्केस्ट्रेशन एक पुल रहता है, और सबसे सादा कारण ध्यान में लागत है। चार लंबे उत्तरों को पढ़ना और उन्हें हाथ से समन्वय करना एक को पढ़ने से बहुत अधिक समय लेता है। मैं किसी को एक नियमित प्रश्न के लिए ऐसा करने के लिए नहीं कहूंगा; यह तब कमाता है जब एक गलत उत्तर तुलना करने में बिताए गए समय से अधिक खर्च करता है।
दूसरी सीमा भंगुरता है, और यह कई रूपों में आती है। उपभोक्ता चैट इंटरफेस महीने दर महीने बदलते हैं, और जो उपकरण उन्हें चलाते हैं, जब वे करते हैं तो टूट जाते हैं: 2026 की गर्मियों के दौरान एक कार्यालय सूट ने एक अनुसंधान मोड को हटाया, एक चैटबॉट ने अपने मुक्त स्तर पर मोड को बंद किया, और एक से अधिक सेवा ने अपना पता नाम दिया या पुनर्निर्देशित किया। कई उपभोक्ता सेवाओं की शर्तें स्वचालित पहुंच को प्रतिबंधित करती हैं, और एक व्यक्ति जो एक एजेंट के साथ अपने स्वयं के लॉग इन ब्राउज़र को चलाता है, एक खाता ब्लॉक के जोखिम को लेता है। एक अनुसंधान कार्यक्रम जो पुल का उपयोग करता है, प्रतिभागियों को बताना है, और मैं इन शर्तों का कोई कानूनी पढ़ना प्रदान नहीं करता हूं। दूसरे चैटबॉट का "मुक्त" पक्ष भी एजेंट की ओर से भुगतान किया जाता है जो उन्हें चलाता है, क्योंकि ब्राउज़र क्रियाएं टर्मिनल एजेंट के समान योजना सीमा पर खींचती हैं (Anthropic, 2026g)। खुले टैब में मैनुअल तुलना मजबूत है। उपभोक्ता चैट पेजों की स्वचालित कटाई दोहराए जाने वाले काम के लिए एक खराब आधार है।
तीसरी सीमा वह है जो सबसे अधिक महत्वपूर्ण है: मॉडल के बीच समझौता स्वतंत्र साक्ष्य नहीं है। जब मॉडल प्रशिक्षण डेटा और विधियाँ साझा करते हैं, तो उनकी त्रुटियाँ सहसंबद्ध होती हैं। 350 से अधिक भाषा मॉडल के एक अध्ययन में पाया गया कि जब दोनों मॉडल गलती करते हैं तो वे लगभग 60% समय एक ही गलत उत्तर पर सहमत होते हैं, और बड़े, अधिक सटीक मॉडल अधिक सहसंबद्ध थे, यहाँ तक कि प्रदाताओं के बीच भी (Kim et al., 2025)। इस श्रृंखला का साथी पत्र अंकगणित देता है: औसत पारस्परिक त्रुटि सहसंबंध rho के साथ, N सहमत मॉडल N_eff = N / (1 + (N - 1) rho) स्वतंत्र राय के बराबर हैं, और कोई भी मॉडल संख्या 1/rho से अधिक नहीं है (Chernets, 2026a)। rho = 0.5 पर, दस सहमत चैटबॉट दो स्वतंत्र से कम के बराबर हैं। चित्र 3 अनुलग्नक D में rho के चार उदाहरणात्मक मानों के लिए सूत्र को खींचता है, जिसमें सीमा 1/rho है जो कोई भी सहमत मॉडल पार नहीं कर सकता। Kim et al. का 60% संयुक्त त्रुटियों का वह हिस्सा है जिसमें दोनों मॉडल ने एक ही गलत उत्तर दिया, जो सूत्र की त्रुटि सहसंबंध rho नहीं है। हाथ में आने वाले क्षेत्र में, rho को ज्ञात उत्तरों वाली वस्तुओं पर अनुमानित किया जाना है (listing C4), और यहाँ और अनुलग्नक D में उपयोग किए गए मान उदाहरणात्मक हैं। विविधता गणना से अधिक महत्वपूर्ण है। एक मॉडल की प्रतियों के बीच बहस अक्सर समान कंप्यूट दिए गए एक एकल मॉडल को हराने में विफल रहती है, जबकि विषम मॉडल मदद करते हैं (Zhang et al., 2025), और दो विविध एजेंट सोलह सजातीय लोगों से मेल खा सकते हैं या उन्हें हरा सकते हैं (Yang et al., 2026)। जनरेटिव AI अपने उपयोगकर्ताओं के बीच आउटपुट को भी सजातीय बनाता है (Doshi & Hauser, 2024), और एक मॉडल को परखने के लिए कहा गया तो अपनी लेखन को पसंद करने के लिए झुकाव रखता है (Panickssery et al., 2024), जो तब महत्वपूर्ण होता है जब एक मॉडल विलीन उत्तर लिखता है।
चित्र 3। समझौता किस लायक है।
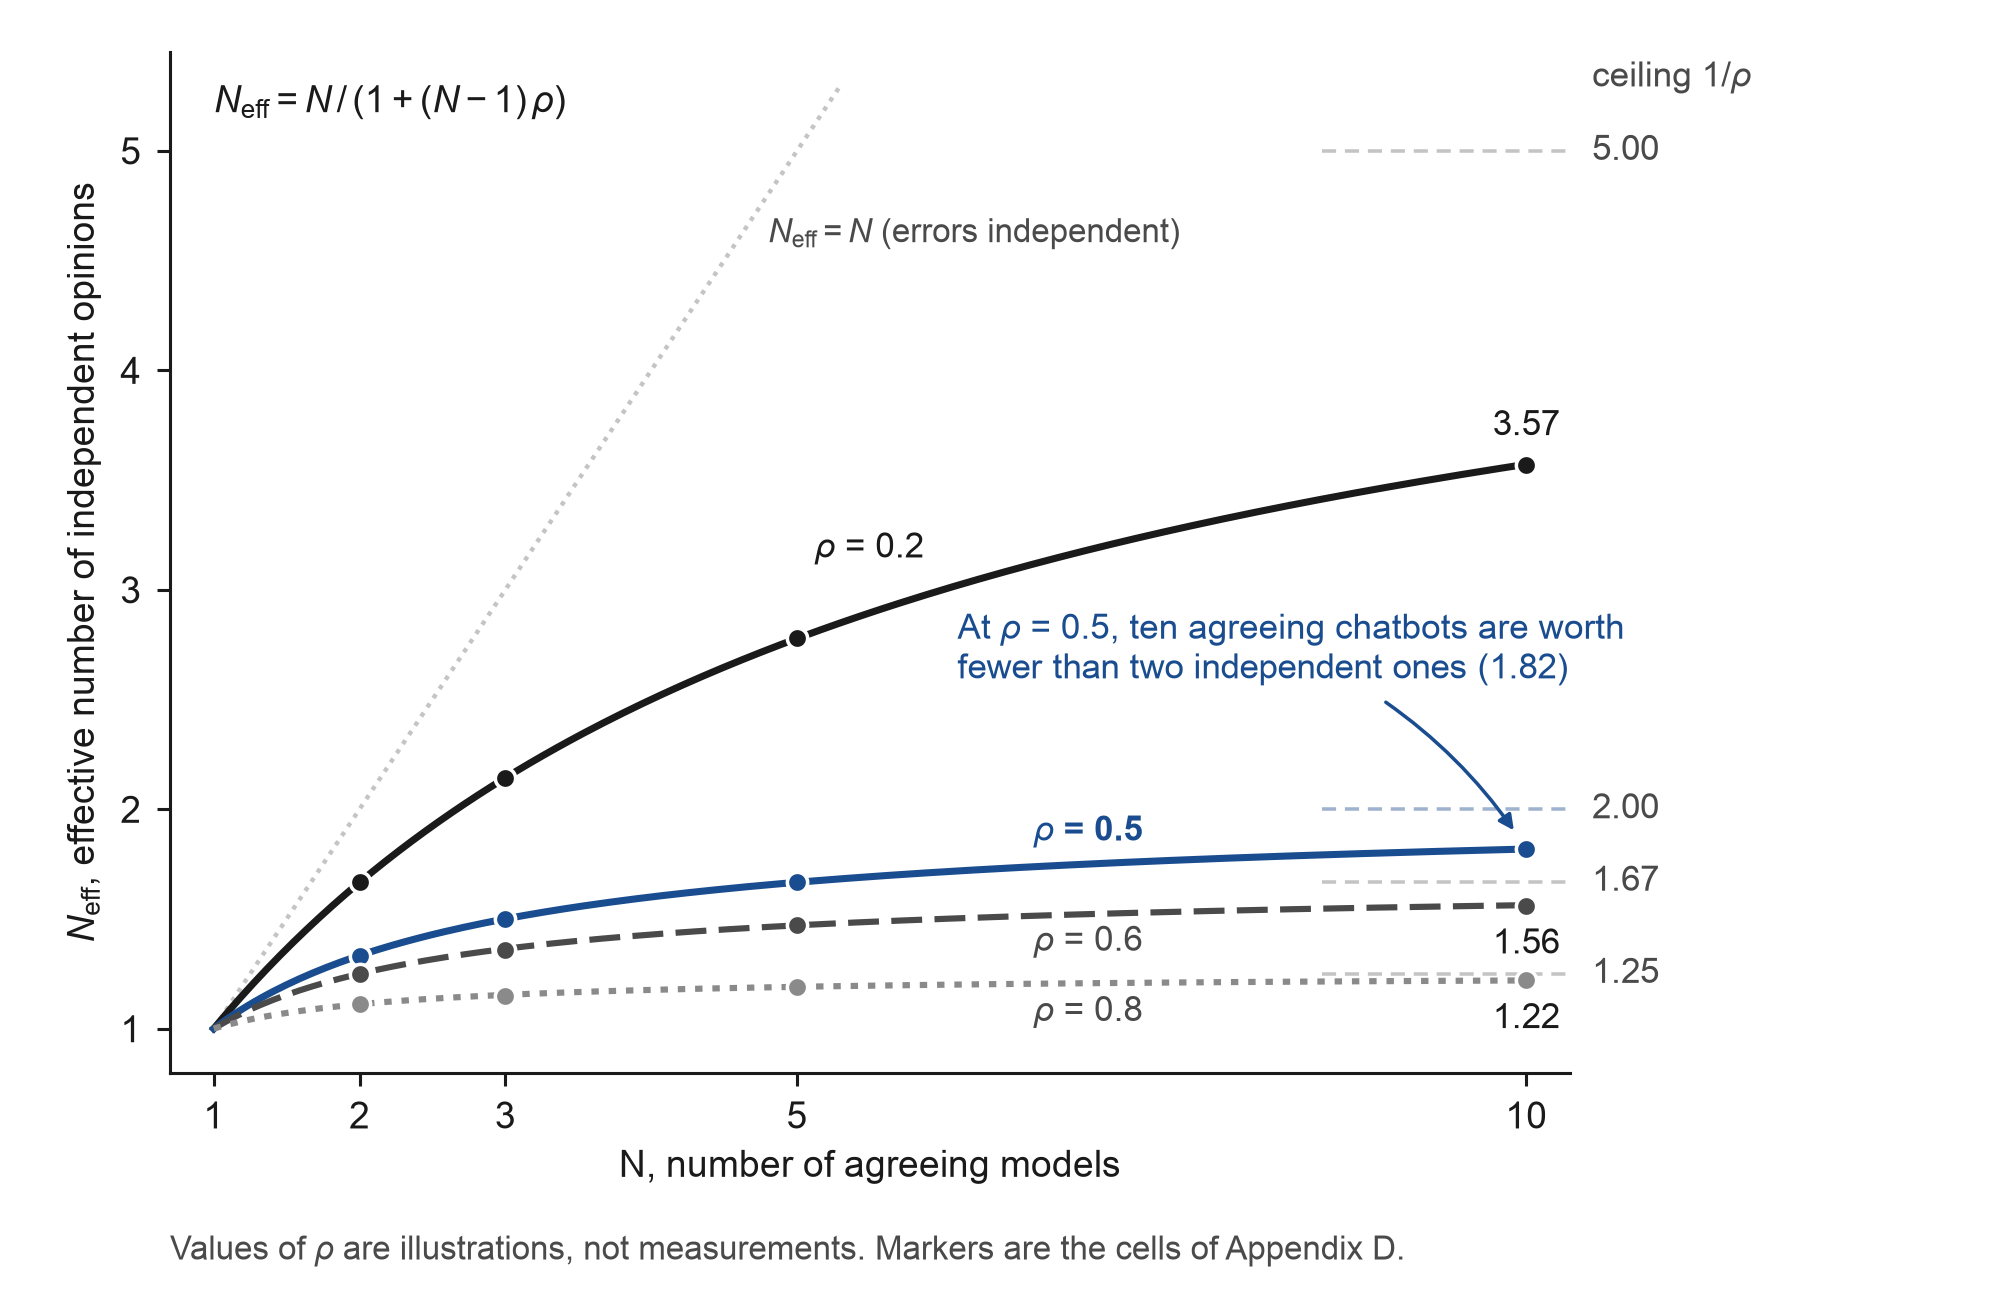
नोट: स्वतंत्र राय की प्रभावी संख्या, N_eff = N / (1 + (N - 1) rho), N सहमत मॉडल के लिए जिनकी त्रुटियों का औसत पारस्परिक सहसंबंध rho है (Chernets, 2026a; Section 6.3)। मार्कर अनुलग्नक D की कोशिकाएँ हैं, उनके बीच की वक्र एक ही सूत्र का पालन करते हैं, और दाईं ओर के धराशायी खंड सीमाएँ 1/rho हैं। rho के चार मान उदाहरणात्मक हैं, जैसे अनुलग्नक D में; rho को हाथ में आने वाले डोमेन में ज्ञात उत्तरों वाली वस्तुओं पर अनुमानित किया जाना है (listing C4)।
पुल पर एक व्यक्ति के लिए व्यावहारिक नियम छोटे होते हैं। मॉडल परिवारों की गणना करें, क्योंकि एक विक्रेता के मॉडल पर चलने वाली एक कार्यालय सहायक उस विक्रेता के चैटबॉट पर कोई दूसरी राय नहीं है। मॉडल के बीच समझौता आपको बता सकता है कि कम जाँच प्रयास कहाँ खर्च करने हैं। यह आपको नहीं बता सकता कि कोई दावा सही है। एक मॉडल द्वारा अकेले किया गया बिंदु सत्यापित करने के लिए एक संकेत के रूप में मानें, क्योंकि यह तुलना में सबसे मूल्यवान चीज हो सकती है या इसकी एकमात्र त्रुटि हो सकती है, और साक्ष्य के साथ आने वाली असहमति को पकड़ें जो मतदान से इसे बाहर करने के बजाय। दावों को स्रोतों के विरुद्ध जाँचें: एक गलत तारीख पर समझौता एक प्रलेखित विफलता मोड है, और प्राथमिक पृष्ठ इसे ठीक करता है जहाँ पाँचवाँ मॉडल नहीं करता। अपने स्वयं के डोमेन में सवालों का एक छोटा सेट पर rho का अनुमान लगाएँ जिसे आप चिह्नित कर सकते हैं, एक परिषद पर भरोसा करने से पहले आप एक सवाल पर जो नहीं कर सकते। कौन क्या कहता है यह रखें, क्योंकि एक विलीन उत्तर जो अपने स्रोतों को छुपाता है वह एकल आत्मविश्वास भरी आवाज वापस लाता है जिसे आयोजन को सवाल उठाने का मतलब था।
एक प्रक्रिया के रूप में लिखा गया, यह साथी पत्र (Chernets, 2026a) के "anchor-and-enrich" प्रोटोकॉल का शिक्षण रूप है। व्यक्ति पहले एक एंकर तय करता है: कार्य, अनुमत साक्ष्य और आउटपुट का आकार। फिर वे अपने स्रोतों या फ़ाइल संदर्भों के साथ अलग-अलग उत्तर प्राप्त करते हैं, दावों को स्रोत द्वारा एक तालिका में निकालते हैं, और प्रत्येक असहमति को इसकी तरह से सॉर्ट करते हैं, चाहे यह तथ्यात्मक संघर्ष हो, अलग व्याख्या, एक छूटी हुई धारणा या प्रारूप का अंतर। वे दावों को सत्यापित करते हैं जो निर्णय को एंकर या प्राथमिक स्रोत के विरुद्ध प्रभावित करते हैं, और वे स्वीकृति निर्णय और जो अनसुलझा रहता है उसे रिकॉर्ड करते हैं। अनुलग्नक C में Listing C3 स्रोत द्वारा दावों की तालिका बनाता है, listing C4 ज्ञात उत्तरों वाली वस्तुओं से rho का अनुमान लगाता है, और अनुलग्नक D कुछ भी चलाए बिना rho की एक श्रृंखला के लिए सीमा देता है। एक और नियम यहाँ संबंधित है, और इसकी कोई दूसरी सदस्यता की लागत नहीं है। एक समीक्षक एक ही परिवार से, एक ताजे संदर्भ में पहली उत्तर पर हमला करने के लिए कहा गया, जल्दबाजी, छोड़े गए निर्देश और न चलाई गई जाँच को पकड़ता है, हालाँकि यह साझा झूठे ज्ञान को नहीं पकड़ सकता। मैं समीक्षक की आदत को स्तर 3 पर एक एजेंट के साथ शुरू करूँगा और केवल एक दूसरा परिवार जोड़ूँगा जब समीक्षक के पास कहने के लिए कुछ न बचा हो और निर्णय महंगा हो।
विपरीत स्थिति को समान रूप से स्पष्ट रूप से कहा जाने की आवश्यकता है। कई कार्यों के लिए एक मजबूत मॉडल एक अच्छे स्रोत सेट और सावधानीपूर्वक मानव समीक्षा के साथ एक विस्तृत परिषद को हरा देगा जो देरी और भ्रम जोड़ता है, और मॉडल जितना भविष्यवाणी करता है। आयोजन उस जगह भुगतान करता है जहाँ एक कार्य वास्तविक अनिश्चितता रखता है, अलग-अलग दृष्टिकोण से लाभ प्राप्त करता है, या अक्सर पर्याप्त समय दोहराता है। यह एक समय-महत्वपूर्ण निर्णय के साथ खराब फिट बैठता है जिसे सत्यापित करने का कोई मौका नहीं है, गोपनीय सामग्री जिसे सेवाओं में नहीं फैलाया जा सकता, और सरल कार्य जहाँ तुलना की लागत लाभ से अधिक है। जहाँ एक परिषद का उपयोग किया जाता है, एजेंटों को अलग-अलग नौकरियाँ दी जानी चाहिए: एक आपूर्ति की गई दस्तावेजों तक सीमित, एक प्राथमिक स्रोत खोजने के लिए भेजा गया, एक असमर्थित दावों को सूचीबद्ध करने के लिए कहा गया, एक उद्धरणों का ऑडिट करने के लिए, व्यक्ति अभी भी adjudicating के साथ। P9 इस तरह लिखा गया है कि यह प्रतिवाद जीत सकता है।
7. CLI आर्केस्ट्रेशन: प्रतिनिधिमंडन की स्थायी परत
7.1 एजेंट एजेंटों को कॉल करते हैं
स्तर 3 पर, प्रत्येक एजेंट के पास एक कमांड-लाइन इंटरफेस है जो कीबोर्ड पर किसी व्यक्ति के बिना चल सकता है: एक प्रश्न अंदर जाता है, एक उत्तर या एक बदली हुई फ़ाइल बाहर आती है। एक बार जब कोई व्यक्ति एक एजेंट का मालिक हो जाता है, तो वह एजेंट दूसरों को कॉल कर सकता है। सिस्टम साहित्य में इसे एजेंट आर्केस्ट्रेशन कहा जाता है। मैं गैर-प्रोग्रामर द्वारा चलाए जाने वाले संस्करण को कमांड-लाइन उपकरणों के माध्यम से CLI आर्केस्ट्रेशन कहता हूँ जिनकी वे पहले से सदस्यता लेते हैं। पहले एजेंट को एक एकल निर्देश ("दूसरे दोनों से इस योजना की समीक्षा माँगो और मुझे बताओ कि वे कहाँ असहमत हैं") एक छोटी टीम का निर्माण करता है।
2026 में यह पैटर्न एक डेवलपर की चाल से विक्रेता-अनुमोदित अभ्यास में बदल गया। OpenAI ने एक आधिकारिक प्लगइन प्रकाशित किया जो अपने कोडिंग एजेंट को Anthropic के अंदर चलाता है, "कोड समीक्षाओं के लिए या कार्यों को प्रतिनिधित्व करने के लिए", एक सामान्य समीक्षा के लिए आदेशों के साथ, एक विरोधाभासी समीक्षा जिसमें दूसरा एजेंट काम को टूटा हुआ मानता है और शिकार करता है, और एक अटके हुए कार्य का बचाव। यह स्थानीय रूप से स्थापित उपकरण और इसकी मौजूदा लॉगिन के माध्यम से काम करता है, किसी भी ChatGPT सदस्यता सहित उपयोग करने योग्य है, और सितंबर 2026 में GitHub पर लगभग 33,400 सितारे थे (OpenAI, 2026a)। 2026 की जनसंख्या जोड़ी Claude Code लेखन और उस आधिकारिक प्लगइन के माध्यम से Codex की जाँच है (OpenAI, 2026a), जबकि तीन या अधिक की परिषदें बिना नेता के छोटे उपकरण बनी हुई हैं। GitHub ने फरवरी 2026 में Anthropic के और OpenAI के एजेंटों को अपनी स्वयं की Copilot सेवा के अंदर उपलब्ध कराया, "आपकी मौजूदा Copilot सदस्यता में पूर्णतः शामिल" (GitHub, 2026c)। xAI का कमांड-लाइन एजेंट एक हेडलेस मोड और Agent Client Protocol के लिए समर्थन भेजता है ताकि उपयोगकर्ता "अपने स्वयं के बॉट और एजेंट आर्केस्ट्रेशन ऐप्स बना सकें" (xAI, 2026)। Google ने अपने पहले कमांड-लाइन एजेंट को सेवामुक्त करने का कारण यह था कि उपयोगकर्ता "एक दूसरे के साथ संचार करने वाले कई एजेंटों की आवश्यकता है" (Google, 2026)। ओपन-सोर्स उपकरण जो एक एजेंट को दूसरों से परामर्श लेने देते हैं, बड़ी संख्या में अनुसरण करते हैं: मॉडल-से-मॉडल परामर्श के लिए एक बहु-प्रदाता सर्वर के पास लगभग 11,800 सितारे थे, एक सहमति-उन्मुख प्लगइन के बारे में 4,100 (GitHub, 2026d)। नीचे, Model Context Protocol, दिसंबर 2025 में एक Linux Foundation निकाय को दान किया गया था, 10,000 से अधिक प्रकाशित सर्वर और उस समय लगभग 97 मिलियन मासिक SDK डाउनलोड के साथ (Linux Foundation, 2025), इसकी जुलाई 2026 विनिर्देश रिलीज़ तक प्रति माह लगभग आधा अरब SDK डाउनलोड की सूचना दी, जिसने प्रोटोकॉल को स्टेटलेस भी बनाया और किसी भी deprecation से पहले बारह महीने की सूचना का वादा किया (Model Context Protocol, 2026)। यह एक लैपटॉप पर एक एजेंट को एक व्यक्ति के बाकी उपकरणों तक पहुँचने का तरीका है, प्रत्येक के लिए एक विक्रेता-विशिष्ट प्लगइन के बिना, और यह पहले से ही इस तरह से बोरिंग हो गया है कि एक वेब प्रोटोकॉल बोरिंग है: मौजूद, प्रलेखित, तब तक अनदेखा किया जाता है जब कुछ टूट जाता है। एक दूसरा मानक, Google का Agent2Agent प्रोटोकॉल विक्रेताओं के पार एजेंटों से बात करने के लिए, मार्च 2026 में संस्करण 1.0 तक पहुँचा (Google Open Source Blog, 2026)। यह स्तर-4 प्लंबिंग है, और आज इसका कोई उपभोक्ता पर-रैंप नहीं है।
तालिका 5। पैटर्न द्वारा आर्केस्ट्रेशन परिदृश्य, सितंबर 2026।
| पैटर्न | उदाहरण (सितंबर 2026) | स्तर | किसके लिए निर्मित | यह क्या खरीदता है | यह जो रिकॉर्ड छोड़ता है | मुख्य जोखिम |
|---|---|---|---|---|---|---|
| ब्राउज़र टैब में मैनुअल तुलना | किसी भी उपभोक्ता चैटबॉट का सेट | 4 (वेब) जब दर्ज किया जाता है और पुनः चलाया जाता है; अन्यथा एक स्तर-1 आदत | कोई भी | कवरेज; तुलना की आदत | स्क्रीनशॉट या कॉपी किए गए उत्तर, संदर्भ अक्सर खो जाता है | ध्यान की लागत; अरिकॉर्ड किया गया प्रमाणन |
| वेब चैट के लिए प्रसारण उपकरण | ChatHub, ChatALL | 4 (वेब) जब दर्ज किया जाता है और पुनः चलाया जाता है; अन्यथा एक स्तर-1 आदत | व्यक्तियों | एक संकेत, समानांतर उत्तर, कोई सामंजस्य नहीं | फलकों में उत्तर; सहेजे जाने तक डिस्क पर कुछ नहीं | जब इंटरफेस बदलते हैं तो टूट जाता है; सेवा की शर्तें |
| परिषद एक उत्पाद सुविधा के रूप में | Perplexity Model Council; Microsoft 365 Copilot अनुसंधान एजेंट (GPT और Claude); Karpathy की LLM Council | 4 (वेब, प्रबंधित) | उन सेवाओं के ग्राहक | सहमति और असहमति के साथ विलीन उत्तर | जो विक्रेता दिखाता है; स्रोत अक्सर गुना किए जाते हैं | विलीन आवाज़ प्रमाणन को छिपाता है; चुनने वाला विक्रेता है |
| एजेंटों के लिए उजागर वेब चैट | OpenCLI और समान | 4 (वेब) से 4 (CLI) में पुल | तकनीकी उपयोगकर्ता | एजेंट वेब सदस्यता का उपयोग कर सकते हैं | फ़ाइलें, यदि एजेंट उन्हें लिखता है | नाजुकता; पहुँच नियम |
| विक्रेता प्लगइन: एक एजेंट दूसरे को प्रतिनिधित्व करता है | Claude Code के लिए OpenAI का प्लगइन; GitHub Agent HQ के अंदर Claude और Codex (Copilot) | 4 (CLI) | डेवलपर्स, फैल रहे हैं | एक सत्र के अंदर क्रॉस-विक्रेता समीक्षा और प्रतिनिधिमंडन | सत्र प्रतिलिपि; समीक्षा आउटपुट | ज्यादातर कोड-आकार; दो सेवाओं का कोटा |
| परिषद और परामर्श सर्वर | एक बहु-प्रदाता परामर्श सर्वर (अंतिम प्रतिबद्धता दिसंबर 2025); सहमति प्लगइन; छोटे CLI परिषद जो प्रति उपकरण एक फ़ाइल लिखते हैं | 4 (CLI) | डेवलपर्स | एक कार्य पर कई परिवार; सहमति नियम | प्रति-उपकरण फ़ाइलें; एक विलीन नोट | अंत के बिना राउंड; सहसंबद्ध त्रुटियाँ; त्याग |
| बहु-एजेंट डैशबोर्ड | फलकों में कई आधिकारिक CLIs, प्रत्येक के अपने कार्य प्रतिलिपि के साथ, एक व्यक्ति उनमें से किसी को भी ले सकता है | 4 (CLI, दृश्यमान) | डेवलपर्स समानांतर एजेंटों की देखरेख कर रहे हैं | पर्यवेक्षण दृश्यमान बनाया गया | प्रति-एजेंट लॉग और diffs | कोड के लिए निर्मित; ध्यान पतला फैलाया गया |
| समय की छत के साथ फैन-आउट स्क्रिप्ट | परिशिष्ट C में सूची C1 | 4 (CLI) | कोई भी जो स्तर-3 एजेंट का मालिक है | समानांतर उत्तर भी रखे जाते हैं जब एक उपकरण अटक जाता है | प्रति उपकरण एक फ़ाइल, किसने उत्तर दिया इसके साथ एक सारांश | एक व्यक्ति को सामंजस्य करने की आवश्यकता है |
| एकल एजेंट, कार्य लिखा और पुनः चलाया गया | एक निर्देश फ़ाइल या अनुसूची पर चलाया गया कौशल | 3 दोहराए जा सकने योग्य बनाया गया | स्तर 3 पर कोई भी | दोहराव जहाँ दूसरा मॉडल उपलब्ध नहीं है | कार्य फ़ाइल, इनपुट, आउटपुट, स्वीकृति नोट | दोहराव एक खराब टेम्पलेट को बढ़ाता है |
पंक्तियाँ पैटर्न का वर्णन करती हैं। अनुलग्नक E में तारकाओं की गिनती एक दिन पर लोकप्रियता का ट्रेस है, और ये उपयोगकर्ता, गुणवत्ता, या अनुबंधों की एक फ़ोल्डर के लिए फिटनेस नहीं हैं। परित्याग तालिका में संबंधित है: सबसे प्रसिद्ध परामर्श सर्वर ने दिसंबर 2025 में अंतिम बार प्रतिबद्ध किया था, और एक से अधिक डैशबोर्ड के रखरखाव कर्ताओं ने काम बंद कर दिया है। एक पेपर जो शिक्षार्थियों को एक एकल नामित ऑर्केस्ट्रेटर की ओर इशारा करता था, वह उन्हें नुकसान पहुंचा रहा होता, यही कारण है कि मैं उन्हें पैटर्न की ओर इशारा करता हूँ: आधिकारिक बाइनरी, गैर-इंटरैक्टिव फ्लैग, डिस्क पर फ़ाइलें, और किसे पूछा गया इसका एक रिकॉर्ड।
7.2 यह परत क्यों रहती है
CLI ऑर्केस्ट्रेशन विक्रेताओं के अपने उपकरणों पर निर्भर करता है, जो विक्रेताओं द्वारा स्वयं स्वचालन के लिए दस्तावेज किए गए मोड में चलाए जाते हैं, और यह इसे ऐसे गुण देता है जो ब्राउज़र टैब के पास नहीं हो सकते। सबसे बढ़कर, इसे लिखा जा सकता है। एक व्यवस्था जो एक बार काम करती थी, जैसे "एक मॉडल के साथ ड्राफ्ट करें, चेकलिस्ट के विरुद्ध एक दूसरी समीक्षा करें, मुझे असहमति दें", को एक निर्देश फ़ाइल या एक कौशल के रूप में सहेजा जा सकता है और अगले सप्ताह फिर से चलाया जा सकता है, यदि आवश्यक हो तो एक समय सारणी पर। अनुभाग 3 ने स्तर 4 को ठीक इसी रूप में परिभाषित किया है, दोहराया जाने वाला काम मॉडल में निर्देशित। कई आगे के गुण निम्नानुसार हैं, जिस क्रम में मैं उन्हें तौलता हूँ। एक कमांड-लाइन फ्लैग एक दस्तावेज़ इंटरफ़ेस है और एक निकास कोड एक प्रतिश्रुति है; एक वेब पेज पर एक स्थिति न तो है, यही कारण है कि उपकरण जो उपभोक्ता चैट पृष्ठों को चलाते हैं, हर बार पेज बदलने पर मरम्मत की जानी चाहिए। प्रत्येक आधिकारिक उपकरण अपने स्वयं के विक्रेता के लॉगिन के तहत चलता है, उस विक्रेता की सैंडबॉक्स और नियम के साथ, इसलिए व्यक्ति फ़ोल्डर से रहस्य रख सकता है, डिफ़ॉल्ट रूप से नेटवर्क को अस्वीकार कर सकता है और प्रति उपकरण विनाशकारी आदेशों से इनकार कर सकता है, जबकि एक ब्राउज़र एजेंट जो हर टैब देख सकता है वह एक बड़ी अनुमति वस्तु है। पैटर्न उपभोक्ता लॉगिन का उपयोग करता है जो व्यक्ति पहले से भुगतान करता है, और मैं अपेक्षा करता हूँ कि, सबसे अधिक, एक ऐसी प्रथा को अलग करने के लिए जो एक गैर-प्रोग्रामर रखता है, जिससे वे एक बार आजमाते हैं। और विक्रेताओं द्वारा इसे आशीर्वाद दिया जाता है। आधिकारिक प्लगइन, GitHub की सेवा के अंदर एजेंट, हेडलेस मोड और कौशल मानक संकेत हैं कि क्रॉस-टूल प्रतिनिधिमंडल मानकीकृत किया जा रहा है, जबकि उपभोक्ता चैट पृष्ठों का स्वचालन पीछा किया जा रहा है।
वेब ऑर्केस्ट्रेशन तुलना की आदत को सिखा सकता है, और CLI ऑर्केस्ट्रेशन वह जगह है जहाँ आदत को रखा जा सकता है, एक वस्तु के रूप में। वस्तु एक फ़ोल्डर है जो असाइनमेंट, अनुमत इनपुट, आउटपुट, किस एजेंट ने क्या उत्पादित किया इसका लॉग, और स्वीकार किए गए का एक नोट रखता है। एक अन्य व्यक्ति इसे निरीक्षण कर सकता है एक निजी चैट को दोहराए बिना, और जिस व्यक्ति ने इसे बनाया वह अगले सप्ताह एक इनपुट बदल सकता है और अंतर देख सकता है। वह रिकॉर्ड जिम्मेदारी को टालना कठिन बनाता है, क्योंकि एक सहेजा असाइनमेंट और एक स्वीकृति नोट एक खराब स्रोत सेट या एक छूटी अनुमोदन को उजागर करते हैं। अनौपचारिक चैट के आदी कार्यालयों में यह एक बोझ लगेगा, और जहाँ काम को जाँचा जाना है, सौंपा जाना है या दोहराया जाना है, वह एक संपत्ति है। समानुपातिकता तय करता है कि कौन सा: एक दो मिनट का अनुरोध एक वर्कफ़्लो फ़ोल्डर की आवश्यकता नहीं है, जबकि एक आवर्ती कार्य जो साझा फ़ाइलों को छूता है वह हो सकता है।
जो अस्तित्व में है वह अधिकांशत: कोड द्वारा आकार दिया जाता है। आधिकारिक प्लगइन, परिषद सर्वर और बहु-एजेंट प्रबंधक सॉफ़्टवेयर समीक्षा को लक्षित करते हैं, हालांकि पैटर्न में कुछ भी कोड के लिए विशिष्ट नहीं है।
7.3 परत व्यक्ति से क्या माँगती है
एजेंटों की एक छोटी टीम को एक प्रबंधक की आवश्यकता है, और प्रबंधक का काम विशिष्ट है। मैं इसके चार भागों को प्रतिनिधिमंडल अनुबंध कहता हूँ:
- लक्ष्य: काम किसके लिए है, इसे इस तरह से बताया जाता है कि एक एजेंट बता सके कि क्या इसे पूरा किया गया है।
- सीमा: एजेंट क्या छू सकते हैं और क्या नहीं, कौन सी कार्रवाई को व्यक्ति की पुष्टि की आवश्यकता है, और समय और कोटा में बजट क्या काम में खर्च हो सकता है।
- कलाकृति: जब काम पूरा हो जाता है तो क्या अस्तित्व में होना चाहिए, और किस रूप में।
- जाँच: व्यक्ति कैसे जानेगा कि कलाकृति सही है, काम शुरू होने से पहले तय किया गया, कौन क्या समीक्षा करता है, और कब रुकना है।
चौथे भाग में स्वचालित निरीक्षण पर साथी पेपर में वर्णित एक जाल है (Chernets, 2026b)। एक समीक्षक जोड़ना सस्ता है, और हर समीक्षक कुछ न कुछ पाता है। एक परिषद बिना एक रोकने वाले नियम के राउंड और आलोचकों को जोड़ने के लिए जाता है जब तक काम समीक्षा में दबा नहीं दिया जाता। एक व्यावहारिक नियम प्रति चरण एक राउंड आलोचना और एक राउंड सुधार की अनुमति है, व्यक्ति यह तय करता है कि क्या एक खोज काम को रोकता है। नियम का एक मापा मूल्य है: उस पत्र में रिपोर्ट किए गए 144 रन के एक यादृच्छिकृत परीक्षण में, एक-राउंड बजट ने आलोचना राउंड को 2.86 से 1.00 प्रति रन तक काटा जबकि 0.11 प्रति रन द्वारा छूटे दोषों को बढ़ाया (95% विश्वास अंतराल 0.005 से 0.204) (Chernets, 2026b)। क्या यह व्यापार करने लायक है यह दांव पर निर्भर करता है, जो बिल्कुल वह तरह का निर्णय है जो प्रबंधक के पास संबंधित है। राउंड और समय की सीमाएं बजट हैं, और एक बजट तय करता है कि कब रुकना है, जो यह सवाल नहीं है कि क्या उत्तर सच है।
अनुबंध पुनः प्रस्तुत करता है कि अच्छे प्रतिनिधिमंडल के लिए लोगों को हमेशा क्या आवश्यक है, एक ऐसे दर्शकों के लिए जिन्होंने कभी सॉफ़्टवेयर को प्रतिनिधिमंडल नहीं किया है, और यह प्रबंधन का कोई नया सिद्धांत दावा नहीं करता है। इसका मूल्य यह है कि प्रत्येक भाग सिखाया जा सकता है, लिखा जा सकता है और जाँचा जा सकता है, और प्रत्येक भाग इस तरह विफल होता है कि जब यह गायब हो तो देखा जा सकता है।
8. ऑपरेटर से मैनेजर तक
8.1 नौकरी में क्या बदलता है
स्तर 1 पर व्यक्ति उत्पादन करता है और मॉडल सहायता करता है। स्तर 3 और 4 पर मॉडल उत्पादन करता है और व्यक्ति निर्देशन देता है, पर्यवेक्षण करता है और स्वीकार करता है। Bainbridge (1983) की स्वचालन की विडंबनाएं यह भविष्यवाणी करती हैं कि यह मानव भूमिका के साथ क्या करता है। स्वचालन दिनचर्या को हटाता है और व्यक्ति को अवशेष छोड़ता है जो अच्छी तरह करना सबसे कठिन है, निगरानी और दुर्लभ विफलताओं में हस्तक्षेप, जबकि वह अभ्यास जो उनके निर्णय का निर्माण करता था, गायब हो जाता है। जनरेटिव AI की विडंबना संस्करण पहले से दस्तावेज किया गया है। जनरेटिव AI लोगों को उत्पादन से मूल्यांकन की ओर स्थानांतरित करता है और कठिन कार्यों को कठिन बनाता है (Simkute et al., 2024), उपकरण में उच्च आत्मविश्वास कम आलोचनात्मक सोच के साथ जाता है (Lee et al., 2025), और अकुशलता संरचनात्मक रूप से अभ्यास के हटाने से अनुसरण करती है (Ferdman, 2025)।
एक एजेंट का प्रबंधन इसलिए अपनी सक्षमता के साथ एक अलग काम है, और सक्षमता उपकरण के साथ मुक्त नहीं आती है। इसमें यह निर्णय करना शामिल है कि क्या प्रत्यायोजित करना है, अनुभाग 7.3 के प्रत्यायोजन अनुबंध को व्यक्त करना, एजेंट के ट्रेस को पढ़ना, और यह तय करना कि परिणाम काफी अच्छा है या नहीं। मैं नौकरी को चार प्रथाओं में विभाजित करता हूं। प्रत्यायोजन काम को एक वितरणयोग्य के रूप में सीमा के साथ नाम देता है। पर्यवेक्षण योजना, मध्यवर्ती आउटपुट या उपकरण ट्रेस को देखता है और कार्य बहाव होने पर हस्तक्षेप करता है, प्रत्येक कुंजीस्ट्रोक को मंजूरी दिए बिना, क्योंकि सबकुछ की मंजूरी थकान है और थकान यह है कि लोग हाँ पर क्लिक करते हैं। सत्यापन स्रोतों, योग की जांच करता है, परिवर्तन और दावे जो एक निर्णय पर निर्भर है, जोखिम के अनुपात में और एजेंट के अपने आत्मविश्वास को फिर से पढ़ने की विधि के अलावा अन्य विधि द्वारा: कोड के लिए परीक्षण और अंतर, अनुबंधों के एक फोल्डर के लिए व्यक्ति स्वयं खोलता है एक पृष्ठ के विरुद्ध स्पॉट जांच, और साहित्य तालिका के लिए पहचानकर्ता की पंक्ति-दर-पंक्ति जांच। प्रत्याहार कार्यक्षेत्र को सीमित करता है, एक चलन को रोकता है या जब कोई शर्त बदलती है तो पहुंच को हटाता है। एक व्यक्ति जो ये चारों करता है वह एक ग्राफिकल डेस्कटॉप एप्लिकेशन के माध्यम से भी एक एजेंट का प्रबंधन कर रहा है। एक व्यक्ति जो एक कार्य को एक अपारदर्शी सेवा को सौंपता है और पहले उत्तर को स्वीकार करता है वह निर्णय को आउटसोर्स कर रहा है, जो एक अलग प्रथा है। Parasuraman और Riley (1997) ने इसमें विफल होने के दोनों तरीके नाम दिए। अनुपयोग वह व्यक्ति है जो प्रत्यायोजित कर सकता है और कभी नहीं करता, आदत या भय से स्तर 1 पर फंसा है। दुरुपयोग वह व्यक्ति है जो चेक के बिना प्रत्यायोजित करता है और जो वापस आता है उसे स्वीकार करता है। दोनों 2026 में दृश्यमान हैं। व्यापक और उथली अपनाने के डेटा स्तर पर अनुपयोग का वर्णन करते हैं (अनुभाग 2.2), और अनुभाग 5.3 की फाइल-हानि रिपोर्ट और डेटाबेस विलोपन दुरुपयोग का वर्णन करते हैं, कभी-कभी पेशेवरों द्वारा जो बेहतर जानते थे। तालिका 6 प्रत्येक प्रथा को प्रत्यायोजन अनुबंध के उस भाग के साथ निर्धारित करती है जो वह लागू करता है, वह जोखिम जो वह पूरा करता है, और दिनांकित ट्रेस जिसके द्वारा एक अध्ययन देख सकता है कि यह हुआ।
तालिका 6। मैनेजर की चार प्रथाएं: प्रत्येक क्या लागू करता है, वह जोखिम जो पूरा करता है, और वह ट्रेस जो छोड़ता है।
| प्रथा | व्यक्ति क्या करता है | यह जो अनुबंध भाग लागू करता है | यदि यह अनुपस्थित है तो जोखिम | अवलोकन योग्य ट्रेस |
|---|---|---|---|---|
| प्रत्यायोजन | काम को एक वितरणयोग्य के रूप में सीमा के साथ नाम देता है (8.1) | लक्ष्य, इतना कहा गया कि एक एजेंट बता सके कि यह पूरा हुआ है या नहीं; कलाकृति: क्या मौजूद होना चाहिए, और किस रूप में (7.3) | अनुपयोग: "वह व्यक्ति जो प्रत्यायोजित कर सकता है और कभी नहीं करता", आदत या भय से स्तर 1 पर फंसा है (8.1) | एक कलाकृति जमा की गई (परिशिष्ट A) |
| पर्यवेक्षण | योजना, मध्यवर्ती आउटपुट या उपकरण ट्रेस को देखता है; कार्य बहाव होने पर हस्तक्षेप करता है, प्रत्येक कुंजीस्ट्रोक को मंजूरी दिए बिना (8.1) | सीमा: एजेंट क्या स्पर्श कर सकते हैं; कौन सी कार्रवाई को एक व्यक्ति की पुष्टि की आवश्यकता है; समय और कोटा में कौन सा बजट (7.3) | अनुमोदन थकान: "थकान यह है कि लोग हाँ पर क्लिक करते हैं" (8.1); एक गार्ड जो बहुत अधिक ब्लॉक करता है अनुपयोग उत्पन्न करता है (5.3) | एक योजना अस्वीकृत; एक अपरिवर्तनीय कदम पुष्टि के लिए रखा गया (परिशिष्ट A) |
| सत्यापन | स्रोतों, योग, परिवर्तन और दावों की जांच करता है जो एक निर्णय पर निर्भर है, एजेंट के अपने आत्मविश्वास को फिर से पढ़ने की विधि के अलावा अन्य विधि द्वारा (8.1) | जांच: व्यक्ति कैसे जानेगा कि कलाकृति सही है, काम शुरू होने से पहले तय किया गया; कब रुकना है (7.3) | दुरुपयोग: "वह व्यक्ति जो चेक के बिना प्रत्यायोजित करता है और जो वापस आता है उसे स्वीकार करता है" (8.1); मॉडल के बीच सहसंबद्ध त्रुटियां (6.3) | एक अंतर या आउटपुट अस्वीकृत; एक दूसरा मॉडल परिवार पूछा गया; एक हर नीचे दर्ज किया गया: पूछा गया, उत्तर दिया गया, समय समाप्त (परिशिष्ट A) |
| प्रत्याहार | कार्यक्षेत्र को सीमित करता है, जब कोई शर्त बदलती है तो एक चलन को रोकता है या पहुंच को हटाता है (8.1) | सीमा, फिर से लागू: क्या रखा जाता है, और एक गलती को कैसे पूर्ववत करना है (3.2, 7.3) | एक लंबे कार्य जो नहीं रोका जा सकता था, जिसके बाद कार्य को हटाने से फाइलें हटा दी गईं (5.3) | परिशिष्ट A के दिनांकित ट्रेस के बीच कोई नहीं; एक दिनांकित स्टॉप, संकीर्ण अनुमति या हटाई गई पहुंच सेवा करेगी |
नोट: एक व्यक्ति जो एक कार्य को एक अपारदर्शी सेवा को सौंपता है और पहले उत्तर को स्वीकार करता है "निर्णय को आउटसोर्स कर रहा है", जो एक अलग प्रथा है (8.1)।
एक छोटी सी डिवाइस सभी चार प्रथाओं में भूमिका को एक साथ रखती है, और मैं इसे स्वीकृति रिकॉर्ड कहता हूं। एक परिणामी या आवर्ती कार्य के लिए यह अभिप्रेत वितरणयोग्य, उपयोग किए गए इनपुट, बाधाएं और अनुमतियां, जहां आउटपुट गया, कोई भौतिक असहमति या विफलता, किए गए चेक, और व्यक्ति का निर्णय स्वीकार, संशोधित, बढ़ाने या छोड़ने के लिए रखता है। यह एजेंट द्वारा निर्मित और व्यक्ति द्वारा निर्भर के बीच एक पंक्ति खींचता है। व्यक्ति के लिए यह उपयोगी है क्योंकि यह विश्वास की भावना को एक जांचने योग्य निर्णय में बदल देता है, एक टीम के लिए क्योंकि एक सहयोगी एक निजी चैट इतिहास के बिना काम का निरीक्षण कर सकता है, और एक शोधकर्ता के लिए क्योंकि यह एक पूर्ण रन को एक निर्भर परिणाम से अलग करता है। यह एक अवरोध भी है। एक व्यक्ति यह तय कर सकता है, एक स्वीकृति मानदंड लिखने में विफल होने के बाद, कि कार्य स्तर 1 पर रहना चाहिए, और मॉडल इसे परिपक्व प्रबंधन के रूप में गिनता है न कि पिछड़े अपनाने के रूप में। मानव-AI सहयोग की शब्दावली में, स्तर 1 से स्तर 4 तक का कदम मानव को लूप में रखता है और यह बदलता है कि लूप क्या है, प्रत्येक उत्तर को पढ़ने से उन शर्तों को निर्धारित करने तक जिस पर उत्तर स्वीकार किए जाते हैं। चित्र 4 उस लूप को चार प्रथाओं के साथ, प्रत्येक चरण पर जोखिम, एक विफल जांच के बाद वापसी और स्वीकृति रिकॉर्ड के साथ खींचता है।
चित्र 4। मैनेजर का नियंत्रण लूप।
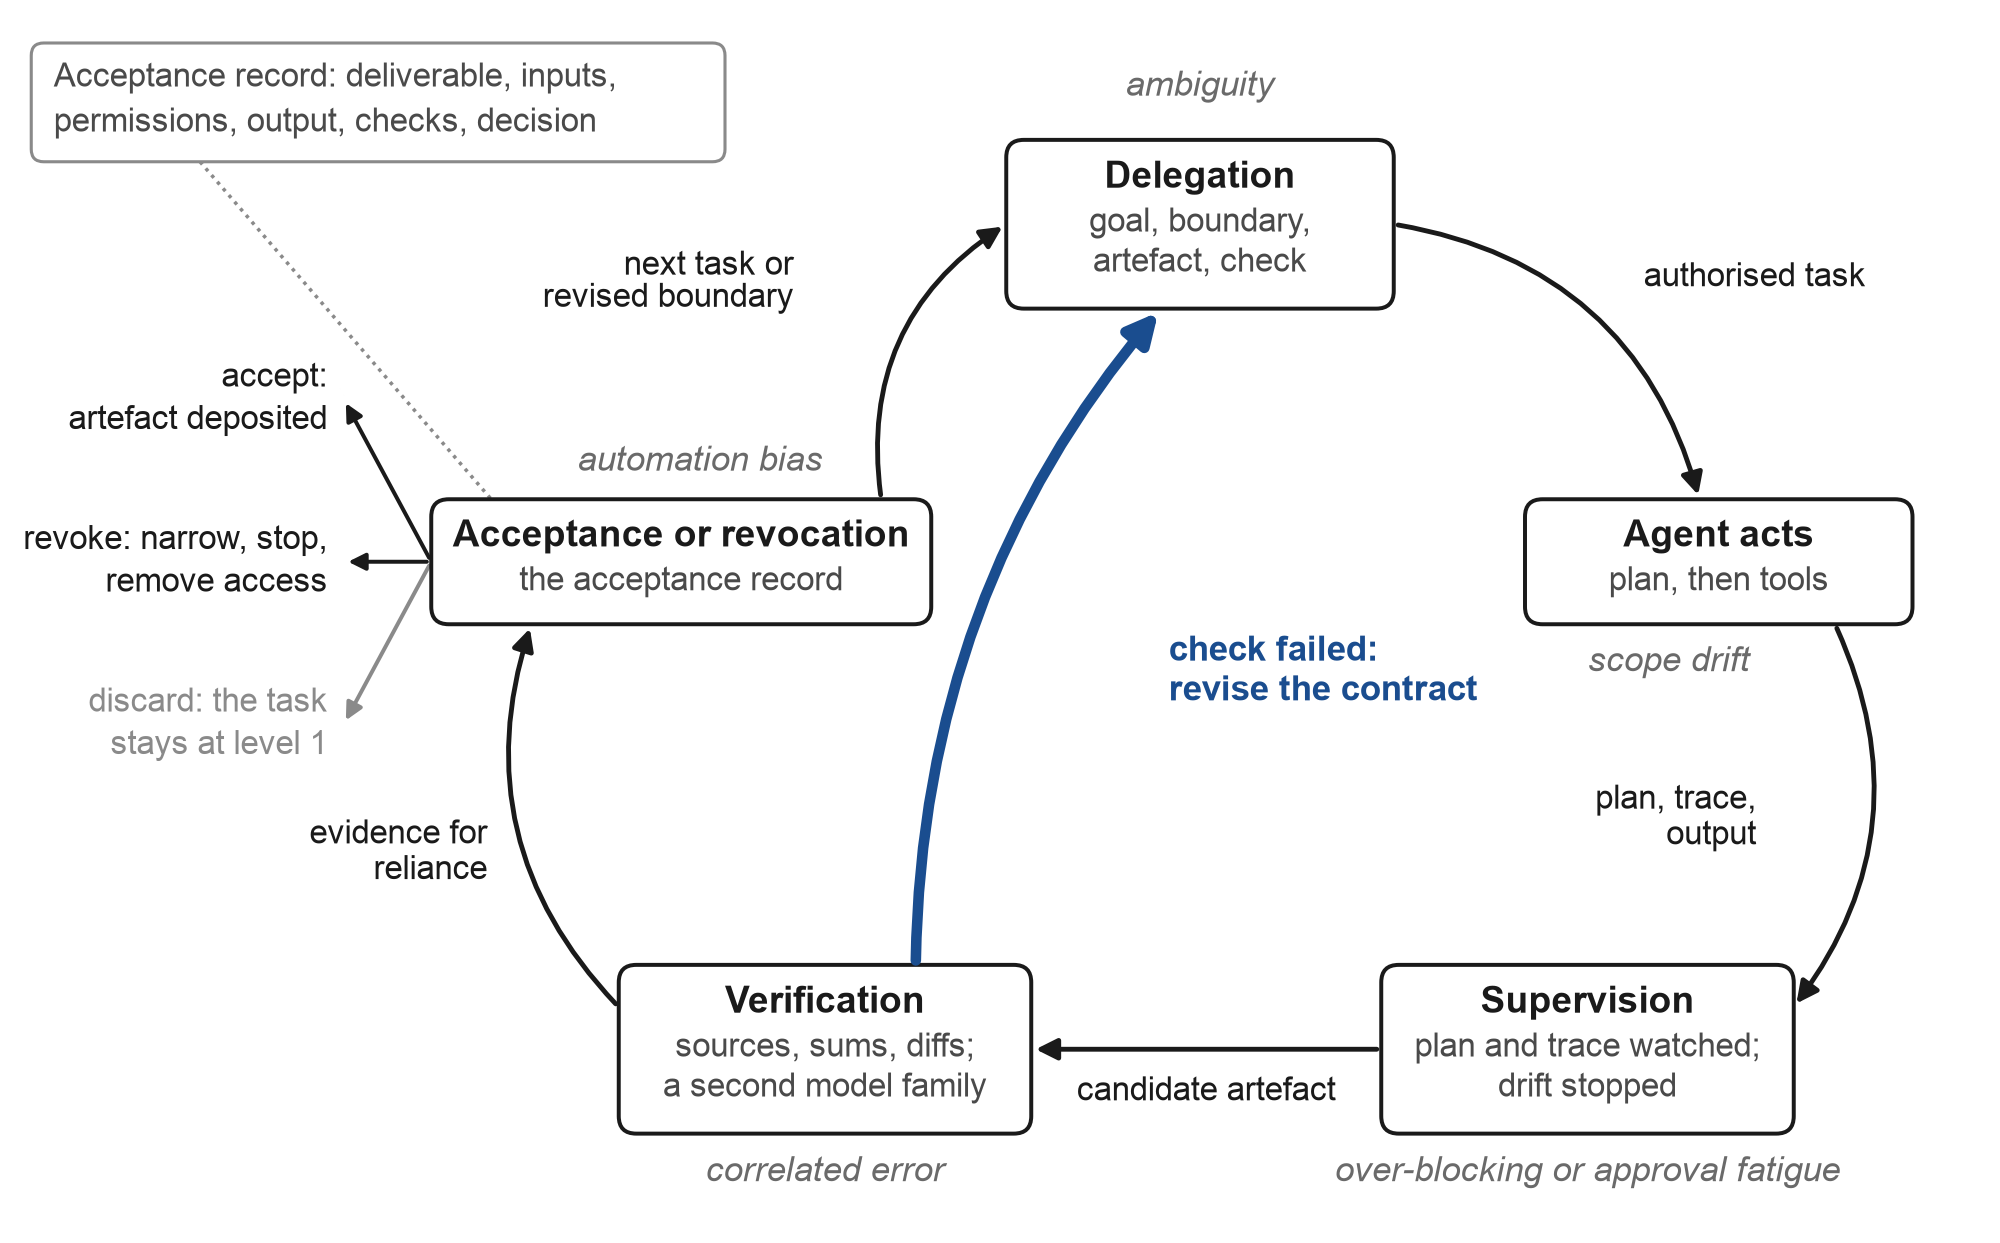
नोट: प्रबंधक का कार्य एक लूप के रूप में है जिसे व्यक्ति चलाता है (खंड 7.3 और 8.1): प्रतिनिधिमंडन अनुबंध को बताता है (लक्ष्य, सीमा, कलाकृति, जांच), एजेंट कार्य करता है, व्यक्ति निरीक्षण करता है और सत्यापित करता है, और फिर परिणाम को स्वीकार करता है, रद्द करता है या त्याग देता है और स्वीकृति रिकॉर्ड लिखता है। भूरे रंग के इटैलिक लेबल प्रत्येक चरण में जोखिम का नाम देते हैं (खंड 5.3, 6.3 और 8.1)। भारी तीर एक विफल जांच से एक संशोधित अनुबंध की वापसी है, और स्वीकृति नोड से हर निकास व्यक्ति का निर्णय है।
8.2 अनुभवी उपयोगकर्ता कम प्रतिनिधिमंडन करते हैं
एक अवलोकन किसी भी सरल कहानी के खिलाफ कटता है जिसमें सभी को एजेंटों के प्रबंधक बन जाना चाहिए। Anthropic ने मार्च 2026 में बताया कि लंबी कार्यकाल वाले उपयोगकर्ता "निर्देशक उपयोग पैटर्न के माध्यम से अधिक जिम्मेदारी को प्रतिनिधि देने की संभावना बहुत कम थी" (Anthropic, 2026e), और इसकी जनवरी 2026 की रिपोर्ट ने संवर्धन, सहयोगी उपयोग जिसमें व्यक्ति लूप में रहता है, नवंबर 2025 में बातचीत के 52% पर रखा था (Anthropic, 2026f)। एक पाठ यह है कि अनुभवी उपयोगकर्ताओं ने सीखा कि प्रतिनिधिमंडन कहाँ विफल होता है और पीछे हट गए। एक अन्य यह है कि उन्होंने काम के उन हिस्सों के लिए सहयोगी के रूप में मॉडल का उपयोग करना सीखा जहाँ उनका अपना निर्णय उत्पाद है। मैं प्रकाशित आंकड़ों से दोनों पाठों को अलग नहीं बता सकता, और दोनों पाठों पर सीढ़ी का अंतिम बिंदु अधिकतम प्रतिनिधिमंडन के अलावा कुछ और है। यह कार्य के आधार पर पूछने, सहयोग करने और प्रतिनिधि देने के बीच चुनने की क्षमता है, और यह जानना कि आपके सामने का कार्य किसे चाहिए। चार-स्तरीय मॉडल वर्णन करता है कि एक व्यक्ति कर सकता है करना। यह कोई दावा नहीं करता कि उन्हें हर बार सबसे अधिक प्रतिनिधि देने वाली चीज करनी चाहिए।
8.3 जिम्मेदारी व्यक्ति के साथ रहती है
विक्रेताओं को स्पष्ट है कि जवाबदेही कहाँ निहित है। Anthropic के स्तर-2 एजेंट के लिए लॉन्च मार्गदर्शन ने उपयोगकर्ताओं को बताया कि वे "आपकी ओर से Claude द्वारा किए गए सभी कार्यों के लिए जिम्मेदार हैं" (The Register, 2026)। यह विशेष रूप से स्तर 3 की कानूनी और व्यावहारिक वास्तविकता है, जहाँ एजेंट मालिक की साख के साथ कार्य करता है, मालिक की फाइलों पर, मालिक के नाम के तहत। एक पेशेदार जो एक एजेंट का प्रबंधक बन जाता है वह एक कार्यकर्ता के लिए भी जवाबदेह बन जाता है जिसकी गलतियाँ तेज हैं। यह एक और कारण है कि प्रतिनिधिमंडन अनुबंध में जांच को काम से पहले तय किया जाना चाहिए, और यह एक और कारण है कि खंड 5.3 की सुरक्षा डिजाइन व्यक्ति को वास्तविक समय में हमले को देखने पर निर्भर नहीं होना चाहिए।
8.4 साक्षरता ढाँचे में प्रबंधक की भूमिका
AI साक्षरता की आधिकारिक परिभाषाएँ इस भूमिका का नाम देना शुरू कर रही हैं, हालाँकि यहाँ समीक्षा की गई कोई भी पाठ "एजेंट" शब्द का उपयोग नहीं करता है। अमेरिकी श्रम विभाग के फरवरी 2026 के AI साक्षरता ढाँचे में अपने सामग्री क्षेत्रों में "प्रभावी रूप से AI को निर्देशित करना" सूचीबद्ध है (US Department of Labor, 2026; ExecutiveGov, 2026)। OECD और European Commission के संयुक्त ढाँचे के जून 2026, जो PISA 2029 मूल्यांकन को खिलाता है, चार डोमेन हैं, जिनमें से एक "AI को प्रबंधित करना" है (OECD & European Commission, 2026)। पहले के शैक्षणिक ढाँचे AI को पहचानने, समझने और मूल्यांकन करने पर जोर दिया गया (Long & Magerko, 2020), और UNESCO के 2024 छात्रों और शिक्षकों के लिए सक्षमता ढाँचे ने समान पंजीकरण निर्धारित किया (UNESCO, 2024a, 2024b)। प्रतिनिधिमंडन अनुबंध प्रबंधन और निर्देशन डोमेन को एजेंटिक मामले के लिए एक शिक्षण योग्य सामग्री देता है: एक लक्ष्य निर्धारित करें, काम को सीमित करें, कलाकृति का नाम दें, जांच का निर्णय लें। व्यवसायियों ने "AI ऑपरेटर" और "एजेंट प्रबंधक" जैसे शीर्षक का उपयोग शुरू किया है जो अपने पेशे के शीर्ष पर इस विशेषज्ञता को प्राप्त करते हैं। मैं "एजेंटों का प्रबंधक" अधिक संकीर्ण रूप से उपयोग करता हूँ, एक भूमिका के बजाय व्यवहार के पैटर्न के लिए जिसे किसी को किराए पर लेना चाहिए, क्योंकि व्यवहार साक्ष्य छोड़ता है और एक शीर्षक नहीं। साक्ष्य कलाकृतियों में है: एक योजना जिसे व्यक्ति ने अस्वीकार किया, एक अंतर जिसे उन्होंने अस्वीकार किया, एक दूसरी राय जिसे उन्होंने लिया, एक अनुसूचित रन जो तब समाप्त हुआ जब वे कीबोर्ड से दूर थे। जहाँ कोई भी निशान मौजूद नहीं है, शीर्षक के पीछे कुछ नहीं है।
9. क्रॉसिंग का माप: एक पूर्व-पंजीकृत कार्यक्रम
9.1 माप की इकाई के रूप में क्रॉसिंग
अधिकांश अपनाने के डेटा उन लोगों की गिनती करते हैं जो "AI का उपयोग करते हैं", कभी-कभी साप्ताहिक या दैनिक रूप से। इस प्रकार की गिनती उस व्यक्ति को अलग नहीं कर सकती जो किसी चैटबॉट से समानार्थी शब्द माँगता है उस व्यक्ति से जो एक त्रैमासिक रिपोर्ट को किसी एजेंट को सौंपता है, और मैं दूसरे व्यक्ति को खोजना चाहता हूँ। अनुभाग 3.3 का कलाकृति नियम अंतर को अवलोकनीय बनाता है, क्योंकि एक क्रॉसिंग केवल तभी दर्ज की जाती है जब एजेंट ने कुछ ऐसा तैयार किया है जो व्यक्ति ने माँगा था, नए स्तर पर। ऑनबोर्डिंग और निरीक्षण पर साहित्य से कई अन्य नियम आते हैं। समापन को अलग से रिपोर्ट किया जाना चाहिए उन लोगों के लिए जिन्होंने बिना सहायता के क्रॉस किया और जिन लोगों को सहायता दी गई, क्योंकि सहायता क्रॉसिंग का अर्थ बदलती है। एक स्टॉप को उस बिंदु पर दर्ज किया जाना चाहिए जहाँ यह हुआ और व्यक्ति के अपने शब्दों में, क्योंकि रुकने के कारण परिणाम का एक बड़ा हिस्सा हैं। हर व्यक्ति जिसे सामग्री मिली, भाजक में शामिल है, जिनमें वे भी शामिल हैं जिन्होंने कभी जवाब नहीं दिया। अंत में, दृढ़ता का अवलोकन उसके बाद किया जाना चाहिए जब शोधकर्ता हर हफ्ते लिखना बंद कर दे; एक कलाकृति जो शोधकर्ता अभी भी किसी के इनबॉक्स में होने के समय तैयार की जाती है, वह शिष्टाचार जितनी ही उपयोग हो सकती है।
9.2 डिज़ाइन
मैं एक पूर्व-पंजीकृत कोहोर्ट कार्यक्रम चलाता हूँ जो इन नियमों को गैर-प्रोग्रामर्स पर लागू करता है (Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, 6 सितंबर 2026 को पंजीकृत और फ्रीज किया गया)। यह एक तीन-चरण पाठ्यक्रम का एक एकल-भुजा संभाव्यता अध्ययन है, और पूर्व-पंजीकरण किसी भी डेटा के संग्रह से पहले फ्रीज किया गया था। जो अनुसरण करता है वह डिज़ाइन है जैसा कि पंजीकृत है।
प्रतिभागी। वे वयस्क जिनका काम काफी हद तक कंप्यूटर पर है। वे अपनी खुद की मशीन और अपनी खुद की AI सदस्यताएँ उपयोग करते हैं (नियोक्ता की को बाहर रखा जाता है), ग्राहक-पहचान और नियोक्ता-गोपनीय सामग्री को व्यायाम से बाहर रखते हैं, और पुष्टि करते हैं कि सॉफ़्टवेयर स्थापित करना उनके नियोक्ता द्वारा लागू किए गए किसी नियम का उल्लंघन नहीं करता है। भर्ती पेशेवर सामाजिक नेटवर्क पर सार्वजनिक घोषणा के माध्यम से एक पूर्व-निर्धारित समय सीमा के भीतर की जाती है, ताकि परिणाम अनुकूल दिखने तक इसे विस्तारित नहीं किया जा सकता। घोषणा का स्क्रीनशॉट लिया जाता है और इसका स्थायी लिंक दर्ज किया जाता है, जो भर्ती पाठ को ठीक करता है। प्रवेश सतत है और प्रत्येक प्रतिभागी का शेड्यूल उनके अपने दिन शून्य से गिना जाता है, क्योंकि उपकरण साप्ताहिक पैमाने पर बदलते हैं। भर्ती 6 सितंबर 2026 को सार्वजनिक घोषणा के साथ खुली, जिस दिन पंजीकरण फ्रीज किया गया था, और 21 दिन बाद, 27 सितंबर 2026 को बंद हो जाती है; लेखन के समय कोहोर्ट क्षेत्र में है, और साकार संख्या, जो भी हो, परिणामों के साथ रिपोर्ट की जाएगी।
चरण 1 (चैट से किसी व्यक्ति की अपनी कंप्यूटर पर एक एजेंट तक)। प्रतिभागी मानक पाठ को चैटबॉट में पेस्ट करता है जिसका वह पहले से उपयोग करता है, और वह चैटबॉट उसे अपनी मशीन पर एक ग्राफिकल एजेंट स्थापित करने के माध्यम से गाइड करता है। मैं किसी के कंप्यूटर को नहीं छूता। चरण तब पूरा होता है जब प्रतिभागी एजेंट द्वारा पहले कार्य के प्रतिक्रिया में तैयार की गई कलाकृति प्रदान करता है। कार्य सभी के लिए आकार में समान है और प्रतिभागी की अपनी कार्य स्थिति से भरा हुआ है, और इसके लिए एजेंट को पूछने, निर्णय लेने, फाइलें बनाने और फॉर्मेट करने की आवश्यकता है। यह आवश्यकता एजेंट को चैटबॉट से अलग करती है। पंजीकरण सटीक शब्दांकन देता है (Chernets, 2026d)। मॉडल की शर्तों में, चरण 1 एक साथ दो स्तरों पर स्वचेतक ऑनबोर्डिंग का परीक्षण करता है, स्तर 1 से स्तर 3 तक। यह एक जानबूझकर की गई पसंद थी। एक स्थानीय एजेंट का एक ग्राफिकल शेल व्यक्ति की अपनी मशीन पर चलता है, इसलिए अनुभाग 3.3 के नियम के अनुसार यह स्तर 3 है, और चरण 1 जो कलाकृति माँगता है वह वह प्रकार है जो संक्रमण 2 को चिह्नित करता है; इसके अनुमति संकेत इसे एक सीमित रंग की सुरक्षा का कुछ हिस्सा देते हैं। कोहोर्ट एक विक्रेता-बाड़ के लिए स्तर-2 वातावरण में एक अलग सप्ताह का उपकरण नहीं करता है, इसलिए यह अनुभाग 10 का P5 परीक्षण नहीं कर सकता (कि एक सीमित मध्य रंग गैर-समापन और घटनाएं को कम करता है); वे अनुमति संकेत डिज़ाइन के एकमात्र सीमित रंग हैं, और कमांड लाइन चरण 3 पर प्रवेश करती है। एक बाद का कोहोर्ट जो चैट और स्थानीय स्थापना के बीच एक स्पष्ट स्तर-2 सप्ताह डालता है वह P5 का स्वच्छ परीक्षण होगा।
चरण 2 (वेब ऑर्केस्ट्रेशन में, एजेंट से शुरू किया गया)। तैयार होने के बाद, प्रतिभागियों को एक ओपन-सोर्स उपकरण प्राप्त होता है जो एक प्रश्न को कई मॉडलों तक डालता है जिन सदस्यताओं के माध्यम से वे पहले से ही भुगतान करते हैं और एक एकल कार्रवाई में एजेंट के अंदर से एक विलीन उत्तर लौटाता है। चरण का उद्देश्य कवरेज और विश्वसनीयता के रूप में पहले से पंजीकृत किया गया था, दृश्यमान मतभेद दूसरे के लिए एक तंत्र के रूप में।
चरण 3 (CLI ऑर्केस्ट्रेशन में)। कमांड-लाइन इंटरफेस के माध्यम से समान ऑर्केस्ट्रेशन।
उपाय। पाँच फ्रीज किए गए मुख्य आइटम, प्रोग्राम के हर कोहोर्ट में समान रूप से शब्दबद्ध, व्यवसाय और कंप्यूटर पर घंटे, वर्तमान AI उपयोग, एक से अधिक AI से पूछने का पूर्व अनुभव, क्या और कैसे उत्तरों की जाँच की जाती है, और क्या कुछ पहले से ही व्यक्ति के कंप्यूटर पर कार्य करता है। हर प्रतिभागी के लिए एक चरण रिकॉर्ड दिनांक, चैटबॉट जिसने उन्हें गाइड किया, प्रयास और घंटे, कलाकृति के साथ समापन, सटीक स्टॉपिंग बिंदु और उनके अपने शब्दों में कारण, और क्या और कैसे जाँचकर्ता ने हस्तक्षेप किया रखता है। पहले महीने के लिए साप्ताहिक, प्रतिभागी एक कलाकृति की रिपोर्ट करते हैं जो उनके एजेंट ने उस हफ्ते (या "कुछ नहीं", जो एक वैध उत्तर है) तैयार की, वे कितनी बार एक प्रश्न को एक से अधिक AI तक डालते हैं और जवाब अलग होने पर क्या हुआ, और चरण 2 से ऐसा कुछ उपयोगी आया कि एक मॉडल ने छोड़ दिया और क्या जाँच करने से यह बदल गया कि वे किस पर भरोसा करते हैं। अवलोकन दिन 60 पर और उसके बाद तिमाही रूप से जारी रहते हैं, जब तक प्रतिभागी इच्छुक हैं।
विश्लेषण और व्याख्या। विश्लेषण वर्णनात्मक है। समापन अनुपात आत्मविश्वास अंतराल के साथ दिए जाते हैं जीवित रहने वाले और पूर्ण भाजक के विरुद्ध, अलग से बिना सहायता और सहायता प्राप्त समापन के लिए; समय और प्रयास वितरण के रूप में रिपोर्ट किए जाते हैं, और रुकने के कारणों को संग्रह के बाद कोडित किया जाता है, कोड और कच्चे शब्दों को जमा किया जाता है। एक व्याख्या नियम पहले से ही तय किया गया था। यदि चरण 1 सामग्री प्राप्त करने वाले आधे से कम लोग एक एजेंट-निर्मित कलाकृति की आपूर्ति करते हैं, तो कोहोर्ट को ऑनबोर्डिंग विफलता का अध्ययन के रूप में रिपोर्ट किया जाता है, और जो लोगों को रोकता है वह परिणाम बन जाता है।
निष्कर्ष की सीमाएँ। पंजीकरण पहले से ही बताता है कि कोई नियंत्रण शर्त नहीं है और इसलिए कोई कारणात्मक दावा नहीं है, और स्वयं-चयनित स्वयंसेवकों से परे कोई सामान्यीकरण नहीं है। एक प्रतिभागी का समय बचाने का अनुमान केवल विश्वास के रूप में रिपोर्ट किया जाता है, क्योंकि इस डोमेन में स्व-रिपोर्ट को सत्य दिशा को उलट करने के लिए दिखाया गया है (Becker et al., 2025)।
प्रकटीकरण और नैतिकता, जैसा कि पंजीकृत है। प्रतिभागियों को लिखित रूप में बताया जाता है कि मैंने सामग्री और उपकरण लिखे हैं, उन्हें पढ़ाता हूँ, और ऑर्केस्ट्रेशन विधि को कवर करने वाली लंबित पेटेंट आवेदनों पर आवेदक हूँ। कोई संस्थागत समीक्षा बोर्ड की राय नहीं मांगी गई: अध्ययन के पीछे कोई संस्थागत संबद्धता नहीं है और कोई संघीय निधि नहीं है। पंजीकरण इसके बजाय सुरक्षा उपायों को बताता है। सहमति लिखित है और कुछ भी रिकॉर्ड किए जाने से पहले दी जाती है। कोई स्वास्थ्य, वित्तीय या कार्य-सामग्री डेटा एकत्र नहीं किए जाते। प्रतिभागी अपनी मशीनों और सदस्यताओं पर काम करते हैं और सार्वजनिक जमा करने तक किसी भी बिंदु पर हटाने के लिए कह सकते हैं। सुरक्षा निर्देशों में एक अलग ब्राउज़र प्रोफ़ाइल, बैंकिंग या चिकित्सा साइटों पर कोई कार्रवाई नहीं, कुछ भी अपरिवर्तनीय करने से पहले पुष्टि, एजेंट में कोई पासवर्ड टाइप नहीं, और वेब सामग्री को डेटा के रूप में माना जाता है। कोई विकलांगता चर एकत्र नहीं किया जाता है और कोई पहुँच-सुविधा दावा नहीं किया जाता है।
9.3 केवल डिज़ाइन
कार्यक्रम से मैं केवल डिज़ाइन लेता हूँ, और कुछ नहीं। कोई प्रतिभागी संख्या, पूर्णता दर या व्यक्तिगत मामले यहाँ नहीं दिखाई देते, जानबूझकर निर्णय से: तर्क (यह पत्र), विधि और कार्यक्रम, और प्रोटोकॉल की प्रेक्षण अवधि के बाद के परिणाम अलग-अलग प्रकाशन हैं, ताकि तर्क को अपने लिए साक्ष्य के रूप में नहीं पढ़ा जा सके। अन्य शोधकर्ता अब समान नियम लागू कर सकते हैं। अनुलग्नक C में सूची C5 एक रिकॉर्ड प्रारूप और एक जाँचक देती है जो उन्हें एनकोड करते हैं। जाँचक एक रिकॉर्ड को अस्वीकार करता है जो स्थापना को एक क्रॉसिंग के रूप में गिनता है, एक एजेंट-निर्मित कलाकृति के बिना पूर्णता, व्यक्ति के अपने शब्दों के बिना एक रोक, एक वास्तविक नाम एक छद्म नाम लेबल की जगह, एक क्षेत्र जो प्रारूप नहीं जानता है, या एक छोड़ा हुआ स्तर जो ठीक वैसे ही दर्ज नहीं है जैसे छोड़ा गया।
9.4 एक मजबूत अगला अध्ययन कैसा दिखता है
समूह एक व्यावहार्यता अध्ययन है, और अनुभाग 10 के अधिकांश प्रस्ताव अन्य डिज़ाइन की आवश्यकता रखते हैं। एक मजबूत अगला अध्ययन दो ऑनबोर्डिंग स्थितियों की तुलना करेगा जो काम को कैसे प्रस्तुत करते हैं इसमें भिन्न होती हैं, कार्य जोखिम और तकनीकी पर्यावरण को जितना संभव हो उतना स्थिर रखते हैं। एक स्थिति सुविधाएँ और स्थापना निर्देश प्रस्तुत करती है; दूसरी प्रतिभागी के अपने आवर्ती कार्य वस्तु के साथ शुरू होती है और अनुभाग 5.1 के पाँच-भाग नक्शे को निकालती है। परिणामों में कलाकृतियाँ, उनकी गुणवत्ता प्रतिभागी के अलावा किसी और द्वारा मूल्यांकित (रेटर के बीच समझौत के साथ रिपोर्ट किए गए, जैसे कि रोक कारणों की कोडिंग के लिए), समय, खोजी गई त्रुटियाँ, परिदृश्य रूप में अनुमति निर्णय, बाद में स्वैच्छिक पुन: उपयोग, और विश्वास परिणामों के विरुद्ध मापा जाता है शामिल होंगे। एक अनुवर्ती शोधकर्ता के साथ निरंतर संपर्क से दृढ़ता को अलग करेगा। एक दूसरा अध्ययन पूछेगा कि क्या कार्यप्रवाह शब्दावली एक व्याकरण है या एक प्रति पेशा, प्रशासनिक, अनुसंधान, संचार और विश्लेषणात्मक कार्यों की तुलना करके। मैं नहीं जानता कि यह क्या है, और उत्तर तय करता है कि क्या पैकेज किए गए उदाहरण एक बार लिखे जा सकते हैं या प्रत्येक क्षेत्र के लिए लिखे जाने चाहिए। दोनों अध्ययनों को एक सत्यापित साधन (Carolus et al., 2023) के साथ AI साक्षरता को आधारभूत करना चाहिए, ताकि विशिष्ट अंतर, यह जानना कि एजेंट को क्या सौंपना है, AI से सामान्य परिचितता से अलग किया जा सके। ऐसे प्रत्येक अध्ययन को कार्यान्वयन को भी प्रलेखित करना चाहिए, क्योंकि एक प्रतिभागी जो बाद के इंटरफेस पर शुरू होता है विभिन्न डिफ़ॉल्ट से मिलता है: इंटरफेस संस्करण, ऑपरेटिंग सिस्टम, क्या एजेंट को नेटवर्क पहुँच थी, अनुमति मोड, और कोई नीति बाधा। अकेले विक्रेता का नाम एक बाद के पाठक को बहुत कम बताता है।
10. प्रस्ताव
खंड 3 का मॉडल और खंड 4 से 8 तक का तर्क ऐसे दावे निहित करते हैं जो विफल हो सकते हैं। तालिका 7 उनमें से पंद्रह को बताती है, प्रत्येक के साथ एक माप, एक परिणाम जो इसे गलत साबित करेगा, और कौन परीक्षा चलाने के लिए तैनात है। ये पूरे क्षेत्र के लिए लिखे गए हैं। खंड 9 का कार्यक्रम, एक तो, केवल कुछ का परीक्षण कर सकता है; कई अन्य विक्रेता टेलीमेट्री के साथ, सर्वेक्षण पैनलों के साथ या एक संगठन में एक छोटे अध्ययन के साथ परीक्षण किए जा सकते हैं। कोई भी समूह की खोज नहीं है।
तालिका 7। प्रस्ताव, माप, अस्मिता और जो उन्हें परीक्षण कर सकते हैं।
| # | प्रस्ताव | माप | यदि गलत साबित हो | कौन इसे चला सकता है |
|---|---|---|---|---|
| P1 | बाधा माइग्रेशन। गैर-प्रोग्रामर्स में जो संक्रमण 2 का प्रयास करते हैं, स्टॉप क्लस्टर इंस्टॉलेशन के बाद (पहले कार्य पर, पहली त्रुटि पर, या अनुमतियों पर) इसके दौरान की तुलना में अधिक, और जिन्होंने इंस्टॉल किया है और कुछ नहीं बनाया है, "मुझे नहीं पता कि क्या पूछना है" तकनीकी, अनुमति और लागत कारणों को संख्या में पार करता है; और, कार्य कठिनाई को स्थिर रखते हुए, पूर्णता एक स्तर के भीतर की तुलना में तीन संक्रमणों पर अधिक तेजी से गिरती है। | कलाकृति नियम के साथ रिकॉर्ड किए गए स्टॉप बिंदु; व्यक्ति के अपने शब्दों में कारण, परिशिष्ट A के नियम द्वारा कोडित; चरण के अनुसार पूर्णता | अधिकांश स्टॉप एजेंट के पहले चलने से पहले होते हैं, या तकनीकी और अनुमति कारण स्थापित गैर-निर्माताओं में प्रमुख होते हैं, या पूर्णता और विफलता पैटर्न सभी चरणों में तुलनीय होते हैं जब कार्य कठिनाई को नियंत्रित किया जाता है | खंड 9 का कार्यक्रम; कोई भी प्रतिकृति |
| P2 | सतह विलय। जहाँ विक्रेता चैट और एजेंट सतहों को मिलाते हैं, सत्र का शेयर जो एजेंट-निर्मित फ़ाइल या कार्य में समाप्त होता है बिना उपयोगकर्ता जो कहते हैं कि वे क्या करना चाहते हैं इसमें कोई परिवर्तन के साथ बढ़ता है; और अग्रणी सहायक 2027 के अंत तक डिफ़ॉल्ट विंडो से उपयोगकर्ता-चुनी गई मोड के बिना फ़ाइल-लिखते हैं। | विलय से पहले और बाद में विक्रेता टेलीमेट्री; सहायकों की एक दिनांकित जनगणना | शेयर विलय के बाद सपाट रहता है; या एक स्थिर, उपयोगकर्ता-चुनी गई एजेंट मोड फ़ाइलों को लिखने के लिए एक पूर्वापेक्षा बनी हुई है | विक्रेता; कोई भी जो आवेदन खोल सकता है |
| P3 | शब्दावली स्थापना पर। लोगों को अपने क्षेत्र से काम किए गए उदाहरण (पैकेज किए गए कार्य, कौशल, टेम्पलेट) देने से स्तर 2 और 3 पर दृढ़ता अधिक बढ़ती है स्थापना सहायता देने से, और कार्यप्रवाह शब्दावली का एक संरचित माप पहुंच और पूर्व AI उपयोग को नियंत्रित करने के बाद कलाकृति पूर्णता की भविष्यवाणी करता है। | दोनों प्रकार की सहायता के तहत दिन-60 दृढ़ता, असाइनमेंट के साथ तुलना में; खंड 5.1 के पाँच भागों की पूर्व-कार्य घोषणा; परिशिष्ट A के नियम द्वारा कोडित स्टॉप कारण | स्थापना सहायता समान या अधिक दृढ़ता का उत्पादन करती है; शब्दावली माप मॉडल में स्थापना सहजता और सामान्य आत्मविश्वास के बाद कुछ नहीं जोड़ता है | दो ऑनबोर्डिंग मार्गों वाली कोई भी प्रयोगशाला |
| P4 | प्रतिवर्ती ऑनबोर्डिंग। जिन लोगों को उनके द्वारा पहले से उपयोग किए जा रहे चैटबॉट द्वारा निर्देशित किया जाता है, वे स्तर 1 से स्तर 3 तक बिना सहायता के एक दर पर पार कर सकते हैं जो मार्ग को व्यावहारिक बनाता है, और स्थिर प्रलेखन दिए गए लोगों की तुलना में पहली कलाकृति तक पहुंचते हैं। | एजेंट-निर्मित कलाकृति के साथ संक्रमण 2 को पूरा करने का अनुपात सभी के विरुद्ध जिन्होंने सामग्री प्राप्त की; निर्देशित और स्थिर स्थितियों के तहत पहली कलाकृति का समय | आधे से कम इसे पूरा करते हैं, थ्रेशोल्ड खंड 9 में अग्रिम रूप से तय किया गया; या स्थिर प्रलेखन समान या उच्च पूर्णता देता है | खंड 9 का कार्यक्रम; दो समूहों वाले प्रशिक्षक |
| P5 | बीच की सीढ़ी। गैर-प्रोग्रामर्स जो एक स्थानीय एजेंट से पहले एक विक्रेता-घिरे वातावरण में समय बिताते हैं, संक्रमण 2 को अधिक बार पूरा करते हैं, कम फ़ाइल-हानि की घटनाओं हैं, और चैट से व्यापक स्थानीय पहुंच तक सीधे स्थानांतरित लोगों की तुलना में दायरे, प्रतिवर्तनीयता और वर्धन के बारे में बेहतर कारण देते हैं। | समान अनुवर्ती के साथ दो-मार्ग समूह; प्राथमिक परिणाम के रूप में कलाकृति; एक घटना लॉग; पहले और बाद में परिदृश्य-आधारित अनुमति निर्णय | चैट से सीधे स्थानीय एजेंट तक असंबद्ध पूर्ण करना स्तर 2 से गुजरने वालों से मेल खाते हैं, तुलनीय घटना दरों पर और समान अनुमति निर्णयों के साथ | दो ऑनबोर्डिंग मार्गों वाली कोई भी प्रयोगशाला; कार्यक्रम का एक बाद का समूह |
| P6 | अड़चन। गैर-प्रोग्रामर्स में जो साप्ताहिक रूप से चैट का उपयोग करते हैं, एक तिमाही में स्तर-3 कलाकृति का उत्पादन करने वाले शेयर कोडिंग एजेंटों का उपयोग करने वाले डेवलपर्स के शेयर से बहुत नीचे रहते हैं साप्ताहिक रूप से। | "क्या आप AI का उपयोग करते हैं" के बजाय कलाकृति आइटम का उपयोग करके एक प्रतिनिधि सर्वेक्षण (खंड 11.3) | गैर-प्रोग्रामर ज्ञान कार्यकर्ताओं में स्तर-3 कलाकृति उत्पादन डेवलपर्स की साप्ताहिक-उपयोग आकृति के पास आता है | राष्ट्रीय सांख्यिकीय कार्यालय; सर्वेक्षण घर |
| P7 | पुल ले जाता है। लोग जो वेब ऑर्केस्ट्रेशन का अभ्यास करते हैं बाद में CLI ऑर्केस्ट्रेशन को अपनाने की अधिक संभावना रखते हैं लोगों की तुलना में जो नहीं करते, और दृश्यमान असहमति बाद में स्रोत एट्रिब्यूशन या उनके कार्य रिकॉर्ड में आलोचना की भविष्यवाणी करती है। | उन लोगों में CLI ऑर्केस्ट्रेशन का अपनाना जिनके पास और बिना पूर्व वेब तुलना के; बचाई गई तुलनाएं और बाद के रिकॉर्ड | कोई अंतर नहीं, या विपरीत; तुलना अधिक संकेत का उत्पादन करती है और बनाए गए चेक में कोई परिवर्तन नहीं | खंड 9 का कार्यक्रम; अनुदैर्ध्य पैनल |
| P8 | CLI स्थायित्व। लोगों के लिए जो दो या अधिक उपभोक्ता सदस्यता के लिए भुगतान करते हैं, आधिकारिक कमांड-लाइन उपकरणों के माध्यम से ऑर्केस्ट्रेशन स्तर 4 का रूप है जो इंटरफ़ेस परिवर्तनों से बचता है, और फ़ाइल-समर्थित चलाता है ब्राउज़र-केवल चलाता है की तुलना में बेहतर पुन: चलाते हैं और अन्य समीक्षक को स्थानांतरित करते हैं। | उस जनसंख्या में स्तर-4 कलाकृतियों की एक दिनांकित जनगणना; एक इंटरफ़ेस परिवर्तन के बाद पुन: चलाने और स्थानांतरण परीक्षण | एक देर से-2027 की जनगणना वेब या प्रोग्रामिंग-इंटरफ़ेस परिषदों को प्रमुख खोजती है और CLI-से-CLI उपकरण पीछे की ओर; ब्राउज़र-केवल कार्यप्रवाह पुन: चलाने और स्थानांतरण पर मेल खाते हैं | उपकरण शोधकर्ता; डेवलपर सर्वेक्षण |
| P9 | संबंधित सहमति। विक्रेता परिवारों में, ज्ञात उत्तरों के साथ ज्ञान-कार्य आइटम पर त्रुटियां पर्याप्त रूप से संबंधित होती हैं कि तीन या अधिक मॉडल के बीच सहमति दो स्वतंत्र विचारों (rho से कम के लायक है लगभग 0.5, जहाँ rho ज्ञात उत्तरों के साथ ज्ञान-कार्य आइटम पर अनुमानित है और बेंचमार्क सहमति दरों से नहीं लिया गया); विभिन्न परिवारों की एक छोटी परिषद एक परिवार की बड़ी परिषद को समान लागत पर हराती है; और स्रोत-जागरूक समीक्षा बहुमत सहमति की तुलना में सही होने की बेहतर भविष्यवाणी करती है। | आइटम बैंकों पर परिवारों के पार पेयरवाइज़ त्रुटि सहसंबंध ज्ञात उत्तरों के साथ (सूची C4); दो काउंसिल डिज़ाइनों के साथ एक चिह्नित आइटम सेट; बहुमत समझौते के विरुद्ध सही होना और स्रोत-जागरूक समीक्षा के विरुद्ध | अधिकांश कार्य प्रकारों के लिए rho 0.2 से नीचे मापा गया; एक दावा-दर-दावा जांच के बाद समान-परिवार काउंसिल जीतती है; या सरल बहुमत समझौता सही होना की भविष्यवाणी विविधता और सत्यापन से भी अच्छी तरह या बेहतर करता है | भाषा-मॉडल शोधकर्ता; साथी पत्र का प्रोटोकॉल |
| P10 | प्रबंधक की दक्षता। स्तर 3 और 4 पर दृढ़ता किसी व्यक्ति की प्रतिनिधिमंडन अनुबंध (लक्ष्य, सीमा, कलाकृति, जांच) को बताने की क्षमता से और पर्यवेक्षण निशानों (योजनाएं अस्वीकृत, अंतर अस्वीकृत, दूसरी राय ली गई) से बेहतर भविष्यवाणी की जाती है बजाय पूर्व तकनीकी अनुभव या प्रॉम्प्ट मात्रा के। | एक छोटा कार्य जो चार भागों को उजागर करता है, अंधे तरीके से स्कोर किया गया; आधारभूत आइटम; स्वीकृति रिकॉर्ड से निशान; दिन 60 पर दृढ़ता | पूर्व तकनीकी अनुभव या प्रॉम्प्ट मात्रा दृढ़ता की भविष्यवाणी उतनी अच्छी या बेहतर करती है, और अनुबंध-कथन कुछ नहीं जोड़ता; या स्तर 3 और 4 पर कलाकृतियां जो नियमित रूप से लक्ष्य, स्रोत, सीमा और जांच को छोड़ देती हैं, स्वतंत्र ऑडिट के तहत भरोसेमंद रहती हैं, जिस स्थिति में योग्यता संरचना अधिक निर्मित है | कोई भी अनुदैर्ध्य कलाकृति अध्ययन |
| P11 | कार्य वर्ग द्वारा अंशांकन। लोग प्रतिनिधिमंडन को बेहतर तरीके से अंशांकित करते हैं जहां प्रतिक्रिया तेज़ और उलट संभव है, कार्य वर्ग द्वारा अलग-अलग स्वीकार, सुधार और संवर्धन करते हैं। | कार्य वर्ग द्वारा स्वीकृति, सुधार, संवर्धन और बाद में त्रुटि की खोज | अंशांकन प्रतिवर्ती और उच्च-परिणाम कार्यों में समान है | प्रयोगशालाएं; स्वीकृति रिकॉर्ड वाली संगठनें |
| P12 | गार्ड से घर्षण। स्तर 3 पर गैर-प्रोग्रामर के बीच, अनुमति प्रॉम्प्ट द्वारा व्यवधान और सुरक्षा ब्लॉक को रोकने का कारण के रूप में अधिक बार नाम दिया जाता है डेवलपर्स के बीच, और वर्गीकारक-संरक्षित स्वायत्तता ऐसे रुकने को कम करती है बिना रिपोर्ट किए गए फ़ाइलों के नुकसान में वृद्धि के। | समूह द्वारा कोडित स्टॉप कारण; डिफ़ॉल्ट मोड में परिवर्तन से पहले और बाद में स्टॉप दरें और घटना रिपोर्ट | समूहों के बीच कोई अंतर नहीं, या स्वायत्तता रिपोर्ट किए गए नुकसान बढ़ाती है | विक्रेता; प्रोग्राम के कोडित स्टॉप कारण |
| P13 | अंतर दोहराता है। लिंग और शिक्षा द्वारा चैट अपनाने में अंतर (Cranney et al., 2026; Daepp & Counts, 2024) कम से कम व्यवसायों के भीतर स्तर-3 कलाकृति उत्पादन में उतने ही बड़े पुनः प्रकट होते हैं। | व्यवसायों के भीतर स्तर-3 कलाकृति उत्पादन में अंतर | एक व्यवसाय के भीतर अनुमान दिखाता है कि अंतर स्तर 3 पर बंद हुआ | श्रम अर्थशास्त्री; बाद के कोहर्ट यदि काफी बड़े हों |
| P14 | आलोचक और दूसरा परिवार। एक समान-परिवार आलोचक जल्दबाजी और छोड़ी गई जांचों को पकड़ता है; एक दूसरा परिवार साझा त्रुटि को पकड़ता है; एक दोष-लेबल सेट पर प्रत्येक ऐसी खामियां योगदान देता है जो दूसरा मिस करता है। | समान लागत पर एक समान-परिवार आलोचक और एक दूसरे-परिवार समीक्षक के बीच पुष्टि की गई खोजों का ओवरलैप | पूर्ण ओवरलैप, या एक स्रोत हावी है | कोई भी दो एजेंट उपकरण और एक लेबल किए गए सेट के साथ |
| P15 | क्षमता या शब्दावली। समान कार्य वर्ग पर, स्तर 2 और 3 पर दृढ़ता किसी व्यक्ति की प्रतिनिधिमंडन अनुबंध को बताने की क्षमता के साथ बदलती है; यदि मॉडल क्षमता बाध्यकारी बाधा थी, तो दृढ़ता कार्य वर्गों के बीच भिन्न होती और एक के भीतर व्यक्तियों में समान होती। | कार्य वर्ग द्वारा दृढ़ता, प्रतिनिधिमंडन अनुबंध के अंधे-स्कोर किए गए कथन के साथ पार की गई | एक कार्य वर्ग के भीतर, दृढ़ता व्यक्तियों में समान है, भले ही उनका अनुबंध स्कोर कुछ भी हो, और केवल वर्गों के बीच भिन्न होती है | कोई भी अध्ययन जो कार्य वर्ग और अनुबंध कथन दोनों को रिकॉर्ड करता है |
उनमें से कुछ बाकी से अधिक मायने रखते हैं। P4 नीति के लिए सबसे भारी वजन करता है, क्योंकि यदि प्रतिबिंबात्मक ऑनबोर्डिंग काम करती है, तो लोगों को एजेंट सिखाने का सबसे महंगा हिस्सा (स्थापना के दौरान उनके बगल में बैठना) उस उपकरण से प्रतिस्थापित किया जा सकता है जो उनके पास पहले से है। P5 वह है जो कोहर्ट परीक्षण नहीं कर सकता, जैसा कि अनुभाग 9.2 कहता है, और यह वह भी है जिस पर सीढ़ी का आकार सबसे अधिक निर्भर है। क्या मध्य रंग अपनी जगह कमाता है यह कुछ ऐसा है जो मुझे अभी तक नहीं पता। P9 परीक्षण करने के लिए सबसे आसान है और काउंसिल के उपयोगकर्ताओं को सबसे अधिक हैरान करने की संभावना है, क्योंकि सहसंबद्ध साक्ष्य (Chernets, 2026a) का अंकगणित और Kim et al. (2025) के माप दोनों सहमति के लायक क्या है इस पर एक सीमा की ओर इशारा करते हैं। P10 वह है जो पाठ्यक्रम को बदल देगा। यदि प्रतिनिधिमंडन अनुबंध को बताने की क्षमता तकनीकी पृष्ठभूमि से बेहतर दृढ़ता की भविष्यवाणी करती है, तो प्रशिक्षण को पहले प्रतिनिधिमंडन सिखाना चाहिए और दूसरा उपकरण सिखाना चाहिए।
11. निहितार्थ
11.1 विक्रेताओं के लिए
खाली फोल्डर के लिए डिज़ाइन करें। विक्रेताओं ने इंस्टॉलर को सरल बनाया है, और यह दिखता है। मुझे लगता है कि इस प्रयास का एक और दौर बर्बाद होगा, क्योंकि नए उपयोगकर्ता की समस्या अब इंस्टॉलर के बाद शुरू होती है, एक खाली फोल्डर के सामने जहाँ एजेंट को कहने के लिए कुछ नहीं है। व्यक्ति के अपने क्षेत्र से कार्य किए गए उदाहरण, जो उन्हें एजेंट को पहली बार खोलने के समय दिए जाएँ, साथ ही एक पहला कार्य जो वास्तविक है, कम जोखिम में है और कुछ ऐसा समाप्त करता है जिसका वे मूल्यांकन कर सकते हैं, सेटअप के किसी भी आगे सरलीकरण की तुलना में अपनाने के लिए अधिक करेंगे। पैकेज किए गए कौशल पहले से ही इस दिशा की ओर संकेत करते हैं (खंड 5.1)। दो चीजें अभी भी गायब हैं: यह चुनने में मदद कि क्या किसी व्यक्ति का कौन सा कार्य सौंपने लायक है, और एक पेशेवर संघ के लिए, न कि केवल एक स्टार्टअप के लिए, अपने सदस्यों के लिए कौशल लिखने का एक तरीका।
अगले विलय के बाद टैब को जो भी नाम दिया जाए, एक व्यक्ति को प्रतिनिधिमंडल के समय एक स्पष्ट उत्तर की आवश्यकता है और चुने गए फोल्डर की भाषा में, प्रश्नों की एक संक्षिप्त सूची के लिए: यह एजेंट क्या पढ़ सकता है, यह क्या बदल सकता है, यह क्या भेज या ट्रिगर कर सकता है, इसे मेरी मंजूरी की आवश्यकता होगी, और मैं इसे कैसे रोकूँ? एक दृश्य अंतर इसका कुछ उत्तर देता है जब फाइलें बदलती हैं, और एक लिखित योजना करती है जब कार्य विविध होते हैं; एक सहमति बैनर इसका कोई उत्तर नहीं देता। अनुमति मॉडल को विलय के बाद दृश्यमान, स्कोप किया गया और प्रतिवर्ती रहना चाहिए, एक पूर्ववत करने और एक स्टॉप बटन के साथ जो काम करता है। फोल्डर स्कोप बिना दोनों के खंड 5.3 की समस्या रिपोर्टों की तरह पढ़ा जाता है।
काम को भी उत्पाद को छोड़ने में सक्षम होना चाहिए। एक उपयोगकर्ता को कार्य निर्देश, इनपुट या उनके पहचानकर्ता, उपकरण क्रियाएँ, आउटपुट और अनुमोदन इतिहास निर्यात करने में सक्षम होना चाहिए। यह एक शासन सुविधा जितना ही एक प्रयोज्यता सुविधा है, क्योंकि यह नए उपयोगकर्ता को एक पूर्ण कार्य से सीखने देता है और एक दल को अपनी स्मृति को एक मालिकाना चैट इतिहास में देने के बिना एक परिणाम की समीक्षा करने देता है। उपयोग को समान तरीके से रिपोर्ट किया जाना चाहिए। एक एजेंट के "साप्ताहिक सक्रिय उपयोगकर्ता" जो फाइलें बनाता है, उन्हें उन लोगों में विभाजित किया जाना चाहिए जिन्होंने एक फाइल बनाई है और जिन्होंने एप्लिकेशन खोला है, और विक्रेताओं के पास ऐसा करने के लिए दूरसंचार है।
हमलों का पता लगाना शौकिया के लिए एक काम नहीं है। मार्गदर्शन जो गैर-प्रोग्रामर को प्रॉम्प्ट इंजेक्शन के संकेतों को पहचानने के लिए कहता है, सबसे कठिन निर्णय को उस व्यक्ति पर रखता है जो इसे बनाने में सबसे कम सक्षम है (खंड 5.3)। सुरक्षित डिफ़ॉल्ट (कार्य प्रतियाँ, बड़े परिवर्तनों से पहले स्नैपशॉट, विनाशकारी आदेश स्पष्ट रूप से अनुमति दिए जाने तक अस्वीकृत, वेब सामग्री को डेटा के रूप में माना जाता है) उत्पाद के हैं। साथ ही, गार्ड जो लगातार बाधित करते हैं काम को उतना ही रोकते हैं जितना गायब गार्ड फाइलें खो देते हैं, और निरीक्षण अतिक्रमण पर साथी पत्र वर्णन करता है कि कैसे ऐसी परतें बढ़ती हैं (Chernets, 2026b)।
प्रोवेनेंस को उत्तरों के विलय को जीवित रहना चाहिए। सभा सुविधाएं जो एक विलीन उत्तर लौटाती हैं, यह दिखाना चाहिए कि कौन सा मॉडल क्या कहता है और कहाँ वे असहमत हैं, उपयोगकर्ता को एक मॉडल को आलोचक की भूमिका निर्दिष्ट करने दें, और एक साक्ष्य अंतर को एक प्रवाह सहमति पैराग्राफ से खोजना आसान बनाएँ। स्रोतों के बिना एक विलीन आवाज एक एकल आत्मविश्वासी उत्तर का अधिकार पुनः स्थापित करता है, स्वचालन पूर्वाग्रह को पुरस्कृत करता है और त्रुटियों के सहसंबंध को छुपाता है (खंड 6.3)।
अंत में, चर्न का उपयोगकर्ता के पक्ष पर एक लागत है। एक व्यक्ति जिसने एक साल के भीतर एक उपकरण सीखा जो नाम बदला, विलय या सेवानिवृत्त किया गया, दो बार भुगतान करता है, इसलिए स्थिर नाम, माइग्रेशन गाइड और उत्पाद परिवर्तन के पार निर्देश फाइलों की निरंतरता स्वयं में अपनाने की सुविधाएँ हैं।
11.2 नियोक्ताओं और प्रशिक्षकों के लिए
मेनू से पहले प्रतिनिधिमंडल अनुबंध सिखाएँ। उत्पाद मेनू मासिक बदलते हैं, जबकि एक लक्ष्य बताने, काम को सीमित करने, कलाकृति का नाम देने और जांच का फैसला करने की क्षमता उपकरण (खंड 4.3 और 7.3) के पार स्थानांतरित होती है। एक संक्षिप्त अभ्यास जो किसी व्यक्ति को उनके अपने आवर्ती कार्यों में से एक के लिए चार भाग लिखने के लिए कहता है, सुविधाओं के दौरे से बेहतर तैयारी का परीक्षण करता है। अभ्यास में क्या है यह नीचे सेट किया गया है, अपघटन के तहत।
लॉगिन गलत चीज को मापते हैं। एक सक्रिय-उपयोगकर्ता गणना वह अंतर नहीं बना सकती जो खंड 9.1 को आवश्यकता था, समानार्थी शब्दों के लिए पूछने वाले व्यक्ति और एक रिपोर्ट को अधिकार देने वाले व्यक्ति के बीच। एजेंट द्वारा उत्पादित कलाकृतियों की गणना जिसे लोगों ने रखना चुना, यह बना सकती है।
लोगों को सीखने के लिए एक अनुमोदित स्थान और यह भी चाहिए कि क्या अनुमति है इसका नक्शा हो। संगठन पहले से ही लाइसेंस देता है उपकरणों के अंदर स्तर 2 उन कर्मचारियों तक पहुँचता है जिन्हें कभी भी एक कार्य लैपटॉप पर एजेंट स्थापित करने की अनुमति नहीं दी जाएगी (खंड 5.4)। स्तर 3 के लिए, एक स्पष्ट नीति, एक सैंडबॉक्स मशीन या एक अनुमोदित कॉन्फ़िगरेशन मूक "नहीं" को हटा देता है कि कई लोग मानते हैं। एक व्यापक प्रतिबंध व्यक्तिगत खातों के माध्यम से उपयोग को चलाता है जहाँ कोई भी इसे नहीं देख सकता, और बिना प्रतिबंध के प्रतिनिधिमंडन गोपनीय सामग्री को उजागर करता है। दोनों के बीच एक कार्य और डेटा वर्गीकरण है। यह कहता है कि कौन सा काम अनुमोदित वातावरण में प्रयास किया जा सकता है, किसे दूसरे व्यक्ति की समीक्षा की आवश्यकता है और कौन सा एजेंट से बाहर रखा गया है; यह नाम देता है कि कौन एक उपकरण को मंजूरी दे सकता है, स्वीकृति रिकॉर्ड कहाँ रहता है, और एक निकट मिस की रिपोर्ट कैसे की जाती है इसकी रिपोर्ट करने के लिए सजा के बिना। स्थानीय स्तर 3 को उन मशीनों पर आवश्यक नहीं होना चाहिए जिन पर कर्मचारी नियंत्रण नहीं करता, क्योंकि क्लाउड एजेंट और किरायेदार-स्कोप्ड स्तर 2 वह पथ हैं जो आईटी विभाग के साथ झगड़े से बचते हैं। एक बार विक्रेताओं ने चैट में पहली रनुंग को अवशोषित कर लिया, स्तर 2 दो नौकरियाँ रखता है। यह बंद मशीनों पर कर्मचारियों के लिए अनुमोदित स्थान है, और यह हर किसी के लिए अंशांकन रनुंग है, जहाँ एक व्यक्ति सीखता है कि अधिकृत कार्य का एक परिधि है इससे पहले कि इसके मालिक हों। क्या यह भी घटनाओं को कम करता है यह P5 है।
जनादेश को सावधानी की आवश्यकता है। AI का उपयोग एक कार्य क्षमता मानदंड बनाना बिना मूल्य के उपयोग का उत्पादन कर सकता है, और कम से कम एक नियोक्ता जिसने ऐसा किया वह एक साल के भीतर निर्णय को पलट गया (Fortune, 2026b)। कलाकृतियों के लिए पूछना जो काम के लिए महत्वपूर्ण हैं उपयोग के लिए पूछने से बेहतर संकेत है। एक बार मासिक, "एक फाइल दिखाएँ जो एक एजेंट ने एक फोल्डर में बनाई है जिसका आपने नाम दिया है" और "एक निर्णय दिखाएँ जिसे आपने बदला क्योंकि दो मॉडल असहमत थे" संक्रमण 2 और 3 को मापता है, जो एक लॉगिन गणना नहीं कर सकती। बिना कलाकृति उपायों के स्तर पर प्रशिक्षण, चाहे कितने हज़ार नामांकित हों, किसी को नहीं बताएगा कि क्या संक्रमण 2 हुआ।
विघटन और सत्यापन को एक साथ पढ़ाया जाना चाहिए, और आलोचक की आदत परिषद से पहले। एक सामान्य संकेत पाठ्यक्रम स्तर-1 शिक्षाशास्त्र है। स्तर-2 और स्तर-3 शिक्षाशास्त्र उस काम से शुरू होता है जो व्यक्ति के पास पहले से है, एक विपणक का शुक्रवार पैकेज, मान लीजिए, या एक शिक्षक के असाइनमेंट का बैच, एक पुनः प्रयोग योग्य विघटन सिखाता है (अनुभाग 5.1 के पाँच भाग, रुकने के लिए एक शर्त के साथ) और फ़ोल्डर की एक प्रति पर त्रुटि पुनर्प्राप्ति सिखाता है। उसके बाद जो मूल्यांकन करना है वह यह है कि क्या व्यक्ति एक असुरक्षित निर्देश को पहचान सकता है, एक उल्टे परीक्षण का नाम बता सकता है, सबूत की जांच कर सकता है और सिस्टम को बंद कर सकता है। स्वीकृति बिंदुओं पर एक ही परिवार का आलोचक सदस्यता में कुछ भी खर्च नहीं करता है, और जब आलोचक चुप हो जाता है और निर्णय महंगा होता है तो एक दूसरा परिवार जोड़ा जाता है। द्रवता रुब्रिक के शीर्ष पर समन्वय कुछ भूमिकाओं के लिए सही गंतव्य है और सभी के लिए गलत पहले दिन की आवश्यकता है।
11.3 नीति के लिए
यूरोपीय संघ की AI साक्षरता का कर्तव्य AI सिस्टम के हर प्रदाता और परिनियोजक पर उनके कर्मचारियों के लिए लागू होता है। 2026 के संशोधनों के बाद, यह उन्हें पर्याप्त स्तर सुनिश्चित करने के बजाय "AI साक्षरता के विकास को समर्थन देने के लिए उपाय करने" की आवश्यकता है, और इसके पर्यवेक्षण और प्रवर्तन नियम 3 अगस्त 2026 से लागू होते हैं (यूरोपीय संघ, 2026; यूरोपीय आयोग, 2026ए, 2026बी)। संयुक्त राज्य में, श्रम विभाग की रूपरेखा "प्रभावी रूप से AI को निर्देशित करना" नाम देती है (यूएस श्रम विभाग, 2026), और OECD और यूरोपीय आयोग रूपरेखा में "AI प्रबंधित करें" नामक एक डोमेन है (OECD & यूरोपीय आयोग, 2026)। मैं एजेंटिक केस में उन शब्दों के लिए एक सामग्री का सुझाव देता हूँ: प्रतिनिधिमंडन अनुबंध के चार भाग, अनुभाग 8.1 के चार प्रथाएं जिनमें रद्द करना शामिल है, मॉडल की तुलना करने की आदत इस ज्ञान के साथ कि समझौता इसके दिखने से कमजोर सबूत है, और अनुभाग 5.3 की बुनियादी सुरक्षा प्रथाएं। मार्गदर्शन को संवादात्मक उपयोग को प्रतिनिधिमंडित कार्रवाई से अलग करना चाहिए। उत्तरार्द्ध के लिए, कर्तव्य को अनुमति दायरा, डेटा वर्गीकरण, सत्यापन, घटना रिपोर्टिंग और रद्दकरण को कवर करना चाहिए, और प्रतिनिधिमंडित कार्यों के लिए आवश्यक भूमिका-विशिष्ट क्षमता और प्राधिकार का दस्तावेज़ करने की आवश्यकता सभी को समान रूप से प्रशिक्षित करने की आवश्यकता की तुलना में अधिक रक्षणीय है। नियामक और कार्मिक प्रतिनिधि यह भी पूछ सकते हैं कि क्या एक नियोक्ता ने अवशिष्ट जिम्मेदारी को कर्मचारियों पर स्थानांतरित कर दिया है बिना प्रयोग योग्य नियंत्रण, समीक्षा के लिए समय, या एक असुरक्षित प्रतिनिधिमंडन को अस्वीकार करने का अधिकार। यह सब एक नियामक साधन से निकाली गई एक डिजाइन और शासन सिफारिश है, और इसका दायरा वह साधन है।
यूरोपीय कर्तव्य एक नियमन विरोधी दौर से बच गया, और यहाँ चर्चा की गई रूपरेखाओं में यह एकमात्र क्षैतिज दायित्व है जो कर्मचारियों के हर सदस्य को कवर करता है जो AI का उपयोग करता है। संयुक्त राज्य में, ढाँचा कार्यबल नीति है। अप्रैल 2025 की एक कार्यकारी आदेश AI शिक्षा पर और जुलाई 2025 की AI कार्य योजना AI साक्षरता और कौशल का विस्तार करने के लिए प्रतिबद्ध है, जिसमें मार्गदर्शन है कि AI साक्षरता कार्यक्रम नियोक्ता-प्रदान की गई शैक्षिक सहायता के रूप में योग्य हो सकते हैं (श्वेत पक्ष, 2025ए, 2025बी); ढाँचा एजेंटों के प्रबंधकों को प्रशिक्षित करने के साथ संगत है और इसे अभी तक आवश्यक नहीं है। कोई भी आधिकारिक पाठ जाँची गई टर्मिनल एजेंटों या ऑर्केस्ट्रेशन का नाम नहीं देता, इसलिए "AI प्रबंधित करें" को चैटबॉट शिष्टाचार या स्तर-4 दिशा के रूप में पढ़ा जा सकता है। साक्षरता कार्यक्रम जो संकेत पर बंद हो जाते हैं स्तर 1 सिखाते हैं। काम, इतने समय में, स्तर 2 से 4 में चल रहा है। आधिकारिक पाठ अभी तक इसका पालन नहीं करते हैं।
सांख्यिकीय एजेंसियां अपने सर्वेक्षणों में AI मॉड्यूल जोड़ सकती हैं एक विशिष्ट परिवर्तन में मदद कर सकते हैं। "क्या आपने एक चैटबॉट का उपयोग किया है" एक स्तर-1 आइटम है। "क्या एक सिस्टम जिसे आपने निर्देशित किया है एक कंप्यूटर पर फ़ाइलें बनाई या बदली हैं जिसे आप पिछले सात दिनों में काम के लिए उपयोग करते हैं" एक स्तर-2 या स्तर-3 आइटम है। "क्या आपने पिछले सात दिनों में एक से अधिक AI सिस्टम के लिए एक ही काम का सवाल रखा है, और क्या उत्तर अलग थे" एक स्तर-4 आइटम है। इस तरह की आइटमों के बिना, P6 को सार्वजनिक डेटा में परीक्षण नहीं किया जा सकता, और एजेंटिक स्तर पर दूसरे स्तर का डिजिटल विभाजन उन लोगों के लिए अदृश्य रहेगा जिनका काम इसे देखना है।
11.4 शोधकर्ताओं के लिए
अनुभाग 2.5 के अंतराल एक एजेंडा हैं। नाम के अनुसार टर्मिनल और डेस्कटॉप एजेंटों का उपयोग करने वाले गैर-प्रोग्रामर का अध्ययन करें, कलाकृतियों के रूप में परिणामों के साथ। प्रतिफलित ऑनबोर्डिंग को एक तंत्र के रूप में अपने आप में अध्ययन करें। वेब ऑर्केस्ट्रेशन को एक अभ्यास के रूप में अध्ययन करें, जिसमें यह शामिल है कि लोग उत्तरों का सामंजस्य कैसे करते हैं और क्या वे प्रामाणिकता रखते हैं। ज्ञान-कार्य कार्यों पर विक्रेता परिवारों में त्रुटियों के सहसंबंध को मापें, और कोड और गणित के बेंचमार्क से अधिक। AI उपयोग में मापी गई लैंगिक और व्यावसायिक अंतराल को विस्तारित करें (क्रेनी एट अल., 2026; हम्लुम & वेस्टरगार्ड, 2025) एजेंटिक स्तरों तक, जहाँ कुछ भी अभी तक ज्ञात नहीं है (P13)। दो आसान मेट्रिक्स, सुविधा उपलब्धता और स्व-रिपोर्ट किए गए समय बचाए गए, कलाकृति पूर्णता, ऑडिट की गई गुणवत्ता, सुधार दरें और बाद में पुनः उपयोग के पक्ष में प्रतिरोध के लायक हैं। त्याग को इसके तंत्र के साथ दर्ज किया जाना चाहिए। एक अनुमति संकेत पर एक रुकना एक इंटरफ़ेस समस्या हो सकती है, डेटा के बारे में एक समझदारीपूर्ण चिंता, एक नियोक्ता नियम, एक खोई हुई मशीन या एक कार्य बिना स्वीकृति मानदंड, और उन्हें "प्रतिरोध" में ढहना सभी को खो देता है। मूल्यांकन को विरोधी होना चाहिए, एक भ्रामक पृष्ठ के साथ, एक दस्तावेज़ में एक छिपा हुआ निर्देश, एक विरोधाभासी स्रोत, एक आंशिक उपकरण विफलता, या एक विश्वास करने योग्य गलत उत्तर जो कई मॉडल साझा करते हैं, क्योंकि प्रबंधक की भूमिका का मतलब कुछ भी है केवल अगर यह उन स्थितियों के तहत परिणामों में सुधार करता है। प्रतिकृति को मेरी सामग्री की कोई आवश्यकता नहीं है; इसे कलाकृति नियम, एक जमी हुई रोक-कारण प्रश्न, कार्यान्वयन का एक रिकॉर्ड, और एक दिनांकित उत्पाद जनगणना की आवश्यकता है। और हरों को प्रकाशित किया जाना चाहिए, क्योंकि एक अध्ययन जो केवल उन को रिपोर्ट करता है जो पार हो गए हम सड़क के बारे में कुछ नहीं बताता है।
12. क्षेत्र और सीमा शर्तें
यहाँ जो प्रस्तुत किया गया है वह एक मॉडल, साक्ष्य संश्लेषण और एक मापन डिज़ाइन है, और प्रत्येक निम्नलिखित तरीकों से सीमाबद्ध है।
समय। साक्ष्य 21 सितंबर 2026 तक चलता है। उत्पाद तथ्य दिनांकित हैं और समय के साथ पुराने हो जाएंगे। मॉडल पहुँच और भूमिका द्वारा परिभाषित है ताकि यह अधिक धीरी गति से पुराना हो।
भूगोल और स्रोत। अधिकांश अपनाने के आंकड़े संयुक्त राज्य अमेरिका से हैं; यूरोपीय आंकड़े वहाँ उद्धृत किए गए हैं जहाँ वे मौजूद हैं। कई मुख्य आंकड़े विक्रेताओं से आते हैं (कोडिंग एजेंटों का उपयोग, चैट और एजेंट को मर्ज करने के कारण, विक्रेता परीक्षण सेट पर इंजेक्शन दरें) और पाठ में विक्रेता डेटा के रूप में चिह्नित हैं। मैं उन्हें इसके लिए उपयोग करता हूँ कि विक्रेता अपने स्वयं के उत्पादों के बारे में क्या जान सकते हैं और उन्हें तदनुसार तौलता हूँ।
जनसंख्या। तर्क ऐसे पेशेवरों की चिंता करता है जिनका काम मुख्य रूप से कंप्यूटर पर है। जो लोग मुख्य रूप से फोन से काम करते हैं, या बिना किसी ऐसे कंप्यूटर के जिस पर उनका नियंत्रण हो, वे यहाँ वर्णित किसी से पहले एक बाधा का सामना करते हैं, और मॉडल उनके बारे में उस बाधा को नाम देने से अधिक कुछ नहीं कहता है (खंड 5.5)।
समूह के बारे में साक्ष्य। केवल पूर्वनिर्धारित डिजाइन का उपयोग किया जाता है। कार्यक्रम का कोई भी परिणाम यहाँ किसी भी दावे को सूचित नहीं करता है, और खंड 10 के प्रस्ताव इसके परिणाम ज्ञात होने से पहले कहे जाते हैं, ताकि उनका न्याय किया जा सके। एक समूह जिसके लिए अपने स्वयं के मशीन की आवश्यकता होती है, ऐसे लोगों को नमूना देता है जो एक एजेंट स्थापित कर सकते हैं; यह उपकरण पहुँच को प्रेरणा से अलग नहीं कर सकता है, और वह सीमा परिणामों के साथ यात्रा करती है।
आदर्शवादी क्षेत्र। मॉडल वर्णन करता है कि प्रत्येक स्तर एक व्यक्ति से क्या पूछता है। यह नहीं मानता है कि उच्च स्तर बेहतर हैं या कि सभी को चढ़ना चाहिए; बहुत से काम के लिए, स्तर 1 या 2 सही जगह है (खंड 8.2)। उच्च-परिणाम वाले काम, गोपनीय रिकॉर्ड, सुरक्षा-महत्वपूर्ण संचालन, समय-महत्वपूर्ण निर्णय और ऐसे कार्य जिनमें कोई निरीक्षणीय स्वीकृति मानदंड नहीं है, को सख्त व्यवस्था की आवश्यकता है, या प्रतिनिधित्व एजेंट उपयोग के बाहर पूरी तरह से रहते हैं।
समन्वय क्या जोड़ता है। एजेंट जोड़ने से कवरेज बढ़ सकता है, असहमति को उजागर कर सकता है और समीक्षा ट्रेल छोड़ सकता है। यह सहसंबद्ध त्रुटि, लागत, देरी और परिश्रम का झूठा रूप भी जोड़ सकता है। प्रतिनिधिमंडन जो स्थायी होता है, एक व्यक्ति को प्रक्रिया का निरीक्षण और परिवर्तन कर सकता है; क्या प्रक्रिया पर भरोसा योग्य है, यह एक अलग प्रश्न है।
साहित्य में क्या कमी है। खंड 2.5 के साहित्य खोज में गैर-प्रोग्रामर द्वारा टर्मिनल या डेस्कटॉप एजेंटों को अपनाने का कोई क्षेत्र अध्ययन नहीं मिला, वेब आर्केस्ट्रेशन के एक नामित अभ्यास का कोई अध्ययन नहीं मिला, एजेंटों को प्रबंधित करने के रूप में एक सक्षमता के साथ कोई उपचार नहीं जिसकी अपनी संरचना हो, और कोई अध्ययन नहीं कि कैसे एक AI प्रणाली एक व्यक्ति के एजेंटिक AI को अपनाने को आधार देती है। ये वह अंतराल हैं जो अध्ययन किया गया है, 21 सितंबर 2026 के अनुसार कहा गया है, और मैं बाजारों, उत्पादों या प्राथमिकता के बारे में कुछ नहीं कहता हूँ।
दावों की स्थिति। तालिका 8 तर्क के तत्वों पर श्रृंखला की आत्मविश्वास भाषा लागू करती है, ताकि एक पाठक देख सके कि प्रत्येक को कितनी दृढ़ता से माना जाता है।
तालिका 8। इस पत्र में दावों की स्थिति।
| तत्व | यहाँ इसे कैसे कहा जाता है | आधार |
|---|---|---|
| चार-स्तरीय मॉडल और कलाकृति नियम | परीक्षण किया जा रहा है (खंड 9 और 10) | संकल्पनात्मक; खंड 3 और परिशिष्ट A में निर्दिष्ट मार्कर |
| तकनीकी बाधा स्थापना और डेस्कटॉप चेहरे के लिए कम हुई है | डेटा इसे समर्थन करते हैं | एक-चरणीय इंस्टॉलर; "कोई टर्मिनल आवश्यक नहीं" दस्तावेज़; चार विक्रेताओं के स्तर-2 उत्पाद भेजे गए |
| टर्मिनल-विरासत एजेंट के अंदर ज्ञान कार्यकर्ता | विक्रेता-रिपोर्ट किए गए, दिशात्मक | 2 जून 2026 को विक्रेता आंकड़ों की प्रेस रिपोर्ट, एक विश्लेषक की सावधानी के साथ |
| विक्रेता चैट में संक्रमण 1 को अवशोषित कर रहे हैं | उत्पाद में देखा गया | Anthropic, 16 सितंबर 2026; OpenAI, 9 जुलाई 2026 |
| कार्यप्रवाह शब्दावली प्रमुख शेष बाधा के रूप में | एक मॉडल के रूप में प्रस्तावित; परीक्षण किया जा रहा है | अप्रत्यक्ष: प्रॉम्पटिंग अध्ययन; विक्रेताओं द्वारा विलय के लिए कहा गया कारण; कार्यक्रम की stop-reason वस्तु |
| पुल के रूप में वेब, टिकाऊ परत के रूप में CLI | परीक्षण किया जा रहा है (P7, P8) | अनुबंध, अनुमति वस्तुएँ, आधिकारिक प्लगइन; वेब इंटरफेस की भंगुरता |
| सहसंबद्ध त्रुटियाँ परिषद क्या खरीदती है, को सीमित करती हैं | डेटा इसे मॉडल मूल्यांकन पर समर्थन करते हैं; उपयोग में मापा जा रहा है | Kim et al. (2025); Chernets (2026a) |
| चिंतनशील अनुकूलन | लागू और मापा जा रहा है; कोई परिणाम रिपोर्ट नहीं किया गया | विक्रेता और पाठ्यक्रम अभ्यास (अवलोकन); कार्यक्रम का चरण 1 (मापन) |
| एजेंटों के प्रबंधक के रूप में भूमिका | व्यवहार का विवरण के रूप में प्रस्तावित; परीक्षण किया जा रहा है (P10) | प्रतिनिधिमंडन अध्ययन; नियोक्ता रूब्रिक्स; आधिकारिक साक्षरता ढाँचे |
| समूह पार दरें | रिपोर्ट नहीं किया गया | प्रोटोकॉल स्थिर; परिणाम पत्र अनुसरण करने के लिए |
| "अभी काम करता है" एक वादे के रूप में | दावा नहीं किया गया | इस पत्र के दायरे से बाहर |
13. निष्कर्ष
टर्मिनल पहले साधारण पेशेवरों और एजेंटिक AI के बीच की बाधा का स्पष्ट चित्र हुआ करता था, और कुछ समय के लिए यह एक उचित तुलना थी। 2026 में यह अब फिट नहीं बैठता। इंस्टालेशन एक कमांड या क्लिक से हो जाता है, जिस चैटबॉट का कोई व्यक्ति पहले से उपयोग करता है वह उन्हें इसमें गाइड कर सकता है, और विक्रेता चैट और एजेंट को एक ही सतह में मर्ज कर रहे हैं। जो धारा 4 और 5 दिखाते हैं वह एक बाधा है जो आगे बढ़ गई है। पहला सीमित प्रयास बहुत आसान हो गया है; जो कठिन रहता है वह पूरे कार्यों पर विश्वसनीय काम प्राप्त करना, उन उत्पादों के साथ तालमेल रखना जो किसी के पैरों के नीचे बदलते हैं, और एक प्रदत्त फ़ोल्डर को सुरक्षित रखना है। एक विक्रेता की आकृतियों पर, प्रेस के माध्यम से रिपोर्ट की गई और दिशात्मक के रूप में पढ़ी जाने वाली, प्रति सप्ताह लगभग दस लाख ज्ञान कर्मचारी पहले से ही एक टर्मिनल-विरासत कोडिंग एजेंट के अंदर हैं। इस बीच, अधिकांश पेशेवर अभी भी AI को केवल एक बातचीत के रूप में ही जानते हैं।
जो अब अवरोधक है वह प्रबंधक का काम है: यह जानना कि क्या सौंपना है, इसे घेरना, परिणाम का नाम देना और यह तय करना कि इसकी जांच कैसे करनी है, फिर एक वातावरण को सुरक्षित रूप से चलाना और मॉडलों की तुलना करना जबकि याद रखना कि उनकी सहमति उससे कमजोर साक्ष्य है जो दिखता है। धारा 3 के चार स्तर उस काम को एक संरचना देते हैं जिसे कोई उत्पाद नहीं रखता, और अनुमति नियम इसे माप की एक इकाई देता है। मैंने अंतिम स्तर (P7) के लिए पुल के रूप में वेब ऑर्केस्ट्रेशन का प्रस्ताव दिया है और इसके रूप को CLI ऑर्केस्ट्रेशन के रूप में दिया है जो स्थायी है (P8); दोनों को इस तरह कहा जाता है कि वे विफल हो सकते हैं।
संक्रमण की शुरुआत करने वाले किसी के लिए, व्यावहारिक परिणाम संचालन का एक क्रम है। पहला प्रश्न यह है कि कौन सा छोटा, अनुमत काम एक व्यक्ति वर्णन कर सकता है, निरीक्षण कर सकता है और यदि प्रयास विफल हो तो सुरक्षित रूप से त्याग सकता है: सार्वजनिक स्रोतों से एक ब्रीफिंग, एक व्यक्तिगत योजना फ़ोल्डर, एक स्प्रेडशीट जिसके लिए किसी और पर कोई निर्भरता नहीं है। वहां से, एक बार में एक प्रबंधकीय जिम्मेदारी जोड़ी जाती है, एक सीमा, फिर एक अनुमोदन, फिर किसी की अपनी कार्यक्षेत्र, फिर एक सहेजा गया कार्य रिकॉर्ड, फिर एक दूसरा और महत्वपूर्ण दृश्य। मूल्यांकन समान क्रम का अनुसरण करता है। एक प्रदर्शन बहुत कम मूल्यवान होता है यदि यह छिपाता है कि व्यक्ति को क्या करने की अनुमति थी, आउटपुट की जांच कैसे की गई और एजेंट विफल होने पर क्या हुआ। प्रत्यायोजन से विचारशील इनकार एक परिणाम के रूप में गिना जाता है। और एक व्यक्ति जो एक सीमित कार्य को दोहरा सकता है, यह कह सकता है कि वे इस पर क्यों निर्भर थे, एक असहमति की ओर इशारा कर सकते हैं जिसने एक निर्णय को बदल दिया और परिस्थितियां बदलने पर पहुंच को संकीर्ण कर सकते हैं, वह भूमिका के अवलोकन योग्य संकेत दिखा रहा है, चाहे उनका नौकरी का शीर्षक कुछ भी कहे।
मॉडल विफल हो सकता है, और धारा 10 कहती है कि कैसे। धारा 9 का कार्यक्रम इसका कुछ हिस्सा उन लोगों पर परीक्षण करेगा जो प्रोग्रामर नहीं हैं, और परिशिष्ट C में कोड दूसरों को समान क्रॉसिंग को मापने और समान पैटर्न का अभ्यास करने देता है। मुझे लगता है कि परिशिष्ट B में नामित उत्पाद एक साल के भीतर पुराने दिखेंगे। धारा 5 की बाधाएं नहीं होनी चाहिए, क्योंकि वे व्यक्ति और काम से संबंधित हैं, कोई भी उत्पाद उनके सामने हो। टर्मिनल ऐसी जगह बन गई है जहां एक एजेंट एक व्यक्ति के लिए काम करता है जिसने इसे प्रबंधित करना सीख लिया है, और कितने लोग यह सीखेंगे, किस मार्ग से और कितनी तेजी से, यह सवाल अगला साल का जवाब देगा।
घोषणाएँ
वित्त पोषण। इस कार्य को किसी बाहरी निधि का समर्थन नहीं रहा।
प्रतिस्पर्धात्मक हित। लेखक बहु-मॉडल ऑर्केस्ट्रेशन विधियों का विकास करते हैं और उन्होंने संबंधित पेटेंट आवेदन दाखिल किए हैं (लंबित; कोई पेटेंट प्रदान नहीं किया गया है)। लेखक ने धारा 9 में वर्णित पूर्वनिर्धारित समूह कार्यक्रम और इसकी सामग्री को डिजाइन किया। इस पत्र में कोई भी निष्कर्ष लेखक के कार्यान्वयन पर निर्भर नहीं है; परिशिष्ट C के सभी पैटर्न सार्वजनिक रूप से उपलब्ध उपकरणों के साथ पुनः पुष्टि योग्य हैं। लेखक परिशिष्ट C में नाम दिए गए दो ओपन-सोर्स प्लगइन्स का भी रखरखाव करते हैं; वे मुक्त और ओपन सोर्स हैं (Apache License 2.0), और इस पत्र में कोई भी निष्कर्ष उन पर निर्भर नहीं है। लेखक शिक्षण सामग्री विकसित कर रहे हैं जो बाद में वाणिज्यिक रूप से प्रदान की जा सकती है; लेखन के समय कुछ भी बेचा नहीं गया है, और धारा 9 में वर्णित समूह को सभी सामग्री मुक्त रूप से प्राप्त हुई।
उपकरण और सत्यापन। AI सहायकों का उपयोग लेखक के निर्देशन में साधन के रूप में किया गया; विचार, अनुसंधान और निष्कर्ष लेखक के हैं। सभी मात्रात्मक दावों और उद्धरणों की जांच प्राथमिक स्रोतों या 21 सितंबर 2026 के अनुसार संग्रहीत प्रतियों के विरुद्ध की गई थी, या जहाँ एक स्रोत को पाठ में और परिशिष्ट B की समयसीमा में माध्यमिक या विक्रेता के रूप में चिह्नित किया गया है, सर्वोत्तम उपलब्ध रिपोर्ट के विरुद्ध; विक्रेताओं द्वारा अपने स्वयं के उत्पादों के बारे में रिपोर्ट की गई आकृतियों को ऐसे के रूप में चिह्नित किया जाता है। जहाँ अनुसंधान विंडो के दौरान एक प्राथमिक पृष्ठ को पुनः प्राप्त नहीं किया जा सका (एक विक्रेता की साइट पर कई पृष्ठों ने एक पहुँच त्रुटि दी), दावे को एक नाम दिए गए माध्यमिक स्रोत से उद्धृत किया जाता है और लेबल किया जाता है, या इसे छोड़ दिया जाता है। संदर्भों में वर्ग कोष्ठक में दिए गए प्रेस शीर्षक ऐसे पृष्ठों के लिए वर्णनात्मक शीर्षक हैं जिनकी सुर्खी को शब्दशः पुनः नहीं पढ़ा गया था।
डेटा और कोड उपलब्धता। परिशिष्ट C में कोड, इसके परीक्षणों के साथ, MIT लाइसेंस के तहत https://github.com/vadimchernets/after-chat पर जमा किया गया है और Zenodo पर संग्रहीत है, https://doi.org/10.5281/zenodo.22944451। समान पैटर्न पर निर्मित दो प्लगइन्स, Roundcall और Sidecall, https://github.com/vadimchernets/roundcall और https://github.com/vadimchernets/sidecall पर हैं (Apache License 2.0)। समान पैटर्न को सॉफ़्टवेयर के बाहर के व्यापारों पर लागू करने वाली पाँच किटें https://github.com/vadimchernets/calling-kits पर हैं (MIT)। इन्हें उन व्यापारों के व्यवसायীयों द्वारा आजमाया नहीं गया है, जिसे रिपोजिटरी में कहा गया है, और इस पत्र में कोई भी दावा उन पर आधारित नहीं है।
नैतिकता। यह पत्र मानव प्रतिभागियों से कोई डेटा रिपोर्ट नहीं करता। जो समूह कार्यक्रम यह वर्णन करता है वह पूर्वनिर्धारित है (OSF, DOI 10.17605/OSF.IO/X4EGQ); इसके परिणाम अलग से रिपोर्ट किए जाएँगे।
लेखक के योगदान। एकमात्र लेखक।
पत्राचार। [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
परिशिष्ट A. मॉडल की शब्दावली
पहुंच। एक मॉडल किसी व्यक्ति की ओर से क्या स्पर्श कर सकता है: बातचीत; विक्रेता-सीमित स्थान में फाइलें और उपकरण; व्यक्ति का अपना कंप्यूटर; कई मॉडल और एजेंट।
भूमिका। काम सफल होने के लिए व्यक्ति को क्या करना चाहिए: पूछना और कॉपी करना; सौंपना और समीक्षा करना; वातावरण का स्वामित्व लेना; कई एजेंटों का प्रबंधन करना।
स्तर। पहुंच और भूमिका का एक संयोजन जिस पर काम किया जाता है (खंड 3.2)। स्तर काम का वर्णन करते हैं; लोग और उत्पाद कई स्तरों तक विस्तारित हो सकते हैं।
संक्रमण को पार करना। रिकॉर्ड किया जाता है जब कोई एजेंट नए स्तर पर एक कलाकृति का उत्पादन करता है जो व्यक्ति ने मांगी थी। इंस्टॉलेशन एक प्रयास है। एक से अधिक स्तरों पर एक कदम की अनुमति है और इसे स्किप के रूप में रिकॉर्ड किया जाता है।
कलाकृति। एजेंट द्वारा निर्मित एक फाइल, फोल्डर, कार्रवाई या आउटपुट, जिसे व्यक्ति प्रदान करता है या रखता है। "कुछ नहीं" एक वैध रिकॉर्ड है।
कार्यप्रवाह शब्दावली। व्यक्ति के कार्य का स्टॉक जिन्हें वे एजेंट को सौंपना जानते हैं, इस तरह से व्यक्त किया गया है कि एजेंट उन्हें पूरा कर सके और परिणाम की जांच की जा सके।
प्रतिबिंबात्मक ऑनबोर्डिंग। एक AI प्रणाली जो किसी व्यक्ति को अधिक सक्षम AI प्रणाली अपनाने में सहायता करती है, जैसे कि एक चैटबॉट जो किसी एजेंट की स्थापना में मार्गदर्शन करता है और उसकी पहली त्रुटियों से पुनर्प्राप्ति करता है।
प्रतिनिधिमंडन अनुबंध। चार चीजें जो एक व्यक्ति एजेंटों को काम सौंपते समय बताता है: लक्ष्य, सीमा, कलाकृति, जांच।
चार प्रथाएं। प्रबंधक एक कार्य के दौरान क्या करता है: प्रतिनिधिमंडन, पर्यवेक्षण, सत्यापन, प्रतिसंहरण (खंड 8.1)।
स्वीकृति रिकॉर्ड। एक परिणामी या आवर्ती कार्य के लिए: इच्छित आउटपुट, इनपुट, बाधाएं और अनुमतियां, आउटपुट स्थान, महत्वपूर्ण असहमति या विफलताएं, की गई जांचें, और स्वीकार, संशोधित, बढ़ाना या त्यागने का निर्णय। यह एजेंट द्वारा निर्मित को उससे अलग करता है जिस पर व्यक्ति ने भरोसा किया।
काम का पांच-भाग मानचित्र। काम की वस्तु, अनुमत इनपुट, परिवर्तन, आउटपुट और जांच: वह रूप जिसमें एक गैर-प्रोग्रामर का आवर्ती कार्य प्रतिनिधिमंडन बन जाता है (खंड 5.1)।
साइड शाखा। ब्राउज़र एप्लिकेशन बिल्डर, जो प्लेटफॉर्म द्वारा होस्ट किए गए प्रोजेक्ट पर कार्य करते हैं न कि व्यक्ति की फाइलों पर; एक अलग सीढ़ी, अपनी अपनी सीढ़ियों के साथ (खंड 3.4)।
वेब ऑर्केस्ट्रेशन। एक प्रश्न कई उपभोक्ता चैटबॉट को ब्राउज़र में, हाथ से या किसी उपकरण के साथ, और उत्तरों की तुलना की जाती है।
CLI ऑर्केस्ट्रेशन। एक एजेंट अन्य एजेंटों के कमांड-लाइन उपकरणों को कॉल करता है, उनके आउटपुट एकत्र करता है और उन्हें मर्ज या जांचता है।
चर्न। उपकरणों का पुनः नामकरण, विलय या सेवानिवृत्ति एक अवधि के भीतर जो किसी नए आने वाले को उन्हें सीखने में लगने वाले समय से कम है।
राय की प्रभावी संख्या (N_eff)। N / (1 + (N - 1) rho) N मॉडल के लिए माध्य-दर-माध्य त्रुटि सहसंबंध rho के साथ; 1/rho से ऊपर की सीमा (Chernets, 2026a)।
कोडेबल आइटम के रूप में मार्कर
गुणात्मक डेटा के कोडर या सर्वेक्षण डिज़ाइनर के लिए, खंड 3 के मार्कर एक नामित कलाकृति के बारे में हाँ/नहीं आइटम तक सीमित हैं। एक कलाकृति के बिना स्व-रिपोर्ट को एक दावे के रूप में रिकॉर्ड किया जाता है और संक्रमण के रूप में नहीं गिना जाता।
- स्तर 1 मौजूद। पिछले सात दिनों में उपभोक्ता चैटबॉट के साथ कम से कम एक सहेजी गई बातचीत; कलाकृति: एक लिंक, एक स्क्रीनशॉट या एक निर्यात। इसे उत्पादित करने में विफलता को "प्रदर्शित नहीं" के रूप में कोडित किया जाता है, जो "अनुपस्थित" की तुलना में एक कमजोर निष्कर्ष है।
- संक्रमण 1 पार। एक फाइल या फाइलों का सेट एक स्कोप्ड एजेंट (डेस्कटॉप, वेब या टेनेंट-होस्टेड) द्वारा एक स्थान के भीतर लिखा गया जो व्यक्ति ने दिया, एक काम के जवाब में जिसे व्यक्ति ने नाम दिया, कम से कम एक अनुमोदन, इनकार या योजना संपादन रिकॉर्ड किए गए। कलाकृति की तारीख संक्रमण तारीख है।
- स्तर 2 मौजूद। संक्रमण 1 पार, साथ ही एक बाद के सप्ताह में एक और स्कोप्ड कलाकृति। दृढ़ता को एक अलग साप्ताहिक आइटम के रूप में रिकॉर्ड किया जाता है, संक्रमण से अलग।
- संक्रमण 2 पार। एक कार्यशील फोल्डर, प्रतिबद्धता या दिनांकित फाइल सेट एक स्थानीय एजेंट या इसके आधिकारिक डेस्कटॉप शेल द्वारा एक मशीन पर उत्पादित जिसे व्यक्ति नियंत्रित करता है, एक काम से जिसे एक से अधिक उपकरण उपयोग की आवश्यकता थी। क्लाउड-होस्टेड काम को अपने स्वयं के क्लाउड वेरिएंट के रूप में कोडित किया जाता है।
- स्तर 3 मौजूद। संक्रमण 2 पार, साथ ही एक ही वर्ग के एजेंट से एक बाद के सप्ताह की कलाकृति।
- संक्रमण 3, पुल रूप। एक दिनांकित फाइल जिसमें प्रश्न, पूछे गए चैटबॉट या वेब मॉडल, कच्चे उत्तर या उनके लिंक, समझौते और असहमति का नोट, और एक नोट है कि क्या कवरेज या विश्वसनीयता (खंड 6.2) दिखाई दिया; हाथ से या एक प्रसारण उपकरण द्वारा निर्मित।
- संक्रमण 3, स्थायी रूप। वही फाइलें, एक रन द्वारा निर्मित जिसने व्यक्ति के अपने लॉगिन पर दो या अधिक आधिकारिक कमांड-लाइन उपकरणों (या एक प्लस दूसरा-परिवार प्लगइन) को आमंत्रित किया, हर के साथ रिकॉर्ड किया गया: पूछा गया, उत्तर दिया गया, समय समाप्त।
- स्तर 4 मौजूद। संक्रमण 3 का कोई भी रूप, साथ ही एक बाद के सप्ताह में एक दूसरा दिनांकित रन।
- सहायता प्राप्त बनाम निरीक्षण। कोई भी संक्रमण जिसमें जांचकर्ता, एक सहकर्मी या एक सशुल्क कोच ने एक स्थापना चरण किया, काम लिखा या एक त्रुटि से पुनर्प्राप्त किया, सहायता प्राप्त है। पूर्ण किए गए दो संख्याओं के रूप में रिपोर्ट किए जाते हैं जहां एक सहायक उपलब्ध था।
- रोकने का कारण। "आपको क्या रोका" का एक मुक्त पाठ उत्तर, सभी से पूछा गया जो पार नहीं हुए और संग्रह के बाद कोडित किए गए। उम्मीदवार कोड, बाद के कोडर को संशोधित करने के लिए एक परिकल्पना के रूप में प्रस्तुत किए गए: कार्यप्रवाह शब्दावली; अनुमति या सुरक्षा संवाद; प्रशासक अधिकार; लागत या कोटा; इंटरफेस का डर; एक विनाशकारी घटना की खबर; संगठनात्मक नीति; तकनीकी त्रुटि; जीवन और समय; अन्य।
- "पूछने के लिए क्या करना है नहीं पता" के लिए कोडिंग नियम (कार्यप्रवाह शब्दावली)। शामिल करें जब व्यक्ति, यह पूछा जाता है कि वे एजेंट को क्या करवाना चाहते हैं, खंड 5.1 के कम से कम एक का नाम नहीं दे सकते: काम की वस्तु, इनपुट वे उपयोग कर सकते हैं, परिवर्तन, आउटपुट या जांच। बाहर रखें जब सभी पाँचों का नाम दिया जाता है और व्यक्ति नीति, जोखिम, लागत या समय के आधार पर इनकार करता है; उन्हें अपने स्वयं के कोड मिलते हैं। दो कोडर स्वतंत्र रूप से कोड करते हैं और अपनी सहमति की रिपोर्ट करते हैं। नियम एक रोक को वर्गीकृत करता है, और व्यक्ति की क्षमता के बारे में कुछ नहीं कहता है।
- चार प्रथाओं के निशान (हाँ/नहीं, प्रत्येक एक दिनांकित कलाकृति से जुड़ा): एक योजना से इनकार किया गया; एक अंतर या आउटपुट अस्वीकार किया गया; एक दूसरा मॉडल परिवार पूछा गया; एक हर को रिकॉर्ड किया गया (किससे पूछा गया, किसने उत्तर दिया, किसका समय समाप्त हुआ); एक अपरिवर्तनीय कदम पुष्टि के लिए रखा गया; एक कलाकृति जमा की गई। ये P10 की पर्यवेक्षण के निशान हैं।
- मार्कर नहीं। एक लाइसेंस खरीद, एक कोर्स बैज, एक इंस्टॉलर लॉग, एक रिपोजिटरी स्टार, एक प्रॉम्प्ट काउंट, या "एक एजेंट उपयोगकर्ता" के रूप में स्व-मूल्यांकन।
अपेंडिक्स बी. दिनांकित समय-सारणी, 2025 से 21 सितंबर 2026
VERIFIED के रूप में चिह्नित प्रविष्टियों को 21 सितंबर 2026 को समाप्त होने वाली अनुसंधान विंडो के दौरान किसी प्राथमिक पृष्ठ पर, या किसी प्रेस रिपोर्ट के लिए किसी नामित माध्यमिक पृष्ठ पर खोला गया था। SECONDARY के रूप में चिह्नित प्रविष्टियां उन प्रेस रिपोर्ट या उत्पाद इतिहास पर आधारित हैं जो किसी प्राथमिक पृष्ठ पर नहीं खोले गए थे; उन्हें अभिविन्यास के लिए दिया जाता है और तर्क में कोई वजन नहीं रखते हैं। यह चार-स्तरीय तर्क के लिए एक कार्यशील समय-सारणी है और किसी भी उद्योग कालक्रम का प्रयास नहीं करती है।
| दिनांक | घटना | स्रोत | स्थिति |
|---|---|---|---|
| 24 फरवरी 2025 | Claude Code अनुसंधान पूर्वावलोकन | उत्पाद इतिहास, व्यापक रूप से रिपोर्ट किया गया | SECONDARY |
| 23 अप्रैल 2025 | AI शिक्षा पर कार्यकारी आदेश 14277 | व्हाइट हाउस (2025a) | VERIFIED |
| 22 मई 2025 | Claude Code सामान्य रूप से उपलब्ध | उत्पाद इतिहास, व्यापक रूप से रिपोर्ट किया गया | SECONDARY |
| 23 जून 2025 | Agent2Agent प्रोटोकॉल Linux Foundation को दान किया गया | Google Open Source Blog (2026) | VERIFIED (विक्रेता) |
| जुलाई 2025 | अमेरिका की AI कार्य योजना AI साक्षरता और कौशल के लिए प्रतिबद्ध है | व्हाइट हाउस (2025b) | VERIFIED |
| 21 जुलाई 2025 | एक एप्लिकेशन-निर्माण एजेंट लाइव सत्र के दौरान एक उत्पादन डेटाबेस को हटा देता है | The Register (2025) | VERIFIED (प्रेस) |
| 20 अगस्त 2025 | एक ब्राउज़र एजेंट के विरुद्ध प्रॉम्प्ट इंजेक्शन प्रदर्शित, चोरी किए गए एकबारी कोड के साथ | Brave (2025) | VERIFIED |
| 25 अगस्त 2025 | ब्राउज़र एजेंट पायलट: बिना शमन के 23.6% हमले की सफलता, शमन के साथ 11.2% | Anthropic (2025) | VERIFIED (विक्रेता) |
| 9 दिसंबर 2025 | Model Context Protocol को Agentic AI Foundation (Linux Foundation) को दान किया गया; 10,000 से अधिक प्रकाशित सर्वर, लगभग 97 मिलियन मासिक SDK डाउनलोड | Linux Foundation (2025) | VERIFIED |
| 9 दिसंबर 2025 | एक परामर्श फर्म घोषणा करती है कि लगभग 30,000 कर्मचारियों को एक विक्रेता के मॉडल पर प्रशिक्षित किया जाएगा | Accenture (2025) | VERIFIED |
| 18 दिसंबर 2025 | Agent Skills प्रारूप एक खुले मानक के रूप में जारी किया गया | SiliconANGLE (2025) | VERIFIED (प्रेस) |
| 22 दिसंबर 2025 | OpenAI: प्रॉम्प्ट इंजेक्शन "कभी भी पूरी तरह से 'हल' होने की संभावना नहीं है" | TechCrunch (2025) | VERIFIED (प्रेस) |
| जनवरी 2026 | Cowork अनुसंधान पूर्वावलोकन, "आपके बाकी काम के लिए Claude Code" | Fortune (2026a); The Register (2026) | VERIFIED (प्रेस) |
| 12 जनवरी 2026 | प्रॉम्प्ट इंजेक्शन के लिए गैर-प्रोग्रामर को देखने के लिए कहने पर आपत्ति | Willison (2026) | VERIFIED |
| 15 जनवरी 2026 | Anthropic Economic Index: 52% बातचीत में संवर्धन (नवंबर 2025) | Anthropic (2026f) | VERIFIED (विक्रेता) |
| 4 और 26 फरवरी 2026 | GitHub Agent HQ: Claude और Codex एजेंट Copilot के अंदर उपलब्ध | GitHub (2026c) | VERIFIED |
| फरवरी 2026 | Perplexity Model Council शीर्ष-स्तरीय सदस्यों के लिए (10 फरवरी को रिपोर्ट किया गया) | Storyboard18 (2026) | VERIFIED (प्रेस) |
| 13 फरवरी 2026 | अमेरिकी श्रम विभाग AI साक्षरता ढांचा ("प्रभावी ढंग से AI निर्देशित करना") | अमेरिकी श्रम विभाग (2026) | VERIFIED |
| 9 मार्च 2026 | Cowork तकनीक Microsoft 365 Copilot में लाई गई | Microsoft (2026a) | VERIFIED |
| 9 मार्च, 19 अप्रैल, 10 जून 2026 | दिए गए फ़ोल्डर के अंदर स्तर-2 एजेंट द्वारा हटाई गई फ़ाइलों की उपयोगकर्ता रिपोर्ट | GitHub मुद्दा रिपोर्ट (2026) | VERIFIED (उपयोगकर्ता रिपोर्ट) |
| 24 मार्च 2026 | Anthropic Economic Index: लंबी कार्यकाल वाले उपयोगकर्ता कम सौंपते हैं | Anthropic (2026e) | VERIFIED (विक्रेता) |
| 30 मार्च 2026 | OpenAI का Claude Code के अंदर अपने एजेंट का उपयोग करने के लिए आधिकारिक प्लगइन; Microsoft का अनुसंधान एजेंट GPT और Claude को एक साथ चलाता है | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| अप्रैल 2026 | JetBrains: काम पर Claude Code 18% (जनवरी 2026), लगभग 3% से (वसंत 2025) | JetBrains Research (2026a) | VERIFIED (विक्रेता सर्वेक्षण) |
| 13 अप्रैल 2026 | Duolingo प्रदर्शन मूल्यांकन से AI उपयोग को हटाता है | Fortune (2026b) | VERIFIED (प्रेस) |
| 5 मई 2026 | Work Trend Index: संगठनात्मक कारक व्यक्तिगत कारकों से दोगुने से अधिक वजन रखते हैं | Microsoft (2026b) | VERIFIED (विक्रेता सर्वेक्षण) |
| 25 अप्रैल 2026 (5 मई को रिपोर्ट किया गया) | एजेंट किसी कंपनी के उत्पादन डेटाबेस और बैकअप को हटा देता है | Information Age (2026) | VERIFIED (प्रेस) |
| 19 मई 2026 | Google Gemini CLI से Antigravity CLI में स्थानांतरण की घोषणा करता है | Google (2026) | VERIFIED |
| 25 मई 2026 | xAI का Grok Build हेडलेस मोड और एजेंट प्रोटोकॉल समर्थन के साथ जारी किया गया | xAI (2026) | VERIFIED (विक्रेता) |
| 26 मई 2026 | अमेरिकी व्यावसायिक AI उपयोग कुल 17% से 20%; छोटी फर्में समतल | अमेरिकी जनगणना ब्यूरो (2026) | VERIFIED |
| 27 मई 2026 | डेवलपर पल्स: 69% एकल एजेंट; 60% अनुमोदित परिवर्तनों को अवरुद्ध करते हैं | Stack Overflow (2026) | VERIFIED |
| 2 जून 2026 | कोडिंग एजेंट 5 मिलियन साप्ताहिक उपयोगकर्ताओं में, लगभग 20% ज्ञान कार्यकर्ता | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (विक्रेता डेटा की प्रेस रिपोर्ट) |
| 15 जून 2026 | PwC AI Jobs Barometer: AI कौशल के लिए 62% मजदूरी प्रीमियम | PwC (2026) | VERIFIED (विक्रेता) |
| 17 जून 2026 | Pew: अमेरिकी वयस्कों का लगभग आधा चैटबॉट का उपयोग करता है | Pew Research Center (2026) | VERIFIED |
| 18 जून 2026 | Gemini CLI व्यक्तिगत स्तरों की सेवा बंद करता है | Google (2026) | VERIFIED |
| जून 2026 | OECD और यूरोपीय आयोग AI साक्षरता ढांचा ("AI को प्रबंधित करें") | OECD & यूरोपीय आयोग (2026) | VERIFIED |
| 29 जून से 3 जुलाई 2026 | Claude Code अपने डिफ़ॉल्ट अनुमति मोड का नाम "Manual" रखता है | Anthropic (2026h) | VERIFIED (विक्रेता) |
| 1 जुलाई 2026 | Gemini Spark डेस्कटॉप एजेंट Mac पर; सर्वोत्तम Remote Labor Index स्वचालन दर 15.8%, रिलीज़ पर 2.5% से | TechCrunch (2026b); Center for AI Safety (2026) | सत्यापित |
| 8 जुलाई 2026 | Indeed: AI से प्रभावित 63% अमेरिकी नौकरी की पदनामें प्रौद्योगिकी व्यवसायों के बाहर हैं | Adrjan (2026) | सत्यापित |
| 9 जुलाई 2026 | कोडिंग-एजेंट ऐप ChatGPT डेस्कटॉप ऐप बन जाता है; ChatGPT Work शुरू होता है | MacRumors (2026) | सत्यापित (प्रेस) |
| 20 जुलाई 2026 | Gallup: 52% अमेरिकी कर्मचारी AI का उपयोग करते हैं, 15% दैनिक | Gallup (2026) | सत्यापित |
| 27 जुलाई 2026 | EU AI ऑमनिबस लागू होता है; AI साक्षरता कर्तव्य "समर्थन के उपायों को लेने" में बदल जाता है | European Commission (2026a, 2026b) | सत्यापित |
| 28 जुलाई 2026 | Model Context Protocol: प्रति माह लगभग आधा अरब SDK डाउनलोड; प्रोटोकॉल स्टेटलेस बनाया गया | Model Context Protocol (2026) | सत्यापित |
| 3 अगस्त 2026 | AI साक्षरता के लिए EU पर्यवेक्षण और प्रवर्तन नियम लागू होते हैं | European Commission (2026a) | सत्यापित |
| अगस्त 2026 | JetBrains: 90% पेशेवर डेवलपर्स साप्ताहिक रूप से कोडिंग एजेंट्स का उपयोग करते हैं; Claude Code कार्य 39% | JetBrains Research (2026b) | सत्यापित (विक्रेता सर्वेक्षण) |
| 9 अगस्त 2026 | OpenAI का एजेंटिक ब्राउज़र बंद कर दिया गया; ब्राउज़िंग ChatGPT ऐप में चली जाती है | 9to5Mac (2026) | सत्यापित (प्रेस) |
| 26 अगस्त 2026 | ब्राउज़र एजेंट आम तौर पर उपलब्ध; डिफ़ॉल्ट रूप से वर्गीकरण के साथ स्वायत्त; विक्रेता द्वारा रिपोर्ट किए गए इंजेक्शन दरें लगभग शून्य | Anthropic (2026d) | सत्यापित (विक्रेता) |
| 1 सितंबर 2026 | St. Louis Fed: 45% कर्मचारी अपनी नौकरियों के लिए AI का उपयोग करते हैं; 50% से अधिक अपनाने वाले कार्यों में 3% से कम | Bick et al. (2026) | सत्यापित |
| 6 सितंबर 2026 | कोहर्ट 1 पूर्व-पंजीकरण जमी हुई | Chernets (2026d) | सत्यापित |
| 9 सितंबर 2026 | Harvard Business Review: कार्य पर एजेंट अपनाने में विश्वास एक केंद्रीय बाधा है | McKinlay et al. (2026) | सत्यापित (सारांश) |
| 16 सितंबर 2026 | Cowork और chat एक Claude में मिल गए | Anthropic (2026c); TechCrunch (2026a) | सत्यापित |
| 22 सितंबर 2026 | आधिकारिक प्लगइन सूची पूरी तरह पढ़ी गई, 310 प्रविष्टियां: धारा 5.1 में नामित पाँच ट्रेडों के लिए कोई नहीं; सामुदायिक सूची 2,282 प्रविष्टियां, शिक्षकों और रियल एस्टेट के लिए पेशकश | Author's reading of the published catalogues | सत्यापित (अपनी गणना) |
अनुलग्नक C. शिक्षण कोड
नीचे दी गई सूचियाँ खंड 5 से 9 के पैटर्न को सिखाती हैं। वे केवल Python मानक लाइब्रेरी और विक्रेताओं के स्वयं के कमांड-लाइन उपकरण का उपयोग करती हैं, जो उपयोगकर्ता की अपनी सदस्यता के साथ हस्ताक्षरित हैं; कोई भी API कुंजी नहीं पढ़ता है। प्रत्येक एक बैठक में पढ़ने के लिए काफी छोटा है, और प्रत्येक बताता है कि यह क्या सिखाता है और यह कहाँ रुकता है। वे परीक्षणों के साथ MIT लाइसेंस के तहत साथी रिपॉजिटरी में जमा हैं, और शामिल होने से पहले हर सूची को चलाया गया था (प्रत्येक को अपने डेमो इनपुट पर, फैन-आउट को stub उपकरणों पर)। यहाँ का हर पैटर्न पहले से कुछ रूप में ओपन-सोर्स उपकरणों में मौजूद है (खंड 7.1); सूचियों का मूल्य यह है कि वे छोटी हैं, टिप्पणी की गई हैं और तर्क से जुड़ी हुई हैं। कोई भी एक शिक्षण मार्ग नहीं है, एक शिक्षार्थी का निदान नहीं है, एक पाठ्यक्रम नहीं है या लेखक के उपकरणों का एक कार्यान्वयन नहीं है। एक गैर-प्रोग्रामर ये फ़ाइलें हाथ से नहीं चलाता है: ये वह तरह की चीज़ हैं जो एक एजेंट एक कौशल के रूप में लपेटता है या एक डेस्कटॉप शेल एक बटन के रूप में प्रकट करता है, और उन्हें प्रिंट करने का बिंदु यह है कि एक पाठक देख सकता है कि ऐसा बटन क्या करता है।
दो स्थापन योग्य Claude Code प्लगइन इन पैटर्नों को रोज़मर्रा के उपयोग में लाते हैं। Roundcall उन AI चैट साइटों से पूछता है जिन पर एक व्यक्ति पहले से साइन इन है, उनके स्वयं के ब्राउज़र के माध्यम से और एक व्यक्ति की गति पर; Sidecall अपनी मशीन पर स्थापित कमांड-लाइन एजेंटों से पूछता है, एक बजट सेटिंग के साथ जो प्रत्येक विक्रेता के मॉडल को चुनता है। दोनों एक ही रिपोर्ट लौटाते हैं कि किसने क्या कहा, जहाँ उत्तर असहमत हैं और केवल एक स्रोत ने क्या कहा। वे https://github.com/vadimchernets/roundcall और https://github.com/vadimchernets/sidecall पर Apache License 2.0 के तहत ओपन सोर्स हैं।
उनमें से कोई भी चलाने से पहले: अपने स्थापित संस्करण पर प्रत्येक उपकरण की --help जाँचें, क्योंकि फ़्लैग रिलीज़ के बीच बदलते हैं; उन्हें एक कार्य फ़ोल्डर में चलाएँ जो प्रतियाँ रखता है, मूल नहीं; और पहले Listing C6 पढ़ें।
C1. एक प्रोब, एक ceiling और आंशिक कैप्चर के साथ फैन-आउट (fanout.py)
सिखाता है: कैसे एक व्यक्ति एक प्रश्न को कई एजेंट CLIs को एक साथ रख सकता है, जो डाउन हैं या कोटा से बाहर हैं उन्हें छोड़ सकता है, एक समय ceiling पर प्रतीक्षा करना बंद कर सकता है, और ceiling से पहले प्रत्येक उपकरण ने जो कुछ लिखा है उसे रख सकता है इसे फेंकने की बजाय। प्रत्येक उपकरण आउटपुट फ़ोल्डर के अंदर एक ताज़ी, खाली फ़ोल्डर में चलता है, कभी भी उस फ़ोल्डर में नहीं जहाँ व्यक्ति ने लॉन्च किया था; उपकरण के नाम सुरक्षित फ़ाइल नामों तक सीमित हैं; एक लंबा प्रश्न एक फ़ाइल में जाता है (--question-file) या, एक उपकरण के लिए जिसके टेम्पलेट में कोई {prompt} नहीं है, उपकरण के मानक इनपुट पर, क्योंकि एक कमांड-लाइन तर्क ऑपरेटिंग सिस्टम द्वारा लंबाई में सीमित है। सीमाएँ: ceiling पर रोकना POSIX प्रक्रिया समूहों का उपयोग करता है (macOS और Linux; Windows पर WSL का उपयोग करें) और उपकरण को रोकने तक वापस गिरता है; एक उपकरण जो केवल अंत में प्रिंट करता है ceiling पर रोके जाने पर कुछ नहीं रखता; यदि इसके पास streaming आउटपुट मोड है तो इसका उपयोग करें। स्क्रिप्ट कुछ भी तुलना नहीं करती; C3 करता है।
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. एक एजेंट के लिए "दूसरी राय" कौशल (second-opinion/SKILL.md)
सिखाता है: CLI ऑर्केस्ट्रेशन का सबसे छोटा रूप, एक लिखित निर्देश जो एक एजेंट को दूसरे विक्रेता के एजेंट से पूछने और इसे मर्ज करने के बजाय अंतर दिखाने के लिए कहता है। सीमाएँ: दो मॉडल एक तुलना हैं, पैनल नहीं; कौशल कहता है कि किन बिंदुओं को अभी भी प्राथमिक स्रोत की आवश्यकता है।
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. किसने क्या कहा (provenance.py)
सिखाता है: कई मॉडलों से पूछने के दो उद्देश्य – कवरेज और विश्वसनीयता – जो स्रोत के अनुसार दावों की एक तालिका, केवल एक स्रोत द्वारा किए गए दावों की सूची, और वे दावे जिनकी संख्याएँ या तारीखें भिन्न हैं, के रूप में दृश्यमान होती हैं। सीमाएँ: यह दोहराए गए शब्दों का मिलान करता है, दोहराए गए अर्थ का नहीं; यह किसी व्यक्ति को बताता है कि किस चीज़ को ध्यान से पढ़ना है, कभी नहीं कि क्या सच है।
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. समझौता कितने स्वतंत्र विचारों के लायक है? (neff.py)
सिखाता है: सहसंबद्ध साक्ष्य का अंकगणित (अनुभाग 6.3): ज्ञात उत्तरों वाली वस्तुओं से माध्य त्रुटि सहसंबंध rho का अनुमान लगाएं, फिर N_eff और इसकी सीमा 1/rho की गणना करें। --demo के साथ चलाएं ताकि आप लगभग 1.6 स्वतंत्र विचारों के मूल्य वाले चार मॉडल देख सकें। सीमाएं: rho कार्य पर निर्भर करता है; इसका अनुमान उन वस्तुओं पर लगाएं जिनकी आप परवाह करते हैं, और दस से अधिक वस्तुओं के साथ।
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. क्रॉसिंग्स का एक रिकॉर्ड, और एक चेकर (crossings.py)
सिखाता है: अनुभाग 9.1 के मापन नियमों को कोड के रूप में। एक रिकॉर्ड को अस्वीकार कर दिया जाता है यदि वह एक इंस्टॉलेशन को क्रॉसिंग के रूप में गिनता है, एक एजेंट-निर्मित कलाकृति के बिना समाप्ति, व्यक्ति के अपने शब्दों के बिना एक रुकना, सहायता का विवरण दिए बिना मदद, एक छद्ययुगल लेबल के बजाय एक नाम (लेबल P के बाद अंक होना चाहिए), एक छोड़ा गया स्तर जो बिल्कुल सूचीबद्ध नहीं है, एक मान जो वास्तविक सच या गलत नहीं है, एक अपठनीय तारीख, एक ऐसा क्षेत्र जिसे प्रारूप नहीं जानता है, या एक स्तर-4 क्रॉसिंग जो दो से कम उपकरणों का नाम देती है जिनसे पूछा और उत्तर दिया गया। एक विकृत लाइन को अस्वीकृत के रूप में रिपोर्ट किया जाता है और कभी भी रन को नहीं रोकता है। सीमाएँ: यह रिकॉर्ड के रूप की जाँच करता है, उनकी सच्चाई नहीं; क्या दोनों उपकरण विभिन्न मॉडल परिवारों के हैं, और क्या व्यवस्था को बाद के सप्ताह में दोहराया गया था (एक दूसरा रिकॉर्ड), शोधकर्ता के लिए छोड़ दिया जाता है; यह एक अनुप्रयोग नहीं, एक शोध उपकरण है।
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
वही रिकॉर्ड प्रारूप JSON Schema (crossings.schema.json) के रूप में प्रकाशित किया जाता है ताकि अन्य उपकरण किसी रिकॉर्ड के आकार की पुष्टि कर सकें; ऊपर दिया गया चेकर उन नियमों को लागू करता है जो स्कीमा व्यक्त नहीं कर सकता (कि एक स्थापना एक क्रॉसिंग नहीं है, कि एक स्टॉप को व्यक्ति के अपने शब्दों की आवश्यकता है, कि मदद के लिए एक विवरण आवश्यक है, और कि एक स्किप रिकॉर्ड किया जाता है)।
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. स्तर 3 से पहले सुरक्षा (safety/)
सिखाता है: खंड 5.3 की प्रथाओं को कॉन्फ़िगरेशन के रूप में। पहली फ़ाइल Claude Code के लिए एक उदाहरण प्रकल्प सेटिंग्स फ़ाइल है: डिफ़ॉल्ट रूप से योजना मोड (विक्रेता ने जुलाई 2026 में अपने डिफ़ॉल्ट मोड का नाम "Manual" रखा; "plan" वैध रहता है और अधिक सुरक्षित शिक्षण विकल्प है), सामान्य विनाशकारी और डाउनलोड कमांड अस्वीकृत, सामान्य गुप्त फ़ाइलें फ़ाइल पाठक और शेल cat दोनों को अस्वीकृत, डिलीशन और वेब फ़ेच के बारे में पूछा गया। एक अस्वीकृति सूची केवल एक सूची है: एक अनुमतिशील मोड या एक अनुसूचीबद्ध आदेश इसके चारों ओर मार्ग ले सकता है, इसलिए सैंडबॉक्स सेटिंग्स नियमों जितनी ही महत्वपूर्ण हैं। दूसरा OpenAI के Codex के लिए एक उदाहरण कॉन्फ़िगरेशन है, इसके प्रति-रन, फ़ोल्डर-स्कोप्ड रूप में दिया गया है: कार्यशील फ़ोल्डर के लिए सीमित लेखन, कोई नेटवर्क नहीं, अनुरोध पर अनुमोदन। तीसरा एक चेकलिस्ट है। सीमाएं: अनुमति नियम और सैंडबॉक्स विस्फोट त्रिज्या को कम करते हैं; वे एक एजेंट को विश्वसनीय नहीं बनाते हैं, और नियम सिंटैक्स संस्करणों के बीच बदलते हैं।
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. निरीक्षण ट्रेस एक लॉग के रूप में (jsonl_log.py)
सिखाता है: एक प्रबंधक के कार्य का सबसे छोटा उपयोगी रिकॉर्ड, प्रति घटना एक टाइमस्टैम्प किया गया JSON ऑब्जेक्ट, ताकि अस्वीकृत योजनाएं, अस्वीकृत diffs, लिए गए दूसरे विचार और पूर्ण किए गए रन (प्रस्ताव P10 के निरीक्षण ट्रेस) को बाद में standard library के साथ गिना जा सके। --demo के साथ चलाएं। सीमाएं: यह एक writer है, tracer नहीं; यह रिकॉर्ड करता है जो व्यक्ति या agent इसे बताता है।
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
परिशिष्ट D. मतों की प्रभावी संख्या की कार्य-सारणी
एक एजेंटों का प्रबंधक जो listing C4 को चलाना नहीं चाहता है, फिर भी छत का उपयोग कर सकता है। प्रत्येक सेल N_eff = N / (1 + (N - 1) rho) है; अंतिम पंक्ति छत 1/rho है, जिसे उस सहसंबंध वाले मॉडल की कोई भी संख्या पार नहीं कर सकती। rho के मानों को सूत्र को दर्शाने और कुछ भी न मापने के लिए चुना गया था। उपयोग में, rho त्रुटियों का माध्य जोड़ीदार सहसंबंध है, जो संयुक्त त्रुटियों के हिस्से से एक अलग मात्रा है जिस पर दो मॉडल सहमत हैं, और इसे हाथ में मौजूद डोमेन में ज्ञात उत्तरों वाली वस्तुओं पर अनुमान लगाया जाना चाहिए (listing C4)।
| N मॉडल | rho = 0.2 (चित्रण) | rho = 0.5 (चित्रण) | rho = 0.6 (चित्रण) | rho = 0.8 (चित्रण) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| छत, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
यह सारणी उस कारण की व्याख्या करती है कि खंड 6 एक व्यक्ति को अगली सदस्यता उसी के दसवें विंडो के बजाय एक अलग परिवार पर खर्च करने के लिए कहता है। परिवारों की विविधता, स्रोतों के विरुद्ध दावे-दावे की जांच और संरक्षित मतभेद वह काम करते हैं जो एक बड़ा N नहीं कर सकता। क्योंकि rho कार्य पर निर्भर करता है, इसका अनुमान व्यक्ति के अपने डोमेन से वस्तुओं पर लगाया जाना चाहिए (listing C4)।
परिशिष्ट E. परिदृश्य जनगणना, 19 से 21 सितंबर 2026
मुख्य पाठ में तालिका 5 उपकरणों को पैटर्न के अनुसार समूहित करती है। यह परिशिष्ट इसके पीछे की कच्ची जनगणना को दर्ज करता है, उन पाठकों के लिए जो संख्याएं जानना चाहते हैं जैसी वे दिए गए तारीखों पर थीं। तारकाएं दैनिक रूप से चलती हैं; वे लोकप्रियता का पता लगाती हैं और गुणवत्ता या उपयोगकर्ताओं की संख्या के बारे में कुछ नहीं कहती हैं, इसलिए उन्हें पाठक की तारीख के अनुसार उद्धृत नहीं किया जाना चाहिए। पैटर्न स्तंभ मेरा मानचित्रण है, और परियोजनाएं स्वयं कोई ऐसा दावा नहीं करती हैं।
| परियोजना | स्थान | तारकाएं (अनुमानित, 21 सितंबर 2026) | लाइसेंस | पैटर्न |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | स्रोत-उपलब्ध, स्वामित्व लाइसेंस | टर्मिनल एजेंट (स्तर 3) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | टर्मिनल एजेंट (स्तर 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | टर्मिनल एजेंट; 18 जून 2026 के बाद से व्यक्तिगत स्तरों को अब सेवा नहीं दी जाती है |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | संपादक और टर्मिनल एजेंट |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | आधिकारिक प्लगइन: एक विक्रेता का एजेंट दूसरे के अंदर |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | रिपॉजिटरी देखें | वेब चैट एजेंटों के लिए उजागर |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | रिपोजिटरी देखें | प्रोग्रामिंग इंटरफेस पर परिषद |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500 (लगभग 847,000 नवीनतम रिलीज़ के डाउनलोड) | Apache-2.0 | ब्राउज़र प्रसारण |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800 (अंतिम कमिट दिसंबर 2025) | Apache-2.0 | मॉडल के बीच परामर्श सर्वर |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | टर्मिनल एजेंट (स्तर 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | ब्राउज़र प्रसारण |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | CLI परिषद |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | एक फ़ाइल प्रति टूल लिखने वाली CLI काउंसिल |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | हेडलेस मोड और एजेंट प्रोटोकॉल के साथ टर्मिनल एजेंट |
कैसे उद्धृत करें
Chernets, V. (2026). Chat के बाद: गैर-प्रोग्रामर्स और एजेंटिक AI के बीच तीन संक्रमण [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}