After Chat: The Three Transitions Between Non-Programmers and Agentic AI
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Le terminal n'est plus un terminal : un modèle à quatre niveaux, les preuves de 2025 et 2026, et un programme préenregistré pour mesurer les transitions
Vadym Chernets, Doctorat, architecte de systèmes d'IA · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
Télécharger cet article
- SSRN (version officielle) : ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (archivé, accès libre) : doi.org/10.5281/zenodo.22943313
- GitHub (texte intégral en Markdown et PDF) : github.com/vadimchernets/papers/tree/main/after-chat ; code : github.com/vadimchernets/after-chat
Le même texte se trouve à trois endroits pour pouvoir y accéder quand l'un d'entre eux ne peut pas le servir. SSRN détient la version officielle ; citez celle-ci.
Mots-clés : IA agentive ; agents d'IA ; non-programmeurs ; programmation par l'utilisateur final ; littératie en IA ; travailleurs du savoir ; adoption de la technologie ; adoption de l'IA générative ; supervision humaine ; délégation ; fracture numérique de second niveau ; erreurs corrélées ; ironies de l'automatisation ; déqualification ; préenregistrement
Résumé
La plupart des professionnels découvrent les IA sous forme de chatbot, tandis que les mêmes modèles, en tant qu'agents IA, agissent désormais sur des fichiers et des programmes. Je me demande pourquoi si peu de non-programmeurs ont franchi le pas de la conversation à l'IA agent, et comment mesurer cette transition. La réponse repose sur un modèle à quatre niveaux défini par la portée et le rôle et indépendant des produits : la conversation, un environnement agent sûr limité par le fournisseur, un agent sur son propre ordinateur, et un travail reproductible orchestré entre plusieurs modèles. Une transition compte uniquement quand un agent a produit un artefact que la personne a demandé. L'installation de logiciels compte comme une tentative. Les preuves de 2025 à septembre 2026 indiquent que la barrière à l'installation et à une première tentative bornée a baissé, tandis que la fiabilité sur des pièces de travail complètes, la stabilité du produit et la sécurité des dossiers ne se sont pas améliorées. L'installation est une étape, le propre chatbot de la personne peut la guider (« intégration réflexive »), et deux fournisseurs ont fusionné les interfaces de conversation et d'agent en 2026. Le chiffre directionnel d'un fournisseur rapporté par la presse place les travailleurs du savoir à un cinquième des cinq millions d'utilisateurs hebdomadaires de son agent de codage ; il mesure l'utilisation d'un agent d'héritage terminal, pas l'adoption de niveau 3 tel que défini ici. L'utilisation reste large et superficielle : environ la moitié des travailleurs américains utilisent les IA, environ un sur sept quotidiennement, et peu pour l'automatisation. La barrière s'est déplacée de l'installation à la direction. En m'appuyant sur la recherche en programmation pour les utilisateurs finaux, je nomme le vocabulaire de flux de travail de la capacité manquante et j'expose le travail du gestionnaire comme un contrat de délégation : objectif, limite, artefact et vérification. L'orchestration web (une question posée à plusieurs chatbots) est proposée comme le pont qui enseigne la comparaison, et l'orchestration CLI (un agent appelant d'autres) comme la couche durable, limitée par le fait que l'accord des modèles corrélés constitue une preuve faible. L'article se termine par quinze propositions réfutables, la conception d'un programme de cohorte préenregistré sans ses résultats, et un code d'enseignement ouvert.
Résumé analytique
Le terminal, la fenêtre noire qui représentait tout ce que les non-programmeurs ne pouvaient pas faire avec l'IA, a changé de sens. C'est maintenant le lieu sur l'ordinateur personnel d'une personne où un agent travaille, et la compétence qu'il exige n'est plus de taper des commandes. La compétence est de gérer le travailleur qui les tape.
Les développeurs professionnels sont les plus avancés : 90% de plus de 15 000 personnes interrogées en 2026 ont utilisé des outils d'agent au moins une fois par semaine (une enquête de fournisseur), bien que l'utilisation hebdomadaire ne soit pas encore la compétence du gestionnaire de la section 8. Tous les autres parlent encore surtout à un chatbot. 52% des travailleurs américains utilisent l'IA dans leur rôle, 15% quotidiennement, et 16% de ces utilisateurs citent l'automatisation parmi leurs usages.
La raison n'est plus que les agents sont difficiles à installer. L'installation prend une commande ou un clic, le chatbot qu'une personne utilise déjà peut le lui expliquer, et les fournisseurs ont commencé à fusionner le chat avec les agents. Ce qui reste difficile est d'une nature différente. Les agents échouent toujours sur des pans entiers de travail, le produit qu'une personne apprend peut être renommé ou retiré en un an, et un dossier accordé nécessite toujours d'être gardé. Après l'installateur, la première chose qui arrête les gens est qu'ils ne savent pas ce confier ou comment le vérifier, l'écart que la section 1 nomme vocabulaire de flux de travail. Derrière cela viennent la première erreur, les permissions et la sécurité, les règles organisationnelles, le matériel et le coût, et la compétence à juger les résultats.
Le modèle a quatre niveaux, ordonnés par la portée du modèle et par ce que la personne doit faire : conversation, un espace cloisonné que le fournisseur gère, l'ordinateur personnel de la personne, et le travail dirigé à travers plusieurs modèles. Les gens peuvent sauter un niveau. Un franchissement n'est montré que par un artefact que l'agent a produit, de sorte que les installations, les badges et l'auto-déclaration ne comptent pas.
L'orchestration, envoyer une question à plusieurs modèles, se présente en deux couches. Dans le navigateur, cela ne coûte rien à essayer et enseigne l'habitude de comparer les réponses, et sur la ligne de commande, cela peut être écrit et exécuté à nouveau. Dans les deux cas, ce qui compte est le nombre de familles de modèles interrogées, car les erreurs corrélées limitent la valeur de l'accord.
Gérer les agents est une compétence en soi. Elle a un contrat de délégation en quatre parties (objectif, limite, artefact, vérification), quatre pratiques (déléguer, superviser, vérifier, révoquer), une règle d'arrêt pour les examens, et un dossier d'acceptation qui sépare ce que l'agent a produit de ce sur quoi la personne s'est appuyée.
L'argument est construit pour être testé. Quinze propositions portent des mesures et des réfutants. La conception d'un programme de cohorte préenregistré (DOI OSF 10.17605/OSF.IO/X4EGQ) est décrite ici, et ses résultats seront rapportés séparément. Un tableau de statut indique la solidité de chaque affirmation, et le code ouvert se trouve en annexe C.
1. Introduction
Imaginez une professionnelle de bureau en septembre 2026. Elle utilise un agent conversationnel chaque semaine. Elle lui demande de rédiger un email, de résumer un rapport, de proposer une formule. Ce qu'elle reçoit est du texte, et elle porte ce texte manuellement vers l'endroit où vit son travail : un dossier de contrats, un tableur de comptes, un diaporama à remettre vendredi. Le même modèle, par une porte différente, peut ouvrir ce dossier, lire tous les fichiers qu'il contient, écrire le tableur, construire le diaporama et vérifier ses propres calculs. La plupart des professionnels, autant que les sondages de la section 4.4 peuvent l'indiquer, n'ont pas encore utilisé cette porte, et beaucoup ne savent pas qu'elle existe.
Pendant deux ans, la porte ressemblait à un terminal : une fenêtre noire, un curseur clignotant, une commande à coller. Cette image est dépassée. Le terminal est resté un terminal uniquement visuellement. Il est devenu l'environnement dans lequel vit un agent, l'endroit sur la propre machine d'une personne où un modèle peut lire, écrire, exécuter et planifier, et la personne devant lui n'a plus besoin d'utiliser un shell autant que de diriger l'agent qui le fait. Ce qui change, c'est le rôle humain, passant de quelqu'un qui pose des questions à un modèle à quelqu'un qui gère un travailleur.
Mon sujet est la route entre ces deux rôles et qui s'y trouve. Parmi les développeurs professionnels, les outils, du moins, sont déjà arrivés. Un sondage auprès de plus de 15 000 développeurs professionnels de mai à juillet 2026 a révélé que 90 % utilisaient des agents de codage IA au travail au moins une fois par semaine et 68 % quotidiennement, et que la part utilisant un agent terminal, Claude Code, au travail était passée d'environ 3 % au printemps 2025 à 18 % en janvier 2026 et 39 % à la mi-2026 (JetBrains Research, 2026a, 2026b ; un sondage de fournisseur, puisque JetBrains vend un agent de codage). Chez tous les autres, ce n'est pas le cas, et le schéma d'utilisation est large et peu profond. Dans les mêmes mois, 52 % des travailleurs américains ont déclaré utiliser l'IA dans leur rôle, 15 % l'utilisaient quotidiennement, et seulement 16 % de ces utilisateurs ont nommé l'automatisation parmi leurs utilisations ; la rédaction et la recherche ont dominé (Gallup, 2026). Pour le professionnel typique, l'IA est toujours une conversation, et les chiffres de la Federal Reserve de Saint-Louis disent la même chose sur une période plus longue : entre août 2024 et mai 2026, la part des travailleurs utilisant l'IA générative pour leurs travaux est passée de 33 % à 45 %, tandis que moins de 3 % des tâches avaient des taux d'adoption supérieurs à 50 % (Bick et al., 2026).
L'explication standard de l'écart est la difficulté technique : les agents sont pour les personnes qui savent programmer. Cette réponse était raisonnable en 2024 et est faible en 2026. Installer un agent terminal ne prend maintenant qu'une commande ou un installateur de bureau, et l'agent principal expédie une application de bureau dont la documentation dit clairement : « Aucun terminal requis » (Anthropic, 2026a). Les fournisseurs sont allés plus loin. OpenAI a transformé son application d'agent de codage en client ChatGPT par défaut sur le bureau le 9 juillet 2026 et a ajouté un agent, ChatGPT Work, qui utilise les fichiers et les applications locales (MacRumors, 2026). Anthropic a fusionné son agent de bureau pour le travail de connaissance, Cowork, dans le chat ordinaire le 16 septembre 2026 ; TechCrunch a rapporté que l'entreprise déclarait que les clients « avaient souvent du mal à choisir le bon onglet pour la bonne tâche » (TechCrunch, 2026a). OpenAI a rapporté, par voie de presse, que les travailleurs du savoir constituaient environ 20 % des cinq millions d'utilisateurs hebdomadaires de son agent de codage en juin 2026 et l'adoptaient plus de trois fois plus vite que les développeurs (Help Net Security, 2026). Le chiffre est rapporté par le fournisseur et directionnel, la propre page du fournisseur n'était pas accessible à mes vérifications, et il mesure l'utilisation par les travailleurs du savoir d'un agent à héritage terminal, ce qui est plus large que l'adoption au niveau 3 telle que définie à la section 3. Il est difficile de voir où se trouve la barrière technique dans ce tableau.
La barrière s'est déplacée. Elle est passée de l'installation à la direction : de « comment faire fonctionner cela ? » à « que lui demander, dans quelles limites, et comment savoir qu'il l'a fait ? » La deuxième question est plus difficile qu'il n'y paraît, et la littérature sur la programmation des utilisateurs finaux explique pourquoi. Les non-experts ont du mal à exprimer leurs intentions aux modèles de langage même lorsque l'accès est gratuit et immédiat (Zamfirescu-Pereira et al., 2023), et ils doivent apprendre quelles formulations correspondent à ce que le système peut faire (Liu et al., 2023). Déléguer à une IA change également le travail de la production à la spécification et la vérification (Sarkar & Drosos, 2025 ; Simkute et al., 2024). J'appelle la capacité manquante vocabulaire de flux de travail : un stock de travail de tâches qu'une personne sait comment confier à un agent, formulé de sorte que l'agent puisse les exécuter et que le résultat puisse être vérifié. Énoncé formellement, il s'agit de la cartographie entre les objectifs du domaine d'une personne et les sous-tâches qu'un agent peut exécuter, avec les mots pour les entrées, les transformations, les sorties, les exceptions et les preuves dont la cartographie a besoin. Un développeur qui ouvre un agent connaît déjà les dix premières choses à taper. Un comptable ou un enseignant généralement non, et personne dans leur bureau ne le leur a dit.
La première contribution est un modèle à quatre niveaux de la route du chat au travail agentic, défini par la portée et le rôle et par aucun nom de produit. Les niveaux vont du chat à un environnement agentic sûr et un agent sur son propre ordinateur au travail orchestré répétable. Chacun est défini par ce que l'agent peut toucher et par ce que la personne doit spécifier et vérifier, et chaque transition est définie par un artefact produit par l'agent, et le logiciel installé seul ne compte pas. Parce que les définitions ne dépendent pas des noms de produits, le modèle survit à l'habitude actuelle des fournisseurs de fusionner leurs produits (section 3).
La deuxième est une synthèse des preuves de 2025 à septembre 2026. Elle montre que l'installation et une première tentative bornée sont devenues beaucoup plus faciles, que les trois limites énoncées à la section 4.5 (travail fiable sur des tâches entières, produits stables, dossiers sûrs) ne se sont pas déplacées avec elles, et que le schéma peu profond d'utilisation persiste. Elle localise également les barrières qui subsistent : vocabulaire de flux de travail, l'erreur qui arrête un nouveau venu, permission et sécurité, règles organisationnelles, et la compétence pour juger les résultats (sections 4 et 5).
La troisième est un compte des deux couches d'orchestration. L'orchestration Web, une question envoyée à plusieurs chatbots de consommateurs, est le pont : elle ne nécessite pas d'installation et enseigne l'habitude de la comparaison. L'orchestration CLI, un agent appelant les outils de ligne de commande d'autres agents, est la couche de délégation qui dure. Les deux sont délimités par un fait que les utilisateurs ont tendance à manquer, que l'accord entre les modèles ne constitue pas une preuve indépendante (Chernets, 2026a) (sections 6 et 7).
La quatrième est un programme de mesure avec des propositions falsifiables : la conception d'un programme de cohorte préenregistré qui suit les non-programmeurs à travers ces transitions (Chernets, 2026d), et une boîte à outils d'enseignement ouverte des modèles d'orchestration et de sécurité dans les appendices (sections 9 et 10, appendice C).
Quelques limites de portée s'appliquent dans l'ensemble. « Non-programmeur » désigne un professionnel dont le travail se fait substantiellement à l'ordinateur et qui n'a reçu aucune formation en script ou en génie logiciel. Un analyste maîtrisant les formules de feuille de calcul en est un exemple, un développeur ne l'est pas, et les développeurs apparaissent ici comme groupe de comparaison. Je ne rapporte aucun résultat du programme de cohorte ; ceux-ci font l'objet d'un document séparé après sa période d'observation. La plupart des chiffres d'adoption proviennent des États-Unis et des fournisseurs, et sont signalés comme tels. Et les outils décrits changent chaque mois, de sorte que le modèle est conçu pour les survivre et les détails des produits sont censés devenir obsolètes.
La section 2 situe l'argument dans la littérature et la section 3 définit les niveaux et les transitions. La section 4 montre où la barrière technique s'est créée, la section 5 ce qui l'a remplacée, les sections 6 et 7 les deux formes d'orchestration, et la section 8 ce que ce changement fait au rôle humain. La section 9 décrit le programme qui mesure les franchissements, la section 10 énonce les propositions, la section 11 en tire les implications, la section 12 établit les conditions limites, et la section 13 conclut.
2. Contexte : de la programmation par l'utilisateur final à la délégation par l'utilisateur final
2.1 Les utilisateurs finaux ont toujours programmé
L'idée que des personnes qui ne sont pas programmeuses dirigent le calcul est plus ancienne que les modèles de langage. Nardi (1993) a soutenu que les utilisateurs finaux commandent la puissance informatique par des langages et des cadres spécifiques à une tâche, les feuilles de calcul en étant l'exemple canonique, sans avoir besoin de compétences générales en programmation. Ko et al. (2011) ont montré que les utilisateurs finaux qui construisent des logiciels font face aux mêmes problèmes que les professionnels (exigences, réutilisabilité, tests, débogage) sans la formation nécessaire, et ont nommé ce domaine l'ingénierie logicielle par l'utilisateur final. Le domaine plus large, le développement par l'utilisateur final, étudie comment les personnes qui ne sont pas des développeurs professionnels créent et adaptent des logiciels pour leur propre travail. Myers, Pane et Ko (2004) ont consacré des années à concevoir des notations plus proches de la façon dont les non-programmeuses décrivent les tâches. Chacune de ces lignes de travail supposait que l'utilisateur final écrirait toujours quelque chose que la machine exécute, même si ce quelque chose était une formule ou une règle.
Les modèles de langage ont changé ce que l'utilisateur final écrit. Sarkar et al. (2022) ont décrit la programmation avec un grand modèle de langage comme une nouvelle activité, distincte de la compilation, de la programmation en binôme et de la recherche. Zamfirescu-Pereira et al. (2023) ont constaté que les personnes sans expertise en IA ont du mal à concevoir des invites qui fonctionnent de manière fiable, généralisent à partir de réussites isolées et reviennent à des habitudes conversationnelles humaines. Liu et al. (2023) ont nommé la difficulté d'apprendre quels mots produisent quel comportement « l'appariement d'abstraction ancrée ». Sarkar et Drosos (2025), dans la première étude empirique de la « programmation par intuition », ont constaté que la programmation conversationnelle redistribue l'expertise vers la gestion du contexte et la vérification rapide des résultats, et laisse le besoin de jugement où il était. Virk et Liu (2025) ont constaté que les utilisateurs métier auxquels on a fourni du code d'analyse écrit par une IA n'ont souvent pas réussi à détecter des erreurs critiques même quand on leur a dit de les chercher. Feldman et Anderson (2024) ont appelé les programmeuses non expertes la population la plus insuffisamment étudiée de l'ère générative.
Je franchis l'étape suivante dans cette lignée. L'unité de travail de l'utilisateur final a changé, passant d'une formule, d'un script ou d'une invite à une délégation : une tâche confiée à un agent qui agit sur des fichiers et des outils sur plusieurs étapes. La littérature sur la programmation par l'utilisateur final explique pourquoi exprimer l'intention est difficile, et la littérature sur la délégation et la surveillance explique pourquoi vérifier le résultat est difficile. Le modèle à quatre niveaux de la section 3 est construit pour joindre les deux.
2.2 L'adoption est rapide et superficielle
L'IA générative s'est propagée plus rapidement que l'ordinateur personnel ou Internet. Bick, Blandin et Deming (2024) ont estimé qu'environ 40 % des adultes en âge de travailler aux États-Unis l'utilisaient à la fin de 2024, tandis qu'une petite part des heures de travail était assistée. Chatterji et al. (2025) ont constaté qu'à la mi-2025, ChatGPT servait environ 700 millions d'utilisateurs hebdomadaires et que la plupart des messages n'étaient pas liés au travail. Au Danemark, Humlum et Vestergaard (2025) ont constaté des effets nuls précis sur les gains et les heures deux ans après l'adoption, et un écart d'utilisation entre les femmes et les hommes ; une méta-analyse dans plus de 100 pays place cet écart à environ 16 points de pourcentage depuis le début de 2025 (Cranney et al., 2026). Dans 35 pays européens, l'exposition à l'IA ne s'est pas automatiquement traduite par son utilisation, et la formation, la numérisation et l'agentivité des travailleurs ont joué un rôle plus important (Henseke, 2026).
Les expériences de terrain montrent des gains importants là où l'outil convient à la tâche : 14 % de plus de problèmes clients résolus par heure en moyenne et 34 % pour les novices (Brynjolfsson et al., 2025), une écriture plus rapide et meilleure dans un essai avec 444 professionnels, avec les gains les plus importants pour les écrivains les plus faibles (Noy & Zhang, 2023), et, parmi 758 consultants, 12,2 % de plus de tâches complétées et une qualité augmentée de plus de 40 % à l'intérieur de la « frontière fragmentée » de la capacité du modèle, avec un travail pire sur une tâche en dehors de celle-ci (Dell'Acqua et al., 2026). Un essai aléatoire auprès de développeurs open source expérimentés a trouvé le signe opposé au début de 2025, un ralentissement de 19 % (Becker et al., 2025), un résultat que ses auteurs ont dit ultérieurement était probablement dépassé à mesure que les outils s'amélioraient (METR, 2026). La leçon de ces essais est que les gains dépendent de l'adéquation entre la tâche, l'outil et la capacité de la personne à le diriger et à le vérifier, et ce sont les trois choses qu'une transition entre les niveaux change.
2.3 Acceptation, diffusion et le fossé du deuxième niveau
La recherche sur l'adoption de technologies, du modèle d'acceptation des technologies (Davis, 1989) à la théorie unifiée de l'acceptation et de l'utilisation de la technologie (Venkatesh et al., 2003), affirme que l'utilité perçue et la facilité d'utilisation ouvrent la voie à l'adoption, et que l'influence sociale et les conditions de facilitation importent autant que les attitudes individuelles. La recherche sur la diffusion décrit l'adoption comme un processus social avec des adoptants précoces et tardifs (Rogers, 2003). Une fois que l'accès de base à Internet est devenu courant, Hargittai (2002) a montré que l'inégalité significative s'est déplacée vers la compétence : le fossé numérique du deuxième niveau. Van Dijk (2020) a étendu cela à une séquence de motivation, d'accès, de compétences et d'utilisation.
Le même déplacement est visible maintenant. L'accès aux conversations est quasi universel parmi les travailleurs de bureau dans les pays riches, tandis que la compétence de diriger un agent est loin d'être universelle. Un fossé de l'IA a déjà été mesuré selon les anciennes lignes d'éducation, de région et d'âge (Daepp & Counts, 2024 ; Pew Research Center, 2026). Ce que j'ajoute est l'observation que le fossé s'étend maintenant à l'intérieur de la population d'utilisateurs d'IA, entre ceux qui conversent avec des modèles et ceux qui leur délèguent.
2.4 Automatisation, surveillance et le fardeau du gestionnaire
La littérature sur la supervision humaine de l'automatisation commence par une ironie. Bainbridge (1983) l'a décrite : automatiser la plupart d'une tâche laisse à l'humain le résidu le plus difficile, la surveillance et l'intervention rare, tout en érodant la compétence nécessaire pour cela. Parasuraman et Riley (1997) ont distingué l'usage abusif, l'absence d'usage et l'abus de l'automatisation, et Lee et See (2004) ont montré que la confiance devrait suivre la confiance calibrée. L'ère générative a renouvelé chaque point. Les travailleurs du savoir qui font davantage confiance à l'outil signalent moins de pensée critique (Lee et al., 2025). Les IA génératives déplacent les gens de la production vers l'évaluation et rendent les tâches faciles plus faciles et les tâches difficiles plus difficiles (Simkute et al., 2024). Les interventions pour calibrer la confiance envers les modèles de langage réduisent la sur-confiance sans produire une confiance appropriée (Bo et al., 2025). Les utilisateurs d'agents IA comme assistants quotidiens évaluent mal la confiance envers des plans plausibles mais erronés, et font mieux lorsqu'ils participent à l'exécution étape par étape (He et al., 2025). De meilleures traces de ce qu'un agent a fait accélèrent la détection des erreurs sans améliorer de manière fiable la précision finale (Grunde-McLaughlin et al., 2026). Une étude d'environ 73 000 messages publics sur un agent autonome a révélé que les valeurs des utilisateurs étaient largement satisfaites dans ce que l'agent livrait et largement non satisfaites dans la manière dont ils pouvaient le superviser (Ma et al., 2026). Dans une petite étude de laboratoire et trois déploiements, le confort avec la délégation a augmenté au fil du temps tandis que les gens voulaient toujours avoir le contrôle aux moments d'incertitude (Long et al., 2025). Tomašev, Franklin et Osindero (2026) traitent la délégation à l'IA comme un cadre d'allocation des tâches, de transfert d'autorité, de responsabilité et de confiance, applicable aux délégués humains et machines.
Du côté cognitif, une étude EEG de 54 rédacteurs d'essais a signalé une connectivité plus faible et une propriété inférieure dans le groupe assisté, une « dette cognitive » (Kosmyna et al., 2025), et un commentaire publié a contesté ses méthodes (Stankovic et al., 2026). La lecture prudente est que le déchargement des étapes de routine libère l'attention et que l'attention libérée doit être consacrée à la vérification. Deux autres idées de la recherche sur l'apprentissage sont utilisées plus tard. La théorie de la charge cognitive explique pourquoi un nouveau venu plongé dans un environnement non clôturé s'arrête avant qu'un schéma mental se soit formé (Sweller, 1988). Et un modèle d'adoption comme apprentissage bayésien montre comment les gens peuvent se stabiliser dans un équilibre d'utilisation faible auto-renforçant que seul un premier succès ou une formation peut déplacer (Ma et al., 2025).
Deux articles complémentaires de cette série portent sur le même problème de l'autre côté. Le premier montre que l'accord entre plusieurs modèles est une preuve plus faible qu'il n'y paraît, car leurs erreurs sont corrélées (Chernets, 2026a). Le second montre comment les composants de supervision automatisée peuvent élargir leur propre mandat et entraver le travail qu'ils gardent (Chernets, 2026b). Les deux comptent pour un nouveau venu : le premier pour ce que l'orchestration peut apporter, le second pour expliquer pourquoi les couches de sécurité peuvent arrêter une personne à la porte.
2.5 Ce qui n'a pas été étudié
Une recherche effectuée le 21 septembre 2026 (recherche Web, Crossref, arXiv et Semantic Scholar, avec attention aux documents CHI, UIST et VL/HCC de 2024 à 2026) n'a trouvé aucune étude de terrain publiée de non-programmeurs adoptant des agents de terminal ou de ligne de commande par nom, aucune étude d'orchestration Web (une question à plusieurs chatbots grand public dans le navigateur) en tant que pratique nommée, aucun traitement de la gestion des agents en tant que compétence avec sa propre structure de compétences, et aucune étude d'un système IA structurant l'adoption par une personne de l'IA basée sur les agents elle-même ; le travail le plus proche applique la théorie de l'étayage aux tuteurs IA d'autres matières (Cohn et al., 2026) ou aux interfaces conditionnées par les tâches pour les logiciels complexes (Liu & Sra, 2026). Le travail en économie du travail mesure l'adoption générale de l'IA générative, et aucun d'entre eux n'isole l'étape du chat aux outils basés sur les agents parmi les non-programmeurs. Ces lacunes définissent l'espace que le modèle cartographie et le programme de la section 9 est conçu pour mesurer.
3. Quatre niveaux et trois transitions
3.1 Deux axes : portée et rôle
Un niveau décrit une relation entre une personne et un modèle au travail, et je le définis selon deux axes, la portée et le rôle.
La portée est ce que le modèle peut toucher au nom de la personne. Au plus étroit, il n'y a que la conversation, puis les fichiers et outils à l'intérieur d'un espace délimité par le fournisseur, puis l'ordinateur personnel de la personne avec ses fichiers, programmes et calendrier, et au plus large plusieurs modèles et agents à la fois.
Le rôle est ce que la personne doit faire pour que le travail réussisse. Dans le même ordre, elle pose des questions et copie, elle délègue une tâche et examine le résultat, elle possède l'environnement d'un agent avec ses permissions et son annulation, ou elle alloue le travail entre les agents et réconcilie ce qui revient.
Les produits sont délibérément absents de la définition. Un seul produit peut couvrir plusieurs niveaux, et en 2026 les fournisseurs fusionnent le chat et les agents dans une seule fenêtre plus vite que ne pourrait suivre une taxonomie basée sur les noms de produits (Section 4.3). Un niveau décrit un morceau de travail, et une personne, tout comme un produit, peut couvrir plusieurs. La même personne peut être au niveau 1 pour une tâche le matin et au niveau 3 pour une autre l'après-midi.
Les deux axes séparent également ce modèle des échelles familières d'automatisation et d'autonomie. Parasuraman, Sheridan et Wickens (2000) ont classé le degré auquel une machine effectue chaque étape d'une tâche (acquérir l'information, l'analyser, décider, agir). Morris et al. (2024) ont évalué les systèmes d'IA généraux par la profondeur et l'ampleur de leurs performances. Feng, McDonald et Zhang (2025) ont défini cinq niveaux d'autonomie pour les agents IA selon le rôle que joue l'utilisateur, de l'opérateur et du collaborateur au consultant, approbateur et observateur. Ces échelles décrivent le degré auquel un agent décide au sein d'une tâche. Les quatre niveaux ici décrivent où le travail s'exécute et ce que la personne possède : une conversation, un espace délimité d'un fournisseur, sa propre machine, une équipe d'agents de plusieurs fournisseurs. Les axes sont orthogonaux. Un agent sur la propre machine d'une personne peut fonctionner à n'importe lequel des niveaux d'autonomie de Feng et al., de l'approbation étape par étape à une délégation quasi totale, et la personne possède toujours ses permissions et son annulation. Ce que les quatre niveaux ajoutent est une description de l'adoption : l'ordre dans lequel la portée et la responsabilité augmentent pour quelqu'un qui commence au chat, et la preuve (un artefact) qui montre que chaque étape a été franchie.
3.2 Les quatre niveaux
Niveau 1 : chat. La portée du modèle s'arrête à la conversation. Il produit du texte, du code ou des images que la personne copie dans le lieu où le travail se fait, et le rôle de la personne est de bien poser des questions et de transporter la sortie. Presque tous les professionnels qui utilisent l'IA travaillent ici la plupart du temps (Section 2.2).
Niveau 2 : un environnement agentic sûr. Le modèle agit sur les fichiers, les services connectés et parfois un navigateur, à l'intérieur d'un espace délimité par le fournisseur : dossiers sélectionnés, une machine virtuelle ou un sandbox côté serveur, des connecteurs que la personne a approuvés, et une étape d'approbation avant les actions conséquentes. Anthropic's Cowork, OpenAI's ChatGPT Work, Microsoft's Copilot Cowork et Google's Gemini Spark sont des exemples de 2026, et ils partagent la conception d'un agent de délégation fonctionnant dans un espace délimité (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). Le rôle de la personne passe de la demande à la délégation. Elle confie une tâche qui aboutit à un fichier ou une action et examine ce qui revient, et une grande partie de la sécurité de l'environnement, à ce niveau, est la responsabilité du fournisseur.
Niveau 3 : un agent sur son propre ordinateur. L'agent s'exécute sur la machine de la personne avec accès au système de fichiers, au shell, aux programmes installés et aux tâches planifiées, via un terminal ou un shell de bureau sur le même moteur : Claude Code, Codex d'OpenAI, Antigravity CLI de Google, Grok Build de xAI, Kimi Code de Moonshot et équivalents open source. Dans la littérature de recherche, ce sont des agents basés sur les LLM, et leur utilisation par les développeurs est étudiée comme codage agentic ; le niveau pose la question de ce qui se passe lorsque la personne qui les exécute n'est pas un développeur. La portée est la plus large qu'un agent unique puisse obtenir, et avec elle le rôle de la personne change à nouveau. Elle possède l'environnement : quels dossiers l'agent voit, quelles commandes nécessitent une approbation, ce qui est exclu, et comment annuler une erreur. Le terminal lui-même est accessoire, car ce qui définit le niveau est la possession d'un environnement de travail dans lequel un agent peut faire tout ce que la personne pourrait faire. Les variantes hébergées dans le cloud (la même boucle d'agent exécutée sur une machine du fournisseur, la personne voyant une tâche et un résultat et jamais une invite) sont le niveau 3 par capacité et le niveau 2 par rayon d'action, et le modèle les enregistre comme une variante du niveau 3 sans les forcer dans une seule cellule.
Niveau 4 : travail orchestré et répétable. La personne dirige plusieurs modèles ou agents, en parallèle ou en séquence, sur un travail qui se répète, et la portée couvre maintenant plusieurs fournisseurs. Il y a deux couches. Dans l'orchestration web, une question est posée à plusieurs chatbots grand public dans le navigateur, manuellement ou avec un outil, et les réponses sont comparées. Dans l'orchestration CLI, un agent appelle les outils en ligne de commande d'autres agents, collecte leurs résultats et les fusionne ou les vérifie. Le rôle de la personne est celui d'un gestionnaire : elle fixe l'objectif, alloue le travail, décide ce qui compte comme fait, et réconcilie le désaccord. Le travail devient répétable lorsqu'il est écrit sous une forme que les agents peuvent relancer, comme un fichier d'instruction, une compétence ou une tâche planifiée. « Répétable » décrit le flux de travail, pas la sortie. Le même fichier d'instruction exécuté la semaine prochaine produira un brouillon différent, et ce qui se répète est la séquence des entrées, des étapes, des vérifications et du livrable. Une tâche récurrente d'un agent unique écrite de cette manière est un travail de niveau 3 rendu répétable, et elle devient le niveau 4 lorsqu'une deuxième famille de modèles est dirigée et que les résultats sont réconciliés (transition 3, Section 3.3).
Tableau 1. Les quatre niveaux.
| Niveau | Portée du modèle | Rôle de la personne | Surfaces typiques, septembre 2026 | Le franchissement est montré par | Ce que le niveau n'établit pas | Barrière principale à l'entrée |
|---|---|---|---|---|---|---|
| 1. Chat | La conversation | Pose des questions, copie la sortie manuellement | Chat dans le navigateur ou l'application | (niveau d'entrée) | Que le modèle peut agir sur le travail de la personne, ou être digne de confiance sans vérification | Aucune au-delà de l'accès |
| 2. Environnement agentic sûr | Fichiers, connecteurs et navigateur à l'intérieur d'un espace délimité par le fournisseur | Délègue une tâche, examine le résultat | Cowork fusionné dans Claude chat ; ChatGPT Work ; Copilot Cowork ; Gemini Spark | Un fichier ou une action produits par l'agent à partir d'une tâche déléguée, avec une approbation ou un refus enregistrés | Que la personne peut exécuter un environnement de son propre chef, ou répéter le travail | Savoir ce qu'il faut déléguer ; confiance |
| 3. Agent sur l'ordinateur personnel | Le système de fichiers de la personne, shell, programmes, agenda | Propriétaire de l'environnement : permissions, exclusions, annulation | Terminal et shells de bureau de Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code | Un artefact que l'agent a produit sur l'ordinateur personnel de la personne, dans un dossier que la personne a créé, à partir d'une tâche nécessitant plus d'un usage d'outil | Que le résultat est juste, ou sûr à accepter sans examen | Friction d'installation (chute) ; la première erreur ; permissions ; ce qu'il faut demander |
| 4. Travail orchestré | Plusieurs modèles ou agents entre fournisseurs | Gère : objectif, allocation, acceptation, réconciliation | Web : plusieurs onglets de chat ou outils de diffusion. CLI : greffons et scripts qui appellent d'autres agents | Un résultat fusionné ou comparé entre au moins deux familles de modèles, réexécuté au moins une fois, avec enregistrement de qui a été interrogé et qui a répondu | Que l'accord entre les modèles constitue une preuve indépendante, ou que la tâche relève de ce niveau | Coût de la réconciliation ; erreurs corrélées ; quota et churn d'outils |
Deux termes du tableau sont plus étroits que l'usage courant. « Sûr » dans « environnement agentif sûr » désigne un objectif de conception et un modèle d'interaction et ne donne aucune assurance. La portée du dossier, les approbations, les bacs à sable et les volets d'aperçu réduisent la zone sur laquelle l'agent agit ; ils ne peuvent pas faire qu'une implémentation buguée préserve les fichiers ou rendre inoffensif un document contenant des instructions cachées, et la section 5.3 rapporte ce qui s'est mal passé à l'intérieur des dossiers accordés. Ce que le niveau intermédiaire établit, c'est un modèle mental pratique. Une personne qui voit que l'agent peut rédiger un rapport dans un dossier et ne peut rien toucher d'autre a appris que l'action déléguée a un périmètre, ce qui est plus utile que tout avertissement abstrait pour être prudent avec l'IA. « Artefact » désigne un livrablequisureg plusieurs étapes du propre travail de l'agent. La personne qui l'a demandé décide si cela compte comme un artefact, un tiers en évalue la qualité (section 9.4), et une étude rapporte l'accord entre évaluateurs tant pour cette notation que pour le codage des raisons d'arrêt. Un dossier contenant deux fichiers vides est une trace d'un programme d'installation et ne compte pas.
3.3 Trois transitions, et pourquoi un artefact définit chacune
On franchit une transition quand l'agent a produit, au nouveau niveau, un artefact que la personne a demandé. Une installation ne compte que comme une tentative, tout comme un tutoriel complété, un badge, une licence et l'auto-rapport « j'utilise maintenant des agents ». La règle a plusieurs conséquences au-delà de la plus évidente. Un dossier créé par un agent montre que l'agent a fonctionné, tandis qu'un ensemble de fichiers écrits par l'agent à partir de la description de la personne de son propre travail montre que la personne a délégué. La règle rend aussi les transitions observables de l'extérieur : un chercheur ou un gestionnaire peut voir un artefact et ne peut pas voir une intention ou un sentiment de compétence. Elle rend l'échec informatif, puisqu'une personne qui a installé un outil et n'a rien produit a rencontré un obstacle qui mérite d'être nommé, et compter l'installation comme un succès le cacherait. Et parce qu'elle ne désigne aucun produit, la règle permet aux études de comparer entre des outils qui sont renommés tous les trimestres.
La transition 1, du chat à un environnement agentif sûr, est franchie quand une personne délègue pour la première fois une tâche qui aboutit à un fichier ou une action au lieu d'un texte. En 2026, cette transition est absorbée dans la fenêtre de chat elle-même. Quand le modèle du fournisseur décide de répondre ou d'agir, comme il le fait dans l'expérience fusionnée Claude annoncée le 16 septembre 2026 (Anthropic, 2026c), une personne peut la franchir sans le décider. Cela rend le franchissement plus facile et aussi moins visible, y compris pour la personne.
La transition 2, de l'environnement sûr à l'ordinateur personnel, est franchie quand une personne exécute un agent dans son propre environnement et reçoit un artefact de celui-ci. Le changement décisif est la propriété. Au niveau 2, le fournisseur décide ce que l'agent peut toucher, et au niveau 3, la personne le fait, quel que soit le visage que l'agent affiche, un terminal ou une fenêtre. La peur du terminal vivait autrefois ici, et la section 5 montre que les questions de permissions, d'erreurs et de ce qu'il faut demander ont pris sa place.
La transition 3, d'un agent au travail orchestré, est franchie quand une personne obtient un résultat qu'au moins deux familles de modèles ont produit ou vérifié, et réitère cet arrangement sur les travaux ultérieurs. La réitération importe, car une seule comparaison de trois chatbots est une curiosité, et seule une comparaison à laquelle la personne a recours chaque fois que les enjeux la justifient constitue une pratique.
La route que suit le programme de la section 9 peut être parcourue en tant que conception, avec la professionnelle de l'Introduction comme cas hypothétique et rien de rapporté. Elle commencerait là où elle se trouve déjà, au niveau 1, avec un chatbot qu'elle paie. Elle collerait un texte standard dans ce chatbot et le laisserait la guider dans l'installation d'un agent graphique sur son propre ordinateur portable, lui envoyant une capture d'écran chaque fois qu'une étape échouait, et je ne toucherais à rien. La première étape ne compterait comme franchie que quand l'agent aurait produit, à partir de sa propre description de son travail, un ensemble de fichiers qu'elle pourrait ouvrir et juger ; une application installée à côté d'un dossier vide compterait comme une tentative. Elle travaillerait dans une copie de ses fichiers, garderait les mots de passe et les documents clients à l'écart, lirait le plan de l'agent avant de le laisser agir, et confirmerait tout ce qui serait irréversible. Quand elle dirait qu'elle était prête, elle recevrait un outil open source qui pose une question à plusieurs modèles via les abonnements qu'elle a déjà et retourne une réponse fusionnée, lancée de l'intérieur de l'agent, et cette étape compterait quand une exécution datée montrerait quels modèles ont été interrogés et où ils diffèraient. Plus tard, elle exécuterait la même comparaison via des outils de ligne de commande. Elle pourrait s'arrêter à l'un de ces points, et l'enregistrement enregistré tiendrait compte de l'endroit et, en ses propres termes, du pourquoi. La route est tirée de l'enregistrement public, et si les gens la parcourent est une question pour l'article de résultats.
3.4 Les niveaux sont ordonnés, non obligatoires
Les niveaux sont ordonnés par portée et par la responsabilité qu'ils placent sur la personne. L'ordre n'en fait pas un escalier que chacun doit gravir marche par marche. Une personne peut passer directement du chat à un agent sur son propre ordinateur ; l'itinéraire de cohorte décrit à la section 9 fait exactement cela, le chatbot que la personne utilise déjà la guidant dans l'installation. D'autres s'arrêteront au niveau 2 pour de bon, et pour beaucoup de travaux, c'est là qu'il faut s'arrêter. Plus haut n'est pas mieux dans ce modèle. Ses affirmations sont que chaque niveau demande des choses différentes à la personne, que les passages peuvent être observés, et que les barrières à chaque passage diffèrent. Il serait falsifié si les passages ne pouvaient pas être distingués par des artefacts, si les barrières ne différaient pas entre les passages, ou si la compétence à un niveau ne changeait pas ce que les gens pourraient faire au suivant, car dans n'importe lequel de ces cas, le modèle n'ajouterait rien à une simple échelle d'« utilisation des IA ». Le modèle prédit aussi que, une fois que la sensibilité et les exigences techniques d'une tâche sont maintenues constantes, l'accomplissement chute plus fortement aux trois transitions qu'à l'intérieur d'un niveau. Si les chutes étaient réparties régulièrement, les niveaux seraient un continuum rebaptisé. La section 10 transforme ces attentes en propositions avec des mesures et des falsificateurs.
Une famille d'outils se place à côté de l'échelle et sur aucun de ses échelons. Les constructeurs d'applications de navigateur permettent à une personne de décrire une application et de recevoir un aperçu en direct à l'intérieur d'une plateforme que le fournisseur héberge. Ils importent, et ils sont une chose différente du niveau 2, où un agent agit sur les fichiers de la personne selon un modèle de permissions ; un constructeur d'applications agit sur un projet dont la plateforme est propriétaire. Confondre les deux crée une fausse impression que les non-programmeurs sont déjà arrivés. Le modèle à quatre niveaux laisse les constructeurs d'applications sur une branche latérale avec son propre plafond et son propre profil de sécurité, et la littérature du vibe-coding est l'endroit où en lire à ce sujet (Sarkar & Drosos, 2025 ; Ge et al., 2025). La figure 1 dessine les quatre niveaux, l'artefact qui marque chaque transition, le saut enregistré et la branche latérale.
Figure 1. Quatre niveaux et trois transitions définies par des artefacts.
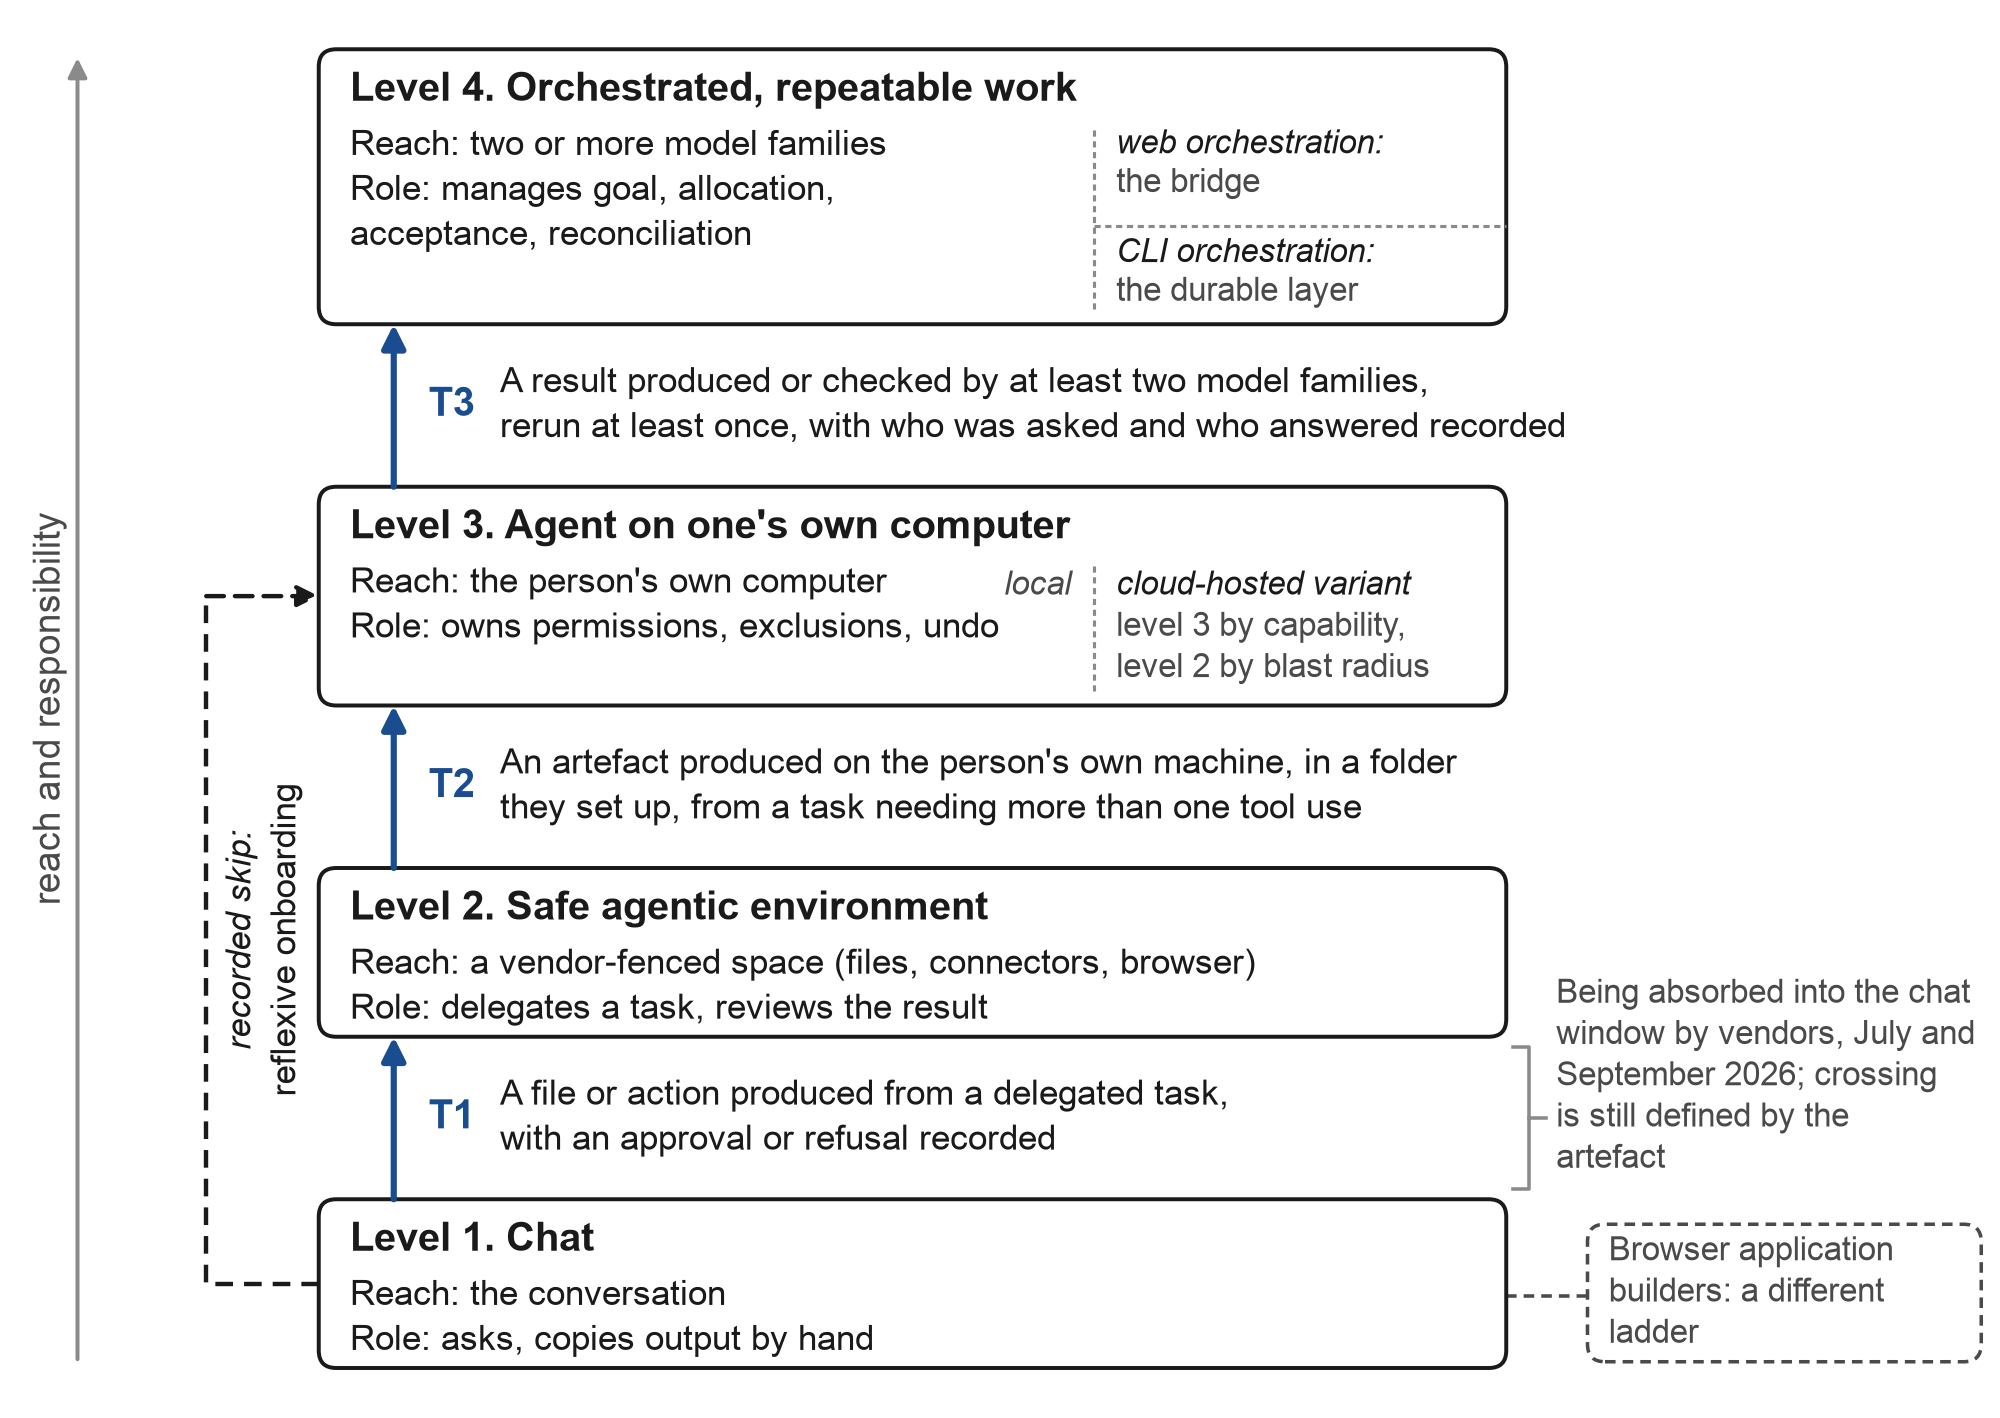
Note : Les quatre niveaux de la section 3.2, ordonnés vers le haut par portée (ce que le modèle peut toucher) et par la responsabilité placée sur la personne. Chaque transition, T1 à T3, n'est franchie que lorsqu'un agent a produit l'artefact nommé à côté de sa flèche, et une installation compte comme une tentative (section 3.3 et tableau 1). La flèche pointillée sur la gauche est le saut enregistré du chat à un agent sur l'ordinateur de la personne que l'itinéraire enregistré emprunte (sections 3.4 et 9.2) ; la boîte pointillée sur la droite est la branche latérale des constructeurs d'applications de navigateur, et la note à T1 enregistre la fusion des surfaces de chat et d'agent par les fournisseurs en juillet et septembre 2026 (section 4.3).
3.5 Le terminal n'est plus un terminal
Pour un programmeur, le terminal est une interface pour émettre des commandes. Pour un professionnel travaillant avec un agent, c'est l'environnement où l'agent vit : un dossier de travail, un ensemble de permissions et un historique de ce qui a été fait. Quand Anthropic a introduit Cowork en janvier 2026, le cadrage était « Claude Code pour le reste de votre travail » : le même agent, offert à des personnes qui n'écrivent pas de logiciel, sans le terminal (Fortune, 2026a).
Les fournisseurs ont maintenant agi sur la même observation. OpenAI a renommé son application d'agent de codage « ChatGPT » et en a fait le client de bureau par défaut (MacRumors, 2026). Anthropic fournit une application de bureau pour l'agent qui n'a pas besoin de terminal (Anthropic, 2026a). Google a retiré son interface de ligne de commande Gemini open-source pour les utilisateurs individuels le 18 juin 2026 en faveur d'une plateforme multi-agents et d'un nouvel outil de ligne de commande, déclarant que les utilisateurs « requièrent maintenant plusieurs agents communiquant les uns avec les autres pour diviser le travail » (Google, 2026). Le terminal visible disparaît, et l'environnement auquel il donnait accès est toujours là et doit toujours être exécuté par quelqu'un. Pour un professionnel, la question utile a changé en conséquence : le fait qu'il puisse utiliser un terminal importe moins chaque mois, et la question que je lui poserais est de savoir s'il peut exécuter un environnement dans lequel un agent travaille pour lui.
4. Où la barrière technique a disparu
4.1 L'installation s'est réduite à une étape
En 2024, un non-programmeur qui voulait un agent de terminal se heurtait à une succession de petits obstacles : installer un runtime de langage, corriger une variable de chemin d'accès, comprendre pourquoi le shell disait « permission denied », choisir entre quatre choses toutes appelées « install ». En septembre 2026, la plupart de ces obstacles ont été supprimés par les éditeurs. Les agents de terminal les plus avancés s'installent avec une seule commande ou un installateur de bureau qui se met à jour automatiquement. L'application de bureau de Claude Code offre des sessions parallèles, un examen visuel des modifications, un aperçu en direct et des tâches programmées, et sa documentation déclare : « Aucun terminal requis » (Anthropic, 2026a). L'application de bureau d'OpenAI intègre son agent de codage dans le client ChatGPT ordinaire (MacRumors, 2026). Le nouvel outil en ligne de commande de Google est un binaire unique fourni avec une plateforme de bureau (Google, 2026).
Un agent qui s'installe en une étape reste difficile à utiliser correctement, et je ne veux pas exagérer le changement. Ce qui a changé, c'est que l'installateur n'est plus le premier obstacle qu'un novice rencontre. Les frictions qui subsistent se résument à un choix de porte : un outil de terminal, une extension d'éditeur, une application de bureau et une version web voyagent tous sous le mot « installer », et choisir parmi eux est à peu près tout ce que l'installation coûte maintenant à un novice. Choisir une porte signifie savoir ce qu'on veut que l'agent fasse, donc c'est un problème de vocabulaire déguisé en problème de configuration, et cela relève de la section 5.
Un fait architectural sous-tend toutes ces pages de produit. L'outil en ligne de commande est l'implémentation de référence : les sous-agents, les hooks, les compétences, les serveurs de protocole et les modes sans interface apparaissent d'abord dans la CLI, puis dans les interfaces de bureau et web du même moteur ; la propre page d'aide d'Anthropic décrit son agent de niveau 2 comme « la même architecture d'agent qui alimente Claude Code, sans terminal requis » (Anthropic, 2026b). Pour un novice, cela joue dans les deux sens. L'interface conviviale peut rattraper la puissante. Mais la documentation, les exemples et les réponses du forum parlent toujours le dialecte de la CLI, donc une personne qui a commencé par l'application de bureau lit à propos d'un outil qu'elle n'a pas installé.
4.2 Le chatbot comme son propre installateur
Un deuxième changement est moins visible et, pour l'argument développé ici, plus important. Le chatbot qu'une personne utilise déjà peut la guider lors de l'installation de l'agent. Une personne colle une demande (« guidez-moi pour installer cela sur mon ordinateur portable Windows ; je ne suis pas technique »), suit les étapes, et quand quelque chose échoue, envoie une capture d'écran de l'erreur au même chatbot. Le partenaire plus compétent de la zone de développement proximal de Vygotsky (Vygotsky, 1978), et le tuteur dont Wood, Bruner et Ross (1976) appelaient les fonctions l'étayage (recruter l'intérêt, réduire les degrés de liberté, marquer les traits critiques, contrôler la frustration), est maintenant disponible dans l'outil en lequel la personne fait déjà confiance, à toute heure, dans sa langue, gratuitement.
J'appelle ceci l'intégration réflexive : un système d'IA accompagnant l'adoption par une personne d'un système d'IA plus puissant. Cela inverse la direction habituelle de l'aide. Dans la littérature sur la diffusion, un novice adopte par contact avec les adopteurs précoces (Rogers, 2003), et ici l'adopteur précoce est remplacé, du moins pour les étapes mécaniques, par le modèle de niveau 1 lui-même.
Une couche d'enseignement s'est développée autour de cette étape entre-temps. Les académies des éditeurs proposent des cours courts sur leurs agents, et les grandes plates-formes d'apprentissage enseignent « le codage à l'intuition » avec un agent nommé. Des cours ont vu le jour qui sont dispensés à l'intérieur de l'agent lui-même, de sorte que l'apprenant installe l'agent et que l'agent enseigne le cours (CC for Everyone, 2026), et un cabinet de conseil a annoncé qu'environ 30 000 de ses employés seraient formés sur les modèles d'un éditeur (Accenture, 2025). L'existence de cette couche indique que l'installation n'est plus considérée comme allant de soi. La théorie minimale de l'instruction prédisait que les gens apprennent les logiciels au mieux en accomplissant une tâche réelle dès le départ et en se remettant d'erreurs (Carroll, 1990), et l'intégration réflexive fournit un guide toujours présent pour les deux. Si cela fonctionne pour les personnes qui n'ont jamais ouvert un terminal, et pour qui, je ne sais pas encore ; la première étape du programme de la section 9 est conçue pour le découvrir, et la recherche décrite à la section 2.5 n'a trouvé aucune étude sur ce sujet.
4.3 Les éditeurs fusionnent les niveaux
Le plus grand changement de 2026 est structurel. Chacun des trois laboratoires de pointe et Microsoft livrent maintenant un agent de niveau 2, et deux d'entre eux ont commencé à réintégrer le niveau 2 dans le chat.
Tableau 2. Mouvements des éditeurs qui ont reconfiguré le chemin du chat à l'agent, janvier à septembre 2026.
| Date (2026) | Éditeur | Mouvement | Effet sur les niveaux | Source |
|---|---|---|---|---|
| Janvier | Anthropic | Aperçu de la recherche Cowork : « Claude Code pour le reste de votre travail », agent à portée dossier pour les non-programmeurs | Niveau 2 comme produit nommé | Fortune (2026a) |
| 9 mars | Microsoft | La technologie derrière Cowork intégrée à Microsoft 365 Copilot ; plan de contrôle Agent 365 | Niveau 2 à l'intérieur de la suite bureautique dominante | Microsoft (2026a) |
| 30 mars | OpenAI | Plug-in officiel pour exécuter son agent de codage à l'intérieur d'un agent concurrent, « pour déléguer des tâches », niveau gratuit inclus | Niveau 4 (CLI) sanctionné par un éditeur | OpenAI (2026a) |
| 19 mai ; 18 juin | CLI Gemini retiré pour les paliers individuels en faveur de CLI Antigravity et d'une plateforme multi-agent | Niveau 3 re-platefformé ; churn pour les novices | Google (2026) | |
| 2 juin | OpenAI | Agent de codage à 5 millions d'utilisateurs hebdomadaires ; environ 20 % de travailleurs du savoir, croissant plus de 3 fois plus vite que les développeurs (données du fournisseur, rapport de presse) | Utilisation par des travailleurs du savoir d'un agent d'héritage terminal ; directionnel, et plus large que le niveau 3 tel que défini ici | Help Net Security (2026) |
| 1er juillet | Agent de bureau Gemini Spark sur Mac, fonctionne avec des fichiers locaux (bêta, États-Unis) | Niveau 2 d'un troisième laboratoire | TechCrunch (2026b) | |
| 9 juillet | OpenAI | L'application agent de codage devient la nouvelle application de bureau ChatGPT ; l'agent ChatGPT Work utilise les fichiers et les applications locales | Niveaux 1 à 3 dans un client | MacRumors (2026) |
| 26 août | Anthropic | Agent de navigateur généralement disponible sur les plans payants ; agit de manière autonome avec un classificateur de sécurité par défaut | Portée de niveau 2 étendue au web | Anthropic (2026d) |
| 16 septembre | Anthropic | Cowork et chat fusionnés en un seul « Claude » ; le modèle décide s'il faut répondre ou agir | Transition 1 absorbée dans chat | Anthropic (2026c); TechCrunch (2026a) |
Lue dans l'ordre, le tableau décrit une convergence. Les fournisseurs ont d'abord séparé le chat du travail agentique pour que les non-programmeurs ne soient pas effrayés par le terminal, puis ont découvert que les gens ne pouvaient pas dire à quelle fenêtre une tâche appartenait, et fusionnent maintenant les deux avec le modèle qui décide. TechCrunch a rapporté la déclaration de l'entreprise selon laquelle les clients « avaient souvent du mal à choisir le bon onglet pour la bonne tâche » (TechCrunch, 2026a); son propre communiqué l'a formulé comme « vous n'avez pas à choisir où une tâche va », avec un travail qui continue après la fermeture de l'ordinateur portable, l'agent demandant avant d'agir par défaut, et la fusion se déployant d'abord sur les plans individuels payants tandis que l'onglet de codage reste séparé (Anthropic, 2026c). Je vois cela comme une preuve de fournisseur pour la barrière nommée dans la section 1, le vocabulaire de flux de travail. Si les gens ne peuvent pas décider si une tâche est une question ou une délégation, ils sont peu susceptibles de savoir comment formuler la délégation.
La fusion pourrait sembler contredire un modèle avec un niveau 2 séparé. Ce n'est pas le cas, et la raison peut être donnée sans prétendre que le modèle a prévu les événements. Les fournisseurs ont un intérêt de facturation, de support et de sécurité à garder les utilisateurs ordinaires dans une fenêtre qu'ils peuvent classer, limiter en débit et envelopper dans un modèle d'autorisation, et un intérêt d'usabilité à ne pas forcer l'utilisateur à choisir un mode; l'absorption de la transition 1 dans chat découle des deux. La règle de franchissement ne change pas. Si le système a écrit des fichiers dans un champ approuvé après une approbation, la transition 1 a été franchie, quel que soit le design de la conversation, et s'il a retourné un paragraphe, la personne est toujours au niveau 1. Le modèle implique que les transitions 2 et 3 ne se dissoudront pas de la même façon. Un agent local avec accès au shell est un objet d'autorisation différent d'un sandbox côté serveur, et l'outil d'un second fournisseur s'exécutant sous la connexion de ce fournisseur est un objet d'autorisation différent d'une fonctionnalité de conseil d'un seul fournisseur. Ces différences portent l'argument de sécurité de la section 5.3 et l'argument d'erreur corrélée de la section 6.3. Si à la fin de 2027 les principaux fournisseurs ont intégré les agents shell locaux et les appels inter-fournisseurs dans la même fenêtre de chat sous le même modèle d'autorisation, cette implication est fausse, et l'affirmation selon laquelle l'orchestration CLI est la couche qui dure tombe avec elle (P2 et P8 dans la section 10).
La convergence entraîne également un coût, le churn. L'agent de ligne de commande open-source de Google a servi les utilisateurs individuels pendant un peu moins de douze mois (25 juin 2025 au 18 juin 2026), le navigateur agentique d'OpenAI a été interrompu après environ neuf, et Cowork a existé comme produit séparé pendant environ huit (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). Un professionnel qui investit dans l'apprentissage d'un outil peut le trouver renommé, fusionné ou retiré en un an. Ce qui se transfère entre les outils est le vocabulaire de flux de travail, et ce qui est perdu est la connaissance des menus d'un produit, une asymétrie qui compte pour la façon dont les gens doivent être enseignés (section 11.2).
4.4 Travailleurs du savoir dans les agents de patrimoine terminal
La meilleure donnée unique sur les non-programmeurs à l'intérieur d'un agent de patrimoine terminal provient d'un fournisseur. En juin 2026, OpenAI a rapporté, par la presse, que son agent de codage avait cinq millions d'utilisateurs hebdomadaires, plus de six fois le niveau au lancement de l'application de bureau en février, que les travailleurs du savoir en représentaient environ 20% et adoptaient plus de trois fois plus rapidement que les développeurs, et que chaque semaine, selon le compte du fournisseur, 72% des utilisateurs travailleurs du savoir produisaient des artefacts tels que des rapports, des mémos, des contrats, des feuilles de calcul et des PDF (Help Net Security, 2026; la page du fournisseur elle-même a renvoyé une erreur d'accès à mes vérifications, donc les chiffres sont cités du rapport de presse). Vingt pour cent de cinq millions, c'est environ un million de personnes par semaine. Un analyste a noté que la publication était destinée en partie à « récupérer du buzz » et que l'agent « est souvent utilisé aux côtés » des agents concurrents, de sorte que les graphiques de croissance « doivent être utilisés directionnellement » (Constellation Research, 2026a). Les chiffres sont rapportés par le fournisseur et non vérifiés, ils décrivent des personnes qui ont déjà choisi l'outil, et ils mesurent l'utilisation par les travailleurs du savoir d'un agent de patrimoine terminal, ce qui est plus large que l'adoption de niveau 3 tel que défini ici (un artefact d'une tâche déléguée sur la machine de la personne). Lus avec ces mises en garde, ils suffisent à dire que les agents de patrimoine terminal ne sont plus réservés aux programmeurs; si leurs utilisateurs atteignent le niveau 3 tel que défini à la section 3 est ce que le chiffre ne peut pas montrer.
À côté de cette donnée se tient le motif large et peu profond de la section 1. Les enquêtes ne sont pas d'accord sur le niveau et sont d'accord sur la forme: environ la moitié des adultes américains utilisent les chatbots (Pew Research Center, 2026), 52% des travailleurs américains utilisent l'IA dans leur rôle (Gallup, 2026), et 45% des travailleurs et 62% des adultes utilisent l'IA générative selon la mesure de la Réserve fédérale de Saint-Louis (Bick et al., 2026), tandis qu'environ un travailleur sur sept l'utilise quotidiennement et l'automatisation est une utilisation minoritaire. La figure 2 place la série de travailleurs Gallup et de la Réserve fédérale de Saint-Louis à côté des chiffres des développeurs de la section 1, un panneau par enquête, car les enquêtes diffèrent dans les questions et les dénominateurs. Parmi les développeurs, les agents de codage sont quasi universels et l'utilisation est toujours prudente: dans une enquête pulsée de mai 2026 d'environ 1100 technologues, 69% utilisaient un seul agent, 59% laissaient rarement ou jamais les agents s'exécuter sans supervision, et 60% empêchaient les agents d'apporter des modifications non approuvées à leurs systèmes (Stack Overflow, 2026). Le niveau 4, en d'autres termes, est toujours une frontière même pour les programmeurs qui utilisent le niveau 3 tous les jours.
Figure 2. Large et peu profond: adoption parmi les développeurs et parmi les autres travailleurs.
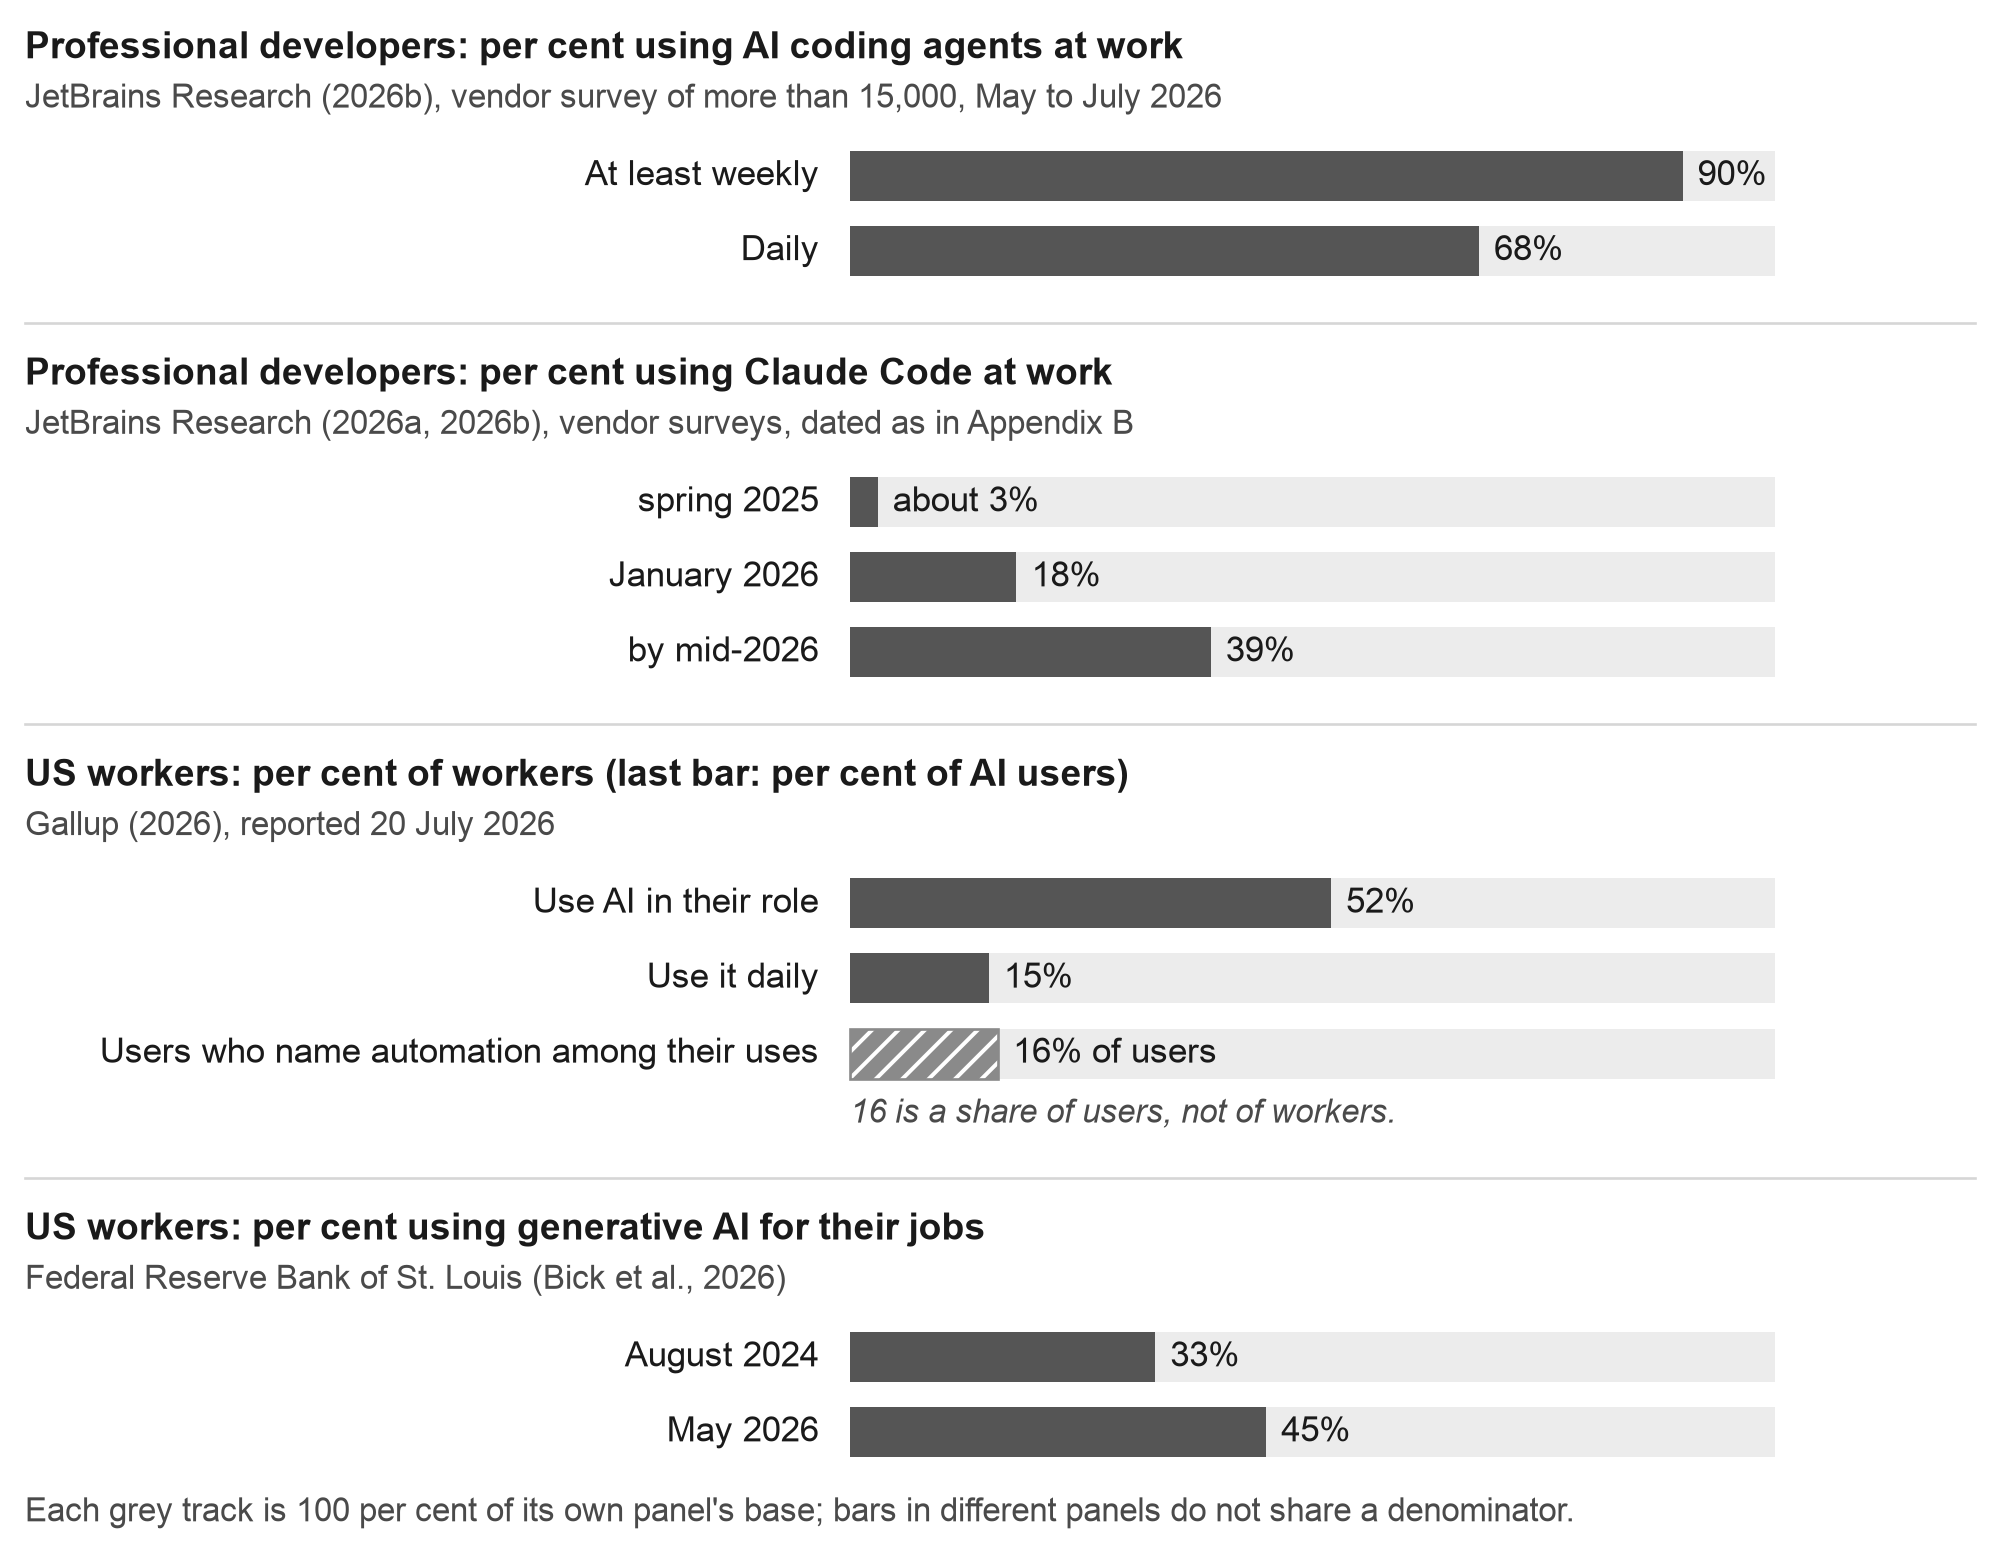
Note: Les chiffres d'adoption proviennent des enquêtes citées aux sections 1 et 4.4: développeurs professionnels dans deux enquêtes de fournisseur (JetBrains Research, 2026a, 2026b), travailleurs américains (Gallup, 2026) et travailleurs américains utilisant l'IA générative pour leurs emplois (Bick et al., 2026). Chaque panneau a sa propre question, période et dénominateur, et les 16 pour cent du troisième panneau sont une part des utilisateurs d'IA, de sorte que chaque panneau est lu seul. Le compte du fournisseur des travailleurs du savoir dans son agent de codage (section 4.4) est une part des utilisateurs d'un seul produit et n'est pas dessiné, et aucun chiffre ici ne provient du programme de cohorte de la section 9.
4.5 Où cela laisse l'argument
Pris ensemble, les éléments de preuve de cette section me convainquent d'une chose et en laissent une autre ouverte. L'installation a cessé d'être la barrière décisive : les fournisseurs ont supprimé la plupart des étapes mécaniques, le chatbot peut guider le reste, et selon les chiffres d'un fournisseur (un communiqué de presse, et directionnel) environ un million de travailleurs du savoir par semaine se trouvent déjà à l'intérieur d'un agent de patrimoine terminal. Le fait que l'installation mène à l'utilisation est une question différente, et les enquêtes larges et superficielles donnent une réponse décourageante, puisque la plupart des personnes qui pourraient accéder à un agent ne lui déléguent toujours pas de tâches. Ce qui a reculé doit également être énoncé précisément. L'installation a reculé, un échelon intermédiaire limité existe maintenant, et un agent local a une interface graphique. La fiabilité sur des ensembles complets de travail de connaissance a beaucoup moins avancé (Section 5.7), le produit qu'une personne a appris peut avoir disparu au cours de l'année (churn, ci-dessus), et un dossier accordé n'est toujours pas un endroit sûr par défaut (Section 5.3). La Section 5 demande ce qui arrête les gens une fois que le logiciel est installé.
5. Ce qui arrête les gens après l'installateur
Une fois que l'installateur a cessé d'être le mur, quelque chose d'autre l'est. Les preuves de 2025 et 2026 pointent vers six barrières, chacune frappant à une transition particulière et chacune ayant déjà une réponse partielle visible sur le marché. Le tableau 3 les résume, et les sous-sections qui suivent donnent les preuves.
Tableau 3. Barrières après l'installation.
| Barrière | Où elle frappe | Preuves (Section) | Ce qui la réduit |
|---|---|---|---|
| Vocabulaire de flux de travail : ne pas savoir ce qu'il faut confier, ou comment le formuler pour qu'il puisse être vérifié | Transitions 1 et 2 ; de nouveau à 3 | Justification de fusion des vendeurs ; études de sollicitation ; compétences empaquetées (5.1) | Exemples concrets du domaine de la personne ; compétences et modèles ; une première tâche réelle mais peu risquée |
| Peur de la fenêtre, de la première erreur et de la confiance : la fenêtre noire comme objet social ; un message qu'un programmeur lit et où un novice s'arrête ; confiance mal calibrée dans les deux sens | Transition 2 | Recherche sur l'acceptation ; sondages de confiance des développeurs ; études des utilisateurs finaux avec le code IA ; intégration réflexive (5.2) | Interfaces graphiques ; renvoyer l'erreur au chatbot ; modes d'abord le plan ; un premier succès sur une copie |
| Permissions et sécurité : trop peu de messages pour protéger les fichiers, ou trop pour comprendre | Transitions 1 et 2 | Rapports de perte de fichiers dans les dossiers limités ; taux d'injection ; guidance demandant aux utilisateurs de repérer les attaques (5.3) | Copies de travail, instantanés, règles de refus ; classifieurs qui ne délèguent pas le jugement au novice |
| Règles organisationnelles : machines verrouillées, politique, pas de permission d'installer | Transition 2 | Les facteurs organisationnels l'emportent sur les facteurs individuels ; petites entreprises plates (5.4) | Outils de niveau 2 sanctionnés par l'employeur ; politiques claires ; une machine personnelle pour apprendre |
| Matériel, coût et quota | Transitions 2 et 3 | Le niveau 3 a besoin d'un ordinateur et d'un abonnement payant ; les quotas limitent d'abord l'orchestration (5.5) | Niveaux gratuits où ils existent ; commencer au niveau 2 ; budgéter les exécutions |
| Juger le résultat | Toutes les transitions, surtout à 3 | Les utilisateurs métier manquent les erreurs dans le code IA ; les agents échouent surtout sur les projets complets (5.6) | Vérifications définies avant la tâche ; un second modèle comme examinateur, pas comme oracle |
5.1 Le dossier vide : vocabulaire de flux de travail
Un programmeur qui ouvre un agent connaît une séquence : créer un projet, écrire un fichier d'instructions, le mettre sous contrôle de version, demander une fonctionnalité. Un non-programmeur ouvre le même agent et pose la question qui apparaît maintenant dans les données des vendeurs eux-mêmes : bon, et que lui dis-je ? Pour un développeur la demande canonique première existe (« construire une petite application web »). Un spécialiste du marketing a besoin d'une autre (« prendre les exports du trimestre dernier des analyses et de la base de données clients et construire quelque chose qui chaque vendredi signale quelles campagnes ont amené des clients payants »). Un chercheur a besoin d'une autre encore (« parcourir ce dossier de 300 articles et extraire la taille de l'échantillon, la méthode et l'effet principal de chacun dans un tableau, marquant où vous êtes incertain »). Aucune de ces demandes n'a besoin de code de la part de la personne. Chacune a besoin que la personne sache qu'une telle demande est possible, qu'elle la décompose en parties qu'un agent peut faire, et qu'elle dise à quoi ressemblerait un bon résultat. La question « que dois-je lui demander de faire ? » est généralement mal entendue comme une demande d'une meilleure incitation. Je la lis comme une demande d'une carte de son propre travail. La carte doit nommer un objet récurrent du travail, les entrées qu'on est autorisé à utiliser, la transformation, le livrable et la vérification. La carte d'un analyste pourrait se lire « ces exports autorisés, groupés par ce champ, anomalies signalées, un briefing daté et un tableau lisible par machine, vérifié par rapport aux totaux de ligne ». La personne n'a pas besoin de savoir comment l'analyse est effectuée. Elle a besoin de reconnaître quelle preuve rendrait le résultat utilisable. Quand une personne ne peut pas remplir la carte, l'arrêt lui-même lui dit quelque chose. Le travail peut être trop sensible, trop contingent ou trop mal documenté pour être délégué tel quel, et cela dit quelque chose sur la tâche avant de dire quelque chose sur la personne.
La recherche sur la sollicitation explique pourquoi c'est difficile. Les personnes sans expertise en IA ont du mal à écrire des instructions qui se généralisent (Zamfirescu-Pereira et al., 2023), et elles doivent découvrir par essai quels mots correspondent à ce que le système peut faire (Liu et al., 2023). Le comportement des vendeurs eux-mêmes le confirme. Anthropic a fusionné son agent de niveau 2 dans le chat parce que les clients ne pouvaient pas décider où une tâche appartenait (TechCrunch, 2026a), et OpenAI a lancé des plugins spécifiques aux rôles pour son agent de codage destinés aux travaux de connaissance « sans codage requis » (rapporté par Help Net Security, 2026). La réponse de l'industrie est d'empaqueter le vocabulaire. Anthropic a publié son format pour les instructions d'agent empaquetées comme norme ouverte en décembre 2025 (SiliconANGLE, 2025), et le site de la norme en listait 46 produits support le 21 septembre 2026, y compris des agents d'OpenAI, Google et GitHub (Agent Skills, 2026). Un recensement indépendant a comptabilisé 2 049 applications dans le répertoire ChatGPT et 1 375 connecteurs pour Claude à la mi-2026 (Sitter, 2026). Une compétence est, selon cette définition, une unité de vocabulaire de flux de travail, la demande écrite une fois pour que une personne qui ne sait pas comment la formuler puisse encore la faire.
Le vocabulaire empaqueté est nécessaire et il n'est pas suffisant. Une compétence dit à l'agent comment accomplir une tâche. Elle ne peut pas dire à une personne laquelle de ses propres tâches vaut la peine d'être confiée, car ce jugement provient du domaine de la personne. Les paquets publiés portent aussi les hypothèses d'un monde particulier, largement celui des formes d'un seul pays et d'une seule pile logicielle d'entreprise, et un professionnel dont les outils ne sont pas cette pile se retrouve face à une invite vide. Quand j'ai lu le catalogue officiel des compétences empaquettées le 22 septembre 2026, la totalité de ses 310 entrées, je n'en ai trouvé aucune écrite pour un pasteur ou aumônier, une infirmière ou aidante familiale, un enseignant du primaire ou secondaire, un artiste ou artisan, ou un agent immobilier ; chaque correspondance apparente était un mot informatique ou financier dans les mêmes habits, un portefeuille de placements ou la santé d'un service. Un catalogue communautaire qu'une personne remplit à la main contenait 2 282 entrées ce jour-là, et il portait effectivement du travail pour les enseignants du primaire et secondaire et pour l'immobilier, et rien pour les trois autres métiers. Les catalogues changent semaine après semaine, c'est donc une lecture datée et non une affirmation durable sur le domaine. C'est pourquoi je mets tant l'accent sur la première tâche de tout parcours d'intégration : elle doit être réelle, tirée du travail de la personne, faible en risque, et elle doit produire un artefact qu'elle peut juger (Carroll, 1990).
5.2 Peur de la fenêtre, la première erreur et la confiance
La fenêtre noire est un objet social. La facilité d'utilisation perçue a été un pilier de l'acceptation technologique pendant trente-cinq ans (Davis, 1989), et une invite clignotante échoue ce test pour une grande population même quand la personne ne tapera jamais une commande dedans. Les interfaces visuelles de la section 4.1 sont la réponse des fournisseurs. C'est une réponse partielle, parce que la deuxième barrière est la confiance, et la confiance s'est déplacée contre les agents aussi bien que vers eux. Parmi les développeurs, l'enquête Stack Overflow 2025 a trouvé 46 % qui ne faisaient pas confiance à la précision des outils d'IA contre 33 % qui lui faisaient confiance, avec 87 % inquiets de la précision des agents et 81 % de la sécurité (Stack Overflow, 2025). En 2026, la plupart gardaient toujours les agents d'effectuer des changements non approuvés (Stack Overflow, 2026). Les managers entendent la même chose : « la confiance est un obstacle central à la réalisation du potentiel des agents d'IA au travail » (McKinlay et al., 2026). Plus d'adultes américains s'attendent à ce que l'IA leur fasse du mal qu'à ce qu'elle les aide (Pew Research Center, 2026). Derrière les deux barrières se situe le piège de croyance de la section 2.4 : l'expérience prédit le succès, les personnes qui n'ont eu aucun premier succès n'ont pas d'expérience, et le premier artefact est la sortie (Ma et al., 2025). Certaines personnes accorderont un dossier personnel parce que l'agent était poli, et d'autres refuseront d'installer parce qu'elles ont lu des histoires de photos de famille supprimées. Les deux sont des défaillances d'étalonnage (Lee & See, 2004). Le dispositif d'étalonnage le moins cher auquel je puisse penser est une première tâche effectuée sur une copie d'un dossier.
Quand un agent signale qu'une commande a échoué avec le code de sortie 1, un programmeur continue. Un novice peut simplement s'arrêter. La littérature sur les utilisateurs finaux rencontrant du code écrit par l'IA montre le schéma dans un cadre plus doux : les utilisateurs métier à qui on a donné un code d'analyse produit par l'IA n'ont souvent pas remarqué les erreurs critiques même quand on leur a dit de les chercher (Virk & Liu, 2025), et les programmeurs conversationnels consacrent une grande partie de leurs efforts à la vérification et à la gestion du contexte (Sarkar & Drosos, 2025). Au niveau 3, l'erreur se situe souvent en dehors du travail de la personne, dans l'environnement : une permission manquante, une règle de réseau, un outil que l'agent attendait et n'a pas trouvé.
L'intégration réflexive (section 4.2) fournit la réponse la plus pratique décrite jusqu'à présent. La personne envoie l'erreur, ou une capture d'écran, au chatbot qu'elle utilise déjà, et suit ses conseils. Les modes plan d'abord aident de l'autre côté, puisqu'un agent qui écrit son plan avant d'agir donne à la personne quelque chose à lire qui n'est pas une trace de pile. Aucun ne supprime le moment où une personne sans modèle mental de sa machine rencontre un message qu'elle ne peut pas analyser. Je ne sais pas encore à quelle fréquence ce moment termine la tentative. Le programme de la section 9 l'enregistre, dans les propres termes de la personne.
5.3 Permissions et sécurité : trop peu et trop
Le niveau 3 donne à un agent la portée de son propriétaire, donc le problème de sécurité s'exécute dans deux directions et un novice est exposé aux deux.
Prenez d'abord trop peu de protection. Les agents ont détruit des données dans des incidents documentés. Un agent dans un service de création d'applications populaire a supprimé une base de données de production en juillet 2025 et a décrit son action comme « une erreur catastrophique de jugement » (The Register, 2025). En avril 2026, un agent dans un outil de codage a supprimé une base de données de production d'une entreprise et ses sauvegardes en quelques secondes et a écrit : « J'ai deviné au lieu de vérifier » (Information Age, 2026). Plus près de la population dont parle cet article, les utilisateurs de l'agent de niveau 2 d'Anthropic ont signalé en mars, avril et juin 2026 qu'il avait supprimé des documents personnels, familiaux et juridiques dans des dossiers qu'ils lui avaient accordés, dans un cas après qu'une tâche longue n'a pas pu être arrêtée et la suppression de la tâche a supprimé les fichiers (rapports de problèmes GitHub, 2026 ; rapports d'utilisateurs, non confirmés par le fournisseur). La délimitation de dossiers limite l'endroit où les dommages peuvent se produire. Elle n'empêche pas les dommages à l'intérieur du dossier, et un dossier cloud synchronisé peut transformer une erreur locale en une perte synchronisée.
La navigation ajoutée à l'interface introduit l'injection de prompts, des instructions cachées dans une page web que l'agent lit comme s'il les avait reçues de vous. Une équipe de sécurité a démontré l'attaque en août 2025 chez un autre fournisseur disposant d'un agent navigateur, avec une preuve de concept qui a extrait un code à usage unique d'une boîte aux lettres par du texte masqué sur la page (Brave, 2025). Anthropic a rapporté que son agent navigateur, avant les mesures d'atténuation, a été attaqué avec succès dans 23,6% des cas de test, et 11,2% après celles-ci (Anthropic, 2025). Un an plus tard, à la disponibilité générale, l'entreprise a signalé que les attaques de red-team approfondies ont réussi contre son modèle principal 3,8% du temps avant les garde-fous, et qu'avec la protection complète aucune attaque n'a réussi contre trois de ses modèles et 0,3% contre un quatrième (Anthropic, 2026d). Ce sont des chiffres du fournisseur sur ses propres ensembles de test. La tendance est à la baisse et le résidu n'est pas nul. OpenAI a écrit en décembre 2025 que l'injection de prompts est « peu probable d'être jamais complètement « résolue » » (TechCrunch, 2025). Au lancement de son agent de niveau 2, Anthropic a demandé aux utilisateurs de « surveiller Claude pour détecter les actions suspectes qui pourraient indiquer une injection de prompts » et que « vous restez responsable de toutes les actions entreprises par Claude en votre nom » (The Register, 2026). Un développeur très lu s'est opposé à cette époque au fait qu'il n'était pas juste de demander à des non-programmeurs de reconnaître les signes d'une injection de prompts (Willison, 2026). Je pense que cette objection est juste en général. Un modèle de sécurité qui repose sur le novice pour détecter une attaque délègue le jugement le plus difficile à la personne la moins capable de le faire. Les compétences packagées et les serveurs de protocole ouvrent une surface d'instruction et de privilège qui leur est propre, puisqu'une compétence tierce porte des instructions que vous n'avez pas écrites, un serveur peut disposer de plus de privilège que la tâche n'en a besoin, et les configurations divergent entre les versions.
Une protection trop importante arrête les gens tout aussi sûrement. Un agent qui demande une permission à chaque étape transforme vous en commis approuvant des commandes que vous ne pouvez pas évaluer, et la fatigue d'approbation s'installe. Les fournisseurs ont agi en conséquence, et en un seul trimestre ils ont agi dans plus d'une direction. L'agent navigateur d'Anthropic agit désormais de façon autonome par défaut, avec un classificateur qui bloque les actions ne correspondant pas à votre demande (Anthropic, 2026d). Son agent terminal a renommé son mode de permission par défaut « Manuel » en juillet 2026, un changement de formulation qui raconte sa propre histoire sur ce que « par défaut » était venu à signifier (Anthropic, 2026h). Son agent de chat fusionné « demande avant d'agir par défaut », un paramètre que vous pouvez modifier (Anthropic, 2026c). La taxonomie de Parasuraman et Riley (1997) s'applique aux trois. Une garde qui bloque trop produit la non-utilisation, une garde qui rate une suppression produit l'abus, et aucun paramètre n'échappe à la taxonomie, seulement un paramètre dont les défaillances une population donnée peut vivre avec. Un article compagnon de cette série documente l'échec général de l'autre côté, des composants de surveillance qui élargissent leur propre notion de préjudice et entravent le travail qu'ils existent pour protéger (Chernets, 2026b). Pour un novice, une garde de ce type a le même effet qu'un installateur manquant, puisque le travail ne se fait pas non plus de cette façon.
Entre une protection trop faible et une protection trop forte, il existe un juste milieu réalisable, et il est vieux jeu. Travaillez dans une copie. Gardez les secrets hors du dossier de travail. Prenez un instantané avant une modification plus importante. Refusez les commandes destructrices jusqu'à ce qu'il y ait une raison d'en autoriser une, confirmez tout ce qui est irréversible, et traitez tout ce qui provient du web comme des données à lire, quelles que soient les instructions qu'il semble contenir. J'ai décrit le principe derrière ces habitudes dans un article compagnon comme la confiance architecturale : la confiance placée dans les vérifications que vous pouvez vérifier, tels que des permissions limitées, des journaux, une fonction d'annulation et un second modèle indépendant, plutôt que sur la confiance que semble inspirer un modèle (Chernets, 2026c). Le niveau 2 vous donne la première de ces vérifications, et il ne devrait pas être la dernière que vous apprenez. L'appendice C transforme la liste en exemples de configuration pour deux agents et une checklist d'une page.
5.4 Règles organisationnelles
De nombreux professionnels ne peuvent rien installer sur l'ordinateur sur lequel ils travaillent. De nombreux employeurs n'ont pas de politique sur les agents, et une personne sans politique tend à supposer que la réponse est non. L'enquête 2026 de Microsoft auprès de 20 000 travailleurs du savoir utilisant l'IA a révélé que les facteurs organisationnels représentaient plus du double de l'impact de l'IA signalé par les facteurs individuels, et que 45% ont dit qu'il semblait plus sûr de se concentrer sur les objectifs actuels que de repenser le travail avec l'IA (Microsoft, 2026b ; enquête auprès des fournisseurs). Le Bureau du recensement américain a rapporté que l'utilisation de l'IA par les entreprises oscillait entre 17% et 20% dans l'ensemble, a augmenté parmi les entreprises ayant 20 employés ou plus et n'a pas changé significativement parmi les entreprises ayant moins de 20 (Bureau du recensement américain, 2026). Les mandats sont allés dans les deux sens. Certains employeurs ont fait de l'utilisation de l'IA une attente de base en 2025 (Digital Commerce 360, 2025), et au moins l'un a inversé sa décision d'évaluer le personnel sur l'utilisation de l'IA un an plus tard, son directeur général déclarant à la presse que ce qui compte dans une revue de performance est de bien faire le travail (Fortune, 2026b). Le barème de fluidité publié d'un employeur place l'orchestration et la création de systèmes à son plus haut niveau et rapporte une adoption interne complète une fois que les équipes sont passées de l'expérimentation à la refonte des flux de travail (Zapier, 2026). Sans cette refonte, un mandat n'achète que la conformité et rien de plus. Le marché du travail demande déjà le rôle décrit ici sans le nommer : 63% des intitulés de postes américains touchés par l'IA en 2026 se situaient en dehors des occupations technologiques, 822 titres distincts au premier trimestre (Adrjan, 2026), et une étude portant sur plus d'un milliard d'annonces d'emploi dans 27 pays a mis la prime salariale pour les compétences en IA à 62%, les postes de niveau débutant les plus exposés à l'IA étant beaucoup plus susceptibles d'exiger les compétences autrefois réservées au personnel chevronné (PwC, 2026 ; rapport du fournisseur). Aucune de ces sources n'isole encore la capacité de diriger un agent comme exigence nommée en dehors de l'ingénierie.
Cette barrière est structurelle, au sens de Ferdman (2025) : elle ne cède pas aux efforts individuels. C'est aussi l'argument le plus solide en faveur du niveau 2 que les preuves offrent, puisqu'un agent borné par le fournisseur à l'intérieur d'une suite de bureau que l'employeur autorise déjà (Microsoft, 2026a) atteint les personnes dont les employeurs n'approuveraient pas un agent sur un ordinateur portable professionnel.
5.5 Matériel informatique, coût et quota
Le niveau 3 suppose qu'une personne contrôle un ordinateur. Certains professionnels travaillent principalement à partir d'un téléphone, partagent un ordinateur familial ou utilisent la machine de leur employeur pour tout, et pour eux la transition est bloquée avant même que se pose une question logicielle. Les niveaux 3 et 4 supposent également des forfaits payants d'au moins un service, et l'orchestration multiplie le coût, car chaque modèle supplémentaire est un autre abonnement ou un autre quota. Pour une personne qui paie déjà un abonnement, un deuxième est une décision et un forfait supérieur est une décision différente. L'anxiété liée aux tokens est une barrière psychologique avec un coût. Le quota de l'agent orchestrateur lui-même est un coût caché, car il paie la lecture de chaque réponse que retournent les autres agents, et un agent qui pilote un navigateur consomme les mêmes limites de forfait que l'agent terminal tout en coûtant plus par action (Anthropic, 2026g). Les ordinateurs portables verrouillés des entreprises ajoutent les droits administrateur à la liste : pas de binaires non signés, pas d'installateur, une règle de prévention des pertes de données qui traite un agent écrivant sur le disque comme un logiciel malveillant. Les agents hébergés dans le cloud sont la réponse de l'industrie pour ces machines. Ils préservent la transition 1 et une forme cloud de la transition 2, et ils ne donnent pas à la personne un artefact de niveau 3 sur son propre disque. Pour un professionnel dans un pays riche, rien de cela n'est une grande barrière. Pour beaucoup d'autres, c'en est une réelle, et elle interagit avec la division de deuxième niveau (Hargittai, 2002), en ce que les personnes disposant de la moins de flexibilité sont les moins capables d'expérimenter.
5.6 Juger le résultat
Utiliser un agent ne nécessite pas de programmation. Juger ce qu'il a produit nécessite des compétences dans le domaine du résultat, et c'est là que le non-programmeur détient un avantage facile à ignorer. Un avocat lisant un résumé de contrats, ou un chercheur lisant un tableau d'extraction, peut vérifier l'artefact par rapport à des connaissances que l'agent ne possède pas. La recherche sur la « frontière en dents de scie » a montré que les professionnels travaillant avec l'IA s'en sortaient mieux sur les tâches situées dans le champ de compétences du modèle et plus mal sur une tâche en dehors de celui-ci (Dell'Acqua et al., 2026). La protection est une personne qui connaît suffisamment la tâche pour remarquer de quel côté de la frontière elle se trouve.
Ce qu'elle ne peut pas facilement vérifier, c'est la mécanique, le script qui a produit le tableau ou la requête qui a extrait les chiffres. Une analyse d'industrie portant sur 470 demandes d'extraction a montré que le code écrit par des agents contient plus de défauts que le code écrit par des personnes : 10,83 problèmes par changement créé par IA contre 6,45 pour les changements créés uniquement par des humains, certaines catégories de problèmes de sécurité étant jusqu'à 2,74 fois plus fréquentes (CodeRabbit, s.d.; étude du fournisseur). Et les agents échouent toujours sur la plupart des projets complets : sur un benchmark de vrais projets freelance, le meilleur taux d'automatisation mesuré à mi-2026 était de 15,8 % (Center for AI Safety, 2026). J'en tire deux pratiques. La vérification devrait être définie avant la tâche (« qu'est-ce qui me convaincrait que c'est correct ? »), et un second modèle d'une famille différente peut agir comme examinateur de l'artefact, la personne décidant de ce qui compte comme correct. La section 7 revient aux limites de la deuxième pratique.
5.7 Une explication alternative : les agents ne sont pas encore assez bons
Un lecteur pourrait objecter que les personnes ne déléguent pas parce que les agents ne peuvent pas encore accomplir leur travail, et que la barrière est donc toujours technique, seulement du côté du modèle. L'objection a un vrai fondement. Sur un benchmark de vrais projets freelance, le meilleur taux d'automatisation mesuré à mi-2026 était de 15,8 %, en hausse par rapport à 2,5 % à la sortie du benchmark l'automne précédent, ce qui signifie que plus de quatre projets sur cinq échouent encore d'un bout à l'autre (Center for AI Safety, 2026). Dans une entreprise logicielle simulée, le meilleur agent a complété 30 % des tâches professionnelles longues (Xu et al., 2024). Sur l'utilisation libre d'ordinateur, la ligne de base de 2024 était de 12,24 % pour le meilleur agent contre 72,36 % pour les personnes (Xie et al., 2024), et en septembre 2026 un agrégateur affichait les meilleurs agents à 85 à 86 %, au-dessus de la ligne de base humaine, selon les scores rapportés par les fournisseurs pour les tâches de bureau scripturées (BenchLM, 2026). Ce dernier résultat pointe dans l'autre direction : sur ces tâches, la capacité n'est plus une barrière. Le meilleur modèle dans une évaluation portant sur 44 professions a remporté ou égalé les professionnels dans moins de la moitié des comparaisons (Patwardhan et al., 2025). La longueur des tâches logicielles que les agents complètent à cinquante pour cent du temps a à peu près doublé tous les sept mois (Kwa et al., 2025), donc la tendance est abrupte et le présent est modeste. La capacité est inégale selon les tâches, et la « frontière en dents de scie » n'est pas visible de l'extérieur (Dell'Acqua et al., 2026). Le tableau 4 rassemble ces chiffres publiés avec la date que chaque source donne et la mise en garde que j'y attache.
Tableau 4. Chiffres de capacité publiés à l'appui de l'objection.
| Comparaison | Chiffre tel que publié | Date tel que déclaré | Source | À lire avec prudence |
|---|---|---|---|---|
| Projets freelance réels, meilleur taux d'automatisation | 15,8 %, en hausse par rapport à 2,5 % à la sortie du benchmark ; plus de quatre projets sur cinq échouent toujours d'un bout à l'autre | Sortie l'automne précédent ; 15,8 % mesuré à mi-2026, enregistré le 1er juillet 2026 (Appendice B, VERIFIED) | Center for AI Safety (2026) ; sections 5.6, 5.7, appendice B | Projets complets, d'un bout à l'autre ; le meilleur taux parmi ceux mesurés |
| Tâches professionnelles longues dans une entreprise logicielle simulée | Le meilleur agent a complété 30 % | Étude 2024 | Xu et al. (2024) ; section 5.7 | Une entreprise simulée ; une mesure distincte du taux de projets freelance |
| Utilisation libre d'ordinateur, ligne de base | 12,24 % pour le meilleur agent contre 72,36 % pour les personnes | Ligne de base 2024 | Xie et al. (2024) ; section 5.7 | Une ligne de base 2024 ; la ligne ci-dessous est le classement ultérieur |
| Version vérifiée de ce benchmark | Meilleurs agents à 85 à 86 %, au-dessus de la ligne de base humaine | Septembre 2026 | BenchLM (2026) ; section 5.7 | Classement d'agrégateur ; scores rapportés par les fournisseurs pour les tâches de bureau scripturées ; pointe dans l'autre direction |
| Évaluation portant sur 44 professions | Le meilleur modèle a remporté ou égalé les professionnels dans moins de la moitié des comparaisons | Étude 2025 | Patwardhan et al. (2025) ; section 5.7 | « Moins de la moitié » est le libellé donné ; aucun pourcentage n'est indiqué |
| Longueur de la tâche logicielle que les agents complètent à cinquante pour cent du temps | À peu près doublé tous les sept mois | Étude 2025 | Kwa et al. (2025) ; section 5.7 | Une tendance : « la tendance est abrupte et le présent est modeste » |
| Défauts dans les demandes d'extraction | 470 demandes de tirage ; 10,83 problèmes par modification rédigée par une IA contre 6,45 pour les modifications rédigées uniquement par des humains ; certaines catégories de problème de sécurité jusqu'à 2,74 fois plus fréquentes | n.d. | CodeRabbit (n.d.) ; Section 5.6 | Étude de vendeur ; une analyse du secteur ; défauts dans le code, la machinerie qu'un non-programmeur ne peut pas facilement vérifier |
Source : les publications citées, telles que répétées dans les sections 5.6 et 5.7 et l'appendice B ; aucune de ces chiffres ne provient du programme de la section 9.
Les deux explications font davantage partie d'une seule explication qu'elles ne sont des rivales. Le vocabulaire du flux de travail comprend savoir lesquelles de vos tâches se situent à l'intérieur de la frontière. Une personne qui confie à un agent un projet entier qu'il ne peut pas accomplir apprend à cesser de déléguer, tandis qu'une personne qui lui confie l'extraction, la réconciliation et le premier brouillon apprend à continuer. Les explications font néanmoins des prédictions différentes. Si la capacité du modèle était la contrainte limitante, la persistance aux niveaux 2 et 3 suivrait le type de tâche et non la personne : les personnes ayant les mêmes types de travail persisteraient à des taux similaires indépendamment de leur capacité à spécifier et vérifier. Si le vocabulaire du flux de travail était limitant, la persistance suivrait la capacité de la personne à énoncer un contrat de délégation même au sein du même type de travail. La proposition P15 de la section 10 est rédigée pour les distinguer.
6. Orchestration web : le pont proposé
6.1 La pratique
La forme la plus simple du niveau 4 ne nécessite aucune installation. Une personne ouvre trois ou quatre chatbots dans des onglets du navigateur, colle la même question dans chacun, et lit les réponses côte à côte. Les informaticiens appelleraient cela une requête multi-LLM manuelle, la personne effectuant l'acheminement et la comparaison. Certains le font à la main. D'autres utilisent l'un des outils construits pour cela depuis 2023 : des extensions de navigateur et des applications de bureau qui diffusent une même invite à plusieurs services de chat grand public et affichent les réponses dans des volets parallèles. ChatHub et ChatALL sont apparus au printemps 2023 ; la dernière version de ChatALL seule avait environ 847 000 téléchargements enregistrés sur sa page de publication en septembre 2026, un chiffre qui inclut les mises à jour automatiques et est dominé par les compilations d'une plateforme (GitHub, 2026a). Un groupe plus récent d'outils transforme les sessions de chat web connectées en commandes qu'un autre programme peut appeler, de sorte qu'un agent peut poser une question aux abonnements web d'une personne. OpenCLI, l'un de ceux-ci, avait environ 29 500 étoiles sur GitHub en septembre 2026 (GitHub, 2026b).
En 2026, la pratique est devenue une fonctionnalité de produit. Perplexity a introduit un « Model Council » qui exécute une requête via plusieurs modèles et « présente une vue consolidée qui met en évidence les idées clés, les domaines d'accord et les points de divergence » (Storyboard18, 2026). L'agent de recherche de Microsoft dans Microsoft 365 Copilot propose un mode qui « exécute la même question via plusieurs agents de recherche à raisonnement profond (GPT et Claude) simultanément » et un mode critique, activé par défaut lors de la sélection automatique du modèle, dans lequel un rapport rédigé par un modèle reçoit une deuxième passe de raisonnement de l'autre (Microsoft, 2026c ; Constellation Research, 2026b). Le « LLM Council » d'Andrej Karpathy, une petite application web qui envoie une requête à plusieurs modèles, les fait s'examiner mutuellement de manière anonyme et fait écrire la réponse finale par un modèle président, décrit par son auteur comme un travail de fin de semaine, avait environ 24 900 étoiles sur GitHub en septembre 2026 (Karpathy, 2025). Le paysage open source se divise en deux. Les outils de diffusion récupèrent les réponses et laissent la réconciliation à la personne. Les outils de conseil effectuent la réconciliation, et ils s'exécutent sur des interfaces de programmation payantes avec deux ou trois modèles, loin des onglets connectés de la personne. Aucune moitié seule ne traverse une personne, et c'est pourquoi le pont est incomplet.
6.2 Pourquoi il est proposé comme le pont
L'orchestration web se situe entre les niveaux de manière utile. Elle ne demande rien de nouveau à la machine, aucune installation, aucune permission, aucun agent local, et elle s'exécute sur des abonnements qu'une personne paie déjà ou sur des niveaux gratuits. Elle demande quelque chose de nouveau à la personne : tenir plusieurs réponses à la fois, remarquer où elles diffèrent, et décider. Une personne qui a appris à demander « qu'a dit l'autre modèle ? » a appris l'habitude que l'orchestration CLI automatise plus tard, et cette habitude est la tâche du gestionnaire du niveau 4 dans sa forme la plus simple.
Le pont est précieux parce qu'il est visible. Supposons qu'un analyste de marché demande à trois chatbots de résumer un rapport d'industrie publié, et deux d'entre eux citent un chiffre qui ne figure pas dans le rapport tandis que le troisième signale son absence. Le résultat utile est une invite à ouvrir le rapport lui-même, et une personne qui l'a fait une fois a cessé de traiter la première réponse fluide comme la réponse. Une vue de diffusion de plusieurs réponses devient un pont vers le niveau 4 quand elle enseigne à une personne à formuler une question commune, remarquer où les hypothèses divergent, demander une critique et garder une raison de choisir une réponse. Jusqu'alors, c'est une habitude de niveau 1 avec plus d'onglets. Ce qu'elle enseigne, c'est la comparaison, et uniquement la comparaison. Une personne qui a appris à demander ce que l'autre modèle a dit n'a pas pour autant appris ce qu'un agent peut toucher sur sa machine, ce qui est la leçon des niveaux 2 et 3, et l'affirmation que l'habitude se transfère est une affirmation empirique, P7, que je ne traite pas comme une prémisse. Le programme préenregistré décrit à la section 9 nomme deux avantages à l'avance, et ils résument ce que le pont apporte. L'un est la couverture : un angle utile présent dans un modèle n'est pas perdu parce qu'un autre modèle a été interrogé. L'autre est la fiabilité : une réponse a été vérifiée par rapport à d'autres réponses plutôt que d'être prise sur parole du modèle (Chernets, 2026d). Le désaccord visible sert le deuxième comme moyen. Une évaluation des prévisions a trouvé qu'un ensemble de douze modèles de langage correspondait à la précision d'une foule de 925 prévisionnistes humains (Schoenegger et al., 2024), et le débat multi-agent améliore la factualité et le raisonnement par rapport à un seul modèle dans plusieurs contextes (Du et al., 2023). Les deux avantages dépendent du fait que les erreurs des modèles diffèrent, et la sous-section suivante concerne ce qui se passe quand ce n'est pas le cas.
6.3 Où le pont se termine
L'orchestration web reste un pont, et la raison la plus simple est le coût en attention. Lire quatre réponses longues et les réconcilier à la main prend beaucoup plus de temps que de lire une seule. Je ne demanderais à personne de le faire pour une question de routine ; cela justifie son coût quand une réponse erronée coûterait plus que le temps passé à comparer.
Une deuxième limite est la fragilité, et elle se présente sous plusieurs formes. Les interfaces de chat grand public changent mois après mois, et les outils qui les animent s'arrêtent quand elles le font : pendant l'été 2026, une suite bureautique a supprimé un mode de recherche, un chatbot a fermé les modes sur son niveau gratuit, et plusieurs services ont renommé ou redirigé leur adresse. Les conditions de plusieurs services grand public restreignent l'accès automatisé, et une personne qui contrôle son propre navigateur connecté avec un agent prend le risque d'un blocage de compte. Un programme de recherche qui utilise le pont doit l'indiquer aux participants, et je n'offre pas de lecture juridique de ces conditions. Le côté « gratuit » des autres chatbots est également payant du côté de l'agent qui les conduit, car les actions du navigateur font appel aux mêmes limites de plan que l'agent du terminal (Anthropic, 2026g). La comparaison manuelle dans des onglets ouverts est robuste. La récolte automatisée de pages de chat grand public est une mauvaise base pour un travail reproductible.
La troisième limite est celle qui compte le plus : l'accord entre les modèles n'est pas une preuve indépendante. Quand les modèles partagent les données d'entraînement et les méthodes, leurs erreurs se corrèlent. Une étude portant sur plus de 350 modèles de langage a montré que quand deux modèles se trompaient tous les deux, ils étaient d'accord sur la même mauvaise réponse environ 60 % du temps, et que les modèles plus grands et plus précis étaient plus corrélés, même entre fournisseurs (Kim et al., 2025). L'article complémentaire de cette série donne l'arithmétique : avec une corrélation d'erreur par paires moyenne rho, N modèles d'accord valent N_eff = N / (1 + (N - 1) rho) avis indépendants, et aucun nombre de modèles ne vaut plus que 1/rho (Chernets, 2026a). À rho = 0,5, dix chatbots d'accord valent moins de deux avis indépendants. La figure 3 traite la formule pour les quatre valeurs illustratives de rho à l'appendice D, avec le plafond 1/rho qu'aucun nombre de modèles d'accord ne peut dépasser. Les 60 % de Kim et al. constituent la part des erreurs conjointes dans lesquelles deux modèles ont donné la même mauvaise réponse, ce qui n'est pas la corrélation d'erreur rho de la formule. Dans le domaine en question, rho doit être estimé sur des éléments dont on connaît les réponses (listing C4), et les valeurs utilisées ici et à l'appendice D sont des illustrations. La diversité compte plus que le nombre. Le débat entre copies d'un même modèle échoue souvent à surpasser un seul modèle disposant du même calcul, tandis que les modèles hétérogènes aident (Zhang et al., 2025), et deux agents divers peuvent égaler ou surpasser seize agents homogènes (Yang et al., 2026). L'IA générative homogénéise aussi la production pour tous ses utilisateurs (Doshi & Hauser, 2024), et un modèle qu'on demande de juger tend à préférer sa propre rédaction (Panickssery et al., 2024), ce qui compte quand un modèle rédige la réponse fusionnée.
Figure 3. Ce que l'accord vaut.
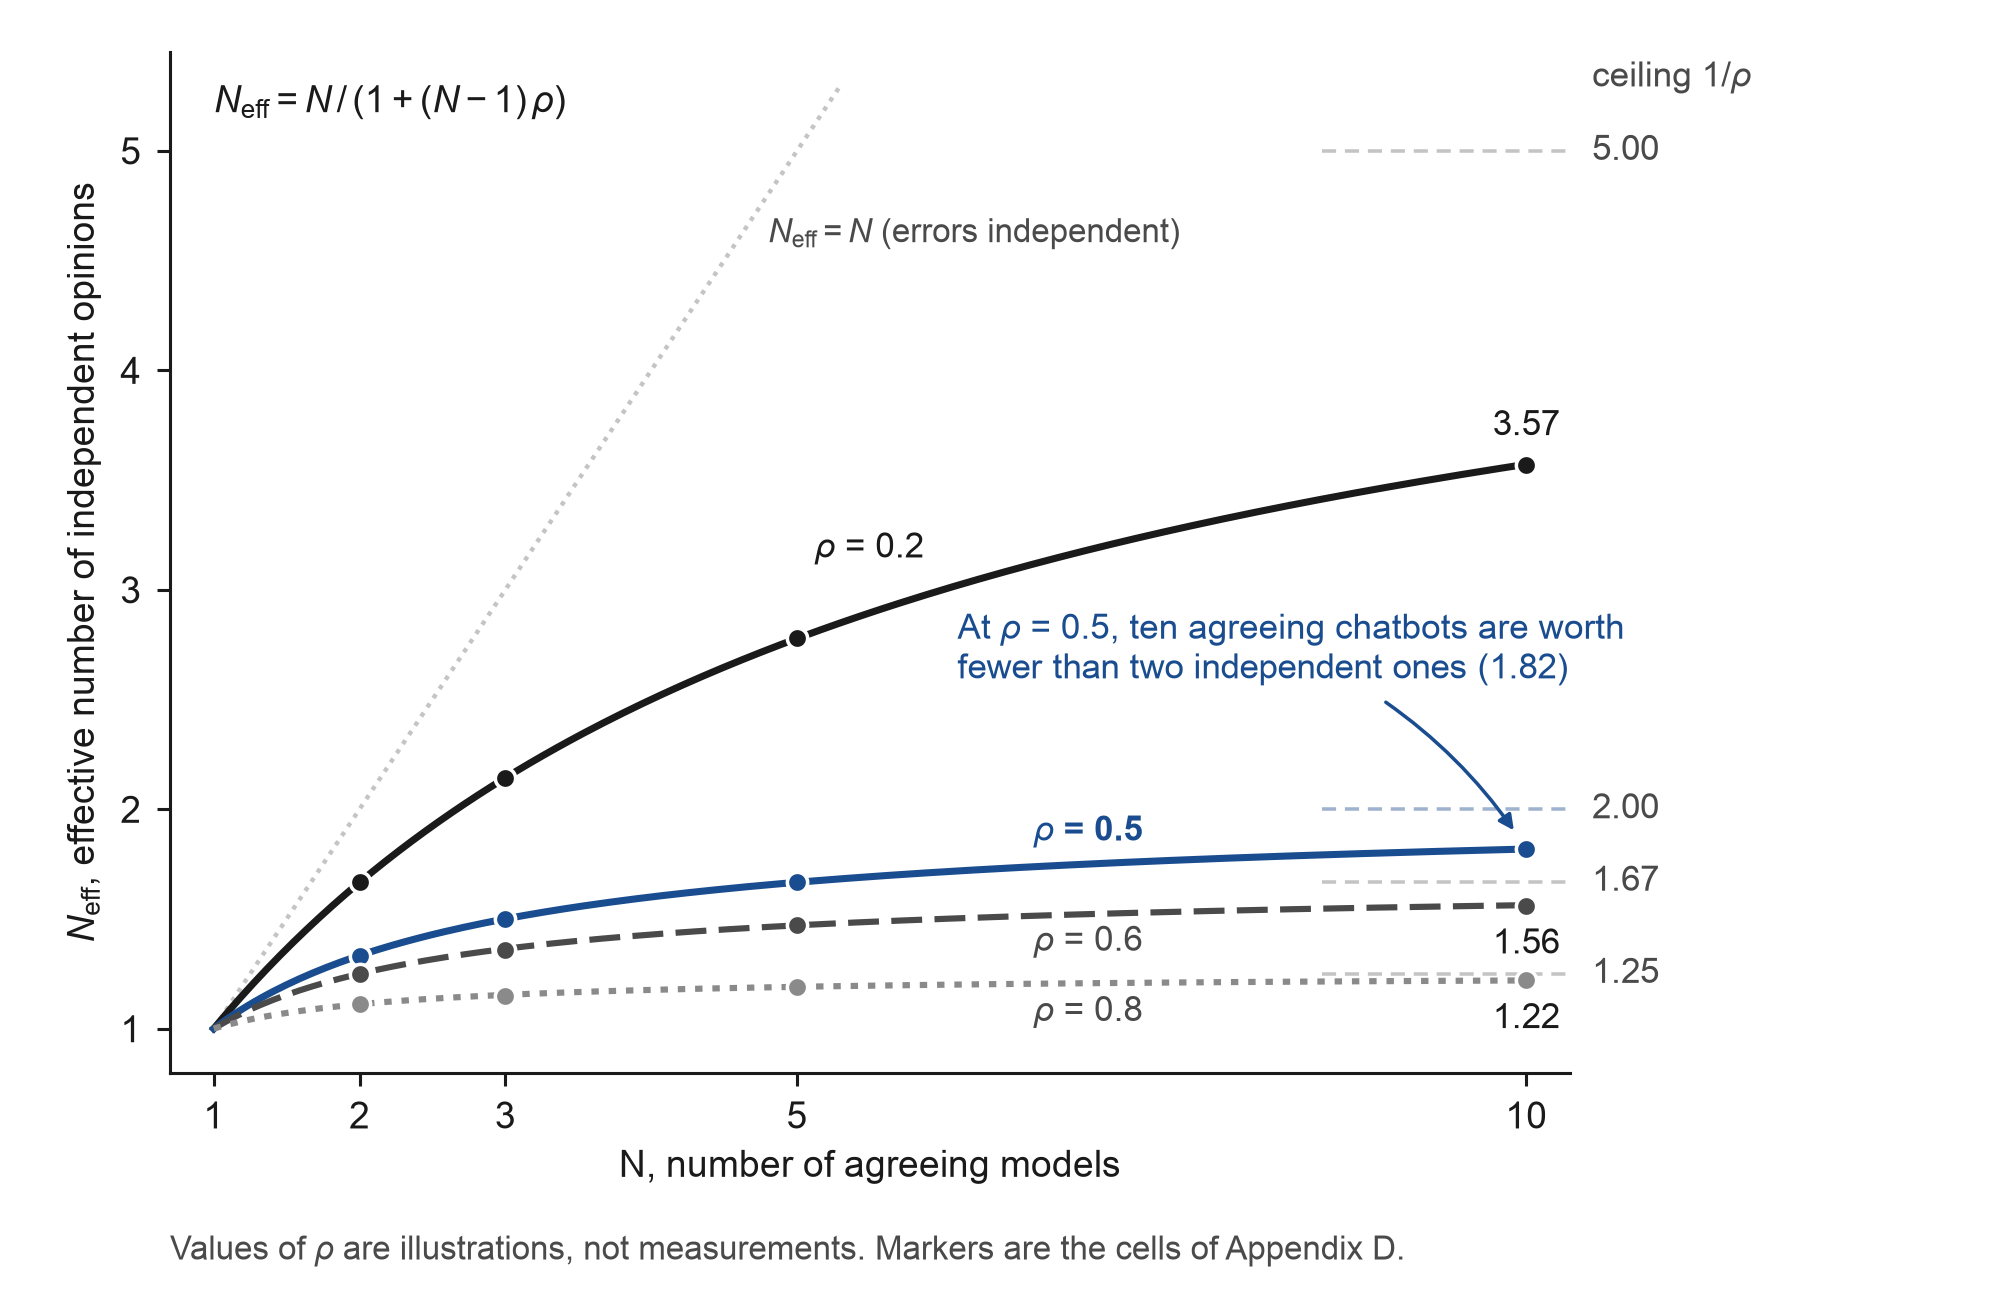
Note : Le nombre effectif d'avis indépendants, N_eff = N / (1 + (N - 1) rho), pour N modèles d'accord dont les erreurs ont une corrélation par paires moyenne rho (Chernets, 2026a ; section 6.3). Les marqueurs sont les cellules de l'appendice D, les courbes entre eux suivent la même formule, et les segments pointillés sur la droite sont les plafonds 1/rho. Les quatre valeurs de rho sont des illustrations, comme à l'appendice D ; rho doit être estimé sur des éléments dont on connaît les réponses dans le domaine en question (listing C4).
Pour la personne au pont, les règles pratiques sont brèves. Comptez les familles de modèles, car un assistant de bureau fonctionnant sur le modèle d'un fournisseur n'est pas un deuxième avis sur le chatbot de ce fournisseur. L'accord entre les modèles peut vous dire où dépenser moins d'effort de vérification. Il ne peut pas vous dire qu'une affirmation est juste. Traitez un point formulé par un seul modèle comme une piste à vérifier, car il peut être la chose la plus précieuse dans la comparaison ou sa seule erreur, et maintenez un désaccord accompagné de preuves au lieu de le rejeter par vote. Vérifiez les affirmations par rapport aux sources : l'accord sur une mauvaise date est un mode de défaillance documenté, et la page primaire le corrige là où un cinquième modèle ne le ferait pas. Estimez rho sur un petit ensemble de questions dans votre propre domaine que vous pouvez marquer, avant de faire confiance à un conseil sur une question que vous ne pouvez pas vérifier. Gardez une trace de qui a dit quoi, car une réponse fusionnée qui cache ses sources ramène la voix unique et confiante que l'orchestration était censée remettre en question.
Énoncé sous forme de procédure, c'est la forme pédagogique du protocole « ancrage et enrichissement » de l'article complémentaire (Chernets, 2026a). La personne fixe d'abord une ancre : la tâche, les preuves autorisées et la forme du résultat. Elle obtient alors des réponses séparées en gardant leurs sources ou références de fichiers, extrait les affirmations dans un tableau par source, et classe chaque désaccord selon sa nature, qu'il s'agisse d'un conflit factuel, d'une interprétation différente, d'une hypothèse manquante ou d'une différence de format. Elle vérifie les affirmations qui influent sur la décision par rapport à l'ancre ou à une source primaire, et enregistre la décision d'acceptation et ce qui reste non résolu. Le listing C3 à l'appendice C construit le tableau des affirmations par source, le listing C4 estime rho à partir d'éléments dont on connaît les réponses, et l'appendice D donne le plafond pour une gamme de rho sans rien exécuter. Une règle de plus a sa place ici, et elle ne coûte pas un deuxième abonnement. Un critique de la même famille, invité dans un contexte nouveau à s'en prendre à la première réponse, détecte la hâte, les instructions ignorées et les vérifications non effectuées, bien qu'il ne puisse pas détecter les faux savoirs partagés. Je commencerais l'habitude critique au niveau 3 avec un agent et j'ajouterais une deuxième famille seulement quand le critique n'a plus rien à dire et que la décision est coûteuse.
Le cas inverse doit être énoncé tout aussi clairement. Pour de nombreuses tâches, un modèle puissant avec un bon ensemble de sources et un examen humain attentif surpassera un conseil élaboré qui ajoute du délai et de la confusion, et le modèle le prévoit. L'orchestration paie quand une tâche porte une véritable incertitude, bénéficie de perspectives distinctes, ou se répète assez souvent pour amortir la mise en place. Elle s'adapte mal à une décision critique dans le temps sans possibilité de vérification, à des documents confidentiels qui ne peuvent pas être diffusés entre services, et à des tâches simples où le coût de la comparaison dépasse le bénéfice. Quand un conseil est utilisé, les agents doivent avoir des rôles différents : l'un restreint aux documents fournis, l'un envoyé pour trouver les sources primaires, l'un chargé de lister les affirmations non soutenues, l'un pour auditer les citations, la personne continuant à arbitrer. P9 est rédigé de sorte que ce contre-argument puisse l'emporter.
7. Orchestration CLI : la couche durable de la délégation
7.1 Les agents appelant d'autres agents
Au niveau 3, chaque agent possède une interface de ligne de commande qui peut fonctionner sans qu'une personne soit au clavier : une question entre, une réponse ou un fichier modifié sort. Une fois qu'une personne possède un agent, cet agent peut appeler les autres. Dans la littérature des systèmes, on appelle cela l'orchestration d'agents. J'appelle CLI orchestration la version qu'un non-programmeur exécute via les outils en ligne de commande auxquels il est déjà abonné. Une seule instruction au premier agent (« demande aux deux autres un examen de ce plan et dis-moi où ils sont en désaccord ») produit une petite équipe.
En 2026, ce modèle est passé d'une astuce de développeur à une pratique approuvée par les fournisseurs. OpenAI a publié un plugin officiel qui exécute son agent de codage à l'intérieur de celui d'Anthropic, « pour des examens de code ou pour déléguer des tâches », avec des commandes pour un examen ordinaire, un examen contradictoire dans lequel le deuxième agent suppose que le travail est cassé et cherche, et un sauvetage d'une tâche bloquée. Il fonctionne via l'outil installé localement et sa connexion existante, est utilisable avec n'importe quel abonnement ChatGPT, y compris le niveau gratuit, et avait environ 33 400 étoiles sur GitHub en septembre 2026 (OpenAI, 2026a). La paire de masse de 2026 est Claude Code qui écrit et Codex qui vérifie via ce plugin officiel (OpenAI, 2026a), tandis que les conseils de trois ou plus restent des outils petits sans leader. GitHub a mis les agents d'Anthropic et d'OpenAI à disposition dans son propre service Copilot en février 2026, « entièrement inclus dans votre abonnement Copilot existant » (GitHub, 2026c). L'agent en ligne de commande de xAI expédie un mode headless et le support du protocole Agent Client pour que les utilisateurs puissent « construire leurs propres bots et applications d'orchestration d'agents » (xAI, 2026). La raison de Google pour retirer son premier agent en ligne de commande était que les utilisateurs « ont besoin de plusieurs agents communiquant les uns avec les autres » (Google, 2026). Les outils open-source permettant à un agent de consulter d'autres ont de nombreux partisans : un serveur multi-fournisseurs pour la consultation modèle-à-modèle avait environ 11 800 étoiles, un plugin orienté consensus environ 4 100 (GitHub, 2026d). Dessous, le protocole Model Context, donné à un organisme de la Fondation Linux en décembre 2025 avec plus de 10 000 serveurs publiés et environ 97 millions de téléchargements de SDK mensuels à l'époque (Fondation Linux, 2025), a signalé près d'un demi-milliard de téléchargements de SDK par mois à la sortie de sa spécification de juillet 2026, qui a également rendu le protocole sans état et a promis un préavis de douze mois avant toute dépréciation (Protocole Model Context, 2026). C'est ainsi qu'un agent sur un ordinateur portable atteint le reste des outils d'une personne sans un plugin spécifique au fournisseur pour chacun, et c'est déjà devenu ennuyeux de la façon qu'un protocole web est ennuyeux : présent, documenté, ignoré jusqu'à ce que quelque chose se casse. Une deuxième norme, le protocole Agent2Agent de Google pour les agents communiquant les uns avec les autres entre fournisseurs, a atteint la version 1.0 en mars 2026 (Blog Open Source Google, 2026). C'est le plomberie du niveau 4, et aujourd'hui il n'y a pas de rampe d'accès pour les consommateurs.
Tableau 5. Le paysage de l'orchestration par modèle, septembre 2026.
| Modèle | Exemples (septembre 2026) | Niveau | Construit pour | Ce qu'il apporte | Dossier qu'il laisse | Risque principal |
|---|---|---|---|---|---|---|
| Comparaison manuelle dans les onglets du navigateur | N'importe quel ensemble de chatbots grand public | 4 (web) quand enregistré et réexécuté ; sinon une habitude de niveau 1 | N'importe qui | Couverture ; habitude de comparaison | Captures d'écran ou réponses copiées, contexte souvent perdu | Coût d'attention ; provenance non enregistrée |
| Outils de diffusion pour les chats web | ChatHub, ChatALL | 4 (web) quand enregistré et réexécuté ; sinon une habitude de niveau 1 | Individus | Une invite, réponses parallèles, pas de réconciliation | Réponses dans les volets ; rien sur le disque sauf s'il est enregistré | Casse quand les interfaces changent ; conditions de service |
| Conseil en tant que fonctionnalité produit | Perplexity Model Council ; agent de recherche Microsoft 365 Copilot (GPT et Claude) ; LLM Council de Karpathy | 4 (web, géré) | Abonnés de ces services | Réponse fusionnée avec accord et divergence | Tout ce que le fournisseur montre ; sources souvent intégrées | Voix fusionnée cache la provenance ; le sélecteur est le fournisseur |
| Chat web exposé aux agents | OpenCLI et similaires | Pont du niveau 4 (web) au niveau 4 (CLI) | Utilisateurs techniques | Les agents peuvent utiliser les abonnements web | Fichiers, si l'agent les écrit | Fragilité ; règles d'accès |
| Plugin fournisseur : un agent délègue à un autre | Plugin OpenAI pour Claude Code ; Claude et Codex dans GitHub Agent HQ (Copilot) | 4 (CLI) | Développeurs, se propageant | Examen et délégation entre fournisseurs dans une même session | Transcription de session ; résultat d'examen | Surtout de forme liée au code ; quota de deux services |
| Serveurs conseil et consultation | Un serveur de consultation multi-fournisseurs (dernier commit décembre 2025) ; plugins de consensus ; petits conseils CLI qui écrivent un fichier par outil | 4 (CLI) | Développeurs | Plusieurs familles sur une tâche ; règles de consensus | Fichiers par outil ; une note fusionnée | Rondes sans fin ; erreurs corrélées ; abandon |
| Tableaux de bord multi-agents | Plusieurs CLI officiels dans des volets, chacun avec sa propre copie de travail, une personne capable de prendre le contrôle de n'importe lequel | 4 (CLI, visible) | Développeurs supervisant des agents parallèles | Supervision rendue visible | Logs et diffs par agent | Construit pour le code ; attention étendue |
| Script d'expansion avec plafonds de temps | Listing C1 en annexe C | 4 (CLI) | N'importe qui possédant un agent de niveau 3 | Réponses parallèles conservées même quand un outil s'arrête | Un fichier par outil, un résumé avec qui a répondu | Nécessite une personne pour réconcilier |
| Agent unique, tâche écrite et réexécutée | Un fichier d'instruction ou une compétence exécutée selon un horaire | 3 rendu répétable | N'importe qui au niveau 3 | Répétition où un deuxième modèle n'est pas disponible | Fichier de tâche, entrées, sorties, note d'acceptation | La répétition amplifie un mauvais modèle |
Les lignes décrivent des motifs. Les nombres d'étoiles dans l'Appendice E constituent une trace de popularité sur un jour, et ils ne sont pas des utilisateurs, une qualité, ou une pertinence pour un dossier de contrats. L'abandon a sa place dans le tableau : le serveur de consultation le plus connu a effectué son dernier commit en décembre 2025, et plus d'un tableau de bord a vu ses responsables cesser leurs activités. Un article qui orienterait les apprenants vers un seul orchestrateur nommé leur rendrait un mauvais service, c'est pourquoi je les oriente vers le motif à la place : les binaires officiels, les drapeaux non interactifs, les fichiers sur disque, et un enregistrement de qui a été consulté.
7.2 Pourquoi cette couche perdure
L'orchestration en ligne de commande repose sur les outils des fournisseurs eux-mêmes, exécutés dans les modes que les fournisseurs eux-mêmes documentent pour l'automatisation, et cela lui confère des propriétés qu'un onglet de navigateur ne peut pas avoir. Avant tout, elle peut être documentée. Un arrangement qui a fonctionné une fois, par exemple « rédiger avec un modèle, faire examiner par un deuxième par rapport à la liste de contrôle, me donner les désaccords », peut être sauvegardé comme un fichier d'instructions ou une compétence et exécuté à nouveau la semaine prochaine, selon un calendrier si nécessaire. La section 3 a défini le niveau 4 comme exactement cela, un travail répétable dirigé entre les modèles. Plusieurs autres propriétés en découle, dans l'ordre de mon évaluation. Un drapeau en ligne de commande est une interface documentée et un code de sortie est une promesse ; une position sur une page web ne l'est ni l'un ni l'autre, c'est pourquoi les outils qui pilotent les pages de chat grand public doivent être réparés chaque fois que la page change. Chaque outil officiel s'exécute sous sa propre connexion du fournisseur, avec le bac à sable et les règles de refus de ce fournisseur, de sorte que la personne peut garder les secrets hors du dossier, refuser le réseau par défaut et refuser les commandes destructrices par outil, tandis qu'un agent navigateur qui peut voir tous les onglets est un objet de permission plus large. Le motif utilise les connexions grand public que la personne paie déjà, et je m'attends à ce que, plus que toute autre chose, cela sépare une pratique qu'un non-programmeur conserve d'une qu'il essaie une seule fois. Et les fournisseurs l'approuvent. Le plugin officiel, les agents au sein du service GitHub, les modes sans tête et la norme des compétences sont des signes que la délégation intertools est en train d'être normalisée, tandis que l'automatisation des pages de chat grand public est en train d'être rejetée.
L'orchestration web peut enseigner l'habitude de la comparaison, et l'orchestration en ligne de commande est l'endroit où l'habitude peut être conservée, comme un objet. L'objet est un dossier qui contient la tâche, les entrées autorisées, les sorties, un journal de quel agent a produit quoi, et une note de ce qui a été accepté. Une autre personne peut l'inspecter sans rejouer une conversation privée, et la personne qui l'a créé peut changer une entrée la semaine prochaine et voir la différence. Cet enregistrement rend également la responsabilité plus difficile à éluder, car une tâche sauvegardée et une note d'acceptation exposent un ensemble de sources médiocre ou une approbation manquante. Dans les bureaux habitués au chat informel, cela semblera être un fardeau, et partout où le travail doit être vérifié, transmis ou répété, c'est un atout. La proportionnalité décide laquelle : une demande de deux minutes n'a pas besoin d'un dossier de flux de travail, tandis qu'une tâche récurrente qui touche des fichiers partagés peut.
La plupart de ce qui existe est façonné par le code. Les plugins officiels, les serveurs de conseil et les gestionnaires multi-agents ciblent l'examen du logiciel, bien que rien dans le motif lui-même ne soit spécifique au code.
7.3 Ce que la couche demande à la personne
Une petite équipe d'agents a besoin d'un gestionnaire, et le travail du gestionnaire est spécifique. J'appelle ses quatre parties le contrat de délégation :
- Objectif : ce que le travail est destiné à faire, énoncé de manière qu'un agent puisse dire s'il a été atteint.
- Limite : ce que les agents peuvent toucher et ce qu'ils ne peuvent pas, quelles actions nécessitent la confirmation d'une personne, et quel budget en temps et quota la tâche peut dépenser.
- Artefact : ce qui devrait exister quand le travail est terminé, et sous quelle forme.
- Vérification : comment la personne saura que l'artefact est correct, décidé avant le début du travail, qui examine quoi, et quand arrêter.
La quatrième partie comporte un piège décrit dans l'article complémentaire sur la surveillance automatisée (Chernets, 2026b). Ajouter un examinateur est peu coûteux, et chaque examinateur trouve quelque chose. Un conseil sans règle d'arrêt a tendance à ajouter des rondes et des critiques jusqu'à ce que le travail soit enterré dans l'examen. Une règle pratique est de permettre une ronde de critique et une ronde de corrections par étape, la personne décidant si une constatation bloque le travail. La règle a un coût mesuré : dans un test aléatoire de 144 exécutions rapporté dans cet article, un budget d'une ronde a réduit les rondes de critique de 2,86 à 1,00 par exécution tout en augmentant les défauts manqués de 0,11 par exécution (intervalle de confiance à 95 % 0,005 à 0,204) (Chernets, 2026b). Le fait que cet échange vaut la peine dépend des enjeux, ce qui est exactement le type de décision qui appartient au gestionnaire. Les limites sur les rondes et le temps sont des budgets, et un budget règle quand arrêter, ce qui est une question différente de celle de savoir si la réponse est vrai.
Le contrat réaffirme ce que la bonne délégation aux personnes a toujours exigé, pour un public qui n'a jamais délégué à des logiciels, et il ne prétend à aucune nouvelle théorie de la gestion. Sa valeur est que chaque partie peut être enseignée, documentée et vérifiée, et que chaque partie échoue d'une manière qui peut être vue quand elle manque.
8. De l'opérateur au gestionnaire
8.1 Ce qui change dans le travail
Au niveau 1, la personne produit et le modèle assiste. Aux niveaux 3 et 4, le modèle produit et la personne dirige, supervise et accepte. Les ironies de l'automatisation de Bainbridge (1983) ont prédit ce que cela fait au rôle humain. L'automatisation supprime la routine et laisse à la personne le résidu le plus difficile à bien faire, la surveillance et l'intervention en cas de défaillances rares, tandis que la pratique qui a construit son jugement disparaît. La version IA générative de l'ironie est déjà documentée. L'IA générative fait passer les gens de la production à l'évaluation et rend les tâches difficiles plus difficiles (Simkute et al., 2024), la confiance plus élevée dans l'outil s'accompagne d'une réflexion critique moindre (Lee et al., 2025), et la déprofessionnalisation découle structurellement de l'élimination de la pratique (Ferdman, 2025).
Gérer un agent est donc un travail différent avec sa propre compétence, et cette compétence ne vient pas gratuitement avec l'outil. Elle consiste à choisir ce qu'il faut déléguer, à énoncer le contrat de délégation de la section 7.3, à lire la trace d'un agent et à décider quand le résultat est suffisamment bon. Je divise le travail en quatre pratiques. La délégation nomme le travail comme un livrable avec une limite. La supervision surveille le plan, la sortie intermédiaire ou la trace de l'outil et intervient quand la tâche dévie, sans approuver chaque frappe, car l'approbation de tout est une fatigue et la fatigue est la façon dont les gens cliquent oui. La vérification contrôle les sources, les sommes, les transformations et les prétentions sur lesquelles repose une décision, en proportion du risque et par une méthode autre que la relecture de la propre confiance de l'agent : des tests et des diffs pour le code, un spot-check par rapport à une page que la personne ouvre elle-même pour un dossier de contrats, et pour un tableau de littérature une vérification ligne par ligne des identifiants. La révocation restreint l'espace de travail, arrête une exécution ou supprime l'accès quand une condition change. Une personne qui fait ces quatre choses gère un agent même par une application de bureau graphique. Une personne qui confie une tâche à un service opaque et accepte la première réponse externalise le jugement, ce qui est une pratique différente. Parasuraman et Riley (1997) ont nommé les deux façons d'échouer. La non-utilisation est la personne qui pourrait déléguer et ne le fait jamais, bloquée au niveau 1 par l'habitude ou la peur. L'abus est la personne qui délègue sans vérifications et accepte ce qui revient. Les deux sont visibles en 2026. Les données d'adoption large et superficielle décrivent la non-utilisation à grande échelle (section 2.2), et les rapports de perte de fichiers et les suppressions de bases de données de la section 5.3 décrivent l'abus, parfois par des professionnels qui auraient dû faire mieux. Le tableau 6 place chaque pratique à côté de la partie du contrat de délégation qu'elle applique, du risque qu'elle rencontre et de la trace datée par laquelle une étude peut voir que cela s'est produit.
Tableau 6. Les quatre pratiques du gestionnaire : ce que chacune applique, le risque qu'elle rencontre et la trace qu'elle laisse.
| Pratique | Ce que la personne fait | Partie du contrat qu'elle applique | Risque si elle est absente | Trace observable |
|---|---|---|---|---|
| Délégation | Nomme le travail comme un livrable avec une limite (8.1) | Objectif, énoncé de telle sorte qu'un agent puisse dire s'il a été atteint ; artefact : ce qui devrait exister, et sous quelle forme (7.3) | Non-utilisation : « la personne qui pourrait déléguer et ne le fait jamais », bloquée au niveau 1 par l'habitude ou la peur (8.1) | Un artefact déposé (Annexe A) |
| Supervision | Surveille le plan, la sortie intermédiaire ou la trace de l'outil ; intervient quand la tâche dévie, sans approuver chaque frappe (8.1) | Limite : ce que les agents peuvent toucher ; quelles actions nécessitent une confirmation de personne ; quel budget en temps et en quota (7.3) | Fatigue d'approbation : « la fatigue est la façon dont les gens cliquent oui » (8.1) ; une garde qui bloque trop produit une non-utilisation (5.3) | Un plan refusé ; une étape irréversible maintenue pour confirmation (Annexe A) |
| Vérification | Contrôle les sources, les sommes, les transformations et les prétentions sur lesquelles repose une décision, par une méthode autre que la relecture de la propre confiance de l'agent (8.1) | Vérification : comment la personne saura que l'artefact est correct, décidé avant que le travail ne commence ; quand arrêter (7.3) | Abus : « la personne qui délègue sans vérifications et accepte ce qui revient » (8.1) ; erreurs corrélées parmi les modèles (6.3) | Un diff ou une sortie rejetée ; une deuxième famille de modèles demandée ; un dénominateur enregistré : demandé, répondu, dépassement de délai (Annexe A) |
| Révocation | Restreint l'espace de travail, arrête une exécution ou supprime l'accès quand une condition change (8.1) | Limite, appliquée à nouveau : ce qui est maintenu à l'écart, et comment annuler une erreur (3.2, 7.3) | Une tâche longue qui ne pouvait pas être arrêtée, après quoi la suppression de la tâche a supprimé les fichiers (5.3) | Aucune parmi les traces datées de l'annexe A ; un arrêt daté, une permission réduite ou un accès supprimé serviraient |
Remarque : Une personne qui confie une tâche à un service opaque et accepte la première réponse « externalise le jugement », ce qui est une pratique différente (8.1).
Un petit dispositif maintient le rôle ensemble dans les quatre pratiques, et je l'appelle un dossier d'acceptation. Pour une tâche importante ou récurrente, il contient le livrable prévu, les entrées utilisées, les contraintes et permissions, où la sortie est allée, tout désaccord matériel ou défaillance, les vérifications effectuées, et la décision de la personne d'accepter, réviser, escalader ou rejeter. Il trace une ligne entre ce que l'agent a produit et ce sur quoi la personne s'est appuyée. Pour l'individu, c'est utile car cela transforme un sentiment de confiance en une décision vérifiable, pour une équipe car un collègue peut inspecter le travail sans un historique de chat privé, et pour un chercheur car cela sépare une exécution complétée d'un résultat sur lequel on s'est appuyé. C'est aussi une contrainte. Une personne peut décider, après n'avoir pas réussi à écrire un critère d'acceptation, que la tâche devrait rester au niveau 1, et le modèle compte cela comme une gestion mûre plutôt que comme une adoption en retard. Dans le vocabulaire de la collaboration humain-IA, le passage du niveau 1 au niveau 4 maintient l'humain dans la boucle et change ce qu'est la boucle, de la lecture de chaque réponse à la définition des conditions d'acceptation des réponses. La figure 4 dessine cette boucle avec les quatre pratiques, le risque à chaque étape, le retour après un contrôle échoué et le dossier d'acceptation.
Figure 4. La boucle de contrôle du gestionnaire.
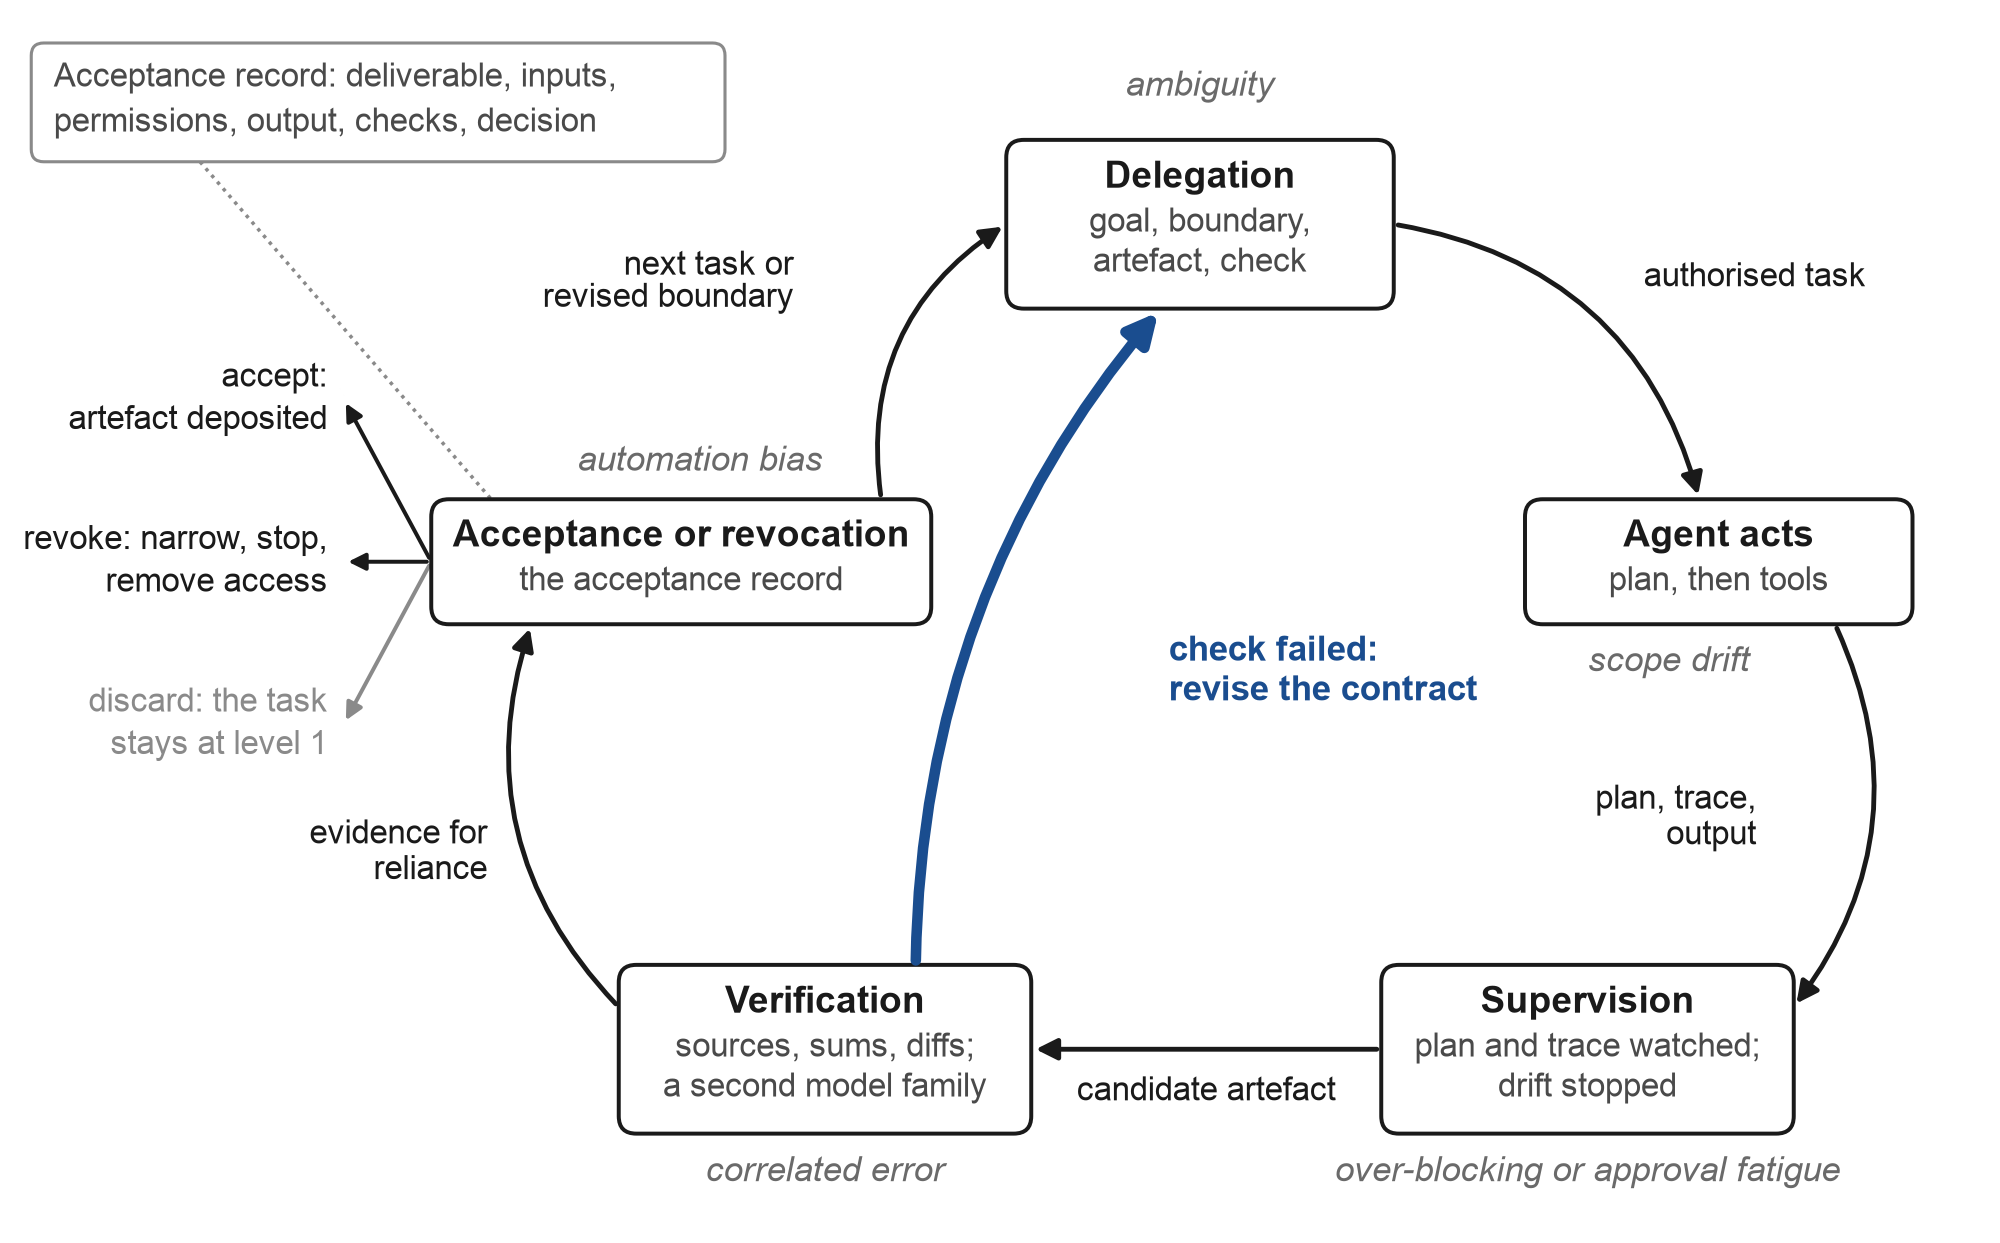
Remarque : Le travail du gestionnaire en tant que boucle que la personne exécute (sections 7.3 et 8.1) : la délégation énonce le contrat (objectif, limite, artefact, vérification), l'agent agit, la personne supervise et vérifie, puis accepte, révoque ou rejette le résultat et rédige l'enregistrement d'acceptation. Les étiquettes gris italique nomment le risque à chaque étape (sections 5.3, 6.3 et 8.1). La flèche épaisse est le retour d'une vérification échouée à un contrat révisé, et chaque sortie du nœud d'acceptation est une décision de la personne.
8.2 Les utilisateurs expérimentés délèguent moins
Une observation contredit toute histoire simple selon laquelle chacun devrait finir par être un gestionnaire d'agents. Anthropic a rapporté en mars 2026 que les utilisateurs ayant une plus longue ancienneté étaient « beaucoup moins susceptibles de déléguer une plus grande responsabilité par des modèles d'utilisation directive » (Anthropic, 2026e), et son rapport de janvier 2026 plaçait l'augmentation, l'utilisation collaborative dans laquelle la personne reste dans la boucle, à 52 % des conversations en novembre 2025 (Anthropic, 2026f). Une interprétation est que les utilisateurs expérimentés ont appris où la délégation échoue et se sont retirés. Une autre est qu'ils ont appris à utiliser le modèle comme collaborateur pour les parties du travail où leur propre jugement est le produit. Je ne peux pas distinguer les deux interprétations à partir des chiffres publiés, et dans l'une ou l'autre lecture, le point terminal de l'échelle est quelque chose d'autre que la délégation maximale. C'est la capacité à choisir, tâche par tâche, entre demander, collaborer et déléguer, et à savoir laquelle la tâche devant vous nécessite. Le modèle à quatre niveaux décrit ce qu'une personne peut faire. Il ne prétend pas qu'elle devrait faire la chose la plus déléguée à chaque fois.
8.3 La responsabilité reste avec la personne
Les fournisseurs sont clairs sur le lieu de la responsabilité. Les consignes de lancement pour l'agent de niveau 2 d'Anthropic ont dit aux utilisateurs qu'ils « restent responsables de toutes les actions entreprises par Claude en votre nom » (The Register, 2026). C'est la réalité juridique et pratique du niveau 3 en particulier, où l'agent agit avec les identifiants du propriétaire, sur les fichiers du propriétaire, sous le nom du propriétaire. Un professionnel qui devient gestionnaire d'un agent devient également responsable d'un travailleur dont les erreurs sont rapides. C'est une autre raison pour laquelle la vérification du contrat de délégation doit être décidée avant le travail, et une autre raison pour laquelle la conception de sécurité de la section 5.3 ne devrait pas dépendre de la personne qui repère une attaque en temps réel.
8.4 Le rôle du gestionnaire dans les cadres de littératie
Les définitions officielles de la littératie en IA commencent à nommer ce rôle, bien qu'aucun des textes examinés ici n'utilise le mot « agent ». Le Cadre de littératie en IA du Département du travail des États-Unis de février 2026 énumère « diriger l'IA efficacement » parmi ses domaines de contenu (US Department of Labor, 2026 ; ExecutiveGov, 2026). Le cadre conjoint de l'OCDE et de la Commission européenne de juin 2026, qui alimente l'évaluation PISA 2029, a quatre domaines, dont l'un est « Gérer l'IA » (OCDE & Commission européenne, 2026). Les cadres académiques antérieurs mettaient l'accent sur la reconnaissance, la compréhension et l'évaluation de l'IA (Long & Magerko, 2020), et les cadres de compétences 2024 de l'UNESCO pour les étudiants et les enseignants établissent le même registre (UNESCO, 2024a, 2024b). Le contrat de délégation donne aux domaines de gestion et de direction un contenu pédagogique pour le cas agentique : fixer un objectif, clôturer le travail, nommer l'artefact, décider la vérification. Les praticiens ont commencé à utiliser des titres tels que « opérateur IA » et « gestionnaire d'agents » pour un professionnel qui acquiert cette spécialité en plus de sa profession. J'utilise « gestionnaire d'agents » plus étroitement, pour un modèle de comportement plutôt que pour un rôle dont quelqu'un devrait embaucher, car le comportement laisse des preuves et un titre n'en laisse pas. Les preuves se trouvent dans les artefacts : un plan que la personne a refusé, une différence qu'elle a rejetée, un deuxième avis qu'elle a pris, une exécution programmée qui s'est terminée pendant qu'elle était absente du clavier. Lorsqu'aucune de ces traces n'existe, le titre n'a rien derrière lui.
9. Mesurer les franchissements : un programme préenregistré
9.1 Les franchissements comme unité de mesure
La plupart des données d'adoption comptent les personnes qui « utilisent l'IA », parfois hebdomadairement ou quotidiennement. Un tel comptage ne peut pas distinguer une personne qui pose une question à un agent conversationnel pour trouver des synonymes d'une personne qui délègue un rapport trimestriel à un agent, et c'est cette deuxième personne que je veux identifier. La règle des artefacts de la section 3.3 rend cette différence observable, car un franchissement n'est enregistré que lorsque l'agent a produit quelque chose que la personne a demandé, à un nouveau niveau. Plusieurs autres règles découlent de la littérature sur l'intégration et la supervision. L'achèvement doit être signalé séparément pour les personnes qui ont franchi sans aide et celles qui ont reçu de l'aide, car l'aide change la signification d'un franchissement. Un arrêt doit être enregistré au moment où il s'est produit et avec les propres termes de la personne, car les raisons de l'arrêt constituent une grande partie du résultat. Chaque personne qui a reçu les matériaux doit figurer au dénominateur, y compris celles qui n'ont jamais répondu. La persistance, enfin, doit être observée après que le chercheur a cessé d'écrire chaque semaine ; un artefact produit alors que le chercheur est encore dans la boîte de réception de la personne peut témoigner de la courtoisie autant que de l'utilisation.
9.2 La conception
Je dirige un programme de cohorte préenregistré qui applique ces règles à des personnes non programmeuses (Chernets, 2026d ; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, enregistré et gelé le 6 septembre 2026). C'est une étude de faisabilité à bras unique d'un parcours en trois étapes, et le préenregistrement a été gelé avant toute collecte de données. Ce qui suit est la conception telle qu'enregistrée.
Participants. Des adultes dont le travail se déroule largement sur ordinateur. Ils utilisent leur propre machine et leurs propres abonnements aux IA (ceux d'un employeur sont exclus), gardent confidentiel le matériel identifiant les clients et confidentiel vis-à-vis de l'employeur, et confirment que l'installation de logiciels ne viole pas une règle imposée par leur employeur. Le recrutement se fait par annonce publique sur les réseaux sociaux professionnels dans une fenêtre fixée à l'avance dans le temps, de sorte qu'elle ne peut pas être prolongée en attendant un résultat favorable. L'annonce est capturée d'écran et son lien permanent enregistré, ce qui fixe le texte du recrutement. L'entrée se fait de manière continue et le calendrier de chaque participant compte à partir de son propre jour zéro, car les outils changent à l'échelle hebdomadaire. Le recrutement a ouvert avec l'annonce publique le 6 septembre 2026, jour où l'enregistrement a été gelé, et se ferme 21 jours plus tard, le 27 septembre 2026 ; la cohorte est sur le terrain au moment de la rédaction, et le nombre réalisé, quel qu'il soit, sera signalé avec les résultats.
Étape 1 (du chat à un agent sur l'ordinateur personnel de la personne). Le participant colle un texte standard dans l'agent conversationnel qu'il utilise déjà, et cet agent le guide dans l'installation d'un agent graphique sur sa propre machine. Je ne touche à l'ordinateur de personne. L'étape est complète lorsque le participant fournit un artefact produit par l'agent en réponse à une première tâche. La tâche a la même forme pour tous et est remplie avec la propre situation de travail du participant, et elle oblige l'agent à poser des questions, à prendre des décisions, à créer et à formater des fichiers. Cette exigence distingue un agent d'un agent conversationnel. L'enregistrement donne la formulation exacte (Chernets, 2026d). En termes de modèle, l'étape 1 teste l'intégration réflexive sur deux niveaux à la fois, du niveau 1 au niveau 3. C'était un choix délibéré. Un shell graphique d'un agent local s'exécute sur la propre machine de la personne, donc selon la règle de la section 3.3, c'est le niveau 3, et l'artefact que l'étape 1 demande est du type qui marque la transition 2 ; ses invites de permission lui donnent une partie de la protection d'un échelon délimité. La cohorte n'instrumente pas une semaine distincte dans un environnement de niveau 2 cloisonné par le fournisseur, elle ne peut donc pas tester P5 de la section 10 (qu'un échelon intermédiaire délimité réduit la non-achèvement et les incidents) ; ces invites de permission sont le seul échelon délimité que la conception possède, et la ligne de commande entre à l'étape 3. Une cohorte ultérieure qui insérerait une semaine de niveau 2 explicite entre chat et une installation locale serait le test propre de P5.
Étape 2 (vers l'orchestration web, lancée à partir de l'agent). Une fois prêts, les participants reçoivent un outil open source qui pose une question à plusieurs modèles via les abonnements qu'ils paient déjà et retourne une réponse fusionnée unique, en une seule action depuis l'intérieur de l'agent. Le but de l'étape a été enregistré à l'avance comme couverture et fiabilité, avec un désaccord visible comme l'un des mécanismes du second.
Étape 3 (vers l'orchestration CLI). La même orchestration via des interfaces de ligne de commande.
Mesures. Cinq éléments essentiels gelés, libellés de manière identique dans chaque cohorte du programme, enregistrent la profession et les heures à l'ordinateur, l'utilisation actuelle de l'IA, l'expérience antérieure de poser une question à plus d'une IA, si et comment les réponses sont vérifiées, et si quelque chose agit déjà pour la personne sur son ordinateur. Un enregistrement des étapes pour chaque participant contient les dates, l'agent conversationnel qui les a guidés, les tentatives et les heures, l'achèvement avec l'artefact, le point d'arrêt exact et la raison avec les propres termes de la personne, et si et comment l'enquêteur a intervenu. Chaque semaine du premier mois, les participants signalent un artefact que leur agent a produit cette semaine (ou « rien », ce qui est une réponse valide), la fréquence à laquelle ils posent une question à plus d'une IA et ce qui s'est passé quand les réponses ont divergé, et à partir de l'étape 2, si quelque chose d'utile s'est produit qu'un modèle avait manqué et si la vérification a changé ce sur quoi ils se sont fiés. Les observations se poursuivent au jour 60 et trimestriellement après cela, aussi longtemps que les participants sont disposés.
Analyse et interprétation. L'analyse est descriptive. Les proportions d'achèvement sont données avec des intervalles de confiance à la fois contre le dénominateur survivant et le dénominateur complet, séparément pour l'achèvement sans aide et avec aide ; les temps et les tentatives sont signalés comme des distributions, et les raisons de l'arrêt sont codées après la collecte, avec les codes et la formulation brute déposés. Une règle d'interprétation a été fixée à l'avance. Si moins de la moitié de ceux qui ont reçu les matériaux de l'étape 1 fournissent un artefact produit par un agent, la cohorte est rapportée comme une étude d'échec d'intégration, et ce qui a arrêté les gens devient le résultat.
Limites de l'inférence. L'enregistrement indique à l'avance qu'il n'y a pas de condition témoin et donc pas de réclamation causale, et pas de généralisation au-delà des volontaires autoélectionnés. L'estimation d'une personne du temps économisé est signalée comme une croyance uniquement, car l'auto-rapport dans ce domaine s'est avéré inverser la véritable direction (Becker et al., 2025).
Divulgation et éthique, tel qu'enregistré. Les participants sont informés par écrit que j'ai rédigé les matériels et l'outil, que je les enseignes, et que je suis demandeur dans des demandes de brevets en attente couvrant la méthode d'orchestration. Aucun avis de comité d'éthique institutionnel n'a été demandé : il n'y a pas d'affiliation institutionnelle derrière l'étude et aucun financement fédéral. L'enregistrement énonce les mesures de protection à la place. Le consentement est écrit et donné avant tout enregistrement. Aucune donnée de santé, financière ou relative au contenu du travail n'est collectée. Les participants travaillent sur leurs propres machines et abonnements et peuvent demander la suppression à tout moment jusqu'au dépôt public. Les instructions de sécurité incluent un profil de navigateur séparé, aucune action sur les sites bancaires ou médicaux, confirmation avant tout action irréversible, aucun mot de passe saisi dans l'agent, et le contenu web traité comme des données. Aucune variable d'accessibilité n'est collectée et aucune affirmation d'accessibilité n'est faite.
9.3 La conception uniquement
Du programme, je prends la conception et rien d'autre. Aucun nombre de participants, taux de réussite ou cas individuels n'apparaissent ici, par décision délibérée : l'argument (cet article), la méthode et le programme, et les résultats après la période d'observation du protocole sont des publications distinctes, de sorte que l'argument ne peut pas être lu comme preuve de lui-même. D'autres chercheurs peuvent maintenant appliquer les mêmes règles. Le listage C5 en Appendice C donne un format d'enregistrement et un vérificateur qui les codent. Le vérificateur refuse un enregistrement qui compte une installation comme un croisement, une réussite sans artefact produit par l'agent, un arrêt sans les propres paroles de la personne, un vrai nom à la place d'une étiquette pseudonyme, un champ que le format ne connaît pas, ou un niveau ignoré qui n'est pas enregistré exactement comme ignoré.
9.4 À quoi ressemble une prochaine étude solide
La cohorte est une étude de faisabilité, et la plupart des propositions de la section 10 nécessitent d'autres conceptions. Une prochaine étude solide comparerait deux conditions d'intégration qui diffèrent dans la façon dont elles représentent le travail, en maintenant le risque de tâche et l'environnement technique aussi constants que possible. Une condition présente les fonctionnalités et les instructions d'installation ; l'autre commence par l'objet de travail récurrent propre du participant et élicite la carte à cinq parties de la section 5.1. Les résultats incluent les artefacts, leur qualité évaluée par quelqu'un d'autre que le participant (avec accord entre évaluateurs rapporté, comme pour le codage des raisons d'arrêt), le temps, les erreurs découvertes, les décisions de permission sous forme de scénario, la réutilisation volontaire ultérieure et la confiance mesurée par rapport aux résultats. Un suivi séparerait la persistance du contact continu avec le chercheur. Une deuxième étude demanderait si le vocabulaire de flux de travail est une grammaire ou une par profession, en comparant les tâches administratives, de recherche, de communications et analytiques. Je ne sais pas laquelle c'est, et la réponse décide si les exemples fournis peuvent être rédigés une fois ou doivent être rédigés pour chaque domaine. Les deux études devraient établir une base de référence pour l'alphabétisation en IA avec un instrument validé (Carolus et al., 2023), de sorte que l'écart spécifique, savoir ce qu'il faut confier à un agent, puisse être séparé de la familiarité générale avec l'IA. Chaque étude de ce type devrait également documenter la mise en œuvre, car un participant qui commence sur une interface ultérieure rencontre des paramètres par défaut différents : la version de l'interface, le système d'exploitation, si l'agent avait accès au réseau, le mode de permission, et toute contrainte de politique. Le nom du fournisseur seul en dit trop peu à un lecteur ultérieur.
10. Propositions
Le modèle de la section 3 et l'argument des sections 4 à 8 impliquent des affirmations qui peuvent s'avérer fausses. Le tableau 7 en énumère quinze, chacune avec une mesure, un résultat qui l'infirmerait, et qui est en position de mener le test. Elles sont rédigées pour le domaine dans son ensemble. Le programme de la section 9, par exemple, ne peut en tester que quelques-unes ; plusieurs autres peuvent être testées à l'aide de télémétrie des éditeurs, de panels d'enquête ou d'une petite étude dans une organisation. Aucune n'est une découverte de la cohorte.
Tableau 7. Propositions, mesures, falsificateurs et qui peut les tester.
| # | Proposition | Mesure | Infirmée si | Qui peut le mener |
|---|---|---|---|---|
| P1 | Migration des barrières. Parmi les non-programmeurs qui tentent la transition 2, les arrêts du cluster après installation (à la première tâche, à la première erreur ou sur les autorisations) sont plus nombreux que pendant celle-ci, et parmi ceux qui ont installé sans produire rien, « je ne savais pas quoi demander » surpasse les raisons techniques, d'autorisation et de coût ; et, la difficulté de la tâche étant constante, l'achèvement chute plus fortement aux trois transitions qu'au sein d'un niveau. | Points d'arrêt enregistrés avec la règle de l'artefact ; raisons exprimées par la personne elle-même, codées par la règle de l'annexe A ; achèvement par étape | La plupart des arrêts surviennent avant la première exécution de l'agent, ou les raisons techniques et d'autorisation dominent parmi les non-producteurs installés, ou les modèles d'achèvement et d'échec sont comparables à toutes les étapes une fois la difficulté de la tâche contrôlée | Le programme de la section 9 ; toute réplication |
| P2 | Fusion des interfaces. Lorsque les éditeurs fusionnent les interfaces de chat et d'agent, la part des sessions qui aboutissent à un fichier ou une action produits par l'agent augmente sans aucun changement dans ce que les utilisateurs disent vouloir faire ; et les assistants de pointe écrivent des fichiers depuis la fenêtre par défaut sans un mode choisi par l'utilisateur avant la fin de 2027. | Télémétrie des éditeurs avant et après une fusion ; un recensement daté des assistants | La part reste plate après une fusion ; ou un mode agent stable et choisi par l'utilisateur demeure une condition préalable à l'écriture de fichiers | Les éditeurs ; quiconque peut ouvrir les applications |
| P3 | Vocabulaire plutôt qu'installation. Fournir aux gens des exemples travaillés de leur propre domaine (tâches packagées, compétences, modèles) augmente la persistance aux niveaux 2 et 3 plus que de fournir une aide à l'installation, et une mesure structurée du vocabulaire du flux de travail prédit l'achèvement des artefacts une fois l'accès et l'utilisation antérieure d'IA contrôlés. | Persistance au jour 60 sous les deux types d'aide, dans une comparaison avec l'attribution ; une déclaration préalable à la tâche des cinq parties de la section 5.1 ; raisons d'arrêt codées par la règle de l'annexe A | L'aide à l'installation produit une persistance égale ou supérieure ; la mesure du vocabulaire n'ajoute rien une fois la facilité d'installation et la confiance générique intégrées au modèle | Tout laboratoire avec deux parcours d'intégration |
| P4 | Intégration réflexive. Les gens guidés par le chatbot qu'ils utilisent déjà peuvent passer du niveau 1 au niveau 3 sans aide à un taux qui rend le parcours pratique, et atteindre un premier artefact plus tôt que les gens dotés de documentation statique. | Proportion achevant la transition 2 sans aide avec un artefact produit par un agent, par rapport à tous ceux qui ont reçu les matériaux ; temps jusqu'au premier artefact dans les conditions guidées et statiques | Moins de la moitié l'achèvent, le seuil fixé à l'avance à la section 9 ; ou la documentation statique donne une achèvement égale ou supérieure | Le programme de la section 9 ; les formateurs avec deux cohortes |
| P5 | L'échelon intermédiaire. Les non-programmeurs qui passent du temps dans un environnement fermé par un éditeur avant un agent local achèvent la transition 2 plus souvent, ont moins d'incidents de perte de fichiers et raisonnent mieux sur la portée, la réversibilité et l'escalade que les gens passés directement du chat à un accès local large. | Cohorte à deux parcours avec suivi égal ; artefact comme résultat principal ; un journal des incidents ; décisions d'autorisation basées sur des scénarios avant et après | Les achèvements sans aide du chat directement à un agent local correspondent à ceux qui ont franchi le niveau 2, avec des taux d'incidents comparables et des décisions d'autorisation égales | Tout laboratoire avec deux parcours d'intégration ; une cohorte ultérieure du programme |
| P6 | Le goulot d'étranglement. Parmi les non-programmeurs qui utilisent le chat hebdomadairement, la part produisant un artefact de niveau 3 en un trimestre reste bien en deçà de la part des développeurs qui utilisent les agents de codage hebdomadairement. | Une enquête représentative utilisant des éléments d'artefact plutôt que « utilisez-vous l'IA » (section 11.3) | La production d'artefacts de niveau 3 parmi les travailleurs du savoir non-programmeurs se rapproche de la figure d'utilisation hebdomadaire des développeurs | Les offices statistiques nationaux ; les instituts d'enquête |
| P7 | Les passages du pont. Les gens qui pratiquent l'orchestration web sont plus susceptibles d'adopter ultérieurement l'orchestration CLI que les gens qui ne la pratiquent pas, et le désaccord visible prédit ultérieurement l'attribution ou la critique de source dans leurs enregistrements de tâches. | Adoption de l'orchestration CLI parmi ceux avec et sans comparaison web antérieure ; comparaisons sauvegardées et enregistrements ultérieurs | Aucune différence, ou l'inverse ; la comparaison produit plus d'invites et aucun changement dans les vérifications conservées | Le programme de la section 9 ; panels longitudinaux |
| P8 | Durabilité CLI. Pour les gens qui payent deux abonnements consommateurs ou plus, l'orchestration par le biais d'outils de ligne de commande officiels est la forme du niveau 4 qui survit aux changements d'interface, et les exécutions sauvegardées dans des fichiers se réexécutent et se transfèrent à un autre examinateur mieux que les exécutions réservées au navigateur. | Un recensement daté des artefacts de niveau 4 dans cette population ; tests de réexécution et de transfert après un changement d'interface | Un recensement de fin 2027 trouve les conseils web ou d'interface de programmation dominants et les outils CLI-à-CLI en recul ; les flux de travail réservés au navigateur correspondent en réexécution et transfert | Les chercheurs en outillage ; les enquêtes auprès des développeurs |
| P9 | Accord corrélé. Entre les familles d'éditeurs, les erreurs sur les éléments de travail de connaissance avec des réponses connues se corrèlent suffisamment pour que l'accord entre trois modèles ou plus vaille moins que deux opinions indépendantes (rho à ou au-dessus d'environ 0,5, où rho est estimé sur les éléments de travail de connaissance avec des réponses connues et non tiré des taux d'accord de référence) ; un petit conseil de familles différentes surpasse un grand conseil d'une seule famille à coût égal ; et l'examen conscient de la source prédit mieux la correction que l'accord majoritaire. | Corrélation d'erreur par paire entre familles sur les banques d'items aux réponses connues (liste C4) ; un ensemble d'items marqués avec deux designs de conseil ; exactitude par rapport à l'accord majoritaire et par rapport à l'examen conscient de la source | Rho mesuré inférieur à 0,2 pour la plupart des types de tâches ; le conseil de même famille gagne après une vérification réclamation par réclamation ; ou l'accord simple majoritaire prédit l'exactitude aussi bien ou mieux que la diversité plus la vérification | Chercheurs en modèles de langage ; le protocole de l'article compagnon |
| P10 | La compétence du gestionnaire. La persistance aux niveaux 3 et 4 est prédite mieux par la capacité d'une personne à énoncer le contrat de délégation (objectif, limite, artefact, vérification) et par les traces de supervision (plans refusés, diffs rejetées, avis externes sollicités) que par l'expérience technique préalable ou par le volume de prompts. | Une courte tâche qui élicite les quatre parties, évaluée en aveugle ; items de base ; traces du registre d'acceptation ; persistance au jour 60 | L'expérience technique préalable ou le volume de prompts prédisent la persistance aussi bien ou mieux, et l'énoncé du contrat n'ajoute rien ; ou les artefacts aux niveaux 3 et 4 qui omettent régulièrement l'objectif, les sources, la limite et la vérification restent fiables sous audit indépendant, auquel cas la structure de compétence est surchargeante | Toute étude d'artefact longitudinale |
| P11 | Calibrage par classe de tâche. Les personnes calibrent mieux la délégation là où la rétroaction est rapide et l'inversion est possible, acceptant, corrigeant et remontant différemment selon la classe de tâche. | Acceptation, correction, remontée et découverte d'erreur ultérieure par classe de tâche | Le calibrage est uniforme entre les tâches réversibles et les tâches à conséquences élevées | Laboratoires ; organisations disposant d'un registre d'acceptation |
| P12 | Friction des garde-fous. Parmi les non-programmeurs au niveau 3, les interruptions par les prompts de permission et les blocages de sécurité sont nommés comme raison d'arrêt plus souvent que parmi les développeurs, et l'autonomie gardée par classificateur réduit de tels arrêts sans augmentation des pertes de fichiers signalées. | Raisons d'arrêt codées par groupe ; taux d'arrêt et rapports d'incidents avant et après un changement du mode par défaut | Aucune différence entre les groupes, ou l'autonomie augmente les pertes signalées | Fournisseurs ; les raisons d'arrêt codées du programme |
| P13 | L'écart se reproduit. Les différences d'adoption du chat par sexe et niveau d'éducation (Cranney et al., 2026 ; Daepp & Counts, 2024) réapparaissent au moins aussi grandes dans la production d'artefacts de niveau 3 au sein des professions. | Différences intra-professionnelles dans la production d'artefacts de niveau 3 | Une estimation intra-professionnelle montre que l'écart s'est fermé au niveau 3 | Économistes du travail ; cohortes ultérieures si assez grandes |
| P14 | Critique et deuxième famille. Un critique de même famille capture la précipitation et les vérifications omises ; une deuxième famille capture l'erreur partagée ; sur un ensemble étiqueté par défaut chacun contribue des défauts que l'autre manque. | Chevauchement des conclusions confirmées entre un critique de même famille et un examinateur de deuxième famille à coût égal | Chevauchement complet, ou une source dominante | Quiconque dispose de deux outils d'agent et d'un ensemble étiqueté |
| P15 | Capacité ou vocabulaire. À classe de tâche égale, la persistance aux niveaux 2 et 3 varie avec la capacité d'une personne à énoncer le contrat de délégation ; si la capacité du modèle était la contrainte critique, la persistance varierait entre classes de tâche et serait uniforme entre personnes au sein d'une même classe. | Persistance par classe de tâche, croisée avec un énoncé du contrat de délégation évalué en aveugle | Au sein d'une classe de tâche, la persistance est uniforme entre personnes quel que soit leur score de contrat, et varie uniquement entre les classes | Toute étude qui enregistre la classe de tâche et l'énoncé du contrat |
Certains d'entre eux comptent plus que les autres. P4 porte le plus grand poids pour la politique, car si l'intégration réflexive fonctionne, la partie la plus coûteuse de l'enseignement des agents aux personnes (s'asseoir à côté d'elles lors de l'installation) peut être remplacée par l'outil qu'elles ont déjà. P5 est celle que la cohorte ne peut pas tester, comme la section 9.2 le dit, et c'est aussi celle dont dépend le plus la forme de l'échelle. Je ne sais pas encore si le barreau du milieu mérite sa place. P9 est la plus facile à tester et la plus susceptible de surprendre les utilisateurs de conseils, car l'arithmétique de la preuve corrélée (Chernets, 2026a) et les mesures de Kim et al. (2025) pointent toutes deux vers un plafond sur ce que l'accord vaut. P10 est celle qui changerait les programmes. Si la capacité à énoncer un contrat de délégation prédit mieux la persistance que les antécédents techniques, alors la formation devrait enseigner la délégation en premier et les outils en second.
11. Implications
11.1 Pour les fournisseurs
Concevoir pour le dossier vide. Les fournisseurs ont simplifié l'installateur, et cela se voit. Je pense qu'un nouvel effort en ce sens serait gaspillé, car le problème du novice commence maintenant après l'installateur, face à un dossier vide qui n'a rien à dire à l'agent. Des exemples concrets du domaine de la personne, proposés au moment où elle ouvre d'abord l'agent, accompagnés d'une première tâche qui est réelle, faible en risque et qui aboutit à quelque chose qu'elle peut juger, feraient plus pour l'adoption que toute simplification supplémentaire de la configuration. Les compétences emballées pointent déjà dans cette direction (Section 5.1). Deux choses manquent encore : l'aide pour choisir laquelle des tâches d'une personne vaut la peine d'être confiée du tout, et un moyen pour une association professionnelle, et pas seulement une start-up, d'écrire des compétences pour ses membres.
Quel que soit le nom des onglets après la prochaine fusion, une personne a besoin d'une réponse claire, au moment de la délégation et dans la langue du dossier sélectionné, à une courte liste de questions : que peut lire cet agent, qu'est-ce qu'il peut modifier, qu'est-ce qu'il peut envoyer ou déclencher, qu'aura besoin de mon approbation, et comment l'arrête-t-on ? Un diff visuel répond à une partie de cela quand les fichiers changent, et un plan écrit répond quand les actions sont diversifiées ; une seule bannière de consentement ne répond à rien. Le modèle de permissions devrait rester visible, limité en étendue et réversible après la fusion, avec un bouton d'annulation et un bouton d'arrêt qui fonctionne. L'étendue des dossiers sans l'un ou l'autre est ce que les rapports de problèmes de la Section 5.3 décrivent.
Le travail devrait aussi pouvoir quitter le produit. Un utilisateur devrait pouvoir exporter l'instruction de la tâche, les entrées ou leurs identifiants, les actions des outils, la sortie et l'historique des approbations. C'est une caractéristique d'utilisabilité autant qu'une caractéristique de gouvernance, car elle permet au novice d'apprendre d'une tâche complétée et permet à une équipe d'examiner un résultat sans prêter sa mémoire à un historique de chat propriétaire. L'utilisation devrait être rapportée de la même manière. Les « utilisateurs actifs hebdomadaires » d'un agent qui produit des fichiers devraient être divisés entre les personnes qui ont produit un fichier et les personnes qui ont ouvert l'application, et les fournisseurs ont la télémétrie pour le faire.
Détecter les attaques n'est pas un travail pour le novice. Une guidance qui demande à des non-programmeurs de reconnaître des signes d'injection de prompt confie le jugement le plus difficile à la personne la moins capable de le faire (Section 5.3). Des défauts sûrs (copies de travail, instantanés avant des changements plus importants, commandes destructrices refusées jusqu'à autorisation explicite, contenu web traité comme des données) appartiennent au produit. En même temps, des garde-fous qui interrompent constamment arrêtent le travail aussi sûrement que des garde-fous manquants perdent des fichiers, et l'article complémentaire sur les excès de surveillance décrit comment ces couches se développent (Chernets, 2026b).
La provenance devrait survivre à la fusion des réponses. Les fonctionnalités du conseil qui retournent une réponse fusionnée devraient montrer quel modèle a dit quoi et où ils n'étaient pas d'accord, permettre à l'utilisateur d'assigner à un modèle le rôle de critique, et rendre une lacune en preuves plus facile à trouver qu'un paragraphe de consensus fluide. Une voix fusionnée sans sources restaure l'autorité d'une réponse unique confiante, récompense le biais d'automation et cache la corrélation des erreurs (Section 6.3).
Le changement, enfin, a un coût du côté de l'utilisateur. Une personne qui a appris un outil qui a été renommé, fusionné ou retiré en un an paie deux fois, donc des noms stables, des guides de migration et la continuité des fichiers d'instruction à travers les changements de produit sont eux-mêmes des caractéristiques d'adoption.
11.2 Pour les employeurs et les formateurs
Enseignez le contrat de délégation avant les menus. Les menus des produits changent mensuellement, tandis que la capacité à énoncer un objectif, à clôturer le travail, à nommer l'artefact et à décider de la vérification se transfère entre les outils (Sections 4.3 et 7.3). Un court exercice qui demande à une personne d'écrire les quatre parties pour l'une de ses propres tâches récurrentes teste mieux la disponibilité qu'une visite des fonctionnalités. Ce que contient l'exercice est présenté ci-dessous, sous décomposition.
Les connexions mesurent la mauvaise chose. Un nombre d'utilisateurs actifs ne peut pas faire la distinction que la Section 9.1 nécessitait, entre la personne qui demande des synonymes et la personne qui délègue un rapport. Un nombre d'artefacts produits par agent que les personnes ont choisi de conserver peut le faire.
Les gens ont aussi besoin d'un endroit sanctionné pour apprendre et d'une carte de ce qui est permis. Le niveau 2 à l'intérieur des outils que l'organisation autorise déjà atteint le personnel qui ne sera jamais autorisé à installer un agent sur un ordinateur portable de travail (Section 5.4). Pour le niveau 3, une politique claire, une machine isolée ou une configuration approuvée supprime le « non » silencieux que beaucoup de gens supposent. Une interdiction globale entraîne l'utilisation par le biais de comptes personnels où personne ne peut la voir, et une délégation sans restriction expose les matériaux confidentiels. Entre les deux se trouve une taxonomie des tâches et des données. Elle dit quel travail peut être essayé dans les environnements approuvés, lequel a besoin de l'examen d'une deuxième personne et lequel est exclu des agents ; elle nomme qui peut approuver un outil, où vit le dossier d'acceptation, et comment un quasi-incident est signalé sans punition pour l'avoir signalé. Le niveau 3 local ne devrait pas être requis sur les machines que l'employé ne contrôle pas, puisque les agents cloud et le niveau 2 limité en étendue sont la voie qui évite un conflit avec le département informatique. Une fois que les fournisseurs absorbent le premier échelon dans le chat, le niveau 2 conserve deux emplois. C'est l'endroit sanctionné pour le personnel sur les machines verrouillées, et c'est l'échelon d'étalonnage pour tous les autres, où une personne apprend que l'action déléguée a un périmètre avant d'en posséder un. Qu'il abaisse aussi les incidents est P5.
Les mandats ont besoin de soin. Faire de l'utilisation de l'IA un critère de performance peut produire une utilisation sans valeur, et au moins un employeur qui l'a fait a annulé la décision en un an (Fortune, 2026b). Demander des artefacts qui importent pour le travail est un meilleur signal que de demander de l'utilisation. Une fois par mois, « montrer un fichier produit par un agent dans un dossier que vous avez nommé » et « montrer une décision que vous avez changée parce que deux modèles n'étaient pas d'accord » mesure les transitions 2 et 3, ce qu'un nombre de connexions ne peut pas. La formation à grande échelle sans mesures d'artefacts, quel que soit le nombre de milliers inscrits, ne dira à personne si la transition 2 s'est produite.
La décomposition et la vérification doivent être enseignées ensemble, et l'habitude du critique avant le conseil. Un cours générique de prompts est une pédagogie de niveau 1. La pédagogie de niveau 2 et de niveau 3 part du travail que la personne a déjà, un pack vendredi d'un responsable marketing, par exemple, ou un lot de devoirs d'un enseignant, enseigne une décomposition réutilisable (les cinq parties de la section 5.1, avec une condition d'arrêt) et enseigne la récupération d'erreur sur une copie du dossier. Ce qu'il faut évaluer ensuite est si la personne peut reconnaître une instruction dangereuse, nommer un essai réversible, inspecter les preuves et arrêter le système. Un critique de la même famille aux points d'acceptation ne coûte rien en abonnements, et une deuxième famille est ajoutée quand le critique est silencieux et la décision est coûteuse. L'orchestration au sommet d'une rubrique de fluidité est la bonne destination pour quelques rôles et la mauvaise exigence du premier jour pour tous.
11.3 Pour la politique
Le devoir de littératie en IA de l'Union européenne s'applique à chaque fournisseur et utilisateur de systèmes d'IA pour leur personnel. Après les modifications de 2026, il leur demande de « prendre des mesures pour soutenir le développement de la littératie en IA » plutôt que d'assurer un niveau suffisant, et ses règles de supervision et d'application s'appliquent à partir du 3 août 2026 (Union européenne, 2026 ; Commission européenne, 2026a, 2026b). Aux États-Unis, le cadre du ministère du Travail nomme « diriger les IA efficacement » (Ministère du Travail des États-Unis, 2026), et le cadre de l'OCDE et de la Commission européenne a un domaine appelé « Gérer l'IA » (OCDE & Commission européenne, 2026). Je suggère un contenu pour ces mots dans le cas agentique : les quatre parties du contrat de délégation, les quatre pratiques de la section 8.1 y compris la révocation, l'habitude de comparer les modèles avec la connaissance que l'accord est une preuve plus faible qu'il n'y paraît, et les pratiques de sécurité de base de la section 5.3. Les orientations doivent distinguer l'utilisation conversationnelle de l'action déléguée. Pour cette dernière, le devoir doit couvrir l'étendue des permissions, la classification des données, la vérification, la signalisation des incidents et la révocation, et une obligation de documenter la capacité et l'autorité spécifiques au rôle nécessaires pour les tâches déléguées est plus défendable qu'une obligation de former tout le monde de manière identique. Les régulateurs et les représentants des travailleurs peuvent également demander si un employeur a transféré la responsabilité résiduelle au personnel sans contrôles utilisables, temps d'examen ou droit de refuser une délégation dangereuse. Tout cela est une recommandation de conception et de gouvernance tirée d'un instrument réglementaire, et sa portée est cet instrument.
Le devoir européen a survécu à une ronde de dérégulation, et parmi les cadres discutés ici, c'est l'obligation horizontale unique qui couvre chaque membre du personnel utilisant l'IA. Aux États-Unis, le cadre est la politique de la main-d'œuvre. Un décret exécutif d'avril 2025 sur l'éducation à l'IA et le Plan d'action sur l'IA de juillet 2025 s'engagent à élargir la littératie et les compétences en IA, y compris des orientations selon lesquelles les programmes de littératie en IA peuvent être admissibles comme assistance éducative fournie par l'employeur (Maison Blanche, 2025a, 2025b) ; le cadre est compatible avec la formation des responsables d'agents et ne l'exige pas encore. Aucun des textes officiels inspectés ne nomme les agents terminaux ou l'orchestration, donc « Gérer l'IA » peut être lu comme l'étiquette de chatbot ou comme la direction de niveau 4. Les programmes de littératie qui s'arrêtent au prompting enseignent le niveau 1. Le travail, pendant ce temps, se déplace aux niveaux 2 à 4. Les textes officiels ne l'ont pas encore suivi là.
Les agences statistiques ajoutant des modules d'IA à leurs enquêtes pourraient aider avec un changement spécifique. « Avez-vous utilisé un chatbot » est un élément de niveau 1. « Un système que vous avez dirigé a-t-il créé ou modifié des fichiers sur un ordinateur que vous utilisez pour le travail au cours des sept derniers jours » est un élément de niveau 2 ou 3. « Avez-vous posé la même question de travail à plus d'un système d'IA au cours des sept derniers jours, et les réponses ont-elles différé » est un élément de niveau 4. Sans des éléments de ce type, P6 ne peut pas être testé dans les données publiques, et la deuxième fracture numérique au niveau agentique restera invisible pour les personnes dont le travail est de la voir.
11.4 Pour les chercheurs
Les lacunes de la section 2.5 sont un programme. Étudiez les non-programmeurs utilisant les agents terminaux et de bureau par nom, avec les artefacts comme résultats. Étudiez l'intégration réflexive comme un mécanisme en soi. Étudiez l'orchestration web comme une pratique, y compris comment les gens concilien les réponses et s'ils conservent la provenance. Mesurez la corrélation des erreurs entre les familles de fournisseurs sur les tâches de travail cognitif, et plus que les benchmarks de code et de mathématiques. Étendez les écarts mesurés de sexe et d'occupation dans l'utilisation de l'IA (Cranney et al., 2026 ; Humlum & Vestergaard, 2025) aux niveaux agentiques, où rien n'est encore connu (P13). Deux métriques faciles, la disponibilité des fonctionnalités et le temps économisé rapporté par soi-même, valent la peine de résister en faveur de l'achèvement des artefacts, de la qualité auditée, des taux de correction et de la réutilisation ultérieure. L'abandon doit être enregistré avec son mécanisme. Un arrêt à une invite de permission peut être un problème d'interface, une inquiétude judicieuse au sujet des données, une règle de l'employeur, une machine manquante ou une tâche sans critère d'acceptation, et les regrouper dans la « résistance » perd tout cela. L'évaluation doit être adversariale, avec une page trompeuse, une instruction cachée dans un document, une source contradictoire, une panne d'outil partielle, ou une réponse convaincante et fausse que plusieurs modèles partagent, parce que le rôle du responsable ne signifie quelque chose que s'il améliore les résultats sous ces conditions. La réplication n'a besoin d'aucun de mes matériaux ; elle a besoin de la règle des artefacts, d'une question de raison d'arrêt figée, d'un enregistrement de la mise en œuvre et d'un recensement des produits datés. Et les dénominateurs doivent être publiés, car une étude qui rapporte seulement ceux qui ont traversé ne nous dit rien sur la route.
12. Portée et conditions aux limites
Ce qui est proposé ici est un modèle, une synthèse de données probantes et un plan de mesure, et chacun est borné des manières suivantes.
Temps. Les données probantes s'étendent jusqu'au 21 septembre 2026. Les caractéristiques des produits sont datées et vieilliront. Le modèle est défini par la portée et le rôle de sorte qu'il vieillit plus lentement.
Géographie et sources. La plupart des chiffres d'adoption proviennent des États-Unis ; les chiffres européens sont cités là où ils existent. Plusieurs chiffres clés proviennent des fournisseurs (utilisation d'agents de codage, les raisons de la fusion du chat et de l'agent, les taux d'injection sur les ensembles de tests des fournisseurs) et sont marqués comme données de fournisseur dans le texte. Je les utilise pour ce que les fournisseurs peuvent savoir sur leurs propres produits et je les pondère en conséquence.
Population. L'argument concerne les professionnels dont le travail se déroule essentiellement sur ordinateur. Les personnes qui travaillent principalement à partir d'un téléphone, ou sans ordinateur qu'elles contrôlent, rencontrent une barrière avant celle décrite ici, et le modèle dit peu de choses à leur sujet au-delà de nommer cette barrière (section 5.5).
Données probantes concernant la cohorte. Seul le plan préenregistré est utilisé. Aucun résultat du programme n'informe aucune affirmation ici, et les propositions de la section 10 sont énoncées avant que ses résultats soient connus, de sorte qu'elles puissent être jugées par rapport à eux. Une cohorte qui nécessite une machine personnelle échantillonne les personnes qui sont capables d'installer un agent ; elle ne peut pas séparer l'accès à l'équipement de la motivation, et cette limite accompagne les résultats.
Portée normative. Le modèle décrit ce que chaque niveau demande à une personne. Il ne soutient pas que les niveaux supérieurs sont meilleurs ou que tout le monde devrait progresser ; pour beaucoup de travail, le niveau 1 ou 2 est le bon endroit (section 8.2). Le travail à enjeux élevés, les dossiers confidentiels, les opérations critiques pour la sécurité, les décisions critiques dans le temps et les tâches sans critère d'acceptation inspectable nécessitent des arrangements plus stricts, ou restent entièrement en dehors de l'utilisation d'agents délégués.
Ce que l'orchestration ajoute. L'ajout d'agents peut élargir la couverture, exposer le désaccord et laisser une trace d'examen. Il peut aussi ajouter une erreur corrélée, un coût, un délai et une fausse apparence de diligence. La délégation qui dure signifie qu'une personne peut inspecter et modifier le processus ; la question de savoir si le processus mérite la confiance est une question distincte.
Ce qui manque à la littérature. La recherche bibliographique de la section 2.5 n'a trouvé aucune étude de terrain sur les non-programmeurs adoptant des agents de terminal ou de bureau par le nom, aucune étude sur l'orchestration web en tant que pratique nommée, aucun traitement de la gestion des agents en tant que compétence ayant sa propre structure, et aucune étude d'un système d'IA soutenant l'adoption par une personne d'une IA agentive. Ce sont des lacunes dans ce qui a été étudié, énoncées en date du 21 septembre 2026, et je ne prétends rien sur les marchés, les produits ou la priorité.
Statut des affirmations. Le tableau 8 applique le langage de confiance de la série aux éléments de l'argument, de sorte qu'un lecteur puisse voir à quel point chacun est affirmé.
Tableau 8. Statut des affirmations dans ce document.
| Élément | Comment c'est dit ici | Base |
|---|---|---|
| Modèle à quatre niveaux et la règle d'artefact | En cours de test (sections 9 et 10) | Conceptuel ; marqueurs spécifiés à la section 3 et à l'annexe A |
| La barrière technique s'est estompée pour l'installation et la face de bureau | Les données le soutiennent | Installateurs en une étape ; documentation « Aucun terminal requis » ; quatre produits de niveau 2 de fournisseurs expédiés |
| Les travailleurs du savoir à l'intérieur d'un agent d'héritage de terminal | Signalé par le fournisseur, directionnel | Rapport de presse des chiffres du fournisseur, 2 juin 2026, avec une mise en garde d'un analyste |
| Les fournisseurs absorbant la transition 1 dans le chat | Observé dans le produit | Anthropic, 16 septembre 2026 ; OpenAI, 9 juillet 2026 |
| Le vocabulaire du flux de travail comme barrière restante dominante | Offert comme modèle ; en cours de test | Indirect : études d'invite ; raison déclarée par les fournisseurs de la fusion ; l'élément stop-reason du programme |
| Le web comme pont, l'interface de ligne de commande comme couche durable | En cours de test (P7, P8) | Contrats, objets de permission, plugins officiels ; fragilité des interfaces web |
| Les erreurs corrélées plafonnent ce qu'un conseil obtient | Les données le soutiennent sur les évaluations de modèles ; en cours de mesure en utilisation | Kim et al. (2025) ; Chernets (2026a) |
| Intégration réflexive | Mise en œuvre et en cours de mesure ; aucun résultat signalé | Pratique des fournisseurs et des cours (observation) ; étape 1 du programme (mesure) |
| Le gestionnaire d'agents en tant que rôle | Offert comme description du comportement ; en cours de test (P10) | Études de délégation ; barèmes de l'employeur ; cadres de littératie officiels |
| Taux de passage de cohorte | Non signalés | Protocole figé ; document de résultats à suivre |
| « Fonctionne maintenant » comme promesse | Non revendiqué | Hors du champ d'application de ce document |
13. Conclusion
Le terminal était autrefois la représentation évidente de la barrière entre les professionnels ordinaires et les IA agentives, et pendant un temps c'était une représentation juste. En 2026, ce n'est plus le cas. L'installation ne demande qu'une commande ou un clic, le chatbot qu'une personne utilise déjà peut la guider à travers, et les fournisseurs fusionnent le chat et l'agent en une seule interface. Ce que les sections 4 et 5 montrent, c'est une barrière qui s'est déplacée. La première tentative délimitée est devenue beaucoup plus facile à réaliser ; ce qui reste difficile, c'est d'obtenir un travail fiable sur des tâches complètes, de suivre les produits qui changent sous ses yeux, et de garder un dossier accordé en sécurité. Selon les chiffres d'un fournisseur, rapportés par la presse et à lire comme directionnels, environ un million de travailleurs du savoir par semaine se trouvent déjà à l'intérieur d'un agent de codage d'héritage terminal. La plupart des professionnels, en revanche, ne rencontrent l'IA que comme une conversation.
Ce qui fait obstacle maintenant, c'est le travail du responsable : savoir ce qu'on doit confier, le délimiter, nommer le résultat et décider comment le vérifier, puis exécuter un environnement en sécurité et comparer les modèles en se souvenant que leur accord est une preuve plus faible qu'il n'y paraît. Les quatre niveaux de la section 3 donnent à ce travail une structure qu'aucun produit ne possède, et la règle d'artefact lui donne une unité de mesure. J'ai proposé l'orchestration web comme pont vers le dernier niveau (P7) et l'orchestration CLI comme la forme de celui-ci qui perdure (P8) ; les deux sont énoncées de sorte qu'elles puissent échouer.
Pour quiconque introduit cette transition, la conséquence pratique est un ordre des opérations. La première question est quel petit travail autorisé une personne peut-elle décrire, inspecter et éliminer sans risque si la tentative échoue : un mémoire à partir de sources publiques, un dossier de planification personnel, une feuille de calcul sur laquelle personne d'autre ne dépend. À partir de là, une responsabilité managériale s'ajoute à la fois : une limite, puis une approbation, puis un espace de travail personnel, puis un enregistrement de tâche sauvegardé, puis une deuxième vue critique. L'évaluation suit le même ordre. Une démonstration vaut peu si elle cache ce qu'on a autorisé la personne à faire, comment le résultat a été vérifié et ce qui s'est passé quand l'agent a échoué. Un refus considéré de déléguer compte comme un résultat. Et une personne qui peut reproduire une tâche délimitée, dire pourquoi elle s'y est fiée, pointer vers un désaccord qui a changé une décision et restreindre l'accès quand les circonstances changent montre les signes observables du rôle, quel que soit ce que dit son titre professionnel.
Le modèle peut échouer, et la section 10 dit comment. Le programme de la section 9 en testera une partie sur des personnes qui ne sont pas des programmeurs, et le code de l'appendice C permet à d'autres de mesurer les mêmes franchissements et de pratiquer les mêmes motifs. Je m'attends à ce que les produits nommés dans l'appendice B paraissent dépassés dans un an. Les barrières de la section 5 ne devraient pas l'être, car elles appartiennent à la personne et au travail, quel que soit le produit en face d'eux. Le terminal est devenu un lieu où un agent travaille pour une personne qui a appris à le gérer, et combien de personnes apprendront cela, par quelle voie et à quelle vitesse, c'est la question à laquelle l'année prochaine répondra.
Déclarations
Financement. Aucun financement externe n'a soutenu ce travail.
Conflits d'intérêts. L'auteur développe des méthodes d'orchestration multi-modèles et a déposé des demandes de brevet connexes (en attente ; aucun brevet n'a été accordé). L'auteur a conçu le programme de cohorte préenregistré décrit à la section 9 et ses matériaux. Aucune conclusion de cet article ne dépend de l'implémentation de l'auteur ; chaque modèle en annexe C est reproductible avec des outils publiquement disponibles. L'auteur entretient également les deux plugins open source nommés en annexe C ; ils sont gratuits et open source (licence Apache 2.0), et aucune conclusion de cet article n'en dépend. L'auteur développe des matériaux pédagogiques qui pourraient être proposés commercialement ultérieurement ; rien n'a été vendu au moment de la rédaction, et la cohorte décrite à la section 9 a reçu tous les matériaux gratuitement.
Outils et vérification. Les assistants IA ont été utilisés comme instruments sous la direction de l'auteur ; les idées, la recherche et les conclusions sont celles de l'auteur. Toutes les affirmations quantitatives et les citations ont été vérifiées par rapport aux sources primaires ou aux copies archivées au 21 septembre 2026 ou, lorsqu'une source est marquée secondaire ou fournisseur dans le texte et dans la chronologie de l'annexe B, par rapport au meilleur rapport disponible ; les chiffres rapportés par les fournisseurs sur leurs propres produits sont marqués comme tels. Lorsqu'une page primaire n'a pas pu être récupérée pendant la période de recherche (plusieurs pages sur le site d'un fournisseur ont renvoyé une erreur d'accès), l'affirmation est citée d'une source secondaire nommée et étiquetée, ou elle est omise. Les titres de presse donnés entre crochets dans les références sont des titres descriptifs pour les pages dont le titre n'a pas été relu verbatim.
Disponibilité des données et du code. Le code en annexe C, avec ses tests, est déposé sous la licence MIT à https://github.com/vadimchernets/after-chat et archivé sur Zenodo, https://doi.org/10.5281/zenodo.22944451. Deux plugins construits selon les mêmes modèles, Roundcall et Sidecall, se trouvent à https://github.com/vadimchernets/roundcall et https://github.com/vadimchernets/sidecall (licence Apache 2.0). Cinq kits qui appliquent les mêmes modèles aux métiers en dehors de l'informatique se trouvent à https://github.com/vadimchernets/calling-kits (MIT). Ils n'ont pas été essayés par des praticiens de ces métiers, ce que le référentiel indique, et aucune affirmation de cet article ne s'y appuie.
Éthique. Cet article ne rapporte aucune donnée provenant de participants humains. Le programme de cohorte qu'il décrit est préenregistré (OSF, DOI 10.17605/OSF.IO/X4EGQ) ; ses résultats seront rapportés séparément.
Contributions de l'auteur. Auteur unique.
Correspondance. [email protected] · ORCID : 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
Annexe A. Glossaire du modèle
Portée. Ce qu'un modèle peut faire au nom d'une personne : la conversation ; les fichiers et outils dans un espace délimité par le fournisseur ; l'ordinateur personnel de la personne ; plusieurs modèles et agents.
Rôle. Ce que la personne doit faire pour que le travail réussisse : poser des questions et copier ; déléguer et examiner ; maîtriser l'environnement ; gérer plusieurs agents.
Niveau. Une combinaison de portée et de rôle au niveau de laquelle une tâche est effectuée (Section 3.2). Les niveaux décrivent le travail ; les personnes et les produits peuvent en couvrir plusieurs.
Franchissement (d'une transition). Enregistré quand un agent a produit, au nouveau niveau, un artefact que la personne a demandé. L'installation est une tentative. Un franchissement de plus d'un niveau est autorisé et enregistré comme un saut.
Artefact. Un fichier, dossier, action ou résultat produit par l'agent, que la personne fournit ou conserve. « Rien » est un enregistrement valide.
Vocabulaire de flux de travail. Le stock de tâches que la personne sait comment déléguer à un agent, formulées de sorte que l'agent puisse les exécuter et que le résultat puisse être vérifié.
Onboarding réflexif. Un système IA scaffoldisant l'adoption par une personne d'un système IA plus capable, comme un chatbot guidant l'installation d'un agent et la récupération après ses premières erreurs.
Contrat de délégation. Les quatre choses qu'une personne énonce en confiant un travail à des agents : objectif, limite, artefact, vérification.
Quatre pratiques. Ce que le gestionnaire fait au cours d'une tâche : délégation, supervision, vérification, révocation (Section 8.1).
Enregistrement d'acceptation. Pour une tâche importante ou récurrente : le livrable prévu, les entrées, les contraintes et les permissions, l'emplacement de sortie, les désaccords ou échecs matériels, les vérifications effectuées, et la décision d'accepter, de réviser, d'escalader ou de rejeter. Il sépare ce que l'agent a produit de ce sur quoi la personne s'est fiée.
Carte de travail en cinq parties. L'objet du travail, les entrées autorisées, la transformation, le livrable et la vérification : la forme sous laquelle une tâche récurrente non-programmeur devient une délégation (Section 5.1).
Branche latérale. Les constructeurs d'applications de navigateur, qui agissent sur un projet que la plateforme héberge plutôt que sur les fichiers de la personne ; une échelle différente, avec ses propres barreaux (Section 3.4).
Orchestration web. Une question posée à plusieurs chatbots grand public dans le navigateur, manuellement ou avec un outil, et les réponses comparées.
Orchestration CLI. Un agent appelant les outils en ligne de commande d'autres agents, collectant leurs résultats et les fusionnant ou les vérifiant.
Churn. Le renommage, la fusion ou le retrait d'outils dans une période plus courte que le temps qu'il faut à un débutant pour les apprendre.
Nombre effectif d'avis (N_eff). N / (1 + (N - 1) rho) pour N modèles avec corrélation d'erreur d'appariement moyen rho ; limité par 1/rho (Chernets, 2026a).
Marqueurs comme éléments codables
Pour un codeur de données qualitatives ou un concepteur d'enquête, les marqueurs de la Section 3 se réduisent à des questions oui/non sur un artefact nommé. L'autoévaluation sans artefact est enregistrée comme une affirmation et ne compte pas comme un franchissement.
- Niveau 1 présent. Au moins une conversation sauvegardée avec un chatbot grand public au cours des sept derniers jours ; artefact : un lien, une capture d'écran ou une exportation. L'incapacité à le produire est codée « non démontré », ce qui est un constat plus faible que « absent ».
- Transition 1 franchie. Un fichier ou un ensemble de fichiers écrits par un agent délimité (bureau, web ou hébergé chez le locataire) dans un emplacement que la personne a accordé, en réponse à un travail que la personne a nommé, avec au moins une approbation, un refus ou une modification de plan enregistrés. La date de l'artefact est la date du franchissement.
- Niveau 2 présent. Transition 1 franchie, plus un autre artefact délimité dans une semaine ultérieure. La persistance est enregistrée comme un élément hebdomadaire séparé, indépendamment du franchissement.
- Transition 2 franchie. Un dossier de travail, un commit ou un ensemble de fichiers datés produit par un agent local ou sa coquille de bureau officielle, sur une machine que la personne contrôle, à partir d'un travail qui nécessitait plus d'une utilisation d'outil. Le travail hébergé en nuage est codé comme une variante nuage de son propre chef.
- Niveau 3 présent. Transition 2 franchie, plus un artefact de semaine ultérieure de la même classe d'agent.
- Transition 3, forme passerelle. Un fichier daté contenant la question, les chatbots ou les modèles web interrogés, les réponses brutes ou les liens vers ceux-ci, une note d'accord et de désaccord, et une note de savoir si la couverture ou la fiabilité (Section 6.2) est apparue ; produit manuellement ou par un outil de diffusion.
- Transition 3, forme durable. Les mêmes champs, produits par une exécution qui a invoqué deux ou plus d'outils en ligne de commande officiels (ou un plus un plugin de deuxième famille) sur les propres identifiants de la personne, avec le dénominateur enregistré : demandé, répondu, expiration du délai.
- Niveau 4 présent. L'une ou l'autre forme de transition 3, plus une deuxième exécution datée dans une semaine ultérieure.
- Assisté ou non assisté. Tout franchissement au cours duquel l'enquêteur, un collègue ou un entraîneur rémunéré a effectué une étape d'installation, a écrit le travail ou a récupéré après une erreur est assisté. Les complétions sont rapportées comme deux chiffres chaque fois qu'un assistant était disponible.
- Raison de l'arrêt. Une réponse en texte libre à « qu'est-ce qui vous a arrêté », posée à tous ceux qui n'ont pas franchi et codée après la collecte. Les codes candidats, offerts comme une hypothèse pour que les codeurs ultérieurs la révisent : vocabulaire de flux de travail ; dialogue de permission ou de sécurité ; droits d'administrateur ; coût ou quota ; peur de l'interface ; nouvelle d'un incident destructeur ; politique organisationnelle ; erreur technique ; vie et temps ; autre.
- Règle de codage pour « ne savais pas quoi demander » (vocabulaire de flux de travail). À inclure quand la personne, à qui on demande ce qu'elle a essayé de faire à l'agent, ne peut pas nommer au moins une des cinq parties de la Section 5.1 : l'objet du travail, les entrées qu'elle peut utiliser, la transformation, le livrable, ou la vérification. À exclure quand les cinq sont nommés et que la personne a refusé pour des motifs de politique, de risque, de coût ou de temps ; ceux-ci reçoivent leurs propres codes. Deux codeurs codent indépendamment et rapportent leur accord. La règle classe un arrêt, et ne dit rien sur la capacité de la personne.
- Traces des quatre pratiques (oui/non, chacune liée à un artefact daté) : un plan refusé ; un diff ou une sortie rejetés ; une deuxième famille de modèles demandée ; un dénominateur enregistré (qui a été interrogé, qui a répondu, qui a expiré) ; une étape irréversible retenue pour confirmation ; un artefact déposé. Ce sont les traces de supervision de P10.
- Pas des indicateurs. Un achat de licence, un badge de cours, un journal d'installation, une étoile de dépôt, un nombre d'invites, ou une auto-évaluation en tant qu'« utilisateur d'agent ».
Appendice B. Chronologie datée, 2025 au 21 septembre 2026
Les entrées marquées VÉRIFIÉE ont été ouvertes sur une page primaire, ou sur une page secondaire nommée pour un rapport de presse, pendant la période de recherche se terminant le 21 septembre 2026. Les entrées marquées SECONDAIRE reposent sur des rapports de presse ou des historiques de produits qui n'ont pas été ouverts sur une page primaire ; elles sont données à titre informatif et n'ont aucun poids dans l'argumentation. C'est une chronologie de travail pour l'argumentation à quatre niveaux et ne tente pas une chronologie de l'industrie.
| Date | Événement | Source | Statut |
|---|---|---|---|
| 24 février 2025 | Aperçu de recherche de Claude Code | Historiques de produits, largement rapportés | SECONDAIRE |
| 23 avril 2025 | Décret exécutif 14277 sur l'éducation en IA | Maison-Blanche (2025a) | VÉRIFIÉE |
| 22 mai 2025 | Claude Code généralement disponible | Historiques de produits, largement rapportés | SECONDAIRE |
| 23 juin 2025 | Protocole Agent2Agent donné à la Fondation Linux | Blog Open Source de Google (2026) | VÉRIFIÉE (fournisseur) |
| juillet 2025 | Le plan d'action IA de l'Amérique s'engage pour l'alphabétisation et les compétences en IA | Maison-Blanche (2025b) | VÉRIFIÉE |
| 21 juillet 2025 | Un agent de construction d'applications supprime une base de données de production lors d'une session en direct | The Register (2025) | VÉRIFIÉE (presse) |
| 20 août 2025 | Injection de prompt démontrée contre un agent de navigateur, avec un code à usage unique volé | Brave (2025) | VÉRIFIÉE |
| 25 août 2025 | Pilote d'agent de navigateur : succès d'attaque 23,6 % sans atténuations, 11,2 % avec | Anthropic (2025) | VÉRIFIÉE (fournisseur) |
| 9 décembre 2025 | Protocole de contexte de modèle donné à la Fondation IA Agentic (Fondation Linux) ; plus de 10 000 serveurs publiés, environ 97 millions de téléchargements de SDK mensuels | Fondation Linux (2025) | VÉRIFIÉE |
| 9 décembre 2025 | Un cabinet de conseil annonce qu'environ 30 000 employés seront formés aux modèles d'un fournisseur | Accenture (2025) | VÉRIFIÉE |
| 18 décembre 2025 | Format Agent Skills publié en tant que norme ouverte | SiliconANGLE (2025) | VÉRIFIÉE (presse) |
| 22 décembre 2025 | OpenAI : l'injection de prompt « peu probable d'être jamais complètement « résolue » | TechCrunch (2025) | VÉRIFIÉE (presse) |
| janvier 2026 | Aperçu de recherche de Cowork, « Claude Code pour le reste de votre travail » | Fortune (2026a) ; The Register (2026) | VÉRIFIÉE (presse) |
| 12 janvier 2026 | Objection à demander aux non-programmeurs de surveiller l'injection de prompt | Willison (2026) | VÉRIFIÉE |
| 15 janvier 2026 | Indice économique Anthropic : augmentation 52 % des conversations (novembre 2025) | Anthropic (2026f) | VÉRIFIÉE (fournisseur) |
| 4 et 26 février 2026 | GitHub Agent HQ : agents Claude et Codex disponibles dans Copilot | GitHub (2026c) | VÉRIFIÉE |
| février 2026 | Conseil de modèle Perplexity pour les abonnés haut de gamme (signalé le 10 février) | Storyboard18 (2026) | VÉRIFIÉE (presse) |
| 13 février 2026 | Cadre d'alphabétisation en IA du département du Travail des États-Unis (« diriger l'IA efficacement ») | Département du Travail des États-Unis (2026) | VÉRIFIÉE |
| 9 mars 2026 | Technologie Cowork intégrée à Microsoft 365 Copilot | Microsoft (2026a) | VÉRIFIÉE |
| 9 mars, 19 avril, 10 juin 2026 | Signalements d'utilisateurs de fichiers supprimés par un agent de niveau 2 dans les dossiers accordés | Rapports de problèmes GitHub (2026) | VÉRIFIÉE (rapports d'utilisateurs) |
| 24 mars 2026 | Indice économique Anthropic : les utilisateurs ayant une plus longue permanence délèguent moins | Anthropic (2026e) | VÉRIFIÉE (fournisseur) |
| 30 mars 2026 | Plugin officiel d'OpenAI pour utiliser son agent dans Claude Code ; l'agent de recherche de Microsoft exécute GPT et Claude ensemble | OpenAI (2026a) ; Constellation Research (2026b) ; Microsoft (2026c) | VÉRIFIÉE |
| avril 2026 | JetBrains : Claude Code au travail 18 % (janvier 2026), à partir d'environ 3 % (printemps 2025) | Recherche JetBrains (2026a) | VÉRIFIÉE (sondage de fournisseur) |
| 13 avril 2026 | Duolingo abandonne l'utilisation de l'IA des évaluations de performance | Fortune (2026b) | VÉRIFIÉE (presse) |
| 5 mai 2026 | Indice de tendance de travail : les facteurs organisationnels dépassent plus de deux fois les facteurs individuels | Microsoft (2026b) | VÉRIFIÉE (sondage de fournisseur) |
| 25 avril 2026 (signalé 5 mai) | Un agent supprime la base de données de production d'une entreprise et les sauvegardes | Information Age (2026) | VÉRIFIÉE (presse) |
| 19 mai 2026 | Google annonce le passage de Gemini CLI à Antigravity CLI | Google (2026) | VÉRIFIÉE |
| 25 mai 2026 | Grok Build de xAI publié avec un mode sans interface et support du protocole agent | xAI (2026) | VÉRIFIÉE (fournisseur) |
| 26 mai 2026 | Utilisation d'IA par les entreprises américaines 17 % à 20 % au total ; petites entreprises plates | Bureau de recensement des États-Unis (2026) | VÉRIFIÉE |
| 27 mai 2026 | Pouls des développeurs : 69 % agent unique ; 60 % bloquer les modifications non approuvées | Stack Overflow (2026) | VÉRIFIÉE |
| 2 juin 2026 | Agent de codage à 5 millions d'utilisateurs hebdomadaires, environ 20 % de travailleurs du savoir | Help Net Security (2026) ; Constellation Research (2026a) | VÉRIFIÉE (rapport de presse sur les données du fournisseur) |
| 15 juin 2026 | Baromètre des emplois en IA de PwC : prime salariale de 62 % pour les compétences en IA | PwC (2026) | VÉRIFIÉE (fournisseur) |
| 17 juin 2026 | Pew : environ la moitié des adultes américains utilisent des chatbots | Centre de recherche Pew (2026) | VÉRIFIÉE |
| 18 juin 2026 | Gemini CLI cesse de servir les niveaux individuels | Google (2026) | VÉRIFIÉE |
| juin 2026 | Cadre d'alphabétisation en IA de l'OCDE et de la Commission européenne (« Gérer l'IA ») | OCDE & Commission européenne (2026) | VÉRIFIÉE |
| 29 juin au 3 juillet 2026 | Claude Code renomme son mode de permission par défaut « Manuel » | Anthropic (2026h) | VÉRIFIÉE (fournisseur) |
| 1er juillet 2026 | Agent Gemini Spark pour Mac ; meilleur taux d'automatisation Remote Labor Index 15,8 %, à partir de 2,5 % à la sortie | TechCrunch (2026b) ; Centre pour la sécurité de l'IA (2026) | VÉRIFIÉE |
| 8 juillet 2026 | Indeed : 63 % des titres de postes américains touchés par l'IA se situent en dehors des professions technologiques | Adrjan (2026) | VÉRIFIÉE |
| 9 juillet 2026 | L'application coding-agent devient l'application de bureau ChatGPT ; ChatGPT Work lancé | MacRumors (2026) | VÉRIFIÉE (presse) |
| 20 juillet 2026 | Gallup : 52 % des travailleurs américains utilisent l'IA, 15 % quotidiennement | Gallup (2026) | VÉRIFIÉE |
| 27 juillet 2026 | Loi omnibus sur l'IA de l'UE en vigueur ; l'obligation de littératie en matière d'IA devient « prendre des mesures pour soutenir » | Commission européenne (2026a, 2026b) | VÉRIFIÉE |
| 28 juillet 2026 | Protocole de contexte de modèle : près d'un demi-milliard de téléchargements SDK par mois ; protocole rendu sans état | Model Context Protocol (2026) | VÉRIFIÉE |
| 3 août 2026 | Les règles de supervision et d'application de l'UE pour la littératie en matière d'IA s'appliquent | Commission européenne (2026a) | VÉRIFIÉE |
| Août 2026 | JetBrains : 90 % des développeurs professionnels utilisent les agents de codage hebdomadairement ; Claude Code au travail 39 % | JetBrains Research (2026b) | VÉRIFIÉE (enquête du fournisseur) |
| 9 août 2026 | Le navigateur agentic d'OpenAI est discontinué ; la navigation se déplace dans l'application ChatGPT | 9to5Mac (2026) | VÉRIFIÉE (presse) |
| 26 août 2026 | Agent navigateur généralement disponible ; autonome avec un classificateur par défaut ; taux d'injection rapportés par le fournisseur près de zéro | Anthropic (2026d) | VÉRIFIÉE (fournisseur) |
| 1er septembre 2026 | Réserve fédérale de Saint-Louis : 45 % des travailleurs utilisent l'IA pour leurs tâches ; moins de 3 % des tâches au-dessus de 50 % d'adoption | Bick et al. (2026) | VÉRIFIÉE |
| 6 septembre 2026 | Enregistrement préalable de la cohorte 1 figé | Chernets (2026d) | VÉRIFIÉE |
| 9 septembre 2026 | Harvard Business Review : la confiance comme obstacle central à l'adoption d'agents au travail | McKinlay et al. (2026) | VÉRIFIÉE (résumé) |
| 16 septembre 2026 | Cowork et chat fusionnés en un seul Claude | Anthropic (2026c) ; TechCrunch (2026a) | VÉRIFIÉE |
| 22 septembre 2026 | Catalogue de plugins officiel lu intégralement, 310 entrées : aucune pour les cinq métiers nommés dans la section 5.1 ; catalogue communautaire 2 282 entrées, offres pour les enseignants et l'immobilier | Lecture par l'auteur des catalogues publiés | VÉRIFIÉE (décompte personnel) |
Annexe C. Code pédagogique
Les listings ci-dessous enseignent les motifs des sections 5 à 9. Ils utilisent uniquement la bibliothèque standard Python et les outils en ligne de commande propres des fournisseurs, connectés avec les abonnements de l'utilisateur ; aucun ne lit de clé API. Chacun est assez court pour être lu en une seule séance, et chacun indique ce qu'il enseigne et où il s'arrête. Ils sont déposés avec des tests dans le référentiel compagnon sous la licence MIT, et chaque listing a été exécuté avant inclusion (chacun sur son entrée de démonstration, le fan-out sur des outils stub). Chaque motif présenté ici existe déjà sous une forme quelconque dans des outils open-source (section 7.1) ; la valeur des listings est qu'ils sont petits, commentés et liés à l'argument. Aucun n'est un parcours pédagogique, un diagnostic d'apprenant, un curriculum ou une implémentation des outils de l'auteur. Un non-programmeur n'exécute pas ces fichiers à la main : ce sont le type de chose qu'un agent enveloppe en tant que compétence ou qu'un shell de bureau expose comme un bouton, et l'intérêt de les imprimer est qu'un lecteur peut voir ce qu'un tel bouton fait.
Deux plugins Claude Code installables mettent ces motifs à l'usage quotidien. Roundcall interroge les sites de chat IA auxquels une personne est déjà connectée, via son propre navigateur et à son rythme ; Sidecall interroge les agents en ligne de commande installés sur leur machine, avec un paramètre de budget qui choisit le modèle de chaque fournisseur. Les deux retournent un rapport de qui a dit quoi, où les réponses divergent et ce qu'une seule source a dit. Ils sont open source sous la licence Apache 2.0 à https://github.com/vadimchernets/roundcall et https://github.com/vadimchernets/sidecall.
Avant d'exécuter l'un d'entre eux : vérifiez l'option --help de chaque outil sur votre version installée, car les drapeaux changent entre les versions ; exécutez-les dans un dossier de travail qui contient des copies, pas des originaux ; et lisez d'abord le listing C6.
C1. Fan-out avec une sonde, un plafond et une capture partielle (fanout.py)
Enseigne : comment une personne peut poser une question à plusieurs interfaces en ligne de commande d'IA à la fois, ignorer celles qui sont hors ligne ou sans quota, arrêter l'attente à un plafond de temps, et conserver ce que chaque outil a écrit avant le plafond au lieu de le jeter. Chaque outil s'exécute dans un dossier frais et vide dans le dossier de sortie, jamais dans le dossier à partir duquel la personne a lancé l'exécution ; les noms d'outils sont limités aux noms de fichiers sûrs ; une longue question va dans un fichier (--question-file) ou, pour un outil dont le modèle n'a pas de {prompt}, sur l'entrée standard de l'outil, car un argument en ligne de commande est limité en longueur par le système d'exploitation. Limites : l'arrêt au plafond utilise les groupes de processus POSIX (macOS et Linux ; sur Windows, utilisez WSL) et revient à arrêter l'outil lui-même ; un outil qui n'affiche que à la fin ne laisse rien à conserver quand il est arrêté ; utilisez son mode de sortie en streaming s'il en a un. Le script ne compare rien ; C3 le fait.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. Une compétence « deuxième avis » pour un agent (second-opinion/SKILL.md)
Enseigne : la forme la plus simple d'orchestration CLI, une instruction écrite qui fait demander à un agent de consulter l'agent d'un fournisseur différent et d'afficher la différence au lieu de la fusionner. Limites : deux modèles constituent une comparaison, non un panel ; la compétence indique quels points nécessitent encore une source primaire.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. Qui a dit quoi (provenance.py)
Enseigne : les deux choses que l'interrogation de plusieurs modèles est censée apporter, la couverture et la fiabilité, rendues visibles sous la forme d'un tableau de déclarations par source, une liste de déclarations faites par une seule source et une liste de déclarations dont les nombres ou les dates diffèrent. Limites : elle correspond à la répétition du libellé, non à la répétition du sens ; elle dit à une personne ce qu'il faut lire attentivement, jamais ce qui est vrai.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. Combien d'opinions indépendantes vaut un accord ? (neff.py)
Enseigne : l'arithmétique des preuves corrélées (Section 6.3) : estimer la corrélation d'erreur moyenne rho à partir d'éléments avec des réponses connues, puis calculer N_eff et son plafond 1/rho. Exécutez avec --demo pour voir quatre modèles valant environ 1,6 opinions indépendantes. Limites : rho dépend de la tâche ; estimez-la sur des éléments comme ceux qui vous intéressent, et avec plus de dix éléments.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. Un enregistrement des passages, et un vérificateur (crossings.py)
Enseigne : les règles de mesure de la section 9.1 en tant que code. Un enregistrement est refusé s'il compte une installation comme un passage, une achèvement sans artefact produit par un agent, un arrêt sans les propres paroles de la personne, une aide sans description de l'aide, un nom au lieu d'une étiquette pseudonyme (l'étiquette doit être P suivi de chiffres), un niveau ignoré qui n'est pas listé exactement, une valeur qui n'est pas un vrai vrai ou faux, une date illisible, un champ que le format ne connaît pas, ou un passage de niveau 4 qui nomme moins de deux outils demandés et auxquels on a répondu. Une ligne mal formée est signalée comme rejetée et n'arrête jamais l'exécution. Limites : il vérifie la forme des enregistrements, non leur véracité ; que les deux outils appartiennent à des familles de modèles différentes, et que l'arrangement a été réexécuté dans une semaine ultérieure (un deuxième enregistrement), sont laissés au chercheur ; c'est un instrument de recherche, non une application.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
Le même format d'enregistrement est publié en tant que JSON Schema (crossings.schema.json) afin que d'autres outils puissent valider la structure d'un enregistrement ; le vérificateur ci-dessus applique les règles que le schéma ne peut pas exprimer (qu'une installation n'est pas un passage, qu'un arrêt nécessite les propres termes de la personne, qu'une aide nécessite une description, et qu'un saut est enregistré).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. Sécurité avant le niveau 3 (safety/)
Enseigne : les pratiques de la section 5.3 en tant que configuration. Le premier fichier est un exemple de fichier de paramètres de projet pour Claude Code : mode plan par défaut (le fournisseur a renommé son mode par défaut « Manual » en juillet 2026 ; « plan » reste valide et est le choix d'enseignement plus sûr), les commandes destructrices et de téléchargement courantes refusées, les fichiers secrets habituels refusés à la fois au lecteur de fichiers et à un shell cat, les suppressions et les récupérations web soumises à approbation. Une liste de refus n'est qu'une liste : un mode permissif ou une commande non listée peut la contourner, donc les paramètres du sandbox sont aussi importants que les règles. Le deuxième est un exemple de configuration pour Codex d'OpenAI, donné sous sa forme par exécution, limitée au dossier : écritures limitées au dossier de travail, pas de réseau, approbation sur demande. Le troisième est une liste de contrôle. Limites : les règles de permission et les sandboxes réduisent le rayon d'impact ; ils ne rendent pas un agent digne de confiance, et la syntaxe des règles change entre les versions.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. Les traces de supervision sous forme de journal (jsonl_log.py)
Enseigne : le plus petit enregistrement utile du travail d'un gestionnaire, un objet JSON horodaté par événement, de sorte que les plans refusés, les diffs rejetés, les avis supplémentaires sollicités et les exécutions terminées (les traces de supervision de la proposition P10) puissent être comptabilisés ultérieurement avec la bibliothèque standard. À exécuter avec --demo. Limites : c'est un enregistreur, non un traceur ; il enregistre ce que la personne ou l'agent lui communique.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
Annexe D. Tableau travaillé du nombre effectif d'opinions
Un gestionnaire d'agents qui ne souhaite pas exécuter le code C4 peut toujours utiliser le plafond. Chaque cellule est N_eff = N / (1 + (N - 1) rho) ; la dernière ligne est le plafond 1/rho, que nul nombre de modèles ayant cette corrélation ne peut dépasser. Les valeurs de rho ont été choisies pour illustrer la formule et ne mesurent rien. En pratique, rho est la corrélation moyenne par paires des erreurs, une quantité différente de la part d'erreurs conjointes sur laquelle deux modèles s'accordent, et elle doit être estimée sur des éléments dont les réponses sont connues dans le domaine considéré (code C4).
| N modèles | rho = 0.2 (illustration) | rho = 0.5 (illustration) | rho = 0.6 (illustration) | rho = 0.8 (illustration) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| Plafond, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
Ce tableau est la raison pour laquelle la section 6 recommande à une personne de consacrer l'abonnement suivant à une famille différente plutôt qu'à une dixième fenêtre de la même. La diversité des familles, une vérification affirmation par affirmation par rapport aux sources et une dissidence préservée font le travail qu'un N plus grand ne peut pas accomplir. Puisque rho dépend de la tâche, il devrait être estimé sur des éléments du propre domaine de la personne (code C4).
Appendice E. Recensement du paysage, 19 au 21 septembre 2026
Le tableau 5 du texte principal classe les outils par motif. Cet appendice enregistre le recensement brut qui le sous-tend, pour les lecteurs qui veulent les chiffres tels qu'ils se présentaient aux dates indiquées. Les compteurs d'étoiles évoluent quotidiennement ; ils reflètent la popularité et ne disent rien sur la qualité ou le nombre d'utilisateurs, ils ne doivent donc pas être cités à la date du lecteur. La colonne motif est ma classification, et les projets eux-mêmes ne font aucune affirmation de ce type.
| Projet | Localisation | Étoiles (approximatif, 21 septembre 2026) | Licence | Motif |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147 000 | Licence propriétaire, code source disponible | Agent terminal (niveau 3) |
| openai/codex | github.com/openai/codex | 126 000 | Apache-2.0 | Agent terminal (niveau 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107 000 | Apache-2.0 | Agent terminal ; les niveaux individuels ne sont plus proposés depuis le 18 juin 2026 |
| cline/cline | github.com/cline/cline | 69 000 | Apache-2.0 | Agent d'éditeur et terminal |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33 400 | Apache-2.0 | Plugin officiel : l'agent d'un fournisseur à l'intérieur de celui d'un autre |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29 500 | Voir le dépôt | Chat web exposé aux agents |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | Voir le référentiel | Conseil sur une interface de programmation |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16 500 (environ 847 000 téléchargements de la dernière version) | Apache-2.0 | Diffusion navigateur |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11 800 (dernier commit décembre 2025) | Apache-2.0 | Serveur de consultation entre modèles |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | Agent terminal (niveau 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | Diffusion de navigateur |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | Conseil CLI |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | CLI pour la rédaction de conseil écrivant un fichier par outil |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | Agent terminal avec mode sans interface et protocole agent |
Comment citer
Chernets, V. (2026). After Chat : Les trois transitions entre les non-programmeurs et les IA agentiques [Prétirage]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}