After Chat: Non-Programmersとエージェント型AIの間の3つの転換
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
ターミナルはもはやターミナルではない:4段階モデル、2025年と2026年の証拠、および横断を測定するための事前登録プログラム
Vadym Chernets, PhD, AIシステムアーキテクト · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
このペーパーをダウンロード
- SSRN(記録版):ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo(アーカイブ、オープンアクセス):doi.org/10.5281/zenodo.22943313
- GitHub(MarkdownおよびPDF形式の完全テキスト):github.com/vadimchernets/papers/tree/main/after-chat; コード:github.com/vadimchernets/after-chat
同じテキストが3つの場所にあるため、そのうちの1つがそれを提供できない場合でも到達できます。SSRNが記録版を保持しています。その版を引用してください。
キーワード:エージェント型AI、AIエージェント、非プログラマー、エンドユーザープログラミング、AI リテラシー、ナレッジワーカー、技術採用、生成AI採用、人間的監督、委譲、第2段階のデジタルディバイド、相関誤差、オートメーションのアイロニー、スキル低下、事前登録
概要
ほとんどの専門家がチャットボットとしてAIに出会いますが、同じモデルはAIエージェントとして、ファイルとプログラムに対して動作するようになりました。非プログラマーがチャットからエージェント的AIへ移行した者が少ない理由、そしてその移行をどのように測定するかについて検討します。答えは、到達範囲と役割によって定義され、製品とは無関係な4段階モデルにあります:チャット、ベンダーに限定された安全なエージェント環境、自分のコンピュータ上のエージェント、複数のモデルにまたがる反復可能な作業の調整です。移行は、エージェントがその人が求めた成果物を生成した場合にのみカウントされます。ソフトウェアのインストールは試行としてカウントされます。2025年から2026年9月までの証拠は、インストール障壁と初回の限定的な試行への障壁は低下している一方で、作業全体の信頼性、製品の安定性、フォルダセーフティは低下していないことを示しています。インストールは1つのステップであり、その人自身のチャットボットがそれを指導でき(「反射的なオンボーディング」)、2ベンダーが2026年にエージェントとチャット表面を統合しました。あるベンダーのプレスリリースで報告された方向性のある数字は、知識労働者をそのコーディングエージェントの週500万ユーザーの5分の1に位置づけています。これは、ターミナルの歴史的継承を持つエージェントの使用を測定し、ここで定義されたレベル3採用ではありません。使用は広く、かつ浅いままです:約半数の米国の労働者がAIを使用し、約7人に1人が毎日使用し、自動化のために使用する者はほとんどいません。障壁はインストールから指示へ移動しました。エンドユーザープログラミング研究に基づき、不足している機能をワークフロー語彙と名付け、マネージャーの仕事を委譲契約として設定します:目標、境界、成果物、確認。ウェブ調整(1つの質問を複数のチャットボットに)比較を教える橋として提案され、CLIオーケストレーション(1つのエージェントが他を呼び出す)は、相関モデルの合意が弱い証拠という事実によって制限される永続的なレイヤーとして提案されます。この論文は15の反証可能な命題、その結果なしの事前登録コーホートプログラムの設計、およびオープンティーチングコードで終わります。
エグゼクティブサマリー
プログラマー以外ができないことすべてを象徴していた黒いウィンドウであるターミナルの意味が変わりました。今それは個人のマシン上でエージェントが働く場所であり、それが要求するスキルはコマンドを入力することではなくなりました。そのスキルはコマンドを入力するワーカーを管理することです。
プロフェッショナル開発者が最も進んでいます。2026年に調査された15,000人以上のうち90%がエージェントツールを少なくとも週1回使用していますが(ベンダー調査)、週1回の使用はまだセクション8の管理者の能力ではありません。他のすべての人はほとんどまだチャットボットと会話しています。米国の労働者の52%がその役割でAIを使用し、15%は毎日使用し、そのユーザーの16%が使用方法の中に自動化を挙げています。
理由はもはやエージェントのインストールが難しいことではありません。インストールにはコマンドまたはクリック1つで済み、すでに使用しているチャットボットがそれをサポートでき、ベンダーはチャットとエージェントの統合を始めています。難しくなるのは別の種類です。エージェントはまだ仕事の全体で失敗し、人が学ぶ製品は1年以内に名前が変わったり廃止されたりすることがあり、許可されたフォルダはまだ監視が必要です。インストーラーの後、人々を最初に止めるのは、何を委譲するか、どのようにそれをチェックするかを知らないことであり、これはセクション1が「ワークフロー語彙」と名付けた隙間です。その後には最初のエラー、権限とセキュリティ、組織的ルール、ハードウェアとコスト、そして結果を判断する能力が続きます。
モデルは4つのレベルがあり、モデルがどこまで到達するか、そして人が何をしなければならないかで順序付けられています。会話、ベンダーが実行する囲まれたスペース、個人のコンピュータ、そして複数のモデルにわたって指示される仕事です。人はレベルをスキップすることができます。境界は、エージェントが作成したアーティファクトによってのみ示されるため、インストール、バッジ、自己報告はカウントされません。
オーケストレーション、1つの質問を複数のモデルに送信することは、2つのレイヤーで行われます。ブラウザではそれを試すのにコストがかからず、回答を比較する習慣を教えます。コマンドラインではそれを書き留めて再度実行できます。どちらでも、重要なのはモデルファミリーの数です。相関誤差が合意の価値を制限するためです。
エージェントの管理は独自の能力です。4つの部分から構成される委譲契約(目標、境界、アーティファクト、チェック)、4つのプラクティス(委譲、監督、検証、取り消し)、レビューの停止ルール、そしてエージェントが作成したものと人が依存したものを分離する受け入れ記録があります。
議論はテストされるように構築されています。15の命題は尺度と反証者を伴っています。事前登録されたコホートプログラムの設計(OSF DOI 10.17605/OSF.IO/X4EGQ)がここに記載されており、その結果は別途報告されます。ステータス表は各主張がどの程度確実に保持されているかを示し、オープンコードは付録Cにあります。
1. はじめに
2026年9月のオフィス専門家を考えてみてください。彼女は毎週チャットボットを使用しています。メールの下書きを作成させたり、レポートを要約させたり、数式を提案させたりと、彼女が受け取るのはテキストであり、それを彼女の仕事が存在する場所に手作業で運び込みます。契約のフォルダ、会計のスプレッドシート、金曜日が締め切りのスライドデッキです。同じモデルは別の方法でアクセスすれば、そのフォルダを開いて、その中のすべてのファイルを読み、スプレッドシートを作成し、デッキを構築して、独自の計算をチェックすることができます。セクション4.4の調査が示す限りでは、ほとんどの専門家はまだそのドアを使用しておらず、多くはそれが存在することを知りません。
2年間、そのドアはターミナルのように見えていました。黒いウィンドウ、点滅するカーソル、貼り付けるコマンド。その描写は時代遅れです。ターミナルはビジュアル的にのみターミナルのままでした。それはエージェントが存在する環境に、ある人自身のマシン上で、モデルが読み、書き、実行し、スケジュール設定できる場所になり、その人の前にいる人はもはやシェルを操作する必要がなく、それを行うエージェントを指示するだけです。何が変わるかというと、人間の役割です。モデルに質問する人から、ワーカーを管理する人へ。
私の主題はこれら2つの役割の間の道と、その上にいる人々です。プロフェッショナル開発者の間では、少なくともツールはすでに到着しています。2026年5月から7月に15,000人以上のプロフェッショナル開発者を対象に実施された調査では、90%が仕事で週に少なくとも1回、68%が毎日AIコーディングエージェントを使用していたこと、Claude Codeという1つのターミナルエージェントを仕事で使用している割合が、2025年春の約3%から2026年1月の18%、2026年半ばには39%に上昇していたことが明らかになりました(JetBrains Research, 2026a, 2026b;ベンダー調査であり、JetBrainsはコーディングエージェントを販売しているため)。他の全員にとっては、そうではなく、使用パターンは広く浅いものです。同じ時期に、米国の労働者の52%が自分の役割でAIを使用していると報告し、15%が毎日それを使用していたこと、これらのユーザーのうち16%のみが自分の使用法の中で自動化を挙げていたこと、執筆と検索が支配的だったことが報告されています(Gallup, 2026)。典型的な専門家にとって、AIはまだ会話であり、セントルイス連邦準備銀行の数字はより長い期間にわたって同じことを述べています。2024年8月から2026年5月の間に、自分たちの仕事のために生成的AIを使用している労働者の割合は33%から45%に上昇しましたが、採用率が50%を超えるタスクは3%未満です(Bick et al., 2026)。
ギャップの標準的な説明は技術的な難しさです。エージェントはプログラミングできる人向けです。その答えは2024年に合理的でしたが、2026年には弱いものです。ターミナルエージェントのインストールは現在、1つのコマンドまたはデスクトップインストーラで実行でき、主流のエージェントは「ターミナルは不要」とドキュメントに明記しているデスクトップアプリケーションを提供しています(Anthropic, 2026a)。ベンダーはさらに進んでいます。OpenAIは2026年7月9日にそのコーディングエージェントアプリケーションをデフォルトのChatGPTデスクトップクライアントに変換し、ローカルファイルとアプリケーションを使用するChatGPT Workというエージェントを追加しました(MacRumors, 2026)。Anthropicは2026年9月16日に、その知識作業用デスクトップエージェント、Coworkを通常のチャットにマージしました。TechCrunchは、会社が顧客は「正しいタスクに対して正しいタブを選択するのに苦労することが多い」と述べたと報告しました(TechCrunch, 2026a)。OpenAIは、プレスを通じて、知識労働者が2026年6月のそのコーディングエージェントの500万週間ユーザーの約20%を占めており、開発者よりも3倍以上速く採用していると報告しました(Help Net Security, 2026)。この数字はベンダー報告であり、方向性があり、ベンダー自身のページは私のチェックにアクセスできず、ターミナルの遺産エージェントの知識労働者の使用を測定しており、これはセクション3で定義されたレベル3採用より広いです。その描写で技術的な障壁がどこにあるかを見ることは難しいです。
障壁は移動しました。インストールから指示への移動です。「これをどのように実行するのか?」から「それに何を求めるのか、どのような制限の中で、それがそれをしたことをどのように知るのか?」への移動です。2番目の質問はそれがサウンドするよりも難しく、エンドユーザープログラミングに関する文献はその理由を説明しています。専門家でない人は、アクセスが自由で即座であっても、言語モデルへの意図を表現するのに苦労します(Zamfirescu-Pereira et al., 2023)、そして彼らは、どのフレーズがシステムが何ができるかにマッピングするかを学ぶ必要があります(Liu et al., 2023)。AIへの委任はまた、生産から指定とチェックへの仕事をシフトします(Sarkar & Drosos, 2025; Simkute et al., 2024)。私は欠けている機能をワークフロー語彙と呼びます。エージェントに引き渡す方法を知っている作業の実行中のストックであり、エージェントがそれらを実行でき、結果がチェックできるように表現されています。正式に述べると、それはある人のドメイン目標とエージェントが実行できるサブタスクの間のマッピングであり、入力、変換、出力、例外、そしてマッピングが必要とする証拠の言葉を使用しています。エージェントを開く開発者は、入力する最初の10個のことをすでに知っています。会計士や教師は通常、そうではなく、彼らのオフィスの誰もそれを彼らに伝えていません。
最初の貢献は、チャットからエージェント的な仕事への道の4レベルのモデルです。これは到達範囲と役割によって定義され、製品名がありません。レベルはチャットから安全なエージェント環境を経由し、自分のコンピュータのエージェントから反復可能なオーケストレーション作業まで実行します。それぞれはエージェントが接触できるもので定義され、その人が指定してチェックする必要があるもので、各遷移はエージェントが作成したアーティファクトによって定義され、インストールされたソフトウェアだけではカウントされません。定義は製品名に依存しないため、モデルはベンダーの現在の製品をマージする習慣を生き残ります(セクション3)。
2番目は2025年から2026年9月までのエビデンス統合です。インストールと最初の限定された試みがはるかに容易になったこと、セクション4.5で設定された3つの制限(全体的なタスク上の信頼できる仕事、安定した製品、安全なフォルダ)がそれらと共に移動していないこと、浅い使用パターンが持続していることを示します。また、残る障壁を特定しています。ワークフロー語彙、新人を止めるエラー、権限と安全性、組織的なルール、および結果を判断する能力(セクション4および5)。
3番目は2つのオーケストレーション層の説明です。Webオーケストレーション、複数のコンシューマーチャットボットに送信された1つの質問は、ブリッジです。インストールは必要なく、比較の習慣を教えます。CLIオーケストレーション、1つのエージェントが他のエージェントのコマンドラインツールを呼び出す、持続する委任の層です。両方とも、ユーザーが見落としがちな事実によって制限されています。モデル間の合意は独立した証拠ではないという事実です(Chernets, 2026a)(セクション6および7)。
4番目は偽造可能な命題を伴う測定プログラムです。これらの遷移全体で非プログラマーに従う事前登録コホートプログラムの設計(Chernets, 2026d)、および付録のオーケストレーションと安全パターンのオープン教育ツールキット(セクション9および10、付録C)。
いくつかのスコープに関する制限が全体を通じて適用されます。「非プログラマー」とは、実質的にコンピュータで仕事をしており、スクリプティングやソフトウェアエンジニアリングの訓練を受けていない専門家を意味します。スプレッドシート数式に精通したアナリストは該当しますが、開発者は該当せず、開発者はここで比較グループとして登場します。コホートプログラムからの結果は報告していません。それらは観察期間後の別の論文に属しています。ほとんどの採用数はアメリカとベンダーから来ており、そのようなものとしてマークされています。また、説明されているツールは月ごとに変わるため、モデルはそれらより長く機能するように構築されており、製品の詳細は時代遅れになることが予想されます。
第2章では議論を文献に位置づけ、第3章では段階と遷移を定義しています。第4章では技術的障壁がどこに行ったかを示し、第5章はそれに何が取って代わったかを示しており、第6章と第7章はオーケストレーションの2つの形態であり、第8章は人間の役割に対して何が起こるかを示しています。第9章は横断を測定するプログラムを説明し、第10章は命題を述べ、第11章は含意を引き出し、第12章は境界条件を設定し、第13章は結論を述べています。
2. 背景: エンドユーザープログラミングからエンドユーザーの委任へ
2.1 エンドユーザーは常にプログラミングを行ってきた
プログラマーではない人々が計算を指示するという考え方は、言語モデルよりも古い。Nardi (1993) は、エンドユーザーが一般的なプログラミングスキルを必要とせず、スプレッドシートが典型的な例であるタスク固有の言語やフレームワークを通じて計算能力を制御することを論じた。Ko et al. (2011) は、ソフトウェアを構築するエンドユーザーが専門家と同じ問題 (要件、再利用、テスト、デバッグ) に直面しているが、訓練を受けていないことを示し、その分野をエンドユーザーソフトウェアエンジニアリングと名付けた。より広い分野であるエンドユーザー開発は、プロフェッショナルではない人々が自分の仕事のためにソフトウェアを作成および適応させる方法を研究している。Myers, Pane and Ko (2004) は、非プログラマーがタスクを説明する方法に近い表記法の設計に何年も費やした。これらの各研究ラインは、エンドユーザーがそれでも何かを書くことを想定していた。それは機械が実行するもの、たとえそれが式またはルールであっても。
言語モデルはエンドユーザーが書くものを変えた。Sarkar et al. (2022) は、大規模言語モデルを使用したプログラミングを、コンパイル、ペアプログラミング、検索とは異なる新しいアクティビティとして説明した。Zamfirescu-Pereira et al. (2023) は、AI の専門知識がない人々が確実に機能するプロンプトの設計に苦労し、単一の成功から過度に一般化し、人間の会話的習慣に戻ることを発見した。Liu et al. (2023) は、どの単語がどの動作を生成するかを学ぶことの難しさを「根拠のある抽象化マッチング」と名付けた。Sarkar and Drosos (2025) は、「バイブコーディング」の最初の実証的研究で、会話型プログラミングは文脈を管理し、結果を迅速に検証する方向へ専門知識を再配置し、判断の必要性をそこに残すことを発見した。Virk and Liu (2025) は、AI が書いた分析コードを与えられたビジネスユーザーが、探すよう指示された場合でも重大なエラーを見落とすことが多いことを発見した。Feldman and Anderson (2024) は、非専門家プログラマーを生成的 AI の時代の最も研究不足の集団と呼んだ。
私はその流れで次のステップを取る。エンドユーザー作業の単位は、式、スクリプト、プロンプトから、委任へと変わった: 複数のステップにわたってファイルとツール対して動作するエージェントに渡されたタスク。エンドユーザープログラミングに関する文献は、意図を表現することが難しい理由を説明し、委任と監視に関する文献は、結果をチェックすることが難しい理由を説明している。セクション 3 の4段階モデルは、この2つを組み合わせるために構築されている。
2.2 採用は急速で浅い
生成的 AI は、パーソナルコンピュータやインターネットよりも速く広がった。Bick, Blandin and Deming (2024) は、2024年後半までに米国の労働年齢人口の約40% がそれを使用していたと推定したが、仕事時間のごく一部だけが支援されていた。Chatterji et al. (2025) は、2025年半ばまでに ChatGPT が約7億人の週間ユーザーにサービスを提供しており、ほとんどのメッセージが仕事関連ではないことを発見した。デンマークでは、Humlum and Vestergaard (2025) は採用から2年後の収益と時間に関する正確なゼロ効果を発見し、女性と男性の間の使用ギャップを発見した; 100カ国以上を対象とするメタ分析では、そのギャップが2025年初頭以降約16ポイントであることを示している (Cranney et al., 2026)。35のヨーロッパ諸国全体で、AI への露出は自動的に使用に変換されず、トレーニング、デジタル化、ワーカーエージェンシーがより重要であった (Henseke, 2026)。
フィールド実験は、ツールがタスクに適合する場合に大きな利益を示している: 平均して1時間あたり14% 多くの顧客問題が解決され、初心者向けで34% (Brynjolfsson et al., 2025)、444人の専門家での試験におけるより速くより良い執筆、最大の利益は弱いライター向け (Noy & Zhang, 2023)、および758人のコンサルタント間で、12.2% 多くのタスクが完了し、品質がモデル能力の「ぎざぎざなフロンティア」内で40% 以上向上し、それ外のタスクでは作業が悪化した (Dell'Acqua et al., 2026)。経験豊富なオープンソース開発者との無作為化試験では、2025年初頭に反対の符号が見つかり、19% の遅化がある (Becker et al., 2025)。その著者らは後に、ツールが改善されたので結果は時代遅れである可能性があると述べた (METR, 2026)。これらの試験の教訓は、利益はタスク、ツール、および人がそれを指示およびチェックする能力の間の適合に依存し、それらはレベル間の遷移が変わる3つのことであるということである。
2.3 受容、拡散、および第二段階の分断
技術受容モデル (Davis, 1989) から、技術受容および使用の統一理論 (Venkatesh et al., 2003) まで、技術採用に関する研究は、認知される有用性と使いやすさが採用の門であることを示しており、社会的影響と促進条件は個々の態度と同じくらい重要である。拡散研究は採用を初期採用者と後期採用者を伴う社会的プロセスとして説明している (Rogers, 2003)。基本的なインターネットアクセスが一般的になると、Hargittai (2002) は意味のある不平等がスキルに移動したことを示した: 第二段階のデジタル分断。Van Dijk (2020) はこれを動機、アクセス、スキル、使用の流れに拡張した。
同じシフトが現在見られている。チャットへのアクセスは、富裕国のオフィスワーカー間でほぼ普遍的であるが、エージェントを指示するスキルは遠く普遍的ではない。AI 分断はすでに教育、地域、年齢の古い系統に沿って測定されている (Daepp & Counts, 2024; Pew Research Center, 2026)。私が追加するのは、分断が現在 AI ユーザーの人口内で実行され、モデルと会話する人と彼らに委任する人の間で実行されるという観察である。
2.4 自動化、監視、およびマネージャーの負担
人間がオートメーション化に監視する文献は矛盾から始まります。Bainbridge (1983) はそれを説明しました。タスクのほとんどを自動化すると、人間には最も難しい部分である監視と稀な介入が残り、それに必要なスキルを低下させます。Parasuraman と Riley (1997) はオートメーションの誤用、不使用、濫用を区別し、Lee と See (2004) は信頼が較正された信頼に従うべきであることを示しました。生成型AI時代は各ポイントを更新しました。ツールをより信頼する知識労働者は批判的思考の低下を報告しています (Lee et al., 2025)。生成型AIは人々を生産から評価へとシフトさせ、簡単なタスクをより簡単に、難しいタスクをより難しくします (Simkute et al., 2024)。言語モデルへの依存を較正するための介入は、過度な依存を減らしますが、適切な依存を生成しません (Bo et al., 2025)。日常のアシスタントとしてAIエージェントを使用するユーザーは、もっともらしいが間違った計画に対して信頼を誤較正し、段階的な実行に参加すると改善します (He et al., 2025)。エージェントが何をしたかの追跡情報がより詳しいと、エラーの検出が高速化されますが、最終的な精度を確実に向上させることはできません (Grunde-McLaughlin et al., 2026)。1つの自律エージェントに関する約73,000件の公開投稿の研究では、ユーザーの値はエージェントが配信した内容でほぼ満たされ、それを監督できる方法ではほぼ満たされていませんでした (Ma et al., 2026)。小規模な実験室研究と3つのデプロイメントでは、委譲への快適さは時間とともに増加しましたが、人々は不確実性の瞬間に制御を望んでいました (Long et al., 2025)。Tomašev、Franklin、Osindero (2026) はAIへの委譲をタスク配分、権限の譲渡、説明責任、信頼のフレームワークとして扱い、人間と機械の委譲者の両方に適用できます。
認知の観点から、54人のエッセイライターのEEG研究は、支援を受けたグループでより弱い接続性と所有権の低下を報告しました。「認知的負債」です (Kosmyna et al., 2025)。公開されたコメントはその方法に異議を唱えました (Stankovic et al., 2026)。安全な読み方は、ルーチンステップを offload すると注意を解放し、解放された注意は確認に費やされるということです。学習研究からのさらに2つのアイデアが後で使用されます。認知負荷理論は、柵のない環境に突然投入された初心者が、精神的スキーマが形成される前に停滞する理由を説明しています (Sweller, 1988)。ベイズ学習としての採用のモデルは、人々がどのように自己強化の低使用平衡に落ち着くことができるかを示します。これは最初の成功またはトレーニングでしか変わりません (Ma et al., 2025)。
このシリーズの2つのコンパニオン論文は、反対側から同じ問題に関連しています。1つ目は、複数のモデル間の一致がそれほど強力な証拠ではないことを示しています。その理由は、それらのエラーが相関しているからです (Chernets, 2026a)。2つ目は、自動化された監督コンポーネントが独自のマンデートを拡大し、それらが保護する作業を妨害する方法を示しています (Chernets, 2026b)。初心者にとって両方が重要です。最初は、オーケストレーションが何を購入できるかについて、2番目は、安全層が人を玄関で停止できる理由についてです。
2.5 研究されていないこと
2026年9月21日に実施された検索 (ウェブ検索、Crossref、arXiv、Semantic Scholar、CHI、UIST、2024年から2026年のVL/HCCペーパーに注目) では、非プログラマーがターミナルまたはコマンドラインエージェントを名前で採用する公開フィールド研究は見つかりませんでした。ウェブオーケストレーション (1つの質問を複数のコンシューマチャットボットにブラウザで送信) に関する命名された実践の研究はありませんでした。エージェントを管理することを自身の能力構造を持つスキルとしての処理はなく、AIシステムが人によるエージェント型AIの採用をスキャフォーリングする研究はありませんでした。最も近い作業は、他の主題のAIチューターへのスキャフォーリング理論を適用します (Cohn et al., 2026) または複雑なソフトウェアのタスク条件付きインターフェース (Liu & Sra, 2026)。労働経済学の作業は一般的な生成型AI採用を測定しており、非プログラマーの間でチャットからエージェント型ツールへのステップを分離するものはありません。これらのギャップはモデルがマッピングするスペースと、セクション9のプログラムを定義して測定するために構築されました。
3. 4つのレベルと3つの転換
3.1 2つの軸: 到達範囲と役割
レベルは、仕事における人とモデルの関係を記述するものであり、到達範囲と役割という2つの軸で定義されます。
到達範囲とは、モデルが人に代わって及ぼすことができる範囲です。最も狭い場合は会話のみですが、その次は、ベンダーが境界を定めたスペース内のファイルとツール、その次は、ファイル、プログラム、スケジュールを持つ人のコンピュータ、最も広い場合は複数のモデルとエージェントです。
役割とは、仕事が成功するために人が行うべきことです。同じ順序で、彼らは尋ねて出力をコピーし、タスクを委譲して結果を確認し、エージェントの環境とそのパーミッション、および取り消し機能を所有するか、エージェント間で仕事を割り当てて戻ってきたものを調整します。
製品は意図的に定義から除外されています。単一の製品は複数のレベルにわたることができ、2026年では、ベンダーはチャットとエージェントを製品名に基づくあらゆる分類法よりも速く1つのウィンドウに統合しています(第4.3節)。レベルは仕事の一部を記述するものであり、1つの製品と同様に、1人の人間も複数のレベルにわたることができます。同じ人が朝は1つのタスクでレベル1にあり、午後に別のタスクでレベル3にあることができます。
2つの軸はまた、このモデルを自動化と自律性の一般的な尺度から区別します。Parasuraman、Sheridan、Wickens(2000)は、タスクの各段階(情報取得、分析、決定、実行)のどの程度を機械が実行するかを分類しました。Morris et al.(2024)は、一般的なAIシステムをそれらのパフォーマンスの深さと幅によって段階分けしました。Feng、McDonald、Zhang(2025)は、ユーザーが担う役割(オペレータ、コラボレータからコンサルタント、承認者、オブザーバーまで)により、AIエージェントの自律性の5つのレベルを定義しました。これらの尺度は、エージェントがタスク内でどの程度決定するかを記述しています。ここでの4つのレベルは、仕事がどこで実行されるかと人が何を所有しているかを記述しています。すなわち、会話、ベンダーの囲まれたスペース、彼らのコンピュータ、複数のベンダーのエージェントのチームです。軸は直交しています。人のコンピュータ上のエージェントは、段階的な承認からほぼ完全な委譲まで、Feng et al.の自律性のどのレベルでも実行できます。人はそのパーミッションと取り消し機能を所有しています。4つのレベルが追加するものは、採用の説明です。チャットから始まる人にとって、到達範囲と責任がどの順序で増加するか、および各ステップが取られたことを示す証拠(成果物)です。
3.2 4つのレベル
レベル1: チャット。モデルの到達範囲は会話で終わります。テキスト、コード、または画像を生成し、人がそれを仕事が行われる場所にコピーし、人の役割は上手に尋ねることと出力を実行することです。AIを使用するほぼすべてのプロフェッショナルはほとんどの場合ここで働いています(第2.2節)。
レベル2: 安全なエージェント環境。モデルはファイル、接続されたサービス、および時にはブラウザで動作し、ベンダーが境界を定めたスペース内で動作します。選択されたフォルダ、仮想マシンまたはサーバー側サンドボックス、人が承認したコネクタ、および重要なアクション前の承認ステップです。AnthropicのCowork、OpenAIのChatGPT Work、MicrosoftのCopilot Cowork、およびGoogleのGemini Sparkは2026年の例であり、それらは囲まれたスペースで動作する委譲エージェントの設計を共有しています(Anthropic、2026b; MacRumors、2026; Microsoft、2026a; TechCrunch、2026b)。人の役割は尋ねることから委譲することへ変わります。ファイルまたはアクションで終わるタスクを委譲し、戻ってきたものを確認します。このレベルでの環境の安全性の大部分は、ベンダーの責任です。
レベル3: 自分のコンピュータ上のエージェント。エージェントは人のマシン上で実行され、ファイルシステム、シェル、インストールされたプログラム、およびスケジュール済みジョブにアクセスし、ターミナルまたはデスクトップシェル経由で同じエンジンを使用します。Claude Code、OpenAIのCodex、GoogleのAntigravity CLI、xAIのGrok Build、MoonShotのKimi Code、およびオープンソースの同等物です。研究文献ではこれらはLLMベースのエージェントであり、開発者によるそれらの使用はエージェント的コーディングとして研究されています。このレベルは、開発者ではない人がそれらを実行する場合に何が起こるかを問います。到達範囲は単一のエージェントが得られる最も広いものであり、それとともに人の役割は再び変わります。彼らは環境を所有しています。エージェントが見るフォルダ、承認が必要なコマンド、何が除外されるか、そしてミスを取り消す方法です。ターミナル自体は付属的なものです。このレベルを定義するのは、エージェントが人がすることができることを何でもできるような作業環境の所有権だからです。クラウドホスト型の変種(同じエージェントループを人が見ることなくベンダーのマシン上で実行され、タスクと結果のみが表示され、プロンプトは表示されない)は、機能的にはレベル3であり、爆風半径的にはレベル2です。このモデルはそれらをレベル3の変種として記録し、1つのセルに無理強いしません。
レベル4: 繰り返し可能で調整された仕事。人は、並行して、または連続して、複数のモデルまたはエージェントを指示し、繰り返される仕事に対して、到達範囲はベンダーをまたがります。2つの層があります。ウェブオーケストレーションでは、1つの質問が複数のコンシューマーチャットボットにブラウザで手動またはツールで送られ、回答が比較されます。CLIオーケストレーションでは、1つのエージェントが他のエージェントのコマンドラインツールを呼び出し、それらの出力を収集し、マージまたは確認します。人の役割はマネージャーです。彼らは目標を設定し、仕事を割り当て、何が完了としてカウントされるかを決定し、意見の相違を調整します。仕事は、エージェントが再度実行できる形式で書き下ろされたときに繰り返し可能になります。命令ファイル、スキル、またはスケジュール済みジョブとして。「繰り返し可能」は出力ではなくワークフローを記述します。次週に同じ命令ファイルを実行すると異なるドラフトが生成され、繰り返されるのは入力、ステップ、チェック、および成果物のシーケンスです。このように書き下ろされた繰り返しのある単一エージェント仕事はレベル3の仕事が繰り返し可能になったものであり、2番目のモデルファミリーが指示され、結果が調整されるとレベル4になります(転換3、第3.3節)。
表1. 4つのレベル。
| レベル | モデルの到達範囲 | 人の役割 | 一般的なサーフェス、2026年9月 | 交差は以下で示される | このレベルが確立しないもの | 入場時の主な障壁 |
|---|---|---|---|---|---|---|
| 1. チャット | 会話 | 尋ねる、手動で出力をコピーする | ブラウザまたはアプリのチャット | (入場レベル) | モデルが人の仕事に対して行動できることや、確認なしで信頼できることが確立できない | アクセス以外になし |
| 2. 安全なエージェント環境 | ベンダーが境界を定めたスペース内のファイル、コネクタ、およびブラウザ | タスクを委譲し、結果を確認する | ClaudeチャットにCoworkを統合;ChatGPT Work;Copilot Cowork;Gemini Spark | 委譲されたタスクからエージェントが生成したファイルまたはアクション。承認または拒否が記録される | その人が自分自身の環境を実行できること、または作業を繰り返せることができること | 何を委譲するかを知っていること;信頼 |
| 3. 自分のコンピュータ上のエージェント | その人のファイルシステム、シェル、プログラム、スケジュール | 環境を所有すること:アクセス権、除外、取り消し | Claude Code、Codex、Antigravity CLI、Grok Build、Kimi Codeのターミナルおよびデスクトップシェル | エージェントがその人のマシン上で生成したアーティファクト。その人が設定したフォルダ内で、複数以上のツール使用を必要とするタスクから | その結果が正しいこと、またはレビューなしで受け入れるのが安全であること | インストール時の摩擦(低下);最初のエラー;アクセス権;何を求めるか |
| 4. 調整された作業 | ベンダー間の複数のモデルまたはエージェント | 管理:目標、配分、受理、調整 | ウェブ:複数のチャットタブまたはブロードキャストツール。CLI:他のエージェントを呼び出すプラグインとスクリプト | 少なくとも2つのモデルファミリーが生成またはチェックした、少なくとも1回再実行された統合または相互チェック結果。誰が尋ねたか、誰が応答したかが記録されている | モデル間の一致が独立した証拠であること、またはそのタスクがこのレベルに属していること | 調整のコスト;相関エラー;クォータとツールの変動 |
表の2つの用語は日常的な用法よりも狭い。「安全なエージェント環境」での「安全」は設計目標と相互作用パターンを名付けており、保証を与えません。フォルダスコープ、承認、サンドボックス、プレビューペインはエージェントが作用する領域を縮小します。これらはバグのある実装がファイルを保持することを実現させることも、隠れた指示を持つドキュメントを無害にすることもできず、セクション5.3は許可されたフォルダ内で何が問題になったかを報告しています。中層が確立するのは実践的な心的モデルです。エージェントが1つのフォルダにレポートを書くことができ、他のものには何も触れることができないことを見ている人は、委譲されたアクションが周囲を持つこと、つまりAIに注意するようにとの抽象的な警告よりもより有用であることを学んでいます。「アーティファクト」は、エージェント自身の作業のいくつかのステップを必要とした成果物を意味します。それを求めた人がそれがアーティファクトとしてカウントするかどうかを決定し、第三者はその品質を評価し(セクション9.4)、研究はその評価とコード化の停止理由の両方についての評定者間の一致を報告します。2つの空のファイルがあるフォルダはインストーラーの痕跡であり、カウントされません。
3.3 3つの遷移、およびアーティファクトが各遷移を定義する理由
遷移は、エージェントがその人が求めたアーティファクトを新しいレベルで生成したときに超えられます。インストール試行としてのみカウントされ、完了したチュートリアル、バッジ、ライセンス、および自己報告「私は今エージェントを使用しています」も同様です。このルールには明白なもの以外にいくつかの結果があります。エージェントが作成したフォルダはエージェントが実行されたことを示し、その人が自分の作業の説明からエージェントが書いたファイルのセットは、その人が委譲したことを示します。このルールはまた遷移を外部から観察可能にします:研究者またはマネージャーはアーティファクトを見ることができ、意図または能力の感覚を見ることはできません。これは失敗を情報提供します。ツールをインストールして何も生成しなかった人は名付ける価値がある障壁に達しているため、インストールを成功としてカウントするとそれを隠すでしょう。また、製品を名付けないため、このルールにより、3か月ごとに名前が変更されるツール全体での比較が可能になります。
遷移1は、チャットから安全なエージェント環境への移行です。人が最初にテキストではなくファイルまたはアクションで終わるタスクを委譲するときに超えられます。2026年、この遷移はチャットウィンドウ自体に吸収されています。ベンダーのモデルが答えるか行動するかを決定する場合、2026年9月16日に発表されたマージされたClaudeエクスペリエンスで行われるように(Anthropic、2026c)、その人はそれを決定することなく超えることができます。これにより、超過はより簡単にもより見えにくくなります。その人を含めて。
遷移2は、安全な環境から自分のコンピュータへの移行です。人が自分の環境でエージェントを実行し、それからアーティファクトを受け取るときに超えられます。決定的な変化は所有権です。レベル2ではベンダーはエージェントが何に触れるかを決定し、レベル3では、その人が決定します。エージェントがどのような顔を見せても、ターミナルまたはウィンドウです。ターミナルへの恐怖はここに住んでいました。セクション5はアクセス権、エラー、および何を求めるかの質問がその場所に取って代わったことを示しています。
遷移3は、1つのエージェントから調整された作業への移行です。人が少なくとも2つのモデルファミリーが生成またはチェックした結果を取得し、その配置を後の作業で再実行するときに超えられます。再実行は重要です。3つのチャットボットを1回比較することは好奇心であり、利害関係がそれを正当化するときにはいつでも人が到達する比較のみが実践の量となるからです。
セクション9の計画が従うルートは、導入部の専門家を仮説的なケースとして、何も報告されていない設計として歩くことができます。彼女はすでにレベル1にいる場所で始まります。彼女が支払うチャットボット。彼女はその標準的なテキストをそのチャットボットに貼り付け、それが彼女の自分のラップトップ上にグラフィカルエージェントをインストールするのをガイドするのを許可し、ステップが失敗するたびにスクリーンショットを送信し、私は何も触れません。最初のステップは、エージェントが自分の作業の説明から、彼女が開いて判断できるファイルセットを生成した場合にのみカウントされます。インストールされたアプリケーション、空のフォルダの横にあるものは試みとしてカウントされます。彼女は自分のファイルのコピーで作業し、パスワードとクライアント文書をそれから外し、行動する前にエージェントの計画を読み、不可逆的なものを確認します。彼女が準備ができたと言ったとき、彼女は1つの質問を彼女がすでに持っているサブスクリプションを通じていくつかのモデルに置き、1つの統合答えを返し、エージェント内から起動される、オープンソースツールを受け取ります。そしてそのステップはその人の言葉で、日付付きの実行がどのモデルが尋ねられたか、そしてどこで異なるかを示すときにカウントされます。後に彼女はコマンドラインツールを通じて同じ比較を実行します。彼女はこれらのポイントのいずれかで停止する可能性があり、登録済みレコードはその場所と彼女の言葉で理由を保持します。ルートは公開登録から取られ、人々がそれを歩くかどうかは結果論文の問題です。
3.4 レベルは順序付けられていますが、強制的ではありません
レベルは到達範囲と、その人に課せられる責任によって順序付けられています。この順序は、誰もが一段ずつ登らなければならない階段ではありません。人は自分のコンピュータ上のチャットから直接エージェントに移行できます。セクション9で説明する一貫性のあるルートは、その人が既に使用しているチャットボットがインストールを通じてガイドすることで、まさにそれを行います。他の人はレベル2で永遠に止まり、多くの作業ではそれが正しい場所です。このモデルではより高いことが良いわけではありません。その主張は、各レベルがその人に異なる要求を課すこと、その交差を観察できること、そして各交差での障壁が異なることです。交差が人工物によって区別できない場合、障壁が交差間で異ならない場合、または一つのレベルでの能力が次のレベルで人々ができることを変えない場合に反証されるでしょう。これらのいずれかの場合、モデルは「AI使用」の単純なスケールに何も追加しないためです。このモデルはまた、タスクの機密性と技術的要件が一定に保たれたら、レベル内よりも3つの遷移でコンプリーション率がより急激に低下することを予測しています。ドロップが均等に分布していた場合、レベルは単なる「ラベルの変更された連続体」になるでしょう。セクション10はこれらの期待を測定値と反証値を持つ命題に変えます。
一つのツール・ファミリーはラダーの隣に属し、それのどのラングにも属しません。ブラウザアプリケーションビルダーは、人がアプリケーションを説明し、ベンダーがホストするプラットフォーム内で実行中のプレビューを受け取ることができます。それらは重要であり、それはレベル2とは異なるものです。レベル2では、エージェントが権限モデルの下で人自身のファイルに作用します。アプリケーションビルダーはプラットフォームが所有するプロジェクトに作用します。この2つを混同することは、プログラマー以外の人がすでに到達したという誤った感覚を生み出します。4レベルモデルはアプリケーションビルダーを独自の天井と独自のセキュリティプロフィールを持つサイドブランチに置き、vibe-codingの文献がそれについて読む場所です(Sarkar & Drosos, 2025; Ge et al., 2025)。図1は4つのレベル、各遷移を標識する人工物、記録されたスキップ、およびサイドブランチを描いています。
図1。 4つのレベルと3つの人工物で定義された遷移。
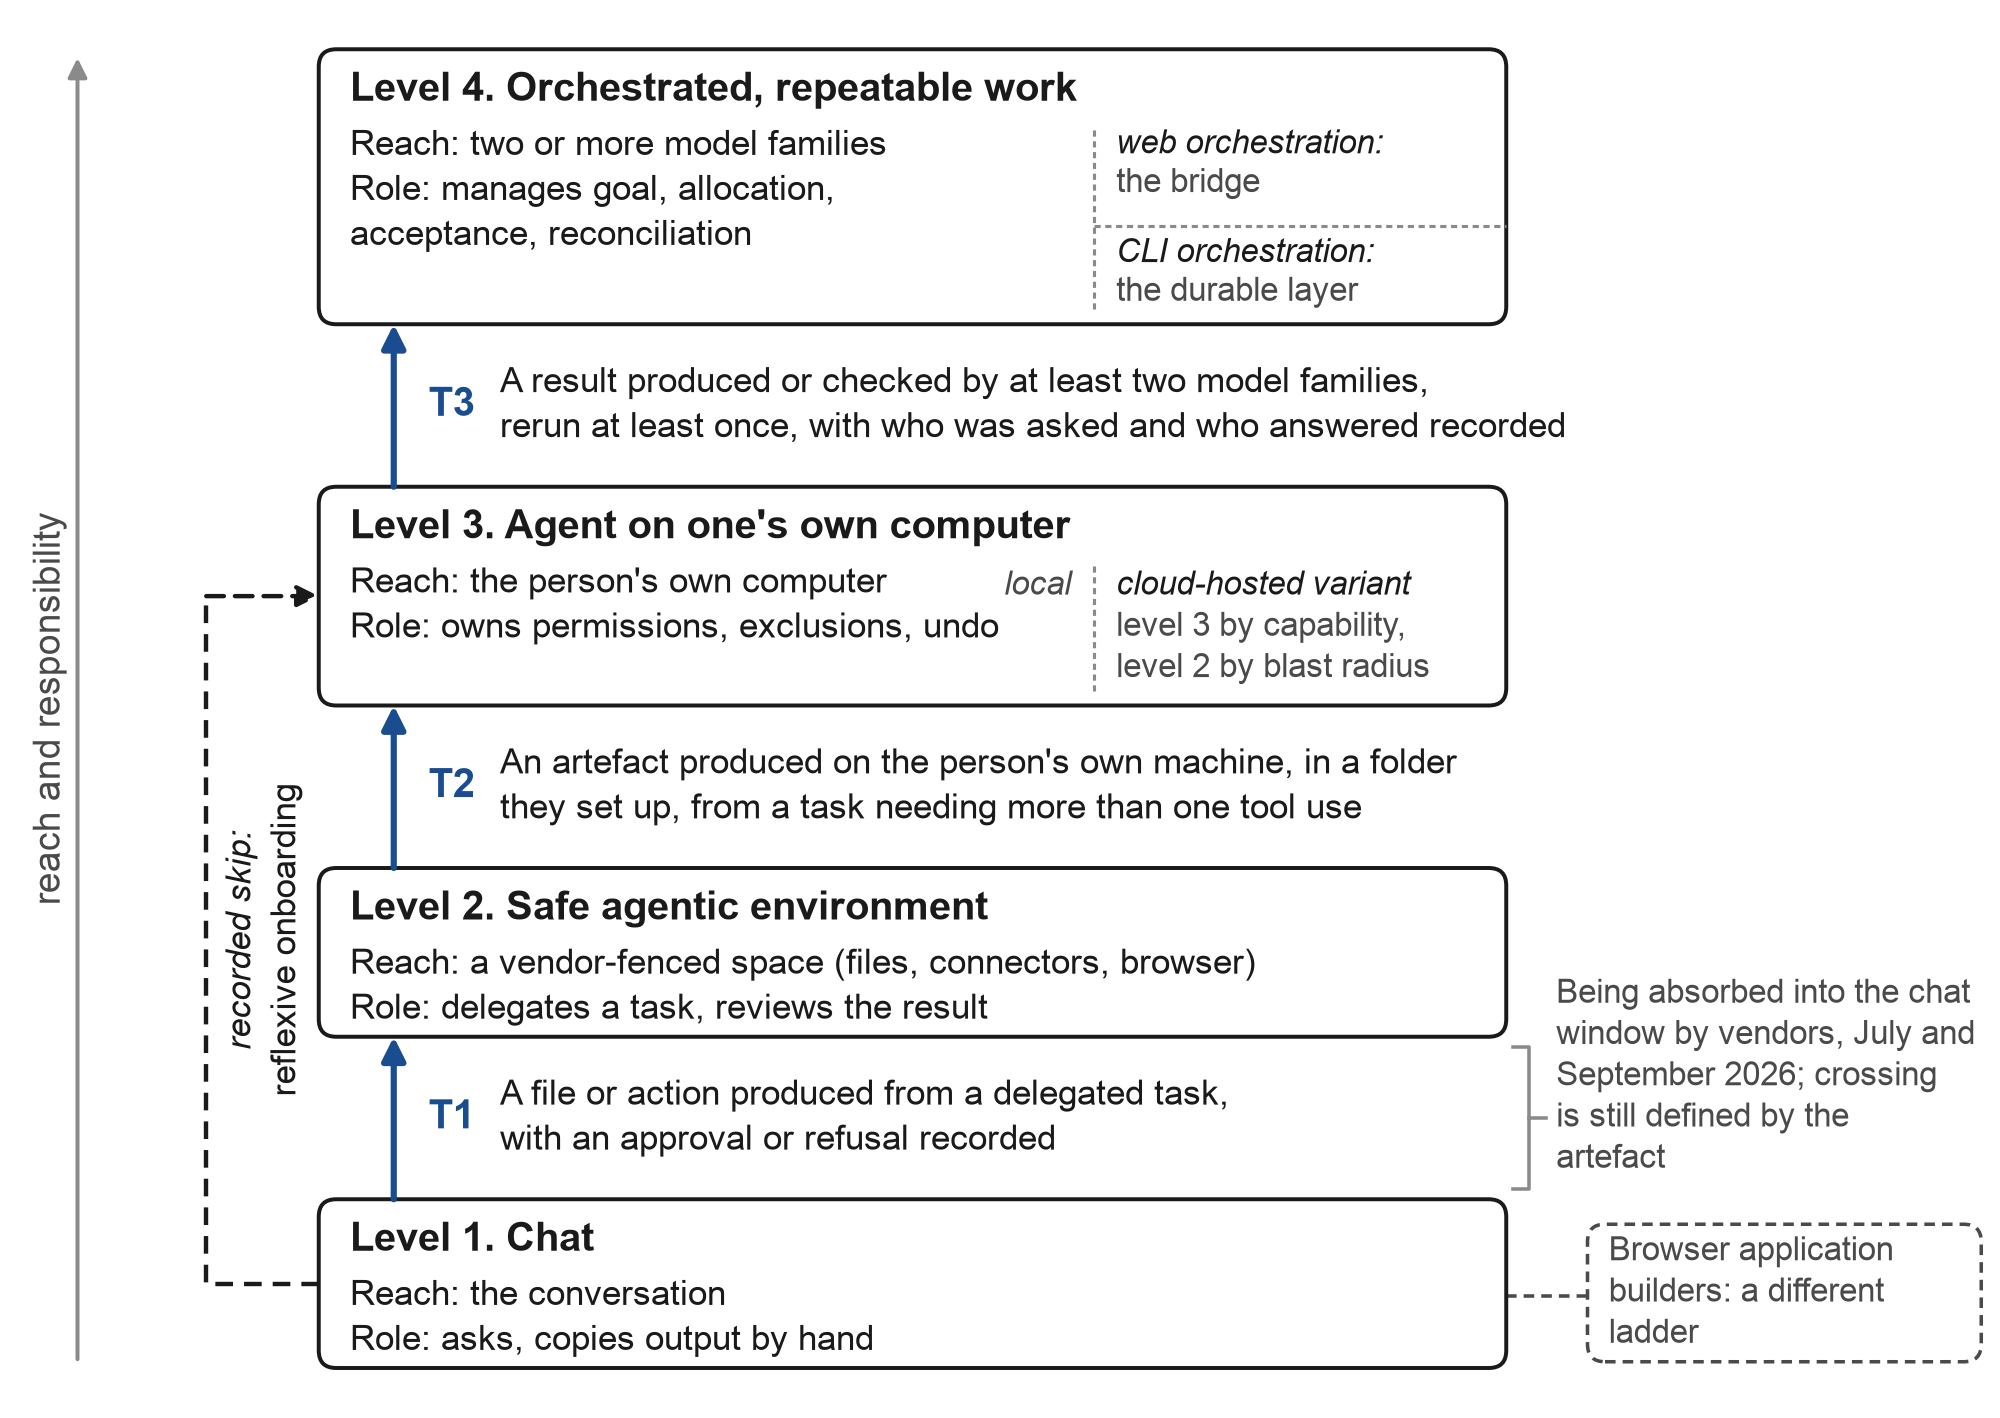
注:セクション3.2の4つのレベルは、到達範囲(モデルが接触する可能性のあるもの)と人に課せられる責任によって上向きに順序付けられています。各遷移(T1からT3)は、エージェントが矢印の隣に名前が付いている人工物を作成し、インストールが試みとしてカウントされた場合にのみ交差します(セクション3.3および表1)。左側の点線矢印は、登録されたルート(セクション3.4および9.2)が取るチャットから人のコンピュータ上のエージェントへの記録されたスキップです。右側の点線ボックスはブラウザアプリケーションビルダーのサイドブランチであり、T1の注記は2026年7月と9月にベンダーによってチャットとエージェントサーフェスを統合したことを記録しています(セクション4.3)。
3.5 ターミナルはもはやターミナルではありません
プログラマーにとって、ターミナルはコマンドを発行するためのインターフェースです。エージェントで働く専門家にとって、それはエージェントが生きている環境です。作業フォルダ、権限のセット、そして何がされたかの履歴です。Anthropicが2026年1月にCoworkを導入したとき、フレーミングは「Claude Code for the rest of your work」でした。同じエージェントが、ソフトウェアを書かない人に提供されました。ターミナルなしで(Fortune, 2026a)。
ベンダーは同じ観察に行動を起こしました。OpenAIはコーディングエージェントアプリケーションの名前を「ChatGPT」に変更し、デフォルトのデスクトップクライアントにしました(MacRumors, 2026)。Anthropicは、ターミナルを必要としないエージェント用のデスクトップアプリケーションを提供しています(Anthropic, 2026a)。Googleは2026年6月18日に個別ユーザー向けのオープンソースGemini CLIを廃止し、マルチエージェントプラットフォームと新しいコマンドラインツールを優先しています。ユーザーは「作業を分割するために相互に通信する複数のエージェントを必要とする」と述べています(Google, 2026)。目に見えるターミナルは消えており、それがアクセスを与えた環境はまだそこにあり、まだ誰かによって実行される必要があります。専門家にとって、有用な質問はそれに応じて変わりました。ターミナルを使用できるかどうかは毎月重要性が低くなり、エージェントが彼ら自身のために作業する環境を実行できるかどうかは、私が彼らに問う質問です。
4. 技術的障壁はどこへ行ったのか
4.1 インストールは1ステップになった
2024年、ターミナルエージェントを欲しい非プログラマーは、小さな壁の列に直面していました。言語ランタイムをインストールし、パス変数を修正し、シェルが「permission denied」と言う理由を理解し、「インストール」という名前の4つのもの間で選択するのです。2026年9月までに、これらのほとんどがベンダーによって削除されました。主要なターミナルエージェントは単一コマンドまたは自動更新するデスクトップインストーラーでインストールします。Claude Codeのデスクトップアプリケーションは、並列セッション、変更の視覚的レビュー、ライブプレビュー、スケジュールされたタスクを提供し、その文書では「ターミナルは不要」と述べています(Anthropic, 2026a)。OpenAIのデスクトップアプリケーションは、コーディングエージェントを通常のChatGPTクライアントに統合します(MacRumors, 2026)。Googleの新しいコマンドラインツールは、デスクトッププラットフォームにバンドルされた単一バイナリです(Google, 2026)。
1ステップでインストールするエージェントは、依然として上手に使うことが難しく、変化を誇張したくはありません。変わったことは、インストーラーがもはや新規参入者が最初にぶつかる壁ではないということです。残る摩擦は、ドア選択です。ターミナルツール、エディタ拡張、デスクトップアプリケーション、ウェブバージョンはすべて「インストール」という言葉で移動し、それらの間で選択することが、インストールが新規参入者に今かかるコストの大部分です。ドア選択は、人がエージェントに何をさせたいのかを知ることを意味するため、これはセットアップ問題に見せかけられた語彙問題であり、第5節に属しています。
これらのすべての製品ページの基礎となる1つのアーキテクチャ的事実があります。コマンドラインツールは参照実装です。サブエージェント、フック、スキル、プロトコルサーバー、ヘッドレスモードはCLIに最初に現れ、その後、同じエンジンのデスクトップおよびウェブ面に現れます。Anthropicの独自のヘルプページは、そのレベル2エージェントを「Claude Codeを支える同じエージェント的アーキテクチャ、ターミナル不要」と説明しています(Anthropic, 2026b)。新規参入者にとって、これは両方向に作用します。親しみやすい顔は、強力な顔に追いつくことができます。しかし、ドキュメント、例、フォーラムの回答はまだCLIの方言で話されているため、デスクトップアプリケーションから始まった人は、インストールしなかったツールについて読んでいます。
4.2 独自のインストーラーとしてのチャットボット
2番目の変化はより目に見えず、ここでの議論にとってより重要です。人がすでに使用しているチャットボットは、エージェントをインストールするプロセスをガイドできます。人はリクエストを貼り付け(「私のWindowsラップトップにこれをインストールするよう案内してください。私は技術的ではありません」)、ステップに従い、何か失敗した場合、エラーのスクリーンショットを同じチャットボットに送信します。ヴィゴツキーの近接発達領域(Vygotsky, 1978)のより知識のある他者であり、Wood、Bruner、Ross(1976)が足場かけと呼んだ機能(興味の募集、自由度の削減、重要な特徴のマーキング、フラストレーション制御)を持つ家庭教師は、人がすでに信頼しているツール、いつでも、彼らの言語で、無料で利用できるようになりました。
私はこれを反射的オンボーディングと呼びます。AIシステムがより能力の高いAIシステムの採用をスカッフォルディングしています。これは通常のヘルプの方向を逆にします。拡散文献では、新規参入者は初期採用者との接触を通じて採用します(Rogers, 2003)。ここでは、初期採用者は、少なくとも機械的なステップについては、レベル1モデル自体に置き換わっています。
その間に、教育層がこのステップの周りで成長しています。ベンダーアカデミーはエージェントについての短期コースを提供し、大規模な学習プラットフォームは名前付きエージェントで「バイブコーディング」を教えます。エージェント内で配信されるコースが現れており、学習者はエージェントをインストールし、エージェントコースを教えます(CC for Everyone, 2026)。1つのコンサルティング企業は、その従業員の約30,000人がベンダーのモデルで訓練されることを発表しました(Accenture, 2025)。このレイヤーの存在は、インストールはもはや自明のものとして扱われていないことを示しています。ミニマリスト命令理論は、人々が最初から実際のタスクを実行し、エラーから回復することによって、ソフトウェアを最もよく学習することを予測していました(Carroll, 1990)。反射的オンボーディングは、両方に対して常に存在するガイドを供給します。ターミナルを開いたことのない人、および、誰のために機能するかどうかについては、私はまだ知りません。第9節のプログラムの最初のステップは、それを調べるために設計されており、セクション2.5で説明されている検索は、それの研究を見つけませんでした。
4.3 ベンダーはレベルをマージしている
2026年の最大の変化は構造的です。3つの最前線研究所とMicrosoftはそれぞれレベル2エージェントを出荷し、2つはレベル2をチャットに折り戻し始めています。
表2。 2026年1月から9月、チャットからエージェントへの道を再形成したベンダー動向。
| 日付(2026) | ベンダー | 動向 | レベルへの影響 | 出典 |
|---|---|---|---|---|
| 1月 | Anthropic | Cowork研究プレビュー:「残りの仕事のためのClaude Code」、非プログラマー向けのフォルダ範囲のエージェント | 名前付き製品としてのレベル2 | Fortune(2026a) |
| 3月9日 | Microsoft | Coworkの背後にある技術をMicrosoft 365 Copilotに統合。Agent 365制御プレーン | 支配的なオフィススイート内のレベル2 | Microsoft(2026a) |
| 3月30日 | OpenAI | 競合するエージェント内でコーディングエージェントを実行する公式プラグイン、「タスクを委譲するため」、無料ティア含む | ベンダーが認可したレベル4(CLI) | OpenAI(2026a) |
| 5月19日。6月18日 | Gemini CLIは個別ティアで廃止され、Antigravity CLIおよび複数エージェントプラットフォームを優先 | レベル3は再プラットフォーム化。新規参入者のためのチャーン | Google(2026) | |
| 6月2日 | OpenAI | コーディングエージェント、週500万ユーザーで、約20%が知識労働者、開発者より3倍以上速く成長中(ベンダーデータ、プレスリポート) | ターミナル由来エージェントの知識労働者利用。方向性があり、ここで定義されているレベル3より広い | Help Net Security(2026) |
| 7月1日 | Gemini Spark デスクトップエージェント(Mac、ローカルファイルで動作、ベータ版、米国) | 第3研究室からのレベル2 | TechCrunch(2026b) | |
| 7月9日 | OpenAI | コーディングエージェントアプリが新しいChatGPTデスクトップアプリになる。ChatGPT Workエージェントはローカルファイルとアプリを使用 | 1つのクライアントでレベル1〜3 | MacRumors(2026) |
| 8月26日 | Anthropic | ブラウザエージェントが有料プランで一般利用可能。デフォルトで安全分類器を使用して自律的に動作 | レベル2のリーチをウェブに拡大 | Anthropic (2026d) |
| 9月16日 | Anthropic | Coworkとチャットが「ひとつのClaude」に統合され、モデルが応答するかアクションを取るかを決定 | Transition 1がチャットに吸収 | Anthropic (2026c); TechCrunch (2026a) |
表を順に読むと、収束を記述しています。ベンダーは最初、非プログラマーが端末を恐れないようにチャットとエージェント作業を分離し、その後、人々がどのウィンドウがどのタスクに属するのかを判断できないことを発見し、現在、モデルが決定する2つを再度統合しています。TechCrunchは、同社が顧客が「正しいタブを選択するのに苦労することが多い」と述べたと報告しており(TechCrunch, 2026a)、同社独自の発表では「タスクがどこに行くかを選択する必要がない」と述べられており、ラップトップが閉じられた後も作業が続行し、エージェントはデフォルトで行動する前に質問し、統合は最初に有料個別プランにロールアウトされ、コーディングタブは別のままです(Anthropic, 2026c)。これをセクション1で名付けられた障壁、ワークフロー語彙についてのベンダー証拠として読みます。人々がタスクが質問であるか委任であるかを判断できない場合、委任をどのように表現するかを知っている可能性は低いです。
統合は個別のレベル2を持つモデルを損なうように見えるかもしれません。そうではなく、理由はベンダーがイベントを予見したと主張せずに与えることができます。ベンダーは、通常のユーザーを分類、レート制限、許可モデルで包むことができるウィンドウ内に留めることに対する請求、サポート、安全保障の利益を持ち、ユーザーにモードを選択させないことに対する使いやすさの利益を持ち、transition 1をチャットに吸収することは両方から続きます。交差ルールは変わりません。システムが承認後に許可されたスコープでファイルを書いた場合、会話の周りのクロームが何であれ、transition 1は交差され、段落を返した場合、その人はまだレベル1にいます。モデルは、transition 2と3が同じ方法で解散しないことを暗示しています。シェルアクセス権を持つローカルエージェントはサーバー側のサンドボックスとは異なる許可オブジェクトであり、そのベンダーのログイン下で実行されている2番目のベンダーのツールは、単一のベンダーのカウンシル機能とは異なる許可オブジェクトです。これらの違いはセクション5.3の安全保障論理とセクション6.3の相関エラー論理を持ち運びます。2027年後半までに主要なベンダーがローカルシェルエージェントと相互ベンダー呼び出しを同じチャットウィンドウに折り畳んだ場合、同じ許可モデルの下で、その含意は間違っており、CLIオーケストレーションが継続するレイヤーであるという主張はそれとともに落ちます(セクション10のP2とP8)。
収束はまた、チャーンというコストを運びます。Googleのオープンソースコマンドラインエージェントは、個々のユーザーに12か月未満(2025年6月25日から2026年6月18日)間提供され、OpenAIのエージェントブラウザは約9か月後に廃止され、Coworkは約8か月間個別の製品として存在しました(Google, 2026; 9to5Mac, 2026; Anthropic, 2026c)。ツールの学習に投資する専門家は、1年以内にツールの名前が変更されたり、統合されたり、廃止されたりする可能性があります。ツール全体で転送されるのはワークフロー語彙であり、失われるのは製品のメニューの知識であり、人々がどのように教えられるべきかについて重要な非対称性です(セクション11.2)。
4.4 ターミナルヘリテージエージェント内の知識労働者
ターミナルヘリテージエージェント内の非プログラマーに関する最良の単一データはベンダーから来ています。2026年6月、OpenAIはプレスを通じて、そのコーディングエージェントが週500万ユーザーを持ち、2月のデスクトップアプリケーションの立ち上げ時のレベルの6倍以上であり、知識労働者はそのうち約20%を占め、開発者の3倍以上の速度で採用されており、毎週、ベンダーのカウントによると、知識労働者ユーザーの72%がレポート、メモ、契約、スプレッドシート、PDFなどのアーティファクトを作成したと報告しました(Help Net Security, 2026; ベンダー自身のページは私のチェックへのアクセスエラーを返したため、数字はプレスリリースから引用されます)。500万の20%は週約100万人です。アナリストは、リリースは部分的に「一部のバズを取り戻す」ことを目的としており、エージェントは「競合エージェントと並んで使用されることが多い」ため、成長チャートは「方向性として使用されるべき」と述べました(Constellation Research, 2026a)。数字はベンダーが報告し、未監査であり、すでにツールを選択した人々を記述しており、ターミナルヘリテージエージェントの知識労働者使用を測定します。これはここで定義されたレベル3採用より広いです(その人自身のマシン上の委任されたタスクからのアーティファクト)。これらの注意事項で読むと、ターミナルヘリテージエージェントはもはやプログラマーのために予約されていません。そのユーザーがセクション3で定義されているようにレベル3に達するかどうかは、図が示すことができないものです。
セクション1の広く浅いパターンがその見方の隣に立っています。調査はレベルについて意見が異なり、形状について同意します。約半分のアメリカ人成人がチャットボットを使用し(Pew Research Center, 2026)、米国労働者の52%が彼らの役割でAIを使用しており(Gallup, 2026)、セントルイス連邦準備制度の測定による労働者の45%と成人の62%が生成的AIを使用しています(Bick et al., 2026)、約7人に1人の労働者がそれを毎日使用し、オートメーションは少数派の使用です。図2は、調査が質問と分母が異なるため、開発者とセクション1の開発者の図の横に、Gallupとセントルイス連邦準備制度の労働者シリーズを、調査ごとに1つのパネルで描画します。開発者の間では、コーディングエージェントはほぼ普遍的であり、使用はまだ慎重です。約1,100人の技術者の2026年5月パルス調査では、69%が単一エージェントを使用し、59%がエージェントを監視なしで実行することはめったにないか、60%がエージェントがそのシステムへの未承認の変更を行うのをブロックしました(Stack Overflow, 2026)。つまり、レベル4は、毎日レベル3を使用するプログラマーのためさえ、まだフロンティアです。
図2。 広く浅い:開発者と他の労働者の間での採用。
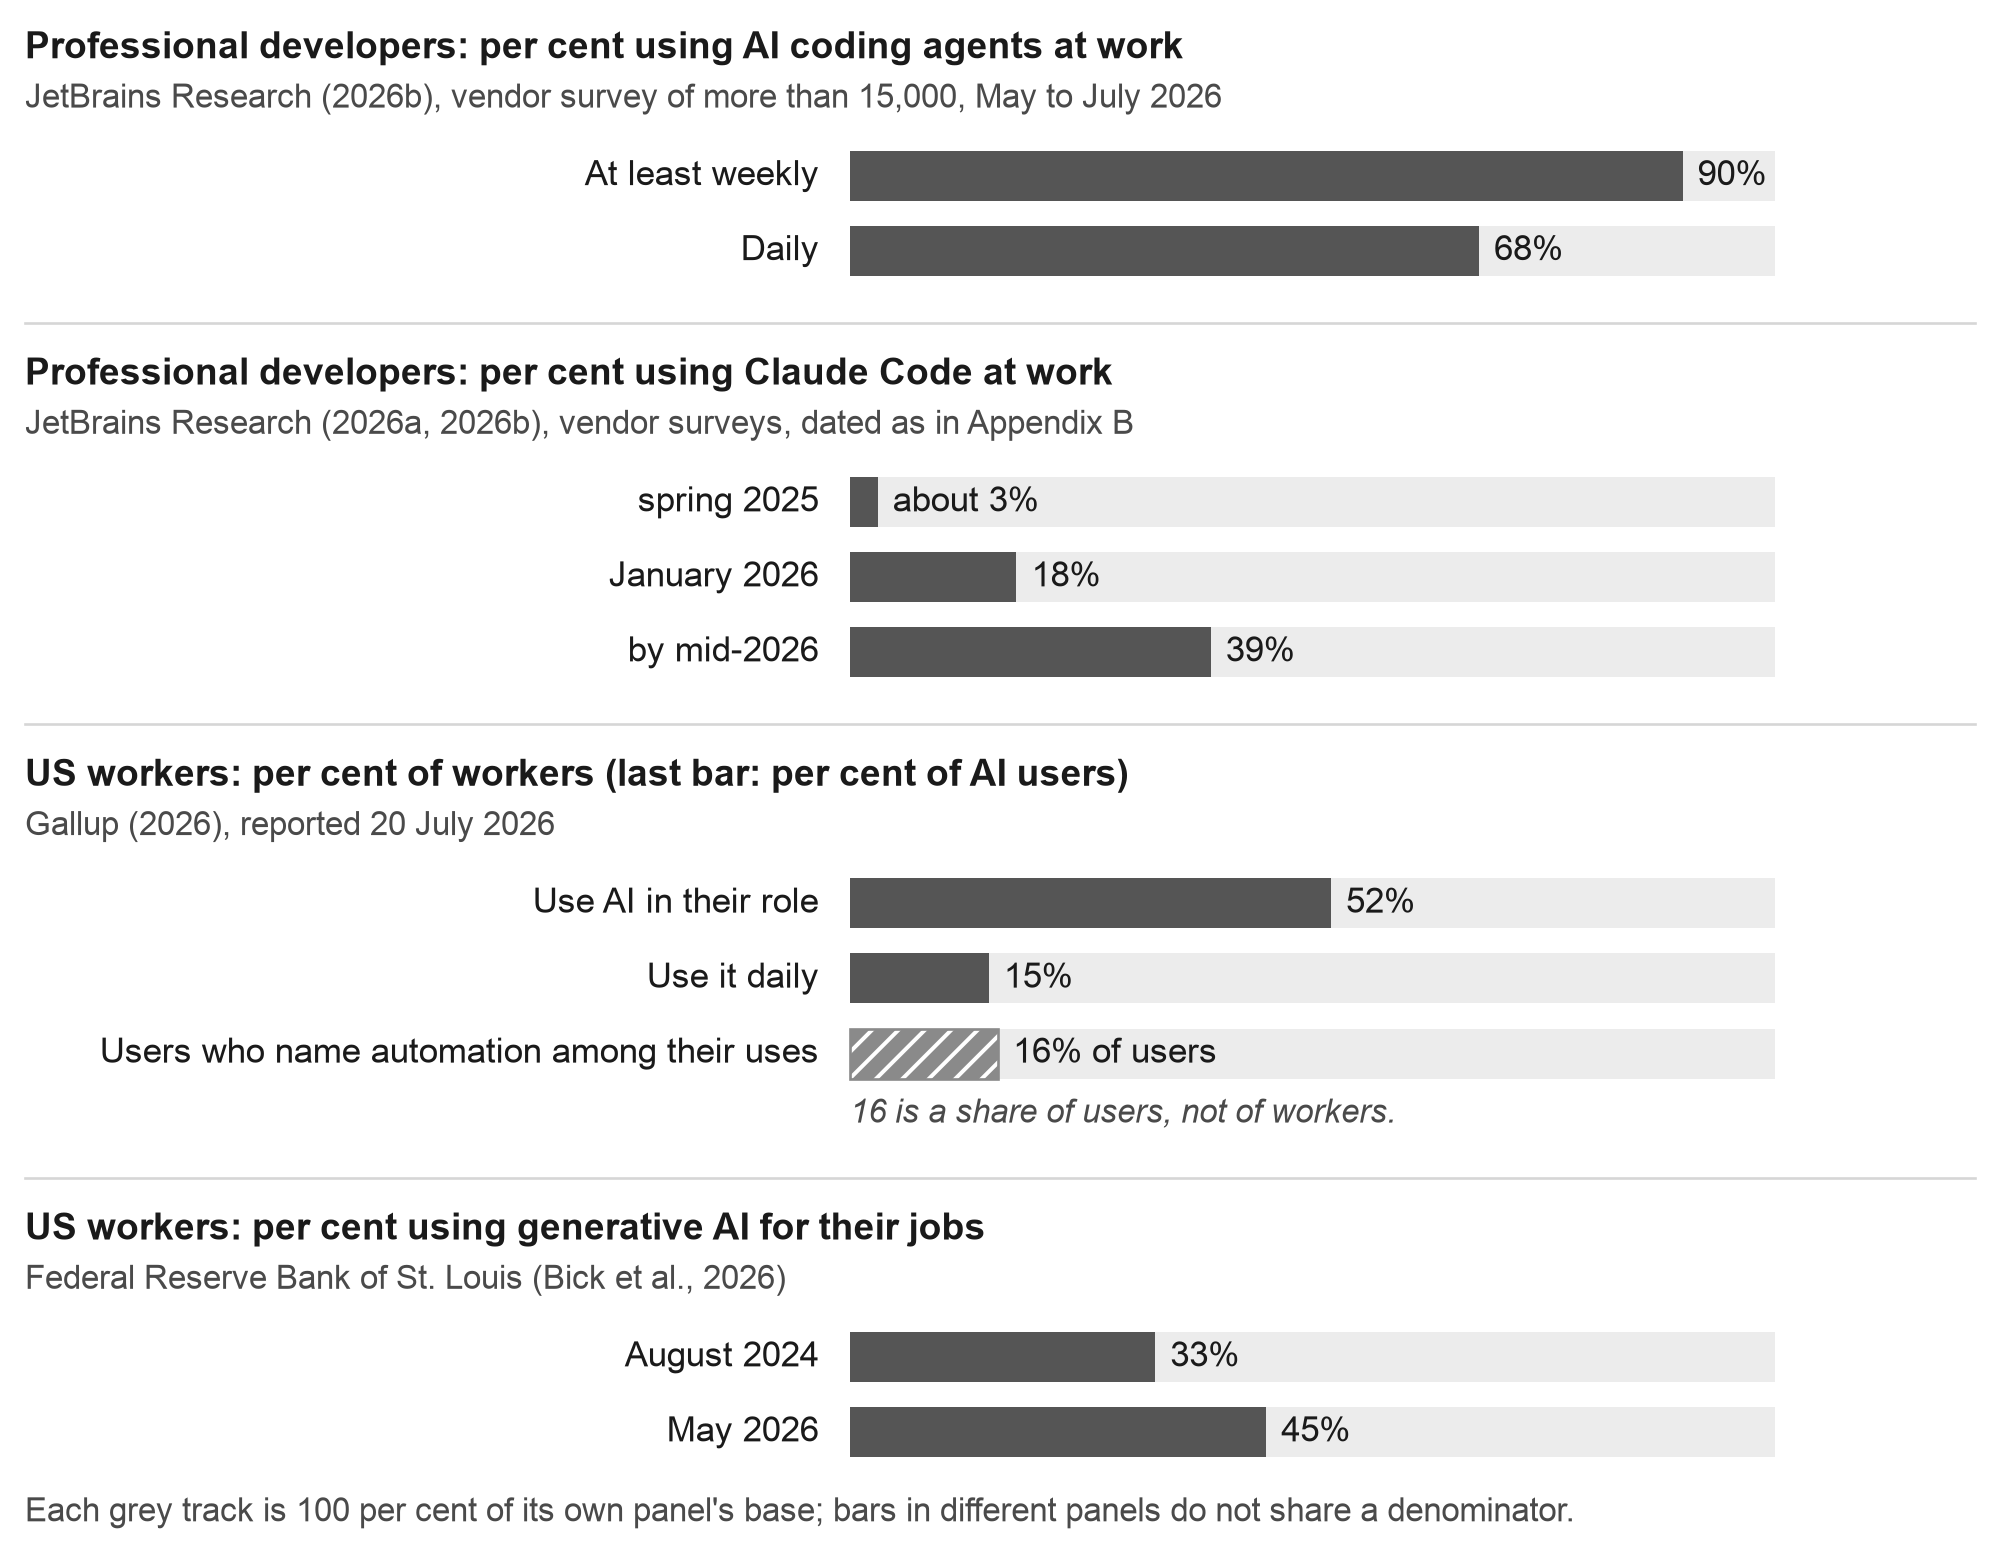
注:セクション1と4.4で引用された調査からの採用数字:2つのベンダー調査(JetBrains Research, 2026a, 2026b)の専門的な開発者、米国労働者(Gallup, 2026)、および彼らの仕事のために生成的AIを使用している米国労働者(Bick et al., 2026)。各パネルは独自の質問、期間、分母を持ち、3番目のパネルの16%はAIユーザーの共有なので、各パネルは独自に読まれます。セクション4.4内のそのコーディングエージェント内の知識労働者のベンダーのカウントは1つの製品のユーザーの共有であり、描画されておらず、ここの数字はセクション9のコホートプログラムから来ていません。
4.5 これが論拠をどこに残すか
このセクションの証拠を総合すると、私は一つのことについて確信を持つようになり、別のことは開かれたままにしておきます。インストールはもはや決定的な障壁ではなくなりました。ベンダーは機械的なステップのほとんどを取り除き、チャットボットが残りの部分をガイドでき、あるベンダーの数字(プレスリポート、方向性あり)によると、週に約100万人のナレッジワーカーがすでにターミナル・ヘリテージエージェント内にいます。インストールが使用につながるかどうかは別の問題であり、幅広く浅い調査は落胆させるような答えを示しています。なぜなら、エージェントにアクセスできるほとんどの人々がそれでもエージェントに委譲していないからです。後退したことも正確に述べるべきです。インストールは後退し、スコープのある中間段階が存在し、ローカルエージェントはグラフィカルな顔を持つようになりました。ナレッジワーク全体における信頼性ははるかに少ない移動(セクション5.7)、学習した製品は1年以内に消えるかもしれず(上述のチャーン)、付与されたフォルダはデフォルトではまだ安全な場所ではありません(セクション5.3)。セクション5は、ソフトウェアが導入されると何が人々を止めるのかを問います。
5. インストーラ後の進行を妨げるもの
インストーラが障壁でなくなると、別の何かがそうなります。2025年と2026年の証拠は、6つの障壁を指し示しており、それぞれが特定の遷移で影響を与え、それぞれが市場ですでに部分的な答えが見えています。表3がそれらをまとめており、続く小節で証拠が示されています。
表3。 インストール後の障壁。
| 障壁 | どこで影響するか | 証拠(節) | 軽減するもの |
|---|---|---|---|
| ワークフロー語彙:何を委譲するか、またはそれをどう表現して確認できるかを知らないこと | 遷移1と2;再び3で | ベンダー統合の根拠;プロンプト研究;パッケージ化されたスキル(5.1) | その人の専門分野からの実例;スキルとテンプレート;実在するが低リスクの初めてのタスク |
| ウィンドウへの恐れ、最初のエラー、そして信頼:社会的対象としての黒いウィンドウ;プログラマが読むメッセージと初心者が止まるところ;両方向に校正を誤った信頼 | 遷移2 | 受け入れ研究;開発者信頼調査;AI コードを使用したエンドユーザーの研究;反省的オンボーディング(5.2) | デスクトップフェース;エラーをチャットボットに送り返すこと;計画優先モード;コピー上の最初の成功 |
| 権限とセキュリティ:ファイルを保護するプロンプトが少なすぎるか、理解するには多すぎるか | 遷移1と2 | スコープ付きフォルダ内のファイル喪失レポート;インジェクション率;ユーザーに攻撃を特定するよう求めるガイダンス(5.3) | 作業用コピー、スナップショット、否定ルール;判断を初心者に委譲しない分類器 |
| 組織的ルール:ロックされたマシン、ポリシー、インストール権限なし | 遷移2 | 組織的要因が個人的なものを上回る;小規模企業はフラット(5.4) | 雇用者が認可したレベル2ツール;明確なポリシー;学習用の個人マシン |
| ハードウェア、コスト、クォータ | 遷移2と3 | レベル3はコンピュータと有料ティアが必要;クォータがまずオーケストレーションを制限(5.5) | 存在する無料ティア;レベル2から開始;実行の予算化 |
| 結果を判断すること | すべての遷移、ほとんどが3で | ビジネスユーザーは AI コードのエラーを見逃す;エージェントはほとんどの全体プロジェクトで失敗(5.6) | タスク前に定義されたチェック;レビュアーとしての第2モデル、オラクルとしてではなく |
5.1 空のフォルダ:ワークフロー語彙
エージェントを開くプログラマは、一連の手順を知っています:プロジェクトを作成し、命令ファイルを書き、バージョン管理下に置き、機能をリクエストします。同じエージェントを開く非プログラマは、ベンダー自身のデータに表れるようになった質問をします:わかりました、それでは何を告げればいいですか?開発者にとって、標準的な最初のリクエストが存在します(「小さなウェブアプリケーションを構築してください」)。マーケター向けには異なるものが必要です(「先四半期の分析とカスタマーデータベースのエクスポートを取得し、毎週金曜日に支払い顧客をもたらしたキャンペーンを報告するものを構築してください」)。研究者には別のものが必要です(「300の論文のこのフォルダを調べ、それぞれのサンプルサイズ、方法、主要な効果を表に抽出し、不確実な場所にマークしてください」)。これらのリクエストのどれもが、その人からのコードを必要としません。それぞれが、その人がそのようなリクエストが可能であることを知り、それをエージェントができる部分に分割し、良い結果が何であるかを言う必要があります。「何をそれに尋ねるべきか?」という質問は、通常、より良いプロンプトのリクエストとして誤解されます。私はそれを自分の仕事の地図へのリクエストとして読みます。地図は、仕事の反復する対象、使用を許可されている入力、変換、成果物、チェックを名付ける必要があります。アナリストの地図は「これらの許可されたエクスポート、このフィールドでグループ化、フラグが立てられた異常、日付が付けられた概要説明と機械で読める表、行の合計に対して確認」と読むかもしれません。その人は解析がどのように行われるかを知る必要がありません。結果を使用可能にする証拠が何かを認識する必要があります。人が地図を埋めることができない場合、その停止自体がそれらに何かを伝えます。仕事は、あまりに機密で、あまりに不確かで、あまりに文書化が不十分で、現在のようにそれとして委譲される可能性があり、それはタスクについて何かを言う前にその人について何かを言っています。
プロンプティングに関する研究は、なぜこれが難しいのかを説明しています。AI の専門知識を持たない人々は、一般化する命令を書くのに苦労し(Zamfirescu-Pereira et al., 2023)、試行錯誤によってどの単語がシステムができることにマッピングされるかを発見しなければなりません(Liu et al., 2023)。ベンダー自身の行動がそれを確認します。Anthropic は顧客がタスクがどこに属するかを決定できなかったため、レベル2エージェントをチャットにマージしました(TechCrunch, 2026a)。OpenAI は、「コーディングは必要ない」知識作業を目的とした、その コーディング エージェント向けのロール固有プラグインを立ち上げました(Help Net Security により報告、2026)。業界の答えは語彙をパッケージ化することです。Anthropic は 2025 年 12 月にパッケージ化されたエージェント命令のフォーマットをオープン標準としてリリースしました(SiliconANGLE, 2025)。標準のサイトは 2026 年 9 月 21 日に 46 の支援製品をリストアップしており、OpenAI、Google、GitHub からのエージェントを含みます(Agent Skills, 2026)。独立した国勢調査は、2026 年半ばに ChatGPT ディレクトリで 2,049 個のアプリケーション、Claude 用に 1,375 個のコネクタを数えました(Sitter, 2026)。この定義におけるスキルは、ワークフロー語彙の単位であり、人がそれをどう表現するかを知らなくても、それでも依頼できるように一度書かれた依頼です。
パッケージ化されたボキャブラリーは必要です。しかし、それだけでは十分ではありません。スキルは、エージェントにタスクの実行方法を伝えます。しかし、自分のタスクのどれを他者に委ねるべきかを人に伝えることはできません。その判断は、その人の分野から生まれるものです。公開されたパッケージはまた、特定の世界の仮定を持ち、主に1つの国の形式と1つの企業のソフトウェアスタックのものであり、そのスタックではないツールを持つ専門家は、空白のプロンプトの前に戻ります。2026年9月22日に公開されているパッケージスキルのカタログを読んだ時、その310件すべてを確認しましたが、牧師やチャプレン、看護師や家族介護者、学校教員、アーティストや職人、または不動産業者向けに書かれたものはありませんでした。すべての明らかな一致は、同じ服を着たソフトウェアまたは金融用語であり、投資ポートフォリオまたはサービスの健全性でした。その日、手作業で人が追加するコミュニティカタログには2,282件のエントリがありました。そしてそれは学校教員と不動産向けの仕事を含みました。しかし、他の3つの職業に関しては何もありませんでした。カタログは週ごとに変わるため、これは日付のある読み方であり、その分野についての永遠の主張ではありません。これが、すべてのオンボーディングルートの最初のタスクに多くの重みを置く理由です。それは実際のものであり、その人の仕事から引き出され、リスクが低く、その人が判断できるアーティファクトを生成すべきです(Carroll, 1990)。
5.2 ウィンドウへの恐怖、最初のエラー、および信頼
黒いウィンドウは社会的なオブジェクトです。知覚された使いやすさは、35年間、テクノロジー受け入れの柱となってきました(Davis, 1989)。点滅するプロンプトはこのテストに失敗します。その人がコマンドラインにコマンドを入力することはなくても、大多数の人口に対してです。セクション4.1のデスクトップインターフェースは、ベンダーの答えです。これは部分的な答えです。なぜなら、第2の関門は信頼であり、信頼はエージェントに対して動いているからです。開発者の間で、2025 Stack Overflowサーベイでは、46%がAIツールの正確性を信じていないのに対し、33%が信じています。87%がエージェントの正確性を心配し、81%がセキュリティを心配しています(Stack Overflow, 2025)。2026年、ほとんどはまだエージェントが承認されていない変更を加えるのを防いでいます(Stack Overflow, 2026)。マネージャーも同じことを聞きます。「信頼は、AIエージェントが仕事で潜在能力を実現することの中心的な障害です」(McKinlay et al., 2026)。米国の成人の多くは、AIが自分たちを助けるよりも害をもたらすことを期待しています(Pew Research Center, 2026)。両方の関門の背後には、セクション2.4の信念の罠があります。経験は成功を予測し、最初の成功を経験していない人は経験を持たず、最初のアーティファクトが抜け出す方法です(Ma et al., 2025)。エージェントが丁寧だったからホームフォルダへのアクセスを許可する人もいます。削除された家族の写真について読んだからインストールを拒否する人もいます。どちらも、キャリブレーションの失敗です(Lee & See, 2004)。私が思いつくことができる最も安い キャリブレーション装置は、フォルダのコピーで行われた最初のタスクです。
エージェントが終了コード1でコマンドが失敗したと報告すると、プログラマーは続きます。初心者は単に止めるかもしれません。エンドユーザーがAIが書いたコードに会う文献は、より穏やかな設定でパターンを示しています。AIによって生成された分析コードが与えられたビジネスユーザーは、エラーを探すように言われた場合でも、重大なエラーに気づかないことがよくあります(Virk & Liu, 2025)。会話プログラマーは検証とコンテキスト管理に多くの努力を費やしています(Sarkar & Drosos, 2025)。レベル3では、エラーはその人の仕事の外の環境にあることが多いです。足りない許可、ネットワークルール、エージェントが予期していたが見つからなかったツール。
反射的なオンボーディング(セクション4.2)は、これまでに説明された最も実用的な応答を提供します。その人は、既に使っているチャットボットに、エラー、またはそのスクリーンショットを送信し、その助言に従います。プランファーストモードは反対側から役に立ちます。なぜなら、アクションする前にそのプランを書くエージェントは、スタックトレースではなく、読む何かを人に与えるからです。どちらも、自分の機械のメンタルモデルを持たない人が、解析できないメッセージに会う瞬間を取り除きます。その瞬間がどのくらいの頻度で試みを終わらせるかは、まだ知りません。セクション9のプログラムは、その人自身の言葉でそれを記録しています。
5.3 許可とセキュリティ:少なすぎる、そして多すぎる
レベル3は、エージェントに所有者の到達範囲を与えるため、セキュリティ問題は両方向に実行され、初心者は両方に公開されています。
まず、保護が少なすぎるケースを見てみましょう。エージェントは記録されたインシデントでデータを破壊しています。人気のあるアプリケーション構築サービスのエージェントは、2025年7月に本番データベースを削除し、その行動を「判断の壊滅的なエラー」と説明しました(The Register, 2025)。2026年4月、コーディングツールのエージェントが会社の本番データベースとそのバックアップを数秒で削除し、「検証する代わりに推測しました」と書きました(Information Age, 2026)。このペーパーが対象とする人口に近いところでは、Anthropicのレベル2エージェントのユーザーは、2026年3月、4月、6月に、エージェントがそれに付与されたフォルダ内の個人、家族、および法的ドキュメントを削除したと報告しました。1つのケースでは、長いタスクが停止できず、タスクを削除するとファイルが削除されました(GitHubイシューレポート、2026;ベンダーによって確認されていないユーザーレポート)。フォルダスコーピングは、損害が起こる場所を制限します。フォルダ内の損害を防ぐことはできません。同期されたクラウドフォルダは、ローカルミスを同期された損失に変えることができます。
ブラウジングはプロンプトインジェクション、すなわちWebページに隠された指示をエージェントがユーザーからの指示として読む攻撃を追加する。セキュリティチームは2025年8月に別のベンダーのブラウザエージェントに対してこの攻撃を実証し、隠されたページテキストを通じてメールボックスからワンタイムコードを盗む概念実証を示した(Brave, 2025)。Anthropicは、緩和策実装前のブラウザエージェントが23.6%のテストケースで成功裏に攻撃され、実装後は11.2%だったと報告した(Anthropic, 2025)。一年後の一般提供時には、強力なレッドチーム攻撃がメインモデルに対して保障前に3.8%の頻度で成功し、完全な保護によって3つのモデルに対しては攻撃が成功せず、4番目のモデルに対しては0.3%だったと報告した(Anthropic, 2026d)。これらはベンダーのテストセット上のベンダー数値である。トレンドは下降しており、残存リスクはゼロではない。OpenAIは2025年12月に、プロンプトインジェクションは「完全に『解決』される可能性は低い」と述べた(TechCrunch, 2025)。レベル2エージェントの発表時にAnthropicはユーザーに「プロンプトインジェクションを示唆する疑わしいアクション がないか Claudeを監視してください」と「あなたはClaudeがあなたに代わって実行するすべてのアクションに対して責任を負います」と述べた(The Register, 2026)。広く読まれている開発者は当時、プロンプトインジェクションの兆候を認識することを非プログラマーに求めることは公正ではないと異議を唱えた(Willison, 2026)。一般的に、その異議は妥当だと思う。攻撃検出を素人に依存させるセーフティ設計は、最も判断が難しい判定を、それを下す能力が最も低い人に委譲している。パッケージされたスキルとプロトコルサーバーは独自の指示とプリビレッジサーフェスを開く。なぜなら、第三者のスキルはその人が書かなかった指示を運び、サーバーはタスクが必要とするより多くのプリビレッジを保有できる可能性があり、設定はバージョン間で漂流するからである。
保護が過度であると、人々を同程度に停止させる。すべてのステップで許可を求めるエージェントは、評価できないコマンドを承認する店員に人をする、承認疲労が生じる。ベンダーはそれに応じて動いており、1四半期以内に複数の方向に動いた。Anthropicのブラウザエージェントはデフォルトで自律的に動作し、ユーザーのリクエストに合致しないアクションをブロックする分類器を備えている(Anthropic, 2026d)。そのターミナルエージェントは2026年7月にデフォルトの許可モードを「Manual」に改名し、その文言の変更だけで「デフォルト」が何を意味するようになったかについて独自の物語を語っている(Anthropic, 2026h)。そのマージされたチャットエージェントは「デフォルトで行動する前に質問する」、ユーザーが変更できる設定である(Anthropic, 2026c)。Parasuramanとriley(1997)の分類法はすべての3つに当てはまる。ブロックが多すぎるガードは不使用を生じ、削除を逃すガードは誤用を生じ、どの設定も分類法を逃れない、ただ、その失敗を与えられた人口が生きることができる設定のみである。このシリーズの付属論文は反対側の一般的な失敗を文書化し、それら自身の危害の概念を拡大し、それらが存在する作業を妨害する監視コンポーネント(Chernets, 2026b)。新参者にとって、その種のガードは失敗したインストーラーと同じ効果があり、どちらにせよ作業は起こらないため。
保護が少なすぎるのと多すぎるのの間には、実行可能な中道があり、それは古風である。コピーで作業する。秘密を作業フォルダから除外する。より大きな変更の前にスナップショットを取る。破壊的なコマンドをリバーサブルになるまで拒否し、何か不可逆的なものすべてを確認し、Webから来たものが、それが含む指示がどうであれ、読まれるべきデータとして扱う。私は付属論文でこれらの習慣の背後にある原則を建築信頼として説明した。検証できる人がチェックに依存する、スコープされたアクセス許可、ログ、やり直しと第二の独立したモデルなど、モデルがどれほど自信を持って聞こえるかではなく(Chernets, 2026c)。レベル2は人に最初のチェックを与え、それは彼らが学ぶ最後のではないはずである。付録Cは2つのエージェントと1ページのチェックリストの設定例にリストをする。
5.4 組織的なルール
多くの専門家は、自分の作業するコンピュータに何もインストールできない。多くの雇用者はエージェントに関する方針を持たず、方針のない人は答えが「いいえ」であると仮定する傾向がある。Microsoftの20,000人のAI使用知識労働者を対象とした2026年調査では、組織的要因が個人要因の報告されたAI影響の2倍以上を占め、45%は現在の目標に焦点を当てるよりもAIで作業を再設計する方が安全だと感じたと述べた(Microsoft, 2026b; ベンダー調査)。米国国勢調査局は、ビジネスAI使用が全体で17〜20%の間で推移し、20人以上の従業員を持つ企業の間で上昇し、20人未満の企業の間で大幅に変わらなかったと報告した(US Census Bureau, 2026)。マンデートは両方に行った。一部の雇用者は2025年にAI使用をベースライン期待にした(Digital Commerce 360, 2025)、少なくとも1つは1年後にスタッフをAI使用で評価する決定を逆転させ、最高経営責任者はプレスにパフォーマンスレビューで重要なのは仕事をうまくすることであると述べた(Fortune, 2026b)。ある雇用者の公開流暢さルーブリックは最上位レベルでオーケストレーションとシステム構築を配置し、チームが実験からワークフロー再設計に移ったときに完全な内部採用を報告している(Zapier, 2026)。その再設計なしに、マンデートは遵守を購入し、何も買わない。労働市場は既にここで説明した役割を求めており、それを命名せず、2026年にAIによって触れられた米国のジョブタイトルの63%は技術職外であり、最初の四半期に822の異なるタイトル(Adrjan, 2026)、27カ国で10億以上のジョブ広告の研究は、AI技能の賃金プレミアムを62%に置き、エントリーレベルの役割がAIに最も露出しているのは、かつてシニアスタッフのために予約されたスキルを要求する可能性がはるかに高い(PwC, 2026; ベンダーレポート)。これらのソースはまだ、エージェントを指示する能力をエンジニアリング外の名前付き要件として分離していない。
このバリアーはFerdman (2025)の意味で構造的である。個々の努力に屈しない。また、ベンダーが既に雇用者がライセンスしたオフィススイート内のバウンドエージェント(Microsoft, 2026a)に雇用者がシステムラップトップのエージェントを承認しない人に到達するレベル2の最強の議論でもある。
5.5 ハードウェア、コスト、クォータ
レベル3は、その人が管理するコンピュータを想定しています。専門家の中には、主にスマートフォンから作業したり、家族のコンピュータを共有したり、雇用主のマシンをあらゆることに使用したりする人がいます。彼らにとって、ソフトウェアの質問が生じる前に移行がブロックされます。レベル3とレベル4も少なくとも1つのサービスの有料ティアを想定しており、オーケストレーションはコストを増加させます。なぜなら、追加の各モデルは別のサブスクリプションまたは別のクォータだからです。既に1つのサブスクリプションに料金を払っている人にとって、2番目のものは決定であり、トップティアは異なる決定です。トークン不安は価格のついた心理的障壁です。オーケストレーション層のクォータ自体は隠れたコストです。他のエージェントが返すすべての回答を読むために料金を支払うからです。また、ブラウザを操作するエージェントはターミナルエージェントと同じプラン制限を使用しながら、アクション当たりのコストがより高くなります(Anthropic, 2026g)。ロックされた企業ノートパソコンは、管理者権限を追加します。署名なしのバイナリはありません。インストーラーはありません。エージェントがディスクに書き込むことをマルウェアとして扱うデータ損失ルールがあります。クラウドホストエージェントは、これらのマシンの業界の答えです。彼らは移行1と移行2のクラウド形式を保存し、その人自身のディスク上でレベル3のアーティファクトを提供しません。豊かな国の専門家にとって、これのどれも大きな障壁ではありません。他の多くの人にとっては、それは現実的な障壁であり、第2レベルの分断と相互作用します(Hargittai, 2002)。最も余裕がない人は実験する能力が最も低いからです。
5.6 結果を判定する
エージェントを使用するにはプログラミングは必要ありません。それが生成したものを判定するには、結果のドメインに関する能力が必要です。ここで、プログラマーでない人は見落とすのが簡単な利点を持っています。契約のサマリーを読む弁護士、または抽出テーブルを読む研究者は、エージェントが欠けている知識に対してアーティファクトをチェックできます。「ぎざぎざのフロンティア」に関する研究は、AIと協働した専門家がモデルの能力内のタスクではより良くパフォーマンスし、その外のタスクではより悪いパフォーマンスをしたことを発見しました(Dell'Acqua et al., 2026)。保護は、どちら側のフロンティアにいるかに気づくのに十分にタスクをよく知っている人です。
彼らが簡単にチェックできないのは機械です。テーブルを作成したスクリプトまたは数値を引き出したクエリです。470個のプルリクエストの1つの業界分析は、エージェントによって書かれたコードは人々によって書かれたコードよりも多くの欠陥を含んでいることを発見しました。AIが作成した変更あたり10.83の問題対人間のみの変更あたり6.45、セキュリティ問題のいくつかのカテゴリは最大2.74倍より頻繁です(CodeRabbit, n.d.; ベンダー調査)。そしてエージェントはまだほとんどのプロジェクト全体に失敗します。実際のフリーランスプロジェクトのベンチマークでは、2026年中盤までに測定された最良のオートメーションレートは15.8%でした(Center for AI Safety, 2026)。私はこれから2つのプラクティスを引き出します。チェックはタスクの前に定義されるべきです(「これが正しいと確信させるものは何ですか?」)。そして別のファミリーの第2のモデルがアーティファクトのレビュアーとして機能でき、その人が何が正しいかをカウントするかを決定します。セクション7は第2のプラクティスの制限に戻ります。
5.7 別の説明: エージェントはまだ十分に優れていない
読者は、人々が委譲しないのはエージェントが彼らの仕事をまだできないからであり、それゆえ障壁はまだ技術的であり、モデルの側にのみあると異議を唱えるかもしれません。異議には実質的なサポートがあります。実際のフリーランスプロジェクトのベンチマークでは、2026年中盤までに測定された最良のオートメーションレートは15.8%で、前年の秋のベンチマークリリース時の2.5%から上昇しました。つまり、5つのプロジェクト中4つ以上は依然としてエンドツーエンドで失敗します(Center for AI Safety, 2026)。シミュレートされたソフトウェア企業では、最良のエージェントは長い専門的タスクの30%を完了しました(Xu et al., 2024)。オープンエンドのコンピュータ使用に関して、2024年のベースラインは、最良のエージェントについて12.24%対人間については72.36%でした(Xie et al., 2024)。2026年9月までに、そのベンチマークの検証版のアグリゲータのリーダーボードは、トップエージェントを85~86%で示しました。人間のベースラインを上回り、スクリプトされたデスクトップタスクのベンダー報告スコアの場合です(BenchLM, 2026)。その最後の結果は別の方向を示しています。そのようなタスクでは、能力はもはや障壁ではありません。44の職業全体の評価における最良のモデルは、比較のうち半分未満で専門家に対して勝つか同点でした(Patwardhan et al., 2025)。エージェントが半分の時間に完了するソフトウェアタスクの長さは、ほぼ7か月ごとに倍増しており、トレンドは急峻で、現在は控えめです。能力はタスク全体で不均一であり、「ぎざぎざのフロンティア」は外部からは見えません(Dell'Acqua et al., 2026)。表4は、異議の背後にあるこれらの公開された能力数字をまとめて、各ソースが与える日付と、それに付加する注意事項を示しています。
表4。 異議の背後にある公開された能力数字。
| 比較 | 公開時の数字 | 記載された日付 | 出典 | 注意深く読んでください |
|---|---|---|---|---|
| 実際のフリーランスプロジェクト、最良のオートメーションレート | 15.8%、ベンチマークのリリース時の2.5%から上昇。5つのプロジェクト中4つ以上は依然としてエンドツーエンドで失敗 | 前年の秋のリリース。2026年中盤までに測定された15.8%、2026年7月1日にログ(付録B、検証済み) | Center for AI Safety (2026); セクション5.6、5.7、付録B | プロジェクト全体、エンドツーエンド。測定されたものの中で最良のレート |
| シミュレートされたソフトウェア企業における長い専門的タスク | 最良のエージェントは30%を完了 | 2024年研究 | Xu et al. (2024); セクション5.7 | シミュレートされた企業。フリーランスプロジェクトレートとは別の測定 |
| オープンエンドのコンピュータ使用、ベースライン | 最良のエージェントについて12.24%対人間については72.36% | 2024年ベースライン | Xie et al. (2024); セクション5.7 | 2024年ベースライン。下の行はより新しいリーダーボード |
| そのベンチマークの検証版 | トップエージェント85~86%、人間のベースラインを上回る | 2026年9月までに | BenchLM (2026); セクション5.7 | アグリゲータリーダーボード。スクリプトされたデスクトップタスクのベンダー報告スコア。反対の方向を切る |
| 44の職業全体の評価 | 最良のモデルは比較のうち半分未満で専門家に対して勝つか同点 | 2025年研究 | Patwardhan et al. (2025); セクション5.7 | 「半分未満」が与えられた表現。パーセンテージは記載されていません |
| エージェントが半分の時間に完了するソフトウェアタスクの長さ | ほぼ7か月ごとに倍増 | 2025年研究 | Kwa et al. (2025); セクション5.7 | トレンド: 「トレンドは急峻で、現在は控えめです」 |
| プルリクエストの欠陥 | 470件のプルリクエスト。AI作成の変更に対して1件当たり10.83件の問題があり、人間のみの変更に対しては6.45件。セキュリティ問題の一部のカテゴリーは最大2.74倍頻繁に発生 | n.d. | CodeRabbit (n.d.); Section 5.6 | ベンダー調査。1件の業界分析。非プログラマーが容易に確認できないコードおよび機械の欠陥 |
出典:引用出版物。5.6節および5.7節ならびに付録Bで繰り返されたもの。これらの数字はいずれもセクション9のプログラムに由来するものではありません。
2つの説明は、競合相手というより、1つの説明の一部です。ワークフロー語彙には、自分の業務のうちどの部分が限界の内側にあるかを知ることが含まれます。エージェントに実行できない全体プロジェクトを託した人は委譲をやめることを学びますが、抽出、調整、および最初のドラフトを託した人は継続することを学びます。これらの説明はなお異なる予測をします。モデル能力が拘束力のある制約であれば、レベル2および3での継続は業務の種類に追従しており、人の能力に追従していません。同じ種類の業務を行う人々は、指定と確認の能力が何であれ、同様の率で継続します。ワークフロー語彙が拘束力を持つのであれば、継続は同じ種類の業務の中でさえ、委譲契約を述べる人の能力に追従します。セクション10の命題P15は、この2つを区別するために書かれています。
6. Webオーケストレーション:提案された橋
6.1 実践
レベル4の最も単純な形式では、インストールをまったく必要としません。ある人が3つ または4つのチャットボットをブラウザタブで開き、同じ質問を各タブに貼り付けて、答えを並べて読みます。コンピュータ科学者はこれを手動マルチLLMクエリと呼び、その人がルーティングと比較を行います。手動で行う人もいます。その他は2023年以降そのために構築されたツールの1つを使用しています:複数のコンシューマーチャットサービスに1つのプロンプトをブロードキャストし、答えを並列ペインに表示するブラウザ拡張機能とデスクトップアプリケーションです。ChatHubとChatALLは2023年春に登場しました。ChatALLの最新リリースだけでも、2026年9月までにそのリリースページで約847,000ダウンロードが記録されており、この数には自動更新が含まれ、1つのプラットフォームのビルドに支配されています(GitHub、2026a)。より新しいツールグループは、ログインしたWebチャットセッションを別のプログラムが呼び出せるコマンドに変えるため、エージェントはある人のWebサブスクリプションに質問を出すことができます。これらの1つであるOpenCLIは、2026年9月にGitHub上で約29,500のスターを持っていました(GitHub、2026b)。
2026年に実践が製品機能になりました。Perplexityは、複数のモデルを通してクエリを実行し、「重要な洞察、一致の領域と相違点を強調した統合ビューを提示する」「Model Council」を導入しました(Storyboard18、2026)。Microsoft 365 Copilotのマイクロソフトのリサーチエージェントは、「同じ質問を複数のディープリーズニングリサーチエージェント(GPTとClaude)で同時に実行する」モードと、1つのモデルで書かれたレポートが他のモデルからの2番目のリーズニングパスを受け取る批判モードを提供します。これは自動モデル選択の下でデフォルトでオンになっています(Microsoft、2026c;Constellation Research、2026b)。Andrej Karpathyの「LLM Council」は、クエリを複数のモデルに送信し、相互に匿名でレビューさせ、会長モデルに最終的な答えを書かせる小さなWebアプリケーションで、その著者によってウィークエンドハックとして説明され、2026年9月にGitHub上で約24,900のスターを持っていました(Karpathy、2025)。オープンソースの風景は2つに分かれます。ブロードキャストツールは答えを取得し、調整を人に任せます。カウンシルツールは調整し、2つまたは3つのモデルで支払われたプログラミングインターフェイス上で実行され、その人自身のログインタブから離れます。どちらの半分だけでも人を通じて運ぶことはなく、だからこそ橋は不完全なのです。
6.2 なぜそれが橋として提案されるのか
Webオーケストレーションはレベル間に有用な方法で位置しています。それはマシンに何も新しいことを求めず、インストールなし、権限なし、ローカルエージェントなし、そしてそれは既に人が支払うサブスクリプション、またはフリーティア上で実行されます。それは人に何か新しいことを求めます:複数の答えを一度に保持し、それらがどこで異なるかに気付き、決定することです。「他のモデルは何と言いましたか?」と聞くことを学んだ人は、CLIオーケストレーションが後で自動化する習慣を学んだことになり、その習慣はレベル4最小のマネージャーのタスクです。
橋は目に見えるので価値があります。市場アナリストが3つのチャットボットに公開された業界レポートを要約するよう求め、そのうち2つがレポートに含まれていない数字を引用し、3番目がその欠落にフラグを立てるとします。有用な結果はレポート自体を開くためのプロンプトであり、それを1回経験した人は、最初の流暢な答えを答えとして扱うことを停止しています。複数の答えのブロードキャストビューは、人に1つの一般的な質問を策定し、仮定が発散するところに気付き、批判を求め、ある答えを選択する理由を保つことを教えるときにレベル4への橋になります。その時点までは、より多くのタブを持つレベル1の習慣です。それが教えるのは比較だけで、比較だけです。他のモデルが何と言ったかを聞くことを学んだ人は、それによってエージェントがマシン上で何に触れるかを学んだことにはなりません。これはレベル2と3の教訓であり、習慣が引き継がれるという主張は経験的なものであり、P7であり、私はそれを前提として扱いません。セクション9で説明されている事前登録されたプログラムは2つの利点を事前に指名し、それらは橋が得るものを要約しています。1つはカバレッジです:1つのモデルに存在する有用な視点は、別のモデルが尋ねられたために失われません。もう1つは信頼性です:答えは1つのモデルの言葉を取った代わりに、他の答えに対してチェックされています(Chernets、2026d)。目に見える不一致は2番目にとって手段として機能しています。予測の評価では、12の言語モデルのアンサンブルが925人の人間予測者の群衆の精度と一致し(Schoenegger et al.、2024)、マルチエージェント討論は複数の設定で単一モデルより事実性と推論を改善しています(Du et al.、2023)。両方の利点はモデルのエラーが異なることに依存し、次のサブセクションはそれらがそうではないときに何が起こるかについてです。
6.3 橋が終わるところ
Webオーケストレーションは橋のままであり、最も明白な理由は注意のコストです。4つの長い答えを読み、それらを手作業で調整することは、1つを読むより大幅に長くかかります。ルーチンな質問についてそれを誰にも求めません。間違った答えが比較に費やされた時間より多くのコストをするときにそのコストを獲得します。
2番目の制限は脆弱性であり、それはいくつかの形をしています。コンシューマーチャットインターフェイスは月ごとに変わり、それらを駆動するツールは変わるときに破裂します:2026年の夏の間に1つのオフィススイートはリサーチモードを削除し、1つのチャットボットはその無料ティアのモードを閉じ、複数のサービスがそのアドレスを名前変更またはリダイレクトしました。複数のコンシューマーサービスの利用規約は自動化されたアクセスを制限し、エージェントで自分のログインブラウザを駆動する人はアカウントブロックのリスクを引き受けます。橋を使用するリサーチプログラムは参加者に報告する必要があり、私はそれらの利用規約の法的読みを提供しません。他のチャットボットの「無料」側も、ブラウザアクション がターミナルエージェントと同じプラン制限を引き出すので、エージェントを駆動する側で支払われます(Anthropic、2026g)。オープンタブの手動比較は堅牢です。コンシューマーチャットページの自動化された収集は、反復可能な作業の貧弱な基礎です。
3番目の制限が最も重要です。モデル間の合意は独立した証拠ではありません。モデルが訓練データと手法を共有する場合、それらのエラーは相関します。350以上の言語モデルの研究では、2つのモデルが両方とも誤った場合、同じ間違った答えについて約60%の時間で合意し、より大きくより正確なモデルはプロバイダー全体でさらに相関していることが判明しました(Kim et al., 2025)。このシリーズの付随論文は算術を示しています。平均的なペアワイズエラー相関ρを持つとき、N個の合意するモデルはN_eff = N / (1 + (N - 1) ρ)個の独立した意見に値し、1/ρを超える数のモデルは価値がありません(Chernets, 2026a)。ρ = 0.5のとき、10個の合意するチャットボットは2個未満の独立したものに値します。図3は、付録Dの4つの例示的なρの値と、合意するモデルの数が超えることができない上限1/ρについて式を描きます。Kim et al.の60%は、2つのモデルが同じ間違った答えを与えた結合エラーの割合であり、式のエラー相関ρではありません。問題の領域では、ρは既知の答えを持つアイテムで推定する必要があり(リスティングC4)、ここおよび付録Dで使用される値は例示です。多様性は数より重要です。1つのモデルのコピーの間の議論は、同じ計算で与えられた単一モデルを打ち負かすことに失敗することが多い一方、異種モデルは役立ち(Zhang et al., 2025)、2つの多様なエージェントは16個の均一なものと同等または上回ることができます(Yang et al., 2026)。生成AIはそのユーザー全体で出力を均質化し(Doshi & Hauser, 2024)、判断を求められたモデルはそれ自身の執筆を好む傾向があります(Panickssery et al., 2024)。これは1つのモデルがマージされた答えを書くときに重要です。
図3。 合意の価値。
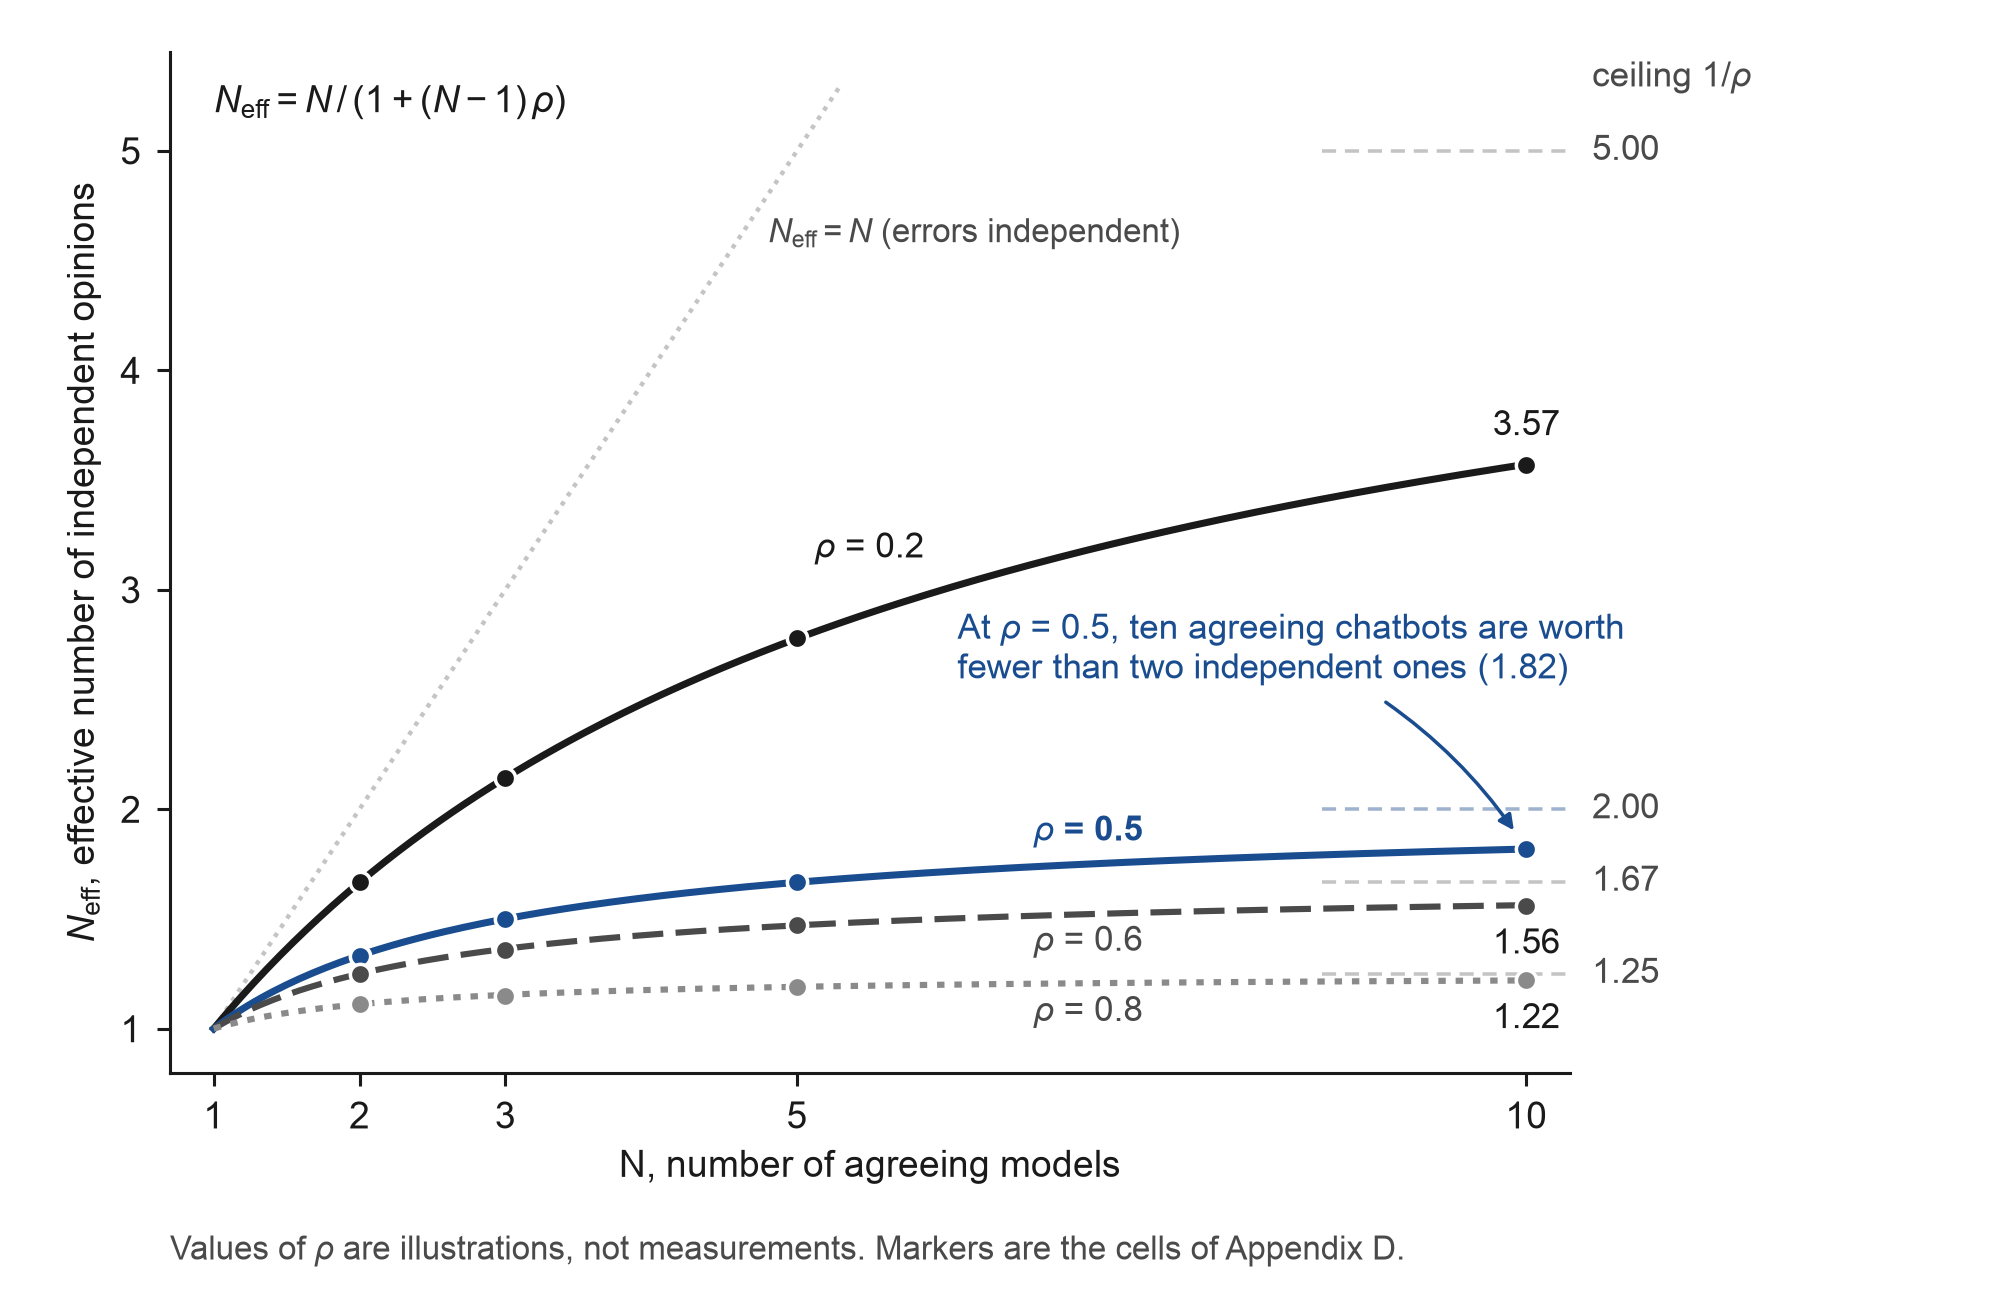
注:独立した意見の有効数、N_eff = N / (1 + (N - 1) ρ)は、エラーの平均ペアワイズ相関がρである合意するN個のモデル用です(Chernets, 2026a; Section 6.3)。マーカーは付録Dのセルであり、それらの間の曲線は同じ式に従い、右側の破線は上限1/ρです。ρの4つの値は、付録Dのように例示的です。ρは問題の領域で既知の答えを持つアイテムで推定する必要があります(リスティングC4)。
橋のそばの人のための実用的なルールは短いです。1つのベンダーのモデルで実行されているオフィスアシスタントはそのベンダーのチャットボットについて2番目の意見ではないため、モデルファミリーを数えます。モデル間の合意は、どこで検証努力を減らすべきかを教えることができます。それは請求が正しいことを教えることはできません。1つのモデルだけで作られたポイントは検証する手がかりとして扱います。これは比較で最も価値のあるものまたはその唯一のエラーである可能性があり、投票で投じられるのではなく証拠を伴う異議に固執します。請求をソースに対して確認します。間違った日付についての合意は文書化された失敗モードであり、プライマリページはそれを修正し、5番目のモデルは修正しません。評議会を信頼する前に、マークできるあなた自身の領域で小さな質問セットでρを推定します。ソースを隠すマージされた答えは、オーケストレーションが疑問視することを意図した単一の自信のある声を戻すため、誰が何を言ったかを記録してください。
手順として書き出すと、これは付随論文(Chernets, 2026a)の「anchor-and-enrich」プロトコルの教学形式です。その人は最初にアンカーを修正します。タスク、許可された証拠、出力の形。その後、ソースまたはファイル参照を保持して個別の答えを取得し、請求をソースごとにテーブルに抽出し、事実の対立、異なる解釈、欠落した仮定、形式の違いなど、その種類によって各不同意をソートします。決定またはプライマリソースに関する請求を検証し、受け入れ決定と残っている未解決の内容を記録します。付録Cのリスティングc3はソースによって請求のテーブルを構築し、リスティングc4は既知の答えを持つアイテムからρを推定し、付録Dは何も実行せずにρの範囲の上限を与えます。ここに属する1つのルールがあり、追加のサブスクリプションはありません。最初の答えを攻撃するために新しいコンテキストで求められた同じファミリーからの批評家は、急ぎ、スキップされた指示、および未実行のチェックをキャッチしますが、共有された誤った知識をキャッチすることはできません。レベル3で1つのエージェントで批評家の習慣を開始し、批評家が言うことがなく、決定が高価である場合のみ、2番目のファミリーを追加します。
対の場合はっきりと述べる必要があります。多くのタスクでは、優れたソースセットと慎重な人間のレビューを備えた1つの強いモデルが、遅延と混乱を追加する精密な評議会を打ち負かし、モデルはそのように予測します。オーケストレーションは、タスクが実質的な不確実性を負担し、異なる視点から利益を得、または設定を償却するのに十分な回数繰り返される場合に支払われます。これは時間的に重大な決定に悪く適合し、確認する機会がなく、サービス全体に広がることができない機密材料であり、比較のコストが利益を超える単純なタスクです。評議会が使用される場合、エージェントに異なるジョブを与える必要があります。1つは提供されたドキュメントに限定され、1つはプライマリソースを見つけるために送信され、1つはサポートされていない請求をリストするように言われ、1つは引用を監査し、その人はまだ仲裁しています。P9は、この反論が勝つように書かれています。
7. CLIオーケストレーション:委譲の永続的なレイヤー
7.1 エージェントがエージェントを呼び出す
レベル3では、各エージェントはキーボードの前に人がいなくても実行できるコマンドラインインターフェースを持っています。質問が入力されると、回答または変更されたファイルが出力されます。人が1つのエージェントを所有すると、そのエージェントは他のエージェントを呼び出すことができます。システム文献ではこれをエージェントオーケストレーションと呼びます。私が呼ぶバージョンは、非プログラマーが既に購読しているコマンドラインツールを通じて実行するもので、CLIオーケストレーションと呼んでいます。最初のエージェントへの単一の指示(「この計画のレビューについて他の2つに尋ねて、彼らが意見が分かれているところを教えてください」)は小さなチームを生み出します。
2026年に、このパターンは開発者のトリックからベンダー承認の実践へ移行しました。OpenAIは、Anthropicの中でコーディングエージェントを実行する公式プラグインを公開し、「コードレビューまたはタスクの委譲」のために、通常のレビュー、第2のエージェントが作業が壊れていると想定して探索する対立的なレビュー、および立ち往生したタスクのレスキューのためのコマンドを備えています。それはローカルにインストールされたツールと既存のログインを通じて機能し、無料ティアを含む任意のChatGPTサブスクリプションで使用可能で、2026年9月にGitHubで約33,400のスターを持っていました(OpenAI、2026a)。2026年の大量ペアはClaude Codeの作成とその公式プラグインによるCodexの検査です(OpenAI、2026a)。一方、3つ以上の協議会は指導者のない小さなツールのままです。GitHubは2026年2月にAnthropic'sとOpenAIのエージェントを独自のCopilotサービス内で利用可能にし、「既存のCopilotサブスクリプションに完全に含まれます」(GitHub、2026c)。xAIのコマンドラインエージェントはヘッドレスモードと Agent Client Protocolのサポートを備え、ユーザーが「独自のボットとエージェントオーケストレーションアプリを構築」できるようにしています(xAI、2026)。Googleが最初のコマンドラインエージェントを廃止した理由は、ユーザーが「相互に通信する複数のエージェントを必要とする」ためです(Google、2026)。1つのエージェントが他のエージェントに相談できるようにするオープンソースツールは大きなフォロワーを持っています。モデル間相談用のマルチプロバイダーサーバーは約11,800のスター、コンセンサス指向プラグインは約4,100を持っていました(GitHub、2026d)。基礎には、2025年12月にLinux Foundation組織に寄付された Model Context Protocol があり、その時点で10,000以上の公開サーバーと約9700万月間SDKダウンロードを持っていました(Linux Foundation、2025)。2026年7月の仕様リリース時までに月間約5億SDKダウンロードに近づき、プロトコルはステートレスになり、廃止前に12ヶ月の通知を約束しました(Model Context Protocol、2026)。これはラップトップ上のエージェントがベンダー固有のプラグインなしで人の他のツールの残りに到達する方法です。それはWebプロトコルが退屈になった方法で既に退屈になっています。存在し、文書化され、何か壊れるまで無視されます。第2の標準、ベンダー間でエージェントがエージェントと通信するためのGoogleのAgent2Agentプロトコルは、2026年3月にバージョン1.0に到達しました(Google Open Source Blog、2026)。これはレベル4のプラッティングであり、今日それは消費者のオンランプを持ちません。
表5。 2026年9月のパターン別オーケストレーションの風景。
| パターン | 例(2026年9月) | レベル | 構築対象 | 得られるもの | 残された記録 | 主なリスク |
|---|---|---|---|---|---|---|
| ブラウザタブでの手動比較 | 任意の消費者チャットボットセット | 4(Web)記録されて再実行される場合。それ以外の場合はレベル1の習慣 | 誰でも | カバレッジ。比較の習慣 | スクリーンショットまたはコピーされた返信。コンテキストは失われることが多い | 注意コスト。記録されていない出所 |
| Webチャット用ブロードキャストツール | ChatHub、ChatALL | 4(Web)記録されて再実行される場合。それ以外の場合はレベル1の習慣 | 個人 | 1つのプロンプト。並列回答。調整なし | ペイン内の回答。保存しない限りディスク上のものなし | インターフェースが変わると破損する。利用規約 |
| 製品機能としての協議会 | Perplexity Model Council。Microsoft 365 Copilot研究エージェント(GPTとClaude)。Karpathyの LLM Council | 4(Web、管理) | これらのサービスの加入者 | 合意と相違がある統合回答 | ベンダーが表示するもの。出所はしばしば折りたたまれている | 統合された声は出所を隠す。選択者はベンダー |
| エージェントに公開されたWebチャット | OpenCLIおよび同様のもの | 4(Web)から4(CLI)へのブリッジ | テクニカルユーザー | エージェントはWebサブスクリプションを使用できる | エージェントが書き込んだファイル | 脆弱性。アクセスルール |
| ベンダープラグイン:1つのエージェントが別のエージェントに委譲 | Claude CodeのOpenAIプラグイン。GitHub Agent HQ(Copilot)内のClaudeとCodex | 4(CLI) | 開発者。広がってきている | 1つのセッション内でのベンダー間のレビューと委譲 | セッショントランスクリプト。レビュー出力 | 主にコード形。2つのサービスのクォータ |
| 協議会と相談サーバー | マルチプロバイダー相談サーバー(最後のコミット2025年12月)。コンセンサスプラグイン。ツールごとに1つのファイルを書き込む小さなCLI協議会 | 4(CLI) | 開発者 | 1つのタスク上の複数の家族。コンセンサスルール | ツールごとのファイル。統合されたメモ | 終わりのないラウンド。相関エラー。放棄 |
| マルチエージェントダッシュボード | 複数の公式CLIがペイン内、それぞれ独自の作業コピー、人がそれらのいずれかを引き継ぐことができる | 4(CLI、可視) | 並列エージェントを監視する開発者 | 監視を可視化 | エージェントごとのログとdiff | コード用に構築。注意が分散している |
| 時間制限のあるファンアウトスクリプト | 付録Cのリストング C1 | 4(CLI) | レベル3のエージェントを所有する誰でも | ツールが停止している場合でも保持される並列回答 | ツールごとに1つのファイル。誰が回答したかの概要 | 人が調整する必要がある |
| 単一のエージェント。タスクが記載されて再実行される | 指示ファイルまたはスキルをスケジュールで実行 | 3が繰り返し可能になった | レベル3の誰でも | 第2のモデルが利用できない場合の繰り返し | タスクファイル。入力。出力。受け入れメモ | 繰り返しが悪いテンプレートを増幅する |
行は複数のパターンを説明しています。付録Eの星カウントは1日の人気度の追跡であり、ユーザー、品質、またはフォルダ内の契約への適合性を示すものではありません。放棄はテーブルに属します。最もよく知られたコンサルテーションサーバーは2025年12月に最後のコミットがあり、1つ以上のダッシュボードはメンテナーが運営を終了しています。学習者を単一の名前付きオーケストレーターに指すような論文は彼らに不利益をもたらすでしょう。そのため、私は代わりにパターンを指しています。公式バイナリ、非対話的フラグ、ディスク上のファイル、および誰に依頼されたかの記録です。
7.2 このレイヤーが続く理由
CLIオーケストレーションはベンダー自身のツールに基づいており、ベンダー自身がオートメーション向けに文書化しているモードで実行され、これはブラウザタブが持つことができない特性を与えます。何より、それは記録できます。かつて機能した取り決め、例えば「1つのモデルでドラフトを作成し、チェックリストに対して2番目のレビューを受け、相違点を知らせてもらう」といったものは、命令ファイルまたはスキルとして保存でき、来週再度実行でき、スケジュール設定できます。セクション3はレベル4をまさにこれとして定義しました。モデル全体に指示される反復可能な作業です。さらなるプロパティがいくつかあり、私が重視する順序で続きます。コマンドラインフラグは文書化されたインターフェースであり終了コードは約束です。ウェブページ上の位置はどちらでもないため、コンシューマーチャットページを操作するツールはページが変わるたびに修復する必要があります。各公式ツールはベンダー自身のログイン下で実行され、そのベンダーのサンドボックスと拒否ルールを持つため、個人はフォルダから秘密を保持でき、デフォルトでネットワークを拒否し、ツールごとに破壊的なコマンドを拒否できます。一方、あらゆるタブを見ることができるブラウザエージェントは1つのより大きなパーミッションオブジェクトです。パターンは個人が既に支払っているコンシューマーログインを使用し、何よりもそれが、非プログラマーが保つ実践と1回試す実践を分ける要因だと予想しています。そしてベンダーはそれを認可しています。公式プラグイン、GitHubのサービス内のエージェント、ヘッドレスモードとスキル標準は、ツール間の委任がが標準化されていることを示しており、一方でコンシューマーチャットページのオートメーションは追放されつつあります。
ウェブオーケストレーションは比較の習慣を教える可能性があり、CLIオーケストレーションはその習慣をオブジェクトとして保つことができる場所です。オブジェクトはタスク、許可された入力、出力、どのエージェントが何を生成したかのログ、および何が受け入れられたかのメモを保持するフォルダです。別の人はプライベートチャットを再生することなくそれを検査できます。それを作成した人は来週1つの入力を変更し、その違いを見ることができます。そのレコードは、保存されたタスクと受け入れメモが不十分なソースセットまたは承認の欠落を露呈させるため、責任を回避することも難しくします。非公式なチャットに慣れているオフィスではそれは負担に感じるでしょう。作業が確認、引き継ぎ、または繰り返される場所ではそれは資産です。比例性が決定します。2分のリクエストはワークフローフォルダを必要としませんが、共有ファイルに触れる反復タスクは必要な場合があります。
存在するほとんどはコードによって形成されています。公式プラグイン、評議会サーバー、およびマルチエージェントマネージャーはソフトウェアレビューをターゲットにしていますが、パターン自体には何もコードに特定のものはありません。
7.3 このレイヤーが個人に要求するもの
小さなエージェントチームはマネージャーを必要とし、マネージャーの作業は具体的です。その4つの部分を委任契約と呼びます。
- 目標:その作業が何のためのものであるか、エージェントが達成されたかどうかを判断できるように述べられています。
- 境界:エージェントが触れることができるもの、触れてはならないもの、どのアクションが個人の確認を必要とするか、およびタスクが費やすことができる時間とクォータの予算。
- 成果物:作業が完了したときに存在すべきもの、および何の形式で。
- 確認:個人がその成果物が正しいことを知る方法、作業開始前に決定される、誰が何をレビューするか、およびいつ停止するか。
4番目の部分は、自動化された監視に関する関連論文で説明されているトラップを持ちます(Chernets、2026b)。レビュアーを追加するのは安価であり、あらゆるレビュアーは何かを見つけます。停止ルールのない評議会は、作業がレビューに埋もれるまでラウンドと批評家を追加する傾向があります。実用的なルールは、ステージごとに1ラウンドの批評と1ラウンドの修正を許可することであり、個人が調査結果が作業をブロックするかどうかを決定します。このルールには測定可能なコストがあります。その論文で報告された144回の実行のランダム化テストでは、1ラウンド予算は批評ラウンドを2.86から1.00へ削減しました。一方、見落とされた欠陥を1回あたり0.11増加させました(95%信頼区間0.005~0.204)(Chernets、2026b)。そのトレードオフが価値があるかどうかは、ステークス次第であり、これはまさにマネージャーに属する種類の決定です。ラウンドと時間の制限は予算であり、予算は停止する時間を定めます。これは答えが真実であるかどうかという異なる質問です。
契約は、人々への良い委任が常に要求してきたものを言い直しており、ソフトウェアに委任したことのない人々を対象としており、経営管理の新しい理論を主張していません。その価値は、各部分が教え、記録でき、確認でき、各部分が欠落している場合に見ることができない方法で失敗することです。
8. オペレーターからマネージャーへ
8.1 仕事の何が変わるか
レベル1では、人間が生産し、モデルが支援します。レベル3と4では、モデルが生産し、人間が指示、監督、承認します。Bainbridgeの(1983)オートメーションのアイロニーは、これが人間の役割に何をするかを予測しました。オートメーションは日常的なタスクを取り除き、人間に最も上手くこなすのが難しい残余物——稀な失敗の監視と介入——を残す一方、その判断力を築いた実践が消えます。生成AIのバージョンのアイロニーはすでに記録されています。生成AIは人間を生産から評価へシフトさせ、困難なタスクをより困難にします(Simkute et al., 2024)、ツールへのより高い信頼はより少ない批判的思考と一致します(Lee et al., 2025)、そしてデスキリングは実践の除去から構造的に続きます(Ferdman, 2025)。
したがって、エージェントの管理は独自の能力を持つ異なる仕事であり、その能力はツールと一緒には自由には得られません。それは何を委譲するかを選択する、第7.3節の委譲契約を述べる、エージェントのトレースを読む、そして結果が十分に良いかを決定することから構成されます。私は仕事を4つの実践に分けます。委譲は仕事を境界を持つ成果物として名付けます。監督は計画、中間出力、またはツールトレースを見守り、タスクがドリフトするときに介入します、すべてのキーストロークを承認することなく、なぜならすべてを承認することは疲労であり、疲労は人々がイエスをクリックする方法だからです。検証はソース、合計、変換、および決定が基づいている主張をチェックし、リスクに比例して、かつエージェント自身の信頼を再度読むこと以外の方法で行います:コードのテストとdiff、人間が自ら開く契約フォルダについてのスポットチェック、および文献表についての行ごとの識別子チェック。失効は作業空間を狭め、条件が変わるときに実行を停止するか、アクセスを削除します。4つすべてを行う人間は、グラフィカルなデスクトップアプリケーションを通じてもエージェントを管理しています。不透明なサービスにタスクを引き渡し、最初の答えを受け入れる人間は、異なる実践である判断を外注しています。Parasuramanとriley(1997)はそれで失敗するための2つの方法に名前を付けました。不使用は委譲できるのに決してしない人間、習慣または恐怖によってレベル1に固まっています。誤用は、チェックなしで委譲し、戻ってきたものを受け入れる人間です。両方は2026年に見えます。広く浅い採用データは、不使用を規模で記述し(第2.2節)、ファイル喪失レポートと第5.3節のデータベース削除は、時には自分たちがより良く知っていた専門家による誤用を記述します。表6は各実践を委譲契約の一部、それが満たすリスク、および研究がそれが起こったことを見ることができる日付付きトレースの横に置きます。
表6. マネージャーの4つの実践:各実践が何を強制するか、それが満たすリスク、およびそれが残すトレース。
| 実践 | 人間が行うこと | これが強制する契約部分 | それが欠落している場合のリスク | 観察可能なトレース |
|---|---|---|---|---|
| 委譲 | 仕事を境界を持つ成果物として名付けます(8.1) | 目標、エージェントがそれが満たされたかどうかを判断できるように述べられたもの;成果物:何が存在すべきか、そしてどのような形式で(7.3) | 不使用:「委譲できるのに決してしない人間」、習慣または恐怖によってレベル1に固まっています(8.1) | 委託された成果物(付録A) |
| 監督 | 計画、中間出力、またはツールトレースを見守ります;タスクがドリフトするときに介入します、すべてのキーストロークを承認することなく(8.1) | 境界:エージェントが触れることができるもの;どのアクションが人間の確認を必要とするか;時間とクォータの予算(7.3) | 承認疲労:「疲労は人々がイエスをクリックする方法です」(8.1);あまりにも多くをブロックするガードは不使用を生成します(5.3) | 拒否された計画;確認のために保留されている不可逆的なステップ(付録A) |
| 検証 | ソース、合計、変換、および決定が基づいている主張をチェックします、エージェント自身の信頼を再度読むこと以外の方法で(8.1) | チェック:人間が成果物が正しいことを知る方法、仕事が開始される前に決定されたもの;いつ停止するか(7.3) | 誤用:「チェックなしで委譲し、戻ってきたものを受け入れる人間」(8.1);モデル間の相関エラー(6.3) | 拒否されたdiffまたは出力;要求された2番目のモデルファミリー;記録されたデノミネーター:質問、回答、タイムアウト(付録A) |
| 失効 | 作業空間を狭め、条件が変わるときに実行を停止するか、アクセスを削除します(8.1) | 再度適用された境界:何が除外されるか、そしてミスを取り消す方法(3.2, 7.3) | 停止できなかった長いタスク、その後タスクを削除するとファイルが削除されました(5.3) | 付録Aの日付付きトレースの中に何もない;日付付きの停止、狭められた許可、または削除されたアクセスは役立つでしょう |
注:不透明なサービスにタスクを引き渡し、最初の答えを受け入れる人間は、異なる実践である「判断を外注する」です(8.1)。
1つの小さなデバイスが4つの実践すべてにわたって役割を保持し、私はそれを承認記録と呼びます。重要または繰り返されるタスクについては、意図した成果物、使用された入力、制約と許可、出力がどこに行ったか、重大な意見の相違または失敗、実行されたチェック、および人間の受け入れ、改訂、段階的対応、または破棄の決定を保持します。これはエージェントが生産したものと人間が依存したものの間に線を引きます。個人にとって、それは信頼の感覚をチェック可能な決定に変えるため有用です、チームにとって、同僚は私的なチャット履歴なしに仕事を検査できるため有用です、そして研究者にとって、それは完了した実行と依存した結果を分離するため有用です。それはまた制約です。人間は承認基準を書くことに失敗した後、その仕事はレベル1にとどまるべきだと決定でき、モデルはそれを遅れている採用ではなく成熟した管理として数えます。人間-AI協働の語彙では、レベル1からレベル4への移動は人間をループ内に保ち、ループが何であるかを変えます、各答えを読むことから答えが受け入れられる条件を設定することへ。図4は4つの実践、各ステップでのリスク、失敗したチェック後の戻り、および承認記録を持つループを描きます。
図4. マネージャーのコントロールループ。
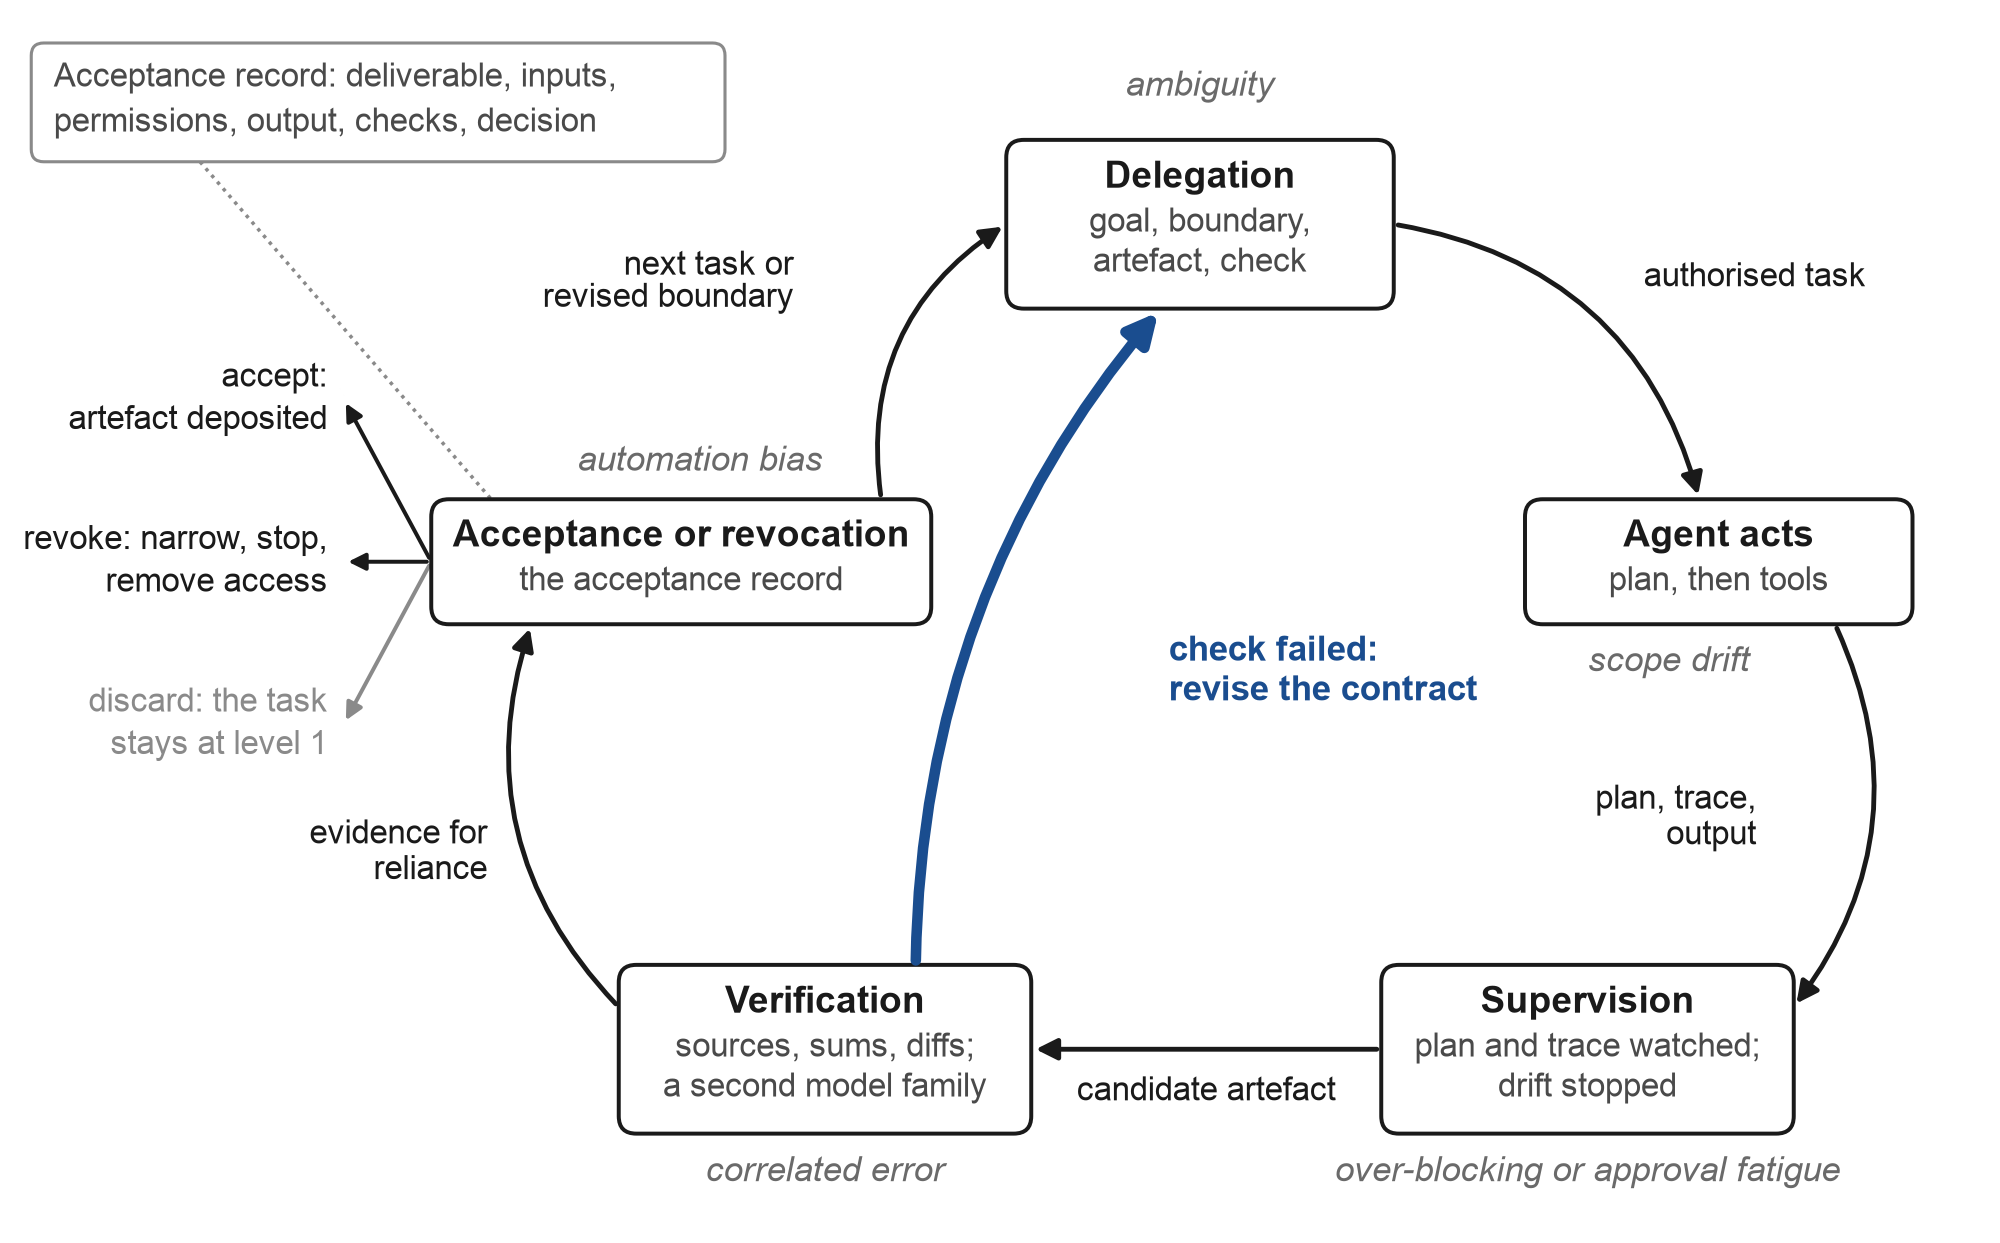
注:マネージャーの仕事はその人が実行するループとして(セクション7.3および8.1):委譲は契約を述べる(目標、境界、成果物、チェック)、エージェントが行動し、その人が監督して検証し、その後結果を受け入れるか、取り消すか、破棄して受け入れ記録を書く。灰色のイタリック体ラベルは各ステップでのリスクに名前を付ける(セクション5.3、6.3および8.1)。太い矢印は失敗したチェックから改訂された契約への戻りであり、受け入れノードからのすべての出口はその人の決定である。
8.2 経験豊富なユーザーはより委譲を少なくする
1つの観察が、誰もが最終的にエージェントのマネージャーになるべきという単純な物語に反している。Anthropicは2026年3月に、より長い任期を持つユーザーは「指示的な使用パターンを通じた責任をより大きく委譲する可能性がはるかに低かった」と報告した(Anthropic, 2026e)。また、その2026年1月の報告書は、拡張(その人がループに留まる協調的な使用)を2025年11月の会話の52%に位置付けた(Anthropic, 2026f)。1つの解釈は、経験豊富なユーザーが委譲が失敗する場所を学び、後退したということである。別の解釈は、彼らが自分たちの判断が産物である仕事の部分に対してモデルを協力者として使用することを学んだということである。公開されている数字からこの2つの解釈を区別することはできず、いずれの解釈でもはしごの終点は最大委譲以外の何かである。それはタスク毎にタスク毎に、尋ねること、協力すること、委譲することの間で選択する能力であり、その前にあるタスクがどれを必要とするかを知ることである。4段階モデルは、その人ができることを説明する。それは常に最も委譲をするものを行うべきであるという請求をしない。
8.3 責任はその人に留まる
ベンダーは説明責任がどこにあるかについて明確である。Anthropicのレベル2エージェントの起動ガイダンスは、ユーザーに「Claudeが代行して実行したすべてのアクションに対して責任を負う」ことを告げた(The Register, 2026)。これは、特にレベル3の法的および実践的現実であり、エージェントは所有者の認証情報で、所有者のファイルで、所有者の名前で行動する。エージェントのマネージャーになるプロフェッショナルは、ワーカーの間違いが速い人に対して責任を負うようになる。これは、委譲契約のチェックが仕事の前に決定されなければならないもう1つの理由であり、セクション5.3の安全設計が、その人がリアルタイムで攻撃を発見することに依存すべきでないもう1つの理由である。
8.4 識字フレームワークにおけるマネージャーの役割
AI識字の公式定義はこの役割に名前を付け始めているが、ここでレビューされたテキストのどれも「エージェント」という言葉を使用していない。米国労働省の2026年2月のAI識字フレームワークは、その内容領域の中で「AIを効果的に指示する」をリストアップしている(米国労働省、2026年; ExecutiveGov、2026年)。OECD および欧州委員会の2026年6月の共同フレームワークは、PISA 2029評価に供給され、4つのドメインを持ち、その1つは「AIを管理する」である(OECD & 欧州委員会、2026年)。初期の学術的フレームワークはAIの認識、理解、評価を強調し(Long & Magerko、2020年)、ユネスコの2024年の学生および教師向けのコンピテンシーフレームワークは同じレジスターを設定している(ユネスコ、2024a、2024b)。委譲契約は、管理および指示ドメインにエージェントケースの教えるコンテンツを与える:目標を設定し、仕事をフェンスし、成果物に名前を付け、チェックを決定する。実務家は「AIオペレーター」および「エージェントマネージャー」などの肩書きを使用し始めており、これは職業の上にこの専門性を獲得するプロフェッショナルであるためである。私は「エージェントのマネージャー」をより狭く使用し、誰かが雇うべき役割ではなく、行動パターンのためであり、なぜなら行動は証拠を残し、肩書きは残さないからである。証拠は成果物の中にある:その人が拒否した計画、彼らが拒否したdiff、彼らが取った2番目の意見、彼らがキーボードから離れている間に終わったスケジュールされた実行。これらの痕跡のどれも存在しない場合、その肩書きの背後には何もない。
9. クロッシングの測定:事前登録プログラム
9.1 測定単位としてのクロッシング
採用データのほとんどは「AIを使用する」人を数えており、時には週単位または日単位で行われています。その種の数え方では、チャットボットに同義語を求める人と、四半期報告書をエージェントに委ねる人を区別することはできません。私が見つけたいのは後者の人です。第3.3節のアーティファクト規則はこの違いを観察可能にします。クロッシングは、エージェントが依頼者の求めたものを新しいレベルで生成した場合にのみ記録されるからです。オンボーディングと監督に関する文献からさらにいくつかの規則が導かれます。補助なしでクロッシングした人と支援を受けた人について、完了を別々に報告する必要があります。支援はクロッシングの意味を変えるからです。中止は発生した時点で、その人自身の言葉で記録する必要があります。中止の理由は結果の大きな部分を占めるからです。返答がなかった人も含め、資料を受け取ったすべての人が分母に含まれます。最後に、研究者が毎週の執筆をやめた後の継続を観察する必要があります。研究者がまだその人のメールボックスにいる間に生成されたアーティファクトは、使用と同じくらい礼儀かもしれないからです。
9.2 デザイン
プログラミング以外の人々に対してこれらの規則を適用する事前登録コホートプログラムを実施しています(Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ、2026年9月6日に登録・凍結)。これは3段階のパスウェイの単一腕実行可能性研究であり、事前登録はデータ収集前に凍結されました。以下は登録されたデザインです。
参加者。仕事の大部分をコンピュータで行う成人です。彼らは自分のマシンと自分のAIサブスクリプション(雇用主のものは除外)を使用し、クライアント識別情報と雇用主の機密資料をエクササイズから除外し、ソフトウェアのインストールが雇用主が適用する規則に違反しないことを確認します。採用は、結果が有利に見えるまで延長できないように事前に固定された期間内の職業ソーシャルネットワークでの公開告知によって行われます。告知はスクリーンショット撮影され、その永続リンクが記録されます。これにより採用テキストが固定されます。参加は継続的であり、各参加者のスケジュールは彼ら自身の日ゼロから計数されます。ツールは週単位で変わるからです。採用は登録が凍結された2026年9月6日の公開告知で開始され、21日後の2026年9月27日に閉鎖されます。コホートは執筆時点でフィールドにあり、実現した数がどのように転じようとも、結果とともに報告されます。
ステップ1(チャットから個人のコンピュータ上のエージェントへ)。参加者は標準テキストを既に使用しているチャットボットに貼り付け、そのチャットボットは彼らを自分のマシンにグラフィカルエージェントをインストールすることをガイドします。私は誰のコンピュータにも触れません。ステップは、参加者がエージェントが最初のタスクに対応して生成したアーティファクトを提供する時点で完了です。タスクは誰にとっても形状が同じで、参加者自身の作業状況で埋められます。エージェントに質問、決定、ファイル作成とフォーマットを要求します。この要件はエージェントをチャットボットから分離します。登録では正確な文言が示されています(Chernets, 2026d)。モデルの用語では、ステップ1は一度にレベル1からレベル3までの2つのレベルにわたって反射的なオンボーディングをテストします。これは意図的な選択でした。ローカルエージェントのグラフィカルシェルは個人のマシンで実行されるため、第3.3節の規則によってレベル3であり、ステップ1が要求するアーティファクトはトランジション2をマークする種類です。そのパーミッションプロンプトはスコープされた段の保護の一部を与えます。コホートはベンダー囲い込みレベル2環境で別の週を計測しないため、第10節のP5をテストできません(スコープされた中間段が不完全および事件を低下させる)。これらのパーミッションプロンプトはデザインが持つ唯一のスコープされた段であり、コマンドラインはステップ3で入ります。チャットとローカルインストール間に明示的なレベル2週を挿入する後続コホートは、P5のクリーンなテストになるでしょう。
ステップ2(エージェントから起動されたWebオーケストレーションへ)。準備ができたら、参加者は既に支払っているサブスクリプションを通じて複数のモデルに1つの質問を実行し、1つのマージされた回答を返す、エージェント内の単一アクションで実行するオープンソースツールを受け取ります。このステップの目的は、カバレッジと信頼性として事前に登録されました。2番目のメカニズムとして見える意見の相違があります。
ステップ3(CLIオーケストレーションへ)。コマンドラインインターフェースを通じた同じオーケストレーション。
測定。プログラムのすべてのコホートで同じ文言で記録された5つの凍結されたコア項目は、職業とコンピュータでの時間、現在のAI使用、複数のAIに尋ねた事前経験、回答がどのようにチェックされるかどうか、および既にコンピュータで個人のために何か行動しているかどうかを記録します。すべての参加者のステップレコードは、日付、彼らをガイドしたチャットボット、試行と時間、アーティファクトとの完了、正確な中止点と彼ら自身の言葉での理由、および研究者がどのように介入したかどうかを保有します。最初の月間は毎週、参加者はエージェントがその週に生成した1つのアーティファクト(または「何もない」。これは有効な回答です)、複数のAIに1つの質問を提示する頻度と回答が異なったときに何が起きたか、およびステップ2以降、1つのモデルが見落としたもので役立つものが何か出てきたかどうか、およびチェックが彼らが頼りにしたものを変更したかどうかを報告します。観察は60日目と四半期ごとにその後も継続され、参加者が喜んでいる限り続きます。
分析と解釈。分析は記述的です。完了比率は、生存している分母と完全な分母の両方に対して信頼区間で与えられ、補助なしおよび支援ありの完了について別々に。時間と試行は分布として報告され、中止の理由は収集後にコード化され、コードと生の文言が寄託されます。1つの解釈規則が事前に固定されました。ステップ1資料を受け取った者の半数未満がエージェント生成アーティファクトを提供する場合、コホートはオンボーディング失敗の研究として報告され、人々を停止させたものが結果になります。
推論の制限。登録は事前にコントロール条件がないため因果主張はなく、自己選択ボランティアを超えた一般化もないことを述べています。参加者の時間節約の推定は、この領域での自己報告が真の方向を反転させることが示されているため、信念としてのみ報告されます(Becker et al., 2025)。
開示と倫理、登録されたものとして。参加者には、私がこれらの材料とツールを作成し、それらを教え、オーケストレーション方法をカバーする保留中の特許申請の出願人であることが書面で告げられます。機関審査委員会の意見は求められていません。本研究の背後に機関的な提携がなく、連邦資金も存在しないためです。登録では代わりにセーフガードを明記しています。同意は書面で与えられ、何も記録される前に得られます。健康、財務、または仕事内容データは収集されません。参加者は自分のマシンとサブスクリプションで作業を行い、公開預託までいつでも削除を要求できます。安全指示には、別のブラウザプロファイル、銀行サイトや医療サイトでのアクション禁止、不可逆的なアクション前の確認、エージェントに入力されるパスワードなし、およびウェブコンテンツをデータとして扱うことが含まれます。障害変数は収集されず、アクセシビリティについてのクレームはなされていません。
9.3 デザインのみ
プログラムからは、デザインのみを引き出します。参加者数、完了率、または個別ケースはここには表示されません。これは意図的な決定です。議論(本論文)、方法とプログラム、およびプロトコルの観察期間後の結果は別の出版物であるため、議論をそれ自体の証拠として読まれることはありません。他の研究者は現在、同じルールを適用できます。附録Cのリストing C5は、記録形式とそれらをエンコードするチェッカーを提供しています。チェッカーは、インストールを交差として数えるレコード、エージェント生成の成果物のない完了、本人の言葉のない停止、疑似匿名ラベルの代わりになっている実名、フォーマットが知らないフィールド、またはスキップとして正確に記録されていないスキップされたレベルを拒否します。
9.4 強力な次の研究が見えるもの
コホートは実行可能性調査であり、セクション10の命題のほとんどは他の設計を必要としています。強力な次の研究は、作業の表現方法が異なり、タスクリスクと技術環境をできるだけ一定に保つ2つのオンボーディング条件を比較するでしょう。1つの条件は機能とインストール指示を提示します。もう1つはセクション5.1の参加者自身の定期的な仕事オブジェクトから始まり、5部構成の地図を引き出します。成果には、成果物、参加者以外の誰かによって評価された品質(コーディング停止理由の場合と同様に評価者間の一致が報告される)、時間、発見されたエラー、シナリオ形式での許可決定、後の自発的な再利用、および結果に対して測定された信頼が含まれます。フォローアップは、研究者との継続的な接触から永続性を分離します。2番目の研究は、行政、研究、通信および分析タスクを比較することによって、ワークフロー語彙が1つの文法であるか職業ごとに1つであるかを尋ねるでしょう。私はそれがどちらであるかを知りません。答えは、パッケージ化された例を1回記述できるか、各分野に対して記述する必要があるかを決定します。両方の研究は、検証された機器(Carolus et al.、2023)でAIリテラシーをベースラインする必要があります。これにより、エージェントに何を渡すかを知るという特定のギャップを、AIの一般的な認識と分離できます。すべてのそのような研究は、後のインターフェースで開始する参加者は異なるデフォルトを満たすため、実装も文書化する必要があります。インターフェースバージョン、オペレーティングシステム、エージェントがネットワークアクセスを持っていたかどうか、許可モード、およびポリシー制約です。ベンダーの名前だけでは、後の読者に対してあまりに少ないことを告げます。
10. 命題
第3章のモデルと第4章から第8章の議論は、失敗する可能性のある主張を示しています。表7は、そのうち15個を、各々の測定値、それを反証する結果、およびテストを実行する立場にある者とともに述べています。これらは分野全体に向けて書かれています。特に第9章のプログラムはいくつかのみをテストできます。その他のいくつかはベンダーテレメトリ、調査パネル、または1つの組織での小規模な研究でテストできます。いずれもコホートの知見ではありません。
表7。 命題、測定値、反証者、およびテストを実行できる者。
| # | 命題 | 測定 | 反証される場合 | 実行可能な者 |
|---|---|---|---|---|
| P1 | バリア移行。 トランジション2を試みる非プログラマーのうち、停止クラスタがインストール後(最初のタスク、最初のエラー、またはパーミッション時に)その間よりも多く発生し、インストールしたが何も生成しなかった者のうち、「何を尋ねるべきかわかりませんでした」が技術的、パーミッション、コスト上の理由を上回っています。また、タスク難易度を一定に保つと、3つのトランジションではレベル内よりも完了がより急激に低下します。 | アーティファクトルールで記録された停止ポイント。本人の言葉による理由は付録Aのルールでコード化。ステップごとの完了 | ほとんどの停止がエージェントが最初に実行される前に発生するか、インストールされた非生産者の間で技術的およびパーミッションの理由が支配的であるか、またはタスク難易度が制御されると完了と失敗のパターンがすべてのステップで比較可能である | 第9章のプログラム。任意の複製 |
| P2 | サーフェスマージング。 ベンダーがチャットとエージェントサーフェスをマージする場所では、エージェント生成ファイルまたはアクションで終了するセッションのシェアが、ユーザーが実行したいことが変わることなく上昇します。また、主要なアシスタントは2027年末までにユーザー選択モードなしにデフォルトウィンドウからファイル書き込みを行います。 | マージの前後のベンダーテレメトリ。アシスタントの日付入り国勢調査 | シェアはマージ後も平坦のままである。または安定した、ユーザー選択されたエージェントモードがファイル書き込みの前提条件のままである | ベンダー。アプリケーションを開くことができる誰でも |
| P3 | インストール上の語彙。 人々に自分の分野からの実際の例(パッケージされたタスク、スキル、テンプレート)を提供することで、インストールヘルプを提供するよりもレベル2と3での永続性が向上します。また、ワークフロー語彙の構造化された測定値は、アクセスと以前のAI使用が制御された後のアーティファクト完了を予測します。 | 2種類のヘルプの下での60日目の永続性、割り当てとの比較。第5.1章の5つの部分の事前タスクステートメント。付録Aのルールでコード化された停止理由 | インストールヘルプが同等またはより大きな永続性を生成する。語彙測定値は、インストール容易性と一般的な自信がモデルにある場合、何も追加しない | 2つのオンボーディングルートを持つ任意のラボラトリ |
| P4 | 反射的オンボーディング。 既に使用しているチャットボットにガイドされる人々は、ルートを実用的にするレートで、補助を受けずにレベル1からレベル3に移行でき、静的ドキュメントが与えられた人々よりも最初のアーティファクトに到達します。 | 材料を受け取ったすべての者に対してエージェント生成アーティファクトでトランジション2を完了する割合。ガイド付きおよび静的条件下での最初のアーティファクトまでの時間 | 半分未満がそれを完了する。第9章で事前に固定されたしきい値。または静的ドキュメントが同等またはより高い完了を与える | 第9章のプログラム。2つのコホートを持つトレーナー |
| P5 | 中段。 ローカルエージェントの前にベンダー柵で囲まれた環境で時間を費やす非プログラマーは、トランジション2をより頻繁に完了し、ファイル損失インシデントが少なく、チャットからローカルアクセスが広い者に移された人々よりもスコープ、可逆性、およびエスカレーションについてより良く推論します。 | 等しいフォローアップの2ルートコホート。主要な成果としてのアーティファクト。インシデントログ。前後のシナリオベースのパーミッション決定 | チャットから直接ローカルエージェントへの補助のない完了が、レベル2を通過した完了と一致する。同等のインシデントレートおよび同等のパーミッション決定で | 2つのオンボーディングルートを持つ任意のラボラトリ。プログラムの後期コホート |
| P6 | ボトルネック。 毎週チャットを使用する非プログラマーのうち、1四半期でレベル3アーティファクトを生成するシェアは、毎週コーディングエージェントを使用する開発者のシェアをはるかに下回ったままです。 | 「AIを使用していますか」ではなく、アーティファクトアイテムを使用した代表的な調査(第11.3章) | 非プログラマー知識労働者の間のレベル3アーティファクト生産が開発者の毎週使用の数字に近づく | 国家統計局。調査機関 |
| P7 | 橋が実行される。 ウェブオーケストレーションを練習する人々は、後にCLIオーケストレーションを採用する可能性がより高く、実行しない人々よりも、目に見える不一致は後のソース属性またはタスク記録での批判を予測します。 | 以前のウェブ比較のある者とない者の間のCLIオーケストレーションの採用。保存された比較と後の記録 | 差異がない、または逆。比較はより多くのプロンプトを生成し、保持されたチェックに変化がない | 第9章のプログラム。縦断的パネル |
| P8 | CLIの耐久性。 2つ以上の消費者サブスクリプションに対して支払う人々のために、公式コマンドラインツールを通じたオーケストレーションはインターフェース変更を生き残るレベル4の形式であり、ファイル支援実行はブラウザオンリー実行よりもインターフェース変更後に再実行および別のレビューアーへの転送が優れています。 | その人口のレベル4アーティファクトの日付入り国勢調査。インターフェース変更後の再実行およびテスト転送 | 2027年後期の国勢調査ではウェブまたはプログラミングインターフェース評議会が支配的であり、CLIからCLIツールが後退しています。ブラウザオンリーのワークフローは再実行と転送で一致する | ツール研究者。開発者調査 |
| P9 | 相関のある同意。 ベンダーファミリー全体で、既知の回答を持つ知識作業アイテムのエラーは3つ以上のモデル間の同意が2つの独立した意見より価値があるほど十分に相関する(rhoは既知の回答を持つ知識作業アイテムで推定され、ベンチマーク同意レートから取られた約0.5以上で、rhoはベンチマーク同意レートから取られていない)。異なるファミリーの小さな評議会は同等のコストで1つのファミリーの大きな評議会に勝ります。またソース認識レビューは多数派同意よりも正確性をより良く予測します。 | 既知の回答を持つアイテムバンク上のファミリー間ペアワイズ誤差相関(リスティングC4);2つの評議会デザインを持つマークされたアイテムセット;多数派合意および情報源を考慮したレビューに対する正確性 | ほとんどのタスクタイプでは相関係数が0.2以下;クレームごとのチェック後に同一ファミリー評議会が勝利;または単純多数派合意は、多様性と検証の組み合わせと同程度かそれ以上に正確性を予測する | 言語モデル研究者;関連論文のプロトコル |
| P10 | マネージャーのコンピテンス。レベル3と4での継続性は、委譲契約(目標、境界、成果物、チェック)を述べる能力および監督トレース(却下されたプラン、拒否されたdiff、得られた第二意見)によってより良く予測されます。先行する技術経験またはプロンプト量によってではなく。 | 4つの部分を引き出す短いタスク、ブラインドスコア;ベースラインアイテム;受け入れ記録からのトレース;60日目での継続性 | 先行する技術経験またはプロンプト量がより良く継続性を予測し、契約述成は何も追加しない;またはレベル3と4の成果物が日常的に目標、情報源、境界、チェックを省略しても独立監査下で信頼できる場合、その場合コンピテンシー構造は過度に構築されている | あらゆる縦断的成果物研究 |
| P11 | タスククラスによるキャリブレーション。フィードバックが速く、反転が可能な場合、人々は委譲をより良くキャリブレーションし、タスククラスによって異なる方法で受け入れ、修正、エスカレーションを行います。 | タスククラスごとの受け入れ、修正、エスカレーション、および後の誤り発見 | 可逆的なタスクと高い結果のタスク間でキャリブレーションは一様である | ラボラトリー;受け入れ記録を持つ組織 |
| P12 | ガードからの摩擦。レベル3の非プログラマーの間で、権限プロンプトとセーフティブロックによる中断は、開発者の間よりも停止の理由としてより頻繁に名付けられ、分類器によって守られた自律性は報告されたファイル喪失の増加なしにそのような停止を減らします。 | グループ別のコード化された停止理由;デフォルトモードの変更前後での停止率およびインシデント報告 | グループ間に違いなし、または自律性が報告された喪失を増加させる | ベンダー;プログラムのコード化された停止理由 |
| P13 | ギャップは再現される。性別と教育によるチャット採用の違い(Cranney et al., 2026;Daepp & Counts, 2024)は職業内のレベル3成果物生産で少なくとも同じくらい大きく再び現れます。 | 職業内レベル3成果物生産における職業内の違い | 職業内推定はギャップがレベル3で閉じたことを示す | 労働経済学者;十分に大きい場合は後続のコホート |
| P14 | 批評家と第二ファミリー。同一ファミリー批評家は急ぎと省略されたチェックを捕捉します;第二ファミリーは共有エラーを捕捉します;欠陥ラベル付きセット上で各々は相手が見落とす欠陥に貢献します。 | 同一ファミリー批評家と第二ファミリーレビュアー間での確認済み知見の重複、同等のコスト | 完全な重複、または一方のソースが優位 | 2つのエージェントツールとラベル付きセットを持つ誰でも |
| P15 | 能力またはボキャブラリー。同じタスククラスで、レベル2と3での継続性は委譲契約を述べる能力によって変動します;モデル能力が制約となる場合、継続性はタスククラス間で変動し、1つの内の個人間で一様となります。 | タスククラス別継続性、ブラインドスコア付き委譲契約の述成と交差 | タスククラス内では、継続性は契約スコアに関わらず個人間で一様であり、クラス間でのみ変動する | タスククラスと契約述成を記録するあらゆる研究 |
それらの中でもいくつかは他より重要です。P4は政策に最も重い重みを持っています。なぜなら、反射的なオンボーディングが機能する場合、エージェントを教える最も高い部分(インストール中に彼らの横に座る)は、彼らが既に持っているツールに置き換えることができるからです。P5はセクション9.2が言及するようにコホートがテストできないもので、はしごの形状が最も依存するものでもあります。中間の踏み段がその場所を獲得するかどうかは、私はまだ知りません。P9は最もテストしやすく、相関証拠の算術(Chernets, 2026a)と Kim et al.(2025)の測定値の両方が同意の価値に対する上限を指しているため、評議会のユーザーを最も驚かせそうです。P10はカリキュラムを変更するであろうものです。委譲契約を述べる能力が技術的背景より継続性をより良く予測する場合、訓練は委譲を最初に、ツールを次に教えるべきです。
11. 含意
11.1 ベンダー向け
空のフォルダーのために設計する。ベンダーはインストーラーを簡潔にしており、その成果が見られます。さらにその努力を重ねることは無駄になると思います。なぜなら、初心者の問題はインストール後に始まり、エージェントに何も言うことがない空のフォルダーの前に立つためです。その人自身の分野からの実践例を、エージェントを初めて開いたその瞬間に提示し、実在する低リスクで判断できる成果に終わる最初のタスクを与えることで、セットアップのさらなる簡潔化よりも採用促進ができるでしょう。すでにパッケージ化されたスキルはこの方向を指しています(セクション5.1)。まだ不足しているのは2つです。その人のタスクのうち、本当に引き継ぐ価値があるものを選ぶ助けと、スタートアップだけでなく専門家協会がその会員のためにスキルを書く方法です。
次のマージ後のタブが何と呼ばれようとも、委譲の瞬間に、選択されたフォルダーの言語で、簡潔な質問リストに明確な答えが必要です。このエージェントは何を読むことができるのか、何を変更できるのか、何を送信またはトリガーできるのか、何が私の承認を必要とするのか、どのようにしてそれを止めるのか。ビジュアルなdiffはファイルが変更されるときの一部に答え、書かれたプランはアクションが多様なときに答えます。1つの同意バナーはそのどれにも答えません。パーミッションモデルはマージ後も見える状態で、スコープされており、元に戻す機能と機能する停止ボタンで可逆的であるべきです。スコープがフォルダーに限定されていながら、どちらもない状態が、セクション5.3の問題レポートをどのように読むのかです。
その仕事は製品から出ることもできるべきです。ユーザーはタスク指示、入力またはその識別子、ツールアクション、出力および承認履歴をエクスポートできるべきです。これはガバナンス機能と同じくらい使いやすさ機能です。初心者が完了したタスクから学ぶことができ、チームが所有メモリを所有者チャット履歴に貸さずに結果を確認できるからです。使用法も同じ方法で報告されるべきです。ファイルを生成するエージェントの「週間アクティブユーザー」は、ファイルを生成した人と、アプリケーションを開いた人に分割されるべきであり、ベンダーはそれを行うテレメトリを持っています。
攻撃を検出するのは初心者の仕事ではありません。プロンプトインジェクションの兆候を認識するよう非プログラマーに求めるガイダンスは、最も困難な判断を、それを行う能力が最も低い人に置きます(セクション5.3)。安全なデフォルト(ワーキングコピー、より大きな変更前のスナップショット、明示的に許可されるまで否定される破壊的なコマンド、ウェブコンテンツがデータとして扱われる)は製品に属します。同時に、絶えず中断するガードは、不足しているガードがファイルを失うのと同じくらい仕事を止めます。監視の過度性に関する関連論文は、そのようなレイヤーがどのように成長するかを説明しています(Chernets、2026b)。
出所は答えのマージを生き残るべきです。マージされた答えを返す評議会機能は、どのモデルが何を言ったのか、どこで同意しなかったのかを表示し、ユーザーが1つのモデルに批評家の役割を割り当てることができ、証拠のギャップを流暢な合意段落より見つけやすくするべきです。出所のないマージされた音声は、単一の自信を持った答えの権威を復元し、オートメーション偏見に報酬を与え、エラーの相関を隠します(セクション6.3)。
最後に、チャーン(頻繁な変更)はユーザー側にコストを持ちます。1年以内に名前が変更された、マージされた、または廃止されたツールを学んだ人は、2倍の代価を払うので、安定した名前、移行ガイド、および製品変更全体の指示ファイルの継続性は、採用機能です。
11.2 雇用主とトレーナー向け
メニューの前に委譲契約を教える。製品メニューは毎月変わりますが、目標を述べ、仕事を柵で囲み、アーティファクト(成果物)に名前を付け、チェックを決める能力はツール全体に転送されます(セクション4.3および7.3)。その人自身の定期的なタスクの1つについて4つの部分を書くよう求める短い演習は、機能のツアーより準備状態をより良くテストします。演習に含まれるものは以下で分解の下で説明されています。
ログインは間違ったものを測定します。アクティブユーザー数は、セクション9.1が必要とした区別を行うことはできません。同義語を求める人と、レポートを委譲する人との区別です。人々が保つことを選んだエージェント製造のアーティファクトの数は、それを行うことができます。
人々はまた、学ぶための聖別された場所と、何が許可されているかのマップが必要です。組織がすでにライセンスしているツール内のレベル2は、職場のノートパソコンにエージェントをインストールすることが許可されない職員に到達します(セクション5.4)。レベル3については、明確なポリシー、サンドボックス化されたマシン、または承認された構成は、多くの人が想定する暗黙の「いいえ」を削除します。一律禁止は個人的なアカウントを通じて使用を促進し、だれもそれを見ることができず、無制限の委譲は機密資料を公開します。この2つの間には、タスクとデータ分類法があります。それは、どの仕事が承認された環境で試すことができるか、どれが2番目の人のレビューが必要であるか、どれがエージェントから除外されるかを言います。それは誰がツールを承認できるのか、受け入れ記録がどこに住んでいるか、そして近未来がどのように報告されるかの名前です。ローカルレベル3は、クラウドエージェントとテナントスコープレベル2がIT部門との戦いを避ける道であるため、従業員が管理していないマシンに必須ではありません。ベンダーが最初の段階をチャットに吸収すると、レベル2は2つのジョブを保ちます。これはロックされたマシンのスタッフの聖別された場所であり、これは誰のための較正段階であり、人は委譲されたアクションが所有する前に周囲があることを学ぶ場所です。それが事件をも低下させるかどうかはP5です。
マンデート(命令)は注意が必要です。AI使用をパフォーマンス基準にすることは価値のない使用を生成でき、それをした少なくとも1人の雇用主は1年以内に決定を逆転させました(Fortune、2026b)。仕事に関係する人工物を求めることは、使用を求めるより良い信号です。月に1回、「名前を付けたフォルダー内のエージェントが生成したファイルを表示する」と「2つのモデルが同意しなかったため変更した決定を表示する」は遷移2と3を測定し、ログイン数はできません。数千人が登録されているにもかかわらず、アーティファクト測定なしに大規模にトレーニングすることは、遷移2が発生したかどうかを誰にも告げません。
分解と検証は一緒に教えるべきであり、評議会前の批判的習慣を教えるべきです。汎用プロンプトコースはレベル1の教育学です。レベル2とレベル3の教育学は、その人が既に持っている仕事から始まり、例えばマーケターの金曜日パックや教師の課題バッチから始まり、再利用可能な分解(セクション5.1の5つの部分と停止条件付き)を教え、フォルダのコピーでのエラー回復を教えます。その後に評価すべきことは、その人が安全でない指示を認識でき、反転可能なトライアルに名前を付けられ、証拠を検査でき、システムを停止できるかどうかです。受け入れポイントでの同じファミリーの批判は、購読料がかかりませんが、批判が沈黙し、決定が高額の場合は、2番目のファミリーが追加されます。流暢性ルーブリックの上部でのオーケストレーションは、いくつかの役割に対しての正しい目的地であり、誰もが最初の日の要件としては間違っています。
11.3 政策向け
欧州連合のAIリテラシー義務は、AI システムのあらゆるプロバイダーおよびデプロイヤーにそのスタッフに適用されます。2026年の改正後、十分なレベルを確保することではなく、「AI リテラシーの開発を支援するための措置を講じる」ことが求められ、その監督および執行規則は2026年8月3日から適用されます(欧州連合、2026年;欧州委員会、2026a、2026b)。米国では、労働省のフレームワークが「AI を効果的に指示する」(米国労働省、2026年)という名前であり、OECD と欧州委員会フレームワークは「AI を管理する」というドメインを持っています(OECD & 欧州委員会、2026年)。エージェント的な場合における、それらの言葉に対するコンテンツを提案します:委任契約の4つの部分、セクション8.1の取り消しを含む4つの慣行、モデルを比較する習慣(合意が見た目ほど強い証拠ではないという知識を含む)、およびセクション5.3の基本的な安全慣行。ガイダンスは会話的使用と委任アクションを区別すべきです。後者の場合、義務は許可スコープ、データ分類、検証、インシデント報告および取り消しをカバーすべき、そして委任タスクに必要な役割固有の能力と権限を文書化する要件は、誰もを同じように訓練する要件よりも防衛可能です。規制当局と労働者代表は、雇用者が残存責任をスタッフに転嫁したが、使用可能な管理、レビュー時間、または安全でない委任を拒否する権利がないかどうかも尋ねることができます。これはすべて1つの規制文書から引き出された設計およびガバナンスの推奨事項であり、その範囲はその文書です。
欧州の義務は規制緩和の一環を経て、ここで討論されたフレームワークの中で、AI を使用するスタッフの全員をカバーするのは1つの水平的義務です。米国ではフレームは労働力政策です。2025年4月のAI教育に関する大統領令および2025年7月のAIアクションプランは、AI リテラシーとスキルの拡大、AI リテラシープログラムが雇用主提供の教育支援として適格である可能性があるというガイダンスを含めてコミットしています(ホワイトハウス、2025a、2025b);フレームはエージェントマネージャーの訓練と互換性があり、それをまだ要求していません。検査された公式テキストのどれも末端エージェントまたはオーケストレーションに言及しないので、「AI を管理する」はチャットボットエチケットまたはレベル4の指示として読むことができます。プロンプトで停止するリテラシープログラムはレベル1を教えます。一方、仕事はレベル2から4に移動しています。公式テキストはまだそこで追跡していません。
統計機関がそれらの調査に AI モジュールを追加することは、1つの特定の変更に役立つことができます。「チャットボットを使用したことがありますか」はレベル1のアイテムです。「あなたが指示したシステムが、過去7日間に仕事に使用するコンピューターでファイルを作成または変更しましたか」はレベル2またはレベル3のアイテムです。「過去7日間に同じ作業の質問を複数の AI システムに提示し、答えが異なりましたか」はレベル4のアイテムです。この種のアイテムがなければ、P6は公開データでテストできず、エージェント層での2番目のレベルのデジタルデバイドは、それを見ることが仕事の人々に見えないままです。
11.4 研究者向け
セクション2.5のギャップは議題です。非プログラマーを名前でターミナルおよびデスクトップエージェントを使用する研究、成果物として成果物を。メカニズムそのものとして、再帰的なオンボーディングを研究します。ウェブオーケストレーションを慣行として研究し、人々がどのように答えを調整するか、および彼らが出所を保つかどうかを含めます。知識作業タスク、およびコードと数学のベンチマーク以上での、ベンダーファミリー全体でのエラーの相関を測定します。AI 使用の測定された性別および職業的ギャップ(Cranney et al., 2026; Humlum & Vestergaard, 2025)をエージェント的レベルに拡張します。ここではまだ何も知られていません(P13)。機能の可用性と自己報告された時間節約という2つの簡単なメトリクスは、成果物の完了、監査された品質、修正率、および後の再利用に対して抵抗する価値があります。放棄はそのメカニズムで記録されるべきです。許可プロンプトでの停止は、インターフェースの問題、データに関する賢明な懸念、雇用主ルール、不足しているマシン、または受け入れ基準がないタスク、および「抵抗」にそれらを折りたたむことは、すべてそれを失うことができます。評価は敵対的であるべきであり、誤解を招くページ、ドキュメント内の隠された指示、矛盾するソース、部分的なツール障害、または複数のモデルが共有する説得力のある間違った答えを使用すべきです。マネージャーの役割は、それらの条件下で成果を改善する場合にのみ、何かを意味するからです。レプリケーションは私の資料の必要はありません。成果物ルール、固定された停止理由の質問、実装の記録、および日付付きの製品センサスが必要です。そして、分子は公開されるべきです。渡った人だけを報告する研究は、道路について何も教えないからです。
12. 範囲と境界条件
ここで提示するのは、モデル、エビデンス総合、測定設計であり、それぞれ以下の方法で限定されています。
時間。エビデンスは2026年9月21日までの範囲です。製品情報は時間とともに古くなります。モデルは到達範囲と役割によって定義されているため、より緩やかに古くなります。
地理と情報源。採用数の大半は米国からのものです。欧州の数値は存在する場合に引用しています。いくつかの重要な数値はベンダーから得たもの(コーディングエージェントの使用、チャットとエージェントを統合した理由、ベンダーテストセットでのインジェクション率)であり、本文中ではベンダーデータとして明記されています。これらはベンダーが自社製品について知ることができるものとして使用し、それに応じて重み付けしています。
対象。本論はコンピュータで実質的に仕事をする専門職を扱っています。主にスマートフォンから、あるいは自分でコントロールできるコンピュータなしで仕事をする人々は、ここで説明する以前の段階で障壁に直面するため、このモデルはそれらについてはその障壁を名付けることを除いてほとんど述べていません(セクション5.5)。
コホートに関するエビデンス。事前登録された設計のみが使用されています。本プログラムの成果は何もここでの主張に影響を与えず、セクション10の命題は結果が知られる前に述べられているため、それに対して評価できます。自分自身のマシンを必要とするコホートは、エージェントをインストールできる人々をサンプルとしており、装備へのアクセスと動機を分離することはできず、この制限は結果とともに存在します。
規範的範囲。このモデルは各レベルが人に何を求めるかを説明しています。より高いレベルがより良いこと、あるいは誰もが上昇すべきことを主張するものではありません。多くの仕事では、レベル1または2が適切な場所です(セクション8.2)。高リスク作業、機密記録、安全性に関わる操作、時間に制約のある意思決定、検査可能な受け入れ基準のないタスクは、より厳密な取り決めが必要であるか、委任されたエージェント使用の対象外に留まります。
オーケストレーションが追加するもの。エージェントを追加することで、カバレッジを拡大し、意見の相違を明らかにし、レビュー証跡を残すことができます。また、相関エラー、コスト、遅延、および勤勉さの見かけ上の外観も追加する可能性があります。継続する委任とは、人がプロセスを検査および変更できることを意味します。プロセスが信頼に値するかどうかは別の問題です。
文献に欠けているもの。セクション2.5の文献検索では、非プログラマーがターミナルまたはデスクトップエージェントを名前で採用する現地研究、ウェブオーケストレーションを名前付きの実践として取り上げた研究、エージェント管理を独自の構造を持つ能力として扱った研究、およびAIシステムが人のエージェント型AI採用をスキャフォルディングする研究が見つかりませんでした。これらは研究されたものの空白であり、2026年9月21日現在のものとして述べられており、市場、製品、または優先順位についての主張はしていません。
主張のステータス。表8は、シリーズの信頼言語を議論の要素に適用しており、読者は各要素がどの程度強く保持されているかを見ることができます。
表8。本論文の主張のステータス。
| 要素 | ここでの述べ方 | 根拠 |
|---|---|---|
| 4段階モデルと成果物ルール | テスト中(セクション9および10) | 概念的;セクション3および付録Aで指定されたマーカー |
| 技術的障壁はインストールおよびデスクトップ面で後退している | データがそれをサポートしている | ワンステップインストーラー;「ターミナル不要」ドキュメント;4つのベンダーのレベル2製品がリリースされた |
| ターミナル由来のエージェント内のナレッジワーカー | ベンダー報告、方向性 | 2026年6月2日のベンダー数値のプレスリリース、アナリストの注釈付き |
| ベンダーが遷移1をチャットに吸収する | 製品で観察された | Anthropic、2026年9月16日;OpenAI、2026年7月9日 |
| ワークフロー語彙が残る主要な障壁 | モデルとして提示;テスト中 | 間接的:プロンプト研究;ベンダーが統合の理由として述べたもの;本プログラムのストップ理由項目 |
| ウェブをブリッジとして、CLIを耐久層として | テスト中(P7、P8) | 契約、許可オブジェクト、公式プラグイン;ウェブインターフェースの脆弱性 |
| 相関エラーが理事会が購入できるものに上限を設ける | データはモデル評価でそれをサポート;使用中に測定中 | Kim et al.(2025);Chernets(2026a) |
| 反射的なオンボーディング | 実装および測定中;成果は報告されていない | ベンダーおよびコース実践(観察);本プログラムのステップ1(測定) |
| エージェントのマネージャーとしての役割 | 行動の説明として提示;テスト中(P10) | 委任研究;雇用者ルーブリック;公式識字フレームワーク |
| コホート交差率 | 報告されていない | プロトコル凍結;結果論文を予定 |
| 「今すぐ機能する」というプロミス | 主張されていない | 本論文の範囲外 |
13. 結論
ターミナルはかつて、通常の専門家とエージェンティックAIの間の障壁を表す明らかなイメージでした。そしてしばらくの間、それは妥当なものでした。2026年現在、それはもはや当てはまりません。インストールはコマンド一つまたはクリック一つで済み、その人がすでに使用しているチャットボットが案内し、ベンダーはチャットとエージェントを単一の画面に統合しています。セクション4と5が示すものは、障壁が移動したということです。最初の限定的な試みははるかに容易になりました。困難なままなのは、全体的なタスクで信頼できる作業を得ること、足元で変わり続けるプロダクトに対応すること、および与えられたフォルダを安全に保つことです。あるベンダーの数字によると、プレスを通じて報道され、方向性を示すものとして読まれるべきものですが、週に約100万人の知識労働者がすでに端末系統のコーディングエージェントの中にいます。一方、ほとんどの専門家はAIを会話としてのみ経験しています。
現在の障壁は、マネジャーの仕事です。何を委譲するか、それを限定する、結果に名前を付ける、それをどのように確認するかを決定する、そして環境を安全に運用し、モデルを比較しながら、それらの合意が見かけほど強力な証拠ではないことを忘れない、ということです。セクション3の4つのレベルはこの仕事に構造を与え、どのプロダクトも所有していません。アーティファクトルールはそれに測定単位を与えます。私はウェブオーケストレーションを最後のレベル(P7)への橋として、CLIオーケストレーションをそれの永続する形式として提案しています(P8)。どちらも失敗する可能性があるように述べられています。
移行を導入する人にとって、実際的な結果は操作の順序です。最初の質問は、その人が説明し、検査でき、試みが失敗した場合に安全に破棄できる、小さく許可された仕事のどれです。公開ソースからのブリーフィング、個人的な計画フォルダ、誰も依存していないスプレッドシートです。そこから、一度に1つの管理責任が追加されます。境界、その後承認、その後自分自身のワークスペース、その後保存されたタスク記録、その後2番目の重要なビューです。評価は同じ順序に従います。その人が何をすることを許可されたか、出力がどのように確認されたか、エージェントが失敗したときに何が起こったかを隠す場合、デモンストレーションはほとんど価値がありません。委任を慎重に拒否することは結果としてカウントされます。限定されたタスクを再現でき、なぜそれに依存したかを説明でき、決定を変えた不一致を指摘でき、状況が変わるときにアクセスを制限できる人は、彼らの職務経歴書が何と言おうと、その役割の目に見える兆候を示しています。
モデルは失敗する可能性があり、セクション10はそのやり方を述べています。セクション9のプログラムはプログラマーではない人々でそれの一部をテストし、付録Cのコードは他の人が同じ交差点を測定し、同じパターンを練習することを可能にします。付録Bで名前を挙げたプロダクトは1年以内に時代遅れに見えると予想しています。セクション5の障壁は、それらがその人と仕事に属しており、どのプロダクトが彼らの前にあるかは関係ありません。ターミナルはエージェントがそれを管理することを学んだ人のために働く場所になり、どのくらいの人々がそれを学ぶのか、どのような経路を通じて、そしてどのくらい速く、それは次の年が答える質問です。
宣言
資金提供。 本研究は外部資金による支援を受けていません。
利益相反。 著者はマルチモデルオーケストレーション手法を開発しており、関連する特許出願(保留中;特許は未取得)を申請しています。著者は第9節で説明するプリレジスター化されたコホートプログラムおよびその資料を設計しました。本論文の知見は著者の実装に依存していません。付録Cのすべてのパターンは公開されているツールで再現可能です。著者はまた、付録Cで名前が挙げられた2つのオープンソースプラグインの保守管理も行っており、これらは無料でオープンソース(Apache License 2.0)であり、本論文のいかなる知見も両者に依存していません。著者は後に商用として提供される可能性のある教材の開発を進めており、執筆時点では何も販売されていなく、第9節で説明するコホートはすべての資料を無料で受け取りました。
ツールと検証。 AIアシスタントは著者の指示の下で道具として使用されており、思想、研究および結論は著者のものです。すべての定量的主張と引用は、2026年9月21日時点での一次資料または保存版と照合されました。また、テキストおよび付録Bのタイムラインで二次資料または製品ベンダーとしてマークされている場合は、入手可能な最良のレポートと照合されています。ベンダーが自社製品について報告した数値はそのようにマークされています。研究期間中に一次ページを取得できなかった場合(あるベンダーのサイト上の複数のページがアクセスエラーを返しました)、主張は名前を指定した二次資料から引用され、ラベル付けされるか、省略されます。参考文献の角括弧内に示されている新聞のタイトルは、見出しが逐語的に再読されなかったページの説明的なタイトルです。
データとコードの利用可能性。 付録Cのコード(テスト付き)はMITライセンスの下でhttps://github.com/vadimchernets/after-chatに置かれており、Zenodoにアーカイブされています(https://doi.org/10.5281/zenodo.22944451)。同じパターンに基づいて構築された2つのプラグイン、RoundcallおよびSidecallはhttps://github.com/vadimchernets/roundcallおよびhttps://github.com/vadimchernets/sidecall(Apache License 2.0)に置かれています。ソフトウェア以外の分野に同じパターンを適用する5つのキットはhttps://github.com/vadimchernets/calling-kits(MIT)に置かれています。これらはそれらの分野の実務家によって試行されておらず、リポジトリが明記している通りであり、本論文のいかなる主張も它らに基づいていません。
倫理。 本論文は人間参加者からのデータを報告していません。本論文が説明するコホートプログラムはプリレジスター化されており(OSF、DOI 10.17605/OSF.IO/X4EGQ)、その結果は別途報告されます。
著者貢献。 単著。
通信先。 [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
付録A. モデルの用語集
リーチ。 モデルが個人の代わりに接触できるもの:会話;ベンダーが限定する空間内のファイルとツール;個人自身のコンピュータ;複数のモデルとエージェント。
ロール。 業務を成功させるために個人がしなければならないこと:質問とコピー;委譲とレビュー;環境の所有;複数のエージェント管理。
レベル。 ある業務が実行されるリーチとロールの組み合わせ(セクション3.2)。レベルは業務を記述します;人と製品は複数にまたがることができます。
クロッシング(遷移の)。 エージェントが新しいレベルで個人が求めたアーティファクトを生成したときに記録されます。インストールは試みです。複数のレベルを超えた移行は許可されており、スキップとして記録されます。
アーティファクト。 エージェントによって生成され、個人が供給または保有するファイル、フォルダ、アクション、または出力。「なし」は有効な記録です。
ワークフロー語彙。 個人がエージェントに委譲できることを知っているタスクの作業用語彙。エージェントがそれを実行でき、結果がチェックできるよう表現されます。
反射的なオンボーディング。 より高機能のAIシステムへの個人の採用をスキャフォールディングするAIシステム。例えば、エージェントのインストールと最初のエラーからの復旧をガイドするチャットボット。
委譲契約。 個人がエージェントに業務を委譲するときに述べる4つのこと:目標、境界、アーティファクト、チェック。
4つのプラクティス。 マネージャーがタスク全体で行うこと:委譲、監督、検証、取り消し(セクション8.1)。
受け入れ記録。 重大または反復的なタスクの場合:意図した納品物、入力、制約と権限、出力場所、重大な不一致または失敗、実施されたチェック、受け入れ、改訂、エスカレーション、または破棄の決定。エージェントが生成したものと個人が依拠したものを分離します。
業務の5部構成マップ。 業務のオブジェクト、許可された入力、変換、納品物、チェック:非プログラマーの反復的なタスクが委譲になる形式(セクション5.1)。
サイドブランチ。 ブラウザアプリケーションビルダー。個人のファイルではなく、プラットフォームがホストするプロジェクトに作用します;独自のランングを持つ別のはしご(セクション3.4)。
Web オーケストレーション。 1つの質問を複数のコンシューマチャットボットに手動またはツールでブラウザで提起し、回答を比較。
CLI オーケストレーション。 1つのエージェントが他のエージェントのコマンドラインツールを呼び出し、出力を収集してマージまたはチェック。
チャーン。 新規ユーザーがツールを学習するのにかかる時間より短い期間内でのツールの名前変更、マージ、または廃止。
有効な意見の数(N_eff)。 平均ペアワイズエラー相関がρのN個モデルに対してN / (1 + (N - 1) rho);上界は1/ρ(Chernets, 2026a)。
コード化可能な項目としてのマーカー
定性データのコーダーまたは調査設計者にとって、セクション3のマーカーは、名付けられたアーティファクトに関するはい/いいえの項目に減少します。アーティファクトのない自己報告は主張として記録され、クロッシングとしてはカウントされません。
- レベル1提示。 過去7日間にコンシューマチャットボットとの保存された会話が少なくとも1つ;アーティファクト:リンク、スクリーンショット、またはエクスポート。それを生成できないことは「示されていない」とコード化され、これは「欠如」より弱い知見です。
- 遷移1クロッシング。 スコープ付きエージェント(デスクトップ、ウェブ、またはテナントホスト)によって個人が付与した場所内に書かれたファイルまたはファイルセット。個人が指定した職務に対応し、少なくとも1つの承認、拒否、またはプラン編集が記録されています。アーティファクトの日付がクロッシング日です。
- レベル2提示。 遷移1クロッシング、さらに後の週のスコープ付きアーティファクト。永続性は、クロッシングとは別に、週単位の項目として記録されます。
- 遷移2クロッシング。 ローカルエージェントまたはその公式デスクトップシェルによって個人が制御するマシン上で生成されたワーキングフォルダ、コミット、または日付付きファイルセット。複数のツール使用が必要だった職務から。クラウドホスト業務は独自のクラウドバリアントとしてコード化されます。
- レベル3提示。 遷移2クロッシング、さらに同じクラスのエージェントからの後の週のアーティファクト。
- 遷移3、ブリッジ形式。 質問、質問されたチャットボットまたはウェブモデル、生のままの回答またはリンク、合意と不合意のメモ、カバレッジまたは信頼性(セクション6.2)が表れたかどうかのメモを保有する日付付きファイル;手動またはブロードキャストツールによって生成。
- 遷移3、耐久形式。 同じフィールド。個人自身のログインで2つ以上の公式コマンドラインツール(または1つプラス第2世代プラグイン)を呼び出した実行によって生成;分母を記録:質問、回答、タイムアウト。
- レベル4提示。 遷移3のいずれかの形式、さらに後の週の2番目の日付付き実行。
- 支援対象対独立。 調査者、同僚、または有給コーチがインストール手順を実行した、職務を書いた、またはエラーから回復した任意のクロッシングは支援対象です。完了は、ヘルパーが利用可能だった場合、2つの数字として報告されます。
- 停止理由。 「何があなたを止めたのか」という自由記述回答。クロッシングしなかった全員に質問され、収集後にコード化。候補コード。後のコーダーが改訂するための仮説として提示:ワークフロー語彙;権限またはセキュリティダイアログ;管理者権限;費用またはクォータ;インターフェイスへの恐れ;破壊的インシデントのニュース;組織ポリシー;技術エラー;生活と時間;その他。
- 「何を聞くべきか分からなかった」についてのコード化ルール(ワークフロー語彙)。 個人が、エージェントに何をさせようとしたか聞かれて、セクション5.1の5つの部分のうち少なくとも1つを名付けることができない場合を含めます:業務のオブジェクト、使用可能な入力、変換、納品物、またはチェック。すべての5つが名付けられ、個人がポリシー、リスク、費用、または時間を根拠に拒否した場合を除外します;それらは独自のコードを取得します。2人のコーダーが独立して コード化し、彼らの合意を報告します。このルールは停止を分類し、個人の能力について何も述べていません。
- 4つのプラクティスの痕跡(はい/いいえ。各々が日付付きアーティファクトに関連付けられています):計画が拒否;diffまたは出力が却下;第2モデルファミリーを依頼;分母を記録(誰が質問されたか、誰が回答したか、誰がタイムアウトしたか);不可逆ステップが確認のために保持;アーティファクトが預金。これらはP10の監督痕跡です。
- マーカーではない。 ライセンス購入、コースバッジ、インストーラーログ、リポジトリスター、プロンプト数、または「エージェントユーザー」としての自己評価。
附録B. 年表 2025年〜2026年9月21日
VERIFIEDと表記されたエントリは、2026年9月21日で終了する調査期間中に、プライマリページ、またはプレスレポート用の名前付きセカンダリページで開かれたものです。SECONDARYと表記されたエントリは、プライマリページでは開かれなかったプレスレポートまたは製品履歴に基づくものであり、参考のために示されており、論証の重みは持ちません。これは4段階の論証のための作業用年表であり、業界の年表を意図したものではありません。
| 日付 | イベント | 出典 | ステータス |
|---|---|---|---|
| 2025年2月24日 | Claude Code リサーチプレビュー | 製品履歴、広くレポート | SECONDARY |
| 2025年4月23日 | 行政命令 14277 AI教育に関する | ホワイトハウス (2025a) | VERIFIED |
| 2025年5月22日 | Claude Code 一般利用開始 | 製品履歴、広くレポート | SECONDARY |
| 2025年6月23日 | Agent2Agent プロトコル Linux Foundation に寄付 | Google Open Source Blog (2026) | VERIFIED (ベンダー) |
| 2025年7月 | America's AI Action Plan が AI リテラシーとスキルにコミット | ホワイトハウス (2025b) | VERIFIED |
| 2025年7月21日 | アプリケーション構築エージェントがライブセッション中に本番データベースを削除 | The Register (2025) | VERIFIED (プレス) |
| 2025年8月20日 | ブラウザエージェントに対する プロンプトインジェクション が実証、ワンタイムコード盗難 | Brave (2025) | VERIFIED |
| 2025年8月25日 | ブラウザエージェント パイロット: 攻撃成功率 対策なし 23.6%、対策ありで 11.2% | Anthropic (2025) | VERIFIED (ベンダー) |
| 2025年12月9日 | Model Context Protocol を Agentic AI Foundation (Linux Foundation) に寄付; 公開サーバー 10,000以上、月間SDK ダウンロード 約9,700万 | Linux Foundation (2025) | VERIFIED |
| 2025年12月9日 | コンサルティング企業が、約30,000人のスタッフが1つのベンダーのモデルについて訓練されると発表 | Accenture (2025) | VERIFIED |
| 2025年12月18日 | Agent Skills フォーマット オープンスタンダードとしてリリース | SiliconANGLE (2025) | VERIFIED (プレス) |
| 2025年12月22日 | OpenAI: プロンプトインジェクション は「完全には『解決』されることはまずない」 | TechCrunch (2025) | VERIFIED (プレス) |
| 2026年1月 | Cowork リサーチプレビュー、「Claude Code for the rest of your work」 | Fortune (2026a); The Register (2026) | VERIFIED (プレス) |
| 2026年1月12日 | 非プログラマーにプロンプトインジェクション を注視するよう求めることへの異議 | Willison (2026) | VERIFIED |
| 2026年1月15日 | Anthropic Economic Index: 会話の52% が拡張 (2025年11月) | Anthropic (2026f) | VERIFIED (ベンダー) |
| 2026年2月4日および26日 | GitHub Agent HQ: Claude と Codex エージェントが Copilot 内で利用可能 | GitHub (2026c) | VERIFIED |
| 2026年2月 | Perplexity Model Council トップティアサブスクライバー向け (2月10日報告) | Storyboard18 (2026) | VERIFIED (プレス) |
| 2026年2月13日 | 米国労働省 AI リテラシー フレームワーク (「AIを効果的に指揮する」) | 米国労働省 (2026) | VERIFIED |
| 2026年3月9日 | Cowork テクノロジー Microsoft 365 Copilot に統合 | Microsoft (2026a) | VERIFIED |
| 2026年3月9日、4月19日、6月10日 | 付与されたフォルダ内のレベル2エージェントによるファイル削除のユーザー報告 | GitHub イシューレポート (2026) | VERIFIED (ユーザーレポート) |
| 2026年3月24日 | Anthropic Economic Index: 長期ユーザーはより委任度が低い | Anthropic (2026e) | VERIFIED (ベンダー) |
| 2026年3月30日 | OpenAI の Claude Code 内でそのエージェントを使用する公式プラグイン; Microsoft のリサーチエージェントは GPT と Claude を一緒に実行 | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| 2026年4月 | JetBrains: Claude Code 勤務中 18% (2026年1月)、約3% (2025年春)から増加 | JetBrains Research (2026a) | VERIFIED (ベンダー調査) |
| 2026年4月13日 | Duolingo が業績評価から AI 使用を廃止 | Fortune (2026b) | VERIFIED (プレス) |
| 2026年5月5日 | Work Trend Index: 組織要因は個人要因を2倍以上上回る | Microsoft (2026b) | VERIFIED (ベンダー調査) |
| 2026年4月25日 (5月5日報告) | エージェントが会社の本番データベースとバックアップを削除 | Information Age (2026) | VERIFIED (プレス) |
| 2026年5月19日 | Google が Gemini CLI から Antigravity CLI への移行を発表 | Google (2026) | VERIFIED |
| 2026年5月25日 | xAI の Grok Build ヘッドレスモードとエージェントプロトコルサポート付きでリリース | xAI (2026) | VERIFIED (ベンダー) |
| 2026年5月26日 | 米国事業 AI 利用 全体で17%から20%; 小規模企業は変わらず | 米国国勢調査局 (2026) | VERIFIED |
| 2026年5月27日 | 開発者パルス: 69% 単一エージェント; 60% 未承認変更をブロック | Stack Overflow (2026) | VERIFIED |
| 2026年6月2日 | コーディングエージェント 週間500万ユーザー、約20% のナレッジワーカー | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (ベンダーデータのプレスレポート) |
| 2026年6月15日 | PwC AI Jobs Barometer: AI スキルで62% の賃金プレミアム | PwC (2026) | VERIFIED (ベンダー) |
| 2026年6月17日 | Pew: 米国成人のほぼ半数がチャットボットを使用 | Pew Research Center (2026) | VERIFIED |
| 2026年6月18日 | Gemini CLI が個人層の提供を停止 | Google (2026) | VERIFIED |
| 2026年6月 | OECD およびヨーロッパ委員会 AI リテラシー フレームワーク (「AI を管理する」) | OECD & ヨーロッパ委員会 (2026) | VERIFIED |
| 2026年6月29日〜7月3日 | Claude Code がデフォルトパーミッションモードを「Manual」に改名 | Anthropic (2026h) | VERIFIED (ベンダー) |
| 2026年7月1日 | Gemini Spark デスクトップエージェント Mac上; Remote Labor Index オートメーション率最高 15.8%、リリース時2.5%から | TechCrunch (2026b); Center for AI Safety (2026) | 検証済み |
| 2026年7月8日 | Indeed: AIに影響を受けた米国の職務のうち63%は技術職以外 | Adrjan (2026) | 検証済み |
| 2026年7月9日 | コーディングエージェントアプリがChatGPTデスクトップアプリに; ChatGPT Workがローンチ | MacRumors (2026) | 検証済み (プレスリリース) |
| 2026年7月20日 | Gallup: 米国労働者の52%がAIを使用、15%は毎日使用 | Gallup (2026) | 検証済み |
| 2026年7月27日 | EU AI包括法が施行; AI識字能力義務が「支援措置を講じる」に変更 | European Commission (2026a, 2026b) | 検証済み |
| 2026年7月28日 | Model Context Protocol: 月間SDKダウンロード数が5億近くに; プロトコルがステートレスに | Model Context Protocol (2026) | 検証済み |
| 2026年8月3日 | EUのAI識字能力に関する監督及び執行規則が適用開始 | European Commission (2026a) | 検証済み |
| 2026年8月 | JetBrains: プロフェッショナル開発者の90%が週1回コーディングエージェントを使用; Claude Codeの職場での使用率39% | JetBrains Research (2026b) | 検証済み (ベンダー調査) |
| 2026年8月9日 | OpenAIのエージェント型ブラウザが廃止; ブラウジング機能がChatGPTアプリに統合 | 9to5Mac (2026) | 検証済み (プレスリリース) |
| 2026年8月26日 | ブラウザエージェントが一般利用可能に; デフォルトでは自律型で分類器を搭載; ベンダー報告のインジェクション率はほぼ0% | Anthropic (2026d) | 検証済み (ベンダー) |
| 2026年9月1日 | セントルイス連邦準備銀行: 労働者の45%が仕事でAIを使用; 採用率が50%を超えるタスクは3%未満 | Bick et al. (2026) | 検証済み |
| 2026年9月6日 | コーホート1事前登録が締め切られた | Chernets (2026d) | 検証済み |
| 2026年9月9日 | Harvard Business Review: エージェント採用の職場での障害として信頼が中心的課題 | McKinlay et al. (2026) | 検証済み (要約) |
| 2026年9月16日 | CoworkとChatが1つのClaudeに統合 | Anthropic (2026c); TechCrunch (2026a) | 検証済み |
| 2026年9月22日 | 公式プラグインカタログ全体を読破、310件: セクション5.1で名挙げられた5つの職種には対応なし; コミュニティカタログ2,282件、教員と不動産業向けのオファーあり | 著者による公開カタログの読破 | 検証済み (自数計) |
付録C. 教育用コード
以下のリストは、セクション5から9のパターンを教えています。Pythonの標準ライブラリとベンダー独自のコマンドラインツールのみを使用し、ユーザー自身のサブスクリプションでサインインしています。APIキーを読み取るものはありません。それぞれは一度の読了で終わるほど短く、それぞれが何を教えるか、どこで止まるかを述べています。テストとともにコンパニオンリポジトリにMITライセンスの下に預けられており、すべてのリストは組み入れ前に実行されています(それぞれのデモ入力で、ファンアウトはスタブツールで)。ここのパターンはすべてオープンソースツールに何らかの形で既に存在しています(セクション7.1)。リストの価値は、それらが小さく、コメント付きで、議論に結びついていることです。教育的経路でもなく、学習者の診断でもなく、カリキュラムでもなく、著者のツールの実装でもありません。プログラマー以外の人がこれらのファイルを手で実行することはありません。エージェントがスキルとしてラップしたり、デスクトップシェルがボタンとして公開したりするようなものです。そして印刷する意味は、読者がそのようなボタンが何をするかを見ることができるということです。
2つのインストール可能なClaude Codeプラグインは、これらのパターンを日常的に使用します。Roundcallは、ユーザーが既にサインインしているAIチャットサイトに、自分のブラウザを通じてユーザーのペースで質問します。Sidecallは、自分のマシンにインストールされているコマンドラインエージェントに質問し、各ベンダーのモデルを選択する予算設定があります。どちらも、誰が何を言ったか、答えが異なる場所、および1つのソースのみが言ったことについて1つのレポートを返します。これらはApache License 2.0の下でhttps://github.com/vadimchernets/roundcallおよびhttps://github.com/vadimchernets/sidecallでオープンソースです。
それらを実行する前に:インストール済みバージョンで各ツールの--helpを確認してください。フラグはリリース間で変わります。オリジナルではなくコピーを保持する作業フォルダで実行してください。そしてリストC6を最初に読んでください。
C1. プローブ、天井、部分的なキャプチャを備えたファンアウト(fanout.py)
教えること:1人の人が1つの質問を複数のエージェントCLIに一度に送信し、ダウンしているか割り当てを超えているものをスキップし、時間の天井で待つのをやめ、天井の前に各ツールが書いたものを保持する方法(捨てるのではなく)。各ツールは出力フォルダ内の新しい空のフォルダで実行され、ユーザーが起動したフォルダでは実行されません。ツール名は安全なファイル名に限定されます。長い質問はファイル(--question-file)に入るか、テンプレートに{prompt}がないツールの場合、ツールの標準入力に入ります。コマンドライン引数はオペレーティングシステムによる長さの制限があるためです。制限:天井での停止はPOSIXプロセスグループを使用します(macOSおよびLinux、WindowsではWSLを使用)。ツールが終了時のみ出力する場合、停止時に保持するものが残りません。ストリーミング出力モードがあれば使用してください。スクリプトは何も比較しません。C3が行います。
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. エージェントの「第二意見」スキル(second-opinion/SKILL.md)
教えること:最小限の形のCLIオーケストレーション。1つのエージェントが異なるベンダーのエージェントに問い合わせ、それを統合するのではなく差異を示すという書き込まれた指示。制限事項:2つのモデルは1つの比較であり、パネルではありません。このスキルはまだ一次資料が必要なポイントを示しています。
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. 誰が何を言ったのか (provenance.py)
教えること: 複数のモデルに質問することで得られる2つのもの、すなわちカバレッジと信頼性は、ソース別のクレームの表、1つのソースのみによるクレームのリスト、および数字または日付が異なるクレームのリストとして可視化されます。制限: 繰り返される表現を照合するものであり、繰り返される意味を照合するものではなく、また人に何を注意深く読むべきかを伝えるものであり、何が真実であるかを伝えるものではありません。
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. 合意は何個の独立した意見に相当するか?(neff.py)
学習内容:相関のある証拠の算術(セクション6.3):既知の答えを持つ項目から平均誤り相関ρを推定し、その後N_effとその上限である1/ρを計算します。--demoで実行すると、約1.6個の独立した意見に相当する4つのモデルが表示されます。限界:ρはタスクに依存しており、関心のある項目と10個以上の項目を使用して推定してください。
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. クロッシングの記録とチェッカー(crossings.py)
教えるもの: 第9.1節の測定ルールをコードとして示します。以下の場合、記録は拒否されます。インストレーションをクロッシングとしてカウントする場合、エージェント製作物のない完了、本人の言葉のないストップ、ヘルプの説明がない場合、疑似ラベルではなく名前を使用している場合(ラベルはPの後に数字が続く必要があります)、記載されていないレベルをスキップしている場合、真偽値ではない値、読み取り不可能な日付、フォーマットが認識しないフィールド、または尋ねられて回答を得た2つ未満のツールを列挙するレベル4クロッシングです。不正な形式の行は拒否として報告され、実行を停止することはありません。制限: レコードの形式をチェックしますが、その真実性はチェックしません。2つのツールが異なるモデルファミリーであるかどうか、およびその配置が後の週に再実行されたかどうか(第2の記録)は、研究者に委ねられます。これはアプリケーションではなく、研究ツールです。
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
同じレコード形式は JSON Schema(crossings.schema.json)として公開されており、他のツールはレコードの形状を検証できます。上記のチェッカーは、スキーマが表現できないルールを強制します(インストレーションはクロッシングではないこと、ストップには本人の言葉が必要であること、ヘルプには説明が必要であること、スキップは記録されることです)。
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. レベル3前のセーフティ (safety/)
教えること: セクション5.3のプラクティスを設定として説明します。最初のファイルはClaude Codeのプロジェクト設定ファイルの例です。デフォルトではプランモード(ベンダーは2026年7月にデフォルトモードを「Manual」に改名しましたが、「plan」は依然として有効で、より安全な教育的選択肢です)、一般的な破壊的コマンドとダウンロードコマンドは拒否され、通常のシークレットファイルはファイルリーダーとシェルのcatの両方に対して拒否され、削除とウェブ取得について確認を求めます。拒否リストはリストに過ぎません。許可モードまたはリストにないコマンドは回避できるため、サンドボックス設定はルールと同じくらい重要です。2番目はOpenAIのCodexの設定例で、実行ごと、フォルダスコープ形式で示されています。書き込みは作業フォルダに限定され、ネットワークなし、リクエストについての承認があります。3番目はチェックリストです。限界: 権限ルールとサンドボックスは影響範囲を縮小しますが、エージェントを信頼できるものにはしません。ルール構文はバージョン間で変わります。
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. スーパービジョントレースをログとして (jsonl_log.py)
学習内容: マネージャーの作業を記録する最小限の有用なレコード、イベントごとにタイムスタンプ付きのJSONオブジェクト1つであり、計画が拒否され、差分が却下され、第二意見が求められ、実行が完了した場合(命題P10のスーパービジョントレース)を後で標準ライブラリでカウントできるようになります。--demoで実行します。制限事項: これはトレーサーではなくライターであり、その人またはエージェントが指示したことを記録します。
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
附録D. 意見の有効数の計算表
listing C4を実行したくないエージェント管理者でも、上限値を使用できます。各セルはN_eff = N / (1 + (N - 1) rho)であり、最後の行は上限値1/rhoで、その相関を持つモデルの数がこれを超えることはできません。rhoの値は公式を説明し測定するために選択されました。実際の使用では、rhoはエラーの平均ペアワイズ相関であり、2つのモデルが同意する結合エラーの割合とは異なる量であり、対象とする領域で既知の答えを持つ項目で推定する必要があります(listing C4)。
| モデル数N | rho = 0.2 (説明用) | rho = 0.5 (説明用) | rho = 0.6 (説明用) | rho = 0.8 (説明用) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| 上限値、1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
この表が第6節で、同じファミリーの10番目のウィンドウではなく次のサブスクリプションを別のファミリーに費やすよう指示する理由です。ファミリーの多様性、ソースに対する請求項ごとの確認、および保持された異議が、より大きなNにはできない仕事を遂行します。rhoはタスクに依存するため、その人自身の領域の項目で推定する必要があります(listing C4)。
付録E. ランドスケープセンサス、2026年9月19日~21日
本文の表5はツールをパターン別にグループ化しています。この付録は、与えられた日付の時点での数字を望むリーダーのために、その背後にある生のセンサスを記録しています。スター数は毎日変動し、人気を示していますが、品質やユーザー数については何も述べていないため、リーダーの日付現在の引用値として用いられるべきではありません。パターン列は私によるマッピングであり、プロジェクト自体はそのような主張をしていません。
| プロジェクト | 場所 | スター数(概算、2026年9月21日) | ライセンス | パターン |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | ソース公開、専有ライセンス | ターミナルエージェント(レベル3) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | ターミナルエージェント(レベル3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | ターミナルエージェント;個別ティアは2026年6月18日以降提供されていません |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | エディタおよびターミナルエージェント |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | 公式プラグイン:一つのベンダーのエージェントが別のベンダーの内部に |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | リポジトリを参照 | エージェントに公開されるウェブチャット |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | リポジトリを参照 | プログラミングインターフェース上の協議会 |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500(最新リリースの約847,000ダウンロード) | Apache-2.0 | ブラウザブロードキャスト |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800(最終コミット:2025年12月) | Apache-2.0 | モデル間のコンサルテーションサーバー |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | ターミナルエージェント (レベル 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | ブラウザ配信 |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | CLIコンシル |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | ツールごとに1ファイルを書くCLIコンシューラー |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | ヘッドレスモードとエージェントプロトコルを備えたターミナルエージェント |
引用方法
Chernets, V. (2026). After Chat: Non-Programmersとエージェント型AIの間の3つの転換 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}