एक ही बार में कई AI से पूछें और देखें कि वे कहाँ असहमत हैं — Tools
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
जब आप किसी एक AI से सवाल पूछते हैं, तो आप को एक आत्मविश्वासी जवाब मिलता है और यह बताने का कोई आसान तरीका नहीं होता कि यह सही है या नहीं। दूसरे और तीसरे AI से पूछना मदद करता है, लेकिन केवल अगर आप देख सकें कि उनके उत्तर कहाँ भिन्न हैं, और केवल अगर आप जानते हों कि उनकी सहमति वास्तव में कितनी कीमत की है। After Chat एक छोटा सा मुफ़्त, खुले स्रोत वाले Python स्क्रिप्ट का सेट है जो एक सवाल को एक साथ कई AI के सामने रखता है और दोनों काम करता है: यह दिखाता है कि किसने क्या कहा, और यह पता लगाता है कि उनकी सहमति की कीमत क्या है। यह आपके अपने कंप्यूटर पर चलता है, उन AI उपकरणों के माध्यम से जिन में आप पहले से साइन इन हैं, कोई API कुंजी के बिना और कोई अतिरिक्त सदस्यता के बिना, और स्क्रिप्ट स्वयं को Python की आवश्यकता है।
एक AI काफी नहीं है, और चार AI चार नहीं हैं
विभिन्न कंपनियों के AI मॉडल अलग-अलग तरीके से प्रशिक्षित होते हैं, इसलिए वे हमेशा एक जैसी त्रुटियाँ नहीं करते। यही कारण है कि लोग एक ही प्रश्न को ChatGPT, Claude, Gemini और Grok में डालते हैं और उत्तरों की तुलना हाथ से करते हैं। उनकी त्रुटियाँ जितनी दिखाई देती हैं उससे अधिक ओवरलैप होती हैं। 350 से अधिक भाषा मॉडलों का एक 2025 अध्ययन पाया गया कि जब दोनों मॉडल गलत होते हैं, तो वे अक्सर एक ही गलत उत्तर देते हैं: एक लीडरबोर्ड डेटासेट पर, 60% समय। तो जब चार AI सहमत होते हैं, तो आपके पास चार से कम स्वतंत्र पुष्टियाँ होती हैं। कई से पूछने का वास्तविक मूल्य असहमति में है: एक बिंदु जो केवल उनमें से एक ने उठाया, या एक ही दावा जिसमें भिन्न संख्याएँ हों।
एक वास्तविक उदाहरण
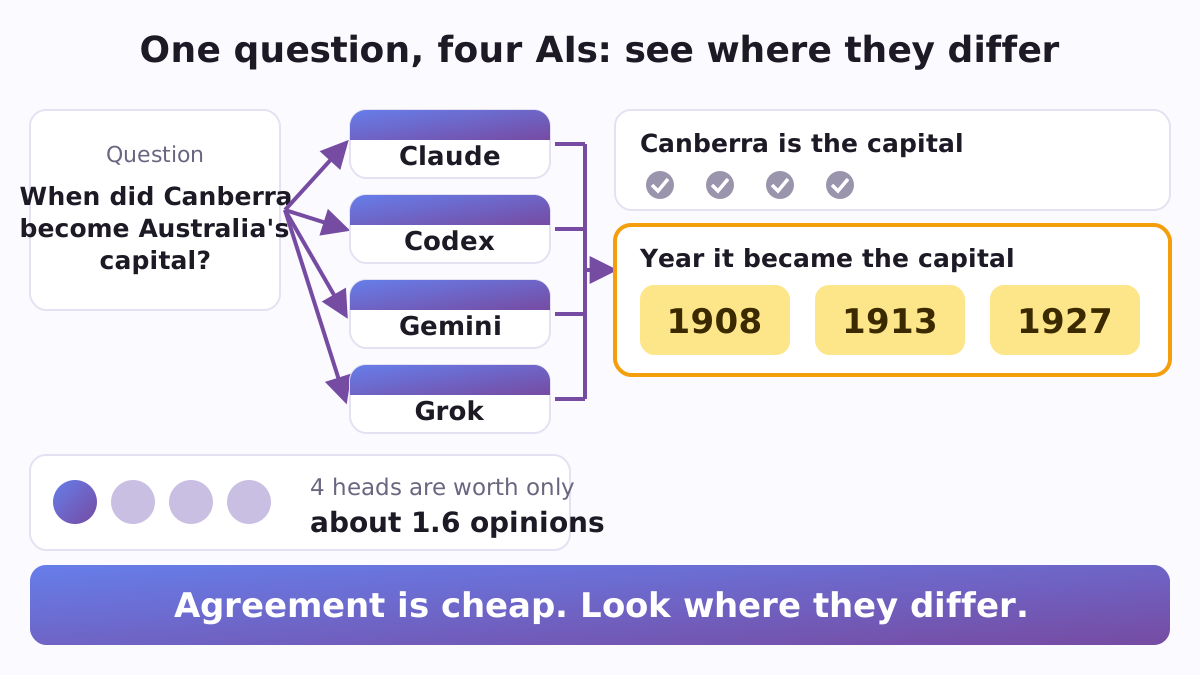
21 सितंबर 2026 को लेखक ने चार AI कमांड-लाइन टूल्स से एक प्रश्न पूछा: "एक वाक्य में: ऑस्ट्रेलिया की राजधानी कौन सी है, और यह राजधानी कब बनी?" सभी चारों ने 25 सेकंड के भीतर उत्तर दिया, और सभी चारों ने कैनबरा कहा। वर्ष के बारे में वे तीन तरीकों से विभाजित हुए: 1908, 1913 और 1927। प्रत्येक वर्ष का बचाव किया जा सकता है: स्थान को 1908 में चुना गया था, शहर का नाम 1913 में दिया गया था, और संसद 1927 में वहां स्थानांतरित हुई थी। अकेले पूछने पर, Codex ने 1927 दिया होता और Grok ने 1913 दिया होता, प्रत्येक एक सादे तथ्य के रूप में। एक साथ, उत्तरों ने तुरंत दिखाया कि प्रश्न के तीन ईमानदार उत्तर हैं, और एक व्यक्ति को जाँच करने के लिए आवश्यक सटीक पंक्ति की ओर इशारा किया।
अंदर क्या है
- सभी को एक साथ पूछें (
fanout.py). यह पहले अपनी सूची में प्रत्येक AI टूल को एक त्वरित परीक्षण प्रश्न भेजता है और किसी भी टूल को छोड़ देता है जो स्थापित नहीं है या उत्तर नहीं देता है। फिर यह आपके प्रश्न को सभी जीवंत टूलों को एक ही समय में, एक समय सीमा के तहत रखता है जो आप चुनते हैं, और प्रत्येक उत्तर को अपनी फ़ाइल में स्ट्रीम करता है। यदि कोई टूल अभी भी समय समाप्त होने पर लिख रहा है, तो अब तक जो लिखा गया है वह रखा जाता है और आंशिक के रूप में चिह्नित किया जाता है, नष्ट नहीं किया जाता है। प्रत्येक AI अपने स्वयं के खाली फ़ोल्डर में शुरू होता है, उस फ़ोल्डर में नहीं जहाँ से आपने लॉन्च किया था, इसलिए यह केवल आपके प्रश्न से काम करता है। एक लंबा प्रश्न, जैसे पाठ का एक पृष्ठ जिसे आप सभी से जांचना चाहते हैं,--question-fileके साथ एक फ़ाइल में जाता है। - देखें कि किसने क्या कहा (
provenance.py). यह प्रत्येक उत्तर को छोटे दावों में तोड़ता है, उन दावों को समूहित करता है जो समान शब्दों में हैं, और एक तालिका मुद्रित करता है: प्रत्येक दावा, और किस AI ने इसे बनाया। तालिका के नीचे दो सूचियाँ आती हैं जो सबसे महत्वपूर्ण हैं: केवल एक AI द्वारा बनाए गए दावे (कुछ ऐसा जो दूसरों ने मिस किया, या उस एक की गलती) और दावे जहाँ AI अलग-अलग संख्याएँ, प्रतिशत या तारीखें देते हैं। यह पाठ फ़ाइलों के किसी भी फ़ोल्डर को पढ़ता है, इसलिए आप चैट वेबसाइटों से उत्तरों को फ़ाइलों में पेस्ट भी कर सकते हैं, प्रत्येक AI के लिए एक, और उन की तुलना कर सकते हैं। - जानें कि समझौता क्या लायक है (
neff.py). इसे ज्ञात उत्तरों के साथ कुछ प्रश्न दें, प्रत्येक AI के लिए सही या गलत चिह्नित, और यह मापता है कि आपके AI कितनी बार एक साथ गलत होते हैं। इससे यह पता चलता है कि वे वास्तव में कितने स्वतंत्र विचारों के लायक हैं। निर्मित उदाहरण में, चार AI जिनकी गलतियाँ ओवरलैप होती हैं, लगभग 1.6 स्वतंत्र विचारों के लायक होते हैं, और ऐसे कोई भी AI कभी भी 2.1 से अधिक लायक नहीं होंगे। - Claude Code के अंदर एक दूसरी राय (
second-opinion/SKILL.md). एक तैयार कौशल: फ़ोल्डर को~/.claude/skills/में कॉपी करें, और Claude Code दूसरी कंपनी के AI से एक ही प्रश्न पूछ सकता है, वह उत्तर बिल्कुल जैसे आया था दिखा सकता है, और दोनों कहाँ सहमत हैं, कहाँ भिन्न हैं, और केवल एक का उल्लेख करते हैं, की एक छोटी तालिका जोड़ सकता है। यह कभी भी दोनों को एक आत्मविश्वास से भरे हुए पाठ में मिश्रित नहीं करता है, और यह दूसरे AI के उत्तर को सामग्री के रूप में मानता है जिसकी तुलना करनी है, कभी भी अनुसरण करने के लिए निर्देश के रूप में नहीं। - AI एजेंटों के लिए सुरक्षित सेटिंग्स (
safety/). Claude Code की अनुमति सेटिंग्स (settings.json) का एक तैयार उदाहरण जो प्रत्येक सत्र को योजना मोड में शुरू करता है,rm -rf,sudo,curlऔरgit pushजैसे आदेशों को अस्वीकार करता है,.envफ़ाइलों और एकsecretsफ़ोल्डर को अपठनीय रखता है, औरrm,mvऔर वेब फेच से पहले पूछता है। Codex के लिए सेटिंग्स इसे केवल अपने कार्यशील फ़ोल्डर के अंदर लिखने दें, नेटवर्क बंद के साथ, और इसे उस सीमा से परे जाने से पहले पूछें। एक 14-बिंदु चेकलिस्ट उनके चारों ओर की आदतों को कवर करती है: एक प्रति में काम करें, पहले एक योजना माँगें, एक अनडू रखें, जानें कि एक लंबी नौकरी को कैसे बंद करें। - शोधकर्ताओं के लिए उपकरण (
crossings.py,crossings.schema.json,jsonl_log.py). एक रिकॉर्ड प्रारूप, एक कठोर जांचक के साथ, इस बात के अध्ययन के लिए कि लोग AI के साथ चैट करने से लेकर AI एजेंटों को वास्तविक काम करने देने तक कैसे आगे बढ़ते हैं। एक ऐप स्थापित करना इसका उपयोग करने के रूप में नहीं गिना जाता है, एक समाप्त चरण को कुछ की आवश्यकता होती है जो एजेंट ने वास्तव में बनाया है, और जब कोई रुकता है, तो रिकॉर्ड उनके अपने शब्दों को रखता है। एक छोटा लॉगर प्रत्येक निर्णय लिखता है, जैसे एक योजना अस्वीकृत या एक दूसरी राय ली गई, JSON की एक टाइमस्टैम्प की गई पंक्ति के रूप में।
यह इसी तरह क्यों बनाया गया है
कई "LLM council" उपकरण एक मर्ज किए गए उत्तर के साथ समाप्त होते हैं। उदाहरण के लिए, Andrej Karpathy के लोकप्रिय llm-council में, आप अपने प्रश्न को OpenRouter के माध्यम से मॉडल को भेजते हैं, एक API सेवा जिसके लिए आप क्रेडिट खरीदते हैं, और एक "chairman" मॉडल अंतिम उत्तर लिखता है। After Chat आप जो कमांड-लाइन उपकरण पहले से उपयोग करते हैं उन्हीं के माध्यम से जाता है, और यह जानबूझकर मर्ज से पहले रुक जाता है: आप को यह तालिका मिलती है कि किसने क्या कहा, और निर्णय आप के साथ रहता है। हर स्क्रिप्ट केवल Python की standard library का उपयोग करती है और एक छोटी फ़ाइल में फिट हो जाती है (सबसे लंबी 200 लाइनों से कम है), इसलिए आप बिल्कुल यह पढ़ सकते हैं कि यह क्या करता है और इसे बदल सकते हैं।
शुरुआत कैसे करें
ये स्क्रिप्ट जहाँ कहीं भी Python 3 चलता है, वहाँ चलती हैं; Windows पर, WSL के अंदर fanout.py चलाएँ। एक लाइव तुलना दो या अधिक AI कमांड-लाइन टूल का उपयोग करती है, जिनमें आप अपने स्वयं के खातों से साइन इन होते हैं। अंतर्निहित सूची में Claude Code (claude), OpenAI Codex (codex), Google का Antigravity CLI (agy, जिसने 18 जून 2026 को व्यक्तिगत Google खातों के लिए Gemini CLI से अधिग्रहण किया) और xAI का Grok Build (grok) शामिल हैं। प्रत्येक टूल की कमांड --tools के साथ पास की गई एक छोटी JSON फ़ाइल में एक पंक्ति है, इसलिए एक और टूल जोड़ना, या एक नई रिलीज़ में बदली हुई किसी फ़्लैग का पालन करना, एक मिनट लगता है। कोई कमांड-लाइन टूल नहीं है? किसी भी AI चैट वेबसाइट से उत्तर को .txt फ़ाइलों में, प्रत्येक AI के लिए एक, पेस्ट करें और उस फ़ोल्डर पर provenance.py चलाएँ: प्रत्येक फ़ाइल का नाम तालिका के एक स्तंभ में बदल जाता है।
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
28 परीक्षण python3 -m unittest tests/test_patterns.py के साथ चलाए जाते हैं। कोड, इसके परीक्षण और सुरक्षा सेटिंग्स सभी github.com/vadimchernets/after-chat पर हैं।
यह कहाँ से आता है
After Chat Vadym Chernets के पेपर After Chat: Non-Programmers और Agentic AI के बीच तीन संक्रमण का साथी कोड है (सितंबर 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019)। यह पेपर पूछता है कि इतने कम लोग AI के साथ चैट करने से लेकर AI एजेंट को अपने लिए काम करने देने तक क्यों नहीं गए हैं, और उस कदम को कैसे मापा जाए। कोड MIT लाइसेंस के तहत है और Zenodo पर आर्काइव किया गया है (DOI 10.5281/zenodo.22944451)। एक ही पैटर्न से दो तैयार Claude Code प्लगइन निकले हैं: Sidecall आपके कंप्यूटर पर AI कमांड-लाइन टूल्स से पूछता है, और Roundcall अपने ब्राउज़र के माध्यम से AI चैट साइटों से पूछता है।
Vadym Chernets Poly A1 भी बनाते हैं, एक ऐसा ऐप जिसमें विभिन्न कंपनियों के AI एक दूसरे के काम की जांच करते हैं।