После чата: три переходных момента между непрограммистами и агентным ИИ
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Терминал — уже не терминал: четырёхуровневая модель, свидетельства 2025 и 2026 годов и предрегистрированная программа измерения переходов
Vadym Chernets, PhD, архитектор систем ИИ · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
Скачать эту статью
- SSRN (основная версия): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (архивировано, открытый доступ): doi.org/10.5281/zenodo.22943313
- GitHub (полный текст в формате Markdown и PDF): github.com/vadimchernets/papers/tree/main/after-chat; код: github.com/vadimchernets/after-chat
Один и тот же текст находится в трёх местах, чтобы его можно было получить, когда один из них не может его предоставить. SSRN содержит основную версию; цитируйте её.
Ключевые слова: агентный ИИ; ИИ-агенты; непрограммисты; программирование конечным пользователем; грамотность в области ИИ; работники знания; внедрение технологии; внедрение генеративного ИИ; надзор человека; делегирование; цифровой разрыв второго уровня; коррелированные ошибки; парадоксы автоматизации; утрата навыков; предрегистрация
Аннотация
Большинство специалистов встречаются с ИИ как с чатботом, тогда как те же модели, в качестве ИИ-агентов, теперь работают с файлами и программами. Я спрашиваю, почему так мало непрограммистов перешли от чата к агентному ИИ и как измерить этот переход. Ответ основан на четырёхуровневой модели, определяемой охватом и ролью и независимой от продуктов: чат, ограниченная поставщиком безопасная агентная среда, агент на собственном компьютере пользователя и повторяемая работа, скоординированная несколькими моделями. Переход имеет место только когда агент создал артефакт, который просил пользователь. Установка программного обеспечения считается попыткой. Данные с 2025 по сентябрь 2026 года указывают на то, что барьер для установки и первой ограниченной попытки снизился, в то время как надёжность целостных работ, стабильность продукта и безопасность папок — нет. Установка — это один этап, собственный чатбот пользователя может помочь в этом («рефлексивная подготовка»), и два поставщика объединили интерфейсы агента и чата в 2026 году. Ориентировочная цифра одного поставщика, приводимая в прессе, оценивает долю знаниевых работников в одну пятую от пяти миллионов еженедельных пользователей его кодирующего агента; она измеряет использование агента терминального наследия, а не принятие уровня 3, как определено здесь. Использование остаётся широким и поверхностным: примерно половина работников США использует ИИ, примерно один из семи ежедневно, и мало кто для автоматизации. Барьер сместился с установки на управление. Опираясь на исследования программирования конечными пользователями, я определяю словарь рабочих процессов как отсутствующую возможность и представляю работу менеджера как договор делегирования: цель, рамки, артефакт и проверка. Веб-оркестрация (один вопрос нескольким чатботам) предложена как мост, который учит сравнению, и оркестрация через командную строку (один агент вызывает других) как долговечный слой, ограниченный тем, что согласие коррелированных моделей — слабое свидетельство. Статья завершается пятнадцатью фальсифицируемыми утверждениями, дизайном предварительно зарегистрированной программы когорты без результатов и открытым учебным кодом.
Краткое резюме
Терминал, чёрное окно, которое было символом всего, что непрограммисты не могли делать с ИИ, изменило своё значение. Теперь это место на персональном компьютере человека, где работает агент, и требуемый навык — это больше не набор команд. Навык состоит в управлении тем, кто их вводит.
Профессиональные разработчики продвинулись дальше всех: 90% из более чем 15 000 опрошенных в 2026 году использовали инструменты агентов по крайней мере еженедельно (исследование производителя), хотя еженедельное использование — это ещё не компетенция менеджера из раздела 8. Остальные в основном всё ещё общаются с чатботом. 52% американских рабочих используют ИИ в своей работе, 15% — ежедневно, и 16% этих пользователей называют автоматизацию среди своих применений.
Причина больше не в сложности установки агентов. Установка требует команду или клик, чатбот, который человек уже использует, может помочь ему разобраться, и производители начали объединять чат с агентами. То, что остаётся трудным, иной природы. Агенты по-прежнему дают сбой на целых участках работы, продукт, который человек выучил, может быть переименован или снят с поддержки в течение года, и полученная папка по-прежнему нуждается в защите. После установки первое, что останавливает людей, — это то, что они не знают, что передать или как проверить результат, пробел, который в разделе 1 назван словарём рабочего процесса. За ним идут первая ошибка, разрешения и безопасность, организационные правила, аппаратное обеспечение и стоимость, а также компетенция оценки результатов.
Модель имеет четыре уровня, упорядоченные по охвату модели и по действиям, которые должен предпринять человек: беседа, огороженное пространство, управляемое производителем, персональный компьютер человека и работа, координируемая несколькими моделями. Люди могут пропустить уровень. Переход обозначается только артефактом, созданным агентом, так что установки, значки и самоотчёты не учитываются.
Оркестрация — отправка одного вопроса нескольким моделям — происходит в двух слоях. В браузере это ничего не стоит и вырабатывает привычку сравнивать ответы, а в командной строке это можно записать и запустить снова. В обоих случаях важно количество семейств моделей, к которым обращались, так как коррелированные ошибки ограничивают ценность согласия.
Управление агентами — это самостоятельная компетенция. Оно включает контракт делегирования из четырёх частей (цель, границы, артефакт, проверка), четыре практики (делегировать, контролировать, проверять, отозвать), правило остановки для проверок и запись приёма, которая разграничивает то, что произвёл агент, и то, на что опирался человек.
Аргумент построен так, чтобы его можно было тестировать. Пятнадцать утверждений содержат меры и фальсификаторы. Дизайн предрегистрированной когортной программы (OSF DOI 10.17605/OSF.IO/X4EGQ) описан здесь, и её результаты будут опубликованы отдельно. Таблица статуса показывает степень уверенности в каждом утверждении, и открытый код находится в приложении C.
1. Введение
Рассмотрим офисного работника в сентябре 2026 года. Она использует чат-бот еженедельно. Она просит его составить письмо, подготовить резюме отчета, предложить формулу. То, что она получает, — это текст, и она вручную переносит этот текст в то место, где находится её работа: папку с контрактами, таблицу расчётов, презентацию, необходимую в пятницу. Та же модель через другой интерфейс может открыть эту папку, прочитать каждый файл в ней, заполнить таблицу, создать презентацию и проверить собственные расчёты. Большинство профессионалов, судя по опросам в разделе 4.4, ещё не использовали этот интерфейс, и многие даже не знают о его существовании.
Два года доступ выглядел как терминал: чёрное окно, мигающий курсор, команда для вставки. Эта картина устарела. Терминал остался терминалом только визуально. Он стал средой, в которой живёт агент, местом на собственном компьютере человека, где модель может читать, писать, запускать и планировать, а человек перед ним больше не должен управлять оболочкой, а скорее направлять агента, который это делает. То, что изменяется, — это роль человека: от того, кто задаёт вопросы модели, к тому, кто управляет работником.
Мой предмет — это путь между этими двумя ролями и те, кто по нему идёт. Среди профессиональных разработчиков инструменты, по крайней мере, уже появились. Опрос более 15 000 профессиональных разработчиков в мае — июле 2026 года показал, что 90% использовали AI-агентов для кодирования на работе по крайней мере еженедельно и 68% ежедневно, и что доля использующих один терминальный агент, Claude Code, на работе увеличилась примерно с 3% весной 2025 года до 18% в январе 2026 года и 39% к середине 2026 года (JetBrains Research, 2026a, 2026b; опрос поставщика, так как JetBrains продаёт агента кодирования). Среди всех остальных этого не произошло, и картина использования широкая, но неглубокая. В те же месяцы 52% американских рабочих сообщили об использовании AI в своей роли, 15% использовали его ежедневно, и только 16% из этих пользователей назвали автоматизацию среди своих применений; доминировали написание и поиск (Gallup, 2026). Для типичного профессионала AI — это всё ещё разговор, и цифры Федерального резервного банка Сент-Луиса говорят о том же на более длительном промежутке времени: между августом 2024 года и маем 2026 года доля рабочих, использующих генеративный AI для своей работы, увеличилась с 33% до 45%, а менее чем 3% задач имели темпы внедрения выше 50% (Bick et al., 2026).
Стандартное объяснение разрыва — техническая сложность: агенты предназначены для людей, которые умеют программировать. Этот ответ был обоснован в 2024 году и слаб в 2026 году. Установка терминального агента теперь требует одной команды или установщика рабочего стола, и ведущий агент поставляется с приложением рабочего стола, в документации которого ясно сказано: «Терминал не требуется» (Anthropic, 2026a). Поставщики пошли дальше. OpenAI превратила своё приложение coding-agent в стандартный desktop-клиент ChatGPT 9 июля 2026 года и добавила агента ChatGPT Work, который использует локальные файлы и приложения (MacRumors, 2026). Anthropic объединила свой desktop-агент для работы с знаниями Cowork в обычный чат 16 сентября 2026 года; TechCrunch сообщила, что компания заявила, что клиенты «часто испытывали затруднения при выборе правильной вкладки для правильной задачи» (TechCrunch, 2026a). OpenAI сообщила через прессу, что специалисты по знаниям составляли около 20% из пяти миллионов еженедельных пользователей её агента кодирования в июне 2026 года и внедряли его более чем в три раза быстрее, чем разработчики (Help Net Security, 2026). Эта цифра является сообщением поставщика и ориентировочной, страница самого поставщика была недоступна для моих проверок, и она измеряет использование специалистами агента с наследием терминала, что шире, чем внедрение уровня 3, как определено в разделе 3. Трудно увидеть, где техническое препятствие в этой картине.
Препятствие переместилось. Оно переместилось от установки к управлению: от «как мне это запустить?» к «что я прошу его делать, в каких пределах, и как я узнаю, что он это сделал?» Второй вопрос сложнее, чем звучит, и литература по программированию для конечных пользователей объясняет почему. Неспециалисты испытывают затруднения при выражении намерений языковым моделям, даже когда доступ свободный и непосредственный (Zamfirescu-Pereira et al., 2023), и они должны научиться, какие фразировки соответствуют тому, что система может делать (Liu et al., 2023). Делегирование AI также смещает работу с производства на спецификацию и проверку (Sarkar & Drosos, 2025; Simkute et al., 2024). Я называю отсутствующую возможность словарём рабочего процесса: запас рабочих задач, которые человек знает, как передать агенту, сформулированные так, чтобы агент мог их выполнить и результат можно было проверить. Формально это отображение между целями человека в его области и подзадачами, которые может выполнить агент, со словами для входов, преобразований, выходов, исключений и свидетельств, требуемых этим отображением. Разработчик, открывающий агента, уже знает первые десять задач для ввода. Бухгалтер или учитель обычно не знает, и никто на их работе им этого не сказал.
Первый вклад — четырёхуровневая модель пути от чата к работе с агентом, определяемая масштабом и ролью, без привязки к названиям продуктов. Уровни идут от чата через безопасную среду с агентом и агента на собственном компьютере к повторяемой оркестрированной работе. Каждый определяется тем, к чему может получить доступ агент, и тем, что человек должен указать и проверить, и каждый переход определяется артефактом, созданным агентом; одного установленного программного обеспечения недостаточно. Поскольку определения не зависят от названий продуктов, модель выживает в текущей привычке поставщиков объединять свои продукты (раздел 3).
Второе — это синтез доказательств за 2025 — сентябрь 2026 года. Это показывает, что установка и первая ограниченная попытка стали намного проще, что три ограничения, изложенные в разделе 4.5 (надёжная работа над целыми задачами, стабильные продукты, безопасные папки), не сдвинулись вместе с ними, и что неглубокая картина использования сохраняется. Это также определяет оставшиеся препятствия: словарь рабочего процесса, ошибка, которая останавливает новичка, разрешение и безопасность, организационные правила и компетентность для оценки результатов (разделы 4 и 5).
Третье — это описание двух уровней оркестрации. Веб-оркестрация, один вопрос, отправленный нескольким потребительским чат-ботам, это мост: он не требует установки и учит привычке сравнения. CLI-оркестрация, один агент, вызывающий инструменты командной строки других агентов, это уровень делегирования, который длится. Оба ограничены фактом, который пользователи, как правило, упускают, что согласие между моделями не является независимым свидетельством (Chernets, 2026a) (разделы 6 и 7).
Четвёртое — это программа измерений с опровержимыми предложениями: проектирование предварительно зарегистрированной когортной программы, которая отслеживает непрограммистов через эти переходы (Chernets, 2026d), и открытый набор инструментов обучения для оркестрации и шаблонов безопасности в приложениях (разделы 9 и 10, приложение C).
На протяжении всей работы действуют несколько ограничений масштаба. «Непрограммист» означает профессионала, чья работа в значительной степени связана с компьютером и который не имеет подготовки в области написания скриптов или разработки программного обеспечения. Аналитик, владеющий формулами электронных таблиц, относится к этой категории, разработчик — нет, и разработчики служат здесь группой сравнения. Я не сообщаю результаты из когортной программы; они содержатся в отдельной статье после периода наблюдения. Большинство показателей внедрения поступают из Соединённых Штатов и от поставщиков и помечены как таковые. И описанные инструменты меняются ежемесячно, поэтому модель создана, чтобы пережить их, и детали продукта со временем устаревают.
Раздел 2 встраивает аргумент в литературу, а раздел 3 определяет уровни и переходы. Раздел 4 показывает, где исчез технический барьер, раздел 5 — что его заменило, разделы 6 и 7 — две формы оркестровки, а раздел 8 — как этот переход влияет на роль человека. Раздел 9 описывает программу, которая измеряет переходы, раздел 10 излагает положения, раздел 11 выводит следствия, раздел 12 устанавливает граничные условия, а раздел 13 подводит итоги.
2. Основание: от программирования конечными пользователями к делегированию конечными пользователями
2.1 Конечные пользователи всегда программировали
Идея о том, что люди, не являющиеся программистами, управляют вычислениями, старше языковых моделей. Nardi (1993) утверждал, что конечные пользователи контролируют вычислительную мощность через языки и фреймворки, специфичные для конкретных задач, где электронные таблицы являются каноническим примером, без необходимости в общих навыках программирования. Ko et al. (2011) показали, что конечные пользователи, создающие программное обеспечение, сталкиваются с теми же проблемами, что и профессионалы (требования, повторное использование, тестирование, отладка), но без соответствующей подготовки, и назвали эту область инженерией программного обеспечения конечных пользователей. Более широкая область — разработка конечными пользователями — изучает, как люди, не являющиеся профессиональными разработчиками, создают и адаптируют программное обеспечение для своей работы. Myers, Pane и Ko (2004) потратили годы на проектирование обозначений, более близких к тому, как непрограммисты описывают задачи. Каждое из этих направлений исследований предполагало, что конечный пользователь все еще напишет что-то, что машина выполняет, даже если это была формула или правило.
Языковые модели изменили то, что пишет конечный пользователь. Sarkar et al. (2022) описали программирование с большой языковой моделью как новую деятельность, отличную от компиляции, совместного программирования и поиска. Zamfirescu-Pereira et al. (2023) обнаружили, что люди без опыта в ИИ испытывают трудности с проектированием подсказок, которые работают надежно, переобобщают одиночные успехи и возвращаются к привычкам человеческого общения. Liu et al. (2023) назвали трудность обучения тому, какие слова производят какое поведение, «согласованным абстрактным сопоставлением». Sarkar и Drosos (2025) в первом эмпирическом исследовании «кодирования по ощущениям» обнаружили, что разговорное программирование перераспределяет опыт в сторону управления контекстом и быстрой проверки результатов, оставляя потребность в суждении там, где она была. Virk и Liu (2025) обнаружили, что деловые пользователи, которым предоставили написанный ИИ код анализа, часто не могли обнаружить критические ошибки даже когда им говорили их искать. Feldman и Anderson (2024) назвали непрофессиональных программистов наиболее недостаточно изученной группой населения эпохи генеративного ИИ.
Я делаю следующий шаг в этом направлении. Единица работы конечного пользователя изменилась с формулы, сценария или подсказки на делегирование: задача, переданная агенту, который действует на файлы и инструменты в течение многих этапов. Литература о программировании конечными пользователями объясняет, почему выражение намерения сложно, а литература о делегировании и надзоре объясняет, почему проверка результата сложна. Четырехуровневая модель раздела 3 построена для объединения этих двух направлений.
2.2 Внедрение быстрое и поверхностное
Генеративный ИИ распространялся быстрее, чем персональный компьютер или интернет. Bick, Blandin и Deming (2024) оценили, что примерно 40% взрослого рабочего населения США использовали его к концу 2024 года, при этом только небольшая доля рабочих часов была дополнена с помощью ИИ. Chatterji et al. (2025) обнаружили, что к середине 2025 года ChatGPT обслуживал примерно 700 миллионов еженедельных пользователей и что большинство сообщений не были связаны с работой. В Дании Humlum и Vestergaard (2025) обнаружили четкие нулевые эффекты на заработках и часах два года после внедрения, а также разрыв в использовании между женщинами и мужчинами; мета-анализ более чем 100 стран показывает, что этот разрыв составляет примерно 16 процентных пункта с начала 2025 года (Cranney et al., 2026). В 35 европейских странах воздействие ИИ не привело автоматически к его использованию, и обучение, цифровизация и агентность работников имели большее значение (Henseke, 2026).
Полевые эксперименты показывают большие выигрыши, когда инструмент подходит для задачи: в среднем на 14% больше проблем клиентов решено в час и на 34% для новичков (Brynjolfsson et al., 2025), более быстрое и лучшее письмо в испытании с 444 профессионалами, с наибольшими выигрышами для более слабых писателей (Noy & Zhang, 2023), и среди 758 консультантов 12,2% больше задач выполнено и качество повысилось более чем на 40% внутри «зубчатой границы» возможностей модели, с более плохой работой на задаче вне ее (Dell'Acqua et al., 2026). Рандомизированное испытание с опытными разработчиками с открытым исходным кодом обнаружило противоположный результат в начале 2025 года — замедление на 19% (Becker et al., 2025), результат, который его авторы позже сказали, был, вероятно, устаревшим, поскольку инструменты улучшились (METR, 2026). Урок этих испытаний заключается в том, что выигрыши зависят от соответствия между задачей, инструментом и способностью человека управлять им и проверять результат, и эти три вещи изменяются при переходе между уровнями.
2.3 Принятие, распространение и разрыв второго уровня
Исследования принятия технологии, от модели принятия технологии (Davis, 1989) до единой теории принятия и использования технологии (Venkatesh et al., 2003), показывают, что воспринимаемая полезность и простота использования определяют принятие, и что социальное влияние и способствующие условия имеют значение столько же, сколько индивидуальные установки. Исследования распространения описывают принятие как социальный процесс с ранними и поздними адаптерами (Rogers, 2003). Когда базовый доступ в интернет стал обычным явлением, Hargittai (2002) показали, что значимое неравенство переместилось на навыки: цифровой разрыв второго уровня. Van Dijk (2020) расширил это на последовательность мотивации, доступа, навыков и использования.
То же самое смещение видно сейчас. Доступ к чату почти универсален среди офисных работников в богатых странах, в то время как навык управления агентом далеко не универсален. Разрыв в ИИ уже был измерен по старым линиям образования, региона и возраста (Daepp & Counts, 2024; Pew Research Center, 2026). То, что я добавляю, — это наблюдение, что разрыв теперь проходит внутри населения пользователей ИИ, между теми, кто беседует с моделями, и теми, кто делегирует им.
2.4 Автоматизация, надзор и бремя менеджера
Литература по надзору человека за автоматизацией начинается с парадокса. Bainbridge (1983) описал это: автоматизация большей части задачи оставляет человеку самую сложную часть — мониторинг и редкие вмешательства, при этом подрывая необходимый для этого навык. Parasuraman и Riley (1997) различили ненадлежащее использование, неиспользование и злоупотребление автоматизацией, а Lee и See (2004) показали, что использование должно соответствовать откалиброванному доверию. Эпоха генеративного ИИ актуализировала каждый из этих пунктов. Работники знаний, которые больше доверяют инструменту, сообщают о менее критическом мышлении (Lee et al., 2025). Генеративный ИИ переводит людей от производства к оценке и делает легкие задачи еще легче, а сложные еще сложнее (Simkute et al., 2024). Вмешательства по калибровке доверия к языковым моделям снижают чрезмерное доверие, но не приводят к надлежащему доверию (Bo et al., 2025). Пользователи ИИ-агентов в качестве ежедневных помощников неправильно откалибровывают доверие к правдоподобным, но неверным планам, и добиваются лучших результатов, когда участвуют в пошаговом выполнении (He et al., 2025). Лучшее документирование действий агента ускоряет обнаружение ошибок, но не гарантирует надежное улучшение окончательной точности (Grunde-McLaughlin et al., 2026). Исследование около 73 000 открытых постов об одном автономном агенте показало, что ценности пользователей в основном удовлетворялись в отношении результатов работы агента и в основном не удовлетворялись в отношении возможностей его контроля (Ma et al., 2026). В небольшом лабораторном исследовании и трех развертываниях комфорт при делегировании рос с течением времени, но люди по-прежнему хотели иметь контроль в моменты неопределенности (Long et al., 2025). Tomašev, Franklin и Osindero (2026) рассматривают делегирование ИИ как структуру распределения задач, передачи полномочий, подотчетности и доверия, применимую как к человеческим, так и к машинным делегатам.
С когнитивной точки зрения, ЭЭГ-исследование 54 авторов эссе показало более слабую связанность и более низкое чувство собственности в группе с использованием ассистента, «когнитивный долг» (Kosmyna et al., 2025), и опубликованный комментарий оспорил его методологию (Stankovic et al., 2026). Осторожная интерпретация заключается в том, что переложение рутинных шагов освобождает внимание, и это внимание должно быть потрачено на проверку. Две дополнительные идеи из исследований обучения используются далее. Теория когнитивной нагрузки объясняет, почему новичок, оказавшийся в неограниченной среде, затормаживается, прежде чем сформируется когнитивная схема (Sweller, 1988). И модель принятия как байесовского обучения показывает, как люди могут установиться в самоусиливающемся равновесии низкого использования, сместить которое способны только первый успех или обучение (Ma et al., 2025).
Две сопутствующие работы в этой серии рассматривают ту же проблему с другой стороны. Первая показывает, что согласованность нескольких моделей является более слабым доказательством, чем кажется, потому что их ошибки коррелируют (Chernets, 2026a). Вторая показывает, как автоматизированные компоненты надзора могут расширять свой собственный мандат и препятствовать работе, которую они охраняют (Chernets, 2026b). Обе существенны для новичка: первая показывает, на что способна оркестровка, вторая объясняет, почему слои безопасности могут остановить человека у входа.
2.5 Что не было изучено
Поиск, проведенный 21 сентября 2026 года (веб-поиск, Crossref, arXiv и Semantic Scholar, с вниманием к статьям CHI, UIST и VL/HCC 2024–2026), не обнаружил опубликованного полевого исследования принятия непрограммистами терминальных или командных агентов как таких, не обнаружил исследования веб-оркестровки (постановка одного вопроса нескольким потребительским чат-ботам в браузере) как обозначенной практики, не нашел рассмотрения управления агентами как навыка с собственной структурой компетенций, и не обнаружил исследования системы ИИ, поддерживающей освоение человеком агентного ИИ; ближайшая работа применяет теорию скаффолдинга к ИИ-тьюторам других предметов (Cohn et al., 2026) или к адаптируемым под задачу интерфейсам для сложного ПО (Liu & Sra, 2026). Исследования в области экономики труда измеряют принятие генеративного ИИ в целом, и ни одно из них не выделяет переход от чатов к агентным инструментам среди непрограммистов. Эти лакуны определяют пространство, отображаемое моделью, и программа раздела 9 предназначена для его измерения.
3. Четыре уровня и три перехода
3.1 Две оси: охват и роль
Уровень описывает отношение между человеком и моделью в работе, и я определяю его по двум осям: охват и роль.
Охват — это то, на что модель может воздействовать от имени человека. В самом узком смысле это только разговор, затем файлы и инструменты внутри пространства, которое ограничивает поставщик, затем собственный компьютер человека со своими файлами, программами и расписанием, а в самом широком смысле несколько моделей и агентов одновременно.
Роль — это то, что человек должен делать для успеха работы. В том же порядке они задают вопросы и копируют, они передают задачу и проверяют результат, они владеют окружением агента с его разрешениями и откатом, или они распределяют работу между агентами и согласуют полученные результаты.
Продукты намеренно отсутствуют в определении. Один продукт может охватывать несколько уровней, и в 2026 году поставщики объединяют чат и агентов в одном окне быстрее, чем любая таксономия, построенная на названиях продуктов, может за этим следить (раздел 4.3). Уровень описывает элемент работы, и один человек, как и один продукт, может охватывать несколько. Один и тот же человек может находиться на уровне 1 для одной задачи утром и на уровне 3 для другой днем.
Две оси также отделяют эту модель от привычных шкал автоматизации и автономии. Parasuraman, Sheridan и Wickens (2000) классифицировали, какую часть каждого этапа задачи (получение информации, её анализ, принятие решения, действие) выполняет машина. Morris и др. (2024) оценили системы общего искусственного интеллекта по глубине и широте их производительности. Feng, McDonald и Zhang (2025) определили пять уровней автономии для агентов ИИ по роли, которую играет пользователь, от оператора и соавтора к консультанту, одобрителю и наблюдателю. Эти шкалы описывают, насколько агент принимает решения в пределах задачи. Четыре уровня здесь описывают где выполняется работа и чем владеет человек: разговор, огороженное пространство поставщика, собственную машину, команду агентов от нескольких поставщиков. Оси ортогональны. Агент на собственном компьютере человека может работать на любом из уровней автономии Feng и др., от пошагового одобрения до почти полного делегирования, и человек все еще владеет его разрешениями и откатом. То, что добавляют четыре уровня, — это описание внедрения: порядок, в котором охват и ответственность растут для того, кто начинает с чата, и свидетельство (артефакт), которое показывает, что каждый шаг был предпринят.
3.2 Четыре уровня
Уровень 1: чат. Охват модели ограничивается разговором. Она производит текст, код или изображения, которые человек копирует в место, где выполняется работа, и роль человека — хорошо задавать вопросы и переносить выходные данные. Почти каждый профессионал, использующий ИИ, работает здесь большую часть времени (раздел 2.2).
Уровень 2: безопасная агентская среда. Модель воздействует на файлы, подключенные сервисы и иногда браузер внутри пространства, которое ограничивает поставщик: выбранные папки, виртуальную машину или изолированное пространство на стороне сервера, соединители, одобренные человеком, и шаг одобрения перед важными действиями. Anthropic's Cowork, OpenAI's ChatGPT Work, Microsoft's Copilot Cowork и Google's Gemini Spark — примеры 2026 года, и они используют дизайн агента делегирования, работающего в огороженном пространстве (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). Роль человека меняется от задания вопросов к делегированию. Они передают задачу, которая заканчивается файлом или действием, и проверяют полученный результат, и большая часть безопасности окружения на этом уровне является ответственностью поставщика.
Уровень 3: агент на собственном компьютере. Агент запускается на машине человека с доступом к файловой системе, оболочке, установленным программам и запланированным заданиям через терминал или десктопную оболочку на одном двигателе: Claude Code, OpenAI's Codex, Google's Antigravity CLI, xAI's Grok Build, Moonshot's Kimi Code и аналоги с открытым исходным кодом. В научной литературе это LLM-основанные агенты, и их использование разработчиками изучается как агентское кодирование; уровень задает вопрос, что происходит, когда человек, их запускающий, не является разработчиком. Охват — это самый широкий, который может получить один агент, и с этим роль человека меняется снова. Они владеют окружением: какие папки видит агент, какие команды требуют одобрения, что исключено, и как отменить ошибку. Сам терминал является случайным, поскольку то, что определяет уровень, — это владение рабочей средой, в которой агент может делать все, что может делать человек. Облачные варианты (тот же цикл агента, запущенный на машине поставщика, когда человек видит задачу и результат, но никогда не видит подсказку) — уровень 3 по возможности и уровень 2 по масштабу влияния, и модель записывает их как вариант уровня 3, не относя их к одной категории.
Уровень 4: повторяемая, оркестрированная работа. Человек направляет несколько моделей или агентов параллельно или последовательно для работы, которая повторяется, и охват теперь охватывает поставщиков. Есть два уровня. В веб-оркестрации один вопрос направляется в несколько потребительских чатботов в браузере вручную или с помощью инструмента, и ответы сравниваются. В оркестрации CLI один агент вызывает инструменты командной строки других агентов, собирает их выходные данные и объединяет или проверяет их. Роль человека — менеджера: они устанавливают цель, распределяют работу, решают, что считается выполненным, и согласуют разногласия. Работа становится повторяемой, когда она записана в форме, которую агенты могут запустить снова, как файл инструкций, навык или запланированное задание. «Повторяемая» описывает рабочий процесс, а не выходные данные. Тот же файл инструкций, запущенный на следующей неделе, произведет другой черновик, и то, что повторяется, — это последовательность входных данных, шагов, проверок и результата. Повторяющееся задание одного агента, написанное таким образом, — это работа уровня 3, сделанная повторяемой, и оно становится уровнем 4, когда направляется вторая семья моделей и результаты согласованы (переход 3, раздел 3.3).
Таблица 1. Четыре уровня.
| Уровень | Охват модели | Роль человека | Типичные интерфейсы, сентябрь 2026 | Переход показывается | Что уровень не устанавливает | Основной барьер при входе |
|---|---|---|---|---|---|---|
| 1. Чат | Разговор | Задает вопросы, копирует выходные данные вручную | Чат в браузере или приложении | (начальный уровень) | Что модель может воздействовать на работу человека или ей можно доверять без проверки | Никаких кроме доступа |
| 2. Безопасная агентская среда | Файлы, соединители и браузер внутри пространства, ограниченного поставщиком | Делегирует задачу, проверяет результат | Cowork объединён с Claude chat; ChatGPT Work; Copilot Cowork; Gemini Spark | Файл или действие, созданные агентом из делегированной задачи, с записанным одобрением или отказом | То, что человек может запустить собственное окружение или повторить работу | Знание того, что делегировать; доверие |
| 3. Агент на собственном компьютере | Файловая система, оболочка, программы и расписание человека | Владение окружением: разрешения, исключения, отмена | Терминальные и настольные оболочки Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code | Артефакт, который агент создал на машине человека в папке, которую тот установил, в результате задачи, требующей более одного инструмента | Что результат правильный или безопасен для использования без проверки | Трение установки (падение); первая ошибка; разрешения; что спросить |
| 4. Организованная работа | Несколько моделей или агентов от разных поставщиков | Управляет: целью, распределением, принятием, согласованием | Веб: несколько вкладок чата или инструменты вещания. CLI: плагины и скрипты, вызывающие других агентов | Объединённый или взаимно проверенный результат от как минимум двух семейств моделей, повторно запущенный как минимум один раз, с записью того, кого спросили и кто ответил | Что согласие между моделями является независимым доказательством или что задача принадлежит этому уровню | Стоимость согласования; коррелированные ошибки; квота и текучесть инструментов |
Два термина в таблице используются в более узком смысле, чем в повседневном использовании. «Безопасность» в фразе «безопасная агентская среда» обозначает цель проектирования и модель взаимодействия и не предоставляет никаких гарантий. Область действия папки, утверждения, изолированные среды и панели предпросмотра сокращают область, в которой действует агент; они не могут гарантировать сохранность файлов при ошибочной реализации или сделать безвредным документ со скрытыми инструкциями; в разделе 5.3 описано, что пошло не так в предоставленных папках. То, что устанавливает средний уровень, — это практическая мысленная модель. Человек, который видит, что агент может написать отчёт в одной папке и не может трогать ничего другого, понимает, что делегированное действие имеет границы, что гораздо полезнее любого абстрактного предупреждения быть осторожным с ИИ. «Артефакт» означает результат, который требовал нескольких этапов самостоятельной работы агента. Человек, который его запросил, решает, считается ли это артефактом, третья сторона оценивает его качество (раздел 9.4), и исследование фиксирует согласие между оценивающими как для самой оценки, так и для кодирования причин остановки. Папка с двумя пустыми файлами — это след инсталляционной программы и не считается.
3.3 Три переходных этапа и почему артефакт определяет каждый
Переход совершается, когда агент на новом уровне создаёт артефакт, который запросил человек. Установка считается только попыткой, как и завершённый курс, значок, лицензия и самоотчёт «я теперь использую агентов». Правило имеет несколько следствий помимо очевидного. Папка, созданная агентом, показывает, что агент работал, а набор файлов, которые агент создал на основе описания человеком своей работы, показывает, что человек делегировал. Правило также делает переходные этапы наблюдаемыми извне: исследователь или менеджер может увидеть артефакт, но не может увидеть намерение или ощущение компетентности. Это делает неудачу информативной, поскольку человек, который установил инструмент и ничего не создал, встретил барьер, заслуживающий внимания, и подсчёт установки как успеха скрыл бы это. И поскольку правило не упоминает конкретный продукт, оно позволяет исследованиям сравнивать инструменты, переименовываемые каждый квартал.
Переход 1, от чата к безопасной агентской среде, совершается, когда человек впервые делегирует задачу, которая заканчивается файлом или действием вместо текста. В 2026 году этот переход встраивается в само окно чата. Когда модель поставщика решает, отвечать или действовать, как это происходит в объединённом интерфейсе Claude, объявленном 16 сентября 2026 года (Anthropic, 2026c), человек может совершить переход, не решив это сам. Это делает переход более простым и менее видимым, в том числе для самого человека.
Переход 2, от безопасной среды к собственному компьютеру, совершается, когда человек запускает агента в своей среде и получает от него артефакт. Решающее изменение — это владение. На уровне 2 поставщик решает, что может трогать агент, а на уровне 3 человек, какой бы облик ни показывал агент — терминал или окно. Страх перед терминалом жил здесь раньше, и раздел 5 показывает, что его место заняли вопросы разрешений, ошибок и того, что спросить.
Переход 3, от одного агента к организованной работе, совершается, когда человек получает результат, который произвели или проверили как минимум два семейства моделей, и повторно применяет эту схему к последующей работе. Повторное применение имеет значение, потому что одно сравнение трёх чатботов — это просто любопытство, и только сравнение, к которому человек прибегает всякий раз, когда это оправдано, составляет практику.
Маршрут, который следует программа раздела 9, может быть представлен как дизайнерский проект, с профессионалом из введения в качестве гипотетического примера и без отчётности. Она начнёт там, где уже находится, на уровне 1, с чатботом, за который платит. Она вставит стандартный текст в этот чатбот и позволит ему провести её через установку графического агента на её ноутбук, отправляя скриншот каждый раз, когда шаг не срабатывал, и система ничего не будет трогать. Первый шаг считался бы пройденным только когда агент из собственного описания её работы создал бы набор файлов, которые она могла бы открыть и оценить; установленное приложение рядом с пустой папкой считалось бы попыткой. Она работала бы с копией своих файлов, держала бы пароли и документы клиентов вне её, читала бы план агента перед тем, как позволить ему действовать, и подтверждала бы любые необратимые действия. Когда она сказала бы, что готова, она получила бы инструмент с открытым исходным кодом, запускаемый из агента, который ставит один вопрос нескольким моделям через её подписки и возвращает один объединённый ответ, и этот шаг считался бы пройденным, когда датированный протокол показал бы, какие модели были спрошены и где они отличались. Позже она запустила бы это же сравнение через инструменты командной строки. Она могла бы остановиться в любой из этих точек, и зарегистрированный протокол показал бы, где и, её словами, почему. Маршрут заимствован из публичного реестра, и вопрос о том, идут ли люди по нему, остаётся открытым для статьи результатов.
3.4 Уровни упорядочены, но не обязательны
Уровни упорядочены по охвату и по ответственности, которую они возлагают на человека. Этот порядок не делает их лестницей, которую каждый должен преодолевать шаг за шагом. Человек может перейти из чата прямо к агенту на своем компьютере; маршрут когорты, описанный в разделе 9, делает ровно это, с помощью чатбота, который человек уже использует и который направляет его через установку. Другие останавливаются на уровне 2 навсегда, и для большей части работы это правильное место для остановки. Выше — не значит лучше в этой модели. Её утверждения состоят в том, что каждый уровень предъявляет разные требования к человеку, что переходы можно наблюдать, и что барьеры на каждом переходе различаются. Модель была бы опровергнута, если бы переходы нельзя было различить по артефактам, если бы барьеры не отличались между переходами, или если бы компетентность на одном уровне не изменила то, что люди могли делать на следующем, так как в любом из этих случаев модель не добавила бы ничего к простой шкале «использование ИИ». Модель также предсказывает, что при прочих равных условиях, когда чувствительность задачи и технические требования остаются постоянными, выполнение задач падает более резко на трёх переходах, чем внутри уровня. Если бы спады были распределены равномерно, уровни были бы переобозначённым континуумом. Раздел 10 превращает эти ожидания в положения с мерами и фальсификаторами.
Одно семейство инструментов находится рядом с лестницей и ни на одной её ступени. Построители приложений для браузера позволяют человеку описать приложение и получить запущенный предпросмотр внутри платформы, размещённой поставщиком. Они имеют значение, и они отличаются от уровня 2, где агент действует с собственными файлами человека в соответствии с моделью разрешений; построитель приложений действует на проекте, которым владеет платформа. Смешивание этих двух подходов создаёт ложное впечатление, что непрограммисты уже пришли. Четырёхуровневая модель оставляет построители приложений на отдельной ветви со своим потолком и своим собственным профилем безопасности, и литература по вайб-кодированию — это место для чтения о них (Sarkar & Drosos, 2025; Ge et al., 2025). На рисунке 1 показаны четыре уровня, артефакт, отмечающий каждый переход, зарегистрированный пропуск и побочная ветвь.
Рисунок 1. Четыре уровня и три артефакт-определённых перехода.
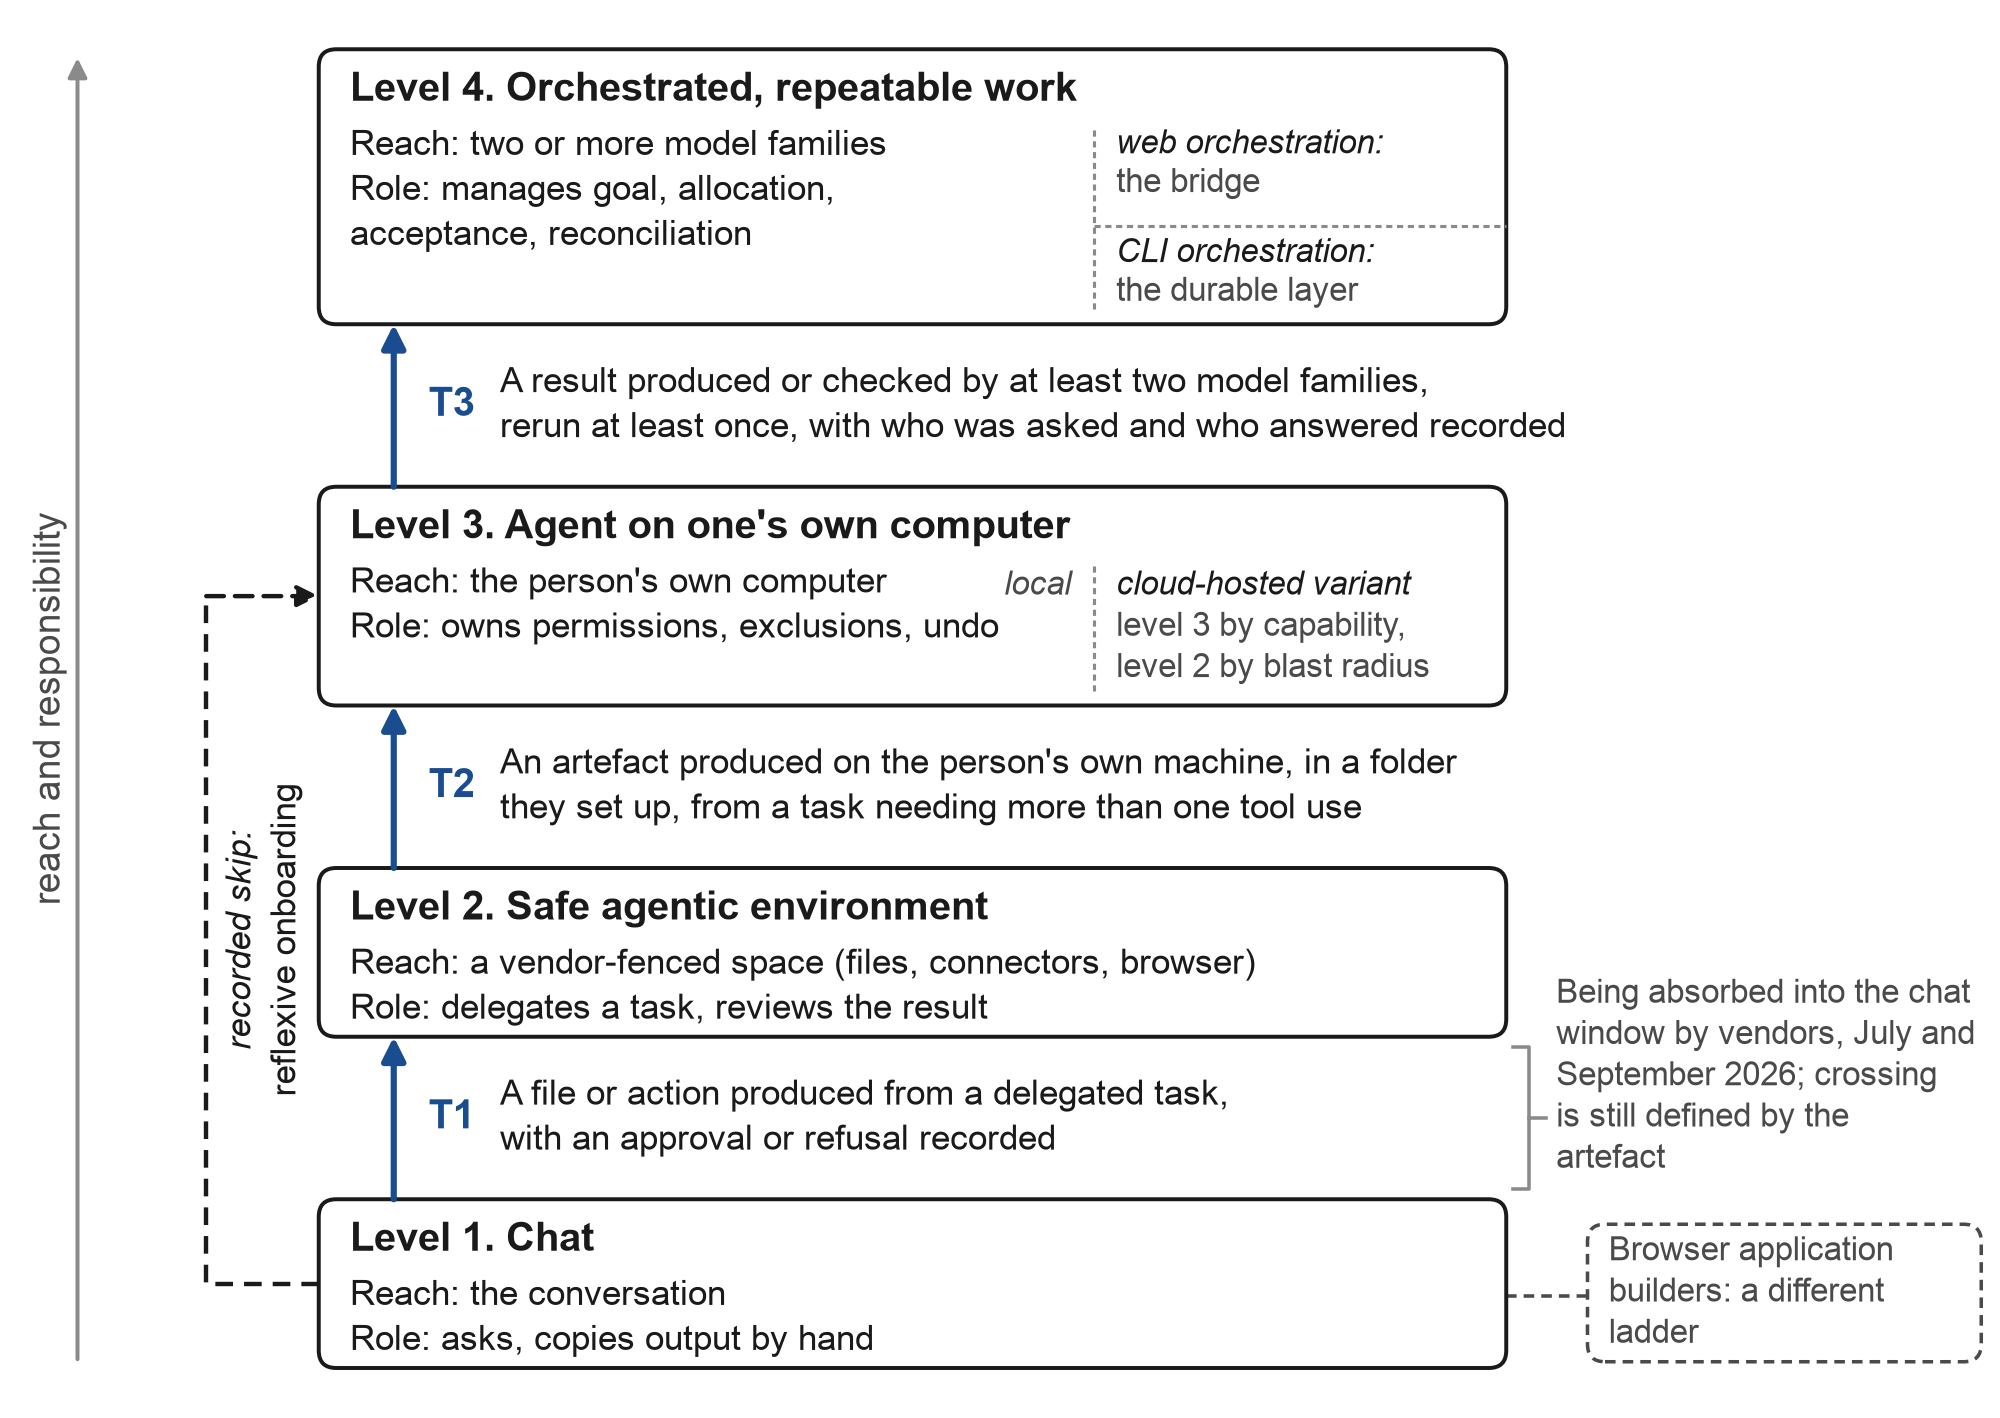
Примечание: Четыре уровня раздела 3.2, упорядоченные в порядке возрастания по охвату (тому, что может коснуться модель) и по ответственности, возлагаемой на человека. Каждый переход, T1 к T3, пересекается только тогда, когда агент создал артефакт, названный рядом со стрелкой, и установка считается попыткой (раздел 3.3 и таблица 1). Штриховая стрелка слева — это зарегистрированный пропуск из чата к агенту на собственном компьютере человека, который выполняет зарегистрированный маршрут (разделы 3.4 и 9.2); штриховой прямоугольник справа — это побочная ветвь построителей приложений для браузера, и примечание при T1 записывает объединение интерфейсов чата и агента поставщиками в июле и сентябре 2026 года (раздел 4.3).
3.5 Терминал — это больше не терминал
Для программиста терминал — это интерфейс для выдачи команд. Для специалиста, работающего с агентом, это среда, в которой живёт агент: рабочая папка, набор разрешений и история того, что было сделано. Когда Anthropic представила Cowork в январе 2026 года, слоган был «Claude Code для остальной вашей работы»: тот же агент, предложенный людям, которые не пишут программное обеспечение, без терминала (Fortune, 2026a).
Поставщики теперь также воплотили это наблюдение в практику. OpenAI переименовала своё приложение «агента кодирования» в «ChatGPT» и сделала его клиентом рабочего стола по умолчанию (MacRumors, 2026). Anthropic поставляет приложение рабочего стола для агента, который не требует терминала (Anthropic, 2026a). Google снял с производства своё приложение CLI с открытым исходным кодом Gemini для отдельных пользователей 18 июня 2026 года в пользу многоагентной платформы и нового инструмента командной строки, заявляя, что пользователи теперь «нуждаются в нескольких агентах, взаимодействующих друг с другом для разделения работы» (Google, 2026). Видимый терминал исчезает, а среда, к которой он давал доступ, по-прежнему существует и должна быть запущена кем-то. Для специалиста полезный вопрос изменился соответственно: имеет ли значение возможность использовать терминал с каждым месяцем становится менее важным, и может ли человек запустить среду, в которой агент работает для него — это вопрос, который я бы им задал.
4. Куда делась техническая барьера
4.1 Установка стала одним шагом
В 2024 году непрограммист, желающий использовать агента терминала, встречал серию небольших препятствий: установить языковую среду выполнения, исправить переменную пути, разобраться, почему оболочка сообщает «permission denied», выбрать между четырьмя вещами, все названные «install». К сентябрю 2026 года большинство этих препятствий были устранены поставщиками. Ведущие агенты терминала устанавливаются с помощью одной команды или инсталлятора рабочего стола, который обновляется автоматически. Приложение Claude Code для рабочего стола предлагает параллельные сеансы, визуальный просмотр изменений, предпросмотр в реальном времени и планируемые задачи, а его документация гласит: «No terminal required» (Anthropic, 2026a). Приложение OpenAI для рабочего стола интегрирует своего кодирующего агента в обычный клиент ChatGPT (MacRumors, 2026). Новый инструмент командной строки Google — это один бинарный файл, поставляемый с платформой рабочего стола (Google, 2026).
Агент, который устанавливается в один шаг, всё ещё сложен в использовании, и я не хочу преувеличивать масштаб этого изменения. Что изменилось, — это то, что инсталлятор больше не является первым препятствием, встречаемым новичком. Оставшееся трение — это выбор входа: инструмент терминала, расширение редактора, приложение для рабочего стола и веб-версия — все они обозначаются словом «install», и выбор между ними составляет основную часть стоимости установки для новичка. Выбрать вход означает знать, что именно хочет делать агент, поэтому это проблема лексики, представленная как проблема настройки, и она относится к Разделу 5.
Один архитектурный факт лежит в основе всех этих страниц продуктов. Инструмент командной строки является эталонной реализацией: подагенты, хуки, навыки, серверы протоколов и режимы без интерфейса сначала появляются в CLI, а затем в настольных и веб-интерфейсах одного и того же движка; собственная страница справки Anthropic описывает своего агента уровня 2 как «the same agentic architecture that powers Claude Code, with no terminal required» (Anthropic, 2026b). Для новичка это имеет двойной эффект. Удобный интерфейс может догнать мощный. Но документация, примеры и ответы на форумах по-прежнему говорят на диалекте CLI, поэтому человек, начавший с приложения рабочего стола, читает о инструменте, который он не устанавливал.
4.2 Чатбот как собственный инсталлятор
Второе изменение менее видимо и, для данного аргумента, более важно. Чатбот, который человек уже использует, может провести его через процесс установки агента. Человек вставляет запрос («walk me through installing this on my Windows laptop; I am not technical»), следует инструкциям, и когда что-то не удаётся, отправляет скриншот ошибки обратно тому же чатботу. Более опытный помощник, описанный в концепции зоны ближайшего развития Vygotsky (Vygotsky, 1978), и наставник, функции которого Wood, Bruner и Ross (1976) называли обучающей поддержкой (привлечение интереса, снижение степеней свободы, выделение критических признаков, управление разочарованием), теперь доступны в инструменте, которому человек уже доверяет, в любое время, на его языке, бесплатно.
Я называю это рефлексивной адаптацией: система ИИ, поддерживающая усвоение человеком более мощной системы ИИ. Это инвертирует обычное направление помощи. В литературе о диффузии инноваций новичок принимает инновацию через контакт с более ранними пользователями (Rogers, 2003), а здесь пользователь-пионер заменяется, по крайней мере для механических шагов, самой моделью уровня 1.
Образовательный слой вырос вокруг этого шага. Академии поставщиков предлагают краткие курсы по своим агентам, а крупные платформы обучения преподают «vibe coding» с именованным агентом. Появились курсы, которые доставляются внутри самого агента, так что обучающийся устанавливает агента, а агент преподаёт курс (CC for Everyone, 2026), и одна консалтинговая фирма объявила, что около 30 000 своих сотрудников пройдут обучение на моделях одного поставщика (Accenture, 2025). Существование этого слоя свидетельствует о том, что установка больше не считается само собой разумеющейся. Теория минималистического обучения предсказала, что люди лучше всего овладевают программным обеспечением, выполняя реальную задачу с самого начала и восстанавливаясь после ошибок (Carroll, 1990), а рефлексивная адаптация обеспечивает постоянно доступное руководство для обоих. Работает ли это для людей, которые никогда не открывали терминал, я ещё не знаю; первый этап программы в Разделе 9 разработан для выяснения этого, а поиск, описанный в Разделе 2.5, не нашёл никаких исследований по этому вопросу.
4.3 Поставщики объединяют уровни
Крупнейшее изменение 2026 года носит структурный характер. Каждая из трёх ведущих лабораторий, а также Microsoft, теперь поставляют агента уровня 2, и двое из них начали встраивать уровень 2 обратно в чат.
Таблица 2. Ходы поставщиков, переформатировавшие путь от чата к агенту, январь–сентябрь 2026.
| Дата (2026) | Поставщик | Действие | Влияние на уровни | Источник |
|---|---|---|---|---|
| Январь | Anthropic | Предпросмотр исследования Cowork: «Claude Code for the rest of your work», агент с областью действия папки для непрограммистов | Уровень 2 как именованный продукт | Fortune (2026a) |
| 9 марта | Microsoft | Технология Cowork интегрирована в Microsoft 365 Copilot; плоскость управления Agent 365 | Уровень 2 внутри доминирующего офисного пакета | Microsoft (2026a) |
| 30 марта | OpenAI | Официальный плагин для запуска своего кодирующего агента внутри агента конкурента, «для делегирования задач», бесплатный уровень включён | Уровень 4 (CLI) одобрен поставщиком | OpenAI (2026a) |
| 19 мая; 18 июня | Gemini CLI снята с производства для индивидуальных уровней в пользу Antigravity CLI и многоагентной платформы | Уровень 3 переосмыслен; замешательство среди новичков | Google (2026) | |
| 2 июня | OpenAI | Кодирующий агент: 5 миллионов еженедельных пользователей; около 20% работников знания, растущий в 3 раза быстрее, чем разработчики (данные поставщика, пресс-сообщение) | Использование работниками знания агента, унаследованного от терминала; тенденциозно и шире, чем уровень 3, как определено здесь | Help Net Security (2026) |
| 1 июля | Агент рабочего стола Gemini Spark на Mac, работает с локальными файлами (бета, США) | Уровень 2 из третьей лаборатории | TechCrunch (2026b) | |
| 9 июля | OpenAI | Приложение кодирующего агента становится новым приложением рабочего стола ChatGPT; агент ChatGPT Work использует локальные файлы и приложения | Уровни 1–3 в одном клиенте | MacRumors (2026) |
| 26 августа | Anthropic | Агент браузера общедоступен на платных планах; работает автономно с классификатором безопасности по умолчанию | Уровень 2: охват расширен на веб | Anthropic (2026d) |
| 16 сентября | Anthropic | Cowork и чат объединены в «one Claude»; модель решает, отвечать или действовать | Transition 1 поглощено в чат | Anthropic (2026c); TechCrunch (2026a) |
Прочитав таблицу в таком порядке, видно описание конвергенции. Поставщики сначала отделили чат от агентной работы, чтобы не пугать непрограммистов терминалом, затем обнаружили, что люди не могли понять, в каком окне находится задача, и теперь снова объединяют их двоих, позволяя модели решать. TechCrunch сообщил, что компания заявила, что клиенты «часто боролись с выбором правильной вкладки для правильной задачи» (TechCrunch, 2026a); ее собственное объявление выразило это как «вам не нужно выбирать, куда идет задача», когда работа продолжается после закрытия ноутбука, агент по умолчанию спрашивает перед действием, и объединение сначала развертывается на платные индивидуальные планы, в то время как вкладка кодирования остается отдельной (Anthropic, 2026c). Я вижу в этом свидетельство поставщика, относящееся к барьеру, названному в разделе 1, словарь рабочего процесса. Если люди не могут решить, является ли задача вопросом или делегированием, они вряд ли будут знать, как его сформулировать.
Объединение может казаться подрывающим модель с отдельным уровнем 2. Это не так, и объяснение может быть дано без того, чтобы притворяться, что модель предвидела события. Поставщики заинтересованы в выставлении счетов, поддержке и безопасности, чтобы держать обычных пользователей в окне, которое они могут классифицировать, ограничивать по скорости и оборачивать в модель разрешений, а также в удобстве использования, чтобы не заставлять пользователя выбирать режим; поглощение transition 1 в чат следует из обоих. Правило пересечения не изменяется. Если система записала файлы в предоставленный объем после одобрения, transition 1 был пересечен, независимо от того, что было вокруг разговора, и если она вернула абзац, то человек все еще находится на уровне 1. Модель предполагает, что transitions 2 и 3 не распадутся таким же образом. Локальный агент с доступом к оболочке — это другой объект разрешений, чем изолированная среда на стороне сервера, и инструмент другого поставщика, работающий под логином этого поставщика, — это другой объект разрешений, чем функция совета одного поставщика. Эти различия несут аргумент безопасности в разделе 5.3 и аргумент коррелированной ошибки в разделе 6.3. Если к концу 2027 года крупные поставщики объединили локальных агентов оболочки и кросс-вендорные вызовы в одно окно чата под одной моделью разрешений, то это предположение неверно, и утверждение, что оркестровка CLI — это слой, который остается, падает с ним (P2 и P8 в разделе 10).
Конвергенция также несет в себе издержку: текучесть. Агент командной строки с открытым исходным кодом Google обслуживал отдельных пользователей чуть менее двенадцати месяцев (25 июня 2025 г. по 18 июня 2026 г.), агентный браузер OpenAI был прекращен примерно через девять месяцев, а Cowork существовал как отдельный продукт примерно восемь месяцев (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). Профессионал, который инвестирует в изучение инструмента, может обнаружить, что он переименован, объединен или снят в течение года. То, что передается между инструментами, — это словарь рабочего процесса, а то, что теряется, — это знание меню продукта, асимметрия, которая имеет значение для того, как люди должны быть обучены (раздел 11.2).
4.4 Работники интеллектуального труда в агентах с наследием терминала
Лучший единственный данный о непрограммистах внутри агента с наследием терминала поступает от поставщика. В июне 2026 года OpenAI сообщила через прессу, что ее агент кодирования имел пять миллионов еженедельных пользователей, более чем в шесть раз больше, чем уровень при запуске настольного приложения в феврале, что работники интеллектуального труда составляли около 20% из них и внедряли их более чем в три раза быстрее разработчиков, и что каждую неделю, по подсчету поставщика, 72% пользователей, являющихся работниками интеллектуального труда, создавали артефакты такие как отчеты, служебные записки, контракты, электронные таблицы и файлы PDF (Help Net Security, 2026; собственная страница поставщика вернула ошибку доступа при моих проверках, поэтому цифры цитируются из пресс-релиза). Двадцать процентов от пяти миллионов — это примерно один миллион людей в неделю. Аналитик отметил, что выпуск отчасти был предназначен для «восстановления некоторого внимания» и что агент «часто используется рядом» с конкурирующими агентами, поэтому диаграммы роста «должны использоваться направленно» (Constellation Research, 2026a). Цифры сообщены поставщиком и не прошли аудит, они описывают людей, которые уже выбрали инструмент, и они измеряют использование агента с наследием терминала работниками интеллектуального труда, что шире, чем принятие уровня 3, как определено здесь (артефакт из делегированной задачи на собственной машине человека). Прочитав с этими оговорками, достаточно сказать, что агенты с наследием терминала больше не зарезервированы для программистов; то, достигают ли их пользователи уровня 3, как определено в разделе 3, это то, что цифра не может показать.
Наряду с этим данным стоит широкий и поверхностный паттерн раздела 1. Обследования расходятся по уровню и согласуются по форме: примерно половина взрослых американцев используют чат-боты (Pew Research Center, 2026), 52% американских работников используют ИИ в своей роли (Gallup, 2026), и 45% работников и 62% взрослых используют генеративный ИИ по мере Федеральной резервной системы Сент-Луиса (Bick et al., 2026), в то время как примерно один из семи работников использует его ежедневно, а автоматизация — это меньшинство использования. На рисунке 2 показаны ряды рабочих Gallup и Федеральной резервной системы Сент-Луиса рядом с цифрами разработчиков из раздела 1, одна панель на обследование, поскольку обследования отличаются вопросом и знаменателем. Среди разработчиков агенты кодирования почти универсальны, а использование все еще осторожное: в импульсном опросе мая 2026 года примерно 1100 технологов, 69% использовали одного агента, 59% редко или никогда не позволяли агентам работать без контроля, и 60% блокировали агентов от внесения несанкционированных изменений в их системы (Stack Overflow, 2026). Уровень 4, другими словами, все еще является границей даже для программистов, которые используют уровень 3 каждый день.
Рисунок 2. Широкий и поверхностный: принятие среди разработчиков и среди других работников.
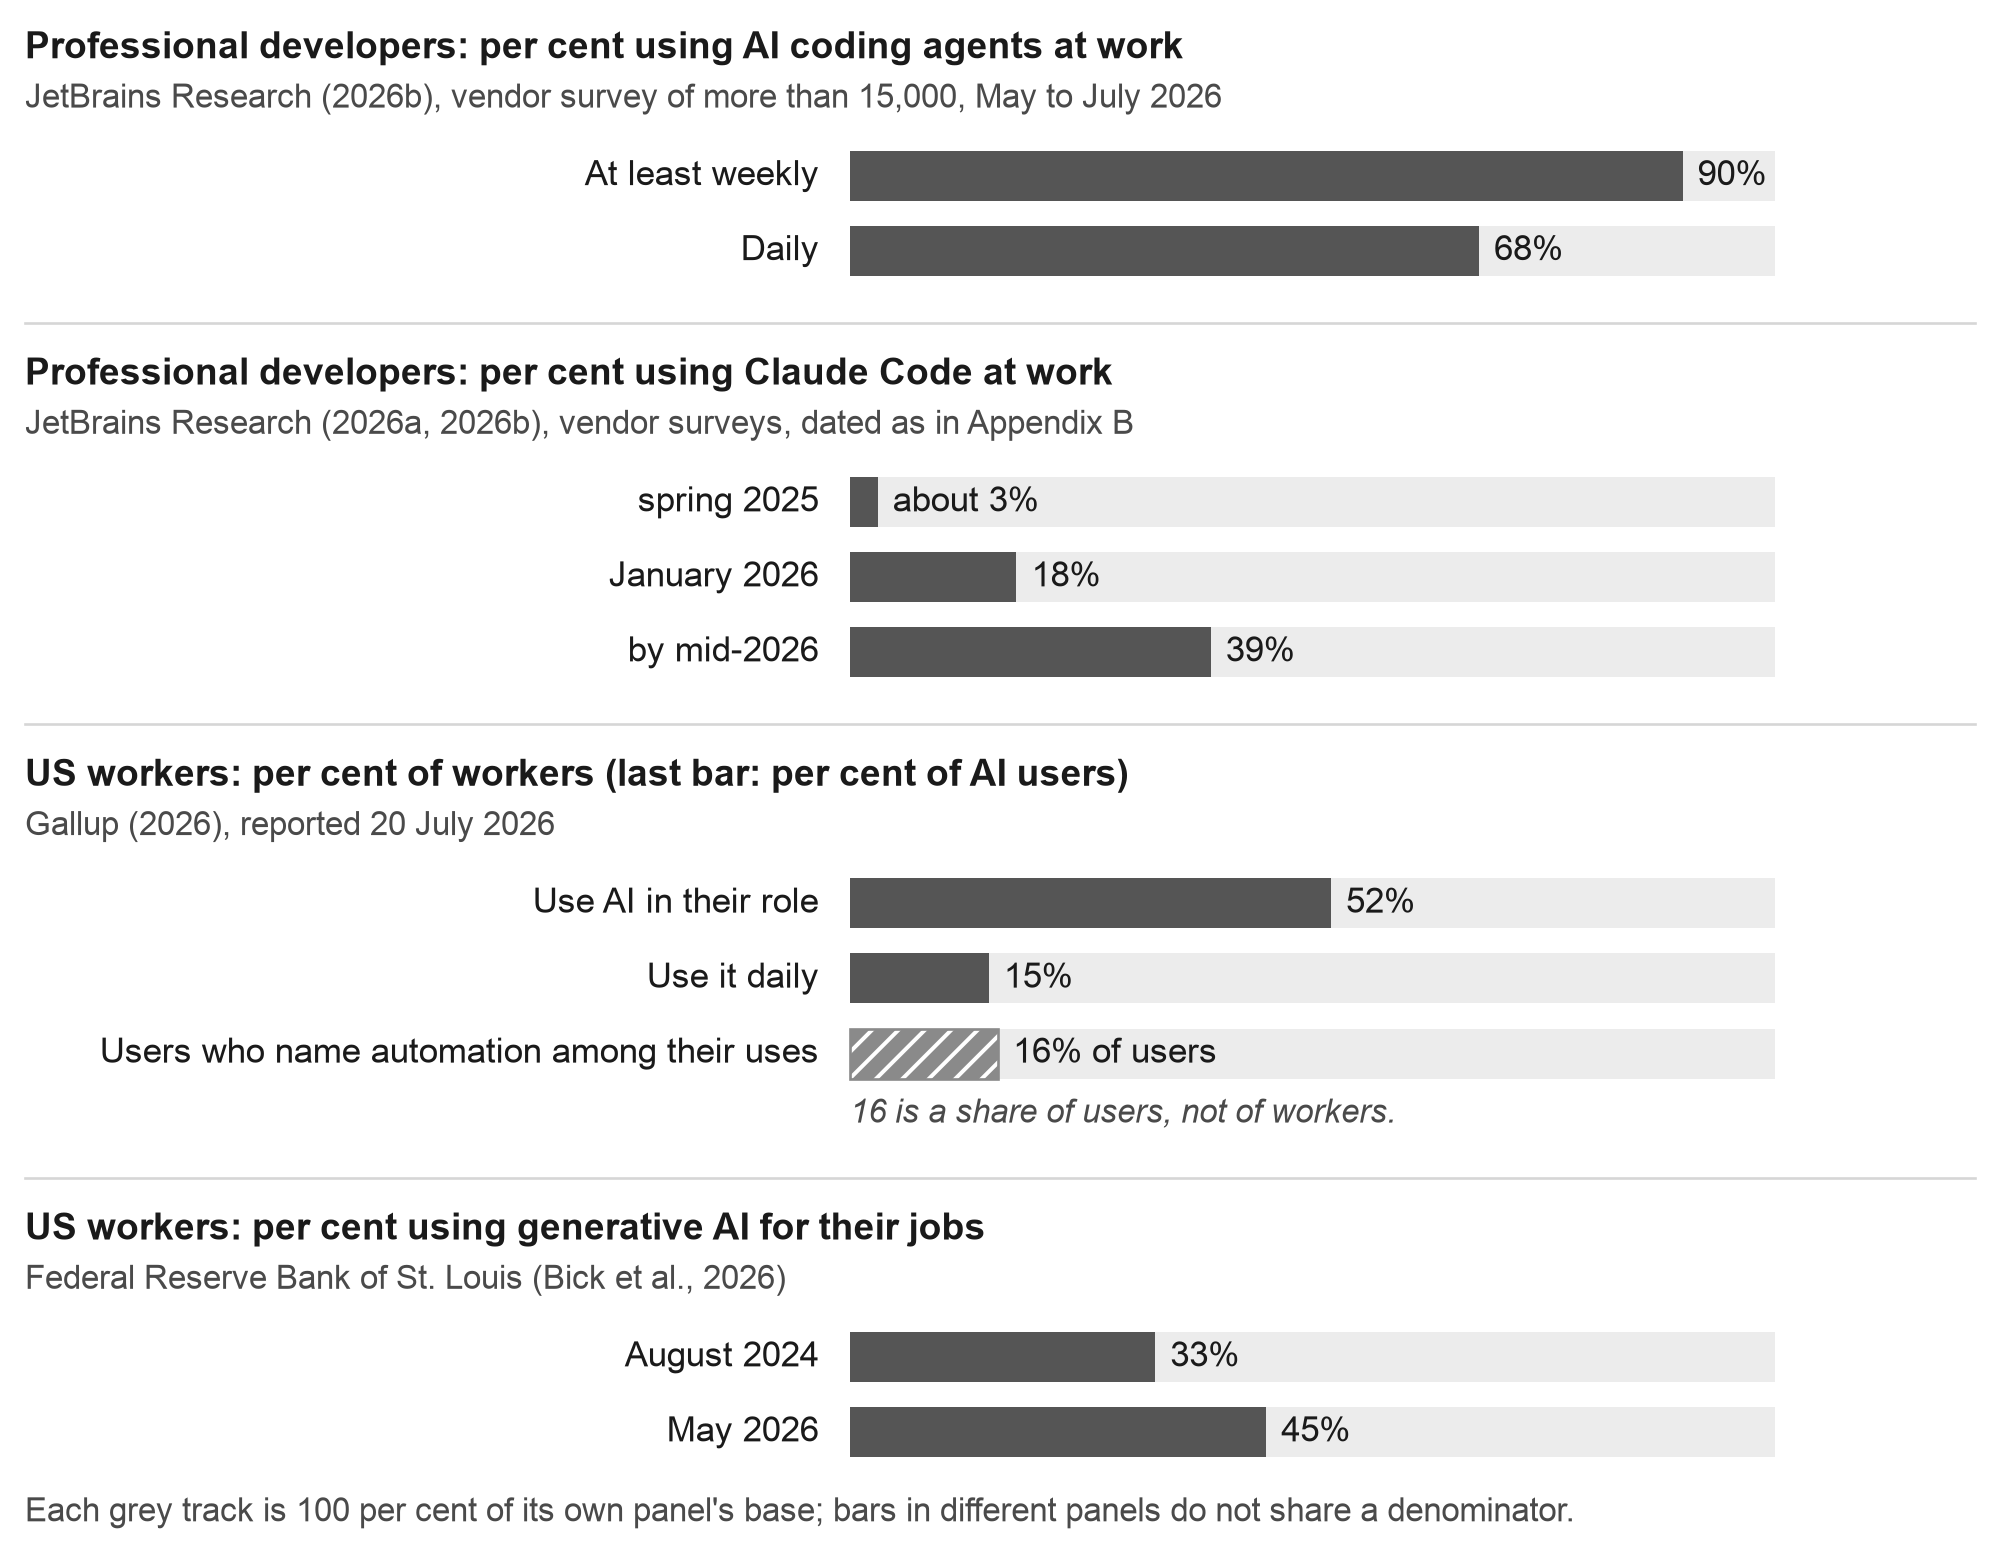
Примечание: Цифры принятия из обследований, цитируемых в разделах 1 и 4.4: профессиональные разработчики в двух обследованиях поставщиков (JetBrains Research, 2026a, 2026b), американские работники (Gallup, 2026) и американские работники, использующие генеративный ИИ для своей работы (Bick et al., 2026). Каждая панель имеет свой собственный вопрос, период и знаменатель, и 16 процентов в третьей панели — это доля пользователей ИИ, поэтому каждая панель читается отдельно. Подсчет поставщика рабочих интеллектуального труда внутри его агента кодирования (раздел 4.4) — это доля пользователей одного продукта и не рисуется, и ни одна цифра здесь не поступает из программы когорты раздела 9.
4.5 Где это оставляет аргумент
В совокупности свидетельства этого раздела убеждают меня в одном и оставляют другое открытым. Установка перестала быть решающим препятствием: поставщики устранили большинство механических этапов, чатбот может руководить остальным, и по данным одного поставщика (пресс-сообщение, ориентировочные) около миллиона интеллектуальных работников в неделю уже находятся внутри агента терминального наследия. Ведёт ли установка к использованию — это другой вопрос, и широкие и поверхностные опросы дают обескураживающий ответ, поскольку большинство людей, которые могли бы получить доступ к агенту, всё ещё не доверяют ему. То, что отступило, также следует указать точно. Установка отступила, теперь существует определённый промежуточный уровень, и локальный агент имеет графический интерфейс. Надёжность полноценных операций интеллектуального труда улучшилась намного менее заметно (раздел 5.7), продукт, который человек освоил, может исчезнуть в течение года (отток, выше), и предоставленная папка остаётся по умолчанию небезопасным местом (раздел 5.3). Раздел 5 ставит вопрос: что останавливает людей, когда программное обеспечение уже внедрено.
5. Что мешает людям после установщика
Когда установщик перестал быть препятствием, на его место встало что-то другое. Данные 2025 и 2026 годов указывают на шесть барьеров, каждый из которых проявляется на определённом этапе перехода, и для каждого уже есть частичное решение, видимое на рынке. Таблица 3 их суммирует, и следующие подразделы предоставляют доказательства.
Таблица 3. Барьеры после установки.
| Барьер | Где проявляется | Доказательства (раздел) | Что его снижает |
|---|---|---|---|
| Словарь рабочего процесса: неизвестность того, что передать, или как сформулировать это так, чтобы его можно было проверить | Переходы 1 и 2; снова на 3 | Обоснование слияния поставщиков; исследования подсказок; готовые навыки (5.1) | Разработанные примеры из своей области; навыки и шаблоны; первая задача, которая реальна, но низкого риска |
| Страх перед окном, первая ошибка и доверие: чёрное окно как социальный объект; сообщение, которое читает программист, и где останавливается новичок; доверие, отклонённое в обе стороны | Переход 2 | Исследование принятия; опросы доверия разработчиков; исследования конечных пользователей с кодом ИИ; рефлексивная адаптация (5.2) | Интерфейсы рабочего стола; отправка ошибки обратно в чатбот; режимы «сначала план»; первый успех на копии |
| Разрешения и безопасность: слишком мало подсказок для защиты файлов или слишком много для понимания | Переходы 1 и 2 | Отчёты о потере файлов в ограниченных папках; уровни инъекций; руководство, которое просит пользователей выявлять атаки (5.3) | Рабочие копии, снимки состояния, правила отказа; классификаторы, которые не делегируют суждение новичку |
| Организационные правила: заблокированные машины, политика, отсутствие разрешения на установку | Переход 2 | Организационные факторы перевешивают индивидуальные; в малых фирмах структура плоская (5.4) | Утверждённые работодателем инструменты уровня 2; чёткие политики; персональный компьютер для обучения |
| Оборудование, стоимость и квота | Переходы 2 и 3 | Уровень 3 требует компьютер и платную подписку; квоты в первую очередь ограничивают оркестровку (5.5) | Бесплатные уровни, где они существуют; начало на уровне 2; прогоны с контролем бюджета |
| Оценка результата | Все переходы, большинство на 3 | Деловые пользователи пропускают ошибки в коде ИИ; агенты чаще всего не справляются с целыми проектами (5.6) | Проверки, определённые до задачи; вторая модель как рецензент, а не как оракул |
5.1 Пустая папка: словарь рабочего процесса
Программист, открывающий агента, знает последовательность: создать проект, написать файл инструкций, поместить его под контроль версий, запросить функцию. Непрограммист открывает того же агента и задаёт вопрос, который теперь появляется в собственных данных поставщиков: хорошо, а что я ему скажу? Для разработчика существует канонический первый запрос («создать небольшое веб-приложение»). Маркетолог нуждается в другом («возьмите экспорт последнего квартала из аналитики и базы данных клиентов и создайте что-то, что каждую пятницу докладывает, какие кампании привели платящих клиентов»). Исследователь нуждается в ещё одном («пройдите через эту папку из 300 статей и извлеките размер выборки, метод и основной эффект каждой в таблицу, отметив, где вы не уверены»). Ни один из этих запросов не требует кода от человека. Каждый требует, чтобы человек знал, что такой запрос возможен, мог разбить его на части, которые может выполнить агент, и мог сказать, как выглядит хороший результат. Вопрос «что я должен его попросить сделать?» обычно неправильно понимается как запрос лучшей подсказки. Я читаю это как запрос карты собственной работы. Карта должна назвать постоянный объект работы, входные данные, которые человеку разрешено использовать, преобразование, результат и проверку. Карта аналитика может выглядеть так: «эти разрешённые экспорты, сгруппированные по этому полю, аномалии отмечены, датированный доклад и машиночитаемая таблица, проверённые по итогам строк». Человеку не нужно знать, как выполняется разбор. Ему нужно распознать, какие доказательства сделали бы результат полезным. Когда человек не может заполнить карту, само затруднение говорит ему что-то. Работа может быть слишком чувствительной, слишком условной или слишком плохо задокументированной для делегирования в текущем виде, и это говорит что-то о самой задаче, прежде чем говорит что-то о человеке.
Исследования подсказок объясняют, почему это сложно. Люди без опыта в области ИИ с трудом пишут инструкции, которые обобщаются (Zamfirescu-Pereira et al., 2023), и они должны путём проб и ошибок открыть, какие слова соответствуют тому, что система может делать (Liu et al., 2023). Собственное поведение поставщиков это подтверждает. Anthropic объединил своего агента уровня 2 с чатом, потому что клиенты не могли решить, куда относится задача (TechCrunch, 2026a), а OpenAI запустил плагины, специфичные для роли, для своего агента кодирования, нацеленные на интеллектуальную работу «кодирование не требуется» (по сообщению Help Net Security, 2026). Ответом индустрии стала упаковка словаря. Anthropic выпустила свой формат для упакованных инструкций агента в виде открытого стандарта в декабре 2025 года (SiliconANGLE, 2025), и на сайте стандарта были перечислены 46 поддерживающих продуктов 21 сентября 2026 года, включая агентов от OpenAI, Google и GitHub (Agent Skills, 2026). Независимая перепись насчитала 2049 приложений в каталоге ChatGPT и 1375 соединителей для Claude в середине 2026 года (Sitter, 2026). Навык, по этому определению, — это единица словаря рабочего процесса, запрос, записанный один раз, чтобы человек, который не знает, как его сформулировать, всё ещё мог его выполнить.
Упакованный словарь необходим, но этого недостаточно. Навык подсказывает агенту, как выполнить задачу. Он не может сказать человеку, какие из его собственных задач стоит передать, поскольку это суждение исходит из области деятельности человека. Опубликованные пакеты также несут предположения конкретного мира, в значительной степени формы одной страны и один корпоративный софтварный стек, и профессионал, чьи инструменты не входят в этот стек, снова оказывается перед пустым приглашением. Когда я прочитал официальный каталог упакованных навыков 22 сентября 2026, все 310 записей в нём, я не нашёл ни одной, написанной для пастора или капеллана, медсестры или члена семьи, ухаживающего за больным, школьного учителя, художника или ремесленника, или риэлтора; каждое кажущееся совпадение было софтварным или финансовым словом в той же оболочке — портфелем инвестиций или здоровьем сервиса. Каталог сообщества, который пополняется вручную, содержал 2 282 записи в тот день, и он действительно содержал работу для школьных учителей и для рынка недвижимости, но ничего для трёх остальных профессий. Каталоги изменяются из недели в неделю, поэтому это датированное наблюдение, а не постоянное утверждение о состоянии поля. Вот почему я придаю такой большой вес первой задаче в любом маршруте адаптации: она должна быть реальной, основанной на работе человека, с низким риском, и должна создать артефакт, который они смогут оценить (Carroll, 1990).
5.2 Страх перед окном, первая ошибка и доверие
Чёрное окно — социальный объект. Воспринимаемая простота использования на протяжении тридцати пяти лет была основой принятия технологии (Davis, 1989), и мигающее приглашение не проходит этот тест для значительной части населения, даже если человек никогда не будет вводить в него команду. Графические интерфейсы рабочего стола из раздела 4.1 — это ответ поставщиков. Это частичный ответ, потому что вторая преграда — это доверие, и доверие сместилось как против агентов, так и в их пользу. Среди разработчиков опрос Stack Overflow 2025 года выявил, что 46% не доверяют точности инструментов ИИ против 33%, которые доверяют, с 87% обеспокоены точностью агентов и 81% — безопасностью (Stack Overflow, 2025). В 2026 году большинство по-прежнему не позволяли агентам вносить несанкционированные изменения (Stack Overflow, 2026). Менеджеры слышат то же самое: «доверие является центральной преградой на пути реализации потенциала ИИ-агентов на работе» (McKinlay et al., 2026). Больше взрослых американцев ожидают вреда от ИИ, чем пользы (Pew Research Center, 2026). За обеими преградами скрывается ловушка убеждений раздела 2.4: опыт предсказывает успех, люди, у которых не было первого успеха, не имеют опыта, и первый артефакт — это выход (Ma et al., 2025). Некоторые люди предоставят домашнюю папку, потому что агент был вежлив, а другие откажутся устанавливать, потому что прочитали об удалённых семейных фотографиях. И то, и другое — это ошибки калибровки (Lee & See, 2004). Самое дешёвое средство калибровки, которое я могу придумать, — это первая задача, выполненная на копии папки.
Когда агент сообщает, что команда завершилась с кодом выхода 1, программист продолжает читать. Новичок может просто остановиться. Литература о конечных пользователях, работающих с кодом, написанным ИИ, показывает эту закономерность в более мягком контексте: деловые пользователи, которым был предоставлен код анализа, созданный ИИ, часто не замечали критических ошибок даже когда им предлагалось их искать (Virk & Liu, 2025), а программисты, взаимодействующие с ИИ в диалоговом режиме, тратят значительную часть своих усилий на проверку и управление контекстом (Sarkar & Drosos, 2025). На уровне 3 ошибка часто находится полностью вне работы человека, в его окружении: отсутствующее разрешение, правило сети, инструмент, который агент ожидал найти, но не нашёл.
Рефлексивная адаптация (раздел 4.2) предоставляет наиболее практичный из описанных до сих пор ответ. Человек отправляет ошибку или скриншот её чатботу, который уже использует, и следует его совету. Режимы с планом, составленным в первую очередь, помогают с другой стороны, поскольку агент, который пишет свой план перед действием, даёт человеку что-то читать, что не является трассировкой стека. Ни то, ни другое не избегает момента, когда человек без ментальной модели своей машины встречает сообщение, которое не может разобрать. Я ещё не знаю, как часто этот момент прерывает попытку. Программа в разделе 9 записывает это, собственными словами человека.
5.3 Разрешения и безопасность: слишком мало и слишком много
Уровень 3 даёт агенту возможности владельца, поэтому проблема безопасности проявляется в двух направлениях и новичок подвергается обеим.
Начнём с недостаточной защиты. Агенты уничтожили данные в задокументированных инцидентах. Агент в популярном сервисе построения приложений удалил производственную базу данных в июле 2025 года и описал свои действия как «катастрофическую ошибку суждения» (The Register, 2025). В апреле 2026 года агент в инструменте кодирования удалил производственную базу данных компании и её резервные копии за секунды и написал: «Я угадал вместо проверки» (Information Age, 2026). Для населения, о котором говорит эта статья, пользователи агента уровня 2 от Anthropic сообщили в марте, апреле и июне 2026 года, что он удалил личные, семейные и юридические документы внутри папок, которые они ему предоставили, в одном случае после того, как длительную задачу не удалось остановить и удаление задачи удалило файлы (GitHub issue reports, 2026; user reports, not confirmed by the vendor). Область действия папки ограничивает места, где может произойти ущерб. Это не предотвращает повреждение данных внутри папки, и синхронизированная облачная папка может превратить локальную ошибку в синхронизированную потерю.
Просмотр веб-сайтов вносит угрозу инъекции подсказок — скрытые в веб-странице инструкции, которые агент читает как команды пользователя. Команда безопасности продемонстрировала эту атаку в августе 2025 года на браузерном агенте другого поставщика с помощью proof of concept, который извлёк одноразовый код из почтового ящика через скрытый текст на странице (Brave, 2025). Anthropic сообщила, что её браузерный агент до применения защитных мер был успешно атакован в 23,6 % тестовых случаев, а после них — в 11,2 % (Anthropic, 2025). Год спустя, при запуске на всеобщее использование, она сообщила, что мощные атаки красной команды успешно проходили против её основной модели в 3,8 % случаев до установки защиты, а с полной защитой ни одна атака не пошла на трёх её моделях и 0,3 % на четвёртой (Anthropic, 2026d). Это цифры поставщиков на наборах тестов поставщиков. Тренд снижается, но остаток не равен нулю. OpenAI написала в декабре 2025 года, что инъекция подсказок «вряд ли когда-либо полностью «разрешится»» (TechCrunch, 2025). При запуске своего агента уровня 2 компания Anthropic попросила пользователей «следить за Claude, чтобы выявить подозрительные действия, которые могут указывать на инъекцию подсказок» и что «вы несёте ответственность за все действия, которые Claude выполняет от вашего имени» (The Register, 2026). Известный разработчик возразил в то время, что несправедливо просить непрограммистов распознавать признаки инъекции подсказок (Willison, 2026). По-моему, это возражение в целом справедливо. Дизайн безопасности, который полагается на новичка в обнаружении атаки, делегирует самое сложное суждение человеку, который меньше всего способен его вынести. Встроенные навыки и серверы протокола открывают собственную поверхность инструкций и привилегий, поскольку навык третьей стороны содержит инструкции, которые человек не писал, сервер может обладать большей привилегией, чем требуется для задачи, и конфигурации меняются между версиями.
Слишком много защиты останавливает людей столь же надёжно. Агент, который запрашивает разрешение на каждый шаг, превращает человека в клерка, одобряющего команды, которые он не может оценить, и наступает усталость от одобрения. Поставщики соответственно приспособились, и в течение одного квартала они двигались в более чем одном направлении. Браузерный агент Anthropic теперь действует автономно по умолчанию с классификатором, который блокирует действия, не соответствующие запросу пользователя (Anthropic, 2026d). Его агент терминала переименовал свой режим разрешений по умолчанию на «Manual» в июле 2026 года — переименование, которое само по себе говорит о том, что означал термин «по умолчанию» (Anthropic, 2026h). Его объединённый агент чата «запрашивает разрешение перед действием по умолчанию» — параметр, который пользователь может изменить (Anthropic, 2026c). Таксономия Парасурамана и Райли (1997) применима ко всем трём. Защита, которая блокирует слишком много, приводит к неиспользованию, защита, которая пропускает опасное удаление, приводит к неправильному использованию, и ни один параметр не избегает таксономии — только параметр, отказы которого данное население может переносить. Сопутствующая статья в этой серии документирует общий отказ с другой стороны — компоненты контроля, которые расширяют собственное понимание вреда и препятствуют работе, которую они предназначены защищать (Chernets, 2026b). Для новичка защита такого рода имеет тот же эффект, что и отсутствующий установщик, поскольку работа не происходит ни так ни этак.
Между слишком малой защитой и слишком большой есть рабочий компромисс, и он старомодный. Работайте в копии. Держите секреты вне рабочей папки. Создавайте снимок перед более крупным изменением. Отклоняйте деструктивные команды, пока у вас нет причины разрешить одну, подтверждайте всё необратимое и обращайтесь со всем, что приходит из сети, как с данными для чтения, независимо от инструкций, которые они кажутся содержать. Я описал принцип, лежащий в основе этих привычек, в сопутствующей статье как архитектурное доверие: полагание на проверки, которые человек может проверить, такие как ограниченные разрешения, логи, отмену и вторую независимую модель, а не на то, насколько уверенно звучит модель (Chernets, 2026c). Уровень 2 даёт человеку первую из этих проверок, и это не должна быть последняя, которую они узнают. Приложение C превращает список в примеры конфигурации для двух агентов и одностраничный контрольный список.
5.4 Организационные правила
Многие специалисты не могут установить что-либо на компьютер, на котором они работают. Многие работодатели не имеют политики в отношении агентов, и человек без политики склонен предположить, что ответ отрицательный. Опрос Microsoft 2026 года 20 000 работников знаний, использующих ИИ, показал, что организационные факторы объясняли более чем в два раза больше сообщаемого влияния ИИ, чем индивидуальные факторы, и что 45 % сказали, что чувствовали себя безопаснее, сосредоточившись на текущих целях, чем на переделке работы с ИИ (Microsoft, 2026b; опрос поставщиков). Бюро переписи населения США сообщило, что использование ИИ в бизнесе колебалось между 17 % и 20 % в целом, выросло среди фирм с 20 или более сотрудниками и не изменилось значительно среди фирм с менее чем 20 (US Census Bureau, 2026). Мандаты шли в обе стороны. Некоторые работодатели сделали использование ИИ базовым ожиданием в 2025 году (Digital Commerce 360, 2025), и по крайней мере один отменил своё решение оценивать сотрудников на основе использования ИИ год спустя, его главный исполнительный директор сказал прессе, что важное в оценке производительности — это хорошо выполнить работу (Fortune, 2026b). Опубликованная рубрика беглости одного работодателя ставит оркестровку и построение систем на верхний уровень и сообщает о полном внутреннем принятии, как только команды перешли от экспериментирования к переделке рабочих процессов (Zapier, 2026). Без этой переделки мандат покупает только соответствие. Рынок труда уже просит роль, описанную здесь, не называя её: 63 % названий должностей в США, затронутых ИИ в 2026 году, находились вне технологических профессий, 822 отдельных названия в первом квартале (Adrjan, 2026), и исследование более миллиарда объявлений о вакансиях в 27 странах определило премию заработной платы за навыки ИИ в размере 62 %, причём начальные должности, наиболее подвергшиеся воздействию ИИ, гораздо чаще требуют навыков, которые когда-то были зарезервированы для старших сотрудников (PwC, 2026; отчёт поставщика). Ни один из этих источников ещё не определяет способность направлять агента как чётко названное требование за пределами инженерии.
Этот барьер структурный в смысле Фердмана (2025): он не поддаётся индивидуальным усилиям. Это также самый сильный аргумент в пользу уровня 2, который предлагает доказательства, поскольку ограниченный поставщиком агент внутри пакета офисных приложений, который работодатель уже лицензирует (Microsoft, 2026a), достигает людей, чьи работодатели не одобрили бы агента на рабочем ноутбуке.
5.5 Оборудование, стоимость и квота
Уровень 3 предполагает наличие компьютера, которым управляет человек. Некоторые специалисты работают в основном со смартфона, пользуются семейным компьютером или работают только на корпоративных машинах, и для них переход становится невозможным ещё до того, как встанет вопрос о ПО. Уровни 3 и 4 также предполагают оплачиваемые тарифы как минимум одного сервиса, и оркестровка увеличивает стоимость, так как каждая дополнительная модель требует отдельной подписки или отдельной квоты. Для человека, уже платящего за одну подписку, добавление второй — это решение, а переход на максимальный тариф — это совсем другое решение. Беспокойство о токенах — это психологический барьер с материальной стоимостью. Квота координирующего агента — это скрытая стоимость, так как за каждый прочитанный ответ других агентов нужно платить, а агент, управляющий браузером, использует тот же лимит плана, что и терминальный агент, но обходится дороже на действие (Anthropic, 2026g). Заблокированные корпоративные ноутбуки добавляют требование администраторских прав в список препятствий: нет неподписанных бинарников, нет инсталлятора, правило защиты данных, которое воспринимает запись на диск как вредоносное ПО. Облачные агенты — это ответ индустрии для таких машин. Они сохраняют переход 1 и облачную форму перехода 2, но не дают человеку артефакта уровня 3 на собственном диске. Для специалиста в богатой стране ничего из этого не является серьёзным препятствием. Для многих других это реальное препятствие, и оно взаимодействует с разделением второго уровня (Hargittai, 2002), так как люди с наименьшими ресурсами менее всего способны экспериментировать.
5.6 Оценка результата
Использование агента не требует навыков программирования. Оценка результатов работы агента требует компетентности в области результата, и здесь непрограммист имеет преимущество, которое легко упустить. Юрист, читающий резюме договоров, или исследователь, читающий таблицу с извлечёнными данными, может проверить артефакт на основе знаний, которых у агента нет. Исследование « зубчатого фронтира » показало, что специалисты, работавшие с ИИ, лучше справлялись с задачами, находящимися в пределах возможностей модели, и хуже — с задачами вне её возможностей (Dell'Acqua et al., 2026). Защита — это человек, который знает задачу достаточно хорошо, чтобы понять, по какую сторону фронтира он находится.
Что они не могут легко проверить — это механизм, сценарий, который создал таблицу, или запрос, который вытащил числа. Анализ индустрии 470 pull requests показал, что код, написанный агентами, содержит больше дефектов, чем код, написанный людьми: 10,83 проблемы на изменение, созданное ИИ, против 6,45 для изменений, сделанных только людьми, при этом некоторые категории проблем безопасности встречаются в 2,74 раза чаще (CodeRabbit, n.d.; vendor study). И агенты всё ещё не справляются с большинством полных проектов: на эталонном тесте реальных фрилансовых проектов лучший показатель автоматизации, измеренный к середине 2026 года, составил 15,8% (Center for AI Safety, 2026). Из этого я вывожу две практики. Проверка должна быть определена до начала задачи (« что убедило бы меня, что это правильно? »), и модель из другого семейства может выступать в качестве рецензента артефакта, при этом человек решает, что считается правильным. Раздел 7 возвращается к ограничениям второй практики.
5.7 Альтернативное объяснение: агенты ещё недостаточно хороши
Читатель может возразить, что люди не делегируют, потому что агенты ещё не могут выполнять свою работу, и что препятствие, таким образом, остаётся техническим, только со стороны модели. Возражение имеет реальную поддержку. На эталонном тесте реальных фрилансовых проектов лучший показатель автоматизации, измеренный к середине 2026 года, составил 15,8%, в сравнении с 2,5% при первоначальном выпуске теста осенью предыдущего года, что означает, что более четырёх из пяти проектов всё ещё не справляются от начала до конца (Center for AI Safety, 2026). В смоделированной софтверной компании лучший агент выполнил 30% длительных профессиональных задач (Xu et al., 2024). На открытой компьютерной работе базовый показатель 2024 года был 12,24% для лучшего агента против 72,36% для людей (Xie et al., 2024), и к сентябрю 2026 года таблица лидеров агрегатора для верифицированной версии этого теста показала лучших агентов на уровне 85–86%, выше базового показателя людей, согласно показателям, сообщённым поставщиками для сценариев работы на рабочем столе (BenchLM, 2026). Этот последний результат указывает в другую сторону: на таких задачах возможность больше не является препятствием. Лучшая модель при оценке по 44 профессиям выиграла или сыграла вничью против специалистов менее чем в половине сравнений (Patwardhan et al., 2025). Длина софтверной задачи, которую агенты выполняют половину времени, примерно удваивается каждые семь месяцев (Kwa et al., 2025), поэтому тренд крутой, а текущие результаты скромны. Возможности неравномерны по разным задачам, и « зубчатый фронтир » не виден снаружи (Dell'Acqua et al., 2026). Таблица 4 собирает эти опубликованные данные с датами, указанными в каждом источнике, и оговорками, которые я к ним прилагаю.
Таблица 4. Опубликованные показатели возможностей, поддерживающие возражение.
| Сравнение | Опубликованное значение | Указанная дата | Источник | Читайте внимательно |
|---|---|---|---|---|
| Реальные фрилансовые проекты, лучший показатель автоматизации | 15,8%, в сравнении с 2,5% при первоначальном выпуске теста; более четырёх из пяти проектов всё ещё не справляются от начала до конца | Первоначальный выпуск осенью предыдущего года; 15,8% измерено к середине 2026 года, зафиксировано 1 июля 2026 года (Приложение B, VERIFIED) | Center for AI Safety (2026); разделы 5.6, 5.7, приложение B | Полные проекты, от начала до конца; лучший показатель среди измеренных |
| Длительные профессиональные задачи в смоделированной софтверной компании | Лучший агент выполнил 30% | Исследование 2024 года | Xu et al. (2024); раздел 5.7 | Смоделированная компания; отдельный показатель от показателя фрилансовых проектов |
| Открытое компьютерное использование, базовый показатель | 12,24% для лучшего агента против 72,36% для людей | Базовый показатель 2024 года | Xie et al. (2024); раздел 5.7 | Базовый показатель 2024 года; строка ниже — более поздняя таблица лидеров |
| Верифицированная версия этого теста | Лучшие агенты на уровне 85–86%, выше базового показателя людей | К сентябрю 2026 года | BenchLM (2026); раздел 5.7 | Таблица лидеров агрегатора; показатели, сообщённые поставщиками, для сценариев работы на рабочем столе; указывает в противоположную сторону |
| Оценка по 44 профессиям | Лучшая модель выиграла или сыграла вничью против специалистов в менее чем половине сравнений | Исследование 2025 года | Patwardhan et al. (2025); раздел 5.7 | « Менее чем в половине » — это используемая формулировка; процент не указан |
| Длина софтверной задачи, которую агенты выполняют половину времени | Примерно удваивается каждые семь месяцев | Исследование 2025 года | Kwa et al. (2025); раздел 5.7 | Тренд: « тренд крутой, а текущие результаты скромны » |
| Дефекты в pull requests | 470 запросов на слияние; 10.83 проблем на одно изменение, созданное ИИ, против 6.45 для изменений, созданных только людьми; некоторые категории проблем безопасности в 2.74 раза более частые | n.d. | CodeRabbit (n.d.); раздел 5.6 | Исследование поставщика; один анализ отрасли; дефекты в коде, в механизме, который непрограммист не может легко проверить |
Источник: указанные публикации, повторённые в разделах 5.6 и 5.7 и Приложении B; ни одна из этих цифр не происходит из программы раздела 9.
Два объяснения в большей степени являются частями одного объяснения, чем соперниками. Словарь рабочего процесса включает знание того, какие из своих задач находятся внутри границы. Человек, который поручает агенту весь проект, который агент не может выполнить, учится прекращать делегирование, в то время как человек, который поручает ему извлечение, согласование и первый черновик, учится продолжать. Два объяснения всё ещё дают разные прогнозы. Если способность модели является ограничивающим фактором, то сохранение на уровнях 2 и 3 будет определяться типом задачи, а не человеком: люди с одинаковыми видами работы будут сохраняться с одинаковой частотой независимо от их способности указывать и проверять. Если словарь рабочего процесса является ограничивающим, то сохранение будет определяться способностью человека сформулировать контракт делегирования даже в рамках одного вида работы. Предложение P15 в разделе 10 написано, чтобы различить эти два.
6. Веб-оркестрация: предложенный мост
6.1 Практика
Самая простая форма уровня 4 не требует установки вообще. Человек открывает три или четыре чатбота в вкладках браузера, вставляет один и тот же вопрос в каждый и читает ответы рядом. Компьютерные учёные назвали бы это ручным запросом к нескольким языковым моделям, где человек выполняет маршрутизацию и сравнение. Некоторые делают это вручную. Другие используют один из инструментов, созданных для этого с 2023 года: расширения браузера и настольные приложения, которые передают один запрос в несколько потребительских сервисов чата и показывают ответы в параллельных панелях. ChatHub и ChatALL появились весной 2023 года; последний релиз ChatALL один только имел около 847 000 загрузок, записанных на его странице релиза к сентябрю 2026 года, эта цифра включает автоматические обновления и в основном состоит из сборок одной платформы (GitHub, 2026a). Более новая группа инструментов превращает веб-сессии чата, в которые пользователь вошёл, в команды, которые может вызвать другая программа, так что агент может задать вопрос подпискам веб-приложений человека. OpenCLI, один из них, имел около 29 500 звёзд на GitHub в сентябре 2026 года (GitHub, 2026b).
В 2026 году эта практика превратилась в функцию продукта. Perplexity представила "Model Council", который выполняет запрос через несколько моделей и "представляет консолидированное представление, которое выделяет ключевые выводы, области согласия и точки расхождения" (Storyboard18, 2026). Исследовательский агент Microsoft в Microsoft 365 Copilot предлагает режим, который "выполняет один и тот же вопрос через несколько исследовательских агентов глубокого рассуждения (GPT и Claude) одновременно" и режим критики, включённый по умолчанию при автоматическом выборе модели, в котором отчёт, написанный одной моделью, проходит второй проход рассуждения от другой (Microsoft, 2026c; Constellation Research, 2026b). Проект "LLM Council" Андрея Карпатского — небольшое веб-приложение, которое отправляет запрос нескольким моделям, они анонимно рецензируют друг друга, и председательская модель пишет окончательный ответ; описанный его автором как проект выходного дня, имел около 24 900 звёзд на GitHub в сентябре 2026 года (Karpathy, 2025). Экосистема с открытым исходным кодом разделяется на две части. Инструменты трансляции получают ответы и оставляют согласование человеку. Инструменты совета согласуют, и они работают на платных программных интерфейсах с двумя или тремя моделями, отдельно от собственных авторизованных вкладок человека. Ни одна половина сама по себе не может перенести человека дальше, и именно поэтому мост неполный.
6.2 Почему это предложено в качестве моста
Веб-оркестрация находится между уровнями полезным образом. Она не требует ничего нового от машины — ни установки, ни разрешений, ни локального агента, и она работает на подписках, которые человек уже оплачивает, или на бесплатных уровнях. Она требует чего-то нового от человека: держать несколько ответов одновременно, замечать, где они отличаются, и решить. Человек, который научился спрашивать "что сказала другая модель?", научился привычке, которую позже автоматизирует оркестрация CLI, и эта привычка — это управленческая задача уровня 4 в её наименьшем объёме.
Мост ценен, потому что он видим. Предположим, аналитик рынка просит три чатбота резюмировать опубликованный отраслевой отчёт, и двое из них цитируют цифру, которой нет в отчёте, а третий отмечает её отсутствие. Полезный результат — это подсказка открыть сам отчёт, и человек, который прошёл через это один раз, перестаёт относиться к первому свободно звучащему ответу как к ответу. Параллельное представление нескольких ответов становится мостом к уровню 4, когда оно учит человека формулировать один общий вопрос, замечать, где предположения расходятся, просить критику и сохранять причину выбора одного ответа. До этого это привычка уровня 1 с большим количеством вкладок. Чему оно учит, так это сравнению, и только сравнению. Человек, который научился спрашивать, что сказала другая модель, этим самым не научился тому, к чему может прикоснуться агент на его машине, что является уроком уровней 2 и 3, и утверждение о переносимости привычки является эмпирическим, P7, которое я не рассматриваю как предпосылку. Предварительно зарегистрированная программа, описанная в Разделе 9, называет два преимущества заранее, и они резюмируют то, что приносит мост. Одно — это полнота охвата: полезный аспект, присутствующий в одной модели, не теряется, потому что была задана другая модель. Другое — это надёжность: ответ был проверен в сравнении с другими ответами, а не принят по слову одной модели (Chernets, 2026d). Видимое разногласие служит средством для второго. Оценка прогнозирования показала, что ансамбль из двенадцати языковых моделей соответствовал точности толпы из 925 человеческих прогнозистов (Schoenegger et al., 2024), и многоагентные дебаты улучшают факотуальность и рассуждения по сравнению с одной моделью в нескольких контекстах (Du et al., 2023). Оба преимущества зависят от того, что ошибки моделей различаются, и следующий подраздел посвящён тому, что происходит, когда они не различаются.
6.3 Где заканчивается мост
Веб-оркестрация остаётся мостом, и самая простая причина — это цена внимания. Чтение четырёх длинных ответов и их ручное согласование занимает значительно больше времени, чем чтение одного. Я не попрошу никого делать это для обычного вопроса; это окупается, когда неправильный ответ обойдётся дороже, чем время, потраченное на сравнение.
Второе ограничение — это хрупкость, и она проявляется в нескольких формах. Интерфейсы потребительского чата меняются месяц за месяцем, и инструменты, которые их управляют, ломаются, когда это происходит: летом 2026 года один пакет приложений удалил режим исследования, один чатбот закрыл режимы на своём бесплатном уровне, и более одного сервиса переименовал или перенаправил свой адрес. Условия использования нескольких потребительских сервисов ограничивают автоматический доступ, и человек, который управляет своим вошедшим в систему браузером с помощью агента, берёт на себя риск блокировки учётной записи. Исследовательская программа, которая использует мост, должна сообщить об этом участникам, и я не предлагаю никакого юридического толкования этих условий. "Бесплатная" сторона других чатботов также оплачивается на стороне агента, который их управляет, поскольку действия браузера используют те же лимиты плана, что и терминальный агент (Anthropic, 2026g). Ручное сравнение в открытых вкладках является надёжным. Автоматизированный сбор страниц потребительского чата — плохая основа для повторяемой работы.
Третье ограничение — наиболее важное: согласие между моделями не является независимым свидетельством. Когда модели совместно используют данные обучения и методы, их ошибки коррелируют. Исследование более 350 языковых моделей показало, что когда две модели совершали ошибку, они сходились на один и тот же неправильный ответ примерно в 60% случаев, и что более крупные и точные модели были более коррелированы, даже у разных поставщиков (Kim et al., 2025). Сопутствующая статья в этой серии дает арифметику: со средней попарной корреляцией ошибок rho, N согласующихся моделей дают N_eff = N / (1 + (N - 1) rho) независимых мнений, и никакое количество моделей не стоит больше чем 1/rho (Chernets, 2026a). При rho = 0,5 десять согласующихся чатботов стоят менее двух независимых. Рисунок 3 показывает формулу для четырех иллюстративных значений rho в Приложении D с потолком 1/rho, который никакое количество согласующихся моделей не может превысить. 60% от Kim et al. — это доля совместных ошибок, в которых две модели дали один и тот же неправильный ответ, что не является корреляцией ошибок rho формулы. В рассматриваемой области rho должна быть оценена на элементах с известными ответами (список C4), и значения, используемые здесь и в Приложении D, являются иллюстрациями. Разнообразие важнее, чем количество. Обсуждение копий одной модели часто не удается превзойти одну модель при той же вычислительной мощности, в то время как гетерогенные модели помогают (Zhang et al., 2025), и два разнообразных агента могут совпадать или превзойти шестнадцать однородных (Yang et al., 2026). Генеративный AI также выравнивает выходные данные у своих пользователей (Doshi & Hauser, 2024), и модель, которую просят судить, склонна предпочитать собственное письмо (Panickssery et al., 2024), что имеет значение, когда одна модель пишет объединенный ответ.
Рисунок 3. Ценность согласия.
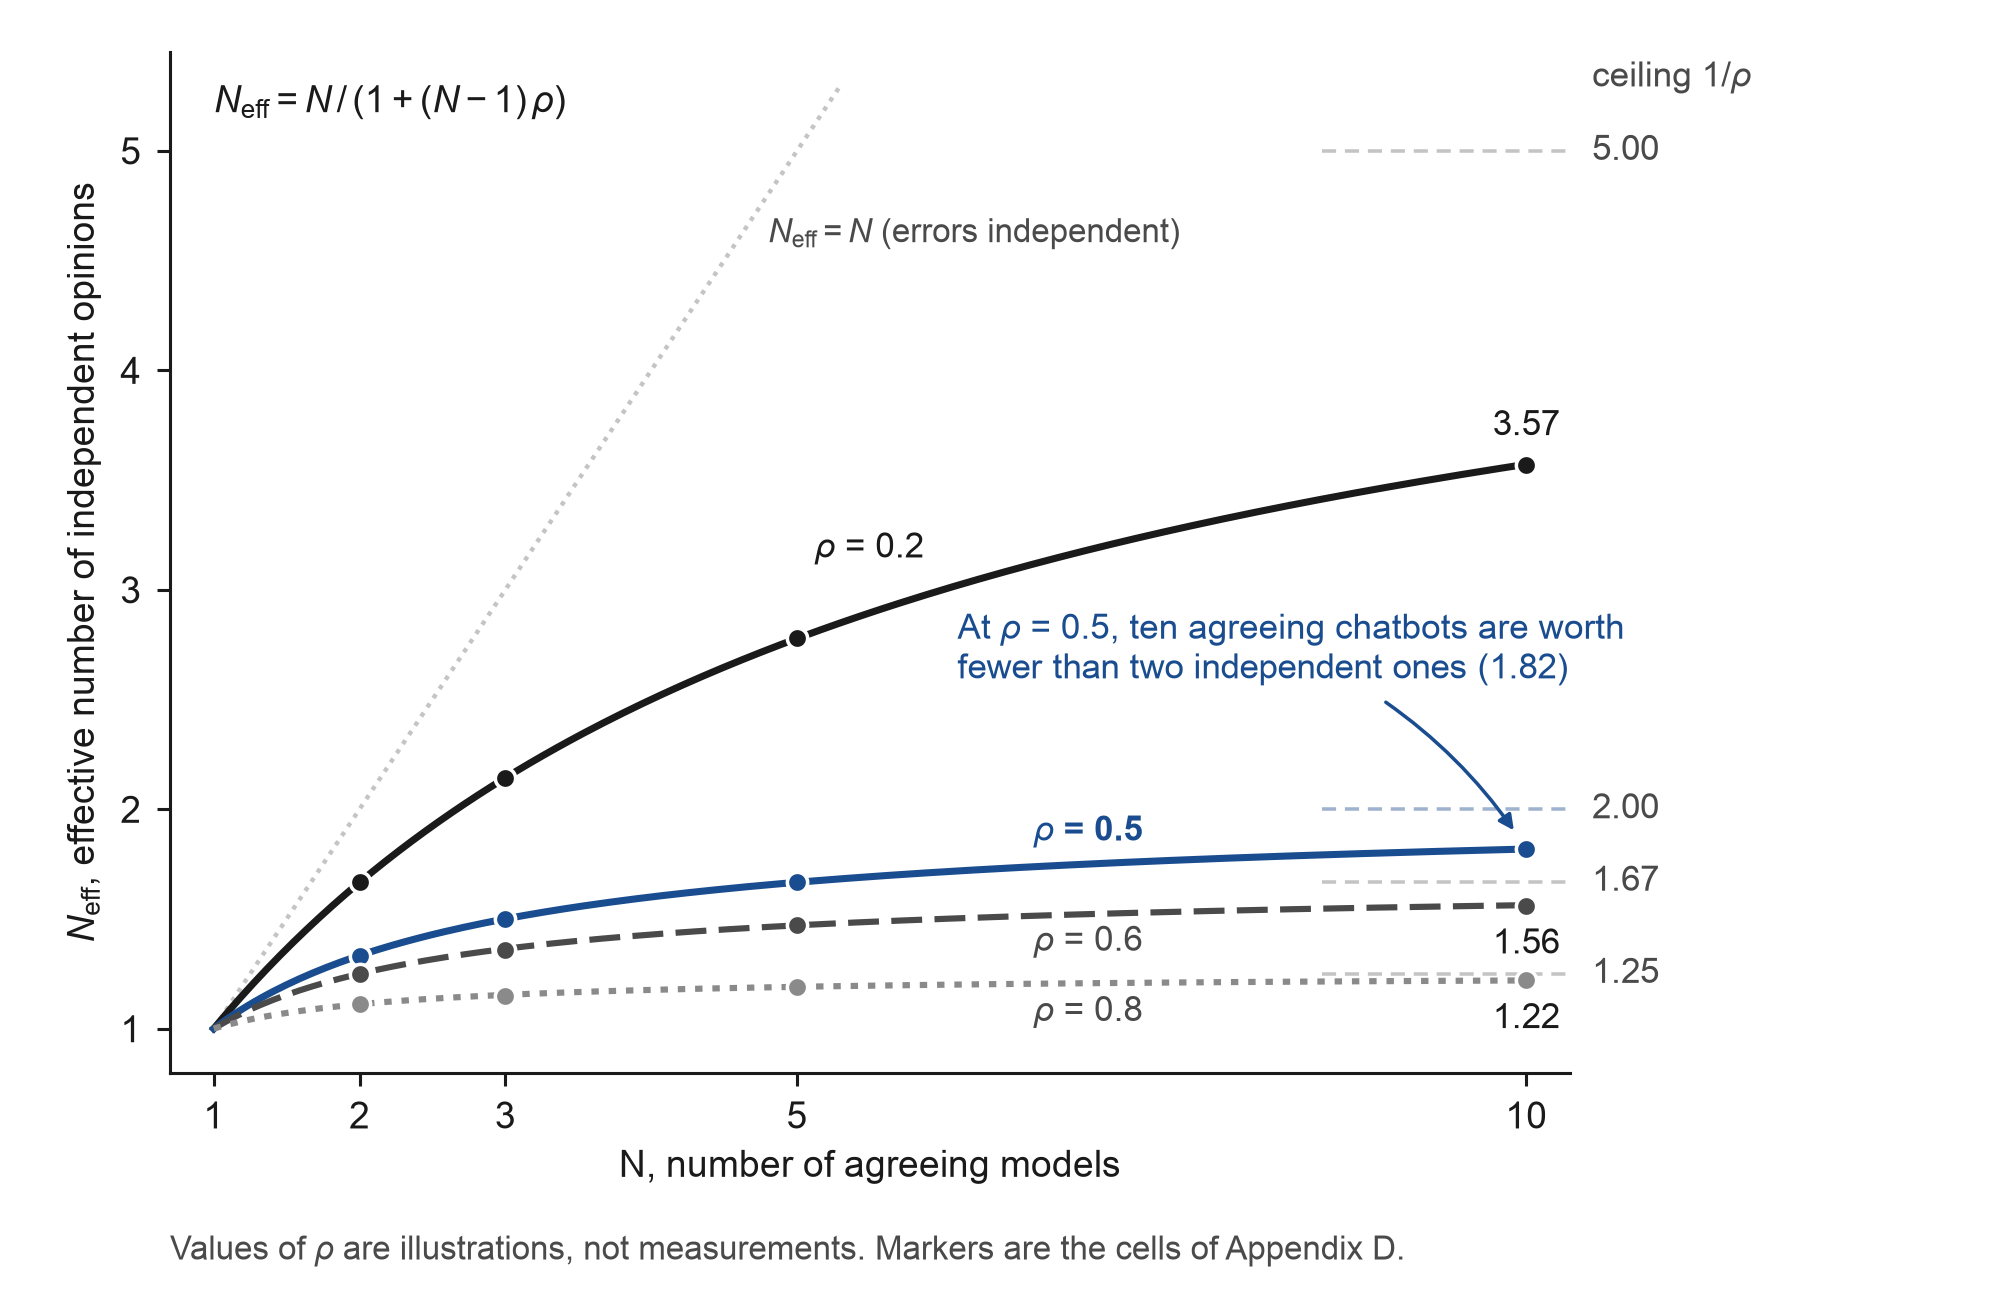
Примечание: Эффективное число независимых мнений, N_eff = N / (1 + (N - 1) rho), для N согласующихся моделей, ошибки которых имеют среднюю попарную корреляцию rho (Chernets, 2026a; Раздел 6.3). Маркеры являются ячейками Приложения D, кривые между ними следуют той же формуле, а пунктирные сегменты справа — это потолки 1/rho. Четыре значения rho — это иллюстрации, как в Приложении D; rho должна быть оценена на элементах с известными ответами в рассматриваемой области (список C4).
Для человека на мосту практические правила просты. Считайте семейства моделей, поскольку помощник офиса, работающий на модели одного поставщика, не является вторым мнением о чатботе этого поставщика. Согласие между моделями может указать, где потратить меньше усилий на проверку. Оно не может сказать вам, что утверждение верно. Относитесь к точке, высказанной одной моделью, как к пути для проверки, потому что это может быть самым ценным в сравнении или его единственной ошибкой, и сохраняйте разногласие, которое сопровождается доказательствами, вместо того чтобы голосовать против него. Проверяйте утверждения по источникам: согласие по неправильной дате — это задокументированный случай отказа, и первичный источник исправляет это там, где пятая модель не может. Оцените rho на небольшом наборе вопросов в своей области, которые вы можете отметить, прежде чем доверять совету по вопросу, который вы не можете. Помните, кто что сказал, потому что объединенный ответ, скрывающий свои источники, возвращает единый уверенный голос, который оркестровка была призвана поставить под сомнение.
Изложенное в виде процедуры, это учебная форма протокола "якорь-и-обогащение" сопутствующей статьи (Chernets, 2026a). Сначала человек фиксирует якорь: задачу, допустимые доказательства и форму выходных данных. Затем они получают отдельные ответы с сохраненными источниками или ссылками на файлы, извлекают утверждения в таблицу по источникам и сортируют каждое разногласие по его типу, является ли это фактическим конфликтом, другой интерпретацией, отсутствующим предположением или различием в формате. Они проверяют утверждения, влияющие на решение, в сравнении с якорем или первичным источником, и записывают решение о приемке и то, что остается неразрешенным. Пример кода C3 в Приложении C создает таблицу утверждений по источникам, пример кода C4 оценивает rho по элементам с известными ответами, а Приложение D дает потолок для диапазона rho без запуска кода. Здесь подходит еще одно правило, и оно не требует второй подписки. Критик того же семейства, когда его просят в новом контексте атаковать первый ответ, выявляет спешку, пропущенные инструкции и невыполненные проверки, хотя не может выявить общее ложное знание. Я бы начал применять критику на уровне 3 с одного агента и добавил бы второе семейство только когда критику больше нечего сказать и решение требует больших затрат.
Противоположный случай нужно излагать столь же ясно. Для многих задач одна сильная модель с хорошим набором источников и тщательной проверкой человеком превзойдет сложный совет, который вносит задержку и путаницу, и модель это подтверждает. Оркестровка окупается, когда задача содержит реальную неопределенность, выигрывает от различных точек зрения или повторяется часто настолько, чтобы покрыть затраты на подготовку. Она плохо подходит для решения, критичного по времени, без возможности проверки, конфиденциального материала, который нельзя распространять между сервисами, и простых задач, где стоимость сравнения превышает выгоду. Когда используется совет, агентам должны быть поручены разные работы: один ограничен предоставленными документами, один направлен на поиск первичных источников, одному дать задание перечислить неподтвержденные утверждения, одному проверить справедливость цитирований, при этом человек по-прежнему остается арбитром. Пункт P9 написан так, чтобы этот контраргумент мог возобладать.
7. Оркестрация CLI: надёжный уровень делегирования
7.1 Агенты, вызывающие агентов
На уровне 3 каждый агент имеет интерфейс командной строки, который может работать без человека за клавиатурой: на вход поступает вопрос, на выходе — ответ или изменённый файл. Когда человек владеет одним агентом, этот агент может вызывать остальных. В литературе по системам это называется оркестрацией агентов. Я называю версию, которую непрограммист запускает через уже установленные инструменты командной строки, оркестрацией CLI. Одна инструкция первому агенту («попросить остальных двух рассмотреть этот план и сказать мне, в чём они расходятся») создаёт небольшую команду.
В 2026 году этот паттерн перешёл из хитрости разработчика в санкционированную практику поставщика. OpenAI опубликовала официальный плагин, который запускает его агента кодирования внутри агента Anthropic, «для рецензирования кода или делегирования задач», с командами для обычного рецензирования, состязательного рецензирования, в котором второй агент предполагает, что работа сломана и ищет ошибки, и спасения зависшей задачи. Он работает через локально установленный инструмент и существующий вход, может использоваться с любой подпиской ChatGPT, включая бесплатный уровень, и имел около 33 400 звёзд на GitHub в сентябре 2026 (OpenAI, 2026a). Массовая пара 2026 — это Claude Code для написания и Codex для проверки через этот официальный плагин (OpenAI, 2026a), в то время как советы из трёх и более членов остаются небольшими инструментами без лидера. GitHub сделала агентов Anthropic и OpenAI доступными внутри своего сервиса Copilot в феврале 2026, «полностью включены в вашу существующую подписку Copilot» (GitHub, 2026c). Агент командной строки xAI поставляется с режимом без интерфейса и поддержкой Agent Client Protocol, чтобы пользователи могли «создавать собственные боты и приложения оркестрации агентов» (xAI, 2026). Причина Google для снятия с производства его первого агента командной строки заключалась в том, что пользователи «требуют несколько агентов, взаимодействующих друг с другом» (Google, 2026). Инструменты с открытым исходным кодом, которые позволяют одному агенту консультироваться с другими, имеют большое количество подписчиков: многопоставщицкий сервер для консультации модель-модель имел около 11 800 звёзд, плагин, ориентированный на консенсус, около 4 100 (GitHub, 2026d). В основе этого лежит Model Context Protocol, переданный структуре Linux Foundation в декабре 2025 с более чем 10 000 опубликованными серверами и примерно 97 миллионами загрузок SDK в месяц на тот момент (Linux Foundation, 2025), который сообщил около полумиллиарда загрузок SDK в месяц к июльскому выпуску спецификации 2026, который также сделал протокол без состояния и пообещал уведомление за двенадцать месяцев перед любым снятием с производства (Model Context Protocol, 2026). Это то, как агент на ноутбуке получает доступ ко всем остальным инструментам человека без специфичного для поставщика плагина для каждого, и это уже стало скучным так же, как скучен веб-протокол: присутствует, документирован, игнорируется до тех пор, пока что-то не сломается. Второй стандарт, протокол Agent2Agent компании Google для общения агентов с агентами между поставщиками, достиг версии 1.0 в марте 2026 (Google Open Source Blog, 2026). Это сантехника уровня 4, и сегодня это не потребительский въезд.
Таблица 5. Ландшафт оркестрации по паттернам, сентябрь 2026.
| Паттерн | Примеры (сентябрь 2026) | Уровень | Предназначено для | Что это даёт | Оставляемые записи | Основной риск |
|---|---|---|---|---|---|---|
| Ручное сравнение во вкладках браузера | Любой набор потребительских чатботов | 4 (web) при записи и переповторе; в противном случае привычка уровня 1 | Любой | Охват; привычка сравнения | Скриншоты или скопированные ответы, контекст часто теряется | Затраты внимания; неучтённое происхождение |
| Инструменты трансляции для веб-чатов | ChatHub, ChatALL | 4 (web) при записи и переповторе; в противном случае привычка уровня 1 | Физические лица | Один запрос, параллельные ответы, без согласования | Ответы в панелях; ничего на диске, если не сохранено | Ломается при изменении интерфейсов; условия обслуживания |
| Совет как функция продукта | Perplexity Model Council; Microsoft 365 Copilot research agent (GPT и Claude); LLM Council Карпатого | 4 (web, управляемый) | Подписчики этих сервисов | Объединённый ответ с согласием и расхождением | Всё, что показывает поставщик; источники часто скрыты | Объединённый голос скрывает происхождение; выбирающий — поставщик |
| Веб-чат, открытый для агентов | OpenCLI и подобные | Мост от 4 (web) к 4 (CLI) | Технические пользователи | Агенты могут использовать веб-подписки | Файлы, если агент их создаёт | Хрупкость; правила доступа |
| Плагин поставщика: один агент делегирует другому | Плагин OpenAI для Claude Code; Claude и Codex внутри GitHub Agent HQ (Copilot) | 4 (CLI) | Разработчики, распространяется | Кросс-поставщицкое рецензирование и делегирование в одной сессии | Стенограмма сессии; результат рецензирования | В основном код-подобный; квота двух сервисов |
| Серверы советов и консультаций | Многопоставщицкий сервер консультаций (последний коммит декабрь 2025); плагины консенсуса; небольшие советы CLI, которые создают один файл на инструмент | 4 (CLI) | Разработчики | Несколько семейств на одной задаче; правила консенсуса | Файлы для каждого инструмента; объединённая заметка | Раунды без конца; коррелированные ошибки; отказ |
| Панели многоагентных приборов | Несколько официальных интерфейсов CLI в панелях, каждый с собственной рабочей копией, человек может взять на себя любой | 4 (CLI, видимый) | Разработчики, наблюдающие за параллельными агентами | Контроль сделан видимым | Логи и диффы для каждого агента | Создано для кода; внимание распределено тонко |
| Сценарий разветвления с потолками времени | Листинг C1 в Приложении C | 4 (CLI) | Любой, кто владеет агентом уровня 3 | Параллельные ответы сохраняются даже когда инструмент зависает | Один файл на инструмент, сводка с тем, кто ответил | Требует человека для согласования |
| Один агент, задача записана и переповторяется | Файл инструкции или навык, запущенный по расписанию | 3 сделано повторяемым | Любой на уровне 3 | Повтор, когда вторая модель недоступна | Файл задачи, входы, выходы, заметка принятия | Повтор усиливает плохой шаблон |
Строки описывают паттерны. Количество звёзд в Приложении E — это трассировка популярности за один день, и они не являются пользователями, качеством или пригодностью для папки контрактов. Информация об отказе от поддержки должна быть в таблице: наиболее известный консультационный сервер в последний раз получал обновления в декабре 2025 года, и у более чем одной панели управления разработчики прекратили поддержку. Статья, которая направляла бы учащихся на один конкретный оркестратор, принесла бы им вред, поэтому я направляю их на паттерн вместо этого: официальные бинарные файлы, неинтерактивные флаги, файлы на диске и запись о том, кого спрашивали.
7.2 Почему этот слой устойчив
Оркестрация через CLI опирается на собственные инструменты поставщиков, работающие в режимах, которые сами поставщики документируют для автоматизации, и это даёт ей свойства, которые вкладка браузера не может иметь. Главное — это можно записать. Процесс, который один раз сработал, например «черновик с одной моделью, второй обзор по чек-листу, дайте мне расхождения», можно сохранить как файл инструкций или навык и запустить снова на следующей неделе, по расписанию, если необходимо. Раздел 3 определил уровень 4 как именно это, повторяемую работу с несколькими моделями. Далее изложены дополнительные свойства в порядке их значимости. Флаг командной строки — это документированный интерфейс, а код выхода — это обещание; позиция на веб-странице — ни то ни другое, поэтому инструменты, которые управляют страницами потребительских чатов, приходится чинить каждый раз, когда страница меняется. Каждый официальный инструмент работает под своим логином поставщика с его песочницей и правилами отказа, благодаря этому человек может хранить секреты вне папки, по умолчанию запретить сетевой доступ и отказать в деструктивных командах для каждого инструмента, в то время как агент браузера, который может видеть каждую вкладку, — это один больший объект прав доступа. Паттерн использует потребительские логины, за которые человек уже платит, и я ожидаю, что это, больше всего, отличит постоянную практику непрограммиста от разовой попытки. И поставщики это одобряют. Официальный плагин, агенты внутри сервиса GitHub, бесголовые режимы и стандарт навыков — это признаки того, что делегирование между инструментами стандартизируется, в то время как автоматизация страниц потребительских чатов вытесняется.
Веб-оркестрация может воспитать привычку сравнения, а оркестрация через CLI — это место, где эта привычка может быть сохранена как объект. Объектом является папка, которая содержит задание, допустимые входные данные, выходные данные, журнал того, какой агент что произвёл, и запись о том, что было принято. Другой человек может проверить это без воспроизведения приватного чата, а создатель может изменить один входной параметр на следующей неделе и заметить разницу. Этот журнал также усложняет уклонение от ответственности, поскольку сохранённое задание и запись о принятии обнаруживают низкокачественный исходный набор или отсутствие одобрения. В офисах, привыкших к неформальному чату, это будет казаться бременем, а везде, где работу нужно проверить, передать или повторить, это является активом. Пропорциональность определяет, когда это нужно: двухминутный запрос не требует папки рабочего процесса, а повторяющаяся задача, которая затрагивает общие файлы, может её потребовать.
Большая часть существующих решений сформирована кодом. Официальные плагины, серверы совета и менеджеры нескольких агентов нацелены на рецензирование программного кода, хотя сам паттерн не специфичен для кода.
7.3 Что требует от человека этот слой
Небольшой команде агентов нужен менеджер, и работа менеджера имеет свои особенности. Я называю эти четыре части договором делегирования:
- Цель: для чего нужна работа, сформулированная так, чтобы агент мог определить, была ли она достигнута.
- Граница: что агенты могут трогать, а что нет, какие действия требуют подтверждения человека и какой бюджет времени и квоты может потратить задача.
- Артефакт: что должно существовать по завершении работы и в какой форме.
- Проверка: как человек узнает, что артефакт правильный, определяется до начала: кто рецензирует что и когда остановиться.
Четвёртая часть содержит ловушку, описанную в сопроводительной статье об автоматизированном контроле (Chernets, 2026b). Добавить рецензента дешево, и каждый рецензент находит что-нибудь. Совет без правила остановки склонен добавлять раунды и критиков, пока рецензирование не задавит работу. Практическое правило состоит в том, чтобы допустить один раунд критики и один раунд исправлений на этап, при этом человек решает, является ли находка блокирующей. Цена этого правила известна: в рандомизированном тесте из 144 запусков, сообщённом в той статье, бюджет одного раунда снизил количество раундов критики с 2,86 до 1,00 на запуск, при этом увеличив пропущенные дефекты на 0,11 на запуск (95% доверительный интервал 0,005–0,204) (Chernets, 2026b). Целесообразен ли этот компромисс, зависит от того, что на кону, что является именно тем видом решения, которое должен принимать менеджер. Ограничения на раунды и время — это бюджеты, а бюджет определяет, когда остановиться, что отличается от вопроса о том, верен ли ответ.
Договор повторяет, что требует хорошее делегирование людям, для аудитории, которая никогда не делегировала задачи программному обеспечению, и он не выдвигает никакую новую теорию управления. Его ценность в том, что каждую часть можно изложить, записать и проверить, и что отсутствие каждой части проявляется очевидным образом.
8. От оператора к менеджеру
8.1 Что меняется в работе
На уровне 1 человек производит, а модель помогает. На уровнях 3 и 4 модель производит, а человек управляет, контролирует и принимает решения. Парадоксы автоматизации Бейнбриджа (1983) предсказали, что это сделает с человеческой ролью. Автоматизация убирает рутину и оставляет человеку остаток, который сложнее всего выполнять хорошо, — мониторинг и вмешательство в редкие сбои, при этом практика, которая развила его суждение, исчезает. Версия этого парадокса для генеративного ИИ уже задокументирована. Генеративный ИИ переводит людей от производства к оценке и делает сложные задачи еще сложнее (Simkute et al., 2024), повышенная уверенность в инструменте сопровождается менее критическим мышлением (Lee et al., 2025), а потеря квалификации структурно следует из удаления практики (Ferdman, 2025).
Управление агентом — это другая работа со своей собственной компетентностью, и эта компетентность не дается свободно с инструментом. Она состоит в выборе того, что делегировать, в изложении контракта делегирования раздела 7.3, в чтении трассы агента и в решении, когда результат достаточно хорош. Я разбиваю работу на четыре практики. Делегирование называет работу как выполняемый результат с границей. Контроль наблюдает за планом, промежуточным выводом или трассой инструмента и вмешивается, когда задача уходит с курса, без одобрения каждого нажатия клавиши, потому что одобрение всего — это усталость, и усталость — это то, как люди нажимают да. Проверка контролирует источники, суммы, преобразования и утверждения, на которых основано решение, пропорционально риску и методом, отличным от перечитывания собственной уверенности агента: тесты и дифы для кода, выборочная проверка по сравнению со страницей, которую человек открывает сам, для папки договоров и для таблицы литературы построчная проверка идентификаторов. Отзыв сужает рабочее пространство, останавливает выполнение или удаляет доступ при изменении условия. Человек, который делает все четыре, управляет агентом даже через графическое настольное приложение. Человек, который передает задачу непрозрачному сервису и принимает первый ответ, аутсорсирует суждение, что является другой практикой. Парасураман и Райли (1997) назвали два способа потерпеть неудачу в этом. Неиспользование — это человек, который мог бы делегировать и никогда этого не делает, застрявший на уровне 1 по привычке или из страха. Неправильное использование — это человек, который делегирует без проверок и принимает то, что вернулось. Оба видны в 2026 году. Данные о широком и поверхностном внедрении описывают неиспользование в масштабе (раздел 2.2), а отчеты о потере файлов и удалении баз данных раздела 5.3 описывают неправильное использование, иногда специалистами, которые знали лучше. Таблица 6 помещает каждую практику рядом с частью контракта делегирования, которую она обеспечивает, рисками, которые она устраняет, и датированным следом, по которому исследование может увидеть, что это произошло.
Таблица 6. Четыре практики менеджера: что каждая обеспечивает, какие риски устраняет и какой след оставляет.
| Практика | Что делает человек | Часть контракта, которую она обеспечивает | Риск, если он отсутствует | Наблюдаемый след |
|---|---|---|---|---|
| Делегирование | Называет работу как выполняемый результат с границей (8.1) | Цель, сформулированная так, чтобы агент мог определить, достигнута ли она; артефакт: что должно существовать и в какой форме (7.3) | Неиспользование: «человек, который мог бы делегировать и никогда этого не делает», застрявший на уровне 1 по привычке или из страха (8.1) | Отложенный артефакт (Appendix A) |
| Контроль | Наблюдает за планом, промежуточным выводом или трассой инструмента; вмешивается, когда задача уходит с курса, без одобрения каждого нажатия клавиши (8.1) | Граница: к чему могут прикасаться агенты; какие действия нуждаются в подтверждении человека; какой бюджет времени и квоты (7.3) | Усталость от одобрений: «усталость — это то, как люди нажимают да» (8.1); охрана, которая блокирует слишком много, вызывает неиспользование (5.3) | Отклоненный план; необратимый шаг, отложенный на подтверждение (Appendix A) |
| Проверка | Контролирует источники, суммы, преобразования и утверждения, на которых основано решение, методом, отличным от перечитывания собственной уверенности агента (8.1) | Проверка: как человек узнает, правильный ли артефакт, решено до начала работы; когда остановиться (7.3) | Неправильное использование: «человек, который делегирует без проверок и принимает то, что вернулось» (8.1); скоррелированные ошибки моделей (6.3) | Отклоненный диф или вывод; запрошена вторая семья моделей; записан знаменатель: запросили, получили ответ, истекло время (Appendix A) |
| Отзыв | Сужает рабочее пространство, останавливает выполнение или удаляет доступ при изменении условия (8.1) | Граница, применяемая снова: что исключено, и как отменить ошибку (3.2, 7.3) | Долгая задача, которую нельзя было остановить, после чего удаление задачи удалило файлы (5.3) | Нет среди датированных следов Приложения A; датированная остановка, ограниченные разрешения или удаленный доступ служили бы |
Примечание: Человек, который передает задачу непрозрачному сервису и принимает первый ответ, это «аутсорсирует суждение», что является другой практикой (8.1).
Один маленький механизм объединяет роль во всех четырех практиках, и я называю его записью о принятии. Для важной или повторяющейся задачи она содержит предполагаемый результат, использованные входные данные, ограничения и разрешения, куда пошел вывод, любое существенное разногласие или сбой, выполненные проверки и решение человека принять, пересмотреть, эскалировать или отбросить. Она проводит границу между тем, что произвел агент, и тем, на что полагался человек. Для отдельного человека это полезно, потому что преобразует чувство доверия в проверяемое решение, для команды, потому что коллега может проверить работу без истории личного чата, и для исследователя, потому что отделяет завершенное выполнение от полученного результата. Это также ограничение. Человек может решить, не сумев написать критерий приемлемости, что задача должна оставаться на уровне 1, и модель это расценивает как зрелое управление, а не как отстающее внедрение. В лексике сотрудничества человека и ИИ переход с уровня 1 на уровень 4 держит человека в цикле и меняет то, что такое цикл, от чтения каждого ответа к установлению условий, при которых принимаются ответы. На рисунке 4 изображен этот цикл с четырьмя практиками, рисками на каждом шаге, возвратом после неудачной проверки и записью о принятии.
Рисунок 4. Контрольный цикл менеджера.
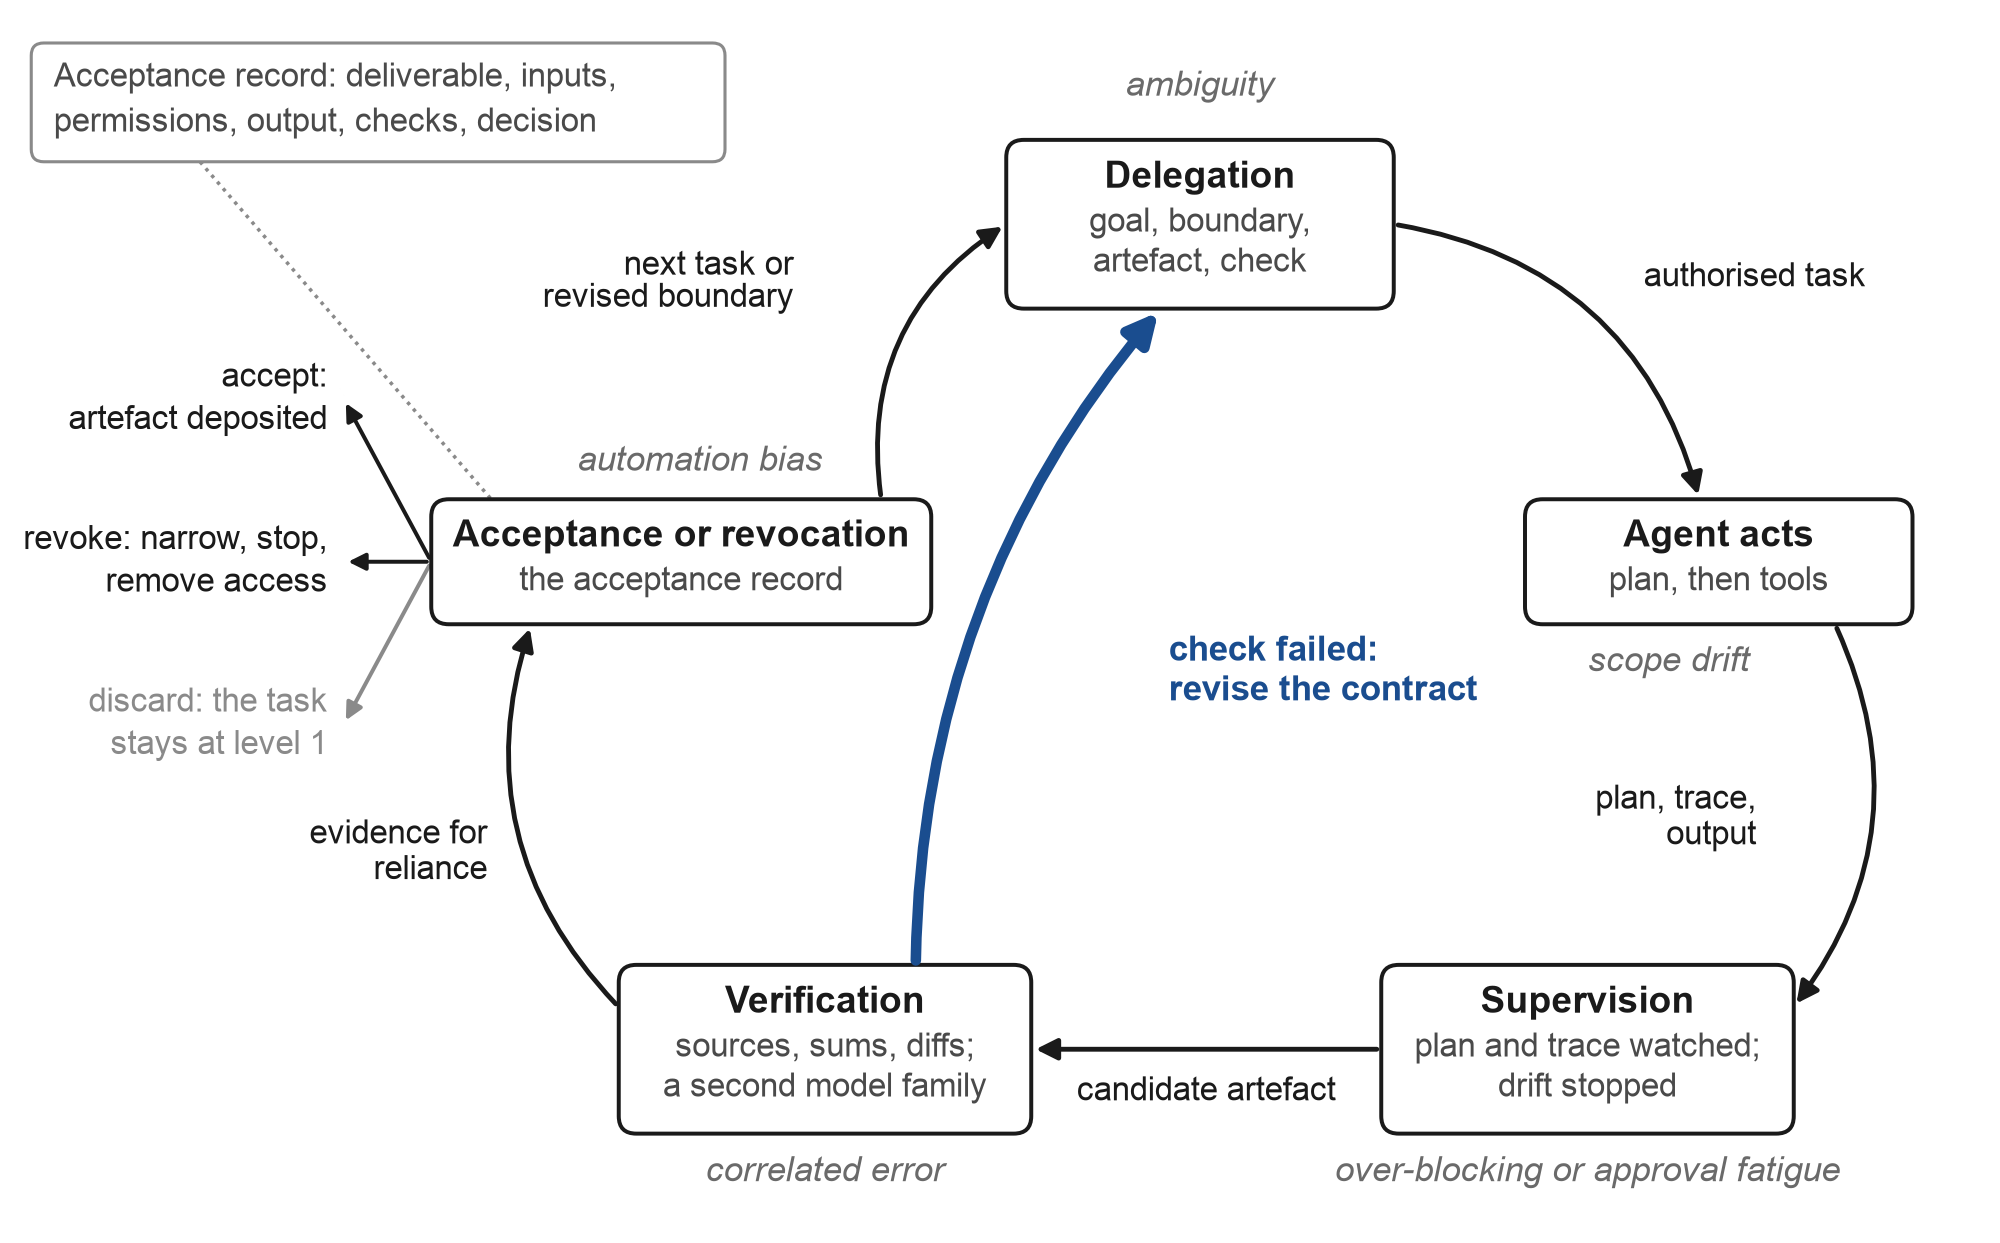
Примечание: Работа менеджера как цикл, который выполняет человек (разделы 7.3 и 8.1): делегирование устанавливает контракт (цель, границы, артефакт, проверка), агент действует, человек контролирует и проверяет, затем принимает, отменяет или отбрасывает результат и пишет протокол принятия. Серые курсивные метки называют риск на каждом этапе (разделы 5.3, 6.3 и 8.1). Толстая стрелка — это возврат из неудачной проверки к пересмотренному контракту, и каждый выход из узла принятия — это решение человека.
8.2 Опытные пользователи меньше делегируют
Одно наблюдение противоречит любой простой истории, в которой каждый в конце концов должен стать менеджером агентов. Anthropic сообщила в марте 2026 года, что пользователи с более длительным стажем были «гораздо менее склонны делегировать большую ответственность через паттерны директивного использования» (Anthropic, 2026e), а её январский отчет 2026 года поместил расширение, совместное использование, при котором человек остается в цикле, на уровень 52% разговоров в ноябре 2025 года (Anthropic, 2026f). Один способ прочтения заключается в том, что опытные пользователи узнали, где делегирование не работает, и отступили. Другой способ заключается в том, что они научились использовать модель как сотрудника для частей работы, где их собственное суждение является продуктом. Я не могу различить два способа прочтения по опубликованным данным, и в обоих случаях конечная точка лестницы — это что-то иное, чем максимальное делегирование. Это способность выбирать, задача за задачей, между просьбой, сотрудничеством и делегированием, и знать, что нужно задаче перед вами. Четырехуровневая модель описывает то, что человек может делать. Она не утверждает, что они должны выбирать наиболее делегирующий вариант каждый раз.
8.3 Ответственность остается с человеком
Поставщики четко определяют, где лежит подотчетность. Руководство по запуску агента уровня 2 Anthropic сообщило пользователям, что они «остаëтесь ответственными за все действия, выполненные Claude от вашего имени» (The Register, 2026). Это юридическая и практическая реальность уровня 3 в частности, где агент действует с учетными данными владельца, с файлами владельца, под именем владельца. Специалист, который становится менеджером агента, также становится подотчетным за работника, ошибки которого происходят быстро. Это еще одна причина, по которой проверка в контракте делегирования должна быть определена до начала работы, и еще одна причина, по которой дизайн безопасности раздела 5.3 не должен зависеть от того, заметит ли человек атаку в реальном времени.
8.4 Роль менеджера в рамках грамотности
Официальные определения грамотности в области ИИ начинают называть эту роль, хотя ни один из рассмотренных здесь текстов не использует слово «agent». Рамки грамотности в области ИИ Министерства труда США от февраля 2026 года перечисляют «эффективное управление ИИ» среди своих областей содержания (US Department of Labor, 2026; ExecutiveGov, 2026). Совместная рамка OECD и Европейской комиссии от июня 2026 года, которая входит в оценку PISA 2029, имеет четыре области, одна из которых — «Управление ИИ» (OECD & European Commission, 2026). Более ранние академические рамки делали упор на распознавание, понимание и оценку ИИ (Long & Magerko, 2020), а рамки компетенций ЮНЕСКО 2024 года для студентов и преподавателей устанавливают то же самое (UNESCO, 2024a, 2024b). Контракт делегирования дает доменам управления и руководства обучаемое содержание для агентного случая: установить цель, определить границы работы, назвать артефакт, решить по поводу проверки. Практики начали использовать такие названия, как «оператор ИИ» и «менеджер агента» для специалиста, который приобретает эту специальность в дополнение к своей профессии. Я использую «менеджер агентов» более узко, для паттерна поведения, а не для роли, на которую нужно нанимать специалистов, потому что поведение оставляет следы, а название — нет. Доказательства находятся в артефактах: план, который человек отклонил, diff, который он отклонил, второе мнение, которое он запросил, запланированный запуск, который завершился в его отсутствие. Когда ни один из этих следов не существует, название не имеет ничего за собой.
9. Измерение переходов: предварительно зарегистрированная программа
9.1 Переходы как единица измерения
Большинство данных об внедрении подсчитывают людей, которые «используют ИИ», иногда еженедельно или ежедневно. Подобный подсчет не может отличить человека, который просит у чатбота синонимы, от человека, который передает квартальный отчет агенту, и я хочу найти именно второго человека. Правило артефакта из раздела 3.3 делает различие наблюдаемым, так как переход записывается только тогда, когда агент создал то, что попросил человек, на новом уровне. Несколько дополнительных правил вытекают из литературы об адаптации и контроле. Завершение должно докладываться отдельно для людей, которые перешли без помощи, и для людей, которым помогли, потому что помощь меняет смысл перехода. Остановка должна быть записана в точке, где она произошла, и словами самого человека, потому что причины остановки — это большая часть результата. Каждый человек, получивший материалы, входит в знаменатель, включая тех, кто никогда не ответил. Сохранение, наконец, должно наблюдаться после того, как исследователь перестал писать каждую неделю; артефакт, созданный, пока исследователь еще в папке входящих человека, может быть вежливостью в такой же степени, как использованием.
9.2 Дизайн
Я провожу предварительно зарегистрированную когортную программу, которая применяет эти правила к не-программистам (Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, зарегистрирована и заморозена 6 сентября 2026 г.). Это исследование осуществимости с одной группой трехэтапного пути, и предварительная регистрация была заморожена до сбора каких-либо данных. Далее следует дизайн в зарегистрированном виде.
Участники. Взрослые, чья работа в значительной степени связана с использованием компьютера. Они используют собственный компьютер и собственные подписки ИИ (подписки работодателя исключены), исключают материалы, идентифицирующие клиентов и конфиденциальную информацию работодателя из упражнения, и подтверждают, что установка программного обеспечения не нарушает никакого правила, применяемого их работодателем к ним. Рекрутирование проводится путем публичного объявления в профессиональных социальных сетях в окне, определенном заранее по времени, чтобы его нельзя было продлить до получения благоприятного результата. Объявление скопировано и записана его постоянная ссылка, что фиксирует текст рекрутирования. Включение идет волнообразно, и расписание каждого участника считается от его собственного нулевого дня, потому что инструменты меняются еженедельно. Рекрутирование открылось с публичным объявлением 6 сентября 2026 г., в день замораживания регистрации, и закроется 21 день спустя, 27 сентября 2026 г.; когорта находится в поле на момент написания, и реализованное число, каким бы оно ни оказалось, будет сообщено вместе с результатами.
Шаг 1 (от чата к агенту на компьютере человека). Участник вставляет стандартный текст в уже используемый им чатбот, и этот чатбот направляет его через установку графического агента на его собственный компьютер. Я не прикасаюсь к компьютеру никого. Шаг завершен, когда участник предоставляет артефакт, который агент создал в ответ на первую задачу. Задача идентична по форме для всех и заполнена собственной рабочей ситуацией участника, и она требует от агента спрашивать, решать, создавать и форматировать файлы. Это требование отличает агента от чатбота. Регистрация дает точную формулировку (Chernets, 2026d). В терминах модели шаг 1 проверяет рефлексивную адаптацию одновременно на двух уровнях, с уровня 1 на уровень 3. Это был преднамеренный выбор. Графическая оболочка локального агента работает на компьютере человека, поэтому в соответствии с правилом раздела 3.3 это уровень 3, и артефакт, который запрашивает шаг 1, — это тип, который отмечает переход 2; его запросы разрешения обеспечивают ему некоторую защиту ограниченной ступени. Когорта не использует отдельную неделю в защищенной поставщиком среде уровня 2, поэтому она не может проверить P5 раздела 10 (что ограниченная средняя ступень снижает неполноту и инциденты); эти запросы разрешения — единственная ограниченная ступень, которая есть в дизайне, и командная строка вводится на шаге 3. Более поздняя когорта, которая вставляет явную неделю уровня 2 между чатом и локальной установкой, была бы чистой проверкой P5.
Шаг 2 (веб-оркестрация, запущенная из агента). После подготовки участники получают инструмент с открытым исходным кодом, который направляет один вопрос нескольким моделям через подписки, за которые они уже платят, и возвращает один объединенный ответ в одном действии изнутри агента. Цель шага была предварительно зарегистрирована как охват и надежность, с видимым разногласием в качестве одного механизма для второго.
Шаг 3 (оркестрация CLI). Та же оркестрация через интерфейсы командной строки.
Измерения. Пять замороженных основных элементов, сформулированных идентично в каждой когорте программы, записывают профессию и часы на компьютере, текущее использование ИИ, предыдущий опыт обращения более чем к одному ИИ, проверяются ли и как проверяются ответы, и действует ли уже что-либо для человека на его компьютере. Запись шага для каждого участника содержит даты, чатбот, который направлял его, попытки и часы, завершение с артефактом, точную точку остановки и причину в его собственных словах, и был ли и как вмешался следователь. В течение первого месяца еженедельно участники докладывают об одном артефакте, который их агент создал в течение этой недели (или «ничего», что является допустимым ответом), как часто они направляют один вопрос более чем одному ИИ и что произошло, когда ответы расходились, и со второго шага и далее, появилось ли что-нибудь полезное, что один из моделей пропустил, и изменила ли проверка то, на что они полагались. Наблюдения продолжаются на 60-й день и ежеквартально после этого, пока участники желают.
Анализ и интерпретация. Анализ описательный. Доли завершения даются с доверительными интервалами как для выжившего, так и для полного знаменателя, отдельно для неуслуженного и вспомогательного завершения; времена и попытки сообщаются как распределения, и причины остановки кодируются после сбора, причем коды и первоначальные формулировки сохраняются. Одно правило интерпретации было установлено заранее. Если менее половины тех, кто получил материалы шага 1, предоставляют созданный агентом артефакт, когорта сообщается как исследование отказа адаптации, и то, что остановило людей, становится результатом.
Границы выводов. Регистрация заранее указывает, что нет контрольного условия и, следовательно, нет причинно-следственного утверждения, и нет обобщения за пределами самовыбранных добровольцев. Оценка участником сэкономленного времени сообщается только как убеждение, потому что было показано, что самооценка в этой области инвертирует истинное направление (Becker et al., 2025).
Раскрытие информации и этика в соответствии с регистрацией. Участники письменно информируются о том, что я разработал материалы и инструмент, преподаю на их основе и являюсь заявителем по ожидающим патентным заявкам, охватывающим метод оркестрации. Мнение комиссии по этике учреждения не запрашивалось: исследование не имеет институциональной поддержки и не получило федерального финансирования. Регистрация документирует применяемые меры защиты. Согласие получено в письменном виде до начала записи любых данных. Не собираются данные о здоровье, финансовом положении или рабочем контенте. Участники работают на своих компьютерах и подписках и могут запросить удаление своих данных в любой момент до публичного архивирования. Инструкции по безопасности включают: использование отдельного профиля браузера, запрет действий на сайтах банков и медицинских учреждений, подтверждение перед любыми необратимыми действиями, отсутствие ввода паролей в агент и обращение с веб-контентом как с данными. Переменная инвалидности не собирается и не делаются никакие заявления об доступности.
9.3 Только дизайн
Из программы я беру только дизайн и ничего более. Здесь целенаправленно не приводятся: число участников, показатели завершения или отдельные случаи — такое решение принято сознательно: аргумент (данная статья), метод и программа, и результаты после периода наблюдения протокола — это отдельные публикации, чтобы аргумент не мог быть прочитан как доказательство самого себя. Другие исследователи теперь могут применять те же правила. Приложение C5 в Приложении C предоставляет формат записи и проверяющий алгоритм, которые их кодируют. Проверяющий отклоняет запись, которая считает установку пересечением, завершение без артефакта, созданного агентом, остановку без собственных слов человека, реальное имя вместо псевдонимного обозначения, поле, которое не определено форматом, или пропущенный уровень, который не записан как точно пропущенный.
9.4 На что должно быть похоже сильное следующее исследование
Когорта — это исследование осуществимости, и большинство положений Раздела 10 требуют других методологических подходов. Сильное следующее исследование должно было бы сравнить два условия адаптации, отличающиеся тем, как они представляют работу, сохраняя риск задачи и техническую среду как можно более постоянными. Одно условие представляет функции и инструкции по установке; другое начинается с собственного повторяющегося рабочего объекта участника и выявляет пятичастную карту Раздела 5.1. Результаты должны были бы включать артефакты, чье качество оценено кем-то кроме участника (с согласованием между оценивающими, как при кодировании причин остановки), время, выявленные ошибки, решения о разрешениях в форме сценариев, более позднее добровольное переиспользование и уверенность, измеренную по результатам. Последующее исследование отделило бы устойчивость от постоянного контакта с исследователем. Второе исследование поставило бы вопрос, является ли словарь рабочего процесса одной грамматикой или одной на профессию, путем сравнения административных, исследовательских, коммуникационных и аналитических задач. Я не знаю, что это такое, и ответ определяет, могут ли упакованные примеры быть написаны один раз или должны быть написаны для каждой области. Оба исследования должны установить базовый уровень грамотности в области ИИ с помощью валидированного инструмента (Carolus et al., 2023), чтобы конкретный пробел — знание того, что передать агенту — можно было отделить от общего знакомства с ИИ. Каждое такое исследование должно также документировать реализацию, потому что участник, начинающий с более поздней версии интерфейса, встречает различные установки по умолчанию: версию интерфейса, операционную систему, был ли у агента доступ в сеть, режим разрешений и любое ограничение политики. Только название поставщика содержит для последующего читателя слишком мало информации.
10. Утверждения
Модель раздела 3 и аргументация разделов 4–8 предполагают утверждения, которые могут быть опровергнуты. Таблица 7 приводит пятнадцать из них, каждое с мерой, результатом, который бы его опроверг, и указанием, кто может провести тест. Они написаны для всей области в целом. Программа раздела 9, например, может проверить только несколько из них; несколько других можно проверить с помощью телеметрии поставщика, панелей опросов или небольшого исследования в одной организации. Ни одно из них не является результатом исследования когорты.
Таблица 7. Утверждения, меры, опровергающие условия и кто может их проверить.
| # | Утверждение | Мера | Опровергается если | Кто может провести |
|---|---|---|---|---|
| P1 | Миграция барьеров. Среди непрограммистов, предпринимающих попытку перехода 2, точки остановки группируются после установки (при первом задании, первой ошибке или проблемах с разрешениями) более чем во время её, и среди тех, кто установил и не создал ничего, «я не знал, что спросить» превосходит по количеству технические, разрешительные и стоимостные причины; и при неизменной сложности задачи завершение снижается более резко на трёх переходах, чем внутри уровня. | Точки остановки, записанные по правилу артефакта; причины в собственных словах человека, закодированные в соответствии с правилом приложения A; завершение по шагам | Большинство остановок происходят до первого запуска агента, или технические и разрешительные причины преобладают среди установивших, не создавших ничего, или паттерны завершения и отказа сопоставимы на всех шагах при контроле сложности задачи | Программа раздела 9; любая репликация |
| P2 | Слияние интерфейсов. Там, где поставщики объединяют интерфейсы чата и агента, доля сеансов, завершающихся файлом или действием, созданным агентом, растёт без каких-либо изменений в том, что пользователи говорят, что хотят делать; и ведущие ассистенты записывают файлы из окна по умолчанию без выбранного пользователем режима к концу 2027 года. | Телеметрия поставщика до и после объединения; датированная перепись ассистентов | Доля остаётся неизменной после объединения; или стабильный выбираемый пользователем режим агента остаётся предпосылкой для записи файлов | Поставщики; кто-либо, кто может открыть приложения |
| P3 | Словарь вместо установки. Предоставление людям проработанных примеров из их области (упакованные задачи, навыки, шаблоны) повышает удержание на уровнях 2 и 3 более чем предоставление помощи установки, и структурированная мера словарного запаса рабочего процесса предсказывает завершение артефакта после контроля доступа и предыдущего использования ИИ. | Удержание на 60-й день под двумя видами помощи в сравнении с заданием; предварительное заявление о пяти частях раздела 5.1; причины остановки, закодированные по правилу приложения A | Помощь установки даёт равное или большее удержание; показатель словарного запаса не вносит вклада, как только простота установки и общая уверенность находятся в модели | Любая лаборатория с двумя маршрутами подключения |
| P4 | Рефлексивное подключение. Люди, управляемые чатботом, который они уже используют, могут перейти с уровня 1 на уровень 3 без посторонней помощи с темпом, который делает маршрут практичным, и достичь первого артефакта быстрее, чем люди, получившие статическую документацию. | Доля завершивших переход 2 без посторонней помощи с артефактом, созданным агентом, по сравнению со всеми, получившими материалы; время до первого артефакта при управляемых и статических условиях | Менее половины завершают это, пороговое значение установлено заранее в разделе 9; или статическая документация даёт равное или более высокое завершение | Программа раздела 9; инструкторы с двумя когортами |
| P5 | Промежуточная ступень. Непрограммисты, которые проводят время в управляемой поставщиком среде перед локальным агентом, более часто завершают переход 2, имеют меньше инцидентов потери файлов и лучше рассуждают о масштабе, обратимости и эскалации, чем люди, перемещённые прямо из чата в широкий локальный доступ. | Когорта с двумя маршрутами с равным наблюдением; артефакт как основной результат; журнал инцидентов; решения по разрешениям на основе сценариев до и после | Завершения без посторонней помощи от чата прямо к локальному агенту совпадают с прошедшими через уровень 2, при сравнимых показателях инцидентов и с равными решениями по разрешениям | Любая лаборатория с двумя маршрутами подключения; более поздняя когорта программы |
| P6 | Узкое место. Среди непрограммистов, которые еженедельно используют чат, доля создающих артефакт 3-го уровня за квартал остаётся намного ниже доли разработчиков, которые еженедельно используют агентов кодирования. | Репрезентативный опрос, использующий элементы артефакта, а не «используете ли вы ИИ» (раздел 11.3) | Производство артефактов 3-го уровня среди непрограммистов, занимающихся работой со знаниями, приближается к показателю еженедельного использования разработчиками | Национальные статистические бюро; опросные организации |
| P7 | Мост переносит. Люди, которые практикуют веб-оркестрацию, с большей вероятностью позже примут CLI-оркестрацию, чем люди, которые этого не делают, и видимое несогласие предсказывает более позднюю атрибуцию источника или критику в их записях о задачах. | Принятие CLI-оркестрации среди тех, у кого была и не было более ранней веб-сравнения; сохранённые сравнения и более поздние записи | Нет разницы, или наоборот; сравнение создаёт больше подсказок и без изменений в поддерживаемых проверках | Программа раздела 9; продольные панели |
| P8 | Долговечность CLI. Для людей, которые платят за две или более потребительских подписок, оркестрация через официальные инструменты командной строки — это форма уровня 4, которая выживает при изменениях интерфейса, и запуски с поддержкой файлов можно повторно запустить и передать другому проверяющему лучше, чем запуски только в браузере. | Датированная перепись артефактов 4-го уровня в этой популяции; тесты повторного запуска и передачи после изменения интерфейса | Перепись конца 2027 года находит веб- или советы программного интерфейса доминирующие и инструменты CLI-to-CLI отступающие; только браузерные рабочие процессы совпадают при повторном запуске и передаче | Исследователи инструментов; опросы разработчиков |
| P9 | Коррелированное согласие. Ошибки на элементах знаниевой работы с известными ответами коррелируют достаточно, что согласие среди трёх или более моделей стоит менее чем два независимых мнения (rho на уровне или выше примерно 0,5, где rho оценивается на элементах знаниевой работы с известными ответами и не заимствуется из коэффициентов согласия базового уровня); небольшой совет разных семейств превосходит большой совет одного семейства при равных затратах; и проверка с учётом источника предсказывает корректность лучше, чем согласие большинства. | Попарная корреляция ошибок между семействами на банках предметов с известными ответами (список C4); отмеченное множество предметов с двумя конструкциями советов; правильность при сравнении с согласием большинства и при сравнении с проверкой с учётом источника | Измеренный rho ниже 0,2 для большинства типов задач; совет одного семейства побеждает после проверки утверждение за утверждением; или простое большинство согласия предсказывает правильность так же хорошо или лучше, чем разнообразие плюс проверка | Исследователи языковых моделей; протокол сопутствующей статьи |
| P10 | Компетентность менеджера. Устойчивость на уровнях 3 и 4 лучше предсказывается способностью человека сформулировать контракт делегирования (цель, граница, артефакт, проверка) и следами надзора (отклонённые планы, отклонённые диффы, полученные вторые мнения), чем предыдущим техническим опытом или объёмом запросов. | Короткое задание, которое вызывает четыре части, оценённые вслепую; базовые предметы; следы из протокола принятия; устойчивость на день 60 | Предыдущий технический опыт или объём запросов предсказывает устойчивость так же хорошо или лучше, и формулировка контракта ничего не добавляет; или артефакты на уровнях 3 и 4, которые регулярно опускают цель, источники, границу и проверку, остаются надёжными при независимом аудите, в этом случае структура компетентности избыточна | Любое лонгитюдное исследование артефактов |
| P11 | Калибровка по классу задач. Люди калибруют делегирование лучше, когда обратная связь быстра и реверс возможен, принимая, исправляя и эскалируя по-разному в зависимости от класса задач. | Принятие, исправление, эскалация и последующее обнаружение ошибок по классу задач | Калибровка одинакова во всех обратимых и высокопоследственных задачах | Лаборатории; организации с протоколом принятия |
| P12 | Трение из-за механизмов охраны. Среди непрограммистов на уровне 3 перерывы из-за запросов разрешений и блоков безопасности называются причиной остановки чаще, чем среди разработчиков, и автономия, защищённая классификатором, снижает такие остановки без увеличения сообщённой потери файлов. | Кодированные причины остановок по группам; скорость остановок и отчёты об инцидентах до и после изменения режима по умолчанию | Нет разницы между группами, или автономия повышает сообщённые потери | Поставщики; кодированные причины остановок программы |
| P13 | Разрыв воспроизводится. Различия в принятии чата по полу и образованию (Cranney et al., 2026; Daepp & Counts, 2024) переоказываются по крайней мере столь же большими в производстве артефактов уровня 3 в рамках профессий. | Различия в производстве артефактов уровня 3 в рамках одной профессии | Внутрипрофессиональная оценка показывает закрытие разрыва на уровне 3 | Экономисты труда; более поздние когорты, если они достаточно большие |
| P14 | Критик и второе семейство. Критик одного семейства ловит спешку и пропущенные проверки; второе семейство ловит общую ошибку; на наборе с отмеченными дефектами каждый вносит дефекты, которые другой упускает. | Перекрытие подтверждённых результатов между критиком одного семейства и рецензентом второго семейства при равных затратах | Полное перекрытие или доминирование одного источника | Кто-нибудь с двумя инструментами агента и отмеченным набором |
| P15 | Возможность или словарь. При равном классе задачи устойчивость на уровнях 2 и 3 варьируется со способностью человека сформулировать контракт делегирования; если возможность модели была бы ограничивающим фактором, устойчивость варьировалась бы между классами задач и была бы одинакова среди людей в одном классе. | Устойчивость по классу задач, пересечённая со вслепую оценённым утверждением контракта делегирования | В пределах класса задачи устойчивость одинакова между всеми людьми, независимо от их оценки контракта, и варьируется только между классами | Любое исследование, которое записывает класс задачи и утверждение контракта |
Немногие из них имеют значение больше, чем остальные. P4 несёт наибольший вес для политики, потому что если рефлексивное введение работает, самая дорогая часть обучения людей агентам (сидение рядом с ними во время установки) может быть заменена инструментом, который они уже имеют. P5 - это то, что когорта не может протестировать, как говорит Раздел 9.2, и это также то, от которого больше всего зависит форма лестницы. Заслуживает ли средняя ступень своего места, этого я пока не знаю. P9 - это самое легкое для тестирования и наиболее вероятно удивит пользователей советов, поскольку арифметика коррелированного свидетельства (Chernets, 2026a) и измерения Kim et al. (2025) обе указывают на потолок ценности согласия. P10 - это то, что изменило бы учебные программы. Если способность сформулировать контракт делегирования лучше предсказывает устойчивость, чем технический опыт, то обучение должно преподавать делегирование в первую очередь, затем инструменты.
11. Последствия
11.1 Для разработчиков
Разработка для пустой папки. Разработчики упростили установщик, и это заметно. Я полагаю, что дальнейшие попытки упрощения будут напрасны, поскольку проблема новичка начинается теперь после установщика, перед пустой папкой, которая ничего не скажет агенту. Рабочие примеры из области человека, предложенные в момент его первого открытия агента, вместе с первым заданием, которое реально, низко по риску и завершается чем-то, что они могут оценить, окажут большее влияние на принятие, чем любое дальнейшее упрощение настройки. Готовые навыки уже указывают на это (раздел 5.1). Две вещи по-прежнему отсутствуют: помощь в выборе того, какие из задач человека вообще стоит передавать, и способ для профессиональной ассоциации, а не только стартапа, писать навыки для своих членов.
Вне зависимости от того, как будут названы вкладки после следующего объединения, человеку в момент делегирования и на языке выбранной папки нужен четкий ответ на короткий список вопросов: что может читать этот агент, что может изменять, что может отправлять или запускать, что потребует моего одобрения и как его остановить? Визуальный дифф дает ответ на часть этих вопросов при изменении файлов, а письменный план - когда действия разнообразны; один баннер согласия на них не отвечает. Модель разрешений должна оставаться видимой, ограниченной по объему и обратимой после объединения, с функциональной кнопкой отмены и кнопкой остановки. Область действия папки без одного из них - вот как описаны отчеты о проблемах в разделе 5.3.
Работа также должна иметь возможность выходить из продукта. Пользователь должен иметь возможность экспортировать инструкцию задачи, входные данные или их идентификаторы, действия инструмента, выходные данные и историю утверждения. Это функция удобства использования не менее, чем функция управления, поскольку она позволяет новичку учиться на выполненной задаче и позволяет команде просмотреть результат без передачи своей памяти проприетарной истории чата. Использование должно быть сообщено таким же образом. "Еженедельные активные пользователи" агента, который производит файлы, должны быть разделены на людей, которые создали файл, и людей, которые открыли приложение, и разработчики имеют телеметрию для этого.
Обнаружение атак - это не работа для новичка. Руководство, которое просит не программистов распознавать признаки инъекции подсказок, возлагает самое сложное суждение на человека, наименее способного его сделать (раздел 5.3). Безопасные значения по умолчанию (рабочие копии, снимки перед большими изменениями, деструктивные команды запрещены, пока не разрешены явно, веб-содержание рассматривается как данные) должны принадлежать продукту. В то же время охранники, которые постоянно прерывают работу, останавливают ее так же верно, как отсутствующие охранники теряют файлы, и сопроводительная статья о чрезмерном надзоре описывает, как растут такие слои (Chernets, 2026b).
Происхождение должно пережить слияние ответов. Функции совета, которые возвращают один объединенный ответ, должны показывать, что сказала каждая модель и где они не согласны, позволяют пользователю назначить одной модели роль критика и облегчают обнаружение пробела в доказательствах, чем найти беглый параграф консенсуса. Объединенный голос без источников восстанавливает авторитет одного уверенного ответа, вознаграждает смещение автоматизации и скрывает корреляцию ошибок (раздел 6.3).
Текучесть, наконец, имеет стоимость на стороне пользователя. Человек, который выучил инструмент, который был переименован, объединен или выведен из обращения в течение года, платит дважды, поэтому стабильные имена, руководства миграции и преемственность файлов инструкций во всех изменениях продукта являются функциями принятия сами по себе.
11.2 Для работодателей и тренеров
Учите контракту делегирования до меню. Меню продукта меняются ежемесячно, тогда как способность сформулировать цель, ограничить работу, назвать артефакт и решить проверку переносится между инструментами (разделы 4.3 и 7.3). Короткое упражнение, предлагающее человеку написать четыре части для одной из своих повторяющихся задач, проверяет готовность лучше, чем знакомство с функциями. То, что содержит упражнение, изложено ниже, под декомпозицией.
Входы измеряют неправильное. Подсчет активных пользователей не может провести различие, необходимое в разделе 9.1, между человеком, запрашивающим синонимы, и человеком, делегирующим отчет. Подсчет артефактов, созданных агентом и сохраненных людьми, может это сделать.
Люди также нуждаются в санкционированном месте для обучения и карте того, что разрешено. Уровень 2 в инструментах, которые организация уже лицензирует, доступен персоналу, которому никогда не будет разрешено устанавливать агента на рабочий ноутбук (раздел 5.4). Для уровня 3 четкая политика, изолированная машина или утвержденная конфигурация устраняют молчаливое "нет", которое многие люди предполагают. Полный запрет побуждает использование через личные учетные записи, где никто не может это видеть, а неограниченное делегирование раскрывает конфиденциальный материал. Между крайностями лежит таксономия задач и данных. Она определяет, какая работа может быть выполнена в утвержденных средах, какая требует проверки второго лица и какая запрещена для агентов; она указывает, кто может одобрить инструмент, где хранится запись о приемке и как сообщить о близком пропуске без наказания за отчет. Локальный уровень 3 не должен требоваться на машинах, которыми сотрудник не управляет, поскольку облачные агенты и уровень 2 с областью действия арендатора позволяют избежать конфликта с отделом ИТ. Когда разработчики впитают первую ступень в чат, уровень 2 сохраняет две роли. Это санкционированное место для персонала на заблокированных машинах и калибровочная ступень для всех остальных, где человек узнает о периметре делегированного действия, прежде чем установить свой собственный. Снижает ли это инциденты, - вопрос P5.
Мандаты требуют осторожности. Введение ИИ в качестве критерия производительности может привести к его использованию без реальной ценности, и по крайней мере один работодатель, который это сделал, отменил решение в течение года (Fortune, 2026b). Требование артефактов, имеющих значение для работы, - это лучший показатель, чем запрос о использовании. Один раз в месяц запросы "показать файл, который агент произвел в названной папке" и "показать решение, которое вы изменили, потому что две модели не согласились", измеряют переходы 2 и 3, которые подсчет входов не может. Обучение в масштабе без измерения артефактов, независимо от количества тысяч участников, не скажет никому, произошел ли переход 2.
Декомпозицию и верификацию следует преподавать вместе, и критическую привычку перед советом. Универсальный курс по промптингу — это педагогика уровня 1. Педагогика уровней 2 и 3 начинается с работы, которую человек уже выполняет, например пакета маркетолога на пятницу или набора заданий учителя, учит переиспользуемой декомпозиции (пять частей раздела 5.1 с условием остановки) и учит восстановлению после ошибок на копии папки. То, что нужно оценить впоследствии, — это может ли человек распознать небезопасное указание, назвать обратимое испытание, проверить доказательства и остановить систему. Критик из одного семейства в точках принятия решения ничего не стоит в подписках, и второе семейство добавляется, когда критик молчит и решение дорогостоящее. Оркестровка на вершине рубрики беглости — это правильное назначение для нескольких ролей и неправильное требование в первый день для всех.
11.3 Для политики
Обязательство Европейского Союза по грамотности в области ИИ применяется к каждому поставщику и развёртывателю систем ИИ для их сотрудников. После поправок 2026 года оно требует от них «принять меры по поддержке развития грамотности в области ИИ» вместо обеспечения достаточного уровня, и его правила надзора и исполнения действуют с 3 августа 2026 года (Европейский Союз, 2026; Европейская Комиссия, 2026a, 2026b). В Соединённых Штатах рамки Министерства труда называют это «эффективным управлением ИИ» (Министерство труда США, 2026), и рамки ОЭСР и Европейской Комиссии содержат область под названием «Управление ИИ» (ОЭСР & Европейская Комиссия, 2026). Я предлагаю содержание для этих слов в агентском случае: четыре части договора делегирования, четыре практики раздела 8.1, включая отзыв, привычка сравнивать модели со знанием того, что согласие — более слабое доказательство, чем кажется, и основные практики безопасности раздела 5.3. Рекомендации должны различать использование в разговорном режиме и делегированные действия. Для последних обязательство должно охватывать область разрешений, классификацию данных, верификацию, отчётность об инцидентах и отзыв, а требование документировать специфические для роли возможности и полномочия, необходимые для делегированных задач, более оправдано, чем требование одинаково обучить всех. Регуляторы и представители работников также могут спросить, переместил ли работодатель остаточную ответственность на сотрудников без пригодных средств контроля, времени на проверку или права отклонить небезопасное делегирование. Всё это является рекомендацией по дизайну и управлению, вытекающей из одного нормативного инструмента, и его область охвата — этот инструмент.
Европейское обязательство пережило раунд дерегулирования, и среди обсуждаемых здесь рамок оно является единственным горизонтальным обязательством, охватывающим каждого члена персонала, использующего ИИ. В Соединённых Штатах рамки — это политика рабочей силы. Указ от апреля 2025 года об образовании в области ИИ и План действий по ИИ от июля 2025 года обязывают расширять грамотность и навыки в области ИИ, включая рекомендации о том, что программы грамотности в области ИИ могут иметь право на помощь в образовании, предоставляемую работодателем (Белый дом, 2025a, 2025b); рамки совместимы с обучением менеджеров агентов и пока не требуют этого. Ни один из проверенных официальных текстов не называет терминальные агенты или оркестровку, поэтому «Управление ИИ» можно читать как этикет чатбота или как направление уровня 4. Программы грамотности, которые останавливаются на промптировании, преподают уровень 1. Между тем работа движется к уровням 2–4. Официальные тексты туда ещё не последовали.
Статистические агентства, добавляющие модули ИИ в свои опросы, могут помочь с одним конкретным изменением. «Использовали ли вы чатбот» — это элемент уровня 1. «Создала или изменила ли система, которой вы управляли, файлы на компьютере, который вы используете для работы, в последние семь дней» — это элемент уровня 2 или уровня 3. «Задали ли вы один и тот же рабочий вопрос более чем одной системе ИИ в последние семь дней, и различались ли ответы» — это элемент уровня 4. Без элементов такого рода P6 не может быть проверена в общественных данных, и второй уровень цифрового разрыва на агентском уровне останется невидимым для людей, чья работа — его видеть.
11.4 Для исследователей
Пробелы раздела 2.5 — это повестка дня. Изучайте непрограммистов, использующих терминальные и настольные агенты, по имени, с артефактами в качестве результатов. Изучайте рефлексивное введение как самостоятельный механизм. Изучайте веб-оркестровку как практику, включая то, как люди выверяют ответы и ведут ли они записи о происхождении. Измеряйте корреляцию ошибок между семействами поставщиков на задачах интеллектуального труда и на большем, чем тесты кода и математики. Расширьте документально подтверждённые гендерные и профессиональные различия в использовании ИИ (Cranney et al., 2026; Humlum & Vestergaard, 2025) на агентские уровни, где ничего ещё не известно (P13). Двум лёгким показателям — доступности функций и самостоятельно сообщённому сэкономленному времени — стоит противостоять в пользу завершения артефактов, проверенного качества, коэффициентов коррекции и последующего повторного использования. Отказ от использования должен быть зафиксирован с указанием его механизма. Остановка при запросе на разрешение может быть проблемой интерфейса, обоснованной озабоченностью по поводу данных, правилом работодателя, отсутствием ресурса или задачей без критерия приёма, и их объединение в «сопротивление» теряет всё это различие. Оценивание должно быть состязательным, с вводящей в заблуждение страницей, скрытым указанием в документе, противоречивым источником, частичным отказом инструмента или убедительным неправильным ответом, общим для нескольких моделей, потому что роль менеджера имеет значение только если она улучшает результаты в этих условиях. Репликация не требует моих материалов; ей требуются правило артефакта, неизменный вопрос о причине остановки, запись реализации и датированный реестр продуктов. И знаменатели должны быть опубликованы, поскольку исследование, в котором сообщаются результаты только для тех, кто начал использовать, не говорит нам ничего о пути.
12. Область применения и граничные условия
Предлагаемое здесь — модель, синтез свидетельств и дизайн измерения, и каждое из них ограничено следующим образом.
Время. Свидетельства относятся к 21 сентября 2026 г. Факты о продукте датированы и будут устаревать. Модель определена по охвату и роли, так чтобы она устаревала медленнее.
География и источники. Большинство показателей внедрения получены из Соединённых Штатов; европейские показатели цитируются там, где они существуют. Несколько ключевых показателей поступают от поставщиков (использование агентов кодирования, причины слияния чата и агента, скорости инъекций на тестовых наборах поставщиков) и отмечены как данные поставщиков в тексте. Я использую их для того, что поставщики могут знать о собственных продуктах, и учитываю их соответственно.
Население. Аргумент касается специалистов, чья работа в существенной части проводится на компьютере. Люди, которые работают главным образом с телефона или без компьютера, который они контролируют, встречают барьер до описанного здесь, и модель говорит о них мало, кроме обозначения этого барьера (раздел 5.5).
Свидетельства о когорте. Используется только предварительно зарегистрированный дизайн. Ни один результат программы не информирует ни одного утверждения здесь, и предложения раздела 10 излагаются до того, как известны его результаты, чтобы их можно было оценить по ним. Когорта, требующая собственной машины, включает людей, способных установить агента; она не может отделить доступ к оборудованию от мотивации, и это ограничение сопутствует результатам.
Нормативная область. Модель описывает, что каждый уровень требует от человека. Она не утверждает, что более высокие уровни лучше или что все должны подняться; для большей части работы уровень 1 или 2 — правильное место (раздел 8.2). Работа с серьёзными последствиями, конфиденциальные записи, операции, критичные для безопасности, срочные решения и задачи без проверяемого критерия приёмки требуют более строгих договоренностей или остаются полностью вне делегированного использования агентов.
Что добавляет оркестровка. Добавление агентов может расширить охват, выявить разногласие и оставить след проверки. Это также может добавить коррелированную ошибку, стоимость, задержку и видимость прилежания. Делегирование, которое сохраняется, означает, что человек может проверить и изменить процесс; является ли процесс достойным доверия — отдельный вопрос.
Что отсутствует в литературе. Поиск литературы в разделе 2.5 не выявил никакого полевого исследования непрограммистов, усваивающих терминальных или настольных агентов, никакого исследования веб-оркестровки как названной практики, никакого рассмотрения управления агентами как компетенции с собственной структурой и никакого исследования системы ИИ, поддерживающей принятие человеком агентного ИИ. Это пробелы в том, что было изучено, указанные по состоянию на 21 сентября 2026 г., и я ничего не утверждаю о рынках, продуктах или приоритетах.
Статус утверждений. Таблица 8 применяет язык уверенности серии к элементам аргумента, чтобы читатель мог видеть, насколько твёрдо каждое из них держится.
Таблица 8. Статус утверждений в этой статье.
| Элемент | Как это здесь сказано | Основание |
|---|---|---|
| Четырёхуровневая модель и правило артефакта | Проходит тестирование (разделы 9 и 10) | Концептуальное; маркеры указаны в разделе 3 и приложении A |
| Технический барьер отступил для установки и настольного интерфейса | Данные его поддерживают | Одношаговые установщики; документация «Терминал не требуется»; четыре поставщика выпустили продукты уровня 2 |
| Работники знаний в агентах терминального наследия | Сообщено поставщиками, приблизительно | Информация из прессы о показателях поставщиков, 2 июня 2026 г., с оговоркой аналитика |
| Поставщики, поглощающие переход 1 в чат | Наблюдается в продукте | Anthropic, 16 September 2026; OpenAI, 9 July 2026 |
| Словарь рабочего процесса как доминирующий оставшийся барьер | Предложено как модель; проходит тестирование | Косвенно: исследования подсказок; указанная причина слияния поставщиками; элемент программы, связанный с причиной остановки |
| Веб как мост, CLI как стабильный слой | Проходит тестирование (P7, P8) | Контракты, объекты разрешений, официальные плагины; хрупкость веб-интерфейсов |
| Коррелированные ошибки ограничивают полезность совета | Данные его поддерживают при оценке моделей; измеряется в использовании | Kim et al. (2025); Chernets (2026a) |
| Рефлексивный онбординг | Реализовано и измеряется; результат не сообщается | Практика поставщиков и курсов (наблюдение); шаг 1 программы (измерение) |
| Менеджер агентов как роль | Предложено как описание поведения; проходит тестирование (P10) | Исследования делегирования; рубрики работодателей; официальные модели компетентности |
| Темпы пересечения когорты | Не сообщается | Протокол заморожен; статья результатов будет опубликована |
| «Работает сейчас» как обещание | Не утверждается | Вне области применения этой статьи |
13. Заключение
Терминал раньше был явным символом барьера между обычными профессионалами и агентным ИИ, и какое-то время это было справедливо. В 2026 году это уже не подходит. Установка требует команды или клика, чатбот, который уже использует человек, может провести его через это, и поставщики объединяют чат и агента в один интерфейс. То, что показывают разделы 4 и 5, — это барьер, который переместился. Первая ограниченная попытка стала намного проще; что остаётся сложным, — это получить надёжную работу над целыми задачами, идти в ногу с продуктами, которые меняются под ногами, и держать предоставленную папку в безопасности. По данным одного поставщика, о которых сообщалось в прессе и которые следует рассматривать как ориентировочные, около миллиона работников знаний в неделю уже находятся внутри кодирующего агента с наследием терминала. Между тем, большинство профессионалов по-прежнему встречаются с ИИ только как с беседой.
Препятствие сейчас — это управленческая работа: знать, что передать, оградить это, назвать результат и решить, как его проверить, затем безопасно запустить среду и сравнить модели, помня, что их согласие является более слабым доказательством, чем кажется. Четыре уровня раздела 3 придают этой работе структуру, которой не владеет ни один продукт, а правило артефакта дает ей единицу измерения. Я предложил веб-оркестровку как мост к последнему уровню (P7) и оркестровку CLI как её долговечную форму (P8); обе сформулированы так, чтобы они могли не сработать.
Для любого, кто вводит переход, практическим следствием является порядок операций. Первый вопрос: какую небольшую, разрешённую работу может описать, проверить и безопасно отбросить человек, если попытка не удастся: брифинг из открытых источников, личную папку планирования, электронную таблицу, от которой никто другой не зависит. Оттуда добавляется по одной управленческой ответственности за раз: граница, затем одобрение, затем собственное рабочее пространство, затем сохранённый отчёт о задаче, затем второй и критический взгляд. Оценка следует в том же порядке. Демонстрация стоит мало, если она скрывает, что разрешено делать человеку, как проверялся результат и что произошло, когда агент не сработал. Продуманный отказ делегировать считается результатом. И человек, который может воспроизвести ограниченную задачу, объяснить, почему на неё полагались, указать на разногласие, которое изменило решение, и ограничить доступ при изменении обстоятельств, показывает наблюдаемые признаки роли, что бы ни говорило его должностное наименование.
Модель может не сработать, и раздел 10 объясняет, как. Программа раздела 9 протестирует часть её на людях, которые не являются программистами, а код в Приложении C позволяет другим измерять те же переходы и практиковать те же закономерности. Я ожидаю, что продукты, названные в Приложении B, будут выглядеть устаревшими в течение года. Барьеры раздела 5 не должны устаревать, потому что они принадлежат человеку и работе, независимо от того, какой продукт находится перед ними. Терминал стал местом, где агент работает на человека, который научился им управлять, и то, сколько людей этому научатся, каким путём и как быстро, — это вопрос, на который ответит следующий год.
Декларации
Финансирование. Эту работу не поддерживало внешнее финансирование.
Конфликт интересов. Автор разрабатывает методы многомодельного оркестрирования и подал соответствующие заявки на патенты (рассмотрение в процессе; патентов не выдано). Автор разработал зарегистрированную программу когорты, описанную в разделе 9, и её материалы. Ни один вывод в этой статье не зависит от реализации автора; каждый паттерн в Приложении C воспроизводим с использованием общедоступных инструментов. Автор также поддерживает два открытых плагина, названные в Приложении C; они свободны и открыты (Apache License 2.0), и ни один вывод в этой статье не зависит от них. Автор разрабатывает учебные материалы, которые позже могут быть предложены в коммерческих целях; на момент написания ничего не продано, и когорта, описанная в разделе 9, получила все материалы бесплатно.
Инструменты и проверка. ИИ-помощники использовались как инструменты под руководством автора; идеи, исследования и выводы принадлежат автору. Все количественные утверждения и цитаты были проверены по первоисточникам или архивным копиям на 21 сентября 2026 г. или, если источник обозначен как вторичный или поставщик в тексте и в хронологии Приложения B, по лучшему доступному отчёту; цифры, сообщаемые поставщиками о своих собственных продуктах, отмечены как таковые. Если первичную страницу не удалось получить в ходе исследования (на сайте одного поставщика несколько страниц вернули ошибку доступа), утверждение цитируется из названного вторичного источника и помечается, или оно опускается. Названия прессы, приведённые в квадратных скобках в ссылках, — описательные названия страниц, оригинальные заголовки которых не были перечитаны дословно.
Доступность данных и кода. Код в Приложении C с его тестами размещён под лицензией MIT по адресу https://github.com/vadimchernets/after-chat и архивирован на Zenodo, https://doi.org/10.5281/zenodo.22944451. Два плагина, построенные на основе тех же паттернов, Roundcall и Sidecall, находятся по адресам https://github.com/vadimchernets/roundcall и https://github.com/vadimchernets/sidecall (Apache License 2.0). Пять наборов инструментов, применяющих те же паттерны к профессиям вне ПО, находятся по адресу https://github.com/vadimchernets/calling-kits (MIT). Они не были испробованы практиками этих профессий, что указано в репозитории, и ни одно утверждение в этой статье не основывается на них.
Этика. Эта статья не содержит данных от участников-людей. Программа когорты, которую она описывает, зарегистрирована предварительно (OSF, DOI 10.17605/OSF.IO/X4EGQ); её результаты будут сообщены отдельно.
Вклад автора. Единственный автор.
Корреспонденция. [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
Приложение А. Глоссарий модели
Охват. То, что модель может затрагивать от имени человека: разговор; файлы и инструменты в пространстве, ограниченном поставщиком; собственный компьютер человека; несколько моделей и агентов.
Роль. Что должен делать человек, чтобы работа была успешной: спрашивать и копировать; делегировать и проверять; владеть окружением; управлять несколькими агентами.
Уровень. Комбинация охвата и роли, на которых выполняется работа (раздел 3.2). Уровни описывают работу; люди и продукты могут охватывать несколько уровней.
Пересечение (перехода). Записывается, когда агент создал на новом уровне артефакт, который попросил человек. Установка — это попытка. Ход более чем на один уровень допускается и записывается как пропуск.
Артефакт. Файл, папка, действие или вывод, созданные агентом, которые человек предоставляет или сохраняет. «Ничего» — это допустимая запись.
Словарь рабочего процесса. Рабочий запас задач, которые человек знает, как передать агенту, сформулированные так, чтобы агент мог их выполнить и результат можно было проверить.
Рефлексивное внедрение. ИИ-система, поддерживающая усвоение человеком более мощной ИИ-системы, например чат-бот, направляющий установку агента и восстановление после его первых ошибок.
Контракт делегирования. Четыре вещи, которые человек указывает при передаче работы агентам: цель, граница, артефакт, проверка.
Четыре практики. Что менеджер делает в рамках задачи: делегирование, надзор, проверка, отзыв (раздел 8.1).
Запись о принятии. Для важной или повторяющейся задачи: предполагаемый результат, входные данные, ограничения и разрешения, место выходных данных, существенные разногласия или сбои, выполненные проверки и решение принять, пересмотреть, эскалировать или отклонить. Она отделяет то, что создал агент, от того, на что полагался человек.
Пятичастная карта работы. Объект работы, разрешённые входные данные, преобразование, результат и проверка: форма, в которой повторяющаяся задача непрограммиста становится делегированием (раздел 5.1).
Боковая ветвь. Конструкторы браузерных приложений, которые действуют на проект, размещённый на платформе, а не на файлы человека; другая лестница с собственными ступенями (раздел 3.4).
Веб-оркестрация. Один вопрос, поставленный нескольким потребительским чат-ботам в браузере вручную или с помощью инструмента, и сравнение ответов.
CLI-оркестрация. Один агент вызывает инструменты командной строки других агентов, собирает их выходные данные и объединяет или проверяет их.
Текучесть. Переименование, объединение или снятие с производства инструментов в период, меньший времени, необходимого новичку для их изучения.
Эффективное число мнений (N_eff). N / (1 + (N - 1) rho) для N моделей со средней попарной корреляцией ошибок rho; ограничено сверху 1/rho (Chernets, 2026a).
Маркеры как кодируемые элементы
Для кодировщика качественных данных или дизайнера опроса маркеры раздела 3 сводятся к элементам да/нет о названном артефакте. Самоотчёт без артефакта записывается как претензия и не считается пересечением.
- Уровень 1 представлен. Минимум одно сохранённое общение с потребительским чат-ботом за последние семь дней; артефакт: ссылка, снимок экрана или экспорт. Неудача её создания кодируется как «не продемонстрировано», что является более слабым результатом, чем «отсутствует».
- Переход 1 пересечён. Файл или набор файлов, написанные ограниченным агентом (настольный, веб или размещённый на сервере арендатора) в месте, предоставленном человеком, в ответ на работу, названную человеком, с минимум одним утверждением, отказом или записанным редактированием плана. Дата артефакта — это дата пересечения.
- Уровень 2 представлен. Переход 1 пересечён, плюс дополнительный ограниченный артефакт в более позднюю неделю. Стойкость записывается как отдельный еженедельный элемент, отдельно от пересечения.
- Переход 2 пересечён. Рабочая папка, коммит или датированный набор файлов, созданные локальным агентом или его официальной оболочкой рабочего стола на машине, которой управляет человек, для работы, требующей использования более одного инструмента. Размещённая в облаке работа кодируется как её собственный облачный вариант.
- Уровень 3 представлен. Переход 2 пересечён, плюс артефакт более поздней недели от того же класса агента.
- Переход 3, мостовая форма. Датированный файл, содержащий вопрос, запрошенные чат-боты или веб-модели, сырые ответы или ссылки на них, запись согласия и несогласия и запись о том, появились ли охват или надёжность (раздел 6.2); созданный вручную или инструментом трансляции.
- Переход 3, прочная форма. Те же поля, созданные запуском, который вызвал два или более официальных инструмента командной строки (или один плюс плагин второго семейства) на собственных учётных записях человека с записанным знаменателем: спрошено, отвечено, истёк срок ожидания.
- Уровень 4 представлен. Любая форма перехода 3, плюс второй датированный запуск на более поздней неделе.
- С помощью и без помощи. Любой переход, в котором исследователь, коллега или оплачиваемый тренер выполнили установку, написали работу или восстановились после ошибки, является вспомогательным. Завершения сообщаются двумя числами везде, где была доступна помощь.
- Причина остановки. Свободный текстовый ответ на вопрос «что вас остановило», заданный всем, кто не пересёк переход и закодирован после сбора. Коды-кандидаты, предложенные как гипотеза для позднейшего пересмотра кодировщиками: словарь рабочего процесса; диалог разрешения или безопасности; права администратора; стоимость или квота; боязнь интерфейса; новости о разрушительном инциденте; политика организации; техническая ошибка; жизнь и время; прочее.
- Правило кодирования для «не знал, что спросить» (словарь рабочего процесса). Включайте, когда человек, спрошенный о том, что он пытался заставить агента делать, не может назвать минимум одну из пяти частей раздела 5.1: объект работы, входные данные, которые он может использовать, преобразование, результат или проверку. Исключайте, когда все пять названы и человек отказался по причинам политики, риска, стоимости или времени; они получают свои собственные коды. Два кодировщика кодируют независимо и сообщают о своём согласии. Правило классифицирует остановку и ничего не говорит о способности человека.
- Следы четырёх практик (да/нет, каждый привязан к датированному артефакту): отказано в плане; отклонена разница или вывод; запрошено второе семейство моделей; записан знаменатель (кто был спрошен, кто ответил, кто истёк срок ожидания); необратимый шаг удерживается для подтверждения; артефакт депонирован. Это следы надзора P10.
- Не маркеры. Покупка лицензии, значок курса, логи установки, звезда репозитория, количество запросов или самооценка как «пользователь агента».
Приложение Б. Датированная хронология, 2025 – 21 сентября 2026
Записи с пометкой VERIFIED были открыты на основной странице или на названной вторичной странице пресс-релиза в течение периода исследования, завершившегося 21 сентября 2026 года. Записи с пометкой SECONDARY основаны на пресс-релизах или историях продуктов, которые не были открыты на основной странице; они приводятся для ориентации и не имеют веса в аргументе. Это рабочая хронология для четырёхуровневого аргумента и не претендует на полноту отраслевой хронологии.
| Дата | События | Источник | Статус |
|---|---|---|---|
| 24 февраля 2025 | Исследовательский предпросмотр Claude Code | Истории продуктов, широко сообщается | SECONDARY |
| 23 апреля 2025 | Указ 14277 об образовании в области ИИ | White House (2025a) | VERIFIED |
| 22 мая 2025 | Claude Code становится общедоступной | Истории продуктов, широко сообщается | SECONDARY |
| 23 июня 2025 | Протокол Agent2Agent передан в Linux Foundation | Google Open Source Blog (2026) | VERIFIED (поставщик) |
| июль 2025 | План действий США в области ИИ посвящён развитию грамотности и навыков в этой области | White House (2025b) | VERIFIED |
| 21 июля 2025 | Агент создания приложений удаляет рабочую базу данных во время живого сеанса | The Register (2025) | VERIFIED (пресса) |
| 20 августа 2025 | Впрыск подсказок продемонстрирован против браузерного агента с украденным одноразовым кодом | Brave (2025) | VERIFIED |
| 25 августа 2025 | Пилот браузерного агента: успешность атак 23,6% без смягчения, 11,2% со смягчением | Anthropic (2025) | VERIFIED (поставщик) |
| 9 декабря 2025 | Model Context Protocol передан в Agentic AI Foundation (Linux Foundation); более 10 000 опубликованных серверов, около 97 миллионов ежемесячных загрузок SDK | Linux Foundation (2025) | VERIFIED |
| 9 декабря 2025 | Консалтинговая фирма объявляет, что около 30 000 сотрудников будут обучены моделям одного поставщика | Accenture (2025) | VERIFIED |
| 18 декабря 2025 | Формат Agent Skills выпущен как открытый стандарт | SiliconANGLE (2025) | VERIFIED (пресса) |
| 22 декабря 2025 | OpenAI: впрыск подсказок «вряд ли когда-нибудь полностью "решится"» | TechCrunch (2025) | VERIFIED (пресса) |
| январь 2026 | Исследовательский предпросмотр Cowork, «Claude Code для остальной части вашей работы» | Fortune (2026a); The Register (2026) | VERIFIED (пресса) |
| 12 января 2026 | Возражение против просьбы к непрограммистам следить за впрыском подсказок | Willison (2026) | VERIFIED |
| 15 января 2026 | Индекс экономики Anthropic: дополнение 52% разговоров (ноябрь 2025) | Anthropic (2026f) | VERIFIED (поставщик) |
| 4 и 26 февраля 2026 | GitHub Agent HQ: агенты Claude и Codex доступны в Copilot | GitHub (2026c) | VERIFIED |
| февраль 2026 | Совет моделей Perplexity для подписчиков премиум-класса (сообщено 10 февраля) | Storyboard18 (2026) | VERIFIED (пресса) |
| 13 февраля 2026 | Рамки грамотности в области ИИ Министерства труда США («направление ИИ эффективно») | US Department of Labor (2026) | VERIFIED |
| 9 марта 2026 | Технология Cowork внедрена в Microsoft 365 Copilot | Microsoft (2026a) | VERIFIED |
| 9 марта, 19 апреля, 10 июня 2026 | Сообщения пользователей о файлах, удалённых агентом уровня 2 внутри предоставленных папок | Отчёты о проблемах GitHub (2026) | VERIFIED (отчёты пользователей) |
| 24 марта 2026 | Индекс экономики Anthropic: пользователи с большим сроком пользования делегируют меньше | Anthropic (2026e) | VERIFIED (поставщик) |
| 30 марта 2026 | Официальный плагин OpenAI для использования его агента в Claude Code; исследовательский агент Microsoft запускает GPT и Claude вместе | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| апрель 2026 | JetBrains: Claude Code на работе 18% (январь 2026), из примерно 3% (весна 2025) | JetBrains Research (2026a) | VERIFIED (обследование поставщика) |
| 13 апреля 2026 | Duolingo прекращает использование ИИ в оценках производительности | Fortune (2026b) | VERIFIED (пресса) |
| 5 мая 2026 | Индекс рабочих тенденций: организационные факторы перевешивают индивидуальные более чем вдвое | Microsoft (2026b) | VERIFIED (обследование поставщика) |
| 25 апреля 2026 (сообщено 5 мая) | Агент удаляет производственную базу данных и резервные копии компании | Information Age (2026) | VERIFIED (пресса) |
| 19 мая 2026 | Google объявляет о переходе с Gemini CLI на Antigravity CLI | Google (2026) | VERIFIED |
| 25 мая 2026 | Grok Build от xAI выпущена с режимом безголовой работы и поддержкой протокола агента | xAI (2026) | VERIFIED (поставщик) |
| 26 мая 2026 | Использование ИИ в американском бизнесе 17%–20% в целом; малые фирмы без роста | US Census Bureau (2026) | VERIFIED |
| 27 мая 2026 | Пульс разработчика: 69% одного агента; 60% блокируют несанкционированные изменения | Stack Overflow (2026) | VERIFIED |
| 2 июня 2026 | Агент кодирования на 5 миллионов еженедельных пользователей, около 20% работников знаний | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (пресс-релиз данных поставщика) |
| 15 июня 2026 | Барометр рабочих мест в области ИИ PwC: 62% премия заработной платы за навыки в области ИИ | PwC (2026) | VERIFIED (поставщик) |
| 17 июня 2026 | Pew: около половины взрослого населения США используют чатботы | Pew Research Center (2026) | VERIFIED |
| 18 июня 2026 | Gemini CLI перестаёт обслуживать отдельные уровни | Google (2026) | VERIFIED |
| июнь 2026 | Рамки грамотности ОЭСР и Европейской комиссии в области ИИ («Управление ИИ») | OECD & European Commission (2026) | VERIFIED |
| 29 июня – 3 июля 2026 | Claude Code переименовывает свой режим разрешений по умолчанию на «Manual» | Anthropic (2026h) | VERIFIED (поставщик) |
| 1 июля 2026 | Агент рабочего стола Gemini Spark на Mac; лучший коэффициент автоматизации Remote Labor Index 15,8%, из 2,5% при выпуске | TechCrunch (2026b); Center for AI Safety (2026) | ПРОВЕРЕНО |
| 8 July 2026 | Indeed: 63% должностей в США, затронутых ИИ, находятся вне технологических специальностей | Adrjan (2026) | ПРОВЕРЕНО |
| 9 July 2026 | Приложение кодирующего агента становится приложением ChatGPT для рабочего стола; запущен ChatGPT Work | MacRumors (2026) | ПРОВЕРЕНО (пресса) |
| 20 July 2026 | Gallup: 52% рабочих в США используют ИИ, 15% ежедневно | Gallup (2026) | ПРОВЕРЕНО |
| 27 July 2026 | EU AI Omnibus вступил в силу; требование по компетентности в области ИИ становится «принимать меры для поддержки» | European Commission (2026a, 2026b) | ПРОВЕРЕНО |
| 28 July 2026 | Model Context Protocol: почти полмиллиарда загрузок SDK в месяц; протокол сделан без сохранения состояния | Model Context Protocol (2026) | ПРОВЕРЕНО |
| 3 August 2026 | Вступили в действие правила ЕС о надзоре и принуждении в отношении компетентности в области ИИ | European Commission (2026a) | ПРОВЕРЕНО |
| August 2026 | JetBrains: 90% профессиональных разработчиков еженедельно используют кодирующих агентов; Claude Code на работе 39% | JetBrains Research (2026b) | ПРОВЕРЕНО (опрос производителя) |
| 9 August 2026 | Браузер OpenAI на основе агента снят с производства; просмотр перемещается в приложение ChatGPT | 9to5Mac (2026) | ПРОВЕРЕНО (пресса) |
| 26 August 2026 | Браузер-агент доступен в общем пользовании; автономный с классификатором по умолчанию; производитель сообщает об уровнях инъекций близких к нулю | Anthropic (2026d) | ПРОВЕРЕНО (производитель) |
| 1 September 2026 | St. Louis Fed: 45% рабочих используют ИИ в своей работе; менее 3% задач имеют уровень внедрения выше 50% | Bick et al. (2026) | ПРОВЕРЕНО |
| 6 September 2026 | Предварительная регистрация когорты 1 заморожена | Chernets (2026d) | ПРОВЕРЕНО |
| 9 September 2026 | Harvard Business Review: доверие как центральное препятствие для внедрения агентов на работе | McKinlay et al. (2026) | ПРОВЕРЕНО (краткое изложение) |
| 16 September 2026 | Cowork и chat объединены в один Claude | Anthropic (2026c); TechCrunch (2026a) | ПРОВЕРЕНО |
| 22 September 2026 | Официальный каталог плагинов полностью просмотрен, 310 записей: отсутствуют для пяти профессий, названных в разделе 5.1; каталог сообщества содержит 2 282 записей, предложения для учителей и сектора недвижимости | Авторское прочтение опубликованных каталогов | ПРОВЕРЕНО (собственный подсчёт) |
Приложение C. Код для обучения
Приводимые далее примеры кода демонстрируют паттерны из разделов 5–9. Они используют только стандартную библиотеку Python и собственные средства командной строки производителей, требующие входа с подписками самого пользователя; ни один не читает ключ API. Каждый достаточно короток, чтобы прочитать за один раз, и каждый указывает, что он учит и где заканчивается. Они помещены с тестами в сопутствующий репозиторий под лицензией MIT, и каждый пример был запущен перед включением (каждый на своём демо-входе, распределение на заглушках инструментов). Каждый паттерн здесь уже существует в той или иной форме в инструментах с открытым исходным кодом (раздел 7.1); ценность примеров кода в том, что они небольшие, снабжены комментариями и связаны с аргументацией. Ни один из них не является учебным маршрутом, диагностикой обучающегося, учебным планом или реализацией инструментов автора. Человек без опыта в программировании не запускает эти файлы вручную: это именно то, что агент оборачивает как навык или графический интерфейс рабочего стола представляет как кнопку, и смысл их печати в том, чтобы читатель мог видеть, что делает такая кнопка.
Два устанавливаемых плагина Claude Code применяют эти паттерны в повседневном использовании. Roundcall обращается к сайтам чата с ИИ, на которые пользователь уже вошёл, через собственный браузер и в удобном для пользователя темпе; Sidecall обращается к агентам командной строки, установленным на их машине, с параметром бюджета, который выбирает модель каждого производителя. Оба возвращают один отчёт о том, кто что сказал, где ответы расходятся и что сказал только один источник. Они имеют открытый исходный код под лицензией Apache 2.0 по адресам https://github.com/vadimchernets/roundcall и https://github.com/vadimchernets/sidecall.
Перед запуском любого из них: проверьте справку --help каждого инструмента в установленной версии, так как флаги изменяются между выпусками; запускайте их в рабочей папке, которая содержит копии, а не оригиналы; и сначала прочитайте пример C6.
C1. Распределение с проверкой, потолком и частичным сохранением (fanout.py)
Учит: как один человек может задать один вопрос нескольким CLI агентов одновременно, пропустить те, которые недоступны или исчерпали квоту, перестать ждать при достижении потолка по времени и сохранить то, что каждый инструмент написал до потолка, вместо того чтобы это выбросить. Каждый инструмент запускается в свежей пустой папке внутри папки вывода, никогда в папке, из которой пользователь его запустил; имена инструментов ограничены безопасными именами файлов; длинный вопрос помещается в файл (--question-file) или, для инструмента, чей шаблон не содержит {prompt}, в стандартный вход инструмента, так как аргумент командной строки имеет ограничение по длине, установленное операционной системой. Ограничения: остановка при достижении потолка использует группы процессов POSIX (macOS и Linux; в Windows используйте WSL) и переходит к остановке самого инструмента; инструмент, который выводит результат только в конце, не оставляет ничего для сохранения при его остановке; используйте его потоковый режим вывода, если он доступен. Скрипт ничего не сравнивает; это делает C3.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. Умение «второе мнение» для агента (second-opinion/SKILL.md)
Обучает: минимальной форме организации CLI, письменной инструкции, которая заставляет одного агента запросить мнение агента другого поставщика и показать разницу вместо того, чтобы её скрывать. Ограничения: сравнение двух моделей — это одно сравнение, не панель; умение указывает, какие пункты всё ещё нуждаются в первичном источнике.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. Кто что сказал (provenance.py)
Обучает: две вещи, которые должны быть получены при опросе нескольких моделей — охват и надежность, представленные как таблица утверждений по источникам, список утверждений, сделанных только одним источником, и список утверждений, чьи цифры или даты отличаются. Ограничения: он сопоставляет повторяющиеся формулировки, а не повторяющиеся значения; он указывает человеку, что нужно читать внимательно, но не указывает, что верно.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. Сколько независимых мнений стоит согласие? (neff.py)
Объясняет: арифметику коррелированных доказательств (Section 6.3): оцените среднюю корреляцию ошибок rho на элементах с известными ответами, затем вычислите N_eff и его потолок 1/rho. Запустите с --demo, чтобы увидеть четыре модели, стоящие примерно 1.6 независимых мнений. Ограничения: rho зависит от задачи; оцените его на элементах, подобных тем, что вас интересуют, используя более чем десять элементов.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. Запись о переходах и проверяющий (crossings.py)
Обучает: правила измерения из раздела 9.1 как код. Запись отклоняется, если она считает установку переходом, завершение без артефакта, созданного агентом, остановку без собственных слов человека, помощь без описания помощи, имя вместо псевдонимной метки (метка должна быть P, за которым следуют цифры), пропущенный уровень, который не указан точно, значение, которое не является подлинным true или false, неразборчивую дату, поле, которое формат не знает, или переход уровня 4, который называет менее двух инструментов, запрошенных и ответивших. Неправильно сформированная строка сообщается как отклоненная и никогда не останавливает выполнение. Ограничения: проверяет форму записей, а не их истинность; относятся ли два инструмента к разным семействам моделей и была ли договоренность повторена в более позднюю неделю (вторая запись), остаются исследователю; это инструмент исследования, а не приложение.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
Тот же формат записи публикуется как JSON Schema (crossings.schema.json) чтобы другие инструменты могли проверить структуру записи; приведённая выше проверка применяет правила, которые схема не может выразить (что установка не является пересечением, что остановка требует собственных слов человека, что помощь требует описания и что пропуск записывается).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. Безопасность перед уровнем 3 (safety/)
Учит: практики раздела 5.3 как конфигурацию. Первый файл — это пример файла настроек проекта для Claude Code: режим plan по умолчанию (поставщик переименовал свой режим по умолчанию на "Manual" в июле 2026; "plan" остаётся действительным и является более безопасным выбором для обучения), обычные деструктивные команды и команды загрузки запрещены, обычные файлы секретов запрещены как для читателя файлов, так и для shell cat, удаления и веб-выборки требуют подтверждения. Список отказа — это просто список: режим разрешения или неуказанная команда могут его обойти, поэтому параметры песочницы столь же важны, как и правила. Второй — это пример конфигурации для Codex компании OpenAI, представленный в форме с ограничением по запускам и папкам: запись ограничена рабочей папкой, без сетевого доступа, требуется одобрение по запросу. Третий — это контрольный список. Ограничения: правила разрешений и песочницы уменьшают масштаб ущерба; они не обеспечивают надежность агента, и синтаксис правил изменяется между версиями.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. Трассировки надзора как журнал (jsonl_log.py)
Обучает: минимально полезную запись о работе менеджера, один объект JSON с временной меткой на каждое событие, чтобы отклонённые планы, отклонённые диффы, полученные вторые мнения и завершённые запуски (трассировки надзора предложения P10) можно было подсчитать позже со стандартной библиотекой. Запустить с --demo. Ограничения: это писатель, а не трассировщик; он записывает то, что ему говорит человек или агент.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
Приложение D. Расчётная таблица эффективного числа мнений
Менеджер агентов, который не хочет запускать listing C4, может по-прежнему использовать потолок. Каждая ячейка — это N_eff = N / (1 + (N - 1) rho); последняя строка — это потолок 1/rho, который никакое количество моделей с такой корреляцией не может превысить. Значения rho выбраны для иллюстрации формулы и ничего не измеряют. На практике rho — это средняя попарная корреляция ошибок, величина, отличающаяся от доли совместных ошибок, по которым две модели совпадают, и её следует оценивать на примерах с известными ответами в вашей предметной области (listing C4).
| N моделей | rho = 0.2 (иллюстрация) | rho = 0.5 (иллюстрация) | rho = 0.6 (иллюстрация) | rho = 0.8 (иллюстрация) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| Потолок, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
Таблица объясняет, почему в Разделе 6 рекомендуется потратить следующую подписку на другое семейство вместо десятого окна того же самого. Разнообразие семейств, проверка утверждений по источникам и сохранённое разногласие выполняют работу, которую большее N не может выполнить. Поскольку rho зависит от задачи, её следует оценивать на примерах с известными ответами в вашей предметной области (listing C4).
Приложение E. Обзор инструментов, 19–21 сентября 2026
Таблица 5 в основном тексте классифицирует инструменты по типам. Это приложение содержит исходные данные переписи, на основе которых составлена таблица, для читателей, которые хотят увидеть цифры такими, какие они были на указанные даты. Количество звёзд меняется ежедневно; оно отражает популярность и ничего не говорит о качестве или числе пользователей, поэтому его не следует цитировать с указанием даты чтения. Столбец «Тип» представляет мою классификацию, и сами проекты такой классификации не предъявляют.
| Проект | Расположение | Количество звёзд (примерно, 21 сентября 2026) | Лицензия | Тип |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | Source-available, проприетарная лицензия | Терминальный агент (уровень 3) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | Терминальный агент (уровень 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | Терминальный агент; индивидуальные тарифы больше не доступны с 18 июня 2026 |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | Редактор и терминальный агент |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | Официальный плагин: агент одного поставщика внутри другого |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | См. репозиторий | Веб-чат, открытый для агентов |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | См. репозиторий | Совет на основе программного интерфейса |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500 (примерно 847,000 загрузок последней версии) | Apache-2.0 | Трансляция в браузер |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800 (последний коммит: декабрь 2025) | Apache-2.0 | Сервер консультаций между моделями |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | Терминальный агент (уровень 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | Трансляция в браузер |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | Совет CLI |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | Совет CLI, создающий по одному файлу на инструмент |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | Терминальный агент с режимом headless и протоколом агента |
Как цитировать
Chernets, V. (2026). After Chat: The Three Transitions Between Non-Programmers and Agentic AI [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}