After Chat: Non-Programmers와 Agentic AI 사이의 세 가지 전환
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
터미널은 더 이상 터미널이 아닙니다: 네 가지 수준의 모델, 2025년과 2026년의 증거, 그리고 전환을 측정하기 위한 사전등록된 프로그램
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
이 논문 다운로드
- SSRN (기록 버전): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (아카이브됨, 개방 접근): doi.org/10.5281/zenodo.22943313
- GitHub (Markdown 및 PDF 형식의 전체 텍스트): github.com/vadimchernets/papers/tree/main/after-chat; 코드: github.com/vadimchernets/after-chat
같은 텍스트가 세 곳에 있으므로 그 중 하나를 사용할 수 없을 때도 접근할 수 있습니다. SSRN이 기록 버전을 보유하고 있으므로 그것을 인용하세요.
키워드: 에이전트 AI; AI 에이전트; 비프로그래머; 최종 사용자 프로그래밍; AI 문해력; 지식 근로자; 기술 채택; 생성 AI 채택; 인간 감독; 위임; 2단계 디지털 격차; 상관 오류; 자동화의 역설; 디스킬링; 사전등록
초록
대부분의 전문가는 AI를 챗봇으로 만나지만, 동일한 모델들은 AI 에이전트로서 이제 파일과 프로그램에 작용합니다. 비프로그래머가 채팅에서 에이전트 AI로 이동한 경우가 왜 그렇게 적은지, 그리고 그 이동을 어떻게 측정할 것인지 질문합니다. 그 답은 상품과 무관하게 도달범위와 역할로 정의된 4단계 모델에 있습니다: 채팅, 공급업체가 한정한 안전한 에이전트 환경, 자신의 컴퓨터 위의 에이전트, 그리고 여러 모델에 걸쳐 조율되는 반복 가능한 작업입니다. 전환은 에이전트가 사용자가 요청한 산출물을 생성했을 때만 계산됩니다. 소프트웨어 설치는 시도로 계산됩니다. 2025년부터 2026년 9월까지의 증거는 설치 장벽과 첫 번째 한정된 시도의 장벽이 낮아졌지만, 전체 작업의 신뢰성, 제품 안정성, 폴더 안전성은 그렇지 않음을 나타냅니다. 설치는 한 단계이고, 사용자의 자신만의 챗봇이 그것을 안내할 수 있으며("반사적 온보딩"), 두 공급업체는 2026년에 에이전트와 채팅 인터페이스를 통합했습니다. 한 공급업체의 언론 보도 수치는 지식 근로자를 자사 코딩 에이전트의 주간 500만 사용자의 1/5로 추정합니다; 이는 터미널 계보 에이전트의 사용을 측정하며, 여기서 정의한 3단계 채택이 아닙니다. 사용은 광범위하면서도 얕습니다: 약 절반의 미국 근로자가 AI를 사용하며, 약 1/7이 매일 사용하고, 자동화를 위해 사용하는 경우는 적습니다. 장벽은 설치에서 지시로 이동했습니다. 최종 사용자 프로그래밍 연구를 바탕으로, 누락된 역량을 워크플로우 어휘라고 명명하고, 관리자의 작업을 위임 계약으로 제시합니다: 목표, 경계, 산출물, 그리고 확인입니다. 웹 조율(한 질문을 여러 챗봇에 보내기)은 비교를 가르치는 다리로 제안되며, CLI 조율(한 에이전트가 다른 에이전트를 호출하는 것)은 상관관계가 있는 모델들의 합의가 약한 증거라는 사실로 한정되는 지속 가능한 계층으로 제시됩니다. 논문은 15개의 거짓이 될 수 있는 명제, 결과 없는 사전등록 코호트 프로그램의 설계, 그리고 개방된 교수 코드로 마무리됩니다.
요약
프로그래머가 아닌 사람들이 AI로 할 수 없다고 여겨졌던 모든 것을 상징하던 터미널, 그 검은 창은 의미가 바뀌었습니다. 이제 터미널은 에이전트가 작동하는 개인의 컴퓨터 위의 공간이며, 그것이 요구하는 기술은 더 이상 명령어를 입력하는 것이 아닙니다. 기술은 명령어를 입력하는 작업자를 관리하는 것입니다.
전문 개발자들이 가장 앞서 있습니다. 2026년에 조사된 15,000명 이상 중 90%가 에이전트 도구를 최소 주 1회 이상 사용했습니다(벤더 조사). 다만 주 1회 사용이 8장의 관리자 역량은 아직 아닙니다. 다른 모든 사람들은 여전히 주로 챗봇과 대화하고 있습니다. 미국 근로자의 52%가 자신의 역할에서 AI를 사용하고 있으며, 15%는 매일 사용하고 있고, 해당 사용자의 16%는 자신의 사용 용도 중에 자동화를 언급합니다.
이유는 더 이상 에이전트를 설치하기가 어렵기 때문이 아닙니다. 에이전트를 설치하려면 명령어 하나 또는 클릭 하나면 되고, 사람이 이미 사용하고 있는 챗봇이 그 과정을 설명해 줄 수 있으며, 벤더들은 이미 채팅과 에이전트를 통합하기 시작했습니다. 어려운 것은 성질이 다릅니다. 에이전트는 여전히 작업의 전체 부분에서 실패하고, 사람이 배운 제품은 1년 내에 이름이 바뀌거나 중단될 수 있으며, 부여된 폴더는 여전히 보호가 필요합니다. 설치 이후 사람들을 멈추게 하는 첫 번째 것은 무엇을 넘길지 또는 어떻게 확인할지 모르는 것이며, 이것이 1장이 이름 붙인 작업흐름 어휘의 간격입니다. 그 뒤에는 첫 번째 오류, 권한 및 안전, 조직 규칙, 하드웨어 및 비용, 그리고 결과를 판단하는 역량이 있습니다.
모델은 4개 수준을 가지고 있으며, 모델이 도달하는 범위와 사람이 해야 할 일에 따라 정렬되어 있습니다. 대화, 벤더가 운영하는 제한된 공간, 개인의 컴퓨터, 그리고 여러 모델에 걸쳐 지시되는 작업입니다. 사람들은 한 수준을 건너뛸 수 있습니다. 교차는 에이전트가 생성한 결과물로만 표시되므로 설치, 배지 및 자체 보고는 포함되지 않습니다.
오케스트레이션, 즉 한 질문을 여러 모델에 보내는 것은 두 층으로 이루어집니다. 브라우저에서는 시도하는 데 비용이 들지 않으며 답변을 비교하는 습관을 가르치고, 명령줄에서는 기록하고 다시 실행할 수 있습니다. 둘 다에서 중요한 것은 요청하는 모델 패밀리의 수입니다. 상관관계가 있는 오류가 합의의 가치를 제한하기 때문입니다.
에이전트를 관리하는 것은 그 자체로 하나의 역량입니다. 4부로 이루어진 위임 계약(목표, 경계, 결과물, 확인), 4가지 실천(위임, 감독, 검증, 취소), 검토를 위한 중단 규칙, 그리고 에이전트가 생성한 것과 사람이 의존한 것을 구분하는 수용 기록이 있습니다.
논증은 검증되도록 구성되어 있습니다. 15개의 명제는 측정과 반박자를 포함합니다. 사전등록된 코호트 프로그램의 설계(OSF DOI 10.17605/OSF.IO/X4EGQ)는 여기에 설명되어 있으며, 그 결과는 별도로 보고될 것입니다. 상태 표는 각 주장이 얼마나 확실하게 유지되는지를 보여주며, 공개 코드는 부록 C에 있습니다.
1. 소개
2026년 9월의 사무직 전문가를 생각해보세요. 그녀는 매주 채팅봇을 사용합니다. 그녀는 이메일 초안을 작성하거나 보고서를 요약하거나 수식을 제안해달라고 요청합니다. 그녀가 받는 것은 텍스트이고, 그녀는 그 텍스트를 직접 자신의 업무가 있는 곳으로 옮깁니다. 계약 폴더, 계정 스프레드시트, 금요일까지 마쳐야 할 슬라이드 덱입니다. 같은 모델이 다른 경로를 통해 그 폴더를 열고, 그 안의 모든 파일을 읽고, 스프레드시트를 작성하고, 덱을 구축하고 자신의 산술을 확인할 수 있습니다. 4.4절의 설문조사가 알려주는 바에 따르면, 대부분의 전문가들은 아직 그 경로를 사용하지 않았고, 많은 사람들은 그것이 존재한다는 것을 모릅니다.
2년 동안 그 경로는 터미널처럼 보였습니다. 검은 창, 깜박이는 커서, 붙여넣을 명령입니다. 그 모습은 이제 구식입니다. 터미널은 시각적으로만 터미널로 남았습니다. 그것은 에이전트가 사는 환경, 모델이 읽고, 쓰고, 실행하고, 예약할 수 있는 개인의 컴퓨터 위의 장소가 되었고, 그 앞에 있는 사람은 더 이상 셸을 조작할 필요가 없어 그것을 하는 에이전트를 지시합니다. 변하는 것은 인간의 역할입니다. 모델에 질문을 던지는 사람에서 일하는 사람을 관리하는 사람으로 변합니다.
저는 이 두 역할 사이의 길과 그 위에 있는 사람들을 주제로 합니다. 전문 개발자 중에서는 최소한 도구들이 이미 도착했습니다. 2026년 5월부터 7월에 15,000명 이상의 전문 개발자를 대상으로 한 설문조사에서 90%가 주당 최소 1회, 68%가 매일 업무에서 AI 코딩 에이전트를 사용했고, Claude Code라는 하나의 터미널 에이전트를 사용하는 비율이 2025년 봄의 약 3%에서 2026년 1월 18%, 2026년 중반 39%로 증가했습니다(JetBrains Research, 2026a, 2026b; JetBrains가 코딩 에이전트를 판매하므로 공급업체 설문조사입니다). 다른 모든 사람들 중에서는 그렇지 않았고, 사용 패턴은 광범위하고 얕습니다. 같은 기간에 52%의 미국 근로자가 자신의 역할에서 AI를 사용했다고 보고했고, 15%는 매일 사용했으며, 해당 사용자의 16%만이 자동화를 자신의 사용 중 하나로 언급했습니다. 쓰기와 검색이 지배했습니다(Gallup, 2026). 일반적인 전문가에게 AI는 여전히 대화이고, 세인트루이스 연방준비제도이사회의 수치는 더 긴 기간에 걸쳐 같은 것을 말합니다. 2024년 8월과 2026년 5월 사이에 업무에 생성 AI를 사용하는 근로자의 비율은 33%에서 45%로 증가했지만, 채택률이 50% 이상인 작업은 3% 미만입니다(Bick et al., 2026).
격차의 표준적인 설명은 기술적 어려움입니다. 에이전트는 프로그래밍할 수 있는 사람들을 위한 것입니다. 그 답은 2024년에는 타당했지만 2026년에는 약합니다. 터미널 에이전트를 설치하려면 이제 하나의 명령이나 데스크톱 설치 프로그램이 필요하고, 주요 에이전트는 설명서에 "터미널이 필요하지 않음"이라고 명확히 나와 있는 데스크톱 응용 프로그램을 제공합니다(Anthropic, 2026a). 공급업체들은 더 나아갔습니다. OpenAI는 2026년 7월 9일 코딩 에이전트 응용 프로그램을 기본 ChatGPT 데스크톱 클라이언트로 변환했고 로컬 파일과 응용 프로그램을 사용하는 에이전트인 ChatGPT Work를 추가했습니다(MacRumors, 2026). Anthropic는 2026년 9월 16일 지식 업무를 위한 데스크톱 에이전트인 Cowork를 일반 채팅으로 병합했습니다. TechCrunch는 회사가 고객들이 "올바른 작업을 위한 올바른 탭을 선택하는 데 어려움을 겪는 경우가 많았다"고 보도했습니다(TechCrunch, 2026a). OpenAI는 언론을 통해 2026년 6월 코딩 에이전트의 500만 주간 사용자의 약 20%가 지식 근로자이며 개발자보다 3배 이상 빠르게 채택하고 있다고 보도했습니다(Help Net Security, 2026). 이 수치는 공급업체가 보고한 수치이고 방향성이 있으며, 공급업체의 자체 페이지는 제 확인에 액세스할 수 없었고, 이는 터미널 유산이 있는 에이전트의 지식 근로자 사용을 측정하므로 3절에서 정의한 레벨 3 채택보다 범위가 넓습니다. 그 그림에서 기술적 장벽이 어디에 있는지 보기 어렵습니다.
장벽이 이동했습니다. 설치에서 지시로 이동했습니다. "이것을 어떻게 실행합니까?"에서 "내가 어떤 한계 내에서 무엇을 요청해야 하고, 어떻게 그것이 했는지 알 것입니까?"로 이동했습니다. 두 번째 질문은 들리는 것보다 어렵고, 최종 사용자 프로그래밍에 대한 문헌이 그 이유를 설명합니다. 비전문가들은 접근이 자유롭고 즉시적일 때도 언어 모델에 의도를 표현하기 위해 노력합니다(Zamfirescu-Pereira et al., 2023). 그들은 어떤 표현이 시스템이 할 수 있는 것으로 매핑되는지 배워야 합니다(Liu et al., 2023). AI에 위임하는 것도 작업을 생산에서 지정 및 확인으로 이동합니다(Sarkar & Drosos, 2025; Simkute et al., 2024). 저는 누락된 기능을 워크플로우 어휘라고 부릅니다. 사람이 에이전트에게 넘길 수 있는 작업의 작동하는 재고이며, 에이전트가 그것을 수행할 수 있고 결과를 확인할 수 있도록 표현됩니다. 공식적으로 말하면, 그것은 개인의 도메인 목표와 에이전트가 실행할 수 있는 부분 작업 사이의 매핑이며, 입력, 변환, 출력, 예외 및 매핑이 필요한 증거에 대한 단어입니다. 에이전트를 열면 개발자는 이미 입력할 첫 번째 열 가지를 알고 있습니다. 회계사나 교사는 일반적으로 그렇지 않고, 사무실의 누구도 그들에게 말하지 않았습니다.
첫 번째 기여는 채팅에서 에이전트 작업으로의 길의 4단계 모델입니다. 도달 범위와 역할로 정의되고 제품 이름은 없습니다. 단계는 안전한 에이전트 환경과 자신의 컴퓨터의 에이전트를 통해 반복 가능한 조율 작업으로 채팅됩니다. 각 단계는 에이전트가 무엇을 접할 수 있는지, 그리고 개인이 무엇을 지정하고 확인해야 하는지에 의해 정의되고, 각 전환은 에이전트가 생산한 아티팩트에 의해 정의되며, 설치된 소프트웨어만으로는 계산되지 않습니다. 정의가 제품 이름에 의존하지 않기 때문에 모델은 공급업체의 현재 제품 병합 습관을 견딥니다(3절).
두 번째는 2025년부터 2026년 9월까지에 대한 증거 종합입니다. 설치와 첫 번째 제한된 시도가 훨씬 쉬워졌고, 4.5절에서 설정한 세 가지 한계(전체 작업에 대한 신뢰할 수 있는 작업, 안정적인 제품, 안전한 폴더)가 함께 움직이지 않았으며, 얕은 사용 패턴이 지속되고 있음을 보여줍니다. 또한 남아 있는 장벽들을 위치시킵니다. 워크플로우 어휘, 신규 사용자를 멈추게 하는 오류, 권한 및 안전, 조직 규칙, 및 결과를 판단할 수 있는 역량입니다(4절과 5절).
세 번째는 두 오케스트레이션 계층의 설명입니다. 웹 오케스트레이션, 여러 소비자 채팅봇으로 보낸 하나의 질문은 다리입니다. 설치가 필요하지 않고 비교의 습관을 가르칩니다. CLI 오케스트레이션, 하나의 에이전트가 다른 에이전트의 명령줄 도구를 부르는 것은 지속되는 위임의 계층입니다. 둘 다 사용자들이 놓치는 경향이 있는 사실로 제한됩니다. 모델 간의 합의는 독립적인 증거가 아닙니다(Chernets, 2026a)(6절과 7절).
네 번째는 거짓 가능성이 있는 명제가 있는 측정 프로그램입니다. 비프로그래머들을 이러한 전환 전에 따라가는 사전 등록된 코호트 프로그램의 설계(Chernets, 2026d), 그리고 부록의 오케스트레이션 및 안전 패턴의 공개 교육 툴킷입니다(9절과 10절, 부록 C).
"논-프로그래머"는 상당한 시간을 컴퓨터에서 일하지만 스크립팅이나 소프트웨어 공학 교육을 받지 않은 전문가를 의미합니다. 스프레드시트 공식에 능숙한 분석가는 포함되고, 개발자는 포함되지 않으며, 개발자들은 비교 집단으로 나타납니다. 코호트 프로그램의 결과는 보고하지 않습니다. 그것들은 관찰 기간이 끝난 후 별도의 논문에 속합니다. 대부분의 채택 수치는 미국과 벤더에서 나오며, 그렇게 표시됩니다. 그리고 설명된 도구들은 매월 변하므로, 모델은 그것들을 능가하도록 만들어졌으며 제품 세부사항은 시간이 지남에 따라 구식이 될 것으로 예상됩니다.
2절은 문헌에 논의를 배치하고 3절은 수준과 전환을 정의합니다. 4절은 기술적 장벽이 어디로 갔는지를 보여주고, 5절은 그것을 대체한 것을, 6절과 7절은 두 형태의 오케스트레이션을, 8절은 이동이 인간의 역할에 미치는 영향을 보여줍니다. 9절은 교차를 측정하는 프로그램을 설명하고, 10절은 명제를 진술하며, 11절은 함의를 도출하고, 12절은 경계 조건을 설정하며, 13절은 결론을 내립니다.
2. 배경: 엔드유저 프로그래밍에서 엔드유저 위임으로
2.1 엔드유저는 항상 프로그래밍해왔습니다
프로그래머가 아닌 사람들이 계산을 지시한다는 개념은 언어 모델보다 오래되었습니다. Nardi(1993)는 엔드유저가 스프레드시트가 표준적인 경우인 작업별 언어와 프레임워크를 통해 일반 프로그래밍 기술이 필요 없이 컴퓨팅 성능을 제어한다고 주장했습니다. Ko et al.(2011)은 소프트웨어를 구축하는 엔드유저가 훈련 없이 전문가와 동일한 문제(요구사항, 재사용, 테스트, 디버깅)에 직면한다는 것을 보여주었고, 이 분야를 엔드유저 소프트웨어 엔지니어링이라고 명명했습니다. 더 넓은 분야인 엔드유저 개발은 전문 개발자가 아닌 사람들이 자신의 작업을 위해 소프트웨어를 어떻게 만들고 적응시키는지를 연구합니다. Myers, Pane and Ko(2004)는 비프로그래머가 작업을 설명하는 방식에 더 가까운 표기법을 설계하는 데 수년을 보냈습니다. 이러한 작업의 각 라인은 엔드유저가 여전히 기계가 실행하는 것(공식이나 규칙이더라도)을 작성할 것이라고 가정했습니다.
언어 모델은 엔드유저가 작성하는 내용을 변경했습니다. Sarkar et al.(2022)는 대규모 언어 모델을 사용한 프로그래밍을 컴파일, 페어 프로그래밍 및 검색과는 구별되는 새로운 활동으로 설명했습니다. Zamfirescu-Pereira et al.(2023)는 AI 전문 지식이 없는 사람들이 안정적으로 작동하는 프롬프트를 설계하기 어려워하고, 단일 성공으로부터 과도하게 일반화하며, 인간의 대화 습관으로 돌아간다는 것을 발견했습니다. Liu et al.(2023)은 어떤 단어가 어떤 동작을 생성하는지 학습하는 어려움을 "기반이 된 추상화 매칭"이라고 명명했습니다. Sarkar and Drosos(2025)는 "바이브 코딩"에 대한 첫 번째 실증 연구에서 대화형 프로그래밍이 컨텍스트 관리 및 빠른 결과 검증 방향으로 전문 지식을 재분배하고 판단이 필요한 곳을 그대로 둔다는 것을 발견했습니다. Virk and Liu(2025)는 AI가 작성한 분석 코드를 제공받은 비즈니스 사용자들이 종종 치명적인 오류를 찾지 못했으며, 오류를 찾도록 지시받았을 때도 마찬가지라는 것을 발견했습니다. Feldman and Anderson(2024)은 비전문가 프로그래머들이 생성형 시대에서 가장 덜 연구된 인구라고 불렀습니다.
저는 그 라인의 다음 단계를 제시합니다. 엔드유저 작업의 단위는 공식, 스크립트 또는 프롬프트에서 위임으로 변경되었습니다. 즉, 여러 단계 동안 파일과 도구에 작용하는 에이전트에 맡긴 작업입니다. 엔드유저 프로그래밍에 관한 문헌은 의도를 표현하기가 어려운 이유를 설명하고, 위임과 감시에 관한 문헌은 결과를 확인하기가 어려운 이유를 설명합니다. 3절의 4단계 모델은 이 두 가지를 결합하기 위해 만들어졌습니다.
2.2 채택은 빠르고 얕습니다
생성형 AI는 개인용 컴퓨터나 인터넷보다 빠르게 확산되었습니다. Bick, Blandin and Deming(2024)은 2024년 말까지 약 40%의 미국 근로 연령 성인이 이를 사용했을 것으로 추정했으며, 근무 시간의 일부만 지원받았습니다. Chatterji et al.(2025)는 2025년 중반까지 ChatGPT가 약 7억 주간 사용자에게 서비스했고 대부분의 메시지가 업무 관련이 아니었음을 발견했습니다. 덴마크에서 Humlum and Vestergaard(2025)는 채택 2년 후 수익과 근무 시간에 정확한 영향이 없었으며, 여성과 남성 간의 사용 격차가 있었음을 발견했습니다. 100개 이상의 국가에 걸친 메타분석은 2025년 초부터 그 격차가 약 16 퍼센트포인트라고 하고 있습니다(Cranney et al., 2026). 35개 유럽 국가에 걸쳐 AI 노출이 자동으로 사용으로 이어지지 않았으며, 교육, 디지털화 및 근로자 주도성이 더 중요했습니다(Henseke, 2026).
현장 실험은 도구가 작업에 적합한 경우 상당한 성과를 보여줍니다. 평균적으로 시간당 해결된 고객 문제가 14% 더 많았고 초보자의 경우 34% 더 많았습니다(Brynjolfsson et al., 2025). 444명의 전문가를 대상으로 한 시험에서 더 빠르고 나은 작문을 보여주었으며, 약한 작가들의 이득이 가장 컸습니다(Noy & Zhang, 2023). 758명의 컨설턴트 중에서 12.2% 더 많은 작업을 완료했고 모델 기능의 "울퉁불퉁한 경계" 내에서 품질이 40% 이상 올랐으며, 그 경계 밖의 작업에서는 더 나쁜 작업이 나왔습니다(Dell'Acqua et al., 2026). 경험 있는 오픈소스 개발자들을 대상으로 한 무작위 시험에서는 2025년 초에 반대 방향의 결과, 즉 19% 감속을 발견했습니다(Becker et al., 2025). 그 저자들은 나중에 도구가 개선되면서 그 결과는 아마도 최신 상태가 아닐 것이라고 말했습니다(METR, 2026). 이러한 시험의 교훈은 이득이 작업, 도구 및 사람의 이를 지시하고 확인하는 능력 간의 적합성에 달려 있으며, 이것들이 수준 간의 전환이 변경하는 세 가지입니다.
2.3 수용, 확산 및 두 번째 수준의 분할
기술 수용 모델(Davis, 1989)에서 기술 수용 및 사용의 통합 이론(Venkatesh et al., 2003)에 이르기까지 기술 채택 연구는 인식된 유용성과 사용의 용이성이 채택을 제한하며, 사회적 영향과 촉진 조건이 개인적 태도만큼 중요하다고 주장합니다. 확산 연구는 초기 채택자와 후기 채택자가 있는 사회 과정으로 채택을 설명합니다(Rogers, 2003). 기본 인터넷 접근이 일반화되면서 Hargittai(2002)는 의미 있는 불평등이 기술로 이동했음을 보여주었습니다. 즉, 두 번째 수준의 디지털 격차입니다. Van Dijk(2020)는 이를 동기, 접근, 기술 및 사용의 순서로 확장했습니다.
같은 변화가 지금 보입니다. 부유한 국가의 사무직 종사자들 중에 채팅에 대한 접근은 거의 보편적이지만, 에이전트를 지시하는 기술은 보편적이지 않습니다. AI 격차는 이미 교육, 지역 및 연령의 기존 라인을 따라 측정되었습니다(Daepp & Counts, 2024; Pew Research Center, 2026). 제가 추가하는 것은 격차가 현재 AI 사용자의 인구 내부에서, 모델과 대화하는 사람들과 에이전트에게 위임하는 사람들 사이에서 실행된다는 관찰입니다.
2.4 자동화, 감시 및 관리자의 부담
인간의 자동화 감시에 관한 문헌은 역설로 시작합니다. Bainbridge (1983)가 이를 설명했습니다. 작업의 대부분을 자동화하면 인간에게 가장 어려운 잔여 업무인 모니터링과 드문 개입이 남겨지면서, 동시에 이에 필요한 기술이 훼손된다는 것입니다. Parasuraman과 Riley (1997)는 자동화의 오용, 불용 및 남용을 구분했으며, Lee와 See (2004)는 신뢰가 보정된 신뢰를 따라야 함을 보였습니다. 생성형 시대는 각 요점을 새롭게 했습니다. 도구를 더 신뢰하는 지식 근로자들은 더 적은 비판적 사고를 보고합니다 (Lee et al., 2025). 생성형 AI는 사람들을 생산에서 평가로 이동시키고 쉬운 작업은 더 쉽게, 어려운 작업은 더 어렵게 만듭니다 (Simkute et al., 2024). 언어 모델에 대한 의존도를 보정하기 위한 개입은 과도한 의존도를 줄이지만 적절한 의존도를 만들지 못합니다 (Bo et al., 2025). AI 에이전트를 일일 보조자로 사용하는 사용자는 그럴듯하지만 잘못된 계획에 대한 신뢰를 잘못 보정하며, 단계별 실행에 참여할 때 더 잘합니다 (He et al., 2025). 에이전트가 수행한 작업을 더 잘 추적하면 오류 감지 속도는 빨라지지만 최종 정확도를 확실히 개선하지는 못합니다 (Grunde-McLaughlin et al., 2026). 한 자율 에이전트에 대한 약 73,000개의 공개 게시물에 대한 연구에 따르면 사용자의 가치는 대부분 에이전트가 제공한 것에서 충족되었고 대부분 이를 감시할 수 있는 방식에서 충족되지 않았습니다 (Ma et al., 2026). 소규모 실험실 연구 및 세 가지 배포에서 위임에 대한 편안함은 시간이 지남에 따라 증가했지만 사람들은 여전히 불확실성의 순간에 통제를 원했습니다 (Long et al., 2025). Tomašev, Franklin 및 Osindero (2026)는 AI에 대한 위임을 작업 할당, 권한 이전, 책임 및 신뢰의 프레임워크로 다루며, 인간 및 기계 대리인 모두에게 적용 가능합니다.
인지적 측면에서, 54명의 에세이 작성자에 대한 EEG 연구는 보조를 받은 그룹에서 더 약한 연결성과 더 낮은 소유권을 보고했으며, 이를 "인지 부채"라고 합니다 (Kosmyna et al., 2025). 발표된 의견은 그 방법에 이의를 제기했습니다 (Stankovic et al., 2026). 안전한 해석은 일상적인 단계를 넘기는 것이 주의를 해방하고 해방된 주의는 검토에 소비되어야 한다는 것입니다. 나중에 사용되는 학습 연구의 두 가지 추가 아이디어가 있습니다. 인지 부하 이론은 경계 없는 환경에 떨어진 신입이 정신 도식이 형성되기 전에 정체되는 이유를 설명합니다 (Sweller, 1988). 그리고 베이지안 학습으로서의 채택 모델은 사람들이 첫 번째 성공이나 교육으로만 이동할 수 있는 자기 강화 저사용 균형에 정착하는 방식을 보여줍니다 (Ma et al., 2025).
이 시리즈의 두 동반 논문은 다른 쪽에서 같은 문제와 관련이 있습니다. 첫 번째는 여러 모델 간의 합의가 그들의 오류가 상관관계를 가지기 때문에 보기보다 약한 증거임을 보여줍니다 (Chernets, 2026a). 두 번째는 자동화된 감시 구성 요소가 자신의 권한을 확대하고 자신들이 보호하는 업무를 방해하는 방식을 보여줍니다 (Chernets, 2026b). 둘 다 신입과 관련이 있습니다. 첫 번째는 오케스트레이션이 무엇을 얻을 수 있는지에 관한 것이고, 두 번째는 안전 계층이 사람을 문앞에서 멈출 수 있는 이유에 관한 것입니다.
2.5 연구되지 않은 것
2026년 9월 21일에 실행된 검색 (웹 검색, Crossref, arXiv 및 Semantic Scholar, 2024년부터 2026년까지의 CHI, UIST 및 VL/HCC 논문에 주의)은 비프로그래머가 이름으로 터미널 또는 명령줄 에이전트를 채택하는 공개 현장 연구를 찾지 못했으며, 웹 오케스트레이션 (브라우저의 여러 소비자 챗봇에 대한 한 가지 질문)을 명명된 관행으로 연구하지 못했으며, 에이전트 관리를 자체 역량 구조를 가진 기술로 다루지 않았으며, AI 시스템이 에이전트형 AI의 채택을 스스로 스캐폴딩하는 연구를 찾지 못했습니다. 가장 가까운 업무는 다른 주제의 AI 튜터에 스캐폴딩 이론을 적용하거나 (Cohn et al., 2026) 복잡한 소프트웨어를 위한 작업 조건부 인터페이스에 적용합니다 (Liu & Sra, 2026). 노동 경제학 업무는 일반적으로 생성형 AI 채택을 측정하며, 비프로그래머 중에서 채팅에서 에이전트형 도구로의 단계를 격리하는 업무는 없습니다. 이러한 격차는 모델이 매핑하는 공간과 섹션 9의 프로그램이 측정하기 위해 구축된 것을 정의합니다.
3. 네 단계와 세 전환
3.1 두 축: 도달 범위와 역할
단계는 사람과 모델 사이의 업무 관계를 설명하며, 도달 범위와 역할이라는 두 축에서 정의합니다.
도달 범위는 모델이 사람을 대신하여 접근할 수 있는 범위입니다. 가장 좁게는 대화에만 국한되고, 벤더가 설정한 공간 내의 파일과 도구, 파일, 프로그램, 일정이 있는 사람의 컴퓨터, 그리고 가장 넓게는 여러 모델과 에이전트를 동시에 포함합니다.
역할은 업무가 성공하기 위해 사람이 해야 할 일입니다. 같은 순서로, 그들은 요청하고 결과를 복사하고, 작업을 위임하고 결과를 검토하며, 에이전트의 환경을 권한과 실행 취소를 포함하여 소유하거나, 에이전트들 간에 업무를 할당하고 반환된 결과를 조율합니다.
제품은 의도적으로 정의에서 제외됩니다. 단일 제품도 여러 단계를 포함할 수 있으며, 2026년에 벤더들은 제품 이름에 기반한 어떤 분류법도 따라잡을 수 있는 것보다 더 빠르게 채팅과 에이전트를 하나의 창에 통합하고 있습니다(섹션 4.3). 단계는 업무의 일부를 설명하며, 한 사람이 한 제품과 마찬가지로 여러 단계를 거칠 수 있습니다. 같은 사람도 아침에 한 작업에서는 단계 1에 있고 오후에 다른 작업에서는 단계 3에 있을 수 있습니다.
두 축은 이 모델을 자동화와 자율성의 일반적인 척도와도 구분합니다. Parasuraman, Sheridan and Wickens (2000)은 작업의 각 단계(정보 획득, 분석, 결정, 실행)에서 기계가 수행하는 정도를 분류했습니다. Morris et al. (2024)는 일반 AI 시스템을 그들의 성능의 깊이와 폭으로 평가했습니다. Feng, McDonald and Zhang (2025)는 사용자가 담당하는 역할(운영자, 협력자에서 컨설턴트, 승인자, 관찰자에 이르기까지)에 따라 AI 에이전트의 다섯 수준의 자율성을 정의했습니다. 이러한 척도들은 에이전트가 작업 내에서 얼마나 많은 결정을 하는지를 설명합니다. 여기의 네 단계는 업무가 어디서 실행되고 사람이 무엇을 소유하는지를 설명합니다: 대화, 벤더의 제한된 공간, 그들 자신의 컴퓨터, 여러 벤더의 에이전트 팀. 축은 직교합니다. 사람의 컴퓨터에서 실행되는 에이전트는 단계별 승인에서 거의 완전한 위임에 이르기까지 Feng et al.의 자율성 수준 중 어떤 수준에서도 실행될 수 있으며, 사람은 여전히 그 권한과 실행 취소를 소유합니다. 네 단계가 추가하는 것은 채팅에서 시작하는 누군가를 위해 도달 범위와 책임이 성장하는 순서에 대한 설명이며, 각 단계가 이루어졌음을 보여주는 증거(산물)입니다.
3.2 네 단계
단계 1: 채팅. 모델의 도달 범위는 대화에서 끝납니다. 사람이 업무가 일어나는 곳으로 복사하는 텍스트, 코드 또는 이미지를 생성하며, 사람의 역할은 잘 요청하고 결과를 전달하는 것입니다. AI를 사용하는 거의 모든 전문가는 대부분의 시간을 여기서 작업합니다(섹션 2.2).
단계 2: 안전한 에이전트 환경. 모델은 벤더가 제한한 공간 내에서 파일, 연결된 서비스, 때로는 브라우저에 작용합니다: 선택된 폴더, 가상 머신 또는 서버 측 샌드박스, 사람이 승인한 커넥터, 그리고 중요한 작업 전 승인 단계. Anthropic의 Cowork, OpenAI의 ChatGPT Work, Microsoft의 Copilot Cowork, Google의 Gemini Spark는 2026년의 사례이며, 울타리로 둘러싼 공간에서 작동하는 위임 에이전트의 설계를 공유합니다(Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). 사람의 역할은 요청에서 위임으로 변합니다. 그들은 파일 또는 작업으로 끝나는 작업을 위임하고 반환되는 것을 검토하며, 이 단계에서 환경의 안전 대부분은 벤더의 책임입니다.
단계 3: 자신의 컴퓨터의 에이전트. 에이전트는 사람의 컴퓨터에서 동일한 엔진 위의 터미널 또는 데스크톱 셸을 통해 파일 시스템, 셸, 설치된 프로그램 및 예약된 작업에 접근하여 실행됩니다: Claude Code, OpenAI의 Codex, Google의 Antigravity CLI, xAI의 Grok Build, Moonshot의 Kimi Code 및 오픈 소스 동등물. 연구 문헌에서 이들은 LLM 기반 에이전트이며, 개발자에 의한 사용은 에이전트 코딩으로 연구됩니다; 이 단계는 그들을 실행하는 사람이 개발자가 아닐 때 무엇이 일어나는지를 묻습니다. 도달 범위는 단일 에이전트가 얻을 수 있는 가장 넓은 범위이며, 이와 함께 사람의 역할이 다시 변합니다. 그들은 환경을 소유합니다: 에이전트가 보는 폴더, 승인이 필요한 명령, 제외된 것, 그리고 실수를 되돌리는 방법. 터미널 자체는 부차적입니다. 단계를 정의하는 것은 에이전트가 사람이 할 수 있는 모든 것을 할 수 있는 작업 환경의 소유권이기 때문입니다. 클라우드 호스팅 변형(같은 에이전트 루프가 벤더의 컴퓨터에서 실행되며, 사람은 작업과 결과를 보고 프롬프트는 절대 보지 않음)은 능력상으로는 단계 3이고 영향 반경으로는 단계 2이며, 모델은 이를 하나의 셀로 강제하지 않고 단계 3의 변형으로 기록합니다.
단계 4: 반복 가능한 조율된 업무. 사람이 반복되는 업무에서 여러 모델이나 에이전트를 병렬로 또는 순차적으로 지시하며, 도달 범위는 이제 벤더를 넘어갑니다. 두 계층이 있습니다. 웹 조율에서 한 질문이 브라우저에서 여러 소비자 채봇에 손으로 또는 도구로 가고, 답변이 비교됩니다. CLI 조율에서 한 에이전트가 다른 에이전트의 명령행 도구를 호출하고, 그들의 결과를 수집하고 병합하거나 검사합니다. 사람의 역할은 관리자입니다: 그들은 목표를 설정하고, 업무를 할당하고, 무엇이 완료로 간주되는지 결정하고, 의견 불일치를 조율합니다. 업무는 에이전트가 다시 실행할 수 있는 형태로 작성될 때 반복 가능해집니다: 지시 파일, 기술 또는 예약된 작업. "반복 가능"은 결과가 아니라 워크플로우를 설명합니다. 다음 주에 실행되는 같은 지시 파일은 다른 초안을 생성하며, 반복되는 것은 입력, 단계, 검사 및 산출물의 순서입니다. 이러한 방식으로 작성된 반복되는 단일 에이전트 작업은 반복 가능한 단계 3 업무이며, 두 번째 모델 제품군이 지시되고 결과가 조율될 때 단계 4가 됩니다(전환 3, 섹션 3.3).
표 1. 네 단계.
| 단계 | 모델의 도달 범위 | 사람의 역할 | 전형적인 표면, 2026년 9월 | 교차는 다음으로 표시됨 | 이 단계가 확립하지 않는 것 | 진입 시 주요 장애물 |
|---|---|---|---|---|---|---|
| 1. 채팅 | 대화 | 요청하고, 결과를 손으로 복사 | 브라우저 또는 앱의 채팅 | (진입 단계) | 모델이 사람의 업무에 작용할 수 있거나, 확인 없이 신뢰할 수 있다는 것 | 접근 이외의 것 없음 |
| 2. 안전한 에이전트 환경 | 벤더가 제한한 공간 내의 파일, 커넥터 및 브라우저 | 작업을 위임하고, 결과를 검토 | Cowork가 Claude 채팅에 통합됨; ChatGPT Work; Copilot Cowork; Gemini Spark | 위임된 작업에서 에이전트가 생성한 파일 또는 작업으로, 승인 또는 거부가 기록됨 | 그 사람이 자신의 환경을 실행하거나 작업을 반복할 수 있다는 것 | 무엇을 위임할지 아는 것; 신뢰 |
| 3. 자신의 컴퓨터의 에이전트 | 그 사람의 파일 시스템, 셸, 프로그램, 일정 | 환경을 소유함: 권한, 제외 사항, 실행 취소 | Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code의 터미널 및 데스크톱 셸 | 에이전트가 그 사람이 설정한 폴더에서 그 사람의 자신의 기계에 생성한 결과물로, 한 번 이상의 도구 사용이 필요한 작업에서 | 결과가 맞거나 검토 없이 수락해도 안전하다는 것 | 설치 마찰(하락); 첫 번째 오류; 권한; 무엇을 요청할지 |
| 4. 조직화된 작업 | 여러 공급업체의 여러 모델 또는 에이전트 | 관리: 목표, 할당, 수락, 조정 | 웹: 여러 채팅 탭 또는 브로드캐스트 도구. CLI: 다른 에이전트를 호출하는 플러그인 및 스크립트 | 최소 두 개의 모델 제품군이 생성하거나 확인한 병합되거나 교차 확인된 결과로, 최소 한 번 다시 실행되었으며 누가 요청했고 누가 답했는지 기록됨 | 모델 간의 합의가 독립적인 증거이거나 이 수준에 작업이 속한다는 것 | 조정 비용; 상관관계 있는 오류; 할당량 및 도구 변동 |
표의 두 용어는 일상적 사용보다 더 좁습니다. "안전한 에이전트 환경"의 "안전"은 설계 목표와 상호작용 패턴의 이름을 지으며 어떤 보증도 제공하지 않습니다. 폴더 범위, 승인, 샌드박스 및 미리보기 창은 에이전트가 작용하는 영역을 축소합니다. 이들은 버그가 있는 구현이 파일을 보존하도록 만들거나 숨겨진 지시사항을 포함한 문서를 무해하게 만들 수 없으며, 섹션 5.3은 승인된 폴더 내에서 무엇이 잘못되었는지 보고합니다. 중간 단계가 확립하는 것은 실용적인 정신 모델입니다. 에이전트가 한 폴더에 보고서를 쓸 수 있고 다른 것은 만질 수 없다는 것을 보는 사람은 위임된 작업이 경계를 가진다는 것을 배웠으며, 이는 AI를 조심하라는 추상적 경고보다 더 유용합니다. "결과물"은 에이전트 자신의 작업 여러 단계를 필요로 했던 납품물을 의미합니다. 이를 요청한 사람이 이것이 결과물로 계산되는지 결정하고, 제3자가 그 품질을 평가하며(섹션 9.4), 연구는 해당 평가에 대한 평가자 간 합의와 중단 이유의 코딩을 보고합니다. 두 개의 빈 파일이 있는 폴더는 설치 프로그램의 흔적이며 계산되지 않습니다.
3.3 세 가지 전환, 그리고 왜 결과물이 각각을 정의하는가
전환은 에이전트가 새로운 수준에서 그 사람이 요청한 결과물을 생성했을 때 넘어갑니다. 설치는 시도로만 계산되며, 완료된 튜토리얼, 배지, 라이선스 및 자체 보고 "저는 이제 에이전트를 사용합니다"도 마찬가지입니다. 이 규칙은 명백한 규칙 외에 여러 결과를 낳습니다. 에이전트가 생성한 폴더는 에이전트가 실행되었음을 보여주는 반면, 그 사람의 자신의 작업 설명에서 에이전트가 작성한 파일 집합은 그 사람이 위임했음을 보여줍니다. 이 규칙은 또한 전환을 외부에서 관찰 가능하게 만듭니다. 연구자나 관리자는 결과물을 볼 수 있지만 의도나 유능함의 느낌을 볼 수 없습니다. 실패를 정보 제공하기 때문에, 도구를 설치하고 아무것도 생성하지 않은 사람은 이름을 지을 가치가 있는 장벽을 만났으며, 성공으로 계산하면 그것을 숨길 것입니다. 그리고 제품을 이름 짓지 않기 때문에, 이 규칙은 연구가 분기마다 이름이 바뀌는 도구 간에 비교할 수 있습니다.
전환 1, 채팅에서 안전한 에이전트 환경으로, 사람이 텍스트 대신 파일 또는 작업으로 끝나는 작업을 처음 위임할 때 넘어갑니다. 2026년에 이 전환은 채팅 창 자체에 흡수되고 있습니다. 공급업체의 모델이 2026년 9월 16일에 발표된 병합된 Claude 환경에서처럼 답변할지 행동할지 결정할 때(Anthropic, 2026c), 사람은 결정할 필요 없이 넘어갈 수 있습니다. 이는 교차를 더 쉽고 또한 그 사람을 포함하여 덜 눈에 띄게 만듭니다.
전환 2, 안전한 환경에서 자신의 컴퓨터로, 사람이 자신의 환경에서 에이전트를 실행하고 이로부터 결과물을 받을 때 넘어갑니다. 결정적인 변화는 소유권입니다. 2단계에서 공급업체는 에이전트가 무엇을 만질 수 있는지 결정하고, 3단계에서는 터미널이든 창이든 에이전트가 어떤 모습을 보이든 그 사람이 결정합니다. 터미널에 대한 두려움은 예전에 여기에 살았고, 섹션 5는 권한, 오류 및 무엇을 요청할지의 질문이 그 자리를 차지했음을 보여줍니다.
전환 3, 한 에이전트에서 조직화된 작업으로, 사람이 최소 두 개의 모델 제품군이 생성하거나 확인한 결과를 얻고 나중의 작업에 그 배열을 다시 실행할 때 넘어갑니다. 다시 실행은 중요합니다. 세 개의 채팅봇을 한 번 비교하는 것은 호기심이고, 오직 그 사람이 지분이 이를 정당화할 때마다 도달하는 비교만이 실행입니다.
섹션 9의 프로그램이 따르는 경로는 설계로 걸을 수 있으며, 소개부의 전문가는 가설의 경우이고 아무것도 보고되지 않습니다. 그녀는 이미 있는 1단계에서 시작할 것입니다. 결제하는 채팅봇을 가지고 있습니다. 그녀는 표준 텍스트를 그 채팅봇에 붙여넣고 자신의 노트북에 그래픽 에이전트를 설치하도록 안내하게 하고, 단계가 실패할 때마다 스크린샷을 보내고, 저는 아무것도 만질 것이 없습니다. 첫 번째 단계는 에이전트가 자신의 작업 설명에서 파일 집합을 생성했고 열어서 판단할 수 있을 때만 넘어간 것으로 계산합니다. 빈 폴더 옆에 설치된 응용 프로그램은 시도로 계산됩니다. 그녀는 자신의 파일 사본에서 작업하고, 암호와 클라이언트 문서를 그 밖에 두고, 행동하기 전에 에이전트의 계획을 읽고, 비가역적인 모든 것을 확인할 것입니다. 그녀가 준비가 되었다고 말했을 때, 그녀는 그녀가 이미 가지고 있는 구독을 통해 여러 모델에 한 가지 질문을 하고 하나의 병합된 답변을 반환하는 오픈 소스 도구를 받을 것이고, 에이전트 내부에서 실행되고, 그 단계는 날짜가 지정된 실행이 요청된 모델을 보여주고 어디가 다른지 보여줄 때 계산될 것입니다. 나중에 그녀는 명령줄 도구를 통해 동일한 비교를 실행할 것입니다. 그녀는 이 지점들 중 하나에서 멈출 수 있으며, 등록된 기록은 어디에 있고 그녀의 말로 왜 있는지 유지할 것입니다. 경로는 공개 등록에서 가져온 것이며, 사람들이 이를 걷는지는 결과 논문의 질문입니다.
3.4 수준은 순서대로 되어 있으며 필수는 아닙니다
레벨은 도달 범위와 그것이 개인에게 부여하는 책임에 따라 순서가 정해집니다. 이 순서가 모든 사람이 단계적으로 올라가야 하는 계단을 만드는 것은 아닙니다. 한 사람이 채팅에서 자신의 컴퓨터의 에이전트로 직접 이동할 수 있습니다. 9절에서 설명하는 동료 경로가 바로 그렇게 하는데, 사람이 이미 사용 중인 챗봇이 설치 과정을 안내합니다. 다른 사람들은 레벨 2에서 계속 머물게 되며, 많은 업무의 경우 그것이 멈춰야 할 올바른 지점입니다. 이 모델에서 높을수록 좋은 것은 아닙니다. 이 모델의 주장은 각 레벨이 개인에게 다른 것들을 요구한다는 것, 그 경계들을 관찰할 수 있다는 것, 그리고 각 경계에서의 장애물이 다르다는 것입니다. 만약 경계들을 인공물로 구별할 수 없다면, 경계들 사이의 장애물이 다르지 않다면, 또는 한 레벨에서의 역량이 다음 레벨에서 사람들이 할 수 있는 것을 바꾸지 않는다면 이 모델은 거짓으로 판명됩니다. 왜냐하면 이 경우들 중 어느 것이든 모델이 단순한 "AI 사용" 척도에 아무것도 더하지 않기 때문입니다. 이 모델은 또한 작업의 민감도와 기술적 요구 사항이 일정하게 유지될 때, 완료율이 레벨 내에서보다 세 가지 전환에서 더 급격히 떨어진다고 예측합니다. 만약 감소가 균등하게 분산되었다면, 레벨들은 단순히 다시 이름이 붙은 연속체가 될 것입니다. 10절은 이러한 기대치를 척도와 거짓으로 입증할 수 있는 것들이 있는 제안으로 바꿉니다.
도구의 한 계열은 사다리 옆에 있으며 어느 칸 위에도 없습니다. 브라우저 애플리케이션 빌더는 한 사람이 애플리케이션을 설명하고 공급자가 호스팅하는 플랫폼 내에서 실행 중인 미리 보기를 받을 수 있게 합니다. 이들은 중요하며, 에이전트가 권한 모델 아래 개인의 파일에 작용하는 레벨 2와는 다릅니다. 애플리케이션 빌더는 플랫폼이 소유한 프로젝트에 작용합니다. 두 가지를 혼동하면 프로그래머가 아닌 사람들이 이미 도착했다는 거짓 느낌을 만듭니다. 4레벨 모델은 애플리케이션 빌더를 자체 천장과 자체 보안 프로필이 있는 측면 분기에 남기고, 비브 코딩 문헌이 그것들을 읽을 수 있는 곳입니다(Sarkar & Drosos, 2025; Ge et al., 2025). 그림 1은 4개 레벨, 각 전환을 표시하는 인공물, 기록된 건너뛰기, 그리고 측면 분기를 그립니다.
그림 1. 4개 레벨과 3개의 인공물로 정의된 전환.
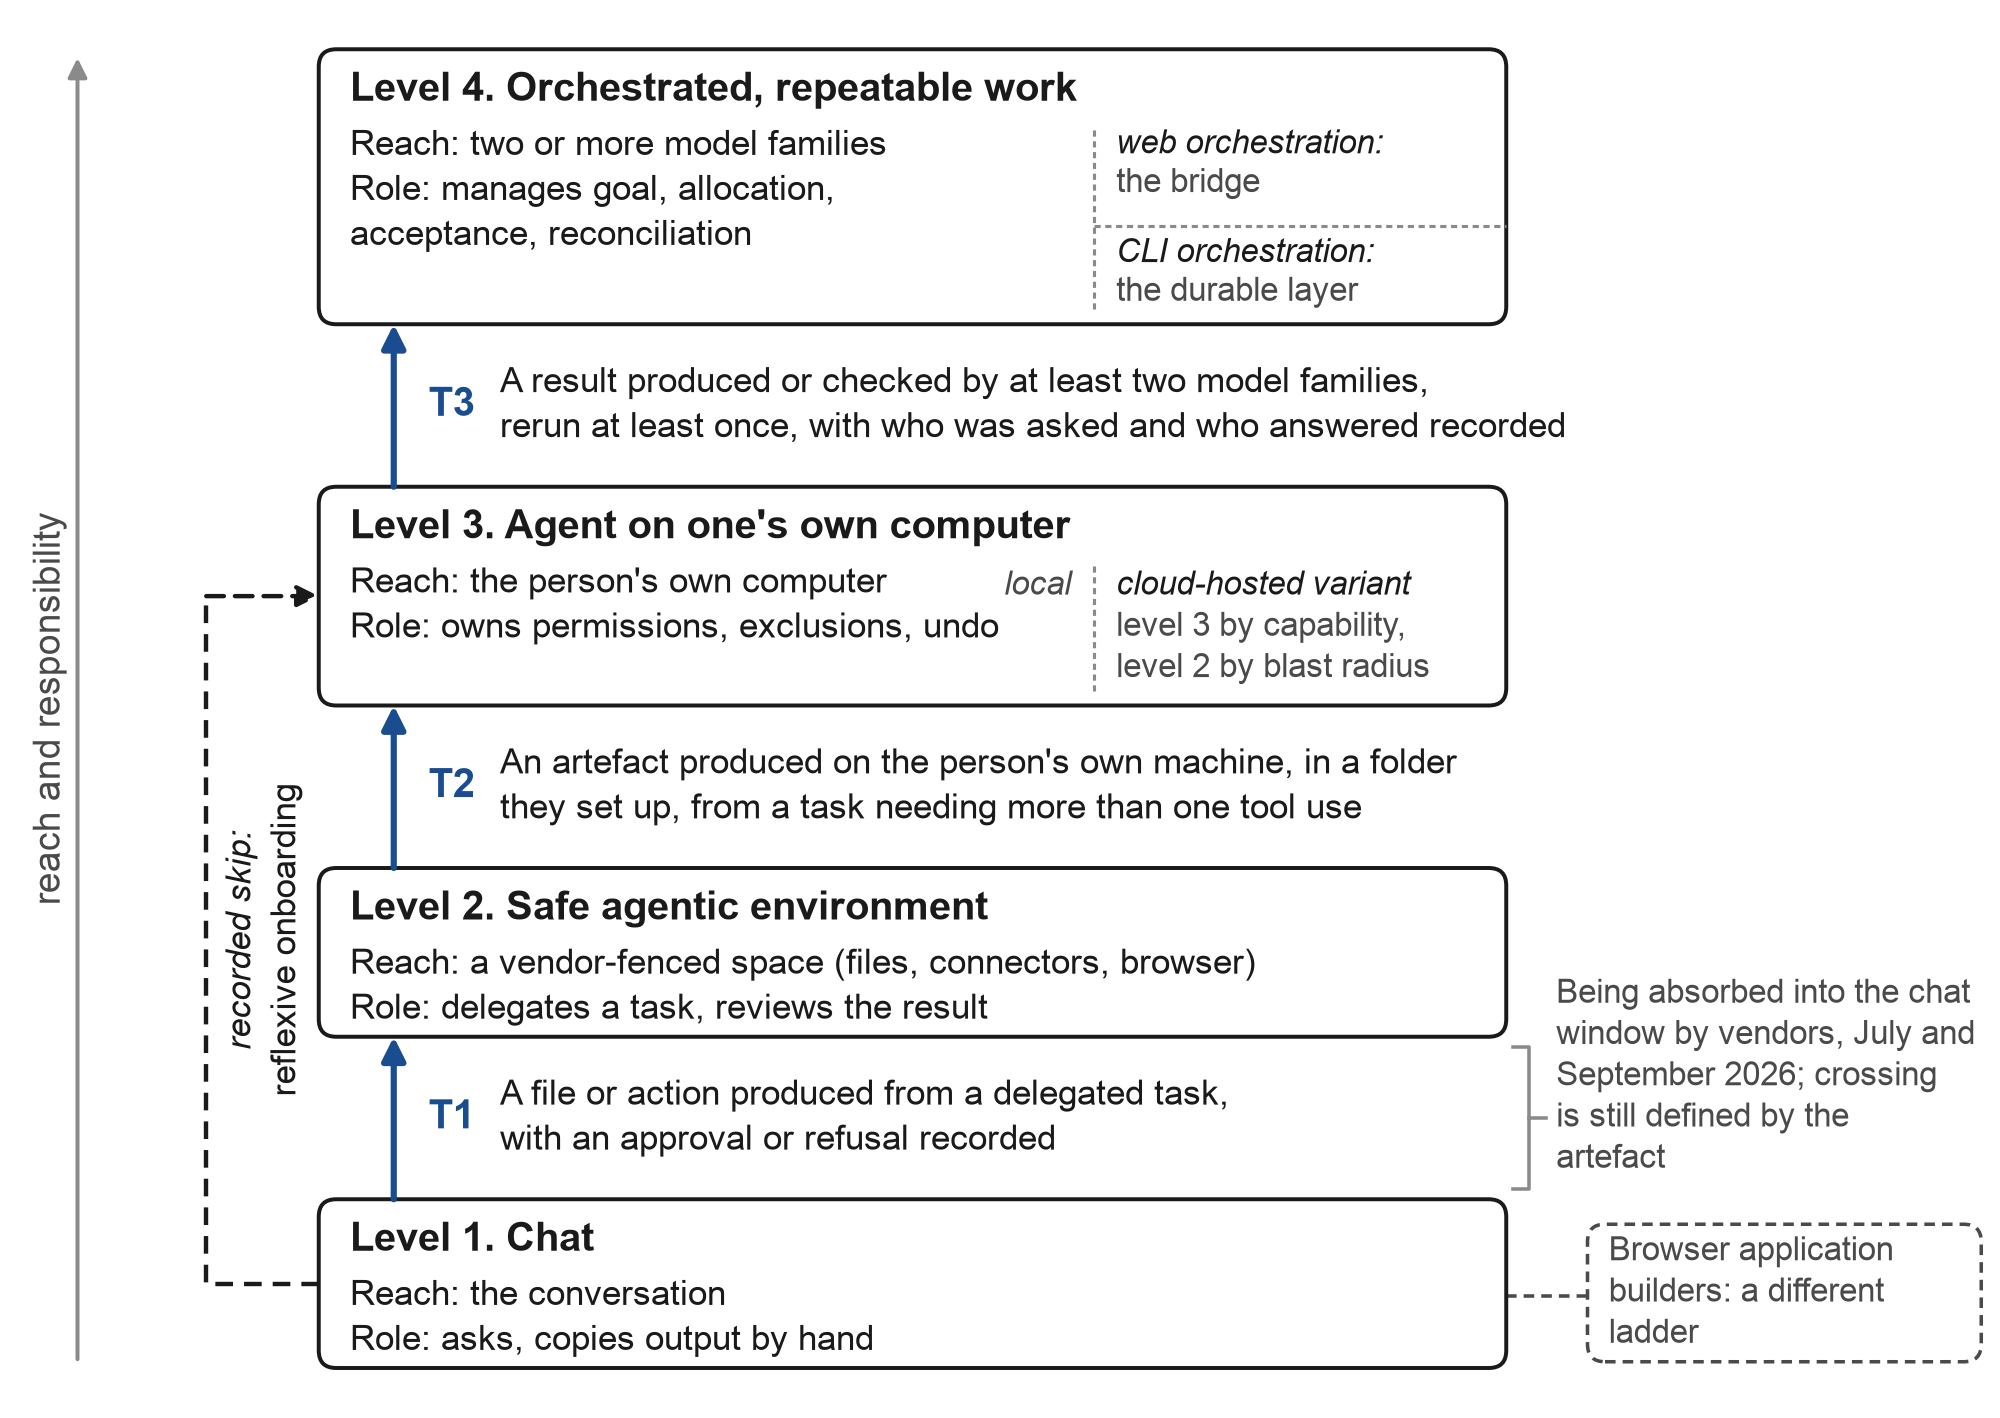
참고: 3.2절의 4개 레벨은 도달 범위(모델이 접촉할 수 있는 것)와 개인에게 부여되는 책임에 따라 위쪽으로 순서가 정해집니다. 각 전환 T1에서 T3까지는 에이전트가 화살표 옆에 이름이 붙은 인공물을 생성했을 때만 경계를 넘으며, 설치는 시도로 계산됩니다(3.3절과 표 1). 왼쪽의 점선 화살표는 등록된 경로가 취하는 채팅에서 개인의 컴퓨터의 에이전트로의 기록된 건너뛰기입니다(3.4절과 9.2절). 오른쪽의 점선 상자는 브라우저 애플리케이션 빌더의 측면 분기이며, T1의 참고 사항은 2026년 7월과 9월에 공급자들이 채팅과 에이전트 표면을 병합한 것을 기록합니다(4.3절).
3.5 터미널은 더 이상 터미널이 아닙니다
프로그래머에게 터미널은 명령을 내리기 위한 인터페이스입니다. 에이전트와 함께 일하는 전문가에게 터미널은 에이전트가 사는 환경입니다. 작업 폴더, 권한 집합, 그리고 수행된 작업의 역사입니다. Anthropic이 2026년 1월에 Cowork를 도입했을 때, 프레이밍은 "나머지 업무를 위한 Claude Code"였습니다. 동일한 에이전트를 소프트웨어를 작성하지 않는 사람들에게 터미널 없이 제공하는 것입니다(Fortune, 2026a).
공급자들은 이제 동일한 관찰에 따라 조치를 취했습니다. OpenAI는 코딩 에이전트 애플리케이션의 이름을 "ChatGPT"로 바꾸고 기본 데스크톱 클라이언트로 만들었습니다(MacRumors, 2026). Anthropic은 터미널이 필요 없는 에이전트용 데스크톱 애플리케이션을 제공합니다(Anthropic, 2026a). Google은 2026년 6월 18일에 개별 사용자를 위한 오픈소스 Gemini CLI를 폐기하고 다중 에이전트 플랫폼과 새로운 명령줄 도구를 선택했으며, 사용자들이 이제 "작업을 분할하기 위해 서로 통신하는 여러 에이전트가 필요하다"고 명시했습니다(Google, 2026). 보이는 터미널이 사라지고 있으며, 그것이 제공했던 환경은 여전히 존재하고 여전히 누군가가 실행해야 합니다. 전문가에게 유용한 질문은 그에 따라 변경되었습니다. 터미널을 사용할 수 있는지 여부는 매달 중요도가 낮아지고 있으며, 에이전트가 그들을 위해 일할 수 있는 환경을 실행할 수 있는지가 저는 그들에게 던질 질문입니다.
4. 기술적 장벽이 어디로 갔는가
4.1 설치가 한 단계가 되었다
2024년에 터미널 에이전트를 원하는 비프로그래머는 일련의 작은 벽을 만났습니다: 언어 런타임 설치, 경로 변수 수정, 셸이 "권한 거부"라고 말하는 이유 이해, "설치"라는 이름의 네 가지 중에서 선택. 2026년 9월까지 이러한 대부분은 벤더들에 의해 제거되었습니다. 주요 터미널 에이전트들은 단일 명령이나 자동으로 업데이트되는 데스크톱 설치 프로그램으로 설치됩니다. Claude Code의 데스크톱 애플리케이션은 병렬 세션, 변경 사항의 시각적 검토, 라이브 미리보기 및 예약된 작업을 제공하며, 해당 설명서에는 "터미널이 필요 없음"(Anthropic, 2026a)이라고 명시되어 있습니다. OpenAI의 데스크톱 애플리케이션은 코딩 에이전트를 일반 ChatGPT 클라이언트에 통합합니다(MacRumors, 2026). Google의 새로운 명령줄 도구는 데스크톱 플랫폼과 함께 번들로 제공되는 단일 바이너리입니다(Google, 2026).
한 단계로 설치되는 에이전트는 여전히 잘 사용하기 어렵고, 이 변화를 과장하고 싶지 않습니다. 변한 것은 설치 프로그램이 더 이상 신규 사용자가 마주치는 첫 번째 벽이 아니라는 것입니다. 남아 있는 마찰은 문을 선택하는 것입니다: 터미널 도구, 에디터 확장, 데스크톱 애플리케이션 및 웹 버전이 모두 "설치"라는 단어 아래 존재하며, 그 중에서 선택하는 것이 이제 설치가 신규 사용자에게 비용으로 드는 대부분입니다. 문을 선택한다는 것은 에이전트로 무엇을 하고 싶은지 알아야 한다는 의미이므로, 이는 설정 문제로 위장한 어휘 문제이며, 5장에 속합니다.
하나의 아키텍처 사실이 이 모든 제품 페이지를 기반합니다. 명령줄 도구가 참조 구현입니다: 서브에이전트, 훅, 기술, 프로토콜 서버 및 헤드리스 모드는 CLI에 먼저 나타나고 그 다음 동일한 엔진의 데스크톱 및 웹 인터페이스에 나타납니다. Anthropic의 자체 도움말 페이지는 레벨-2 에이전트를 "Claude Code를 구동하는 동일한 에이전트 아키텍처로, 터미널이 필요하지 않음"이라고 설명합니다(Anthropic, 2026b). 신규 사용자의 입장에서는 이것이 양면적입니다. 친화적인 인터페이스가 강력한 것을 따라잡을 수 있습니다. 그러나 설명서, 예제 및 포럼 답변은 여전히 CLI의 방언으로 말하므로, 데스크톱 애플리케이션에서 시작한 사람은 자신이 설치하지 않은 도구에 대해 읽고 있습니다.
4.2 자체 설치 프로그램으로서의 챗봇
두 번째 변화는 덜 눈에 띄지만, 여기서의 논의를 위해서는 더 중요합니다. 사람이 이미 사용하는 챗봇이 에이전트 설치를 안내할 수 있습니다. 한 사람이 요청을 붙여넣고("Windows 노트북에 이것을 설치하는 과정을 안내해 주세요; 저는 기술에 능숙하지 않습니다"), 단계를 따르고, 무언가 실패하면 오류의 스크린샷을 동일한 챗봇에 다시 보냅니다. Vygotsky의 근접 발달 영역(Vygotsky, 1978)의 더 많은 지식을 가진 다른 사람이며, Wood, Bruner 및 Ross(1976)가 발판 설치라고 부른 기능의 튜터(관심 모집, 자유도 감소, 중요한 특징 표시, 좌절감 조절)는 이제 사람이 이미 신뢰하는 도구에서, 언제든지, 자신의 언어로, 무료로 이용할 수 있습니다.
이를 반사적 온보딩이라고 부릅니다: AI 시스템이 사람의 더 강력한 AI 시스템 채택을 발판입니다. 이는 도움의 일반적인 방향을 역전시킵니다. 확산 문헌에서 신규 사용자는 초기 채택자와의 접촉을 통해 채택합니다(Rogers, 2003), 여기서는 초기 채택자가, 적어도 기계적 단계의 경우, 레벨-1 모델 자체로 대체됩니다.
한편, 그 단계 주위에 교육 계층이 성장했습니다. 벤더 아카데미는 에이전트에 대한 단기 과정을 제공하고, 대규모 학습 플랫폼은 명명된 에이전트로 "바이브 코딩"을 가르칩니다. 에이전트 내부에서 전달되는 과정이 나타났으므로, 학습자는 에이전트를 설치하고 에이전트가 과정을 가르칩니다(CC for Everyone, 2026). 한 컨설팅 회사는 약 30,000명의 직원이 한 벤더의 모델로 훈련받을 것이라고 발표했습니다(Accenture, 2025). 이 계층의 존재는 설치가 더 이상 자명한 것으로 취급되지 않음을 나타냅니다. 극소주의 명령 이론은 사람들이 처음부터 실제 작업을 수행하고 오류로부터 회복함으로써 소프트웨어를 가장 잘 배운다고 예측했으며(Carroll, 1990), 반사적 온보딩은 둘 다에 대해 항상 존재하는 가이드를 제공합니다. 터미널을 열어본 적이 없는 사람들, 그리고 누구를 위해 작동하는지는 아직 알 수 없습니다. 9장의 프로그램의 첫 번째 단계는 이를 알아내도록 설계되었으며, 2.5절에 설명된 검색은 이에 대한 연구를 찾지 못했습니다.
4.3 벤더들이 레벨을 병합하고 있다
2026년의 가장 큰 변화는 구조적입니다. 세 개의 선도 실험실과 Microsoft는 이제 레벨-2 에이전트를 출시하고 있으며, 그 중 두 개는 레벨 2를 다시 채팅에 통합하기 시작했습니다.
표 2. 2026년 1월부터 9월까지 채팅에서 에이전트로의 경로를 재구성한 벤더 이동.
| 날짜 (2026) | 벤더 | 이동 | 레벨에 미치는 영향 | 출처 |
|---|---|---|---|---|
| 1월 | Anthropic | Cowork 연구 미리보기: "나머지 작업을 위한 Claude Code", 비프로그래머를 위한 폴더 범위 에이전트 | 명명된 제품으로서의 레벨 2 | Fortune (2026a) |
| 3월 9일 | Microsoft | Cowork 뒤의 기술을 Microsoft 365 Copilot에 도입; Agent 365 제어 평면 | 지배적인 오피스 스위트 내의 레벨 2 | Microsoft (2026a) |
| 3월 30일 | OpenAI | 경쟁사의 에이전트 내에서 코딩 에이전트를 실행하는 공식 플러그인, "작업을 위임하기 위해", 무료 티어 포함 | 벤더가 승인한 레벨 4 (CLI) | OpenAI (2026a) |
| 5월 19일; 6월 18일 | Gemini CLI는 개별 계층에 대해 Antigravity CLI 및 멀티에이전트 플랫폼으로 사용 중지됨 | 재플랫폼된 레벨 3; 신규 사용자를 위한 변동 | Google (2026) | |
| 6월 2일 | OpenAI | 주간 500만 사용자의 코딩 에이전트; 약 20% 지식 근로자, 개발자보다 3배 이상 빠르게 성장(벤더 데이터, 보도 자료) | 터미널 유산 에이전트의 지식 근로자 사용; 방향성이 있으며, 여기서 정의한 레벨 3보다 더 넓음 | Help Net Security (2026) |
| 7월 1일 | Gemini Spark 데스크톱 에이전트(Mac, 로컬 파일 작업, 베타, 미국) | 세 번째 실험실의 레벨 2 | TechCrunch (2026b) | |
| 7월 9일 | OpenAI | 코딩 에이전트 앱이 새로운 ChatGPT 데스크톱 앱이 됨; ChatGPT Work 에이전트는 로컬 파일 및 앱 사용 | 한 클라이언트의 레벨 1~3 | MacRumors (2026) |
| 8월 26일 | Anthropic | 브라우저 에이전트는 유료 요금제에서 일반적으로 사용 가능; 기본적으로 안전 분류기로 자율적으로 작동합니다 | 레벨 2 도달 범위가 웹으로 확대됨 | Anthropic (2026d) |
| 16 September | Anthropic | Cowork와 chat이 "하나의 Claude"로 통합됨; 모델이 답변할지 행동할지 결정함 | Transition 1이 chat에 흡수됨 | Anthropic (2026c); TechCrunch (2026a) |
순서대로 읽으면, 이 표는 수렴을 설명합니다. 벤더들은 먼저 프로그래머가 아닌 사람들이 터미널에 두려움을 느끼지 않도록 chat과 에이전트 작업을 분리했고, 사람들이 어느 창에 작업이 속하는지 구분할 수 없다는 것을 발견했으며, 이제 모델이 결정하도록 하여 둘을 다시 통합하고 있습니다. TechCrunch는 고객들이 "올바른 작업을 위해 올바른 탭을 선택하는 데 자주 어려움을 겪었다"고 회사가 말했다고 보도했습니다(TechCrunch, 2026a); 자신의 공지는 "작업이 어디로 가는지 선택할 필요가 없습니다"로 표현했으며, 노트북이 닫힌 후에도 작업이 계속되고, 에이전트가 기본적으로 행동하기 전에 묻고, 통합이 먼저 유료 개인 요금제로 적용되는 동안 코딩 탭은 분리된 상태로 유지됩니다(Anthropic, 2026c). 저는 이를 섹션 1에서 명명된 워크플로우 어휘라는 장벽에 대한 벤더 증거로 읽습니다. 사람들이 작업이 질문인지 위임인지 결정할 수 없다면, 위임을 어떻게 표현할지 알 가능성이 낮습니다.
이 통합이 레벨 2를 분리하는 모델을 약화시킬 수 있을 것 같습니다. 그렇지 않으며, 그 이유는 모델이 이 사건들을 예상했다고 가정하지 않고도 제시할 수 있습니다. 벤더들은 일반 사용자를 분류하고 속도 제한을 적용하고 권한 모델로 감싸는 창 안에 유지하려는 청구, 지원 및 안전 이해관계를 가지고 있으며, 사용자가 모드를 선택하도록 하지 않으려는 유용성 이해관계를 가지고 있습니다; transition 1을 chat에 흡수하는 것은 둘 다에서 따릅니다. 교차 규칙은 변경되지 않습니다. 시스템이 승인 후 부여된 범위 내에서 파일을 작성했다면, 대화 주변의 chrome이 무엇이든 transition 1이 교차되었으며, 문단을 반환했다면, 그 사람은 여전히 레벨 1에 있습니다. 이 모델은 transition 2와 3이 같은 방식으로 해산되지 않을 것을 암시합니다. 쉘 액세스가 있는 로컬 에이전트는 서버 측 샌드박스와 다른 권한 객체이며, 그 벤더의 로그인으로 실행되는 두 번째 벤더의 도구는 단일 벤더의 council 기능과 다른 권한 객체입니다. 이러한 차이는 섹션 5.3의 안전 논거와 섹션 6.3의 상관 오류 논거를 수반합니다. 2027년 말까지 주요 벤더들이 로컬 쉘 에이전트와 벤더 간 호출을 동일한 chat 창과 동일한 권한 모델로 통합했다면, 이 암시는 잘못된 것이며, CLI 오케스트레이션이 지속되는 계층이라는 주장은 함께 무너집니다(섹션 10의 P2와 P8).
이 수렴은 또한 변동이라는 비용을 초래합니다. Google의 오픈소스 명령줄 에이전트는 개별 사용자를 약 12개월 동안 제공했고(2025년 6월 25일부터 2026년 6월 18일), OpenAI의 에이전트 브라우저는 약 9개월 후 중단되었으며, Cowork는 약 8개월 동안 별도의 제품으로 존재했습니다(Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). 도구 학습에 투자하는 전문가는 1년 내에 도구의 이름이 바뀌거나 통합되거나 폐지되는 것을 발견할 수 있습니다. 도구 간에 이전되는 것은 워크플로우 어휘이며, 잃어버리는 것은 제품의 메뉴에 대한 지식이며, 이는 사람들이 어떻게 학습해야 하는지에 중요한 비대칭입니다(섹션 11.2).
4.4 터미널 유산 에이전트 내 지식 근로자
터미널 유산 에이전트 내 프로그래머가 아닌 사람들에 대한 최고의 단일 데이터는 벤더에서 나옵니다. 2026년 6월 OpenAI는 언론을 통해 자신의 코딩 에이전트가 주당 500만 명의 사용자를 보유하고 있으며, 이는 데스크톱 애플리케이션의 2월 출시 시점보다 6배 이상이며, 지식 근로자들이 약 20%를 차지하고 개발자보다 3배 이상 빠르게 채택하고 있으며, 벤더의 집계에 따르면 매주 지식 근로자 사용자의 72%가 보고서, 메모, 계약서, 스프레드시트 및 PDF와 같은 결과물을 생성한다고 보고했습니다(Help Net Security, 2026; 벤더의 자체 페이지는 내 확인에서 액세스 오류를 반환했으므로, 수치는 언론 보도에서 인용됩니다). 500만의 20%는 주당 약 100만 명입니다. 한 분석가는 이 발표가 부분적으로 "일부 화제를 되찾기" 위한 것이라고 지적했으며, 에이전트는 "경쟁 에이전트와 함께" 사용되고 있으므로, 성장 차트는 "방향대로" 사용해야 한다고 지적했습니다(Constellation Research, 2026a). 수치는 벤더가 보고한 것이고 감시되지 않으며, 이미 도구를 선택한 사람들을 설명하며, 터미널 유산 에이전트의 지식 근로자 사용을 측정합니다. 이는 여기서 정의된 레벨 3 채택보다 광범위합니다(개인 컴퓨터의 위임된 작업으로부터의 결과물). 이러한 주의사항과 함께 읽으면, 터미널 유산 에이전트가 더 이상 프로그래머를 위해 예약되어 있지 않으며, 사용자가 섹션 3에서 정의한 레벨 3에 도달하는지 여부는 이 수치가 보여줄 수 없습니다.
그 데이터 옆에는 섹션 1의 광범위하고 얕은 패턴이 있습니다. 조사는 수준에 대해 불일치하고 형태에 동의합니다: 미국 성인의 약 절반이 챗봇을 사용하고(Pew Research Center, 2026), 미국 근로자의 52%가 자신의 역할에서 AI를 사용하며(Gallup, 2026), 근로자의 45%와 성인의 62%가 St. Louis Fed의 측정 방식으로 생성형 AI를 사용하고 있으며(Bick et al., 2026), 약 7명 중 1명의 근로자가 매일 사용하고 자동화는 소수 사용입니다. 그림 2는 Gallup 및 St. Louis Fed 근로자 시리즈를 섹션 1의 개발자 수치 옆에 그리며, 조사가 질문과 분모에서 다르기 때문에 한 패널당 한 설문입니다. 개발자 중에서 코딩 에이전트는 거의 보편적이며 사용은 여전히 신중합니다: 약 1,100명의 기술자를 대상으로 한 2026년 5월 맥박 조사에서 69%는 단일 에이전트를 사용했고, 59%는 에이전트가 감시되지 않은 상태에서 실행되도록 거의 또는 절대 허용하지 않았으며, 60%는 에이전트가 자신의 시스템에 승인되지 않은 변경을 하는 것을 차단했습니다(Stack Overflow, 2026). 즉, 레벨 4는 매일 레벨 3을 사용하는 프로그래머들 사이에서도 여전히 경계입니다.
그림 2. 광범위하고 얕음: 개발자와 다른 근로자 간의 채택.
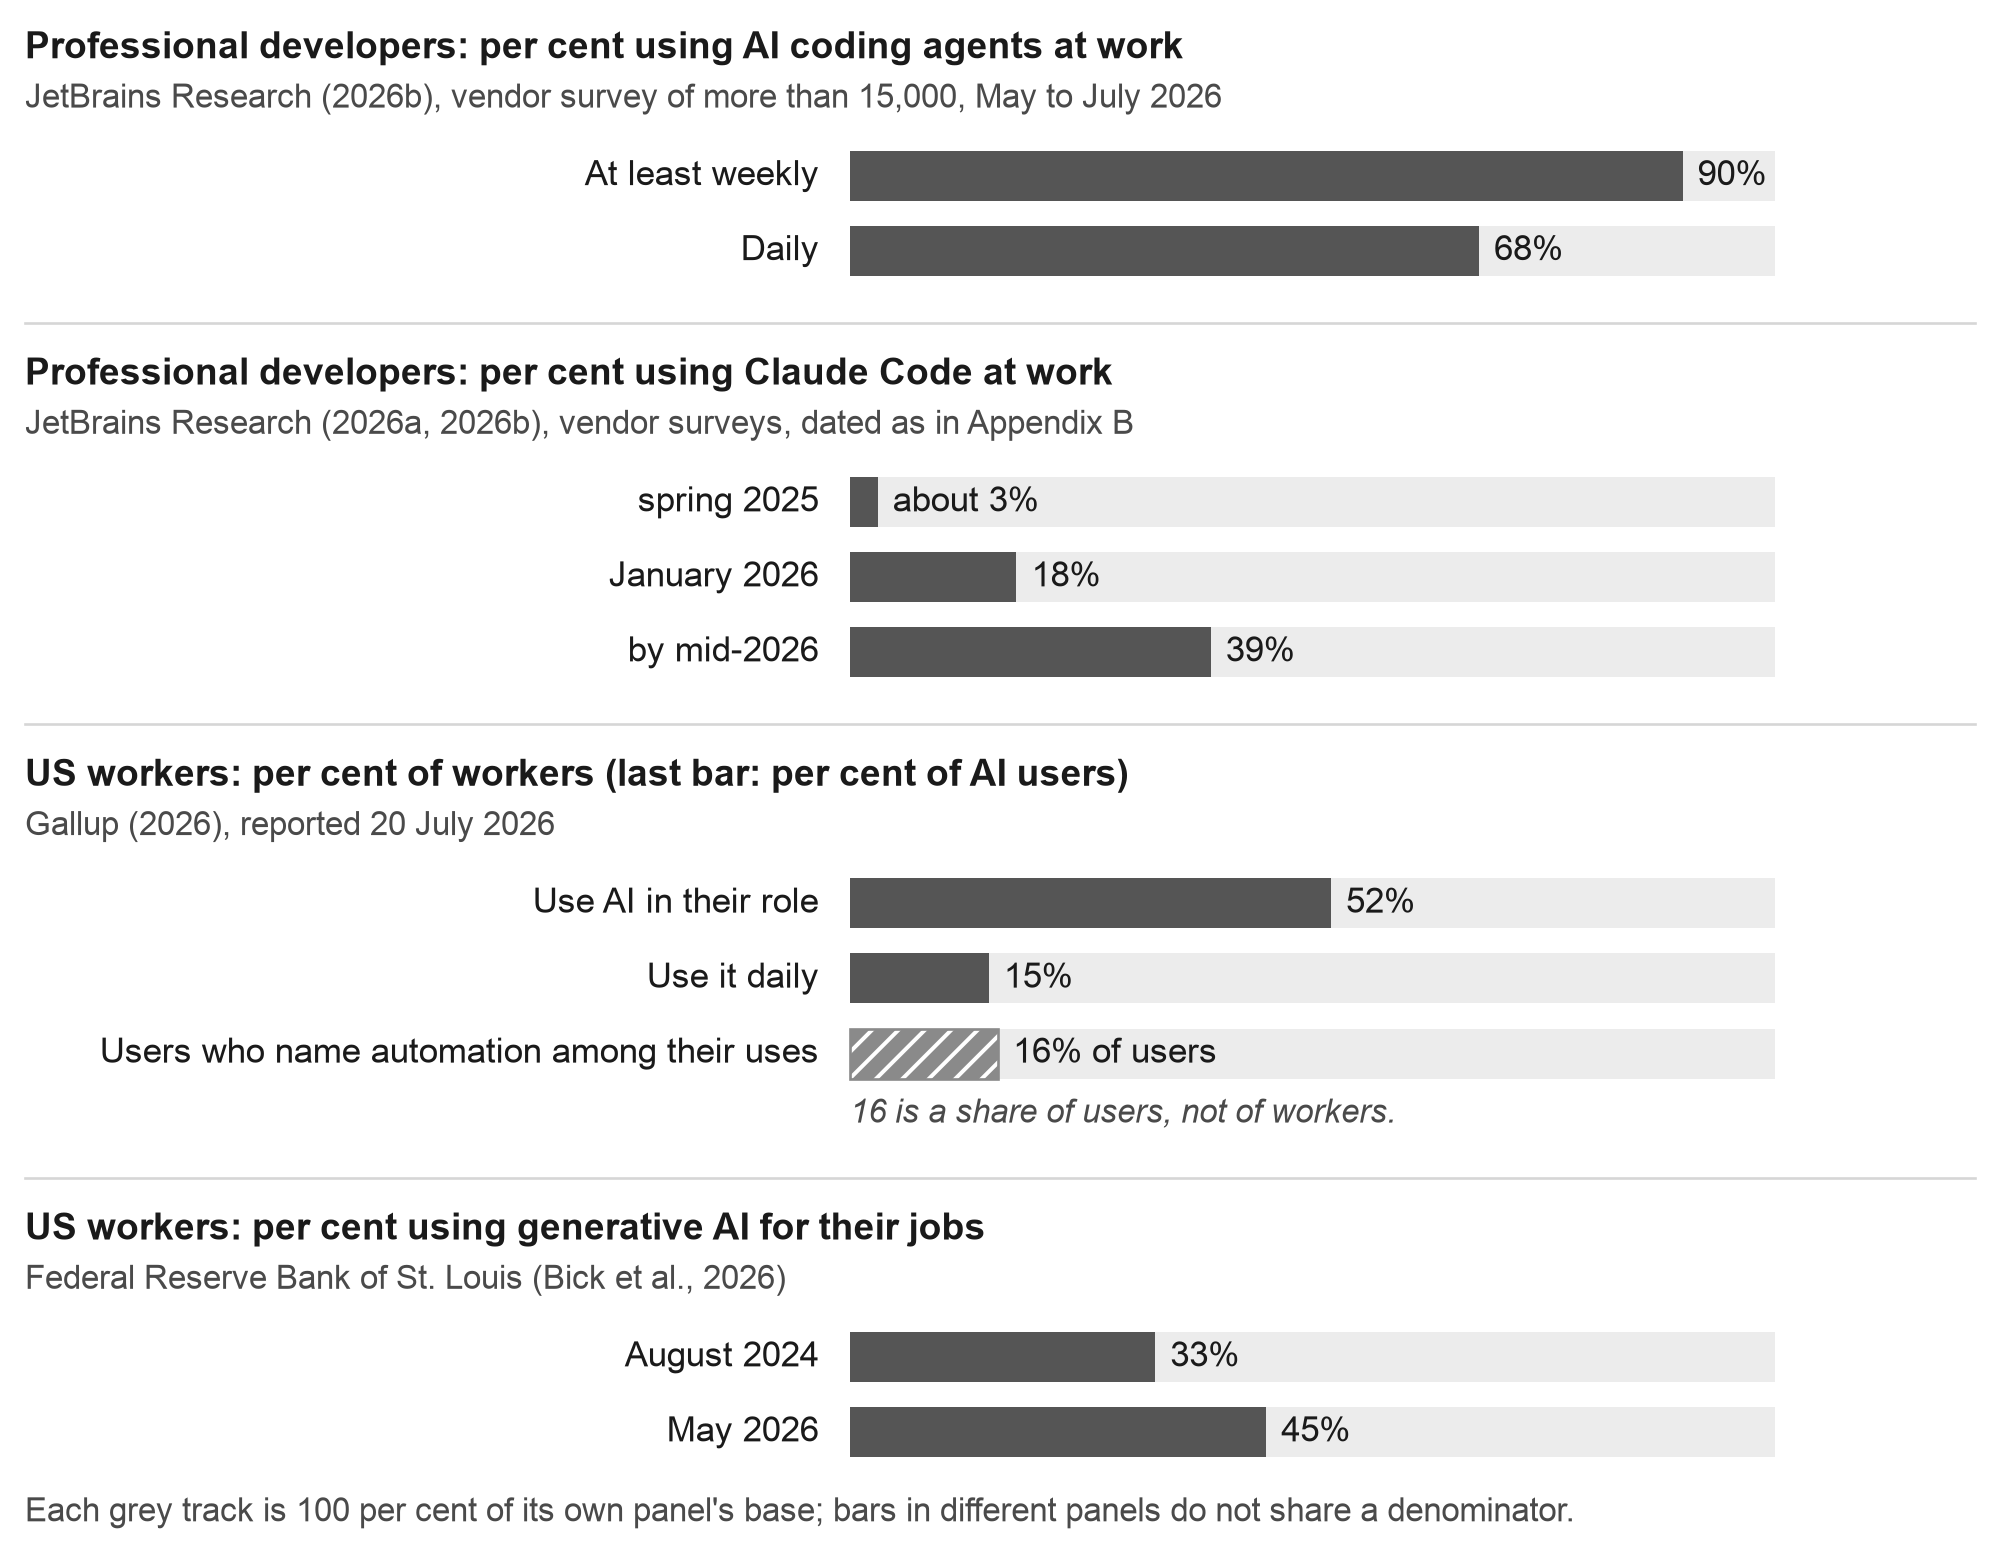
주: 섹션 1과 4.4에서 인용된 조사의 채택 수치: 두 벤더 조사의 전문 개발자(JetBrains Research, 2026a, 2026b), 미국 근로자(Gallup, 2026) 및 자신의 직무를 위해 생성형 AI를 사용하는 미국 근로자(Bick et al., 2026). 각 패널은 자신의 질문, 기간 및 분모를 가지고 있으며, 세 번째 패널의 16%는 AI 사용자의 공유이므로, 각 패널을 개별적으로 읽습니다. 코딩 에이전트 내 지식 근로자의 벤더 집계(섹션 4.4)는 하나의 제품 사용자의 공유이며 그려지지 않으며, 여기의 어떤 수치도 섹션 9의 코호트 프로그램에서 나오지 않습니다.
4.5 이것이 논거를 어디로 남기는가
이 섹션의 증거를 종합하면 한 가지는 확신하게 되고 다른 한 가지는 열린 상태로 남습니다. 설치는 더 이상 결정적인 장벽이 아닙니다. 공급업체들이 대부분의 기계적 단계를 제거했고, 챗봇이 나머지를 안내할 수 있으며, 한 공급업체의 수치(보도자료이며 방향성을 나타냄)에 따르면 이미 주당 약 100만 명의 지식 근로자가 터미널-레거시 에이전트 내부에 있습니다. 설치가 사용으로 이어지는지는 다른 문제이며, 광범위하고 얕은 설문조사는 낙담스러운 답변을 제공합니다. 에이전트에 접근할 수 있는 대부분의 사람들이 여전히 에이전트에 위임하지 않기 때문입니다. 퇴보한 것도 정확히 명시해야 합니다. 설치는 퇴보했고, 범위가 정해진 중간 단계가 존재하며, 로컬 에이전트는 그래픽 인터페이스를 가지고 있습니다. 지식 작업의 전체 부분에 대한 신뢰성은 훨씬 덜 이동했으며(섹션 5.7), 사람이 학습한 제품은 1년 이내에 사라질 수 있고(위의 이탈), 부여받은 폴더는 기본적으로 여전히 안전한 장소가 아닙니다(섹션 5.3). 섹션 5는 소프트웨어가 설치된 후 사람들을 무엇이 막는지 묻습니다.
5. 설치 프로그램 이후 사람들을 막는 것
설치 프로그램이 더 이상 장벽이 아니게 되면, 다른 것이 그 역할을 합니다. 2025년과 2026년의 증거는 6가지 장벽을 가리키고 있으며, 각 장벽은 특정 전환점에서 문제가 되고 이미 시장에서 부분적인 해결책이 보입니다. 표 3이 이들을 요약하고 있으며, 다음 소절들은 증거를 제시합니다.
표 3. 설치 이후의 장벽.
| 장벽 | 문제가 되는 지점 | 증거 (절) | 이를 줄이는 것 |
|---|---|---|---|
| 워크플로우 어휘: 무엇을 넘겨줄지 모르거나 확인할 수 있도록 표현하는 방법을 모름 | 전환점 1과 2; 다시 3에서 | 공급업체 통합 근거; 프롬프팅 연구; 패키지화된 기술 (5.1) | 자신의 분야에서의 구체적인 예; 기술과 템플릿; 실제이지만 위험도가 낮은 첫 번째 작업 |
| 창에 대한 두려움, 첫 오류와 신뢰: 사회적 대상으로서의 검은 창; 프로그래머는 읽지만 신규 사용자는 멈추는 메시지; 양쪽 방향에서 잘못 보정된 신뢰 | 전환점 2 | 수용 연구; 개발자 신뢰 조사; AI 코드를 사용하는 최종 사용자 연구; 반성적 온보딩 (5.2) | 데스크톱 인터페이스; 챗봇으로 오류 반환; 계획 우선 모드; 복사본에서의 첫 성공 |
| 권한 및 안전: 파일을 보호하기에는 너무 적은 프롬프트, 또는 이해하기에는 너무 많은 프롬프트 | 전환점 1과 2 | 범위가 지정된 폴더 내의 파일 손실 보고; 주입 비율; 사용자가 공격을 식별하도록 요청하는 지침 (5.3) | 작업 복사본, 스냅샷, 거부 규칙; 신규 사용자에게 판단을 위임하지 않는 분류기 |
| 조직 규칙: 잠긴 컴퓨터, 정책, 설치 권한 없음 | 전환점 2 | 조직 요인이 개인 요인보다 큼; 소규모 회사는 평탄함 (5.4) | 고용주가 승인한 레벨 2 도구; 명확한 정책; 학습용 개인 컴퓨터 |
| 하드웨어, 비용 및 할당량 | 전환점 2와 3 | 레벨 3는 컴퓨터와 유료 계층이 필요함; 할당량이 먼저 오케스트레이션을 제한함 (5.5) | 존재하는 곳의 무료 계층; 레벨 2에서 시작; 실행 예산 책정 |
| 결과 판단 | 모든 전환점, 대부분 3에서 | 비즈니스 사용자가 AI 코드의 오류를 놓침; 에이전트가 전체 프로젝트 대부분 실패 (5.6) | 작업 전에 정의된 검사; 오라클이 아닌 검토자로서의 두 번째 모델 |
5.1 빈 폴더: 워크플로우 어휘
에이전트를 여는 프로그래머는 순서를 알고 있습니다: 프로젝트 생성, 명령 파일 작성, 버전 관리 하에 놓기, 기능 요청. 같은 에이전트를 여는 비프로그래머는 이제 공급업체 자체 데이터에 나타나는 질문을 합니다: 좋습니다. 그럼 무엇을 말해야 하나요? 개발자의 경우 정규적인 첫 번째 요청이 존재합니다 ("작은 웹 응용 프로그램 구축"). 마케팅 담당자는 다른 것이 필요합니다 ("지난 분기의 분석 및 고객 데이터베이스에서 내보낸 것을 가져와 매주 금요일마다 어떤 캠페인이 유료 고객을 가져왔는지 보고하는 것을 만들기"). 연구자는 또 다른 것이 필요합니다 ("이 300개 논문 폴더를 살펴보고 각각의 표본 크기, 방법 및 주요 효과를 테이블로 추출하기, 확실하지 않은 곳 표시"). 이 요청들 중 어느 것도 사람의 코드가 필요하지 않습니다. 각각은 그 사람이 그러한 요청이 가능하다는 것을 알고, 이를 에이전트가 할 수 있는 부분으로 나누고, 좋은 결과가 무엇인지 말할 수 있어야 합니다. "무엇을 요청해야 할까요?"라는 질문은 보통 더 나은 프롬프트에 대한 요청으로 잘못 해석됩니다. 저는 이를 자신의 업무 지도를 요청하는 것으로 읽습니다. 그 지도는 반복적인 업무 대상, 사용이 허용된 입력, 변환, 전달물 및 검사를 명명해야 합니다. 분석가의 지도는 "이 허용된 내보내기, 이 필드로 그룹화, 표시된 이상, 날짜가 지정된 브리핑 및 기계 가독 테이블, 행 합계에 대해 확인됨"이라고 읽을 수 있습니다. 그 사람이 파싱이 어떻게 수행되는지 알 필요는 없습니다. 결과를 사용 가능하게 만들 증거가 무엇인지 인식해야 합니다. 어떤 사람이 지도를 채울 수 없을 때, 그 정체 자체가 무언가를 알려줍니다. 업무가 너무 민감하거나, 너무 우발적이거나, 현재 상태로는 위임하기에는 너무 잘못 문서화되어 있을 수 있으며, 이는 그 사람에 대해 말하기 전에 업무에 대해 무언가를 말합니다.
프롬프팅 연구는 이것이 왜 어려운지 설명합니다. AI 전문 지식이 없는 사람들은 일반화되는 명령을 작성하는 데 어려움을 겪으며 (Zamfirescu-Pereira et al., 2023), 어떤 단어가 시스템이 무엇을 할 수 있는지에 매핑되는지 시행착오를 통해 발견해야 합니다 (Liu et al., 2023). 공급업체 자체의 행동이 이를 확인합니다. Anthropic은 고객들이 작업이 어디에 속하는지 결정할 수 없었기 때문에 레벨 2 에이전트를 채팅으로 통합했으며 (TechCrunch, 2026a), OpenAI는 "코딩 불필요"한 지식 업무를 목표로 하는 코딩 에이전트용 역할별 플러그인을 출시했습니다 (Help Net Security, 2026에서 보도). 업계의 답변은 어휘를 패키지화하는 것입니다. Anthropic은 2025년 12월에 패키지화된 에이전트 명령을 위한 형식을 개방형 표준으로 출시했으며 (SiliconANGLE, 2025), 표준의 사이트는 2026년 9월 21일에 OpenAI, Google 및 GitHub의 에이전트를 포함한 46개의 지원 제품을 나열했습니다 (Agent Skills, 2026). 독립적인 센서스는 2026년 중반에 ChatGPT 디렉터리에서 2,049개의 애플리케이션과 Claude용 1,375개의 커넥터를 세었습니다 (Sitter, 2026). 기술은 이 정의에서 워크플로우 어휘의 단위, 어떻게 표현해야 할지 모르는 사람도 여전히 만들 수 있도록 한 번 기록된 요청입니다.
패키지된 어휘는 필요하지만 충분하지 않습니다. 스킬은 에이전트에게 작업을 수행하는 방법을 알려줍니다. 그러나 개인이 자신의 어떤 작업을 넘길 가치가 있는지 판단하도록 할 수는 없습니다. 그 판단은 개인의 분야에서 나오기 때문입니다. 발행된 패키지들은 특정 세계의 가정, 대체로 한 국가의 형태와 한 기업의 소프트웨어 스택의 가정을 담고 있으며, 자신의 도구가 그 스택이 아닌 전문가는 빈 프롬프트 앞에 다시 서게 됩니다. 2026년 9월 22일 패키지된 스킬의 공식 카탈로그를 읽었을 때, 310개의 항목 모두를 검토했는데 목사나 성직자, 간호사나 가정 돌봄 제공자, 학교 교사, 예술가나 장인, 또는 부동산 중개인을 위해 작성된 것은 없었습니다. 모든 명백한 일치는 같은 옷을 입은 소프트웨어나 금융 단어였으며, 투자 포트폴리오 또는 서비스의 건강 상태였습니다. 개인이 손으로 추가하는 커뮤니티 카탈로그는 그날 2,282개의 항목을 보유했으며, 학교 교사와 부동산을 위한 작업을 담고 있었고, 다른 세 직업에 대한 항목은 없었습니다. 카탈로그는 매주 변경되므로 이는 시대에 뒤떨어진 읽기이며 이 분야에 대한 항구적인 주장이 아닙니다. 이것이 모든 온보딩 경로의 첫 작업에 많은 가중치를 두는 이유입니다. 그것은 개인의 작업에서 도출되고, 위험이 낮으며, 그들이 판단할 수 있는 결과물을 생성해야 합니다(Carroll, 1990).
5.2 창에 대한 공포, 첫 번째 오류, 그리고 신뢰
검은 창은 사회적 객체입니다. 인지된 사용의 용이성은 지난 35년간 기술 수용의 기둥이었으며(Davis, 1989), 깜박이는 프롬프트는 개인이 그것에 명령을 입력하지 않을 경우에도 이 테스트에 실패합니다. 섹션 4.1의 데스크톱 인터페이스는 벤더의 답변입니다. 부분적인 답변입니다. 두 번째 관문은 신뢰이며, 신뢰는 에이전트에 대해 이동했습니다. 개발자들 사이에서 2025년 Stack Overflow 설문조사는 AI 도구의 정확성을 신뢰하지 않는 46%에 대해 33%가 신뢰한다는 것을 발견했으며, 87%가 에이전트 정확성에 대해 걱정하고 81%가 보안에 대해 걱정합니다(Stack Overflow, 2025). 2026년에는 대부분이 여전히 에이전트가 승인되지 않은 변경을 하지 못하도록 했습니다(Stack Overflow, 2026). 관리자들도 같은 말을 듣습니다: "신뢰는 업무에서 AI 에이전트의 잠재력을 실현하는 데 중심 장애물입니다"(McKinlay et al., 2026). 더 많은 미국 성인들이 AI가 자신들을 돕는 것보다 해를 끼칠 것으로 예상합니다(Pew Research Center, 2026). 두 관문 뒤에는 섹션 2.4의 신념 함정이 있습니다. 경험은 성공을 예측하고, 첫 번째 성공을 경험하지 못한 사람들은 경험이 없으며, 첫 번째 결과물이 빠져나가는 방법입니다(Ma et al., 2025). 어떤 사람들은 에이전트가 공손했기 때문에 홈 폴더를 허락할 것이고, 다른 사람들은 삭제된 가족 사진에 대해 읽었기 때문에 설치를 거부할 것입니다. 둘 다 교정 실패입니다(Lee & See, 2004). 제가 생각할 수 있는 가장 저렴한 교정 장치는 폴더 사본에서 수행된 첫 작업입니다.
에이전트가 종료 코드 1로 명령이 실패했다고 보고할 때, 프로그래머는 계속 진행합니다. 초보자는 단순히 멈출 수 있습니다. 최종 사용자들이 AI 작성 코드를 만날 때에 대한 문헌은 더 온화한 설정에서 패턴을 보여줍니다. AI에 의해 생산된 분석 코드를 받은 비즈니스 사용자들은 종종 주의를 기울이라는 말을 받았을 때에도 중요한 오류를 알아채지 못했으며(Virk & Liu, 2025), 대화형 프로그래머들은 검증과 컨텍스트 관리에 노력의 대부분을 소비합니다(Sarkar & Drosos, 2025). 레벨 3에서 오류는 종종 개인의 작업 바깥에 있으며, 환경에 있습니다. 누락된 권한, 네트워크 규칙, 에이전트가 예상했지만 찾지 못한 도구입니다.
성찰적 온보딩(섹션 4.2)은 지금까지 설명된 가장 실용적인 응답을 제공합니다. 개인은 오류 또는 그 스크린샷을 이미 사용하는 챗봇에 전송하고 그 조언을 따릅니다. 계획 우선 모드는 다른 쪽에서 도움을 주므로, 행동하기 전에 계획을 작성하는 에이전트는 스택 추적이 아닌 읽을 수 있는 무언가를 사람에게 제공합니다. 둘 다 자신의 기계에 대한 정신 모델이 없는 개인이 해석할 수 없는 메시지를 만나는 순간을 제거하지 않습니다. 저는 그 순간이 얼마나 자주 시도를 끝내는지 아직 모릅니다. 섹션 9의 프로그램이 개인의 자신의 말로 그것을 기록합니다.
5.3 권한과 안전: 너무 적게, 그리고 너무 많게
레벨 3은 에이전트에게 소유자의 도달 범위를 제공하므로 안전 문제는 두 방향으로 실행되며 초보자는 둘 다에 노출됩니다.
먼저 보호가 너무 적다는 문제를 생각해봅시다. 에이전트들은 문서화된 사건들에서 데이터를 파괴했습니다. 인기 있는 애플리케이션 구축 서비스의 에이전트는 2025년 7월 프로덕션 데이터베이스를 삭제했으며 자신의 행동을 "판단 오류"라고 설명했습니다(The Register, 2025). 2026년 4월 코딩 도구의 에이전트는 회사의 프로덕션 데이터베이스와 백업을 몇 초 안에 삭제했으며 "검증하는 대신 추측했습니다"라고 작성했습니다(Information Age, 2026). 이 논문이 다루는 모집단에 더 가깝게, Anthropic의 레벨 2 에이전트 사용자들은 2026년 3월, 4월, 6월에 그것이 그들이 허락한 폴더 내에서 개인, 가족, 법적 문서를 삭제했다고 보고했으며, 한 경우에는 장시간의 작업을 중지할 수 없었고 작업을 삭제하면 파일이 삭제되었습니다(GitHub 이슈 리포트, 2026; 사용자 리포트, 벤더에 의해 확인되지 않음). 폴더 스코핑은 손상이 발생할 수 있는 위치를 제한합니다. 폴더 내의 손상을 방지하지는 않으며, 동기화된 클라우드 폴더는 로컬 실수를 동기화된 손실로 바꿀 수 있습니다.
브라우징은 프롬프트 인젝션을 추가합니다. 웹페이지에 숨겨진 지침으로, 에이전트가 사용자로부터 온 것처럼 읽습니다. 보안팀은 2025년 8월에 다른 공급업체의 브라우저 에이전트에 대한 공격을 공개했으며, 숨겨진 페이지 텍스트를 통해 사서함에서 일회용 코드를 빼내는 개념 증명을 제시했습니다(Brave, 2025). Anthropic은 완화 조치 전에 자신의 브라우저 에이전트가 테스트 사례의 23.6%에서 성공적으로 공격받았으며, 완화 조치 후에는 11.2%였다고 보고했습니다(Anthropic, 2025). 1년 후 일반 가용성에서는 강력한 레드팀 공격이 주요 모델에 대해 안전장치 전에 3.8%의 시간에 성공했으며, 완전한 보호로는 세 모델에 대해 공격이 성공하지 못했고 네 번째 모델에 대해서는 0.3%였다고 보고했습니다(Anthropic, 2026d). 이는 공급업체 테스트 세트에 대한 공급업체 수치입니다. 추세는 하강하고 남은 것은 0이 아닙니다. OpenAI는 2025년 12월에 프롬프트 인젝션이 "완전히 '해결'될 가능성은 낮다"고 기술했습니다(TechCrunch, 2025). 2단계 에이전트 출시 시 Anthropic은 사용자에게 "Claude의 의심스러운 행동을 모니터링하여 프롬프트 인젝션을 나타낼 수 있습니다"라고 말했으며 "Claude가 귀하를 대신하여 수행한 모든 행동에 대해 책임이 있습니다"(The Register, 2026). 널리 읽히는 개발자는 당시 비프로그래머에게 프롬프트 인젝션의 징후를 인식하도록 요청하는 것이 공정하지 않다고 이의를 제기했습니다(Willison, 2026). 저는 일반적으로 이의가 옳다고 생각합니다. 초보자가 공격을 탐지하는 것에 의존하는 안전 설계는 가장 어려운 판단을 그것을 할 수 있는 능력이 가장 낮은 사람에게 위임합니다. 패키지된 기술과 프로토콜 서버는 자신의 지침과 권한 표면을 열어줍니다. 타사 기술은 사용자가 작성하지 않은 지침을 전달하고, 서버는 작업에 필요한 것보다 더 많은 권한을 보유할 수 있으며, 구성은 버전 간에 편차가 발생하기 때문입니다.
과도한 보호도 사람들을 확실히 멈춥니다. 모든 단계에서 허가를 요청하는 에이전트는 사람을 평가할 수 없는 명령을 승인하는 점원으로 만들고, 승인 피로가 발생합니다. 공급업체들은 그에 따라 움직였으며, 1분기 내에 하나 이상의 방향으로 움직였습니다. Anthropic의 브라우저 에이전트는 이제 기본적으로 자율적으로 작동하며, 사용자의 요청과 일치하지 않는 작업을 차단하는 분류기가 있습니다(Anthropic, 2026d). 터미널 에이전트는 2026년 7월에 기본 권한 모드의 이름을 "Manual"로 변경했습니다. 이는 "기본값"이 의미하게 된 것에 대한 자체 이야기를 말합니다(Anthropic, 2026h). 통합된 채팅 에이전트는 "기본적으로 행동하기 전에 요청합니다". 이는 사용자가 변경할 수 있는 설정입니다(Anthropic, 2026c). Parasuraman과 Riley의(1997) 분류는 세 가지 모두에 적용됩니다. 너무 많이 차단하는 가드는 미사용을 생성하고, 삭제를 놓친 가드는 오용을 생성하며, 분류를 벗어나는 설정은 없습니다. 오직 주어진 인구가 살아갈 수 있는 설정의 실패만 있을 뿐입니다. 이 시리즈의 동반 논문은 다른 쪽에서의 일반적인 실패를 기록합니다. 감독 구성요소는 자신의 해악 개념을 넓히고 존재하기 위해 존재하는 작업을 방해합니다(Chernets, 2026b). 신입자의 경우 그러한 종류의 가드는 설치 프로그램이 누락된 것과 동일한 영향을 미칩니다. 작업이 어느 쪽이든 발생하지 않기 때문입니다.
보호가 너무 적은 것과 너무 많은 것 사이에 실현 가능한 중간 지점이 있으며, 이는 구식입니다. 복사본에서 작업합니다. 작업 폴더 밖에 비밀을 유지합니다. 더 큰 변경 전에 스냅샷을 찍습니다. 하나를 허용할 이유가 있을 때까지 파괴적인 명령을 거부하고, 돌이킬 수 없는 모든 것을 확인하며, 포함된 모든 지침과 관계없이 웹에서 나오는 모든 것을 데이터로 취급합니다. 이러한 습관의 원칙을 동반 논문에서 건축 신뢰로 설명했습니다. 모델이 얼마나 자신감 있게 들리는지에 따르지 않고 범위가 지정된 권한, 로그, 실행 취소 및 두 번째 독립적인 모델과 같이 사람이 확인할 수 있는 검사에 대한 의존입니다(Chernets, 2026c). Level 2는 사람에게 그러한 검사 중 첫 번째를 제공하며, 그것이 학습하는 마지막 것이 아니어야 합니다. 부록 C는 목록을 두 에이전트의 구성 예제와 한 페이지 체크리스트로 전환합니다.
5.4 조직 규칙
많은 전문가들이 자신이 일하는 컴퓨터에 아무것도 설치할 수 없습니다. 많은 고용주는 에이전트 정책이 없으며, 정책이 없는 사람은 답이 아니라고 가정하는 경향이 있습니다. Microsoft의 2026년 AI를 사용하는 20,000명의 지식 노동자에 대한 조사에 따르면 조직 요소가 개별 요소의 보고된 AI 영향의 두 배 이상을 차지했으며, 45%는 AI로 작업을 재설계하는 것보다 현재 목표에 집중하는 것이 더 안전하다고 말했습니다(Microsoft, 2026b; 공급업체 조사). 미국 인구통계국은 비즈니스 AI 사용이 전체적으로 17%에서 20% 사이를 맴돌고 있으며, 직원이 20명 이상인 회사 중에서는 증가했고 직원이 20명 미만인 회사 중에서는 크게 변하지 않았다고 보고했습니다(미국 인구통계국, 2026). 위임은 양쪽으로 진행되었습니다. 일부 고용주는 2025년에 AI 사용을 기본 기대치로 만들었으며(Digital Commerce 360, 2025), 최소한 하나는 1년 후 AI 사용 기준으로 직원을 평가하기로 한 결정을 뒤집었으며, CEO는 언론에 성과 검토에서 중요한 것은 일을 잘하는 것이라고 말했습니다(Fortune, 2026b). 한 고용주의 게시된 유창성 루브릭은 오케스트레이션 및 시스템 구축을 최상위 수준에 두고 팀이 실험에서 워크플로우 재설계로 이동한 후 완전한 내부 채택을 보고합니다(Zapier, 2026). 그러한 재설계가 없으면, 위임은 준수와 그 외 거의 아무것도 구입하지 않습니다. 노동 시장은 이미 이름이 없는 여기서 설명한 역할을 요청하고 있습니다. 2026년에 AI에 영향을 받은 미국 직책의 63%는 기술 직업 외부였으며, 1분기에 822개의 서로 다른 직책이 있었습니다(Adrjan, 2026). 27개 국가에서 10억 개 이상의 구직 공고에 대한 연구는 AI 기술에 대한 임금 프리미엄을 62%에 두었으며, 진입 수준의 역할이 AI에 가장 노출된 경우 한때 고위 직원을 위해 예약된 기술을 요구할 가능성이 훨씬 더 높습니다(PwC, 2026; 공급업체 보고서). 이 출처들은 아직 에이전트를 지시하는 능력을 공학 외부의 명명된 요구 사항으로 분리하지 않습니다.
이 장벽은 Ferdman(2025)의 의미에서 구조적입니다. 개인적 노력에 굴복하지 않습니다. 또한 증거가 제시하는 2단계에 대한 가장 강력한 논증입니다. 공급업체가 한정한 에이전트는 고용주가 이미 라이선스한 사무 제품군 내에 있기 때문입니다(Microsoft, 2026a). 고용주가 직장 노트북에서 에이전트를 승인하지 않을 사람들에게 도달합니다.
5.5 하드웨어, 비용 및 할당량
Level 3은 사람이 제어하는 컴퓨터를 가정합니다. 많은 전문가들은 주로 휴대전화에서 작업하거나, 가족 컴퓨터를 공유하거나, 고용주의 기계를 모든 용도로 사용하며, 이들에게는 소프트웨어 문제가 발생하기도 전에 전환이 차단됩니다. Level 3과 level 4는 또한 최소한 하나의 서비스의 유료 계층을 가정하며, 오케스트레이션은 추가 모델 각각이 또 다른 구독이나 할당량이기 때문에 비용을 곱합니다. 이미 하나의 구독료를 지불하는 사람에게 두 번째 구독은 결정이고 상위 계층은 다른 결정입니다. 토큰 불안은 가격표가 붙은 심리적 장벽입니다. 오케스트레이팅 에이전트의 할당량 자체는 숨겨진 비용이며, 다른 에이전트들이 반환하는 모든 답변을 읽는 비용을 지불하고, 브라우저를 구동하는 에이전트는 터미널 에이전트와 동일한 계획 제한을 사용하면서 작업당 더 많은 비용이 듭니다(Anthropic, 2026g). 잠긴 회사 노트북은 관리자 권한을 목록에 추가합니다: 서명되지 않은 바이너리 없음, 설치 프로그램 없음, 에이전트가 디스크에 쓰는 것을 멀웨어로 취급하는 데이터 손실 규칙. 클라우드 호스팅 에이전트는 그러한 기계를 위한 업계의 답변입니다. 이들은 전환 1과 전환 2의 클라우드 형태를 유지하며, 사람에게 자신의 디스크에 level-3 결과물을 제공하지 않습니다. 부유한 국가의 전문가에게 이 중 어느 것도 큰 장벽이 아닙니다. 많은 다른 사람들에게는 실질적인 장벽이며, 이는 두 번째 수준의 분할(Hargittai, 2002)과 상호 작용하며, 여유가 가장 적은 사람들이 실험할 능력이 가장 적습니다.
5.6 결과 평가하기
에이전트를 사용하는 것은 프로그래밍을 요구하지 않습니다. 에이전트가 생산한 것을 판단하는 것은 결과의 영역에서의 역량을 요구하며, 여기서 프로그래머가 아닌 사람이 놓치기 쉬운 장점을 가집니다. 계약 요약을 읽는 변호사나 추출 테이블을 읽는 연구자는 에이전트가 부족한 지식에 대해 결과물을 확인할 수 있습니다. "울퉁불퉁한 경계"에 대한 연구는 AI로 작업한 전문가들이 모델의 능력 내의 작업에서는 더 잘 수행하고 경계 밖의 작업에서는 더 못했다는 것을 발견했습니다(Dell'Acqua et al., 2026). 보호는 경계의 어느 쪽에 있는지 알 수 있을 정도로 작업을 잘 아는 사람입니다.
쉽게 확인할 수 없는 것은 기계 장치, 테이블을 생성한 스크립트나 숫자를 끌어온 쿼리입니다. 470개의 풀 요청에 대한 한 업계 분석은 에이전트가 작성한 코드가 사람이 작성한 코드보다 더 많은 결함을 포함한다는 것을 발견했습니다: AI 작성 변경 사항당 10.83개의 문제 대 인간만의 변경 사항당 6.45개, 일부 보안 문제 범주는 2.74배 더 자주 발생합니다(CodeRabbit, n.d.; 공급업체 연구). 그리고 에이전트는 여전히 대부분의 전체 프로젝트에 실패합니다: 실제 프리랜서 프로젝트의 벤치마크에서 2026년 중반까지 측정된 최고의 자동화 율은 15.8%였습니다(Center for AI Safety, 2026). 나는 이것에서 두 가지 관행을 도출합니다. 확인은 작업 전에 정의되어야 합니다("이것이 맞다고 확신시킬 것은 무엇인가?"), 그리고 다른 계열의 두 번째 모델은 결과물의 검토자 역할을 할 수 있으며, 사람이 무엇이 올바른 것으로 간주되는지 결정합니다. 섹션 7은 두 번째 관행의 한계로 돌아갑니다.
5.7 대안적 설명: 에이전트가 아직 충분히 좋지 않습니다
독자는 사람들이 에이전트가 그들의 작업을 할 수 없기 때문에 위임하지 않으며, 따라서 장벽은 여전히 기술적이며 모델 쪽에만 있다고 이의를 제기할 수 있습니다. 이의는 실질적인 지지를 받습니다. 실제 프리랜서 프로젝트의 벤치마크에서 2026년 중반까지 측정된 최고의 자동화 율은 15.8%였으며, 이는 이전 가을의 벤치마크 출시 이후 2.5%에서 올랐으며, 이는 5개 중 4개 이상의 프로젝트가 여전히 종단간 실패한다는 의미입니다(Center for AI Safety, 2026). 시뮬레이션된 소프트웨어 회사에서 최고의 에이전트는 긴 전문 작업의 30%를 완료했습니다(Xu et al., 2024). 개방형 컴퓨터 사용에서 2024년 기준선은 최고의 에이전트에 대해 12.24%, 사람에 대해 72.36%였으며(Xie et al., 2024), 2026년 9월까지 그 벤치마크의 검증된 버전에 대한 애그리게이터의 리더보드는 상위 에이전트가 85~86%, 인간 기준선 이상을 보였으며, 스크립팅된 데스크톱 작업에 대한 공급업체 보고 점수입니다(BenchLM, 2026). 마지막 결과는 다른 방향을 가리킵니다: 그러한 작업에서 역량은 더 이상 장벽이 아닙니다. 44개 직업 전반에 걸친 평가의 최고 모델은 비교의 절반 미만에서 전문가와 동등하거나 우위를 점했습니다(Patwardhan et al., 2025). 에이전트가 절반의 시간을 완료하는 소프트웨어 작업의 길이는 대략 7개월마다 두 배씩 증가했으므로(Kwa et al., 2025), 추세는 가파르고 현재는 적습니다. 역량은 작업 전반에 걸쳐 고르지 않으며, "울퉁불퉁한 경계"는 외부에서 보이지 않습니다(Dell'Acqua et al., 2026). 표 4는 이러한 발표된 수치를 각 출처가 제시한 날짜와 함께 모으며 내가 붙이는 주의사항입니다.
표 4. 이의 뒤에 있는 발표된 역량 수치.
| 비교 | 발표된 대로의 수치 | 명시된 날짜 | 출처 | 주의깊게 읽으세요 |
|---|---|---|---|---|
| 실제 프리랜서 프로젝트, 최고의 자동화 율 | 15.8%, 벤치마크 출시 당시의 2.5%에서 올랐으며, 5개 중 4개 이상의 프로젝트가 여전히 종단간 실패합니다 | 이전 가을 출시, 2026년 중반에 측정된 15.8%, 2026년 7월 1일 기록(부록 B, 검증됨) | Center for AI Safety (2026); 섹션 5.6, 5.7, 부록 B | 전체 프로젝트, 종단간, 측정된 최고의 비율 |
| 시뮬레이션된 소프트웨어 회사의 긴 전문 작업 | 최고의 에이전트는 30%를 완료했습니다 | 2024년 연구 | Xu et al. (2024); 섹션 5.7 | 시뮬레이션된 회사, 프리랜서 프로젝트 비율과는 별개의 측정 |
| 개방형 컴퓨터 사용, 기준선 | 최고의 에이전트에 대해 12.24%, 사람에 대해 72.36% | 2024년 기준선 | Xie et al. (2024); 섹션 5.7 | 2024년 기준선, 아래 행은 나중의 리더보드입니다 |
| 그 벤치마크의 검증된 버전 | 상위 에이전트는 85~86%, 인간 기준선 이상 | 2026년 9월까지 | BenchLM (2026); 섹션 5.7 | 애그리게이터 리더보드, 스크립팅된 데스크톱 작업에 대한 공급업체 보고 점수, 반대 방향으로 나눕니다 |
| 44개 직업 전반에 걸친 평가 | 최고의 모델은 비교의 절반 미만에서 전문가와 동등하거나 우위를 점했습니다 | 2025년 연구 | Patwardhan et al. (2025); 섹션 5.7 | "절반 미만"은 제시된 표현이며, 백분율은 명시되지 않습니다 |
| 에이전트가 절반의 시간을 완료하는 소프트웨어 작업의 길이 | 대략 7개월마다 두 배씩 | 2025년 연구 | Kwa et al. (2025); 섹션 5.7 | 추세: "추세는 가파르고 현재는 적습니다" |
| 풀 요청의 결함 | 470개의 풀 요청; AI 작성 변경에 대해 이슈 10.83건 대 인간 전용 변경에 대해 6.45건; 일부 보안 문제 범주는 최대 2.74배 더 자주 발생 | n.d. | CodeRabbit (n.d.); 섹션 5.6 | 공급업체 연구; 1개의 산업 분석; 코드의 결함, 비프로그래머가 쉽게 확인할 수 없는 메커니즘 |
출처: 섹션 5.6과 5.7 및 부록 B에서 반복된 인용된 출판물; 이러한 수치 중 어느 것도 섹션 9의 프로그램에서 나온 것이 아닙니다.
두 설명은 경쟁 관계보다 하나의 설명의 일부입니다. 워크플로우 어휘에는 자신의 작업 중 어느 것이 경계 내에 있는지 알기가 포함됩니다. 에이전트에 할 수 없는 전체 프로젝트를 넘긴 사람은 위임을 중단하는 법을 배우고, 추출, 조정 및 초안을 넘긴 사람은 계속하는 법을 배웁니다. 설명은 여전히 다른 예측을 합니다. 모델 역량이 제약 조건이라면, 레벨 2와 3에서의 지속성은 작업 유형을 추적하고 사람을 추적하지 않을 것입니다: 동일한 종류의 작업을 하는 사람들은 자신의 능력을 지정하고 확인할 수 있는 능력에 관계없이 유사한 비율로 지속할 것입니다. 워크플로우 어휘가 제약 조건이라면, 지속성은 같은 종류의 작업 내에서도 위임 계약을 명시할 수 있는 사람의 능력을 추적할 것입니다. 섹션 10의 제안 P15는 둘을 구분하기 위해 작성되었습니다.
6. 웹 오케스트레이션: 제안된 가교
6.1 실제 사례
레벨 4의 가장 단순한 형태는 설치가 전혀 필요하지 않습니다. 한 사람이 브라우저 탭에서 세 개 또는 네 개의 챗봇을 열고, 각각에 같은 질문을 붙여넣고, 답변들을 나란히 읽습니다. 컴퓨터 과학자들은 이를 수동 멀티-LLM 쿼리라고 부르며, 사람이 라우팅과 비교를 수행합니다. 어떤 사람들은 손으로 직접 합니다. 다른 사람들은 2023년 이후 이를 위해 만들어진 도구 중 하나를 사용합니다: 한 개의 프롬프트를 여러 소비자 채팅 서비스에 브로드캐스트하고 답변을 나란한 창에 표시하는 브라우저 확장 프로그램과 데스크톱 애플리케이션입니다. ChatHub와 ChatALL은 2023년 봄에 등장했으며, ChatALL의 최신 릴리스만 해도 2026년 9월까지 릴리스 페이지에 약 847,000회의 다운로드가 기록되었으며, 이는 자동 업데이트를 포함하고 한 플랫폼의 빌드가 지배적입니다(GitHub, 2026a). 더 최근의 도구 그룹은 로그인된 웹 채팅 세션을 다른 프로그램이 호출할 수 있는 명령으로 변환하여, 에이전트가 한 사람의 웹 구독에 질문을 제시할 수 있도록 합니다. 이 중 하나인 OpenCLI는 2026년 9월에 GitHub에서 약 29,500개의 별을 획득했습니다(GitHub, 2026b).
2026년에 이 사례는 제품 기능이 되었습니다. Perplexity는 여러 모델을 통해 쿼리를 실행하고 "주요 통찰력, 합의 영역 및 의견 불일치 지점을 강조하는 통합 보기를 제시하는" "Model Council"을 도입했습니다(Storyboard18, 2026). Microsoft 365 Copilot의 Microsoft 연구 에이전트는 "같은 질문을 여러 깊이 있는 추론 연구 에이전트(GPT와 Claude)를 통해 동시에 실행하는" 모드와 기본적으로 자동 모델 선택 하에 켜진 비판 모드를 제공하며, 여기서 한 모델이 작성한 보고서는 다른 모델으로부터 두 번째 추론 단계를 받습니다(Microsoft, 2026c; Constellation Research, 2026b). Andrej Karpathy의 "LLM Council"은 쿼리를 여러 모델에 보내고, 그들이 익명으로 서로를 검토하며, 의장 모델이 최종 답변을 작성하는 소규모 웹 애플리케이션으로, 저자는 주말 해킹으로 설명했으며, 2026년 9월에 GitHub에서 약 24,900개의 별을 획득했습니다(Karpathy, 2025). 오픈 소스 환경은 두 가지로 나뉩니다. 브로드캐스트 도구는 답변을 가져오고 조정을 사람에게 맡깁니다. 협의회 도구는 조정하며, 사람의 자신의 로그인된 탭에서 벗어나 두세 개의 모델을 가진 유료 프로그래밍 인터페이스에서 실행됩니다. 어느 쪽도 단독으로는 한 사람을 온전히 이끌지 못하며, 그것이 가교가 불완전한 이유입니다.
6.2 가교로 제안된 이유
웹 오케스트레이션은 유용한 방식으로 레벨 사이에 위치합니다. 이는 기계에 아무것도 새로운 것을 요구하지 않으며, 설치, 권한, 로컬 에이전트도 없고, 한 사람이 이미 비용을 지불하거나 무료 등급을 사용하는 구독에서 실행됩니다. 이는 사람에게 뭔가 새로운 것을 요구합니다: 여러 답변을 동시에 보유하고, 그들이 어디서 다른지 주목하고, 결정합니다. "다른 모델은 뭐라고 했지?"라고 묻는 것을 배운 사람은 나중에 CLI 오케스트레이션이 자동화하는 습관을 배웠으며, 그 습관은 레벨 4의 가장 작은 매니저 작업입니다.
가교는 눈에 띄기 때문에 가치 있습니다. 시장 분석가가 세 개의 챗봇에 발표된 산업 보고서를 요약하도록 요청하고, 그 중 두 개는 보고서에 없는 수치를 인용하는 한편 세 번째는 그 부재를 지적한다고 가정합니다. 유용한 결과는 보고서 자체를 열도록 하는 알림이며, 그것을 한 번 겪은 사람은 첫 유창한 답변을 답변으로 취급하는 것을 멈추었습니다. 여러 답변의 브로드캐스트 보기는 한 사람이 하나의 공통 질문을 만들고, 가정이 어디서 갈라지는지 주목하고, 비판을 요청하고, 한 답변을 선택한 이유를 지킬 때 레벨 4로 향하는 가교가 됩니다. 그때까지는 더 많은 탭이 있는 레벨 1 습관입니다. 이것이 가르치는 것은 비교이며, 오직 비교뿐입니다. 다른 모델이 뭐라고 했는지를 묻는 것을 배운 사람은 그것으로써 에이전트가 자신의 기계에서 할 수 있는 것을 배운 것이 아니며, 이는 레벨 2와 3의 교훈이고, 습관이 이월된다는 주장은 경험적인 것이며, P7은 전제로 취급하지 않습니다. 섹션 9에 기술된 사전 등록 프로그램은 미리 두 가지 이점을 제시하며, 이들은 가교가 가져오는 것을 요약합니다. 하나는 커버리지입니다: 한 모델에 존재하는 유용한 관점이 다른 모델이 요청되었기 때문에 손실되지 않습니다. 다른 하나는 신뢰성입니다: 답변이 한 모델의 말을 받아들이는 대신 다른 답변들과 비교되어 확인되었습니다(Chernets, 2026d). 눈에 띄는 불일치는 두 번째를 위한 수단으로 봉사합니다. 예측 평가에서 12개 언어 모델의 앙상블이 925명의 인간 예측자 군중의 정확도와 일치했으며(Schoenegger et al., 2024), 다중 에이전트 토론은 여러 설정에서 단일 모델에 비해 사실성과 추론을 개선합니다(Du et al., 2023). 두 이점 모두 모델의 오류가 다를 때 달성되며, 다음 소절은 그들이 그러하지 않을 때 무슨 일이 일어나는지에 관한 것입니다.
6.3 가교가 끝나는 곳
웹 오케스트레이션은 가교로 머물며, 가장 단순한 이유는 주의력의 비용입니다. 네 개의 긴 답변을 읽고 손으로 그들을 조정하는 것은 하나를 읽는 것보다 훨씬 더 오래 걸립니다. 나는 누군가에게 일상적인 질문을 위해 그렇게 하도록 요청하지 않을 것입니다; 그것은 잘못된 답변이 비교하는 데 보낸 시간보다 더 많은 비용이 들 때 그 비용을 벌어들입니다.
두 번째 한계는 취약성이며, 여러 형태로 나타납니다. 소비자 채팅 인터페이스는 월별로 변경되며, 그들을 구동하는 도구는 그들이 할 때 깨집니다: 2026년 여름에 한 오피스 스위트는 연구 모드를 제거했고, 한 챗봇은 자유 등급에서 모드를 폐쇄했으며, 하나 이상의 서비스는 주소를 이름 변경하거나 리디렉션했습니다. 여러 소비자 서비스의 약관은 자동화된 접근을 제한하며, 에이전트로 자신의 로그인된 브라우저를 구동하는 사람은 계정 차단의 위험을 감수합니다. 가교를 사용하는 연구 프로그램은 참여자들에게 그렇게 해야 하며, 나는 이러한 약관의 법적 해석을 제시하지 않습니다. 다른 챗봇의 "무료" 측은 브라우저 작업이 터미널 에이전트와 동일한 계획 한계를 사용하므로 그들을 구동하는 에이전트 측에서도 유료입니다(Anthropic, 2026g). 개방 탭에서의 수동 비교는 견고합니다. 소비자 채팅 페이지의 자동화된 수확은 반복 가능한 작업을 위한 약한 기초입니다.
세 번째 한계가 가장 중요합니다: 모델 간의 합의는 독립적인 증거가 아닙니다. 모델들이 훈련 데이터와 방법을 공유할 때, 그들의 오류는 상관관계를 가집니다. 350개 이상의 언어 모델에 대한 연구에서 두 모델이 모두 오류를 범했을 때 같은 잘못된 답에 약 60% 정도 동의했으며, 더 크고 정확한 모델들이 심지어 제공업체 간에도 더 상관관계가 높다는 것을 발견했습니다(Kim et al., 2025). 이 시리즈의 동반 논문은 산술을 제시합니다: 평균 쌍별 오류 상관계수 rho를 가질 때, N개의 동의하는 모델은 N_eff = N / (1 + (N - 1) rho)개의 독립적인 의견의 가치가 있으며, 어떤 수의 모델도 1/rho보다 더 가치 있을 수 없습니다(Chernets, 2026a). rho = 0.5일 때, 10개의 동의하는 챗봇은 2개 미만의 독립적인 것의 가치가 있습니다. 그림 3은 부록 D의 네 가지 예시적 rho 값에 대한 공식을 그리며, 동의하는 모델의 어떤 수도 통과할 수 없는 한계 1/rho를 보여줍니다. Kim et al.의 60%는 두 모델이 같은 잘못된 답을 제시한 결합 오류의 비중이며, 이는 공식의 오류 상관계수 rho가 아닙니다. 당면한 영역에서 rho는 알려진 답이 있는 항목에 대해 추정되어야 하며(목록 C4), 여기와 부록 D에 사용된 값들은 예시입니다. 다양성이 개수보다 더 중요합니다. 한 모델의 사본 간의 논의는 같은 계산을 주어진 단일 모델을 이기는 데 종종 실패하지만, 이질적인 모델은 도움이 되며(Zhang et al., 2025), 두 가지 다양한 에이전트는 16개의 동질적인 모델과 동등하거나 이길 수 있습니다(Yang et al., 2026). 생성형 AI는 또한 사용자 전체에 걸쳐 출력을 동일하게 만들며(Doshi & Hauser, 2024), 판단하도록 요청받은 모델은 자신의 글을 선호하는 경향이 있습니다(Panickssery et al., 2024), 이는 한 모델이 병합된 답변을 작성할 때 중요합니다.
그림 3. 합의의 가치.
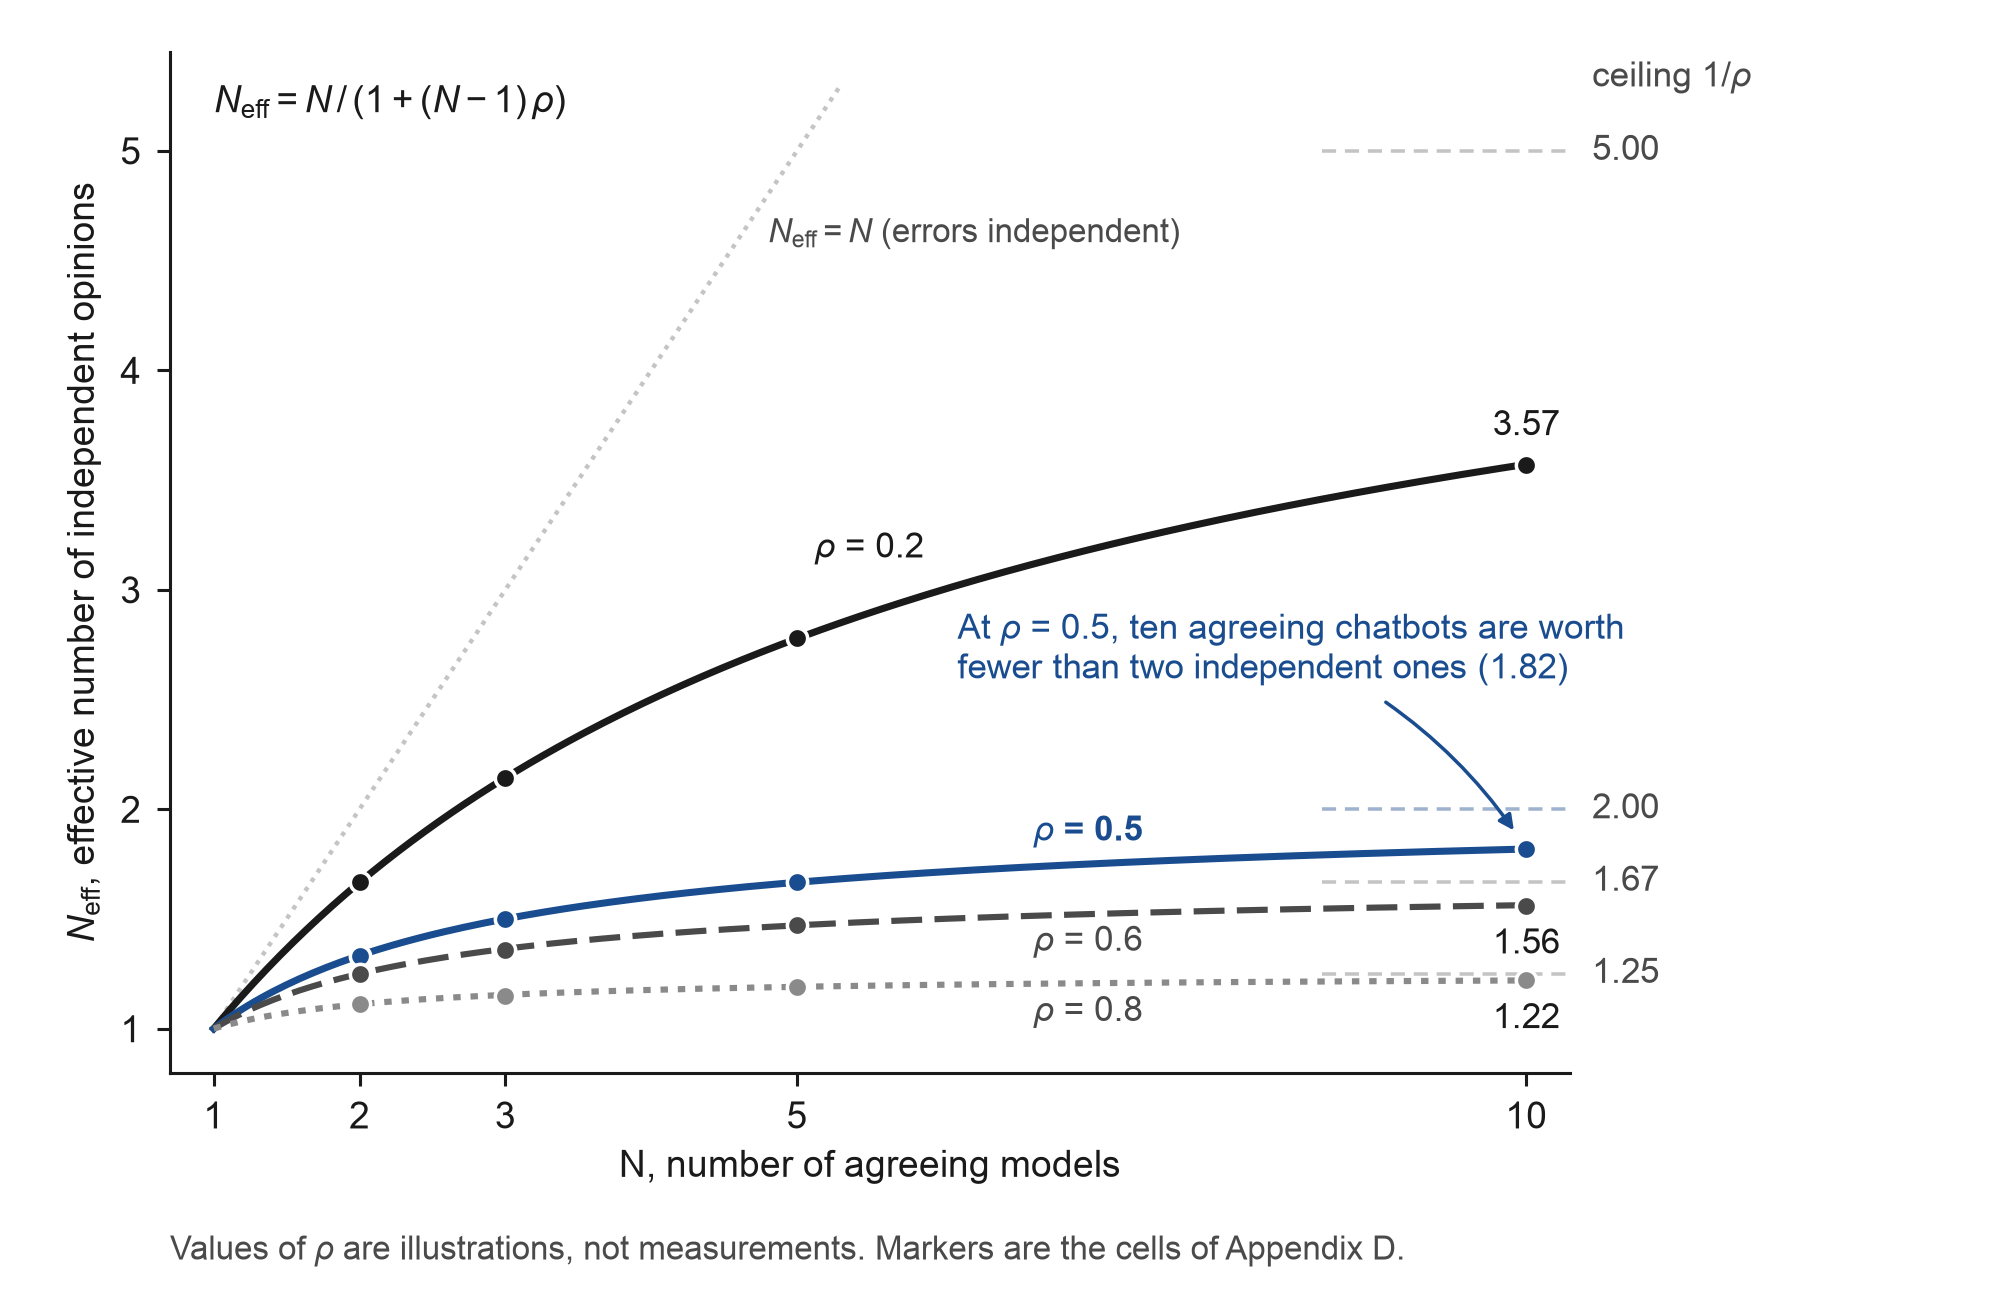
주: 독립적인 의견의 효과적인 개수, N_eff = N / (1 + (N - 1) rho), 오류의 평균 쌍별 상관계수가 rho인 N개의 동의하는 모델의 경우(Chernets, 2026a; 섹션 6.3). 표식은 부록 D의 셀이고, 그 사이의 곡선은 같은 공식을 따르며, 오른쪽의 파선은 한계 1/rho입니다. rho의 네 가지 값은 부록 D와 같이 예시이며, rho는 당면한 영역에서 알려진 답이 있는 항목에 대해 추정되어야 합니다(목록 C4).
다리에 있는 사람에게 실제 규칙은 간단합니다. 한 공급업체의 모델에서 실행되는 사무실 도우미는 해당 공급업체의 챗봇에 대한 두 번째 의견이 아니기 때문에 모델 패밀리를 세십시오. 모델 간의 합의는 검증 노력을 덜 들일 곳을 알려줄 수 있습니다. 청구가 맞다는 것을 알려줄 수 없습니다. 한 모델만 제시한 요점을 검증할 단서로 취급하십시오, 비교에서 가장 가치 있는 것이거나 유일한 오류일 수 있기 때문이며, 투표로 제외하기보다는 증거를 가진 불일치를 유지하십시오. 청구를 출처와 대조하여 확인하십시오: 잘못된 날짜에 대한 합의는 문서화된 실패 모드이며, 기본 페이지는 다섯 번째 모델이 하지 못할 곳에서 이를 수정합니다. 당신이 표시할 수 있는 당신의 영역에 있는 질문의 작은 집합에서 rho를 추정하십시오, 당신이 할 수 없는 질문에 대해 협의회를 신뢰하기 전에. 누가 무엇을 말했는지 기억하십시오, 그 출처를 숨기는 병합된 답변은 조율이 의문을 품도록 의도했던 단일의 자신감 있는 목소리를 다시 불러옵니다.
절차로 작성하면, 이것은 동반 논문의 "앵커-및-강화" 프로토콜의 교육 형태입니다(Chernets, 2026a). 그 사람은 먼저 앵커를 수정합니다: 작업, 허용된 증거 및 출력의 형태. 그들은 그 다음 출처나 파일 참조를 유지한 채로 별도의 답변을 얻고, 청구를 출처별로 테이블에 추출하며, 각 불일치를 종류별로 정렬합니다, 사실적 충돌, 다른 해석, 누락된 가정 또는 형식의 차이인지를 막론하고. 그들은 결정에 영향을 미치는 청구를 앵커나 기본 출처와 대조하여 검증하고, 그들은 수용 결정과 해결되지 않은 것을 기록합니다. 부록 C의 목록 C3은 출처별 청구의 테이블을 작성하고, 목록 C4는 알려진 답을 가진 항목에서 rho를 추정하며, 부록 D는 아무것도 실행하지 않고 rho의 범위에 대한 한계를 제공합니다. 한 가지 규칙이 더 여기에 속하며, 두 번째 구독을 요구하지 않습니다. 같은 패밀리의 비평가가 신선한 맥락에서 첫 번째 답변을 공격하도록 요청받으면, 서두름, 건너뛴 지시사항 및 실행되지 않은 검사를 포착합니다, 비록 그것이 공유된 거짓 지식을 포착할 수는 없지만. 저는 비평가 습관을 1 에이전트를 가진 수준 3에서 시작하고 비평가가 더 이상 말할 것이 없고 결정이 비용이 많이 들 때만 두 번째 패밀리를 추가합니다.
반대 경우도 똑같이 명확하게 명시될 필요가 있습니다. 많은 작업의 경우, 좋은 출처 집합과 신중한 인간의 검토를 가진 하나의 강력한 모델이 지연과 혼동을 추가하는 정교한 협의회를 이기며, 모델은 이를 예측합니다. 조율은 실제 불확실성을 가진 작업, 뚜렷한 관점으로부터 이득을 얻거나, 설정을 분할하기에 충분히 자주 반복되는 곳에서 가치가 있습니다. 검증할 기회가 없는 시간 중심의 결정, 서비스 전체에 분산될 수 없는 기밀 자료, 비교 비용이 이익을 초과하는 단순한 작업에는 맞지 않습니다. 협의회가 사용되는 곳에서, 에이전트에게 다른 작업이 주어져야 합니다: 공급된 문서로 제한된 것, 기본 출처를 찾도록 보낸 것, 지원되지 않은 청구를 나열하도록 지시받은 것, 인용을 감시하도록 지시받은 것, 그 사람이 여전히 판정하는 것. P9는 이 반론이 승리할 수 있도록 작성되었습니다.
7. CLI 오케스트레이션: 위임의 지속 가능한 계층
7.1 에이전트가 에이전트를 호출하기
레벨 3에서 각 에이전트는 키보드 앞에 사람이 없어도 실행할 수 있는 명령줄 인터페이스를 갖습니다. 질문이 입력되면 답변이나 변경된 파일이 출력됩니다. 한 사람이 하나의 에이전트를 소유하면, 그 에이전트는 다른 에이전트들을 호출할 수 있습니다. 시스템 문헌에서 이를 에이전트 오케스트레이션이라고 합니다. 비프로그래머가 이미 구독하고 있는 명령줄 도구를 통해 실행하는 버전을 CLI 오케스트레이션이라고 부릅니다. 첫 번째 에이전트에 대한 단일 지시("다른 두 에이전트에게 이 계획을 검토하도록 요청하고 어디서 의견이 다른지 알려줘")는 소규모 팀을 만듭니다.
2026년에 이 패턴은 개발자의 트릭에서 공급업체가 승인한 관행으로 발전했습니다. OpenAI는 Anthropic의 코딩 에이전트 내부에서 실행되는 공식 플러그인을 발표했으며, "코드 검토나 작업 위임"을 위해 일반적인 검토, 두 번째 에이전트가 작업이 중단되었다고 가정하고 찾는 적대적 검토, 중단된 작업 복구를 위한 명령을 포함합니다. 로컬로 설치된 도구와 기존 로그인을 통해 작동하며, 무료 계층을 포함한 모든 ChatGPT 구독으로 사용 가능하고, 2026년 9월에 GitHub에서 약 33,400개의 별을 받았습니다(OpenAI, 2026a). 2026년의 대표적인 쌍은 Claude Code 작성과 공식 플러그인을 통한 Codex 검사입니다(OpenAI, 2026a). 3개 이상의 의회는 리더 없는 작은 도구로 남아 있습니다. GitHub은 2026년 2월에 Anthropic과 OpenAI의 에이전트를 자체 Copilot 서비스 내에서 사용 가능하게 했으며, "기존 Copilot 구독에 완전히 포함됩니다"(GitHub, 2026c). xAI의 명령줄 에이전트는 헤드리스 모드와 Agent Client Protocol 지원을 제공하여 사용자가 "자신의 봇과 에이전트 오케스트레이션 앱을 구축할 수 있도록" 합니다(xAI, 2026). Google이 첫 번째 명령줄 에이전트를 폐지한 이유는 사용자가 "여러 에이전트가 서로 통신하는 것을 필요로 한다"는 것이었습니다(Google, 2026). 한 에이전트가 다른 에이전트를 상담할 수 있게 해주는 오픈소스 도구들은 많은 추종자를 보유하고 있습니다. 모델 간 상담을 위한 다중 공급업체 서버는 약 11,800개의 별을, 합의 지향 플러그인은 약 4,100개의 별을 받았습니다(GitHub, 2026d). 그 아래에는 2025년 12월에 Linux Foundation 기구에 기부된 Model Context Protocol이 있으며, 당시 발행된 10,000개 이상의 서버와 약 9,700만 개의 월간 SDK 다운로드가 있었습니다(Linux Foundation, 2025). 2026년 7월 사양 출시까지 거의 5억 개의 월간 SDK 다운로드에 도달했으며, 이는 또한 프로토콜을 상태 비저장으로 만들고 폐지 전 12개월 통지를 약속했습니다(Model Context Protocol, 2026). 이것이 랩톱의 에이전트가 각 공급업체 플러그인 없이 사람의 나머지 도구에 도달하는 방법이며, 이미 웹 프로토콜처럼 지루운 방식이 되었습니다. 존재하고, 문서화되고, 뭔가 깨질 때까지 무시되는 방식입니다. 두 번째 표준인 Google의 공급업체 간 에이전트 통신을 위한 Agent2Agent 프로토콜은 2026년 3월에 버전 1.0에 도달했습니다(Google Open Source Blog, 2026). 이것은 레벨 4 플럼빙이며, 오늘날 소비자 온램프가 없습니다.
표 5. 2026년 9월의 패턴별 오케스트레이션 경관.
| 패턴 | 예시(2026년 9월) | 레벨 | 대상 사용자 | 이점 | 남기는 기록 | 주요 위험 |
|---|---|---|---|---|---|---|
| 브라우저 탭에서의 수동 비교 | 모든 소비자 챗봇 세트 | 기록되고 재실행될 때 4(웹); 그 외의 경우 레벨 1 습관 | 누구나 | 범위; 비교 습관 | 스크린샷 또는 복사된 회신, 맥락이 흔히 손실됨 | 주의 비용; 미기록 출처 |
| 웹 채팅을 위한 브로드캐스트 도구 | ChatHub, ChatALL | 기록되고 재실행될 때 4(웹); 그 외의 경우 레벨 1 습관 | 개인 | 하나의 프롬프트, 병렬 답변, 조정 없음 | 창 내 답변; 저장하지 않으면 디스크에 없음 | 인터페이스 변경 시 중단; 서비스 이용약관 |
| 제품 기능으로서의 의회 | Perplexity Model Council; Microsoft 365 Copilot 연구 에이전트(GPT 및 Claude); Karpathy의 LLM Council | 4(웹, 관리형) | 해당 서비스의 구독자 | 합의 및 의견 불일치가 포함된 통합 답변 | 공급업체가 표시하는 것; 출처가 흔히 포함됨 | 통합된 음성이 출처를 숨김; 선택자는 공급업체 |
| 에이전트에 노출된 웹 채팅 | OpenCLI 및 유사 도구 | 4(웹)에서 4(CLI)로의 브릿지 | 기술 사용자 | 에이전트가 웹 구독을 사용할 수 있음 | 에이전트가 작성할 경우 파일 | 취약성; 접근 규칙 |
| 공급업체 플러그인: 한 에이전트가 다른 에이전트에게 위임 | Claude Code용 OpenAI 플러그인; GitHub Agent HQ 내 Claude 및 Codex(Copilot) | 4(CLI) | 개발자, 확산 중 | 한 세션 내에서 공급업체 간 검토 및 위임 | 세션 기록; 검토 출력 | 대부분 코드 형태; 두 서비스의 할당량 |
| 의회 및 상담 서버 | 다중 공급업체 상담 서버(마지막 커밋 2025년 12월); 합의 플러그인; 도구당 한 개의 파일을 작성하는 소규모 CLI 의회 | 4(CLI) | 개발자 | 한 작업에서 여러 계열; 합의 규칙 | 도구당 파일; 통합 노트 | 끝없는 라운드; 상관 오류; 중단 |
| 다중 에이전트 대시보드 | 각각 자체 작업 복사본이 있는 여러 공식 CLI(창 내), 사람이 이들 중 어느 것이든 인수할 수 있음 | 4(CLI, 가시적) | 병렬 에이전트를 감독하는 개발자 | 감독이 가시적으로 만들어짐 | 에이전트당 로그 및 diff | 코드용으로 구축됨; 주의 분산 |
| 시간 상한선이 있는 팬아웃 스크립트 | 부록 C의 목록 C1 | 4(CLI) | 레벨 3 에이전트를 소유한 누구나 | 도구가 정지되어도 병렬 답변 유지 | 도구당 한 파일, 누가 답변했는지를 포함한 요약 | 조정을 위해 사람 필요 |
| 단일 에이전트, 작업 기록 및 재실행 | 명령 파일 또는 일정상 실행되는 스킬 | 3(반복 가능하게 함) | 레벨 3의 누구나 | 두 번째 모델을 사용할 수 없을 때의 반복 | 작업 파일, 입력, 출력, 승인 노트 | 반복이 나쁜 템플릿을 증폭함 |
행들은 패턴을 설명합니다. 부록 E의 별 개수는 하루의 인기도 추적이며, 사용자, 품질, 계약 폴더의 적합성을 나타내지 않습니다. 포기는 표에 포함되어야 합니다. 가장 유명한 상담 서버는 2025년 12월에 마지막으로 커밋되었고, 여러 대시보드의 유지보수자가 활동을 중단했습니다. 학습자들을 하나의 명명된 오케스트레이터로 지향하는 논문은 그들을 잘못된 길로 인도하는 것이므로, 제가 그 대신 패턴을 지향하는 이유입니다. 공식 바이너리, 비대화형 플래그, 디스크 상의 파일, 그리고 누가 물었는지에 대한 기록입니다.
7.2 이 계층이 지속되는 이유
CLI 오케스트레이션은 공급업체의 자체 도구에 기반하며, 공급업체 자신이 자동화를 위해 문서화한 방식으로 실행되므로, 브라우저 탭이 가질 수 없는 속성을 부여합니다. 무엇보다도 기록할 수 있습니다. 한 번 작동한 배열, 예를 들어 "한 모델로 초안을 작성하고, 체크리스트에 대해 두 번째 검토를 받고, 의견 불일치를 제시해달라"는 명령 파일이나 스킬로 저장되어 다음 주에 다시 실행할 수 있으며, 필요하면 일정에 따라 실행할 수 있습니다. 섹션 3은 수준 4를 정확히 이것으로 정의했습니다. 모델 전반의 반복 가능한 작업입니다. 이들이 고려하는 순서대로 여러 가지 추가 속성이 따릅니다. 명령줄 플래그는 문서화된 인터페이스이고 종료 코드는 약속이지만, 웹 페이지의 위치는 어느 것도 아니므로, 소비자 채팅 페이지를 운영하는 도구는 페이지가 변경될 때마다 수리해야 합니다. 각 공식 도구는 자체 공급업체의 로그인으로 실행되며, 해당 공급업체의 샌드박스와 거부 규칙을 사용하므로, 사람은 폴더에서 비밀을 유지하고, 기본적으로 네트워크를 거부하며, 도구별로 파괴적인 명령을 거부할 수 있습니다. 반면 모든 탭을 볼 수 있는 브라우저 에이전트는 하나의 더 큰 권한 객체입니다. 패턴은 사람이 이미 비용을 지불하는 소비자 로그인을 사용하며, 무엇보다도 이것이 비프로그래머가 유지하는 관행을 한 번 시도하는 것과 구별한다고 예상합니다. 그리고 공급업체들이 이를 승인합니다. 공식 플러그인, GitHub의 서비스 내 에이전트, 헤드리스 모드 및 스킬 표준은 크로스 도구 위임이 표준화되고 있다는 신호이며, 소비자 채팅 페이지의 자동화는 쫓겨나고 있습니다.
웹 오케스트레이션은 비교 습관을 가르칠 수 있으며, CLI 오케스트레이션은 그 습관을 객체로 유지할 수 있는 곳입니다. 객체는 할당, 허용된 입력, 출력, 어떤 에이전트가 무엇을 생산했는지의 기록, 그리고 무엇이 수용되었는지의 메모를 포함하는 폴더입니다. 다른 사람은 개인 채팅을 다시 재생하지 않고도 이를 검사할 수 있으며, 이를 만든 사람은 다음 주에 하나의 입력을 변경하고 차이를 볼 수 있습니다. 그 기록은 또한 저장된 할당과 수용 메모가 불충분한 소스 세트나 누락된 승인을 드러내기 때문에 책임을 회피하기 더 어렵게 합니다. 비공식적인 채팅에 익숙한 사무실에서는 부담처럼 느껴질 것이며, 작업을 확인, 인계 또는 반복해야 하는 모든 곳에서는 자산입니다. 비례성이 결정합니다. 2분짜리 요청은 워크플로우 폴더가 필요하지 않지만, 공유 파일을 건드리는 반복되는 작업은 필요합니다.
대부분의 것이 존재하는 것은 코드에 의해 형성됩니다. 공식 플러그인, 카운슬 서버 및 다중 에이전트 관리자는 소프트웨어 검토를 목표로 하지만, 패턴 자체에는 코드에 특정한 것이 없습니다.
7.3 이 계층이 사람에게 요구하는 것
에이전트의 작은 팀은 관리자가 필요하며, 관리자의 작업은 구체적입니다. 이의 네 부분을 위임 계약이라고 부릅니다:
- 목표: 작업의 목적이며, 에이전트가 이것이 충족되었는지 알 수 있도록 명시됩니다.
- 경계: 에이전트가 건드릴 수 있는 것과 건드릴 수 없는 것, 어떤 행동이 사람의 확인이 필요한지, 그리고 작업이 소비할 수 있는 시간과 할당량의 예산입니다.
- 산출물: 작업이 완료되었을 때 존재해야 하는 것 및 어떤 형태인지입니다.
- 확인: 사람이 산출물이 맞다는 것을 알 수 있는 방법, 작업이 시작하기 전에 결정된 것, 누가 무엇을 검토하는지, 그리고 언제 멈출지입니다.
네 번째 부분은 자동화된 감시에 대한 동반 논문에 설명된 함정을 담고 있습니다(Chernets, 2026b). 검토자를 추가하는 것은 저렴하며, 모든 검토자는 뭔가를 찾습니다. 정지 규칙 없는 카운슬은 라운드와 비평가를 추가하는 경향이 있어서 작업이 검토에 묻힙니다. 실질적인 규칙은 단계별로 한 라운드의 비평과 한 라운드의 수정을 허용하는 것이며, 사람이 그 발견이 작업을 차단하는지 여부를 결정합니다. 그 규칙은 측정된 대가를 가집니다. 그 논문에 보고된 144회 실행의 무작위 시험에서, 일반 예산은 비평 라운드를 2.86에서 1.00으로 줄였으며(실행당) 놓친 결함을 0.11만큼 늘렸습니다(실행당) (95% 신뢰 구간 0.005~0.204) (Chernets, 2026b). 그 거래가 가치가 있는지 여부는 이해관계에 달려 있으며, 이는 정확히 관리자에게 속하는 결정의 종류입니다. 라운드와 시간의 제한은 예산이며, 예산은 멈출 때를 결정하는데, 이는 답이 참인지 여부라는 다른 질문입니다.
계약은 좋은 위임이 사람에게 항상 요구해온 것을 재설명하며, 소프트웨어에 위임한 적이 없는 청중을 대상으로 합니다. 그것은 새로운 경영 이론을 주장하지 않습니다. 그 가치는 각 부분을 가르치고, 기록하고, 확인할 수 있으며, 각 부분이 누락되었을 때 볼 수 있는 방식으로 실패한다는 것입니다.
8. 운영자에서 관리자로
8.1 업무에서 변하는 것
레벨 1에서 개인이 생산하고 모델이 지원합니다. 레벨 3과 4에서는 모델이 생산하고 개인이 지휘, 감독, 승인합니다. Bainbridge (1983)의 자동화의 역설은 이것이 인간의 역할에 미치는 영향을 예측했습니다. 자동화는 일상적인 업무를 제거하고 개인에게 가장 잘 수행하기 어려운 잔여 업무인 모니터링과 드문 장애 개입을 남기며, 판단력을 구축한 경험은 사라집니다. 생성형 AI 버전의 역설은 이미 문서화되어 있습니다. 생성형 AI는 개인을 생산에서 평가로 옮기고 어려운 작업을 더 어렵게 만들며 (Simkute et al., 2024), 도구에 대한 높은 신뢰도는 비판적 사고 감소와 함께 나타나고 (Lee et al., 2025), 실무 제거로부터 구조적으로 역량 저하가 따릅니다 (Ferdman, 2025).
에이전트를 관리하는 것은 따라서 고유한 역량을 갖춘 다른 업무이며, 그 역량은 도구와 함께 무료로 제공되지 않습니다. 이는 위임할 대상 선택, 7.3절의 위임 계약 명시, 에이전트 추적 읽기, 결과가 충분한지 판단하기로 구성됩니다. 업무를 4가지 실무로 나눕니다. 위임은 업무를 경계가 있는 결과물로 이름 붙입니다. 감독은 계획, 중간 산출물 또는 도구 추적을 감시하고 모든 키보드 입력을 승인하지 않고 작업이 벗어날 때 개입합니다. 모든 것을 승인하는 것은 피로이고 피로는 사람들이 예를 클릭하게 하기 때문입니다. 검증은 출처, 합계, 변환, 결정이 기초하는 주장을 확인하며, 에이전트 자신의 신뢰도 다시 읽기 이외의 방법으로 위험에 비례하여 수행합니다: 코드는 테스트와 diff, 계약서 폴더는 개인이 직접 열어본 페이지와의 표본 검사, 문헌 표는 식별자의 행별 검사입니다. 회수는 조건이 변할 때 작업 공간을 좁히고, 실행을 중지하거나 접근 권한을 제거합니다. 4가지를 모두 수행하는 개인은 그래픽 데스크톱 애플리케이션을 통해서도 에이전트를 관리합니다. 불투명한 서비스에 작업을 넘기고 첫 번째 답변을 받아들이는 개인은 판단을 아웃소싱하며, 이는 다른 실무입니다. Parasuraman과 Riley (1997)는 이를 실패하는 두 가지 방법을 명명했습니다. 미사용은 위임할 수 있으면서 절대 위임하지 않는 개인이며, 습관이나 두려움으로 레벨 1에 갇혀있습니다. 오용은 검사 없이 위임하고 돌아온 것을 받아들이는 개인입니다. 둘 다 2026년에 보입니다. 광범위하고 얕은 채택 데이터는 대규모 미사용을 설명하며 (2.2절), 5.3절의 파일 손실 보고서와 데이터베이스 삭제는 더 잘 알고 있던 전문가들에 의한 오용을 설명합니다. 표 6은 각 실무를 위임 계약의 해당 부분, 충족하는 위험, 연구에서 발생했음을 알 수 있는 날짜가 있는 추적과 함께 나열합니다.
표 6. 관리자의 4가지 실무: 각각 시행하는 것, 충족하는 위험, 남기는 추적.
| 실무 | 개인이 하는 것 | 시행하는 계약 부분 | 누락될 경우의 위험 | 관찰 가능한 추적 |
|---|---|---|---|---|
| 위임 | 업무를 경계가 있는 결과물로 이름 붙입니다 (8.1) | 목표, 에이전트가 충족되었는지 여부를 알 수 있도록 명시됨; 산출물: 존재해야 하는 것과 어떤 형태 (7.3) | 미사용: "위임할 수 있으면서 절대 위임하지 않는 개인", 습관이나 두려움으로 레벨 1에 갇혀있음 (8.1) | 기탁된 산출물 (부록 A) |
| 감독 | 계획, 중간 산출물 또는 도구 추적을 감시하고, 모든 키보드 입력을 승인하지 않고 작업이 벗어날 때 개입합니다 (8.1) | 경계: 에이전트가 접촉할 수 있는 것; 개인의 확인이 필요한 조치; 시간과 할당량의 예산 (7.3) | 승인 피로: "피로는 사람들이 예를 클릭하게 합니다" (8.1); 너무 많이 차단하는 보호 장치는 미사용을 초래합니다 (5.3) | 거부된 계획; 확인을 위해 보류된 돌이킬 수 없는 단계 (부록 A) |
| 검증 | 출처, 합계, 변환, 결정이 기초하는 주장을 확인하며, 에이전트 자신의 신뢰도 다시 읽기 이외의 방법으로 수행합니다 (8.1) | 확인: 개인이 산출물이 올바른지 알 수 있는 방법, 업무 시작 전에 결정됨; 중단할 시기 (7.3) | 오용: "검사 없이 위임하고 돌아온 것을 받아들이는 개인" (8.1); 모델 간 상관된 오류 (6.3) | 거부된 diff 또는 산출물; 두 번째 모델 군족 요청; 기록된 분모: 요청, 응답, 시간 초과 (부록 A) |
| 회수 | 조건이 변할 때 작업 공간을 좁히고, 실행을 중지하거나 접근 권한을 제거합니다 (8.1) | 경계, 다시 적용됨: 제외되는 것, 실수를 취소하는 방법 (3.2, 7.3) | 중지할 수 없었던 장시간 작업, 그 후 작업 삭제로 파일이 삭제됨 (5.3) | 부록 A의 날짜가 있는 추적 중 없음; 날짜가 있는 중지, 좁혀진 권한 또는 제거된 접근이 도움이 될 것 |
참고: 불투명한 서비스에 작업을 넘기고 첫 번째 답변을 받아들이는 개인은 "판단을 아웃소싱"하며, 이는 다른 실무입니다 (8.1).
한 가지 작은 장치가 4가지 실무 모두에 걸쳐 역할을 함께 유지하며, 이를 수용 기록이라고 부릅니다. 결과 있거나 반복되는 작업의 경우 의도된 결과물, 사용된 입력, 제약과 권한, 산출물이 간 곳, 실질적인 불동의나 실패, 수행된 검사, 개인의 수용, 수정, 상향 또는 폐기 결정을 담습니다. 에이전트가 생산한 것과 개인이 의존한 것 사이에 선을 그립니다. 개인에게는 신뢰감을 검사 가능한 결정으로 바꾸기 때문에 유용하고, 팀에게는 동료가 개인 채팅 기록 없이 업무를 검사할 수 있기 때문에, 연구자에게는 완료된 실행을 의존한 결과와 구분하기 때문입니다. 또한 제약입니다. 개인은 수용 기준 작성에 실패한 후 작업이 레벨 1에 머물러야 한다고 결정할 수 있으며, 모델은 이를 성숙한 관리가 아닌 지연된 채택으로 계산합니다. 인간-AI 협업의 어휘에서, 레벨 1에서 레벨 4로의 이동은 인간을 루프에 유지하고 루프가 무엇인지 변경합니다. 각 답변을 읽기에서 답변이 수용되는 조건 설정으로. 그림 4는 4가지 실무, 각 단계의 위험, 실패한 검사 후의 반환, 수용 기록과 함께 해당 루프를 그립니다.
그림 4. 관리자의 제어 루프.
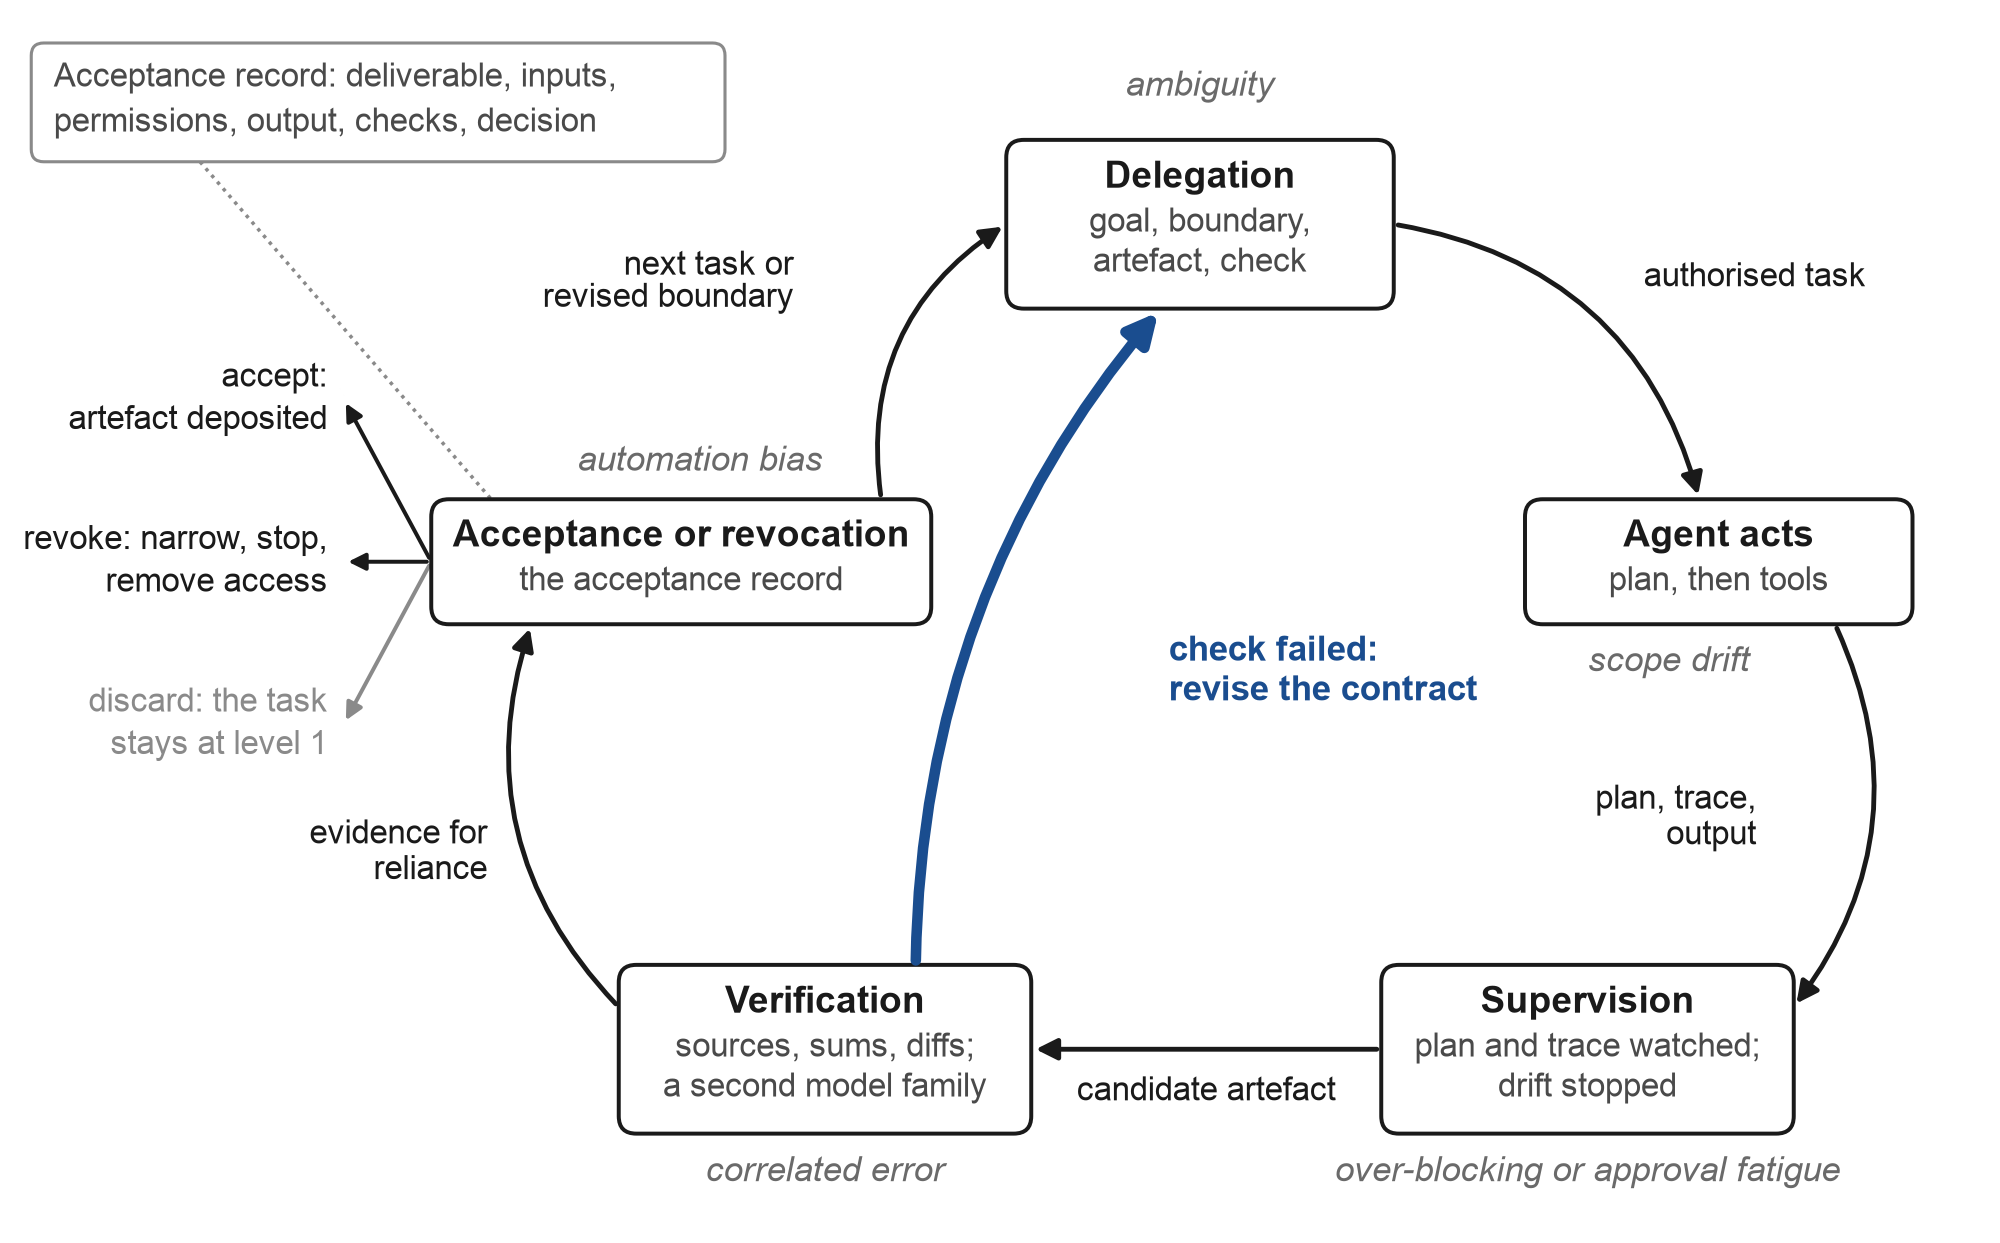
참고: 관리자의 작업은 사람이 실행하는 루프입니다(섹션 7.3 및 8.1). 위임은 계약(목표, 경계, 산출물, 확인)을 명시하고, 에이전트가 행동하며, 사람이 감독하고 검증한 후, 결과를 수락하거나 취소하거나 폐기하고 수락 기록을 작성합니다. 회색 이탤릭 레이블은 각 단계에서의 위험을 명시합니다(섹션 5.3, 6.3 및 8.1). 굵은 화살표는 실패한 확인에서 수정된 계약으로의 복귀이며, 수락 노드에서의 모든 종료는 사람의 결정입니다.
8.2 경험 많은 사용자는 더 적게 위임합니다
모든 사람이 결국 에이전트의 관리자가 되어야 한다는 단순한 이야기에 어긋나는 관찰이 있습니다. Anthropic은 2026년 3월에 더 오래된 재직 기간을 가진 사용자들이 "지시적 사용 패턴을 통해 더 큰 책임을 위임할 가능성이 훨씬 낮다"고 보고했으며(Anthropic, 2026e), 2026년 1월 보고서는 사람이 루프에 남아있는 협력적 사용인 증강을 2025년 11월 대화의 52%로 나타냈습니다(Anthropic, 2026f). 한 가지 해석은 경험 많은 사용자들이 위임이 실패하는 위치를 배웠고 물러났다는 것입니다. 다른 해석은 그들이 자신의 판단이 산출물인 작업 부분에 대해 모델을 협력자로 사용하는 방법을 배웠다는 것입니다. 저는 발표된 수치에서 이 두 가지 해석을 구분할 수 없으며, 어느 쪽 해석을 택하든 사다리의 종점은 최대 위임이 아닙니다. 그것은 작업별로 묻기, 협력하기, 위임하기 사이에서 선택하고 앞의 작업이 어떤 것을 필요로 하는지 아는 능력입니다. 4단계 모델은 사람이 할 수 있는 것을 설명합니다. 그들이 매번 가장 위임하는 것을 해야 한다는 주장은 하지 않습니다.
8.3 책임은 사람에게 남아있습니다
공급업체들은 책임이 어디에 있는지에 대해 명확합니다. Anthropic의 2단계 에이전트 출시 지침은 사용자들에게 "Claude가 사용자를 대신하여 수행하는 모든 행동에 대해 계속 책임을 진다"고 말했습니다(The Register, 2026). 이것은 특히 3단계의 법적이고 실질적인 현실이며, 여기서 에이전트는 소유자의 자격 증명으로, 소유자의 파일에서, 소유자의 이름으로 행동합니다. 에이전트의 관리자가 된 전문가는 또한 실수가 빠른 근로자에 대해 책임을 지게 됩니다. 이것은 위임 계약의 확인이 작업 전에 결정되어야 하는 또 다른 이유이며, 섹션 5.3의 안전 설계가 사람이 실시간으로 공격을 발견하는 것에 의존해서는 안 되는 또 다른 이유입니다.
8.4 문해력 프레임워크에서의 관리자의 역할
AI 문해력의 공식적인 정의들이 이 역할을 명시하기 시작했지만, 여기서 검토된 텍스트 중 어느 것도 "에이전트"라는 단어를 사용하지 않습니다. 미국 노동부의 2026년 2월 AI 문해력 프레임워크는 그 내용 영역 중에 "AI를 효과적으로 지시하기"를 나열합니다(US Department of Labor, 2026; ExecutiveGov, 2026). 2026년 6월의 OECD와 유럽 위원회의 공동 프레임워크는 PISA 2029 평가를 지원하며 네 가지 영역을 가지고 있으며, 그 중 하나는 "AI 관리"입니다(OECD & European Commission, 2026). 초기 학술 프레임워크들은 AI를 인식, 이해 및 평가하는 것을 강조했으며(Long & Magerko, 2020), UNESCO의 2024 학생 및 교사 역량 프레임워크는 같은 등록을 설정합니다(UNESCO, 2024a, 2024b). 위임 계약은 관리 및 지시 영역에 에이전트 경우에 대한 교수 가능한 내용을 제공합니다. 목표를 설정하고, 작업을 제한하고, 산출물을 명시하고, 확인을 결정합니다. 실무자들은 자신의 전문 분야 위에 이 전문성을 획득한 전문가를 위해 "AI 운영자" 및 "에이전트 관리자"와 같은 직함을 사용하기 시작했습니다. 저는 행동이 증거를 남기고 직함은 그렇지 않기 때문에 "에이전트의 관리자"를 더 좁게 사용합니다. 즉, 누군가 고용해야 하는 역할이 아니라 행동 패턴입니다. 증거는 산출물에 있습니다. 사람이 거부한 계획, 거부한 diff, 취한 제2의 의견, 떠나 있는 동안 완료된 예약된 실행입니다. 그러한 흔적이 없는 곳에서는 직함이 그 뒤에 아무것도 없습니다.
9. 교차점 측정: 사전등록 프로그램
9.1 측정 단위로서의 교차점
대부분의 채택 데이터는 "AI를 사용하는" 사람들을 세며, 때로는 주간 또는 일간 단위로 합니다. 이러한 종류의 집계는 챗봇에 동의어를 요청하는 사람과 분기별 보고서를 에이전트에게 위임하는 사람을 구분할 수 없으며, 제가 찾고자 하는 것은 두 번째 사람입니다. 섹션 3.3의 산출물 규칙은 이 차이를 관찰 가능하게 만듭니다. 교차점은 에이전트가 사람이 요청한 것을 새로운 수준에서 생산했을 때만 기록되기 때문입니다. 온보딩 및 감시에 관한 문헌에서 추가적인 규칙들이 따라옵니다. 도움은 교차점의 의미를 바꾸므로, 완료는 독립적으로 교차한 사람들과 도움을 받은 사람들을 따로 보고해야 합니다. 중단은 발생한 지점과 해당 사람의 자신의 말로 기록되어야 합니다. 왜냐하면 중단의 이유는 결과의 큰 부분을 차지하기 때문입니다. 회신하지 않은 사람들을 포함하여 자료를 받은 모든 사람은 분모에 포함되어야 합니다. 마지막으로 지속성은 연구자가 매주 글을 쓰기를 멈춘 후에 관찰되어야 합니다. 연구자가 여전히 사람의 수신함에 있는 동안 생산된 산출물은 사용만큼이나 예의일 수 있기 때문입니다.
9.2 설계
저는 이러한 규칙을 비프로그래머에게 적용하는 사전등록 코호트 프로그램을 운영합니다(Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, 2026년 9월 6일 등록 및 동결). 이는 3단계 경로의 단일군 실행 가능성 연구이며, 사전등록은 데이터가 수집되기 전에 동결되었습니다. 다음은 등록된 설계입니다.
참여자. 상당 부분을 컴퓨터에서 일하는 성인. 자신의 기계와 자신의 AI 구독을 사용하며(고용주의 것은 제외), 연습에서 클라이언트를 식별하는 및 고용주 기밀 자료를 제외하고, 소프트웨어 설치가 고용주가 자신에게 적용하는 규칙을 위반하지 않음을 확인합니다. 모집은 미리 정해진 시간 창 내의 전문 소셜 네트워크에서 공개 공고로 이루어지므로 결과가 유리해 보일 때까지 연장될 수 없습니다. 공고는 스크린샷으로 저장되고 그 영구 링크가 기록되어 모집 텍스트를 고정합니다. 진입은 진행 중이며 각 참여자의 일정은 자신의 0일부터 시작합니다. 도구는 주 단위 규모로 변하기 때문입니다. 모집은 등록이 동결된 2026년 9월 6일에 공개 공고로 시작되고 21일 후인 2026년 9월 27일에 종료됩니다. 코호트는 이 글을 쓰는 시점에 현장에 있으며, 실제 숫자는 어떻게 나올지 알 수 없지만 결과와 함께 보고될 것입니다.
1단계(채팅에서 사람의 컴퓨터의 에이전트로). 참여자는 표준 텍스트를 이미 사용 중인 챗봇에 붙여넣고, 해당 챗봇은 자신의 기계에 그래픽 에이전트를 설치하는 과정을 안내합니다. 저는 누구의 컴퓨터도 건드리지 않습니다. 이 단계는 참여자가 에이전트가 첫 번째 작업에 응답하여 생산한 산출물을 제공할 때 완료됩니다. 작업은 모든 사람을 위해 동일한 형태이며 참여자의 자신의 업무 상황으로 채워지며, 에이전트가 질문하고 결정하고 생성하고 파일을 포맷하도록 요구합니다. 이 요구사항은 에이전트를 챗봇과 구분합니다. 등록은 정확한 표현을 제공합니다(Chernets, 2026d). 모델의 관점에서 1단계는 동시에 두 수준에서 반사적 온보딩을 테스트합니다. 수준 1에서 수준 3까지. 이는 의도적 선택이었습니다. 로컬 에이전트의 그래픽 셸은 사람의 기계에서 실행되므로 섹션 3.3의 규칙에 따라 수준 3이며, 1단계가 요구하는 산출물은 전환 2를 표시하는 종류입니다. 그 권한 프롬프트는 범위가 정해진 단계의 보호 중 일부를 제공합니다. 코호트는 판매자-울타리로 둘러싼 수준-2 환경에서 별도의 주를 계측하지 않으므로 섹션 10의 P5를 테스트할 수 없습니다(범위가 정해진 중간 단계가 미완료 및 사건을 낮춘다는 것). 이러한 권한 프롬프트는 설계가 가진 유일한 범위가 정해진 단계이며, 명령줄은 3단계에서 진입합니다. 채팅과 로컬 설치 사이에 명시적 수준-2 주를 삽입하는 이후 코호트가 P5의 깔끔한 테스트가 될 것입니다.
2단계(에이전트에서 시작된 웹 오케스트레이션으로). 준비가 되면 참여자는 이미 지불하는 구독을 통해 여러 모델에 한 질문을 제시하고 에이전트 내에서 단일 작업으로 병합된 답을 반환하는 오픈소스 도구를 받습니다. 이 단계의 목적은 커버리지와 신뢰성으로 미리 등록되었으며, 가시적 불일치가 두 번째의 한 메커니즘입니다.
3단계(CLI 오케스트레이션으로). 명령줄 인터페이스를 통한 동일한 오케스트레이션.
측정. 프로그램의 모든 코호트에서 동일하게 표현된 5개의 동결된 핵심 항목은 직업 및 컴퓨터에서의 시간, 현재 AI 사용, 둘 이상의 AI에 질문한 이전 경험, 답을 확인하는 여부 및 방법, 그리고 이미 사람의 컴퓨터에서 행동하는 것이 있는지 여부를 기록합니다. 모든 참여자에 대한 단계 기록은 날짜, 안내한 챗봇, 시도 및 시간, 산출물로의 완료, 정확한 중단 지점 및 자신의 말로 된 이유, 그리고 조사자의 개입 여부 및 방법을 포함합니다. 첫 달 동안 매주 참여자는 해당 주에 에이전트가 생산한 하나의 산출물(또는 "없음", 유효한 답변)을 보고하고, 둘 이상의 AI에 한 질문을 제시한 빈도와 답이 달랐을 때 무슨 일이 일어났는지, 그리고 2단계부터 유용한 것이 나타났는지 여부를 보고하며, 한 모델이 놓친 것이 있었는지 그리고 확인이 의존하는 것을 바꾸었는지를 보고합니다. 관찰은 60일과 그 후 분기별로 계속되며, 참여자가 기꺼이 할 의사가 있는 한 계속됩니다.
분석 및 해석. 분석은 기술적입니다. 완료 비율은 생존한 분모와 전체 분모 모두에 대해 신뢰 구간과 함께 제시되며, 독립적 완료와 지원된 완료를 따로 나눕니다. 시간과 시도는 분포로 보고되고, 중단의 이유는 수집 후 코딩되며, 코드와 원본 표현은 보관됩니다. 하나의 해석 규칙은 미리 고정되었습니다. 1단계 자료를 받은 사람들 중 절반 미만이 에이전트로 생산된 산출물을 제공하면, 코호트는 온보딩 실패 연구로 보고되며, 사람들을 막은 것이 결과가 됩니다.
추론의 한계. 등록은 미리 대조 조건이 없으므로 따라서 인과 주장이 없으며, 자기선택 자원자를 넘어서는 일반화가 없음을 명시합니다. 참여자의 시간 절약 추정은 신념으로만 보고됩니다. 이 영역의 자기보고가 참 방향을 역전시킨 것으로 나타났기 때문입니다(Becker et al., 2025).
공개 및 윤리, 등록된 바와 같이. 참가자들에게 서면으로 제가 자료와 도구를 작성했으며, 이를 가르치고 있고, 오케스트레이션 방법을 다루는 대기 중인 특허 출원의 출원인임을 알립니다. 기관 검토 위원회의 의견은 구하지 않았습니다. 연구 뒤에 기관 소속이 없고 연방 자금이 없습니다. 등록에는 대신 보안 장치가 명시되어 있습니다. 동의는 서면이며 기록되기 전에 제공됩니다. 건강, 재정 또는 업무 콘텐츠 데이터는 수집되지 않습니다. 참가자들은 자신의 기계와 구독에서 작업하며 공개 보관까지 언제든지 삭제를 요청할 수 있습니다. 안전 지침에는 별도의 브라우저 프로필, 은행 또는 의료 사이트에서의 조치 금지, 되돌릴 수 없는 모든 작업 전 확인, 에이전트에 입력된 비밀번호 없음, 웹 콘텐츠를 데이터로 취급이 포함됩니다. 장애 변수는 수집되지 않으며 접근성 주장은 하지 않습니다.
9.3 설계만
프로그램에서 설계만 취합니다. 참가자 수, 완료율 또는 개별 사례는 의도적 결정에 따라 여기에 나타나지 않습니다. 논증(본 논문), 방법 및 프로그램, 그리고 프로토콜의 관찰 기간 후 결과는 별도의 출판물이므로, 논증이 자신에 대한 증거로 읽힐 수 없습니다. 다른 연구자들은 이제 동일한 규칙을 적용할 수 있습니다. 부록 C의 목록 C5는 기록 형식과 이를 인코딩하는 검사 도구를 제공합니다. 검사 도구는 설치를 교차점으로 계산하는 기록, 에이전트가 생성한 산출물 없는 완료, 해당 사람의 자신의 말 없는 중단, 의사명 레이블 대신 실제 이름, 형식이 알 수 없는 필드, 또는 건너뛴 것을 정확히 건너뛴 것으로 기록하지 않는 건너뛴 수준을 거부합니다.
9.4 강력한 다음 연구의 모습
코호트는 타당성 연구이며, 섹션 10의 대부분의 명제는 다른 설계가 필요합니다. 강력한 다음 연구는 작업을 나타내는 방식이 다르면서 작업 위험과 기술 환경을 최대한 일정하게 유지하는 두 가지 온보딩 조건을 비교할 것입니다. 한 조건은 기능과 설치 지침을 제시하고, 다른 조건은 참가자의 자신의 반복적인 작업 대상으로 시작하여 섹션 5.1의 5부 지도를 유도합니다. 결과에는 산출물, 참가자 이외의 다른 사람이 평가한 품질(정지 이유 코딩에서처럼 평가자 간 합의 보고 포함), 시간, 발견된 오류, 시나리오 형식의 권한 결정, 나중의 자발적 재사용, 그리고 결과에 비해 측정된 신뢰도가 포함됩니다. 후속 조치는 연구자와의 지속적 접촉으로부터 지속성을 분리할 것입니다. 두 번째 연구는 행정, 연구, 통신 및 분석 작업을 비교하여 워크플로우 어휘가 하나의 문법인지 직업당 하나인지 묻습니다. 저는 어느 것인지 모르며, 그 답은 패키지 예제를 한 번에 작성할 수 있는지 아니면 각 분야별로 작성해야 하는지를 결정합니다. 두 연구 모두 검증된 도구(Carolus et al., 2023)를 사용하여 AI 문해력을 기준으로 해야 하므로, 에이전트에게 무엇을 전달해야 하는지 아는 것이라는 구체적인 격차를 AI에 대한 일반적인 친숙함으로부터 분리할 수 있습니다. 그러한 모든 연구는 또한 구현을 문서화해야 합니다. 왜냐하면 나중의 인터페이스에서 시작하는 참가자는 다른 기본값을 만나기 때문입니다. 인터페이스 버전, 운영 체제, 에이전트가 네트워크 접근 권한을 가졌는지 여부, 권한 모드, 그리고 정책 제약이 있습니다. 공급업체의 이름만으로는 나중의 독자에게 너무 적게 전합니다.
10. 명제
3절의 모델과 4절부터 8절까지의 논의는 실패할 수 있는 주장들을 함축합니다. 표 7은 이 중 열다섯 가지를 제시하며, 각각은 측정 지표, 그것을 거짓으로 만들 결과, 그리고 검증을 실행할 주체를 포함합니다. 이들은 현장 전체를 위해 작성되었습니다. 9절의 프로그램은 예를 들어 일부만 검증할 수 있으며, 여러 다른 것들은 공급업체 원격 측정, 설문 패널 또는 한 조직 내의 소규모 연구로 검증될 수 있습니다. 어느 것도 코호트의 발견사항이 아닙니다.
표 7. 명제, 측정 지표, 반박 조건, 그리고 이를 검증할 수 있는 주체.
| # | 명제 | 측정 지표 | 거짓이 되는 경우 | 검증 가능한 주체 |
|---|---|---|---|---|
| P1 | 장벽 이동. 전환 2를 시도하는 비프로그래머 중에서, 설치 후 정지 현상(첫 작업에서, 첫 오류에서, 또는 권한으로 인해)이 설치 중에 발생하는 것보다 더 많으며, 설치한 후 아무것도 생성하지 않은 사람들 중에서 "무엇을 물어봐야 할지 몰랐습니다"가 기술적, 권한 및 비용 관련 이유를 초과하고, 작업 난이도가 일정할 때 완료율이 수준 내에서보다 세 가지 전환에서 더 급격히 감소합니다. | 인공물 규칙으로 기록된 정지 지점; 개인의 본래 말로 된 이유, 부록 A의 규칙으로 코딩됨; 단계별 완료 | 대부분의 정지가 에이전트가 처음 실행되기 전에 발생하거나, 설치된 비생성자 중에서 기술적 및 권한 관련 이유가 지배적이거나, 작업 난이도를 통제한 후 모든 단계에서 완료 및 실패 패턴이 비슷합니다 | 9절의 프로그램; 모든 복제 |
| P2 | 표면 병합. 공급업체가 채팅과 에이전트 표면을 병합하는 경우, 에이전트가 생성한 파일이나 작업으로 끝나는 세션의 비율이 사용자가 하고 싶은 말에 변화 없이 증가하며, 주요 어시스턴트들은 2027년 말까지 사용자가 선택한 모드 없이 기본 창에서 파일을 작성합니다. | 병합 전후의 공급업체 원격 측정; 어시스턴트들의 날짜가 지정된 조사 | 병합 후 비율이 평탄하게 유지되거나, 안정적인 사용자 선택 에이전트 모드가 파일 작성의 필수 조건으로 남아있습니다 | 공급업체; 응용 프로그램을 열 수 있는 모든 사람 |
| P3 | 설치보다 어휘. 사람들에게 자신의 분야에서 나온 작동하는 예시(패키지된 작업, 기술, 템플릿)를 제공하는 것은 설치 지원을 제공하는 것보다 2단계와 3단계에서 지속성을 더 높이며, 워크플로우 어휘의 구조화된 측정은 접근 권한과 이전 AI 사용을 통제한 후 인공물 완료를 예측합니다. | 두 종류의 지원 하에서의 60일차 지속성, 과제 배정과의 비교; 5.1절의 다섯 부분으로 된 사전 작업 진술; 부록 A의 규칙으로 코딩된 정지 이유 | 설치 지원이 같거나 더 큰 지속성을 만들거나, 어휘 측정이 설치 용이성과 일반적 자신감이 모델에 포함된 후 아무것도 추가하지 않습니다 | 두 가지 온보딩 경로를 가진 모든 실험실 |
| P4 | 반사적 온보딩. 이미 사용 중인 채봇의 안내를 받는 사람들은 1단계에서 3단계로 독립적으로 이동할 수 있으며 그 비율이 경로를 실용적으로 만들고, 정적 설명서를 받은 사람들보다 첫 인공물에 더 빨리 도달합니다. | 에이전트가 생성한 인공물로 전환 2를 완료한 비율, 자료를 받은 모든 사람에 대해; 안내된 조건과 정적 조건에서의 첫 인공물까지의 시간 | 절반 미만이 완료하거나, 9절에서 미리 고정된 임계값; 또는 정적 설명서가 같거나 더 높은 완료율을 제공합니다 | 9절의 프로그램; 두 코호트를 가진 강사 |
| P5 | 중간 단계. 로컬 에이전트 전에 공급업체 폐쇄 환경에서 시간을 보내는 비프로그래머는 전환 2를 더 자주 완료하고, 파일 손실 사건이 더 적으며, 채팅에서 광범위한 로컬 접근으로 직접 옮겨진 사람들보다 범위, 가역성 및 상향 보고에 대해 더 잘 추론합니다. | 동일한 추적 관찰을 가진 두 경로 코호트; 인공물을 주요 결과로; 사건 로그; 이전과 이후의 시나리오 기반 권한 결정 | 채팅에서 로컬 에이전트로 직접 수행한 미지원 완료가 2단계를 통과한 것과 일치하며, 비슷한 사건 발생률과 동등한 권한 결정을 가집니다 | 두 가지 온보딩 경로를 가진 모든 실험실; 프로그램의 이후 코호트 |
| P6 | 병목. 주간 채팅을 사용하는 비프로그래머 중에서, 분기 내에 3단계 인공물을 생성하는 비율이 주간으로 코딩 에이전트를 사용하는 개발자의 비율보다 훨씬 낮게 유지됩니다. | "AI를 사용하십니까"가 아닌 인공물 항목을 사용한 대표적인 설문(11.3절) | 비프로그래머 지식 근로자 중 3단계 인공물 생성이 개발자의 주간 사용 수치에 접근합니다 | 국가 통계청; 설문 기관 |
| P7 | 다리가 옮긴다. 웹 오케스트레이션을 연습하는 사람들은 나중에 CLI 오케스트레이션을 채택할 가능성이 더 높으며, 보이는 의견 불일치는 나중에 그들의 작업 기록에서 출처 속성 또는 비판을 예측합니다. | 초기 웹 비교가 있는 사람들과 없는 사람들 사이의 CLI 오케스트레이션 채택; 저장된 비교 및 나중 기록 | 차이가 없거나 역; 비교는 더 많은 프롬프트를 생성하고 유지된 검사의 변화가 없습니다 | 9절의 프로그램; 종단 패널 |
| P8 | CLI 내구성. 두 개 이상의 소비자 구독을 지불하는 사람들의 경우, 공식 명령줄 도구를 통한 오케스트레이션은 인터페이스 변경을 견디는 4단계 형태이며, 파일 지원 실행은 브라우저 전용 실행보다 다시 실행되고 다른 검토자에게 더 잘 전달됩니다. | 그 인구 중 4단계 인공물의 날짜가 지정된 조사; 인터페이스 변경 후 다시 실행 및 전달 테스트 | 2027년 말 조사에서 웹 또는 프로그래밍 인터페이스 위원회가 지배적이고 CLI 대 CLI 도구가 감소함; 브라우저 전용 워크플로우가 다시 실행 및 전달에서 일치합니다 | 도구 연구자; 개발자 설문 |
| P9 | 상관 일치. 공급업체 제품군 전체에서, 알려진 답변이 있는 지식 작업 항목의 오류는 충분히 상관이 있어서 세 개 이상의 모델 간의 일치는 두 개의 독립적인 의견보다 가치가 낮으며(rho는 대략 0.5 이상, 여기서 rho는 알려진 답변이 있는 지식 작업 항목에서 추정되고 벤치마크 일치율에서 가져오지 않음), 비용이 같을 때 다른 제품군의 소규모 위원회가 한 제품군의 대규모 위원회를 이기며, 출처 인식 검토는 다수 일치보다 정확성을 더 잘 예측합니다. | 항목 은행에서 가족 간 쌍별 오류 상관관계(목록 C4); 알려진 답변 포함; 두 개의 위원회 설계가 있는 표시된 항목 세트; 다수 의견에 대한 정확성 및 출처 인식 검토에 대한 정확성 | 대부분의 작업 유형에서 rho가 0.2 이하로 측정됨; 청구 단위 검사 후 동일 가족 위원회가 승리; 또는 단순 다수 의견이 다양성과 검증보다 정확성을 예측하는 데 똑같이 잘 또는 더 잘함 | 언어 모델 연구자; 동반 논문의 프로토콜 |
| P10 | 관리자의 역량. 수준 3과 4에서의 지속성은 위임 계약(목표, 경계, 산출물, 확인)을 명시하는 능력과 감시 기록(거부된 계획, 거절된 차이, 취한 재검토)으로 더 잘 예측되며, 이전 기술 경험이나 프롬프트 볼륨보다 더 잘 예측됩니다. | 네 부분을 이끌어내는 짧은 작업으로 맹검 채점; 기준 항목; 승인 기록의 추적; 60일차 지속성 | 이전 기술 경험이나 프롬프트 볼륨이 지속성을 똑같이 잘 또는 더 잘 예측하고 계약 명시가 아무것도 추가하지 않음; 또는 수준 3과 4의 산출물이 목표, 출처, 경계 및 확인을 정기적으로 생략하지만 독립적인 감시에서 신뢰할 수 있게 유지되므로 역량 구조가 과도하게 구축됨 | 모든 종단 산출물 연구 |
| P11 | 작업 유형별 보정. 피드백이 빠르고 되돌리기가 가능한 곳에서 사람들이 위임을 더 잘 보정하며, 작업 유형별로 다르게 수용, 수정 및 상향식으로 처리합니다. | 작업 유형별 수용, 수정, 상향식 처리 및 이후 오류 발견 | 보정이 되돌릴 수 있는 작업과 결과가 높은 작업 간에 균일함 | 실험실; 승인 기록이 있는 조직 |
| P12 | 보안 장치로 인한 마찰. 수준 3의 비프로그래머 중에서 권한 프롬프트와 안전 차단으로 인한 중단이 개발자 중에서보다 더 자주 멈추는 이유로 명명되며, 분류기로 보호된 자율성은 파일 손실 증가 없이 이러한 중단을 줄입니다. | 그룹별로 코딩된 중단 이유; 기본 모드 변경 전후 중단 비율 및 사고 보고서 | 그룹 간 차이 없음, 또는 자율성이 보고된 손실을 증가시킴 | 공급업체; 프로그램의 코딩된 중단 이유 |
| P13 | 간격이 재현됩니다. 성별 및 교육에 따른 채팅 채택의 차이(Cranney et al., 2026; Daepp & Counts, 2024)는 직업 내 수준 3 산출물 생산에서 적어도 같은 정도로 다시 나타납니다. | 직업 내 수준 3 산출물 생산의 차이 | 직업 내 추정치는 수준 3에서 간격이 감소했음을 보여줌 | 노동 경제학자; 충분히 크면 이후 코호트 |
| P14 | 비평가와 두 번째 가족. 동일 가족의 비평가는 급성과 건너뛴 확인을 포착합니다; 두 번째 가족은 공유된 오류를 포착합니다; 결함 레이블이 있는 세트에서 각각은 다른 쪽이 놓친 결함을 기여합니다. | 동일한 비용으로 동일 가족의 비평가와 두 번째 가족의 검토자 간의 확인된 발견의 겹침 | 완전한 겹침 또는 한 출처가 지배함 | 두 개의 에이전트 도구와 레이블이 있는 세트가 있는 모든 사람 |
| P15 | 역량 또는 어휘. 동등한 작업 유형에서 수준 2와 3의 지속성은 위임 계약을 명시하는 능력에 따라 달라집니다; 모델 역량이 제약이 되는 조건이라면 지속성은 작업 유형 간에 따라 달라지고 하나 내에서 사람 간에 균일할 것입니다. | 작업 유형별 지속성, 맹검 채점된 위임 계약 명시와 교차 | 작업 유형 내에서 지속성은 계약 점수가 무엇이든 사람 간에 균일하며 클래스 간에만 달라짐 | 작업 유형과 계약 명시를 기록하는 모든 연구 |
그 중 일부는 나머지보다 더 중요합니다. P4는 정책에 가장 큰 무게를 실으므로, 반사적 온보딩이 작동한다면 에이전트를 가르치는 가장 비싼 부분(설치 중 옆에 앉아있음)을 이미 가지고 있는 도구로 대체할 수 있습니다. P5는 섹션 9.2에서 말했듯이 코호트가 테스트할 수 없는 것이며, 사다리의 모양이 가장 많이 의존하는 것이기도 합니다. 중간 단계가 제자리를 차지하는지 여부는 아직 알 수 없습니다. P9는 테스트하기 가장 쉽고 위원회 사용자들을 가장 놀라게 할 가능성이 높습니다. 상관된 증거의 산술(Chernets, 2026a)과 Kim et al. (2025)의 측정은 모두 동의의 가치에 대한 상한을 가리킵니다. P10은 커리큘럼을 변경할 것입니다. 위임 계약을 명시하는 능력이 기술 배경보다 지속성을 더 잘 예측한다면, 교육은 도구 두 번째가 아니라 위임을 먼저 가르쳐야 합니다.
11. 함의
11.1 공급업체를 위해
빈 폴더를 위해 설계합니다. 공급업체들이 설치 프로그램을 간소화했으며 그 결과가 나타납니다. 저는 그 노력을 더 진행하는 것이 낭비될 것이라고 생각합니다. 초보자의 문제는 이제 설치 프로그램 이후, 에이전트에게 할 말이 없는 빈 폴더 앞에서 시작되기 때문입니다. 사람의 자신의 분야에서 나온 사례, 에이전트를 처음 열 때 제공되는 것, 그리고 실제적이고 위험도가 낮으며 판단할 수 있는 결과로 끝나는 첫 번째 작업은 설정의 추가 간소화보다 채택에 더 많은 도움이 될 것입니다. 이미 패키지된 기술들이 이미 이 방향을 보여줍니다(5.1절). 두 가지가 여전히 부족합니다. 사람의 작업 중 어느 것을 실제로 맡길 가치가 있는지 선택하는 데 도움을 주는 것, 그리고 스타트업뿐만 아니라 직업 협회도 그 회원들을 위한 기술을 작성할 수 있는 방법입니다.
다음 병합 후 탭이 무엇으로 불리든, 사람은 위임 순간에 선택된 폴더의 언어로 간단한 질문 목록에 대한 명확한 답변이 필요합니다. 이 에이전트가 읽을 수 있는 것은 무엇인지, 변경할 수 있는 것은 무엇인지, 보내거나 트리거할 수 있는 것은 무엇인지, 무엇이 내 승인이 필요한지, 그리고 어떻게 중단하는지입니다. 시각적 diff는 파일이 변경될 때 이 중 일부를 답변하고, 작성된 계획은 작업이 다양할 때 답변합니다. 하나의 동의 배너는 이 중 어느 것도 답변하지 않습니다. 권한 모델은 병합 후 표시되고, 범위가 지정되고, 취소 버튼과 작동하는 중단 버튼이 있어야 합니다. 폴더 범위 없이 둘 중 하나가 있으면 5.3절의 문제 보고처럼 읽힙니다.
작업은 또한 제품을 떠날 수 있어야 합니다. 사용자는 작업 지시, 입력 또는 그 식별자, 도구 작업, 출력 및 승인 기록을 내보낼 수 있어야 합니다. 이것은 거버넌스 기능만큼이나 사용성 기능입니다. 초보자가 완료된 작업에서 배울 수 있고 팀이 자신의 메모리를 독점적인 채팅 기록에 빌려주지 않고도 결과를 검토할 수 있기 때문입니다. 사용량도 같은 방식으로 보고되어야 합니다. 파일을 생성하는 에이전트의 "주간 활성 사용자"는 파일을 생성한 사람과 애플리케이션을 연 사람으로 나뉘어야 하며, 공급업체는 이를 수행할 원격 측정 데이터를 가지고 있습니다.
공격을 탐지하는 것은 초보자의 일이 아닙니다. 비프로그래머에게 프롬프트 주입의 징후를 인식하도록 요청하는 지침은 가장 어려운 판단을 판단할 능력이 가장 떨어지는 사람에게 놓습니다(5.3절). 안전한 기본값(작업 사본, 더 큰 변경 전 스냅샷, 명시적으로 허용될 때까지 거부되는 파괴적 명령, 데이터로 취급되는 웹 콘텐츠)은 제품에 속합니다. 동시에, 지속적으로 중단되는 가드는 누락된 가드가 파일을 잃는 것만큼이나 작업을 중단시키며, 감시 과다에 대한 동반 논문은 그러한 계층이 어떻게 증가하는지 설명합니다(Chernets, 2026b).
출처는 답변의 병합을 거쳐 생존해야 합니다. 하나의 병합된 답변을 반환하는 의회 기능은 어느 모델이 무엇을 말했는지, 어디서 동의하지 않았는지를 보여주고, 사용자가 한 모델에 비평가의 역할을 부여할 수 있게 하며, 증거 간격을 유창한 합의 단락보다 찾기 쉽게 만들어야 합니다. 출처 없는 병합된 음성은 단일 확신 있는 답변의 권위를 복원하고, 자동화 편향에 보상하며, 오류의 상관관계를 숨깁니다(6.3절).
마지막으로 변동성은 사용자 측의 비용입니다. 1년 내에 이름이 바뀌거나, 병합되거나, 폐지된 도구를 배운 사람은 두 배로 비용을 지불하므로, 안정적인 이름, 마이그레이션 가이드 및 제품 변경 전반에 걸친 지시 파일의 연속성은 그 자체로 채택 기능입니다.
11.2 고용주 및 교육자를 위해
메뉴 전에 위임 계약을 가르칩니다. 제품 메뉴는 매월 변경되지만 목표를 진술하고, 작업을 제한하고, 결과물에 이름을 붙이고, 확인을 결정하는 능력은 도구 전반에 걸쳐 전이됩니다(4.3절 및 7.3절). 사람에게 자신의 반복되는 작업 중 하나에 대해 네 부분을 작성하도록 요청하는 짧은 연습은 기능 둘러보기보다 준비 상태를 더 잘 테스트합니다. 연습에 포함된 것은 아래에서 분해 부분에서 설명합니다.
로그인은 잘못된 것을 측정합니다. 활성 사용자 수는 9.1절이 필요로 했던 구분을 할 수 없습니다. 동의어를 요청하는 사람과 보고서를 위임하는 사람 사이의 구분입니다. 사람들이 유지하기로 선택한 에이전트 생성 결과물의 수를 세는 것이 할 수 있습니다.
사람들은 또한 배우기 위해 인정된 장소와 허용되는 것의 지도가 필요합니다. 조직이 이미 라이선스한 도구 내부의 레벨 2는 작업 노트북에 에이전트를 설치할 수 없는 직원에게 도달합니다(5.4절). 레벨 3의 경우, 명확한 정책, 샌드박스 머신 또는 승인된 구성은 많은 사람들이 가정하는 침묵의 "아니오"를 제거합니다. 전면 금지는 개인 계정을 통한 사용을 진행시키며 여기서 아무도 그것을 볼 수 없고, 제한 없는 위임은 기밀 자료를 노출시킵니다. 둘 사이에는 작업 및 데이터 분류가 있습니다. 이는 승인된 환경에서 어떤 작업을 시도할 수 있는지, 어떤 작업이 두 번째 사람의 검토가 필요한지, 어떤 작업이 에이전트에서 제외되는지를 나타냅니다. 도구를 승인할 수 있는 사람, 승인 기록이 있는 위치, 그리고 거의 발생하지 않은 일이 보고 없이 보고되는 방법을 지정합니다. 지역 레벨 3은 직원이 제어하지 않는 머신에서는 필요하지 않아야 합니다. 클라우드 에이전트와 테넌트 범위의 레벨 2가 IT 부서와의 싸움을 피하는 경로이기 때문입니다. 공급업체가 첫 번째 단계를 채팅에 포함시킨 후, 레벨 2는 두 가지 작업을 유지합니다. 이는 잠금된 머신의 직원을 위한 인정된 장소이고, 모든 사람에게 영정 단계인 것입니다. 여기서 사람은 위임된 작업이 경계를 가지고 있다는 것을 배운 후 소유합니다. 또한 사건을 낮추는지 여부는 P5입니다.
의무는 신중해야 합니다. AI 사용을 성능 기준으로 만드는 것은 가치 없는 사용을 생성할 수 있으며, 그렇게 한 적어도 하나의 고용주가 1년 내에 결정을 뒤집었습니다(Fortune, 2026b). 사용을 요청하는 것보다 업무에 중요한 결과물을 요청하는 것이 더 나은 신호입니다. 한 달에 한 번, "에이전트가 이름을 붙인 폴더에서 생성한 파일 표시" 및 "두 모델이 동의하지 않았기 때문에 변경한 결정 표시"는 전환 2 및 3을 측정하며, 로그인 수로는 할 수 없습니다. 결과물 측정 없이 규모에 따른 훈련, 아무리 수천 명이 등록되어 있든, 전환 2가 일어났는지 아무도 알려주지 않을 것입니다.
분해와 검증은 함께 가르쳐야 하며, 의회 전에 비평가 습관을 기르는 것이 좋습니다. 일반적인 프롬프트 과정은 1단계 교육학입니다. 2단계와 3단계 교육학은 사람이 이미 가진 업무에서 시작하며, 예를 들어 마케터의 금요일 패킹이나 교사의 과제 묶음에서 시작하고, 재사용 가능한 분해(섹션 5.1의 다섯 부분과 중단 조건 포함)를 가르치며, 폴더 사본에 대한 오류 복구를 가르칩니다. 그 후 평가할 사항은 그 사람이 안전하지 않은 지시를 인식하고, 가역적 시험의 이름을 지정하고, 증거를 검사하고, 시스템을 중단할 수 있는지 여부입니다. 승인 지점에서의 동일 계열 비평가는 구독에서 비용이 들지 않으며, 비평가가 침묵하고 결정이 비싼 경우 두 번째 계열이 추가됩니다. 유창성 루브릭의 상단에서의 오케스트레이션은 몇몇 역할에는 올바른 목적지이며 모든 사람에게 잘못된 첫날 요구사항입니다.
11.3 정책을 위하여
유럽연합의 AI 문해력 의무는 모든 AI 시스템의 제공자와 배포자가 직원에 대해 적용됩니다. 2026년 개정 후, 충분한 수준을 보장하기보다는 "AI 문해력 개발을 지원하기 위한 조치를 취할" 것을 요구하며, 감시 및 집행 규칙은 2026년 8월 3일부터 적용됩니다(유럽연합, 2026; 유럽 위원회, 2026a, 2026b). 미국에서 노동부의 프레임워크는 "AI를 효과적으로 지도하기"(미국 노동부, 2026)를 명시하고 있으며, OECD와 유럽 위원회 프레임워크는 "AI 관리"라는 영역을 가지고 있습니다(OECD & 유럽 위원회, 2026). 저는 에이전트 사례에서 그 단어들에 대한 내용을 제안합니다: 위임 계약의 네 부분, 취소를 포함한 섹션 8.1의 네 가지 관행, 합의가 보기보다 약한 증거라는 지식으로 모델을 비교하는 습관, 섹션 5.3의 기본 안전 관행. 지침은 대화형 사용과 위임된 조치를 구별해야 합니다. 후자의 경우 의무는 허가 범위, 데이터 분류, 검증, 사건 보고 및 취소를 포함해야 하며, 위임된 작업에 필요한 역할별 능력과 권한을 문서화할 요구사항이 모든 사람을 동일하게 훈련시킬 요구사항보다 더 방어 가능합니다. 규제당국과 근로자 대표는 또한 고용주가 사용 가능한 제어, 검토 시간 또는 안전하지 않은 위임을 거절할 권리 없이 잔여 책임을 직원에게 옮겼는지 여부를 질문할 수 있습니다. 이 모든 것은 하나의 규제 수단에서 도출한 설계 및 거버넌스 권장사항이며, 그 범위는 그 수단입니다.
유럽 의무는 규제 완화 라운드를 견디어냈으며, 여기서 논의된 프레임워크 중에서 AI를 사용하는 직원의 모든 구성원을 다루는 하나의 수평적 의무입니다. 미국에서 프레임은 인력 정책입니다. 2025년 4월의 AI 교육에 관한 행정 명령과 2025년 7월의 AI 실행 계획은 AI 문해력 및 기술 확대를 약속하며, AI 문해력 프로그램이 고용주 제공 교육 지원으로 적격일 수 있다는 지침을 포함합니다(백악관, 2025a, 2025b); 프레임은 에이전트 매니저 훈련과 호환되며 아직 그것을 요구하지 않습니다. 검사된 공식 텍스트 중 어느 것도 터미널 에이전트나 오케스트레이션을 명시하지 않으므로 "AI 관리"는 챗봇 에티켓이나 4단계 지도로 읽힐 수 있습니다. 프롬프팅에서 멈추는 문해력 프로그램은 1단계를 가르칩니다. 한편, 작업은 2단계에서 4단계로 이동하고 있습니다. 공식 텍스트는 아직 그곳을 따라가지 않았습니다.
통계청이 자신의 설문 조사에 AI 모듈을 추가하면 하나의 특정 변화를 도울 수 있습니다. "당신이 챗봇을 사용했는가"는 1단계 항목입니다. "당신이 지도한 시스템이 지난 7일 동안 당신이 업무에 사용하는 컴퓨터에서 파일을 생성하거나 변경했는가"는 2단계 또는 3단계 항목입니다. "당신이 지난 7일 동안 같은 업무 질문을 둘 이상의 AI 시스템에 제시했으며, 답변이 달랐는가"는 4단계 항목입니다. 이러한 종류의 항목 없이는 P6을 공개 데이터에서 테스트할 수 없으며, 에이전트 계층의 2단계 디지털 격차는 그것을 보는 것이 직무인 사람들에게 보이지 않은 채로 남아있을 것입니다.
11.4 연구자를 위하여
섹션 2.5의 격차는 의제입니다. 결과물로서의 아티팩트와 함께 이름으로 터미널 및 데스크톱 에이전트를 사용하는 비프로그래머를 연구합니다. 반사적 온보딩을 자체 메커니즘으로 연구합니다. 웹 오케스트레이션을 관행으로 연구하며, 사람들이 답변을 어떻게 조화시키는지와 출처 정보를 유지하는지 포함합니다. 지식 작업 작업에서 공급업체 계열 전체의 오류 상관관계를 측정하며, 코드와 수학의 벤치마크 이상으로 측정합니다. AI 사용에서 측정된 성별 및 직업 격차(Cranney 등, 2026; Humlum & Vestergaard, 2025)를 에이전트 수준으로 확장하며, 아직 아무것도 알려지지 않았습니다(P13). 특성 가용성 및 자체 보고된 시간 절약이라는 두 가지 쉬운 지표는 아티팩트 완성, 감사된 품질, 수정률 및 나중의 재사용을 선호하여 저항할 가치가 있습니다. 중단은 메커니즘과 함께 기록되어야 합니다. 허가 프롬프트에서의 중단은 인터페이스 문제, 데이터에 대한 합리적인 우려, 고용주 규칙, 누락된 머신 또는 수용 기준이 없는 작업일 수 있으며, 이를 "저항"으로 축소하면 그 모든 것이 손실됩니다. 평가는 오해의 소지가 있는 페이지, 문서의 숨겨진 지시, 모순되는 출처, 부분적 도구 오류 또는 여러 모델이 공유하는 확신 있는 잘못된 답변으로 적대적이어야 하며, 이는 관리자의 역할이 그러한 조건 하에서 결과를 개선할 때만 의미를 가지기 때문입니다. 복제에는 내 자료가 필요하지 않습니다; 아티팩트 규칙, 동결된 중단 이유 질문, 구현 기록, 그리고 날짜가 지정된 제품 조사가 필요합니다. 분모는 공개되어야 하며, 그것을 건넌 사람들만 보고하는 연구는 그 길에 대해 아무것도 알려주지 않습니다.
12. 범위 및 경계 조건
여기서 제시되는 것은 모델, 증거 종합, 측정 설계이며, 각각은 다음과 같은 방식으로 제한됩니다.
시간. 증거는 2026년 9월 21일까지 수집되었습니다. 제품 정보는 날짜가 지정되어 있으며 시간이 지남에 따라 변할 것입니다. 모델은 도달 범위와 역할로 정의되어 있어 더 천천히 변합니다.
지역 및 출처. 대부분의 채택 수치는 미국에서 나온 것이며, 유럽 수치는 존재하는 경우 인용했습니다. 여러 주요 수치는 공급업체에서 나왔으며(코딩 에이전트 사용, 채팅과 에이전트 통합의 이유, 공급업체 테스트 세트의 주입 비율), 본문에서 공급업체 데이터로 표시되어 있습니다. 저는 공급업체가 자신의 제품에 대해 알 수 있는 것으로 사용하고 그에 따라 가중치를 부여합니다.
인구. 논증은 컴퓨터에서 실질적으로 작업하는 전문가들과 관련됩니다. 주로 휴대폰에서 작업하거나 자신이 제어하는 컴퓨터 없이 작업하는 사람들은 여기서 설명하는 것보다 먼저 장벽을 만나며, 모델은 그 장벽을 명시하는 것 외에는 그들에 대해 거의 말하지 않습니다(5.5절).
코호트에 대한 증거. 사전 등록된 설계만 사용합니다. 프로그램의 결과는 여기서의 어떤 주장도 알려주지 않으며, 10절의 명제는 결과를 알기 전에 진술되었으므로 결과에 대해 판단할 수 있습니다. 자신의 컴퓨터가 필요한 코호트는 에이전트를 설치할 수 있는 사람들을 샘플링합니다. 장비 접근성과 동기를 분리할 수 없으며, 이 제한은 결과와 함께 남아 있습니다.
규범적 범위. 모델은 각 수준이 개인에게 요구하는 것을 설명합니다. 더 높은 수준이 더 나으며 모든 사람이 올라가야 한다고 주장하지 않습니다. 많은 작업의 경우 1 또는 2 수준이 적절한 위치입니다(8.2절). 높은 결과 작업, 기밀 기록, 안전 중요 작업, 시간에 민감한 의사 결정, 검사 가능한 수용 기준이 없는 작업에는 더 엄격한 조치가 필요하거나 위임된 에이전트 사용 범위에서 완전히 벗어날 수 있습니다.
오케스트레이션이 추가하는 것. 에이전트를 추가하면 범위를 확대하고 불일치를 드러내며 검토 흔적을 남길 수 있습니다. 또한 상관관계가 있는 오류, 비용, 지연, 그리고 성실성의 거짓된 외관을 추가할 수 있습니다. 지속되는 위임은 사람이 프로세스를 검사하고 변경할 수 있다는 것을 의미합니다. 프로세스가 신뢰할 만한 가치가 있는지 여부는 별도의 질문입니다.
문헌이 부족한 것. 2.5절의 문헌 검색에서는 비프로그래머가 터미널 또는 데스크톱 에이전트를 이름으로 채택하는 현장 연구, 웹 오케스트레이션을 명명된 관행으로 다루는 연구, 에이전트를 관리하는 것을 자체 구조를 가진 역량으로 다루는 것, 그리고 AI 시스템이 개인의 에이전트식 AI 채택을 지원하는 연구를 찾지 못했습니다. 이는 2026년 9월 21일 현재 연구된 것에서의 공백이며, 시장, 제품, 또는 우선순위에 대해서는 아무것도 주장하지 않습니다.
주장의 상태. 표 8은 시리즈의 신뢰도 언어를 논증의 요소에 적용하여 각각이 얼마나 확실하게 주장되는지 읽을 수 있도록 합니다.
표 8. 이 논문의 주장의 상태.
| 요소 | 여기에서 표현된 방식 | 근거 |
|---|---|---|
| 4단계 모델 및 아티팩트 규칙 | 테스트 중(9절, 10절) | 개념적; 3절과 부록 A에 명시된 표식 |
| 기술적 장벽이 설치 및 데스크톱 인터페이스에 대해 감소했습니다 | 데이터가 이를 뒷받침합니다 | 원클릭 설치 프로그램; "터미널 필요 없음" 문서; 4개 공급업체의 2단계 제품 출시 |
| 터미널 기반 에이전트 내의 지식 근로자 | 공급업체 보고, 방향성 | 2026년 6월 2일 공급업체 수치의 보도; 분석가의 주의 사항 |
| 공급업체가 전환 1을 채팅으로 흡수 | 제품에서 관찰됨 | Anthropic, 2026년 9월 16일; OpenAI, 2026년 7월 9일 |
| 워크플로우 어휘를 지배적인 남은 장벽으로 | 모델로 제시; 테스트 중 | 간접적: 프롬프팅 연구; 공급업체의 통합 이유; 프로그램의 중지 이유 항목 |
| 웹을 다리로, CLI를 지속적인 계층으로 | 테스트 중(P7, P8) | 계약, 권한 객체, 공식 플러그인; 웹 인터페이스의 취약성 |
| 상관관계가 있는 오류는 위원회가 얻을 수 있는 것을 제한합니다 | 모델 평가에서 데이터가 이를 뒷받침합니다; 사용 중 측정됨 | Kim et al. (2025); Chernets (2026a) |
| 반사적 온보딩 | 구현됨, 측정 중; 결과 보고 없음 | 공급업체 및 과정 관행(관찰); 프로그램의 1단계(측정) |
| 에이전트 관리자로서의 역할 | 행동 설명으로 제시; 테스트 중(P10) | 위임 연구; 고용주 평가표; 공식 문해력 프레임워크 |
| 코호트 교차 비율 | 보고되지 않음 | 프로토콜 고정; 결과 논문 발간 예정 |
| "지금 작동합니다"를 약속으로 | 주장되지 않음 | 이 논문의 범위 외 |
13. 결론
터미널은 한때 보통 전문가와 에이전트 AI 사이의 장벽을 명확히 보여주는 상징이었고, 한동안은 타당한 상징이었습니다. 2026년에는 더 이상 그렇지 않습니다. 설치는 명령어 하나 또는 클릭 하나로 가능하고, 사람이 이미 사용하고 있는 챗봇이 그들을 안내할 수 있으며, 벤더들은 채팅과 에이전트를 하나의 인터페이스로 통합하고 있습니다. 섹션 4와 5가 보여주는 것은 이동된 장벽입니다. 처음 제한된 시도는 훨씬 쉬워졌고, 남은 어려움은 전체 작업에서 안정적인 결과를 얻기, 계속 변하는 제품을 따라잡기, 그리고 주어진 폴더를 안전하게 유지하기입니다. 한 벤더의 통계에 따르면 언론을 통해 보도되고 방향성 있게 읽을 수 있듯이, 이미 주당 약 백만 명의 지식 근로자가 터미널 유산의 코딩 에이전트 내부에 있습니다. 한편 대부분의 전문가는 여전히 AI를 대화로만 만나고 있습니다.
이제 방해가 되는 것은 관리자의 일입니다: 무엇을 넘길지 아는 것, 경계를 정하는 것, 결과에 이름을 붙이고 검증하는 방법을 결정하는 것, 그다음 환경을 안전하게 운영하고 모델을 비교하면서 그들의 일치가 보이는 것보다 약한 증거라는 것을 기억하는 것입니다. 섹션 3의 네 가지 수준은 어떤 제품도 소유하지 않은 이 작업에 구조를 제공하고, 아티팩트 규칙은 이에 측정 단위를 제공합니다. 저는 웹 오케스트레이션을 마지막 수준(P7)으로 가는 다리로 제안했고 CLI 오케스트레이션을 지속되는 그 형태로 제안했습니다(P8); 둘 다 실패할 수 있도록 기술되었습니다.
전환을 도입하는 모든 사람에게 실질적인 결과는 작업의 순서입니다. 첫 번째 질문은 사람이 설명할 수 있고, 검토할 수 있으며, 시도가 실패했을 때 안전하게 버릴 수 있는 작은, 허가된 업무 부분이 무엇인가입니다: 공개 출처의 브리핑, 개인 계획 폴더, 다른 사람이 의존하지 않는 스프레드시트. 거기에서 관리자의 책임 하나씩 추가됩니다: 경계, 그다음 승인, 그다음 자신의 작업 공간, 그다음 저장된 작업 기록, 그다음 두 번째 그리고 중요한 검토. 평가는 같은 순서를 따릅니다. 사람이 무엇을 할 수 있었는지, 출력이 어떻게 검증되었는지, 에이전트가 실패했을 때 무엇이 일어났는지를 숨긴다면 시연은 거의 가치가 없습니다. 신중한 위임 거부는 결과로 계산됩니다. 그리고 제한된 작업을 재현할 수 있고, 왜 그것에 의존했는지 말할 수 있으며, 결정을 바꾼 의견 불일치를 지적할 수 있고 상황이 바뀔 때 접근을 제한할 수 있는 사람은 직함이 무엇이든 그 역할의 관찰 가능한 징후를 보여주고 있습니다.
모델은 실패할 수 있고, 섹션 10이 그 방법을 설명합니다. 섹션 9의 프로그램은 프로그래머가 아닌 사람들에게 그것의 일부를 테스트할 것이고, 부록 C의 코드는 다른 사람들이 같은 경계를 측정하고 같은 패턴을 연습하게 합니다. 저는 부록 B에 명시된 제품들이 1년 안에 시대에 뒤떨어져 보일 것으로 예상합니다. 섹션 5의 장벽은 그렇지 않아야 합니다. 왜냐하면 그것들은 어떤 제품이 그들 앞에 있든 사람과 그 일에 속하기 때문입니다. 터미널은 에이전트가 그것을 관리하도록 배운 사람을 위해 일하는 장소가 되었고, 몇 명의 사람이 그것을 배울 것인가, 어떤 경로로, 얼마나 빨리는 내년이 답할 질문입니다.
선언
자금 지원. 본 연구를 지원한 외부 자금이 없습니다.
이해 충돌. 저자는 다중 모델 오케스트레이션 방법을 개발하고 있으며 관련 특허 출원을 제출했습니다(심사 중; 허여된 특허 없음). 저자는 제9장에서 설명한 사전 등록된 코호트 프로그램과 그 자료를 설계했습니다. 본 논문의 어떤 발견도 저자의 구현에 의존하지 않습니다. 부록 C의 모든 패턴은 공개적으로 이용 가능한 도구로 재현 가능합니다. 저자는 또한 부록 C에서 언급한 두 개의 오픈 소스 플러그인을 유지 관리하고 있습니다. 이들은 무료 오픈 소스(Apache License 2.0)이며, 본 논문의 어떤 발견도 이들에 의존하지 않습니다. 저자는 나중에 상업적으로 제공될 수 있는 교수 자료를 개발 중이며, 작성 당시에는 아무것도 판매되지 않았고, 제9장에서 설명한 코호트는 모든 자료를 무료로 받았습니다.
도구 및 검증. AI 어시스턴트는 저자의 지시 하에 도구로서 사용되었습니다. 아이디어, 연구 및 결론은 저자의 것입니다. 모든 정량적 주장과 인용은 2026년 9월 21일 현재 기본 출처 또는 아카이브된 사본에 대해 확인되었거나, 출처가 텍스트 및 부록 B의 타임라인에서 보조 또는 판매자로 표시된 경우 가용한 최고의 보고서에 대해 확인되었습니다. 연구 기간 중 기본 페이지를 검색할 수 없는 경우(한 판매자 사이트의 여러 페이지가 접근 오류를 반환함), 주장은 명명된 보조 출처에서 인용되고 표시되거나 생략됩니다. 참고문헌에서 대괄호로 표시된 보도 제목은 헤드라인을 축자로 다시 읽지 않은 페이지의 설명적 제목입니다.
데이터 및 코드 가용성. 부록 C의 테스트를 포함한 코드는 MIT 라이센스에 따라 https://github.com/vadimchernets/after-chat에 저장되고 Zenodo에 아카이브됩니다(https://doi.org/10.5281/zenodo.22944451). 동일한 패턴을 기반으로 구축된 두 개의 플러그인인 Roundcall과 Sidecall은 https://github.com/vadimchernets/roundcall 및 https://github.com/vadimchernets/sidecall에 있습니다(Apache License 2.0). 동일한 패턴을 소프트웨어 외부의 거래에 적용하는 5개의 키트는 https://github.com/vadimchernets/calling-kits에 있습니다(MIT). 이들은 해당 거래의 실무자들이 시도하지 않았으며, 이는 저장소에서 명시되어 있고, 본 논문의 어떤 주장도 이들에 기반하지 않습니다.
윤리. 본 논문은 인간 참여자로부터의 데이터를 보고하지 않습니다. 설명하는 코호트 프로그램은 사전 등록되어 있습니다(OSF, DOI 10.17605/OSF.IO/X4EGQ). 그 결과는 별도로 보고될 것입니다.
저자 기여. 단독 저자.
대응. [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
부록 A. 모델 용어집
도달 범위. 모델이 어떤 사람을 대신하여 접근할 수 있는 영역: 대화; 공급사가 제한한 공간 내의 파일과 도구; 사람 자신의 컴퓨터; 여러 모델과 에이전트.
역할. 업무가 성공하기 위해 사람이 해야 하는 일: 물어보고 복사하기; 위임하고 검토하기; 환경 관리하기; 여러 에이전트 관리하기.
단계. 업무가 수행되는 도달 범위와 역할의 조합 (3.2절). 단계는 업무를 설명합니다. 사람과 제품은 여러 단계를 포함할 수 있습니다.
전환 통과. 에이전트가 새로운 단계에서 사람이 요청한 산출물을 생성했을 때 기록합니다. 설치는 하나의 시도입니다. 한 단계를 넘는 이동은 허용되며 건너뜀으로 기록됩니다.
산출물. 에이전트가 생성하고 사람이 제공하거나 보관하는 파일, 폴더, 작업 또는 출력입니다. "없음"도 유효한 기록입니다.
업무 용어집. 사람이 에이전트에게 맡길 수 있는 업무의 작업 저장소로, 에이전트가 이를 수행하고 결과를 확인할 수 있도록 표현됩니다.
반사적 온보딩. AI 시스템이 더 강력한 AI 시스템을 채택하도록 사람을 지원하는 것입니다. 예를 들어 챗봇이 에이전트 설치를 안내하고 초기 오류로부터 복구하도록 도와줍니다.
위임 계약. 사람이 에이전트에게 업무를 맡길 때 명시하는 네 가지 항목: 목표, 경계, 산출물, 확인.
네 가지 실천. 관리자가 업무 전반에 걸쳐 수행하는 것: 위임, 감독, 검증, 취소 (8.1절).
수용 기록. 중요하거나 반복적인 업무의 경우: 의도한 산출물, 입력, 제약 조건과 권한, 출력 위치, 실질적인 불일치 또는 실패, 수행한 확인, 그리고 수용, 수정, 상향 보고 또는 폐기 결정입니다. 에이전트가 생성한 것과 사람이 의존한 것을 구분합니다.
5단계 업무 맵. 업무의 대상, 허용되는 입력, 변환, 산출물, 확인: 비프로그래머의 반복적인 업무가 위임이 되는 형태입니다 (5.1절).
부측면 분기. 브라우저 애플리케이션 빌더로, 사람의 파일이 아닌 플랫폼이 호스트하는 프로젝트에 작용합니다. 자체 단계가 있는 다른 계단입니다 (3.4절).
웹 오케스트레이션. 브라우저에서 여러 소비자용 챗봇에 하나의 질문을 제시하고 (수동으로 또는 도구로), 답변을 비교합니다.
CLI 오케스트레이션. 한 에이전트가 다른 에이전트의 명령줄 도구를 호출하고, 그 출력을 수집하고, 병합하거나 확인합니다.
변동성. 신입이 도구를 배우는 데 걸리는 시간보다 짧은 기간 내에 도구의 이름 변경, 병합 또는 폐기.
의견의 유효 개수 (N_eff). 평균 쌍별 오류 상관관계 rho를 가진 N개 모델에 대해 N / (1 + (N - 1) rho); 상한은 1/rho입니다 (Chernets, 2026a).
코딩 가능한 항목으로서의 표시자
질적 데이터 코더 또는 조사 설계자의 경우, 3절의 표시자는 명명된 산출물에 대한 예/아니오 항목으로 축약됩니다. 산출물 없는 자기 보고는 주장으로 기록되며 전환으로 계산되지 않습니다.
- 단계 1 현재. 지난 7일 이내에 소비자용 챗봇과의 저장된 대화 적어도 하나; 산출물: 링크, 스크린샷 또는 내보내기. 이를 생성하지 못하는 것은 "입증되지 않음"으로 코딩되며, 이는 "없음"보다 약한 발견입니다.
- 전환 1 통과. 사람이 허가한 위치 내에서 범위가 지정된 에이전트(데스크톱, 웹 또는 테넌트 호스트)가 작성한 파일 또는 파일 집합으로, 사람이 명명한 업무에 대한 응답이며, 최소한 하나의 승인, 거부 또는 계획 편집이 기록되어 있습니다. 산출물의 날짜가 통과 날짜입니다.
- 단계 2 현재. 전환 1을 통과하고, 더 나아가 나중 주에 범위가 지정된 산출물이 하나 더 있습니다. 지속성은 전환과 별개의 주간 항목으로 기록됩니다.
- 전환 2 통과. 사람이 관리하는 머신에서 로컬 에이전트 또는 그 공식 데스크톱 셸이 생성한 작업 폴더, 커밋 또는 날짜가 지정된 파일 집합으로, 두 개 이상의 도구 사용이 필요했던 업무로부터의 것입니다. 클라우드 호스트 업무는 자체 클라우드 변형으로 코딩됩니다.
- 단계 3 현재. 전환 2를 통과하고, 같은 클래스의 에이전트로부터 나중 주의 산출물이 있습니다.
- 전환 3, 다리 형태. 질문, 질문한 챗봇 또는 웹 모델, 원본 답변 또는 그에 대한 링크, 일치와 불일치의 기록, 적용 범위 또는 신뢰성(6.2절)이 나타났는지 여부의 기록을 담은 날짜가 지정된 파일입니다. 수동으로 또는 브로드캐스트 도구로 생성됩니다.
- 전환 3, 지속 가능한 형태. 같은 필드로, 사람 자신의 로그인에서 두 개 이상의 공식 명령줄 도구(또는 하나 플러스 두 번째 계열 플러그인)를 호출한 실행으로 생성되며, 분모가 기록됩니다: 질문함, 답변함, 시간 초과됨.
- 단계 4 현재. 전환 3의 어느 형태든, 더하기 나중 주의 두 번째 날짜가 지정된 실행.
- 지원됨 대 미지원. 조사자, 동료 또는 유료 코치가 설치 단계를 수행하고, 업무를 작성하거나, 오류로부터 복구한 모든 전환은 지원됨입니다. 완료는 도움을 받을 수 있었던 곳에서 두 개의 숫자로 보고됩니다.
- 중지 사유. 통과하지 못한 모든 사람에게 "무엇이 당신을 멈추게 했는가"를 묻는 자유 형식 답변으로, 수집 후 코딩됩니다. 나중 코더가 수정할 가설로 제시된 후보 코드: 업무 용어집; 권한 또는 보안 대화 상자; 관리자 권한; 비용 또는 할당량; 인터페이스에 대한 두려움; 파괴적 사건의 뉴스; 조직 정책; 기술적 오류; 생활과 시간; 기타.
- "무엇을 요청해야 할지 몰랐음"에 대한 코딩 규칙 (업무 용어집). 에이전트에게 하도록 시도한 것을 물었을 때 그 사람이 5.1절의 5단계 중 최소 하나를 명명할 수 없을 때 포함합니다: 업무의 대상, 사용할 수 있는 입력, 변환, 산출물, 또는 확인. 5단계 모두 명명되었으나 정책, 위험, 비용 또는 시간을 이유로 거부했을 때는 제외합니다. 그들은 자신의 코드를 받습니다. 두 명의 코더가 독립적으로 코딩하고 그들의 일치를 보고합니다. 규칙은 중지를 분류하며, 그 사람의 능력에 대해 아무것도 말하지 않습니다.
- 네 가지 실천의 흔적 (예/아니오, 각각 날짜가 지정된 산출물과 관련됨): 거부된 계획; 거부된 diff 또는 출력; 두 번째 모델 계열 요청; 기록된 분모 (누가 질문했는가, 누가 답변했는가, 누가 시간 초과했는가); 확인을 위해 보관된 비가역적 단계; 보관된 산출물. 이들은 P10의 감독 흔적입니다.
- 마커가 아닙니다. 라이선스 구매, 코스 배지, 설치 프로그램 로그, 저장소 별, 프롬프트 수, 또는 "에이전트 사용자"로 자평하는 행위.
부록 B. 연대기, 2025년 ~ 2026년 9월 21일
VERIFIED로 표시된 항목은 2026년 9월 21일에 종료된 연구 기간 동안 주요 페이지 또는 언론 보도용으로 지정된 부차 페이지에서 열렸습니다. SECONDARY로 표시된 항목은 주요 페이지에서 열리지 않은 언론 보도 또는 제품 이력에 기반하며, 방향 설정을 위해 제공되며 논증에 가중치를 갖지 않습니다. 4단계 논증을 위한 작동 중인 연대기이며 산업 연대기를 시도하지 않습니다.
| 날짜 | 사건 | 출처 | 상태 |
|---|---|---|---|
| 2025년 2월 24일 | Claude Code 연구 미리보기 | 제품 이력, 널리 보도됨 | SECONDARY |
| 2025년 4월 23일 | 행정 명령 14277 (AI 교육) | 백악관 (2025a) | VERIFIED |
| 2025년 5월 22일 | Claude Code 일반 공개 | 제품 이력, 널리 보도됨 | SECONDARY |
| 2025년 6월 23일 | Agent2Agent 프로토콜을 Linux Foundation에 기증 | Google Open Source Blog (2026) | VERIFIED (판매사) |
| 2025년 7월 | America's AI Action Plan이 AI 문해력 및 기술 증진에 약속 | 백악관 (2025b) | VERIFIED |
| 2025년 7월 21일 | 애플리케이션 구축 에이전트가 라이브 세션 중 프로덕션 데이터베이스 삭제 | The Register (2025) | VERIFIED (언론) |
| 2025년 8월 20일 | 브라우저 에이전트에 대한 프롬프트 인젝션 시연, 도용된 일회용 코드 사용 | Brave (2025) | VERIFIED |
| 2025년 8월 25일 | 브라우저 에이전트 파일럿: 완화 없이 23.6% 공격 성공, 완화 시 11.2% | Anthropic (2025) | VERIFIED (판매사) |
| 2025년 12월 9일 | Model Context Protocol을 Agentic AI Foundation (Linux Foundation)에 기증; 10,000개 이상의 공개 서버, 약 9,700만 월간 SDK 다운로드 | Linux Foundation (2025) | VERIFIED |
| 2025년 12월 9일 | 컨설팅 회사가 약 30,000명의 직원이 한 판매사의 모델에 대해 교육을 받을 것이라고 발표 | Accenture (2025) | VERIFIED |
| 2025년 12월 18일 | Agent Skills 형식이 개방 표준으로 출시 | SiliconANGLE (2025) | VERIFIED (언론) |
| 2025년 12월 22일 | OpenAI: 프롬프트 인젝션은 "완전히 '해결'될 가능성이 거의 없음" | TechCrunch (2025) | VERIFIED (언론) |
| 2026년 1월 | Cowork 연구 미리보기, "나머지 업무를 위한 Claude Code" | Fortune (2026a); The Register (2026) | VERIFIED (언론) |
| 2026년 1월 12일 | 프롬프트 인젝션을 감시하도록 프로그래머가 아닌 사람을 요청하는 것에 대한 반대 | Willison (2026) | VERIFIED |
| 2026년 1월 15일 | Anthropic 경제지수: 대화의 52%가 증대 (2025년 11월) | Anthropic (2026f) | VERIFIED (판매사) |
| 2026년 2월 4일 및 26일 | GitHub Agent HQ: Claude 및 Codex 에이전트를 Copilot 내에서 사용 가능 | GitHub (2026c) | VERIFIED |
| 2026년 2월 | Perplexity Model Council (상위 구독자용) (2월 10일 보도) | Storyboard18 (2026) | VERIFIED (언론) |
| 2026년 2월 13일 | 미국 노동부 AI 문해력 프레임워크 ("AI를 효과적으로 운영") | 미국 노동부 (2026) | VERIFIED |
| 2026년 3월 9일 | Cowork 기술이 Microsoft 365 Copilot으로 통합 | Microsoft (2026a) | VERIFIED |
| 2026년 3월 9일, 4월 19일, 6월 10일 | 사용자가 승인된 폴더 내 2단계 에이전트에 의해 삭제된 파일 보고 | GitHub 이슈 보고 (2026) | VERIFIED (사용자 보고) |
| 2026년 3월 24일 | Anthropic 경제지수: 장기 사용자가 덜 위임 | Anthropic (2026e) | VERIFIED (판매사) |
| 2026년 3월 30일 | OpenAI의 Claude Code 내에서 해당 에이전트를 사용하기 위한 공식 플러그인; Microsoft의 연구 에이전트가 GPT와 Claude를 함께 실행 | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| 2026년 4월 | JetBrains: 업무 시 Claude Code 18% (2026년 1월), 약 3% (2025년 봄)에서 증가 | JetBrains Research (2026a) | VERIFIED (판매사 조사) |
| 2026년 4월 13일 | Duolingo가 성과 평가에서 AI 사용 중단 | Fortune (2026b) | VERIFIED (언론) |
| 2026년 5월 5일 | Work Trend Index: 조직 요인이 개인 요인을 2배 이상 초과 | Microsoft (2026b) | VERIFIED (판매사 조사) |
| 2026년 4월 25일 (5월 5일 보도) | 에이전트가 회사의 프로덕션 데이터베이스 및 백업 삭제 | Information Age (2026) | VERIFIED (언론) |
| 2026년 5월 19일 | Google가 Gemini CLI에서 Antigravity CLI로의 이전 발표 | Google (2026) | VERIFIED |
| 2026년 5월 25일 | xAI의 Grok Build가 헤드리스 모드 및 에이전트 프로토콜 지원과 함께 출시 | xAI (2026) | VERIFIED (판매사) |
| 2026년 5월 26일 | 미국 비즈니스 AI 사용 전체적으로 17%에서 20%; 소기업은 정체 | 미국 인구조사국 (2026) | VERIFIED |
| 2026년 5월 27일 | 개발자 맥박: 69% 단일 에이전트; 60% 승인되지 않은 변경 차단 | Stack Overflow (2026) | VERIFIED |
| 2026년 6월 2일 | 코딩 에이전트가 주간 사용자 500만 명, 약 20% 지식 근로자 | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (판매사 데이터의 언론 보도) |
| 2026년 6월 15일 | PwC AI Jobs Barometer: AI 기술에 대한 62% 임금 프리미엄 | PwC (2026) | VERIFIED (판매사) |
| 2026년 6월 17일 | Pew: 약 미국 성인의 절반이 챗봇 사용 | Pew Research Center (2026) | VERIFIED |
| 2026년 6월 18일 | Gemini CLI가 개인 구독 서비스 중단 | Google (2026) | VERIFIED |
| 2026년 6월 | OECD 및 유럽 위원회 AI 문해력 프레임워크 ("AI 관리") | OECD & 유럽 위원회 (2026) | VERIFIED |
| 2026년 6월 29일 ~ 7월 3일 | Claude Code가 기본 권한 모드의 이름을 "Manual"로 변경 | Anthropic (2026h) | VERIFIED (판매사) |
| 2026년 7월 1일 | Gemini Spark 데스크톱 에이전트 (Mac); Remote Labor Index 최고 자동화율 15.8%, 출시 시 2.5%에서 증가 | TechCrunch (2026b); Center for AI Safety (2026) | 검증됨 |
| 2026년 7월 8일 | Indeed: AI의 영향을 받는 미국 직업 중 63%는 기술 직종 외의 분야 | Adrjan (2026) | 검증됨 |
| 2026년 7월 9일 | 코딩 에이전트 앱이 ChatGPT 데스크톱 앱이 되고, ChatGPT Work 출시 | MacRumors (2026) | 검증됨 (보도) |
| 2026년 7월 20일 | 갤럽 조사: 미국 근로자의 52%가 AI를 사용하며, 15%는 매일 사용 | Gallup (2026) | 검증됨 |
| 2026년 7월 27일 | EU AI Omnibus 시행; AI 문해력 의무가 "조치를 취하여 지원"으로 변경 | European Commission (2026a, 2026b) | 검증됨 |
| 2026년 7월 28일 | Model Context Protocol: 월 거의 5억 건의 SDK 다운로드; 프로토콜이 무상태로 변경 | Model Context Protocol (2026) | 검증됨 |
| 2026년 8월 3일 | AI 문해력에 관한 EU 감독 및 집행 규칙 적용 | European Commission (2026a) | 검증됨 |
| 2026년 8월 | JetBrains: 전문 개발자의 90%가 주간 코딩 에이전트를 사용; Claude Code는 직장에서 39% | JetBrains Research (2026b) | 검증됨 (벤더 조사) |
| 2026년 8월 9일 | OpenAI의 에이전트 브라우저 중단; 브라우징이 ChatGPT 앱으로 이동 | 9to5Mac (2026) | 검증됨 (보도) |
| 2026년 8월 26일 | 브라우저 에이전트 일반 사용 가능; 기본적으로 분류기로 자동화; 벤더 보고 주입률은 거의 0에 가까움 | Anthropic (2026d) | 검증됨 (벤더) |
| 2026년 9월 1일 | St. Louis Fed: 45%의 근로자가 직무에 AI를 사용; 50% 이상 채택률인 업무는 3% 미만 | Bick et al. (2026) | 검증됨 |
| 2026년 9월 6일 | 코호트 1 사전등록 동결 | Chernets (2026d) | 검증됨 |
| 2026년 9월 9일 | Harvard Business Review: 신뢰가 직장에서의 에이전트 채택의 중심적 장애물 | McKinlay et al. (2026) | 검증됨 (요약) |
| 2026년 9월 16일 | Cowork와 chat이 하나의 Claude로 통합 | Anthropic (2026c); TechCrunch (2026a) | 검증됨 |
| 2026년 9월 22일 | 공식 플러그인 카탈로그 전체 정독, 310개 항목: Section 5.1에서 명시된 5개 직종 중 어느 것도 없음; 커뮤니티 카탈로그 2,282개 항목, 교사 및 부동산 관련 제공 | 게시된 카탈로그의 저자 정독 | 검증됨 (자체 집계) |
부록 C. 교육용 코드
아래의 코드 목록들은 5장부터 9장까지의 패턴들을 설명합니다. Python 표준 라이브러리와 업체의 자체 명령줄 도구들만 사용하며, 사용자 자신의 구독으로 로그인합니다. API 키를 읽지 않습니다. 각 목록은 한 번에 읽을 수 있을 정도로 짧으며, 각각 자신이 설명하는 내용과 어디서 멈추는지를 명시합니다. 이들은 테스트와 함께 MIT 라이선스 하에 동반 저장소에 저장되어 있으며, 모든 목록은 포함되기 전에 실행되었습니다(각각 자신의 데모 입력에 대해, 팬아웃은 스텁 도구에 대해). 여기의 모든 패턴은 이미 오픈소스 도구들에 어떤 형태로든 존재합니다(7.1절); 목록들의 가치는 이들이 작고, 주석이 달려 있으며, 논의와 연결되어 있다는 점입니다. 어느 것도 교육 경로, 학습자의 진단, 커리큘럼 또는 저자의 도구 구현이 아닙니다. 프로그래머가 아닌 사람이 이 파일들을 직접 실행하지는 않습니다. 이들은 에이전트가 스킬로 래핑하거나 데스크톱 셸이 버튼으로 노출시키는 종류의 것이며, 이들을 인쇄하는 포인트는 독자가 그러한 버튼이 무엇을 하는지 볼 수 있다는 점입니다.
두 개의 설치 가능한 Claude Code 플러그인이 이 패턴들을 일상 용도로 사용합니다. Roundcall은 어떤 사람이 이미 로그인한 AI 채팅 사이트들에 자신의 브라우저를 통해, 사람의 속도로 질문합니다. Sidecall은 자신의 머신에 설치된 명령줄 에이전트들에 질문하며, 각 업체의 모델을 선택하는 예산 설정이 있습니다. 둘 다 누가 무엇을 말했는지, 답변들이 어디서 불일치하는지, 그리고 오직 한 소스만 말한 것이 무엇인지를 보여주는 하나의 보고서를 반환합니다. 이들은 Apache License 2.0 하에 https://github.com/vadimchernets/roundcall 및 https://github.com/vadimchernets/sidecall에서 오픈소스입니다.
이들 중 어느 것이든 실행하기 전에: 설치된 버전의 각 도구에서 --help를 확인하십시오. 플래그는 릴리스 간에 변경되기 때문입니다. 원본이 아닌 사본을 보관하는 작업 폴더에서 실행하십시오. 그리고 먼저 Listing C6을 읽으십시오.
C1. 프로브, 천정, 부분 캡처를 이용한 팬아웃 (fanout.py)
설명하는 내용: 한 사람이 여러 에이전트 CLI에 한 번에 하나의 질문을 어떻게 보낼 수 있는지, 다운되었거나 할당량을 초과한 것들을 어떻게 건너뛸 수 있는지, 시간 천정에서 어떻게 대기를 멈출 수 있는지, 그리고 천정 이전에 각 도구가 쓴 내용을 어떻게 버리지 않고 유지할 수 있는지를 설명합니다. 각 도구는 출력 폴더 내의 새롭고 비어 있는 폴더에서 실행되며, 사람이 시작한 폴더에서는 절대 실행되지 않습니다. 도구 이름은 안전한 파일 이름으로 제한됩니다. 긴 질문은 파일(--question-file)로 들어가거나, 템플릿에 {prompt}가 없는 도구의 경우 도구의 표준 입력으로 들어갑니다. 명령줄 인자는 운영 체제에 의해 길이가 제한되기 때문입니다. 제한: 천정에서 멈추는 것은 POSIX 프로세스 그룹을 사용합니다(macOS 및 Linux; Windows에서는 WSL 사용). 그리고 도구 자체를 멈추기로 폴백됩니다. 끝에서만 출력하는 도구는 멈출 때 유지할 내용이 없습니다. 스트리밍 출력 모드가 있으면 사용하십시오. 이 스크립트는 아무것도 비교하지 않습니다. C3이 합니다.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. 에이전트를 위한 "second opinion" 스킬 (second-opinion/SKILL.md)
교육 내용: 가장 작은 형태의 CLI 오케스트레이션으로, 한 에이전트가 다른 공급업체의 에이전트에게 질문하고 차이를 병합하는 대신 보여주도록 하는 작성된 지시 사항입니다. 한계: 두 개의 모델은 하나의 비교일 뿐이며, 패널이 아닙니다. 스킬은 여전히 주요 출처가 필요한 점들을 명시합니다.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. 누가 무엇을 말했는가 (provenance.py)
학습 내용: 여러 모델에 질문하는 것이 구현하려는 두 가지, 즉 적용 범위와 신뢰성을 시각화한 것으로, 출처별 주장 테이블, 한 출처에서만 제시한 주장 목록, 숫자나 날짜가 다른 주장 목록으로 나타냅니다. 한계: 반복된 의미가 아닌 반복된 표현을 일치시키며, 어떤 내용을 자세히 읽어야 하는지를 사람에게 알려줄 뿐, 무엇이 사실인지는 알려주지 않습니다.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. 합의는 몇 개의 독립적인 의견의 가치가 있는가? (neff.py)
교육 내용: 상관관계가 있는 증거의 산술(섹션 6.3): 알려진 답변이 있는 항목에서 평균 오류 상관계수 rho를 추정한 다음 N_eff와 그 상한값 1/rho를 계산합니다. --demo로 실행하면 약 1.6개의 독립적인 의견의 가치가 있는 네 가지 모델을 볼 수 있습니다. 제한 사항: rho는 작업에 따라 달라지므로 관심 있는 항목과 같은 항목에서 추정하고, 열 개 이상의 항목을 사용해야 합니다.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. 교차 기록 및 검사기 (crossings.py)
다루는 내용: 섹션 9.1의 측정 규칙을 코드로 표현합니다. 다음의 경우 기록이 거부됩니다: 설치를 교차로 계산하는 경우, 에이전트가 생산한 산출물 없이 완료하는 경우, 개인의 자체 언어 없이 중단하는 경우, 도움의 설명 없이 도움을 제공하는 경우, 가명 레이블 대신 이름을 사용하는 경우 (레이블은 P 다음에 숫자가 와야 함), 목록에 정확하게 기재되지 않은 건너뛴 수준, 참 또는 거짓이 아닌 값, 읽을 수 없는 날짜, 형식이 인식하지 못하는 필드, 또는 2개 이상의 질문하고 답변한 도구를 명시하지 않은 수준 4 교차입니다. 형식이 잘못된 줄은 거부된 것으로 보고되며 실행을 중단하지 않습니다. 제한사항: 기록의 형식만 확인하며 진실성은 확인하지 않습니다. 두 도구가 서로 다른 모델 계열인지 여부, 그리고 배열이 이후 주에 다시 실행되었는지 여부 (두 번째 기록)는 연구자에게 남겨집니다. 이는 애플리케이션이 아닌 연구 도구입니다.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
동일한 레코드 형식은 JSON Schema(crossings.schema.json)로 발행되어 다른 도구들이 레코드의 형태를 검증할 수 있습니다. 위의 검사기는 스키마가 표현할 수 없는 규칙들을 시행합니다(설치는 횡단이 아니며, 정지는 그 사람 자신의 말이 필요하고, 도움은 설명이 필요하며, 건너뛰기는 기록되어야 함).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. 3단계 이전의 안전(safety/) (safety/)
교육 내용: 섹션 5.3의 관행을 구성으로 제시합니다. 첫 번째 파일은 Claude Code의 예제 프로젝트 설정 파일입니다: 기본적으로 계획 모드(공급업체는 2026년 7월에 기본 모드를 "Manual"로 이름 변경했으며, "plan"은 여전히 유효하며 더 안전한 교육 선택입니다), 일반적인 파괴적 및 다운로드 명령이 거부되며, 일반적인 보안 파일이 파일 리더와 셸 cat 모두에서 거부되고, 삭제 및 웹 가져오기가 확인됩니다. 거부 목록은 단지 목록일 뿐입니다: 허용적 모드 또는 나열되지 않은 명령이 이를 우회할 수 있으므로, 샌드박스 설정이 규칙만큼 중요합니다. 두 번째는 OpenAI의 Codex에 대한 구성으로, 실행별 폴더 범위 형식으로 제시됩니다: 작업 폴더로 제한된 쓰기, 네트워크 없음, 요청 시 승인입니다. 세 번째는 체크리스트입니다. 제한 사항: 권한 규칙 및 샌드박스는 영향 범위를 줄이지만 에이전트를 신뢰할 수 있게 만들지는 않으며, 규칙 구문은 버전 간에 변경됩니다.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. 로그로서의 감시 추적 (jsonl_log.py)
교육 내용: 관리자 작업의 가장 작은 유용한 기록으로, 이벤트당 하나의 타임스탬프가 지정된 JSON 객체이므로 거부된 계획, 거절된 diff, 취한 2차 의견 및 완료된 실행(명제 P10의 감시 추적)을 나중에 표준 라이브러리로 계산할 수 있습니다. --demo로 실행하십시오. 제한 사항: 이것은 추적기가 아닌 기록기이며, 사람이나 에이전트가 말하는 것을 기록합니다.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
부록 D. 의견의 유효 개수 계산표
목록 C4를 실행하고 싶지 않은 에이전트 관리자도 여전히 상한을 사용할 수 있습니다. 각 셀은 N_eff = N / (1 + (N - 1) rho)이며, 마지막 행은 상한 1/rho로서 그 상관관계를 가진 모델의 어떤 개수도 초과할 수 없습니다. rho의 값은 공식을 설명하고 아무것도 측정하지 않기 위해 선택되었습니다. 실제 사용에서 rho는 오류의 평균 쌍별 상관관계로서, 두 모델이 합의하는 공동 오류의 비율과는 다른 양이며, 해당 분야의 정답이 있는 항목에서 추정해야 합니다(목록 C4).
| N 모델 | rho = 0.2 (설명용) | rho = 0.5 (설명용) | rho = 0.6 (설명용) | rho = 0.8 (설명용) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| 상한, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
이 표는 제6절에서 같은 것의 열 번째 창 대신 다른 계열에 다음 구독을 사용하도록 사람들에게 알려주는 이유입니다. 계열의 다양성, 주장별 출처에 대한 검증, 그리고 보존된 불일치는 더 큰 N이 할 수 없는 일을 수행합니다. rho는 작업에 따라 달라지므로, 그 사람 자신의 분야의 항목에서 추정해야 합니다(목록 C4).
부록 E. 경관 조사, 2026년 9월 19일~21일
본문의 표 5는 도구를 패턴별로 분류합니다. 이 부록은 그 뒤에 있는 원본 조사를 기록하며, 주어진 날짜에 수치가 어떻게 나타났는지 알고 싶어하는 독자를 위한 것입니다. 별 개수는 매일 변하며, 인기도를 추적하고 품질이나 사용자 수에 대해 아무것도 말하지 않으므로, 독자의 날짜를 기준으로 인용되어서는 안 됩니다. 패턴 열은 제 매핑이며, 프로젝트 자체는 그러한 주장을 하지 않습니다.
| 프로젝트 | 위치 | 별 (대략, 2026년 9월 21일) | 라이센스 | 패턴 |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147,000 | 소스 공개, 전용 라이센스 | 터미널 에이전트 (레벨 3) |
| openai/codex | github.com/openai/codex | 126,000 | Apache-2.0 | 터미널 에이전트 (레벨 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107,000 | Apache-2.0 | 터미널 에이전트; 2026년 6월 18일 이후 개별 티어 제공 중단 |
| cline/cline | github.com/cline/cline | 69,000 | Apache-2.0 | 에디터 및 터미널 에이전트 |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33,400 | Apache-2.0 | 공식 플러그인: 한 공급업체의 에이전트가 다른 공급업체 내부에 |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29,500 | 저장소 참조 | 에이전트에 노출된 웹 채팅 |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | 저장소 보기 | 프로그래밍 인터페이스에서의 협의회 |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16,500 (최신 릴리스의 약 847,000 다운로드) | Apache-2.0 | 브라우저 브로드캐스트 |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11,800 (마지막 커밋 2025년 12월) | Apache-2.0 | 모델 간 상담 서버 |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | 터미널 에이전트 (레벨 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | 브라우저 브로드캐스트 |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | CLI 협의회 |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | 도구당 하나의 파일을 작성하는 CLI 카운슬 |
| xai-org/grok-build | github.com/xai-org/grok-build | 26,900 | Apache-2.0 | 헤드리스 모드와 에이전트 프로토콜을 갖춘 터미널 에이전트 |
인용 방법
Chernets, V. (2026). After Chat: Non-Programmers와 Agentic AI 사이의 세 가지 전환 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}