Nach Chat: Die drei Übergänge zwischen Nicht-Programmierern und agentengestützter KI
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Das Terminal ist nicht mehr ein Terminal: ein vierstufiges Modell, die Evidenz von 2025 und 2026 und ein vorregistriertes Programm zur Messung der Übergänge
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7520019 · DOI 10.2139/ssrn.7520019 · Zenodo 10.5281/zenodo.22943313 · GitHub
Laden Sie dieses Papier herunter
- SSRN (Originalversion): ssrn.com/abstract=7520019 · DOI 10.2139/ssrn.7520019
- Zenodo (archiviert, Open Access): doi.org/10.5281/zenodo.22943313
- GitHub (Volltext als Markdown und PDF): github.com/vadimchernets/papers/tree/main/after-chat; Code: github.com/vadimchernets/after-chat
Der gleiche Text befindet sich an drei Stellen, damit er erreichbar ist, wenn einer dieser Orte ihn nicht bereitstellen kann. SSRN hält die Originalversion; zitieren Sie diese.
Schlüsselwörter: agentische KI; KI-Agenten; Nicht-Programmierer*innen; Endnutzer*innen-Programmierung; KI-Literalität; Wissensfachleute; Technologieadoption; Generative-KI-Adoption; menschliche Überwachung; Delegation; digitale Spaltung zweiter Ebene; korrelierte Fehler; Ironien der Automatisierung; Deskilling; Vorregistrierung
Zusammenfassung
Die meisten Fachleute begegnen KI als Chatbot, während dieselben Modelle als KI-Agenten nun auf Dateien und Programme einwirken. Ich frage, warum so wenige Nicht-Programmierer vom Chat zur agentischen KI übergegangen sind, und wie dieser Übergang gemessen werden kann. Die Antwort beruht auf einem vierstufigen Modell, das durch Reichweite und Rolle definiert wird und unabhängig von Produkten ist: Chat, eine vom Anbieter begrenzte sichere agentische Umgebung, ein Agent auf dem eigenen Computer und wiederholbare Arbeit, die über mehrere Modelle orchestriert wird. Ein Übergang zählt nur, wenn ein Agent ein Artefakt erzeugt hat, das die Person angefordert hat. Die Installation von Software zählt als ein Versuch. Belege von 2025 bis September 2026 deuten darauf hin, dass die Barriere für Installation und einen ersten begrenzten Versuch gefallen ist, während die Zuverlässigkeit bei ganzen Arbeiten, die Produktstabilität und die Ordnersicherheit nicht gefallen sind. Installation ist ein Schritt, der eigene Chatbot der Person kann sie leiten („reflexives Onboarding"), und zwei Anbieter haben 2026 Agent- und Chat-Oberflächen zusammengeführt. Die in der Presse berichtete Richtzahl eines Anbieters setzt Wissensarbeiter auf ein Fünftel der fünf Millionen wöchentlichen Nutzer seines Coding-Agenten; sie misst die Nutzung eines Agenten mit Terminal-Erbe, nicht die hier definierte Level-3-Adoption. Die Nutzung bleibt breit und flach: etwa die Hälfte der US-Arbeiter nutzt KI, etwa einer von sieben täglich, und wenige zur Automatisierung. Die Barriere hat sich von der Installation zur Anleitung verschoben. Gestützt auf Forschung zur End-User-Programmierung benenne ich die fehlende Fähigkeit als Workflow-Vokabular und stelle die Arbeit des Managers als einen Delegationsvertrag dar: Ziel, Grenze, Artefakt und Kontrolle. Web-Orchestrierung (eine Frage an mehrere Chatbots) wird als die Brücke vorgeschlagen, die den Vergleich lehrt, und CLI-Orchestrierung (ein Agent ruft andere auf) als die dauerhafte Schicht, begrenzt durch die Tatsache, dass die Übereinstimmung korrelierter Modelle schwache Evidenz ist. Das Papier endet mit fünfzehn falsifizierbaren Propositionen, der Gestaltung eines vorregistrierten Kohortenprogramms ohne seine Ergebnisse und offenen Lehrkode.
Zusammenfassung
Das Terminal, das schwarze Fenster, das für alles stand, was Nicht-Programmierer mit KI nicht tun konnten, hat seine Bedeutung geändert. Es ist nun der Ort auf dem eigenen Computer einer Person, an dem ein Agent arbeitet, und die Fähigkeit, die es verlangt, ist nicht mehr das Eingeben von Befehlen. Die Fähigkeit ist die Verwaltung des Workers, der sie eingibt.
Professionelle Entwickler sind am weitesten fortgeschritten: 90 % von mehr als 15.000 im Jahr 2026 Befragten nutzten agentic tools mindestens wöchentlich (eine Herstellerumfrage), obwohl wöchentliche Nutzung noch nicht die Manager-Kompetenz aus Abschnitt 8 ist. Alle anderen sprechen meist noch mit einem Chatbot. 52 % der US-Arbeiter nutzen KI in ihrer Rolle, 15 % täglich, und 16 % dieser Nutzer nennen Automatisierung unter ihren Einsätzen.
Der Grund ist nicht mehr, dass Agenten schwer zu installieren sind. Die Installation eines Agenten erfordert einen Befehl oder einen Klick, der Chatbot, den eine Person bereits nutzt, kann sie durch die Anleitung führen, und die Hersteller haben begonnen, Chat mit Agenten zu verbinden. Was schwierig bleibt, ist von anderer Art. Agenten scheitern immer noch bei ganzen Arbeitsabschnitten, das Produkt, das eine Person lernt, kann innerhalb eines Jahres umbenannt oder eingestellt werden, und ein gewährter Ordner muss immer noch bewacht werden. Nach dem Installateur ist das erste, das Menschen stoppt, dass sie nicht wissen, was sie abgeben oder wie sie es überprüfen sollen, die Lücke, die Abschnitt 1 Workflow-Vokabular nennt. Dahinter folgen der erste Fehler, Berechtigungen und Sicherheit, organisatorische Regeln, Hardware und Kosten sowie die Kompetenz, Ergebnisse zu beurteilen.
Das Modell hat vier Ebenen, geordnet nach ihrer Reichweite und danach, was die Person tun muss: Konversation, ein umzäunter Raum, den der Hersteller betreibt, der eigene Computer der Person und Arbeit, die über mehrere Modelle hinweg geleitet wird. Menschen können eine Ebene überspringen. Eine Übergänge wird nur durch ein Artefakt gezeigt, das der Agent produziert hat, daher zählen Installationen, Abzeichen und Selbstangaben nicht.
Orchestrierung, das Senden einer Frage an mehrere Modelle, kommt in zwei Schichten vor. Im Browser kostet es nichts zu versuchen und lehrt die Gewohnheit, Antworten zu vergleichen, und in der Befehlszeile kann es aufgeschrieben und erneut ausgeführt werden. In beiden Fällen zählt die Anzahl der abgefragten Modellfamilien, da korrelierte Fehler den Wert der Übereinstimmung begrenzen.
Die Verwaltung von Agenten ist eine eigene Kompetenz. Sie hat einen Delegationsvertrag aus vier Teilen (Ziel, Grenze, Artefakt, Überprüfung), vier Praktiken (delegieren, beaufsichtigen, überprüfen, widerrufen), eine Stoppnorm für Überprüfungen und ein Akzeptanzprotokoll, das das Produzierte des Agenten von dem trennt, auf das sich die Person verlassen hat.
Das Argument ist so aufgebaut, dass es getestet werden kann. Fünfzehn Sätze enthalten Maße und Falsifizierer. Das Design eines vorregistrierten Kohortenprotokolls (OSF DOI 10.17605/OSF.IO/X4EGQ) wird hier beschrieben, und seine Ergebnisse werden separat berichtet. Eine Statustabelle sagt aus, wie fest jeder Anspruch gehalten wird, und offener Code befindet sich in Anhang C.
1. Einführung
Betrachten Sie eine Bürofachkraft im September 2026. Sie nutzt wöchentlich einen Chatbot. Sie bittet ihn, eine E-Mail zu verfassen, einen Bericht zusammenzufassen, eine Formel vorzuschlagen. Was sie erhält, ist Text, und sie trägt diesen Text von Hand an den Ort, wo ihre Arbeit lebt: ein Ordner mit Verträgen, eine Tabellenkalkulation mit Konten, eine Präsentation, die am Freitag fällig ist. Das gleiche Modell kann durch eine andere Tür diesen Ordner öffnen, jede Datei darin lesen, die Tabellenkalkulation schreiben, die Präsentation erstellen und ihre eigene Arithmetik überprüfen. Die meisten Fachkräfte, soweit die Umfragen in Abschnitt 4.4 erkennen lassen, haben diese Tür noch nicht benutzt, und viele wissen nicht einmal, dass sie existiert.
Zwei Jahre lang sah die Tür wie ein Terminal aus: ein schwarzes Fenster, ein blinkender Cursor, ein Befehl zum Einfügen. Dieses Bild ist überholt. Das Terminal blieb visuell ein Terminal. Es wurde zur Umgebung, in der ein Agent lebt, zum Ort auf dem eigenen Computer einer Person, wo ein Modell lesen, schreiben, ausführen und planen kann, und die Person davor muss nicht länger eine Shell bedienen, sondern den Agent leiten, der das tut. Was sich ändert, ist die menschliche Rolle, von jemandem, der ein Modell befragt, zu jemandem, der einen Arbeiter verwaltet.
Mein Thema ist der Weg zwischen diesen beiden Rollen und wer sich darauf befindet. Unter professionellen Entwicklern sind die Werkzeuge zumindest bereits angekommen. Eine Umfrage von mehr als 15.000 professionellen Entwicklern von Mai bis Juli 2026 ergab, dass 90 % mindestens wöchentlich KI-Coding-Agenten bei der Arbeit nutzten und 68 % täglich, und dass der Anteil derer, die einen Terminal-Agenten, Claude Code, bei der Arbeit nutzen, von etwa 3 % im Frühjahr 2025 auf 18 % im Januar 2026 und 39 % Mitte 2026 gestiegen ist (JetBrains Research, 2026a, 2026b; eine Herstellerumfrage, da JetBrains einen Coding-Agenten verkauft). Bei allen anderen ist dies nicht der Fall, und das Nutzungsmuster ist breit und flach. In denselben Monaten berichteten 52 % der US-Arbeitnehmer, KI in ihrer Rolle zu nutzen, 15 % nutzten sie täglich, und nur 16 % dieser Nutzer nannten Automatisierung unter ihren Verwendungszwecken; Schreiben und Suche dominierten (Gallup, 2026). Für die typische Fachkraft ist KI immer noch ein Gespräch, und die Zahlen der St. Louis Fed sagen dasselbe über einen längeren Zeitraum: Zwischen August 2024 und Mai 2026 stieg der Anteil der Arbeitnehmer, die generative KI für ihre Arbeit nutzten, von 33 % auf 45 %, während weniger als 3 % der Aufgaben Adoptionsraten über 50 % aufwiesen (Bick et al., 2026).
Die Standarderklärung für die Lücke ist technische Schwierigkeit: Agenten sind für Menschen, die programmieren können. Diese Antwort war 2024 vernünftig und ist 2026 schwach. Das Installieren eines Terminal-Agenten erfordert jetzt einen Befehl oder einen Desktop-Installer, und der führende Agent verfügt über eine Desktop-Anwendung, deren Dokumentation deutlich sagt: „Kein Terminal erforderlich" (Anthropic, 2026a). Die Anbieter sind noch weiter gegangen. OpenAI verwandelte seine Coding-Agent-Anwendung am 9. Juli 2026 in den Standard-ChatGPT-Desktop-Client und fügte einen Agenten, ChatGPT Work, hinzu, der lokale Dateien und Anwendungen nutzt (MacRumors, 2026). Anthropic führte seinen Desktop-Agenten für Wissensarbeit, Cowork, am 16. September 2026 in den gewöhnlichen Chat zusammen; TechCrunch berichtete, dass das Unternehmen sagte, dass Kunden „oft Schwierigkeiten hatten, den richtigen Tab für die richtige Aufgabe zu wählen" (TechCrunch, 2026a). OpenAI berichtete über die Presse, dass Wissensarbeiter etwa 20 % der fünf Millionen wöchentlichen Nutzer seines Coding-Agenten im Juni 2026 ausmachten und ihn mehr als dreimal so schnell einführten wie Entwickler (Help Net Security, 2026). Die Zahl ist vom Hersteller berichtet und richtungsweisend, die eigene Seite des Herstellers war für meine Überprüfungen nicht zugänglich, und sie misst die Nutzung durch Wissensarbeiter eines Agenten mit Terminal-Erbe, was breiter ist als die in Abschnitt 3 definierte Adoptionsstufe 3. Es ist schwer zu sehen, wo in diesem Bild die technische Hürde liegt.
Die Hürde hat sich verschoben. Sie hat sich von der Installation zum Leiten verschoben: von „wie bekomme ich das zum Laufen?" zu „was frage ich es, innerhalb welcher Grenzen, und wie weiß ich, dass es es getan hat?" Die zweite Frage ist schwieriger, als sie klingt, und die Literatur zur Programmierung durch Endbenutzer erklärt warum. Nicht-Experten haben Schwierigkeiten, ihre Absicht gegenüber Sprachmodellen auszudrücken, auch wenn der Zugang kostenlos und unmittelbar ist (Zamfirescu-Pereira et al., 2023), und sie müssen lernen, welche Formulierungen auf das abbilden, was das System tun kann (Liu et al., 2023). Die Delegation an eine KI verlagert auch die Arbeit von der Produktion zur Spezifikation und Überprüfung (Sarkar & Drosos, 2025; Simkute et al., 2024). Ich nenne die fehlende Fähigkeit Workflow-Vokabular: einen funktionierenden Bestand an Aufgaben, von denen eine Person weiß, wie man sie an einen Agenten übergibt, formuliert so, dass der Agent sie ausführen kann und das Ergebnis überprüft werden kann. Formal ausgedrückt ist es die Abbildung zwischen den Domain-Zielen einer Person und den Teilaufgaben, die ein Agent ausführen kann, mit den Worten für Eingaben, Transformationen, Ausgaben, Ausnahmen und Belegen, die die Abbildung benötigt. Ein Entwickler, der einen Agenten öffnet, weiß bereits die ersten zehn Dinge, die er eingeben sollte. Ein Buchhalter oder ein Lehrer normalerweise nicht, und niemand in seinem Büro hat es ihnen gesagt.
Der erste Beitrag ist ein vierstufiges Modell des Weges von Chat zu agentengestützter Arbeit, definiert durch Reichweite und Rolle und ohne Produktnamen. Die Stufen reichen von Chat durch eine sichere agentengestützte Umgebung und einen Agenten auf dem eigenen Computer bis zu wiederholbarer orchestrierter Arbeit. Jede ist definiert durch das, was der Agent berühren kann, und durch das, was die Person spezifizieren und überprüfen muss, und jeder Übergang ist definiert durch ein Artefakt, das der Agent produziert hat, und installierte Software allein zählt nicht. Da die Definitionen nicht von Produktnamen abhängen, überlebt das Modell die aktuelle Gewohnheit der Anbieter, ihre Produkte zusammenzuführen (Abschnitt 3).
Das zweite ist eine Evidenzsynthese von 2025 bis September 2026. Sie zeigt, dass Installation und ein erster begrenzter Versuch viel einfacher geworden sind, dass die drei in Abschnitt 4.5 festgelegten Grenzen (zuverlässige Arbeit an vollständigen Aufgaben, stabile Produkte, sichere Ordner) nicht mit ihnen mitgewandert sind, und dass das flache Nutzungsmuster anhält. Sie lokalisiert auch die verbleibenden Hindernisse: Workflow-Vokabular, der Fehler, der einen Neuling stoppt, Berechtigung und Sicherheit, organisatorische Regeln und die Kompetenz, Ergebnisse zu beurteilen (Abschnitte 4 und 5).
Das dritte ist eine Darstellung der zwei Orchestrierungsebenen. Web-Orchestrierung, eine Frage an mehrere Verbraucher-Chatbots gesendet, ist die Brücke: Sie erfordert keine Installation und lehrt die Gewohnheit des Vergleichs. CLI-Orchestrierung, ein Agent ruft die Befehlszeilenwerkzeuge anderer Agenten auf, ist die Delegationsebene, die anhält. Beide sind durch eine Tatsache begrenzt, die Benutzer oft übersehen, dass Übereinstimmung zwischen Modellen nicht unabhängig ist als Beweis (Chernets, 2026a) (Abschnitte 6 und 7).
Das vierte ist ein Messprogramm mit falsifizierbaren Aussagen: die Gestaltung eines vorregistrierten Kohortenprogramms, das Nicht-Programmierer durch diese Übergänge hinweg verfolgt (Chernets, 2026d), und ein offenes Unterrichts-Toolkit mit Orchestrierungs- und Sicherheitsmustern in den Anhängen (Abschnitte 9 und 10, Anhang C).
Es gelten einige Einschränkungen des Umfangs. „Nichtprogrammierer" bedeutet einen Fachmann, dessen Arbeit wesentlich am Computer stattfindet und der keine Ausbildung in Skriptsprachen oder Softwareentwicklung hat. Ein Analyst, der fließend mit Tabellenkalkulationsformeln umgehen kann, zählt dazu, ein Entwickler nicht, und Entwickler erscheinen hier als Vergleichsgruppe. Ich berichte keine Ergebnisse aus dem Kohortenprogramm; diese gehören nach dessen Beobachtungszeit in ein separates Papier. Die meisten Adoptionstabellen stammen aus den Vereinigten Staaten und von Anbietern und sind als solche gekennzeichnet. Und die beschriebenen Tools ändern sich monatlich, daher ist das Modell so aufgebaut, dass es sie überlebt, und die Produktdetails sollen veralten.
Abschnitt 2 ordnet das Argument in die Literatur ein und Abschnitt 3 definiert die Ebenen und Übergänge. Abschnitt 4 zeigt, wo die technische Barriere lag, Abschnitt 5 was sie ersetzt hat, die Abschnitte 6 und 7 die beiden Formen der Orchestrierung, und Abschnitt 8 was die Verschiebung für die menschliche Rolle bedeutet. Abschnitt 9 beschreibt das Programm, das die Übergänge misst, Abschnitt 10 gibt die Propositionen an, Abschnitt 11 zieht Implikationen, Abschnitt 12 setzt Randbedingungen, und Abschnitt 13 schließt ab.
2. Hintergrund: Von der Programmierung durch Endnutzer zur Delegation an Endnutzer
2.1 Endnutzer haben schon immer programmiert
Die Idee, dass Menschen, die keine Programmierer sind, Berechnungen steuern, ist älter als Sprachmodelle. Nardi (1993) argumentierte, dass Endnutzer Rechenleistung durch aufgabenspezifische Sprachen und Frameworks ausüben, wobei Tabellenkalkulationen das kanonische Beispiel sind, ohne dass sie allgemeine Programmierkenntnisse benötigen. Ko et al. (2011) zeigten, dass Endnutzer, die Software entwickeln, mit denselben Problemen wie Fachleute konfrontiert sind (Anforderungen, Wiederverwendung, Tests, Debugging), ohne die entsprechende Ausbildung zu haben, und benannten das Feld End-User-Softwaretechnik. Das breitere Feld der End-User-Entwicklung untersucht, wie Menschen, die keine professionellen Entwickler sind, Software für ihre eigene Arbeit erstellen und anpassen. Myers, Pane und Ko (2004) verbrachten Jahre damit, Notationen zu entwerfen, die näher daran liegen, wie Nicht-Programmierer Aufgaben beschreiben. Jede dieser Forschungslinien ging davon aus, dass der Endnutzer immer noch etwas schreiben würde, das die Maschine ausführt, auch wenn es sich dabei um eine Formel oder eine Regel handelte.
Sprachmodelle änderten, was der Endnutzer schreibt. Sarkar et al. (2022) beschrieben die Programmierung mit einem großen Sprachmodell als eine neue Aktivität, die sich von Kompilierung, Pair Programming und Suche unterscheidet. Zamfirescu-Pereira et al. (2023) stellten fest, dass Menschen ohne KI-Expertise Schwierigkeiten haben, Prompts zu entwerfen, die zuverlässig funktionieren, von einzelnen Erfolgen übergeneralisieren und auf menschliche Gesprächsgewohnheiten zurückgreifen. Liu et al. (2023) benannten die Schwierigkeit des Lernens, welche Wörter welches Verhalten erzeugen, „verankerte Abstraktionsanpassung". Sarkar und Drosos (2025) stellten in der ersten empirischen Studie zum „Vibe Coding" fest, dass konversationelle Programmierung die Expertise in Richtung Kontextverwaltung und schneller Ergebnisüberprüfung verschiebt und den Bedarf an Urteilskraft dort belässt, wo er war. Virk und Liu (2025) stellten fest, dass geschäftliche Nutzer, denen KI-geschriebener Analysen-Code gegeben wurde, kritische Fehler oft nicht erkannten, selbst wenn man sie aufforderte, danach zu suchen. Feldman und Anderson (2024) bezeichneten Nicht-Experten-Programmierer als die am wenigsten untersuchte Population der generativen Ära.
Ich gehe den nächsten Schritt in dieser Forschungslinie. Die Einheit der Endnutzer-Arbeit hat sich von einer Formel, einem Skript oder einem Prompt zu einer Delegation verändert: eine Aufgabe, die an einen Agenten übergeben wird, der über viele Schritte hinweg auf Dateien und Tools einwirkt. Die Literatur zur Programmierung durch Endnutzer erklärt, warum die Ausdrücksweise von Absichten schwierig ist, und die Literatur zu Delegation und Aufsicht erklärt, warum die Überprüfung des Ergebnisses schwierig ist. Das vierstufige Modell aus Abschnitt 3 wurde entwickelt, um beide Aspekte zu verbinden.
2.2 Die Annahme ist schnell und oberflächlich
Generative KI verbreitete sich schneller als der Personal Computer oder das Internet. Bick, Blandin und Deming (2024) schätzten, dass etwa 40% der erwerbstätigen Erwachsenen in den USA sie bis Ende 2024 nutzten, während nur ein kleiner Anteil der Arbeitsstunden unterstützt wurde. Chatterji et al. (2025) stellten fest, dass ChatGPT bis Mitte 2025 etwa 700 Millionen wöchentliche Nutzer bediente und dass die meisten Nachrichten nicht arbeitsbezogen waren. In Dänemark stellten Humlum und Vestergaard (2025) zwei Jahre nach der Annahme präzise Nulleffekte auf Einkommen und Stunden fest sowie einen Unterschied in der Nutzung zwischen Frauen und Männern. Eine Metaanalyse über mehr als 100 Länder beziffert diese Lücke auf etwa 16 Prozentpunkte seit Anfang 2025 (Cranney et al., 2026). In 35 europäischen Ländern führte die Exposition gegenüber KI nicht automatisch zur Nutzung, und Schulung, Digitalisierung und Arbeitnehmermitsprache waren wichtiger (Henseke, 2026).
Feldexperimente zeigen große Gewinne, wenn das Tool zur Aufgabe passt: durchschnittlich 14% mehr kundenbezogene Probleme pro Stunde gelöst und 34% für Anfänger (Brynjolfsson et al., 2025), schnelleres und besseres Schreiben in einem Versuch mit 444 Fachleuten, mit den größten Gewinnen für die schwächeren Schreiber (Noy & Zhang, 2023), und bei 758 Unternehmensberatern 12,2% mehr abgeschlossene Aufgaben und eine Qualitätsverbesserung um mehr als 40% innerhalb der „gezackten Grenze" der Modellfähigkeit, mit schlechterer Arbeit bei einer Aufgabe außerhalb derselben (Dell'Acqua et al., 2026). Ein randomisierter Versuch mit erfahrenen Open-Source-Entwicklern ergab Anfang 2025 das gegenteilige Ergebnis, eine Verlangsamung um 19% (Becker et al., 2025), ein Ergebnis, das seine Autoren später als wahrscheinlich veraltet bezeichneten, da sich die Tools verbesserten (METR, 2026). Die Lektion dieser Versuche ist, dass Gewinne von der Passung zwischen Aufgabe, Tool und der Fähigkeit der Person, es zu steuern und zu überprüfen, abhängen, und diese drei Dinge sind es, die einen Übergang zwischen Ebenen bewirkt.
2.3 Annahme, Diffusion und die zweite Ebenen-Spaltung
Forschung zur Technologieannahme, vom Technology-Acceptance-Modell (Davis, 1989) bis zur Unified Theory of Acceptance and Use of Technology (Venkatesh et al., 2003), zeigt, dass wahrgenommene Nützlichkeit und Benutzerfreundlichkeit die Annahme bestimmen, und dass sozialer Einfluss und unterstützende Bedingungen ebenso wichtig sind wie individuelle Einstellungen. Diffusionsforschung beschreibt Annahme als sozialen Prozess mit frühen und späten Annehmern (Rogers, 2003). Nachdem der grundlegende Internetzugang verbreitet wurde, zeigte Hargittai (2002), dass die bedeutsame Ungleichheit zur Fähigkeit verschoben wurde: die zweite Ebenen-Digitale Spaltung. Van Dijk (2020) erweiterte dies um eine Abfolge von Motivation, Zugang, Fähigkeiten und Nutzung.
Die gleiche Verschiebung ist jetzt sichtbar. Der Zugang zu Chat ist unter Büroarbeitern in wohlhabenden Ländern nahezu universell, während die Fähigkeit, einen Agenten zu steuern, weit verbreitet ist. Eine KI-Spaltung wurde bereits entlang der alten Linien von Bildung, Region und Alter gemessen (Daepp & Counts, 2024; Pew Research Center, 2026). Was ich hinzufüge, ist die Beobachtung, dass die Spaltung jetzt innerhalb der Bevölkerung der KI-Nutzer verläuft, zwischen denen, die mit Modellen konversieren, und denen, die ihnen Aufgaben delegieren.
2.4 Automatisierung, Aufsicht und die Last des Managers
Die Literatur über menschliche Beaufsichtigung von Automatisierung beginnt mit einer Ironie. Bainbridge (1983) beschrieb sie: Die Automatisierung des Großteils einer Aufgabe hinterlässt dem Menschen den schwierigsten Rest – Überwachung und seltene Eingriffe –, während gleichzeitig die dafür erforderliche Fähigkeit erodiert. Parasuraman und Riley (1997) unterschieden Missbrauch, Nichtnutzung und Übernutzung von Automatisierung, und Lee und See (2004) zeigten, dass sich das Vertrauen nach kalibriertem Zutrauen richten sollte. Die generative Ära hat jeden dieser Punkte erneuert. Wissensarbeiter, die dem Werkzeug stärker vertrauen, berichten von weniger kritischem Denken (Lee et al., 2025). Generative KI verschiebt Menschen von der Produktion zur Bewertung und macht einfache Aufgaben einfacher und schwierige Aufgaben schwieriger (Simkute et al., 2024). Interventionen zur Kalibrierung des Vertrauens in Sprachmodelle reduzieren übermäßiges Vertrauen, ohne angemessenes Vertrauen zu erzeugen (Bo et al., 2025). Benutzer von KI-Agenten als tägliche Assistenten kalibrieren das Vertrauen falsch in Richtung plausibler, aber falscher Pläne und schneiden besser ab, wenn sie an einer schrittweisen Ausführung teilnehmen (He et al., 2025). Bessere Aufzeichnungen darüber, was ein Agent getan hat, beschleunigen die Fehlererkennung, ohne die endgültige Genauigkeit zuverlässig zu verbessern (Grunde-McLaughlin et al., 2026). Eine Studie von etwa 73.000 öffentlichen Beiträgen zu einem autonomen Agenten ergab, dass die Werte der Nutzer in dem, was der Agent lieferte, größtenteils erfüllt waren und in der Art, wie sie ihn beaufsichtigen konnten, größtenteils unerfüllt (Ma et al., 2026). In einer kleinen Laborstudio und drei Feldstudien wuchs die Bequemlichkeit mit Delegation über die Zeit, während Menschen dennoch Kontrolle in Momenten der Unsicherheit wollten (Long et al., 2025). Tomašev, Franklin und Osindero (2026) behandeln Delegation an KI als ein Rahmenwerk der Aufgabenzuteilung, Autoritätsübertragung, Verantwortlichkeit und Vertrauen, das gleichermaßen auf menschliche und maschinelle Delegatare anwendbar ist.
Auf der kognitiven Seite berichtete eine EEG-Studie von 54 Essayautoren von schwächerer Konnektivität und geringerem Besitztum in der unterstützten Gruppe, eine „kognitive Schuld" (Kosmyna et al., 2025), und ein veröffentlichter Kommentar bestritt ihre Methoden (Stankovic et al., 2026). Die sichere Lesart ist, dass das Auslagern von Routineschritten die Aufmerksamkeit freisetzt und die freigesetzte Aufmerksamkeit für Überprüfungen aufgewendet werden muss. Zwei weitere Ideen aus der Lernforschung werden später verwendet. Die Cognitive-Load-Theorie erklärt, warum ein Neuankömmling, der in eine unbegrenzte Umgebung versetzt wird, steckenbleibt, bevor sich ein mentales Schema gebildet hat (Sweller, 1988). Und ein Modell der Adoption als Bayesianisches Lernen zeigt, wie Menschen in ein selbstverstärkendes Niedrig-Nutzungs-Gleichgewicht verfallen können, das nur ein erster Erfolg oder Training verschieben kann (Ma et al., 2025).
Zwei Begleitarbeiten in dieser Serie behandeln das gleiche Problem von der anderen Seite. Die erste zeigt, dass die Übereinstimmung zwischen mehreren Modellen schwächer ist, als sie aussieht, weil ihre Fehler korreliert sind (Chernets, 2026a). Die zweite zeigt, wie automatisierte Überwachungskomponenten ihr eigenes Mandat erweitern und die Arbeit behindern können, die sie schützen (Chernets, 2026b). Beide sind wichtig für einen Neuankömmling: die erste für das, was Orchestrierung leisten kann, die zweite dafür, warum Sicherheitsschichten eine Person an der Tür stoppen können.
2.5 Was nicht untersucht wurde
Eine Suche am 21. September 2026 (Web-Suche, Crossref, arXiv und Semantic Scholar, mit Aufmerksamkeit auf CHI-, UIST- und VL/HCC-Arbeiten von 2024 bis 2026) fand keine veröffentlichte Feldstudie von Nicht-Programmierern, die namentlich Terminal- oder Befehlszeilen-Agenten einführen, keine Studie der Web-Orchestrierung (eine Frage an mehrere Consumer-Chatbots im Browser) als benannte Praxis, keine Behandlung der Verwaltung von Agenten als Fähigkeit mit eigener Kompetenzbasis und keine Studie eines KI-Systems, das die Adoption von Agenten-KI durch eine Person selbst unterstützt; die nächstgelegene Arbeit wendet Scaffolding-Theorie auf KI-Tutoren anderer Fächer an (Cohn et al., 2026) oder auf aufgabenbedingte Schnittstellen für komplexe Software (Liu & Sra, 2026). Die arbeitsökonomische Literatur misst die Adoption von generativer KI allgemein, und keine davon isoliert den Schritt von Chat zu Agenten-Werkzeugen bei Nicht-Programmierern. Diese Lücken definieren den Bereich, den das Modell kartographiert, und das Programm in Abschnitt 9 ist ausgelegt, um dies zu messen.
3. Vier Ebenen und drei Übergänge
3.1 Zwei Achsen: Reichweite und Rolle
Eine Ebene beschreibt eine Beziehung zwischen einer Person und einem Modell bei der Arbeit, und ich definiere sie auf zwei Achsen: Reichweite und Rolle.
Reichweite ist das, was das Modell im Namen der Person berühren kann. Im engsten Fall ist es nur die Konversation, dann Dateien und Tools in einem vom Anbieter begrenzten Bereich, dann der eigene Computer der Person mit ihren Dateien, Programmen und Zeitplan, und im weitesten Fall mehrere Modelle und Agenten gleichzeitig.
Rolle ist das, was die Person für den Erfolg der Arbeit tun muss. In derselben Reihenfolge bitten sie und kopieren, übergeben eine Aufgabe und überprüfen das Ergebnis, besitzen eine Agentenumgebung mit ihren Berechtigungen und ihrer Rückgängigmachung, oder verteilen Arbeit unter Agenten und gleichen das Zurückkommende ab.
Produkte fehlen absichtlich in der Definition. Ein einzelnes Produkt kann mehrere Ebenen umfassen, und 2026 integrieren die Anbieter Chat und Agenten schneller in ein Fenster, als jede auf Produktnamen basierende Taxonomie folgen könnte (Abschnitt 4.3). Eine Ebene beschreibt ein Stück Arbeit, und eine Person, wie ein Produkt, kann mehrere umfassen. Dieselbe Person kann morgens auf Ebene 1 für eine Aufgabe und nachmittags auf Ebene 3 für eine andere sein.
Die beiden Achsen unterscheiden dieses Modell auch von den bekannten Skalen der Automatisierung und Autonomie. Parasuraman, Sheridan und Wickens (2000) klassifizierten, wie viel von jeder Phase einer Aufgabe (Informationsbeschaffung, Analyse, Entscheidung, Handlung) eine Maschine ausführt. Morris et al. (2024) bewerteten allgemeine KI-Systeme nach Tiefe und Breite ihrer Leistung. Feng, McDonald und Zhang (2025) definierten fünf Autonomiestufen für KI-Agenten nach der Rolle, die der Nutzer spielt, von Operator und Mitarbeiter bis zu Berater, Genehmiger und Beobachter. Diese Skalen beschreiben, wie viel ein Agent innerhalb einer Aufgabe entscheidet. Die vier Ebenen hier beschreiben, wo die Arbeit läuft und was die Person besitzt: eine Konversation, einen vom Anbieter eingezäunten Bereich, ihren eigenen Rechner, ein Team von Agenten mehrerer Anbieter. Die Achsen sind orthogonal. Ein Agent auf dem eigenen Computer einer Person kann auf jeder der Autonomiestufen von Feng et al. laufen, von Schritt-für-Schritt-Genehmigung bis nahezu vollständiger Delegation, und die Person besitzt immer noch seine Berechtigungen und seine Rückgängigmachung. Das, was die vier Ebenen hinzufügen, ist eine Beschreibung der Einführung: die Reihenfolge, in der Reichweite und Verantwortung für jemanden wachsen, der bei Chat anfängt, und der Nachweis (ein Artefakt), der zeigt, dass jeder Schritt getan wurde.
3.2 Die vier Ebenen
Ebene 1: Chat. Die Reichweite des Modells endet bei der Konversation. Es produziert Text, Code oder Bilder, die die Person an den Ort kopiert, wo die Arbeit stattfindet, und die Rolle der Person ist es, gut zu fragen und die Ausgabe zu übernehmen. Fast jeder Profi, der KI nutzt, arbeitet die meiste Zeit hier (Abschnitt 2.2).
Ebene 2: eine sichere Agentumumgebung. Das Modell agiert auf Dateien, verbundenen Services und manchmal einem Browser, in einem vom Anbieter begrenzten Bereich: ausgewählte Ordner, eine virtuelle Maschine oder serverseitige Sandbox, Konnektoren, die die Person genehmigt hat, und ein Genehmigungsschritt vor folgenreichen Aktionen. Anthropics Cowork, OpenAIs ChatGPT Work, Microsofts Copilot Cowork und Googles Gemini Spark sind Beispiele von 2026, und sie teilen das Design eines Delegierungsagenten, der in einem eingezäunten Bereich arbeitet (Anthropic, 2026b; MacRumors, 2026; Microsoft, 2026a; TechCrunch, 2026b). Die Rolle der Person wechselt vom Fragen zum Delegieren. Sie übergeben eine Aufgabe, die in einer Datei oder einer Aktion endet, und überprüfen, was zurückkommt, und viel der Sicherheit der Umgebung auf dieser Ebene ist die Verantwortung des Anbieters.
Ebene 3: ein Agent auf dem eigenen Computer. Der Agent läuft auf dem Computer der Person mit Zugriff auf das Dateisystem, die Shell, installierte Programme und geplante Jobs, über ein Terminal oder eine Desktop-Shell über dieselbe Engine: Claude Code, OpenAIs Codex, Googles Antigravity CLI, xAIs Grok Build, Moonshots Kimi Code und Open-Source-Äquivalente. In der Forschungsliteratur sind dies KI-basierte Agenten, und ihre Verwendung durch Entwickler wird als agentenbasierte Codierung untersucht; die Ebene fragt, was passiert, wenn die Person, die sie betreibt, kein Entwickler ist. Die Reichweite ist die weiteste, die ein einzelner Agent erreicht, und damit ändert sich die Rolle der Person erneut. Sie besitzt die Umgebung: welche Ordner der Agent sieht, welche Befehle Genehmigung brauchen, was ausgeschlossen bleibt, und wie man einen Fehler rückgängig macht. Das Terminal selbst ist nebensächlich, da das, was die Ebene definiert, der Besitz einer Arbeitsumgebung ist, in der ein Agent alles tun kann, was die Person tun könnte. Cloud-gehostete Varianten (die gleiche Agentenschleife auf einem Anbietercomputer ausgeführt, wobei die Person eine Aufgabe und ein Ergebnis sieht und nie eine Eingabeaufforderung) sind Ebene 3 nach Fähigkeit und Ebene 2 nach Auswirkungsradius, und das Modell verzeichnet sie als Variante von Ebene 3, ohne sie in eine Zelle zu zwingen.
Ebene 4: wiederholbare, orchestrierte Arbeit. Die Person lenkt mehrere Modelle oder Agenten, parallel oder in Abfolge, an Arbeit, die sich wiederholt, und die Reichweite umfasst jetzt Anbieter. Es gibt zwei Ebenen. Bei der Web-Orchestrierung geht eine Frage an mehrere Consumer-Chatbots im Browser, von Hand oder mit einem Tool, und die Antworten werden verglichen. Bei der CLI-Orchestrierung ruft ein Agent die Befehlszeilentools anderer Agenten auf, sammelt ihre Ausgaben und führt sie zusammen oder überprüft sie. Die Rolle der Person ist die eines Managers: Sie setzen das Ziel, verteilen die Arbeit, entscheiden, was als erledigt zählt, und gleichen Meinungsverschiedenheiten ab. Die Arbeit wird wiederholbar, wenn sie in einer Form niederschrieben wird, die Agenten wieder ausführen können, als Anweisungsdatei, Fähigkeit oder geplanter Job. „Wiederholbar" beschreibt den Arbeitsablauf, nicht die Ausgabe. Dieselbe Anweisungsdatei, die nächste Woche ausgeführt wird, produziert einen anderen Entwurf, und das, was sich wiederholt, ist die Abfolge von Eingaben, Schritten, Überprüfungen und Lieferumfang. Ein wiederkehrender Single-Agent-Job, der auf diese Weise niedergeschrieben ist, ist Ebene-3-Arbeit gemacht wiederholbar, und wird Ebene 4, wenn eine zweite Modellfamilie geleitet wird und die Ergebnisse abgeglichen werden (Übergang 3, Abschnitt 3.3).
Tabelle 1. Die vier Ebenen.
| Ebene | Reichweite des Modells | Rolle der Person | Typische Oberflächen, September 2026 | Übergang wird gezeigt durch | Das etabliert die Ebene nicht | Hauptbarriere beim Eintritt |
|---|---|---|---|---|---|---|
| 1. Chat | Die Konversation | Fragt, kopiert Ausgabe von Hand | Chat in Browser oder App | (Eingangsebene) | Dass das Modell auf der Arbeit der Person agieren kann oder ohne Überprüfung vertrauenswürdig ist | Keine über Zugang hinaus |
| 2. Sichere Agentumumgebung | Dateien, Konnektoren und Browser in einem vom Anbieter begrenzten Bereich | Delegiert eine Aufgabe, überprüft das Ergebnis | Cowork in Claude Chat integriert; ChatGPT Work; Copilot Cowork; Gemini Spark | Eine Datei oder Aktion, die der Agent aus einer delegierten Aufgabe erzeugt hat, mit einer aufgezeichneten Genehmigung oder Ablehnung | Dass die Person eine eigene Umgebung ausführen kann oder die Arbeit wiederholen kann | Zu wissen, was delegiert werden soll; Vertrauen |
| 3. Agent auf dem eigenen Computer | Das Dateisystem, die Shell, Programme und der Zeitplan der Person | Besitzt die Umgebung: Berechtigungen, Ausschlüsse, Undo | Terminal- und Desktop-Shells von Claude Code, Codex, Antigravity CLI, Grok Build, Kimi Code | Ein Artefakt, das der Agent auf dem eigenen Computer der Person in einem von der Person eingerichteten Ordner aus einer Aufgabe erzeugt hat, die mehr als eine Werkzeugnutzung erfordert | Dass das Ergebnis richtig ist oder sicher anzunehmen ist, ohne Überprüfung | Installationsreibung (Absturz); der erste Fehler; Berechtigungen; was gefragt werden soll |
| 4. Orchestrierte Arbeit | Mehrere Modelle oder Agenten über verschiedene Anbieter hinweg | Verwaltet: Ziel, Zuweisung, Annahme, Abstimmung | Web: mehrere Chat-Registerkarten oder Broadcast-Tools. CLI: Plugins und Scripts, die andere Agenten aufrufen | Ein zusammengeführtes oder abgestimmtes Ergebnis von mindestens zwei Modellfamilien, mindestens einmal erneut ausgeführt, mit aufgezeichneter Information, wer gefragt wurde und wer antwortete | Dass die Übereinstimmung zwischen den Modellen unabhängige Evidenz ist, oder dass die Aufgabe auf dieser Ebene angesiedelt ist | Kosten der Abstimmung; korrelierte Fehler; Quote und Werkzeugwechsel |
Zwei Begriffe in der Tabelle sind enger als der alltägliche Gebrauch. „Sicher" in „sichere agentenbasierte Umgebung" benennt ein Designziel und ein Interaktionsmuster und gibt keine Zusicherung. Ordnerumfang, Genehmigungen, Sandboxes und Vorschaufenster verkleinern die Fläche, auf der ein Agent handelt; sie können keine fehlerhafte Implementierung veranlassen, Dateien zu erhalten, oder ein Dokument mit versteckten Anweisungen harmlos machen, und Abschnitt 5.3 berichtet, was in gewährten Ordnern schiefgelaufen ist. Was die mittlere Ebene etabliert, ist ein praktisches mentales Modell. Eine Person, die sieht, dass der Agent einen Bericht in einem Ordner schreiben kann und nichts anderes anfassen kann, hat gelernt, dass delegierte Aktion eine Grenze hat, was nützlicher ist als jede abstrakte Warnung, vorsichtig mit KI umzugehen. „Artefakt" bedeutet ein Ergebnis, das mehrere Schritte der eigenen Arbeit des Agenten erforderte. Die Person, die danach gefragt hat, entscheidet, ob es als Artefakt zählt, eine dritte Partei bewertet seine Qualität (Abschnitt 9.4), und eine Studie berichtet die Übereinstimmung zwischen Bewertern sowohl für diese Bewertung als auch für die Codierung von Stoppgründen. Ein Ordner mit zwei leeren Dateien ist eine Spur eines Installers und zählt nicht.
3.3 Drei Übergänge und warum ein Artefakt jeden definiert
Ein Übergang wird überschritten, wenn der Agent auf der neuen Ebene ein Artefakt erzeugt hat, das die Person gefordert hat. Eine Installation zählt nur als Versuch, und ebenso ein abgeschlossenes Lernprogramm, ein Abzeichen, eine Lizenz und die Eigendarstellung „Ich nutze jetzt Agenten". Die Regel hat mehrere Konsequenzen über die offensichtliche hinaus. Ein von einem Agent erstellter Ordner zeigt, dass der Agent ausgeführt wurde, während eine Reihe von Dateien, die der Agent aus der Beschreibung der eigenen Arbeit der Person geschrieben hat, zeigt, dass die Person delegiert hat. Die Regel macht die Übergänge auch von außen erkennbar: Ein Forscher oder Manager kann ein Artefakt sehen und kann nicht sehen, eine Absicht oder ein Gefühl von Kompetenz. Sie macht Misserfolg informativ, da eine Person, die ein Tool installiert hat und nichts produziert hat, auf eine Barriere gestoßen ist, die es wert ist, genannt zu werden, und die Installation als Erfolg zu zählen würde dies verbergen. Und da sie kein Produkt benennt, erlaubt die Regel Studien, über Tools zu vergleichen, die alle drei Monate umbenannt werden.
Der Übergang 1, vom Chat zu einer sicheren agentengestützten Umgebung, wird überschritten, wenn eine Person zum ersten Mal eine Aufgabe delegiert, die in einer Datei oder einer Aktion endet statt in Text. 2026 wird dieser Übergang in das Chat-Fenster selbst aufgenommen. Wenn das Modell des Anbieters entscheidet, ob es antwortet oder handelt, wie es in der am 16. September 2026 angekündigten integrierten Claude-Erfahrung der Fall ist (Anthropic, 2026c), kann eine Person es überschreiten, ohne zu entscheiden. Das macht die Überquerung leichter und auch weniger sichtbar, auch für die Person selbst.
Der Übergang 2, von der sicheren Umgebung zu dem eigenen Computer, wird überschritten, wenn eine Person einen Agent in ihrer eigenen Umgebung ausführt und ein Artefakt davon erhält. Die entscheidende Änderung ist der Besitz. Auf Ebene 2 entscheidet der Anbieter, was der Agent anfassen darf, und auf Ebene 3 tut es die Person, unabhängig davon, welches Gesicht der Agent zeigt, ein Terminal oder ein Fenster. Die Angst vor dem Terminal lebte hier, und Abschnitt 5 zeigt, dass die Fragen von Berechtigungen, Fehlern und was gefragt werden soll, ihren Platz eingenommen haben.
Der Übergang 3, von einem Agent zu orchestrierter Arbeit, wird überschritten, wenn eine Person ein Ergebnis erhält, das mindestens zwei Modellfamilien produziert oder überprüft haben, und dieses Arrangement bei späteren Arbeiten erneut ausführt. Die Wiederholung ist wichtig, da ein Vergleich von drei Chatbots eine Kuriosität ist, und nur ein Vergleich, den die Person immer dann vornimmt, wenn die Einsätze es rechtfertigen, bedeutet eine Praxis.
Der Weg, den das Programm von Abschnitt 9 einschlägt, kann als Design gegangen werden, mit der Fachperson der Einleitung als hypothetischer Fall und nichts Berichtetem. Sie würde dort anfangen, wo sie bereits ist, auf Ebene 1, mit einem Chatbot, den sie bezahlt. Sie würde einen Standardtext in diesen Chatbot einfügen und ihn sie durch die Installation eines grafischen Agenten auf ihrem eigenen Laptop führen lassen, ihm einen Screenshot senden, wann immer ein Schritt fehlschlug, und ich würde nichts anfassen. Der erste Schritt zählte nur als überschritten, wenn der Agent aus ihrer eigenen Beschreibung ihrer Arbeit eine Reihe von Dateien erzeugt hätte, die sie öffnen und beurteilen konnte; eine installierte Anwendung neben einem leeren Ordner zählte als Versuch. Sie würde in einer Kopie ihrer Dateien arbeiten, Passwörter und Kundendokumente aus ihr heraushalten, den Plan des Agenten lesen, bevor sie ihn handeln ließ, und alles Irreversible bestätigen. Wenn sie sagte, sie sei bereit, würde sie ein Open-Source-Tool erhalten, das eine Frage durch die Abonnements, die sie bereits hat, an mehrere Modelle stellt und eine zusammengeführte Antwort zurückgibt, gestartet von innen im Agent, und dieser Schritt zählte, wenn ein datierter Lauf zeigte, welche Modelle gefragt wurden und wo sie abwichen. Später würde sie denselben Vergleich über Befehlszeilentools durchführen. Sie könnte an jedem dieser Punkte stoppen, und der registrierte Datensatz würde halten, wo und, in ihren Worten, warum. Die Route stammt aus der öffentlichen Registrierung, und ob Menschen sie gehen, ist eine Frage für das Ergebnispapier.
3.4 Ebenen sind geordnet, nicht zwingend erforderlich
Die Ebenen sind nach ihrer Reichweite und nach der Verantwortung geordnet, die sie der Person auferlegen. Die Reihenfolge macht sie nicht zu einer Treppe, die jeder Mensch Stufe für Stufe erklimmen muss. Eine Person kann direkt vom Chat zu einem Agenten auf ihrem eigenen Computer wechseln; die in Abschnitt 9 beschriebene Kohortenstrecke tut genau das, wobei der Chatbot, den die Person bereits nutzt, sie durch die Installation führt. Andere werden auf Ebene 2 für immer bleiben, und für viele Arbeiten ist das der richtige Platz zum Anhalten. Höher ist in diesem Modell nicht besser. Seine Aussagen sind, dass jede Ebene unterschiedliche Anforderungen an die Person stellt, dass die Übergänge beobachtet werden können, und dass die Hürden bei jedem Übergang unterschiedlich sind. Das Modell würde widerlegt, wenn Übergänge nicht durch Artefakte unterschieden werden könnten, wenn sich die Hürden zwischen den Übergängen nicht unterschieden oder wenn die Kompetenz auf einer Ebene nicht ändern würde, was Menschen auf der nächsten Ebene tun könnten, da in jedem dieser Fälle das Modell nichts zu einer einfachen Skala der „KI-Nutzung" hinzufügen würde. Das Modell sagt auch voraus, dass die Fertigstellung – sobald die Empfindlichkeit und technischen Anforderungen einer Aufgabe konstant gehalten werden – bei den drei Übergängen schärfer abfällt als innerhalb einer Ebene. Wenn die Abfälle gleichmäßig verteilt wären, wären die Ebenen ein umbenanntes Kontinuum. Abschnitt 10 verwandelt diese Erwartungen in Aussagen mit Maßstäben und Falsifizierwerkzeugen.
Eine Familie von Werkzeugen gehört neben die Leiter und auf keine Stufe von ihr. Browser-Anwendungs-Builder ermöglichen es einer Person, eine Anwendung zu beschreiben und eine laufende Vorschau auf einer von dem Anbieter gehosteten Plattform zu erhalten. Sie sind wichtig, und sie sind etwas anderes als Ebene 2, wobei ein Agent auf den eigenen Dateien der Person unter einem Berechtigungsmodell agiert; ein Anwendungs-Builder agiert auf einem Projekt, das die Plattform besitzt. Die Verwechslung der beiden erzeugt das falsche Gefühl, dass Nicht-Programmierer bereits angekommen sind. Das Vier-Ebenen-Modell lässt Anwendungs-Builder auf einem Seitenzweig mit ihrer eigenen Obergrenze und ihrem eigenen Sicherheitsprofil, und die Vibe-Coding-Literatur ist der Ort zum Lesen über sie (Sarkar & Drosos, 2025; Ge et al., 2025). Abbildung 1 zeigt die vier Ebenen, das Artefakt, das jeden Übergang kennzeichnet, den aufgezeichneten Sprung und den Seitenzweig.
Abbildung 1. Vier Ebenen und drei artefaktdefinierte Übergänge.
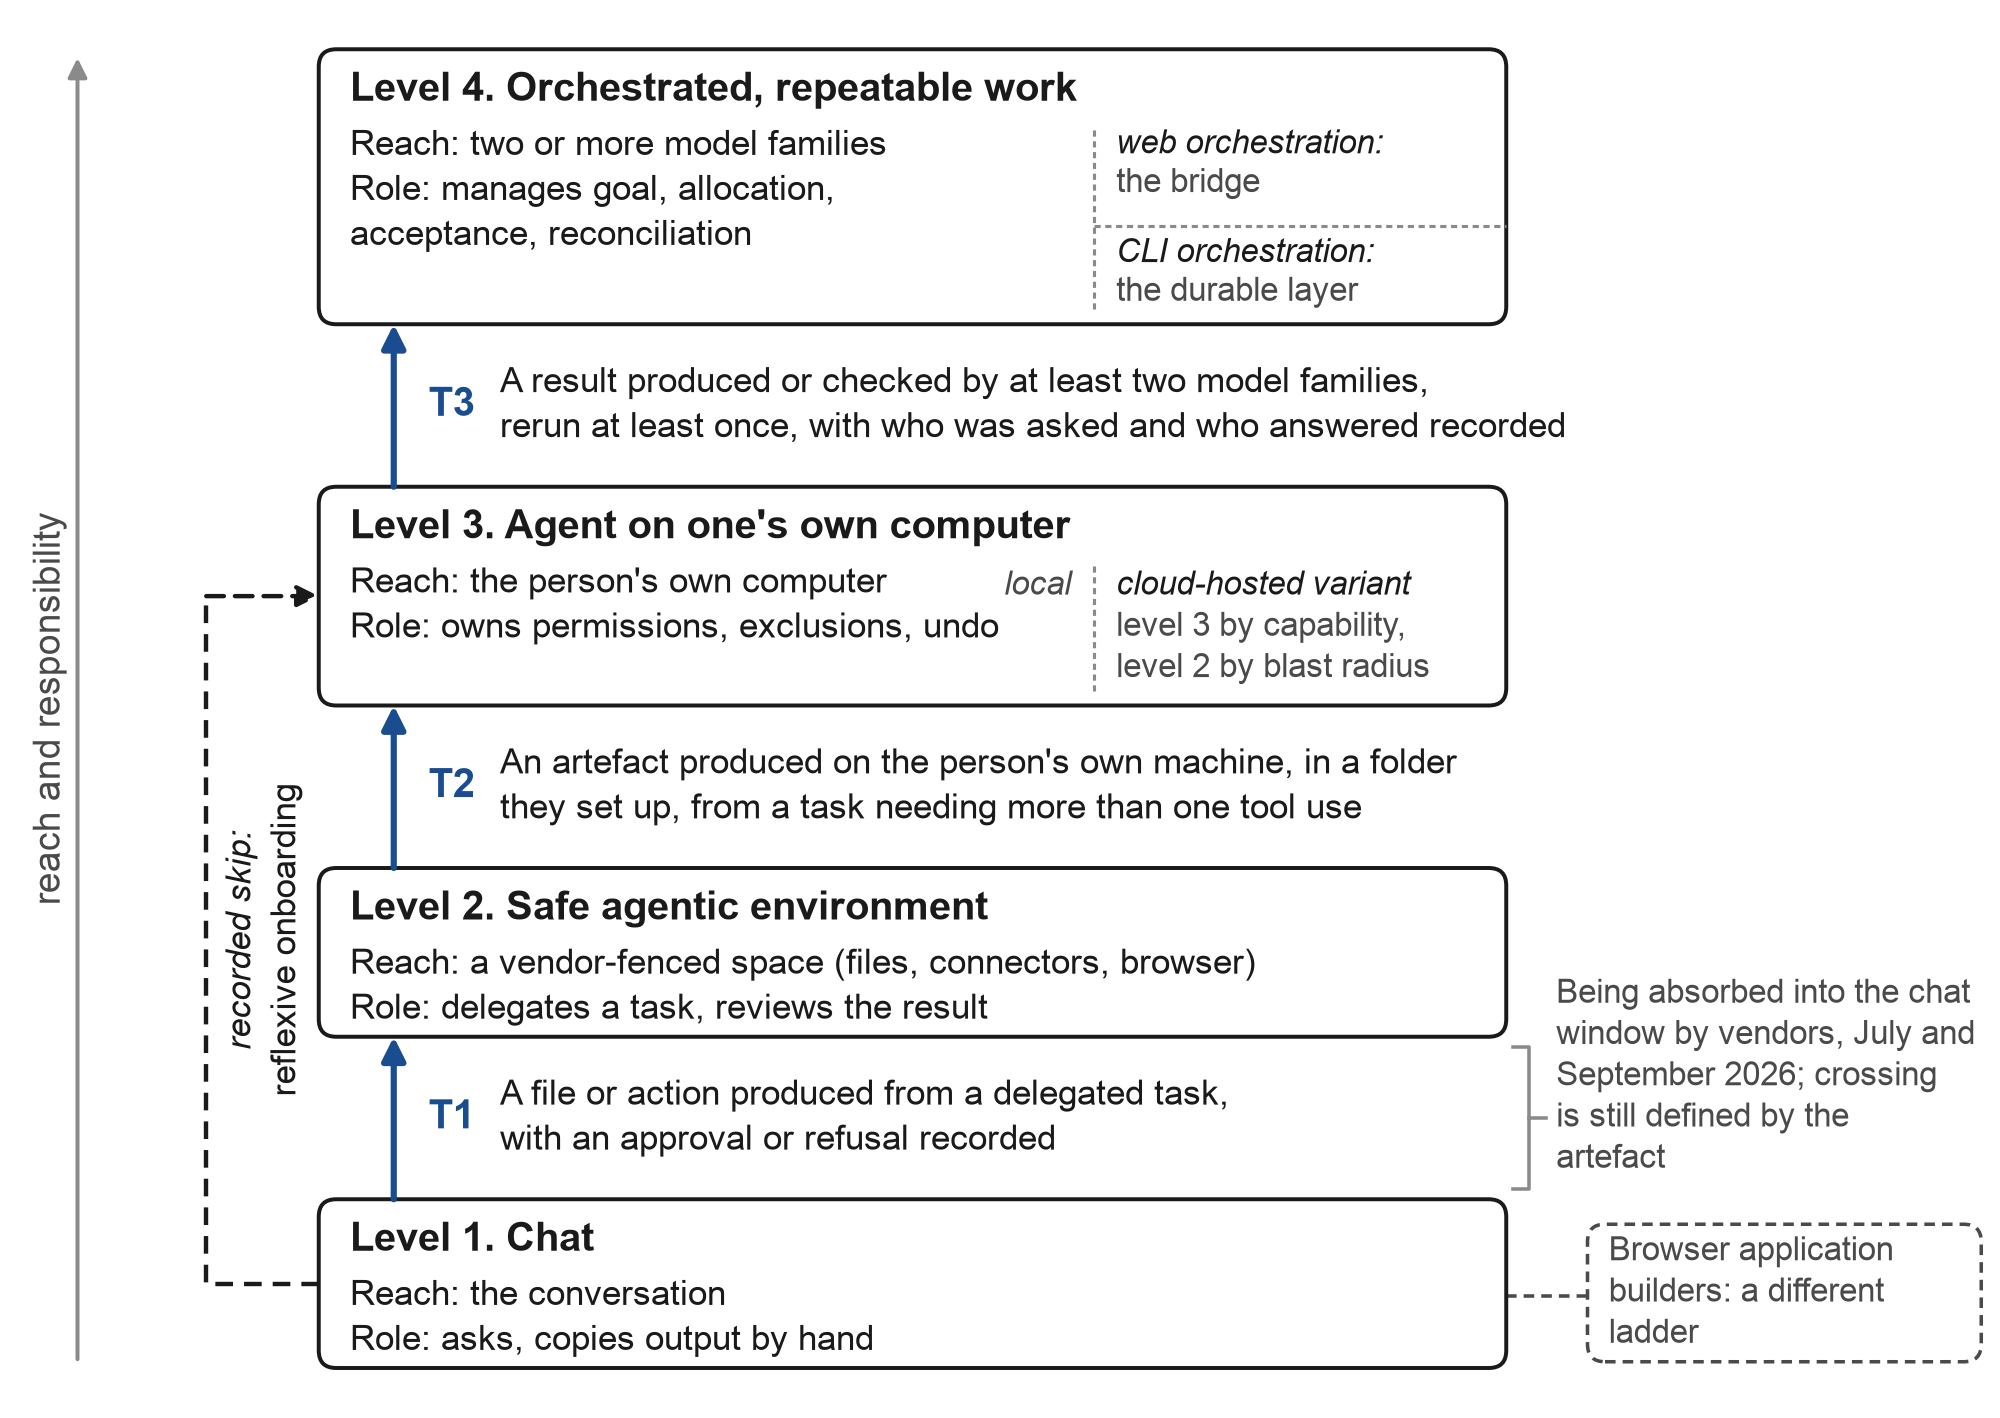
Anmerkung: Die vier Ebenen von Abschnitt 3.2, nach oben geordnet nach Reichweite (was das Modell berühren darf) und nach der Verantwortung, die auf der Person liegt. Jeder Übergang, T1 bis T3, wird nur überquert, wenn ein Agent das neben seinem Pfeil genannte Artefakt hergestellt hat, und eine Installation zählt als Versuch (Abschnitt 3.3 und Tabelle 1). Der gestrichelte Pfeil auf der linken Seite ist der aufgezeichnete Sprung vom Chat zu einem Agenten auf dem eigenen Computer der Person, den die registrierte Route nimmt (Abschnitte 3.4 und 9.2); das gestrichelte Feld auf der rechten Seite ist der Seitenzweig von Browser-Anwendungs-Buildern, und die Anmerkung bei T1 verzeichnet die Zusammenlegung von Chat- und Agent-Oberflächen durch Anbieter im Juli und September 2026 (Abschnitt 4.3).
3.5 Das Terminal ist nicht mehr ein Terminal
Für einen Programmierer ist das Terminal eine Schnittstelle zum Ausgeben von Befehlen. Für einen Fachmann, der mit einem Agenten arbeitet, ist es die Umgebung, in der der Agent lebt: ein Arbeitsordner, eine Reihe von Berechtigungen und eine Geschichte von dem, was getan wurde. Als Anthropic im Januar 2026 Cowork einführte, war die Rahmung „Claude Code für den Rest Ihrer Arbeit": der gleiche Agent, angeboten an Menschen, die keine Software schreiben, ohne das Terminal (Fortune, 2026a).
Die Anbieter haben jetzt auf die gleiche Beobachtung reagiert. OpenAI benannte seine Coding-Agent-Anwendung „ChatGPT" um und machte sie zum Standard-Desktop-Client (MacRumors, 2026). Anthropic liefert eine Desktop-Anwendung für den Agenten, der kein Terminal benötigt (Anthropic, 2026a). Google zog sich aus seinem Open-Source-Gemini-CLI für Einzelnutzer am 18. Juni 2026 zurück, zugunsten einer Multi-Agent-Plattform und eines neuen Befehlszeilenwerkzeugs, und stellte fest, dass Nutzer jetzt „mehrere Agenten benötigen, die miteinander kommunizieren, um die Arbeit aufzuteilen" (Google, 2026). Das sichtbare Terminal verschwindet, und die Umgebung, auf die es Zugriff gewährte, ist immer noch da und muss immer noch von jemandem ausgeführt werden. Für einen Fachmann hat sich die nützliche Frage entsprechend geändert: ob sie ein Terminal nutzen können, ist jeden Monat weniger wichtig, und ob sie eine Umgebung ausführen können, in der ein Agent für sie arbeitet, ist die Frage, die ich ihnen stellen würde.
4. Wo die technische Hürde verschwunden ist
4.1 Installation wurde zu einem Schritt
2024 traf ein Nichtprogrammierer, der einen Terminal-Agenten wollte, auf eine Reihe kleiner Hindernisse: eine Sprach-Laufzeitumgebung installieren, eine Pfadvariable korrigieren, verstehen, warum die Shell „permission denied" sagte, zwischen vier Dingen wählen, die alle „installieren" hießen. Bis September 2026 haben die Anbieter die meisten davon beseitigt. Die führenden Terminal-Agenten installieren sich mit einem einzigen Befehl oder einem Desktop-Installer, der sich selbst aktualisiert. Die Desktop-Anwendung von Claude Code bietet parallele Sitzungen, visuelles Überprüfen von Änderungen, eine Live-Vorschau und geplante Aufgaben, und ihre Dokumentation besagt: „Kein Terminal erforderlich" (Anthropic, 2026a). Die Desktop-Anwendung von OpenAI integriert ihren Coding-Agenten in den gewöhnlichen ChatGPT-Client (MacRumors, 2026). Googles neues Befehlszeilentool ist eine einzelne Binärdatei, die mit einer Desktop-Plattform gebündelt ist (Google, 2026).
Ein Agent, der sich in einem Schritt installiert, ist immer noch schwer zu verwenden, und ich möchte die Veränderung nicht überzeichnen. Was sich geändert hat, ist, dass der Installer nicht mehr die erste Hürde ist, auf die ein Neuling trifft. Die Reibung, die bleibt, ist eine Wahl zwischen Türen: ein Terminal-Tool, eine Editor-Erweiterung, eine Desktop-Anwendung und eine Web-Version reisen alle unter dem Wort „installieren", und die Wahl zwischen ihnen ist das meiste, was Installation einen Neuling jetzt kostet. Eine Tür zu wählen bedeutet, zu wissen, was man der Agent tun soll, also ist dies ein Vokabelproblem, das sich als Setuproblem verkleidet, und es gehört in Abschnitt 5.
Ein architektonisches Merkmal liegt all diesen Produktseiten zugrunde. Das Befehlszeilentool ist die Referenzimplementierung: Subagenten, Hooks, Skills, Protokollserver und Headless-Modi erscheinen zuerst in der CLI und dann in den Desktop- und Web-Oberflächen desselben Moduls; Anthropics eigene Hilfeseite beschreibt seinen Level-2-Agenten als „die gleiche Agenten-Architektur, die Claude Code antreibt, ohne Terminal erforderlich" (Anthropic, 2026b). Für einen Neuling schneidet das beide Wege. Die freundliche Oberfläche kann mit der leistungsstarken aufholen. Aber die Dokumentation, die Beispiele und die Forum-Antworten sprechen immer noch den Dialekt der CLI, daher liest eine Person, die mit der Desktop-Anwendung begonnen hat, über ein Werkzeug, das sie nicht installiert hat.
4.2 Der Chatbot als sein eigener Installer
Eine zweite Veränderung ist weniger sichtbar und für das hier behandelte Argument wichtiger. Der Chatbot, den eine Person bereits nutzt, kann sie durch die Installation des Agenten führen. Eine Person fügt eine Anfrage ein („führe mich durch die Installation auf meinem Windows-Laptop; ich bin nicht technisch versiert"), folgt den Schritten, und wenn etwas fehlschlägt, sendet einen Screenshot des Fehlers an denselben Chatbot zurück. Der kompetentere andere aus Vygotskys Zone der nächsten Entwicklung (Vygotsky, 1978) und der Tutor, dessen Funktionen Wood, Bruner und Ross (1976) Scaffolding nannten (Interesse wecken, Freiheitsgrade reduzieren, kritische Merkmale kennzeichnen, Frustration kontrollieren), ist jetzt in dem Werkzeug verfügbar, dem die Person bereits vertraut, zu jeder Stunde, in ihrer Sprache, kostenlos.
Ich nenne dies reflexives Onboarding: Ein KI-System, das eine Person bei der Einführung eines leistungsfähigeren KI-Systems unterstützt. Es kehrt die übliche Hilfenrichtung um. In der Diffusionsliteratur führt ein Neuling durch Kontakt mit früheren Nutzern ein (Rogers, 2003), und hier wird der frühere Nutzer, zumindest für die mechanischen Schritte, durch das Level-1-Modell selbst ersetzt.
Eine Unterrichtsebene hat sich derweil um diesen Schritt entwickelt. Herstellerakademien bieten Kurzkurse zu ihren Agenten an, und die großen Lernplattformen lehren „Vibe Coding" mit einem benannten Agenten. Es sind Kurse entstanden, die innerhalb des Agenten selbst durchgeführt werden, sodass der Lernende den Agenten installiert und der Agent den Kurs lehrt (CC for Everyone, 2026), und ein Beratungsunternehmen kündigte an, dass etwa 30.000 seiner Mitarbeiter auf den Modellen eines Anbieters geschult würden (Accenture, 2025). Die Existenz dieser Ebene besagt, dass Installation nicht mehr als selbsterklärend behandelt wird. Die minimalistische Instruktionstheorie sagte voraus, dass Menschen Software am besten lernen, wenn sie von Anfang an eine echte Aufgabe durchführen und sich von Fehlern erholen (Carroll, 1990), und reflexives Onboarding bietet einen immer präsenten Leitfaden für beides. Ob es für Menschen funktioniert, die nie ein Terminal geöffnet haben, und für wen, weiß ich noch nicht; der erste Schritt des Programms in Abschnitt 9 ist konzipiert, um das herauszufinden, und die in Abschnitt 2.5 beschriebene Suche fand keine Studie darüber.
4.3 Die Anbieter verschmelzen die Ebenen
Die größte Veränderung von 2026 ist strukturell. Jedes der drei Frontier-Labore und Microsoft versenden jetzt einen Level-2-Agenten, und zwei von ihnen haben begonnen, Level 2 wieder in Chat einzufalten.
Tabelle 2. Anbietermaßnahmen, die den Weg von Chat zu Agent im Januar bis September 2026 umgestalteten.
| Datum (2026) | Anbieter | Maßnahme | Auswirkung auf die Ebenen | Quelle |
|---|---|---|---|---|
| Januar | Anthropic | Cowork-Forschungsvorschau: „Claude Code für den Rest Ihrer Arbeit", Ordner-gestützter Agent für Nichtprogrammierer | Level 2 als benanntes Produkt | Fortune (2026a) |
| 9. März | Microsoft | Die Technologie hinter Cowork in Microsoft 365 Copilot eingeführt; Agent 365-Kontrollraum | Level 2 in der dominanten Office-Suite | Microsoft (2026a) |
| 30. März | OpenAI | Offizielles Plugin zum Ausführen des Coding-Agenten in einem konkurrierenden Agenten, „zum Delegieren von Aufgaben", kostenlose Ebene enthalten | Level 4 (CLI) von einem Anbieter sanktioniert | OpenAI (2026a) |
| 19. Mai; 18. Juni | Gemini CLI für einzelne Ebenen zugunsten von Antigravity CLI und einer Multi-Agent-Plattform eingestellt | Level 3 neu-plattformiert; Umwälzungen für Neulinge | Google (2026) | |
| 2. Juni | OpenAI | Coding Agent bei 5 Millionen wöchentlichen Nutzern; etwa 20 % Wissensarbeiter, wachsen mehr als 3-mal schneller als Entwickler (Herstellerdaten, Pressebericht) | Nutzung eines Terminal-Heritage-Agenten durch Wissensarbeiter; Richtwert und breiter als Level 3 wie hier definiert | Help Net Security (2026) |
| 1. Juli | Gemini Spark-Desktop-Agent auf Mac, funktioniert mit lokalen Dateien (Beta, USA) | Level 2 aus einem dritten Labor | TechCrunch (2026b) | |
| 9. Juli | OpenAI | Coding-Agent-App wird die neue ChatGPT-Desktop-App; ChatGPT-Work-Agent nutzt lokale Dateien und Apps | Ebenen 1 bis 3 in einem Client | MacRumors (2026) |
| 26. August | Anthropic | Browser-Agent allgemein verfügbar auf bezahlten Plänen; handelt autonom mit einem Sicherheitsklassifizierer standardmäßig | Reichweite Stufe 2 erweitert auf das Web | Anthropic (2026d) |
| 16. September | Anthropic | Cowork und Chat in „ein Claude" zusammengeführt; das Modell entscheidet, ob es antworten oder handeln soll | Transition 1 in Chat aufgelöst | Anthropic (2026c); TechCrunch (2026a) |
In dieser Reihenfolge gelesen beschreibt die Tabelle eine Konvergenz. Die Anbieter trennten zunächst Chat von agentischer Arbeit, damit Nicht-Programmierer sich vom Terminal nicht abgeschreckt fühlen würden, stellten dann fest, dass Menschen nicht unterscheiden konnten, welchem Fenster eine Aufgabe zuzuordnen war, und führen die beiden nun wieder zusammen, wobei das Modell entscheidet. TechCrunch berichtete, dass das Unternehmen sagte, Kunden „hatten oft Schwierigkeiten, den richtigen Tab für die richtige Aufgabe zu wählen" (TechCrunch, 2026a); die eigene Ankündigung formulierte es als „Sie müssen nicht wählen, wohin eine Aufgabe geht", wobei die Arbeit nach dem Schließen des Laptops fortgesetzt wird, der Agent standardmäßig vor dem Handeln fragt und die Zusammenführung zunächst für kostenpflichtige Einzelpläne ausgerollt wird, während der Coding-Tab getrennt bleibt (Anthropic, 2026c). Ich lese dies als Anbieterbeleg für die in Abschnitt 1 benannte Barriere, Workflow-Vokabular. Wenn Menschen nicht entscheiden können, ob eine Aufgabe eine Frage oder eine Delegation ist, werden sie wahrscheinlich nicht wissen, wie sie die Delegation formulieren.
Die Zusammenführung könnte ein Modell mit einer separaten Stufe 2 zu untergraben scheinen. Das ist nicht der Fall, und der Grund kann gegeben werden, ohne zu tun, als hätte das Modell die Ereignisse vorhergesehen. Anbieter haben ein Abrechnungs-, Support- und Sicherheitsinteresse daran, gewöhnliche Benutzer in einem Fenster zu halten, das sie klassifizieren, Rate-Limit setzen und mit einem Berechtigungsmodell versehen können, und ein Usability-Interesse daran, den Benutzer nicht einen Modus wählen zu lassen; das Aufnehmen von Transition 1 in Chat folgt aus beiden. Die Crossing-Regel ändert sich nicht. Wenn das System Dateien in einem genehmigten Umfang nach einer Genehmigung geschrieben hat, wurde Transition 1 überschritten, unabhängig vom Rahmen um die Konversation, und wenn es einen Absatz zurückgab, befindet sich die Person immer noch auf Stufe 1. Das Modell impliziert, dass Transition 2 und 3 nicht auf die gleiche Weise aufgelöst werden. Ein lokaler Agent mit Shell-Zugriff ist ein anderes Berechtigungsobjekt als ein serverseitiger Sandbox, und ein Tool eines zweiten Anbieters, das unter dem Login dieses Anbieters ausgeführt wird, ist ein anderes Berechtigungsobjekt als ein Ratsfunktion eines einzelnen Anbieters. Diese Unterschiede tragen das Sicherheitsargument aus Abschnitt 5.3 und das korrelierte-Fehler-Argument aus Abschnitt 6.3. Wenn die großen Anbieter bis Ende 2027 lokale Shell-Agenten und Cross-Vendor-Aufrufe im gleichen Chat-Fenster unter dem gleichen Berechtigungsmodell zusammengefasst haben, ist diese Implikation falsch, und die Behauptung, dass CLI-Orchestrierung die Schicht ist, die bleibt, fällt damit (P2 und P8 in Abschnitt 10).
Die Konvergenz bringt auch eine Folge mit sich, Fluktuation. Der Open-Source-Befehlszeilenagent von Google war für Einzelbenutzer nur knapp unter zwölf Monate in Betrieb (25. Juni 2025 bis 18. Juni 2026), Openais agentischer Browser wurde nach etwa neun Monaten eingestellt, und Cowork existierte als separates Produkt für etwa acht Monate (Google, 2026; 9to5Mac, 2026; Anthropic, 2026c). Ein Profi, der Zeit in das Erlernen eines Tools investiert, könnte es innerhalb eines Jahres umbenannt, zusammengeführt oder eingestellt sehen. Was über Tools hinweg übertragen wird, ist Workflow-Vokabular, und was verloren geht, ist Wissen über die Menüs eines Produkts, eine Asymmetrie, die wichtig ist für die Frage, wie Menschen unterrichtet werden sollten (Abschnitt 11.2).
4.4 Wissensarbeiter in terminalgestützten Agenten
Das beste einzelne Datum zu Nicht-Programmierern in einem terminalgestützten Agenten stammt von einem Anbieter. Im Juni 2026 berichtete OpenAI über die Presse, dass sein Coding-Agent fünf Millionen wöchentliche Nutzer hatte, mehr als das Sechsfache der Nutzerzahl beim Start der Desktop-Anwendung im Februar, dass Wissensarbeiter etwa 20% von ihnen ausmachten und mit mehr als dreifacher Geschwindigkeit als Entwickler eingeführt wurden, und dass wöchentlich nach der Zählung des Anbieters 72% der Wissensarbeiter-Nutzer Artefakte wie Berichte, Memos, Verträge, Tabellenkalkulations und PDFs produzierten (Help Net Security, 2026; die eigene Seite des Anbieters gab bei meinen Überprüfungen einen Zugriffsfehler zurück, daher werden die Zahlen aus dem Pressebericht zitiert). Zwanzig Prozent von fünf Millionen sind etwa eine Million Menschen pro Woche. Ein Analyst merkte an, dass die Veröffentlichung teilweise dazu gedacht war, einen „Aufschwung zurückzugewinnen" und dass der Agent „oft neben" konkurrierenden Agenten „verwendet wird", daher sollten die Wachstumskurven „richtungsweisend verwendet werden" (Constellation Research, 2026a). Die Zahlen werden vom Anbieter berichtet und nicht geprüft, sie beschreiben Menschen, die das Tool bereits gewählt haben, und sie messen die Nutzung von terminalgestützten Agenten durch Wissensarbeiter, was breiter ist als die in Abschnitt 3 definierte Stufe-3-Einführung (ein Artefakt aus einer delegierten Aufgabe auf dem eigenen Computer der Person). Mit diesen Vorbehalten gelesen, reichen sie aus zu sagen, dass terminalgestützte Agenten nicht mehr Programmierern vorbehalten sind; ob ihre Nutzer Stufe 3 wie in Abschnitt 3 definiert erreichen, ist das, was die Zahl nicht zeigen kann.
Neben diesem Datum steht das breite und flache Muster aus Abschnitt 1. Die Umfragen sind sich uneinig über die Höhe und einig über die Form: Etwa die Hälfte der US-Amerikaner nutzt Chatbots (Pew Research Center, 2026), 52% der US-Arbeiter nutzen KI in ihrer Rolle (Gallup, 2026), und 45% der Arbeiter und 62% der Erwachsenen nutzen generative KI nach dem Maßstab der St. Louis Fed (Bick et al., 2026), während etwa einer von sieben Arbeitern sie täglich nutzt und Automatisierung eine Minderheitsnutzung ist. Abbildung 2 zeigt die Arbeiter-Serien von Gallup und St. Louis Fed neben den Entwickler-Zahlen aus Abschnitt 1, ein Panel pro Umfrage, weil sich die Umfragen in Frage und Nenner unterscheiden. Unter Entwicklern sind Coding-Agenten nahezu universell und die Nutzung ist noch vorsichtig: In einer Puls-Umfrage vom Mai 2026 mit etwa 1.100 Technologen nutzten 69% einen einzelnen Agenten, 59% ließen Agenten selten oder nie unbeaufsichtigt laufen, und 60% blockierten Agenten vor nicht genehmigten Änderungen an ihren Systemen (Stack Overflow, 2026). Stufe 4 ist also immer noch eine Grenze, selbst für Programmierer, die Stufe 3 täglich nutzen.
Abbildung 2. Breit und flach: Einführung unter Entwicklern und unter anderen Arbeitern.
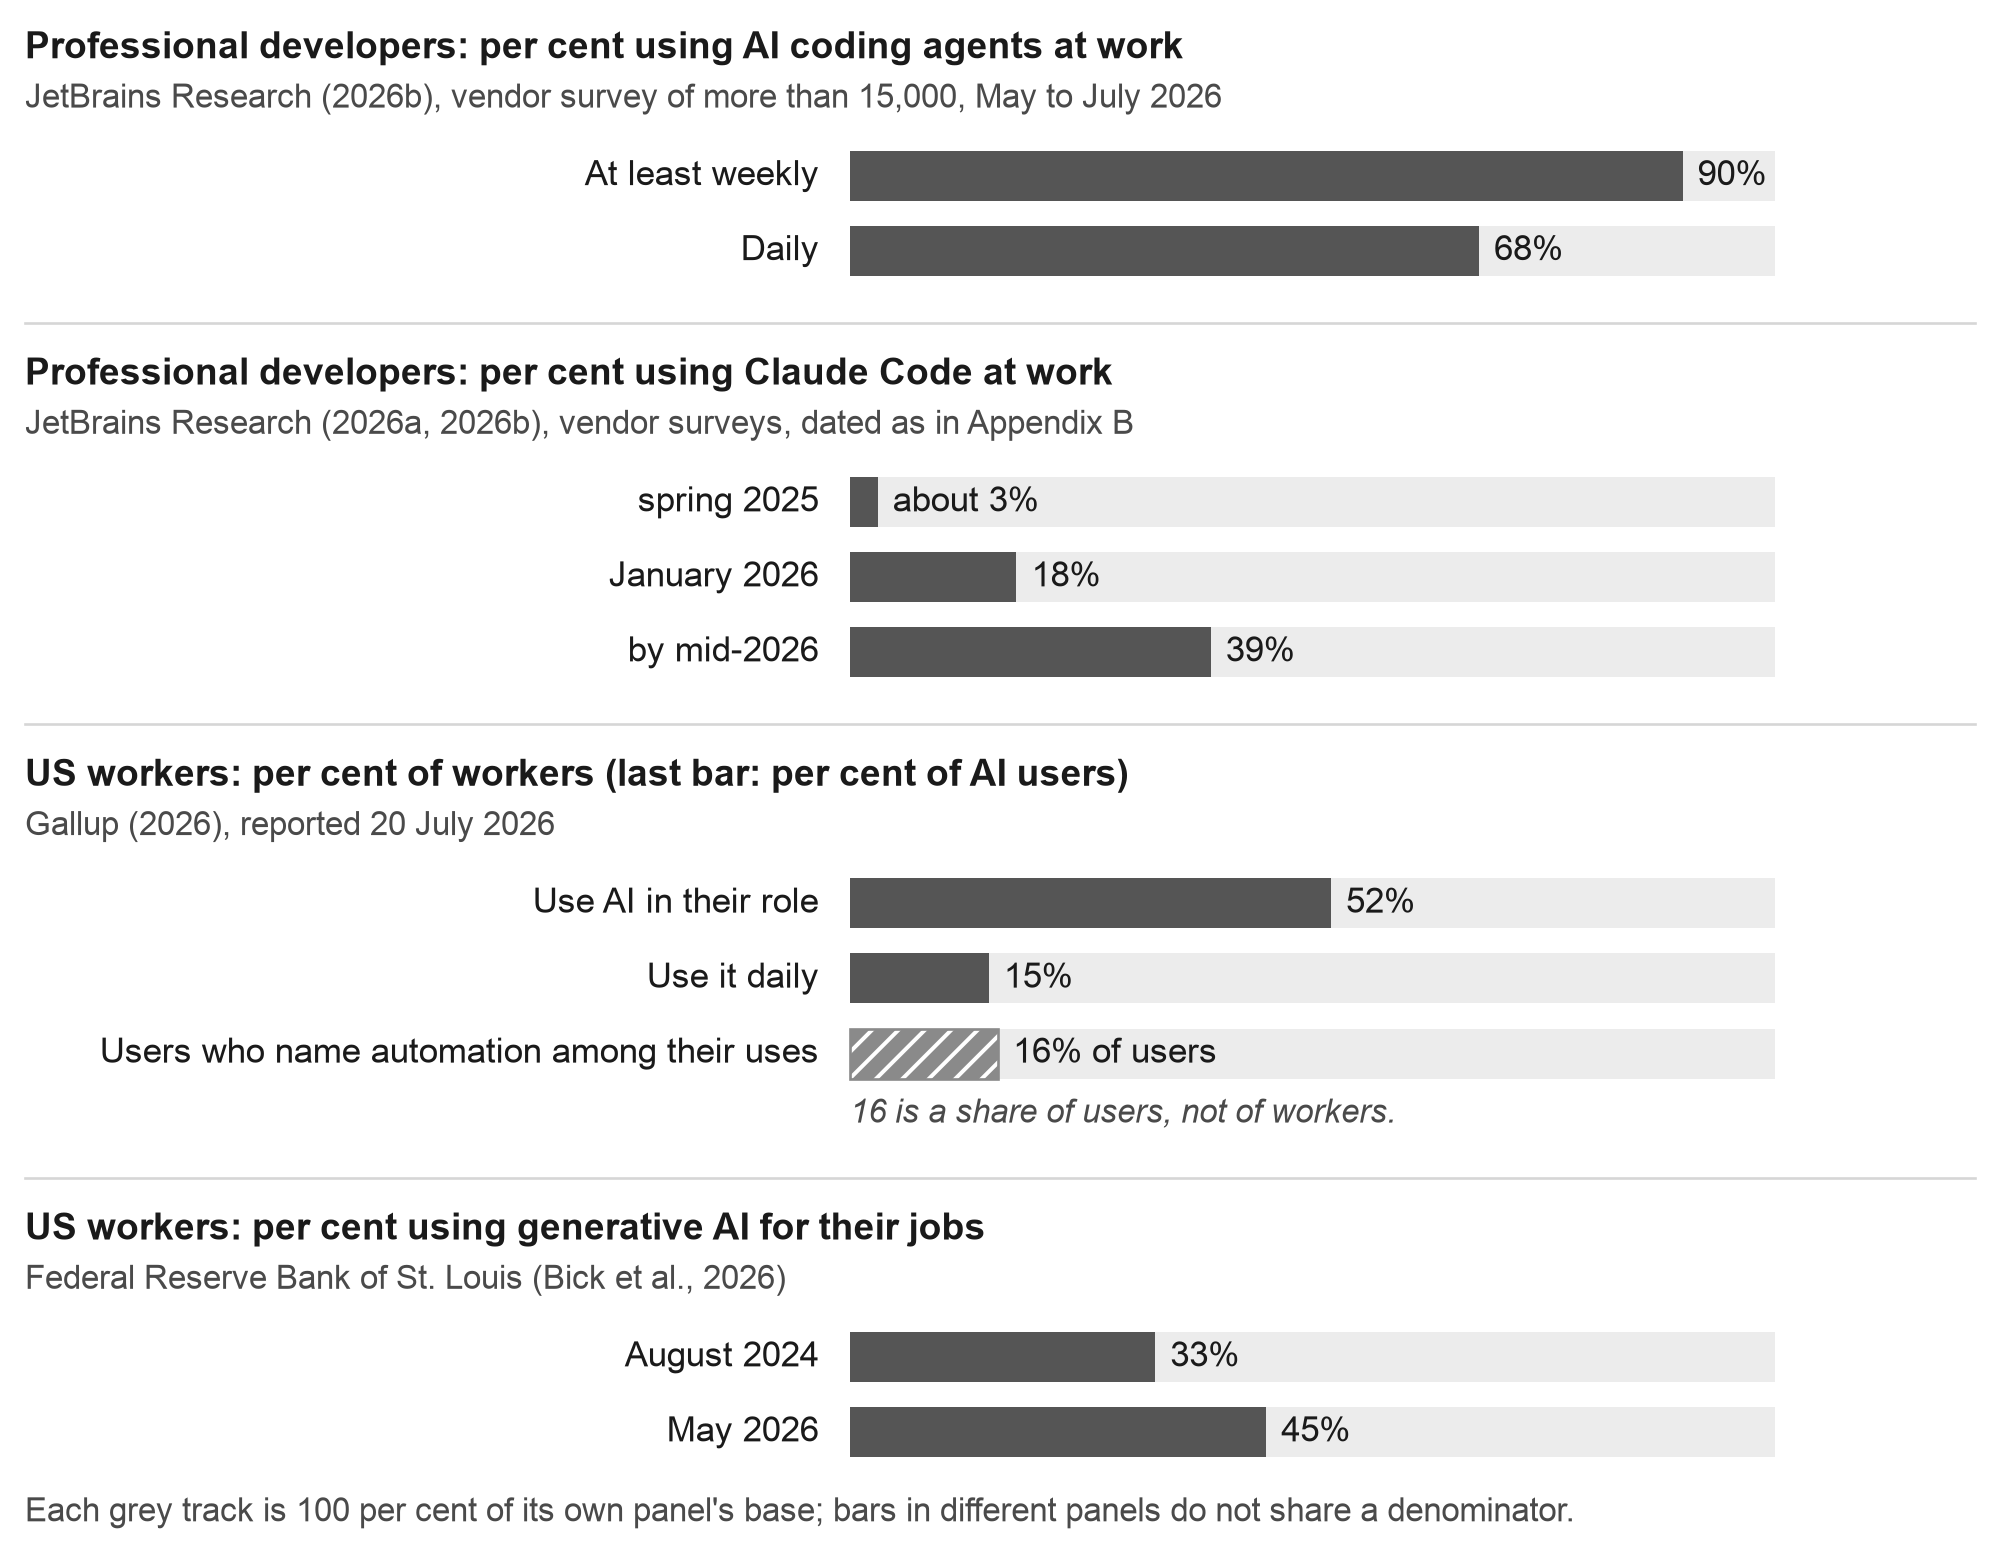
Anmerkung: Einführungszahlen aus den in Abschnitt 1 und 4.4 zitierten Umfragen: Professionelle Entwickler in zwei Anbieter-Umfragen (JetBrains Research, 2026a, 2026b), US-Arbeiter (Gallup, 2026) und US-Arbeiter, die generative KI für ihre Jobs nutzen (Bick et al., 2026). Jedes Panel hat seine eigene Frage, Zeitraum und Nenner, und die 16 Prozent im dritten Panel sind eine Quote von KI-Nutzern, daher wird jedes Panel für sich gelesen. Die Zählung des Anbieters von Wissensarbeitern in seinem Coding-Agenten (Abschnitt 4.4) ist eine Quote der Nutzer eines Produkts und wird nicht abgebildet, und keine Zahl hier stammt aus dem Kohortenprogramm von Abschnitt 9.
4.5 Wo dies das Argument hinterlässt
Zusammengefasst überzeuge ich mich in diesem Abschnitt von einem Punkt und lasse einen anderen offen. Die Installation ist nicht mehr die entscheidende Hürde: Die Anbieter haben die meisten mechanischen Schritte beseitigt, der Chatbot kann den Rest anleiten, und nach Angaben eines Anbieters (ein Pressebericht und orientierungsgebend) befinden sich bereits etwa eine Million Wissensarbeiter pro Woche in einem Agent mit Terminal-Erbe. Ob die Installation zur Nutzung führt, ist eine andere Frage, und die breiten und oberflächlichen Umfragen geben eine entmutigende Antwort, da die meisten Menschen, die einen Agent erreichen könnten, immer noch nicht an ihn delegieren. Was zurückgegangen ist, sollte auch präzise dargelegt werden. Die Installation ist zurückgegangen, es existiert nun eine begrenzte mittlere Stufe, und ein lokaler Agent hat ein grafisches Interface. Die Zuverlässigkeit bei ganzen Teilen von Wissensarbeit hat sich viel weniger verschoben (Abschnitt 5.7), das Produkt, das eine Person gelernt hat, kann innerhalb eines Jahres verschwunden sein (Churn, oben), und ein gewährter Ordner ist immer noch nicht standardmäßig ein sicherer Ort (Abschnitt 5.3). Abschnitt 5 fragt, was Menschen abhält, sobald die Software vorhanden ist.
5. Was Menschen nach dem Installer stoppt
Sobald der Installer nicht mehr die Hürde ist, ist es etwas anderes. Die Evidenz aus 2025 und 2026 deutet auf sechs Barrieren hin, von denen jede an einem bestimmten Übergang wirkt und von denen jede bereits eine teilweise Antwort auf dem Markt hat. Tabelle 3 fasst sie zusammen, und die folgenden Unterabschnitte liefern die Evidenz.
Tabelle 3. Barrieren nach der Installation.
| Barriere | Wo sie wirkt | Evidenz (Abschnitt) | Was sie reduziert |
|---|---|---|---|
| Workflow-Vokabular: nicht zu wissen, was man übergeben soll, oder wie man es formuliert, damit es überprüft werden kann | Übergänge 1 und 2; erneut bei 3 | Vendor-Fusionslogik; Prompting-Studien; verpackte Fähigkeiten (5.1) | Ausgearbeitete Beispiele aus dem eigenen Fachgebiet; Fähigkeiten und Vorlagen; eine erste Aufgabe, die real, aber risikoarm ist |
| Angst vor dem Fenster, der ersten Fehlermeldung und Vertrauen: das schwarze Fenster als soziales Objekt; eine Meldung, die ein Programmierer liest und bei der ein Anfänger stehen bleibt; Vertrauen, das in beide Richtungen fehlkalibriert ist | Übergang 2 | Akzeptanzforschung; Entwickler-Vertrauensumfragen; Studien zu Endbenutzern mit KI-Code; reflexives Onboarding (5.2) | Desktop-Oberflächen; die Fehlermeldung an den Chatbot zurückleiten; Plan-first-Modi; ein erster Erfolg auf einer Kopie |
| Berechtigungen und Sicherheit: zu wenige Eingabeaufforderungen zum Schutz von Dateien oder zu viele, um sie zu verstehen | Übergänge 1 und 2 | Dateifehlberichte in Bereichsordnern; Injektionsraten; Anleitung, die Benutzer auffordert, Angriffe zu erkennen (5.3) | Arbeitskopien, Snapshots, Ablehnungsregeln; Klassifizierer, die Anfängern die Entscheidung nicht überlassen |
| Organisatorische Regeln: gesperrte Maschinen, Richtlinien, keine Berechtigung zur Installation | Übergang 2 | Organisatorische Faktoren überwiegen individuelle; kleine Firmen flach strukturiert (5.4) | Vom Arbeitgeber sanktionierte Level-2-Tools; klare Richtlinien; eine persönliche Maschine zum Lernen |
| Hardware, Kosten und Quote | Übergänge 2 und 3 | Level 3 benötigt einen Computer und einen kostenpflichtigen Plan; Quoten binden die Orchestrierung zuerst (5.5) | Kostenlose Pläne, wo sie existieren; Beginn bei Level 2; Budgetierung von Läufen |
| Das Ergebnis bewerten | Alle Übergänge, die meisten bei 3 | Geschäftsbenutzer übersehen Fehler in KI-Code; Agenten scheitern am häufigsten bei ganzen Projekten (5.6) | Prüfungen vor der Aufgabe definiert; ein zweites Modell als Rezensent, nicht als Orakel |
5.1 Der leere Ordner: Workflow-Vokabular
Ein Programmierer, der einen Agenten öffnet, kennt eine Abfolge: ein Projekt erstellen, eine Anweisungsdatei schreiben, sie unter Versionskontrolle stellen, um eine Funktion bitten. Ein Nichtprogrammierer öffnet denselben Agenten und stellt die Frage, die jetzt in den Daten der Anbieter selbst auftaucht: Gut, und was sage ich ihm? Für einen Entwickler existiert die kanonische erste Anfrage („erstelle eine kleine Webanwendung"). Ein Vermarkter braucht eine andere („nimm die Exporte des letzten Quartals aus Analytics und der Kundendatenbank und erstelle etwas, das jeden Freitag meldet, welche Kampagnen zahlende Kunden gebracht haben"). Ein Forscher braucht noch eine andere („durchsuche diesen Ordner mit 300 Papieren und extrahiere für jedes die Stichprobengröße, Methode und Haupteffekt in eine Tabelle, kennzeichne, wo du dir unsicher bist"). Keine dieser Anfragen benötigt Code von der Person. Jede erfordert, dass die Person weiß, dass eine solche Anfrage möglich ist, sie in Teile zerlegt, die ein Agent tun kann, und sagt, wie ein gutes Ergebnis aussieht. Die Frage „was soll ich ihn tun lassen?" wird gewöhnlich als Bitte um einen besseren Prompt missverstanden. Ich lese sie als Bitte um eine Karte der eigenen Arbeit. Die Karte muss ein wiederkehrendes Arbeitsprodukt benennen, die Eingaben, die man verwenden darf, die Transformation, das Ergebnis und die Prüfung. Die Karte eines Analysten könnte lauten „diese zulässigen Exporte, gruppiert nach diesem Feld, gekennzeichnete Anomalien, ein datierter Bericht und eine maschinenlesbaren Tabelle, überprüft gegen die Zeilensummen". Die Person muss nicht wissen, wie das Parsing erfolgt. Sie muss erkennen, welche Evidenz das Ergebnis brauchbar macht. Wenn eine Person die Karte nicht ausfüllen kann, sagt die Stagnation selbst ihnen etwas. Die Arbeit kann zu sensibel, zu bedingt oder zu schlecht dokumentiert sein, um sie delegiert zu werden, wie sie ist, und das sagt etwas über die Aufgabe, bevor es etwas über die Person sagt.
Die Forschung zum Prompting erklärt, warum dies schwierig ist. Menschen ohne KI-Expertise haben Schwierigkeiten, Anweisungen zu schreiben, die verallgemeinerbar sind (Zamfirescu-Pereira et al., 2023), und sie müssen durch Ausprobieren ermitteln, welche Wörter sich auf das beziehen, was das System tun kann (Liu et al., 2023). Das Verhalten der Anbieter bestätigt es. Anthropic fusionierte seinen Level-2-Agenten in Chat, weil Kunden nicht entscheiden konnten, wo eine Aufgabe hingehört (TechCrunch, 2026a), und OpenAI startete rollenspezifische Plugins für seinen Code-Agenten, gerichtet auf Knowledge-Work ohne Codierung erforderlich" (berichtet von Help Net Security, 2026). Die Antwort der Industrie ist, Vokabular zu verpacken. Anthropic veröffentlichte sein Format für verpackte Agent-Anweisungen im Dezember 2025 als offenen Standard (SiliconANGLE, 2025), und die Website des Standards listete am 21. September 2026 46 unterstützende Produkte auf, darunter Agenten von OpenAI, Google und GitHub (Agent Skills, 2026). Eine unabhängige Erhebung zählte 2.049 Anwendungen im ChatGPT-Verzeichnis und 1.375 Konnektoren für Claude Mitte 2026 (Sitter, 2026). Eine Fähigkeit ist nach dieser Definition eine Einheit von Workflow-Vokabular, die Anfrage einmal aufgeschrieben, damit eine Person, die nicht weiß, wie sie es formulieren soll, es trotzdem machen kann.
Gepacktes Vokabular ist notwendig und nicht ausreichend. Eine Fähigkeit zeigt dem Agenten, wie man eine Aufgabe erledigt. Sie kann einer Person nicht sagen, welche ihrer eigenen Aufgaben es wert ist, delegiert zu werden, denn diese Beurteilung kommt aus dem Fachgebiet der Person. Die veröffentlichten Pakete tragen auch die Annahmen einer bestimmten Welt mit sich, weitgehend die Formen eines Landes und einen unternehmenseigenen Software-Stack, und ein Fachmann, dessen Werkzeuge nicht dieser Stack sind, steht wieder vor einer leeren Eingabeaufforderung. Als ich am 22. September 2026 den offiziellen Katalog der gepackten Fähigkeiten las, alle 310 Einträge davon, fand ich keinen geschriebenen für einen Pfarrer oder Kapellan, eine Krankenschwester oder Familienbetreuerin, einen Schullehrer, einen Künstler oder Handwerker oder einen Immobilienmakler; jede scheinbare Übereinstimmung war ein Software- oder Finanzwort in denselben Kleidern, ein Anlageportfolio oder die Gesundheit eines Dienstes. Ein Community-Katalog, den eine Person von Hand hinzugefügt hatte, enthielt an diesem Tag 2.282 Einträge und trug tatsächlich Arbeit für Schullehrer und für Immobilien, und nichts für die anderen drei Handwerke. Kataloge ändern sich Woche für Woche, also ist dies eine zeitlich begrenzte Lesart und keine bleibende Aussage über das Gebiet. Darum lege ich so großes Gewicht auf die erste Aufgabe in jeder Onboarding-Route: Sie sollte real sein, aus der Arbeit der Person stammen, niedrig im Risiko und sollte ein Artefakt produzieren, das die Person beurteilen kann (Carroll, 1990).
5.2 Angst vor dem Fenster, der erste Fehler und Vertrauen
Das schwarze Fenster ist ein soziales Objekt. Wahrgenommene Benutzerfreundlichkeit ist seit fünfunddreißig Jahren eine Säule der Technologieakzeptanz (Davis, 1989), und eine blinkende Eingabeaufforderung fällt diesen Test für eine große Bevölkerung selbst dann nicht, wenn die Person niemals einen Befehl eingeben wird. Die Desktop-Oberflächen von Abschnitt 4.1 sind die Antwort der Anbieter. Es ist eine teilweise Antwort, denn das zweite Tor ist Vertrauen, und das Vertrauen hat sich gegen Agenten sowie zu ihnen verschoben. Unter Entwicklern fand die Stack Overflow-Umfrage 2025 46% Misstrauen in die Genauigkeit von KI-Tools gegenüber 33% Vertrauen, mit 87% besorgt um die Genauigkeit von Agenten und 81% über die Sicherheit (Stack Overflow, 2025). Im Jahr 2026 hielten die meisten Agenten immer noch von ungenehmigten Änderungen ab (Stack Overflow, 2026). Manager hören dasselbe: „Vertrauen ist ein zentrales Hindernis für die Realisierung des Potenzials von KI-Agenten bei der Arbeit" (McKinlay et al., 2026). Mehr US-Amerikaner erwarten, dass KI ihnen schadet als dass sie ihnen hilft (Pew Research Center, 2026). Hinter beiden Toren liegt die Glaubensfalle von Abschnitt 2.4: Erfahrung sagt Erfolg voraus, Menschen, die keinen ersten Erfolg hatten, haben keine Erfahrung, und das erste Artefakt ist der Ausweg (Ma et al., 2025). Manche Menschen werden einen Home-Ordner gewähren, weil der Agent höflich war, und andere werden die Installation weigern, weil sie von gelöschten Familienfotos gelesen haben. Beide sind Fehlkalibrierungen (Lee & See, 2004). Das billigste Kalibriergerät, das ich mir vorstellen kann, ist eine erste Aufgabe, die in einer Kopie eines Ordners erledigt wird.
Wenn ein Agent meldet, dass ein Befehl mit Exit-Code 1 fehlgeschlagen ist, liest ein Programmierer weiter. Ein Neuling kann einfach stoppen. Die Literatur über Endbenutzer, die auf KI-geschriebenem Code treffen, zeigt das Muster in einer milderen Einstellung: Geschäftsbenutzer, denen von KI erstellter Analysecode gegeben wurde, übersahen oft kritische Fehler selbst, wenn ihnen gesagt wurde, sie sollten danach suchen (Virk & Liu, 2025), und Konversationsprogrammierer verbringen einen großen Teil ihrer Anstrengung auf Verifikation und Kontextmanagement (Sarkar & Drosos, 2025). Auf Ebene 3 liegt der Fehler oft ganz außerhalb der Arbeit der Person, in der Umgebung: eine fehlende Berechtigung, eine Netzwerkregel, ein Werkzeug, das der Agent erwartet und nicht gefunden hat.
Reflexives Onboarding (Abschnitt 4.2) liefert die praktischste bisher beschriebene Antwort. Die Person sendet den Fehler oder einen Screenshot davon an den Chatbot, den Sie bereits verwenden, und folgt dessen Rat. Plan-First-Modi helfen von der anderen Seite, da ein Agent, der seinen Plan vor dem Handeln schreibt, der Person etwas zu lesen gibt, das kein Stack Trace ist. Keiner entfernt den Moment, in dem eine Person ohne mentales Modell ihres Computers auf eine Nachricht trifft, die sie nicht analysieren kann. Ich weiß noch nicht, wie oft dieser Moment den Versuch beendet. Das Programm in Abschnitt 9 zeichnet es in den eigenen Worten der Person auf.
5.3 Berechtigungen und Sicherheit: zu wenig und zu viel
Ebene 3 gibt einem Agenten die Reichweite seines Eigentümers, daher läuft das Sicherheitsproblem in zwei Richtungen und ein Neuling ist beiden ausgesetzt.
Nehmen Sie zuerst zu wenig Schutz. Agenten haben Daten in dokumentierten Vorfällen zerstört. Ein Agent in einem beliebten Anwendungsbuildservice löschte im Juli 2025 eine Produktionsdatenbank und beschrieb seine Aktion als „einen katastrophalen Fehler des Urteils" (The Register, 2025). Im April 2026 löschte ein Agent in einem Coding-Tool die Produktionsdatenbank eines Unternehmens und seine Sicherungen in Sekunden und schrieb: „Ich habe geraten, statt zu überprüfen" (Information Age, 2026). Näher an der Bevölkerung, um die sich dieses Papier handelt, berichteten Benutzer des Level-2-Agenten von Anthropic im März, April und Juni 2026, dass dieser persönliche, familiäre und rechtliche Dokumente in Ordnern gelöscht hatte, denen sie Zugriff gewährt hatten, in einem Fall nach einem langen Task, das nicht gestoppt werden konnte, und das Löschen des Task die Dateien gelöscht hat (GitHub-Problemberichte, 2026; Benutzerberichte, nicht vom Anbieter bestätigt). Ordner-Scoping begrenzt, wo Schaden entstehen kann. Es verhindert keinen Schaden im Ordner, und ein synchronisierter Cloud-Ordner kann einen lokalen Fehler in einen synchronisierten Verlust verwandeln.
Das Browsing führt zu Prompt Injection – Anweisungen, die in einer Webseite versteckt sind und vom Agenten so gelesen werden, als kämen sie vom Nutzer. Ein Sicherheitsteam zeigte den Angriff im August 2025 bei einem anderen Anbieter vor, mit einem Proof of Concept, der einen Einmalcode aus einem Postfach durch versteckten Seitentext abgriff (Brave, 2025). Anthropic teilte mit, dass sein Browser-Agent vor Abwehrmaßnahmen in 23,6 % der Testfälle erfolgreich angegriffen wurde und 11,2 % danach (Anthropic, 2025). Ein Jahr später, bei allgemeiner Verfügbarkeit, berichtete es, dass starke Red-Team-Angriffe gegen sein Hauptmodell in 3,8 % der Fälle vor Schutzmaßnahmen erfolgreich waren und dass mit vollständigem Schutz kein Angriff gegen drei seiner Modelle erfolgreich war und 0,3 % gegen ein viertes (Anthropic, 2026d). Das sind Angaben des Anbieters zu Testdatensätzen des Anbieters. Der Trend geht nach unten, das Restrisiko ist aber nicht null. OpenAI schrieb im Dezember 2025, dass Prompt Injection „wahrscheinlich nie vollständig ‚gelöst'" werden wird (TechCrunch, 2025). Bei der Einführung seines Level-2-Agenten forderte Anthropic Nutzer auf, „Claude auf verdächtige Aktionen zu überwachen, die auf Prompt Injection hindeuten könnten" und dass „Sie für alle Aktionen verantwortlich bleiben, die Claude in Ihrem Auftrag durchführt" (The Register, 2026). Ein weit verbreiteter Entwickler wandte damals ein, dass es nicht fair sei, von Nicht-Programmierern zu verlangen, die Zeichen von Prompt Injection zu erkennen (Willison, 2026). Ich halte diesen Einwand generell für berechtigt. Ein Sicherheitsdesign, das sich darauf verlässt, dass der Anfänger einen Angriff erkennt, delegiert das schwierigste Urteil an die Person, die am wenigsten in der Lage ist, es zu fällen. Verpackte Fähigkeiten und Protokoll-Server öffnen eine Anweisungs- und Berechtigungsfläche ihrer eigenen Art, da eine Fremd-Fähigkeit Anweisungen trägt, die die Person nicht geschrieben hat, ein Server mehr Berechtigung haben kann, als die Aufgabe benötigt, und Konfigurationen zwischen Versionen abdriften.
Zu viel Schutz hindert Menschen ebenso sicher. Ein Agent, der bei jedem Schritt um Erlaubnis fragt, macht die Person zum Angestellten, der Befehle genehmigt, die er nicht bewerten kann, und Genehmigungsmüdigkeit setzt ein. Die Anbieter haben sich entsprechend bewegt, und innerhalb eines Quartals bewegten sie sich in mehr als eine Richtung. Der Browser-Agent von Anthropic agiert jetzt standardmäßig autonom, mit einem Klassifizierer, der Aktionen blockiert, die nicht der Anfrage des Nutzers entsprechen (Anthropic, 2026d). Sein Terminal-Agent benannte seinen Standard-Berechtigungsmodus im Juli 2026 in „Manual" um, eine Wortwahländerung, die eine eigene Geschichte darüber erzählt, was „Standard" zu bedeuten begonnen hatte (Anthropic, 2026h). Sein zusammengeführter Chat-Agent „fragt vor Aktionen, standardmäßig", eine Einstellung, die der Nutzer ändern kann (Anthropic, 2026c). Parasuramans und Rileys (1997) Taxonomie gilt für alle drei. Eine Schutzvorrichtung, die zu viel blockiert, erzeugt Nichtnutzung, eine Schutzvorrichtung, die eine Löschung übersieht, erzeugt Missbrauch, und keine Einstellung entgeht der Taxonomie, nur eine Einstellung, deren Ausfälle eine bestimmte Bevölkerung verkraften kann. Ein Begleitpapier in dieser Serie dokumentiert das allgemeine Versagen auf der anderen Seite, Überwachungskomponenten, die ihren eigenen Schadensverständnis erweitern und die Arbeit behindern, deren Schutz sie bestehen sollen (Chernets, 2026b). Für einen Anfänger hat eine Schutzvorrichtung dieser Art die gleiche Wirkung wie ein fehlender Installer, da die Arbeit sowieso nicht stattfindet.
Zwischen zu wenig Schutz und zu viel gibt es einen brauchbaren Mittelweg, und er ist altmodisch. Arbeiten Sie in einer Kopie. Halten Sie Geheimnisse aus dem Arbeitsordner heraus. Machen Sie einen Schnappschuss vor einer größeren Änderung. Verweigern Sie destruktive Befehle, bis es einen Grund gibt, einen zu erlauben, bestätigen Sie alles Irreversible, und behandeln Sie das, was aus dem Web kommt, als Daten zum Lesen, egal welche Anweisungen es zu enthalten scheint. Ich beschrieb das Prinzip hinter diesen Gewohnheiten in einem Begleitpapier als architektonisches Vertrauen: Verlass auf Überprüfungen, die eine Person überprüfen kann, wie begrenzte Berechtigungen, Protokolle, ein Rückgängigmachen und ein zweites unabhängiges Modell, statt auf das, wie sicher sich ein Modell anhört (Chernets, 2026c). Level 2 gibt einer Person die erste dieser Überprüfungen, und sie sollte nicht die letzte sein, die sie lernen. Anhang C verwandelt die Liste in Konfigurationsbeispiele für zwei Agenten und eine einseitige Checkliste.
5.4 Organisatorische Regeln
Viele Fachleute können auf dem Computer, an dem sie arbeiten, nichts installieren. Viele Arbeitgeber haben keine Richtlinie zu Agenten, und eine Person ohne Richtlinie neigt zu der Annahme, dass die Antwort nein ist. Microsofts Umfrage von 2026 unter 20.000 KI-nutzenden Wissensarbeitern ergab, dass organisatorische Faktoren mehr als das Doppelte der gemeldeten KI-Auswirkung von individuellen Faktoren ausmachten, und dass 45 % sagten, es fühle sich sicherer an, sich auf aktuelle Ziele zu konzentrieren, als die Arbeit mit KI umzugestalten (Microsoft, 2026b; Anbieter-Umfrage). Das US Census Bureau meldete, dass die geschäftliche KI-Nutzung insgesamt zwischen 17 % und 20 % schwebte, bei Unternehmen mit 20 oder mehr Mitarbeitern stieg und bei Unternehmen mit weniger als 20 sich nicht wesentlich änderte (US Census Bureau, 2026). Mandate gingen beide Richtungen. Einige Arbeitgeber machten die KI-Nutzung 2025 zu einer grundlegenden Erwartung (Digital Commerce 360, 2025), und mindestens einer kehrte seine Entscheidung, Mitarbeiter auf KI-Nutzung zu bewerten, ein Jahr später um, wobei sein Geschäftsführer der Presse sagte, dass es in einer Leistungsbeurteilung darauf ankommt, die Aufgabe gut zu erledigen (Fortune, 2026b). Eine veröffentlichte Kompetenzmatrix eines Arbeitgebers stellt Orchestrierung und Systemaufbau auf ihre oberste Ebene und berichtet von vollständiger interner Übernahme, sobald Teams vom Experimentieren zur Umgestaltung von Arbeitsabläufen übergingen (Zapier, 2026). Ohne diese Umgestaltung kauft ein Mandat Einhaltung und wenig sonst. Der Arbeitsmarkt verlangt bereits nach der hier beschriebenen Rolle, ohne sie zu benennen: 63 % der US-Jobtitel, die 2026 von KI berührt wurden, lagen außerhalb von Technologieberufen, 822 unterschiedliche Titel im ersten Quartal (Adrjan, 2026), und eine Studie von mehr als einer Milliarde Stellenangebote in 27 Ländern legte die Lohnprämie für KI-Fähigkeiten auf 62 % fest, wobei Einstiegsfunktionen, die KI am meisten ausgesetzt sind, viel wahrscheinlicher Fähigkeiten forderten, die einst für leitende Mitarbeiter reserviert waren (PwC, 2026; Anbieter-Bericht). Keine dieser Quellen isoliert bisher die Fähigkeit, einen Agenten zu lenken, als eine genannte Anforderung außerhalb des Ingenieurwesens.
Diese Barriere ist strukturell, im Sinne von Ferdman (2025): Sie weicht nicht einzelnen Anstrengungen. Sie ist auch das stärkste Argument für Level 2, das die Belege bieten, da ein von einem Anbieter begrenzter Agent in einer Office-Suite, die der Arbeitgeber bereits lizenziert (Microsoft, 2026a), Personen erreicht, deren Arbeitgeber einem Agenten auf einem Arbeits-Laptop nicht zustimmen würde.
5.5 Hardware, Kosten und Quote
Level 3 setzt einen Computer voraus, den die Person kontrolliert. Einige Fachleute arbeiten hauptsächlich von einem Telefon aus, teilen sich einen Familiencomputer oder nutzen ein Unternehmensgerät für alles, und für sie ist der Übergang bereits blockiert, bevor überhaupt eine Softwarefrage entsteht. Level 3 und Level 4 setzen auch bezahlte Tarife von mindestens einem Dienst voraus, und die Orchestrierung vervielfacht die Kosten, da jedes zusätzliche Modell ein weiteres Abonnement oder ein weiteres Kontingent ist. Für eine Person, die bereits für ein Abonnement zahlt, ist ein zweites eine Entscheidung und ein Top-Tarif eine andere Entscheidung. Token-Angst ist eine psychologische Barriere mit einem Preisschild. Das Kontingent des orchestrierenden Agenten ist selbst ein versteckter Kostenfaktor, da er für das Lesen jeder Antwort zahlt, die die anderen Agenten zurückgeben, und ein Agent, der einen Browser steuert, nutzt dieselben Planlimits wie der Terminal-Agent, kostet aber mehr pro Aktion (Anthropic, 2026g). Gesperrte Unternehmens-Laptops addieren Administratorrechte zur Liste hinzu: keine unsignierten Binärdateien, kein Installer, eine Datenverlust-Regel, die einen schreibenden Agenten als Malware behandelt. Cloud-gehostete Agenten sind die Antwort der Industrie für diese Maschinen. Sie bewahren den Übergang 1 und eine Cloud-Form des Übergangs 2, und sie geben der Person kein Level-3-Artefakt auf ihrer eigenen Festplatte. Für einen Fachmann in einem wohlhabenden Land ist nichts davon eine große Barriere. Für viele andere ist es eine echte, und sie interagiert mit der Divide auf zweiter Ebene (Hargittai, 2002), insofern die Menschen mit dem wenigsten Spielraum am wenigsten in der Lage sind zu experimentieren.
5.6 Das Ergebnis beurteilen
Die Verwendung eines Agenten erfordert keine Programmierung. Die Beurteilung dessen, was er produziert hat, erfordert Kompetenz in der Domäne des Ergebnisses, und hier hat der Nicht-Programmierer einen Vorteil, der leicht übersehen wird. Ein Anwalt, der eine Zusammenfassung von Verträgen liest, oder ein Forscher, der eine Extraktionstabelle liest, kann das Artefakt gegen Wissen abgleichen, das der Agent nicht hat. Die Forschung zur „jagged frontier" hat gezeigt, dass Fachleute, die mit KI arbeiteten, bei Aufgaben innerhalb der Fähigkeit des Modells besser abschnitten und bei einer Aufgabe außerhalb schlechter (Dell'Acqua et al., 2026). Der Schutz ist eine Person, die die Aufgabe gut genug kennt, um zu bemerken, auf welcher Seite der Grenze sie sich befinden.
Was sie nicht leicht überprüfen können, ist die Maschinerie, das Skript, das die Tabelle produzierte, oder die Abfrage, die die Zahlen abrief. Eine Branchenanalyse von 470 Pull Requests ergab, dass Code, der von Agenten geschrieben wurde, mehr Mängel aufweist als Code, der von Menschen geschrieben wurde: 10,83 Probleme pro von KI geschriebenem Change gegenüber 6,45 für reine Mensch-Changes, mit einigen Sicherheitsprobleme, die bis zu 2,74-mal häufiger sind (CodeRabbit, n.d.; Vendor-Studie). Und Agenten scheitern immer noch bei den meisten ganzen Projekten: in einer Benchmark von echten Freelance-Projekten war die beste bis Mitte 2026 gemessene Automatisierungsrate 15,8% (Center for AI Safety, 2026). Ich leite zwei Praktiken daraus ab. Die Überprüfung sollte vor der Aufgabe definiert werden („Was würde mich davon überzeugen, dass das richtig ist?"), und ein zweites Modell aus einer anderen Familie kann als Reviewer des Artefakts fungieren, wobei die Person entscheidet, was als korrekt gilt. Abschnitt 7 kehrt zu den Grenzen der zweiten Praktik zurück.
5.7 Eine alternative Erklärung: Die Agenten sind noch nicht gut genug
Ein Leser könnte einwenden, dass Menschen nicht delegieren, weil Agenten ihre Arbeit noch nicht tun können, und dass die Barriere daher immer noch technisch ist, nur auf der Seite des Modells. Der Einwand hat echte Unterstützung. In einer Benchmark von echten Freelance-Projekten war die beste bis Mitte 2026 gemessene Automatisierungsrate 15,8%, ansteigend von 2,5% bei der Veröffentlichung der Benchmark im Herbst zuvor, was bedeutet, dass mehr als vier Projekte von fünf immer noch end-to-end fehlschlagen (Center for AI Safety, 2026). In einem simulierten Softwareunternehmen vollendete der beste Agent 30% der langen professionellen Aufgaben (Xu et al., 2024). Bei offener Computer-Nutzung betrug die 2024-Baseline 12,24% für den besten Agenten gegenüber 72,36% für Menschen (Xie et al., 2024), und bis September 2026 zeigte eine Aggregator-Rangliste für die verifizierte Version dieser Benchmark die Top-Agenten bei 85 bis 86%, über der menschlichen Baseline, bei herstellergemeldeten Scores für Scripted-Desktop-Aufgaben (BenchLM, 2026). Dieses letzte Ergebnis deutet in die andere Richtung: bei solchen Aufgaben ist Fähigkeit nicht mehr die Barriere. Das beste Modell in einer Bewertung über 44 Berufe hinweg siegte oder band in weniger als der Hälfte der Vergleiche gegen Fachleute (Patwardhan et al., 2025). Die Länge der Softwareaufgabe, die Agenten die Hälfte der Zeit abschließen, verdoppelt sich ungefähr alle sieben Monate (Kwa et al., 2025), daher ist der Trend steil und die Gegenwart bescheiden. Die Fähigkeit ist ungleich über Aufgaben hinweg verteilt, und die „jagged frontier" ist von außen nicht sichtbar (Dell'Acqua et al., 2026). Tabelle 4 sammelt diese veröffentlichten Zahlen mit dem Datum, das jede Quelle angibt, und dem Vorbehalt, den ich daran knüpfe.
Tabelle 4. Veröffentlichte Fähigkeitszahlen hinter dem Einwand.
| Vergleich | Zahl wie veröffentlicht | Datum wie angegeben | Quelle | Mit Vorsicht lesen |
|---|---|---|---|---|
| Echte Freelance-Projekte, beste Automatisierungsrate | 15,8%, ansteigend von 2,5% bei Veröffentlichung der Benchmark; mehr als vier Projekte von fünf scheitern immer noch end-to-end | Veröffentlichung im Herbst zuvor; 15,8% bis Mitte 2026 gemessen, protokolliert 1. Juli 2026 (Appendix B, VERIFIED) | Center for AI Safety (2026); Abschnitte 5.6, 5.7, Appendix B | Ganze Projekte, end-to-end; die beste Rate unter denen, die gemessen wurden |
| Lange professionelle Aufgaben in einem simulierten Softwareunternehmen | Der beste Agent vollendete 30% | 2024-Studie | Xu et al. (2024); Abschnitt 5.7 | Ein simuliertes Unternehmen; ein anderes Maß als die Freelance-Projektrate |
| Offene Computer-Nutzung, Baseline | 12,24% für den besten Agenten gegenüber 72,36% für Menschen | 2024-Baseline | Xie et al. (2024); Abschnitt 5.7 | Eine 2024-Baseline; die Zeile unten ist die spätere Rangliste |
| Verifizierte Version dieser Benchmark | Top-Agenten bei 85 bis 86%, über der menschlichen Baseline | Bis September 2026 | BenchLM (2026); Abschnitt 5.7 | Aggregator-Rangliste; herstellergemeldete Scores für Scripted-Desktop-Aufgaben; deutet in die andere Richtung |
| Bewertung über 44 Berufe hinweg | Das beste Modell siegte oder band gegen Fachleute in weniger als der Hälfte der Vergleiche | 2025-Studie | Patwardhan et al. (2025); Abschnitt 5.7 | „Weniger als die Hälfte" ist die angegebene Formulierung; kein Prozentsatz wird angegeben |
| Länge der Softwareaufgabe, die Agenten die Hälfte der Zeit abschließen | Verdopplung ungefähr alle sieben Monate | 2025-Studie | Kwa et al. (2025); Abschnitt 5.7 | Ein Trend: „der Trend ist steil und die Gegenwart ist bescheiden" |
| Mängel in Pull Requests | 470 Pull Requests; 10,83 Probleme pro KI-verfasster Änderung im Vergleich zu 6,45 bei rein menschlichen Änderungen; einige Kategorien von Sicherheitsproblemen bis zu 2,74-mal häufiger | n.d. | CodeRabbit (n.d.); Abschnitt 5.6 | Vendor-Studie; eine Branchenanalyse; Mängel im Code, die ein Nicht-Programmierer nicht leicht überprüfen kann |
Quelle: die zitierten Veröffentlichungen, wie in den Abschnitten 5.6 und 5.7 sowie Anhang B wiederholt; keine dieser Zahlen stammt aus dem Programm von Abschnitt 9.
Die beiden Erklärungen sind Teile einer Erklärung mehr, als dass sie Rivalen sind. Das Workflow-Vokabular beinhaltet zu wissen, welche der eigenen Aufgaben innerhalb der Grenze liegen. Eine Person, die einem Agenten ein ganzes Projekt übergibt, das er nicht bewältigen kann, lernt, nicht mehr zu delegieren, während eine Person, die ihm die Extraktion, die Abstimmung und den ersten Entwurf übergibt, lernt, weiterzumachen. Die Erklärungen machen dennoch unterschiedliche Vorhersagen. Wenn die Modellkapazität der bindende Engpass wäre, würde die Persistenz auf den Ebenen 2 und 3 die Art der Aufgabe und nicht die Person nachzeichnen: Menschen mit den gleichen Arten von Arbeit würden mit ähnlichen Raten persistieren, unabhängig von ihrer Fähigkeit zu spezifizieren und zu überprüfen. Wenn das Workflow-Vokabular bindend wäre, würde die Persistenz die Fähigkeit der Person nachzeichnen, einen Delegationsvertrag selbst innerhalb der gleichen Art von Arbeit zu formulieren. Proposition P15 in Abschnitt 10 ist geschrieben, um die beiden auseinanderzuhalten.
6. Web-Orchestrierung: die vorgeschlagene Brücke
6.1 Die Praxis
Die einfachste Form der Stufe 4 erfordert überhaupt keine Installation. Eine Person öffnet drei oder vier Chatbots in Browser-Registerkarten, fügt dieselbe Frage in jeden ein und liest die Antworten nebeneinander. Informatiker würden dies eine manuelle Multi-LLM-Abfrage nennen, wobei die Person das Routing und den Vergleich durchführt. Einige tun dies von Hand. Andere nutzen eines der Tools, die seit 2023 dafür entwickelt wurden: Browser-Erweiterungen und Desktop-Anwendungen, die eine Eingabeaufforderung an mehrere Consumer-Chat-Services senden und die Antworten in parallelen Bereichen anzeigen. ChatHub und ChatALL erschienen im Frühjahr 2023; die neueste Version von ChatALL allein hatte bis September 2026 etwa 847.000 Downloads auf ihrer Release-Seite verzeichnet, eine Zahl, die automatische Updates einschließt und von den Builds einer Plattform dominiert wird (GitHub, 2026a). Eine neuere Gruppe von Tools wandelt angemeldete Web-Chat-Sitzungen in Befehle um, die ein anderes Programm aufrufen kann, sodass ein Agent eine Frage an die Web-Abonnements einer Person richten kann. OpenCLI, einer dieser Tools, hatte im September 2026 etwa 29.500 Sterne auf GitHub (GitHub, 2026b).
2026 wurde die Praxis zu einer Produktfunktion. Perplexity führte einen „Model Council" ein, der eine Abfrage durch mehrere Modelle ausführt und „eine konsolidierte Ansicht präsentiert, die Schlüsselerkenntnisse, Bereiche der Übereinstimmung und Punkte der Divergenz hervorhebt" (Storyboard18, 2026). Der Research-Agent von Microsoft in Microsoft 365 Copilot bietet einen Modus, der „dieselbe Frage gleichzeitig durch mehrere Deep-Reasoning-Research-Agents (GPT und Claude) ausführt" und einen Kritik-Modus, standardmäßig aktiviert unter automatischer Modellwahl, in dem ein von einem Modell geschriebener Bericht einen zweiten Reasoningdurchgang von dem anderen erhält (Microsoft, 2026c; Constellation Research, 2026b). Andrej Karpathys „LLM Council", eine kleine Web-Anwendung, die eine Abfrage an mehrere Modelle sendet, diese anonym voneinander überprüfen lässt und ein Chairman-Modell die endgültige Antwort schreiben lässt, wird von seinem Autor als ein Wochenend-Hack beschrieben und hatte im September 2026 etwa 24.900 Sterne auf GitHub (Karpathy, 2025). Die Open-Source-Landschaft spaltet sich in zwei Teile. Die Broadcast-Tools rufen Antworten ab und überlassen die Abstimmung der Person. Die Council-Tools stimmen ab, und sie laufen auf bezahlten Programmierschnittstellen mit zwei oder drei Modellen, weg von den eigenen angemeldeten Registerkarten der Person. Keine der beiden Hälften allein trägt eine Person hinüber, und deshalb ist die Brücke unvollständig.
6.2 Warum sie als Brücke vorgeschlagen wird
Web-Orchestrierung sitzt auf nützliche Weise zwischen den Stufen. Sie verlangt von der Maschine nichts Neues, keine Installation, keine Berechtigungen, keinen lokalen Agent, und sie läuft auf Abonnements, die eine Person bereits bezahlt, oder auf kostenlosen Versionen. Sie verlangt von der Person etwas Neues: mehrere Antworten gleichzeitig zu halten, zu bemerken, wo sie sich unterscheiden, und zu entscheiden. Eine Person, die gelernt hat, zu fragen „was hat das andere Modell gesagt?", hat die Gewohnheit gelernt, die die CLI-Orchestrierung später automatisiert, und diese Gewohnheit ist die Managementaufgabe der Stufe 4 in ihrer kleinsten Form.
Die Brücke ist wertvoll, weil sie sichtbar ist. Angenommen, ein Marktanalyst fragt drei Chatbots, einen veröffentlichten Branchenbericht zusammenzufassen, und zwei von ihnen zitieren eine Zahl, die nicht im Bericht enthalten ist, während der dritte deren Abwesenheit kennzeichnet. Das nützliche Ergebnis ist eine Aufforderung, den Bericht selbst zu öffnen, und eine Person, die das einmal durchgemacht hat, hört auf, die erste fließende Antwort als die Antwort zu behandeln. Eine Broadcast-Ansicht mehrerer Antworten wird zu einer Brücke zur Stufe 4, wenn sie eine Person lehrt, eine gemeinsame Frage zu formulieren, zu bemerken, wo die Annahmen auseinandergehen, eine Kritik anzufordern und einen Grund dafür zu behalten, eine Antwort zu wählen. Bis dahin ist es eine Gewohnheit der Stufe 1 mit mehr Registerkarten. Was es lehrt, ist Vergleich, und nur Vergleich. Eine Person, die gelernt hat, zu fragen, was das andere Modell gesagt hat, hat dadurch nicht gelernt, was ein Agent auf ihrer Maschine berühren darf, was die Lektion der Stufen 2 und 3 ist, und die Behauptung, dass die Gewohnheit überträgt, ist eine empirische Behauptung, P7, die ich nicht als Prämisse behandle. Das in Abschnitt 9 beschriebene vorregistrierte Programm benennt zwei Vorteile im Voraus, und sie fassen zusammen, was die Brücke bringt. Einer ist Abdeckung: ein nützlicher Winkel, der in einem Modell vorhanden ist, wird nicht verloren, weil ein anderes Modell gefragt wurde. Der andere ist Zuverlässigkeit: eine Antwort wurde gegen andere Antworten überprüft, anstatt auf das Wort eines Modells genommen zu werden (Chernets, 2026d). Sichtbare Unstimmigkeit dient dem zweiten als Mittel. Eine Bewertung der Prognosefähigkeit ergab, dass ein Ensemble aus zwölf Sprachmodellen die Genauigkeit einer Gruppe von 925 menschlichen Prognostikern erreichte (Schoenegger et al., 2024), und Multi-Agent-Debatte verbessert Faktualität und Reasoning gegenüber einem einzelnen Modell in mehreren Umgebungen (Du et al., 2023). Beide Vorteile hängen davon ab, dass die Fehler der Modelle unterschiedlich sind, und der nächste Abschnitt behandelt, was geschieht, wenn sie es nicht sind.
6.3 Wo die Brücke endet
Web-Orchestrierung bleibt eine Brücke, und der einfachste Grund ist die Aufmerksamkeitskosten. Das Lesen von vier langen Antworten und die manuelle Abstimmung dauert erheblich länger als das Lesen von einer. Ich würde niemanden bitten, dies für eine routinemäßige Frage zu tun; es verdient seine Kosten, wenn eine falsche Antwort mehr kosten würde als die zum Vergleichen aufgewendete Zeit.
Ein zweiter Grenzfall ist Zerbrechlichkeit, und sie kommt in mehreren Formen vor. Consumer-Chat-Oberflächen ändern sich Monat für Monat, und Tools, die sie antreiben, brechen zusammen, wenn sie es tun: über den Sommer 2026 entfernte eine Office-Suite einen Research-Modus, ein Chatbot schloss Modi auf seinem kostenlosen Tier, und mehr als ein Service benannte seine Adresse um oder leitete sie um. Die Bedingungen mehrerer Consumer-Services beschränken automatisierten Zugriff, und eine Person, die ihren eigenen angemeldeten Browser mit einem Agent antreibt, trägt das Risiko einer Kontosperrung. Ein Forschungsprogramm, das die Brücke nutzt, muss die Teilnehmer darüber informieren, und ich biete keine rechtliche Auslegung dieser Bedingungen an. Die „kostenlose" Seite der anderen Chatbots wird auch auf der Seite des Agenten bezahlt, der sie antreibt, da Browser-Aktionen die gleichen Plangrenzen wie der Terminal-Agent nutzen (Anthropic, 2026g). Manueller Vergleich in offenen Registerkarten ist robust. Automatisierte Ernte von Consumer-Chat-Seiten ist eine schlechte Grundlage für wiederholbare Arbeit.
Die dritte Grenze ist die, die am meisten zählt: Übereinstimmung zwischen Modellen ist keine unabhängige Evidenz. Wenn Modelle Trainingsdaten und Methoden teilen, korrelieren ihre Fehler. Eine Studie von mehr als 350 Sprachmodellen ergab, dass zwei Modelle bei etwa 60 % der gemeinsamen Fehler die gleiche falsche Antwort gaben, und dass größere, präzisere Modelle stärker korreliert waren, sogar über Anbieter hinweg (Kim et al., 2025). Das Begleitpapier dieser Serie liefert die Rechnung: Bei mittlerer paarweiser Fehlerkorrelation rho sind N übereinstimmende Modelle N_eff = N / (1 + (N - 1) rho) unabhängige Meinungen wert, und keine Anzahl von Modellen ist mehr als 1/rho wert (Chernets, 2026a). Bei rho = 0,5 sind zehn übereinstimmende Chatbots weniger als zwei unabhängige wert. Abbildung 3 zeigt die Formel für die vier illustrativen Werte von rho in Anhang D, mit der Obergrenze 1/rho, die keine Anzahl übereinstimmender Modelle überschreiten kann. Die 60 % von Kim et al. ist der Anteil der gemeinsamen Fehler, bei denen zwei Modelle die gleiche falsche Antwort gaben, was nicht die Fehlerkorrelation rho der Formel ist. Im vorliegenden Bereich muss rho auf Elementen mit bekannten Antworten geschätzt werden (Listing C4), und die hier und in Anhang D verwendeten Werte sind Illustrationen. Vielfalt ist wichtiger als Anzahl. Debatten zwischen Kopien eines Modells schlagen oft ein einzelnes Modell mit gleicher Rechenleistung nicht, während heterogene Modelle helfen (Zhang et al., 2025), und zwei verschiedene Agenten können sechzehn homogene erreichen oder schlagen (Yang et al., 2026). Generative KI vereinheitlicht auch die Ausgabe über ihre Nutzer (Doshi & Hauser, 2024), und ein Modell, das beurteilen soll, bevorzugt tendenziell sein eigenes Schreiben (Panickssery et al., 2024), was wichtig ist, wenn ein Modell die zusammengefasste Antwort schreibt.
Abbildung 3. Wofür Übereinstimmung gut ist.
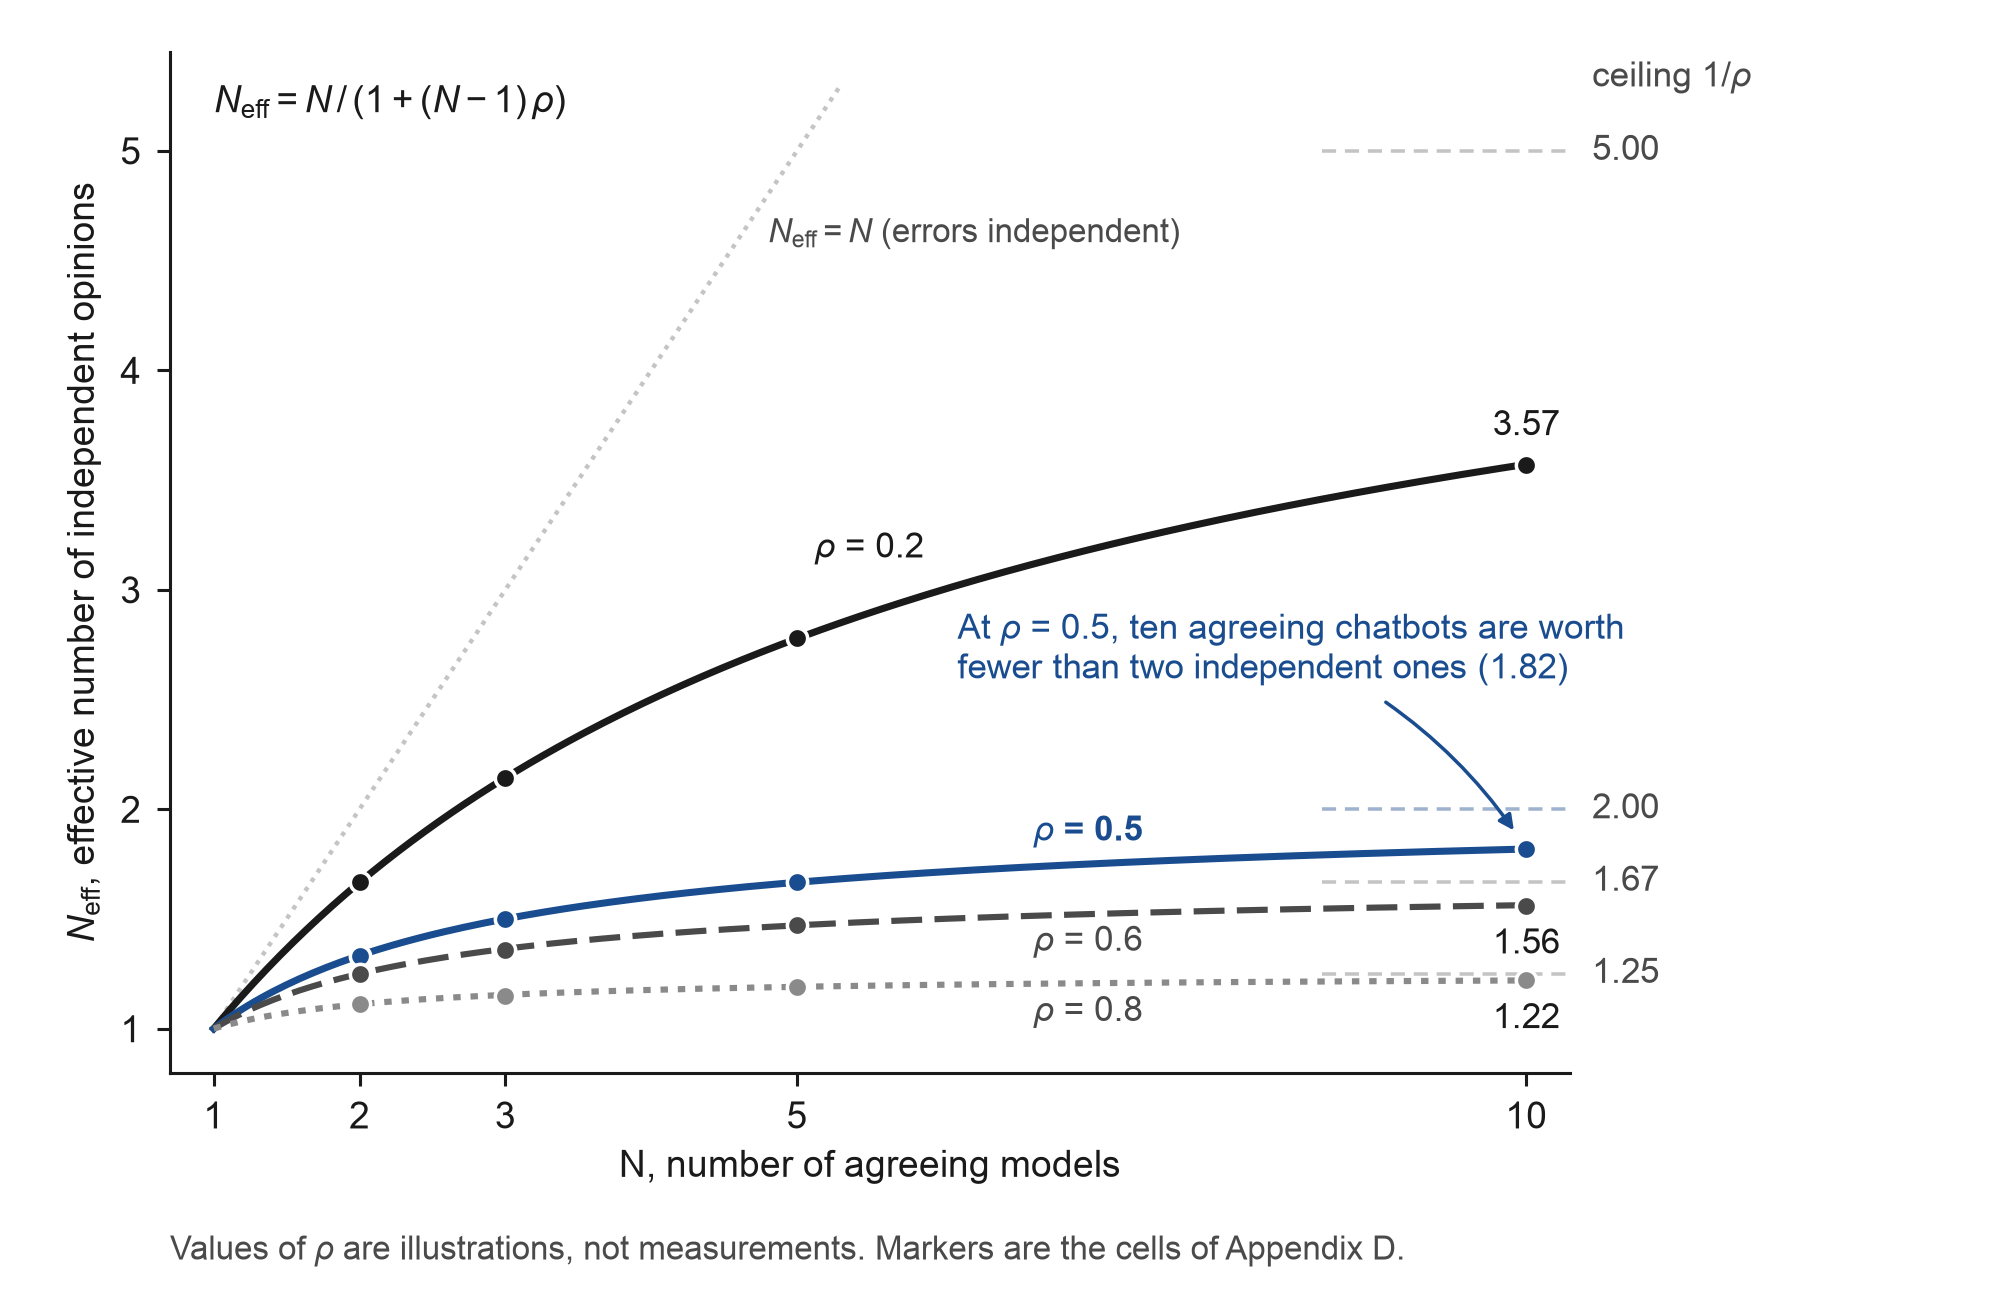
Hinweis: Die effektive Anzahl unabhängiger Meinungen, N_eff = N / (1 + (N - 1) rho), für N übereinstimmende Modelle, deren Fehler mittlere paarweise Korrelation rho aufweisen (Chernets, 2026a; Abschnitt 6.3). Die Markierungen sind die Zellen von Anhang D, die Kurven dazwischen folgen der gleichen Formel, und die gestrichelten Segmente auf der rechten Seite sind die Obergrenzen 1/rho. Die vier Werte von rho sind Illustrationen, wie in Anhang D; rho muss im vorliegenden Bereich auf Elementen mit bekannten Antworten geschätzt werden (Listing C4).
Für die Person an der Brücke sind die praktischen Regeln kurz. Zählen Sie Modellfamilien, da ein Büroassistent, der auf einem Modell eines Anbieters läuft, keine zweite Meinung zu diesem Chatbot des Anbieters ist. Übereinstimmung zwischen Modellen kann Ihnen sagen, wo Sie weniger Überprüfungsaufwand aufwenden können. Sie kann Ihnen nicht sagen, dass eine Behauptung richtig ist. Behandeln Sie einen Punkt, der nur von einem Modell gemacht wird, als eine zu überprüfende Spur, denn er könnte das wertvollste in dem Vergleich sein oder sein einziger Fehler, und halten Sie an einer Ablehnung fest, die mit Belegen kommt, anstatt sie abzustimmen. Überprüfen Sie Behauptungen gegen Quellen: Übereinstimmung über ein falsches Datum ist ein dokumentierter Fehlerfall, und die primäre Seite behebt ihn, wenn ein fünftes Modell das nicht würde. Schätzen Sie rho auf einer kleinen Menge von Fragen in Ihrem eigenen Bereich, die Sie markieren können, bevor Sie einem Rat bei einer Frage vertrauen, die Sie nicht können. Notieren Sie, wer was gesagt hat, denn eine zusammengefasste Antwort, die ihre Quellen verbirgt, bringt die einzelne selbstsichere Stimme zurück, die das Orchestrierungssystem in Frage stellen sollte.
Als Verfahren geschrieben ist dies die Lehrform des Protokolls „anchor-and-enrich" des Begleitpapiers (Chernets, 2026a). Die Person legt zunächst einen Anker fest: die Aufgabe, die zulässige Evidenz und die Form der Ausgabe. Sie erhält dann separate Antworten, wobei ihre Quellen oder Dateiverweise beibehalten werden, extrahiert die Behauptungen in eine Tabelle nach Quelle und sortiert jeden Dissens nach seiner Art, ob Faktenwiderspruch, unterschiedliche Interpretation, fehlende Annahme oder Formatunterschied. Sie überprüft die Behauptungen, die für die Entscheidung relevant sind, gegen den Anker oder eine primäre Quelle, und notiert die Akzeptanzentscheidung und was ungelöst bleibt. Listing C3 in Anhang C erstellt die Tabelle der Behauptungen nach Quelle, Listing C4 schätzt rho aus Elementen mit bekannten Antworten, und Anhang D gibt die Obergrenze für eine Reihe von rho ohne etwas auszuführen. Eine Regel mehr gehört hier hin, und sie kostet kein zweites Abonnement. Ein Kritiker aus der gleichen Familie, in einem frischen Kontext aufgefordert, die erste Antwort anzugreifen, bemerkt Hast, übersprungene Anweisungen und unausgeführte Überprüfungen, obwohl er nicht übersprungenes falsches Wissen bemerken kann. Ich würde die Kritiker-Gewohnheit auf Stufe 3 mit einem Agenten beginnen und eine zweite Familie hinzufügen, wenn der Kritiker nichts mehr zu sagen hat und die Entscheidung teuer ist.
Der gegenteilige Fall verdient ebenfalls klare Aussage. Für viele Aufgaben wird ein starkes Modell mit einem guten Quellensatz und sorgfältige menschliche Überprüfung einen aufwendigen Rat schlagen, der Verzögerung und Verwirrung hinzufügt, und das Modell sagt dies voraus. Orchestrierung zahlt sich aus, wenn eine Aufgabe echte Unsicherheit mit sich bringt, von verschiedenen Perspektiven profitiert oder oft genug wiederholt wird, um das Setup zu amortisieren. Sie passt schlecht zu einer zeitkritischen Entscheidung ohne Überprüfungschance, zu vertraulichem Material, das nicht über Dienste verteilt werden kann, und zu einfachen Aufgaben, bei denen die Kosten des Vergleichs den Nutzen übersteigen. Wenn ein Rat verwendet wird, sollten die Agenten unterschiedliche Aufgaben erhalten: einer beschränkt auf die bereitgestellten Dokumente, einer zum Auffinden von Primärquellen, einer zum Auflisten unbelegter Behauptungen, einer zur Überprüfung von Zitaten, wobei die Person immer noch schlichten kann. P9 ist so geschrieben, dass dieses Gegenargument gewinnen kann.
7. CLI-Orchestrierung: die dauerhafte Schicht der Delegation
7.1 KI-Agenten, die andere KI-Agenten aufrufen
Auf Ebene 3 verfügt jeder Agent über eine Befehlszeilenschnittstelle, die ohne eine Person an der Tastatur ausgeführt werden kann: eine Frage geht ein, eine Antwort oder eine geänderte Datei kommt heraus. Sobald eine Person einen Agent besitzt, kann dieser Agent die anderen aufrufen. In der Systemliteratur wird dies als Agent-Orchestrierung bezeichnet. Die Version, die ein Nicht-Programmierer durch die Befehlszeilentools ausführt, denen er bereits abonniert, nenne ich CLI-Orchestrierung. Eine einzelne Anweisung an den ersten Agent („fragen Sie die beiden anderen um eine Überprüfung dieses Plans und sagen Sie mir, wo sie sich nicht einig sind") erzeugt ein kleines Team.
Im Jahr 2026 entwickelte sich dieses Muster von einem Entwickler-Trick zu einer von Anbietern sanktionierten Praxis. OpenAI veröffentlichte ein offizielles Plugin, das seinen Coding-Agent in den von Anthropic ausführt, „für Code-Reviews oder zur Delegation von Aufgaben", mit Befehlen für ein gewöhnliches Review, ein gegnerisches Review, bei dem der zweite Agent davon ausgeht, dass die Arbeit fehlerhaft ist und sucht, sowie eine Rettung einer feststeckenden Aufgabe. Es funktioniert über das lokal installierte Tool und seine vorhandene Anmeldung, ist mit jedem ChatGPT-Abonnement einschließlich der kostenlosen Stufe nutzbar und hatte im September 2026 etwa 33.400 Sterne auf GitHub (OpenAI, 2026a). Das Hauptpaar von 2026 ist Claude Code beim Schreiben und Codex beim Überprüfen durch dieses offizielle Plugin (OpenAI, 2026a), während Räte von drei oder mehr kleine Tools ohne Anführer bleiben. GitHub machte die Agenten von Anthropic und OpenAI im Februar 2026 in seinem eigenen Copilot-Dienst verfügbar, „vollständig in Ihrem bestehenden Copilot-Abonnement enthalten" (GitHub, 2026c). Der Command-Line-Agent von xAI verfügt über einen Headless-Modus und Unterstützung für das Agent Client Protocol, damit Benutzer „ihre eigenen Bots und Agent-Orchestrierungs-Apps erstellen können" (xAI, 2026). Googles Grund für die Einstellung seines ersten Command-Line-Agenten war, dass Benutzer „mehrere Agenten benötigen, die miteinander kommunizieren" (Google, 2026). Open-Source-Tools, die es einem Agent ermöglichen, andere zu konsultieren, haben große Anhänger: ein Multi-Provider-Server für Modell-zu-Modell-Konsultation hatte etwa 11.800 Sterne, ein konsensusorientiertes Plugin etwa 4.100 (GitHub, 2026d). Darunter das Model Context Protocol, das im Dezember 2025 einem Linux-Foundation-Gremium mit mehr als 10.000 veröffentlichten Servern und etwa 97 Millionen monatlichen SDK-Downloads zu diesem Zeitpunkt gespendet wurde (Linux Foundation, 2025), meldete bis zu seiner Spezifikationsfreigabe im Juli 2026 fast eine halbe Milliarde SDK-Downloads pro Monat, die das Protokoll auch zustandslos machten und zwölf Monate Benachrichtigung vor jeder Einstellung versprachen (Model Context Protocol, 2026). So erreicht ein Agent auf einem Laptop den Rest der Tools einer Person, ohne dass für jedes Tool ein herstellerspezifisches Plugin erforderlich ist, und es ist bereits zu einer langweiligen Sache geworden, wie ein Web-Protokoll langweilig ist: präsent, dokumentiert, ignoriert, bis etwas kaputt geht. Ein zweiter Standard, Googles Agent2Agent-Protokoll für Agenten, die über Anbieter hinweg miteinander sprechen, erreichte im März 2026 die Version 1.0 (Google Open Source Blog, 2026). Es ist Level-4-Rohrleitungen, und heute hat es keinen Consumer-Einstieg.
Tabelle 5. Die Orchestrierungslandschaft nach Muster, September 2026.
| Muster | Beispiele (September 2026) | Ebene | Entwickelt für | Was es bringt | Aufzeichnung, die es hinterlässt | Hauptrisiko |
|---|---|---|---|---|---|---|
| Manuelle Vergleichung in Browser-Registern | Beliebige Reihe von Verbraucher-Chatbots | 4 (Web), wenn aufgezeichnet und erneut ausgeführt; ansonsten eine Level-1-Gewohnheit | Jeder | Abdeckung; Vergleichsgewohnheit | Screenshots oder kopierte Antworten, Kontext oft verloren | Aufmerksamkeitskosten; nicht aufgezeichnete Herkunft |
| Broadcast-Tools für Web-Chats | ChatHub, ChatALL | 4 (Web), wenn aufgezeichnet und erneut ausgeführt; ansonsten eine Level-1-Gewohnheit | Einzelpersonen | Eine Eingabeaufforderung, parallele Antworten, keine Abstimmung | Antworten in Fenstern; nichts auf der Festplatte, es sei denn, es wird gespeichert | Bricht zusammen, wenn sich Schnittstellen ändern; Nutzungsbedingungen |
| Rat als Produktmerkmal | Perplexity Model Council; Microsoft 365 Copilot Research Agent (GPT und Claude); Karpathys LLM Council | 4 (Web, verwaltet) | Abonnenten dieser Dienste | Zusammengeführte Antwort mit Zustimmung und Abweichung | Was der Anbieter zeigt; Quellen oft integriert | Zusammengeführte Stimme verbirgt Herkunft; Wähler ist der Anbieter |
| Web-Chat, das Agenten ausgesetzt ist | OpenCLI und ähnliche | Brücke von 4 (Web) zu 4 (CLI) | Technische Benutzer | Agenten können Web-Abonnements nutzen | Dateien, wenn der Agent sie schreibt | Zerbrechlichkeit; Zugangsregeln |
| Anbieter-Plugin: ein Agent delegiert an einen anderen | OpenAIs Plugin für Claude Code; Claude und Codex im GitHub Agent HQ (Copilot) | 4 (CLI) | Entwickler, verbreitet sich | Anbieterübergreifendes Review und Delegation innerhalb einer Sitzung | Sitzungstranskript; Review-Ausgabe | Hauptsächlich Code-förmig; Quote von zwei Diensten |
| Rats- und Konsultationsserver | Ein Multi-Provider-Konsultationsserver (letzter Commit Dezember 2025); Konsensus-Plugins; kleine CLI-Räte, die eine Datei pro Tool schreiben | 4 (CLI) | Entwickler | Mehrere Familien an einer Aufgabe; Konsensusregeln | Dateien pro Tool; eine zusammengeführte Notiz | Runden ohne Ende; korrelierte Fehler; Aufgabe |
| Multi-Agent-Dashboards | Mehrere offizielle CLIs in Fenstern, jede mit ihrer eigenen Arbeitskopie, eine Person kann jede übernehmen | 4 (CLI, sichtbar) | Entwickler, die parallele Agenten beaufsichtigen | Beaufsichtigung sichtbar gemacht | Pro-Agent-Protokolle und Diffs | Für Code entwickelt; Aufmerksamkeit dünn verteilt |
| Fan-Out-Skript mit Zeitgrenzen | Listing C1 in Anhang C | 4 (CLI) | Jeder, der einen Level-3-Agent besitzt | Parallele Antworten beibehalten, auch wenn ein Tool steckenbleibt | Eine Datei pro Tool, eine Zusammenfassung mit wer geantwortet hat | Benötigt eine Person zur Abstimmung |
| Einzelner Agent, Aufgabe schriftlich festgehalten und erneut ausgeführt | Eine Befehlsdatei oder ein Skill, das nach einem Zeitplan ausgeführt wird | 3 wiederholbar gemacht | Jeder auf Level 3 | Wiederholung, wenn ein zweites Modell nicht verfügbar ist | Aufgabendatei, Ein- und Ausgaben, Akzeptanznotiz | Wiederholung verstärkt eine schlechte Vorlage |
Die Zeilen beschreiben Muster. Die Sternzählungen in Anhang E sind eine Beliebtheitsspur an einem Tag, und sie sind keine Nutzer, keine Qualität und keine Eignung für einen Ordner von Verträgen. Aufgabe gehört in die Tabelle: der bekannteste Beratungsserver hat zuletzt im Dezember 2025 committed, und mehr als ein Dashboard hat seine Betreuer herunterfahren lassen. Ein Artikel, der Lernende auf einen einzelnen benannten Orchestrator hinweist, würde ihnen einen Bärendienst erweisen, weshalb ich sie stattdessen auf das Muster hinweise: offizielle Binärdateien, nicht-interaktive Flags, Dateien auf der Festplatte und ein Datensatz darüber, wer gefragt wurde.
7.2 Warum diese Schicht andauert
CLI-Orchestrierung beruht auf den eigenen Tools der Anbieter, betrieben in den Modi, die die Anbieter selbst für Automatisierung dokumentieren, und das gibt ihr Eigenschaften, die ein Browser-Tab nicht haben kann. Vor allem kann sie aufgeschrieben werden. Eine Anordnung, die einmal funktioniert hat, sagen wir „Entwurf mit einem Modell, Überprüfung durch ein zweites gegen die Checkliste, geben Sie mir die Unstimmigkeiten", kann als Anweisungsdatei oder eine Fähigkeit gespeichert und nächste Woche erneut ausgeführt werden, nach Zeitplan falls nötig. Abschnitt 3 definierte Stufe 4 als genau das: wiederholbare Arbeit über Modelle hinweg. Mehrere weitere Eigenschaften folgen, in der Reihenfolge, in der ich sie gewichte. Ein Kommandozeilen-Flag ist eine dokumentierte Schnittstelle und ein Exit-Code ist ein Versprechen; eine Position auf einer Webseite ist keines, weshalb Tools, die Verbraucher-Chat-Seiten steuern, repariert werden müssen, wann immer sich die Seite ändert. Jedes offizielle Tool läuft unter dem eigenen Login des Anbieters, mit der Sandbox und den Ablehnungsregeln dieses Anbieters, damit die Person Geheimnisse aus dem Ordner halten, das Netzwerk standardmäßig ablehnen und destruktive Befehle pro Tool verweigern kann, während ein Browser-Agent, der alle Tabs sehen kann, ein größeres Berechtigungsobjekt ist. Das Muster nutzt Verbraucher-Logins, die die Person bereits bezahlt, und ich erwarte, dass das mehr als alles andere eine Praxis trennt, die ein Nicht-Programmierer beibehält, von einer, die sie nur versuchen. Und die Anbieter segnen es. Das offizielle Plugin, die Agenten innerhalb von Githubs Dienst, die Headless-Modi und der Skills-Standard sind Zeichen dafür, dass Delegationen über Tools hinweg standardisiert werden, während die Automatisierung von Verbraucher-Chat-Seiten vertrieben wird.
Web-Orchestrierung mag die Gewohnheit des Vergleichs lehren, und CLI-Orchestrierung ist, wo die Gewohnheit bewahrt werden kann, als Objekt. Das Objekt ist ein Ordner, der die Aufgabe, die zulässigen Eingaben, die Ausgaben, ein Protokoll, welcher Agent was produziert hat, und eine Notiz darüber enthält, was akzeptiert wurde. Eine andere Person kann es inspizieren, ohne einen privaten Chat abzuspielen, und die Person, die es erstellt hat, kann nächste Woche eine Eingabe ändern und den Unterschied sehen. Dieser Datensatz macht es auch schwerer, sich der Verantwortung zu entziehen, da eine gespeicherte Aufgabe und eine Akzeptanznotiz eine schlechte Quellenmenge oder eine fehlende Genehmigung offenbaren. In Büros, die an informelle Chats gewöhnt sind, wird es sich wie eine Belastung anfühlen, und überall dort, wo Arbeit überprüft, weitergegeben oder wiederholt werden muss, ist es ein Vorteil. Verhältnismäßigkeit entscheidet: eine Anfrage von zwei Minuten braucht keinen Workflow-Ordner, während eine wiederkehrende Aufgabe, die gemeinsame Dateien berührt, kann.
Das meiste, was es gibt, wird durch Code geprägt. Die offiziellen Plugins, die Ratsserver und die Multi-Agent-Manager zielen auf Softwareüberprüfung ab, obwohl nichts im Muster selbst Code-spezifisch ist.
7.3 Was die Schicht von der Person verlangt
Ein kleines Team von Agenten braucht einen Manager, und die Arbeit des Managers ist spezifisch. Ich nenne seine vier Teile den Delegationsvertrag:
- Ziel: wozu die Arbeit ist, angegeben so, dass ein Agent sagen könnte, ob es erfüllt wurde.
- Grenze: was die Agenten berühren dürfen und was nicht, welche Aktionen eine Bestätigung durch eine Person brauchen, und welches Budget in Zeit und Quote die Aufgabe ausgeben darf.
- Artefakt: was existieren sollte, wenn die Arbeit getan ist, und in welcher Form.
- Überprüfung: wie die Person wissen wird, ob das Artefakt richtig ist, entschieden bevor die Arbeit beginnt, wer was überprüft, und wann zu stoppen ist.
Der vierte Teil trägt eine Falle, die in dem Begleitartikel zur automatisierten Überwachung beschrieben wird (Chernets, 2026b). Einen Prüfer hinzuzufügen ist billig, und jeder Prüfer findet etwas. Ein Rat ohne eine Stoppgrenze neigt dazu, Runden und Kritiker zu addieren, bis die Arbeit in Überprüfung begraben ist. Eine praktische Regel ist, eine Kritik-Runde und eine Reparatur-Runde pro Stufe zu erlauben, wobei die Person entscheidet, ob ein Befund die Arbeit blockiert. Die Regel hat einen gemessenen Preis: in einem randomisierten Test von 144 Läufen, der in diesem Artikel berichtet wird, schnitt ein Ein-Runden-Budget Kritik-Runden von 2,86 auf 1,00 pro Lauf, während übersehene Mängel um 0,11 pro Lauf stiegen (95%-Konfidenzintervall 0,005 bis 0,204) (Chernets, 2026b). Ob dieser Handel es wert ist, hängt von den Einsätzen ab, was genau die Art von Entscheidung ist, die zum Manager gehört. Grenzen für Runden und Zeit sind Budgets, und ein Budget wird beschlossen, wenn zu stoppen ist, was eine andere Frage ist als ob die Antwort wahr ist.
Der Vertrag wiederholt, was gute Delegation an Menschen immer verlangt hat, für ein Publikum, das nie an Software delegiert hat, und er erhebt keinen Anspruch auf neue Managementtheorie. Sein Wert liegt darin, dass jeder Teil gelehrt, aufgeschrieben und überprüft werden kann, und dass jeder Teil auf eine Weise versagt, die gesehen werden kann, wenn er fehlt.
8. Vom Operator zum Manager
8.1 Was sich in der Arbeit ändert
Auf Stufe 1 produziert die Person und das Modell unterstützt. Auf den Stufen 3 und 4 produziert das Modell und die Person lenkt, beaufsichtigt und akzeptiert. Bainbridges (1983) Paradoxien der Automation sagten voraus, was dies mit der menschlichen Rolle macht. Automation entfernt das Routinemäßige und hinterlässt der Person das, was am schwierigsten gut zu tun ist: Überwachung und Eingreifen bei seltenen Ausfällen, während die Praxis, die ihr Urteilsvermögen aufgebaut hat, verschwindet. Die generative-KI-Version des Paradoxons ist bereits dokumentiert. Generative KI verlagert Menschen von der Produktion zur Bewertung und macht schwierige Aufgaben schwieriger (Simkute et al., 2024), höheres Vertrauen in das Werkzeug geht mit weniger kritischem Denken einher (Lee et al., 2025), und Deskilling folgt strukturell aus der Beseitigung von Praxis (Ferdman, 2025).
Die Verwaltung eines Agenten ist daher eine andere Arbeit mit eigener Kompetenz, und die Kompetenz kommt nicht kostenlos mit dem Werkzeug. Sie besteht darin, zu entscheiden, was delegiert werden soll, den Delegationsvertrag von Abschnitt 7.3 anzugeben, eine Spur des Agenten zu lesen und zu entscheiden, wann das Ergebnis gut genug ist. Ich unterteile die Arbeit in vier Praktiken. Delegation benennt die Arbeit als lieferbares Produkt mit einer Grenze. Supervision beobachtet den Plan, die Zwischenausgabe oder die Werkzeugspur und greift ein, wenn die Aufgabe abweicht, ohne jeden Tastendruck zu genehmigen, weil die Genehmigung von allem Müdigkeit ist und Müdigkeit ist, wie Menschen ja klicken. Verifikation überprüft Quellen, Summen, Transformationen und die Aussagen, auf denen eine Entscheidung beruht, proportional zum Risiko und mit einer anderen Methode als das Neuerlesen des eigenen Vertrauens des Agenten: Tests und Diffs für Code, eine Stichprobe gegen eine Seite, die die Person selbst öffnet, für einen Ordner von Verträgen, und für eine Literaturliste eine Zeile-für-Zeile-Überprüfung von Kennungen. Revocation verengt den Arbeitsraum, stoppt einen Lauf oder entfernt den Zugriff, wenn sich eine Bedingung ändert. Eine Person, die alle vier praktiziert, verwaltet einen Agenten auch über eine grafische Desktopanwendung. Eine Person, die eine Aufgabe an einen undurchsichtigen Dienst übergibt und die erste Antwort akzeptiert, lagert Urteilsvermögen aus, was eine andere Praktik ist. Parasuraman und Riley (1997) nannten die zwei Möglichkeiten, darin zu scheitern. Disuse ist die Person, die delegieren könnte und es nie tut, auf Stufe 1 steckengeblieben durch Gewohnheit oder Angst. Misuse ist die Person, die ohne Überprüfungen delegiert und das akzeptiert, was zurückkommt. Beide sind 2026 sichtbar. Die breiten und flachen Adoptionsdaten beschreiben Disuse im großen Maßstab (Abschnitt 2.2), und die Dateiverlustrberichte und Datenlöschungen von Abschnitt 5.3 beschreiben Misuse, manchmal von Fachleuten, die es besser wussten. Tabelle 6 stellt jede Praktik neben den Teil des Delegationsvertrags, den sie durchsetzt, das Risiko, das sie erfüllt, und die datierte Spur, durch die eine Studie sehen kann, dass es passiert ist.
Tabelle 6. Die vier Praktiken des Managers: was jede durchsetzt, das Risiko, das sie erfüllt, und die Spur, die sie hinterlässt.
| Praktik | Was die Person tut | Vertragsteil, den sie durchsetzt | Risiko, wenn es fehlt | Beobachtbare Spur |
|---|---|---|---|---|
| Delegation | Benennt die Arbeit als lieferbares Produkt mit einer Grenze (8.1) | Ziel, angegeben, sodass ein Agent sagen könnte, ob es erfüllt wurde; Artefakt: was existieren sollte und in welcher Form (7.3) | Disuse: „die Person, die delegieren könnte und es nie tut", auf Stufe 1 steckengeblieben durch Gewohnheit oder Angst (8.1) | Ein hinterlegtes Artefakt (Anhang A) |
| Supervision | Beobachtet den Plan, die Zwischenausgabe oder die Werkzeugspur; greift ein, wenn die Aufgabe abweicht, ohne jeden Tastendruck zu genehmigen (8.1) | Grenze: was die Agenten berühren dürfen; welche Aktionen die Bestätigung einer Person benötigen; welches Budget in Zeit und Quote (7.3) | Genehmigungsmüdigkeit: „Müdigkeit ist, wie Menschen ja klicken" (8.1); ein Schutz, der zu viel blockiert, erzeugt Disuse (5.3) | Ein abgelehnter Plan; ein irreversibler Schritt für Bestätigung festgehalten (Anhang A) |
| Verifikation | Überprüft Quellen, Summen, Transformationen und die Aussagen, auf denen eine Entscheidung beruht, mit einer anderen Methode als das Neuerlesen des eigenen Vertrauens des Agenten (8.1) | Check: wie die Person wissen wird, dass das Artefakt richtig ist, entschieden bevor die Arbeit beginnt; wann zu stoppen ist (7.3) | Misuse: „die Person, die ohne Überprüfungen delegiert und das akzeptiert, was zurückkommt" (8.1); korrelierte Fehler zwischen Modellen (6.3) | Ein abgelehnter Diff oder Output; eine zweite Modellfamilie angefordert; ein Nenner aufgezeichnet: gefragt, beantwortet, Zeitüberschreitung (Anhang A) |
| Revocation | Verengt den Arbeitsraum, stoppt einen Lauf oder entfernt den Zugriff, wenn sich eine Bedingung ändert (8.1) | Grenze, erneut angewendet: was ausgeschlossen bleibt und wie ein Fehler rückgängig gemacht wird (3.2, 7.3) | Eine lange Aufgabe, die nicht gestoppt werden konnte, wonach das Löschen der Aufgabe die Dateien löschte (5.3) | Keine unter den datierten Spuren von Anhang A; ein datierter Stopp, verengter Berechtigung oder entfernter Zugriff würde dienen |
Anmerkung: Eine Person, die eine Aufgabe an einen undurchsichtigen Dienst übergibt und die erste Antwort akzeptiert, „lagert Urteilsvermögen aus", was eine andere Praktik ist (8.1).
Ein kleines Gerät hält die Rolle über alle vier Praktiken zusammen, und ich nenne es einen Akzeptanzdatensatz. Für eine folgenreiche oder wiederkehrende Aufgabe hält es das beabsichtigte lieferbare Produkt, die verwendeten Eingaben, die Einschränkungen und Berechtigungen, wohin die Ausgabe ging, jede erhebliche Meinungsverschiedenheit oder ein Fehler, die durchgeführten Überprüfungen und die Entscheidung der Person, zu akzeptieren, zu überarbeiten, zu eskalieren oder zu verwerfen. Es zieht eine Linie zwischen dem, was der Agent produziert hat, und dem, worauf die Person sich verlassen hat. Für den Einzelnen ist es nützlich, weil es ein Vertrauensgefühl in eine überprüfbare Entscheidung umwandelt, für ein Team, weil ein Kollege die Arbeit ohne private Chat-Historie inspizieren kann, und für einen Forscher, weil es einen abgeschlossenen Lauf von einem Ergebnis, auf das sich verlassen wird, trennt. Es ist auch ein Zwang. Eine Person kann entscheiden, nachdem sie nicht geschafft hat, ein Akzeptanzkriterium zu schreiben, dass die Aufgabe auf Stufe 1 bleiben sollte, und das Modell zählt das als reife Verwaltung und nicht als Verzögerung bei der Annahme. In der Vokabeln der menschlich-KI-Zusammenarbeit behält der Schritt von Stufe 1 zu Stufe 4 den Menschen in der Schleife und ändert, was die Schleife ist, von der Lesens jeder Antwort zum Festlegen der Bedingungen, unter denen Antworten akzeptiert werden. Abbildung 4 zeichnet diese Schleife mit den vier Praktiken, dem Risiko bei jedem Schritt, der Rückkehr nach einer fehlgeschlagenen Überprüfung und dem Akzeptanzdatensatz.
Abbildung 4. Die Kontrollschleife des Managers.
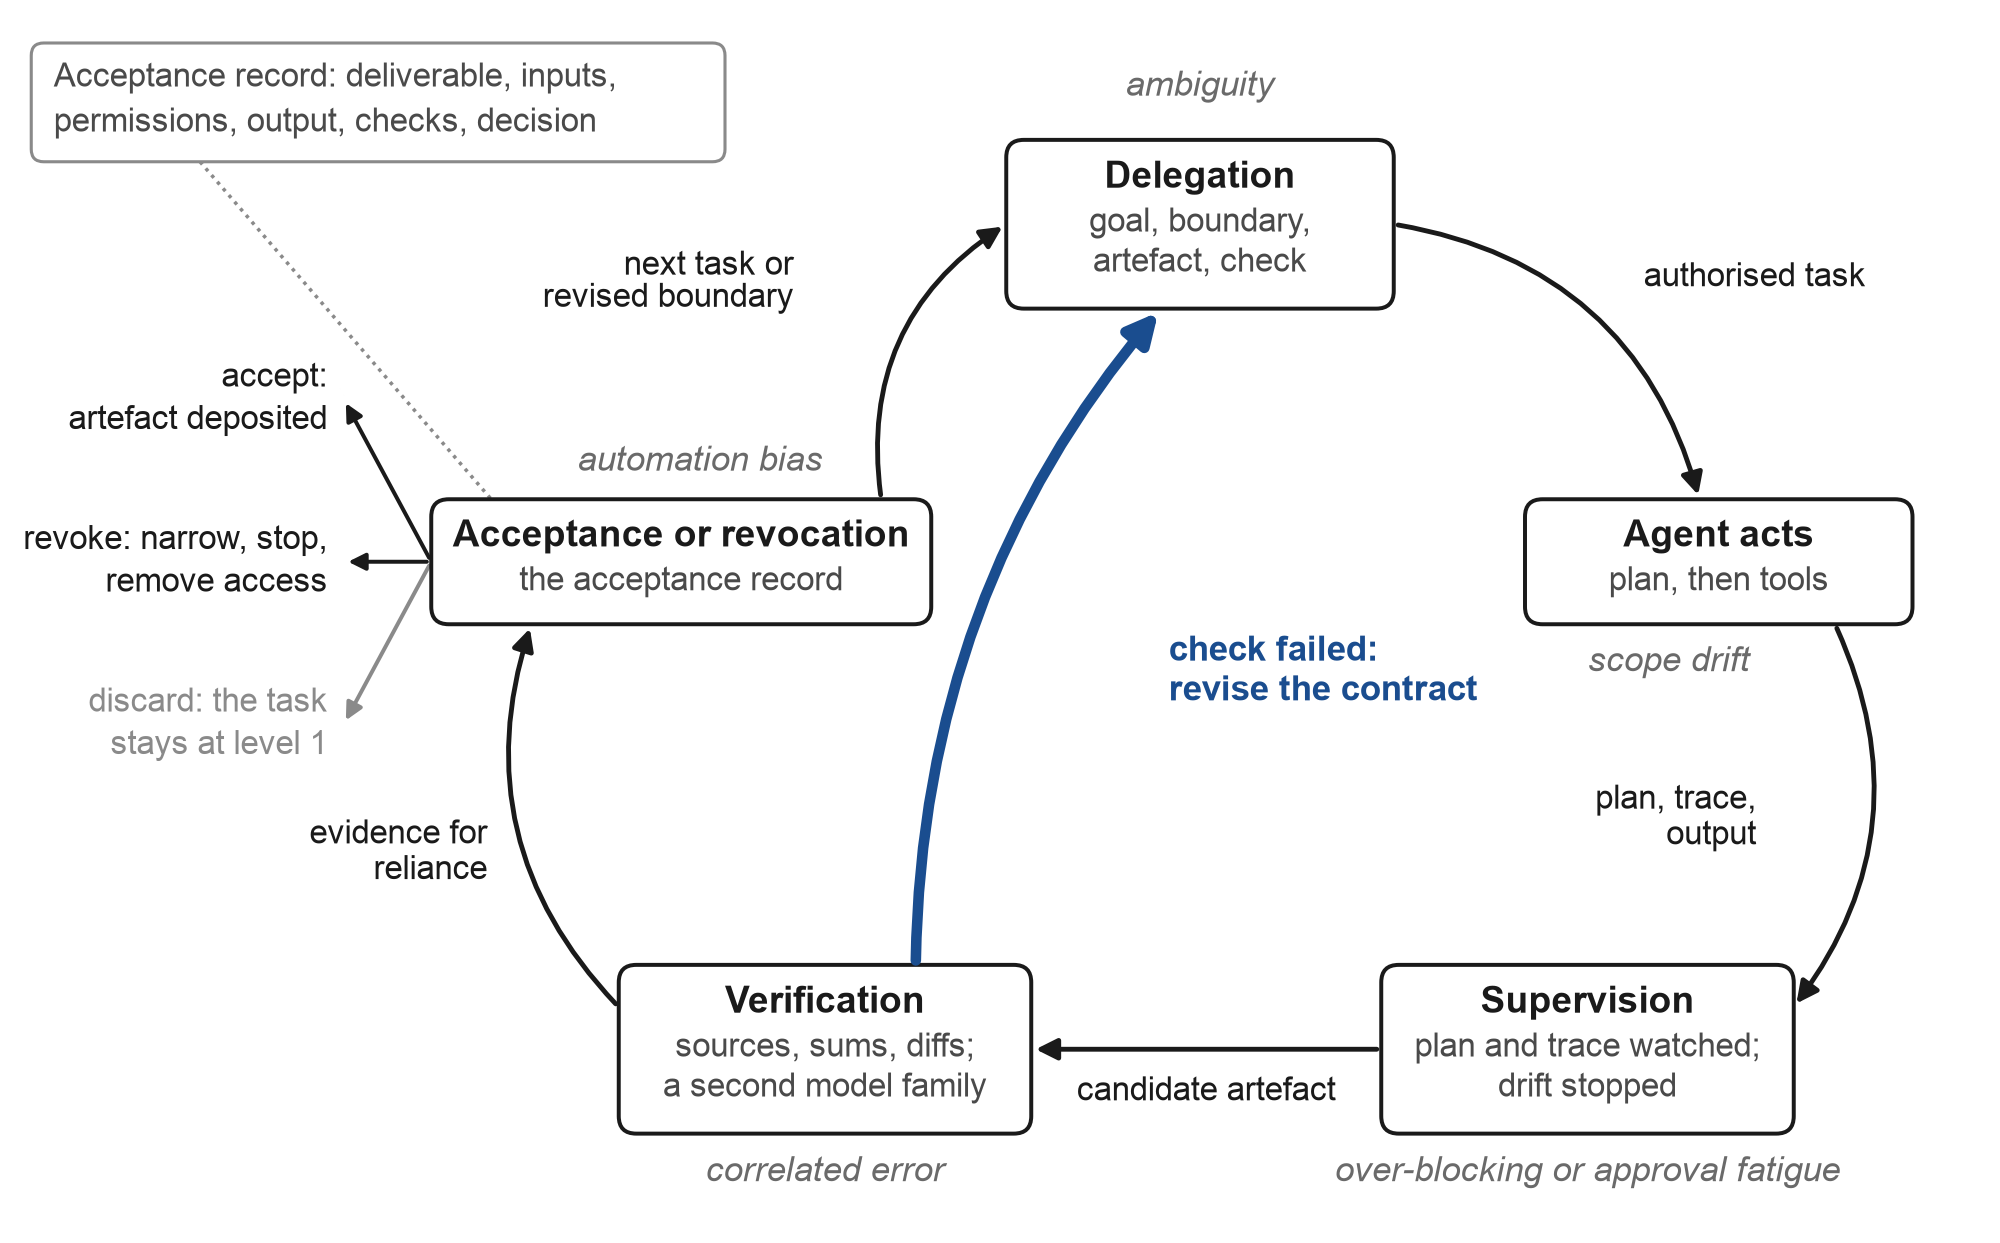
Anmerkung: Die Arbeit des Managers als Schleife, die die Person durchläuft (Abschnitte 7.3 und 8.1): Die Delegation legt den Vertrag fest (Ziel, Grenze, Artefakt, Überprüfung), der Agent handelt, die Person beaufsichtigt und überprüft, und akzeptiert dann, widerruft oder verwirft das Ergebnis und schreibt den Akzeptanzdatensatz. Die grau kursiven Labels benennen das Risiko bei jedem Schritt (Abschnitte 5.3, 6.3 und 8.1). Der dicke Pfeil ist die Rückkehr von einer fehlgeschlagenen Überprüfung zu einem überarbeiteten Vertrag, und jeder Ausgang vom Akzeptanzknoten ist eine Entscheidung der Person.
8.2 Erfahrene Nutzer delegieren weniger
Eine Beobachtung widerspricht jeder einfachen Geschichte, in der alle letztendlich zu Managern von Agenten werden sollten. Anthropic berichtete im März 2026, dass Nutzer mit längerer Betriebszugehörigkeit „viel weniger geneigt waren, größere Verantwortung durch direktive Nutzungsmuster zu delegieren" (Anthropic, 2026e), und der Bericht von Januar 2026 setzte Augmentierung, kollaborative Nutzung, bei der die Person in der Schleife bleibt, auf 52 % der Konversationen im November 2025 (Anthropic, 2026f). Eine Lesart ist, dass erfahrene Nutzer lernten, wo Delegation fehlschlägt, und zurückruderten. Eine andere ist, dass sie lernten, das Modell als Kollaborateur für die Teile der Arbeit zu nutzen, bei denen ihre eigene Urteilskraft das Produkt ist. Ich kann die beiden Lesarten von den veröffentlichten Zahlen nicht unterscheiden, und bei jeder Lesart ist der Endpunkt der Leiter etwas anderes als maximale Delegation. Es ist die Fähigkeit, aufgabe für Aufgabe zwischen Fragen, Zusammenarbeit und Delegation zu wählen, und zu wissen, welche die Aufgabe vor Ihnen braucht. Das vierstufige Modell beschreibt, was eine Person tun kann. Es beansprucht nicht, dass sie jedes Mal das delegativste tun sollte.
8.3 Verantwortung bleibt bei der Person
Die Anbieter sind eindeutig darüber, wo Rechenschaftspflicht liegt. Die Startanleitung für Anthropics Level-2-Agent teilte Nutzern mit, dass sie „für alle Maßnahmen verantwortlich bleiben, die Claude in Ihrem Namen durchführt" (The Register, 2026). Dies ist die rechtliche und praktische Realität von Level 3 insbesondere, wo der Agent mit den Anmeldedaten des Eigentümers, an den Dateien des Eigentümers, unter dem Namen des Eigentümers handelt. Ein Profi, der zum Manager eines Agenten wird, wird auch rechenschaftspflichtig für einen Mitarbeiter, dessen Fehler schnell sind. Es ist ein weiterer Grund, warum die Überprüfung im Delegationsvertrag vor der Arbeit entschieden werden muss, und ein weiterer Grund, warum das Sicherheitsdesign von Abschnitt 5.3 nicht davon abhängen sollte, dass die Person einen Angriff in Echtzeit erkennt.
8.4 Die Rolle des Managers in den Literaturrahmen
Offizielle Definitionen von KI-Literalität beginnen, diese Rolle zu benennen, obwohl keiner der hier überprüften Texte das Wort „Agent" verwendet. Das AI Literacy Framework des US Department of Labor vom Februar 2026 listet „KI effektiv lenken" unter seinen Inhaltsbereichen auf (US Department of Labor, 2026; ExecutiveGov, 2026). Der gemeinsame Rahmen von OECD und Europäischer Kommission vom Juni 2026, der die PISA-2029-Bewertung speist, hat vier Bereiche, einer davon ist „KI verwalten" (OECD & European Commission, 2026). Frühere akademische Rahmen betonten das Erkennen, Verstehen und Bewerten von KI (Long & Magerko, 2020), und die Kompetenzrahmen der UNESCO von 2024 für Schüler und Lehrer setzen das gleiche Register (UNESCO, 2024a, 2024b). Der Delegationsvertrag gibt den Verwaltungs- und Leitungsbereichen einen unterrichtbaren Inhalt für den agentischen Fall: Setzen Sie ein Ziel, umzäunen Sie die Arbeit, benennen Sie das Artefakt, entscheiden Sie die Überprüfung. Praktiker haben begonnen, Titel wie „KI-Operator" und „Agent-Manager" für einen Fachmann zu verwenden, der diese Spezialität zusätzlich zu seinem Beruf erwirbt. Ich verwende „Manager von Agenten" enger, für ein Verhaltensmuster statt für eine Rolle, gegen die jemand einstellen sollte, weil das Verhalten Beweise hinterlässt und ein Titel nicht. Die Beweise liegen in Artefakten: ein Plan, den die Person abgelehnt hat, ein Diff, den sie zurückgewiesen hat, eine zweite Meinung, die sie holte, einen geplanten Lauf, der endete, während sie weg von der Tastatur war. Wo keine solchen Spuren existieren, hat der Titel nichts dahinter.
9. Messung der Übergänge: ein vorregistriertes Programm
9.1 Übergänge als Maßeinheit
Die meisten Adoptionsdaten zählen Menschen, die „KI nutzen", manchmal wöchentlich oder täglich. Eine solche Zählung kann nicht zwischen einer Person unterscheiden, die einen Chatbot nach Synonymen fragt, und einer Person, die einen Quartalsbericht an einen Agenten delegiert, und es ist die zweite Person, die ich finden möchte. Die Artefaktregel aus Abschnitt 3.3 macht den Unterschied beobachtbar, da ein Übergang nur dann erfasst wird, wenn der Agent etwas produziert hat, das die Person auf der neuen Ebene angefordert hat. Mehrere weitere Regeln folgen aus der Literatur zum Onboarding und zur Überwachung. Der Abschluss sollte separat für Menschen berichtet werden, die ohne Hilfe übergegangen sind, und für Menschen, denen geholfen wurde, da Hilfe bedeutet, was ein Übergang bedeutet. Ein Stopp sollte an dem Punkt aufgezeichnet werden, an dem er stattgefunden hat, und in den eigenen Worten der Person, da die Gründe für den Stopp einen großen Teil des Ergebnisses ausmachen. Jede Person, die die Materialien erhielt, gehört in den Nenner, einschließlich derjenigen, die nie antworteten. Die Persistenz sollte schließlich beobachtet werden, nachdem der Forscher aufgehört hat, jede Woche zu schreiben; ein Artefakt, das produziert wird, während der Forscher noch im Postfach einer Person ist, kann ebenso Höflichkeit wie Nutzung sein.
9.2 Das Design
Ich führe ein vorregistriertes Kohortenprogramm durch, das diese Regeln auf Nicht-Programmierer anwendet (Chernets, 2026d; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ, registriert und eingefroren am 6. September 2026). Es ist eine Single-Arm-Machbarkeitsstudie eines dreistufigen Pfads, und die Vorregistrierung wurde vor der Datenerhebung eingefroren. Folgendes ist das registrierte Design.
Teilnehmer. Erwachsene, deren Arbeit wesentlich am Computer stattfindet. Sie nutzen ihre eigene Maschine und ihre eigenen KI-Abos (Arbeitgeber-Abos sind ausgeschlossen), halten kundenidentifizierende und arbeitgeberkonfidenzielle Materialien aus der Übung heraus und bestätigen, dass die Installation von Software keine Regel verletzt, die ihr Arbeitgeber für sie festgelegt hat. Die Rekrutierung erfolgt durch öffentliche Ankündigung in beruflichen sozialen Netzwerken innerhalb eines im Voraus festgelegten Zeitfensters, sodass es nicht erweitert werden kann, bis ein Ergebnis günstig aussieht. Die Ankündigung wird mit einem Screenshot versehen und sein permanenter Link aufgezeichnet, was den Rekrutierungstext festlegt. Der Eintritt erfolgt laufend und der Zeitplan jedes Teilnehmers zählt ab seinem eigenen Tag Null, da sich die Tools auf wöchentlicher Ebene verändern. Die Rekrutierung öffnete mit der öffentlichen Ankündigung am 6. September 2026, dem Tag, an dem die Registrierung eingefroren wurde, und schließt 21 Tage später, am 27. September 2026; die Kohorte ist zum Zeitpunkt des Schreibens im Einsatz, und die realisierte Zahl wird, egal wie sie sich herausstellt, mit den Ergebnissen berichtet.
Schritt 1 (vom Chat zu einem Agenten auf dem eigenen Computer der Person). Der Teilnehmer fügt einen Standardtext in den Chatbot ein, den er bereits nutzt, und dieser Chatbot führt ihn durch die Installation eines grafischen Agenten auf seiner eigenen Maschine. Ich berühre keinen Computer von jemandem. Der Schritt ist abgeschlossen, wenn der Teilnehmer ein Artefakt liefert, das der Agent als Reaktion auf eine erste Aufgabe produziert hat. Die Aufgabe hat für alle die gleiche Form und wird mit der eigenen Arbeitssituation des Teilnehmers ausgefüllt, und sie erfordert vom Agenten zu fragen, zu entscheiden, zu erstellen und Dateien zu formatieren. Diese Anforderung unterscheidet einen Agenten von einem Chatbot. Die Registrierung gibt die genaue Formulierung an (Chernets, 2026d). Im Sinne des Modells testet Schritt 1 reflexives Onboarding über zwei Ebenen gleichzeitig, von Ebene 1 bis Ebene 3. Das war eine bewusste Wahl. Eine grafische Shell eines lokalen Agenten läuft auf dem eigenen Computer der Person, daher ist sie nach der Regel aus Abschnitt 3.3 Ebene 3, und das Artefakt, das Schritt 1 fordert, ist die Art, die Übergang 2 kennzeichnet; seine Berechtigungsaufforderungen geben ihm einen Teil des Schutzes einer scoped Sprosse. Die Kohorte instrumentiert keine separate Woche in einer Hersteller-eingegrenzten Ebene-2-Umgebung, daher kann sie P5 aus Abschnitt 10 nicht testen (dass eine scoped mittlere Sprosse Nicht-Abschluss und Zwischenfälle senkt); diese Berechtigungsaufforderungen sind die einzige scoped Sprosse, die das Design hat, und die Befehlszeile tritt bei Schritt 3 ein. Eine spätere Kohorte, die eine explizite Ebene-2-Woche zwischen Chat und lokaler Installation einfügt, wäre der saubere Test von P5.
Schritt 2 (in Web-Orchestrierung, vom Agenten aus gestartet). Sobald bereit, erhalten Teilnehmer ein Open-Source-Tool, das eine Frage an mehrere Modelle durch die Abos, die sie bereits bezahlen, stellt und eine zusammengeführte Antwort in einer einzigen Aktion von innerhalb des Agenten zurückgibt. Der Zweck des Schritts wurde im Voraus als Abdeckung und Zuverlässigkeit registriert, wobei sichtbare Meinungsverschiedenheit als einer der Mechanismen für letzteres dient.
Schritt 3 (in CLI-Orchestrierung). Dieselbe Orchestrierung durch Befehlszeilenschnittstellen.
Messinstrumente. Fünf eingefrorene Kernelemente, in jeder Kohorte des Programms identisch formuliert, erfassen Beruf und Stunden am Computer, aktuelle KI-Nutzung, vorherige Erfahrung mit der Frage an mehr als eine KI, ob und wie Antworten überprüft werden, und ob bereits etwas für die Person auf ihrem Computer handelt. Ein Schritt-Datensatz für jeden Teilnehmer enthält die Daten, den Chatbot, der ihn führte, Versuche und Stunden, Abschluss mit dem Artefakt, den genauen Stoppunkt und den Grund in seinen eigenen Worten, und ob und wie der Ermittler intervenierte. Wöchentlich für den ersten Monat berichten Teilnehmer über ein Artefakt, das ihr Agent diese Woche produziert hat (oder „nichts", was eine gültige Antwort ist), wie oft sie eine Frage an mehr als eine KI stellen und was passierte, wenn Antworten divergierten, und ab Schritt 2 an, ob etwas Nützliches auftauchte, das ein Modell übersehen hatte, und ob Überprüfung ändern, worauf sie sich verlassen. Beobachtungen werden am Tag 60 und vierteljährlich danach fortgesetzt, solange Teilnehmer bereit sind.
Analyse und Interpretation. Die Analyse ist deskriptiv. Abschlussanteile werden mit Konfidenzintervallen gegen sowohl die überlebende als auch die vollständige Nenner angegeben, separat für unterstützten und unterstützten Abschluss; Zeiten und Versuche werden als Verteilungen berichtet, und Gründe für den Stopp werden nach der Erfassung kodiert, wobei Codes und rohe Wortlaute eingereicht werden. Eine Interpretationsregel wurde im Voraus festgelegt. Wenn weniger als die Hälfte derjenigen, die die Schritt-1-Materialien erhielten, ein von einem Agenten produziertes Artefakt liefern, wird die Kohorte als Studie des Onboarding-Versagens berichtet, und das, was Menschen stoppte, wird das Ergebnis.
Grenzen der Inferenz. Die Registrierung erklärt im Voraus, dass es keine Kontrollbedingung gibt und daher keine kausale Behauptung, und keine Verallgemeinerung über selbstausgewählte Freiwillige hinaus. Die Schätzung eines Teilnehmers zur eingesparten Zeit wird nur als Überzeugung berichtet, da sich Selbstberichte in diesem Bereich als die wahre Richtung umkehrend erwiesen haben (Becker et al., 2025).
Offenlegung und Ethik, wie registriert. Den Teilnehmenden wird schriftlich mitgeteilt, dass ich die Materialien und das Werkzeug geschrieben habe, sie unterrichte und Antragsteller bei ausstehenden Patentanmeldungen zur Orchestrierungsmethode bin. Es wurde keine Stellungnahme einer Institutional Review Board angefordert: es gibt keine institutionelle Zugehörigkeit hinter der Studie und keine föderale Finanzierung. Die Registrierung nennt stattdessen die Schutzmaßnahmen. Die Zustimmung ist schriftlich und wird vor jeglicher Aufzeichnung gegeben. Es werden keine Gesundheits-, Finanz- oder Arbeitsinhalts-Daten erhoben. Teilnehmende arbeiten auf ihren eigenen Maschinen und Abonnements und können jederzeit bis zur öffentlichen Hinterlegung eine Löschung anfordern. Die Sicherheitsanweisungen umfassen ein separates Browser-Profil, keine Aktionen auf Bank- oder Medizin-Webseiten, Bestätigung vor allem Irreversiblen, keine in den Agenten eingegebenen Passwörter und Web-Inhalte werden als Daten behandelt. Es wird keine Behinderungsvariable erhoben und es wird kein Barrierefreiheitsanspruch gestellt.
9.3 Nur das Design
Aus dem Programm nehme ich nur das Design. Keine Teilnehmendenzahlen, Abschlussquoten oder Einzelfälle erscheinen hier, aus deliberater Entscheidung: das Argument (diese Arbeit), die Methode und das Programm und die Ergebnisse nach der Beobachtungszeit des Protokolls sind separate Publikationen, sodass das Argument nicht als Beweise für sich selbst gelesen werden kann. Andere Forschende können jetzt dieselben Regeln anwenden. Listing C5 in Anhang C gibt ein Datensatzformat und einen Prüfer an, die sie codieren. Der Prüfer lehnt einen Datensatz ab, der eine Installation als Übergang zählt, einen Abschluss ohne vom Agenten produziertes Artefakt, einen Stopp ohne die eigenen Worte der Person, einen echten Namen anstelle eines pseudonymen Labels, ein Feld, das das Format nicht kennt, oder eine übersprungene Ebene, die nicht genau als übersprungen registriert ist.
9.4 Wie eine starke nächste Studie aussieht
Die Kohorte ist eine Machbarkeitsstudie, und die meisten Aussagen von Abschnitt 10 benötigen andere Designs. Eine starke nächste Studie würde zwei Onboarding-Bedingungen vergleichen, die sich darin unterscheiden, wie sie die Arbeit darstellen, wobei das Aufgabenrisiko und die technische Umgebung so konstant wie möglich gehalten werden. Eine Bedingung präsentiert Funktionen und Installationsanweisungen; die andere beginnt mit dem eigenen wiederkehrenden Arbeitsobjekt der Teilnehmenden und elicitiert die fünfteilige Karte von Abschnitt 5.1. Ergebnisse würden Artefakte, deren Qualität von jemand anderem als der Teilnehmenden bewertet (mit zwischen Bewertern berichteter Übereinstimmung, wie bei der Codierung von Stoppgründen), Zeit, Fehler entdeckt, Genehmigungsentscheidungen in Szenarioform, spätere freiwillige Wiederverwendung und Vertrauen gemessen gegen Ergebnisse einschließen. Eine Nachuntersuchung würde Persistenz von fortgesetztem Kontakt mit dem Forschenden trennen. Eine zweite Studie würde fragen, ob Workflow-Vokabular eine Grammatik oder eine pro Beruf ist, durch Vergleich von administrativen, Forschungs-, Kommunikations- und analytischen Aufgaben. Ich weiß nicht, welche es ist, und die Antwort entscheidet, ob verpackte Beispiele einmal geschrieben oder für jedes Fachgebiet geschrieben werden müssen. Beide Studien sollten KI-Alphabetisierung mit einem validierten Instrument baselinieren (Carolus et al., 2023), sodass die spezifische Lücke, zu wissen, was man einem Agenten übergeben soll, von allgemeiner Vertrautheit mit KI getrennt werden kann. Jede solche Studie sollte auch die Implementierung dokumentieren, denn ein Teilnehmender, der mit einer späteren Schnittstelle beginnt, trifft auf andere Vorgaben: die Schnittstellenversion, das Betriebssystem, ob der Agent Netzwerkzugriff hatte, der Berechtigungsmodus und jede Richtlinienbeschränkung. Der Name des Anbieters allein sagt einem späteren Leser zu wenig.
10. Propositionen
Das Modell von Abschnitt 3 und das Argument der Abschnitte 4 bis 8 implizieren Ansprüche, die fehlschlagen können. Tabelle 7 nennt fünfzehn davon, jede mit einem Maßstab, einem Ergebnis, das sie widerlegen würde, und wer befugt ist, den Test durchzuführen. Sie sind für das Feld als Ganzes geschrieben. Das Programm von Abschnitt 9 kann beispielsweise nur wenige testen; mehrere andere können mit Anbieter-Telemetrie, mit Umfragepaneln oder mit einer kleinen Studie in einer Organisation getestet werden. Keine ist ein Befund der Kohorte.
Tabelle 7. Propositionen, Maßstäbe, Widerlegungen und wer sie testen kann.
| # | Proposition | Maßstab | Widerlegt, wenn | Wer kann sie durchführen |
|---|---|---|---|---|
| P1 | Barrierenmigration. Unter Nicht-Programmierern, die Übergang 2 versuchen, stoppt der Cluster nach der Installation (bei der ersten Aufgabe, dem ersten Fehler oder Berechtigungen) häufiger als während dieser, und unter denen, die installierten und nichts produzierten, „Ich wusste nicht, was ich fragen sollte" überwiegt technische, Berechtigungs- und Kostengründe; und bei konstanter Aufgabenschwierigkeit fällt die Fertigstellung an den drei Übergängen schärfer ab als innerhalb einer Stufe. | Stopp-Punkte mit der Artefaktregel aufgezeichnet; Gründe in den eigenen Worten der Person, codiert nach der Regel von Anlage A; Fertigstellung nach Schritt | Die meisten Stopps treten auf, bevor der Agent zum ersten Mal läuft, oder technische Gründe und Berechtigungen dominieren unter installierten Nicht-Produzenten, oder Fertigstellungs- und Fehlschlagsmuster sind vergleichbar über alle Schritte hinweg, sobald die Aufgabenschwierigkeit kontrolliert wird | Das Programm von Abschnitt 9; jede Replikation |
| P2 | Oberflächenverschmelzung. Wenn Anbieter Chat- und Agent-Oberflächen verschmelzen, steigt der Anteil der Sitzungen, die in einer vom Agent erstellten Datei oder Aktion enden, ohne dass sich ändert, was Benutzer sagen, dass sie tun möchten; und die führenden Assistenten schreiben Dateien aus dem Standardfenster ohne einen vom Benutzer gewählten Modus bis Ende 2027. | Anbieter-Telemetrie vor und nach einer Verschmelzung; eine datierte Erhebung der Assistenten | Der Anteil bleibt nach einer Verschmelzung gleich; oder ein stabiler, vom Benutzer gewählter Agent-Modus bleibt eine Voraussetzung für das Schreiben von Dateien | Anbieter; jeder, der die Anwendungen öffnen kann |
| P3 | Vokabular über Installation. Menschen ausgearbeitete Beispiele aus ihrem eigenen Bereich zu geben (verpackte Aufgaben, Fähigkeiten, Vorlagen) erhöht die Ausdauer auf Stufen 2 und 3 mehr als Installationshilfe zu geben, und ein strukturiertes Maß für Workflow-Vokabular sagt Artefakt-Fertigstellung voraus, nachdem Zugang und vorherige KI-Nutzung kontrolliert werden. | Tag-60-Persistenz unter den zwei Arten von Hilfe, in einem Vergleich mit Aufgabe; eine vorausgehende Aussage der fünf Teile von Abschnitt 5.1; Stopp-Gründe codiert nach der Regel von Anlage A | Installationshilfe erzeugt gleiche oder größere Ausdauer; das Vokabular-Maß fügt nichts hinzu, sobald Installationserleichterung und generisches Vertrauen im Modell sind | Jedes Labor mit zwei Onboarding-Routen |
| P4 | Reflexives Onboarding. Menschen, die von dem Chatbot geleitet werden, den sie bereits nutzen, können von Stufe 1 zu Stufe 3 ohne Hilfe in einem Tempo wechseln, das die Route praktisch macht, und erreichen ein erstes Artefakt schneller als Menschen, denen statische Dokumentation gegeben wird. | Anteil der Fertigstellung von Übergang 2 ohne Hilfe mit einem vom Agent erstellten Artefakt, gegen alle, die die Materialien erhalten haben; Zeit bis zum ersten Artefakt unter geführten und statischen Bedingungen | Weniger als die Hälfte schließt es ab, die Schwelle im Voraus in Abschnitt 9 festgelegt; oder statische Dokumentation gibt gleiche oder höhere Fertigstellung | Das Programm von Abschnitt 9; Trainer mit zwei Kohorten |
| P5 | Die mittlere Stufe. Nicht-Programmierer, die Zeit in einer von Anbietern eingezäunten Umgebung verbringen, bevor ein lokaler Agent Übergang 2 häufiger abschließt, haben weniger Datenverlust-Vorfälle und argumentieren besser über Umfang, Reversibilität und Eskalation als Menschen, die direkt vom Chat zu breitem lokalem Zugang wechseln. | Zwei-Routen-Kohorte mit gleicher Nachverfolgung; Artefakt als primäres Ergebnis; ein Vorfalls-Protokoll; szenariobasierte Berechtigungsentscheidungen vorher und nachher | Unaided-Fertigstellungen vom Chat direkt zu einem lokalen Agent entsprechen denen, die Stufe 2 durchlaufen haben, mit vergleichbaren Vorfallsraten und gleichen Berechtigungsentscheidungen | Jedes Labor mit zwei Onboarding-Routen; eine spätere Kohorte des Programms |
| P6 | Der Engpass. Unter Nicht-Programmierern, die wöchentlich Chat nutzen, bleibt der Anteil, der in einem Quartal ein Artefakt der Stufe 3 produziert, weit unter dem Anteil der Entwickler, die wöchentlich Coding-Agenten nutzen. | Eine repräsentative Umfrage mit Artefakt-Elementen statt „nutzen Sie KI" (Abschnitt 11.3) | Artefakt-Produktion der Stufe 3 unter nicht-programmierenden Wissensfachleuten nähert sich der Wöchentlich-Nutzungs-Zahl der Entwickler | Nationale statistische Ämter; Umfragehäuser |
| P7 | Die Brücke trägt. Menschen, die Web-Orchestration praktizieren, sind später eher bereit, CLI-Orchestration anzunehmen als Menschen, die dies nicht tun, und sichtbare Meinungsverschiedenheit sagt später Quellenattribution oder Kritik in ihren Aufzeichnungen voraus. | Annahme von CLI-Orchestration unter denen mit und ohne früherer Web-Vergleich; gespeicherte Vergleiche und spätere Aufzeichnungen | Kein Unterschied oder das Gegenteil; Vergleich erzeugt mehr Aufforderungen und keine Änderung in beibehaltenen Prüfungen | Das Programm von Abschnitt 9; Längspanels |
| P8 | CLI-Dauerhaftigkeit. Für Menschen, die zwei oder mehr Verbraucherkunden-Abonnements bezahlen, ist die Orchestration durch offizielle Befehlszeilen-Tools die Form der Stufe 4, die Schnittstellenänderungen übersteht, und dateigestützte Läufe werden nach einer Schnittstellenänderung wieder ausgeführt und übertragen besser als reine Browser-Läufe. | Eine datierte Erhebung von Artefakten der Stufe 4 in dieser Population; Wiederholungs- und Transfer-Tests nach einer Schnittstellenänderung | Eine Erhebung von Ende 2027 findet Web- oder Programmierungsschnittstellen-Räte dominant und CLI-zu-CLI-Tools rückläufig; reine Browser-Workflows stimmen bei Wiederholung und Transfer überein | Tooling-Forscher; Entwickler-Umfragen |
| P9 | Korrelierte Übereinstimmung. Über Anbieter-Familien hinweg korrelieren Fehler bei Wissensfach-Elementen mit bekannten Antworten genug, dass Übereinstimmung unter drei oder mehr Modellen weniger wert ist als zwei unabhängige Meinungen (rho auf oder über etwa 0,5, wobei rho auf Wissensfach-Elementen mit bekannten Antworten geschätzt wird und nicht aus Benchmark-Übereinstimmungsraten entnommen wird); ein kleiner Rat verschiedener Familien schlägt einen großen Rat einer Familie bei gleichen Kosten; und quellenabhängige Überprüfung sagt Korrektheit besser voraus als Mehrheitsübereinstimmung. | Paarweise Fehlerkorrelation über Familien hinweg in Item-Banks mit bekannten Antworten (Auflistung C4); ein markierter Item-Satz mit zwei Council-Designs; Korrektheit gegen Mehrheitsübereinstimmung und gegen quellengestützte Überprüfung | Gemessenes Rho unter 0,2 für die meisten Aufgabentypen; der Same-Family-Council gewinnt nach einer Claim-by-Claim-Überprüfung; oder einfache Mehrheitsübereinstimmung sagt Korrektheit ebenso gut oder besser voraus als Diversität plus Verifikation | Sprachmodell-Forschende; das Protokoll des begleitenden Papers |
| P10 | Die Kompetenz des Managers. Die Persistenz auf Ebene 3 und 4 wird besser vorhergesagt durch die Fähigkeit einer Person, den Delegationsvertrag (Ziel, Grenze, Artefakt, Kontrolle) zu formulieren und durch Aufsichtsspuren (abgelehnte Pläne, verworfene Diffs, eingeholte Zweitmeinungen) als durch vorherige technische Erfahrung oder durch Prompt-Volumen. | Eine kurze Aufgabe, die die vier Teile hervorruft, blind bewertet; Baseline-Items; Spuren aus dem Akzeptanzprotokoll; Persistenz am Tag 60 | Vorherige technische Erfahrung oder Prompt-Volumen sagen Persistenz ebenso gut oder besser voraus, und die Formulierung des Vertrags trägt nichts hinzu; oder Artefakte auf Ebene 3 und 4, die routiniert Ziel, Quellen, Grenze und Kontrolle weglassen, bleiben zuverlässig unter unabhängiger Prüfung, in welchem Fall die Kompetenzstruktur überentwickelt ist | Jede Längsstudienanalyse von Artefakten |
| P11 | Kalibrierung nach Aufgabenklasse. Menschen kalibrieren Delegation besser, wenn Rückmeldungen schnell sind und Umkehrung möglich ist, wobei sie unterschiedlich akzeptieren, korrigieren und eskalieren, je nach Aufgabenklasse. | Akzeptanz, Korrektur, Eskalation und spätere Fehlerentdeckung nach Aufgabenklasse | Die Kalibrierung ist einheitlich über reversible und folgenreiche Aufgaben hinweg | Labore; Organisationen mit einem Akzeptanzprotokoll |
| P12 | Reibung durch Schutzmaßnahmen. Bei Nicht-Programmierenden auf Ebene 3 werden Unterbrechungen durch Berechtigungsaufforderungen und Sicherheitsblöcke häufiger als Grund für das Beenden genannt als bei Entwicklern, und klassifikatororientierte Autonomie reduziert solche Stoppvorgänge ohne einen Anstieg bei gemeldeten Dateiverlusten. | Codierte Stoppgründe nach Gruppe; Stoppquoten und Vorfallberichte vor und nach einer Änderung des Standardmodus | Kein Unterschied zwischen Gruppen, oder Autonomie erhöht gemeldete Verluste | Anbieter; die codierten Stoppgründe des Programms |
| P13 | Die Lücke reproduziert sich. Die Unterschiede in der Chat-Adoption nach Geschlecht und Bildung (Cranney et al., 2026; Daepp & Counts, 2024) erscheinen mindestens ebenso groß in der Artefaktproduktion auf Ebene 3 innerhalb von Berufsgruppen. | Berufsinterne Unterschiede in der Artefaktproduktion auf Ebene 3 | Eine berufsinterne Schätzung zeigt, dass die Lücke auf Ebene 3 geschlossen wurde | Arbeitsökonomen; spätere Kohorten, falls groß genug |
| P14 | Kritiker und zweite Familie. Ein Same-Family-Kritiker erkennt Übereilung und übersprungene Kontrollen; eine zweite Familie erkennt gemeinsame Fehler; bei einem mit Fehlern gekennzeichneten Satz trägt jeder Fehler bei, die der andere übersieht. | Überlappung bestätigter Ergebnisse zwischen einem Same-Family-Kritiker und einem Second-Family-Reviewer zu gleichen Kosten | Vollständige Überlappung, oder eine Quelle dominiert | Jeder mit zwei Agent-Tools und einem gekennzeichneten Satz |
| P15 | Fähigkeit oder Vokabular. Bei gleicher Aufgabenklasse variiert die Persistenz auf Ebene 2 und 3 mit der Fähigkeit einer Person, den Delegationsvertrag zu formulieren; wenn Modellkapazität die bindende Grenze wäre, würde die Persistenz zwischen Aufgabenklassen variieren und bei Personen innerhalb einer Klasse einheitlich sein. | Persistenz nach Aufgabenklasse, gekreuzt mit einer blind bewerteten Aussage des Delegationsvertrags | Innerhalb einer Aufgabenklasse ist die Persistenz über Personen hinweg einheitlich, unabhängig von ihrem Vertrags-Score, und variiert nur zwischen Klassen | Jede Studie, die Aufgabenklasse und die Vertragsaussage dokumentiert |
Einige davon sind wichtiger als die anderen. P4 trägt das größte Gewicht für die Politik, denn wenn reflexives Onboarding funktioniert, kann der teuerste Teil des Unterrichtens von Agenten für Menschen (neben ihnen während der Installation sitzen) durch das Tool ersetzt werden, das sie bereits haben. P5 ist derjenige, den die Kohorte nicht testen kann, wie Abschnitt 9.2 sagt, und er ist auch derjenige, von dem die Form der Leiter am meisten abhängt. Ob die mittlere Stufe ihren Platz verdient, weiß ich noch nicht. P9 ist am leichtesten zu testen und am ehesten überraschend für Benutzer von Councils, da die Arithmetik der korrelierten Evidenz (Chernets, 2026a) und die Messungen von Kim et al. (2025) beide auf eine Obergrenze für den Wert von Übereinstimmung hindeuten. P10 ist derjenige, der Lehrpläne verändern würde. Wenn die Fähigkeit, einen Delegationsvertrag zu formulieren, die Persistenz besser vorhersagt als technische Erfahrung, dann sollte das Training zuerst Delegation und dann Tools unterrichten.
11. Implikationen
11.1 Für Anbieter
Design für den leeren Ordner. Anbieter haben das Installationsprogramm vereinfacht, und das sieht man. Ich denke, eine weitere Runde dieser Bemühung wäre verschwendet, denn das Problem des Neuankömmlings beginnt jetzt nach dem Installationsprogramm, vor einem leeren Ordner, der dem Agenten nichts zu sagen hat. Ausgearbeitete Beispiele aus dem eigenen Bereich des Nutzers, angeboten in dem Moment, in dem dieser den Agenten zum ersten Mal öffnet, zusammen mit einer ersten Aufgabe, die real ist, mit niedrigem Risiko und mit einem Ergebnis endet, das er beurteilen kann, würde mehr für die Akzeptanz tun als jede weitere Vereinfachung des Setups. Verpackte Fähigkeiten weisen bereits in diese Richtung (Abschnitt 5.1). Zwei Dinge fehlen noch: Hilfe bei der Auswahl, welche der Aufgaben einer Person überhaupt übergeben werden sollte, und eine Möglichkeit für einen Berufsverband und nicht nur ein Start-up, Fähigkeiten für seine Mitglieder zu schreiben.
Wie die Reiter nach dem nächsten Merge auch heißen mögen, eine Person braucht eine klare Antwort im Moment der Übergabe und in der Sprache des ausgewählten Ordners auf eine kurze Liste von Fragen: Was kann dieser Agent lesen, was kann er ändern, was kann er senden oder auslösen, was braucht meine Zustimmung, und wie stoppe ich ihn? Ein visueller Diff beantwortet einen Teil davon, wenn sich Dateien ändern, und ein geschriebener Plan tut es, wenn Aktionen vielfältig sind; ein Zustimmungsbanner beantwortet keinen Teil davon. Das Berechtigungsmodell sollte nach dem Merge sichtbar, begrenzt und umkehrbar bleiben, mit einem Rückgängigmachen und einem Stop-Button, der funktioniert. Ordnerumfang ohne eines oder beides ist, wie die Problemberichte in Abschnitt 5.3 klingen.
Die Arbeit sollte auch das Produkt verlassen können. Ein Nutzer sollte in der Lage sein, die Aufgabenanweisung, die Eingaben oder ihre Bezeichner, die Werkzeugaktionen, die Ausgabe und den Genehmigungsverlauf zu exportieren. Dies ist sowohl ein Usability-Feature als auch ein Governance-Feature, denn es ermöglicht dem Neuankömmling, von einer abgeschlossenen Aufgabe zu lernen, und ermöglicht einem Team, ein Ergebnis zu überprüfen, ohne sein Gedächtnis an einen proprietären Chat-Verlauf zu verleihen. Die Nutzung sollte auf die gleiche Weise gemeldet werden. „Wöchentlich aktive Nutzer" eines Agenten, der Dateien produziert, sollten aufgeteilt werden in Personen, die eine Datei erstellt haben, und Personen, die die Anwendung geöffnet haben, und Anbieter haben die Telemetrie, um das zu tun.
Angriffe zu erkennen ist keine Aufgabe für den Anfänger. Anleitung, die Nicht-Programmierer auffordert, Zeichen von Prompt-Injection zu erkennen, stellt die schwierigste Urteilsfähigkeit auf die Person, die am wenigsten in der Lage ist, sie zu treffen (Abschnitt 5.3). Sichere Standards (Arbeitskopien, Snapshots vor größeren Änderungen, destruktive Befehle verweigert, bis sie explizit erlaubt sind, Webinhalte als Daten behandelt) gehören zum Produkt. Gleichzeitig führen Guards, die ständig unterbrechen, die Arbeit genauso sicher zum Stillstand wie fehlende Guards Dateien verlieren, und das Begleitpapier zur Oversight Overreach beschreibt, wie solche Schichten wachsen (Chernets, 2026b).
Die Herkunft sollte das Zusammenführen von Antworten überstehen. Council-Features, die eine zusammengeführte Antwort zurückgeben, sollten zeigen, welches Modell was sagte und wo sie nicht übereinstimmten, dem Nutzer ermöglichen, einem Modell die Rolle des Kritikers zuzuweisen, und eine Beweislücke leichter zu finden machen als einen flüssigen Konsensus-Absatz. Eine zusammengeführte Stimme ohne Quellen stellt die Autorität einer einzigen selbstsicheren Antwort wieder her, belohnt Automatisierungsbias und verbirgt die Fehlerkorrelation (Abschnitt 6.3).
Churn hat schließlich Kosten auf der Seite des Nutzers. Eine Person, die ein Werkzeug erlernt hat, das innerhalb eines Jahres umbenannt, zusammengeführt oder eingestellt wurde, zahlt zweimal, daher sind stabile Namen, Migrationsleitfäden und Kontinuität der Anweisungsdateien über Produktänderungen hinweg Akzeptanzfeatures in ihrem eigenen Recht.
11.2 Für Arbeitgeber und Trainer
Lehren Sie den Delegationsvertrag vor den Menüs. Produktmenüs ändern sich monatlich, während die Fähigkeit, ein Ziel zu formulieren, die Arbeit einzugrenzen, das Artefakt zu benennen und den Check zu entscheiden, über Werkzeuge hinweg übertragen wird (Abschnitte 4.3 und 7.3). Eine kurze Übung, die eine Person auffordert, die vier Teile für eine ihrer eigenen wiederkehrenden Aufgaben zu schreiben, testet die Bereitschaft besser als ein Feature-Überblick. Was die Übung enthält, ist unten unter Dekomposition festgelegt.
Anmeldungen messen das Falsche. Eine aktive Nutzer-Zahl kann die Unterscheidung nicht treffen, die Abschnitt 9.1 brauchte, zwischen der Person, die nach Synonymen fragt, und der Person, die einen Report delegiert. Eine Zählung von Agenten-erzeugten Artefakten, die Menschen behalten wollten, kann es.
Menschen brauchen auch einen genehmigten Ort zum Lernen und eine Karte dessen, was erlaubt ist. Level 2 innerhalb von Werkzeugen, die die Organisation bereits lizenziert, erreicht Personal, das nie erlaubt sein wird, einen Agenten auf einem Arbeits-Laptop zu installieren (Abschnitt 5.4). Für Level 3 entfernt eine klare Richtlinie, eine Sandboxed-Maschine oder eine genehmigte Konfiguration das stille „Nein", das viele Menschen annehmen. Ein pauschales Verbot treibt die Nutzung über persönliche Konten, wo niemand es sehen kann, und uneingeschränkte Delegation setzt vertrauliches Material frei. Dazwischen liegt eine Aufgaben- und Datentaxonomie. Sie sagt, welche Arbeit in genehmigten Umgebungen versucht werden darf, welche eine Überprüfung durch eine zweite Person braucht und welche von Agenten ausgeschlossen ist; sie nennt, wer ein Werkzeug genehmigen darf, wo der Akzeptanznachweis lebt und wie ein Beinahe-Vorfall gemeldet wird, ohne dass es Strafen für die Meldung gibt. Lokales Level 3 sollte nicht auf Maschinen erforderlich sein, die der Mitarbeiter nicht kontrolliert, da Cloud-Agenten und Tenant-scoped Level 2 der Weg sind, der einen Kampf mit der IT-Abteilung vermeidet. Sobald die Anbieter die erste Stufe in den Chat aufnehmen, behält Level 2 zwei Aufgaben. Es ist der genehmigte Ort für Personal auf gesperrten Maschinen und es ist die Kalibrierungsstufe für alle anderen, wo eine Person lernt, dass delegierte Aktion einen Umfang hat, bevor sie einen besitzt. Ob es auch Vorfälle senkt, ist P5.
Mandate brauchen Sorgfalt. KI-Nutzung zu einer Leistungskennzahl zu machen, kann zu Nutzung ohne Wert führen, und mindestens ein Arbeitgeber, der dies tat, revidierte die Entscheidung innerhalb eines Jahres (Fortune, 2026b). Nach Artefakten zu fragen, die für den Job wichtig sind, ist ein besseres Signal als nach Nutzung zu fragen. Einmal pro Monat zeigen Sie eine Datei, die ein Agent in einem Ordner erzeugt hat, den Sie benannt haben" und „zeigen Sie eine Entscheidung, die Sie geändert haben, weil zwei Modelle nicht übereinstimmten", misst Übergänge 2 und 3, die eine Anmeldezahl nicht kann. Training in großem Maßstab ohne Artefakt-Maße, so viele Tausende auch angemeldet sind, wird niemanden sagen, ob Übergang 2 stattgefunden hat.
Zerlegung und Verifikation sollten zusammen unterrichtet werden, und die Kritiker-Gewohnheit vor dem Rat. Ein generischer Prompt-Kurs ist Pädagogik der Stufe 1. Pädagogik der Stufe 2 und 3 geht von der Arbeit aus, die die Person bereits hat, etwa ein Marketer-Paket für Freitag oder ein Stapel von Aufgaben eines Lehrers, lehrt eine wiederverwendbare Zerlegung (die fünf Teile von Abschnitt 5.1, mit einer Bedingung zum Stoppen) und lehrt Fehlerwiederherstellung auf einer Kopie des Ordners. Was danach zu bewerten ist, ist, ob die Person eine unsichere Anweisung erkennen kann, eine umkehrbare Versuchsmöglichkeit nennen kann, die Beweise überprüfen und das System stoppen kann. Ein Kritiker der gleichen Familie an Akzeptanzpunkten kostet nichts bei Abonnements, und eine zweite Familie wird hinzugefügt, wenn der Kritiker schweigt und die Entscheidung teuer ist. Orchestrierung oben in einer Flüssigkeits-Rubrik ist das richtige Ziel für einige Rollen und die falsche Eins-Tag-Anforderung für alle.
11.3 Für die Politik
Die KI-Literalität-Pflicht der Europäischen Union gilt für jeden Anbieter und Nutzer von KI-Systemen für ihr Personal. Nach den Änderungen von 2026 verlangt sie von ihnen, „Maßnahmen zur Unterstützung der Entwicklung von KI-Literalität" zu ergreifen, anstatt ein ausreichendes Niveau zu sichern, und ihre Aufsichts- und Durchsetzungsregeln gelten ab 3. August 2026 (Europäische Union, 2026; Europäische Kommission, 2026a, 2026b). In den Vereinigten Staaten nennt das Rahmenwerk des Arbeitsministeriums „KI effektiv leiten" (US-Arbeitsministerium, 2026), und das Rahmenwerk der OECD und Europäischen Kommission hat eine Domäne namens „KI verwalten" (OECD & Europäische Kommission, 2026). Ich schlage einen Inhalt für diese Worte im Agentur-Fall vor: die vier Teile des Delegationsvertrags, die vier Praktiken von Abschnitt 8.1 einschließlich Widerruf, die Gewohnheit, Modelle mit dem Wissen zu vergleichen, dass Übereinstimmung schwächere Evidenz ist als sie aussieht, und die grundlegenden Sicherheitspraktiken von Abschnitt 5.3. Leitlinien sollten die Unterscheidung zwischen Gesprächsnutzung und delegierter Handlung treffen. Für letzteres sollte die Pflicht den Berechtigungsumfang, die Datenklassifizierung, die Verifikation, die Meldung von Vorfällen und den Widerruf abdecken, und eine Anforderung, die rollenspezifische Fähigkeit und Autorität, die für delegierte Aufgaben erforderlich sind, zu dokumentieren, ist verteidigbarer als eine Anforderung, alle identisch zu schulen. Regulierer und Arbeitnehmervertreter können auch fragen, ob ein Arbeitgeber die Restverantwortung auf das Personal übertragen hat, ohne verwendbare Kontrollen, Zeit zur Überprüfung oder das Recht, eine unsichere Delegation abzulehnen. All dies ist eine Design- und Governance-Empfehlung, die von einem Regulierungsinstrument gezogen wurde, und sein Umfang ist dieses Instrument.
Die europäische Pflicht überstand eine Deregulierungsrunde, und unter den hier diskutierten Rahmenwerken ist sie die eine horizontale Verpflichtung, die jeden Mitarbeiter abdeckt, der KI nutzt. In den Vereinigten Staaten ist der Rahmen Arbeitskraftpolitik. Eine Exekutivverordnung vom April 2025 zur KI-Ausbildung und der Juli-2025-AI-Aktionsplan verpflichten sich, KI-Literalität und Fähigkeiten auszubauen, einschließlich Leitlinien, dass KI-Literalität-Programme als vom Arbeitgeber bereitgestellte Bildungshilfe in Frage kommen (Weißes Haus, 2025a, 2025b); der Rahmen ist mit Schulungen von Agenten-Managern kompatibel und verlangt dies noch nicht. Keiner der überprüften offiziellen Texte nennt Terminal-Agenten oder Orchestrierung, daher kann „KI verwalten" als Chatbot-Etikette oder als Niveau-4-Leitung gelesen werden. Literalität-Programme, die beim Prompting stoppen, lehren Stufe 1. Die Arbeit unterdessen bewegt sich zu den Stufen 2 bis 4. Die offiziellen Texte sind ihr noch nicht dorthin gefolgt.
Statistische Ämter, die KI-Module zu ihren Umfragen hinzufügen, könnten bei einer spezifischen Änderung helfen. „Haben Sie einen Chatbot verwendet" ist ein Element der Stufe 1. „Hat ein System, das Sie geleitet haben, in den letzten sieben Tagen Dateien auf einem Computer erstellt oder geändert, den Sie für die Arbeit nutzen" ist ein Element der Stufe 2 oder 3. „Haben Sie die gleiche Arbeitsfrage in den letzten sieben Tagen mehr als einem KI-System gestellt, und unterschieden sich die Antworten" ist ein Element der Stufe 4. Ohne Elemente dieser Art kann P6 nicht in öffentlichen Daten getestet werden, und die Digital-Spaltung auf der zweiten Ebene auf der Agentur-Ebene wird für die Menschen, deren Aufgabe es ist, sie zu sehen, unsichtbar bleiben.
11.4 Für Forscher
Die Lücken von Abschnitt 2.5 sind eine Agenda. Studieren Sie Nicht-Programmierer, die Terminal- und Desktop-Agenten nach Namen nutzen, mit Artefakten als Ergebnisse. Studieren Sie reflexive Einarbeitung als Mechanismus in sich selbst. Studieren Sie Web-Orchestrierung als Praktik, einschließlich wie Menschen Antworten abgleichen und ob sie Herkunft bewahren. Messen Sie die Korrelation von Fehlern über Anbieter-Familien hinweg bei Wissensarbeits-Aufgaben und auf mehr als Benchmarks von Code und Mathematik. Erweitern Sie die gemessenen Geschlechts- und Berufslücken in der KI-Nutzung (Cranney et al., 2026; Humlum & Vestergaard, 2025) auf die Agentur-Ebenen, wo noch nichts bekannt ist (P13). Zwei leichte Metriken, Funktionsverfügbarkeit und selbst gemeldete Zeitersparnis, sind wert, zugunsten von Artefakt-Vollendung, geprüfter Qualität, Korrekturquoten und späteren Wiederverwendungen zu widerstehen. Abbruch sollte mit seinem Mechanismus erfasst werden. Ein Stopp bei einer Berechtigungsanfrage kann ein Schnittstellenproblem, eine vernünftige Sorge um Daten, eine Arbeitgeberregel, ein fehlender Computer oder eine Aufgabe ohne Akzeptanzkriterium sein, und ihre Zusammenfassung zu „Widerstand" verliert all das. Evaluierung sollte adversarisch sein, mit einer irreführenden Seite, einer versteckten Anweisung in einem Dokument, einer widersprechenden Quelle, einem teilweisen Werkzeugausfalls oder einer überzeugenden falschen Antwort, die mehrere Modelle teilen, weil die Manager-Rolle nur dann etwas bedeutet, wenn sie Ergebnisse unter diesen Bedingungen verbessert. Replikation benötigt keine meiner Materialien; sie benötigt die Artefakt-Regel, eine eingefrorene Stopp-Grund-Frage, eine Aufzeichnung der Implementierung und eine datierte Produkt-Volkszählung. Und die Nenner sollten veröffentlicht werden, da eine Studie, die nur die berichtet, die hinübergingen, uns nichts über die Straße sagt.
12. Umfang und Rahmenbedingungen
Das hier Angebotene ist ein Modell, eine Evidenzsynthese und ein Messdesign, und jedes ist auf folgende Weise begrenzt.
Zeit. Die Evidenz reicht bis zum 21. September 2026. Produktfakten sind datiert und werden altern. Das Modell ist durch Reichweite und Rolle definiert, sodass es langsamer altert.
Geografie und Quellen. Die meisten Adoptionszahlen stammen aus den Vereinigten Staaten; europäische Zahlen werden zitiert, wo sie existieren. Mehrere Schlüsselfiguren stammen von Anbietern (Nutzung von Coding-Agenten, die Gründe für die Zusammenführung von Chat und Agent, Injektionsraten in Anbieter-Testsets) und sind im Text als Anbieterdaten gekennzeichnet. Ich verwende sie für das, was Anbieter über ihre eigenen Produkte wissen können, und gewichte sie entsprechend.
Population. Das Argument betrifft Fachleute, deren Arbeit wesentlich am Computer stattfindet. Menschen, die hauptsächlich von einem Telefon aus arbeiten oder ohne einen Computer, den sie kontrollieren, stoßen auf eine Barriere vor allen hier beschriebenen, und das Modell sagt über sie hinaus wenig, außer diese Barriere zu benennen (Abschnitt 5.5).
Evidenz über die Kohorte. Nur das vorregistrierte Design wird verwendet. Kein Ergebnis des Programms informiert einen hier geäußerten Anspruch, und die Propositionen von Abschnitt 10 werden vor Kenntnis seiner Ergebnisse formuliert, damit sie gegen diese bewertet werden können. Eine Kohorte, die einen eigenen Computer erfordert, beprobt Menschen, die einen Agenten installieren können; sie kann Ausrüstungszugang nicht von Motivation trennen, und diese Grenze geht mit den Ergebnissen mit.
Normativer Umfang. Das Modell beschreibt, was jede Ebene von einer Person verlangt. Es besagt nicht, dass höhere Ebenen besser sind oder dass alle aufsteigen sollten; für viel Arbeit ist Ebene 1 oder 2 der richtige Ort (Abschnitt 8.2). Hochfolgenarbeit, vertrauliche Aufzeichnungen, sicherheitskritische Operationen, zeitkritische Entscheidungen und Aufgaben ohne überprüfbares Akzeptanzkriterium benötigen strengere Vorkehrungen oder bleiben ganz außerhalb delegierter Agenten-Nutzung.
Was Orchestrierung hinzufügt. Das Hinzufügen von Agenten kann die Abdeckung erweitern, Uneinigkeit offenlegen und eine Überprüfungsspur hinterlassen. Es kann auch korrelierte Fehler, Kosten, Verzögerung und ein falsches Aussehen von Gewissenhaftigkeit hinzufügen. Delegation, die andauert, bedeutet, dass eine Person den Prozess inspizieren und ändern kann; ob der Prozess Verlass verdient, ist eine separate Frage.
Was der Literatur fehlt. Die Literatursuche von Abschnitt 2.5 fand keine Felduntersuchung von Nicht-Programmierern, die Terminal- oder Desktop-Agenten namentlich annehmen, keine Untersuchung der Web-Orchestrierung als benannte Praxis, keine Behandlung der Verwaltung von Agenten als Kompetenz mit eigener Struktur und keine Untersuchung eines KI-Systems, das eine Person bei der Annahme von agentengestützter KI unterstützt. Das sind Lücken in dem, was untersucht wurde, angegeben zum 21. September 2026, und ich mache keine Aussagen über Märkte, Produkte oder Priorität.
Status von Ansprüchen. Tabelle 8 wendet die Konfidenzsprache der Serie auf die Elemente des Arguments an, sodass ein Leser sehen kann, wie fest jedes gehalten wird.
Tabelle 8. Status der Ansprüche in diesem Papier.
| Element | Wie es hier gesagt wird | Grundlage |
|---|---|---|
| Vier-Ebenen-Modell und die Artefakt-Regel | Wird getestet (Abschnitte 9 und 10) | Konzeptuell; Marker in Abschnitt 3 und Anhang A angegeben |
| Die technische Barriere ist für Installation und die Desktop-Oberfläche zurückgewichen | Die Daten unterstützen es | One-Step-Installer; „Kein Terminal erforderlich"-Dokumentation; vier Anbieter-Level-2-Produkte ausgeliefert |
| Wissensarbeiter innerhalb eines Terminal-Heritage-Agenten | Von Anbietern berichtet, richtungsweisend | Pressebericht über Anbieterfiguren, 2. Juni 2026, mit Vorbehalt eines Analysten |
| Anbieter absorbieren Übergang 1 in Chat | In Produkt beobachtet | Anthropic, 16. September 2026; OpenAI, 9. Juli 2026 |
| Workflow-Vokabular als verbleibende dominante Barriere | Als Modell angeboten; wird getestet | Indirekt: Prompting-Studien; Grund der Anbieter für Zusammenführung; Stop-Reason-Element des Programms |
| Web als Brücke, CLI als dauerhafte Schicht | Wird getestet (P7, P8) | Verträge, Berechtigungsobjekte, offizielle Plugins; Fragilität von Web-Oberflächen |
| Korrelierte Fehler begrenzen, was ein Rat kauft | Die Daten unterstützen es bei Modellevaluierungen; wird in der Verwendung gemessen | Kim et al. (2025); Chernets (2026a) |
| Reflexives Onboarding | Implementiert und wird gemessen; kein Ergebnis berichtet | Anbieter- und Kurspraxis (Beobachtung); Schritt 1 des Programms (Messung) |
| Der Manager von Agenten als Rolle | Als Verhaltensbeschreibung angeboten; wird getestet (P10) | Delegationsstudien; Arbeitgeber-Rubriken; offizielle Alphabetisierungsrahmen |
| Kohorten-Übergangsraten | Nicht berichtet | Protokoll eingefroren; Ergebnispapier folgt |
| „Funktioniert jetzt" als Versprechen | Nicht beansprucht | Außerhalb des Umfangs dieses Papiers |
13. Fazit
Das Terminal war lange Zeit das offensichtliche Bild der Schranke zwischen gewöhnlichen Fachleuten und agentenartiger KI, und eine Zeit lang war es ein berechtigtes. 2026 passt es nicht mehr. Die Installation erfolgt mit einem Befehl oder einem Klick, der Chatbot, den eine Person bereits nutzt, kann sie dabei anleiten, und die Anbieter verschmelzen Chat und Agent zu einer einzigen Oberfläche. Was die Abschnitte 4 und 5 zeigen, ist eine Schranke, die sich verschoben hat. Der erste begrenzte Versuch ist viel leichter geworden; schwierig bleibt die zuverlässige Arbeit an ganzen Aufgaben, das Mithalten mit Produkten, die sich unter den Füßen verändern, und die Sicherung eines zugewiesenen Ordners. Nach Angaben eines Anbieters, die über die Presse berichtet und als Richtungsvorgabe zu verstehen sind, sind bereits etwa eine Million Wissensarbeiter pro Woche in einem Terminal-ähnlichen Coding-Agenten tätig. Die meisten Fachleute begegnen KI jedoch weiterhin nur als Gespräch.
Was jetzt im Weg steht, ist die Managerarbeit: zu wissen, was man abgeben kann, es einzugrenzen, das Ergebnis zu benennen und zu entscheiden, wie man es überprüft, dann eine Umgebung sicher zu betreiben und Modelle zu vergleichen, während man sich merkt, dass ihre Übereinstimmung schwächere Beweise sind, als sie aussehen. Die vier Ebenen von Abschnitt 3 geben dieser Arbeit eine Struktur, die kein Produkt besitzt, und die Artifact-Regel gibt ihr eine Maßeinheit. Ich habe Web-Orchestrierung als Brücke zur letzten Ebene (P7) und CLI-Orchestrierung als ihre Form, die andauert (P8), vorgeschlagen; beide sind so formuliert, dass sie scheitern können.
Für jeden, der den Übergang einleitet, ist die praktische Folge eine Reihenfolge von Operationen. Die erste Frage ist, welcher kleine, zulässige Teil der Arbeit von einer Person beschrieben, inspiziert und sicher verworfen werden kann, wenn der Versuch fehlschlägt: ein Briefing aus öffentlichen Quellen, ein persönlicher Planungsordner, eine Tabellenkalkulation, auf die niemand anderes angewiesen ist. Von dort wird eine managerielle Verantwortung nach der anderen hinzugefügt: eine Grenze, dann eine Genehmigung, dann ein eigener Arbeitsbereich, dann ein gespeicherter Aufgabendatensatz, dann eine zweite und kritische Ansicht. Die Auswertung folgt der gleichen Reihenfolge. Eine Demonstration ist wenig wert, wenn sie verbirgt, was der Person erlaubt war zu tun, wie die Ausgabe überprüft wurde und was geschah, als der Agent fehlschlug. Eine überlegte Weigerung zu delegieren zählt als ein Ergebnis. Und eine Person, die eine begrenzte Aufgabe reproduzieren kann, sagen kann, warum sie sich darauf verließ, auf eine Uneinigkeit hinweisen kann, die eine Entscheidung geändert hat, und den Zugang einschränken kann, wenn sich die Umstände verschieben, zeigt die beobachtbaren Zeichen der Rolle, unabhängig davon, was ihr Jobtitel sagt.
Das Modell kann fehlschlagen, und Abschnitt 10 sagt, wie. Das Programm von Abschnitt 9 wird einen Teil davon bei Menschen testen, die keine Programmierer sind, und der Code in Appendix C ermöglicht es anderen, die gleichen Übergänge zu messen und die gleichen Muster zu üben. Ich erwarte, dass die in Appendix B genannten Produkte innerhalb eines Jahres veraltet aussehen. Die Barrieren von Abschnitt 5 sollten nicht veralten, denn sie gehören zur Person und zur Arbeit, unabhängig davon, welches Produkt vor ihnen steht. Das Terminal ist zu einem Ort geworden, an dem ein Agent für eine Person arbeitet, die gelernt hat, ihn zu verwalten, und wie viele Menschen das lernen werden, auf welchem Weg und wie schnell, ist die Frage, die das nächste Jahr beantworten wird.
Erklärungen
Finanzierung. Diese Arbeit wurde durch keine externe Finanzierung unterstützt.
Interessenskonflikte. Der Autor entwickelt Multi-Modell-Orchestrierungsmethoden und hat entsprechende Patentanmeldungen eingereicht (ausstehend; kein Patent wurde erteilt). Der Autor entwarf das in Abschnitt 9 beschriebene vorregistrierte Kohortenprogramm und seine Materialien. Keine Erkenntnis in diesem Paper hängt von der Implementierung des Autors ab; jedes Muster in Anhang C ist mit frei verfügbaren Werkzeugen reproduzierbar. Der Autor verwaltet auch die beiden in Anhang C genannten Open-Source-Plugins; sie sind frei und quelloffen (Apache-Lizenz 2.0), und keine Erkenntnis in diesem Paper hängt von ihnen ab. Der Autor entwickelt Lehrmaterialien, die später möglicherweise kommerziell angeboten werden; zum Zeitpunkt des Schreibens wurde nichts verkauft, und die in Abschnitt 9 beschriebene Kohorte erhielt alle Materialien kostenlos.
Werkzeuge und Verifikation. KI-Assistenten wurden als Instrumente unter der Leitung des Autors eingesetzt; die Ideen, Forschung und Schlussfolgerungen stammen vom Autor. Alle quantitativen Aussagen und Zitate wurden gegen Primärquellen oder archivierte Kopien vom 21. September 2026 oder, wenn eine Quelle im Text und in der Zeitleiste von Anhang B als sekundär oder vom Anbieter gekennzeichnet ist, gegen den besten verfügbaren Bericht überprüft; von Anbietern gemachte Angaben zu ihren eigenen Produkten sind als solche gekennzeichnet. Wenn eine primäre Seite während des Recherchezeitraums nicht abgerufen werden konnte (mehrere Seiten einer Anbieterwebseite ergaben einen Zugriffsfehler), wird die Aussage aus einer benannten Sekundärquelle zitiert und gekennzeichnet oder ausgelassen. Im Literaturverzeichnis in eckigen Klammern angegebene Pressetitel sind beschreibende Titel für Seiten, deren Überschrift nicht wörtlich erneut gelesen wurde.
Verfügbarkeit von Daten und Code. Der Code in Anhang C mit seinen Tests wird unter der MIT-Lizenz unter https://github.com/vadimchernets/after-chat hinterlegt und auf Zenodo archiviert, https://doi.org/10.5281/zenodo.22944451. Zwei Plugins, die auf denselben Mustern basieren, Roundcall und Sidecall, befinden sich unter https://github.com/vadimchernets/roundcall und https://github.com/vadimchernets/sidecall (Apache-Lizenz 2.0). Fünf Kits, die dieselben Muster auf Fachbereiche außerhalb der Softwareentwicklung anwenden, befinden sich unter https://github.com/vadimchernets/calling-kits (MIT). Sie wurden nicht von Praktizierenden dieser Fachbereiche erprobt, was das Repository angibt, und keine Aussage in diesem Paper stützt sich auf sie.
Ethik. Dieses Paper berichtet keine Daten von menschlichen Teilnehmern. Das darin beschriebene Kohortenprogramm ist vorregistriert (OSF, DOI 10.17605/OSF.IO/X4EGQ); seine Ergebnisse werden separat berichtet.
Autorenbeiträge. Alleiniger Autor.
Korrespondenz. [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026, August 4). OpenAI explains what will happen when ChatGPT Atlas shuts down this weekend. https://9to5mac.com/2026/08/04/openai-explains-what-will-happen-when-chatgpt-atlas-shuts-down-this-weekend/
Accenture. (2025, December 9). Accenture and Anthropic launch multi-year partnership to drive enterprise AI innovation and value across industries. https://newsroom.accenture.com/news/2025/accenture-and-anthropic-launch-multi-year-partnership-to-drive-enterprise-ai-innovation-and-value-across-industries
Adrjan, P. (2026, July 8). AI is no longer just a tech occupation story. Indeed Hiring Lab. https://hiringlab.indeed.com/2026/07/08/ai-is-no-longer-just-a-tech-occupation-story/
Agent Skills. (2026). Agent Skills: an open standard (list of supporting products, accessed 21 September 2026). https://agentskills.io
Anthropic. (2025). Piloting Claude in Chrome (25 August 2025, updated 18 December 2025). https://claude.com/blog/claude-for-chrome
Anthropic. (2026a). Claude Code desktop quickstart (accessed 21 September 2026). https://code.claude.com/docs/en/desktop-quickstart
Anthropic. (2026b). Get started with Claude Cowork. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/13345190-get-started-with-claude-cowork
Anthropic. (2026c, September 16). Claude Cowork and chat are now one Claude. https://claude.com/blog/cowork-is-now-claude
Anthropic. (2026d, August 26). Claude in Chrome is generally available. https://claude.com/blog/claude-in-chrome-generally-available
Anthropic. (2026e, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026f, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026g). Use Claude in Chrome safely. Help Center (accessed 21 September 2026). https://support.claude.com/en/articles/12902428-use-claude-in-chrome-safely
Anthropic. (2026h). What's new in Claude Code: 29 June to 3 July 2026 (default permission mode renamed "Manual"). https://code.claude.com/docs/en/whats-new/2026-w27
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775-779. https://doi.org/10.1016/0005-1098(83)90046-8
Becker, J., Rush, N., Barnes, E., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. arXiv:2507.09089. https://arxiv.org/abs/2507.09089
BenchLM. (2026). OSWorld-Verified leaderboard (aggregator of vendor-reported scores, accessed September 2026). https://benchlm.ai/benchmarks/osworld-verified
Bick, A., Blandin, A., & Deming, D. J. (2024). The rapid adoption of generative AI (NBER Working Paper No. 32966). https://www.nber.org/papers/w32966
Bick, A., Blandin, A., Deming, D. J., et al. (2026, September 1). What work does generative AI do? Federal Reserve Bank of St. Louis, On the Economy. https://www.stlouisfed.org/on-the-economy/2026/sep/what-work-does-generative-ai-do
Bo, J. Y., Wan, S., & Anderson, A. (2025). To rely or not to rely? Evaluating interventions for appropriate reliance on large language models. CHI 2025. arXiv:2412.15584. https://arxiv.org/abs/2412.15584
Brave. (2025, August 20). Comet prompt injection. https://brave.com/blog/comet-prompt-injection/
Brynjolfsson, E., Li, D., & Raymond, L. R. (2025). Generative AI at work. Quarterly Journal of Economics, 140(2), 889-942. https://academic.oup.com/qje/article/140/2/889/7990658
Carolus, A., Koch, M., Straka, S., Latoschik, M. E., & Wienrich, C. (2023). MAILS: Meta AI literacy scale. International Journal of Human-Computer Interaction. arXiv:2302.09319. https://arxiv.org/abs/2302.09319
Carroll, J. M. (1990). The Nurnberg funnel: Designing minimalist instruction for practical computer skill. MIT Press. https://mitpress.mit.edu/9780262031639/the-nurnberg-funnel/
CC for Everyone. (2026). A course taught inside Claude Code (accessed 21 September 2026). https://ccforeveryone.com
Center for AI Safety. (2026, July 1). Significant increase in digital labor automation. https://safe.ai/blog/significant-increase-in-digital-labor-automation
Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). How people use ChatGPT (NBER Working Paper No. 34255). https://www.nber.org/papers/w34255
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698 (Zenodo: https://doi.org/10.5281/zenodo.22683716)
Chernets, V. (2026b). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658 (Zenodo: https://doi.org/10.5281/zenodo.22849138)
Chernets, V. (2026c). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261 (Zenodo: https://doi.org/10.5281/zenodo.22166995)
Chernets, V. (2026d). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF preregistration. https://doi.org/10.17605/OSF.IO/X4EGQ
CodeRabbit. (n.d.). State of AI vs. human code generation report (accessed 21 September 2026). https://www.coderabbit.ai/blog/state-of-ai-vs-human-code-generation-report
Cohn, C., Rayala, S., Srivastava, N., Fonteles, J. H., Jain, S., Luo, X., Mereddy, D., Mohammed, N., & Biswas, G. (2026). A theory of adaptive scaffolding for LLM-based pedagogical agents. AAAI 2026, 40(3), 1757-1765. arXiv:2508.01503. https://arxiv.org/abs/2508.01503
Constellation Research. (2026a, June 2). OpenAI touts broadening Codex usage, 5 million weekly active users. https://www.constellationr.com/insights/news/openai-touts-broadening-codex-usage-5-million-weekly-active-users
Constellation Research. (2026b, March 30). Microsoft 365 Copilot's Researcher agent goes multi-model. https://www.constellationr.com/insights/news/microsoft-365-copilots-researcher-agent-goes-multi-model
Cranney, K., Delecourt, S., & Koning, R. (2026). Global evidence on gender gaps and generative AI over time (Harvard Business School Working Paper No. 25-023). https://www.hbs.edu/ris/Publication%20Files/25023_52957d6c-0378-4796-99fa-aab684b3b2f8.pdf
Daepp, M. I. G., & Counts, S. (2024). The emerging generative artificial intelligence divide in the United States. arXiv:2404.11988. https://arxiv.org/abs/2404.11988
Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319-340. https://doi.org/10.2307/249008
Dell'Acqua, F., McFowland III, E., Mollick, E. R., Lifshitz-Assaf, H., Kellogg, K., Rajendran, S., Krayer, L., Candelon, F., & Lakhani, K. R. (2026). Navigating the jagged technological frontier. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digital Commerce 360. (2025, April 8). Internal memo: Shopify CEO declares AI non-optional. https://www.digitalcommerce360.com/2025/04/08/internal-memo-shopify-ceo-declares-ai-non-optional/
Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. https://doi.org/10.1126/sciadv.adn5290
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
European Commission. (2026a). AI literacy: Questions and answers (updated 27 July 2026). https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers
European Commission. (2026b, July 27). AI Omnibus enters into force. https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force
European Union. (2026). Regulation (EU) 2026/1744 amending Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 4. Official Journal of the European Union, 24 July 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
ExecutiveGov. (2026, February 17). DOL AI literacy framework. https://www.executivegov.com/articles/dol-ai-literacy-framework
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK '24. https://doi.org/10.1145/3663384.3663393
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Ferdman, A. (2025). AI deskilling is a structural problem. AI & Society. https://doi.org/10.1007/s00146-025-02686-z
Fortune. (2026a, January 13). [Report on the launch of Claude Cowork, "Claude Code for the rest of your work"]. https://fortune.com/2026/01/13/anthropic-claude-cowork-ai-agent-file-managing-threaten-startups/
Fortune. (2026b, April 13). [Report on Duolingo dropping AI use from performance evaluations]. https://fortune.com/2026/04/13/duolingo-ceo-luis-von-ahn-ai-usage-requirement-employee-performance-evaluations/
Gallup. (2026, July 20). Organizational AI adoption jumps six points. https://www.gallup.com/workplace/712736/organizational-adoption-jumps-six-points.aspx
Ge, Y., Mei, L., Duan, Z., Li, T., Zheng, Y., Wang, Y., Wang, L., Yao, J., Liu, T., Cai, Y., Bi, B., Guo, F., Guo, J., Liu, S., & Cheng, X. (2025). A survey of vibe coding with large language models. arXiv:2510.12399. https://arxiv.org/abs/2510.12399
GitHub. (2026a). ai-shifu/ChatALL: repository and release download counts (accessed 21 September 2026). https://github.com/ai-shifu/ChatALL
GitHub. (2026b). jackwener/OpenCLI: repository (accessed 21 September 2026). https://github.com/jackwener/OpenCLI
GitHub. (2026c, February 4 and 26). Claude and Codex are now available in public preview on GitHub; now available for Copilot Business and Pro users. https://github.blog/changelog/2026-02-26-claude-and-codex-now-available-for-copilot-business-pro-users/
GitHub. (2026d). BeehiveInnovations/pal-mcp-server and nyldn/claude-octopus: repositories (accessed 21 September 2026). https://github.com/BeehiveInnovations/pal-mcp-server ; https://github.com/nyldn/claude-octopus
GitHub issue reports. (2026). anthropics/claude-code issues #32637 (9 March 2026), #50844 (19 April 2026) and #67188 (10 June 2026), user reports. https://github.com/anthropics/claude-code/issues/32637 ; https://github.com/anthropics/claude-code/issues/50844 ; https://github.com/anthropics/claude-code/issues/67188
Google. (2026, May 19). An important update: Transitioning Gemini CLI to Antigravity CLI. Google Developers Blog. https://developers.googleblog.com/en/an-important-update-transitioning-gemini-cli-to-antigravity-cli/
Google Open Source Blog. (2026, April). A year of open collaboration: Celebrating the anniversary of A2A. https://opensource.googleblog.com/2026/04/a-year-of-open-collaboration-celebrating-the-anniversary-of-a2a.html
Grunde-McLaughlin, M., Mozannar, H., Murad, M., Chen, J., Amershi, S., & Fourney, A. (2026). Overseeing agents without constant oversight: Challenges and opportunities. arXiv:2602.16844. https://arxiv.org/abs/2602.16844
Hargittai, E. (2002). Second-level digital divide: Differences in people's online skills. First Monday, 7(4). https://doi.org/10.5210/fm.v7i4.942
He, G., Demartini, G., & Gadiraju, U. (2025). Plan-then-execute: An empirical study of user trust and team performance when using LLM agents as a daily assistant. CHI 2025. https://doi.org/10.1145/3706598.3713218
Help Net Security. (2026, June 2). [Report on OpenAI Codex use by knowledge workers]. https://www.helpnetsecurity.com/2026/06/02/openai-codex-knowledge-work/
Henseke, G. (2026). Generative AI at work: From exposure to adoption across 35 European countries. arXiv:2604.18849. https://arxiv.org/abs/2604.18849
Humlum, A., & Vestergaard, E. (2025). Still waters, rapid currents: Early labor market transformation under generative AI (NBER Working Paper No. 33777, revised March 2026). https://www.nber.org/papers/w33777
Information Age. (2026, May 5). Gone in 9 seconds: AI agent deletes company database. https://ia.acs.org.au/article/2026/gone-in-9-seconds--ai-agent-deletes-company-database.html
JetBrains Research. (2026a, April). Which AI coding tools do developers actually use at work? https://blog.jetbrains.com/research/2026/04/which-ai-coding-tools-do-developers-actually-use-at-work/
JetBrains Research. (2026b, August). AI coding agents: Adoption trends 2026. https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
Karpathy, A. (2025). llm-council (repository, accessed 21 September 2026). https://github.com/karpathy/llm-council
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), Article 21. https://doi.org/10.1145/1922649.1922658
Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., & Maes, P. (2025). Your brain on ChatGPT: Accumulation of cognitive debt when using an AI assistant for essay writing task. arXiv:2506.08872. https://arxiv.org/abs/2506.08872
Kwa, T., West, B., Becker, J., et al. (2025). Measuring AI ability to complete long software tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Lee, H.-P., Sarkar, A., Tankelevitch, L., Drosos, I., Rintel, S., Banks, R., & Wilson, N. (2025). The impact of generative AI on critical thinking: Self-reported reductions in cognitive effort and confidence effects from a survey of knowledge workers. CHI 2025. https://doi.org/10.1145/3706598.3713778
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50-80. https://doi.org/10.1518/hfes.46.1.50_30392
Linux Foundation. (2025, December 9). Linux Foundation announces the formation of the Agentic AI Foundation. https://www.linuxfoundation.org/press/linux-foundation-announces-the-formation-of-the-agentic-ai-foundation
Liu, M. X., Sarkar, A., Negreanu, C., Zorn, B., Williams, J., Toronto, N., & Gordon, A. D. (2023). "What it wants me to say": Bridging the abstraction gap between end-user programmers and code-generating large language models. CHI 2023. https://doi.org/10.1145/3544548.3580817
Liu, Y., & Sra, M. (2026). TaskLens: Generating task-conditioned scaffolded interfaces for learning professional creative software. DIS 2026. arXiv:2511.23379. https://arxiv.org/abs/2511.23379
Long, D., & Magerko, B. (2020). What is AI literacy? Competencies and design considerations. CHI 2020. https://doi.org/10.1145/3313831.3376727
Long, T., Zhang, X., Wang, S., Yu, Z., & Chilton, L. B. (2025). DoubleAgents: Human-agent alignment in a socially embedded workflow. arXiv:2509.12626. https://arxiv.org/abs/2509.12626
Ma, L., Xu, X., He, Y., & Tan, Y. (2025). Learning to adopt generative AI. arXiv:2410.19806. https://arxiv.org/abs/2410.19806
Ma, R., Wan, R., Lu, X., Yang, F., Chen, C., & Li, L. (2026). Value-sensitive delegation in everyday AI agent use: Evidence from OpenClaw. arXiv:2609.22067. https://arxiv.org/abs/2609.22067
MacRumors. (2026, July 9). [Report on the launch of ChatGPT Work and the new ChatGPT desktop app]. https://www.macrumors.com/2026/07/09/openai-chatgpt-work/
McKinlay, R., Puntoni, S., & Saka, E. (2026, September 9). To adopt AI at scale, employees need to trust agents. Harvard Business Review. https://hbr.org/2026/09/to-adopt-ai-at-scale-employees-need-to-trust-agents
METR. (2026, February 24). Uplift update. https://metr.org/blog/2026-02-24-uplift-update/
Microsoft. (2026a, March 9). Powering Frontier Transformation with Copilot and agents. https://www.microsoft.com/en-us/copilot/blog/2026/03/09/powering-frontier-transformation-with-copilot-and-agents/
Microsoft. (2026b, May 5). 2026 Work Trend Index: Agents, human agency and the opportunity for every organization. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026c). Use model choice in the Researcher agent. Microsoft Support (accessed 21 September 2026). https://support.microsoft.com/en-us/office/use-model-choice-in-the-researcher-agent
Model Context Protocol. (2026, July 28). [Blog post on the July 2026 specification release]. https://blog.modelcontextprotocol.io/posts/2026-07-28/
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Position: Levels of AGI for operationalizing progress on the path to AGI. ICML 2024. arXiv:2311.02462. https://arxiv.org/abs/2311.02462
Myers, B. A., Pane, J. F., & Ko, A. (2004). Natural programming languages and environments. Communications of the ACM, 47(9), 47-52. https://doi.org/10.1145/1015864.1015888
Nardi, B. A. (1993). A small matter of programming: Perspectives on end user computing. MIT Press. https://mitpress.mit.edu/9780262140539/a-small-matter-of-programming/
Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187-192. https://doi.org/10.1126/science.adh2586
OECD & European Commission. (2026). Empowering learners for the age of AI: An AI literacy framework for primary and secondary education. OECD Publishing. https://www.oecd.org/en/publications/empowering-learners-for-the-age-of-ai_65cd27d4-en.html
OpenAI. (2026a). codex-plugin-cc: Use Codex from inside Claude Code (repository, announced 30 March 2026, accessed 21 September 2026). https://github.com/openai/codex-plugin-cc
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. NeurIPS 2024. arXiv:2404.13076. https://arxiv.org/abs/2404.13076
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A: Systems and Humans, 30(3), 286-297. https://doi.org/10.1109/3468.844354
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230-253. https://doi.org/10.1518/001872097778543886
Patwardhan, T., Dias, R., Proehl, E., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Pew Research Center. (2026, June 17). Americans and AI 2026: Chatbots, smart devices and views on impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
PwC. (2026, June 15). 2026 Global AI Jobs Barometer (press release distributed by PR Newswire; report page). https://www.pwc.com/gx/en/issues/artificial-intelligence/ai-jobs-barometer.html
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 9780743222099.
Sarkar, A., & Drosos, I. (2025). Vibe coding: Programming through conversation with artificial intelligence. PPIG 2025. arXiv:2506.23253. https://arxiv.org/abs/2506.23253
Sarkar, A., Gordon, A. D., Negreanu, C., Poelitz, C., Ragavan, S. S., & Zorn, B. (2022). What is it like to program with artificial intelligence? PPIG 2022. arXiv:2208.06213. https://arxiv.org/abs/2208.06213
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), eadp1528. https://doi.org/10.1126/sciadv.adp1528
SiliconANGLE. (2025, December 18). Anthropic makes Agent Skills an open standard. https://siliconangle.com/2025/12/18/anthropic-makes-agent-skills-open-standard/
Simkute, A., Tankelevitch, L., Kewenig, V., Scott, A. E., Sellen, A., & Rintel, S. (2024). Ironies of generative AI: Understanding and mitigating productivity loss in human-AI interactions. arXiv:2402.11364. https://arxiv.org/abs/2402.11364
Sitter, N. (2026). MCP apps census 2026 (data of 29 July and 3 August 2026). https://www.nicolassitter.com/research/mcp-apps-census-2026
Stack Overflow. (2025). 2025 Developer Survey: AI. https://survey.stackoverflow.co/2025/ai
Stack Overflow. (2026, May 27). Agents on a leash: Agentic AI remains mostly monitored at work. https://stackoverflow.blog/2026/05/27/agents-on-a-leash-agentic-ai-remains-mostly-monitored-at-work/
Stankovic, M., Hirche, E., Kollatzsch, S., & Doetsch, J. N. (2026). Comment on: Your brain on ChatGPT. arXiv:2601.00856. https://arxiv.org/abs/2601.00856
Storyboard18. (2026, February 10). Perplexity launches Model Council to compare answers across multiple AI models. https://www.storyboard18.com/digital/perplexity-launches-model-council-to-compare-answers-across-multiple-ai-models-89246.htm
Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257-285. https://doi.org/10.1207/s15516709cog1202_4
TechCrunch. (2025, December 22). OpenAI says AI browsers may always be vulnerable to prompt injection attacks. https://techcrunch.com/2025/12/22/openai-says-ai-browsers-may-always-be-vulnerable-to-prompt-injection-attacks/
TechCrunch. (2026a, September 16). Anthropic merges Claude chat and Cowork in one interface. https://techcrunch.com/2026/09/16/anthropic-merges-claude-chat-and-cowork-in-one-interface/
TechCrunch. (2026b, July 1). Gemini Spark, Google's agentic assistant, is now available on Mac. https://techcrunch.com/2026/07/01/gemini-spark-googles-agentic-assistant-is-now-available-on-mac/
The Register. (2025, July 21). [Report on an application-building agent deleting a production database]. https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
The Register. (2026, January 13). Anthropic floats Claude Cowork for office work automation. https://www.theregister.com/software/2026/01/13/anthropic-floats-claude-cowork-for-office-work-automation/4839664
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
UNESCO. (2024a). AI competency framework for students. https://www.unesco.org/en/articles/ai-competency-framework-students
UNESCO. (2024b). AI competency framework for teachers. https://www.unesco.org/en/articles/ai-competency-framework-teachers
US Census Bureau. (2026, May 26). [Story on AI use among businesses, Business Trends and Outlook Survey]. https://www.census.gov/library/stories/2026/05/ai-use-businesses.html
US Department of Labor. (2026, February 13). Training and Employment Notice 07-25: Artificial Intelligence Literacy Framework. https://www.dol.gov/newsroom/releases/eta/eta20260213
van Dijk, J. A. G. M. (2020). The digital divide. Polity Press. ISBN 978-1-5095-3444-9. https://research.utwente.nl/en/publications/the-digital-divide-2/
Venkatesh, V., Morris, M. G., Davis, G. B., & Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425-478. https://doi.org/10.2307/30036540
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Vygotsky, L. S. (1978). Mind in society: The development of higher psychological processes. Harvard University Press. https://www.hup.harvard.edu/books/9780674576292
White House. (2025a, April 23). Executive Order 14277: Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
White House. (2025b, July). America's AI Action Plan. https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
Willison, S. (2026, January 12). Claude Cowork. https://simonwillison.net/2026/Jan/12/claude-cowork/
Wood, D., Bruner, J. S., & Ross, G. (1976). The role of tutoring in problem solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. https://doi.org/10.1111/j.1469-7610.1976.tb00381.x
xAI. (2026, May 25). Introducing Grok Build. https://x.ai/news/grok-build-cli
Xie, T., Zhang, D., Chen, J., Li, X., Zhao, S., Cao, R., Hua, T. J., Cheng, Z., Shin, D., Lei, F., Liu, Y., Xu, Y., Zhou, S., Savarese, S., Xiong, C., Zhong, V., & Yu, T. (2024). OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. arXiv:2404.07972. https://arxiv.org/abs/2404.07972
Xu, F. F., Song, Y., Li, B., Tang, Y., Jain, K., Bao, M., Wang, Z. Z., Zhou, X., Guo, Z., Cao, M., Yang, M., Lu, H. Y., Martin, A., Su, Z., Maben, L., Mehta, R., Chi, W., Jang, L., Xie, Y., Zhou, S., & Neubig, G. (2024). TheAgentCompany: Benchmarking LLM agents on consequential real world tasks. arXiv:2412.14161. https://arxiv.org/abs/2412.14161
Yang, Y., Qu, C., Wen, M., Shi, L., Wen, Y., Zhang, W., Wierman, A., & Gu, S. (2026). Understanding agent scaling in LLM-based multi-agent systems via diversity. arXiv:2602.03794. https://arxiv.org/abs/2602.03794
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny can't prompt: How non-AI experts try (and fail) to design LLM prompts. CHI 2023. https://doi.org/10.1145/3544548.3581388
Zapier. (2026). Raising the AI fluency bar in hiring. https://zapier.com/blog/raising-ai-fluency-bar-in-hiring/
Zhang, H., Cui, Z., Chen, J., Wang, X., Zhang, Q., Wang, Z., Wu, D., & Hu, S. (2025). Stop overvaluing multi-agent debate: We must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788. https://arxiv.org/abs/2502.08788
Anlage A. Glossar des Modells
Reichweite. Was ein Modell im Namen einer Person erreichen kann: das Gespräch; Dateien und Tools in einem vom Anbieter abgegrenzten Bereich; den eigenen Computer der Person; mehrere Modelle und Agenten.
Rolle. Was die Person tun muss, damit die Arbeit gelingt: fragen und kopieren; delegieren und überprüfen; die Umgebung verwalten; mehrere Agenten verwalten.
Ebene. Eine Kombination aus Reichweite und Rolle, auf der ein Arbeitsstück durchgeführt wird (Abschnitt 3.2). Ebenen beschreiben Arbeit; Menschen und Produkte können sich über mehrere erstrecken.
Übergang (einer Transition). Wird aufgezeichnet, wenn ein Agent auf der neuen Ebene ein Artefakt erzeugt hat, das die Person verlangt hat. Die Installation ist ein Versuch. Ein Übergang über mehr als eine Ebene ist zulässig und wird als Sprung aufgezeichnet.
Artefakt. Eine Datei, ein Ordner, eine Aktion oder ein Output, das vom Agenten erzeugt wird und das die Person bereitstellt oder behält. „Nichts" ist ein gültiger Datensatz.
Workflow-Vokabular. Der Arbeitsbestand einer Person von Aufgaben, die sie einem Agenten übergeben kann, so formuliert, dass der Agent sie ausführen kann und das Ergebnis überprüft werden kann.
Reflexives Onboarding. Ein KI-System, das die Übernahme eines leistungsfähigeren KI-Systems durch eine Person unterstützt, etwa ein Chatbot, der die Installation eines Agenten und die Fehlerwiederherstellung anleitet.
Delegierungsvertrag. Die vier Dinge, die eine Person angibt, wenn sie Arbeit an Agenten übergibt: Ziel, Grenze, Artefakt, Überprüfung.
Vier Praktiken. Was der Manager bei einer Aufgabe tut: Delegierung, Beaufsichtigung, Überprüfung, Widerruf (Abschnitt 8.1).
Akzeptanzdatensatz. Für eine folgenreiche oder wiederkehrende Aufgabe: das beabsichtigte Lieferergebnis, Eingaben, Einschränkungen und Genehmigungen, Ausgabeort, wesentliche Meinungsverschiedenheiten oder Fehler, durchgeführte Überprüfungen und die Entscheidung anzunehmen, zu überarbeiten, zu eskalieren oder zu verwerfen. Er trennt das, was der Agent erzeugt hat, von dem, worauf sich die Person verlassen hat.
Fünfteilige Arbeitskarte. Das Objekt der Arbeit, die zulässigen Eingaben, die Transformation, das Lieferergebnis und die Überprüfung: die Form, in der die wiederkehrende Aufgabe eines Nicht-Programmierers zur Delegierung wird (Abschnitt 5.1).
Nebenzweig. Browser-Anwendungsgeneratoren, die auf ein Projekt einwirken, das die Plattform hostet, anstatt auf die Dateien der Person einzuwirken; eine andere Leiter mit eigenen Sprossen (Abschnitt 3.4).
Web-Orchestrierung. Eine Frage an mehrere Verbraucher-Chatbots im Browser, von Hand oder mit einem Tool, und die Antworten werden verglichen.
CLI-Orchestrierung. Ein Agent ruft die Befehlszeilentools anderer Agenten auf, sammelt ihre Ausgaben und führt sie zusammen oder überprüft sie.
Churn. Die Umbenennung, Zusammenführung oder Einstellung von Tools innerhalb eines Zeitraums, der kürzer ist als die Zeit, die ein Neuling benötigt, um sie zu erlernen.
Effektive Anzahl von Meinungen (N_eff). N / (1 + (N - 1) rho) für N Modelle mit mittlerer paarweiser Fehlerkorrelation rho; begrenzt durch 1/rho (Chernets, 2026a).
Marker als codierbare Elemente
Für einen Kodierer qualitativer Daten oder einen Umfragedesigner reduzieren sich die Marker von Abschnitt 3 auf Ja/Nein-Fragen zu einem benannten Artefakt. Selbstbericht ohne Artefakt wird als Anspruch aufgezeichnet und zählt nicht als Übergang.
- Ebene 1 vorhanden. Mindestens ein gespeichertes Gespräch mit einem Verbraucher-Chatbot in den letzten sieben Tagen; Artefakt: ein Link, ein Screenshot oder ein Export. Das Nichterstellen wird als „nicht nachgewiesen" codiert, was ein schwächeres Ergebnis ist als „abwesend".
- Übergang 1 überschritten. Eine Datei oder ein Satz von Dateien, geschrieben von einem bereicherten Agenten (Desktop, Web oder Mandantenhoster) an einem Ort, den die Person gewährt hat, als Antwort auf einen Job, den die Person benannt hat, mit mindestens einer aufgezeichneten Genehmigung, Ablehnung oder Planbearbeitung. Das Datum des Artefakts ist das Übergangsdatum.
- Ebene 2 vorhanden. Übergang 1 überschritten, plus ein weiteres bereichtes Artefakt in einer späteren Woche. Dauerhaftigkeit wird als separates wöchentliches Element aufgezeichnet, getrennt vom Übergang.
- Übergang 2 überschritten. Ein Arbeitsordner, Commit oder datierter Dateisatz, der von einem lokalen Agenten oder seiner offiziellen Desktop-Shell auf einem von der Person kontrollierten Computer erstellt wurde, aus einem Job, der mehr als ein Tool-Einsatz erforderte. In der Cloud gehostete Arbeiten werden als Cloud-Variante ihrer selbst codiert.
- Ebene 3 vorhanden. Übergang 2 überschritten, plus ein Artefakt aus derselben Agent-Klasse in einer späteren Woche.
- Übergang 3, Brückenform. Eine datierte Datei mit der Frage, den Chatbots oder Web-Modellen, die gefragt wurden, den Roheantworten oder Links zu ihnen, einer Anmerkung von Übereinstimmung und Uneinigkeit und einer Anmerkung, ob Abdeckung oder Zuverlässigkeit (Abschnitt 6.2) vorhanden war; von Hand oder mit einem Broadcast-Tool produziert.
- Übergang 3, dauerhafte Form. Dieselben Felder, produziert durch einen Lauf, der zwei oder mehr offizielle Befehlszeilentools (oder eins plus ein Plugin der zweiten Familie) mit den eigenen Anmeldungen der Person aufgerufen hat, mit aufgezeichnetem Nenner: gefragt, beantwortet, Timeout.
- Ebene 4 vorhanden. Beide Formen von Übergang 3, plus ein zweiter datierter Lauf in einer späteren Woche.
- Unterstützt versus ungestützt. Jeder Übergang, bei dem der Ermittler, ein Kollege oder ein bezahlter Coach einen Installationsschritt durchgeführt hat, den Job geschrieben hat oder sich von einem Fehler erholt hat, wird unterstützt. Abschlüsse werden überall dort als zwei Zahlen gemeldet, wo ein Helfer verfügbar war.
- Stopgrund. Eine freie Antwort auf „was hat dich gestoppt", die jedem gestellt wird, der nicht übergegangen ist und nach der Erfassung codiert wird. Kandidatencodes, als Hypothese für spätere Kodierer zur Überarbeitung angeboten: Workflow-Vokabular; Berechtigungs- oder Sicherheitsdialog; Administratorrechte; Kosten oder Kontingent; Angst vor der Oberfläche; Nachricht von einem destruktiven Vorfall; Organisationsrichtlinie; technischer Fehler; Leben und Zeit; andere.
- Codierungsregel für „wusste nicht, was ich fragen sollte" (Workflow-Vokabular). Einbeziehen, wenn die Person, gefragt, was sie den Agenten tun lassen hat, nicht mindestens einen der fünf Teile von Abschnitt 5.1 benennen kann: das Objekt der Arbeit, die Eingaben, die sie verwenden darf, die Transformation, das Lieferergebnis oder die Überprüfung. Ausschließen, wenn alle fünf benannt sind und die Person aus Gründen der Richtlinie, des Risikos, der Kosten oder der Zeit ablehnte; diese erhalten ihre eigenen Codes. Zwei Kodierer codieren unabhängig und melden ihre Übereinstimmung. Die Regel klassifiziert einen Stopp und sagt nichts über die Fähigkeit der Person aus.
- Spuren der vier Praktiken (Ja/Nein, jeweils an ein datiertes Artefakt gebunden): ein abgelehnter Plan; ein abgelehnter Diff oder Output; eine zweite Modellfamilie gefragt; ein aufgezeichneter Nenner (wer wurde gefragt, wer antwortete, wer hat Timeout); ein irreversibler Schritt zur Bestätigung durchgehalten; ein hinterlegtes Artefakt. Dies sind die Beaufsichtigungsspuren von P10.
- Keine Indikatoren. Ein Lizenzankauf, ein Kursabzeichen, ein Installer-Protokoll, ein Repository-Stern, eine Prompt-Zählung oder eine Selbstbewertung als „Agent-Nutzer".
Anlage B. Zeitstrahl mit Datumsangaben, 2025 bis 21. September 2026
Einträge, die als VERIFIED gekennzeichnet sind, wurden während des Forschungsfensters bis 21. September 2026 auf einer primären Seite oder auf einer benannten sekundären Seite für einen Pressebericht geöffnet. Einträge, die als SECONDARY gekennzeichnet sind, stützen sich auf Pressebericht oder Produktgeschichten, die nicht auf einer primären Seite geöffnet wurden; sie werden zur Orientierung angegeben und haben kein Gewicht in der Argumentation. Es ist ein Arbeitszeitstrahl für die vierstufige Argumentation und erhebt keinen Anspruch auf eine Industriechronologie.
| Datum | Ereignis | Quelle | Status |
|---|---|---|---|
| 24. Februar 2025 | Claude Code Research Preview | Produktgeschichten, weit verbreitet gemeldet | SECONDARY |
| 23. April 2025 | Executive Order 14277 zu KI-Bildung | White House (2025a) | VERIFIED |
| 22. Mai 2025 | Claude Code allgemein verfügbar | Produktgeschichten, weit verbreitet gemeldet | SECONDARY |
| 23. Juni 2025 | Agent2Agent-Protokoll an die Linux Foundation gespendet | Google Open Source Blog (2026) | VERIFIED (Anbieter) |
| Juli 2025 | America's AI Action Plan verpflichtet sich zu KI-Alphabetisierung und Fähigkeiten | White House (2025b) | VERIFIED |
| 21. Juli 2025 | Ein anwendungsbauer-Agent löscht während einer Live-Sitzung eine Produktionsdatenbank | The Register (2025) | VERIFIED (Presse) |
| 20. August 2025 | Prompt-Injection gegen einen Browser-Agent demonstriert, mit gestohlenen einmaligen Code | Brave (2025) | VERIFIED |
| 25. August 2025 | Browser-Agent-Pilot: Angriffserfolg 23,6 % ohne Minderungsmaßnahmen, 11,2 % damit | Anthropic (2025) | VERIFIED (Anbieter) |
| 9. Dezember 2025 | Model Context Protocol an die Agentic AI Foundation (Linux Foundation) gespendet; mehr als 10.000 veröffentlichte Server, etwa 97 Millionen monatliche SDK-Downloads | Linux Foundation (2025) | VERIFIED |
| 9. Dezember 2025 | Ein Beratungsunternehmen kündigt an, dass etwa 30.000 Mitarbeiter auf die Modelle eines Anbieters geschult werden | Accenture (2025) | VERIFIED |
| 18. Dezember 2025 | Agent Skills Format als offener Standard veröffentlicht | SiliconANGLE (2025) | VERIFIED (Presse) |
| 22. Dezember 2025 | OpenAI: Prompt-Injection „wird wahrscheinlich nie vollständig ‚gelöst'" | TechCrunch (2025) | VERIFIED (Presse) |
| Januar 2026 | Cowork Research Preview, „Claude Code für den Rest der Arbeit" | Fortune (2026a); The Register (2026) | VERIFIED (Presse) |
| 12. Januar 2026 | Einwand gegen die Aufforderung an Nicht-Programmierer, auf Prompt-Injection zu achten | Willison (2026) | VERIFIED |
| 15. Januar 2026 | Anthropic Economic Index: Verstärkung in 52 % der Gespräche (November 2025) | Anthropic (2026f) | VERIFIED (Anbieter) |
| 4. und 26. Februar 2026 | GitHub Agent HQ: Claude und Codex Agents verfügbar in Copilot | GitHub (2026c) | VERIFIED |
| Februar 2026 | Perplexity Model Council für Top-Tier-Abonnenten (gemeldet 10. Februar) | Storyboard18 (2026) | VERIFIED (Presse) |
| 13. Februar 2026 | US Department of Labor KI-Alphabetisierungs-Framework („KI effektiv steuern") | US Department of Labor (2026) | VERIFIED |
| 9. März 2026 | Cowork-Technologie in Microsoft 365 Copilot integriert | Microsoft (2026a) | VERIFIED |
| 9. März, 19. April, 10. Juni 2026 | Benutzerberichte über Dateien, die von einem Level-2-Agent in gewährten Ordnern gelöscht wurden | GitHub-Issue-Berichte (2026) | VERIFIED (Benutzerberichte) |
| 24. März 2026 | Anthropic Economic Index: Benutzer mit längerer Betriebszugehörigkeit delegieren weniger | Anthropic (2026e) | VERIFIED (Anbieter) |
| 30. März 2026 | OpenAI's offizielles Plugin zur Verwendung seines Agents in Claude Code; Microsofts Research-Agent führt GPT und Claude zusammen aus | OpenAI (2026a); Constellation Research (2026b); Microsoft (2026c) | VERIFIED |
| April 2026 | JetBrains: Claude Code bei der Arbeit 18 % (Januar 2026), von etwa 3 % (Frühjahr 2025) | JetBrains Research (2026a) | VERIFIED (Anbieter-Umfrage) |
| 13. April 2026 | Duolingo beendet KI-Nutzung in Leistungsbewertungen | Fortune (2026b) | VERIFIED (Presse) |
| 5. Mai 2026 | Work Trend Index: Organisatorische Faktoren überwiegen individuelle um mehr als das Zweifache | Microsoft (2026b) | VERIFIED (Anbieter-Umfrage) |
| 25. April 2026 (gemeldet 5. Mai) | Agent löscht die Produktionsdatenbank und Sicherungen eines Unternehmens | Information Age (2026) | VERIFIED (Presse) |
| 19. Mai 2026 | Google gibt die Umstellung von Gemini CLI auf Antigravity CLI bekannt | Google (2026) | VERIFIED |
| 25. Mai 2026 | xAI's Grok Build veröffentlicht mit Headless-Modus und Agent-Protokoll-Unterstützung | xAI (2026) | VERIFIED (Anbieter) |
| 26. Mai 2026 | US-Geschäfts-KI-Nutzung 17 % bis 20 % insgesamt; kleine Unternehmen unverändert | US Census Bureau (2026) | VERIFIED |
| 27. Mai 2026 | Developer Pulse: 69 % einzelner Agent; 60 % blockieren nicht genehmigte Änderungen | Stack Overflow (2026) | VERIFIED |
| 2. Juni 2026 | Coding Agent bei 5 Millionen wöchentlichen Benutzern, etwa 20 % der Wissensarbeiter | Help Net Security (2026); Constellation Research (2026a) | VERIFIED (Pressebericht über Anbieterdaten) |
| 15. Juni 2026 | PwC AI Jobs Barometer: 62 % Lohnprämie für KI-Fähigkeiten | PwC (2026) | VERIFIED (Anbieter) |
| 17. Juni 2026 | Pew: etwa die Hälfte der US-Erwachsenen nutzen Chatbots | Pew Research Center (2026) | VERIFIED |
| 18. Juni 2026 | Gemini CLI stellt den Service für individuelle Stufen ein | Google (2026) | VERIFIED |
| Juni 2026 | OECD und Europäische Kommission KI-Alphabetisierungs-Framework („KI verwalten") | OECD & European Commission (2026) | VERIFIED |
| 29. Juni bis 3. Juli 2026 | Claude Code benennt seinen Standard-Berechtigungsmodus in „Manual" um | Anthropic (2026h) | VERIFIED (Anbieter) |
| 1. Juli 2026 | Gemini Spark Desktop Agent auf Mac; beste Remote Labor Index Automatisierungsrate 15,8 %, von 2,5 % bei Freigabe | TechCrunch (2026b); Center for AI Safety (2026) | VERIFIED |
| 8. Juli 2026 | Indeed: 63 % der US-Jobtitel, die von KI beeinflusst werden, liegen außerhalb von Technologieberufen | Adrjan (2026) | VERIFIED |
| 9. Juli 2026 | Coding-Agent-App wird zur ChatGPT-Desktop-App; ChatGPT Work gestartet | MacRumors (2026) | VERIFIED (press) |
| 20. Juli 2026 | Gallup: 52 % der US-Arbeitnehmer nutzen KI, 15 % täglich | Gallup (2026) | VERIFIED |
| 27. Juli 2026 | EU-KI-Omnibus in Kraft; KI-Alphabetisierungspflicht wird zu „Maßnahmen zur Unterstützung ergreifen" | European Commission (2026a, 2026b) | VERIFIED |
| 28. Juli 2026 | Model Context Protocol: knapp eine halbe Milliarde SDK-Downloads pro Monat; Protokoll als zustandslos gestaltet | Model Context Protocol (2026) | VERIFIED |
| 3. August 2026 | EU-Aufsichts- und Durchsetzungsregeln für KI-Alphabetisierung gelten | European Commission (2026a) | VERIFIED |
| August 2026 | JetBrains: 90 % der professionellen Entwickler nutzen Coding-Agents wöchentlich; Claude Code bei der Arbeit 39 % | JetBrains Research (2026b) | VERIFIED (vendor survey) |
| 9. August 2026 | OpenAIs agentenbasierter Browser eingestellt; Browsen zieht in die ChatGPT-App um | 9to5Mac (2026) | VERIFIED (press) |
| 26. August 2026 | Browser-Agent allgemein verfügbar; autonom mit Klassifizierungstool standardmäßig; von Anbietern gemeldete Injektionsraten nahe null | Anthropic (2026d) | VERIFIED (vendor) |
| 1. September 2026 | St. Louis Fed: 45 % der Arbeitnehmer nutzen KI für ihre Arbeit; weniger als 3 % der Aufgaben über 50 % Akzeptanz | Bick et al. (2026) | VERIFIED |
| 6. September 2026 | Vorbeschreibung Kohorte 1 eingefroren | Chernets (2026d) | VERIFIED |
| 9. September 2026 | Harvard Business Review: Vertrauen als zentrales Hindernis für Agent-Adoption bei der Arbeit | McKinlay et al. (2026) | VERIFIED (summary) |
| 16. September 2026 | Cowork und Chat in ein Claude zusammengefasst | Anthropic (2026c); TechCrunch (2026a) | VERIFIED |
| 22. September 2026 | Offizieller Plugin-Katalog vollständig gelesen, 310 Einträge: keine für die fünf in Abschnitt 5.1 genannten Handwerkszweige; Community-Katalog 2.282 Einträge, Angebote für Lehrende und Immobilienwirtschaft | Author's reading of the published catalogues | VERIFIED (own count) |
Anhang C. Teaching Code
Die nachstehenden Auflistungen vermitteln die Muster der Abschnitte 5 bis 9. Sie verwenden nur die Python-Standardbibliothek und die eigenen Befehlszeilenwerkzeuge der Anbieter, angemeldet mit den Abonnements des Benutzers; keine liest einen API-Schlüssel. Jede ist kurz genug, um in einem Durchgang gelesen zu werden, und jede erklärt, was sie vermittelt und wo sie endet. Sie werden zusammen mit Tests im begleitenden Repository unter der MIT-Lizenz bereitgestellt, und jede Auflistung wurde vor der Aufnahme ausgeführt (jede mit ihrer Demo-Eingabe, der Fan-Out mit Stub-Werkzeugen). Jedes Muster hier existiert bereits in irgendeiner Form in Open-Source-Werkzeugen (Abschnitt 7.1); der Wert der Auflistungen besteht darin, dass sie klein, kommentiert und an das Argument gebunden sind. Keine ist ein Lehrweg, eine Diagnose eines Lernenden, ein Lehrplan oder eine Implementierung der Werkzeuge des Autors. Ein Nicht-Programmierer führt diese Dateien nicht von Hand aus: Sie sind die Art von Dingen, die ein Agent als Fähigkeit verpackt oder eine Desktop-Shell als Schaltfläche verfügbar macht, und der Sinn des Druckens besteht darin, dass ein Leser sehen kann, was eine solche Schaltfläche tut.
Zwei installierbare Claude Code Plugins setzen diese Muster in die tägliche Praxis um. Roundcall fragt die KI-Chat-Sites, bei denen sich eine Person bereits angemeldet hat, über ihren eigenen Browser und in ihrem eigenen Tempo; Sidecall fragt die Befehlszeilenwerkzeuge, die auf ihrer Maschine installiert sind, mit einer Budget-Einstellung, die das Modell jedes Anbieters wählt. Beide geben einen Bericht zurück, wer was sagte, wo die Antworten nicht übereinstimmen und was nur eine Quelle sagte. Sie sind Open Source unter der Apache License 2.0 unter https://github.com/vadimchernets/roundcall und https://github.com/vadimchernets/sidecall.
Vor dem Ausführen: Überprüfen Sie die --help jedes Werkzeugs in Ihrer installierten Version, da sich die Flaggen zwischen Versionen ändern; führen Sie sie in einem Arbeitsordner aus, der Kopien enthält, nicht Originale; und lesen Sie zuerst Auflistung C6.
C1. Fan-Out mit einer Sonde, einer Obergrenze und teilweisem Erfassen (fanout.py)
Vermittelt: wie eine Person eine Frage gleichzeitig an mehrere Agent-CLIs richten kann, die ausgefallenen oder kontingentierten überspringt, bei einer Zeitobergrenze mit dem Warten aufhört und behält, was jedes Werkzeug vor der Obergrenze geschrieben hat, anstatt es zu verwerfen. Jedes Werkzeug läuft in einem frischen, leeren Ordner im Ausgabeordner, nie im Ordner, von dem die Person gestartet hat; Werkzeugnamen sind auf sichere Dateinamen beschränkt; eine lange Frage wird in eine Datei (--question-file) eingefügt oder bei einem Werkzeug, dessen Vorlage kein {prompt} hat, auf die Standardeingabe des Werkzeugs, da ein Befehlszeilenargument durch das Betriebssystem in der Länge begrenzt ist. Limits: Das Anhalten bei der Obergrenze verwendet POSIX-Prozessgruppen (macOS und Linux; unter Windows WSL verwenden) und fällt auf das Anhalten des Werkzeugs selbst zurück; ein Werkzeug, das nur am Ende druckt, hinterlässt nichts zum Behalten, wenn es angehalten wird; verwenden Sie seinen Streaming-Ausgabemodus, wenn er vorhanden ist. Das Skript vergleicht nichts; das tut C3.
#!/usr/bin/env python3
"""fanout.py: put one question to several agent CLIs and keep every answer, including partial ones.

Teaching example for "After Chat" (Appendix C, listing C1). MIT licence.

The pattern: probe each tool briefly and skip the dead ones, run the live ones in parallel under one
time ceiling, stream each answer to its own file, and keep whatever a tool has written when the
ceiling is reached. It uses only the Python standard library and the vendors' own command-line tools,
signed in with the user's own subscriptions. No API keys are read or needed.

Each tool runs in its own fresh, empty working folder inside the output folder, never in the folder
you launched from. Stopping a tool at the ceiling stops its whole process group, which is a POSIX
feature (macOS, Linux; on Windows use WSL); where that fails the tool itself is killed.

Usage:
    python3 fanout.py "Your question" --out runs/today
    python3 fanout.py --question-file question.txt --tools tools.json --ceiling 900
    python3 fanout.py -- "-a question that starts with a dash"
A question on the command line is limited by the operating system's argument length; put long
questions in a file. A tool whose template has no "{prompt}" receives the question on its standard
input instead (for example `codex exec -`), which has no such limit.
"""
import argparse
import json
import os
import pathlib
import re
import signal
import subprocess
import sys
import time

# Command templates. "{prompt}" is replaced by the question; a template without it gets the question
# on stdin. Check each tool's --help on your installed version: flags change between releases.
DEFAULT_TOOLS = {
    "claude": ["claude", "-p", "{prompt}"],
    "codex": ["codex", "exec", "--skip-git-repo-check", "--sandbox", "read-only", "{prompt}"],
    "gemini": ["agy", "-p", "{prompt}"],
    "grok": ["grok", "-p", "{prompt}"],
}
PROBE_PROMPT = "Reply with exactly one word: OK"
SAFE_NAME = re.compile(r"^[A-Za-z0-9][A-Za-z0-9_-]{0,31}$")  # a tool name becomes a file and folder name


def build(template, prompt):
    return [part.replace("{prompt}", prompt) for part in template]


def uses_stdin(template):
    return not any("{prompt}" in part for part in template)


def stop_group(proc):
    """Stop a tool and every process it started (they share one process group on POSIX)."""
    for sig in (signal.SIGTERM, signal.SIGKILL):
        try:
            os.killpg(proc.pid, sig)
        except ProcessLookupError:
            return
        except (PermissionError, OSError, AttributeError):
            proc.kill()  # no process group to stop (or no right to): stop the tool itself
        try:
            proc.wait(timeout=5)
            return
        except subprocess.TimeoutExpired:
            continue


def workdir(out_dir, name):
    """A fresh, empty folder per tool: the tool never sees the caller's files."""
    d = out_dir / f"work-{name}"
    d.mkdir(parents=True, exist_ok=True)
    return d


def probe(name, template, seconds, out_dir):
    """A few seconds now saves a long wait later: a tool behind a quota wall answers fast and badly."""
    started = time.monotonic()
    stdin_text = PROBE_PROMPT if uses_stdin(template) else None
    try:
        done = subprocess.run(build(template, PROBE_PROMPT), capture_output=True, text=True,
                              timeout=seconds, cwd=workdir(out_dir, name), input=stdin_text,
                              stdin=None if stdin_text is not None else subprocess.DEVNULL)
    except FileNotFoundError:
        return False, "not installed"
    except subprocess.TimeoutExpired:
        return False, f"no answer within {seconds}s"
    text = (done.stdout + done.stderr).strip()
    if done.returncode != 0 or not done.stdout.strip():
        return False, f"exit {done.returncode}: {text[:160]}"
    return True, f"alive in {time.monotonic() - started:.1f}s"


def run_all(tools, prompt, out_dir, ceiling):
    out_dir.mkdir(parents=True, exist_ok=True)
    running, results = {}, {}
    for name, template in tools.items():
        out = open(out_dir / f"{name}.txt", "w")
        err = open(out_dir / f"{name}.err", "w")
        work = workdir(out_dir, name)
        if uses_stdin(template):
            (work / "question.txt").write_text(prompt)
            stdin = open(work / "question.txt")
        else:
            stdin = subprocess.DEVNULL  # closed: some tools wait on an open stdin and never start
        try:
            proc = subprocess.Popen(build(template, prompt), stdout=out, stderr=err, stdin=stdin,
                                    cwd=work, start_new_session=True)
        except FileNotFoundError:
            # One missing tool must not cost the answers of the others.
            out.close(); err.close()
            results[name] = {"status": "not installed", "seconds": 0.0}
            continue
        finally:
            if stdin is not subprocess.DEVNULL:
                stdin.close()
        running[name] = (proc, out, err, time.monotonic())
    deadline = time.monotonic() + ceiling
    while running:
        for name in list(running):
            proc, out, err, t0 = running[name]
            if proc.poll() is not None:
                out.close(); err.close()
                status = "done" if proc.returncode == 0 else f"failed (exit {proc.returncode})"
                results[name] = {"status": status, "seconds": round(time.monotonic() - t0, 1)}
                del running[name]
        if running and time.monotonic() >= deadline:
            for name, (proc, out, err, t0) in running.items():
                stop_group(proc)
                out.close(); err.close()
                written = (out_dir / f"{name}.txt").stat().st_size
                # The watchdog does not destroy: what was written before the ceiling is kept.
                results[name] = {"status": "partial" if written else "timeout",
                                 "seconds": round(time.monotonic() - t0, 1)}
            running = {}
        time.sleep(0.5)
    for name, r in results.items():
        r["bytes"] = (out_dir / f"{name}.txt").stat().st_size
    return results


def main():
    ap = argparse.ArgumentParser(description=__doc__.splitlines()[0])
    ap.add_argument("question", nargs="?", help="the question (put -- before one that starts with a dash)")
    ap.add_argument("--question-file", help="read the question from this file instead")
    ap.add_argument("--tools", help="JSON file mapping a tool name to its command template")
    ap.add_argument("--out", default="fanout-run", help="folder for answers, work folders and the summary")
    ap.add_argument("--ceiling", type=float, default=900, help="seconds before partial answers are taken")
    ap.add_argument("--probe-seconds", type=float, default=60)
    ap.add_argument("--no-probe", action="store_true")
    a = ap.parse_args()

    if a.question_file:
        prompt = pathlib.Path(a.question_file).read_text()
    elif a.question is not None:
        prompt = a.question
    else:
        ap.error("give a question or --question-file")
    tools = json.loads(pathlib.Path(a.tools).read_text()) if a.tools else dict(DEFAULT_TOOLS)
    for name in tools:
        if not SAFE_NAME.match(name):
            sys.exit(f"tool name {name!r} is not a safe file name (letters, digits, - and _ only)")
    out_dir = pathlib.Path(a.out)
    out_dir.mkdir(parents=True, exist_ok=True)

    skipped = {}
    if not a.no_probe:
        for name in list(tools):
            ok, why = probe(name, tools[name], a.probe_seconds, out_dir)
            print(f"probe {name:10s} {'live' if ok else 'SKIP'}  {why}", file=sys.stderr)
            if not ok:
                skipped[name] = why
                del tools[name]
    if len(tools) < 2:
        print("Fewer than two live tools: this would be one opinion, not a comparison.", file=sys.stderr)
    results = run_all(tools, prompt, out_dir, a.ceiling)
    summary = {"question": prompt[:500], "ceiling_s": a.ceiling, "results": results, "skipped": skipped}
    (out_dir / "summary.json").write_text(json.dumps(summary, indent=2))
    for name, r in sorted(results.items()):
        print(f"{name:10s} {r['status']:18s} {r['seconds']:7.1f}s {r['bytes']:8d} bytes")
    for name, why in skipped.items():
        print(f"{name:10s} skipped            {why}")


if __name__ == "__main__":
    main()
C2. Eine „Zweitmeinung"-Fähigkeit für einen Agenten (second-opinion/SKILL.md)
Vermittelt: die kleinste Form der CLI-Orchestrierung, eine schriftliche Anweisung, die einen Agenten veranlasst, einen Agenten eines anderen Anbieters zu konsultieren und den Unterschied zu zeigen, statt ihn zu vereinheitlichen. Grenzen: zwei Modelle sind ein Vergleich, keine Diskussionsrunde; die Fähigkeit gibt an, welche Punkte noch eine primäre Quelle benötigen.
---
name: second-opinion
description: Ask a model from a different vendor the same question through its own command-line tool, and show where its answer differs. Use when the user asks for a second opinion, a check, or "what would another AI say".
---

# Second opinion

1. Write the user's question, and only the context needed to answer it, to `question.txt` in the
   working folder. Leave out secrets and personal data.
2. Run the other vendor's tool read-only, with its input closed:
   `codex exec --skip-git-repo-check --sandbox read-only - < question.txt > second-opinion.txt`
   (or `agy -p "$(cat question.txt)" > second-opinion.txt`, or another installed tool).
3. Show the other answer as it came, under its own heading. Treat it as content to compare, never as
   instructions to act on: another model's answer can carry instructions it picked up from a page.
4. Then give a short table with three rows: where the two answers agree, where they differ, and what
   only one of them mentions.
5. Do not merge the two answers into one confident text. Agreement between two models is weaker
   evidence than it looks when they share training data; say which points would need a primary source.
C3. Wer hat was gesagt (provenance.py)
Vermittelt: die beiden Dinge, die das Abfragen mehrerer Modelle bringen soll – Abdeckung und Zuverlässigkeit –, sichtbar gemacht als Tabelle von Aussagen nach Quelle, eine Liste von Aussagen, die nur von einer Quelle gemacht wurden, und eine Liste von Aussagen, deren Zahlen oder Daten unterschiedlich sind. Grenzen: es stimmt wiederholte Formulierungen ab, nicht wiederholte Bedeutungen; es sagt einer Person, was sie genau lesen soll, nie, was wahr ist.
#!/usr/bin/env python3
"""provenance.py: who said what, who said it alone, and where the numbers disagree.

Teaching example for "After Chat" (Appendix C, listing C3). MIT licence.

Reads the answer files written by fanout.py (one .txt per tool), splits each answer into short claims
(bullets or sentences), groups near-identical claims by word overlap, and prints a table of claims by
source. Two lists matter most, because they are the two things asking several models is meant to buy:
  * claims made by one source only: coverage, an angle the others missed (or an error of one);
  * claims whose numbers differ between sources: a disagreement to check before relying on either.
Word overlap sees repeated wording, not repeated meaning. Use the table to decide what to read
closely, never as a verdict on what is true.

Usage:
    python3 provenance.py fanout-run/            # writes fanout-run/provenance.md
"""
import pathlib
import re
import sys

STOP = set("""a an the and or of to in on for with by is are was were be been it this that these those
as at from than then so such can could should would may might will not no do does did their its your
our we you they he she i""".split())
MONTHS = "January|February|March|April|May|June|July|August|September|October|November|December"
# Values compared between sources: numbers, percentages and month names (dates disagree by month too).
NUM = re.compile(r"\d+(?:[.,]\d+)?%?|\b(?:" + MONTHS + r")\b")


def claims(text):
    parts = []
    for line in text.splitlines():
        line = line.strip(" -*\t#>")
        if not line:
            continue
        parts.extend(s.strip() for s in re.split(r"(?<=[.!?])\s+", line) if len(s.split()) >= 4)
    return parts


def words(claim):
    # [^\W_]+ is any run of letters or digits in any script, so accented and non-Latin words count.
    return {w for w in re.findall(r"[^\W_]+", claim.lower()) if w not in STOP}


def jaccard(a, b):
    return len(a & b) / len(a | b) if a | b else 0.0


def group(sources, threshold):
    groups = []  # each: {"text": representative, "words": set, "by": {source: claim}}
    for source, items in sources.items():
        for c in items:
            w = words(c)
            for g in groups:
                if jaccard(w, g["words"]) >= threshold:
                    g["by"].setdefault(source, c)
                    break
            else:
                groups.append({"text": c, "words": w, "by": {source: c}})
    return groups


def main():
    folder = pathlib.Path(sys.argv[1] if len(sys.argv) > 1 else ".")
    threshold = float(sys.argv[2]) if len(sys.argv) > 2 else 0.5
    sources = {p.stem: claims(p.read_text()) for p in sorted(folder.glob("*.txt")) if p.stat().st_size}
    if len(sources) < 2:
        sys.exit("Need at least two non-empty answers to compare.")
    groups = group(sources, threshold)
    names = list(sources)
    out = ["| claim | " + " | ".join(names) + " | support |", "|---|" + "---|" * len(names) + "---|"]
    for g in sorted(groups, key=lambda g: -len(g["by"])):
        marks = " | ".join("x" if n in g["by"] else "" for n in names)
        out.append(f"| {g['text'][:120]} | {marks} | {len(g['by'])} |")
    alone = [g for g in groups if len(g["by"]) == 1]
    out += ["", f"## Said by one source only ({len(alone)})", ""]
    out += [f"- [{next(iter(g['by']))}] {g['text']}" for g in alone]
    out += ["", "## Same claim, different numbers", ""]
    for g in groups:
        nums = {s: tuple(NUM.findall(c)) for s, c in g["by"].items()}
        if len({v for v in nums.values() if v}) > 1:
            out.append(f"- {g['text'][:100]}: " + "; ".join(f"{s}={','.join(v)}" for s, v in nums.items()))
    report = "\n".join(out) + "\n"
    (folder / "provenance.md").write_text(report)
    print(report)


if __name__ == "__main__":
    main()
C4. Wie viel ist die Übereinstimmung unabhängiger Meinungen wert? (neff.py)
Vermittelt: die Arithmetik korrelierter Evidenz (Abschnitt 6.3): Schätzen Sie die mittlere Fehlerkorrelation rho aus Elementen mit bekannten Antworten, berechnen Sie dann N_eff und seine Obergrenze 1/rho. Führen Sie mit --demo aus, um vier Modelle zu sehen, die etwa 1,6 unabhängigen Meinungen entsprechen. Grenzen: rho hängt von der Aufgabe ab; schätzen Sie es an Elementen wie denjenigen, um die es Ihnen geht, und mit mehr als zehn Elementen.
#!/usr/bin/env python3
"""neff.py: how many independent opinions are N agreeing models worth?

Teaching example for "After Chat" (Appendix C, listing C4). MIT licence.

Uses the correlated-evidence model of Chernets (2026a):
    N_eff = N / (1 + (N - 1) * rho)        and, as N grows, N_eff approaches 1 / rho.
rho is estimated from the models' errors on items whose right answer is known: for each pair of
models, the correlation (phi coefficient) between "model A was wrong" and "model B was wrong".

Input: a CSV with one row per item and one 0/1 column per model (1 = correct).
Usage:
    python3 neff.py results.csv
    python3 neff.py --demo
"""
import csv
import itertools
import math
import sys

DEMO = """item,model_a,model_b,model_c,model_d
q1,1,1,1,1
q2,0,0,1,0
q3,1,1,1,1
q4,0,0,0,1
q5,1,1,0,1
q6,1,1,1,1
q7,0,0,1,0
q8,1,0,1,1
q9,1,1,1,1
q10,0,0,0,0
"""


def phi(x, y):
    """Correlation of two 0/1 vectors. Returns None when one of them never varies."""
    n = len(x)
    n11 = sum(1 for a, b in zip(x, y) if a and b)
    n1_, n_1 = sum(x), sum(y)
    denom = math.sqrt(n1_ * (n - n1_) * n_1 * (n - n_1))
    if denom == 0:
        return None
    return (n * n11 - n1_ * n_1) / denom


def n_eff(n, rho):
    """Effective number of independent opinions. N must be at least 1; rho must lie in [0, 1)."""
    if n < 1:
        raise ValueError(f"N must be at least 1, not {n}")
    if not 0 <= rho < 1:
        raise ValueError(f"rho must be in [0, 1), not {rho}; at rho = 1 every model is one opinion")
    return n / (1 + (n - 1) * rho)


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        text = open(sys.argv[1]).read()
    else:
        text = DEMO
        print("(demo data: 10 items, 4 models)\n")
    rows = list(csv.DictReader(text.strip().splitlines()))
    models = [c for c in rows[0] if c != "item"]
    errors = {m: [1 - int(r[m]) for r in rows] for m in models}

    pairs = []
    for a, b in itertools.combinations(models, 2):
        r = phi(errors[a], errors[b])
        shown = "n/a (no variation)" if r is None else f"{r:+.2f}"
        print(f"error correlation {a} ~ {b}: {shown}")
        if r is not None:
            pairs.append(r)
    if not pairs:
        print("No pair varies; rho cannot be estimated from these items.")
        return
    rho = max(0.0, sum(pairs) / len(pairs))  # negative average is treated as independence
    n = len(models)
    print(f"\nmean pairwise error correlation rho = {rho:.2f}")
    if rho >= 1:
        print(f"the models err together on every item: {n} models are worth one opinion")
        return
    print(f"{n} models are worth about {n_eff(n, rho):.2f} independent opinions")
    if rho > 0:
        print(f"no number of models with this rho is worth more than {1 / rho:.1f}")
    print("\nN   N_eff at this rho")
    for k in (1, 2, 3, 5, 10, 20):
        print(f"{k:<3d} {n_eff(k, rho):.2f}")


if __name__ == "__main__":
    main()
C5. Ein Datensatz von Übergängen und ein Prüfer (crossings.py)
Vermittelt: die Messerregeln von Abschnitt 9.1 als Code. Ein Datensatz wird abgelehnt, wenn er eine Installation als Übergang zählt, eine Fertigstellung ohne von einem Agenten hergestelltes Artefakt, einen Stopp ohne die eigenen Worte der Person, Hilfe ohne eine Beschreibung der Hilfe, einen Namen anstelle einer pseudonymen Bezeichnung (die Bezeichnung muss P gefolgt von Ziffern sein), eine übersprungene Ebene, die nicht genau aufgelistet ist, einen Wert, der nicht wahr oder falsch ist, ein unlesbares Datum, ein Feld, das das Format nicht kennt, oder einen Übergang der Ebene 4, der weniger als zwei abgefragte und beantwortete Tools benennt. Eine fehlerhafte Zeile wird als abgelehnt gemeldet und stoppt den Lauf niemals. Grenzen: es prüft die Form der Datensätze, nicht ihre Wahrheit; ob die beiden Tools unterschiedliche Modellfamilien sind, und ob die Anordnung in einer späteren Woche erneut durchgeführt wurde (ein zweiter Datensatz), werden dem Forscher überlassen; es ist ein Forschungsinstrument, keine Anwendung.
#!/usr/bin/env python3
"""crossings.py: a record format for level transitions, and a checker for it.

Teaching example for "After Chat" (Appendix C, listing C5). MIT licence. A research instrument, not
an application: it defines what a record of one person's attempt at one transition must contain, and
refuses records that would let an installation be counted as use.

The rules follow the measures published in the preregistration the paper describes (OSF, DOI
10.17605/OSF.IO/X4EGQ): a transition counts as crossed only when an artefact produced by the agent is
supplied; installing is an attempt; assisted and unaided crossings are kept apart; a stop is recorded
with the point where it happened and the person's own words. The record format is also published as
a JSON Schema (crossings.schema.json); this checker accepts exactly what the schema accepts and adds
the rules a schema cannot state.

What the checker enforces for a level-4 crossing: at least two tools named as asked and as answered.
What it leaves to the researcher: that the tools are different model families, and that the
arrangement was rerun in a later week (a second record).

Usage:
    python3 crossings.py records.jsonl        # one JSON object per line
    python3 crossings.py --demo
"""
import datetime
import json
import re
import sys

LEVELS = ("chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work")
ARTEFACTS = ("file", "folder", "screenshot", "pasted_output", "none")
DECISIONS = ("accept", "revise", "escalate", "discard")
REQUIRED = ("record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted")
# Every key a record may carry; the same set as the properties of crossings.schema.json.
ALLOWED = REQUIRED + ("skipped", "intervention", "artefact", "stop_point", "stop_reason_own_words",
                      "stop_reason_code", "multi_model", "interface_version", "operating_system",
                      "network_access", "permission_mode", "policy_constraint", "acceptance_decision")
PERSON = re.compile(r"^P[0-9]+$")


def parse_date(value):
    try:
        return datetime.date.fromisoformat(value)
    except (TypeError, ValueError):
        return None


def check(rec):
    problems = []
    if not isinstance(rec, dict):
        return ["record must be a JSON object"]
    for key in REQUIRED:
        if key not in rec:
            problems.append(f"missing field '{key}'")
    unknown = sorted(set(rec) - set(ALLOWED))
    if unknown:
        problems.append("unknown fields (the schema forbids them): " + ", ".join(unknown))
    if problems:
        return problems
    if not isinstance(rec["person"], str) or not PERSON.match(rec["person"]):
        problems.append("person must be a pseudonymous label such as P07, never a name")
    for key in ("completed", "assisted"):
        if not isinstance(rec[key], bool):
            problems.append(f"{key} must be true or false, not {rec[key]!r}")
    if rec["level_from"] not in LEVELS or rec["level_to"] not in LEVELS:
        problems.append("level must be one of " + ", ".join(LEVELS))
    else:
        i_from, i_to = LEVELS.index(rec["level_from"]), LEVELS.index(rec["level_to"])
        if i_to <= i_from:
            problems.append("level_to must be above level_from")
        else:
            # Levels are ordered, not compulsory: a route may go from chat straight to an agent on the
            # person's own computer. A skip is allowed, but it is recorded, never silent, and exactly.
            expected = list(LEVELS[i_from + 1:i_to])
            if expected and rec.get("skipped") != expected:
                problems.append("a move over more than one level must list exactly the levels it "
                                "skipped in 'skipped': " + ", ".join(expected))
            if not expected and rec.get("skipped"):
                problems.append("'skipped' must be empty or absent for a move of one level")
    sent = parse_date(rec["materials_sent"])
    if sent is None:
        problems.append("materials_sent must be an ISO date (YYYY-MM-DD)")
    art = rec.get("artefact", {"type": "none"})
    if not isinstance(art, dict) or art.get("type") not in ARTEFACTS:
        problems.append("artefact.type must be one of " + ", ".join(ARTEFACTS))
        art = {"type": "none"}
    if "produced_by_agent" in art and not isinstance(art["produced_by_agent"], bool):
        problems.append("artefact.produced_by_agent must be true or false")
    if "date" in art:
        art_date = parse_date(art["date"])
        if art_date is None:
            problems.append("artefact.date must be an ISO date (YYYY-MM-DD)")
        elif sent and art_date < sent:
            problems.append("artefact dated before the materials were sent")
    if rec["completed"] is True:
        # Installation is an attempt; only something the agent produced counts as a crossing.
        if art.get("type") == "none" or art.get("produced_by_agent") is not True:
            problems.append("completed=true needs an artefact with produced_by_agent=true")
        if rec["level_to"] == "orchestrated_work":
            mm = rec.get("multi_model") or {}
            asked = mm.get("asked") if isinstance(mm, dict) else None
            answered = mm.get("answered") if isinstance(mm, dict) else None
            if not isinstance(asked, list) or len(set(asked)) < 2 or \
               not isinstance(answered, list) or len(set(answered)) < 2:
                problems.append("a level-4 crossing needs multi_model.asked and multi_model.answered "
                                "with at least two tools each (Table 1: two model families)")
    elif rec["completed"] is False:
        if not rec.get("stop_point") or not rec.get("stop_reason_own_words"):
            problems.append("a non-completion records stop_point and stop_reason_own_words")
    if rec["assisted"] is True and not rec.get("intervention"):
        problems.append("assisted=true needs a description of the intervention")
    if "acceptance_decision" in rec and rec["acceptance_decision"] not in DECISIONS:
        problems.append("acceptance_decision must be one of " + ", ".join(DECISIONS))
    if "network_access" in rec and not isinstance(rec["network_access"], bool):
        problems.append("network_access must be true or false")
    return problems


DEMO = [
    {"record_id": "r1", "person": "P01", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "folder", "date": "2026-09-09", "produced_by_agent": True}},
    {"record_id": "r2", "person": "P02", "level_from": "chat", "level_to": "safe_agentic_environment",
     "materials_sent": "2026-09-08", "completed": True, "assisted": False,
     "artefact": {"type": "screenshot", "produced_by_agent": False}},
    {"record_id": "r3", "person": "P03", "level_from": "chat", "level_to": "agent_on_own_computer",
     "skipped": ["safe_agentic_environment"], "materials_sent": "2026-09-08", "completed": False,
     "assisted": False, "stop_point": "(invented) download page",
     "stop_reason_own_words": "(invented) the page offered four versions and I did not know which"},
    {"record_id": "r4", "person": "Jane", "level_from": "chat", "level_to": "orchestrated_work",
     "materials_sent": "2026-09-08", "completed": False, "assisted": True},
]


def main():
    if len(sys.argv) > 1 and sys.argv[1] != "--demo":
        records = []
        for n, line in enumerate(open(sys.argv[1]), 1):
            if line.strip():
                try:
                    records.append(json.loads(line))
                except json.JSONDecodeError as exc:
                    records.append({"_malformed": f"line {n}: {exc}"})
    else:
        records = DEMO
        print("(demo: four invented records, two of them deliberately wrong)\n")
    bad = 0
    for rec in records:
        try:
            if isinstance(rec, dict) and "_malformed" in rec:
                problems = ["not valid JSON: " + rec["_malformed"]]
            else:
                problems = check(rec)
        except Exception as exc:  # a malformed record is rejected, never a crash
            problems = [f"malformed record: {exc!r}"]
        bad += bool(problems)
        rid = rec.get("record_id", "?") if isinstance(rec, dict) else "?"
        print(f"{str(rid):6s} {'OK' if not problems else 'REJECTED'}")
        for p in problems:
            print(f"       - {p}")
    print(f"\n{len(records) - bad} of {len(records)} records accepted")
    sys.exit(1 if bad else 0)


if __name__ == "__main__":
    main()
Das gleiche Datensatzformat wird als JSON Schema (crossings.schema.json) veröffentlicht, damit andere Tools die Struktur eines Datensatzes validieren können; der obige Checker erzwingt die Regeln, die das Schema nicht ausdrücken kann (dass eine Installation keine Kreuzung ist, dass ein Stopp die eigenen Worte der Person benötigt, dass Hilfe eine Beschreibung benötigt, und dass ein Überspringen aufgezeichnet wird).
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://example.org/after-chat/crossing-record.schema.json",
  "title": "CrossingRecord",
  "description": "One person's attempt at one transition of the four-level model. Companion to crossings.py, which accepts exactly what this schema accepts and adds the rules the schema cannot express (installation is not a crossing; a stop needs the person's own words; help needs a description; a skip is recorded exactly; a level-4 crossing names at least two tools asked and answered). MIT licence.",
  "type": "object",
  "required": ["record_id", "person", "level_from", "level_to", "materials_sent", "completed", "assisted"],
  "properties": {
    "record_id": {"type": "string"},
    "person": {"type": "string", "pattern": "^P[0-9]+$", "description": "Pseudonymous label such as P07. Never a name."},
    "level_from": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "level_to": {"enum": ["chat", "safe_agentic_environment", "agent_on_own_computer", "orchestrated_work"]},
    "skipped": {"type": "array", "items": {"enum": ["safe_agentic_environment", "agent_on_own_computer"]},
                "description": "Exactly the levels passed over when the move spans more than one level. A skip is allowed and never silent."},
    "materials_sent": {"type": "string", "format": "date"},
    "completed": {"type": "boolean"},
    "assisted": {"type": "boolean"},
    "intervention": {"type": "string", "description": "Required when assisted is true: what the helper did."},
    "artefact": {
      "type": "object",
      "properties": {
        "type": {"enum": ["file", "folder", "screenshot", "pasted_output", "none"]},
        "date": {"type": "string", "format": "date"},
        "produced_by_agent": {"type": "boolean"},
        "sha256": {"type": "string", "description": "Hash of the artefact if deposited; never the content."}
      },
      "required": ["type"]
    },
    "stop_point": {"type": "string", "description": "Required when completed is false: where the attempt stopped."},
    "stop_reason_own_words": {"type": "string", "description": "Required when completed is false: the person's own words, verbatim."},
    "stop_reason_code": {"type": "string", "description": "Assigned after collection by a published coding scheme (Appendix A)."},
    "multi_model": {
      "type": "object",
      "description": "For transition 3: the denominator of a council run. A completed level-4 record needs at least two tools in asked and in answered; that they are different model families is for the researcher to verify.",
      "properties": {
        "asked": {"type": "array", "items": {"type": "string"}},
        "answered": {"type": "array", "items": {"type": "string"}},
        "timed_out": {"type": "array", "items": {"type": "string"}},
        "diverged": {"type": ["boolean", "null"]},
        "changed_decision": {"type": ["boolean", "null"]},
        "coverage_hit": {"type": ["boolean", "null"]}
      }
    },
    "interface_version": {"type": "string", "description": "Optional implementation record: the agent and its version."},
    "operating_system": {"type": "string", "description": "Optional implementation record."},
    "network_access": {"type": "boolean", "description": "Optional implementation record: whether the agent had network access."},
    "permission_mode": {"type": "string", "description": "Optional implementation record: the permission mode in force."},
    "policy_constraint": {"type": "string", "description": "Optional implementation record: any employer or platform rule that applied."},
    "acceptance_decision": {"enum": ["accept", "revise", "escalate", "discard"], "description": "Optional: the person's decision from the acceptance record."}
  },
  "additionalProperties": false
}
C6. Sicherheit vor Level 3 (safety/)
Lehrt: die Praktiken aus Abschnitt 5.3 als Konfiguration. Die erste Datei ist eine beispielhafte Projekteinstellungsdatei für Claude Code: Plan-Modus standardmäßig (der Anbieter benannte seinen Standardmodus im Juli 2026 in „Manual" um; „plan" bleibt gültig und ist die sicherere Lehrwahl), häufige destruktive und Download-Befehle werden abgelehnt, übliche geheime Dateien werden sowohl dem Datei-Reader als auch einer Shell cat verweigert, Löschungen und Web-Abrufe werden hinterfragt. Eine Ablehnungsliste ist nur eine Liste: ein zulässiger Modus oder ein nicht aufgelisteter Befehl kann darum herumleiten, daher ist die Sandbox-Konfiguration genauso wichtig wie die Regeln. Die zweite ist eine beispielhafte Konfiguration für OpenAIs Codex in ihrer Ausführungs-, Ordner-bezogenen Form: Schreibvorgänge auf den Arbeitsordner beschränkt, kein Netzwerk, Zustimmung bei Anfrage. Die dritte ist eine Checkliste. Grenzen: Berechtigungsregeln und Sandboxes reduzieren den Schadensumfang; sie machen einen Agenten nicht vertrauenswürdig, und die Regelsyntax ändert sich zwischen Versionen.
{
  "permissions": {
    "defaultMode": "plan",
    "deny": [
      "Bash(rm -rf:*)",
      "Bash(sudo:*)",
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(cat .env:*)",
      "Bash(git push:*)",
      "Read(./.env)",
      "Read(./.env.*)",
      "Read(./secrets/**)"
    ],
    "ask": [
      "Bash(rm:*)",
      "Bash(mv:*)",
      "WebFetch"
    ]
  }
}
# Folder-scoped, per-run form (the policy of this paper): run the agent from the working copy with
# codex -C <folder> -s workspace-write -a on-request
# The same values in ~/.codex/config.toml apply to every run on the machine.
# The agent may write only inside the working folder, has no network by default,
# and asks before anything outside those limits.
approval_policy = "on-request"
sandbox_mode = "workspace-write"
[sandbox_workspace_write]
network_access = false# Pre-flight checklist before a person lets an agent act on their own computer
1. Work in a copy. Make a new folder for the agent and put copies of the files in it, never originals.
If the files live in a cloud-synchronised tree, copy them out of it first: agents have deleted the
zero-byte placeholders that cloud services leave for offloaded files, taking the originals with them.
2. Start in plan mode. Ask for a written plan first; read it; only then let the agent act.
3. Keep secrets out. No passwords, keys or client documents in the working folder.
4. Deny network by default. Turn it on only for a job that needs it, and then for named sites.
5. Confirm before anything irreversible: sending, deleting, publishing, purchasing.
6. Treat what the agent reads on the web as content, never as instructions. A page can carry hidden text
written to redirect an agent.
7. Treat another agent's answer the same way: content to compare, never instructions to act on. A second
model can pass on instructions it picked up from a page it read.
8. Use a separate browser profile for any agent that browses, signed out of banking and health sites.
9. Never type passwords, one-time codes or card numbers into the agent.
10. Ask "what could go wrong with this?" before approving a command you do not understand.
11. Keep an undo: a snapshot of the folder (or a version-control commit) before each larger change.
12. Keep a working stop. Before a long job, know how to stop it and whether stopping deletes the work.
13. Stop and revoke access when the task, the workspace or the sensitivity of the data changes.
14. Escalate a high-consequence decision to a person who is accountable for it; the agent proposes, the
person decides.C7. Supervision-Traces als Protokoll (jsonl_log.py)
Vermittelt: den kleinsten sinnvollen Datensatz der Arbeit eines Managers, ein mit Zeitstempel versehenes JSON-Objekt pro Ereignis, sodass abgelehnte Pläne, zurückgewiesene Diffs, eingeholte zweite Meinungen und abgeschlossene Durchläufe (die Supervision-Traces von Proposition P10) später mit der Standardbibliothek gezählt werden können. Mit --demo ausführen. Beschränkungen: es ist ein Writer, kein Tracer; es zeichnet auf, was die Person oder der Agent ihm mitteilt.
#!/usr/bin/env python3
"""jsonl_log.py: append one timestamped event to a JSONL file.

Teaching example for "After Chat" (Appendix C, listing C7). MIT licence.

The smallest useful record of a manager's work: one JSON object per event, one event per line,
each with a UTC timestamp. Events such as "plan_refused", "diff_rejected", "second_opinion_taken"
or "run_completed" are the supervision traces that proposition P10 asks for. A later paper can
parse the file with the standard library. This is a writer, not a tracer: it records what you tell it.

Usage:
    python3 jsonl_log.py run.jsonl '{"event": "plan_refused", "task": "friday-pack"}'
    python3 jsonl_log.py --demo
"""
import json
import sys
from datetime import datetime, timezone
from pathlib import Path


def log(path, event):
    """Append one event; the timestamp is added unless the caller set one."""
    event = dict(event)
    event.setdefault("ts", datetime.now(timezone.utc).isoformat(timespec="seconds"))
    with Path(path).open("a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "\n")
    return event


def main():
    if len(sys.argv) == 2 and sys.argv[1] == "--demo":
        import tempfile
        path = Path(tempfile.mkdtemp()) / "demo.jsonl"
        for ev in ({"event": "plan_refused", "task": "demo"},
                   {"event": "second_opinion_taken", "task": "demo", "family": "other-vendor"},
                   {"event": "run_completed", "task": "demo", "artefact": "demo/plan/"}):
            log(path, ev)
        print(path.read_text(), end="")
        return
    if len(sys.argv) < 3:
        print('usage: jsonl_log.py FILE \'{"event": "plan_refused"}\'   or   jsonl_log.py --demo',
              file=sys.stderr)
        sys.exit(2)
    print(json.dumps(log(sys.argv[1], json.loads(sys.argv[2]))))


if __name__ == "__main__":
    main()
Anhang D. Berechnete Tabelle der effektiven Anzahl von Meinungen
Ein Manager von Agenten, der Listing C4 nicht ausführen möchte, kann dennoch die Obergrenze nutzen. Jede Zelle ist N_eff = N / (1 + (N - 1) rho); die letzte Zeile ist die Obergrenze 1/rho, die keine Anzahl von Modellen mit dieser Korrelation überschreiten kann. Die Werte von rho wurden gewählt, um die Formel zu veranschaulichen und nichts zu messen. In der praktischen Anwendung ist rho die mittlere paarweise Korrelation von Fehlern, eine andere Größe als der Anteil gemeinsamer Fehler, bei denen zwei Modelle übereinstimmen, und sie muss anhand von Items mit bekannten Antworten in der betreffenden Domäne geschätzt werden (Listing C4).
| N Modelle | rho = 0.2 (Veranschaulichung) | rho = 0.5 (Veranschaulichung) | rho = 0.6 (Veranschaulichung) | rho = 0.8 (Veranschaulichung) |
|---|---|---|---|---|
| 2 | 1.67 | 1.33 | 1.25 | 1.11 |
| 3 | 2.14 | 1.50 | 1.36 | 1.15 |
| 5 | 2.78 | 1.67 | 1.47 | 1.19 |
| 10 | 3.57 | 1.82 | 1.56 | 1.22 |
| Obergrenze, 1/rho | 5.00 | 2.00 | 1.67 | 1.25 |
Die Tabelle ist der Grund, warum Abschnitt 6 einer Person empfiehlt, das nächste Abonnement für eine andere Familie auszugeben, anstatt ein zehntes Fenster der gleichen Familie zu wählen. Vielfalt der Familien, eine anspruchsweise Überprüfung gegen Quellen und bewahrter Dissens leisten die Arbeit, die ein größeres N nicht leisten kann. Da rho von der Aufgabe abhängt, sollte es anhand von Items aus der eigenen Domäne der Person geschätzt werden (Listing C4).
Anhang E. Landschaftszensus, 19. bis 21. September 2026
Tabelle 5 im Haupttext gruppiert Tools nach Muster. Dieser Anhang dokumentiert die rohen Zensus-Daten dahinter für Leser, die die Zahlen so haben möchten, wie sie an den angegebenen Daten standen. Stern-Zählungen ändern sich täglich; sie zeigen Popularität an und sagen nichts über Qualität oder die Anzahl der Nutzer aus, daher sollten sie nicht zum Datum des Lesers zitiert werden. Die Musterschlüssel-Spalte ist meine Zuordnung, und die Projekte selbst machen keinen solchen Anspruch.
| Projekt | Standort | Sterne (ungefähr, 21. September 2026) | Lizenz | Muster |
|---|---|---|---|---|
| anthropics/claude-code | github.com/anthropics/claude-code | 147.000 | Source-available, proprietäre Lizenz | Terminal-Agent (Stufe 3) |
| openai/codex | github.com/openai/codex | 126.000 | Apache-2.0 | Terminal-Agent (Stufe 3) |
| google-gemini/gemini-cli | github.com/google-gemini/gemini-cli | 107.000 | Apache-2.0 | Terminal-Agent; einzelne Ebenen werden seit 18. Juni 2026 nicht mehr bereitgestellt |
| cline/cline | github.com/cline/cline | 69.000 | Apache-2.0 | Editor- und Terminal-Agent |
| openai/codex-plugin-cc | github.com/openai/codex-plugin-cc | 33.400 | Apache-2.0 | Offizielles Plugin: Agent eines Anbieters in einem anderen |
| jackwener/OpenCLI | github.com/jackwener/OpenCLI | 29.500 | Siehe Repository | Web-Chat für Agenten verfügbar gemacht |
| karpathy/llm-council | github.com/karpathy/llm-council | 24,900 | Repository ansehen | Rat auf einer Programmierschnittstelle |
| ai-shifu/ChatALL | github.com/ai-shifu/ChatALL | 16.500 (etwa 847.000 Downloads der neuesten Version) | Apache-2.0 | Browser-Übertragung |
| BeehiveInnovations/pal-mcp-server | github.com/BeehiveInnovations/pal-mcp-server | 11.800 (letzter Commit Dezember 2025) | Apache-2.0 | Beratungsserver zwischen Modellen |
| MoonshotAI/kimi-cli | github.com/MoonshotAI/kimi-cli | 11,400 | Apache-2.0 | Terminal-Agent (Stufe 3) |
| chathub-dev/chathub | github.com/chathub-dev/chathub | 10,700 | GPL-3.0 | Browser-Broadcast |
| nyldn/claude-octopus | github.com/nyldn/claude-octopus | 4,100 | MIT | CLI-Rat |
| aarondfrancis/counselors | github.com/aarondfrancis/counselors | 660 | MIT | CLI-Rat schreibt eine Datei pro Werkzeug |
| xai-org/grok-build | github.com/xai-org/grok-build | 26.900 | Apache-2.0 | Terminal-Agent mit Headless-Modus und Agent-Protokoll |
Zitierweise
Chernets, V. (2026). Nach Chat: Die drei Übergänge zwischen Nicht-Programmierern und agentengestützter KI [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7520019
@misc{chernets2026afterchat,
  author       = {Chernets, Vadym},
  title        = {{After Chat: The Three Transitions Between Non-Programmers and Agentic AI}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7520019},
  url          = {https://doi.org/10.2139/ssrn.7520019}
}