प्रोग्रामर विभाजन के बाद: AI एजेंट के माध्यम से निर्माण करने वाले लोगों के लिए एक मापदंड
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
सत्यापित प्रतिनिधिमंडन क्षितिज, प्रवर्धन लाभ, भूमिका नामों का एक पुरानी तारीख का नक्शा, और 2031 तक प्रत्येक वर्ष स्कोर किए गए 41 पंजीकृत पूर्वानुमान
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
यह पेपर डाउनलोड करें
- SSRN (रिकॉर्ड संस्करण): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (संग्रहीत, खुली पहुंच): doi.org/10.5281/zenodo.23267266
- OSF (41 पूर्वानुमान, 9 अक्टूबर 2026 को पंजीकृत): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (पूर्ण पाठ Markdown के रूप में): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; परिशिष्ट C का कोड: github.com/vadimchernets/delegation-horizon
SSRN रिकॉर्ड संस्करण रखता है; उसे उद्धृत करें।
कीवर्ड: AI एजेंट; एजेंटिक AI; गैर-प्रोग्रामर; कोडिंग एजेंट; नौकरी के शीर्षक; कौशल-आधारित भर्ती; मुख्य-एजेंट सिद्धांत; अंतिम-उपयोगकर्ता सॉफ्टवेयर इंजीनियरिंग; AI साक्षरता; सत्यापित प्रतिनिधिमंडन क्षितिज; साक्र-पार बिंदु; पूर्वपंजीकृत पूर्वानुमान
सारांश
एक बहीखाता करने वाला एक एजेंट से सुलह के लिए एक उपकरण मांगता है; एक डेवलपर एक को बिलिंग सिस्टम बदलने के लिए कहता है। प्रत्येक को एक दिन का काम स्वीकार करना चाहिए और यह दिखाना चाहिए कि यह सही है। अक्टूबर 2026 तक वकील उसी एजेंटों के लिए कार्य निर्धारित कर रहे थे। लगभग 400,000 सत्रों में, कोड-उत्पादक कार्य पर विक्रेता-सत्यापित सफलता प्रोग्रामिंग व्यवसायों के लिए 34% और दूसरों के लिए 29% थी, हालांकि व्यवसाय शिक्षा नहीं है। कोई कैरियर सीढ़ी नहीं कहती कि एजेंटों के माध्यम से कुछ बनाने वाला व्यक्ति क्या वितरित करने के लिए भरोसेमंद हो सकता है। मैं एक शीर्षक के स्थान पर एक माप का प्रस्ताव देता हूं। सत्यापित प्रतिनिधिमंडल क्षितिज एक योग्य विशेषज्ञ के संदर्भ घंटों में सबसे बड़ा सुसंगत कार्य है, जिसे एक व्यक्ति नियमित रूप से एजेंटों को सौंपता है और एक स्वतंत्र जांच के बाद स्वीकार करता है जिसे एजेंटों ने नहीं देखा। प्रवर्धन लाभ, प्रति घंटे ध्यान के लिए स्वीकृत संदर्भ घंटे, एक सत्यापित थ्रूपुट है, न कि गति के कारण अनुमान। दोनों को प्रति डोमेन स्कोर किया जाता है, घंटा से त्रैमासिक; एक डेस्क परीक्षण ने एक सीमा को ठीक किया। तीन बड़े नियोक्ताओं ने 2026 में टोकन गणना की कोशिश की और उन्हें छोड़ दिया: एक रैंकिंग हटाया गया, एक लीडरबोर्ड गेम किया गया, एक बजट खर्च किया गया। जांचा गया काम खर्च से गेम करना कठिन है, और प्रत्येक शेष मार्ग एक बताए गए बचाव को पूरा करता है। एक दिनांकित मानचित्र प्रतिद्वंद्वी नामों (निर्माता, एजेंट प्रबंधक, प्रधान और अन्य) को बिना चुने रिकॉर्ड करता है। पृष्ठभूमि तटस्थता यह परिकल्पना है कि एक समान क्षितिज पर एक प्रोग्रामिंग शिक्षा जांचे गए गुणवत्ता की भविष्यवाणी करना बंद कर देता है। साख क्रॉसओवर बिंदु वह क्षण है, डोमेन द्वारा डोमेन, जब IT शिक्षा के बिना लोगों के उत्पाद समान जांच के तहत प्रोग्रामर के उत्पादों को ओवरटेक करने लगते हैं, जिसके बाद डिग्री और वरिष्ठता लेबल वजन खो देते हैं। इकतालीस दिनांकित भविष्यवाणियां, 9 अक्टूबर 2026 को तीन अंधे मॉडल पूर्वानुमानों की माध्यिका पर मूल्य निर्धारित, OSF पर पंजीकृत हैं और 2031 तक सालाना स्कोर की जाएंगी; एक अध्ययन जो कभी नहीं चलाया गया एक विफलता के रूप में गिना जाता है, और अपने स्वयं के डोमेन में ओवरटेकिंग 0.35 पर खड़ी है।
कार्यकारी सारांश
2026 तक बहीखाता पालकों ने कोडिंग एजेंटों की तुलना उसी तरह कर रहे थे जैसे प्रोग्रामर एक साल पहले करते थे, वकील उनके साथ अपने स्वयं के उपकरण बना रहे थे, और सॉफ़्टवेयर के बाहर के लोग एक विक्रेता के कोडिंग-एजेंट उपयोगकर्ताओं का तेजी से बढ़ता हुआ हिस्सा बन गए थे; दूसरे विक्रेता के रिकॉर्ड में, लगभग 400,000 सत्र, ऐसे व्यवसाय जो प्रोग्राम नहीं करते वे कोडिंग कार्य पर सत्यापित सफलता में प्रोग्रामर से कुछ प्रतिशत अंक पीछे थे (34% बनाम 29%)। जहाँ काम किया जाता है, प्रोग्रामर और बाकी सभी के बीच की सीमा पतली हो गई है। नौकरी के शीर्षकों, वेतन ग्रेड और रिज्यूमे में यह वहीं खड़ी है जहाँ पहले खड़ी थी।
कुछ प्रोग्रामर और कुछ डोमेन पेशेवर अब एक कार्यप्रवाह साझा करते हैं: वे एजेंटों को काम सौंपते हैं और यह तय करते हैं कि इसे स्वीकार करना है या नहीं। कार्य और कार्यप्रवाह पूरी पेशेवरियों से पहले विलीन हो गए हैं, इसलिए किसी व्यक्ति के बारे में सूचनात्मक प्रश्न यह है कि वे कितने बड़े काम को सौंप सकते हैं और साबित कर सकते हैं, चाहे वे पुरानी सीमा के किस तरफ आएं। मैं उस प्रश्न के लिए जो माप प्रस्तावित करता हूँ, सत्यापित प्रत्यायन क्षितिज, कुछ डिज़ाइन विकल्पों पर आधारित है, और यह सारांश प्रत्येक के लिए कारण देता है। इकाई वह समय है जो एक योग्य विशेषज्ञ को चाहिए (एक घंटा, एक दिन, एक सप्ताह, एक महीना, एक तिमाही), क्योंकि दोनों पुरानी सीढ़ियाँ इसे पढ़ सकती हैं और पेशेवरियों के बीच कोई अनुवाद आवश्यक नहीं है। एक बहीखाता पालक का सुलह उपकरण और एक डेवलपर का बिलिंग परिवर्तन एक ही नियम का सामना करते हैं। केवल वह काम जो एजेंटों ने न देखे हुए परीक्षण में पास हुआ है गिना जाता है, और एक परिवार के मॉडलों के बीच समझौता ऐसी परीक्षा के रूप में नहीं गिना जाता है, क्योंकि उनकी त्रुटियाँ संबंधित हैं। एक दूसरी संख्या, प्रवर्धन लाभ, रिकॉर्ड करता है कि व्यक्ति का प्रत्येक घंटा ध्यान कितना जाँचा हुआ काम देता है (असफल काम फिर भी ध्यान की लागत करता है, और एजेंटों का अनाधिकृत समय नहीं करता है), ताकि कोई जो एजेंट के साथ छोटे लूप में काम करता है उसे उसी तरह श्रेय दिया जाता है जैसे कोई जो बड़े टुकड़ों को सौंपता है। दोनों संख्याएँ प्रति डोमेन रखी जाती हैं, एक समरूप कारण के लिए: एक वकील जो सॉफ़्टवेयर में चला जाता है और एक प्रोग्रामर जो कानून में चला जाता है दोनों एक ही चीज खोते हैं, एक ऐसे क्षेत्र में काम स्वीकार करने की क्षमता जिसे वे नहीं जानते। थ्रेशहोल्ड को नियम v1.1 के रूप में संस्करण किया गया है और डेस्क-परीक्षण किया गया है, और डेस्क परीक्षण ने पहले से ही उनमें से एक को सही किया है (परिशिष्ट E)।
नाम तय नहीं हुए हैं। बिल्डर, एजेंटिक इंजीनियर, एजेंट प्रबंधक, AI ऑपरेटर, ऑर्केस्ट्रेटर और प्रिंसिपल सभी अक्टूबर 2026 तक उपयोग में हैं, प्रत्येक के साथ एक मालिक और एक तारीख है। मैं उन्हें बिना चुने मैप करता हूँ, ताकि चाहे कौन जीते, वह एक पैमाने पर पढ़ा जा सके: सप्ताह पर एक बिल्डर, दिन पर एक एजेंट प्रबंधक।
बाजार ने पहले से ही एक शॉर्टकट आजमाया है। 2026 में टोकन काउंट को बड़े नियोक्ताओं के कर्मचारियों के माप के रूप में आजमाया गया और महीनों में विफल हो गया: Meta पर कर्मचारी की अनौपचारिक रैंकिंग को हटा दिया गया और कंपनी के आधिकारिक मार्गदर्शन ने बाद में टोकन काउंट को बाहर निकाल दिया, Amazon पर एक लीडरबोर्ड खाली कार्यों के साथ खेला गया और हटा दिया गया, और Uber ने अपने वार्षिक AI बजट को चार महीने में खर्च कर दिया। इनपुट की गिनती व्यय को पुरस्कृत करती है। स्वीकार किए गए काम की गिनती, स्वतंत्र रूप से जाँची गई, डिज़ाइन के आधार पर इस तरह से फुलाना कठिन है। शेष मार्ग (आसान जाँच, उदार रेटर, छिपी हुई सहायता और काम को टुकड़ों में विभाजित करना) प्रत्येक अनुभाग 5.8 में एक रक्षा से मिलता है: यादृच्छिक लेखा परीक्षा, घंटों के स्वतंत्र रेटर, विफलताओं का सार्वजनिक रिकॉर्ड, काम की एक सुसंगत इकाई और रोपित त्रुटियाँ।
दो भविष्यवाणियाँ मेरे तारीख वाले थीसिस को लेकर जाती हैं। पृष्ठभूमि तटस्थता कहती है कि एक ही स्तर पर प्रोग्रामिंग शिक्षा जाँची गई गुणवत्ता की भविष्यवाणी करना बंद कर देती है। क्रेडेंशियल क्रॉसओवर बिंदु वह क्षण है, एक डोमेन में, जब बिना IT शिक्षा वाले लोगों द्वारा बनाए गए उत्पाद समान एजेंटों का उपयोग करने वाले प्रोग्रामरों को पीछे छोड़ देने लगते हैं, जिसके बाद डिग्री और जूनियर और सीनियर लेबल वजन खो देते हैं। गुणवत्ता समता उस क्षण से पहले आती है, डिग्री आवश्यकताओं का नौकरी की पोस्टिंग में क्रॉसिंग इसका दृश्यमान संकेत है, और प्रत्येक भाग अपने आप पर तारीख और परीक्षण किया गया है। मुख्य भविष्यवाणी वर्तमान राय के विरुद्ध चलती है, और कागज जहाँ भविष्यवाणी बताता है वहाँ ऐसा कहता है। प्रत्येक भविष्यवाणी उस परिणाम का भी नाम देती है जो इसे खारिज करेगा, ताकि पाठक अग्रिम रूप से देख सके कि विफलता कैसी दिखेगी। सभी 41 एक तालिका में प्रकट होते हैं जिसमें संभावनाएँ, थ्रेशहोल्ड, फॉलबैक स्रोत और अंतिम तारीखें हैं, 9 अक्टूबर 2026 को OSF पर पंजीकृत (DOI 10.17605/OSF.IO/VW6P9) और 2031 तक प्रत्येक वर्ष Brier नियम द्वारा स्कोर किए गए हैं। सत्ताइस सार्वजनिक डेटा से हल होते हैं। चौदह को डेटा एकत्र करने से पहले अलग से पंजीकृत अध्ययन की आवश्यकता है, और लापता या अनिर्णायक साक्ष्य को अनसुलझा दर्ज किया जाता है और सफलता के रूप में नहीं गिना जाता है; एक अध्ययन जो कभी नहीं चलता है परीक्षण कार्यक्रम की विफलता है और स्कोरकार्ड पर रहता है। संभावनाओं को 9 अक्टूबर 2026 को तीन अंधे मॉडल पूर्वानुमानों के माध्यिका के रूप में तय किया गया था, जिसे मैंने अपनाया, और OSF पर पंजीकृत हैं; अपने स्वयं के डोमेन में आगे बढ़ने की संभावना 0.35 है।
जब निर्माण कम खर्चीला होता है, तब विश्वास दुर्लभ फ़िल्टर बन जाता है। ऐप स्टोर और कोड होस्ट बाढ़ की स्थिति में हैं, प्लेटफ़ॉर्म अज्ञात योगदानकर्ताओं के लिए अपने दरवाजे बंद कर रहे हैं, और एजेंट तेजी से किसी और के समाधान को अपनाने के बजाय एक समाधान लिख रहे हैं। जो व्यक्ति निर्माण करता है उसके बगल में, दो साथी कार्य दृश्यमान हैं: एक फिनिशर उत्पाद को लोगों तक लाता है, और एक गारंटर इसके लिए हस्ताक्षर करता है। दूसरा नाम 2025 के भूमिका के विवरण से आता है, और मैं गारंटर के लिए भी एक माप का प्रस्ताव देता हूँ।
१. परिचय
२३ सितंबर २०२६ को एक ब्लॉग ने बुककीपर्स के लिए दो कोडिंग एजेंट्स, Claude Code और Codex की तुलना की, जो लेनदेन को वर्गीकृत करने और खातों का समन्वय करने के लिए थे (Growthy, 2026)। एक साल पहले यह तुलना प्रोग्रामर्स के लिए थी, और प्रोग्रामर्स के थ्रेड्स में यह अब भी है, पूरी तरह से शिविरों और निष्ठाओं के साथ। जो बदल गया वह पाठक था। जो लोग अब एजेंट्स के बीच चुनाव कर रहे हैं वे बहीखाता रखते हैं, अनुबंध लिखते हैं और अभियान चलाते हैं, और जिन एजेंट्स के बीच वे चुनाव कर रहे हैं वे वही हैं जो सॉफ्टवेयर डेवलपर्स उपयोग करते हैं।
दशकों से अर्थव्यवस्था ने दो सीढ़ियाँ रखी हैं। सॉफ्टवेयर में सीढ़ियों के पायदान जूनियर, मिड-लेवल, सीनियर, स्टाफ और प्रिंसिपल थे, जिनकी कीमत अनुभव के वर्षों और किसी प्रोजेक्ट को कितने इंजीनियरों की आवश्यकता थी, इस आधार पर थी। अन्यत्र पायदान विश्लेषक, सलाहकार, प्रबंधक, निदेशक और भागीदार थे। सीढ़ियाँ IT विभाग के दरवाजे पर मिलती थीं, इस अर्थ में कि दूसरी सीढ़ी पर एक पेशेवर को पहली सीढ़ी पर किसी से इसे कमीशन करके सॉफ्टवेयर मिलता था। २०२५ और २०२६ में दोनों सीढ़ियों ने एक ही काम का वर्णन करना शुरू किया। डेवलपर्स को बताया गया कि उनकी मुख्य गतिविधियाँ प्रतिनिधिमंडल और सत्यापन बन गई हैं (GitHub, 2025b)। सॉफ्टवेयर के बाहर के पेशेवर, एक टर्मिनल या डेस्कटॉप विंडो में एजेंट के साथ, उन उपकरणों, साइट्स और छोटे अनुप्रयोगों का निर्माण करना शुरू किया जो वे कमीशन करते थे (Bloomberg Law, 2026; OpenAI, 2026)। न तो सीढ़ी कहती है कि ऐसा व्यक्ति क्या प्रदान करने के लिए विश्वस्त हो सकता है, और न ही कोई यह कहता है कि एक पूर्व डेवलपर की तुलना एक पूर्व विश्लेषक से कैसे करें जो अब वही काम कर रहे हैं।
अनुसरण करने वाले प्रश्न यह हैं कि उस सीमा के मर्ज किए गए पक्ष पर लोगों को क्या कहा जाए, एक बार जब डिग्री और सेवा के वर्ष नियोक्ता को यह बताना बंद कर दें कि वे क्या प्रदान कर सकते हैं, उनके स्तर को कैसे मापा जाए, और सीमा कब गायब हो सकती है। उनमें से अंतिम को दिनांकित भविष्यवाणियों के रूप में इसका उत्तर मिलता है।
इस प्रश्न का एक दिनांकित मूल। १ अक्टूबर २०२६ को मैंने एक पूर्वानुमान दिया: एक से दो वर्षों के भीतर एजेंटिक क्षमता इतनी दूर बढ़ेगी कि तकनीकी शिक्षा की अब आवश्यकता नहीं है, और इसके बिना लोग बेहतर अनुप्रयोग, साइट्स और उत्पाद बनाएंगे, प्रोग्रामर्स के कोड से बेहतर कोड के साथ। उसी शाम बाद में मैंने एक निष्कर्ष जोड़ा। जब IT शिक्षा के बिना लोगों द्वारा बनाए गए उत्पाद IT पेशेवारों द्वारा बनाए गए उत्पादों से आगे निकलने लगते हैं, तो IT डिग्रियाँ और जूनियर और सीनियर के लेबल फिर से तेजी से वजन खो देंगे। (दोनों कथन उस दिन के मेरे नोट्स से अनुवादित हैं।) अनुभाग ६ और ११ दोनों को दिनांकित, उपाय, सीमाएँ और परिणाम के साथ भविष्यवाणियों में बदल देते हैं जो उन्हें खंडित करेंगे। दूसरा कथन उस क्षण को नाम देता है जिसे पत्र का बाकी हिस्सा प्रमाणपत्र क्रॉसओवर बिंदु कहता है।
इस श्रृंखला में साथी पत्र चैट से एजेंट्स तक गैर-प्रोग्रामर्स का अनुसरण किया और एजेंट कहाँ काम करता है और व्यक्ति को क्या मालिकाना करना चाहिए, इसके द्वारा चार स्तरों को परिभाषित किया (Chernets, 2026a)। इसने केवल तब एक संक्रमण गिना जब एजेंट ने एक कलाकृति का उत्पादन किया था, और इसने एजेंट्स के प्रबंधक को एक नौकरी का शीर्षक बनाने से इनकार कर दिया, "एक भूमिका किसी को नियोग करना चाहिए, क्योंकि व्यवहार साक्ष्य छोड़ता है और एक शीर्षक नहीं" (Chernets, 2026a, अनुभाग 8.4) के लिए "व्यवहार के पैटर्न के लिए शब्द का उपयोग किया। वर्तमान पत्र इस शर्त से शुरू होता है: एक स्तर दिया जाता है, और कोई भी शीर्षक इससे जुड़ा हो सकता है, केवल साक्ष्य पर, अर्थ कार्य एजेंट्स को सौंपा गया, एक व्यक्ति द्वारा स्वीकार किया गया, और एजेंट्स ने नहीं देखे चेक से सुनिश्चित किया गया।
अनुभाग ३ अक्टूबर २०२६ में परिसंचरण में नामों का एक दिनांकित मानचित्र देता है। अनुभाग ५ वह पैमाना देता है जिस पर उन नामों में से कोई भी पढ़ा जा सकता है, सत्यापित प्रतिनिधिमंडन क्षितिज इसके दूसरे अक्ष के साथ, प्रवर्धन लाभ। अनुभाग ६ दो परिकल्पनाएं, पृष्ठभूमि तटस्थता और प्रमाणपत्र क्रॉसओवर बिंदु, बताता है और पूछता है कि एक व्यापार का कितना अनुभव जाँच की प्रक्रिया के लिए खड़ा हो सकता है। अनुभाग ७ और ८ विश्वास, वह सीमा जो घुल नहीं जाती, और व्यक्ति के बगल में दो भागीदार कार्य को लेते हैं जो निर्माण करते हैं। अनुभाग ११ दिनांकित भविष्यवाणियों को संभावनाओं, सीमाओं और वापसी स्रोतों के साथ सेट करता है, OSF पर पंजीकृत और २०३१ तक जनता में हर साल स्कोर किया जाता है।
मैं नामों के बीच नहीं चुनता। बाजार संभवतः महीनों के भीतर चुनेगा, और एक पत्र जो एक शब्द पर दांव लगाता है वह गलत है जब कोई और शब्द जीत जाता है। एक पत्र जो ठीक कर सकता है वह पैमाना है। अनुभाग ५ इसे पूरी तरह परिभाषित करता है; संक्षेप में, सत्यापित प्रतिनिधिमंडन क्षितिज पूछता है कि काम का कितना बड़ा टुकड़ा, घंटों में एक योग्य विशेषज्ञ को आवश्यकता होगी, एक व्यक्ति नियमित रूप से एजेंट्स को हाथ में देता है और स्वीकृति के पीछे एक स्वतंत्र जाँच के साथ स्वीकार करता है, और प्रवर्धन लाभ पूछता है कि व्यक्ति के अपने ध्यान का प्रत्येक घंटा कितने ऐसे घंटे प्राप्त करता है। दोनों को प्रति डोमेन रखा जाता है, दिनांकित किया जाता है, और घंटे से त्रैमासिक तक पाँच सीढ़ियों पर रखा जाता है। आकृति १ दोनों पुरानी सीढ़ियों को उस के बगल में रखती है।
प्रमाणपत्र क्रॉसओवर बिंदु की एक परिभाषा पूरे पत्र को परोसती है। एक डोमेन में, यह वह क्षण है जब IT शिक्षा के बिना लोगों द्वारा बनाए गए उत्पाद, एक ही स्वतंत्र जाँच के तहत स्वीकार किए गए, प्रोग्रामर्स के साथ शुरू होने लगते हैं जो एक ही एजेंट्स का उपयोग करते हैं, जिसके बाद डिग्री और जूनियर और सीनियर के लेबल भाड़े पर अपना वजन खो देते हैं। गुणवत्ता समानता उस क्षण से पहले का कदम है, और नौकरी की पोस्टिंग में डिग्री की आवश्यकताओं की क्रॉसिंग इसका दृश्य संकेत है। पृष्ठभूमि तटस्थता, वह परिकल्पना कि शिक्षा एक समान सीढ़ी पर जाँची गई गुणवत्ता की भविष्यवाणी करना बंद कर देती है, वह तंत्र है जो इसे समझाएगा। इन चारों भागों में से प्रत्येक अपनी दिनांकित भविष्यवाणी (अनुभाग 6.2) है।
साक्ष्य २०२५ और २०२६ से लिया गया है, एक अवधि जिसमें एजेंट विकास का एक महीना बदलता है कि एक माप को क्या गिनना होगा। एक व्यापक रूप से उद्धृत आंकड़ा बड़ी प्रौद्योगिकी फर्मों में नई-स्नातक भाड़े को इसके २०१९ के स्तर से बहुत दूर रखता है। इसे छोड़ा जाता है, जैसे २०२२ की भाड़े के शिखर के साथ तुलना, क्योंकि वे एजेंट्स से पहले एक दुनिया को मापते हैं। एजेंट्स से पहले की श्रृंखला केवल पूर्ववर्तियों के रूप में प्रवेश करती है, और भाड़े का मैक्रोइकॉनॉमिक्स अनुभाग 2.4 का LinkedIn समकक्ष द्वारा किया जाता है। पुरानी कार्य सिद्धांत, पूर्वापेक्षा या सादृश्य के रूप में भी प्रवेश करती है: Jaques जिम्मेदारी के समय-अवधि पर, Jensen और Meckling प्रतिनिधिमंडन की लागत पर, एक सोने की भीड़ और एक फोटोग्राफर।
आकृति १. दो सीढ़ियाँ और एक माप।
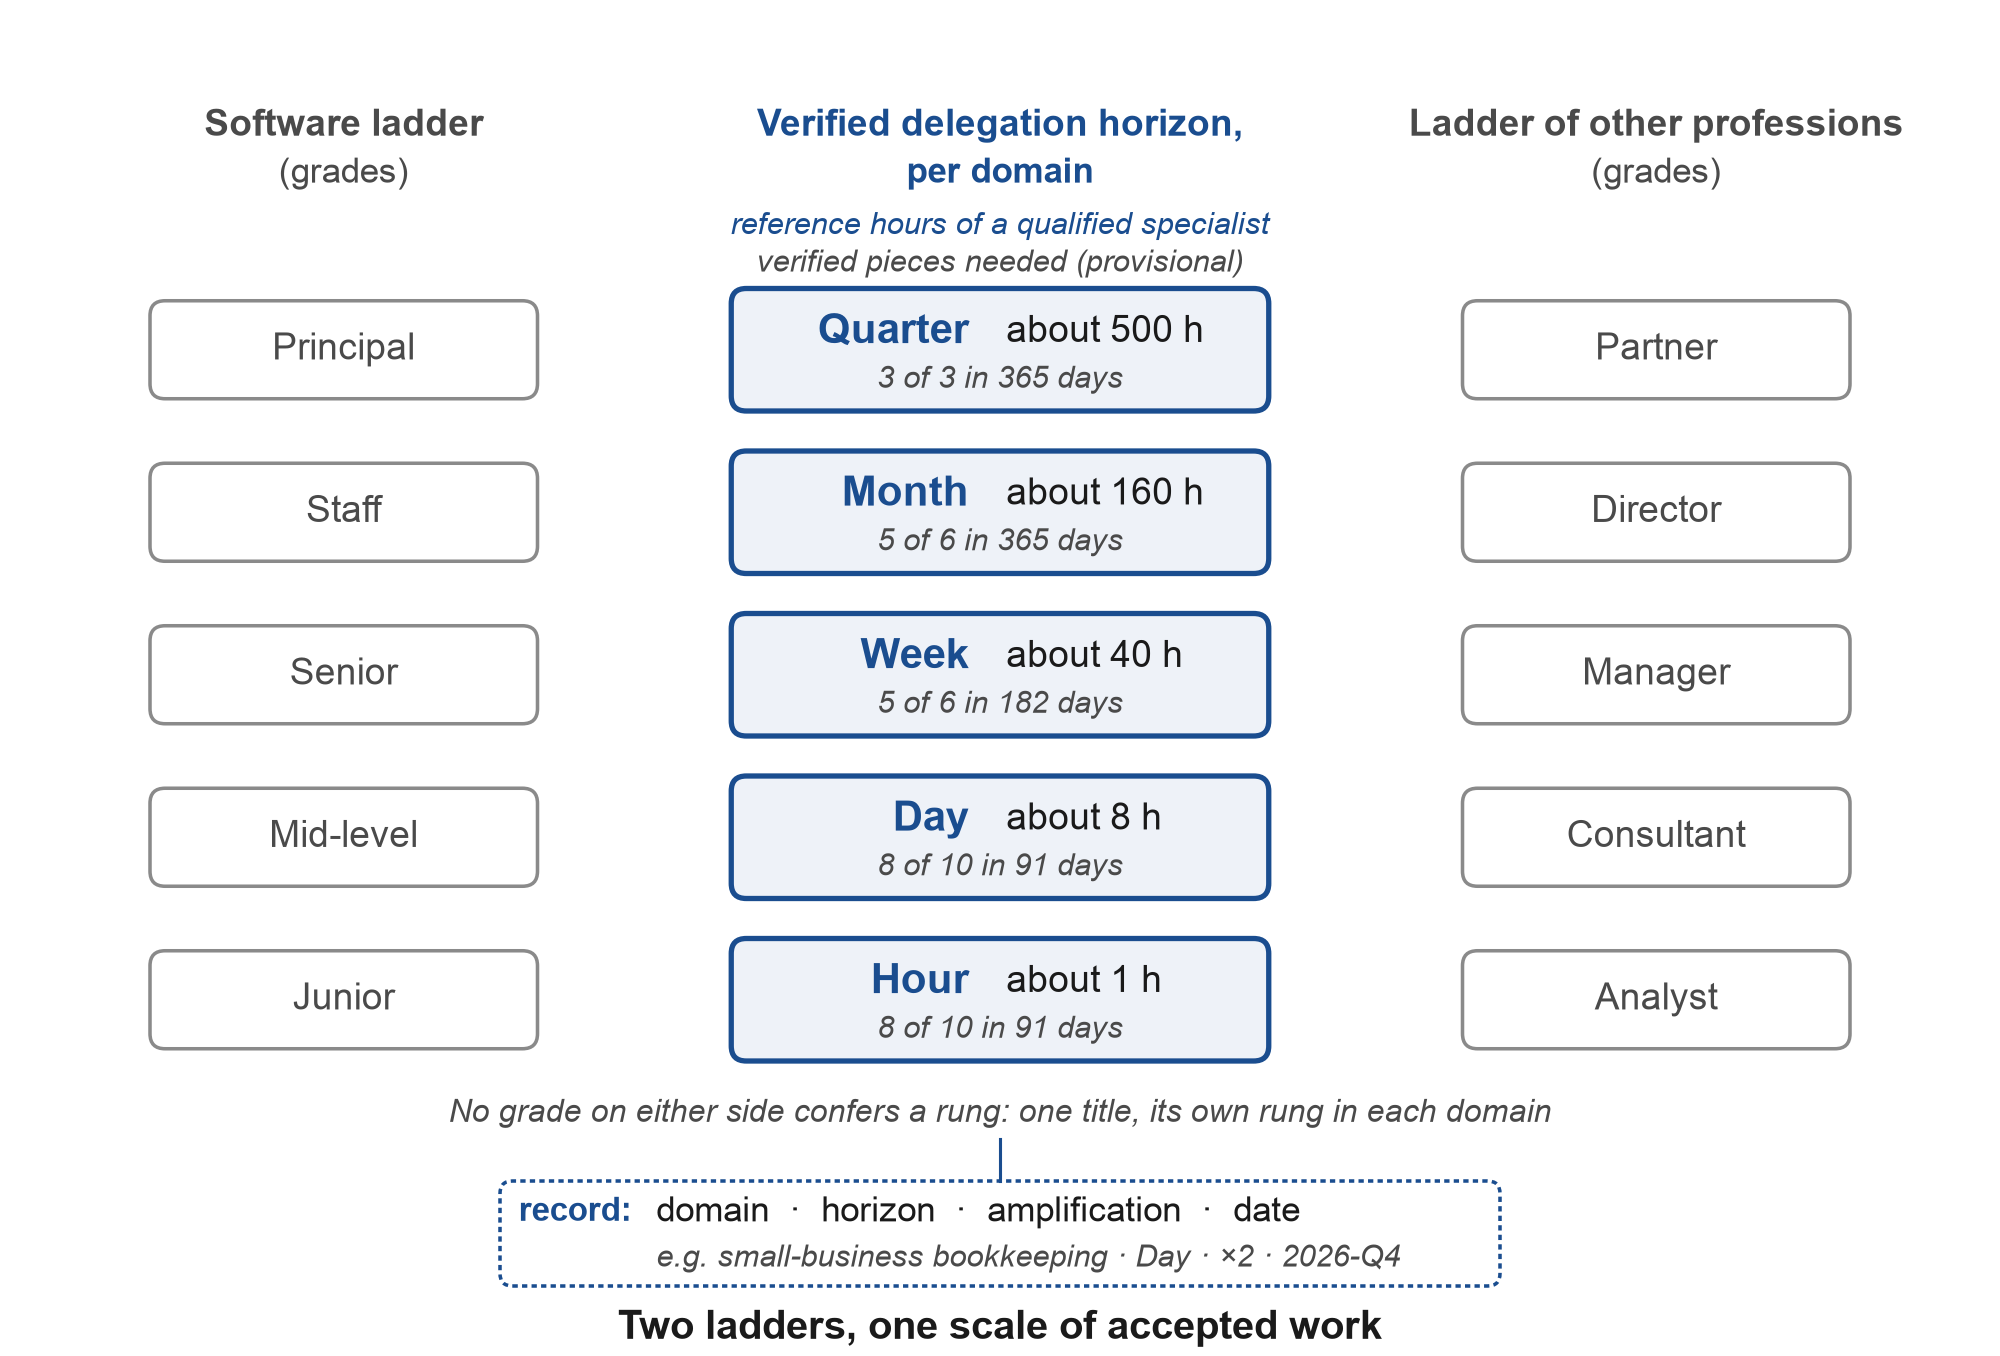
नोट: पुरानी सीढ़ियों को साथ में पाँच सीढ़ियों के साथ खींचा जाता है और जानबूझकर जुड़े नहीं होते हैं: न तो सीढ़ी पर कोई ग्रेड एक सीढ़ी को प्रदान करता है, और एक ही व्यक्ति प्रत्येक डोमेन में एक अलग सीढ़ी रखता है (अनुभाग 5.2)। सीढ़ियों को अनुभाग 5.2 (नियम v1.1) की गणनाओं और विंडो के साथ एक योग्य विशेषज्ञ के संदर्भ घंटों में गिना जाता है। दिखाया गया रिकॉर्ड परिशिष्ट C4 के कार्य किए गए उदाहरण द्वारा मुद्रित किया जाता है।
उन भागों के आसपास, खंड 2 अभिसरण के साक्ष्य को रखता है और खंड 4 बताता है कि बाजार का पहला उपाय कैसे विफल हुआ, जो इस तरह के एक उपाय का मामला है। खंड 9 जांचता है कि प्रोग्रामर की बातचीत के कौन से विषय अन्य व्यवसायों में स्थानांतरित होते हैं, और खंड 10 निहितार्थ निकालता है। खंड 12 थीसिस के विरुद्ध साक्ष्य एकत्र करता है, खंड 13 इसकी सीमा शर्तों को बताता है, और खंड 14 निष्कर्ष निकालता है।
2. दो दुनियाएँ एकत्रित हो रही हैं: 2025 और 2026 से साक्ष्य
2.1 प्रोग्रामर का काम, पुनर्परिभाषित
वे विक्रेता जो डेवलपर्स को बेचते हैं, अब डेवलपर के काम को एजेंट को निर्देशित करने के रूप में वर्णित करते हैं। GitHub के "एक डेवलपर की नई पहचान" के विवरण ने प्रतिनिधिमंडन और सत्यापन को काम के केंद्र में रखा (GitHub, 2025b)। Anthropic ने अगस्त 2025 में अपने 132 इंजीनियरों और शोधकर्ताओं का सर्वेक्षण किया। उन्होंने अपने काम के लगभग 60% में AI का उपयोग करने की सूचना दी और लगभग 50% की आत्म-मूल्यांकित उत्पादकता लाभ की सूचना दी, और खुद को अधिक "पूर्ण-स्टैक" बन रहे हैं के रूप में वर्णित किया (Anthropic, 2025a)। अधिकांश ने कहा कि वे अपने काम के केवल एक पाँचवें हिस्से को पूरी तरह प्रत्यायोजित कर सकते हैं, और उनके AI-सहायक काम का 27% ऐसे कार्यों से मिलकर बना था जो AI के बिना बिल्कुल नहीं किए जाते (Anthropic, 2025a)। पूर्ण प्रतिनिधिमंडन अकेले पर निर्मित एक माप इसलिए दुनिया के सबसे उन्नत उपयोगकर्ताओं के साथ AI के काम का सबसे अधिक एक पाँचवाँ हिस्सा देखेगा, जिसके कारण खंड 5 एक दूसरी धुरी जोड़ता है। एक ही रिपोर्ट ने "पर्यवेक्षण का विरोधाभास" नाम दिया: मॉडल की निगरानी करना कोडिंग कौशल लेता है जो तब क्षीण हो जाते हैं जब सब कुछ इसे सौंप दिया जाता है।
शब्दों ने काम का अनुसरण किया। Andrej Karpathy ने 2 फरवरी 2025 को "vibe coding" नाम दिया (Karpathy, 2025), Collins ने इसे वर्ष का शब्द बनाया (Collins Dictionary, 2025), और एक साल बाद Karpathy "agentic engineering" की ओर चले गए। Sequoia के AI Ascent पर 30 अप्रैल 2026 को उन्होंने अंतर को "vibe coding तल को बढ़ाता है, agentic engineering छत को एक्सट्रपोलेट करता है" के रूप में रखा (Karpathy, 2026; Willison, 2026a)। एक शैक्षणिक पत्र ने agentic engineer को एक नए पेशेवर आर्कीटाइप के रूप में वर्णित किया, जिसमें जिम्मेदारी कोड की लेखकत्व से परिणामों की स्वामित्व में स्थानांतरित हुई (Alenezi, 2026), और Microsoft ने अपने ग्राहकों में काम के पैटर्न को लेखक, संपादक, निर्देशक और आयोजक के रूप में वर्णित किया (Microsoft, 2026b)।
2.2 बाकी सभी, एक ही एजेंट के अंदर
दो विक्रेताओं ने सॉफ्टवेयर के बाहर के लोगों द्वारा कोडिंग एजेंटों के व्यापक उपयोग की सूचना दी है, जिनके पास विभिन्न चयन और माप सीमाएँ हैं। OpenAI ने जून 2026 में सूचित किया कि इसके कोडिंग एजेंट के साप्ताहिक उपयोगकर्ता जो डेवलपर नहीं हैं, अगस्त 2025 के बाद से व्यक्तिगत उपयोगकर्ताओं में 137 गुना और संगठनों में 189 गुना बढ़े हैं (OpenAI, 2026)। आधार कम था और डेटा विक्रेता के हैं। एक ही रिपोर्ट एक वितरण देती है जो खंड 5 के लिए महत्वपूर्ण है। मई 2026 में एजेंट के व्यक्तिगत उपयोगकर्ताओं के लगभग 0.1% के नमूने में, 80.6% ने कम से कम एक अनुरोध किया जिसकी हाथ से अवधि, एक मॉडल द्वारा अनुमानित, 30 मिनट से अधिक थी, 70.2% कम से कम एक घंटे से अधिक थी, और 25.6% कम से कम आठ घंटे से अधिक थी। ये लंबे अनुरोध करने वाले उपयोगकर्ताओं के शेयर हैं, जिनकी अवधि एक मॉडल द्वारा अनुमानित है, जो पूरा होने की दर या सत्यापित क्षितिज से एक अलग बात है, और खंड 5 बताता है कि अंतर क्यों महत्वपूर्ण है। एजेंट के व्यावसायिक कार्यों के लिए एक चौथाई से अधिक काम इंजीनियरिंग काम था।
Anthropic का Claude Code का अध्ययन, 16 जून 2026 को प्रकाशित, थीसिस के लिए सार्वजनिक डेटा के सबसे करीब है (Anthropic, 2026e)। इसने अक्टूबर 2025 और अप्रैल 2026 के बीच लगभग 235,000 लोगों द्वारा लगभग 400,000 सत्रों का विश्लेषण किया। विशेषज्ञता को व्यवहार से तीन संकेतों द्वारा निर्धारित किया गया था: व्यक्ति ने कार्य कितने सटीकता से कहा, उन्होंने सत्यापन के लिए क्या माँगा, और किसने किसे ठीक किया। Python के बिना एक बुककीपर जिसने सटीक समन्वय नियम लिखे और किनारे के मामलों को पकड़ा, विशेषज्ञ के रूप में मूल्यांकन किया गया था। सत्रों में जहाँ कोड का उत्पादन किया गया था, दस सबसे बड़े व्यवसायों में से प्रत्येक प्रोग्रामिंग व्यवसायों से सत्यापित सफलता में सात प्रतिशत अंक से अधिक नहीं रह गया, जहाँ सफलता का अर्थ पारित परीक्षण या प्रतिबद्ध काम जैसे साक्ष्य द्वारा समर्थित पूरी होना है। विक्रेता का वर्गीकरण सत्र प्रतिलेख में संकेत पर आंशिक रूप से आधारित है, जैसे उपयोगकर्ता की स्पष्ट पुष्टि, और रिपोर्ट नोट करती है कि प्रबंधकों की थोड़ी अधिक दर आंशिक रूप से प्रतिबिंबित हो सकती है कि वे सफलता की रिपोर्ट कैसे करते हैं, इसलिए "सत्यापित" यहाँ विक्रेता का शब्द है, एक स्वतंत्र जाँच नहीं। कोड-उत्पादक सत्रों पर एकत्रित यह 34% के विरुद्ध 29% था (सभी सत्रों में लगभग 30% 26% के विरुद्ध), और प्रबंधन प्रोग्रामर्स से थोड़ा बेहतर था। ये डेटा लोगों को व्यवसाय द्वारा क्रमित करते हैं और शिक्षा के बारे में कुछ नहीं कहते हैं: एक लेखाकार कंप्यूटर विज्ञान की डिग्री रख सकता है, और एक प्रोग्रामर के पास कोई नहीं हो सकता। रिपोर्ट ने निष्कर्ष निकाला कि "कोडिंग एजेंट सफल प्रोग्रामिंग के लिए कोडिंग पृष्ठभूमि को कम प्रासंगिक बना रहे हैं"। लोगों ने क्या करना है इसके बारे में लगभग 70% निर्णय लिए और एजेंट ने कैसे करना है इसके बारे में लगभग 80% निर्णय लिए। एक विशेषज्ञ की निर्देश सेट लगभग बारह एजेंट कार्रवाइयों को बंद कर देती है, एक नौसिखिए की लगभग पाँच।
एक ही बदलाव उन स्रोतों में दिखाई देता है जो एजेंट बेचने वाली कंपनियों से नहीं आते हैं। वकील, कनिष्ठ सहयोगियों से लेकर भागीदारों तक, विक्रेताओं की प्रतीक्षा करने के बजाय Claude Code के साथ अपने स्वयं के उपकरणों के कार्यशील प्रोटोटाइप बना रहे हैं, और व्यापक AI पहुंच वाले वकीलों का शेयर 2025 में 61% से 2026 में 83% तक बढ़ा (Bloomberg Law, 2026; Artificial Lawyer, 2026)। बुककीपर एजेंटों की तुलना करते हैं (Growthy, 2026)। Lovable, एक ब्राउजर-आधारित ऐप बिल्डर, सितंबर 2026 में $600 मिलियन वार्षिकीकृत राजस्व को पार कर गया (TechCrunch, 2026a)। एक अनुमान के अनुसार, Claude Code ने फरवरी 2026 की शुरुआत में GitHub पर सार्वजनिक प्रतिबद्धताओं का लगभग 4% लेखक किया (SemiAnalysis, 2026)।
2.3 तनाव में सीढ़ियाँ
नियोक्ताओं ने अभी तक यह कहे बिना कि उन्हें क्या प्रतिस्थापित करता है, अपनी सीढ़ियों का नाम बदलना शुरू कर दिया है। 1 जून 2026 से Deloitte ने अपने लगभग 181,500 अमेरिकी कर्मचारियों को नई शीर्षक दीं जो नौकरी परिवार द्वारा आयोजित थे और एक नेतृत्व स्तर जोड़ा (Business Insider, 2026)। इसके आंतरिक स्तर और वेतन सिद्धांत जगह पर रहे (Fortune, 2026a), इसलिए यह माप के साथ एक पुनर्नामकरण था जैसा कि यह था। LinkedIn को एक "Associate Product Builder" ट्रैक के साथ अपने सहयोगी उत्पाद प्रबंधक कार्यक्रम को प्रतिस्थापित करने के लिए बताया गया था और किसी भी कार्य से लोगों के लिए एक "Full Stack Builder" भूमिका खोली गई थी (Lenny's Newsletter, 2025)। Microsoft ने 20,000 सर्वेक्षण किए गए AI उपयोगकर्ताओं में से 3,233, लगभग 16%, को "Frontier Professionals" के रूप में गिना जो मल्टीस्टेप एजेंट चलाते हैं और अपनी प्रक्रियाओं को पुनर्डिजाइन करते हैं (Microsoft, 2026a)। Srinivasan और Wei ने फरवरी 2026 में Harvard Business Review में तर्क दिया कि कंपनियों को एजेंट प्रबंधकों की आवश्यकता है, और उम्मीद है कि शीर्षक 12 से 18 महीने के भीतर मानक बन जाएगा (Srinivasan & Wei, 2026)। कुछ नियोक्ता आगे जाते हैं और पदों में नई भूमिका लिखते हैं: State Street ने एक "Agentic Product Builder" का विज्ञापन दिया जो अभी भी प्रोग्रामिंग की आवश्यकता रखता है (State Street, 2026)। 7 अक्टूबर 2026 को Dust ने "AI Operator" को उस व्यक्ति के रूप में पेश किया जो साझा एजेंट कार्यप्रवाह बनाता है और बनाए रखता है (Dust, 2026)।
भर्ती ने ध्यान दिया है। साक्षात्कारों का शेयर जिसमें उम्मीदवारों के AI का उपयोग चर्चा की गई थी, 2025 की तीसरी तिमाही में 0.33% से 2026 की दूसरी तिमाही में 4.54% तक बढ़ा (Metaview, 2026)। सवाल किसी भी उत्तर के पैमाने के अस्तित्व से पहले भर्ती में प्रवेश कर गया है।
2.4 पद, प्रविष्टि-स्तर भर्ती और शिक्षा
यूएस नौकरी की पोस्टिंग जो "agentic AI" का उल्लेख करती हैं, 2024 में 151 से बढ़कर 2025 में 16,541 हो गई (Stanford HAI, 2026)। Lightcast द्वारा की गई एक अलग गणना में 2025 में agentic AI कौशल का उल्लेख करने वाली 86,000 से अधिक पोस्टिंग मिलीं, जो उन कौशलों के उल्लेखों में 280% की वार्षिक वृद्धि है और विज्ञापित माध्यिका वेतन $153,000 है; कौशल मुख्य रूप से मौजूदा नौकरी के शीर्षकों में जोड़े गए थे (Lightcast, 2026a)। AI Index उन पोस्टिंग को गिनता है जिनमें "agentic AI" वाक्यांश है, जबकि Lightcast का ब्लॉग उन पोस्टिंग को गिनता है जिनमें अपनी स्वयं की टैक्सोनॉमी में agentic कौशल हैं, जो 16,541 और लगभग 86,000 के बीच की अधिकांश दूरी की व्याख्या करता है। संख्याएं विभिन्न चीजें मापती हैं और यहां अलग रखी जाती हैं।
प्रवेश-स्तर की नियुक्ति कमजोर हुई है, और कारण विवादास्पद है। LinkedIn ने पाया कि अप्रैल से जून 2026 में यूएस प्रवेश-स्तर की नियुक्ति सभी स्तरों के लिए 6.9% की तुलना में साल-दर-साल 7.6% कम थी, और उन व्यवसायों में जो AI से बढ़ते हैं, प्रवेश-स्तर की नियुक्ति उन व्यवसायों में सभी स्तरों के लिए 6.5% की तुलना में 9.6% गिरी (LinkedIn Economic Graph, 2026)। LinkedIn स्वयं गिरावट को AI की तुलना में आर्थिक अनिश्चितता के लिए अधिक जिम्मेदार मानता है, और यह नोट करता है कि प्रवेश-स्तर की भूमिकाओं में, जो AI से सुरक्षित हैं वे फ्रांस, यूनाइटेड किंगडम और यूनाइटेड स्टेट्स में सबसे अधिक गिरे। Stanford "canaries" अध्ययन के अगस्त 2026 के अपडेट में AI-प्रभावित व्यवसायों में 22- से 25-वर्ष-पुराने लोगों की रोजगार अपेक्षा से लगभग 19% कम पाया गया है अनुभवी कार्यकर्ताओं के लिए कोई तुलनीय अंतराल नहीं है, और परिणाम को वर्णनात्मक के रूप में वर्णित करता है (Stanford Digital Economy Lab, 2026a)। दो अन्य स्रोत समान तंत्र पाते हैं। Federal Reserve Bank of Dallas के अर्थशास्त्रियों ने, Current Population Survey माइक्रोडेटा का उपयोग करते हुए, AI exposure से जुड़ी रोजगार में कमी केवल युवा कार्यकर्ताओं में पाई, मुख्य रूप से बिदाई के बजाय काम से बाहर लोगों की कम गतिविधि से संचालित (Atkinson & Yamco, 2026)। लगभग 65 मिलियन कार्यकर्ताओं को कवर करने वाले रिज्यूमे डेटा में, उन फर्मों में junior रोजगार जिन्होंने generative AI को अपनाया था, गैर-अपनाने वाली फर्मों की तुलना में adoption के छह quarters बाद लगभग 9% कम था, फिर से अलगाव के बजाय धीमी नियुक्ति के माध्यम से (Hosseini & Lichtinger, 2026)। पूरी अर्थव्यवस्था में, Yale Budget Lab अभी भी कोई स्पष्ट संकेत नहीं पाता है कि AI-exposed व्यवसाय तुलनीय unexposed लोगों की तुलना में बदतर हैं (Yale Budget Lab, 2026), इसलिए दबाव प्रवेश rung पर बैठता है, संपूर्ण व्यवसाय में नहीं। नियोक्ताओं ने 2026 के पहले आधे हिस्से में घोषित 101,743 नौकरी में कटौती में AI का हवाला दिया, सभी घोषित कटौती का लगभग 23% (Challenger, Gray & Christmas, 2026)।
शिक्षा भी आगे बढ़ रही है। नई अंडरग्रेजुएट कंप्यूटर विज्ञान majors 2026 Taulbee सर्वेक्षण द्वारा कवर किए गए विभागों में 13% गिरी, जो North America में PhD-granting विभागों को गिनता है; इसके लेखक इसे नामांकन पाइपलाइन में संकुचन के पहले स्पष्ट संकेत के रूप में वर्णित करते हैं, साथ ही record degree उत्पादन (Computing Research Association, 2026)। 673 German IT apprentices के साथ एक क्षेत्र प्रयोग ने उन्हें AI होने पर उनके औपचारिक प्रशिक्षण के बाहर कार्यों पर 26 से 31 प्रतिशत अंकों का लाभ दिया (Stanford Digital Economy Lab, 2026b)। जून 2026 के OECD और European Commission संयुक्त ढांचे में "Manage AI" नामक एक domain शामिल है (OECD & European Commission, 2026)।
Table A1 (Appendix F) इस convergence के दस सिग्नल और उनके स्रोत सूचीबद्ध करता है, और प्रत्येक के लिए वह क्या दिखाता है और क्या नहीं दिखाता है। एक साथ पढ़ने के लिए, वे यह भी दिखाते हैं कि माप कहां गायब है: coding agents के भीतर गैर-developers पर vendor डेटा वृद्धि दिखाता है, उनके परिणामों की गुणवत्ता नहीं। व्यवसायों की निकटता verified success concerns में occupation है, degree नहीं। नाम बदले गए ladders और सर्वेक्षण segments titles हैं, measures नहीं। और कमजोर entry rung को AI द्वारा caused दिखाया नहीं गया है।
ये सिग्नल, कुछ आत्मविश्वास के साथ, दिखाते हैं कि agent work को सेट करना और स्वीकार करना अब पुरानी सीमा के दोनों ओर किया जाता है, और नियोक्ताओं, स्कूलों और vendors ने चीजों का नाम बदलना शुरू किया है। क्या software के बाहर के लोग यह काम programmers जितना अच्छी तरह करते हैं? सिग्नल इसे खुला छोड़ते हैं, और वे इसके लिए कोई measure भी नहीं दिखाते हैं। Section 5 measure का प्रस्ताव देता है, Section 11 गुणवत्ता के सवाल पर तारीखें लगाता है, और Section 12 उन सबूतों को निर्धारित करता है जिन्हें भविष्यवाणियों को दूर करना होगा।
2026 के सबूत उन लोगों को अलग करते हैं जो दिखा सकते हैं कि परिणाम सही है उन लोगों से जो नहीं कर सकते। एक programming शिक्षा उस ability के लिए एक मार्ग है। किसी domain की command, जांच की आदत और जांच के लिए tools अन्य हैं, और Section 2.2 के डेटा सुझाव देते हैं कि वे पहले के लिए अधिक बार खड़े हो सकते हैं जो पुरानी ladders मानते हैं, हालांकि अभी तक नहीं कि वे हमेशा कर सकते हैं। Section 5 का measure उस दावे का परीक्षण करने के लिए बनाया गया है।
3. परिचलन में नाम: एक दिनांकित मानचित्र
3.1 मैं एक नाम क्यों नहीं चुनता
2026 में हर कुछ हफ्तों में एक कंपनी या परामर्शदाता, कभी-कभी एक पत्रिका, यहाँ वर्णित लोगों के लिए एक नाम का प्रस्ताव रखता था, और उनमें से कुछ नाम चिपके रहेंगे। क्योंकि उपयोग अनिर्णीत है, मैं एक की सिफारिश करने के बजाय दो काम करता हूँ: पहले से ही परिचलन में नामों का मानचित्र बनाएँ, जिनमें वे भी शामिल हैं जो लिए जा चुके हैं, यह दिखाते हुए कि किसने प्रत्येक को कब और किस अर्थ में प्रस्तुत किया, और एक माप प्रदान करें जिस पर उनमें से कोई भी पढ़ा जा सकता है। यदि "builder" जीतता है, तो रिकॉर्ड "builder at Week" पढ़ता है; यदि "agent manager" जीतता है, तो यह "agent manager at Day" पढ़ता है। प्राथमिकता माप, सीढ़ी, परिभाषाओं और भविष्यवाणियों के लिए दावी की जाती है, जिनमें उन्हें नाम देने वाले शब्द भी शामिल हैं (सत्यापित प्रतिनिधिमंडन क्षितिज, प्रवर्धन लाभ, साक्रेपत्र क्रॉसओवर बिंदु), और किसी भी भूमिका के नाम के लिए नहीं; अनुभाग 3.3 में जोड़े गए भूमिका के नाम प्राथमिकता के बिना उम्मीदवार के रूप में प्रस्तुत किए जाते हैं।
3.2 छः परतें
उम्मीदवार सभी एक स्लॉट के लिए प्रतिस्पर्धा नहीं करते हैं। कुछ एक कौशल का नाम देते हैं जो लगभग सभी के पास होगा, अन्य एक पेशे, एक माप, एक क्षण, एक साथी, या एक संकेत का नाम देते हैं जो विफल हो गया। तालिका A2 (परिशिष्ट F) पहले से ही उपयोग में आने वाले नामों को सूचीबद्ध करता है, उनके स्वामियों के साथ, और दूसरे भाग में, इस अध्ययन में प्रस्तावित या केवल सादे विवरण के रूप में यहाँ उपयोग किए गए नामों को, साथ ही उन प्रकारों के साथ जिन पर विचार किया गया था और एक तरफ रखा गया था, ताकि एक पाठक पूरे परिवार को देख सके। चित्र 2 परत के अनुसार नामों को रखता है और प्रत्येक को पेश किए जाने की तारीख के अनुसार।
चित्र 2। परिचलन में नाम, परत और प्रत्येक को पेश किए जाने की तारीख के अनुसार।
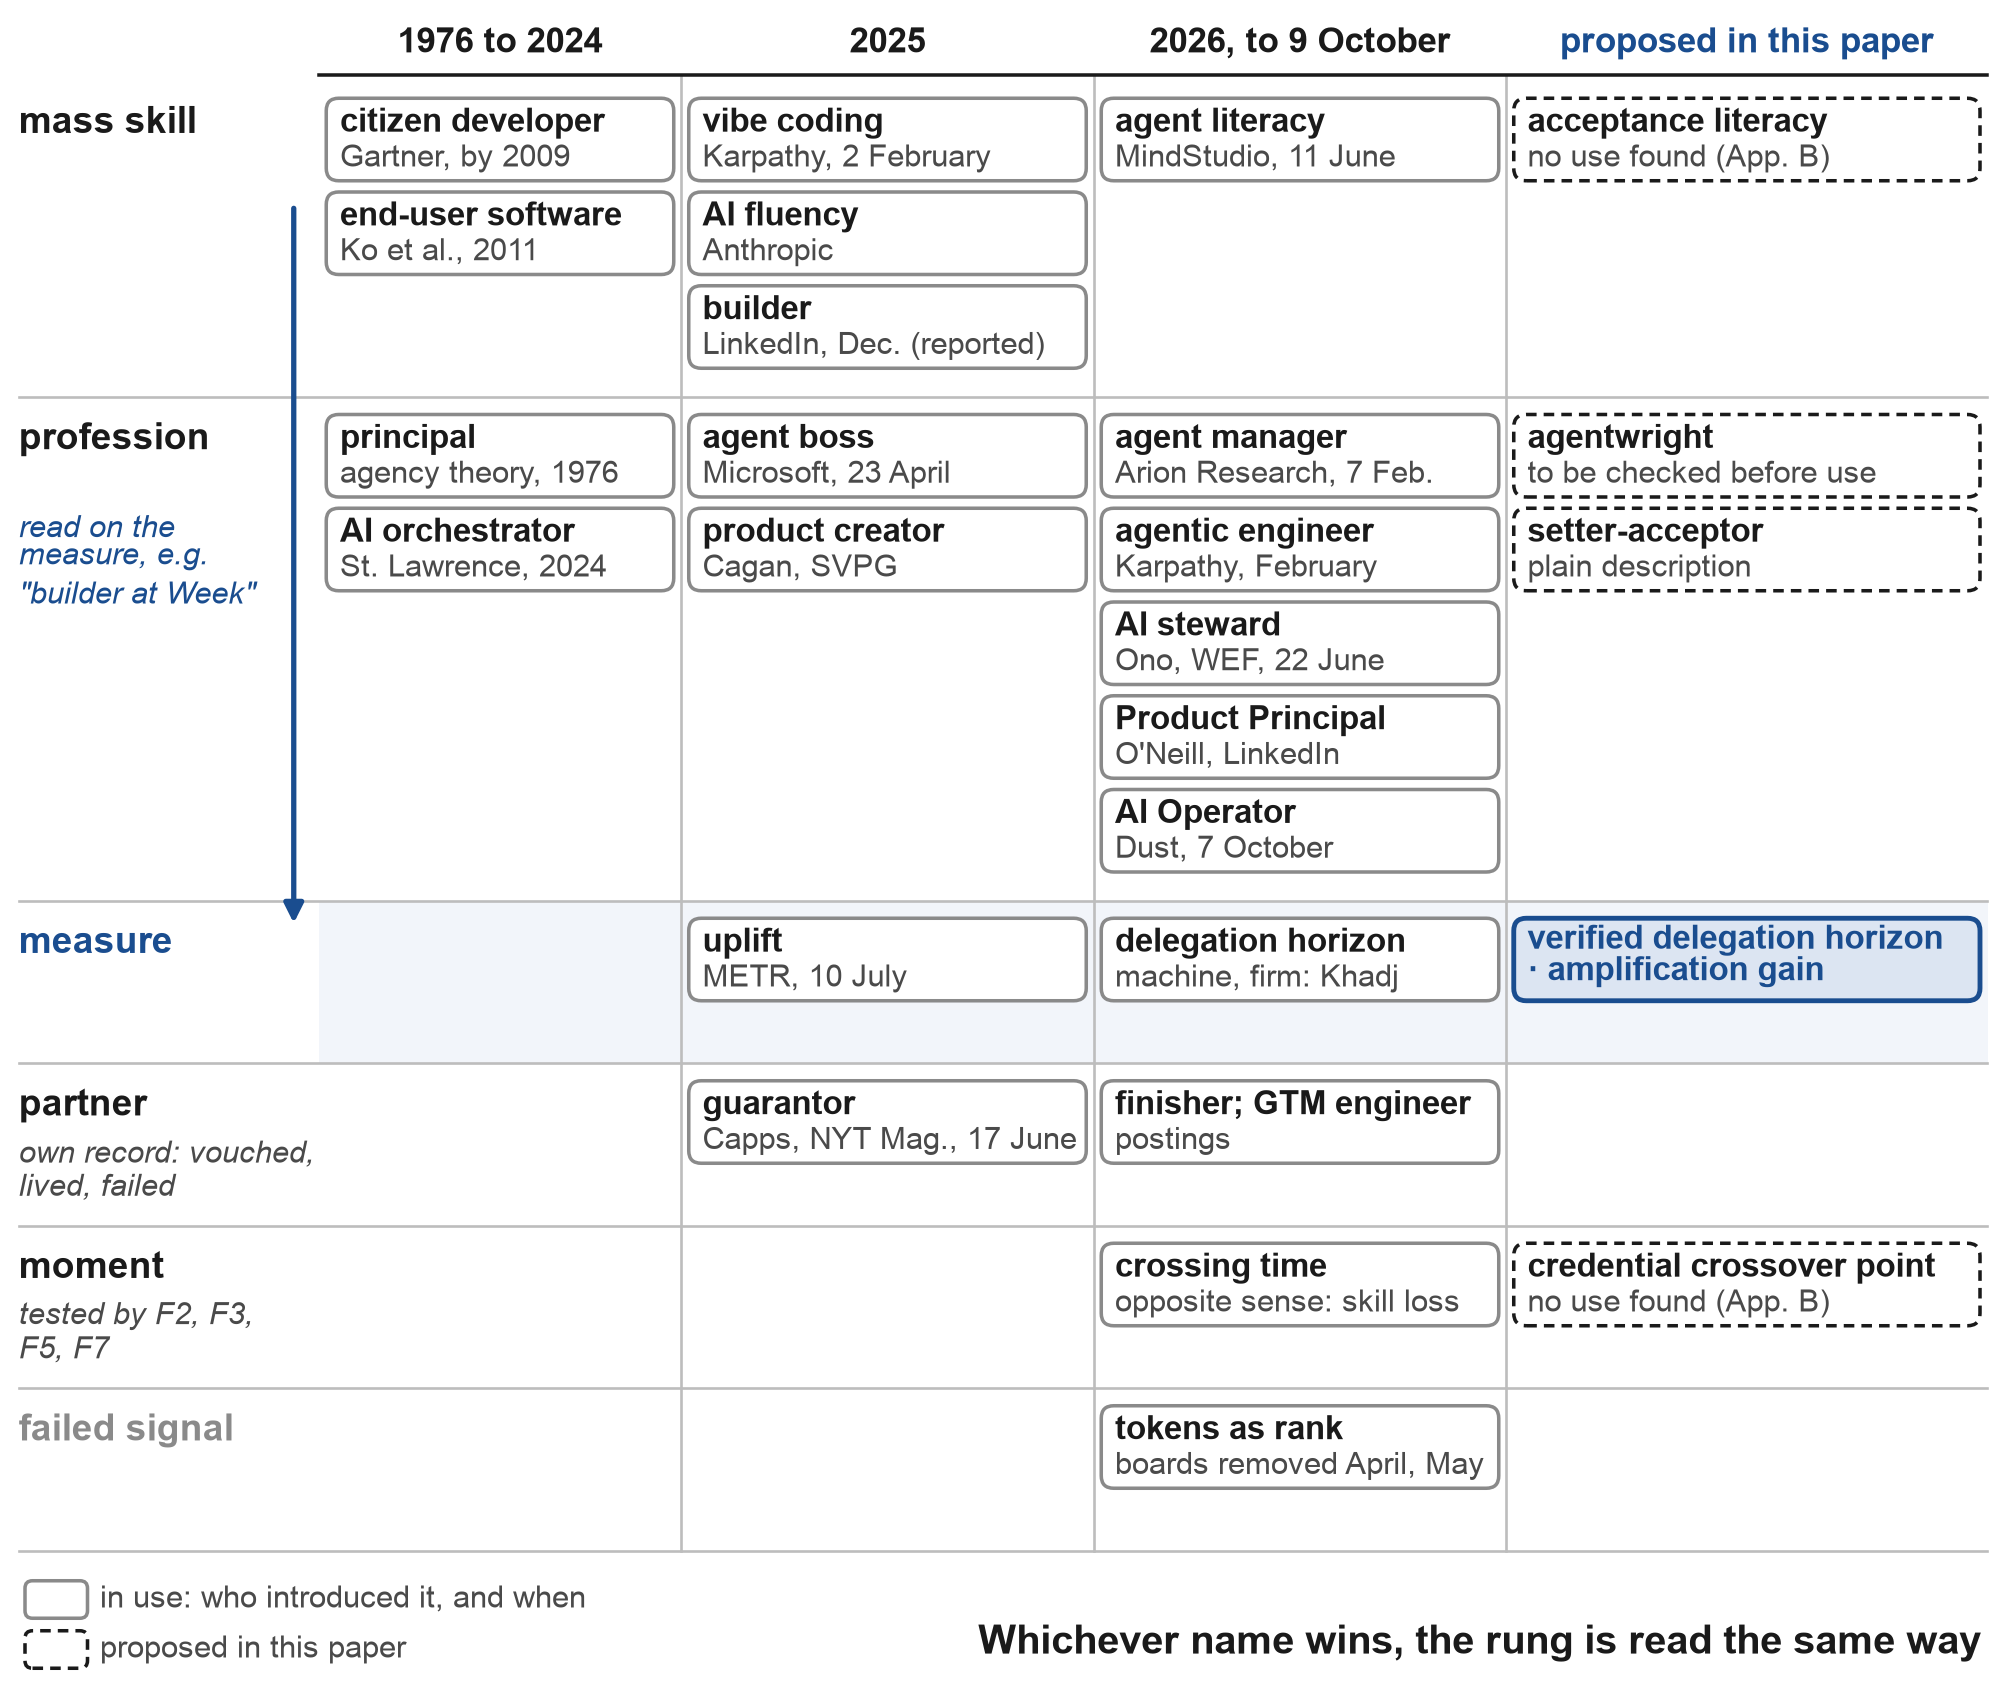
नोट: मालिक और तारीखें तालिका A2 का अनुसरण करते हैं। एक नाम जिसका स्रोत केवल एक वर्ष देता है, उसमें कोई महीना नहीं होता है। यह आंकड़ा एक चयन है; तालिका A2 हर उम्मीदवार को सूचीबद्ध करता है। केवल द्रव्यमान-कौशल और पेशे की परतें माप पर पढ़ी जाती हैं ("builder at Week", "agent manager at Day", अनुभाग 3.1)। साथी के पास अपना रिकॉर्ड है, कितने उत्पादों को वाउच किया गया था, प्रत्येक कितने समय तक रहा और कितने विफल हो गए (अनुभाग 7.2), और क्षण एक पायदान नहीं है बल्कि दिनांकित भविष्यवाणियों F2, F3, F5 और F7 द्वारा परीक्षण किया जाता है (अनुभाग 11.2)। माप पंक्ति में "Delegation horizon" मशीन या फर्म अर्थ है (Khadj, 2026; Alonso, 2026), अनुभाग 5 का व्यक्तिगत माप नहीं। यह आंकड़ा कौन से नाम की प्रबलता होगी इसके बारे में कोई निर्णय नहीं करता है।
3.3 मानचित्र पर टिप्पणियाँ
"Builder" संभवतः द्रव्यमान HR में जीत रहा है: LinkedIn ने इसे अपनाया है, और पत्रकारों ने 2026 में लिखा कि अब बे एरिया में हर कोई एक builder है (SF Standard, 2026)। शब्द से लड़ने का कोई कारण नहीं है, क्योंकि यह स्तर के बारे में कुछ नहीं कहता है और स्तर ही वह है जो माप प्रदान करता है।
प्रबंधकीय नाम (agent manager, AI operator, orchestrator) क्षैतिज हैं: वे सामान्य रूप से agents को चलाने का वर्णन करते हैं, किसी विशेष डोमेन में नहीं। अनुभाग 6.3 यह कारण देता है कि prompt engineer का अनुसरण करने की उम्मीद क्यों करें, एक शीर्षक जो 2023 में हर जगह था और 2025 में अप्रचलित कहा जाता था (Fortune, 2025; TechRepublic, 2025)।
"Principal" के पीछे सबसे मजबूत सिद्धांत है और सबसे बुरे टकराव हैं। एजेंसी सिद्धांत में प्रधान वह पक्ष है जो प्रतिनिधिमंडन करता है और निगरानी की लागत वहन करता है (Jensen & Meckling, 1976), और Anthropic के अपने मॉडलों के लिए संविधान "principals" को उन लोगों को कहता है जिनकी ओर से मॉडल कार्य करता है (Anthropic, 2026b)। Verheul (2026) तर्क देते हैं कि जब मशीनें एजेंसी फ़ंक्शन को करती हैं, तो एक फर्म में लोग केवल प्रधान पद धारण करते हैं और कैरियर सीढ़ी गायब हो जाती है। मैं निदान को स्वीकार करता हूँ और इसके बदले में एक नई सीढ़ी का प्रस्ताव करता हूँ। पहचान और पहुँच प्रबंधन में, हालांकि, "agent principal" एजेंट की अपनी पहचान का नाम देता है, इच्छित अर्थ का विपरीत, इसलिए अंग्रेजी वाक्यांश "Agent Principal" का उपयोग एक व्यक्ति के लिए नहीं किया जाना चाहिए। O'Neill का "Product Principal" लगभग इसी अर्थ में एक पूर्वदृष्टांत है और इस रूप में उद्धृत किया जाता है, और JetBrains का AIDEs ढाँचा पहले से ही प्रमुख-एजेंट संबंध के गुणों के रूप में डेवलपर स्तरों का वर्णन करता है (Tikhomirov, 2026)।
यहाँ प्रस्तावित नाम (agentwright, setter-acceptor, agent director) परिवार में उम्मीदवारों के रूप में शामिल होते हैं, उनमें से कोई पसंदीदा नहीं है। Agentwright खोजे गए विद्वतापूर्ण आधारों में मुक्त है, लेकिन सर्च इंजन इसे "Agent Wright" में विभाजित करते हैं, यह एक ब्राउज़र-परीक्षण उपकरण की तरह लगता है जो डेवलपर्स जानते हैं, और अक्टूबर 2026 तक शब्द पहले से ही एक Python पैकेज और एजेंट कौशल की एक सूची के लिए उपयोग किया जा रहा था, इसलिए यह एक प्रकार बना रहता है जिसे एक योग्यता की आवश्यकता होगी।
अर्थ के बारे में एक अवलोकन बाजार से पसंद लिए बिना दर्ज किया जा सकता है। अर्थ से, "principal" अनुभाग 8 के पेशे के सबसे निकट है, दूसरों के लिए किया गया काम जिम्मेदारी के साथ परिणाम के लिए, और "builder" द्रव्यमान कौशल के सबसे निकट है, अपने लिए किया गया काम।
4. क्यों एक माप: वर्ष जब टोकन को सीनियरिटी के रूप में आजमाया गया
बाजार ने एक स्केल के लिए इंतज़ार नहीं किया। 2026 में इसने कई को आजमाया, और क्योंकि प्रकरण अपने प्रकार में भिन्न हैं, वे यहाँ अलग रखे गए हैं, उसी क्रम में जिसमें वे घटित हुए।
Meta पर, एक कर्मचारी ने एक आंतरिक डैशबोर्ड बनाया जिसका उपनाम "Claudeonomics" था जो लगभग 85,000 सहकर्मियों को खपत किए गए टोकन द्वारा स्थान दिया, तीस दिनों में उनमें से 60 ट्रिलियन से अधिक (Shopifreaks, 2026a)। यह एक कर्मचारी की परियोजना थी, जिसके पास कोई आधिकारिक स्थिति नहीं थी, और इसे अप्रैल में ले जाया गया जब इसकी बाहर कंपनी के रूप में रिपोर्ट की गई थी। Meta की आधिकारिक रेखा अलग से चली। फरवरी से AI का उपयोग कर्मचारी मूल्यांकन का एक औपचारिक हिस्सा था, और सितंबर की शुरुआत में WIRED और CIO ने नई मार्गदर्शन की सूचना दी जिसके तहत Meta "AI adoption dashboards या token counts का उपयोग प्रभाव का मूल्यांकन करने के लिए नहीं करेगा" और "AI Native" लेबल को एक मानदंड के रूप में ड्रॉप किया (CIO, 2026b; Shopifreaks, 2026b)। Amazon पर टोकन के उपयोग का एक लीडरबोर्ड खाली कार्यों के साथ गेम किया गया था और मई में हटा दिया गया (CIO, 2026a), जो Goodhart's law का सबसे स्वच्छ रूप है: एक बार जब माप एक लक्ष्य बन गया, तो यह मापना बंद कर दिया। Uber का मामला एक बजट घटना है। कंपनी ने अपना वार्षिक AI बजट चार महीने में खर्च किया और कर्मचारियों को $1,500 प्रति माह तक सीमित किया (Fortune, 2026b)। जुलाई में Cognition के मुख्य कार्यकारी ने कहा कि कंपनियों को उत्पादकता को मापना चाहिए, न कि AI usage को (Fortune, 2026c)।
प्रतिउदाहरण उतने ही महत्वपूर्ण हैं। Shopify अपनी प्रदर्शन और peer reviews में AI usage के बारे में प्रश्न जोड़ता है (Shopify, 2026), और एक टिप्पणीकार की अपेक्षा है कि token metrics को "मार नहीं किया जाएगा, बल्कि downgrade किया जाएगा" (Kingy AI, 2026)। कोई व्यक्ति AI का उपयोग कैसे करता है, इसके बारे में प्रश्न वॉल्यूम द्वारा एक रैंकिंग से एक अलग चीज़ है, और अनुभाग 11 में भविष्यवाणी F8 उन्हें अलग करती है।
अनुभाग 9 में जांची गई डेवलपर्स की threads एकल लोगों में एक ही प्रवृत्ति दिखाती हैं। वे अपने को inputs के साथ परिचय देते हैं: $1,148 का एक मासिक AI बिल, एक subscription का screenshot, लगभग 330 कुछ 600 pull requests के (एक इकाई जिसे thread में बहुत अनुमानित के रूप में वर्णित किया गया है), तीन दिनों में 36 stages बनाए गए। उनमें से एक ने गणना की जांच किए बिना अपने agent द्वारा गणना की गई बचत प्रकाशित की, जो token episode है एक व्यक्ति द्वारा दोहराया गया। इनमें से प्रत्येक खर्च या उत्पादित चीज़ गिनता है; क्या स्वीकृत था, किसके द्वारा और किस जांच के बाद, अप्रकाशित है।
मैं माप के लिए एक सीधा पाठ निकालता हूँ: काम गिनें, और केवल वह काम जो agents द्वारा देखी गई जांच को पास किया। एक ही परिवार के models के बीच समझौता वह जांच नहीं हो सकता, क्योंकि उनकी त्रुटियाँ संबंधित हैं और उनका समझौता स्वतंत्र राय से कम मूल्यवान है जितना वह दिखता है (Chernets, 2026b)। अधिक टोकन खर्च करने से इस तरह से बनाया गया माप inflate नहीं हो सकता, क्योंकि unaccepted काम इसमें कुछ नहीं जोड़ता। इसे inflate करने के अन्य तरीके बने हुए हैं, और अनुभाग 5.8 उन्हें उनकी defences के साथ सूचीबद्ध करता है।
5. माप: सत्यापित प्रतिनिधिमंडन क्षितिज और प्रवर्धन लाभ
5.1 संदर्भ घंटे
दोनों अक्ष एक इकाई का उपयोग करते हैं, संदर्भ घंटा: वह समय जो एक योग्य विशेषज्ञ को हाथ से समान कार्य करने के लिए चाहिए। संदर्भ जानबूझकर बाहरी है। यह कि व्यक्ति स्वयं कार्य कर सकता था या नहीं, इस माप में प्रवेश नहीं करता, और न ही उनकी पृष्ठभूमि। एक बहीखाता पद्धति का समन्वय उपकरण और एक डेवलपर का बिलिंग मॉड्यूल दोनों को यह मापा जाता है कि एक सक्षम पेशेवर ने उन पर कितना समय व्यय किया होता।
संदर्भ घंटे दो स्रोतों में से एक से आते हैं। एक है कार्यों का एक फ्रोजन बैंक जिनके हाथ से किए गए समय को 2025 और 2026 में मापा गया था; GDPval, जिसके कार्य 44 व्यवसायों से लिए गए हैं और उनके विशेषज्ञों के समय, दर्शाता है कि ऐसा बैंक बनाया जा सकता है (Patwardhan et al., 2025)। दूसरा है दो स्वतंत्र रेटर जो यह नहीं जानते कि किसने काम किया, घंटों का अनुमान लगाते हैं; जहां एक डोमेन के रेटर बहुत दूर साबित होते हैं, संदर्भ इसके बजाय पाँच से नौ रेटर के एक अंशांकित पैनल का माध्यिका हो सकता है, रंग के आधार पर स्कोर किया जाता है (परिशिष्ट G2)। मैं बैंक को जानबूझकर फ्रोज करता हूं, जिस तरह मीटर को एक बार पेरिस के पास एक तिजोरी में रखा जाता था, क्योंकि कुछ वर्षों में कुछ लोग अभी भी इन कार्यों को हाथ से करेंगे और तुलना करने के लिए कुछ नहीं बचेगा। बैंक को प्रत्येक डोमेन के लिए, हर रंग पर कार्य रखना चाहिए, प्रत्येक के साथ यह बताने वाले कथन कि क्या पूरा माना जाता है, हाथ से किए गए समय, छिपी जांच, और कुछ रोपित त्रुटियां जिनकी पहचान स्वीकृति का हिस्सा है। GDPval के हाथ से किए गए समय विशेषज्ञों की सत्यापित आत्म-रिपोर्ट हैं, जबकि उसके समीक्षा समय को मापा गया था, जो वह मानक है जो एक बैंक को पूरा करना चाहिए या सुधारना चाहिए। माप को स्वयं को न्यायिक करने से रखने के लिए, क्षितिज को एक सेट कार्यों पर स्कोर किया जाता है और इसके बारे में परिकल्पनाओं का परीक्षण करने के लिए उपयोग की जाने वाली गुणवत्ता (अनुभाग 6) दूसरे पर है।
5.2 सत्यापित प्रतिनिधिमंडन क्षितिज
परिभाषा। किसी व्यक्ति का किसी डोमेन में सत्यापित प्रतिनिधिमंडन क्षितिज संदर्भ घंटों में काम का सबसे बड़ा आकार है, जिस पर व्यक्ति नियमित रूप से एजेंटों को काम सौंपता है, इसे स्वीकार करता है, और इसे एक स्वतंत्र जांच द्वारा पुष्टि करवाता है जो एजेंटों ने नहीं देखा।
एक अनुच्छेद में नियम। प्रतिनिधिमंडित काम को सत्यापित माना जाता है, और क्षितिज में प्रवेश करता है, केवल जब निम्नलिखित सभी सत्य हों। इसे यह बताने वाले लिखित कथन के साथ सेट किया गया था कि क्या पूरा माना जाएगा, और इसके संदर्भ घंटे बैंक या दो रेटर से आते हैं। व्यक्ति ने इसे एक सुसंगत डिलीवरेबल के रूप में स्वीकार किया: काम का एक महीना 160 एक घंटे की टिकटों में काटा गया है 160 घंटे, जबकि चरणों में किया गया काम और एक पूरे के रूप में स्वीकार किया गया है पूरे के संदर्भ घंटों द्वारा गिनती करता है। एक स्वतंत्र जांच ने इसकी पुष्टि की, और जांच स्वतंत्र है जब यह डेटा में एजेंटों से भिन्न हो (इनपुट जो एजेंटों ने नहीं बनाया), एक्सेस में (एजेंट इसे नहीं देख या संपादित नहीं कर सकते) और प्रोत्साहन में (जो कोई इसे चलाता है वह पास से कुछ नहीं प्राप्त करता है)। चार प्रकार योग्य हैं: छिपी हुई स्वीकृति परीक्षण, एक योग्य मानव समीक्षक, इच्छित उपयोगकर्ताओं द्वारा वास्तविक उपयोग, या दूसरे परिवार का मॉडल जो उन स्रोतों के विरुद्ध सत्यापित करता है जो व्यक्ति खोलता है और एक निर्णय छोड़ता है जिसका ऑडिट किया जा सकता है। आत्म-समीक्षा और एक परिवार के मॉडलों में सहमति गिनती नहीं करते, क्योंकि उनकी अंधी धब्बे एजेंटों के अपने के साथ मेल खाते हैं। रंग की विंडो के भीतर (घंटे और दिन पर 91 दिन, सप्ताह पर 182, महीने और त्रैमासिकी पर 365) व्यक्ति ने उस आकार के आवश्यक संख्या में टुकड़ों को स्वीकार किया, घंटे और दिन पर दस, सप्ताह और महीने पर छह और त्रैमासिकी पर तीन, और कम से कम हर दस में से आठ पारित, जिसका अर्थ है सप्ताह और महीने पर छह में से पाँच और त्रैमासिकी पर सभी तीन। सप्ताह से ऊपर उन टुकड़ों में से कम से कम एक रोपित त्रुटियां ले जाता है। कोई भी एक छूटी हुई रोपित त्रुटि, किसी भी प्रकार की, सप्ताह से ऊपर के रंग को उस विंडो के लिए अवरुद्ध करता है, और इसके साथ टुकड़ा न तो रंग की ओर गिनती करता है और न ही प्रवर्धन लाभ की ओर। जहां त्रुटि को पूर्ववत नहीं किया जा सकता (पैसा स्थानांतरित, रोगी का रिकॉर्ड, फाइलिंग जिसे वापस नहीं लिया जा सकता), ऐसे प्रत्येक टुकड़े को पास होना चाहिए, एक छिपी हुई परीक्षा या योग्य मानव डिफ़ॉल्ट जांच के रूप में और दूसरी पंक्ति के रूप में दूसरे परिवार का मॉडल, और कठोर नियम केवल उन टुकड़ों पर लागू होता है। प्रत्येक हैंडओवर को लॉग किया जाता है, विफलताएं और त्यागे गए टुकड़े शामिल, उन्हें दिए गए ध्यान के साथ। रंग को फिर से हर त्रैमासिकी की पुष्टि की जाती है: सप्ताह और ऊपर, रंग के आकार का कम से कम एक सत्यापित टुकड़ा पिछले 91 दिनों के भीतर गिरना चाहिए, तो क्षितिज साल के करीब के काम पर आराम नहीं कर सकता। नीचे दिए गए अनुच्छेद प्रत्येक भाग के कारण देते हैं।
स्कोरिंग नियम। प्रत्येक रंग के लिए सेट की गई विंडो के भीतर (घंटे और दिन के लिए 91 दिन, सप्ताह के लिए 182, महीने और त्रैमासिकी के लिए 365), एक रंग गिनती करता है यदि व्यक्ति ने डोमेन में उस आकार के आवश्यक संख्या में टुकड़ों को स्वीकार किया (घंटे और दिन के लिए दस, ऊपर कम, जैसा कि नीचे सेट है), और कम से कम हर दस में से आठ इन प्रकारों में से एक की जांच पारित: छिपी हुई स्वीकृति परीक्षण, एक योग्य मानव समीक्षक, इच्छित उपयोगकर्ताओं द्वारा वास्तविक उपयोग, या दूसरे परिवार का एक मॉडल जो स्रोतों के विरुद्ध सत्यापित किया। आत्म-समीक्षा और एक परिवार के मॉडलों में सहमति गिनती नहीं करते। जहां त्रुटियों को पूर्ववत नहीं किया जा सकता (पैसा स्थानांतरित, रोगी का रिकॉर्ड, फाइलिंग जिसे वापस नहीं लिया जा सकता), ऐसे प्रत्येक टुकड़े को पास होना चाहिए, और कठोर सीमा केवल उन टुकड़ों पर लागू होती है। इन टुकड़ों के लिए डिफ़ॉल्ट जांच एक छिपी हुई परीक्षा या योग्य मानव है, दूसरी पंक्ति के रूप में दूसरे परिवार का एक मॉडल।
ऊपरी रंग। दस की एक एकल गिनती ऊपरी रंगों को किसी के भी पहुंच से बाहर रखेगी, क्योंकि तीन महीने में 40 संदर्भ घंटों के दस टुकड़े एक विशेषज्ञ के 400 घंटे का काम है, और 500 घंटों के दस टुकड़े 5,000 हैं। नियम इसलिए विंडो को लंबा करता है और गिनती को कम करता है जैसे रंग बढ़ता है: घंटे और दिन के लिए 91 दिनों में दस टुकड़े, सप्ताह के लिए 182 दिनों में छह, महीने के लिए 365 दिनों में छह और त्रैमासिकी के लिए 365 दिनों में तीन, दस में से आठ के समान अंश के साथ (जिसका अर्थ है सप्ताह और महीने के लिए छह में से पाँच, और त्रैमासिकी के लिए सभी तीन)। सप्ताह से ऊपर, विंडो में रंग के आकार का कम से कम एक टुकड़ा रोपित त्रुटियां ले जाना चाहिए। कोई भी रोपित त्रुटि जो व्यक्ति को याद आती है, जो भी प्रकार की हो, सप्ताह से ऊपर के रंग को उस विंडो के लिए अवरुद्ध करता है, और छूटी हुई रोपित त्रुटि वाला टुकड़ा न तो रंग की ओर और न ही प्रवर्धन लाभ की ओर सत्यापित के रूप में गिनती करता है। त्रैमासिकी एक दुर्लभ रंग बनी रहने का इरादा है, और ऊपर की गिनती इसलिए सेट की जाती है।
हर हस्तांतरण को लॉग किया जाता है। लॉग एजेंटों को सौंपे गए हर टुकड़े को रिकॉर्ड करता है, जिसमें वे भी शामिल हैं जो जांच में विफल रहे और जो इससे पहले छोड़ दिए गए, और केवल एक सुसंगत डिलीवरेबल के रूप में स्वीकृत टुकड़ा एक रंग की ओर गिना जाता है। एक महीने का काम 160 एक घंटे की टिकटों में विभाजित 160 घंटे है, एक महीना नहीं: संदर्भ घंटों का अनुमान उस डिलीवरेबल के लिए लगाया जाता है जिसे उपयोगकर्ता, क्लाइंट या समीक्षक एक पूरे के रूप में स्वीकार करता है, METR के सुसंगत कार्यों की भावना में। विलोम भी सत्य है: चरणों में किया गया काम और एक सुसंगत डिलीवरेबल के रूप में स्वीकृत उस डिलीवरेबल के संदर्भ घंटों द्वारा पूरा गिना जाता है, इससे कितने चरण लगे इसकी परवाह किए बिना।
स्वतंत्रता। एक जांच स्वतंत्र होती है जब वह एजेंटों से डेटा में भिन्न होती है (यह ऐसे इनपुट का उपयोग करती है जो एजेंटों ने तैयार नहीं किए), पहुंच में (एजेंट इसे देख या संपादित नहीं कर सकते) और प्रोत्साहन में (जो इसे चलाता है वह पास से कुछ नहीं पाता)। दूसरे परिवार का मॉडल त्रुटियों की विविधता जोड़ता है। यह केवल तब गिना जाता है जब यह उन स्रोतों के विरुद्ध सत्यापित करता है जिन्हें व्यक्ति ने खोला, और इसका निर्णय एक ऐसा इनपुट है जिसका ऑडिट किया जा सकता है।
एक टुकड़ा काम इस पथ का अनुसरण करता है (चित्र 3)। एक कार्य यह लिखित कथन के साथ निर्धारित किया जाता है कि क्या पूरा माना जाएगा। इसके संदर्भ घंटे बैंक से या दो मूल्यांकनकर्ताओं से लिए जाते हैं। एजेंट काम करते हैं जबकि व्यक्ति ध्यान देता है, जिसे लॉग किया जाता है। व्यक्ति टुकड़े को स्वीकार करता है, अस्वीकार करता है या त्यागता है, एक स्वतंत्र जांच की पुष्टि या खंडन करती है, और लॉग की लाइन उस क्षण लिखी जाती है, जहां आवश्यक हो शुरुआत की तारीख को एक अलग फील्ड में रखा जाता है। जहां एक विलंबित परिणाम मौजूद है (एक फाइलिंग स्वीकृत, एक रिलीज़ एक महीने के बाद भी चल रहा है), इसे तब रिकॉर्ड किया जाता है जब यह आता है। क्षितिज और लाभ उन रिकॉर्ड से एक तारीख के साथ संगणित किए जाते हैं।
चित्र 3। एक टुकड़ा काम, एक रिकॉर्ड।
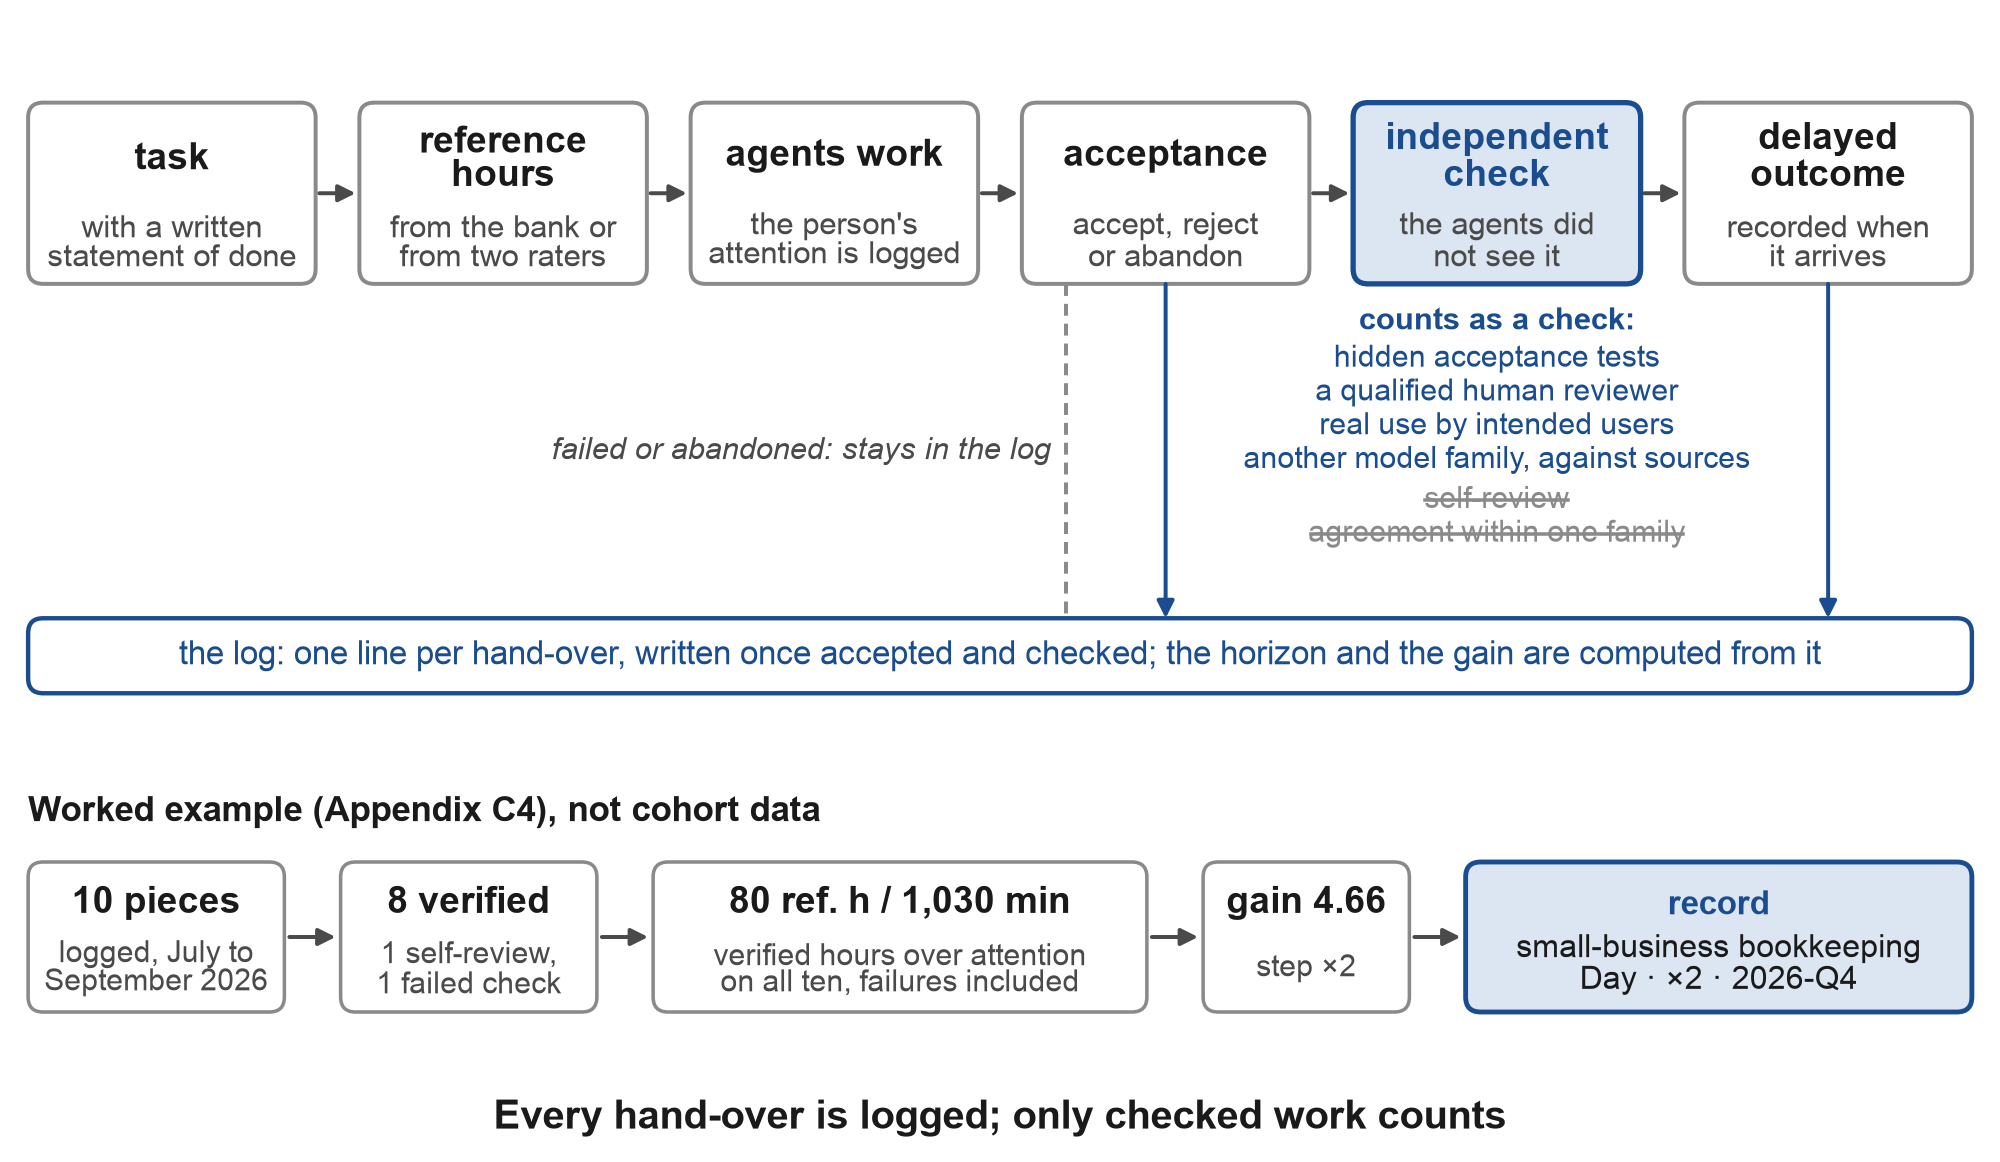
नोट: ऊपरी पंक्ति खंड 5.2 का पथ है। चार प्रकार की स्वतंत्र जांच स्कोरिंग नियम के हैं। स्व-समीक्षा और एक परिवार के मॉडलों के बीच समझौता गिनती नहीं करते। विफल और त्यागे गए टुकड़े लॉग में रहते हैं और विस्तार लाभ के हर में अपने मिनट जोड़ते हैं। निचली पंक्ति परिशिष्ट C4 का काम किया गया उदाहरण है, एक निर्मित लॉग, सह्र्ट डेटा नहीं: दस टुकड़े, आठ सत्यापित, 80 संदर्भ घंटे 1,030 मिनट के ध्यान के विरुद्ध, 4.66 की लाभ (चरण ×2) और रिकॉर्ड "small-business bookkeeping · Day · ×2 · 2026-Q4"।
पुनः-सत्यापन। एक क्षितिज हर तिमाही में फिर से पुष्टि की जाती है। खंड 2.1 के Anthropic के पर्यवेक्षण विरोधाभास से यह पता चलता है कि क्यों: एक क्षितिज जो अर्जित की गई जबकि जांच कौशल क्षयित होता है उधार है, और एक त्रैमासिक जांच दिखाती है कि क्या यह अभी भी सत्य है। उन रंगों के लिए जिनकी खिड़कियां एक तिमाही से अधिक समय तक चलती हैं (सप्ताह, महीना और तिमाही), जांच का एक ठोस रूप है: रंग के आकार का कम से कम एक सत्यापित टुकड़ा पिछले 91 दिनों के भीतर गिरना चाहिए, ताकि एक रंग लगभग एक साल पुराने टुकड़ों पर आराम नहीं कर सके।
5.3 सीढ़ी
मैं पांच रंगों को समय की इकाइयों में नाम देता हूं क्योंकि समय की इकाइयों को पेशों के बीच कोई अनुवाद नहीं चाहिए, लॉग से पढ़ा जा सकता है, और प्रौद्योगिकी के साथ बढ़ते हैं बिना पुनः नामकरण के। तालिका 1 उन्हें उदाहरणों और गिनती के साथ देती है जिसकी प्रत्येक को आवश्यकता है।
तालिका 1। सत्यापित प्रतिनिधिमंडन क्षितिज की सीढ़ी।
| रंग | सौंपे गए और सत्यापित काम का आकार | सॉफ़्टवेयर में उदाहरण | अन्यत्र उदाहरण | आवश्यक सत्यापित टुकड़े, खिड़की |
|---|---|---|---|---|
| घंटा | लगभग 1 संदर्भ घंटा | एक स्क्रिप्ट, एक छोटी मरम्मत | दस्तावेज़ों के ढेर से निकाले गए उत्तर | 91 दिनों में 10 में से 8 |
| दिन | लगभग 8 | एक सुविधा, एक छोटा आंतरिक उपकरण | माह के अंत की रिपोर्ट अपनी जांच के साथ | 91 दिनों में 10 में से 8 |
| सप्ताह | लगभग 40 | विनिर्देश के लिए एक साइट या आंतरिक उपकरण, रातोंरात चलने के साथ | एक पूर्ण due-diligence पैक, एक अभियान प्रणाली | 182 दिनों में 6 में से 5 |
| महीना | लगभग 160, आमतौर पर कई धाराओं में | एक उत्पाद रिलीज़; स्वीकृति नियम जो दूसरे काम करते हैं | अभ्यास का उपकरण, नियमों के साथ जो सहकर्मी उपयोग करते हैं | 365 दिनों में 6 में से 5 |
| तिमाही | लगभग 500 | लाइव उपयोगकर्ताओं के साथ एक उत्पाद लाइन | एजेंटों के माध्यम से चलाई गई एक सेवा लाइन | 365 दिनों में 3 में से 3 |
नोट: एक रंग केवल खंड 5.2 के स्कोरिंग नियम द्वारा अर्जित किया जाता है, प्रत्येक डोमेन में अलग से, नियमों की गिनती v1.1 के साथ (परिशिष्ट E)। पुरानी सीढ़ी पर कोई ग्रेड एक रंग नहीं देता, और एक व्यक्ति वित्तीय उपकरणों में सप्ताह पर और वेब अनुप्रयोगों में दिन पर हो सकता है।
एक रिज्यूमे या HR फाइल के लिए रिकॉर्ड डोमेन, क्षितिज, विस्तार और तारीख रखता है, उदाहरण के लिए "small-business bookkeeping · Day · ×2 · 2026-Q4"। तारीख रिकॉर्ड में है क्योंकि समान रंग एक साल बाद कुछ अलग अर्थ होगा, जैसे तकनीक आगे बढ़ता है।
5.4 विस्तार लाभ
जो सभी एजेंटों के साथ अच्छी तरह काम करते हैं वे उन्हें बड़े टुकड़े नहीं सौंपते। खंड 9 के डेवलपर्स में से एक, जो चार मशीनों के साथ बनाते हैं, उनमें से तीन को "व्यक्तिगत दक्षता का बूस्ट" के रूप में वर्णित करता है जिसमें कोई स्वायत्त एजेंट नहीं हैं। स्वायत्त एजेंट जो वह भी चलाते हैं "दैनिक काम के लिए जड़ नहीं लेते," वह लिखते हैं, और वह "boost, not delegation" पसंद करते हैं (अनुवादित)। उनका सबसे लंबा प्रवाह तीन दिनों में 36 चरणों तक चला, प्रत्येक चरण सौंपे और प्रतिबद्ध, फिर एजेंट से सब कुछ तैनात होने की पुष्टि करने के लिए कहा गया। खंड 5.2 के नियम के अनुसार वह पुष्टि स्व-समीक्षा है, इसलिए उनका रिकॉर्ड जैसा पोस्ट किया गया कोई सत्यापित रंग नहीं दिखाता, और धागा उनके लाभ के लिए कोई संख्या नहीं देता। जहां वह एक स्वतंत्र जांच के साथ खड़े होंगे यह क्या स्वीकार किया गया था पर निर्भर करता है। यदि 36 चरण एक सुसंगत डिलीवरेबल के रूप में स्वीकृत थे, प्रवाह पूरा गिना जाता है, अपने संदर्भ घंटों द्वारा, जैसे परिशिष्ट C के चरणबद्ध काम, खंड C4, करता है। यदि प्रत्येक चरण अपने आप पर स्वीकृत था, प्रत्येक एक छोटा टुकड़ा है और वह पहली धुरी पर घंटे पर खड़ा है। पोस्ट नहीं कहता कि कौन सा। फिर भी वह ऐसे उपकरण बनाता है जो सॉफ़्टवेयर को प्रतिस्थापित करता है जिसे वह खरीदता था, और वह दूसरी धुरी के हर को स्वयं नाम देता है जब वह समय को एकमात्र बाधा कहता है।
वह कोई अपवाद नहीं है। Anthropic ने बताया कि छह महीने या उससे अधिक अनुभव वाले उपयोगकर्ता "निर्देशात्मक उपयोग पैटर्न के माध्यम से अधिक जिम्मेदारी सौंपने की संभावना बहुत कम थी", मॉडल के साथ अधिक पुनरावृत्तिमूलक तरीके से काम करते थे, और कठिन कार्य लाते थे, जिसमें नियंत्रण के बाद तीन से पाँच अंक अधिक सफलता थी (Anthropic, 2026d)। Claude.ai में, सहयोगी उपयोग ने नवंबर 2025 में स्वचालन को 52% से 45% तक ले गया, और बातचीत एक-बार प्रोग्रामेटिक अनुरोधों की तुलना में अधिक बार सफल रही, 67% बनाम 49% (Anthropic, 2026a)। उच्च वेतन वाले व्यवसायों में लोगों ने लगभग 1.5 गुना अधिक बारी लीं, और महिलाओं ने समान व्यवसाय में पुरुषों की तुलना में 7.3 अंक कम स्वचालन किया (Anthropic, 2026f)। Stanford के 1,500 कर्मचारियों के सर्वेक्षण में, 104 व्यवसायों में से 47 में सबसे पसंदीदा व्यवस्था व्यक्ति और एजेंट के बीच समान भागीदारी थी (Shao et al., 2025)। इसलिए केवल प्रतिनिधिमंडल पर निर्मित एक उपाय सबसे अनुभवी उपयोगकर्ताओं, सबसे अधिक भुगतान और महिलाओं को कम आंकता, हालांकि इन डेटा में कुछ भी नहीं कहता है कि उनका काम बदतर है।
परिभाषा। प्रवर्धन लाभ अंतिम 91 दिनों में डोमेन में स्वीकृत, सत्यापित कार्य के संदर्भ घंटे विभाजित किसी व्यक्ति के ध्यान के घंटे से है, व्यक्ति के स्तर की खिड़की जो भी हो। बाहरी सहायता के साथ किया गया कार्य (एक सहकर्मी या ठेकेदार इसे लॉग से बाहर ठीक करता है) ऐसे दर्ज किया जाता है और अंश में कुछ नहीं जोड़ता, जबकि व्यक्ति के मिनट इस पर हर में रहते हैं। ध्यान में योजना बनाना, निर्देश देना, पढ़ना, जाँच करना और ठीक करना शामिल है। जब व्यक्ति कुछ और कर रहा हो तो एजेंट चलने का समय नहीं गिना जाता।
प्रवर्धन लाभ एक सत्यापित थ्रूपुट है: ध्यान के घंटे प्रति स्वीकृत, जाँचा हुआ आउटपुट। यह एक कारणात्मक अनुमान नहीं है कि एजेंट के साथ समान व्यक्ति बिना उनके तुलना में कितना तेज़ काम करता है। उस तुलनात्मक अर्थ में लाभ के लिए एक आधार चाहिए, समान व्यक्ति या मेल खाते लोग बिना एजेंट के समान प्रकार का काम कर रहे हैं, और केवल एक तुलनात्मक अध्ययन ही इसकी आपूर्ति कर सकता है।
विफल कार्य अंश में कुछ नहीं जोड़ता और अपने सभी मिनट हर में जोड़ता है, जो आत्म-धोखे को दृश्यमान रखता है। METR के 2025 परीक्षण में, अनुभवी डेवलपर्स का मानना था कि AI ने उन्हें गति दी है जबकि माप से पता चला कि वे 19% धीमे थे (METR, 2025)।
दूसरी अक्ष के चरण ×1 ("एक दिन के लिए एक दिन"), ×2, ×5 ("एक दिन के लिए एक सप्ताह"), ×20 ("एक दिन के लिए एक महीना") और ×60 ("एक दिन के लिए एक तिमाही") हैं। दोनों पैमाने स्वतंत्र हैं, इसलिए एक पर एक चरण दूसरे पर एक स्तर के बराबर नहीं है। जब कोई व्यक्ति कई एजेंटों को समानांतर में चलाता है, तो ध्यान अभी भी एक बार गिना जाता है, व्यक्ति के अपने मिनटों में: तीन धाराओं को देखने में एक घंटा बिताया गया हर में एक घंटा है, प्रत्येक के विरुद्ध लॉग किए गए मिनटों के अनुपात में टुकड़ों के बीच साझा किया जाता है। एक स्कोर उस सेटिंग के साथ रिपोर्ट किया जाता है जिसने इसे तैयार किया (मॉडल और उपकरण, जाँच की तरह, और कार्यों का स्तर), क्योंकि समान व्यक्ति कठोर जाँच के तहत अलग-अलग स्कोर करेगा।
5.5 दो अक्ष, चार प्रोफाइल और एक सीमा
लोगों को दोनों अक्षों पर रखने से चार प्रोफाइल मिलते हैं (Figure 4)। एक शिक्षार्थी के पास एक छोटा क्षितिज और कम लाभ होता है। एक प्रवर्धक के पास एक छोटा क्षितिज और उच्च लाभ होता है, जैसे 36 चरणों का निर्माता यदि उसके चरण एक-एक करके स्वीकृत किए जाते। एक प्रतिनिधि के पास एक लंबा क्षितिज और उच्च लाभ होता है। चौथी प्रोफाइल, जिसे मैं निरीक्षक कहता हूँ, एक लंबा क्षितिज कम लाभ के साथ है: एजेंट लंबे समय तक चलते हैं, और जाँच और पुनः कार्य लाभ को खा जाते हैं, इसलिए यह एक स्तर की तुलना में अधिक एक चेतावनी संकेत है।
दोनों अक्ष एक सीमा से जुड़े हुए हैं। ध्यान एक कार्य को सेट करने और इसकी जाँच करने में जाता है। H को एक कार्य के संदर्भ घंटे के लिए लिखें, V को जाँच करने में लगने वाले ध्यान के घंटों के लिए, और S को इसे सेट करने में बिताए गए घंटों के लिए। फिर लाभ G = H / (S + V + पुनः कार्य), और इसलिए G ≤ H / V। यदि जाँच अकेले हाथ से किए गए समय का एक चौथाई लेती है, तो लाभ ×4 से अधिक नहीं हो सकता, भले ही एजेंट कितने समय तक बिना ध्यान दिए चले। उसी सीमा से, चरण ×2, ×5, ×20 और ×60 केवल तब खुले हैं जब जाँच हाथ से किए गए समय का 50%, 20%, 5% और लगभग 1.7% से अधिक नहीं लेती है (Figure 4)। यह कथित लेखांकन सीमाओं के साथ एक सरलीकृत मॉडल है: यह उस कार्य के मूल्य को अनदेखा करता है जो व्यक्ति बिल्कुल नहीं कर सकता था, यह मानता है कि जाँच का समय कार्य के साथ मापता है, और प्रति कार्य होता है, इसलिए एक व्यक्ति जो छोटे कार्यों को सस्ते में जाँच सकता है बड़े लोगों के लिए गणना की गई सीमा को हरा सकता है। अर्थव्यवस्था के स्तर पर, Catalini et al. (2026) एक ही बात कहते हैं: बाध्यकारी बाधा "मानव सत्यापन बैंडविड्थ" बन जाती है, और एजेंट क्या निष्पादित कर सकते हैं और लोग क्या सत्यापित करने को बर्दाश्त कर सकते हैं के बीच एक "मापन योग्यता अंतराल" खुल जाता है।
GDPval व्यावहारिक रूप में सीमा का क्या मतलब है यह दिखाता है। अपने 220-कार्य सोने के सबसेट पर, इसके विशेषज्ञों ने (और लेखकों ने सत्यापित किया) औसतन 404 मिनट प्रति कार्य हाथ से, और एक डिलीवरेबल की समीक्षा करने में एक मापा 109 मिनट, लगभग 27%, जो सीमा को उस प्रकार के कार्यों के लिए ×3.7 के करीब रखता है। मॉडलों ने अपने मसौदे विशेषज्ञों की तुलना में 90 से 327 गुना तेजी से तैयार किए। फिर भी ऐसे परिदृश्य में जहाँ कोई व्यक्ति मॉडल को आजमाता है और फिर इसके काम को ठीक करता है, लेखकों की गणना (एक माप नहीं) ने GPT-5 को 1.12 की गति दी जब मॉडल को एक बार आजमाया जाता है और 1.39 जब इसे कई बार आजमाया जाता है, एक ही तालिका के दो अलग कॉलम (Patwardhan et al., 2025)। एजेंट की गति जो भी हो, जाँच की कीमत सीमा निर्धारित करती है, और वह कीमत स्तर के साथ बढ़ती है, क्योंकि एक बड़ा कार्य जाँच करने में अधिक खर्च होता है। Kamara (2026) इस लागत को सत्यापन घर्षण कहते हैं। Section 9 के थ्रेड्स में चिकित्सकों ने इसे अपने शब्दों में रखा: एक बिंदु के बाद, एजेंट कोड की जाँच "हाथ से इसे फिर से लिखने से कम और कम अलग" होती है, और इसे स्वयं लिखने की तुलना में अधिक समय ले सकता है (अनुवादित)।
समान लाभ दो रास्तों से पहुँचा जा सकता है। एक लंबी पट्टी एक बड़ा कार्य सौंपती है और अंत में इसकी जाँच करती है; छोटे, तेजी से लूप छोटे कार्य सौंपते हैं और प्रत्येक को जाँचते हैं जैसे यह आता है। मेरी परिकल्पना यह है कि बड़े परिणाम के अंत में जाँच करने की तुलना में छोटे कार्यों की जाँच करना अक्सर सस्ता है, और Anthropic के डेटा उस तरह संकेत करते हैं। बातचीत एक-बार अनुरोधों की तुलना में अधिक बार सफल रहीं, और लेखकों के अपने विस्तारीकरण से एक-बार अनुरोध लगभग 3.5 घंटों के कार्यों पर 50% सफलता तक पहुँचते हैं जबकि बातचीत लगभग 19 घंटों के कार्यों पर इसे प्राप्त करती (Anthropic, 2026a)। सहयोगी उपयोग का हिस्सा अगस्त 2025 में स्वचालन से नीचे गिरा और नवंबर तक 52% से 45% वापस आ गया। छोटे-लूप रोड मानव-AI सहयोग साहित्य अध्ययन के करीब है, और प्रवर्धन लाभ इसे लंबे प्रतिनिधिमंडल के रूप में पूरी तरह से श्रेय देता है। Section 11 में पूर्वानुमान F19 से F21 छोटे-लूप रोड का परीक्षण करते हैं।
Figure 4। दो अक्ष, चार प्रोफाइल और जाँच जो सीमा निर्धारित करती है।
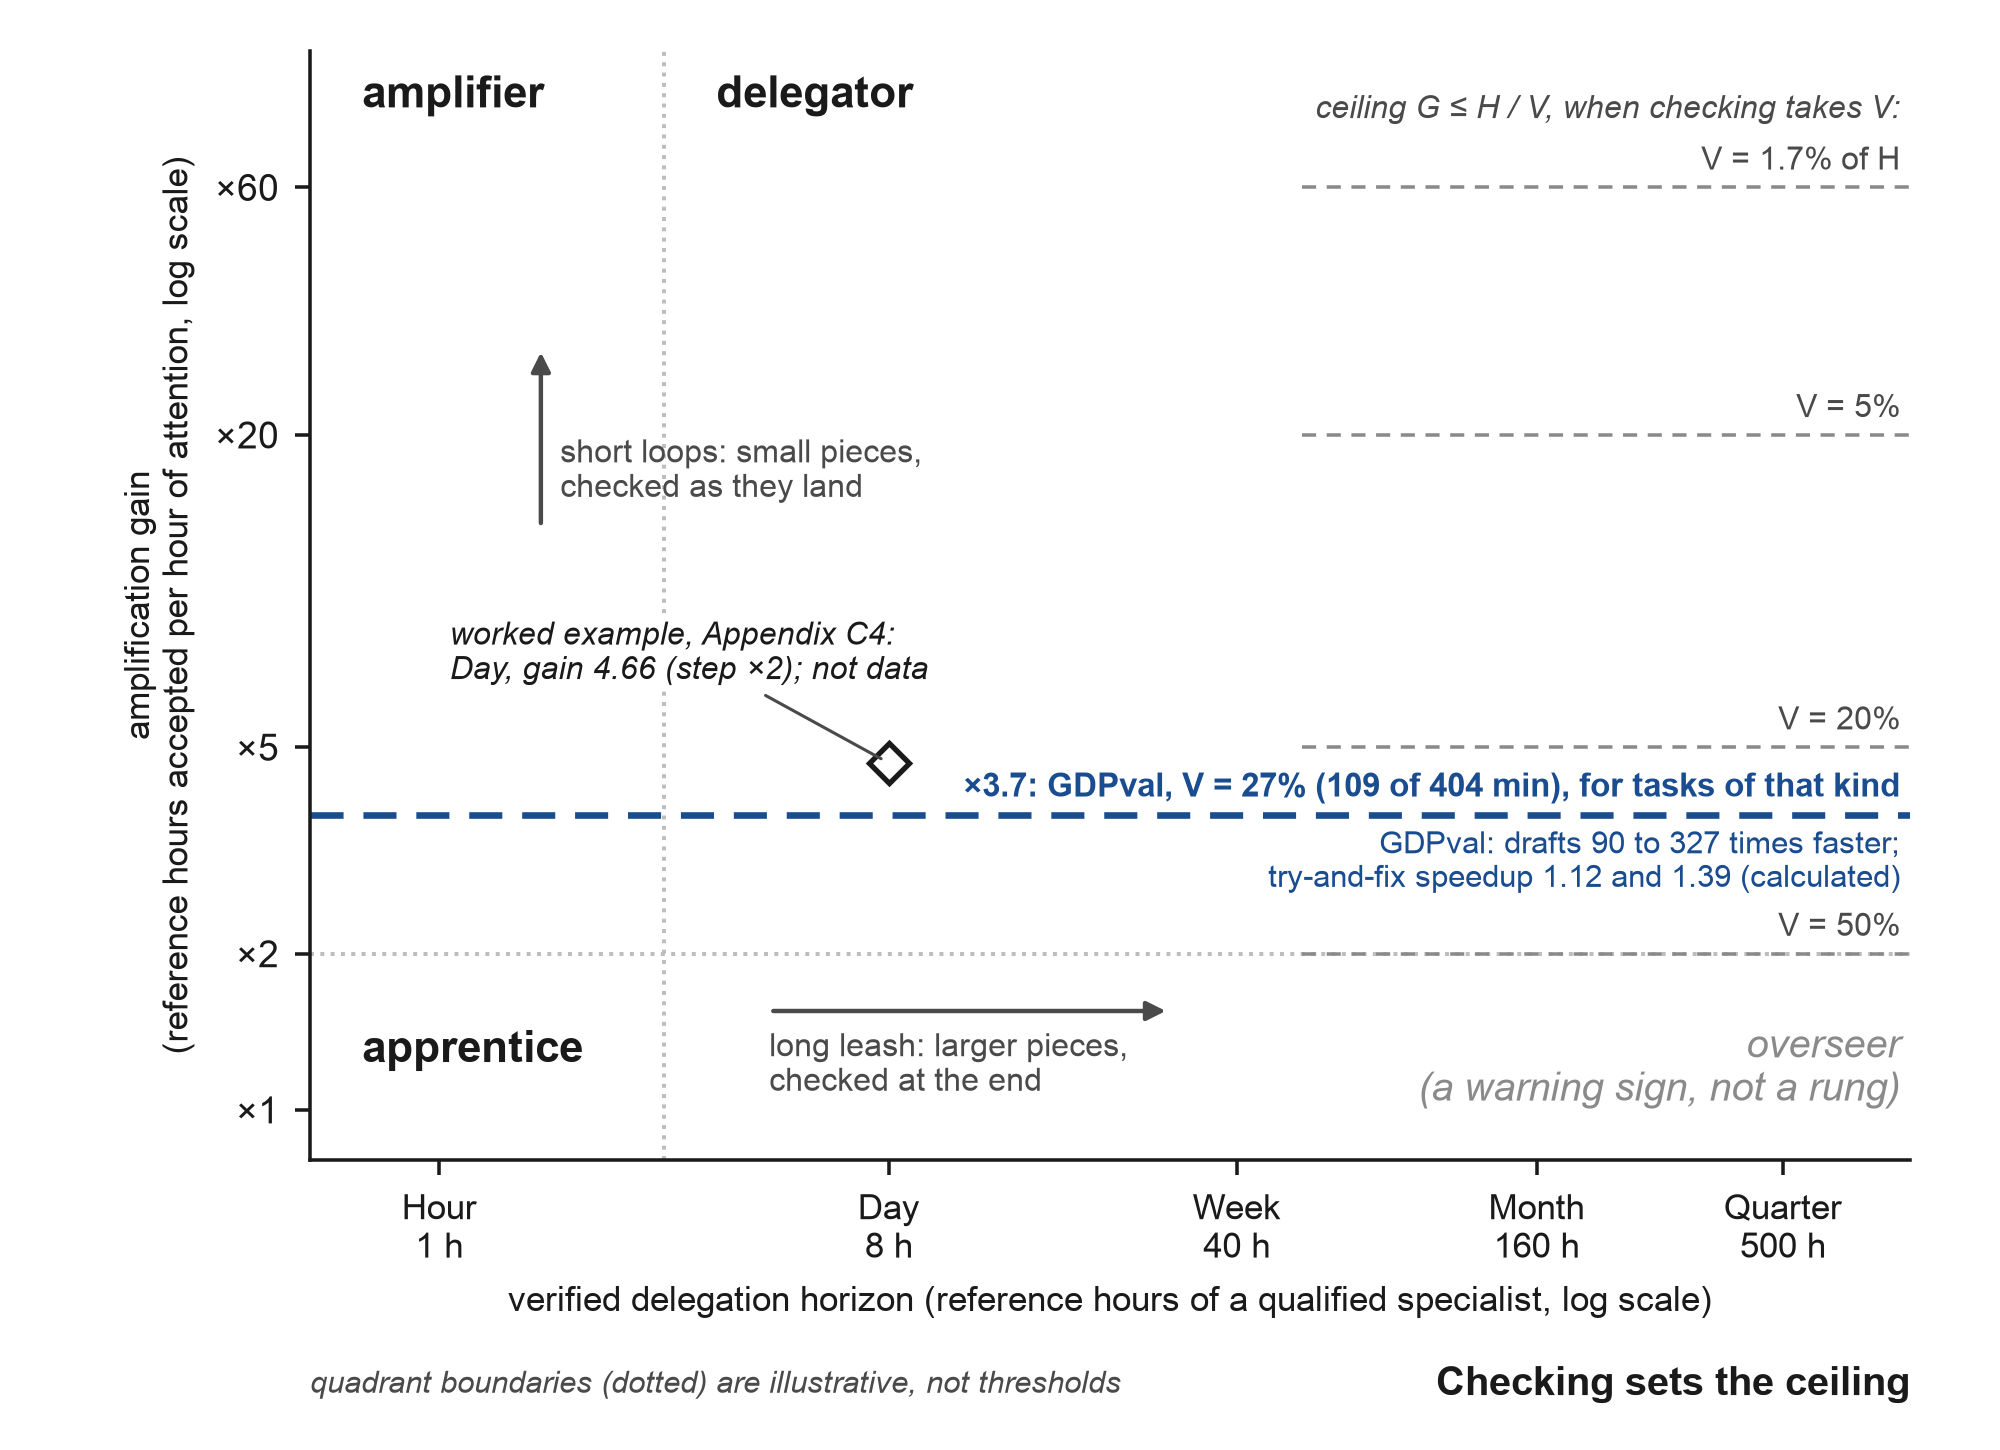
नोट: चतुर्भुज प्रोफाइल हैं, सीढ़ी की पायदान नहीं, और उनकी सीमाएँ केवल सचित्र हैं। प्रत्येक ग्रे रेखा खंड 5.5 की सीमा G ≤ H / V है, जहाँ हाथ से किए गए समय H में जाँच के समय V का एक निश्चित हिस्सा दिया गया है। एक्सेंट रेखा GDPval के 220-कार्य सोने के सबसेट पर इसके औसत का उपयोग करती है, हाथ से 404 मिनट और मॉडल आउटपुट की विशेषज्ञ समीक्षा के 109 मिनट (Patwardhan et al., 2025), और उस तरह के कार्यों के लिए धारण करती है। गति में सुधार 1.12 और 1.39 लेखकों की गणना हैं, कोई माप नहीं। हीरा परिशिष्ट C4 का कार्य उदाहरण है, डेटा नहीं। यह GDPval रेखा के ऊपर है क्योंकि सीमा कार्य के प्रत्येक प्रकार के लिए अलग से परिकलित की जाती है, और सस्ती जाँच की जाने वाली छोटी चीजें बड़ी चीजों के लिए परिकलित सीमा को हरा सकती हैं (खंड 5.5)। खंड 5.4 में 36 चरणों का मामला प्लॉट नहीं किया गया है: यह पोस्ट कोई लाभ नहीं देती है और कोई स्वतंत्र जाँच नहीं है।
5.6 यह माप कहाँ से आता है, और क्या नया है
इस माप के पूर्वज हैं, और सबसे पुराना Elliott Jaques है, जिन्होंने किसी भी कार्य के किसी भी कार्य की स्तर को इसके विवेक के समय-अवधि द्वारा मापा: सबसे लंबा समय जब कोई व्यक्ति अपने स्वयं के निर्णय पर काम करता है इससे पहले कि कोई भी परिणाम की समीक्षा करे। उन्होंने तर्क दिया कि उचित वेतन उस अवधि के साथ बढ़ता है (Jaques, 1956)। सत्यापित प्रतिनिधिमंडल क्षितिज एजेंटों के युग में इस विचार को एक परिवर्तन के साथ लाता है। Jaques ने मापा कि एक व्यक्ति कितने समय तक जाँच के बिना काम करता है, जबकि यह माप गणना करता है कि एक व्यक्ति एजेंटों को कितना काम सौंपता है, स्वीकार करता है और जाँचता है। ये दोनों अलग हो सकते हैं, और उनके स्तर, महीनों और वर्षों में गिने जाते हैं, इन पायदानों पर मानचित्र नहीं बनाते हैं।
प्रिंसिपल-एजेंट सिद्धांत दूसरा पूर्वज है। Jensen और Meckling (1976) ने प्रतिनिधिमंडल को निगरानी, बंधन और अवशिष्ट हानि के रूप में मूल्य दिया। जाँच एजेंट को काम सौंपने की निगरानी लागत है, और क्षितिज वह बिंदु चिह्नित करता है जहाँ एक बड़े टुकड़े की जाँच अब भुगतान नहीं करती है।
METR मशीनों को एक ही अक्ष पर मापता है। इसका समय क्षितिज कार्य की लंबाई है, मानव घंटों में, जो एक मॉडल दिए गए सफलता दर पर पूरा करता है (Kwa et al., 2025)। वसंत 2026 में इसके डैशबोर्ड पर सीमांत मॉडल लगभग 50% सफलता पर 17 घंटे तक पहुँचा, हालांकि METR ही चेतावनी देता है कि इसके वर्तमान कार्यों के साथ 16 घंटे से ऊपर की माप अविश्वसनीय है। 80% सफलता पर क्षितिज फरवरी 2026 में लगभग 1.2 घंटे से अप्रैल में लगभग 3.1 घंटे तक गया, दो बिंदु जो विकास की गति को मापे बिना दर्शाते हैं। 2023 के बाद डैशबोर्ड पर मॉडल के पार फिट किए गए प्रवृत्ति को हर 4.2 महीने (128.7 दिन) में दोगुना किया जाता है, और डैशबोर्ड को 8 सितंबर 2026 के बाद अपडेट नहीं किया गया था जब इसे अंतिम बार एक्सेस किया गया था (METR, 2026c)। AI Futures Project के पूर्वसूचक 4 से 4.5 महीने का दोगुना समय के साथ काम करते हैं (AI Futures Project, 2026)। स्वीकृत कार्य 50% क्षितिज की तुलना में 80% क्षितिज के अनुरूप है। जो एक मॉडल कभी-कभी समाप्त करता है और जो यह विश्वसनीय रूप से समाप्त करता है, के बीच का अंतर व्यक्ति का काम है, जो यह दिखाना है कि एक परिणाम सही है और इसे देखना है। चित्र A3 (परिशिष्ट F) इन मशीन क्षितिज को पायदानों के विरुद्ध सेट करता है।
2026 का सिद्धांत समान अंतर की ओर इशारा करता है। Huang, Xiao और Vishnoi (2026) AI के तहत प्रतिनिधिमंडन को मॉडल करते हैं और पाते हैं कि सत्यापन की क्षमता में छोटे अंतर परिणामों में बड़े अंतर पैदा करते हैं: AI उन लोगों की मदद करता है जो जाँचते हैं और उन लोगों को हानि पहुँचाता है जो बहुत अधिक सौंपते हैं। उनका पेपर ICML 2026 में स्वीकृत किया गया था, और वे इस प्रभाव को सत्यापन प्रवर्धन कहते हैं। 24 अध्ययनों की एक संरचित समीक्षा पाई कि इसके फोकल कॉर्पस में कोई भी सत्यापित उपकरण एजेंटों की देखरेख के लिए आवश्यक कौशल के पूर्ण संयोजन को कवर नहीं करता है (गुंजाइश, अनुमतियाँ, पुनरावृत्ति, स्वतंत्र समीक्षा और साक्ष्य-आधारित समापन), हालांकि कुछ उपकरण इसके कुछ हिस्सों को कवर करते हैं (Veri', 2026)। DeepMind की बुद्धिमान AI प्रतिनिधिमंडन की रूपरेखा सामान्य रूप से प्रतिनिधिमंडन का वर्णन करती है और इसमें कोई व्यक्ति-स्तर का माप नहीं है (Tomašev et al., 2026), और प्रतिनिधिमंडन की अर्थशास्त्र अब अपने स्वयं की सीमांत मॉडल हैं (Wang, 2026)। Chen और Meng (2026) दिखाते हैं कि जेनरेटिव AI एक कार्य के भीतर कौशल अंतर को संपीड़ित करता है और मूल्य को दुर्लभ पूरक संपत्तियों में स्थानांतरित करता है, और वे जोड़ते हैं कि व्यक्ति-दर-कार्य पैनल डेटा जो उनकी भविष्यवाणियों का परीक्षण करने के लिए आवश्यक है "अभी तक बड़े पैमाने पर मौजूद नहीं है"। मैं जो माप प्रस्तावित करता हूँ वह बिल्कुल उस तरह का डेटा तैयार करता है, क्योंकि प्रत्येक लॉग किया गया टुकड़ा एक व्यक्ति, एक आकार और एक तारीख रखता है।
दूसरे अक्ष के अपने पड़ोसी हैं, और प्रवर्धन लाभ उनके व्यक्ति-स्तर, सत्यापित रूप है। Engelbart (1962) ने कंप्यूटिंग को मानव बुद्धि को बढ़ाने के रूप में तैयार किया, और "superagency" 2025 में उसी उम्मीद के लिए McKinsey का शब्द है (McKinsey, 2025)। Anthropic Economic Index गति से बातचीत को स्कोर करता है (AI के बिना समय AI के साथ समय से विभाजित) और एजेंट स्वायत्तता 1 से 5 के पैमाने पर, दोनों एक मॉडल द्वारा निर्णय (Anthropic, 2026a)। Stanford का WORKBank मानव भागीदारी को 1 से H5 के पैमाने पर ग्रेड देता है जो कार्यकर्ता पसंद करते हैं (Shao et al., 2025)। एक 2026 निबंध ने पर्यवेक्षणीय क्षमता को उपयोगी सत्यापित आउटपुट के विरुद्ध मानव प्रयास के रूप में परिभाषित किया और स्पष्ट रूप से इसे एक संख्या देने से इनकार किया (em360, 2026), और "amplified oversight" AI सुरक्षा के लिए लोगों को अपने से मजबूत प्रणालियों की देखरेख करने में मदद करने के लिए एक शब्द है। एक खोज एजेंट के अवलोकन से मानव समय की समान जाँच की ओर बदलाव दिखता है: एजेंट 26 मिनट प्रति सत्र के लिए अकेले काम करता है, जहाँ एक सादे खोज ने 33 सेकंड लिया (Yang et al., 2026)। प्रतिनिधिमंडन की ओर से, Khadj (2026) और Alonso (2026) "delegation horizon" का उपयोग करते हैं कि एक मशीन या एक फर्म कितनी दूर प्रतिनिधिमंडन कर सकता है, CHI 2026 कार्य "decision horizons" पर आत्म-निर्देशन के नुकसान का अध्ययन करता है (University of Lübeck, 2026), और Dawson (2026) और Metal Toad (2026) AI प्रतिनिधिमंडन के व्यावहारिक स्तर प्रकाशित करते हैं। इनमें से कोई भी व्यक्ति को एक स्तर पर नहीं रखता है जिसे एक स्वतंत्र जाँच ने पुष्ट किया है।
सबसे हाल की रूपरेखा यहाँ सीधे तुलना की जाती है। JetBrains Research का AIDEs फ्रेमवर्क (Tikhomirov, 2026) माप के साथ दो विशेषताएँ साझा करता है: यह प्रतिनिधिमंडन को एक प्रिंसिपल-एजेंट संबंध के रूप में मानता है, और यह पायदानों में प्रतिनिधिमंडन को क्रमित करता है, उनमें से पाँच, स्वायत्तता और योजना जैसी विशेषताओं द्वारा वर्णित। यह चार पर भिन्न होता है। इसका विषय सॉफ्टवेयर विकास है, जबकि क्षितिज किसी भी क्षेत्र में स्कोर किया जाता है। इसके स्तर यह बताते हैं कि काम कैसे सौंपा जाता है, जबकि एक पायदान काम के आकार द्वारा निर्धारित होती है, एक योग्य विशेषज्ञ के संदर्भ घंटों में। इसमें कोई नियम नहीं है कि जाँच एजेंटों से स्वतंत्र हो, जबकि एक पायदान केवल उन टुकड़ों की गणना करता है जिन्हें एजेंटों ने न देखी गई जाँच द्वारा पुष्ट किया है। और इसमें एक विंडो पर कोई गणना नहीं है और कोई दूसरा अक्ष नहीं है, जबकि एक पायदान को दिनांकित विंडो पर एक पास शेयर की आवश्यकता है और प्रवर्धन लाभ ध्यान के घंटे जोड़ता है। एजेंसी की भाषा साझा की जाती है; इकाई, स्वतंत्रता नियम और सॉफ्टवेयर से परे की गुंजाइश यह है जो यह पेपर प्रस्तावित करता है।
2025 और 2026 में कई पैमाने प्रकाशित किए गए थे, और तालिका 2 में से कोई भी पैमाना एक व्यक्ति को सत्यापित काम द्वारा नहीं मापता है। तालिका 2 मुख्य लोगों को उनके द्वारा मापा जाता है इसके आधार पर समूहित करता है; तालिका A3 (परिशिष्ट F) उनमें से प्रत्येक को सूचीबद्ध करता है।
तालिका 2. 2025 और 2026 के पैमाने, जो उन्हें मापते हैं इसके आधार पर समूहित।
| परिवार | उदाहरण | मापी गई इकाई | क्या यह किसी व्यक्ति को सत्यापित प्रत्यायोजित कार्य द्वारा रखता है? |
|---|---|---|---|
| एजेंटों और मशीनों की स्वायत्तता के स्तर | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | एजेंट, मॉडल या टीम की स्थापना | नहीं |
| डेवलपर के अभ्यास के चरण | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | अभ्यास, पर्यवेक्षण कार्य या कार्य पैटर्न | नहीं |
| संगठनों और फर्मों द्वारा प्रत्यायोजन | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | एक संगठन, एक प्रबंधक, एक फर्म या सामान्य रूप से प्रत्यायोजन | नहीं |
| प्रधान-एजेंट संबंध के रूप में डेवलपर प्रत्यायोजन | JetBrains Research (Tikhomirov), September 2026 | एक डेवलपर का प्रत्यायोजन | केवल डेवलपर; जांच के लिए कोई स्वतंत्रता नियम नहीं और आकार की कोई इकाई नहीं |
| दक्षता और साक्षरता ढांचे | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | दक्षताएँ या साक्षरता | कोई परीक्षा, सीमाएँ या स्तर नहीं |
| सत्यापित प्रत्यायोजन क्षितिज और प्रवर्धन लाभ | This paper | एक डोमेन में एक व्यक्ति | हाँ, अनुभाग 5.2 के नियम द्वारा |
नोट: "सत्यापित प्रत्यायोजित कार्य द्वारा किसी व्यक्ति को रखता है" का अर्थ है कि पैमाना एजेंटों को सौंपे गए कार्य के आकार द्वारा एक व्यक्ति को एक स्तर पर रखता है और यह एजेंटों द्वारा न देखी गई जांच द्वारा पुष्टि की जाती है। निकटतम पड़ोसी JetBrains के पाँच स्तर हैं: वे प्रधान और एजेंट की भाषा साझा करते हैं, और सत्यापन के नियम (एक स्वतंत्र जांच जो एजेंटों द्वारा न देखी गई हो) और इकाई (संदर्भ घंटे) में भिन्न हैं। तालिका A3 (परिशिष्ट F) प्रत्येक पैमाने को अलग से सूचीबद्ध करता है।
एक चिकित्सक ने किसी भी व्यक्तिगत पैमाने पर आपत्ति को अच्छी तरह से रखा: "आपकी स्वायत्तता का स्तर भंडार की एक संपत्ति है, न कि डेवलपर की और न ही मॉडल की" (Phoenix, 2026)। मैं इसका आधा स्वीकार करता हूँ। एक क्षितिज एक व्यक्ति का है, एक डोमेन में, एक जांच शासन के तहत, और छिपे हुए परीक्षणों के साथ एक अच्छी तरह से निर्मित भंडार उस शासन का हिस्सा है, जो एक कारण है कि क्षितिज को प्रति डोमेन और एक तारीख के साथ दर्ज किया जाता है।
5.7 साथी पत्र से दो प्रश्न
साथी पत्र ने यह प्रश्न खुला छोड़ा कि अनुभवी उपयोगकर्ता कम प्रत्यायोजन क्यों करते हैं, क्या वे जल गए या उनका निर्णय उत्पाद है (Chernets, 2026a)। दूसरा अक्ष दोनों को अलग बता सकता है। यदि निर्देशात्मक उपयोग का हिस्सा गिरता है जबकि सत्यापित लाभ बढ़ता है, तो निर्णय उत्पाद है; यदि लाभ भी गिरता है, तो वे जल गए थे। साथी पत्र ने यह भी पूछा कि क्या प्रत्यायोजन की शब्दावली एक व्याकरण है या एक प्रति व्यवसाय। मैं एक स्थिति लेता हूँ: व्याकरण एक है (कार्य निर्धारित करें, फिर साक्ष्य पर स्वीकार करें), जबकि जो साक्ष्य के रूप में गिना जाता है वह डोमेन द्वारा भिन्न होता है, जिसके कारण सीढ़ियाँ साझा की जाती हैं और स्कोरिंग प्रति डोमेन होती है।
परिशिष्ट C का साधन प्रत्येक व्यक्ति और डोमेन के लिए एक निर्देशात्मक हिस्सा रिपोर्ट करता है, टुकड़ों पर गिना जाता है (एक टुकड़े में सौंपे गए टुकड़ों का हिस्सा, चरणों या संयुक्त कार्य के विरुद्ध), इसलिए एक पहली, मोटी परीक्षा उसी रिकॉर्ड पर चलाई जा सकती है जो सीढ़ियों को देती है। पूर्वानुमान F20 एक तारीख के साथ परीक्षा को अपनी पंजीकृत माप पर, "लॉग से निर्देश देने के बजाय जांच या संपादित करने वाले एक व्यक्ति के मोड़ का हिस्सा" (तालिका A6) पर बताता है: वहाँ हिस्सा परिशिष्ट C के कार्य लॉग के टुकड़ों के बजाय सत्र लॉग के मोड़ों पर गिना जाता है, इसलिए यह दोनों में से बेहतर गिना जाता है।
5.8 इस पैमाने को कैसे खेला जा सकता है, और बचाव
स्वीकृत, स्वतंत्र रूप से जांचे गए कार्य को गिनना सबसे सस्ता मार्ग, खर्च को बंद करता है, लेकिन एक दृढ़ व्यक्ति या एक लक्ष्य की खोज करने वाले नियोक्ता के पास अभी भी अन्य हैं। तालिका 3 उन्हें उस बचाव के साथ सूचीबद्ध करती है जो नियम प्रदान करते हैं। बचाव की लागत होती है, और लागत डिजाइन का हिस्सा है: एक ऑडिट की गई सीढ़ी एक स्व-रिपोर्ट की गई को मूल्य देती है, उसी तरह जैसे एक ऑडिट किया गया खाता एक बयान को मूल्य देता है।
तालिका 3. इस पैमाने को खेलने के तरीके, और बचाव।
| मार्ग | यह कैसा दिखता है | बचाव |
|---|---|---|
| आसान जांच | छिपे हुए परीक्षण जो कमजोर समाधान पास करते हैं; एक समीक्षक जो ऊपरी सतह देखता है | स्वीकृत टुकड़ों के एक हिस्से का एक दूसरे स्वतंत्र जांचकर्ता द्वारा यादृच्छिक ऑडिट; सप्ताह से ऊपर से रोपित त्रुटियाँ; जांच का प्रकार स्कोर के आगे मुद्रित होता है |
| दहलीज से बस ऊपर कार्यों को चुनना | दिन तक पहुँचने के लिए 8.1 संदर्भ घंटों के कई टुकड़े | आकारों के वितरण से सीढ़ियों को पढ़ें, स्वीकृत आकार की माध्यिका सीढ़ी के बगल में रिपोर्ट की गई |
| घंटों के उदार मूल्यांकनकर्ता | मूल्यांकनकर्ता जो संदर्भ घंटों को फुलाते हैं | दो मूल्यांकनकर्ता व्यक्ति को अंधा करके; एक निश्चित अनुपात से ऊपर असहमति टुकड़े को जमे हुए बैंक में या एक तीसरे मूल्यांकनकर्ता को भेजती है; मूल्यांकनकर्ताओं के रिकॉर्ड ऑडिट किए जाते हैं |
| छिपी हुई सहायता | एक सहकर्मी या ठेकेदार लॉग के बाहर काम को ठीक करता है | प्रति टुकड़ा ध्यान दर्ज किया जाता है; यादृच्छिक साक्षात्कार या पुनः चलाएँ; बाहरी सहायता एक क्षेत्र के रूप में दर्ज की जाती है और व्यक्ति के लाभ से बाहर रखी जाती है |
| स्लाइसिंग | एक महीने का कार्य एक घंटे की टिकट में काटा गया | केवल एक सुसंगत वितरण योग्य, समग्र रूप से स्वीकृत, एक सीढ़ी की ओर गिना जाता है |
| विफलताओं को छिपाना | त्यागे गए या विफल टुकड़े लॉग से बाहर छोड़े गए | हर हस्तांतरण दर्ज किया गया, अपनी प्रारंभिक तारीख के साथ, और जब इसे स्वीकार किया जाता है, अस्वीकार किया जाता है या त्यागा जाता है तो बंद किया जाता है; विफलताओं का एक सार्वजनिक रिकॉर्ड; एक पास दर जो बहुत स्वच्छ दिखती है एक ऑडिट को ट्रिगर करती है |
| सहसंबद्ध जांच | एक ही परिवार के दूसरे मॉडल की सहमति | गिना नहीं (अनुभाग 5.2) |
| समानांतर प्रवाह | ध्यान प्रति प्रवाह एक बार गिना जाता है | ध्यान प्रति व्यक्ति-मिनट एक बार गिना जाता है (अनुभाग 5.4) |
थ्रेसहोल्ड डिजाइन विकल्प हैं, जिन्हें नियम v1.1 के रूप में संस्करणित किया गया है और डेटा के बाद केवल एक नए संस्करण में बदला जाता है। एक विंडो में दस टुकड़े सबसे छोटी गिनती है जिस पर 80% पास शेयर कुछ मायने रखता है (दस में से आठ पास)। निचले रंगों की 91-दिन की विंडो, और ऊपरी रंगों में आवश्यक हाल के टुकड़े, त्रैमासिक पुनः-सत्यापन और वह गति से मेल खाते हैं जिस पर उपकरण बदलते हैं। रंग नियम एक योग्यता नियम है और किसी व्यक्ति की विश्वसनीयता का कोई अनुमान नहीं लगाता है। दस में से आठ पास लगभग 44% से 97% तक (सटीक 95% अंतराल) कहीं भी सच्ची पास दर के अनुरूप हैं, और तीन में से तीन लगभग 37% जितना कम (एकपक्षीय 95% बाउंड) के साथ। पंजीकृत अंशांकन अध्ययन विश्वसनीयता का अनुमान लगाता है। 80% का शेयर METR के 80% क्षितिज के उपयोग को विश्वसनीय कार्य के स्तर के रूप में अनुसरण करता है, और 1, 8, 40, 160 और 500 घंटों के रंग कार्य घंटा, दिन, सप्ताह, महीना और त्रैमासिक का पालन करते हैं, ताकि उन्हें व्यवसायों के बीच कोई अनुवाद की आवश्यकता न हो। थ्रेसहोल्ड का एक डेस्क परीक्षण सिमुलेशन और मॉडल रेटर के साथ नियमों की जांच की (परिशिष्ट E)। इसने गणना की कि ज्ञात विश्वसनीयता वाला व्यक्ति कितनी बार प्रत्येक रंग अर्जित करता है (चित्र A2, परिशिष्ट E)। 0.8 की सच्ची पास दर पर, Day 68% विंडो में अर्जित किया जाता है और अगली विंडो में वही निर्णय 56% में दोहराया जाता है, यही कारण है कि रिकॉर्ड रंग के आगे गिनती प्रिंट करता है, जैसे "Day (8/10)"। इसने नियमों के पहले संस्करण में एक त्रुटि भी पाई: Month पर चार में से चार Quarter पर तीन में से तीन से अधिक कमाने के लिए कठिन थे (0.8 की पास दर पर 41% बनाम 51%), इसलिए Month अब एक वर्ष में छह में से पाँच माँगता है। गिनती को दस से आठ या बारह तक, या शेयर को 0.8 से 0.7 या 0.9 तक ले जाने से, Day निर्णय सिमुलेटेड लॉग के 8% से 11% के लिए बदलता है, और दोनों को ले जाने से यह 22% तक बदलता है। चार परिवारों के चार मॉडल रेटर, संदर्भ घंटों का अनुमान अंधा लगा रहे हैं, 30 कार्यों को लगातार आदेश दिया गया (लॉग घंटों पर अंतर्वर्गीय सहसंबंध 0.89), लेकिन अंशांकन प्रोटोकॉल के मानदंड 70% के विरुद्ध केवल 62% जोड़ी को 1.5 के अनुपात में रखा, और उनके समग्र स्तर में एक कारक दो से भिन्न; केवल एक कार्य के सार्वजनिक पहचानकर्ता दिए गए, उनका माध्य अनुमान मापा गया मानव समय के 1.5 के भीतर 14 कार्यों में से 3 के लिए गिरा। मॉडल रेटर इसलिए दो मानव रेटर को प्रतिस्थापित नहीं कर सकते हैं, और क्षेत्र अध्ययन के रेटर पहले मापा गया समय के साथ कार्यों पर अंशांकन करते हैं। अंशांकन प्रोटोकॉल अगले परीक्षणों को अग्रिम रूप से ठीक करता है: मानव रेटर के बीच समझौता (मानदंड: कम से कम 1.5 के 70% जोड़ी), दो क्रमिक विंडो के पार व्यक्ति के रंग की दोहराए जाने (भारित कप्पा कम से कम 0.6), और एक रंग की समान आकार (AUC कम से कम 0.7) के नए कार्यों को पास करने की भविष्यवाणी करने की क्षमता। इसके प्रोटोकॉल और पंजीकरण पाठ साथी रिपॉजिटरी में हैं, और काम करने वाले पेशेवरों के साथ एक पहला परीक्षण, संदर्भ घंटों पर उनके समझौते का, पंजीकृत है और परिशिष्ट G में वर्णित है।
तालिका A4 (परिशिष्ट F) कठिन मामलों के लिए नियम देती है जो पहले सामने आते हैं।
परिशिष्ट C, खंड C4, एक व्यक्ति के दस पंक्तियों के लॉग के माध्यम से एकल रिकॉर्ड तक काम करता है।
6. पृष्ठभूमि तटस्थता और प्रमाण पत्र क्रॉसओवर बिंदु
6.1 पृष्ठभूमि तटस्थता
परिकल्पना यह है कि एक डोमेन में समान सत्यापित क्षितिज पर, प्रोग्रामिंग शिक्षा स्वतंत्र रूप से जांचे गए कार्य की गुणवत्ता की भविष्यवाणी नहीं करती है जब डोमेन की आज्ञा और स्वीकृति साक्षरता को ध्यान में रखा जाता है।
Anthropic का यह निष्कर्ष कि "Claude को सफलता की ओर ले जाने की क्षमता कोड लिखने की क्षमता की तुलना में डोमेन की आज्ञा से अधिक आती है" परिकल्पना के अनुरूप है लेकिन इसका परीक्षण नहीं करता है (Anthropic, 2026e): इसका डेटा लोगों को शिक्षा के आधार पर नहीं, व्यवसाय के आधार पर क्रमबद्ध करता है, और धारा 2.2 का 34% बनाम 29% का अंतर व्यवसायों के बीच का अंतर है। केवल F7 का अध्ययन परिकल्पना का परीक्षण करता है। एक मजबूत प्रतिद्वंद्वी भी मौजूद है। Savva (2026) AI-संवर्धित ज्ञान कार्य को एक प्रमुख-एजेंट समस्या के रूप में मॉडल करता है और भविष्यवाणी करता है कि AI आसान कार्यों पर लोगों के बीच अंतराल को कम करता है और कठिन कार्यों पर उन्हें चौड़ा करता है। यदि Savva सही है, तो पृष्ठभूमि तटस्थता छोटे कार्यों पर लागू होगी और उच्च सीढ़ियों पर विफल होगी, इसलिए भविष्यवाणी F7 को Day पर और Week और उसके ऊपर पर अलग से स्कोर किया जाता है, जहां परिकल्पना को अपनी कठिनतम परीक्षा का सामना करना पड़ता है।
स्वीकृति साक्षरता वह कौशल है जिस पर परिकल्पना निर्भर करती है। इसका अर्थ है पहले से बताना कि क्या किया गया माना जाएगा, और फिर इसे दिखाना: एक छिपी हुई परीक्षा के माध्यम से, स्रोतों के विरुद्ध जांच करने वाले मॉडल का एक दूसरा परिवार, उस स्रोत के साथ तुलना जिसे व्यक्ति ने स्वयं खोला, या आश्वासन के स्थान पर एक कलाकृति। Agent साक्षरता सामान्य रूप से प्रतिनिधित्व, जांच और प्रबंधन को कवर करती है (MindStudio, 2026); स्वीकृति साक्षरता इसके केंद्र में सबूत का एक मानक रखती है। यह TAM परंपरा के प्रौद्योगिकी स्वीकृति से भी भिन्न है, जो अध्ययन करती है कि लोग प्रौद्योगिकी को अपनाते हैं या नहीं, क्योंकि यहां स्वीकृति किसी कार्य को स्वीकार करने का निर्णय है। साथी पत्र का स्वीकृति रिकॉर्ड एक सीढ़ी के लिए साक्ष्य की इकाई बन जाता है।
6.2 प्रमाण पत्र क्रॉसओवर बिंदु
एक डोमेन में प्रमाण पत्र क्रॉसओवर बिंदु वह क्षण है जब IT शिक्षा के बिना लोगों द्वारा बनाए गए उत्पाद, समान स्वतंत्र जांच के तहत स्वीकृत, उन लोगों द्वारा बनाए गए उत्पादों को पार करने लगते हैं जो समान एजेंटों का उपयोग करने वाले प्रोग्रामर हैं, जिसके बाद IT में एक डिग्री और जूनियर और सीनियर के लेबल उस डोमेन में नियोजन के लिए अपनी भविष्यसूचक शक्ति खो देते हैं।
यह परिभाषा मेरी 8 अक्टूबर 2026 की भविष्यवाणी का सटीक संस्करण है (धारा 1)। इसके घटक प्रत्येक अवलोकनीय हैं और प्रत्येक अपने समय पर दिनांकित हैं, ताकि जब वे संरेखित हों तो क्षण को पढ़ा जा सके। गुणवत्ता समानता क्षण से पहले का कदम है: एक डोमेन में, IT शिक्षा के बिना लोगों के उत्पाद प्रोग्रामरों के उत्पादों से कोई बदतर नहीं हैं जिनके पास समान एजेंट हैं, समान कार्यों पर, अंधी जांच के तहत (भविष्यवाणी F2)। Overtaking क्षण ही है, जब वे उत्पाद समान जांच पर बेहतर हो जाते हैं (F3, F4a और F4b के साथ मुक्ति और रखरखाव के चरणों के साथ)। पोस्टिंग में क्रॉसिंग दृश्यमान संकेत है, जब पोस्टिंग जो एजेंटिक कौशल मांगती हैं उन पोस्टिंग की तुलना में एक डिग्री की कम मांग करती हैं जो ऐसा नहीं करती हैं (F5)। पृष्ठभूमि तटस्थता तंत्र है, क्योंकि समान सीढ़ी पर शिक्षा जांचे गए गुणवत्ता की भविष्यवाणी करना बंद कर देती है (F7)।
एक डोमेन में क्रॉसओवर बिंदु पहले साल से दिनांकित है जिसमें, उसी नामित डोमेन में, overtaking दिखाया जाता है (F3) और पोस्टिंग में क्रॉसिंग का डोमेन अनुरूप पूरा किया जाता है (F5 उस डोमेन की पोस्टिंग पर गणना की जाती है; परिशिष्ट D)। Parity without overtaking बिंदु का दृष्टिकोण है, और overtaking के बिना पोस्टिंग में एक क्रॉसिंग दिखाएगी कि नियोक्ता साक्ष्य से आगे बढ़ रहे हैं। F2, F3, F5 और F7 इसलिए समान नामित डोमेन पर एक कार्यक्रम बनाते हैं: डोमेन पंजीकरण में निर्धारित हैं, F2, F3 और F7 का प्रयोग उनमें चलाया जाता है, और F5 की गणना IT व्यवसायों के जमे हुए सेट पर और उन प्रत्येक डोमेन की पोस्टिंग पर की जाती है। क्रॉसओवर बिंदु को एक डोमेन के लिए घोषित किया जाता है केवल जब गुणवत्ता नियम (F3) और नियोजन नियम (F5 का डोमेन अनुरूप) दोनों उसी डोमेन में पूरे किए जाते हैं; अकेला कोई भी कुछ नहीं घोषित करता है।
पहले दो घटकों को मेल खाते कार्यों पर प्रयोगों द्वारा परीक्षण किया जाता है (धारा 11)। तीसरा नौकरी की पोस्टिंग में पहले से देखा जा सकता है। Lightcast ने सितंबर 2026 में रिपोर्ट किया कि AI कौशल की आवश्यकता वाली IT पोस्टिंग अभी भी उन IT पोस्टिंग की तुलना में चार साल की डिग्री के लिए पूछने की अधिक संभावना है जिनमें ऐसा नहीं है। AI पोस्टिंग के बीच, डिग्री की आवश्यकताएं "2024 से स्पष्ट गिरावट में हैं" जबकि वे अन्य IT पोस्टिंग में बढ़ीं (Lightcast, 2026b)। दोनों रेखाएं अभिसरण कर रही हैं और पार नहीं हुई हैं (चित्र 5)। Lightcast 300 से अधिक AI कौशलों द्वारा AI पोस्टिंग को परिभाषित करता है, इसलिए इसकी रेखाएं सामान्य रूप से AI कार्य का वर्णन करती हैं। एजेंटिक सबसेट, एजेंटिक कौशलों की एक जमी हुई सूची द्वारा परिभाषित (Lightcast, 2026a), वह है जो भविष्यवाणी उपयोग करती है, और इसकी आधारेखा पंजीकरण से पहले ली जाती है।
दिशा का एक पूर्वज है। Bone, González Ehlinger और Stephany (2025), लगभग ग्यारह मिलियन UK रिक्तियों का उपयोग करके 2024 के मध्य तक, AI भूमिकाओं में शिक्षा आवश्यकताओं में गिरावट पाई और कौशल और डिग्री से जुड़े मजदूरी प्रीमियम की तुलना की। उस काम ने एजेंटों से पहले AI के लिए कौशल-आधारित नियोजन का दस्तावेज़ दिया। यह पत्र एजेंटिक कौशलों तक उस लाइन को विस्तारित करता है, एक दिनांकित सीमा और मेल खाती पोस्टिंग के साथ तुलना के साथ, और पोस्टिंग आवश्यकताओं को स्वतंत्र रूप से जांचे गए प्रदर्शन से जोड़ने का प्रस्ताव देता है, परीक्षाओं में जो पूर्व-पंजीकृत होने वाली हैं। PwC की AI Jobs Barometer सभी देशों में एक ही दिशा की रिपोर्ट करता है और जहाँ यह समान मात्रा को मापता है वहाँ फॉलबैक स्रोत के रूप में कार्य करता है (PwC, 2026)।
एक दूसरा सूचक यह है कि नियोक्ता क्या कहते हैं और क्या करते हैं के बीच की दूरी। कई नियोक्ताओं ने एजेंटों के आने से पहले अपनी नीतियों से डिग्री की आवश्यकताओं को हटाया, फिर भी Burning Glass Institute और Harvard Business School को पता चला कि परिवर्तन 700 में से एक से कम नियोजन को प्रभावित करता है (Burning Glass Institute & Harvard Business School, 2024)। पोस्टिंग दूसरे तरीके से चली गई: नवंबर 2025 में, Indeed पर 19.3% US पोस्टिंग ने एक स्नातक डिग्री या उच्चतर के लिए पूछा, एक साल पहले की तुलना में काफी ऊपर (Indeed Hiring Lab, 2026)। कागज पर हटाई गई एक डिग्री की आवश्यकता एक नीति परिवर्तन है, और क्रॉसओवर केवल तब दिखाता है जब नियोजन ही बदल जाता है। एक ऑडिट अध्ययन, मेल खाते पोर्टफोलियो भेजते हुए जो केवल शिक्षा में भिन्न होते हैं असली पोस्टिंग के लिए, वह पहले देखेगा, और भविष्यवाणी F26 एक निर्धारित करता है।
एक डिग्री उन गेटों के एक परिवार से संबंधित है जो लोगों को एक लेबल द्वारा प्रवेश देते हैं: एक प्लेटफॉर्म पर एक प्रोफाइल, एक नौकरी का शीर्षक, एक डिग्री और, आंशिक रूप से, एक लाइसेंस। एक लेबल नियोक्ता को काम के बारे में केवल इतना बताता है कि इसे धारण करना काम करने में सक्षम होने के साथ कितना जाता है। एजेंट एक तरफ से उस लिंक को ढीला करते हैं, क्योंकि बिना लेबल वाले लोग अब ऐसा काम तैयार करते हैं जो व्यापार जैसा दिखता है (Section 2.2), और एक लेबल जो किसी व्यक्ति के अपने शब्द पर निर्भर करता है, दावा करने के लिए हमेशा सस्ता था। एक गेट जो काम को स्वयं जांचता है न तो इस पर निर्भर करता है। Appendix G का रेटर अध्ययन दुर्घटना से अंतर से मिला। Prolific अध्ययन में प्रतिभागियों को उन फिल्टर के माध्यम से प्रवेश देता है जिनके उत्तर ज्यादातर स्व-रिपोर्ट किए गए हैं, आयु और निवास के देश मुख्य अपवाद हैं जिन्हें यह सत्यापित करता है (Prolific, 2026)। अपनी फिल्टर्स द्वारा बुककीपिंग नमूने में प्रवेश दिए गए 60 लोगों में से, 11 ने व्यापार के एक पहले-सप्ताह प्रश्न का गलत उत्तर दिया (Appendix G2): लेबल ने उन्हें अंदर जाने दिया, और व्यापार का एक प्रश्न उन्हें रोक गया।
शोधकर्ताओं ने जिन्होंने एजेंटों से पहले ऐसे प्लेटफॉर्म पर प्रोग्रामर की भर्ती की थी, वे समान पैटर्न की रिपोर्ट करते हैं और अपने स्वयं के ज्ञान प्रश्नों के साथ स्क्रीन करते हैं: एक अध्ययन में, एक प्लेटफॉर्म के 42% कार्यकर्ताओं ने प्रोग्रामिंग कौशल का दावा किया था लेकिन ऐसे प्रश्नों के मानदंड को पूरा नहीं किया (Danilova et al., 2021), और दूसरे में, Prolific पर, 206 प्रतिवादियों में से 55 जिन्होंने Node.js में प्रोग्रामिंग की रिपोर्ट की थी, इसके सभी प्रोग्रामिंग प्रश्नों को पास किया (Reid et al., 2022)। एक ज्ञान प्रश्न स्वयं वितरित कार्य की जांच की तुलना में एक कमजोर गेट है, और चैट मॉडल इसे भी कमजोर करते हैं: एक सिमुलेटेड हमले में, ChatGPT ने प्रोग्रामर के लिए मौजूदा स्क्रीनिंग प्रश्नों को आसानी से हल किया (Serafini et al., 2024), और 2026 तक यह उन स्थिर दृश्य प्रश्नों को भी पार कर गया था जिन्हें इसे प्रतिरोध करने के लिए डिज़ाइन किया गया था, जबकि ऑडियो प्रश्न जो अपनी सामग्री को कड़े समय सीमा के तहत चरण दर चरण प्रकट करते हैं अभी भी आयोजित किए गए (Serafini et al., 2026)। नियोजन की शर्तों में, ऊपर दिए गए परिभाषा द्वारा अनुमानित डिग्री के लिए वजन की हानि पहली तरह का एक गेट दूसरी तरह को रास्ता दे रहा है, और सत्यापित प्रतिनिधिमंडल क्षितिज दूसरी तरह का एक गेट है: यह न केवल वह रिकॉर्ड करता है जो एक व्यक्ति कहता है कि वे हैं, बल्कि वह जो उन्होंने सौंपा है और वह क्या पास हुआ है जो एजेंट ने नहीं देखा।
लाइसेंस दोनों प्रकारों के बीच बैठते हैं। एक लाइसेंस जो एक बार पास की गई परीक्षा पर निर्भर करता है, वह तब से एक लेबल के रूप में काम करता है; एक लाइसेंस जिसके धारक के काम का निरीक्षण किया जाता है वह एक चेक के करीब है। संयुक्त राज्य में पब्लिक कंपनी अकाउंटिंग ओवरसाइट बोर्ड के साथ पंजीकृत ऑडिट फर्म अपने ऑडिट काम का निरीक्षण करते हैं, हर साल यदि वे नियमित रूप से 100 से अधिक जारीकर्ताओं का ऑडिट करते हैं और अन्यथा कम से कम तीन साल में एक बार, जब तक कि बोर्ड नियम द्वारा एक और कार्यसूची निर्धारित न करे (Sarbanes-Oxley Act of 2002, s. 104), एक फर्म के हस्ताक्षरित काम के लिए एक धीमा समकक्ष, Section 5.2 एक क्षितिज से पूछता है का पुनः-सत्यापन। लाइसेंसिंग स्वयं दूसरी तरह की ओर बढ़ना शुरू कर दिया है। मई 2024 के बाद से ओरेगॉन ने कानून स्नातकों को बार परीक्षा के बिना लाइसेंस का एक रास्ता दिया है, Supervised Practice Portfolio Examination: कम से कम 675 घंटे की निरीक्षण की गई प्रथा पर उम्मीदवार आठ टुकड़े लिखित काम, दो ग्राहक इंटरैक्शन और दो बातचीत प्रस्तुत करता है, और Bar Examiners के बोर्ड द्वारा लागू रूब्रिक्स को लागू करने वाले ग्रेडर्स फैसला करते हैं कि क्या प्रत्येक न्यूनतम योग्यता दिखाता है। 5 जनवरी 2026 तक, 205 उम्मीदवारों ने आवेदन किया है और 49 लाइसेंसप्राप्त वकील बन गए हैं, उनमें से पहले दिसंबर 2024 में (Oregon State Board of Bar Examiners, 2026)। कानून की डिग्री अभी भी आवश्यक है, इसलिए जांचा गया काम परीक्षा को बदलता है, स्कूल को नहीं। लेखा में कदम छोटा है: मई 2025 में AICPA और NASBA ने CPA लाइसेंस के लिए एक पथ के लिए मॉडल कानून को मंजूरी दी जो एक स्नातक की डिग्री से परे 30 क्रेडिट घंटे के अध्ययन के स्थान पर व्यावसायिक अनुभव का एक दूसरा वर्ष मांगता है, परीक्षा रखी गई है, और प्रत्येक राज्य को इसे लागू करना चाहिए इससे पहले कि उम्मीदवार इसका उपयोग कर सकें (Journal of Accountancy, 2025)। कानून लाइसेंस को क्या आरक्षित करता है, माप की एक सीमा रहती है (Section 13)। Table A8 (Appendix F) इस खंड के गेट्स को एक-दूसरे के साथ सेट करता है कि प्रत्येक क्या जांचता है।
"credential" का एक दूसरा अर्थ एजेंट सुरक्षा में है, जहां यह एक गुप्त कुंजी या टोकन को दर्शाता है। यहाँ इसका अर्थ एक डिग्री या प्रमाणपत्र है। "credential crossover point" वाक्यांश इस अर्थ में 9 अक्टूबर 2026 को खोजे गए विद्वानों के आधारों में कोई मिलान नहीं लौटाया (Appendix B)।
Figure 5. सत्यापित सफलता और पोस्टिंग में डिग्री की आवश्यकता में अंतर: क्या देखा जाता है, और 2027 क्या परीक्षण करेगा।
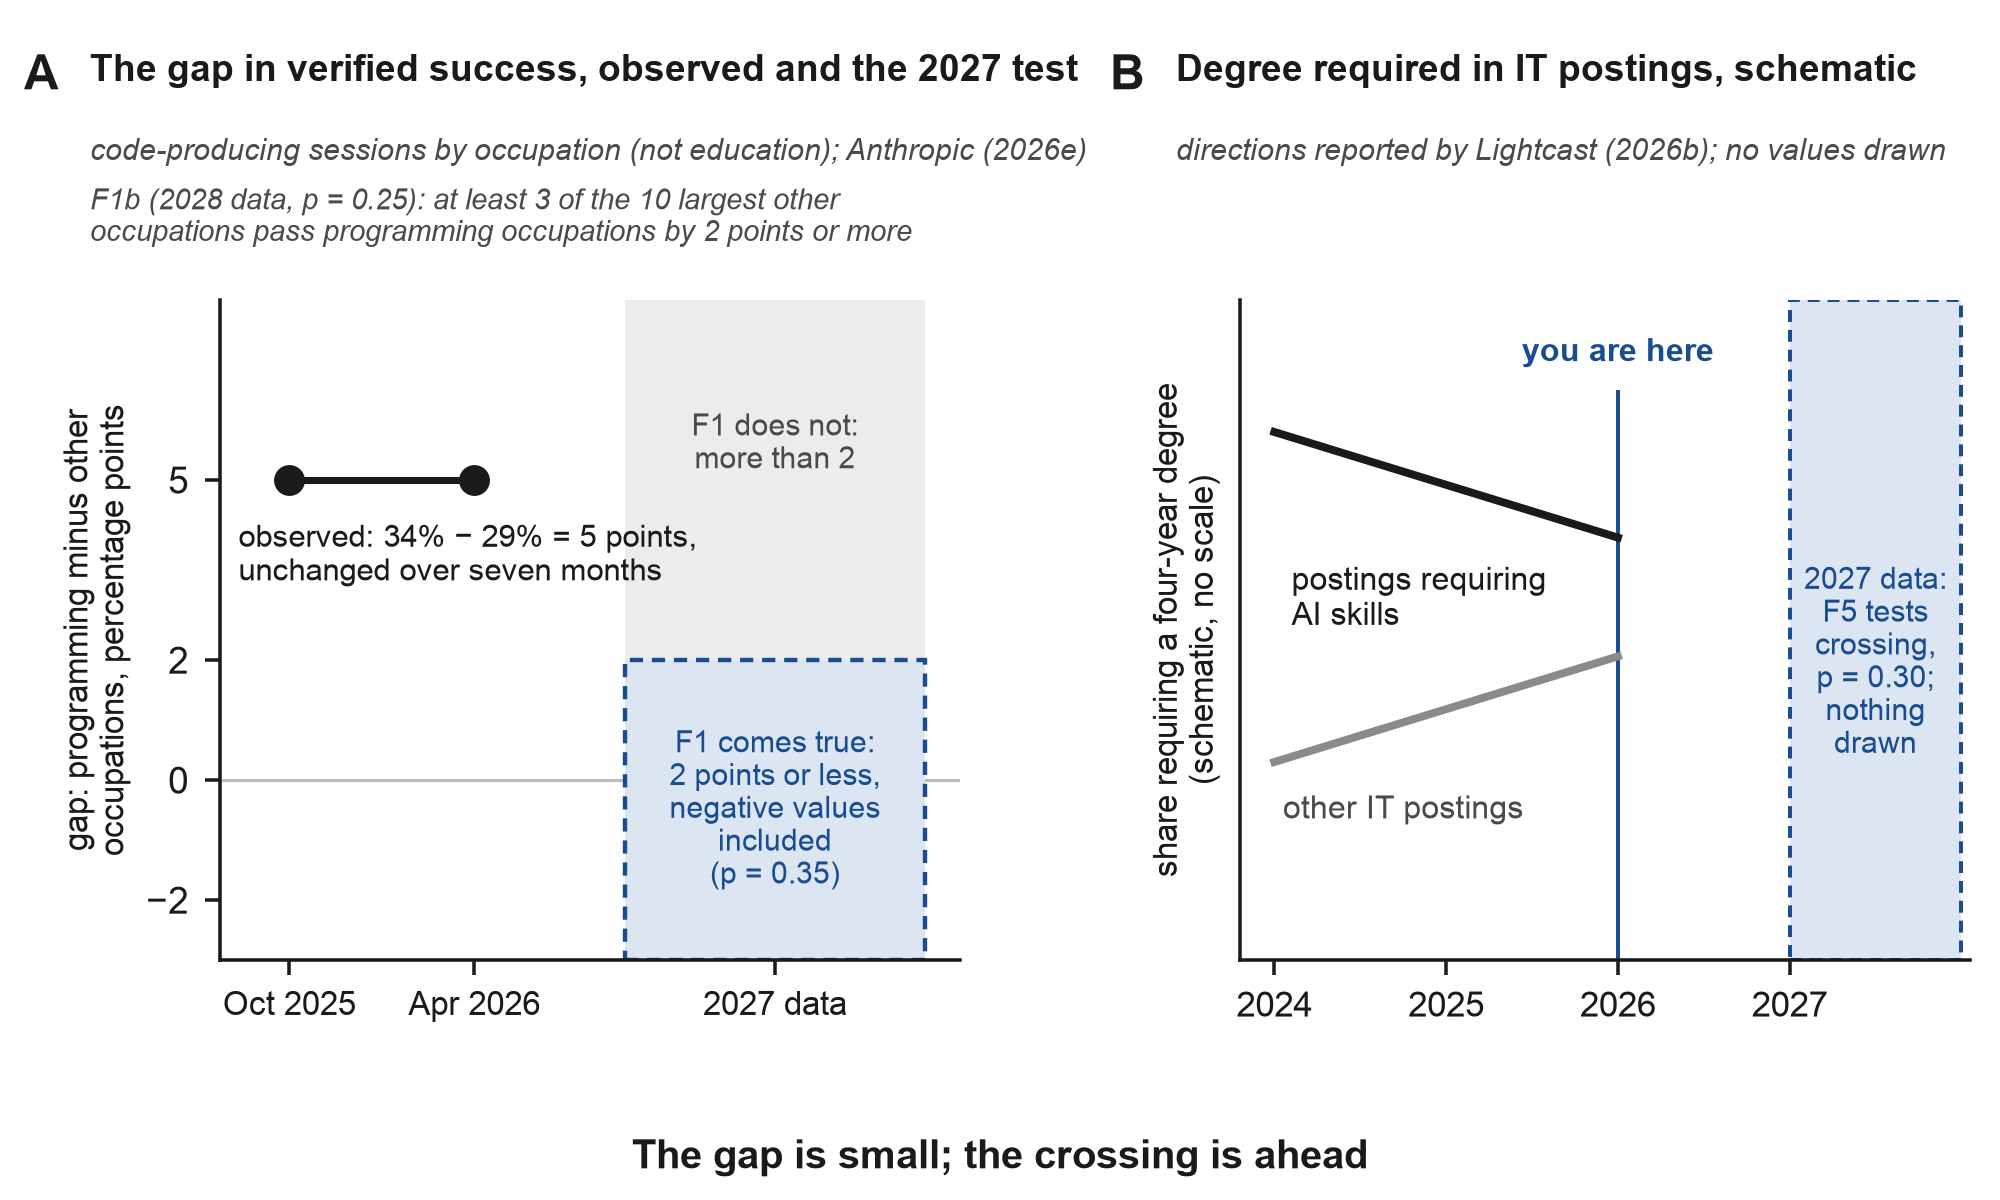
Note: Panel A uses Anthropic (2026e), code-producing sessions, 34% for programming occupations against 29% for other occupations, unchanged for seven months. Occupation is not education, and success means accomplishment backed by evidence such as tests or commits. The band is the threshold of prediction F1 (a gap of 2 points or less, negative values included, probability 0.35); F1b (probability 0.25) is in Table A6. Panel B draws only the directions Lightcast (2026b) reported up to 2026, without its values. The 2027 window is left empty: no crossing is drawn, because prediction F5 (probability 0.30) is what will decide it।
6.3 Domains: प्रोग्रामर का लाभ क्षैतिज क्यों था
AI जो सबसे पहले सस्ता करता है वह कुछ भी हो सकता है जो क्षैतिज है, प्रत्येक उद्योग में समान है, और तंत्र स्पष्ट है: एक क्षमता जो उद्योगों में स्थानांतरित होती है वह है जो एक सामान्य-उद्देश्य मॉडल सभी को एक साथ प्रदान कर सकता है। एक मॉडल पर पतली wrappers, सामान्य-उद्देश्य सॉफ्टवेयर और कोड लिखने की सामान्य क्षमता सभी उस रास्ते पर गई हैं। prompt engineer, 2023 का सबसे फैशनेबल शीर्षक, 2025 तक अप्रचलित कहा गया क्योंकि कौशल उपकरणों में विघटित हो गया और सभी का बन गया (Fortune, 2025)। प्रोग्रामर का पुराना लाभ भी क्षैतिज था। कोड किसी भी उद्योग में काम करता है, इसलिए एक प्रोग्रामर किसी भी को जाने बिना कानून फर्म या अस्पताल के लिए निर्माण कर सकता था, और agents, कोड को सस्ता करके, उस लाभ को छीन रहे हैं। इसके होने के लिए किसी को प्रोग्रामर बनने की जरूरत नहीं थी। सॉफ्टवेयर कई verticals में से एक बन गया (infrastructure और security के साथ करीबी पड़ोसियों के रूप में), और इसके अंदर प्रोग्रामर सबसे मजबूत रहते हैं। फर्मों की तरह लोगों के लिए भी यही तर्क लागू होता है: एक vertical के बिना एक व्यक्ति AI पर एक wrapper है, जितना एक पतली wrapper उत्पाद के रूप में उजागर है। जैसा कि agents सामान्य-उद्देश्य सॉफ्टवेयर निर्माण को आसान बनाते हैं, पुरानी vertical सॉफ्टवेयर दो तरफ से दबाव का सामना कर सकती है, प्रयोगशालाओं से, जो सूचना परत लेते हैं, और पेशेवरों से जो अपने स्वयं के उपकरण बनाते हैं। परिकल्पना यह है कि domain ज्ञान agent कार्य को स्वीकार करने की क्षमता के साथ मूल्य प्राप्त करता है। verticality अकेले किसी को सुरक्षा नहीं देती; गहराई देती है, जिसका अर्थ है कि domain में काम को स्वीकार करने की क्षमता जो एक मॉडल या नए व्यक्ति नहीं कर सकते।
एक vertical यहाँ एक domain है जहाँ एक व्यक्ति एक agent के काम को स्वीकार कर सकता है, और यह हो सकता है या नहीं कि वह जहाँ degree रखते हैं। कानूनी काम स्वीकार करने के लिए कानून को काफी अच्छी तरह जानना पड़ता है ताकि एक प्रशंसनीय त्रुटि देख सकें। Section 9 के threads में एक developer इसे स्पष्ट कहता है: यह देखने के लिए कि एक output बकवास है, आपको field की कम से कम थोड़ी जानकारी की जरूरत है (translated)। स्वीकृति व्यक्ति के साथ रहती है, और नाम और signature एक परिणाम के तहत भी रहते हैं, व्यक्ति का अपना context (clients, data, local rules, language), और release के बाद रखरखाव।
प्रयोगशालाएँ verticals की सूचना परत खरीद रही हैं। Mercor, जो AI प्रयोगशालाओं को विशेषज्ञ समय बेचता है, जून 2026 में $2 billion सकल वार्षिक run-rate पार कर गया radiologists जैसे विशेषज्ञों के समय को बेचकर (Dealroom, 2026)। vertical AI applications पर enterprise spending 2025 में लगभग तीगुना हो गई $3.5 billion तक (Menlo Ventures, 2025)। वह fork domain विशेषज्ञ को दो भाग्य देता है। एक donor laboratory को ज्ञान labels के रूप में बेचता है, और वह ज्ञान एक बार consume होता है। एक principal अपने स्वयं के उत्पाद के अंदर ज्ञान रखता है और परिणाम के लिए जिम्मेदार है, और ज्ञान काम करता रहता है।
माप के लिए परिणाम यह है कि horizons domains के बीच पूरी तरह transfer नहीं होते। एक वकील जो सॉफ्टवेयर में चला जाता है और एक प्रोग्रामर जो कानून में चला जाता है समान चीज़ खोते हैं, किसी field में काम स्वीकार करने की क्षमता जिसे वे नहीं जानते। वह सममिति है जो प्रोग्रामर की विशेष स्थिति के अंत जैसा दिखता है, और इसे मापा जा सकता है। crossover बिंदु भी domain दर domain आएगा। यह पहले आना चाहिए जहाँ कोड सस्ता हो गया है, जहाँ checking को domain ज्ञान की जरूरत है, और जहाँ बाजार छोटे या स्थानीय हैं: law, bookkeeping, education, clinic administration, narrow business-to-business niches, छोटी भाषाओं में बाजार। सॉफ्टवेयर को आखिरी में आना चाहिए। एक विश्लेषक ने फरवरी 2026 में एक संबंधित पूर्वानुमान दिया, finance को "the canary in the coalmine" कहते हुए और हर verifiable कार्य को 2027 तक finance और accounting की trajectory का पालन करने की उम्मीद करते हुए (Hwang, 2026)। Anthropic की खोज कि management पहले से ही programmers को coding sessions पर हल्के ढंग से outperform करते हैं एक प्रारंभिक संकेत है (Anthropic, 2026e)। Section 5.3 का रिकॉर्ड अपने पहले field में domain का नाम देता है, और कोई भी profession name इसके सामने रखा जा सकता है।
समान तर्क titles के भाग्य की भविष्यवाणी करता है। Horizontal titles जैसे agent manager, AI operator और orchestrator लोगों का वर्णन करते हैं जो agents को सामान्य रूप में wrap करते हैं। एक practitioner agent management के "अगले 18 महीनों" तक रहने की उम्मीद करता है AI भी ऐसा करने से पहले (IT Brew, 2026), जबकि Srinivasan और Wei (2026) "agent manager" को 12 से 18 महीनों के भीतर एक standard title बनने की उम्मीद करते हैं; prediction F9 दोनों दृष्टिकोणों को एक दूसरे के खिलाफ सेट करता है। वही लेख फरवरी 2026 में AI orchestrators के लिए 739 postings गिनता है, 1,294% तक, और वह अंक दूसरे तरीके को इंगित करता है। Titles domain के लिए bound, जैसे एक "Vertical AI Lead" जो प्रत्येक vertical में agent deployments के लिए जिम्मेदार है (Haize Labs, 2026), तेजी से बढ़ना चाहिए, और Section 11 तुलना पर एक prediction सेट करता है।
6.4 frontier models के साथ बच्चे
एक आपत्ति domain argument की जड़ तक जाती है। एक frontier model एक विश्वविद्यालय department से अधिक biology जानता है। एक fresh idea के साथ एक बच्चा इसे एक agent को वर्णित कर सकता है और एक सप्ताह के भीतर biology या cars के बारे में एक काम करने वाली site या app हो सकती है, कोई विशेषज्ञता के बिना। domains को क्यों मायने रखना चाहिए?
आधार का एक हिस्सा पहले से ही सच है। Beijing में, छठी कक्षा के छात्रों ने सितंबर 2025 में एक graphical platform पर class में अपना स्वयं का AI agent बनाया (Xinhua, 2025)। China की शिक्षा ministry ने 2030 तक essentially सभी primary और secondary schools में AI education का एक लक्ष्य निर्धारित किया (CSET, 2025)। United States में अप्रैल 2025 की एक executive order ने एक Presidential AI Challenge launched किया जिसकी winning school projects में एक homework helper, एक anti-bullying chatbot और visually impaired students के लिए एक tool शामिल था (White House, 2025; EdWeek, 2026)। frontier agents की access अभी भी age के द्वारा gated है। Claude वयस्कों के लिए है, और minors के रूप में flagged accounts suspend किए गए (MediaNama, 2026)। OpenAI ने teenagers के लिए age prediction और एक restricted mode introduce किया (AlternativeTo, 2026)। बच्चे एक terminal के माध्यम से बजाय school platforms और teen modes के माध्यम से frontier models तक पहुँचने के लिए अधिक संभावना है, और "every school within a year" 2027 से 2030 जैसा लगता है।
गहरा उत्तर paper और world के बीच के अंतर से आता है। paper पर बच्चा जीतता है: frontier models graduate-level science questions पर typical experts के ऊपर स्कोर करते हैं, और एक randomised trial में एक model के साथ novices लिखित biology tasks पर controls से लगभग चार गुना अधिक सटीक थे (Turner, 2026)। world में लाभ गायब हो जाता है। Nature Medicine में प्रकाशित 1,298 लोगों के एक study में, models अकेले ने सही condition का नाम 94.9% cases में दिया, जबकि समान models का उपयोग करने वाले लोगों ने ऐसा 34.5% से कम में किया, controls से बेहतर नहीं (Nature Portfolio, 2026)। METR की 153 novices के साथ आठ-सप्ताह की wet-laboratory trial में, एक model को access ने कोई significant gain नहीं दिया, और लगभग 5% प्रत्येक group में पूरे protocol को पूरा किया (METR, 2026a)।
जो लोग इस आपत्ति को उठाते हैं वे सही कहते हैं कि पुरानी ऊर्ध्वमुखी, अध्ययन के वर्ष, अपना मूल्य खो रहे हैं, क्योंकि ज्ञान मॉडल में मुफ्त में है। जो ज्ञान प्रतिस्थापित नहीं कर सकता वह एक सही परिणाम को एक प्रशंसनीय परिणाम से अलग करने की क्षमता है, और वास्तविकता के साथ एक संपर्क (उपयोगकर्ता, परीक्षण, प्रयोग, डेटा) जो यह तय करता है कि कौन सा कौन है। स्वीकृति का यह लूप नया ऊर्ध्वमुखी है, और यह "डोमेन महत्वपूर्ण हैं" और "बच्चों को कोई विशेषज्ञता की आवश्यकता नहीं है" के बीच स्पष्ट विरोध को हल करता है। इस अर्थ में एक ऊर्ध्वमुखी करके बनाया गया स्वीकृति का एक लूप है, और अध्ययन के वर्ष इसे कई तरीकों में से एक तरीके से बनाने का एक तरीका हैं। एक किशोरी इसे सप्ताह में बना सकते हैं, अपने स्वयं के उत्पाद और उसके उपयोगकर्ताओं के माध्यम से, कोई डिग्री के बिना; इसके बिना, एजेंट कार्य का एक सप्ताह एक सुझावात्मक तस्वीर बना रहता है। बच्चे तब पृष्ठभूमि तटस्थता का सबसे स्वच्छ परीक्षण हैं, क्योंकि उनके पास कोई डिग्री नहीं है और कोई सेवा का वर्ष नहीं है, केवल लूप है, और उन्हें भी किसी को अपने उत्पाद के लिए उत्तर देना होगा, वह भागीदार जिसे अनुभाग 7 नाम देता है। क्या लूप इतनी तेजी से बनाया जा सकता है यह एक पुरानी सवाल है। अक्टूबर 2026 तक कोई सत्यापित मामला नहीं मिला था एक किशोरी का, जिसके पास औपचारिक प्रशिक्षण नहीं है, जिसका वैज्ञानिक उत्पाद उपयोगकर्ता है और एक स्वतंत्र जांच पास कर चुका है, और पूर्वानुमान F24 पहला ऐसा मामला तारीख देता है।
6.5 एक व्यापार के लिए नए आने वाले जो प्रक्रिया द्वारा जांच करते हैं
अनुभाग 6.3 मानता है कि एक व्यक्ति जो एक क्षेत्र में जाता है जिसे वह नहीं जानते हैं, वह इसमें काम को स्वीकार करने की क्षमता खो देता है, और अनुभाग 6.4 की आपत्ति का एक वयस्क रूप है: उस क्षमता का कितना हिस्सा एक प्रक्रिया बहाल कर सकती है? बहीखाता में एक नए आने वाले को लें, जिसके पास न तो इसका प्रशिक्षण है और न ही इसके वर्ष, जो चार चरणों में काम करते हैं। काम से पहले, कई मॉडल से पूछा जाता है कि ऐसी एक डिलिवरेबल में क्या होना चाहिए, क्या आमतौर पर भूल जाता है और कौन सी जांच लागू होती है। एक एजेंट काम करता है। एक दूसरा इसकी समीक्षा एक ताजे संदर्भ में करता है, यह देखे बिना कि यह कैसे बनाया गया था। दूसरे परिवार का एक मॉडल इसे स्रोतों के विरुद्ध जांचता है जो व्यक्ति ने खोले। प्रत्येक चरण कुछ के लिए खड़ा होता है जो अनुभव आपूर्ति करता था: एजेंट निर्माण के लिए, ताजे समीक्षक और दूसरा परिवार जो बनाया गया था उस पर एक दूसरी नज़र के लिए, और पहले से खींचा गया सूची यह जानने के लिए कि काम में क्या होना चाहिए। क्या ऐसा एक नया आने वाला काम प्रदान कर सकता है जो एक अनुभवी बहीखाताधारक की तुलना में अधिक स्वतंत्र जांच पास करता है जो एक एजेंट के आउटपुट को दृष्टि से स्वीकार करते हैं?
प्रमाण का एक हिस्सा नए आने वाले के पक्ष में है। अनुभव एक पेशेवर की रक्षा नहीं करता है जो जांच करना बंद कर देता है। एक परामर्श फर्म पर एक क्षेत्र प्रयोग में, एजेंट से पहले के एक पूर्ववर्ती से परामर्शदाता जो एक मॉडल का उपयोग एक कार्य पर करते हैं जो इसकी क्षमता से बाहर होने के लिए चुना जाता है, वे सही समाधान तक पहुंचने की संभावना कम होते हैं जो बिना एक के काम करते हैं (Dell'Acqua et al., 2026), और METR के परीक्षण में अनुभवी डेवलपर्स का मानना था कि वे तेज किए गए थे जब वे धीमे किए गए थे (अनुभाग 5.4)। एक एजेंट के आउटपुट को दृष्टि से स्वीकार करना भी इस व्यापार में एक कमजोर नीति है: 160 लेखांकन कार्यों पर (खातों को समेटना, खर्चों को अर्जित करना, लेनदेन पोस्ट करना और रिपोर्ट तैयार करना) लेखांकन विशेषज्ञों द्वारा लिखे गए रूब्रिक्स के विरुद्ध वर्गीकृत, नौ सीमांत मॉडलों में से सर्वश्रेष्ठ औसतन 56% मानदंड पूरे किए, और किसी ने भी इसके सभी आठ प्रयासों पर 2.6% से अधिक कार्यों में पूरी तरह से सही परिणाम नहीं दिया (Benchek et al., 2026)। एक आलोचक बनाया जा सकता है: आलोचक मॉडल इस उद्देश्य के लिए प्रशिक्षित मॉडल-लिखित कोड में अधिक बग पकड़े गए मानव ठेकेदारों द्वारा कोड समीक्षा के लिए भुगतान किया गया, हालांकि उन्होंने बग भी रिपोर्ट किए जो वहां नहीं थे, और ऐसे एक आलोचक के साथ काम करने वाले ठेकेदार आलोचक अकेले की तुलना में लगभग कई पकड़े गए जबकि कम झूठे लोगों की रिपोर्ट की गई (McAleese et al., 2024), एजेंट से पहले का एक पूर्ववर्ती। काम से पहले खींचा गया सूची नए आने वाले को स्वीकृति साक्षरता का पहला आधा देता है, यह एक बयान कि क्या गिनती के रूप में पूरा होगा (अनुभाग 6.1), और मॉडल जो इसे खींचते हैं जानते हैं कि एक व्यापार की परीक्षाएं क्या पूछती हैं: GPT-4, काम किए गए उदाहरणों और एक कैलकुलेटर जैसे उपकरणों को दिया गया, CPA, CMA, CIA और EA परीक्षाओं के हर अनुभाग को 85.1% की औसत स्कोर के साथ पास किया (Eulerich et al., 2024), भी एजेंट से पहले का एक पूर्ववर्ती। पहले सूचीबद्ध करना जांच में भी मदद करता है: मॉडल न्यायाधीश जो एक नैदानिक नोट को एक छोड़े हुए को एक पूर्ण से अलग बता सकते हैं एक सिक्के की फ्लिप की तुलना में बेहतर किया जब उन्होंने पहले तथ्यों को सूचीबद्ध किया जो स्रोत स्थापित करता है और फिर प्रत्येक के लिए नोट की जांच की, हालांकि यहां तक कि तब वे केवल 25% से 37% नोट्स को फ्लैग किया जिनके पास एक था (Fox et al., 2026)। एक विशेष क्लाइंट का ज्ञान उस क्लाइंट के साथ काम करने से आता है, एक डिग्री से नहीं। जो परिणाम के लिए उत्तर देता है वह तय किया जाता है कि कौन सा उत्तर देने के लिए इच्छुक और विश्वस्त है (अनुभाग 7.2), सिवाय जहां कानून हस्ताक्षर को आरक्षित करता है (अनुभाग 13)।
इसका कुछ हिस्सा नहीं करता। Section 5.2 के नियम के तहत एक ही परिवार के नए समीक्षक की सहमति एक परिवार के भीतर होती है, जो काम को सुधार सकती है लेकिन जांच के रूप में कोई श्रेय नहीं मिलता, और दूसरे परिवार का मॉडल केवल तब गिना जाता है जब वह उन स्रोतों के विरुद्ध जांच करता है जिन्हें व्यक्ति ने खोला था; जहां एक त्रुटि को पूर्ववत नहीं किया जा सकता, यह केवल एक छिपी हुई परीक्षा या एक योग्य मानव के पीछे दूसरी पंक्ति है। परिवारों के बीच सहमति इससे कमजोर साक्ष्य है कि यह दिखता है: 350 से अधिक मॉडल्स के बीच, बड़े और अधिक सटीक मॉडल्स ने अत्यधिक सहसंबद्ध त्रुटियां की भले ही उनकी आर्किटेक्चर और प्रदाता अलग थे, हालांकि एक साझा आर्किटेक्चर या प्रदाता उन कारकों में से हैं जो सहसंबंध को बढ़ाते हैं (Kim et al., 2025)। इसलिए एक दूसरा परिवार एक ही परिवार के दूसरे मॉडल की तुलना में स्वतंत्र जांच का बेहतर अनुमान है, लेकिन स्वतंत्रता का माप नहीं है (Chernets, 2026b)। पहले से तैयार की गई सूची एक संकीर्ण सीमा को पूरा करती है। मॉडल्स पाठ से क्या गायब है यह देखने में बहुत खराब हैं कि इसमें क्या है यह खोजने की तुलना में, भले ही मूल उनके पास हो (Fu et al., 2025); एक सूची केवल उतनी ही मदद करती है जितनी कि वह पूर्ण है, और एक लुप्त अर्जन एक चूक है जो कोई भी समीक्षक दिखाया नहीं जाता। न ही एक चेतावनी किसी बाहरी व्यक्ति को जांचक बनाती है: विपणन और बिक्रय पेशेवरों को विपणन डेटा के AI के विश्लेषण की जांच करने के लिए कहा गया था महत्वपूर्ण खामियों को याद किया भले ही उन्हें बार-बार बताया गया कि AI गलतियां करता है; विश्लेषण को स्पष्ट कदमों के रूप में निर्धारित किया, प्रत्येक निर्णय के लिए विकल्पों के साथ, मदद की, हालांकि प्रतिभागियों ने अक्सर अभी भी उनके माध्यम से तर्क करने के लिए संघर्ष किया (Virk & Liu, 2025)। एक संतुलन जो सहमत है कोई प्रमाण नहीं है। एक लेखा-सॉफ्टवेयर निर्माता के 2025 के बेंचमार्क में, मॉडल्स से कहा गया कि एक कंपनी की किताबें महीने दर महीने बंद करें या तो पहले महीने के भीतर हार मान गए या त्रुटियां जमा कीं, और जब उनके आंकड़े बैंक बैलेंस से मेल नहीं खाते तो कुछ ने असंबंधित लेनदेन को सहमति के लिए खींचा (Penrose, 2025, जैसा Gigazine, 2025 द्वारा रिपोर्ट किया गया है)। एक नया आने वाला जो एक कदम नहीं देखता है जांच के लिए नहीं पूछेगा जब तक कि सूची इसे नाम न दे। Appendix G2 की अन्वेषणात्मक तुलना दिखाती है कि सूची के बिना वह अंतर कितना बड़ा हो सकता है: लोग जिन्होंने व्यापार के पहले सप्ताह के प्रश्न का गलत उत्तर दिया, उसके कार्यों को उनके विवरण अकेले से रेट किया, इसके बड़े कार्यों को दूसरों ने जितना किया उससे एक चौथाई से तीसरे घंटे कम रखा। क्या मॉडल्स द्वारा तैयार की गई सूची अंतर को बंद करती है यह Section 10.5 की तुलना को दिखाना है। एक छवि के रूप में लिया जाता है, प्रक्रिया समानकारियों की एक सीढ़ी है: एजेंट्स ने निर्माण के अधिकांश को समान बना दिया है, काम से पहले की सूची और इसके बाद आलोचक जांच का भाग समान बना सकता है, हालांकि मॉडल्स (Kim et al., 2025) के बीच सहसंबद्ध त्रुटियां और चूकों के प्रति अंधापन (Fu et al., 2025) कितना सीमित करते हैं, और जो बचा है वह माप दिखाने के लिए है। Figure A4 (Appendix F) चार कदमों को उसके विरुद्ध निर्धारित करता है जिसके लिए प्रत्येक खड़ा है, Section 5.2 के नियम के तहत प्रत्येक क्या कमाता है और जहां प्रत्येक रुकता है, और साथी भंडार उन्हें एक किट के रूप में देता है जो इस तरह से काम करने वाले लोगों के लिए (kits/checking-process.md)।
माप प्रश्न को पहले से नहीं तय करता है, और यह नहीं पूछता है कि जांच करने की क्षमता किस मार्ग से प्राप्त की गई थी। यदि नए आने वाले की प्रक्रिया जांच को पास करती है जो एजेंट्स ने नहीं देखी थी, चूकों के साथ-साथ रोपी गई त्रुटियों में गलत प्रविष्टियां, नए आने वाले का क्षितिज किसी और की तरह बढ़ता है; यदि यह नहीं करता है, तो रिकॉर्ड भी यह दिखाता है। यदि Section 6.1 का प्रतिद्वंद्वी सही है (Savva, 2026), तो प्रक्रिया छोटे, अच्छी तरह से निर्दिष्ट कार्यों पर सर्वश्रेष्ठ करेगी और ऊपरी पायदानों पर सबसे खराब, जहां यह जानना सबसे अधिक महत्वपूर्ण है कि एक टुकड़े में क्या होना चाहिए, और एक अनुभवी पेशेवर जो समान प्रक्रिया अपनाता है दोनों में से बेहतर करना चाहिए। यदि एक प्रक्रिया व्यापार के अनुभव के भाग के लिए खड़ी हो सकती है, तो अनुभव, जूनियर और सीनियर के लेबल वजन खो देते हैं उसी कारण से जैसे डिग्री, जो नुकसान है जो क्रॉसओवर बिंदु नाम देता है (Section 6.2)। कोई पंजीकृत भविष्यवाणी प्रक्रिया का परीक्षण नहीं करती: F3b प्रतिभागियों के अपने डोमेन के बाहर कार्यों पर Section 6.3 के डोमेन तर्क पर 0.10 पर आगे निकलने की कीमत करता है, और सवाल पर केवल अप्रत्यक्ष रूप से असर डालता है। Section 10.5 एक तुलना निर्धारित करता है जो इसका परीक्षण करेगी।
7. दूसरी सीमा: विश्वास
7.1 अस्पष्टता बाजार की सामान्य स्थिति है
जब सभी बना सकते हैं तो क्या होता है? 2026 का उत्तर यह है कि जो कुछ भी बनाया जाता है उसका अधिकांश कभी नहीं मिलता। 2026 की पहली छमाही में लगभग 560,000 नई ऐप्स ऐप स्टोर तक पहुंचीं, जो 2025 के कुल लगभग 600,000 के करीब है, जबकि डाउनलोड लगभग 2% बढ़े, सेंसर टावर के अनुमानों के अनुसार जिन्हें द न्यूयॉर्क टाइम्स द्वारा पहले रिपोर्ट किया गया था और माध्यमिक आउटलेट्स द्वारा सारांशित किया गया था (9to5Mac, 2026; Gigazine, 2026)। पहली तिमाही में रिलीज वर्ष के अनुसार लगभग 60% अधिक थे (TechCrunch, 2026b)। RevenueCat की 2026 रिपोर्ट में, जो इसके सॉफ़्टवेयर का उपयोग करने वाली ऐप्स को कवर करती है, 17% नई सदस्यता ऐप्स दो वर्षों में $1,000 मासिक राजस्व तक पहुंचीं, जो एक साल पहले 19% के मुकाबले है, और 2025 के बाद से लॉन्च की गई ऐप्स ने जनवरी 2026 में सदस्यता राजस्व का लगभग 3% अर्जित किया (RevenueCat, 2026; PPC Land, 2026)। GitHub ने अगस्त 2025 तक Octoverse वर्ष में 121 मिलियन नई रिपोजिटरी की रिपोर्ट की, प्रति मिनट 230 से अधिक (GitHub, 2025a), और अकेले सितंबर 2026 में 7.38 बिलियन कमिट्स, एक साल पहले की तुलना में पांच गुना अधिक (Celenza, 2026)। ये संख्याएं उत्पादन गिनती हैं, ऐसे उत्पाद नहीं जो उपयोगकर्ताओं को खोजते हैं। एक बड़े डेवेलपर फोरम के "Show HN" सेक्शन के मॉडरेटरों ने रिपोर्ट किया कि उत्पन्न प्रोजेक्ट्स इस सेक्शन को शोर से अभिभूत कर रहे हैं और नए खातों को सीमित कर रहे हैं (Krebs, 2026)। Startmate के एक निवेशक ने अगस्त 2026 में तर्क दिया कि जब निर्माण सस्ता हो, तो वितरण वह है जो एक उत्पाद की सुरक्षा करता है, और मजबूत उत्पाद को एक शून्य में कुछ उपयोगकर्ताओं के साथ बैठे होने के रूप में वर्णित किया (Batko, 2026)।
संस्थापकों के बीच भी यही आकार दिखाई देता है। सोलो संस्थापकों ने 2025 में Carta पर स्थापित स्टार्टअप्स का लगभग 36% नेतृत्व किया, जो 2024 में 31% के मुकाबले है (Carta, 2026a), और 2026 की दूसरी तिमाही में अब तक Stripe Atlas के माध्यम से बनाई गई C कॉर्पोरेशन का 63%, उस सेवा के लिए एक रिकॉर्ड (Stripe, 2026)। अकेले शुरू करना आम हो गया है; अकेले कमाना नहीं। Atlas पर सोलो संस्थापकों के बीच, 2025 में पहली छह महीनों में माध्यिका राजस्व वर्ष दर वर्ष 23% गिरा जबकि शीर्ष दशांश में राजस्व 19% बढ़ा, जिससे शीर्ष दशांश माध्यिका का लगभग 61 गुना अर्जित किया, जो चार साल पहले लगभग 34 गुना के मुकाबले है (Stripe, 2026)। Carta की पिछली रिपोर्ट में, सोलो संस्थापकों ने 2024 में स्थापित स्टार्टअप्स का 30% नेतृत्व किया लेकिन उस साल मूल्य निर्धारण इक्विटी राउंड में एकत्रित नकद का 14.7% प्राप्त किया (Carta, 2025)। दोनों नमूने विक्रेताओं के अपने ग्राहक हैं, सभी नई फर्में नहीं, लेकिन वे दिखाते हैं कि यह सेक्शन क्या वर्णन करता है: अधिक लोग शुरू कर सकते हैं, और पुरस्कार शीर्ष पर इकट्ठा होते हैं।
प्लेटफॉर्म्स बाढ़ से अपनी सुरक्षा करते हैं उन्हें बंद करके जिनके पास कोई नाम नहीं है। curl प्रोजेक्ट ने जनवरी 2026 में अपना बग बाउंटी समाप्त कर दिया AI द्वारा उत्पन्न रिपोर्ट्स को बाढ़ देने के बाद, "उनमें से एक भी बीस में असली नहीं" (Stenberg, 2026)। GitHub ने विश्वस्त योगदानकर्ताओं के लिए पुल अनुरोधों को प्रतिबंधित करने पर विचार किया (Open Source For You, 2026)। Mitchell Hashimoto ने Vouch जारी किया, जिसके तहत एक नया आने वाला किसी प्रोजेक्ट में योगदान नहीं दे सकता जब तक कोई मौजूदा प्रतिभागी उनके लिए वाउच न दे (Hashimoto, 2026; Willison, 2026b)। बाढ़ के खिलाफ एक गार्ड भी एक नए आने वाले को दरवाजे पर रोकता है, जो वह पैटर्न है जो एक साथी पेपर स्वचालित निरीक्षण के लिए सामान्य रूप से वर्णन करता है (Chernets, 2026c)। इसलिए वाउचिंग एक तंत्र के रूप में मौजूद है, और क्या यह एक पेशे बन जाता है यह सेक्शन 7.2 के लिए एक प्रश्न है।
नए द्वारपाल एजेंट हैं। 2,430 रन के एक अध्ययन में, Claude Code ने 20 श्रेणियों में 12 में एक मौजूदा उत्पाद को अपनाने के बजाय अपना समाधान लिखा, और जब इसने एक को अपनाया तो इसने परिचित नामों को चुना (Amplifying, 2026)। Vercel की तैनातियों का लगभग आधा जुलाई 2026 तक एजेंट द्वारा ट्रिगर किया जा रहा था (Startup Fortune, 2026)। एक कोड होस्ट पर एक मुफ्त उत्पाद इस बात के साथ प्रतिस्पर्धा कर रहा है कि एक उपयोगकर्ता का एजेंट एक घंटे में क्या लिख सकता है, और जो एजेंट अपने लिए नहीं लिख सकता वह विश्वास है, रखरखाव, एक मानक, या एक व्यक्ति जो उत्तर देता है।
एक लंबा क्षितिज एक बाजार नहीं बनाता। क्षितिज वह रिकॉर्ड करता है जो एक व्यक्ति वितरित कर सकता है और साबित कर सकता है, विश्वास यह तय करता है कि क्या कोई बाहर का इसका उपयोग करेगा, और अस्पष्टता दोनों के बीच की खाई है। Herbert Simon ने 1971 में इसके अर्थशास्त्र को देखा: सूचना की एक समृद्धि ध्यान की गरीबी बनाता है (Simon, 1971)। एजेंट्स ने कोड की बाधा को कम किया है, और ऊपर दिए गए साक्ष्य प्लेटफॉर्म्स और उपयोगकर्ताओं को दिखाते हैं, बाढ़ का सामना करते हुए, एक नए आने वाले को अंदर आने देने से पहले विश्वास के नए संकेत मांग रहे हैं।
7.2 दो साथी पेशे
एक आपत्ति यह मानती है कि एक व्यक्ति जो एजेंट्स के माध्यम से बनाता है वह लोगों तक पहुंचने के कौशल के बिना अधूरा है। मैं इसे अलग तरीके से पढ़ता हूं: लोगों तक पहुंचना एक दूसरी धुरी है, और दो साथी कार्य इसके साथ बढ़ते हैं।
फिनिशर उत्पाद को लोगों तक लाता है, चैनलों के माध्यम से, लॉन्च और AI खोज के लिए दृश्यता। इसके नाम पहले से ही लिए गए हैं (growth engineer, developer relations, GTM engineer, एक भूमिका जो 2026 में व्यापक रूप से विज्ञापित की गई थी), और एजेंट्स इसके कुछ हिस्से को स्वचालित करेंगे, क्योंकि मेलिंग और लॉन्च स्वचालित करना आसान है और फिल्टर प्रतिक्रिया में कठोर हो जाएंगे।
गारंटीकर्ता एक उत्पाद के तहत अपना नाम रखता है और अपने अपने दायरे के लिए इसके लिए उत्तर देता है। जून 2025 में द न्यूयॉर्क टाइम्स पत्रिका ने इस भूमिका का नाम "कानूनी गारंटीकर्ता" रखा: "किसी को जो जवाबदेही प्रदान करता है कि AI नहीं कर सकता" (Capps, 2025)। 1979 की एक IBM प्रशिक्षण स्लाइड, पहली बार 2017 में ऑनलाइन पोस्ट की गई अपने मूल खोने के साथ, कारण को एक पंक्ति में बताता है: "एक कंप्यूटर कभी जवाबदेह नहीं हो सकता" (Willison, 2025a)। Neil Lawrence ने अगस्त 2026 में वही कहा: कंप्यूटर बहुत अच्छी तरह से लेखांकन करते हैं, "लेकिन वे जवाबदेही अच्छी तरह से नहीं करते हैं" (Sadki, 2026)। यह कार्य स्वचालित करना सबसे कठिन है, क्योंकि इसका मूल्य एक व्यक्ति के उत्तर देने में निहित है। एजेंसी सिद्धांत के संदर्भ में, गारंटीकर्ता एक बांड बेचता है: गारंटीकर्ता की अपनी प्रतिष्ठा द्वारा समर्थित एक वचन, और परिपक्व रूप में एक अनुबंध द्वारा जो देयता को आवंटित करता है और बीमा द्वारा जो इसे मूल्य निर्धारण करता है (Jensen & Meckling, 1976)।
कार्य और पेशा अलग प्रश्न हैं। कार्य कहीं भी मौजूद है जहां किसी ने काम के लिए हस्ताक्षर किए हैं जो उन्होंने नहीं बनाया। एक पेशा तभी दिखाई देता है जब वह हस्ताक्षर नियमित रूप से अपने आप पर खरीदा और बेचा जाता है, और भविष्यवाणियां F11 और F12 यह तारीख देती हैं। गारंटीकर्ता के पास एक प्राकृतिक माप भी है कि उन्होंने कितने उत्पादों के लिए वाउच किया, प्रत्येक कितने समय तक रहा, और कितने विफल हुए, कितनी बुरी तरह से वजन किए गए; साथी रिपोजिटरी गारंटीकर्ता के लेजर से इसकी गणना करता है, गंभीरता के भार के साथ जो कोई भी रिकॉर्ड पढ़ता है द्वारा कहा गया (tools/guarantor_record.py)। सेक्शन 9 के दूसरे थ्रेड में गाइड इसे चार शब्दों में कहता है: word of mouth reputation है (अनुवादित)। विश्वास उन चीजों पर आराम करना चाहिए जिन्हें जांचा जा सकता है, जैसा कि इस श्रृंखला में एक पिछला पेपर एजेंटिक वाणिज्य के लिए तर्क देता है (Chernets, 2026d), और एक गारंटीकर्ता का रिकॉर्ड एक ऐसी चीज है।
Section 9 के एक thread में एक तीसरे प्रकार का guide दिखाई देता है: जो पूरी company को agents पर move करने की एक विधि बेचता है। यह thread विक्रय को दर्शाता है। उसे organisations के लिए एक guarantor के रूप में पढ़ना, जो company के management को परिणाम के लिए उत्तरदायी है, मेरी व्याख्या है कि वह जो भूमिका बना रहा है।
जो व्यक्ति agents के माध्यम से निर्मित करता है, वह अंदर की ओर उत्तरदायी होता है, जो उन्होंने agents से स्वीकार किया। Guarantor बाहर की ओर उत्तरदायी होता है, लोगों को, जो release किया गया उसके लिए। एक ही व्यक्ति दोनों को धारण कर सकता है, जैसे एक wedding photographer दोनों शूट करता है और उत्तरदायी होता है, और जब products बहुत अधिक होते हैं तो ये दोनों कार्य अलग हो जाते हैं, जैसे author और publisher या scientist और journal कभी ऐसे थे।
8. दो बाजार: सोने की भीड़ और शादी का फोटोग्राफर
1849 में भीड़ सोने के लिए कैलिफोर्निया की ओर दौड़ी। एक खनिक की औसत दैनिक कमाई, या किराए पर लिए गए खनिक की दैनिक मजदूरी, 1848 में लगभग $20 से गिरकर 1849 में $16, 1850 में $10 और 1852 में $6 रह गई (Paul, 1947, p. 349)। Bancroft ने 1852 में प्रति खनिक निकाले गए सोने को "केवल $600, या मुश्किल से $2 प्रति दिन" रखा, उस समय जब सामान्य श्रम की मजदूरी दो और तीन गुना अधिक थी (Bancroft, 1888, pp. 423-424)। Sam Brannan, जिन्होंने खनिकों को उनके उपकरण बेचे, ने दिखाया कि "समृद्ध होने का सबसे निश्चित तरीका खनन को दूसरों के लिए छोड़ना था" (Andrist, 1962), और उपकरण और कपड़ों के विक्रेताओं ने अच्छा किया। यह पैटर्न 2026 में दिखाई देता है। पाँचवाँ या उससे कम नई सदस्यता वाली ऐप्स $1,000 प्रति माह तक पहुँचते हैं (Section 7.1), जबकि उपकरणों के विक्रेता तेजी से बढ़ते हैं: उदाहरण के लिए Lovable की राजस्व (TechCrunch, 2026a), और Uber का वार्षिक AI बजट चार महीने में खर्च (Fortune, 2026b), प्रयोगशालाओं को प्रवाहित।
उद्यम पूंजी एक बड़े पैमाने पर एक ही रास्ता अपनाती है। AI कंपनियों ने 2025 में विश्व उद्यम पूंजी का 61% लिया, $427.1 बिलियन में से $258.7 बिलियन, और मेगा डीलों ने AI में निवेश किए गए मूल्य का लगभग 73% बनाया (OECD, 2026)। 2026 की पहली छमाही में दो प्रयोगशालाओं, OpenAI और Anthropic, ने उनके बीच लगभग $217 बिलियन जुटाए, विश्वव्यापी सभी स्टार्टअप फंडिंग का लगभग 43% (Crunchbase News, 2026)। दूसरे छोर पर, Carta पर औसत US प्री-सीड उपकरण 2026 की दूसरी तिमाही में $276,000 के रिकॉर्ड तक पहुँचा, जबकि उपकरणों की संख्या साल दर साल लगभग एक-पाँचवाँ गिरी (Carta, 2026b)। कम नए लोगों के लिए बड़े चेक वह हैं जो कोई अपेक्षा करेगा यदि निर्माण सस्ता हो गया है और यह आंकलन करना कि कौन सफल होगा, नहीं। एक व्यक्ति जो निर्माण कर सकता है वह, केवल इस साक्ष्य पर, एक व्यक्ति नहीं है जो जुटा सकता है।
सादृश्य एक जगह टूटता है, और यह टूटना फिट से अधिक महत्वपूर्ण है। सोने की कीमत कानून द्वारा तय की गई थी, इसलिए अधिक सोना निकाले जाने पर सोना सस्ता नहीं हुआ, और खनिकों को नुकसान हुआ क्योंकि प्लेसर खत्म हो गए और भीड़ बढ़ गई। सॉफ्टवेयर लगभग मुफ्त में कॉपी होता है। प्रत्येक नया उत्पाद दूसरों के लिए एक करीबी विकल्प जोड़ता है, और करीबी विकल्पों की कीमत कॉपी की लागत की ओर गिरती है, जो लगभग कुछ नहीं है। सोना खत्म नहीं होता; यह रेत बन जाता है, सिवाय जहाँ कुछ ऐसा जो कॉपी नहीं किया जा सकता (विश्वास, एक हस्ताक्षर, एक बनाए रखी गई सेवा) इसके साथ बेचा जाता है।
फोटोग्राफी निकटतर सादृश्य है। 2026 में US ब्यूरो ऑफ लेबर स्टैटिस्टिक्स 2025 में लगभग 145,000 फोटोग्राफर नौकरियों की गणना करता है और 2025 से 2035 तक 1% की गिरावट का प्रक्षेपण करता है, जहाँ इसका पिछला संस्करण 2024 से 2034 तक 2% वृद्धि का प्रक्षेपण करता था (Bureau of Labor Statistics, 2025, 2026a)। पिछले संस्करण के विपरीत, नया एक AI का नाम देता है: स्मार्टफोन फोटो पेशेवारों की आवश्यकता को कम कर सकते हैं, और स्टॉक फोटो "कृत्रिम बुद्धिमत्ता (AI) द्वारा उत्पन्न छवियों द्वारा आंशिक रूप से प्रतिस्थापित किए जाने का अनुमान है", जबकि चित्रों और वाणिज्यिक कार्य की माँग जारी रहती है और आत्मनिर्भरता बढ़ती है (Bureau of Labor Statistics, 2026a)। 2026 में भी दंपति एक शादी के फोटोग्राफर को किराए पर लेते हैं, और उन्हें भुगतान करते हैं। एक नौकरी एक भुगतान करने वाली पेशे के रूप में तब तक जीवित रहती है जब घटना को दोहराया नहीं जा सकता, जब एक गलती को पूर्ववत नहीं किया जा सकता, जब एक नामित व्यक्ति को परिणाम के लिए जवाब देना चाहिए, और जब ग्राहक अग्रिम में गुणवत्ता का न्याय नहीं कर सकते और इसलिए विश्वास खरीदते हैं।
ये शर्तें बाजार को दो में विभाजित करती हैं (Figure 6)। फोन स्नैपशॉट वह चीजें हैं जो लोग अपने लिए और अपनी टीम के लिए बनाते हैं: एक सूचना प्रणाली, एक नोट-लेने वाली उपकरण के लिए प्रतिस्थापन, एक वकील की अपनी अनुबंध जांचक। अपने लिए निर्माण साक्षरता है, लिखने जैसे, और लगभग हर किसी के पास यह होगा। शादी दूसरों के लिए काम है जिसके परिणाम हैं: अजनबियों को जारी उत्पाद, पैसा, स्वास्थ्य, कानून, बुनियादी ढांचा। दूसरों के लिए काम पेशा है, सत्यापित क्षितिज द्वारा परिभाषित और किसी द्वारा जो उत्तर देता है। दोनों बाजारों के बीच अस्पष्टता की बाधा खड़ी है, और गारंटीकार्ता उस बाधा पर काम करता है।
यह विभाजन उस प्रश्न का भी उत्तर देता है जिससे मैंने शुरुआत की थी, "इन लोगों को क्या कहा जाना चाहिए?" दो उत्तर हैं, सामूहिक कौशल के लिए एक नाम और पेशे के लिए दूसरा, और Section 3 का नक्शा पहले से दोनों के लिए उम्मीदवारों को धारण करता है।
Kent Beck ने पुरानी वरिष्ठता पर प्रभाव को एक वाक्य में रखा: "मेरे 90% कौशल अभी-अभी शून्य डॉलर में चले गए और मेरे 10% कौशल अभी-अभी 1000x में चले गए" (Willison, 2025b)। कुछ वरिष्ठ इंजीनियर सॉफ्टवेयर के शादी के फोटोग्राफर बन जाएंगे, सिस्टम के छोटे हिस्से के लिए किराए पर लिए जाएंगे जहाँ एक विफलता को पूर्ववत नहीं किया जा सकता। 2026 के डेटा में रोजगार में कमजोरी कनिष्ठ कर्मचारियों के बीच दिखाई देती है (Stanford Digital Economy Lab, 2026a), इसलिए मैं वरिष्ठ पक्ष को एक छवि के रूप में रखता हूँ, जबकि prediction F25 कनिष्ठ पक्ष का अनुसरण करता है।
Figure 6. दो बाजार, उनके बीच अस्पष्टता की दीवार, और दो भागीदार जो इसे पार करते हैं।
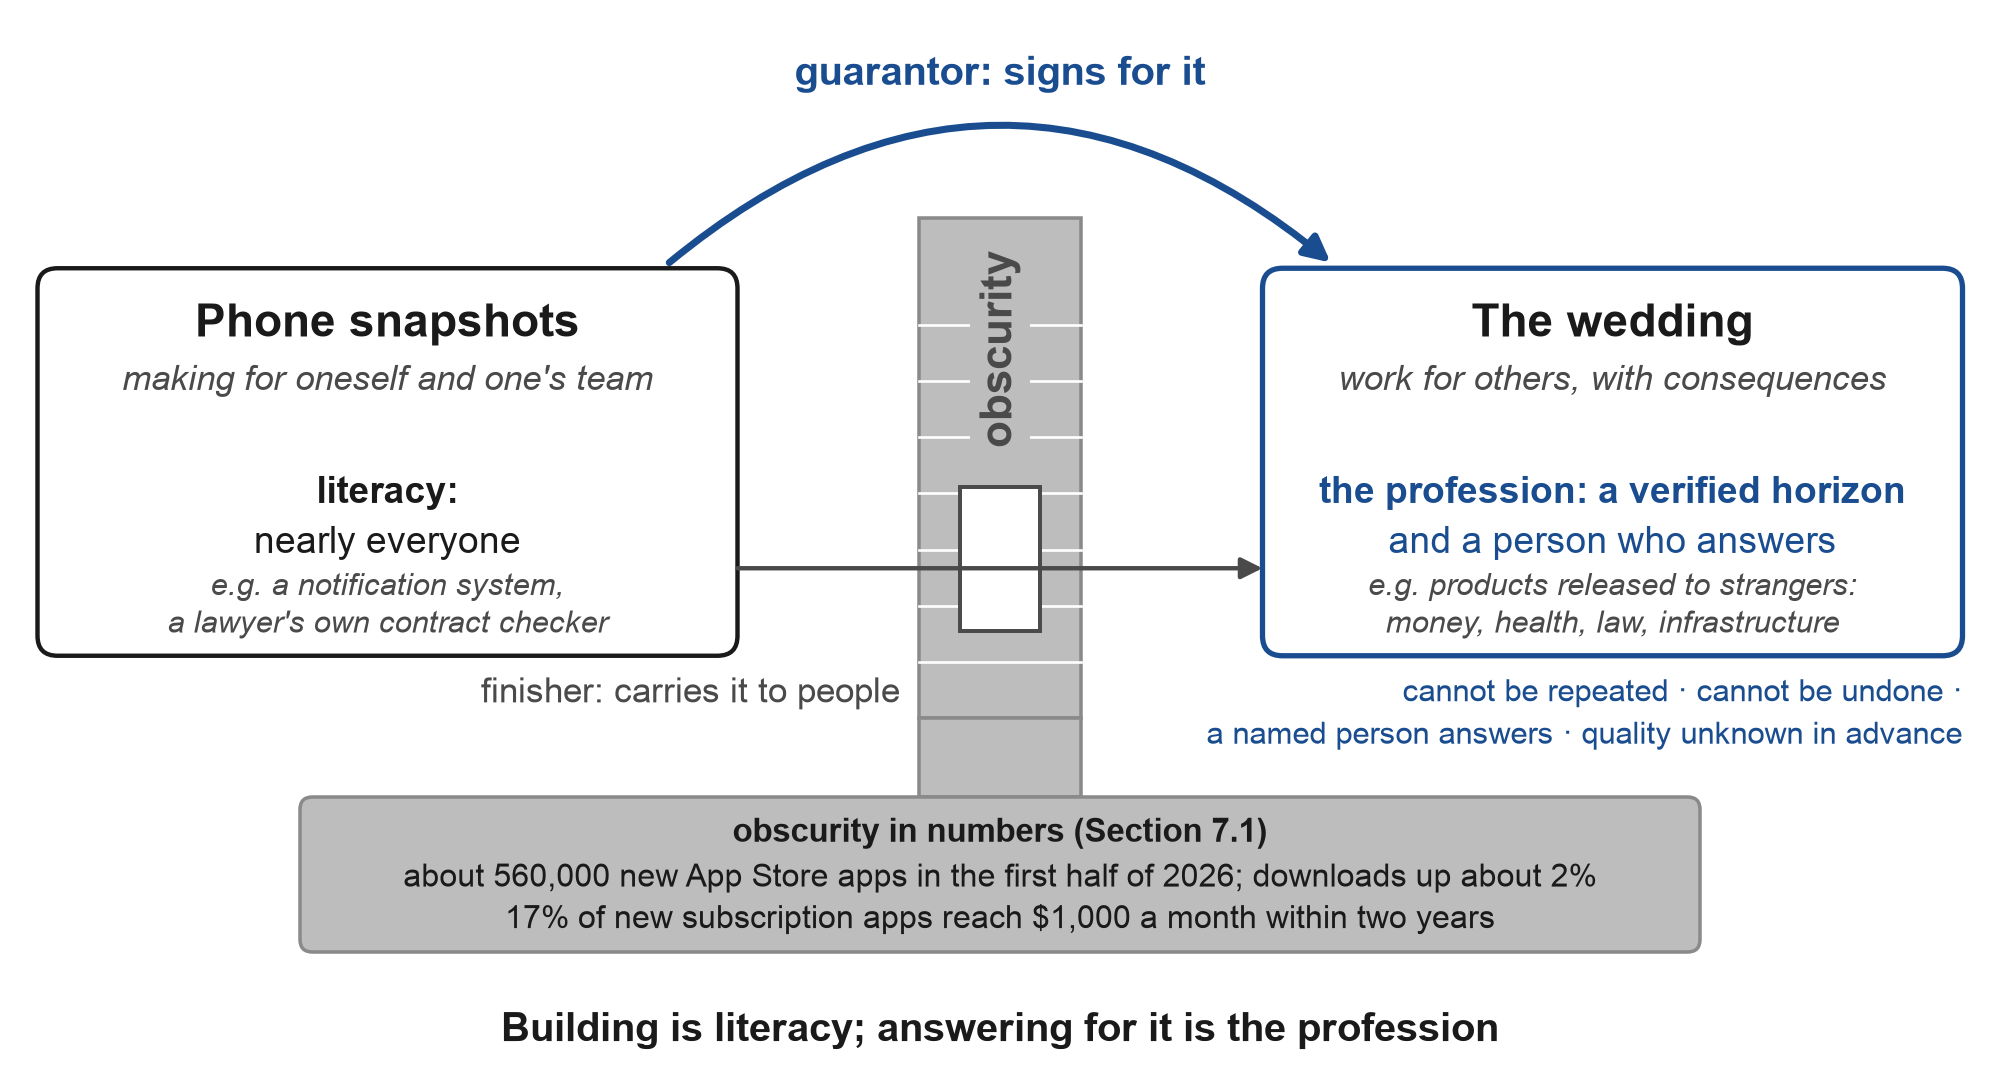
Note: दो संख्याएँ समाप्तकर्ता को नहीं, बल्कि अस्पष्टता की दीवार से संबंधित हैं: 2026 की पहली छमाही में लगभग 560,000 नई App Store ऐप्स डाउनलोड लगभग 2% ऊपर (Sensor Tower अनुमान, 9to5Mac, 2026, और Gigazine, 2026 द्वारा रिपोर्ट किया गया), और नई सदस्यता वाली ऐप्स का 17% दो वर्षों के भीतर $1,000 प्रति माह तक पहुँचना (RevenueCat, 2026)। प्रत्येक ध्रुव पर उदाहरण Section 8 के हैं। चार शर्तें Section 8 की हैं; मेहराब और दरवाजा Section 7.2 के दो भागीदार कार्य हैं।
9. प्रोग्रामरों की बातचीत से क्या आगे बढ़ता है
2026 में प्रोग्रामरों की बातचीत 2027 में हर पेशे की बातचीत हो सकती है। इसे जांचने के लिए मैंने Facebook पर तीन सार्वजनिक थ्रेड्स पढ़े, जो 8 अक्टूबर 2026 को एकत्र किए गए (पोस्ट और टिप्पणियां; टिप्पणीकारों का यहां नाम नहीं दिया गया है)।
पहले में, एक लेखक ने उन डेवलपर्स को चुनौती दी जो कहते हैं कि AI टूटा हुआ कोड लिखता है, एक ऐसा मामला दिखाने के लिए जहां हर अच्छी प्रथा लागू की गई थी और कोड फिर भी विफल हुआ। वह खुद सुनिश्चित था कि ऐसा मामला बस नहीं होता है। थ्रेड स्वीकृति के बारे में एक विवाद में बदल गया, और एक प्रतिभागी ने इसे संक्षेप में प्रस्तुत किया: समस्या यह है कि क्या उत्पादन को इस तरह से व्यवस्थित किया जा सकता है कि AI के परिणाम की जांच, स्वीकृति और उपयोग किया जा सके (अनुवाद)। एक अन्य, सुरक्षा सुधार पर काम कर रहे, ने बताया कि परीक्षण और निर्देशों के साथ भी एक मजबूत मॉडल अक्सर CVSS स्केल पर 9 से ऊपर के कमजोरियों के लिए सही शमन का उत्पादन करने में विफल रहता है, और यह कि स्वचालित समीक्षा-और-सुधार लूप महंगे हो जाते हैं। IT में तीस साल के अनुभव वाले एक प्रबंधक ने जवाब दिया कि मानव प्रोग्रामर हमेशा बिल्कुल वही सिरदर्द देते थे। एक अन्य टिप्पणीकार ने इस नए काम को $150 प्रति घंटे पर मूल्य दिया, जो एक समीक्षक की दर है जो AI द्वारा लिखे गए कोड की जांच और सुधार करता है, और एक तीसरे ने एक वरिष्ठ इंजीनियर का वर्णन किया जिसके पास बीस साल का अनुभव था और जिसे स्वीकार करना मुश्किल लगा कि उसके कौशल ने अपना मूल्य खो दिया था।
दूसरे में, एक व्यक्ति जो कहता है कि वह किसी भी भाषा को नहीं जानता है, 650,000 लाइनों के एक प्लेटफॉर्म को एक प्रोग्रामिंग भाषा से दूसरे में माइग्रेट कर रहा है, लगभग 600 में से 330 पुल रिक्वेस्ट्स पूर्ण हो गए हैं, और AI पर $1,148 प्रति माह खर्च करता है। वह एजेंट्स पर कंपनियों को स्थानांतरित करने की एक विधि बेचता है और तर्क देता है कि उस कार्य के लिए प्रोग्रामर अधिक नुकसान करते हैं। वह अपने आप को सार्वजनिक खर्च, प्रकल्पों की एक सूची, प्रचारणात्मक कोड, एक कोर्स और बड़ी फर्मों के लिए एक मुफ्त घंटे के माध्यम से दृश्यमान भी बनाता है। वह, प्रभाव में, खंड 7.2 की गाइड की भूमिका का निर्माण कर रहा है, और वह सामग्री के साथ अस्पष्टता से लड़ रहा है।
तीसरा एक ऐसे व्यक्ति को दिखाता है जो अपने लिए चार मशीनों पर निर्माण कर रहा है, खंड 5.4 के 36-चरण प्रवाह के साथ। वह बताता है कि छह महीने से एक साल पहले के उसके किसी भी वर्कफ़्लो को नहीं रखा जाता है, कि वह तीन महीनों में उन्हें फिर से बदलने की उम्मीद करता है, और कि वह चूकने का एक निरंतर भय महसूस करता है। टिप्पणियां इस बात पर बहस करती हैं कि कौन सा एजेंट किस शिविर से संबंधित है।
तालिका A5 (परिशिष्ट F) थ्रेड्स के विषयों को 2025 और 2026 में सॉफ्टवेयर के बाहर लोगों के बीच दृश्यमान के साथ सेट करती है। इसकी पंक्तियां चित्रणात्मक मामले हैं, नमूना नहीं।
तालिका A5 जो दिखाती है वह यह है कि कार्य आगे बढ़ता है और रूप पीछे रहता है। एक बुककीपर जो एक परिवार के मॉडल्स को दूसरे के साथ जांचना सीखता है, फिर भी इसे "समन्वय नियम" और "किसने इसकी जांच की", कहेगा, एक हार्नेस के लिए कोई शब्द नहीं होगा, और एजेंट की पसंद को पहचान का मामला नहीं मानेगा। थ्रेड्स के स्थिति संकेतक, बड़ा व्यक्तिगत बिल, शिविर और चार मशीनें, प्रत्येक पेशे की शीर्ष परत के साथ रहती हैं, जितना फ़ोटोग्राफर लेंस के बारे में बहस करते हैं और उनके ग्राहक नहीं करते।
यह क्रॉसिंग परतों में भी आती है: पहले प्रत्येक पेशे का शीर्ष दसवां हिस्सा या तो, फिर प्रशिक्षण कार्यक्रम, फिर उत्पाद जो सेटअप को अंदर छिपाता है। यह क्रम विसरण सिद्धांत है जो एजेंट्स पर लागू होता है, और इसके लिए कोई प्राथमिकता यहां दावा नहीं की जाती है; Rogers (2003) ने नवप्रवर्तकों और प्रारंभिक अपनाने वालों को लगभग छठे भाग पर रखा। OpenAI की अपनी रिपोर्ट नोट करती है कि कंपनी के बाहर "तकनीकी उपयोग प्रमुख मोड बना हुआ है" (OpenAI, 2026), और Anthropic ने पाया कि तकनीकी उपयोगकर्ता पहले आए और कम भुगतान वाले कार्यों वाले लोग बाद में आए (Anthropic, 2026f)। खंड 11 पाठ्यचर्या और पोस्ट्स को पढ़कर जांचे जा सकने वाले भविष्यवाणी के रूप में कार्यों की क्रॉसिंग को बताता है।
10. निहितार्थ
10.1 नियोक्ताओं और मानव संसाधन के लिए
एक नियोक्ता जो रिकॉर्ड के आधार पर ग्रेडिंग करता है, वह "Domain · horizon · amplification · date" से "senior" या "manager" की तुलना में अधिक सीखता है, और रिकॉर्ड कार्यों के बीच यात्रा करता है। एक नियोग परीक्षा अनुसरण करती है: उम्मीदवार को उनके अपने क्षेत्र में एक दिन का काम सौंपें, जिसे एजेंट के माध्यम से किया जाए, और इसे एक जांच द्वारा सही दिखाया जाए जिसे उम्मीदवार ने डिज़ाइन नहीं किया, कुछ रोपित त्रुटियों के साथ जिन्हें उम्मीदवार को खोजना चाहिए। Jaques की वेतन तर्क, जिसके तहत उचित वेतन जिम्मेदारी के दायरे के साथ बढ़ता है, सत्यापित क्षितिज द्वारा वेतन के लिए एक प्रारंभिक परिकल्पना देता है। क्या यह सत्य है यह एक अनुभवजन्य प्रश्न है, और अनुभाग 11 में भविष्यवाणी F18 इसे बताती है: जहां नियोक्ता सत्यापित कार्य द्वारा ग्रेडिंग करते हैं, पायदान को अनुभव के वर्षों की तुलना में वेतन और प्रदर्शन की बेहतर भविष्यवाणी करनी चाहिए।
टोकन द्वारा रैंकिंग एक अलग मामला है, और अनुभाग 4 की घटना दिखाती है कि यह कहां ले जाती है। जहां उपयोग पर बिल्कुल भी चर्चा की जाती है, यह किसी भी विधि की तरह प्रदर्शन समीक्षा में है, कई इनपुट में से एक के रूप में।
अंत में, क्या देखना है, वह है कि संगठन वास्तव में किसे नियुक्त करता है। नीति पृष्ठ से हटाई गई डिग्री आवश्यकता अपने आप में बहुत कुछ नहीं बदलती (अनुभाग 6.2)। समान सत्यापित क्षितिज पर नियुक्त किए गए लोगों में परिवर्तन वह है जो क्रॉसओवर बिंदु एक फर्म के अंदर से कैसा दिखता है।
10.2 शिक्षा और स्कूलों के लिए
स्कूलों के लिए पाठ है वाक्य रचना से पहले स्वीकृति सिखाना। जो कौशल किसी व्यक्ति को सीढ़ी पर ले जाते हैं, कहते हैं कि क्या किया जाना है, एक जांच चुनते हैं जिसे एजेंट नहीं देख सकता, और अपने क्षेत्र में एक प्रशंसनीय त्रुटि को पहचानते हैं, किसी भी अनुशासन में सिखाया जा सकता है। एक प्रमाणपत्र उतना ही मूल्यवान है जितना इसकी जांच है, इसलिए एक प्रमाणपत्र को सत्यापित क्षितिज का विवरण देना चाहिए जो यह प्रमाणित करता है, क्षेत्र और तारीख के साथ।
पाठ्यक्रम में AI साक्षरता जोड़ने वाले स्कूल OECD और European Commission ढांचे के "Manage AI" डोमेन को ठोस सामग्री दे सकते हैं: एक छोटा सा काम सौंपा गया, एक जांच पहले से निर्धारित की गई, और एक वयस्क जो अजनबियों को जारी की गई किसी भी चीज के लिए उत्तरदायी है।
10.3 विक्रेताओं और प्लेटफार्मों के लिए
विक्रेता उत्पाद को स्वीकृति छोड़ने दे सकते हैं। एक व्यक्ति को कार्य, इनपुट, जांच और स्वीकार करने का निर्णय निर्यात करने में सक्षम होना चाहिए, ताकि रिकॉर्ड किसी नियोक्ता या स्कूल तक यात्रा कर सके। उपयोग को तब उसी तरह रिपोर्ट किया जाएगा, जो आवेदन खोलने वाले लोगों के बजाय सत्यापित काम स्वीकार करने वाले लोगों की गणना करके।
एक प्लेटफार्म पहले से ही इस रास्ते पर चला गया है, विक्रेता की ओर से। जनवरी 2026 में LinkedIn ने Lovable, Replit, Descript और Relay.app द्वारा जारी सत्यापित AI कौशल दिखाना शुरू किया कि एक सदस्य वास्तव में प्रत्येक उपकरण का उपयोग कैसे करता है (LinkedIn, 2026a)। ऐसा बैज एक उपकरण का उपयोग प्रमाणित करता है, जिसे उपकरण के अपने विक्रेता द्वारा आंका जाता है उन स्तरों के विरुद्ध जो विक्रेता निर्धारित करता है; यह किसी ऐसे व्यक्ति द्वारा जांचे गए परिणाम को प्रमाणित नहीं करता है जिसे व्यक्ति ने नहीं चुना। यही प्लेटफार्म भर्तीकर्मियों को एजेंट बेचता है, अप्रैल 2026 तक $450 मिलियन वार्षिक राजस्व चलाने दर से आगामी भर्ती उत्पादों के साथ (LinkedIn, 2026b), और जुलाई 2026 में सदस्यों को पोस्ट की रिपोर्ट करने के लिए एक बटन दिया जो "AI slop जैसा लगता है" (TechCrunch, 2026c), डिटेक्टर विक्रेता Pangram के अनुमान के बाद कि साइट पर अप्रैल से जून 2026 में 41% लंबी पोस्ट पूरी तरह से उत्पन्न थीं (The Decoder, 2026)। जब किसी के काम के बारे में पाठ का उत्पादन करने का कोई खर्च नहीं है, एक प्रोफ़ाइल कम कहता है, और सत्यापित काम का एक रिकॉर्ड जो किसी भी एकल विक्रेता पर निर्भर नहीं है, अधिक कहता है।
जो प्लेटफार्म 2026 में अज्ञात के लिए अपने दरवाजे बंद कर गए, जैसा कि कई ने किया, वे वाउचिंग के माध्यम से दूसरा दरवाजा खोल सकते हैं। एक नया आने वाला जिसका काम एक ज्ञात व्यक्ति पर हस्ताक्षर करता है वह पास करता है, और वाउचर का रिकॉर्ड इसके साथ बढ़ता या सिकुड़ता है जो अगला होता है।
10.4 उन उत्पादों के लिए जो लोगों को एजेंट में शामिल करते हैं
ऑनबोर्डिंग उत्पाद आमतौर पर पहली स्क्रीन पर "शुरुआती" और "प्रोग्रामर" को अलग करते हैं। उपाय सुझाव देता है कि दोनों दरवाजों को एक प्रश्न से बदला जाए: आप एजेंट को क्या पहले से हाथ सकते हैं और जांच सकते हैं, अभी कुछ नहीं, एक घंटा, एक दिन या एक सप्ताह? जब तक दरवाजे विलय न हों, IT शिक्षा के बारे में एक बार पूछना, सहमति के साथ, पृष्ठभूमि तटस्थता को उत्पाद के अपने उपयोगकर्ताओं पर परीक्षण किया जाने दें।
10.5 शोधकर्ताओं के लिए
शोधकर्ता व्यक्ति-द्वारा-कार्य पैनल बना सकते हैं जो Chen और Meng (2026) कहते हैं कि अस्तित्व में नहीं हैं, उन लोगों के साथ लोगों की तुलना करें जो समान एजेंट का उपयोग अंधी जांच के तहत करते हैं, काम के साथ अंश की रिपोर्ट करें जो जांच में विफल हुई, और संदर्भ बैंक को जमे हुए और प्रकाशित रखें। Appendix C का साधन पहले से ही ऐसा करता है: यह ऐसे टुकड़ों की गणना नहीं करता है जिनकी जांच स्वतंत्र के रूप में दर्ज नहीं की जाती है, और यह एक तारीख के साथ दोनों अक्ष की रिपोर्ट करता है।
अनुभाग 6.5 से एक तुलना अनुसरण करती है और चलाई नहीं गई है। बैंक के समान कार्यों पर, जांच के तहत जो एजेंट ने नहीं देखी और दोनों प्रकार की रोपित त्रुटियों के साथ, गलत प्रविष्टियां और लापता वाले, यह व्यापार में अनुभव (वर्तमान या अनुपस्थित) को काम के तरीके के साथ क्रॉस करेगा (एक एजेंट जिसका आउटपुट जैसा है स्वीकार किया जाता है, या अनुभाग 6.5 की जांच प्रक्रिया)। अनुभव एक ज्ञान स्क्रीन और काम के रिकॉर्ड द्वारा स्थापित किया जाएगा, एक प्रोफ़ाइल लेबल द्वारा नहीं (अनुभाग 6.2), और जिन टुकड़ों की त्रुटियों को पूर्ववत नहीं किया जा सकता है, उन्हें एक छिपी हुई परीक्षा या योग्य मानव द्वारा जांचा जाएगा, जैसा कि अनुभाग 5.2 आवश्यक है। चूक और गलत प्रविष्टियों को अलग से स्कोर किया जाएगा: पहले से तैयार की गई सूची पहले की ओर लक्ष्य की गई है और समीक्षकों दूसरी ओर, और Appendix G2 जो सुझाव देता है उसका अंतर पहले की तरह है। तुलना दिखाएगी कि एक व्यापार का अनुभव कितना प्रक्रिया के लिए खड़ा हो सकता है, और किस पायदान पर वह रुक जाता है। उन पेशेवरों के साथ तुलना जो एजेंट के बिना काम करते हैं यहां कुछ नहीं तय करेगी, अनुभाग 11.1 में दिए गए कारण के लिए। अनुभाग 11 की भविष्यवाणियां जमे हुई हैं और इस तुलना को शामिल नहीं करती, जिसे डेटा एकत्र किए जाने से पहले अपने आप पर पंजीकृत किया जाएगा। साथी रिपॉजिटरी इसे एक प्रोटोकॉल के रूप में रखता है जिसे अनुकूल और पंजीकृत किया जाए (kits/process-vs-experience-study.md), एक उपकरण के साथ जो किसी कार्य की रोपित त्रुटियों को हाथ से पहले मुहर लगाता है और इसके बाद गलत प्रविष्टियों और चूक को अलग से स्कोर करता है (tools/planted.py), और एक विश्लेषण जो चार भुजाओं को प्रिंट करता है और, त्रुटि के प्रत्येक प्रकार को अलग करके, नए लोगों के बीच प्रक्रिया का प्रभाव, एक एजेंट के तहत अनुभव का प्रभाव और उनकी बातचीत, जो लोगों को फिर से नमूना लेते हैं (tools/process_study.py)।
11. दिनांकित पूर्वानुमान, पंजीकृत और स्कोर किए गए
11.1 पूर्वानुमान लिखने के नियम
मैंने पूर्वानुमान ऐसे नियमों के तहत लिखे जो उन्हें जांचने योग्य रखते हैं। समान की तुलना समान से की जाती है: गैर-प्रोग्रामर की तुलना प्रोग्रामर से की जाती है जो एक ही एजेंटों का उपयोग करते हैं, समान कार्यों पर, समान समय के साथ, क्योंकि प्रोग्रामर से तुलना जो AI के बिना काम करते हैं वह यहाँ कुछ नहीं सुलझाता।
"बेहतर" को तीन अर्थों में विभाजित किया गया है, प्रत्येक को अपने आप पर परीक्षण किया गया है। कोड के लिए, परीक्षण छिपे हुए परीक्षण, सुरक्षा समीक्षा, और एक महीने बाद दूसरे एजेंट द्वारा रखरखाव की जांच करने के लिए किया गया परिवर्तन हैं। किसी उत्पाद के लिए, परीक्षण यह है कि क्या यह अजनबियों तक पहुँचा और छह महीने बाद भी जीवित था। रिज्यूमे के लिए, परीक्षा पोस्टिंग में डिग्री का वजन है। लोकप्रियता को "बेहतर" के माप के रूप में नहीं माना जाता है, क्योंकि यह वितरण का परीक्षण करता है, जो एक अलग पेशा हो सकता है (अनुभाग 7.2)।
पूर्वानुमान किसी पेशे के नाम पर भी निर्भर नहीं करते। वे "एजेंटों के माध्यम से काम करने वाले IT शिक्षा के बिना लोगों" के बारे में बात करते हैं, इसलिए वे जीवित रहते हैं चाहे कोई भी नाम जीते।
11.2 पूर्वानुमान
तालिका 4 दस मुख्य पूर्वानुमान संक्षिप्त रूप में देता है; तालिका A6 (परिशिष्ट D) और साथी भंडार की फ़ाइल predictions/predictions.csv सभी 41 देता है, प्रत्येक एक माप के साथ, 2025 या 2026 से एक आधार रेखा, तीन परिणामों के लिए नियम (सच हुआ, नहीं हुआ, अनसुलझा), एक जांच तारीख और एक अंतिम तारीख, एक संभावना, एक फॉलबैक स्रोत और निकटतम पूर्व या प्रतिकूल पूर्वानुमान। एक संभावना एक पूर्वानुमानकर्ता को बहाना नहीं देता है जो गलत साबित होता है, लेकिन यह त्रुटि को स्कोर योग्य बनाता है। 35% पर किया गया एक पूर्वानुमान जो विफल हो जाता है, अपने आप में बहुत कुछ नहीं कहता। क्या 35% सही संख्या थी यह केवल सेट में दिखता है, जहाँ ऐसे पूर्वानुमानों का लगभग एक तिहाई सच होना चाहिए। Brier नियम (Brier, 1950) सेट पर सटीकता का एक समग्र स्कोर देता है, कैलिब्रेशन को जो होता है उससे अलग करने की क्षमता के साथ जोड़ता है। मुख्य पूर्वानुमान वर्तमान विचार के खिलाफ चलता है, क्योंकि नियोजन डेटा अभी भी AI कार्य के लिए डिग्री का पक्ष लेते हैं, Gartner अधिकांश vibe-कोडित अनुप्रयोगों को सेवानिवृत्त होने की उम्मीद करता है, और Andrew Ng तर्क देते हैं कि प्रोग्राम की गहरी समझ जीतती है। तालिका दूसरे तरीके से दांव लगाती है, बताई गई बाधाओं पर: अपने स्वयं के डोमेन (F3) में ओवरटेकिंग की पंजीकृत संभावना 0.35 है। यह सम मतों से नीचे बैठता है क्योंकि विक्रेता डेटा अभी भी प्रोग्रामिंग व्यवसायों को लगभग 5 अंक आगे रखते हैं (अनुभाग 2.2) और Savva (2026) कठिन कार्यों पर व्यापक अंतराल की भविष्यवाणी करता है (अनुभाग 6.1), और 0.25 से ऊपर क्योंकि समानता, पहला कदम, 0.70 पर मूल्य है; स्वतंत्र मॉडल पूर्वानुमानकर्ता 0.25 से 0.55 तक थे। चित्र 7 प्रत्येक पूर्वानुमान को इसके जांच वर्ष और इसकी संभावना पर रखता है।
पूर्वानुमान दो सेटों में विभाजित हैं। सेट A (27 पूर्वानुमान) सार्वजनिक डेटा और predictions/resolve/ में फ्रोजन प्रश्नों, सूचियों और कोडबुक से समाधान करता है, इसलिए कोई भी इसे मेरे बिना स्कोर कर सकता है। सेट B (14 पूर्वानुमान: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) एक अनुसंधान कार्यक्रम है: इसे डेटा की आवश्यकता है जो कोई सार्वजनिक स्रोत प्रकाशित नहीं करता है और केवल एक अध्ययन से समाधान करता है जो डेटा एकत्र करने से पहले अलग से पंजीकृत होता है, एक नामित मालिक, प्रोटोकॉल और शक्ति गणना के साथ। नौ सेट B पूर्वानुमानों के लिए जिनके नियम एक अंतराल पर लिखे हैं, साथी भंडार फ्रोजन आए-सच और न-किए गए नियमों को एक अध्ययन के अनुमानों पर लागू करता है और फ्रोजन शब्दों को प्रत्येक निर्णय के बगल में प्रिंट करता है (predictions/set_b.py)। एक सेट B पूर्वानुमान जिसका प्रोटोकॉल 30 जून 2027 तक पंजीकृत नहीं है, को संचालित न किए गए के रूप में दर्ज किया जाता है और प्रत्येक स्कोरकार्ड पर परीक्षण कार्यक्रम की विफलता के रूप में सूचीबद्ध किया जाता है। Brier स्कोर तब दो बार रिपोर्ट किया जाता है, केवल समाधान किए गए पूर्वानुमानों पर और प्रत्येक पूर्वानुमान के साथ जो संचालित नहीं किया गया था, मानो पूर्वानुमान गलत था, इसलिए एक अध्ययन जो कभी नहीं चलाया जाता है गणना से बाहर नहीं निकल सकता। F2, F3 और F3b के प्रयोग एक अध्ययन हैं जिनमें 1,500 लोग प्रति समूह हैं: यह लगभग 0.8 शक्ति देता है 5 अंकों के एक सच्चे लाभ का पता लगाने के लिए (दो-पक्षीय अल्फा 0.05, 50% के पास एक पास शेयर पर, सबसे प्रतिकूल केस), जहाँ 400 प्रति समूह इसे केवल 30% समय दिखाएंगे। प्रत्येक अध्ययन-आधारित पूर्वानुमान के लिए, एक अंतराल जो न तो आए-सच नियम को पूरा करता है और न ही न-किए गए नियम को अनसुलझा है, विफलता नहीं।
संभावनाओं को 9 अक्टूबर 2026 को ठीक किया गया था। प्रत्येक तीन परिवारों (Claude Opus, एक OpenAI मॉडल और Gemini) के मॉडलों के तीन अंध पूर्वानुमानों का माध्यिका है जो समान तालिका को मेरी संख्याओं को देखे बिना मूल्य दिया; मैंने इन माध्यिकाओं को अपनी संभावनाओं के रूप में अपनाया, वे OSF पर पंजीकृत हैं, और मेरे पहले के ड्राफ्ट से हर बदलाव परिवर्तन लॉग में दर्ज है। 4 परिवारों से 4 स्वतंत्र मॉडल पूर्वानुमानकर्ताओं का एक पहला दौर भी तालिका को अंध से मूल्य दिया। प्रत्येक ने एक संदर्भ वर्ग, एक पंक्ति का तर्क और एक संभावना दी, और उनका समूहित पूर्वानुमान (बाधाओं का ज्यामितीय माध्य) तालिका 4 में पंजीकृत संभावना के बगल में दिखाया गया है, CSV में प्रसार के साथ। जहाँ पंजीकृत संभावना उस दौर के माध्यिका से 0.15 से अधिक भिन्न होती है (F28 और F32) कारण परिवर्तन लॉग में दिया गया है। सभी संभावनाएँ पूर्वानुमान के समाधान की शर्त पर हैं, क्योंकि Brier स्कोर समाधान किए गए पूर्वानुमानों पर गणना की जाती है। समाधान किया गया शेयर इसके बगल में रिपोर्ट किया गया है।
तालिका 4. दस मुख्य पूर्वानुमान, सीमाएँ, अंतिम तारीखें और संभावनाएँ (सभी 41 तालिका A6 में)।
| # | पूर्वानुमान | सीमा | अंतिम तारीख | p | मॉडल | डेटा |
|---|---|---|---|---|---|---|
| F1 | विक्रेता डेटा में सत्यापित सफलता में अंतराल बंद होता है | प्रोग्रामिंग घटा अन्य व्यवसाय 2 अंक या कम (अब 34% बनाम 29%) | 31 दिसंबर 2028 | 0.35 | 0.39 (0.25 से 0.65) | सार्वजनिक |
| F2 | अपने स्वयं के डोमेन में गुणवत्ता समानता | (गैर-IT घटा प्रोग्रामर) के 95% बाउंड माइनस 10 अंक से ऊपर; 1,500 प्रति समूह | 8 अक्टूबर 2028 | 0.70 | 0.67 (0.62 से 0.70) | अपना अध्ययन |
| F3 | अपने स्वयं के डोमेन में ओवरटेकिंग (गुणवत्ता में क्रॉसओवर) | 95% बाउंड शून्य से ऊपर; समान अध्ययन | 8 अक्टूबर 2029 | 0.35 | 0.33 (0.25 से 0.55) | अपना अध्ययन |
| F5 | पोस्टिंग में क्रॉसिंग | एजेंटिक पोस्टिंग में डिग्री शेयर मिलान पोस्टिंग के नीचे 2 अंक या अधिक, 2027 की दो लगातार तिमाहियां | 31 दिसंबर 2028 | 0.30 | 0.34 (0.25 से 0.60) | सार्वजनिक |
| F7 | पृष्ठभूमि तटस्थता | IT शिक्षा के लिए अनुपात की 90% अंतराल दिन और सप्ताह पर 0.67 से 1.5 के भीतर | 31 दिसंबर 2029 | 0.42 | 0.43 (0.40 से 0.48) | अपना अध्ययन |
| F14 | दोनों अक्ष अलग रहते हैं | log horizon और log gain का Spearman 0.8 या उससे कम; gain आउट-ऑफ-सैंपल R squared में 0.02 जोड़ता है | 30 सितंबर 2028 | 0.52 | 0.49 (0.45 से 0.50) | अपना अध्ययन |
| F19 | जांच छत निर्धारित करती है | महीने 1 से 3 में जांच का हिस्सा महीने 4 से 6 में सत्यापित आउटपुट की भविष्यवाणी करने में horizon को हराता है | 30 सितंबर 2028 | 0.45 | 0.44 (0.30 से 0.65) | अपना अध्ययन |
| F26 | नियुक्ति प्रथा अनुसरण करती है | ऑडिट अध्ययन: कॉलबैक अंतर 3 अंक से कम, 95% अंतराल 5 के भीतर | 31 दिसंबर 2029 | 0.35 | 0.32 (0.25 से 0.35) | अपना अध्ययन |
| F27 | Agent-निर्मित उत्पाद पूर्वानुमान से आगे रहते हैं | 31 दिसंबर 2026 तक फ्रीज किए गए नमूने के 50% से कम 2028 के अंत तक सेवानिवृत्त हुए (Gartner: 60%) | 31 मार्च 2029 | 0.32 | 0.35 (0.20 से 0.55) | सार्वजनिक |
| F28 | मशीनें 80% पर Day तक पहुंचती हैं | METR 2027 के अंत तक 80% horizon 8 घंटे या अधिक (अप्रैल 2026 में 3.1 घंटे) | 30 जून 2028 | 0.80 | 0.66 (0.55 से 0.80) | सार्वजनिक |
नोट: p संभावना है कि पूर्वानुमान सच हो जाता है, यह देते हुए कि यह संकल्प है: 9 अक्तूबर 2026 की तीन ब्लाइंड मॉडल पूर्वानुमानों का माध्यिका, जिसे मैंने अपनाया। मॉडल: स्वतंत्र मॉडल पूर्वानुमानकर्ताओं का पूलित पूर्वानुमान जिन्होंने मेरी संख्याएं नहीं देखीं (odds की ज्यामितीय माध्य), उनकी सीमा के साथ। डेटा: सार्वजनिक का अर्थ है कि कोई भी सार्वजनिक स्रोतों से संकल्प कर सकता है (सेट A); अपना अध्ययन का अर्थ है एक अलग से पूर्वनिबंधित अध्ययन (सेट B)। सभी पूर्वानुमानों के लिए सच हुए, नहीं हुए और अनसुलझे, फॉलबैक स्रोतों और पूर्व पूर्वानुमानों के नियम तालिका A6 में और predictions/predictions.csv में हैं। अपनी अंतिम तारीख तक तुलनीय डेटा के बिना एक पूर्वानुमान अनसुलझा है और कभी भी सफलता के रूप में गिना नहीं जाता है। प्रोग्राम OSF में पंजीकृत है (Chernets, 2026e) में कोई परिकल्पना नहीं है और IT शिक्षा के बारे में नहीं पूछता है, इसलिए यह सेट B की परीक्षा नहीं कर सकता।
चित्र 7. पूर्वानुमान रजिस्टर: हर दिनांकित पूर्वानुमान अपने जांच वर्ष और कथित संभावना पर।
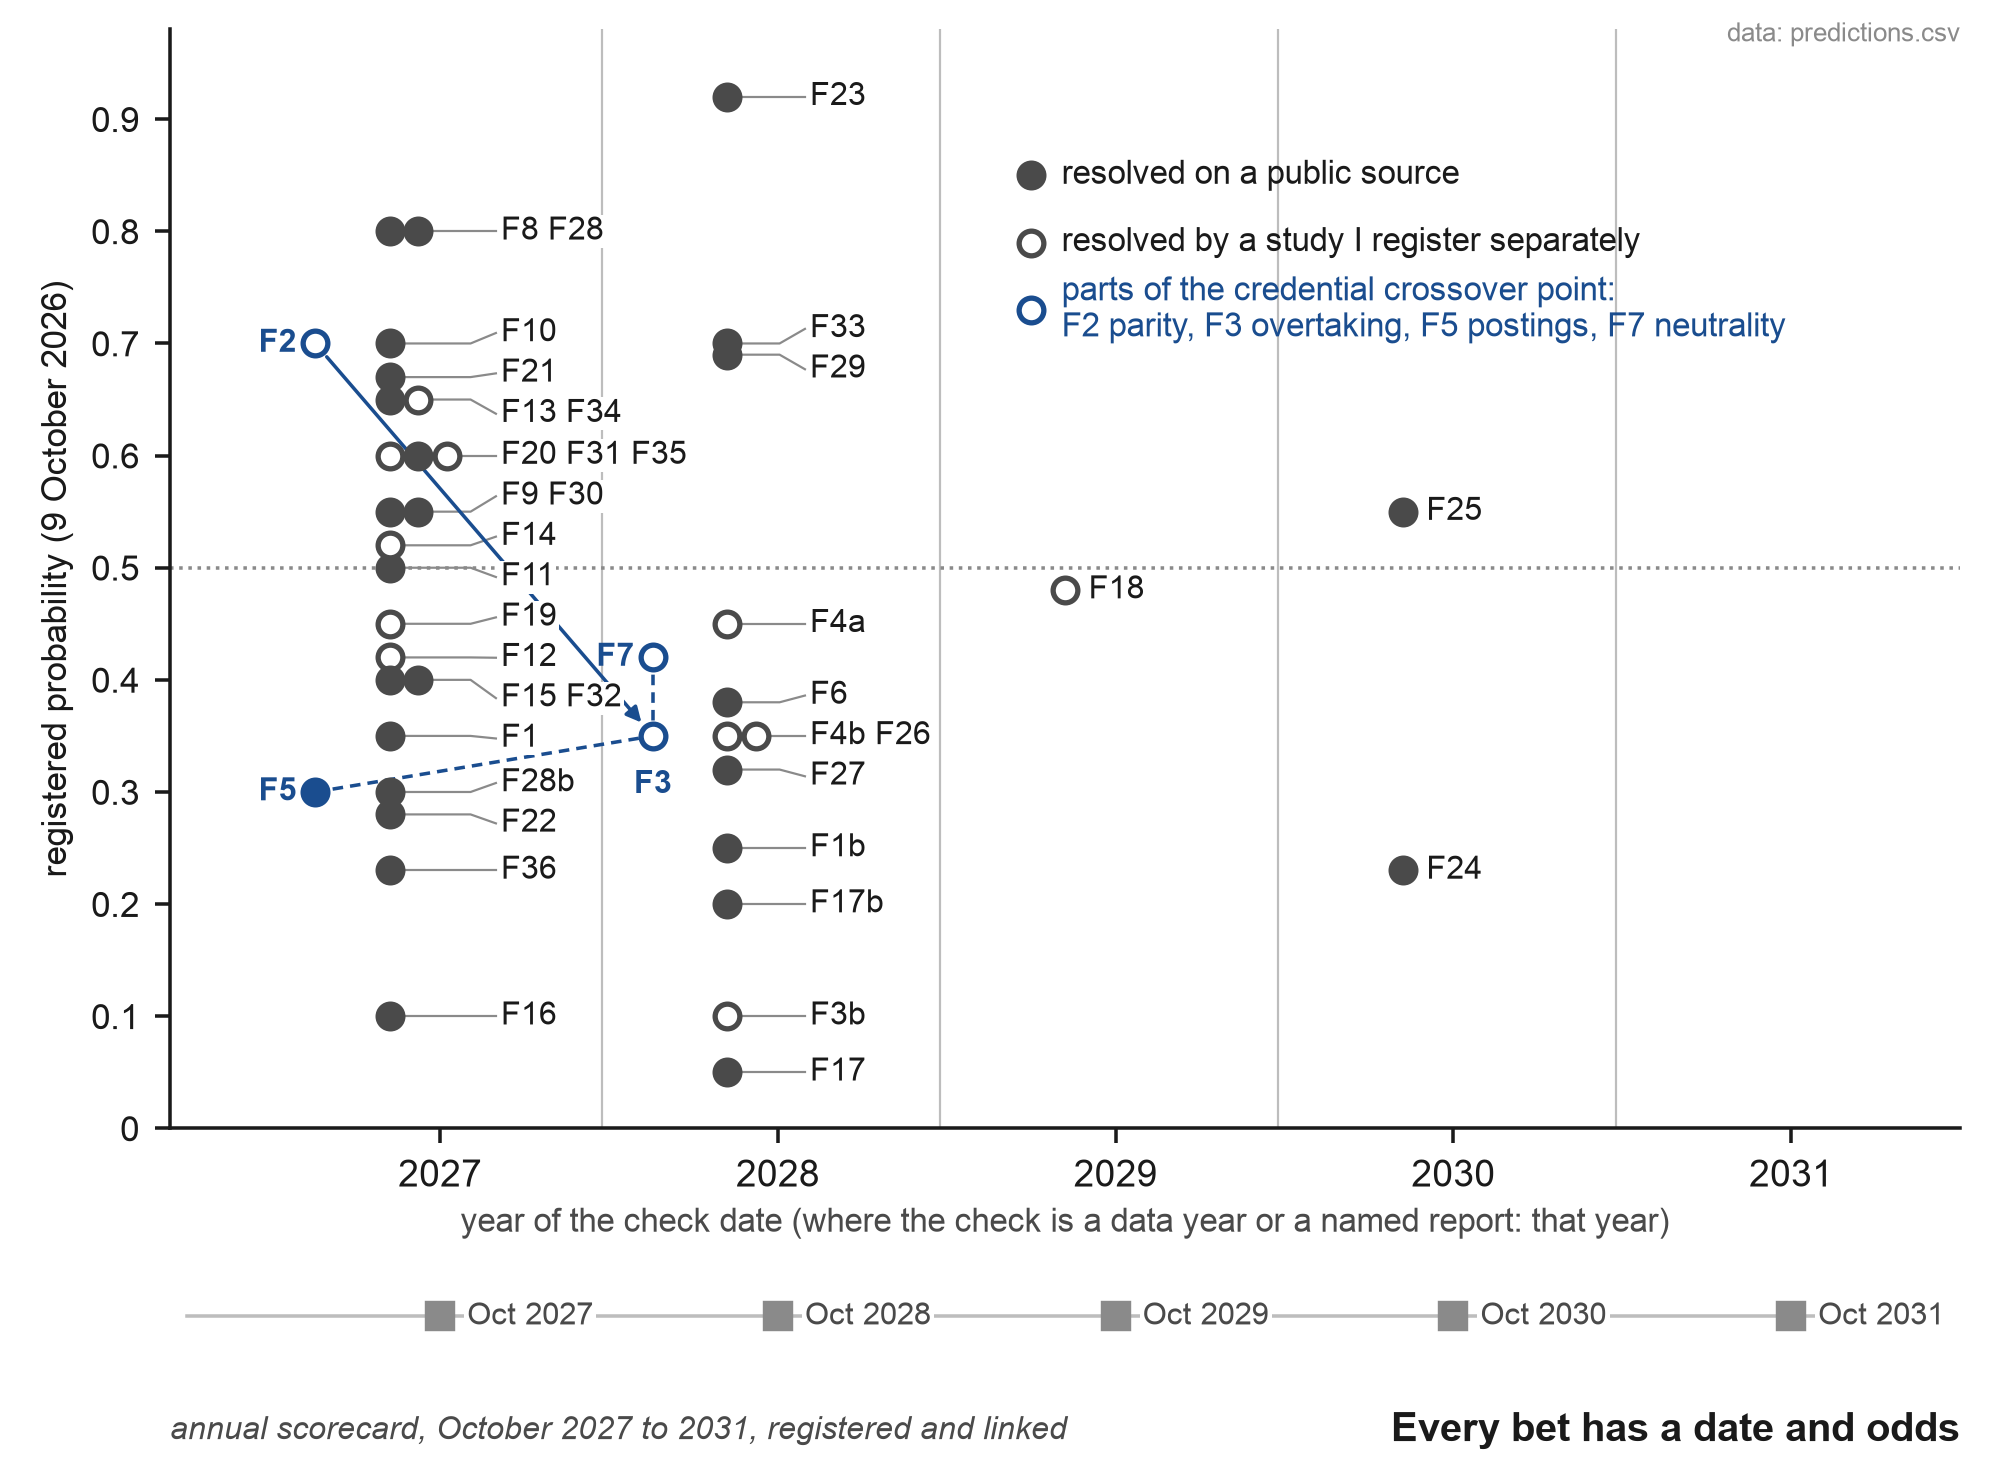
नोट: प्रत्येक मार्कर तालिका A6 के 41 पूर्वानुमानों में से एक है, जिसे इसकी जांच तारीख के वर्ष में रखा गया है (जहां जांच एक डेटा वर्ष या नामित रिपोर्ट है, वह वर्ष) और इसकी पंजीकृत संभावना पर। भरे हुए मार्कर एक सार्वजनिक स्रोत पर संकल्प करते हैं। खोखले मार्कर केवल डेटा एकत्र किए जाने से पहले अलग से पंजीकृत अध्ययन के माध्यम से संकल्प करते हैं। साख क्रॉसओवर बिंदु के चार भाग accent रंग में हैं: गुणवत्ता समानता (F2) आगे बढ़ने की ओर ले जाती है (F3)। पोस्टिंग में क्रॉसिंग (F5) इसका दृश्य संकेत है और पृष्ठभूमि तटस्थता (F7) इसका तंत्र है। केवल समानता को 0.70 से अधिक मूल्य दिया जाता है। आगे बढ़ना, यह क्षण, 0.35 पर खड़ा है। अक्ष के नीचे के वर्ग वार्षिक स्कोरकार्ड चिह्नित करते हैं, जिन्हें OSF पर पंजीकृत किया जाना है और अक्तूबर 2027 से 2031 तक DOI द्वारा जुड़ा हुआ है। संभावनाएं 9 अक्तूबर 2026 को निर्धारित की गईं और OSF पर पंजीकृत हैं।
एक वार्षिक माप पूर्वानुमानों के साथ है लेकिन स्वयं एक पूर्वानुमान नहीं है, नामों की दौड़: प्रत्येक वर्ष समान क्वेरीज गिनती देती हैं कि तालिका A2 के प्रत्येक उम्मीदवार US पोस्टिंग में और OpenAlex और Crossref में कितनी बार दिखाई देते हैं। प्रश्न जो कभी केवल एक दीर्घकालिक जांच था, क्या SOC 2028 agent-निर्देशित कार्य के लिए एक व्यवसाय को नाम देगा, अब पूर्वानुमान F23 है, संभावना के साथ (Bureau of Labor Statistics, 2026b)। 9 अक्तूबर 2026 को Bureau of Labor Statistics ने न तो SOC 2028 संरचना का प्रस्ताव और न ही अंतिम प्रकाशित किया था; अंतिम संरचना 2027 में अपेक्षित है।
11.3 पूर्व पूर्वानुमान
9 अक्तूबर 2026 को मैंने Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket और Long Bets में खोज की, साथ ही खुले वेब (कंपनी अनुसंधान पृष्ठ, विश्लेषक रिलीज़, arXiv, SSRN और समाचार) में, दिनांकित पूर्वानुमानों के लिए कि तकनीकी शिक्षा के बिना लोग, AI agents के माध्यम से काम करते हुए, प्रोग्रामर्स को मेल खाएंगे या बेहतर करेंगे जो समान agents का उपयोग करते हैं। कोई भी मिली गई एक तारीख और एक खंडन परिणाम ले जाती है। निकटतम ये हैं। Gartner ने 2021 में पूर्वानुमान किया कि 2024 तक, 80% प्रौद्योगिकी उत्पाद और सेवाएं ऐसे लोगों द्वारा निर्मित होंगी जो प्रौद्योगिकी पेशेवर नहीं हैं (Gartner, 2021)। Mark Cuban ने 2017 में कहा कि वह दर्शनशास्त्र की प्रमुख होना पसंद करेंगे, आलोचनात्मक सोच को प्रोग्रामिंग को outvalue करने की उम्मीद करते हुए (Black Enterprise, 2017)। D. H. Hansson ने 26 अगस्त 2026 के Lex Fridman Podcast पर "100%" का उत्तर दिया जब पूछा गया कि क्या समस्याएं हैं जिनके लिए प्रोग्रामर्स agentic engineering में गैर-प्रोग्रामर्स से बदतर हैं (Lex Fridman Podcast, 2026)। Anthropic ने जून 2026 में देखा कि coding agents एक coding पृष्ठभूमि को कम प्रासंगिक बना रहे हैं (Anthropic, 2026e)। विपरीत दिशा में पूर्वानुमान मौजूद हैं। Gartner 2028 तक vibe-coded applications के 60% के सेवानिवृत्त होने की उम्मीद करता है (Gartner, 2026, Tray.ai द्वारा सारांशित, 2026), और 2024 में 2026 के माध्यम से यह अपेक्षा करता था कि संगठनों के पांचवें भाग अपनी संरचना को समतल करने के लिए AI का उपयोग करेंगे (Gartner, 2024)। Srinivasan और Wei (2026) "agent manager" को 12 से 18 महीने के भीतर एक मानक शीर्षक बनने की उम्मीद करते हैं। Forrester Fortune 100 कंपनियों के 60% द्वारा एक head of AI governance नियुक्त करने की उम्मीद करता था (Forrester, 2025)। Manifold पर बाजार 2030 तक एक तिहाई कम junior developer भूमिकाएं लगभग 74% पर रखते हैं, और 2023 से 2028 तक US developers में 15% से अधिक की गिरावट लगभग 42% पर है (Manifold, 2026b; Manifold, 2026c)। Manifold पर, संभावना कि यह 2027 तक गैर-प्रोग्रामर्स के लिए AI के साथ छोटी scripts लिखना सामान्य होगा लगभग 27% पर खड़ा था (Manifold, 2026a), और वह प्रश्न केवल उपयोग के बारे में पूछता है, गुणवत्ता के किसी भी माप के साथ। यहां के पूर्वानुमान इन सभी से अलग हैं इसमें वे लोगों की तुलना लोगों से करते हैं जो समान agent का उपयोग करते हैं, शिक्षा को चर बनाते हैं, और एक तारीख, एक माप और एक खंडन परिणाम ले जाते हैं। खोज लॉग परिशिष्ट B में है। अपनाने में परतें (Rogers, 2003), machine समय horizons (Kwa et al., 2025) और यह अवलोकन कि junior भूमिकाएं सिकुड़ रही हैं पहले काम हैं, और उनके लिए कोई प्राथमिकता दावी नहीं की गई है।
11.4 Freezing और scoring
एक भविष्यवाणी कहाँ रहे ताकि कोई भी, इसका लेखक भी नहीं, चुपचाप इसे बदल सके? इस श्रृंखला जो स्थानों का उपयोग करती है, उनमें से केवल एक को फ्रीज़ करती है। एक OSF पंजीकरण को संपादित या हटाया नहीं जा सकता; इसे वापस लिया जा सकता है, लेकिन इसके शीर्षक, तारीखों, DOI और वापसी के कारण के साथ एक पृष्ठ बना रहता है (OSF, 2026)। Zenodo जमाकर्ता को प्रकाशन के 30 दिनों के बाद फ़ाइलें बदलने या हटाने देता है, और उसके बाद केवल नए संस्करण (OpenAIRE, 2025)। SSRN संशोधन पर PDF को बदलता है। इसलिए भविष्यवाणियों को पहले OSF पर पंजीकृत किया जाएगा, एक खुली-अंत वाला पंजीकरण जो तुरंत सार्वजनिक किया जाता है, कोई प्रतिबंध नहीं, क्योंकि एक प्रतिबंध रिकॉर्ड को छुपाएगा और इसके DOI को रोकेगा, और एक प्राथमिकता जिसे कोई नहीं देख सकता वह बहुत कम मूल्य की है।
9 अक्टूबर 2026 को तालिका को पूर्वपंजीकृत भविष्यवाणियों के एक सेट के रूप में OSF पर पंजीकृत किया गया था (DOI 10.17605/OSF.IO/VW6P9), और पत्र को SSRN और Zenodo पर पोस्ट किया गया था; प्रत्येक आधारभूत स्रोत के स्नैपशॉट को Wayback Machine में संग्रहीत किया गया है। 2027 से 2031 तक प्रत्येक वर्ष, पंजीकरण की वार्षिकी पर, एक स्कोरकार्ड प्रकाशित किया जाता है जो प्रत्येक भविष्यवाणी को सूचीबद्ध करता है, इसकी स्थिति (सच आई, नहीं, अभी नहीं, अनसुलझा, आयोजित नहीं) और साक्ष्य। यह समग्र रूप से, सेट के अनुसार और परिवार के अनुसार हल की गई भविष्यवाणियों पर Brier स्कोर की रिपोर्ट करता है, जहाँ जुड़ी भविष्यवाणियाँ एक बार गिनी जाती हैं, पंजीकृत तालिका के परिवार कॉलम में वर्गीकृत (F1 और F1b; F2, F3 और F3b; F4a और F4b; F5, F6 और F33; F9 और F31; F15 और F16; F17 और F17b; F28 और F28b); हल किया गया शेयर; एक सबसे बुरी सीमा जिसमें अपनी अंतिम तारीख के बाद प्रत्येक भविष्यवाणी और अभी भी अनसुलझी, और आयोजित नहीं की गई प्रत्येक भविष्यवाणी को स्कोर किया जाता है जैसे पूर्वानुमान गलत था; आयोजित नहीं की गई भविष्यवाणियों के साथ और बिना स्कोर; और तीन संदर्भों के विरुद्ध Brier कौशल स्कोर: एक सपाट 0.5, तालिका 4 के पूलित मॉडल पूर्वसूचकर्ता, और बाजार मूल्य जहाँ पंजीकरण दिन पर एक बाजार मौजूद था। चुनिंदा गैर-समाधान इसलिए स्कोर में सुधार नहीं कर सकते। स्कोरकार्ड को स्वयं OSF पर पंजीकृत किया जाता है, मूल से DOI द्वारा जुड़ा होता है, और Zenodo पर जमा किया जाता है। कम से कम दो परिवारों के मॉडल प्रत्येक स्कोरकार्ड को स्वतंत्र रूप से फ्रीज़ किए गए नियमों के विरुद्ध जाँचते हैं; जहाँ वे असहमत हैं नियम तय करता है और असहमति की रिपोर्ट की जाती है। पंजीकरण पाठ परिशिष्ट D में है, और चित्र A1 (परिशिष्ट D) जाँच और अंतिम तारीखों का पूर्ण कैलेंडर दिखाता है। स्कोरिंग शुरू होने से पहले दो प्रतिबद्धताएँ नियत हो जाती हैं। F27 के लिए एजेंट-निर्मित उत्पादों का नमूना 31 दिसंबर 2026 को Zenodo पर फ्रीज़ किया जाता है, और F5 और F30 की आधारभूतियाँ पंजीकरण से पहले गणना की जाती हैं और संग्रहीत की जाती हैं। F27 नमूने का प्रोटोकॉल, पंजीकरण छोड़ने वाले प्रत्येक विकल्प के लिए एक डिफ़ॉल्ट के साथ, और जो उपकरण इसे एक पहले से निर्धारित बीज द्वारा खींचता है और इसे सील करता है, साथी भंडार में हैं (kits/f27-sample.md, tools/freeze_sample.py)।
एक बार भविष्यवाणियों के पंजीकृत होने के बाद, सार्वजनिक लोगों को भी वहाँ पोस्ट किया जाएगा जहाँ बाहरी पूर्वसूचकर्ता उन्हें मूल्य दे सकते हैं: Manifold पर पाँच बाजार (F5, F8, F10, F11 और F22, जो पोस्ट करने के लिए मुक्त हैं; ये पाँचों इसलिए चुने गए क्योंकि प्रत्येक एक सार्वजनिक स्रोत और एक बाहरी श्रृंखला पर हल होता है जिसे कोई भी पढ़ सकता है, मेरे अपने डेटा में से कोई नहीं), Metaculus पर एक प्रश्न (पोस्टिंग में क्रॉसिंग, F5), और F2, F3 और F7 के प्रयोगों के लिए सामाजिक विज्ञान भविष्यवाणी मंच, ताकि अन्य लोगों के पूर्वानुमान डेटा मौजूद होने से पहले एकत्र किए जाएँ। परिणाम पर पैसे का व्यापार करने वाली भविष्यवाणी बाजारों का उपयोग नहीं किया जाता है।
11.5 सहकोर्ट कार्यक्रम
मैं एक पूर्वपंजीकृत सहकोर्ट कार्यक्रम चलाता हूँ (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ) जो गैर-प्रोग्रामर को चैट से एजेंटों तक ऑर्केस्ट्रेशन तक अनुसरण करता है (Chernets, 2026e)। इसका पहला सहकोर्ट एक एकल-बाह व्यवहार्यता अध्ययन है जिसके अपने पंजीकृत परिणाम हैं, जो इसकी अपनी रिपोर्ट में रिपोर्ट किए जाते हैं। F7, F14 और F18 से F20 जैसी भविष्यवाणियाँ, जिन्हें व्यक्ति-स्तर के डेटा की आवश्यकता है, डेटा एकत्र किए जाने से पहले उनके लिए पंजीकृत एक बाद के सहकोर्ट में परीक्षण किए जाते हैं, जिसमें इसके फ्रीज़ किए गए आइटमों में IT शिक्षा के बारे में एक प्रश्न है। परिशिष्ट C के रिकॉर्ड, सहमति के साथ रखे गए, वह सहकोर्ट के लिए प्राकृतिक डेटा हैं।
12. वह साक्ष्य जिसके विरुद्ध भविष्यवाणियाँ दाँव लगाती हैं
अनुभाग 11 की भविष्यवाणियाँ 2026 से साक्ष्य की कई किस्मों के विरुद्ध चलती हैं, और उनमें से प्रत्येक ने माप के नियम या भविष्यवाणी को आकार दिया।
सुरक्षा गति के साथ नहीं रही है। सौ से अधिक मॉडलों में, Veracode की 2026 रिपोर्ट में उत्पन्न कोड का वह हिस्सा जो सुरक्षा परीक्षण में सफल रहा, 56% पर रहा (Veracode, 2026)। वे परीक्षण केवल मॉडलों पर, मानक प्रॉम्प्ट्स के बिना सुरक्षा निर्देशों के बिना, और एजेंटिक हार्नेस, टूल्स या मानव समीक्षा के बिना चलाए गए, इसलिए वे कच्चे माल का वर्णन करते हैं जिससे कोई व्यक्ति शुरुआत करता है। vibe coding द्वारा निर्मित 5,600 सार्वजनिक अनुप्रयोगों की एक निष्क्रिय स्कैन में 2,000 से अधिक असुरक्षाएँ, 400 से अधिक उजागर गुप्त और व्यक्तिगत डेटा की 175 उजागरियाँ मिलीं, और इसके लेखक इन्हें एक निचली सीमा के रूप में प्रस्तुत करते हैं (Escape, 2026)। यही कारण है कि F2 में एक अंधी सुरक्षा समीक्षा शामिल है, और यही कारण है कि अपरिवर्तनीय कार्य को प्रत्येक भाग को पास करने की आवश्यकता है (अनुभाग 5.2)।
परीक्षण पास करना स्वीकृति से कम है। METR ने रखरखाव करने वालों को एजेंट-लिखित सुधारों की समीक्षा करने के लिए कहा जो एक बेंचमार्क के परीक्षणों को पास कर गए थे और पाया कि लगभग आधे को उनके जैसे विलय नहीं किया जाता; एजेंट्स एक पहले की पीढ़ी के थे समीक्षा लूप के बिना, इसलिए हिस्सा अब कम हो सकता है (METR, 2026b)। स्कोरिंग नियम छिपे हुए परीक्षणों, योग्य समीक्षकों और वास्तविक उपयोग के साथ उत्तर देता है, और F2 एक महीने बाद एक रखरखाव परिवर्तन जोड़ता है।
सत्यापन अनुभव पर निर्भर करता है। vibe coding द्वारा बनाने वाले 162 लोगों के एक सर्वेक्षण में, हर समूह ने उत्पन्न कोड के जोखिमों को मान्यता दी, लेकिन उन्होंने इसे कैसे जाँचा यह अनुभव के साथ भिन्न था। लेखक इसे एक धारणा-कार्य अंतराल कहते हैं (Fawzy et al., 2026)। व्यावसायिक उपयोगकर्ता और शुरुआती तेजी से काम करने वाले प्रोटोटाइप बनाते हैं, जबकि कोड की गुणवत्ता असमान है और पुनः काम अनुसरण करता है (Gama et al., 2026)। व्यावसायिक उपयोगकर्ताओं ने एक AI के विश्लेषण में भौतिक त्रुटियों को चेतावनी के बाद भी याद किया (Virk & Liu, 2025)। 52 कनिष्ठ इंजीनियरों का एक यादृच्छिकृत अध्ययन जो एक नई लाइब्रेरी सीख रहे थे, AI के साथ 50% की समझ स्कोर और बिना 67% पाई गई, और गति में कोई महत्वपूर्ण लाभ नहीं। जिन्होंने मॉडल से स्पष्टीकरण माँगे वे 65% या अधिक स्कोर किए, और जिन्होंने सभी कोड को सौंप दिया वे 40% से कम स्कोर किए (Anthropic, 2026c)। यह सबसे मजबूत कारण है कि माप स्वीकृति साक्षरता और रोपित त्रुटियों पर निर्भर करता है: कौशल जो लोगों को अलग करता है वह है जो ये अध्ययन भिन्न दिखाते हैं।
कोई भी प्रकाशित तुलना गैर-प्रोग्रामर को प्रोग्रामर के विरुद्ध सेट नहीं करती जो समान एजेंट्स का उपयोग करते हैं। Esnaola et al. (2026) को पाया कि ChatGPT के माध्यम से GPT-4o का उपयोग करने वाले कुछ गैर-प्रोग्रामर छोटी, अच्छी तरह से निर्दिष्ट प्रोग्रामिंग समस्याओं को एक स्तर पर हल करते हैं जो प्रोग्रामर के बिना AI के काम करने के समान है, और तेजी से; लेखक अध्ययन को अन्वेषणात्मक कहते हैं। प्रोग्रामर बिना AI के काम करते थे, इसलिए डिजाइन में कोई प्रोग्रामर-AI के साथ आर्म नहीं था, और इसने छोटे व्यक्तिगत कार्यों का अध्ययन किया, निरंतर विकास नहीं; एक प्रतिकृति पैकेज सार्वजनिक है (Esnaola et al., 2026)। Anthropic के डेटा में, जो लोग एक कार्य के लिए नए थे उनका सत्यापित सफलता दर 15% था अधिक अनुभवी उपयोगकर्ताओं के लिए 28% से 33% के विरुद्ध (Anthropic, 2026e)। वहाँ, "शुरुआती" का मतलब कार्य के लिए एक शुरुआती है, जैसा कि एक मॉडल द्वारा न्याय किया जाता है, और IT शिक्षा के बारे में कुछ नहीं कहता है। वह अंतर शिक्षा को प्रतिबिंबित करता है या कार्य से परिचितता यह है कि F7 को अलग करने के लिए लिखा गया है। पहले भी, एक ग्राहक-सहायता फर्म में उत्पादक AI ने शुरुआती और कम-कुशल एजेंटों की उत्पादकता में वृद्धि की और सबसे अनुभवी की थोड़ी (Brynjolfsson et al., 2025), एजेंटों से पहले का एक पूर्ववर्ती। 2024 में Procter & Gamble में चैट मॉडलों के साथ एक क्षेत्र प्रयोग ने पाया कि AI वाले व्यक्तियों ने इसके बिना टीमों का मिलान किया और उनके व्यावसायिक पृष्ठभूमि की परवाह किए बिना संतुलित कार्य का उत्पादन किया, एजेंटों से पहले का एक पूर्ववर्ती (Dell'Acqua et al., 2025)। F2, F3 और F7 को लापता तुलना की आपूर्ति के लिए डिजाइन किया गया है।
सम्मानित आवाजें मजबूत संस्करण से असहमत हैं। Karpathy एक मंजिल और एक छत रखते हैं (अनुभाग 2.1)। Andrew Ng ने अगस्त 2026 में तर्क दिया कि जो डेवलपर्स गहराई से समझते हैं कि प्रोग्राम कैसे काम करते हैं वे उन लोगों को बहुत अधिक बेहतर प्रदर्शन करते हैं जो समझ के बिना vibe code करते हैं (Ng, 2026)। नियोजन डेटा अभी के लिए उसी तरह इंगित करता है: पद जो AI कौशल की आवश्यकता करते हैं वे तुलनीय पदों की तुलना में अधिक संभावना से एक चार वर्षीय डिग्री की आवश्यकता करते हैं जो नहीं करते (Lightcast, 2026b), और LinkedIn प्रवेश-स्तर की नियोजन में बहुत कमजोरी को अर्थव्यवस्था को जिम्मेदार ठहराता है (अनुभाग 2.4)। भविष्यवाणियाँ इन विचारों को अपने प्रतिपक्षी के रूप में लेती हैं, अग्रिम रूप से बताए गए बाधाओं के साथ।
13. गुंजाइश और सीमा शर्तें
समय। साक्ष्य 9 अक्टूबर 2026 तक चलता है। उत्पाद के तथ्य जल्दी पुरानी हो जाते हैं, इसलिए उपाय संदर्भ घंटे और जांच में परिभाषित किया गया है, कोई उत्पाद नाम नहीं दिया गया।
स्रोत। सबसे मजबूत साक्ष्य का अधिकांश हिस्सा अपने स्वयं के उत्पादों के बारे में विक्रेताओं से आता है: OpenAI अपने कोडिंग एजेंट पर, Anthropic अपने सत्रों पर। ये विक्रेता डेटा के रूप में चिह्नित हैं और उपयोग किए जाते हैं जो विक्रेता जान सकते हैं। कई प्रेस-रिपोर्ट किए गए एपिसोड, जैसे टोकन रैंकिंग, नामित आउटलेट द्वारा रिपोर्ट पर आधारित हैं और इस तरह उद्धृत हैं। माध्यमिक स्रोत (Growthy, Startup Fortune, Shopifreaks) को पोस्ट करने से पहले Wayback Machine में संग्रहीत किया जाता है, और प्राथमिक रिपोर्ट का हवाला दिया जाता है जहाँ इसे प्राप्त किया जा सकता था।
जनसंख्या। यह तर्क कंप्यूटर पर किए गए कार्य, एजेंटों के माध्यम से, उन लोगों द्वारा किए गए कार्य से संबंधित है जो इसकी जांच कर सकते हैं। जिन लोगों के पास कंप्यूटर नहीं है जिसे वे नियंत्रित करते हैं, और जो कार्य बिल्कुल भी जांचा नहीं जा सकता, वह उपाय के बाहर आता है।
उपाय क्या दावा करता है। एक सत्यापित क्षितिज उस चीज का वर्णन करता है जो एक व्यक्ति ने एक जांच व्यवस्था के तहत, एक डोमेन में, एक तारीख पर प्रदान की। यह दावा नहीं करता कि हर कार्य के लिए अधिक बेहतर है। अधिकांश कार्य Hour पर आता है, और कार्य को हाथ से रखने का चुनाव एक वैध निर्णय है। उन डोमेन में जहां एक गलती को पूर्ववत नहीं किया जा सकता, खंड 5.2 की सख्त सीमा लागू होती है, और कुछ कार्य को बिल्कुल भी एजेंटों को नहीं सौंपा जाना चाहिए।
नाम। खंड 3 का नक्शा 8 और 9 अक्टूबर 2026 को पाए गए उपयोग को दर्ज करता है। नाम उसके बाद अपनाए और त्यागे जाएंगे, यही कारण है कि नक्शा नामों की वार्षिक दौड़ के साथ युग्मित है और कोई एक नाम नहीं चुना गया है।
मजबूत थीसिस। कि जिन लोगों को तकनीकी शिक्षा नहीं है वे प्रोग्रामर की तुलना में बेहतर उत्पाद बनाएंगे, यह तारीखों और सीमा वाली भविष्यवाणियों के रूप में कहा जाता है (F2 से F7)। मैं इसे एक पूर्वानुमान के रूप में प्रस्तुत करता हूँ, जिसे सार्वजनिक रूप से स्कोर किया जाना है।
कानून द्वारा आरक्षित कार्य। जहां कानून एक कार्य को लाइसेंस के लिए आरक्षित करता है, न तो उपाय और न ही लेबल गेट के वजन का नुकसान (खंड 6.2 और 6.5) उस कार्य को बदलता है। यूनाइटेड किंगडम में कोई भी व्यक्ति वैधानिक लेखा परीक्षक के रूप में कार्य नहीं कर सकता जो नियुक्ति के लिए पात्र नहीं है, जिसमें एक मान्यता प्राप्त पर्यवेक्षी निकाय की सदस्यता और इसके नियमों के तहत पात्रता है (Companies Act 2006, ss. 1212 और 1213), और संयुक्त राज्य अमेरिका में केवल Public Company Accounting Oversight Board के साथ पंजीकृत एक फर्म एक जारीकर्ता पर एक लेखा परीक्षा रिपोर्ट तैयार या जारी कर सकता है (Sarbanes-Oxley Act of 2002, s. 102)। बहीखातों में ऐसे आरक्षण संकीर्ण हैं: संयुक्त राज्य अमेरिका में एक बहीखाता क्लर्क को आमतौर पर एक प्रमाणन भी रखने की आवश्यकता नहीं है (Bureau of Labor Statistics, 2026c)। कानून में वे व्यापक हैं: इंग्लैंड और वेल्स छह कानूनी गतिविधियों को आरक्षित करते हैं, जिनमें मुकदमे की कार्यवाही और प्रोबेट गतिविधियां हैं (Legal Services Act 2007, s. 12)। कार्य इसलिए हस्ताक्षर रहते हुए आगे बढ़ सकता है, और लाइसेंसप्राप्त हस्ताक्षरकर्ता तब खंड 7.2 के गारंटर के कार्य को एक ऐसे रूप में करता है जिसे कानून पहले से ही मूल्य देता है। एक लाइसेंस स्वयं एक लेबल द्वारा या जांचे गए कार्य द्वारा कितना मानता है, इस पर खंड 6.2 में चर्चा की गई है।
एजेंट-पूर्व डेटा। 2025 से पहले की श्रृंखला केवल पूर्ववर्तियों के रूप में प्रवेश करती है, क्योंकि वे एजेंटों के बिना कार्य का वर्णन करती हैं। नियुक्ति का व्यापक अर्थशास्त्र 2026 LinkedIn डेटा द्वारा किया जाता है (खंड 2.4), जो अर्थव्यवस्था की ओर अधिक इशारा करते हैं AI की तुलना में।
दावों की स्थिति। तालिका A7 (Appendix F) प्रत्येक तत्व पर श्रृंखला की आत्मविश्वास की भाषा लागू करती है।
14. निष्कर्ष
एक बहीखाता जो कोडिंग एजेंटों की तुलना कर रहा है और एक वकील जो अपना स्वयं का अनुबंध जाँचक बना रही है, अब उसी तरह काम करती हैं जैसे एक डेवलपर करती है जब वह एक मॉड्यूल को एजेंट को सौंपती है और परिणाम की जाँच करती है। 2026 तक तीनों एक ही कार्यप्रवाह साझा करते हैं, और न तो पुनरायु में से कोई यह कह सकता है कि उनमें से कौन आगे है। एक शीर्षक इसे सुलझा नहीं सकता, क्योंकि 2026 में प्रस्तावित हर शीर्षक या तो एक नारा है या किसी का नौकरी विज्ञापन है, और बाजार ने उनमें से किसी को नहीं चुना है। एक माप इसे सुलझा सकता है, बशर्ते वह सही चीज़ की गणना करे।
यहाँ प्रस्तावित माप पेशे का नाम दिए जाने की प्रतीक्षा नहीं करता। यह बहीखाता, वकील और डेवलपर को एक पैमाने पर पढ़ता है, उस कार्य का आकार जो प्रत्येक ने एजेंटों को सौंपा और जाँचा, एक डोमेन और एक तारीख में, दूसरी धुरी के साथ यह कि उनके अपने ध्यान का एक घंटा कितना सत्यापित कार्य खरीदता है। इसकी सीमाएँ संस्करणित हैं और डेस्क-परीक्षित हैं, और डेस्क परीक्षण ने पहले से ही उनमें से एक को सुधार दिया है; इसके नियम उन तरीकों का नाम देते हैं जिनसे रिकॉर्ड को गेम किया जा सकता है और प्रत्येक के लिए एक रक्षा, और इसकी छत बताती है कि जाँच की कीमत सीमा निर्धारित करती है चाहे एजेंट की गति कुछ भी हो। एक नियोक्ता, एक स्कूल या एक प्लेटफॉर्म के लिए प्रश्न बदल जाता है। इसके बजाय पूछने के कि क्या कोई व्यक्ति एक प्रोग्रामर है, या उन्होंने कितना AI उपयोग किया, वे किसी के अपने क्षेत्र में एक दिन के काम के लिए पूछते हैं जो एक जाँच को पारित करता है जिसे व्यक्ति ने डिज़ाइन नहीं किया। कोई भी नाम जो बाजार चुनता है उसे उस पैमाने पर पढ़ा जा सकता है।
तारीख वाली भविष्यवाणियाँ उस थीसिस को ले जाती हैं जिससे यह पत्र शुरू हुआ। डोमेन दर डोमेन, उन लोगों द्वारा बनाए गए उत्पाद जिनके पास IT शिक्षा नहीं है, उन प्रोग्रामर्स को पार करना शुरू कर देंगे जो समान एजेंटों का उपयोग करते हैं। समान सत्यापित क्षितिज पर, एक प्रोग्रामिंग शिक्षा जाँचे गए काम की गुणवत्ता की भविष्यवाणी करना बंद कर देगी। और नौकरी के विज्ञापनों में, डिग्री आवश्यकताओं की पंक्तियाँ पार करेंगी, पहले उन डोमेन में जहाँ विशेषज्ञ स्वयं काम को स्वीकार कर सकते हैं और आखिरी में सॉफ़्टवेयर में। यदि 2027 और 2028 के स्कोरकार्ड इन पूर्वानुमानों के विरुद्ध जाते हैं, तो वे सार्वजनिक रूप से Brier स्कोर के साथ ऐसा कहेंगे। यदि पूर्वानुमान सही साबित होते हैं, तो जूनियर और सीनियर शब्द जीवित रह सकते हैं, अपने अर्थ को उस काम के आकार की ओर स्थानांतरित करते हुए जिसे कोई व्यक्ति साबित कर सकता है; क्या बड़े नियोक्ता अपनी ग्रेड सीढ़ियों को ऐसे माप से बदलते हैं यह स्वयं यहाँ एक भविष्यवाणी है (F17), p = 0.05 पर पंजीकृत।
एक सीमा जो कुछ भी होता है इन भविष्यवाणियों के बावजूद बनी रहेगी। निर्माण एक साक्षरता बन रहा है, लेखन की तरह। जो निर्मित है उसके लिए उत्तरदायी होना एक पेशा बना रहता है, और दोनों के बीच खड़ी है अस्पष्टता, 2026 के बाजार की स्थिति, जिसमें अच्छा काम अदृश्य रहता है और प्लेटफॉर्म अज्ञात लोगों के लिए अपने दरवाज़े बंद कर देते हैं। जो व्यक्ति एजेंटों के माध्यम से निर्माण करता है उसे एक साझेदार की आवश्यकता होगी जो काम के लिए हस्ताक्षर करता है, या उसे वह साझेदार बनना होगा, और गारंटीकर्ता बदले में उस काम से मापा जा सकता है जिसके लिए उन्होंने वकालत की और उसमें से कितना खड़ा रहा।
एक अमेरिकी कहावत है कि भगवान ने आदमियों को बनाया और कर्नल कोल्ट ने उन्हें बराबर बना दिया। एजेंट निर्माण के लिए कुछ समान करते हैं: एक के साथ, एक व्यापार के बाहर का व्यक्ति ऐसा काम उत्पन्न कर सकता है जो व्यापार जैसा दिखता है। जाँच को बराबर करना कठिन है (अनुभाग 5.2 और 12)। परिशिष्ट G के रेटर अध्ययन में, बहीखाता नमूने में स्वीकार किए गए लगभग पाँच में से एक लोगों ने व्यापार के पहले सप्ताह के प्रश्न का गलत उत्तर दिया, और एक अन्वेषक तुलना में उन्होंने बड़े कार्यों को बाकी लोगों की तुलना में कम घंटों पर दर दिया (परिशिष्ट G2)। क्या स्वतंत्र जाँच की एक प्रक्रिया जाँच के लिए वह कर सकती है जो एजेंटों ने निर्माण के लिए किया, यह अनुभाग 6.5 का खुला प्रश्न है। जो अभी भी लोगों को अलग करता है वह यह है कि वे क्या जाँच और स्वीकार कर सकते हैं, और यही वह है जो सत्यापित प्रतिनिधिमंडल क्षितिज मापता है।
घोषणाएँ
वित्त पोषण। इस कार्य को किसी बाहरी वित्त पोषण ने समर्थन नहीं दिया।
प्रतिस्पर्धी हित। लेखक बहु-मॉडल ऑर्केस्ट्रेशन विधियाँ विकसित करता है और संबंधित पेटेंट आवेदन दाखिल किए हैं (लंबित; कोई पेटेंट दी नहीं गई है)। लेखक ने खंड 11.5 और परिशिष्ट G में वर्णित पूर्व-पंजीकृत कोहोर्ट कार्यक्रम और इसकी सामग्री को डिज़ाइन किया है और एक शिक्षण अनुप्रयोग विकसित करता है जो लोगों को AI एजेंटों के साथ काम करने में मदद करता है। इस पत्र में कोई निष्कर्ष लेखक के कार्यान्वयन पर निर्भर नहीं है; परिशिष्ट C में उपकरण केवल Python मानक पुस्तकालय का उपयोग करता है।
उपकरण और सत्यापन। AI सहायकों का उपयोग लेखक के निर्देशन के तहत उपकरण के रूप में किया गया; विचार, अनुसंधान और निष्कर्ष लेखक के हैं। मात्रात्मक दावों और उद्धरणों की प्राथमिक स्रोतों या अभिलेखीय प्रतियों के विरुद्ध 9 अक्तूबर 2026 को, या 10 अक्तूबर 2026 को उस दिन जोड़े गए स्रोतों के लिए जाँच की गई, जहाँ उन्हें प्राप्त किया जा सके। जहाँ केवल एक प्रेस रिपोर्ट या विक्रेता का पृष्ठ उपलब्ध था, दावे को पाठ में उस रिपोर्ट या विक्रेता को निरूपित किया जाता है। संदर्भों में वर्ग कोष्ठक में दिए गए शीर्षक उन पृष्ठों के लिए वर्णनात्मक शीर्षक हैं जिनकी सुर्खी शब्दशः पुनः पढ़ी नहीं गई थी।
डेटा और कोड उपलब्धता। परिशिष्ट C के कोड और स्कीमा, सीमा की डेस्क परीक्षा (परिशिष्ट E) और भविष्यवाणी फाइलें MIT लाइसेंस के तहत एक साथी भंडार में जारी की जाती हैं (https://github.com/vadimchernets/delegation-horizon), Zenodo पर रिलीज़ v1.1.0 के रूप में संग्रहीत (अवधारणा DOI 10.5281/zenodo.23267444, जो नवीनतम रिलीज़ को हल करता है); परिशिष्ट C में मुद्रित कोड भंडार के समान है, बाइट दर बाइट, और tools/paper_sync.py इसकी जाँच करता है, कार्यशील उदाहरण और तालिकाएँ 4 और A6 को भंडार के विरुद्ध जब भी इसके परीक्षण इस पाठ के साथ चलते हैं। तालिकाओं 4 और A6 की भविष्यवाणियाँ 9 अक्तूबर 2026 को OSF पर पंजीकृत की गईं (DOI 10.17605/OSF.IO/VW6P9)। परिशिष्ट G की Prolific रेटर अध्ययन 9 अक्तूबर 2026 को OSF पर पंजीकृत की गई थी, किसी भी डेटा एकत्र किए जाने से पहले (DOI 10.17605/OSF.IO/V92R8); इसकी विश्लेषण स्क्रिप्ट (pilot/human_raters.py) उस पंजीकरण के साथ दाखिल की गई है और साथी भंडार में फाइल किए गए के रूप में है, OSF द्वारा प्रत्येक फाइल की गई फाइल के लिए रिपोर्ट की गई SHA-256 के साथ pilot/registered-SHA256.txt में सूचीबद्ध है, साथ ही Prolific निर्यात को परिवर्तित करने, तालिका G2 मुद्रित करने और G2 की तुलना चलाने के लिए स्क्रिप्ट के साथ जो पंजीकृत नहीं था। गुमनाम डेटा, Prolific पहचानकर्ताओं को सादे लेबल से बदलकर, एक ही फ़ोल्डर में जोड़ा जाएगा। भविष्यवाणियों के साथ पंजीकृत फाइलें predictions/registered-SHA256.txt में अपने SHA-256 के साथ सूचीबद्ध हैं, OSF पर दाखिल की गई सूची, और भंडार की परीक्षा उनमें से हर एक की तुलना इसके साथ करती है।
नैतिकता। परिशिष्ट G लोगों से डेटा के दो स्रोतों की रिपोर्ट करता है। Prolific रेटर अध्ययन एक गुमनाम ऑनलाइन रेटिंग कार्य है: वयस्क पेशेवरों ने Prolific पर भाग लेने से पहले सूचित सहमति दी, प्लेटफॉर्म के माध्यम से भुगतान किया गया, और कोई नाम या संपर्क विवरण नहीं दिए। कोहोर्ट खाता रिकॉर्ड को सारांशित करता है, नामों, स्थानों या भाषाओं के बिना, उन वयस्कों के जिन्होंने पूर्व-पंजीकृत कोहोर्ट कार्यक्रम (OSF, DOI 10.17605/OSF.IO/X4EGQ) और गुमनाम प्रकाशन के लिए सहमति दी थी; कार्यक्रम के पंजीकृत परिणाम अलग से रिपोर्ट किए जाते हैं। कार्य एक स्वतंत्र शोधकर्ता द्वारा किया गया था जिसके पास कोई संस्थागत नैतिकता समिति नहीं थी। खंड 9 में चर्चा किए गए सार्वजनिक धागे रूपांतरित किए गए हैं, और उनके लेखकों के नाम नहीं दिए गए हैं।
लेखक योगदान। एकमात्र लेखक।
पत्राचार। [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
परिशिष्ट A. शब्दकोश
संदर्भ घंटा। एक योग्य विशेषज्ञ को किसी काम को हाथ से करने के लिए आवश्यक समय, जो एक जमी हुई कार्य बैंक से या दो स्वतंत्र रेटर्स से लिया जाता है जो नहीं जानते कि किसने काम किया।
सत्यापित प्रत्यायोजन क्षितिज। संदर्भ घंटों में काम का सबसे बड़ा आकार, जिसमें एक व्यक्ति नियमित रूप से काम को एजेंटों को सौंपता है, इसे स्वीकार करता है, और इसे एक स्वतंत्र जांच द्वारा पुष्टि करवाता है जो एजेंटों ने नहीं देखी। प्रत्येक डोमेन में अनुभाग 5.2 के नियम द्वारा स्कोर किया जाता है।
स्वतंत्र जांच। छिपे हुए स्वीकृति परीक्षण, एक योग्य मानव समीक्षक, इच्छित उपयोगकर्ताओं द्वारा वास्तविक उपयोग, या एक अन्य परिवार का मॉडल स्रोतों के विरुद्ध सत्यापन, जो एजेंटों से डेटा, पहुंच और प्रोत्साहन में भिन्न है। आत्म-समीक्षा और एक परिवार के मॉडलों के बीच समझौता स्वतंत्र जांच नहीं हैं।
रोपित त्रुटि। एक त्रुटि जो हस्तांतरण से पहले एक कार्य में रखी जाती है, जिसे व्यक्ति को पकड़ना चाहिए, या तो एक गलत प्रविष्टि या किसी ऐसी चीज़ की चूक जो काम को शामिल करना चाहिए। एक टुकड़ा जिसमें रोपित त्रुटि मिस हो गई है, सत्यापित के रूप में नहीं गिनती है, और किसी रंग की विंडो में कोई भी मिस सप्ताह के ऊपर की रंगों को अवरुद्ध करता है।
प्रवर्धन लाभ। स्वीकृत, सत्यापित काम के संदर्भ घंटे पिछले 91 दिनों में व्यक्ति के ध्यान के घंटों से विभाजित, विफल काम को भाजक में शामिल किया गया और बाहरी सहायता के साथ किया गया काम अंश से बाहर रखा गया।
लाभ की छत। एक सरलीकृत मॉडल में, H संदर्भ घंटों के एक टुकड़े के लिए प्रवर्धन लाभ G जिसकी जांच V घंटों का ध्यान लेती है, G ≤ H / V को संतुष्ट करता है, अर्थात्, जांच में हाथ से समय का हिस्सा।
रंग। घंटा (लगभग 1 संदर्भ घंटा), दिन (लगभग 8), सप्ताह (लगभग 40), महीना (लगभग 160), त्रैमासिक (लगभग 500)। नियम v1.1 की गिनती और खिड़कियां: घंटे और दिन के लिए 91 दिनों में दस टुकड़े, सप्ताह के लिए 182 दिनों में छह, महीने के लिए 365 दिनों में छह (उनमें से पांच सत्यापित), त्रैमासिक के लिए 365 दिनों में तीन। सप्ताह और उससे ऊपर के लिए, पिछले 91 दिनों में रंग के आकार का कम से कम एक सत्यापित टुकड़ा।
रिकॉर्ड। डोमेन · क्षितिज · प्रवर्धन · तारीख, उदाहरण के लिए "small-business bookkeeping · दिन · ×2 · 2026-Q4"।
स्वीकृति साक्षरता। पहले से बताने का कौशल कि क्या किया जाना माना जाएगा और फिर इसे ऐसे साक्ष्य के साथ दिखाना जो एक एजेंट नहीं बना सकता।
पृष्ठभूमि तटस्थता। परिकल्पना कि, एक डोमेन में समान सत्यापित क्षितिज पर, प्रोग्रामिंग शिक्षा एक बार डोमेन आदेश और स्वीकृति साक्षरता पर विचार करने के बाद स्वतंत्र रूप से जांचे गए काम की गुणवत्ता की भविष्यवाणी नहीं करती है।
क्रेडेंशियल क्रॉसओवर बिंदु। एक डोमेन में वह क्षण, जब आईटी शिक्षा के बिना लोगों के उत्पाद, समान जांच के तहत स्वीकृत, उसी एजेंटों का उपयोग करने वाले प्रोग्रामर के उत्पादों को आगे निकलना शुरू करते हैं, जिसके बाद डिग्री आवश्यकताएं और जूनियर और सीनियर के लेबल भर्ती में भविष्य कहने वाली शक्ति खो जाते हैं। इसके घटक गुणवत्ता समता (पिछला चरण), ओवरटेकिंग (क्षण), पोस्टिंग में क्रॉसिंग (संकेत) और पृष्ठभूमि तटस्थता (तंत्र) हैं।
गारंटीकर्ता। एक व्यक्ति जो दूसरों द्वारा बनाए गए उत्पाद के लिए हस्ताक्षर करता है और इसके लिए अपने दायरे को जवाबदेह करता है, जिसे वे कितने उत्पादों के लिए वाउच करते हैं और कितने पकड़ते हैं, इससे मापा जाता है।
फिनिशर। एक व्यक्ति जो किसी उत्पाद को उसके उपयोगकर्ताओं तक लाता है।
दो बाजार। अपने लिए बनाना (साक्षरता) और दूसरों के लिए परिणामों के साथ काम (पेशा)।
परिशिष्ट बी. खोज लॉग, 8 और 9 अक्टूबर 2026
नामों और शर्तों की वेब जांच 8 अक्टूबर 2026 को कई AI सहायकों द्वारा स्वतंत्र रूप से और समानांतर में, और 9 अक्टूबर 2026 को विस्तारित वेब खोज के साथ एक सहायक द्वारा चलाई गई थी। प्रत्येक उत्तर को उसके स्रोतों के साथ पूरी तरह रखा गया था। विद्वत्तापूर्ण जांच 9 अक्टूबर 2026 को निम्नानुसार चलाई गई थी।
| आधार | यह क्या खोज करता है | इस पत्र की शर्तों के लिए परिणाम |
|---|---|---|
| arXiv (API) | सटीक वाक्यांश, सभी फील्ड | "delegation horizon": 0; "delegation ladder" या "ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | शीर्षक और सारांश | एक खोज ने 0 लौटाया और दूसरी दर-सीमित थी (HTTP 429); जमा करने से पहले दोहराई जानी है |
| OpenAlex | शीर्षक, सारांश, कुछ पूर्ण पाठ | "credential crossover": 0; "agentwright": केवल असंबंधित मिलान; "background neutrality": असंबंधित; "acceptance literacy": केवल तकनीकी स्वीकृति पर कार्य |
| Crossref | मेटाडेटा जिसमें SSRN सारांश शामिल हैं | "principal" एक पेशे के रूप में: केवल एजेंसी सिद्धांत |
| Europe PMC | खुले पूर्ण पाठ | कोई सटीक मिलान नहीं |
| Zenodo | रिकॉर्ड और विवरण | किसी भी शर्त के लिए कोई मिलान नहीं |
| DOAJ | खुली-पहुंच पत्रिकाएं | "delegation horizon": चार असंबंधित मिलान |
| Google Scholar | पूर्ण पाठ, SSRN | "delegation horizon": 6, 2026 के पत्रों में मशीनों या फर्मों के लिए उपयोग किया गया है (Khadj, 2026; Alonso, 2026); "verified delegation horizon", "credential crossover", "credential crossover point" और "agentwright": 0 (9 अक्टूबर 2026 को बिना त्रुटियों के दोहराया गया); "acceptance literacy", "background neutrality" और "amplification gain": केवल अन्य अर्थों में मिलान |
| DBLP; SSRN पृष्ठ | बॉट सुरक्षा द्वारा अवरुद्ध (DBLP) या 403 लौटाया (SSRN); Crossref और Scholar के माध्यम से कवर किया गया |
पूर्व पूर्वानुमानों को Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket और Long Bets पर, और खुली वेब पर खोजा गया था; Metaculus और कुछ Gartner पृष्ठों ने HTTP 403 लौटाया और जहां उपलब्ध हों वहां संग्रहीत या पुनर्मुद्रित प्रतियों के माध्यम से पढ़े गए। परिणामों को खंड 11.3 में संक्षेपित किया गया है। रिपोर्टिंग PRISMA 2020 की वस्तु 6 का अनुसरण करती है (Page et al., 2021): प्रत्येक आधार और अंतिम पहुंच की तारीख सूचीबद्ध है। एक मिलान जो नहीं मिला है, उसे उस तारीख को उस पर नहीं मिला के रूप में रिपोर्ट किया जाता है, और ऐसे आधारों के बारे में कोई दावा नहीं किया जाता है जिनको खोजा नहीं गया।
परिशिष्ट C. मापन उपकरण
यह परिशिष्ट एक अनुसंधान उपकरण, एक रिकॉर्ड प्रारूप और एक स्कोरर प्रदान करता है, जो Python मानक पुस्तकालय में है, MIT लाइसेंस के अंतर्गत। यह सिखाता है कि धारा 5.2 के नियम कोड कैसे बनते हैं। यह एक आवेदन नहीं है और किसी व्यक्ति के बारे में कोई निर्णय नहीं लेता जो व्यक्ति या अनुसंधानकर्ता द्वारा आपूर्ति किए गए रिकॉर्ड से दो संख्याओं की गणना करने से परे है। यह नहीं आंकता कि क्या कोई जांच अच्छी तरह से चुनी गई थी; यह अपने द्वारा दिए गए क्षेत्रों पर विश्वास करता है। विशेष रूप से यह स्वतंत्रता का परीक्षण नहीं करता। धारा 5.2 की तीन शर्तों (डेटा, पहुंच और प्रोत्साहन) में से यह केवल जांच के प्रकार को पढ़ता है और क्या एजेंटों ने इसे देखा, और स्वतंत्रता स्वयं तालिका 3 की यादृच्छिक लेखापरीक्षा द्वारा पुष्टि की जाती है।
C1. रिकॉर्ड
एजेंटों को सौंपे गए कार्य के प्रत्येक टुकड़े के लिए JSON Lines फ़ाइल की एक पंक्ति, जब टुकड़ा स्वीकृत, अस्वीकृत या परित्यक्त किया जाता है तो लिखा जाता है। हाथ से दिया गया आरंभ होने की तारीख started फ़ील्ड में जाती है, नियम v1.1 से अपेक्षित; स्कोरर अभी भी बिना इसके पंक्तियों को पढ़ता है और चेतावनी देता है। ऐसे टुकड़े जो जांच में विफल रहे या परित्यक्त किए गए, लॉग में रहते हैं।
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| क्षेत्र | अर्थ |
|---|---|
| person | एक छद्म नाम लेबल, कभी वास्तविक नाम नहीं |
| domain | वह क्षेत्र जिसमें कार्य स्वीकृत किया गया था |
| date | स्वीकृति, अस्वीकृति या परित्याग की तारीख, जब पंक्ति लिखी जाती है (ISO प्रारूप) |
| started | हस्तांतरण शुरू होने की तारीख (ISO प्रारूप); नियम v1.1 से अपेक्षित, तारीख से बाद की नहीं |
| reference_hours | पूरी डिलिवरेबल के लिए एक योग्य विशेषज्ञ के हाथों से किए गए घंटे |
| reference_basis | संदर्भ कहाँ से आया: एक नाम वाला कार्य बैंक या दो मूल्यांकनकर्ता |
| attention_minutes | व्यक्ति की योजना, निर्देश, पढ़ना, जाँच और सुधार की मिनट |
| mode | one_piece, stages या together (one_piece Section 5.7 के निर्देशक शेयर की ओर गिना जाता है) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review या none |
| agent_saw_check | क्या एजेंट जाँच को देख सकते थे (गिने जाने के लिए false होना चाहिए) |
| passed | क्या जाँच पास हुई (विफल या परित्यक्त टुकड़ों के लिए false) |
| irreversible | क्या इस प्रकार के कार्य में कोई गलती को पूर्ववत नहीं किया जा सकता (यह टुकड़ा तब पास होना चाहिए) |
| planted_errors | हस्तांतरण से पहले कार्य में कितनी त्रुटियाँ रोपी गई थीं |
| planted_missed | उनमें से कितनी व्यक्ति को पकड़ने में विफल रहा (कोई भी मिस टुकड़े को अपुष्ट बना देता है और विंडो में Week और ऊपर को ब्लॉक करता है) |
| outside_help | क्या किसी सहकर्मी या ठेकेदार ने लॉग से बाहर मदद की (ऐसा टुकड़ा लाभ के न्यूमरेटर में कुछ नहीं जोड़ता) |
| task_id, model, tools | वैकल्पिक: कार्य बैंक पहचानकर्ता, उपयोग किए गए एजेंट और मॉडल, और उनके उपकरण (Section 5.4) |
| checker | वैकल्पिक: जिसने जाँच चलाई, एक भूमिका के रूप में, कभी वास्तविक नाम नहीं |
| rater_hours | वैकल्पिक: reference_hours के पीछे मूल्यांकनकर्ताओं के अनुमान; यदि दो हैं और बड़ा छोटे से 1.5 गुना से अधिक है, तो स्कोरर "needs third rater" प्रिंट करता है (Table 3); तीसरे अनुमान के साथ माध्यिका तय करता है और ध्वज प्रिंट नहीं किया जाता है |
| audit | वैकल्पिक: none, passed या failed, एक दूसरी, स्वतंत्र जाँच का परिणाम; एक विफल ऑडिट टुकड़े को अपुष्ट बना देता है |
| revoked | वैकल्पिक: true यदि एक विलंबित परिणाम ने टुकड़े को रद्द किया (Table A4); एक रद्द किया गया टुकड़ा अपुष्ट है |
C2. horizon.py
नीचे दिया गया कोड नियम v1.1 लागू करता है और companion repository में horizon.py के समान है, बाइट दर बाइट।
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. एक व्यावहारिक उदाहरण
नीचे दिया गया लॉग जुलाई और सितंबर 2026 के बीच एक व्यक्ति द्वारा एजेंटों को सौंपे गए दस बुककीपिंग कार्यों को रखता है।
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
python3 horizon.py work-log.jsonl --as-of 2026-10-09 चलाने से रिकॉर्ड और इसके पीछे की जांचों के बारे में एक लाइन प्रिंट होती है:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
सभी दस टुकड़े कम से कम 8 संदर्भ घंटे हैं। दो को सत्यापित के रूप में गणना नहीं की जाती: एक केवल स्व-समीक्षा द्वारा जांचा गया था, और एक विशेषज्ञ की जांच में विफल रहा। दस में से आठ बिल्कुल वह हिस्सा है जो Day को आवश्यक है, और अपरिवर्तनीय टुकड़ा पारित हुआ, इसलिए स्तर Day है। Week पहुंच से बाहर है, क्योंकि कोई टुकड़ा 40 घंटे तक नहीं पहुंचता है। सत्यापित टुकड़े 80 संदर्भ घंटे जमा करते हैं, 1,030 मिनट के विरुद्ध (लगभग 17.2 घंटे) सभी दस पर खर्च की गई ध्यान, विफलताएं शामिल हैं, जो 4.66 का लाभ और चरण ×2 देता है। कोई भी टुकड़ा लगाई गई त्रुटियों या बाहरी सहायता नहीं रखता है, इसलिए उन दोनों नियमों में से कोई परिणाम को नहीं बदलता है। यदि विफल टुकड़ा लॉग से बाहर छोड़ दिया गया होता, तो स्तर नौ टुकड़ों पर विश्राम करता और दस की गिनती में विफल होता, यही कारण है कि विफलताएं रिकॉर्ड में संबंधित हैं। स्तर के बगल की गणना, 8/10, दिखाती है कि फैसला कितना करीब था (परिशिष्ट E), और दूसरी पंक्ति गिने गए टुकड़ों के पीछे जांच के प्रकार और माध्य स्वीकृत आकार, 9.0 घंटे देती है, इसलिए एक पाठक यह देख सकता है कि क्या क्षितिज एक सीमा के ठीक ऊपर टुकड़ों पर विश्राम करता है (तालिका 3)। व्यक्ति का ध्यान, 1,030 मिनट, सौंपे गए 96 संदर्भ घंटों का लगभग 18% है और सत्यापित 80 का लगभग 21% है। एक résumé के लिए रिकॉर्ड "small-business bookkeeping · Day · ×2 · 2026-Q4" पढ़ता है।
साथी उपकरण tools/explain.py एक ही नियमों से एक ही फैसले के पीछे कारणों को प्रिंट करता है। Day आकार के दस टुकड़ों में से आठ सत्यापित हैं और आठ आवश्यक हैं, एक गणना जो 44% से 97% (अनुभाग 5.8) के बीच कहीं भी सच्ची पास दर के साथ सुसंगत है, इसलिए उस आकार का कोई अन्य विफल टुकड़ा अवशोषित नहीं हो सकता है। यदि कुछ नया लॉग नहीं किया जाता है, तो Day 18 अक्टूबर 2026 के माध्यम से रहता है; 19 अक्टूबर को 20 जुलाई को बंद किया गया टुकड़ा 91-दिन की खिड़की से बाहर निकलता है, और Day आकार के नौ टुकड़े बने रहते हैं, Day को आवश्यक दस से कम। Week के लिए यह हर स्थिति को सूचीबद्ध करता है जो अभी भी अनुपस्थित है: 182 दिनों में कम से कम 40 घंटे के छह टुकड़े, उनमें से एक लगाई गई त्रुटियों के साथ और एक अंतिम 91 दिनों में सत्यापित।
निर्मित लॉग भी एक ट्रेस वहन करता है जो तालिका 3 का नाम देता है: इसके दस टुकड़ों में से पाँच बिल्कुल 8 घंटे पर रेट किए गए थे, Day की मंजिल, और tools/too_clean.py इसे "audit first" के साथ चिह्नित करता है, ट्रेस के साथ "5 of 10 pieces sit just above a rung threshold"। एक ध्वज एक लॉग को ऑडिट में भेजता है और इसके बारे में कुछ नहीं निर्णय लेता है; स्तर के बगल 9.0 घंटे की माध्य एक पाठक को यही दिखाती है।
C5. साथी संग्रहालय
साथी संग्रहालय (https://github.com/vadimchernets/delegation-horizon) उपकरण और सामग्रियां रखता है जो पाठकों को कागज के प्रत्येक भाग का उपयोग करने देते हैं। मुख्य फाइलें, अनुभाग के अनुसार:
| अनुभाग | फाइलें | वे क्या करते हैं |
|---|---|---|
| 5.2, C1 से C4 | horizon.py, log.schema.json, examples/ |
Scorer, एक लॉग लाइन की स्कीमा, काम किया हुआ उदाहरण और लाइनें जो इसे प्रिंट करनी चाहिए |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
प्रश्नों का उत्तर देकर लॉग लिखना, स्तर के पीछे गणना के साथ एक रिकॉर्ड कार्ड, और एक ऑफ़लाइन ब्राउज़र पृष्ठ में समान स्कोरिंग; दोनों एक स्प्रेडशीट पढ़ते हैं जिसे अल्पविराम या अर्धविराम के साथ सहेजा गया है |
| 5.2, 5.8, C4 | tools/explain.py |
एक लॉग अपना स्तर क्यों अर्जित करता है: प्रत्येक स्थिति जो रहती है या विफल होती है, slack, दिन जब स्तर समाप्त हो जाता है यदि कुछ नया लॉग नहीं किया जाता है, और अगले स्तर को क्या चाहिए |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Raters के अनुमानों से संदर्भ घंटे, और raters को कैसे चुनें, स्वीकार करें और ब्रीफ करें |
| 5.8, तालिका 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
पुनरुत्पादक ऑडिट नमूना, लॉग के लिए झंडे जो बहुत स्वच्छ दिखते हैं, हाथ से पहले सील की गई लगाई गई त्रुटियां और प्रकार द्वारा स्कोर की गई (गलत प्रविष्टि या छोड़ना), ऑडिट और लगाई गई-त्रुटि मार्गदर्शन |
| 6.2, 10.3 | tools/verify_record.py |
एक पोर्टेबल रिकॉर्ड की प्राप्त पक्ष: क्या इसके साथ भेजा गया लॉग वह फाइल है जिसे स्कोर किया गया था, क्या scorer समान है, और क्या rescoring रिकॉर्ड, फील्ड द्वारा फील्ड के समान देता है |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
व्यापार के प्रश्न द्वारा लोगों को स्वीकार करना लेबल के बजाय, और एक लेबल कितना रिसाव करता है, एक सटीक अंतराल के साथ (परिशिष्ट G2: 9.5% से 30.4% में 60 में से 11) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
अनुभाग 6.5 के चार चरण और प्रत्येक नियम के तहत क्या अर्जित करता है (चित्र A4), और अनुभाग 10.5 की तुलना एक प्रोटोकॉल के रूप में पंजीकृत करने के लिए, इसके विश्लेषण, गलत प्रविष्टियों और छोड़े जाने के साथ |
| 5.8, परिशिष्ट E | pilot/ |
सीमाओं का डेस्क परीक्षण, 30 कार्यों का एक बैंक, कैलिब्रेशन प्रोटोकॉल अपने पंजीकरण पाठ और सहमति फॉर्म के साथ |
| परिशिष्ट G2 | pilot/ |
पंजीकृत विश्लेषण human_raters.py जैसा कि OSF पर दाखिल किया गया, Prolific निर्यात का रूपांतरण, स्क्रिप्ट जो तालिका G2 को पंजीकृत कार्यों के साथ प्रिंट करता है, स्क्रीनिंग की तुलना, और उन्हें चलाने के लिए एक सिंथेटिक निर्यात |
| 7.2 | templates/, tools/guarantor_record.py |
एक कार्य बैंक के लिए कार्य कार्ड, एक गारंटी देने वाले का खाता बही, और गारंटी देने वाले का रिकॉर्ड इससे गणना की गई: उत्पाद वाउच किए गए, कितने 6 और 12 महीने रहते थे, गंभीरता द्वारा विफलताएं |
| 11, तालिकाएं 4 और A6, C3 | predictions/, brier.py, tools/power.py |
41 भविष्यद्वाणियां जैसा पंजीकृत, OSF पर दाखिल उनके हैश की सूची के साथ, संकल्प नियम और फाइलें, स्कोरिंग उपकरण, जो एक Set B भविष्यद्वाणी दर्ज नहीं किए गए रिकॉर्ड और Brier स्कोर दोनों रिपोर्ट इसके बिना और इसे गलत के रूप में स्कोर किए गए (अनुभाग 11.2), और अनुभाग 11.2 के नमूना आकार |
| 11, Set B | predictions/set_b.py |
नौ Set B भविष्यद्वाणियों के frozen आए-सच और नहीं-किए गए नियम एक अंतराल पर लिखे गए, एक अध्ययन के अनुमानों पर लागू |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
प्रोटोकॉल और F27 नमूने का ड्रा (बंद पूल पहले पंजीकृत, कुंजी बाद में एक सार्वजनिक यादृच्छिकता beacon से ली गई), Zenodo पर frozen और इसका hash 31 दिसंबर 2026 तक OSF पर पंजीकृत, और F27 के शब्दों द्वारा प्रत्येक स्कोरिंग तारीख पर इसकी जीवंतता |
| C2 से C4, तालिकाएं 4 और A6 | tools/paper_sync.py |
इस पाठ को संग्रह के विरुद्ध जाँचता है: सूचियों को बाइट दर बाइट, कार्यित उदाहरण और उसका आउटपुट, भविष्यवाणियों की तालिकाएँ, समुच्चय की गणना, नाम दी गई प्रत्येक फ़ाइल और अंतःस्थापित प्रत्येक आकृति |
| परिशिष्ट D, परिशिष्ट F | figures/ |
वह लिपियाँ जो भविष्यवाणी तालिका से आकृति A1 को और स्कोरर के नियमों से आकृति A4 को खींचती हैं |
वही फ़ाइलें पाठक के अनुसार:
| पाठक | यहाँ से शुरू करें | यह क्या देता है |
|---|---|---|
| एक व्यक्ति जो कार्य को एजेंटों को सौंपता है | templates/work-log.csv, record_card.py या checker.html, tools/explain.py |
स्प्रेडशीट में रखी गई एक लॉग, रिकॉर्ड और उसका कार्ड, और अगले स्तर को क्या चाहिए |
| एक नियोक्ता या एक HR टीम | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
एक सशुल्क एक-दिवसीय कार्य परीक्षण जिसमें अंधा रेटर हो, व्यापार का एक प्रश्न जो लेबल की जगह हो, एक स्तर क्या कहता है और नहीं कहता है, और किसी उम्मीदवार का निर्णय कितना करीब था |
| किसी व्यापार में एक नया आने वाला | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
खंड 6.5 के चरण और प्रत्येक क्या अर्जित करता है, "पूर्ण" को हस्तांतरण से पहले कहा गया, और रोपित विस्मरणों पर अभ्यास |
| एक लेखा परीक्षक या एक गारंटीकर्ता | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
फिर से जाँचने के लिए एक नमूना, एक लॉग के निशान जो बहुत साफ-सुथरा दिखता है, रोपित त्रुटियाँ जिनकी मुहर दिखाती है कि सूची को बदला गया या नहीं |
| एक शोधकर्ता | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
डेस्क परीक्षण, रेटर अध्ययन और उनकी लिपियाँ, तुलना के लिए प्रोटोकॉल, नमूना आकार, और पंजीकृत भविष्यवाणियाँ उनके स्कोरकार्ड उपकरणों के साथ |
परिशिष्ट D. भविष्यवाणियों के लिए पंजीकरण पाठ (OSF)
शीर्षक। AI एजेंटों के माध्यम से कार्य पर दिनांकित भविष्यवाणियां, 2026 से 2031: जमे हुए पूर्वानुमान और वार्षिक स्कोरिंग।
प्रकार। खुली पंजीकरण, तुरंत सार्वजनिक, कोई प्रतिबंध नहीं।
सारांश। यह पंजीकरण "After the Programmer Divide: One Measure for People Who Build Through AI Agents" (SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266) में कही गई दिनांकित भविष्यवाणियों को स्थिर करता है। संलग्न तालिका प्रत्येक भविष्यवाणी के लिए देती है: इसका शब्दांकन; इसका माप; एक सार्वजनिक स्रोत और एक वैकल्पिक स्रोत; 2025 या 2026 का आधार रेखा जिसमें पहुंच तारीख और एक संग्रहीत स्नैपशॉट हो; एक जांच तारीख और एक अंतिम तारीख; इस पंजीकरण की तारीख पर तय की गई संभावना; और तीन परिणामों के लिए सीमाएं: सच हुआ, सच नहीं हुआ, अनसुलझा।
स्कोरिंग। प्रत्येक भविष्यवाणी को उसकी जांच तारीख पर या उसके बाद की पहली वार्षिक जांच पर स्कोर किया जाता है जिसमें डेटा मौजूद हो, और उसकी अंतिम तारीख से बाद में नहीं। हल की गई भविष्यवाणियों को Brier नियम द्वारा स्कोर किया जाता है। अपनी अंतिम तारीख तक तुलनीय डेटा के बिना भविष्यवाणी को अनसुलझा दर्ज किया जाता है और इसे सफलता के रूप में नहीं गिना जाता।
समुच्चय और संभावनाएं। समुच्चय A सार्वजनिक डेटा और predictions/resolve/ में फाइलों से हल होता है, जिनके SHA-256 हैश इस पंजीकरण में सूचीबद्ध हैं। समुच्चय B केवल डेटा संग्रह से पहले अलग से पंजीकृत अध्ययनों से हल होता है; एक समुच्चय B भविष्यवाणी जिसका प्रोटोकॉल 30 जून 2027 तक पंजीकृत नहीं है, उसे आचरण न किया गया दर्ज किया जाता है, परीक्षण कार्यक्रम की विफलता के रूप में; Brier स्कोर को हल की गई भविष्यवाणियों पर और प्रत्येक भविष्यवाणी आचरण न की गई के साथ गलत के रूप में स्कोर किए गए दोनों को रिपोर्ट किया जाता है। संभावनाएं समाधान पर सशर्त हैं। वे 9 अक्टूबर 2026 को एकत्र किए गए तीन ब्लाइंड मॉडल पूर्वानुमानों की माध्यिका हैं (Claude Opus, एक OpenAI मॉडल और Gemini) और लेखक द्वारा अपनाई गई हैं; चार मॉडलों के पहले के पूल किए गए पूर्वानुमान संदर्भ के लिए संलग्न हैं।
क्रॉसओवर बिंदु। F2, F3, F5 और F7 को समान नामित डोमेन में मापा जाता है: छोटे व्यवसाय की बहीखाता, और कानूनी और विपणन दस्तावेज़, कार्य बैंक के दो गैर-सॉफ़्टवेयर डोमेन (परिशिष्ट E); F5 के पोस्टिंग समरूप के लिए वे SOC 43-3031, 23-2011 और 13-1161 के लिए मानचित्र बनाते हैं। तीसरा बैंक डोमेन, छोटे आंतरिक वेब उपकरण, प्रोग्रामर का घर डोमेन है और क्रॉसओवर डोमेन नहीं है। एक डोमेन में क्रॉसओवर बिंदु पहला वर्ष है जिसमें F3 और डोमेन का F5 समरूप दोनों उसी नामित डोमेन में पूरे हों; न ही अकेले इसे घोषित करता है।
स्कोरिंग जोड़। प्रत्येक स्कोरकार्ड भी हल किए गए का हिस्सा, समुच्चय और परिवार द्वारा Brier स्कोर, एक सबसे बुरी सीमा जो अतिदेय अनसुलझी भविष्यवाणियों को गलत के रूप में स्कोर करती है, और 0.5, पूल किए गए मॉडल पूर्वानुमानकर्ताओं और बाजार मूल्यों के विरुद्ध Brier कौशल स्कोर रिपोर्ट करता है।
वार्षिक जांच। 2027 से 2031 तक प्रत्येक वर्ष, इस पंजीकरण की वर्षगांठ पर, लेखक एक स्कोरकार्ड प्रकाशित करता है जो यहां पंजीकृत हर भविष्यवाणी को कवर करता है। प्रत्येक स्कोरकार्ड स्वयं OSF पर पंजीकृत है, DOI द्वारा इस पंजीकरण से जुड़ा है, और Zenodo पर जमा किया गया है।
निश्चित नियम। कोई भविष्यवाणी हटाई, पुनः शब्दबद्ध या नई तारीख दी नहीं जाती है। बाद में जोड़ी गई कुछ भी अलग से पंजीकृत है और इसकी अपनी तारीख रखती है। यदि कोई नामित स्रोत प्रकाशन बंद कर देता है या अपनी विधि बदल देता है, तो वैकल्पिक स्रोत का उपयोग किया जाता है, बशर्ते यह समान मात्रा को मापे; यदि कोई तुलनीय स्रोत नहीं है, तो भविष्यवाणी अनसुलझी है।
स्वतंत्र जांच। प्रत्येक स्कोरकार्ड को कम से कम दो अलग-अलग परिवारों के मॉडलों द्वारा यहां जमे हुए नियमों के विरुद्ध जांचा जाता है। जहां वे असहमत हैं, नियम निर्णय लेता है और असहमति की रिपोर्ट की जाती है। एक मानव मध्यस्थ, लेखक द्वारा पहले स्कोरकार्ड से पहले नाम दिया गया है, दो मॉडल परिवारों के बीच विवादों का निर्णय लेता है।
अपना डेटा। भविष्यवाणियां जो लेखक के समूह डेटा पर निर्भर हैं, केवल एक अलग पूर्व-पंजीकरण के तहत परीक्षण की जाती हैं जो उन डेटा के संग्रहण से पहले दाखिल किया जाता है, जैसा कि OSF पर पंजीकृत कार्यक्रम (DOI 10.17605/OSF.IO/X4EGQ) प्रत्येक समूह के लिए करता है।
प्रतिस्पर्धी हित। जैसा कि पत्र में घोषित किया गया है।
फाइलें। भविष्यवाणियां तालिका (CSV, और संलग्न पत्र की तालिका A6); संग्रहीत स्नैपशॉट की सूची; predictions/resolve/ (जमे हुए क्वेरी, सूचियां और कोडबुक, हैश के साथ); resolution-rules.md; changelog-v1-v2.md।
संलग्न भविष्यवाणियां तालिका A6 है, और चित्र A1 इसके कैलेंडर को खींचता है।
चित्र A1। जांच का कैलेंडर, 2026 से 2031।
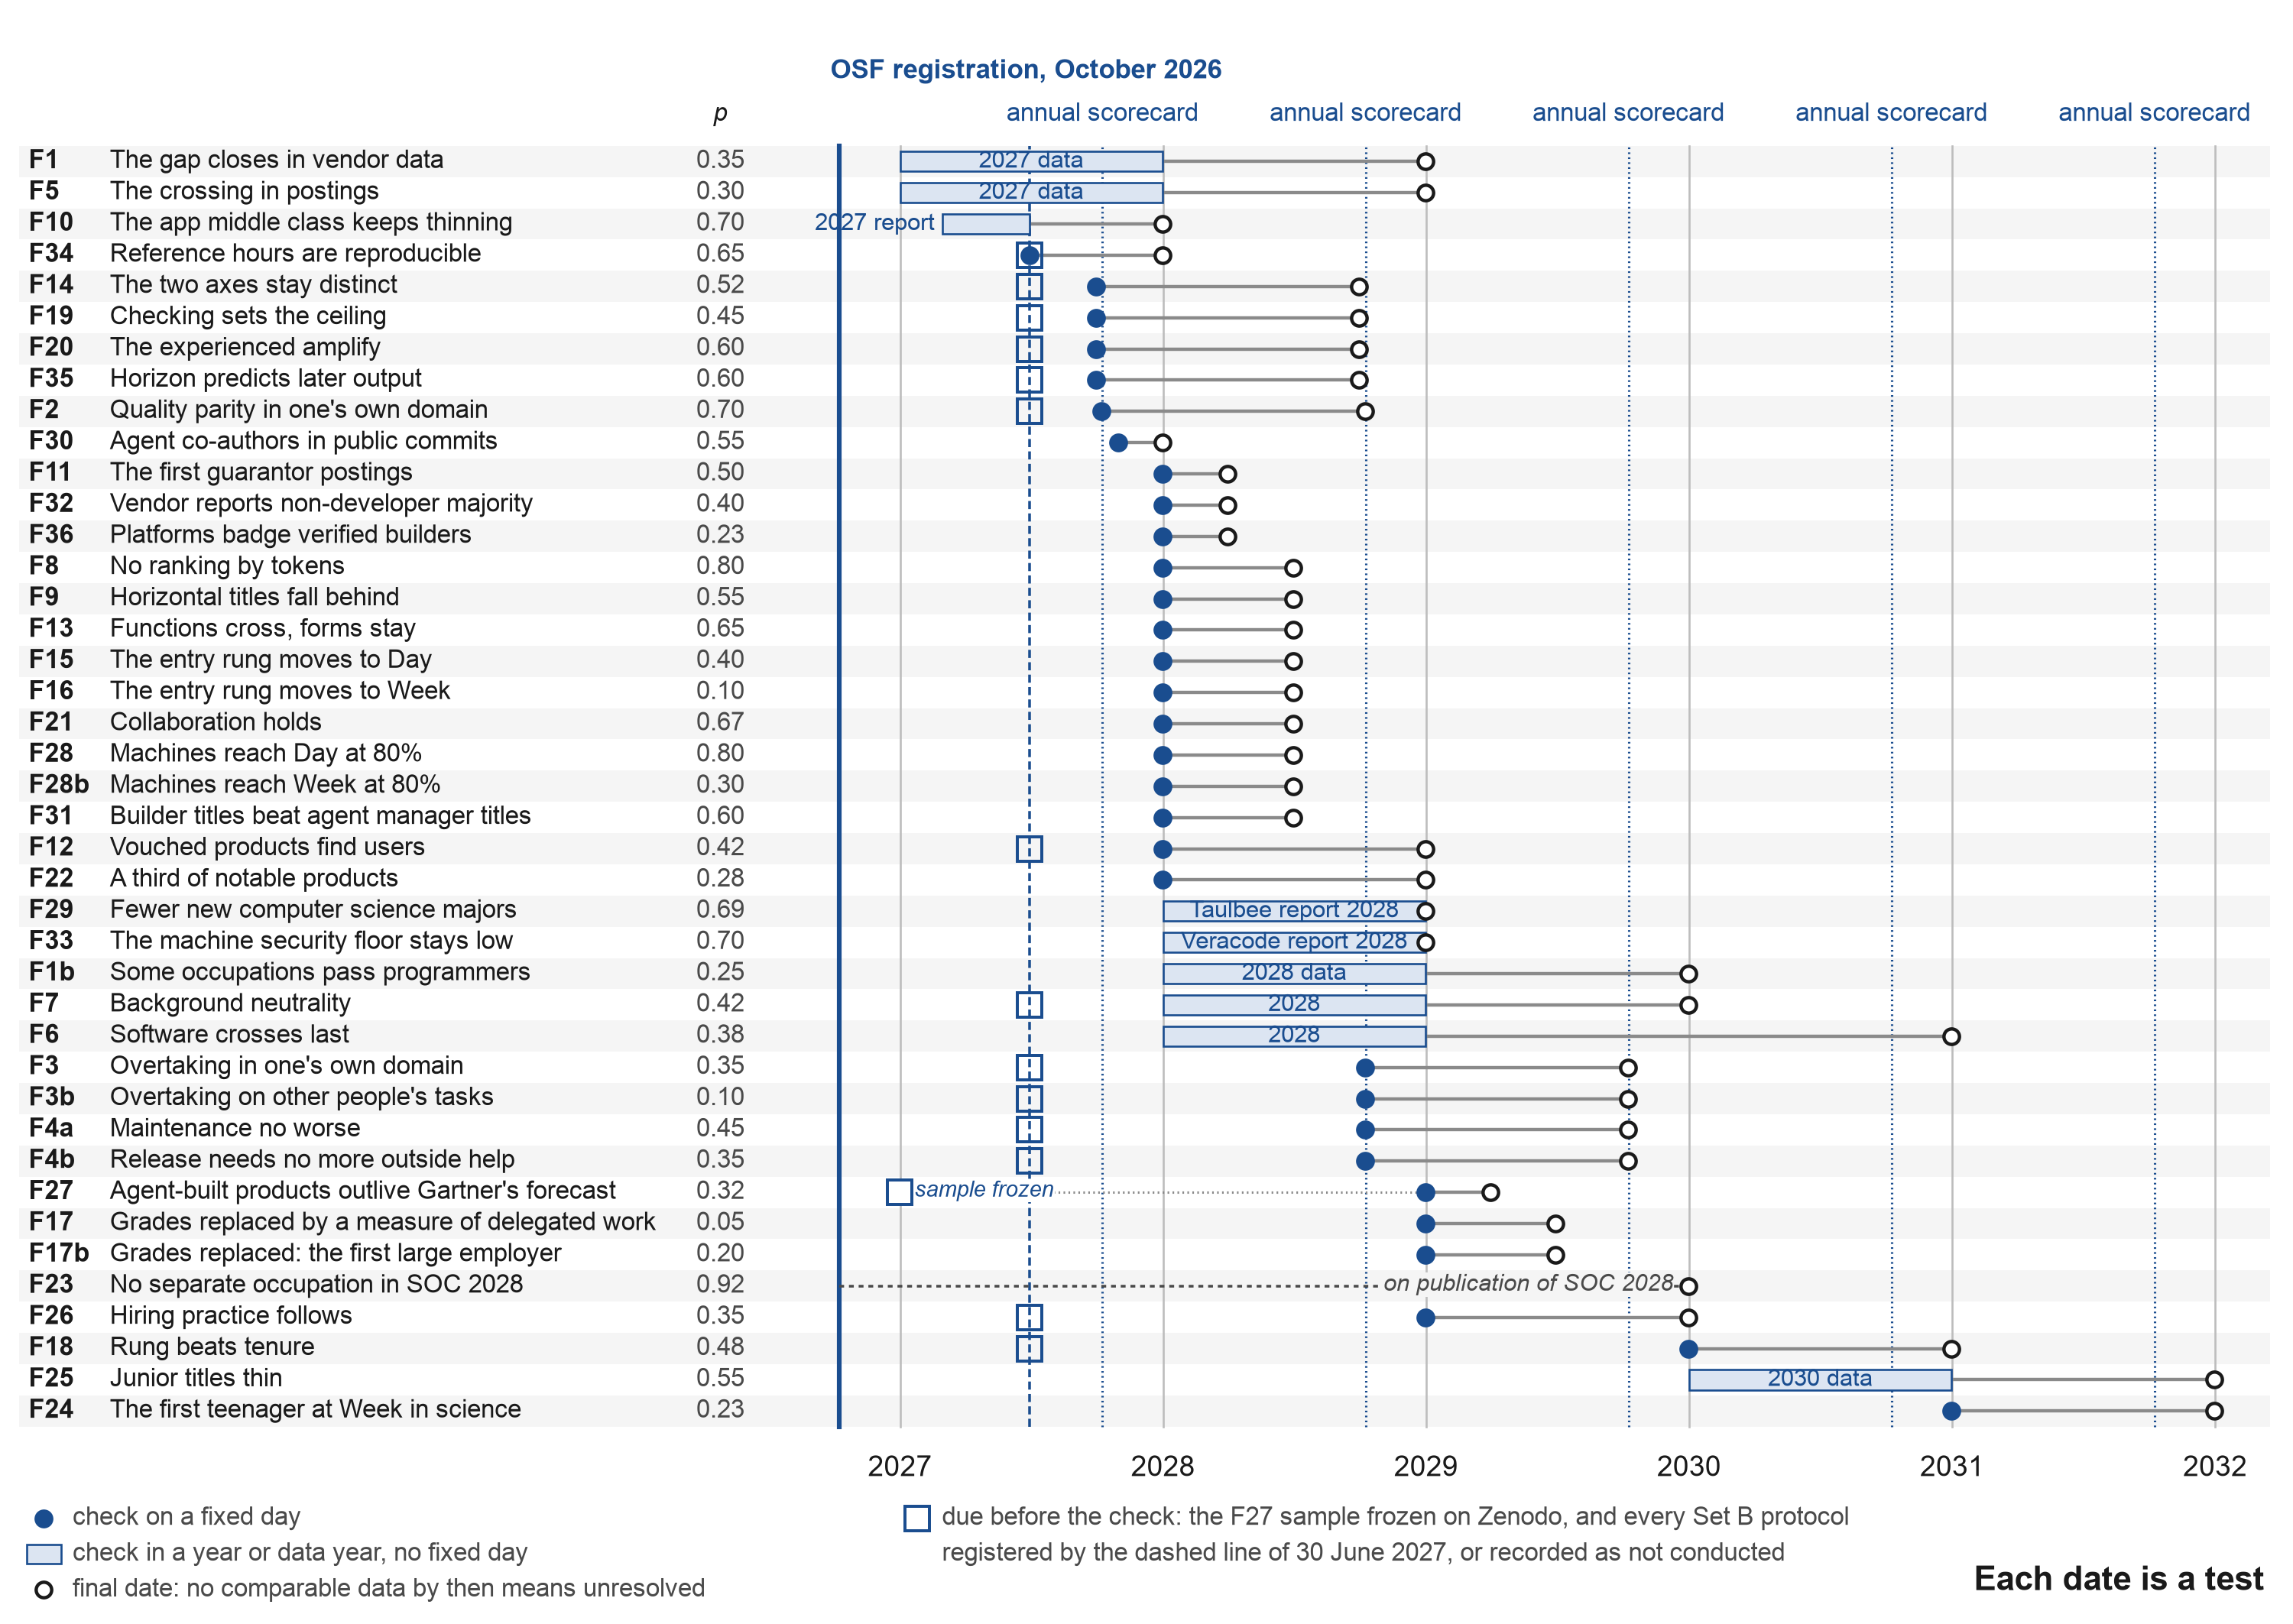
नोट: तालिका A6 की प्रत्येक भविष्यवाणी के लिए एक पंक्ति, जांच तारीख के अनुसार क्रमबद्ध, इसकी संभावना के साथ। एक भरा हुआ बिंदु एक निश्चित दिन पर जांच है। एक हल्का बार एक वर्ष में या एक निश्चित दिन के बिना डेटा वर्ष में जांच है। वलय अंतिम तारीख है, जिसके बाद तुलनीय डेटा के बिना भविष्यवाणी को अनसुलझा दर्ज किया जाता है (अनुभाग 11.4)। बिंदीदार रेखाएं वार्षिक स्कोरकार्ड को चिह्नित करती हैं, जिन्हें 2027 से 2031 तक प्रत्येक अक्टूबर में OSF पर पंजीकृत किया जाना है। एक खोखला वर्ग जांच से पहले एक प्रतिबद्धता को चिह्नित करता है: F27 नमूना, 31 दिसंबर 2026 तक Zenodo पर जमा किया गया, और 30 जून 2027 की धराशायी रेखा पर, 14 समुच्चय B अध्ययनों में से प्रत्येक का प्रोटोकॉल, जिसके बिना भविष्यवाणी को आचरण न किया गया दर्ज किया जाता है (अनुभाग 11.2)। आंकड़ा स्वयं भविष्यवाणी तालिका से उत्पन्न होता है, साथी भंडार में figures/figure_a1_calendar.py द्वारा, और केवल इसके साथ बदलता है।
तालिका A6। सभी 41 दिनांकित भविष्यवाणियां: समुच्चय, उपाय, सीमाएं, संभावनाएं, मॉडल पूर्वानुमान, वैकल्पिक और पूर्व पूर्वानुमान।
| # (समुच्चय) | भविष्यवाणी, माप, आधार रेखा और सीमा | तारीखें, संभावना, मॉडल पूर्वानुमान, अनसुलझा नियम, वैकल्पिक और पूर्व पूर्वानुमान |
|---|---|---|
| F1 (A) | विक्रेता डेटा में अंतराल बंद होता है। कोड-उत्पादक सत्रों पर सत्यापित सफलता, प्रोग्रामिंग बनाम अन्य व्यवसाय: 34% बनाम 29%, सात महीने के लिए अपरिवर्तित (Anthropic, 2026e)। अंतराल प्रोग्रामिंग व्यवसायों की सफलता दर घटा अन्य व्यवसायों की दर है, इसके संकेत के साथ। सच हुआ यदि अंतराल 2 अंक या उससे कम है, नकारात्मक मान शामिल हैं, 2027 के डेटा पर एक तुलनीय रिपोर्ट में; सच नहीं हुआ यदि यह 2 से अधिक है। आधार रेखा: कोड-उत्पादक सत्रों पर सत्यापित सफलता: प्रोग्रामिंग 34% बनाम अन्य व्यवसाय 29%, सात महीने के लिए अपरिवर्तित (Anthropic, 2026e) | जाँच: 2027 डेटा। अंतिम तारीख: 31 दिसंबर 2028। p = 0.35; मॉडल 0.39 (0.25 से 0.65)। अनसुलझा यदि: अंतिम तारीख तक 2027 डेटा पर कोई रिपोर्ट नहीं, या सत्र परिभाषा बदल गई (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: कोई भी विक्रेता रिपोर्ट तुलनीय सत्रों पर व्यवसाय द्वारा सत्यापित सफलता दे रही है। निकटतम पूर्व या विपरीत पूर्वानुमान: Anthropic: अंतर "न तो चौड़ा हुआ है और न ही संकीर्ण हुआ है" |
| F1b (A) | कुछ व्यवसाय प्रोग्रामर को पार करते हैं। F1 के समान माप। 10 सबसे बड़े गैर-प्रोग्रामिंग व्यवसाय रजिस्ट्रेशन पर फ्रीज किए गए हैं क्योंकि Anthropic (2026e) में सत्र शेयर वाले 10 सबसे बड़े हैं। एक व्यवसाय प्रोग्रामिंग से केवल अधिक होता है यदि इसकी सफलता दर 2 पॉइंट या अधिक से अधिक है (10 तुलनाओं में बहुलता के लिए एक मार्जिन)। 2028 डेटा में कम से कम 3 में से 10 में ऐसा करने पर सत्य हुआ। बेसलाइन: F1 के अनुसार; प्रबंधन पहले से ही प्रोग्रामिंग से थोड़ा आगे है (Anthropic, 2026e) | जाँच: 2028 डेटा। अंतिम तारीख: 31 दिसंबर 2029। p = 0.25; मॉडल 0.30 (0.20 से 0.45)। अनसुलझा यदि: अंतिम तारीख तक 2028 डेटा पर कोई रिपोर्ट नहीं, या सत्र परिभाषा बदल गई (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: F1 के अनुसार। निकटतम पूर्व या विपरीत पूर्वानुमान: प्रबंधन पहले से ही प्रोग्रामिंग से थोड़ा आगे है (Anthropic, 2026e) |
| F2 (B) | अपने स्वयं के डोमेन में गुणवत्ता समता (क्रॉसओवर बिंदु से पहले का कदम)। समान एजेंट, समान समय, अंधा स्वीकृति और सुरक्षा जाँच, एक महीने के बाद दूसरे एजेंट द्वारा रखरखाव परिवर्तन; एक अध्ययन जिसमें प्रति समूह 1,500 लोग हैं। 95% अंतराल के निचले बाउंड के लिए (IT शिक्षा के बिना लोग माइनस प्रोग्रामर) माइनस 10 पॉइंट से ऊपर है यदि सत्य हुआ; यदि ऊपरी बाउंड माइनस 10 से नीचे है तो नहीं; अन्यथा अनसुलझा। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं; अलग से पूर्वनिर्धारित अध्ययन, प्रति समूह 1,500 लोग | जाँच: 8 अक्टूबर 2027। अंतिम तारीख: 8 अक्टूबर 2028। p = 0.70; मॉडल 0.67 (0.62 से 0.70)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं, या एक अंतराल जो न तो नियम को पूरा करता है (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: समान डिज़ाइन के साथ एक स्वतंत्र अध्ययन। निकटतम पूर्व या विपरीत पूर्वानुमान: D. H. Hansson (2026), "100%" (कोई तारीख नहीं, कोई माप नहीं); Esnaola et al. (2026) |
| F3 (B) | अपने स्वयं के डोमेन में ओवरटेकिंग (गुणवत्ता में क्रॉसओवर बिंदु)। F2 के रूप में (प्रति समूह 1,500 0.05 के दो-पक्षीय अल्फा के साथ 5 पॉइंट के सत्य लाभ का पता लगाने के लिए लगभग 0.8 शक्ति देते हैं; प्रति समूह 400 लगभग 0.3 देंगे)। 95% अंतराल के निचले बाउंड यदि शून्य से ऊपर है तो सत्य हुआ; यदि ऊपरी बाउंड शून्य से नीचे है तो नहीं; अन्यथा अनसुलझा। बेसलाइन: F2 के अनुसार | जाँच: 8 अक्टूबर 2028। अंतिम तारीख: 8 अक्टूबर 2029। p = 0.35; मॉडल 0.33 (0.25 से 0.55)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं, या एक अंतराल जो न तो नियम को पूरा करता है (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: F2 के अनुसार। निकटतम पूर्व या विपरीत पूर्वानुमान: कोई नहीं मिला तारीख के साथ |
| F3b (B) | दूसरे लोगों के कार्यों पर ओवरटेकिंग। F3 के अनुसार, लेकिन प्रतिभागियों के अपने डोमेन के बाहर के कार्यों पर। बेसलाइन: F2 के अनुसार, प्रतिभागियों के अपने डोमेन के बाहर के कार्यों पर | जाँच: 8 अक्टूबर 2028। अंतिम तारीख: 8 अक्टूबर 2029। p = 0.10; मॉडल 0.13 (0.07 से 0.35)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं, या एक अंतराल जो न तो नियम को पूरा करता है (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: F2 के अनुसार। निकटतम पूर्व या विपरीत पूर्वानुमान: अनुभाग 6.3 का डोमेन तर्क भविष्यवाणी करता है कि यह विफल होता है |
| F4a (B) | रखरखाव कोई बदतर नहीं। लेखकों की शिक्षा के अनुसार 12 महीने के भीतर परित्यक्त स्वीकृत उत्पादों का हिस्सा। 95% अंतराल के ऊपरी बाउंड के लिए अंतर (गैर-प्रोग्रामर माइनस प्रोग्रामर) 10 पॉइंट से नीचे है यदि सत्य हुआ। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं; Gartner (Tyagi, 2026, Tray.ai, 2026 द्वारा सारांशित) 2028 तक 60% vibe-coded अनुप्रयोगों सेवानिवृत्त होने की अपेक्षा करता है, सभी अनुप्रयोगों की गणना करते हुए | जाँच: 8 अक्टूबर 2028। अंतिम तारीख: 8 अक्टूबर 2029। p = 0.45; मॉडल 0.49 (0.34 से 0.68)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं, या एक अंतराल जो न तो नियम को पूरा करता है (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: लेखक सर्वेक्षण के साथ उत्पाद रजिस्ट्री। निकटतम पूर्व या विपरीत पूर्वानुमान: Gartner (Tyagi, 2026, Tray.ai, 2026 द्वारा सारांशित): 2028 तक 60% vibe-coded अनुप्रयोग सेवानिवृत्त हुए "क्योंकि वे अनुमानित व्यावसायिक मूल्य प्रदान करने में विफल रहे"; F4a से एक व्यापक जनसंख्या, जो केवल स्वीकृत उत्पादों की गणना करती है |
| F4b (B) | रिलीज़ को कोई अधिक बाहरी सहायता की आवश्यकता नहीं है। रिलीज़ पर बाहरी तकनीकी सहायता की आवश्यकता वाले उत्पादों का हिस्सा। 10-पॉइंट मार्जिन पर गैर-हीन यदि सत्य हुआ; अंतर को प्रोटोटाइप, रिलीज़, रखरखाव के क्रम में बंद होने की उम्मीद है। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं | जाँच: 8 अक्टूबर 2028। अंतिम तारीख: 8 अक्टूबर 2029। p = 0.35; मॉडल 0.37 (0.22 से 0.50)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं, या एक अंतराल जो न तो नियम को पूरा करता है (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: F4a के अनुसार। निकटतम पूर्व या विपरीत पूर्वानुमान: Gartner (Tyagi, 2026, Tray.ai, 2026 द्वारा सारांशित): सॉफ़्टवेयर इंजीनियरिंग टीमों का 30% नागरिक विकासकर्ताओं और व्यावसायिक उपयोगकर्ताओं द्वारा निर्मित vibe-coded अनुप्रयोगों को बनाए रखने से "भौतिक क्षमता तनाव" के तहत |
| F5 (A) | पोस्टिंग में क्रॉसिंग (दृश्यमान संकेत)। IT व्यवसायों के एक फ्रीज़ किए गए सेट में US पोस्टिंग; रजिस्ट्रेशन तारीख पर वर्तमान Lightcast Open Skills वर्गीकरण रिलीज़ द्वारा परिभाषित agentic कौशल (संस्करण संख्या predictions/resolve/F5.md में दर्ज की गई है), agentic कौशल की फ्रीज़ की गई सूची के साथ; उन कौशलों वाली पोस्टिंग में चार साल की डिग्री की आवश्यकता वाले पोस्टिंग का हिस्सा बनाम उन कौशलों के बिना पोस्टिंग व्यवसाय (SOC 6-अंक), वरिष्ठता, राज्य और त्रैमासिक पर बिल्कुल मेल खाती है। agentic बेसलाइन (2026 Q2 और Q3) लिया जाता है और रजिस्ट्रेशन से पहले संग्रहीत किया जाता है। 2027 की दो लगातार त्रैमासी में अंतर नकारात्मक 2 पॉइंट या अधिक है यदि सत्य हुआ, 95% अंतराल शून्य को बाहर करते हुए। बेसलाइन: AI पोस्टिंग अभी भी एक डिग्री की अधिक संभावना है लेकिन 2024 के बाद परिवर्तित हो रही है (Lightcast, 2026b); agentic बेसलाइन रजिस्ट्रेशन से पहले लिया जाता है | जाँच: 2027 डेटा। अंतिम तारीख: 31 दिसंबर 2028। p = 0.30; मॉडल 0.34 (0.25 से 0.60)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं (कभी भी सफलता के रूप में नहीं गिना गया)। वैकल्पिक: PwC AI Jobs Barometer, केवल यदि यह agentic कौशलों वाली पोस्टिंग के लिए डिग्री आवश्यकताओं की रिपोर्ट करता है बनाम मेल खाती पोस्टिंग; अन्यथा अनसुलझा। निकटतम पूर्व या विपरीत पूर्वानुमान: Gartner (2021): 2024 तक IT के बाहर निर्मित अधिकांश प्रौद्योगिकी उत्पाद; Bone et al. (2025) UK पोस्टिंग में AI कौशलों पर |
| F6 (A) | सॉफ़्टवेयर सबसे आखिर में पार करता है। डोमेन की स्थिर सूची: कानून, लेखांकन और बहीखाता, शिक्षा, क्लिनिक प्रशासन, विपणन, रियल एस्टेट, बीमा, मानव संसाधन, रसद, सॉफ़्टवेयर विकास, IT बुनियाढांचा, सुरक्षा, डेवलपर टूल्स। डोमेन द्वारा पहली F5-प्रकार की क्रॉसिंग का क्रम। यह सच साबित हुआ यदि सॉफ़्टवेयर विकास, बुनियाढांचा, सुरक्षा और डेवलपर टूल्स सभी कम से कम आधे अन्य डोमेन के बाद पार करते हैं। आधार: कोई भी डोमेन अभी तक पार नहीं हुआ है (F5-प्रकार तुलना) | जांच: 2028। अंतिम तारीख: 31 दिसंबर 2030। p = 0.38; मॉडल 0.37 (0.25 से 0.55)। अनसुलझा यदि: अंतिम तारीख तक स्थिर सूची के आधे से कम गैर-सॉफ़्टवेयर डोमेन पार हो गए हैं, या कोई तुलनीय स्रोत नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: समान F5-प्रकार तुलना सहित एक अन्य पोस्टिंग स्रोत डोमेन द्वारा; गुणवत्ता के अध्ययन (F2-प्रकार) गिने नहीं जाते हैं, और ऐसे स्रोत के बिना भविष्यवाणी अनसुलझी रहती है। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Hwang (2026): वित्त "कोयले की खान में कनारी" |
| F7 (B) | पृष्ठभूमि तटस्थता। IT शिक्षा पर एक प्रश्न के साथ अलग से पंजीकृत कोहोर्ट; क्षितिज एक कार्य सेट पर स्कोर किया गया, गुणवत्ता को आयोजित-आउट कार्यों पर स्कोर किया गया। समान रन पर IT शिक्षा से जुड़ी स्वतंत्र जांच पास करने के ऑड्स अनुपात, डोमेन कमांड और स्वीकृति साक्षरता को नियंत्रित करते हुए। 0.67 से 1.5 का मार्जिन किसी भी तरफ 1.5 का ऑड्स अनुपात है, लगभग 0.22 का एक मानकीकृत अंतर है (Chinn का रूपांतरण), परंपरागत रूप से एक छोटा प्रभाव। यह सच साबित हुआ यदि 90% अंतराल 0.67 से 1.5 (तुल्यता) के भीतर स्थित है, अलग से दिन पर और सप्ताह और ऊपर पर। आधार: कोई सार्वजनिक आधार नहीं; IT शिक्षा पर एक प्रश्न के साथ अलग से पंजीकृत कोहोर्ट | जांच: 2028। अंतिम तारीख: 31 दिसंबर 2029। p = 0.42; मॉडल 0.43 (0.40 से 0.48)। अनसुलझा यदि: कोई अन्य संयोजन, केवल एक स्तर पर तुल्यता दिखाई गई, या अंतिम तारीख तक कोई डेटा नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: समान वस्तुओं के साथ एक स्वतंत्र कोहोर्ट। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Anthropic की डोमेन कमांड पर टिप्पणी; Savva (2026), प्रतिद्वंद्वी |
| F8 (A) | टोकन द्वारा कोई रैंकिंग नहीं। Fortune 500 नियोक्ता जो 2027 के दौरान एक आधिकारिक मूल्यांकन मानदंड के रूप में टोकन गणना का उपयोग करते हैं, नियोक्ता द्वारा या दो स्वतंत्र आउटलेट द्वारा प्रलेखित (AI उपयोग के बारे में प्रश्न गिने नहीं जाते हैं)। यह सच साबित हुआ यदि ऐसे दो से कम नियोक्ता पाए जाते हैं। आधार: टोकन गणना को 2026 में एक मूल्यांकन मानदंड के रूप में आजमाया गया (कागज का अनुभाग 4) | जांच: 31 दिसंबर 2027। अंतिम तारीख: 30 जून 2028। p = 0.80; मॉडल 0.79 (0.60 से 0.90)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: predictions/resolve/F8.md में स्थिर प्रश्नों के साथ व्यावसायिक प्रेस संग्रह खोज। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Kingy AI (2026): "निम्नस्तरीय, मारा नहीं गया"; Flowtivity (2026): "अपरिवर्तनीय" |
| F9 (A) | क्षैतिज शीर्षक पिछड़ जाते हैं। US पोस्टिंग, समान स्थिर प्रश्न (predictions/resolve/F9.md), Q4 2026 और Q4 2027, प्रत्येक गणना उसी त्रैमासिक में सभी US पोस्टिंग से विभाजित: एजेंट प्रबंधक, AI ऑपरेटर, AI ऑर्केस्ट्रेटर एक डोमेन का नाम देने वाली शीर्षक के विरुद्ध (उदाहरण के लिए "कानूनी AI लीड", "वर्टिकल AI लीड")। यह सच साबित हुआ यदि डोमेन-नामित शीर्षक का सामान्यीकृत हिस्सा क्षैतिज लोगों की तुलना में एक बड़े कारक से बढ़ता है। आधार: Q4 2026 में स्थिर प्रश्नों पर US पोस्टिंग गणना | जांच: 31 दिसंबर 2027। अंतिम तारीख: 30 जून 2028। p = 0.55; मॉडल 0.58 (0.45 से 0.75)। अनसुलझा यदि: किसी भी परिवार के पास Q4 2026 में 50 से कम पोस्टिंग हैं, या अंतिम तारीख तक कोई डेटा नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: समान प्रश्नों के साथ Indeed या LinkedIn खोज गणना। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Srinivasan और Wei (2026): "एजेंट प्रबंधक" 12 से 18 महीने के भीतर एक मानक शीर्षक; IT Brew (2026): "अगले 18 महीने" |
| F10 (A) | ऐप मध्यम वर्ग पतला होता रहता है। नई सदस्यता ऐप्स का हिस्सा जो दो वर्षों के भीतर $1,000 मासिक राजस्व तक पहुंचता है, RevenueCat 2026 के समान उपाय (17%)। यह सच साबित हुआ यदि 17% से कम है। आधार: 17% नई सदस्यता ऐप्स दो वर्षों के भीतर $1,000 मासिक राजस्व तक पहुंचती हैं (RevenueCat, 2026) | जांच: RevenueCat 2027 रिपोर्ट। अंतिम तारीख: 31 दिसंबर 2027। p = 0.70; मॉडल 0.68 (0.60 से 0.80)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: Sensor Tower या Appfigures राजस्व सीमा। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: RevenueCat का अपना ट्रेंड (कोई प्राथमिकता दावा नहीं); कई vibe-कोडेड ऐप्स विज्ञापनों से कमाते हैं, जो RevenueCat नहीं देखता है |
| F11 (A) | पहली गारंटर पोस्टिंग। चिकित्सा, कानून, वित्त या शिक्षा में 1,000 से अधिक कर्मचारियों वाले नियोक्ताओं द्वारा पोस्टिंग जो AI-उत्पादित कार्य के लिए हस्ताक्षर करने और इसके लिए व्यक्तिगत जिम्मेदारी का नाम देते हैं। predictions/resolve/F11.md में स्थिर प्रश्न: "साइन ऑफ" "AI-जनरेटेड" के साथ, "AI आउटपुट के लिए जवाबदेह", "AI प्रमाणीकरण", "AI गारंटर"; पोस्टिंग जहां "गारंटर" या "क्रेडेंशियल" कुंजियों या एक्सेस का संदर्भ देते हैं, को बाहर रखा गया है। यह सच साबित हुआ यदि कम से कम 5 नियोक्ताओं से कम से कम 10 ऐसी पोस्टिंग पाई जाती हैं और संग्रहीत की जाती हैं। आधार: लेखन के समय कोई ऐसी पोस्टिंग नहीं पाई गई | जांच: 31 दिसंबर 2027। अंतिम तारीख: 31 मार्च 2028। p = 0.50; मॉडल 0.42 (0.25 से 0.55)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: Google Jobs और LinkedIn के माध्यम से पाई गई संग्रहीत पोस्टिंग। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Capps (2025), "कानूनी गारंटर"; Forrester (2025): Fortune 100 का 60% AI शासन के प्रमुख को नियुक्त करेगा |
| F12 (B) | वाउचड उत्पाद उपयोगकर्ताओं को खोजते हैं। अपने यादृच्छिकृत अध्ययन: पात्र उत्पादों में, एक नामित गारंटर को यादृच्छिक रूप से नियुक्त किया गया। 90 दिनों के भीतर दस असंबंधित उपयोगकर्ताओं तक पहुंचने वाले हिस्सा। यह सच साबित हुआ यदि वाउचड हिस्सा अधिक है, 95% अंतराल शून्य को बाहर रखता है। आधार: कोई सार्वजनिक आधार नहीं; अपने यादृच्छिकृत अध्ययन | जांच: 31 दिसंबर 2027। अंतिम तारीख: 31 दिसंबर 2028। p = 0.42; मॉडल 0.43 (0.30 से 0.60)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं है (कभी सफलता के रूप में गिना नहीं जाता)। फॉलबैक: कोई नहीं। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Hashimoto's Vouch (एक तंत्र, भविष्यवाणी नहीं) |
| F13 (A) | कार्य पार करते हैं, रूप रहते हैं। तीन गैर-IT व्यवसायों में पाठ्यक्रम और पोस्ट, कोडिंग से पहले प्रकाशित एक कोडबुक के साथ दो कोडर द्वारा कोडित (predictions/resolve/F13-codebook.md): जांच, मॉडल विकल्प लागत और लंबे समय से सिखाया गया; व्यक्तिगत खर्च और मॉडल शिविर केवल शीर्ष-स्तर के उपयोगकर्ताओं में पाए गए। यह सच साबित हुआ यदि कार्यात्मक विषय स्थिति विषय से कम से कम तीन से एक से अधिक हैं। आधार: कोई सार्वजनिक आधार नहीं; तीन गैर-IT व्यवसायों में पाठ्यक्रम और पोस्ट पर दो कोडर | जांच: 31 दिसंबर 2027. अंतिम तारीख: 30 जून 2028. p = 0.65; मॉडल 0.69 (0.55 से 0.82)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: सार्वजनिक कोर्स सूचियाँ। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Rogers (2003), गोद लेने की परतें (कोई प्राथमिकता दावा नहीं की गई) |
| F14 (B) | दोनों अक्ष अलग रहते हैं। कम से कम 200 लॉग में लॉग क्षितिज और लॉग लाभ के बीच व्यक्ति-स्तरीय Spearman सहसंबंध। यदि सहसंबंध 0.8 या उससे कम है और लाभ, क्षितिज में जोड़ा गया, छह महीने बाद सत्यापित आउटपुट के लिए नमूना-बाहर R² को कम से कम 0.02 से बढ़ाता है तो सत्य है। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं; कम से कम 200 लॉग | जांच: 30 सितंबर 2027. अंतिम तारीख: 30 सितंबर 2028. p = 0.52; मॉडल 0.49 (0.45 से 0.50)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: कोई नहीं। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: कोई नहीं मिला |
| F15 (A) | प्रवेश चरण दिन को स्थानांतरित होता है। सॉफ्टवेयर और तीन अन्य व्यवसायों में 200 US प्रवेश-स्तरीय पोस्टिंग और टेक-होम कार्यों के एक स्थिर नमूने में, माध्य पहला कार्यभार, दो मूल्यांकनकर्ताओं द्वारा संदर्भ घंटों में दर किया गया, दिन पर या उससे ऊपर है। बेसलाइन: 200 US प्रवेश-स्तरीय पोस्टिंग और टेक-होम कार्यों का स्थिर नमूना, दो मूल्यांकनकर्ताओं द्वारा संदर्भ घंटों में दर किया गया | जांच: 31 दिसंबर 2027. अंतिम तारीख: 30 जून 2028. p = 0.40; मॉडल 0.49 (0.30 से 0.70)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: Indeed Hiring Lab प्रवेश-स्तरीय नमूने। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Washington Monthly (2026): "प्रवेश-स्तरीय भूमिकाएँ मध्य-स्तरीय भूमिकाओं की तरह अधिक बन रही हैं"; METR का फिट क्षितिज प्रवृत्ति हर 4.2 महीने में दोगुना होती है |
| F16 (A) | प्रवेश चरण सप्ताह को स्थानांतरित होता है। समान माप; माध्य सप्ताह पर या उससे ऊपर। बेसलाइन: F15 के रूप में | जांच: 31 दिसंबर 2027. अंतिम तारीख: 30 जून 2028. p = 0.10; मॉडल 0.14 (0.06 से 0.40)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: F15 के रूप में। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Kwa et al. (2025), मशीन समय क्षितिज (मशीनें, लोग नहीं) |
| F17 (A) | ग्रेड को प्रत्यायोजित कार्य के माप से प्रतिस्थापित किया गया। 50 सबसे बड़े US नियोक्ताओं में से, जो सार्वजनिक रूप से ग्रेड सीढ़ियों को सत्यापित प्रत्यायोजित कार्य के माप से प्रतिस्थापित करते हैं। यदि कम से कम 10 हों तो सत्य है। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं | जांच: 31 दिसंबर 2028. अंतिम तारीख: 30 जून 2029. p = 0.05; मॉडल 0.05 (0.02 से 0.20)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: नियोक्ता फाइलिंग और प्रेस। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Gartner (2024): 2026 तक, 20% संगठन संरचना को समतल करने के लिए AI का उपयोग करेंगे; Microsoft (2025): "एजेंट बॉस" |
| F17b (A) | ग्रेड प्रतिस्थापित: पहला बड़ा नियोक्ता। 50 सबसे बड़े US नियोक्ताओं में से, कम से कम एक सार्वजनिक रूप से ग्रेड सीढ़ियों को सत्यापित प्रत्यायोजित कार्य के माप से प्रतिस्थापित करता है। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं | जांच: 31 दिसंबर 2028. अंतिम तारीख: 30 जून 2029. p = 0.20; मॉडल 0.21 (0.05 से 0.50)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: नियोक्ता फाइलिंग और प्रेस। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: F17 का कोमल जुड़वाँ |
| F18 (B) | चरण कार्यकाल को हराता है। नियोक्ता या समूह डेटा में, सत्यापित चरण अनुभव के वर्षों की तुलना में वेतन में अधिक विचरण की व्याख्या करता है (दर की गई कार्यक्षमता का उपयोग केवल तब किया जाता है जब वेतन अनुपलब्ध हो, विश्लेषण से पहले तय किया गया हो)। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं | जांच: 31 दिसंबर 2029. अंतिम तारीख: 31 दिसंबर 2030. p = 0.48; मॉडल 0.52 (0.40 से 0.60)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: प्रकाशित HR विश्लेषण। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Jaques (1956), दायित्व के विस्तार के आधार पर वेतन |
| F19 (B) | जांच सीमा निर्धारित करती है (नमूने से बाहर)। कम से कम 200 लॉग। जांच और क्षितिज पर व्यतीत ध्यान का हिस्सा, दोनों महीने 1 से 3 में मापे गए; सत्यापित आउटपुट (संदर्भ घंटों में स्वीकृत टुकड़े, लाभ सूत्र नहीं) महीने 4 से 6 में। यदि आयोजित-बाहर व्यक्तियों में, जांच शेयर के पास बाद के सत्यापित आउटपुट के साथ क्षितिज की तुलना में अधिक आंशिक सहसंबंध हो तो सत्य है। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं | जांच: 30 सितंबर 2027. अंतिम तारीख: 30 सितंबर 2028. p = 0.45; मॉडल 0.44 (0.30 से 0.65)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: कोई नहीं। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Huang et al. (2026), सत्यापन प्रवर्धन। v1 ने लाभ का उपयोग किया, जिसमें निर्माण द्वारा क्षितिज होता है; v2 बाद में, अलग से मापे गए परिणाम की भविष्यवाणी करता है |
| F20 (B) | अनुभवी प्रवर्धित करते हैं। निर्देशात्मक शेयर: एक व्यक्ति के मोड़ों का शेयर जो लॉग से जांच या संपादन के बजाय निर्देश देते हैं। सत्यापित लाभ: व्यक्ति के ध्यान के प्रति घंटे स्वीकृत संदर्भ घंटे। उन लोगों में जिनका निर्देशात्मक शेयर छह महीने में गिरा, महीने 6 पर सत्यापित लाभ महीने-0 मूल्य का कम से कम 95% है अधिकांश के लिए। बेसलाइन: कोई सार्वजनिक बेसलाइन नहीं | जांच: 30 सितंबर 2027. अंतिम तारीख: 30 सितंबर 2028. p = 0.60; मॉडल 0.62 (0.55 से 0.70)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: कोई नहीं। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Anthropic (2026d), सीखने के वक्र |
| F21 (A) | सहयोग धारण करता है। Anthropic आर्थिक सूचकांक के Claude.ai संवाद नमूने में सहयोगी उपयोग (वर्धन) का शेयर, API नमूना नहीं, 2027 में प्रकाशित हर रिपोर्ट में 40% से ऊपर रहता है। बेसलाइन: नवंबर 2025 में स्वचालन के मुकाबले सहयोगी उपयोग 52% (Anthropic, 2026a) | जांच: 31 दिसंबर 2027. अंतिम तारीख: 30 जून 2028. p = 0.67; मॉडल 0.68 (0.60 से 0.75)। अनसुलझा यदि: अंतिम तारीख तक तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: अन्य विक्रेताओं की रिपोर्ट में तुलनीय शेयर। निकटतम पूर्व या प्रतिद्वंद्वी पूर्वानुमान: Anthropic (2026a): नवंबर 2025 में 45% के मुकाबले 52% |
| F22 (A) | उल्लेखनीय उत्पादों का एक तिहाई। 2027 के बारह Product Hunt मासिक लीडरबोर्ड में सबसे अधिक अपवोट वाले 100 उत्पाद, 1 जनवरी 2028 को सूची स्थिर की गई। सूचीबद्ध निर्माताओं को कोडित किया गया है; एक उत्पाद बिना प्रोग्रामिंग शिक्षा के बनाया गया माना जाता है यदि कोई सूचीबद्ध निर्माता प्रोग्रामिंग शिक्षा या एक पिछली प्रोग्रामिंग नौकरी (स्व-सिखाए गए लोग प्रोग्रामिंग नौकरियों के साथ प्रोग्रामर गिने जाते हैं) बताता है। दो कोडर, एक दूसरे से अंधे। यदि कम से कम 30 में से 100 योग्य हों तो सत्य है। बेसलाइन: Manifold: vibe-कोडित सॉफ्टवेयर 100 मिलियन मासिक उपयोगकर्ताओं के साथ 2026 के अंत तक, लगभग 28% | जांच: 31 दिसंबर 2027। अंतिम तारीख: 31 दिसंबर 2028। p = 0.28; models 0.29 (0.14 to 0.50)। अनसुलझा यदि: 100 उत्पादों में से 50 से कम में कोडेबल कथन हो, या अंतिम तारीख तक कोई डेटा न हो (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: दूसरी फ्रोज़न रैंकिंग (Hacker News Show HN top 100 of 2027)। निकटतम पूर्व या विरोधी पूर्वानुमान: Gartner (2021); Manifold: vibe-coded software with 100 million monthly users by end 2026, about 28% |
| F23 (A) | SOC 2028 में कोई अलग व्यवसाय नहीं। 2028 के लिए US मानक व्यावसायिक वर्गीकरण में एजेंटों के माध्यम से निर्देशित कार्य के लिए कोई अलग व्यवसाय नहीं है। आधार: SOC 2018 का ऐसा कोई व्यवसाय नहीं है | जांच: SOC 2028 का प्रकाशन। अंतिम तारीख: 31 दिसंबर 2029। p = 0.92; models 0.93 (0.80 to 0.98)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा न हो (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: BLS संशोधन सूचनाएं (9 अक्टूबर 2026 को जांचा गया: अभी तक कोई प्रस्तावित या अंतिम संरचना नहीं; अंतिम संरचना 2027 में अपेक्षित)। निकटतम पूर्व या विरोधी पूर्वानुमान: कोई नहीं मिला |
| F24 (A) | विज्ञान में पहला किशोर। एक वैज्ञानिक उत्पाद एक सॉफ्टवेयर, एक डेटासेट या एक पेपर है जिसका उपयोग प्रकाशित अनुसंधान में कम से कम दस असंबंधित लोगों द्वारा किया जाता है या कम से कम एक समीक्षा की गई पत्रिका में उद्धृत किया जाता है। 18 साल से कम उम्र के एक व्यक्ति का सार्वजनिक रूप से प्रलेखित मामला बिना औपचारिक प्रशिक्षण के जिसके वैज्ञानिक उत्पाद के ऐसे उपयोगकर्ता हैं और स्वतंत्र जांच के तहत सप्ताह अर्जित करते हैं। आधार: लेखन के समय का कोई ऐसा प्रलेखित मामला नहीं | जांच: 31 दिसंबर 2030। अंतिम तारीख: 31 दिसंबर 2031। p = 0.23; models 0.21 (0.02 to 0.45)। अनसुलझा यदि: केवल यदि खोज स्रोत उपलब्ध नहीं हैं; अंतिम तारीख तक कोई प्रलेखित मामला न होना ने नहीं। फॉलबैक: कोई नहीं। निकटतम पूर्व या विरोधी पूर्वानुमान: चीन का सभी स्कूलों में 2030 तक AI शिक्षा का लक्ष्य (CSET, 2025) |
| F25 (A) | जूनियर शीर्षक पतले। 2025 पर समान प्रश्नों के विरुद्ध 2030 में "junior" या "entry-level" शीर्षक वाले US सॉफ्टवेयर पोस्टिंग का शेयर। सच हो गया यदि कम से कम एक तिहाई तक नीचे हो। आधार: 2025 में "junior" या "entry-level" शीर्षक वाले US सॉफ्टवेयर पोस्टिंग का शेयर, समान प्रश्न | जांच: 2030 डेटा। अंतिम तारीख: 31 दिसंबर 2031। p = 0.55; models 0.54 (0.45 to 0.60)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा न हो (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: Indeed Hiring Lab। निकटतम पूर्व या विरोधी पूर्वानुमान: Manifold: 2030 तक एक तिहाई कम जूनियर डेवलपर भूमिकाएं, about 74%; 2023 से 2028 तक US डेवलपर्स 15% से अधिक कम, about 42%; market 0.74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9 अक्टूबर 2026 (junior SWE openings 1 जनवरी 2030 तक कम से कम 33% कम; एक संबंधित, समान नहीं, उपाय)) |
| F26 (B) | नियोजन अभ्यास अनुसरण करता है। स्वयं के ऑडिट अध्ययन: सत्यापित कार्य की मिलान पोर्टफोलियो जो केवल IT शिक्षा में भिन्न होती हैं, दो गैर-IT डोमेन में वास्तविक पोस्टिंग को भेजी गई हैं। सच हो गया यदि कॉलबैक दरें 3 अंकों से कम से भिन्न हों, 95% अंतराल प्लस या माइनस 5 के अंदर। आधार: कोई सार्वजनिक आधार नहीं; स्वयं के ऑडिट अध्ययन | जांच: 31 दिसंबर 2028। अंतिम तारीख: 31 दिसंबर 2029। p = 0.35; models 0.32 (0.25 to 0.35)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा न हो, या एक अंतराल जो किसी भी नियम को पूरा न करता हो (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: कोई नहीं। निकटतम पूर्व या विरोधी पूर्वानुमान: Burning Glass Institute and Harvard Business School (2024): 700 में एक से कम नियोजन परिवर्तित |
| F27 (A) | एजेंट-निर्मित उत्पाद Gartner के पूर्वानुमान को पार करते हैं। कम से कम 300 सार्वजनिक उत्पादों का एक नमूना मुख्य रूप से कोडिंग एजेंटों के साथ निर्मित, अक्टूबर से दिसंबर 2026 में लॉन्च, 31 दिसंबर 2026 तक Zenodo पर फ्रोज़न; साथी स्क्रिप्ट द्वारा लाइवनेस जांच की गई। सच हो गया यदि 31 दिसंबर 2028 को 50% से कम सेवानिवृत्त हों (अप्राप्य या 12 महीने के लिए अपडेट न किए गए)। आधार: Gartner (Tyagi, 2026): 2028 तक 60% vibe-coded applications सेवानिवृत्त | जांच: 31 दिसंबर 2028। अंतिम तारीख: 31 मार्च 2029। p = 0.32; models 0.35 (0.20 to 0.55)। अनसुलझा यदि: नमूना 31 दिसंबर 2026 तक फ्रोज़न नहीं था (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: प्रत्येक उत्पाद की Wayback Machine स्नैपशॉट। निकटतम पूर्व या विरोधी पूर्वानुमान: Gartner (Tyagi, 2026): 60% सेवानिवृत्त |
| F28 (A) | मशीनें 80% पर दिन तक पहुंचती हैं। METR का सर्वश्रेष्ठ सार्वजनिक रूप से जारी मॉडल के लिए 80% समय क्षितिज 31 दिसंबर 2027 तक 8 घंटे (दिन) तक पहुंचता है। आधार: अप्रैल 2026 में 80% पर लगभग 3.1 घंटे (METR, 2026c; डैशबोर्ड 8 सितंबर 2026 के बाद अपडेट नहीं किया गया) | जांच: 31 दिसंबर 2027। अंतिम तारीख: 30 जून 2028। p = 0.80; models 0.66 (0.55 to 0.80)। अनसुलझा यदि: न तो METR और न ही फॉलबैक अंतिम तारीख तक 80% क्षितिज की रिपोर्ट करता है (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: METR की विधि की एक स्वतंत्र प्रतिकृति (उदाहरण के लिए Epoch AI)। निकटतम पूर्व या विरोधी पूर्वानुमान: METR का सज्जित क्षितिज प्रवृत्ति लगभग हर 4.2 महीने में दोगुना |
| F28b (A) | मशीनें 80% पर सप्ताह तक पहुंचती हैं। F28 के रूप में, threshold 40 घंटे (सप्ताह)। आधार: F28 के रूप में | जांच: 31 दिसंबर 2027। अंतिम तारीख: 30 जून 2028। p = 0.30; models 0.20 (0.10 to 0.55)। अनसुलझा यदि: F28 के रूप में। फॉलबैक: F28 के रूप में। निकटतम पूर्व या विरोधी पूर्वानुमान: F28 के रूप में |
| F29 (A) | कम नए कंप्यूटर विज्ञान प्रमुख। 2028 में प्रकाशित CRA Taulbee सर्वेक्षण द्वारा रिपोर्ट किए गए नए स्नातक प्रमुख कंप्यूटर विज्ञान में (शैक्षणिक वर्ष 2027 से 2028) 2026 में प्रकाशित सर्वेक्षण के विरुद्ध। आधार: 2026 में प्रकाशित CRA Taulbee सर्वेक्षण | जांच: Taulbee रिपोर्ट 2028। अंतिम तारीख: 31 दिसंबर 2028। p = 0.69; models 0.67 (0.50 to 0.75)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा न हो (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: NSC Research Center प्रमुख द्वारा नामांकन। निकटतम पूर्व या विरोधी पूर्वानुमान: CRA 2025 और 2026 में गिरते हुए CS नामांकन की रिपोर्ट |
| F30 (A) | सार्वजनिक प्रतिबद्ध में एजेंट सह-लेखक। GH Archive में सार्वजनिक पुश इवेंट का शेयर जिसकी प्रतिबद्ध संदेशें एजेंट सह-लेखक ट्रेलर ले जाते हैं (predictions/resolve/F30.md में फ्रोज़न नियमित अभिव्यक्तियां), सितंबर 2027 विरुद्ध सितंबर 2026। आधार: GH Archive, सितंबर 2026, पंजीकरण से पहले मापा और संग्रहीत | जांच: 31 अक्टूबर 2027। अंतिम तारीख: 31 दिसंबर 2027। p = 0.55; models 0.59 (0.40 to 0.75)। अनसुलझा यदि: अंतिम तारीख तक कोई तुलनीय डेटा न हो (कभी सफलता के रूप में नहीं गिना)। फॉलबैक: GitHub Innovation Graph। निकटतम पूर्व या विरोधी पूर्वानुमान: कोई नहीं मिला |
| F31 (A) | बिल्डर शीर्षक एजेंट प्रबंधक शीर्षक को हराते हैं। US पोस्टिंग, फ्रोज़न Indeed प्रश्न (predictions/resolve/F31.md), Q4 2027: बिल्डर परिवार के शीर्षक एजेंट प्रबंधक परिवार के विरुद्ध। आधार: समान प्रश्नों पर Q4 2026 में गिनती | जांच: 31 दिसंबर 2027। अंतिम तारीख: 30 जून 2028। p = 0.60; मॉडल 0.63 (0.50 से 0.74)। अनुत्तरित यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: एक ही प्रश्नों के साथ LinkedIn खोज गणना। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: श्रीनिवासन और वेई (2026): "agent manager" 12 से 18 महीनों के भीतर एक मानक शीर्षक |
| F32 (A) | एक विक्रेता कहता है कि इसके कोडिंग एजेंट के अधिकांश उपयोगकर्ता डेवलपर नहीं हैं। Anthropic, OpenAI, Google या GitHub द्वारा बनाया गया एक कोडिंग एजेंट का विक्रेता सार्वजनिक रूप से रिपोर्ट करता है कि जो लोग सॉफ्टवेयर डेवलपर नहीं हैं, वे उस एजेंट के साप्ताहिक उपयोगकर्ताओं का बहुमत हैं। आधार रेखा: लेखन के समय कोई ऐसी रिपोर्ट नहीं | जांच: 31 दिसंबर 2027। अंतिम तारीख: 31 मार्च 2028। p = 0.40; मॉडल 0.31 (0.13 से 0.70)। अनुत्तरित यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: विक्रेता आर्थिक या उपयोग रिपोर्ट। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: ऐप-बिल्डर विक्रेता (Lovable, Replit) पहले से ही ज्यादातर गैर-डेवलपर उपयोगकर्ताओं का वर्णन करते हैं; यह सामान्य कोडिंग एजेंटों से इसे पूछता है |
| F33 (A) | मशीन सुरक्षा तल कम रहता है। AI-जनित कोड नमूनों का हिस्सा जो Veracode के GenAI कोड सुरक्षा रिपोर्ट में सुरक्षा परीक्षण पास करते हैं। आधार रेखा: 56% पास दर, रुकी हुई (Veracode, 2026) | जांच: Veracode रिपोर्ट 2028। अंतिम तारीख: 31 दिसंबर 2028। p = 0.70; मॉडल 0.67 (0.57 से 0.80)। अनुत्तरित यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: जनित कोड में सुरक्षा की एक तुलनीय स्वतंत्र बेंचमार्क। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Veracode: नए मॉडल के साथ सुरक्षा में कोई सुधार नहीं |
| F34 (B) | संदर्भ घंटे पुनरुत्पादन योग्य हैं। तीन रेटर्स के दो स्वतंत्र पैनल समान 50 कार्यों के लिए संदर्भ घंटों का अनुमान लगाते हैं; लॉग घंटों की इंट्राक्लास सहसंबंध (दो-तरफा, पूर्ण समझौता)। आधार रेखा: सीमाओं की डेस्क पायलट (परिशिष्ट E) | जांच: 30 जून 2027। अंतिम तारीख: 31 दिसंबर 2027। p = 0.65; मॉडल 0.65 (0.40 से 0.75)। अनुत्तरित यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं, या एक अंतराल जो किसी भी नियम को पूरा नहीं करता (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: कोई नहीं। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: METR की मानव आधार रेखाएं (मशीनें, लोग नहीं) |
| F35 (B) | क्षितिज बाद के आउटपुट की भविष्यवाणी करता है। कम से कम 200 लॉग: महीने 0 पर क्षितिज कार्यकाल और IT शिक्षा के लिए जोड़ा गया महीनों 4 से 6 में सत्यापित आउटपुट के लिए नमूना बाहर R वर्गीकृत बढ़ाता है। आधार रेखा: कोई सार्वजनिक आधार रेखा नहीं | जांच: 30 सितंबर 2027। अंतिम तारीख: 30 सितंबर 2028। p = 0.60; मॉडल 0.58 (0.45 से 0.70)। अनुत्तरित यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: कोई नहीं। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: Burning Glass Institute और Harvard Business School (2024) |
| F36 (A) | प्लेटफॉर्म सत्यापित निर्माताओं को बैज करते हैं। कम से कम Upwork, Fiverr, GitHub, Product Hunt, Toptal और Contra में से दो एक सार्वजनिक बैज या प्रोफ़ाइल फील्ड पेश करते हैं जो स्वतंत्र रूप से सत्यापित AI-निर्मित कार्य को प्रमाणित करता है (कौशल प्रश्नोत्तरी नहीं)। आधार रेखा: लेखन के समय कोई ऐसा बैज नहीं | जांच: 31 दिसंबर 2027। अंतिम तारीख: 31 मार्च 2028। p = 0.23; मॉडल 0.24 (0.07 से 0.70)। अनुत्तरित यदि: अंतिम तारीख तक कोई तुलनीय डेटा नहीं (कभी सफलता के रूप में नहीं गिना जाता)। फॉलबैक: प्लेटफॉर्म सहायता पृष्ठ और संग्रहीत घोषणाएं। निकटतम पूर्व या प्रतिकूल पूर्वानुमान: कोई नहीं मिला |
नोट: सेट A सार्वजनिक डेटा से संबंधित है; सेट B अलग से पूर्व-पंजीकृत अध्ययन से (30 जून 2027 तक प्रोटोकॉल, अन्यथा आयोजित नहीं, जिसे स्कोरकार्ड परीक्षण कार्यक्रम की विफलता के रूप में गिना जाता है)। p संकल्प पर सशर्त है। मॉडल: स्वतंत्र मॉडल पूर्वानुमानकर्ताओं की बाधाओं का ज्यामितीय माध्य जिन्होंने मेरी संख्याएं नहीं देखीं, उनकी सीमा के साथ; व्यक्तिगत पूर्वानुमान predictions/m2-probabilities.csv में। Came-true और did-not नियम हर पंक्ति के लिए predictions/predictions.csv में हैं। पंक्तियों F4a और F4b में Gartner पूर्वानुमान को संदर्भ सूची के अनुसार उद्धृत किया जाता है जैसा कि Tray.ai (2026) द्वारा सारांश द्वारा, अपने स्वयं के शब्दों के साथ उद्धृत; पंजीकृत फाइल समान पूर्वानुमान और अधिक संक्षिप्त समान संख्याएं देता है और Gartner (Tyagi, 2026) का हवाला देता है।
परिशिष्ट E. थ्रेसहोल्ड की डेस्क टेस्ट
यह परिशिष्ट अनुभाग 5.2 के नियमों की डेस्क टेस्ट की रिपोर्ट करता है, जो 9 अक्टूबर 2026 को सिमुलेशन और मॉडल रेटर के साथ चलाई गई थी, और अगले संस्करण को ठीक करने वाली कैलिब्रेशन प्रोटोकॉल को निर्धारित करता है। प्रत्येक संख्या साथी रिपॉजिटरी में दो स्क्रिप्ट द्वारा उत्पन्न की जाती है (pilot/), जो परिशिष्ट C के स्कोरर को अपरिवर्तित रूप से कॉल करते हैं और केवल इसके स्थिरांक को स्वैप करते हैं।
E1. एक रंग कितनी बार अर्जित होता है
एक व्यक्ति के लिए जिसके टुकड़े स्वतंत्र रूप से सच्ची संभावना p के साथ पास होते हैं, तालिका E1 विंडो में टुकड़ों की न्यूनतम संख्या के साथ प्रत्येक रंग को अर्जित करने की संभावना देती है। मान सटीक द्विपद संभावनाएं हैं; horizon.py के माध्यम से एक मोंटे कार्लो रन, विंडो में टुकड़े फैलाए गए, रोपित त्रुटि और हाल के टुकड़े के साथ, 0.01 के भीतर सहमत है।
तालिका E1. सच्ची पास दर द्वारा रंग अर्जित करने की संभावना।
| नियम | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| घंटा और दिन, 91 दिनों में 10 में से 8 | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| सप्ताह, 182 दिनों में 6 में से 5 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| महीना, पहला संस्करण, 365 दिनों में 4 में से 4 | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| महीना, वर्तमान, 365 दिनों में 6 में से 5 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| त्रैमासिक, 365 दिनों में 3 में से 3 | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
नोट: नियम एक योग्यता नियम है। ये संभावनाएं नियम का वर्णन करती हैं, किसी व्यक्ति का नहीं।
तीन निष्कर्ष अनुसरण करते हैं। प्रथम, पहला संस्करण व्यवस्थित नहीं था: महीना, चार में से चार पर, प्रत्येक p पर त्रैमासिक की तुलना में अर्जित करना कठिन था। पाँच में से चार की गिनती ने त्रुटि को उलट दिया होता, p = 0.8 पर महीना को दिन और सप्ताह की तुलना में आसान बना दिया होता (0.74), इसलिए महीना अब एक वर्ष में छह में से पाँच माँगता है, लगभग 960 संदर्भ घंटे के बजाय 640। इसके साथ, दिन, सप्ताह, महीना और त्रैमासिक 0.77 और ऊपर के प्रत्येक p के लिए आसान से सबसे कठिन तक क्रमबद्ध होते हैं, वह सीमा जहाँ योग्यता महत्वपूर्ण है। 0.76 के नीचे सप्ताह दिन की तुलना में थोड़ा आसान है (p = 0.7 पर 0.42 बनाम 0.38)। दोनों को तब अधिकांश समय अस्वीकार किया जाता है, और यह रिपोर्ट किया जाता है और अपरिवर्तित छोड़ा जाता है। तीन या अधिक टुकड़ों की कोई भी गिनती प्रत्येक p पर तीन में से तीन के विरुद्ध क्रमबद्ध नहीं की जा सकती, क्योंकि वक्र पार हो जाते हैं। दूसरा, एक निर्णय शोर वाला है: p = 0.8 पर समान निर्णय अगली विंडो में दिन पर विंडो के 56%, सप्ताह और महीना पर 55% और त्रैमासिक पर 50% के लिए दोहराया जाता है। इसलिए रिकॉर्ड रंग के आगे गिनती को प्रिंट करता है ("दिन (8/10)"), और एक रिपोर्ट एक रंग को स्थिर के रूप में चिह्नित कर सकती है जब यह पिछली विंडो में भी रहता था। p = 0.8 पर एक दिन जो दो विंडो में चल रहा है वह 46% मामलों में होता है, इसलिए स्थिरता एक आवश्यकता नहीं, एक लेबल है। तीसरा, एक विश्वसनीय व्यक्ति अभी भी चूक सकता है: p = 0.95 पर त्रैमासिक वर्षों के 14% में चूक जाता है, जो एक रंग की कीमत है जो तीन टुकड़ों पर टिका है।
चित्र A2, पैनल A, नियम v1.1 के लिए इन संभावनाओं को p के विरुद्ध प्लॉट करता है।
E2. गिनती और शेयर के प्रति संवेदनशीलता
पत्र ने रिपोर्ट करने का वचन दिया था कि जब गिनती दस से आठ या बारह तक चली जाती है और शेयर 0.8 से 0.7 या 0.9 तक कितने लोग रंग बदलते हैं। उत्तर दिन पर 10,000 सिमुलेटेड लॉग के लिए दिया गया है, प्रत्येक में विंडो में दिन आकार के 6 से 16 टुकड़े हैं और सच्ची पास दर 0.5 और 1.0 के बीच समान रूप से तैयार की गई है। वर्तमान नियम (दस, 0.8) दिन को 30% को देता है, और तालिका E2 उन नियमों के तहत शेयर देती है जिनका निर्णय दस टुकड़े और 0.8 के शेयर के विरुद्ध बदलता है।
तालिका E2. सिमुलेटेड लॉग का शेयर जिसका दिन निर्णय दस टुकड़े और 0.8 के शेयर के विरुद्ध बदलता है।
| न्यूनतम गिनती | शेयर 0.7 | शेयर 0.8 | शेयर 0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
नोट: लॉग की आबादी सिमुलेशन की एक धारणा है। E5 के क्षेत्र अध्ययन वास्तविक लॉग पर इस विश्लेषण को दोहराता है।
एक स्थिर को एक कदम स्थानांतरित करने से लगभग दस में से एक निर्णय बदलता है। दोनों को स्थानांतरित करने से पाँच में से एक तक बदलता है। शेयर की गिनती से अधिक महत्वता है।
E3. एक रंग के किनारे पर रेटर शोर
यदि दो रेटर निष्पक्ष हैं और उनके जोड़ी के 80% 1.5 के अनुपात के भीतर आते हैं, अनुभाग 5.8 में 70% के मानदंड के ऊपर, और संदर्भ उनके दो अनुमानों का ज्यामितीय माध्य है, तो एक टुकड़ा जिसका सच्चा आकार 7 संदर्भ घंटे है, 20% समय दिन आकार पर स्कोर किया जाता है, और 9 घंटे का एक टुकड़ा 23% समय दिन आकार से कम पड़ता है। यह कारण है कि रिकॉर्ड रंग के आगे स्वीकृत आकार का माध्यिका रिपोर्ट करता है (तालिका 3): एक दिगंत जो एक थ्रेसहोल्ड के ठीक ऊपर के टुकड़ों पर निर्मित है, दिखाता है।
E4. संदर्भ घंटों के मॉडल रेटर
चार परिवारों से चार भाषा मॉडल (Anthropic, OpenAI, Google और Moonshot), प्रत्येक अकेले काम कर रहे हैं और एक दूसरे और किसी भी प्रकाशित समय के अंधे, 9 अक्टूबर 2026 को 44 कार्यों के संदर्भ घंटों का अनुमान लगाया गया है। तीस तीन कम जोखिम वाले डोमेन में एक नई बैंक के कार्य थे (छोटे व्यवसाय के लेखांकन, छोटे आंतरिक वेब उपकरण, कानूनी और विपणन दस्तावेज), प्रत्येक के साथ एक लिखित कथन किया गया और एक छिपा हुआ चेक। चौदह METR के समय-क्षितिज डेटा से सार्वजनिक कार्य थे (METR, 2026d) केवल उनके सार्वजनिक पहचानकर्ता द्वारा 12 मिनट से 14.6 घंटे तक मापा गया मानव आधारभूत समय के साथ रेटर को दिया गया। तालिका E3 परिणाम देती है।
तालिका E3. चार अंधे मॉडल रेटर की सहमति और सटीकता।
| माप | 30 कार्यों की बैंक (पूरा होने का कथन) | 14 कार्य मापा गए समय के साथ (केवल पहचानकर्ता) |
|---|---|---|
| 1.5 के अनुपात के भीतर अनुमान के जोड़ी (रेटर के 6 जोड़ी) | 62% (जोड़ी द्वारा 27% से 97% तक) | 35% |
| अंतर-वर्ग सहसंबंध ICC(2,1), लॉग घंटे | 0.89 | 0.60 |
| सभी चार रेटर कार्य को एक ही रंग आकार पर रखते हैं | 60% | 36% |
| माप किए गए समय के 1.5 के भीतर चार का अर्थ | मापा नहीं गया | 21% (14 में से 3) |
| माप किए गए समय के 2 के भीतर चार का अर्थ | मापा नहीं गया | 43% (14 में से 6) |
नोट: मॉडल रेटर्स खंड 5.1 के दोनों मानव रेटर्स की जगह लेते हैं और उनके बारे में कोई सबूत नहीं हैं।
कार्य पूर्ण होने का पूरा विवरण दिए जाने पर, मॉडल्स इस बात पर सहमत थे कि कौन से कार्य बड़े थे, लेकिन स्तर पर नहीं: बैंक पर एक रेटर के अनुमानों का ज्यामितीय माध्य 5.1 घंटे था और दूसरे का 10.4 घंटे। इस तरह का एक निश्चित ऑफसेट सबसे सस्ती त्रुटि है जिसे हटाया जा सकता है, जो यह है कि क्षेत्र अध्ययन में रेटर्स पहले मापे गए समय वाले कार्यों पर कैलिब्रेशन करते हैं। केवल एक पहचानकर्ता दिए जाने पर, अनुमान कम उपयोगी थे, जो मापे गए हाथ से किए गए समय वाले फ्रोजन बैंक (खंड 5.1) को शीर्षक से बनाए गए अनुमानों पर समर्थन देता है। तालिका 3 के नियम के तहत, जहां 1.5 से अधिक की असहमति एक टुकड़े को एक तीसरे रेटर के पास भेजती है, दो ऐसे रेटर्स दस में से लगभग चार टुकड़ों को एक तीसरे के पास भेजते हैं।
चित्र A2। डेस्क पर रंग का नियम: एक रंग अर्जित करने की संभावना, और मॉडल रेटर्स कितनी अच्छी तरह घंटों पर सहमत हैं।
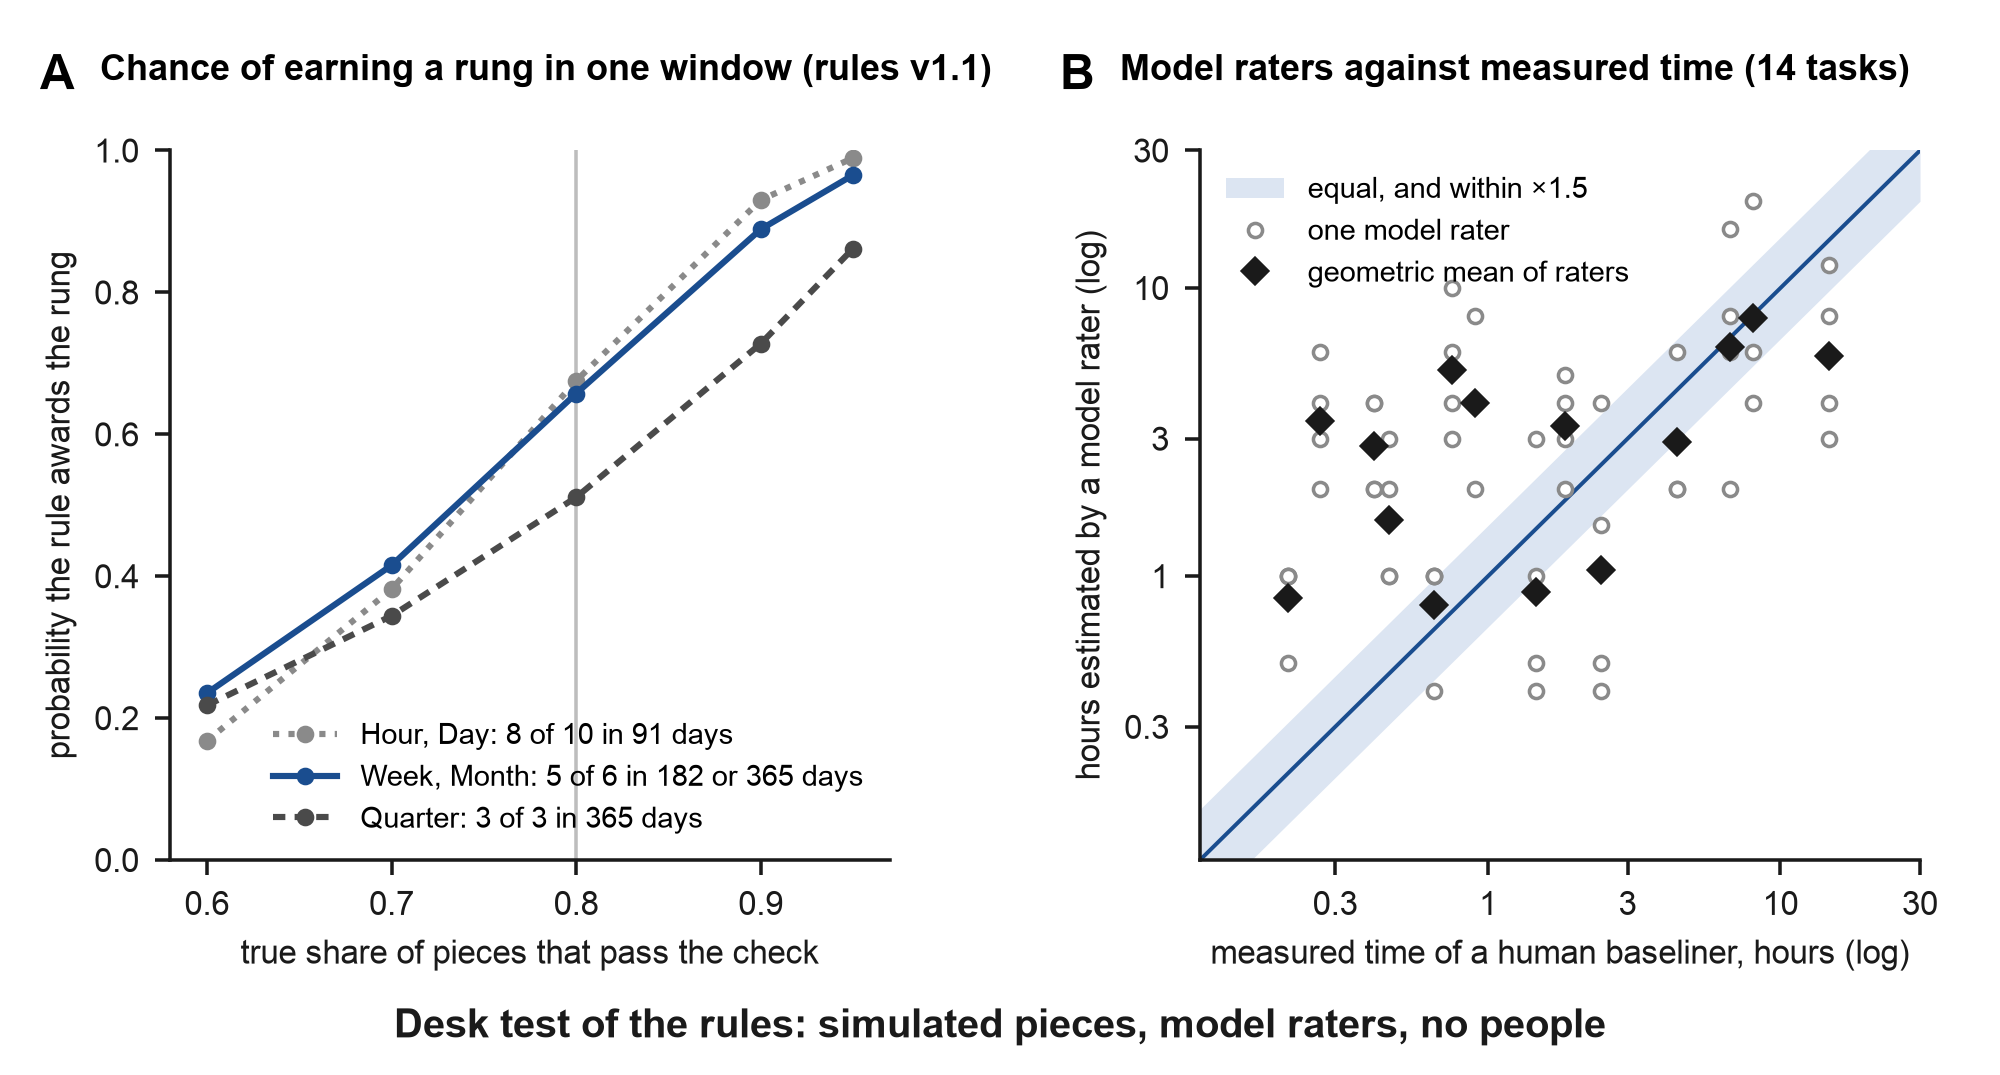
नोट: अनुकरणीय टुकड़ों और मॉडल रेटर्स के साथ एक डेस्क परीक्षण। पैनल A नियमों v1.1 के तहत प्रत्येक रंग के लिए, इस संभावना को देता है कि नियम एक विंडो में रंग देता है जब प्रत्येक टुकड़ा क्षैतिज अक्ष पर साझे के साथ स्वतंत्र रूप से अपनी जांच पास करता है। समान संख्या और समान संख्या वाले पास वाले रंग एक ही वक्र का पालन करते हैं। पैनल B संदर्भ घंटे सेट करता है जो चार मॉडल रेटर्स, प्रत्येक एक अलग परिवार का, 14 कार्यों के लिए अनुमानित करते हैं जो एक मानव बेसलाइनर (METR के कार्य डेटा) के लिए मापे जाते हैं। बैंड 1.5 के कारक के भीतर समझौते को चिह्नित करता है। डेस्क परीक्षण जिसने दोनों पैनल का उत्पादन किया वह इस परिशिष्ट में वर्णित है, और इसका कोड और आउटपुट साथी भंडार में हैं।
E5. कैलिब्रेशन प्रोटोकॉल
प्रोटोकॉल और पंजीकरण पाठ साथी भंडार में हैं (pilot/pilot-protocol.md, pilot/preregistration-draft.md)। संक्षेप में, 60 वयस्क भाग लेते हैं, 30 सॉफ्टवेयर पृष्ठभूमि के साथ और 30 के बिना, बैंक के तीन डोमेन में, 91 दिनों की दो विंडो पर। सभी एक ही एजेंट उपकरण का उपयोग करते हैं, संस्करणों को लॉग किया जाता है, और जांचें छिपी हुई परीक्षाएं या दो अंधे डोमेन समीक्षक हैं। हाथ से किए गए समय बैंक के कार्यों के एक पांचवें हिस्से पर मापे जाते हैं, प्रत्येक हस्तांतरण को इसकी शुरुआत की तारीख के साथ लॉग किया जाता है, और स्वीकृत टुकड़ों के एक यादृच्छिक दसवें हिस्से का ऑडिट किया जाता है। मानदंड डेटा से पहले निर्धारित किए जाते हैं: 1.5 के भीतर मानव अनुमानों के कम से कम 70% जोड़े, मापे गए वाले 1.5 के भीतर कम से कम 60% अनुमानित घंटे, दो विंडो पर रंग की दोहराव कम से कम 0.6 के भारित कप्पा के साथ, नए कार्यों को पास करने की भविष्यवाणी कम से कम 0.7 के AUC के साथ, 5% से कम लॉग लाइनें खोई हुई हैं, और कम से कम 95% विफल हस्तांतरण दर्ज किए गए हैं। सहमति फॉर्म केवल इस अध्ययन के लिए लिखा गया है और कोई अन्य सहमति का पुनः उपयोग नहीं करता। महीना और त्रैमासिक, अपरिवर्तनीय कार्य और उच्च-जोखिम डोमेन इस छह महीने के क्षेत्र अध्ययन के बाहर हैं।
E6. डेस्क परीक्षण क्या तय करता है और आगे क्या आता है
यह दिखाता है कि ज्ञात विश्वसनीयता वाले व्यक्ति के लिए नियम कैसे व्यवहार करते हैं, जहां वे असंगत थे (एक असंगति अब ठीक की गई है), एक निर्णय दो स्थिरांकों के प्रति कितना संवेदनशील है, और मॉडल रेटर्स कार्यों को सामंजस्यपूर्ण रूप से आदेश देते हैं लेकिन स्तर में असहमत हैं। E5 का कैलिब्रेशन प्रोटोकॉल एक डेस्क परीक्षण छोड़ता है: कैसे वे नियमों के तहत व्यवहार करते हैं, चाहे एक रंग वास्तविक व्यक्ति के लिए दोहराता है, और क्या यह नए कार्य की भविष्यवाणी करता है; मानव रेटर्स के बीच समझौते का पहले परीक्षण किया जाता है (परिशिष्ट G)। दहलीजें इसलिए नियम v1.1 के रूप में डेस्क-परीक्षण की जाती हैं, और कैलिब्रेशन अध्ययन अगला संस्करण सेट करता है।
पुनरुत्पादित करने के लिए: python3 pilot/simulate_rules.py और python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 या बाद में, मानक पुस्तकालय केवल; seed 20261009)।
परिशिष्ट एफ. अनुपूरक तालिकाएँ और आँकड़े
A1, A2 और इसी तरह संख्या वाली वस्तुएँ परिशिष्ट वस्तुएँ हैं। उन्हें प्रत्येक नोट में दिए गए खंडों से उद्धृत किया गया है।
तालिका A1. अभिसरण के संकेत, 2025 से अक्टूबर 2026।
| संकेत | स्रोत और तारीख | यह क्या दर्शाता है | यह क्या दर्शाता नहीं है |
|---|---|---|---|
| डेवलपर का कार्य प्रतिनिधिमंडन और सत्यापन के रूप में वर्णित | GitHub, 8 दिसंबर 2025 | विक्रेता के खाते में भूमिका परिवर्तित हो गई है | कि डेवलपर्स के स्तर को इस तरह मापा जाता है |
| कोडिंग एजेंट के अंदर गैर-डेवलपर्स 137 गुना (व्यक्तियों) और 189 गुना (संगठनों) बढ़े | OpenAI, जून 2026 | कम आधार से तेजी से वृद्धि; नमूना किए गए एक चौथाई उपयोगकर्ताओं ने कम से कम एक अनुरोध किया जिसका अनुमान 8 घंटे से अधिक है | उनके परिणामों की गुणवत्ता; विक्रेता डेटा |
| कोड-उत्पादक सत्रों पर सत्यापित सफलता में प्रोग्रामिंग व्यवसायों के 7 अंकों के भीतर दस सबसे बड़े व्यवसाय | Anthropic, 16 जून 2026 | व्यवसायों के बीच छोटा अंतर; सफलता परीक्षणों या प्रतिबद्धताओं जैसे साक्ष्य द्वारा समर्थित है; विशेषज्ञता को व्यवहार द्वारा आंका जाता है | शिक्षा (व्यवसाय डिग्री नहीं है); शिप किए गए उत्पादों की गुणवत्ता |
| वकील अपने स्वयं के उपकरण निर्माण कर रहे हैं; व्यापक AI पहुँच 83% बनाम 61% | Bloomberg Law, 20 अप्रैल 2026 | डोमेन विशेषज्ञ निर्माण कर रहे हैं, खरीद नहीं रहे | वे उपकरण कितने समय तक बनाए रखते हैं |
| लगभग 181,500 कर्मचारियों के लिए सीढ़ी का नाम बदला गया | Business Insider और Fortune, 22 जनवरी 2026 | नियोक्ता शीर्षकों को बदल रहे हैं | एक नया माप (आंतरिक स्तर रखे गए) |
| "फ्रंटियर प्रोफेशनल्स": 20,000 AI उपयोगकर्ताओं में से 3,233 | Microsoft, 5 मई 2026 | उन्नत उपयोगकर्ताओं का एक सर्वेक्षण खंड | एक भूमिका या एक ग्रेड |
| 2025 में एजेंटिक AI का उल्लेख करने वाली 16,541 पोस्टिंग (2024 में 151) | Stanford AI Index 2026 | पोस्टिंग में कौशल की माँग | नए व्यवसाय |
| प्रविष्टि स्तर की नियुक्ति समग्र से अधिक कम हुई | LinkedIn Economic Graph, अगस्त 2026 | मध्य-2026 में एक कमजोर प्रविष्टि रंग | कि AI ने इसका कारण बना (LinkedIn अर्थव्यवस्था की ओर इशारा करता है) |
| PhD-प्रदान करने वाले विभागों में नए CS प्रमुख 13% कम हुए | CRA Taulbee, जून 2026 | प्रतिक्रिया दे रहे छात्र | एक दीर्घकालीन प्रवृत्ति; सभी संस्थान |
| Q2 2026 में साक्षात्कारों के 4.54% में AI उपयोग पर चर्चा की गई (Q3 2025 में 0.33%) | Metaview, 2026 | प्रश्न भर्ती में प्रवेश कर गया है | उत्तर के लिए एक पैमाना |
नोट: विक्रेता डेटा को ऐसे चिह्नित किया गया है। पुरानी तुलनाएँ (2019 या 2022 के साथ) नियम द्वारा छोड़ी गई हैं (खंड 1)।
तालिका A2. 9 अक्टूबर 2026 को परत द्वारा परिसंचरण में नाम और प्रस्तावित नाम। भाग 1: उपयोग में नाम, उनके मालिक और स्थिति के साथ। भाग 2: इस अध्ययन में प्रस्तावित नाम, सादा विवरण, और विचार किए गए रूप।
| परत | उम्मीदवार | परिचय, और कब (भाग 1) | जिस अर्थ में इसका उपयोग किया जाता है | के लिए | के विरुद्ध |
|---|---|---|---|---|---|
| भाग 1 | |||||
| बड़े पैमाने पर कौशल | builder, Full Stack Builder | LinkedIn, दिसंबर 2025 (रिपोर्ट किया गया); "हर कोई अब निर्माता है" (SF Standard, 2026) | कोई भी जो निर्माण करता है, किसी भी कार्य से | पहले से ही HR में जीत रहा है | स्तर के बारे में कुछ नहीं कहता |
| बड़े पैमाने पर कौशल | vibe coding, vibe coder | Karpathy, 2 फरवरी 2025 | कोड पढ़े बिना निर्माण करना | व्यापक रूप से ज्ञात | मजाक; फर्श का नाम रखता है |
| बड़े पैमाने पर कौशल | AI fluency (four Ds) | Anthropic, 2025b | प्रतिनिधिमंडन, विवरण, विवेक, परिश्रम | जमीन को कवर करता है | स्तरों के बिना दक्षताएँ |
| बड़े पैमाने पर कौशल | agent literacy | MindStudio, 11 जून 2026 | प्रतिनिधिमंडन, जाँच, प्रबंधन | अर्थ में करीब | लिया गया; सबूत का कोई मानक नहीं |
| पेशा | agentic engineer | Karpathy, फरवरी 2026; Alenezi, जून 2026 | एक इंजीनियर जो एजेंटों को निर्देशित करता है | इंजीनियरों का 2026 का शब्द | इंजीनियरिंग से जुड़ा |
| पेशा | agent boss | Microsoft, 23 अप्रैल 2025 | हर कर्मचारी जो एजेंटों का प्रबंधन करता है | यादगार | एक नारा बिना माप के |
| पेशा | agent manager | Arion Research, 7 फरवरी 2026; Srinivasan और Wei, Harvard Business Review, 12 फरवरी 2026 | एक भूमिका जो एक टीम में एजेंटों को चलाती है | एक मुख्य दावेदार के रूप में रिपोर्ट किया गया (aicodex, 2026); इसके लेखक इसे 12 से 18 महीनों के भीतर एक मानक शीर्षक बनने की अपेक्षा करते हैं | एक क्षैतिज प्रबंधक का शीर्षक (खंड 6.3) |
| पेशा | AI Agent Owner; AI Agent Supervisor | Writer, 2026; Digg discussion, 2026 | एक व्यक्ति जो एक तैनात एजेंट के लिए जवाबदेह है | स्वामित्व का नाम रखता है | एक एकल विक्रेता या मंच का उपयोग |
| पेशा | AI orchestrator | St. Lawrence, 2024 सेमिनार और 2025 की किताब; फरवरी 2026 में 739 पोस्टिंग (IT Brew, 2026) | एक व्यावसायिक पेशेवर जो AI का समन्वय करता है | पोस्टिंग में | कई बार लिया गया; क्षैतिज |
| पेशा | AI Operator | Dust, 7 अक्टूबर 2026 | साझा एजेंट वर्कफ़्लो बनाता है और बनाए रखता है | परिचित | कंसोल की तरह लगता है; Anthropic में एक "operator" एक कंपनी है जो API पर निर्माण कर रही है (Anthropic, 2026b) |
| पेशा | AI steward, AI work architect | Ono, World Economic Forum, 22 जून 2026 | एक AI कार्य की सीमा निर्धारित करता है, दूसरा परिणामों की जाँच करता है | अर्थ में सबसे करीबी पूर्ववर्ती | दो भूमिकाएँ, कोई माप नहीं |
| पेशा | product creator | Cagan, SVPG, 2025 | एक व्यक्ति जो एक उत्पाद को विचार से बाजार तक ले जाता है | उत्पाद भाषा | लिया गया; कोई माप नहीं |
| पेशा | Product Principal | O'Neill, LinkedIn post, 2026 | एजेंटों के लिए लक्ष्य निर्धारित करता है, परिणाम को स्वीकार करता है और उत्तर देता है | लगभग इस पेपर का अर्थ | उस अर्थ में लिया गया; पूर्वनिर्धारित के रूप में उद्धृत करें |
| पेशा | Principal Agentic Context Engineer | Job title collected by Turkovic, 24 अप्रैल 2026 | एजेंट कार्य में एक वरिष्ठता ग्रेड | दर्शाता है कि "principal" पहले से ही एक ग्रेड के रूप में उपयोग किया गया है | ग्रेड, पेशा नहीं |
| Profession | AI Product Builder; Agentic Product Builder | n8n posting, 2026; State Street posting, 2026 | निर्मित उत्पाद और सत्यापन अभ्यास आवश्यक; कोडिंग पसंदीदा (n8n) या आवश्यक (State Street) | नियोक्ता दोनों दिशाओं में कोडिंग आवश्यकता पर आगे बढ़ रहे हैं | एकल नियोक्ताओं की पदवियाँ |
| Profession | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | एक पेशा जिसका नाम एक उद्योग के लिए रखा गया है | क्षेत्र-सीमित नाम जारी किए जा रहे हैं | एक प्रस्ताव, एक उद्योग |
| Profession | principal | Agency theory (Jensen & Meckling, 1976); "principals" in Claude's constitution (Anthropic, 2026b); The Principal Firm (Verheul, 2026); principal-agent framing of AI agents (Berkeley California Management Review, 2025; Tikhomirov, 2026) | वह पक्ष जिसकी ओर से एजेंट कार्य करता है और जो जांच की लागत वहन करता है | इसके पीछे का सिद्धांत; "agent" शब्द से मेल खाता है | पहचान और प्रवेश प्रबंधन में "Agent principal" का अर्थ एजेंट की अपनी पहचान है, विपरीत अर्थ; साथ ही Principal Engineer की ग्रेड |
| Measure | delegation horizon (machine or firm sense) | Khadj, 2026 (एक प्रारंभिक संस्करण में एक "Delegation Horizon Index", 0 से 100); Alonso, 2026 ("a delegation horizon" कार्य की श्रृंखलाओं के लिए) | एक मशीन या फर्म कितनी दूर तक प्रतिनिधिमंडल कर सकते हैं उससे पहले कि एक मानव को हस्तक्षेप करना पड़े | दिखाता है कि वाक्यांश प्राकृतिक है | Machine या firm, एक व्यक्ति नहीं |
| Measure | uplift; speedup; autonomy 1 to 5; H1 to H5; supervisory capacity | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | औसत लाभ, बातचीत-स्तर की गति, एजेंट स्वायत्तता, पसंदीदा मानव संलिप्तता, प्रति प्रयास उपयोगी आउटपुट | प्रवर्धन लाभ के स्थापित पड़ोसी | कार्य, बातचीत या उपकरण मापें, किसी व्यक्ति के सत्यापित आउटपुट को नहीं |
| Moment | crossing time | The geometry of learning under AI delegation (2026) | वह बिंदु जिसके बाद AI को प्रतिनिधिमंडल करना कौशल क्षय के माध्यम से जो हासिल करता है उससे अधिक खर्चीला हो जाता है | रूप में करीब है | विपरीत अर्थ: कौशल हानि, साख वजन नहीं |
| Partner | guarantor | "Legal guarantor" in Capps (2025), New York Times Magazine | AI जो जिम्मेदारी नहीं दे सकता उसे प्रदान करता है | सटीक | कानूनी रंग |
| Partner | finisher; distribution engineer; GTM engineer | GTM engineer in postings, 2026 | उत्पाद को लोगों तक लाता है | आज के लिए भुगतान किया गया | आंशिक रूप से स्वचालित (Section 7) |
| Failed signal | tokenmaxxing | Press usage, 2026 (CIO, 2026a) | खपत किए गए टोकन द्वारा रैंकिंग या प्रतिस्पर्धा | एक वास्तविक अभ्यास का नाम देता है | एक पेशा नहीं (Section 4) |
| Older names | citizen developer; end-user software engineering; Code Runner, Adaptor, Writer, Builder | Gartner, by 2009; Ko et al., 2011; Feldman & Anderson, 2024 | IT के बाहर निर्माण; अंत उपयोगकर्ता इंजीनियरिंग समस्याओं का सामना कर रहे हैं | लंबी वंशावली | पुरानी विभाजन के एक ओर से बंधा हुआ |
| Part 2 | Candidate | Status | Sense | For | Against |
| Mass skill | acceptance literacy | यहाँ प्रस्तावित; Appendix B के आधारों में कोई उपयोग नहीं मिला | पहले से कहना कि क्या किया गया है, फिर इसे दिखाना | मूल का नाम देता है | एक कौशल, एक व्यक्ति नहीं; प्रौद्योगिकी स्वीकृति अनुसंधान से अलग किया जाना चाहिए |
| Profession | agentwright | यहाँ प्रस्तावित; Appendix B के आधारों में कोई उपयोग नहीं मिला | वह जो एजेंटों के माध्यम से काम करता है, जैसे एक नाटककार एक नाटक बनाता है | विद्वत्तापूर्ण आधारों में स्वतंत्र; लेखकत्व रखता है | खोज इंजन इसे "Agent Wright" में विभाजित करते हैं; एक ब्राउज़र-परीक्षण उपकरण की तरह लगता है; अक्टूबर 2026 तक आंशिक रूप से लिया गया है (एक Python पैकेज और एजेंट कौशल की एक सूची), इसलिए इसे एक योग्यता की आवश्यकता होगी |
| Profession | domain orchestrator (legal orchestrator, fintech orchestrator) | इस अध्ययन के एक पूर्व मसौदे में प्रस्तावित | एक व्यक्ति गहन डोमेन ज्ञान के साथ जो उस डोमेन के लिए एजेंट सिस्टम को इकट्ठा करता है | भूमिका को एक ऊर्ध्वाधर से जोड़ता है (Section 6.3) | "Multi-domain orchestrator" 5G और 6G नेटवर्क प्रबंधन में एक स्थापित शब्द है |
| Profession | setter-acceptor; agent director | सादे विवरण | कार्य सेट करता है और परिणाम स्वीकार करता है | सटीक | एक विवरण, एक नाम नहीं; "director" एक प्रबंधक की पद है |
| Profession | Agent-Directed Product Creator; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | इस अध्ययन के मॉडल परामर्श में निर्मित वेरिएंट | एजेंट कार्य के लेखकत्व और प्रबंधन पर विविधताएँ | विकल्पों की जगह दिखाएँ | लंबे, या लिए गए नामों के करीब (steward, creator, architect) |
| Profession ladder | Specifier, Verifier, Domain Orchestrator; setter, acceptor, coordinator, loop owner | इस अध्ययन की प्रारंभिक सीढ़ियाँ | एजेंट कार्य के लिए बढ़ती जिम्मेदारी के चरण | पठनीय | घंटे में रंग से बदला गया, जिसे पेशों के बीच अनुवाद की आवश्यकता नहीं है |
| Measure | verified delegation horizon (also: personal or human delegation horizon) | यहाँ प्रस्तावित | एक व्यक्ति द्वारा एजेंटों को सौंपे गए सबसे बड़े सत्यापित कार्य | Jaques और METR में निहित | भाग 1 में मशीन और फर्म की भावना से अलग किया जाना चाहिए |
| Measure | amplification gain | यहाँ प्रस्तावित | ध्यान के प्रति घंटे सत्यापित कार्य | लघु-लूप बिल्डरों को श्रेय देता है | एक जमे हुए संदर्भ की आवश्यकता है |
| Moment | credential crossover point | यहाँ प्रस्तावित; Appendix B के आधारों में कोई उपयोग नहीं मिला | जब IT शिक्षा के बिना लोगों के उत्पाद एक ही जाँच के तहत प्रोग्रामर के उत्पादों को पार करना शुरू करते हैं, और साख वजन खो देता है | भागों में देखने योग्य (Section 6.2) | "Credential" एजेंट सुरक्षा में एक गुप्त कुंजी भी मायने रखता है; पहले उपयोग पर परिभाषित करें |
| Moment | Skill Inversion Point; Background Neutrality Point; expertise crossover point; credential decoupling | विचार किए गए वेरिएंट | एक ही क्षण को कौशल, पृष्ठभूमि, विशेषज्ञता या साख से देखा जाता है | प्रत्येक एक भाग पर जोर देता है | प्रत्येक केवल Section 6.2 के घटकों में से एक को कवर करता है |
| Partner | co-signer; trust broker; distribution principal | विचार किए गए वेरिएंट | वह साथी जो उत्पाद पर हस्ताक्षर करता है या इसे ले जाता है | सादा | गारंटर या फिनिशर से संकरा |
| विफल संकेत | टोकन वरिष्ठता (टोकन रैंक के रूप में) | 2026 प्रकरण के लिए यहाँ प्रयुक्त शब्द | लोगों को उपभोग किए गए टोकन द्वारा रैंक करना | एक वास्तविक घटना का नाम देता है | कोई व्यवसाय नहीं (अनुभाग 4) |
नोट: स्थिति 8 और 9 अक्टूबर 2026 पर वेब और डेटाबेस खोजों को दर्शाती है (परिशिष्ट B)। "कोई उपयोग नहीं मिला" उन तारीखों पर वहाँ सूचीबद्ध आधारों को संदर्भित करता है और ऐसे आधारों के बारे में कुछ नहीं कहता जिनकी खोज नहीं की गई। भाग 2 में भिन्नताएँ अध्ययन के अपने मसौदों से आती हैं और विकल्पों का परिवार दृश्यमान रहे इसके लिए सूचीबद्ध हैं।
तालिका A3. 2025 और 2026 के पैमाने और प्रत्येक क्या मापता है (पूर्ण सूची)।
| पैमाना | स्रोत | मापी गई इकाई | सत्यापित प्रत्यायोजित कार्य द्वारा किसी व्यक्ति को मापता है? |
|---|---|---|---|
| AI एजेंटों के लिए स्वायत्तता के स्तर (संचालक से पर्यवेक्षक) | Feng et al., 2025 | एजेंट | नहीं |
| ऑटोकंप्लीट से सॉफ्टवेयर फैक्टरी तक पाँच स्तर | Shapiro, जनवरी 2026 | मशीन या टीम की सेटअप | नहीं |
| AI-सहायता प्राप्त विकास के आठ चरण | Yegge, 2026 | प्रोग्रामर का अभ्यास, एजेंटों की संख्या के आधार पर | नहीं |
| क्षमता सीढ़ी (ट्रिगर से एजेंट टीम) | Memari & Rudolph, 2026 | कार्य का स्वचालन | नहीं |
| कोडिंग एजेंटों की निगरानी के सात चरण | Park et al., 2026 | निगरानी कार्य के चरण | नहीं |
| विकास में प्रत्यायोजन के पाँच स्तर (AIDEs) | JetBrains Research (Tikhomirov), सितंबर 2026 | एक डेवलपर का प्रत्यायोजन, मुख्य-एजेंट संबंध के रूप में तैयार | केवल डेवलपर; कोई सत्यापन नियम नहीं |
| निर्णय लेने में AI प्रत्यायोजन के स्तर | Dawson, 2026; Metal Toad, 2026 | किसी संगठन या प्रबंधक का प्रत्यायोजन | नहीं |
| बुद्धिमान AI प्रत्यायोजन | Tomašev et al. (DeepMind), फरवरी 2026 | सामान्य रूप से प्रत्यायोजन | कोई व्यक्ति-स्तरीय उपाय नहीं |
| प्रत्यायोजन सीमांत (प्रारंभिक संस्करण: प्रत्यायोजन क्षितिज सूचकांक, 0 से 100) | Khadj, 2026 | किसी फर्म या एजेंट का प्रत्यायोजन | नहीं (मशीनें और फर्मों) |
| लेखक, संपादक, निर्देशक, संयोजक | Microsoft, मई 2026 | कार्य पैटर्न | नहीं |
| AI दक्षता ढाँचा (आठ क्षेत्र, चार स्तर) | AI Certification Standards, 23 अगस्त 2026 | पेशेवरों में दक्षताएँ | कोई परीक्षा या सीमाएँ नहीं |
| AI सुगमता (चार Ds) | Anthropic, 2025b | साक्षरता | कोई स्तर नहीं |
| मशीन समय क्षितिज | METR, 2025-2026 | मॉडल | नहीं (केवल मशीनें) |
| सत्यापित प्रत्यायोजन क्षितिज और प्रवर्धन लाभ | यह पेपर | किसी डोमेन में एक व्यक्ति | हाँ, अनुभाग 5.2 के नियम के अनुसार |
नोट: "सत्यापित प्रत्यायोजित कार्य द्वारा किसी व्यक्ति को मापता है" का अर्थ है कि पैमाना एक व्यक्ति को एजेंटों को सौंपे गए कार्य के आकार के अनुसार एक स्तर पर रखता है और एजेंटों द्वारा न देखे गए जाँच द्वारा पुष्टि किया गया है। JetBrains के स्तर इस बारे में हैं कि डेवलपर कितना प्रत्यायोजन करते हैं, और वे पहले से ही मुख्य और एजेंट की भाषा का उपयोग करते हैं। वे निकटतम पड़ोसी हैं, और उनमें जाँचों के लिए एक स्वतंत्रता नियम और आकार की एक इकाई की कमी है।
तालिका A4. कठिन मामले और नियम उनके साथ कैसा व्यवहार करते हैं।
| मामला | उपचार |
|---|---|
| वह कार्य जिसे व्यक्ति हाथ से कभी नहीं कर सकता था | संदर्भ घंटे अभी भी एक योग्य विशेषज्ञ से आते हैं; व्यक्ति का अपना कौशल प्रवेश नहीं करता |
| वह कार्य जिसकी गुणवत्ता केवल महीनों बाद दिखाई देती है | अस्थायी रूप से स्वीकार किया गया; विलंबित परिणाम तब दर्ज किया जाता है जब वह आता है और टुकड़े को रद्द कर सकता है |
| एक डोमेन जहाँ पास कोई योग्य मानव समीक्षक नहीं है | छिपी हुई परीक्षाएँ या इच्छित उपयोगकर्ताओं द्वारा वास्तविक उपयोग; अन्य परिवार के केवल स्रोतों के साथ एक मॉडल जिसे व्यक्ति ने खोला |
| एक ही मॉडल परिवार का अंधा समीक्षक, एक ताजे संदर्भ में | एक स्वतंत्र जाँच नहीं: same_family के रूप में दर्ज किया गया (परिशिष्ट C), यह कोई क्रेडिट अर्जित नहीं करता, हालाँकि यह एक स्वतंत्र जाँच से पहले कार्य में सुधार कर सकता है (अनुभाग 6.5) |
| एक टीम जो कार्य को एक साथ स्वीकार करती है | प्रत्येक व्यक्ति अपना ध्यान लॉग करता है; टुकड़ा उस व्यक्ति के लिए गिना जाता है जिसने स्वीकृति पर हस्ताक्षर किए |
| एक टुकड़ा जो जाँच पास करता है लेकिन बाद में गलत पाया जाता है | अगली पुनः-सत्यापन पर विफल के रूप में दर्ज किया गया, और रंग को पुनः स्कोर किया गया |
| अप्रतिवर्ती कार्य साधारण कार्य के साथ मिश्रित | सख्त नियम केवल अप्रतिवर्ती टुकड़ों पर लागू होता है (अनुभाग 5.2) |
तालिका A5. डेवलपर्स के धागों में विषय और अन्य व्यवसायों में उनके समकक्ष, 2025-2026 (सचित्र मामले)।
| धागों में विषय | सॉफ्टवेयर के बाहर समकक्ष | स्रोत | पार किया गया? |
|---|---|---|---|
| बुरे आउटपुट के लिए कौन जिम्मेदार है, मॉडल या कार्य निर्धारित करने वाला व्यक्ति | "वर्कस्लॉप": AI आउटपुट जो कार्य को इसके प्राप्तकर्ता को स्थानांतरित करता है, प्रति घटना लगभग दो घंटे और प्रति कर्मचारी $186 प्रति माह; सहकर्मी इसके भेजने वालों को कम सक्षम मानते हैं | The Decoder (2025); BetterUp (2026) | हाँ, दृढ़ता से |
| जाँच की कीमत (समीक्षा के लिए $150 प्रति घंटा) | समान वर्कस्लॉप लागत | The Decoder (2025) | हाँ |
| एक मजबूत मॉडल योजना बनाता है और समीक्षा करता है, सस्ते मॉडल कार्य करते हैं | Atlassian में भूमिका द्वारा आवंटित AI बजट | HCA Magazine (2026) | कंपनियों में |
| अधिभार, उपकरणों में निरंतर परिवर्तन, छूटने का भय | 25-26% विपणनकर्ताओं, HR में 19%, सॉफ्टवेयर में 17% द्वारा रिपोर्ट किए गए "AI ब्रेन फ्राई" | Search Engine Journal (2026) | हाँ, IT के बाहर अधिक दृढ़ता से |
| खरीदे गए सॉफ्टवेयर के स्थान पर अपने स्वयं के उपकरण | वकील एजेंटों के साथ उपकरण बनाते हैं; सर्वेक्षण किए गए 35% उद्यम खरीदे गए सॉफ्टवेयर का कुछ अपने स्वयं के साथ प्रतिस्थापन कर रहे हैं (विक्रेता का नमूना) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | शीर्ष परत में |
| एजेंटों की तुलना | बुककीपर दो कोडिंग एजेंटों की तुलना कर रहे हैं | Growthy (2026) | हाँ |
| एक कंपनी को प्रोग्रामर के बिना एजेंटों पर स्थानांतरित करना | वकील और फर्मों को विक्रेताओं के स्थान पर एजेंटों के साथ बनाते हुए | ब्लूमबर्ग लॉ (2026); आर्टिफिशियल लॉयर (2026) | आंशिक रूप से; परामर्श व्यवसाय को केवल धागे में देखा जाता है |
| एक व्यक्तिगत AI बिल $1,000 प्रति माह से अधिक एक स्थिति मार्कर के रूप में | कोई स्थिति समकक्ष नहीं मिला; निकटतम कंपनी कैप और भत्ते हैं (Uber का $1,500 प्रति माह कैप, Atlassian के AI वॉलेट) | Fortune (2026b); HCA Magazine (2026); 9 अक्टूबर 2026 की खोज | नहीं, स्थिति के रूप में; हाँ, बजट पंक्ति के रूप में |
| एक एजेंट के शिविर से संबंधित होना | कोई समकक्ष नहीं मिला | 9 अक्टूबर 2026 की खोज | नहीं, और आवश्यक नहीं |
नोट: धागे गुणात्मक साक्ष्य हैं जिन्हें उनके विषयों के लिए चुना गया है और ये जनसंख्या का प्रतिनिधित्व नहीं करते हैं। "पार किया गया" यह दर्ज करता है कि क्या 9 अक्टूबर 2026 को सूचीबद्ध स्रोतों में कोई समकक्ष मिला था।
चित्र A3। रंगों के पैमाने पर मशीन क्षितिज।
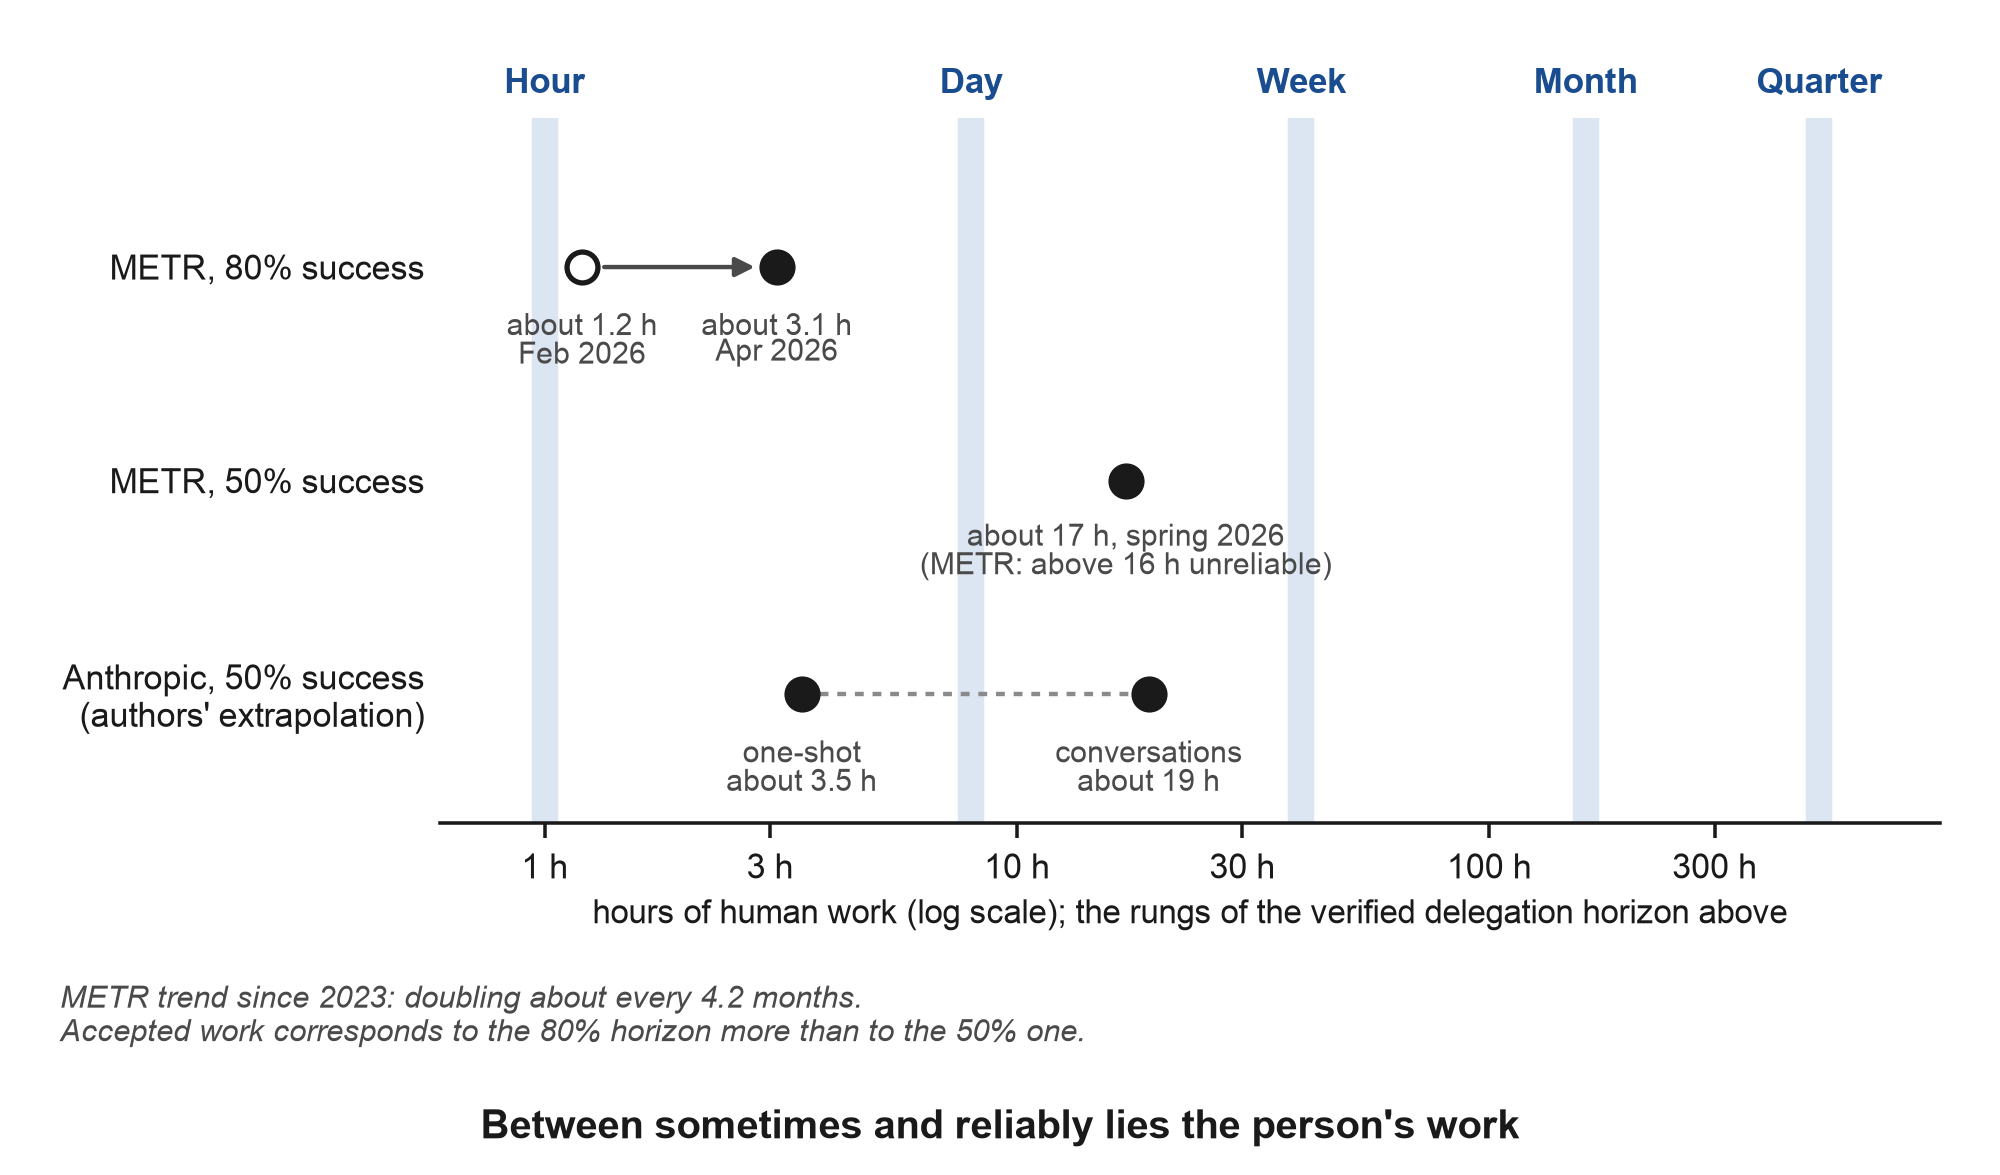
नोट: METR का समय क्षितिज 80% सफलता पर, फरवरी 2026 में लगभग 1.2 घंटे और अप्रैल में लगभग 3.1 घंटे। 50% सफलता पर, वसंत 2026 में लगभग 17 घंटे, जिसे METR स्वयं 16 घंटे से ऊपर अविश्वसनीय कहता है (METR, 2026c)। Anthropic के 50% अंक, एक-शॉट अनुरोधों के लिए लगभग 3.5 घंटे और वार्तालापों के लिए लगभग 19 घंटे, लेखकों का अनुमान हैं (Anthropic, 2026a)। मशीन क्षितिज मॉडल को मापते हैं, लोगों को नहीं। छायांकित स्तंभ केवल दिखाते हैं कि अनुभाग 5.3 की रंगें घंटों की एक ही धुरी पर कहाँ गिरती हैं (अनुभाग 5.6)।
चित्र A4। अनुभाग 6.5 की जांच प्रक्रिया: प्रत्येक चरण किसके लिए खड़ा है, नियम के तहत क्या अर्जित करता है, और कहाँ रुकता है।
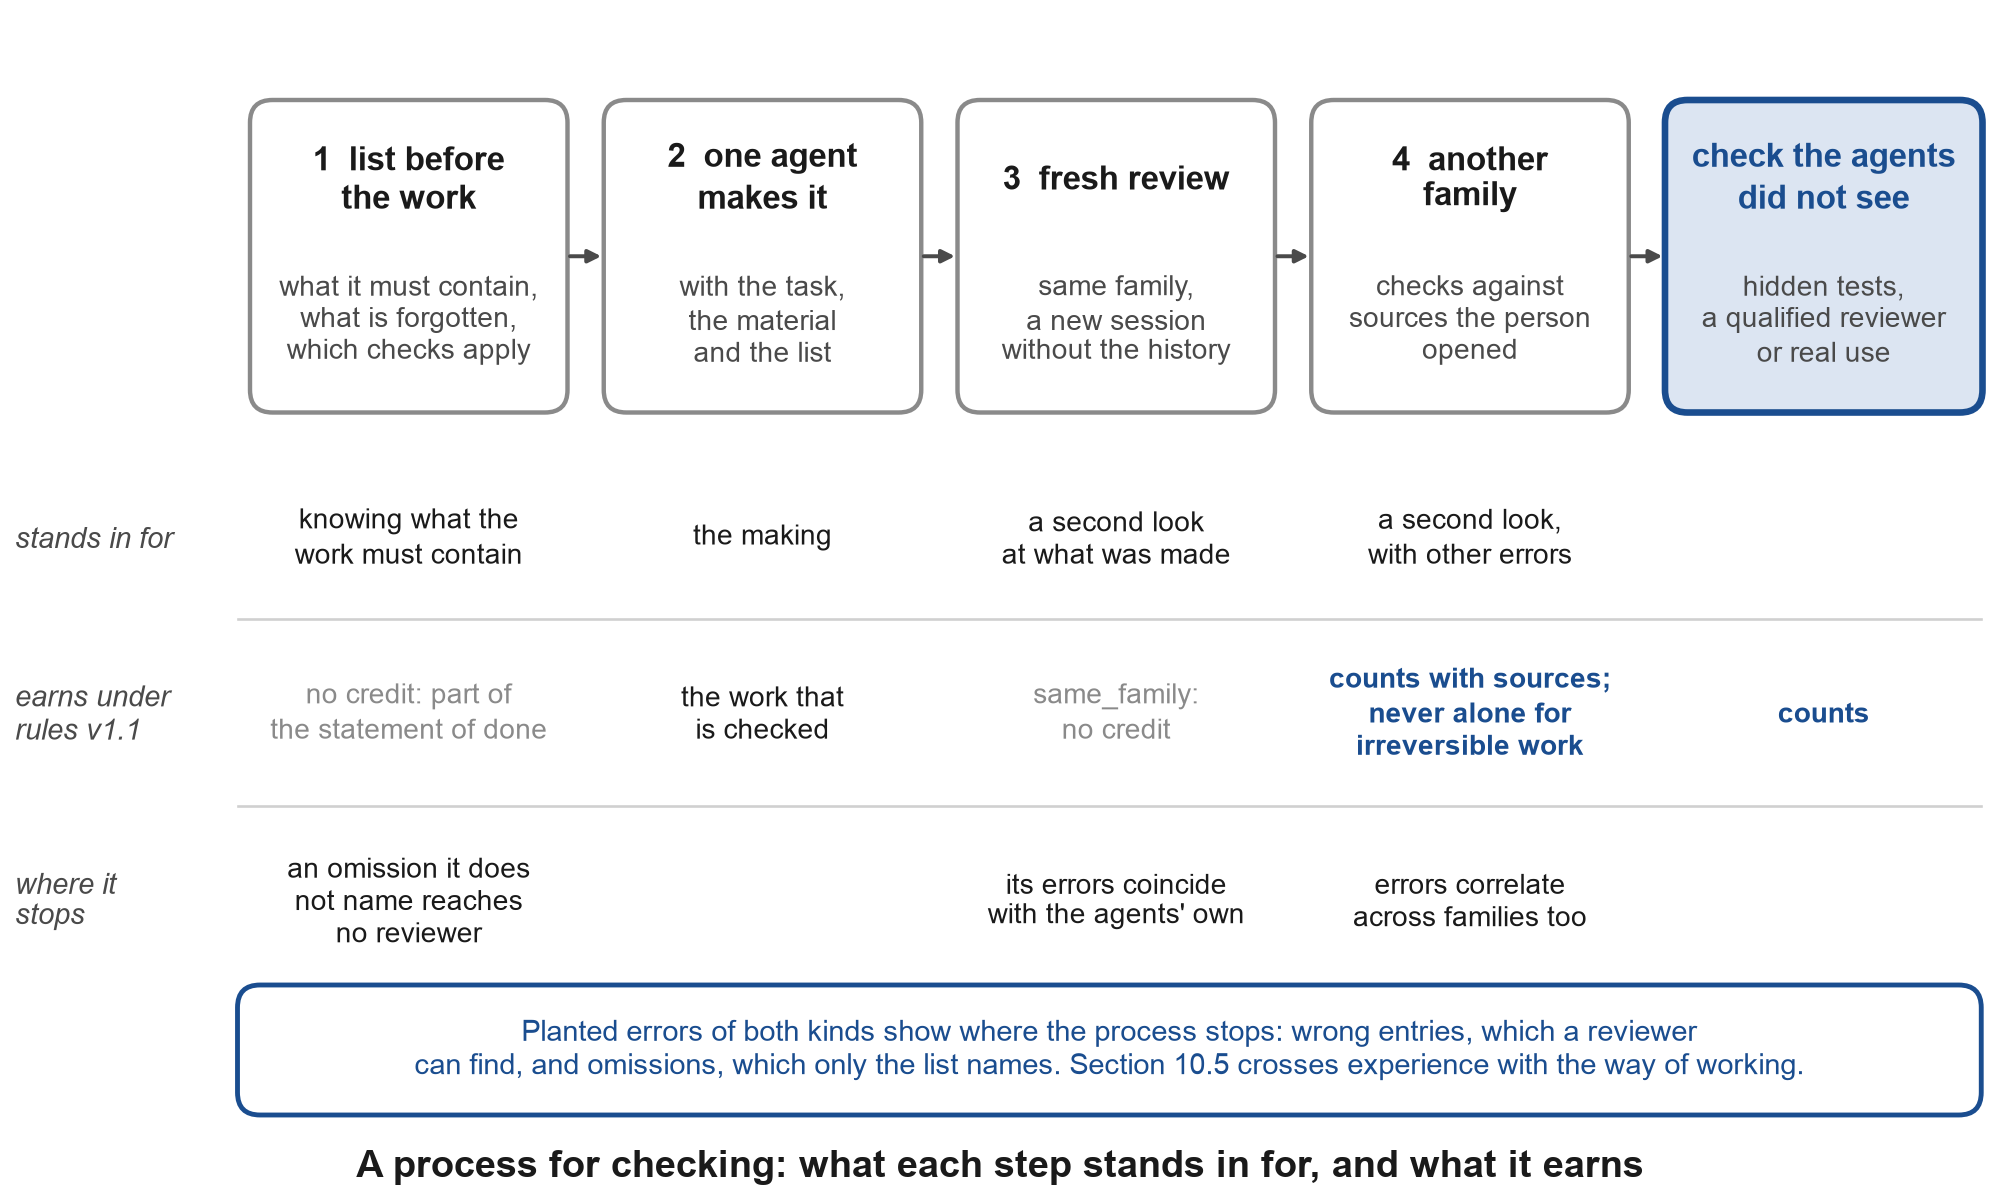
नोट: चार चरण और प्रत्येक किसके लिए खड़ा है, वे अनुभाग 6.5 के हैं। क्रेडिट की पंक्ति अनुभाग 5.2 और तालिका A4 के स्कोरिंग नियम का अनुसरण करती है: एक ताजे संदर्भ में एक ही परिवार के मॉडल द्वारा समीक्षा को same_family के रूप में दर्ज किया जाता है और कोई क्रेडिट अर्जित नहीं करता है, हालांकि यह काम को बेहतर बना सकता है; किसी अन्य परिवार का मॉडल केवल तब गिनता है जब यह उन स्रोतों के विरुद्ध जांचता है जिन्हें व्यक्ति ने खोला, और अपरिवर्तनीय काम के लिए कभी अकेले नहीं। अंतिम पंक्ति Fu et al. (2025) को चूक पर और Kim et al. (2025) को मॉडल के पार सहसंबंधित त्रुटियों पर सारांशित करती है। कोई पंजीकृत भविष्यवाणी परीक्षण प्रक्रिया नहीं करता है; अनुभाग 10.5 तुलना निर्धारित करता है जो होगी। चित्र figures/figure_a4_checking_process.py द्वारा साथी भंडार में खींचा गया है, जो horizon.py से प्रत्येक प्रकार की जांच का क्रेडिट पढ़ता है। प्रत्येक चरण एक व्यापार के अनुभव का हिस्सा खड़ा है; अनुभाग 14 इसे समकालीनों की सीढ़ी के रूप में लौटता है।
तालिका A7। इस पत्र में दावों की स्थिति।
| तत्व | इसे कैसे रखा जाता है | आधार |
|---|---|---|
| प्रोग्रामर और अन्य अब प्रतिनिधिमंडल और स्वीकृति के कार्यों और कार्यप्रवाह को साझा करते हैं | डेटा इसे कार्यों और कार्यप्रवाह के स्तर पर समर्थन करता है; व्यवसायों के रूप में पूरे विलय नहीं हुए हैं | अनुभाग 2; विक्रेता लॉग और 2025-2026 के सर्वेक्षण |
| दो पुरानी सीढ़ियाँ वह काम नहीं मापती हैं | देखा गया | नए माप के बिना नाम बदली गई सीढ़ियाँ (Deloitte); साक्षात्कार में AI उपयोग के प्रश्न में प्रवेश एक पैमाने के बिना |
| टोकन गणना वरिष्ठता के एक उपाय के रूप में विफल होती है | प्रारंभिक मामलों में देखा गया | 2026 के प्रेस रिपोर्ट (अनुभाग 4): Meta में एक कर्मचारी की अनौपचारिक रैंकिंग, हटाई गई, और Meta का बाद का आधिकारिक मार्गदर्शन टोकन गणना के विरुद्ध; Amazon में एक लीडरबोर्ड, गेम किया गया और हटाया गया; Uber का AI बजट चार महीने में खर्च किया गया, एक बजट घटना |
| सत्यापित प्रतिनिधिमंडल क्षितिज और प्रवर्धन लाभ | प्रस्तावित; नियम v1.1 डेस्क-परीक्षण किए गए; साथी भंडार में अंशांकन प्रोटोकॉल; पंजीकृत परीक्षण के तहत संदर्भ घंटों पर पेशेवरों की सहमति | परिभाषाएं और नियम (अनुभाग 5); उपकरण (परिशिष्ट C); सीमा के डेस्क परीक्षण (परिशिष्ट E) |
| जांच के शेयर द्वारा निर्धारित लाभ की छत | एक मॉडल के रूप में पेश किया गया; GDPval औसत द्वारा चित्रित | अनुभाग 5.5 |
| पृष्ठभूमि तटस्थता | परिकल्पना; पंजीकृत होने के लिए परीक्षण (F7) | Anthropic (2026e) इसकी ओर इशारा करता है; Savva (2026) एक प्रतिद्वंद्वी है |
| साख क्रॉसओवर बिंदु | परिकल्पना; घटक अलग से दिनांकित (समानता F2, आगे निकलना F3, पोस्टिंग F5, तटस्थता F7) | Lightcast (2026b) अभिसरण रेखाएं दिखाता है; Bone et al. (2025) इसके पहले AI भूमिकाओं के लिए हैं |
| गेट जो एक स्व-रिपोर्ट किए गए लेबल रिसाव द्वारा प्रवेश करते हैं; गेट जो काम की जांच करते हैं | एक मॉडल के रूप में पेश किया गया; रिसाव को एक बार चित्रित किया गया, रेटर अध्ययन की स्क्रीनिंग द्वारा | अनुभाग 6.2 और 13; परिशिष्ट G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Oregon State Board of Bar Examiners (2026) |
| सॉफ्टवेयर अंतिम पार करता है | भविष्यवाणी (F6), OSF पर पंजीकृत 40 अन्य के साथ | डोमेन तर्क (अनुभाग 6.3) |
| एक जांच प्रक्रिया एक व्यापार के अनुभव का हिस्सा खड़ी हो सकती है | परिकल्पना, पंजीकृत नहीं; कोई पंजीकृत भविष्यवाणी इसे परीक्षा करता है, और F3b (p = 0.10) केवल अप्रत्यक्ष रूप से इससे संबंधित है; एक तुलना अनुभाग 10.5 में निर्धारित की गई है | अनुभाग 6.5; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) और Benchek et al. (2026) एक ओर; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) और Virk and Liu (2025) दूसरी ओर |
| विश्वास दूसरी सीमा के रूप में; गारंटीकर्ता एक साथी व्यवसाय के रूप में | एक मॉडल के रूप में पेश किया गया; भविष्यवाणियां F11 और F12 | अनुभाग 7 |
| गैर-प्रोग्रामर एजेंट के माध्यम से काम कर रहे हैं | एक चलती हुई समूह में देखा गया, अनुमान के बिना वर्णित; पंजीकृत परिणाम अलग से रिपोर्ट किए गए | अनुभाग 11.5; परिशिष्ट G |
तालिका A8। गेट जो लेबल द्वारा प्रवेश करते हैं और गेट जो काम की जांच करते हैं: प्रत्येक क्या जांचता है, और क्या देखा गया था।
| गेट | यह किस पर प्रवेश करता है | क्या देखा गया था | स्रोत |
|---|---|---|---|
| एक अनुसंधान मंच के प्रतिभागी फ़िल्टर | उत्तर अधिकतर व्यक्ति के अपने शब्द पर दिए गए; आयु और निवास देश सत्यापित | 60 लोगों के एक बहीखाता नमूने में से 11 ने व्यापार का एक प्रथम-सप्ताह प्रश्न गलत तरीके से उत्तर दिया, उनमें से 8 ने डेबिट और क्रेडिट को उलट कर | Prolific (2026); Appendix G2 |
| एक क्राउडवर्क प्लेटफॉर्म पर कथित प्रोग्रामिंग कौशल | व्यक्ति का अपना शब्द | 42% ने शोधकर्ताओं के ज्ञान प्रश्नों के मानदंड को पूरा नहीं किया | Danilova et al. (2021) |
| Prolific पर रिपोर्ट की गई Node.js में प्रोग्रामिंग | व्यक्ति का अपना शब्द | 206 में से 55 सभी प्रोग्रामिंग प्रश्नों में उत्तीर्ण हुए | Reid et al. (2022) |
| एक स्थिर ज्ञान प्रश्न, पाठ या छवियों में | एक उत्तर, जो एक चैट मॉडल दे सकता है | ChatGPT ने आसानी से प्रोग्रामर के लिए मौजूदा स्क्रीनिंग प्रश्नों को हल कर दिया, और 2026 तक इसे प्रतिरोध करने के लिए डिज़ाइन किए गए स्थिर दृश्य प्रश्नों को पार कर गया | Serafini et al. (2024, 2026) |
| एक कठोर समय सीमा के तहत चरण दर चरण प्रकट किया गया एक ऑडियो प्रश्न | समय दबाव के तहत दिया गया एक उत्तर | 2026 में भी एक चैट मॉडल के विरुद्ध रखा गया | Serafini et al. (2026) |
| एक नीति से हटाई गई डिग्री आवश्यकता | एक लेबल, कागज पर हटाया गया | 700 में एक से कम किराया बदला गया; नवंबर 2025 में Indeed पर अमेरिकी पोस्टिंग का 19.3% एक वर्ष पहले की तुलना में स्नातक की डिग्री या उच्च की मांग करता था | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| एक बार पास की गई परीक्षा द्वारा एक लाइसेंस | एक बार जांचा गया ज्ञान | तब से एक लेबल के रूप में काम करता है | Section 6.2 |
| एक लाइसेंसप्राप्त ऑडिट फर्म के हस्ताक्षरित कार्य का निरीक्षण | हस्ताक्षरित कार्य, बार-बार जांचा गया | उन फर्मों के लिए हर साल जो नियमित रूप से 100 से अधिक जारीकर्ताओं का ऑडिट करती हैं, अन्यथा कम से कम हर तीन साल में एक बार | Sarbanes-Oxley Act of 2002, s. 104 |
| पर्यवेक्षित कार्य के एक पोर्टफोलियो द्वारा एक लाइसेंस | जांचा गया कार्य, एक बार; कानून की डिग्री अभी भी आवश्यक है | 5 जनवरी 2026 तक 205 उम्मीदवार आवेदन कर चुके थे और 49 लाइसेंसप्राप्त थे, पहला दिसंबर 2024 में | Oregon State Board of Bar Examiners (2026) |
| सत्यापित प्रत्यायोजन क्षितिज | सोपान किया गया कार्य जो एक जांच को पार कर गया जो एजेंटों ने नहीं देखा, हर त्रैमासिक में पुष्टि की गई | एक पायदान अपने पीछे की गणना और जांच के प्रकार के साथ, विफलताओं को लॉग में रखा गया | Sections 5.2 and 5.3 |
नोट: पंक्तियाँ वे मामले हैं जिन्हें Section 6.2 उद्धृत करता है। वे विभिन्न आबादी और विभिन्न प्रश्नों से आते हैं और एक-दूसरे के साथ यह देखने के लिए रखे गए हैं कि प्रत्येक गेट क्या जांचता है, दरों की तुलना करने के लिए नहीं। एक दूसरी तरह का गेट किसी भी प्रथम प्रकार के गेट के सामने जोड़ा जा सकता है: साथी भंडार में संदर्भ घंटों के मूल्यांकनकार व्यापार का एक प्रश्न द्वारा स्वीकार किए जाते हैं (kits/reference-hours-raters.md), जैसे Appendix G2 की रेटर अध्ययन ने अपने रेटर्स को स्क्रीन किया। kits/trade-screen.md यह निर्धारित करता है कि ऐसा प्रश्न कैसे लिखें और इसे कैसे रिपोर्ट करें, और tools/gate_leak.py साझा देता है कि एक लेबल कितना प्रतिशत छोड़ता है, एक सटीक अंतराल के साथ।
परिशिष्ट G. जो लोग पहले से ही यह कर रहे हैं: गैर-प्रोग्रामर समूह और Prolific रेटर अध्ययन
यह परिशिष्ट माप के लिए एक पूरक है, इसका तर्क नहीं; अनुभाग 6.2, 6.5 और 14 G2 के स्क्रीनिंग परिणाम को उदाहरण के रूप में उद्धृत करते हैं। यह लोगों से दो रिकॉर्ड जोड़ता है: गैर-प्रोग्रामरों का एक विवरण जो सितंबर और अक्टूबर 2026 में चैट से एजेंट के साथ काम करने की ओर चले गए (G1), और एक पंजीकृत रेटर अध्ययन जिसमें कार्यरत पेशेवरों ने कार्य बैंक के संदर्भ घंटों का मूल्यांकन किया (G2)।
G1. गैर-प्रोग्रामर जो चैट से एजेंट की ओर चले गए
6 सितंबर 2026 से मैंने प्रोग्रामिंग पृष्ठभूमि के बिना वयस्कों को चरण दर चरण और साधारण संदेशिंग के माध्यम से, एक चैट सहायक से अपने स्वयं के कंप्यूटर पर स्थापित एक कोडिंग एजेंट तक निर्देशित किया जिसके लिए वे अपनी स्वयं की उपभोक्ता सदस्यता से भुगतान करते हैं, और फिर कई मॉडल के साथ काम करने के लिए। वे एक दर्जन से अधिक व्यवसायों से आए, जिनमें बुककीपिंग और कार्यालय का काम, कानून, विपणन और बिक्रय, डिजाइन, फोटोग्राफी और रीटचिंग, अनुवाद और संपादन, संगीत, निर्माण, परिवहन और लॉजिस्टिक्स, रियल एस्टेट, देखभाल कार्य, सार्वजनिक प्रशासन और गैर-लाभकारी सामुदायिक कार्य शामिल हैं; चार ने सॉफ्टवेयर में पिछले या वर्तमान कार्य की सूचना दी। नीचे दिया गया विवरण वर्णनात्मक है: यह रिपोर्ट करता है कि लोगों ने क्या किया और क्या उन्हें रोका, जैसा कि 9 अक्टूबर 2026 तक रिकॉर्ड किया गया है, और यह इस पेपर के किसी भी दर की गणना नहीं करता है और किसी भी दावे का परीक्षण नहीं करता है।
तालिका G1. 9 अक्टूबर 2026 तक समूह कितनी दूर आ गया था (लोगों की संख्या)।
| चरण | लोग |
|---|---|
| रिकॉर्ड में: सहमति दी और प्रवेश प्रश्नावली वापस की | 119 |
| अपने स्वयं के कंप्यूटर और सदस्यता पर एक एजेंट स्थापित किया और इसके साथ काम शुरू किया | 35 |
| अपने स्वयं के काम पर एक कलाकृति का उत्पादन किया, या कम से कम एक चरण पूरा किया | 24 |
| रुके, एक बताए गए कारण के साथ | 23 |
| जिनमें से: अपना कंप्यूटर नहीं है (केवल फोन, या एक डिवाइस जो एजेंट को चला नहीं सकता) | 9 |
| जिनमें से: एक सदस्यता की लागत | 5 |
| जिनमें से: अस्वीकार किया (जो उनके पास था वह काफी था, कोई दिलचस्पी नहीं, या शुरुआती ढांचा फिट नहीं था) | 6 |
| जिनमें से: स्वास्थ्य, परिवार या समय | 2 |
| जिनमें से: सेवा वह जगह पर उपलब्ध नहीं थी जहां वे रहते हैं | 1 |
नोट: प्रतिभागी रिकॉर्ड और माप के नवीनतम सारांश से हाथ से गिनती की गई, प्रत्येक व्यक्ति के लिए सबसे उन्नत घटना का उपयोग करते हुए। दूसरी पंक्ति के 35 लोग तालिका G1b की 35 पंक्तियां हैं, और तीसरी पंक्ति के 24 इसकी पहली 24 पंक्तियां हैं। एक कलाकृति तब गिनती है जब व्यक्ति ने यह दिखाया या बताया कि एजेंट ने क्या उत्पादन किया; एक व्यक्ति जिसने बाद में एक कलाकृति का उत्पादन किया (P60) और दोनों पंक्तियों में गिना जाता है। शेष 62 लोगों को उस तारीख तक, या तो स्थापना चरण प्राप्त हुआ था बिना यह सूचित किए कि यह किया गया था या अभी तक इस तक नहीं पहुंचे थे।
तालिका G1a. पूरा समूह क्षेत्र और निवास के देश के अनुसार, और 9 अक्टूबर 2026 तक प्रत्येक से कितने एजेंट के पास गए।
| क्षेत्र और देश | समूह में | एजेंट के पास गए |
|---|---|---|
| उत्तरी अमेरिका | 37 | 10 |
| संयुक्त राज्य अमेरिका | 35 | 10 |
| कनाडा | 2 | 0 |
| पश्चिमी यूरोप | 20 | 7 |
| जर्मनी | 12 | 5 |
| आयरलैंड | 3 | 1 |
| स्पेन | 2 | 1 |
| यूनाइटेड किंगडम | 1 | 0 |
| ऑस्ट्रिया | 1 | 0 |
| स्विट्जरलैंड | 1 | 0 |
| मध्य और पूर्वी यूरोप, नाम वाले देश | 9 | 1 |
| पोलैंड | 3 | 0 |
| मोल्दोवा | 2 | 0 |
| लातविया | 2 | 0 |
| एस्टोनिया | 1 | 0 |
| रोमानिया | 1 | 1 |
| देश का खुलासा नहीं किया गया | 53 | 17 |
| कुल | 119 | 35 |
नोट: प्रतिभागी रिकॉर्ड के देश स्तंभ से। "देश का खुलासा नहीं किया गया" उन प्रतिभागियों को एकत्रित करता है जिनका देश अध्ययन के गोपनीयता नियम के तहत प्रकट किया गया है और जिन्होंने एक नहीं दिया।
लोगों ने एजेंट के साथ क्या किया। तालिका G1b सभी को सूचीबद्ध करती है जो 9 अक्टूबर 2026 तक एक चैट सहायक से एक एजेंट को निर्देशित करने के लिए चले गए, एक पंक्ति प्रत्येक: वह कार्य जो उन्होंने इसे दिया और इसने क्या उत्पादन किया। जिन लोगों ने एक कलाकृति का उत्पादन किया या अपने काम पर एक चरण समाप्त किया, वे पहले आते हैं, मोटे तौर पर कितनी दूर वे गए हैं; जिन लोगों ने एजेंट स्थापित किया है और शुरू किया है, बिना किसी रिपोर्ट किए गए परिणाम के, अनुसरण करते हैं। व्यवसाय रिकॉर्ड में दिए गए हैं, तटस्थ शब्दों में। छोटे उद्धरण प्रतिभागियों के स्वयं के शब्द हैं; जो "(अनुवादित)" चिह्नित हैं, वे एक अन्य भाषा में लिखे गए थे और मेरे शाब्दिक अनुवाद में दिए गए हैं।
तालिका G1b. जो लोग अब तक चले गए हैं (35 लोग, 9 अक्टूबर 2026 तक)।
| # | प्रतिभागी | व्यवसाय | देश या क्षेत्र | उन्होंने एजेंट के साथ क्या किया | उनके अपने शब्दों में |
|---|---|---|---|---|---|
| 1 | P20 | छवि प्रसंस्करण, रीटचिंग, फोटोग्राफी | खुलासा नहीं किया गया | एजेंट ने उसके लक्ष्यों के बारे में पूछा और एक महीने की योजना फ़ोल्डर और फाइलों के रूप में बनाई (विषय के अनुसार सप्ताह, एक संदर्भ फाइल, एक ट्रैकर); इसने फिर ब्राउज़र को स्वयं चलाकर उसे नौ AI सेवाओं में पंजीकृत किया और अपनी प्रगति फाइल में एक से इनकार दर्ज किया; उसने एक प्रश्न को 11 वेब AI के माध्यम से चलाया और परिणाम और सीमाएं एक फाइल में लिखीं; अपनी स्वयं की स्टॉक फोटोग्राफ पर इसने एक आदेश में एक मेटाडेटा CSV का उत्पादन किया और इसे जांचा | - |
| 2 | P73 | संपर्क लेंस बिक्रय व्यवसाय | आयरलैंड | दूसरे विक्रेता से दूसरा एजेंट स्थापित किया; दोनों ने अपनी स्वयं की सोशल-मीडिया योजना की एक प्रति को पढ़ा और वह उन बिंदुओं का एक पृष्ठ रखा जिनमें वे भिन्न थे; प्रत्येक एजेंट के लिए एक नियम फाइल लिखी और एक पढ़ने-योग्य और कार्य लॉग के साथ शाम समाप्त की | "मैं प्रशिक्षण जारी रख सकता हूं।" |
| 3 | P48 | कार्यालय कार्य और ऑनलाइन बिक्री | प्रकट नहीं किया गया | उसने एक दस्तावेज़ जो वह हर सप्ताह लिखती है, उसे एक चेकलिस्ट के साथ एक टेम्पलेट में बदल दिया और अगला वह इससे तेजी से लिखा; एक दूसरी कर्मचारी उसके ड्राफ्ट को अंधे तरीके से पढ़ती है; दो AI ने एक पूरी केस फ़ोल्डर को पढ़ा और उसने तीन सबसे महंगी निष्कर्षों पर खुद निर्णय लिया | "कौन सा AI बेहतर है यह प्रश्न गलत है।" (अनुवादित) |
| 4 | P44 | विपणन, बिक्री और परामर्श | प्रकट नहीं किया गया | डेस्कटॉप बटन बनाए जो एजेंट कार्य चलाते हैं ("परियोजना स्थिति", "नई वस्तुओं की सूची", "दस्तावेज़ सारांश", "फ़ाइल के लिए नोट"); दूसरी सदस्यता पर एक दूसरा एजेंट स्थापित किया और एक कार्य की संयुक्त समीक्षा चलाई: एक सारांश फ़ाइल और दो पूर्ण समीक्षाएं | - |
| 5 | P21 | गैर-लाभकारी सामुदायिक संगठन | Germany | कौशल और आदतों के साथ एक महीने का इंटरैक्टिव कार्यक्रम बनाया जिसमें प्रगति ट्रैकिंग है; एजेंट को कैटलॉग से एक शुरुआती दिशा चुनने दी और चार सप्ताह की योजना लिखी; फिर तीन एजेंट सेशन समानांतर में चलाए: कुछ मिनटों में एक प्रस्तुति, और एक बॉट जो सूचियों को देखता है और मैसेंजर को मेल भेजता है | "आपकी विशेष आवश्यकताओं के अनुसार बनाया गया एक उपकरण, बजाय इंटरनेट पर समझौते या सशुल्क सदस्यता खोजने के।" |
| 6 | P05 | एक निदेशक की सहायक, पूर्व प्रोग्रामर | United States | एजेंट ने उसकी मशीन पर पांच फ़ाइलें बनाईं: एक सारांश और विषय के अनुसार चार सप्ताह की योजना; बाद में इसने 76 संपर्कों की सूची को एक वेब संदेश पृष्ठ के माध्यम से आमंत्रण भेजे, अपने आप क्लिक करते हुए, उसके अपने नंबर पर एक परीक्षण संदेश के बाद | "अब से मैं विभिन्न दैनिक कार्यों को उनके बीच विभाजित करूंगा और वास्तव में परिणामों की तुलना करूंगा।" |
| 7 | P01 | इंटीरियर डिजाइनर और ड्राफ्टर, प्रशिक्षण में | Spain | एजेंट को दो पास में नौकरी के अवसरों की एक फ़ाइल बनाने दी, दूसरा पहले से व्यापक; इसकी तुलना दूसरे चैटबॉट की दो रिपोर्टों से की, सहमति और विचलन को अलग रखा; अपनी CV और पोर्टफोलियो को अपनी फ़ाइलों के ईमानदार पाठ से फिर से लिखा, और अपनी व्यावसायिक प्रोफ़ाइल को संशोधित किया | "जब यह इतनी गहराई से खोद सकता है और दिलचस्प लेकिन आम तौर पर अलग डेटा बना सकता है उनका विश्लेषण करने के लिए।" (अनुवादित) |
| 8 | P18 | इंटरनेट विपणन | प्रकट नहीं किया गया | एजेंट ने उसकी डेस्कटॉप को साफ किया: दस्तावेज़ बनाए, उन्हें फ़ोल्डर में क्रमबद्ध किया, त्रुटियां खोजीं और उन्हें ठीक किया; बाद में इसने उसके अपने विषयों पर ईमेल समाचार सूचनाएं सेट की | "मैंने इस तरह की चीजों के बारे में सुना था, लेकिन इसे कार्यान्वयन में देखकर मुझे वास्तव में विश्वास हो गया।" |
| 9 | P19 | सार्वजनिक प्रशासन अधिकारी | प्रकट नहीं किया गया | अपने पाठ संस्करण के एक लंबे बहु-पुस्तक संपादन को एक दिन में प्रूफरीड किया; दो बड़ी परियोजनाएं एक सप्ताह में पूरी कीं; अब एक अनुवाद वर्कफ़्लो के लिए एक प्लगइन संग्रह बना रहे हैं | "मैंने बस एक सप्ताह में दो बड़ी परियोजनाएं पूरी कीं... वाह।" (अनुवादित) |
| 10 | P35 | अनुबंध, चालान और सीमा शुल्क दस्तावेज़ | United States | पहला कार्य आवाज से किया; एजेंट ने उसके कंप्यूटर के कैश को साफ किया, ऐप्स बंद किए और एक बुकिंग साइट पर एक नियुक्ति स्लॉट खोज निकाला इसे खोलकर स्वयं; एक प्रिंट-ऑन-डिमांड दिशा प्रस्तावित की; निविदा कागजी कार्य में मदद करता है; अब टर्मिनल में चलता है | "हाँ, यह काम किया, हमने किया।" (अनुवादित) |
| 11 | P72 | AI के साथ बनाई गई स्टॉक छवियां और वीडियो | Romania | ऑर्केस्ट्रेशन टूल के साथ कई AI के माध्यम से एक कार्य चलाया, आवाज इनपुट सेट किया, और कैटलॉग से फ्रीलांस दिशाएं चुनीं | - |
| 12 | P41 | दंत सहायक, पितृत्व अवकाश पर | United States | एजेंट ने एक शेड्यूल, एक योजना और ड्राफ्ट बनाए; अपने स्वयं के इंस्टॉलर की छह प्रतियां और उसकी मशीन पर एक कार्यालय सूट की पांच प्रतियां खोजीं और अतिरिक्त को हटाया; उसने एक सामुदायिक कक्षा के लिए एक पाठ निर्देशित किया और एजेंट ने इसे टाइप किया, संदर्भ और लिंक जोड़े, अनुवाद किया और सहेजा, फिर उसके कहने पर इसे फिर से तैयार किया | "मैं प्रसन्न हूँ।" |
| 13 | P24 | संगीतकार और कवि | Germany | एक छवि कार्य को ग्यारह AI को भेजा और परिणामों को एक गैलरी पृष्ठ के साथ एक फ़ोल्डर में सहेजा; एजेंट को संगीत व्यवस्था का कंकाल बनाने दिया, जिसने उसे निराश किया | "लेखकत्व का नैतिक पहलू मेरे लिए अनसुलझा रहता है।" |
| 14 | P102 | एक सॉफ्टवेयर कंपनी का प्रबंधन करता है | प्रकट नहीं किया गया | पहले से ही आगमन पर एक एजेंट में दैनिक काम किया; एक प्रश्न को 11 AI के माध्यम से चलाया (10 ने उत्तर दिया) और रन फ़ाइल भेजी; अब कमाई कैटलॉग के माध्यम से काम कर रहे हैं | - |
| 15 | P40 | अनुसंधान इंजीनियर और वेब डेवलपर | प्रकट नहीं किया गया | जानबूझकर शुरुआत के रूप में मार्ग चला: अपनी डाउनलोड फ़ोल्डर में लगभग सौ ढीली फ़ाइलें फ़ोल्डर में क्रमबद्ध की, पहले और बाद में स्क्रीनशॉट के साथ; पाठ्यक्रम सामग्री में दो सुधार वापस किए | - |
| 16 | P75 | दूरस्थ तकनीकी सहायता | प्रकट नहीं किया गया | एजेंट ने उसकी डेस्कटॉप पर एक फ़ोल्डर बनाया जिसमें एक मौसमी संगीत वीडियो चैनल के लिए एक लॉन्च योजना है (नाम, ट्रैक विचार, शीर्षक, एक पोस्टिंग शेड्यूल); टर्मिनल चरण पूरा किया | - |
| 17 | P60 | घरेलू देखभाल | United States | एजेंट के कुछ प्रश्नों के बाद, एक महीने की योजना फ़ाइलों में विभाजित (दाता, वित्त, पत्र टेम्पलेट); बाद में छोड़ा, शुरुआत के ढांचे को बहुत बुनियादी पाया | - |
| 18 | P64 | सामान्य सार्वजनिक सेवा, रसद और आपूर्ति | प्रकट नहीं किया गया | एजेंट के साथ एक महीने की योजना बनाई, जिसने उसकी कंप्यूटर पर फ़ाइलें बनाईं; दस AI सेवाओं में पंजीकृत | "AI व्यक्ति के अनुकूल होता है। यह तारीफ करता है, एक निश्चित अर्थ में।" (अनुवादित) |
| 19 | P28 | सामान्य सार्वजनिक सेवा | प्रकट नहीं किया गया | एजेंट ने अपने वर्तमान पद से करियर पथ तैयार किए और, जब उसने एक को अस्वीकार कर दिया, तो उसके पहले के व्यापार, घड़ी की मरम्मत के लिए एक विकास योजना (कौशल, प्रमाणन, अपनी कार्यशाला) | - |
| 20 | P14 | औद्योगिक पर्वतारोही | United States | "रिफ्लेक्स स्क्वायर" बनाया, एक छोटा प्रतिक्रिया-गति प्रशिक्षक, एजेंट के साथ सेटअप के दौरान इसके अपने सुझाव पर | "अभी के लिए, Code में कोडिंग कुछ ऐसा नहीं है जिसकी मुझे अपने दैनिक जीवन में आवश्यकता है।" |
| 21 | P67 | तैराकी प्रशिक्षक, प्रत्यक्ष बिक्री भी | प्रकट नहीं किया गया | एजेंट को बताया कि वह सीधी बिक्री शुरू की है; इसने पाँच प्रकार की सहायता प्रदान की और एक नमूना उत्पाद कार्ड का मसौदा तैयार किया | - |
| 22 | P12 | छात्र | Germany | मुफ्त AI सेवाओं में पंजीकृत, ऑर्केस्ट्रेशन फ़ोल्डर चलाया, और एजेंट के साथ कैटलॉग से चार दिशाएं चुनीं (पत्रकारिता, एक किताब, मुद्रीकरण, AI में गहराई); अपने निबंध देगा | - |
| 23 | P71 | वकालत और जनस्वास्थ्य | Germany | उन्होंने अपना खुद का प्रॉम्प्ट लिखा; एजेंट ने इसे संक्षिप्त किया और अन्य AIs को छवियाँ बनाने के लिए कहा; टर्मिनल चरण और कीस्ट्रोक को याद रखने के लिए अपना एक अतिरिक्त परीक्षण कार्य किया | "कार्य पूर्ण, अगला भेजें।" |
| 24 | P22 | गैर-लाभकारी सामुदायिक संगठन | not disclosed | एजेंट में कैटलॉग कार्य किया (कुछ साइटें इसके साइन-इन को ब्लॉक करती थीं); टर्मिनल चरण किया और फिर एजेंट से ही कहा कि क्या किया गया है यह समझाएं; ईमेल समाचार सतर्कता सेट करें | "पूर्ण हुआ, अगला क्या है?" (अनुवादित) |
| 25 | P59 | वीडियोग्राफर | United States | एजेंट को अपने स्थानीय बाजार में लाभजनक संपत्ति सूचियाँ खोजने के लिए एक विस्तृत संक्षिप्त दिया (जाँच, कोई खर्च नहीं, लाभ द्वारा रैंक किया गया); परिणाम अभी तक दिखाए नहीं गए हैं | "अगर पहला काम करता है तो मुझे दूसरे की क्यों जरूरत है।" |
| 26 | P84 | not stated | not disclosed | टर्मिनल के माध्यम से स्वयं एजेंट स्थापित किया; एक सामुदायिक संगठन के लिए एक वेबसाइट बना रहे हैं | "कुछ कर रहा हूँ, लेकिन मुझे लगता है हमें बात करनी चाहिए।" (अनुवादित) |
| 27 | P66 | एक अवकाश सुविधा में प्रशासक | not disclosed | पाठ्यक्रम के लिए एक लैपटॉप खरीदा, एजेंट स्थापित किया और सामान्य मोड से एजेंट के टैब में चले गए; दस AIs में खाते खोलने के चरण पर | "सब कुछ एक विदेशी भाषा में है, अगला क्या है?" (अनुवादित) |
| 28 | P82 | सुरक्षा कार्य; ट्रकिंग के लिए एक डिस्पैच सेवा बना रहे हैं | United States | स्थापित किया; अपनी चैट और परियोजनाओं को दूसरे चैटबॉट से स्थानांतरित किया दोनों की तुलना करने के लिए | - |
| 29 | P70 | सोशल मीडिया के लिए अनुसंधान और वीडियो संपादन | United States | एक रूममेट की मदद से एजेंट को काम करने लगाया, पहले एक परीक्षण फ़ाइल हाथ से बनाने के बाद | - |
| 30 | P17 | अंतर्राष्ट्रीय कानून वकील | not disclosed | स्थापन पूर्ण; पहला कार्य भेजा गया | "मैंने सब कुछ किया।" (अनुवादित) |
| 31 | P93 | बुजुर्गों की देखभाल में प्रत्यक्ष समर्थन पेशेवर | not disclosed | सादे चैट से एजेंट में स्थानांतरित हुए और भुगतान किया; पहला कार्य भेजा गया | - |
| 32 | P54 | ऑर्डर पर केक बनाता है | not disclosed | एक नए लैपटॉप पर स्थापित और भुगतान किया; पहला कार्य भेजा गया | - |
| 33 | P26 | कंक्रीट निर्माण | United States | एक मरम्मत किए गए लैपटॉप पर स्थापित और इसकी एक तस्वीर भेजी; पहला कार्य भेजा गया | "अगला क्या है" |
| 34 | P03 | एक विदेश व्यापार कंपनी का निदेशक | United States | P35 के साथ मिलकर स्थापित किया; पहला कार्य भेजा गया | - |
| 35 | P45 | फ़ोटो और वीडियो सामग्री, प्रोग्रामिंग पृष्ठभूमि | Germany | दस AIs में खाते खोलने के चरण तक पहुँचे, जो एक कार्यशील एजेंट की पूर्वनिर्मित करता है; विवरण रिकॉर्ड नहीं किए गए | - |
नोट: प्रतिभागी रिकॉर्ड से संकलित। पंक्तियाँ 1 से 24 तालिका G1 की तीसरी पंक्ति हैं; पंक्तियाँ 25 से 35 ने 9 अक्टूबर 2026 तक एजेंट स्थापित किया और बिना रिपोर्ट किए गए परिणाम के शुरू किया। "-" का अर्थ है कि रिकॉर्ड इस अवधि के लिए प्रतिभागी के लिए कोई उपयोगी शब्द नहीं रखता है।
नए लोग एजेंटों को निर्देशित करने के बारे में कैसे बात करते हैं। जिन लोगों ने कुछ सप्ताह पहले केवल एक चैट सहायक का उपयोग किया था, वे अपने नए काम को अपने स्वयं के शब्दों में वर्णित करते हैं। मैंने प्रतिभागी रिकॉर्ड और दैनिक अवलोकन नोट्स से हर उस मार्ग को एकत्रित किया जो 35 लोगों के लिए प्रतिभागी के अपने शब्दों में दिया गया है जिन्होंने एक एजेंट स्थापित किया (32 लोगों से 161 मार्ग, लगभग 1,070 शब्द) और गिने, शब्द के तनों को मिलाकर, जिस सिस्टम को वे निर्देशित करते हैं, उसके लिए शब्द, वे इसके लिए क्या करते हैं और स्वयं के लिए; गणनाएँ मोटी हैं, और "यह" में कुछ उपयोग शामिल हैं जो उपकरण का संदर्भ नहीं देते हैं।
तालिका G1c। शब्द जो नए लोग एजेंटों को निर्देशित करने के लिए उपयोग करते हैं (उनकी अपनी रिपोर्ट में घटनाएँ)।
| शब्द जो नाम देता है | शब्द, श्रेणियों में अनुवादित | गिनती |
|---|---|---|
| वह प्रणाली जिसे वे निर्देशित करते हैं | "यह" | 35 |
| एक मॉडल या उत्पाद नाम (Claude, GPT, Codex और अन्य) | 16 | |
| उपकरण, कार्यक्रम, ऐप | 11 | |
| "AI", "AIs" | 9 | |
| एजेंट | 1 | |
| सहायक, सहायक, कार्यकर्ता | 0 | |
| वे इसके लिए क्या करते हैं | सेट अप, स्थापित, चलाएँ | 10 |
| पूछो, प्रश्न करो, अनुरोध करो | 9 | |
| कार्य, निर्देश, प्रॉम्प्ट | 7 | |
| जाँच करो, तुलना करो | 4 | |
| विभाजित करो, सौंपो | 2 | |
| स्वयं के बारे में | डेवलपर, शुरुआती | 5 |
उनके कुछ अपने शब्द (अंग्रेजी में उद्धरण; जिन्हें "(अनुवादित)" चिह्नित किया गया है वे दूसरी भाषा में लिखे गए थे और अनुवाद मेरा है):
- "यह केवल सवालों के जवाब नहीं देता है बल्कि वास्तव में फाइलों और दस्तावेजों के साथ काम कर सकता है।" (P18, इंटरनेट मार्केटिंग)
- "AI का उपयोग करते समय सबसे बड़ी गलतियों में से एक यह मान लेना है कि आत्मविश्वास से दिया गया जवाब स्वचालित रूप से सही है।" (P20, फोटोग्राफर और रिटचर; अनुवादित)
- "मुझे वास्तव में अब एक डेवलपर जैसा महसूस हो रहा है।" (P21, गैर-लाभकारी सामुदायिक संगठन)
- "जो मैं चाहता हूँ उसे पाने के लिए मुझे यह सोचना होगा कि अनुरोध को कैसे रखा जाए।" (P48, कार्यालय कार्य और ऑनलाइन बिक्री; अनुवादित)
- "मुझे लगता है कि उत्तर दो लोगों के लिए एक प्रश्न जैसा है।" (P59, वीडियोग्राफर)
- "एक बार एक AI बेहतर सलाह देता है, अगली बार यह दूसरा तरीका होता है।" (P48, कार्यालय कार्य और ऑनलाइन बिक्री; अनुवादित)
तीन लंबे मार्ग प्रतिभागियों के अपने आवाज में गति दिखाते हैं। एक आंतरिक डिजाइनर प्रशिक्षण में, एक एजेंट की अपनी पहली शाम को, किसी को भी मॉडल की परिषद दिखाने से पहले: "इसने एक फ़ोल्डर बनाया और स्वयं दस्तावेजों के साथ अच्छी तरह काम किया खोले [...] और अंत में मुझे रिक्तियाँ नामक दो फाइलें मिलीं इस एक रिक्तियों से उस एक से और मैंने उन्हें फिर से एक दूसरे को भेजा ताकि वे एक दूसरे के काम का मूल्यांकन करें" (P01, अनुवादित, एक आवाज संदेश के स्वचालित प्रतिलेखन से)। एक औद्योगिक पर्वतारोही, उस दिन जब वह एक एजेंट के साथ अपना पहला छोटा कार्यक्रम बनाया, पहले से ही अगली भूमिका के लिए पूछ रहा है: "शायद यह सीखना कि एजेंट कैसे बनाएँ जो मेरे लिए काम का हिस्सा कर सकते हैं - सोशल नेटवर्क पर पोस्ट करना, मुझे चीजों की याद दिलाना, या मुझे सुझाव देना।" (P14)। और गैर-लाभकारी सामुदायिक काम में एक प्रतिभागी, अपने पहले सप्ताहों के बाद: "मैं एक विशाल नई संभावना को खुलते हुए महसूस करता हूँ - कुछ नए की थ्रेसहोल्ड पर खड़े होने जैसा।" (P21)।
वे सिस्टम को इसके उत्पाद नाम से या सरल रूप से "it" कहते हैं, लगभग कभी "agent" नहीं, और अनुभाग 3 के मानचित्र के शीर्षकों में से कोई भी दिखाई नहीं देता; फिर भी वे कार्यों को निर्धारित करने, दो उत्तरों की तुलना करने और एक आत्मविश्वासी उत्तर की जांच करने के बारे में बात करते हैं, जो वह कार्य है जिसे उपाय गिनता है। मानचित्र की तरह, फ़ंक्शन एक नाम से पहले आता है, और यह एक विवरण के रूप में पेश किया जाता है, किसी दावे की परीक्षा के रूप में नहीं।
ये ही लोग एक अलग से पूर्व-पंजीकृत कार्यक्रम में भी भाग लेते हैं (OSF, DOI 10.17605/OSF.IO/X4EGQ), जिसके परिणाम वहाँ रिपोर्ट किए जाते हैं।
G2. Prolific रेटर अध्ययन: क्या पेशेवर संदर्भ घंटों पर सहमत हैं?
उपाय प्रत्येक कार्य को संदर्भ घंटों में आकार देता है, और अनुभाग 5.2 का नियम दो विशेषज्ञों को अंधा रेट करने के लिए कहता है और जब उनके अनुमान 1.5 के गुणांक से अधिक भिन्न हों तो एक तीसरे को बुलाता है। रेटर अध्ययन यह पूछता है कि क्या कार्यरत पेशेवर इतनी निकटता से सहमत होते हैं। इसे 9 अक्तूबर 2026 को OSF पर एक पूर्व-पायलट के रूप में पंजीकृत किया गया था, किसी भी डेटा के संग्रह से पहले (DOI 10.17605/OSF.IO/V92R8), और उसी दिन Prolific पर लॉन्च किया गया था।
डिज़ाइन। दो स्वतंत्र नमूने, कुल 119 प्रतिभागी भर्ती और भुगतान किए गए: 60 बुककीपर (वर्तमान भूमिका लेखाकार, बुककीपर, चार्टर्ड या प्रमाणित लेखाकार, लेखा परीक्षक या कर विशेषज्ञ) और 59 वेब और सॉफ्टवेयर डेवलपर (वर्तमान भूमिका सॉफ्टवेयर इंजीनियर, सॉफ्टवेयर डेवलपर या वेब डेवलपर)। सभी यूनाइटेड किंगडम, संयुक्त राज्य अमेरिका, आयरलैंड, कनाडा, ऑस्ट्रेलिया या न्यूजीलैंड में रहते हैं, कम से कम 100 पिछली प्रस्तुतियों पर कम से कम 98% Prolific अनुमोदन दर रखते हैं, और केवल एक अध्ययन लेते हैं। प्रत्येक प्रतिभागी अपने स्वयं के डोमेन के दस कार्यों को कार्य बैंक v0 (BK01 से BK10 या WT01 से WT10, जैसा कि pilot/task-bank-v0.csv में फ्रीज़ किया गया है) से AI उपकरणों के बिना अकेले काम करने वाले योग्य पेशेवर के केंद्रित कार्य के घंटों में दर देते हैं, एक कार्य को फिर से दर देते हैं (BK03 या WT03) एक रीटेस्ट के रूप में, और एक दक्षता प्रश्न और एक ध्यान जांच का उत्तर देते हैं। एक प्रतिभागी जो दोनों में से किसी में विफल होता है, को बाहर रखा जाता है और भुगतान किया जाता है; एक अनुमान जो एक सकारात्मक संख्या नहीं है या 2000 घंटे से अधिक है, को हटा दिया जाता है।
परिणाम। प्राथमिक: प्रति डोमेन, रेटर जोड़ियों का हिस्सा, सभी कार्यों पर, जिनके दो अनुमान 1.5 के अनुपात के भीतर आते हैं, अंशांकन प्रोटोकॉल में निर्धारित 0.70 की सीमा के विरुद्ध। माध्यमिक: प्रत्येक रेटर के व्यक्तिगत स्तर को हटाने के बाद समान हिस्सा, लॉग घंटों पर ICC(2,1), 1.5 के भीतर परीक्षण-रीटेस्ट हिस्सा, और प्रत्येक कार्य का माध्य अनुमान बैंक के इरादे के रंग के विरुद्ध। तुलना के लिए, परिशिष्ट E के चार मॉडल रेटर इन 20 कार्यों पर अपनी 56% जोड़ियों को 1.5 के भीतर रखते हैं: दस बुककीपिंग कार्यों पर 47% और दस वेब कार्यों पर 65%। विश्लेषण स्क्रिप्ट human_raters.py है, डेटा से पहले OSF पंजीकरण के साथ दाखिल, और परिणाम जो भी हो, रिपोर्ट किया जाता है।
परिणाम।
स्क्रीनिंग। प्रतिभागियों को उनकी Prolific प्रोफाइल में पेशे के आधार पर स्वीकार किया गया था, और Prolific के फ़िल्टर के पीछे के अधिकांश उत्तर स्व-रिपोर्ट किए गए हैं (Prolific, 2026), इसलिए दक्षता प्रश्न डिज़ाइन की एकमात्र जांच थी। बुककीपिंग नमूने में यह बैंक में प्राप्त ग्राहक भुगतान के लिए दोहरी प्रविष्टि पर एक बहुविकल्पीय प्रश्न था। उस नमूने में भर्ती किए गए 60 लोगों में से 11 (18%) ने इसका गलत उत्तर दिया, उनमें से आठ ने डेबिट और क्रेडिट को उलट दिया, और किसी ने भी ध्यान जांच में विफल नहीं हुए; जैसा कि पंजीकृत है, वे नीचे दिए गए परिणामों से बाहर रखे गए हैं और उन्हें भुगतान किया गया था। एक तुलना जो पंजीकृत नहीं थी, इन 11 लोगों ने बैंक के बड़े कार्यों को नमूने के अन्य प्रतिभागियों की तुलना में कम घंटों में दर दिया: सप्ताह रंग के लिए अभिप्रेत तीन कार्यों (BK08 से BK10) के लिए उनके माध्य 6, 6 और 8 घंटे थे, अन्य 49 के लिए 8, 8 और 12 के विरुद्ध। 11 लोगों के साथ यह परीक्षण किया जाना है, अनुमान नहीं, और जल्दबाजी या एक गलत प्रश्न एक समान निशान छोड़ेगी; यह इस पढ़ाई के अनुरूप है कि जो व्यक्ति किसी व्यापार को नहीं जानता वह इसके बड़े कार्यों के सभी चरणों को नहीं देखता (अनुभाग 6.5)। वेब-उपकरण नमूने में समान तुलना दोहराई नहीं गई: 8 डेवलपर्स जिन्होंने अपना दक्षता प्रश्न विफल किया, सप्ताह के लिए अभिप्रेत तीन कार्यों के माध्य 24.5, 27.5 और 19 घंटे देते हैं, अन्य 50 के लिए 20, 16 और 20 के विरुद्ध, इसलिए सीसा केवल बुककीपिंग पर आधारित है (नीचे अन्वेषणात्मक विश्लेषण)।
इस अनुभाग के लिए स्क्रिप्ट साथी भंडार में हैं (pilot/)। prolific_to_long.py Prolific निर्यात से रेटिंग की लंबी फ़ाइल लिखता है; यह प्रत्येक अनुमान को लिखे अनुसार पढ़ता है, एक उत्तर को कोई संख्या या कई के साथ रखता है, जैसे एक श्रेणी, पाठ के रूप में ताकि पंजीकृत नियम इसे हटा दे, और हर उत्तर को सूचीबद्ध करता है जो एक सादा संख्या नहीं है। table_g2.py उसी कार्यों पर मॉडल रेटर्स के बगल में, पंजीकृत स्क्रिप्ट के अपरिवर्तित कार्यों के साथ तालिका G2 को प्रिंट करता है। screen_compare.py ऊपर स्क्रीनिंग की तुलना को पुनः गणना करता है, सप्ताह के कार्यों के लिए सटीक अंतराल और रेटर्स पर एक क्रमचय परीक्षण के साथ।
समझौता। स्थान 9 और 10 अक्टूबर 2026 को भरे गए, और 118 प्रतिभागियों ने प्रतिक्रियाएँ दीं, 60 बहीखाता पेशेवर और 58 डेवलपर्स; एक डेवलपर के उत्तर, जिनके सबमिशन को मंजूरी दी गई और भुगतान किया गया, सर्वेक्षण उपकरण द्वारा सहेजे नहीं गए। पंजीकृत बहिष्करणों के बाद (11 बहीखाता पेशेवर और 8 डेवलपर्स ने दक्षता प्रश्न में विफल रहे; किसी ने भी ध्यान जाँच में विफल नहीं रहे), 49 बहीखाता पेशेवर और 50 डेवलपर्स बने रहते हैं। पंजीकृत सीमा दोनों क्षेत्रों में पूरी नहीं हुई: 28% बहीखाता पेशेवरों के जोड़े और 25% डेवलपर्स के जोड़े 1.5 के अनुपात के भीतर थे, 0.70 के विरुद्ध (तालिका G3)। पेशेवरों ने कार्यों को सुसंगत रूप से आदेश दिया, प्रत्येक क्षेत्र के माध्यिकाएँ Hour के लिए प्रस्तावित कार्यों से Week के लिए प्रस्तावित कार्यों तक बढ़ी, लेकिन वे घंटों पर दो मूल्यांकनकर्ताओं के नियम से अधिक असहमत थे। प्रत्येक मूल्यांकनकर्ता के व्यक्तिगत स्तर को हटाने से हिस्सा केवल 34% और 35% तक बढ़ा, इसलिए असहमति कार्य के बारे में है न कि पूर्णांकन की आदत के बारे में। लॉग घंटों पर ICC(2,1) बहीखाता पद्धति के लिए 0.34 और वेब उपकरणों के लिए 0.46 था, और एक मूल्यांकनकर्ता के एक ही कार्य के दो अनुमान 53% और 74% मामलों में 1.5 के भीतर सहमत थे। परिशिष्ट E के चार मॉडल मूल्यांकनकर्ता, एक ही 20 कार्यों पर 56% पर, पेशेवरों की तुलना में एक दूसरे से अधिक निकटता से सहमत थे, जो मॉडल की सटीकता की तुलना में पेशेवरों के विस्तार के बारे में अधिक कहता है। चिकित्सकों के विरुद्ध बैंक लगभग एक सीढ़ी ऊँचा बैठता है: हर कार्य जो Day के लिए प्रस्तावित था, उसका माध्यिका 2 से 7 घंटे था, जो Hour है, और हर कार्य जो Week के लिए प्रस्तावित था, उसका माध्यिका 8 से 20 घंटे था, जो Day है। ऊपर की खोजपरक तुलना में, 11 बहिष्कृत बहीखाता पेशेवर दूसरों की तुलना में एक दूसरे से बेहतर सहमत नहीं थे (1.5 के भीतर 28% जोड़े)। परिणाम मूल्यांकनकर्ता नियम के तीन भाग निर्धारित करते हैं। मूल्यांकनकर्ता मापे गए समय के साथ कार्यों पर अंशांकन करते हैं, जो स्तर को एंकर करता है जिस माध्यिकाओं को दिखाया गया है गलत होना। एक भाग दो मूल्यांकनकर्ताओं के बजाय एक पैनल के माध्यिका द्वारा आकार दिया जाता है, क्योंकि इस चौड़ाई का विस्तार अधिकांश जोड़ों को एक तीसरे मूल्यांकनकर्ता के पास भेज देगा। और कार्य बैंक को चिकित्सकों के माध्यिकाओं से पुनः बांडित किया जाता है, जो इसके कार्यों को एक सीढ़ी नीचे ले जाता है (तालिका G3b)।
तालिका G2। डोमेन के आधार पर संदर्भ घंटों पर पेशेवरों की समझौता।
| डोमेन | रखे गए | बहिष्कृत | 1.5 के भीतर जोड़े | मूल्यांकनकर्ता स्तर को हटाने के बाद | ICC(2,1), लॉग घंटे | 1.5 के भीतर परीक्षण-पुनः परीक्षण |
|---|---|---|---|---|---|---|
| बहीखाता पद्धति | 49 | 11 | 0.283 | 0.335 | 0.335 (49 पूर्ण) | 0.531 (n = 49) |
| वेब उपकरण | 50 | 8 | 0.247 | 0.349 | 0.461 (49 पूर्ण) | 0.735 (n = 49) |
नोट: 1.5 के भीतर जोड़ों के लिए पंजीकृत सीमा: 0.70, दोनों डोमेन में पूरी नहीं हुई। बहिष्करण दक्षता प्रश्न की विफलताएँ हैं; कोई भी प्रतिभागी ध्यान जाँच में विफल नहीं रहा। जोड़े एक डोमेन के सभी दस कार्यों पर लिए जाते हैं (बहीखाता पद्धति के लिए 11,760, वेब उपकरणों के लिए 11,809)। परीक्षण-पुनः परीक्षण BK03 या WT03 के एक मूल्यांकनकर्ता के दो अनुमानों की तुलना करता है। human_raters.py का आउटपुट पंजीकृत के रूप में (DOI 10.17605/OSF.IO/V92R8)।
तालिका G3b। प्रत्येक कार्य का माध्यिका अनुमान बैंक द्वारा अभिप्रेत सीढ़ी के विरुद्ध (घंटे)।
| अभिप्रेत सीढ़ी | बहीखाता कार्य: माध्यिका | माध्यिका की सीढ़ी | वेब उपकरण कार्य: माध्यिका | माध्यिका की सीढ़ी |
|---|---|---|---|---|
| Hour | BK01: 2.0; BK02: 2.0; BK03: 1.5 | Hour | WT01: 1.0; WT02: 1.0; WT03: 2.0 | Hour |
| Day | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | Hour | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | Hour |
| Week | BK08: 8.0; BK09: 8.0; BK10: 12.0 | Day | WT08: 20.0; WT09: 16.0; WT10: 20.0 | Day |
नोट: रखे गए मूल्यांकनकर्ताओं पर माध्यिकाएँ। 8 घंटे से नीचे की माध्यिका Hour पर गिरती है और 8 से 40 घंटे से नीचे की माध्यिका Day पर गिरती है। Day या Week के लिए प्रस्तावित हर कार्य एक सीढ़ी नीचे गिरता है।
अन्वेषणात्मक विश्लेषण। इस पैराग्राफ में विश्लेषण पंजीकृत नहीं थे। वे पंजीकृत लोडर, बहिष्करण और परीक्षण का पुनः उपयोग करते हैं, और उनकी स्क्रिप्ट और आउटपुट साथी भंडार में pilot/exploratory_prolific.py और pilot/results/prolific-2026-10/exploratory-output.txt हैं। पुनः नमूना लेने वाले मूल्यांकनकर्ता 0.24 से 0.33 (बहीखाता) और 0.21 से 0.29 (वेब उपकरण) के 95% अंतराल प्राथमिक शेयर पर डालते हैं। पैनल आकार (तालिका G4)। प्रत्येक कार्य के लिए, k रखे गए मूल्यांकनकर्ताओं के दो असंयुक्त पैनल 2,000 बार खींचे गए और उनके माध्यिकाओं की तुलना की गई। कच्चे अनुमानों पर, दोनों माध्यिकाएँ केवल 15 बहीखाता कर्मचारियों या 21 डेवलपर्स प्रति पैनल से 70% ड्रॉ में कम से कम 1.5 के भीतर सहमत हुईं। प्रत्येक मूल्यांकनकर्ता के व्यक्तिगत स्तर को हटाने के साथ, जो मापे गए समय के साथ कार्यों पर कैलिब्रेशन करने का इरादा है, सात के पैनल 0.71 और 0.69 तक पहुँचे, और नौ के पैनल 0.77 और 0.76 तक। एक ही सीढ़ी पर उतरना, जो माप रिकॉर्ड करता है, कम की आवश्यकता है: प्रति पैनल पाँच कैलिब्रेटेड मूल्यांकनकर्ता 0.81 और 0.84 ड्रॉ में ऐसा करते थे। धारा 5.2 के दो-मूल्यांकनकर्ता नियम के तहत एक तीसरे मूल्यांकनकर्ता को 72% और 75% टुकड़ों पर बुलाया जाएगा। अनुभव (तालिका G4b)। पूर्ण उत्तरों वाले 98 रखे गए मूल्यांकनकर्ताओं में से 43 ने अपने क्षेत्र में 10 साल से अधिक की रिपोर्ट की। वे एक दूसरे से बाकी हिस्सों की तुलना में अधिक निकटता से सहमत नहीं थे, और क्षेत्र में वर्षों ने भविष्यवाणी नहीं की कि कोई मूल्यांकनकर्ता दूसरों के माध्यिका से कितना दूर बैठा था (रैंक सहसंबंध +0.18 और -0.10, क्रमचय p = 0.21 और 0.47)। वरिष्ठ डेवलपर्स ने अन्य डेवलपर्स की तुलना में अधिक अनुमान लगाया (दूसरों के माध्यिका का 1.32 गुना 0.76 के विरुद्ध, p = 0.02); वरिष्ठ बहीखाता कर्मचारियों ने नहीं किया (1.04 बनाम 1.07, p = 0.88)। कार्य। असहमति आकार के साथ बढ़ता है: 20 कार्यों में से छह सबसे विवादास्पद में से पाँच सप्ताह के लिए अभिप्रेत कार्य थे, जहाँ 24% (बहीखाता) और 20% (वेब उपकरण) जोड़े 1.5 के भीतर थे, घंटे के लिए अभिप्रेत कार्यों पर 31% और 27% के विरुद्ध; एक सप्ताह के कार्य की अंतःचतुर्थक रेंज 4 से 8 के गुणनखंड में विस्तृत थी। गति और इकाइयाँ। बहीखाता कर्मचारियों के सबसे तेजी से चौथाई (पूरे सर्वेक्षण के लिए 3.6 मिनट या उससे कम) बाकी हिस्सों की तुलना में अधिक निकटता से सहमत हुए (0.37 बनाम 0.26), और डेवलपर्स के बीच गति कोई अंतर नहीं बनाता (0.24 बनाम 0.24)। कुछ कार्यों के घंटों के बजाय मिनटों में उत्तर देने से किसी भी डोमेन में कोई अंतर नहीं हुआ (0.31 बनाम 0.31; 0.28 बनाम 0.31)। दो बहीखाता कर्मचारियों ने घंटे के लिए अभिप्रेत एक कार्य को 40 घंटे या अधिक दिए, जो मिनट को घंटों के रूप में टाइप किए गए जैसा लगता है; उनके बिना बहीखाता शेयर 0.284 है। एक रखे गए डेवलपर ने संख्याओं के बजाय पाठ टाइप किया, इसलिए उनके अनुमानों में से केवल एक विश्लेषण में प्रवेश किया। स्क्रीनिंग। प्रत्येक मूल्यांकनकर्ता के सप्ताह के कार्यों के अनुमानों की तुलना उनके घंटे के कार्यों के अनुमानों के साथ की गई, ताकि एक व्यक्तिगत स्तर रद्द हो जाए, बहीखाता कर्मचारियों को छोड़ा गया बड़े कार्यों को छोटे के 3.2 गुना रेट किया गया था 6.2 गुना रखे गए के विरुद्ध (क्रमचय p = 0.10), और डेवलपर्स को छोड़ा गया 15.8 गुना रखे गए 10.6 के विरुद्ध (p = 0.37)। पुनः परीक्षण। दोहराया गया अनुमान 25 बहीखाता कर्मचारियों के लिए पहले से अधिक था और 4 के लिए कम था, और 17 डेवलपर्स के लिए अधिक था और 2 के लिए कम था (दोनों में सटीक चिन्ह परीक्षण p < 0.001), ज्यामितीय माध्य पर लगभग 30% द्वारा, जो बीच में रेट किए गए बड़े कार्यों पर लंगर डालने के अनुरूप है। एक साथ ये परिणाम काम में और इसके पैमाने में फैलाव रखते हैं न कि जल्दबाजी, जूनियर या अयोग्य मूल्यांकनकर्ताओं के एक उप-समूह में, और वे पैनल को आकार देते हैं जो नियम की आवश्यकता है: कैलिब्रेटेड मूल्यांकनकर्ता, प्रति टुकड़ा पाँच से नौ, सीढ़ी द्वारा स्कोर किए गए (तालिका G4)।
तालिका G4। प्रति कार्य k मूल्यांकनकर्ताओं के दो स्वतंत्र पैनल: ड्रॉ का शेयर जिनके माध्यिकाएँ 1.5 / शेयर के भीतर सहमत हैं एक ही सीढ़ी पर (अन्वेषणात्मक)।
| प्रति पैनल मूल्यांकनकर्ता | बहीखाता, कच्चा | बहीखाता, स्तर हटाया गया | वेब उपकरण, कच्चा | वेब उपकरण, स्तर हटाया गया |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
नोट: सभी दस अनुमानों वाले रखे गए मूल्यांकनकर्ता (प्रति डोमेन 49); 2,000 ड्रॉ प्रति कार्य, पैनल एक ड्रॉ के भीतर असंयुक्त; बीज 20261011। स्तर हटाया गया: प्रत्येक मूल्यांकनकर्ता का माध्य लॉग अनुपात प्रत्येक कार्य पर सभी मूल्यांकनकर्ताओं के माध्यिका से नमूने में घटाया जाता है, जैसा कि पंजीकृत माध्यमिक परिणाम में है, इसलिए ये स्तंभ अलग एंकर कार्यों पर कैलिब्रेशन जो देंगे का एक ऊपरी अनुमान हैं। पंजीकृत नहीं; pilot/exploratory_prolific.py का आउटपुट।
तालिका G4b। क्षेत्र में वर्ष और समझौता (पूर्ण उत्तरों वाले रखे गए मूल्यांकनकर्ता, अन्वेषणात्मक)।
| डोमेन | समूह | मूल्यांकनकर्ता | समूह के अंदर 1.5 के भीतर जोड़े | दूसरों के माध्यिका के विरुद्ध स्तर |
|---|---|---|---|---|
| बहीखाता | 10 वर्ष से अधिक | 23 | 0.268 | 1.04 |
| बहीखाता | 10 वर्ष या उससे कम | 26 | 0.299 | 1.07 (p = 0.88) |
| वेब उपकरण | 10 वर्ष से अधिक | 20 | 0.297 | 1.32 |
| वेब उपकरण | 10 वर्ष या उससे कम | 29 | 0.242 | 0.76 (p = 0.02) |
नोट: स्तर एक मूल्यांकनकर्ता के अनुमानों का ज्यामितीय माध्य अनुपात है समान कार्यों पर अन्य मूल्यांकनकर्ताओं के माध्यिका के लिए; p माध्य लॉग स्तर में अंतर का दो-तरफा क्रमचय परीक्षण है (5,000 क्रमचय)। पंजीकृत नहीं।
कैसे उद्धृत करें
Chernets, V. (2026). प्रोग्रामर विभाजन के बाद: AI एजेंट के माध्यम से निर्माण करने वाले लोगों के लिए एक मापदंड [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}