Verification Theater: AI Verifier Panels की मापी गई विफलता के तरीके
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
Vadym Chernets, स्वतंत्र शोधकर्ता · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
NeurIPS 2026 वर्कशॉप "Who Verifies the Agents? Toward Reliable Agent Development" (गैर-आर्काइवल) में पोस्टर के रूप में स्वीकृत। संग्रहीत प्रति: 10.5281/zenodo.23197641। PDF: verification-theater.pdf। नीचे दिए गए आंकड़े और तालिकाएं LaTeX स्रोत से परिवर्तित हैं; PDF आधिकारिक है।
सारांश
बहु-एजेंट सत्यापन एक डिफ़ॉल्ट विश्वास तंत्र बनता जा रहा है: एक उत्तर पर विश्वास किया जाता है क्योंकि स्वतंत्र मॉडल इस पर सहमत हुए हैं। एक पूर्व-पंजीकृत, अंधे, तापमान-शून्य संग्रह में जिसमें सोलह मॉडल (नौ सीमांत विक्रेता, सात स्थानीय खुले-वजन) ने 1,500 तथ्यात्मक प्रश्नों का उत्तर दिया (साथ ही एक 750-प्रश्न बहुविकल्प हथियार और एक अन्वेषणकारी संवाद हथियार), हम मापते हैं कि पैनल सत्यापन कब काम करना बंद कर देता है जबकि यह काम करता दिख रहा है—एक स्थिति जिसे हम सत्यापन थिएटर कहते हैं। हम चार विफलता शासन रिपोर्ट करते हैं। पहला, एक कठिनाई व्यतिक्रम: स्वतंत्र समझौते की प्रमाणन वृद्धि—2.7–4.6 प्रश्नों के आसान तीन पंचमक पर—दूसरे-सबसे कठिन पंचमक पर 0.82 में गिरती है और सबसे कठिन पर शून्य तक, जहां प्रतिकृत उत्तर 342 मामलों में से 0 में सही थे (स्वतंत्रता के तहत 13 अपेक्षित)। एक छोड़-पैनल-बाहर पुनः-स्तरीकरण (13 गैर-पैनल मॉडल द्वारा रैंक की गई कठिनाई) पूलित व्यतिक्रम को हटाता है (78/354 सही, वृद्धि 2.36) जबकि शून्य क्रॉस-ब्लॉक पैनल के लिए बना रहता है (0/116); हम पूरे समय दोनों कोडिंग एक साथ रिपोर्ट करते हैं: जिन प्रश्नों को तैनात जनसंख्या सबसे कठिन पाती है, समझौता त्रुटि प्रमाणन के रूप में कार्य करता है। दूसरा, विवश उत्तर स्थान: बहुविकल्प के तहत (स्थानीय स्तर), पैनलों ने 4.0–7.9% प्रश्नों पर एक गलत उत्तर को सर्वसम्मति से प्रमाणित किया, बनाम उसी स्तर के 1.5–4.6% खुले-रूप उत्तरों पर और 0.3–4.9% सीमांत खुले-रूप पर। तीसरा, स्वतंत्रता के लिए प्रॉक्सी के रूप में उपयोग किए गए लेबल अनुभवजन्य रूप से विफल होते हैं: भू-राजनीतिक ब्लॉक त्रुटि सहसंबंध की भविष्यवाणी नहीं करता है (माध्य अंतःब्लॉक 0.285 बनाम क्रॉस-ब्लॉक 0.274, अंतर ), और एक तर्क मॉडल उसी आधार से आसवित किया गया जैसा इसका पैनल-साथी सबसे कम सहसंबद्ध जोड़ियों में से एक था (; 15 यूएस/सीएन-ब्लॉक स्थानीय जोड़ियों का 14 वां, सभी 21 स्थानीय जोड़ियों का 20 वां)। चौथा, अनुरूपता: एक सत्यापनकर्ता जिसने अंधे में एक उत्तर से असहमति व्यक्त की थी, जब इसे सहकर्मी के रूप में दिखाया गया तो 38.5% मामलों में उसी उत्तर को समर्थित किया; एक विपरीत-संकेत नियंत्रण दिखाता है कि ये फ्लिप एक आत्मविश्वासी प्रस्ताव की उपस्थिति को ट्रैक करते हैं, इसकी सत्यता को नहीं (38.9% गलत की ओर बनाम 34.7% सही की ओर; McNemar सटीक )। हम तर्क देते हैं कि इन शासनों की एक आर्थिक जड़ है और एक मापन अनुशासन प्राप्त करते हैं जो सत्यापन को इसके थिएटर से अलग करता है।
परिचय: थिएटर समस्या
AI मॉडल के पैनल एक दूसरे की जांच करते हुए विश्वास बुनियादी ढांचे के रूप में तैनात किए जा रहे हैं, और उनके बीच समझौता तेजी से सबूत के रूप में मूल्य निर्धारित किया जा रहा है। सुरक्षा अनुसंधान के पास लंबे समय से संरक्षण के सौंदर्यशास्त्र का उत्पादन करने वाली लेकिन इसके सार के बिना तंत्र के लिए एक नाम है (Schneier, 2003); हम पूछते हैं, रूपक के बजाय माप के साथ, कब पैनल सत्यापन उस नाम को अर्जित करता है। मुख्य निष्कर्ष एक व्युत्क्रम है: समझौते का प्रमाणीकरण मूल्य आसान प्रश्नों पर केंद्रित है और गायब हो जाता है—या उलट जाता है—ठीक वहीं जहां सत्यापन सबसे अधिक महत्वपूर्ण है। हम इसे एक एकल विसंगति के रूप में नहीं बल्कि चार अलग-अलग शासनों में से एक के रूप में मानते हैं जिसमें एक सत्यापनकर्ता पैनल जांच का आभास रखते हुए अपने सार को खोता है, और हम चारों को एक सामान्य आर्थिक कारण और एक सामान्य उपाय से जोड़ते हैं।
ठोस रूप से, यह पत्र योगदान देता है: (C1) कठिनाई-स्तरीकृत प्रमाणीकरण लिफ्ट का एक माप जो दिखाता है कि स्वतंत्र समझौते का प्रमाणीकरण मूल्य आसान प्रश्नों पर केंद्रित है और, जनसंख्या कठिनाई माप के तहत, सबसे कठिन पंचमक पर उलट जाता है (342 प्रतिकृत उत्तरों में से 0 सही; पैनल-स्वतंत्र कठिनाई के तहत पूल किया गया व्युत्क्रम गायब हो जाता है और क्रॉस-ब्लॉक पैनल के लिए शून्य बना रहता है, 0/116)—दोनों कोडिंग पूरे समय एक साथ रिपोर्ट किए जाते हैं; (C2) साक्ष्य कि सीमित (बहुविकल्पीय) उत्तर स्थान सर्वसम्मत प्रमाणित त्रुटि को 4.0–7.9% तक धकेलते हैं, खुले रूप के कोष्ठक 0.3–4.9% से अच्छी तरह ऊपर; (C3) दो पूर्व-पंजीकृत शून्य परिणाम जो दिखाते हैं कि स्वतंत्रता प्रॉक्सी के रूप में नियमित रूप से उपयोग किए जाने वाले लेबल—भू-राजनीतिक ब्लॉक और मॉडल वंशावली—त्रुटि सहसंबंध की भविष्यवाणी नहीं करते हैं, इसलिए स्वतंत्रता को ब्रांड या पारिवारिक वृक्ष से मान लेने के बजाय प्रति-जोड़ी के रूप में एक -मैट्रिक्स के रूप में मापा जाना चाहिए; और (C4) एक आत्मविश्वास प्रस्ताव की उपस्थिति को ट्रैक करने वाले संवाद-मोड सत्यापनकर्ताओं का प्रदर्शन करते हुए एक रिवर्स-प्रॉम्प्ट नियंत्रण के साथ एक अनुरूपता माप। अंधी संग्रह प्रोटोकॉल और विश्वास निर्माण साथी पत्र में पूरी तरह से कहा गया है और यहां केवल जहां तक माप के लिए आवश्यक है, सारांशित किए गए हैं; इस पत्र में परिणाम के रूप में रिपोर्ट किया गया सब कुछ (C1–C4) यहां मापा जाता है और इससे पुनः कहा नहीं जाता है। इन से हम प्राप्त करते हैं (C5) एक माप अनुशासन—प्रकाशित प्रति-कार्य-वर्ग -मैट्रिक्स, कठिनाई-स्तरीकृत प्रमाणीकरण दावे, अंधी-प्रथम प्रलोभन, और कठिन-शासन संवर्धन—जो परिचालन रूप से सत्यापन को इसके थिएटर से अलग करता है।
पूर्व कार्य और रूपरेखा
दोष-सहन करने वाली सहमति (BFT) स्वतंत्र विफलताओं को मानती है—यह धारणा है जिसे हम परीक्षण करते हैं और अयोग्य पाते हैं। सहमति-विरोधाभास साहित्य पहले से ही सजातीय झुंडों में समझौता-स्थिरीकृत त्रुटि को नाम देता है (Shehata and Li, 2026)। zkML यह सत्यापित करता है कि एक गणना चली, न कि यह कि इसका उत्तर सत्य है—पूरक, प्रतिद्वंद्वी नहीं। सत्यापनकर्ता की दुविधा प्रोत्साहन विश्लेषण की आपूर्ति करती है; (Raji et al., 2022) लेखा परीक्षक-चयन समस्या की आपूर्ति करते हैं; (Du et al., 2024), (Farquhar et al., 2024), और (Ding, 2026) समझौता-संकेत साहित्य की आपूर्ति करते हैं जिसे यह पत्र दबाव-परीक्षण करता है। विश्वास निर्माण को स्वयं एक साथी पत्र में पेश किया गया था (Chernets, 2026); यह पत्र मानचित्र बनाता है कि निर्माण का सत्यापन इंजन कहां विफल होता है जबकि चलते हुए प्रदर्शित होता है। परीक्षण-समय-गणना कार्य निर्माणात्मक पक्ष से पूरक निष्कर्ष तक पहुंचता है: विविध पहलू सत्यापनकर्ताओं के समूह किसी भी एकल सत्यापनकर्ता से बेहतर प्रदर्शन करते हैं (Lifshitz et al., 2025), असंबद्ध परिवारों से निकाले गए छोटे न्यायाधीशों का एक पैनल एक अंश की लागत पर एकल बड़े न्यायाधीश से बेहतर प्रदर्शन करता है (Verga et al., 2024), और बहु-एजेंट बहस का एक व्यवस्थित पुनर्मूल्यांकन मॉडल विषमता को एकमात्र विश्वसनीय सुधारक के रूप में पहचानता है (Zhang et al., 2025); बहस रेखा संरचित प्रतिकूल तर्क दिखाती है जो कमजोर न्यायाधीशों को सत्य के करीब उत्तर तक पहुंचने में मदद करती है (Khan et al., 2024)। साथी-समीक्षित साक्ष्य पहले से ही प्रदाता-पार त्रुटि सहसंबंध में पर्याप्त प्रलेखित करता है—सबसे सटीक मॉडलों के बीच सबसे बड़ा, यहां तक कि भिन्न आर्किटेक्चर और प्रदाताओं में भी (Kim et al., 2025)—जो स्वतंत्र रूप से लेबल से इसे अनुमान लगाने के बजाय निर्भरता को मापने की प्रेरणा देता है। वह साहित्य विविधता के लिए पैनलों का चयन करता है; यह पत्र मापता है कि चयनित के लिए संपत्ति कितनी है—और सत्यापन में इसकी अनुपस्थिति पूर्ण रूप से कितनी लागत करती है।
डेटा और माप
एक पूर्व-पंजीकृत, अंधा संग्रह (प्रोटोकॉल की पुष्टिकारी डेटा संग्रह से पहले सार्वजनिक रूप से जमी हुई; https://osf.io/4y9dv पर सार्वजनिक पंजीकरण): सोलह मॉडल SimpleQA के 4,326 आइटम में से 1,500 का एक पूर्व-पंजीकृत यादृच्छिक उप-नमूना (निश्चित बीज, किसी भी संग्रह से पहले खींचा गया; उप-नमूना CSV इसके SHA-256 के साथ जमी हुई पंजीकरण से जुड़ी हुई) शून्य तापमान पर बताए गए 0–100 आत्मविश्वास के साथ (13,446 स्वच्छ सीमांत उत्तर; 8,802 स्थानीय-स्तर उत्तर); स्थानीय स्तर पर 750-आइटम TruthfulQA MC1 शाखा, आधिकारिक भंडार फ़ाइल की एक जमी हुई प्रति (790 आइटम, विहित CSV के लिए बाइट-समान) से प्राप्त, एक पूर्व-पंजीकृत निर्माता द्वारा जिसे प्रति आइटम कम से कम दो विशिष्ट गलत विकल्प की आवश्यकता है (निश्चित शफल बीज; 695 आइटम सभी सात मॉडल द्वारा पूरी तरह से उत्तर दिए गए); एक अन्वेषणात्मक सक्रिय-बनाम-अंधा संवाद शाखा। SimpleQA को एक सीमांत मॉडल के विरुद्ध विरोधात्मक रूप से संग्रहीत किया गया है, जिसमें प्रति प्रश्न एक निर्विवाद उत्तर है (Wei et al., 2024): कठिन स्तर इसलिए वास्तविक पैरामीट्रिक-ज्ञान सीमाओं की जांच करता है, और ग्रेडिंग स्वर्ण के समतुल्य तक कम हो जाती है। TruthfulQA विवश-उत्तर-स्थान शाखा प्रदान करता है (Lin et al., 2022)। पैनल एकल अंधे संग्रह के विश्लेषणात्मक संयोजन हैं; सभी पुन: विश्लेषण निर्धारक हैं (स्ट्रिंग-समतुल्य कोडिंग अस्वीकार और शून्य-ओवरलैप के साथ गैर-सहमति के रूप में गिने जाते हैं; अनिर्णीत जोड़े कोष्ठक के रूप में रिपोर्ट किए जाते हैं)। कठिनाई को अवलोकन संबंधी रूप से प्रश्न के अनुसार माध्य 16-मॉडल सटीकता के रूप में परिचालित किया जाता है, जो 300 प्रश्नों की रैंक क्विंटाइल में विभाजित है। समान कच्चा संग्रह साथी पत्र (Chernets, 2026) को आधार देता है, जो यहां विस्तृत विश्लेषणों की पूल की गई प्रमाणीकरण अनुपात और संक्षिप्त सारांश की रिपोर्ट करता है; कठिनाई-स्तरीकृत लिफ्ट सीढ़ी, मजबूती सुइट, -मैट्रिक्स, और अनुरूपता अपघटन केवल इस पत्र में दिखाई देते हैं, और प्रत्येक शेष ओवरलैप को पाठ में क्रॉस-फ्लैग किया गया है।
खुले रूप की ग्रेडिंग दो-चरणीय है: एक निर्धारक स्ट्रिंग-समतुल्य पास (सीमांत ग्रेड का 26.8%) साथ ही अस्वीकार पहचान (6.6%), शेष 66.5% एक LLM ग्रेडर द्वारा ग्रेड किए जाते हैं; एक मानव स्पॉट-जांच एक यादृच्छिक नमूने पर ग्रेडर से 98% पर सहमत हुई ()। क्योंकि दो-तिहाई ग्रेड मॉडल-उत्पादित हैं, सभी शीर्षलेख परिणाम ग्रेडर-त्रुटि संवेदनशीलता पुनः नमूना के साथ होते हैं (मॉडल-ग्रेड किए गए फैसलों का 10% पलट गया, 200 बीजीय पुनः नमूने; अनुभाग 4 और परिशिष्ट A)।
विफलता शासन I: कठिनाई का व्युत्क्रम
तीन पूर्व-निर्दिष्ट सीमांत पैनल एकल अंध संग्रह के विश्लेषणात्मक 3-मॉडल संयोजन हैं: US-ब्लॉक (Anthropic, OpenAI, Google), CN-ब्लॉक (DeepSeek, Alibaba, Moonshot), और क्रॉस-ब्लॉक (Anthropic, DeepSeek, Mistral); एक उत्तर को प्रतिकृति के रूप में गिना जाता है जब प्राथमिक के दोनों पैनल-साथियों में से कम से कम एक ने अनुभाग 3 के फ्रोज़न नियतात्मक कोडिंग के तहत स्वतंत्र रूप से एक समकक्ष उत्तर प्रदान किया है, और लिफ्ट है। तीनों पैनलों में पूलित, प्रतिकृत उत्तर की सही होने की संभावना सबसे कठिन पंचमक पर 0.0% (0/342, CI 0.0–1.1) से लेकर 12.8%, 57.5%, और 81.0% तक 95.1% तक सबसे आसान पर बढ़ती है; गैर-प्रतिकृत उत्तरों पर संबंधित लिफ्ट 0.00 / 0.82 / 2.68 / 3.09 / 4.56 चलती है। सबसे कठिन 20% प्रश्नों पर प्रत्येक देखे गए समझौते ने एक गलत उत्तर को प्रमाणित किया, और अगले पंचमक पर बिंदु अनुमान समझौते को असहमति के साथ समता नीचे रखता है (0.82, CI [0.51, 1.21]); सबसे कठिन-पंचमक शून्य प्रत्येक पैनल में अलग से प्रतिकृत होता है (US 0.00–4.25, CN 0.00–9.76, क्रॉस-ब्लॉक 0.00–4.04); Q2 सब-समता CN और क्रॉस-ब्लॉक पैनलों में रहती है, जबकि US पैनल का Q2 लिफ्ट 1.20 है। पूलित प्रमाणन लिफ्ट का अधिकांश भाग आसान प्रश्नों द्वारा वहन किया जाता है, इसलिए एक अस्तरित लिफ्ट दावा यह बढ़ाता है कि सत्यापन जहां आवश्यक है वहां क्या प्रदान करता है। Q1 शून्य को एक लाइव बेस दर के विरुद्ध मापा जाता है, न कि एक फर्श के विरुद्ध: गैर-प्रतिकृत Q1 उत्तर 3.9% समय सही होते हैं (89/2286), इसलिए स्वतंत्रता सही प्रतिकृत उत्तरों की भविष्यवाणी करती है—देखा गया 0 (ऊपरी सीमा 1.1%) स्तर की अपनी बेस दर से महत्वपूर्ण रूप से नीचे बैठता है। स्वतंत्रता बेंचमार्क यहां रूढ़िवादी है, उदार नहीं: एक शून्य जो पूर्ण मापा अंतर-मॉडल सहसंबंध संरचना को संरक्षित करता है—स्तर के प्रश्नों में सही लेबल का एक सामान्य क्रमपरिवर्तन, प्रतिकृति संरचना फ्रोज़न (2,000 क्रमपरिवर्तन)—11.7–12.4 सही प्रतिकृत उत्तरों की अपेक्षा करता है और कभी भी देखा गया 0 नहीं (; न्यूनतम 3); मापा गया जोड़ीदार को एक विश्लेषणात्मक द्विचर शून्य में गुना करने से अपेक्षा बढ़ती है, क्योंकि सकारात्मक रूप से सहसंबद्ध त्रुटियां सकारात्मक रूप से सहसंबद्ध सही उत्तरों का अर्थ निकालती हैं। स्तर को क्या भरता है वह स्वयं सूचनात्मक है: 342 कक्ष 106 प्रश्नों तक फैलते हैं—साधारण संकीर्ण तथ्य (माध्यिका 17 शब्द), अस्पष्ट वाक्यांश नहीं, और मॉडल शायद ही कभी उन पर परहेज करते हैं (0.5 प्रश्न प्रति 9 उत्तर)। उनके गलत उत्तर समूह: इन प्रश्नों के 70.8% पर नौ सीमांत मॉडलों में से कम से कम तीन ने एक ही गलत उत्तर दिया, और एक से अधिक पैनल द्वारा प्रतिकृत प्रश्नों के 67.4% पर, स्वतंत्र रूप से रचित पैनलों ने समान गलत सर्वसम्मति को प्रमाणित किया—आमतौर पर एक प्रसिद्ध-पड़ोसी उत्तर सही लेकिन कम प्रमुख इकाई को विस्थापित करता है। सभी 106 सोने के लेबल का एक मैनुअल विषय-वस्तु निर्णय 2 विवादास्पद और 0 बिल्कुल गलत पाया गया; एक स्पष्ट रूप से बचाव योग्य पैनल उत्तर और दो आंशिक रूप से बचाव योग्य उत्तरों को श्रेय देना कठिनतम-पंचमक गणना को 0/342 से 13/342 (3.8%) तक ले जाता है, इसलिए निकट-शून्य निष्कर्ष आखिरी अक्षर से नरम करते समय रहता है (एक फ्लैग किया गया लेबल: एक 2010 रॉयल अकादमी चुनाव एक सम्मान शीर्षक के विरुद्ध स्कोर किया गया जो अकादमी सम्मानित नहीं करती है)। दावा सीधे परीक्षण योग्य है: यह तैनात जनसंख्या की अपनी सटीकता द्वारा स्तरित किसी भी प्रतिकृति में Q1 लिफ्ट की भविष्यवाणी करता है (पैनल-स्वतंत्र स्तरीकरण के तहत भविष्यवाणी पूलित लिफ्ट नहीं क्रॉस-ब्लॉक शून्य है)। न ही शून्य एक ग्रेडर कलाकृति है: हर पैनल और मूल ग्रेडर (तापमान शून्य, समान फ्रोज़न समकक्षता-से-सोने संकेत) के बाहर एक विक्रेता परिवार से एक स्वतंत्र दूसरा ग्रेडर 342 Q1 प्रतिकृत फैसलों को फिर से ग्रेड करता था और 342/342 पर सहमत होता था (सही करने के लिए फ्लिप 0/342, ऊपरी सीमा 1.1%); 10% मॉडल-ग्रेडेड लेबल के कृत्रिम फ्लिपिंग को प्रमाणित-त्रुटि साझा को प्रत्येक रीसैम्पल (परिशिष्ट) में 86.5% पर या ऊपर छोड़ देता है।
पैनल-बहिष्कृत पुनः-स्तरीकरण।
क्योंकि पैनल सदस्य जनसंख्या कठिनाई सूचकांक में योगदान देते हैं, सबसे कठिन क्विंटाइल आंशिक रूप से पैनल की अपनी विफलता पर निर्भर है। केवल 13 गैर-पैनल मॉडलों द्वारा पुनः-स्तरीकरण करते हुए, सबसे कठिन क्विंटाइल पर प्रतिलिपित उत्तर 78/354 मामलों में सही हैं (22.0%, संयुक्त लिफ्ट 2.36, स्वतंत्रता के तहत 33/354 अपेक्षित से ऊपर), और शून्य केवल क्रॉस-ब्लॉक पैनल के लिए ही बना रहता है (0/116; 0/88 उस स्तर पर जहाँ सभी 13 गैर-पैनल मॉडल विफल होते हैं)। बचा हुआ शून्य स्वयं विशेषता है: स्तर की आधार दर 31/778 = 3.98% है (विल्सन 2.8–5.6%), जो स्वतंत्रता के तहत 116 में से 4.6 सही की अपेक्षा देता है; एक सहसंबंध-संरक्षण क्रमपरिवर्तन शून्य (2,000 क्रमपरिवर्तन) देता है, 95% श्रेणी , और — शून्य से काफी नीचे, हालांकि इसके तहत पहुँचने योग्य नहीं है। इसलिए ऊपर का व्युत्क्रम यह दावा है कि सत्यापन कहाँ विफल होता है, इसके सापेक्ष कि तैनात जनसंख्या को क्या कठिन लगता है, पैनल-स्वतंत्र कठिनाई के सापेक्ष नहीं। दूसरे संवेदनशीलता जांच के रूप में, हमने एक पूर्णतः लेबल-मुक्त प्रतिलिपि कोडिंग (अंधे उत्तरों की नियतात्मक स्ट्रिंग तुलना केवल, कभी भी सत्यता लेबल से परामर्श न करते हुए) के तहत सीढ़ी को पुनः प्राप्त किया: Q1 परिणाम अनिवार्य रूप से अपरिवर्तित है (2/344 प्रतिलिपित उत्तर सही, 0.6% [0.2–2.1]; लिफ्ट 0.15) और दो सबसे कठिन क्विंटाइलों पर 1 से नीचे की लिफ्टें बनी रहती हैं, जबकि शीर्ष-क्विंटाइल लिफ्ट क्षीण हो जाती है (4.56 से 2.33) क्योंकि विशुद्ध स्ट्रिंग मिलान एक ही सही उत्तर के सतही रूपांतरों को मिस करता है; बहु-विकल्प परिणाम अप्रभावित हैं, क्योंकि वहाँ समझौता उत्तर पत्र द्वारा कोडित है और निर्माण द्वारा लेबल-मुक्त है।
तीन मजबूती जांचें व्युत्क्रम का समर्थन करती हैं। (i) प्रश्न-स्तर बूटस्ट्रैप (क्विंटाइल के भीतर 2,000 बीजित पुनः नमूने) पाँच लिफ्टों के लिए 95% CIs देता है [0.00, 0.00], [0.51, 1.21], [2.32, 3.09], [2.84, 3.35], और [4.16, 5.03]: कठिन-व्यवस्था अंतराल आसान-व्यवस्था वाले को पूरी तरह बाहर करते हैं। (ii) ग्रेडर-त्रुटि संवेदनशीलता: मॉडल-ग्रेडेड निर्णयों का 10% फ्लिप करना (200 बीजित पुनः नमूने; 342 सबसे कठिन-क्विंटाइल प्रतिलिपित उत्तरों का 97.1% मॉडल-ग्रेडेड है और इसलिए फ्लिप करने योग्य है) सबसे कठिन क्विंटाइल की प्रमाणित-त्रुटि हिस्से को हर पुनः नमूने में 86.5% पर या उससे ऊपर रखता है, 92% पुनः नमूनों में Q1 लिफ्ट को 1 के नीचे रखता है (माध्यिका 0.82), और कभी भी Q1–Q2 लिफ्टों को Q3–Q5 लिफ्टों के पास नहीं लाता है, जो सभी 200 पुनः नमूनों में 2 से ऊपर रहती हैं। (iii) सात-मॉडल स्थानीय स्तर स्वतंत्र मॉडलों और पैनलों के साथ कठिन–आसान विपरीत को प्रतिलिपित करता है, गैर-एकरस रूप से (Q3 ): लिफ्टें 0.00 / 0.94 / 0.00 / 1.89 / 4.37 समान क्विंटाइलों में, सबसे कठिन क्विंटाइल पर 166 प्रतिलिपित उत्तरों में से 0 सही हैं; यह स्तर 94.8% LLM-ग्रेडेड है और (ii) जैसी ही ग्रेडर-संवेदनशीलता पुनः नमूने द्वारा कवर किया गया है।
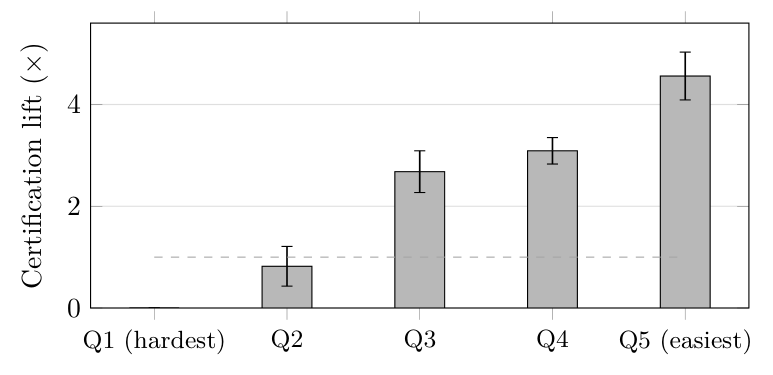 कठिनाई क्विंटाइल द्वारा प्रमाणन लिफ्ट, तीन सीमांत पैनलों पर संयुक्त, प्रश्न-स्तर बूटस्ट्रैप 95% अंतराल के साथ (2,000 बीजित पुनः नमूने; परिशिष्ट A.1)। धारीदार रेखा लिफ्ट = 1 को चिह्नित करती है, गैर-प्रतिलिपित उत्तरों के साथ समता: दो सबसे कठिन क्विंटाइल बिंदु अनुमान द्वारा इसके पास या नीचे बैठते हैं (Q1 0.00×—एक मापा शून्य, लापता डेटा नहीं; Q2 0.82×, इसका CI समता को पार करता है), तीन सबसे आसान इसके अच्छी तरह ऊपर हैं।
विफलता शासन II: सीमित उत्तर स्थान
बहुविकल्पीय प्रश्नों पर, चार पूर्व-निर्दिष्ट स्थानीय-स्तरीय पैनलों ने 695 पूरी तरह से उत्तरित प्रश्नों (प्रति-पैनल: 4.0, 5.9, 6.6, 7.9) के 4.0–7.9% पर एकमत रूप से एक गलत विकल्प पर अभिसरण किया, जबकि सीमांत स्तर पर आत्मविश्वासपूर्ण एकमत गलत उत्तरों के लिए 0.3–4.9% का एक नियतात्मक ब्रैकेट है। स्थानीय स्तर के अपने खुले-रूप के उत्तरों (8,802 ग्रेडेड SimpleQA प्रतिक्रियाएं) पर समान प्रमाणन मीट्रिक की पुनः गणना करना स्तर–प्रारूप को भ्रामक करता है: समान स्थानीय पैनल कठोर नियतात्मक कोडिंग के तहत खुले-रूप की वस्तुओं के केवल 1.5–4.6% पर एकमत आत्मविश्वास त्रुटियों को प्रमाणित करते हैं (अनिश्चित ब्रैकेट सहित 9.8% तक), जो सीमांत खुले-रूप श्रेणी के अनुरूप है—एक पैटर्न जो मॉडल स्तर के बजाय सीमित उत्तर स्थान द्वारा संचालित त्रुटि प्रमाणन के अनुरूप है; हालांकि, एक भ्रम बना हुआ है: बहुविकल्पीय भुजा और खुले-रूप की भुजाएं विभिन्न प्रश्न सेट हैं (TruthfulQA MC1 बनाम SimpleQA), इसलिए प्रारूप और प्रश्न सेट यहां अलग नहीं हैं, और दावे का कारणात्मक रूप केवल एक ही-प्रश्न प्रारूप स्वैप द्वारा निर्धारित है, जो हमने नहीं चलाया।1 प्रति-पैनल बूटस्ट्रैप उस अंतराल पर अंतराल डालता है जहां यह संचालित है: MC माइनस खुले-रूप प्रमाणित-सहमति-त्रुटि है pp [2.9, 6.8] (पायलट), pp [3.9, 8.1] (US-स्थानीय), और pp [2.6, 6.3] (क्रॉस-ब्लॉक), प्रत्येक शून्य को बाहर करता है; CN-स्थानीय पैनल, जिसका खुले-रूप सेल पाद टिप्पणी के 87-आइटम सेट पर निर्भर करता है, इसे हल नहीं करता है। एक मेनू बिखरी हुई त्रुटियों को साझी त्रुटियों में परिवर्तित करता है: जब उत्तर स्थान छोटा होता है, तो समान मॉडल एक ही विकर्षक पर पड़ते हैं और पैनल की एकमतता एक त्रुटि-प्रवर्धक बन जाती है। दरें स्वतंत्र त्रुटियों द्वारा समझाई नहीं जा सकतीं: प्रत्येक सदस्य के साथ अपनी सीमांत दर पर स्वतंत्र रूप से गलत होने और त्रुटियां गलत विकल्पों पर फैली हुई (), अपेक्षित एकमत-समान-गलत-विकल्प दर चार पैनलों में 0.49–0.92% है—देखी गई 4.0–7.9%, स्वतंत्रता आधार पर 4.9–13.5 अतिरिक्त है। डिज़ाइन परिणाम, एक परीक्षणीय नियम के रूप में कहा गया: कोई भी इंटरफेस जो एजेंटों को एक निश्चित विकल्प सेट सौंपता है, वह समान सामग्री पर खुले-रूप निष्कर्षण की तुलना में गौरव से अधिक प्रमाणित-सहमति-त्रुटि की अपेक्षा करना चाहिए।
सभी तीन पैनलिस्टों से बताए गए आत्मविश्वास की आवश्यकता होने से प्रभाव को मुश्किल से दांत आता है: प्रमाणित-सहमति-त्रुटि श्रेणी 4.0–7.9% से 4.0–7.2% तक चली जाती है (प्रति-पैनल 4.0, 5.2, 6.0, 7.2), अर्थात् लगभग सभी एकमत गलत उत्तर भी आत्मविश्वास वाले हैं। विफलता किसी सांस्थानिक स्थान तक भी सीमित नहीं है: कम से कम 20 वस्तुओं वाली दस TruthfulQA श्रेणियों में, पूलित प्रमाणित-सहमति-त्रुटि 1.0% (षड्यंत्र) से 8.6% (अर्थशास्त्र) तक फैली हुई है, कानून, स्वास्थ्य, और समाजशास्त्र बीच में हैं (परिशिष्ट A)।
विफलता व्यवस्था III: स्वतंत्रता लेबल स्वतंत्रता की भविष्यवाणी नहीं करते
36 सीमांत विक्रेता जोड़ियों (1,448 साझा प्रश्न) में, जोड़ीदार त्रुटि सहसंबंध 0.123–0.395 तक फैला है, और यह अवधि उन लेबलों द्वारा संगठित नहीं है जिन तक लोग पहुँचते हैं: सबसे अधिक और कम से कम सहसंबद्ध जोड़ियों दोनों अंतःखंड हैं (googlexai 0.395 बनाम googleopenai 0.123), अंतःखंड और अंतःखंड के बीच का मतलब के द्वारा से भिन्न होते हैं, और समान-आधार वंशावली जोड़ी 695 पूर्ण-उत्तरित बहु-विकल्प वस्तुओं पर छह US/CN-खंड स्थानीय मॉडलों द्वारा बनाई गई 15 जोड़ियों में से 14वीं रैंक है (; सातवाँ स्थानीय मॉडल EU-खंड है और पूर्व-पंजीकृत खंड/वंशावली डिज़ाइन के बाहर है—इसे शामिल करने से 21 जोड़ियों मिलती हैं, जिनमें से वंशावली जोड़ी 20वीं रैंक है)। दोनों पूर्व-पंजीकृत शून्य (खंड, वंशावली) पुनः विश्लेषण में बने रहते हैं; जो भविष्यवाणीपूर्ण रहता है वह मापा हुआ सहसंबंध स्वयं है। व्यावहारिक नियम: स्वतंत्रता एक प्रति-जोड़ी, प्रति-कार्य-वर्ग मात्रा है जिसे मापा जाना है (एक -मैट्रिक्स), ब्रांड, झंडे, या पारिवारिक वृक्ष से अनुमान नहीं लगाया जाना है—लेबल द्वारा एक पैनल असेंबल करना कास्टिंग है, सत्यापन नहीं। जोड़ीदार अनुभवजन्य त्रुटि निर्भरता को मापते हैं, पूर्ण सांख्यिकीय स्वतंत्रता को नहीं: कम तीन या अधिक पैनलों में उच्च-क्रम निर्भरता को बाहर नहीं करते हैं, स्वतंत्रता को एक मापा, कार्य-शर्तबद्ध मात्रा के रूप में मानने का एक और कारण है, न कि एक माना हुआ गुण।
सभी 630 खंड लेबल असाइनमेंट पर नौ विक्रेताओं के लिए एक सटीक क्रमपरिवर्तन परीक्षण कोई खंड प्रभाव का सबूत नहीं पाता है: का अवलोकित अंतःखंड-ऋण-अंतःखंड अंतर 630 पुनः लेबलिंग में से 132 द्वारा अधिक या मेल खाया जाता है (एक-पक्षीय ; अंतर के लिए क्लस्टर्ड-बूटस्ट्रैप 95% CI )। परीक्षण दावे को सीमित करता है—छोटे खंड प्रभाव बाहर नहीं किए जाते हैं—और परिचालन निष्कर्ष बना रहता है: लेबल प्रति-जोड़ी माप के स्थान पर उपयोग करने योग्य कोई संकेत नहीं रखता है। क्योंकि ऊपर से बंधा हुआ है जब जोड़ी की आधार त्रुटि दरें भिन्न होती हैं, हमने सीमांत-सामान्यीकृत अनुपात पर विश्लेषण को फिर से चलाया: दोनों पूर्व-पंजीकृत शून्य बचे रहते हैं (खंड अंतर , क्रमपरिवर्तन ; वंशावली जोड़ी 15 में से 14वीं रहती है), प्रसार बना रहता है (0.278–0.821 सीमांत जोड़ियों में), और चरम दो अंतःखंड जोड़ियों को स्थानांतरित करते हैं (anthropicmoonshot 0.821, mistralopenai 0.278)—किसी भी मीट्रिक के तहत, कोई लेबल प्रसार को संगठित नहीं करता है। मैट्रिक्स को सभी सोलह मॉडलों तक विस्तारित करते हुए: 81 प्रश्नों पर जो हर मॉडल द्वारा उत्तर दिए गए थे, जोड़ीदार से तक फैला है (120 जोड़ियां; ब्लॉक साधन: सीमांत–सीमांत 0.320, स्थानीय–स्थानीय 0.350, सीमांत–स्थानीय 0.210)—एक परिमाण का क्रम प्रसार जो हमारे डेटा में कोई लेबल वर्गीकरण भविष्यवाणी नहीं करता है (चित्र 2)। 81 सामान्य वस्तुओं के साथ, व्यक्तिगत कक्ष अनुमान व्यापक अंतराल रखते हैं; परिणाम प्रसार स्वयं है, कोई एकल कक्ष नहीं।
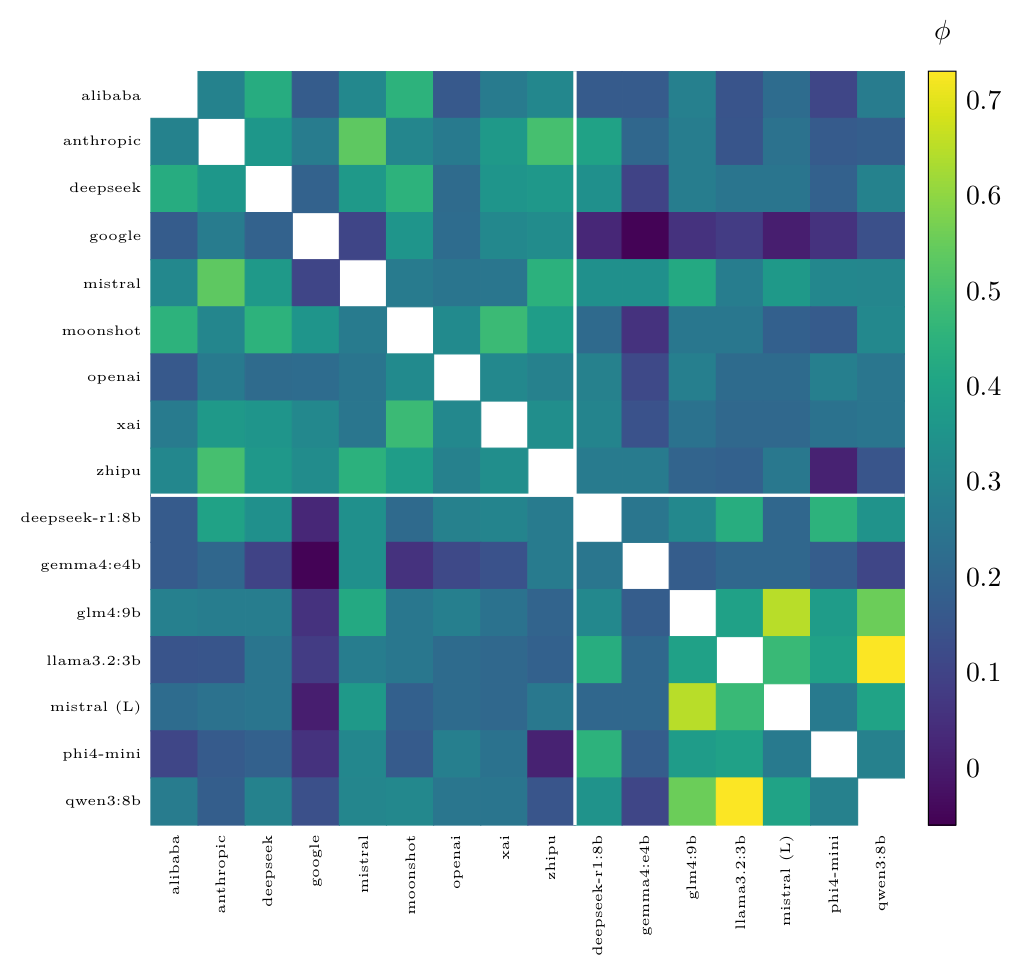 सभी सोलह मॉडलों के बीच युग्मवार त्रुटि-सहसंबंध (ϕ) उन 81 प्रश्नों पर जिनका उत्तर हर मॉडल द्वारा दिया गया था (नौ सीमांत विक्रेता, फिर सात स्थानीय खुले-भार; सीमांत/स्थानीय विभाजन सफेद नियमों द्वारा चिह्नित है)। प्रत्येक विकर्ण-बाहरी कक्ष 120 अद्वितीय युग्मों में से एक है; विकर्ण (आत्म-सहसंबंध = 1.0) डिज़ाइन द्वारा खाली छोड़ा गया है ताकि यह रंग पैमाने को संपीड़ित न करे। ϕ −0.05 से 0.73 तक फैलता है (माध्य 0.27): यह कि कोई भी दो सत्यापनकर्ताओं की त्रुटियां कितनी सहसंबद्ध हैं, इसमें एक परिमाण-का-परिमाण प्रसार है, जिसकी भविष्यवाणी आप के डेटा में कोई भी गुट या वंश लेबल नहीं करता। मान deterministically emit_phi_matrix.py द्वारा उत्सर्जित होते हैं (analysis_week1.py sec. W5 का पुनः उपयोग करते हुए); कोई भी हाथ से दर्ज नहीं हैं।
विफलता व्यवस्था IV: सत्यापन जो समर्पण करता है (अन्वेषणात्मक)
जब एक सत्यापक जो अंधे अवस्था में असहमत था, उसे एक सहयोगी के प्रस्ताव के समान उत्तर दिखाया गया, तो वह 38.5% मामलों में (168/436) आत्मसमर्पण कर गया; जब उसने अंधे अवस्था में सही उत्तर दिया था, तो वह इसे गलत उत्तर के लिए 30.9% (46/149) में त्याग दिया, प्रति-विक्रेता त्याग दर 13.1% से 51.6% तक है (पूरे असहमत-अंधे उपसमुच्चय पर प्रति-विक्रेता आत्मसमर्पण 20.4–58.1% तक फैला हुआ है)।
क्या ये उलटफेर तर्कसंगत विश्वास अद्यतन के बजाय अनुरूपता हो सकते हैं? एक रिवर्स-प्रॉम्प्ट नियंत्रण इसके विरुद्ध तर्क देता है। छः-मॉडल स्थानीय पैनल पर हमने जोड़ी गई प्रक्रिया को उजागर दिशा उलटकर फिर से चलाया: एक सत्यापक जो अंधे अवस्था में असहमत था, उसे समान प्रश्न सेट के लिए दिखाया गया था, या तो आत्मविश्वास से गलत उत्तर (प्रत्यक्ष बांह) या स्वर्ण उत्तर (रिवर्स बांह)। दोनों बाहें प्रॉम्प्ट-समान हैं—एक साझा टेम्पलेट ("प्रस्तावित उत्तर: …"), दिखाया गया उत्तर केवल सामग्री में भिन्न है, कोई आत्मविश्वास मूल्य या स्रोत एट्रिब्यूशन प्रदर्शित नहीं है—इसलिए विपरीत दिखाए गए उत्तर के सत्य मूल्य को अलग करता है। यदि सत्यापक साक्ष्य पर अद्यतन कर रहे थे, तो सही उत्तर के संपर्क में आने से उन्हें अधिक स्थानांतरित करना चाहिए; इसके बजाय दोनों बाहें लगभग समान फ्लिप दर का उत्पादन करीं—गलत उत्तर की ओर 38.9%, सही उत्तर की ओर 34.7%—और जोड़ी-भीतर तुलना अद्यतन कथा के लिए गलत तरीके से चलती है: 174 असंगत जोड़े में से, सत्यापक ने गलत उत्तर के लिए अपनी अंधी स्थिति को 104 में और सही उत्तर के लिए 70 में छोड़ दिया (McNemar exact )। मॉडल स्तर पर दोनों बाहें अभेद्य थीं (सबसे अनुपालक सत्यापक के लिए 89.9% बनाम 89.9% फ्लिप प्रवृत्ति, सबसे कम के लिए 1.5% बनाम 1.5%): जो समझौता को ट्रिगर करता है वह यह है कि एक आत्मविश्वास प्रस्ताव मौजूद है, यह नहीं कि यह सही है—प्राथमिकता-प्रशिक्षित उपचारवाद का पैनल-सत्यापन चेहरा (Sharma et al., 2024)। और न ही असमरूपता सबसे अनुपालक सत्यापक पर निर्भर करता है: इसे छोड़कर 835 युग्मित आइटम असंगत गणना 94 बनाम 60 के साथ रह जाते हैं (exact )। दो अतिरिक्त विघटन इस पाठ्यक्रम को सुदृढ़ करते हैं (परिशिष्ट A): किसी भी बांह में प्रत्येक दर्ज फ्लिप कथित पश्चात्-उजागर आत्मविश्वास के साथ आया (उस सीमा से नीचे 0 फ्लिप, ), और प्रत्यक्ष बांह में सत्यापक जो अंधे अवस्था में सही थे, उन्होंने सही उत्तर को 40.8% मामलों में (20/49) त्याग दिया, सीमांत निष्कर्ष को प्रतिबिंबित करते हुए। नियंत्रण स्थानीय स्तर पर चलाया गया (सीमाएं)। इस नियंत्रण का एक गद्य सारांश साथी पत्र में भी दिखाई देता है (Chernets, 2026); प्रति-मॉडल विघटन, आत्मविश्वास-गेट विभाजन, और सही-अंधे त्याग विश्लेषण केवल यहां रिपोर्ट किए जाते हैं।
यह एक डिज़ाइन दावे को सीमित करता है: जब लक्ष्य स्वतंत्र असहमति को मापना है, तो निष्कर्षण को अंधे-पहले होना चाहिए—एक पैनल जो स्थिति को प्रतिबद्ध करने से पहले विचार-विमर्श करता है, वह अपनी असहमति को नहीं मापता है, यह इसे मिटा देता है।
चर्चा: थिएटर का अर्थशास्त्र (अनुमान, प्रमाण नहीं)
यह खंड प्रमाण के बजाय चर्चा है: यह कोई नया माप रिपोर्ट नहीं करता, और इसमें कुछ भी ऊपर दिए गए चार मापे गए शासनों के साथ समान रूप से नहीं पढ़ा जाना चाहिए। यह कहा जा रहा है, चार शासन बने रह सकते हैं क्योंकि कोई भी पक्ष उन्हें नोटिस करने के लिए भुगतान नहीं किया जाता: उपभोक्ता सत्यापन गुणवत्ता का मूल्य निर्धारण नहीं कर सकते, प्लेटफॉर्म को संदेह के बजाय आत्मविश्वास के लिए भुगतान किया जाता है, और प्रत्येक सत्यापनकर्ता की सबसे सस्ती रणनीति सहमति देना है। लेखा परीक्षक-चयन समस्या जोड़ें (स्वतंत्रता जो कोई भी चेकर्स को चुनता है उसकी संपत्ति है) और लिंक-फार्म पूर्वाग्रह (कोई भी समझौता संकेत जो वाणिज्यिक वजन रखता है कृषि को आमंत्रित करता है), और थिएटर एक संतुलन है, एक दुर्घटना नहीं—एक अनुमान जो माप प्रेरित करता है लेकिन परीक्षण नहीं करता। प्रोत्साहन खाता इंजीनियरिंग जड़ता और माप मानकों की अनुपस्थिति को पूरक करता है, बल्कि बाहर नहीं करता; इसे अलग रखा जाता है क्योंकि यह गलत सिद्ध करने योग्य घटक है। यह खंड आदर्श दावों के बजाय गलत सिद्ध करने योग्य बाजार भविष्यवाणियां करता है—उदाहरण के लिए, अनिरीक्षित पैनलों को समय के साथ न्यूनतम-विविधता संरचना की ओर अभिसरण करना चाहिए क्योंकि सहसंबद्ध पैनल सस्ते होते हैं और अधिक सहमत होते हैं।
थिएटर से मापन तक
समाधान एक अनुशासन है, घटक नहीं: (1) पैनल के मापे गए -मैट्रिक्स को कार्य वर्ग के अनुसार प्रकाशित करें, इसकी ब्रांड सूची नहीं (प्रति कार्य वर्ग एक अंध संग्रह पर्याप्त है—इस पत्र का 16-मॉडल मैट्रिक्स एक एकल 1,500-आइटम पास से आया); (2) प्रत्येक प्रमाणन दावे को कठिनाई के अनुसार स्तरीभूत करें और कठिन-शासन लिफ्ट को अलग से रिपोर्ट करें (कठिनाई को कार्य वर्ग से अनुकलन संग्रह के अनुसार संचालित किया जाता है, अनुमान में प्रति आइटम नहीं); (3) हमेशा अंध-प्रथम उद्दीपन करें—पैनल सत्यापन की प्रतिबद्धता-प्रकट योजना, जो कंप्यूट जोड़ने के बजाय उद्दीपन को पुनर्व्यवस्थित करती है, क्योंकि अंध उत्तर समानांतरकरणीय हैं; (4) सबसे कठिन शासन को एक संवर्धन ट्रिगर के रूप में मानें—प्रश्नों पर जहां पैनल की मापी गई लिफ्ट है, सहमति मानव के लिए या परित्याग के लिए मार्ग दिखानी चाहिए, प्रमाणन के लिए कभी नहीं। प्रत्येक नियम इस तरह कहा जाता है कि तैनात किए गए सिस्टम को इसके विरुद्ध ऑडिट किया जा सकता है।
एक व्यावहारिक उदाहरण के रूप में, इस पत्र के स्वयं के सीमांत पैनल पर इस विधि को लागू करें। नियम (1): इसकी स्वतंत्रता को अनुभाग 6 के मापे गए -मैट्रिक्स के रूप में रिपोर्ट किया जाता है (विस्तार 0.123–0.395), विक्रेता सूची के रूप में नहीं—जो यह छिपा सकता था कि सबसे सहसंबद्ध जोड़ी इंट्रा-ब्लॉक है (googlexai)। नियम (2): इसकी प्रमाणन लिफ्ट स्तरीभूत रिपोर्ट की जाती है (तालिका 1), कठिन-शासन लिफ्ट ( Q1 पर, Q2 पर) के साथ एकल समग्र सुर्खियों में मिश्रित होने के बजाय अलग से कहा जाता है। नियम (3): यहां प्रत्येक उत्तर को किसी भी पैनल के इकट्ठा होने से पहले अंध में उद्दीपित किया गया था, जो ठीक वही है जो अनुरूपता हथियार (अनुभाग 7) को मापने योग्य बनाता है न कि संभ्रांत। नियम (4): क्योंकि पैनल की मापी गई लिफ्ट दो कठिनतम क्विंटाइल पर है, इसी पैनल का एक ऑडिट किया गया तैनाती उन प्रश्नों को परित्याग या मानव समीक्षा के लिए मार्ग देगा, सर्वसम्मति प्रमाणन के लिए कभी नहीं। अनुशासन इसलिए काल्पनिक नहीं है: यह वह प्रोटोकॉल है जिसके तहत पत्र की संख्याएं तैनात की गई थीं।
सीमाएँ
प्रति स्तर एकल बेंचमार्क परिवार (SimpleQA खुली-रूप सीमांत; TruthfulQA MC स्थानीय), इसलिए शासन की सीमाएँ बेंचमार्क-सापेक्ष हैं; प्रत्येक सीमांत विक्रेता को एक बजट/मध्य-स्तर मॉडल द्वारा दर्शाया जाता है, इसलिए विक्रेता-क्षमता दावे नहीं बनाए जाते हैं। कठिनाई स्तरीकरण अवलोकन संबंधी है (एक पूर्व-पंजीकृत संग्रह के बाद-तथ्य) और क्विंटाइल असाइनमेंट का डेटा मूल्यांकन किए गए मॉडल के साथ साझा किया जाता है। अनुरूपता शाखा अन्वेषणात्मक है और में मामूली है; इसके रिवर्स-प्रॉम्प्ट नियंत्रण में स्थानीय मॉडल का उपयोग किया गया था, इसलिए सीमांत पैनलों में स्थानांतरण सादृश्य द्वारा है, माप द्वारा नहीं। मोटे तौर पर दो-तिहाई खुली-रूप ग्रेड एक LLM ग्रेडर से आते हैं (मानव स्पॉट-चेक 98% समझौता; सभी 342 कठिनतम-क्विंटाइल का एक क्रॉस-परिवार पुनः-ग्रेडिंग निर्णयों के साथ सहमत 342/342; परिशिष्ट में संवेदनशीलता पुनः-नमूनाकरण)। दोनों बेंचमार्क सार्वजनिक हैं, इसलिए प्रशिक्षण-सेट रिसाव को नियम के अंतर्गत नहीं किया जा सकता है; SimpleQA पर इसकी दिशा स्मृत-सही उत्तरों का पक्ष लेती है, जो कठोर स्तर को सिकोड़ता है और कठोर-शासन परिणामों को रूढ़िवादी बनाता है; TruthfulQA पर सार्वजनिक कॉर्पस स्वयं गलतफहमियों को ले जाता है, इसलिए दिशा वहाँ स्पष्ट नहीं है— खंड 5 की प्रारूप-सामग्री चेतावनी द्वारा पहले से ही एक वैकल्पिक पाठ। कठोर प्रश्नों पर समझौता विफल होने के कारण के बारे में कोई कारणात्मक दावा नहीं बनाया जाता है—तंत्र के उम्मीदवार (साझा पूर्वाग्रह, साझा अंधे धब्बे, साझा प्रशिक्षण डेटा) का नाम दिया जाता है लेकिन अलग नहीं किया जाता है।
निष्कर्ष
सहमति स्वतंत्रता और योग्यता को मापने के बाद ही साक्ष्य है, और यह माप सस्ता है—यहाँ का पूरा पुनः विश्लेषण सार्वजनिक कच्ची फ़ाइलों से साधारण हार्डवेयर पर सेकंड में चलता है। जब तक पैनल अपने -मेट्रिसेस और स्तरीकृत लिफ्ट्स के साथ शिप न करें, "सर्वसम्मति द्वारा सत्यापित" को उसी तरह पढ़ा जाना चाहिए जैसे सुरक्षा इंजीनियरों ने एक बैग की खोज को पढ़ना सीखा है।
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
पुनरुत्पादनशीलता परिशिष्ट
सभी पुनः-विश्लेषण कच्चे ग्रेडेड JSONL फ़ाइलों और दो स्थिर-बीज स्क्रिप्ट्स दिए गए निर्धारक हैं (एक आधारभूत स्क्रिप्ट जो हर हेडलाइन संख्या को पुनः प्राप्त करती है और एक सप्ताह-1 ऐड-ऑन जो नीचे दिए गए बूटस्ट्रैप, संवेदनशीलता और अपघटन तालिकाएँ बनाती है); पूर्ण पुनः गणना किसी GPU, नेटवर्क या मॉडल कॉल के बिना वस्तु हार्डवेयर पर 15 सेकंड से कम समय लेती है। फ्रोजन पूर्व-पंजीकरण और प्रतिकृति पैकेज (सार्वजनिक OSF पंजीकरण): https://osf.io/4y9dv।
लिफ्ट सीढ़ी के लिए बूटस्ट्रैप आत्मविश्वास अंतराल
क्विंटाइल के भीतर प्रश्न-स्तरीय पुनः नमूनाकरण, 2,000 बीजित ड्रा, तीनों सीमांत पैनलों पर पूलित।
| क्विंटाइल | विल्सन 95% | बूट 95% | लिफ्ट | लिफ्ट बूट 95% | |
|---|---|---|---|---|---|
| Q1 (सबसे कठिन) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5 (सबसे आसान) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
कठिनाई क्विंटाइल द्वारा प्रमाणन लिफ्ट विल्सन और बूटस्ट्रैप 95% अंतराल के साथ (प्रतिशत के लिए, लिफ्ट के लिए अनुपात)। लीव-पैनल-आउट कठिनाई के तहत (13 गैर-पैनल मॉडल द्वारा रैंक किया गया) पूलित Q1 सेल 78/354 (22.0%, लिफ्ट 2.36) है, शून्य क्रॉस-ब्लॉक पैनल (0/116) के लिए बना रहता है; खंड 4। बेसरेट क्विंटाइल प्रति: 3.9 / 15.6 / 21.5 / 26.2 / 20.8% ( = 2286 / 2308 / 2209 / 1778 / 912)।
ग्रेडर-त्रुटि संवेदनशीलता
8,948 मॉडल-ग्रेडेड सीमांत निर्णयों का 10% फ्लिप करना (200 बीजित पुनः नमूने; समझौता कोडिंग और क्विंटाइल असाइनमेंट मूल नियतात्मक प्रोटोकॉल कोडिंग पर फ्रोजन ताकि केवल सही लेबल चलते हैं): सबसे कठिन-क्विंटाइल "प्रमाणित सही" सेल 0/342 से 33/342 की माध्यिका तक बढ़ता है (9.6%; 95% श्रेणी 23–46), इसलिए Q1 समझौते का प्रमाणित-त्रुटि हिस्सा हर पुनः नमूने में 86.5% पर या उससे ऊपर रहता है; Q1 लिफ्ट 92% पुनः नमूनों में 1 से नीचे रहता है (माध्यिका 0.82, 95% श्रेणी 0.56–1.08) जबकि Q3–Q5 लिफ्ट कभी 2 से नीचे नहीं जाता है (माध्यिका 2.17 / 2.51 / 3.42)। 342 Q1 प्रतिकृत उत्तरों में से, 332 (97.1%) मॉडल-ग्रेडेड हैं और इसलिए इस अभ्यास में फ्लिप योग्य हैं। सिंथेटिक फ्लिप से परे, एक क्रॉस-फैमिली ऑडिट ने सभी 342 Q1 प्रतिकृत निर्णयों को एक स्वतंत्र दूसरे ग्रेडर के साथ दोबारा ग्रेड किया (एक विक्रेता परिवार हर पैनल के बाहर और मूल ग्रेडर के परिवार के बाहर; तापमान 0; बाइट-समान फ्रोजन प्रॉम्प्ट): समझौता 342/342 (सही के लिए फ्लिप 0/342, विल्सन ऊपरी सीमा 1.1%), मॉडल-ग्रेडेड (332) और स्ट्रिंग/रिफ्यूसल-कोडेड (10) सेल में समान। क्योंकि 342 सेल 106 अद्वितीय प्रश्नों में विस्तृत हैं, एक क्लस्टर-रूढ़िवादी पाठ प्रश्नों को इकाई के रूप में मानता है: 0/106 एक विल्सन ऊपरी सीमा 3.4% देता है; खंड 4 का प्रश्न-स्तरीय क्रमचय शून्य पहले से क्लस्टर स्तर पर संचालित होता है।
रिवर्स-प्रॉम्प्ट नियंत्रण: प्रति-मॉडल अपघटन
छह स्थानीय मॉडल, 2,399 वैध युग्मित प्रेक्षण; flip = सत्यापक अपने अंधे उत्तर को दिखाए गए उत्तर के लिए छोड़ देता है।
| सत्यापक | प्रत्यक्ष (गलत की ओर) | विपरीत (सही की ओर) | अंतर |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| समूहीकृत | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
सत्यापक और समूह के अनुसार फ्लिप दरें। कोई भी मॉडल सही उत्तर की ओर आत्मविश्वासपूर्ण गलत उत्तर की तुलना में अधिक आसानी से फ्लिप नहीं करता है। युग्मित पुनर्गणना: 1,028 आइटम दोनों समूहों में मौजूद हैं (296 दोनों में फ्लिप किए गए, 558 किसी में नहीं); असंगत जोड़े 104 (केवल गलत) बनाम 70 (केवल सही), सटीक द्विपद मैकनेमर (अनुलक्षणात्मक )। सभी 884 दर्ज फ्लिप में कथित एक्सपोजर के बाद का आत्मविश्वास है; उस सीमा के नीचे फ्लिप दर 0/547 है।
TruthfulQA श्रेणी द्वारा MC प्रमाणित-सहमति-त्रुटि
चार पूर्व-निर्दिष्ट स्थानीय पैनलों पर समूहीकृत (प्रति आइटम-पैनल घटनाएं; कम से कम 20 आइटम वाली श्रेणियां): Economics 8.6%, Fiction 6.2%, Paranormal 6.0%, Law 5.9%, Superstitions 5.7%, Stereotypes 5.4%, Sociology 4.9%, Health 4.9%, Misconceptions 2.6%, Conspiracies 1.0%। सभी तीन सदस्यों में आत्मविश्वास के साथ प्रति-पैनल दरें : 4.0% (CN-स्थानीय), 5.2% (पार-खंड), 6.0% (पायलट), 7.2% (US-स्थानीय)।
4.6% की ऊपरी सीमा एक स्थानीय पैनल पर निर्भर करती है जो तर्क मॉडल के 98 ग्रेडेबल उत्तरों के साथ केवल 87 आइटम साझा करती है; इसे छोड़ते हुए, कठोर स्थानीय खुले-रूप की सीमा 1.5–1.8% है।↩︎
कैसे उद्धृत करें
Chernets, V. (2026). Verification Theater: AI Verifier Panels की मापी गई विफलता के तरीके [Paper presentation]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}