프로그래머 분할 이후: AI 에이전트를 통해 구축하는 사람들을 위한 하나의 척도
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
검증된 위임 지평선, 증폭 이득, 역할 이름의 시간 경과된 맵, 그리고 2031년까지 매년 채점된 41개의 등록된 예측
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
이 논문 다운로드
- SSRN (기록 버전): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (보관됨, 개방 접근): doi.org/10.5281/zenodo.23267266
- OSF (41개 예측, 2026년 10월 9일 등록됨): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (마크다운 전문): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; 부록 C 코드: github.com/vadimchernets/delegation-horizon
SSRN이 기록 버전을 보유합니다. 그것을 인용하십시오.
키워드: AI 에이전트; 에이전트 AI; 비프로그래머; 코딩 에이전트; 직책; 기술 기반 채용; 주인-대리인 이론; 최종 사용자 소프트웨어 엔지니어링; AI 문해력; 검증된 위임 지평선; 자격 교차점; 사전 등록 예측
초록
회계사가 에이전트에게 조정 도구를 요청하고, 개발자가 청구 시스템 변경을 요청합니다. 각각은 하루 업무를 수락하고 그것이 유지된다는 것을 보여야 합니다. 2026년 10월까지 변호사들도 동일한 에이전트에게 업무를 할당하고 있었습니다. 약 400,000개의 세션에서 코드 생성 업무에 대한 벤더 검증 성공률은 프로그래밍 직종의 경우 34%, 기타 직종의 경우 29%였으며, 직종이 교육과 같지는 않습니다. 에이전트를 통해 성장하는 사람이 제공할 수 있다고 신뢰할 수 있는 것을 나타내는 경력 경로는 없습니다. 저는 직함 대신 사용할 수 있는 척도를 제안합니다. 검증된 위임 범위는 자격 있는 전문가의 기준 시간으로 표현된 가장 큰 응집력 있는 업무로, 사람이 정기적으로 에이전트에게 넘기고 에이전트가 보지 못한 독립적인 검사 후 수락하는 것입니다. 증폭 이득, 수락된 기준 시간당 주의 시간은 검증된 처리량이지 속도 향상의 인과적 추정치가 아닙니다. 둘 다 영역당, Hour to Quarter로 점수가 매겨집니다. 탁상 시험이 한 가지 임계값을 수정했습니다. 세 명의 대규모 고용주가 2026년에 토큰 개수를 시도했고 포기했습니다. 하나는 순위를 제거했고, 하나는 리더보드를 조작했으며, 하나는 예산을 사용했습니다. 검사된 업무는 지출로 조작하기가 더 어렵고, 각 나머지 경로는 명시된 방어를 충족합니다. 날짜가 지정된 지도는 경쟁사 이름(빌더, 에이전트 관리자, 주임 및 기타)을 선택하지 않고 기록합니다. 배경 중립성은 동등한 범위에서 프로그래밍 교육이 검사된 품질을 예측하는 것을 멈춘다는 가설입니다. 자격증 교차점은 영역별로, IT 교육을 받지 않은 사람들의 제품이 동일한 검사 하에서 프로그래머의 제품을 능가하기 시작하는 순간이며, 그 이후로 학위 및 경력 레이블의 가중치가 감소합니다. 41개의 날짜 지정 예측은 2026년 10월 9일에 세 개의 블라인드 모델 예측의 중앙값으로 책정되어 OSF에 등록되고 2031년까지 매년 점수가 매겨집니다. 실행되지 않은 연구는 실패로 간주되며, 자신의 영역에서의 추월은 0.35입니다.
요약
2026년이 되자 부기사들은 1년 전 프로그래머들이 그랬던 방식으로 코딩 에이전트를 비교하고 있었고, 변호사들은 에이전트를 활용해 자체 도구를 구축하고 있었으며, 소프트웨어 분야 밖의 사람들이 한 벤더의 코딩 에이전트 사용자 중에서 빠르게 성장하는 부분이 되었습니다. 다른 벤더의 기록에는 약 40만 개의 세션이 있었는데, 프로그래밍을 하지 않는 직업군이 코딩 작업에서 검증된 성공률로 프로그래머보다 몇 퍼센트 포인트 뒤처졌습니다(34% 대 29%). 작업이 수행되는 곳에서 프로그래머와 다른 모든 사람 사이의 경계는 얇아졌습니다. 직책, 급여 등급, 이력서에서는 원래대로 남아 있습니다.
일부 프로그래머와 일부 도메인 전문가는 이제 워크플로우를 공유합니다. 에이전트에 작업을 넘기고 이를 수용할지 결정합니다. 작업과 워크플로우는 전체 직업 이전에 통합되었으므로, 한 사람에 대한 유용한 질문은 이전의 오래된 경계가 어느 쪽이든 그들이 얼마나 큰 작업을 넘길 수 있고 증명할 수 있는가입니다. 내가 제안하는 그 질문에 대한 척도인 검증된 위임 범위는 몇 가지 설계 선택에 기반하고 있으며, 이 요약은 각각의 이유를 제시합니다. 단위는 자격을 갖춘 전문가가 필요로 했을 시간(1시간, 1일, 1주, 1개월, 1분기)입니다. 왜냐하면 두 오래된 사다리 모두 이를 읽을 수 있고 직업 간 번역이 필요하지 않기 때문입니다. 부기사의 조정 도구와 개발자의 청구 변경은 동일한 규칙을 따릅니다. 에이전트가 본 적 없는 확인을 통과한 작업만 계산되며, 한 제품군의 모델 간 합의는 오류가 상관관계가 있기 때문에 그러한 확인으로 계산되지 않습니다. 두 번째 숫자인 증폭 이득은 사람의 관심 시간 당 확인된 작업이 얼마나 많이 생성되는지 기록합니다(실패한 작업도 관심이 필요하고 에이전트의 미확인 시간은 포함되지 않음). 따라서 짧은 루프 내에서 에이전트 옆에서 작업하는 사람이 큰 부분을 넘기는 사람만큼 완전히 인정됩니다. 두 숫자 모두 도메인별로 유지되며, 대칭적인 이유가 있습니다. 소프트웨어로 이동하는 변호사와 법률로 이동하는 프로그래머는 자신이 모르는 분야에서 작업을 수용할 수 있는 능력이라는 동일한 것을 잃습니다. 임계값은 규칙 v1.1로 버전 관리되고 책상에서 테스트되었으며, 책상 테스트는 이미 그 중 하나를 수정했습니다(부록 E).
이름이 정해지지 않았습니다. 빌더, 에이전틱 엔지니어, 에이전트 관리자, AI 운영자, 오케스트레이터, 주요 인물이 모두 2026년 10월까지 사용 중이며, 각각 소유자와 날짜를 가지고 있습니다. 나는 그들을 선택 없이 매핑하므로, 누가 이기든 한 척도로 읽을 수 있습니다. 주 단위의 빌더, 날짜 단위의 에이전트 관리자입니다.
시장은 이미 지름길을 시도했습니다. 2026년에 토큰 수는 대규모 고용주에서 직원의 척도로 시도되었고 몇 개월 내에 실패했습니다. 직원의 Meta에서의 비공식 순위가 제거되었고, 회사의 공식 지침은 나중에 토큰 수를 배제했으며, Amazon의 리더보드는 빈 작업으로 조작되어 제거되었고, Uber는 연간 AI 예산을 4개월 만에 소진했습니다. 입력값 계산은 지출을 보상합니다. 독립적으로 검증된 수용된 작업의 계산은 설계상 그런 방식으로 부풀리기가 더 어렵습니다. 남아있는 경로(쉬운 확인, 관대한 평가자, 숨겨진 도움, 조각으로 나뉜 작업)는 각각 섹션 5.8의 방어를 만납니다. 무작위 감사, 시간의 독립적 평가자, 실패의 공개 기록, 일관된 작업 단위, 심어진 오류입니다.
두 가지 예측이 나의 날짜가 지정된 논문을 뒷받침합니다. 배경 중립성은 동일한 단계에서 프로그래밍 교육이 검증된 품질을 더 이상 예측하지 않는다고 말합니다. 자격 교차점은 도메인에서 IT 교육 없이 만든 제품이 같은 에이전트를 사용하는 프로그래머의 제품을 능가하기 시작하는 순간이며, 그 이후로 학위와 주니어 및 시니어 레이블의 무게가 줄어듭니다. 품질 동등성은 그 순간 이전에 오며, 직무 공고의 학위 요구사항 교차는 가시적 신호이며, 각 부분은 자체적으로 날짜가 지정되고 테스트됩니다. 주요 예측은 현재 의견에 어긋나며, 논문은 그것이 예측을 명시하는 곳에서 그렇게 말합니다. 각 예측은 또한 그것을 반박할 결과의 이름을 지으므로, 독자는 미리 실패가 무엇처럼 보일지 알 수 있습니다. 41개 모두 확률, 임계값, 대체 소스 및 최종 날짜가 포함된 표에 나타나며, 2026년 10월 9일 OSF에 등록되고(DOI 10.17605/OSF.IO/VW6P9) Brier 규칙으로 2031년까지 매년 점수를 받습니다. 27개는 공개 데이터에서 해결됩니다. 14개는 데이터 수집 전에 별도로 등록된 연구가 필요하며, 증거가 부족하거나 불확실한 것으로 기록되지 않으며 성공으로 계산되지 않습니다. 실행되지 않는 연구는 테스트 프로그램의 실패이며 점수판에 남아있습니다. 확률은 2026년 10월 9일 세 개의 맹검 모델 예측의 중앙값으로 정해졌으며, 내가 채택했고 OSF에 등록되었습니다. 자신의 도메인에서 추월할 확률은 0.35입니다.
구축 비용이 적을 때, 신뢰는 희소 필터가 됩니다. 앱 스토어와 코드 호스트는 홍수를 겪고 있고, 플랫폼은 미지의 기여자에게 문을 닫고 있으며, 에이전트는 다른 사람의 것을 채택하는 대신 점점 더 해결책을 작성합니다. 구축하는 사람 옆에 두 가지 파트너 기능이 보입니다. 완성자는 제품을 사람들에게 가져오고, 보증인은 그것에 서명합니다. 두 번째 이름은 2025년 역할 설명에서 나오며, 나는 보증인을 위한 척도도 제안합니다.
1. 소개
2026년 9월 23일, 부기사들을 위한 블로그가 거래를 분류하고 계정을 조정하기 위해 Claude Code와 Codex라는 두 코딩 에이전트를 비교했습니다(Growthy, 2026). 1년 전에는 그 비교가 프로그래머들의 것이었으며, 프로그래머들의 스레드에서는 지금도 진영과 충성도와 함께 존재합니다. 변한 것은 독자였습니다. 이제 에이전트 중에서 선택하는 사람들은 장부를 기록하고, 계약을 작성하며, 캠페인을 운영합니다. 그리고 그들이 선택하는 에이전트는 소프트웨어 개발자들이 사용하는 것입니다.
수십 년 동안 경제는 두 개의 사다리를 유지했습니다. 소프트웨어에서 단계는 주니어, 미드레벨, 시니어, 스태프, 프린시팔이었으며, 경험 연수와 프로젝트에 필요한 엔지니어 수에 따라 책정되었습니다. 다른 곳에서는 단계가 분석가, 컨설턴트, 관리자, 이사, 파트너였습니다. 사다리는 IT 부서의 문에서 만났습니다. 즉, 두 번째 사다리의 전문가는 첫 번째 사다리의 누군가에게 소프트웨어를 의뢰하여 얻었습니다. 2025년과 2026년에 두 사다리 모두 같은 작업을 설명하기 시작했습니다. 개발자들은 자신들의 주요 활동이 위임과 검증이 되었다고 말해졌습니다(GitHub, 2025b). 터미널이나 데스크톱 창에 에이전트를 가진 소프트웨어 외부의 전문가들은 과거에 의뢰하던 도구, 사이트, 소규모 애플리케이션을 구축하기 시작했습니다(Bloomberg Law, 2026; OpenAI, 2026). 어느 사다리도 그러한 사람이 전달할 수 있다고 신뢰할 수 있는 것이 무엇인지 말하지 않으며, 어느 사다리도 이제 같은 일을 하는 전직 개발자와 전직 분석가를 어떻게 비교할 것인지 말합니다.
다음의 질문들은 그 경계의 통합된 쪽에 있는 사람들을 무엇이라고 부를 것인지, 학위와 근무 연수가 더 이상 고용주에게 그들이 전달할 수 있는 것을 말해 주지 않으면 그들의 수준을 어떻게 측정할 것인지, 그리고 경계가 언제 사라질 수 있는지입니다. 마지막 것은 날짜 지정된 예측의 형태로 답변을 받습니다.
그 질문은 또한 날짜 지정된 출처를 가지고 있습니다. 2026년 10월 8일, 나는 예측을 제시했습니다. 1~2년 이내에 에이전트 기능이 너무 크게 성장하여 기술 교육이 더 이상 필요하지 않을 것이고, 그것이 없는 사람들이 더 나은 애플리케이션, 사이트, 제품을 구축할 것이며, 코드는 프로그래머의 코드보다 더 나을 것입니다. 같은 저녁 늦게 나는 따름정을 추가했습니다. IT 교육이 없는 사람들이 만든 제품이 IT 전문가들이 만든 제품을 능가하기 시작할 때, IT 학위와 주니어, 시니어라는 레이블은 이력서에서 빠르게 무게를 잃을 것입니다. (두 진술 모두 그 날의 내 메모에서 번역되었습니다.) 섹션 6과 11은 둘 다 날짜, 측정, 임계값 및 그들을 반박할 결과가 있는 예측으로 바뀝니다. 두 번째 진술은 나머지 논문이 자격 증명 교차점이라고 부르는 순간을 명시합니다.
이 시리즈의 동반 논문은 비프로그래머를 채팅에서 에이전트로 따라가고 에이전트가 작동하는 위치와 사람이 소유해야 하는 것으로 네 가지 수준을 정의했습니다(Chernets, 2026a). 에이전트가 창작물을 생산한 경우에만 전환을 계산했으며, "행동은 증거를 남기고 제목은 남기지 않기 때문에 에이전트 관리자를 직무 제목으로 만들기를 거절했으며, '누군가 고용해야 할 역할이 아니라 행동 패턴이라는 용어를 사용했습니다"(Chernets, 2026a, 섹션 8.4). 현재 논문은 그 조건에서 시작합니다. 수준은 부여되며, 모든 제목은 그것에 첨부될 수 있습니다. 단, 증거가 있을 때만, 즉 에이전트에 전달된 작업, 사람이 수락하고, 에이전트가 보지 못한 검사로 확인된 때만입니다.
섹션 3은 2026년 10월에 유통 중인 이름의 날짜 지정된 맵을 제공합니다. 섹션 5는 그 이름 중 어느 것이든 읽을 수 있는 척도, 검증된 위임 범위와 그 두 번째 축인 증폭 이득을 제공합니다. 섹션 6은 배경 중립성과 자격 증명 교차점이라는 두 가지 가설을 제시하고, 거래의 경험 중 얼마만큼이 검사 프로세스로 대체될 수 있는지 묻습니다. 섹션 7과 8은 신뢰, 해산되지 않는 경계, 그리고 건설하는 사람 옆의 두 파트너 기능을 다룹니다. 섹션 11은 확률, 임계값 및 대체 소스와 함께 날짜 지정된 예측을 설정하고, 2031년까지 매년 공개적으로 점수가 매겨집니다.
나는 이름들 중에서 선택하지 않습니다. 시장이 선택할 것입니다. 아마도 수개월 이내에, 그리고 한 단어에 베팅하는 논문은 다른 단어가 우승하는 날에 틀립니다. 논문이 할 수 있는 것은 척도를 고정하는 것입니다. 섹션 5는 완전히 정의합니다. 간단히 말해서, 검증된 위임 범위는 정규적으로 에이전트에 전달되고 수락 뒤의 독립적인 검사로 수락되는 작업, 정규적으로 그리고 증폭 이득은 사람 자신의 주의 각 시간이 산출하는 그러한 시간의 수를 묻습니다. 둘 다 도메인별로, 날짜가 지정되고, 시간에서 분기까지 5개 단계에 배치됩니다. Figure 1은 두 개의 오래된 사다리를 그 옆에 놓습니다.
자격 증명 교차점의 한 정의가 전체 논문을 제공합니다. 도메인에서, 그것은 같은 독립적인 검사로 수락된 IT 교육 없는 사람들이 만든 제품이 같은 에이전트를 사용하는 프로그래머의 제품을 능가하기 시작하는 순간이며, 그 후에 학위와 주니어, 시니어라는 레이블은 채용에서 무게를 잃습니다. 품질 동등성은 그 순간 이전 단계이며, 직무 공고에서 학위 요구 사항의 교차는 그 가시적 신호입니다. 교육이 동등한 단계에서 검사된 품질을 예측하는 것을 멈춘다는 가설인 배경 중립성이 그것을 설명할 메커니즘입니다. 이 네 부분 각각은 자신의 날짜 지정된 예측을 수행합니다(섹션 6.2).
증거는 2025년과 2026년에서 나옵니다. 에이전트 개발의 한 달이 측정이 계산해야 하는 것을 변경하는 기간입니다. 널리 인용된 수치는 대형 기술 회사의 신규 졸업생 채용이 2019년 수준보다 훨씬 낮다고 합니다. 그것은 제외됩니다. 2022년의 채용 최고점과의 비교도 제외됩니다. 에이전트 이전의 세계를 측정하기 때문입니다. 에이전트 입장 이전의 시리즈는 전임자로만 들어가고, 채용의 거시경제학은 섹션 2.4의 LinkedIn 대응점으로 수행됩니다. 오래된 작업은 또한 이론, 선례 또는 유추로 들어갑니다. Jaques의 책임 시간 범위에 대한 것, Jensen과 Meckling의 위임 비용에 대한 것, 골드 러시, 그리고 사진작가.
Figure 1. 두 개의 사다리와 한 가지 측정.
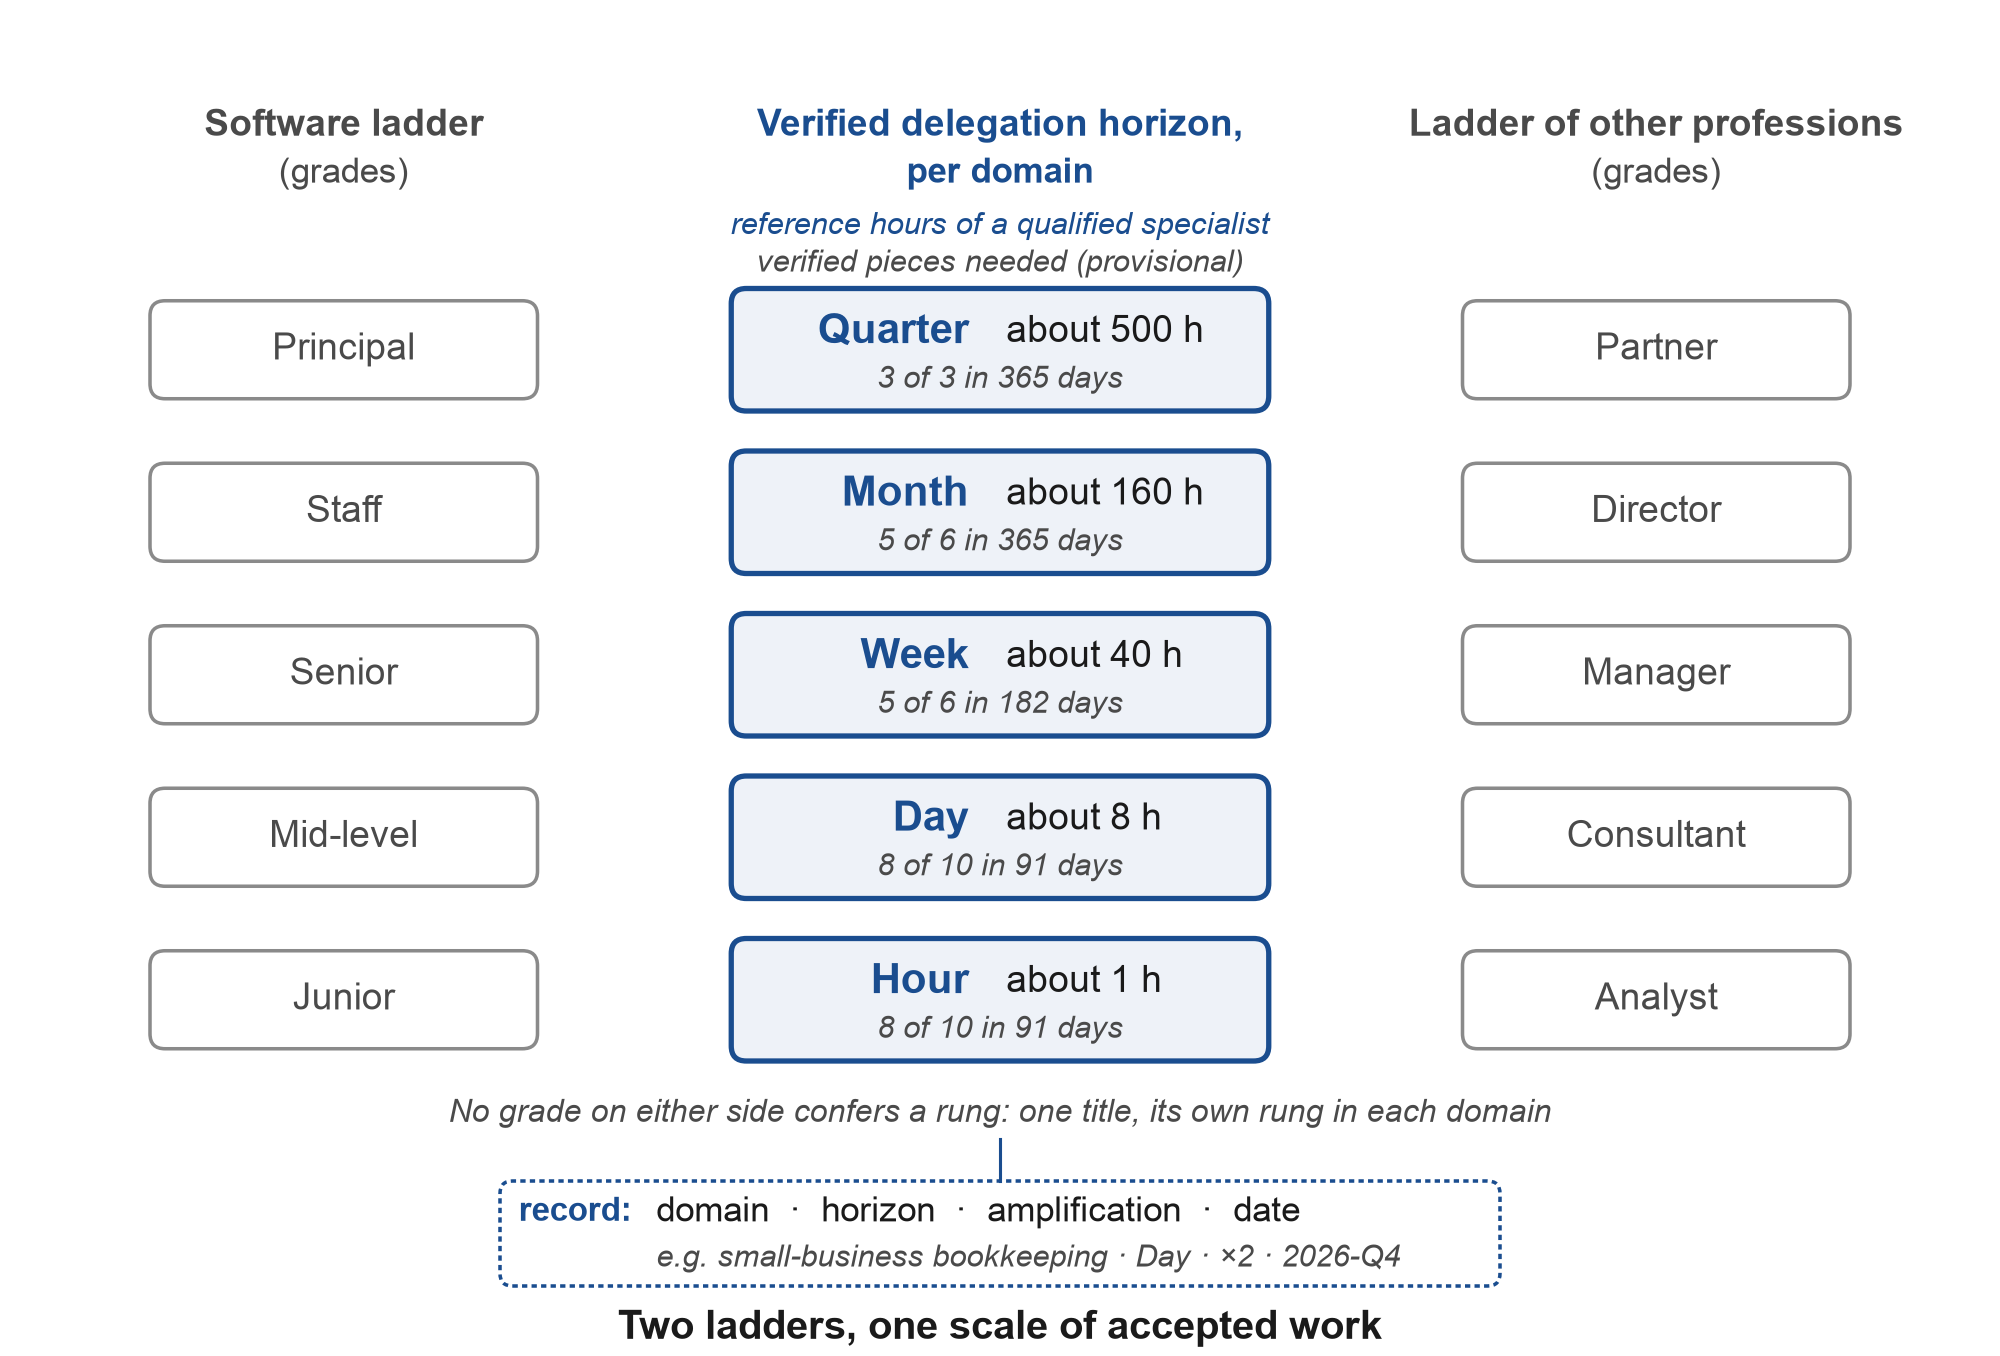
주: 오래된 사다리는 5개 단계와 나란히 그려지며 의도적으로 연결되지 않습니다. 어느 한 사다리의 어느 등급도 단계를 부여하지 않으며, 같은 사람이 각 도메인에서 별도의 단계를 유지합니다(섹션 5.2). 단계는 섹션 5.2의 계산 및 창문이 있는 정규화된 전문가의 참조 시간을 기준으로 계산됩니다(규칙 v1.1). 표시된 기록은 부록 C4의 작업 예제에서 출력한 것입니다.
그 부분들 주변에서 섹션 2는 수렴의 증거를 제시하고 섹션 4는 시장의 첫 번째 측정이 어떻게 실패했는지를 설명합니다. 이는 이러한 종류의 측정에 해당합니다. 섹션 9는 프로그래머들의 대화의 어떤 주제들이 다른 직업으로 넘어가는지 확인하고, 섹션 10은 그 함의를 도출합니다. 섹션 12는 논제에 대한 증거를 수집하고, 섹션 13은 그 경계 조건을 명시하며, 섹션 14는 결론을 내립니다.
2. 수렴하는 두 세계: 2025년과 2026년의 증거
2.1 프로그래머의 일, 재정의되다
개발자에게 판매하는 벤더들은 이제 개발자의 일을 에이전트 지휘로 설명합니다. GitHub의 "개발자의 새로운 정체성"에 대한 설명은 위임과 검증을 업무의 중심에 두었습니다(GitHub, 2025b). Anthropic은 2025년 8월 자사의 엔지니어 및 연구원 132명을 대상으로 설문 조사했습니다. 그들은 업무의 약 60%에서 AI를 사용하고 있다고 보고했으며, 자가 평가로는 약 50%의 생산성 향상을 기록했으며, 자신들이 더욱 "풀스택"이 되고 있다고 설명했습니다. 대부분은 자신의 업무 중 5분의 1 정도만 완전히 위임할 수 있다고 말했으며, AI 지원 업무의 27%는 AI 없이는 전혀 수행되지 않았을 작업들이었습니다(Anthropic, 2025a). 완전한 위임만을 바탕으로 한 지표는 따라서 세계에서 가장 고급 사용자들이 AI로 하는 일의 5분의 1에 불과할 것이며, 이것이 섹션 5에서 두 번째 축을 추가하는 이유입니다. 같은 보고서는 "감독의 역설"을 언급했습니다: 모델을 감독하는 것이 모든 것을 맡길 때 쇠퇴하는 코딩 기술을 필요로 한다는 것입니다.
단어들이 일을 따랐습니다. Andrej Karpathy는 2025년 2월 2일에 "바이브 코딩"을 명명했으며(Karpathy, 2025), Collins는 이를 올해의 단어로 만들었고(Collins Dictionary, 2025), 1년 뒤 Karpathy는 "에이전틱 엔지니어링"으로 옮겨갔습니다. Sequoia의 AI Ascent에서 2026년 4월 30일에 그는 이 차이를 "바이브 코딩은 하한을 올리고, 에이전틱 엔지니어링은 상한을 외삽한다"고 표현했습니다(Karpathy, 2026; Willison, 2026a). 한 학술 논문은 에이전틱 엔지니어를 새로운 전문가 원형으로 설명했으며, 책임이 코드의 저작에서 결과의 소유로 이동한다고 했습니다(Alenezi, 2026). Microsoft는 고객의 업무 패턴을 저자, 편집자, 감독, 오케스트레이터로 설명했습니다(Microsoft, 2026b).
2.2 그 외 모두, 같은 에이전트 내에서
두 벤더는 소프트웨어 외의 사람들에 의한 코딩 에이전트의 광범위한 사용을 보고하며, 서로 다른 선택 및 측정 한계를 가집니다. OpenAI는 2026년 6월 개발자가 아닌 사람들의 코딩 에이전트 주간 사용자가 2025년 8월 이후 개인 사용자 중에는 137배, 조직 중에는 189배 증가했다고 보고했습니다(OpenAI, 2026). 기초는 낮았고 데이터는 벤더의 것입니다. 같은 보고서는 섹션 5에 중요한 분포를 제시합니다. 2026년 5월 에이전트의 개별 사용자 약 0.1%의 표본에서, 80.6%는 모델로 추정한 손으로 수행했을 경우의 소요 시간이 30분을 초과하는 요청을 최소 하나 했으며, 70.2%는 1시간 이상, 25.6%는 8시간 이상의 요청을 최소 하나 했습니다. 이는 오래 걸리는 요청을 하는 사용자의 몫이며, 모델로 추정한 소요 시간이고, 이는 완료율이나 검증된 범위와는 다른 것이며, 섹션 5에서 그 차이가 중요한 이유를 설명합니다. 비즈니스 기능을 위한 에이전트의 업무 중 4분의 1 이상은 엔지니어링 업무였습니다.
Anthropic의 Claude Code 연구는 2026년 6월 16일에 발표되었으며, 논지에 가장 가까운 공개 데이터입니다(Anthropic, 2026e). 2025년 10월과 2026년 4월 사이에 약 235,000명의 약 400,000개의 세션을 분석했습니다. 전문성은 행동으로부터 판단되었으며, 세 가지 징후로: 사람이 작업을 얼마나 정확하게 설명했는지, 검증을 위해 무엇을 요청했는지, 그리고 누가 누구를 수정했는지입니다. Python이 없는 부기사가 정확한 조정 규칙을 작성하고 엣지 케이스를 잡았을 때 전문가로 평가되었습니다. 코드가 생산된 세션에서, 10개의 가장 큰 직종 각각은 프로그래밍 직종을 검증된 성공에서 7 퍼센트 포인트 이상 뒤떨어지지 않았으며, 성공은 통과한 테스트나 커밋된 업무 같은 증거로 뒷받침되는 성취를 의미합니다. 벤더의 분류는 사용자의 명시적 확인 같은 세션 기록의 신호에 일부 근거하며, 보고서는 관리자의 약간 더 높은 비율이 그들이 성공을 보고하는 방식을 반영할 수 있다고 언급하므로, 여기서 "검증된"은 벤더의 용어이지, 독립적인 확인이 아닙니다. 코드 생산 세션에 걸쳐 집계하면 34%에 대해 29%였으며(모든 세션에 걸쳐 약 30%에 대해 26%), 관리자는 프로그래머보다 약간 더 잘했습니다. 이 데이터는 사람을 직종별로 분류하며 교육에 대해 아무것도 말하지 않습니다: 회계사가 컴퓨터 과학 학위를 가질 수 있고, 프로그래머는 없을 수 있습니다. 보고서는 "코딩 에이전트는 코딩 배경을 성공적인 프로그래밍과 덜 관련있게 만들고 있다"고 결론지었습니다. 사람은 무엇을 할지에 대한 결정의 약 70%를 했고 에이전트는 어떻게 할지에 대한 결정의 약 80%를 했습니다. 전문가의 지시 세트는 약 12개의 에이전트 작업을 촉발했고, 초보자의 것은 약 5개였습니다.
같은 변화는 에이전트를 판매하는 회사들로부터 나오지 않은 출처들에서 보입니다. 변호사들은 주니어 어소시에이트부터 파트너까지, 벤더를 기다리는 대신 Claude Code로 자신의 도구의 작동 프로토타입을 구축해왔으며, 광범위한 AI 접근 권한을 가진 변호사의 몫은 2025년 61%에서 2026년 83%로 올랐습니다(Bloomberg Law, 2026; Artificial Lawyer, 2026). 부기사들은 에이전트를 비교합니다(Growthy, 2026). Lovable, 브라우저 기반 앱 빌더는 2026년 9월 연간 수익 $600 백만을 넘었습니다(TechCrunch, 2026a). 한 추정에 따르면, Claude Code는 2026년 초 2월 GitHub의 공개 커밋의 약 4%를 저작했습니다(SemiAnalysis, 2026).
2.3 긴장 상태의 사다리들
고용주들은 무엇을 대체할지는 아직 말하지 않고 그들의 사다리의 이름을 바꾸기 시작했습니다. 2026년 6월 1일부터 Deloitte는 약 181,500명의 미국 직원에게 직무 계열별로 정렬된 새로운 직함을 부여하고 리더십 수준을 추가했습니다(Business Insider, 2026). 그것의 내부 수준과 급여 원칙은 그대로 유지되었으므로(Fortune, 2026a), 이는 측정값이 그대로인 이름 변경이었습니다. LinkedIn은 부 제품 매니저 프로그램을 "Associate Product Builder" 트랙으로 바꾸고 "Full Stack Builder" 역할을 어떤 기능의 사람에게도 개방했다고 보도되었습니다(Lenny's Newsletter, 2025). Microsoft는 조사된 20,000명의 AI 사용자 중 3,233명, 약 16%을 다단계 에이전트를 운영하고 그들의 프로세스를 재설계하는 "Frontier Professionals"로 집계했습니다(Microsoft, 2026a). Srinivasan과 Wei는 2026년 2월 Harvard Business Review에서 회사들이 에이전트 매니저를 필요로 한다고 주장했으며, 그 직함이 12~18개월 내에 표준이 될 것으로 예상했습니다(Srinivasan & Wei, 2026). 어떤 고용주는 더 나아가 새로운 역할을 공고에 씁니다: State Street는 여전히 프로그래밍을 요구하는 "Agentic Product Builder"를 광고했습니다(State Street, 2026). 2026년 10월 7일 Dust는 공유 에이전트 워크플로우를 구축하고 유지하는 사람으로서 "AI Operator"를 소개했습니다(Dust, 2026).
채용이 주목했습니다. 후보자의 AI 사용이 논의된 직무 인터뷰의 몫은 2025년 3분기의 0.33%에서 2026년 2분기의 4.54%로 올랐습니다(Metaview, 2026). 답변을 위한 척도가 존재하기 전에 그 질문이 채용에 들어갔습니다.
2.4 공고, 초급 채용 및 교육
「에이전틱 AI」를 언급하는 미국 채용 공고는 2024년 151개에서 2025년 16,541개로 증가했습니다(Stanford HAI, 2026). 라이트캐스트의 다른 집계에 따르면 2025년 에이전틱 AI 기술을 언급한 채용 공고가 86,000개 이상이었으며, 이는 해당 기술 언급의 280% 연간 증가이고 중앙값 광고 급여는 $153,000입니다. 이러한 기술은 대부분 기존 직책에 추가되었습니다(Lightcast, 2026a). AI 지수는 「에이전틱 AI」라는 문구를 포함하는 공고를 계산하는 반면, 라이트캐스트의 블로그는 자체 분류 체계에서 에이전틱 기술을 가진 공고를 계산하며, 이것이 16,541과 약 86,000 사이의 거리 대부분을 설명합니다. 이 숫자들은 서로 다른 것을 측정하며 여기서는 구분하여 제시합니다.
초급 채용이 약화되었으며, 그 원인은 논쟁의 대상입니다. 링크드인은 2026년 4월~6월 미국 초급 채용이 전년 대비 7.6% 감소했으며, 모든 수준은 6.9% 감소했다고 발견했고, AI가 보강하는 직종에서는 초급 채용이 6.5% 감소한 모든 수준에 대해 9.6% 감소했습니다(LinkedIn Economic Graph, 2026). 링크드인은 이 감소의 더 많은 부분을 AI보다는 경제적 불확실성에 돌리며, 초급 직무 중에서 AI로부터 보호된 직무가 프랑스, 영국, 미국에서 가장 많이 감소했다고 지적합니다. 2026년 8월 스탠포드 「카나리」 연구의 업데이트는 AI 노출 직종의 22~25세 고용이 기대치보다 약 19% 낮으며 경험 있는 노동자에 대한 비교 가능한 격차가 없다고 발견했으며, 그 결과를 기술적(Stanford Digital Economy Lab, 2026a)이라고 설명합니다. 다른 두 출처가 같은 메커니즘을 발견합니다. 달라스 연방준비은행의 경제학자들은 현재 인구 조사 마이크로데이터를 사용하여 AI 노출과 관련된 고용 감소가 청년 노동자 중에서만 발생하며, 주로 해고보다는 노동력 외부에서 일로 이동하는 사람이 줄어들기 때문이라는 것을 발견했습니다(Atkinson & Yamco, 2026). 약 6,500만 명의 노동자를 포함하는 이력서 데이터에서 생성형 AI를 채택한 회사의 초급 고용은 비채택 회사보다 채택 후 6분기에 약 9% 낮았으며, 역시 해고보다는 더 느린 채용을 통해서였습니다(Hosseini & Lichtinger, 2026). 전체 경제 전체에서 예일 예산 연구소는 여전히 AI 노출 직종이 비교 가능한 노출되지 않은 직종보다 더 나쁜 상황이라는 명확한 신호를 발견하지 못합니다(Yale Budget Lab, 2026). 따라서 압박은 전체 직종이 아니라 초급 직급에 있습니다. 고용주들은 2026년 상반기 공표된 일자리 감소 101,743개 중 AI를 언급했으며, 이는 모든 공표된 감소의 약 23%입니다(Challenger, Gray & Christmas, 2026).
교육도 변하고 있습니다. 북미 박사학위 수여 학과를 집계하는 2026 태울비 조사가 다룬 학과에서 새로운 학부 컴퓨터과학 전공은 13% 감소했으며, 그 저자들은 이를 등록 파이프라인의 첫 명확한 축소 신호이자 기록적인 학위 배출과 함께 설명합니다(Computing Research Association, 2026). 673명의 독일 IT 도제생을 대상으로 한 현장 실험은 그들이 AI를 가졌을 때 공식 훈련 외 과제에서 26~31 백분 포인트의 이익을 발견했습니다(Stanford Digital Economy Lab, 2026b). 2026년 6월의 OECD와 유럽위원회의 공동 프레임워크는 「AI 관리」라는 도메인을 포함합니다(OECD & European Commission, 2026).
표 A1(부록 F)은 이 수렴의 열 가지 신호와 그들의 출처를 나열하며, 각각에 대해 그것이 보여주는 것과 보여주지 않는 것을 나타냅니다. 함께 읽으면, 그들은 또한 측정이 누락된 곳을 보여줍니다. 코딩 에이전트 내 비개발자에 대한 공급업체 데이터는 성장을 보여주며, 결과의 품질이 아닙니다. 직종의 근접성은 검증된 성공에 관한 직종이지, 정도가 아닙니다. 이름이 바뀐 사다리와 조사 세그먼트는 제목이지, 측정이 아닙니다. 그리고 더 약한 초급 직급은 AI로 인한 것으로 밝혀지지 않았습니다.
이 신호들은 제법 확신을 가지고 에이전트 일을 설정하고 수용하는 것이 이제 오래된 경계의 양쪽에서 이루어지며, 고용주, 학교, 공급업체들이 이름을 바꾸기 시작했음을 보여줍니다. 소프트웨어 외부의 사람들이 프로그래머처럼 이 일을 합니까? 신호들은 이를 열려 있게 하며, 그들은 이에 대한 측정도 보여주지 않습니다. 섹션 5는 측정을 제안하고, 섹션 11은 품질 문제에 날짜를 기하며, 섹션 12는 예측이 극복해야 할 증거를 제시합니다.
2026 증거는 결과가 옳다는 것을 보여줄 수 있는 사람들과 할 수 없는 사람들을 구분합니다. 프로그래밍 교육은 그 능력으로 가는 한 경로입니다. 영역에 대한 명령, 검토 습관, 검토 도구가 다른 것들이며, 섹션 2.2의 데이터는 그들이 오래된 사다리가 가정하는 것보다 종종 첫 번째를 대신할 수 있다고 제안하지만, 아직 그들이 항상 할 수 있다는 것은 아닙니다. 섹션 5의 측정은 그 주장을 테스트하도록 만들어졌습니다.
3. 유통 중인 이름들: 시간순 지도
3.1 제가 하나의 이름을 선택하지 않는 이유
2026년 내내 몇 주마다 한 회사나 컨설턴트, 때로는 매체가 여기서 설명하는 사람들을 위한 이름을 제안했으며, 그러한 이름 중 일부는 정착할 것입니다. 사용법이 확정되지 않았기 때문에, 나는 하나를 추천하는 대신 두 가지를 합니다. 유통 중인 이름들을 지도화합니다. 채택된 이름들을 포함하여, 각각을 누가 소개했는지, 언제, 어떤 의미로 소개했는지를 포함하고, 그 중 어느 것이든 읽을 수 있는 척도를 제시합니다. "builder"가 우승하면, 기록은 "builder at Week"로 읽히고, "agent manager"가 우승하면, "agent manager at Day"로 읽힙니다. 우선순위는 척도, 사다리, 정의 및 예측(검증된 위임 지평, 증폭 이득, 자격 교차점이라는 용어 포함)과 역할 이름이 아닌 것들에 주장됩니다. 섹션 3.3에 추가된 역할 이름들은 우선순위 없이 후보로 제시됩니다.
3.2 여섯 계층
후보들이 모두 하나의 자리를 놓고 경쟁하지는 않습니다. 어떤 것들은 거의 모든 사람이 갖게 될 기술을 명명하고, 다른 것들은 직업, 척도, 순간, 파트너, 또는 실패한 신호를 명명합니다. 표 A2(부록 F)는 이미 사용 중인 이름들을 그들의 소유자와 함께 나열하고, 두 번째 부분에서는 이 연구에서 제안되거나 순수한 설명으로서만 여기서 사용된 이름들을 고려했다가 제쳐진 변형들과 함께 나열하여, 독자가 전체 가족을 볼 수 있도록 합니다. 그림 2는 이름들을 계층별로, 그리고 각각이 소개된 날짜별로 배치합니다.
그림 2. 유통 중인 이름들, 계층별 및 각각이 소개된 날짜별.
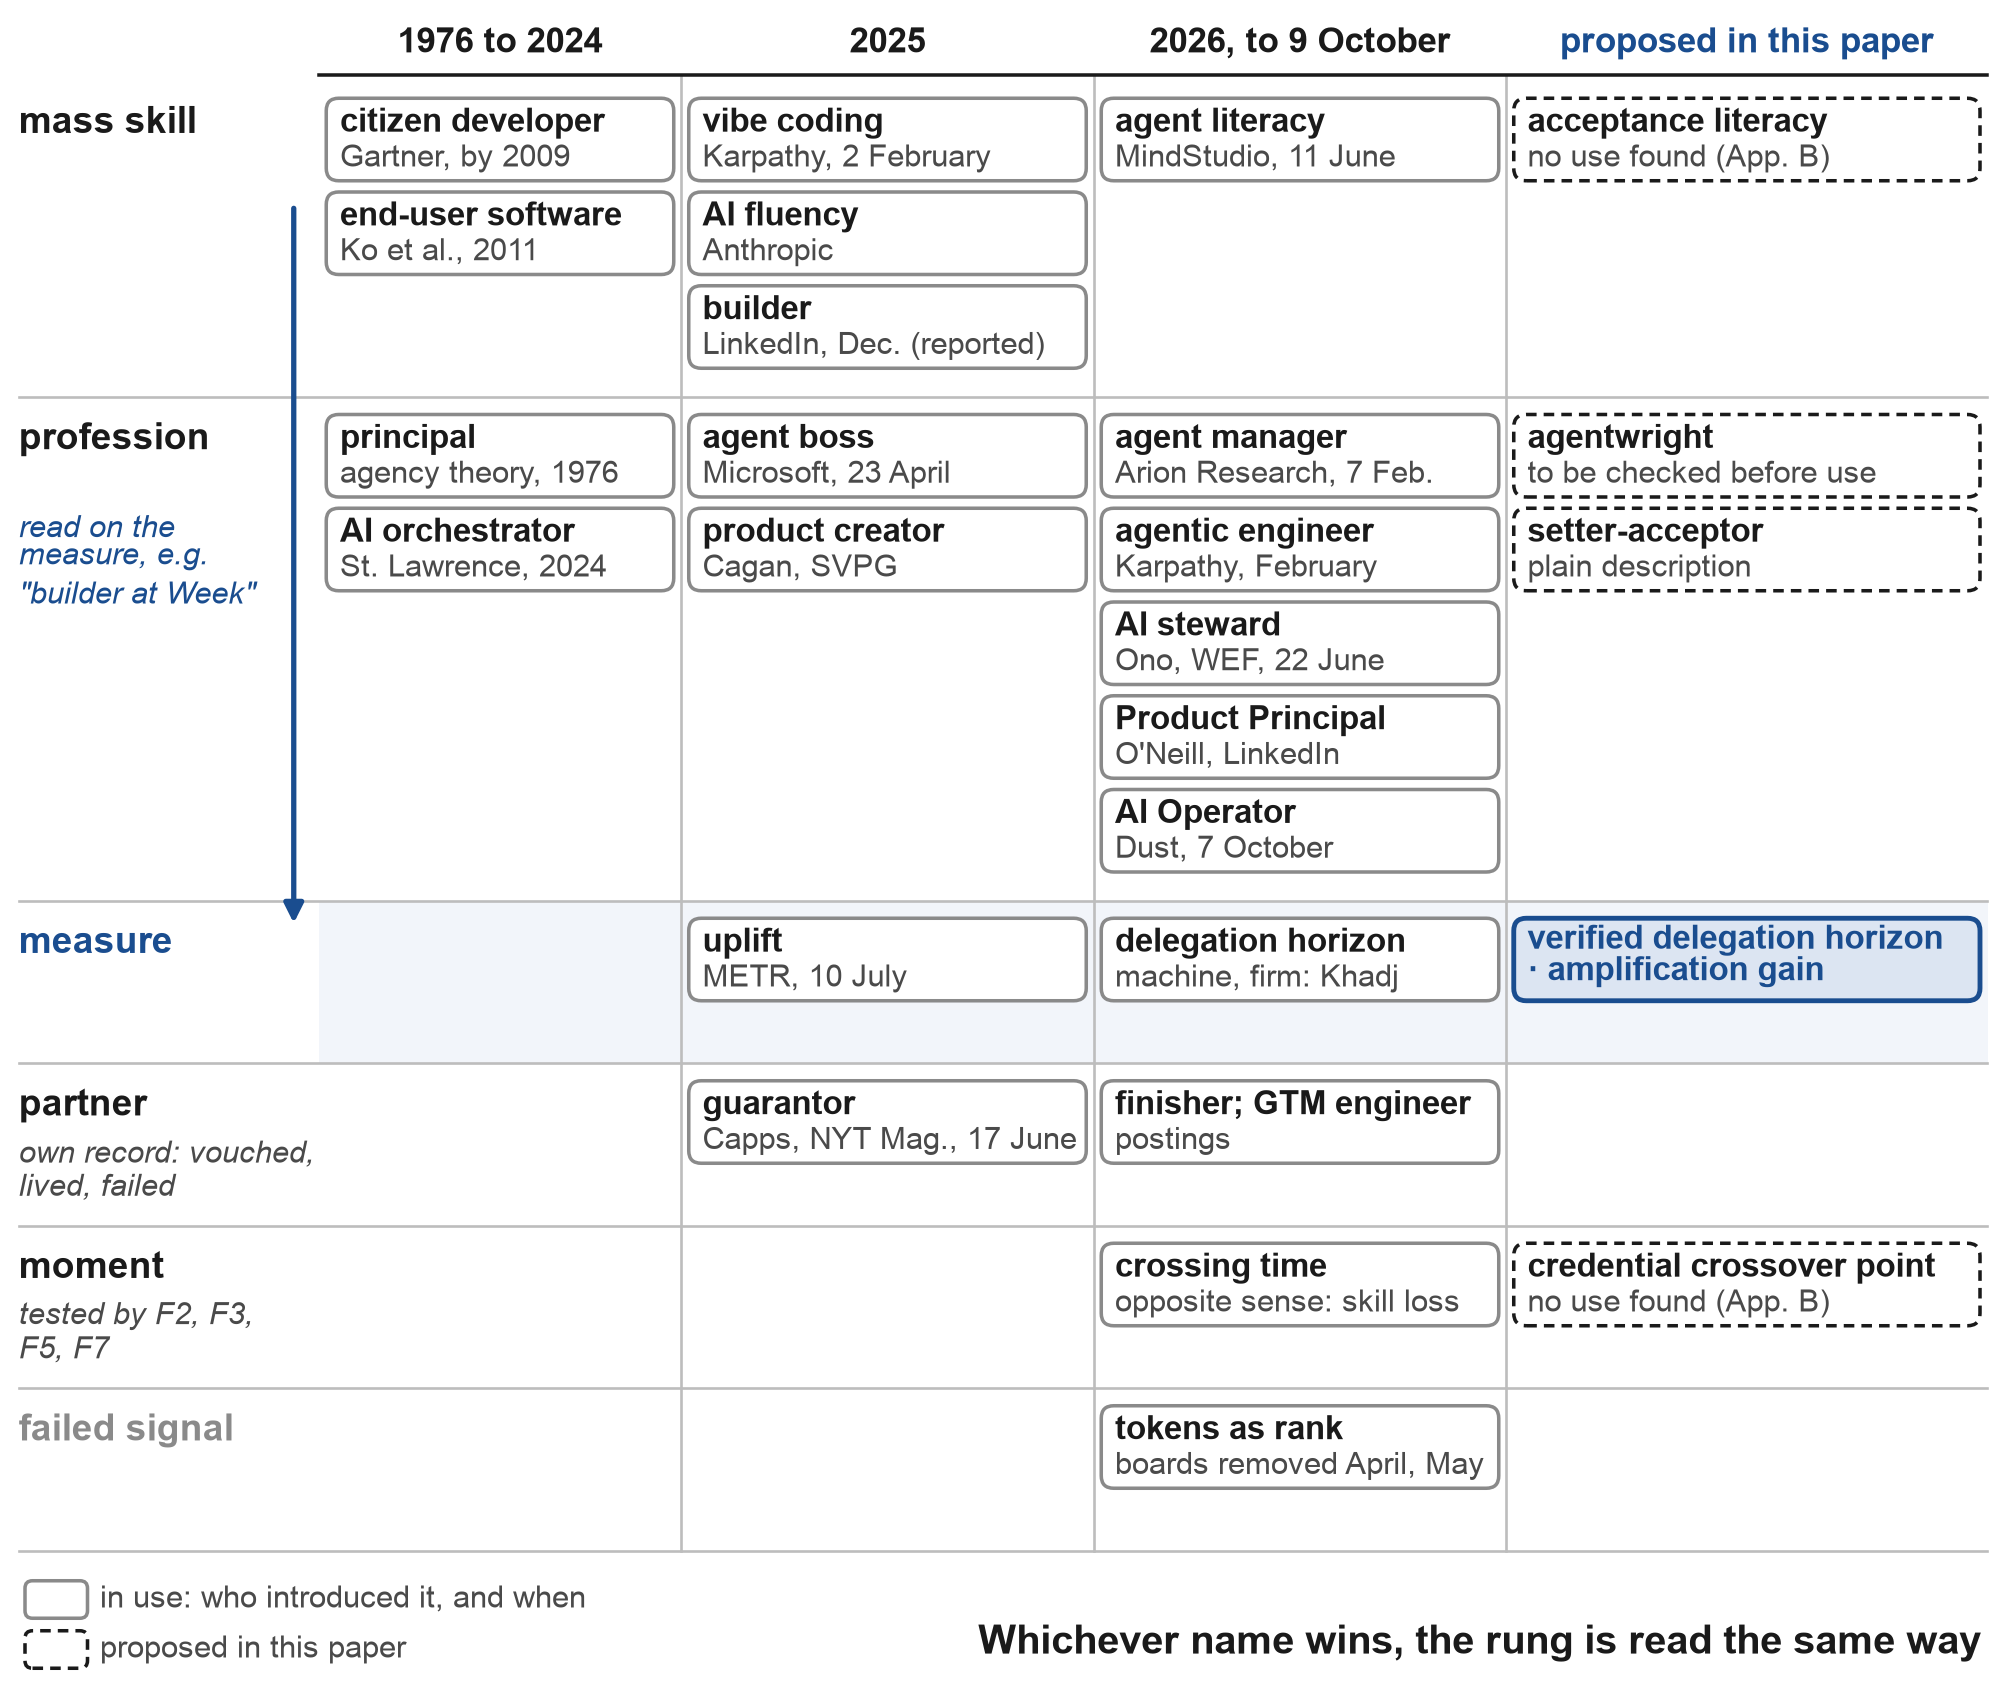
주: 소유자와 날짜는 표 A2를 따릅니다. 출처가 연도만 제시한 이름은 월을 포함하지 않습니다. 그림은 선택본입니다. 표 A2는 모든 후보를 나열합니다. 대중 기술과 직업 계층만 척도 위에서 읽힙니다("builder at Week", "agent manager at Day", 섹션 3.1). 파트너는 자신의 기록을 가지고 있습니다. 얼마나 많은 제품이 보증되었는지, 각각이 얼마나 오래 살았는지, 얼마나 많은 제품이 실패했는지(섹션 7.2), 그리고 순간은 사다리가 아니라 날짜가 지정된 예측 F2, F3, F5 및 F7로 테스트됩니다(섹션 11.2). 척도 행의 "위임 지평"은 기계 또는 회사 의미입니다(Khadj, 2026; Alonso, 2026), 섹션 5의 개인적 척도가 아닙니다. 그림은 어느 이름이 우승할지에 대해 판단을 내리지 않습니다.
3.3 지도에 대한 언급
"Builder"는 아마도 대중 HR에서 우승하고 있습니다. LinkedIn이 이를 채택했고, 기자들은 2026년에 Bay Area의 모든 사람이 이제 builder라고 작성했습니다(SF Standard, 2026). 이 단어가 수준에 대해 아무것도 말하지 않으므로, 그 단어와 싸울 이유가 없고 수준은 척도가 제공하는 것입니다.
관리 이름들(agent manager, AI operator, orchestrator)은 수평적입니다. 그들은 특정 도메인이 아닌 일반적으로 에이전트를 실행하는 것을 설명합니다. 섹션 6.3은 이들이 prompt engineer를 따를 것으로 예상하는 이유를 제시합니다. prompt engineer는 2023년에 모든 곳에 있었던 직함이고 2025년에 구식이라고 불렸습니다(Fortune, 2025; TechRepublic, 2025).
"Principal"은 가장 강력한 이론과 최악의 충돌을 가지고 있습니다. 대리인 이론에서 principal은 위임하고 모니터링 비용을 부담하는 당사자입니다(Jensen & Meckling, 1976). Anthropic의 모델 헌법은 "principals"을 모델이 대신 행동하는 사람들이라고 부릅니다(Anthropic, 2026b). Verheul(2026)은 기계가 대리 기능을 수행할 때 회사의 사람들은 principal 직책만을 가지며 경력 사다리가 사라진다고 주장합니다. 나는 그 진단을 받아들이고 그 자리에 새로운 사다리를 제안합니다. 그러나 신원 및 액세스 관리에서 "agent principal"은 에이전트 자신의 신원을 명명하며, 이는 의도된 의미의 반대이므로, 영어 표현 "Agent Principal"은 개인을 위해 사용되어서는 안 됩니다. O'Neill의 "Product Principal"은 거의 이 의미에서의 선례이며 그와 같이 인용되며, JetBrains의 AIDEs 프레임워크는 이미 개발자 수준을 principal-agent 관계의 속성으로 설명합니다(Tikhomirov, 2026).
여기서 제안된 이름들(agentwright, setter-acceptor, agent director)은 가족에 후보로 가입합니다. 어느 것도 선호되지 않습니다. Agentwright는 검색된 학술 데이터베이스에서는 자유롭지만, 검색 엔진은 이를 "Agent Wright"로 분할하며, 개발자들이 알고 있는 브라우저 테스트 도구처럼 들리고, 2026년 10월까지 이 단어는 이미 Python 패키지와 에이전트 기술 카탈로그에 사용되었으므로, 한정어가 필요한 변형으로 남아 있습니다.
시장에서 선택을 빼앗지 않고 의미에 대한 하나의 관찰을 기록할 수 있습니다. 의미상, "principal"은 섹션 8의 직업에 가장 가깝습니다. 다른 사람들을 위해 수행되는 일로 결과에 대한 책임을 지고, "builder"는 대중 기술에 가장 가깝습니다. 자신을 위해 수행되는 일입니다.
4. 척도가 필요한 이유: 토큰이 경력의 지표로 시도된 해
시장은 척도를 기다리지 않았습니다. 2026년에 여러 척도를 시도했고, 사례들이 성격이 다르므로 발생한 순서대로 여기에서 분리하여 다룹니다.
Meta에서 한 직원이 "Claudeonomics"라는 별명의 내부 대시보드를 만들어 약 85,000명의 동료들을 사용한 토큰으로 순위를 매겼으며, 30일 동안 60조 개 이상의 토큰이 사용되었습니다(Shopifreaks, 2026a). 그것은 한 직원의 프로젝트였고 공식적인 지위가 없었으며, 회사 외부에서 보도된 후 4월에 폐지되었습니다. Meta의 공식 입장은 별개로 진행되었습니다. 2월부터 AI 사용은 직원 평가의 공식적인 부분이었으며, 9월 초에 WIRED와 CIO는 Meta가 "AI 도입 대시보드나 토큰 수를 영향을 평가하는 데 사용하지 않을 것"이며 "AI Native" 레이블을 기준으로서 폐지했다는 새로운 지침을 보도했습니다(CIO, 2026b; Shopifreaks, 2026b). Amazon에서는 토큰 사용의 순위표가 빈 작업으로 조작되었고 5월에 제거되었습니다(CIO, 2026a). 이것이 굿하트의 법칙을 가장 깔끔하게 나타낸 사례입니다: 척도가 목표가 되면 더 이상 측정하지 않습니다. Uber의 경우는 예산 사건입니다. 회사는 연간 AI 예산을 4개월 만에 소진했고 직원들을 월 1,500달러로 제한했습니다(Fortune, 2026b). 7월에 Cognition의 최고경영자는 회사들이 AI 사용량이 아닌 생산성을 측정해야 한다고 말했습니다(Fortune, 2026c).
반례들도 중요합니다. Shopify는 성과 및 동료 검토에 AI 사용에 대한 질문을 추가합니다(Shopify, 2026). 한 평론가는 토큰 지표가 "폐지되지 않고 하향 조정될 것"이라고 예상합니다(Kingy AI, 2026). 사람이 AI를 어떻게 사용하는지에 대한 질문은 사용량 기준 순위와는 다른 것이며, 섹션 11의 예측 F8이 이를 구별합니다.
섹션 9에서 검토한 개발자 스레드들은 개인 한 명 내에서 동일한 본능을 보여줍니다. 그들은 입력을 통해 자신을 소개합니다: 월 1,148달러의 AI 청구서, 구독 스크린샷, 약 600개 중 약 330개의 풀 요청(해당 스레드에서 매우 근사한 것으로 설명된 단위), 3일 만에 만들어진 36개 단계. 그 중 한 명은 자신의 에이전트가 계산한 절감액을 확인하지 않고 게시했는데, 이것은 한 사람이 반복한 토큰 에피소드입니다. 이들 각각은 소비되거나 생산된 것을 세며, 에이전트가 보지 못한 검사 후에 누가 허용했는지는 기록되지 않습니다.
척도에 대해 한 가지 직접적인 교훈을 도출합니다: 작업을 세고, 에이전트가 보지 못한 검사를 통과한 작업만 세십시오. 동일한 패밀리의 모델들 간의 합의는 그 검사가 될 수 없습니다. 왜냐하면 그들의 오류는 상관관계가 있고 그들의 합의는 보이는 것보다 적은 독립적인 의견으로 가치가 있기 때문입니다(Chernets, 2026b). 더 많은 토큰을 소비하는 것은 이런 방식으로 만들어진 척도를 부풀릴 수 없습니다. 수용되지 않은 작업은 그것에 아무것도 더하지 않기 때문입니다. 다른 부풀리는 방식들이 남아 있으며, 섹션 5.8이 그들의 방어책과 함께 나열합니다.
5. 측정: 검증된 위임 범위와 증폭 이득
5.1 참조 시간
두 축 모두 하나의 단위를 사용합니다. 참조 시간: 적격 전문가가 동일한 작업을 손으로 수행하는 데 필요한 시간입니다. 참조는 의도적으로 외부적입니다. 해당 사람이 직접 작업을 수행할 수 있었는지 여부는 측정에 포함되지 않으며, 그들의 배경도 포함되지 않습니다. 부기사의 조정 도구와 개발자의 청구 모듈은 모두 능력 있는 전문가가 투입했을 시간으로 측정됩니다.
참조 시간은 두 가지 출처 중 하나에서 나옵니다. 하나는 2025년과 2026년에 손으로 측정한 시간을 가진 고정된 작업 은행입니다. GDPval은 44개 직종의 작업과 전문가의 시간을 포함하며, 이러한 은행을 구축할 수 있음을 보여줍니다(Patwardhan et al., 2025). 다른 하나는 누가 작업을 수행했는지 모르면서 시간을 추정하는 두 명의 독립적인 평가자입니다. 어떤 영역의 평가자들이 너무 멀리 떨어져 있다면, 참조는 대신 순위별로 채점된 5명에서 9명의 보정된 평가 위원회의 중앙값이 될 수 있습니다(부록 G2). 저는 이 은행을 의도적으로 고정합니다. 마치 미터가 한때 파리 근처의 금고에 보관되었던 것처럼, 몇 년이 지나면 거의 아무도 이러한 작업을 손으로 수행하지 않을 것이고 비교할 것이 아무것도 남지 않을 것이기 때문입니다. 은행은 각 영역에 대해 모든 순위의 작업을 보유해야 하며, 각각은 완료된 것이 무엇인지에 대한 서면 진술, 손으로 측정한 시간, 숨은 확인, 그리고 수용의 일부인 몇 가지 의도적으로 심어진 오류를 포함해야 합니다. GDPval의 손으로 측정한 시간은 전문가의 검증된 자기 보고이며, 검토 시간은 측정된 것이며, 이것이 은행이 만족하거나 개선해야 할 표준입니다. 측정이 자신을 판단하지 않도록 하기 위해, 위임 범위는 한 세트의 작업에서 채점되고, 그것에 대한 가설을 테스트하는 데 사용되는 품질(섹션 6)은 다른 작업에서 수행됩니다.
5.2 검증된 위임 범위
정의. 어떤 영역에서 개인의 검증된 위임 범위는 개인이 정기적으로 에이전트에게 작업을 위임하고, 이를 수용하며, 에이전트가 보지 못한 독립적인 확인으로 확인된 최대 작업 규모(참조 시간 단위)입니다.
규칙을 한 문단으로. 위임된 작업은 다음이 모두 성립할 때만 검증된 것으로 간주되며 위임 범위에 포함됩니다. 완료된 것이 무엇인지에 대한 서면 진술로 설정되었으며, 그 참조 시간은 은행이나 두 명의 평가자에게서 나왔습니다. 개인이 하나의 응집력 있는 결과물로 이를 수용했습니다: 한 달의 작업을 160개의 1시간 티켓으로 나누면 160시간이며, 단계별로 수행되고 하나의 전체로 수용된 작업은 그 전체의 참조 시간으로 전체로 계산됩니다. 독립적인 확인이 이를 확인했으며, 확인은 데이터(에이전트가 생성하지 않은 입력)에서 다르고, 접근(에이전트가 이를 보거나 편집할 수 없음)에서 다르며, 인센티브(이를 실행하는 사람이 통과에서 아무것도 얻지 못함)에서 다를 때 독립적입니다. 네 가지 종류가 적격입니다: 숨은 수용 테스트, 자격을 갖춘 인간 검토자, 의도된 사용자에 의한 실제 사용, 또는 개인이 열어둔 출처에 대해 검증하고 감시할 수 있는 판정을 남기는 다른 가족의 모델입니다. 자체 검토와 한 가족의 모델들 간의 합의는 계산되지 않습니다. 그들의 맹점이 에이전트 자신의 맹점과 일치하기 때문입니다. 순위의 창(Hour과 Day에서 91일, Week에서 182일, Month와 Quarter에서 365일) 내에서 개인은 그 크기 이상의 필요한 수의 조각들을 수용했으며, Hour과 Day에서 10개, Week과 Month에서 더 적고 Quarter에서 3개이며, 10개 중 최소 8개가 통과했으며, 이는 Week과 Month에서 6개 중 5개, Quarter에서 3개를 의미합니다. Week 이상에서 최소 1개의 그러한 조각은 의도적으로 심어진 오류를 포함합니다. 놓친 의도적 오류 1개(어떤 종류든)는 그 창에서 Week 이상의 순위를 차단하며, 그것을 포함하는 조각은 순위를 향해서도 증폭 이득을 향해서도 계산되지 않습니다. 오류를 취소할 수 없는 경우(돈이 이동됨, 환자의 기록, 철회할 수 없는 신청), 모든 그러한 조각은 숨은 테스트나 자격을 갖춘 인간을 기본 확인으로, 다른 가족의 모델을 2차 선으로 통과해야 하며, 더 엄격한 규칙이 그러한 조각들에만 적용됩니다. 모든 인수인계는 실패하고 포기된 조각을 포함하여 주의깊게 기록됩니다. 순위는 매분기마다 다시 확인됩니다: Week 이상에서는 순위 크기의 최소 1개의 검증된 조각이 지난 91일 이내에 포함되어야 하므로, 위임 범위는 거의 1년 전의 작업에 의존할 수 없습니다. 아래 문단은 각 부분의 이유를 제시합니다.
채점 규칙. 각 순위에 대해 설정된 창(Hour과 Day의 경우 91일, Week의 경우 182일, Month와 Quarter의 경우 365일) 내에서, 개인이 영역에서 그 크기 이상의 필요한 수의 조각들을 수용한 경우 순위가 계산됩니다(Hour과 Day의 경우 10개, 위에 설정된 대로 위로는 더 적음). 그리고 최소 10개 중 8개가 다음 중 하나의 확인을 통과했습니다: 숨은 수용 테스트, 자격을 갖춘 인간 검토자, 의도된 사용자에 의한 실제 사용, 또는 출처에 대해 검증한 다른 가족의 모델입니다. 자체 검토와 한 가족의 모델들 간의 합의는 계산되지 않습니다. 오류를 취소할 수 없는 경우(돈이 이동됨, 환자의 기록, 신청을 철회할 수 없음), 모든 그러한 조각은 통과해야 하며, 더 엄격한 임계값이 그러한 조각들에만 적용됩니다. 이러한 조각의 경우 기본 확인은 숨은 테스트나 자격을 갖춘 인간이며, 다른 가족의 모델을 2차 선으로 사용합니다.
상위 순위. 10개의 단일 수는 상위 순위를 아무의 손에도 닿을 수 없게 할 것입니다. 10개의 40 참조 시간 조각이 3개월에 400시간의 전문가 작업이고, 10개의 500시간은 5,000이기 때문입니다. 따라서 규칙은 순위가 올라갈수록 창을 길게 하고 수를 낮춥니다: Hour과 Day의 경우 91일에 10개, Week의 경우 182일에 6개, Month의 경우 365일에 6개, Quarter의 경우 365일에 3개이며, 같은 10분의 8의 비율(이는 Week과 Month의 경우 6분의 5, Quarter의 경우 3분의 3을 의미함)입니다. 이전 버전은 Month에서 4분의 4를 요청했습니다. 부록 E의 책상 테스트는 이것이 Month를 Quarter보다 신뢰도가 높은 사람에게 더 어렵게 만들었으며, 수가 변경되었음을 보여주었습니다. Week 이상에서는 창 내 순위 크기의 최소 1개 조각이 의도적으로 심어진 오류를 포함해야 합니다. 개인이 놓친 의도적 오류는 그 종류가 무엇이든 그 창에서 Week 이상의 순위를 차단하며, 놓친 의도적 오류가 있는 조각은 검증된 것으로 계산되지 않으며, 순위를 향해서도 증폭 이득을 향해서도 계산되지 않습니다. Quarter는 드문 순위로 남으려는 의도이며, 위의 수는 그렇게 설정됩니다.
모든 인수인계가 기록됩니다. 로그는 검사에 실패한 항목과 검사 전에 버려진 항목을 포함하여 에이전트에게 넘겨진 모든 항목을 기록하며, 하나의 일관된 결과물로 수락된 항목만 계단에 포함됩니다. 160개의 1시간 티켓으로 나뉜 한 달의 작업은 한 달이 아니라 160시간입니다. 참조 시간은 사용자, 클라이언트 또는 검토자가 METR의 일관된 작업의 정신으로 전체적으로 수락하는 결과물에 대해 예상됩니다. 반대도 마찬가지입니다. 단계별로 수행되고 하나의 일관된 결과물로 수락된 작업은 그것을 완성하는 데 걸린 단계 수에 관계없이 해당 결과물의 참조 시간으로 전체 작업으로 계산됩니다.
독립성. 검사가 독립적이려면 에이전트와 데이터(에이전트가 생성하지 않은 입력 사용), 접근성(에이전트가 이를 보거나 편집할 수 없음), 인센티브(이를 실행하는 사람이 통과로부터 이익을 얻지 않음)에서 달라야 합니다. 다른 계열의 모델은 오류의 다양성을 추가합니다. 개인이 연 출처에 대해 검증할 때만 계산되며, 그 판정은 감사할 수 있는 하나의 입력입니다.
하나의 작업이 이 경로를 따릅니다(그림 3). 작업은 완료로 간주될 항목에 대한 서면 설명과 함께 설정됩니다. 참조 시간은 은행이나 두 명의 평가자로부터 가져옵니다. 에이전트가 작업을 수행하는 동안 개인이 주의를 기울이며, 이는 기록됩니다. 개인이 항목을 수락하거나 거부하거나 버리고, 독립적인 검사가 확인하거나 반박하며, 로그의 줄은 그 순간에 작성되고 시작 날짜는 필요한 경우 별도의 필드로 보관됩니다. 지연된 결과(제출이 수락됨, 한 달 후에도 실행 중인 배포)가 있는 경우, 이를 받을 때 기록됩니다. 범위와 이득은 이러한 기록에서 날짜와 함께 계산됩니다.
그림 3. 하나의 작업, 하나의 기록.
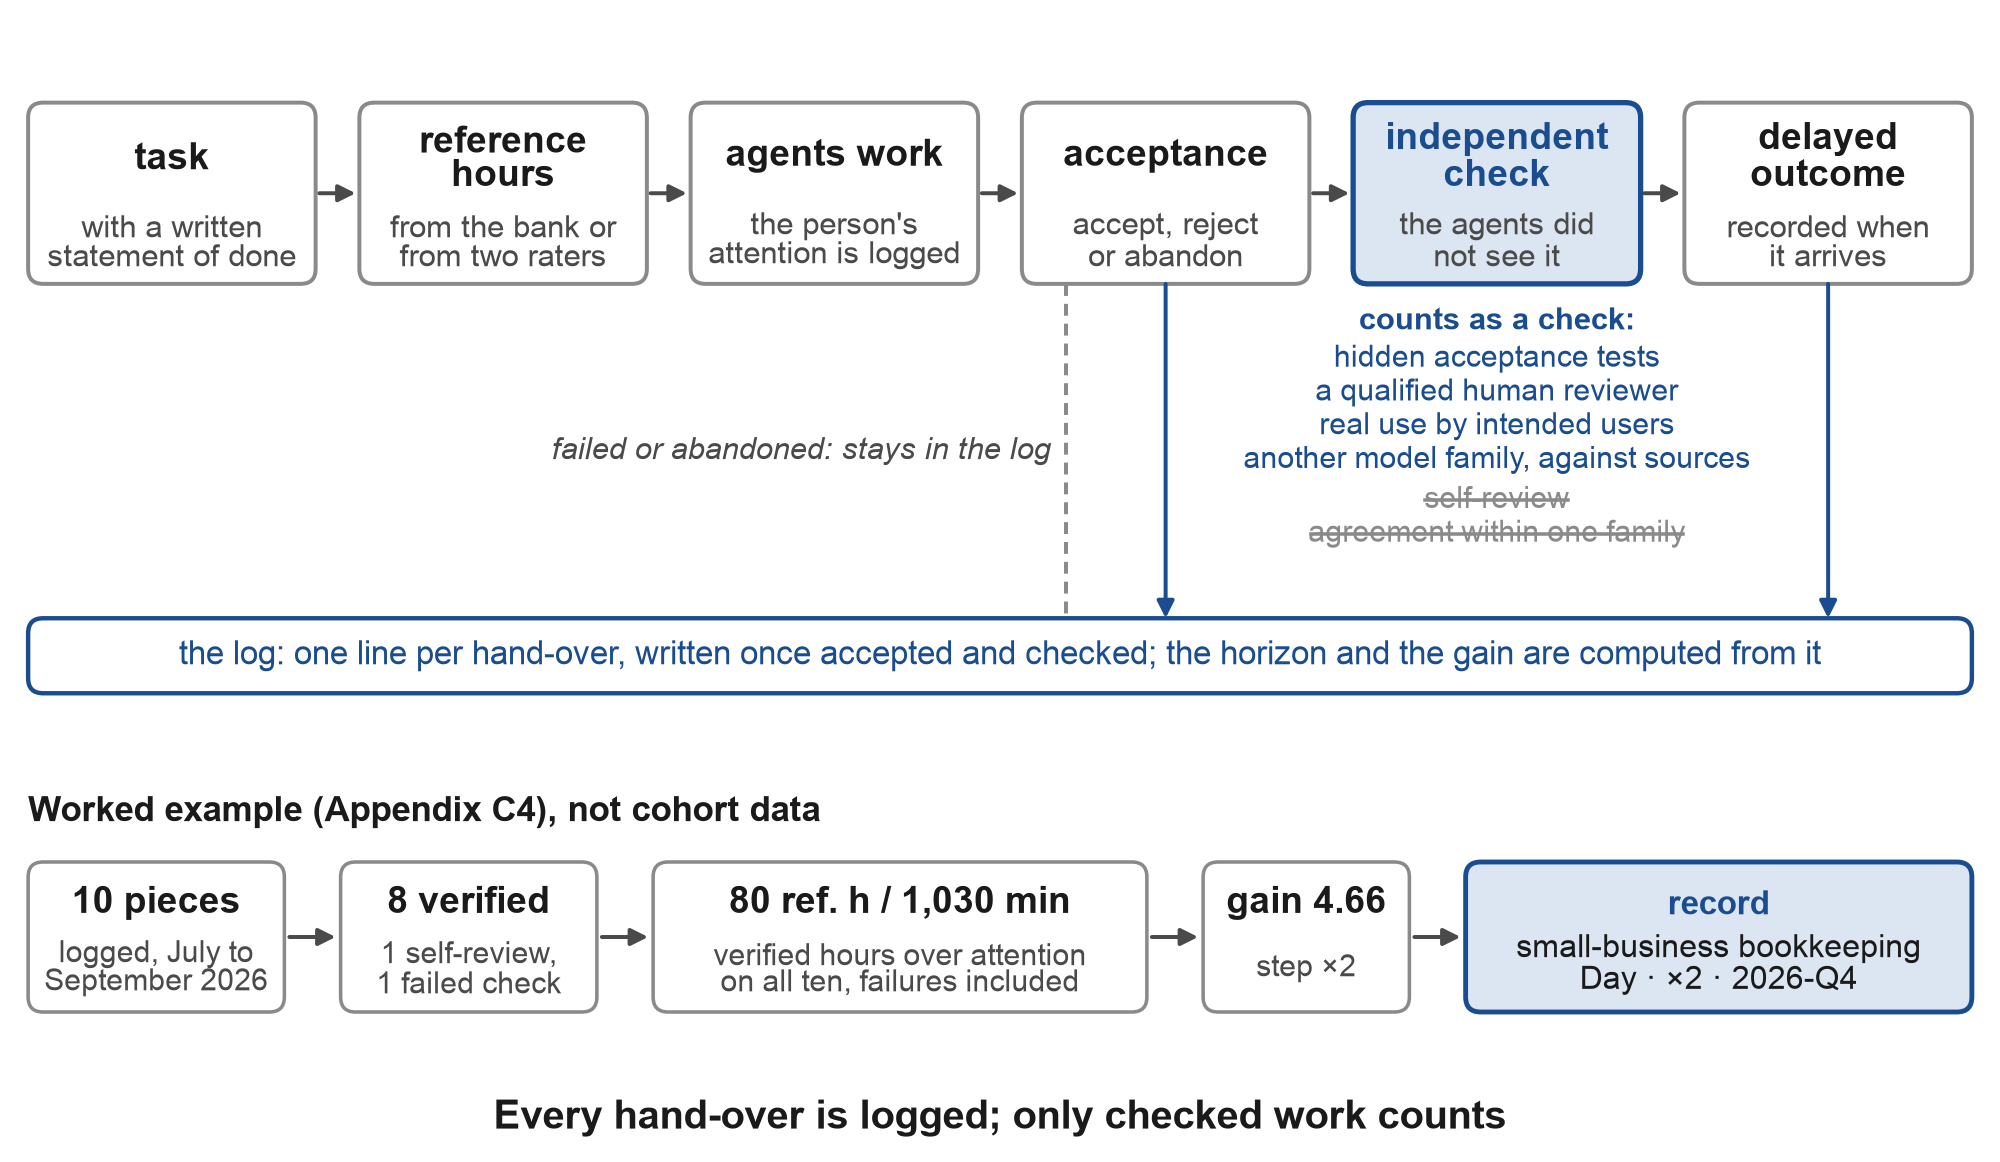
참고: 위의 행은 섹션 5.2의 경로입니다. 네 가지 종류의 독립적 검사는 채점 규칙의 것입니다. 자체 검토와 한 계열의 모델 간 합의는 계산되지 않습니다. 실패하고 버려진 항목은 로그에 남아 있고 증폭 이득의 분모에 분을 추가합니다. 아래 행은 부록 C4의 작업 예시이며, 구성된 로그이지 코호트 데이터가 아닙니다. 10개 항목, 8개 검증, 1,030분의 주의에 대한 80개 참조 시간, 4.66의 이득(단계 ×2), 그리고 "소규모 비즈니스 부기 · Day · ×2 · 2026-Q4"의 기록입니다.
재검증. 범위는 매분기마다 다시 확인됩니다. Anthropic의 감시 역설(섹션 2.1)은 그 이유를 설명합니다. 검사 기술이 저하되는 동안 얻은 범위는 차용된 것이며, 분기별 검사는 그것이 여전히 유지되는지를 보여줍니다. 분기보다 긴 윈도우를 실행하는 계단의 경우(주, 월, 분기), 검사는 구체적인 형태를 갖습니다. 계단 크기의 검증된 항목 최소 1개가 최근 91일 이내에 있어야 하므로, 계단이 거의 1년 된 항목에 기반할 수 없습니다.
5.3 계단
시간 단위를 사용하는 이유는 시간 단위가 직업 간에 변환할 필요가 없으며, 로그에서 읽을 수 있고, 기술의 발전에 따라 성장할 수 있기 때문입니다. 표 1은 예시와 각각에 필요한 수를 제시합니다.
표 1. 검증된 위임 범위의 계단.
| 계단 | 넘겨진 및 검증된 작업의 규모 | 소프트웨어의 예시 | 기타 분야의 예시 | 필요한 검증된 항목, 윈도우 |
|---|---|---|---|---|
| Hour | 약 1개의 참조 시간 | 스크립트, 작은 수정 | 문서 더미에서 추출한 답변 | 91일 내 10개 중 8개 |
| Day | 약 8개 | 기능, 작은 내부 도구 | 검사를 포함한 월말 보고서 | 91일 내 10개 중 8개 |
| Week | 약 40개 | 명세에 따른 사이트 또는 내부 도구(야간 실행 포함) | 완전한 실사 자료, 캠페인 시스템 | 182일 내 6개 중 5개 |
| Month | 약 160개, 보통 여러 흐름으로 | 제품 출시; 다른 사람들이 따르는 승인 규칙 | 동료들이 사용하는 규칙이 있는 진료소의 도구 | 365일 내 6개 중 5개 |
| Quarter | 약 500개 | 실제 사용자가 있는 제품 라인 | 에이전트를 통해 운영되는 서비스 라인 | 365일 내 3개 중 3개 |
참고: 계단은 섹션 5.2의 채점 규칙에 의해서만, 각 분야에서 별도로, 부록 E의 규칙 v1.1 수에 따라 얻어집니다. 이전 계단의 등급은 계단을 부여하지 않으며, 개인은 재정 도구에서 Week에, 웹 애플리케이션에서 Day에 있을 수 있습니다.
이력서 또는 인사 파일의 기록은 분야, 범위, 증폭, 날짜를 포함합니다. 예를 들어 "소규모 비즈니스 부기 · Day · ×2 · 2026-Q4"입니다. 기술이 발전함에 따라 같은 계단은 1년 후에 다른 의미를 가지기 때문에 날짜는 기록에 포함됩니다.
5.4 증폭 이득
에이전트와 잘 협력하는 모두가 큰 항목을 넘기는 것은 아닙니다. 섹션 9의 개발자 중 한 명은 네 대의 기계로 구축하며 그 중 세 대를 "개인 효율성의 부스트"로 설명하며 그 위에는 자율 에이전트가 없습니다. 그가 운영하는 자율 에이전트는 일상 업무에서 "뿌리를 내리지 못했다"고 그는 쓰고, "부스트, 위임이 아니라"고 선호합니다(번역됨). 그의 가장 긴 흐름은 3일 동안 36단계를 실행했으며, 각 단계는 넘기고 커밋되며, 에이전트는 모든 것이 배포되었음을 확인하도록 요청받았습니다. 섹션 5.2의 규칙에 따라 그 확인은 자체 검토이므로, 그의 게시된 기록에는 검증된 계단이 전혀 표시되지 않으며, 스레드는 그의 이득에 대한 수를 제공하지 않습니다. 그가 독립적 검사를 사용했을 때 어디에 있을지는 수락된 것에 달려 있습니다. 36단계가 하나의 일관된 결과물로 수락되었다면, 흐름은 전체적으로, 부록 C, 섹션 C4의 단계별 작업처럼 참조 시간으로 계산됩니다. 각 단계가 독립적으로 수락되었다면, 각각은 작은 항목이고 그는 첫 번째 축에서 Hour에 있습니다. 게시물은 어느 것인지 말하지 않습니다. 그러나 그는 이전에 구매하던 소프트웨어를 대체하는 도구를 구축하며, 시간을 유일한 병목으로 부를 때 두 번째 축의 분모를 스스로 이름 붙입니다.
그는 예외가 아닙니다. Anthropic은 6개월 이상의 경험을 가진 사용자들이 "지시적 사용 패턴을 통해 더 큰 책임을 위임할 가능성이 훨씬 낮았고", 모델과 더욱 반복적으로 작업했으며, 더 어려운 작업을 가져왔으며, 통제 후 성공률이 3~5포인트 높았다고 보고했습니다(Anthropic, 2026d). Claude.ai에서 협업 사용은 2025년 11월에 자동화 52% 대 45%를 기록했으며, 대화는 일회성 프로그래밍 방식의 요청보다 더 자주 성공했습니다. 67% 대 49%(Anthropic, 2026a). 더 높은 급여의 직업에 종사하는 사람들은 약 1.5배 많은 턴을 수행했으며, 같은 직업의 여성은 남성보다 7.3포인트 덜 자동화했습니다(Anthropic, 2026f). Stanford의 1,500명의 근로자 조사에서 104개 직업 중 47개에서 가장 선호하는 배치는 개인과 에이전트 간의 동등한 파트너십이었습니다(Shao et al., 2025). 따라서 위임만을 기반으로 구축한 척도는 가장 경험이 많은 사용자, 최고 급여 근로자, 여성을 과소평가할 것입니다. 다만 이 데이터에는 그들의 업무가 더 나쁘다는 것을 나타내는 것이 없습니다.
정의. 증폭 이득은 허용되고 검증된 업무의 기준 시간을 그에 소비된 개인의 관심 시간으로 나눈 값으로, 개인의 직급과 관계없이 해당 영역의 지난 91일 동안 측정합니다. 외부 도움(동료나 계약자가 기록 외부에서 수정)으로 수행한 업무는 이렇게 기록되며 분자에 아무것도 추가하지 않지만, 개인이 그 업무에 소비한 시간은 분모에 유지됩니다. 관심은 계획, 지시, 읽기, 확인 및 수정을 포함합니다. 에이전트가 실행되는 동안 개인이 다른 작업을 수행하는 시간은 계산되지 않습니다.
증폭 이득은 검증된 처리량입니다. 관심 시간당 허용되고 확인된 산출물입니다. 에이전트 사용 시 동일 인물이 에이전트 없이 작업하는 것보다 얼마나 빨리 일하는지에 대한 인과적 추정치는 아닙니다. 이러한 비교 의미의 이득은 기준이 필요합니다. 동일인물이나 에이전트 없이 동일한 종류의 업무를 수행하는 매칭된 사람들이 필요하며, 오직 비교 연구만이 이를 제공할 수 있습니다.
실패한 업무는 분자에 아무것도 추가하지 않으며 모든 시간을 분모에 추가하므로 자기기만을 드러낼 수 있게 합니다. METR의 2025년 시험에서 경험 많은 개발자들은 AI가 그들을 빨라지게 했다고 믿었으나 측정 결과 19% 더 느렸습니다(METR, 2025).
두 번째 축의 단계는 ×1("하루에 하루"), ×2, ×5("하루에 일주일"), ×20("하루에 한 달"), ×60("하루에 분기")입니다. 두 척도는 독립적이므로 한 척도의 단계는 다른 척도의 직급과 같지 않습니다. 개인이 여러 에이전트를 병렬로 실행할 때, 관심은 여전히 개인의 시간으로 한 번만 계산됩니다. 세 개의 스트림을 보는 데 소비한 한 시간은 분모에서 한 시간이며, 각각에 대해 기록된 시간에 비례하여 각 부분 간에 공유됩니다. 점수는 그것을 생성한 설정(모델과 도구, 확인의 종류, 작업의 직급)과 함께 보고됩니다. 동일인물이 더 엄격한 확인에서는 다르게 점수를 받기 때문입니다.
5.5 두 축, 네 가지 프로필 그리고 한 가지 한계
개인을 두 축 모두에 배치하면 네 가지 프로필이 나옵니다(그림 4). 견습생은 짧은 지평과 낮은 이득을 가집니다. 증폭기는 짧은 지평과 높은 이득을 가지며, 36단계의 건설자처럼 그의 단계들이 하나씩 허용되었다면 마찬가지입니다. 위임자는 긴 지평과 높은 이득을 가집니다. 네 번째 프로필인 감시자는 긴 지평과 낮은 이득을 가집니다. 에이전트가 오랜 시간 실행되고, 확인과 수정이 이득을 소비하므로 이는 직급보다는 경고 신호입니다.
두 축은 한 가지 한계로 연결되어 있습니다. 관심은 작업을 설정하고 확인하는 데 들어갑니다. H를 한 조각의 기준 시간, V를 그것을 확인하는 데 드는 관심 시간, S를 그것을 설정하는 데 소비한 시간이라고 하면, 이득 G = H / (S + V + 수정)이고, 따라서 G ≤ H / V입니다. 확인만 수작업 시간의 1/4을 차지하면, 에이전트가 무인으로 실행되는 기간이 아무리 길어도 이득은 ×4를 초과할 수 없습니다. 동일한 한계로, ×2, ×5, ×20, ×60 단계는 확인이 수작업 시간의 50%, 20%, 5%, 약 1.7% 이하를 차지할 때만 열려 있습니다(그림 4). 이는 명시된 회계 한계를 가진 단순화된 모델입니다. 개인이 전혀 할 수 없었을 업무의 가치를 무시하고, 확인 시간이 조각에 따라 확장된다고 가정하며, 조각 단위로 유지됩니다. 따라서 작은 조각을 저비용으로 확인하는 개인은 큰 조각을 위해 계산된 한계를 초과할 수 있습니다. 경제 수준에서 Catalini et al. (2026)은 동일한 지점을 제시합니다. 구속력 있는 제약은 "인간 검증 대역폭"이 되며, 에이전트가 실행할 수 있는 것과 사람들이 검증할 여유가 있는 것 사이에 "측정 가능성 갭"이 열립니다.
GDPval은 한계가 실제로 무엇을 의미하는지 보여줍니다. 220개 작업의 금(gold) 부분집합에서 전문가들은 (저자들이 검증함) 평균적으로 수작업으로 작업당 404분을 보고했으며, 결과물을 검토하는 데 측정된 109분이 걸렸습니다. 약 27%로, 이는 그러한 종류의 작업에 대해 한계를 약 ×3.7에 놓습니다. 모델은 전문가보다 90~327배 빠르게 초안을 생성했습니다. 그러나 개인이 모델을 시도한 후 그 업무를 수정하는 시나리오에서 저자들의 계산(측정이 아닌)은 GPT-5에 대해 모델을 한 번 시도했을 때 1.12배, 여러 번 시도했을 때 1.39배 속도 향상을 제시했습니다. 동일한 표의 두 개 열입니다(Patwardhan et al., 2025). 에이전트의 속도가 무엇이든, 확인의 대가가 한계를 설정하며, 더 큰 조각을 확인하는 데 비용이 더 들기 때문에 직급이 높아질수록 이 대가는 증가합니다. Kamara (2026)는 이 비용을 검증 마찰이라고 부릅니다. 9절의 스레드에서 실천가들은 자신의 말로 표현합니다. 특정 지점을 지나면 에이전트 코드 확인은 "손으로 다시 작성하는 것과 점점 더 차이가 적어지며", 직접 작성하는 것보다 오래 걸릴 수 있습니다(번역됨).
동일한 이득은 두 가지 방법으로 도달할 수 있습니다. 긴 줄은 큰 조각을 넘기고 끝에서 확인합니다. 짧고 빠른 루프는 작은 조각을 넘기고 도착하는 대로 각각을 확인합니다. 제 가설은 작은 조각을 따라가며 확인하는 것이 결국 큰 결과를 확인하는 것보다 저렴한 경우가 많으며, Anthropic의 데이터는 이를 가리킵니다. 대화는 일회성 요청보다 더 자주 성공했으며, 저자들 자신의 추정에 의하면 일회성 요청은 약 3.5시간의 작업에서 50% 성공에 도달하는 반면 대화는 약 19시간의 작업에서 도달할 것입니다(Anthropic, 2026a). 협업 사용의 비율은 2025년 8월에 자동화 아래로 떨어졌으며 11월에는 52% 대 45%로 다시 앞서갔습니다. 단락 루프 방법은 인간-AI 협업 문헌이 연구하는 것에 가깝고, 증폭 이득은 긴 위임만큼 완전히 인정합니다. 11절의 예측 F19~F21은 단락 루프 방법을 테스트합니다.
그림 4. 두 축, 네 가지 프로필 그리고 확인이 설정하는 한계입니다.
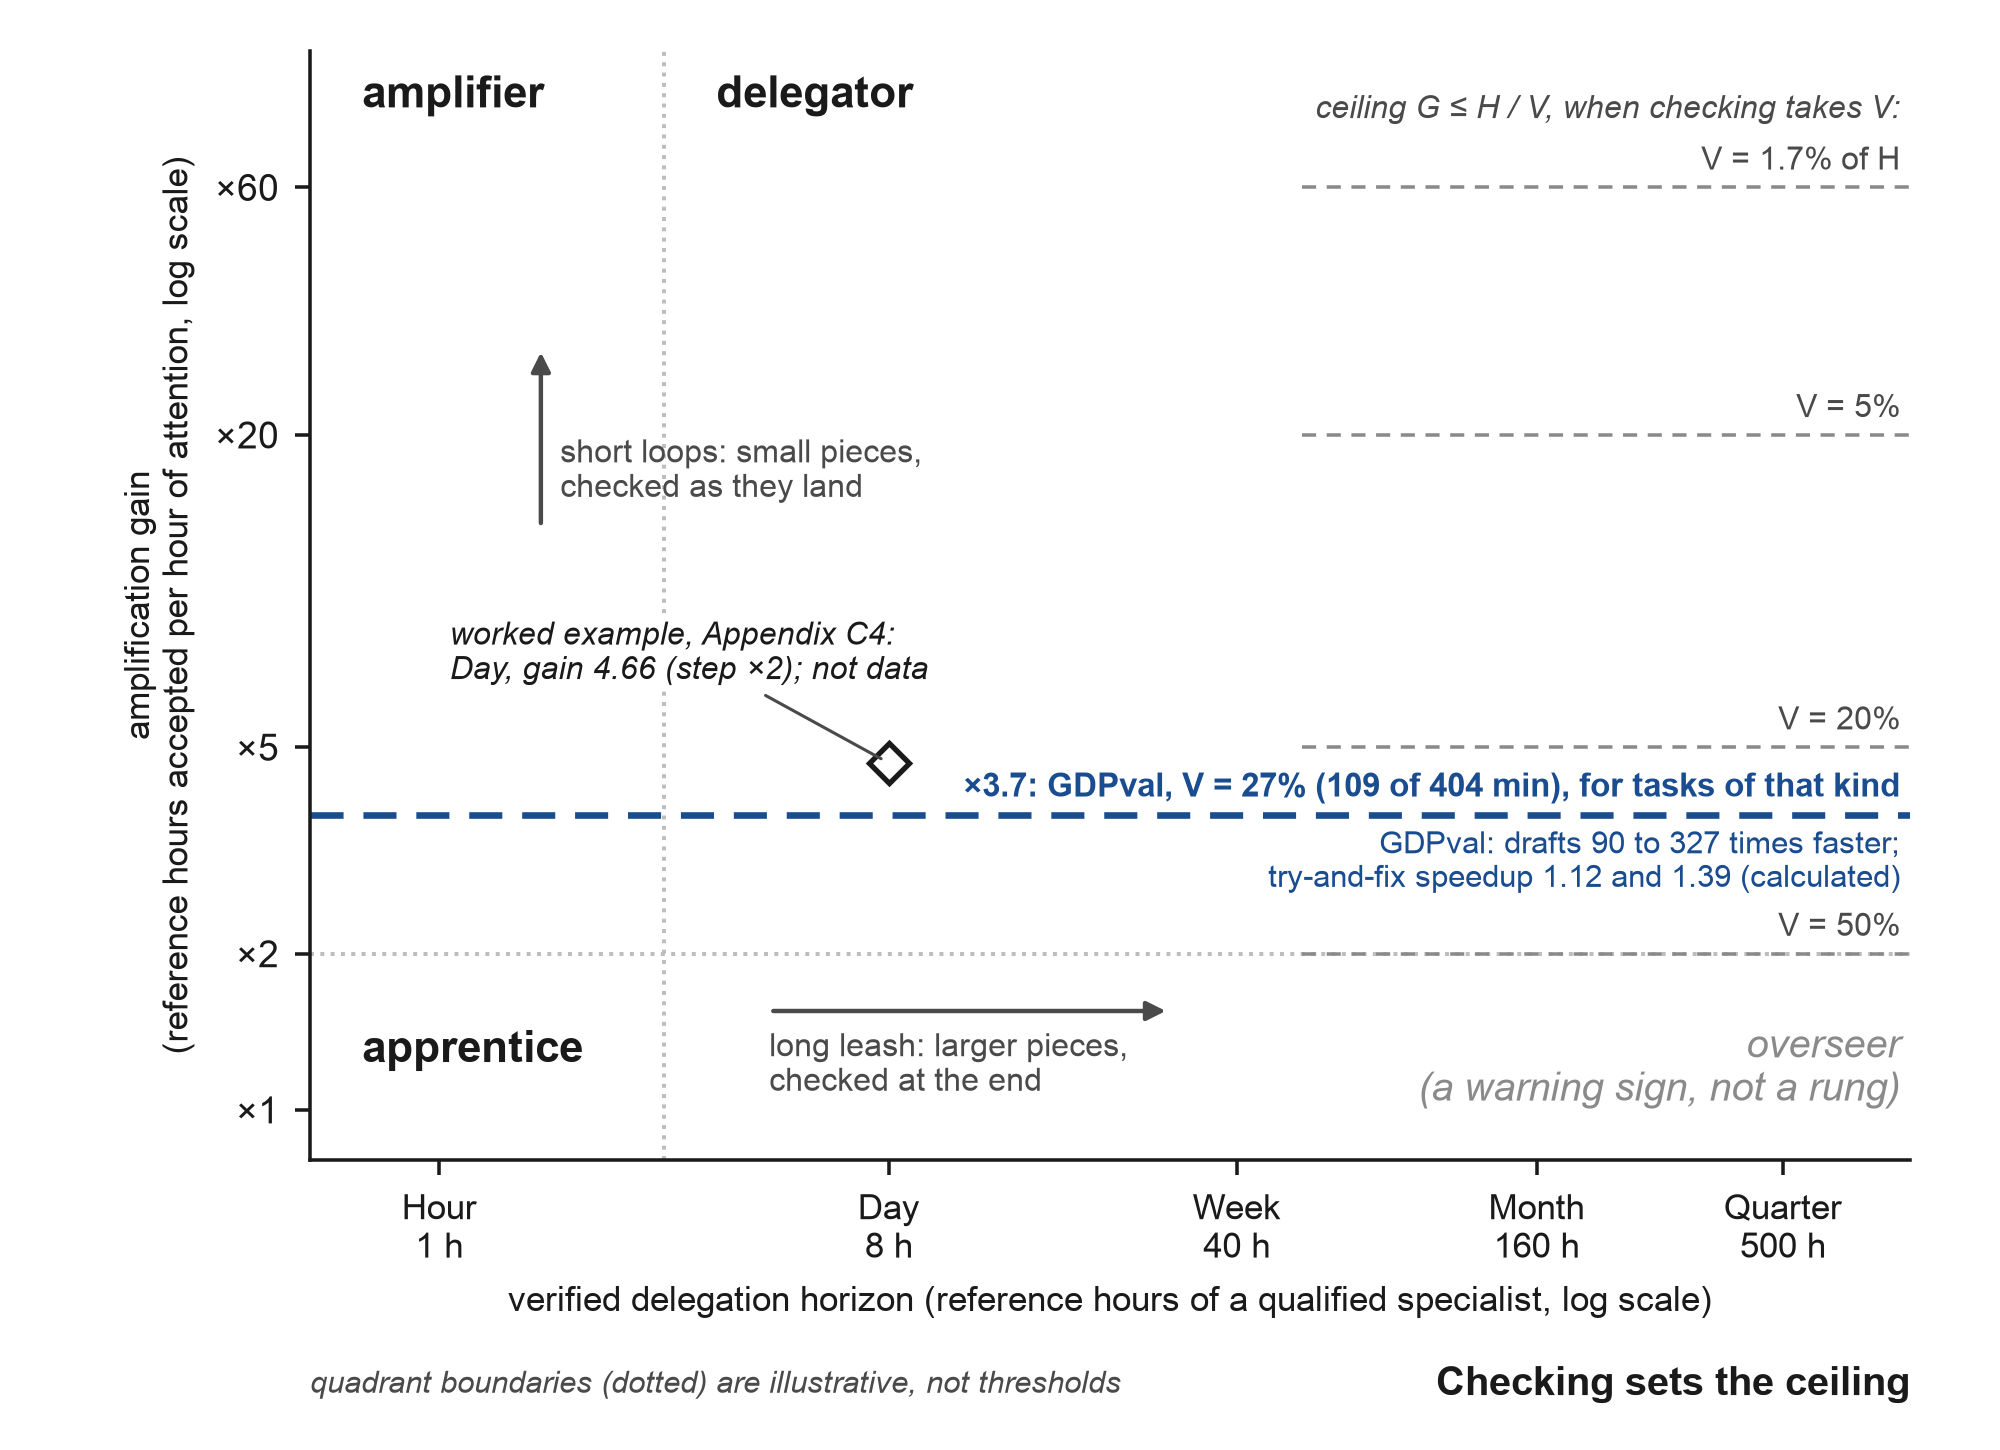
주의: 사분면은 단계가 아니라 프로필이며, 그 경계는 예시적입니다. 각 회색 선은 손으로 하는 시간 H에서 검사 시간의 주어진 비율 V에 대한 섹션 5.5의 한계 G ≤ H / V입니다. 강조선은 GDPval의 220개 작업 금표준 부분집합, 손으로 404분, 모델 출력의 전문가 검토 109분에서의 평균을 사용하며(Patwardhan et al., 2025), 그러한 종류의 작업에 적용됩니다. 속도 향상 1.12와 1.39는 저자들의 계산이며, 측정값이 아닙니다. 다이아몬드는 부록 C4의 작업 예시이며, 데이터가 아닙니다. 이는 GDPval 선 위에 있는데, 이는 천장이 작업 종류별로 계산되고, 저렴하게 확인된 작은 부분들이 큰 부분들을 위해 계산된 천장을 초과할 수 있기 때문입니다(섹션 5.5). 섹션 5.4의 36단계 경우는 도표에 표시되지 않습니다: 게시물은 이득도, 독립적인 검사도 없습니다.
5.6 이 측정이 어디에서 나왔는지, 그리고 무엇이 새로운지
이 측정에는 선행 측정들이 있으며, 가장 오래된 것은 Elliott Jaques이며, 그는 모든 기능의 모든 직책 수준을 그 재량의 시간 범위로 측정했습니다: 누군가 결과를 검토하기 전에 한 사람이 자신의 판단으로 일하는 가장 긴 시간입니다. 그는 공정한 급여가 그 범위에 따라 증가한다고 주장했습니다(Jaques, 1956). 검증된 위임 지평선은 이 개념을 에이전트 시대로 한 가지 변화와 함께 가져갑니다. Jaques는 한 사람이 검사 없이 일하는 기간을 측정했지만, 이 측정은 한 사람이 에이전트에 맡기는 일의 양, 수용하고 검사하는 양을 계산합니다. 두 가지가 달라질 수 있으며, 그의 계층은 월 단위와 년 단위로 계산되며, 이 단계들과 일치하지 않습니다.
주인-에이전트 이론이 두 번째 선행 이론입니다. Jensen과 Meckling(1976)은 위임을 감시, 담보 및 잔여 손실로 가격 책정했습니다. 검사는 에이전트에 작업을 맡기는 감시 비용이며, 지평선은 더 큰 부분을 검사하는 것이 더 이상 가치가 없는 지점을 표시합니다.
METR은 같은 축에서 기계를 측정합니다. 시간 지평선은 주어진 성공률에서 모델이 완료하는 작업의 길이(인간 시간)입니다(Kwa et al., 2025). 2026년 봄에 그 대시보드의 최첨단 모델은 50% 성공률에서 약 17시간에 도달했으나, METR 자체는 16시간 이상의 측정값이 현재 작업으로는 신뢰할 수 없다고 경고합니다. 80% 성공률에서의 지평선은 2026년 2월에 약 1.2시간에서 4월에 약 3.1시간으로 증가했으며, 이 두 지점은 성장 속도를 측정하지 않고 설명합니다. 2023년 이후 대시보드에서 모델 전반에 적용된 추세는 약 4.2개월(128.7일)마다 2배가 되며, 대시보드는 2026년 9월 8일에 마지막으로 접근했을 때 이후 업데이트되지 않았습니다(METR, 2026c). AI 미래 프로젝트의 예측자들은 4~4.5개월의 2배 시간으로 작업합니다(AI Futures Project, 2026). 수용된 작업은 50% 지평선보다 80% 지평선에 더 많이 해당합니다. 모델이 때로는 완료하는 것과 안정적으로 완료하는 것 사이의 간격이 사람의 작업이며, 이는 결과가 맞다는 것을 보여주고 이를 관철시키는 것입니다. 그림 A3(부록 F)은 이러한 기계 지평선을 단계들과 비교합니다.
2026년의 이론은 같은 간격을 가리킵니다. Huang, Xiao 및 Vishnoi(2026)는 AI 하에서의 위임을 모델링하고 검증 능력의 작은 차이가 결과의 큰 차이를 만든다는 것을 발견합니다: AI는 검사하는 사람들을 돕고 너무 많이 맡기는 사람들에게 해를 끼칩니다. 그들의 논문은 ICML 2026에서 수락되었으며, 그들은 그 효과를 검증 증폭이라고 부릅니다. 24개 연구의 구조화된 검토에서 그 초점 말뭉치의 검증된 도구는 에이전트를 감독하는 데 필요한 기술의 전체 조합(범위, 권한, 복구, 독립적 검토 및 증거 기반 종료)을 다루는 것이 없으나, 일부 도구는 그 부분을 다룹니다(Veri', 2026). DeepMind의 지능형 AI 위임 프레임워크는 일반적으로 위임을 설명하며 사람 수준의 측정을 포함하지 않습니다(Tomašev et al., 2026), 위임의 경제학은 이제 자신의 최첨단 모델을 가집니다(Wang, 2026). Chen과 Meng(2026)은 생성 AI가 작업 내 기술 차이를 압축하고 가치를 희소 상보 자산으로 전환하며, 그들의 예측을 시험하는 데 필요한 사람별 작업 패널 데이터가 "규모 있게 아직 존재하지 않는다"고 덧붙입니다. 제가 제안하는 측정은 정확히 그러한 종류의 데이터를 생성하며, 각 기록된 부분은 사람, 크기 및 날짜를 담습니다.
두 번째 축은 자신의 이웃을 가지고 있으며, 증폭 이득은 그들의 사람 수준, 검증된 형식입니다. Engelbart(1962)는 컴퓨팅을 인간 지능 증강으로 구성했으며, "슈퍼에이전시"는 2025년 이 동일한 희망에 대한 McKinsey의 단어입니다(McKinsey, 2025). Anthropic 경제 지수는 회화를 속도 향상(AI 없는 시간을 AI를 사용한 시간으로 나눈 값)과 1~5 범위의 에이전트 자율성으로 채점하며, 둘 다 모델에 의해 판단됩니다(Anthropic, 2026a). Stanford의 WORKBank는 근로자들이 선호하는 인간 개입을 H1에서 H5까지의 범위로 평가합니다(Shao et al., 2025). 2026년 에세이는 감독 역량을 인간 노력에 대한 유용한 검증된 출력으로 정의했으며 명시적으로 그것에 숫자를 부여하는 것을 거절했으며(em360, 2026), "증폭된 감독"은 사람들이 자신보다 강한 시스템을 감독하도록 돕기 위한 AI 안전 용어입니다. 검색 에이전트의 관찰은 인간 시간이 검사 방향으로 전환되는 같은 변화를 보여줍니다: 에이전트는 세션당 26분 동안 단독으로 작업하는데, 일반 검색은 33초가 걸렸습니다(Yang et al., 2026). 위임 측면에서, Khadj(2026)와 Alonso(2026)는 기계나 회사가 위임할 수 있는 정도에 "위임 지평선"을 사용하며, CHI 2026 작업은 "의사 결정 지평선"에 대해 자기 방향 상실을 연구하며(University of Lübeck, 2026), Dawson(2026)과 Metal Toad(2026)는 AI 위임의 실무자 수준을 발행합니다. 이 모든 곳은 독립적 검사가 확인한 작업으로 사람을 수준에 두지 않습니다.
가장 가까운 최근 프레임워크는 여기서 직접 비교됩니다. JetBrains Research의 AIDEs 프레임워크(Tikhomirov, 2026)는 측정과 두 가지 특징을 공유합니다: 위임을 주인-에이전트 관계로 취급하며, 위임을 수준으로 순서 지으며, 자율성 및 계획과 같은 속성으로 설명된 5개 단계입니다. 네 가지에서 다릅니다. 그 주제는 소프트웨어 개발이지만, 지평선은 모든 도메인에서 채점됩니다. 그 수준은 작업이 어떻게 위임되는지를 설명하지만, 단계는 자격 있는 전문가의 참조 시간으로 작업 크기에 의해 설정됩니다. 검사가 에이전트의 독립적이어야 한다는 규칙이 없으며, 단계는 에이전트가 보지 못한 검사로 확인된 부분만 계산합니다. 그리고 창 위에 계산이 없으며 두 번째 축이 없으며, 단계는 날짜 창 위의 통과 공유와 증폭 이득이 주의의 시간을 더합니다. 기관의 언어는 공유됩니다; 단위, 독립성 규칙 및 소프트웨어 범위가 무엇이 이 논문이 제안하는 것입니다.
많은 척도가 2025년과 2026년에 발행되었으며, 표 2의 척도 중 어떤 것도 검증된 작업으로 사람을 측정하지 않습니다. 표 2는 그들이 측정하는 것에 의해 주요 것들을 분류합니다; 표 A3(부록 F)은 각각을 나열합니다.
표 2. 2025년과 2026년의 척도, 그들이 측정하는 것에 의해 분류됨.
| 분류 | 예시 | 측정 단위 | 검증된 위임 작업으로 개인을 배치합니까? |
|---|---|---|---|
| 에이전트와 기계의 자율성 수준 | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | 에이전트, 모델 또는 팀의 설정 | 아니오 |
| 개발자 실무의 단계 | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | 실무, 감독 작업 또는 작업 패턴 | 아니오 |
| 조직과 회사에 의한 위임 | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | 조직, 관리자, 회사 또는 일반적인 위임 | 아니오 |
| 주인-대리인 관계로서의 개발자 위임 | JetBrains Research (Tikhomirov), September 2026 | 개발자의 위임 | 개발자만; 검증에 대한 독립성 규칙 없음, 규모 단위 없음 |
| 역량 및 문해력 프레임워크 | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | 역량 또는 문해력 | 시험, 임계값 또는 수준 없음 |
| 검증된 위임 지평선 및 증폭 이득 | This paper | 영역의 개인 | 예, 5.2절의 규칙에 의함 |
주: "검증된 위임 작업으로 개인을 배치한다"는 것은 척도가 에이전트에게 할당된 작업의 규모에 따라 개인을 수준에 배치하고, 에이전트가 보지 못한 검증으로 확인된다는 의미입니다. 가장 가까운 사례는 JetBrains의 5단계입니다. 주인과 대리인의 언어를 공유하며, 검증 규칙(에이전트가 보지 못한 독립적인 검증)과 단위(참조 시간)에서 다릅니다. Table A3(부록 F)은 각 척도를 별도로 나열합니다.
한 실무자는 개인 척도에 대한 이의를 잘 표현했습니다: "당신의 자율성 수준은 저장소의 속성이지, 개발자의 속성도 모델의 속성도 아닙니다"(Phoenix, 2026). 이 중 절반을 동의합니다. 지평선은 개인에 속하며, 영역 내에서, 검증 체계 하에서 존재하고, 숨겨진 테스트가 있는 잘 구축된 저장소는 그 체계의 일부이며, 이것이 지평선이 영역별, 날짜와 함께 기록되는 이유 중 하나입니다.
5.7 동반 논문의 두 가지 질문
동반 논문은 경험 많은 사용자가 덜 위임하는 이유가 무엇인지—그들이 피해를 입었거나 그들의 판단이 결과물인지에 대한 질문을 남겨두었습니다(Chernets, 2026a). 두 번째 축이 둘을 구분할 수 있습니다. 명령적 사용의 비중이 감소하면서 검증된 이득이 증가한다면 판단이 결과물입니다. 이득도 감소한다면 그들은 피해를 입었습니다. 동반 논문은 또한 위임의 어휘가 하나의 문법인지 직업마다 하나씩인지 질문했습니다. 저는 입장을 취합니다: 문법은 하나입니다(작업을 설정한 다음 증거에 따라 수락함). 증거로 간주되는 것이 영역에 따라 다르기 때문에, 단계는 공유되고 채점은 영역별로 발생합니다.
부록 C의 도구는 각 개인과 영역에 대해 명령적 비중을 보고합니다. 조각 단위로 계산되며(한 조각에서 넘겨진 조각의 비중, 단계나 공동 작업과 비교), 같은 기록에서 첫 번째의 대략적인 검증을 실행할 수 있습니다. 예측 F20은 등록된 측정의 날짜와 함께 검증을 기술합니다: "로그에서 지시가 아닌 검증하거나 편집하는 개인의 차례의 비중"(Table A6). 거기서 비중은 부록 C의 작업 로그의 조각이 아닌 세션 로그의 차례를 통해 계산되므로, 두 개의 계산 중 더 세분화된 것입니다.
5.8 측정을 조작하는 방법과 방어
수락된, 독립적으로 검증된 작업을 세는 것은 가장 저렴한 경로인 지출을 막지만, 결정된 개인이나 목표를 추구하는 고용주는 여전히 다른 경로를 가질 수 있습니다. Table 3은 규칙이 제공하는 방어와 함께 이들을 나열합니다. 방어에는 비용이 들며, 그 비용은 설계의 일부입니다: 감사된 단계는 자체 보고된 단계보다 더 가치가 있습니다. 감사된 계정이 명세서보다 더 가치 있는 것과 같은 방식입니다.
Table 3. 측정을 조작하는 방법과 방어.
| 경로 | 모양 | 방어 |
|---|---|---|
| 쉬운 검증 | 약한 솔루션이 통과하는 숨겨진 테스트, 대충 읽는 검토자 | 두 번째 독립 검증자에 의한 수락된 조각의 일부의 무작위 감사, Week 이상으로 심는 오류, 점수 옆에 검증의 종류 인쇄 |
| 임계값 바로 위의 작업 선택 | Day에 도달하기 위해 8.1 참조 시간의 많은 조각 | 크기 분포에서 읽은 단계, 중앙값 수락 크기가 단계 옆에 보고됨 |
| 관대한 시간 평가자 | 참조 시간을 부풀리는 평가자 | 개인에게 맹검된 두 평가자, 고정 비율 이상의 불일치는 조각을 동결된 은행 또는 세 번째 평가자로 보냄, 평가자의 기록 감사 |
| 숨겨진 도움 | 동료 또는 계약자가 로그 외부에서 작업 수정 | 조각별로 기록된 주의, 무작위 인터뷰 또는 재생, 외부 도움이 필드로 기록되고 개인의 이득에서 제외됨 |
| 분할 | 한 달의 작업을 1시간 티켓으로 자르기 | 일관된 결과물만, 전체로 수락되는 것만 단계를 향해 계산됨 |
| 실패 숨기기 | 중단되거나 실패한 조각이 로그에서 제외됨 | 모든 위임이 로그되며, 시작 날짜 포함, 수락, 거부 또는 중단될 때 종료, 실패의 공개 기록, 너무 깔끔한 통과율은 감사 촉발 |
| 상관관계 검증 | 같은 계열의 두 번째 모델이 동의 | 계산되지 않음(5.2절) |
| 병렬 스트림 | 주의가 스트림당 한 번 계산됨 | 주의가 개인-분당 한 번 계산됨(5.4절) |
임계값은 설계 선택으로, 규칙 v1.1로 버전 관리되며 데이터 이후의 새 버전에서만 변경됩니다. 윈도우의 10개 항목은 80% 통과 비율이 의미를 갖는 가장 작은 개수입니다(10개 중 8개 통과). 하위 등급의 91일 윈도우와 상위 등급에서 요구되는 최근 항목은 분기별 재검증 및 도구 변경 속도와 일치합니다. 등급 규칙은 적격성 규칙이며 개인의 신뢰성을 추정하지 않습니다. 10개 중 8개의 통과는 약 44%에서 97% 사이의 참 통과율과 일치하며(정확한 95% 구간), 3개 중 3개는 약 37% 정도의 낮은 수준과 일치합니다(편측 95% 경계). 등록된 보정 연구는 신뢰성을 추정합니다. 80%의 비율은 METR의 신뢰할 수 있는 작업 수준으로서의 80% 지평선 사용을 따르고, 1, 8, 40, 160, 500시간의 등급은 근무시간, 일, 주, 월, 분기를 따르므로 직업 간 변환이 필요하지 않습니다. 임계값의 데스크 테스트는 시뮬레이션과 모델 평가자를 통해 규칙을 검증했습니다(부록 E). 알려진 신뢰성을 가진 개인이 각 등급을 획득하는 빈도를 계산했습니다(그림 A2, 부록 E). 참 통과율이 0.8일 때 Day는 68%의 윈도우에서 획득되고 동일한 판정이 다음 윈도우에서 56%의 확률로 반복되므로, 기록은 "Day (8/10)"과 같이 등급 옆에 개수를 인쇄합니다. 또한 규칙의 첫 번째 버전에서 오류를 발견했습니다. Month에서 4개 중 4개가 Quarter에서 3개 중 3개보다 획득하기 더 어려웠습니다(통과율 0.8에서 41% 대 51%). 이제 Month는 1년에 6개 중 5개를 요구합니다. 개수를 10에서 8 또는 12로, 비율을 0.8에서 0.7 또는 0.9로 이동하면 시뮬레이션된 로그의 8%에서 11%에 대해 Day 판정을 변경하고, 둘 다 이동하면 최대 22%까지 변경됩니다. 4개 계열의 4명의 모델 평가자는 맹검으로 참조 시간을 추정하여 30개 작업을 일관되게 정렬했습니다(로그 시간에서 급내 상관 0.89). 하지만 보정 프로토콜의 1.5 비율 기준인 70%에 비해 쌍의 62%만 1.5 비율 범위 내에 있었고, 전체 수준에서 2배 차이가 났습니다. 작업의 공개 식별자만 주어졌을 때, 이들의 평균 추정값은 14개 작업 중 3개의 측정된 인간 시간의 1.5 이내에 속했습니다. 따라서 모델 평가자는 두 명의 인간 평가자를 대체할 수 없으며, 현장 연구의 평가자는 먼저 측정된 시간이 있는 작업에 대해 보정합니다. 보정 프로토콜은 다음 테스트를 사전에 수정합니다. 인간 평가자 간의 일치(기준: 쌍의 최소 70%가 1.5 범위 내), 연속 두 윈도우에 걸친 개인의 등급 반복성(가중 카파 최소 0.6), 그리고 등급이 동일한 크기의 새로운 작업 통과를 예측하는 능력(AUC 최소 0.7)입니다. 이 프로토콜과 등록 텍스트는 동반 저장소에 있으며, 참조 시간에 대한 동의에 관한 근무 전문가를 대상으로 한 첫 번째 테스트는 등록되고 부록 G에 설명되어 있습니다.
표 A4(부록 F)는 먼저 나타나는 어려운 경우의 규칙을 제공합니다.
부록 C, 섹션 C4는 한 개인의 10개 라인 로그를 생성하는 단일 기록으로 진행합니다.
6. 배경 중립성과 자격증 교차점
6.1 배경 중립성
가설은 한 영역에서 동등한 검증된 수준에 도달했을 때, 프로그래밍 교육은 영역에 대한 명령과 수용 문해력을 고려한 후 독립적으로 검증된 작업의 질을 예측하지 못한다는 것입니다.
Anthropic의 "Claude를 성공으로 이끄는 능력은 코드를 작성하는 능력보다 영역에 대한 명령에서 더 많이 나온다"는 발견은 이 가설과 일치하지만 이를 검증하지는 않습니다(Anthropic, 2026e): 그 데이터는 교육이 아닌 직업으로 사람들을 분류하며, 2.2절의 34% 대 29% 격차는 직업 간의 격차입니다. 오직 F7의 연구만이 이 가설을 검증합니다. 강력한 대안도 존재합니다. Savva(2026)는 AI 강화 지식 업무를 주인-대리인 문제로 모델링하고 AI가 쉬운 작업에서는 격차를 좁히고 어려운 작업에서는 격차를 넓힌다고 예측합니다. Savva가 맞다면, 배경 중립성은 단기 작업에서 유지되고 더 높은 수준에서는 실패할 것이므로, 예측 F7은 Day에서와 Week 이상에서 별도로 점수가 매겨지며, 이는 가설이 가장 어려운 검증에 직면합니다.
수용 문해력은 이 가설이 의존하는 기술입니다. 이는 미리 완료된 것으로 간주될 것을 명시하고 이를 보여주는 것을 의미합니다: 숨겨진 테스트, 출처에 대해 검증하는 두 번째 모델 계열, 사람이 직접 연 출처와의 비교, 또는 보증 대신 산출물을 통해. 에이전트 문해력은 일반적으로 위임, 검증 및 관리를 포함합니다(MindStudio, 2026); 수용 문해력은 증거의 표준을 중심에 두고 있습니다. 또한 사람들이 기술을 채택하는지 여부를 연구하는 TAM 전통의 기술 수용과는 다릅니다. 여기서 수용은 작업을 수용하기로 내리는 결정이기 때문입니다. 동반 논문의 수용 기록은 수준에 대한 증거의 단위가 됩니다.
6.2 자격증 교차점
한 영역의 자격증 교차점은 IT 교육을 받지 않은 사람들이 만든 제품이 동일한 독립적 검증을 받으면서 같은 에이전트를 사용하는 프로그래머가 만든 제품을 추월하기 시작하는 순간이며, 그 이후 IT 학위와 주니어, 시니어라는 레이블은 해당 영역의 채용에서 예측력을 잃습니다.
이 정의는 2026년 10월 8일에 제가 작성한 예측을 정확하게 한 것입니다(1절). 그 구성 요소는 각각 관찰 가능하며 각각 자체적으로 날짜가 지정되어 있으므로, 모두 일치할 때 그 순간을 읽을 수 있습니다. 질 동등성은 그 순간 이전의 단계입니다: 한 영역에서, IT 교육을 받지 않은 사람들의 제품은 같은 에이전트로 같은 작업에서 프로그래머의 제품만큼 좋으며, 맹검 검증에서 그렇습니다(예측 F2). 추월은 그 순간 자체로, 같은 검증에서 그 제품이 더 나아질 때입니다(F3, F4a와 F4b의 출시 및 유지 보수 단계 포함). 채용공고의 교차는 보이는 신호로, 에이전트 기술을 요구하는 채용공고가 그렇지 않은 유사한 채용공고보다 학위를 덜 자주 요구할 때입니다(F5). 배경 중립성은 메커니즘으로, 동등한 수준에서 교육이 검증된 질을 더 이상 예측하지 못하기 때문입니다(F7).
한 영역의 교차점은 그 같은 명명된 영역에서, 추월이 나타나는(F3) 첫 번째 해와 그 영역의 채용공고의 교차에 해당하는 것이 충족되는(F5가 그 영역의 채용공고에서 계산됨; 부록 D) 첫 번째 해로 날짜가 지정됩니다. 추월 없는 동등성은 그 지점에 접근하는 것이며, 추월 없는 채용공고의 교차는 고용주가 증거보다 앞서가고 있음을 보여줄 것입니다. F2, F3, F5, F7은 따라서 같은 명명된 영역에 대한 하나의 프로그램을 형성합니다: 영역은 등록에 고정되고, F2, F3, F7의 실험이 그들 내에서 실행되며, F5는 고정된 IT 직업 세트와 각 영역의 채용공고 모두에서 계산됩니다. 자격증 교차점은 한 영역에서 품질 규칙(F3)과 채용 규칙(F5의 영역 유사체)이 모두 충족될 때만 그 영역에 대해 선언됩니다; 둘 중 하나만으로는 아무것도 선언하지 않습니다.
처음 두 구성 요소는 일치하는 작업에 대한 실험으로 검증됩니다(11절). 세 번째는 이미 채용공고에서 관찰할 수 있습니다. Lightcast는 2026년 9월에 AI 기술을 필요로 하는 IT 채용공고가 AI 기술 없이 IT 채용공고보다 4년제 학위를 요구할 가능성이 여전히 더 높다고 보고했습니다. 하지만 AI 채용공고 중에서 학위 요구 사항은 2024년 이후 "명확한 감소 추세"에 있는 반면 다른 IT 채용공고에서는 상승했습니다(Lightcast, 2026b). 두 추세선이 수렴하고 있으며 아직 교차하지 않았습니다(그림 5). Lightcast는 300개 이상의 AI 기술로 AI 채용공고를 정의하므로 그 추세선은 전반적인 AI 업무를 설명합니다. 에이전트 부분집합은 고정된 에이전트 기술 목록으로 정의되며(Lightcast, 2026a), 이것이 예측이 사용하는 것이며 그 기준선은 등록 전에 취합니다.
그 방향에는 선례가 있습니다. Bone, González Ehlinger, Stephany(2025)는 2024년 중반까지 약 1,100만 개의 영국 공석을 사용하여 AI 역할에서 교육 요구 사항이 감소했음을 발견했으며 기술과 학위에 부여된 임금 프리미엄을 비교했습니다. 그 저작은 에이전트 이전에 AI에서 기술 기반 채용을 기록했습니다. 이 논문은 그 추세선을 에이전트 기술로 확장하고, 날짜가 지정된 임계값과 일치하는 채용공고와의 비교를 가지며, 채용공고 요구 사항을 독립적으로 검증된 성능과 연결하도록 제안합니다. PwC의 AI Jobs Barometer는 여러 국가에서 같은 방향을 보고하며 같은 수량을 측정하는 경우 대체 출처 역할을 합니다(PwC, 2026).
두 번째 지표는 고용주가 말하는 것과 그들이 하는 것 사이의 거리입니다. 많은 고용주가 에이전트가 도착하기 전에 학위 요구 사항을 정책에서 제거했으나, Burning Glass Institute와 Harvard Business School은 그 변화가 700명 중 1명 미만의 채용에 영향을 미쳤다는 것을 발견했습니다(Burning Glass Institute & Harvard Business School, 2024). 채용공고는 다른 방향으로 움직였습니다: 2025년 11월에 Indeed의 미국 채용공고의 19.3%가 학사 학위 이상을 요구했으며, 이는 1년 전보다 상당히 증가한 것입니다(Indeed Hiring Lab, 2026). 서류상 제거된 학위 요구 사항은 정책 변화이며, 교차점은 채용 자체가 변할 때만 나타납니다. 교육에서만 다른 일치하는 포트폴리오를 실제 채용공고에 보내는 감시 연구가 그것을 먼저 볼 것이며, 예측 F26이 하나를 설정합니다.
학위는 라벨을 통해 사람들을 받아들이는 게이트 계열에 속합니다: 플랫폼의 프로필, 직책, 학위, 그리고 부분적으로 자격증이 그것입니다. 라벨은 그것을 가지는 것이 일을 할 수 있는 능력과 함께 진행되는 만큼만 고용주에게 일에 대해 말합니다. 에이전트는 라벨 없는 사람들이 이제 그 직업처럼 보이는 일을 생산하고 있기 때문에(2.2절), 그리고 개인의 말에 기반한 라벨은 항상 청구하기 쉬웠기 때문에 한쪽에서 그 연결을 느슨하게 합니다. 일 자체를 확인하는 게이트는 어느 쪽에도 의존하지 않습니다. 부록 G의 평가자 연구는 우연히 그 차이를 만났습니다. Prolific은 대부분 자체 보고된 답변인 필터를 통해 연구에 참가자들을 받아들이는데, 나이와 거주 국가가 확인하는 주요 예외입니다(Prolific, 2026). 기록 유지 표본에 필터가 받아들인 60명 중 11명이 그 직업의 첫 주 질문에 잘못 답했습니다(부록 G2): 라벨이 그들을 들여보냈고, 그 직업의 한 질문이 그들을 멈췄습니다.
에이전트 이전에 그러한 플랫폼에서 프로그래머를 모집한 연구자들은 동일한 패턴을 보고했으며 자신의 지식 질문으로 선별했습니다: 한 연구에서 플랫폼의 프로그래밍 기술을 명시한 근로자의 42%가 그러한 질문의 기준을 충족하지 못했으며(Danilova et al., 2021), 다른 연구에서 Prolific의 경우 Node.js 프로그래밍을 보고한 206명의 응답자 중 55명이 모든 프로그래밍 질문을 통과했습니다(Reid et al., 2022). 지식 질문 자체는 전달된 일의 확인보다 약한 게이트이며, 채팅 모델도 그것을 약하게 합니다: 시뮬레이션된 공격에서 ChatGPT는 프로그래머를 위한 기존 선별 질문을 쉽게 풀었으며(Serafini et al., 2024), 2026년까지 그것을 저항하도록 설계된 정적 시각 질문도 통과했으나, 엄격한 시간 제한 하에 단계별로 내용을 드러내는 오디오 질문은 여전히 유지되었습니다(Serafini et al., 2026). 위의 정의 용어로, 학위가 예측하는 가중치 손실은 첫 번째 종류의 게이트가 두 번째 종류로 양보하는 것이며, 확인된 위임 지평은 두 번째 종류의 게이트입니다: 그것은 사람이 자신이 누구인지 말하는 것이 아니라 그들이 넘겨준 것과 에이전트가 보지 못한 확인이 통과한 것을 기록합니다.
자격증은 두 종류 사이에 있습니다. 한 번 통과한 시험에 기반한 자격증은 그 이후로 라벨로 작동합니다; 보유자의 일이 검사되는 자격증은 확인에 더 가깝습니다. 미국의 공개기업회계감시위원회에 등록된 감사 회사는 자신의 감사 일이 매년 검사를 받으며(100명 이상의 발행자를 정기적으로 감사하는 경우) 최소 3년마다 한 번, 위원회가 규칙으로 다른 일정을 정하지 않는 한(2002년 사르박스-옥슬리 법, s. 104), 회사의 서명된 일에 대한 느린 대응으로, 5.2절이 지평에 요구하는 재확인입니다. 자격증 발급 자체는 두 번째 종류로 이동하기 시작했습니다. 2024년 5월부터 오리건은 법학 졸업생에게 변호사시험 없이 자격증을 취득하는 경로를 제공했습니다: 감독된 실무 포트폴리오 시험은 최소 675시간의 감독된 실무를 통해 후보자가 8개의 서면 작업, 2개의 클라이언트 상호작용 및 2개의 협상을 제출하며, 변호사회 시험 위원회의 루브릭을 적용하는 채점자들이 각각이 최소 역량을 보이는지 판단합니다. 2026년 1월 5일까지 205명의 후보자가 신청했으며 49명이 변호사 자격증을 취득했으며, 첫 번째는 2024년 12월입니다(오리건 주 변호사회 시험 위원회, 2026). 법학 학위는 여전히 필수이므로 확인된 일은 시험을 대체하지 학교를 대체하지 않습니다. 회계에서는 이동이 더 작습니다: 2025년 5월 AICPA와 NASBA는 CPA 자격증 경로에 대한 모범 입법을 승인했으며, 학사 학위 이상의 30학점 시간 대신 2년의 전문 경험을 요구하고, 시험은 유지되며, 각 주는 후보자가 사용하기 전에 이를 제정해야 합니다(Journal of Accountancy, 2025). 법이 자격증에 예약한 것은 측정의 경계로 남습니다(13절). 표 A8(부록 F)은 이 절의 게이트를 각각이 확인하는 것으로 나란히 설정합니다.
"자격증"이라는 용어는 에이전트 보안에서 두 번째 의미를 가지는데, 여기서는 비밀 키 또는 토큰을 나타냅니다. 여기서는 학위 또는 인증서를 의미합니다. "자격증 교차점"이라는 문구는 이 의미에서 2026년 10월 9일에 검색된 학술 기반에서 일치하는 결과를 반환하지 않았습니다(부록 B).
그림 5. 확인된 성공의 격차와 게시물의 학위 요건: 관찰되는 것과 2027이 테스트할 것입니다.
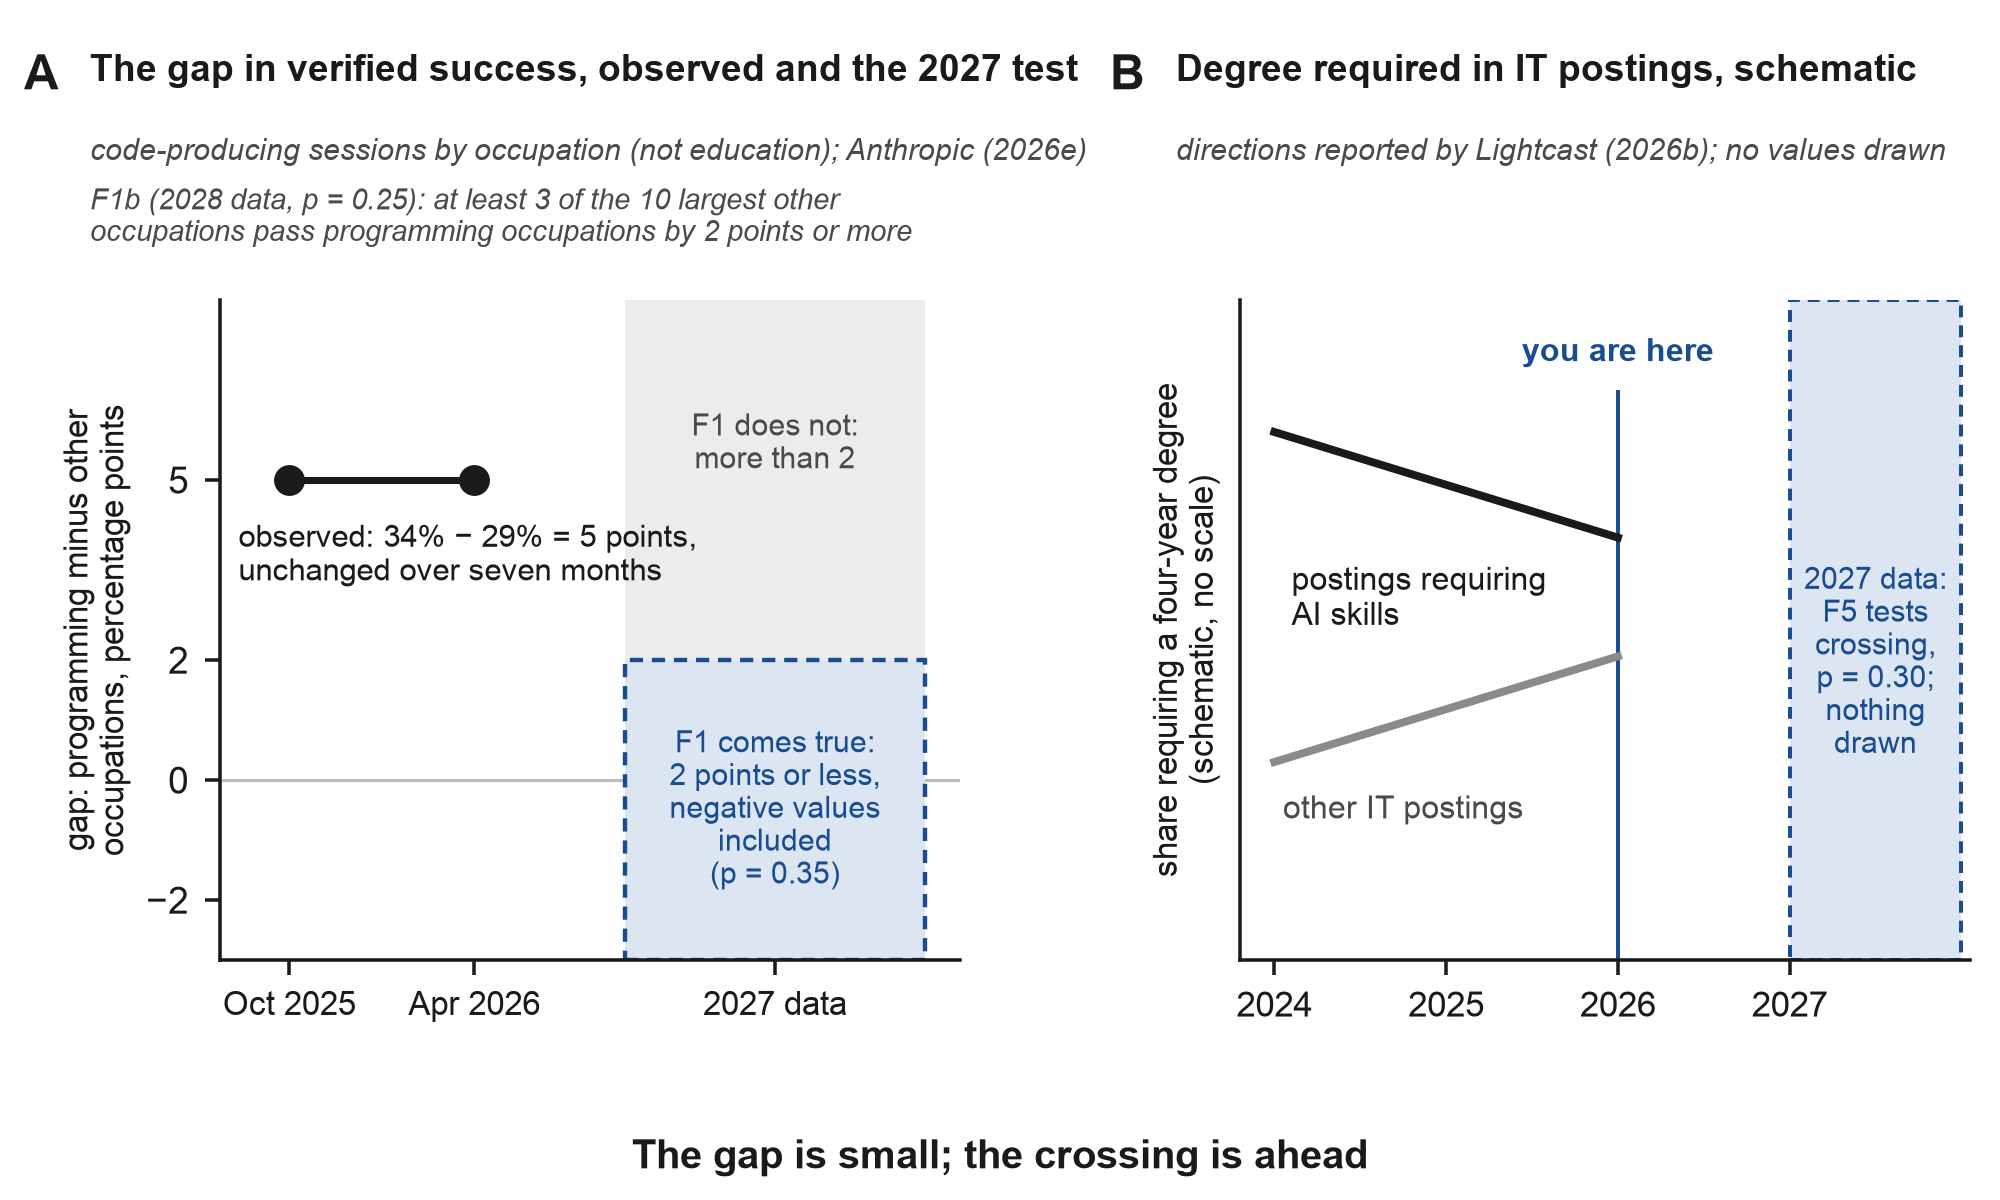
주: 패널 A는 Anthropic (2026e), 코드 생산 세션, 프로그래밍 직업의 경우 34%, 다른 직업의 경우 29%, 7개월 동안 변화 없음을 사용합니다. 직업은 교육이 아니며, 성공은 테스트 또는 커밋과 같은 증거로 뒷받침된 성취를 의미합니다. 대역은 예측 F1(2포인트 이하의 격차, 음수 값 포함, 확률 0.35)의 임계값입니다; F1b (확률 0.25)는 표 A6에 있습니다. 패널 B는 Lightcast (2026b)가 2026년까지 보고한 방향만 그리며, 값은 없습니다. 2027 창은 비워두었습니다: 예측 F5(확률 0.30)가 결정할 것이기 때문에 교차는 그려지지 않습니다.
6.3 도메인: 프로그래머의 이점이 수평이었던 이유
AI가 가장 먼저 저렴하게 만드는 것은 모든 산업에서 동일한 수평적인 것이며, 그 메커니즘은 명확합니다. 산업 간 이전 가능한 역량은 범용 모델이 모든 산업에 동시에 제공할 수 있는 것입니다. 모델 위의 얇은 래퍼, 범용 소프트웨어, 코드를 작성하는 일반적인 능력은 모두 그 길을 따랐습니다. 프롬프트 엔지니어는 2023년의 가장 유행한 직함이었지만 2025년에는 그 기술이 도구에 녹아들고 모두의 것이 되면서 구식이 되었습니다(Fortune, 2025). 프로그래머의 예전 장점도 수평적이었습니다. 코드는 모든 산업에서 작동하므로 프로그래머는 법률회사나 병원을 알지 못해도 그곳을 위해 개발할 수 있었고, 에이전트는 코드를 저렴하게 만함으로써 그 장점을 빼앗고 있습니다. 이것이 일어나기 위해 누구도 프로그래머가 될 필요가 없었습니다. 소프트웨어는 많은 수직 분야 중 하나가 되었고(인프라와 보안이 가까운 이웃), 그 내부에서 프로그래머들은 여전히 가장 강력합니다. 같은 논리가 기업뿐만 아니라 사람에게도 적용됩니다. 수직 분야가 없는 사람은 AI 위의 래퍼이며, 얇은 래퍼 제품만큼 취약합니다. 에이전트가 범용 소프트웨어를 더 쉽게 구축하게 만들면서 기존의 수직 소프트웨어는 실험실(정보 계층을 차지하는)과 자체 도구를 구축하는 전문가(두 방향 모두)로부터 압력을 받을 수 있습니다. 가설은 도메인 지식이 에이전트 작업을 수용하는 능력과 결합될 때 가치를 얻는다는 것입니다. 수직성 자체는 누구도 보호하지 않습니다. 깊이가 보호하며, 이는 모델이나 신규자가 속임수를 쓸 수 없는 도메인의 작업을 수용할 수 있는 능력을 의미합니다.
여기서 수직 분야는 사람이 에이전트의 작업을 수용할 수 있는 도메인이며, 그것이 반드시 그들이 학위를 가진 곳은 아닙니다. 법적 작업을 수용하려면 그럴듯한 오류를 발견할 수 있을 정도로 법률을 충분히 잘 알아야 합니다. 제9장의 스레드에 있는 한 개발자는 이를 명확히 말합니다. 어떤 결과물이 말도 안 된다는 것을 보려면 그 분야를 조금이라도 알아야 합니다(번역됨). 수용은 사람과 함께 머물며, 결과물 아래의 이름과 서명, 사람 자신의 맥락(클라이언트, 데이터, 현지 규칙, 언어), 그리고 출시 후 유지보수도 그러합니다.
실험실들은 수직 분야의 정보 계층을 구매하고 있습니다. 전문가 시간을 AI 실험실에 판매하는 Mercor는 방사선 전문의와 같은 전문가들의 시간을 판매함으로써 2026년 6월에 연간 총 20억 달러 이상의 실적을 달성했습니다(Dealroom, 2026). 수직 AI 응용 프로그램에 대한 기업 지출은 2025년에 35억 달러로 거의 3배 증가했습니다(Menlo Ventures, 2025). 그 분기는 도메인 전문가에게 두 가지 운명을 제시합니다. 기여자는 지식을 레이블로서 실험실에 판매하고, 그 지식은 한 번 소비됩니다. 주요 행위자는 지식을 자신의 제품 내에 유지하고 결과에 책임을 지며, 지식은 계속 작동합니다.
측정에 대한 결과는 지평선이 도메인 간에 온전히 이전되지 않는다는 것입니다. 소프트웨어로 이동하는 변호사와 법으로 이동하는 프로그래머는 같은 것을 잃습니다. 즉, 자신이 모르는 분야에서 일을 수용할 수 있는 능력입니다. 그 대칭성이 프로그래머의 특수한 위치의 종말이 어떻게 보이는지이며, 이는 측정할 수 있습니다. 교차점은 또한 도메인별로 도달할 것입니다. 코드가 저렴해진 곳, 확인이 도메인 지식을 필요로 하는 곳, 시장이 작거나 지역적인 곳에서 먼저 나타날 것입니다. 법률, 부기, 교육, 클리닉 관리, 좁은 기업 간 틈새시장, 소수 언어로 된 시장입니다. 소프트웨어 자체는 가장 늦게 나타나야 합니다. 한 분석가는 2026년 2월에 금융을 "탄광의 카나리"라고 부르며 관련 예측을 했고 모든 검증 가능한 작업이 2027년까지 금융 및 회계의 궤적을 따를 것으로 예상했습니다(Hwang, 2026). Anthropic의 관리자가 이미 코딩 세션에서 프로그래머를 약간 능가한다는 발견은 초기 신호입니다(Anthropic, 2026e). 제5.3장의 기록은 첫 번째 필드에서 도메인을 명명하며, 모든 직업 이름을 그 앞에 놓을 수 있습니다.
같은 추론은 직함의 운명을 예측합니다. 에이전트 매니저, AI 운영자, 오케스트레이터와 같은 수평적 직함은 일반적으로 에이전트를 래핑하는 사람들을 설명합니다. 한 실무자는 에이전트 관리가 AI가 그것도 하기 전에 "향후 18개월"동안 지속될 것으로 예상하는 반면(IT Brew, 2026), Srinivasan과 Wei(2026)는 "에이전트 매니저"가 12~18개월 내에 표준 직함이 될 것으로 예상합니다. 예측 F9는 두 견해를 맞세웁니다. 같은 기사는 2026년 2월 AI 오케스트레이터 채용 공고 739개를 집계했으며, 이는 1,294% 증가했고, 그 수치는 다른 방향을 가리킵니다. "수직 AI 리드"와 같이 도메인에 바인딩된 직함은 각 수직 분야에서 에이전트 배포에 책임을 지며(Haize Labs, 2026), 더 빠르게 성장해야 하며, 제11장은 비교에 대한 예측을 설정합니다.
6.4 프론티어 모델을 가진 아이들
한 가지 반론은 도메인 주장의 근본으로 갑니다. 프론티어 모델은 대학 부서보다 생물학을 더 많이 압니다. 새로운 아이디어를 가진 아이는 그것을 에이전트에 설명하고 전문성 없이 일주일 내에 생물학이나 자동차에 관한 작동하는 사이트나 앱을 가질 수 있습니다. 도메인이 왜 중요할까요?
전제 중 일부는 이미 참입니다. 베이징에서 6학년 학생들은 2025년 9월에 그래픽 플랫폼에서 수업 중에 자신의 AI 에이전트를 구축했습니다(Xinhua, 2025). 중국의 교육부는 2030년까지 기본적으로 모든 초등 및 중등학교에서 AI 교육이라는 목표를 설정했습니다(CSET, 2025). 미국에서 2025년 4월의 행정명령은 우승 학교 프로젝트가 숙제 도우미, 따돌림 방지 챗봇, 시각 장애 학생을 위한 도구를 포함한 대통령 AI 도전을 시작했습니다(White House, 2025; EdWeek, 2026). 프론티어 에이전트에 대한 접근은 여전히 나이로 제한됩니다만. Claude는 성인용이며, 미성년자에 속하는 것으로 표시된 계정은 정지되었습니다(MediaNama, 2026). OpenAI는 나이 예측과 십대를 위한 제한된 모드를 도입했습니다(AlternativeTo, 2026). 아이들은 터미널을 통해서보다는 학교 플랫폼과 십대 모드를 통해 프론티어 모델에 도달할 가능성이 더 높으며, "매년 모든 학교"는 2027년부터 2030년처럼 보입니다.
더 깊은 답변은 종이와 세상의 차이에서 나옵니다. 종이 위에서 아이는 승리합니다. 프론티어 모델은 대학원 수준의 과학 질문에서 전형적인 전문가보다 높은 점수를 받으며, 무작위 시험에서 모델을 가진 신입은 필기 생물학 작업에서 대조군보다 약 4배 더 정확했습니다(Turner, 2026). 세상에서는 장점이 사라집니다. Nature Medicine에 발표된 1,298명에 대한 연구에서, 모델 자체는 94.9%의 경우에 올바른 진단명을 지었고, 같은 모델을 사용한 사람들은 34.5% 미만으로 대조군보다 나을 바 없었습니다(Nature Portfolio, 2026). METR의 8주간 습식 실험실 시험에서 153명의 신입자들을 대상으로, 모델에 대한 접근은 유의미한 이득을 주지 않았으며, 각 그룹에서 약 5%가 전체 프로토콜을 완료했습니다(METR, 2026a).
이의를 제기하는 사람들의 말이 맞습니다. 오래된 수직적 구조, 즉 수년간의 공부가 가치를 잃고 있는데, 지식이 모델에 무료로 들어있기 때문입니다. 지식이 대체할 수 없는 것은 올바른 결과를 그럴듯한 결과와 구별하는 능력, 그리고 어느 것이 어느 것인지를 결정하는 현실과의 접촉(사용자, 테스트, 실험, 데이터)입니다. 이 수용의 루프가 새로운 수직적 구조이며, "도메인이 중요하다"와 "아이들은 전문성이 필요 없다" 사이의 명백한 갈등을 해결합니다. 이러한 의미에서 수직적 구조는 행동을 통해 구축된 수용의 루프이며, 수년간의 공부는 여러 방법 중 하나입니다. 십대 청소년은 자신의 제품과 그 사용자를 통해 몇 주 만에 이를 구축할 수 있으며, 학위가 없어도 됩니다. 없으면 일주일간의 에이전트 작업도 설득력 있는 그림으로 남습니다. 그러면 아이들은 배경 중립성을 가장 깔끔하게 테스트합니다. 학위도 없고 근무 연한도 없고 오직 루프만 있기 때문이며, 또한 자신의 제품을 답할 누군가, 즉 섹션 7이 이름 붙인 파트너가 필요하기 때문입니다. 루프를 그렇게 빠르게 구축할 수 있는지 여부는 시대에 뒤떨어진 질문입니다. 2026년 10월까지 형식적 훈련이 없는 십대 청소년의 과학 제품이 사용자를 가지고 있으며 독립적 검증을 통과한 확인된 사례는 발견되지 않았으며, 예측 F24는 이러한 첫 사례의 날짜를 기록합니다.
6.5 과정으로 검증하는 직업 신입자
섹션 6.3은 자신이 알지 못하는 분야로 들어가는 사람이 그 분야에서 일을 수용하는 능력을 잃는다고 주장하며, 섹션 6.4의 이의는 성인 형태를 가집니다. 그 능력의 얼마나 많은 부분을 과정이 회복할 수 있을까요? 부기 경험이 없고 근무 연한도 없는 부기 신입자가 네 단계로 작업합니다. 작업 전에, 여러 모델에 그러한 결과물이 무엇을 포함해야 하는지, 흔히 빠뜨려지는 것이 무엇인지, 어떤 검증이 적용되는지를 묻습니다. 한 에이전트가 작업을 수행합니다. 두 번째는 신선한 맥락에서 이를 검토하며, 어떻게 만들어졌는지 보지 않습니다. 다른 계열의 모델은 그 사람이 열어본 출처에 대해 검증합니다. 각 단계는 경험이 과거에 제공했던 것을 대신합니다. 에이전트는 제작 역할을 하고, 신선한 검토자와 두 번째 계열은 만들어진 것을 두 번 보는 역할을 하며, 미리 작성된 목록은 작업이 포함해야 할 것을 아는 역할을 합니다. 그러한 신입자가 한 에이전트의 결과물을 무조건 수용하는 경험 있는 부기사보다 더 많은 독립적 검증을 통과하는 일을 제공할 수 있을까요?
증거의 일부는 신입자를 호의합니다. 경험은 검증을 멈춘 전문가를 보호하지 않습니다. 컨설팅 회사의 현장 실험에서, 에이전트 이전의 선임자인 그 능력 범위 밖에 있도록 선택된 과제에 모델을 사용한 컨설턴트는 모델 없이 작업한 컨설턴트보다 올바른 해결책에 도달할 가능성이 낮았습니다(Dell'Acqua et al., 2026). METR의 시험에서는 경험 있는 개발자들이 속도가 올라갔다고 믿었을 때 실제로는 속도가 떨어졌습니다(섹션 5.4). 한 에이전트의 결과물을 무조건 수용하는 것은 이 분야에서도 약한 정책입니다. 회계 전문가가 작성한 채점표에 대해 채점된 160개의 회계 작업(계정 조정, 비용 발생, 거래 기록 및 보고서 작성)에서, 9개의 최첨단 모델 중 최고의 것이 평균 56%의 기준을 충족했으며, 어느 것도 8개의 시도 중 2.6% 이상에서 완전히 올바른 결과를 생산하지 않았습니다(Benchek et al., 2026). 비평가를 구축할 수 있습니다. 목적으로 훈련된 비평가 모델은 코드 검토 비용을 받는 인간 계약자보다 모델이 작성한 코드에서 더 많은 버그를 발견했으나, 존재하지 않는 버그도 보고했으며, 그러한 비평가와 함께 일하는 계약자는 비평가 단독과 거의 같은 수를 발견했으나 거짓 긍정은 더 적게 보고했습니다(McAleese et al., 2024). 작업 전에 작성된 목록은 신입자에게 수용 문해력의 전반부, 즉 무엇이 완료로 간주될 것인지에 대한 진술을 제공합니다(섹션 6.1). 이를 작성하는 모델은 직업의 시험이 무엇을 요구하는지 압니다. GPT-4는 풀이 예제와 계산기 같은 도구가 주어졌을 때 CPA, CMA, CIA 및 EA 시험의 모든 섹션을 통과했으며 평균 점수는 85.1%였습니다(Eulerich et al., 2024). 목록을 먼저 작성하면 검증에도 도움이 됩니다. 누락이 있는 임상 기록과 완전한 기록을 동전 던지기보다 거의 구별할 수 없었던 모델 판사는 먼저 출처가 확립한 사실을 나열하고 각각에 대해 기록을 검사했을 때 더 잘 수행했으나, 그때에도 누락이 있는 기록의 25%에서 37%만 표시했습니다(Fox et al., 2026). 특정 클라이언트에 대한 지식은 학위가 아니라 그 클라이언트와 작업함으로써 나옵니다. 결과에 대해 누가 책임을 지는지는 책임을 지고자 하고 신뢰할 수 있는 사람에 의해 결정됩니다(섹션 7.2). 법이 서명을 예약하는 경우는 예외입니다(섹션 13).
그 중 일부는 그렇지 않습니다. Section 5.2의 규칙에 따르면, 같은 계열의 새로운 검토자는 가족 내 합의이며, 이는 업무를 개선할 수 있지만 검사로서 신용을 얻지 못하고, 다른 계열의 모델은 그 사람이 연 출처에 대해 검사할 때만 계산됩니다. 실수를 취소할 수 없는 경우, 그것은 숨겨진 테스트나 적격 인간 뒤의 두 번째 줄일 뿐입니다. 계열 간 합의는 보기보다 약한 증거입니다. 350개 이상의 모델에 걸쳐, 더 크고 정확한 모델들은 아키텍처와 제공자가 달랐을 때도 높은 상관관계의 오류를 만들었으며, 공유 아키텍처나 제공자가 상관관계를 높이는 요인 중 하나입니다(Kim et al., 2025). 따라서 두 번째 계열은 같은 계열의 두 번째 모델보다 독립적 검사의 더 나은 추측이지만, 독립성의 측정은 아닙니다(Chernets, 2026b). 미리 작성된 목록은 더 좁은 한계를 충족합니다. 모델은 텍스트에서 빠진 것을 발견하는 데 원본이 옆에 있어도 그 안에 있는 것을 찾는 데보다 훨씬 더 능숙하지 못합니다(Fu et al., 2025). 목록은 완전한 정도까지만 도움이 되며, 빠진 누적은 어떤 검토자도 보지 못하는 누락입니다. 경고도 외부자를 검사자로 만들지 못합니다. 마케팅 및 판매 전문가들에게 마케팅 데이터의 AI 분석을 검사하도록 요청받았을 때, AI가 실수를 한다고 반복해서 말한 후에도 중요한 결함을 놓쳤습니다. 분석을 명시적 단계로 제시하고 각 결정에 대한 대안을 제시하면 도움이 되었지만, 참가자들은 종종 그들을 통해 추론하기 위해 여전히 고생했습니다(Virk & Liu, 2025). 합의하는 균형도 증거가 아닙니다. 한 회계 소프트웨어 제조업체의 2025년 벤치마크에서, 회사의 장부를 월별로 마감하도록 요청받은 모델들은 첫 번째 달 내에 포기했거나 오류를 누적했으며, 그들의 수치가 은행 잔액과 일치하지 않을 때 일부는 그들이 일치하도록 관련 없는 거래를 끌어들였습니다(Penrose, 2025, Gigazine에서 보도함, 2025). 한 단계를 보지 못하는 신규자는 목록이 그것을 이름 짓지 않는 한 그것을 검사하도록 요청하지 않을 것입니다. Appendix G2의 탐색적 비교는 목록 없이 그 간격이 얼마나 클 수 있는지 보여줍니다. 무역의 첫 주 질문을 잘못 대답한 사람들은, 그 설명만으로 그 작업을 평가했을 때, 다른 사람들보다 더 큰 작업을 시간으로 4분의 1에서 3분의 1 더 적게 두었습니다. 모델에 의해 작성된 목록이 간격을 좁히는지 여부는 Section 10.5의 비교가 보여줄 것입니다. 이미지로 찍으면, 그 과정은 이퀄라이저의 사다리입니다. 에이전트는 제작의 많은 부분을 동등하게 만들었고, 업무 전의 목록과 그 후의 비평가는 검사의 일부를 동등하게 만들 수 있지만, 모델 간 상관관계 오류(Kim et al., 2025)와 누락에 대한 맹목성(Fu et al., 2025)은 얼마나 많을 수 있는지에 한계를 정하며, 나머지는 측정이 보여줄 것입니다. Figure A4 (Appendix F)는 네 단계를 각각이 대신하는 것, Section 5.2의 규칙에 따라 각각이 얻는 것, 그리고 각각이 어디서 멈추는지에 대해 설정하며, 동반 저장소는 이러한 방식으로 작동하는 사람들을 위한 키트로 그들을 제공합니다(kits/checking-process.md).
측정은 문제를 미리 해결하지 않으며, 검사 능력을 어느 경로로 획득했는지 묻지 않습니다. 신규자의 과정이 에이전트가 보지 못한 검사를 통과하고 잘못된 항목뿐만 아니라 누락도 심은 오류 중에 있다면, 신규자의 지평은 누구나처럼 올라갑니다. 그렇지 않으면, 기록도 그것을 보여줍니다. Section 6.1의 경쟁자가 맞다면(Savva, 2026), 그 과정은 짧고 잘 명시된 작업에서 최고의 성과를 보일 것이고 위쪽 단계에서 최악의 성과를 보일 것이며, 여기서 어떤 조각이 포함해야 하는지 아는 것이 가장 중요합니다. 그리고 같은 과정을 채택하는 경험 많은 전문가는 둘 다보다 더 잘 해야 합니다. 과정이 무역의 경험의 일부를 대신할 수 있다면, 경험, 신입, 선임을 포함한 레이블은 도수가 잃는 이유와 같은 이유로 무게를 잃으며, 이는 교차점이 이름 짓는 손실입니다(Section 6.2). 등록된 예측이 그 과정을 테스트하지 않습니다. F3b는 Section 6.3의 도메인 논증에서 참가자의 자신 도메인 외의 작업에서 0.10으로 추월 가격을 책정하며, 간접적으로만 문제에 관련됩니다. Section 10.5은 그것을 테스트할 비교를 설정합니다.
7. 두 번째 경계: 신뢰
7.1 모호성은 시장의 정상 상태입니다
누구나 만들 수 있을 때 어떤 일이 일어날까요? 2026년의 답은 만들어진 대부분의 것이 발견되지 않는다는 것입니다. 약 560,000개의 새로운 앱이 2026년 상반기에 앱 스토어에 도달했으며, 이는 2025년 전체의 약 600,000개에 가깝습니다. 한편 다운로드는 약 2% 증가했습니다. 이는 Sensor Tower의 추정치로, 뉴욕 타임즈가 처음 보도했으며 2차 매체들(9to5Mac, 2026; Gigazine, 2026)에 의해 요약되었습니다. 첫 분기의 출시는 전년 대비 약 60% 증가했습니다(TechCrunch, 2026b). RevenueCat의 2026년 보고서에 따르면, 자사 소프트웨어를 사용하는 앱들 중 17%의 새로운 구독 앱이 2년 내에 월간 수익 $1,000에 도달했으며, 1년 전에는 19%였습니다. 2025년 이후 출시된 앱들은 2026년 1월에 구독 수익의 약 3%를 벌었습니다(RevenueCat, 2026; PPC Land, 2026). GitHub는 2025년 8월까지의 Octoverse 연도에 121백만 개의 새로운 저장소를 보고했으며, 이는 분당 230개 이상입니다(GitHub, 2025a). 2026년 9월만 해도 738억 개의 커밋이 있었으며, 이는 1년 전의 5배 이상입니다(Celenza, 2026). 이러한 수치는 생산량을 세는 것이지, 사용자를 찾은 제품을 세는 것이 아닙니다. 대규모 개발자 포럼의 "Show HN" 섹션의 중재자들은 생성된 프로젝트들이 섹션을 노이즈로 압도하고 새로운 계정을 제한한다고 보고했습니다(Krebs, 2026). Startmate의 한 투자자는 2026년 8월에 빌딩이 저렴할 때는 배포가 제품을 보호하는 것이라고 주장했으며, 강력한 제품들이 소수의 사용자만으로 공백 상태에 있다고 설명했습니다(Batko, 2026).
창업자들 사이에서도 같은 패턴이 나타납니다. 솔로 창업자들이 2025년 Carta에서 설립된 스타트업의 약 36%를 주도했으며, 2024년에는 31%였습니다(Carta, 2026a). 2026년 상반기 현재 Stripe Atlas를 통해 설립된 C 법인의 63%를 주도했으며, 이는 해당 서비스 기록입니다(Stripe, 2026). 혼자 시작하는 것이 흔해졌지만, 혼자 버는 것은 그렇지 않습니다. Atlas의 솔로 창업자들 중에서 중앙값 수익이 2025년에 전년 대비 23% 감소했지만 상위 십분위수의 수익은 19% 증가했으므로, 상위 십분위수가 중앙값의 약 61배를 벌었으며, 4년 전에는 약 34배였습니다(Stripe, 2026). Carta의 이전 보고서에서 솔로 창업자들이 2024년에 설립된 스타트업의 30%를 주도했지만, 그해 시장 공모 자본 조달의 14.7%를 받았습니다(Carta, 2025). 두 표본 모두 벤더 자신의 고객들이며 모든 신규 기업이 아니지만, 이 섹션이 설명하는 것을 보여줍니다: 더 많은 사람들이 시작할 수 있으며, 보상은 상위에 집중됩니다.
플랫폼은 이름 없는 자들을 차단함으로써 홍수로부터 자신을 보호합니다. curl 프로젝트는 AI가 생성한 보고서들이 이를 압도한 후 2026년 1월에 버그 바운티를 종료했으며, "20개 중 1개도 되지 않는" 것이 실제였습니다(Stenberg, 2026). GitHub는 신뢰할 수 있는 기여자에게만 풀 리퀘스트를 제한하는 것을 검토했습니다(Open Source For You, 2026). Mitchell Hashimoto는 Vouch를 출시했으며, 이를 통해 신입자는 기존 참여자가 보증하지 않는 한 프로젝트에 기여할 수 없습니다(Hashimoto, 2026; Willison, 2026b). 홍수에 대한 방어는 또한 신입자를 문 앞에서 막으며, 이는 동반 논문이 자동화된 감시 전반에 대해 설명하는 패턴입니다(Chernets, 2026c). 따라서 보증은 메커니즘으로 존재하며, 이것이 직업이 될지는 7.2절의 질문입니다.
새로운 관문지기는 에이전트입니다. 2,430번의 실행에 대한 연구에서 Claude Code는 20개 카테고리 중 12개에서 기존 제품을 채택하는 대신 자체 솔루션을 작성했으며, 채택했을 때는 익숙한 이름을 선택했습니다(Amplifying, 2026). 2026년 7월까지 Vercel의 배포의 약 절반이 에이전트에 의해 트리거되었습니다(Startup Fortune, 2026). 코드 호스트의 무료 제품은 사용자의 에이전트가 한 시간 내에 작성할 수 있는 모든 것과 경쟁하고 있으며, 에이전트가 자체적으로 작성할 수 없는 것은 신뢰, 유지보수, 표준, 또는 답변하는 사람입니다.
긴 지평선이 시장을 만들지 않습니다. 지평선은 한 사람이 전달하고 증명할 수 있는 것을 기록하고, 신뢰는 외부의 누군가가 그것을 사용할지 여부를 결정하며, 모호성은 둘 사이의 간격입니다. Herbert Simon은 1971년에 이것의 경제학을 보았습니다: 정보의 풍요는 주의의 빈곤을 만듭니다(Simon, 1971). 에이전트는 코드의 진입 장벽을 낮추었으며, 위의 증거는 플랫폼과 사용자가 홍수에 직면하여 신입자를 들이기 전에 신뢰의 새로운 신호를 요구하는 것을 보여줍니다.
7.2 두 가지 파트너 직업
한 가지 반론은 에이전트를 통해 제품을 만드는 사람이 사람들에게 도달하는 기술 없이는 불완전하다고 합니다. 나는 그것을 다르게 읽습니다: 사람들에게 도달하는 것은 두 번째 축이며, 두 가지 파트너 기능이 그것을 따라 성장합니다.
완성자는 제품을 채널, 출시, AI 검색 가시성을 통해 사람들에게 가져옵니다. 그 이름은 이미 정해졌습니다(성장 엔지니어, 개발자 관계, GTM 엔지니어, 2026년에 광범위하게 공고된 역할). 에이전트는 메일링과 출시가 자동화하기 쉽고 필터는 대응하여 경화되므로 그 일부를 자동화할 것입니다.
보증인은 자신의 이름을 제품에 걸고 자신의 원으로 책임을 집니다. 2025년 6월 뉴욕 타임즈 매거진은 이 역할을 "법적 보증인"이라고 이름 지었습니다: "AI가 할 수 없는 책임을 제공하는 사람"(Capps, 2025). 1979년의 IBM 교육 슬라이드는 2017년에 원본이 손실된 채 온라인에 처음 게시되었으며, 이유를 한 줄에 담았습니다: "컴퓨터는 절대 책임을 질 수 없습니다"(Willison, 2025a). Neil Lawrence는 2026년 8월에 같은 말을 했습니다: 컴퓨터는 회계를 매우 잘 하지만, "책임성을 잘 하지 못합니다"(Sadki, 2026). 이 기능은 자동화하기 가장 어렵습니다. 왜냐하면 그 가치는 한 사람이 답변하는 데 있기 때문입니다. 대리인 이론의 관점에서 보증인은 채권을 판매합니다: 보증인 자신의 평판으로 뒷받침된 약속, 성숙한 형태로는 책임을 할당하고 가격을 책정하는 보험이 있는 계약(Jensen & Meckling, 1976).
기능과 직업은 별개의 질문입니다. 기능은 자신이 만들지 않은 일에 서명하는 누군가가 있는 곳이면 어디든 존재합니다. 직업은 그 서명이 정기적으로 자체적으로 사고팔릴 때만 나타나며, 예측 F11과 F12는 언제 그런 일이 일어나는지 날짜를 정합니다. 보증인은 또한 그들이 보증한 제품의 개수, 각각이 얼마나 오래 지속되었는지, 얼마나 많은 제품이 실패했는지(심각도에 따라 가중치 적용)로 측정할 수 있습니다. 동반 저장소는 보증인의 원장에서 계산하며, 심각도의 가중치는 기록을 읽는 사람이 명시합니다(tools/guarantor_record.py). 9절의 두 번째 스레드의 가이드는 4개 단어로 말합니다: 입소문은 평판입니다(번역됨). 신뢰는 확인할 수 있는 것에 기초해야 하며, 이전 이 시리즈의 논문에서 주장하듯이 에이전트 상거래를 위해(Chernets, 2026d), 보증인의 기록은 그러한 것 중 하나입니다.
섹션 9의 한 스레드에서 세 번째 유형이 나타납니다: 전체 회사를 에이전트로 옮기는 방법을 판매하는 가이드입니다. 스레드는 판매 과정을 보여줍니다. 그를 조직의 보증인, 즉 회사의 경영진에게 결과에 대해 책임을 지는 사람으로 읽는 것은 그가 구축하고 있는 역할에 대한 나의 해석입니다.
에이전트를 통해 구축하는 사람은 내부적으로 답합니다. 에이전트로부터 받아들인 것에 대해 말입니다. 보증인은 외부적으로, 사람들에게 답하며, 공개된 것에 대해 책임을 집니다. 한 사람이 둘 다 맡을 수 있습니다. 결혼식 사진작가가 촬영도 하고 책임도 지듯이 말입니다. 제품이 너무 많으면 두 기능이 분리되며, 저자와 출판사, 과학자와 학술지가 한때 그랬던 것처럼 말입니다.
8. 두 시장: 골드러시와 웨딩 사진작가
1849년 캘리포니아 금광에 몰려든 사람들이 있었습니다. 광부의 평균 일일 채산량 또는 고용된 광부의 일급은 1848년 약 20달러에서 1849년 16달러, 1850년 10달러, 1852년 6달러로 떨어졌습니다(Paul, 1947, p. 349). Bancroft는 1852년 광부당 채산된 금을 "겨우 600달러, 즉 하루 2달러 미만"으로 기록했으며, 이는 일반 노동자의 임금이 2배에서 3배 높던 시기였습니다(Bancroft, 1888, pp. 423-424). 광부들에게 도구를 판매한 Sam Brannan은 "번영하는 가장 확실한 방법은 채광을 남에게 맡기는 것"이었음을 보여주었으며(Andrist, 1962), 도구와 천을 판매하는 사람들은 잘 되었습니다. 이 패턴은 2026년에도 보입니다. 신규 구독 앱의 5분의 1 이하만 월 1,000달러에 도달합니다(섹션 7.1). 한편 도구 판매자들은 빠르게 성장합니다. 예를 들어 Lovable의 매출(TechCrunch, 2026a)과 Uber의 4개월 동안 소진한 연간 AI 예산(Fortune, 2026b)이 연구실로 흐릅니다.
벤처 자본도 더 큰 규모에서 같은 경로를 따릅니다. 2025년 AI 기업들은 전 세계 벤처 캐피탈의 61%인 4,271억 달러 중 2,587억 달러를 차지했으며, 메가 딜이 AI 투자 가치의 약 73%를 차지했습니다(OECD, 2026). 2026년 상반기 두 개의 연구실인 OpenAI와 Anthropic은 약 2,170억 달러를 함께 조성했으며, 이는 전 세계 스타트업 펀딩의 약 43%입니다(Crunchbase News, 2026). 다른 한편, Carta에서 추적한 평균 미국 프리시드 펀딩은 2026년 2분기에 276,000달러로 기록을 갱신했으며, 펀딩 건수는 전년 대비 약 5분의 1 감소했습니다(Carta, 2026b). 더 적은 수의 신규 참가자에게 더 큰 액수의 자금을 제공하는 것은 구축이 저렴해지고 성공할 사람을 판단하기가 어려워진 경우 예상할 수 있는 결과입니다. 구축할 수 있는 사람이 그 증거만으로는 자금을 조성할 수 있는 사람이 아닙니다.
비유는 한 가지 점에서 깨지며, 이 깨짐은 일치점보다 더 중요합니다. 금의 가격은 법으로 고정되었으므로 더 많이 채굴되어도 금이 더 저렴해지지 않았으며, 광부들은 사금 채광지가 고갈되고 인파가 늘어나면서 손실을 입었습니다. 소프트웨어는 거의 무료로 복제됩니다. 모든 새로운 제품은 다른 제품에 대한 밀접한 대체제를 추가하며, 밀접한 대체제의 가격은 복제 비용, 즉 거의 0에 가까운 수준으로 떨어집니다. 금이 고갈되지 않습니다. 복제할 수 없는 것(신뢰, 서명, 유지 관리되는 서비스)이 함께 판매되는 경우를 제외하고는 모래가 됩니다.
사진이 더 나은 비유입니다. 2026년 미국 노동통계청은 2025년 약 145,000개의 사진작가 직업을 집계하고 있으며, 2025년부터 2035년까지 1% 감소를 예상하고 있습니다. 이전 판은 2024년부터 2034년까지 2% 성장을 예상했습니다(노동통계청, 2025, 2026a). 이전 판과 달리 새 판은 AI를 명시합니다. 스마트폰 사진이 전문가의 필요성을 줄일 수 있으며, 스톡 사진은 "인공지능(AI) 생성 이미지로 부분적으로 대체될 것으로 예상되는" 반면, 초상화 및 상업 사진에 대한 수요는 계속되고 자영업이 증가합니다(노동통계청, 2026a). 2026년에도 부부들은 웨딩 사진작가를 고용하고 돈을 지불합니다. 행사를 반복할 수 없을 때, 실수를 되돌릴 수 없을 때, 특정한 사람이 결과에 대해 책임을 져야 할 때, 의뢰인이 사전에 품질을 판단할 수 없어 신뢰를 구매할 때 직업이 유료 전문직으로 생존합니다.
이러한 조건들이 시장을 둘로 나눕니다(그림 6). 휴대폰 스냅샷은 사람들이 자신과 팀을 위해 만드는 것입니다. 알림 시스템, 메모 작성 도구의 대체물, 변호사 자신의 계약 검토자입니다. 자신을 위해 만드는 것은 문서 작성처럼 문해력이며, 거의 모든 사람이 이를 가질 것입니다. 웨딩은 다른 사람을 위한 결과가 따르는 작업입니다. 낯선 사람들에게 공개되는 제품, 돈, 건강, 법, 인프라입니다. 다른 사람을 위한 일은 검증된 지평선과 책임질 사람으로 정의되는 전문직입니다. 두 시장 사이에는 불명확성의 장벽이 있으며, 보증인은 그 장벽에서 일합니다.
이 분할은 제가 시작한 질문 "이 사람들을 뭐라고 불러야 할까?"에도 답합니다. 두 가지 답변이 있습니다. 대중적 기술 하나와 전문직 하나입니다. 섹션 3의 지도는 이미 둘 다에 대한 후보를 보유하고 있습니다.
Kent Beck은 오래된 선임 지위에 미치는 영향을 한 문장으로 표현했습니다. "내 기술의 90%가 0달러가 되었고 10%의 기술은 1000배가 되었습니다"(Willison, 2025b). 일부 선임 엔지니어는 소프트웨어의 웨딩 사진작가가 되어 실패를 되돌릴 수 없는 시스템의 작은 부분에 대해 고용될 것입니다. 2026년 데이터에서 고용 약화는 초급 근로자들 사이에서 보이므로(Stanford Digital Economy Lab, 2026a), 선임 부분을 이미지로 유지하면서 예측 F25는 초급 부분을 따릅니다.
그림 6. 두 시장, 그들 사이의 불명확성의 벽, 그리고 그것을 넘는 두 파트너.
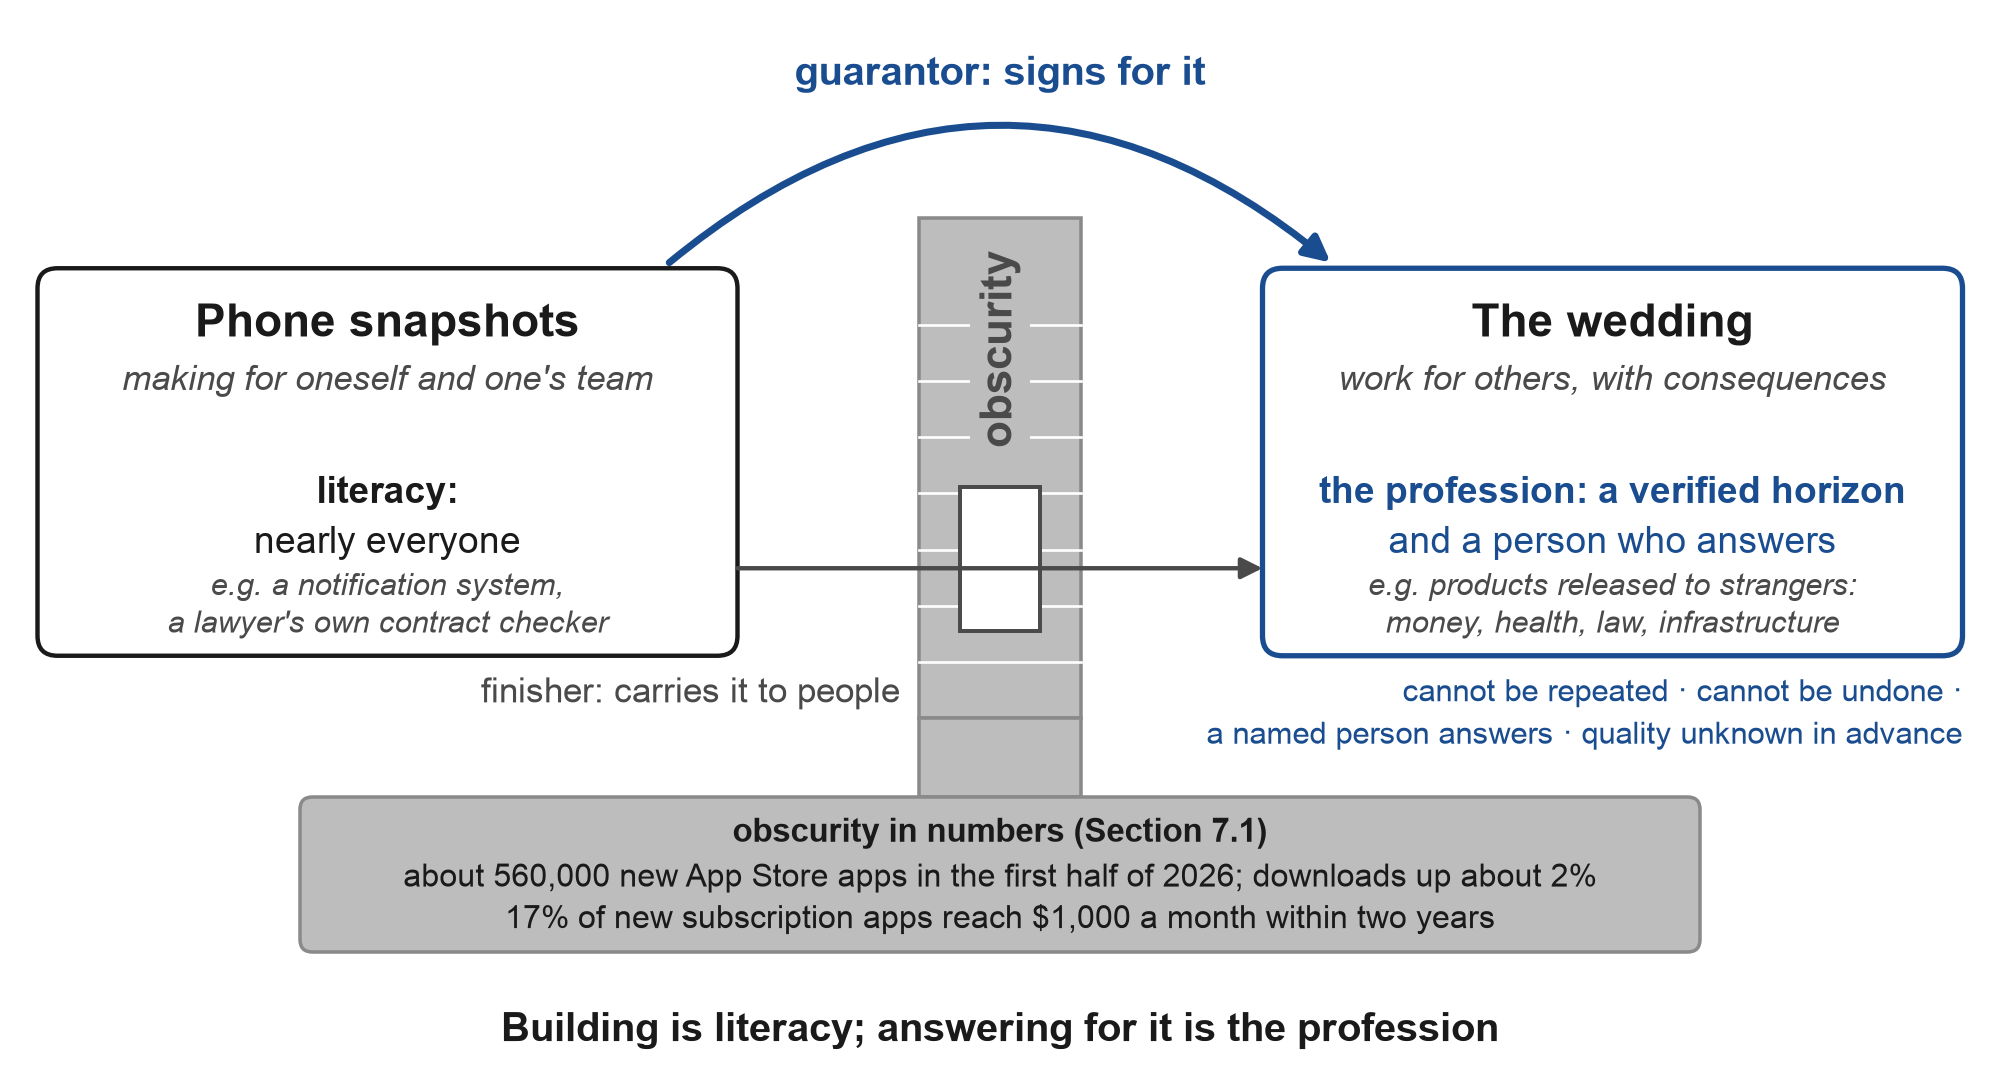
참고: 두 수치는 마무리꾼이 아니라 불명확성의 벽에 속합니다. 2026년 상반기 약 560,000개의 새로운 앱스토어 앱(다운로드는 약 2% 증가)(Sensor Tower 추정, 9to5Mac, 2026 및 Gigazine, 2026에서 보고), 그리고 17%의 신규 구독 앱이 2년 내에 월 1,000달러에 도달합니다(RevenueCat, 2026). 각 극단의 예시는 섹션 8의 것입니다. 네 가지 조건은 섹션 8의 것입니다. 아치와 문은 섹션 7.2의 두 파트너 함수입니다.
9. 프로그래머 대화에서 건너가는 것
2026년 프로그래머들의 대화는 2027년 모든 직업의 대화가 될 수 있습니다. 이를 확인하기 위해 2026년 10월 8일에 수집한 페이스북의 공개 스레드 3개를 읽었습니다(게시물과 댓글; 댓글 작성자는 여기서 언급하지 않음).
첫 번째 스레드에서 한 저자는 AI가 broken code를 작성한다고 말하는 개발자들에게 좋은 관행을 모두 적용했는데도 코드가 여전히 실패한 경우를 보여달라고 도전했습니다. 그는 그러한 경우가 단순히 발생하지 않는다고 확신했습니다. 스레드는 수용성에 대한 논쟁으로 발전했고, 한 참여자가 이를 요약했습니다. 문제는 프로덕션이 AI의 결과를 검토하고 수용하고 사용할 수 있도록(translated) 조직할 수 있는지 여부입니다. 보안 수정에 종사하는 다른 사람은 테스트와 지침이 있어도 강력한 모델이 CVSS 척도에서 9 이상으로 평가된 취약점에 대한 올바른 완화를 생성하는 데 자주 실패하며, 자동 검토 및 수정 루프가 비용이 많이 든다고 보고했습니다. IT 경력 30년인 관리자는 인간 프로그래머들이 항상 정확히 같은 골칫거리를 안겨왔다고 대답했습니다. 다른 댓글 작성자는 새로운 작업을 시간당 150달러로 책정했는데, 이는 AI가 작성한 코드를 검토하고 수정하는 검토자의 요금입니다. 또 다른 사람은 경력 20년의 시니어 엔지니어가 자신의 기술이 가치를 잃었다는 사실을 받아들이기 어려워했다고 설명했습니다.
두 번째 스레드에서 언어를 모두 모른다고 말하는 한 사람이 650,000줄 규모의 플랫폼을 한 프로그래밍 언어에서 다른 언어로 마이그레이션하고 있으며, 약 600개 중 330개의 pull request를 완료했고 AI에 월 1,148달러를 지출합니다. 그는 회사를 에이전트로 이동시키는 방법을 판매하며 그 작업에서는 프로그래머가 해보다 더 많은 해를 끼친다고 주장합니다. 그는 또한 공개 지출, 프로젝트 목록, 프로모션 코드, 강좌, 대규모 회사를 위한 무료 시간을 통해 자신을 가시화합니다. 그는 사실상 섹션 7.2의 가이드 역할을 구축하고 있으며, 콘텐츠로 불명확성에 대항하고 있습니다.
세 번째 스레드는 4대의 기계에서 자신을 위해 구축 중인 한 사람을 보여줍니다. 섹션 5.4의 36단계 흐름을 따릅니다. 그는 6개월에서 1년 전의 워크플로우 중 아무것도 남아있지 않다고 보고하며, 3개월 내에 다시 변경될 것으로 예상하고, 지속적으로 기회를 놓칠 것 같은 두려움을 느낀다고 말합니다. 댓글들은 어떤 에이전트가 어느 진영에 속하는지에 대해 논쟁합니다.
표 A5(부록 F)는 스레드의 주제를 2025년과 2026년 소프트웨어 외의 사람들 사이에서 보이는 것과 비교합니다. 그 행들은 표본이 아닌 설명적 사례입니다.
표 A5가 보여주는 것은 기능은 건너가고 형식은 남는다는 것입니다. 한 가족의 모델을 다른 모델로 검토하는 방법을 배우는 부기사는 여전히 이를 "조정 규칙"과 "누가 검토했는가"라고 부를 것이며, harness에 대한 단어가 없을 것이고, 에이전트 선택을 정체성의 문제로 취급하지 않을 것입니다. 스레드의 지위 표지, 큰 개인 청구서, 진영, 4대의 기계는 사진작가들이 렌즈에 대해 논쟁하고 그들의 고객이 하지 않는 것처럼 각 직업의 최상층에 머물러 있습니다.
건너가기는 또한 층으로 발생합니다. 먼저 각 직업의 상위 10분의 1 정도, 그 다음 교육 프로그램, 그 다음 설정을 내부에 숨기는 제품입니다. 그 순서는 에이전트에 적용된 확산 이론이며, 여기서 우선순위는 주장되지 않습니다. Rogers(2003)는 혁신자와 초기 채택자를 채택자의 약 6분의 1로 함께 놓았습니다. OpenAI 자신의 보고서는 회사 외부에서 "기술적 사용이 지배적 모드로 남아있다"고 기술합니다(OpenAI, 2026). Anthropic은 기술 사용자가 먼저 왔고 임금이 낮은 작업을 가진 사람들이 나중에 왔다는 것을 발견했습니다(Anthropic, 2026f). 섹션 11은 기능의 건너가기를 커리큘럼과 게시물을 읽음으로써 확인할 수 있는 예측으로 제시합니다.
10. 함의
10.1 고용주 및 인사담당자를 위하여
기록으로 등급을 매기는 고용주는 "senior" 또는 "manager"보다 "Domain · horizon · amplification · date"에서 더 많은 정보를 얻으며, 이 기록은 함수들 사이를 이동합니다. 채용 시험이 뒤따릅니다: 지원자에게 자신의 영역에서 하루치 업무를 agents를 통해 수행하도록 하고, 지원자가 설계하지 않은 확인으로 올바르게 표시되도록 하며, 지원자가 찾아야 할 몇 가지 의도적인 오류를 포함시킵니다. 책임 범위가 증가하면서 공정한 임금이 상승한다는 Jaques의 임금 논리는 검증된 horizon에 따른 임금에 대한 시작 가설을 제공합니다. 이것이 유지되는지는 경험적 질문이며, Section 11의 예측 F18에서 다룹니다: 고용주가 검증된 업무로 등급을 매기는 경우, 경험 연수보다 단계(rung)가 임금과 성과를 더 잘 예측해야 합니다.
토큰으로의 순위 매기기는 다른 문제이며, Section 4의 사례는 그것이 어디로 이어지는지 보여줍니다. 사용량이 논의된다면, 다른 방법과 마찬가지로 성과 검토에 포함되어야 하며, 많은 입력 중 하나입니다.
결국 주의할 점은 조직이 실제로 누구를 고용하는가입니다. 정책 페이지에서 학위 요구사항을 제거하는 것만으로는 거의 변화가 없습니다(Section 6.2). 검증된 horizon이 동일할 때 고용된 사람이 변하는 것이 기업 내부에서 교차점이 어떻게 보이는지입니다.
10.2 교육 및 학교를 위하여
학교의 교훈은 구문 이전에 수용을 가르치는 것입니다. 사람을 사다리 위로 올려주는 기술, 즉 완료된 것이 무엇인지 명시하기, agent가 볼 수 없는 확인 선택하기, 자신의 분야에서 그럴듯한 오류 인식하기는 어떤 학문에서나 가르칠 수 있습니다. 인증서는 자신의 확인이 무엇인지에 따라 가치가 있으므로, 인증서는 자신이 인증하는 검증된 horizon을 domain과 date와 함께 명시해야 합니다.
AI 리터러시를 교과 과정에 추가하는 학교는 OECD와 유럽위원회 프레임워크의 "Manage AI" domain에 구체적인 내용을 제공할 수 있습니다: 넘겨진 작은 업무 한 개, 미리 정해진 확인, 그리고 낯선 사람에게 공개되는 어떤 것에 대해 책임을 지는 성인입니다.
10.3 공급업체 및 플랫폼을 위하여
공급업체는 제품을 수용에서 떠나도록 할 수 있습니다. 기록이 고용주나 학교로 이동할 수 있도록 사람이 작업, 입력, 확인 및 수용 결정을 내보낼 수 있어야 합니다. 그러면 사용량은 같은 방식으로 보고되며, 애플리케이션을 연 사람들이 아닌 검증된 업무를 수용한 사람들을 세어서 보고합니다.
한 플랫폼은 이미 공급업체 측에서 이 길을 가고 있습니다. 2026년 1월 LinkedIn은 Lovable, Replit, Descript 및 Relay.app에서 발급한 검증된 AI 기술이 회원이 각 도구를 실제로 사용한 방식을 바탕으로 표시되기 시작했습니다(LinkedIn, 2026a). 이러한 배지는 도구의 공급업체가 공급업체가 설정하는 계층에 대해 판단한 도구의 사용을 인증하며, 사람이 선택하지 않은 사람이 확인한 결과를 인증하지는 않습니다. 같은 플랫폼은 모집담당자에게 agents를 판매하며, 2026년 4월까지 연간 4억 5천만 달러 이상의 기업적 채용 제품 수익을 창출했고(LinkedIn, 2026b), 2026년 7월에는 회원에게 "AI slop 같은" 게시물을 신고하는 버튼을 제공했습니다(TechCrunch, 2026c). 탐지기 공급업체 Pangram은 2026년 4월부터 6월까지 사이트의 긴 게시물 중 41%가 완전히 생성되었다고 추정한 후에 말입니다(The Decoder, 2026). 자신의 업무에 대한 텍스트가 생성하는 데 비용이 들지 않을 때, 프로필은 더 적게 말하며, 단일 공급업체에 의존하지 않는 검증된 업무의 기록은 더 많이 말합니다.
2026년에 많은 플랫폼처럼 미지의 것에 대해 문을 닫은 플랫폼은 vouching을 통해 두 번째 문을 열 수 있습니다. 알려진 사람이 서명한 업무의 신참자는 통과하고, voucher의 기록은 다음에 일어나는 것에 따라 증가하거나 축소됩니다.
10.4 사람들을 agents에 온보딩하는 제품을 위하여
온보딩 제품은 일반적으로 첫 번째 화면에서 "beginners"와 "programmers"를 분리합니다. 이 측정은 두 개의 문을 하나의 질문으로 바꾸는 것을 제안합니다: 이미 agent에 넘기고 확인할 수 있는 것, 아직 아무것도 없음, 1시간, 1일 또는 1주? 문이 합쳐질 때까지, IT 교육에 대해 한 번 묻고 동의를 얻으면 배경 중립성이 제품의 자체 사용자에 대해 테스트될 수 있습니다.
10.5 연구자를 위하여
연구자는 Chen과 Meng(2026)이 존재하지 않는다고 말하는 person-by-task 패널을 구축하고, 같은 agents를 사용하는 사람들을 블라인드 확인 하에서 비교하고, 실패한 확인을 포함한 업무와 함께 분모를 보고하며, 참조 은행을 동결하고 공시할 수 있습니다. Appendix C의 도구는 이미 이를 수행합니다: 확인이 독립적이지 않은 것으로 기록된 조각을 세지 않으며, 두 축을 모두 날짜와 함께 보고합니다.
Section 6.5에서 따르고 실행되지 않은 비교가 하나 있습니다. 은행의 동일한 작업에서, agents가 보지 못한 확인 하에서, 그리고 잘못된 항목과 누락된 항목 모두의 의도적인 오류로, 거래의 경험(현재 또는 부재)과 작업 방식(출력이 그대로 수용되는 하나의 agent 또는 Section 6.5의 확인 프로세스)을 교차할 것입니다. 경험은 지식 화면과 업무 기록으로 확립되며, 프로필 레이블(Section 6.2)이 아니며, 오류를 취소할 수 없는 조각은 숨겨진 테스트 또는 자격 있는 인간이 확인할 것입니다(Section 5.2 참조). 누락과 잘못된 항목은 분리되어 점수가 매겨집니다: 미리 작성된 목록은 첫 번째를 목표로 하고 검토자는 두 번째를 목표로 하며, Appendix G2가 제안하는 격차는 첫 번째 종류입니다. 비교는 프로세스가 거래의 경험을 얼마나 많이 대체할 수 있는지, 그리고 언제 멈추는지를 보여줄 것입니다. agents 없이 일하는 전문가와의 비교는 Section 11.1에서 주어진 이유 때문에 여기서 아무것도 결정할 것이 아닙니다. Section 11의 예측은 동결되며 이 비교를 포함하지 않습니다. 이는 데이터 수집 전에 자체적으로 등록되며 companion 저장소가 이를 프로토콜로 유지하여 적응 및 등록할 수 있게 합니다(kits/process-vs-experience-study.md), 자신의 과제로 의도된 오류를 밀봉하고 이후 잘못된 항목과 누락을 분리하여 점수를 매기는 도구(tools/planted.py), 그리고 4개의 팔을 인쇄하는 분석, 그리고 각 종류의 오류에 대해, newcomers 중 프로세스의 효과, 하나의 agent 하에서 경험의 효과 및 이들의 상호작용, 사람을 리샘플하는 간격(tools/process_study.py).
11. 날짜 기록된 예측, 등록되고 채점됨
11.1 예측 작성 규칙
검증 가능하도록 유지하는 규칙 아래에서 예측을 작성했습니다. 유사한 것끼리 비교합니다: 비프로그래머를 같은 에이전트를 사용하는 프로그래머와, 같은 작업에서, 같은 시간 동안 비교하는데, 이는 AI 없이 일하는 프로그래머와의 비교는 여기서 아무것도 결정하지 못하기 때문입니다.
"더 좋은"은 세 가지 의미로 나뉘며, 각각 독립적으로 테스트합니다. 코드의 경우 테스트는 숨겨진 테스트, 보안 검토, 그리고 한 달 후 다른 에이전트가 유지보수성을 확인하기 위해 변경한 사항입니다. 제품의 경우 테스트는 제품이 낯선 사람들에게 도달했고 6개월 후에도 여전히 존재하는지 여부입니다. 이력서의 경우 테스트는 채용공고에서 학위의 가중치입니다. 인기도는 "더 좋은"의 측도로 사용되지 않습니다. 인기도는 배포를 테스트하기 때문인데, 이는 별개의 전문 분야일 수 있기 때문입니다(섹션 7.2).
예측은 또한 전문 분야의 이름에 의존하지 않습니다. "IT 교육 없이 에이전트를 통해 일하는 사람들"에 대해 말하므로, 어느 이름이 이기든 존속합니다.
11.2 예측
표 4는 10가지 핵심 예측을 간단하게 제시합니다. 표 A6(부록 D)과 동반 저장소의 파일 predictions/predictions.csv는 모든 41개를 제시하며, 각각은 측도, 2025년 또는 2026년의 기준선, 3가지 결과에 대한 규칙(실현됨, 실현되지 않음, 미해결), 확인 날짜와 최종 날짜, 확률, 대체 출처, 가장 가까운 사전 예측 또는 반대 예측을 포함합니다. 확률은 예측자가 잘못된 것으로 판명되는 것을 변명할 수 없지만, 오류를 채점할 수 있게 합니다. 35%에서 작성되었는데 실패한 하나의 예측은 그 자체로는 거의 말해주지 않습니다. 35%이 올바른 숫자였는지 여부는 집합 전체에서만 드러나며, 이러한 예측의 약 삼분의 일이 실현되어야 합니다. Brier 규칙(Brier, 1950)은 집합에 걸쳐 정확도의 전체 점수를 제공하며, 보정과 일어나는 것과 일어나지 않는 것을 구별하는 능력을 결합합니다. 주요 예측은 현재 의견에 맞서 실행되는데, 채용 데이터가 여전히 AI 작업에 대한 학위를 선호하고, Gartner는 대부분의 vibe-coded 응용 프로그램이 폐기될 것으로 예상하며, Andrew Ng는 프로그램에 대한 깊은 이해가 승리한다고 주장하기 때문입니다. 표는 명시된 확률로 반대의 배팅을 합니다: 자신의 영역에서 추월하는 등록된 확률(F3)은 0.35입니다. 이는 벤더 데이터가 여전히 프로그래밍 직업을 약 5포인트 앞에 두고(섹션 2.2) Savva(2026)가 더 어려운 작업에서 더 큰 격차를 예측하기 때문에(섹션 6.1) 짝수 확률 아래에 있으며, 동등성(그 이전 단계)이 0.70으로 가격이 책정되고 독립적인 모델 예측자들이 0.25에서 0.55 사이의 범위였기 때문에 0.25 위에 있습니다. 그림 7은 모든 예측을 확인 연도와 확률에 배치합니다.
예측은 두 가지 집합으로 나뉩니다. 집합 A(27개 예측)는 공개 데이터와 predictions/resolve/의 동결된 쿼리, 목록 및 코드북에서 해결되므로 누구나 나 없이 채점할 수 있습니다. 집합 B(14개 예측: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35)는 연구 프로그램입니다: 공개 출처가 발행하지 않는 데이터가 필요하며 데이터 수집 전에 별도로 등록된 연구에서만 해결되며, 이름이 있는 소유자, 프로토콜 및 파워 계산이 있습니다. 규칙이 구간에서 작성된 9개의 집합 B 예측의 경우, 동반 저장소는 동결된 실현됨 및 실현되지 않음 규칙을 연구의 추정치에 적용하고 각 판정 옆에 동결된 단어를 인쇄합니다(predictions/set_b.py). 프로토콜이 2027년 6월 30일까지 등록되지 않은 집합 B 예측은 미수행으로 기록되고 모든 채점카드에서 테스트 프로그램의 실패로 나열됩니다. Brier 점수는 해결된 예측에 대해서만 두 번 보고되며 수행되지 않은 각 예측은 예측이 잘못된 것처럼 채점되므로 절대 실행되지 않는 연구는 계산에서 떨어질 수 없습니다. F2, F3 및 F3b의 실험은 1,500명의 그룹당 하나의 연구입니다: 이는 약 0.8의 파워를 제공하여 참된 5포인트 이점을 감지합니다(양측 알파 0.05, 통과 공유가 50% 근처, 가장 불리한 경우), 여기서 400명의 그룹당은 약 30%의 시간만 이를 표시합니다. 모든 연구 기반 예측의 경우, 실현됨 규칙도 실현되지 않음 규칙도 충족하지 않는 구간은 미해결이며, 실패가 아닙니다.
확률은 2026년 10월 9일에 고정되었습니다. 각각은 내 숫자를 보지 않고 같은 표에 가격을 책정한 세 가지 모델 계열(Claude Opus, OpenAI 모델 및 Gemini)의 세 명의 맹목적인 예측자의 중앙값입니다. 나는 이 중앙값을 내 확률로 채택했으며, 이들은 OSF에 등록되고, 내 이전 초안의 모든 변경 사항은 변경 로그에 기록됩니다. 4개 계열의 4명의 독립적인 모델 예측자로부터의 이전 라운드도 표에 가격을 책정했습니다. 각각은 참조 클래스, 한 줄짜리 주장 및 확률을 제공했으며, 이들의 풀된 예측(확률의 기하 평균)은 표 4의 등록된 확률 옆에 표시되며, 스프레드는 CSV에 있습니다. 등록된 확률이 해당 라운드의 중앙값과 0.15 이상 차이가 나는 경우(F28 및 F32) 이유는 변경 로그에 제시됩니다. 모든 확률은 Brier 점수가 해결된 예측에 대해 계산되기 때문에 예측이 해결되는 것을 조건으로 합니다. 해결된 공유는 옆에 보고됩니다.
표 4. 임계값, 최종 날짜 및 확률을 포함한 10가지 핵심 예측(모든 41개는 표 A6).
| # | 예측 | 임계값 | 최종 날짜 | p | 모델 | 데이터 |
|---|---|---|---|---|---|---|
| F1 | 검증된 성공의 격차가 벤더 데이터에서 닫힙니다 | 프로그래밍 마이너스 기타 직업 2포인트 이상(현재 34% 대 29%) | 2028년 12월 31일 | 0.35 | 0.39 (0.25~0.65) | 공개 |
| F2 | 자신의 영역에서의 품질 동등성 | (비-IT 마이너스 프로그래머)의 하한 95% 경계가 마이너스 10포인트 이상; 그룹당 1,500명 | 2028년 10월 8일 | 0.70 | 0.67 (0.62~0.70) | 자체 연구 |
| F3 | 자신의 영역에서 추월(품질에서의 교차점) | 하한 95% 경계가 0 이상; 같은 연구 | 2029년 10월 8일 | 0.35 | 0.33 (0.25~0.55) | 자체 연구 |
| F5 | 채용공고에서의 교차점 | 에이전트식 채용공고에서의 학위 공유가 일치하는 채용공고보다 2포인트 이상 낮음, 2027년의 연속된 2개 분기 | 2028년 12월 31일 | 0.30 | 0.34 (0.25~0.60) | 공개 |
| F7 | 배경 중립성 | IT 교육을 위한 확률비의 90% 구간이 0.67~1.5 범위 내, Day에서와 Week에서 | 2029년 12월 31일 | 0.42 | 0.43 (0.40~0.48) | 자체 연구 |
| F14 | 두 축이 구별된 상태로 유지됩니다 | 로그 지평선과 로그 이득의 스피어만 계수가 0.8 이하; 이득이 표본 외 R 제곱에 0.02를 추가합니다 | 30 September 2028 | 0.52 | 0.49 (0.45 to 0.50) | own study |
| F19 | 확인이 상한선을 설정합니다 | 1~3개월의 확인 점유율이 4~6개월의 검증된 결과를 예측하는 데 있어 지평선을 능가합니다 | 30 September 2028 | 0.45 | 0.44 (0.30 to 0.65) | own study |
| F26 | 채용 관행이 뒤따릅니다 | 감사 연구: 콜백 격차가 3포인트 미만, 95% 신뢰 구간이 5 내 | 31 December 2029 | 0.35 | 0.32 (0.25 to 0.35) | own study |
| F27 | 에이전트로 구축한 제품이 예측보다 오래 지속됩니다 | 2026년 12월 31일까지 동결된 표본의 50% 미만이 2028년 말까지 중단됩니다(Gartner: 60%) | 31 March 2029 | 0.32 | 0.35 (0.20 to 0.55) | public |
| F28 | 기계가 80%에서 Day에 도달합니다 | METR 80% 지평선이 2027년 말까지 8시간 이상입니다(2026년 4월 3.1시간) | 30 June 2028 | 0.80 | 0.66 (0.55 to 0.80) | public |
참고: p는 예측이 해결된다고 주어진 예측이 참일 등록된 확률입니다: 2026년 10월 9일 세 개의 블라인드 모델 예측의 중앙값으로, 제가 채택했습니다. 모델: 제 숫자를 보지 않은 독립적인 모델 예측가들의 풀 예측(확률의 기하평균)과 그들의 범위입니다. 데이터: public은 Set A인 누구든 공개 출처에서 해결 가능함을 의미하고, own study는 별도로 사전 등록된 연구(Set B)를 의미합니다. 참, 거짓, 미해결 규칙, 모든 예측에 대한 폴백 출처 및 이전 예측은 표 A6과 predictions/predictions.csv에 있습니다. 최종 날짜까지 비교 가능한 데이터가 없는 예측은 미해결이며 성공으로 계산되지 않습니다. OSF(Chernets, 2026e)에 등록된 프로그램은 가설을 가지지 않으며 IT 교육에 대해 묻지 않으므로 Set B를 테스트할 수 없습니다.
Figure 7. 예측 레지스터: 모든 시간 기한의 예측과 명시된 확률입니다.
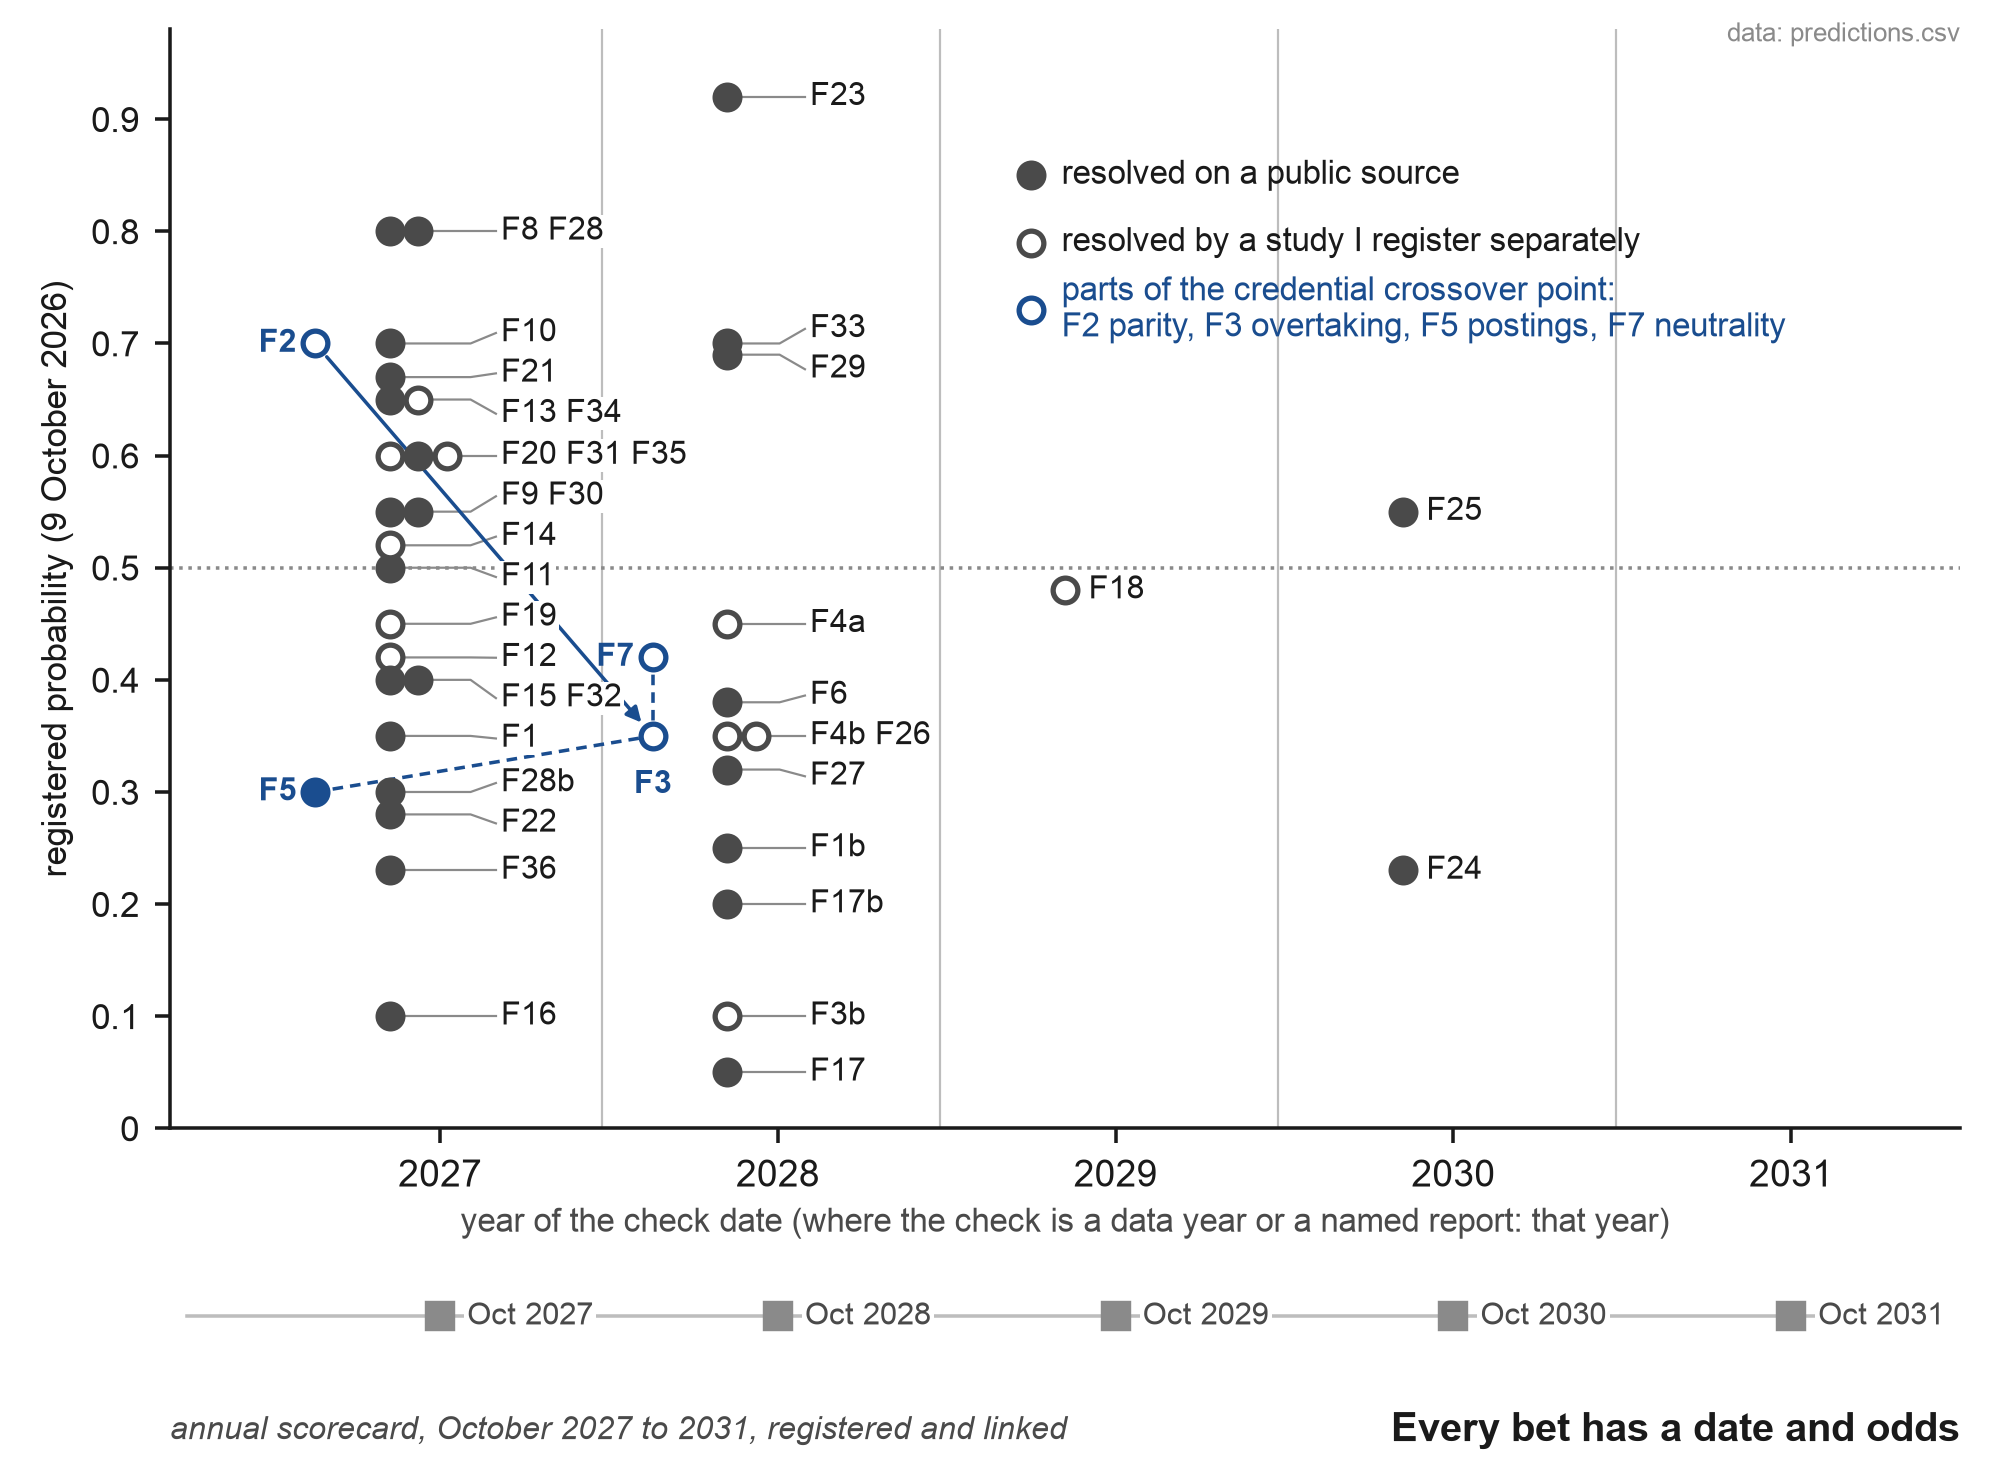
참고: 각 마커는 표 A6의 41개 예측 중 하나로, 확인 날짜의 연도(확인이 데이터 연도 또는 명명된 보고서인 경우 해당 연도)와 등록된 확률에 배치됩니다. 채워진 마커는 공개 출처에서 해결됩니다. 빈 마커는 데이터 수집 전에 별도로 등록된 연구를 통해서만 해결됩니다. 자격 증명 교차점의 네 부분은 강조 색상입니다: 품질 패리티(F2)가 추월(F3)로 이어집니다. 게시물의 교차점(F5)은 이의 눈에 띄는 신호이며 배경 중립성(F7)은 그 메커니즘입니다. 오직 패리티만 짝수 확률(0.70) 이상으로 가격이 책정됩니다. 추월, 그 순간 자체는 0.35에 있습니다. 축 아래의 정사각형은 연간 채점표를 표시하며, OSF에 등록되고 DOI로 연결되어야 합니다, 2027년 10월부터 2031년까지. 확률은 2026년 10월 9일에 고정되었으며 OSF에 등록됩니다.
하나의 연간 측정이 예측 자체가 아닌 예측을 수반합니다, 이름의 경쟁: 매년 동일한 쿼리가 표 A2의 각 후보가 미국 게시물과 OpenAlex 및 Crossref에 얼마나 자주 나타나는지 계산합니다. 한 때 장기적 확인일 뿐이던 질문인 SOC 2028이 에이전트 지향 작업의 직업을 명명할지 여부는 이제 확률이 있는 예측 F23입니다(Bureau of Labor Statistics, 2026b). 2026년 10월 9일 노동통계청은 제안된 SOC 2028 구조나 최종 구조를 발표하지 않았습니다. 최종 구조는 2027년에 예상됩니다.
11.3 이전 예측
2026년 10월 9일 저는 Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket 및 Long Bets, 그리고 개방형 웹(회사 연구 페이지, 분석가 보고서, arXiv, SSRN 및 뉴스)에서 기술 교육이 없는 사람들이 AI 에이전트를 통해 동일한 에이전트를 사용하는 프로그래머와 동등하거나 능가할 것이라는 날짜가 있는 예측을 검색했습니다. 발견된 것 중 반박하는 결과가 있는 날짜를 포함하는 것은 없습니다. 가장 가까운 것들은 다음과 같습니다. Gartner는 2021년에 2024년까지 기술 제품 및 서비스의 80%가 기술 전문가가 아닌 사람들에 의해 구축될 것이라고 예측했습니다(Gartner, 2021). Mark Cuban은 2017년 철학 전공을 하는 것이 더 낫다고 말했으며, 비판적 사고가 프로그래밍을 능가할 것으로 예상했습니다(Black Enterprise, 2017). D. H. Hansson은 2026년 8월 26일 Lex Fridman 팟캐스트에서 프로그래머가 에이전트 엔지니어링에 있어 비프로그래머보다 나쁜 문제가 있는지 묻는 질문에 "100%"라고 답했습니다(Lex Fridman Podcast, 2026). Anthropic은 2026년 6월에 코딩 에이전트가 코딩 배경을 덜 관련성 있게 만들고 있다고 관찰했습니다(Anthropic, 2026e). 반대 방향의 예측이 존재합니다. Gartner는 2028년까지 비브 코딩된 응용 프로그램의 60%가 중단될 것으로 예상합니다(Gartner, 2026, Tray.ai, 2026으로 요약됨), 그리고 2024년에는 2026년을 통해 조직의 5분의 1이 AI를 사용하여 구조를 평탄화할 것으로 예상했습니다(Gartner, 2024). Srinivasan과 Wei(2026)는 "에이전트 관리자"가 12~18개월 내에 표준 직함이 될 것으로 예상합니다. Forrester는 2025년까지 Fortune 100 기업의 60%가 AI 거버넌스 책임자를 임명할 것으로 예상했습니다(Forrester, 2025). Manifold의 시장은 2030년까지 주니어 개발자 역할을 3분의 1 적게 배치하는 것을 약 74%로, 2023년부터 2028년까지 미국 개발자의 15% 이상 감소를 약 42%로 평가합니다(Manifold, 2026b; Manifold, 2026c). Manifold에서 2027년까지 비프로그래머가 AI로 작은 스크립트를 쓰는 것이 일반화될 확률은 약 27% 근처였습니다(Manifold, 2026a), 그 질문은 품질 측정이 없는 사용만을 묻습니다. 여기의 예측은 동일한 에이전트를 사용하는 사람들과 사람들을 비교하고, 교육을 변수로 만들고, 날짜, 측정 및 반박하는 결과를 포함하는 이 모든 것과 다릅니다. 검색 로그는 부록 B에 있습니다. 레이어의 채택(Rogers, 2003), 기계 시간 지평선(Kwa et al., 2025) 및 주니어 역할이 축소되고 있다는 관찰은 이전 작업이며, 이에 대해 우선순위가 주장되지 않습니다.
11.4 동결 및 채점
예측이 저자를 포함한 누구도 조용히 변경할 수 없는 곳에 어디에 있어야 할까요? 이 시리즈가 사용하는 장소 중에서 오직 하나만 고정됩니다. OSF 등록은 편집하거나 삭제할 수 없으며, 철회할 수 있지만 제목, 날짜, DOI 및 철회 사유가 포함된 페이지가 남아 있습니다(OSF, 2026). Zenodo는 발행 후 30일 동안 파일을 변경하거나 삭제할 수 있으며, 그 이후에는 새 버전만 가능합니다(OpenAIRE, 2025). SSRN은 개정할 때 PDF를 교체합니다. 따라서 예측은 먼저 OSF에 등록되며, 즉시 공개되는 개방형 등록으로, 금지 기간이 없습니다. 금지 기간이 있으면 레코드를 숨기고 DOI를 보류하기 때문이며, 아무도 볼 수 없는 우선순위는 거의 가치가 없습니다.
2026년 10월 9일에 표는 사전 등록된 예측 세트로 OSF에 등록되었으며(DOI 10.17605/OSF.IO/VW6P9), 논문은 SSRN과 Zenodo에 게시되었고 모든 기준선 소스의 스냅샷은 Wayback Machine에 보관되어 있습니다. 2027년부터 2031년까지 매년 등록 기념일에 모든 예측의 상태(실현됨, 실현되지 않음, 아직 만기 도달하지 않음, 미결, 미실시)와 증거를 나열하는 스코어카드가 발행됩니다. 연결된 예측이 한 번 계산되고 등록된 표의 가족 열로 그룹화된(F1과 F1b; F2, F3 및 F3b; F4a와 F4b; F5, F6 및 F33; F9와 F31; F15와 F16; F17과 F17b; F28과 F28b) 해결된 예측 전체, 집합별, 가족별 Brier 점수를 보고합니다. 해결된 비율, 최종 날짜가 지났지만 여전히 미결인 모든 예측과 미실시된 모든 예측이 예측이 잘못된 것으로 점수가 매겨지는 최악의 경계, 미실시된 예측을 포함한 점수와 제외한 점수, 세 가지 참고값에 대한 Brier 기술 점수(고정된 0.5, 표 4의 풀링된 모델 예측자, 등록일에 시장이 존재했던 시장 가격)가 포함됩니다. 따라서 선택적 미해결은 점수를 개선할 수 없습니다. 스코어카드 자체는 OSF에 등록되고 원본과 DOI로 연결되며 Zenodo에 보관됩니다. 최소 두 가족의 모델이 각 스코어카드를 고정된 규칙에 대해 독립적으로 확인하며, 불일치할 경우 규칙이 결정하고 불일치가 보고됩니다. 등록 텍스트는 부록 D에 있으며, 그림 A1(부록 D)은 확인 및 최종 날짜의 전체 일정을 보여줍니다. 점수가 시작되기 전에 두 가지 약속이 만기됩니다. F27의 에이전트 구축 제품 샘플은 2026년 12월 31일까지 Zenodo에서 고정되며, F5와 F30의 기준선은 등록 전에 계산되고 보관됩니다. F27 샘플의 프로토콜(등록이 남겨둔 각 선택에 대한 기본값 포함)과 미리 고정된 시드로 이를 그리고 봉인하는 도구는 동반 저장소에 있습니다(kits/f27-sample.md, tools/freeze_sample.py).
예측이 등록되면, 공개된 예측은 외부 예측자가 이를 평가할 수 있는 곳에도 게시됩니다. Manifold의 5개 시장(F5, F8, F10, F11 및 F22, 무료로 게시 가능하며 이 5개는 각각 공개 소스와 누구나 읽을 수 있는 외부 시리즈에서 해결되고 나의 자체 데이터가 없기 때문에 선택됨), Metaculus의 1개 질문(게시 횡단, F5), 그리고 F2, F3 및 F7의 실험을 위한 사회과학 예측 플랫폼으로, 데이터가 존재하기 전에 다른 사람들의 예측을 수집할 수 있습니다. 결과에 대해 돈을 거래하는 예측 시장은 사용되지 않습니다.
11.5 코호트 프로그램
저는 채팅에서 에이전트, 오케스트레이션까지 비프로그래머를 추적하는 사전 등록된 코호트 프로그램을 운영합니다(Chernets, 2026e; OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ). 첫 번째 코호트는 자체 등록된 결과가 있는 단일 팔 실행 가능성 연구이며, 이는 자체 보고서에서 보고됩니다. F7, F14 및 F18~F20과 같은 개인 수준 데이터가 필요한 예측은 데이터 수집 전에 등록되는 나중의 코호트에서 테스트되며, 고정된 항목 중에서 IT 교육에 대한 질문이 있습니다. 동의 하에 보관되는 부록 C의 레코드는 해당 코호트의 자연 데이터입니다.
12. 예측이 반박하는 증거
11절의 예측들은 2026년의 여러 종류의 증거에 반하며, 각각은 측정의 규칙이나 예측을 형성했습니다.
보안은 발전 속도를 따라가지 못했습니다. 100개 이상의 모델에서 보안 테스트를 통과한 생성 코드의 비중은 Veracode의 2026 보고서에서 56%로 유지되었습니다(Veracode, 2026). 이러한 테스트는 모델 단독으로, 보안 지침이 없는 표준 프롬프트 하에서, 에이전트 하네스, 도구 또는 인간 검토 없이 실행되었으므로, 사람이 시작하는 원자재를 설명합니다. 바이브 코딩으로 구축된 5,600개의 공개 애플리케이션의 수동 스캔에서 2,000개 이상의 취약점, 400개 이상의 노출된 시크릿, 개인 데이터의 175개 노출이 발견되었으며, 그 저자들은 이를 하한으로 제시합니다(Escape, 2026). 이것이 F2가 맹검 보안 검토를 포함하는 이유이고, 돌이킬 수 없는 작업이 모든 부분을 통과해야 하는 이유입니다(5.2절).
테스트 통과는 수락에 미치지 못합니다. METR은 벤치마크의 테스트를 통과한 에이전트 작성 수정을 검토하도록 유지관리자에게 요청했고 약 절반이 그대로 병합되지 않았을 것임을 발견했습니다. 에이전트는 검토 루프 없는 이전 세대였으므로, 그 비중은 이제 더 낮을 수 있습니다(METR, 2026b). 채점 규칙은 숨겨진 테스트, 자격 있는 검토자 및 실제 사용으로 답하며, F2는 한 달 뒤의 유지관리 변경을 추가합니다.
검증은 경험에 달려 있습니다. 바이브 코딩으로 구축하는 162명의 설문조사에서 모든 그룹이 생성 코드의 위험을 인식했지만, 그들이 검사한 방식은 경험에 따라 달랐습니다. 저자들은 이를 지각-행동 간격이라고 부릅니다(Fawzy et al., 2026). 비즈니스 사용자와 초보자는 작동하는 프로토타입을 빠르게 생성하지만, 코드 품질은 불균등하며 리워크가 뒤따릅니다(Gama et al., 2026). 비즈니스 사용자들은 경고를 받은 후에도 AI의 분석에서 중대한 오류를 놓쳤습니다(Virk & Liu, 2025). 새로운 라이브러리를 배우는 52명의 주니어 엔지니어에 대한 무작위 연구는 AI로 50%, AI 없이 67%의 이해도 점수를 발견했으며, 속도에서 유의한 이득은 없었습니다. 모델에 설명을 요청한 사람들은 65% 이상을 얻었고, 모든 코드를 넘긴 사람들은 40% 미만을 얻었습니다(Anthropic, 2026c). 이것이 측정이 수락 리터러시와 심어진 오류에 기초하는 가장 강력한 이유입니다. 사람들을 구분하는 기술은 이러한 연구들이 변화하는 것을 보여주는 것입니다.
비프로그래머를 동일한 에이전트를 사용하는 프로그래머와 비교하는 공개된 비교는 없습니다. Esnaola et al. (2026)은 ChatGPT를 통해 GPT-4o를 사용하는 일부 비프로그래머가 작고 명확하게 명시된 프로그래밍 문제를 AI 없이 작업하는 프로그래머와 비슷한 수준에서 그리고 더 빠르게 해결했다는 것을 발견했으며, 저자들은 연구를 탐색적이라고 부릅니다. 프로그래머는 AI 없이 작업했으므로 설계에는 AI가 있는 프로그래머 그룹이 없었고, 지속적인 개발이 아닌 짧은 개별 작업을 연구했습니다. 복제 패키지는 공개입니다(Esnaola et al., 2026). Anthropic의 데이터에서 작업이 처음인 사람들은 15%의 검증된 성공률을 가지고 있었고, 더 경험 많은 사용자는 28%에서 33%를 가지고 있었습니다(Anthropic, 2026e). 거기서 "초보"는 모델에 의해 판단된 작업의 초보를 의미하며, IT 교육에 대해 아무것도 말하지 않습니다. 그 간격이 교육을 반영하는지 작업에 대한 친숙함을 반영하는지는 F7이 구분하기 위해 작성된 것입니다. 더 초기에는 고객 지원 회사의 생성 AI가 초보자와 저기술 에이전트의 생산성을 가장 많이 높였고 가장 경험 많은 사람의 생산성은 거의 높이지 못했습니다(Brynjolfsson et al., 2025), 에이전트 이전부터의 선행 연구입니다. 2024년 Procter & Gamble의 채팅 모델 현장 실험에서 AI가 있는 개인은 AI 없는 팀과 일치했으며 전문 배경에 관계없이 균형 잡힌 작업을 생성했습니다. 이는 에이전트 이전부터의 선행 연구입니다(Dell'Acqua et al., 2025). F2, F3, F7은 누락된 비교를 제공하도록 설계되었습니다.
존경받는 목소리들은 강한 버전에 동의하지 않습니다. Karpathy는 하한과 상한을 유지합니다(2.1절). Andrew Ng는 2026년 8월에 프로그램이 어떻게 작동하는지 깊이 있게 이해하는 개발자가 그러한 이해 없이 바이브 코딩하는 개발자를 훨씬 능가한다고 주장했습니다(Ng, 2026). 채용 데이터는 지금으로서는 같은 방향을 가리킵니다. AI 기술이 필요한 채용 공고는 여전히 AI가 필요하지 않은 비교 가능한 공고보다 4년제 학위가 필요할 가능성이 더 높습니다(Lightcast, 2026b), LinkedIn은 입급 채용의 약세의 대부분을 경제에 돌립니다(2.4절). 예측은 이러한 견해를 상대방으로 삼으며, 배당률이 미리 명시되어 있습니다.
13. 범위 및 경계 조건
시간. 증거는 2026년 10월 9일까지 포함합니다. 제품 사실은 빠르게 구식이 되므로, 측정치는 참조 시간 및 확인을 기준으로 정의되며, 특정 제품은 명명하지 않습니다.
출처. 가장 강력한 증거의 대부분은 자신의 제품에 관한 판매사 정보에서 나옵니다. OpenAI는 코딩 에이전트에 관해, Anthropic은 세션에 관해 제공합니다. 이는 판매사 데이터로 표시되며 판매사가 알 수 있는 것에 사용합니다. 토큰 순위 같은 여러 언론 보도 사건은 명명된 매체의 보도에 기초하며 그렇게 인용됩니다. 2차 출처(Growthy, Startup Fortune, Shopifreaks)는 게시 전에 웨이백 머신에 보관되며, 주요 보고서는 도달할 수 있는 곳이라면 어디서든 인용됩니다.
모집단. 논의는 에이전트를 통해 컴퓨터에서 수행되며, 확인할 수 있는 사람이 하는 작업에 관한 것입니다. 통제할 수 있는 컴퓨터가 없는 사람과 전혀 확인할 수 없는 작업은 측정 범위를 벗어납니다.
측정치가 주장하는 바. 검증된 수평선은 확인 체계 하에서 특정 영역과 날짜에 사람이 전달한 것을 설명합니다. 모든 작업에 대해 높을수록 낫다고 주장하지는 않습니다. 많은 작업은 Hour에 적합하며, 작업을 수동으로 유지하도록 선택하는 것은 정당한 결정입니다. 실수를 되돌릴 수 없는 영역에서는 5.2절의 더 엄격한 임계값이 적용되며, 일부 작업은 에이전트에 전혀 맡겨져서는 안 됩니다.
이름. 3절의 지도는 2026년 10월 8일과 9일에 발견된 사용을 기록합니다. 그 이후로 이름이 채택되고 폐기되므로, 지도는 연간 이름 경쟁과 쌍을 이루며 단일 이름은 선택되지 않습니다.
강한 주장. 기술 교육 없는 사람들이 프로그래머보다 더 나은 제품을 만들 것이라는 주장은 날짜 및 임계값(F2~F7)이 있는 일련의 예측으로 제시됩니다. 이를 공개적으로 채점할 예보로 제시합니다.
법에 의해 보유된 행위. 법이 행위를 라이선스에 의해 보유하는 경우, 측정치도 라벨 게이트(6.2절 및 6.5절)의 가중치 감소도 그 행위를 이동하지 않습니다. 영국에서는 인정된 감시 기구의 회원이 아니고 그 규칙에 따른 적격성이 없는 사람(2006년 회사법 1212조 및 1213조)은 법정 감시인으로 행위할 수 없으며, 미국에서는 공개 회사 회계 감시위원회에 등록된 회사만이 발행자에 대한 감시 보고서를 작성하거나 발행할 수 있습니다(2002년 사르베인스-옥슬리 법 102조). 부기에서 이러한 예약은 좁습니다. 미국의 부기 사무원은 일반적으로 인증조차 보유할 필요가 없습니다(노동통계청, 2026c). 법에서 이들은 더 넓습니다. 잉글랜드와 웨일스는 소송 수행 및 유산 활동을 포함한 6가지 법적 활동을 보유합니다(2007년 법률 서비스법 12조). 따라서 업무는 이동하지만 서명은 유지되며, 면허 서명자는 그 다음 법이 이미 가격을 책정하는 형식으로 7.2절의 보증자 기능을 수행합니다. 라이선스 자체가 라벨에 의해 또는 확인된 작업에 의해 얼마나 많이 허용하는지는 6.2절에서 논의됩니다.
에이전트 이전 데이터. 2025년 이전의 계열은 에이전트 없는 업무를 설명하므로 선행 자료로만 입력됩니다. 채용의 거시경제학은 경제를 AI보다 더 지적하는 2026년 LinkedIn 데이터(2.4절)로 전달됩니다.
주장의 상태. 표 A7(부록 F)은 각 요소에 계열의 신뢰도 언어를 적용합니다.
14. 결론
코딩 에이전트를 비교하는 부기사와 자신의 계약 검토 도구를 구축하는 변호사는 이제 개발자가 모듈을 에이전트에 넘기고 결과를 확인할 때와 같은 방식으로 일합니다. 2026년에는 세 명이 하나의 워크플로우를 공유하고 있으며, 예전의 두 직급 체계 중 누가 더 앞서 있는지 말할 수 없습니다. 직함으로는 이를 결정할 수 없습니다. 2026년에 제안된 모든 직함이 슬로건이거나 누군가의 채용 광고이기 때문이며, 시장이 그중 하나를 선택하지 않았기 때문입니다. 올바른 항목을 세는 척도가 있으면 이를 해결할 수 있습니다.
여기서 제안하는 척도는 직업이 명명될 때까지 기다리지 않습니다. 부기사, 변호사, 개발자를 하나의 척도로 읽습니다. 각자가 에이전트에 넘기고 검증한 업무의 규모를 특정 분야와 날짜에 측정하며, 두 번째 축은 자신의 주의 시간 1시간이 얼마나 많은 검증된 업무를 만들어냈는지를 나타냅니다. 이 척도의 임계값은 버전이 관리되고 실제로 검사되었으며, 실제 검사로 이미 하나의 임계값을 수정했습니다. 규칙은 기록을 조작할 수 있는 방법과 각각의 방어책을 명시하고 있으며, 상한선은 검증 비용이 에이전트의 속도에 관계없이 한계를 설정하는 이유를 설명합니다. 고용주, 학교 또는 플랫폼의 경우 질문이 달라집니다. 사람이 프로그래머인지, 또는 AI를 얼마나 많이 사용했는지 묻는 대신, 본인이 설계하지 않은 검사를 통과한 자신의 분야에서의 하루 업무를 요청합니다. 시장이 선택한 모든 이름을 그 척도로 읽을 수 있습니다.
날짜가 지정된 예측은 이 논문을 시작한 논제를 포함합니다. 분야별로, IT 교육 없이 사람들이 만든 제품이 같은 에이전트를 사용하는 프로그래머의 제품을 추월하기 시작할 것입니다. 동등한 검증 범위에서 프로그래밍 교육은 더 이상 검증된 업무의 질을 예측하지 못할 것입니다. 그리고 채용공고에서 학위 요건 항목의 라인이 교차할 것입니다. 먼저 전문가가 스스로 업무를 수용할 수 있는 분야에서, 마지막으로는 소프트웨어에서 교차할 것입니다. 2027년과 2028년의 스코어카드가 이 예측에 반하면, 브리어 점수와 함께 공개적으로 그렇게 말할 것입니다. 예측이 맞으면, 주니어와 시니어라는 단어는 생존할 수 있습니다. 단, 의미가 사람이 증명할 수 있는 업무의 규모 쪽으로 이동할 것입니다. 대규모 고용주가 등급 체계를 이러한 척도로 대체할지 여부는 그 자체로 여기서의 예측입니다(F17), p = 0.05로 등록됨.
이 예측들에 무엇이 일어나든 한 가지 경계는 남아 있을 것입니다. 건설은 쓰기처럼 문해력이 되고 있습니다. 건설된 것에 대한 책임은 여전히 전문직이며, 그 둘 사이에 모호함이 서 있습니다. 2026년 시장의 조건이며, 좋은 일이 보이지 않고 플랫폼이 미지의 사람들에게 문을 닫는 곳입니다. 에이전트를 통해 건설하는 사람은 업무에 서명할 파트너가 필요하거나, 그 파트너 자신이 되어야 하며, 보증인은 그들이 보증한 것과 그것이 얼마나 많이 유지되었는지로 측정될 수 있습니다.
미국의 말에는 "신이 인간을 만들었고 콜트 대령이 그들을 평등하게 만들었다"는 속담이 있습니다. 에이전트는 만드는 일에서 비슷한 일을 합니다. 하나의 에이전트를 가진 거래 밖의 사람은 거래처럼 보이는 일을 만들 수 있습니다. 검증은 평등화하기가 더 어렵습니다(5.2절과 12절). 부록 G의 평가자 연구에서 자신의 말로 부기 표본에 인정된 거의 5명 중 1명이 거래의 첫째 주 질문에 잘못 답했으며, 탐색적 비교에서 그들은 더 큰 업무를 나머지가 한 것보다 적은 시간으로 평가했습니다(부록 G2). 독립적인 검사 프로세스가 에이전트가 만드는 일을 위해 한 것을 검증을 위해 할 수 있는지 여부는 6.5절의 열린 질문입니다. 여전히 사람들을 분리하는 것은 그들이 검증하고 수용할 수 있는 것이며, 그것이 검증된 위임 범위가 측정하는 것입니다.
선언
자금 지원. 이 연구는 외부 자금 지원을 받지 않았습니다.
이해 상충. 저자는 다중 모델 오케스트레이션 방법을 개발하고 있으며 관련 특허 출원을 제출했습니다(심사 중; 등록된 특허는 없습니다). 저자는 섹션 11.5 및 부록 G에서 설명한 사전 등록된 코호트 프로그램과 그 자료를 설계했으며, AI 에이전트로 작업하는 것을 돕는 교육 애플리케이션을 개발하고 있습니다. 이 논문의 어떤 결과도 저자의 구현에 의존하지 않습니다. 부록 C의 도구는 Python 표준 라이브러리만 사용합니다.
도구 및 검증. AI 어시스턴트는 저자의 지시 하에 도구로 사용되었습니다. 아이디어, 연구 및 결론은 저자의 것입니다. 정량적 주장과 인용은 2026년 10월 9일 현재 또는 그날 추가된 출처의 경우 2026년 10월 10일 현재의 원본 출처 또는 보관된 사본에 대해 확인했습니다. 보도자료나 공급업체의 페이지만 이용할 수 있는 경우, 주장은 본문에서 해당 보도자료나 공급업체에 귀속됩니다. 참고문헌의 대괄호 안에 제시된 제목은 헤드라인을 그대로 다시 읽지 않은 페이지의 설명적 제목입니다.
데이터 및 코드 가용성. 부록 C의 코드 및 스키마, 임계값의 데스크 테스트(부록 E) 및 예측 파일은 MIT 라이센스에 따라 동반 저장소(https://github.com/vadimchernets/delegation-horizon)에서 공개되며, Zenodo에 릴리스 v1.1.0으로 아카이브됩니다(개념 DOI 10.5281/zenodo.23267444, 최신 릴리스로 확인됨). 부록 C에 인쇄된 코드는 저장소의 코드와 바이트 단위로 동일하며, tools/paper_sync.py는 이 텍스트와 함께 테스트가 실행될 때마다 이를 확인하고, 작동 예시와 표 4 및 A6을 저장소에 대해 확인합니다. 표 4 및 A6의 예측은 2026년 10월 9일에 OSF에 등록되었습니다(DOI 10.17605/OSF.IO/VW6P9). 부록 G의 Prolific 평가자 연구는 2026년 10월 9일에 OSF에 등록되었으며, 데이터를 수집하기 전에 등록되었습니다(DOI 10.17605/OSF.IO/V92R8). 해당 분석 스크립트(pilot/human_raters.py)는 해당 등록에 제출되었으며 동반 저장소에 제출된 그대로 있으며, OSF가 각 제출된 파일에 대해 보고하는 SHA-256이 pilot/registered-SHA256.txt에 나열되어 있고, Prolific 내보내기를 변환하고, 표 G2를 인쇄하고, 등록되지 않은 G2의 비교를 실행하는 스크립트와 함께 나열됩니다. Prolific 식별자가 일반 레이블로 바뀐 익명화된 데이터는 동일한 폴더에 추가될 예정입니다. 예측과 함께 등록된 파일은 predictions/registered-SHA256.txt에 SHA-256과 함께 나열되어 있으며, OSF에 제출된 매니페스트이고, 저장소의 테스트는 각각을 모두 비교합니다.
윤리. 부록 G는 사람들로부터의 두 가지 데이터 출처를 보고합니다. Prolific 평가자 연구는 익명의 온라인 평가 작업입니다. 성인 전문가들은 참여하기 전에 Prolific에서 정보에 입각한 동의를 제공했으며, 플랫폼을 통해 급여를 받았고, 이름이나 연락처 정보를 제공하지 않았습니다. 코호트 계정은 이름, 장소 또는 언어 없이 사전 등록된 코호트 프로그램(OSF, DOI 10.17605/OSF.IO/X4EGQ)에 동의하고 익명화된 출판에 동의한 성인의 기록을 요약합니다. 프로그램의 등록된 결과는 별도로 보고됩니다. 이 연구는 제도적 윤리 위원회 없이 독립적인 연구자가 수행했습니다. 섹션 9에서 논의한 공개 스레드는 의역되었으며, 저자는 명명되지 않았습니다.
저자 기여도. 단독 저자.
대응. [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
부록 A. 용어집
기준 시간. 자격을 갖춘 전문가가 손으로 업무를 수행하는 데 필요한 시간으로, 고정된 작업 저장소에서 또는 누가 업무를 수행했는지 모르는 두 명의 독립적인 평가자로부터 얻은 것입니다.
검증된 위임 범위. 사람이 정기적으로 에이전트에게 업무를 넘기고, 받고, 에이전트가 보지 못한 독립적인 검증으로 확인받는 최대 업무 규모로, 기준 시간 단위입니다. 제5.2절의 규칙에 따라 도메인별로 점수를 매깁니다.
독립적 검증. 숨겨진 수용 테스트, 자격을 갖춘 인간 검토자, 의도된 사용자들의 실제 사용, 또는 데이터, 접근성, 동기가 에이전트와 다르고 출처를 기반으로 검증하는 다른 계열의 모델입니다. 자체 검토 및 한 계열의 모델들 간의 합의는 독립적 검증이 아닙니다.
심어진 오류. 인수 전에 업무에 심어진 오류로, 사람이 반드시 잡아야 하며, 잘못된 항목 또는 업무에 포함되어야 할 내용의 누락입니다. 심어진 오류를 놓친 작업은 검증된 것으로 간주되지 않으며, 계단의 창에서 하나라도 놓치면 주간 이상의 계단을 차단합니다.
증폭 이득. 지난 91일간 도메인에서의 사람의 주의 시간으로 나눈 수용되고 검증된 업무의 기준 시간입니다. 실패한 업무는 분모에 포함되고 외부 도움으로 완료된 업무는 분자에서 제외됩니다.
이득의 한계. 단순화된 모델에서, H 기준 시간의 작업에 대한 증폭 이득 G로 검증에 V 시간의 주의가 필요하면 G ≤ H / V를 만족합니다. 즉, 검증이 차지하는 손 작업 시간의 비율의 역수입니다.
계단. 시간(약 1 기준 시간), 일(약 8), 주(약 40), 월(약 160), 분기(약 500). 규칙 v1.1의 개수 및 창: 시간 및 일의 경우 91일 내 10개 작업, 주의 경우 182일 내 6개, 월의 경우 365일 내 6개(이 중 5개는 검증됨), 분기의 경우 365일 내 3개. 주 이상의 경우, 지난 91일 내 해당 계단의 규모의 검증된 작업이 최소 1개 필요합니다.
기록. 도메인 · 범위 · 증폭 · 날짜. 예: "소규모 사업 부기 · 일 · ×2 · 2026-Q4".
수용 문해력. 미리 완료된 것으로 간주될 항목을 명시하고 에이전트가 조작할 수 없는 증거로 이를 보여주는 기술입니다.
배경 중립성. 도메인에서 동등한 검증된 범위에서 프로그래밍 교육 여부가 도메인 숙련도와 수용 문해력을 고려했을 때 독립적으로 검증된 업무의 품질을 예측하지 못한다는 가설입니다.
자격증 교차점. 도메인에서 IT 교육이 없는 사람들의 제품이 동일한 검증 기준 하에서 수용되기 시작해 같은 에이전트를 사용하는 프로그래머의 제품을 추월하는 순간입니다. 이후로 학위 요건과 주니어 및 시니어 레이블은 채용에서 예측력을 잃습니다. 그 구성 요소는 품질 동등성(이전 단계), 추월(그 순간), 채용공고의 교차(신호), 배경 중립성(메커니즘)입니다.
보증인. 다른 사람이 만든 제품에 서명하고 자신의 원에 대해 책임지는 사람으로, 자신이 보증한 제품의 수와 유지된 제품의 수로 측정합니다.
마무리 담당자. 제품을 사용자에게 전달하는 사람입니다.
두 시장. 자신을 위한 제작(문해력)과 결과가 따르는 다른 사람을 위한 업무(전문직)입니다.
부록 B. 검색 기록, 2026년 10월 8일 및 9일
이름과 용어에 대한 웹 검색을 2026년 10월 8일에 여러 AI 어시스턴트가 독립적으로 병렬로 실행했으며, 2026년 10월 9일에 확장된 웹 검색 기능을 갖춘 하나의 어시스턴트가 실행했습니다. 각 답변은 출처와 함께 전체로 보관했습니다. 학술 검색은 2026년 10월 9일에 다음과 같이 실행했습니다.
| 베이스 | 검색 대상 | 본 논문의 용어에 대한 결과 |
|---|---|---|
| arXiv (API) | 정확한 문구, 모든 필드 | "delegation horizon": 0; "delegation ladder" 또는 "ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | 제목 및 초록 | 한 검색은 0을 반환했고 다른 검색은 속도 제한됨(HTTP 429); 제출 전에 반복할 예정 |
| OpenAlex | 제목, 초록, 일부 전문 | "credential crossover": 0; "agentwright": 관련 없는 일치만 있음; "background neutrality": 관련 없음; "acceptance literacy": 기술 수용에 관한 작업만 |
| Crossref | SSRN 초록을 포함한 메타데이터 | "principal" (전문직으로서): 대리인 이론만 |
| Europe PMC | 공개 전문 | 정확한 일치 없음 |
| Zenodo | 기록 및 설명 | 어떤 용어도 일치하지 않음 |
| DOAJ | 공개 접근 저널 | "delegation horizon": 4개의 관련 없는 일치 |
| Google Scholar | 전문, SSRN | "delegation horizon": 6개, 기계 또는 회사를 위해 2026년 논문에서 사용됨(Khadj, 2026; Alonso, 2026); "verified delegation horizon", "credential crossover", "credential crossover point" 및 "agentwright": 0(2026년 10월 9일에 오류 없이 반복됨); "acceptance literacy", "background neutrality" 및 "amplification gain": 다른 의미의 일치만 |
| DBLP; SSRN 페이지 | 봇 보호로 차단됨(DBLP) 또는 403 반환됨(SSRN); Crossref 및 Scholar를 통해 커버됨 |
이전 예측을 Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket 및 Long Bets에서 그리고 개방 웹에서 검색했으며, Metaculus 및 일부 Gartner 페이지는 HTTP 403을 반환했고 가능한 경우 보관되거나 재인쇄된 사본을 통해 읽었습니다. 결과는 섹션 11.3에 요약되어 있습니다. 보고는 PRISMA 2020(Page et al., 2021)의 항목 6을 따릅니다: 모든 베이스와 마지막 접근 날짜가 나열됩니다. 찾을 수 없는 일치는 해당 날짜에 해당 베이스에서 찾을 수 없는 것으로 보고하며, 검색하지 않은 베이스에 대해서는 어떤 주장도 하지 않습니다.
부록 C. 측정 도구
이 부록은 Python 표준 라이브러리에서 MIT 라이선스 하에 제공되는 연구 도구, 레코드 형식 및 채점기를 제시합니다. 섹션 5.2의 규칙이 어떻게 코드가 되는지 보여줍니다. 이는 응용 프로그램이 아니며 사람이나 연구자가 제공하는 레코드에서 두 개의 숫자를 계산하는 것 이상으로 개인에 대한 어떤 결정도 내리지 않습니다. 체크가 잘 선택되었는지 판단하지 않으며, 주어진 필드를 신뢰합니다. 특히 독립성을 테스트하지 않습니다. 섹션 5.2의 세 가지 조건(데이터, 접근 및 인센티브) 중에서 체크의 종류와 에이전트가 이를 확인했는지 여부만 읽으며, 독립성 자체는 표 3의 무작위 감사로 확인됩니다.
C1. 레코드
에이전트에 할당된 작업 조각 하나당 JSON Lines 파일의 한 줄로, 조각이 수락되거나 거부되거나 포기될 때 작성됩니다. 인계가 시작된 날짜는 started 필드에 입력되며, 규칙 v1.1에서 예상됩니다. 채점기는 여전히 이 필드가 없는 줄을 읽고 경고합니다. 체크에 실패한 조각이나 포기된 조각은 로그에 남습니다.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| 필드 | 의미 |
|---|---|
| person | 가명 라벨로, 실명이 아닌 경우 |
| domain | 작업이 수락된 영역 |
| date | 수락, 거절 또는 포기 날짜, 줄이 작성된 시점 (ISO 형식) |
| started | 인수 개시 날짜 (ISO 형식); 규칙 v1.1에서 예상되며, date보다 늦지 않음 |
| reference_hours | 전체 납품물에 대한 자격이 있는 전문가의 수작업 시간 |
| reference_basis | 참조 출처: 명명된 작업 은행 또는 두 평가자 |
| attention_minutes | 계획, 지시, 읽기, 확인 및 수정의 담당자 분 |
| mode | one_piece, stages 또는 together (one_piece는 섹션 5.7의 지시 점유율에 계산됨) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review 또는 none |
| agent_saw_check | 에이전트가 확인을 볼 수 있었는지 여부 (계산되려면 false여야 함) |
| passed | 확인이 통과했는지 여부 (실패하거나 포기된 조각의 경우 false) |
| irreversible | 이러한 종류의 작업의 실수를 취소할 수 없는지 여부 (이 조각은 그러면 통과해야 함) |
| planted_errors | 인수 전에 작업에 심은 오류의 개수 |
| planted_missed | 담당자가 잡지 못한 오류의 개수 (모든 누락은 조각을 미검증으로 만들고 창에서 주 이상을 차단함) |
| outside_help | 동료 또는 계약자가 로그 외에서 도움을 주었는지 여부 (이러한 조각은 이득의 분자에 아무것도 추가하지 않음) |
| task_id, model, tools | 선택사항: 작업 은행 식별자, 사용된 에이전트 및 모델, 그리고 해당 도구 (섹션 5.4) |
| checker | 선택사항: 확인을 실행한 대상 또는 대상, 역할로서 실명이 아닌 경우 |
| rater_hours | 선택사항: reference_hours 뒤의 평가자 추정치; 두 명이 있고 더 큰 값이 더 작은 값의 1.5배를 초과하면, 채점자가 "제3 평가자 필요" 출력 (표 3); 세 번째 추정치가 있으면 중앙값이 결정되고 플래그는 인쇄되지 않음 |
| audit | 선택사항: none, passed 또는 failed, 두 번째 독립적인 확인의 결과; 감사 실패는 조각을 미검증으로 만듦 |
| revoked | 선택사항: 지연된 결과가 조각을 취소한 경우 true (표 A4); 취소된 조각은 미검증 상태 |
C2. horizon.py
아래 코드는 규칙 v1.1을 구현하며 동반 저장소의 horizon.py와 바이트 단위로 동일합니다.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. 구체적인 사례
아래 로그는 2026년 7월부터 9월 사이에 한 사람이 에이전트에게 맡긴 열 개의 부기 업무를 포함합니다.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
python3 horizon.py work-log.jsonl --as-of 2026-10-09를 실행하면 레코드와 그 뒤의 확인 사항에 대한 라인을 출력합니다:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
10개 항목 모두 최소 8시간의 참고 시간을 가집니다. 2개는 검증된 것으로 계산되지 않습니다. 하나는 자체 검토로만 확인되었고, 하나는 전문가의 검사에 실패했습니다. 10개 중 8개는 정확히 Day가 요구하는 비율이고, 돌이킬 수 없는 항목은 통과했으므로 이 단계는 Day입니다. Week는 어떤 항목도 40시간에 도달하지 못하므로 도달 불가능합니다. 검증된 항목들의 합계는 80시간의 참고 시간이며, 실패를 포함한 10개 모두에 소비된 주의력은 1,030분(약 17.2시간)으로, 4.66의 이득과 ×2 단계를 제공합니다. 어떤 항목도 심어진 오류나 외부 도움을 포함하지 않았으므로, 이러한 규칙 중 어느 것도 결과를 바꾸지 않습니다. 실패한 항목이 기록에서 제외되었다면, 단계는 9개 항목에 기반했을 것이고 10개 항목의 개수 요구를 실패했을 것입니다. 이것이 실패가 기록에 포함되어야 하는 이유입니다. 단계 옆의 개수인 8/10은 판단이 얼마나 근접했는지 보여줍니다(부록 E). 두 번째 줄은 계산된 항목 뒤의 검사 종류와 수용된 중앙값인 9.0시간을 제공하므로 독자는 수평선이 임계값 바로 위의 항목에 기반하는지 확인할 수 있습니다(표 3). 이 사람의 주의력인 1,030분은 인수된 96시간의 약 18%이고 검증된 80시간의 약 21%입니다. 이력서의 기록은 "영세 상인 부기 · Day · ×2 · 2026-Q4"입니다.
동반 도구 tools/explain.py는 동일한 규칙에서 동일한 판정의 이유를 출력합니다. Day 크기의 10개 항목 중 8개는 검증되었고 8개가 필요하며, 이는 실제 통과율이 44%에서 97% 사이의 어디든 있을 수 있음과 일치합니다(섹션 5.8). 따라서 그러한 크기의 추가 실패 항목은 수용될 수 없습니다. 새로운 항목이 기록되지 않으면 Day는 2026년 10월 18일까지 유지됩니다. 10월 19일에 7월 20일에 종료된 항목이 91일 창을 벗어나고, Day 크기의 9개 항목이 남으며, Day가 필요로 하는 10개에 1개 부족합니다. Week의 경우, 여전히 누락된 모든 조건을 나열합니다. 182일 내에 최소 40시간의 6개 항목이 필요하며, 이 중 하나는 심어진 오류를 포함하고 하나는 지난 91일 내에 검증되었습니다.
구성된 기록은 또한 표 3이 이름을 붙인 추적을 포함합니다. 10개 항목 중 5개는 정확히 8시간(Day의 최소값)으로 평가되었으며, tools/too_clean.py는 이를 "감사 우선"으로 표시하며 추적 내용은 "10개 항목 중 5개가 단계 임계값 바로 위에 있음"입니다. 플래그는 기록을 감사로 보내고 그에 대해 결정하지 않습니다. 단계 옆의 9.0시간의 중앙값은 독자에게 동일한 내용을 보여줍니다.
C5. 동반 저장소
동반 저장소(https://github.com/vadimchernets/delegation-horizon)는 독자가 논문의 각 부분을 사용할 수 있게 해주는 도구와 자료를 보유하고 있습니다. 섹션별 주요 파일:
| 섹션 | 파일 | 기능 |
|---|---|---|
| 5.2, C1 to C4 | horizon.py, log.schema.json, examples/ |
채점기, 한 로그 줄의 스키마, 작업 예시 및 출력해야 할 줄 |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
질문에 답하여 로그 작성, 단계 뒤의 개수가 있는 기록 카드, 오프라인 브라우저 페이지에서의 동일한 채점. 둘 다 쉼표 또는 세미콜론으로 저장한 스프레드시트를 읽습니다 |
| 5.2, 5.8, C4 | tools/explain.py |
로그가 단계를 획득하는 이유: 보유하거나 실패하는 각 조건, 여유, 새로운 항목이 기록되지 않을 경우 단계가 소멸하는 날짜, 다음 단계가 필요로 하는 것 |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
평가자 추정에서의 참고 시간, 평가자 선택, 승인 및 브리핑 방법 |
| 5.8, 표 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
재현 가능한 감사 샘플, 너무 깔끔해 보이는 기록에 대한 플래그, 인수 전에 밀봉된 심어진 오류 및 종류별로 채점된 것(잘못된 항목 또는 누락), 감사 및 심어진 오류 가이드 |
| 6.2, 10.3 | tools/verify_record.py |
휴대용 기록의 수신 측면: 함께 전송된 로그가 채점된 파일인지, 채점자가 동일한지, 재채점이 필드별로 동일한 기록을 제공하는지 여부 |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
라벨 대신 직업의 질문으로 사람을 인정하기, 라벨이 얼마나 누출되는지, 정확한 간격 포함(부록 G2의 60 중 11: 9.5%에서 30.4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
섹션 6.5의 4단계 및 각각이 규칙(그림 A4) 하에서 획득하는 것, 섹션 10.5의 등록 프로토콜로의 비교, 잘못된 항목과 누락 따로 |
| 5.8, 부록 E | pilot/ |
임계값의 책상 테스트, 30개 작업 은행, 등록 텍스트 및 동의 양식과 함께한 보정 프로토콜 |
| 부록 G2 | pilot/ |
OSF에 제출된 등록 분석 human_raters.py, Prolific 내보내기의 변환, 등록된 함수와 함께 표 G2를 인쇄하는 스크립트, 선별의 비교, 이를 실행할 수 있는 합성 내보내기 |
| 7.2 | templates/, tools/guarantor_record.py |
작업 은행의 작업 카드, 보증인의 원장, 보증인의 기록: 보증한 제품, 6개월 및 12개월 유지된 개수, 심각도별 실패 |
| 11, 표 4 및 A6, C3 | predictions/, brier.py, tools/power.py |
등록된 41개 예측, OSF에 제출된 해시 매니페스트, 해결 규칙 및 파일, 채점 도구(집합 B 예측이 수행되지 않은 것을 기록하고 Brier 점수를 이것 없이도 보고하며 잘못된 것으로 채점한 것도 보고함)(섹션 11.2), 섹션 11.2의 샘플 크기 |
| 11, 집합 B | predictions/set_b.py |
간격에 작성된 9개 집합 B 예측의 고정된 실현된 규칙 및 미실현 규칙, 연구의 추정에 적용됨 |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
F27 샘플의 프로토콜 및 추출(먼저 등록된 폐쇄 풀, 이후 공개 난수 비콘에서 취한 키), Zenodo에 동결되고 해시는 2026년 12월 31일까지 OSF에 등록됨, 각 채점 날짜의 생동감을 F27의 단어로 |
| C2 to C4, 표 4 및 A6 | tools/paper_sync.py |
이 텍스트를 저장소에 대해 검사합니다: 목록의 바이트 단위, 작동 예시와 그 출력, 예측 테이블, 집합의 개수, 언급된 모든 파일과 포함된 모든 그림 |
| 부록 D, 부록 F | figures/ |
예측 테이블에서 그림 A1을 그리고 채점자의 규칙에서 그림 A4를 그리는 스크립트 |
독자별 동일 파일:
| 독자 | 시작 | 제공 내용 |
|---|---|---|
| 에이전트에게 작업을 할당하는 사람 | templates/work-log.csv, record_card.py 또는 checker.html, tools/explain.py |
스프레드시트에 기록된 로그, 기록과 그 카드, 다음 단계에 필요한 것 |
| 고용주 또는 인사 팀 | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
맹평가가 수행하는 유급 1일 업무 테스트, 라벨 대신의 직무 관련 질문, 단계가 말하고 말하지 않는 것, 후보자의 판정이 얼마나 가까운지 |
| 직무의 신입 | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
6.5절의 단계와 각각이 얻는 것, 인수 전에 명시된 "완료", 의도적 누락에 대한 연습 |
| 감사자 또는 보증인 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
다시 검사할 샘플, 너무 깔끔해 보이는 로그의 흔적, 목록이 변경되었는지 보여주는 봉인이 있는 의도적 오류 |
| 연구자 | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
탁상 테스트, 평가자 연구와 그 스크립트, 비교 프로토콜, 샘플 크기, 점수카드 도구와 함께 등록된 예측 |
부록 D. 예측에 대한 등록 텍스트 (OSF)
제목. 2026~2031년 AI 에이전트를 통한 업무에 대한 시간 지정 예측: 동결된 예측과 연간 채점.
유형. 공개 종료 등록, 즉시 공개, 유예 기간 없음.
요약. 이 등록은 "After the Programmer Divide: One Measure for People Who Build Through AI Agents"(SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266)에 명시된 시간 지정 예측을 동결합니다. 첨부된 표는 각 예측에 대해 다음을 제시합니다: 예측 내용; 측정 방법; 공개 출처 및 대체 출처; 접근 날짜 및 아카이브된 스냅샷이 포함된 2025년 또는 2026년 기준; 확인 날짜 및 최종 날짜; 이 등록 날짜에 고정된 확률; 그리고 세 가지 결과에 대한 임계값: 참, 거짓, 미결정.
채점. 각 예측은 확인 날짜 이후 또는 그 날짜에 첫 연간 확인 시 데이터가 존재하는 시점에서 채점되며, 최종 날짜 이전이어야 합니다. 해결된 예측은 Brier 규칙으로 채점합니다. 최종 날짜까지 비교 가능한 데이터가 없는 예측은 미결정으로 기록되며 성공으로 계산되지 않습니다.
세트 및 확률. 세트 A는 공개 데이터 및 predictions/resolve/ 파일에서 해결되며, 이 등록에 나열된 SHA-256 해시가 있습니다. 세트 B는 데이터 수집 전에 따로 등록된 연구에서만 해결됩니다. 프로토콜이 2027년 6월 30일까지 등록되지 않은 세트 B 예측은 미수행으로 기록되며 테스트 프로그램의 실패입니다. Brier 점수는 해결된 예측에 대해 보고되며, 미수행된 모든 예측은 오류로 채점됩니다. 확률은 해결을 조건으로 합니다. 확률은 2026년 10월 9일에 수집한 세 개의 블라인드 모델 예측(Claude Opus, OpenAI 모델 및 Gemini)의 중앙값이며 저자가 채택했습니다. 네 개 모델의 이전 풀 예측은 참고용으로 첨부되어 있습니다.
교차점. F2, F3, F5 및 F7은 동일한 명명된 도메인에서 측정됩니다: 소규모 사업 부기, 법률 및 마케팅 문서는 작업 은행의 두 가지 비소프트웨어 도메인(부록 E)입니다. F5의 게시물 유사 항목의 경우 SOC 43-3031, 23-2011 및 13-1161로 매핑됩니다. 세 번째 은행 도메인인 소규모 내부 웹 도구는 프로그래머의 주요 도메인이며 교차 도메인이 아닙니다. 도메인의 교차점은 F3과 해당 도메인의 F5 유사 항목이 동일한 명명된 도메인에서 모두 충족되는 첫 번째 연도입니다. 어느 하나만으로는 교차점을 나타내지 않습니다.
채점 추가 사항. 각 스코어카드는 또한 해결된 비율, 세트 및 계열별 Brier 점수, 연체된 미결정 예측을 오류로 채점하는 최악의 경계, 그리고 0.5, 풀 모델 예측자 및 시장 가격에 대한 Brier 기술 점수를 보고합니다.
연간 확인. 2027년부터 2031년까지 매년 이 등록의 기념일에 저자는 여기에 등록된 모든 예측을 다루는 스코어카드를 발표합니다. 각 스코어카드는 OSF에 등록되며 DOI로 이 등록에 연결되고 Zenodo에 제출됩니다.
고정된 규칙. 어떤 예측도 제거, 재표현 또는 새로운 날짜가 지정되지 않습니다. 나중에 추가된 모든 항목은 별도로 등록되며 자체 날짜를 가집니다. 명명된 출처가 출판을 중단하거나 방법을 변경하는 경우 대체 출처가 사용됩니다. 동일한 수량을 측정하는 경우 비교 가능한 출처가 없으면 예측은 미결정입니다.
독립적인 검토. 각 스코어카드는 여기에 동결된 규칙에 대해 최소 두 개의 서로 다른 계열의 모델로 확인됩니다. 이들이 불일치하는 경우 규칙이 결정하고 불일치가 보고됩니다. 인간 중재자는 저자가 첫 번째 스코어카드 전에 지정하며 두 모델 계열 간의 분쟁을 해결합니다.
자체 데이터. 저자의 코호트 데이터에 의존하는 예측은 OSF(DOI 10.17605/OSF.IO/X4EGQ)에 등록된 프로그램이 각 코호트에 대해 하는 것처럼 데이터 수집 전에 별도로 등록된 사전 등록에서만 테스트됩니다.
이해 상충. 논문에서 선언한 대로입니다.
파일. 예측 표(CSV 및 첨부 논문의 표 A6); 아카이브된 스냅샷 목록; predictions/resolve/(동결된 쿼리, 목록 및 코드북, 해시 포함); resolution-rules.md; changelog-v1-v2.md.
첨부된 예측 표는 표 A6이며, 그림 A1은 해당 달력을 그립니다.
그림 A1. 2026~2031년의 확인 달력입니다.
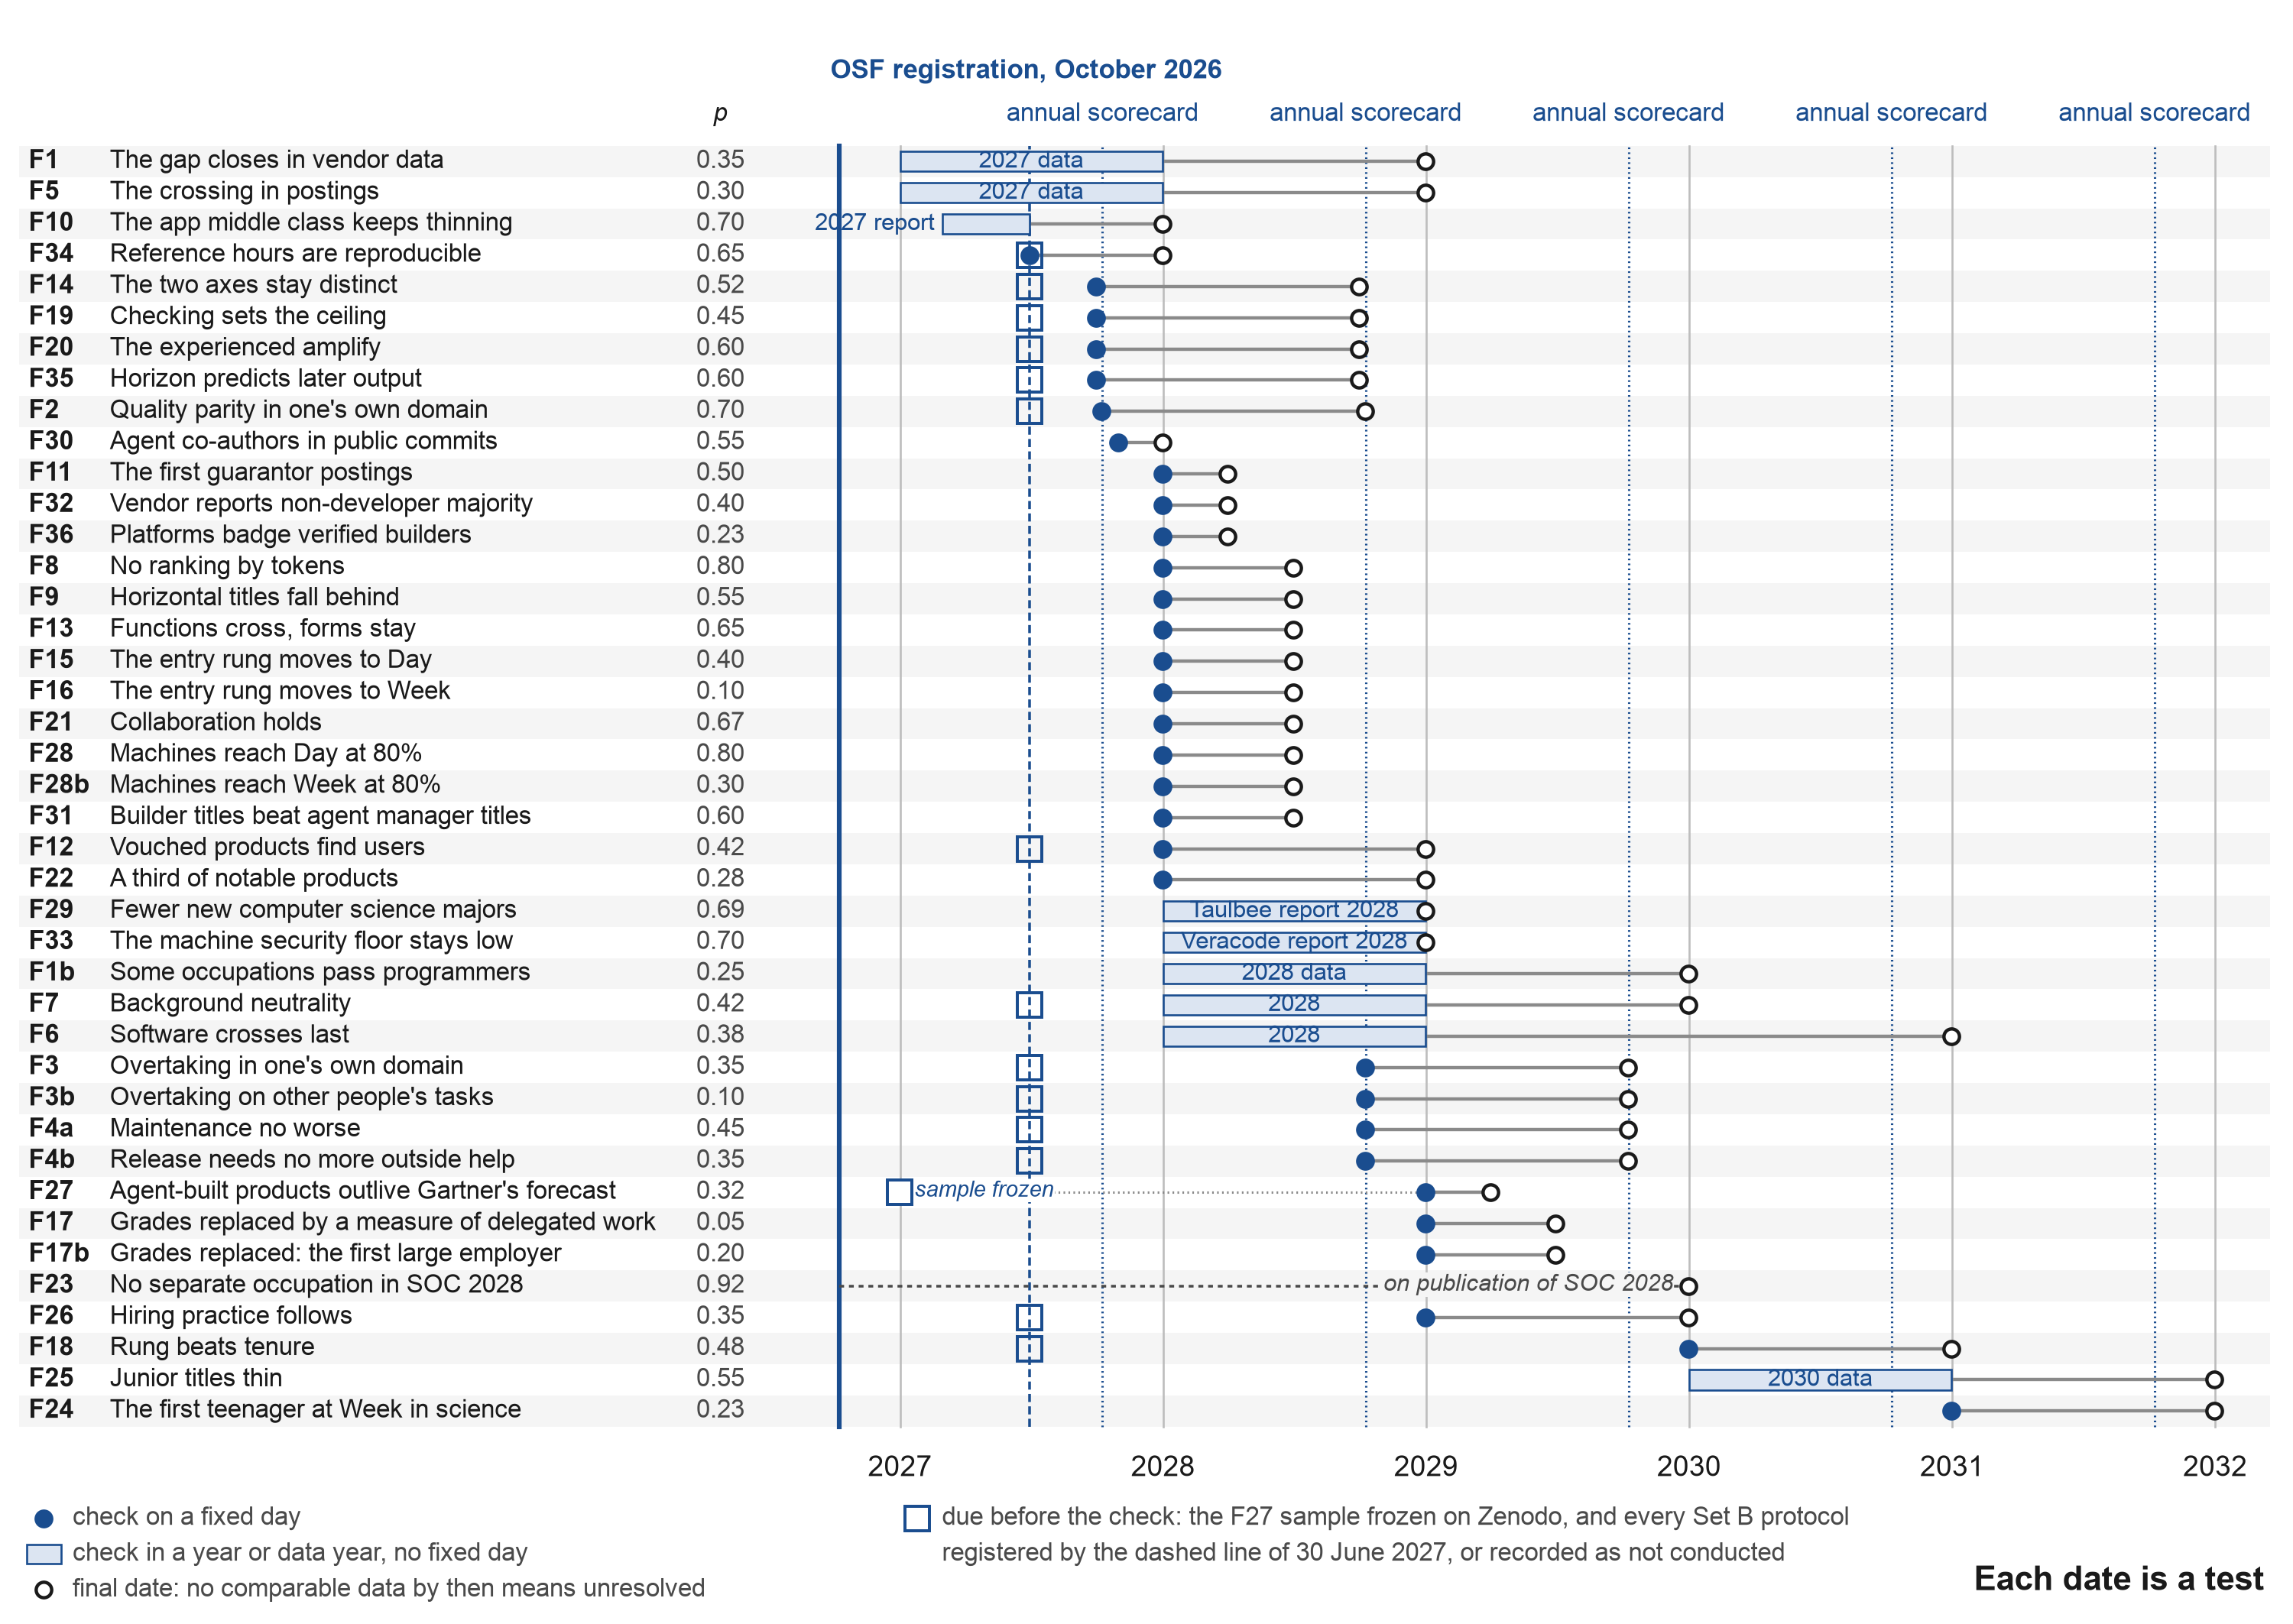
주: 표 A6의 예측 1행씩, 확인 날짜별로 정렬되며 확률을 포함합니다. 채워진 점은 고정된 날짜의 확인입니다. 밝은 막대는 고정된 날짜 없이 연도 또는 데이터 연도의 확인입니다. 링은 최종 날짜이며, 그 후 비교 가능한 데이터가 없는 예측은 미결정으로 기록됩니다(섹션 11.4). 점선은 OSF에 2027년부터 2031년 10월까지 등록할 연간 스코어카드를 표시합니다. 속이 빈 사각형은 확인 전 기한을 표시합니다: 2026년 12월 31일까지 Zenodo에 동결된 F27 샘플, 그리고 2027년 6월 30일의 대시선에 14개 세트 B 연구 각각의 프로토콜. 프로토콜이 없으면 예측은 미수행으로 기록됩니다(섹션 11.2). 그림은 예측 표 자체에서 동반 저장소의 figures/figure_a1_calendar.py로 생성되며, 표와만 함께 변경됩니다.
표 A6. 모든 41개의 시간 지정 예측: 세트, 측정, 임계값, 확률, 모델 예측, 대체 및 이전 예측입니다.
| # (세트) | 예측, 측정, 기준 및 임계값 | 날짜, 확률, 모델 예측, 미결정 규칙, 대체 및 이전 예측 |
|---|---|---|
| F1 (A) | 벤더 데이터에서 간격이 좁혀집니다. 코드 생성 세션에서 검증된 성공, 프로그래밍 대 다른 직업: 34% 대 29%, 7개월 동안 변경 없음(Anthropic, 2026e). 간격은 프로그래밍 직업의 성공률에서 다른 직업의 성공률을 뺀 값이며, 부호가 포함됩니다. 2027년 데이터에 대한 비교 가능한 보고서에서 간격이 2포인트 이하(음수 포함)이면 참이고, 2포인트 이상이면 거짓입니다. 기준: 코드 생성 세션에서 검증된 성공: 프로그래밍 34% 대 다른 직업 29%, 7개월 동안 변경 없음(Anthropic, 2026e) | 확인: 2027년 데이터. 최종 날짜: 2028년 12월 31일. p = 0.35; 모델 0.39 (0.25~0.65). 미해결 조건: 최종 날짜까지 2027년 데이터 보고 없음, 또는 세션 정의 변경 (성공으로 계산되지 않음). 대체안: 비교 가능한 세션에서 직업별 검증된 성공을 보고하는 모든 공급업체 보고서. 최근 또는 반대 예측: Anthropic: 격차 "확대되지도 좁혀지지도 않음" |
| F1b (A) | 일부 직업이 프로그래머를 초과합니다. F1과 동일한 측정. 10대 프로그래밍 외 직업은 Anthropic (2026e)에서 세션 점유율이 가장 큰 10개 직업으로 등록 시점에 고정됩니다. 직업은 성공률이 2포인트 이상 높을 때만 프로그래밍을 초과합니다 (10개 비교에 대한 다중성 마진). 2028년 데이터에서 최소 3개가 그러할 경우 참으로 계산됩니다. 기준: F1과 동일; 관리직이 이미 프로그래밍보다 약간 앞서 있음 (Anthropic, 2026e) | 확인: 2028년 데이터. 최종 날짜: 2029년 12월 31일. p = 0.25; 모델 0.30 (0.20~0.45). 미해결 조건: 최종 날짜까지 2028년 데이터 보고 없음, 또는 세션 정의 변경 (성공으로 계산되지 않음). 대체안: F1과 동일. 최근 또는 반대 예측: 관리직이 이미 프로그래밍보다 약간 앞서 있음 (Anthropic, 2026e) |
| F2 (B) | 자신의 영역에서의 품질 동등성 (교차점 이전 단계). 동일 에이전트, 동일 시간, 맹목적 수용 및 보안 검사, 1개월 후 다른 에이전트에 의한 유지보수 변경; 그룹당 1,500명 1개 연구. 95% 구간의 하한 (IT 교육을 받지 않은 사람 빼기 프로그래머)이 마이너스 10포인트를 초과할 경우 참으로 계산됩니다; 상한이 마이너스 10 아래에 있을 경우 거짓; 그 외의 경우 미해결. 기준: 공개 기준 없음; 별도로 사전등록된 연구, 그룹당 1,500명 | 확인: 2027년 10월 8일. 최종 날짜: 2028년 10월 8일. p = 0.70; 모델 0.67 (0.62~0.70). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음, 또는 어느 규칙도 충족하지 않는 구간 (성공으로 계산되지 않음). 대체안: 동일한 설계의 독립적 연구. 최근 또는 반대 예측: D. H. Hansson (2026), "100%" (날짜 없음, 측정 없음); Esnaola et al. (2026) |
| F3 (B) | 자신의 영역에서의 초월 (품질의 교차점). F2와 동일 (그룹당 1,500명은 양측 알파 0.05에서 5포인트의 참 이점을 감지할 약 0.8의 검정력 제공; 그룹당 400명은 약 0.3 제공). 95% 구간의 하한이 0 초과일 경우 참으로 계산됩니다; 상한이 0 미만일 경우 거짓; 그 외의 경우 미해결. 기준: F2와 동일 | 확인: 2028년 10월 8일. 최종 날짜: 2029년 10월 8일. p = 0.35; 모델 0.33 (0.25~0.55). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음, 또는 어느 규칙도 충족하지 않는 구간 (성공으로 계산되지 않음). 대체안: F2와 동일. 최근 또는 반대 예측: 날짜가 있는 것 없음 |
| F3b (B) | 다른 사람의 업무에서의 초월. F3와 동일하되, 참가자 자신의 영역 외 업무에서. 기준: F2와 동일하되, 참가자 자신의 영역 외 업무에서 | 확인: 2028년 10월 8일. 최종 날짜: 2029년 10월 8일. p = 0.10; 모델 0.13 (0.07~0.35). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음, 또는 어느 규칙도 충족하지 않는 구간 (성공으로 계산되지 않음). 대체안: F2와 동일. 최근 또는 반대 예측: 섹션 6.3의 영역 논증은 실패를 예측합니다 |
| F4a (B) | 유지보수 악화 없음. 저자 교육별 12개월 내 포기된 수용 제품의 점유율. 95% 구간의 상한 (프로그래머 빼기 비프로그래머의 차이)이 10포인트 미만일 경우 참으로 계산됩니다. 기준: 공개 기준 없음; Gartner (Tyagi, 2026, Tray.ai, 2026 요약)는 2028년까지 감정 코딩 애플리케이션의 60% 폐기 예상, 모든 애플리케이션 계산 | 확인: 2028년 10월 8일. 최종 날짜: 2029년 10월 8일. p = 0.45; 모델 0.49 (0.34~0.68). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음, 또는 어느 규칙도 충족하지 않는 구간 (성공으로 계산되지 않음). 대체안: 저자 조사를 포함한 제품 등록부. 최근 또는 반대 예측: Gartner (Tyagi, 2026, Tray.ai, 2026 요약): 2028년까지 감정 코딩 애플리케이션의 60% 폐기 "예측 가능한 비즈니스 가치 제공 실패로"; F4a보다 더 광범위한 모집단으로 수용 제품만 계산 |
| F4b (B) | 출시에 더 이상 외부 도움 필요 없음. 출시 시 외부 기술 지원이 필요한 제품의 점유율. 10포인트 마진의 비열등성일 경우 참으로 계산됩니다; 격차는 프로토타입, 출시, 유지보수 순서로 축소될 것으로 예상됩니다. 기준: 공개 기준 없음 | 확인: 2028년 10월 8일. 최종 날짜: 2029년 10월 8일. p = 0.35; 모델 0.37 (0.22~0.50). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음, 또는 어느 규칙도 충족하지 않는 구간 (성공으로 계산되지 않음). 대체안: F4a와 동일. 최근 또는 반대 예측: Gartner (Tyagi, 2026, Tray.ai, 2026 요약): 소프트웨어 엔지니어링 팀의 30%가 시민 개발자와 비즈니스 사용자가 구축한 감정 코딩 애플리케이션 유지보수로부터 "실질적 역량 부담" 상태 |
| F5 (A) | 공고에서의 교차 (가시적 신호). 고정된 IT 직업 집합의 미국 공고; 등록 날짜에 현재인 Lightcast Open Skills 택소노미 릴리스로 정의된 에이전트 스킬 (버전 번호는 predictions/resolve/F5.md에 기록); 해당 스킬을 가진 공고에서 4년 학위를 요구하는 점유율 대 그 스킬 없는 공고로, 직업 (SOC 6자리), 수준, 주 및 분기별로 정확하게 일치. 에이전트 기준 (2026 Q2 및 Q3)은 등록 전에 가져와 보관됩니다. 차이가 2포인트 이상 음수이고 95% 구간이 0을 제외하는 2027년의 연속 2분기에서 참으로 계산됩니다. 기준: AI 공고는 여전히 학위를 요구할 가능성이 높지만 2024년 이후 수렴 중 (Lightcast, 2026b); 에이전트 기준은 등록 전에 가져옵니다 | 확인: 2027년 데이터. 최종 날짜: 2028년 12월 31일. p = 0.30; 모델 0.34 (0.25~0.60). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음 (성공으로 계산되지 않음). 대체안: PwC AI Jobs Barometer (에이전트 스킬을 가진 공고에 대한 학위 요구사항을 일치된 공고와 보고할 경우만); 그 외의 경우 미해결. 최근 또는 반대 예측: Gartner (2021): 2024년까지 IT 외부에서 구축된 기술 제품 대부분; Bone et al. (2025) 영국 공고의 AI 스킬 |
| F6 (A) | 소프트웨어가 마지막에 교차합니다. 고정된 도메인 목록: 법률, 회계 및 부기, 교육, 임상 행정, 마케팅, 부동산, 보험, 인사, 물류, 소프트웨어 개발, IT 인프라, 보안, 개발자 도구. 도메인별 첫 번째 F5형 교차의 순서. 소프트웨어 개발, 인프라, 보안, 개발자 도구가 모두 다른 도메인의 절반 이상이 교차한 후에 교차하면 참입니다. 기준: 아직 교차한 도메인이 없습니다(F5형 비교). | 확인: 2028년. 최종 일자: 2030년 12월 31일. p = 0.38; 모델 0.37 (0.25~0.55). 미결정 조건: 최종 일자까지 고정된 비소프트웨어 도메인 중 절반 미만이 교차했거나, 비교 가능한 출처가 없는 경우(성공으로 계산되지 않음). 대체안: 동일한 F5형 도메인별 비교를 사용하는 다른 게시물 출처; 품질 연구(F2형)는 계산되지 않으며, 이러한 출처가 없으면 예측은 미결정입니다. 가장 가까운 사전 또는 반대 예측: Hwang (2026): 금융 "광산의 카나리" |
| F7 (B) | 배경 중립성. IT 교육에 대한 질문이 있는 별도 등록 코호트; 지평선은 한 가지 작업 세트로 채점되고, 품질은 보류된 작업으로 채점됩니다. 동일 수준의 IT 교육과 관련된 독립적 확인 통과의 오즈비(도메인 명령 및 수용 문해력 통제). 0.67~1.5 범위는 1.5의 오즈비(어느 쪽이든), 표준화된 차이 약 0.22입니다(Chinn 변환). 종래의 작은 효과입니다. 90% 신뢰 구간이 0.67~1.5(동등성) 범위 내에 있으면 참이며, Day와 Week 이상에서 각각 참입니다. 기준: 공개 기준이 없음; IT 교육에 대한 질문이 있는 별도 등록 코호트 | 확인: 2028년. 최종 일자: 2029년 12월 31일. p = 0.42; 모델 0.43 (0.40~0.48). 미결정 조건: 한 수준에서만 동등성이 표시된 경우를 포함하여 다른 모든 조합, 또는 최종 일자까지 데이터가 없는 경우(성공으로 계산되지 않음). 대체안: 동일한 항목을 가진 독립적 코호트. 가장 가까운 사전 또는 반대 예측: Anthropic의 도메인 명령 관찰; Savva (2026), 경쟁 상대 |
| F8 (A) | 토큰 수로 순위를 매기지 않습니다. 2027년 동안 공식 평가 기준으로 토큰 수를 사용하는 Fortune 500 고용주(고용주 또는 독립적 출처 두 곳에서 기록됨)(AI 사용 관련 질문은 계산되지 않음). 그러한 고용주가 두 곳 미만인 경우 참입니다. 기준: 토큰 수가 2026년 평가 기준으로 시도됨(논문의 섹션 4). | 확인: 2027년 12월 31일. 최종 일자: 2028년 6월 30일. p = 0.80; 모델 0.79 (0.60~0.90). 미결정 조건: 최종 일자까지 비교 가능한 데이터가 없는 경우(성공으로 계산되지 않음). 대체안: predictions/resolve/F8.md의 고정된 쿼리를 사용한 비즈니스 언론 아카이브 검색. 가장 가까운 사전 또는 반대 예측: Kingy AI (2026): "제거되지 않고 강등됨"; Flowtivity (2026): "돌이킬 수 없음" |
| F9 (A) | 수평 직책이 뒤쳐집니다. 미국 게시물, 동일한 고정된 쿼리(predictions/resolve/F9.md), 2026년 4분기 및 2027년 4분기, 각 개수를 동일한 분기의 모든 미국 게시물로 나눔: 에이전트 관리자, AI 운영자, AI 오케스트레이터 대 도메인을 명명하는 직책(예: "법률 AI 리드", "수직 AI 리드"). 정규화된 도메인명 직책의 몫이 수평 직책의 몫보다 더 큰 요인으로 증가하면 참입니다. 기준: 2026년 4분기의 고정된 쿼리에 대한 미국 게시물 수 | 확인: 2027년 12월 31일. 최종 일자: 2028년 6월 30일. p = 0.55; 모델 0.58 (0.45~0.75). 미결정 조건: 어느 한 쪽이 2026년 4분기에 50개 미만의 게시물을 가지고 있거나, 최종 일자까지 데이터가 없는 경우(성공으로 계산되지 않음). 대체안: 동일한 쿼리를 사용한 Indeed 또는 LinkedIn 검색 수. 가장 가까운 사전 또는 반대 예측: Srinivasan and Wei (2026): 12~18개월 내에 표준 직책인 "에이전트 관리자"; IT Brew (2026): "다음 18개월" |
| F10 (A) | 앱 중산층이 계속 줄어들고 있습니다. 2년 내에 월 1,000달러 수익에 도달하는 새로운 구독 앱의 몫(RevenueCat 2026과 동일한 측정, 17%). 17% 미만이면 참입니다. 기준: 새로운 구독 앱 중 17%가 2년 내에 월 1,000달러 수익에 도달합니다(RevenueCat, 2026). | 확인: RevenueCat 2027 보고서. 최종 일자: 2027년 12월 31일. p = 0.70; 모델 0.68 (0.60~0.80). 미결정 조건: 최종 일자까지 비교 가능한 데이터가 없는 경우(성공으로 계산되지 않음). 대체안: Sensor Tower 또는 Appfigures 수익 임계값. 가장 가까운 사전 또는 반대 예측: RevenueCat 자체 추세(우선순위 없음); 많은 비공식 앱이 광고에서 수익을 얻으며, RevenueCat은 이를 보지 못합니다 |
| F11 (A) | 첫 번째 보증인 게시물입니다. 의료, 법률, 금융 또는 교육 분야에서 1,000명 이상의 직원을 보유한 고용주의 게시물로서 AI가 생성한 작업에 대한 서명 및 개인적 책임을 명시합니다. predictions/resolve/F11.md의 고정된 쿼리: "sign off"와 "AI-generated", "accountable for AI output", "AI attestation", "AI guarantor"; "guarantor" 또는 "credential"이 키 또는 액세스를 의미하는 게시물은 제외됩니다. 그러한 게시물이 5명 이상의 고용주로부터 최소 10개 이상 발견되어 보관되면 참입니다. 기준: 작성 시점에 그러한 게시물이 없습니다 | 확인: 2027년 12월 31일. 최종 일자: 2028년 3월 31일. p = 0.50; 모델 0.42 (0.25~0.55). 미결정 조건: 최종 일자까지 비교 가능한 데이터가 없는 경우(성공으로 계산되지 않음). 대체안: Google Jobs 및 LinkedIn을 통해 발견된 보관된 게시물. 가장 가까운 사전 또는 반대 예측: Capps (2025), "법적 보증인"; Forrester (2025): Fortune 100 중 60%가 AI 거버넌스 담당자를 임명할 예정 |
| F12 (B) | 보증된 제품이 사용자를 찾습니다. 자체 무작위 연구: 적격 제품 중에서 무작위로 배정된 명명된 보증인. 90일 내에 10명의 관계없는 사용자에게 도달하는 몫. 보증된 몫이 더 높고 95% 신뢰 구간이 0을 제외하면 참입니다. 기준: 공개 기준이 없음; 자체 무작위 연구 | 확인: 2027년 12월 31일. 최종 일자: 2028년 12월 31일. p = 0.42; 모델 0.43 (0.30~0.60). 미결정 조건: 최종 일자까지 비교 가능한 데이터가 없는 경우(성공으로 계산되지 않음). 대체안: 없음. 가장 가까운 사전 또는 반대 예측: Hashimoto's Vouch(예측이 아닌 메커니즘) |
| F13 (A) | 함수는 교차하고, 형식은 유지됩니다. 세 가지 비IT 전문 분야의 커리큘럼 및 게시물(코딩 전에 발행된 코드북으로 두 명의 코더에 의해 코딩됨)(predictions/resolve/F13-codebook.md): 확인, 비용으로 모델 선택 및 긴 실행 교육; 개인 지출 및 모델 캠프는 상위 계층 사용자 사이에서만 발견됨. 기능 주제가 상태 주제보다 최소 3:1의 비율로 많으면 참입니다. 기준: 공개 기준이 없음; 세 가지 비IT 전문 분야의 커리큘럼 및 게시물에 대한 두 명의 코더 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.65; 모델 0.69 (0.55~0.82). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 공개 과정 목록. 가장 가까운 선행 또는 상충 예측: Rogers (2003), 채택의 계층(우선순위 미주장) |
| F14 (B) | 두 축이 구별된 상태로 유지된다. 최소 200개의 로그에서 로그 호라이즌과 로그 이득 사이의 인물 수준 스피어만 상관계수. 상관계수가 0.8 이하이고 호라이즌에 더한 이득이 6개월 후 검증된 출력에 대한 표본 외 R 제곱을 최소 0.02만큼 증가시킬 경우 참이 됨. 기준선: 공개 기준선 없음; 최소 200개의 로그 | 확인: 2027년 9월 30일. 최종 날짜: 2028년 9월 30일. p = 0.52; 모델 0.49 (0.45~0.50). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 없음. 가장 가까운 선행 또는 상충 예측: 찾은 것 없음 |
| F15 (A) | 진입 단계가 Day로 이동한다. 소프트웨어 및 기타 세 직종의 고정된 샘플 200개 미국 진입 수준 채용공고 및 과제에서 두 평가자가 참조 시간으로 평가한 중앙값 첫 과제가 Day 이상이다. 기준선: 200개 미국 진입 수준 채용공고 및 과제의 고정된 샘플, 두 평가자가 참조 시간으로 평가함 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.40; 모델 0.49 (0.30~0.70). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: Indeed Hiring Lab 진입 수준 샘플. 가장 가까운 선행 또는 상충 예측: Washington Monthly (2026): "진입 수준 직무가 중급 직무처럼 되고 있음"; METR의 적합 호라이즌 추세 약 4.2개월마다 두 배 증가 |
| F16 (A) | 진입 단계가 Week로 이동한다. 동일한 측정; 중앙값이 Week 이상. 기준선: F15와 동일 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.10; 모델 0.14 (0.06~0.40). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: F15와 동일. 가장 가까운 선행 또는 상충 예측: Kwa et al. (2025), 기계 시간 호라이즌(사람이 아닌 기계) |
| F17 (A) | 성적이 위임된 업무의 척도로 대체된다. 미국 상위 50개 고용주 중 공개적으로 직급 사다리를 검증된 위임 업무의 척도로 대체하는 고용주. 최소 10개 이상인 경우 참이 됨. 기준선: 공개 기준선 없음 | 확인: 2028년 12월 31일. 최종 날짜: 2029년 6월 30일. p = 0.05; 모델 0.05 (0.02~0.20). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 고용주 제출 서류 및 보도자료. 가장 가까운 선행 또는 상충 예측: Gartner (2024): 2026년까지 조직의 20%가 구조를 평탄화하기 위해 AI를 사용할 것; Microsoft (2025): "에이전트 보스" |
| F17b (A) | 성적이 대체됨: 첫 번째 대규모 고용주. 미국 상위 50개 고용주 중 최소 1개 이상이 공개적으로 직급 사다리를 검증된 위임 업무의 척도로 대체한다. 기준선: 공개 기준선 없음 | 확인: 2028년 12월 31일. 최종 날짜: 2029년 6월 30일. p = 0.20; 모델 0.21 (0.05~0.50). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 고용주 제출 서류 및 보도자료. 가장 가까운 선행 또는 상충 예측: F17의 약한 쌍둥이 |
| F18 (B) | 단계가 근속 기간을 능가한다. 고용주 또는 집단 데이터에서 검증된 단계가 근무 연수보다 급여의 더 많은 분산을 설명함(평가된 성과는 급여를 사용할 수 없는 경우에만 사용되며, 분석 전에 고정됨). 기준선: 공개 기준선 없음 | 확인: 2029년 12월 31일. 최종 날짜: 2030년 12월 31일. p = 0.48; 모델 0.52 (0.40~0.60). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 출판된 인사 분석. 가장 가까운 선행 또는 상충 예측: Jaques (1956), 책임 범위에 따른 급여 |
| F19 (B) | 확인이 상한을 설정한다(표본 외). 최소 200개의 로그. 1~3개월에서 소비한 확인 및 호라이즌의 주의 비율; 4~6개월의 검증된 출력(이득 공식이 아닌 수락된 항목의 참조 시간). 보유된 인물에서 확인 비율이 호라이즌보다 나중의 검증된 출력과 더 높은 부분 상관을 가질 경우 참이 됨. 기준선: 공개 기준선 없음 | 확인: 2027년 9월 30일. 최종 날짜: 2028년 9월 30일. p = 0.45; 모델 0.44 (0.30~0.65). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 없음. 가장 가까운 선행 또는 상충 예측: Huang et al. (2026), 검증 증폭. v1은 구성상 호라이즌을 포함하는 이득을 사용함; v2는 나중에 별도로 측정된 결과를 예측함 |
| F20 (B) | 경험자들이 증폭한다. 지시 비율: 로그에서 확인 또는 편집이 아닌 명령을 주는 인물의 차례 비율. 검증된 이득: 인물의 주의 시간당 수락된 참조 시간. 6개월 동안 지시 비율이 감소한 인물 중에서 6개월의 검증된 이득이 0개월의 이득의 최소 95% 이상인 경우, 대다수에 해당함. 기준선: 공개 기준선 없음 | 확인: 2027년 9월 30일. 최종 날짜: 2028년 9월 30일. p = 0.60; 모델 0.62 (0.55~0.70). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 없음. 가장 가까운 선행 또는 상충 예측: Anthropic (2026d), 학습 곡선 |
| F21 (A) | 협업이 유지된다. Anthropic Economic Index의 API 샘플이 아닌 Claude.ai 대화 샘플에서 협업 사용(증강)의 비율이 2027년에 출판된 모든 보고서에서 40% 이상으로 유지된다. 기준선: 2025년 11월 협업 사용 52% vs 자동화 45% (Anthropic, 2026a) | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.67; 모델 0.68 (0.60~0.75). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음(성공으로 계산되지 않음). 대체: 다른 공급업체 보고서의 비교 가능한 비율. 가장 가까운 선행 또는 상충 예측: Anthropic (2026a): 2025년 11월 52% vs 45% |
| F22 (A) | 주목할 만한 제품의 3분의 1. 2027년 12개월의 Product Hunt 월간 리더보드 전체에서 가장 많은 찬성표를 받은 100개 제품, 2028년 1월 1일에 목록 고정. 나열된 제작자들은 코딩됨; 제품이 프로그래밍 교육 없이 만들어진 것으로 계산되면 나열된 제작자 중 누도 프로그래밍 교육 또는 과거 프로그래밍 직업을 명시하지 않은 경우(자습 프로그래머로 프로그래밍 직업을 가진 사람은 프로그래머로 계산됨). 두 명의 코더, 서로 모르는 상태. 100개 중 최소 30개 이상이 적격인 경우 참이 됨. 기준선: Manifold: 2026년 말까지 월 1억 명의 사용자를 가진 감각 코딩 소프트웨어, 약 28% | 확인: 2027년 12월 31일. 최종 날짜: 2028년 12월 31일. p = 0.28; 모델 0.29 (0.14~0.50). 미해결 조건: 100개 제품 중 50개 미만이 코딩 가능한 진술을 보유하거나 최종 날짜까지 데이터가 없는 경우 (성공으로 계산되지 않음). 대체: 2027년 해커 뉴스 Show HN 상위 100개의 두 번째 동결 순위. 가장 가까운 선행 또는 반대 예측: Gartner (2021); Manifold: 2026년 말까지 월간 활성 사용자 1억 명인 바이브 코딩 소프트웨어, 약 28% |
| F23 (A) | SOC 2028에 별도 직업 없음. 2028년 미국 표준 직업 분류에는 에이전트를 통한 업무를 위한 별도 직업이 없습니다. 기준: SOC 2018에는 이러한 직업이 없습니다 | 확인: SOC 2028 발행. 최종 날짜: 2029년 12월 31일. p = 0.92; 모델 0.93 (0.80~0.98). 미해결 조건: 최종 날짜까지 비교 가능한 데이터가 없는 경우 (성공으로 계산되지 않음). 대체: BLS 개정 공지 (2026년 10월 9일 확인: 아직 제안되거나 최종 구조가 없음; 최종 구조는 2027년에 예상됨). 가장 가까운 선행 또는 반대 예측: 찾은 것 없음 |
| F24 (A) | Science Week의 첫 번째 십대. 과학 제품은 최소 10명의 관련 없는 사람이 발표한 연구에 사용하거나 최소 1개의 동료심사 논문에 인용된 소프트웨어, 데이터셋 또는 논문입니다. 정규 교육 없이 18세 미만인 사람이 그러한 사용자를 가진 과학 제품을 보유하고 독립적 확인 하에 Week를 획득한 공개적으로 문서화된 사례입니다. 기준: 작성 시점에 그러한 문서화된 사례 없음 | 확인: 2030년 12월 31일. 최종 날짜: 2031년 12월 31일. p = 0.23; 모델 0.21 (0.02~0.45). 미해결 조건: 검색 소스를 사용할 수 없는 경우에만; 최종 날짜까지 문서화된 사례가 없는 것은 아닙니다. 대체: 없음. 가장 가까운 선행 또는 반대 예측: 중국의 2030년까지 모든 학교에서의 AI 교육 목표 (CSET, 2025) |
| F25 (A) | 주니어 직책 축소. 2025년 동일 쿼리에 대한 2030년의 "junior" 또는 "entry-level"을 직책에 포함한 미국 소프트웨어 공고 비중. 최소 3분의 1 감소 시 실현. 기준: 2025년의 동일 쿼리에 대한 "junior" 또는 "entry-level"을 직책에 포함한 미국 소프트웨어 공고 비중 | 확인: 2030년 데이터. 최종 날짜: 2031년 12월 31일. p = 0.55; 모델 0.54 (0.45~0.60). 미해결 조건: 최종 날짜까지 비교 가능한 데이터가 없는 경우 (성공으로 계산되지 않음). 대체: Indeed Hiring Lab. 가장 가까운 선행 또는 반대 예측: Manifold: 2030년까지 주니어 개발자 역할 3분의 1 감소, 약 74%; 미국 개발자 2023년에서 2028년까지 15% 이상 감소, 약 42%; 시장 0.74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 2026년 10월 9일 (주니어 SWE 공석 2030년 1월 1일까지 최소 33% 감소; 관련되었으나 동일하지 않은 지표)) |
| F26 (B) | 고용 관행 추종. 자체 감사 연구: IT 교육에서만 다른 확인된 업무 포트폴리오를 두 개의 비IT 분야의 실제 공고에 제출. IT 교육 여부에서만 다름. 콜백 비율이 3포인트 미만으로 다르고 95% 신뢰 구간이 플러스 마이너스 5 내에 있으면 실현. 기준: 공개 기준 없음; 자체 감사 연구 | 확인: 2028년 12월 31일. 최종 날짜: 2029년 12월 31일. p = 0.35; 모델 0.32 (0.25~0.35). 미해결 조건: 최종 날짜까지 비교 가능한 데이터가 없거나 두 규칙을 모두 충족하지 않는 신뢰 구간 (성공으로 계산되지 않음). 대체: 없음. 가장 가까운 선행 또는 반대 예측: Burning Glass Institute와 Harvard Business School (2024): 700명 중 1명 미만이 변경됨 |
| F27 (A) | 에이전트 구축 제품이 Gartner의 예측을 능가합니다. 2026년 10월~12월에 주로 코딩 에이전트로 구축되고 2026년 12월 31일까지 Zenodo에 동결된 최소 300개의 공개 제품 샘플; 동반 스크립트로 생동성 확인됨. 2028년 12월 31일에 50% 미만이 폐기된 경우(도달 불가능하거나 12개월 동안 업데이트되지 않음) 실현. 기준: Gartner (Tyagi, 2026): 2028년까지 바이브 코딩 애플리케이션의 60% 폐기 | 확인: 2028년 12월 31일. 최종 날짜: 2029년 3월 31일. p = 0.32; 모델 0.35 (0.20~0.55). 미해결 조건: 샘플이 2026년 12월 31일까지 동결되지 않은 경우 (성공으로 계산되지 않음). 대체: 각 제품의 Wayback Machine 스냅샷. 가장 가까운 선행 또는 반대 예측: Gartner (Tyagi, 2026): 60% 폐기 |
| F28 (A) | 기계가 80%에서 Day에 도달합니다. 가장 우수한 공개 출시 모델에 대한 METR의 80% 시간 지평이 2027년 12월 31일까지 8시간(Day)에 도달합니다. 기준: 2026년 4월에 80%에서 약 3.1시간 (METR, 2026c; 대시보드는 2026년 9월 8일 이후 업데이트되지 않음) | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.80; 모델 0.66 (0.55~0.80). 미해결 조건: METR 또는 대체가 최종 날짜까지 80% 지평을 보고하지 않음 (성공으로 계산되지 않음). 대체: METR 방법의 독립적 복제 (예: Epoch AI). 가장 가까운 선행 또는 반대 예측: METR의 적합된 지평 추세가 약 4.2개월마다 배가 |
| F28b (A) | 기계가 80%에서 Week에 도달합니다. F28과 같으나 임계값 40시간(Week). 기준: F28과 같음 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.30; 모델 0.20 (0.10~0.55). 미해결 조건: F28과 같음. 대체: F28과 같음. 가장 가까운 선행 또는 반대 예측: F28과 같음 |
| F29 (A) | 신입 컴퓨터 과학 전공이 감소합니다. 2028년에 발행된 CRA Taulbee Survey가 보고한 신입 학부 전공 컴퓨터 과학 대 2026년에 발행된 설문조사. 기준: 2026년에 발행된 CRA Taulbee Survey | 확인: Taulbee 보고서 2028. 최종 날짜: 2028년 12월 31일. p = 0.69; 모델 0.67 (0.50~0.75). 미해결 조건: 최종 날짜까지 비교 가능한 데이터가 없는 경우 (성공으로 계산되지 않음). 대체: NSC Research Center 전공별 등록. 가장 가까운 선행 또는 반대 예측: 2025년과 2026년의 CS 등록 감소에 대한 CRA 보고서 |
| F30 (A) | 공개 커밋의 에이전트 공저자. GH Archive의 공개 푸시 이벤트 중 커밋 메시지가 에이전트 공저자 트레일러를 포함하는 비율 (predictions/resolve/F30.md의 동결된 정규 표현식), 2026년 9월 대 2027년 9월. 기준: GH Archive, 2026년 9월, 등록 전 측정 및 보관 | 확인: 2027년 10월 31일. 최종 날짜: 2027년 12월 31일. p = 0.55; 모델 0.59 (0.40~0.75). 미해결 조건: 최종 날짜까지 비교 가능한 데이터가 없는 경우 (성공으로 계산되지 않음). 대체: GitHub Innovation Graph. 가장 가까운 선행 또는 반대 예측: 찾은 것 없음 |
| F31 (A) | Builder 직책이 에이전트 매니저 직책을 능가합니다. 미국 공고, 동결된 Indeed 쿼리 (predictions/resolve/F31.md), Q4 2027: builder 계열 직책 대 에이전트 매니저 계열 직책. 기준: 동일 쿼리의 Q4 2026 수치 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 6월 30일. p = 0.60; 모델 0.63 (0.50~0.74). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음 (성공으로 계산되지 않음). 대체 방법: 동일한 쿼리를 사용한 LinkedIn 검색 횟수. 가장 가까운 이전 또는 반대 예측: Srinivasan and Wei (2026): "agent manager"가 12~18개월 내에 표준 직책 |
| F32 (A) | 공급업체가 자신의 코딩 에이전트 사용자 대부분이 개발자가 아니라고 말합니다. Anthropic, OpenAI, Google 또는 GitHub에서 만든 코딩 에이전트의 공급업체가 해당 에이전트의 주간 사용자 대부분이 소프트웨어 개발자가 아님을 공개적으로 보고합니다. 기준: 작성 당시 그러한 보고서 없음 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 3월 31일. p = 0.40; 모델 0.31 (0.13~0.70). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음 (성공으로 계산되지 않음). 대체 방법: 공급업체 경제 또는 사용 현황 보고서. 가장 가까운 이전 또는 반대 예측: 앱 빌더 공급업체 (Lovable, Replit)는 이미 대부분 개발자가 아닌 사용자를 설명합니다; 이것은 일반 코딩 에이전트에 대해 묻습니다 |
| F33 (A) | 머신 보안 기준선이 낮게 유지됩니다. Veracode의 GenAI 코드 보안 보고서에서 보안 테스트를 통과하는 AI 생성 코드 샘플의 비중. 기준: 56% 통과율, 정체 (Veracode, 2026) | 확인: 2028년 Veracode 보고서. 최종 날짜: 2028년 12월 31일. p = 0.70; 모델 0.67 (0.57~0.80). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음 (성공으로 계산되지 않음). 대체 방법: 생성된 코드의 보안에 대한 비교 가능한 독립적 벤치마크. 가장 가까운 이전 또는 반대 예측: Veracode: 최신 모델에서도 보안 개선 없음 |
| F34 (B) | 참조 시간이 재현 가능합니다. 두 개의 독립적인 3명 평가자 패널이 동일한 50개 작업에 대한 참조 시간을 추정합니다; 로그 시간의 급내 상관 계수 (양방향, 절대 일치). 기준: 임계값의 데스크 파일럿 (부록 E) | 확인: 2027년 6월 30일. 최종 날짜: 2027년 12월 31일. p = 0.65; 모델 0.65 (0.40~0.75). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음, 또는 두 규칙을 모두 충족하지 않는 간격 (성공으로 계산되지 않음). 대체 방법: 없음. 가장 가까운 이전 또는 반대 예측: METR의 인간 기준선 (사람이 아닌 기계) |
| F35 (B) | 지평선이 나중의 결과를 예측합니다. 최소 200개 로그: 월 0의 지평선을 재직 기간 및 IT 교육과 함께 더하면 4~6개월의 검증된 결과에 대한 표본 외 R 제곱이 상승합니다. 기준: 공개 기준선 없음 | 확인: 2027년 9월 30일. 최종 날짜: 2028년 9월 30일. p = 0.60; 모델 0.58 (0.45~0.70). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음 (성공으로 계산되지 않음). 대체 방법: 없음. 가장 가까운 이전 또는 반대 예측: Burning Glass Institute and Harvard Business School (2024) |
| F36 (A) | 플랫폼이 검증된 빌더에 배지를 부여합니다. Upwork, Fiverr, GitHub, Product Hunt, Toptal 및 Contra 중 최소 2개가 독립적으로 검증된 AI 빌드 작업을 인증하는 공개 배지 또는 프로필 필드를 도입합니다 (기술 퀴즈 아님). 기준: 작성 당시 그러한 배지 없음 | 확인: 2027년 12월 31일. 최종 날짜: 2028년 3월 31일. p = 0.23; 모델 0.24 (0.07~0.70). 미해결 조건: 최종 날짜까지 비교 가능한 데이터 없음 (성공으로 계산되지 않음). 대체 방법: 플랫폼 도움말 페이지 및 아카이브된 공지사항. 가장 가까운 이전 또는 반대 예측: 찾은 것 없음 |
참고: 세트 A는 공개 데이터에서 해결되고, 세트 B는 별도로 사전등록된 연구에서 해결됩니다 (프로토콜 2027년 6월 30일까지, 그렇지 않으면 실시되지 않으며, 스코어카드에서는 이를 테스트 프로그램의 실패로 계산합니다). p는 해결을 조건으로 합니다. 모델: 내 숫자를 보지 않은 독립 모델 예측 담당자의 홀드 기하 평균과 그들의 범위; 개별 예측은 predictions/m2-probabilities.csv에 있습니다. Came-true 및 did-not 규칙은 예측/predictions.csv의 모든 행에 있습니다. F4a 및 F4b 행에서 Gartner 예측은 참고 목록에서 Tray.ai (2026)의 요약을 통해 인용되며, 자신의 단어가 인용됩니다; 등록된 파일은 동일한 예측과 동일한 숫자를 더 간단히 제공하고 Gartner (Tyagi, 2026)를 인용합니다.
부록 E. 임계값의 데스크 테스트
이 부록은 2026년 10월 9일에 시뮬레이션과 모델 평가자를 통해 실행된 섹션 5.2의 규칙에 대한 데스크 테스트 결과를 보고하며, 다음 버전을 규정하는 보정 프로토콜을 제시합니다. 모든 숫자는 동반 저장소의 두 스크립트(pilot/)에서 생성되며, 이들은 부록 C의 평가자를 변경하지 않은 상태로 호출하고 그 상수만 교환합니다.
E1. 런그가 획득되는 빈도
조각이 참 확률 p로 독립적으로 통과하는 사람의 경우, 표 E1은 윈도우 내에서 정확히 최소 조각 수로 각 런그를 획득할 확률을 제공합니다. 값은 정확한 이항 확률이며, horizon.py를 통한 몬테카를로 실행(조각이 윈도우에 걸쳐 분산되고 의도적 오류 및 최근 조각이 제자리에 있음)은 0.01 범위 내에서 일치합니다.
표 E1. 참 통과율별 런그 획득 확률.
| 규칙 | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| 시간 및 일, 91일 내 10개 중 8개 | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| 주, 182일 내 6개 중 5개 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| 월, 첫 번째 버전, 365일 내 4개 중 4개 | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| 월, 현재, 365일 내 6개 중 5개 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| 분기, 365일 내 3개 중 3개 | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
주: 규칙은 자격 규칙입니다. 이러한 확률은 규칙을 설명하며, 개인을 설명하지 않습니다.
세 가지 결과가 도출됩니다. 첫째, 첫 번째 버전은 정렬되지 않았습니다: 월(4개 중 4개)은 모든 p에서 분기보다 획득하기 어려웠습니다. 5개 중 4개의 개수는 오류를 역으로 만들어 p = 0.8(0.74)에서 월을 일 및 주보다 쉽게 만들었을 것이므로, 월은 이제 1년에 6개 중 5개를 요구하며, 약 640 참조 시간 대신 960 참조 시간입니다. 이를 통해 일, 주, 월, 분기는 0.77 이상의 모든 p에 대해 가장 쉬운 것부터 가장 어려운 것까지 정렬되며, 이는 자격이 중요한 범위입니다. 0.76 이하에서는 주가 일보다 약간 더 쉽습니다(p = 0.7에서 0.42 대 0.38). 둘 다 대부분 거부되며, 이는 보고되고 변경되지 않은 상태로 유지됩니다. 곡선이 교차하기 때문에 3개 이상의 조각 수는 모든 p에서 3개 중 3개에 대해 정렬될 수 없습니다. 둘째, 평가는 잡음이 있습니다: p = 0.8에서 다음 윈도우의 동일한 평가는 일 56%, 주 55%, 월 55%, 분기 50%의 윈도우에서 반복됩니다. 따라서 기록은 런그 옆에 개수를 출력하며("일(8/10)"), 보고서는 런그가 이전 윈도우에서도 유지되었을 때 런그를 안정적으로 표시할 수 있습니다. p = 0.8에서 연속된 두 윈도우에서 일이 유지되는 경우는 46%의 경우에서 발생하므로, 안정성은 요구 사항이 아닌 라벨입니다. 셋째, 신뢰할 수 있는 사람도 놓칠 수 있습니다: p = 0.95에서 분기는 14%의 연도에서 놓쳐지며, 이는 3개의 조각에 의존하는 런그의 대가입니다.
그림 A2, 패널 A는 규칙 v1.1에 대해 이러한 확률을 p에 대해 나타냅니다.
E2. 개수 및 점유율에 대한 민감도
논문은 개수가 10에서 8 또는 12로 이동하고 점유율이 0.8에서 0.7 또는 0.9로 이동할 때 몇 명이 런그를 변경하는지 보고하겠다고 약속했습니다. 답은 일 크기의 6개에서 16개 조각을 윈도우에 가지고 있는 10,000개의 시뮬레이션된 로그에서 일에서 주어지며, 참 통과율은 0.5에서 1.0 사이에 균등하게 추출됩니다. 현재 규칙(10, 0.8)은 그 중 30%에 일을 제공하며, 표 E2는 다른 규칙에서 평가가 변경되는 점유율을 제공합니다.
표 E2. 10개 조각 및 0.8의 점유율에 대비하여 일 평가가 변경된 시뮬레이션된 로그의 점유율.
| 최소 개수 | 점유율 0.7 | 점유율 0.8 | 점유율 0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
주: 로그의 모집단은 시뮬레이션의 가정입니다. E5의 필드 연구는 실제 로그에서 이 분석을 반복합니다.
상수 하나를 한 단계 이동하면 약 10개 중 1개의 평가가 변경됩니다. 두 개를 모두 이동하면 최대 5개 중 1개가 변경됩니다. 점유율이 개수보다 더 중요합니다.
E3. 런그 가장자리에서의 평가자 잡음
두 평가자가 편향되지 않고 그들의 쌍의 80%가 1.5의 비율 내에 떨어지면(섹션 5.8의 70% 기준 이상), 참조가 두 추정값의 기하평균이면, 참 크기가 7 참조 시간인 조각은 20%의 시간에 일 크기로 점수가 매겨지며, 9시간의 조각은 23%의 시간에 일 크기에 미치지 못합니다. 이것이 기록이 런그 옆에 중앙값 허용 크기를 보고하는 이유입니다(표 3): 임계값 바로 위의 조각에 구축된 지평선이 표시됩니다.
E4. 참조 시간의 모델 평가자
4개 가족(Anthropic, OpenAI, Google, Moonshot)의 4개 언어 모델은 각각 단독으로 작동하고 다른 모델 및 공개된 시간에 맹목적이며, 2026년 10월 9일에 44개 작업의 참조 시간을 추정했습니다. 30개는 3개의 저위험 도메인의 새로운 은행 작업(소규모 사업 회계, 소규모 내부 웹 도구, 법률 및 마케팅 문서)이었으며, 각각 완료 진술과 숨겨진 확인이 있습니다. 14개는 METR의 시간 지평선 데이터(METR, 2026d)의 공개 작업으로 12분에서 14.6시간의 측정된 인간 기준선 시간이 있었으며, 공개 식별자만으로 평가자에게 제공되었습니다. 표 E3은 결과를 제공합니다.
표 E3. 4명의 맹목적 모델 평가자의 일치도 및 정확도.
| 측정 | 30개 작업의 은행(완료 진술) | 측정된 시간이 있는 14개 작업(식별자만) |
|---|---|---|
| 1.5의 비율 내의 추정값 쌍(평가자의 6개 쌍) | 62%(쌍별로 27%에서 97%) | 35% |
| 급내 상관 계수 ICC(2,1), 로그 시간 | 0.89 | 0.60 |
| 모든 4명의 평가자가 동일한 런그 크기에서 작업을 배치 | 60% | 36% |
| 4명의 평균이 측정된 시간의 1.5 범위 내 | 측정되지 않음 | 21%(14개 중 3개) |
| 4명의 평균이 측정된 시간의 2 범위 내 | 측정되지 않음 | 43%(14개 중 6개) |
주의: 모델 평가자는 5.1절의 두 명의 인간 평가자를 대신하며 그들에 대한 증거가 아닙니다.
완전한 완료 진술이 주어졌을 때, 모델들은 어떤 작업이 더 컸는지에 대해서는 동의했지만 수준에 대해서는 동의하지 않았습니다. 한 평가자의 은행 전체 추정치의 기하평균은 5.1시간이고 다른 평가자의 것은 10.4시간이었습니다. 이러한 종류의 고정 오프셋은 제거하기 가장 저렴한 오류이며, 이것이 현장 연구의 평가자들이 먼저 측정된 시간의 작업으로 보정하는 이유입니다. 식별자만 주어졌을 때, 추정치는 거의 쓸모가 없었으며, 이는 제목에서 만든 추정치보다는 측정된 손으로 계산한 시간의 동결된 은행(5.1절)을 지원합니다. 표 3의 규칙에 따르면, 1.5 이상의 불일치가 항목을 세 번째 평가자에게 보내는 경우, 그러한 두 명의 평가자는 10개 중 약 4개 항목을 세 번째 평가자에게 보낼 것입니다.
그림 A2. 책상 위의 단계 규칙: 단계를 획득할 확률과 모델 평가자들이 시간에 대해 얼마나 동의하는지.
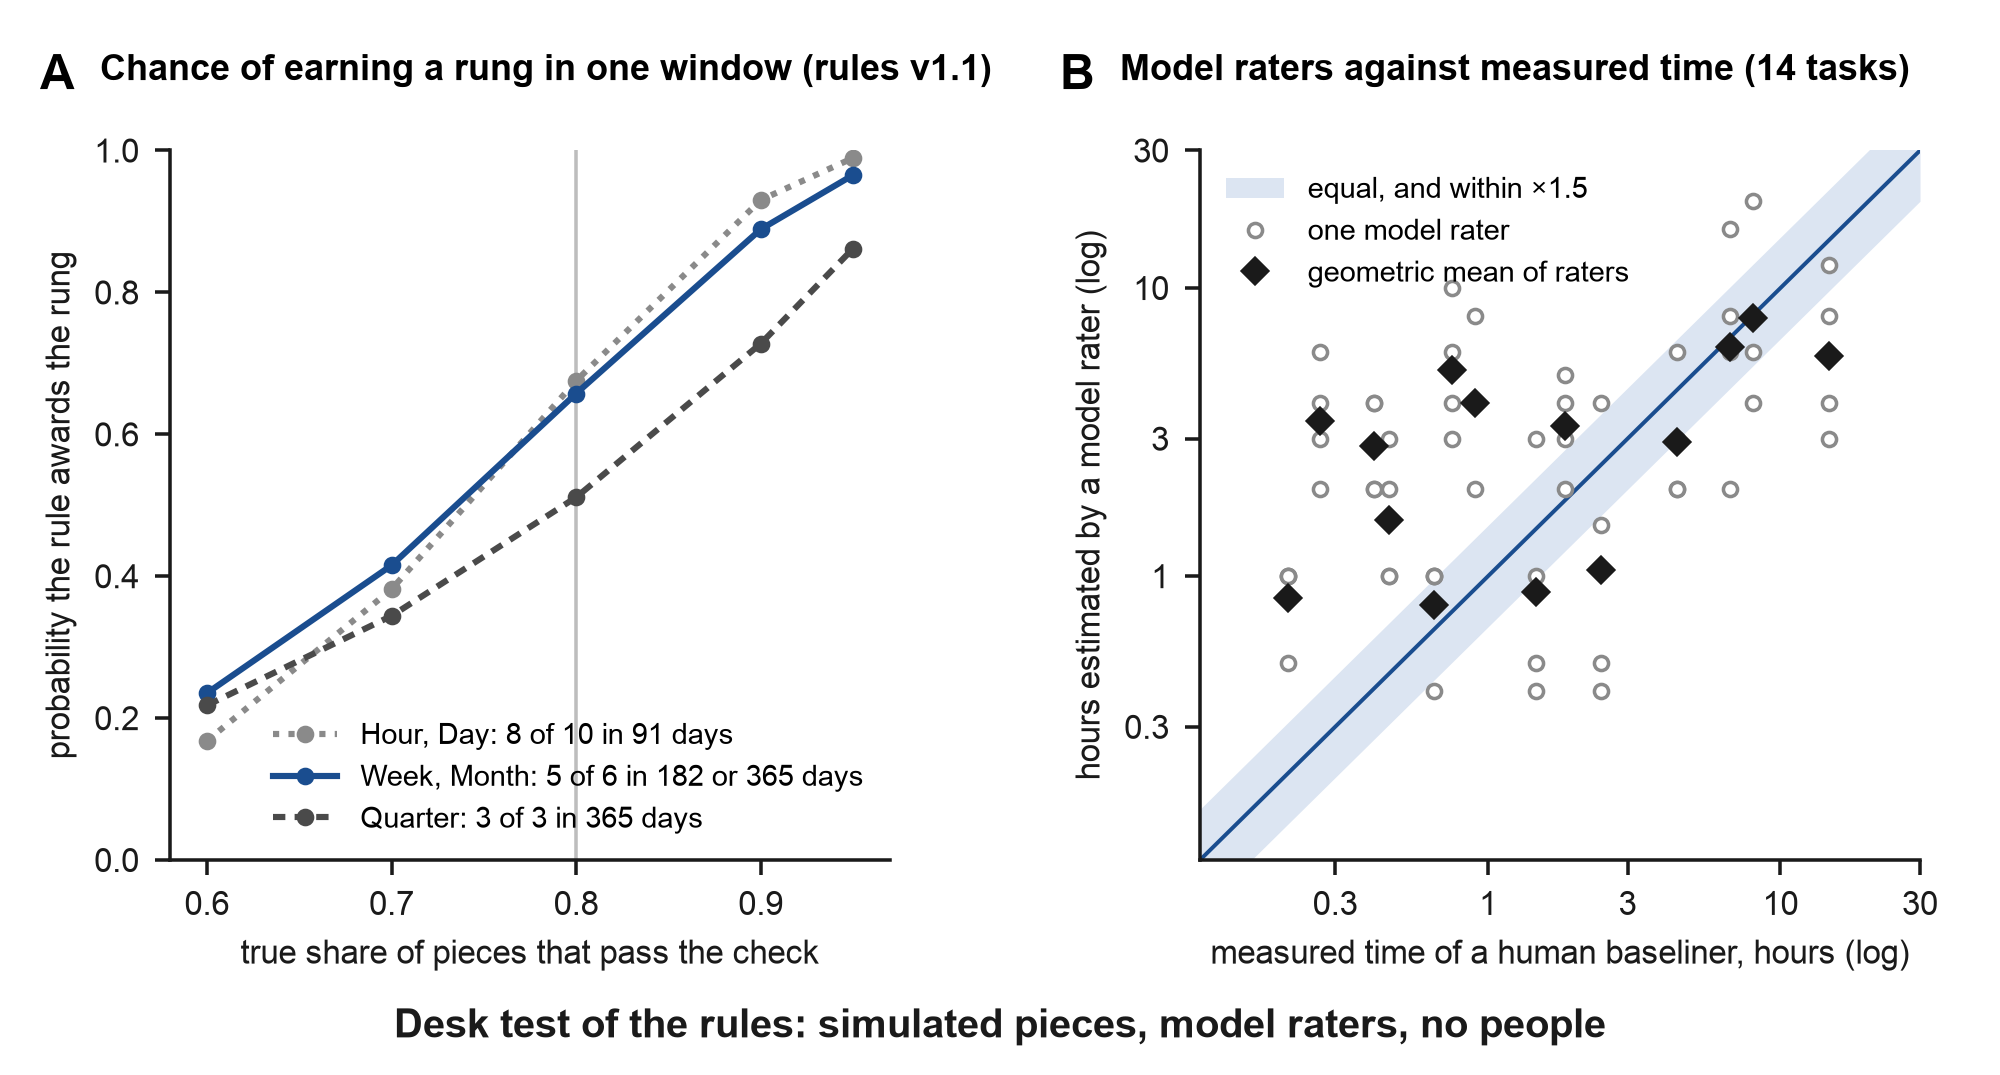
주의: 시뮬레이션된 항목과 모델 평가자를 사용한 책상 테스트입니다. 패널 A는 규칙 v1.1에서 각 단계에 대해 각 항목이 수평축의 공유도로 독립적으로 확인에 통과할 때 한 기간에 규칙이 단계를 부여할 확률을 나타냅니다. 같은 수와 같은 수의 통과를 가진 단계들은 같은 곡선을 따릅니다. 패널 B는 4명의 모델 평가자(각각 다른 계열)가 인간 베이스라이너(METR의 작업 데이터)에 대해 측정한 시간에 대해 추정한 14개 작업의 기준 시간을 설정합니다. 밴드는 1.5배 이내의 일치를 나타냅니다. 두 패널을 모두 생성한 책상 테스트는 이 부록에 설명되어 있으며, 그 코드와 출력은 동반 저장소에 있습니다.
E5. 보정 프로토콜
프로토콜과 등록 텍스트는 동반 저장소에 있습니다(pilot/pilot-protocol.md, pilot/preregistration-draft.md). 간단히 말해, 60명의 성인이 참여하며, 소프트웨어 배경이 있는 30명과 없는 30명이 은행의 세 영역에서 91일의 두 기간 동안 참여합니다. 모두 버전이 기록된 동일한 에이전트 도구를 사용하며, 확인은 숨겨진 테스트 또는 두 명의 맹목적 도메인 검토자입니다. 손으로 계산한 시간은 은행 작업의 5분의 1에 대해 측정되고, 모든 인계는 시작 날짜와 함께 기록되며, 수락된 항목의 무작위 10분의 1이 감사됩니다. 기준은 데이터 전에 설정됩니다: 인간 추정치 쌍의 최소 70%가 1.5 이내, 평가된 시간의 최소 60%가 측정된 시간의 1.5 이내, 가중 카파 0.6 이상으로 두 기간에 걸친 단계의 반복성, 새로운 작업 통과 예측의 AUC 최소 0.7, 손실된 로그 라인 5% 미만, 그리고 실패한 인계 기록의 최소 95%. 동의서는 이 연구만을 위해 작성되었으며 다른 동의를 재사용하지 않습니다. 월과 분기, 돌이킬 수 없는 작업 및 고위험 도메인은 이 6개월 현장 연구 범위 밖입니다.
E6. 책상 테스트가 해결하는 것과 다음으로 올 것
알려진 신뢰성을 가진 사람에 대해 규칙이 어떻게 작동하는지, 불일치한 곳(하나의 불일치가 이제 수정됨), 평결이 두 상수에 얼마나 민감한지, 그리고 모델 평가자들이 작업을 일관되게 순서대로 배열하지만 수준에 대해 불일치하는지를 보여줍니다. E5의 보정 프로토콜은 책상 테스트가 사람들에게 남겨두는 것을 취합니다: 그들이 규칙에 따라 어떻게 행동하는지, 실제 사람을 위해 단계가 반복되는지, 그리고 새로운 작업을 예측하는지, 인간 평가자 간의 일치는 먼저 테스트됩니다(부록 G). 따라서 임계값은 규칙 v1.1로 책상 테스트되며, 보정 연구는 다음 버전을 설정합니다.
재현하려면: python3 pilot/simulate_rules.py 및 python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 이상, 표준 라이브러리만; seed 20261009)를 실행합니다.
부록 F. 보충 표 및 그림
A1, A2 등으로 번호 매겨진 객체들은 부록 객체입니다. 각 주석에 명시된 섹션에서 인용됩니다.
표 A1. 수렴의 신호, 2025년~2026년 10월.
| 신호 | 출처 및 날짜 | 나타내는 바 | 나타내지 않는 바 |
|---|---|---|---|
| 개발자의 직무가 위임 및 검증으로 설명됨 | GitHub, 2025년 12월 8일 | 벤더의 역할 설명이 변경되었음 | 개발자의 수준이 그런 식으로 측정되는 것 |
| 코딩 에이전트 내 개발자가 아닌 사용자가 137배(개인) 및 189배(조직) 증가 | OpenAI, 2026년 6월 | 낮은 기반에서의 빠른 성장; 표본 사용자의 4분의 1이 8시간 이상으로 추정되는 요청을 최소 하나 이상 생성 | 결과의 품질; 벤더 데이터 |
| 코드 생성 세션의 검증된 성공도에서 프로그래밍 직업과 7포인트 차이 범위 내의 상위 10개 직업 | Anthropic, 2026년 6월 16일 | 직업 간 작은 격차; 테스트 또는 커밋 같은 증거로 뒷받침된 성공; 행동으로 판단한 전문성 | 교육(직업은 학위가 아님); 배송된 제품의 품질 |
| 변호사들이 자체 도구를 구축함; 광범위한 AI 접근 83% vs 61% | Bloomberg Law, 2026년 4월 20일 | 도메인 전문가들이 구매하지 않고 구축함 | 그 도구들이 유지되는 기간 |
| 약 181,500명의 직원을 위해 직급 이름이 변경됨 | Business Insider 및 Fortune, 2026년 1월 22일 | 직책을 변경하는 고용주 | 새로운 측정(내부 수준 유지됨) |
| "Frontier Professionals": 20,000명의 AI 사용자 중 3,233명 | Microsoft, 2026년 5월 5일 | 고급 사용자의 설문 조사 세그먼트 | 역할이나 등급 |
| 에이전틱 AI를 언급한 채용공고 16,541개(2024년에는 151개) | Stanford AI Index 2026 | 채용공고에서의 기술 수요 | 새로운 직업 |
| 신입 채용이 전체보다 더 많이 감소 | LinkedIn Economic Graph, 2026년 8월 | 2026년 중반의 약한 신입 채용 | AI가 원인이라는 것(LinkedIn은 경제를 지적) |
| 박사 학위 수여 부서에서 새로운 CS 전공자 13% 감소 | CRA Taulbee, 2026년 6월 | 반응하는 학생들 | 장기 추세; 모든 기관 |
| 2026년 2분기 인터뷰에서 AI 사용 논의 4.54%(2025년 3분기에는 0.33%) | Metaview, 2026 | 채용 프로세스에 진입한 질문 | 답변 척도 |
주: 벤더 데이터는 그렇게 표시됩니다. 이전 비교(2019년 또는 2022년과의 비교)는 규칙에 따라 생략됩니다(섹션 1).
표 A2. 2026년 10월 9일 현재 유통 중인 이름과 제안된 이름, 계층별. 파트 1: 사용 중인 이름, 소유자 및 상태. 파트 2: 본 연구에서 제안한 이름, 순수 설명 및 검토된 변형.
| 계층 | 후보 | 도입자 및 시기(파트 1) | 사용되는 의미 | 찬성 | 반대 |
|---|---|---|---|---|---|
| 파트 1 | |||||
| 대중 기술 | builder, Full Stack Builder | LinkedIn, 2025년 12월(보도); "이제 모두 빌더다"(SF Standard, 2026) | 모든 기능에서 구축하는 모든 사람 | 이미 HR에서 승리하고 있음 | 수준에 대해 아무것도 말하지 않음 |
| 대중 기술 | vibe coding, vibe coder | Karpathy, 2025년 2월 2일 | 코드를 읽지 않고 구축함 | 널리 알려짐 | 조롱; 최저 수준을 명명함 |
| 대중 기술 | AI fluency (네 가지 D) | Anthropic, 2025b | 위임, 설명, 판단, 근면 | 범위를 포괄함 | 수준 없는 역량 |
| 대중 기술 | agent literacy | MindStudio, 2026년 6월 11일 | 위임, 확인, 관리 | 의미상 가까움 | 점유됨; 표준 증거 없음 |
| 전문 직업 | agentic engineer | Karpathy, 2026년 2월; Alenezi, 2026년 6월 | 에이전트를 지휘하는 엔지니어 | 2026년 엔지니어의 단어 | 엔지니어링과 연결됨 |
| 전문 직업 | agent boss | Microsoft, 2025년 4월 23일 | 에이전트를 관리하는 모든 직원 | 기억하기 쉬움 | 측정 없는 슬로건 |
| 전문 직업 | agent manager | Arion Research, 2026년 2월 7일; Srinivasan and Wei, Harvard Business Review, 2026년 2월 12일 | 팀에서 에이전트를 운영하는 역할 | 최유력 후보로 보도됨(aicodex, 2026); 저자들은 12~18개월 내에 표준 직책이 될 것으로 예상 | 수평 관리자의 직책(섹션 6.3) |
| 전문 직업 | AI Agent Owner; AI Agent Supervisor | Writer, 2026; Digg discussion, 2026 | 배포된 에이전트에 책임이 있는 사람 | 소유권을 명명함 | 단일 벤더 또는 포럼의 용법 |
| 전문 직업 | AI orchestrator | St. Lawrence, 2024년 세미나 및 2025년 저서; 2026년 2월 739개 채용공고(IT Brew, 2026) | AI를 조율하는 비즈니스 전문가 | 채용공고에 있음 | 여러 번 점유됨; 수평적 |
| 전문 직업 | AI Operator | Dust, 2026년 10월 7일 | 공유 에이전트 워크플로우를 구축하고 유지 관리함 | 친숙함 | 콘솔처럼 들림; Anthropic에서 "operator"는 API를 기반으로 구축하는 회사(Anthropic, 2026b) |
| 전문 직업 | AI steward, AI work architect | Ono, World Economic Forum, 2026년 6월 22일 | 한 명은 AI 작업의 범위를 설정하고, 다른 한 명은 결과를 확인함 | 의미상 가장 가까운 선행 역할 | 두 역할, 측정 없음 |
| 전문 직업 | product creator | Cagan, SVPG, 2025 | 아이디어에서 시장까지 제품을 이끌어가는 한 사람 | 제품 언어 | 점유됨; 측정 없음 |
| 전문 직업 | Product Principal | O'Neill, LinkedIn post, 2026 | 에이전트의 목표를 설정하고, 결과를 수용하고 그에 대한 책임을 짐 | 거의 이 논문의 의미 | 그 의미로 점유됨; 선행례로 인용 |
| 전문 직업 | Principal Agentic Context Engineer | Turkovic가 수집한 직책, 2026년 4월 24일 | 에이전트 작업의 선임 등급 | "principal"이 이미 등급으로 사용됨을 보여 줌 | 등급이지, 직업이 아니다 |
| 직업 | AI Product Builder; Agentic Product Builder | n8n 게시, 2026; State Street 게시, 2026 | 제품 구축 및 검증 실행 필요; 코딩 선호 (n8n) 또는 필수 (State Street) | 고용주들이 양쪽 방향으로 코딩 요구사항을 움직이고 있음을 보여줍니다 | 개별 고용주의 직책 |
| 직업 | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | 한 산업을 위해 명명된 직업 | 도메인 제한적 이름이 발급되고 있음을 보여줍니다 | 한 가지 제안, 한 산업 |
| 직업 | principal | Agency theory (Jensen & Meckling, 1976); Claude의 constitution의 "principals" (Anthropic, 2026b); The Principal Firm (Verheul, 2026); AI agents의 principal-agent framing (Berkeley California Management Review, 2025; Tikhomirov, 2026) | 에이전트가 대리하는 당사자이며 검증 비용을 부담하는 자 | 이론적 근거; "agent"라는 단어와 일치합니다 | ID 및 접근 관리에서 "Agent principal"은 에이전트 자체의 정체성을 의미하며, 반대 의미입니다; 또한 Principal Engineer 등급 |
| 측정 | delegation horizon (기계 또는 기업 의미) | Khadj, 2026 (초기 버전은 "Delegation Horizon Index", 0~100을 포함함); Alonso, 2026 (업무 체인에 대한 "a delegation horizon") | 기계 또는 기업이 인간이 개입하기 전에 위임할 수 있는 범위 | 이 표현이 자연스러움을 보여줍니다 | 개인이 아닌 기계 또는 기업 |
| 측정 | uplift; speedup; autonomy 1 to 5; H1 to H5; supervisory capacity | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | 평균 이득, 대화 수준 속도 향상, 에이전트 자율성, 선호되는 인간 개입, 노력당 유용한 산출물 | 증폭 이득의 확립된 인접 항목들 | 개인의 검증된 산출물이 아닌 작업, 대화 또는 도구를 측정합니다 |
| 순간 | crossing time | AI 위임 하의 학습 기하학 (2026) | AI에 위임하는 것이 기술 쇠퇴를 통해 얻는 것보다 더 많은 비용이 드는 지점 | 형식상 가깝습니다 | 반대 의미: 자격증 가중치가 아닌 기술 손실 |
| 파트너 | guarantor | Capps (2025), New York Times Magazine의 "Legal guarantor" | AI가 할 수 없는 책임을 제공합니다 | 정확함 | 법률적 색채 |
| 파트너 | finisher; distribution engineer; GTM engineer | 2026년 게시의 GTM engineer | 제품을 사람들에게 가져옵니다 | 오늘 지급됨 | 부분적으로 자동화 가능 (Section 7) |
| 실패한 신호 | tokenmaxxing | 언론 사용, 2026 (CIO, 2026a) | 소비된 토큰으로 순위 또는 경쟁 | 실제 관행을 이름 지웁니다 | 직업이 아님 (Section 4) |
| 오래된 이름들 | citizen developer; end-user software engineering; Code Runner, Adaptor, Writer, Builder | Gartner, 2009년까지; Ko et al., 2011; Feldman & Anderson, 2024 | IT 외부에서의 구축; 공학 문제를 마주하는 최종 사용자 | 긴 계보 | 옛 분할의 한쪽에 제한됨 |
| Part 2 | 후보 | 상태 | 의미 | 찬성 | 반대 |
| 대중적 기술 | acceptance literacy | 여기에서 제안됨; Appendix B의 기반에서 사용 발견 안 됨 | 무엇이 완료되었는지 미리 말하고, 그것을 보여주기 | 핵심을 이름 짓습니다 | 기술이 아닌 기술; 기술 수용 연구와 구분해야 합니다 |
| 직업 | agentwright | 여기에서 제안됨; Appendix B의 기반에서 사용 발견 안 됨 | 플레이라이트가 연극을 만드는 것처럼 에이전트를 통해 일을 만드는 자 | 학술 기반에서 자유로움; 저자성을 담고 있습니다 | 검색 엔진이 "Agent Wright"로 분할합니다; 브라우저 테스트 도구처럼 들립니다; 2026년 10월까지 부분적으로 점유됨 (Python 패키지 및 에이전트 기술 카탈로그), 한정자가 필요합니다 |
| 직업 | domain orchestrator (legal orchestrator, fintech orchestrator) | 이 연구의 이전 초안에서 제안됨 | 해당 도메인의 깊은 도메인 지식을 갖춘 에이전트 시스템을 조립하는 사람 | 역할을 수직으로 연결함 (Section 6.3) | "Multi-domain orchestrator"는 5G 및 6G 네트워크 관리에서 확립된 용어입니다 |
| 직업 | setter-acceptor; agent director | 일반적 설명 | 작업을 설정하고 결과를 수용합니다 | 정확함 | 설명이지 이름이 아님; "director"는 관리자의 직책입니다 |
| 직업 | Agent-Directed Product Creator; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | 이 연구의 모델 상담에서 생성된 변형 | 에이전트 작업의 저자성과 청지기 관리의 변형 | 선택지의 공간을 보여줍니다 | 길거나, 점유된 이름에 가까움 (steward, creator, architect) |
| 직업 사다리 | Specifier, Verifier, Domain Orchestrator; setter, acceptor, coordinator, loop owner | 이 연구의 초기 사다리 | 에이전트 작업에 대한 책임 증가 단계 | 읽기 쉬움 | 시간 단위의 계단으로 대체됨, 직업 간 번역이 필요 없습니다 |
| 측정 | verified delegation horizon (또한: personal or human delegation horizon) | 여기에서 제안됨 | 사람이 에이전트에게 맡기는 가장 큰 검증된 작업 조각 | Jaques와 METR에 근거함 | Part 1의 기계 및 기업 의미와 구분해야 합니다 |
| 측정 | amplification gain | 여기에서 제안됨 | 주의 시간당 검증된 작업 | 짧은 루프 구축자에게 신용을 제공합니다 | 동결된 참조가 필요합니다 |
| 순간 | credential crossover point | 여기에서 제안됨; Appendix B의 기반에서 사용 발견 안 됨 | IT 교육을 받지 않은 사람들의 제품이 동일한 검사 하에서 프로그래머의 제품을 추월하기 시작할 때, 그리고 자격증의 가중치가 떨어질 때 | 부분적으로 관찰 가능 (Section 6.2) | "Credential"은 또한 에이전트 보안의 비밀 키를 의미합니다; 처음 사용에서 정의합니다 |
| 순간 | Skill Inversion Point; Background Neutrality Point; expertise crossover point; credential decoupling | 고려된 변형 | 기술, 배경, 전문성 또는 자격증에서 본 동일한 순간 | 각각은 한 부분을 강조합니다 | 각각은 Section 6.2의 구성 요소 중 하나만 다룹니다 |
| 파트너 | co-signer; trust broker; distribution principal | 고려된 변형 | 제품에 서명하거나 전달하는 파트너 | 단순함 | 보증인이나 마무리자보다 좁음 |
| 실패한 신호 | 토큰 선순위 (등급으로서의 토큰) | 2026년 에피소드에 대해 여기서 사용한 용어 | 소비한 토큰별로 사람을 순위 매김 | 실제 사건의 이름 | 전문직이 아님 (섹션 4) |
주: 상태는 2026년 10월 8일과 9일의 웹 및 데이터베이스 검색을 반영합니다 (부록 B). "사용 사례를 찾지 못함"은 해당 날짜에 그곳에 나열된 베이스를 의미하며 검색하지 않은 베이스에 대해서는 아무것도 주장하지 않습니다. 2부의 변형은 연구의 자체 초안에서 나온 것이며 옵션의 계열이 계속 보이도록 나열되어 있습니다.
표 A3. 2025년과 2026년의 척도와 각각이 측정하는 것 (전체 목록).
| 척도 | 출처 | 측정된 단위 | 검증된 위임된 업무로 사람을 측정합니까? |
|---|---|---|---|
| AI 에이전트의 자율성 수준 (운영자에서 관찰자까지) | Feng et al., 2025 | 에이전트 | 아니오 |
| 자동완성에서 소프트웨어 팩토리까지의 5단계 | Shapiro, 2026년 1월 | 머신 또는 팀의 설정 | 아니오 |
| AI 지원 개발의 8단계 | Yegge, 2026 | 프로그래머의 관행, 에이전트 수로 | 아니오 |
| 능력 사다리 (트리거에서 에이전트 팀까지) | Memari & Rudolph, 2026 | 업무의 자동화 | 아니오 |
| 코딩 에이전트 감독의 7단계 | Park et al., 2026 | 감독 업무의 단계 | 아니오 |
| 개발에서 위임의 5단계 (AIDEs) | JetBrains Research (Tikhomirov), 2026년 9월 | 개발자의 위임, 주인-에이전트 관계로 표현됨 | 개발자만; 검증 규칙 없음 |
| 의사결정에서 AI 위임의 수준 | Dawson, 2026; Metal Toad, 2026 | 조직 또는 관리자의 위임 | 아니오 |
| 지능형 AI 위임 | Tomašev et al. (DeepMind), 2026년 2월 | 일반적인 위임 | 개인 수준 측정 없음 |
| 위임 경계 (초기 버전: 위임 수평 지수, 0~100) | Khadj, 2026 | 기업 또는 에이전트의 위임 | 아니오 (머신과 기업) |
| 저자, 편집자, 감독, 조직자 | Microsoft, 2026년 5월 | 업무 패턴 | 아니오 |
| AI 역량 체계 (8개 영역, 4개 수준) | AI 인증 표준, 2026년 8월 23일 | 직종별 역량 | 시험이나 임계값 없음 |
| AI 유창성 (4개 D) | Anthropic, 2025b | 문해력 | 수준 없음 |
| 머신 시간 수평선 | METR, 2025-2026 | 모델 | 아니오 (머신만) |
| 검증된 위임 수평선과 증폭 이득 | 본 논문 | 도메인의 개인 | 예, 섹션 5.2의 규칙에 의해 |
주: "검증된 위임된 업무로 사람을 측정한다"는 것은 척도가 에이전트에 넘겨진 업무의 규모와 에이전트가 보지 못한 확인에 따라 개인을 수준에 배치한다는 의미합니다. JetBrains의 수준은 개발자가 얼마나 위임하는지에 관한 것이며, 이미 주인과 에이전트의 언어를 사용합니다. 가장 가까운 이웃이며, 점검의 독립성 규칙과 크기 단위가 부족합니다.
표 A4. 어려운 경우와 규칙이 이를 다루는 방법.
| 경우 | 처리 |
|---|---|
| 그 사람이 손으로 절대 할 수 없었을 일 | 기준 시간은 여전히 자격 있는 전문가에서 나옵니다. 그 사람의 자신의 기술은 포함되지 않습니다 |
| 품질이 몇 개월 후에만 나타나는 일 | 임시로 수락됨; 지연된 결과는 도착할 때 기록되며 그 조각을 취소할 수 있습니다 |
| 근처에 자격 있는 인간 검토자가 없는 도메인 | 숨겨진 테스트 또는 의도한 사용자의 실제 사용; 그 사람이 열린 출처만 있는 다른 계열의 모델 |
| 새로운 맥락에서 같은 모델 계열의 눈먼 비평가 | 독립적인 점검이 아님: 같은 계열로 기록됨 (부록 C), 신용을 얻지 못하지만, 독립적인 점검 전에 작업을 개선할 수 있습니다 (섹션 6.5) |
| 함께 작업을 수락하는 팀 | 각 사람은 자신의 주의력을 기록합니다. 조각은 수락에 서명한 사람에게 계산됩니다 |
| 점검을 통과했지만 나중에 잘못된 것으로 밝혀진 조각 | 다음 재검증에서 실패로 기록되고, 계단이 다시 점수 매겨집니다 |
| 일반 작업과 섞인 돌이킬 수 없는 작업 | 더 엄격한 규칙이 되돌릴 수 없는 조각에만 적용됩니다 (섹션 5.2) |
표 A5. 2025-2026년 개발자 스레드의 주제와 다른 직종의 대응물 (예시 사례).
| 스레드의 주제 | 소프트웨어 외부의 대응물 | 출처 | 교차했습니까? |
|---|---|---|---|
| 나쁜 산출물에 대해 책임을 지는 사람, 모델인지 아니면 작업을 설정한 사람인지 | "업무 낭비": 그 수신자에게 업무를 이동하는 AI 산출물, 사건당 약 2시간이고 월 직원당 $186; 동료는 발신자의 능력이 덜 하다고 판단합니다 | The Decoder (2025); BetterUp (2026) | 예, 강하게 |
| 점검의 가격 (검토를 위해 시간당 $150) | 동일한 업무 낭비 비용 | The Decoder (2025) | 예 |
| 강력한 모델은 계획하고 검토하며, 저가 모델은 업무를 수행합니다 | Atlassian의 역할별로 할당된 AI 예산 | HCA Magazine (2026) | 회사에서 |
| 과부하, 도구의 끊임없는 변화, 놓칠까봐의 두려움 | 마케터의 25-26%, HR의 19%, 소프트웨어의 17%가 보고한 "AI 뇌 피로" | Search Engine Journal (2026) | 예, IT 외부에서 더 강하게 |
| 구입한 소프트웨어 대신 자체 도구 | 에이전트로 도구를 구축하는 변호사; 조사된 기업의 35%가 구입한 소프트웨어의 일부를 자신의 것으로 교체 (공급업체의 샘플) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | 최상위 계층에서 |
| 에이전트 비교 | 두 코딩 에이전트를 비교하는 부기장 | Growthy (2026) | 예 |
| 프로그래머 없이 에이전트로 회사 이전 | 공급업체 대신 에이전트로 구축하는 변호사와 법률사무소 | Bloomberg Law (2026); Artificial Lawyer (2026) | 일부만 해당; 자문 사업 자체는 스레드에서만 나타남 |
| 월 $1,000 이상의 개인 AI 요금을 지위 표시자로 | 지위 대응물 없음; 가장 가까운 것은 회사 상한선과 수당(Uber의 월 $1,500 상한선, Atlassian의 AI 지갑) | Fortune (2026b); HCA Magazine (2026); 2026년 10월 9일 검색 | 지위로서는 아니오, 예산 항목으로서는 예 |
| 한 에이전트의 진영에 속함 | 대응물 없음 | 2026년 10월 9일 검색 | 아니오, 필요 없음 |
주: 스레드는 주제에 따라 선택된 정성적 증거이며 인구를 대표하지 않습니다. "교차"는 2026년 10월 9일에 나열된 출처에서 대응물이 발견되었는지를 기록합니다.
그림 A3. 계단의 척도에서의 기계 지평선.
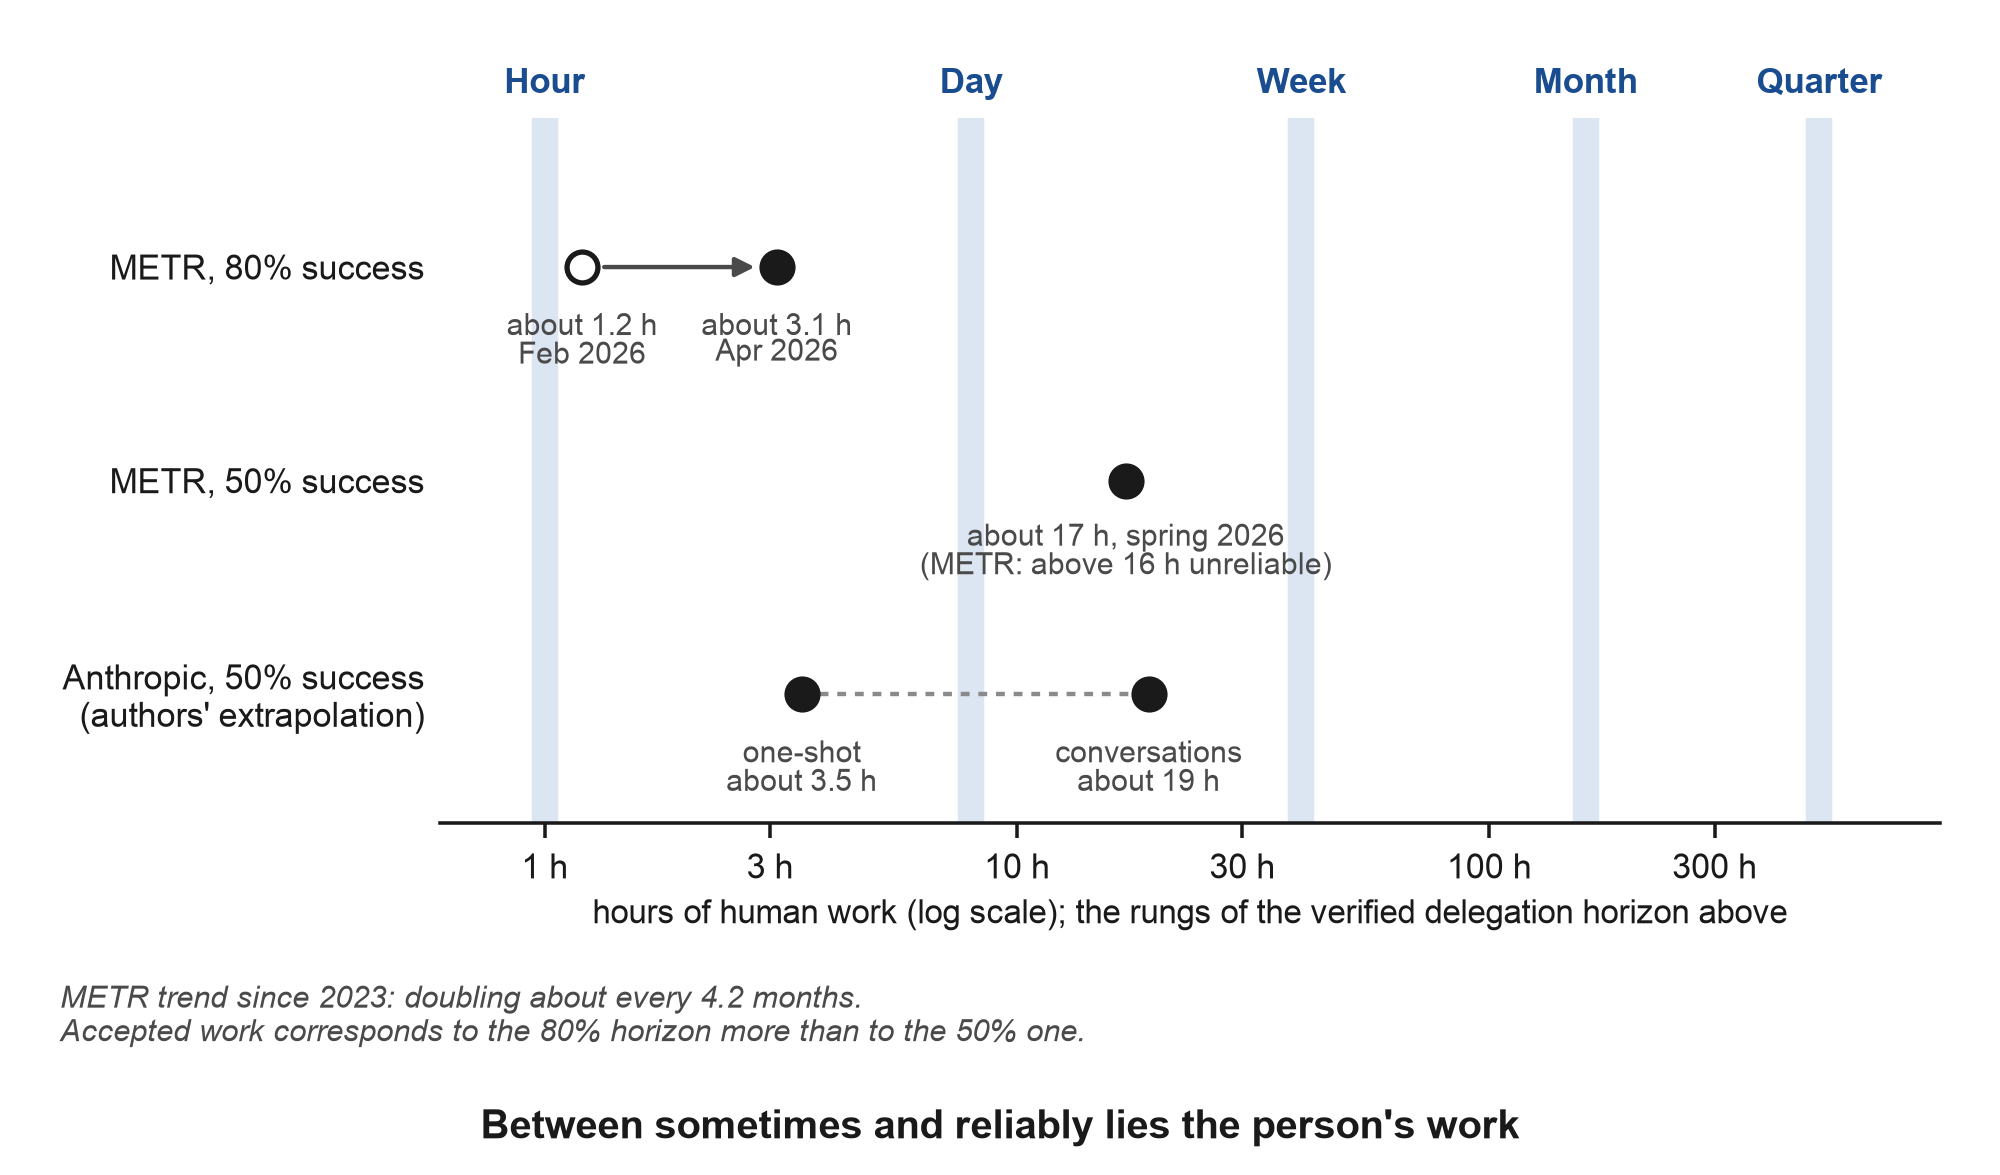
주: METR의 시간 지평선은 80% 성공률에서 2026년 2월 약 1.2시간, 4월 약 3.1시간입니다. 50% 성공률에서 2026년 봄 약 17시간이며, METR은 16시간 이상에서는 신뢰할 수 없다고 명시합니다(METR, 2026c). Anthropic의 50% 지점은 일회성 요청의 경우 약 3.5시간, 대화의 경우 약 19시간이며, 저자들의 추론입니다(Anthropic, 2026a). 기계 지평선은 사람이 아닌 모델을 측정합니다. 음영된 열은 섹션 5.3의 계단이 시간의 같은 축에 떨어지는 위치만 표시합니다(섹션 5.6).
그림 A4. 섹션 6.5의 확인 과정: 각 단계가 무엇을 나타내는지, 규칙 하에서 무엇을 얻는지, 어디서 멈추는지.
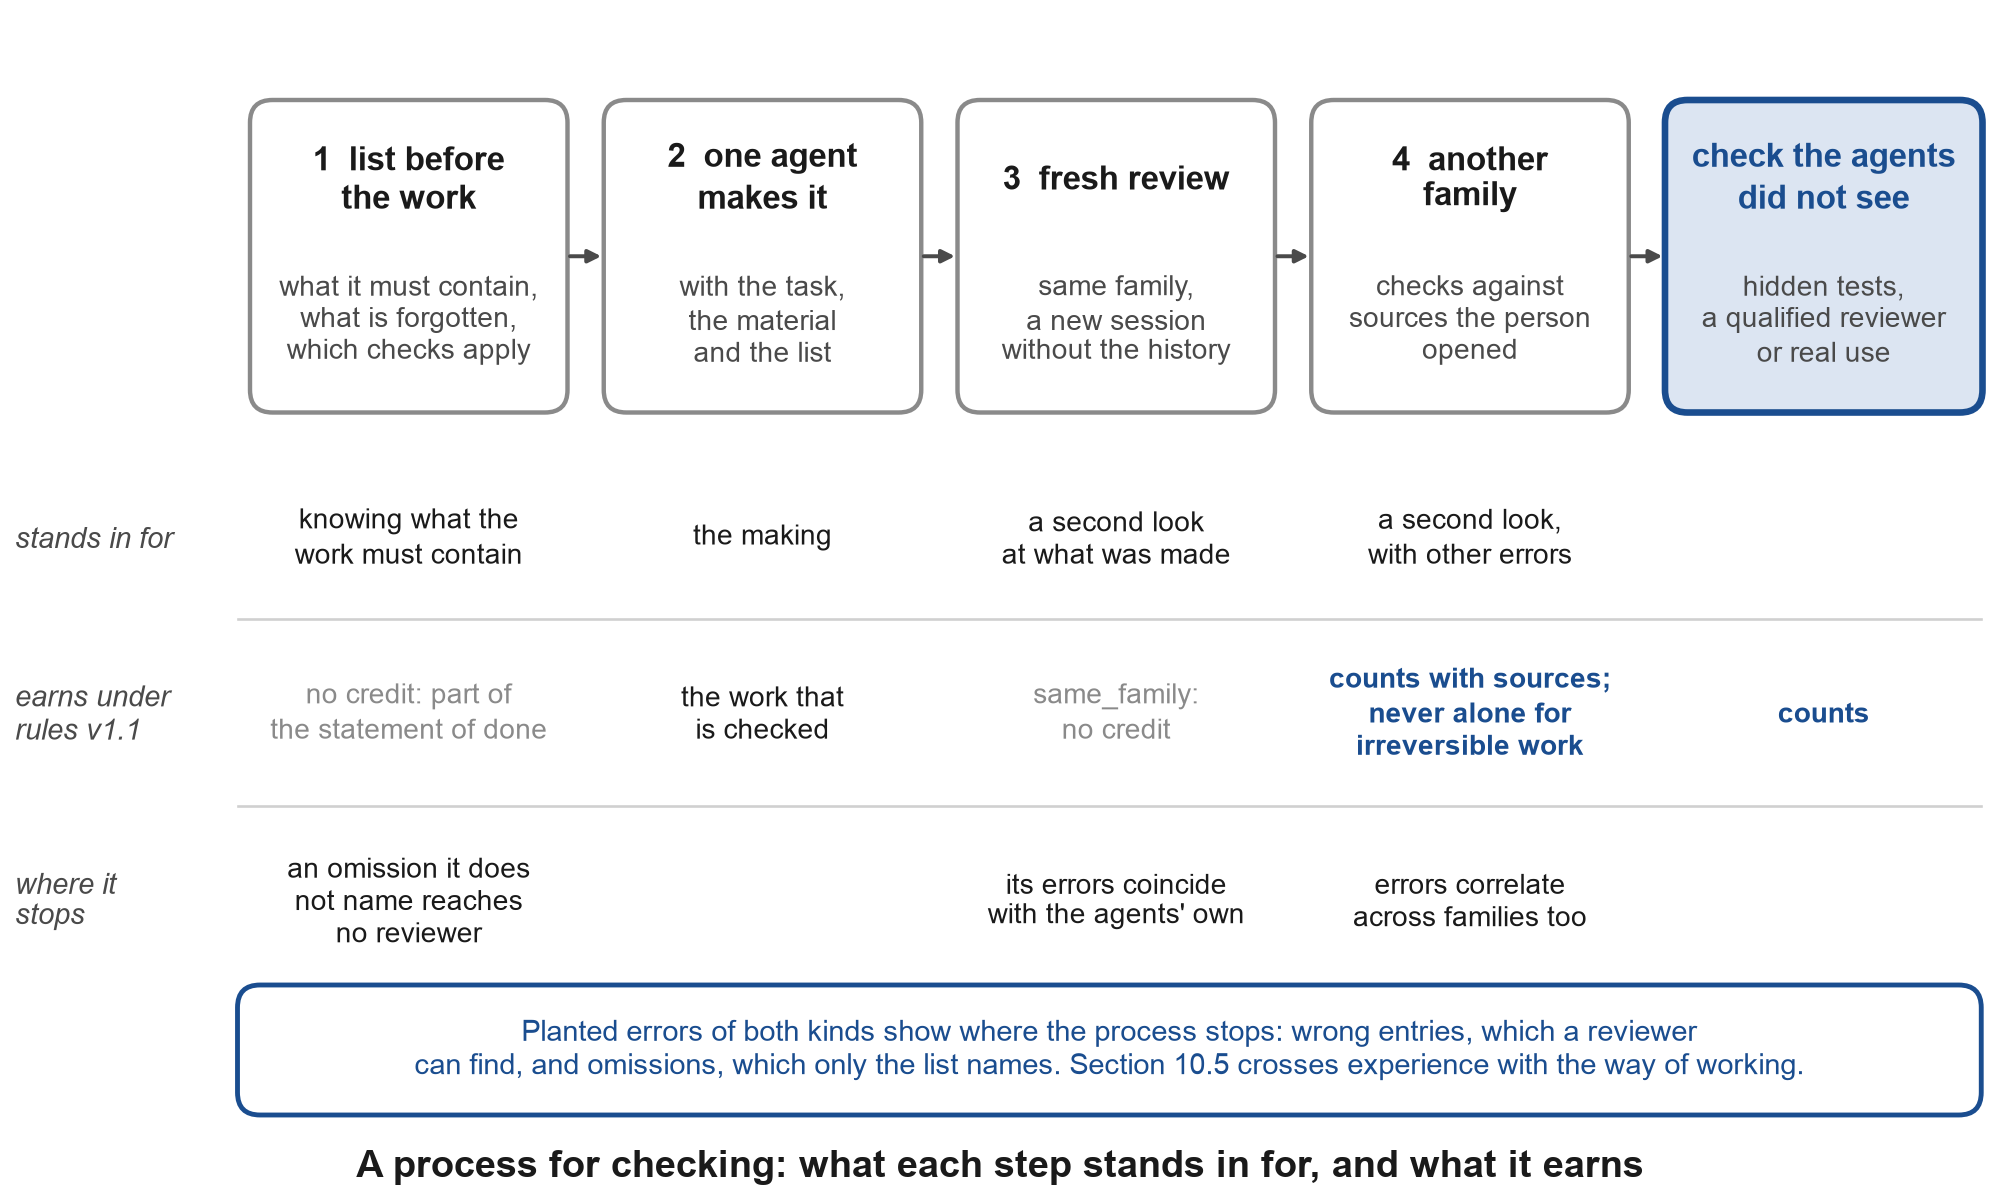
주: 네 단계와 각 단계가 나타내는 것은 섹션 6.5의 것입니다. 신용 행은 섹션 5.2와 표 A4의 채점 규칙을 따릅니다: 새로운 맥락에서 같은 계열의 모델에 의한 검토는 same_family로 기록되며 신용을 얻지 못하지만, 작업을 개선할 수 있습니다; 다른 계열의 모델은 그 사람이 연 출처에 대해 확인할 때만 계산되며, 돌이킬 수 없는 작업의 경우 절대 단독으로 계산되지 않습니다. 마지막 행은 생략에 대한 Fu et al. (2025)과 모델 간 상관관계가 있는 오류에 대한 Kim et al. (2025)을 요약합니다. 등록된 예측 테스트는 이 과정을 검증하지 않습니다; 섹션 10.5는 필요한 비교를 제시합니다. 그림은 동반 저장소의 figures/figure_a4_checking_process.py로 그려졌으며, 이는 horizon.py에서 각 종류의 확인 신용을 읽습니다. 각 단계는 무역 경험의 일부를 나타냅니다; 섹션 14는 평준화 사다리로 이것으로 돌아갑니다.
표 A7. 본 논문의 주장 상태.
| 요소 | 이를 어떻게 유지하는가 | 근거 |
|---|---|---|
| 프로그래머와 다른 사람들이 이제 위임과 수용의 작업과 워크플로우를 공유함 | 데이터는 작업과 워크플로우 수준에서이를 지원합니다; 전체 직업으로서 합쳐진 것은 아닙니다 | 섹션 2; 2025-2026년 공급업체 로그 및 조사 |
| 두 개의 오래된 사다리는 해당 작업을 측정하지 않습니다 | 관찰됨 | 새로운 측정 없이 이름을 바꾼 사다리(Deloitte); AI 사용 질문이 척도 없이 인터뷰에 들어가는 것 |
| 토큰 수는 선임 수준의 척도로 실패합니다 | 초기 사례에서 관찰됨 | 2026년 보도(섹션 4): Meta의 직원 비공식 순위(삭제됨) 및 Meta의 이후 토큰 수에 대한 공식 지침; Amazon의 리더보드(게임됨 및 제거됨); Uber의 AI 예산이 4개월 내에 소진됨, 예산 이벤트 |
| 검증된 위임 지평선 및 증폭 이득 | 제안됨; 규칙 v1.1 책상 테스트; 동반 저장소의 보정 프로토콜; 등록된 테스트에서 참고 시간에 대한 전문가들의 합의 | 정의 및 규칙(섹션 5); 도구(부록 C); 임계값의 책상 테스트(부록 E) |
| 확인 점유율로 설정된 이득의 상한선 | 모델로 제시됨; GDPval 평균으로 예시됨 | 섹션 5.5 |
| 배경 중립성 | 가설; 등록할 테스트(F7) | Anthropic (2026e)이 이를 지적합니다; Savva (2026)는 경쟁자입니다 |
| 자격증 교차점 | 가설; 구성요소를 별도로 날짜 지정(동등성 F2, 추월 F3, 게시 F5, 중립성 F7) | Lightcast (2026b)는 수렴선을 보여줍니다; Bone et al. (2025)는 AI 역할에 앞서갑니다 |
| 자기 보고 레이블 유출로 인정하는 게이트; 작업을 확인하는 게이트는 유지됩니다 | 모델로 제시됨; 유출은 평가자 연구의 선별로 한 번 예시됩니다 | 섹션 6.2 및 13; 부록 G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Oregon State Board of Bar Examiners (2026) |
| 소프트웨어가 마지막에 교차 | 예측(F6), 표 A6의 다른 40개와 함께 OSF에 등록됨 | 도메인 논증(섹션 6.3) |
| 확인 과정은 무역 경험의 일부를 나타낼 수 있습니다 | 가설, 등록되지 않음; 등록된 예측 테스트는 이를 검증하지 않으며, F3b (p = 0.10)는 간접적으로만 이와 관련이 있습니다; 비교는 섹션 10.5에 제시됩니다 | 섹션 6.5; 한편으로는 Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) 및 Benchek et al. (2026); 다른 한편으로는 Kim et al. (2025), Chernets (2026b), Fu et al. (2025) 및 Virk and Liu (2025) |
| 신뢰를 두 번째 경계로; 보증인을 파트너 직업으로 | 모델로 제시됨; 예측 F11 및 F12 | 섹션 7 |
| 에이전트를 통해 일하는 비프로그래머 | 실행 중인 코호트에서 관찰됨, 추론 없이 설명됨; 등록된 결과는 별도로 보고됨 | 섹션 11.5; 부록 G |
표 A8. 레이블로 허용하는 게이트와 작업을 확인하는 게이트: 각각 무엇을 확인하는지, 무엇이 관찰되었는지.
| 게이트 | 무엇에 따라 허용하는가 | 관찰된 것 | 출처 |
|---|---|---|---|
| 연구 플랫폼의 참여자 필터 | 대부분의 답변이 그 사람의 진술에만 바탕을 두어 제시됨; 나이와 거주 국가 확인됨 | 기록 유지 샘플에 입학한 60명 중 11명이 첫째 주 거래 문제에 잘못 답변했으며, 그 중 8명은 차변과 대변을 역으로 기재했습니다 | Prolific (2026); Appendix G2 |
| 크라우드워크 플랫폼에 명시된 프로그래밍 능력 | 해당 인물의 자기 보고 | 42%가 연구자들의 지식 문제 기준을 충족하지 못했습니다 | Danilova et al. (2021) |
| Prolific에서 보고된 Node.js 프로그래밍 | 해당 인물의 자기 보고 | 206명 중 55명이 모든 프로그래밍 문제를 통과했습니다 | Reid et al. (2022) |
| 텍스트 또는 이미지로 제시된 정적 지식 문제 | 채팅 모델이 제공할 수 있는 답변 | ChatGPT는 기존 프로그래머 선별 문제를 쉽게 해결했으며, 2026년까지 이를 저항하도록 설계된 정적 시각 문제를 통과했습니다 | Serafini et al. (2024, 2026) |
| 엄격한 시간 제한 하에서 단계적으로 공개되는 음성 문제 | 시간 압박 하에서 제공된 답변 | 2026년에도 여전히 채팅 모델에 대해 유효합니다 | Serafini et al. (2026) |
| 정책에서 제거된 학위 요건 | 서면으로 제거된 라벨 | 700명 중 1명 미만의 채용에 변화가 있었으며, 2025년 11월 Indeed의 미국 채용공고 중 19.3%가 학사학위 이상을 요구했으며, 이는 1년 전보다 증가했습니다 | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| 한 번 통과한 시험에 의한 자격증 | 한 번 확인된 지식 | 이후로는 라벨로 작동합니다 | Section 6.2 |
| 면허를 취득한 감시 회사의 서명된 업무 검사 | 서명된 업무, 반복 검사 | 정기적으로 100명 이상의 발행자를 감시하는 회사의 경우 매년, 그 외의 경우 최소 3년마다 1회 | Sarbanes-Oxley Act of 2002, s. 104 |
| 감시된 업무 포트폴리오에 의한 자격증 | 확인된 업무, 한 번; 법학 학위는 여전히 필수입니다 | 2026년 1월 5일까지 205명이 지원했고 49명이 자격을 취득했으며, 처음은 2024년 12월이었습니다 | Oregon State Board of Bar Examiners (2026) |
| 확인된 위임 지평선 | 에이전트가 보지 못한 검사를 통과한 제출된 업무, 매 분기마다 확인됨 | 그 뒤의 개수와 검사의 종류가 있는 단계, 실패는 로그에 유지됩니다 | Sections 5.2 and 5.3 |
주: 행들은 Section 6.2가 인용하는 사례들입니다. 이들은 서로 다른 모집단과 서로 다른 질문에서 나오며, 각 게이트가 확인하는 것을 비교하기 위해 나란히 배치되었으며, 비율로 비교하기 위한 것이 아닙니다. 첫 번째 종류의 게이트 앞에 두 번째 종류의 게이트를 추가할 수 있습니다: 동반 저장소의 참조 시간 평가자들은 거래의 한 문제로 허용되었습니다 (kits/reference-hours-raters.md), 부록 G2의 평가자 연구가 평가자를 선별한 방식과 같습니다. kits/trade-screen.md는 그러한 문제를 작성하고 보고하는 방법을 설명하며, tools/gate_leak.py는 라벨이 통과시키는 비율을 정확한 구간과 함께 제공합니다.
부록 G. 이미 그렇게 하고 있는 사람들: 비프로그래머 집단과 Prolific 평가자 연구
이 부록은 측정의 보충 자료이며 해당 논의의 일부가 아닙니다. 섹션 6.2, 6.5, 14는 G2의 선별 결과를 예시로 인용합니다. 이 부록은 사람들로부터의 두 가지 기록을 추가합니다. 2026년 9월과 10월에 채팅에서 에이전트를 통한 작업으로 이동한 비프로그래머들의 기록(G1)과 과제 은행의 참고 시간에 대해 평가한 현직 전문가들이 참여한 등록된 평가자 연구(G2)입니다.
G1. 채팅에서 에이전트로 이동한 비프로그래머들
2026년 9월 6일부터 저는 프로그래밍 배경이 없는 성인들을 단계별로, 일반적인 메시징을 통해 채팅 어시스턴트에서 자신의 컴퓨터에 설치되고 자신의 소비자 구독으로 결제되는 코딩 에이전트로 안내했고, 그 후 여러 모델과 함께 작업하도록 했습니다. 그들은 부기, 사무직, 법률, 마케팅 및 영업, 디자인, 사진 및 보정, 번역 및 편집, 음악, 건설, 운송 및 물류, 부동산, 돌봄 노동, 공공 행정, 비영리 지역 사회 활동 등 다양한 직업에서 왔으며, 4명은 소프트웨어 관련 과거 또는 현재 경력을 보유하고 있습니다. 아래 기록은 설명적입니다. 2026년 10월 9일까지 사람들이 한 일과 무엇이 그들을 멈추게 했는지를 기록된 대로 보고하며, 이 논문의 어떤 비율도 계산하지 않고 어떤 주장도 검증하지 않습니다.
표 G1. 2026년 10월 9일까지 집단이 도달한 정도(사람 수).
| 단계 | 사람 |
|---|---|
| 기록에 포함됨: 동의했고 입장 설문지를 반환함 | 119 |
| 자신의 컴퓨터와 구독에 에이전트를 설치하고 에이전트와의 작업을 시작함 | 35 |
| 산출물을 생산했거나 자신의 업무에서 최소 하나의 단계를 완료함 | 24 |
| 명시된 이유로 중단함 | 23 |
| 이 중: 자신의 컴퓨터가 없음(휴대폰만 사용하거나 에이전트를 실행할 수 없는 장치) | 9 |
| 이 중: 구독 비용 | 5 |
| 이 중: 거부함(현재 상태로 충분함, 관심 없음, 또는 초보자 프레이밍이 맞지 않음) | 6 |
| 이 중: 건강, 가족 또는 시간 | 2 |
| 이 중: 서비스가 거주 지역에서 이용 불가능함 | 1 |
주: 참가자 기록과 최신 측정 요약에서 손으로 계산하여 각 사람에 대해 기록된 가장 진전된 사건을 사용합니다. 두 번째 행의 35명은 표 G1b의 35개 행이며, 세 번째 행의 24명은 그 처음 24개 행입니다. 산출물은 사람이 그것을 보여줬거나 에이전트가 생성한 것을 설명했을 때 계산됩니다. 산출물을 생산한 후 나중에 중단한 한 사람(P60)이 두 행 모두에 계산됩니다. 나머지 62명은 그 날짜까지 설치 단계를 완료된 것으로 보고하지 않았거나 아직 그 단계에 도달하지 않은 상태였습니다.
표 G1a. 거주 지역과 국가별 전체 집단 그리고 2026년 10월 9일까지 각 지역에서 에이전트로 이동한 사람들의 수.
| 지역 및 국가 | 집단에 포함됨 | 에이전트로 이동함 |
|---|---|---|
| 북미 | 37 | 10 |
| 미국 | 35 | 10 |
| 캐나다 | 2 | 0 |
| 서유럽 | 20 | 7 |
| 독일 | 12 | 5 |
| 아일랜드 | 3 | 1 |
| 스페인 | 2 | 1 |
| 영국 | 1 | 0 |
| 오스트리아 | 1 | 0 |
| 스위스 | 1 | 0 |
| 중부 및 동유럽, 명시된 국가 | 9 | 1 |
| 폴란드 | 3 | 0 |
| 몰도바 | 2 | 0 |
| 라트비아 | 2 | 0 |
| 에스토니아 | 1 | 0 |
| 루마니아 | 1 | 1 |
| 국가 공개 안 함 | 53 | 17 |
| 합계 | 119 | 35 |
주: 참가자 기록의 국가 열에서 확인합니다. "국가 공개 안 함"은 연구의 개인정보 보호 규칙에 따라 국가가 보류된 참가자와 국가를 제시하지 않은 참가자들을 포함합니다.
사람들이 에이전트와 한 일. 표 G1b는 2026년 10월 9일까지 채팅 어시스턴트에서 에이전트를 지시하는 쪽으로 이동한 모든 사람을 나열하며, 각 사람마다 한 행씩입니다. 그들이 에이전트에 준 작업과 에이전트가 생산한 것입니다. 산출물을 생산했거나 자신의 업무에서 한 단계를 완료한 사람들이 먼저 나열되며, 대략 얼마나 멀리 진행했는지에 따라 정렬됩니다. 에이전트를 설치하고 시작했지만 아직 보고된 결과가 없는 사람들이 뒤따릅니다. 직업은 기록에 나온 대로 중립적인 표현으로 표기합니다. 짧은 인용문은 기록에서 참가자 자신의 말입니다. "(번역됨)"으로 표시된 인용문은 다른 언어로 작성되었으며 제 문자적 번역으로 제시됩니다.
표 G1b. 지금까지 이동한 모두(2026년 10월 9일 기준 35명).
| # | 참가자 | 직업 | 국가 또는 지역 | 에이전트와 한 일 | 자신의 말로 |
|---|---|---|---|---|---|
| 1 | P20 | 이미지 처리, 보정, 사진 | 공개 안 함 | 에이전트가 목표에 대해 묻고 폴더와 파일로 한 달 계획을 만들었습니다(주제별 주, 참고 파일, 추적기). 그 후 브라우저 자체를 통해 9개의 AI 서비스에 등록했고 거절을 진행 파일에 기록했습니다. 11개의 웹 AI를 통해 한 질문을 실행했고 결과와 한계를 파일에 썼습니다. 자신의 스톡 사진에서 한 명령으로 메타데이터 CSV를 생성했고 확인했습니다 | - |
| 2 | P73 | 콘택트렌즈 판매 사업 | 아일랜드 | 다른 공급업체의 두 번째 에이전트를 설치했습니다. 둘 다 자신의 소셜미디어 계획 복사본을 읽었고 그녀는 그들이 차이나는 지점들의 페이지를 유지했습니다. 각 에이전트를 위한 규칙 파일을 작성했고 읽기 파일과 작업 로그로 저녁을 마감했습니다 | "계속 훈련할 수 있습니다." |
| 3 | P48 | 사무 업무 및 온라인 판매 | 공개되지 않음 | 매주 작성하는 문서를 체크리스트가 있는 템플릿으로 변환하고 이를 사용해 다음 문서를 더 빠르게 작성함; 두 번째 직원이 맹검으로 초안을 읽음; AI 두 개가 전체 사건 폴더를 읽게 하고 가장 비용이 많이 드는 세 가지 결과는 자신이 직접 결정함 | "어느 AI가 더 좋은지라는 질문은 잘못된 것입니다." (번역) |
| 4 | P44 | 마케팅, 판매 및 컨설팅 | 공개되지 않음 | 에이전트 작업을 실행하는 데스크톱 버튼을 만듦("프로젝트 상태", "신규 항목 목록", "문서 요약", "파일 메모"); 다른 구독에 두 번째 에이전트를 설치하고 한 작업에 대한 공동 검토를 실행함: 요약 파일과 두 개의 완전한 검토 | - |
| 5 | P21 | 비영리 커뮤니티 조직 | 독일 | 진행률 추적 기능이 있는 한 달간의 인터랙티브 기술 및 습관 프로그램을 구축함; 에이전트에게 카탈로그에서 시작 방향을 선택하고 4주 계획을 작성하게 함; 그 후 세 개의 에이전트 세션을 병렬로 실행: 몇 분 내의 발표와 목록을 확인하고 일치하는 항목을 메신저로 보내는 봇 | "인터넷을 뒤져 타협하거나 유료 구독을 찾는 대신 특정 요구에 맞춤화된 도구." |
| 6 | P05 | 이사의 보좌관, 전직 프로그래머 | 미국 | 에이전트가 자신의 컴퓨터에 5개의 파일을 생성함: 개요와 주제별 4주 계획; 나중에 자신의 번호로 테스트 메시지를 보낸 후 76명의 연락처 목록으로 웹 메시징 페이지를 통해 초대장을 자동으로 클릭하여 전송함 | "앞으로 다양한 일일 작업을 그들 사이에 나누어 정말로 결과를 비교할 것입니다." |
| 7 | P01 | 실내 디자이너 및 제도사, 교육 중 | 스페인 | 에이전트에게 채용 공고 파일을 두 번 작성하게 함, 두 번째는 첫 번째보다 더 광범위함; 다른 챗봇의 두 보고서와 비교하여 일치점과 차이점을 분리함; 자신의 파일을 충실하게 읽고 CV와 포트폴리오를 다시 작성했으며 전문 프로필을 수정함 | "그렇게 깊이 파고들어 분석할 수 있는 흥미롭지만 일반적으로 별개의 데이터를 만들 수 있을 때." (번역) |
| 8 | P18 | 인터넷 마케팅 | 공개되지 않음 | 에이전트가 데스크톱을 정리함: 문서를 생성하고, 폴더로 정렬하고, 오류를 찾아 수정함; 나중에 자신의 주제에 대한 이메일 뉴스 알림을 설정함 | "이런 것들에 대해 들었지만, 실제로 작동하는 것을 보니 정말 확신이 섰습니다." |
| 9 | P19 | 공공 행정 공무원 | 공개되지 않음 | 자신의 긴 다중 권책 텍스트 판본을 하루 만에 교정함; 1주일 안에 두 개의 대규모 프로젝트를 완료함; 현재 번역 워크플로우용 플러그인 컬렉션을 구축 중 | "두 개의 주요 프로젝트를 단 1주일 만에 마쳤습니다... 와." (번역) |
| 10 | P35 | 계약서, 송장 및 통관 서류 | 미국 | 첫 번째 작업을 음성으로 수행함; 에이전트가 컴퓨터의 캐시를 정리하고 앱을 종료한 후 자신을 열어서 예약 사이트에서 예약 시간을 찾음; 인쇄 온디맨드 방향을 제안함; 입찰 서류를 지원함; 현재 터미널에서 실행 중 | "네, 작동했습니다. 우리가 했습니다." (번역) |
| 11 | P72 | AI로 만든 스톡 이미지 및 비디오 | 루마니아 | 오케스트레이션 도구를 사용하여 한 작업을 여러 AI로 실행하고, 음성 입력을 설정하고, 카탈로그에서 프리랜스 방향을 선택함 | - |
| 12 | P41 | 치과 보조원, 육아휴직 중 | 미국 | 에이전트가 일정, 계획 및 초안을 만듦; 자신의 설치 프로그램 6개와 사무실 스위트 5개를 컴퓨터에서 찾아 중복 제거함; 커뮤니티 수업을 위해 수업 내용을 받아적고 에이전트가 입력하고, 참고자료와 링크를 추가하고, 번역 및 저장한 후 자신의 지시에 따라 수정함 | "기뻐합니다." |
| 13 | P24 | 음악인 및 시인 | 독일 | 이미지 작업 하나를 11개의 AI로 보내고 결과를 갤러리 페이지가 있는 폴더에 저장함; 에이전트에게 음악 편곡의 틀을 만들게 했는데, 그것이 그를 실망시킴 | "저작권의 윤리적 측면은 저에게 여전히 미해결 상태입니다." |
| 14 | P102 | 소프트웨어 회사 관리 | 공개되지 않음 | 이미 도착할 때 에이전트에서 매일 작업함; 한 질문을 11개의 AI로 실행(10개 답변)하고 실행 파일을 보냄; 현재 수입 카탈로그를 진행 중 | - |
| 15 | P40 | 연구 엔지니어 및 웹 개발자 | 공개되지 않음 | 의도적인 초보자로서 경로를 걸음: 다운로드 폴더의 약 100개의 느슨한 파일을 폴더로 정렬하고, 전후 스크린샷 포함; 교육 자료에 두 개의 수정 사항을 반환함 | - |
| 16 | P75 | 원격 기술 지원 | 공개되지 않음 | 에이전트가 데스크톱에 폴더를 만들었고 계절 음악 비디오 채널 출시 계획이 포함됨(이름, 트랙 아이디어, 제목, 게시 일정); 터미널 단계 완료 | - |
| 17 | P60 | 가정 간병 | 미국 | 에이전트의 몇 가지 질문 후, 1개월 계획을 파일로 나눔(기부자, 재정, 편지 템플릿); 나중에 초보자 프레이밍이 너무 기본적이라고 판단하여 떠남 | - |
| 18 | P64 | 제복 공공 서비스, 물류 및 공급 | 공개되지 않음 | 에이전트로 월간 계획을 만들었고, 에이전트가 자신의 컴퓨터에 파일을 생성함; 10개의 AI 서비스에 등록함 | "AI는 사람에 맞춰집니다. 어떤 의미에서는 아첨합니다." (번역) |
| 19 | P28 | 제복 공공 서비스 | 공개되지 않음 | 에이전트가 현재 직책에서 직업 경로를 제시했고, 직책을 거절했을 때 이전 직업인 시계 수리(기술, 자격증, 자신의 워크숍)에 대한 개발 계획을 제시함 | - |
| 20 | P14 | 산업 등반가 | 미국 | 에이전트의 설정 중 제안으로 "Reflex Square"라는 작은 반응 속도 트레이너를 만듦 | "현재로서는 Code에서의 코딩이 제 일상생활에서 필요한 것이 아닙니다." |
| 21 | P67 | 수영 코치, 또한 직접 판매 | 공개되지 않음 | 에이전트에게 직접 판매를 시작했다고 말함; 에이전트가 5가지 종류의 도움을 제안하고 샘플 상품 카드를 작성함 | - |
| 22 | P12 | 학생 | 독일 | 무료 AI 서비스에 등록하고, 오케스트레이션 폴더를 실행했으며, 에이전트와 함께 카탈로그에서 4가지 방향을 선택함(저널리즘, 책, 수익화, AI에 더 깊이 파고들기); 자신의 에세이를 제공할 예정 | - |
| 23 | P71 | 옹호 및 공중보건 | Germany | 자신의 프롬프트를 작성했으며, 에이전트가 이를 단축하고 다른 AI들이 이미지를 생성하도록 했음. 터미널 단계를 수행했으며 키 입력을 기억하기 위해 자신의 추가 테스트 작업을 수행함 | "작업 완료, 다음 것을 보내십시오." |
| 24 | P22 | 비영리 지역사회 단체 | 공개되지 않음 | 에이전트에서 목록 작업을 수행했음(일부 사이트에서 로그인 차단됨). 터미널 단계를 수행한 후 에이전트 자체에 무엇을 했는지 설명하도록 요청함. 이메일 뉴스 알림 설정함 | "완료했습니다. 다음은?" |
| 25 | P59 | 영상 제작자 | United States | 에이전트에 지역 시장에서 수익성 있는 부동산 목록을 찾기 위한 상세한 지시사항을 제공했음(점검, 지출 없음, 이득으로 순위 매김). 결과는 아직 표시되지 않음 | "첫 번째가 작동하는데 왜 두 번째가 필요합니까?" |
| 26 | P84 | 명시되지 않음 | 공개되지 않음 | 터미널을 통해 스스로 에이전트를 설치했음. 지역사회 단체를 위한 웹사이트 구축 중 | "뭔가를 하고 있는데 우리가 이야기해야 할 것 같습니다." |
| 27 | P66 | 레저 시설 관리자 | 공개되지 않음 | 과정을 위해 노트북을 구매하고 에이전트를 설치했으며 일반 모드에서 에이전트의 탭으로 이동함. 10개의 AI 계정 개설 단계에 있음 | "모든 것이 외국어로 되어 있습니다. 다음은?" |
| 28 | P82 | 보안 업무. 트럭 운송 디스패치 서비스 구축 중 | United States | 설치함. 두 채팅봇을 비교하기 위해 다른 채팅봇에서 자신의 채팅 및 프로젝트를 옮김 | - |
| 29 | P70 | 소셜 미디어 연구 및 영상 편집 | United States | 먼저 손으로 테스트 파일을 만든 후 룸메이트의 도움으로 에이전트를 작동하게 함 | - |
| 30 | P17 | 국제법 변호사 | 공개되지 않음 | 설치 완료. 첫 작업 전송됨 | "모든 것을 했습니다." |
| 31 | P93 | 노인 돌봄 직접 지원 전문가 | 공개되지 않음 | 일반 채팅에서 에이전트로 이동하고 비용 지불함. 첫 작업 전송됨 | - |
| 32 | P54 | 맞춤 케이크 제작 | 공개되지 않음 | 새 노트북에 설치하고 비용 지불함. 첫 작업 전송됨 | - |
| 33 | P26 | 콘크리트 건설 | United States | 수리된 노트북에 설치하고 사진을 전송함. 첫 작업 전송됨 | "다음은?" |
| 34 | P03 | 외무역 회사 이사 | United States | P35와 함께 설치함. 첫 작업 전송됨 | - |
| 35 | P45 | 사진 및 영상 콘텐츠, 프로그래밍 배경 | Germany | 10개의 AI 계정 개설 단계에 도달했으며, 이는 작동하는 에이전트를 전제로 함. 상세 사항이 기록되지 않음 | - |
참고: 참가자 기록에서 편집됨. 1~24행은 표 G1의 3번째 행. 25~35행은 2026년 10월 9일까지 보고된 결과 없이 에이전트를 설치하고 시작한 사람들. "-"는 이 기간에 참가자의 사용 가능한 말이 기록에 없음을 의미합니다.
에이전트 지시 방식에 대해 이야기하는 신규 사용자들. 단 몇 주 전만 해도 채팅 어시스턴트만 사용했던 사람들이 새로운 업무에 대해 자신의 말로 설명합니다. 저는 에이전트를 설치한 35명(32명에서 161개 구절, 약 1,070단어)의 참가자 기록과 일일 관찰 기록에서 제공하는 참가자 자신의 표현으로 된 모든 구절을 수집했으며, 단어 어근을 일치시켜 자신이 지시하는 시스템, 시스템에 하는 행동, 그리고 자신들에 대한 단어를 계산했습니다. 계산은 대략적이며, "it"은 도구를 지칭하지 않는 일부 용법을 포함합니다.
표 G1c. 신규 사용자들이 에이전트 지시를 위해 사용하는 단어(보고서의 발생 횟수).
| 단어가 명명하는 것 | 단어, 범주로 번역됨 | 횟수 |
|---|---|---|
| 자신이 지시하는 시스템 | "it" | 35 |
| 모델 또는 제품명(Claude, GPT, Codex 등) | 16 | |
| 도구, 프로그램, 앱 | 11 | |
| "AI", "AI들" | 9 | |
| 에이전트 | 1 | |
| 어시스턴트, 도우미, 작업자 | 0 | |
| 시스템에 하는 행동 | 설정, 설치, 실행 | 10 |
| 묻기, 질문, 요청 | 9 | |
| 작업, 지시, 프롬프트 | 7 | |
| 확인, 비교 | 4 | |
| 나누기, 넘기기 | 2 | |
| 자신들 | 개발자, 초보자 | 5 |
자신의 말 중 몇 가지(영어로 된 인용; "(번역됨)"으로 표시된 것은 다른 언어로 작성되었으며 번역은 제 것입니다):
- "질문에만 답하는 게 아니라 실제로 파일과 문서로 일할 수 있습니다." (P18, 인터넷 마케팅)
- "AI를 사용할 때 가장 큰 실수 중 하나는 확신 있는 답변이 자동으로 정확하다고 가정하는 것입니다." (P20, 사진가 및 수정 전문가)
- "저는 정말 개발자가 된 기분이 듭니다." (P21, 비영리 지역사회 단체)
- "내가 원하는 것을 얻으려면 요청을 어떻게 할지 생각해야 합니다." (P48, 사무직 및 온라인 판매)
- "답변이 두 사람을 향한 질문 같은 느낌입니다." (P59, 영상 제작자)
- "한 번은 한 AI가 더 좋은 조언을 주고, 다음 번에는 다른 쪽이 더 낫습니다." (P48, 사무직 및 온라인 판매)
세 가지 더 긴 구절은 참가자들 자신의 목소리로 변화를 보여줍니다. 훈련 중인 인테리어 디자이너가 에이전트와 함께 첫날 저녁, 아무도 모델 위원회를 보여주기 전: "폴더를 만들었고 문서를 열 때처럼 자신이 잘 작동했으며 [...] 결국 이것에서 공실이라고 불리는 두 파일, 그것에서도 공실이라고 불리는 것을 얻었고 다시 그들을 서로에게 보내서 서로의 일을 평가했습니다" (P01, 번역, 음성 메시지의 자동 전사본에서). 산업용 로프 클라이머가 에이전트로 첫 번째 작은 프로그램을 만든 날, 이미 다음 역할을 요청하고 있습니다: "소셜 네트워크에 게시하거나 내게 상기를 주거나 제안을 해주는 것처럼 내 일의 일부를 할 수 있는 에이전트를 구축하는 방법을 배우기." (P14). 그리고 비영리 지역사회 업무에 참여하던 참가자가 처음 몇 주 후: "광활한 새로운 가능성이 열리고 있는 것을 느낍니다 - 뭔가 새로운 것의 입구에 서 있는 것처럼." (P21).
그들은 시스템을 제품명으로 부르거나 단순히 "it"이라고 부르지만, 거의 "agent"라고 부르지 않으며, 3절의 지도에 나타나는 제목들은 어디에도 없습니다. 그런데 그들은 작업을 설정하고, 두 개의 답변을 비교하고, 확신 있는 답변을 확인하는 것에 대해 이야기합니다. 이것이 측정이 세는 일입니다. 지도에서처럼 기능이 이름 앞에 나타나고, 이는 어떤 주장을 검증하는 것이 아니라 설명으로 제공됩니다.
같은 사람들이 별도로 사전등록된 프로그램(OSF, DOI 10.17605/OSF.IO/X4EGQ)에도 참여하며, 그 결과는 그곳에 보고됩니다.
G2. Prolific 평가자 연구: 전문가들이 참조 시간에 동의합니까?
측정은 각 작업을 참조 시간으로 크기를 정하며, 5.2절의 규칙은 두 전문가가 맹검으로 평가하도록 요구하고, 그들의 추정치가 1.5배 이상 차이나면 세 번째 전문가를 호출합니다. 평가자 연구는 현업 전문가들이 그 정도로 근접하게 동의하는지 묻습니다. 데이터 수집 전인 2026년 10월 9일에 OSF에 사전 파일럿으로 등록되었으며(DOI 10.17605/OSF.IO/V92R8), 같은 날 Prolific에서 시작되었습니다.
설계. 독립적인 두 표본, 총 119명의 참가자 모집 및 보수 지급: 60명의 부기사(현재 역할: 회계사, 부기사, 공인 회계사, 감사인 또는 세무 전문가) 및 59명의 웹 및 소프트웨어 개발자(현재 역할: 소프트웨어 엔지니어, 소프트웨어 개발자 또는 웹 개발자). 모두 영국, 미국, 아일랜드, 캐나다, 호주 또는 뉴질랜드에 거주하며, Prolific 승인률이 최소 100회 이상의 이전 제출에서 최소 98% 이상이고, 연구 1개만 참여합니다. 각 참가자는 자신의 도메인에서 작업 은행 v0(BK01부터 BK10 또는 WT01부터 WT10, pilot/task-bank-v0.csv에 고정됨)의 10개 작업을 AI 도구 없이 단독으로 일하는 자격 있는 전문가의 집중 작업 시간으로 평가하고, 한 작업(BK03 또는 WT03)을 재검증으로 다시 평가하며, 역량 질문 하나와 주의력 점검 하나에 답합니다. 둘 중 하나에 불합격한 참가자는 제외되고 급여를 받으며, 양수가 아니거나 2000시간을 초과하는 추정치는 삭제됩니다.
결과. 주요: 도메인별로, 모든 작업에 대해 두 추정치가 1.5의 비율 내에 있는 평가자 쌍의 비중(보정 프로토콜에 설정된 0.70의 임계값에 대비). 보조: 각 평가자의 개인 수준을 제거한 후의 같은 비중, log 시간에 대한 ICC(2,1), 1.5 이내의 재검증 비중, 그리고 각 작업의 중앙값 추정치(은행이 의도한 단계에 대비). 비교를 위해, 부록 E의 4명의 모델 평가자는 이 20개 작업에 대해 그들의 쌍의 56%를 1.5 이내에 배치했습니다: 10개의 부기 작업에서 47%, 10개의 웹 작업에서 65%. 분석은 human_raters.py 스크립트이며, 데이터 전에 OSF 등록과 함께 제출되었고, 결과는 어떻든 보고됩니다.
결과.
선별. 참가자는 Prolific 프로필의 직업에 따라 허용되었으며, Prolific의 필터 뒤의 대부분의 답변은 자가 보고됨(Prolific, 2026)이므로, 역량 질문은 설계의 유일한 거래 점검이었습니다. 부기 표본에서 고객이 받은 은행 입금에 대한 복식부기에 관한 객관식 문제였습니다. 그 표본에 허용된 60명 중 11명(18%)이 그것을 틀렸고, 그 중 8명은 차변과 대변을 역전시켰으며, 누구도 주의력 점검에 불합격하지 않았습니다. 등록된 대로, 그들은 아래 결과에서 제외되고 급여를 받았습니다. 등록되지 않은 비교에서, 이 11명은 표본의 다른 참가자들보다 은행의 더 큰 작업을 더 적은 시간으로 평가했습니다: 주(Week) 단계를 의도한 3개 작업(BK08부터 BK10)의 중앙값은 6, 6, 8시간이었고, 다른 49명은 8, 8, 12였습니다. 11명으로는 이것은 추정치가 아니라 검증할 선도이며, 성급함이나 질문의 오독은 유사한 흔적을 남길 것입니다. 거래를 모르는 사람이 그 더 큰 작업의 모든 단계를 보지 못한다는 해석에 맞습니다(6.5절). 웹 도구 표본에서 같은 비교는 반복되지 않았습니다: 역량 질문에 불합격한 8명의 개발자는 주(Week)를 의도한 3개 작업에 대해 중앙값이 24.5, 27.5, 19시간이었고, 다른 50명은 20, 16, 20이었으므로, 선도는 부기에만 남아 있습니다(아래 탐색적 분석).
이 절의 스크립트는 동반 저장소(pilot/)에 있습니다. prolific_to_long.py는 Prolific 내보내기에서 평가의 긴 파일을 작성합니다. 이는 각 추정치를 작성된 대로 읽고, 숫자가 없거나 범위 같은 여러 개가 있는 답변을 텍스트로 유지하여 등록된 규칙이 삭제하게 하며, 순수한 숫자가 아닌 모든 답변을 나열합니다. table_g2.py는 등록된 스크립트의 함수를 변경되지 않은 상태로 호출하여 같은 작업에 대해 모델 평가자 옆에 표 G2를 인쇄합니다. screen_compare.py는 위의 선별 비교를 정확한 간격과 주(Week) 작업에 대해 평가자에 대한 순열 검정으로 다시 계산합니다.
합의. 자리들은 2026년 10월 9일과 10일에 채워졌으며, 118명의 참가자가 응답했습니다. 60명의 부기사와 58명의 개발자였고, 승인되고 지급된 한 명의 개발자 응답은 설문 도구에 저장되지 않았습니다. 등록된 제외 사항 후(11명의 부기사와 8명의 개발자가 역량 질문에 실패했으며, 주의력 검사에 실패한 사람은 없음), 49명의 부기사와 50명의 개발자가 남습니다. 어느 영역에서도 등록된 임계값을 충족하지 못했습니다. 부기사 쌍의 28%와 개발자 쌍의 25%가 1.5 비율 범위 내에 있었으며, 0.70에 못 미쳤습니다(표 G3). 전문가들은 작업을 일관되게 순서대로 정렬했으며, 각 영역의 중앙값이 시간용으로 의도된 작업에서 주(週)용으로 의도된 작업으로 상승했지만, 시간 단위의 불일치는 두 평정자 규칙이 허용하는 범위보다 더 컸습니다. 각 평정자의 개인적 수준을 제거하면 비율이 34%와 35%로만 상승했으므로, 불일치는 올림 또는 내림의 습관보다는 작업 자체에 관한 것입니다. 로그 시간에 대한 ICC(2,1)은 부기에서 0.34, 웹 도구에서 0.46이었으며, 평정자의 동일 작업에 대한 두 추정값은 53%와 74%의 경우에 1.5 범위 내에서 일치했습니다. 부록 E의 4명의 모델 평정자는 동일한 20개 작업에서 56%로 전문가들보다 더 밀접하게 서로 일치했으며, 이는 모델의 정확성보다는 전문가들의 분산에 대해 더 많이 말해줍니다. 실무자와 비교할 때 은행은 약 한 단계 높습니다. 일(日)용으로 의도된 모든 작업의 중앙값은 2~7시간이었으며, 이는 시간이고, 주(週)용으로 의도된 모든 작업의 중앙값은 8~20시간이었으며, 이는 일(日)입니다. 위의 탐색적 비교에서, 11명의 제외된 부기사는 다른 사람들보다 서로 더 나은 일치를 보이지 않았습니다(쌍의 28%가 1.5 범위 내). 결과는 평정자 규칙의 세 부분을 설정합니다. 평정자들은 측정된 시간이 있는 작업으로 교정하며, 이는 중앙값이 벗어난 것으로 표시되는 수준을 고정시킵니다. 작업은 두 평정자가 아니라 패널의 중앙값으로 크기가 조정되며, 이는 이 정도 크기의 분산이 대부분의 쌍을 세 번째 평정자에게 보낼 것이기 때문입니다. 그리고 작업 은행은 실무자의 중앙값으로부터 다시 범위가 지정되며, 이는 작업을 한 단계 낮춥니다(표 G3b).
표 G2. 영역별 기준 시간에 대한 전문가의 합의.
| 영역 | 유지됨 | 제외됨 | 1.5 범위 내 쌍 | 평정자 수준 제거 후 | ICC(2,1), 로그 시간 | 재검사 1.5 범위 내 |
|---|---|---|---|---|---|---|
| 부기 | 49 | 11 | 0.283 | 0.335 | 0.335 (49 완료) | 0.531 (n = 49) |
| 웹 도구 | 50 | 8 | 0.247 | 0.349 | 0.461 (49 완료) | 0.735 (n = 49) |
주: 1.5 범위 내 쌍에 대한 등록된 임계값: 0.70, 어느 영역에서도 충족되지 않음. 제외 사항은 역량 질문 실패이며, 주의력 검사에 실패한 참가자는 없습니다. 쌍은 영역의 모든 10개 작업에 걸쳐 취합니다(부기의 경우 11,760, 웹 도구의 경우 11,809). 재검사는 평정자의 BK03 또는 WT03에 대한 두 추정값을 비교합니다. human_raters.py의 출력(DOI 10.17605/OSF.IO/V92R8).
표 G3b. 은행이 의도한 단계에 대한 각 작업의 중앙값 추정(시간).
| 의도된 단계 | 부기 작업: 중앙값 | 중앙값의 단계 | 웹 도구 작업: 중앙값 | 중앙값의 단계 |
|---|---|---|---|---|
| 시간 | BK01: 2.0; BK02: 2.0; BK03: 1.5 | 시간 | WT01: 1.0; WT02: 1.0; WT03: 2.0 | 시간 |
| 일 | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | 시간 | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | 시간 |
| 주 | BK08: 8.0; BK09: 8.0; BK10: 12.0 | 일 | WT08: 20.0; WT09: 16.0; WT10: 20.0 | 일 |
주: 유지된 평정자들에 대한 중앙값. 8시간 미만의 중앙값은 시간에 속하고, 8시간 이상 40시간 미만의 중앙값은 일에 속합니다. 일 또는 주용으로 의도된 모든 작업은 한 단계 더 낮습니다.
탐색적 분석. 이 단락의 분석들은 등록되지 않았습니다. 등록된 로더, 제외 조건 및 테스트를 재사용하며, 스크립트와 출력은 동반 저장소의 pilot/exploratory_prolific.py와 pilot/results/prolific-2026-10/exploratory-output.txt입니다. 평가자를 재표본화하면 일차 점유율에 대해 0.24~0.33(부기)과 0.21~0.29(웹 도구)의 95% 신뢰구간이 나옵니다. 패널 규모(표 G4). 각 작업에 대해 k명의 유지된 평가자로 구성된 두 개의 겹치지 않는 패널을 2,000회 추출하고 중앙값을 비교했습니다. 원시 추정에서 두 중앙값이 1.5 이내로 일치한 것은 패널당 최소 15명의 부기자 또는 21명의 개발자에서만 70% 이상의 추출에서 나타났습니다. 각 평가자의 개인적 수준을 제거한 경우, 이는 측정된 시간이 있는 작업에 대한 보정이 의도하는 바인데, 7명의 패널은 0.71과 0.69에 도달했고 9명의 패널은 0.77과 0.76에 도달했습니다. 동일한 수준에 도달하는 것, 즉 측정이 기록하는 것은 더 적게 필요합니다: 패널당 5명의 보정된 평가자가 0.81과 0.84의 추출에서 그렇게 했습니다. 5.2절의 2평가자 규칙에서는 72%와 75%의 항목에 대해 3번째 평가자가 호출됩니다. 경력(표 G4b). 완전한 답변을 제공한 98명의 유지된 평가자 중 43명이 자신의 분야에서 10년 이상의 경력을 보유하고 있다고 보고했습니다. 그들은 다른 사람들보다 서로 더 밀접하게 일치하지 않았으며, 분야 경력 년수는 평가자가 다른 사람들의 중앙값에서 얼마나 멀리 떨어져 있는지를 예측하지 못했습니다(순위 상관계수 +0.18과 -0.10, 순열 p = 0.21과 0.47). 선임 개발자는 다른 개발자보다 더 높게 추정했습니다(다른 사람들의 중앙값의 1.32배 대 0.76배, p = 0.02); 선임 부기자는 그렇지 않았습니다(1.04대 1.07, p = 0.88). 작업. 불일치는 규모에 따라 증가합니다: 20개 작업 중 가장 논쟁이 많은 6개 중 5개는 주(Week)를 위한 작업으로, 쌍의 24%(부기)와 20%(웹 도구)가 1.5 이내였으며, 시간(Hour)을 위한 작업에서는 31%와 27%였습니다; 주 작업의 사분위수 범위는 4~8배를 차지했습니다. 속도 및 단위. 가장 빠른 4분의 1의 부기자(전체 설문조사에 3.6분 이하)는 나머지보다 더 밀접하게 일치했습니다(0.37 대 0.26), 개발자 중에서는 속도가 차이가 없었습니다(0.24 대 0.24). 일부 작업에 시간이 아닌 분 단위로 답한 것은 두 도메인 모두에서 차이가 없었습니다(0.31 대 0.31; 0.28 대 0.31). 2명의 부기자가 시간을 위한 작업에 40시간 이상을 소비했는데, 이는 분을 시간으로 입력한 것으로 보입니다; 이들을 제외하면 부기 점유율은 0.284입니다. 1명의 유지된 개발자가 숫자 대신 텍스트를 입력했으므로 해당 추정값 중 1개만 분석에 포함되었습니다. 선별. 각 평가자의 주 작업 추정을 시간 작업 추정과 비교하여 개인적 수준이 상쇄되도록 하면, 제외된 부기자는 더 큰 작업을 더 작은 작업의 3.2배로 평가한 반면 유지된 부기자는 6.2배였습니다(순열 p = 0.10), 제외된 개발자는 15.8배 대 10.6배였습니다(p = 0.37). 재시험. 반복 추정이 첫 번째보다 높았던 경우 부기자 25명, 낮았던 경우 4명이었으며, 개발자는 높았던 경우 17명, 낮았던 경우 2명이었습니다(정확 부호 검정 p < 두 경우 모두 0.001), 기하평균에서 약 30%로, 이는 그 사이에 평가된 더 큰 작업에 대한 앵커링과 일치합니다. 이 결과들을 종합하면 서둘러 일하는 평가자, 경력이 부족한 평가자 또는 부적격 평가자의 하위 집단보다는 작업의 산포와 그 규모에 위치하며, 규칙이 필요한 패널의 크기를 결정합니다: 보정된 평가자, 항목당 5~9명, 수준으로 채점합니다(표 G4).
표 G4. 작업당 k명의 평가자로 구성된 두 개의 독립 패널: 중앙값이 1.5 이내로 일치하는 추출의 점유율 / 동일한 수준에 있는 점유율(탐색적).
| 패널당 평가자 | 부기, 원시 | 부기, 수준 제거됨 | 웹 도구, 원시 | 웹 도구, 수준 제거됨 |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
주: 10개 추정치를 모두 보유한 유지된 평가자(도메인당 49명); 작업당 2,000회 추출, 추출 내에서 겹치지 않는 패널; 시드 20261011. 수준 제거됨: 각 평가자의 평균 로그 비율을 각 작업에서 모든 평가자의 중앙값에 대해 표본에서 빼냅니다, 등록된 2차 결과와 마찬가지로, 이 열들은 측정된 시간이 있는 별도의 앵커 작업에 대한 보정이 제공할 수 있는 것의 상한 추정입니다. 등록되지 않음; pilot/exploratory_prolific.py의 출력.
표 G4b. 분야 경력 년수와 일치(완전한 답변을 제공한 유지된 평가자, 탐색적).
| 도메인 | 그룹 | 평가자 | 그룹 내 1.5 이내의 쌍 | 다른 평가자들의 중앙값에 대한 수준 |
|---|---|---|---|---|
| 부기 | 10년 초과 | 23 | 0.268 | 1.04 |
| 부기 | 10년 이하 | 26 | 0.299 | 1.07 (p = 0.88) |
| 웹 도구 | 10년 초과 | 20 | 0.297 | 1.32 |
| 웹 도구 | 10년 이하 | 29 | 0.242 | 0.76 (p = 0.02) |
주: 수준은 평가자의 추정치를 동일한 작업에서 다른 평가자들의 중앙값으로 나눈 기하평균 비율입니다; p는 평균 로그 수준의 차이에 대한 양측 순열 검정(5,000회 순열)입니다. 등록되지 않음.
인용 방법
Chernets, V. (2026). 프로그래머 분할 이후: AI 에이전트를 통해 구축하는 사람들을 위한 하나의 측정 [사전인쇄]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}