Au-delà de la division des programmeurs : une mesure pour les personnes qui construisent par le biais d'agents IA
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
L'horizon de délégation vérifié, le gain d'amplification, une carte datée des noms de rôles, et 41 prédictions enregistrées notées chaque année jusqu'à 2031
Vadym Chernets, PhD, architecte de systèmes IA · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
Télécharger cet article
- SSRN (version de référence) : ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (archivé, accès ouvert) : doi.org/10.5281/zenodo.23267266
- OSF (les 41 prédictions, enregistrées le 9 octobre 2026) : doi.org/10.17605/OSF.IO/VW6P9
- GitHub (texte complet en Markdown) : github.com/vadimchernets/papers/tree/main/after-the-programmer-divide ; code de l'appendice C : github.com/vadimchernets/delegation-horizon
SSRN détient la version de référence ; citez celle-ci.
Mots-clés : agents IA ; IA agentique ; non-programmeurs ; agents de codage ; titres d'emploi ; recrutement basé sur les compétences ; théorie du mandataire ; ingénierie logicielle utilisateur final ; alphabétisation en IA ; horizon de délégation vérifié ; point de croisement des diplômes ; prédictions préenregistrées
Résumé
Un comptable demande à un agent un outil de rapprochement ; un développeur en demande un pour modifier un système de facturation. Chacun doit accepter une journée de travail et montrer qu'elle tient. En octobre 2026, les avocats donnaient aussi des tâches aux mêmes agents. Sur environ 400 000 sessions, le succès vérifié par le fournisseur sur le travail de production de code était de 34 % pour les professions de programmation et de 29 % pour les autres, bien que la profession ne soit pas l'éducation. Aucune échelle de carrière ne précise ce qu'une personne qui construit par des agents peut être de confiance pour livrer. Je propose une mesure à la place d'un titre. L'horizon de délégation vérifiée est le plus grand morceau de travail cohérent, en heures de référence d'un spécialiste qualifié, qu'une personne remet régulièrement aux agents et accepte après une vérification indépendante que les agents n'ont pas effectuée. Le gain d'amplification, heures de référence acceptées par heure d'attention, est un débit vérifié, non une estimation causale de l'accélération. Les deux sont notés par domaine, d'une heure à un trimestre ; un test de bureau a corrigé un seuil. Trois grands employeurs ont essayé les décomptes de jetons et les ont abandonnés en 2026 : un classement supprimé, un tableau de bord truqué, un budget dépensé. Le travail vérifié est plus difficile à manipuler par les dépenses, et chaque itinéraire restant respecte une défense déclarée. Une carte datée enregistre les noms rivaux (constructeur, gestionnaire d'agent, principal et autres) sans choisir. La neutralité de base est l'hypothèse qu'à un horizon égal une formation en programmation cesse de prédire la qualité vérifiée. Le point de croisement des compétences est le moment, domaine par domaine, où les produits des personnes sans formation informatique commencent à surpasser ceux des programmeurs sous les mêmes vérifications, après quoi les diplômes et les étiquettes d'ancienneté perdent du poids. Quarante et une prédictions datées, évaluées le 9 octobre 2026 à la médiane de trois prévisions de modèles en aveugle, sont enregistrées sur OSF et notées annuellement jusqu'en 2031 ; une étude jamais exécutée compte comme un échec, et le dépassement dans son propre domaine est fixé à 0,35.
Résumé exécutif
D'ici 2026, les comptables comparaient les agents de codage de la même façon que les programmeurs l'avaient fait un an plus tôt, les avocats construisaient leurs propres outils avec eux, et les personnes en dehors de l'informatique étaient devenues une part à croissance rapide des utilisateurs d'agents de codage d'un fournisseur ; dans les archives d'un autre fournisseur, environ 400 000 sessions, les professions qui ne programment pas n'étaient en retrait que de quelques points de pourcentage par rapport aux programmeurs en termes de succès vérifiés sur les travaux de codage (34 % contre 29 %). Là où le travail est effectué, la frontière entre les programmeurs et tous les autres s'est amenuisée. Dans les titres de poste, les grades de rémunération et les curriculum vitæ, elle se tient où elle se tenait.
Certains programmeurs et certains professionnels du domaine partagent maintenant un flux de travail : ils confient le travail à des agents et décident de l'accepter ou non. Les tâches et les flux de travail se sont fusionnés avant les professions entières, de sorte que la question pertinente à propos d'une personne est la taille du travail qu'elle peut confier et prouver, quel que soit le côté de l'ancienne frontière d'où elle vient. La mesure que je propose pour cette question, l'horizon de délégation vérifiée, repose sur quelques choix de conception, et ce résumé donne la raison de chacun. L'unité est le temps qu'un spécialiste qualifié aurait dû consacrer (une heure, un jour, une semaine, un mois, un trimestre), car les deux anciennes échelles peuvent la lire et aucune traduction entre les professions n'est nécessaire. L'outil de rapprochement d'un comptable et la modification de facturation d'un développeur font face à la même règle. Seul le travail qui a réussi une vérification que les agents n'ont pas vue est comptabilisé, et l'accord entre les modèles d'une même famille ne compte pas comme une telle vérification, car leurs erreurs sont corrélées. Un deuxième chiffre, le gain d'amplification, enregistre le volume de travail vérifiée que chaque heure d'attention de la personne produit (le travail échoué coûte toujours de l'attention, et le temps non contrôlé des agents ne compte pas), de sorte que quelqu'un qui travaille aux côtés d'un agent dans des boucles courtes est crédité aussi pleinement que quelqu'un qui confie de grandes pièces. Les deux chiffres sont conservés par domaine, pour une raison symétrique : un avocat qui se lance dans l'informatique et un programmeur qui se lance dans le droit perdent la même chose, la capacité à accepter le travail dans un domaine qu'ils ne connaissent pas. Les seuils sont versionnés en règles v1.1 et testés sur le terrain, et le test sur le terrain a déjà corrigé l'un d'entre eux (Appendice E).
Les noms ne sont pas définitifs. Constructeur, ingénieur agentiel, gestionnaire d'agent, opérateur IA, orchestrateur et principal sont tous en usage en octobre 2026, chacun avec un propriétaire et une date. Je les mappe sans choisir, de sorte que quel que soit celui qui l'emporte, on peut le lire sur une seule échelle : un constructeur à la semaine, un gestionnaire d'agent au jour.
Le marché a déjà tenté un raccourci. En 2026, les comptes de jetons ont été essayés comme mesure des effectifs chez les grands employeurs et ont échoué en quelques mois : le classement officieux d'un employé chez Meta a été supprimé et les directives officielles de l'entreprise ont ensuite exclu les comptes de jetons, un classement chez Amazon a été joué avec des tâches vides et supprimé, et Uber a dépensé son budget annuel en IA en quatre mois. Un compte des entrées récompense la dépense. Un compte du travail accepté, vérifiée indépendamment, est plus difficile à gonfler de cette façon par conception. Les voies qui restent (contrôles faciles, évaluateurs généreux, aide cachée et travail découpé en morceaux) font chacune face à une défense dans la section 5.8 : audits aléatoires, évaluateurs indépendants des heures, un registre public des défaillances, une unité cohérente de travail et des erreurs plantées.
Deux prédictions portent ma thèse datée. La neutralité du contexte dit qu'au même échelon, une formation en programmation cesse de prédire la qualité vérifiée. Le point de passage des titres de compétence est le moment, dans un domaine, où les produits créés par des personnes sans formation en informatique commencent à surpasser ceux des programmeurs utilisant les mêmes agents, après lequel un diplôme et les étiquettes junior et senior perdent du poids. La parité de qualité arrive avant ce moment, un croisement des exigences en matière de diplômes dans les offres d'emploi en est le signe visible, et chaque partie est datée et testée par elle-même. La prédiction principale va à l'encontre de l'opinion actuelle, et l'article le dit là où elle énonce la prédiction. Chaque prédiction nomme également le résultat qui la réfuterait, de sorte qu'un lecteur peut voir à l'avance ce qu'un échec ressemblerait. Les 41 figurent toutes dans un tableau avec les probabilités, les seuils, les sources de secours et les dates finales, enregistré sur OSF le 9 octobre 2026 (DOI 10.17605/OSF.IO/VW6P9) et noté selon la règle de Brier chaque année jusqu'en 2031. Vingt-sept se résolvent à partir de données publiques. Quatorze nécessitent des études enregistrées séparément avant que les données ne soient collectées, et les preuves manquantes ou non concluantes sont enregistrées comme non résolues et ne compte pas comme un succès ; une étude qui n'a jamais été menée est un échec du programme de test et reste sur le tableau de bord. Les probabilités ont été fixées le 9 octobre 2026 comme la médiane de trois prévisions de modèle en aveugle, que j'ai adoptées, et sont enregistrées sur OSF ; la probabilité de dépasser dans son propre domaine est de 0,35.
Quand la construction coûte peu, la confiance devient le filtre rare. Les app stores et les hébergeurs de code sont inondés, les plateformes ferment leurs portes aux contributeurs inconnus, et les agents rédigent de plus en plus une solution au lieu d'en adopter une d'un tiers. À côté de la personne qui construit, deux fonctions de partenariat sont visibles : un finisseur apporte le produit aux gens, et un garant le signe. Le deuxième nom vient d'une description de 2025 du rôle, et je propose une mesure pour le garant également.
1. Introduction
Le 23 septembre 2026, un blog destiné aux comptables a comparé deux agents de codage, Claude Code et Codex, pour catégoriser les transactions et rapprocher les comptes (Growthy, 2026). Un an auparavant, cette comparaison appartenait aux programmeurs, et elle y appartient toujours dans les fils de discussion des programmeurs, avec ses camps et ses loyautés. Ce qui a changé, c'est le lecteur. Les personnes qui choisissent maintenant entre les agents tiennent des livres, rédigent des contrats et gèrent des campagnes, et les agents entre lesquels elles choisissent sont ceux que les développeurs de logiciels utilisent.
Pendant des décennies, l'économie a maintenu deux échelles. En informatique, les échelons étaient junior, intermédiaire, senior, staff et principal, tarifés selon les années d'expérience et selon le nombre d'ingénieurs qu'un projet nécessitait. Ailleurs, les échelons étaient analyste, consultant, directeur, directeur général et associé. Les échelles se rencontraient à la porte du département informatique, en ce sens qu'un professionnel de la deuxième échelle obtenait des logiciels en les commandant à quelqu'un du premier. En 2025 et 2026, les deux échelles ont commencé à décrire le même travail. Les développeurs se sont vu dire que leurs principales activités étaient devenues la délégation et la vérification (GitHub, 2025b). Les professionnels en dehors de l'informatique, avec un agent dans un terminal ou une fenêtre de bureau, ont commencé à construire les outils, les sites et les petites applications qu'ils avaient l'habitude de commander (Bloomberg Law, 2026; OpenAI, 2026). Aucune des deux échelles ne dit ce qu'on peut faire confiance à une telle personne de livrer, et aucune ne dit comment comparer un ancien développeur avec un ancien analyste qui font maintenant le même travail.
Les questions qui suivent portent sur ce qu'on devrait appeler les personnes du côté fusionné de cette frontière, comment mesurer leur niveau une fois qu'un diplôme et des années de service cessent de dire à un employeur ce qu'elles peuvent livrer, et quand la frontière pourrait disparaître. La dernière reçoit sa réponse sous la forme de prédictions datées.
Cette question a aussi une origine datée. Le 8 octobre 2026, j'ai énoncé une prévision : dans un à deux ans, la capacité agentielle croîtra tellement que l'éducation technique ne sera plus nécessaire, et les personnes sans elle construiront de meilleures applications, des sites et des produits, avec un code meilleur que celui des programmeurs. Plus tard le même soir, j'ai ajouté un corollaire. Quand les produits réalisés par des personnes sans formation en informatique commenceront à dépasser ceux réalisés par des professionnels de l'informatique, les diplômes en informatique et les étiquettes junior et senior perdront rapidement du poids sur un CV. (Les deux déclarations sont traduites de mes notes de ce jour.) Les sections 6 et 11 transforment les deux en prédictions avec des dates, des mesures, des seuils et des résultats qui les réfuteraient. La deuxième déclaration nomme le moment que le reste du document appelle le point de croisement des diplômes.
L'article complémentaire de cette série a suivi les non-programmeurs du chat aux agents et a défini quatre niveaux selon le lieu où un agent travaille et ce que la personne doit posséder (Chernets, 2026a). Il n'a compté une transition que lorsqu'un agent avait produit un artefact, et il a refusé de faire du gestionnaire d'agents un titre de poste, en utilisant le terme « pour un modèle de comportement plutôt que pour un rôle auquel quelqu'un devrait embaucher, parce que le comportement laisse des preuves et un titre ne le fait pas » (Chernets, 2026a, section 8.4). L'article présent part de cette condition : un niveau est accordé, et n'importe quel titre peut s'y attacher, seulement sur preuve, c'est-à-dire travail confié aux agents, accepté par une personne, et confirmé par une vérification que les agents n'ont pas vue.
La section 3 donne une carte datée des noms en circulation en octobre 2026. La section 5 donne l'échelle sur laquelle n'importe lequel de ces noms peut être lu, l'horizon de délégation vérifié avec son deuxième axe, le gain d'amplification. La section 6 énonce deux hypothèses, la neutralité de l'arrière-plan et le point de croisement des diplômes, et demande combien de l'expérience d'un métier un processus de vérifications peut remplacer. Les sections 7 et 8 traitent de la confiance, la frontière qui ne se dissout pas, et les deux fonctions partenaires à côté de la personne qui construit. La section 11 énonce des prédictions datées avec des probabilités, des seuils et des sources de secours, enregistrées sur OSF et évaluées chaque année jusqu'en 2031 publiquement.
Je ne choisis pas parmi les noms. Le marché choisira, probablement dans quelques mois, et un article qui parie sur un mot est faux le jour où un autre mot gagne. Ce qu'un article peut fixer, c'est l'échelle. La section 5 la définit en détail ; en bref, l'horizon de délégation vérifié demande quelle taille de travail, en heures qu'un spécialiste qualifié aurait dû consacrer, une personne remet régulièrement aux agents et accepte avec une vérification indépendante derrière l'acceptation, et le gain d'amplification demande combien de telles heures chaque heure d'attention propre de la personne engendre. Les deux sont conservés par domaine, datés et placés sur cinq échelons allant d'une Heure à un Trimestre. La figure 1 place les deux anciennes échelles à côté de celle-ci.
Une définition du point de croisement des diplômes sert l'ensemble du document. Dans un domaine, c'est le moment où les produits réalisés par des personnes sans formation en informatique, acceptés selon les mêmes vérifications indépendantes, commencent à dépasser ceux des programmeurs qui utilisent les mêmes agents, après quoi un diplôme et les étiquettes junior et senior perdent leur poids dans l'embauche. La parité de qualité est l'étape avant ce moment, et un croisement des exigences de diplôme dans les offres d'emploi en est le signe visible. La neutralité de l'arrière-plan, l'hypothèse que l'éducation cesse de prédire la qualité vérifiée à un échelon égal, est le mécanisme qui l'expliquerait. Chacune de ces quatre parties porte sa propre prédiction datée (section 6.2).
Les preuves proviennent de 2025 et 2026, une période au cours de laquelle un mois de développement d'agents change ce qu'une mesure doit compter. Un chiffre largement cité situe l'embauche de nouveaux diplômés dans les grandes sociétés technologiques bien en dessous de son niveau de 2019. Il est laissé de côté, tout comme les comparaisons avec le pic d'embauche de 2022, car elles mesurent un monde avant les agents. Les séries d'avant l'émergence des agents n'entrent que comme antécédents, et la macroéconomie de l'embauche est portée par le contrepoint LinkedIn de la section 2.4. Les travaux plus anciens entrent également comme théorie, précédent ou analogie : Jaques sur l'étendue temporelle de la responsabilité, Jensen et Meckling sur le coût de la délégation, une ruée vers l'or et un photographe.
Figure 1. Deux échelles et une mesure.
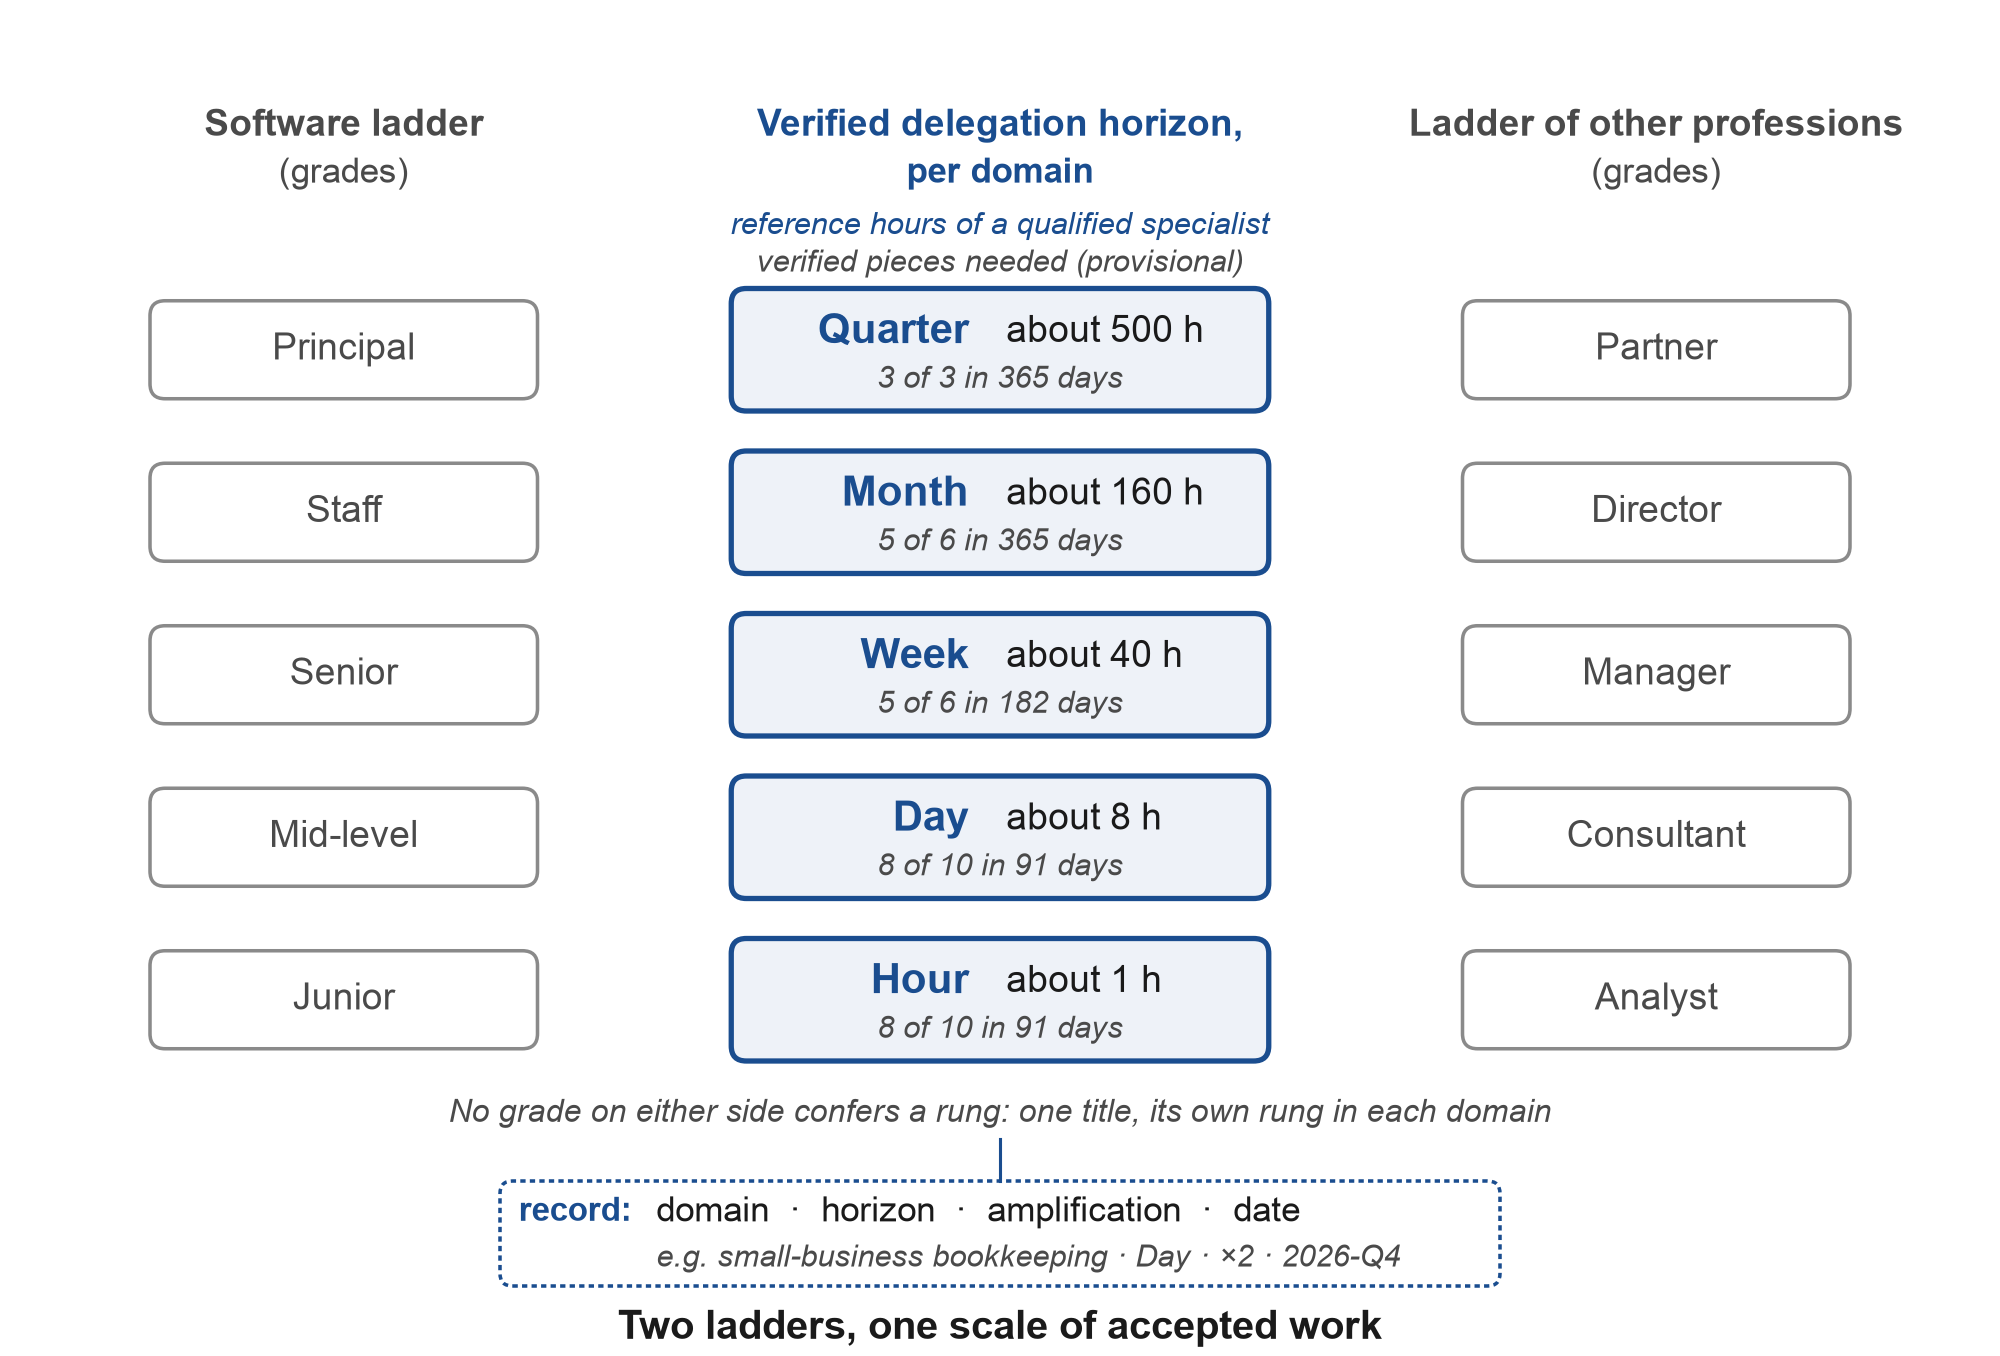
Note : Les anciennes échelles sont dessinées côte à côte avec les cinq échelons et ne sont délibérément pas connectées : aucun grade sur l'une ou l'autre échelle n'accorde un échelon, et la même personne tient un échelon séparé dans chaque domaine (section 5.2). Les échelons sont comptés en heures de référence d'un spécialiste qualifié, avec les comptes et les fenêtres de la section 5.2 (règles v1.1). L'enregistrement montré est celui imprimé par l'exemple travaillé de l'appendice C4.
À cet égard, la section 2 expose les preuves de convergence et la section 4 explique comment la première mesure du marché a échoué, ce qui est le cas pour une mesure de ce type. La section 9 vérifie quels sujets des conversations des programmeurs se retrouvent dans d'autres professions, et la section 10 en tire les implications. La section 12 recueille les preuves contre la thèse, la section 13 énonce ses conditions aux limites, et la section 14 conclut.
2. Deux mondes qui convergent : données probantes de 2025 et 2026
2.1 Le métier de programmeur, redéfini
Les fournisseurs qui vendent aux développeurs décrivent désormais le métier du développeur comme la direction d'agents. Le compte rendu de GitHub sur « la nouvelle identité d'un développeur » plaçait la délégation et la vérification au centre du travail (GitHub, 2025b). Anthropic a sondé 132 de ses propres ingénieurs et chercheurs en août 2025. Ils ont signalé utiliser l'IA dans environ 60 % de leur travail et un gain de productivité autoévalué d'environ 50 %, et se sont décrits comme devenant plus « full-stack ». La plupart ont déclaré qu'ils ne pouvaient déléguer entièrement que jusqu'à un cinquième de leur travail, et 27 % du travail assisté par l'IA consistait en tâches qui n'auraient pas du tout été effectuées sans l'IA (Anthropic, 2025a). Une mesure fondée sur la seule délégation complète ne verrait donc au maximum qu'un cinquième de ce que les utilisateurs les plus avancés au monde font avec l'IA, raison pour laquelle la section 5 ajoute un deuxième axe. Le même rapport nommait un « paradoxe de la supervision » : superviser le modèle exige les compétences en codage qui s'atrophient quand tout lui est confié.
Les mots ont suivi le travail. Andrej Karpathy a nommé le « vibe coding » le 2 février 2025 (Karpathy, 2025), Collins en a fait un mot de l'année (Collins Dictionary, 2025), et un an plus tard Karpathy a avancé vers l'« agentic engineering ». À l'AI Ascent de Sequoia le 30 avril 2026, il a formulé la différence ainsi : « le vibe coding relève le plancher, l'agentic engineering extrapole le plafond » (Karpathy, 2026 ; Willison, 2026a). Un article académique décrivait l'ingénieur agentic comme un nouveau prototype professionnel, la responsabilité se déplaçant de l'auteur du code au propriétaire des résultats (Alenezi, 2026), et Microsoft décrivait les modèles de travail chez ses clients comme auteur, éditeur, directeur et orchestrateur (Microsoft, 2026b).
2.2 Tous les autres, à l'intérieur des mêmes agents
Deux fournisseurs signalent une large utilisation des agents de codage par des personnes en dehors de l'informatique, avec des limites différentes en matière de sélection et de mesure. OpenAI a signalé en juin 2026 que les utilisateurs hebdomadaires de son agent de codage qui ne sont pas des développeurs avaient augmenté 137 fois chez les utilisateurs individuels et 189 fois chez les organisations depuis août 2025 (OpenAI, 2026). La base était faible et les données proviennent du fournisseur. Le même rapport donne une distribution qui a de l'importance pour la section 5. Dans un échantillon d'environ 0,1 % des utilisateurs individuels de l'agent en mai 2026, 80,6 % ont fait au moins une demande dont la durée à la main, telle qu'estimée par un modèle, dépassait 30 minutes, 70,2 % au moins une au-dessus d'une heure, et 25,6 % au moins une au-dessus de huit heures. Ce sont des parts d'utilisateurs qui font des demandes longues, avec des durées estimées par un modèle, ce qui est différent d'un taux d'accomplissement ou d'un horizon vérifié, et la section 5 explique pourquoi la différence importe. Plus d'un quart du travail de l'agent pour les fonctions commerciales était un travail d'ingénierie.
L'étude d'Anthropic sur Claude Code, publiée le 16 juin 2026, est la donnée publique la plus proche de la thèse (Anthropic, 2026e). Elle a analysé environ 400 000 sessions par environ 235 000 personnes entre octobre 2025 et avril 2026. L'expertise a été jugée à partir du comportement, par trois signes : la précision avec laquelle la personne énonçait la tâche, ce qu'elle demandait de vérifier, et qui corrigeait qui. Un comptable sans connaissances en Python qui a écrit des règles de rapprochement exactes et a détecté les cas limites a été noté expert. Dans les sessions où du code a été produit, chacune des dix plus grandes professions traînait les professions de programmation de pas plus de sept points de pourcentage en matière de succès vérifié, où le succès signifie l'accomplissement appuyé par des preuves telles que les tests réussis ou le travail engagé. La classification du fournisseur repose en partie sur des signaux dans la transcription de la session, tels qu'une confirmation explicite de l'utilisateur, et le rapport note que le taux légèrement plus élevé des managers peut en partie refléter la façon dont ils signalent le succès, donc « vérifié » ici est le terme du fournisseur, non une vérification indépendante. Agrégé sur les sessions produisant du code, il était de 34 % contre 29 % (environ 30 % contre 26 % sur toutes les sessions), et la gestion a légèrement surpassé les programmeurs. Ces données trient les gens par profession et ne disent rien sur l'éducation : un comptable peut avoir un diplôme en informatique, et un programmeur peut n'en avoir aucun. Le rapport a conclu que « les agents de codage rendent un parcours en codage moins pertinent pour la programmation réussie ». Les personnes ont pris environ 70 % des décisions sur ce qu'il faut faire et l'agent environ 80 % des décisions sur comment. Un ensemble d'instructions d'un expert déclenchait environ douze actions d'agent, celui d'un novice environ cinq.
Le même changement apparaît dans les sources qui ne proviennent pas des entreprises vendant les agents. Des avocats, des associés juniors aux associés, ont construit des prototypes de travail de leurs propres outils avec Claude Code au lieu d'attendre les fournisseurs, et la part des avocats ayant un accès large à l'IA est passée de 61 % en 2025 à 83 % en 2026 (Bloomberg Law, 2026 ; Artificial Lawyer, 2026). Les comptables comparent les agents (Growthy, 2026). Lovable, un constructeur d'applications basé sur navigateur, a dépassé 600 millions de dollars de revenus annualisés en septembre 2026 (TechCrunch, 2026a). Selon une estimation, Claude Code a rédigé environ 4 % des commits publics sur GitHub au début de février 2026 (SemiAnalysis, 2026).
2.3 Les échelons sous tension
Les employeurs ont commencé à renommer leurs échelons sans dire encore ce qui les remplace. À partir du 1er juin 2026, Deloitte a donné à ses environ 181 500 employés des États-Unis de nouveaux titres organisés par famille d'emplois et a ajouté un niveau de leadership (Business Insider, 2026). Ses niveaux internes et ses principes de rémunération sont restés en place (Fortune, 2026a), donc c'était un renommage avec la mesure telle qu'elle était. LinkedIn aurait remplacé son programme de chef de produit associé par une piste « Associate Product Builder » et aurait ouvert un rôle « Full Stack Builder » aux personnes de toute fonction (Lenny's Newsletter, 2025). Microsoft a compté 3 233 sur 20 000 utilisateurs d'IA interrogés, environ 16 %, comme « Frontier Professionals » qui exécutent des agents multitâches et redessinent leurs processus (Microsoft, 2026a). Srinivasan et Wei ont argumenté dans la Harvard Business Review en février 2026 que les entreprises avaient besoin de gestionnaires d'agents, et s'attendaient à ce que le titre devienne standard dans 12 à 18 mois (Srinivasan & Wei, 2026). Certains employeurs vont plus loin et intègrent le nouveau rôle dans les offres : State Street a annoncé un « Agentic Product Builder » qui exige toujours de la programmation (State Street, 2026). Le 7 octobre 2026, Dust a présenté l'« AI Operator » comme la personne qui construit et maintient les flux de travail des agents partagés (Dust, 2026).
L'embauche a remarqué. La part des entretiens d'embauche au cours desquels l'utilisation de l'IA par les candidats a été discutée a augmenté de 0,33 % au troisième trimestre de 2025 à 4,54 % au deuxième trimestre de 2026 (Metaview, 2026). La question a fait son entrée dans l'embauche avant qu'une échelle pour la réponse n'existe.
2.4 Offres d'emploi, embauche au niveau d'entrée et éducation
Les offres d'emploi américaines mentionnant « agentic AI » sont passées de 151 en 2024 à 16 541 en 2025 (Stanford HAI, 2026). Un comptage différent, par Lightcast, a trouvé plus de 86 000 offres en 2025 mentionnant les compétences en IA agentive, une augmentation annuelle de 280 % des mentions de ces compétences et un salaire médian annoncé de 153 000 dollars ; les compétences ont été principalement ajoutées à des titres de poste existants (Lightcast, 2026a). L'AI Index compte les offres contenant l'expression « agentic AI », tandis que le blog de Lightcast compte les offres portant des compétences en IA agentive selon sa propre taxonomie, ce qui explique la plupart de l'écart entre 16 541 et environ 86 000. Les chiffres mesurent des choses différentes et sont tenus séparés ici.
L'embauche au niveau débutant s'est affaiblie, et la cause en est contestée. LinkedIn a constaté que l'embauche américaine au niveau débutant d'avril à juin 2026 était en baisse de 7,6 % en variation annuelle par rapport à 6,9 % pour tous les niveaux, et dans les professions que l'IA augmente, l'embauche au niveau débutant a baissé de 9,6 % par rapport à 6,5 % pour tous les niveaux dans ces professions (LinkedIn Economic Graph, 2026). LinkedIn elle-même attribue davantage la baisse à l'incertitude économique qu'à l'IA, et note que, parmi les rôles au niveau débutant, ceux protégés de l'IA ont connu les plus fortes baisses en France, au Royaume-Uni et aux États-Unis. La mise à jour d'août 2026 de l'étude « canaries » de Stanford a trouvé l'emploi des 22-25 ans dans les professions exposées à l'IA environ 19 % au-dessous des attentes, sans écart comparable pour les travailleurs expérimentés, et décrit le résultat comme descriptif (Stanford Digital Economy Lab, 2026a). Deux autres sources trouvent le même mécanisme. Les économistes de la Banque de réserve fédérale de Dallas, utilisant les microdonnées de l'enquête sur la population active actuelle, ont trouvé des baisses d'emploi liées à l'exposition à l'IA uniquement parmi les jeunes travailleurs, entraînées principalement par moins de personnes entrant au travail de l'extérieur du marché du travail plutôt que par des licenciements (Atkinson & Yamco, 2026). Dans les données de curriculum vitae couvrant environ 65 millions de travailleurs, l'emploi junior dans les entreprises qui ont adopté l'IA générative était environ 9 % inférieur à celui des non-adoptants six trimestres après l'adoption, à nouveau par un recrutement plus lent plutôt que par des séparations (Hosseini & Lichtinger, 2026). Dans l'ensemble de l'économie, le Yale Budget Lab trouve toujours aucun signe clair que les professions exposées à l'IA s'en sortent moins bien que les professions comparables non exposées (Yale Budget Lab, 2026), donc la pression se situe au premier échelon, pas dans la profession dans son ensemble. Les employeurs ont cité l'IA dans 101 743 réductions d'effectifs annoncées au cours du premier semestre 2026, environ 23 % de tous les réductions d'effectifs annoncées (Challenger, Gray & Christmas, 2026).
L'éducation évolue aussi. Les nouveaux étudiants en informatique de premier cycle ont baissé de 13 % dans les départements couverts par l'enquête Taulbee 2026, qui compte les départements décernant des doctorats en Amérique du Nord ; ses auteurs décrivent cela comme les premiers signes clairs de contraction du pipeline d'inscription, aux côtés d'une production de diplômes record (Computing Research Association, 2026). Une expérience de terrain avec 673 apprentis informatiques allemands a trouvé des gains de 26 à 31 points de pourcentage sur les tâches en dehors de leur formation formelle lorsqu'ils avaient accès à l'IA (Stanford Digital Economy Lab, 2026b). Le cadre conjoint de l'OCDE et de la Commission européenne de juin 2026 comprend un domaine appelé « Manage AI » (OCDE & Commission européenne, 2026).
Le tableau A1 (Appendice F) énumère dix signaux de cette convergence avec leurs sources, et pour chacun ce qu'il montre et ce qu'il ne montre pas. Lus ensemble, ils montrent également où la mesure fait défaut : les données des fournisseurs sur les non-développeurs au sein des agents de codage montrent la croissance, non la qualité de leurs résultats. La proximité des professions dans les préoccupations concernant la réussite vérifiée concerne la profession, non le degré. Les échelons renommés et les segments d'enquête sont des titres, pas des mesures. Et l'échelon d'entrée plus faible n'est pas montré comme étant causé par l'IA.
Ces signaux montrent, avec une certaine confiance, que fixer et accepter le travail d'agent se fait désormais des deux côtés de l'ancienne frontière, et que les employeurs, les écoles et les fournisseurs ont commencé à renommer les choses. Les personnes en dehors de l'informatique font-elles ce travail aussi bien que les programmeurs ? Les signaux laissent cela ouvert, et ils ne montrent aucune mesure pour cela non plus. La section 5 propose la mesure, la section 11 met en date la question de la qualité, et la section 12 énumère la preuve que les prédictions doivent surmonter.
La preuve 2026 sépare les personnes qui peuvent montrer qu'un résultat est juste des personnes qui ne le peuvent pas. Une formation en programmation est un itinéraire vers cette capacité. La maîtrise d'un domaine, une habitude de vérifier et des outils pour vérifier en sont d'autres, et les données de la section 2.2 suggèrent qu'ils peuvent tenir lieu du premier plus souvent que les anciens échelons l'supposent, bien que pas encore qu'ils le peuvent toujours. La mesure de la section 5 est construite pour tester cette affirmation.
3. Les noms en circulation : une cartographie datée
3.1 Pourquoi je ne choisis pas un nom
Tous les quelques mois en 2026, une entreprise ou un consultant, parfois un magazine, proposait un nom pour les personnes décrites ici, et certains de ces noms s'imposeront. Parce que l'usage est incertain, je fais deux choses au lieu d'en recommander une : je cartographie les noms déjà en circulation, y compris ceux qui sont pris, avec qui a introduit chacun, quand et en quel sens, et j'offre une mesure selon laquelle chacun d'eux peut être lu. Si « builder » l'emporte, le registre lit « builder à la Semaine » ; si « agent manager » l'emporte, il lit « agent manager au Jour ». La priorité est revendiquée pour la mesure, l'échelle, les définitions et les prédictions, y compris les termes qui les nomment (horizon de délégation vérifié, gain d'amplification, point de croisement des accréditations), et pour aucun nom de rôle ; les noms de rôle ajoutés à la Section 3.3 sont offerts comme candidats sans priorité.
3.2 Six couches
Les candidats ne sont pas tous en compétition pour une seule place. Certains nomment une compétence que presque tout le monde aura, d'autres une profession, une mesure, un moment, un partenaire, ou un signal qui a échoué. Le Tableau A2 (Appendice F) énumère les noms déjà en usage, avec leurs propriétaires, et, dans une deuxième partie, les noms proposés dans cette étude ou utilisés ici uniquement comme descriptions simples, ainsi que les variantes qui ont été considérées et écartées, afin qu'un lecteur puisse voir toute la famille. La Figure 2 place les noms par couche et par la date à laquelle chacun a été introduit.
Figure 2. Les noms en circulation, par couche et par la date à laquelle chacun a été introduit.
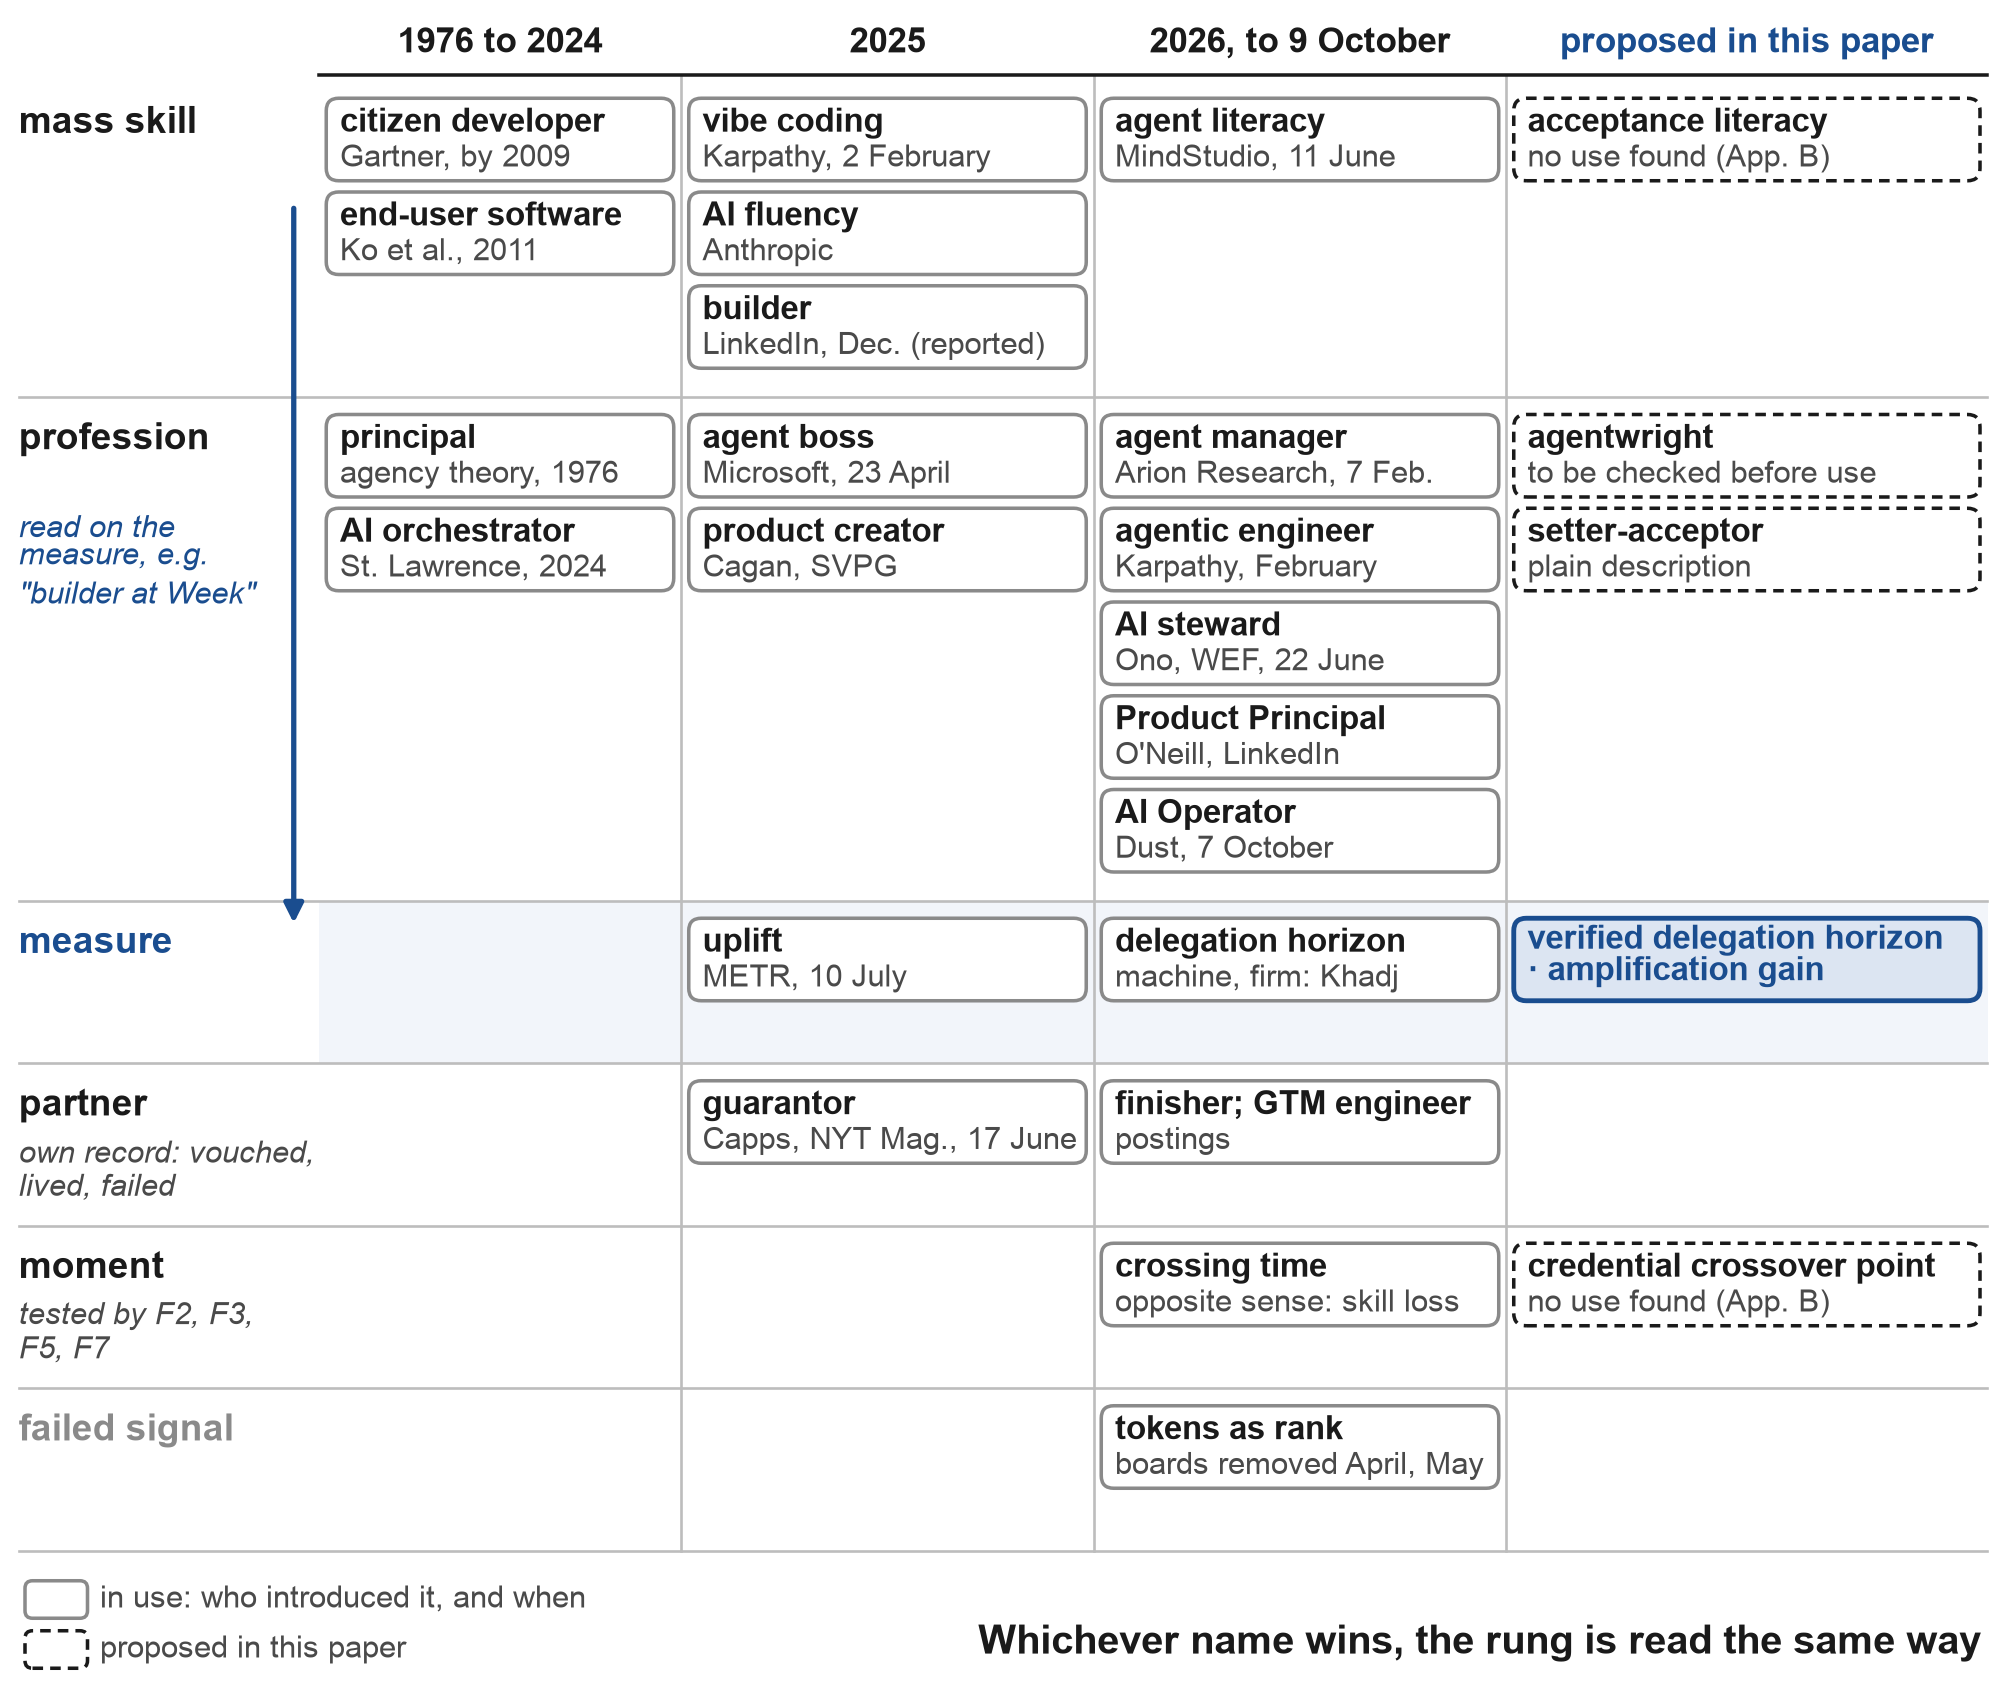
Note : Les propriétaires et les dates suivent le Tableau A2. Un nom dont la source ne donne qu'une année ne porte pas de mois. La figure est une sélection ; le Tableau A2 énumère tous les candidats. Seules les couches de compétence de masse et de profession sont lues sur la mesure (« builder à la Semaine », « agent manager au Jour », Section 3.1). Le partenaire a un registre qui lui est propre, combien de produits ont été cautionnés, combien de temps chacun a duré et combien ont échoué (Section 7.2), et le moment n'est pas un échelon mais est testé par les prédictions datées F2, F3, F5 et F7 (Section 11.2). « Horizon de délégation » dans la ligne de mesure est le sens de la machine ou de l'entreprise (Khadj, 2026 ; Alonso, 2026), pas la mesure personnelle de la Section 5. La figure ne porte aucun jugement sur le nom qui prévaudra.
3.3 Remarques sur la cartographie
« Builder » gagne probablement dans les RH de masse : LinkedIn l'a adopté, et les journalistes ont écrit en 2026 que tout le monde dans la Bay Area est maintenant un builder (SF Standard, 2026). Il n'y a aucune raison de combattre le mot, puisqu'il ne dit rien sur le niveau et le niveau est ce que la mesure fournit.
Les noms managériaux (agent manager, AI operator, orchestrator) sont horizontaux : ils décrivent la gestion des agents en général, dans aucun domaine particulier. La Section 6.3 donne la raison de s'attendre à ce qu'ils suivent le prompt engineer, un titre qui était partout en 2023 et a été appelé obsolète en 2025 (Fortune, 2025 ; TechRepublic, 2025).
« Principal » a la théorie la plus solide derrière lui et les pires collisions. Dans la théorie de l'agence, le principal est la partie qui délègue et paie les frais de surveillance (Jensen & Meckling, 1976), et la constitution d'Anthropic pour ses modèles appelle « principals » ceux au nom desquels le modèle agit (Anthropic, 2026b). Verheul (2026) soutient que lorsque les machines exercent la fonction d'agence, les personnes dans une entreprise ne détiennent que des postes de principal et l'échelle des carrières disparaît. J'accepte ce diagnostic et propose une nouvelle échelle à sa place. En gestion des identités et des accès, cependant, « agent principal » nomme l'identité propre de l'agent, l'inverse du sens prévu, donc la phrase anglaise « Agent Principal » ne devrait pas être utilisée pour une personne. « Product Principal » d'O'Neill est un précédent dans presque ce sens et est cité comme tel, et le framework AIDEs de JetBrains décrit déjà les niveaux de développeurs comme des propriétés d'une relation principal-agent (Tikhomirov, 2026).
Les noms proposés ici (agentwright, setter-acceptor, agent director) rejoignent la famille en tant que candidats, aucun d'eux un favori. Agentwright est libre dans les bases savantes consultées, mais les moteurs de recherche le divisent en « Agent Wright », il ressemble à un outil de test de navigateur que les développeurs connaissent, et en octobre 2026 le mot était déjà utilisé pour un package Python et un catalogue de compétences d'agents, donc il reste une variante qui aurait besoin d'un qualificatif.
Une observation sur le sens peut être enregistrée sans enlever le choix au marché. Par le sens, « principal » est le plus proche de la profession de la Section 8, le travail effectué pour d'autres avec responsabilité du résultat, et « builder » le plus proche de la compétence de masse, le travail effectué pour soi.
4. Pourquoi une mesure : l'année où les jetons ont été essayés comme ancienneté
Le marché n'a pas attendu une échelle. En 2026, il en a essayé plusieurs, et comme les épisodes diffèrent par nature, ils sont gardés séparés ici, dans l'ordre où ils se sont produits.
Chez Meta, un employé a créé un tableau de bord interne surnommé « Claudeonomics » qui classait environ 85 000 collègues selon les jetons consommés, plus de 60 billions d'entre eux en trente jours (Shopifreaks, 2026a). C'était un projet d'un seul employé, sans statut officiel, et il a été supprimé en avril après avoir été signalé en dehors de l'entreprise. La ligne officielle de Meta a évolué séparément. À partir de février, l'utilisation de l'IA était une partie formelle de l'évaluation des employés, et début septembre WIRED et CIO ont rapporté de nouvelles directives selon lesquelles Meta « n'utilisera pas de tableaux de bord d'adoption de l'IA ou de comptages de jetons pour évaluer l'impact » et a abandonné l'étiquette « AI Native » comme critère (CIO, 2026b; Shopifreaks, 2026b). Chez Amazon, un tableau des scores d'utilisation des jetons a été manipulé avec des tâches vides et supprimé en mai (CIO, 2026a), ce qui est la loi de Goodhart sous sa forme la plus pure : une fois que la mesure est devenue une cible, elle a cessé de mesurer. Le cas d'Uber est un événement budgétaire. L'entreprise a dépensé son budget annuel en IA en quatre mois et a limité les employés à 1 500 $ par mois (Fortune, 2026b). En juillet, le directeur général de Cognition a déclaré que les entreprises devraient mesurer la productivité, pas l'utilisation de l'IA (Fortune, 2026c).
Les contre-exemples sont tout aussi importants. Shopify ajoute des questions sur l'utilisation de l'IA à ses évaluations de performance et ses évaluations par les pairs (Shopify, 2026), et un commentateur s'attend à ce que les métriques de jetons soient « dégradées, pas éliminées » (Kingy AI, 2026). Les questions sur la façon dont une personne utilise l'IA sont une chose différente d'un classement par volume, et la prédiction F8 à la section 11 les distingue.
Les fils de discussion des développeurs examinés à la section 9 montrent le même instinct chez des personnes isolées. Ils se présentent avec des données : une facture mensuelle d'IA de 1 148 $, une capture d'écran d'un abonnement, environ 330 sur 600 pull requests effectuées (une unité décrite dans le fil comme très approximative), 36 étapes construites en trois jours. L'un d'eux a publié les économies que son agent avait calculées pour lui sans vérifier le calcul, ce qui est l'épisode du jeton répété par une personne. Chacun de ces cas compte ce qui a été dépensé ou produit ; ce qui a été accepté, par qui et après quelle vérification, n'est pas enregistré.
J'en tire une leçon directe pour la mesure : compter le travail, et seulement le travail qui a passé un contrôle que les agents n'ont pas vu. L'accord entre les modèles de la même famille ne peut pas être ce contrôle, car leurs erreurs sont corrélées et leur accord vaut moins d'opinions indépendantes qu'il n'y paraît (Chernets, 2026b). Dépenser plus de jetons ne peut pas gonfler une mesure construite de cette façon, puisque le travail non accepté n'y ajoute rien. D'autres façons de la gonfler subsistent, et la section 5.8 les énumère avec leurs défenses.
5. La mesure : horizon de délégation vérifié et gain d'amplification
5.1 Heures de référence
Les deux axes utilisent une unité, l'heure de référence : le temps qu'un spécialiste qualifié aurait besoin pour faire le même travail à la main. La référence est externe à dessein. Le fait que la personne aurait pu faire le travail elle-même n'entre pas en compte dans la mesure, pas plus que ses antécédents. Un outil de rapprochement de compte pour un comptable et un module de facturation pour un développeur sont tous deux mesurés par le temps qu'un professionnel compétent y aurait consacré.
Les heures de référence proviennent de deux sources. L'une est une banque gelée de tâches dont les temps manuels ont été mesurés en 2025 et 2026 ; GDPval, avec des tâches tirées de 44 professions et les temps d'experts, montre qu'une telle banque peut être constituée (Patwardhan et al., 2025). L'autre est deux évaluateurs indépendants qui estiment les heures sans savoir qui a effectué le travail ; quand les évaluateurs d'un domaine s'écartent trop l'un de l'autre, la référence peut être la médiane d'un panel calibré de cinq à neuf évaluateurs, notés par échelon (Appendice G2). Je gèle la banque délibérément, comme le mètre était autrefois gardé dans un coffre près de Paris, parce que dans quelques années peu de gens feront encore ces tâches à la main et il n'y aura plus rien pour comparer. La banque devrait contenir, pour chaque domaine, des tâches à chaque échelon, chacune avec une déclaration écrite de ce qui compte comme achevé, des temps mesurés manuellement, les vérifications cachées, et quelques erreurs plantées dont la détection fait partie de l'acceptation. Les temps manuels de GDPval sont des auto-déclarations vérifiées d'experts, tandis que ses temps d'examen ont été mesurés, ce qui est le standard qu'une banque devrait atteindre ou améliorer. Pour éviter que la mesure ne se juge elle-même, l'horizon est noté sur un ensemble de tâches et la qualité utilisée pour tester des hypothèses à ce sujet (Section 6) sur un autre.
5.2 L'horizon de délégation vérifié
Définition. L'horizon de délégation vérifié d'une personne dans un domaine est la taille maximale de travail, en heures de référence, à laquelle la personne confie régulièrement du travail à des agents, l'accepte, et en a confirmation par une vérification indépendante que les agents n'ont pas vue.
La règle en un paragraphe. Une part de travail déléguée compte comme vérifiée, et entre dans l'horizon, seulement quand tous les éléments suivants sont remplis. Elle a été établie avec une déclaration écrite de ce qui comptera comme achevé, et ses heures de référence proviennent de la banque ou de deux évaluateurs. La personne l'a acceptée comme un tout cohérent : un mois de travail divisé en 160 tickets d'une heure est 160 Heures, tandis que le travail effectué par étapes et accepté comme un ensemble compte pour le tout, selon les heures de référence de cet ensemble. Une vérification indépendante l'a confirmée, et une vérification est indépendante quand elle diffère des agents dans les données (entrées que les agents n'ont pas produites), dans l'accès (les agents ne pouvaient pas la voir ou l'éditer) et dans les incitations (celui qui la lance ne gagne rien d'une validation). Quatre types conviennent : tests d'acceptation cachés, un examinateur humain qualifié, utilisation réelle par les utilisateurs prévus, ou un modèle d'une autre famille qui vérifie par rapport à des sources que la personne a ouvertes et qui laisse un verdict qui peut être audité. L'auto-examen et l'accord entre modèles d'une même famille ne comptent pas, car leurs angles morts coïncident avec ceux des agents eux-mêmes. Dans la fenêtre de l'échelon (91 jours à l'Heure et au Jour, 182 à la Semaine, 365 au Mois et au Trimestre) la personne a accepté le nombre requis de parts d'au moins cette taille, dix à l'Heure et au Jour, six à la Semaine et au Mois et trois au Trimestre, et au moins huit sur dix ont réussi, ce qui signifie cinq sur six à la Semaine et au Mois et les trois au Trimestre. De la Semaine vers le haut, au moins une de ces parts contient des erreurs plantées. Une erreur plantée manquée, de quelque nature, bloque les échelons de la Semaine vers le haut pour cette fenêtre, et la part qui la contient ne compte ni vers un échelon ni vers le gain d'amplification. Où une erreur ne peut pas être annulée (argent déplacé, dossier d'un patient, un classement qui ne peut pas être retiré), chaque telle part doit réussir, avec un test caché ou un humain qualifié comme vérification par défaut et un modèle d'une autre famille comme deuxième ligne, et la règle plus stricte s'applique à ces seules parts. Chaque remise est enregistrée, les échecs et les parts abandonnées compris, avec l'attention qu'ils ont requise. L'échelon est confirmé à nouveau chaque trimestre : à la Semaine et au-dessus, au moins une part vérifiée de la taille de l'échelon doit tomber dans les 91 derniers jours, donc un horizon ne peut pas reposer sur un travail datant de près d'un an. Les paragraphes ci-dessous donnent les raisons de chaque partie.
Règle de notation. Dans la fenêtre définie pour chaque échelon (91 jours pour l'Heure et le Jour, 182 pour la Semaine, 365 pour le Mois et le Trimestre), un échelon compte si la personne a accepté le nombre requis de parts d'au moins cette taille dans le domaine (dix pour l'Heure et le Jour, moins au-dessus, comme indiqué ci-dessous), et au moins huit sur dix ont réussi une vérification de l'un de ces types : tests d'acceptation cachés, un examinateur humain qualifié, utilisation réelle par les utilisateurs prévus, ou un modèle d'une autre famille qui a vérifié par rapport à des sources. L'auto-examen et l'accord entre modèles d'une même famille ne comptent pas. Où les erreurs ne peuvent pas être annulées (argent déplacé, dossier d'un patient, un classement qui ne peut pas être retiré), chaque telle part doit réussir, et le seuil plus strict s'applique à ces seules parts. Pour ces parts, la vérification par défaut est un test caché ou un humain qualifié, avec un modèle d'une autre famille en deuxième ligne.
Échelons supérieurs. Un seul compte de dix mettrait les échelons supérieurs hors de portée de quiconque, puisque dix parts de 40 heures de référence en trois mois représentent 400 heures de travail d'un spécialiste, et dix parts de 500 heures c'est 5 000. La règle allonge donc la fenêtre et abaisse le compte à mesure que l'échelon augmente : dix parts en 91 jours pour l'Heure et le Jour, six en 182 jours pour la Semaine, six en 365 jours pour le Mois et trois en 365 jours pour le Trimestre, avec la même proportion de huit sur dix (ce qui signifie cinq sur six pour la Semaine et le Mois, et les trois pour le Trimestre). Une version antérieure demandait quatre sur quatre au Mois ; le test sur le terrain de l'Appendice E a montré que cela rendait le Mois plus difficile à obtenir que le Trimestre pour une personne de quelque fiabilité que ce soit, et le compte a été modifié. De la Semaine vers le haut, au moins une part de la taille de l'échelon dans la fenêtre doit contenir des erreurs plantées. Toute erreur plantée que la personne manque, de quelque nature, bloque les échelons de la Semaine vers le haut pour cette fenêtre, et une part avec une erreur plantée manquée ne compte pas comme vérifiée, ni vers un échelon ni vers le gain d'amplification. Le Trimestre est destiné à rester un échelon rare, et les comptes ci-dessus sont établis pour qu'il en soit ainsi.
Chaque remise est enregistrée. Le journal enregistre chaque pièce remise aux agents, y compris celles qui ont échoué la vérification et celles abandonnées avant celle-ci, et seule une pièce acceptée comme une livrable cohérente compte pour un échelon. Un mois de travail divisé en 160 tickets d'une heure représente 160 Hours, non pas un Month : les heures de référence sont estimées pour la livrable que l'utilisateur, le client ou l'examinateur accepte dans son ensemble, dans l'esprit des tâches cohérentes de METR. La réciproque vaut aussi : le travail effectué par étapes et accepté comme une livrable cohérente compte en entier, selon les heures de référence de cette livrable, quel que soit le nombre d'étapes nécessaires.
Indépendance. Une vérification est indépendante quand elle diffère des agents par les données (elle utilise des entrées que les agents n'ont pas produites), par l'accès (les agents ne pouvaient pas la voir ou l'éditer) et par les incitations (celui qui l'exécute ne gagne rien d'une réussite). Un modèle d'une autre famille ajoute une diversité d'erreurs. Elle compte seulement quand elle vérifie par rapport aux sources que la personne a ouvertes, et son verdict est une entrée qui peut être auditée.
Une pièce de travail emprunte ce chemin (Figure 3). Une tâche est fixée avec une déclaration écrite de ce qui comptera comme terminé. Ses heures de référence sont tirées de la banque ou de deux évaluateurs. Les agents font le travail tandis que la personne consacre son attention, ce qui est enregistré. La personne accepte, rejette ou abandonne la pièce, une vérification indépendante confirme ou réfute, et la ligne du journal est écrite à ce moment, avec la date de début conservée comme champ distinct où cela importe. Quand un résultat différé existe (un dossier accepté, une version toujours en cours après un mois), il est enregistré à son arrivée. L'horizon et le gain sont calculés à partir de ces enregistrements, avec une date.
Figure 3. Une pièce de travail, un enregistrement.
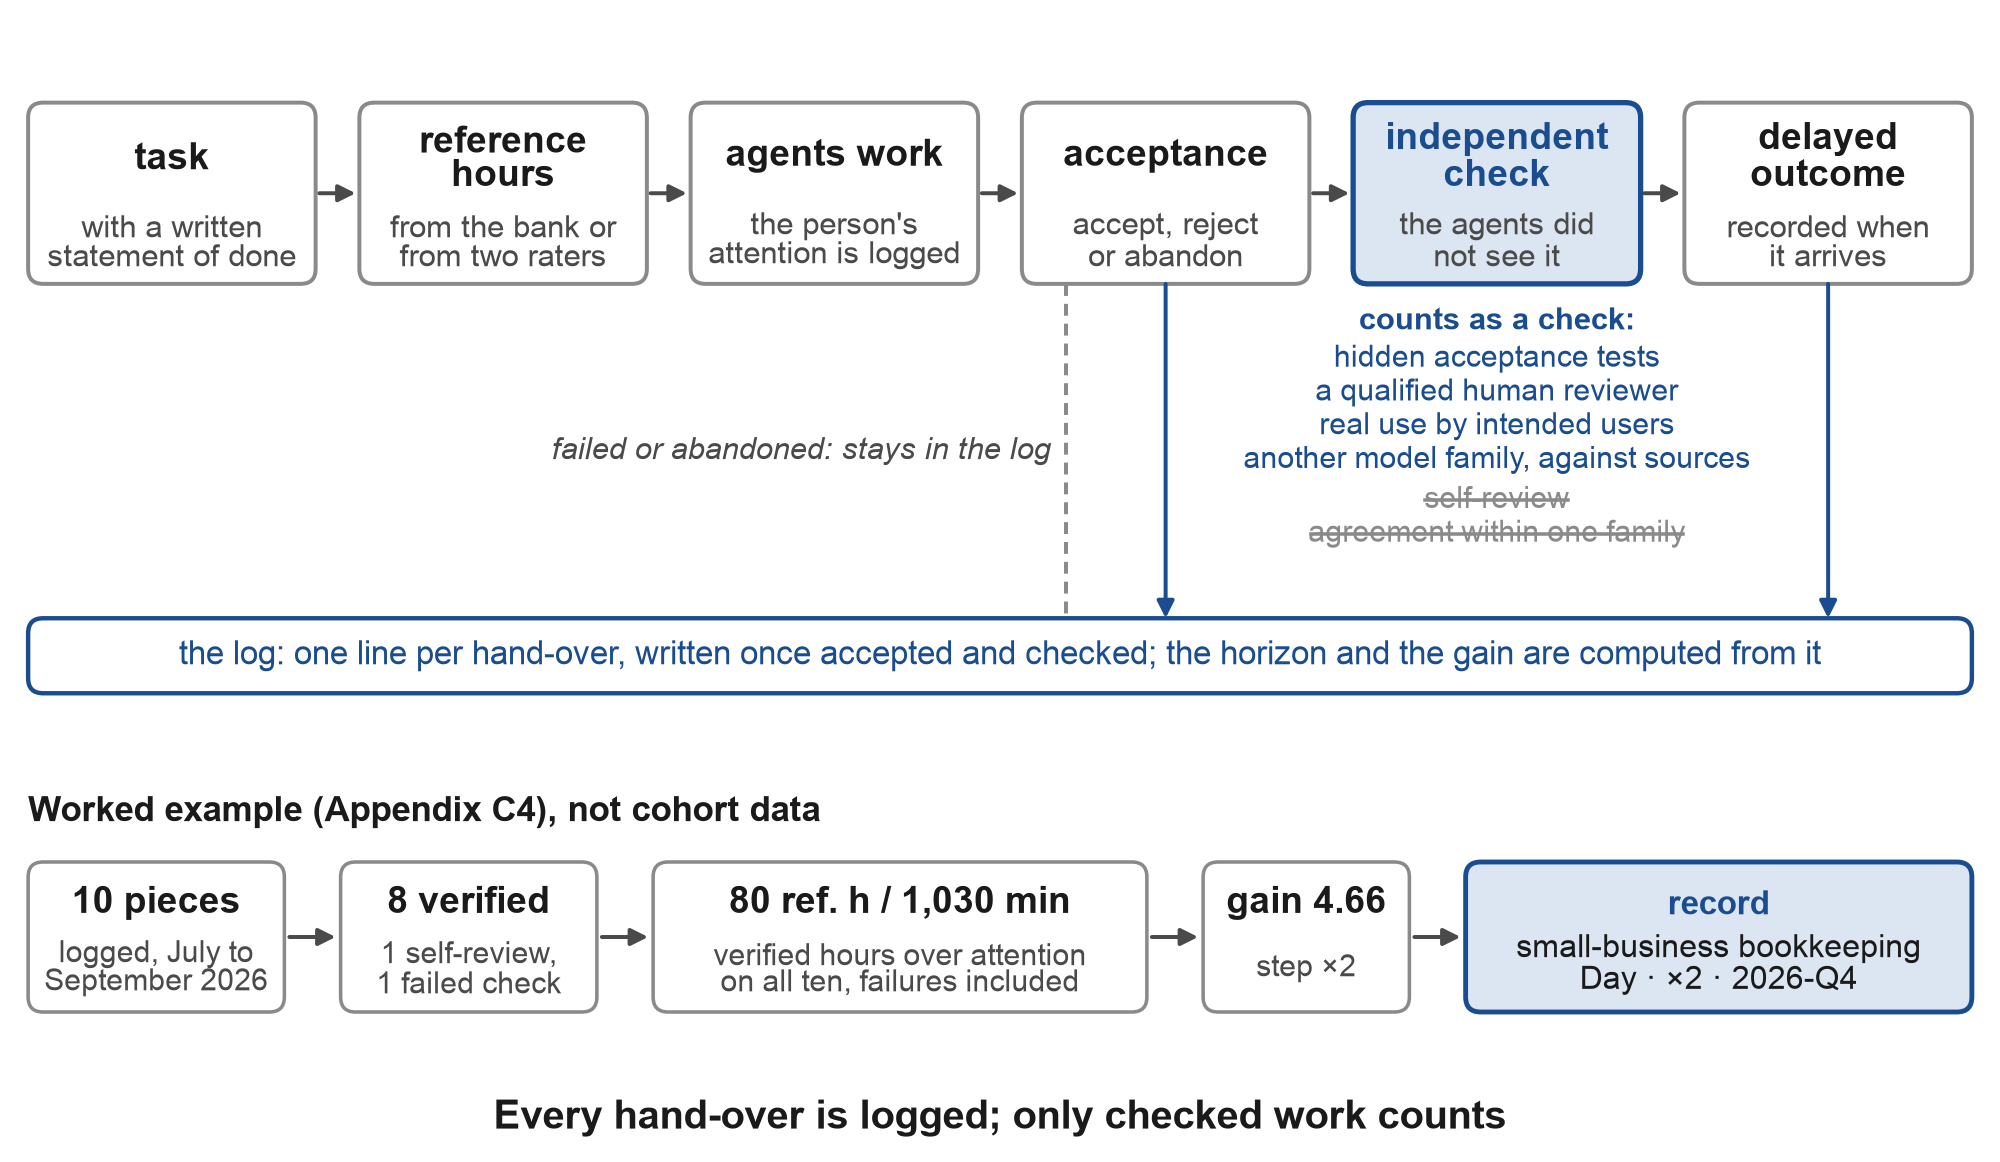
Note : La ligne supérieure est le chemin de la section 5.2. Les quatre types de vérification indépendante sont ceux de la règle de notation. L'auto-examen et l'accord entre modèles d'une même famille ne comptent pas. Les pièces échouées et abandonnées restent dans le journal et ajoutent leurs minutes au dénominateur du gain d'amplification. La ligne inférieure est l'exemple travaillé de l'Appendice C4, un journal construit, non pas des données de cohorte : dix pièces, huit vérifiées, 80 heures de référence contre 1 030 minutes d'attention, un gain de 4,66 (étape ×2) et l'enregistrement « small-business bookkeeping · Day · ×2 · 2026-Q4 ».
Re-vérification. Un horizon est confirmé à nouveau chaque trimestre. Le paradoxe de la supervision d'Anthropic (section 2.1) explique pourquoi : un horizon gagné tandis que la compétence de vérification s'érode est emprunté, et une vérification trimestrielle montre s'il tient toujours. Pour les échelons dont les fenêtres s'étendent plus longtemps qu'un trimestre (Week, Month et Quarter), la vérification a une forme concrète : au moins une pièce vérifiée de la taille de l'échelon doit tomber dans les 91 derniers jours, de sorte qu'un échelon ne peut pas reposer sur des pièces proches d'un an.
5.3 L'échelle
Je nomme les cinq échelons en unités de temps car les unités de temps n'ont besoin d'aucune traduction entre les professions, peuvent être lues dans les journaux et croissent avec la technologie sans renommage. Le tableau 1 les donne avec des exemples et les décomptes que chacun nécessite.
Tableau 1. L'échelle de l'horizon vérifié de la délégation.
| Échelon | Taille du travail remis et vérifié | Exemple en logiciel | Exemple ailleurs | Pièces vérifiées nécessaires, fenêtre |
|---|---|---|---|---|
| Hour | Environ 1 heure de référence | Un script, une petite correction | Des réponses tirées d'une pile de documents | 8 de 10 en 91 jours |
| Day | Environ 8 | Une fonctionnalité, un petit outil interne | Un rapport de fin de mois avec ses vérifications | 8 de 10 en 91 jours |
| Week | Environ 40 | Un site ou outil interne conforme aux spécifications, avec exécutions nocturnes | Un dossier complet de diligence raisonnable, un système de campagne | 5 de 6 en 182 jours |
| Month | Environ 160, généralement en plusieurs flux | Une version de produit ; règles d'acceptation par lesquelles d'autres travaillent | L'outillage d'une pratique, avec règles que les collègues utilisent | 5 de 6 en 365 jours |
| Quarter | Environ 500 | Une ligne de produits avec utilisateurs en direct | Une ligne de service exécutée via des agents | 3 de 3 en 365 jours |
Note : Un échelon n'est gagné que par la règle de notation de la section 5.2, séparément dans chaque domaine, avec les décomptes des règles v1.1 (Appendice E). Aucune note sur une ancienne échelle ne confère un échelon, et une personne peut être à Week en outils financiers et à Day en applications web.
L'enregistrement pour un CV ou un dossier RH contient le domaine, l'horizon, l'amplification et la date, par exemple « small-business bookkeeping · Day · ×2 · 2026-Q4 ». La date appartient à l'enregistrement car le même échelon signifiera quelque chose de différent dans un an, à mesure que la technologie progresse.
5.4 Gain d'amplification
Tout le monde qui travaille bien avec les IA ne leur confie pas de grandes pièces. L'un des développeurs de la section 9, qui construit avec quatre machines, décrit trois d'entre elles comme « un coup de pouce d'efficacité personnelle » sans aucun agent autonome sur elles. Les agents autonomes qu'il exécute aussi « n'ont pas pris racine » pour le travail quotidien, écrit-il, et il préfère « coup de pouce, non délégation » (traduction). Son flux le plus long s'est étendu sur 36 étapes en trois jours, chaque étape remise et validée, l'agent étant ensuite invité à confirmer que tout était déployé. Selon la règle de la section 5.2, cette confirmation est un auto-examen, donc son enregistrement tel que posté ne montre aucun échelon vérifié du tout, et le fil ne donne aucun chiffre pour son gain. Où il en serait avec une vérification indépendante dépend de ce qui a été accepté. Si les 36 étapes ont été acceptées comme une livrable cohérente, le flux compte en entier, selon ses heures de référence, comme le travail par étapes de l'Appendice C, section C4, le fait. Si chaque étape a été acceptée seule, chacune est une petite pièce et il en est au Hour sur le premier axe. Le post ne le dit pas. Pourtant, il construit des outils qui remplacent les logiciels qu'il avait l'habitude d'acheter, et il nomme lui-même le dénominateur du deuxième axe quand il appelle le temps le seul goulot d'étranglement.
Il n'est pas une exception. Anthropic a rapporté que les utilisateurs ayant six mois ou plus d'expérience étaient « beaucoup moins susceptibles de déléguer une plus grande responsabilité par des modèles d'utilisation directifs », travaillaient avec le modèle de manière plus itérative et apportaient des tâches plus difficiles, avec un taux de succès trois à cinq points plus élevé après contrôles (Anthropic, 2026d). Dans Claude.ai, l'utilisation collaborative a devancé l'automatisation 52 % à 45 % en novembre 2025, et les conversations ont réussi plus souvent que les demandes programmatiques ponctuelles, 67 % contre 49 % (Anthropic, 2026a). Les personnes dans les professions mieux rémunérées ont fait environ 1,5 fois plus de tours, et les femmes ont automatisé 7,3 points de moins que les hommes dans la même profession (Anthropic, 2026f). Dans l'enquête de Stanford auprès de 1 500 travailleurs, l'arrangement le plus préféré dans 47 des 104 professions était un partenariat égal entre la personne et l'agent (Shao et al., 2025). Une mesure fondée uniquement sur la délégation sous-estimerait donc les utilisateurs les plus expérimentés, les mieux rémunérés et les femmes, bien que rien dans ces données ne dit que leur travail est moins bon.
Définition. Le gain d'amplification est les heures de référence de travail accepté et vérifié divisées par les heures d'attention de la personne consacrées à celui-ci, au cours des 91 derniers jours dans le domaine, quelle que soit la fenêtre du niveau de la personne. Le travail réalisé avec une aide extérieure (un collègue ou un entrepreneur le corrigeant en dehors du journal) est enregistré comme tel et n'ajoute rien au numérateur, tandis que les minutes de la personne sur celui-ci restent au dénominateur. L'attention couvre la planification, l'instruction, la lecture, la vérification et la correction. Le temps que l'agent s'exécute pendant que la personne fait autre chose ne compte pas.
Le gain d'amplification est un débit vérifié : travail accepté et vérifié par heure d'attention. Ce n'est pas une estimation causale de la rapidité avec laquelle la même personne travaille avec des agents par rapport à sans eux. Un gain dans ce sens comparatif nécessite une référence, la même personne ou des personnes appariées effectuant le même type de travail sans agents, et seule une étude comparative peut le fournir.
Le travail échoué n'ajoute rien au numérateur et toutes ses minutes au dénominateur, ce qui maintient l'auto-tromperie visible. Dans l'essai 2025 de METR, les développeurs expérimentés croyaient que l'IA les avait accélérés alors que les mesures ont montré qu'ils étaient 19 % plus lents (METR, 2025).
Les étapes du deuxième axe sont ×1 (« un jour pour un jour »), ×2, ×5 (« une semaine pour un jour »), ×20 (« un mois pour un jour ») et ×60 (« un trimestre pour un jour »). Les deux échelles sont indépendantes, donc une étape sur l'une n'est pas égale à un niveau sur l'autre. Quand une personne exécute plusieurs agents en parallèle, l'attention est toujours comptée une fois, en minutes de la personne : une heure passée à regarder trois flux est une heure au dénominateur, partagée entre les éléments en proportion des minutes enregistrées pour chacun. Un score est rapporté avec le réglage qui l'a produit (le modèle et les outils, le type de vérification, et le niveau des tâches), car la même personne obtiendra des scores différents selon une vérification plus stricte.
5.5 Deux axes, quatre profils et un plafond
Placer les personnes sur les deux axes donne quatre profils (Figure 4). Un apprenti a un horizon court et un gain faible. Un amplificateur a un horizon court et un gain élevé, comme le constructeur de 36 étapes si ses étapes étaient acceptées une par une. Un délégateur a un horizon long et un gain élevé. Le quatrième profil, que j'appelle le superviseur, est un horizon long avec un gain faible : les agents s'exécutent longtemps, et la vérification et la retouche consomment le bénéfice, donc c'est un signe d'avertissement plus qu'un niveau.
Les deux axes sont liés par un plafond. L'attention est consacrée à la mise en place d'un travail et à sa vérification. Écrivez H pour les heures de référence d'un élément, V pour les heures d'attention que sa vérification prend, et S pour les heures consacrées à sa mise en place. Alors gain G = H / (S + V + retouche), et donc G ≤ H / V. Si la vérification seule prend un quart du temps manuel, le gain ne peut pas dépasser ×4, peu importe combien de temps l'agent s'exécute sans surveillance. Par la même limite, les étapes ×2, ×5, ×20 et ×60 ne sont accessibles que lorsque la vérification prend au plus 50 %, 20 %, 5 % et environ 1,7 % du temps manuel (Figure 4). C'est un modèle simplifié avec des limites comptables énoncées : il ignore la valeur du travail que la personne n'aurait pas pu faire du tout, il suppose que le temps de vérification s'ajuste avec l'élément, et il s'applique par élément, donc une personne qui vérifie des petits éléments à bon marché peut dépasser le plafond calculé pour les grands. Au niveau de l'économie, Catalini et al. (2026) font le même point : la contrainte déterminante devient « la bande passante de vérification humaine », et un « écart de mesurabilité » s'ouvre entre ce que les agents peuvent exécuter et ce que les personnes peuvent se permettre de vérifier.
GDPval montre ce que la limite signifie en pratique. Sur son sous-ensemble de 220 tâches d'or, ses experts ont rapporté (et les auteurs ont vérifié) en moyenne 404 minutes par tâche à la main, et examiner un livrable a pris 109 minutes mesurées, environ 27 %, ce qui place le plafond près de ×3,7 pour les tâches de ce type. Les modèles ont produit leurs brouillons 90 à 327 fois plus vite que les experts. Pourtant, dans le scénario où une personne essaie le modèle puis corrige son travail, le calcul des auteurs (pas une mesure) a donné à GPT-5 une accélération de 1,12 quand le modèle est essayé une fois et 1,39 quand il est essayé plusieurs fois, deux colonnes séparées du même tableau (Patwardhan et al., 2025). Peu importe la vitesse de l'agent, le prix de la vérification définit le plafond, et ce prix augmente avec le niveau, car un élément plus grand coûte plus cher à vérifier. Kamara (2026) appelle ce coût friction de vérification. Les praticiens dans les threads de la section 9 l'expriment avec leurs propres mots : au-delà d'un certain point, vérifier le code de l'agent « diffère de moins en moins de le réécrire à la main », et peut prendre plus de temps que de l'écrire soi-même (traduit).
Le même gain peut être atteint par deux chemins. Une longue laisse remet un grand élément et le vérifie à la fin ; des boucles courtes et rapides remettent de petits éléments et vérifient chacun à son arrivée. Mon hypothèse est que vérifier de petits éléments en cours de route coûte souvent moins cher que de vérifier un grand résultat à la fin, et les données d'Anthropic le montrent. Les conversations ont réussi plus souvent que les demandes ponctuelles, et par l'extrapolation des auteurs eux-mêmes les demandes ponctuelles atteignent 50 % de succès sur des tâches d'environ 3,5 heures tandis que les conversations l'atteindraient sur des tâches d'environ 19 heures (Anthropic, 2026a). La part de l'utilisation collaborative est tombée au-dessous de l'automatisation en août 2025 et était de retour en tête, 52 % à 45 %, en novembre. Le chemin de la boucle courte est proche de ce que la littérature sur la collaboration humain-IA étudie, et le gain d'amplification la crédite aussi complètement que la longue délégation. Les prédictions F19 à F21 à la section 11 testent le chemin de la boucle courte.
Figure 4. Deux axes, quatre profils et les plafonds que définit la vérification.
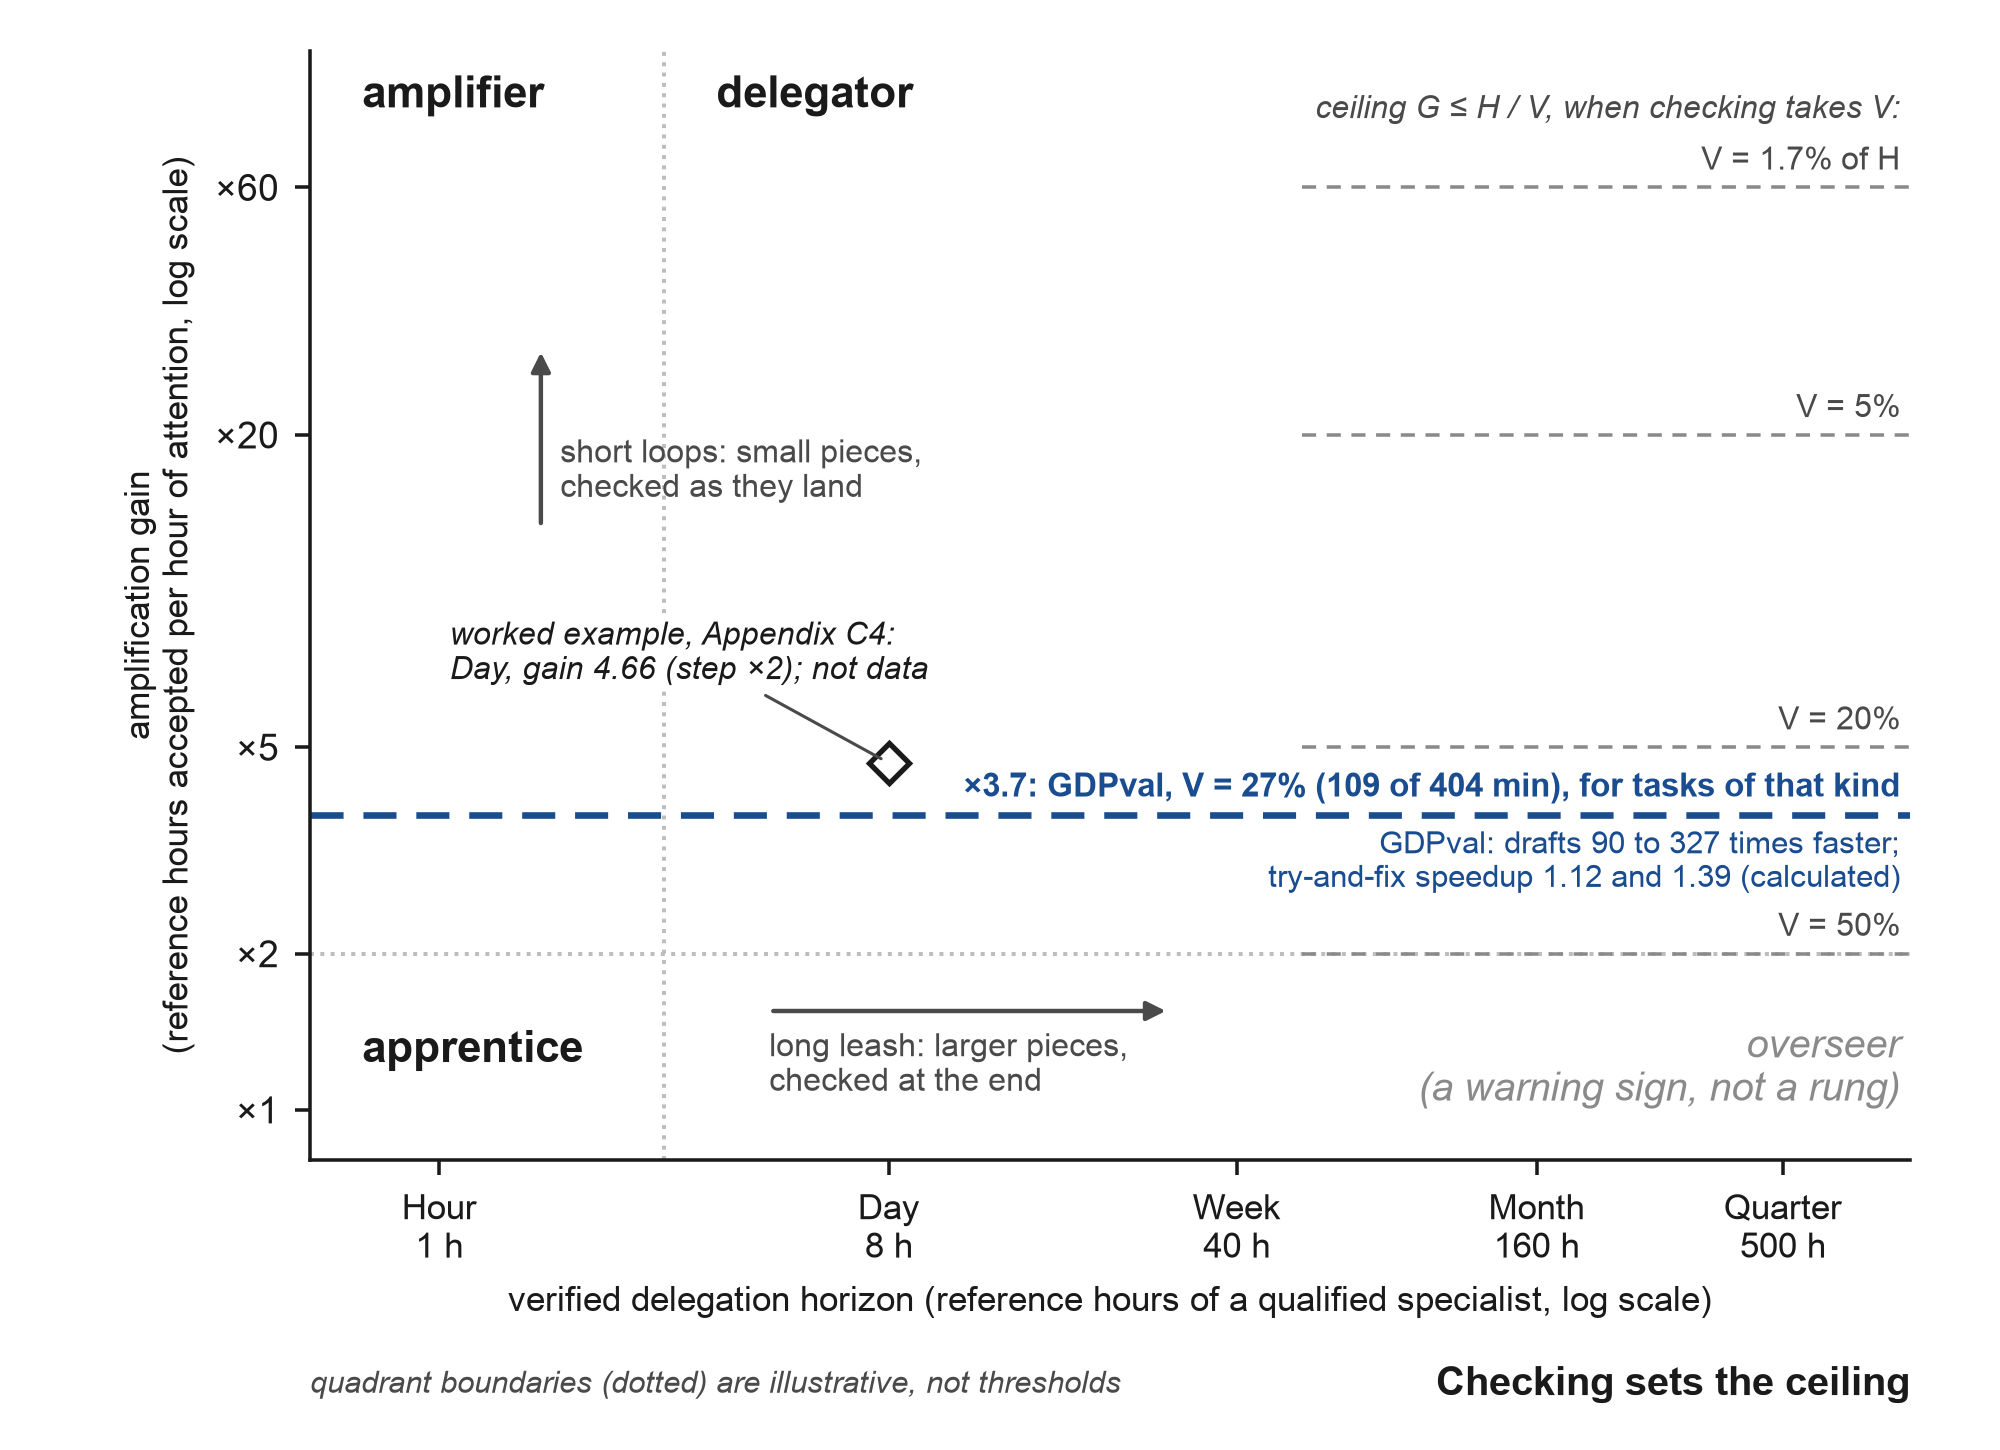
Remarque : Les quadrants sont des profils, non des échelons, et leurs frontières sont illustratives. Chaque ligne grise est la limite G ≤ H / V de la section 5.5 pour une part donnée de temps de vérification V dans le temps manuel H. La ligne d'accent utilise les moyennes de GDPval sur son sous-ensemble or de 220 tâches, 404 minutes à la main et 109 minutes d'examen expert de la production du modèle (Patwardhan et al., 2025), et s'applique aux tâches de ce type. Les accélérations 1,12 et 1,39 sont le calcul des auteurs, non une mesure. Le losange est l'exemple travaillé de l'appendice C4, non des données. Il se situe au-dessus de la ligne GDPval car le plafond est calculé par type de tâche, et les petites pièces vérifiées à bas coût peuvent surpasser un plafond calculé pour les grandes (section 5.5). Le cas de 36 étapes à la section 5.4 n'est pas tracé : le document ne donne ni gain ni vérification indépendante.
5.6 D'où provient la mesure et ce qui est nouveau
La mesure a des ancêtres, et le plus ancien est Elliott Jaques, qui a mesuré le niveau de tout emploi, dans toute fonction, par son délai discrétionnaire : la plus longue période pendant laquelle une personne travaille selon son propre jugement avant que quelqu'un d'autre examine le résultat. Il a soutenu que la rémunération équitable augmente avec ce délai (Jaques, 1956). L'horizon de délégation vérifié prolonge cette idée à l'ère des agents avec un changement. Jaques mesurait la durée pendant laquelle une personne travaillait sans surveillance, tandis que cette mesure compte le volume de travail qu'une personne délègue aux agents, accepte et fait vérifier. Les deux peuvent diverger, et ses strates, comptées en mois et années, ne correspondent pas à ces échelons.
La théorie principal-agent est le deuxième ancêtre. Jensen et Meckling (1976) ont évalué la délégation comme une surveillance, un cautionnement et une perte résiduelle. La vérification est le coût de surveillance de la délégation de travail à un agent, et l'horizon marque le point où vérifier une pièce plus grande ne paie plus.
METR mesure les machines sur le même axe. Son horizon temporel est la longueur de la tâche, en heures humaines, qu'un modèle complète à un taux de réussite donné (Kwa et al., 2025). Au printemps 2026, le modèle frontalier de son tableau de bord a atteint environ 17 heures à 50 % de réussite, bien que METR lui-même avertisse que les mesures supérieures à 16 heures ne sont pas fiables avec ses tâches actuelles. L'horizon à 80 % de réussite a augmenté d'environ 1,2 heure en février 2026 à environ 3,1 heures en avril, deux points qui illustrent le rythme de croissance sans mesurer son taux. La tendance ajustée au tableau de bord sur les modèles depuis 2023 double environ tous les 4,2 mois (128,7 jours), et le tableau de bord n'avait pas été mis à jour après le 8 septembre 2026 lors de son dernier accès (METR, 2026c). Les prévisionnistes du projet AI Futures travaillent avec un temps de doublement de 4 à 4,5 mois (AI Futures Project, 2026). Le travail accepté correspond à l'horizon à 80 % plus qu'à celui à 50 %. L'écart entre ce qu'un modèle termine parfois et ce qu'il termine de façon fiable est le travail de la personne, qui consiste à montrer qu'un résultat est correct et à l'accompagner. La figure A3 (appendice F) compare ces horizons de machine aux échelons.
La théorie de 2026 pointe vers le même écart. Huang, Xiao et Vishnoi (2026) modélisent la délégation sous IA et constatent que les petites différences de capacité de vérification produisent de grandes différences de résultats : l'IA aide ceux qui vérifient et nuit à ceux qui délèguent trop. Leur article a été accepté à ICML 2026, et ils appellent cet effet amplification de vérification. Un examen structuré de 24 études a révélé qu'aucun instrument validé dans son corpus focal ne couvre la combinaison complète de compétences nécessaires pour superviser les agents (portée, permissions, récupération, examen indépendant et fermeture fondée sur des preuves), bien que certains instruments en couvrent des parties (Veri', 2026). Le cadre de DeepMind pour la délégation intelligente d'IA décrit la délégation en général et ne contient aucune mesure au niveau de la personne (Tomašev et al., 2026), et l'économie de la délégation a maintenant ses propres modèles frontaliers (Wang, 2026). Chen et Meng (2026) montrent que l'IA générative compresse les différences de compétences au sein d'une tâche et déplace la valeur vers des actifs complémentaires rares, et ils ajoutent que les données de panel personne-par-tâche nécessaires pour tester leurs prédictions « n'existent pas encore à grande échelle ». La mesure que je propose produit des données de ce type exact, puisque chaque pièce enregistrée comporte une personne, une taille et une date.
Le deuxième axe a ses propres voisins, et le gain d'amplification est leur forme vérifiée au niveau de la personne. Engelbart (1962) a présenté l'informatique comme augmentant l'intellect humain, et « superagentivité » est le mot de McKinsey pour le même espoir en 2025 (McKinsey, 2025). L'indice économique Anthropic note les conversations selon l'accélération (temps sans IA divisé par le temps avec) et l'autonomie de l'agent sur une échelle de 1 à 5, tous deux jugés par un modèle (Anthropic, 2026a). WORKBank de Stanford évalue l'implication humaine que les travailleurs préfèrent sur une échelle de H1 à H5 (Shao et al., 2025). Un essai de 2026 a défini la capacité de supervision comme la production utile vérifiée par rapport à l'effort humain et a explicitement refusé de lui donner un chiffre (em360, 2026), et « surveillance amplifiée » est un terme de sécurité de l'IA pour aider les gens à superviser des systèmes plus forts qu'eux. L'observation d'un agent de recherche montre le même changement du temps humain vers la vérification : l'agent travaille seul pendant 26 minutes par session, tandis qu'une recherche simple prenait 33 secondes (Yang et al., 2026). Du côté de la délégation, Khadj (2026) et Alonso (2026) utilisent « horizon de délégation » pour jusqu'où une machine ou une entreprise peut déléguer, les travaux CHI 2026 sur les « horizons décisionnels » étudient la perte d'autonomie (Université de Lübeck, 2026), et Dawson (2026) et Metal Toad (2026) publient les niveaux de délégation IA des praticiens. Aucun de ces endroits ne place une personne à un niveau par travail qu'une vérification indépendante a confirmé.
Le cadre récent le plus proche est comparé ici directement. Le cadre AIDEs de JetBrains Research (Tikhomirov, 2026) partage deux caractéristiques avec la mesure : il traite la délégation comme une relation principal-agent, et il ordonne la délégation en niveaux, cinq au total, décrits par des attributs tels que l'autonomie et la planification. Il en diffère sur quatre points. Son sujet est le développement de logiciels, tandis que l'horizon est évalué dans tout domaine. Ses niveaux décrivent comment le travail est délégué, tandis qu'un échelon est défini par la taille du travail, en heures de référence d'un spécialiste qualifié. Il n'a pas de règle selon laquelle la vérification doit être indépendante des agents, tandis qu'un échelon ne compte que les pièces confirmées par une vérification que les agents n'ont pas vue. Et il n'a ni compte sur une fenêtre ni deuxième axe, tandis qu'un échelon nécessite une part de passage sur une fenêtre datée et le gain d'amplification ajoute les heures d'attention. Le langage de l'agentivité est partagé ; l'unité, la règle d'indépendance et la portée au-delà du logiciel sont ce que cet article propose.
De nombreuses échelles ont été publiées en 2025 et 2026, et aucune des échelles du tableau 2 ne mesure une personne par travail vérifié. Le tableau 2 groupe les principales par ce qu'elles mesurent ; le tableau A3 (appendice F) les énumère chacune.
Tableau 2. Échelles de 2025 et 2026, groupées par ce qu'elles mesurent.
| Famille | Exemples | Unité mesurée | Place une personne par un travail délégué vérifié ? |
|---|---|---|---|
| Niveaux d'autonomie des agents et des machines | Feng et al., 2025; Shapiro, janvier 2026; Memari & Rudolph, 2026; METR, 2025-2026 | L'agent, le modèle ou la configuration de l'équipe | Non |
| Stades de la pratique d'un développeur | Yegge, 2026; Park et al., 2026; Microsoft, mai 2026 | Pratique, travail de supervision ou modèles de travail | Non |
| Délégation par les organisations et les entreprises | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), février 2026; Khadj, 2026 | Une organisation, un gestionnaire, une entreprise ou la délégation en général | Non |
| Délégation de développeur comme relation principal-agent | JetBrains Research (Tikhomirov), septembre 2026 | Une délégation de développeur | Développeurs uniquement ; pas de règle d'indépendance pour les vérifications et pas d'unité de taille |
| Cadres de compétence et d'alphabétisation | AI Certification Standards, 23 août 2026; Anthropic AI Fluency, 2025b | Compétences ou alphabétisation | Pas d'examen, de seuils ou de niveaux |
| Horizon de délégation vérifié et gain d'amplification | Cet article | Une personne dans un domaine | Oui, selon la règle de la section 5.2 |
Note : « Place une personne par un travail délégué vérifié » signifie que l'échelle place un individu à un niveau selon la taille du travail confié aux agents et confirmée par une vérification que les agents n'ont pas vue. Le voisin le plus proche est les cinq niveaux de JetBrains : ils partagent le langage de principal et d'agent, et diffèrent dans la règle de vérification (une vérification indépendante que les agents n'ont pas vue) et dans l'unité (heures de référence). Le tableau A3 (Appendice F) énumère chaque échelle séparément.
Un praticien a bien exprimé l'objection à toute échelle personnelle : « votre niveau d'autonomie est une propriété du référentiel, pas du développeur et pas du modèle » (Phoenix, 2026). J'accepte la moitié de cela. Un horizon appartient à une personne, dans un domaine, sous un régime de vérification, et un référentiel bien construit avec des tests cachés en fait partie, ce qui est une raison pour laquelle l'horizon est enregistré par domaine et avec une date.
5.7 Deux questions de l'article complémentaire
L'article complémentaire a laissé ouverte la question de savoir pourquoi les utilisateurs expérimentés délèguent moins, s'ils ont eu des problèmes ou si leur jugement est le produit (Chernets, 2026a). Le deuxième axe peut les distinguer. Si la part d'utilisation directive diminue tandis que le gain vérifié augmente, le jugement est le produit ; si le gain diminue aussi, ils ont eu des problèmes. L'article complémentaire a également demandé si le vocabulaire de la délégation est une grammaire ou une par profession. Je prends position : la grammaire est une (définir la tâche, puis l'accepter sur la base de preuves), tandis que ce qui compte comme preuve varie selon le domaine, ce qui est pourquoi les barreaux sont partagés et la notation se fait par domaine.
L'instrument de l'Appendice C rapporte une part directive pour chaque personne et domaine, comptée sur des éléments (la part des éléments confiés en un seul bloc, par rapport aux étapes ou au travail conjoint), de sorte qu'un premier test grossier peut être effectué sur les mêmes enregistrements qui donnent les barreaux. La prédiction F20 énonce le test avec une date sur sa mesure enregistrée, la « part des tours d'une personne qui donnent des instructions plutôt que de vérifier ou d'éditer, à partir du journal » (Tableau A6) : là la part est comptée sur les tours du journal de session plutôt que sur les éléments du journal de travail de l'Appendice C, donc c'est le plus fin des deux comptages.
5.8 Comment la mesure peut être manipulée, et les défenses
Compter le travail accepté et vérifié indépendamment ferme la route la moins chère, la dépense, mais une personne déterminée ou un employeur poursuivant un objectif a toujours d'autres options. Le tableau 3 les énumère avec la défense que les règles fournissent. Les défenses coûtent quelque chose, et le coût fait partie de la conception : un barreau audité vaut plus qu'un barreau auto-déclaré, de la même façon qu'un compte audité vaut plus qu'une déclaration.
Tableau 3. Façons de manipuler la mesure, et les défenses.
| Route | À quoi cela ressemble | Défense |
|---|---|---|
| Vérifications faciles | Tests cachés qu'une solution faible réussit ; un relecteur qui survole | Audit aléatoire d'une part des éléments acceptés par un deuxième vérificateur indépendant ; erreurs plantées à partir de Week ; le type de vérification est imprimé à côté du score |
| Choisir des tâches juste au-dessus d'un seuil | Beaucoup d'éléments de 8.1 heures de référence pour atteindre Day | Les barreaux se lisent à partir de la distribution des tailles, avec la taille acceptée médiane rapportée à côté du barreau |
| Évaluateurs généreux d'heures | Évaluateurs qui gonflent les heures de référence | Deux évaluateurs en aveugle quant à la personne ; désaccord au-dessus d'un ratio fixe envoie l'élément à la banque gelée ou à un tiers évaluateur ; dossiers des évaluateurs audités |
| Aide cachée | Un collègue ou un entrepreneur corrige le travail en dehors du journal | Attention enregistrée par élément ; entretiens ou relectures aléatoires ; l'aide externe enregistrée comme un champ et exclue du gain de la personne |
| Découpage | Un mois de travail découpé en tickets d'une heure | Seul un livrable cohérent, accepté dans son ensemble, compte pour un barreau |
| Masquer les échecs | Les éléments abandonnés ou échoués sont omis du journal | Chaque remise enregistrée, avec sa date de début, et fermée quand elle est acceptée, rejetée ou abandonnée ; un dossier public des échecs ; un taux de réussite qui semble trop net déclenche un audit |
| Vérification corrélée | Un deuxième modèle de la même famille qui s'accorde | Non compté (Section 5.2) |
| Flux parallèles | Attention comptée une fois par flux | Attention comptée une fois par personne-minute (Section 5.4) |
Les seuils sont des choix de conception, versionnés comme règles v1.1 et modifiés uniquement dans une nouvelle version après les données. Dix pièces dans une fenêtre est le plus petit nombre auquel une part de réussite de 80 % signifie quelque chose (huit réussites sur dix). La fenêtre de 91 jours des échelons inférieurs, et de la pièce récente requise aux échelons supérieurs, correspond à la révérification trimestrielle et au rythme auquel les outils changent. La règle d'échelon est une règle de qualification et ne fait aucune estimation de la fiabilité d'une personne. Huit réussites sur dix sont compatibles avec un vrai taux de réussite se situant n'importe où entre environ 44 % et 97 % (intervalle exact à 95 %), et trois sur trois avec un taux aussi bas qu'environ 37 % (borne unilatérale à 95 %). L'étude de calibrage enregistrée estime la fiabilité. La part de 80 % suit l'utilisation par METR de l'horizon à 80 % comme niveau de travail fiable, et les échelons de 1, 8, 40, 160 et 500 heures suivent l'heure de travail, le jour, la semaine, le mois et le trimestre, de sorte qu'ils n'ont besoin d'aucune traduction entre les professions. Un test de faisabilité des seuils a vérifié les règles par simulation et avec des évaluateurs de modèle (Appendice E). Il a calculé à quelle fréquence une personne d'une fiabilité connue obtient chaque échelon (Figure A2, Appendice E). À un vrai taux de réussite de 0,8, Day est obtenu dans 68 % des fenêtres et le même verdict se répète dans la fenêtre suivante dans 56 %, ce qui explique pourquoi l'enregistrement affiche le nombre à côté de l'échelon, comme dans « Day (8/10) ». Il a également trouvé une erreur dans la première version des règles : quatre sur quatre à Month était plus difficile à obtenir que trois sur trois à Quarter (41 % contre 51 % à un taux de réussite de 0,8), donc Month demande maintenant cinq sur six en un an. Déplacer le nombre de dix à huit ou douze, ou la part de 0,8 à 0,7 ou 0,9, change le verdict Day pour 8 % à 11 % des journaux simulés, et déplacer les deux change le verdict pour jusqu'à 22 %. Quatre évaluateurs de modèle provenant de quatre familles, estimant les heures de référence en aveugle, ont classé 30 tâches de manière cohérente (corrélation intraclasse 0,89 sur les heures de journal) mais ont mis seulement 62 % des paires dans un rapport de 1,5, contre le critère de 70 % du protocole de calibrage, et différaient d'un facteur deux dans leur niveau global ; étant donné seulement l'identifiant public d'une tâche, leur estimation moyenne se situait dans 1,5 des temps humains mesurés pour 3 des 14 tâches. Les évaluateurs de modèle ne peuvent donc pas remplacer les deux évaluateurs humains, et les évaluateurs de l'étude sur le terrain étalonnent d'abord sur des tâches avec des temps mesurés. Le protocole de calibrage fixe les tests suivants à l'avance : accord entre les évaluateurs humains (critère : au moins 70 % des paires dans 1,5), répétabilité de l'échelon d'une personne sur deux fenêtres consécutives (kappa pondéré au moins 0,6), et la capacité d'un échelon à prédire la réussite de nouvelles tâches de la même taille (AUC au moins 0,7). Son protocole et son texte d'enregistrement se trouvent dans le dépôt compagnon, et un premier test avec des professionnels actifs, de leur accord sur les heures de référence, est enregistré et décrit dans l'Appendice G.
Le tableau A4 (Appendice F) donne la règle pour les cas difficiles qui se présentent en premier.
L'appendice C, section C4, parcourt le journal de dix lignes d'une personne jusqu'à l'enregistrement unique qu'il produit.
6. Neutralité de l'origine et le point de basculement des qualifications
6.1 Neutralité de l'origine
L'hypothèse est qu'à horizon vérifié égal dans un domaine, une formation en programmation ne prédit pas la qualité du travail vérifié indépendamment une fois que la maîtrise du domaine et l'acceptabilité de la littératie sont prises en compte.
La conclusion d'Anthropic selon laquelle « la capacité à orienter Claude vers le succès provient davantage de la maîtrise d'un domaine que de la capacité à écrire du code » est cohérente avec l'hypothèse mais ne la teste pas (Anthropic, 2026e) : ses données trient les gens par profession, non par formation, et l'écart de 34 % contre 29 % de la section 2.2 est un écart entre professions. Seule l'étude de F7 teste l'hypothèse. Une hypothèse rivale forte existe aussi. Savva (2026) modélise le travail enrichi par l'IA comme un problème principal-agent et prédit que l'IA rétrécit les écarts entre les gens sur les tâches faciles et les élargit sur les difficiles. Si Savva a raison, la neutralité de l'origine tiendra sur les tâches courtes et échouera aux échelons supérieurs, donc la prédiction F7 est évaluée séparément au jour et à la semaine et plus, où l'hypothèse fait face à son test le plus difficile.
L'acceptabilité de la littératie est la compétence sur laquelle l'hypothèse s'appuie. Cela signifie énoncer à l'avance ce qui comptera comme terminé, puis l'afficher : par un test caché, une deuxième famille de modèles vérifiant par rapport aux sources, une comparaison avec une source que la personne a elle-même ouverte, ou un artefact à la place d'une assurance. La littératie d'agent couvre la délégation, la vérification et la gestion en général (MindStudio, 2026) ; l'acceptabilité de la littératie place un standard de preuve à son centre. Cela diffère aussi de l'acceptation technologique au sens de la tradition TAM, qui étudie si les gens adoptent une technologie, puisque l'acceptation ici est la décision d'accepter un morceau de travail. Le dossier d'acceptation de l'article compagnon devient l'unité de preuve pour un échelon.
6.2 Le point de basculement des qualifications
Le point de basculement des qualifications dans un domaine est le moment où les produits fabriqués par les gens sans formation en informatique, acceptés selon les mêmes vérifications indépendantes, commencent à surpasser ceux fabriqués par les programmeurs utilisant les mêmes agents, après quoi un diplôme en informatique et les étiquettes junior et senior perdent leur poids prédictif dans l'embauche pour ce domaine.
Cette définition est ma prévision du 8 octobre 2026 rendue exacte (section 1). Ses composants sont chacun observable et chacun daté individuellement, de sorte que le moment peut être lu quand ils s'alignent. La parité de qualité est l'étape avant le moment : dans un domaine, les produits des gens sans formation en informatique ne sont pas pires que ceux des programmeurs avec les mêmes agents, sur les mêmes tâches, sous vérifications en aveugle (prédiction F2). Le dépassement est le moment lui-même, quand ces produits deviennent meilleurs sur les mêmes vérifications (F3, avec les étapes de publication et de maintenance en F4a et F4b). Le croisement dans les offres d'emploi est le signe visible, quand les offres d'emploi demandant des compétences agentives exigent un diplôme moins souvent que les offres comparables qui ne le demandent pas (F5). La neutralité de l'origine est le mécanisme, puisqu'à un échelon égal l'éducation cesse de prédire la qualité vérifiée (F7).
Le point de basculement dans un domaine est daté par la première année au cours de laquelle, dans ce même domaine nommé, le dépassement est montré (F3) et l'analogue du domaine du croisement dans les offres d'emploi est rencontré (F5 calculé sur les offres d'emploi de ce domaine ; appendice D). La parité sans dépassement est l'approche du point, et un croisement dans les offres d'emploi sans dépassement montrerait les employeurs avancer devant les preuves. F2, F3, F5 et F7 forment donc un programme sur les mêmes domaines nommés : les domaines sont fixés dans l'enregistrement, l'expérience de F2, F3 et F7 est exécutée en eux, et F5 est calculée à la fois sur l'ensemble gelé des professions informatiques et sur les offres d'emploi de chacun de ces domaines. Le point de basculement est déclaré pour un domaine seulement quand la règle de qualité (F3) et la règle d'embauche (l'analogue du domaine de F5) sont tous deux remplis dans ce même domaine ; l'un seul ne déclare rien.
Les deux premiers composants sont testés par des expériences sur des tâches appariées (section 11). Le troisième peut déjà être observé dans les offres d'emploi. Lightcast a rapporté en septembre 2026 que les offres informatiques exigeant des compétences en IA sont toujours plus susceptibles de demander un diplôme de quatre ans que les offres informatiques sans elles. Parmi les offres d'IA, cependant, les exigences en matière de diplôme ont été en « déclin clair depuis 2024 » tandis qu'elles ont augmenté dans d'autres offres informatiques (Lightcast, 2026b). Les deux lignes convergent et n'ont pas croisé (figure 5). Lightcast définit les offres d'IA par plus de 300 compétences en IA, donc ses lignes décrivent le travail en IA en général. Le sous-ensemble agentif, défini par une liste gelée de compétences agentives (Lightcast, 2026a), est celui que la prédiction utilise, et sa base de référence est prise avant l'enregistrement.
La direction a un précédent. Bone, González Ehlinger et Stephany (2025), utilisant environ onze millions de postes vacants au Royaume-Uni jusqu'à mi-2024, ont constaté que les exigences en matière d'éducation ont diminué dans les rôles en IA et ont comparé les primes de salaire attachées aux compétences et aux diplômes. Ce travail a documenté l'embauche basée sur les compétences en IA avant les agents. Cet article prolonge cette ligne aux compétences agentives, avec un seuil daté et une comparaison avec les offres d'emploi appariées, et propose de lier les exigences de publication aux performances vérifiées indépendamment, dans des tests qui doivent être préenregistrés. Le baromètre AI Jobs Barometer de PwC rapporte la même direction dans tous les pays et sert de source de secours partout où il mesure la même quantité (PwC, 2026).
Un deuxième indicateur est la distance entre ce que disent les employeurs et ce qu'ils font. De nombreux employeurs ont supprimé les exigences en matière de diplôme de leurs politiques avant l'arrivée des agents, mais le Burning Glass Institute et la Harvard Business School ont constaté que le changement affectait moins d'une embauche sur 700 (Burning Glass Institute & Harvard Business School, 2024). Les offres d'emploi ont allé dans l'autre sens : en novembre 2025, 19,3 % des offres d'emploi aux États-Unis sur Indeed demandaient un diplôme de baccalauréat ou supérieur, considérablement plus que un an plus tôt (Indeed Hiring Lab, 2026). Une exigence de diplôme supprimée sur le papier est un changement de politique, et le basculement ne s'affiche que quand l'embauche elle-même change. Une étude d'audit, envoyant des portefeuilles appariés qui diffèrent uniquement dans l'éducation à de véritables offres d'emploi, verrait cela en premier, et la prédiction F26 en établit une.
Un diplôme appartient à une famille de portes qui admettent les gens par une étiquette : un profil sur une plateforme, un titre de poste, un diplôme et, en partie, une licence. Une étiquette dit à un employeur ce que le travail représente seulement dans la mesure où la posséder va de pair avec être capable de faire le travail. Les agents desserrent ce lien d'un côté, puisque des gens sans l'étiquette produisent maintenant un travail qui ressemble à celui du métier (Section 2.2), et une étiquette qui repose sur la parole propre d'une personne a toujours été bon marché à revendiquer. Une porte qui vérifie le travail lui-même ne dépend d'aucun des deux. L'étude de cotation de l'Appendice G a rencontré la différence par accident. Prolific admet des participants à une étude par des filtres dont les réponses sont surtout auto-déclarées, l'âge et le pays de résidence étant les principales exceptions qu'elle vérifie (Prolific, 2026). Parmi les 60 personnes que ses filtres ont admises à l'échantillon de comptabilité, 11 ont répondu incorrectement à une question de première semaine du métier (Appendice G2) : l'étiquette les a laissées entrer, et une question du métier les a arrêtées.
Les chercheurs qui ont recruté des programmeurs sur de telles plateformes avant les agents ont signalé le même schéma et ont filtré avec leurs propres questions de connaissances : dans une étude, 42 % des travailleurs d'une plateforme qui ont déclaré des compétences en programmation ne répondaient pas aux critères de telles questions (Danilova et al., 2021), et dans une autre, sur Prolific, 55 des 206 répondants qui ont déclaré programmer en Node.js ont réussi toutes ses questions de programmation (Reid et al., 2022). Une question de connaissances est elle-même une porte plus faible qu'une vérification du travail livré, et les modèles de conversation l'affaiblissent aussi : dans une attaque simulée, ChatGPT a facilement résolu les questions de filtrage existantes pour les programmeurs (Serafini et al., 2024), et en 2026 il a aussi dépassé les questions visuelles statiques qui avaient été conçues pour y résister, tandis que les questions audio qui révèlent leur contenu étape par étape sous une limite de temps stricte ont toujours tenu bon (Serafini et al., 2026). Dans les termes de l'embauche, la perte de poids que la définition ci-dessus prédit pour un diplôme est une porte du premier type cédant la place à une porte du deuxième type, et l'horizon de délégation vérifié est une porte du deuxième type : elle enregistre non pas ce qu'une personne dit qu'elle est, mais ce qu'elle a remis et ce qui a réussi une vérification que les agents n'ont pas vue.
Les licences se situent entre les deux types. Une licence qui repose sur un examen réussi une fois fonctionne, à partir de là, comme une étiquette ; une licence dont le travail du titulaire est inspecté se rapproche davantage d'une vérification. Les cabinets d'audit enregistrés auprès de la Commission de surveillance de la comptabilité des sociétés ouvertes aux États-Unis voient leur travail d'audit inspecté, chaque année s'ils vérifient régulièrement plus de 100 émetteurs et au moins une fois tous les trois ans autrement, à moins que la Commission ne fixe un autre calendrier par règlement (Sarbanes-Oxley Act of 2002, s. 104), un homologue plus lent, pour le travail signé d'un cabinet, de la révérification que la Section 5.2 demande d'un horizon. La licence elle-même a commencé à se déplacer vers le deuxième type. Depuis mai 2024, l'Oregon offre aux diplômés en droit une voie vers la licence sans l'examen du barreau, le Supervised Practice Portfolio Examination : sur au moins 675 heures de pratique supervisée, le candidat soumet huit pièces de travail écrit, deux interactions avec des clients et deux négociations, et les évaluateurs appliquant des rubriques du Barreau de l'Ordre des avocats jugent si chacune montre une compétence minimale. Au 5 janvier 2026, 205 candidats avaient postulé et 49 étaient devenus avocats autorisés, le premier d'entre eux en décembre 2024 (Oregon State Board of Bar Examiners, 2026). Le diplôme en droit est toujours requis, donc le travail vérifié remplace l'examen, pas l'école. En comptabilité, le mouvement est plus petit : en mai 2025, l'AICPA et la NASBA ont approuvé une législation modèle pour une voie vers la licence CPA qui demande une deuxième année d'expérience professionnelle à la place de 30 heures de crédit d'étude au-delà d'un diplôme de bachelor, l'examen étant conservé, et chaque État doit l'adopter avant que les candidats puissent l'utiliser (Journal of Accountancy, 2025). Ce que la loi réserve à une licence reste une limite de la mesure (Section 13). Le Tableau A8 (Appendice F) met les portes de cette section côte à côte selon ce que chacune vérifie.
Le terme « credential » a un second sens en sécurité des agents, où il désigne une clé secrète ou un jeton. Ici, il signifie un diplôme ou un certificat. La phrase « credential crossover point » en ce sens n'a retourné aucune correspondance dans les bases de données savantes consultées le 9 octobre 2026 (Appendice B).
Figure 5. L'écart dans le succès vérifié et l'exigence de diplôme dans les offres d'emploi : ce qui est observé, et ce que 2027 testera.
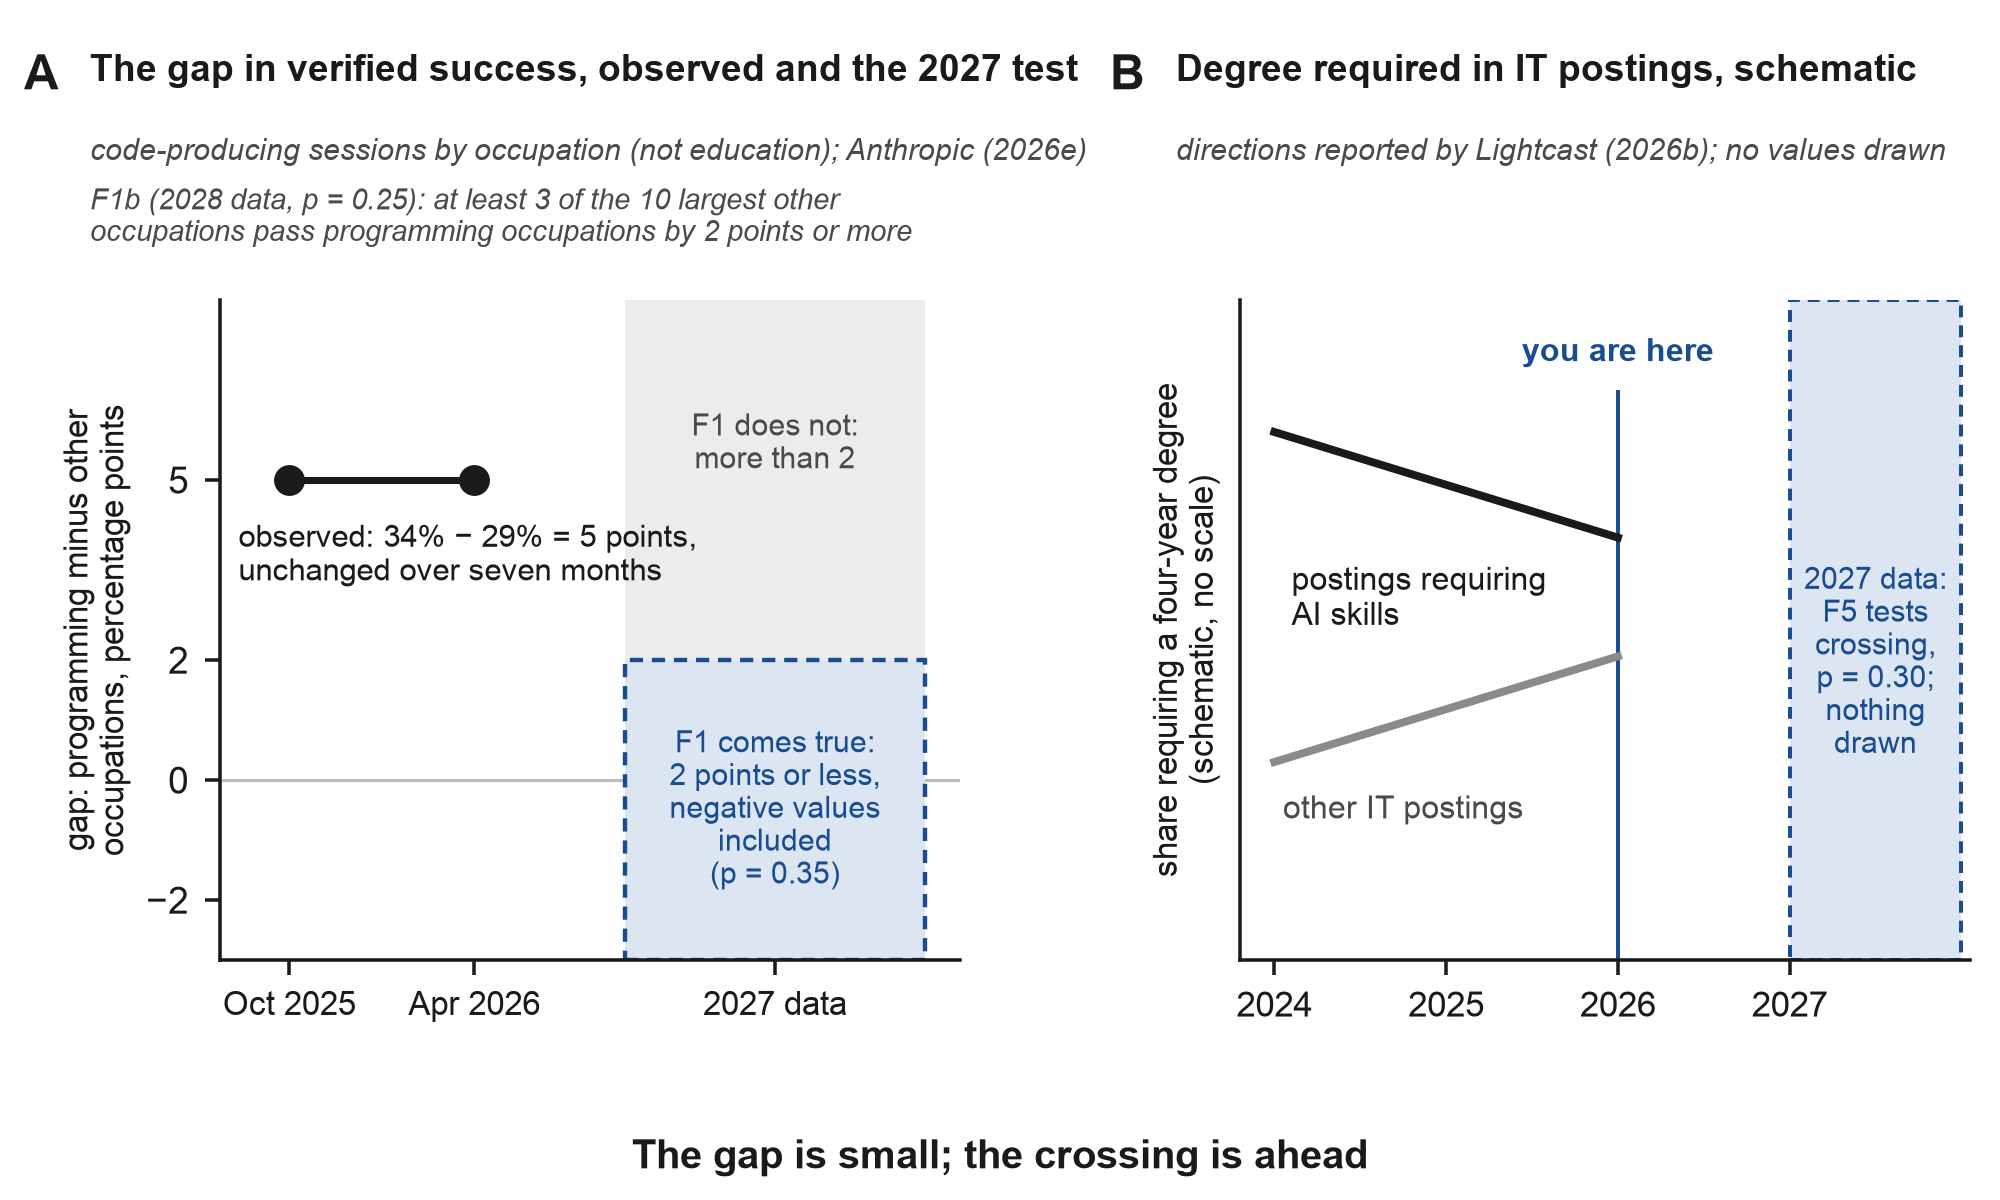
Note : Le panneau A utilise Anthropic (2026e), les sessions produisant du code, 34 % pour les professions de programmation contre 29 % pour les autres professions, inchangé pendant sept mois. La profession n'est pas l'éducation, et le succès signifie un accomplissement soutenu par des preuves telles que des tests ou des commits. La bande est le seuil de prédiction F1 (un écart de 2 points ou moins, valeurs négatives incluses, probabilité 0,35) ; F1b (probabilité 0,25) est dans le Tableau A6. Le panneau B ne tire que les directions que Lightcast (2026b) a signalées jusqu'à 2026, sans ses valeurs. La fenêtre 2027 est laissée vide : aucun croisement n'est dessiné, car la prédiction F5 (probabilité 0,30) est ce qui le décidera.
6.3 Domaines : pourquoi l'avantage du programmeur était horizontal
Ce que l'IA rend bon marché en premier lieu, c'est tout ce qui est horizontal, identique dans chaque industrie, et le mécanisme est clair : une capacité qui se transfère entre les industries est une capacité qu'un modèle à usage général peut fournir à toutes à la fois. Les minces couches sur un modèle, les logiciels à usage général et la capacité générale à écrire du code ont tous suivi cette voie. L'ingénieur de prompt, le titre le plus à la mode en 2023, a été déclaré obsolète en 2025 parce que la compétence s'est dissoute dans les outils et est devenue celle de tout le monde (Fortune, 2025). L'ancien avantage du programmeur était aussi horizontal. Le code fonctionne dans n'importe quelle industrie, donc un programmeur pouvait construire pour un cabinet juridique ou un hôpital sans connaître ni l'un ni l'autre, et les agents, en rendant le code bon marché, leur enlèvent cet avantage. Personne n'avait besoin de devenir programmeur pour que cela se produise. Le logiciel est devenu une verticale parmi d'autres (avec l'infrastructure et la sécurité comme voisins proches), et à l'intérieur les programmeurs restent les plus forts. La même logique s'applique aux personnes qu'aux entreprises : une personne sans verticale est une couche sur l'IA, aussi exposée qu'un produit mince couche. À mesure que les agents rendent les logiciels à usage général plus faciles à construire, l'ancien logiciel vertical peut faire face à une pression de deux côtés, des laboratoires qui prennent la couche d'information, et des professionnels qui construisent leurs propres outils. L'hypothèse est que la connaissance du domaine associée à la capacité d'accepter le travail des agents gagne en valeur. La verticalité en soi ne protège personne ; la profondeur le fait, c'est-à-dire la capacité à accepter du travail dans le domaine qu'un modèle ou un nouveau venu ne peut pas simuler.
Une verticale ici est un domaine où une personne peut accepter le travail d'un agent, et ce peut être ou ne pas être le domaine où elle détient un diplôme. Accepter du travail juridique demande de bien connaître la loi pour repérer une erreur plausible. Un développeur dans les fils de la section 9 l'énonce clairement : pour voir qu'un résultat est nonsensique, vous avez besoin de connaître au moins un peu le domaine (traduit). L'acceptation reste à la personne, ainsi que le nom et la signature sous un résultat, le propre contexte de la personne (clients, données, règles locales, langue), et la maintenance après la libération.
Les laboratoires achètent la couche d'information des verticales. Mercor, qui vend le temps d'experts aux laboratoires d'IA, a dépassé un taux annuel brut de 2 milliards de dollars en juin 2026 en vendant le temps d'experts tels que des radiologues (Dealroom, 2026). Les dépenses des entreprises en applications verticales d'IA ont presque triplé pour atteindre 3,5 milliards de dollars en 2025 (Menlo Ventures, 2025). Cette bifurcation donne à l'expert du domaine deux destins. Un donateur vend la connaissance à un laboratoire sous forme d'étiquettes, et cette connaissance est consommée une fois. Un principal garde la connaissance à l'intérieur de son propre produit et répond du résultat, et la connaissance continue à fonctionner.
La conséquence pour la mesure est que les horizons ne se transfèrent pas entièrement entre les domaines. Un avocat qui passe au logiciel et un programmeur qui passe au droit perdent la même chose, la capacité à accepter du travail dans un domaine qu'ils ne connaissent pas. Cette symétrie est à quoi ressemble la fin de la position spéciale du programmeur, et elle peut être mesurée. Le point de croisement arrivera aussi domaine par domaine. Il devrait venir en premier où le code est devenu bon marché, où la vérification demande la connaissance du domaine, et où les marchés sont petits ou locaux : le droit, la comptabilité, l'éducation, l'administration clinique, les créneaux étroits interentreprises, les marchés en langues moins parlées. Le logiciel lui-même devrait venir en dernier. Un analyste a fait une prévision connexe en février 2026, appelant la finance « le canari de la mine » et s'attendant à ce que chaque tâche vérifiable suive la trajectoire de la finance et de la comptabilité d'ici 2027 (Hwang, 2026). La découverte d'Anthropic selon laquelle la direction surpasse déjà légèrement les programmeurs sur les sessions de codage est un signe précoce (Anthropic, 2026e). Le dossier de la section 5.3 nomme le domaine dans son premier champ, et n'importe quel nom de profession peut être mis devant lui.
Le même raisonnement prédit le sort des titres. Les titres horizontaux tels que gestionnaire d'agent, opérateur IA et orchestrateur décrivent les personnes qui enveloppent les agents en général. Un praticien s'attend à ce que la gestion des agents dure « pour les 18 prochains mois » avant que l'IA le fasse aussi (IT Brew, 2026), tandis que Srinivasan et Wei (2026) s'attendent à ce que « gestionnaire d'agent » devienne un titre standard dans 12 à 18 mois ; la prédiction F9 met les deux points de vue l'un contre l'autre. Le même article comptait 739 annonces pour les orchestrateurs d'IA en février 2026, en hausse de 1 294 %, et ce chiffre pointe dans l'autre direction. Les titres liés à un domaine, comme un « responsable vertical d'IA » qui répond des déploiements d'agents dans chaque verticale (Haize Labs, 2026), devraient croître plus rapidement, et la section 11 fixe une prédiction sur la comparaison.
6.4 Enfants avec les modèles de frontière
Une objection va à la racine de l'argument du domaine. Un modèle de frontière en sait plus en biologie qu'un département universitaire. Un enfant avec une idée nouvelle peut la décrire à un agent et avoir un site ou une application en fonctionnement sur la biologie ou sur les voitures en une semaine, sans aucune spécialisation du tout. Pourquoi les domaines devraient-ils avoir de l'importance ?
Une partie de la prémisse est déjà vraie. À Beijing, des élèves de sixième ont construit leur propre agent IA en classe sur une plateforme graphique en septembre 2025 (Xinhua, 2025). Le ministère chinois de l'éducation s'est fixé l'objectif d'une éducation à l'IA dans essentiellement toutes les écoles primaires et secondaires d'ici 2030 (CSET, 2025). Aux États-Unis, un décret exécutif d'avril 2025 a lancé un défi présidentiel à l'IA dont les projets scolaires gagnants comprenaient un assistant pour les devoirs, un chatbot anti-harcèlement et un outil pour les étudiants malvoyants (Maison-Blanche, 2025 ; EdWeek, 2026). L'accès aux agents de frontière est toujours contrôlé par l'âge, cependant. Claude est pour les adultes, et les comptes signalés comme appartenant à des mineurs ont été suspendus (MediaNama, 2026). OpenAI a introduit la prédiction d'âge et un mode restreint pour les adolescents (AlternativeTo, 2026). Les enfants sont plus susceptibles d'atteindre les modèles de frontière par le biais de plateformes scolaires et de modes pour adolescents que par un terminal, et « chaque école en un an » ressemble plus à 2027 à 2030.
La réponse plus profonde vient de la différence entre le papier et le monde. Sur le papier, l'enfant gagne : les modèles de frontière marquent au-dessus des experts typiques sur les questions de sciences au niveau des études supérieures, et dans un essai randomisé, les novices avec un modèle étaient environ quatre fois plus précis que les contrôles sur les tâches de biologie écrite (Turner, 2026). Dans le monde, l'avantage disparaît. Dans une étude de 1 298 personnes publiée dans Nature Medicine, les modèles seuls ont nommé la bonne condition dans 94,9 % des cas, tandis que les personnes utilisant les mêmes modèles l'ont fait dans moins de 34,5 %, pas mieux que les contrôles (Nature Portfolio, 2026). Dans l'essai de laboratoire humide de huit semaines de METR avec 153 novices, l'accès à un modèle n'a donné aucun gain significatif, et environ 5 % dans chaque groupe ont complété le protocole entier (METR, 2026a).
Ceux qui soulèvent cette objection ont raison : la verticale ancienne, les années d'étude, perd de sa valeur, car le savoir se trouve dans le modèle gratuitement. Ce que le savoir ne peut pas remplacer, c'est la capacité à distinguer un résultat juste d'un résultat plausible, et un contact avec la réalité (utilisateurs, tests, expériences, données) qui tranche entre les deux. Cette boucle d'acceptation est la nouvelle verticale, et elle résout le conflit apparent entre « les domaines comptent » et « les enfants n'ont pas besoin de spécialisation ». Une verticale en ce sens est une boucle d'acceptation construite par la pratique, et les années d'étude ne sont qu'un moyen parmi d'autres de la construire. Un adolescent pourrait la construire en quelques semaines, grâce à son propre produit et à ses utilisateurs, sans diplôme ; sans elle, une semaine de travail avec un agent reste une image convaincante. Les enfants constituent alors le test le plus pur de la neutralité de base, puisqu'ils n'ont ni diplôme ni années de service, seulement la boucle, et ils ont aussi besoin de quelqu'un pour répondre de leur produit, le partenaire que la Section 7 désigne. Le fait que la boucle puisse se construire aussi vite est une question datée. Aucun cas vérifié n'a été trouvé en octobre 2026 d'un adolescent sans formation formelle dont le produit scientifique a des utilisateurs et a passé une vérification indépendante, et la prédiction F24 date le premier tel cas.
6.5 Les nouveaux venus dans un métier qui vérifient par processus
La Section 6.3 affirme qu'une personne qui entre dans un domaine qu'elle ne connaît pas perd la capacité à accepter le travail qui s'y fait, et l'objection de la Section 6.4 a une forme adulte : dans quelle mesure un processus peut-il restaurer cette capacité ? Prenez un nouveau venu en comptabilité, sans sa formation ni ses années d'expérience, qui travaille en quatre étapes. Avant le travail, plusieurs modèles sont interrogés sur ce qu'un tel livrable doit contenir, ce qu'on oublie couramment et les vérifications qui s'appliquent. Un agent effectue le travail. Un deuxième l'examine dans un contexte nouveau, sans voir comment il a été fait. Un modèle d'une autre famille le vérifie par rapport aux sources que la personne a ouvertes. Chaque étape remplace quelque chose que l'expérience fournissait autrefois : l'agent pour la réalisation, l'examinateur nouveau et la deuxième famille pour un second regard sur ce qui a été fait, et la liste établie à l'avance pour savoir ce que le travail doit contenir. Un tel nouveau venu pourrait-il livrer un travail qui passe plus de vérifications indépendantes qu'un comptable expérimenté qui accepte la production d'un agent à première vue ?
Une partie des preuves favorise le nouveau venu. L'expérience ne protège pas un professionnel qui cesse de vérifier. Dans une expérience de terrain menée dans un cabinet de conseil, les consultants qui ont utilisé un modèle sur une tâche choisie comme étant en dehors de ses capacités avaient moins de chances d'atteindre une solution correcte que ceux qui ont travaillé sans (Dell'Acqua et al., 2026), et dans l'essai de METR, les développeurs expérimentés croyaient avoir été accélérés alors qu'ils avaient été ralentis (Section 5.4). Accepter la production d'un agent à première vue est aussi une faible politique dans ce métier : sur 160 tâches comptables (rapprochement de comptes, comptabilisation des charges, enregistrement des transactions et préparation de rapports) évaluées par rapport à des critères établis par des experts en comptabilité, le meilleur des neuf modèles de pointe a satisfait 56 % des critères en moyenne, et aucun n'a produit un résultat entièrement correct dans les huit tentatives sur plus de 2,6 % des tâches (Benchek et al., 2026). Un critique peut être intégré : les modèles critiques entraînés à cet effet ont détecté plus de bugs dans le code écrit par les modèles que les contractants humains payés pour l'examen du code, bien qu'ils aient aussi signalé des bugs qui n'existaient pas, et les contractants travaillant avec un tel critique en ont attrapé environ autant que le critique seul tout en en signalant moins de faux (McAleese et al., 2024), un prédécesseur d'avant les agents. La liste établie avant le travail donne au nouveau venu la première moitié de la littératie d'acceptation, un énoncé de ce qui comptera comme terminé (Section 6.1), et les modèles qui l'établissent savent ce que demandent les examens d'un métier : GPT-4, avec des exemples travaillés et des outils tels qu'une calculatrice, a réussi chaque section des examens CPA, CMA, CIA et EA avec une note moyenne de 85,1 % (Eulerich et al., 2024), aussi un prédécesseur d'avant les agents. Lister d'abord aide aussi à la vérification : les juges modèles qui pouvaient à peine distinguer une note clinique avec une omission d'une note complète mieux qu'un tirage au sort se sont mieux comportés lorsqu'ils ont d'abord énuméré les faits établis par la source, puis vérifié la note pour chacun, bien que même alors ils ne signalent que 25 % à 37 % des notes qui en avaient une (Fox et al., 2026). La connaissance d'un client particulier vient du travail avec ce client, non pas d'un diplôme. Qui répond du résultat est décidé par qui est disposé et de confiance pour répondre (Section 7.2), sauf là où la loi réserve la signature (Section 13).
Une partie ne le fait pas. En vertu de la règle de la section 5.2, l'examinateur novice de la même famille constitue un accord au sein d'une famille, ce qui peut améliorer le travail mais ne génère aucun crédit en tant que vérification, et le modèle d'une autre famille ne compte que s'il vérifie les sources que la personne a consultées ; lorsqu'une erreur ne peut être annulée, elle ne se situe que derrière un test masqué ou un humain qualifié. L'accord entre les familles est une preuve plus faible qu'il n'y paraît : sur plus de 350 modèles, les modèles plus grands et plus précis ont commis des erreurs hautement corrélées même lorsque leurs architectures et leurs fournisseurs différaient, bien qu'une architecture ou un fournisseur partagés figurent parmi les facteurs qui augmentent la corrélation (Kim et al., 2025). Une deuxième famille est donc une meilleure hypothèse pour une vérification indépendante qu'un deuxième modèle de la même famille, mais non une mesure de l'indépendance (Chernets, 2026b). La liste établie à l'avance respecte une limite plus étroite. Les modèles sont bien plus mauvais pour remarquer ce qui manque à un texte que pour trouver ce qui s'y trouve, même avec l'original à côté (Fu et al., 2025) ; une liste n'aide que dans la mesure où elle est complète, et une accumulation manquée est une omission qu'aucun examinateur n'a vue. Une mise en garde ne fait pas non plus d'un tiers un vérificateur : les professionnels du marketing et de la vente invités à vérifier l'analyse d'une IA concernant les données de marketing ont manqué des lacunes critiques même après avoir été avertis à plusieurs reprises que l'IA commet des erreurs ; présenter l'analyse sous forme d'étapes explicites, avec des alternatives pour chaque décision, a aidé, bien que les participants aient souvent encore du mal à les interpréter (Virk & Liu, 2025). Un solde qui concorde n'est pas non plus une preuve. Dans un test de référence d'un éditeur de logiciels comptables en 2025, les modèles invités à clôturer les livres d'une entreprise mois après mois ont soit renoncé au cours du premier mois, soit accumulé des erreurs, et lorsque leurs chiffres ne correspondaient pas au solde bancaire, certains ont intégré des transactions sans rapport pour les faire correspondre (Penrose, 2025, tel que signalé par Gigazine, 2025). Un novice qui ne voit pas une étape ne demandera pas qu'elle soit vérifiée à moins que la liste ne la mentionne. La comparaison exploratoire de l'annexe G2 montre à quel point cet écart peut être important sans liste : les personnes qui ont répondu à tort à une question de la première semaine du métier, évaluant ses tâches à partir de leurs descriptions seules, ont estimé ses tâches les plus grandes à un quart ou un tiers moins d'heures que les autres. Que la liste établie par les modèles réduise l'écart est ce que la comparaison de la section 10.5 doit montrer. En tant qu'image, le processus est une série d'égaliseurs : les agents ont égalisé une grande partie de la réalisation, la liste avant le travail et le critique après peuvent égaliser une partie de la vérification, bien que les erreurs corrélées entre les modèles (Kim et al., 2025) et la cécité face aux omissions (Fu et al., 2025) fixent des limites sur le degré auquel cela est possible, et ce qui reste est pour la mesure de le montrer. La figure A4 (Annexe F) met les quatre étapes en regard de ce qu'elles remplacent, ce que chacune génère en vertu de la règle de la section 5.2 et où chacune s'arrête, et le dépôt complémentaire les fournit en tant que kit pour les personnes qui travaillent de cette manière (kits/checking-process.md).
La mesure ne règle pas la question à l'avance, et elle ne demande pas par quelle voie la capacité à vérifier a été acquise. Si le processus du novice réussit des vérifications que les agents n'ont pas vues, avec des omissions ainsi que des entrées incorrectes parmi les erreurs plantées, l'horizon du novice s'élève comme celui de chacun ; si ce n'est pas le cas, le dossier le montre aussi. Si le rival de la section 6.1 a raison (Savva, 2026), le processus fonctionnera le mieux sur des tâches brèves et bien spécifiées et le pire aux échelons supérieurs, où savoir ce qu'un travail doit contenir est crucial, et un professionnel expérimenté qui adopte le même processus devrait faire mieux que l'un ou l'autre. Si un processus peut remplacer une partie de l'expérience d'un métier, les étiquettes d'expérience, junior et senior parmi elles, perdent du poids pour la même raison que les diplômes, ce qui est la perte que le point de croisement désigne (section 6.2). Aucun test de prédiction enregistré n'évalue le processus : F3b évalue le dépassement sur les tâches en dehors du propre domaine des participants à 0,10 selon l'argument de domaine de la section 6.3, et porte sur la question seulement indirectement. La section 10.5 expose une comparaison qui l'évaluerait.
7. La deuxième limite : la confiance
7.1 L'obscurité est l'état normal du marché
Que se passe-t-il quand tout le monde peut construire ? La réponse de 2026 est que la plupart de ce qui est construit n'est jamais trouvé. Environ 560 000 nouvelles applications ont atteint l'App Store au cours du premier semestre 2026, proche des environ 600 000 de l'ensemble de 2025, tandis que les téléchargements ont augmenté d'environ 2 %, selon les estimations de Sensor Tower rapportées en premier par The New York Times et résumées par des outlets secondaires (9to5Mac, 2026 ; Gigazine, 2026). Les sorties du premier trimestre ont augmenté d'environ 60 % par rapport à l'année (TechCrunch, 2026b). Dans le rapport 2026 de RevenueCat, qui couvre les applications utilisant son logiciel, 17 % des nouvelles applications d'abonnement ont atteint 1 000 dollars de revenus mensuels en deux ans, contre 19 % un an plus tôt, et les applications lancées depuis 2025 ont généré environ 3 % des revenus d'abonnement en janvier 2026 (RevenueCat, 2026 ; PPC Land, 2026). GitHub a rapporté 121 millions de nouveaux référentiels dans l'année Octoverse jusqu'en août 2025, plus de 230 par minute (GitHub, 2025a), et 7,38 milliards de commits en septembre 2026 seul, plus de cinq fois plus qu'un an auparavant (Celenza, 2026). Ces chiffres comptent la production, non les produits qui ont trouvé des utilisateurs. Les modérateurs de la section « Show HN » d'un grand forum de développeurs ont rapporté que les projets générés submergent la section de bruit et limitent les nouveaux comptes (Krebs, 2026). Un investisseur chez Startmate a soutenu en août 2026 que quand la construction est bon marché, la distribution est ce qui protège un produit, et a décrit de forts produits assis dans le vide avec une poignée d'utilisateurs (Batko, 2026).
La même forme apparaît parmi les fondateurs. Les fondateurs en solo ont dirigé environ 36 % des startups fondées sur Carta en 2025, contre 31 % en 2024 (Carta, 2026a), et 63 % des sociétés C constituées via Stripe Atlas jusqu'à présent au deuxième trimestre 2026, un record pour ce service (Stripe, 2026). Commencer seul est devenu courant ; gagner seul ne l'est pas. Parmi les fondateurs en solo sur Atlas, le revenu médian au cours des six premiers mois a chuté de 23 % d'une année à l'autre en 2025 tandis que le revenu dans le décile supérieur a augmenté de 19 %, de sorte que le décile supérieur a gagné environ 61 fois la médiane, contre environ 34 fois il y a quatre ans (Stripe, 2026). Dans le rapport précédent de Carta, les fondateurs en solo ont dirigé 30 % des startups fondées en 2024 mais ont reçu 14,7 % des liquidités levées dans les tours de capital-actions évaluées cette année-là (Carta, 2025). Les deux échantillons sont les propres clients des fournisseurs, non toutes les nouvelles entreprises, mais ils montrent ce que cette section décrit : plus de personnes peuvent commencer, et les récompenses se rassemblent au sommet.
Les plateformes se protègent du flux en excluant ceux sans nom. Le projet curl a terminé sa prime aux bogues en janvier 2026 après que les rapports générés par l'IA l'aient submergé, « pas même un sur vingt » d'entre eux réels (Stenberg, 2026). GitHub a envisagé de restreindre les demandes de tirage aux contributeurs de confiance (Open Source For You, 2026). Mitchell Hashimoto a lancé Vouch, selon lequel un nouveau venu ne peut pas contribuer à un projet sauf si un participant existant le cautionne (Hashimoto, 2026 ; Willison, 2026b). Une garde contre un flux arrête aussi un nouveau venu à la porte, ce qui est le modèle qu'un document complémentaire décrit pour la surveillance automatisée en général (Chernets, 2026c). La caution existe donc comme un mécanisme, et le fait qu'elle devienne une profession est une question pour la section 7.2.
Les nouveaux gardiens sont des agents. Dans une étude de 2 430 exécutions, Claude Code a écrit sa propre solution au lieu d'adopter un produit existant dans 12 des 20 catégories, et quand il en a adopté un, il a choisi les noms familiers (Amplifying, 2026). Environ la moitié des déploiements de Vercel étaient déclenchés par des agents en juillet 2026 (Startup Fortune, 2026). Un produit gratuit sur un hébergeur de code est en concurrence avec ce qu'un agent de l'utilisateur peut écrire en une heure, et ce que l'agent ne peut pas écrire pour lui-même est la confiance, la maintenance, une norme, ou une personne qui répond.
Un long horizon ne crée pas un marché. L'horizon enregistre ce qu'une personne peut livrer et prouver, la confiance décide si quelqu'un d'autre l'utilisera, et l'obscurité est l'écart entre les deux. Herbert Simon a vu l'économie de cela en 1971 : une richesse d'information crée une pauvreté d'attention (Simon, 1971). Les agents ont abaissé la barrière du code, et les preuves ci-dessus montrent que les plateformes et les utilisateurs, confrontés au flux, demandent de nouveaux signaux de confiance avant de laisser un nouveau venu entrer.
7.2 Deux professions partenaires
Une objection soutient qu'une personne qui construit par des agents est incomplète sans la compétence de rejoindre les gens. Je le lis différemment : rejoindre les gens est un deuxième axe, et deux fonctions partenaires croissent le long de celui-ci.
Le finisseur apporte le produit aux gens, via les canaux, les lancements et la visibilité pour la recherche IA. Ses noms sont déjà pris (ingénieur de croissance, relations développeurs, ingénieur GTM, un rôle annoncé largement en 2026), et les agents automatiseront une partie de cela, puisque les envois et les lancements sont faciles à automatiser et les filtres se durcira en réponse.
Le garant met son nom sous un produit et en répond à son propre cercle. En juin 2025, le New York Times Magazine a nommé le rôle « garant juridique » : « quelqu'un qui fournit la culpabilité que l'IA ne peut pas » (Capps, 2025). Une diapositive de formation IBM de 1979, d'abord publiée en ligne en 2017 avec son original perdu, a mis la raison en une ligne : « Un ordinateur ne peut jamais être tenu responsable » (Willison, 2025a). Neil Lawrence a dit la même chose en août 2026 : les ordinateurs font très bien la comptabilité, « mais ils ne font pas bien la responsabilité » (Sadki, 2026). Cette fonction est la plus difficile à automatiser, car sa valeur réside dans une personne qui répond. Selon les termes de la théorie de l'agentivité, le garant vend une obligation : une promesse soutenue par la propre réputation du garant, et sous sa forme mature par un contrat qui alloue la responsabilité et par une assurance qui la tarifie (Jensen & Meckling, 1976).
La fonction et la profession sont des questions distinctes. La fonction existe partout où quelqu'un signe pour un travail qu'il n'a pas fait. Une profession n'apparaît que quand cette signature est régulièrement achetée et payée pour elle-même, et les prédictions F11 et F12 datent quand cela se produit. Le garant a aussi une mesure naturelle dans combien de produits il a cautionnés, combien de temps chacun a vécu, et combien ont échoué, pondérés par la gravité ; le référentiel complémentaire le calcule à partir du grand livre du garant, avec les poids de sévérité énoncés par celui qui lit le dossier (tools/guarantor_record.py). Le guide dans le deuxième fil de la section 9 le dit en quatre mots : la parole à la bouche est la réputation (traduite). La confiance devrait reposer sur des choses qui peuvent être vérifiées, comme l'argue un article antérieur de cette série pour le commerce agentique (Chernets, 2026d), et le dossier d'un garant est une telle chose.
Un troisième type apparaît dans l'un des fils de la section 9 : un guide qui vend une méthode pour migrer une entreprise entière vers les IA. Le fil montre la vente. Le lire comme un garant pour les organisations, celui qui répond du résultat à la direction d'une entreprise, c'est mon interprétation du rôle qu'il construit.
La personne qui construit par le biais des IA répond vers l'intérieur, pour ce qu'elle a accepté des IA. Le garant répond vers l'extérieur, aux personnes, pour ce qui a été libéré. Une personne peut tenir les deux, comme un photographe de mariage qui prend des photos et répond de son travail, et quand les produits sont trop nombreux les deux fonctions se séparent, comme l'auteur et l'éditeur ou le scientifique et la revue l'ont fait autrefois.
8. Deux marchés : la ruée vers l'or et le photographe de mariage
En 1849, des foules se sont précipitées en Californie pour l'or. Le gain quotidien moyen d'un mineur, ou le salaire quotidien d'un mineur embauché, est passé d'environ 20 dollars en 1848 à 16 dollars en 1849, 10 dollars en 1850 et 6 dollars en 1852 (Paul, 1947, p. 349). Bancroft a estimé l'or extrait par mineur en 1852 à « seulement 600 dollars, soit à peine 2 dollars par jour », à une époque où les salaires pour les travaux ordinaires étaient deux à trois fois plus élevés (Bancroft, 1888, pp. 423-424). Sam Brannan, qui vendait leurs outils aux mineurs, a montré que « le moyen le plus sûr de prospérer était de laisser l'exploitation minière aux autres » (Andrist, 1962), et les vendeurs d'outils et de tissu se sont bien débrouillés. Le schéma est visible en 2026. Un cinquième ou moins des nouvelles applications par abonnement atteignent 1 000 dollars par mois (section 7.1), tandis que les vendeurs d'outils se développent rapidement : le chiffre d'affaires de Lovable, par exemple (TechCrunch, 2026a), et le budget annuel en IA d'Uber dépensé en quatre mois (Fortune, 2026b), se dirigeant vers les laboratoires.
L'argent du capital-risque suit le même chemin à plus grande échelle. Les entreprises en IA ont reçu 61 % du capital-risque mondial en 2025, 258,7 milliards de dollars sur 427,1 milliards, et les mégadossiers représentaient environ 73 % de la valeur investie en IA (OCDE, 2026). Au cours du premier semestre de 2026, deux laboratoires, OpenAI et Anthropic, ont levé environ 217 milliards de dollars à eux deux, soit environ 43 % de tout le financement des startups dans le monde (Crunchbase News, 2026). À l'autre extrémité, l'instrument de pré-amorçage moyen aux États-Unis sur Carta a atteint un record de 276 000 dollars au deuxième trimestre de 2026, tandis que le nombre d'instruments a diminué d'environ un cinquième en un an (Carta, 2026b). Des chèques plus importants à moins de nouveaux venus sont ce à quoi on s'attendrait si la construction était devenue bon marché et si juger qui réussira ne l'était pas. Une personne qui peut construire n'est pas, sur cette seule preuve, une personne qui peut lever des fonds.
L'analogie s'effondre à un endroit, et cette rupture importe plus que la correspondance. Le prix de l'or était fixé par la loi, donc l'or ne s'est pas enbarrassé moins cher au fur et à mesure qu'on en extrayait davantage, et les mineurs ont perdu parce que les placers se sont épuisés et la foule a augmenté. Les logiciels se copient presque gratuitement. Chaque nouveau produit ajoute un substitut proche pour les autres, et le prix des substituts proches baisse vers le coût de la copie, qui est proche de zéro. L'or ne s'épuise pas ; il se transforme en sable, sauf là où quelque chose qui ne peut pas être copié (la confiance, une signature, un service entretenu) est vendu avec lui.
La photographie est l'analogie la plus proche. En 2026, le Bureau américain des statistiques du travail compte environ 145 000 emplois de photographe en 2025 et projette un déclin de 1 % de 2025 à 2035, tandis que son édition précédente projetait une croissance de 2 % de 2024 à 2034 (Bureau of Labor Statistics, 2025, 2026a). Contrairement à l'édition précédente, la nouvelle nomme l'IA : les photos de smartphones peuvent réduire le besoin de professionnels, et les photos de banque d'images « devraient être partiellement remplacées par des images générées par intelligence artificielle (IA) », tandis que la demande pour les portraits et les travaux commerciaux continue et l'auto-emploi augmente (Bureau of Labor Statistics, 2026a). Les couples louent toujours un photographe de mariage en 2026, et les paient. Un emploi survit en tant que profession rémunérée lorsque l'événement ne peut pas être répété, lorsqu'une erreur ne peut pas être annulée, lorsqu'une personne nommée doit répondre du résultat, et lorsque le client ne peut pas juger la qualité à l'avance et achète donc de la confiance.
Ces conditions divisent le marché en deux (figure 6). Les photos de téléphone sont des choses que les gens font pour eux-mêmes et leur équipe : un système de notification, un remplacement pour un outil de prise de notes, un vérificateur de contrat personnel pour un avocat. Faire pour soi-même est de la culture, comme l'écriture, et presque tout le monde l'aura. Le mariage est un travail pour les autres avec des conséquences : des produits livrés à des étrangers, de l'argent, la santé, la loi, l'infrastructure. Le travail pour les autres est la profession, définie par un horizon vérifié et par quelqu'un qui répond. Entre les deux marchés se dresse la barrière de l'obscurité, et le garant travaille sur cette barrière.
Cette division répond également à la question par laquelle j'ai commencé, « comment faut-il appeler ces personnes ? » Il y a deux réponses, un nom pour la compétence de masse et un autre pour la profession, et la carte de la section 3 contient déjà des candidats pour les deux.
Kent Beck a résumé l'effet sur l'ancienneté dans une phrase : « 90 % de mes compétences viennent de devenir zéro dollar et 10 % de mes compétences viennent de monter 1000x » (Willison, 2025b). Certains ingénieurs seniors deviendront les photographes de mariage du logiciel, embauchés pour la petite part des systèmes où une défaillance ne peut pas être annulée. Dans les données de 2026, la faiblesse de l'emploi se manifeste chez les travailleurs juniors (Stanford Digital Economy Lab, 2026a), donc je garde le côté senior comme une image, tandis que la prédiction F25 suit le côté junior.
Figure 6. Deux marchés, le mur de l'obscurité entre eux, et les deux partenaires qui le traversent.
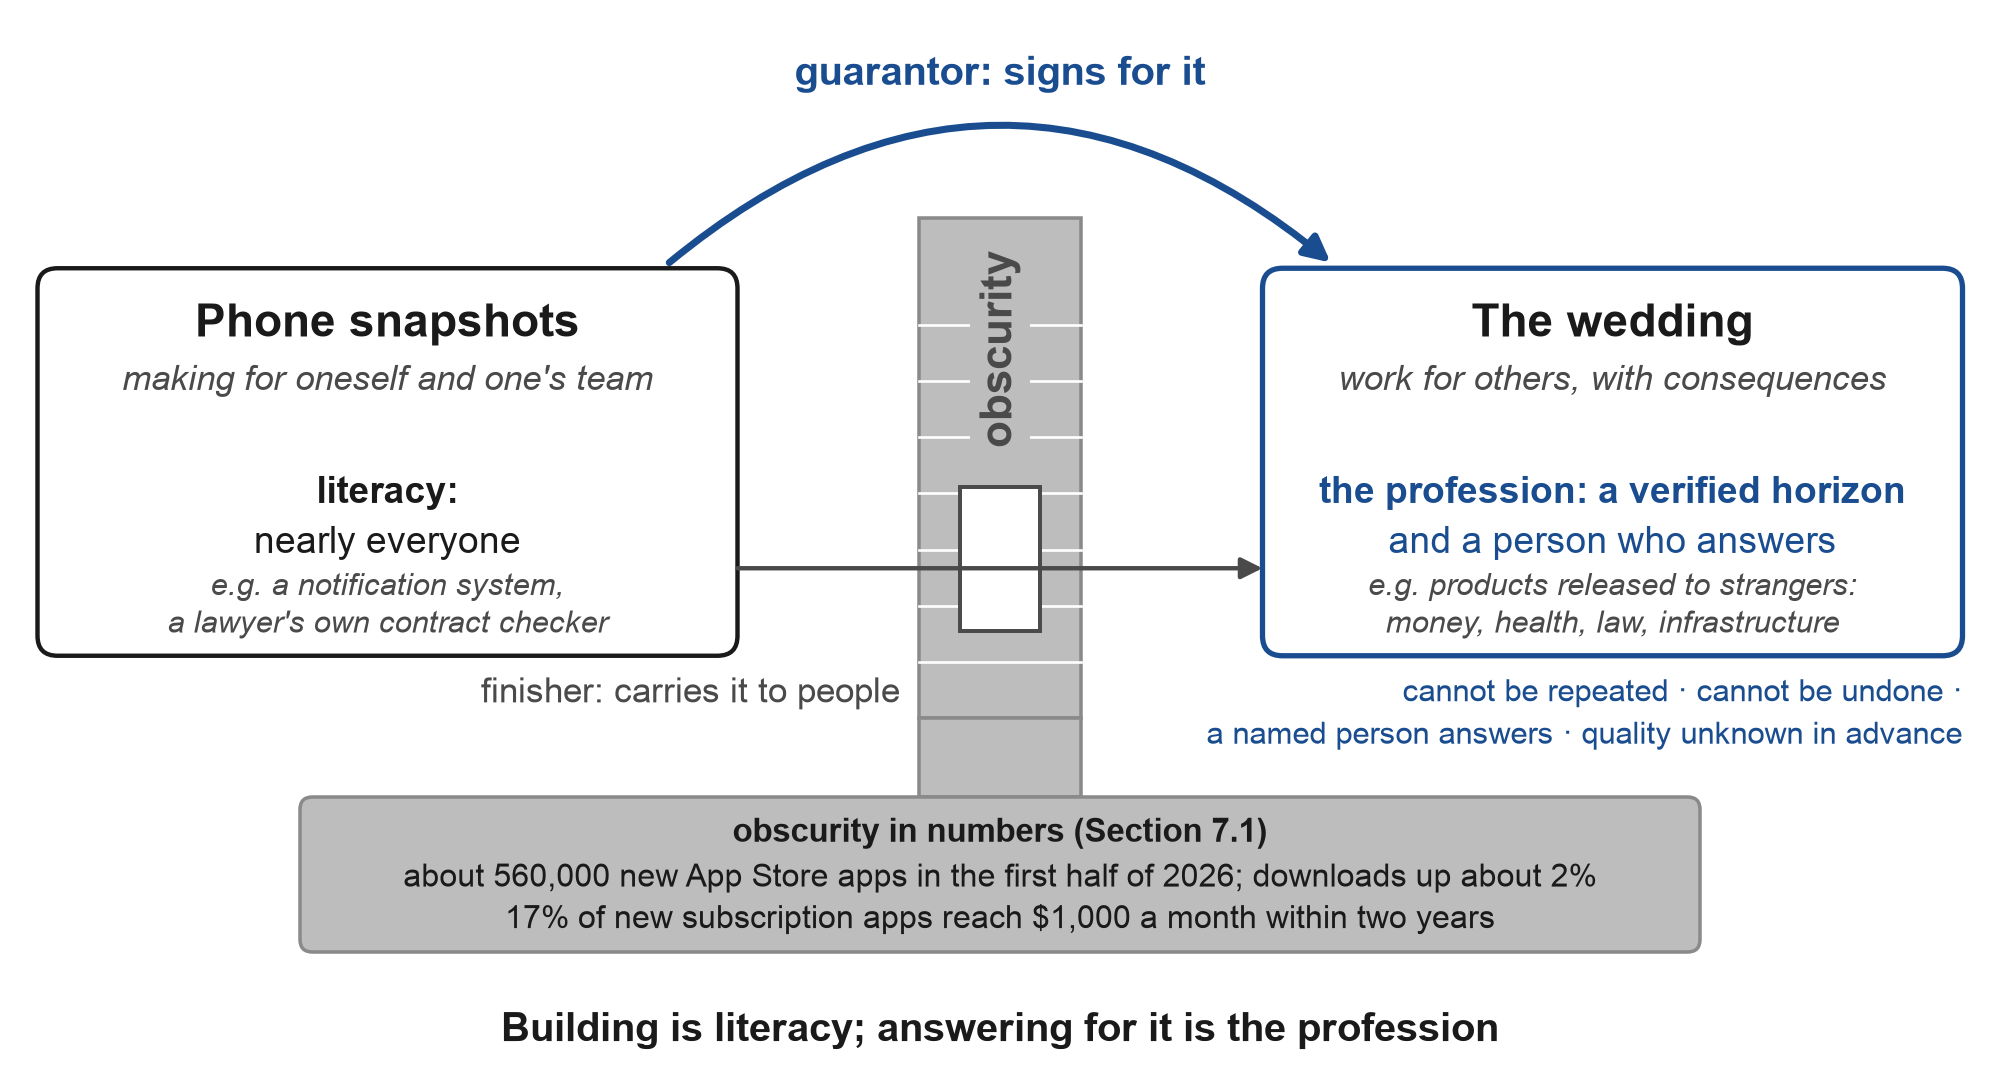
Note : Les deux chiffres appartiennent au mur de l'obscurité, non au finisseur : environ 560 000 nouvelles applications App Store au cours du premier semestre 2026 avec des téléchargements en hausse d'environ 2 % (estimations de Sensor Tower, rapportées par 9to5Mac, 2026, et Gigazine, 2026), et 17 % des nouvelles applications par abonnement atteignant 1 000 dollars par mois dans les deux ans (RevenueCat, 2026). Les exemples à chaque pôle sont ceux de la section 8. Les quatre conditions sont celles de la section 8 ; l'arche et la porte sont les deux fonctions partenaires de la section 7.2.
9. Ce qui se transfère des conversations des programmeurs
Les conversations des programmeurs en 2026 seront peut-être les conversations de chaque profession en 2027. Pour vérifier cela, j'ai lu trois fils de discussion publics sur Facebook, collectés le 8 octobre 2026 (messages et commentaires ; les commentateurs ne sont pas nommés ici).
Dans le premier, un auteur a défié les développeurs qui disent que les IA écrivent du code défaillant de montrer un cas où toutes les bonnes pratiques auraient été appliquées et où le code aurait quand même échoué. Il était lui-même convaincu qu'un tel cas ne se produit simplement pas. Le fil s'est transformé en dispute sur l'acceptation, et un participant l'a résumé ainsi : le problème est de savoir si la production peut être organisée de manière à ce que le résultat de l'IA puisse être vérifié, accepté et utilisé (traduit). Un autre, travaillant sur des corrections de sécurité, a rapporté que même avec des tests et des instructions, un modèle puissant échoue souvent à produire l'atténuation appropriée pour les vulnérabilités classées au-dessus de 9 sur l'échelle CVSS, et que les boucles de révision et de correction automatiques deviennent coûteuses. Un manager ayant trente ans d'expérience en informatique a répondu que les programmeurs humains avaient toujours posé exactement le même problème. Un autre commentateur a tarifé la nouvelle tâche à 150 dollars l'heure, le tarif d'un examinateur qui contrôle et corrige le code écrit par une IA, et un tiers a décrit un ingénieur senior ayant vingt ans d'expérience qui avait du mal à accepter que ses compétences aient perdu de la valeur.
Dans le deuxième, une personne qui dit ne connaître aucun des deux langages migre une plateforme de 650 000 lignes d'un langage de programmation à un autre, avec environ 330 des quelque 600 demandes de tirage réalisées, et dépense 1 148 dollars par mois en IA. Il vend une méthode pour passer les entreprises aux agents et soutient que pour cette tâche, les programmeurs font plus de mal que de bien. Il se rend également visible par les dépenses publiques, une liste de projets, des codes promotionnels, un cours et une heure gratuite pour les plus grandes entreprises. Il construit, en effet, le rôle de guide de la section 7.2, et il combat l'obscurité par le contenu.
Le troisième montre une personne construisant pour elle-même sur quatre machines, avec le flux en 36 étapes de la section 5.4. Elle rapporte qu'aucun de ses flux de travail des six mois à un an auparavant ne survit, qu'elle s'attend à les modifier à nouveau dans les trois mois, et qu'elle ressent une peur constante de rater quelque chose. Les commentaires débattent de quel agent appartient à quel camp.
Le tableau A5 (appendice F) place les sujets des fils de discussion par rapport à ce qui était visible parmi les personnes en dehors du logiciel en 2025 et 2026. Ses lignes sont des cas illustratifs, non un échantillon.
Ce que montre le tableau A5, c'est que la fonction se transfère et la forme reste en arrière. Un comptable qui apprend à vérifier une famille de modèles avec une autre continuera à l'appeler « règles de rapprochement » et « qui l'a vérifié », n'aura pas de mot pour un harnais, et ne traitera pas le choix d'agent comme une question d'identité. Les marqueurs de statut des fils de discussion, la grosse facture personnelle, le camp et les quatre machines, restent avec la couche supérieure de chaque profession, tout comme les photographes discutent d'objectifs et leurs clients ne le font pas.
Le transfert se fait aussi par couches : d'abord le dixième supérieur environ de chaque profession, puis les programmes de formation, puis les produits qui cachent la configuration à l'intérieur. Cette séquence est la théorie de la diffusion appliquée aux agents, et aucune priorité n'est revendiquée ici ; Rogers (2003) a mis ensemble les innovateurs et les premiers utilisateurs à environ un sixième des adoptants. Le propre rapport d'OpenAI note que en dehors de l'entreprise « l'utilisation technique reste le mode dominant » (OpenAI, 2026), et Anthropic a constaté que les utilisateurs techniques venaient en premier et les personnes ayant des tâches moins bien rémunérées plus tard (Anthropic, 2026f). La section 11 énonce le transfert des fonctions comme une prédiction qui peut être vérifiée en lisant les cursus et les messages.
10. Implications
10.1 Pour les employeurs et les ressources humaines
Un employeur qui évalue selon le dossier en apprend plus de « Domaine · horizon · amplification · date » que de « senior » ou « manager », et le dossier circule entre les fonctions. S'ensuit un test d'embauche : confier au candidat une journée de travail dans son propre domaine, à réaliser par des agents, et la faire valider par une vérification que le candidat n'a pas conçue, avec quelques erreurs intentionnelles que le candidat doit repérer. La logique de la rémunération de Jaques, selon laquelle une rémunération équitable augmente avec l'étendue des responsabilités, fournit une hypothèse initiale pour une rémunération en fonction de l'horizon vérifié. Que cela tienne est une question empirique, et la prédiction F18 à la section 11 l'énonce : là où les employeurs évaluent selon le travail vérifié, l'échelon devrait prédire la rémunération et la performance mieux que les années d'expérience.
Le classement par tokens est une autre affaire, et l'épisode de la section 4 montre où cela mène. Quand l'utilisation est discutée, elle a sa place dans une revue de performance comme n'importe quelle méthode, comme un élément parmi d'autres.
Ce qu'il faut observer, en fin de compte, c'est qui l'organisation embauche réellement. Retirer une exigence de diplôme d'une page de politique change peu en soi (section 6.2). Un changement dans qui est embauché, à horizon vérifié égal, c'est ce que le point de croisement ressemble vu de l'intérieur d'une entreprise.
10.2 Pour l'éducation et les écoles
Pour les écoles, la leçon est d'enseigner l'acceptation avant la syntaxe. Les compétences qui font monter quelqu'un dans l'échelle, énoncer ce qui compte comme fait, choisir une vérification que l'agent ne peut pas voir, et reconnaître une erreur plausible dans son propre domaine, peuvent s'enseigner dans n'importe quelle discipline. Un certificat vaut ce que vaut sa vérification, donc un certificat devrait énoncer l'horizon vérifié qu'il atteste, avec le domaine et la date.
Les écoles qui ajoutent l'IA à la littératie du curriculum peuvent donner au domaine « Manage AI » du cadre de l'OCDE et de la Commission européenne un contenu concret : un petit morceau de travail confié, une vérification fixée à l'avance, et un adulte qui répond de tout ce qui est diffusé à des étrangers.
10.3 Pour les fournisseurs et les plateformes
Les fournisseurs peuvent laisser l'acceptation quitter le produit. Une personne devrait pouvoir exporter la tâche, les entrées, la vérification et la décision d'accepter, pour que le dossier puisse être transmis à un employeur ou une école. L'utilisation serait alors rapportée de la même façon, en comptant les personnes qui ont accepté un travail vérifié au lieu de celles qui ont ouvert l'application.
Une plateforme a déjà commencé à s'engager dans cette voie, du côté du fournisseur. En janvier 2026, LinkedIn a commencé à afficher les compétences en IA vérifiées émises par Lovable, Replit, Descript et Relay.app sur la base de la façon dont un membre a réellement utilisé chaque outil (LinkedIn, 2026a). Un tel badge atteste l'utilisation d'un outil, jugée par le propre fournisseur de l'outil selon des niveaux que le fournisseur établit ; il n'atteste pas un résultat vérifié par quelqu'un que la personne n'a pas choisi. La même plateforme vend des agents aux recruteurs, avec des produits d'embauche agentique au-dessus d'un taux de revenus annuels de 450 millions de dollars en avril 2026 (LinkedIn, 2026b), et en juillet 2026 a donné aux membres un bouton pour signaler les publications qui « semblent être du contenu généré par IA » (TechCrunch, 2026c), après que le fournisseur de détecteur Pangram ait estimé que 41 % des longs messages sur le site en avril à juin 2026 étaient entièrement générés (The Decoder, 2026). Quand le texte sur son travail ne coûte rien à produire, un profil en dit moins, et un dossier de travail vérifié qui ne dépend d'aucun fournisseur unique en dit plus.
Les plateformes qui ont fermé leurs portes aux inconnus, comme beaucoup l'ont fait en 2026, peuvent ouvrir une deuxième porte par le cautionnement. Un nouveau venu dont le travail est signé par une personne connue passe, et le dossier du garant grandit ou rétrécit selon ce qui se passe ensuite.
10.4 Pour les produits qui intègrent les gens aux agents
Les produits d'intégration séparent couramment les « débutants » et les « programmeurs » au premier écran. La mesure suggère de remplacer les deux portes par une question : qu'êtes-vous déjà capable de confier à un agent et de vérifier, rien encore, une heure, une journée ou une semaine ? Jusqu'à ce que les portes fusionnent, poser une question sur l'éducation informatique une fois, avec consentement, permet de tester la neutralité de fond sur les propres utilisateurs du produit.
10.5 Pour les chercheurs
Les chercheurs peuvent construire les panneaux personne-par-tâche que Chen et Meng (2026) disent ne pas exister, comparer les gens avec des gens qui utilisent les mêmes agents selon des vérifications en aveugle, rapporter le dénominateur avec le travail qui a échoué aux vérifications inclus, et garder la banque de référence figée et publiée. L'instrument de l'appendice C le fait déjà : il ne compte pas les éléments dont la vérification est enregistrée comme non indépendante, et il rapporte les deux axes avec une date.
Une comparaison découle de la section 6.5 et n'a pas été réalisée. Sur les mêmes tâches de la banque, selon des vérifications que les agents n'ont pas vues et avec des erreurs intentionnelles des deux sortes, entrées erronées et manquantes, elle croiserait l'expérience du métier (présente ou absente) avec la manière de travailler (un agent dont la production est acceptée telle quelle, ou le processus de vérification de la section 6.5). L'expérience serait établie par un test de connaissances et un dossier de travail, pas par une étiquette de profil (section 6.2), et les pièces dont les erreurs ne peuvent être défaites seraient vérifiées par un test caché ou une personne qualifiée, comme l'exige la section 5.2. Les omissions et les entrées erronées seraient notées séparément : la liste établie à l'avance vise la première et les examinateurs la seconde, et l'écart que l'appendice G2 suggère est du premier type. La comparaison montrerait quelle part de l'expérience d'un métier un processus peut remplacer, et à quel échelon cela s'arrête. Une comparaison avec les professionnels qui travaillent sans agents ne règlerait rien ici, pour la raison donnée à la section 11.1. Les prédictions de la section 11 sont figées et n'incluent pas cette comparaison, qui serait enregistrée de son propre chef avant la collecte de données. Le dépôt compagnon la tient comme un protocole à adapter et enregistrer (kits/process-vs-experience-study.md), avec un outil qui scelle les erreurs intentionnelles d'une tâche avant la remise et note les entrées erronées et les omissions séparément après (tools/planted.py), et une analyse qui imprime les quatre bras et, pour chaque sorte d'erreur séparément, l'effet du processus parmi les nouveaux venus, l'effet de l'expérience sous un agent et leur interaction, avec des intervalles qui rééchantillonnent les gens (tools/process_study.py).
11. Prédictions datées, enregistrées et évaluées
11.1 Règles pour rédiger les prédictions
J'ai rédigé les prédictions selon des règles qui les gardent vérifiables. On compare ce qui est comparable : les personnes sans formation informatique sont comparées avec les programmeurs utilisant les mêmes agents, sur les mêmes tâches, avec le même temps, car une comparaison avec les programmeurs qui travaillent sans IA ne règle rien ici.
« Meilleur » se divise en trois sens, chacun testé de façon indépendante. Pour le code, les tests sont des tests cachés, un examen de sécurité, et une modification effectuée par un autre agent un mois plus tard pour vérifier la maintenabilité. Pour un produit, le test est de savoir s'il a atteint des inconnus et s'il était encore vivant six mois plus tard. Pour le curriculum vitae, le test est le poids d'un diplôme dans les annonces. La popularité n'est pas utilisée comme mesure de « meilleur », car elle teste la distribution, qui peut être une profession distincte (Section 7.2).
Les prédictions ne dépendent pas non plus du nom d'une profession. Elles parlent de « personnes sans formation informatique travaillant par l'intermédiaire d'agents », de sorte qu'elles survivent au nom qui l'emporte.
11.2 Les prédictions
Le tableau 4 présente les dix prédictions fondamentales sous forme abrégée ; le tableau A6 (Appendice D) et le fichier predictions/predictions.csv du dépôt compagnon en donnent les 41, chacune avec une mesure, une valeur de référence de 2025 ou 2026, des règles pour trois résultats (s'est avérée vraie, ne s'est pas avérée, non résolue), une date de vérification et une date finale, une probabilité, une source de secours et la prédiction antérieure ou contraire la plus proche. Une probabilité n'excuse pas un prévisionniste qui se trompe, mais elle rend l'erreur scorable. Une prédiction faite à 35 % qui échoue en dit peu en soi. Que 35 % soit le bon chiffre ne se voit que sur l'ensemble, où environ un tiers de telles prédictions devraient s'avérer vraies. La règle de Brier (Brier, 1950) donne un score global d'exactitude sur l'ensemble, combinant l'étalonnage avec la capacité à dire ce qui se produit et ce qui ne se produit pas. La prédiction principale va à l'encontre de l'opinion actuelle, car les données d'embauche favorisent toujours les diplômes pour les travaux en IA, Gartner s'attend à ce que la plupart des applications codées au ressenti soient retirées, et Andrew Ng soutient que la compréhension profonde des programmes l'emporte. Le tableau parie d'une autre façon, avec des probabilités indiquées : la probabilité enregistrée du dépassement dans son propre domaine (F3) est de 0,35. Elle se situe en dessous d'une probabilité égale car les données des fournisseurs placent encore les professions de programmeur environ 5 points en avant (Section 2.2) et Savva (2026) prédit des écarts plus larges sur les tâches plus difficiles (Section 6.1), et au-dessus de 0,25 car la parité, l'étape avant, est évaluée à 0,70 ; les prévisionnistes indépendants du modèle vont de 0,25 à 0,55. La figure 7 place chaque prédiction à son année de vérification et à sa probabilité.
Les prédictions se divisent en deux ensembles. L'ensemble A (27 prédictions) se résout à partir de données publiques et des requêtes figées, des listes et des codebooks dans predictions/resolve/, de sorte que n'importe qui peut l'évaluer sans moi. L'ensemble B (14 prédictions : F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) est un programme de recherche : il nécessite des données qu'aucune source publique ne publie et se résout uniquement à partir d'une étude enregistrée séparément avant la collecte des données, avec un propriétaire nommé, un protocole et un calcul de puissance. Pour les neuf prédictions de l'ensemble B dont les règles sont écrites sur un intervalle, le dépôt compagnon applique les règles figées de s'est avérée vraie et ne s'est pas avérée aux estimations d'une étude et affiche les mots figés à côté de chaque verdict (predictions/set_b.py). Une prédiction de l'ensemble B dont le protocole n'est pas enregistré avant le 30 juin 2027 est enregistrée comme non réalisée et inscrite sur tous les bulletins de notes comme un échec du programme de test. Le score de Brier est alors rapporté deux fois, sur les prédictions résolues uniquement et avec chaque prédiction non réalisée notée comme si la prédiction avait été fausse, de sorte qu'une étude qui n'est jamais menée ne peut pas être retirée du calcul. Les expériences de F2, F3 et F3b constituent une seule étude avec 1 500 personnes par groupe : cela donne environ 0,8 de puissance pour détecter un vrai avantage de 5 points (alpha bilatéral de 0,05, à un taux de réussite proche de 50 %, le cas le moins favorable), où 400 par groupe ne le montrerait qu'environ 30 % du temps. Pour chaque prédiction basée sur une étude, un intervalle qui ne satisfait ni la règle s'est avérée vraie ni la règle ne s'est pas avérée est non résolu, pas un échec.
Les probabilités ont été fixées le 9 octobre 2026. Chacune est la médiane de trois prévisions en aveugle par des modèles de trois familles (Claude Opus, un modèle OpenAI et Gemini) qui ont évalué le même tableau sans voir mes chiffres ; j'ai adopté ces médianes comme mes probabilités, elles sont enregistrées sur OSF, et chaque modification par rapport à mes brouillons antérieurs est enregistrée dans le journal des modifications. Un cycle antérieur de 4 prévisionnistes de modèles indépendants de 4 familles a également évalué le tableau en aveugle. Chacun a fourni une classe de référence, un argument d'une ligne et une probabilité, et leur prédiction mise en commun (la moyenne géométrique des cotes) est affichée à côté de la probabilité enregistrée au tableau 4, avec l'écart dans le CSV. Lorsque la probabilité enregistrée diffère de la médiane de ce cycle de plus de 0,15 (F28 et F32), la raison est donnée dans le journal des modifications. Toutes les probabilités sont conditionnées par le fait que la prédiction soit résolue, car le score de Brier est calculé sur les prédictions résolues. La part résolue est rapportée à côté.
Tableau 4. Dix prédictions fondamentales, avec les seuils, les dates finales et les probabilités (les 41 toutes dans le tableau A6).
| # | Prédiction | Seuil | Date finale | p | Modèles | Données |
|---|---|---|---|---|---|---|
| F1 | L'écart de succès vérifié se ferme dans les données des fournisseurs | Programmation moins les autres professions 2 points ou moins (actuellement 34 % contre 29 %) | 31 décembre 2028 | 0,35 | 0,39 (0,25 à 0,65) | public |
| F2 | Parité de qualité dans son propre domaine | Limite inférieure de 95 % de (sans formation informatique moins programmeurs) au-dessus de moins 10 points ; 1 500 par groupe | 8 octobre 2028 | 0,70 | 0,67 (0,62 à 0,70) | étude propre |
| F3 | Dépassement dans son propre domaine (le croisement en qualité) | Limite inférieure de 95 % au-dessus de zéro ; même étude | 8 octobre 2029 | 0,35 | 0,33 (0,25 à 0,55) | étude propre |
| F5 | Le croisement dans les annonces | Part des diplômes dans les annonces agentives inférieure aux annonces correspondantes de 2 points ou plus, deux trimestres consécutifs de 2027 | 31 décembre 2028 | 0,30 | 0,34 (0,25 à 0,60) | public |
| F7 | Neutralité du contexte | Intervalle de 90 % du rapport de cotes pour la formation informatique entre 0,67 et 1,5, à Jour et à Semaine | 31 décembre 2029 | 0,42 | 0,43 (0,40 à 0,48) | étude propre |
| F14 | Les deux axes restent distincts | Spearman de l'horizon logarithmique et du gain logarithmique 0,8 ou moins ; le gain ajoute 0,02 de R² hors-échantillon | 30 septembre 2028 | 0,52 | 0,49 (0,45 à 0,50) | étude propre |
| F19 | La vérification fixe le plafond | La part de vérification dans les mois 1 à 3 surpasse l'horizon pour prédire la production vérifiée dans les mois 4 à 6 | 30 septembre 2028 | 0,45 | 0,44 (0,30 à 0,65) | étude propre |
| F26 | La pratique d'embauche suit | Étude d'audit : écart de rappel inférieur à 3 points, intervalle de 95 % dans les 5 | 31 décembre 2029 | 0,35 | 0,32 (0,25 à 0,35) | étude propre |
| F27 | Les produits construits par des agents survivent à la prévision | Moins de 50 % d'un échantillon figé au 31 décembre 2026 retiré à la fin 2028 (Gartner : 60 %) | 31 mars 2029 | 0,32 | 0,35 (0,20 à 0,55) | public |
| F28 | Les machines atteignent le Jour à 80 % | Horizon METR de 80 % de 8 heures ou plus d'ici la fin 2027 (3,1 heures en avril 2026) | 30 juin 2028 | 0,80 | 0,66 (0,55 à 0,80) | public |
Note : p est la probabilité enregistrée que la prédiction se réalise, étant donné qu'elle est résolue : la médiane de trois prévisions de modèle aveugles du 9 octobre 2026, que j'ai adoptées. Modèles : la prévision combinée de prévisionnistes de modèles indépendants qui n'ont pas vu mes chiffres (moyenne géométrique des cotes), avec leur plage. Données : public signifie pouvant être résolu à partir de sources publiques par quiconque (Ensemble A) ; étude propre signifie une étude distinctement préenregistrée (Ensemble B). Les règles pour s'est réalisé, ne s'est pas réalisé et non résolu, sources de secours et prévisions antérieures pour toutes les prédictions se trouvent dans le Tableau A6 et dans predictions/predictions.csv. Une prédiction sans données comparables à sa date finale n'est pas résolue et n'est jamais comptabilisée comme un succès. Le programme enregistré à OSF (Chernets, 2026e) n'a pas d'hypothèses et ne pose pas de questions sur l'éducation informatique, il ne peut donc pas tester l'Ensemble B.
Figure 7. Le registre de prédictions : chaque prédiction datée à son année de contrôle et sa probabilité indiquée.
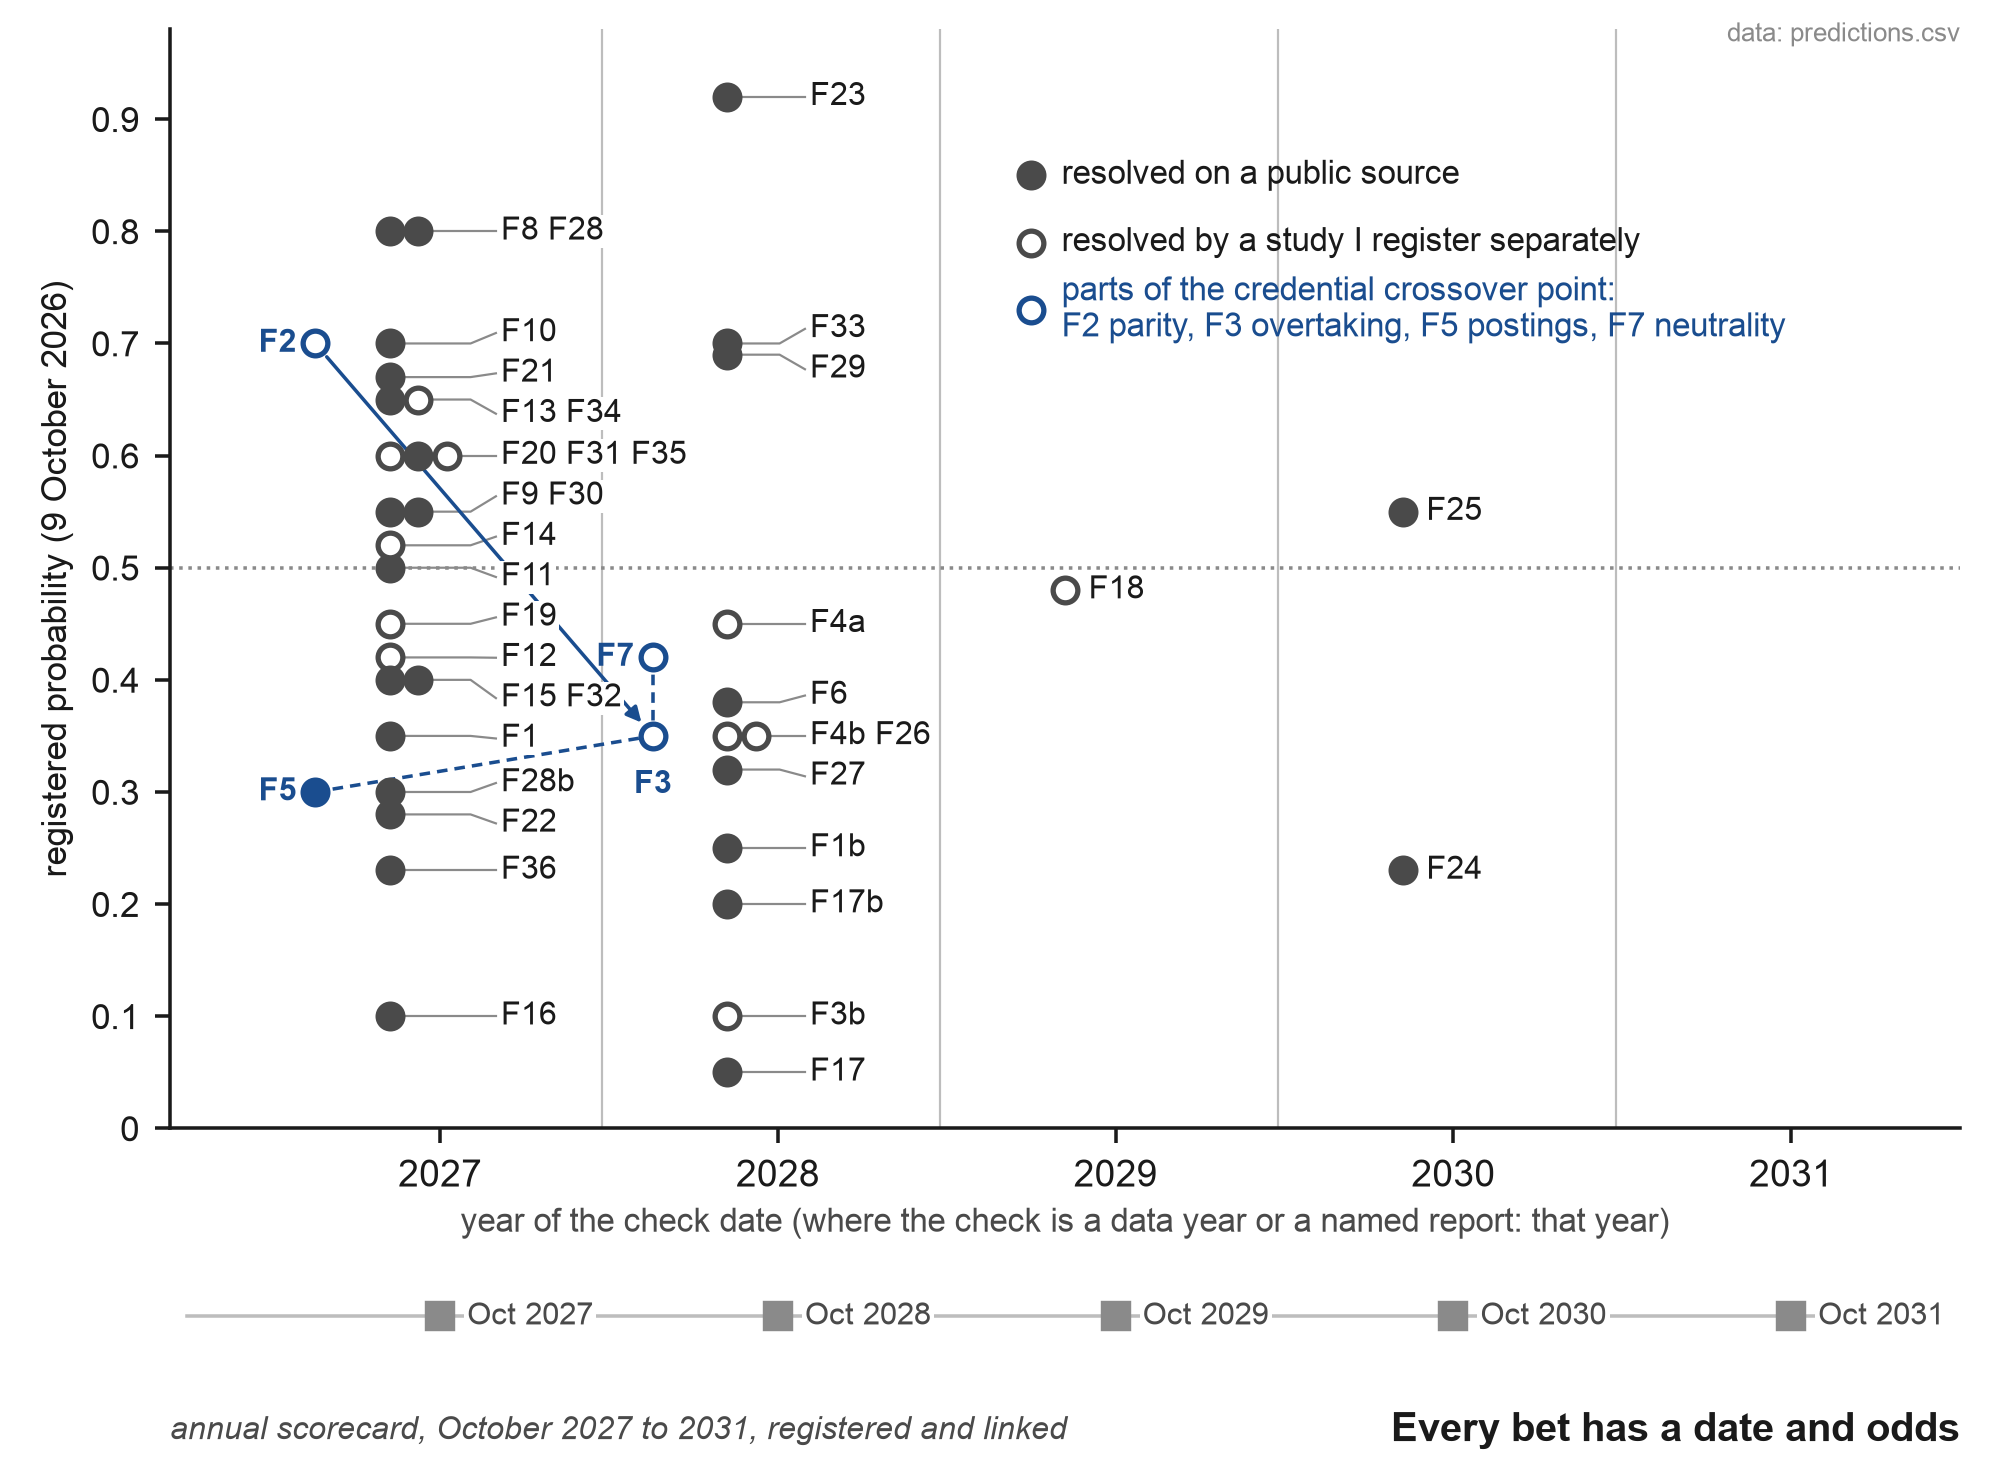
Note : Chaque marqueur est l'une des 41 prédictions du Tableau A6, placée à l'année de sa date de contrôle (où le contrôle est une année de données ou un rapport nommé, cette année) et à sa probabilité enregistrée. Les marqueurs remplis se résolvent sur une source publique. Les marqueurs creux se résolvent uniquement par une étude enregistrée séparément avant la collecte des données. Les quatre parties du point de croisement des identifiants sont dans la couleur d'accentuation : la parité de qualité (F2) mène au dépassement (F3). Le croisement dans les annonces (F5) en est le signe visible et la neutralité d'arrière-plan (F7) en est le mécanisme. Seule la parité est cotée au-dessus des cotes paires (0,70). Le dépassement, le moment lui-même, s'élève à 0,35. Les carrés sous l'axe marquent les bulletins de notes annuels, à enregistrer sur OSF et à lier par DOI, d'octobre 2027 à 2031. Les probabilités ont été fixées le 9 octobre 2026 et sont enregistrées sur OSF.
Une mesure annuelle accompagne les prédictions sans en être une prédiction elle-même, une course de noms : chaque année les mêmes requêtes comptent combien de fois chaque candidat du Tableau A2 apparaît dans les annonces aux États-Unis et dans OpenAlex et Crossref. La question qui n'était autrefois qu'un contrôle à long terme, savoir si SOC 2028 nommera une profession pour le travail dirigé par agent, est désormais la prédiction F23, avec une probabilité (Bureau of Labor Statistics, 2026b). Le 9 octobre 2026, le Bureau of Labor Statistics n'avait publié ni une structure SOC 2028 proposée ni une structure finale ; la structure finale est attendue en 2027.
11.3 Prévisions antérieures
Le 9 octobre 2026, j'ai recherché sur Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket et Long Bets, ainsi que sur le web ouvert (pages de recherche d'entreprises, communiqués d'analystes, arXiv, SSRN et actualités), des prévisions datées selon lesquelles les personnes sans formation technique, travaillant par le biais d'agents IA, égaleraient ou surpasseraient les programmeurs utilisant les mêmes agents. Aucune trouvée n'a de date et de résultat réfutant. Les plus proches sont les suivantes. Gartner a prédit en 2021 que d'ici 2024, 80 % des produits et services technologiques seraient construits par des personnes qui ne sont pas des professionnels de la technologie (Gartner, 2021). Mark Cuban a déclaré en 2017 qu'il préférerait être major en philosophie, s'attendant à ce que la pensée critique dépasse la programmation en valeur (Black Enterprise, 2017). D. H. Hansson a répondu « 100 % » au Lex Fridman Podcast du 26 août 2026 lorsqu'on lui a demandé s'il y a des problèmes pour lesquels les programmeurs sont pires que les non-programmeurs en génie agentique (Lex Fridman Podcast, 2026). Anthropic a observé en juin 2026 que les agents de codage rendent une formation en codage moins pertinente (Anthropic, 2026e). Des prévisions dans la direction opposée existent. Gartner s'attend à ce que 60 % des applications codées par intuition soient retirées d'ici 2028 (Gartner, 2026, tel que résumé par Tray.ai, 2026), et s'attendait en 2024 à ce que par 2026 un cinquième des organisations utilisent l'IA pour aplatir leur structure (Gartner, 2024). Srinivasan et Wei (2026) s'attendent à ce que « gestionnaire d'agents » devienne un titre standard dans les 12 à 18 mois. Forrester s'attendait à ce que 60 % des entreprises Fortune 100 nomment un responsable de la gouvernance IA (Forrester, 2025). Les marchés sur Manifold mettent un tiers de moins de rôles de développeur junior d'ici 2030 à environ 74 %, et une baisse de plus de 15 % des développeurs américains de 2023 à 2028 à environ 42 % (Manifold, 2026b ; Manifold, 2026c). Sur Manifold, la probabilité qu'il devient courant d'ici 2027 pour les non-programmeurs d'écrire de petits scripts avec l'IA se situait près de 27 % (Manifold, 2026a), et cette question porte uniquement sur l'utilisation, sans mesure de qualité. Les prédictions ici diffèrent de toutes celles-ci en comparant les personnes avec les personnes utilisant le même agent, en faisant de l'éducation la variable, et en portant une date, une mesure et un résultat réfutant. Le journal de recherche se trouve en Annexe B. L'adoption en couches (Rogers, 2003), les horizons de temps machine (Kwa et al., 2025) et l'observation que les rôles juniors diminuent sont des travaux antérieurs, et aucune priorité n'est revendiquée pour eux.
11.4 Gel et notation
Où une prédiction devrait-elle résider pour que personne, son auteur inclus, ne puisse discrètement la modifier ? Parmi les emplacements que cette série utilise, un seul gèle. Un enregistrement OSF ne peut pas être modifié ni supprimé ; il peut être retiré, mais une page comportant son titre, ses dates, son DOI et la raison du retrait persiste (OSF, 2026). Zenodo permet au déposant de modifier ou de supprimer des fichiers pendant 30 jours après la publication, et seulement de nouvelles versions après cela (OpenAIRE, 2025). SSRN remplace le PDF lors de la révision. Les prédictions seront donc enregistrées sur OSF d'abord, comme un enregistrement sans date limite rendu public immédiatement, sans embargo, car un embargo cacherait l'enregistrement et retiendrait son DOI, et une priorité que personne ne peut voir vaut peu.
Le 9 octobre 2026, le tableau a été enregistré sur OSF en tant qu'ensemble de prédictions préenregistrées (DOI 10.17605/OSF.IO/VW6P9), et l'article a été publié sur SSRN et Zenodo ; des instantanés de chaque source de référence sont archivés dans la Wayback Machine. Chaque année de 2027 à 2031, à l'anniversaire de l'enregistrement, une fiche de score est publiée qui énumère chaque prédiction sans exception, son statut (s'est réalisée, ne s'est pas réalisée, pas encore due, non résolue, non conduite) et la preuve. Elle rapporte le score de Brier sur les prédictions résolues au global, par ensemble et par famille, où les prédictions liées comptent une fois, regroupées comme dans la colonne famille du tableau enregistré (F1 et F1b ; F2, F3 et F3b ; F4a et F4b ; F5, F6 et F33 ; F9 et F31 ; F15 et F16 ; F17 et F17b ; F28 et F28b) ; la part résolue ; une limite inférieure dans laquelle chaque prédiction passée sa date finale et toujours non résolue, et chaque prédiction non conduite, est notée comme si la prévision avait été erronée ; le score avec et sans les prédictions non conduites ; et le score de compétence de Brier par rapport à trois références : un plat 0,5, les prévisionnistes du modèle regroupés du tableau 4, et le prix du marché là où un marché existait le jour de l'enregistrement. La non-résolution sélective ne peut donc pas améliorer le score. La fiche de score elle-même est enregistrée sur OSF, liée à l'original par DOI, et déposée sur Zenodo. Des modèles d'au moins deux familles vérifient chaque fiche de score indépendamment par rapport aux règles gelées ; lorsqu'ils divergent, la règle décide et la divergence est rapportée. Le texte d'enregistrement se trouve en Appendice D, et la figure A1 (Appendice D) montre le calendrier complet des dates de vérification et finales. Deux engagements arrivent à échéance avant le début de la notation. L'échantillon de produits construits par agent pour F27 est gelé sur Zenodo avant le 31 décembre 2026, et les lignes de base de F5 et F30 sont calculées et archivées avant l'enregistrement. Le protocole de l'échantillon F27, avec une valeur par défaut pour chaque choix que l'enregistrement laisse ouvert, et l'outil qui le trace par une graine fixée à l'avance et le scelle se trouvent dans le référentiel compagnon (kits/f27-sample.md, tools/freeze_sample.py).
Une fois les prédictions enregistrées, les prédictions publiques seront également affichées où les prévisionnistes extérieurs peuvent les évaluer : cinq marchés sur Manifold (F5, F8, F10, F11 et F22, qui sont gratuits à afficher ; ces cinq ont été choisis car chacun se résout sur une source publique et une série externe que n'importe qui peut lire, sans aucune de mes propres données), une question sur Metaculus (le croisement dans les affichages, F5), et la Plateforme de prédiction des sciences sociales pour les expériences de F2, F3 et F7, afin que les prévisions d'autres personnes soient recueillies avant que les données n'existent. Les marchés de prédiction qui parient de l'argent sur le résultat ne sont pas utilisés.
11.5 Le programme de cohorte
J'exécute un programme de cohorte préenregistré (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ) qui suit les non-programmeurs du chat aux agents à l'orchestration (Chernets, 2026e). Sa première cohorte est une étude de faisabilité à bras unique avec ses propres résultats enregistrés, qui sont rapportés dans son propre rapport. Les prédictions telles que F7, F14 et F18 à F20, qui nécessitent des données au niveau des personnes, sont testées dans une cohorte ultérieure enregistrée pour elles avant que les données ne soient collectées, avec une question sur l'éducation informatique parmi ses éléments gelés. Les enregistrements de l'Appendice C, conservés avec consentement, sont les données naturelles pour cette cohorte.
12. Les preuves contre lesquelles les prédictions parient
Les prédictions de la section 11 vont à l'encontre de plusieurs sortes de preuves de 2026, et chacune d'elles a façonné une règle de la mesure ou une prédiction.
La sécurité n'a pas suivi le rythme. Dans plus de cent modèles, la part du code généré ayant réussi les tests de sécurité s'est maintenue à 56 % dans le rapport 2026 de Veracode (Veracode, 2026). Ces tests ont été exécutés sur les modèles seuls, selon des invites standard sans instructions de sécurité, et sans cadre agentique, outils ou révision humaine, de sorte qu'ils décrivent la matière première dont part une personne. Un balayage passif de 5 600 applications publiques construites par codage intuitif a trouvé plus de 2 000 vulnérabilités, plus de 400 secrets exposés et 175 expositions de données personnelles, et ses auteurs présentent celles-ci comme une limite inférieure (Escape, 2026). C'est pourquoi F2 comprend une révision de sécurité à l'aveugle, et pourquoi les travaux irréversibles doivent passer chacune de leurs étapes (section 5.2).
Réussir les tests est loin d'être accepté. METR a demandé aux responsables d'examiner les correctifs rédigés par un agent qui avaient réussi les tests d'un benchmark et a trouvé qu'environ la moitié n'auraient pas été fusionnés en l'état ; les agents étaient d'une génération antérieure sans boucle de révision, de sorte que la part peut maintenant être plus basse (METR, 2026b). La règle de notation répond avec des tests cachés, des relecteurs qualifiés et une utilisation réelle, et F2 ajoute une modification de maintenance un mois plus tard.
La vérification dépend de l'expérience. Dans une enquête auprès de 162 personnes qui construisent par codage intuitif, chaque groupe a reconnu les risques du code généré, mais la manière dont elles l'ont vérifié a varié selon l'expérience. Les auteurs appellent cela un fossé perception-action (Fawzy et al., 2026). Les utilisateurs professionnels et les novices produisent rapidement des prototypes fonctionnels, tandis que la qualité du code est inégale et les retouches s'ensuivent (Gama et al., 2026). Les utilisateurs professionnels ont également manqué des erreurs matérielles dans l'analyse d'une IA même après en avoir été avertis (Virk & Liu, 2025). Une étude randomisée de 52 ingénieurs juniors apprenant une nouvelle bibliothèque a trouvé des scores de compréhension de 50 % avec l'IA contre 67 % sans, et aucun gain significatif de vitesse. Ceux qui ont demandé au modèle des explications ont obtenu un score de 65 % ou plus, et ceux qui ont confié tout le code ont obtenu un score de moins de 40 % (Anthropic, 2026c). C'est la raison la plus forte pour laquelle la mesure repose sur l'alphabétisation de l'acceptation et les erreurs semées : la compétence qui sépare les gens est celle que ces études montrent comme variable.
Aucune comparaison publiée n'oppose les non-programmeurs aux programmeurs utilisant les mêmes agents. Esnaola et al. (2026) ont trouvé que certains non-programmeurs utilisant GPT-4o via ChatGPT ont résolu de petits problèmes de programmation bien spécifiés à un niveau comparable aux programmeurs travaillant sans IA, et plus rapidement ; les auteurs qualifient l'étude d'exploratoire. Les programmeurs travaillaient sans IA, de sorte que le plan n'avait pas de bras programmeurs-avec-IA, et il étudiait des tâches individuelles brèves, non un développement soutenu ; un paquet de réplication est public (Esnaola et al., 2026). Dans les données d'Anthropic, les personnes nouvelles à une tâche avaient un taux de succès vérifié de 15 % contre 28 à 33 % pour les utilisateurs plus expérimentés (Anthropic, 2026e). Là, « novice » signifie novice dans la tâche, tel que jugé par un modèle, et ne dit rien sur la formation informatique. Que cet écart reflète l'éducation ou la familiarité avec la tâche est ce que F7 est écrit pour séparer. Plus tôt encore, l'IA générative dans une entreprise de service à la clientèle a augmenté la productivité des agents novices et peu qualifiés le plus et celle des plus expérimentés peu (Brynjolfsson et al., 2025), un prédécesseur d'avant les agents. En 2024, une expérience de terrain chez Procter & Gamble avec des modèles de chat a trouvé que les individus avec IA égalaient les équipes sans et produisaient un travail équilibré indépendamment de leurs antécédents professionnels, un prédécesseur d'avant les agents (Dell'Acqua et al., 2025). F2, F3 et F7 sont conçus pour fournir la comparaison manquante.
Des voix respectées ne sont pas d'accord avec la version forte. Karpathy maintient un plancher et un plafond (section 2.1). Andrew Ng a soutenu en août 2026 que les développeurs qui comprennent profondément comment les programmes fonctionnent surpassent de loin ceux qui codent intuitivement sans cette compréhension (Ng, 2026). Les données d'embauche pointent dans la même direction pour l'instant : les offres qui exigent des compétences en IA sont toujours plus susceptibles d'exiger un diplôme de quatre ans que les offres comparables qui ne l'exigent pas (Lightcast, 2026b), et LinkedIn attribue une grande partie de la faiblesse de l'embauche au niveau débutant à l'économie (section 2.4). Les prédictions prennent ces points de vue comme leur contrepartie, avec des cotes énoncées à l'avance.
13. Champ et conditions limites
Temps. Les données couvrent jusqu'au 9 octobre 2026. Les faits relatifs aux produits vieilliront rapidement, aussi la mesure est-elle définie en référence à des heures et à des vérifications, sans mention de produit spécifique.
Sources. Une grande partie des preuves les plus solides proviennent des éditeurs sur leurs propres produits : OpenAI sur son agent de codage, Anthropic sur ses sessions. Ces sources sont identifiées comme données d'éditeur et utilisées pour ce que les éditeurs peuvent connaître. Plusieurs épisodes rapportés par la presse, comme les classements de tokens, reposent sur des rapports d'organes de presse nommés et sont cités comme tels. Les sources secondaires (Growthy, Startup Fortune, Shopifreaks) sont archivées dans la Wayback Machine avant publication, et le rapport principal est cité partout où il a pu être consulté.
Population. L'argument concerne le travail effectué à un ordinateur, par des agents, par des personnes pouvant le vérifier. Les personnes sans ordinateur qu'elles contrôlent, et le travail qui ne peut absolument pas être vérifié, sortent du champ de la mesure.
Ce que la mesure affirme. Un horizon vérifié décrit ce qu'une personne a livré sous régime de vérification, dans un domaine, à une date donnée. Il n'affirme pas que plus élevé est mieux pour chaque tâche. Beaucoup de travail doit rester à l'heure, et le choix de garder le travail à la main est une décision légitime. Dans les domaines où une erreur ne peut pas être annulée, le seuil plus strict de la section 5.2 s'applique, et certains travaux ne doivent pas du tout être confiés aux agents.
Noms. La carte de la section 3 enregistre l'utilisation observée les 8 et 9 octobre 2026. Les noms seront adoptés et abandonnés après cette date, ce qui explique pourquoi la carte s'accompagne d'une compétition annuelle de noms et qu'aucun nom unique n'est choisi.
La thèse forte. L'idée que les personnes sans formation technique construiront de meilleurs produits que les programmeurs est énoncée comme un ensemble de prédictions avec dates et seuils (F2 à F7). Je la présente comme une prévision, à être évaluée publiquement.
Actes réservés par la loi. Lorsque la loi réserve un acte à une licence, ni la mesure ni la perte de poids par les portes de label (sections 6.2 et 6.5) ne déplacent cet acte. Au Royaume-Uni, nul ne peut exercer les fonctions d'expert-comptable statutory qui n'est pas admissible à la nomination, ce qui exige l'adhésion à un organisme de surveillance reconnu et l'admissibilité selon ses règles (Companies Act 2006, art. 1212 et 1213), et aux États-Unis, seule une firme enregistrée auprès du Public Company Accounting Oversight Board peut préparer ou émettre un rapport d'audit sur un émetteur (Sarbanes-Oxley Act de 2002, art. 102). En comptabilité, ces réserves sont restreintes : un employé de comptabilité aux États-Unis n'est généralement pas tenu de détenir même une certification (Bureau of Labor Statistics, 2026c). En droit, elles sont plus larges : l'Angleterre et le Pays de Galles réservent six activités juridiques, parmi lesquelles la conduite du contentieux et les activités successorales (Legal Services Act 2007, art. 12). Le travail peut donc se déplacer tandis que la signature reste, et le signataire autorisé exerce alors la fonction de garant de la section 7.2 sous une forme que la loi valorise déjà. La mesure dans laquelle une licence elle-même admet par un label ou par du travail vérifié est discutée à la section 6.2.
Données antérieures aux agents. Les séries antérieures à 2025 n'interviennent que comme antécédents, car elles décrivent le travail sans agents. La macroéconomie de l'embauche est portée par les données LinkedIn de 2026 (section 2.4), qui pointent vers l'économie plutôt que vers l'IA.
Statut des affirmations. Le tableau A7 (annexe F) applique le langage de confiance de la série à chaque élément.
14. Conclusion
Une comptable comparant les agents de codage et une avocate construisant son propre vérificateur de contrats travaillent désormais comme le fait une développeuse quand elle confie un module à un agent et en vérifie le résultat. D'ici 2026, les trois partagent un flux de travail identique, et ni l'une ni l'autre des anciennes hiérarchies ne peut dire laquelle d'entre elles a progressé davantage. Un titre ne règlerait pas la question, car tout titre proposé en 2026 est soit un slogan, soit l'annonce d'emploi de quelqu'un, et le marché n'a tranché entre eux. Une mesure peut le faire, pourvu qu'elle compte la bonne chose.
La mesure proposée ici n'attend pas que la profession soit nommée. Elle lit la comptable, l'avocate et la développeuse sur une même échelle, la taille du travail que chacune a confié aux agents et fait vérifier, dans un domaine et à une date donnés, avec un second axe pour le travail vérifié qu'une heure de leur propre attention a acheté. Ses seuils sont versionnés et testés sur le terrain, et le test sur le terrain en a déjà corrigé un ; ses règles énoncent les façons dont l'enregistrement peut être falsifié et une défense pour chacune, et son plafond explique pourquoi le coût de la vérification fixe la limite, quelle que soit la vitesse de l'agent. Pour un employeur, une école ou une plateforme, la question change. Au lieu de demander si une personne est une programmeuse, ou combien d'IA elle a utilisé, ils demandent une journée de travail dans le domaine propre de la personne qui a passé une vérification que la personne n'a pas conçue. N'importe quel nom que le marché choisit peut être lu sur cette échelle.
Les prédictions datées portent la thèse qui a ouvert cet article. Domaine par domaine, les produits fabriqués par des personnes sans formation informatique commenceront à surpasser ceux des programmeurs qui utilisent les mêmes agents. À un horizon vérifié égal, une formation en programmation cessera de prédire la qualité du travail contrôlé. Et dans les offres d'emploi, les lignes concernant les exigences de diplôme se croiseront, d'abord dans les domaines où les experts peuvent accepter le travail eux-mêmes et en dernier lieu dans le logiciel. Si les tableaux de bord de 2027 et 2028 contredisent ces prévisions, ils le diront en public, avec un score de Brier. Si les prévisions se confirment, les mots junior et senior peuvent survivre, leur sens se déplaçant vers la taille du travail qu'une personne peut prouver ; le fait que les grands employeurs remplacent leurs hiérarchies de grades par une telle mesure est lui-même une prédiction ici (F17), enregistrée à p = 0,05.
Une limite subsistera, quoi qu'il advienne de ces prédictions. Construire est en train de devenir une littératie, comme l'écriture. Répondre de ce qui est construit reste une profession, et entre les deux se tient l'obscurité, l'état du marché en 2026, dans lequel le bon travail passe inaperçu et les plateformes ferment leurs portes aux inconnus. La personne qui construit par des agents aura besoin d'un partenaire qui signe pour le travail, ou devra elle-même devenir ce partenaire, et le garant à son tour peut être mesuré par ce pour quoi il s'est porté garant et par la part qui a tenu.
Un dicton américain veut que Dieu ait créé les hommes et que le colonel Colt les ait rendus égaux. Les agents font quelque chose de similaire pour la fabrication : avec un, une personne en dehors d'un métier peut produire un travail qui ressemble à celui du métier. La vérification est plus difficile à égaliser (sections 5.2 et 12). Dans l'étude des évaluateurs de l'appendice G, près d'une personne sur cinq admise à l'échantillon de comptabilité sur parole a répondu incorrectement à une question de première semaine du métier, et dans une comparaison exploratoire, elles ont évalué les tâches plus importantes en un nombre d'heures moins important que les autres (appendice G2). Le fait qu'un processus de vérifications indépendantes puisse faire pour la vérification ce que les agents ont fait pour la fabrication est la question ouverte de la section 6.5. Ce qui sépare encore les gens, c'est ce qu'ils peuvent vérifier et accepter, et c'est ce que mesure l'horizon de délégation vérifié.
Déclarations
Financement. Aucun financement externe n'a soutenu ce travail.
Conflits d'intérêts. L'auteur développe des méthodes d'orchestration multi-modèles et a déposé des demandes de brevets connexes (en attente ; aucun brevet n'a été accordé). L'auteur a conçu le programme de cohorte préenregistré décrit à la section 11.5 et l'appendice G et ses matériels, et développe une application pédagogique qui aide les personnes à travailler avec les agents IA. Aucun résultat de cet article ne dépend de l'implémentation de l'auteur ; l'instrument de l'appendice C utilise uniquement la bibliothèque standard de Python.
Outils et vérification. Les assistants IA ont été utilisés comme instruments sous la direction de l'auteur ; les idées, la recherche et les conclusions sont celles de l'auteur. Les affirmations quantitatives et les citations ont été vérifiées par rapport aux sources primaires ou à des copies archivées au 9 octobre 2026, ou au 10 octobre 2026 pour les sources ajoutées ce jour-là, lorsqu'elles ont pu être retrouvées. Lorsque seul un rapport de presse ou une page de fournisseur était disponible, l'affirmation est attribuée à ce rapport ou ce fournisseur dans le texte. Les titres donnés entre crochets dans les références sont des titres descriptifs pour les pages dont l'en-tête n'a pas été relu mot pour mot.
Disponibilité des données et du code. Le code et le schéma de l'appendice C, le test de bureau des seuils (appendice E) et les fichiers de prédiction sont publiés sous la licence MIT dans un dépôt d'accompagnement (https://github.com/vadimchernets/delegation-horizon), archivés sur Zenodo en tant que version v1.1.0 (concept DOI 10.5281/zenodo.23267444, qui se résout à la version la plus récente) ; le code imprimé à l'appendice C est identique à celui du dépôt, byte pour byte, et tools/paper_sync.py le vérifie, ainsi que l'exemple travaillé et les tableaux 4 et A6 par rapport au dépôt chaque fois que ses tests s'exécutent aux côtés de ce texte. Les prédictions des tableaux 4 et A6 ont été enregistrées sur OSF le 9 octobre 2026 (DOI 10.17605/OSF.IO/VW6P9). L'étude de notation Prolific de l'appendice G a été enregistrée sur OSF le 9 octobre 2026, avant la collecte de données (DOI 10.17605/OSF.IO/V92R8) ; son script d'analyse (pilot/human_raters.py) est déposé auprès de cet enregistrement et se trouve dans le dépôt d'accompagnement tel que déposé, avec le SHA-256 qu'OSF rapporte pour chaque fichier déposé listé dans pilot/registered-SHA256.txt, ainsi que les scripts qui convertissent les exports Prolific, impriment le tableau G2 et exécutent la comparaison de G2 qui n'a pas été enregistrée. Les données anonymisées, avec les identifiants Prolific remplacés par des étiquettes simples, seront ajoutées au même dossier. Les fichiers enregistrés avec les prédictions sont listés avec leur SHA-256 dans predictions/registered-SHA256.txt, le manifeste déposé sur OSF, et un test du dépôt compare chacun d'eux avec lui.
Éthique. L'appendice G rapporte deux sources de données provenant de personnes. L'étude de notation Prolific est une tâche de notation en ligne anonyme : des professionnels adultes ont donné leur consentement éclairé sur Prolific avant de participer, ont été rémunérés par la plateforme et n'ont fourni aucun nom ni coordonnées. Le résumé de cohorte synthétise, sans noms, lieux ou langues, les dossiers d'adultes qui ont consenti au programme de cohorte préenregistré (OSF, DOI 10.17605/OSF.IO/X4EGQ) et à la publication anonymisée ; les résultats enregistrés du programme sont rapportés séparément. Le travail a été réalisé par un chercheur indépendant sans comité d'éthique institutionnel. Les fils de discussion publics examinés à la section 9 sont paraphrasés, et leurs auteurs ne sont pas nommés.
Contributions de l'auteur. Auteur unique.
Correspondance. [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
Appendice A. Glossaire
Heure de référence. Le temps qu'un spécialiste qualifié aurait besoin pour effectuer un travail à la main, tiré d'une banque de tâches gelée ou de deux évaluateurs indépendants qui ne savent pas qui a effectué le travail.
Horizon de délégation vérifié. La plus grande taille de travail, en heures de référence, à laquelle une personne confie régulièrement du travail à des agents, l'accepte et le fait confirmer par une vérification indépendante que les agents n'ont pas vue. Noté par domaine selon la règle de la section 5.2.
Vérification indépendante. Tests d'acceptation cachés, un examinateur humain qualifié, utilisation réelle par les utilisateurs prévus, ou un modèle d'une autre famille vérifiant par rapport aux sources, différant des agents par les données, l'accès et les incitations. L'auto-examen et l'accord entre modèles d'une même famille ne constituent pas des vérifications indépendantes.
Erreur plantée. Une erreur placée dans une tâche avant la remise, que la personne doit détecter, soit une entrée erronée, soit l'omission de quelque chose que le travail doit contenir. Un travail avec une erreur plantée manquée ne compte pas comme vérifié, et tout manquement dans la fenêtre d'un échelon bloque les échelons à partir de Semaine vers le haut.
Gain d'amplification. Heures de référence de travail accepté et vérifié divisées par les heures d'attention de la personne au cours des 91 derniers jours dans le domaine, le travail échoué inclus au dénominateur et le travail effectué avec aide extérieure exclu du numérateur.
Plafond de gain. Dans un modèle simplifié, le gain d'amplification G pour un travail de H heures de référence dont la vérification prend V heures d'attention satisfait G ≤ H / V, c'est-à-dire l'inverse de la part du temps à la main que la vérification prend.
Échelons. Heure (environ 1 heure de référence), Jour (environ 8), Semaine (environ 40), Mois (environ 160), Trimestre (environ 500). Les comptes et fenêtres des règles v1.1 : dix travaux en 91 jours pour Heure et Jour, six en 182 jours pour Semaine, six en 365 jours pour Mois (cinq d'entre eux vérifiés), trois en 365 jours pour Trimestre. Pour Semaine et au-delà, au moins un travail vérifié de la taille de l'échelon au cours des 91 derniers jours.
Enregistrement. Domaine · horizon · amplification · date, par exemple « tenue de livres pour petite entreprise · Jour · ×2 · 2026-T4 ».
Littératie d'acceptation. La compétence de définir à l'avance ce qui comptera comme fait et de le montrer avec des preuves qu'un agent ne peut pas fabriquer.
Neutralité de formation. L'hypothèse que, à un horizon vérifié égal dans un domaine, une formation en informatique ne prédit pas la qualité du travail vérifié indépendamment une fois que la maîtrise du domaine et la littératie d'acceptation sont prises en compte.
Point de croisement des accréditations. Le moment, dans un domaine, où les produits de personnes sans formation informatique, acceptés selon les mêmes vérifications, commencent à dépasser ceux des programmeurs utilisant les mêmes agents, après quoi les exigences de diplôme et les étiquettes junior et senior perdent leur pouvoir prédictif en matière d'embauche. Ses composantes sont la parité de qualité (l'étape précédente), le dépassement (le moment), le croisement dans les offres d'emploi (le signe) et la neutralité de formation (le mécanisme).
Garant. Une personne qui signe pour un produit fait par d'autres et en répond auprès de son cercle, mesuré par le nombre de produits pour lesquels elle s'est portée garant et combien ont tenu.
Finisseur. Une personne qui amène un produit à ses utilisateurs.
Deux marchés. Faire pour soi-même (littératie) et travailler pour d'autres avec des conséquences (profession).
Appendice B. Journal de recherche, 8 et 9 octobre 2026
Des vérifications web de noms et de termes ont été effectuées le 8 octobre 2026 avec plusieurs assistants IA cherchant indépendamment et en parallèle, et le 9 octobre 2026 par un assistant disposant d'une recherche web étendue. Chaque réponse a été conservée intégralement, avec ses sources. Les vérifications savantes ont été effectuées le 9 octobre 2026, comme suit.
| Base | Ce qu'elle recherche | Résultat pour les termes de cet article |
|---|---|---|
| arXiv (API) | Phrase exacte, tous les champs | « delegation horizon » : 0 ; « delegation ladder » ou « ladder of delegation » : 0 ; « time span of discretion » : 0 |
| Semantic Scholar | Titre et résumé | Une recherche a retourné 0 et une autre a été limitée en débit (HTTP 429) ; à répéter avant la soumission |
| OpenAlex | Titre, résumé, partie du texte intégral | « credential crossover » : 0 ; « agentwright » : correspondances non pertinentes uniquement ; « background neutrality » : non pertinent ; « acceptance literacy » : travaux sur l'acceptation technologique uniquement |
| Crossref | Métadonnées incluant les résumés SSRN | « principal » comme profession : théorie de l'agentiel uniquement |
| Europe PMC | Textes intégraux ouverts | Aucune correspondance exacte |
| Zenodo | Dossiers et descriptions | Aucune correspondance pour aucun terme |
| DOAJ | Revues en accès libre | « delegation horizon » : quatre correspondances non pertinentes |
| Google Scholar | Textes intégraux, SSRN | « delegation horizon » : 6, utilisé dans des articles de 2026 pour les machines ou les entreprises (Khadj, 2026 ; Alonso, 2026) ; « verified delegation horizon », « credential crossover », « credential crossover point » et « agentwright » : 0 (répété le 9 octobre 2026 sans erreurs) ; « acceptance literacy », « background neutrality » et « amplification gain » : correspondances dans d'autres sens uniquement |
| DBLP ; pages SSRN | Bloqué par la protection contre les robots (DBLP) ou retour 403 (SSRN) ; couvert via Crossref et Scholar |
Les prévisions antérieures ont été recherchées sur Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket et Long Bets, et sur le web ouvert ; Metaculus et certaines pages Gartner ont retourné HTTP 403 et ont été lues via des copies archivées ou réimprimées le cas échéant. Les résultats sont synthétisés à la section 11.3. Le rapport suit l'élément 6 de PRISMA 2020 (Page et al., 2021) : chaque base et la date du dernier accès sont énumérées. Une correspondance non trouvée est signalée comme non trouvée à cette date, et aucune affirmation n'est faite concernant les bases qui n'ont pas été recherchées.
Appendice C. L'instrument de mesure
Cette appendice fournit un instrument de recherche, un format d'enregistrement et un scoreur, dans la bibliothèque standard Python, sous la licence MIT. Elle enseigne comment les règles de la section 5.2 deviennent du code. Ce n'est pas une application et ne prend aucune décision concernant une personne au-delà du calcul des deux nombres à partir des enregistrements que la personne ou un chercheur fournit. Elle ne juge pas si une vérification a été bien choisie ; elle fait confiance aux champs qui lui sont donnés. En particulier, elle ne teste pas l'indépendance. Des trois conditions de la section 5.2 (données, accès et incitations), elle ne lit que le type de vérification et si les agents l'ont vue, et l'indépendance elle-même est confirmée par l'audit aléatoire du tableau 3.
C1. L'enregistrement
Une ligne d'un fichier JSON Lines par travail remis aux agents, écrite lorsque le travail est accepté, rejeté ou abandonné. La date à laquelle la remise a commencé figure dans le champ started, attendu selon les règles v1.1 ; le scoreur lit toujours les lignes sans celui-ci et avertit. Les travaux qui ont échoué à la vérification ou ont été abandonnés restent dans le journal.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| Champ | Signification |
|---|---|
| person | Une étiquette pseudonyme, jamais un vrai nom |
| domain | Le domaine dans lequel le travail a été accepté |
| date | Date d'acceptation, de rejet ou d'abandon, au moment où la ligne est écrite (format ISO) |
| started | Date du début de la remise (format ISO) ; attendue à partir des règles v1.1, pas plus tard que date |
| reference_hours | Heures manuelles d'un spécialiste qualifié pour l'ensemble du livrable |
| reference_basis | Origine de la référence : une banque de tâches nommée ou deux évaluateurs |
| attention_minutes | Minutes de planification, d'instruction, de lecture, de vérification et de correction de la personne |
| mode | one_piece, stages ou together (one_piece compte dans la part de directive de la section 5.7) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review ou none |
| agent_saw_check | Si les agents pouvaient voir la vérification (doit être false pour compter) |
| passed | Si la vérification a réussi (false pour les pièces échouées ou abandonnées) |
| irreversible | Si une erreur dans ce type de travail ne peut pas être annulée (cette pièce doit alors réussir) |
| planted_errors | Nombre d'erreurs plantées dans la tâche avant la remise |
| planted_missed | Nombre d'entre elles que la personne n'a pas détectées (toute omission rend la pièce non vérifiée et bloque Week et au-dessus dans la fenêtre) |
| outside_help | Si un collègue ou un prestataire a aidé hors du journal (une telle pièce n'ajoute rien au numérateur du gain) |
| task_id, model, tools | Optionnel : identifiant de banque de tâches, les agents et modèles utilisés, et leurs outils (section 5.4) |
| checker | Optionnel : qui ou quoi a effectué la vérification, en tant que rôle, jamais un vrai nom |
| rater_hours | Optionnel : estimations des évaluateurs derrière reference_hours ; s'il y a deux estimations et que la plus grande est plus de 1,5 fois la plus petite, le scoreur affiche « needs third rater » (tableau 3) ; avec une troisième estimation la médiane décide et l'indicateur n'est pas affiché |
| audit | Optionnel : none, passed ou failed, le résultat d'une vérification seconde et indépendante ; un audit échoué rend la pièce non vérifiée |
| revoked | Optionnel : true si un résultat ultérieur a annulé la pièce (tableau A4) ; une pièce annulée est non vérifiée |
C2. horizon.py
Le code ci-dessous implémente les règles v1.1 et est identique, octet pour octet, à horizon.py dans le dépôt associé.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. Un exemple concret
Le journal ci-dessous contient dix tâches de comptabilité confiées à des agents par une personne entre juillet et septembre 2026.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
L'exécution de python3 horizon.py work-log.jsonl --as-of 2026-10-09 affiche l'enregistrement et une ligne concernant les vérifications qui le sous-tendent :
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Les dix pièces font toutes au moins 8 heures de référence. Deux ne sont pas comptabilisées comme vérifiées : l'une a été examinée uniquement par auto-examen, et l'autre a échoué à la vérification d'un expert. Huit sur dix, c'est exactement ce que Jour exige, et la pièce irréversible a réussi, donc l'échelon est Jour. Semaine est hors de portée, car aucune pièce n'atteint 40 heures. Les pièces vérifiées totalisent 80 heures de référence, contre 1 030 minutes (environ 17,2 heures) d'attention consacrées à l'ensemble des dix, défaillances comprises, ce qui donne un gain de 4,66 et l'étape ×2. Aucune pièce n'a porté d'erreurs plantées ou d'aide extérieure, donc aucune de ces règles ne change le résultat. Si la pièce défaillante avait été exclue du journal, l'échelon aurait reposé sur neuf pièces et aurait échoué le décompte de dix, ce qui explique pourquoi les défaillances figurent dans le dossier. Le nombre à côté de l'échelon, 8/10, indique la proximité du verdict (Appendice E), et la deuxième ligne donne les types de vérification derrière les pièces comptabilisées et la taille médiane acceptée, 9,0 heures, de sorte qu'un lecteur peut voir si l'horizon repose sur des pièces juste au-dessus d'un seuil (Tableau 3). L'attention de la personne, 1 030 minutes, représente environ 18 % des 96 heures de référence remises et environ 21 % des 80 qui ont été vérifiées. Le dossier pour un résumé se lit comme suit : « petite comptabilité commerciale · Jour · ×2 · 2026-T4 ».
L'outil compagnon tools/explain.py affiche les raisons derrière le même verdict, selon les mêmes règles. Huit sur dix pièces de taille Jour sont vérifiées et huit sont nécessaires, un décompte cohérent avec un vrai taux de réussite n'importe où de 44 % à 97 % (Section 5.8), de sorte qu'aucune autre pièce défaillante de cette taille ne peut être absorbée. Si rien de nouveau n'est journalisé, Jour tient jusqu'au 18 octobre 2026 ; le 19 octobre, la pièce fermée le 20 juillet quitte la fenêtre de 91 jours, et neuf pièces de taille Jour restent, une de court du dix que Jour exige. Pour Semaine, elle énumère chaque condition manquante : six pièces d'au moins 40 heures en 182 jours, l'une d'elles avec erreurs plantées et l'une vérifiée dans les 91 derniers jours.
Le journal construit porte également une trace que le Tableau 3 nomme : cinq de ses dix pièces ont été évaluées à exactement 8 heures, le plancher de Jour, et tools/too_clean.py la marque comme « audit en premier », avec la trace « 5 pièces sur 10 se situent juste au-dessus d'un seuil d'échelon ». Un drapeau envoie un journal à un audit et ne décide rien à son sujet ; la médiane de 9,0 heures à côté de l'échelon montre la même chose à un lecteur.
C5. Le référentiel compagnon
Le référentiel compagnon (https://github.com/vadimchernets/delegation-horizon) contient l'instrument et les matériaux qui permettent aux lecteurs d'utiliser chaque partie de l'article. Les fichiers principaux, par section :
| Section | Fichiers | Ce qu'ils font |
|---|---|---|
| 5.2, C1 à C4 | horizon.py, log.schema.json, examples/ |
Scorer, schéma d'une ligne de journal, l'exemple travaillé et les lignes qu'il doit afficher |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
Rédaction du journal en répondant à des questions, une carte de record avec le décompte derrière l'échelon, et le même scoring dans une page de navigateur hors ligne ; tous deux lisent une feuille de calcul enregistrée avec des virgules ou des points-virgules |
| 5.2, 5.8, C4 | tools/explain.py |
Pourquoi un journal mérite son échelon : chaque condition qui tient ou échoue, le jeu, le jour où l'échelon expire si rien de nouveau n'est journalisé, et ce que l'échelon suivant exige |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Heures de référence à partir des estimations des évaluateurs, et comment choisir, admettre et briefer les évaluateurs |
| 5.8, Tableau 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
Exemple d'audit reproductible, drapeaux pour les journaux qui semblent trop propres, erreurs plantées scellées avant la remise et notées par type (entrée erronée ou omission), guides d'audit et d'erreur plantée |
| 6.2, 10.3 | tools/verify_record.py |
Le côté récepteur d'un record portable : si le journal envoyé avec celui-ci est le fichier qui a été noté, si le scorer est le même, et si la nouvelle notation donne le même record, champ par champ |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
Admettre les gens par une question du métier au lieu d'une étiquette, et combien une étiquette fuit, avec un intervalle exact (11 sur 60 dans l'Appendice G2 : 9,5 % à 30,4 %) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
Les quatre étapes de la Section 6.5 et ce que chacune rapporte selon la règle (Figure A4), et la comparaison de la Section 10.5 comme protocole à enregistrer, avec son analyse, entrées erronées et omissions à part |
| 5.8, Appendice E | pilot/ |
Test de bureau des seuils, une banque de 30 tâches, le protocole d'étalonnage avec son texte d'enregistrement et son formulaire de consentement |
| Appendice G2 | pilot/ |
L'analyse enregistrée human_raters.py telle qu'elle a été déposée sur OSF, la conversion des exportations Prolific, le script qui affiche le Tableau G2 avec les fonctions enregistrées, la comparaison du dépistage, et une exportation synthétique pour les exécuter |
| 7.2 | templates/, tools/guarantor_record.py |
Fiche de tâche pour une banque de tâches, un registre du garant, et le record du garant calculé à partir de celui-ci : produits garantis, combien ont duré 6 et 12 mois, défaillances par gravité |
| 11, Tableaux 4 et A6, C3 | predictions/, brier.py, tools/power.py |
Les 41 prédictions telles qu'enregistrées, avec le manifeste de leurs hashes déposé sur OSF, les règles de résolution et les fichiers, les outils de scoring, qui enregistrent une prédiction de l'Ensemble B non menée à bien et rapportent le score de Brier à la fois sans elle et avec elle notée comme erronée (Section 11.2), et les tailles d'échantillon de la Section 11.2 |
| 11, Ensemble B | predictions/set_b.py |
Les règles figées devenues vraies et non vraies des neuf prédictions de l'Ensemble B écrites sur un intervalle, appliquées aux estimations d'une étude |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
Le protocole et le tirage de l'échantillon F27 (le pool fermé enregistré en premier, la clé prise après à partir d'un phare d'aléa public), figé sur Zenodo et son hash enregistré sur OSF avant le 31 décembre 2026, et sa vivacité à chaque date de scoring selon les mots de F27 |
| C2 à C4, Tableaux 4 et A6 | tools/paper_sync.py |
Vérifie ce texte par rapport au dépôt : les fichiers octet par octet, l'exemple travaillé et son résultat, les tableaux de prédictions, les dénombrements des ensembles, chaque fichier nommé et chaque figure intégrée |
| Appendix D, Appendix F | figures/ |
Les scripts qui dessinent Figure A1 à partir du tableau de prédictions et Figure A4 à partir des règles du scorer |
Les mêmes fichiers par lecteur :
| Lecteur | Commencer par | Ce qu'il fournit |
|---|---|---|
| Une personne qui confie des tâches à des agents | templates/work-log.csv, record_card.py ou checker.html, tools/explain.py |
Un journal tenu dans une feuille de calcul, l'enregistrement et sa fiche, et ce que l'échelon suivant doit faire |
| Un employeur ou une équipe RH | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
Un test de travail rémunéré d'une journée avec un évaluateur en aveugle, une question du métier à la place d'une étiquette, ce qu'un échelon dit et ne dit pas, et la proximité du verdict du candidat |
| Un novice dans un métier | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
Les étapes de la Section 6.5 et ce que chacune rapporte, « terminé » énoncé avant la transmission, et pratique sur les omissions plantées |
| Un auditeur ou un garant | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
Un échantillon à vérifier à nouveau, les traces d'un journal qui semble trop propre, des erreurs plantées dont le sceau indique si la liste a été modifiée |
| Un chercheur | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
Le test de bureau, l'étude des évaluateurs et leurs scripts, les protocoles des comparaisons, les tailles d'échantillon, et les prédictions enregistrées avec leurs outils de scorecard |
Appendice D. Texte d'enregistrement pour les prédictions (OSF)
Titre. Prédictions datées sur le travail par les agents IA, 2026 à 2031 : prévisions gelées et notation annuelle.
Type. Enregistrement ouvert, public immédiatement, sans embargo.
Résumé. Cet enregistrement gèle les prédictions datées énoncées dans « After the Programmer Divide: One Measure for People Who Build Through AI Agents » (SSRN 7589918 ; Zenodo DOI 10.5281/zenodo.23267266). Le tableau joint donne, pour chaque prédiction : sa formulation ; sa mesure ; une source publique et une source de secours ; une base de référence 2025 ou 2026 avec la date d'accès et un snapshot archivé ; une date de vérification et une date finale ; une probabilité fixée à la date de cet enregistrement ; et les seuils pour trois résultats : s'est réalisée, ne s'est pas réalisée, non résolue.
Notation. Chaque prédiction est notée à la première vérification annuelle le jour ou après sa date de vérification à laquelle les données existent, et au plus tard à sa date finale. Les prédictions résolues sont notées selon la règle de Brier. Une prédiction sans données comparables à sa date finale est enregistrée comme non résolue et n'est pas comptée comme un succès.
Ensembles et probabilités. L'ensemble A se résout à partir de données publiques et des fichiers dans predictions/resolve/, dont les hashes SHA-256 sont listés dans cet enregistrement. L'ensemble B se résout uniquement à partir d'études enregistrées séparément avant la collecte de données ; une prédiction de l'ensemble B dont le protocole n'est pas enregistré avant le 30 juin 2027 est enregistrée comme non menée, comme un échec du programme de test ; le score de Brier est rapporté à la fois sur les prédictions résolues et avec chaque prédiction non menée notée comme incorrecte. Les probabilités sont conditionnelles à la résolution. Elles sont la médiane de trois prévisions aveugles de modèles collectées le 9 octobre 2026 (Claude Opus, un modèle OpenAI et Gemini) et adoptées par l'auteur ; les prévisions groupées antérieures de quatre modèles sont jointes pour référence.
Point de croisement. F2, F3, F5 et F7 sont mesurés dans les mêmes domaines nommés : comptabilité des petites entreprises, et documents juridiques et marketing, les deux domaines non logiciels de la banque de tâches (Appendice E) ; pour l'analogue des annonces de F5 ils correspondent à SOC 43-3031, 23-2011 et 13-1161. Le troisième domaine de la banque, petits outils web internes, est le domaine d'origine des programmeurs et n'est pas un domaine de croisement. Le point de croisement dans un domaine est la première année dans laquelle F3 et l'analogue du domaine de F5 sont tous deux satisfaits dans ce même domaine nommé ; aucun seul ne le déclare.
Additions à la notation. Chaque scorecard rapporte également la part résolue, le score de Brier par ensemble et par famille, une limite inférieure qui note les prédictions non résolues en retard comme incorrectes, et le score de compétence Brier par rapport à 0,5, aux prévisionnistes du modèle groupé et aux prix du marché.
Vérifications annuelles. Chaque année de 2027 à 2031, à l'anniversaire de cet enregistrement, l'auteur publie une scorecard couvrant chaque prédiction enregistrée ici. Chaque scorecard est elle-même enregistrée sur OSF, liée à cet enregistrement par DOI, et déposée sur Zenodo.
Règles fixes. Aucune prédiction n'est supprimée, reformulée ou donnée une nouvelle date. Tout ce qui est ajouté ultérieurement est enregistré séparément et porte sa propre date. Si une source nommée cesse de publier ou change sa méthode, la source de secours est utilisée, à condition qu'elle mesure la même quantité ; si aucune source comparable n'existe, la prédiction est non résolue.
Vérification indépendante. Chaque scorecard est vérifiée par rapport aux règles gelées ici par des modèles d'au moins deux familles différentes. Lorsqu'ils sont en désaccord, la règle décide et le désaccord est rapporté. Un arbitre humain, nommé par l'auteur avant la première scorecard, décide les différends entre les deux familles de modèles.
Données propres. Les prédictions qui reposent sur les données de cohorte de l'auteur sont testées uniquement selon un pré-enregistrement séparé déposé avant que ces données ne soient collectées, comme le programme enregistré à OSF (DOI 10.17605/OSF.IO/X4EGQ) le fait pour chaque cohorte.
Conflits d'intérêts. Tels que déclarés dans l'article.
Fichiers. Tableau des prédictions (CSV et Tableau A6 de l'article joint) ; liste des snapshots archivés ; predictions/resolve/ (requêtes gelées, listes et codebook, avec hashes) ; resolution-rules.md ; changelog-v1-v2.md.
Le tableau des prédictions joint est le Tableau A6, et la Figure A1 en trace le calendrier.
Figure A1. Le calendrier des vérifications, 2026 à 2031.
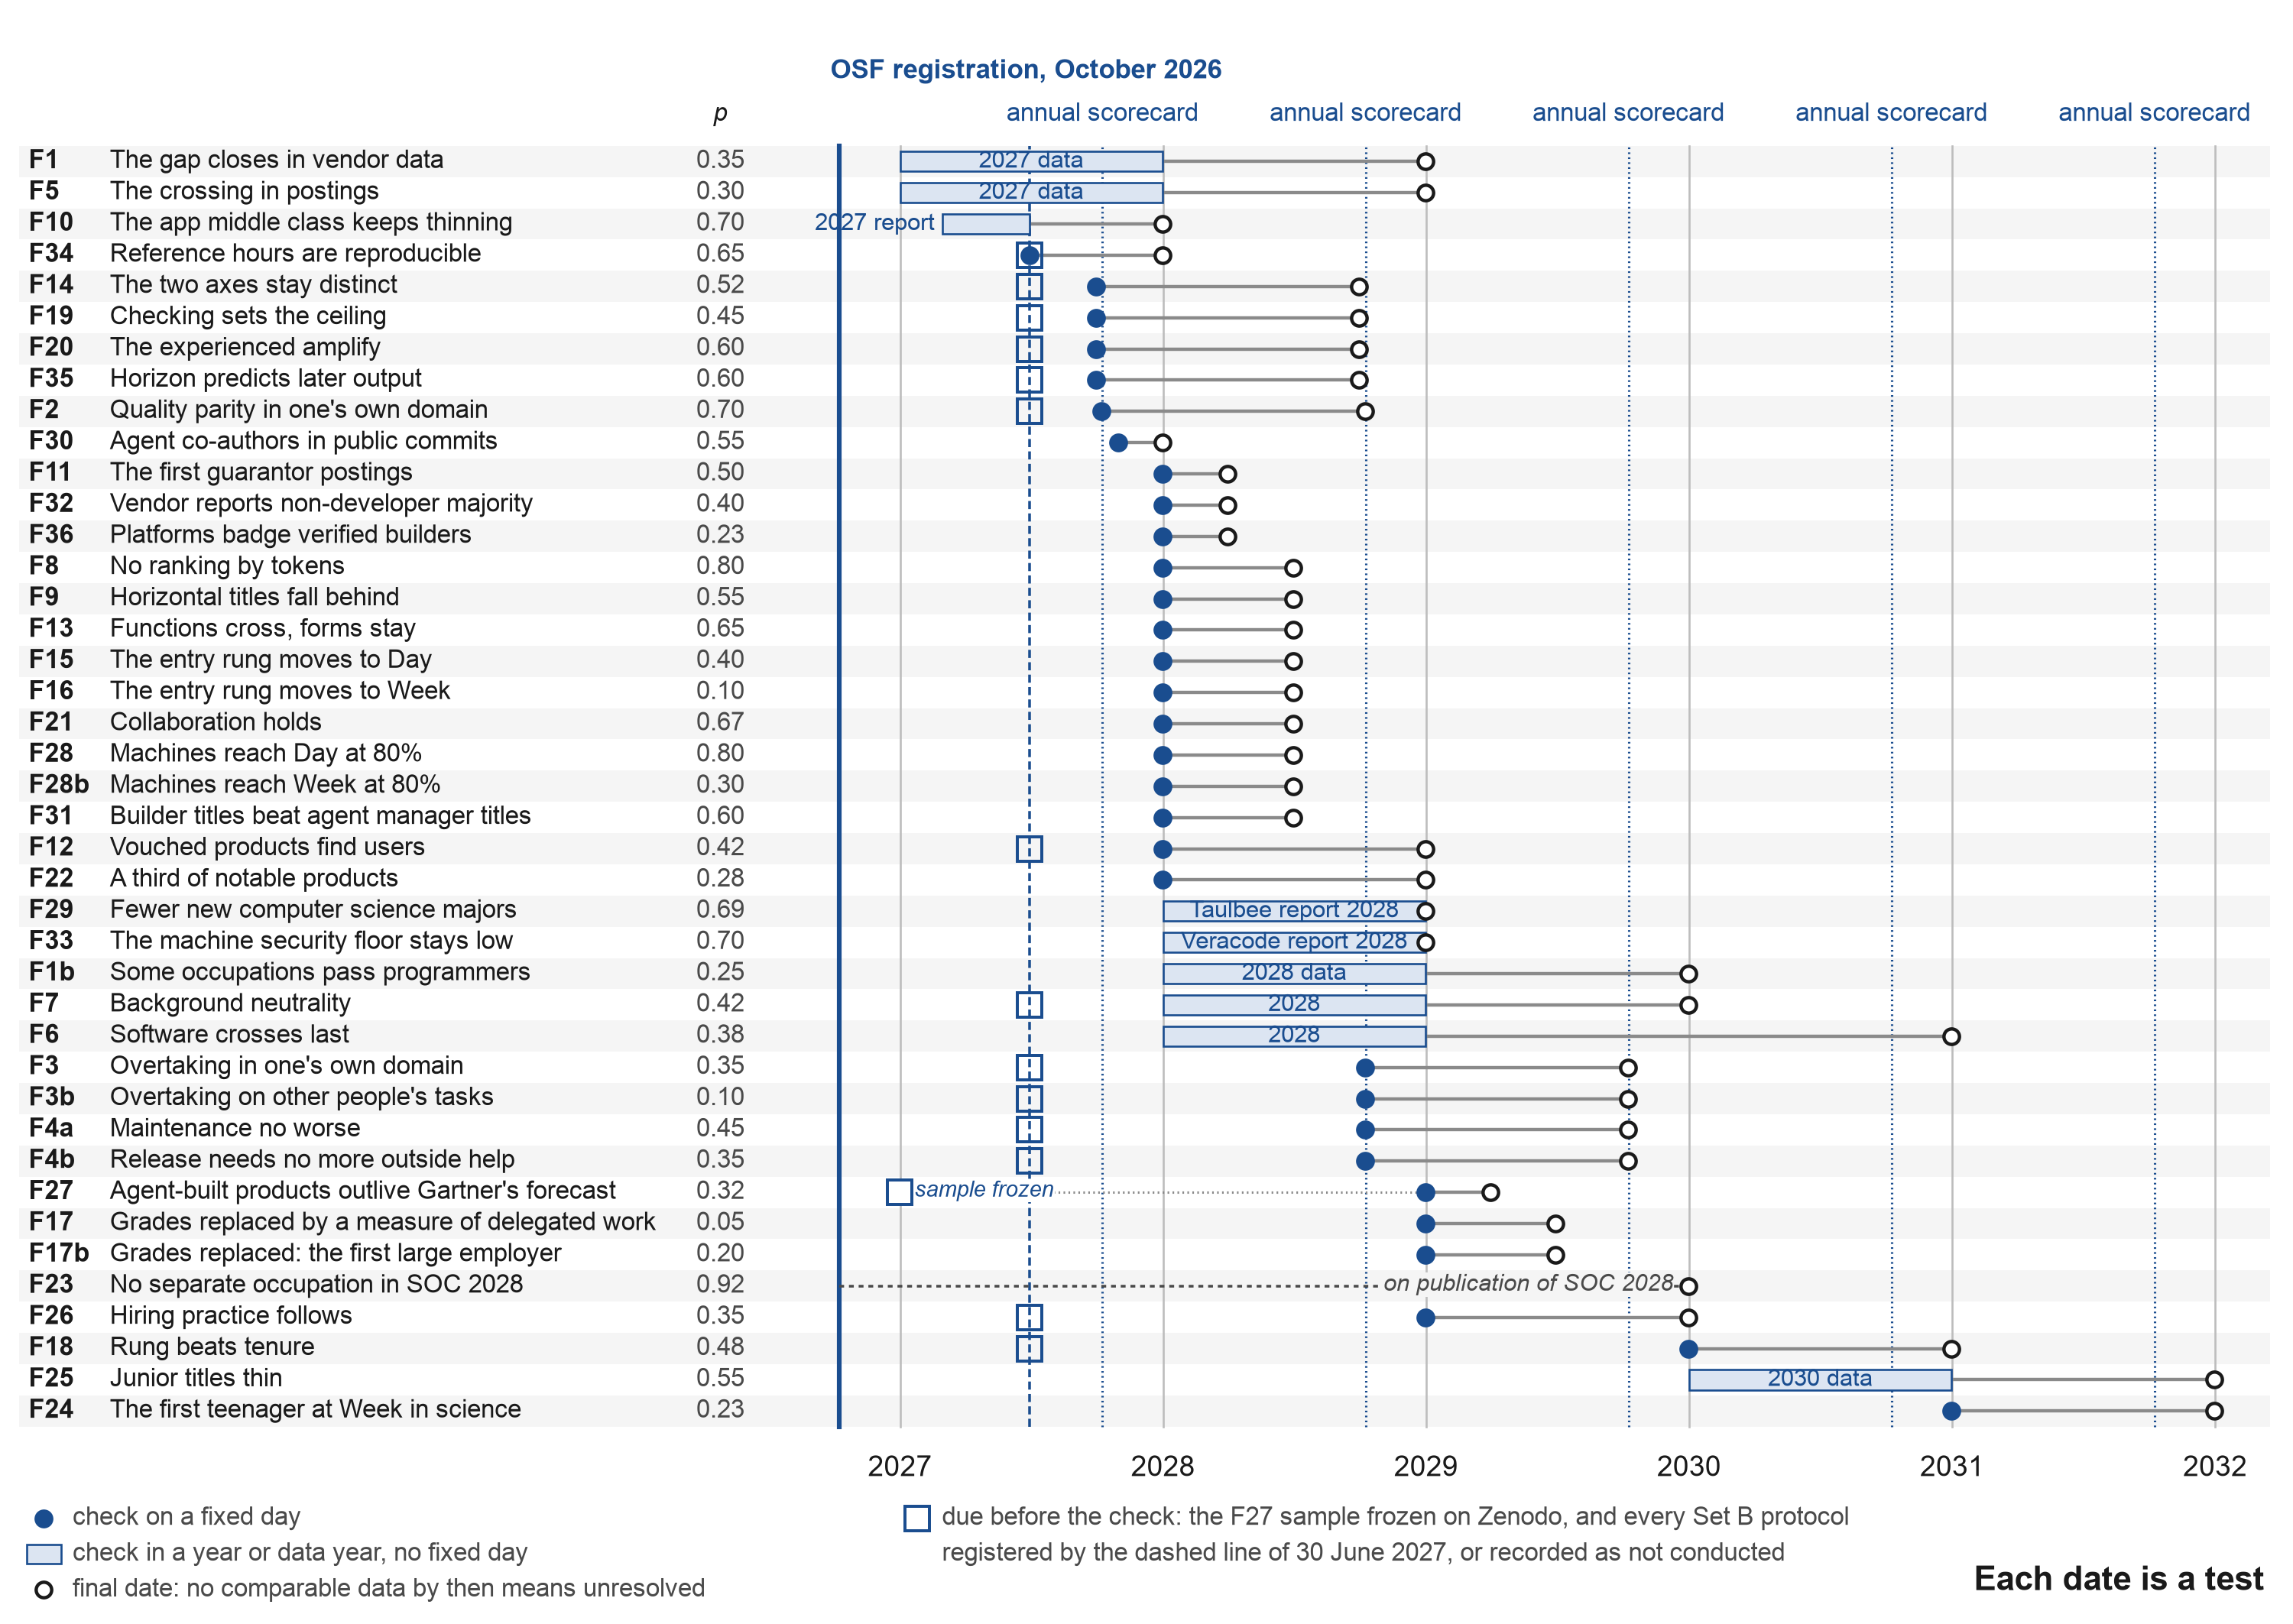
Note : Une ligne par prédiction du Tableau A6, triée par date de vérification, avec sa probabilité. Un point rempli est une vérification à un jour fixe. Une barre légère est une vérification dans une année ou une année de données sans jour fixe. L'anneau est la date finale, après laquelle une prédiction sans données comparables est enregistrée comme non résolue (Section 11.4). Les lignes pointillées marquent les scorecards annuelles, à enregistrer sur OSF chaque octobre de 2027 à 2031. Un carré creux marque un engagement dû avant la vérification : l'échantillon F27, gelé sur Zenodo avant le 31 décembre 2026, et, sur la ligne pointillée du 30 juin 2027, le protocole de chacune des 14 études de l'ensemble B, sans lesquels la prédiction est enregistrée comme non menée (Section 11.2). La figure est générée à partir du tableau de prédictions lui-même, par figures/figure_a1_calendar.py dans le référentiel compagnon, et ne change qu'avec lui.
Tableau A6. Les 41 prédictions datées : ensembles, mesures, seuils, probabilités, prévisions de modèles, sources de secours et prévisions antérieures.
| # (ensemble) | Prédiction, mesure, base de référence et seuil | Dates, probabilité, prévisions de modèles, règle de non-résolution, source de secours et prévision antérieure |
|---|---|---|
| F1 (A) | L'écart se ferme dans les données des fournisseurs. Succès vérifié sur les sessions productrices de code, programmation par rapport à d'autres professions : 34 % par rapport à 29 %, inchangé pendant sept mois (Anthropic, 2026e). L'écart est le taux de réussite des professions de programmation moins celui des autres professions, avec son signe. S'est réalisée si l'écart est de 2 points ou moins, valeurs négatives incluses, dans un rapport comparable sur les données de 2027 ; ne s'est pas réalisée s'il est plus que 2. Base de référence : Succès vérifié sur les sessions productrices de code : programmation 34 % par rapport à d'autres professions 29 %, inchangé pendant sept mois (Anthropic, 2026e) | Vérifier : données 2027. Date finale : 31 décembre 2028. p = 0,35 ; modèles 0,39 (0,25 à 0,65). Non résolu si : Aucun rapport sur les données 2027 à la date finale, ou la définition de session a changé (jamais compté comme un succès). Secours : Tout rapport de fournisseur donnant un succès vérifié par occupation sur des sessions comparables. Prévision antérieure ou contraire la plus proche : Anthropic : l'écart « n'a ni s'est élargi ni s'est rétréci » |
| F1b (A) | Certaines professions dépassent les programmeurs. Même mesure que F1. Les 10 plus grandes professions non-programmation sont gelées à l'enregistrement comme les 10 ayant les plus grandes parts de session chez Anthropic (2026e). Une profession dépasse la programmation uniquement si son taux de succès est supérieur de 2 points ou plus (une marge pour la multiplicité sur 10 comparaisons). Devenu vrai si au moins 3 des 10 le font dans les données 2028. Référence : Comme F1 ; la gestion est déjà légèrement en avance sur la programmation (Anthropic, 2026e) | Vérifier : données 2028. Date finale : 31 décembre 2029. p = 0,25 ; modèles 0,30 (0,20 à 0,45). Non résolu si : Aucun rapport sur les données 2028 à la date finale, ou la définition de session a changé (jamais compté comme un succès). Secours : Comme F1. Prévision antérieure ou contraire la plus proche : La gestion est déjà légèrement en avance (Anthropic, 2026e) |
| F2 (B) | Parité de qualité dans son propre domaine (l'étape avant le point de croisement). Même agent, même moment, acceptation en aveugle et contrôles de sécurité, une modification de maintenance par un autre agent après un mois ; une étude avec 1 500 personnes par groupe. Devenu vrai si la limite inférieure de l'intervalle à 95 % pour (personnes sans formation informatique moins programmeurs) se situe au-dessus de moins 10 points ; n'a pas si la limite supérieure se situe en dessous de moins 10 ; autrement non résolu. Référence : Aucune référence publique ; étude préenregistrée séparément, 1 500 personnes par groupe | Vérifier : 8 octobre 2027. Date finale : 8 octobre 2028. p = 0,70 ; modèles 0,67 (0,62 à 0,70). Non résolu si : Aucune donnée comparable à la date finale, ou un intervalle qui ne satisfait à aucune règle (jamais compté comme un succès). Secours : Une étude indépendante avec la même conception. Prévision antérieure ou contraire la plus proche : D. H. Hansson (2026), « 100 % » (pas de date, pas de mesure) ; Esnaola et al. (2026) |
| F3 (B) | Dépassement dans son propre domaine (le point de croisement en qualité). Comme F2 (1 500 par groupe donne environ 0,8 puissance pour détecter un avantage vrai de 5 points avec un alpha bilatéral de 0,05 ; 400 par groupe donnerait environ 0,3). Devenu vrai si la limite inférieure de l'intervalle à 95 % se situe au-dessus de zéro ; n'a pas si la limite supérieure se situe en dessous de zéro ; autrement non résolu. Référence : Comme F2 | Vérifier : 8 octobre 2028. Date finale : 8 octobre 2029. p = 0,35 ; modèles 0,33 (0,25 à 0,55). Non résolu si : Aucune donnée comparable à la date finale, ou un intervalle qui ne satisfait à aucune règle (jamais compté comme un succès). Secours : Comme F2. Prévision antérieure ou contraire la plus proche : Aucune trouvée avec une date |
| F3b (B) | Dépassement sur les tâches d'autres personnes. Comme F3, mais sur les tâches en dehors du domaine des participants. Référence : Comme F2, sur les tâches en dehors du domaine des participants | Vérifier : 8 octobre 2028. Date finale : 8 octobre 2029. p = 0,10 ; modèles 0,13 (0,07 à 0,35). Non résolu si : Aucune donnée comparable à la date finale, ou un intervalle qui ne satisfait à aucune règle (jamais compté comme un succès). Secours : Comme F2. Prévision antérieure ou contraire la plus proche : L'argument de domaine de la section 6.3 prédit qu'il échoue |
| F4a (B) | Maintenance pas pire. Part des produits acceptés abandonnés dans les 12 mois, selon la formation des auteurs. Devenu vrai si la limite supérieure de l'intervalle à 95 % pour la différence (non-programmeurs moins programmeurs) se situe en dessous de 10 points. Référence : Aucune référence publique ; Gartner (Tyagi, 2026, tel que résumé par Tray.ai, 2026) s'attend à ce que 60 % des applications codées à l'énergie soient retirées d'ici 2028, en comptant toutes les applications | Vérifier : 8 octobre 2028. Date finale : 8 octobre 2029. p = 0,45 ; modèles 0,49 (0,34 à 0,68). Non résolu si : Aucune donnée comparable à la date finale, ou un intervalle qui ne satisfait à aucune règle (jamais compté comme un succès). Secours : Registres de produits avec enquêtes auprès des auteurs. Prévision antérieure ou contraire la plus proche : Gartner (Tyagi, 2026, tel que résumé par Tray.ai, 2026) : 60 % des applications codées à l'énergie retirées d'ici 2028 « parce qu'elles ne livrent pas la valeur commerciale prévisible » ; une population plus large que F4a, qui compte uniquement les produits acceptés |
| F4b (B) | La publication n'a pas besoin de plus d'aide extérieure. Part des produits nécessitant une aide technique extérieure à la publication. Devenu vrai si non inférieur avec une marge de 10 points ; l'écart devrait se fermer dans l'ordre prototype, publication, maintenance. Référence : Aucune référence publique | Vérifier : 8 octobre 2028. Date finale : 8 octobre 2029. p = 0,35 ; modèles 0,37 (0,22 à 0,50). Non résolu si : Aucune donnée comparable à la date finale, ou un intervalle qui ne satisfait à aucune règle (jamais compté comme un succès). Secours : Comme F4a. Prévision antérieure ou contraire la plus proche : Gartner (Tyagi, 2026, tel que résumé par Tray.ai, 2026) : 30 % des équipes d'ingénierie logicielle en « tension de capacité matérielle » pour maintenir les applications codées à l'énergie construites par les développeurs citoyens et les utilisateurs métier |
| F5 (A) | Le croisement dans les offres d'emploi (le signe visible). Offres d'emploi aux États-Unis dans un ensemble gelé de professions informatiques ; compétences agentiques définies par la taxonomie des compétences ouvertes Lightcast en vigueur à la date d'enregistrement (numéro de version enregistré dans predictions/resolve/F5.md), avec la liste gelée des compétences agentiques ; la part exigeant un diplôme de quatre ans dans les offres ayant ces compétences par rapport aux offres sans elles, appairées exactement sur la profession (SOC 6 chiffres), l'ancienneté, l'État et le trimestre. La référence agentique (T2 et T3 2026) est prise et archivée avant l'enregistrement. Devenu vrai si la différence est négative de 2 points ou plus, l'intervalle à 95 % excluant zéro, dans deux trimestres consécutifs de 2027. Référence : Les offres IA exigent toujours plus probablement un diplôme mais convergent depuis 2024 (Lightcast, 2026b) ; la référence agentique est prise avant l'enregistrement | Vérifier : données 2027. Date finale : 31 décembre 2028. p = 0,30 ; modèles 0,34 (0,25 à 0,60). Non résolu si : Aucune donnée comparable à la date finale (jamais compté comme un succès). Secours : PwC AI Jobs Barometer, uniquement s'il rapporte les exigences de diplôme pour les offres avec compétences agentiques par rapport aux offres appairées ; autrement non résolu. Prévision antérieure ou contraire la plus proche : Gartner (2021) : la plupart des produits technologiques construits en dehors de l'informatique d'ici 2024 ; Bone et al. (2025) sur les compétences en IA dans les offres britanniques |
| F6 (A) | Le logiciel arrive en dernier. Liste figée de domaines : droit, comptabilité et tenue de livres, éducation, administration clinique, marketing, immobilier, assurance, ressources humaines, logistique, développement de logiciels, infrastructure informatique, sécurité, outils de développement. Ordre des premiers franchissements de type F5 par domaine. S'est avéré vrai si le développement de logiciels, l'infrastructure, la sécurité et les outils de développement traversent tous après au moins la moitié des autres domaines. Ligne de base : Aucun domaine n'a encore traversé (comparaison de type F5) | Vérification : 2028. Date finale : 31 décembre 2030. p = 0,38 ; modèles 0,37 (0,25 à 0,55). Non résolu si : Moins de la moitié des domaines non-logiciels de la liste figée ont traversé à la date finale, ou pas de source comparable (jamais comptée comme un succès). Recours : Une autre source d'annonces avec la même comparaison de type F5 par domaine ; les études de qualité (type F2) ne comptent pas, et sans une telle source la prédiction n'est pas résolue. Prévision antérieure ou contreprévision la plus proche : Hwang (2026) : la finance « le canari dans la mine » |
| F7 (B) | Neutralité contextuelle. Cohorte enregistrée séparément avec une question sur la formation informatique ; horizon coté sur un ensemble de tâches, qualité sur des tâches retenues. Rapport de cotes du passage des vérifications indépendantes associées à la formation informatique à un niveau égal, contrôlé par la maîtrise du domaine et l'alphabétisation d'acceptation. La marge 0,67 à 1,5 est un rapport de cotes de 1,5 dans chaque direction, environ une différence standardisée de 0,22 (conversion de Chinn), conventionnellement un petit effet. S'est avéré vrai si l'intervalle de 90 % se situe dans 0,67 à 1,5 (équivalence), séparément au Jour et à la Semaine et au-dessus. Ligne de base : Pas de ligne de base publique ; cohorte enregistrée séparément avec une question sur la formation informatique | Vérification : 2028. Date finale : 31 décembre 2029. p = 0,42 ; modèles 0,43 (0,40 à 0,48). Non résolu si : Toute autre combinaison, y compris l'équivalence montrée à un seul niveau, ou pas de données à la date finale (jamais comptée comme un succès). Recours : Une cohorte indépendante avec les mêmes éléments. Prévision antérieure ou contreprévision la plus proche : Observation d'Anthropic sur la maîtrise du domaine ; Savva (2026), la rivale |
| F8 (A) | Pas de classement par tokens. Employeurs du Fortune 500 utilisant les comptages de tokens comme critère d'évaluation officiel pendant 2027, documenté par l'employeur ou par deux sources indépendantes (les questions sur l'utilisation de l'IA ne comptent pas). S'est avéré vrai si moins de deux tels employeurs sont trouvés. Ligne de base : Les comptages de tokens ont été essayés comme critère d'évaluation en 2026 (Section 4 de l'article) | Vérification : 31 décembre 2027. Date finale : 30 juin 2028. p = 0,80 ; modèles 0,79 (0,60 à 0,90). Non résolu si : Pas de données comparables à la date finale (jamais comptée comme un succès). Recours : Recherche des archives de la presse économique avec les requêtes figées dans predictions/resolve/F8.md. Prévision antérieure ou contreprévision la plus proche : Kingy AI (2026) : « dégradé, pas tué » ; Flowtivity (2026) : « irréversible » |
| F9 (A) | Les titres horizontaux prennent du retard. Annonces aux États-Unis, mêmes requêtes figées (predictions/resolve/F9.md), Q4 2026 et Q4 2027, chaque nombre divisé par toutes les annonces aux États-Unis du même trimestre : responsable d'agent, opérateur IA, orchestrateur IA contre des titres nommant un domaine (par exemple « responsable IA juridique », « responsable IA vertical »). S'est avéré vrai si la part normalisée des titres nommant un domaine augmente d'un facteur plus grand que celui des titres horizontaux. Ligne de base : Comptages d'annonces aux États-Unis sur les requêtes figées en Q4 2026 | Vérification : 31 décembre 2027. Date finale : 30 juin 2028. p = 0,55 ; modèles 0,58 (0,45 à 0,75). Non résolu si : L'une ou l'autre famille a moins de 50 annonces en Q4 2026, ou pas de données à la date finale (jamais comptée comme un succès). Recours : Comptages de recherche Indeed ou LinkedIn avec les mêmes requêtes. Prévision antérieure ou contreprévision la plus proche : Srinivasan et Wei (2026) : « responsable d'agent » un titre standard dans 12 à 18 mois ; IT Brew (2026) : « les 18 prochains mois » |
| F10 (A) | La classe moyenne des applications s'amincit. Part des nouvelles applications d'abonnement atteignant 1 000 dollars de revenus mensuels dans deux ans, même mesure que RevenueCat 2026 (17 %). S'est avéré vrai si inférieur à 17 %. Ligne de base : 17 % des nouvelles applications d'abonnement atteignent 1 000 dollars de revenus mensuels dans deux ans (RevenueCat, 2026) | Vérification : rapport RevenueCat 2027. Date finale : 31 décembre 2027. p = 0,70 ; modèles 0,68 (0,60 à 0,80). Non résolu si : Pas de données comparables à la date finale (jamais comptée comme un succès). Recours : Seuils de revenus Sensor Tower ou Appfigures. Prévision antérieure ou contreprévision la plus proche : Tendance propre de RevenueCat (aucune priorité revendiquée) ; de nombreuses applications codées par vibes gagnent des publicités, que RevenueCat ne voit pas |
| F11 (A) | Les premières annonces de garants. Annonces d'employeurs comptant plus de 1 000 employés en médecine, droit, finance ou éducation qui nomment la signature de travaux produits par l'IA et la responsabilité personnelle pour ceux-ci. Requêtes figées dans predictions/resolve/F11.md : « sign off » avec « généré par l'IA », « responsable de la production de l'IA », « attestation IA », « garant IA » ; les annonces où « garant » ou « accréditation » font référence à des clés ou à l'accès sont exclues. S'est avéré vrai si au moins 10 telles annonces d'au moins 5 employeurs sont trouvées et archivées. Ligne de base : Aucune telle annonce trouvée au moment de la rédaction | Vérification : 31 décembre 2027. Date finale : 31 mars 2028. p = 0,50 ; modèles 0,42 (0,25 à 0,55). Non résolu si : Pas de données comparables à la date finale (jamais comptée comme un succès). Recours : Annonces archivées trouvées via Google Jobs et LinkedIn. Prévision antérieure ou contreprévision la plus proche : Capps (2025), « garant juridique » ; Forrester (2025) : 60 % du Fortune 100 pour nommer un responsable de la gouvernance de l'IA |
| F12 (B) | Les produits cautionnés trouvent des utilisateurs. Étude randomisée propre : parmi les produits éligibles, un garant nommé assigné au hasard. Part atteignant dix utilisateurs non liés dans 90 jours. S'est avéré vrai si la part cautionnée est plus élevée, avec l'intervalle de 95 % excluant zéro. Ligne de base : Pas de ligne de base publique ; étude randomisée propre | Vérification : 31 décembre 2027. Date finale : 31 décembre 2028. p = 0,42 ; modèles 0,43 (0,30 à 0,60). Non résolu si : Pas de données comparables à la date finale (jamais comptée comme un succès). Recours : Aucun. Prévision antérieure ou contreprévision la plus proche : Vouch d'Hashimoto (un mécanisme, pas une prévision) |
| F13 (A) | Les fonctions traversent, les formes restent. Programmes et publications dans trois professions non-informatiques, codés par deux codeurs avec un code publié avant le codage (predictions/resolve/F13-codebook.md) : vérification, choix du modèle par coût et longues exécutions enseignées ; dépenses personnelles et camps de modèles trouvés uniquement parmi les utilisateurs de haut niveau. S'est avéré vrai si les sujets fonctionnels surpassent les sujets de statut d'au moins trois pour un. Ligne de base : Pas de ligne de base publique ; deux codeurs sur les programmes et publications dans trois professions non-informatiques | Vérification : 31 décembre 2027. Date finale : 30 juin 2028. p = 0,65 ; modèles 0,69 (0,55 à 0,82). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Catalogues de cours publics. Prévision antérieure ou contraire la plus proche : Rogers (2003), couches d'adoption (aucune priorité revendiquée) |
| F14 (B) | Les deux axes restent distincts. Corrélation de Spearman au niveau des personnes entre l'horizon logarithmique et le gain logarithmique dans au moins 200 journaux. S'est réalisé si la corrélation est de 0,8 ou inférieure et si le gain, ajouté à l'horizon, augmente le R carré hors échantillon pour le résultat vérifié six mois plus tard d'au moins 0,02. Baseline : Aucune baseline publique ; au moins 200 journaux | Vérification : 30 septembre 2027. Date finale : 30 septembre 2028. p = 0,52 ; modèles 0,49 (0,45 à 0,50). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Aucune. Prévision antérieure ou contraire la plus proche : Aucune trouvée |
| F15 (A) | L'échelon d'entrée se déplace vers Day. Dans un échantillon gelé de 200 offres d'emploi au niveau d'entrée aux États-Unis et de tâches à emporter dans le domaine des logiciels et trois autres professions, la première mission médiane, évaluée en heures de référence par deux évaluateurs, est Day ou plus. Baseline : Échantillon gelé de 200 offres d'emploi au niveau d'entrée aux États-Unis et tâches à emporter, évaluées en heures de référence par deux évaluateurs | Vérification : 31 décembre 2027. Date finale : 30 juin 2028. p = 0,40 ; modèles 0,49 (0,30 à 0,70). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Échantillons au niveau d'entrée du Indeed Hiring Lab. Prévision antérieure ou contraire la plus proche : Washington Monthly (2026) : « les rôles au niveau d'entrée deviennent davantage comme des rôles de niveau intermédiaire » ; tendance d'horizon ajustée du METR doublant environ tous les 4,2 mois |
| F16 (A) | L'échelon d'entrée se déplace vers Week. Même mesure ; médiane à Week ou plus. Baseline : Comme F15 | Vérification : 31 décembre 2027. Date finale : 30 juin 2028. p = 0,10 ; modèles 0,14 (0,06 à 0,40). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Comme F15. Prévision antérieure ou contraire la plus proche : Kwa et al. (2025), horizons temporels des machines (machines, pas les personnes) |
| F17 (A) | Les notes remplacées par une mesure du travail délégué. Parmi les 50 plus grands employeurs américains, ceux qui remplacent publiquement les échelles de grades par une mesure du travail délégué vérifié. S'est réalisé si au moins 10. Baseline : Aucune baseline publique | Vérification : 31 décembre 2028. Date finale : 30 juin 2029. p = 0,05 ; modèles 0,05 (0,02 à 0,20). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Dépôts des employeurs et presse. Prévision antérieure ou contraire la plus proche : Gartner (2024) : d'ici 2026, 20 % des organisations utiliseront l'IA pour aplatir la structure ; Microsoft (2025) : « agent patron » |
| F17b (A) | Notes remplacées : le premier grand employeur. Parmi les 50 plus grands employeurs américains, au moins un remplace publiquement les échelles de grades par une mesure du travail délégué vérifié. Baseline : Aucune baseline publique | Vérification : 31 décembre 2028. Date finale : 30 juin 2029. p = 0,20 ; modèles 0,21 (0,05 à 0,50). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Dépôts des employeurs et presse. Prévision antérieure ou contraire la plus proche : Version plus douce de F17 |
| F18 (B) | L'échelon surpasse l'ancienneté. Dans les données d'employeur ou de cohorte, l'échelon vérifié explique plus de variance dans la rémunération que les années d'expérience (la performance évaluée est utilisée uniquement lorsque la rémunération n'est pas disponible, fixée avant l'analyse). Baseline : Aucune baseline publique | Vérification : 31 décembre 2029. Date finale : 31 décembre 2030. p = 0,48 ; modèles 0,52 (0,40 à 0,60). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Analyses RH publiées. Prévision antérieure ou contraire la plus proche : Jaques (1956), rémunération selon l'étendue des responsabilités |
| F19 (B) | La vérification fixe le plafond (hors échantillon). Au moins 200 journaux. Part de l'attention consacrée à la vérification et à l'horizon, tous deux mesurés aux mois 1 à 3 ; résultat vérifié (pièces acceptées en heures de référence, pas la formule de gain) aux mois 4 à 6. S'est réalisé si, chez les personnes retenues, la part de vérification a une corrélation partielle plus élevée avec la sortie vérifiée ultérieure que l'horizon. Baseline : Aucune baseline publique | Vérification : 30 septembre 2027. Date finale : 30 septembre 2028. p = 0,45 ; modèles 0,44 (0,30 à 0,65). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Aucune. Prévision antérieure ou contraire la plus proche : Huang et al. (2026), amplification de vérification. v1 utilisait le gain, qui contient l'horizon par construction ; v2 prédit un résultat ultérieur, séparément mesuré |
| F20 (B) | Les expérimentés amplifient. Part directive : part des tours d'une personne qui donnent des instructions plutôt que de vérifier ou d'éditer, selon le journal. Gain vérifié : heures de référence acceptées par heure d'attention de la personne. Parmi les personnes dont la part directive a baissé sur six mois, le gain vérifié au mois 6 est au moins 95 % de sa valeur au mois 0 pour la majorité. Baseline : Aucune baseline publique | Vérification : 30 septembre 2027. Date finale : 30 septembre 2028. p = 0,60 ; modèles 0,62 (0,55 à 0,70). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Aucune. Prévision antérieure ou contraire la plus proche : Anthropic (2026d), courbes d'apprentissage |
| F21 (A) | La collaboration tient. La part de l'utilisation collaborative (augmentation) dans l'échantillon de conversation Claude.ai de l'Anthropic Economic Index, pas l'échantillon API, reste supérieure à 40 % dans chaque rapport publié en 2027. Baseline : L'utilisation collaborative 52 % contre l'automatisation 45 % en novembre 2025 (Anthropic, 2026a) | Vérification : 31 décembre 2027. Date finale : 30 juin 2028. p = 0,67 ; modèles 0,68 (0,60 à 0,75). Non résolu si : Aucune donnée comparable à la date finale (jamais comptabilisé comme un succès). Solution de secours : Parts comparables dans les rapports d'autres fournisseurs. Prévision antérieure ou contraire la plus proche : Anthropic (2026a) : 52 % contre 45 % en novembre 2025 |
| F22 (A) | Un tiers des produits notables. Les 100 produits ayant reçu le plus de votes sur les douze classements mensuels de Product Hunt de 2027, liste gelée le 1er janvier 2028. Les créateurs énumérés sont codifiés ; un produit compte comme réalisé sans formation en programmation si aucun créateur énuméré ne déclare de formation en programmation ou d'emploi antérieur en programmation (les personnes autodidactes ayant des emplois en programmation comptent comme des programmeurs). Deux codeurs, aveugles l'un à l'autre. S'est réalisé si au moins 30 des 100 se qualifient. Baseline : Manifold : logiciels codifiés à l'ambiance avec 100 millions d'utilisateurs mensuels à la fin 2026, environ 28 % | Vérifier : 31 décembre 2027. Date limite : 31 décembre 2028. p = 0,28 ; modèles 0,29 (0,14 à 0,50). Non résolu si : Moins de 50 des 100 produits ont une déclaration codable, ou pas de données à la date limite (jamais comptabilisé comme un succès). Solution de secours : Un deuxième classement figé (Hacker News Show HN top 100 de 2027). Prévision antérieure ou contraire la plus proche : Gartner (2021) ; Manifold : logiciel vibe-coded avec 100 millions d'utilisateurs mensuels d'ici fin 2026, environ 28 % |
| F23 (A) | Pas de profession distincte dans la SOC 2028. La Classification type des professions des États-Unis pour 2028 ne contient pas de profession distincte pour le travail effectué par l'intermédiaire d'agents. Référence : la SOC 2018 n'a pas de telle profession | Vérifier : Publication de la SOC 2028. Date limite : 31 décembre 2029. p = 0,92 ; modèles 0,93 (0,80 à 0,98). Non résolu si : Pas de données comparables à la date limite (jamais comptabilisé comme un succès). Solution de secours : Avis de révision du BLS (vérifiés 9 octobre 2026 : aucune structure proposée ou définitive pour le moment ; structure définitive attendue en 2027). Prévision antérieure ou contraire la plus proche : Aucune trouvée |
| F24 (A) | Le premier adolescent à Week in science. Un produit scientifique est un logiciel, un ensemble de données ou un article utilisé dans la recherche publiée par au moins dix personnes indépendantes ou cité dans au moins un article examiné par les pairs. Un cas documenté publiquement d'une personne de moins de 18 ans sans formation formelle dont le produit scientifique a de tels utilisateurs et gagne Week selon une vérification indépendante. Référence : Aucun cas documenté au moment de la rédaction | Vérifier : 31 décembre 2030. Date limite : 31 décembre 2031. p = 0,23 ; modèles 0,21 (0,02 à 0,45). Non résolu si : Seulement si les sources de recherche ne sont pas disponibles ; l'absence d'un cas documenté à la date limite est ne l'a pas fait. Solution de secours : Aucune. Prévision antérieure ou contraire la plus proche : Objectif de la Chine en matière d'éducation à l'IA dans toutes les écoles d'ici 2030 (CSET, 2025) |
| F25 (A) | Les titres juniors s'amincissent. Part des offres d'emploi en logiciels aux États-Unis avec « junior » ou « débutant » dans le titre en 2030, par rapport à 2025 sur les mêmes requêtes. Devenu réalité si baisse d'au moins un tiers. Référence : Part des offres d'emploi en logiciels aux États-Unis avec « junior » ou « débutant » dans le titre en 2025, mêmes requêtes | Vérifier : Données 2030. Date limite : 31 décembre 2031. p = 0,55 ; modèles 0,54 (0,45 à 0,60). Non résolu si : Pas de données comparables à la date limite (jamais comptabilisé comme un succès). Solution de secours : Indeed Hiring Lab. Prévision antérieure ou contraire la plus proche : Manifold : un tiers de postes de développeur junior en moins d'ici 2030, environ 74 % ; développeurs américains en baisse de plus de 15 % de 2023 à 2028, environ 42 % ; marché 0,74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9 octobre 2026 (offres d'emploi de développeur junior en baisse d'au moins 33 % d'ici le 1er janvier 2030 ; une mesure connexe, non identique)) |
| F26 (B) | La pratique d'embauche suit. Étude d'audit personnelle : portefeuilles appariés de travaux vérifiés différant uniquement par la formation informatique envoyés à des offres réelles dans deux domaines non informatiques. Devenu réalité si les taux de rappel diffèrent de moins de 3 points, avec l'intervalle de 95 % à l'intérieur de plus ou moins 5. Référence : Pas de référence publique ; étude d'audit personnelle | Vérifier : 31 décembre 2028. Date limite : 31 décembre 2029. p = 0,35 ; modèles 0,32 (0,25 à 0,35). Non résolu si : Pas de données comparables à la date limite, ou un intervalle qui ne respecte aucune règle (jamais comptabilisé comme un succès). Solution de secours : Aucune. Prévision antérieure ou contraire la plus proche : Burning Glass Institute et Harvard Business School (2024) : moins d'une embauche sur 700 a changé |
| F27 (A) | Les produits construits par agent dépassent la prévision de Gartner. Un échantillon d'au moins 300 produits publics construits principalement avec des agents de codage, lancés octobre à décembre 2026, figés sur Zenodo d'ici 31 décembre 2026 ; la viabilité vérifiée par le script d'accompagnement. Devenu réalité si moins de 50 % sont retirés (inaccessibles ou non mis à jour pendant 12 mois) le 31 décembre 2028. Référence : Gartner (Tyagi, 2026) : 60 % des applications vibe-coded retirées d'ici 2028 | Vérifier : 31 décembre 2028. Date limite : 31 mars 2029. p = 0,32 ; modèles 0,35 (0,20 à 0,55). Non résolu si : L'échantillon n'a pas été figé d'ici 31 décembre 2026 (jamais comptabilisé comme un succès). Solution de secours : Snapshots Wayback Machine de chaque produit. Prévision antérieure ou contraire la plus proche : Gartner (Tyagi, 2026) : 60 % retirés |
| F28 (A) | Les machines atteindront Jour à 80 %. L'horizon temporel à 80 % de METR pour le meilleur modèle publiquement publié atteint 8 heures (Jour) d'ici 31 décembre 2027. Référence : Environ 3,1 heures à 80 % en avril 2026 (METR, 2026c ; tableau de bord non mis à jour après 8 septembre 2026) | Vérifier : 31 décembre 2027. Date limite : 30 juin 2028. p = 0,80 ; modèles 0,66 (0,55 à 0,80). Non résolu si : Ni METR ni la solution de secours ne rapportent un horizon à 80 % à la date limite (jamais comptabilisé comme un succès). Solution de secours : Une réplication indépendante de la méthode de METR (par exemple Epoch AI). Prévision antérieure ou contraire la plus proche : La tendance d'horizon ajustée de METR double environ tous les 4,2 mois |
| F28b (A) | Les machines atteindront Semaine à 80 %. Comme F28, seuil 40 heures (Semaine). Référence : Comme F28 | Vérifier : 31 décembre 2027. Date limite : 30 juin 2028. p = 0,30 ; modèles 0,20 (0,10 à 0,55). Non résolu si : Comme F28. Solution de secours : Comme F28. Prévision antérieure ou contraire la plus proche : Comme F28 |
| F29 (A) | Moins de nouveaux spécialistes en informatique. Nouveaux majors d'études de premier cycle en informatique rapportés par l'enquête Taulbee de la CRA publiée en 2028 (année universitaire 2027 à 2028) par rapport à l'enquête publiée en 2026. Référence : Enquête CRA Taulbee publiée en 2026 | Vérifier : Rapport Taulbee 2028. Date limite : 31 décembre 2028. p = 0,69 ; modèles 0,67 (0,50 à 0,75). Non résolu si : Pas de données comparables à la date limite (jamais comptabilisé comme un succès). Solution de secours : Centre de recherche NSC inscription par spécialité. Prévision antérieure ou contraire la plus proche : Rapports de la CRA sur la baisse des inscriptions en informatique en 2025 et 2026 |
| F30 (A) | Coauteurs agents dans les validations publiques. Part des événements de poussée publiques dans GH Archive dont les messages de validation comportent une bande dessinée de coauteur agent (expressions régulières figées dans predictions/resolve/F30.md), septembre 2027 par rapport à septembre 2026. Référence : GH Archive, septembre 2026, mesuré et archivé avant l'enregistrement | Vérifier : 31 octobre 2027. Date limite : 31 décembre 2027. p = 0,55 ; modèles 0,59 (0,40 à 0,75). Non résolu si : Pas de données comparables à la date limite (jamais comptabilisé comme un succès). Solution de secours : Graphique d'innovation GitHub. Prévision antérieure ou contraire la plus proche : Aucune trouvée |
| F31 (A) | Les titres de constructeur battent les titres de gestionnaire d'agent. Offres d'emploi aux États-Unis, requêtes Indeed figées (predictions/resolve/F31.md), Q4 2027 : titres de la famille des constructeurs par rapport à la famille des gestionnaires d'agents. Référence : Nombres à Q4 2026 sur les mêmes requêtes | Vérification : 31 décembre 2027. Date limite : 30 juin 2028. p = 0,60 ; modèles 0,63 (0,50 à 0,74). Non résolu si : Aucune donnée comparable à la date limite (jamais compté comme un succès). Secours : Les recherches LinkedIn comptent avec les mêmes requêtes. Prévision antérieure ou contraire la plus proche : Srinivasan and Wei (2026) : « agent manager » titre standard en 12 à 18 mois |
| F32 (A) | Un fournisseur affirme que la plupart des utilisateurs de son agent de codage ne sont pas des développeurs. Un fournisseur d'un agent de codage créé par Anthropic, OpenAI, Google ou GitHub rapporte publiquement que les personnes qui ne sont pas des développeurs logiciels constituent la majorité des utilisateurs hebdomadaires de cet agent. Référence : Aucun tel rapport au moment de la rédaction | Vérification : 31 décembre 2027. Date limite : 31 mars 2028. p = 0,40 ; modèles 0,31 (0,13 à 0,70). Non résolu si : Aucune donnée comparable à la date limite (jamais compté comme un succès). Secours : Rapports économiques ou d'utilisation des fournisseurs. Prévision antérieure ou contraire la plus proche : Les fournisseurs de générateurs d'applications (Lovable, Replit) décrivent déjà principalement des utilisateurs non développeurs ; ceci le demande pour les agents de codage généraux |
| F33 (A) | Le plancher de sécurité des machines reste bas. Part des exemples de code générés par l'IA qui réussissent les tests de sécurité dans le rapport de sécurité du code GenAI de Veracode. Référence : Taux de réussite de 56 %, stagnant (Veracode, 2026) | Vérification : Rapport Veracode 2028. Date limite : 31 décembre 2028. p = 0,70 ; modèles 0,67 (0,57 à 0,80). Non résolu si : Aucune donnée comparable à la date limite (jamais compté comme un succès). Secours : Un benchmark indépendant comparable de la sécurité du code généré. Prévision antérieure ou contraire la plus proche : Veracode : pas d'amélioration de la sécurité avec les modèles plus récents |
| F34 (B) | Les heures de référence sont reproductibles. Deux groupes d'experts indépendants de trois évaluateurs estiment les heures de référence pour les mêmes 50 tâches ; corrélation intraclasse (bidirectionnelle, accord absolu) des heures en log. Référence : Essai de bureau des seuils (Appendice E) | Vérification : 30 juin 2027. Date limite : 31 décembre 2027. p = 0,65 ; modèles 0,65 (0,40 à 0,75). Non résolu si : Aucune donnée comparable à la date limite, ou un intervalle qui ne respecte aucune règle (jamais compté comme un succès). Secours : Aucun. Prévision antérieure ou contraire la plus proche : Les lignes de base humaines de METR (machines, pas des personnes) |
| F35 (B) | Horizon prédit une production ultérieure. Au moins 200 logs : horizon au mois 0 ajouté à la tenure et à la formation en TI augmente le R carré hors échantillon pour la production vérifiée aux mois 4 à 6. Référence : Aucune référence publique | Vérification : 30 septembre 2027. Date limite : 30 septembre 2028. p = 0,60 ; modèles 0,58 (0,45 à 0,70). Non résolu si : Aucune donnée comparable à la date limite (jamais compté comme un succès). Secours : Aucun. Prévision antérieure ou contraire la plus proche : Burning Glass Institute and Harvard Business School (2024) |
| F36 (A) | Les plateformes certifient les créateurs vérifiés. Au moins deux parmi Upwork, Fiverr, GitHub, Product Hunt, Toptal et Contra introduisent un badge public ou un champ de profil certifiant un travail construit par l'IA indépendamment vérifiée (pas un questionnaire de compétences). Référence : Aucun tel badge au moment de la rédaction | Vérification : 31 décembre 2027. Date limite : 31 mars 2028. p = 0,23 ; modèles 0,24 (0,07 à 0,70). Non résolu si : Aucune donnée comparable à la date limite (jamais compté comme un succès). Secours : Pages d'aide des plateformes et annonces archivées. Prévision antérieure ou contraire la plus proche : Aucune trouvée |
Note : L'ensemble A se résout à partir de données publiques ; l'ensemble B à partir d'études séparément pré-enregistrées (protocole au plus tard le 30 juin 2027, sinon non menées, ce que le bilan compte comme un échec du programme de test). p est conditionnel à la résolution. Modèles : moyenne géométrique des cotes de probabilité des prévisionnistes indépendants qui n'ont pas vu mes chiffres, avec leur plage ; les prévisions individuelles dans predictions/m2-probabilities.csv. Les règles Came-true et did-not pour chaque ligne se trouvent dans predictions/predictions.csv. Aux lignes F4a et F4b, la prévision Gartner est citée comme la liste de références la cite, via le résumé de Tray.ai (2026), avec ses propres termes cités ; le fichier enregistré donne la même prévision et les mêmes chiffres plus brièvement et cite Gartner (Tyagi, 2026).
Appendice E. Test de bureau des seuils
Cette appendice rend compte du test de bureau des règles de la section 5.2, exécuté le 9 octobre 2026 par simulation et avec des évaluateurs modèles, et énonce le protocole d'étalonnage qui fixe la version suivante. Chaque nombre est produit par deux scripts du dépôt compagnon (pilot/), qui appellent le cotateur de l'appendice C inchangé et ne remplacent que ses constantes.
E1. À quelle fréquence un échelon est-il obtenu
Pour une personne dont les éléments réussissent indépendamment avec une probabilité vraie p, le tableau E1 donne la chance d'obtenir chaque échelon avec exactement le nombre minimum d'éléments dans la fenêtre. Les valeurs sont des probabilités binomiales exactes ; une exécution Monte Carlo via horizon.py, avec les éléments répartis sur la fenêtre, l'erreur plantée et l'élément récent en place, concorde à 0,01 près.
Tableau E1. Probabilité d'obtenir un échelon, par taux de réussite vrai.
| Règle | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| Heure et Jour, 8 sur 10 en 91 jours | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Semaine, 5 sur 6 en 182 jours | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Mois, première version, 4 sur 4 en 365 jours | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Mois, actuel, 5 sur 6 en 365 jours | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Trimestre, 3 sur 3 en 365 jours | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
Remarque : la règle est une règle de qualification. Ces probabilités décrivent la règle, non une personne.
Trois conclusions en découlent. Premièrement, la première version n'était pas ordonnée : Mois, à quatre sur quatre, était plus difficile à obtenir que Trimestre pour chaque p. Un compte de quatre sur cinq aurait inversé l'erreur, rendant Mois plus facile que Jour et Semaine à p = 0,8 (0,74), donc Mois demande maintenant cinq sur six en un an, environ 960 heures de référence au lieu de 640. Avec cela, Jour, Semaine, Mois et Trimestre sont ordonnés du plus facile au plus difficile pour chaque p de 0,77 et au-dessus, la plage où la qualification importe. En dessous de 0,76 Semaine est légèrement plus facile que Jour (0,42 contre 0,38 à p = 0,7). Les deux sont alors refusés la plupart du temps, et c'est signalé et laissé inchangé. Aucun compte de trois éléments ou plus ne peut être ordonné contre trois sur trois pour chaque p, car les courbes se croisent. Deuxièmement, un verdict est bruyant : à p = 0,8 le même verdict se répète dans la fenêtre suivante pour 56 % des fenêtres à Jour, 55 % à Semaine et Mois et 50 % à Trimestre. L'enregistrement imprime donc le compte à côté de l'échelon (« Jour (8/10) »), et un rapport peut marquer un échelon comme stable s'il s'est maintenu dans la fenêtre précédente également. À p = 0,8 un Jour maintenu dans deux fenêtres consécutives se produit dans 46 % des cas, donc la stabilité est une étiquette, non une exigence. Troisièmement, une personne fiable peut quand même échouer : à p = 0,95 Trimestre est manqué dans 14 % des années, ce qui est le prix d'un échelon qui repose sur trois éléments.
La figure A2, panneau A, trace ces probabilités en fonction de p pour les règles v1.1.
E2. Sensibilité au compte et à la proportion
L'article promettait de signaler combien de personnes changent d'échelon quand le compte passe de dix à huit ou douze et la proportion de 0,8 à 0,7 ou 0,9. La réponse est donnée pour 10 000 journaux simulés à Jour, chacun avec entre 6 et 16 éléments de taille Jour dans la fenêtre et un taux de réussite vrai tiré uniformément entre 0,5 et 1,0. La règle actuelle (dix, 0,8) donne Jour à 30 % d'entre eux, et le tableau E2 donne la proportion dont le verdict change sous les autres règles.
Tableau E2. Proportion de journaux simulés dont le verdict Jour change par rapport à dix éléments et une proportion de 0,8.
| Compte minimum | Proportion 0.7 | Proportion 0.8 | Proportion 0.9 |
|---|---|---|---|
| 8 | 22 % | 8 % | 15 % |
| 10 | 10 % | 0 % | 11 % |
| 12 | 16 % | 9 % | 17 % |
Remarque : la population de journaux est une hypothèse de la simulation. L'étude de terrain de E5 répète cette analyse sur de vrais journaux.
Déplacer une seule constante change environ un verdict sur dix. Déplacer les deux change jusqu'à un sur cinq. La proportion compte plus que le compte.
E3. Bruit d'évaluateur à la limite d'un échelon
Si deux évaluateurs sont sans biais et que 80 % de leurs paires se situent dans un ratio de 1,5, au-dessus du critère de 70 % de la section 5.8, et que la référence est la moyenne géométrique de leurs deux estimations, alors un élément dont la véritable taille est 7 heures de référence est coté à la taille Jour 20 % du temps, et un élément de 9 heures n'atteint pas la taille Jour 23 % du temps. C'est pourquoi l'enregistrement rapporte la taille médiane acceptée à côté de l'échelon (tableau 3) : un horizon construit sur des éléments juste au-dessus d'un seuil s'affiche.
E4. Évaluateurs modèles des heures de référence
Quatre modèles de langage issus de quatre familles (Anthropic, OpenAI, Google et Moonshot), chacun travaillant seul et aveugle aux autres et à tout moment publié, ont estimé les heures de référence de 44 tâches le 9 octobre 2026. Trente étaient des tâches d'une nouvelle banque dans trois domaines à faible risque (tenue de livres pour petites entreprises, petits outils web internes, documents juridiques et marketing), chacune avec une déclaration de fait et une vérification cachée. Quatorze étaient des tâches publiques des données d'horizon temporel du METR (METR, 2026d) avec des temps de référence humains mesurés de 12 minutes à 14,6 heures, donnés aux évaluateurs par leur identifiant public uniquement. Le tableau E3 donne les résultats.
Tableau E3. Accord et exactitude de quatre évaluateurs modèles aveugles.
| Mesure | Banque de 30 tâches (déclaration de fait) | 14 tâches avec temps mesurés (identifiant uniquement) |
|---|---|---|
| Paires d'estimations dans un ratio de 1,5 (6 paires d'évaluateurs) | 62 % (de 27 % à 97 % par paire) | 35 % |
| Corrélation intraclasse ICC(2,1), heures en log | 0.89 | 0.60 |
| Les quatre évaluateurs placent la tâche à la même taille d'échelon | 60 % | 36 % |
| Moyenne des quatre dans un ratio de 1,5 du temps mesuré | non mesuré | 21 % (3 sur 14) |
| Moyenne des quatre dans un ratio de 2 du temps mesuré | non mesuré | 43 % (6 sur 14) |
Remarque : les évaluateurs modèles remplacent les deux évaluateurs humains de la section 5.1 et ne constituent pas une preuve à leur sujet.
Donnée une déclaration complète de fin de tâche, les modèles s'accordaient sur la taille des tâches, mais non sur le niveau : la moyenne géométrique des estimations d'un évaluateur sur la banque était de 5,1 heures et celle d'un autre de 10,4. Un décalage fixe de ce type est l'erreur la moins coûteuse à corriger, ce qui explique pourquoi les évaluateurs sur le terrain procèdent d'abord à un étalonnage sur des tâches dont les durées sont mesurées. Donnée un identifiant uniquement, les estimations s'avéraient peu utiles, ce qui soutient une banque figée avec des durées mesurées à la main (section 5.1) par rapport aux estimations établies à partir d'un titre. Selon la règle du tableau 3, où un désaccord supérieur à 1,5 envoie une pièce à un troisième évaluateur, deux tels évaluateurs enverraient environ quatre pièces sur dix à un troisième.
Figure A2. La règle des barreaux au bureau : la probabilité de gagner un barreau, et le degré d'accord des évaluateurs modèles sur les heures.
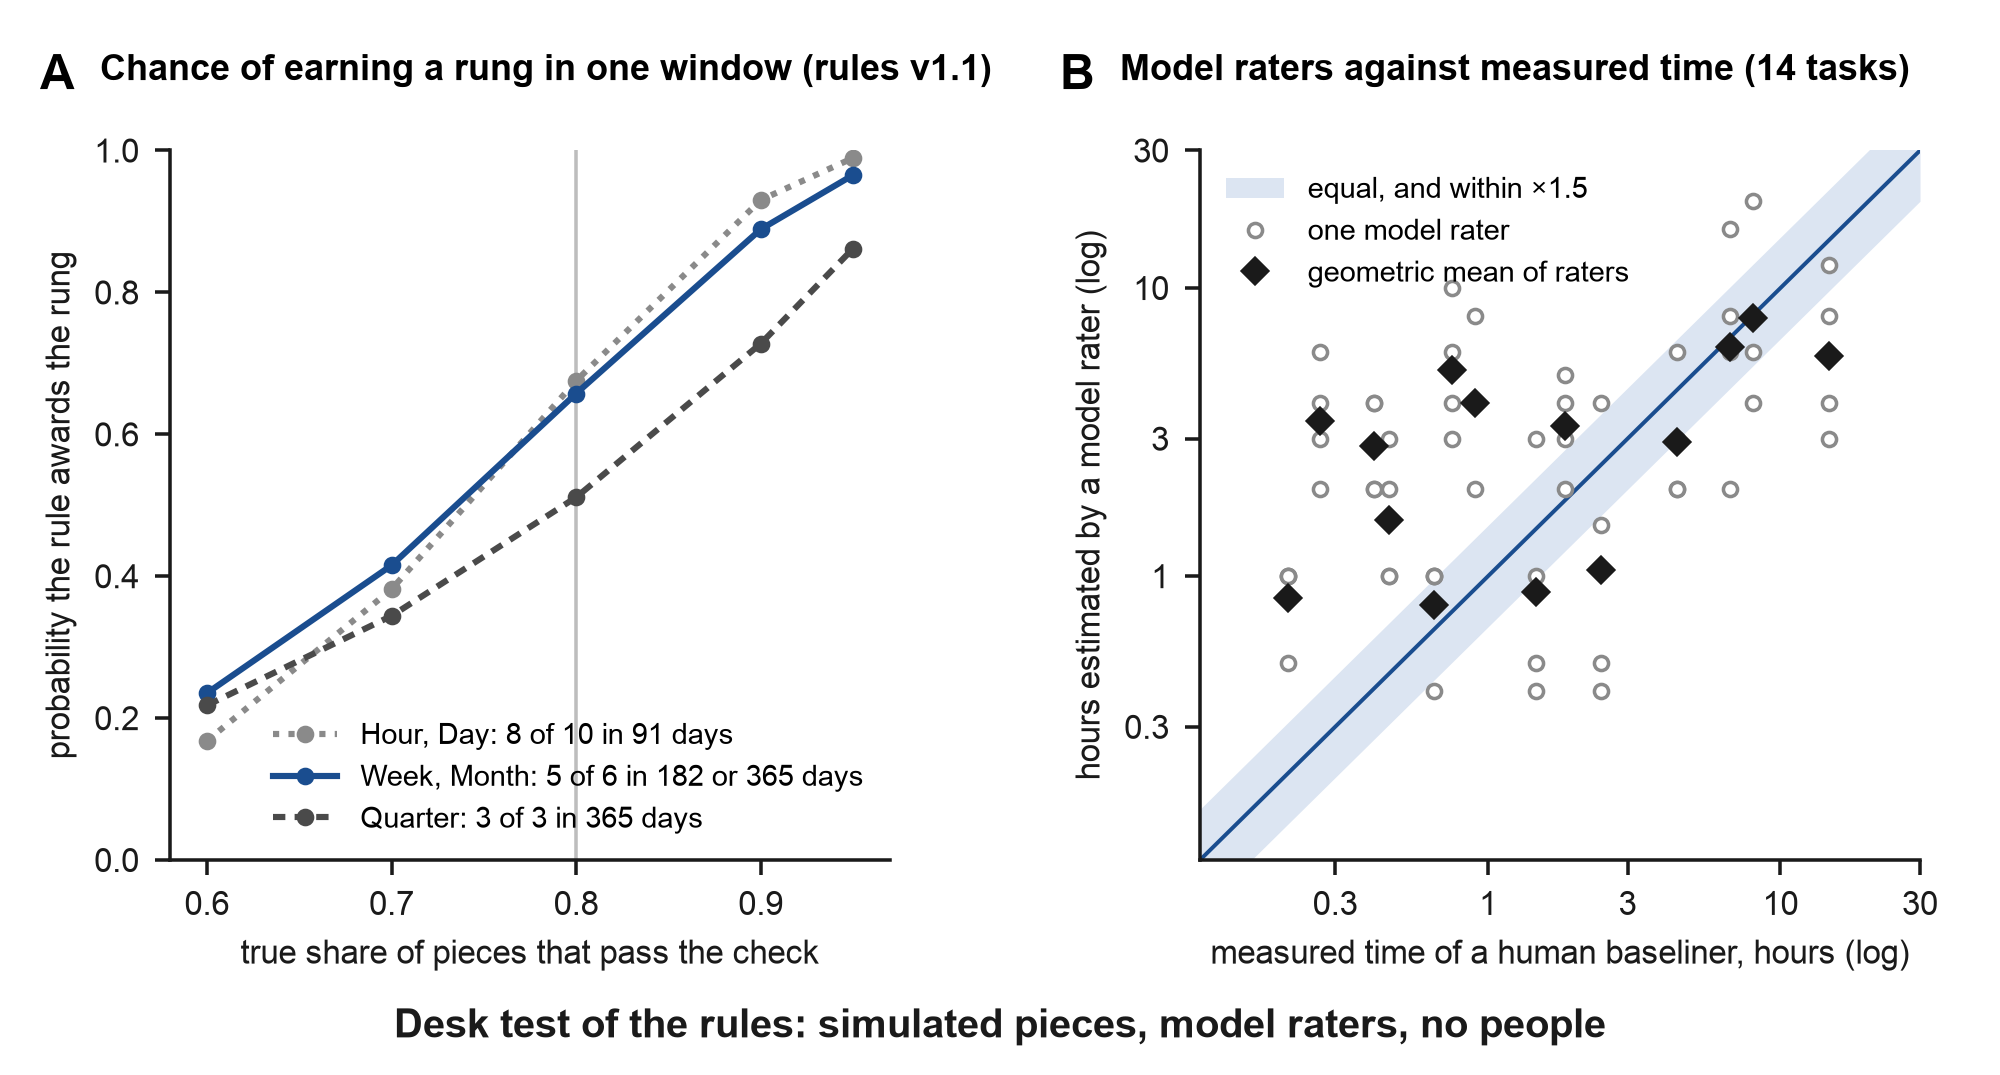
Remarque : un test de bureau avec des pièces simulées et des évaluateurs modèles. Le panneau A donne, pour chaque barreau selon les règles v1.1, la probabilité que la règle attribue le barreau dans une fenêtre lorsque chaque pièce réussit son vérification indépendamment avec la part sur l'axe horizontal. Les barreaux ayant le même nombre et le même nombre de réussites suivent la même courbe. Le panneau B établit les heures de référence que quatre évaluateurs modèles, chacun d'une famille différente, ont estimées pour 14 tâches par rapport au temps mesuré pour un évaluateur humain (données de tâche de METR). La bande marque l'accord dans un facteur de 1,5. Le test de bureau qui a produit les deux panneaux est décrit dans cette annexe, et son code et ses résultats se trouvent dans le référentiel compagnon.
E5. Le protocole d'étalonnage
Le protocole et le texte d'enregistrement se trouvent dans le référentiel compagnon (pilot/pilot-protocol.md, pilot/preregistration-draft.md). Brièvement, 60 adultes participent, 30 ayant une formation en informatique et 30 sans, dans les trois domaines de la banque, sur deux fenêtres de 91 jours. Tous utilisent les mêmes outils d'agent, avec les versions enregistrées, et les vérifications sont des tests cachés ou deux examinateurs de domaine en aveugle. Les durées mesurées à la main sont prises sur un cinquième des tâches de la banque, chaque passation est enregistrée avec sa date de début, et un dixième aléatoire des pièces acceptées est audité. Les critères sont établis avant les données : au moins 70 % des paires d'estimations humaines dans 1,5, au moins 60 % des heures évaluées dans 1,5 des heures mesurées, répétabilité du barreau sur les deux fenêtres avec un kappa pondéré d'au moins 0,6, prédiction du succès de nouvelles tâches avec une AUC d'au moins 0,7, moins de 5 % de lignes de journal perdues, et au moins 95 % des passations échouées enregistrées. Le formulaire de consentement est rédigé pour cette étude uniquement et ne réutilise aucun autre consentement. Le mois et le trimestre, les travaux irréversibles et les domaines à haut risque sont en dehors de cette étude de terrain de six mois.
E6. Ce que le test de bureau établit, et la suite
Il montre comment les règles se comportent pour une personne de fiabilité connue, où elles étaient incohérentes (une incohérence est maintenant corrigée), la sensibilité d'un verdict aux deux constantes, et que les évaluateurs modèles ordonnent les tâches de manière cohérente mais désaccord sur le niveau. Le protocole d'étalonnage de E5 reprend ce qu'un test de bureau laisse aux personnes : comment elles se comportent selon les règles, si un barreau se répète pour une vraie personne, et si cela prédit un nouveau travail ; l'accord entre les évaluateurs humains est testé en premier (Annexe G). Les seuils sont donc testés au bureau comme règles v1.1, et l'étude d'étalonnage établit la version suivante.
Pour reproduire : python3 pilot/simulate_rules.py et python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 ou ultérieur, bibliothèque standard uniquement ; graine 20261009).
Appendice F. Tableaux et figures supplémentaires
Les objets numérotés A1, A2 et ainsi de suite sont des objets d'appendice. Ils sont cités dans les sections nommées dans chaque note.
Tableau A1. Signaux de convergence, 2025 à octobre 2026.
| Signal | Source et date | Ce qu'il montre | Ce qu'il ne montre pas |
|---|---|---|---|
| Le travail des développeurs décrit comme délégation et vérification | GitHub, 8 décembre 2025 | La description du rôle par le fournisseur s'est déplacée | Que le niveau des développeurs soit mesuré de cette façon |
| Les non-développeurs au sein d'un agent de codage ont augmenté 137 fois (individus) et 189 fois (organisations) | OpenAI, juin 2026 | Croissance rapide à partir d'une base faible ; un quart des utilisateurs échantillonnés ont fait au moins une demande estimée à plus de 8 heures | La qualité de leurs résultats ; les données du fournisseur |
| Les dix plus grandes professions à moins de 7 points des professions de programmation en matière de succès vérifié sur les sessions générant du code | Anthropic, 16 juin 2026 | Petit écart entre les professions ; succès soutenu par des preuves telles que les tests ou les commits ; expertise jugée par le comportement | L'éducation (la profession n'est pas le diplôme) ; la qualité des produits déployés |
| Les avocats construisant leurs propres outils ; accès large à l'IA 83 % contre 61 % | Bloomberg Law, 20 avril 2026 | Les experts du domaine qui construisent, ne pas acheter | Combien de temps ces outils sont maintenus |
| L'échelle renommée pour environ 181 500 employés | Business Insider et Fortune, 22 janvier 2026 | Les employeurs changeant les titres | Une nouvelle mesure (les niveaux internes ont été conservés) |
| « Frontier Professionals » : 3 233 sur 20 000 utilisateurs d'IA | Microsoft, 5 mai 2026 | Un segment d'enquête d'utilisateurs avancés | Un rôle ou une classe |
| 16 541 annonces mentionnant l'IA agentique en 2025 (151 en 2024) | Stanford AI Index 2026 | La demande de compétence dans les annonces | Les nouvelles professions |
| L'embauche au niveau débutant en baisse plus que l'ensemble | LinkedIn Economic Graph, août 2026 | Un échelon d'entrée plus faible à la mi-2026 | Que l'IA en soit la cause (LinkedIn l'attribue à l'économie) |
| Les nouveaux majeurs en informatique en baisse de 13 % dans les départements qui décernent des doctorats | CRA Taulbee, juin 2026 | Les étudiants réagissant | Une tendance à long terme ; toutes les institutions |
| L'utilisation de l'IA discutée dans 4,54 % des entretiens au Q2 2026 (0,33 % au Q3 2025) | Metaview, 2026 | La question a fait son entrée dans l'embauche | Une échelle pour la réponse |
Note : Les données des fournisseurs sont marquées comme telles. Les comparaisons antérieures (avec 2019 ou 2022) sont omises par règle (Section 1).
Tableau A2. Noms en circulation et noms proposés, par couche, au 9 octobre 2026. Partie 1 : noms en usage, avec leurs propriétaires et statut. Partie 2 : noms proposés dans cette étude, descriptions simples et variantes envisagées.
| Couche | Candidate | Introduit par, et quand (partie 1) | Sens dans lequel il est utilisé | Pour | Contre |
|---|---|---|---|---|---|
| Partie 1 | |||||
| Compétence de masse | builder, Full Stack Builder | LinkedIn, décembre 2025 (rapporté) ; « tout le monde est un builder maintenant » (SF Standard, 2026) | Quiconque construit, de n'importe quelle fonction | Déjà gagnant dans les RH | Ne dit rien sur le niveau |
| Compétence de masse | vibe coding, vibe coder | Karpathy, 2 février 2025 | Construire sans lire le code | Largement connu | Moqueur ; nomme le plancher |
| Compétence de masse | Maîtrise de l'IA (quatre D) | Anthropic, 2025b | Délégation, description, discernement, diligence | Couvre le terrain | Compétences sans niveaux |
| Compétence de masse | littératie des agents | MindStudio, 11 juin 2026 | Déléguer, vérifier, gérer | Proche en sens | Pris ; aucune norme de preuve |
| Profession | ingénieur agentique | Karpathy, février 2026 ; Alenezi, juin 2026 | Un ingénieur qui dirige les agents | Le mot des ingénieurs de 2026 | Lié à l'ingénierie |
| Profession | chef des agents | Microsoft, 23 avril 2025 | Tout employé qui gère les agents | Mémorable | Un slogan sans mesure |
| Profession | gestionnaire des agents | Arion Research, 7 février 2026 ; Srinivasan et Wei, Harvard Business Review, 12 février 2026 | Un rôle qui exécute les agents dans une équipe | Rapporté comme le favori (aicodex, 2026) ; ses auteurs s'attendent à ce qu'il devienne un titre standard dans 12 à 18 mois | Le titre d'un gestionnaire horizontal (Section 6.3) |
| Profession | Propriétaire d'agent IA ; Superviseur d'agent IA | Écrivain, 2026 ; discussion Digg, 2026 | Une personne responsable d'un agent déployé | Nomme la propriété | L'utilisation d'un seul fournisseur ou forum |
| Profession | orchestrateur IA | St. Lawrence, séminaire 2024 et livre 2025 ; 739 annonces en février 2026 (IT Brew, 2026) | Un professionnel des affaires qui coordonne l'IA | Dans les annonces | Pris plusieurs fois ; horizontal |
| Profession | Opérateur IA | Dust, 7 octobre 2026 | Construit et maintient les workflows des agents partagés | Familier | Ressemble à une console ; chez Anthropic, un « opérateur » est une entreprise qui construit sur l'API (Anthropic, 2026b) |
| Profession | gardien de l'IA, architecte du travail en IA | Ono, Forum économique mondial, 22 juin 2026 | L'un fixe les limites du travail en IA, l'autre vérifie les conséquences | Le prédécesseur le plus proche en sens | Deux rôles, aucune mesure |
| Profession | créateur de produits | Cagan, SVPG, 2025 | Une personne qui porte un produit de l'idée au marché | Langage produit | Pris ; aucune mesure |
| Profession | Principal Produit | O'Neill, post LinkedIn, 2026 | Fixe les objectifs pour les agents, accepte et rend des comptes pour le résultat | Presque le sens de cet article | Pris en ce sens ; citer comme précédent |
| Profession | Ingénieur de contexte agentique principal | Titre d'emploi recueilli par Turkovic, 24 avril 2026 | Une classe d'ancienneté dans le travail des agents | Montre que « principal » est déjà utilisé comme classe | Grade, pas une profession |
| Profession | AI Product Builder; Agentic Product Builder | n8n posting, 2026; State Street posting, 2026 | Built products and verification practice required; coding preferred (n8n) or required (State Street) | Montre les employeurs bouger sur l'exigence de codage dans les deux sens | Titres d'employeurs individuels |
| Profession | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | Une profession nommée pour une industrie | Montre des noms liés au domaine en cours d'émission | Une proposition, une industrie |
| Profession | principal | Agency theory (Jensen & Meckling, 1976); "principals" in Claude's constitution (Anthropic, 2026b); The Principal Firm (Verheul, 2026); principal-agent framing of AI agents (Berkeley California Management Review, 2025; Tikhomirov, 2026) | La partie pour le compte de laquelle un agent agit et qui supporte le coût du contrôle | Théorie derrière; correspond au mot « agent » | « Agent principal » dans la gestion des identités et des accès signifie l'identité propre de l'agent, le sens opposé; aussi le grade Principal Engineer |
| Measure | delegation horizon (machine or firm sense) | Khadj, 2026 (an early version carried a "Delegation Horizon Index", 0 to 100); Alonso, 2026 ("a delegation horizon" for chains of work) | Jusqu'à quel point une machine ou une entreprise peut déléguer avant qu'un humain ne doive intervenir | Montre que l'expression est naturelle | Machine ou entreprise, pas une personne |
| Measure | uplift; speedup; autonomy 1 to 5; H1 to H5; supervisory capacity | METR, 2025; Anthropic Economic Index, 2025-2026; Shao et al., 2025; em360, 2026 | Gains moyens, accélération au niveau de la conversation, autonomie de l'agent, implication humaine préférée, sortie utile par effort | Voisins établis du gain d'amplification | Mesure des tâches, conversations ou outils, pas la sortie vérifiée d'une personne |
| Moment | crossing time | The geometry of learning under AI delegation (2026) | Le point après lequel déléguer à l'IA coûte plus par la perte de compétences qu'il ne gagne | Proche dans la forme | Sens opposé : perte de compétences, pas poids des accréditations |
| Partner | guarantor | "Legal guarantor" in Capps (2025), New York Times Magazine | Fournit la responsabilité que l'IA ne peut pas | Exact | Coloration légale |
| Partner | finisher; distribution engineer; GTM engineer | GTM engineer in postings, 2026 | Apporte le produit aux gens | Payé aujourd'hui | Partiellement automatisable (Section 7) |
| Failed signal | tokenmaxxing | Press usage, 2026 (CIO, 2026a) | Classement ou concurrence selon les tokens consommés | Nomme une pratique réelle | Pas une profession (Section 4) |
| Older names | citizen developer; end-user software engineering; Code Runner, Adaptor, Writer, Builder | Gartner, by 2009; Ko et al., 2011; Feldman & Anderson, 2024 | Construire en dehors de l'informatique; les utilisateurs finaux faisant face à des problèmes d'ingénierie | Longue lignée | Lié à un seul côté de la vieille division |
| Partie 2 | Candidat | Statut | Sens | Pour | Contre |
| Mass skill | acceptance literacy | Proposed here; no use found in the bases of Appendix B | Dire à l'avance ce qui compte comme fait, puis le montrer | Nomme le cœur | Une compétence, pas une personne; doit être distinguée de la recherche sur l'acceptation technologique |
| Profession | agentwright | Proposed here; no use found in the bases of Appendix B | Celui qui crée du travail par des agents, comme un dramaturge crée une pièce | Libre dans les bases savantes; porte l'auteur | Les moteurs de recherche le divisent en « Agent Wright »; ressemble à un outil de test de navigateur; partiellement pris en octobre 2026 (un package Python et un catalogue de compétences d'agent), il faudrait donc un qualificatif |
| Profession | domain orchestrator (legal orchestrator, fintech orchestrator) | Proposed in an earlier draft of this study | Une personne ayant une connaissance approfondie du domaine qui assemble des systèmes d'agents pour ce domaine | Lie le rôle à une verticale (Section 6.3) | « Multi-domain orchestrator » est un terme établi dans la gestion des réseaux 5G et 6G |
| Profession | setter-acceptor; agent director | Plain descriptions | Fixe la tâche et accepte le résultat | Exact | Une description, pas un nom; « director » est un rang de gestionnaire |
| Profession | Agent-Directed Product Creator; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | Variants produced in this study's model consultations | Variations sur l'auteur et la responsabilité du travail d'agent | Montrent l'espace des options | Long, ou proche des noms pris (steward, creator, architect) |
| Profession ladder | Specifier, Verifier, Domain Orchestrator; setter, acceptor, coordinator, loop owner | Early ladders of this study | Étapes de responsabilité croissante pour le travail d'agent | Lisible | Remplacé par échelons en heures, qui ne nécessitent pas de traduction entre les professions |
| Measure | verified delegation horizon (also: personal or human delegation horizon) | Proposed here | Le plus grand morceau de travail vérifié qu'une personne confie aux agents | Enraciné dans Jaques et METR | Doit être distingué du sens machine et entreprise dans la partie 1 |
| Measure | amplification gain | Proposed here | Travail vérifié par heure d'attention | Crédite les constructeurs de boucle courte | Nécessite une référence gelée |
| Moment | credential crossover point | Proposed here; no use found in the bases of Appendix B | Quand les produits de personnes sans formation informatique commencent à dépasser ceux des programmeurs sous les mêmes contrôles, et les accréditations perdent du poids | Observable en parties (Section 6.2) | « Credential » signifie aussi une clé secrète dans la sécurité des agents; définir à la première utilisation |
| Moment | Skill Inversion Point; Background Neutrality Point; expertise crossover point; credential decoupling | Variants considered | Le même moment vu sous l'angle des compétences, des antécédents, de l'expertise ou des accréditations | Chacun souligne une partie | Chacun ne couvre qu'un des composants de la Section 6.2 |
| Partner | co-signer; trust broker; distribution principal | Variants considered | Le partenaire qui signe ou porte le produit | Ordinaire | Plus étroit que le garant ou le finisseur |
| Signal échoué | ancienneté des jetons (jetons en tant que rang) | Terme utilisé ici pour l'épisode 2026 | Classement des personnes par jetons consommés | Nomme un événement réel | Pas une profession (Section 4) |
Note : Le statut reflète les recherches sur le web et dans les bases de données les 8 et 9 octobre 2026 (Appendice B). « Aucune utilisation trouvée » fait référence aux bases listées à ces dates et ne prétend rien sur les bases qui n'ont pas été consultées. Les variantes de la deuxième partie proviennent des brouillons propres à l'étude et sont listées afin que la famille d'options reste visible.
Tableau A3. Échelles de 2025 et 2026 et ce que chacune mesure (liste complète).
| Échelle | Source | Unité mesurée | Mesure une personne par le travail délégué vérifié ? |
|---|---|---|---|
| Niveaux d'autonomie pour les agents IA (opérateur à observateur) | Feng et al., 2025 | L'agent | Non |
| Cinq niveaux, de l'autocomplétion à l'usine logicielle | Shapiro, janvier 2026 | La machine ou la configuration de l'équipe | Non |
| Huit étapes du développement assisté par IA | Yegge, 2026 | La pratique d'un programmeur, par nombre d'agents | Non |
| L'échelle de capacité (déclencheur à équipe d'agents) | Memari & Rudolph, 2026 | L'automatisation du travail | Non |
| Sept étapes de supervision des agents de codage | Park et al., 2026 | Étapes du travail de supervision | Non |
| Cinq niveaux de délégation en développement (AIDEs) | JetBrains Research (Tikhomirov), septembre 2026 | La délégation d'un développeur, encadrée comme une relation principal-agent | Développeurs seulement ; aucune règle de vérification |
| Niveaux de délégation de l'IA dans la prise de décision | Dawson, 2026 ; Metal Toad, 2026 | La délégation d'une organisation ou d'un responsable | Non |
| Délégation intelligente de l'IA | Tomašev et al. (DeepMind), février 2026 | La délégation en général | Pas de mesure au niveau personnel |
| La frontière de délégation (version précoce : Indice d'horizon de délégation, 0 à 100) | Khadj, 2026 | La délégation d'une entreprise ou d'un agent | Non (machines et entreprises) |
| Auteur, éditeur, directeur, orchestrateur | Microsoft, mai 2026 | Modèles de travail | Non |
| Cadre de compétence en IA (huit domaines, quatre niveaux) | Normes de certification en IA, 23 août 2026 | Compétences dans les professions | Aucun examen ni seuils |
| Fluidité en IA (quatre D) | Anthropic, 2025b | Littératie | Aucun niveau |
| Horizon temporel des machines | METR, 2025-2026 | Le modèle | Non (machines seulement) |
| Horizon de délégation vérifié et gain d'amplification | Cet article | Une personne dans un domaine | Oui, selon la règle de la section 5.2 |
Note : « Mesure une personne par le travail délégué vérifié » signifie que l'échelle place un individu à un niveau selon l'ampleur du travail confié aux agents et confirmé par une vérification que les agents n'ont pas vue. Les niveaux de JetBrains concernent le degré de délégation des développeurs, et ils utilisent déjà le langage du principal et de l'agent. Ils sont le voisin le plus proche, et il leur manque une règle d'indépendance pour les vérifications et une unité de taille.
Tableau A4. Cas difficiles et comment les règles les traitent.
| Cas | Traitement |
|---|---|
| Travail que la personne n'aurait jamais pu faire à la main | Les heures de référence proviennent toujours d'un spécialiste qualifié ; la compétence propre de la personne n'entre pas en jeu |
| Travail dont la qualité n'apparaît que des mois plus tard | Accepté provisoirement ; le résultat retardé est enregistré à son arrivée et peut révoquer le travail |
| Un domaine sans évaluateur humain qualifié à proximité | Tests cachés ou utilisation réelle par les utilisateurs prévus ; un modèle d'une autre famille seulement avec des sources que la personne a ouvertes |
| Un critique aveugle de la même famille de modèles, dans un contexte nouveau | Pas une vérification indépendante : enregistré comme same_family (Appendice C), il n'obtient aucun crédit, bien qu'il puisse améliorer le travail avant une vérification indépendante (Section 6.5) |
| Une équipe qui accepte le travail ensemble | Chaque personne enregistre sa propre attention ; le travail compte pour la personne qui a signé l'acceptation |
| Un travail qui passe la vérification mais s'avère ultérieurement erroné | Enregistré comme échoué à la prochaine re-vérification, et l'échelon est reclassé |
| Travail irréversible mélangé au travail ordinaire | La règle la plus stricte s'applique aux travaux irréversibles seulement (Section 5.2) |
Tableau A5. Sujets dans les discussions de développeurs et leurs équivalents dans d'autres professions, 2025-2026 (cas illustratifs).
| Sujet dans les discussions | Équivalent en dehors de l'informatique | Source | Transposé ? |
|---|---|---|---|
| Qui est responsable de la mauvaise production, le modèle ou celui qui a défini la tâche | « Travail salopé » : sortie d'IA qui transfère le travail à son destinataire, environ deux heures par incident et 186 $ par employé par mois ; les collègues jugent les expéditeurs moins compétents | The Decoder (2025) ; BetterUp (2026) | Oui, fortement |
| Le coût de la vérification (150 $ l'heure pour l'examen) | Le même coût de travail salopé | The Decoder (2025) | Oui |
| Un modèle puissant planifie et examine, les modèles bon marché font le travail | Budgets d'IA alloués par rôle chez Atlassian | HCA Magazine (2026) | Dans les entreprises |
| Surcharge, changement constant d'outils, peur de rater quelque chose | « Épuisement cérébral de l'IA » signalé par 25-26 % des spécialistes du marketing, 19 % en RH, 17 % en informatique | Search Engine Journal (2026) | Oui, plus fortement en dehors de l'informatique |
| Outils propres à la place des logiciels achetés | Avocats construisant des outils avec des agents ; 35 % des entreprises sondées remplaçant certains logiciels achetés par leurs propres outils (échantillon du fournisseur) | Artificial Lawyer (2026) ; Bloomberg Law (2026) ; Retool (2026) | Au niveau supérieur |
| Comparaison des agents | Comptables comparant deux agents de codage | Growthy (2026) | Oui |
| Faire passer une entreprise aux agents sans programmeurs | Avocats et cabinets construisant avec des agents à la place des fournisseurs | Bloomberg Law (2026) ; Artificial Lawyer (2026) | En partie ; l'activité de conseil elle-même n'apparaît que dans le fil |
| Une facture mensuelle d'IA personnelle supérieure à 1 000 dollars en tant que marqueur de statut | Aucun équivalent de statut trouvé ; les plus proches sont les plafonds et allocations des entreprises (le plafond mensuel d'Uber de 1 500 dollars, les portefeuilles IA d'Atlassian) | Fortune (2026b) ; HCA Magazine (2026) ; recherche du 9 octobre 2026 | Non, en tant que statut ; oui, en tant que ligne budgétaire |
| Appartenir au camp d'un agent | Aucun équivalent trouvé | Recherche du 9 octobre 2026 | Non, et non nécessaire |
Note : Les fils sont des preuves qualitatives choisies pour leurs sujets et ne représentent pas une population. « Ayant un équivalent » indique si un équivalent a été trouvé dans les sources énumérées, le 9 octobre 2026.
Figure A3. Horizons des machines à l'échelle des échelons.
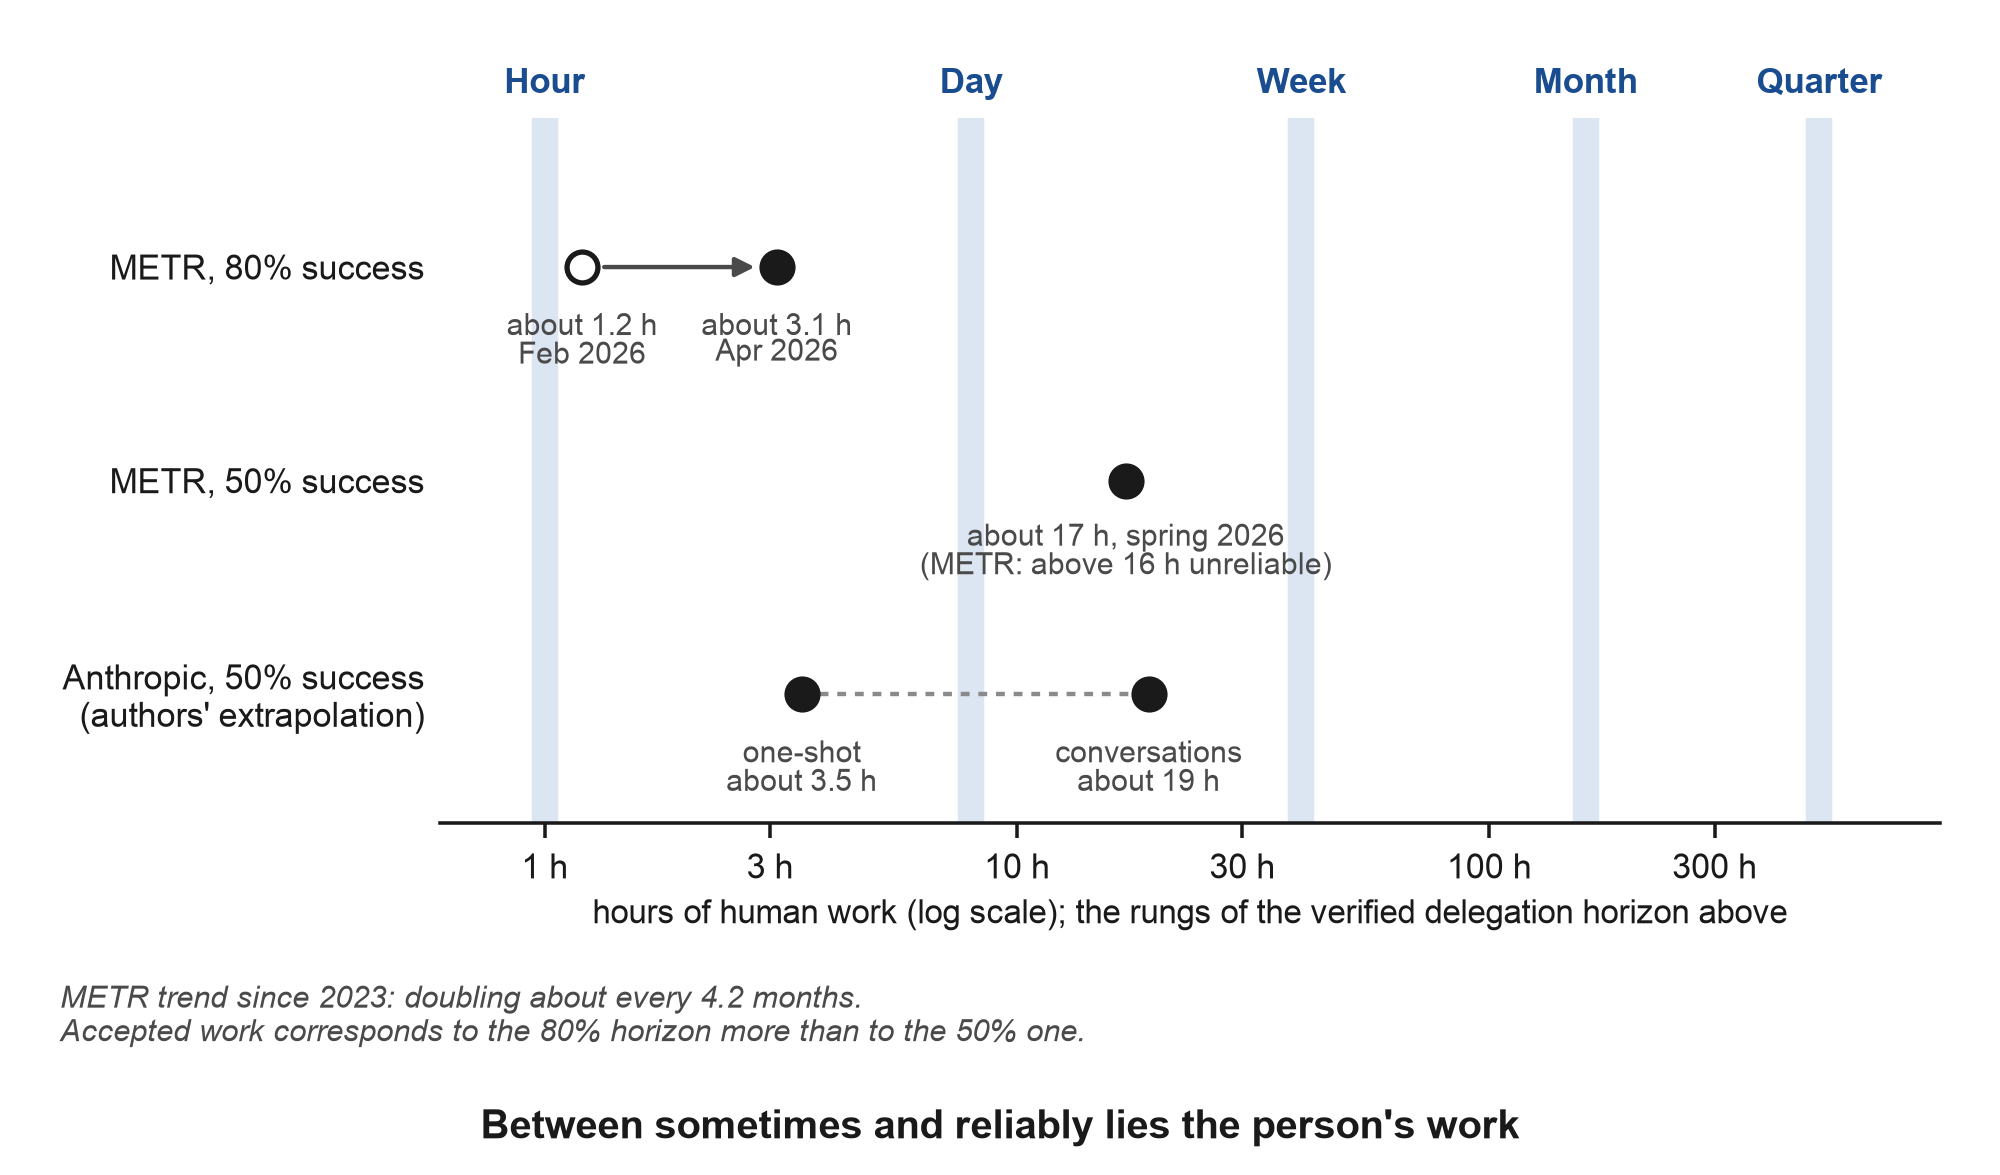
Note : L'horizon temporel de METR à 80 % de réussite, environ 1,2 heure en février 2026 et environ 3,1 heures en avril. À 50 % de réussite, environ 17 heures au printemps 2026, que METR lui-même juge peu fiable au-delà de 16 heures (METR, 2026c). Les points à 50 % d'Anthropic, environ 3,5 heures pour les requêtes en un seul tour et environ 19 heures pour les conversations, sont une extrapolation des auteurs (Anthropic, 2026a). Les horizons des machines mesurent les modèles, non les personnes. Les colonnes ombrées ne montrent que l'endroit où les échelons de la section 5.3 se situent sur le même axe des heures (section 5.6).
Figure A4. Le processus de vérification de la section 6.5 : ce que chaque étape représente, ce qu'elle apporte selon la règle, et où elle s'arrête.
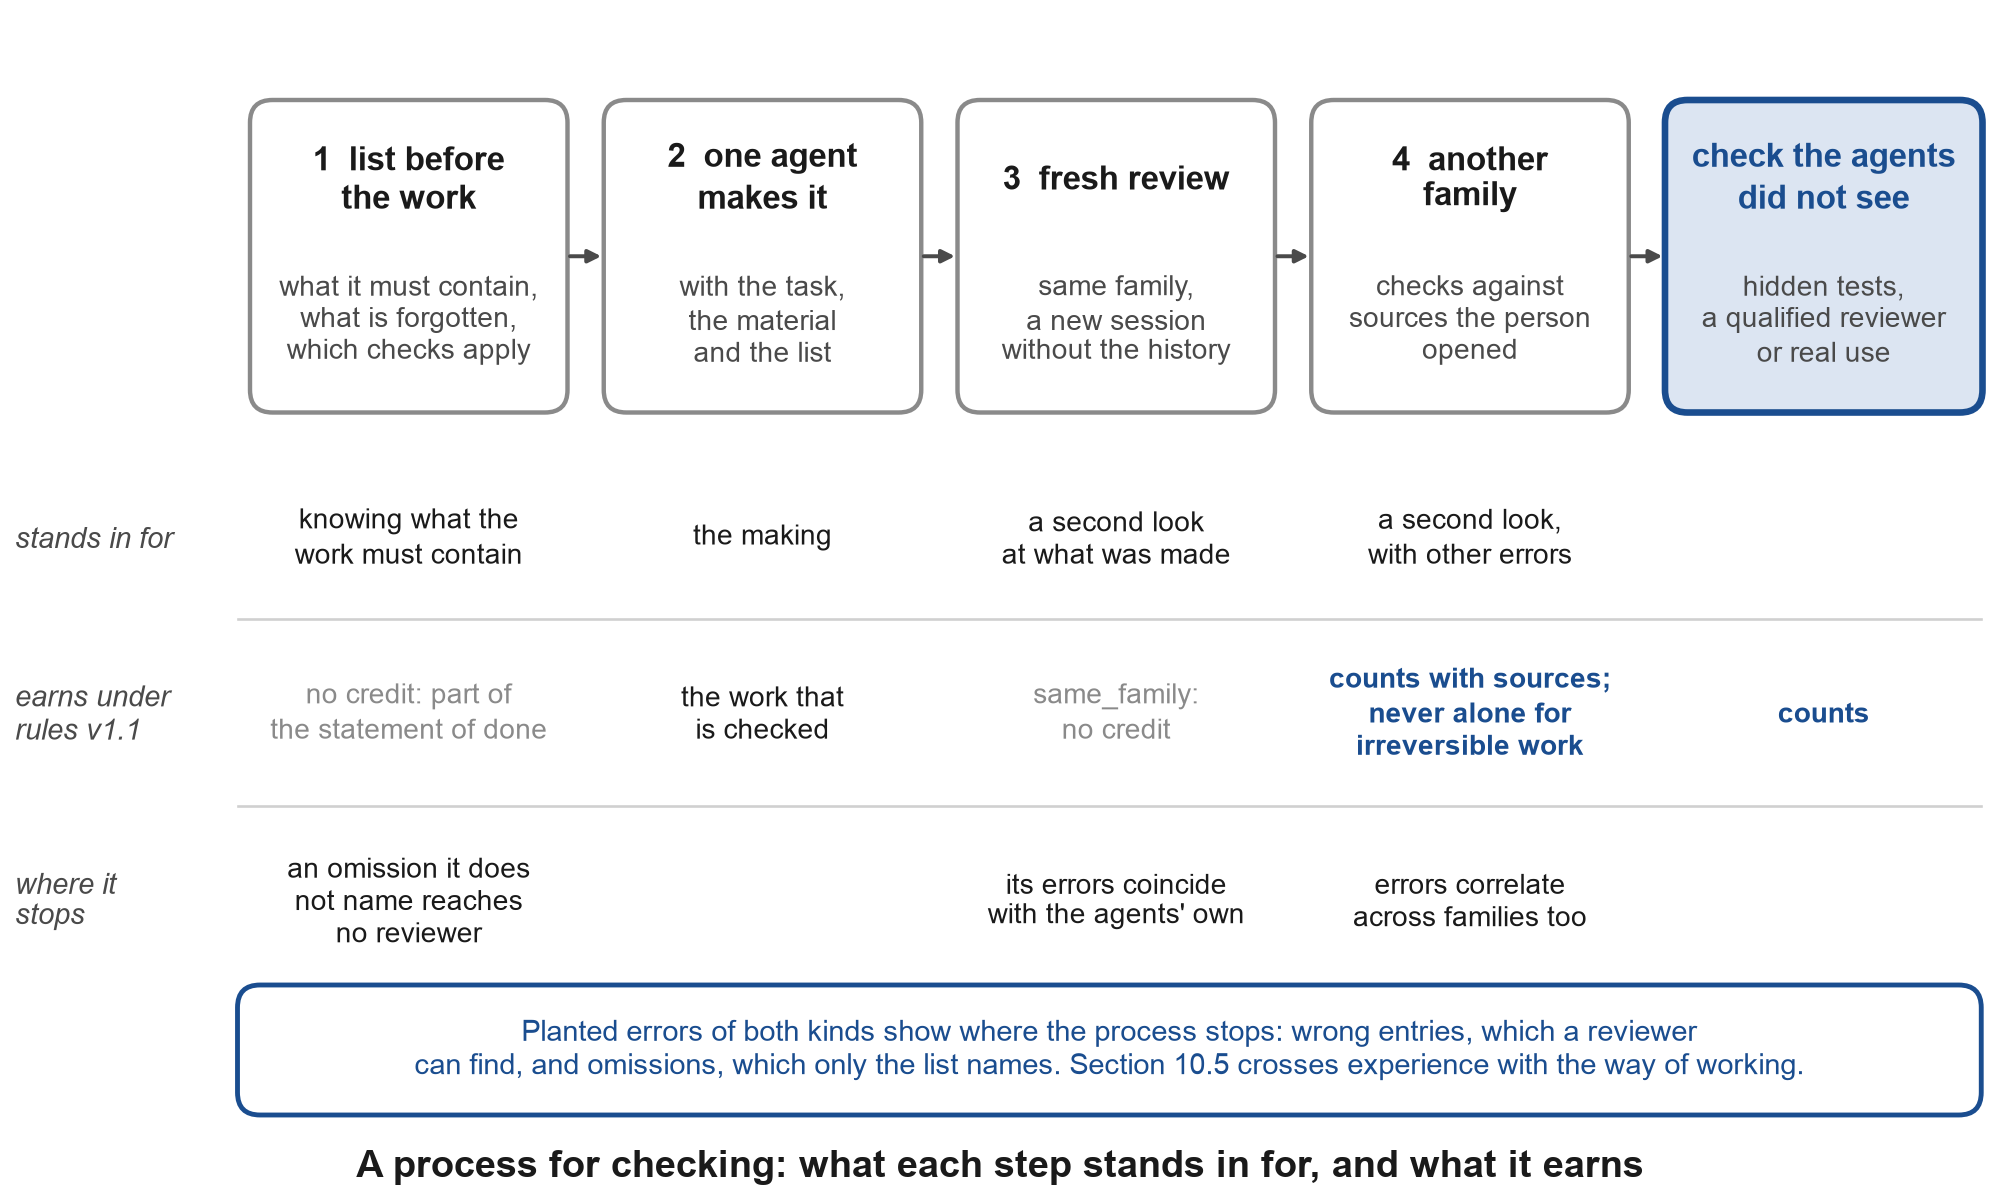
Note : Les quatre étapes et ce que chacune représente sont celles de la section 6.5. La ligne de crédit suit la règle de notation de la section 5.2 et du tableau A4 : un examen par un modèle de la même famille dans un contexte neuf est enregistré comme same_family et n'apporte aucun crédit, bien qu'il puisse améliorer le travail ; un modèle d'une autre famille ne compte que lorsqu'il vérifie par rapport aux sources que la personne a ouvertes, et jamais seul pour un travail irréversible. La dernière ligne résume Fu et al. (2025) sur les omissions et Kim et al. (2025) sur les erreurs qui se corrèlent entre les modèles. Aucun test de prédiction enregistré ne valide le processus ; la section 10.5 expose la comparaison qui le ferait. La figure est créée par figures/figure_a4_checking_process.py dans le dépôt complémentaire, qui lit le crédit de chaque type de vérification à partir de horizon.py. Chaque étape représente une part de l'expérience d'un métier ; la section 14 y revient comme une échelle d'égalisateurs.
Tableau A7. Statut des affirmations de cet article.
| Élément | Comment c'est établi | Fondement |
|---|---|---|
| Les programmeurs et d'autres partagent maintenant les tâches et les flux de travail de délégation et d'acceptation | Les données le soutiennent au niveau des tâches et des flux de travail ; les professions dans leur ensemble ne se sont pas fusionnées | Section 2 ; journaux des fournisseurs et enquêtes de 2025-2026 |
| Les deux anciennes échelles ne mesurent pas ce travail | Observé | Échelles renommées sans nouvelle mesure (Deloitte) ; question de l'utilisation de l'IA entrant dans les entretiens sans échelle |
| Les comptages de tokens échouent comme mesure de l'ancienneté | Observé dans les premiers cas | Rapports de presse de 2026 (section 4) : le classement non officiel d'un employé chez Meta, supprimé, et la guidance officielle ultérieure de Meta contre les comptages de tokens ; un classement chez Amazon, truqué et supprimé ; le budget IA d'Uber dépensé en quatre mois, un événement budgétaire |
| Horizon de délégation vérifié et gain d'amplification | Proposé ; règles v1.1 testées au bureau ; protocole d'étalonnage dans le dépôt complémentaire ; accord des professionnels sur les heures de référence selon test enregistré | Définitions et règles (section 5) ; instrument (Appendice C) ; test au bureau des seuils (Appendice E) |
| Plafond du gain fixé par la part de la vérification | Présenté comme un modèle ; illustré par les moyennes GDPval | Section 5.5 |
| Neutralité de base | Hypothèse ; tests à enregistrer (F7) | Anthropic (2026e) la désigne ; Savva (2026) est une rivale |
| Point de croisement des diplômes | Hypothèse ; composantes datées séparément (parité F2, dépassement F3, offres F5, neutralité F7) | Lightcast (2026b) montre des lignes convergentes ; Bone et al. (2025) la précèdent pour les rôles IA |
| Les portes qui admettent par une fuite de libellé auto-déclaré ; les portes qui vérifient le travail tiennent | Présenté comme un modèle ; la fuite est illustrée une fois, par le criblage de l'étude d'évaluation | Sections 6.2 et 13 ; Appendice G2 ; Danilova et al. (2021) ; Reid et al. (2022) ; Serafini et al. (2024, 2026) ; Oregon State Board of Bar Examiners (2026) |
| Le logiciel passe en dernier | Prédiction (F6), avec 40 autres au tableau A6, enregistrée sur OSF | Argument de domaine (section 6.3) |
| Un processus de vérification peut représenter une part de l'expérience d'un métier | Hypothèse, non enregistrée ; aucun test de prédiction enregistré ne la valide, et F3b (p = 0,10) ne la concerne que indirectement ; une comparaison est exposée dans la section 10.5 | Section 6.5 ; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) et Benchek et al. (2026) d'un côté ; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) et Virk et Liu (2025) de l'autre |
| La confiance comme deuxième frontière ; garant comme profession partenaire | Présenté comme un modèle ; prédictions F11 et F12 | Section 7 |
| Les non-programmeurs travaillant par des agents | Observé dans une cohorte en cours, décrit sans inférence ; les résultats enregistrés rapportés séparément | Section 11.5 ; Appendice G |
Tableau A8. Les portes qui admettent par un libellé et les portes qui vérifient le travail : ce que chacune vérifie, et ce qui a été observé.
| Porte | Ce qu'elle admet sur | Ce qui a été observé | Source |
|---|---|---|---|
| Un filtre de participants d'une plateforme de recherche | Réponses données surtout sur la parole de la personne ; l'âge et le pays de résidence vérifiés | Sur 60 personnes admises à un échantillon de comptabilité, 11 ont répondu incorrectement à une question de première semaine du métier, 8 d'entre elles en inversant le débit et le crédit | Prolific (2026); Appendix G2 |
| Compétence en programmation déclarée sur une plateforme de travail participatif | Déclaration de la personne | 42 % n'ont pas satisfait aux critères des questions de connaissance des chercheurs | Danilova et al. (2021) |
| Programmation en Node.js déclarée sur Prolific | Déclaration de la personne | 55 sur 206 ont réussi toutes les questions de programmation | Reid et al. (2022) |
| Une question de connaissance statique, en texte ou en images | Une réponse qu'un modèle de dialogue peut fournir | ChatGPT a facilement résolu les questions de sélection existantes pour les programmeurs, et en 2026 a franchi les questions visuelles statiques conçues pour y résister | Serafini et al. (2024, 2026) |
| Une question audio révélée étape par étape sous une limite de temps stricte | Une réponse donnée sous pression temporelle | Toujours efficace contre un modèle de dialogue en 2026 | Serafini et al. (2026) |
| Une exigence de diplôme supprimée d'une politique | Un label, supprimé sur le papier | Moins d'une embauche sur 700 a changé ; 19,3 % des offres d'emploi aux États-Unis sur Indeed demandaient un diplôme de premier cycle ou supérieur en novembre 2025, en augmentation par rapport à un an plus tôt | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| Une licence par un examen réussi une seule fois | Connaissance, vérifiée une seule fois | Fonctionne comme un label à partir de ce moment | Section 6.2 |
| Inspection des travaux signés d'un cabinet d'audit agréé | Travaux signés, vérifiés encore et encore | Chaque année pour les cabinets qui contrôlent régulièrement plus de 100 émetteurs, au moins une fois tous les trois ans sinon | Sarbanes-Oxley Act of 2002, s. 104 |
| Une licence par un portefeuille de travaux supervisés | Travaux vérifiés, une seule fois ; le diplôme en droit est toujours requis | 205 candidats avaient présenté une demande au 5 janvier 2026 et 49 ont été agréés, le premier en décembre 2024 | Oregon State Board of Bar Examiners (2026) |
| L'horizon de délégation vérifiée | Travaux livrés ayant réussi une vérification que les agents n'ont pas vue, confirmée tous les trimestres | Un échelon avec le nombre à côté et les types de vérification, les défaillances conservées dans le journal | Sections 5.2 and 5.3 |
Note : Les lignes sont les cas que la section 6.2 cite. Elles proviennent de populations différentes et de questions différentes et sont présentées côte à côte pour ce que chaque portail vérifie, non pour être comparées en tant que taux. Un portail de deuxième type peut être ajouté devant n'importe quel portail de premier type : les évaluateurs des heures de référence dans le dépôt compagnon sont admis par une question du métier (kits/reference-hours-raters.md), comme l'étude des évaluateurs de l'Appendix G2 a sélectionné ses évaluateurs. kits/trade-screen.md explique comment rédiger une telle question et la signaler, et tools/gate_leak.py donne la part qu'un label laisse passer, avec un intervalle exact.
Appendice G. Des gens qui le font déjà : une cohorte de non-programmeurs et une étude d'évaluateurs Prolific
Cet appendice est un supplément à la mesure, non une partie de son argument ; les sections 6.2, 6.5 et 14 citent le résultat de filtrage de G2 comme illustration. Il ajoute deux dossiers de gens : un récit de non-programmeurs qui sont passés du chat aux agents en septembre et octobre 2026 (G1), et une étude d'évaluateurs enregistrée dans laquelle des professionnels en activité ont évalué les heures de référence de la banque de tâches (G2).
G1. Des non-programmeurs qui sont passés du chat aux agents
À partir du 6 septembre 2026, j'ai guidé des adultes sans formation en programmation, pas à pas et par le biais d'une messagerie ordinaire, d'un assistant de chat à un agent de codage installé sur leur propre ordinateur et financé par leur propre abonnement à titre individuel, puis au travail avec plusieurs modèles. Ils provenaient de plus d'une douzaine de métiers, notamment la comptabilité et le travail de bureau, le droit, le marketing et la vente, le design, la photographie et la retouche, la traduction et l'édition, la musique, la construction, le transport et la logistique, l'immobilier, le travail de soin, l'administration publique et le travail communautaire à but non lucratif ; quatre ont signalé un travail passé ou présent dans le logiciel. Le récit ci-dessous est descriptif : il rapporte ce que les gens ont fait et ce qui les a arrêtés, tel qu'enregistré au 9 octobre 2026, et il ne calcule aucun taux ni ne teste aucune affirmation de cet article.
Tableau G1. La progression de la cohorte au 9 octobre 2026 (décompte de personnes).
| Étape | Personnes |
|---|---|
| Dans le dossier : consentement obtenu et questionnaire d'entrée retourné | 119 |
| Installation d'un agent sur leur propre ordinateur et abonnement et démarrage du travail avec celui-ci | 35 |
| Production d'un artefact ou accomplissement d'au moins une étape, sur leur propre travail | 24 |
| Arrêt, avec une raison énoncée | 23 |
| dont : pas d'ordinateur personnel (téléphone seulement, ou un appareil qui ne peut pas exécuter l'agent) | 9 |
| dont : le coût d'un abonnement | 5 |
| dont : refus (ce qu'ils avaient suffisait, pas d'intérêt, ou le cadre débutant ne correspondait pas) | 6 |
| dont : santé, famille ou temps | 2 |
| dont : le service n'était pas disponible où ils habitent | 1 |
Note : Comptage manuel à partir du dossier des participants et du dernier résumé des mesures, en utilisant l'événement le plus avancé enregistré pour chaque personne. Les 35 personnes de la deuxième ligne sont les 35 lignes du tableau G1b, et les 24 de la troisième ligne sont ses 24 premières lignes. Un artefact compte quand la personne l'a montré ou décrit ce que l'agent a produit ; une personne qui a produit un artefact s'est arrêtée plus tard (P60) et est comptée dans les deux lignes. Les 62 personnes restantes avaient, à cette date, soit reçu l'étape d'installation sans la signaler comme effectuée, soit ne l'avaient pas encore atteinte.
Tableau G1a. L'ensemble de la cohorte par région et pays de résidence, et combien de chacun sont passés à un agent au 9 octobre 2026.
| Région et pays | Dans la cohorte | Passés à un agent |
|---|---|---|
| Amérique du Nord | 37 | 10 |
| États-Unis | 35 | 10 |
| Canada | 2 | 0 |
| Europe occidentale | 20 | 7 |
| Allemagne | 12 | 5 |
| Irlande | 3 | 1 |
| Espagne | 2 | 1 |
| Royaume-Uni | 1 | 0 |
| Autriche | 1 | 0 |
| Suisse | 1 | 0 |
| Europe centrale et orientale, pays nommés | 9 | 1 |
| Pologne | 3 | 0 |
| Moldavie | 2 | 0 |
| Lettonie | 2 | 0 |
| Estonie | 1 | 0 |
| Roumanie | 1 | 1 |
| Pays non divulgué | 53 | 17 |
| Total | 119 | 35 |
Note : À partir de la colonne pays du dossier des participants. « Pays non divulgué » regroupe les participants dont le pays est retenu en vertu de la règle de confidentialité de l'étude et ceux qui n'en ont pas fourni.
Ce que les gens ont fait avec un agent. Le tableau G1b énumère tous ceux qui étaient passés d'un assistant de chat à la direction d'un agent au 9 octobre 2026, une ligne chacun : quelle tâche ils lui ont donnée et ce qu'il a produit. Les personnes qui ont produit un artefact ou terminé une étape sur leur propre travail viennent en premier, ordonnées à peu près par la distance parcourue ; celles qui avaient installé l'agent et commencé, sans résultat signalé pour le moment, suivent. Les professions sont données telles qu'elles figurent dans le dossier, en formulation neutre. Les courtes citations sont les propres paroles des participants tirées du dossier ; celles marquées « (traduit) » ont été écrites dans une autre langue et sont données dans ma traduction littérale.
Tableau G1b. Tous ceux qui ont franchi le pas jusqu'à présent (35 personnes, au 9 octobre 2026).
| # | Participant | Profession | Pays ou région | Ce qu'ils ont fait avec un agent | Selon leurs propres paroles |
|---|---|---|---|---|---|
| 1 | P20 | traitement d'images, retouche, photographie | non divulgué | L'agent a demandé ses objectifs et a élaboré un plan mensuel sous forme de dossiers et de fichiers (semaines par sujet, un fichier de référence, un suivi) ; il l'a ensuite enregistré dans neuf services IA en pilotant le navigateur lui-même et a enregistré le refus dans son fichier de progression ; il a exécuté une question par le biais de 11 IA Web et a écrit les résultats et limites dans un fichier ; sur ses propres photographies stock, il a produit un CSV de métadonnées en une commande et l'a vérifié | - |
| 2 | P73 | entreprise de vente de lentilles de contact | Irlande | Installation d'un deuxième agent d'un autre fournisseur ; les deux ont lu une copie de son propre plan de médias sociaux et elle a conservé une page des points sur lesquels ils différaient ; a écrit un fichier de règles pour chaque agent et a fermé la soirée avec un fichier lisez-moi et un journal de travail | « Je peux continuer la formation. » |
| 3 | P48 | travail de bureau et ventes en ligne | non divulgué | A transformé un document qu'elle rédige chaque semaine en modèle avec une liste de contrôle et a rédigé le suivant à partir de celui-ci plus rapidement ; un deuxième travailleur lit ses brouillons sans contexte ; a laissé deux IA lire un dossier complet et a décidé elle-même des trois conclusions les plus coûteuses | « La question de savoir quelle IA est meilleure est mal formulée. » |
| 4 | P44 | marketing, ventes et conseil | non divulgué | A créé des boutons de bureau qui exécutent des tâches d'agent (« statut du projet », « inventaire des nouveaux éléments », « résumé du document », « note au dossier ») ; a installé un deuxième agent sur un autre abonnement et a exécuté un examen conjoint d'une tâche : un fichier de résumé plus deux examens complets | - |
| 5 | P21 | organisation communautaire à but non lucratif | Allemagne | A créé un programme interactif d'un mois sur les compétences et les habitudes avec suivi des progrès ; a laissé l'agent choisir une direction de départ dans le catalogue et rédiger un plan de quatre semaines ; a ensuite exécuté trois sessions d'agent en parallèle : une présentation en quelques minutes et un bot qui surveille les annonces et envoie les correspondances à son messenger | « Un outil adapté à vos besoins spécifiques, plutôt que de parcourir Internet à la recherche de compromis ou d'abonnements payants. » |
| 6 | P05 | assistante d'un directeur, ancienne programmeuse | États-Unis | L'agent a créé cinq fichiers sur sa machine : un aperçu et un plan de quatre semaines par thème ; plus tard, il a envoyé des invitations à une liste de 76 contacts via une page de messagerie web, en cliquant lui-même, après un message d'essai sur son propre numéro | « À partir de maintenant, je vais diviser différentes tâches quotidiennes entre eux et vraiment comparer les résultats. » |
| 7 | P01 | designer d'intérieur et dessinateur en formation | Espagne | A laissé l'agent construire un fichier des offres d'emploi en deux passes, la deuxième plus large que la première ; l'a comparé à deux rapports d'un autre chatbot, les accords et les divergences mis à part ; a réécrit son CV et son portfolio à partir d'une lecture honnête de ses propres fichiers et a révisé son profil professionnel | « Quand il peut creuser si profondément et créer des données intéressantes mais en général séparées pour les analyser. » |
| 8 | P18 | marketing Internet | non divulgué | L'agent a rangé son bureau : a créé des documents, les a triés dans des dossiers, a trouvé des erreurs et les a corrigées ; plus tard, il a configuré des alertes de nouvelles par courrier électronique sur ses propres sujets | « J'avais entendu parler de choses comme ça, mais le voir en action m'a vraiment convaincue. » |
| 9 | P19 | agent de l'administration publique | non divulgué | A corrigé une longue édition de texte multi-livre de sa propre rédaction en une seule journée ; a terminé deux grands projets en une semaine ; construit maintenant une collection de plugins pour un flux de travail de traduction | « J'ai finalisé deux grands projets en une seule semaine... wow. » |
| 10 | P35 | contrats, factures et documents douaniers | États-Unis | A effectué la première tâche par la voix ; l'agent a nettoyé le cache de son ordinateur, a fermé les applications et a trouvé un créneau de rendez-vous sur un site de réservation en l'ouvrant lui-même ; a proposé une direction d'impression à la demande ; aide à la paperasse des appels d'offres ; s'exécute maintenant dans le terminal | « Oui, ça a marché, on l'a fait. » |
| 11 | P72 | images stock et vidéos créées avec IA | Roumanie | A exécuté une tâche via de nombreuses IA avec l'outil d'orchestration, a configuré l'entrée vocale et a choisi des directions freelance dans le catalogue | - |
| 12 | P41 | assistante dentaire en congé parental | États-Unis | L'agent a créé un calendrier, un plan et des brouillons ; a trouvé six copies de son propre installateur et cinq d'une suite bureautique sur sa machine et a supprimé les extras ; elle a dicté une leçon pour un cours communautaire et l'agent l'a dactylographiée, a ajouté des références et des liens, a traduit et enregistré, puis l'a reworkée sur son ordre | « Je suis ravie. » |
| 13 | P24 | musicienne et poète | Allemagne | A envoyé une tâche d'image à onze IA et a enregistré les résultats dans un dossier avec une page galerie ; a laissé l'agent construire le squelette d'un arrangement musical, qui l'a déçu | « L'aspect éthique de la paternité reste non résolu pour moi. » |
| 14 | P102 | dirige une société de logiciels | non divulgué | Avait déjà travaillé quotidiennement dans un agent à l'arrivée ; a exécuté une question via 11 IA (10 ont répondu) et a envoyé le fichier d'exécution ; travaille maintenant sur le catalogue des gains | - |
| 15 | P40 | ingénieur de recherche et développeur web | non divulgué | A suivi le chemin en tant que débutant délibéré : environ cent fichiers libres dans son dossier de téléchargements triés dans des dossiers, avec des captures d'écran avant et après ; a retourné deux corrections aux matériels de cours | - |
| 16 | P75 | assistance technique à distance | non divulgué | L'agent a créé un dossier sur son bureau avec un plan de lancement pour un canal vidéo musicale saisonnière (noms, idées de piste, titres, un calendrier de publication) ; étape de terminal terminée | - |
| 17 | P60 | aide à domicile | États-Unis | Après quelques questions de l'agent, un plan d'un mois divisé en fichiers (donateurs, finances, modèles de lettres) ; plus tard parti, trouvant le cadre de débutant trop basique | - |
| 18 | P64 | service public en uniforme, logistique et approvisionnement | non divulgué | A créé un plan d'un mois avec l'agent, qui a créé les fichiers sur son ordinateur ; s'est inscrit dans dix services IA | « L'IA s'adapte à la personne. Elle flatte, en un certain sens. » |
| 19 | P28 | service public en uniforme | non divulgué | L'agent a exposé les trajectoires de carrière à partir de son poste actuel et, quand il en a refusé une, un plan de développement pour son ancien métier, la réparation de montres (compétences, certification, atelier personnel) | - |
| 20 | P14 | grimpeur industriel | États-Unis | A construit « Reflex Square », un petit entraîneur de vitesse de réaction, avec l'agent à sa propre suggestion lors de la configuration | « Pour l'instant, coder dans Code n'est pas quelque chose dont j'ai besoin dans ma vie quotidienne. » |
| 21 | P67 | entraîneur de natation, aussi ventes directes | non divulgué | A dit à l'agent qu'elle avait commencé dans les ventes directes ; il a proposé cinq types d'aide et a rédigé un exemple de fiche produit | - |
| 22 | P12 | étudiant | Allemagne | S'est inscrit aux services IA gratuits, a exécuté le dossier d'orchestration et, avec l'agent, a choisi quatre directions du catalogue (journalisme, un livre, monétisation, approfondir l'IA) ; lui donnera ses propres essais | - |
| 23 | P71 | plaidoyer et santé publique | Allemagne | A rédigé son propre prompt ; l'agent l'a raccourci et a demandé à d'autres IA de créer les images ; a effectué l'étape du terminal et une tâche de test supplémentaire de sa propre initiative pour se souvenir des touches du clavier | « Tâche terminée, envoyez la suivante. » |
| 24 | P22 | organisation communautaire à but non lucratif | non divulgué | A effectué la tâche du catalogue dans l'agent (certains sites ont bloqué sa connexion) ; a effectué l'étape du terminal puis a demandé à l'agent lui-même d'expliquer ce qui avait été fait ; a configuré des alertes de nouvelles par courriel | « Terminé, quoi de neuf ? » |
| 25 | P59 | vidéographe | États-Unis | A donné à l'agent un briefing détaillé pour trouver des annonces immobilières rentables sur son marché local (vérifications, pas de dépenses, classées par bénéfice) ; les résultats ne sont pas encore affichés | « Pourquoi aurais-je besoin d'une deuxième si la première fonctionne. » |
| 26 | P84 | non indiqué | non divulgué | A installé l'agent via le terminal lui-même ; construit un site web pour une organisation communautaire | « Fais quelque chose, mais je pense que nous devrions discuter. » |
| 27 | P66 | administrateur d'une structure de loisirs | non divulgué | A acheté un ordinateur portable pour le cours, installé l'agent et est passé du mode général à l'onglet de l'agent ; à l'étape d'ouverture de comptes auprès de dix IA | « Tout est dans une langue étrangère, quoi de neuf ? » |
| 28 | P82 | travail de sécurité ; construction d'un service de dispatch pour le transport routier | États-Unis | A installé ; a transféré ses conversations et ses projets d'un autre chatbot pour comparer les deux | - |
| 29 | P70 | recherche et montage vidéo pour les réseaux sociaux | États-Unis | A fait fonctionner l'agent avec l'aide d'un colocataire, après avoir d'abord créé un fichier de test à la main | - |
| 30 | P17 | avocate en droit international | non divulgué | Installation effectuée ; première tâche envoyée | « J'ai tout fait. » |
| 31 | P93 | professionnel d'aide directe dans les soins aux personnes âgées | non divulgué | Est passé du chat simple à l'agent et a payé ; première tâche envoyée | - |
| 32 | P54 | fabricant de gâteaux sur commande | non divulgué | A installé et payé sur un nouvel ordinateur portable ; première tâche envoyée | - |
| 33 | P26 | construction en béton | États-Unis | A installé sur un ordinateur portable réparé et en a envoyé une photo ; première tâche envoyée | « Et après » |
| 34 | P03 | directrice d'une entreprise de commerce extérieur | États-Unis | A installé avec P35 ; première tâche envoyée | - |
| 35 | P45 | contenu photo et vidéo, formation en programmation | Allemagne | A atteint l'étape d'ouverture de comptes auprès de dix IA, ce qui suppose un agent fonctionnant ; les détails n'ont pas été enregistrés | - |
Note : Compilé à partir du dossier des participants. Les lignes 1 à 24 sont la troisième ligne du tableau G1 ; les lignes 25 à 35 avaient installé l'agent et commencé sans résultat signalé au 9 octobre 2026. « - » signifie que le dossier ne contient aucune parole utilisable du participant pour cette période.
Comment les nouveaux venus parlent de diriger des agents. Des personnes qui quelques semaines auparavant n'avaient utilisé qu'un assistant de chat décrivent leur nouveau travail avec leurs propres mots. J'ai collecté chaque passage que le dossier des participants et les notes d'observation quotidienne fournissent avec les propres termes d'un participant, pour les 35 personnes qui ont installé un agent (161 passages de 32 personnes, environ 1 070 mots) et j'ai compté, en établissant une correspondance entre les radicaux des mots, les mots pour le système qu'ils dirigent, pour ce qu'ils en font et pour eux-mêmes ; les chiffres sont approximatifs, et « cela » comprend certains usages qui ne font pas référence à l'outil.
Tableau G1c. Mots que les nouveaux venus utilisent pour diriger des agents (occurrences dans leurs propres rapports).
| Ce que le mot désigne | Mots, traduits en catégories | Nombre |
|---|---|---|
| Le système qu'ils dirigent | « cela » | 35 |
| un nom de modèle ou de produit (Claude, GPT, Codex et autres) | 16 | |
| outil, programme, application | 11 | |
| « IA », « les IA » | 9 | |
| agent | 1 | |
| assistant, aide, travailleur | 0 | |
| Ce qu'ils en font | configurer, installer, exécuter | 10 |
| demander, questionner, solliciter | 9 | |
| tâche, instruction, prompt | 7 | |
| vérifier, comparer | 4 | |
| diviser, confier | 2 | |
| Eux-mêmes | développeur, débutant | 5 |
Quelques-unes de leurs propres paroles (citations en anglais ; celles marquées « (traduit) » ont été rédigées dans une autre langue et la traduction est la mienne) :
- « Cela ne se contente pas de répondre à des questions mais peut réellement travailler avec des fichiers et des documents. » (P18, marketing Internet)
- « L'une des plus grandes erreurs lors de l'utilisation de l'IA est de supposer qu'une réponse confiante est automatiquement correcte. » (P20, photographe et retoucheur)
- « Je me sens vraiment développeur maintenant. » (P21, organisation communautaire à but non lucratif)
- « Pour obtenir ce que je veux, je dois réfléchir à la façon de formuler la demande. » (P48, travail de bureau et ventes en ligne)
- « Je pense que la réponse ressemble à une question à deux personnes. » (P59, vidéographe)
- « Une fois, une IA donne le meilleur conseil, la fois suivante c'est l'autre qui gagne. » (P48, travail de bureau et ventes en ligne)
Trois passages plus longs montrent le changement avec la propre voix des participants. Un décorateur d'intérieur en formation, lors de sa première soirée avec un agent, avant que quiconque ne lui ait montré un conseil de modèles : « il a créé un dossier et a aussi bien fonctionné lui-même comme avec des documents ouvert [...] et à la fin j'ai obtenu deux fichiers appelés offres d'emploi de celui-ci offres d'emploi de celui-là et les ai aussi repris les ai envoyées l'une à l'autre pour qu'elles évaluent le travail de l'autre » (P01, traduit, à partir d'une transcription automatique d'un message vocal). Un alpiniste industriel, le jour où il a construit son premier petit programme avec un agent, demandant déjà le prochain rôle : « peut-être apprendre à construire des agents qui pourraient faire une partie du travail pour moi - publier sur les réseaux sociaux, me rappeler des choses, ou me faire des suggestions. » (P14). Et une participante dans le travail communautaire à but non lucratif, après ses premières semaines : « Je sens un vaste nouveau potentiel qui s'ouvre - comme si j'étais sur le seuil de quelque chose de nouveau. » (P21).
Ils nomment le système par son nom de produit ou simplement « il », presque jamais « agent », et aucun des titres sur la carte de la section 3 n'apparaît ; pourtant, ils parlent de fixer des tâches, de comparer deux réponses et de vérifier une réponse fiable, ce qui est le travail que la mesure compte. Comme dans la carte, la fonction arrive avant un nom pour elle, et ceci est offert comme une description, non comme un test d'une quelconque affirmation.
Les mêmes personnes participent aussi à un programme enregistré séparément (OSF, DOI 10.17605/OSF.IO/X4EGQ), dont les résultats y sont rapportés.
G2. L'étude Prolific des évaluateurs : les professionnels s'accordent-ils sur les heures de référence ?
La mesure évalue chaque travail en heures de référence, et la règle de la section 5.2 demande à deux spécialistes d'évaluer un travail en aveugle et appelle un tiers quand leurs estimations diffèrent de plus d'un facteur de 1,5. L'étude des évaluateurs demande si les professionnels en exercice s'accordent aussi étroitement. Elle a été enregistrée sur OSF comme une pré-pilote le 9 octobre 2026, avant la collecte de données (DOI 10.17605/OSF.IO/V92R8), et lancée sur Prolific le même jour.
Conception. Deux échantillons indépendants, 119 participants recrutés et rémunérés en tout : 60 comptables (rôle actuel comptable, aide-comptable, expert-comptable agréé ou certifié, auditeur ou spécialiste fiscal) et 59 développeurs web et logiciels (rôle actuel ingénieur logiciel, développeur logiciel ou développeur web). Tous vivent au Royaume-Uni, aux États-Unis, en Irlande, au Canada, en Australie ou en Nouvelle-Zélande, ont un taux d'approbation Prolific d'au moins 98 % sur au moins 100 soumissions précédentes, et participent à une seule étude. Chaque participant évalue les dix tâches de son propre domaine de la banque de tâches v0 (BK01 à BK10 ou WT01 à WT10, tels que figés dans pilot/task-bank-v0.csv) en heures de travail concentré pour un professionnel qualifié travaillant seul sans outils IA, évalue une tâche à nouveau (BK03 ou WT03) comme test-retest, et répond à une question de compétence et à une vérification de l'attention. Un participant qui échoue l'une ou l'autre est exclu et rémunéré ; une estimation qui n'est pas un nombre positif ou qui dépasse 2000 heures est abandonnée.
Résultats. Primaire : par domaine, la part des paires d'évaluateurs, sur toutes les tâches, dont les deux estimations se situent dans un ratio de 1,5, par rapport au seuil de 0,70 fixé dans le protocole d'étalonnage. Secondaire : la même part après suppression du niveau personnel de chaque évaluateur, ICC(2,1) sur les heures logarithmiques, la part test-retest dans 1,5, et l'estimation médiane de chaque tâche par rapport au degré que la banque visait. À titre de comparaison, les quatre évaluateurs modèles de l'Appendice E mettent 56 % de leurs paires sur ces 20 tâches dans 1,5 : 47 % sur les dix tâches de comptabilité et 65 % sur les dix tâches web. L'analyse est le script human_raters.py, déposé avec l'enregistrement OSF avant les données, et le résultat est rapporté quel qu'il soit.
Résultats.
Dépistage. Les participants ont été admis en fonction de la profession dans leur profil Prolific, et la plupart des réponses derrière les filtres de Prolific sont autodéclarées (Prolific, 2026), de sorte que la question de compétence était la seule vérification du métier dans la conception. Dans l'échantillon de comptabilité, c'était une question à choix multiples sur la comptabilité en partie double pour un paiement client reçu à la banque. Sur les 60 personnes admises dans cet échantillon, 11 (18 %) y ont répondu incorrectement, huit d'entre elles en inversant le débit et le crédit, et aucune n'a échoué la vérification de l'attention ; comme enregistré, elles sont exclues des résultats ci-dessous et ont été rémunérées. Dans une comparaison qui n'a pas été enregistrée, ces 11 ont évalué les tâches plus grandes de la banque à moins d'heures que les autres participants de l'échantillon : leurs médianes pour les trois tâches destinées au degré Semaine (BK08 à BK10) étaient 6, 6 et 8 heures, contre 8, 8 et 12 pour les autres 49. Avec 11 personnes, c'est une piste à tester, pas une estimation, et la hâte ou une question mal comprise laisserait une trace similaire ; cela correspond à la lecture qu'une personne qui ne connaît pas un métier ne voit pas toutes les étapes de ses tâches plus importantes (section 6.5). Dans l'échantillon des outils web, la même comparaison ne s'est pas répétée : les 8 développeurs qui ont échoué leur question de compétence ont donné les trois tâches destinées à la Semaine des médianes de 24,5, 27,5 et 19 heures, contre 20, 16 et 20 pour les autres 50, de sorte que la piste repose uniquement sur la comptabilité (analyses exploratoires ci-dessous).
Les scripts pour cette section se trouvent dans le dépôt compagnon (pilot/). prolific_to_long.py écrit le fichier long des évaluations à partir des exports Prolific ; il lit chaque estimation telle qu'écrite, conserve une réponse sans numéro ou avec plusieurs, comme une plage, comme texte afin que la règle enregistrée la supprime, et liste chaque réponse qui n'est pas un simple nombre. table_g2.py imprime le tableau G2 avec les fonctions du script enregistré appelées inchangées, à côté des évaluateurs modèles sur les mêmes tâches. screen_compare.py recalcule la comparaison du dépistage ci-dessus, avec l'intervalle exact et un test de permutation sur les évaluateurs pour les tâches de Semaine.
Accord. Les places ont été pourvues les 9 et 10 octobre 2026, et 118 participants ont laissé des réponses, 60 comptables et 58 développeurs ; les réponses d'un développeur, dont la soumission a été approuvée et rémunérée, n'ont pas été enregistrées par l'outil de sondage. Après les exclusions enregistrées (11 comptables et 8 développeurs ont échoué à la question de compétence ; aucun n'a échoué au contrôle d'attention), 49 comptables et 50 développeurs restent. Le seuil enregistré n'a été atteint dans aucun des deux domaines : 28 % des paires de comptables et 25 % des paires de développeurs se situaient dans un rapport de 1,5, contre 0,70 (tableau G3). Les professionnels ont ordonné les tâches de manière cohérente, les médianes de chaque domaine augmentant des tâches destinées à Heure à celles destinées à Semaine, mais ils ont divergé sur les heures au-delà de ce que la règle de deux évaluateurs permet. Retirer le niveau personnel de chaque évaluateur n'a augmenté la part que jusqu'à 34 % et 35 %, le désaccord porte donc sur le travail lui-même plutôt que sur une habitude d'arrondir vers le haut ou vers le bas. ICC(2,1) sur les heures logarithmiques était 0,34 pour la comptabilité et 0,46 pour les outils web, et les deux estimations d'un évaluateur pour la même tâche concordaient dans une marge de 1,5 en 53 % et 74 % des cas. Les quatre évaluateurs de modèle de l'Annexe E, à 56 % sur les mêmes 20 tâches, concordaient entre eux plus étroitement que les professionnels, ce qui en dit plus sur la dispersion des professionnels que sur la précision des modèles. Face aux praticiens, la banque se situe environ un échelon au-dessus : chaque tâche destinée à Jour avait une médiane de 2 à 7 heures, ce qui est Heure, et chaque tâche destinée à Semaine une médiane de 8 à 20 heures, ce qui est Jour. Dans la comparaison exploratoire ci-dessus, les 11 comptables exclus concordaient entre eux pas mieux que les autres (28 % des paires dans 1,5). Les résultats définissent trois volets de la règle d'évaluation. Les évaluateurs s'étalonnent sur des tâches aux durées mesurées, ce qui ancre le niveau que les médianes montrent être décalé. Une tâche est dimensionnée par la médiane d'un panel plutôt que par deux évaluateurs, car une dispersion de cette ampleur enverrait la plupart des paires à un tiers évaluateur. Et la banque de tâches est re-regroupée à partir des médianes des praticiens, ce qui abaisse ses tâches d'un échelon (tableau G3b).
Tableau G2. Accord des professionnels sur les heures de référence, par domaine.
| Domaine | Conservés | Exclus | Paires dans 1,5 | Après suppression du niveau d'évaluateur | ICC(2,1), heures logarithmiques | Test-retest dans 1,5 |
|---|---|---|---|---|---|---|
| Comptabilité | 49 | 11 | 0,283 | 0,335 | 0,335 (49 complets) | 0,531 (n = 49) |
| Outils web | 50 | 8 | 0,247 | 0,349 | 0,461 (49 complets) | 0,735 (n = 49) |
Note : Seuil enregistré pour les paires dans 1,5 : 0,70, non atteint dans aucun des deux domaines. Les exclusions sont des échecs à la question de compétence ; aucun participant n'a échoué au contrôle d'attention. Les paires sont prises sur les dix tâches d'un domaine (11 760 pour la comptabilité, 11 809 pour les outils web). Test-retest compare les deux estimations d'un évaluateur pour BK03 ou WT03. Résultat de human_raters.py tel qu'enregistré (DOI 10.17605/OSF.IO/V92R8).
Tableau G3b. Estimation médiane de chaque tâche par rapport à l'échelon que la banque visait (heures).
| Échelon visé | Tâche de comptabilité : médiane | Échelon de la médiane | Tâche d'outils web : médiane | Échelon de la médiane |
|---|---|---|---|---|
| Heure | BK01 : 2,0 ; BK02 : 2,0 ; BK03 : 1,5 | Heure | WT01 : 1,0 ; WT02 : 1,0 ; WT03 : 2,0 | Heure |
| Jour | BK04 : 3,0 ; BK05 : 2,0 ; BK06 : 3,0 ; BK07 : 4,0 | Heure | WT04 : 7,0 ; WT05 : 6,0 ; WT06 : 4,0 ; WT07 : 4,0 | Heure |
| Semaine | BK08 : 8,0 ; BK09 : 8,0 ; BK10 : 12,0 | Jour | WT08 : 20,0 ; WT09 : 16,0 ; WT10 : 20,0 | Jour |
Note : Médianes sur les évaluateurs conservés. Une médiane inférieure à 8 heures relève de Heure et une de 8 à moins de 40 heures relève de Jour. Chaque tâche visée pour Jour ou Semaine tombe un échelon plus bas.
Analyses exploratoires. Les analyses de ce paragraphe n'ont pas été enregistrées. Elles réutilisent le chargeur, les exclusions et le test enregistrés, et leur script et résultat sont pilot/exploratory_prolific.py et pilot/results/prolific-2026-10/exploratory-output.txt dans le dépôt complémentaire. Le rééchantillonnage des évaluateurs place les intervalles à 95 % de 0,24 à 0,33 (tenue de livres) et 0,21 à 0,29 (outils web) sur la part primaire. Taille du panel (Tableau G4). Pour chaque tâche, deux panels disjoints de k évaluateurs conservés ont été tirés 2 000 fois et leurs médianes comparées. Sur les estimations brutes, les deux médianes ont concordé à moins de 1,5 dans au moins 70 % des tirages seulement à partir de 15 comptables ou 21 développeurs par panel. Avec le niveau personnel de chaque évaluateur supprimé, ce que l'étalonnage sur les tâches avec des temps mesurés est censé faire, les panels de sept ont atteint 0,71 et 0,69, et les panels de neuf 0,77 et 0,76. Atterrir sur le même échelon, ce que la mesure enregistre, en nécessite moins : cinq évaluateurs étalonnés par panel l'ont fait dans 0,81 et 0,84 des tirages. Selon la règle des deux évaluateurs de la section 5.2, un troisième évaluateur serait appelé sur 72 % et 75 % des pièces. Expérience (Tableau G4b). 43 des 98 évaluateurs conservés avec des réponses complètes ont déclaré plus de 10 ans d'expérience dans leur domaine. Ils n'ont pas concordé entre eux plus étroitement que les autres, et les années dans le domaine n'ont pas prédit à quelle distance un évaluateur se situait par rapport à la médiane des autres (corrélation de rang +0,18 et −0,10, permutation p = 0,21 et 0,47). Les développeurs seniors ont estimé plus haut que les autres développeurs (1,32 par rapport à 0,76 fois la médiane des autres, p = 0,02) ; les comptables seniors ne l'ont pas fait (1,04 par rapport à 1,07, p = 0,88). Tâches. Le désaccord croît avec la taille : cinq des six les plus contestées des 20 tâches étaient des tâches destinées à la semaine, où 24 % (tenue de livres) et 20 % (outils web) des paires se situaient dans les 1,5, contre 31 % et 27 % sur les tâches destinées à l'heure ; l'intervalle interquartile d'une tâche de semaine s'étendait sur un facteur de 4 à 8. Vitesse et unités. Le quart le plus rapide des comptables (3,6 minutes ou moins pour l'ensemble du sondage) a concordé plus étroitement que le reste (0,37 contre 0,26), et parmi les développeurs, la vitesse n'a fait aucune différence (0,24 contre 0,24). Répondre à certaines tâches en minutes plutôt qu'en heures n'a fait aucune différence dans l'un ou l'autre domaine (0,31 contre 0,31 ; 0,28 contre 0,31). Deux comptables ont consacré 40 heures ou plus à une tâche destinée à l'heure, ce qui ressemble à des minutes tapées comme des heures ; sans eux, la part de tenue de livres est 0,284. Un développeur conservé a tapé du texte au lieu de chiffres, de sorte qu'une seule de ses estimations est entrée dans l'analyse. Dépistage. En comparant les estimations de chaque évaluateur pour les tâches de semaine avec ses propres estimations pour les tâches d'heure, de sorte qu'un niveau personnel s'annule, les comptables exclus ont évalué les tâches plus grandes 3,2 fois les plus petites par rapport à 6,2 fois pour les conservés (permutation p = 0,10), et les développeurs exclus 15,8 fois par rapport à 10,6 (p = 0,37). Retest. L'estimation répétée était plus élevée que la première pour 25 comptables et inférieure pour 4, et plus élevée pour 17 développeurs et inférieure pour 2 (test de signe exact p < 0,001 dans les deux cas), d'environ 30 % sur la moyenne géométrique, ce qui est compatible avec l'ancrage sur les tâches plus grandes évaluées entre-temps. Ensemble, ces résultats placent l'écart dans le travail et son échelle plutôt que dans un sous-groupe d'évaluateurs pressés, juniors ou non qualifiés, et ils dimensionnent le panel que la règle nécessite : des évaluateurs étalonnés, cinq à neuf par pièce, notés par échelon (Tableau G4).
Tableau G4. Deux panels indépendants de k évaluateurs par tâche : part des tirages dont les médianes concordent dans les 1,5 / part sur le même échelon (exploratoire).
| Évaluateurs par panel | Tenue de livres, brut | Tenue de livres, niveau supprimé | Outils web, brut | Outils web, niveau supprimé |
|---|---|---|---|---|
| 1 | 0,28 / 0,51 | 0,34 / 0,62 | 0,24 / 0,46 | 0,34 / 0,60 |
| 3 | 0,43 / 0,68 | 0,51 / 0,76 | 0,37 / 0,60 | 0,52 / 0,78 |
| 5 | 0,51 / 0,77 | 0,63 / 0,81 | 0,43 / 0,68 | 0,62 / 0,84 |
| 7 | 0,58 / 0,82 | 0,71 / 0,84 | 0,49 / 0,74 | 0,69 / 0,87 |
| 9 | 0,62 / 0,85 | 0,77 / 0,87 | 0,54 / 0,78 | 0,76 / 0,89 |
| 15 | 0,71 / 0,88 | 0,88 / 0,91 | 0,64 / 0,84 | 0,86 / 0,94 |
| 21 | 0,76 / 0,89 | 0,94 / 0,95 | 0,72 / 0,84 | 0,92 / 0,98 |
Note : Évaluateurs conservés avec les dix estimations (49 par domaine) ; 2 000 tirages par tâche, panels disjoints dans un tirage ; seed 20261011. Niveau supprimé : le log ratio moyen de chaque évaluateur par rapport à la médiane de tous les évaluateurs sur chaque tâche est soustrait en échantillon, comme dans le résultat secondaire enregistré, de sorte que ces colonnes constituent une estimation supérieure de ce que l'étalonnage sur des tâches d'ancrage distinctes donnerait. Non enregistré ; résultat de pilot/exploratory_prolific.py.
Tableau G4b. Années dans le domaine et concordance (évaluateurs conservés avec réponses complètes, exploratoire).
| Domaine | Groupe | Évaluateurs | Paires dans les 1,5 au sein du groupe | Niveau par rapport à la médiane des autres |
|---|---|---|---|---|
| Tenue de livres | Plus de 10 ans | 23 | 0,268 | 1,04 |
| Tenue de livres | 10 ans ou moins | 26 | 0,299 | 1,07 (p = 0,88) |
| Outils web | Plus de 10 ans | 20 | 0,297 | 1,32 |
| Outils web | 10 ans ou moins | 29 | 0,242 | 0,76 (p = 0,02) |
Note : Le niveau est le ratio de moyenne géométrique des estimations d'un évaluateur à la médiane des autres évaluateurs sur les mêmes tâches ; p est un test de permutation bilatéral (5 000 permutations) de la différence de niveau log moyen. Non enregistré.
Comment citer
Chernets, V. (2026). Au-delà de la division des programmeurs : une mesure pour les personnes qui construisent par le biais d'agents IA [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}