कमजोर रूप से विभेदकारी, प्रोफाइल इंजेक्शन द्वारा मरम्मत नहीं की गई, और हेराफेरी योग्य: LLM मूल्यांकन में आत्म-आत्मविश्वास
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
NeurIPS 2026 कार्यशाला "TAE (Trust-AI-Eval): क्या हम AI मूल्यांकन पर विश्वास कर सकते हैं?" (गैर-संग्रहीय) में एक पोस्टर के रूप में स्वीकृत। संग्रहीत प्रति: 10.5281/zenodo.23197651। PDF: self-confidence-evaluation.pdf। नीचे दिए गए आंकड़े और तालिकाएँ LaTeX स्रोत से परिवर्तित हैं; PDF आधिकारिक है।
सारांश
मूल्यांकन पाइपलाइनें तेजी से एक मॉडल के अपने बयान किए गए आत्मविश्वास को विश्वास संकेत के रूप में उपयोग करती हैं—एक न्यायाधीश-विश्वसनीयता भार के रूप में, एक परित्याग ट्रिगर के रूप में, या एक आत्म-रिपोर्ट की गई दक्षता प्रोफाइल के रूप में। हम परीक्षण करते हैं कि क्या उस संकेत को वजन के योग्य है, एक पूर्व-पंजीकृत, प्रोटोकॉल-जमे हुए संग्रह का उपयोग करके (16 मॉडल—नौ प्रदाताओं में से प्रत्येक से एक बजट/मध्य-स्तरीय API मॉडल, साथ ही सात स्थानीय ओपन-वेट; 22,248 ग्रेड किए गए उत्तर तापमान शून्य पर 0–100 आत्मविश्वास के साथ)। चार निष्कर्ष। (1) अधिक आत्मविश्वास सभी सोलह मूल्यांकित मॉडलों में सुसंगत है: विशिष्ट बयान किया गया आत्मविश्वास नौ API मॉडलों में से सात के लिए 85–95 पर बैठता है जबकि सटीकता 16.5–66.5% तक फैली हुई है, और 60.1% सीमांत उत्तर आत्मविश्वास के साथ बयान किए गए 80 गलत हैं। (2) स्व-आत्मविश्वास कमजोर रूप से विभेदकारी है: मॉडल की अपनी शुद्धता की भविष्यवाणी के लिए इसका AUROC 0.532–0.788 तक फैला हुआ है और नौ मॉडलों में से छह के लिए 0.62 से नीचे बैठता है। (3) स्वतंत्र मॉडलों का एक पैनल 0.832 AUROC तक पहुंचता है जहां स्व-मूल्यांकन 0.545 देता है ( , 95% CI ); पैनल समझौते की कड़ी लेबल-मुक्त पुनः कोडिंग के तहत पैनल अभी भी आगे है (0.775 बनाम 0.545)। (4) मॉडल की अपनी मापी गई प्रति-डोमेन सटीकता प्रोफाइल को इंजेक्ट करना प्लेसीबो-नियंत्रित एकल-विक्रेता सीढ़ी के एक पुष्टि रंग पर भेदभाव में स्पष्ट रूप से सुधार नहीं करता (AUROC , Holm-समायोजित ), जबकि समान इंजेक्शन चैनल कारणात्मक रूप से हेरफेर योग्य है: एक झूठी प्रोफाइल ने एक खोजपूर्ण रंग के स्व-मूल्यांकन AUROC को संयोग स्तर (0.474) तक संचालित किया और, एक बार जब आइटम विषय-लेबल किए जाते हैं, तो पाँच स्थानीय मॉडलों में से चार में कैलिब्रेशन को बिगाड़ा। हम यह निष्कर्ष निकालते हैं कि स्व-मूल्यांकित आत्मविश्वास, जैसा कि वर्तमान में खुले-रूप तथ्यात्मक पुनरावृत्ति में मौखिक पूर्णांक आत्मविश्वास पर मापा जाता है, माप का लक्ष्य है, विश्वास का इनपुट नहीं: ऐसे हार्नेस जो स्व-रिपोर्ट की गई दक्षता का उपभोग करते हैं, एक अप्रमाणित इनपुट चैनल को विरासत में प्राप्त करते हैं। शीर्षक के तीन खंड विभिन्न साक्ष्यों पर आराम करते हैं और हम उन्हें पूरे समय लेबल करते हैं: कमजोर रूप से विभेदकारी सोलह मॉडलों में पुष्टि है; प्रोफाइल इंजेक्शन द्वारा मरम्मत नहीं की गई एक विक्रेता परिवार पर एक पुष्टि रंग है, देखी गई प्रभाव के लिए कम शक्तिशाली; हेरफेर योग्य अन्वेषणात्मक है, मिलान किए गए आइटमों पर कारणात्मक दिशा दिखाई गई है लेकिन तैनात किए गए हार्नेस पर कोई परीक्षण किया गया हमला नहीं। न्यायाधीश-शैली का स्व-मूल्यांकन, जहां एक मॉडल दूसरे मॉडल के उत्तर को रेट करता है, एक अलग कार्य है और यहां परीक्षण नहीं किया गया है।
परिचय
आधुनिक मूल्यांकन अभ्यास चुपचाप एक मॉडल के कथित आत्मविश्वास को एक मापन उपकरण के रूप में मानता है: LLM न्यायाधीश निश्चितता के अंक की रिपोर्ट करते हैं, एजेंट ढांचे आत्म-मूल्यांकित क्षमता पर निर्भर करते हैं, परित्याग नीतियां मौखिक अनिश्चितता पर ट्रिगर करती हैं, और अंशांकन बेंचमार्क मान लेते हैं कि आत्म-रिपोर्ट चैनल कम से कम ईमानदार है। यह धारणा सुविधाजनक है—आत्म-रिपोर्ट मुफ़्त हैं, हमेशा उपलब्ध हैं, और उत्तर के समान पास में उत्पन्न होती हैं—और इसे खपत के बिंदु पर लगभग कभी भी जांचा नहीं जाता है। हम पूर्व प्रश्न पूछते हैं: आत्म-मूल्यांकन संकेत कितना विभेदक है, क्या इसे मॉडल की अपनी मापी गई प्रोफ़ाइल के साथ मरम्मत की जा सकती है, और क्या इसे हेरफेर किया जा सकता है?
हम एक पूर्व-पंजीकृत, प्रोटोकॉल-जमे हुए, अंधे संग्रह के साथ उत्तर देते हैं: सोलह मॉडल (नौ प्रदाताओं में से प्रत्येक से एक बजट/मध्य-स्तरीय API मॉडल, साथ ही सात स्थानीय खुले-वजन), प्रत्येक में 1,500 2023 के बाद की तथ्यात्मक प्रश्नें, तापमान शून्य, हर उत्तर के साथ कथित 0–100 आत्मविश्वास—22,248 ग्रेडेड उत्तर, सभी विश्लेषण कच्चे से नियतात्मक। इस मापन मानक के विरुद्ध, आत्म-रिपोर्ट चैनल तीन क्रमिक रूप से अधिक दयालु परीक्षाओं में विफल हो जाता है।
C1 (कमजोर रूप से विभेदक)। कथित आत्मविश्वास संतृप्त और दक्षता से असंबंधित है: प्रति-मॉडल मेडियन नौ API मॉडल में से सात के लिए 85–95 पर बैठते हैं जबकि सटीकता 16.5–66.5% तक फैली हुई है, और सीमांत उत्तरों का 60.1% जो आत्मविश्वास के साथ कथित है 80 गलत हैं। मॉडल की अपनी प्रति-आइटम सही होने की भविष्यवाणी के रूप में, आत्म-आत्मविश्वास केवल 0.532–0.788 AUROC तक पहुंचता है, यह मॉडल पर निर्भर करता है—हर बूटस्ट्रैप CI संयोग को बाहर करता है, लेकिन नौ में से छह मॉडल 0.62 से नीचे बैठते हैं, और यहां तक कि उनमें से सबसे अच्छे पर चयनात्मक भविष्यवाणी भी पर्याप्त अवशिष्ट त्रुटि छोड़ जाती है (अनुभाग 4)। स्वतंत्र मॉडलों का एक पैनल 0.832 तक पहुंचता है जहां आत्म-मूल्यांकन 0.545 देता है—एक लाभ जो पैनल समझौते की सख्त लेबल-मुक्त पुनः कोडिंग में भी बना रहता है—जबकि दूसरे पैनल पर स्पष्ट प्रति-उदाहरण बड़े हिस्से में मॉडल-आइटम आत्म-ज्ञान के बजाय मॉडल के बीच पहचान को दर्शाता है (अनुभाग 4 में अपघटन); यह पहचान करना कि किस मॉडल की आत्म-रिपोर्ट अच्छी तरह से भेद करती है, अभी भी स्वतंत्र मापन की आवश्यकता है जो आत्म-रिपोर्ट को बदलने का इरादा रखती थी।
C2 (प्रोफ़ाइल इंजेक्शन से कोई पुष्टिकारी मरम्मत नहीं)। सबसे प्रत्यक्ष मरम्मत—उत्तर समय पर मॉडल को इसकी अपनी मापी गई प्रति-डोमेन सटीकता प्रोफ़ाइल सौंपना—एक जमे हुए, प्लेसबो-नियंत्रित सीढ़ी प्रयोग के एक पुष्टिकारी रंग पर प्लेसबो प्रोफ़ाइल को महत्वपूर्ण रूप से नहीं मारा (AUROC , कच्चा , Holm-समायोजित ; कोई पुष्टिकारी समापन बिंदु पारित नहीं हुआ)। हम इसे प्रवृत्ति के रूप में नहीं, एक शून्य के रूप में रिपोर्ट करते हैं (अनुभाग 5)।
C3 (हेरफेर योग्य)। इंजेक्शन चैनल जो मरम्मत का उपयोग करेगी जालसाजी स्वीकार करता है: एक शफल (गलत) प्रोफ़ाइल ने एक अन्वेषणात्मक सीमांत रंग के आत्म-मूल्यांकन AUROC को संयोग स्तर तक चलाया (0.474 बनाम 0.710; ड्रॉप ), एक एकल जालसाजी "95% सटीकता" दावा एक स्थानीय मॉडल के कथित आत्मविश्वास को एक ऐसी चीज़ पर 50 से 95 तक ले गया जिसे वह गलत मानता है, और एक बार जब आइटम विषय-लेबल किए जाते हैं, तो पांच स्थानीय मॉडल में से चार एक गलत प्रोफ़ाइल का उपभोग करते हैं अपने नुकसान के लिए (Brier से ; अनुभाग 6)।
एक साथ ये परिणाम भूमिका परिवर्तन के लिए तर्क देते हैं: आत्म-मूल्यांकित आत्मविश्वास को मूल्यांकन का एक मापा लक्ष्य होना चाहिए, न कि एक अनुचित इनपुट। अनुभाग 7 न्यायाधीश पाइपलाइन, एजेंट रूटिंग, और कठोर डिजाइन के परिणामों को स्पष्ट करता है; सहायक पेपर (Chernets, 2026) पैनल-आधारित विकल्प की विफलता के तरीकों की जांच करता है और यहां उद्धृत किया गया है, पुनः कथन नहीं किया गया है।
संबंधित कार्य
मौखिक आत्मविश्वास और अंशांकन। आधुनिक नेटवर्क का गलत अंशांकन एक दीर्घकालीन खोज है (Guo et al., 2017), और QA-ट्यून किए गए भाषा मॉडलों के लिए अंशांकन वर्तमान मॉडल पीढ़ी से बहुत पहले ही अपर्याप्त पाया गया था (Jiang et al., 2021)। मॉडलों को शब्दों में अनिश्चितता व्यक्त करने के लिए सिखाया जा सकता है (Lin et al., 2022b) और बड़े मॉडल आत्म-मूल्यांकन जांचों पर आंशिक रूप से "जानते हैं कि वे क्या जानते हैं" (Kadavath et al., 2022), फिर भी वे बड़ी हद तक यह पहचानने में विफल रहते हैं कि वे क्या नहीं जानते (Yin et al., 2023); प्राप्त आत्मविश्वास की अनुभवजन्य जांचें विभिन्न प्राप्ति प्रारूपों में लगातार अति आत्मविश्वास खोजती हैं (Xiong et al., 2024), मौखिक स्कोर कभी-कभी टोकन संभावनाओं की तुलना में बेहतर अंशांकित होते हैं फिर भी फिर भी फूले हुए होते हैं (Tian et al., 2023)। आंतरिक-स्थिति जांच फ्रेम को तीव्र करती है: छिपी हुई-परत सक्रियताओं पर सरल वर्गीकारक 71–83% पर सत्यता प्राप्त करते हैं (Azaria and Mitchell, 2023)—विफलता मौखिक आउटपुट चैनल में रहती है, आवश्यक नहीं कि आंतरिक प्रतिनिधित्व में। हमारा योगदान स्केल और डिज़ाइन है: एक पूर्व-पंजीकृत, जमी हुई, 16-मॉडल अंधा संग्रह जो समान प्राप्ति को जमीनी सत्य के विरुद्ध और समान वस्तुओं पर स्वतंत्र-पैनल सहमति के विरुद्ध स्कोर करता है—साथ ही दो प्रश्न जो यह साहित्य शायद ही कभी पूछता है: क्या संकेत को मॉडल के स्वयं के मापा गए प्रोफाइल से मरम्मत की जा सकती है, और क्या मरम्मत चैनल पर हमला किया जा सकता है?
डाउनस्ट्रीम स्व-रिपोर्ट का उपभोग। LLM-as-judge पाइपलाइनें न्यायाधीश पूर्वाग्रहों और विश्वसनीयता सीमाओं को प्राप्त करती हैं (Zheng et al., 2023), और सहमति-आधारित आत्मविश्वास संकेत स्वयं ही ऑडिट के अधीन हैं (Ding, 2026); शब्दार्थ-एन्ट्रॉपी डिटेक्टर (Farquhar et al., 2024) स्व-रिपोर्ट को दरकिनार करते हुए उत्तर वितरण को मापते हैं। तीसरे पक्ष की मूल्यांकन फ्रेमवर्क स्वतंत्र माप के लिए शासन मामला बनाते हैं (Raji et al., 2022); हम इसे एक मात्रात्मक तल देते हैं: नौ API मॉडलों में से छह के लिए, पाइपलाइन जो स्व-रिपोर्ट का उपभोग करेगा वह 0.62 से नीचे का AUROC रखता है।
अविश्वस्त इनपुट। अप्रत्यक्ष प्रॉम्प्ट इंजेक्शन दिखाता है कि LLM द्वारा ग्रहण किए गए किसी भी पाठ चैनल एक हमले की सतह है (Greshake et al., 2023)। खंड 6 एक विशिष्ट, अब तक अनाम उदाहरण का पता लगाता है: स्व-सक्षमता प्रोफाइल स्लॉट जो अंशांकन मरम्मत का उपयोग करेगी, एक प्रमाणीकृत इनपुट चैनल है, और इसे जाली करने से भेदभाव मौका स्तर तक गिरता है।
पैनल और उनकी स्वयं की विफलताएं। विविध मॉडलों के पैनल एक तेजी से मानक मूल्यांकन साधन हैं (Verga et al., 2024)। पैनल संकेत जिसे हम तुलनाकार के रूप में उपयोग करते हैं, वह एक निःशुल्क दोपहर का भोजन नहीं है: इसकी विफलता के शासन (कठिनाई व्युत्क्रमण, सीमित उत्तर रिक्त स्थान, लेबल-आधारित स्वतंत्रता धारणाएं, अनुरूपता) एक साथी सबमिशन में मापा जाता है (Chernets, 2026) समान कच्चे संग्रह पर; यह पत्र स्व-आकलन कहानी की मालिकी करता है, साथी पैनल कहानी की मालिकी करता है, और दोनों के बीच कोई तालिका डुप्लिकेट नहीं है।
बेंचमार्क। हम एक post-2023 SimpleQA सबसेट पर प्राप्ति करते हैं (Wei et al., 2024) बिल्कुल 2021-विंटेज TruthfulQA के विरुद्ध मापी गई बेंचमार्क-आयु अंतराल के कारण (Lin et al., 2022a) (खंड 3)।
पूर्व-पंजीकृत प्रयोग: डिजाइन और डेटा
एक पूर्व-पंजीकृत, अंधा संग्रह, प्रोटोकॉल सार्वजनिक रूप से पुष्टिकारी डेटा से पहले जमे हुए: सोलह मॉडल (नौ प्रदाताओं में से प्रत्येक प्रदाता के लिए एक बजट/मध्य-स्तरीय एपीआई मॉडल, साथ ही सात स्थानीय खुले-वजन) ने समान 1,500 पोस्ट-2023 तथ्यात्मक प्रश्नों (SimpleQA सबसेट) का उत्तर तापमान शून्य पर दिया, प्रत्येक उत्तर के साथ 0–100 आत्मविश्वास का कथन; कुल 22,248 ग्रेडेड उत्तर (13,446 अग्रणी, 8,802 स्थानीय)।
पूर्व-पंजीकरण और जमना।
संग्रह प्रोटोकॉल को किसी भी पुष्टिकारी डेटा के अस्तित्व से पहले सार्वजनिक पंजीकरण में जमा दिया गया था (पुनरुत्पादनशीलता परिशिष्ट में एक्सेस मार्ग)। पंजीकरण बेंचमार्क और सबसैम्पल को पूर्व-निर्दिष्ट करता है (यादृच्छिक , निश्चित बीज, सबसैम्पल फ़ाइल का SHA-256 दर्ज), मॉडल रोस्टर, निष्कर्षण प्रारूप, ग्रेडिंग प्रक्रिया, विश्लेषण योजना—जिसमें खंड 4 में उपयोग किए गए पैनल समझौते बनाम अपने आत्मविश्वास की AUROC तुलना, एक पूर्व-निर्दिष्ट माध्यमिक मीट्रिक (पंजीकरण का प्राथमिक समापन बिंदु, पैनल असहमति का आत्मविश्वास-त्रुटि ध्वज दर, एक पैनल-पक्षीय मात्रा है जो साथी प्रस्तुति में रिपोर्ट की गई है)—और पोस्ट-हॉक मीट्रिक चयन के विरुद्ध एक निर्णय नियम। एक छोटे खोजपूर्ण पायलट (95 TruthfulQA आइटम, तीन स्थानीय मॉडल) पाइपलाइन की जांच करने के लिए जमने से पहले चला; इसकी संख्याएं कभी भी पुष्टिकारी डेटा के साथ मिश्रित नहीं होती हैं।
मॉडल और निष्कर्षण।
उनके एपीआई के माध्यम से नौ अग्रणी प्रदाता—प्रत्येक प्रदाता के लिए एक बजट/मध्य-स्तरीय मॉडल, इसलिए नीचे प्रदाता के नाम एकल मॉडल को लेबल करते हैं, उत्पाद लाइनों को नहीं (पुनरुत्पादनशीलता परिशिष्ट में सटीक मॉडल आईडी और संग्रह तिथियां)—और सात स्थानीय खुले-वजन मॉडल। प्रत्येक मॉडल तापमान 0 पर प्रत्येक आइटम का स्वतंत्र रूप से उत्तर देता है और समान प्रतिक्रिया में 0–100 का एक पूर्णांक आत्मविश्वास बताता है; पैनल इस एकल अंधे संग्रह के विश्लेषणात्मक संयोजन हैं—कोई मॉडल कभी किसी अन्य मॉडल का आउटपुट नहीं देखता है।
ग्रेडिंग।
सोने के लिए सामान्यीकृत स्ट्रिंग समतुल्यता और इंकार की गई गई पहचान पहले; अनसुलझे खुले-रूप के मामले एक स्थानीय खुले-वजन एलएलएम ग्रेडर को जाते हैं जो केवल सोने के लिए समतुल्यता के लिए प्रतिबंधित है (qwen3:8b, स्थानीय)। एक 50-आइटम मानव स्पॉट-चेक ने 98% समझौता पाया (एक रूढ़िवादी त्रुटि); 342 सबसे कठिन-परत सर्वसम्मति निर्णय के क्रॉस-परिवार ऑडिट ने 342/342 सहमत किया (सीमाएं)। कोई बहिष्कार नहीं सिवाय पार्स विफलताओं के (रिपोर्ट किया गया); वे एक स्थानीय तर्क मॉडल में केंद्रित होते हैं, जो केवल 1,500 में से 98 ग्रेडेबल उत्तर रखता है—सभी स्थानीय-स्तरीय दावे प्रति-मॉडल ले जाते हैं। सभी पुष्टिकारी विश्लेषण कच्चे JSONL से निर्धारणीय हैं।
बेंचमार्क पसंद, मापा गया।
पोस्ट-2023 प्राथमिक बेंचमार्क एक डिजाइन निर्णय है जो माप द्वारा न्यायसंगत है, अनुमान द्वारा नहीं: एक खोजपूर्ण बेंचमार्क-आयु तुलना में, समान मॉडल ने 2021-विंटेज TruthfulQA MC पर से प्रतिशत अंक अधिक स्कोर किया पोस्ट-2023 SimpleQA से (deepseek pp, 95% CI ; mistral ; zhipu ; उदाहरण के लिए, 89.2% बनाम 28.4%)—एक अंतराल जो बेंचमार्क-आयु और एक्सपोजर प्रभावों के साथ सुसंगत है, हालांकि यह डिजाइन संदूषण को कठिनाई और निर्माण अंतरों से अलग नहीं कर सकता। कोई शीर्षक संख्या पुराने बेंचमार्क पर आधारित नहीं है; स्थानीय स्तर पर 750-आइटम TruthfulQA MC1 आर्म का उपयोग केवल वहां किया जाता है जहां इसे इस तरह लेबल किया गया हो।
पूर्व-पंजीकृत बनाम खोजपूर्ण।
पूर्व-पंजीकृत और पुष्टिकारी: उपरोक्त संग्रह और पैनल-बनाम-अपने AUROC तुलना (खंड 4)। खोजपूर्ण, और जहां भी उपयोग किया जाता है वहां इस तरह लेबल किया गया: बेंचमार्क-आयु तुलना आर्म, खंड 6 की सीमांत प्रोफ़ाइल-इंजेक्शन और स्थानीय माइक्रोप्रोब। खंड 5 की प्रोफ़ाइल-इंजेक्शन सीढ़ी एक अलग जमी हुई, प्लेसिबो-नियंत्रित प्रोटोकॉल है (भुजाएं, समापन बिंदु, और Holm परिवार इसके पुष्टिकारी चरण से पहले तय किए गए)।
परिणाम 1: आत्मविश्वास गलत अंशांकित है और कमजोर रूप से विभेदकारी है
हम दो गुणों को अलग करते हैं जिन्हें "अंशांकन" शब्द अक्सर मिला देता है: बड़े पैमाने पर अंशांकन (क्या आत्मविश्वास स्तर सटीकता स्तर से मेल खाता है?) और विभेद (क्या आत्मविश्वास एक मॉडल के अपने सही उत्तरों को गलत उत्तरों से ऊपर रखता है?)।
अंशांकन। व्यक्त किया गया आत्मविश्वास संतृप्त है और क्षमता से अलग है: नौ API मॉडल में, व्यक्त किया गया आत्मविश्वास नौ में से सात के लिए 85–95 (प्रति मॉडल माध्यिका) पर बैठता है जबकि सटीकता 16.5–66.5% में फैली हुई है; दो अलग हैं—इनकार-भारी मॉडल (10.3% सटीकता पर माध्यिका 42) और एक विकीर्ण-आत्मविश्वास मॉडल (माध्यिका 60)। हर मॉडल बड़े पैमाने पर अत्यधिक आत्मविश्वास रखता है: आत्मविश्वास-माइनस-सटीकता अंतराल (CITL, तालिका 1) से प्रतिशत बिंदु तक फैला है। ECE कॉलम लगभग CITL के बराबर है: आत्मविश्वास–सटीकता अंतराल नौ में से सात मॉडल के लिए हर भरे हुए बिन में सकारात्मक है (अन्य दो में से एक को छोड़कर), इसलिए बिन वाला और वैश्विक गलत अंशांकन संयोग करते हैं। यहां तक कि इनकार-भारी मॉडल pp (ECE 0.310) बनाए रखता है—इसकी निम्न बैंड इनकार व्यवहार को दर्शाती है, न कि अंशांकित आत्म-ज्ञान को। इसका विभेद लाभ का एक हिस्सा इसी तरह यांत्रिक हो सकता है—कम व्यक्त किए गए आत्मविश्वास पर गलत श्रेणीबद्ध इनकार AUROC को बढ़ाते हैं (इनकार पंक्तियों को छोड़कर यह 0.660 है, )—इसलिए हम इसके 0.788 को प्राप्त आत्म-ज्ञान पर एक ऊपरी सीमा के रूप में पढ़ते हैं, न कि अंशांकन रैंकिंग के रूप में। नौ API मॉडल में समूहीकृत, 80 आत्मविश्वास के साथ बताए गए 60.1% उत्तर गलत हैं (9,310 में से 5,598); प्रति-मॉडल दर 29.0–83.2% में फैली है (मैक्रो-औसत 57.6%)। एक उपभोक्ता जो उच्च व्यक्त किए गए आत्मविश्वास पर विश्वास करता है, त्रुटियों के बहुमत को स्वीकार करता है। विभेद। मॉडल की अपनी सटीकता के भविष्यवक्ता के रूप में, आत्मविश्वास मॉडल के आधार पर AUROC 0.532–0.788 प्राप्त करता है। Bootstrap 95% CI (तालिका 1) हर मॉडल के लिए 0.5 को छोड़ देते हैं, इसलिए संकेत शाब्दिक रूप से यादृच्छिक नहीं है—लेकिन नौ में से छह मॉडल के लिए यह 0.62 से नीचे है। परिणाम परिचालन है: 20% कवरेज पर (केवल शीर्ष-आत्मविश्वास पाचन भाग की वस्तुओं का उत्तर देते हुए), तीन मजबूत आत्म-AUROC मॉडल की त्रुटि दरें अभी भी 75.3%, 33.3%, और 15.1% हैं (तालिका 2)—तीसरे के लिए केवल एक अर्थपूर्ण कमी, और अन्य दोनों के लिए एक विश्वास द्वार से बहुत दूर।
एक वास्तुकला विकल्प—स्वतंत्र मॉडल जो सहमत हों—AUROC 0.832 (95% CI ) तक पहुंचता है उस पैनल पर जहां स्व-मूल्यांकन 0.545 () देता है; आइटम-क्लस्टर्ड अंतर, , शून्य को एक विस्तृत हाशिए से बाहर रखता है। तीन पूर्व-निर्दिष्ट पैनल: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), क्रॉस-ब्लॉक (Anthropic, DeepSeek, Mistral); शीर्षक तुलना CN पैनल है। दूसरे पूर्व-निर्दिष्ट पैनल पर पूलित तुलना प्रतीत होता है कि उलट जाती है: स्व-मूल्यांकन 0.842 पैनल जनसंख्या पर पूलित बनाम पैनल 0.697; । एक अपघटन दिखाता है कि यह स्पष्ट उलट मुख्य रूप से मॉडल पहचान को प्रतिबिंबित करता है न कि प्रति-आइटम स्व-ज्ञान को: पूलित 0.842 तीन मॉडल को मिलाता है जिनके भीतर-मॉडल स्व-AUROCs केवल 0.596–0.784 हैं (मैक्रो-औसत 0.709; पैनल-जनसंख्या मान—तालिका 1 पूर्ण ग्रेडेड सेट की रिपोर्ट करता है), और भीतर-मॉडल रैंक सामान्यीकरण के बाद (जो मॉडल के बीच स्तर के अंतर को हटाता है जबकि प्रत्येक मॉडल की अपनी रैंकिंग को संरक्षित करता है) पूलित मान 0.672 तक गिरता है—एक मॉडल-पहचान योगदान। 0.545 पैनल एक ही जांच पास करता है (0.545 पूलित बनाम 0.582 रैंक-सामान्यीकृत): इसकी स्व-मूल्यांकन विफलता सच में प्रति-आइटम है। जो उलट का बचता है वह एक संकीर्ण कथन है: सर्वाधिक अस्वीकृति-भारी मॉडल जिसके पास सबसे मजबूत स्व-आत्मविश्वास भेदभाव है (पूर्ण ग्रेडेड सेट पर 0.788) वास्तव में इस पैनल के सहमति संकेत को बेहतर बनाता है—और यह पहचानना कि वह मॉडल कौन सा है वह स्वतंत्र माप की आवश्यकता है जिसे आप स्व-रिपोर्ट को प्रतिस्थापित करने का इरादा रखते थे। तीसरा पूर्व-निर्दिष्ट पैनल (क्रॉस-ब्लॉक) दोनों के बीच पड़ता है: पैनल 0.722 बनाम अपना 0.659 , ।
पैनल संकेत के लेबल-मुक्त पुनः कोडिंग के प्रति संवेदनशीलता।
पैनल संकेत के पीछे विहित समतुल्यता कोडिंग प्राथमिक मॉडल के अपने सही होने के लेबल से परामर्श करती है (दोनों उत्तर सही दर्जे को दो बार सहमति गिनती), इसलिए पैनल समझौता आंशिक रूप से लक्ष्य लेबल का एक नियतात्मक कार्य है—एक लेबल-मध्यस्थ निर्भरता, हालांकि स्व-वोट रिसाव नहीं: निर्माण द्वारा एक मॉडल का अपना रिकॉर्ड कभी भी अपने स्वयं के पैनल संकेत में प्रवेश नहीं करता है। एक लेबल-मुक्त पुनः कोडिंग (केवल स्ट्रिंग समझौता; न तो प्राथमिक और न ही पैनलिस्ट की सही होने के झंडे परामर्श किए गए) पैनल AUROC को उस पैनल पर 0.832 से 0.775 तक कम करता है जहां स्व-मूल्यांकन 0.545 देता है, और दूसरे पर 0.697 से 0.628 तक; शीर्षक पैनल लाभ सख्त कोडिंग (0.775 बनाम 0.545) को सहन करता है।
तालिका 1 प्रति-मॉडल चित्र देता है; आकृति 1 सभी सोलह मॉडल के पार एक ही विघटन दिखाता है: सभी मॉडल कैलिब्रेशन विकर्ण के ऊपर स्थित हैं, और स्थानीय स्तर 85–100 बताए गए आत्मविश्वास पर एक बैंड तक गिरता है 9.2% सटीकता।
| मॉडल | Acc. (%) | Mean conf. | CITL (pp) | Brier | ECE | Self-AUROC | 95% CI | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
पुष्टिकारी SimpleQA संग्रह पर प्रति-मॉडल अंशांकन (सीमांत स्तर, पूर्ण श्रेणीकृत सेट; प्रदाता नाम प्रति प्रदाता एकत्र किए गए एक बजट/मध्य-स्तर मॉडल को लेबल करते हैं)। CITL: बड़े पैमाने पर अंशांकन, बताई गई आत्मविश्वास माइनस सटीकता, प्रतिशत बिंदुओं में। ECE: 10-बिन प्रत्याशित अंशांकन त्रुटि। Self-AUROC: मॉडल की अपनी प्रति-आइटम शुद्धता के भविष्यद्वक्ता के रूप में बताई गई आत्मविश्वास (टाई-सही मान–व्हिटनी), बूटस्ट्रैप 95% CI के साथ (मॉडल के भीतर पंक्ति-स्तर पुनः नमूनाकरण, 2,000 आरेखण, निर्धारित सीड)। सभी मान कच्चे श्रेणीकृत JSONL से नियतात्मक पुनर्गणना हैं; प्रत्येक CI 0.5 को बाहर करता है। CITL गैर-गोल मतलब का उपयोग करता है; प्रदर्शित मान दशमलव स्थान में गोल हैं। {#tab:vendor}
| कवरेज पर त्रुटि दर | |||||
|---|---|---|---|---|---|
| 2-6 मॉडल | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
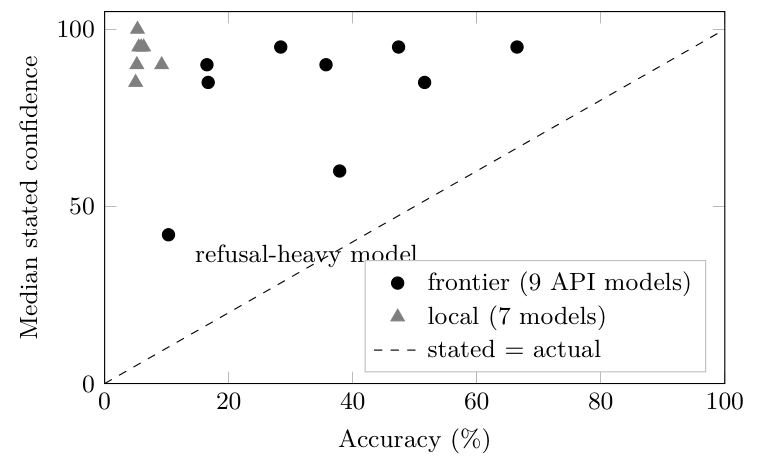 सभी सोलह मूल्यांकन किए गए मॉडलों में सुसंगत अति-आत्मविश्वास: प्रति-मॉडल माध्यिका कथित आत्मविश्वास (तालिका 1 में साधन दिखाई देते हैं) बनाम सभी 16 मॉडलों पर एक ही 1,500 अंधे SimpleQA आइटम पर वास्तविक सटीकता। सभी मॉडल कैलिब्रेशन विकर्ण के ऊपर स्थित हैं; अस्वीकार-भारी मॉडल (माध्यिका कथित आत्मविश्वास 42 10.3% सटीकता पर, CITL +31.0 pp) सर्वोत्तम स्व-AUROC, 0.788 रखता है, फिर भी अति-आत्मविश्वास रहता है; सबसे छोटा कैलिब्रेशन अंतराल फैलाए गए-आत्मविश्वास मॉडल (+11.1 pp) का है। अग्रभाग माध्यिकाएं प्रति मॉडल: 95/85/95/60/90/95/85/90/42 तालिका 1 की पंक्ति क्रम में; सात-मॉडल स्थानीय स्तर 5.0–9.2% सटीकता को माध्यिका आत्मविश्वास 85–100 पर फैलाता है (पार्स-विफलता बहिष्कार के बाद प्रति स्थानीय मॉडल ग्रेडेड n 98–1,498; स्थानीय स्तर हेरफेर जांचों और इस चित्र को परोसता है, भेदभाव दावों को नहीं)।
परिणाम 2: मापे गए प्रोफाइल इंजेक्शन से विभेदन में कोई पुष्टिकारी सुधार नहीं
एक प्राकृतिक मरम्मत मॉडल को उत्तर के समय अपनी स्वयं की मापी गई क्षमता प्रोफाइल—धारण किए गए डेटा से प्रति-डोमेन सटीकता—देना है। एक प्लेसबो-नियंत्रित सीढ़ी प्रयोग में (भुजाएं: कोई प्रोफाइल नहीं, समग्र स्तर के लिए मेल खाता प्लेसबो प्रोफाइल, स्वयं की मापी गई प्रोफाइल, शफल की गई प्रोफाइल), स्वयं-प्रोफाइल भुजा ने पुष्टिकारी समापन बिंदु पर प्लेसबो को महत्वपूर्ण रूप से हराया नहीं: AUROC , 95% CI , कच्चा , होल्म-समायोजित ; कोई पुष्टिकारी समापन बिंदु पारित नहीं हुआ। हम इसे एक स्पष्ट रूप से संकीर्ण दायरे के साथ एक शून्य के रूप में रिपोर्ट करते हैं: एक पुष्टिकारी सीढ़ी पर, विभेदन को मापे गए-प्रोफाइल इंजेक्शन द्वारा सही नहीं किया गया था। बिंदु अनुमान सकारात्मक है, लेकिन पूर्व-पंजीकृत सुधार के तहत मरम्मत प्रदर्शित नहीं की गई है; डिजाइन केवल मध्यम प्रभावों के लिए संचालित था (SE CI से: 80% शक्ति केवल AUROC के लिए, देखे गए से बड़ा —इसलिए डेटा एक सच्चे शून्य और एक छोटे सच्चे प्रभाव दोनों के साथ संगत हैं)। डिजाइन की छत सीमित करने वाला कारक नहीं है। प्रत्येक आइटम की स्वयं की बिन सटीकता—गणना की गई छोड़ो-एक-बाहर, इसलिए एक आइटम कभी अपने स्वयं के भविष्यवाणीकार में योगदान नहीं देता—उस आइटम की सुधार की एकमात्र भविष्यवाणी के रूप में एक oracle AUROC 0.758 पुष्टिकारी विषय के लिए पैदा करता है (चार सीढ़ी विषयों के पार 0.716–0.789), प्रति-बिन सटीकता प्रसार SD 0.195 और 21 बिन पर 0.15–1.00 की सीमा के साथ। बिन इसलिए पर्याप्त रूप से भिन्न होते हैं कि एक सच्ची प्रोफाइल पर्याप्त जानकारी ले जा सकती है: शून्य इंजेक्शन चैनल के बारे में है, बैटरी को बहुत सपाट नहीं है जो एक को पंजीकृत करने के लिए। 1 अन्वेषक पैटर्न (जहां आधारभूत अंशांकन सबसे कमजोर है वहां बड़ा लाभ) केवल परिकल्पना-उत्पन्न करने वाले हैं।
सीढ़ी डिजाइन और प्लेसबो सत्यापन।
चार जमे हुए सीढ़ियां (विषय: Claude Haiku 4.5, Sonnet 5, Opus 4.8, और Fable 5; सटीक IDs claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), प्रत्येक अन्यथा समान प्रॉम्प्ट की एक अंशांकन स्लॉट में चार अंधे भुजाओं के साथ: off (प्रोफाइल-आकार की संरचनात्मक खालीपन), placebo (अंशांकन-अप्रासंगिक प्रोफाइल समग्र स्तर के लिए मेल खाता; प्रति सीढ़ी सच्ची प्रोफाइल के विरुद्ध सत्यापित —मापा गया , , , ), core (मॉडल की स्वयं की मापी गई प्रति-डोमेन प्रोफाइल), और shuffled (बिन-क्रमचयित गलत प्रोफाइल; एक विफल हेराफेरी जांच के बाद अन्वेषक जिसने इसे पुष्टिकारी स्थिति से हटा दिया)। 315-आइटम बैटरी 21 डोमेन बिन पर फैली हुई है जिसमें जाल आइटम और एक स्पष्ट त्याग टोकन है; आइटम–भुजा असाइनमेंट पुष्टिकारी चरण से पहले जमे हुए थे, प्रति-आइटम यादृच्छिक भुजा क्रम और विषय-दृश्यमान पाठ में कोई भुजा नाम नहीं। एक पूर्व-पंजीकृत अपमानता बाउंड (off सटीकता ) ने सभी पुष्टिकारी गणना से चार में से तीन सीढ़ियों को हटा दिया; तालिका 3 एक पात्र सीढ़ी की रिपोर्ट करता है। जीवित रहने वाली सीढ़ी का off-भुजा सटीकता 0.85 सीमा के विरुद्ध 0.847 है, जबकि हटाई गई सीढ़ियां 0.855, 0.888, और 0.900 पर बैठी हैं—off-भुजा उत्तर-केवल AUROCs 0.575, 0.628, और 0.500 के साथ (वर्णनात्मक रूप से, निकट-छत सटीकता मरम्मत के लिए कम अंशांकन संकेत छोड़ता है)। सभी चार विषय एक एकल विक्रेता परिवार से लिए गए हैं; सीमाओं को देखें।
| आर्म | सटीकता (सभी आइटम) | AUROC | ब्रियर | ECE | युग्मित AUROC (कोरआर्म) |
|---|---|---|---|---|---|
| बंद (कोई प्रोफ़ाइल नहीं) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| प्लेसबो | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| कोर (अपनी प्रोफ़ाइल) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| शफल किया गया (झूठा) | 0.842 | 0.589 | 0.140 | 0.113 | गणना नहीं की गई (खोजपूर्ण) |
प्रोफाइल-इंजेक्शन सीढ़ी, पुष्टिकारी-पात्र चरण (विषय: Claude Sonnet 5; : 294 गैर-जाल वस्तुएँ 2 पूर्व-पंजीकृत नई-प्रक्रिया प्रतिकृतियाँ—हार्नेस न तो तापमान और न ही बीज को उजागर करता है; AUROC उत्तरित-केवल)। पुष्टिकारी तुलनाएँ (वस्तु-समूहित बूटस्ट्रैप): coreplacebo AUROC , 95% CI , कच्चा ; coreoff , CI , कच्चा ; दोनों Holm सुधार में विफल हैं () और दो-तरफा वस्तुबैच गेट (एक पूर्व-पंजीकृत दृढ़ता आवश्यकता वस्तु और संग्रह बैच दोनों द्वारा समूहित)। युग्मित- स्तंभ जमे हुए विश्लेषण की वस्तु-समूहित युग्मित तुलनाओं को core के विरुद्ध दोहराता है; ये प्रति-आर्म AUROC स्तंभ के अंकगणितीय अंतर नहीं हैं, और shuffled के लिए कोई पुष्टिकारी युग्मित तुलना की गई थी (पुष्टिकारी चरण से पहले अन्वेषणात्मक में कम किया गया)। हम अपनी अपनी परिकल्पना के विरुद्ध नोट करते हैं कि core अंशांकन पर प्रभुत्व नहीं रखता है: इसका ECE (0.099) placebo के (0.090) से बदतर है, जो पुष्टिकारी शून्य को शून्य के रूप में पढ़ने का एक और कारण है। {#tab:ladder}
परिणाम 3: आत्म-छवि चैनल हेरफेर योग्य है
यदि एक मूल्यांकन हार्नेस एक आत्म-दक्षता प्रोफ़ाइल का उपभोग करता है, तो वह स्लॉट एक इनपुट चैनल है, और इनपुट को जाली बनाया जा सकता है। हम घटती हुई साक्ष्यात्मक शक्ति के तीन दावों में अंतर करते हैं और बताते हैं कि प्रत्येक परिणाम कौन सा समर्थन करता है। (i) कारणात्मक हेरफेर योग्यता—नीचे प्रदर्शित: एक झूठी प्रोफ़ाइल को प्रतिस्थापित करने से नियंत्रित चलन में कथित आत्मविश्वास कारणात्मक रूप से परिवर्तित होता है और अंशांकन खराब होता है। (ii) अखंडता कमजोरी—सशर्त: यह केवल उन हार्नेस के लिए महत्वपूर्ण है जो वास्तव में एक ऐसे स्रोत से दक्षता प्रोफ़ाइल इंजेक्ट करते हैं जिस पर कोई प्रतिकूल प्रभाव डाल सकता है। (iii) तैनात मूल्यांकन पाइपलाइन में व्यावहारिक हमले की सतह—एक परिकल्पना जिसे यह पत्र प्रेरित करता है लेकिन परीक्षण नहीं करता है। सच्ची प्रोफ़ाइल को एक फेरबदल (झूठी) प्रोफ़ाइल से बदलना एक अन्वेषणात्मक सीमांत रंग के आत्म-मूल्यांकन AUROC को मौका स्तर तक ले गया: सच्ची प्रोफ़ाइल के साथ 0.710 बनाम 0.474 (छत-तिरस्कृत अन्वेषणात्मक रंग; आइटम-क्लस्टर्ड बूटस्ट्रैप: 0.710 [0.586, 0.820] बनाम 0.474 [0.349, 0.599], अंतर [, ])। इसके विपरीत, पुष्टिकरण-पात्र रंग पर shuffled placebo और core के बीच स्थित था (0.589 बनाम 0.578 और 0.625; आइटम-क्लस्टर्ड युग्मित विपरीत, अन्वेषणात्मक: )। यह रंग निर्माण के अनुसार कमजोर हेरफेर साक्ष्य है: झूठी प्रोफ़ाइल पूर्व-पंजीकृत जांच में दो बार विफल हुई (बाहरी न्यायाधीश 0.99/0.94 बनाम सीमा); जमे हुए नियम ने पुष्टिकरण डेटा के अस्तित्व से पहले भुजा को तिरस्कृत कर दिया, एक विषय पहचानी जाने वाली असंभव प्रोफ़ाइल को खारिज कर सकता है, और कोई भी खपत-जांच मौजूद नहीं है। स्वतंत्र निष्कर्ष: एक सीमांत न्यायाधीश विश्वसनीयता अकेले से जालसाजी का पता लगाता है। शून्य-लागत स्थानीय रुख पर, एक एकल निर्मित दावा ("इस डोमेन में 95% सटीकता") ने एक मॉडल के समान आइटम पर कथित आत्मविश्वास को 50 से 95 तक बढ़ा दिया; प्रभाव उन मॉडलों में केंद्रित है जिनके पास घोषणात्मक अंशांकन खोने का है; इस जांच में सबसे बड़ा बदलाव ( बिंदु) उस मॉडल में हुआ जिसके पास सबसे अधिक था (glm4:9b)। दो सीमांत शर्तें प्रभाव को सीमित करती हैं: मॉडल को वर्तमान आइटम को एक प्रोफ़ाइल बिन के साथ जोड़ने में सक्षम होना चाहिए (अलेबल आइटम पर छोटे स्थानीय मॉडल प्रोफ़ाइल को अनदेखा करते हैं; डेल्टा , परिणाम 2 के जमे हुए शून्य के अनुरूप), और छत-पिन किए गए मॉडल (आत्मविश्वास की परवाह किए बिना) के पास हमला करने के लिए कुछ नहीं है।
हेरफेर साक्ष्य—एक अन्वेषणात्मक सीमांत रंग, एक स्थानीय माइक्रोजांच, और एक विषय-लेबल स्थानीय पास—कारणात्मक हेरफेर योग्यता, दावा (i) को स्थापित करता है। तालिका 4 माइक्रोजांच दिखाती है: एक ही आइटम, एक ही मॉडल, और इंजेक्ट की गई आत्म-प्रोफ़ाइल में एक पंक्ति का परिवर्तन बिंदुओं तक कथित आत्मविश्वास को स्थानांतरित करता है।
अन्वेषणात्मक विषय-लेबल पास: सीमा के दोनों ओर, सक्रिय।
ऊपर दी गई पहली सीमांत शर्त (मॉडल को आइटम को प्रोफ़ाइल बिन के साथ जोड़ने में सक्षम होना चाहिए) स्वयं परीक्षणीय है: प्रत्येक जांच को उसके विषय के साथ लेबल करना—जमे हुए प्रोटोकॉल से एक प्रकट विचलन—संबंध बाधा को हटाता है। एक पूर्ण स्थानीय पास में (पाँच मॉडल, 16 प्रत्येक भुजा के लिए दृढ़ जांच, तापमान 0, स्थिर बीज), झूठी प्रोफ़ाइल जो अलेबल आइटम पर निष्क्रिय थी, एक बार आइटम लेबल किए जाने पर पाँच में से चार मॉडल द्वारा खपत की जाती है: Brier द्वारा (glm4:9b), (llama3.2:3b, सटीकता 37.5%25.0% गिरती है), (mistral:7b), और (phi4-mini) द्वारा खराब हुआ; प्रति-जांच बूटस्ट्रैप CI पर प्रत्येक मॉडल के लिए शून्य को शामिल करते हैं, इसलिए माइक्रोजांच दिशा और तंत्र को प्रति-मॉडल प्रभाव आकार के बजाय स्थापित करती है;
पाँचवाँ (qwen3:8b) बैटरी को छत पर उत्तर देता है (100% सटीकता, दोनों भुजाओं में 100 विश्वास, ), "हमला करने के लिए कुछ नहीं" सीमा को पुनरुत्पादित करते हुए। तंत्र दिशात्मक और सममितीय है: एक झूठा उच्च दावा सबसे कमजोर बिन में विश्वास को ठीक से बढ़ाता है (llama3.2 भौतिकी: कथित विश्वास 0100 25% हेल्ड-आउट सटीकता वाली बिन में; phi4-mini तर्क 1365), और एक झूठा निम्न दावा सही उत्तरों पर विश्वास को कम करता है (llama3.2 इतिहास 1000 75% हेल्ड-आउट सटीकता पर), जो मॉडल द्वारा अन्यथा उत्तर दिए जाने वाले आइटमों पर संयम को प्रेरित करने तक, सीमा के दोनों ओर लाइव रन द्वारा प्रदर्शित किए जाते हैं: अनलेबल किए गए आइटम, प्रोफ़ाइल निष्क्रिय (जमा हुआ शून्य); लेबल किए गए आइटम, नकली आत्म-छवि सीधे कथित विश्वास में प्रसारित होती है और अंत से अंत तक कैलिब्रेशन को कम करती है।
| मॉडल | विश्वास @ "0%" | विश्वास @ "95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
स्थानीय माइक्रोप्रोब (खोजपूर्ण): आइटम के डोमेन में इंजेक्ट किए गए प्रोफ़ाइल स्लॉट "0% सटीकता" बनाम "95% सटीकता" का दावा करते समय एक ही (गलत उत्तर दिए गए) आइटम पर कथित विश्वास; पाँच स्थानीय ओपन-वेट मॉडल, तापमान 0। छत-पिन किए गए मॉडल (नीचे की पंक्ति) के पास हमले के लिए कोई घोषणात्मक कैलिब्रेशन नहीं है। {#tab:microprobe}
मूल्यांकन अभ्यास के लिए निहितार्थ
हमारे परिणाम एक कार्य परिवार (पोस्ट-2023 खुले-रूप तथ्यात्मक QA) पर एक निष्कर्षण प्रारूप के साथ मापे जाते हैं; नीचे के निहितार्थ उन मापों से एक्सट्रापोलेट करते हैं।
(1) बयान किए गए आत्मविश्वास की भूमिका को उलटें। स्व-रिपोर्ट किया गया आत्मविश्वास मूल्यांकन का एक मापा लक्ष्य होना चाहिए, वर्तमान निष्कर्षण के तहत इनपुट नहीं। सहायक संख्याएं: उच्च-आत्मविश्वास सीमांत उत्तरों का 60.1% गलत है, और सर्वश्रेष्ठ स्व-AUROC (0.788) उस मॉडल का है जिसे एक सटीकता लीडरबोर्ड अंतिम स्थान पर रैंक करेगा—न ही रैंकिंग भविष्यद्वाणी करता है कि किसके स्व-रिपोर्ट भेद करते हैं।
(2) जजों की पाइपलाइनें कमजोर रूप से भेदभावपूर्ण भार विरासत में लेती हैं। कोई भी LLM-as-judge या ensemble योजना जो वोटों को स्व-निश्चितता के आधार पर वजन करती है, यहाँ नौ मॉडलों में से छह के लिए, 0.62 से नीचे AUROC वाले एक संकेत को आयात करती है—चुप्पी से, क्योंकि संतृप्त 85–95 बैंड लॉग में आश्वस्त दिखता है। यदि निश्चितता भार बिल्कुल भी उपयोग की जाती है, तो भार रिपोर्ट स्वयं से नहीं, बल्कि मापा गया प्रति-मॉडल अंशांकन से आना चाहिए।
(3) प्रोफ़ाइल स्लॉट को प्रमाणित करें। अनुभाग 6 का तीन-स्तरीय खतरे का मॉडल चिंता को क्रमबद्ध करता है: कारण में हेराफेरी का प्रदर्शन किया गया है, अखंडता की कमजोरी एक हार्नेस पर सशर्त है जो वास्तव में प्रभावशील स्रोत से प्रोफाइल इंजेक्ट करता है, और तैनात पाइपलाइनों में एक व्यावहारिक हमला सतह एक परिकल्पना बनी हुई है। सशर्त वर्ग में हार्नेस के लिए, मरम्मत चैनल जोखिम है: वही इंजेक्ट किया गया प्रोफ़ाइल जो अंशांकन को ठीक करने वाला था जालसाजी स्वीकार करता है जो भेदभाव को संयोग स्तर (0.474) पर धकेलते हैं और एक बार आइटम जुड़ाव योग्य हों तो ब्रियर स्कोर को अंत से अंत तक गिरा देते हैं। ऐसी हार्नेस को एक अखंडता द्वार की आवश्यकता है—हस्ताक्षरित प्रोफाइल, मूल जांच, या न्यूनतम रूप से जो प्रोफाइल को मापता है उसे अनुमान समय पर इसे आपूर्ति करने वाले से अलग करना। एक अप्रमाणित स्व-छवि स्लॉट एक अंशांकन पेलोड के साथ एक खुला प्रॉम्प्ट-इंजेक्शन पोर्ट है।
(4) बाहरी माप विकल्प है—अपने स्वयं के ऑडिट के साथ। स्वतंत्र-पैनल सहमति स्व-मूल्यांकन पर हावी है जहाँ स्व-मूल्यांकन सबसे खराब विफल होता है (AUROC ), लेकिन पैनलों के अपने मापे गए विफलता शासन हैं, साथी पत्र में जांचे गए (Chernets, 2026); ऑडिट के बिना पैनल संकेत को अपनाना एक स्तर ऊपर वही गलती दोहराता है। एक अन्वेषणात्मक के रूप में पूर्व-पंजीकृत विस्तार एक तीसरा कोण जोड़ता है: 12 निर्देशित प्रोफ़ाइल-स्वैप जोड़े (3,780 कॉल) में, एक अन्य मॉडल की मापी गई प्रोफ़ाइल को प्रतिस्थापित करने से AUROC सर्वाधिक से स्थानांतरित हुआ—और कभी-कभी सहायक रहा—जबकि स्थानांतरण हानि की समानता-रैंक भविष्यद्वाणी विफल रही (Spearman ): मापी गई प्रोफाइलें पोर्टेबल उपकरण हैं, विशेषाधिकार प्राप्त स्व-पहुंच नहीं। एक व्यावहारिक स्व-मूल्यांकन नैदानिक बैटरी परिशिष्ट में वर्णित है।
सीमाएँ
शीर्षक के लिए एकल बेंचमार्क परिवार (2023 के बाद की खुली-प्रारूप तथ्यात्मक प्रश्नोत्तरी); प्रत्येक प्रदाता को एक बजट/मध्य-स्तरीय मॉडल द्वारा प्रतिनिधित्व किया जाता है, इसलिए प्रदाता-स्तरीय सामान्यीकरण का दावा नहीं किया जाता है; कथित-आत्मविश्वास का निष्कर्षण शीर्षक संख्याओं के लिए एक प्रॉम्प्ट प्रारूप है—हालाँकि एक अन्वेषणात्मक दो-चरण शाखा (150 आइटम पाँच स्थानीय मॉडल) से पता चलता है कि प्रारूप अपराधी नहीं है: एक स्थिरहीन पश्च-तुष्टि आत्मविश्वास प्रश्न ने कथित आत्मविश्वास और आत्मविश्वास-त्रुटि दरों को कम किया लेकिन विभेद को नहीं (स्व-AUROC 0.43–0.61 दोनों प्रारूपों में; पूल्ड पेयर्ड-बूटस्ट्रैप AUROC जोड़ियों पर, निर्धारक no-LLM लेबल 142–150 पंक्तियों पर प्रति मॉडल—स्ट्रिंग-केवल ग्रेडर से एक लेबल विचलन, जिसके तहत 90% मामले अनसुलझे हैं); इंजेक्शन नल एक सीढ़ी की एक पुष्टिकरण सीढ़ी है (315 आइटम, 21 बिन), सभी चार विषय एक एकल विक्रेता परिवार से, और यह बेहतर मरम्मत डिजाइन को नियम से बाहर नहीं करता है; हेराफेरी का प्रमाण एक अन्वेषणात्मक सीमांत सीढ़ी, एक स्थानीय माइक्रोप्रोब, और एक विषय-लेबल स्थानीय पास को जोड़ता है (एक प्रकटीकृत विचलन)—एक पुष्टिकरण हमला अध्ययन नहीं है; ग्रेडिंग आंशिक रूप से LLM-आधारित है और इसका मानव सत्यापन एक 50-आइटम स्पॉट-चेक है (98% सहमति, एक रूढ़िवादी त्रुटि)। ग्रेडर का विक्रेता परिवार भी एक CN-पैनल सदस्य को नियुक्त करता है, इसलिए ग्रेडर स्वतंत्रता स्वयं मापी जाती है: सभी पैनलों और ग्रेडर के बाहर एक परिवार से एक दूसरे ग्रेडर ने सभी 342 सबसे कठिन-क्विंटाइल सर्वसम्मति निर्णयों को फिर से ग्रेड किया और 342/342 से सहमत हुए। ग्रेडर स्वयं एक स्थानीय-स्तर विषय है; सभी 1,441 स्व-ग्रेडेड पंक्तियों का एक क्रॉस-परिवार रीग्रेड 98.3% से सहमत हुआ, असहमति स्व-उदारता की ओर चल रही है (24 डाउन-फ्लिप बनाम 1 अप; सटीकता 5.94.4%)—अति-आत्मविश्वास की तस्वीर को मजबूत करना; एक पूर्ण स्तरीकृत पुनः-ऑडिट भविष्य का काम रहता है। पैनल-बनाम-स्व तुलनाएँ साथी सबमिशन के साथ डेटा साझा करती हैं; कोई भी तालिका दोहराई नहीं जाती है, सीमा अनुभागों 1–2 में बताई गई है, और इस पेपर का दायरा केवल स्व-मूल्यांकन तक रहता है।
निष्कर्ष
आत्म-मूल्यांकन, जैसा कि वर्तमान में प्राप्त किया जाता है, एक मूल्यांकन संकेत को पास करना चाहिए इसके तीन परीक्षण विफल करता है: यह सही-गलत को निर्णय लेने के लिए द्वार के रूप में उपयोग करने के लिए बहुत कमजोरी से ट्रैक करता है फिर भी गंभीर रूप से अत्यधिक आत्मविश्वासी रहता है, सबसे सीधा आत्म-ज्ञान हस्तक्षेप प्लेसिबो नियंत्रण के तहत कोई प्रदर्शनीय मरम्मत नहीं दिया, और इसका इनपुट चैनल जालसाजी स्वीकार करता है जो भेदभाव को संयोग स्तर तक धकेलता है। जब तक मॉडल मापे गए साक्ष्य पर अंशांकन अर्जित नहीं करते, तब तक कहा गया आत्मविश्वास एक घटना है जिसका अध्ययन करना है, न कि एक संकेत जिसका उपभोग करना है।
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
व्यावहारिक उपकरण: एक आत्म-मूल्यांकन नैदानिक
इस अध्ययन का एक उपोत्पाद एक सघन आत्म-मूल्यांकन नैदानिक है: अध्ययन के डोमेन बिन (संख्यात्मक, तर्क, भौतिकी, इतिहास, कोड, संभाव्यता, और अन्य) में फैले हुए संक्षिप्त, नियतात्मक रूप से ग्रेडेबल जांच का एक निश्चित बैटरी, साथ ही स्पष्ट परहेज़ टोकन वाली जाल वस्तुएं। प्रत्येक उत्तर में 0–100 आत्मविश्वास होता है, और उपकरण Brier स्कोर, अत्यधिक आत्मविश्वास अंतराल (औसत आत्मविश्वास माइनस सटीकता), आत्मविश्वास विभेदन (सही माइनस गलत उत्तरों पर औसत आत्मविश्वास), और जाल-परहेज़ दर का एक समग्र स्कोर करता है, परिणाम को सच्चा-अंशांकित से आत्मविश्वास से अंधा तक की स्तरों में मैप करता है। यह इस पत्र की थीसिस को क्रियान्वित करता है—अंशांकन एक मॉडल के बारे में मापने के लिए कुछ है, इसके स्व-रिपोर्ट को पढ़ने के लिए नहीं—और इसे प्रतिकृति पैकेज के साथ एक उपकरण के रूप में जारी किया जाता है, एक परिणाम के रूप में नहीं: यह पुनर्निर्मित जांच का उपयोग करता है जमे हुए बैटरी की बजाय, और इसका विभेदन स्कोर एक प्रॉक्सी है, सीढ़ी का AUROC एंडपॉइंट नहीं।
पुनरुत्पादकता परिशिष्ट
इस पेपर की सभी मुख्य संख्याएं रिलीज़ किए गए कच्चे JSONL के नियतात्मक कार्य हैं; कोई भी चरण यादृच्छिकता, नेटवर्क पहुंच, GPU संगणना, या किसी भी मॉडल को फिर से प्रश्न करने में शामिल नहीं है।
डेटा उपलब्धता।
जमे हुए प्री-रजिस्ट्रेशन और प्रतिकृति पैकेज (सार्वजनिक OSF पंजीकरण): https://osf.io/4y9dv। ओरेकल-सीलिंग स्क्रिप्ट oracle_auroc.py इस पेपर के साथ https://doi.org/10.5281/zenodo.23197651 पर जमा की गई है।
आह्वान संकेत (शब्दशः)।
सिस्टम: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. उपयोगकर्ता मोड़ में नंगे प्रश्न होते हैं; इनकार को ग्रेडिंग स्क्रिप्ट में जमे हुए इनकार शब्दकोश द्वारा उत्तर फ़ील्ड से पहचाना जाता है।
मॉडल पहचानकर्ता और रन तारीखें।
प्रदाता प्रति एक बजट/मध्य-स्तरीय API मॉडल, 2026-07-24 पर धुएं-सत्यापित लाइव और जुलाई 2026 के अंत में एकत्र किए गए (चलने वाली मेनिफेस्ट में प्रति-कॉल टाइमस्टैम्प, प्रतिकृति पैकेज के साथ जारी): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (एक प्रकटीकृत संग्रह विचलन: पहले पक्ष के खाते पर 1,500 में से 670 आइटम, शेष एक एग्रीगेटर मार्ग के माध्यम से समान पहले-पक्ष बुनियादी ढांचे द्वारा सेवा की गई तर्क अक्षम, प्रति कॉल दर्ज served_by; एक पहली-पक्षीय-केवल संवेदनशीलता विभाजन पूर्व-प्रतिबद्ध); zhipu glm-4.5; mistral mistral-small-latest। स्थानीय स्तर (Ollama, तापमान 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b।
साथी पेपर (Chernets, 2026) एक ही जमे हुए पंजीकरण और कच्चे संग्रह को साझा करता है। प्रतिकृति पैकेज में शामिल हैं: जमे हुए पंजीकरण पाठ और प्रोटोकॉल, सटीक मॉडल पहचानकर्ताओं के साथ चलने वाली मेनिफेस्ट, कच्चे ग्रेडेड संग्रह (सीमांत और स्थानीय स्तर, साथ ही खोजपूर्ण बेंचमार्क-आयु तुलना भुजा), और तीन निर्भरता-मुक्त CPU स्क्रिप्ट। पहला (compute_panel_vs_own_auroc.py) पैनल-समझौता बनाम स्वयं-आत्मविश्वास AUROC तुलना (अनुभाग 4) की विहित परिभाषा है और सभी गैर-विहित वैकल्पिक पाठ (बाइनरी पैनल संकेत, अनिर्धारित कोडिंग, टाई हैंडलिंग, पूलिंग वेरिएंट) को विहित मानों के साथ मुद्रित करता है ताकि पाठ की पसंद ऑडिट योग्य हो। दूसरा (analysis_tae_week1.py) टेबल 1, चित्र 1 निर्देशांक, अनुभाग 3 की बेंचमार्क-आयु अंतराल को फिर से प्रिंट करता है, और तालिका 3 में रिपोर्ट किए गए जमे हुए सीढ़ी मानों की सीढ़ी की जमी विश्लेषण फाइल के विरुद्ध एक केवल-पढ़ने के लिए जांच करता है। तीसरा (analysis_tae_decomposition.py) पूलित-AUROC अपघटन और अनुभाग 4 का रैंक-सामान्यीकरण, पैनल संकेत की लेबल-मुक्त रीकोडिंग, प्रति-मॉडल उच्च-आत्मविश्वास त्रुटि दरें, तालिका 1 के CITL/Brier/ECE स्तंभ, तालिका 2 के जोखिम-कवरेज मान, और अनुभाग 5 के पदावनत-रंग वर्णनात्मक को फिर से प्रिंट करता है। प्रत्येक स्क्रिप्ट Python मानक लाइब्रेरी के साथ एक लैपटॉप CPU पर सेकंड में चलती है। प्रोफ़ाइल-इंजेक्शन सीढ़ी अपने स्वयं के जमे हुए बंडल (प्रोटोकॉल, बैटरी, प्रति-भुजा स्कोर किए गए पंक्तियां, और विश्लेषण JSON) के रूप में आती है, पैकेज से इंगित की गई है।
जमे हुए प्रति-आइटम भुजा स्कोर (
scored-arms-*.jsonl; गैर-जाल, स्थितिok; पुष्टिकारक विषय के लिए)oracle_auroc.pyद्वारा गणना की गई, इस पेपर के साथ जारी; एक आइटम की सभी भुजाओं और प्रतिकृतियों को एक साथ छोड़ दिया जाता है।↩︎
इस पेपर को कैसे उद्धृत करें
Chernets, V. (2026). कमजोर रूप से विभेदकारी, प्रोफ़ाइल इंजेक्शन द्वारा मरम्मत नहीं, और हेराफेरी योग्य: LLM मूल्यांकन में आत्म-आत्मविश्वास [पेपर प्रस्तुति]। NeurIPS 2026 वर्कशॉप: TAE। Zenodo। https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}