プログラマーの分断を超えて: AIエージェントを通じて構築する人々のための一つの指標
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
検証された委譲の地平、増幅ゲイン、役割名の年代地図、および2031年までは毎年採点される41個の登録予測
Vadym Chernets、PhD、AIシステムアーキテクト · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
このペーパーをダウンロード
- SSRN(正式版): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo(アーカイブ、オープンアクセス): doi.org/10.5281/zenodo.23267266
- OSF(41個の予測、2026年10月9日登録): doi.org/10.17605/OSF.IO/VW6P9
- GitHub(Markdownの完全なテキスト): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; 付録Cのコード: github.com/vadimchernets/delegation-horizon
SSRNが正式版を保持しています。それを引用してください。
キーワード: AIエージェント;エージェンティックAI;非プログラマー;コーディングエージェント;職務名;スキルベースの採用;プリンシパル=エージェント理論;エンドユーザーソフトウェアエンジニアリング;AI識字能力;検証された委譲の地平;認定資格の交差点;事前登録予測
Abstract
経理担当者がエージェントに調整ツールを求め、開発者がそれに請求システムを変更させる。それぞれが1日の仕事を受け入れ、それが成立することを示さなければならない。2026年10月までに、弁護士も同じエージェントにタスクを設定していた。約400,000セッションで、ベンダー検証済みのコード生成作業の成功率はプログラミング職で34%、その他の職で29%であったが、職業は教育ではない。誰もが「エージェント経由で構築する者が何を信頼して納品できるかは、どのキャリアラダーも示していない。タイトルの代わりに測度を提案する。検証済みの委任範囲(verified delegation horizon)は、有資格の専門家の参照時間で測定した、人が定期的にエージェントに任せ、エージェントが見ていない独立した検査の後に受け入れる、最大の一貫性のある仕事である。増幅ゲイン(注意1時間当たりの受け入れた参照時間)は、検証済みのスループットであり、高速化の因果推定ではない。両者とも領域ごと、時間から四半期で採点される。机上テストが1つのしきい値を修正した。3つの大規模雇用主が2026年にトークンカウントを試し、それを放棄した。1つのランキングが削除され、1つのリーダーボードがゲーム化され、1つの予算が費やされた。チェック済みの仕事は支出によるゲーム化が難しく、残りの各経路は述べられた防御に適合する。日付付きマップは、選択せずに競合する名前(ビルダー、エージェントマネージャー、プリンシパルおよび他)を記録する。背景中立性は、同等の範囲においてプログラミング教育がチェック済み品質を予測することを止めるという仮説である。認証交差点は、領域ごと、同じチェックの下でIT教育を受けていない人の製品がプログラマーのそれを追い抜く瞬間であり、その後、学位と職務経歴ラベルは重みを失う。2026年10月9日に3つのブラインドモデル予測の中央値で価格設定された41の日付付き予測は、OSFに登録され、2031年まで年ごとにスコアリングされる。実施されていない研究は失敗としてカウントされ、自分の領域での追い抜きは0.35に立つ。
エグゼクティブサマリー
2026年までに、簿記係はプログラマーが1年前にしたのと同じ方法でコーディングエージェントを比較していました。弁護士は独自のツールを構築していました。ソフトウェア以外の人々は、ベンダーのコーディングエージェント利用者の急速に成長する部分となっていました。別のベンダーの記録では、約400,000セッションで、プログラミングしない職業はプログラマーに対して、コーディング作業での検証済み成功率でわずか数ポイント遅れていました(34%対29%)。仕事が行われる場所では、プログラマーとその他すべての人々の間の境界は薄くなりました。職務経歴書、給与等級、履歴書では、変わらず存在しています。
プログラマーと専門領域の専門家の一部は、現在共通のワークフローを共有しています。彼らは仕事をエージェントに任せ、それを受け入れるかどうかを決定します。タスクとワークフローは、職業全体の前に統合されました。したがって、人についての有益な質問は、古い境界のどちら側からであれ、彼らが任せることができ、証明できる仕事の大きさです。検証済み委任範囲と呼ばれる、この質問に対して私が提案する尺度は、いくつかの設計上の選択に基づいており、このサマリーはそれぞれの理由を述べています。単位は、適格な専門家が必要とした時間です(1時間、1日、1週間、1ヶ月、1四半期)。古い両方のはしごがこれを読むことができ、職業間の翻訳は必要ないためです。簿記係の調整ツールと開発者の請求変更は、同じルールに直面します。エージェントが見なかったチェックに合格した作業のみがカウントされます。1つのファミリーのモデル間の合意はそのようなチェックとしてカウントされません。なぜなら、それらのエラーは相関しているためです。2番目の数値「増幅利得」は、その人の注意の1時間当たりにチェック済み作業がどの程度生み出すかを記録します(失敗した作業でも注意コストがかかり、エージェントの未確認時間は含まれません)。短いループでエージェントの隣で作業する人は、大きな作業を任せる人と同じくらい信用されます。両方の数値は領域ごとに保持されます。理由は対称的です。ソフトウェアに移行した弁護士と法律に移行したプログラマーは、同じものを失います。知らない分野で作業を受け入れる能力です。閾値はルールv1.1としてバージョン管理されており、机上テストされています。机上テストはすでに1つを修正しました(付録E)。
名前はまだ決定されていません。ビルダー、エージェンティックエンジニア、エージェントマネージャー、AIオペレーター、オーケストレーター、プリンシパルはすべて2026年10月時点で使用されており、それぞれに所有者と日付があります。私はどれを選ぶことなくマッピングしているので、どれが勝つにせよ、1つのスケールで読むことができます。ビルダーは週単位、エージェントマネージャーは日単位です。
市場はすでにショートカットを試みました。2026年、トークン数は大規模雇用者での職員の尺度として試みられましたが、数ヶ月以内に失敗しました。Metaで従業員の非公式ランキングが削除され、同社の公式ガイダンスはトークン数を後に除外しました。Amazonのリーダーボードは空のタスクでゲームされ、削除されました。Uberは年間AIの予算を4ヶ月で費やしました。入力のカウントは支出を報酬します。独立してチェックされた受け入れられた作業のカウントは、設計上、その方法で膨らませるのが難しいです。残っているルート(簡単なチェック、寛容な評価者、隠された支援、作業の分割)はそれぞれセクション5.8での防御を満たします。ランダム監査、時間の独立した評価者、失敗の公開記録、一貫性のあるユニット、そして植え付けられたエラーです。
背景中立性は、2つの予測が私の日付付き論文を支えています。同じ段階で、プログラミング教育はチェック済み品質を予測することを止めます。資格交差点は、ドメイン内の瞬間であり、IT教育なしで同じエージェントを使用するプログラマーの製品が開始される瞬間です。その後、学位とジュニアとシニアのラベルは重みを失います。品質パリティはその瞬間より前に来ます。職務経歴書の学位要件の交差がその可視的な兆候です。各部分は日付が付けられ、独自でテストされます。主な予測は現在の意見に反します。論文は予測を述べるとき、そう述べています。各予測は、それを反論する結果にも名前を付けているため、読者は事前に失敗がどのように見えるかを見ることができます。すべて41が、確率、閾値、フォールバックソース、最終日付を持つテーブルに表示されます。2026年10月9日にOSFに登録されました(DOI 10.17605/OSF.IO/VW6P9)。2031年まで毎年Brier規則でスコアされました。27は公開データから解決します。14は、データが収集される前に別々に登録された研究が必要です。不足しているか結論の出ない証拠は未解決として記録され、成功としてカウントされません。決して実行されない研究は、テストプログラムの失敗であり、スコアカードに残ります。確率は2026年10月9日に、3つのブラインドモデル予測の中央値として修正されました。それを採用し、OSFに登録されました。独自のドメインで追い越す確率は0.35です。
ビルディングコストが少ないとき、信頼は希少なフィルターになります。アプリストアとコードホストであふれています。プラットフォームは未知の貢献者に戸を閉じています。エージェントはますます他の誰かの解決策を採用するのではなく、解決策を書きます。ビルダーの隣に、2つのパートナー機能が見えます。フィニッシャーは製品を人々にもたらします。保証人がそれに署名します。2番目の名前は2025年の役割の説明から来ており、保証人の尺度も提案します。
1. 序論
2026年9月23日、簿記係向けのブログが、取引の分類と勘定の照合のための2つのコーディングエージェント、Claude CodeとCodexを比較しました(Growthy, 2026)。1年前、その比較はプログラマーのものであり、プログラマーのスレッドではいまだにそうです。キャンプと忠誠心も含めて。変わったのは読者でした。エージェントを選んでいる人たちは帳簿をつけ、契約を書き、キャンペーンを運営しており、彼らが選んでいるエージェントはソフトウェア開発者が使うものです。
何十年もの間、経済は2つのはしごを保有していました。ソフトウェアではステップはジュニア、ミッドレベル、シニア、スタッフ、プリンシパルであり、経験年数とプロジェクトが必要とするエンジニアの数で価格設定されていました。その他の場所では、ステップはアナリスト、コンサルタント、マネージャー、ディレクター、パートナーでした。はしごはIT部門のドアで出会い、その意味で第2のはしごにいる専門家は第1のはしごにいる誰かからそれを委託することでソフトウェアを取得しました。2025年と2026年、両方のはしごは同じ仕事を説明し始めました。開発者には、彼らの主な活動が委任と検証になったと言われました(GitHub, 2025b)。ターミナルまたはデスクトップウィンドウのエージェントを持つソフトウェア外の専門家は、彼らが使用していたツール、サイト、小さなアプリケーションを構築し始めました(Bloomberg Law, 2026; OpenAI, 2026)。どちらのはしごも、そのような人が何を提供することが信頼できるかは言わず、どちらもいまや同じ仕事をしている元開発者と元アナリストを比較する方法も言いません。
以下の質問は、その境界のマージされた側にいる人を何と呼ぶべきか、学位と勤続年数がそれらが何を提供できるかを雇用者に伝えなくなった場合にそれらのレベルをどのように測定するべきか、そしてその境界がいつ消える可能性があるかです。それらの最後は、日付が付けられた予測の形で答えを得ます。
その質問にも日付が付けられた由来があります。2026年10月8日、私は予測を述べました。1〜2年以内に、エージェントの機能は非常に成長するため、技術教育はもはや必要なく、それなしの人々はより良いアプリケーション、サイト、製品を構築し、プログラマーのコードより優れたコードを構築します。その夜遅く、私は派生的なものを追加しました。IT教育なしの人々によって製造された製品がIT専門家によって製造されたものを追い抜き始めるとき、IT度とジュニアとシニアのラベルは履歴書の重みを急速に失うでしょう。(両方の声明は、その日の私の注釈から翻訳されています。)セクション6と11は、両方を日付、尺度、閾値、およびそれらを反論する結果を持つ予測に変えます。2番目の声明は、論文の残りがCredential Crossover Pointと呼ぶ瞬間に名前を付けます。
このシリーズの関連論文は、チャットからエージェントへの非プログラマーに従い、エージェントが機能する場所とその人が所有する必要があるものによって4つのレベルを定義しました(Chernets, 2026a)。エージェントが成果物を作成したときにのみ移行をカウントし、エージェントのマネージャーをジョブタイトルにするのを辞め、「動作が証拠を残し、タイトルはしないため、誰かが雇うべき役割ではなく、むしろ動作のパターンを表す用語を使用しました」(Chernets, 2026a, Section 8.4)。本論文はその条件から始まります。レベルは証拠に基づいてのみ付与され、タイトルはそれに付与される可能性があります。つまり、エージェントに渡された仕事、人によって受け入れられ、エージェントが見ていなかったチェックで確認されます。
セクション3は2026年10月に流通している名前の日付が付けられたマップを示します。セクション5は、これらの名前のいずれかを読むことができるスケール、確認された委任の地平線とその2番目の軸、増幅ゲインを示します。セクション6は、背景の中立性と認証情報クロスオーバーポイント、および チェックのプロセスが職人の経験のどれほどを代わることができるかという2つの仮説を述べています。セクション7と8は、信頼、溶解しない境界、および構築する人の隣の2つのパートナー機能を取り上げます。セクション11は、OSFに登録され、2031年までは毎年公開でスコアリングされた確率、閾値、フォールバックソースを持つ日付付き予測を設定します。
名前の中から選びません。市場はおそらく数か月以内に選択し、1つの単語に賭ける論文は別の単語が勝つ日に間違っています。論文が修正できるのはスケールです。セクション5はそれを完全に定義します。つまり、検証された委任の地平線は、有資格の専門家が必要とした時間を単位として、人が定期的にエージェントに渡し、受け入れの後に独立したチェックを受け入れる仕事のサイズを尋ね、増幅ゲインはその人の注意の各時間がいくつの時間を生じるかを尋ねます。両方はドメインごとに保持され、日付が付けられ、時間から四半期の5つのステップに配置されます。図1は、2つの古いはしごをその隣に設定します。
認証情報クロスオーバーポイントの1つの定義が論文全体に役立ちます。ドメインでは、それはIT教育なしの人々によって製造された製品が、同じ独立したチェックの下で受け入れられ、同じエージェントを使用するプログラマーのものを追い抜き始める瞬間です。その後、学位とジュニアとシニアのラベルは採用時の重みを失います。品質パリティはその瞬間の前のステップであり、職務記述書における学位要件の交差は目に見える兆候です。教育が等しいランクでチェックされた品質を予測するのをやめるという仮説である背景の中立性は、それを説明するメカニズムです。これら4つの部分のそれぞれは独自の日付付き予測を実行します(セクション6.2)。
証拠は2025年と2026年から取られており、エージェント開発の1か月は測定が何をカウントする必要があるかを変える期間です。新卒採用を大規模なテクノロジー企業で大幅に低いレベルで置く広く引用される数字は、2019年のレベル以下です。エージェントの前の世界を測定するため、それは除外されています。2022年のピーク採用との比較も同様です。エージェントの前からのシリーズは、前身としてのみ入ります。採用のマクロ経済学はセクション2.4のLinkedinの対応によって実施されます。古い作品も理論、先例、または類推として入ります。Jaquesの責任の時間範囲、Jensen and Mecklingの委任のコスト、ゴールドラッシュと写真家。
図1。 2つのはしごと1つの尺度。
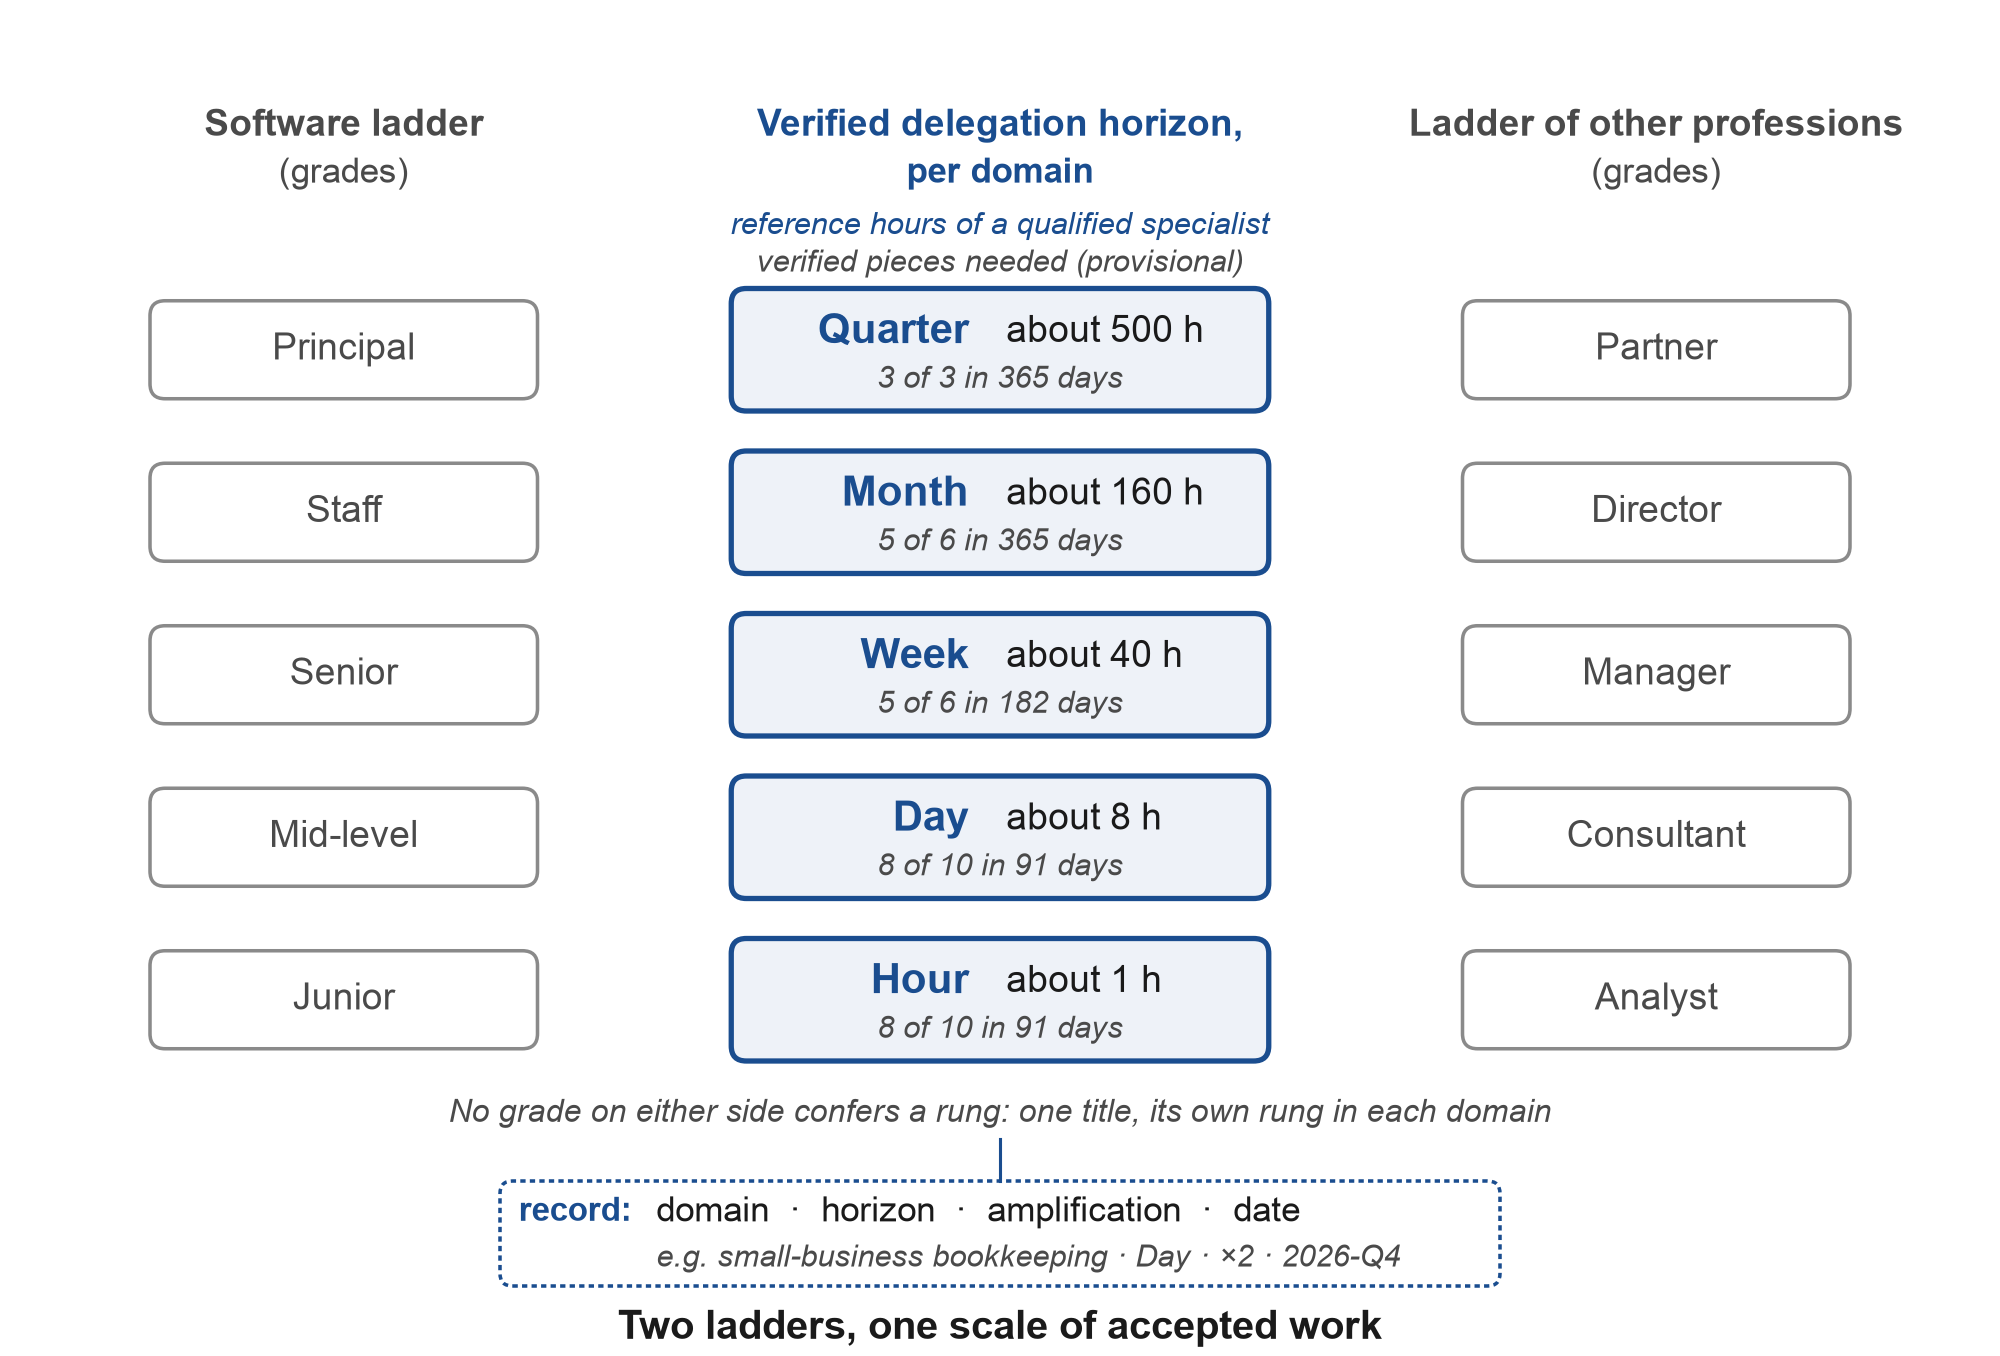
注:古いはしごは並べて描かれており、意図的に接続されていません。どのはしごのグレードもステップを授与しません。同じ人は各ドメインで別のステップを保有しています(セクション5.2)。ステップはセクション5.2の数とウィンドウを持つ有資格の専門家の参照時間で数えられます(ルールv1.1)。表示されるレコードは、付録C4の作業例によって印刷されたものです。
これらのセクションの周辺について、セクション2は収束の証拠を述べており、セクション4は市場の最初の指標がどのように失敗したかを説明しており、これはこの種の指標の場合です。セクション9は、プログラマーの会話のどのトピックが他の職業に越境するかを確認し、セクション10は含意を導き出しています。セクション12は論文に対する証拠を収集し、セクション13はその境界条件を述べ、セクション14は結論を述べています。
2. 収束する二つの世界:2025年と2026年の証拠
2.1 プログラマーの仕事、再定義される
開発者に売却するベンダーは、開発者の仕事をエージェントの指示として説明するようになりました。GitHubは「開発者の新しいアイデンティティ」に関する説明で、委譲と検証を仕事の中心に置きました(GitHub, 2025b)。Anthropicは2025年8月に自社のエンジニアと研究者132人を調査しました。彼らは自分の仕事の約60%でAIを使用しており、自己評価による生産性向上は約50%で、自分たちはより「フルスタック」になっていると説明しました。ほとんどの人が仕事の5分の1までのみ完全に委譲できると述べ、AIを使用した仕事の27%はAIなしではまったく実行されなかったはずのタスクでした(Anthropic, 2025a)。完全な委譲のみに基づいた指標では、世界で最も先進的なAIユーザーが行うことの最大5分の1しか見えないため、第5節で2番目の軸が追加されます。同じレポートは「監督のパラドックス」という名称を付けました:モデルを監督することは、すべてがそれに手渡されるときに萎縮するコーディングスキルを必要とします。
言葉は仕事に従いました。Andrej Karpathyは2025年2月2日に「vibe coding」という名前を付け(Karpathy, 2025)、Collinsはそれを年間用語にし(Collins Dictionary, 2025)、1年後Karpathyは「agentic engineering」に移行しました。Sequoiaの2026年4月30日のAI Ascentで、彼は「vibe codingは下限を上げ、agentic engineeringは上限を外挿する」という違いを述べました(Karpathy, 2026; Willison, 2026a)。学術論文は、agentic engineerを新しい職業上の原型として説明し、責任はコードの著作から成果の所有へシフトしました(Alenezi, 2026)。Microsoftは、その顧客における仕事のパターンを著者、編集者、ディレクター、オーケストレーターとして説明しました(Microsoft, 2026b)。
2.2 ソフトウェア以外の人々も同じエージェントの中へ
2つのベンダーは、ソフトウェア以外の人々によるコーディングエージェントの広範な使用を報告しており、異なる選択と測定の制限があります。OpenAIは2026年6月に、開発者ではない自社コーディングエージェントの週次ユーザーが、2025年8月以降、個人ユーザーの間で137倍、組織の間で189倍増加したと報告しました(OpenAI, 2026)。ベースは低く、データはベンダーのものです。同じレポートは第5節に重要な分布を提供します。2026年5月の約0.1%のエージェント個人ユーザーのサンプルで、80.6%は手作業による期間がモデルによる推定で30分を超える少なくとも1つのリクエストを発行し、70.2%は少なくとも1時間以上のもの、25.6%は少なくとも8時間以上のものを発行しました。これらは長いリクエストを発行するユーザーの割合であり、期間はモデルによって推定されており、完了率または検証済みの期間とは異なるものです。第5節は、なぜこの違いが重要なのかを説明しています。エージェントのビジネス機能に対する仕事の4分の1以上はエンジニアリング作業でした。
Anthropicが2026年6月16日に発表したClaude Codeの研究は、このテーゼに最も近い公開データです(Anthropic, 2026e)。2025年10月から2026年4月の間に、約235,000人による約400,000セッションを分析しました。専門知識は行動から判断され、3つの兆候によって判断されました:その人がタスクをどの程度正確に述べたか、何の検証を求めたか、そして誰が誰を訂正したかです。Pythonを持たない簿記係で正確な調整ルールを書き、エッジケースを検出した人は専門家と評価されました。コードが生成されたセッションで、10の最大職業のそれぞれは、プログラミング職業を検証済み成功で最大7ポイント以下の割合で後れました。成功はテストの合格やコミットされた作業などの証拠によって支持される達成を意味します。ベンダーの分類は、セッショントランスクリプト内のシグナルに部分的に基づいており、ユーザーの明示的な確認など、レポートはマネージャーのわずかに高いレートは、彼らが成功をどのように報告するかを部分的に反映しているかもしれないため、ここでの「検証済み」はベンダーの用語であり、独立した確認ではないと述べています。コードを生成するセッションを集計すると、34%対29%(全セッション全体で約30%対26%)であり、管理はプログラマーより若干優れていました。このデータは職業で人々をソートし、教育についての何も言いません:会計士はコンピュータサイエンスの学位を持つかもしれません、プログラマーは持たないかもしれません。レポートは、「コーディングエージェントがコーディングの背景をプログラミングの成功に対して関連性を低くしている」と結論付けました。人々は何をするかについての決定の約70%をし、エージェントはどのようにするかについての決定の約80%をしました。専門家の命令セットは約12のエージェントアクション、初心者のそれは約5を発火させました。
同じシフトは、エージェントを販売している会社から来ていない情報源に表示されます。初級アソシエートからパートナーまでのすべてのレベルの弁護士は、ベンダーを待つ代わりに、Claude Codeで自分のツールの作業プロトタイプを構築してきました。2025年から2026年にかけて、幅広いAIアクセスを持つ弁護士の割合は61%から83%に上昇しました(Bloomberg Law, 2026; Artificial Lawyer, 2026)。簿記係はエージェントを比較します(Growthy, 2026)。Lovableはブラウザベースのアプリビルダーで、2026年9月に年間収入6億ドルを超えました(TechCrunch, 2026a)。ある推定によれば、Claude Codeは2026年2月初旬にGitHubのパブリックコミットの約4%を著作しました(SemiAnalysis, 2026)。
2.3 圧力を受けるラダー
雇用者はラダーの名前を変更し始めましたが、まだそれらを何が置き換わるのかは述べていません。2026年6月1日からDeloitteは、その約181,500人の米国スタッフに、職務族によって組織された新しいタイトルを与え、リーダーシップレベルを追加しました(Business Insider, 2026)。その内部レベルと給与原則は所定の位置に留まったため(Fortune, 2026a)、これは測定値がそのままであったリネーミングでした。LinkedInは、関連するアソシエートプロダクトマネージャープログラムを「Associate Product Builder」トラックに置き換え、任意の機能から人々に「Full Stack Builder」ロールを開いたと報告されました(Lenny's Newsletter, 2025)。Microsoftは調査された20,000人のAIユーザーのうち3,233人(約16%)を、マルチステップエージェントを実行し、プロセスを再設計する「Frontier Professionals」としてカウントしました(Microsoft, 2026a)。SrinivasanとWeiは2026年2月にHarvard Business Reviewで、企業はエージェントマネージャーを必要とし、12~18ヶ月以内にタイトルが標準になることを期待していると主張しました(Srinivasan & Wei, 2026)。一部の雇用者はさらに進み、新しいロールを投稿に書き込みます:State Streetは、プログラミングを要求するまだ「Agentic Product Builder」をアドバタイズしました(State Street, 2026)。2026年10月7日、Dustは共有エージェントワークフローを構築・保守する人として「AI Operator」を導入しました(Dust, 2026)。
採用は気づきました。候補者のAI使用が議論された面接の割合は、2025年第3四半期の0.33%から2026年第2四半期の4.54%に上昇しました(Metaview, 2026)。質問は答えのための規模が存在する前に採用に入りました。
2.4 ポスティング、エントリーレベル採用、教育
「エージェントAI」に言及する米国の求人は、2024年の151件から2025年の16,541件に増加しました(Stanford HAI、2026年)。Lightcastによる別の集計では、2025年にエージェントAIスキルに言及した求人が86,000件を超え、これらのスキルへの言及が年間280%増加し、公表されている中央値の給与は153,000ドルでした。これらのスキルはほとんどが既存の職種に追加されました(Lightcast、2026a)。AI Indexは「エージェントAI」というフレーズを含む求人を集計する一方、Lightcastのブログはエージェントスキルを独自の分類法で集計しており、これが16,541と約86,000の間のほとんどの差を説明しています。これらの数字は異なるものを測定しており、ここでは区別されています。
エントリーレベルの採用が弱まっており、その原因は議論の余地があります。LinkedInは、2026年4月から6月の米国エントリーレベルの採用が前年同期比7.6%減少し、全体では6.9%減少していることを発見しました。AIが強化する職種では、エントリーレベルの採用が9.6%減少し、これらの職種全体では6.5%減少しました(LinkedIn Economic Graph、2026年)。LinkedInは、この低下の多くを経済的不確実性によるものとし、AIの影響によるものではないと判断しており、エントリーレベルの役割の中で、AIから隔離されたものがフランス、イギリス、米国で最も低下したことを指摘しています。2026年8月のStanford「canaries」研究の更新では、AI露出職種における22歳から25歳の雇用が予想より約19%低く、経験豊かな労働者には比較可能なギャップがなく、この結果を記述的なものと説明しています(Stanford Digital Economy Lab、2026a)。他の2つの情報源も同じメカニズムを発見しています。ダラス連邦準備銀行のエコノミストは、現人口統計調査のマイクロデータを使用して、労働力外から仕事に移行する人が少ないことによって主に駆動される若年労働者のみで、AI露出にリンクされた雇用の減少を発見しました。レイオフではなく(Atkinson & Yamco、2026年)。約6,500万人の労働者に関する履歴書データでは、生成AIを採用した企業の初級雇用は、採用から6四半期後の非採用企業よりも約9%低く、これもまた採用の遅さを通じてではなく、分離を通じてです(Hosseini & Lichtinger、2026年)。経済全体にわたって、イェール予算研究所は、AI露出職種が比較可能な非露出職種よりも悪い傾向があるという明確な兆候を発見していません(Yale Budget Lab、2026年)。したがって、圧力は職種全体ではなく、エントリー段階に位置しています。雇用主は2026年前半に発表された人員削減の中でAIを引用し、101,743件の発表された人員削減の約23%を占めました(Challenger、Gray & Christmas、2026年)。
教育も動いています。2026年のTaulbee調査でカバーされた学部コンピュータサイエンス専攻の新規学生は13%減少しました。これは北米のPhD授与部門をカウントしています。その著者はこれを登録パイプラインの最初の明確な縮小の兆候として説明しており、学位生産の記録と共に述べています(Computing Research Association、2026年)。673人のドイツのIT見習いを対象とした実地実験では、正式な訓練の外のタスクで26から31パーセントポイントの利益を発見しました。彼らがAIを持っていたとき(Stanford Digital Economy Lab、2026b)。2026年6月のOECDと欧州委員会の共同枠組みには、「AI管理」と呼ばれるドメインが含まれています(OECD & European Commission、2026年)。
表A1(付録F)は、この収束の10のシグナルとそれらのソースを列挙し、各シグナルについて、それが示すもの、示さないものを列挙しています。一緒に読むと、測定が欠けている場所も示しています。コーディングエージェント内の開発者以外に関するベンダーデータは、成長を示しており、その結果の品質は示していません。職種の接近性に関する検証済み成功懸念は、職種を関係していますが、程度ではありません。改名されたはしごと調査セグメントはタイトルですが、測定ではありません。そして、より弱いエントリー段階はAIによって引き起こされていることが示されていません。
これらのシグナルは、ある程度の自信を持って、エージェント作業の設定と受け入れが古い境界の両側で行われていること、雇用主、学校、ベンダーが物事の改名を始めたことを示しています。ソフトウェア外の人々もこの作業をプログラマーと同じくらい上手にしていますか。シグナルはそれを開いたままにし、それの測定も示されていません。セクション5は測定を提案し、セクション11は品質の問題に日付を付け、セクション12は予測が克服する必要がある証拠を設定しています。
2026年の証拠は、結果が正しいことを示すことができる人々と、そうできない人々を区別しています。プログラミング教育はその能力への1つのルートです。ドメインのコマンド、チェックの習慣、チェックのためのツールは他のものであり、セクション2.2のデータは、古いはしごが仮定するよりも、それらが最初の代わりに立つことができることをより頻繁に示唆していますが、まだ常に立つことができることを示していません。セクション5の測定は、その主張をテストするために構築されています。
3. 流通している名称:年代付きの地図
3.1 なぜ名称を選ばないのか
2026年の数週間ごとに、企業またはコンサルタント、時には雑誌が、ここで説明する人々に対して名称を提案し、そうした名称の一部は定着するでしょう。用法が不確定であるため、私は1つを推奨する代わりに2つのことを行います。すなわち、既に流通している名称(採用されているものを含む)を、各名称を導入した者、時期、および意味とともに地図化し、それらのいずれもが読み取られるべき尺度を提供することです。「builder」が勝利を収めれば、その記録は「builder at Week」と読まれ、「agent manager」が勝利を収めれば、「agent manager at Day」と読まれます。優先度は、尺度、ラダー、定義および予測、それらに名前を付ける用語(検証済み委任水平線、増幅ゲイン、認証情報クロスオーバーポイント)に対して主張されており、役割名に対してではありません。セクション3.3で追加された役割名は、優先度なしの候補として提示されます。
3.2 6つのレイヤー
候補がすべて1つのスロットについて競合するわけではありません。ほぼすべての人が持つスキルに名前を付けるものもあれば、職業、尺度、モーメント、パートナー、または失敗した信号に名前を付けるものもあります。表A2(付録F)は既に使用されている名称とその所有者を列挙しており、第2部では、この研究で提案された名称または単なる説明としてここで使用される名称、および検討されて除外されたバリアントを一緒に掲載しているため、読者は全体的なファミリーを見ることができます。図2は名称をレイヤー別に、および各名称が導入された日付別に配置しています。
図2. 流通している名称、レイヤー別および各名称が導入された日付別。
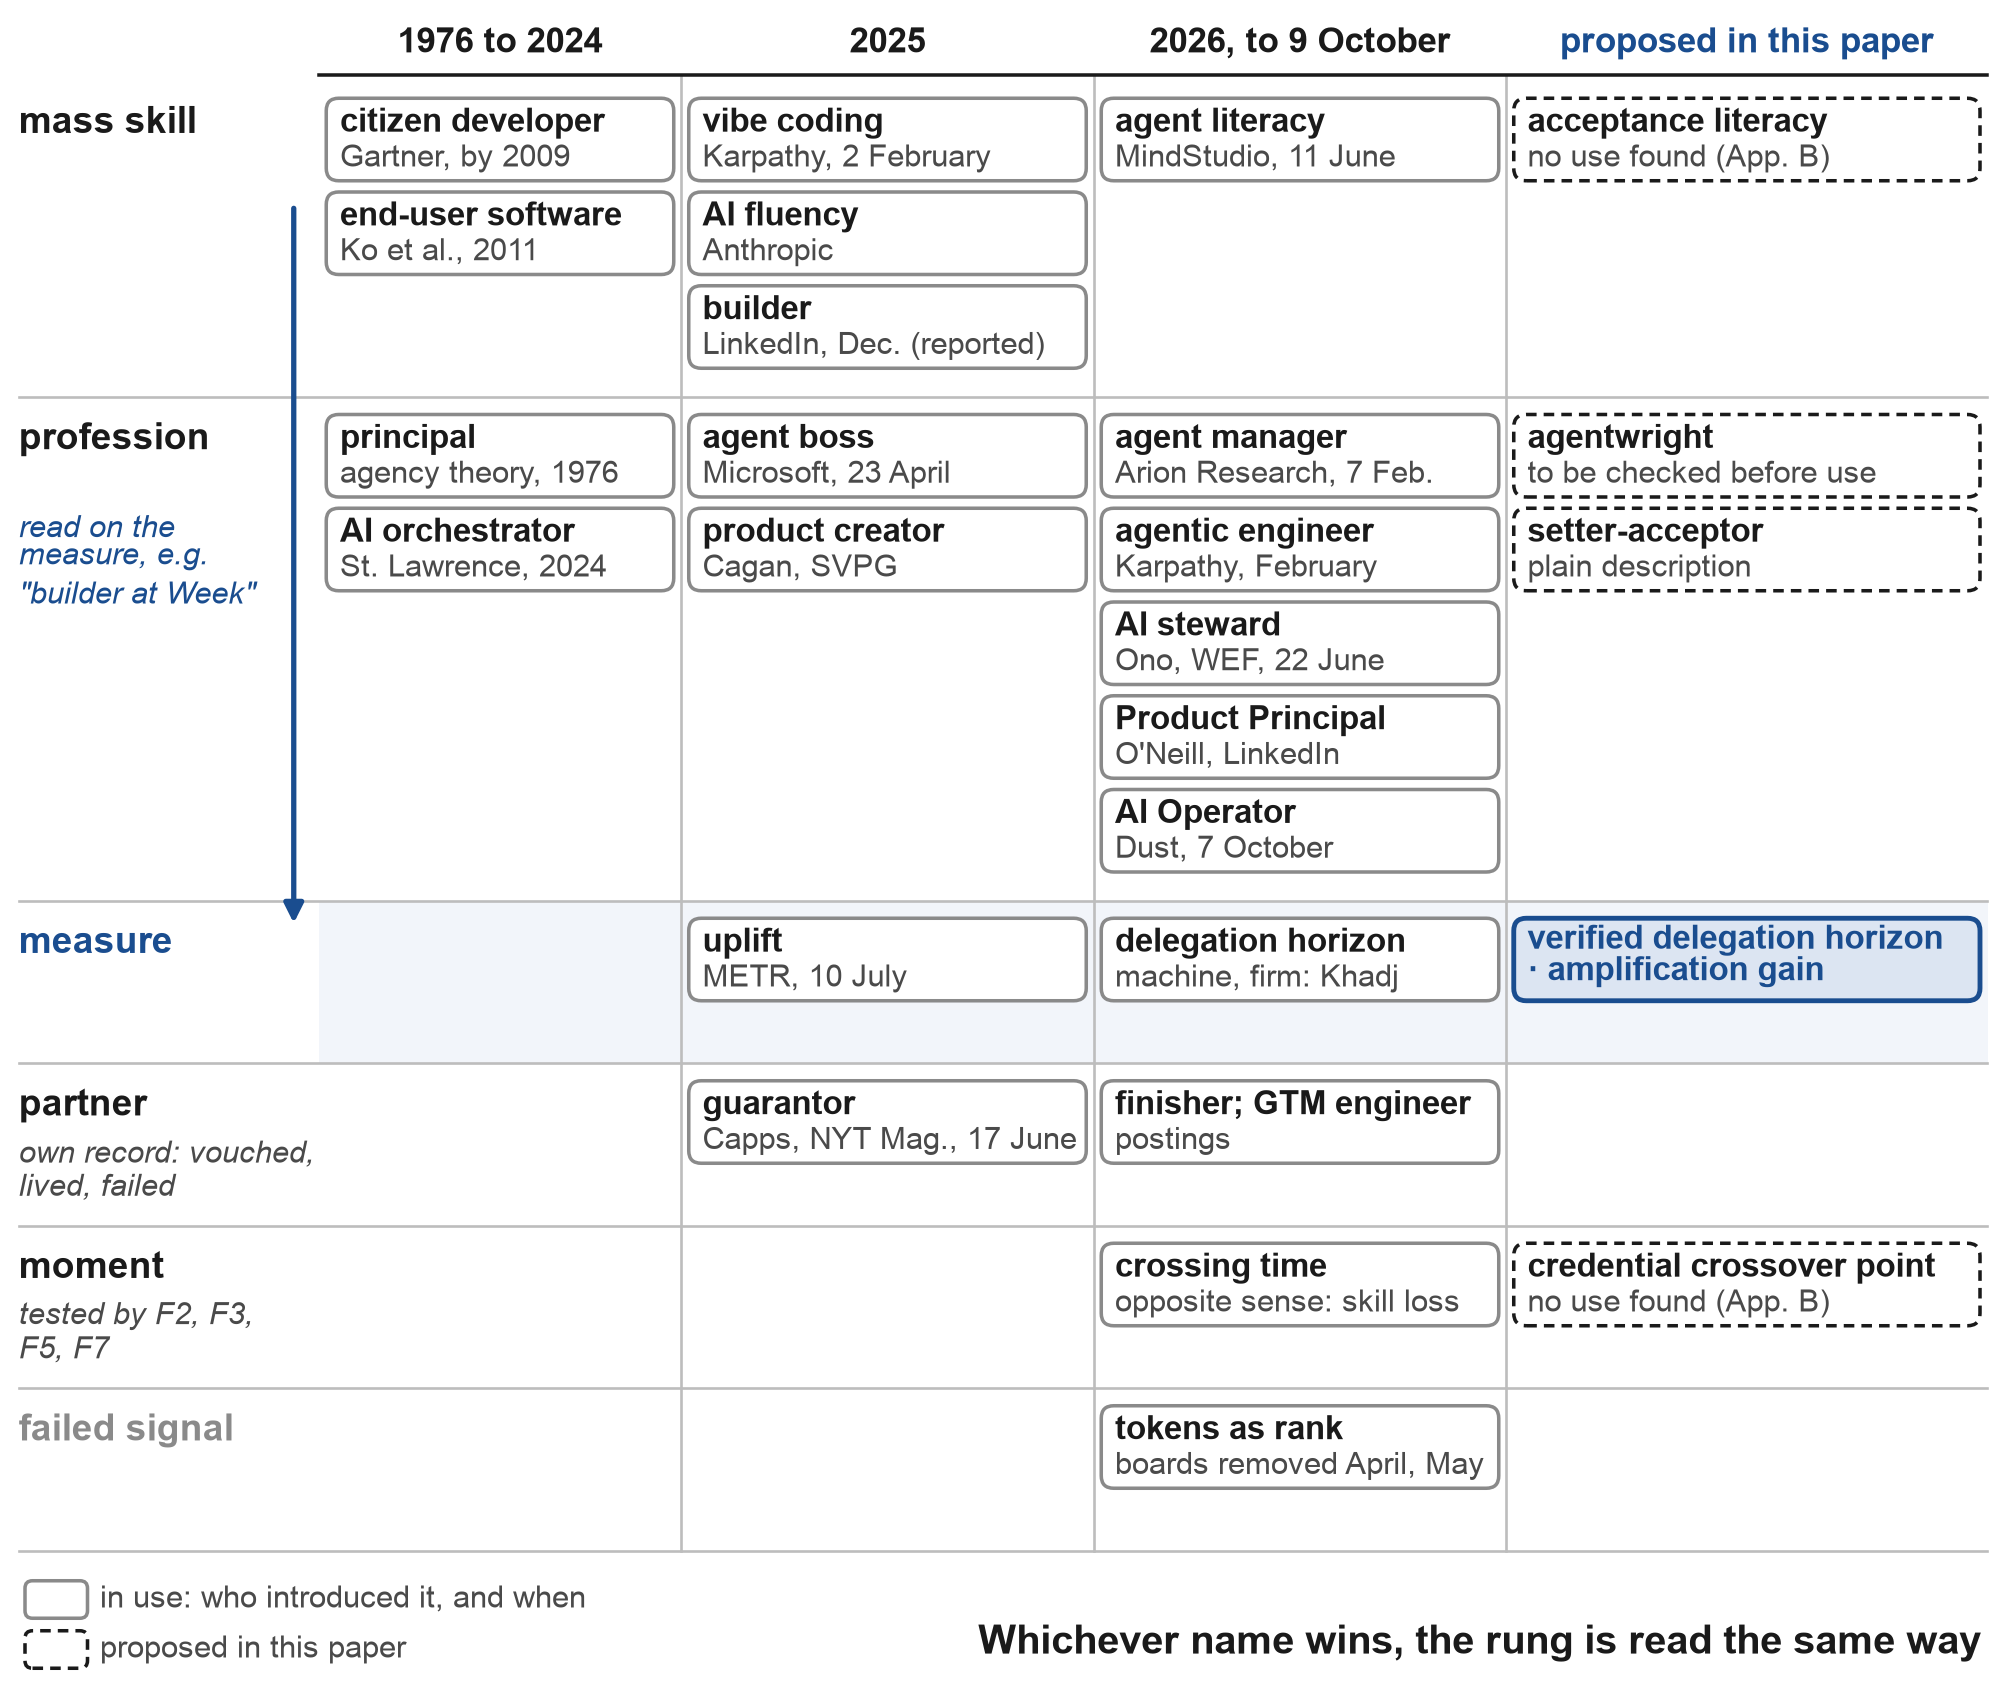
注:所有者および日付は表A2に従います。ソースが年のみを示す名称は月を含みません。図は選択肢です。表A2がすべての候補を列挙します。mass-skillレイヤーとprofessionレイヤーのみが尺度で読み取られます(「builder at Week」、「agent manager at Day」、セクション3.1)。パートナーは独自の記録を持ち、何個の製品が保証されたか、各製品がどのくらい生存したか、および何個が失敗したかです(セクション7.2)。モーメントはランクではなく、年代付き予測F2、F3、F5およびF7によってテストされます(セクション11.2)。尺度行の「Delegation horizon」は、機械または企業の意味です(Khadj、2026年;Alonso、2026年)。セクション5の個人的な尺度ではありません。図は、どの名称が勝利するかについての判断を含みません。
3.3 地図に関する注釈
「Builder」はおそらくマス・HRで勝利を収めています。LinkedInがそれを採用し、ジャーナリストは2026年にベイエリアの誰もが今や「builder」であると書きました(SF Standard、2026年)。その言葉は何もレベルについて述べていないため、その言葉と戦う理由はなく、レベルは尺度が供給するものです。
管理名(agent manager、AI operator、orchestrator)は水平的です。それらは、特定のドメインではなく、一般的にエージェントを実行することを説明しています。セクション6.3は、2023年にどこにでもあった、2025年に時代遅れと呼ばれたprompt engineerに続くと予想される理由を示しています(Fortune、2025年;TechRepublic、2025年)。
「Principal」は最も強い理論と最悪の衝突を持っています。エージェンシー理論では、主体は委任し、監視コストを負担する当事者です(Jensen & Meckling、1976年)。Anthropicのモデルの憲法は、モデルがその代理として作用する人々を「principals」と呼びます(Anthropic、2026b年)。Verheul(2026年)は、機械がエージェンシー機能を実行する場合、企業の人々は主体のポジションのみを保持し、キャリアラダーが消滅すると主張しています。私は診断を受け入れ、その代わりに新しいラダーを提案します。アイデンティティおよびアクセス管理では、「agent principal」はエージェント自身のアイデンティティに名前を付けており、意図した意味の逆であるため、人に対して英語のフレーズ「Agent Principal」を使用してはいけません。O'Neilの「Product Principal」はほぼこの意味での先例であり、そのように引用されています。JetBrainsのAIDEsフレームワークは既にdeveloperレベルをprincipal-agent関係の属性として説明しています(Tikhomirov、2026年)。
ここで提案された名称(agentwright、setter-acceptor、agent director)は、それらのいずれもが好みではない候補としてファミリーに加わります。Agentwrightは検索された学術的ベースで自由ですが、検索エンジンはそれを「Agent Wright」に分割し、開発者が知っているブラウザテストツールのように聞こえ、2026年10月までに、その言葉は既にPythonパッケージおよびエージェントスキルのカタログに使用されていたため、修飾子が必要なバリアントのままです。
市場から選択を取る必要なく、意味についての1つの観察を記録することができます。意味によって、「principal」はセクション8の職業に最も近いです。すなわち、結果に対する責任を持つ他の人のために行われた仕事であり、「builder」は最も近いです。すなわち、自分自身のために行われた仕事というマススキルです。
4. 尺度が必要とされた理由:トークンが職歴の指標として試みられた年
市場は尺度の出現を待たなかった。2026年、それは複数試されたが、エピソードは性質が異なるため、ここでは発生順に分けて記述される。
Meta では、ある従業員が「Claudeonomics」というニックネームの内部ダッシュボードを構築し、約85,000人の同僚をトークン消費量でランク付けしていた。30日間で60兆個を超えるトークンが消費されていた(Shopifreaks, 2026a)。それは1人の従業員によるプロジェクトで、公式な立場はなく、4月に社外に報告された後、削除された。Meta の公式な立場は別の形で動いた。2月からは AI 使用が従業員評価の正式な一部となり、9月初めに WIRED と CIO は、Meta が「AI 採用ダッシュボードまたはトークン数を影響を評価するために使用しない」とし、「AI Native」というラベルを基準から外すという新しいガイダンスを報告した(CIO, 2026b; Shopifreaks, 2026b)。Amazon ではトークン使用のリーダーボードが空のタスクでゲーム化され、5月に削除された(CIO, 2026a)。これは Goodhart の法則の最も純粋な形である。尺度が目標になるとすぐに、それは測定を停止する。Uber のケースは予算イベントである。同社は年間 AI 予算を4か月で使い果たし、従業員を月1,500ドルに上限設定した(Fortune, 2026b)。7月には Cognition の最高経営責任者は、企業は AI 使用ではなく生産性を測定すべきだと述べた(Fortune, 2026c)。
反例も同じくらい重要である。Shopify はパフォーマンスとピアレビューに AI 使用に関する質問を追加している(Shopify, 2026)。1人のコメンテーターは、トークンメトリクスは「廃止されるのではなく、格下げされる」と予想している(Kingy AI, 2026)。人がどのように AI を使用しているかについての質問は、量によるランク付けとは異なるもので、第11節の予測 F8 がこれらを区別している。
第9節で検証された開発者のスレッドは、単一の人々の中で同じ本能を示している。彼らは入力で自分たちを紹介する:月1,148ドルの AI 請求、サブスクリプションのスクリーンショット、約600のプルリクエストのうち約330(スレッドで非常に近似的として説明される単位)、3日間で構築された36段階。彼らの1人は、計算をチェックせずに、彼のエージェントが彼のために計算した節約を公開した。これは1人によって繰り返されたトークンエピソードである。これらのそれぞれは、何が使用されたか、または生産されたかをカウントしている。誰が、どの検査の後で受け入れたかは記録されない。
尺度のための1つの直接的な教訓を引き出す:仕事をカウントし、エージェントが見なかった検査に合格した仕事のみをカウントする。同じファミリーのモデル間の合意はその検査であることはできない。なぜなら、それらのエラーは相関しており、それらの合意は見えるほど多くの独立した意見の価値がないからである(Chernets, 2026b)。より多くのトークンを費やすことは、受け入れられていない仕事がそれに何も追加しないため、この方法で構築された尺度を膨らませることはできない。それを膨らませる他の方法は存在し、第5.8節がそれらの防御とともにリストしている。
5. 測定:検証済み委譲地平線と増幅ゲイン
5.1 参考時間
両軸は1つの単位を使用します。参考時間です。これは、資格を持つ専門家が同じ作業を手作業で行うのに必要な時間です。参考値は意図的に外部から設定されています。その人が自分で作業を行うことができたかどうかは測定に含まれず、その背景も含まれません。簿記係の照合ツールと開発者の請求モジュールの両方も、有能な専門家が費やしたであろう時間で測定されます。
参考時間は2つのソースのいずれかから取得されます。1つは、手作業での時間が2025年と2026年に測定された凍結されたタスク銀行です。44の職業とその専門家の時間を含むGDPvalは、そのような銀行を構築できることを示しています(Patwardhan et al., 2025)。もう1つは、誰が作業を行ったか知らずに時間を推定する2人の独立した評価者です。ドメインの評価者が大きく異なる場合、参考値は代わりに、段階別にスコア化された5~9人の評価者の校正パネルの中央値である可能性があります(付録G2)。パリ近くの金庫に保管されていたメートルの場合と同様に、銀行を意図的に凍結します。数年で、これらのタスクを手作業で行う人はほとんどいなくなり、比較するものが何も残らなくなるからです。銀行は、各ドメインに対して、すべての段階でタスク、完了とカウントされるもののステートメント、手作業での時間測定、隠されたチェック、および検出が受け入れの一部である植え付けられたエラーを保持する必要があります。GDPvalの手作業時間は専門家の検証済み自己報告であり、その確認時間は測定されたもので、これが銀行が達成すべき、またはそれ以上に向上させるべき基準です。測定値が自分自身を判定しないようにするために、地平線は1つのタスク集合でスコア化され、品質はそれについての仮説をテストするために別のタスク集合で使用されます(セクション6)。
5.2 検証済み委譲地平線
定義。ドメインにおける人の検証済み委譲地平線は、人がエージェントに定期的に作業を委譲し、それを受け入れ、エージェントが見なかった独立したチェックによって確認される、参考時間での最大作業サイズです。
1段落での規則。委譲された作業が検証済みとカウントされ、地平線に含まれるのは、以下のすべてが成立する場合のみです。完了とカウントされるもののステートメント付きで設定され、その参考時間は銀行または2つの評価者から取得されました。その人がそれを1つの統一されたデリバラブルとして受け入れました。1か月の作業を160個の1時間チケットに分割した場合は160時間ですが、段階的に行われ、1つの全体として受け入れられた作業は、その全体の参考時間で全体としてカウントされます。独立したチェックが確認しました。チェックが独立しているのは、エージェントが作成しなかったデータ(入力)、アクセス(エージェントは見たり編集したりできない)、およびインセンティブ(それを実行する誰かがパスから何も得られない)において異なる場合です。4つの種類が適格です。隠された受け入れテスト、資格を持つ人間の査読者、意図されたユーザーによる実際の使用、または、その人が開いたソースに対して検証し、監査できる判定を残す別のファミリーのモデルです。自己査読および1つのファミリーのモデル間の合意は、それらの盲点がエージェント自身の盲点と一致するため、カウントされません。段階のウィンドウ内(時間と日は91日、週は182日、月と四半期は365日)、その人はそのサイズ以上の必要数のピースを受け入れました。時間と日は10、週以上はより少なく、以下のように設定され、少なくとも10個のうち8つが合格しました。これは、週と月で6つのうち5つ、四半期で3つすべてを意味します。週以上、段階のサイズの少なくとも1つのピースは植え付けられたエラーを含みます。何らかの種類の植え付けられたエラーが1つ見落とされた場合、そのウィンドウの週以上の段階をブロックし、それを含むピースは段階にもクレジット利得にもカウントされません。エラーを元に戻せない場合(お金が移動した、患者の記録、撤回できない提出物)、すべてのそのようなピースは合格する必要があり、隠されたテストまたは資格を持つ人間がデフォルトチェックであり、別のファミリーのモデルが第2線であり、より厳密なルールがそれらのピースのみに適用されます。すべての手渡しは記録されます。失敗と放棄されたピースはそれに与えた注意を含めて。段階は四半期ごとに確認されます。週以上では、段階のサイズの少なくとも1つの検証済みピースが過去91日以内に含まれている必要があり、地平線は約1年前の作業に基づくことはできません。以下の段落は、各部分の理由を提供します。
スコアリングルール。各段階に設定されたウィンドウ内(時間と日は91日、週は182日)、段階は、その人がドメイン内でそのサイズ以上の必要数のピースを受け入れた場合、カウントされます(時間と日は10、以上はより少なく、以下のように設定)、および少なくとも10個のうち8つが、次の1種類のチェックに合格しました。隠された受け入れテスト、資格を持つ人間の査読者、意図されたユーザーによる実際の使用、またはソースに対して検証した別のファミリーのモデルです。自己査読および1つのファミリーのモデル間の合意はカウントされません。エラーを元に戻せない場合(お金が移動した、患者の記録、提出物が撤回できない)、すべてのそのようなピースは合格する必要があり、より厳密なしきい値はそれらのピースのみに適用されます。これらのピースの場合、デフォルトチェックは隠されたテストまたは資格を持つ人間であり、別のファミリーのモデルが第2線です。
上位段階。10の単一カウントは、上位段階を誰の手の届かないところに置きます。10個の40参考時間のピースが3か月で400時間の専門家の仕事であり、500時間の10個のピースが5,000だからです。したがって、ルールはウィンドウを長くし、段階が上がるにつれてカウントを低下させます。時間と日は91日で10個、週は182日で6個、月は365日で6個、四半期は365日で3個であり、同じ10個のうち8つのシェア(週と月で6個のうち5個、四半期で3個すべてを意味します)。前のバージョンは月に4個を要求しました。付録Eのデスクテストは、これが月を四半期の人にとって稼ぐのが難しくなることを示していたため、カウントは変更されました。週以上では、ウィンドウ内の段階のサイズの少なくとも1つのピースが植え付けられたエラーを含む必要があります。その人が見落とした植え付けられたエラーは、何であれ、そのウィンドウの週以上の段階をブロックし、見落とされた植え付けられたエラーを含むピースは、段階にもクレジット利得にも検証済みとしてカウントされません。四半期は稀な段階であることを目的としており、上記のカウントはそれがそうするように設定されています。
すべてのハンドオーバーが記録されます。 ログはエージェントに渡されたすべてのピースを記録します。チェックに失敗したものや、チェック前に放棄されたものも含まれ、コヒーレントな成果物として受け入れられたピースだけが一段の進捗にカウントされます。1か月の仕事を160の1時間チケットに分割することは160時間であり、1か月ではありません。参照時間は、ユーザー、クライアント、またはレビュアーがMETRのコヒーレントなタスクの精神に従って全体として受け入れる成果物に対して推定されます。その逆も成り立ちます。段階的に行われ、1つのコヒーレントな成果物として受け入れられた仕事は、それがいくつの段階を要したかに関わらず、その成果物の参照時間によって全体としてカウントされます。
独立性。 チェックが独立しているとは、エージェントとデータが異なる場合(エージェントが生成していない入力を使用する場合)、アクセスが異なる場合(エージェントがそれを見たり編集したりできない場合)、およびインセンティブが異なる場合(それを実行する人は合格から何も得られない場合)です。別のファミリーのモデルはエラーの多様性を加えます。その判定がその人が開いたソースに対して検証され、その判定が監査可能な1つの入力である場合にのみカウントされます。
1つの仕事がこのパス(図3)を辿ります。タスクは完了としてカウントされるものの書面による記述で設定されます。その参照時間は銀行から取得されるか、2人の評価者から取得されます。エージェントが仕事を行い、その人は注意を費やします。これはログに記録されます。その人がピースを受け入れ、拒否、または放棄し、独立したチェックが確認または反論し、ログのラインはその時点で書き込まれ、開始日は重要な場所では別のフィールドとして保持されます。遅延した結果が存在する場合(受理されたファイリング、1か月後も実行中のリリース)、それが到着したときに記録されます。ホライズンとゲインはそれらのレコードから日付付きで計算されます。
図3。 1つの仕事、1つのレコード。
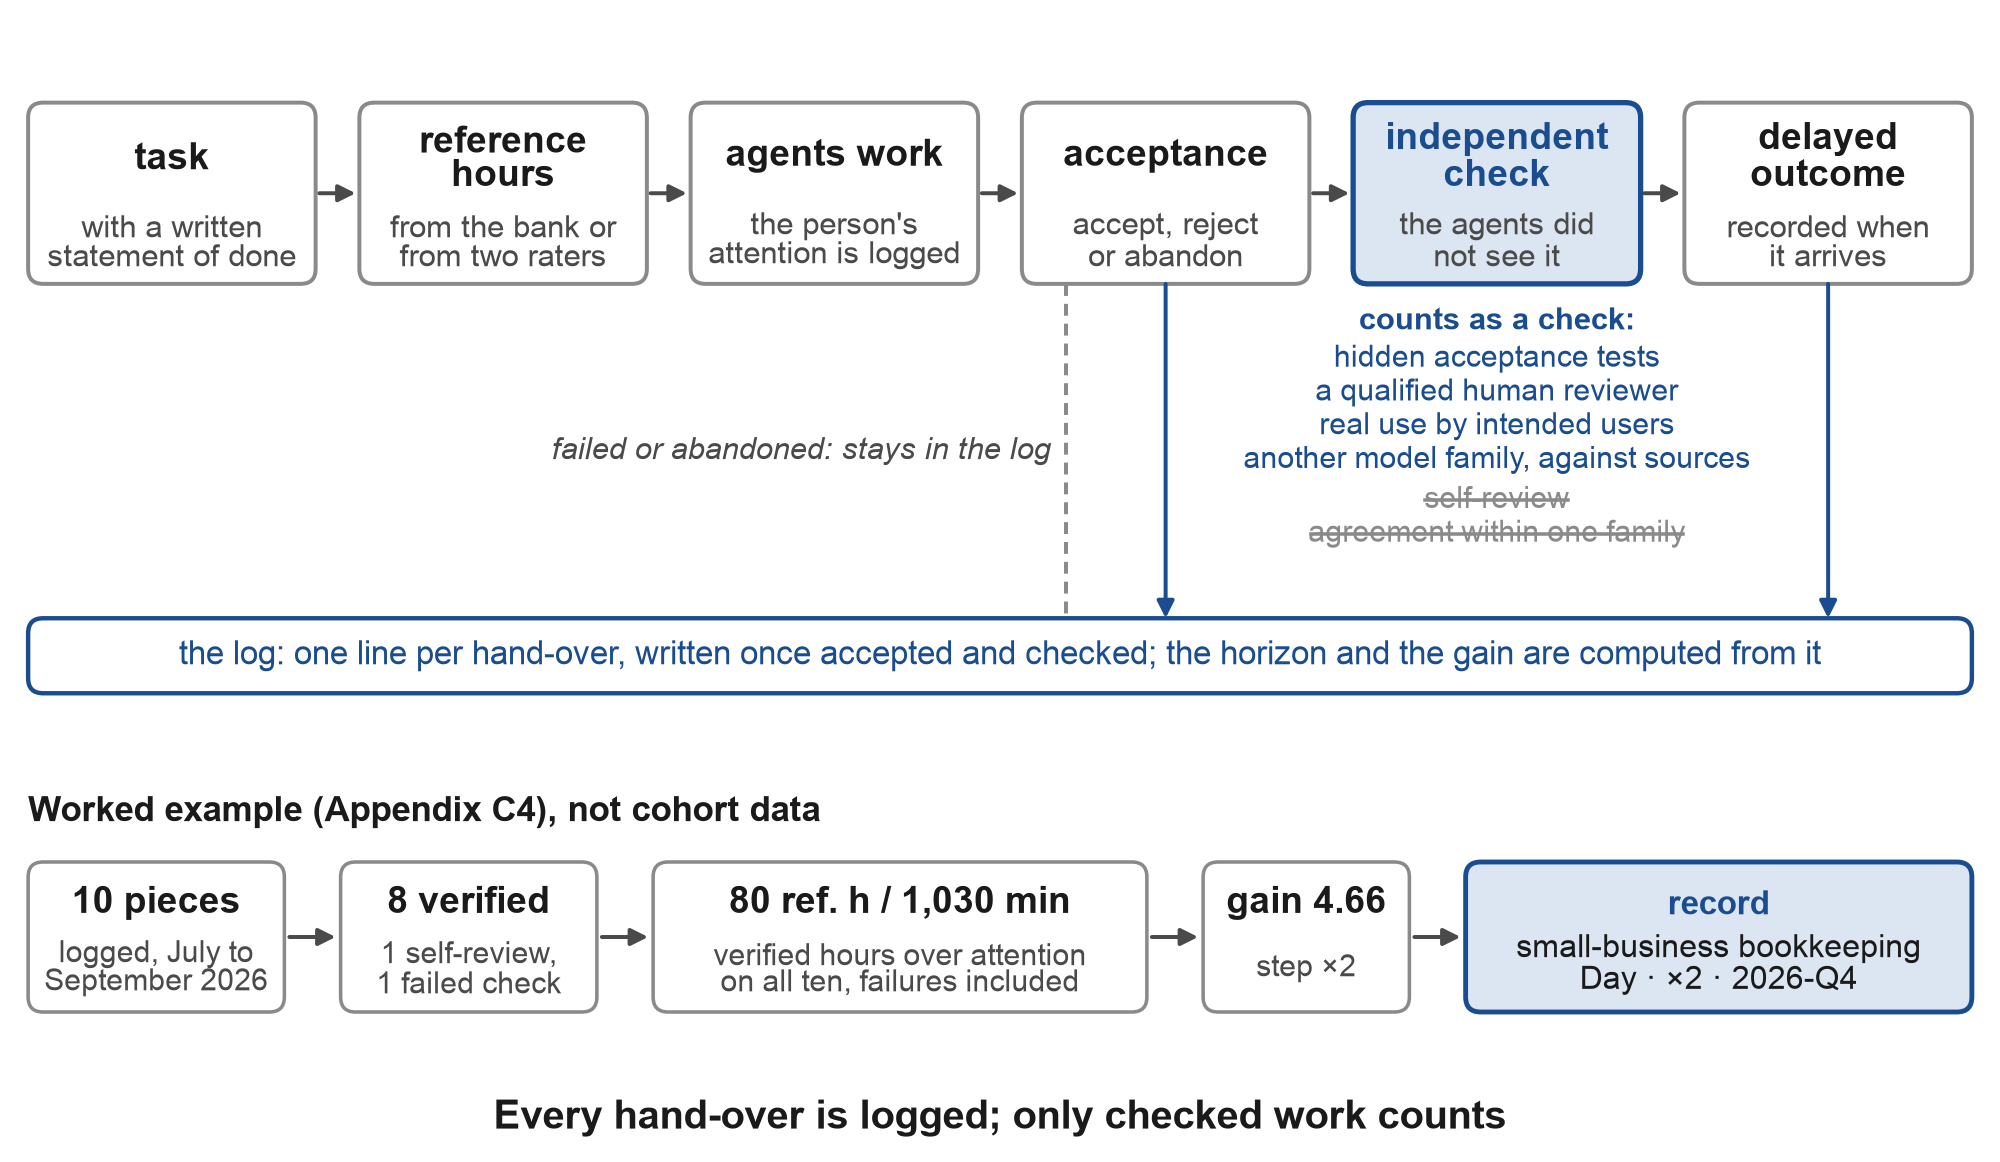
注:上の行はセクション5.2のパスです。4種類の独立チェックはスコアリング規則のものです。自己レビューと1つのファミリーのモデル間の一致はカウントされません。失敗したピースと放棄されたピースはログに留まり、その分未を増幅ゲインの分母に加えます。下の行は付録C4の実例で、構成されたログであり、コホートデータではありません。10ピース、8検証済み、1,030分の注意に対する80参照時間、4.66のゲイン(ステップ×2)、およびレコード「小規模企業簿記·日·×2·2026-Q4」。
再検証。 ホライズンは毎四半期ごとに再度確認されます。セクション2.1のAnthropicの監督のパラドックスはその理由を説明しています。チェック技能が低下している間に得られたホライズンは借入金であり、四半期チェックはそれがまだ成立するかどうかを示しています。ウィンドウが四半期より長い段のために(週、月、四半期)、チェックは具体的な形式を取ります。段のサイズの少なくとも1つの検証済みピースが過去91日以内に落ちる必要があるため、段は約1年前のピースに依存することはできません。
5.3 ラダー
5つの段を時間単位で名前付けています。時間単位は職業間での翻訳の必要がなく、ログから読み取ることができ、技術とともに成長し、名前を変更する必要がないためです。表1は例とそれぞれが必要なカウント数を示しています。
表1。 検証済み委譲ホライズンのラダー。
| 段 | ハンドオーバーされて検証された仕事のサイズ | ソフトウェアの例 | その他の場所での例 | 必要な検証済みピース、ウィンドウ |
|---|---|---|---|---|
| 時間 | 約1参照時間 | スクリプト、小さな修正 | ドキュメントのスタックから引き出した回答 | 91日以内に10中8 |
| 日 | 約8 | 機能、小さな内部ツール | チェック付きの月末レポート | 91日以内に10中8 |
| 週 | 約40 | 仕様に従ったサイトまたは内部ツール、夜間実行付き | 完全なデューデリジェンスパック、キャンペーンシステム | 182日以内に6中5 |
| 月 | 約160、通常は複数のストリーム | 製品リリース、他の人が従う受け入れ規則 | 同僚が使用する規則付きの実践ツール | 365日以内に6中5 |
| 四半期 | 約500 | ライブユーザーがいる製品ライン | エージェント経由で実行されるサービスライン | 365日以内に3中3 |
注:段はセクション5.2のスコアリング規則によってのみ得られ、各ドメインで別々に、付録Eの規則v1.1のカウント数です。古いラダーのグレードはどれも段を与えず、ある人は財務ツールで週にあり、ウェブアプリケーションで日にあることができます。
レジュメまたはHRファイルのレコードは、例えば「小規模企業簿記·日·×2·2026-Q4」の場合、ドメイン、ホライズン、増幅、および日付を保持しています。技術が移動するにつれて、同じ段は1年後に異なる意味を持つため、日付はレコードに属しています。
5.4 増幅ゲイン
エージェントとうまく仕事をするすべての人が大きなピースを彼らに渡すわけではありません。セクション9の開発者の1人は、4つのマシンで構築し、そのうち3つを「個人的な効率の向上」と説明しており、自律的なエージェントはありません。彼が実行する自律的なエージェントは「日常の仕事に定着しなかった」と書いており、彼は「ブースト、委譲ではなく」を好む(翻訳)。最長のフロー3日間で36段階に実行され、各段階がハンドオーバーされコミットされ、エージェントはすべてがデプロイされたことを確認するよう求められました。セクション5.2の規則では、その確認は自己レビューであるため、投稿されたままの彼のレコードは検証済みの段を全く表示せず、スレッドは彼のゲインの数字を与えません。独立チェックで彼がどこに立つかは、何が受け入れられたかに依存します。36段階が1つのコヒーレントな成果物として受け入れられた場合、フローは全体にカウントされ、その参照時間によって、付録Cのセクションc4の段階的な仕事のようにします。各段階がそれ自体で受け入れられた場合、それぞれは小さなピースであり、彼は最初の軸で時間に立っています。投稿はどちらかは言いません。しかし彼は以前購入していたソフトウェアを置き換えるツールを構築し、時間が唯一のボトルネックであると言ったときに2番目の軸の分母を自分で名前付けています。
彼は例外ではありません。Anthropicは、6ヶ月以上の経験を持つユーザーは「指示的な使用パターンを通じてより大きな責任を委譲する可能性がはるかに低く」、モデルとより反復的に作業し、より難しいタスクに取り組み、統制後の成功率が3~5ポイント高いことを報告しました(Anthropic, 2026d)。Claude.aiでは、2025年11月の協調的な使用がオートメーションを52%から45%にリードし、会話は一度限りのプログラム的リクエストよりも成功率が高く、67%対49%でした(Anthropic, 2026a)。給与が高い職業の人々は約1.5倍多くのターンを取得し、女性は同じ職業の男性よりも7.3ポイント少ないオートメーションを行いました(Anthropic, 2026f)。Stanfordの1,500人の労働者を対象とした調査では、104の職業のうち47の職業において最も望ましい配置は、人間とエージェントの間の対等なパートナーシップでした(Shao et al., 2025)。委譲のみに基づいて構築された尺度は、したがって最も経験豊富なユーザー、最も高給の職業の人々、および女性を過小評価するでしょう。ただし、これらのデータには彼らの仕事がより悪いということを示唆するものは何もありません。
定義。増幅利益は、受け入れられた検証済みの仕事の参照時間を、その領域の過去91日間でそれに費やされた人の注意時間で割ったものです。人物のラングのウィンドウが何であれ関係ありません。外部の助け(ログから外れて修正する同僚または請負業者)で行われた仕事はそのように記録され、分子に何も追加しない一方で、その人物の分(ふん)は分母に留まります。注意は計画、指示、読み取り、確認、および修正をカバーします。エージェントが実行されている間、その人が他のことをしている時間はカウントされません。
増幅利益は検証されたスループットです。受け入れられた、チェックされた出力を注意の時間で割ったものです。これは、同じ人がエージェントなしでそれらなしでどのくらい速く働くかについての因果推定ではありません。その比較的な意味での利益は、ベースライン、エージェントなしで同じ種類の仕事をしている同じ人またはマッチした人を必要とします。比較研究のみがそれを提供できます。
失敗した仕事は分子に何も追加せず、すべての分(ふん)を分母に追加します。これにより自己欺瞞が見えます。METRの2025年の試行では、経験豊富な開発者はAIが彼らのスピードアップをしたと信じていましたが、測定によると彼らは19%遅かったです(METR, 2025)。
第2軸のステップは×1(「1日当たり1日」)、×2、×5(「1日当たり1週間」)、×20(「1日当たり1ヶ月」)、および×60(「1日当たり1四半期」)です。2つのスケールは独立しているため、1つのステップは他方のラングと等しくありません。人物が複数のエージェントを並行して実行する場合、注意はまだ1回だけカウントされます。人物自身の分(ふん)で、3つのストリームを見つめるのに費やされた1時間は分母の1時間です。各に対してログされた分(ふん)に比例して、ピース間で共有されます。スコアは、それを生成した設定(モデルとツール、チェックの種類、タスクのラング)とともに報告されます。同じ人はより厳格なチェックの下で異なるスコアを取得するためです。
5.5 2つの軸、4つのプロフィール、および上限
人物を両軸に配置すると、4つのプロフィール(図4)が得られます。見習いは短い視野と低い利益を持っています。増幅器は短い視野と高い利益を持っており、ステージが1つずつ受け入れられた場合、36ステージのビルダーのようなものです。委譲人は長い視野と高い利益を持っています。4番目のプロフィール、私が監督者と呼ぶもの、は長い視野と低い利益です。エージェントは長時間実行され、チェックと修正が利益を食べるため、それはラングというより警告の兆候です。
2つの軸は上限でリンクされています。注意は仕事のピースを設定することと、それをチェックすることに費やされます。ピースの参照時間にはHを、チェックに費やされた注意時間にはVを、設定に費やされた時間にはSを書きます。その後、利益G = H / (S + V + やり直し)、したがってG ≤ H / V。チェックだけが手作業時間の4分の1を取る場合、エージェントが無視されて実行される期間がどれほど長くても、利益は×4を超えることはできません。同じ結合により、ステップ×2、×5、×20、および×60は、チェックが手作業時間の50%以下、20%、5%、および約1.7%を取る場合にのみ開いています(図4)。これは、記述された会計上の限界を持つ単純化されたモデルです。それは、人物がまったく行うことができなかった仕事の価値を無視し、チェック時間がピースでスケールすることを仮定し、ピースあたり成り立ちます。したがって、安価に小さなピースをチェックする人は、大きなものについて計算された上限を破ることができます。経済のレベルでは、Catalini et al.(2026)は同じポイントを作ります。拘束力のある制約は「人間の検証帯域幅」となり、「測定可能性ギャップ」は、エージェントが実行できることと、人々が検証を許容できることの間で開きます。
GDPvalは、実際に限界が何を意味するかを示します。その220タスクのゴールドサブセットでは、専門家は(著者が検証した)手でタスクあたり平均404分を報告し、成果物のレビューに測定された109分、約27%を取りました。これにより、そのような種類のタスクの上限は約×3.7に近くなります。モデルは、専門家よりも90~327倍速く草案を作成しました。ただし、人物がモデルを試してからその仕事を修正するシナリオでは、著者の計算(測定ではなく)は、モデルが1回試行された場合のGPT-5の高速化が1.12で、複数回試行された場合が1.39でした。同じテーブルの2つの別々の列(Patwardhan et al., 2025)。エージェントの速度が何であれ、チェックの価格は上限を設定し、その価格はラングに応じて上昇します。より大きなピースはチェックに費用がかかるからです。Kamara(2026)はこの費用を検証摩擦と呼びます。セクション9のスレッドの実務家は自分の言葉でそれを述べています。一定のポイントを超えると、エージェントコードのチェック「手作業でそれを書き直すことと異なる部分と異なる部分が少なくなり」、自分で書くよりも長くかかることができます(翻訳済み)。
同じ利益は2つの道で到達できます。長いひもは大きなピースを引き渡し、終了時にチェックします。短く、速いループは小さなピースを引き渡し、それぞれが着陸するときにチェックします。私の仮説は、小さなピースを途中でチェックすることは、多くの場合、最後に大きな結果をチェックするよりも安いということであり、Anthropicのデータはそちらを指しています。会話は一度限りのリクエストよりも成功率が高く、著者自身の推定により、一度限りのリクエストは約3.5時間のタスクで50%の成功に到達する一方、会話は約19時間のタスクで到達します(Anthropic, 2026a)。協調的な使用のシェアは2025年8月下で下に下がり、11月には前面に戻りました。52%対45%。短いループの道は人間AI協調文献が研究するものに近いであり、増幅利益はそれを長い委譲と同等にクレジットします。セクション11の予測F19~F21は短いループの道をテストします。
図4。2つの軸、4つのプロフィール、およびチェックが設定する上限。
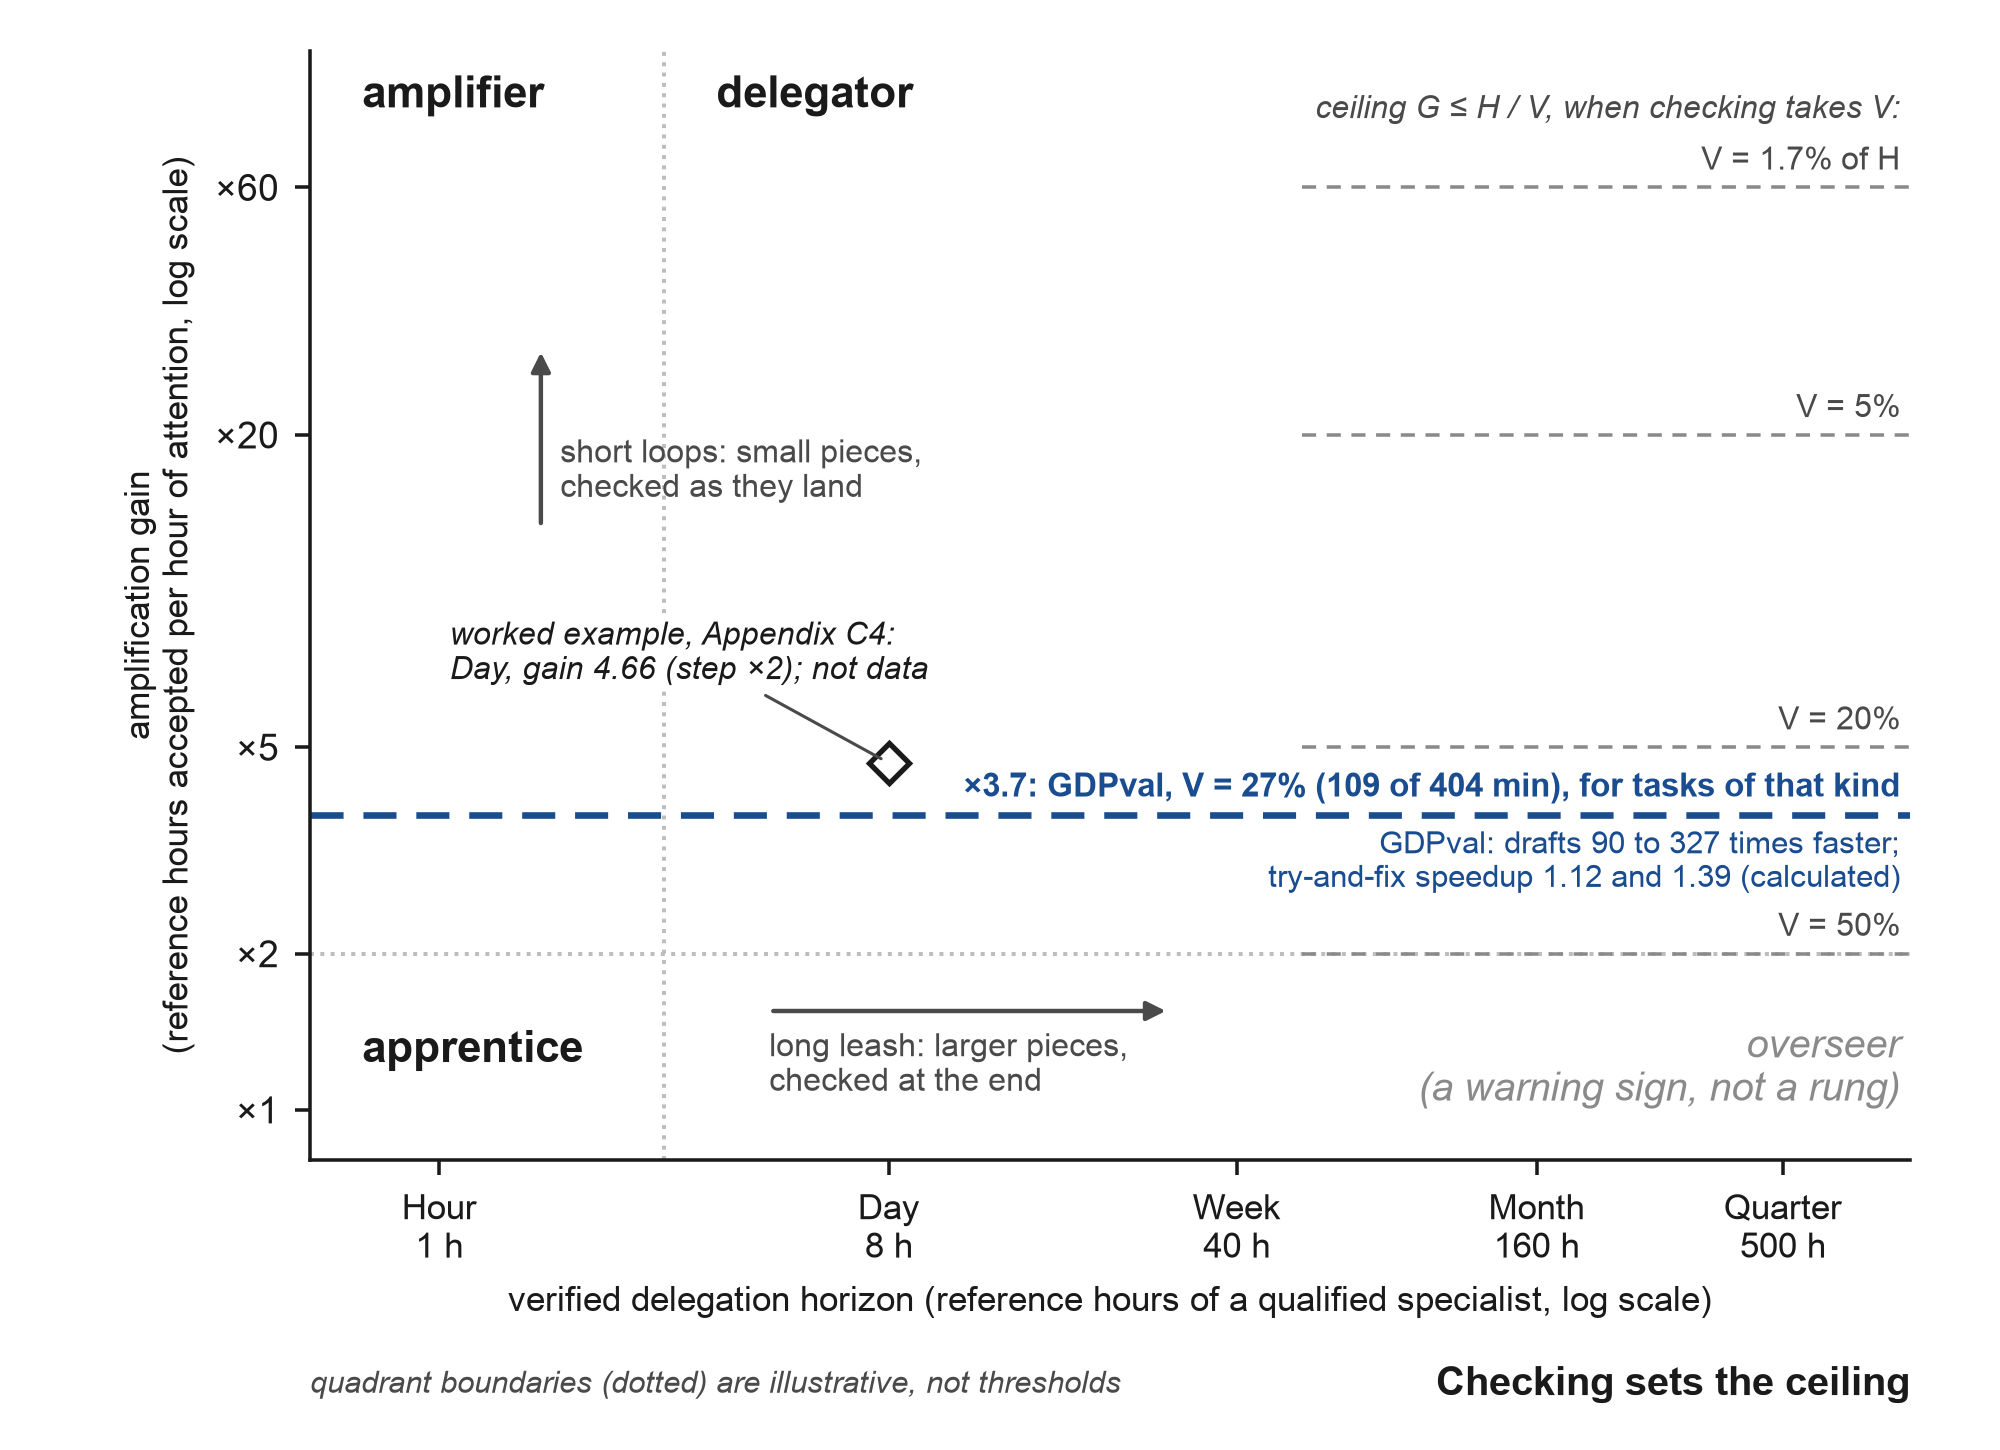
注:象限ははしご段ではなくプロフィールであり、その境界は図示的です。各灰色の線はセクション5.5の限定G ≤ H / Vで、手作業の時間Hにおける検査時間Vの特定の割合に対するものです。アクセント線はGDPvalの220タスク金標準サブセットの平均値を使用しており、404分の手作業と109分の専門家による模型出力の確認です(Patwardhan et al., 2025)。加速度1.12と1.39は著者らの計算であり、測定値ではありません。ダイヤモンドは付録C4の実施例であり、データではありません。天井がタスクの種類ごとに計算されるため、GDPval線より上にあり、小さく検査された部分は大きなタスク向けに計算された天井を上回ることができます(セクション5.5)。セクション5.4の36段階の場合は図示されていません。この記事は利得をもたらさず、独立した検査もありません。
5.6 測定基準はどこから来ているのか、そして何が新しいのか
測定基準には先祖があり、最古のものはエリオット・ジャックです。彼はいかなる職能のいかなる職務のレベルも、その裁量の時間幅によって測定しました。これは人が誰かが結果を確認する前に自分自身の判断で働く最長の時間です。彼は、公正な給与はその幅に応じて上昇することを主張しました(Jaques, 1956)。検証された委任地平線は、その概念をエージェントの時代へ1つの変更で持ち込みます。ジャックは人が検査なしで働く期間を測定しましたが、この測定基準は人がエージェントに委任する、受け入れ、検査させる作業量を数えます。この2つは異なる可能性があり、彼の階層(数ヶ月および数年で数えられる)は、これらのはしご段にはマップされません。
主-代理人理論は第2の先祖です。ジェンセンとメックリング(1976)は委任を監視、ボンディング、および残余損失として価格設定しました。検査はエージェントに作業を委任する監視コストであり、地平線はより大きなピースの検査がもはや報われない時点をマークします。
METRは機械を同じ軸で測定します。その時間地平線は、モデルが特定の成功率で完了するタスクの長さ(人間時間単位)です(Kwa et al., 2025)。2026年春、ダッシュボード上のフロンティアモデルは50%の成功率で約17時間に達しました。ただし、METRそのものは16時間を超える測定値が現在のタスクでは信頼できないことを注意しています。80%の成功率での地平線は、2026年2月の約1.2時間から4月の約3.1時間に上昇しました。これらの2つのポイントは、その速度を測定することなく成長のペースを示しています。2023年以降のダッシュボード全体の傾向は約4.2ヶ月(128.7日)で2倍になり、ダッシュボードは2026年9月8日にアクセスされた後は更新されていません(METR, 2026c)。AI未来プロジェクトの予測者は4~4.5ヶ月の倍増時間で働いています(AI Futures Project, 2026)。受け入れられた作業は50%の地平線よりも80%の地平線に対応しています。モデルが時々終了するもの(場合によっては完了するもの)と確実に終了するもの(確実に完了するもの)の間のギャップは、人の仕事であり、結果が正しいことを示し、それを最後まで見ることです。図A3(付録F)は、これらの機械地平線をはしご段に対して設定します。
2026年の理論は同じギャップを指しています。ファン、シャオ、ヴィシュノイ(2026)はAIの下での委任をモデル化し、検証能力の小さな違いが結果に大きな違いをもたらすことを発見しました。AIは検査する人を助け、あまりにも多く委任する人に害をもたらします。彼らの論文はICML 2026で受理され、彼らはこの効果を検証増幅と呼んでいます。24の研究の構造化レビューは、焦点コーパスで検証された機器がないことを発見しました。これはエージェント(範囲、権限、回復、独立した確認、証拠ベースの終了)を監督するために必要なスキルの完全な組み合わせをカバーしているはずですが、いくつかの機器はそれの一部をカバーしています(Veri', 2026)。DeepMindのインテリジェントAI委任フレームワークは委任を一般的に説明し、人レベルの測定値を含みません(Tomašev et al., 2026)。委任の経済学は現在独自のフロンティアモデルを持っています(Wang, 2026)。チェンとモン(2026)は、生成AIがタスク内のスキル差を圧縮し、価値を希少な補完資産にシフトすることを示しており、彼らは人ごとのタスクパネルデータが「まだ大規模には存在しない」と追加しています。私が提案する測定基準は、ログされた各ピースが人、サイズ、日付を持つため、正確にそのような種類のデータを生成します。
第2軸には独自の隣接があり、増幅利得はそれらの人レベル、検証済みの形式です。エンゲルバルト(1962)はコンピューティングを人間の知性の増強を補うものとして定義し、「スーパーエージェンシー」は2025年のマッキンゼーの同じ希望に対する言葉です(McKinsey, 2025)。Anthropic Economic Indexは会話をスピードアップ(AIなしの時間をAIなしの時間で割ったもの)とエージェント自律性で評価しており、両方ともモデルによって判定されます(Anthropic, 2026a)。スタンフォード大学のWORKBankは、人間が好む労働者の参加を1~5のスケールのH1からH5にグレード化しています(Shao et al., 2025)。2026年のエッセイは監督能力を人間の努力に対する有用な検証済み出力として定義し、明示的に数値を与えることを辞退しました(em360, 2026)。「増幅された監督」はAIセーフティの用語で、より強いシステムを監督するのに人々を支援するためのものです。検索エージェントの観察は、人間の時間が検査へシフトするのと同じことを示しています。エージェントは1回のセッションあたり26分間単独で作業し、標準的な検索は33秒かかりました(Yang et al., 2026)。委任の側面では、カディジ(2026)とアロンソ(2026)は「委任地平線」を機械または企業がどの程度委任できるかに使用し、CHI 2026の「決定地平線」に関する研究は自己方向の喪失を研究し(Lübeck大学, 2026)、ドーソン(2026)とメタルトード(2026)はAI委任の開業医レベルを公開しています。独立した検査で確認された作業によって人をレベルに配置する場所はありません。
最も近い最近のフレームワークはここで直接比較されます。JetBrains ResearchのAIDEsフレームワーク(Tikhomirov, 2026)は、測定基準と2つの特徴を共有しています。委任を主-代理人の関係として扱い、委任を5つのレベルで順序付けます。これらは自律性と計画などの属性によって説明されます。4つの点で異なります。その対象はソフトウェア開発ですが、地平線はいかなる領域でもスコア付けされます。そのレベルは仕事がどのように委任されるかを説明しますが、はしご段はその仕事のサイズ(資格のある専門家の参照時間)によって設定されます。チェックが代理人独立である必要がないのに対し、はしご段は代理人が見なかったチェックで確認されたピースのみをカウントします。そしてそれは窓の上をカウントせず、第2軸を持たないのに対し、はしご段は日付のウィンドウ上のパス共有を必要とし、増幅利得は注意の時間を追加します。エージェンシーの言語は共有されています。単位、独立性ルール、ソフトウェアを超えたスコープはこの論文が提案するものです。
多くのスケールが2025年と2026年に公開され、表2のスケールのいずれも検証済み作業によって人を測定しません。表2は、それらが測定するもので主なものをグループ化します。表A3(付録F)はそれぞれをリストしています。
表2. 2025年と2026年のスケール、それらが測定するもでグループ化されたもの。
| ファミリー | 例 | 測定される単位 | 検証済みの委譲作業によって人を位置づけるか? |
|---|---|---|---|
| エージェントと機械の自律レベル | Feng et al., 2025; Shapiro, January 2026; Memari & Rudolph, 2026; METR, 2025-2026 | エージェント、モデル、またはチームのセットアップ | いいえ |
| 開発者の実践のステージ | Yegge, 2026; Park et al., 2026; Microsoft, May 2026 | 実践、監督作業、または作業パターン | いいえ |
| 組織と企業による委譲 | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), February 2026; Khadj, 2026 | 組織、マネージャー、企業、または一般的な委譲 | いいえ |
| 開発者の委譲をプリンシパル・エージェント関係として | JetBrains Research (Tikhomirov), September 2026 | 開発者の委譲 | 開発者のみ。チェックの独立性ルールなし、サイズの単位なし |
| 能力とリテラシーのフレームワーク | AI Certification Standards, 23 August 2026; Anthropic AI Fluency, 2025b | 能力またはリテラシー | 試験、閾値、またはレベルなし |
| 検証済み委譲地平と増幅ゲイン | This paper | 領域内の人 | はい、セクション5.2のルールによって |
注:「検証済みの委譲作業によって人を位置づける」とは、スケールが、エージェントに委譲された作業の規模とエージェントが見ていないチェックによって確認されたかどうかで、個人をレベルに置くということです。最も近い類似は JetBrains の5つのレベルです。それらはプリンシパルとエージェントの言語を共有し、検証のルール(エージェントが見ていない独立的なチェック)と単位(参照時間)が異なります。表 A3(付録 F)は各スケールを個別に列挙しています。
あるプラクティショナーは個人スケールへの異議をよく述べています。「あなたの自律レベルはリポジトリの特性であり、開発者の特性でもなく、モデルの特性でもない」(Phoenix, 2026)。その半分に同意します。地平は人に属し、領域内にあり、チェック体制下にあり、隠されたテストを持つよく構築されたリポジトリはそのチェック体制の一部です。これが地平が領域ごとに日付とともに記録される理由の一つです。
5.7 相手の論文からの2つの質問
相手の論文は、経験豊富なユーザーがなぜより少なく委譲するのか、彼らが失敗したのか、それとも彼らの判断が成果なのかという質問を未解決のままにしていました(Chernets, 2026a)。第2軸はその2つを区別することができます。指示的使用の共有が低下しながら検証済みゲインが上昇する場合、判断が成果です。ゲインも低下する場合、彼らは失敗しました。相手の論文はまた、委譲の語彙が1つの文法か職業ごとの文法かを尋ねていました。私は立場を表明します。文法は1つです(タスクを設定し、その後証拠に基づいて受け入れる)。一方、何が証拠として数えられるかは領域によって異なります。これが段階が共有され、スコアリングが領域ごとに行われる理由です。
付録 C の楽器は、各人と領域の指示的共有を報告し、ピース上で数えられます(1つのピースで委譲されたピースの共有対ステージまたは共同作業)。したがって、最初の粗いテストは、段階を与えるのと同じ記録上で実行できます。予測 F20 は登録された測定の日付を含むテストを述べています。「ログからの指示を与える、チェックまたは編集するのではなく人のターンの共有」(表 A6)。そこの共有はセッション ログのターンにわたって数えられます。付録 C の作業ログのピースにわたってではなく、2つの数え方のより細かいものです。
5.8 測定がどのようにゲーム化できるか、そして防御策
受け入れられた、独立してチェックされた作業を数えることは最も安い経路である支出を閉じますが、決心した人または目標を追う雇用主はまだ他の経路を持っています。表3はそれらとルールが提供する防御策をリストしています。防御策は何かのコストがかかり、そのコストは設計の一部です。監査された段階は自己報告されたものより価値があります。監査されたアカウントが声明より価値がある方法と同じです。
表3。 測定をゲーム化する方法、および防御策。
| 経路 | それがどのように見えるか | 防御策 |
|---|---|---|
| 簡単なチェック | 弱いソリューションが合格する隠されたテスト。ざっと目を通すレビューアー | 受け入れられたピースの共有の無作為監査(第2の独立したチェッカーによる)。Week 以上から植えられたエラー。チェックの種類がスコアの横に印刷されている |
| 閾値のすぐ上のタスクを選択する | 8.1 参照時間の多くのピース(Day に到達するため) | サイズの分布から読まれた段階。受け入れられた中央値サイズが段階の横に報告されている |
| 時間を寛大に評価するレーター | 参照時間を膨らませるレーター | その人に盲目の2人のレーター。固定比率を超える不一致は、ピースを凍結銀行または第3のレーターに送ります。レーターのレコードを監査 |
| 隠された助け | 同僚または請負業者がログ外で作業を修正 | ピックあたりのログイン注意。無作為の面接またはリプレイ。外部の助けを記録され、その人のゲインから除外される |
| スライシング | 1ヶ月の作業が1時間のチケットに切られている | 全体として受け入れられた、一貫性のある成果物のみが段階に向かって数えられます |
| 失敗を隠す | 放棄または失敗したピースがログから削除される | すべてのハンドオーバーがログされ、開始日付を含む。受け入れられた、拒否された、または放棄されたときに閉じられる。失敗の公開記録。クリーンに見えるパス率は監査をトリガーします |
| 相関チェック | 同じファミリーの第2のモデルが同意 | 計数されません(セクション5.2) |
| 並列ストリーム | ストリームごとに1回数えられた注意 | 人当たり分ごとに1回数えられた注意(セクション5.4) |
閾値は設計選択であり、ルール v1.1 としてバージョン管理され、データ取得後の新しいバージョンでのみ変更されます。ウィンドウ内の 10 件は、80% の合格シェアが意味を持つ最小数です(10 件中 8 件の合格)。下位のラングの 91 日間のウィンドウ、および上位のラングで必要な最近の件は、四半期ごとの再検証とツールの変化のペースと一致しています。ラングルールは適格性のルールであり、個人の信頼性の推定値を提供しません。10 件中 8 件の合格は、真の合格率がおよそ 44% から 97%(正確な 95% 区間)のどこかと一致しており、3 件中 3 件はおよそ 37% と同じくらい低い(片側 95% 境界)と一致しています。登録されたキャリブレーション研究は信頼性を推定します。80% のシェアは METR による 80% の地平線の使用に従い、信頼できる作業のレベルとして、1、8、40、160、500 時間のラングは労働時間、日、週、月、四半期に従っているため、職業間での翻訳は不要です。閾値のデスク テストはシミュレーションとモデル評価者(付録 E)で ルールを確認しました。既知の信頼性を持つ個人が各ラングを獲得する頻度を計算しました(図 A2、付録 E)。真の合格率 0.8 では、Day は 68% のウィンドウで獲得され、同じ判定が次のウィンドウで 56% 繰り返されます。これが、記録が「Day (8/10)」のようにラングの隣に数を出力する理由です。また、ルールの最初のバージョンのエラーも見つかりました。Month での 4 件中 4 件は Quarter での 3 件中 3 件より獲得が難しかった(合格率 0.8 で 41% 対 51%)ため、Month は現在 1 年間に 6 件中 5 件を要求します。数を 10 から 8 または 12 に、またはシェアを 0.8 から 0.7 または 0.9 に移動すると、シミュレートされたログの 8% から 11% の Day 判定が変わります。両方を移動すると、最大 22% で変わります。4 つのファミリーから 4 つのモデル評価者は、参照時間をブラインドで推定し、30 個のタスクを一貫して(ログ時間の級内相関 0.89)順序付けしましたが、ペアの 62% のみをキャリブレーション プロトコルの基準である 70% の 1.5 の比率内に配置し、全体的なレベルで係数 2 で異なりました。タスクの公開識別子のみが与えられた場合、彼らの平均推定値は 14 個のタスク中 3 個について測定された人間の時間の 1.5 以内に収まりました。したがって、モデル評価者は 2 人の人間の評価者に代わることはできず、フィールド研究の評価者は、測定された時間を持つタスク上で最初にキャリブレーションします。キャリブレーション プロトコルは次のテストを事前に修正します。人間の評価者間の合意(基準:ペアの少なくとも 70% が 1.5 以内)、2 つの連続ウィンドウ全体での個人のラングの再現性(重み付き kappa 少なくとも 0.6)、およびラングが同じサイズの新しいタスクに合格することを予測する能力(AUC 少なくとも 0.7)。そのプロトコルと登録テキストはコンパニオン リポジトリにあり、参照時間に関する彼らの合意の専門家との最初のテストは、登録され、付録 G で説明されています。
表 A4(付録 F)は、最初に起こるハード ケースのルールを示しています。
付録 C、セクション C4 は、10 行のあるユーザーのログをそれが生成する単一レコードまで処理します。
6. 背景中立性と資格認定交差点
6.1 背景中立性
仮説は、ある領域での検証済みの水準が等しい場合、プログラミング教育は、領域の習熟度と受け入れリテラシーを考慮に入れると、独立して検証された業務の質を予測しないというものである。
Anthropicの「Claudeを成功に導く能力は、コードを書く能力よりも領域の習熟度から生じる」という知見は仮説と一貫しているが、それをテストしていない(Anthropic, 2026e)。そのデータは人々を職業で分類しており、セクション2.2の34%対29%のギャップは職業間のギャップである。仮説をテストするのはF7の研究だけである。強力な代替仮説も存在する。Savva(2026)はAI支援知識業務をプリンシパル・エージェント問題としてモデル化し、AIが簡単なタスクでは人々の間のギャップを狭め、難しいタスクでは広げると予測している。Savvaが正しければ、背景中立性は短期タスクで成立し、高い段階では失敗するため、予測F7は日単位および週以上で別々にスコア化される。ここで仮説は最も厳しいテストに直面する。
受け入れリテラシーは仮説が依拠するスキルである。これは事前に完了の基準を明示し、その後それを示すことを意味する。隠れたテスト、ソースに対して検証する第二の一族のモデル、その人が自分で開いたソースとの比較、または保証に代わる成果物を通じて示す。エージェント・リテラシーは一般的に委任、検証、管理を対象とする(MindStudio, 2026)。受け入れリテラシーはその中心に証拠の基準を置く。また、TAM伝統の意味における技術受け入れとは異なる。それは人々が技術を採用するかどうかを研究するが、ここでの受け入れは業務の受け入れの決定である。companion paperの受け入れ記録は段階の証拠の単位となる。
6.2 資格認定交差点
ある領域における資格認定交差点は、IT教育を受けていない人々によって製作され、同じ独立した検証下で受け入れられた製品が、同じエージェントを使用するプログラマーが製作したものを上回り始める時点であり、その後IT学位および初級および上級というラベルは、その領域での採用において予測力を失う。
この定義は2026年10月8日に立てた私の予測を正確にしたものである(セクション1)。その構成要素はそれぞれ観察可能であり、それぞれ独立して日付が付けられているため、それらが一致したときに時点を読み取ることができる。品質パリティは時点の前の段階である。ある領域では、IT教育を受けていない人々の製品は、同じエージェントを使用するプログラマーの製品と同じくらい優れている。同じタスク、盲検査の下で(予測F2)。追い越しは時点そのものであり、これらの製品が同じ検査でより優れたものになるときである(F3、F4aおよびF4bのリリースとメンテナンスの段階を伴う)。掲示における交差は可視的な兆候であり、エージェント的スキルを要求する掲示がそれを要求しない比較可能な掲示よりも頻繁に学位を要求しなくなるときである(F5)。背景中立性は機構であり、等しい段階で教育は検証された品質を予測しなくなるからである(F7)。
ある領域における交差点は、その同じ名前の領域で、追い越しが示される(F3)最初の年、および領域の類似物となる掲示における交差が満たされる(その領域の掲示に対して計算されたF5。付録D)によって日付が付けられる。パリティなしの追い越しは時点への接近であり、追い越しなしの掲示における交差は、雇用者が証拠の先を行っていることを示すだろう。したがってF2、F3、F5、F7は同じ名前の領域に対する一つのプログラムを形成する。領域は登録で固定され、F2、F3、F7の実験がそれらで実行され、F5はIT職業の凍結セットおよびそれぞれの領域の掲示の両方で計算される。交差点は、品質ルール(F3)と採用ルール(F5の領域類似物)の両方が同じ領域で満たされたときにのみ、領域に対して宣言される。どちらか一方だけでは何も宣言しない。
最初の2つの構成要素は、マッチングされたタスク上の実験によってテストされる(セクション11)。3番目はすでに求人掲示で監視できる。Lightcastは2026年9月、AIスキルを要求するIT掲示は、それを要求しないIT掲示よりも4年制学位を要求する可能性が高いと報告した。ただし、AI掲示の中でも、学位要件は「2024年以来明らかに減少」しているのに対し、他のIT掲示では増加している(Lightcast, 2026b)。2つのラインは収束しており、交差していない(図5)。Lightcastは300以上のAIスキルでAI掲示を定義しているため、そのラインは一般的なAI業務を記述している。エージェント的サブセット、凍結されたエージェント的スキルリストで定義される(Lightcast, 2026a)は、予測が使用するものであり、そのベースラインは登録前に取得される。
この方向には先例がある。Bone、González EhlingerおよびStephany(2025)は、2024年半ばまでのおよそ1100万のイギリスの空席を使用して、AI職での教育要件が低下し、スキルと学位に付与される賃金プレミアムを比較した。その業務は、エージェント前のAIでのスキルベースの採用を文書化した。この論文は、エージェント的スキルにその線を拡張し、日付のしきい値と比較可能な掲示との比較を伴い、掲示要件を独立して検証されたパフォーマンスにリンクすることを提案し、事前に登録されるテストを行う。PwCのAI Jobs Barometerは、国全体で同じ方向を報告し、それが同じ量を測定する場合はどこでもフォールバック情報源として機能する(PwC, 2026)。
2番目の指標は、雇用者が言うことと行うことの距離である。多くの雇用者はエージェントが到着する前に方針から学位要件を削除したが、Burning Glass InstituteとHarvard Business Schoolは、その変更が700人に1人未満の採用に影響を与えたことを発見した(Burning Glass Institute & Harvard Business School, 2024)。掲示は反対方向に動いた。2025年11月、Indeed上のUS掲示の19.3%は学士号以上を要求し、1年前から大幅に増加した(Indeed Hiring Lab, 2026)。紙から削除された学位要件は方針変更であり、交差は採用自体が変わるときにのみ示される。教育のみで異なるマッチングされたポートフォリオを実際の掲示に送信する監査研究は、それを最初に見るだろう。予測F26が1つを設定する。
学位は、人々にラベルで入場を認める門の一族に属します。プラットフォーム上のプロフィール、職務経歴書、学位、そして部分的には免許です。ラベルは、雇用主に対して、それを持つことが仕事をできることと一致する範囲でのみ仕事について伝えます。エージェントはそれを一方の側から緩めます。ラベルのない人々が今や取引のように見える仕事を生産しているからです(セクション2.2)。また、個人の言葉に基づくラベルは常に主張するのが安かったからです。仕事自体をチェックする門はどちらにも依存しません。Appendix Gの評価者研究はその違いに偶然出会いました。Prolificは、ほとんどが自己報告される回答をフィルタで研究に参加者を認めます。年齢と居住国がそれが検証する主な例外です(Prolific, 2026)。そのフィルタが簿記サンプルに認めた60人のうち、11人は取引の初週の質問に間違った回答をしました(Appendix G2)。ラベルは彼らを入場させ、取引の1つの質問は彼らを止めました。
エージェント前にそのようなプラットフォームでプログラマーを採用した研究者は同じパターンを報告し、自身の知識質問でスクリーニングしました。1つの研究では、プラットフォームのプログラミングスキルを述べた労働者の42%がそのような質問の基準を満たしませんでした(Danilova et al., 2021)。別の研究では、Prolificで、Node.jsでプログラミングを報告した206人の回答者のうち55人が、そのすべてのプログラミング質問に合格しました(Reid et al., 2022)。知識質問は、それ自体が提供された仕事のチェックより弱い門であり、チャットモデルもそれを弱めます。シミュレートされた攻撃では、ChatGPTはプログラマーのための既存のスクリーニング質問を簡単に解きました(Serafini et al., 2024)。2026年までに、それに対抗するように設計された静的な視覚的質問も通過しました。一方、その内容を厳密な時間制限の下で段階的に明かす音声質問は依然として保たれました(Serafini et al., 2026)。採用の観点では、上記の定義が学位のために予測する重みの喪失は、第一種の門が第二種の門に変わることであり、検証された委譲地平線は第二種の門です。それは、人が自分たちが何であるかを言ったことではなく、彼らが引き渡したものとエージェントが見なかった手段がチェックに合格したことを記録します。
免許は両者の間にあります。かつて合格した試験に基づく免許は、その後、ラベルとして機能します。保有者の仕事が検査される免許はチェックに近いです。米国の公開会社会計監視委員会に登録された監査法人は、その監査仕事が毎年検査されます。通常100以上の発行者を監査する場合、その他の場合は少なくとも3年ごとに1回です。委員会が規則により別のスケジュールを設定しない限り(Sarbanes-Oxley Act of 2002, s. 104)。これは、法人の署名された仕事の遅い対応です。セクション5.2が地平線に要求する再検証の対応です。免許は第二種の方向に動き始めています。2024年5月からオレゴン州は、法学部の卒業生に司法試験なしでラベルへのパスを提供しています。監視対象実践ポートフォリオ試験です。少なくとも675時間の監視対象実践の間に、候補者は8つの著作、2つのクライアント相互作用と2つの交渉を提出します。司法試験委員会の規則を適用する採点者は、それぞれが最小限の能力を示しているかどうかを判断します。2026年1月5日までに、205人の候補者が申請し、49人が弁護士として認可されました。最初の候補者は2024年12月でした(Oregon State Board of Bar Examiners, 2026)。法律の学位は依然として必須なので、チェックされた仕事は学校ではなく試験を置き換えます。会計では、移動はより小さいです。2025年5月にAICPAとNASBAは、CPA免許へのパスのためのモデル法制定を承認しました。これは、学士号を超えた30単位時間の研究の代わりに、専門的経験の第2年を求めます。試験は保持されます。各州はそれを制定する前に、候補者がそれを使用できる必要があります(Journal of Accountancy, 2025)。法が免許に確保するものはこのセクションの測定の境界を保つ(セクション13)。表A8(Appendix F)は、このセクションの門を各々がチェックするもので並べて設定します。
「credential」という用語は、エージェントセキュリティにおける第二の意味があります。ここでは、秘密鍵またはトークンを意味します。ここでは、学位または証明書を意味します。この意味で「credential crossover point」という語句は、2026年10月9日に検索した学術ベースに一致するものを返しませんでした(Appendix B)。
Figure 5. 検証された成功のギャップと投稿における学位要件:観察されたもの、および2027がテストするもの。
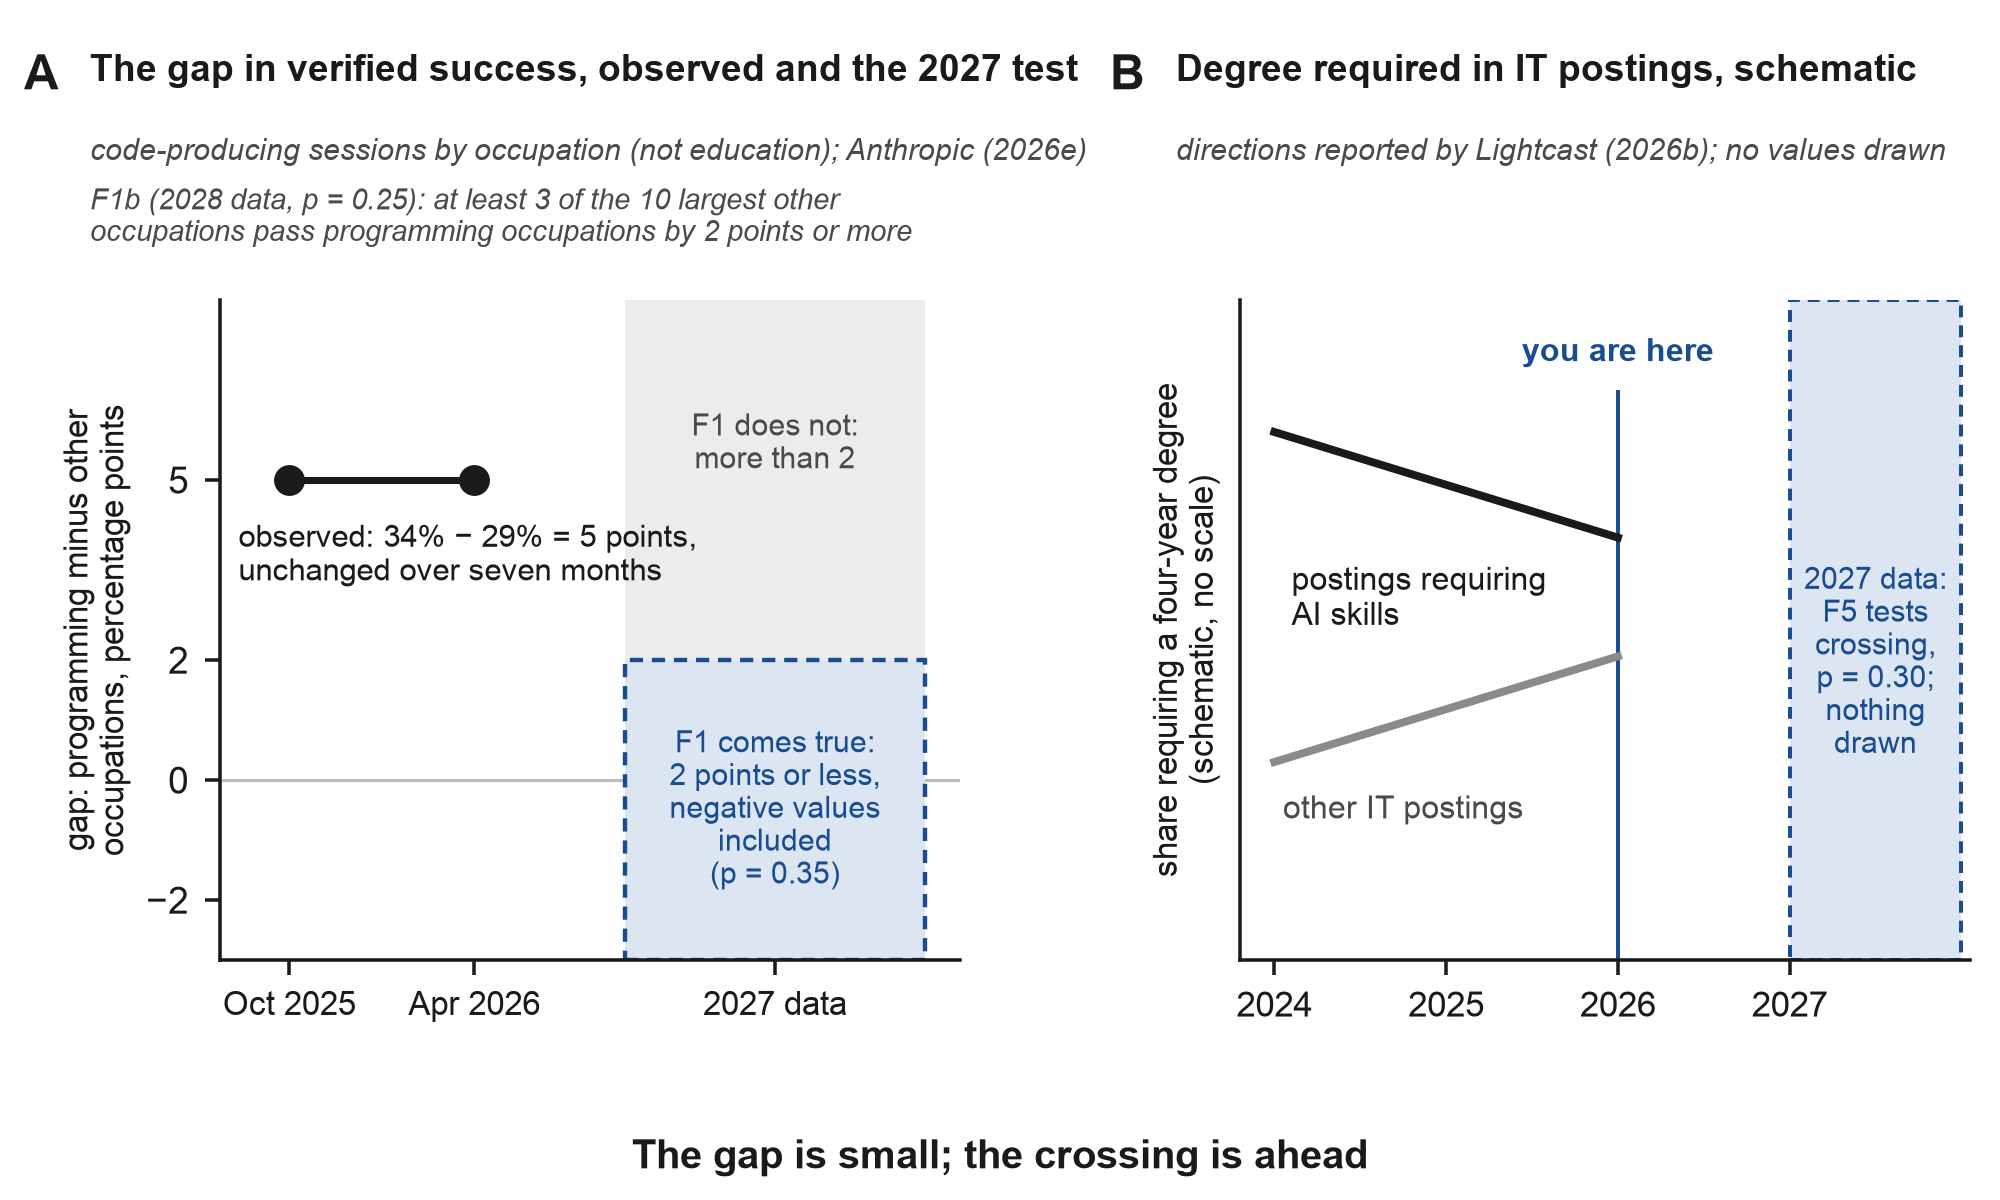
注:パネルAはAnthropicを使用しています(2026e)。コード生成セッション。プログラミング職業で34%。他の職業で29%。7か月間変わりません。職業は教育ではなく、成功はテストやコミットなどの証拠によってサポートされた達成を意味します。バンドは予測F1の閾値です(2ポイント以下のギャップ。負の値を含む。確率0.35)。F1b(確率0.25)は表A6にあります。パネルBは、Lightcastが2026年までに報告した方向のみを描きます。その値は含みません。2027年のウィンドウは空白のままです。交差は引かれていません。予測F5(確率0.30)がそれを決定するからです。
6.3 Domains: プログラマーの利点が水平であった理由
AIが最初に安くするのは、すべての業界で同じ水平的なもので、メカニズムは明白です。業界を超えて転移する能力は、汎用モデルがすべての業界に一度に供給できるものです。モデルの上の薄いラッパー、汎用ソフトウェア、コードを書く一般的な能力はすべてそのようになりました。2023年の最も流行のあるタイトルであったプロンプトエンジニアは、2025年までに時代遅れと呼ばれました。スキルがツールに溶け込み、誰もが持つようになったからです(Fortune, 2025)。プログラマーの昔の利点も水平的でした。コードはあらゆる業界で機能するので、プログラマーは法律事務所や病院向けに、どちらも知らずに構築でき、エージェントはコードを安くすることで、その利点を奪い去っています。これが起こるためにプログラマーになる必要はありませんでした。ソフトウェアは多くの垂直分野の1つになり(インフラストラクチャとセキュリティが近い隣人として)、その内部ではプログラマーが最も強いままです。同じロジックが企業と同じく人にも適用されます。垂直分野がない人はAIの薄いラッパーであり、薄いラッパー製品と同じくらい露出しています。エージェントが汎用ソフトウェアをより簡単に構築するようにするにつれて、古い垂直分野ソフトウェアは、情報層を取る研究所と、独自のツールを構築する専門家の2つの側面から圧力を受ける可能性があります。仮説は、ドメイン知識とエージェント作業を受け入れる能力が結合されると価値を獲得することです。垂直性だけでは誰も保護できません。深さ、つまりモデルまたは新規参入者が偽ることができないドメインでの作業を受け入れる能力が保護します。
ここでの垂直分野は、人がエージェントの仕事を受け入れることができるドメインであり、それが彼らが学位を持っている場所かもしれないし、そうでないかもしれません。法的な仕事を受け入れるには、もっともらしいエラーを見つけるのに十分な法律を知っている必要があります。第9章のスレッドの1人の開発者がそれを簡潔に言っています。出力が無意味であることを見るには、フィールドの少なくとも少しを知る必要があります(翻訳)。受け入れは人と一緒にとどまり、結果の下の名前と署名、人自身のコンテキスト(クライアント、データ、地域ルール、言語)、およびリリース後のメンテナンスも同じです。
研究所は垂直分野の情報層を購入しています。AIの研究所に専門家の時間を販売するMercorは、放射線科医などの専門家の時間を販売することで、2026年6月に年間総走行率で20億ドルを超えました(Dealroom, 2026)。垂直AIアプリケーションへのエンタープライズ支出は2025年に35億ドルにほぼ3倍に増加しました(Menlo Ventures, 2025)。そのフォークはドメイン専門家に2つの運命を与えます。ドナーはラベルとしてナレッジを研究所に売却し、そのナレッジは一度消費されます。プリンシパルはナレッジを独自の製品内に保ち、結果に対して答え、ナレッジは機能し続けます。
測定の結果は、地平線が領域全体に転移しないということです。ソフトウェアに移動する弁護士と法律に移動するプログラマーは同じことを失い、彼らが知らないフィールドで仕事を受け入れる能力を失います。その対称性がプログラマーの特別な立場の終わりがどのように見えるかであり、それは測定できます。クロスオーバーポイントはドメインごとにも到着します。コードが安くなった場所、チェックがドメイン知識を必要とする場所、および市場が小さいまたはローカルである場所で最初に来るべきです。法律、簿記、教育、診療所管理、狭いビジネス対ビジネスのニッチ、より小さい言語の市場。ソフトウェア自体は最後に来るべきです。1人のアナリストは2026年2月に関連する予測を行い、ファイナンスを「炭鉱のカナリア」と呼び、2027年までにすべての検証可能なタスクがファイナンスと会計の軌跡に従うことを期待していました(Hwang, 2026)。Anthropicのマネジメントがすでにコーディングセッションでプログラマーをわずかに上回っているという調査結果は、初期の兆候です(Anthropic, 2026e)。第5.3章の記録は最初のフィールドにドメインを指定し、任意の職業名をそれの前に置くことができます。
同じ推論はタイトルの運命を予測します。エージェントマネージャー、AIオペレーター、オーケストレーターなどの水平的なタイトルは、一般的にエージェントをラップする人々を説明しています。1人の実務者は、エージェント管理が「次の18ヶ月間」続くことを期待していますが、AIがそれを行う前に(IT Brew, 2026)、SrinivasanとWei(2026)は「エージェントマネージャー」が12〜18ヶ月以内に標準のタイトルになることを期待しています。予測F9は2つのビューを互いに対立させます。同じ記事は2026年2月にAIオーケストレーターの739の投稿を数え、1,294%上昇しました。そしてその数字は反対の方向を指しています。各垂直分野のエージェント展開に対して答える「Vertical AI Lead」などのドメインにバインドされたタイトルは、より速く成長するべきであり、第11章は比較に対する予測を設定します。
6.4 フロンティアモデルを持つ子供たち
反対はドメイン議論の根底に行きます。フロンティアモデルは大学部門より多くの生物学を知っています。新しいアイデアを持つ子供はそれをエージェントに記述して、専門化なしで1週間以内に生物学や車についてのサイトまたはアプリで動作できます。ドメインが重要なのはなぜですか?
前提の一部は既に真実です。北京では、6年生が2025年9月にグラフィカルプラットフォーム上のクラスで独自のAIエージェントを構築しました(Xinhua, 2025)。中国の教育省は2030年までに本質的にすべての小学校と中学校でAI教育を目標として設定しました(CSET, 2025)。米国では、2025年4月の行政命令が大統領AIチャレンジを開始し、その獲得学校プロジェクトには宿題ヘルパー、いじめ対策チャットボット、および視覚障害のある学生向けのツールが含まれていました(White House, 2025; EdWeek, 2026)。フロンティアエージェントへのアクセスはまだ年齢によってゲートされています。Claudeは大人向けであり、未成年者に属していると判断されたアカウントは中断されました(MediaNama, 2026)。OpenAIは年齢予測と十代向けの制限されたモードを導入しました(AlternativeTo, 2026)。子供はターミナルを通してよりも学校プラットフォームと10代のモードを通してフロンティアモデルに到達する可能性が高く、「1年以内にすべての学校」はより2027〜2030のようにみえます。
より深い答えは紙と世界の違いから来ます。紙の上で子供が勝ちます。フロンティアモデルは大学院レベルの科学の質問で一般的な専門家を上回るスコアを獲得し、ランダム化された試験では、モデルを持つ初心者は書かれた生物学タスクでコントロールより約4倍正確でした(Turner, 2026)。世界では利点は消えます。Nature Medicineで発表された1,298人の研究では、モデルだけが正しい状態を94.9%のケースで指定し、同じモデルを使用している人は34.5%未満で行い、コントロール以下でした(Nature Portfolio, 2026)。METRの153人の初心者との8週間の湿潤実験室試験では、モデルへのアクセスは有意な利得を与えず、各グループの約5%が全体のプロトコルを完了しました(METR, 2026a)。
異議を唱える人たちは正しい。昔ながらの垂直構造、すなわち長年の学習は価値を失いつつある。知識はモデルに無料で存在するからだ。知識が置き換えられないのは、正しい結果とそれらしい結果を区別する能力、そして現実とのつながり(ユーザー、テスト、実験、データ)であり、それが両者を区別するものだ。その受け入れのループが新しい垂直構造であり、「領域は重要である」と「子どもは専門化を必要としない」という見かけ上の矛盾を解決する。この意味における垂直構造は、実践によって構築された受け入れのループであり、長年の学習はそれを構築する複数の方法の一つに過ぎない。10代の若者は、学位なしに、自分たちの製品とそのユーザーを通じて、数週間でそれを構築することができる。それなしでは、1週間のエージェント作業は説得力のある絵のままだ。その場合、子どもたちは背景中立性の最も純粋なテストである。彼らは学位も勤続年数もなく、ループだけを持っているからだ。また、彼らは自分たちの製品に責任を持つ誰かが必要である。第7章が述べるパートナーである。ループがそれほど速く構築できるかどうかは、時代遅れの問題だ。2026年10月までに、正式な訓練を受けていない10代の若者で、科学的な製品がユーザーを持ち、独立した検証に合格した確認済みのケースは見つかっていない。予測F24は最初のそのようなケースの時期を示す。
6.5 プロセスでチェックする業界の新人
第6.3章は、自分が知らない分野に移った人は、その分野で仕事を受け入れる能力を失うと述べており、第6.4章の異議には大人らしい形がある。そうした能力のうち、どのくらいをプロセスで回復できるだろうか。帳簿作成の新人を想定しよう。その訓練も勤続年数も持たず、4つのステップで働いている。作業前に、複数のモデルに、そのような成果物は何を含む必要があるか、何が一般的に忘れられるか、どのようなチェックが適用されるかを尋ねる。1つのエージェントが作業を行う。別のエージェントが、それがどのように作られたかを見ずに、新しいコンテキストでそれをレビューする。別のファミリーのモデルが、その人が開いたソースに対して確認する。各ステップは、経験がかつて供給していたものに代わる。エージェントは作成のために、新しいレビュアーと2番目のファミリーは作られたものを別の観点から見るために、事前に作成されたリストは作業が何を含む必要があるかを知るために。事前に作成されたリストを持つそのような新人は、経験豊富な帳簿係よりも、より多くの独立したチェックに合格する仕事を提供できるだろうか。その経験豊富な帳簿係は1つのエージェントの出力を見たままで受け入れるだろうか。
エビデンスの一部は新人に有利だ。経験は、チェックを止めた専門家を保護しない。コンサルティング会社での現地実験で、エージェント前の前任者から、その能力の外にあることが選ばれたタスクでモデルを使用したコンサルタントは、それなしで働いた人よりも正しい解決策に到達する可能性が低かった(Dell'Acqua et al., 2026)。また、METRの試行では、経験豊富な開発者は、自分たちが速くなったと信じていたが、実は遅くなっていた(第5.4章)。1つのエージェントの出力を見たままで受け入れることも、この業界では弱い方針だ。160の会計タスク(勘定照合、費用の発生、取引の転記、報告書作成)を、会計専門家が作成したルーブリックに対して採点した場合、9つのフロンティアモデルの最良のものは平均56%の基準を満たし、8回の試みすべてで100%正しい結果を生成したものはなく、タスクの2.6%を超えていない(Benchek et al., 2026)。批評家を組み込むことができる。その目的のために訓練された批評家モデルは、モデルが書いたコードのバグをコードレビューに支払われた人間の請負業者よりも多く捉えたが、彼らはそこにないバグも報告し、そのような批評家で作業している請負業者は批評家だけと同じくらい多くを捉えたが、より少ない誤検知を報告した(McAleese et al., 2024)。これはエージェント前の前任者だ。作業前に作成されたリストは、新人に受け入れ識字の最初の半分を与える。完了とは何かという陳述(第6.1章)であり、それを描く模型は、ある業界の試験が何を求めるかを知っている。GPT-4は、実例とツール(電卓など)が与えられた場合、CPA、CMA、CIA、EA試験のすべてのセクションに合格し、平均スコアは85.1%だった(Eulerich et al., 2024)。これもエージェント前の前任者だ。最初にリストすることはチェックにも役立つ。省略のある臨床メモと完全なメモをコイン投げほどよく区別できなかった模型判定は、最初にソースが確立した事実をリストアップしてからメモをそれぞれについてチェックしたときはより良くなったが、それでも彼らは、省略のあるメモのわずか25%から37%しかフラグを立てなかった(Fox et al., 2026)。特定の顧客についての知識は、学位からではなく、その顧客との仕事から得られる。結果の責任を持つのは、誰が責任を持つ意思と信頼があるかによって決まる(第7.2章)。法律が署名を留保する場合を除く(第13章)。
それの一部はそうではありません。セクション5.2のルールの下では、同じファミリーの新しいレビュアーは1つのファミリー内での合意であり、これは作業を改善する可能性がありますがチェックとしてのクレジットは得られず、別のファミリーのモデルはその人が開いたソースに対してチェックする場合にのみカウントされます。エラーを取り消すことができない場合、それは隠されたテストまたは適格な人間の背後にある2番目の線にすぎません。ファミリー間での合意は、それが見えるよりも弱い証拠です。350以上のモデルにわたって、より大きく正確なモデルは、それらのアーキテクチャとプロバイダーが異なっていても、高度に相関したエラーを作成しました。ただし、共有アーキテクチャまたはプロバイダーは相関を高める要因の中にあります(Kim et al., 2025)。したがって、2番目のファミリーは同じファミリーの2番目のモデルよりも独立したチェックの方がより良い推測ですが、独立性の測定ではありません(Chernets, 2026b)。事前に作成されたリストはより狭い制限を満たします。モデルは、テキストに含まれているものを見つけるのと同様に、テキストから欠けているものに気付くのにはるかに劣ります。元のテキストがその横にあっても(Fu et al., 2025)。リストは、それが完全である限り、それにのみ役立ちます。欠落した計上は、レビュアーが表示されない省略です。警告を発することは、外部者をチェッカーにすることもありません。マーケティングおよび販売専門家にAIのマーケティングデータ分析をチェックするよう求められた場合、AIが誤りを犯すことを繰り返し言われた後でも、重大な欠陥を見逃しました。分析を明示的なステップとして、各決定の代替案を使って書き出すことは役に立ちました。ただし、参加者は多くの場合、それらを推論するのに苦労しました(Virk & Liu, 2025)。一致するバランスは証拠でもありません。2025年の1つの会計ソフトウェアメーカーのベンチマークでは、月ごとに会社の帳簿を締めるように求められたモデルは、最初の月以内に放棄したか、エラーを蓄積しました。その数字が銀行残高と一致しなかった場合、一部は関連のないトランザクションを引き込んで合意させました(Penrose, 2025、Gigazine, 2025によって報告)。ステップを見ないために参加した新参者は、リストがそれを名付けない限り、それをチェックするよう求めません。付録G2の探索的比較は、リストなしでそのギャップがどのくらい大きいかを示しています。その説明だけからそのタスクを評価し、最初の週の質問に間違って答えた人々は、より大きなタスクを他の人々よりも4分の1から3分の1少ない時間で見積もりました。モデルによって作成されたリストがギャップを閉じるかどうかは、セクション10.5の比較で示すためのものです。画像として取られたプロセスは、イコライザーのはしごです。エージェントは製造の多くを等化しました。仕事の前のリストと批評家がチェックの一部を等化する可能性があります。ただし、モデル間の相関したエラー(Kim et al., 2025)とテキストの省略に対する盲目性(Fu et al., 2025)は、どのくらいできるかに限界を設定し、残りは測定が示すものです。図A4(付録F)は、それぞれが何に対して、セクション5.2のルールの下でそれぞれが得るもの、および各ステップが停止する場所に対して4つのステップを設定します。コンパニオンリポジトリはそれらをこの方法で機能する人々のキットとして提供します(kits/checking-process.md)。
この測定は問題を事前に解決するものではなく、チェックする能力がどのルートで取得されたかを尋ねるものでもありません。新参者のプロセスがエージェントが見なかったチェックを通過する場合、誤ったエントリと同様に植え付けられたエラーの中の省略があります。新参者の地平線は誰のように上昇します。そうでない場合は、レコードがそれも示します。セクション6.1のライバルが正しい場合(Savva, 2026)、プロセスは短く、明確に指定されたタスクで最良に機能し、知識が何を含む必要があるかが最も重要である上部のランクで最悪となります。経験のある専門家が同じプロセスを採用する場合、どちらよりも良い結果が得られるはずです。プロセスがトレードの経験の一部に対して機能する場合、経験、ジュニア、シニアを含むラベルは、学位が同じ理由で重みを失うため、クロスオーバーポイント(セクション6.2)が失う損失です。登録された予測はプロセスをテストしません。F3bは参加者自身のドメイン外のタスクでの追い越しの価格を、セクション6.3のドメイン議論で0.10に設定し、問題に間接的にのみ関係します。セクション10.5は、それをテストするであろう比較を設定します。
7. 第二の境界: 信頼
7.1 不明瞭性は市場の正常な状態である
誰もが構築できるようになるとどうなるか。2026年の答えは、構築されたもののほとんどは発見されることがないということです。2026年上半期に約560,000個の新しいアプリがApp Storeに到達し、2025年全体の約600,000個に近く、ダウンロードは約2%増加しました。これはSensor Towerの推定値で、最初にThe New York Timesが報道し、二次的なメディア(9to5Mac, 2026; Gigazine, 2026)が要約しています。第1四半期のリリースは前年比約60%増でした(TechCrunch, 2026b)。RevenueCatの2026年レポートでは、そのソフトウェアを使用するアプリをカバーしており、新しいサブスクリプションアプリの17%が2年以内に月間1,000ドルの収益に達しました。1年前は19%でした。2025年以降に開始されたアプリは2026年1月のサブスクリプション収益の約3%を稼ぎました(RevenueCat, 2026; PPC Land, 2026)。GitHubは2025年8月までのOctoverse年に121百万の新しいリポジトリを報告し、1分あたり230以上でした(GitHub, 2025a)。2026年9月だけで73億8000万のコミットがあり、1年前の5倍以上でした(Celenza, 2026)。これらの数字は生産を数えており、ユーザーを見つけた製品ではありません。大規模な開発者フォーラムの「Show HN」セクションのモデレーターは、生成されたプロジェクトがセクションをノイズで圧倒し、新しいアカウントを制限していると報告しました(Krebs, 2026)。Startmateの投資家は2026年8月に、構築が安い場合は流通が製品を保護するものであると主張し、少数のユーザーしかいない強い製品を説明しました(Batko, 2026)。
創業者の間でも同じパターンが見られます。Cartaで2025年に設立されたスタートアップの約36%がソロ創業者によって率いられ、2024年は31%でした(Carta, 2026a)。Stripe Atlasを通じて2026年第2四半期までに設立されたC法人の63%がそうで、そのサービスの記録です(Stripe, 2026)。一人で始めることは一般的になりました。一人で稼ぐことはそうではありません。Atlas上のソロ創業者の中で、2025年の最初の6ヶ月の中央値の収益は前年比23%低下し、上位10分位数の収益は19%上昇したため、上位10分位数は中央値の約61倍を稼ぎました。4年前は約34倍でした(Stripe, 2026)。Cartaの前回のレポートでは、ソロ創業者は2024年に設立されたスタートアップの30%を率いましたが、その年の価格設定されたエクイティラウンドで調達された現金の14.7%を受け取りました(Carta, 2025)。両方のサンプルはベンダー自身の顧客であり、すべての新しい企業ではありませんが、このセクションが説明するものを示しています: より多くの人々が開始でき、報酬は上部に集まります。
プラットフォームは名前のない人々を締め出すことによって洪水から自分自身を保護します。curlプロジェクトは2026年1月にバグバウンティを終了しました。AIが生成したレポートが圧倒した後で、「20個に1つさえ本当ではない」とのことです(Stenberg, 2026)。GitHubは信頼できる貢献者へのプルリクエストを制限することを検討しました(Open Source For You, 2026)。Mitchell Hashimotoはウェブサイト上で「Vouch」をリリースしました。新参者は既存の参加者がそれらを保証しない限り、プロジェクトに貢献できません(Hashimoto, 2026; Willison, 2026b)。洪水に対する警備員はまた新参者をドアで止めます。これは関連論文が一般的な自動化された監視について説明するパターンです(Chernets, 2026c)。したがって、保証は機構として存在し、それが職業になるかどうかはセクション7.2の質問です。
新しいゲートキーパーはエージェントです。2,430回の実行の研究では、Claude Codeは20のカテゴリのうち12で既存の製品を採用する代わりに独自のソリューションを書きました。それを採用した場合、よく知られた名前を選びました(Amplifying, 2026)。Vercelのデプロイメントの約半分は2026年7月までにエージェントによってトリガーされていました(Startup Fortune, 2026)。コードホスト上の無料製品は、ユーザーのエージェントが1時間で何を書くことができるかと競争しており、エージェント自体が書くことができない信頼、メンテナンス、標準、または答える人です。
長い地平線は市場を作りません。地平線は人が提供でき、証明できるものを記録し、信頼は誰かが外側でそれを使用するかどうかを決定し、不明瞭性は2つの間のギャップです。ハーバート・サイモンは1971年にこれの経済学を見ました: 情報の富は注意の貧困を作ります(Simon, 1971)。エージェントはコードの障壁を低くしており、上記の証拠はプラットフォームとユーザーが洪水に直面して新参者を入れる前に信頼の新しいシグナルを求めていることを示しています。
7.2 2つのパートナー職業
一つの異議は、エージェントを通じて構築する人は人々に到達するスキルなしに不完全であるということです。それを異なって読みます: 人々に到達することは第二の軸であり、2つのパートナー機能がそれに沿って成長します。
フィニッシャーは、チャネル、起動、およびAI検索への可視性を通じて、製品を人々にもたらします。その名前はすでに取られています(成長エンジニア、開発者関係、GTMエンジニア、2026年に広く宣伝された役割)。エージェントはその一部を自動化します。メーリングと起動は自動化しやすく、フィルターが応答で硬化するからです。
保証人は製品の下に名前を置き、独自のサークルに対してそれに答えます。2025年6月、ニューヨークタイムズマガジンはこの役割を「法的保証人」と名付けました。「AIができない責任を提供する人」(Capps, 2025)。1979年のIBMトレーニングスライド。2017年にオンラインで最初に投稿されており、元のものは失われています。理由を1行で述べています: 「コンピュータは決して責任を負わされることはできません」(Willison, 2025a)。ニール・ローレンスは2026年8月に同じことを言いました: コンピュータは会計をとても上手に行いますが、「彼らは責任をうまく行いません」(Sadki, 2026)。この機能は自動化が最も難しいです。その価値は人が答えるにあるからです。エージェンシー理論の用語では、保証人は債券を売ります: 保証人自身の評判に支えられた約束であり、成熟した形では保証人の責任を割り当てる契約とそれを価格設定する保険によって支えられています(Jensen & Meckling, 1976)。
関数と職業は別の質問です。その署名は彼らが作らなかった仕事のために存在するどこでも機能します。職業は、その署名が定期的に独自に購入および支払われた場合にのみ表示され、予測F11とF12はそれが起こるときを日付けます。保証人には、彼らが保証した製品の数、それぞれがどのくらい長く生きたか、そして何人が失敗したか、いかに悪く重み付けされたか、の自然な尺度もあります。関連リポジトリは保証人の台帳から計算し、重大度の重みは記録を読む人によって述べられます(tools/guarantor_record.py)。セクション9の第二のスレッドのガイドは、4つの単語でそれを言っています: クチコミは評判です(翻訳)。信頼は、このシリーズの前のペーパーがエージェント商取引のために主張するようにチェックできるもの(Chernets, 2026d)に基づくべきであり、保証人の記録はそのようなことの1つです。
第9節のスレッドの1つに3番目のタイプが現れます。企業全体をエージェントに移行させるための方法を売るガイドです。このスレッドはその販売を示しています。彼を組織の保証人として、つまり企業の経営陣に結果について答える人物として読むことは、彼が構築しているロールの私の解釈です。
エージェントを通じて構築する人物は内向きに答え、エージェントから受け入れたものについて責任を負います。保証人は外向きに答え、人々に対して、リリースされたものについて責任を負います。1人が両方を保持することができます。結婚式のカメラマンが撮影と回答の両方を行うように、そして製品が多すぎる場合には2つの機能が分離します。著者と出版社、または科学者と学術誌がかつてそうであったように。
8. 2つの市場:ゴールドラッシュとウェディングフォトグラファー
1849年、群衆がゴールドを求めてカリフォルニアに殺到しました。鉱夫の平均日当たり採掘量、または雇用された者の日給は、1848年の約20ドルから1849年の16ドル、1850年の10ドル、1852年の6ドルへと低下しました(Paul, 1947, p. 349)。Bancraftは1852年の鉱夫当たりの採掘ゴールドを「わずか600ドル、つまり1日当たり2ドル程度」と述べており、その時点では一般労働者の賃金はその2~3倍でした(Bancroft, 1888, pp. 423-424)。鉱夫に道具を売ったSam Brannanは、「繁栄する最も確実な方法は採掘を他人に任せることだ」と示しており(Andrist, 1962)、道具と布の売り手はうまくいきました。このパターンは2026年に見られます。新しいサブスクリプションアプリの5分の1以下が月間1,000ドルに達しており(セクション7.1)、一方、ツールの売り手は急速に成長しています。例えばLovableの収益(TechCrunch, 2026a)やUberの年間AI予算が4か月で使い切られている(Fortune, 2026b)ことから、それが研究所へ流れ込んでいることが分かります。
ベンチャーマネーはより大規模な規模で同じ道をたどっています。AI企業は2025年に世界的なベンチャーキャピタルの61%、つまり4,271億ドルのうち2,587億ドルを獲得し、メガディールはAIへの投資価値の約73%を占めました(OECD, 2026)。2026年上半期には、OpenAIとAnthropicの2つの研究所が約2,170億ドルを調達し、これは世界中のスタートアップ資金全体の約43%でした(Crunchbase News, 2026)。一方、Cartaの米国プリシード・インストルメントの平均は2026年第2四半期に記録的な27万6,000ドルに達し、一方でインストルメント数は前年比約5分の1減少しました(Carta, 2026b)。より少数の新規参入者へのより大きな小切手は、ビルディングが安価になり、誰が成功するかを判断することができていない場合に期待されるものです。ビルディングができる人が、その証拠だけに基づいて、資金調達ができる人であるわけではありません。
このアナロジーは1つの場所で破綻しており、その破綻は適合性よりも重要です。ゴールドの価格は法律で固定されていたため、より多くのゴールドが採掘されてもゴールドは安くならず、鉱夫は採掘地が枯渇し、群衆が増えたために損をしました。ソフトウェアはほぼ無料でコピーできます。すべての新しい製品は他の製品に対する密接な代替品を追加し、密接な代替品の価格はコピーの費用、つまりほぼゼロに向かいます。ゴールドは枯渇しません。それは砂になります。ただし、コピーできないもの(信頼、署名、保守されたサービス)が一緒に販売される場合を除きます。
写真撮影がより密接なアナロジーです。2026年、米国労働統計局は2025年の写真家の職業数を約145,000と数えており、2025年から2035年への1%の減少を予測しており、前版は2024年から2034年への2%の成長を予測していました(Bureau of Labor Statistics, 2025, 2026a)。前版と異なり、新版はAIに言及しています。スマートフォンの写真は専門家の必要性を減らす可能性があり、ストック写真は「人工知能(AI)生成画像によって部分的に置き換えられる可能性があります」が、肖像画と商用仕事の需要は続き、自営業は成長しています(Bureau of Labor Statistics, 2026a)。2026年、カップルはまだウェディングフォトグラファーを雇い、彼らに給与を支払います。イベントを繰り返すことができず、間違いを取り消すことができず、指名された人が結果に対して責任を負わなければならず、クライアントが事前に品質を判断できないため信頼を買う必要がある場合に、職業は有給の専門職として存続します。
これらの条件は市場を2つに分割しています(図6)。電話のスナップショットは、人々が自分たちとチームのために作るもので、通知システム、メモ取りツールの置き換え、弁護士自身の契約チェッカーです。自分のために作ることは、執筆のような識字であり、ほぼすべての人が持つようになります。ウェディングは、他の人のための結果を伴う仕事です。見知らぬ人に公開される製品、お金、健康、法律、インフラストラクチャ。他の人のための仕事は、検証されたホライゾンと応答する人によって定義される専門職です。2つの市場の間には、曖昧性の障壁が立ちはだかり、保証人はその障壁で機能します。
この分割は、「これらの人々は何と呼ばれるべきか?」という私が始めた質問にも答えています。2つの答えがあります。1つは大量スキルの名前であり、もう1つは専門職の名前であり、セクション3の地図はすでに両方の候補を保持しています。
Kent Beckは古いシニアリティへの影響を1つの文で述べました。「私のスキルの90%がちょうどゼロドルになり、私のスキルの10%がちょうど1000倍になった」(Willison, 2025b)。一部のシニアエンジニアは、ソフトウェアのウェディングフォトグラファーになり、失敗を取り消すことができないシステムの小さな割合のために雇用されます。2026年のデータでは、ジュニアワーカー間で雇用の弱さが見られます(Stanford Digital Economy Lab, 2026a)。そのため、私はシニア側をイメージとして保ちながら、予測F25はジュニア側に従います。
図6. 2つの市場、その間の曖昧性の壁、およびそれを越える2つのパートナー。
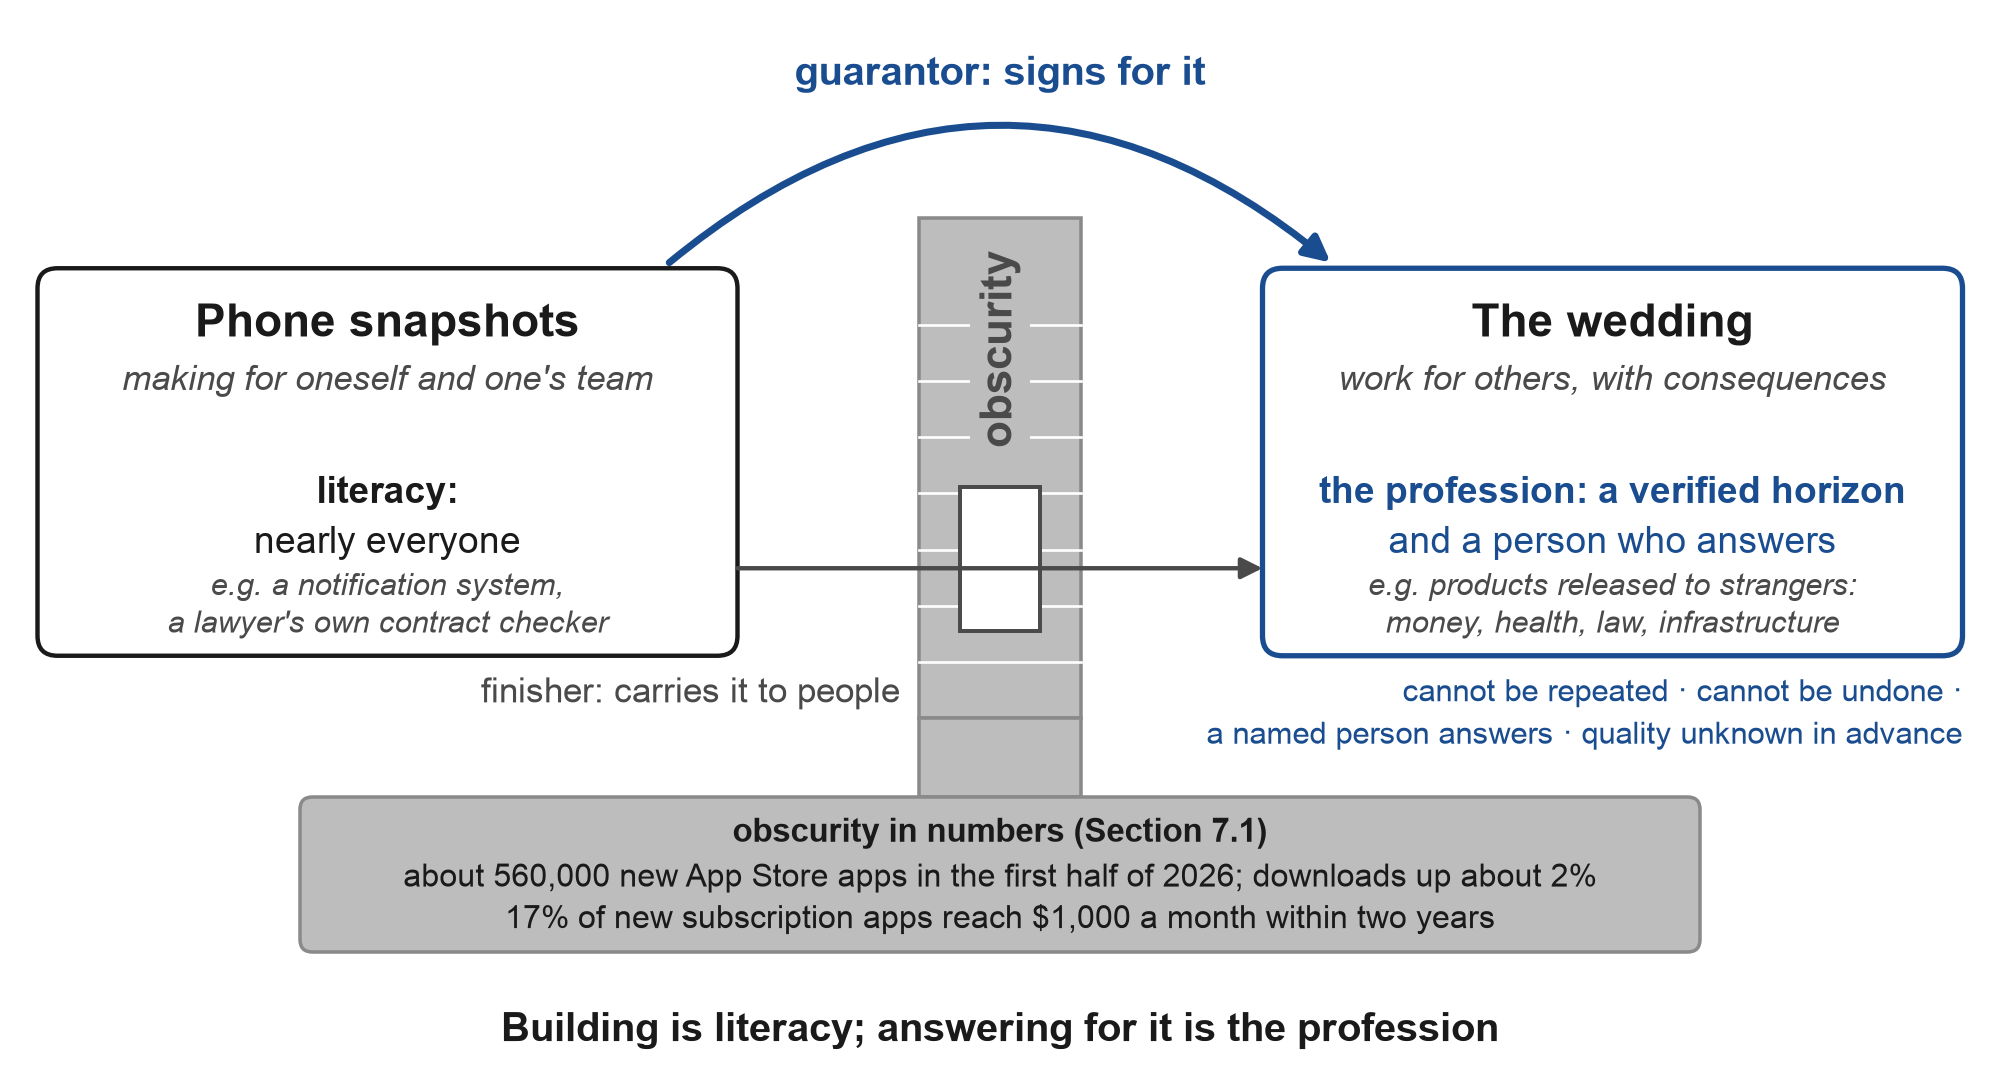
注:2つの数字は、フィニッシャーではなく、曖昧性の壁に属しています。2026年上半期の新規App Storeアプリ約560,000個でダウンロードが約2%増加し(Sensor Tower推定、9to5Macおよびgigazineによって報告、2026)、新規サブスクリプションアプリの17%が2年以内に月間1,000ドルに達しました(RevenueCat, 2026)。各極の例はセクション8のものです。4つの条件はセクション8のものです。アーチとドアはセクション7.2の2つのパートナー機能です。
9. プログラマーの会話から何が広がるか
2026年のプログラマーの会話は、2027年のあらゆる職業の会話になるかもしれません。これを確認するため、私は2026年10月8日に収集されたFacebook上の3つの公開スレッドを読みました(投稿とコメント。コメント者の名前はここでは記載していません)。
最初のスレッドでは、AIが壊れたコードを書くと言う開発者に対して、あらゆる優れた実践が適用されたにもかかわらずコードが失敗したケースを示すよう挑戦している著者がいました。彼自身は、そのようなケースは単に起こらないと確信していました。スレッドは受け入れについての議論に発展し、ある参加者がそれをまとめました。問題は、AIの結果を検査し、受け入れ、使用できるよう(翻訳)本番環境を組織できるかどうかかということです。セキュリティ修正に取り組んでいる別の参加者は、テストと指示があってもでも強力なモデルがCVSSスケールで9以上の脆弱性に対する適切な対策を生成することができないことが多く、自動レビューと修正のループはコストがかかると報告しました。IT業界で30年のキャリアを持つマネージャーは、人間のプログラマーも常に全く同じ頭痛の種をもたらしてきたと返答しました。別のコメント者はこの新しいタスクを時給150ドル(AIが書いたコードを検査して修正するレビュアーのレート)で価格を付け、第3の人物は20年の経験を持つシニアエンジニアが自分のスキルが価値を失ったことを受け入れるのが難しいと感じていると述べました。
2番目のスレッドでは、プログラミング言語を両方知らないと言う人が650,000行のプラットフォームを別のプログラミング言語に移行しており、約600のプルリクエストのうち約330が完了し、AIに月1,148ドルを費やしています。彼はエージェントに企業を移行させるための方法を販売し、そのタスクではプログラマーは害になると主張しています。彼はまた、公開支出、プロジェクトのリスト、プロモーションコード、コースを通じて自分を可視化し、より大きい企業向けに無料の時間を提供しています。彼は実質的にセクション7.2のガイドのロールを構築しており、彼はコンテンツで無名性と戦っています。
3番目のスレッドは、4台のマシン上で自分自身のために構築している人を示しています。セクション5.4の36段階のフローです。彼は6ヶ月から1年前のワークフローは何も残らないと報告しており、3ヶ月以内にそれらを再度変更することを期待しており、常に取り残されることへの恐怖を感じています。コメントは、どのエージェントがどのキャンプに属するかについて議論しています。
表A5(付録F)は、スレッドのトピックを2025年と2026年にソフトウェア以外の人々の間で見えたものに対して設定しています。その行は例示的なケースであり、サンプルではありません。
表A5が示すことは、機能は広がり、形式は後に残るということです。あるモデルのファミリーを別のもので検査することを学ぶ簿記係は、それでも「調整ルール」と「誰がそれを検査したか」と呼び、ハーネスの言葉を持たず、エージェントの選択をアイデンティティの問題として扱いません。スレッドのステータスマーカー、大きな個人請求、キャンプ、4台のマシンは、各職業の最上層に留まります。写真家がレンズについて議論し、彼らのクライアントがそうしないのとちょうど同じように。
この広がりはまた層状に起こります。最初に各職業の上位10分の1程度、次に訓練プログラム、次にセットアップを内部に隠すプロダクトです。その順序はエージェントに適用される拡散理論であり、ここでは優先順位は主張されていません。Rogers(2003)はイノベーターとアーリーアダプターを一緒にアダプターの約6分の1に置きました。OpenAIの独自のレポートは、会社外では「技術的な使用が支配的なモード」であることに注目しています(OpenAI、2026)。Anthropicは、技術ユーザーが最初に来て、より低い報酬のタスクを持つ人々が後に来たことを発見しました(Anthropic、2026f)。セクション11は、カリキュラムと投稿を読むことで検査できる予測として機能の広がりを述べています。
10. 含意
10.1 雇用主と人事部門向け
記録による採点を行う雇用主は、「上級」や「マネージャー」よりも「領域·地平線·増幅·日付」からより多くを学び、その記録は機能間で移動します。採用試験が続きます。応募者に自らの領域での1日分の仕事を提示し、エージェントを通じて実行させ、応募者が設計しなかったチェックで正しく示させ、応募者が見つけなければならない意図的なエラーをいくつか埋め込みます。責任の範囲が広がるにつれて公正な給与が上昇するというJaquesの給与の論理は、検証済みの地平線による給与の開始仮説を提示します。それが成立するかどうかは経験的問題であり、セクション11の予測F18がそれを述べています。雇用主が検証済みの仕事によって採点する場合、ランクは勤続年数よりも給与と業績をより良く予測すべきです。
トークンによるランク付けは別の問題であり、セクション4の事例はそれがどこに導くかを示しています。使用方法について話し合われる場合、それは他の方法と同じように、多くの入力の1つとして業績評価に含まれるべきです。
結局のところ注視すべきは、組織が実際に誰を雇用するかです。ポリシーページから学位要件を削除しても、それ自体はほとんど変わりません(セクション6.2)。検証済みの地平線が等しい中で誰が雇用されるかの変化が、企業内部からのクロスオーバーポイントの見え方です。
10.2 教育と学校向け
学校にとっての教訓は、構文の前に受容を教えることです。人をキャリアラダーを上るその人を上へと導くスキル、完了したと見なされるもの述べること、エージェントが見ることのできないチェックを選択すること、および自分の領域で妥当なエラーを認識することは、あらゆる分野で教えることができます。証明書はそのチェックがどの程度の価値があるかに依存するため、証明書は領域と日付を示す、検証済みの地平線を証明すべきです。
カリキュラムにAIリテラシーを追加する学校は、OECDおよび欧州委員会のフレームワークの「AI管理」領域に具体的な内容を与えることができます。小さな仕事の1つを引き渡し、チェックを事前に固定し、他者にリリースされたものに対して責任を持つ成人です。
10.3 ベンダーとプラットフォーム向け
ベンダーは製品から受容を削除することができます。人は、タスク、入力、チェック、および受け入れの決定をエクスポートできるようにして、記録が雇用主または学校に移動できるようにする必要があります。使用状況は、その後、アプリケーションを開いた人ではなく、検証済みの仕事を受け入れた人をカウントすることで、同じ方法で報告されます。
あるプラットフォームは、ベンダー側からこの道をすでに歩み始めています。2026年1月、LinkedInはLovable、Replit、DescriptおよびRelay.appによって発行された検証済みAIスキルを、メンバーが各ツールを実際に使用する方法に基づいて表示し始めました(LinkedIn、2026a)。そのようなバッジはツールの使用を証明し、ツール自体のベンダーがベンダーが設定したティアに対して判断されます。選択しなかった誰かによってチェックされた結果を証明するものではありません。同じプラットフォームは採用担当者にエージェントを販売しており、2026年4月までにエージェンティック採用製品で年間4億5000万ドル以上の収益を上げており、2026年7月にメンバーに「AIスラップのように見える」投稿を報告するボタンを提供しました(TechCrunch、2026c)、検出器ベンダーのPangramが2026年4月から6月のサイト上の長い投稿の41%が完全に生成されたと推定した後(The Decoder、2026)。自分の仕事について述べたテキストが生成に何もかからない場合、プロフィールはより少なく述べ、単一のベンダーに依存しない検証済み仕事の記録はより多く述べます。
2026年に多くが行ったように、未知の者に扉を閉じたプラットフォームは、ボーチングを通じて2番目の扉を開くことができます。既知の人が署名する仕事を行った新参者が通過し、保証人の記録は次に何が起こるかと一緒に成長したり縮小したりします。
10.4 エージェントに人々をオンボーディングする製品向け
オンボーディング製品は一般に最初の画面で「初心者」と「プログラマー」を分けます。この測定は、2つのドアを1つの質問に置き換えることを提唱しています。エージェントに既にを手渡して確認できるもの、まだ何も、1時間、1日、または1週間?ドアが統合されるまで、同意を得て1回IT教育について尋ねることで、背景の中立性を製品自体のユーザーでテストできます。
10.5 研究者向け
研究者はChenとMeng(2026)が存在しないと述べる人ごとのタスクパネルを構築し、同じエージェントを盲検チェックの下で使用する人と人を比較し、チェックに失敗した仕事を含む分母を報告し、参照バンクを固定して公開したままにすることができます。付録Cの楽器はすでにこれを行っています。チェックが独立していないと記録されたピースをカウントせず、両軸に日付を付けて報告します。
セクション6.5から1つの比較が続き、実行されていません。銀行の同じタスクで、エージェントが見ないチェックの下で、両方の種類の意図的なエラーがあり、誤ったエントリと欠落したもの、それは業界の経験(存在する、または存在しない)と作業の方法(出力が受け入れられたとおりに行う1つのエージェント、またはセクション6.5のチェックプロセス)で交差します。経験はプロフィールラベル(セクション6.2)ではなく、知識スクリーンと仕事の記録によって確立されます。エラーを元に戻せないピースは、セクション5.2で要求されるように、隠されたテストまたは適格な人間によってチェックされます。欠落と誤ったエントリは別々にスコア付けされます。事前に作成されたリストは最初のものを目的とし、レビューアーは2番目のものを目的とし、付録G2が示唆するギャップは最初の種類です。比較は、プロセスが業界の経験の多くに対応できるか、そしてどのランクで停止するかを示します。エージェントなしで仕事をする専門家との比較はここでは何も決めないでしょう。セクション11.1で与えられた理由のため。セクション11の予測は固定され、この比較を含めていません。これはデータが収集される前に自身で登録されます。コンパニオンリポジトリはプロトコルとして保持し、適応および登録します(kits/process-vs-experience-study.md)、タスクの意図的なエラーをハンドオーバーの前にシールし、その後に誤ったエントリと欠落を別々にスコア付けするツール(tools/planted.py)、および4つのアームを出力する分析、そしてエラーの各種類は別として、新人の中でのプロセスの効果、1つのエージェント下での経験の効果とそれらの相互作用、人を再サンプリングする区間があります(tools/process_study.py)。
11. 日付が記入された予測、登録および採点済み
11.1 予測を記述するためのルール
予測を検証可能に保つルールの下で記述しました。似ているものは似ているもの同士で比較されます。プログラマでない人は、同じエージェントを使い、同じタスクで、同じ時間で作業するプログラマと比較されます。なぜなら、AIなしで作業するプログラマとの比較はここでは何も解決しないからです。
「より良い」は3つの意味に分割され、それぞれが個別にテストされます。コードの場合、テストは隠されたテスト、セキュリティレビュー、および保守性を確認するために1か月後に別のエージェントによって行われた変更です。製品の場合、テストは見知らぬ人に到達し、6か月後にまだ生きているかどうかです。履歴書の場合、テストは投稿における学位の重要性です。人気度は「より良い」の尺度として使用されません。なぜなら、それは配布をテストするもので、それは別の職業かもしれないからです(セクション7.2)。
予測は職業の名前にも依存しません。「IT教育のない人がエージェントを通じて作業する」ことについて述べているので、どちらの名前が勝つかに関わらず成り立ちます。
11.2 予測
表4は10の中核的な予測を短い形式で示しています。表A6(付録D)および付属リポジトリのファイルpredictions/predictions.csvは、41すべてを示しており、各々は測定値、2025年または2026年からのベースライン、3つの成果のためのルール(実現した、しなかった、未解決)、確認日および最終日、確率、フォールバックソース、および最も近い事前または反対の予測を含みます。確率は、間違っていることが判明した予測家を免除しません。しかし、エラーをスコア化可能にします。35%で行われ、失敗した1つの予測はそれ自体ではほとんど何も述べていません。35%が正しい数字であるかどうかは、セット全体でのみ示され、約3分の1のそのような予測が実現するはずです。Brierルール(Brier、1950)は、キャリブレーションと何が起こるのか起こらないのかを区別する能力を組み合わせて、セット全体の精度の1つの全体的なスコアを提供します。メインの予測は現在の意見に反します。採用データはAI業務の学位を依然として支持しており、Gartnerはほとんどのバイブコード化されたアプリケーションが廃止されることを期待しており、Andrew Ngはプログラムの深い理解が勝つと主張しているためです。表は反対の賭けをしており、明記されたオッズで:自分の領域での追い抜きの登録確率(F3)は0.35です。ベンダーデータがプログラミング職をまだ約5ポイント進めており(セクション2.2)、Savva(2026)がより難しいタスクでより広いギャップを予測しており(セクション6.1)、パリティ(その前のステップ)が0.70で価格設定されているため、偶然よりも低い位置にあります。独立したモデル予測家は0.25から0.55の範囲でした。図7は、すべての予測をその確認年と確率に配置します。
予測は2つのセットに分かれます。セットA(27の予測)は公開データおよび凍結されたクエリ、predictions/resolve/内のリストおよびコードブックから解決されるため、誰でも私なしでスコア付けできます。セットB(14の予測:F2、F3、F3b、F4a、F4b、F7、F12、F14、F18、F19、F20、F26、F34、F35)は研究プログラムです。それは公開ソースが公開していないデータを必要とし、データが収集される前に別に登録された研究からのみ解決され、指定された所有者、プロトコル、および検出力計算があります。ルールが間隔で書かれているセットB予測のうち9つの場合、付属リポジトリは凍結された実現およびしなかったルールを研究の推定値に適用し、凍結された単語を各判定の横に出力します(predictions/set_b.py)。プロトコルが2027年6月30日までに登録されていないセットB予測は、実施されていないものとして記録され、すべてのスコアカードにテストプログラムの失敗として一覧表示されます。その場合、Brierスコアは解決済み予測のみで2回報告され、実施されない各予測は予測が間違っていたかのようにスコア付けされるため、実行されない研究はカウントから脱落することができません。F2、F3、およびF3bの実験は、グループあたり1,500人の1つの研究です。これは、5ポイントの真の利点を検出するために約0.8の検出力を与えます(両側アルファ0.05、合格シェアが50%に近い、最も不利な場合)。グループあたり400ではそれを約30%の時間でのみ示します。すべての研究ベースの予測について、実現ルールにも実現しなかったルールにも適合しない間隔は、失敗ではなく、未解決です。
確率は2026年10月9日に固定されました。それぞれは、同じテーブルを私の数字を見ずに価格設定した3つのファミリーのモデルの3つの盲検予測の中央値です(Claude Opus、OpenAIモデル、およびGemini)。これらの中央値を確率として採用され、OSFに登録され、以前の草案からのすべての変更は変更ログに記録されています。4つのファミリーの4つの独立したモデル予測家の以前のラウンドも、テーブルを盲検で価格設定しました。それぞれが参照クラス、1行の議論、および確率を与え、それらの集計された予測(オッズの幾何平均)は表4の登録確率の隣に表示され、スプレッドはCSVに含まれます。登録確率がそのラウンドの中央値から0.15以上異なる場合(F28およびF32)、理由は変更ログに記載されています。すべての確率は予測が解決されることに条件付きです。Brierスコアは解決済み予測で計算されるためです。解決済みの割合は、それの横に報告されます。
表4。10の中核的な予測、閾値、最終日、および確率(すべて41を表A6に示す)。
| # | 予測 | 閾値 | 最終日 | p | モデル | データ |
|---|---|---|---|---|---|---|
| F1 | ベンダーデータで確認された成功のギャップが縮小する | プログラミング引く他の職業2ポイント以下(現在34%対29%) | 2028年12月31日 | 0.35 | 0.39(0.25~0.65) | 公開 |
| F2 | 自分の領域での品質パリティ | (非IT引くプログラマ)の下側95%境界がマイナス10ポイントを超える。グループあたり1,500 | 2028年10月8日 | 0.70 | 0.67(0.62~0.70) | 独自の研究 |
| F3 | 自分の領域での追い抜き(品質のクロスオーバー) | 下側95%境界がゼロを超える。同じ研究 | 2029年10月8日 | 0.35 | 0.33(0.25~0.55) | 独自の研究 |
| F5 | 投稿内のクロッシング | エージェント型投稿内の学位シェアがマッチした投稿より2ポイント以上下回る。2027年の2つの連続四半期 | 2028年12月31日 | 0.30 | 0.34(0.25~0.60) | 公開 |
| F7 | 背景中立性 | IT教育のオッズ比の90%区間は0.67~1.5、DayおよびWeekで | 2029年12月31日 | 0.42 | 0.43(0.40~0.48) | 独自の研究 |
| F14 | 2つの軸は異なったままである | 対数地平線と対数利得のスピアマン相関が0.8以下であり、利得がサンプル外R二乗に0.02を加える | 30 September 2028 | 0.52 | 0.49 (0.45 to 0.50) | own study |
| F19 | チェックが上限を設定する | 1~3か月目のチェック共有が4~6か月目の確認済み出力の予測において地平線に勝る | 30 September 2028 | 0.45 | 0.44 (0.30 to 0.65) | own study |
| F26 | 採用実践が後に続く | 監査研究:コールバック差は3ポイント未満、95%信頼区間は5以内 | 31 December 2029 | 0.35 | 0.32 (0.25 to 0.35) | own study |
| F27 | エージェント構築製品は予測を超える寿命を持つ | 2026年12月31日に凍結されたサンプルの50%未満が2028年末に廃止された(Gartner: 60%) | 31 March 2029 | 0.32 | 0.35 (0.20 to 0.55) | public |
| F28 | 機械は80%でDay到達 | METR 80%地平線が2027年末までに8時間以上(2026年4月は3.1時間) | 30 June 2028 | 0.80 | 0.66 (0.55 to 0.80) | public |
注記:pは予測が解決される場合にそれが真実である登録確率であり、2026年10月9日の3つのブラインドモデル予測の中央値で、私が採用しました。モデル:私の数字を見なかった独立したモデル予測者のプール予測(オッズの幾何平均)で、その範囲です。データ:publicは任意のユーザーが公開源から解決可能であること(セットA)を意味し、own studyは別個に事前登録された研究であること(セットB)を意味します。真である、真でない、未解決のルール、すべての予測のフォールバック源と事前予測はTable A6およびpredictions/predictions.csvにあります。最終日までに比較可能なデータがない予測は未解決であり、成功として数えられることはありません。OSFに登録されたプログラム(Chernets, 2026e)は仮説を持たず、IT教育について質問しないため、セットBをテストできません。
Figure 7. 予測登録:すべての日付付き予測をその確認年と登録確率で示します。
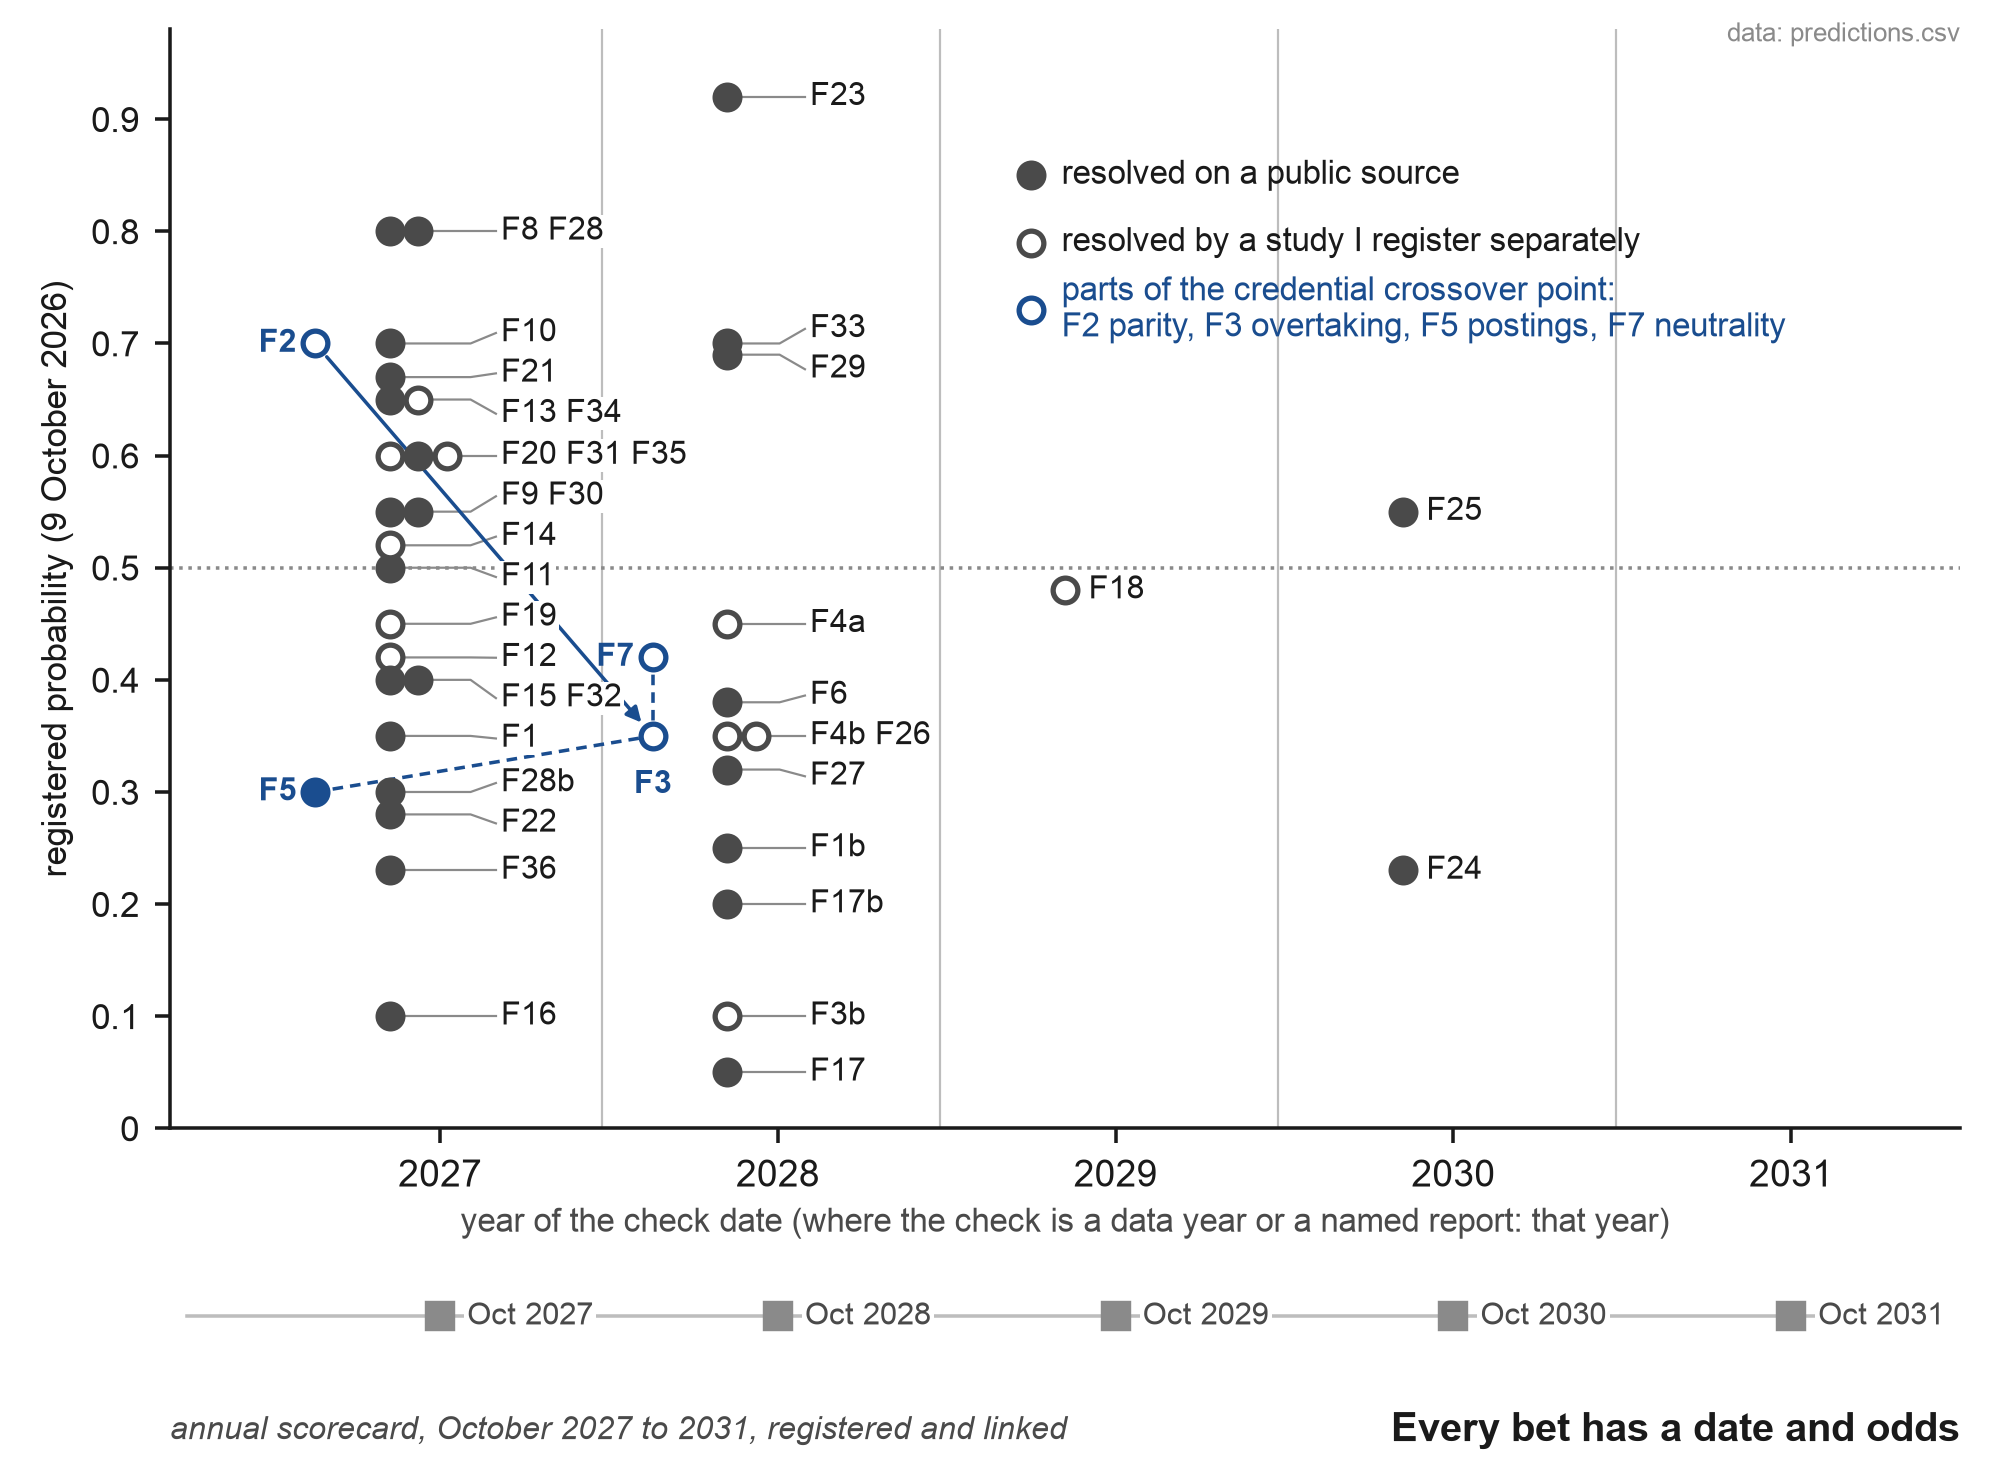
注記:各マーカーはTable A6の41の予測の1つであり、その確認日の年(確認が数据年または指定された報告書である場合、その年)とその登録確率に配置されています。塗りつぶされたマーカーは公開源で解決されます。中空マーカーはデータ収集前に別個に登録された研究を通じてのみ解決されます。資格交差点の4つの部分はアクセントカラーで示されています:品質パリティ(F2)は追い越し(F3)につながります。投稿での交差(F5)はその可視的な兆候であり、背景の中立性(F7)がそのメカニズムです。パリティのみが均等オッズ以上(0.70)で価格設定されています。追い越し、その瞬間は0.35にあります。軸の下の四角は年間スコアカードをマークしており、2027年10月から2031年にOSFに登録されてDOIでリンクされる予定です。確率は2026年10月9日に確定され、OSFに登録されています。
1つの年間測定は予測自体ではなく予測に付随しており、名前のレース:毎年、同じクエリがTable A2の各候補がUS投稿とOpenAlexおよびCrossrefに現れる頻度を数えます。かつて長期チェックのみであった質問、2028年SOCが代理人指向作業の職業を命名するかどうか、は現在予測F23であり、確率(労働統計局、2026b)を持っています。2026年10月9日に労働統計局は提案されたまたは最終的なSOC 2028構造のいずれも発表していませんでした。最終構造は2027年に予想されています。
11.3 以前の予測
2026年10月9日に、Metaculus、Manifold、Good Judgment Open、Kalshi、Polymarket、Long Betsを検索し、また公開ウェブ(企業研究ページ、アナリストリリース、arXiv、SSRN、ニュース)でも、技術教育がない人々がAIエージェントを通じて働いてプログラマーと同じエージェントを使用したプログラマーに匹敵するまたは上回るパフォーマンスを発揮する日付付き予測を検索しました。見つかったものの中に日付と反論結果を伴うものはありません。最も近いものは以下の通りです。Gartnerは2021年に、2024年までに技術製品およびサービスの80%が技術専門家ではない人々によって構築されると予測しました(Gartner, 2021)。Mark Cubanは2017年に、批判的思考がプログラミングより価値があると予想し、哲学専攻になったほうがよいと述べました(Black Enterprise, 2017)。D. H. Hanssonは2026年8月26日のLex Fridman Podcastで、プログラマーが代理人エンジニアリングにおいて非プログラマーより悪い問題があるかどうか尋ねられたとき、「100%」と回答しました(Lex Fridman Podcast, 2026)。Anthropicは2026年6月に、コーディングエージェントがコーディング背景をより関連性の低いものにしていると観察しました(Anthropic, 2026e)。反対方向の予測が存在します。Gartnerは2028年までにvibe-codeアプリケーションの60%が廃止されると予想しており(Gartner, 2026、Tray.aiでまとめられた、2026)、2024年に2026年までを通じて組織の5分の1がAIを使用して構造をフラット化すると予想しました(Gartner, 2024)。SrinivasanとWei (2026)は「agent manager」が12~18か月以内に標準的なタイトルになると予想しています。Forresterは2025年に、Fortune 100企業の60%がAIガバナンスのトップを任命することを期待していました(Forrester, 2025)。Manifoldの市場では、2030年までの大学院開発者職が約74%、2023年から2028年の米国開発者の15%以上の減少が約42%です(Manifold, 2026b; Manifold, 2026c)。Manifoldでは、非プログラマーが2027年までにAIで小さなスクリプトを書くことが一般的になる確率は約27%でした(Manifold, 2026a)、その質問は使用についてのみ尋ね、品質の測定はありません。ここでの予測は、同じエージェントを使用する人々と比較し、教育を変数にし、日付、測定、反論結果を含むという点で、すべてこれらと異なります。検索ログはAppendix Bにあります。層での採用(Rogers, 2003)、機械時間地平線(Kwa et al., 2025)、ジュニア職が縮小しているという観察は以前の作業であり、優先順位は主張されていません。
11.4 凍結とスコアリング
予測はどこに置くべきか、その作成者を含む誰もが静かに変更できないようにするために?このシリーズが使用する場所のうち、凍結されるのは1つだけです。OSF登録は編集も削除もできません。撤回することはできますが、そのタイトル、日付、DOI、および撤回理由を含むページが残ります(OSF、2026)。Zenodoは寄託者が公開後30日間ファイルを変更または削除できます。その後は新しいバージョンのみです(OpenAIRE、2025)。SSRNは改訂時にPDFを置き換えます。したがって、予測はOSFに最初に登録されます。オープンエンドの登録として、エンバーゴなしで直ちに公開されます。エンバーゴはレコードを隠し、そのDOIを保留するためです。誰も見ることができない優先度はほとんど価値がないからです。
2026年10月9日、表はOSFに事前登録された予測セットとして登録されました(DOI 10.17605/OSF.IO/VW6P9)。論文はSSRNおよびZenodoに投稿されました。すべてのベースライン情報源のスナップショットはWayback Machineにアーカイブされています。2027年から2031年までの毎年、登録日の記念日に、すべての予測を例外なく列挙し、その状態(実現した、しなかった、まだ期限が来ていない、未解決、実施されなかった)および証拠を記載したスコアカードが公開されます。解決済み予測全体についてBrierスコア、セット別および家族別(リンクされた予測は1回カウント、登録テーブルの家族列のようにグループ化:F1およびF1b、F2、F3およびF3b、F4aおよびF4b、F5、F6およびF33、F9およびF31、F15およびF16、F17およびF17b、F28およびF28b)、解決済みの割合、最終日を過ぎてもまだ未解決のすべての予測および実施されなかったすべての予測が予測が外れたかのようにスコア化される最悪の境界線、実施されなかった予測の有無でのスコア、および3つの参照に対するBrier技能スコア:一律0.5、表4の統合予測モデル、および登録日に市場が存在する場合の市場価格を報告します。選択的な未解決はしたがってスコアを改善することができません。スコアカード自体はOSFに登録され、DOIによって元のものにリンクされ、Zenodoに寄託されます。少なくとも2つの家族のモデルが凍結されたルールに対して各スコアカードを独立して確認します。不同意がある場合はルールが決定し、不同意が報告されます。登録テキストは付録Dにあります。図A1(付録D)は確認日と最終日の完全なカレンダーを示します。2つの約束は採点が開始される前に期限となります。F27のエージェント構築製品のサンプルは2026年12月31日までにZenodoで凍結されます。F5およびF30のベースラインは登録前に計算およびアーカイブされます。F27サンプルのプロトコル(登録が開いたままにしている各選択肢のデフォルト値付き)およびそれを事前に固定されたシードで描画し、密封するツールは付属リポジトリにあります(kits/f27-sample.md、tools/freeze_sample.py)。
予測が登録されると、公開されたものは外部予測者がそれらに価格をつけることができる場所に投稿されます:Manifoldの5つのマーケット(F5、F8、F10、F11およびF22。これらは無料で投稿でき、これら5つはそれぞれが公開情報源および外部シリーズで解決でき、誰でも読むことができ、私自身のデータはありません)、Metaculusの1つの質問(投稿での交差、F5)、およびF2、F3およびF7の実験のためのSocial Science Prediction Platform。これにより、他の人の予測がデータが存在する前に収集されます。結果にお金を賭けるPrediction marketは使用されていません。
11.5 コホートプログラム
チャットからエージェントからオーケストレーションへの非プログラマーを追跡する事前登録されたコホートプログラムを実施しています(OSF、https://osf.io/x4egq、DOI 10.17605/OSF.IO/X4EGQ)(Chernets、2026e)。その最初のコホートは独自の登録済みアウトカムを備えた単一腕の実現可能性研究であり、そのアウトカムは独自のレポートで報告されます。F7、F14およびF18からF20などの人的レベルのデータが必要な予測は、データ収集前に登録された後の新しいコホートでテストされます。その凍結された項目の中にIT教育についての質問があります。付録Cのレコード(同意とともに保管)がそのコホートの自然なデータです。
12. 予測が反対している証拠
第11節の予測は2026年のいくつかの種類の証拠に反しており、それぞれが測定ルールまたは予測を形作りました。
セキュリティは追いついていません。100を超えるモデル全体で、セキュリティテストに合格した生成コードのシェアは、Veracodeの2026年レポートで56%のままでした(Veracode, 2026)。これらのテストはモデル単独で実行され、セキュリティ指示なしの標準プロンプト、およびエージェント的なハーネス、ツール、または人的レビューなしで行われたため、人が開始する原材料を説明しています。バイブコーディングで構築された5,600の公開アプリケーションの受動的なスキャンでは、2,000を超える脆弱性、400を超える露出したシークレット、および175の個人データの露出が見つかり、その著者はこれを下限として提示しています(Escape, 2026)。これが、F2にブラインドセキュリティレビューが含まれている理由であり、取り消し不可能な作業がすべてのピースをパスする必要がある理由です(セクション5.2)。
テストに合格することは受け入れられることとは別です。METRはメンテナーに、ベンチマークのテストに合格したエージェント作成の修正をレビューするよう依頼し、約半分がそのままマージされなかったことを発見しました。エージェントはレビューループなしの前の世代だったため、シェアは現在より低い可能性があります(METR, 2026b)。スコアリングルールは隠されたテスト、適格なレビュアー、および実際の使用で答え、F2は1か月後にメンテナンスの変更を追加します。
検証は経験に依存します。バイブコーディングで構築する162人の調査では、すべてのグループが生成コードのリスクを認識していましたが、それをチェックする方法は経験によって異なりました。著者はこれを知覚-行動ギャップと呼んでいます(Fawzy et al., 2026)。ビジネスユーザーと初心者は迅速に機能するプロトタイプを生成しますが、コード品質は不均一で、リワークが続きます(Gama et al., 2026)。ビジネスユーザーはまた、警告を受けた後でもAIの分析の重大なエラーを見逃しました(Virk & Liu, 2025)。新しいライブラリを学んでいる52人のジュニアエンジニアのランダム化研究では、AIで50%、AIなしで67%の理解スコアが見つかり、速度に大きな利得はありませんでした。モデルに説明を求めた人は65%以上のスコアを獲得し、すべてのコードを引き渡した人は40%未満のスコアを獲得しました(Anthropic, 2026c)。これは、測定が受け入れリテラシーと植え付けられたエラーに基づいている最も強い理由です。人を分離するスキルは、これらの研究が変動を示すものです。
公開されている比較で、同じエージェントを使用するプログラマーに対して非プログラマーを設定したものはありません。Esnaola et al. (2026)は、ChatGPTを通じてGPT-4oを使用する一部の非プログラマーが、AIなしで働くプログラマーに匹敵するレベルで小さく、よく指定されたプログラミングの問題を解決し、より速く解決することを発見しました。著者は研究を探索的と呼んでいます。プログラマーはAIなしで働いたため、設計には開発者-with-AI腕がなく、短い個別のタスクを研究し、継続的な開発ではありませんでした。複製パッケージは公開されています(Esnaola et al., 2026)。Anthropicのデータでは、タスクに新しかった人は、より経験豊富なユーザーの28〜33%に対して15%の検証済み成功率がありました(Anthropic, 2026e)。ここで、「初心者」とは、モデルによって判断されるタスクの初心者を意味し、IT教育については何も言いません。そのギャップが教育またはタスクへの精通を反映しているかどうかは、F7が分離するために書かれている理由です。さらに早く、カスタマーサポート企業での生成AIは、初心者および低スキルエージェントの生産性を最も高め、最も経験豊富なエージェントの生産性をほとんど上げませんでした(Brynjolfsson et al., 2025)、エージェントの前の前身です。2024年、Procter & Gambleでのチャットモデルを使用したフィールド実験では、AIを持つ個人は、そのプロフェッショナルな背景に関係なく、それなしでチームと一致し、バランスの取れた仕事を生産しました。これはエージェントの前の前身です(Dell'Acqua et al., 2025)。F2、F3、およびF7は、欠落している比較を提供するように設計されています。
尊敬された声は強いバージョンに同意しません。Karpathyは床と天井を保持しています(セクション2.1)。Andrew Ngは2026年8月に、プログラムがどのように機能するかを深く理解している開発者は、その理解なしにバイブコードする人々をはるかに上回る(Ng, 2026)と主張しました。採用データは現在の同じ方向を指しています。AIスキルが必要な投稿は、AIスキルが必要ない同等の投稿よりも4年制学位が必要である可能性がまだ高く(Lightcast, 2026b)、LinkedInは入門レベルの採用の多くの弱さを経済に起因させています(セクション2.4)。予測はこれらの見解をカウンターパーティとして取り上げ、オッズは事前に述べられています。
13. 範囲と境界条件
時間。証拠は2026年10月9日まで及びます。製品事実は急速に陳腐化するため、測定は参照時間とチェックで定義され、製品名は含まれません。
情報源。最も強力な証拠の多くは、ベンダーが自社製品について提供するものです。OpenAIはそのコーディングエージェントについて、Anthropicはそのセッションについて提供しています。これらはベンダーデータとしてマークされ、ベンダーが知り得ることのために使用されます。トークンランキングなど、プレスで報告されたいくつかのエピソードは、指定された報道機関による報告に基づいており、そのように引用されています。二次情報源(Growthy、Startup Fortune、Shopifreaks)は投稿前にWayback Machineにアーカイブされ、主要な報告は到達可能な場合はそのつど引用されます。
対象。論点は、コンピュータで行われ、エージェントを通じて、それをチェックできる人々によって行われた作業に関するものです。自分が制御するコンピュータを持たない人々、およびまったくチェックできない作業は、この測定の範囲外です。
測定が主張すること。検証された地平は、チェック体制下で、ある領域において、ある日付において、人が提供したものを記述します。それはすべてのタスクに対してより高い方が良いと主張するものではありません。多くの作業は時間単位に属しており、作業を手作業で保つことを選択することは正当な決定です。ミスを取り消すことができない領域では、セクション5.2のより厳密な閾値が適用され、一部の作業はエージェントに委ねられるべきではありません。
名前。セクション3の地図は、2026年10月8日と9日に見つかった用法を記録しています。その後、名前は採用され、廃棄されるため、地図は年次の名前競争と対にされ、単一の名前は選択されません。
強力なテーゼ。技術教育を受けていない人々がプログラマーより優れた製品を構築するということは、日付と閾値を持つ一連の予測(F2からF7)として述べられています。私はそれを予測として提示し、公開でスコア化されることを意図しています。
法律で留保された行為。法が行為をライセンスに留保する場合、この測定もラベルによるウェイト損失(セクション6.2および6.5)も、その行為を動かしません。英国では、法定監査人として行動することが認められない者は誰もが、認可された監督機関の会員資格と当該機関の規則に基づく適格性を要求する(2006年会社法第1212条および第1213条)、米国では、登録された公開会社監査委員会に登録された企業のみが発行人に関する監査報告書を作成または発行することができます(2002年サルベンス・オクスリー法第102条)。簿記ではこれらの留保は限定的です。米国の簿記作成事務員は通常、資格さえ必要とされません(労働統計局、2026c)。法律ではより幅広いです。イングランドおよびウェールズは6つの法的活動を留保しており、その中には訴訟の遂行と遺産活動が含まれます(2007年法律サービス法第12条)。したがって、作業は移動できますが署名は留保され、許可されたサイナーはセクション7.2の保証人機能を法律がすでに価格を設定した形式で実行します。ライセンス自体がラベルまたはチェック作業によってどの程度認められるかについては、セクション6.2で説明されています。
エージェント前データ。2025年前のシリーズは、エージェントなしの作業を記述しているため、先駆者としてのみ入り込みます。採用のマクロ経済学は2026年のLinkedInデータ(セクション2.4)によって担われており、これはAIよりも経済を指し示しています。
主張の状態。表A7(付録F)は、シリーズの信頼言語を各要素に適用しています。
14. 結論
コーディングエージェントを比較する簿記係と独自の契約チェッカーを構築する弁護士は、モジュールをエージェントに渡して結果を確認する開発者と同じ方法で仕事をするようになりました。2026年までに、この3人は1つのワークフローを共有するようになり、旧来のいずれのはしごも、どちらがより先に進んでいるかを言うことはできません。タイトルは問題を解決しません。なぜなら2026年に提案されたすべてのタイトルはスローガンか誰かの求人広告のいずれかであり、市場はそれらの中から選択していないからです。測定値は問題を解決することができます。ただし、適切なものを数える必要があります。
ここで提案する測定値は、その職業が命名されるのを待ちません。簿記係、弁護士、開発者を1つのスケール上で読み、各自がエージェントに渡して確認した仕事のサイズを、特定の領域と日付で読みます。第2軸は、彼ら自身の注意の1時間でいくらの検証済みの仕事を購入したかです。その閾値はバージョン管理されており机上でテストされており、机上テストはすでにそのうちの1つを修正しています。その規則は記録がゲーム化される方法とそれぞれの防御方法を明らかにしており、その上限は、チェックの価格が何にせよエージェントの速度に関係なく制限を設定する理由を説明しています。雇用者、学校、プラットフォームにとっては、質問は変わります。ある人がプログラマーであるかどうか、またはどの程度AIを使用したかを尋ねるのではなく、その人自身の分野での1日の仕事であって、その人が設計しなかったチェックに合格したものを求めます。市場が選択するあらゆる名前をそのスケール上で読むことができます。
日付付きの予測は、このペーパーの開始時の論文を伝えます。領域ごとに、IT教育を受けていない人々によって作られた製品は、同じエージェントを使用するプログラマーのそれを追い越し始めるでしょう。等しい検証済みの地平線では、プログラミング教育は、チェックされた仕事の品質を予測することはできなくなります。そして求人票では、学位要件の線は交差し、最初は専門家が自分たちで仕事を受け入れることができる領域で、最後はソフトウェアで交差します。2027年と2028年のスコアカードがこれらの予測に反対する場合、それらはブリアースコアを使用して公開でそう言うでしょう。予測が成立する場合、junior と senior という言葉は生き残る可能性があり、その意味は、ある人が証明できる仕事のサイズに向かってシフトします。大規模な雇用者がその成績ラダーをそのような測定値に置き換えるかどうかは、それ自体がここでの予測です(F17)。p = 0.05で登録されています。
これらの予測に何が起こるかに関係なく、1つの境界が残ります。構築は書くのと同じリテラシーになりつつあります。構築されたものについて責任を負うことは職業のままであり、その2つの間に立つのが不明確さであり、これは2026年の市場の状態です。良い仕事は見えず、プラットフォームは未知のものにドアを閉めています。エージェントを通じて構築する人には、その仕事に署名するパートナーが必要になるか、自分自身がそのパートナーになる必要があります。保証人は、何を保証したか、そしてそのうちどの程度が実現したかによって測定できます。
アメリカの諺によると、神は人間を創造し、コルト大佐は彼らを平等にしました。エージェントは製造における何か似たようなことを行います。1つあれば、業界外の人でも、業界のような見た目の仕事を生み出すことができます。チェックはより平等にしにくいです(セクション5.2および12)。付録Gの評価者研究では、自分の言葉で簿記見本に認められた5人のうち1人近くが、その業界の初週の質問に誤って答え、探索的な比較では、彼らはより大きなタスクをそれ以外の人が行ったよりも少ない时間で評価しました(付録G2)。独立したチェックのプロセスがエージェントが製造のためにしたことをチェックするためにできるかどうかは、セクション6.5の未解決の質問です。人々を分ける何かは、彼らがチェックして受け入れることができるものであり、これが検証済み委譲地平線が測定するものです。
声明
資金提供。 本研究は外部からの資金支援を受けていません。
利益相反。 著者はマルチモデルオーケストレーション方法を開発しており、関連する特許出願を提出しています(審査中;特許は未付与)。著者はセクション11.5および付録Gに記載された事前登録コホートプログラムとその資料を設計し、AI エージェントを使って作業を進めるのに役立つ教育アプリケーションを開発しています。本論文のいかなる知見も著者の実装に依存しません;付録CにおけるツールはPython標準ライブラリのみを使用しています。
ツールと検証。 AIアシスタントは著者の指示の下でツールとして使用されました;アイデア、研究および結論は著者のものです。定量的主張および引用は、2026年10月9日時点での一次資料またはアーカイブコピー、またはその日に追加された資料については2026年10月10日時点で検証されました(取得可能な場合)。プレスレポートまたはベンダーのページのみが入手可能な場合、主張は本文中でそのレポートまたはベンダーに帰属します。参考文献内の角括弧で示されたタイトルは、ヘッドラインが逐語的に再度読み取られなかったページの説明的タイトルです。
データとコードの可用性。 付録C、閾値のデスクテスト(付録E)および予測ファイルのコードとスキーマはMITライセンスの下で付属リポジトリ(https://github.com/vadimchernets/delegation-horizon)で公開されており、Zenodoにリリースv1.1.0としてアーカイブされています(コンセプトDOI 10.5281/zenodo.23267444、最新リリースに解決);付録Cに記載されたコードはリポジトリのものと同一です(バイト単位で)、tools/paper_sync.pyはこのテキスト横で実行されるときテストに対してこの、実装例およびテーブル4とA6をリポジトリと照合します。テーブル4とA6の予測は2026年10月9日にOSFに登録されました(DOI 10.17605/OSF.IO/VW6P9)。付録GのProlific評価者研究は2026年10月9日にOSFに登録され、データ収集前でした(DOI 10.17605/OSF.IO/V92R8);その分析スクリプト(pilot/human_raters.py)はその登録書に提出されており、提出されたファイルを含む付属リポジトリに保存されています(OSFが報告する各提出ファイルのSHA-256はpilot/registered-SHA256.txtに記載)、Prolific エクスポートを変換し、テーブルG2をプリントし、登録されなかったG2の比較を実行するスクリプトとともに。Prolific識別子が単純なラベルで置き換えられた匿名化データは、同じフォルダに追加されます。予測で登録されたファイルはその SHA-256とともにpredictions/registered-SHA256.txtに記載されており、OSFに提出されたマニフェスト、およびリポジトリのテストはそれらのすべてをそれと比較します。
倫理。 付録Gは人からのデータの2つの供給源を報告しています。Prolific評価者研究は匿名のオンライン評価タスクです:成人の専門家がProlificで参加前に情報を得た上で同意し、プラットフォーム経由で報酬を受け取り、名前または連絡先の詳細を提供しませんでした。コホートアカウントはセクションに要約されます;事前登録コホートプログラムに同意した成人の記録(OSF、DOI 10.17605/OSF.IO/X4EGQ)および匿名化公開の名前、場所、言語なし;プログラムの登録された成果は別途報告されます。本研究は制度倫理委員会のない独立した研究者により実施されました。セクション9で議論された公開スレッドは言い換えられており、その著者は名前が記載されていません。
著者の貢献。 単一著者。
対応。 [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
付録A. 用語集
参照時間。 有資格の専門家が手作業で業務を遂行するのに必要とされる時間で、凍結されたタスク銀行または業務を遂行した者を知らない2人の独立した評価者から得られたものです。
検証済み委任範囲。 ある人物が定期的に業務をエージェントに委任し、受け入れ、エージェントが見ていない独立チェックで確認された業務のサイズの最大値で、参照時間で測定されます。第5.2節の規則によってドメインごとに採点されます。
独立チェック。 隠されたアクセプタンステスト、有資格の人間レビュアー、対象ユーザーによる実際の使用、またはデータ、アクセス、インセンティブが異なり、エージェントとは異なるファミリーのモデルがソースに対して検証することです。自己レビューと1つのファミリー内のモデル間の合意は独立チェックではありません。
埋め込まれたエラー。 引き渡し前にタスクに埋め込まれたエラーで、その人物が捕捉しなければならないもので、誤った入力または業務が含まれなければならない何かの省略のいずれかです。埋め込まれたエラーを見落とした部分は検証済みとしてカウントされず、ステップの窓内での見落としは週以上のステップをブロックします。
増幅ゲイン。 受け入れられた検証済み業務の参照時間をドメインでの過去91日間のその人物の注意時間で除したもので、分母には失敗した業務が含まれ、分子には外部の助けで行われた業務は含まれません。
ゲインの上限。 簡略化されたモデルでは、チェックに V時間の注意を要する H参照時間の部分の増幅ゲイン G は G ≤ H / V を満たします。つまり、チェックが手作業時間の占める割合の逆数です。
ステップ。 時間(約1参照時間)、日(約8)、週(約40)、月(約160)、四半期(約500)。ルールv1.1のカウントと窓:時間と日については91日間に10個、週については182日間に6個、月については365日間に6個(そのうち5個は検証済み)、四半期については365日間に3個。週以上については、過去91日間以内にそのステップサイズの検証済み部分が少なくとも1つ必要です。
記録。 ドメイン・範囲・増幅・日付、例えば「中小企業簿記・日・×2・2026-Q4」です。
アクセプタンスリテラシー。 完了と見なされるものを事前に述べ、エージェントが捏造できない証拠でそれを示すスキルです。
背景の中立性。 ドメイン内の検証済み範囲が等しい場合、プログラミング教育はドメイン知識とアクセプタンスリテラシーを考慮すると独立してチェックされた業務の品質を予測しないという仮説です。
認定資格の交差点。 ドメイン内のある瞬間で、IT教育を受けていない人々の製品が同じチェックの下で受け入れられ、同じエージェントを使用するプログラマーのものを上回り始め、その後、学位要件と初級と上級というラベルは採用に予測力を失う瞬間です。その構成要素は品質パリティ(前のステップ)、追い越し(その瞬間)、投稿での交差(兆候)、背景の中立性(メカニズム)です。
保証人。 他人が作成した製品に署名し、自分のサークルに対して責任を負う人で、自分が推奨した製品の数と持続した数で測定されます。
仕上げ人。 製品をそのユーザーにもたらす人です。
2つの市場。 自分自身のための制作(リテラシー)と結果を伴う他人のための業務(専門職)です。
付録B. 検索ログ、2026年10月8日および9日
名前および用語のウェブチェックは2026年10月8日に複数のAIアシスタントが独立して並行して実行し、2026年10月9日に1つのアシスタントが拡張ウェブ検索で実行しました。各回答は完全な形で、そのソースとともに保持されました。学術的なチェックは2026年10月9日に以下のように実行されました。
| ベース | 検索内容 | 本論文の用語に対する結果 |
|---|---|---|
| arXiv (API) | 正確なフレーズ、全フィールド | 「delegation horizon」: 0; 「delegation ladder」または「ladder of delegation」: 0; 「time span of discretion」: 0 |
| Semantic Scholar | タイトルおよび要約 | 1つの検索は0を返し、別の検索はレート制限された(HTTP 429); 提出前に繰り返す必要があります |
| OpenAlex | タイトル、要約、一部の全文 | 「credential crossover」: 0; 「agentwright」: 無関係なマッチのみ; 「background neutrality」: 無関係; 「acceptance literacy」: 技術受容に関する研究のみ |
| Crossref | SSRNの要約を含むメタデータ | 専門職としての「principal」: 代理人理論のみ |
| Europe PMC | オープン全文 | 正確なマッチなし |
| Zenodo | レコードおよび説明 | いかなる用語についても一致なし |
| DOAJ | オープンアクセスジャーナル | 「delegation horizon」: 4つの無関係なマッチ |
| Google Scholar | 全文、SSRN | 「delegation horizon」: 6件、機械または企業に対して2026年の論文で使用(Khadj, 2026; Alonso, 2026); 「verified delegation horizon」、「credential crossover」、「credential crossover point」および「agentwright」: 0件(2026年10月9日にエラーなしで繰り返し); 「acceptance literacy」、「background neutrality」および「amplification gain」: 他の意味でのマッチのみ |
| DBLP; SSRNページ | ボット保護によってブロック(DBLP)またはHTTP 403を返す(SSRN); Crossrefおよびスカラーを通じてカバーされています |
以前の予測はMetaculus、Manifold、Good Judgment Open、Kalshi、PolymarketおよびLong Betsで検索され、オープンウェブでも検索されました; MetaculusおよびいくつかのGartnerページはHTTP 403を返し、利用可能な場合はアーカイブまたは再版された複写を通じて読まれました。結果はセクション11.3で要約されています。報告はPRISMA 2020の項目6に従います(Page et al., 2021): すべてのベースと最後のアクセス日が記載されています。検出されないマッチはその日付に見つからないと報告され、検索されなかったベースについては何の主張もされません。
付録C. 測定器具
この付録は、研究用の器具、記録形式、およびスコアラーをPythonの標準ライブラリの下、MITライセンスで提供しています。第5.2節の規則がどのようにコードになるかを示しています。これはアプリケーションではなく、個人に関する決定は行わず、その人または研究者が提供する記録から2つの数値を計算するだけです。チェックが適切に選ばれたかどうかは判定しません。与えられたフィールドを信頼します。特に独立性はテストしません。第5.2節の3つの条件(データ、アクセス、およびインセンティブ)のうち、チェックの種類とエージェントがそれを見たかどうかだけを読み、独立性そのものはTable 3のランダム監査によって確認されます。
C1. 記録
エージェントに渡された作業の1つについて、1行のJSONLinesファイル。作業が受け入れられ、拒否され、または放棄されたときに記述されます。引き渡しが開始された日付はstartedフィールドに入り、ルールv1.1から期待されます。スコアラーはそれなしで行を読み、警告を出します。チェックに失敗した、または放棄されたpiece(作業項目)はログに残ります。
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| フィールド | 意味 |
|---|---|
| person | 仮名のラベルであり、実名ではありません |
| domain | 作業が受け入れられた分野 |
| date | 受け入れ、却下、または放棄の日付。このリストが書かれた日付(ISO形式) |
| started | 引き継ぎが開始された日付(ISO形式)。ルール v1.1 で必須で、date 以前です |
| reference_hours | 成果物全体に対する有資格者による手作業の時間 |
| reference_basis | 参照元:名前付きタスク銀行または2人の評価者 |
| attention_minutes | 本人の計画、指示、読み込み、確認および修正の分数 |
| mode | one_piece、stages または together(one_piece は Section 5.7 の指示的シェアにカウントされます) |
| check | hidden_tests、expert、real_use、other_family_with_sources、same_family、self_review または none |
| agent_saw_check | エージェントがチェックを見ることができたかどうか(カウントされるには false である必要があります) |
| passed | チェックに合格したかどうか(失敗または放棄された成果物の場合は false) |
| irreversible | この種の作業の誤りが取り消せないかどうか(この成果物は合格する必要があります) |
| planted_errors | 引き継ぎ前にタスクに埋め込まれたエラー数 |
| planted_missed | 本人が見落とした数(1件の見落としにより成果物は未検証になり、ウィンドウ内の Week 以上をブロックします) |
| outside_help | 同僚またはコントラクターがログの外で支援したかどうか(そのような成果物は利得の分子に何も加えません) |
| task_id, model, tools | オプション:タスク銀行識別子、使用されたエージェントとモデル、およびそれらのツール(Section 5.4) |
| checker | オプション:チェックを実行した人または何か。役割として記載され、実名ではありません |
| rater_hours | オプション:reference_hours の背後にある評価者の推定値。2人の評価者がいて、大きい方が小さい方の 1.5 倍以上の場合、スコアラーは「第3評価者が必要」と出力します(Table 3)。第3推定値があれば中央値が採用され、このフラグは出力されません |
| audit | オプション:none、passed または failed。第2の独立したチェックの結果。失敗した監査により成果物は未検証になります |
| revoked | オプション:遅延した結果により成果物が取り消された場合は true(Table A4)。取り消された成果物は未検証です |
C2. horizon.py
以下のコードはルール v1.1 を実装しており、コンパニオンリポジトリの horizon.py と1バイト単位で同一です。
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. 実践例
以下のログは、2026年7月から9月の間に1人の人物がエージェントに依頼した10件の簿記業務の記録です。
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
python3 horizon.py work-log.jsonl --as-of 2026-10-09を実行すると、レコードとそれに関連するチェックについての行が出力されます:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
10個すべてのピースは最低8時間の参照時間を持っています。2つは検証済みとしてカウントされません。1つは自己レビューのみでチェックされ、もう1つは専門家のチェックに失敗しました。10個中8個はDayが要求する正確なシェアであり、一方的なピースが合格したため、段階はDayです。Weekは到達不可能です。どのピースも40時間に達していないからです。検証済みのピースは合計80時間の参照時間に達し、全10個に費やされた注意は1,030分(約17.2時間)で、失敗を含み、利得は4.66で段階は×2です。どのピースも植え込まれたエラーや外部の支援を受けていないため、これらのルールのいずれも結果を変えません。失敗したピースがログから除外されていた場合、段階は9個のピースに基づき、10個のカウント要件に失敗していたでしょう。これが失敗をレコードに含める理由です。段階の隣のカウント8/10は、判断がどれほど接近していたかを示し(付録E)、第2行は計算済みピースの背後にあるチェック種別と中央値で受け入れられたサイズである9.0時間を示すため、読者は視点閾値のちょうど上のピースに基づいているかどうかを確認できます(表3)。その人の注意である1,030分は、手渡された96時間の参照時間の約18%、検証済みの80時間の約21%です。履歴書のレコードは「小企業簿記·Day·×2·2026-Q4」と読まれます。
付属ツールtools/explain.pyは、同じルールから同じ判定の背後にある理由を出力します。Day規模の10個中8個のピースが検証済みで8個が必要です。カウントは44%から97%の真のパス率(セクション5.8)と一致するため、その規模の追加の失敗したピースは吸収されません。何も新しくログされなければ、Day は2026年10月18日まで保持されます。10月19日に7月20日に終了したピースが91日ウィンドウを離れ、Day規模の9個のピースが残り、Dayが必要とする10個に1つ不足します。Weekについては、まだ欠けているすべての条件をリストしています。182日間で最低40時間のピースが6つ、その1つは植え込まれたエラーを持ち、1つは過去91日以内に検証されました。
構築されたログはまた表3が名付けるトレースを含みます。その10個のピースの5つは正確に8時間(Dayの下限)で評価され、tools/too_clean.pyは「監査優先」とマークし、トレース「10個中5個のピースが丁度段階閾値の上に位置」を付けます。フラグはログを監査に送り、それについて何も決定しません。段階の隣の9.0時間の中央値は、読者にも同じことを示します。
C5. 付属リポジトリ
付属リポジトリ(https://github.com/vadimchernets/delegation-horizon)は、読者が論文の各部分を使用できるようにする機器と資料を保持しています。主なファイルはセクション別です。
| セクション | ファイル | 機能 |
|---|---|---|
| 5.2、C1からC4 | horizon.py、log.schema.json、examples/ |
スコアラー、1行のログのスキーマ、実行例と出力しなければならない行 |
| 5.2、5.3 | tools/log_piece.py、record_card.py、checker.html |
質問に答えてログを書き込む、段階の背後のカウントを伴うレコードカード、およびオフラインブラウザページで同じスコアリング。コンマまたはセミコロンで保存されたスプレッドシートを読む |
| 5.2、5.8、C4 | tools/explain.py |
ログがその段階を獲得する理由。保持または失敗する各条件、余裕、何も新しくログされない場合に段階が失効する日、および次の段階が必要とするもの |
| 5.1 | tools/reference_hours.py、kits/reference-hours-raters.md |
レーター推定からの参照時間、およびレーターを選択、入会、および説明する方法 |
| 5.8、表3 | audit_sample.py、tools/too_clean.py、tools/planted.py、kits/ |
再現可能な監査サンプル、きれい過ぎて見えるログのフラグ、引き渡し前に密閉された植え込みエラーおよび種別別(誤ったエントリまたは省略)でスコアされる、監査および植え込みエラーガイド |
| 6.2、10.3 | tools/verify_record.py |
ポータブルレコードの受信側。それで送信されたログは、スコアリングされたファイル、スコアラーが同じ、および再スコアリングが同じレコードをフィールドごとに与えるかどうか |
| 6.2 | kits/trade-screen.md、tools/gate_leak.py |
ラベルではなく職業の質問で人々を入会させること、およびラベルがどれほど漏らすか、正確な間隔を伴って(付録G2で60中11。9.5%から30.4%) |
| 6.5、10.5 | kits/checking-process.md、kits/process-vs-experience-study.md、tools/process_study.py |
セクション6.5の4つのステップとルール(図A4)の下で各ステップが獲得するもの、およびセクション10.5の比較をプロトコルとして登録し、その分析、誤ったエントリと省略を除く |
| 5.8、付録E | pilot/ |
閾値のデスクテスト、30のタスクのバンク、キャリブレーションプロトコルとその登録テキストおよび同意書 |
| 付録G2 | pilot/ |
OSFに提出された登録分析human_raters.py、Prolific出力の変換、登録された関数を伴う表G2を出力するスクリプト、スクリーニングの比較、およびそれらを実行するための合成出力 |
| 7.2 | templates/、tools/guarantor_record.py |
タスクバンク用タスクカード、保証人の台帳、および保証人のレコードはそこから計算。製品は6および12ヶ月間生存した数、重大度別の失敗 |
| 11、表4およびA6、C3 | predictions/、brier.py、tools/power.py |
登録された41の予測とそのハッシュのマニフェストはOSFに提出、解決ルールおよびファイル、スコアリングツール。セットB予測が実施されず、ブライアースコア記録に報告されないセット、またはそれなしで間違いスコアリング(セクション11.2)、およびセクション11.2のサンプルサイズ |
| 11、セットB | predictions/set_b.py |
9つのセットB予測の凍結した来真および来ないルール、区間で記述され、研究の推定に適用 |
| 11.4、F27 | kits/f27-sample.md、tools/freeze_sample.py、tools/liveness.py |
プロトコルおよびF27サンプルの抽出(最初に登録されたクローズドプール、その後、公開乱数ビーコンから取られたキー)、Zenodoで凍結し、そのハッシュは2026年12月31日までにOSFに登録、および各スコアリング日のF27の言葉によるその生命 |
| C2からC4、表4およびA6 | tools/paper_sync.py |
このテキストをリポジトリと照合します。リスティングはバイト単位で、実装例とその出力、予測表、セットのカウント、名前の付いたすべてのファイル、組み込まれたすべての図 |
| 付録D、付録F | figures/ |
予測表から図A1を描くスクリプト、スコアラーの規則から図A4を描くスクリプト |
読者別の同じファイル:
| 読者 | 最初に確認する項目 | 得られるもの |
|---|---|---|
| 作業をエージェントに渡す人 | templates/work-log.csv、record_card.pyまたはchecker.html、tools/explain.py |
スプレッドシートに記録されたログ、記録とそのカード、次の段階で必要なもの |
| 雇用主またはHRチーム | kits/hiring-test/、kits/trade-screen.md、kits/scope-statement.md、tools/explain.py |
盲検評価者による有給1日間の実務テスト、ラベルの代わりの業界の質問、段階の説明と説明されていない事項、候補者の判定がどの程度正確か |
| 業界の新規参入者 | kits/checking-process.md、kits/acceptance-card.md、kits/planted-errors-guide.md |
セクション6.5のステップと各ステップが得られるもの、引き渡し前に記された「完了」、植え込まれた脱落のための練習 |
| 監査人または保証人 | audit_sample.py、tools/too_clean.py、tools/planted.py、kits/audit-checklist.md |
再度確認するサンプル、あまりにも整然としたログの痕跡、シールがリストが変更されたかどうかを示す植え込まれたエラー |
| 研究者 | pilot/、kits/matched-task-study.md、kits/process-vs-experience-study.md、tools/power.py、predictions/ |
机上テスト、評価者研究とそのスクリプト、比較のためのプロトコル、サンプルサイズ、登録済みの予測とそのスコアカードツール |
附録D. 予測のための登録文(OSF)
タイトル。 AI エージェントを通じた仕事に関する年号付き予測、2026年から2031年: 凍結された予測と年間スコアリング。
タイプ。 オープンエンド登録、公開直後、エンバーゴなし。
概要。 この登録は、「After the Programmer Divide: One Measure for People Who Build Through AI Agents」(SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266)に述べられている年号付き予測を凍結します。添付の表は、各予測について以下を示します: その表現; その測定; 公開ソースおよび代替ソース; アクセス日時とアーカイブされたスナップショット付きの2025年または2026年のベースライン; チェック日付と最終日付; この登録の日付に固定された確率; および3つの結果のしきい値: 当たった、当たらなかった、未解決。
スコアリング。 各予測は、チェック日付以降の最初の年間チェックでデータが存在し、かつ最終日付以前でスコア付けされます。解決された予測はブリアー則によってスコア付けされます。最終日付までに比較可能なデータがない予測は未解決として記録され、成功としてカウントされません。
セットと確率。 セットAは公開データおよびpredictions/resolve/内のファイルから解決されます。そのSHA-256ハッシュはこの登録に列挙されています。セットBはデータ収集前に別途登録された研究からのみ解決されます; プロトコルが2027年6月30日までに登録されないセットBの予測は実施されなかったものとして記録され、テスト プログラムの失敗です; ブリアースコアは解決された予測に関して報告され、実施されなかったすべての予測を間違ったものとしてスコア付けされています。確率は解決を条件としています。これらは、2026年10月9日に収集された3つのブラインドモデル予測(Claude Opus、OpenAIモデル、Gemini)の中央値であり、著者によって採用されています; 4つのモデルの以前のプール予測は参考のため添付されています。
クロスオーバーポイント。 F2、F3、F5、およびF7は同じ名前のドメイン内で測定されます: 小規模ビジネス簿記、および法律とマーケティング文書、タスク銀行の2つの非ソフトウェア ドメイン(附録E); F5の投稿類似物については、SOC 43-3031、23-2011、および13-1161にマップされます。第3銀行ドメインである小規模内部Webツールはプログラマーのホームドメインであり、クロスオーバー ドメインではありません。ドメイン内のクロスオーバーポイントは、F3と同じ名前のドメイン内のドメイン類似物のF5の両方が満たされる最初の年です; どちらか一つだけではそれを宣言しません。
スコアリング追加。 各スコアカードは、解決されたシェア、セット別および族別のブリアースコア、超過期限未解決予測を間違ったものとしてスコア付けする最悪の境界、および0.5、プール済みモデル予測者、市場価格に対するブリアースキルスコアも報告します。
年間チェック。 2027年から2031年まで毎年、この登録の記念日に、著者はここに登録されているすべての予測を対象とするスコアカードを公開します。各スコアカード自体はOSFで登録され、DOIによってこの登録にリンクされ、Zenodoに寄託されます。
固定ルール。 予測は削除、再表現、または新しい日付を与えられません。後で追加されたものはすべて別途登録され、独自の日付を持ちます。名前付きソースが公開を停止するか、その方法を変更する場合、代替ソースが使用されます。ただし、同じ量を測定することが条件です; 比較可能なソースが存在しない場合、予測は未解決です。
独立した確認。 各スコアカードはここで凍結されたルールに対して、少なくとも2つの異なる族からのモデルによってチェックされます。彼らが不同意の場合、ルールが決定し、不同意が報告されます。人間の仲裁人は、著者によって最初のスコアカードの前に指名されます。2つのモデル族間の紛争に決定を下します。
独自データ。 著者のコホートデータに依存する予測は、OSFに登録されているプログラム(DOI 10.17605/OSF.IO/X4EGQ)が各コホートのために行うように、データが収集される前に提出される個別の事前登録の下でのみテストされます。
利益相反。 論文に記載されているように宣言されました。
ファイル。 予測表(CSV、および添付論文の表A6); アーカイブされたスナップショットのリスト; predictions/resolve/(凍結されたクエリ、リスト、コードブック、ハッシュ付き); resolution-rules.md; changelog-v1-v2.md。
添付の予測表は表A6です。図A1がそのカレンダーを描画します。
図A1。 チェックのカレンダー、2026年から2031年。
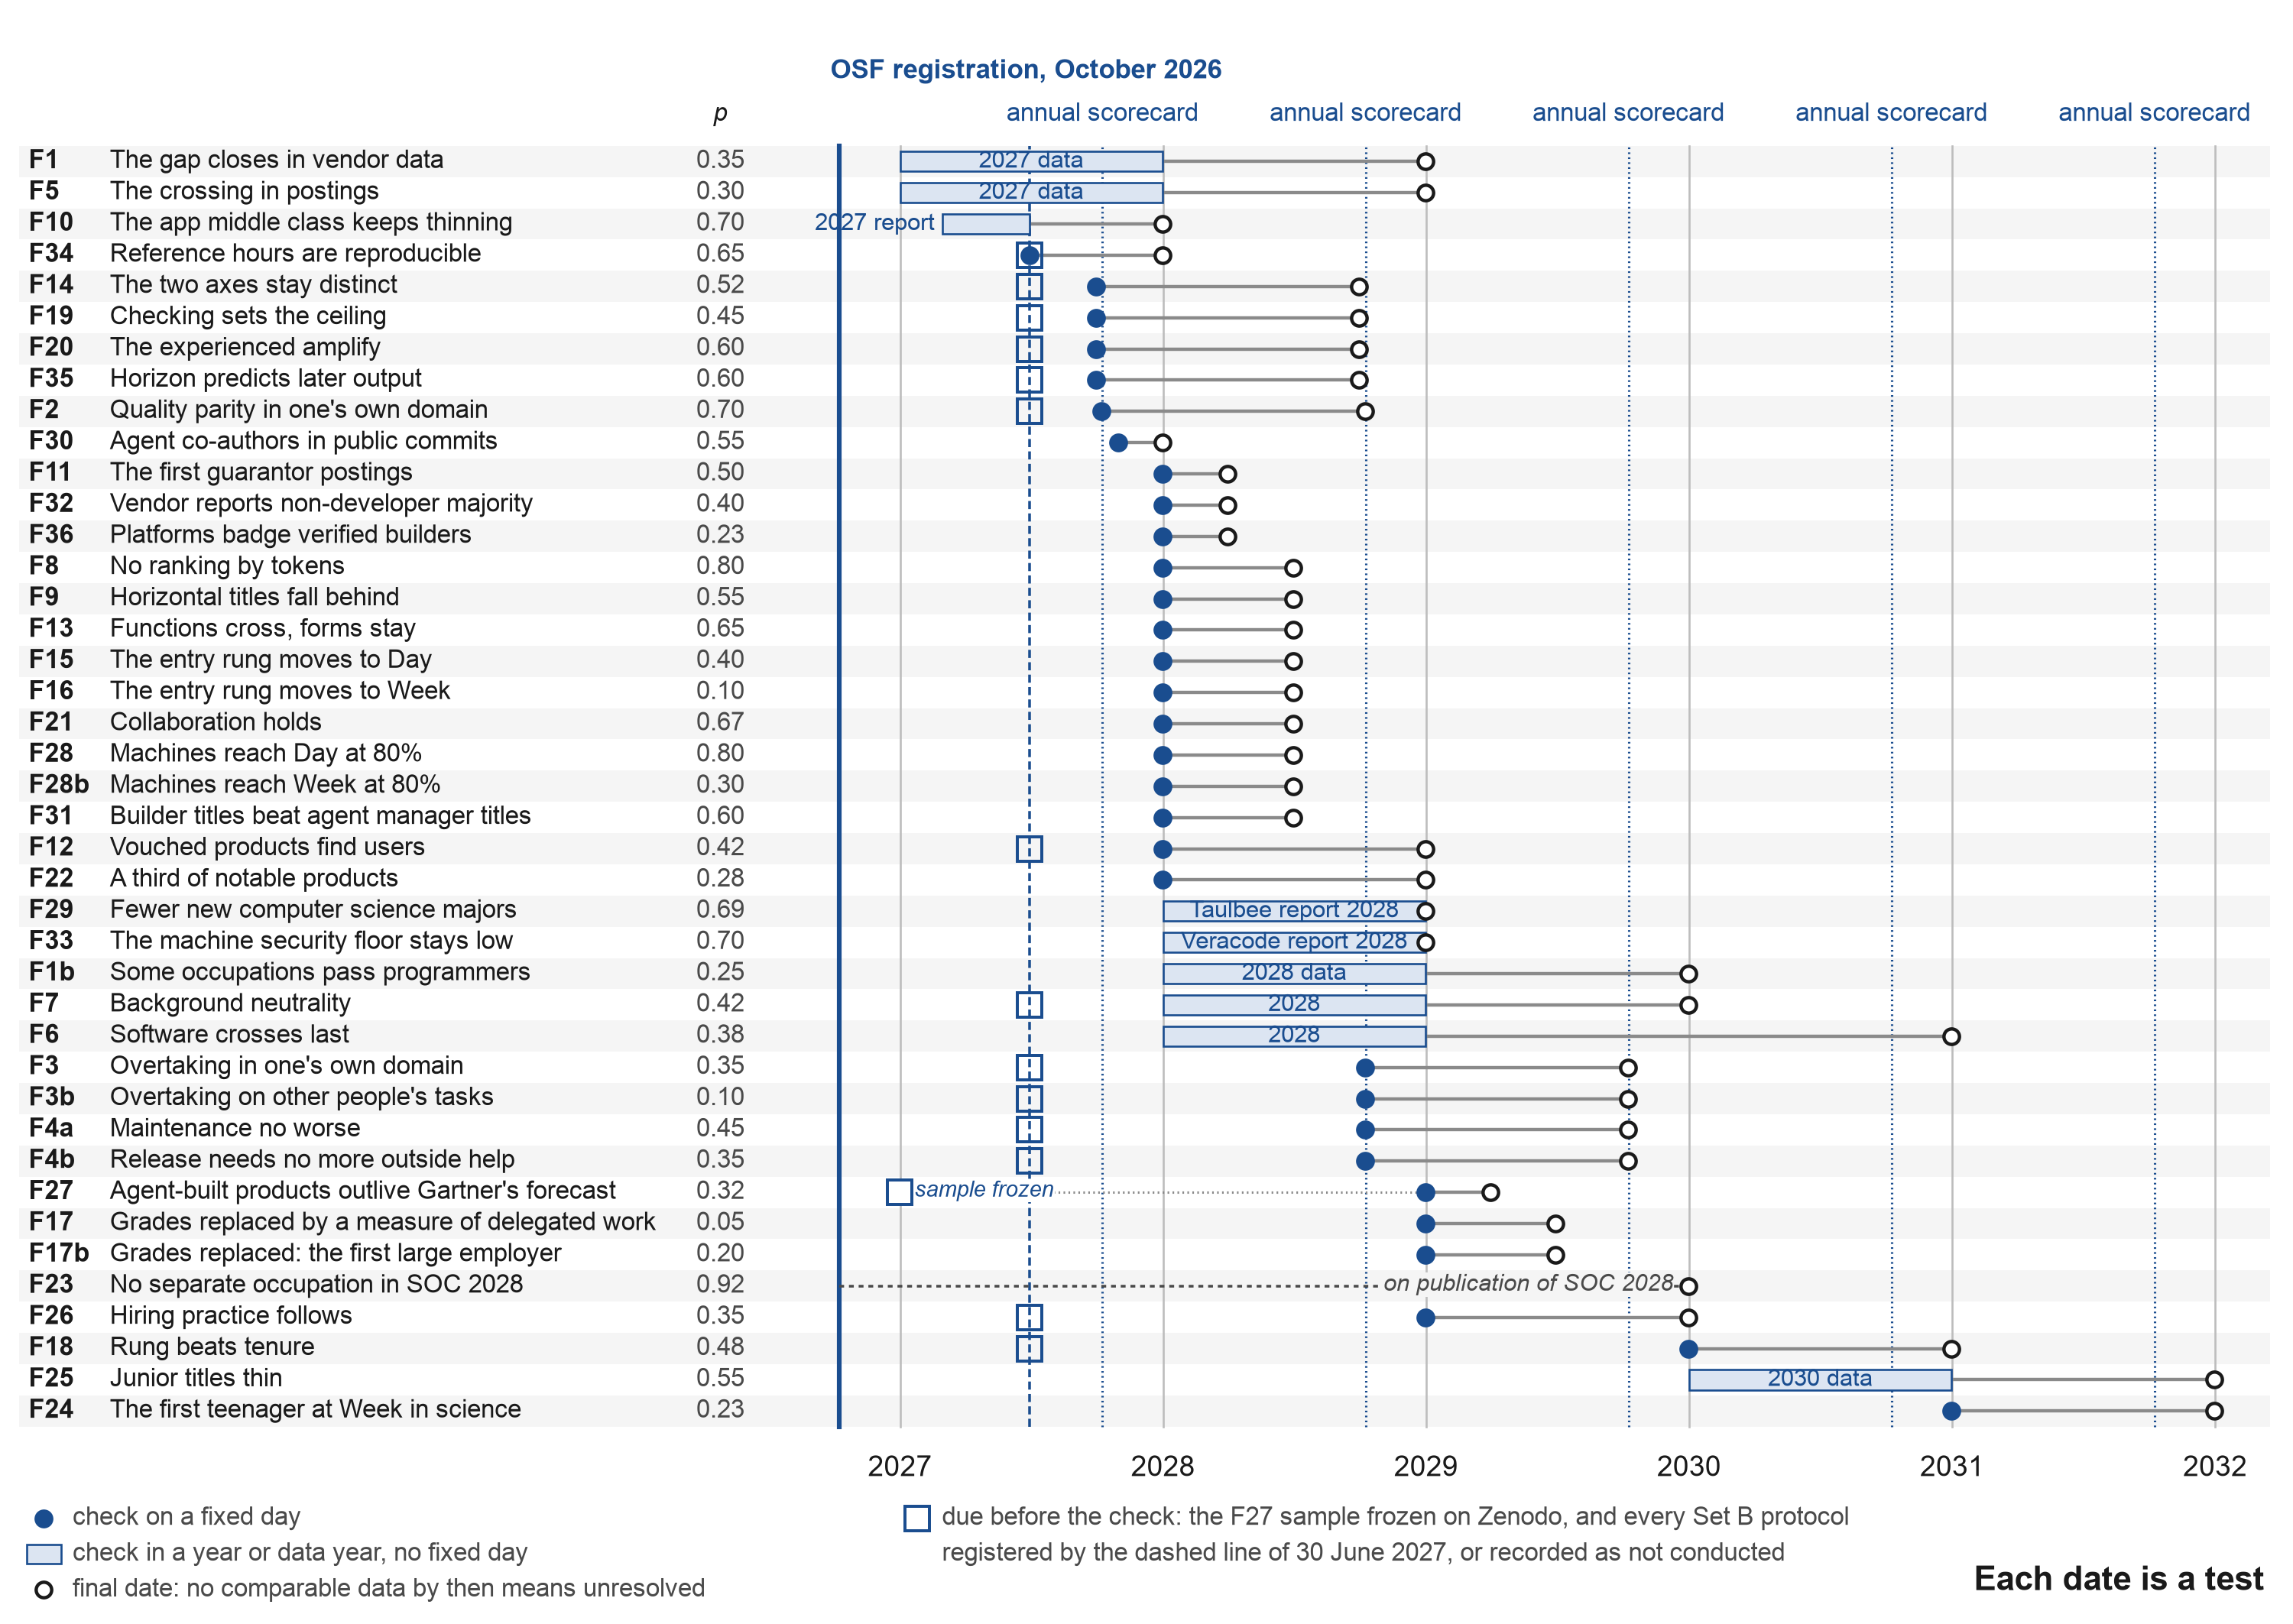
注: 表A6の各予測に1行、チェック日付でソートされ、その確率を示します。塗りつぶされた点は固定日のチェックです。薄い棒は年または固定日なしのデータ年のチェックです。リングは最終日付であり、その後比較可能なデータのない予測は未解決として記録されます(セクション11.4)。点線は年間スコアカードをマークし、2027年から2031年の10月にOSFで登録されます。空洞の正方形はチェック前の期限を示します: F27サンプルは2026年12月31日までにZenodoに凍結され、2027年6月30日の破線上に、各14セットB研究のプロトコルがあり、これなしで予測は実施されなかったものとして記録されます(セクション11.2)。図は予測表自体から、コンパニオン リポジトリのfigures/figure_a1_calendar.pyによって生成され、それでのみ変更されます。
表A6。 すべての41個の年号付き予測: セット、測定、しきい値、確率、モデル予測、フォールバック、および事前予測。
| # (セット) | 予測、測定、ベースライン、およびしきい値 | 日付、確率、モデル予測、未解決ルール、フォールバック、および事前予測 |
|---|---|---|
| F1 (A) | ギャップはベンダーデータで閉じます。 コード生成セッション、プログラミング対他の職業での検証済み成功: 34%対29%、7か月間変わらず(Anthropic、2026e)。ギャップはプログラミング職の成功率から他の職業の成功率を引いたもの、その符号付きです。2027年データの比較可能なレポートでギャップが2ポイント以下(負の値を含む)の場合、当たったもの; 2ポイント以上の場合、当たらなかったもの。ベースライン: コード生成セッションでの検証済み成功: プログラミング34%対他の職業29%、7か月間変わらず(Anthropic、2026e) | チェック: 2027年データ。最終日: 2028年12月31日。p = 0.35; モデル 0.39 (0.25 to 0.65)。未解決とする場合: 最終日までに2027年データのレポートがない、またはセッション定義が変更された場合(成功とは決してカウントされない)。フォールバック: 比較可能なセッションで職業別の検証済み成功を与えるベンダーレポート。最も近い先行または対抗予測: Anthropic: ギャップは「広がりも狭まりもしていない」 |
| F1b (A) | 一部の職業がプログラマーを上回る。F1と同じ測度。10の最大非プログラミング職業は登録時にAnthropicでセッションシェアが最大の10として固定される(2026e)。ある職業がプログラミングを上回るのは、その成功率が2ポイント以上高い場合のみである(10の比較での多重性の余裕)。2028年データで少なくとも3つがそうである場合に現実化した。ベースライン: F1と同じ; 経営はすでにプログラミングを若干上回っている(Anthropic, 2026e) | チェック: 2028年データ。最終日: 2029年12月31日。p = 0.25; モデル 0.30 (0.20 to 0.45)。未解決とする場合: 最終日までに2028年データのレポートがない、またはセッション定義が変更された場合(成功とは決してカウントされない)。フォールバック: F1と同じ。最も近い先行または対抗予測: 経営はすでに若干先行している(Anthropic, 2026e) |
| F2 (B) | 自分の領域でのクオリティ同等性(クロスオーバーポイント前のステップ)。同じエージェント、同じ時間、ブラインド受け入れとセキュリティチェック、1か月後の別のエージェントによるメンテナンス変更; グループあたり1,500人の1つの研究。95%区間の下限が(IT教育なし マイナス プログラマー)で マイナス10ポイントを上回る場合に現実化した; 上限がマイナス10を下回る場合は現実化しない; そうでなければ未解決。ベースライン: 公開ベースラインなし; 別途事前登録研究、グループあたり1,500人 | チェック: 2027年10月8日。最終日: 2028年10月8日。p = 0.70; モデル 0.67 (0.62 to 0.70)。未解決とする場合: 最終日までに比較可能なデータがない、またはどちらのルールも満たさない区間がある場合(成功とは決してカウントされない)。フォールバック: 同じデザインの独立した研究。最も近い先行または対抗予測: D. H. Hansson (2026)、「100%」(日付なし、測度なし); Esnaola et al. (2026) |
| F3 (B) | 自分の領域での追い抜き(クオリティでのクロスオーバーポイント)。F2と同じ(グループあたり1,500は両側アルファ 0.05 で真の優位性 5ポイントを検出するための約 0.8 の検力を与える; グループあたり400は約 0.3 を与える)。95%区間の下限がゼロを上回る場合に現実化した; 上限がゼロを下回る場合は現実化しない; そうでなければ未解決。ベースライン: F2と同じ | チェック: 2028年10月8日。最終日: 2029年10月8日。p = 0.35; モデル 0.33 (0.25 to 0.55)。未解決とする場合: 最終日までに比較可能なデータがない、またはどちらのルールも満たさない区間がある場合(成功とは決してカウントされない)。フォールバック: F2と同じ。最も近い先行または対抗予測: 日付のあるものは見つからなかった |
| F3b (B) | 他者のタスクでの追い抜き。F3と同じだが、参加者の自分の領域外のタスク上で。ベースライン: F2と同じ、参加者の自分の領域外のタスク上で | チェック: 2028年10月8日。最終日: 2029年10月8日。p = 0.10; モデル 0.13 (0.07 to 0.35)。未解決とする場合: 最終日までに比較可能なデータがない、またはどちらのルールも満たさない区間がある場合(成功とは決してカウントされない)。フォールバック: F2と同じ。最も近い先行または対抗予測: セクション6.3の領域論証はそれが失敗することを予測している |
| F4a (B) | メンテナンスは悪化していない。受け入れられた製品のうち12か月以内に中止された製品のシェア、著者の教育別。95%区間の上限が(非プログラマー マイナス プログラマー)の差で10ポイントを下回る場合に現実化した。ベースライン: 公開ベースラインなし; Gartner (Tyagi, 2026、Tray.ai, 2026 による要約) は2028年までにバイブコード化されたアプリケーションの60%が廃止されることを予想している、すべてのアプリケーションをカウントして | チェック: 2028年10月8日。最終日: 2029年10月8日。p = 0.45; モデル 0.49 (0.34 to 0.68)。未解決とする場合: 最終日までに比較可能なデータがない、またはどちらのルールも満たさない区間がある場合(成功とは決してカウントされない)。フォールバック: 著者調査を伴う製品レジストリ。最も近い先行または対抗予測: Gartner (Tyagi, 2026、Tray.ai, 2026 による要約): 2028年までにバイブコード化されたアプリケーションの60%が廃止される「予測可能なビジネス価値を提供していないため」; F4aより広い母集団で、受け入れられた製品のみをカウントする |
| F4b (B) | リリース時に外部の助けは不要。リリース時に外部の技術的助けを必要とする製品のシェア。10ポイントのマージンで非劣勢である場合に現実化した; ギャップはプロトタイプ、リリース、メンテナンスの順序で閉じることが予想されている。ベースライン: 公開ベースラインなし | チェック: 2028年10月8日。最終日: 2029年10月8日。p = 0.35; モデル 0.37 (0.22 to 0.50)。未解決とする場合: 最終日までに比較可能なデータがない、またはどちらのルールも満たさない区間がある場合(成功とは決してカウントされない)。フォールバック: F4aと同じ。最も近い先行または対抗予測: Gartner (Tyagi, 2026、Tray.ai, 2026 による要約): ソフトウェアエンジニアリングチームの30%が市民開発者とビジネスユーザーによって構築されたバイブコード化されたアプリケーションを維持することから「重大な容量逼迫」の下にある |
| F5 (A) | ポスティングでのクロスオーバー(目に見える兆候)。米国のポスティング固定IT職業セット; エージェンティックスキルは登録日現在のLightcast Open Skills分類法リリースによって定義される(予測/解決/F5.mdにバージョン番号が記録されている)、エージェンティックスキルの固定リスト; 4年制学位を要求するポスティングのシェア これらのスキルを持つポスティング対 それらなしポスティング、職業(SOC 6桁)、シニアリティ、州および四半期で正確にマッチング。エージェンティックベースライン(2026 Q2およびQ3)は登録前に取得および保存される。2027年の2つの連続した四半期で、95%区間がゼロを除外して、差が2ポイント以上負である場合に現実化した。ベースライン: AIポスティングはまだ学位を要求する可能性が高いが、2024年以降収束している(Lightcast, 2026b); エージェンティックベースラインは登録前に取得される | チェック: 2027年データ。最終日: 2028年12月31日。p = 0.30; モデル 0.34 (0.25 to 0.60)。未解決とする場合: 最終日までに比較可能なデータがない場合(成功とは決してカウントされない)。フォールバック: PwC AI Jobs Barometer、エージェンティックスキルを持つポスティング対マッチングされたポスティングの学位要件をレポートする場合のみ; そうでなければ未解決。最も近い先行または対抗予測: Gartner (2021): 2024年までにほとんどのテクノロジー製品がIT外で構築; Bone et al. (2025) 英国ポスティングでのAIスキル |
| F6 (A) | ソフトウェアが最後に越える。ドメインの固定リスト:法律、会計経理、教育、クリニック管理、マーケティング、不動産、保険、人事、物流、ソフトウェア開発、IT基盤、セキュリティ、開発者ツール。ドメイン別の最初のF5型越境の順序。ソフトウェア開発、基盤、セキュリティ、開発者ツールがすべて他の少なくとも半数のドメインより後に越えた場合に成立。ベースライン:まだどのドメインも越えていない(F5型比較) | 確認:2028年。最終日:2030年12月31日。p = 0.38;モデル 0.37(0.25~0.55)。未解決の条件:最終日までに非ソフトウェアドメインの半数以上が越えていない、または比較可能なソース がない(成功と数えられない)。フォールバック:同じF5型比較によるドメイン別の別の求人情報ソース;品質に関する研究(F2型)はカウントされず、そのようなソースがない場合は予測は未解決。最も近い先行または反対予測:Hwang (2026):金融「炭鉱のカナリア」 |
| F7 (B) | 背景の中立性。IT教育に関する質問を含む別途登録されたコホート;地平線は1つのタスクセットで得点化、品質は保持されたタスクで得点化。等しいランクでのIT教育と関連する独立チェック合格のオッズ比、ドメイン理解と受容性識字をコントロール。0.67~1.5の幅はいずれかの方向のオッズ比1.5で、標準化差約0.22(Chinnの変換)、慣例的には小さい効果。90%信頼区間が0.67~1.5(同等性)の範囲内にある場合、Day およびWeek以上で別途成立。ベースライン:公開ベースラインなし;IT教育に関する質問を含む別途登録されたコホート | 確認:2028年。最終日:2029年12月31日。p = 0.42;モデル 0.43(0.40~0.48)。未解決の条件:その他の組み合わせ、レベル1つでのみ同等性が示された場合を含む、または最終日までにデータがない場合(成功と数えられない)。フォールバック:同じ項目を含む独立したコホート。最も近い先行または反対予測:Anthropicのドメイン理解に関する観察;Savva (2026)、競争相手 |
| F8 (A) | トークン数による順位付けなし。2027年間に公式な評価基準としてトークン数を使用しているFortune 500企業、雇用主またはそれぞれ独立した2つのメディアで文書化されたもの(AIの使用に関する質問はカウントされない)。2社未満の雇用主が見つかった場合に成立。ベースライン:2026年にトークン数が評価基準として試行(論文のセクション4) | 確認:2027年12月31日。最終日:2028年6月30日。p = 0.80;モデル 0.79(0.60~0.90)。未解決の条件:最終日までに比較可能なデータがない場合(成功と数えられない)。フォールバック:predictions/resolve/F8.mdの固定クエリによるビジネスプレスアーカイブの検索。最も近い先行または反対予測:Kingy AI (2026):「低下した、殺されていない」;Flowtivity (2026):「不可逆的」 |
| F9 (A) | 横並びタイトルが遅れる。米国求人、同じ固定クエリ(predictions/resolve/F9.md)、2026年第4四半期および2027年第4四半期、各カウントを同じ四半期のすべての米国求人で除算:エージェント・マネージャー、AIオペレータ、AIオーケストレータとドメインを名乗るタイトル(例「リーガルAIリード」、「バーティカルAIリード」)に対して。正規化されたドメイン名タイトルのシェアが横並びのものよりも大きい要因で成長した場合に成立。ベースライン:2026年第4四半期の固定クエリでの米国求人カウント | 確認:2027年12月31日。最終日:2028年6月30日。p = 0.55;モデル 0.58(0.45~0.75)。未解決の条件:2026年第4四半期に、どちらかのファミリーが50未満の求人数である場合、または最終日までにデータがない場合(成功と数えられない)。フォールバック:同じクエリでのIndeedまたはLinkedInの検索カウント。最も近い先行または反対予測:Srinivasan および Wei (2026):「エージェント・マネージャー」12~18か月以内に標準的なタイトル;IT Brew (2026):「次の18か月」 |
| F10 (A) | アプリの中流階級が薄れ続ける。2年以内に月間売上1,000ドルに達する新規サブスクリプションアプリのシェア、RevenueCat 2026と同じ尺度(17%)。17%未満の場合に成立。ベースライン:新規サブスクリプションアプリの17%が2年以内に月間売上1,000ドルに達する(RevenueCat、2026) | 確認:RevenueCat 2027レポート。最終日:2027年12月31日。p = 0.70;モデル 0.68(0.60~0.80)。未解決の条件:最終日までに比較可能なデータがない場合(成功と数えられない)。フォールバック:Sensor TowerまたはAppfiguresの売上閾値。最も近い先行または反対予測:RevenueCat自体のトレンド(優先順位を主張していない);多くのバイブコードアプリは広告から収益を得ており、RevenueCatは見えない |
| F11 (A) | 最初の保証人求人。1,000人以上の職員を持つ医療、法律、金融、教育の雇用主による求人で、AI生成作業への署名と個人的な責任を名乗るもの。predictions/resolve/F11.mdの固定クエリ:「AI生成」を伴う「sign off」、「AI出力に対する責任」、「AI認証」、「AIガランティ」;「保証人」または「認定資格」が鍵またはアクセスを指す求人は除外。少なくとも5社の雇用主から少なくとも10件のそのような求人が見つかり、アーカイブされた場合に成立。ベースライン:執筆時点ではそのような求人は見つからない | 確認:2027年12月31日。最終日:2028年3月31日。p = 0.50;モデル 0.42(0.25~0.55)。未解決の条件:最終日までに比較可能なデータがない場合(成功と数えられない)。フォールバック:Google JobsおよびLinkedInを通じて見つかったアーカイブ求人。最も近い先行または反対予測:Capps (2025)、「法的保証人」;Forrester (2025):Fortune 100の60%がAIガバナンスの責任者を任命する |
| F12 (B) | 保証付き製品がユーザーを見つける。独自のランダム化研究:適格な製品の中で、指定された保証人がランダムに割り当てられた。90日以内に10人の無関係なユーザーに達するシェア。保証付きシェアが高く、95%信頼区間がゼロを除外する場合に成立。ベースライン:公開ベースラインなし;独自のランダム化研究 | 確認:2027年12月31日。最終日:2028年12月31日。p = 0.42;モデル 0.43(0.30~0.60)。未解決の条件:最終日までに比較可能なデータがない場合(成功と数えられない)。フォールバック:なし。最も近い先行または反対予測:橋本のVouch(予測ではなくメカニズム) |
| F13 (A) | 機能は越え、形式は留まる。3つの非IT職業のカリキュラムと投稿、コーディング前に公開されたコードブック(predictions/resolve/F13-codebook.md)を用いた2人のコーダーによってコード化:確認、費用による モデル選択と長時間の実行が教えられた;個人支出とモデル・キャンプはトップレイヤーユーザーの間でのみ見つかった。機能的なトピックがステータストピックを少なくとも3対1で上回る場合に成立。ベースライン:公開ベースラインなし;3つの非IT職業のカリキュラムと投稿の2人のコーダー | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.65; モデル 0.69 (0.55 to 0.82)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: 公開コース カタログ。最も近い先行予測または反対予測: Rogers (2003)、採用レイヤー (優先順位なし主張) |
| F14 (B) | 2つの軸は明確なままです。 少なくとも200ログにおけるログ水平線とログ利益の人レベルのSpearman相関。 相関が0.8以下であり、利益を水平線に加えた値が、6ヶ月後の検証済み出力のサンプル外R二乗を少なくとも0.02上げる場合に真になります。 ベースライン: 公開ベースラインなし; 少なくとも200ログ | 確認: 2027年9月30日。最終日: 2028年9月30日。p = 0.52; モデル 0.49 (0.45 to 0.50)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: なし。最も近い先行予測または反対予測: 見つかりません |
| F15 (A) | エントリー段階がDayに移動します。 ソフトウェアおよび他の3つの職業における、200のアメリカのエントリーレベル求人とテイクホームタスクの凍結されたサンプルにおいて、2人の評価者により参考時間で評価された、メディアン最初割り当てはDay以上です。 ベースライン: 200のアメリカのエントリーレベル求人とテイクホームタスクの凍結されたサンプル、2人の評価者により参考時間で評価されたもの | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.40; モデル 0.49 (0.30 to 0.70)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: Indeed Hiring Lab エントリーレベルサンプル。最も近い先行予測または反対予測: Washington Monthly (2026): 「エントリーレベル役は中レベル役のようになりつつあります」; METRの適合水平線トレンドは約4.2ヶ月ごとに2倍になっています |
| F16 (A) | エントリー段階がWeekに移動します。 同じ測定; メディアンはWeek以上です。 ベースライン: F15同様 | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.10; モデル 0.14 (0.06 to 0.40)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: F15同様。最も近い先行予測または反対予測: Kwa et al. (2025)、マシン時間水平線 (人ではなくマシン) |
| F17 (A) | 成績は委譲作業の測定に置き換えられます。 アメリカ最大50企業のうち、成績ラダーを検証済み委譲作業の測定に公開で置き換える企業。 少なくとも10の場合に真になります。 ベースライン: 公開ベースラインなし | 確認: 2028年12月31日。最終日: 2029年6月30日。p = 0.05; モデル 0.05 (0.02 to 0.20)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: 雇用主ファイリングとプレス。最も近い先行予測または反対予測: Gartner (2024): 2026年まで、20%の組織がAIを使用して構造をフラット化します; Microsoft (2025): 「エージェントボス」 |
| F17b (A) | 成績置き換え: 最初の大企業。 アメリカ最大50企業のうち、少なくとも1つが成績ラダーを検証済み委譲作業の測定に公開で置き換えます。 ベースライン: 公開ベースラインなし | 確認: 2028年12月31日。最終日: 2029年6月30日。p = 0.20; モデル 0.21 (0.05 to 0.50)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: 雇用主ファイリングとプレス。最も近い先行予測または反対予測: F17のより柔らかい双子 |
| F18 (B) | 段階は勤続年数より優れています。 雇用主またはコホートデータでは、検証済み段階は年数より給与の変動をより説明します (評価されたパフォーマンスは給与が利用できない場合のみ使用され、分析前に修正されます)。 ベースライン: 公開ベースラインなし | 確認: 2029年12月31日。最終日: 2030年12月31日。p = 0.48; モデル 0.52 (0.40 to 0.60)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: 公開HR分析。最も近い先行予測または反対予測: Jaques (1956)、責任範囲による給与 |
| F19 (B) | チェックは上限を設定します (サンプル外)。 少なくとも200ログ。 チェックに費やされた注意の割合および水平線、1~3ヶ月で両方測定; 検証済み出力 (利得公式ではなく、参考時間での受け入れられた作品)、4~6ヶ月。 保留出された人では、チェック割合が後の検証済み出力より水平線との高い部分相関を持つ場合に真になります。 ベースライン: 公開ベースラインなし | 確認: 2027年9月30日。最終日: 2028年9月30日。p = 0.45; モデル 0.44 (0.30 to 0.65)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: なし。最も近い先行予測または反対予測: Huang et al. (2026)、検証増幅。v1は利得を使用しましたが、構造上水平線を含みます; v2は後で別々に測定された結果を予測します |
| F20 (B) | 経験者は増幅します。 指令共有: 人のターンの割合で、ログから指示を与えるまたはチェックまたは編集するのではなく。 検証済み利益: 人の注意1時間あたりの受け入れられた参考時間。 指令共有が6ヶ月以上減少した人の中で、月6の検証済み利益は月0値の少なくとも95%です大多数。 ベースライン: 公開ベースラインなし | 確認: 2027年9月30日。最終日: 2028年9月30日。p = 0.60; モデル 0.62 (0.55 to 0.70)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: なし。最も近い先行予測または反対予測: Anthropic (2026d)、学習曲線 |
| F21 (A) | コラボレーションが続きます。 Anthropic Economic Indexのサンプルのうち、APIサンプルではなく、Claude.ai会話サンプルでのコラボレーティブ使用 (拡張) の割合は、2027年に公開された各レポートで40%以上のままです。 ベースライン: 2025年11月のコラボレーティブ使用52% vs オートメーション45% (Anthropic, 2026a) | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.67; モデル 0.68 (0.60 to 0.75)。未解決: 最終日までに比較可能なデータがない場合 (成功としてカウントされない)。フォールバック: 他のベンダーレポートで比較可能な割合。最も近い先行予測または反対予測: Anthropic (2026a): 2025年11月で52% vs 45% |
| F22 (A) | 注目すべき製品の3分の1。 2027年の12か月間のProduct Huntの月間ランキング全体で最も投票数が多い100製品。リスト凍結2028年1月1日。記載されたメーカーはコード化されます; 製品は、記載されたメーカーが誰もプログラミング教育またはプログラミングの過去仕事を述べていない場合、プログラミング教育なしで作成されたとカウントされます (プログラミング仕事を持つ自習者はプログラマーとしてカウントされます)。 2人のコーダー、互いに盲目。 100人中30人以上が適格である場合に真になります。 ベースライン: Manifold: 2026年末までに1億人の月次ユーザーを持つバイブコードソフトウェア、約28% | 確認: 2027年12月31日。最終日: 2028年12月31日。p = 0.28; モデル 0.29 (0.14 〜 0.50)。未解決: 100個の製品のうち50個未満がコード化可能なステートメントを持つ場合、または最終日までにデータがない場合(成功としてカウントされません)。フォールバック: 第2の固定ランキング (Hacker News Show HN 2027年トップ100)。最も近い先行または反対予測: Gartner (2021); Manifold: 2026年末までに月間1億ユーザーを持つバイブコードソフトウェア、約28% |
| F23 (A) | SOC 2028に別の職種がない。 2028年の米国標準職業分類には、エージェントを通じて指示される作業の別の職種は含まれていません。ベースライン: SOC 2018にはそのような職種がありません | 確認: SOC 2028の公開。最終日: 2029年12月31日。p = 0.92; モデル 0.93 (0.80 〜 0.98)。未解決: 最終日までに比較可能なデータがない場合(成功としてカウントされません)。フォールバック: BLS改訂通知 (2026年10月9日確認: 提案または最終構造はまだありません; 最終構造は2027年に予想)。最も近い先行または反対予測: 見つかりません |
| F24 (A) | 科学Week の最初の10代。 科学製品はソフトウェア、データセット、または発表された研究で少なくとも10人の無関係な人によって使用されたか、少なくとも1つのピアレビュー論文で引用された論文です。正式な訓練のない18歳未満の人で、その科学製品がそのようなユーザーを持ち、独立したチェックの下でWeekを獲得した場合の公開ドキュメント化されたケース。ベースライン: 執筆時点でそのようなドキュメント化されたケースはありません | 確認: 2030年12月31日。最終日: 2031年12月31日。p = 0.23; モデル 0.21 (0.02 〜 0.45)。未解決: 検索ソースが利用できない場合のみ; 最終日までにドキュメント化されたケースがないことはしませんでした。フォールバック: なし。最も近い先行または反対予測: 中国の2030年までにすべての学校でのAI教育の目標 (CSET, 2025) |
| F25 (A) | ジュニアタイトル薄い。 2030年の米国ソフトウェア求人のうち、タイトルに「ジュニア」または「エントリーレベル」がある割合と、同じクエリで2025年。少なくとも3分の1減少した場合に実現。ベースライン: 2025年の米国ソフトウェア求人のうち、タイトルに「ジュニア」または「エントリーレベル」がある割合、同じクエリ | 確認: 2030年データ。最終日: 2031年12月31日。p = 0.55; モデル 0.54 (0.45 〜 0.60)。未解決: 最終日までに比較可能なデータがない場合(成功としてカウントされません)。フォールバック: Indeed Hiring Lab。最も近い先行または反対予測: Manifold: 2030年までにジュニア開発者職が3分の1減少、約74%; 米国開発者が2023年から2028年に15%以上減少、約42%; 市場 0.74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 2026年10月9日 (ジュニアSWEの求人が2030年1月1日までに少なくとも33%減少; 関連するが同一でない尺度)) |
| F26 (B) | 採用慣行が続く。 独自の監査研究: IT教育のみが異なる認証済み作業のマッチングされたポートフォリオを2つの非IT分野の実際の求人に送付。コールバック率が3ポイント未満異なり、95%区間がプラスまたはマイナス5の内側である場合に実現。ベースライン: 公開ベースラインなし; 独自の監査研究 | 確認: 2028年12月31日。最終日: 2029年12月31日。p = 0.35; モデル 0.32 (0.25 〜 0.35)。未解決: 最終日までに比較可能なデータがない場合、または両方のルールを満たさない区間 (成功としてカウントされません)。フォールバック: なし。最も近い先行または反対予測: Burning Glass Institute および Harvard Business School (2024): 700採用のうち1未満が変更 |
| F27 (A) | エージェント構築製品がGartnerの予測を上回る。 2026年10月〜12月に主にコーディングエージェントで構築され、2026年12月31日までにZenodoで固定化された少なくとも300個の公開製品のサンプル; liveness は companion スクリプトで確認。2028年12月31日に50%未満が廃止されている(到達不可能または12ヶ月間更新されていない)場合に実現。ベースライン: Gartner (Tyagi, 2026): バイブコード化されたアプリケーションの60%が2028年までに廃止 | 確認: 2028年12月31日。最終日: 2029年3月31日。p = 0.32; モデル 0.35 (0.20 〜 0.55)。未解決: サンプルが2026年12月31日までに固定化されなかった場合(成功としてカウントされません)。フォールバック: 各製品のWayback Machineスナップショット。最も近い先行または反対予測: Gartner (Tyagi, 2026): 60%廃止 |
| F28 (A) | 機械が80%でDayに到達。 METR の最高の公開リリースモデルに対する80%時間地平が2027年12月31日までに8時間(Day)に到達。ベースライン: 2026年4月の80%で約3.1時間 (METR, 2026c; ダッシュボードは2026年9月8日以降更新されていません) | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.80; モデル 0.66 (0.55 〜 0.80)。未解決: METRもフォールバックも最終日までに80%地平を報告しない場合(成功としてカウントされません)。フォールバック: METRのメソッドの独立した複製 (例えば Epoch AI)。最も近い先行または反対予測: METR の適合地平トレンドは約4.2ヶ月ごとに2倍 |
| F28b (A) | 機械が80%でWeekに到達。 F28と同様、閾値40時間(Week)。ベースライン: F28と同様 | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.30; モデル 0.20 (0.10 〜 0.55)。未解決: F28と同様。フォールバック: F28と同様。最も近い先行または反対予測: F28と同様 |
| F29 (A) | 新しいコンピュータサイエンス専攻がより少ない。 2028年に公開された CRA Taulbee Survey で報告された新しい学部専攻コンピュータサイエンス(2027年〜2028年度)対2026年に公開された調査。ベースライン: 2026年に公開された CRA Taulbee Survey | 確認: Taulbee レポート 2028。最終日: 2028年12月31日。p = 0.69; モデル 0.67 (0.50 〜 0.75)。未解決: 最終日までに比較可能なデータがない場合(成功としてカウントされません)。フォールバック: NSC Research Center 主要別登録者数。最も近い先行または反対予測: 2025年と2026年のCS登録者数の減少に関する CRA レポート |
| F30 (A) | 公開コミットにおけるエージェント共著者。 GH Archive の公開push イベントのうち、コミットメッセージがエージェント共著者トレーラーを持つ割合 (predictions/resolve/F30.md の凍結された正規表現)、2027年9月対2026年9月。ベースライン: GH Archive、2026年9月、登録前に測定およびアーカイブ | 確認: 2027年10月31日。最終日: 2027年12月31日。p = 0.55; モデル 0.59 (0.40 〜 0.75)。未解決: 最終日までに比較可能なデータがない場合(成功としてカウントされません)。フォールバック: GitHub Innovation Graph。最も近い先行または反対予測: 見つかりません |
| F31 (A) | ビルダータイトルがエージェントマネージャータイトルを上回る。 米国求人、凍結された Indeed クエリ (predictions/resolve/F31.md)、2027年第4四半期: ビルダーファミリーのタイトル対エージェントマネージャーファミリー。ベースライン: 同じクエリで2026年第4四半期のカウント | 確認: 2027年12月31日。最終日: 2028年6月30日。p = 0.60; モデル 0.63 (0.50~0.74)。未解決の場合: 最終日までに比較可能なデータがない場合 (成功と数えられない)。代替案: 同じクエリを使用したLinkedIn検索の結果。最も近い過去の予測またはカウンター予測: Srinivasan and Wei (2026): 「エージェントマネージャー」は12~18か月以内に標準的な職務名となる |
| F32 (A) | ベンダーは、コーディングエージェントのほとんどのユーザーが開発者ではないと述べている。 Anthropic、OpenAI、GoogleまたはGitHubが開発したコーディングエージェントのベンダーが、そのエージェントの週次ユーザーの大多数はソフトウェア開発者ではないと公開報告する。ベースライン: 執筆時点でそのような報告はない | 確認: 2027年12月31日。最終日: 2028年3月31日。p = 0.40; モデル 0.31 (0.13~0.70)。未解決の場合: 最終日までに比較可能なデータがない場合 (成功と数えられない)。代替案: ベンダーの経済または利用レポート。最も近い過去の予測またはカウンター予測: アプリビルダーベンダー (Lovable、Replit) はすでに非開発者ユーザーが大多数であることを説明しており、この質問は一般的なコーディングエージェントに関するもの |
| F33 (A) | 機械セキュリティの下限は低いままである。 VeracodeのGenAIコードセキュリティレポートでセキュリティテストに合格するAI生成コードサンプルの割合。ベースライン: 56%の合格率、停滞 (Veracode、2026) | 確認: Veracodeレポート2028。最終日: 2028年12月31日。p = 0.70; モデル 0.67 (0.57~0.80)。未解決の場合: 最終日までに比較可能なデータがない場合 (成功と数えられない)。代替案: 生成コード内のセキュリティの比較可能な独立ベンチマーク。最も近い過去の予測またはカウンター予測: Veracode: より新しいモデルでセキュリティは改善されない |
| F34 (B) | 参照時間は再現可能である。 2つの独立した評価者パネル (各3名) が同じ50タスクの参照時間を推定し、対数時間の級内相関係数 (2元、絶対一致) を求める。ベースライン: しきい値のデスク試験 (付録E) | 確認: 2027年6月30日。最終日: 2027年12月31日。p = 0.65; モデル 0.65 (0.40~0.75)。未解決の場合: 最終日までに比較可能なデータがない場合、またはいずれかのルールも満たさない区間の場合 (成功と数えられない)。代替案: なし。最も近い過去の予測またはカウンター予測: METRの人間ベースライン (人ではなく機械) |
| F35 (B) | Horizonはより後の出力を予測する。 最低200個のログ: 0か月目のhorizonに保有期間とIT教育を加えた値が、4~6か月目の検証済み出力の標本外R二乗を向上させる。ベースライン: 公開ベースラインなし | 確認: 2027年9月30日。最終日: 2028年9月30日。p = 0.60; モデル 0.58 (0.45~0.70)。未解決の場合: 最終日までに比較可能なデータがない場合 (成功と数えられない)。代替案: なし。最も近い過去の予測またはカウンター予測: Burning Glass Institute とハーバード・ビジネス・スクール (2024) |
| F36 (A) | プラットフォームはAIで構築された成果物の検証バッジを付与する。 Upwork、Fiverr、GitHub、Product Hunt、ToptalおよびContraのうち、少なくとも2つが、独立検証されたAI構築作業 (スキルクイズではない) を認証する公開バッジまたはプロフィールフィールドを導入する。ベースライン: 執筆時点でそのようなバッジはない | 確認: 2027年12月31日。最終日: 2028年3月31日。p = 0.23; モデル 0.24 (0.07~0.70)。未解決の場合: 最終日までに比較可能なデータがない場合 (成功と数えられない)。代替案: プラットフォームのヘルプページとアーカイブされた発表。最も近い過去の予測またはカウンター予測: 見つかったものなし |
注記: セットAは公開データから解決され、セットBは別途事前登録された研究から解決されます (プロトコルは2027年6月30日までに作成、そうしないと実施されず、スコアカードではこれをテストプログラムの失敗と見なします)。pは解決を条件としています。モデル: 私の数字を見なかった独立的なモデル予測者の確率のオッズの幾何平均で、その範囲を示します; 個別予測はpredictions/m2-probabilities.csvにあります。各行のCame-true and did-notルールはpredictions/predictions.csvにあります。行F4aおよびF4bではGartner予測は参考文献リストが引用している通り、Tray.ai (2026) による要約を通じて引用され、その独自の言葉が引用されています; 登録ファイルは同じ予測と同じ数字をより簡潔に提供し、Gartner (Tyagi、2026) を引用しています。
付録E. しきい値のデスクテスト
本付録は、Section 5.2の規則のデスクテストを報告しています。2026年10月9日にシミュレーションとモデル評価者により実施され、次のバージョンを固定するキャリブレーションプロトコルが示されています。すべての数値は、コンパニオンリポジトリ(pilot/)の2つのスクリプトにより生成され、これらは付録Cのスコアラーを変更せずに呼び出し、その定数のみを入れ替えています。
E1. ランチが獲得される頻度
作品が真の確率pで独立して合格する人について、表E1は、ウィンドウ内で正確に最小数の作品でそれぞれのランチを獲得する確率を示しています。値は正確な二項確率です。horizon.pyによるモンテカルロ実行は、ウィンドウ全体に作品が分散され、植え込まれたエラーと最近の作品が配置された状態で、0.01以内で一致しています。
表E1。 真の合格率別のランチ獲得確率。
| 規則 | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| Hour and Day、91日間で10個中8個 | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Week、182日間で6個中5個 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Month、第1版、365日間で4個中4個 | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Month、現在、365日間で6個中5個 | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Quarter、365日間で3個中3個 | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
注記: 規則は適格化の規則です。これらの確率は規則を説明し、人を説明するものではありません。
3つの知見が続きます。第一に、第1版は順序付けられていませんでした。Monthが4個中4個では、すべてのpでQuarterより獲得が難しかったのです。5個中4個のカウントがエラーを逆にし、p = 0.8でMonthをDayおよびWeekより簡単にしていたはずです(0.74)。そのため、Monthは現在、1年間で6個中5個を要求しており、これは640参照時間ではなく約960参照時間です。これにより、Day、Week、MonthおよびQuarterは、0.77以上のすべてのpに対して最も簡単から最も難しい順に順序付けられます。これは適格化が重要な範囲です。0.76以下では、WeekはわずかにDayより簡単です(p = 0.7で0.42対0.38)。その場合、両者はほとんどの場合に却下され、これが報告されたままになっています。3個以上の作品のカウントは、曲線が交差するため、すべてのpで3個中3個に対して順序付けることはできません。第二に、判決はノイズが多いです。p = 0.8では、同じ判決が次のウィンドウで繰り返される確率は、Dayで56%、WeekおよびMonthで55%、Quarterで50%です。したがって、レコードは、ランチの横にカウントを出力し(「Day (8/10)」)、レポートは、前のウィンドウでも成立した場合、ランチを安定したものとしてマークすることがあります。p = 0.8では、2つの連続したウィンドウで保たれたDayは、ケースの46%で発生するため、安定性はラベルであり、要件ではありません。第三に、信頼できる人でも逃すことができます。p = 0.95ではQuarterは14%の年で逃され、これは3つの作品に基づくランチの代価です。
図A2、パネルA、は、これらの確率をルールv1.1に対してpの関数としてプロットしています。
E2. カウントとシェアへの感度
論文は、カウントが10から8または12に移動し、シェアが0.8から0.7または0.9に移動する場合、何人の人がランチを変更するかを報告することを約束しました。答えはDay級の6から16個の作品でウィンドウ内を持つ各Day級の10,000個のシミュレートされたログに対して与えられ、真の合格率は0.5から1.0の間で均等に引き出されます。現在の規則(10個、0.8)はそれらの30%にDayを与え、表E2は他の規則の下で判決が変わるシェアを与えます。
表E2。 10個の作品とシェア0.8に対するDay判決が変わるシミュレートされたログのシェア。
| 最小カウント | シェア0.7 | シェア0.8 | シェア0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
注記: ログの母集団はシミュレーションの仮定です。E5の現地調査は、実ログについてこの分析を繰り返します。
どちらかの定数を1ステップ移動すると、約10分の1の判決が変わります。両方を移動すると、最大5分の1に変わります。シェアはカウントより重要です。
E3. ランチの端でのレーターノイズ
2人の評価者が不偏で、その対の80%が1.5の比率以内に下落し、Section 5.8の70%の基準を超え、参照が2つの推定値の幾何平均である場合、真のサイズが7参照時間である作品はDay size 20%の時間でスコアされ、9時間の作品はDay size 23%の時間で不足しています。これがレコードがランチ横に中央値の受け入れサイズを報告する理由です(表3): しきい値のちょうど上の作品に基づいて構築された地平が表示されます。
E4. 参照時間のモデル評価者
4つのファミリー(Anthropic、OpenAI、Google、Moonshot)からの4つの言語モデルは、それぞれ単独で動作し、互いにおよびすべての公開時間に対して盲目で、2026年10月9日に44のタスクの参照時間を推定しました。30は、3つの低リスク領域(小規模ビジネス簿記、小規模内部ウェブツール、法律およびマーケティング文書)の新しい銀行のタスクであり、それぞれに完了の書面による声明と隠れたチェックがあります。14はMETRの時間地平データ(METR、2026d)からのパブリックタスクであり、12分から14.6時間までの測定された人間ベースラインタイムを評価者にその公開識別子のみで与えました。表E3は結果を示しています。
表E3。 4つの盲目モデル評価者の一致と精度。
| 測定 | 30タスクの銀行(完了の声明) | 測定された時間を持つ14タスク(識別子のみ) |
|---|---|---|
| 評価者の6対が1.5の比率以内の推定値 | 62%(対27%から97%) | 35% |
| 級内相関ICC(2,1)、対数時間 | 0.89 | 0.60 |
| 4つのすべての評価者がタスクを同じランチサイズに配置 | 60% | 36% |
| 4つの平均が測定時間の1.5以内 | 測定されていない | 21%(14中3) |
| 4つの平均が測定時間の2以内 | 測定されていない | 43%(14中6) |
注記: モデルレーターはセクション5.1の2人の人間レーターの代わりを務めており、彼らに関する証拠ではありません。
完全な「完了」ステートメントが与えられた場合、モデルはどのタスクがより大きいかについては合意しましたが、レベルについては合意しませんでした。1人のレーターの推定値の銀行全体での幾何平均は5.1時間で、もう1人の推定値は10.4時間でした。このような固定オフセットは除去するのに最も費用がかからないエラーであり、現場研究のレーターが最初に測定された時間のタスクでキャリブレーションを行う理由です。識別子だけが与えられた場合、推定値はほとんど役に立たず、これはタイトルから行われた推定値よりも、測定された手作業の時間を備えた凍結された銀行をサポートしています(セクション5.1)。表3の規則では、1.5を超える不一致がピースを第3のレーターに送信する場合、2人のそのようなレーターは10個のピースのうち約4個を第3に送信します。
図A2。 デスク上のラング規則: ラングを獲得する確率、およびモデルレーターが時間についてどの程度同意しているか。
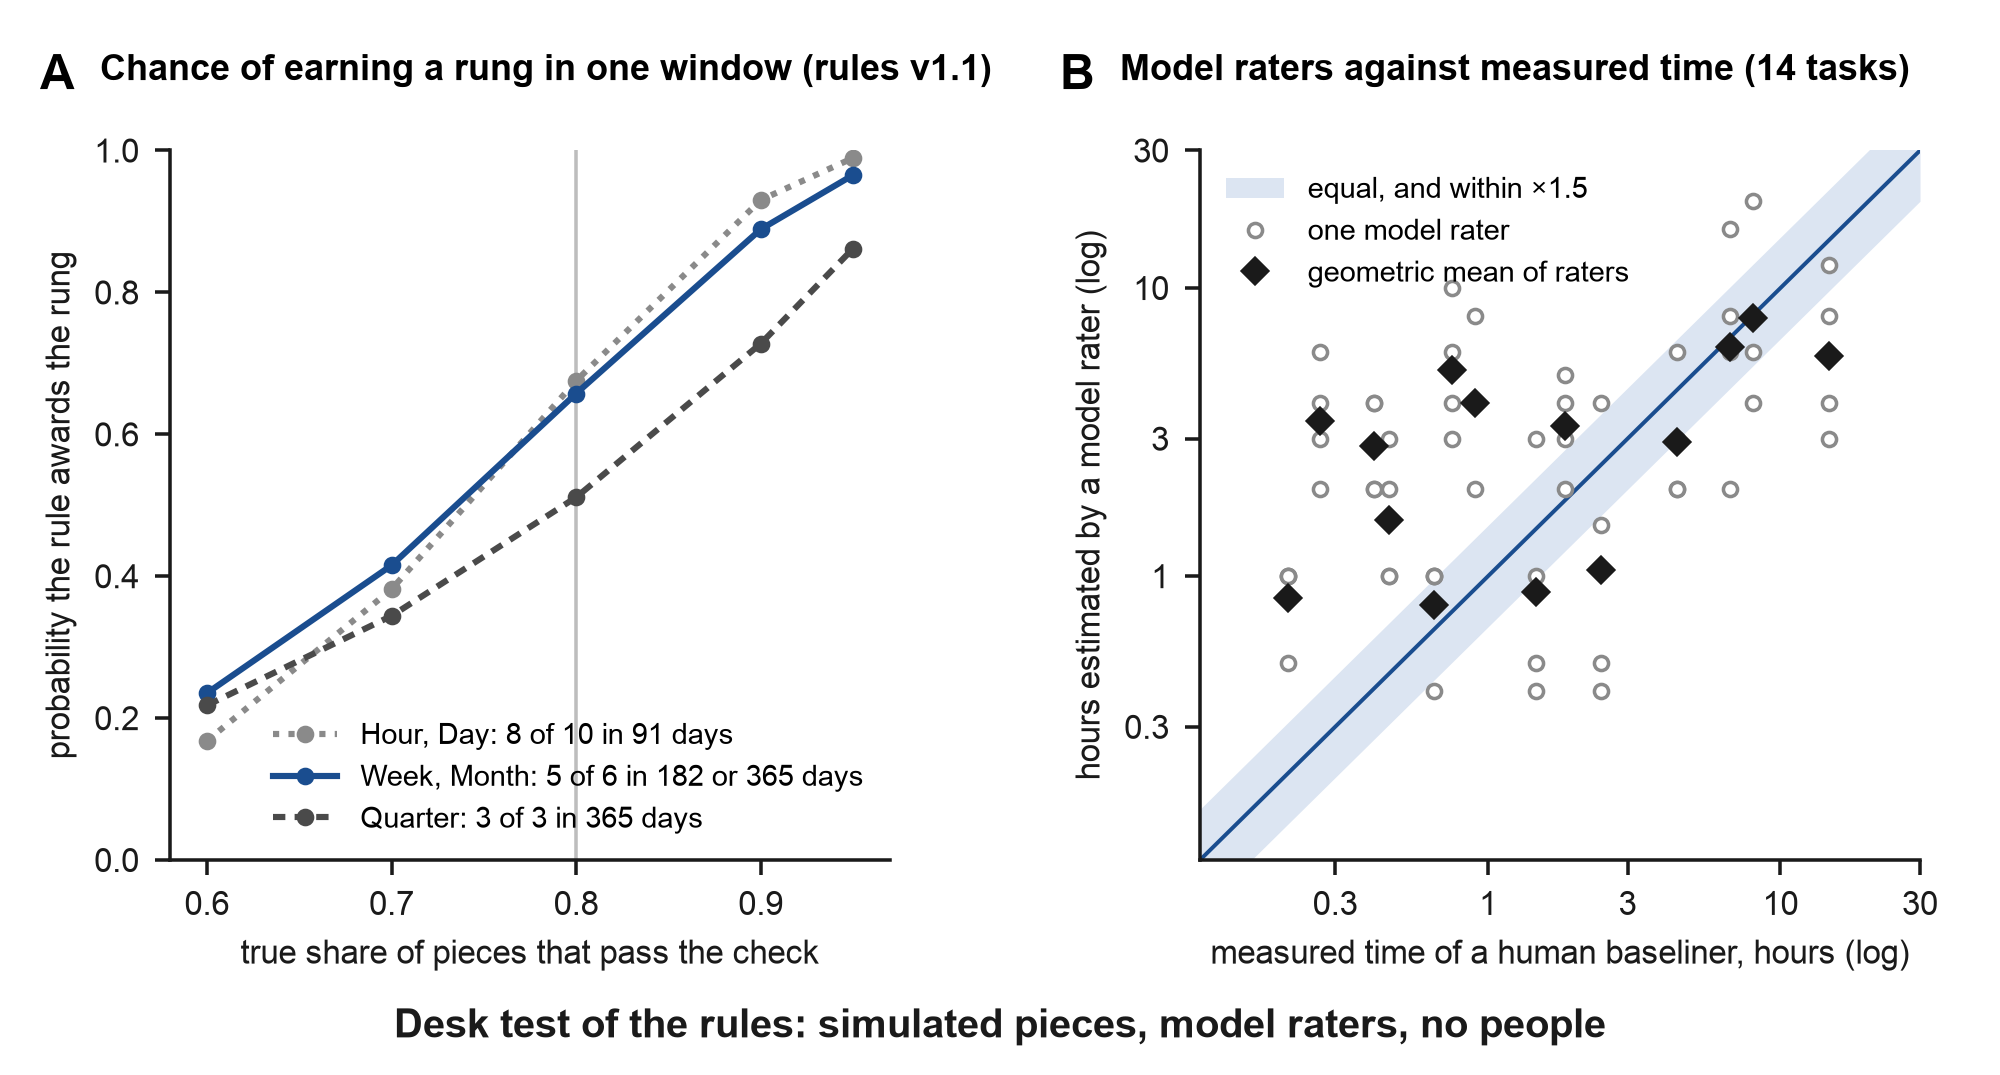
注記: シミュレートされたピースとモデルレーターを使用したデスクテスト。パネルAは、規則v1.1下の各ラングについて、各ピースが水平軸の共有で独立して確認に合格する確率を与えます。同じカウントと同じ数のパスを持つラングは同じ曲線に従います。パネルBは、4つのモデルレーター(それぞれ異なるファミリーの)が、人間のベースライナー(METRのタスクデータ)に対して測定された時間に対して14個のタスクに対して推定した参照時間を設定します。バンドは1.5の係数内での一致をマークしています。両方のパネルを生成したデスクテストはこの付録に記載されており、そのコードと出力はコンパニオンリポジトリにあります。
E5. キャリブレーションプロトコル
プロトコルと登録テキストはコンパニオンリポジトリにあります(pilot/pilot-protocol.md、pilot/preregistration-draft.md)。簡潔に言うと、60人の成人が参加します。30人はソフトウェアの背景を持ち、30人は背景を持たず、銀行の3つのドメインにわたって、91日間の2つのウィンドウにわたってです。すべて同じエージェントツールを使用し、バージョンがログに記録され、チェックは隠されたテストまたは2つのブラインドドメインレビュアーです。手作業の時間は銀行タスクの5分の1で測定され、すべてのハンドオーバーはその開始日でログに記録され、受け入れられたピースのランダムな10分の1が監査されます。基準はデータの前に設定されます: 人間の推定値の少なくとも70%が1.5以内、測定値の1.5以内の定格時間の少なくとも60%、2つのウィンドウ全体のラングの繰り返し可能性で加重カッパが少なくとも0.6、新しいタスクの合格予測でAUCが少なくとも0.7、ログ行の5%未満が失われ、失敗したハンドオーバーの少なくとも95%が記録されています。同意フォームはこの研究のためだけに作成され、他の同意を再利用していません。月と四半期、不可逆的な作業と高リスク領域はこの6ヶ月の現場研究外です。
E6. デスクテストが決定するもの、および次は何か
既知の信頼性を持つ人物のルールがどのように動作するか、それらが矛盾していた場所(1つの矛盾は現在修正されています)、評決が2つの定数にどの程度敏感であるか、およびモデルレーターが一貫してタスクを注文しますが、レベルで不一致であることを示しています。E5のキャリブレーションプロトコルは、デスクテストが人に残すものを取り上げます: ルール下での動作方法、ラングが実際の人物に対して繰り返されるかどうか、および新しい作業を予測するかどうか。人間のレーター間の一致は最初にテストされます(付録G)。したがって、閾値はルールv1.1としてデスク テストされ、キャリブレーション研究は次のバージョンを設定します。
再現するには: python3 pilot/simulate_rules.py および python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9以降、標準ライブラリのみ; シード20261009)。
付録F. 補足表および図
A1、A2などの番号が付いた項目は付録項目です。これらは、各注記に記載されたセクションから引用されています。
表A1. 収束の信号、2025年10月2026年。
| 信号 | 出典および日付 | それが示すもの | それが示さないもの |
|---|---|---|---|
| 開発者の職務が委任と検証として説明されている | GitHub、2025年12月8日 | ベンダーの役割の説明が移行している | 開発者のレベルがその方法で測定されていること |
| コーディングエージェント内の非開発者が137倍(個人)および189倍(組織)に増加 | OpenAI、2026年6月 | 低い基盤からの急速な成長。サンプル調査ユーザーの4分の1が8時間以上と推定されるリクエストを少なくとも1つ作成 | その結果の品質。ベンダーデータ |
| コード生成セッションの検証済み成功において、プログラミング職種の7ポイント以内の10の最大職業 | Anthropic、2026年6月16日 | 職業間の小さなギャップ。テストまたはコミットなどの証拠によって裏付けされた成功。行動によって判断される専門知識 | 教育(職業は学位ではない)。出荷された製品の品質 |
| 弁護士が自分たちのツールを構築している。広範なAIアクセス83%対61% | Bloomberg Law、2026年4月20日 | ドメイン専門家が購入ではなく構築している | それらのツールがどのくらい長く保守されるか |
| 約181,500人のスタッフのためにラダーが改名された | Business InsiderおよびFortune、2026年1月22日 | 雇用主がタイトルを変更している | 新しい測定(内部レベルは保持) |
| 「フロンティアプロフェッショナルズ」:20,000人のAIユーザーのうち3,233人 | Microsoft、2026年5月5日 | 高度なユーザーの調査セグメント | 役割またはグレード |
| 2025年にエージェンティックAIについて言及している16,541の投稿(2024年は151) | Stanford AI Index 2026 | 投稿におけるスキルの需要 | 新しい職業 |
| エントリーレベルの採用が全体より大幅に減少 | LinkedIn Economic Graph、2026年8月 | 2026年半ばのより弱いエントリーレベル | AIがそれを引き起こしたこと(LinkedInは経済を指摘) |
| PhD授与部門の新規CS専攻が13%減少 | CRA Taulbee、2026年6月 | 学生の反応 | 長期的な傾向。すべての機関 |
| 2026年第2四半期のインタビューの4.54%でAI使用について議論(2025年第3四半期は0.33%) | Metaview、2026年 | この質問が採用に入ってきた | 回答のスケール |
注:ベンダーデータはそのようにマークされています。古い比較(2019年または2022年との)はルール(セクション1)により省略されています。
表A2. 2026年10月9日現在、レイヤー別の流通中の名前と提案された名前。パート1:所有者とステータス付きの使用中の名前。パート2:本研究で提案された名前、簡潔な説明、および検討されたバリアント。
| レイヤー | 候補 | 導入者および時期(パート1) | 使用される意味 | 利点 | 欠点 |
|---|---|---|---|---|---|
| パート1 | |||||
| 大衆スキル | ビルダー、フルスタックビルダー | LinkedIn、2025年12月(報告)。「今や皆がビルダーだ」(SF Standard、2026年) | あらゆる機能から構築する誰でも | 既にHRで勝利している | レベルについて何も述べていない |
| 大衆スキル | バイブコーディング、バイブコーダー | Karpathy、2025年2月2日 | コードを読まずに構築する | 広く知られている | 嘲笑。下限を名付ける |
| 大衆スキル | AI流暢性(4つのD) | Anthropic、2025b年 | 委任、説明、識別、勤勉 | 分野をカバーしている | レベルのない能力 |
| 大衆スキル | エージェントリテラシー | MindStudio、2026年6月11日 | 委任、確認、管理 | 意味で密接 | 既に使用されている。証拠の標準がない |
| 専門職 | エージェンティックエンジニア | Karpathy、2026年2月。Alenezi、2026年6月 | エージェントを指揮するエンジニア | エンジニアの2026年の言葉 | エンジニアリングに結びついている |
| 専門職 | エージェントボス | Microsoft、2025年4月23日 | エージェントを管理するすべての従業員 | 記憶に残る | 測定のないスローガン |
| 専門職 | エージェントマネージャー | Arion Research、2026年2月7日。Srinivasan and Wei、Harvard Business Review、2026年2月12日 | チーム内のエージェントを実行する役割 | フロントランナーとして報告される(aicodex、2026年)。著者は12〜18ヶ月以内に標準的なタイトルになると予想 | 水平マネージャーのタイトル(セクション6.3) |
| 専門職 | AIエージェントオーナー。AIエージェントスーパーバイザー | ライター、2026年。Digg議論、2026年 | 展開されたエージェントの責任を負う人 | 所有権を名付ける | 単一ベンダーまたはフォーラムの使用 |
| 専門職 | AIオーケストレーター | St. Lawrence、2024年セミナーおよび2025年書籍。2026年2月に739投稿(IT Brew、2026年) | AIを調整するビジネスプロフェッショナル | 投稿で使用 | 何度も使用されている。水平 |
| 専門職 | AIオペレーター | Dust、2026年10月7日 | 共有エージェントワークフローを構築および保守する | 親しみやすい | コンソールのように聞こえる。Anthropicでは「オペレーター」はAPIの上に構築している企業です(Anthropic、2026b年) |
| 専門職 | AIスチュワード、AI作業アーキテクト | Ono、世界経済フォーラム、2026年6月22日 | 1つはAI作業の境界を設定し、他はその結果をチェック | 意味で最も近い先行例 | 2つの役割、測定がない |
| 専門職 | プロダクトクリエーター | Cagan、SVPG、2025年 | プロダクトをアイデアから市場へ伝える1人の人物 | プロダクト言語 | 既に使用されている。測定がない |
| 専門職 | プロダクトプリンシパル | O'Neill、LinkedIn投稿、2026年 | エージェントの目標を設定し、結果を受け入れて対答する | ほぼこの論文の意味 | その意味で既に使用されている。先例として引用 |
| 専門職 | プリンシパルエージェンティックコンテキストエンジニア | Turkovic、2026年4月24日により収集されたジョブタイトル | エージェント作業の上級グレード | 「プリンシパル」が既にグレードとして使用されていることを示す | 等級であり、職業ではない |
| 職業 | AI Product Builder; Agentic Product Builder | n8n投稿、2026年; State Street投稿、2026年 | 製品構築と検証実践が必須; コーディングが推奨(n8n)または必須(State Street) | 雇用者がコーディング要件において双方向に動いていることを示す | 単一雇用者のタイトル |
| 職業 | Chartered Financial Intelligence Architect | Clark、SSRN、2026年 | 1つの業界に名付けられた職業 | ドメイン固有の名称が発行されていることを示す | 1つの提案、1つの業界 |
| 職業 | principal | Agency理論(Jensen & Meckling、1976年); Claudeの憲法における「principals」(Anthropic、2026b); The Principal Firm(Verheul、2026年); AIエージェントのprincipal-agentフレーミング(Berkeley California Management Review、2025年; Tikhomirov、2026年) | エージェントが行動する当事者であり、チェックコストを負担する者 | その背景にある理論; 「agent」という言葉に対応 | アイデンティティ・アクセス管理における「Agent principal」はエージェント自身のアイデンティティを意味し、逆の意味; またPrincipal Engineerという等級 |
| 指標 | delegation horizon(機械または企業の意味) | Khadj、2026年(初期版は「Delegation Horizon Index」0〜100を含む); Alonso、2026年(仕事の連鎖に対する「a delegation horizon」) | 人間が介入する必要が生じるまで、機械または企業がどこまで委任できるか | この表現が自然であることを示す | 機械または企業であり、個人ではない |
| 指標 | uplift; speedup; autonomy 1 to 5; H1 to H5; supervisory capacity | METR、2025年; Anthropic Economic Index、2025〜2026年; Shao et al.、2025年; em360、2026年 | 平均的な利得、会話レベルのスピードアップ、エージェントの自律性、好ましい人間の関与、努力あたりの有用な出力 | 増幅利得の確立された周辺概念 | 個人の検証済み出力ではなく、タスク、会話またはツールを測定 |
| 時点 | crossing time | AI委任下での学習の幾何学(2026年) | AIへの委任がスキル低下を通じて得るものより多くのコストをかけるようになる時点 | 形式が近い | 逆の意味: 資格証の重みではなく、スキル喪失 |
| パートナー | guarantor | Capps(2025年)の「Legal guarantor」、New York Times Magazine | AIが提供できない責任を提供する | 正確 | 法的な色合い |
| パートナー | finisher; distribution engineer; GTM engineer | 投稿におけるGTM engineer、2026年 | 製品を人々にもたらす | 現在有給 | 部分的に自動化可能(セクション7) |
| 失敗した信号 | tokenmaxxing | プレス用語、2026年(CIO、2026a) | 消費されたトークンでランク付けまたは競争する | 実際の実践に名前を付ける | 職業ではない(セクション4) |
| 古い名称 | citizen developer; end-user software engineering; Code Runner、Adaptor、Writer、Builder | Gartner、2009年までに; Ko et al.、2011年; Feldman & Anderson、2024年 | IT外での構築; エンジニアリング問題に直面するエンドユーザー | 長い系統 | 古い分割の片側に限定 |
| Part 2 | 候補 | 状態 | 意味 | 利点 | 課題 |
| 大衆的スキル | acceptance literacy | ここで提案; 付録Bのベースでの使用は見つからない | 何が完了と見なされるかを事前に述べ、その後それを示す | 中核に名前を付ける | スキルであり、個人ではない; 技術受容研究と区別する必要がある |
| 職業 | agentwright | ここで提案; 付録Bのベースでの使用は見つからない | 劇作家が戯曲を作るように、エージェントを通じて仕事を作る者 | 学術ベースでは自由; 著作権を担う | 検索エンジンはそれを「Agent Wright」に分割する; ブラウザテストツールのように聞こえる; 2026年10月までに部分的に取得されている(Pythonパッケージとエージェントスキルのカタログ)ので、修飾子が必要になる |
| 職業 | domain orchestrator(法務オーケストレーター、fintech オーケストレーター) | 本研究の以前のドラフトで提案 | その領域のためにエージェントシステムを組み立てる深いドメイン知識を持つ人 | その役割を垂直分野に結び付ける(セクション6.3) | 「Multi-domain orchestrator」は5Gおよび6Gネットワーク管理で確立された用語 |
| 職業 | setter-acceptor; agent director | 平易な記述 | タスクを設定して結果を受け入れる | 正確 | 記述であり、名前ではない; 「director」はマネージャーのランク |
| 職業 | Agent-Directed Product Creator; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | 本研究のモデル協議で生成されたバリエーション | エージェント作業の著作権と管理のバリエーション | 選択肢の空間を示す | 長い、または取得された名前に近い(steward、creator、architect) |
| 職業のはしご | Specifier、Verifier、Domain Orchestrator; setter、acceptor、coordinator、loop owner | 本研究の初期段階のはしご | エージェント作業の責任の増加段階 | 読みやすい | 時間単位のランクに置き換えられ、職業間の翻訳が不要 |
| 指標 | verified delegation horizon(また: personal または human delegation horizon) | ここで提案 | 個人がエージェントに委ねる最大の検証済み作業 | Jaquesとmeterに根付いている | Part 1の機械および企業の意味と区別する必要がある |
| 指標 | amplification gain | ここで提案 | 注意の1時間あたりの検証済み作業 | 短いループの構築者にクレジットを与える | 凍結された参照が必要 |
| 時点 | credential crossover point | ここで提案; 付録Bのベースでの使用は見つからない | IT教育を受けていない人々の製品が同じチェック下のプログラマーのものを上回り始める時点、および資格証が重みを失う時点 | 部分的に観察可能(セクション6.2) | 「credential」はエージェントセキュリティにおける秘密鍵も意味する; 最初の使用時に定義する |
| 時点 | Skill Inversion Point; Background Neutrality Point; expertise crossover point; credential decoupling | 検討されたバリエーション | スキル、背景、専門知識または資格から見た同じ時点 | それぞれが1つの部分を強調 | それぞれはセクション6.2のコンポーネントの1つのみをカバー |
| パートナー | co-signer; trust broker; distribution principal | 検討されたバリエーション | 製品に署名または保有するパートナー | シンプル | 保証人または仕上げ人よりも狭い |
| 失敗したシグナル | トークンシニオリティ(ランクとしてのトークン) | 2026年エピソードに使用される用語 | 消費されたトークンで人々をランキング | 実在するイベントに名前を付けている | 職業ではない(セクション4) |
注記:ステータスは2026年10月8日および9日のウェブおよびデータベース検索を反映しています(付録B)。「使用例が見つかりません」とは、それらの日付にそこにリストされているベースを指し、検索されなかったベースについては何も主張していません。パート2のバリアントは研究独自のドラフトから来たもので、オプションのファミリーが見える状態に保つためにリストされています。
表A3。2025年および2026年のスケールと各スケールが測定するもの(完全なリスト)。
| スケール | 出典 | 測定される単位 | 検証済みの委譲された仕事で人を測定しますか? |
|---|---|---|---|
| AIエージェントの自律性のレベル(オペレーターから観察者まで) | Feng et al., 2025 | エージェント | いいえ |
| オートコンプリートからソフトウェアファクトリーまでの5つのレベル | Shapiro, 2026年1月 | マシンまたはチームのセットアップ | いいえ |
| AI支援開発の8つのステージ | Yegge, 2026 | プログラマーの実践、エージェント数別 | いいえ |
| カパビリティラダー(トリガーからエージェントチームまで) | Memari & Rudolph, 2026 | 仕事のオートメーション | いいえ |
| コーディングエージェントの監督の7つのステージ | Park et al., 2026 | 監督仕事のステージ | いいえ |
| 開発における委譲の5つのレベル(AIDEs) | JetBrains Research(Tikhomirov)、2026年9月 | 開発者の委譲、プリンシパル・エージェント関係として枠付けされた | 開発者のみ。検証ルールなし |
| 意思決定におけるAI委譲のレベル | Dawson, 2026; Metal Toad, 2026 | 組織またはマネージャーの委譲 | いいえ |
| インテリジェントなAI委譲 | Tomašev et al.(DeepMind)、2026年2月 | 一般的な委譲 | 人レベルの測定なし |
| 委譲フロンティア(初期版:委譲地平指数、0~100) | Khadj, 2026 | 企業またはエージェントの委譲 | いいえ(マシンと企業) |
| 著者、編集者、ディレクター、オーケストレーター | Microsoft、2026年5月 | 仕事パターン | いいえ |
| AI コンピテンシーフレームワーク(8つの領域、4つのレベル) | AI認定基準、2026年8月23日 | 職業全体の能力 | 試験またはしきい値なし |
| AI Fluency(4つのD) | Anthropic, 2025b | リテラシー | レベルなし |
| マシンタイムホライズン | METR, 2025-2026 | モデル | いいえ(マシンのみ) |
| 検証済み委譲地平とアンプリフィケーション利益 | 本論文 | 領域内の人物 | はい、セクション5.2のルールによります |
注記:「検証済み委譲仕事で人を測定する」とは、スケールが個人をエージェントに引き渡された仕事の規模に従ってレベルを配置し、エージェントが見ることができなかったチェックによって確認されることを意味します。JetBrainsのレベルは開発者がどの程度委譲するかに関するもので、既にプリンシパルとエージェントの言語を使用しています。これらは最も近い隣人であり、チェックの独立性ルールとサイズの単位が不足しています。
表A4。困難なケースとルールがそれらをどのように扱うか。
| ケース | 処置 |
|---|---|
| その人が手作業では決してできなかった仕事 | 参考時間は依然として有資格スペシャリストから来ます。その人自身のスキルは含まれません |
| 品質が数か月後にのみ明らかになる仕事 | 暫定的に受け入れられました。遅延した結果は到着時に記録され、その部分を取り消すことができます |
| 近くに有資格の人間レビュアーがいない領域 | 隠しテストまたは意図されたユーザーによる実際の使用。別のファミリーのモデルは、その人が開いたソースとのみ使用できます |
| 同じモデルファミリーのブラインドクリティック、新しいコンテキストで | 独立したチェックではありません:same_familyとして記録されます(付録C)。クレジットは得られません。ただし、独立したチェック前に仕事を改善する可能性があります(セクション6.5) |
| 仕事を一緒に受け入れるチーム | 各人が自分の注意をログします。その部分は受け入れに署名した人についてカウントされます |
| チェックに合格したが後で間違っていることが判明した部分 | 次の再検証で失敗として記録され、ランジが再スコア付けされます |
| 不可逆的な仕事が通常の仕事と混在している | より厳しいルールが不可逆的な部分のみに適用されます(セクション5.2) |
表A5。開発者のスレッドのトピックと他の職業の対応物、2025-2026年(例示的なケース)。
| スレッドのトピック | ソフトウェア外での対応物 | 出典 | 乗り越えられましたか? |
|---|---|---|---|
| 悪い出力の責任は誰にあるのか、モデルか、タスクを設定した人か | 「仕事スロップ」:受信者に仕事をシフトさせるAI出力。インシデントあたり約2時間、月あたり従業員1人あたり186ドル。同僚はその送信者をより無能だと判断します | The Decoder(2025年); BetterUp(2026年) | はい、強く |
| チェックのコスト(レビューに月150ドル) | 同じ仕事スロップコスト | The Decoder(2025年) | はい |
| 強力なモデルが計画して確認し、安いモデルが仕事をします | Atlassianの役割別に割り当てられたAIバジェット | HCA Magazine(2026年) | 企業では |
| 過負荷、ツールの絶え間ない変更、見逃すことへの恐怖 | マーケターの25~26%、HR 19%、ソフトウェア 17% が報告した「AI脳疲労」 | Search Engine Journal(2026年) | はい、IT外ではより強く |
| 購入したソフトウェアの代わりに独自のツール | エージェントを使用してツールを構築する弁護士。調査対象企業の35%が購入したソフトウェアの一部を独自のもので置き換えています(ベンダーのサンプル) | Artificial Lawyer(2026年); Bloomberg Law(2026年); Retool(2026年) | トップレイヤーで |
| エージェントの比較 | 2つのコーディングエージェントを比較する簿記係 | Growthy(2026年) | はい |
| プログラマーなしでエージェントに会社を移動させる | エージェントを使用して構築し、ベンダーに代わる弁護士と企業 | Bloomberg Law (2026); Artificial Lawyer (2026) | 部分的に見られます。コンサルティング事業自体はスレッドにのみ見られます |
| 月額1,000ドル以上のパーソナルAI料金をステータスシンボルとして | ステータスの対応物は見つかりません。最も近いものは企業の上限と手当です(Uberの月額1,500ドルの上限、AtlassianのAIウォレット) | Fortune (2026b); HCA Magazine (2026); 2026年10月9日の検索 | ステータスとしてはいいえ。予算項目としてははい |
| あるエージェントのキャンプに属すること | 対応物は見つかりません | 2026年10月9日の検索 | いいえ。また必要ありません |
注:スレッドはトピックのために選ばれた定性的証拠であり、母集団を表していません。「越えた」は、2026年10月9日に記載されたソースで対応物が見つかったかどうかを記録しています。
Figure A3. 段のスケールでの機械の地平線。
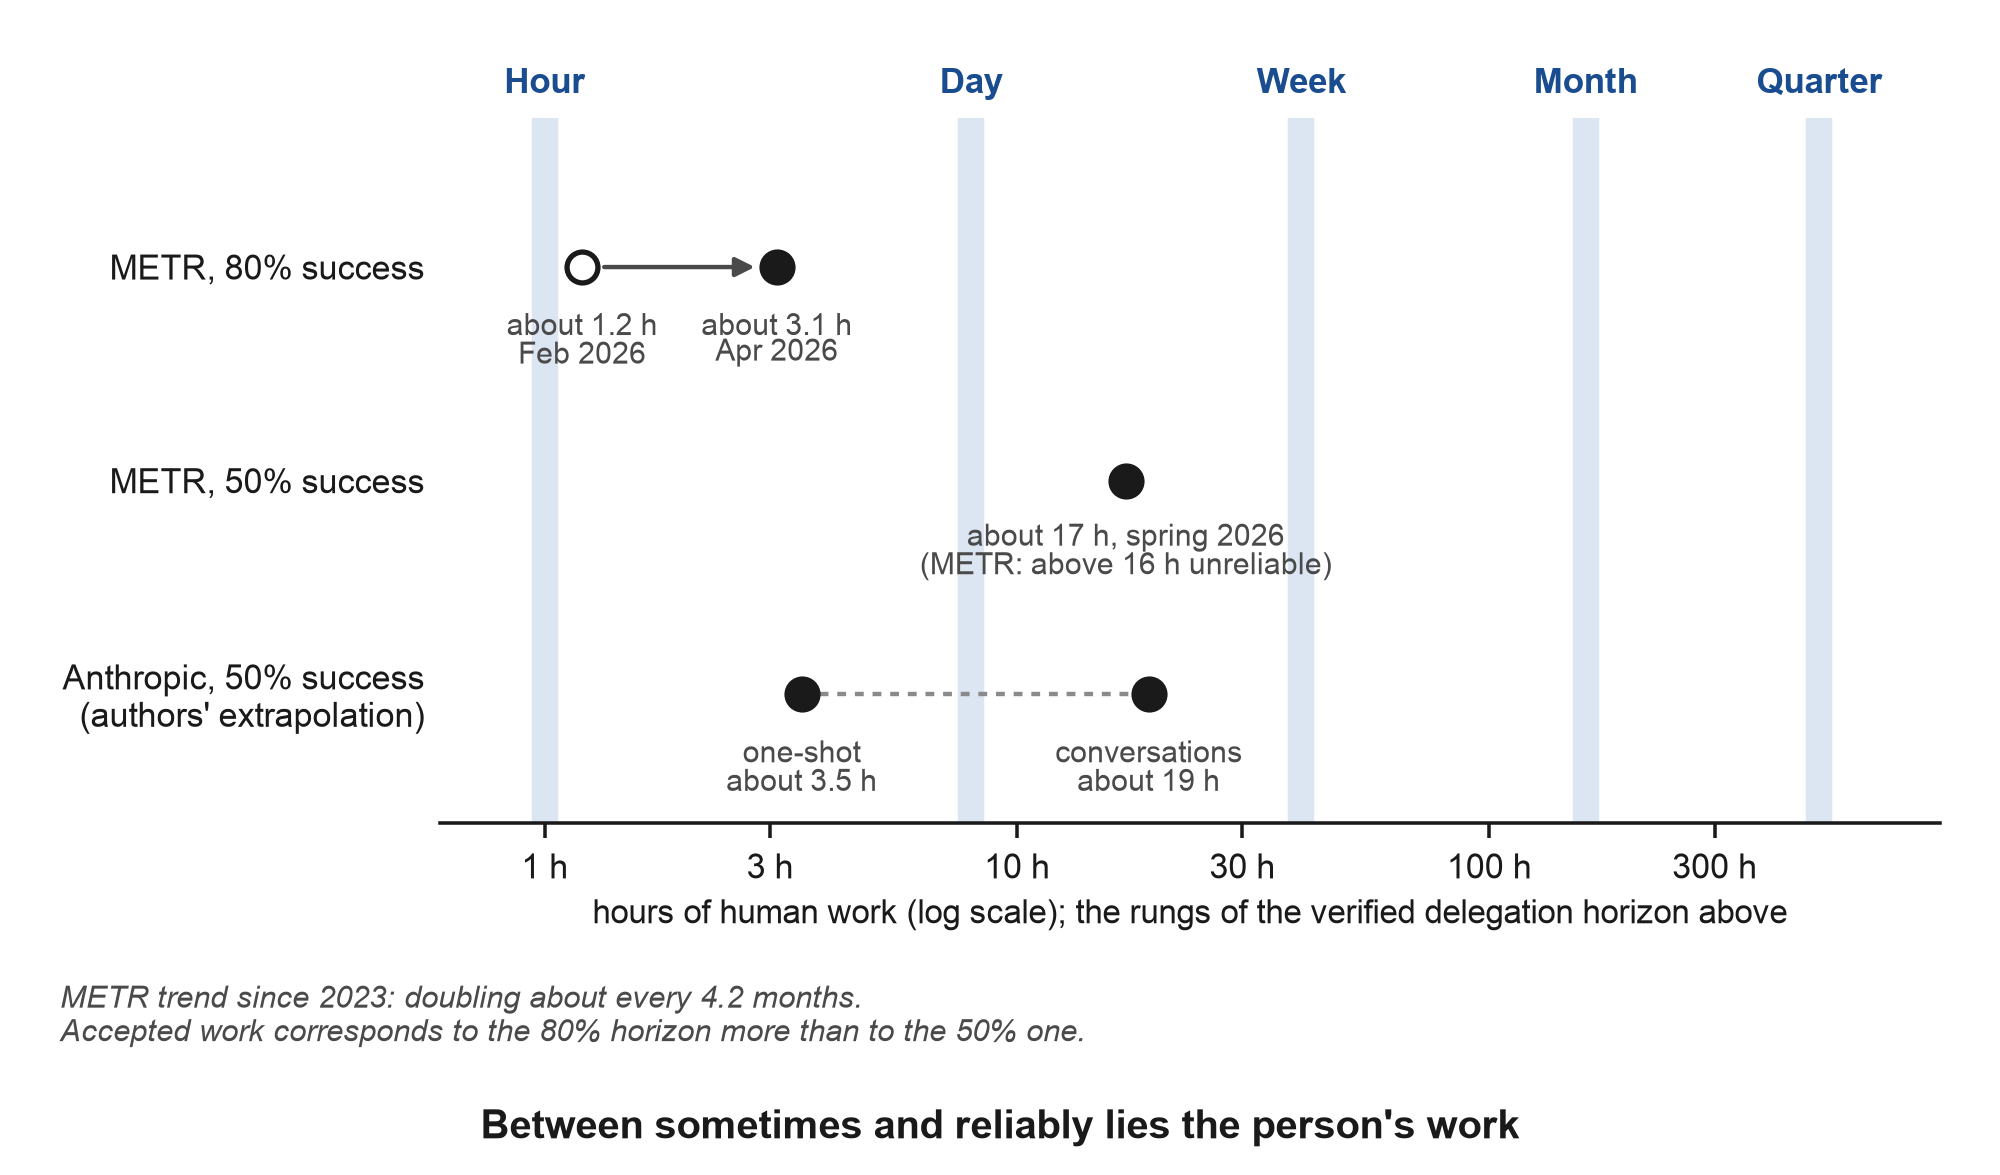
注:METRの時間地平線は80%の成功で、2026年2月は約1.2時間、2026年4月は約3.1時間です。50%の成功では、2026年春は約17時間です。METR自体は16時間以上を信頼できないと呼んでいます(METR, 2026c)。Anthropicの50%ポイントは、ワンショットリクエストで約3.5時間、会話で約19時間です。これは著者の外挿です(Anthropic, 2026a)。機械の地平線はモデルを測定し、人々ではありません。網掛けの列は、セクション5.3の段のみがセクション5.6の同じ時間軸に落ちる場所を示しています。
Figure A4. セクション6.5の検査プロセス:各ステップが何に相当するか、ルールの下で何を獲得するか、どこで停止するか。
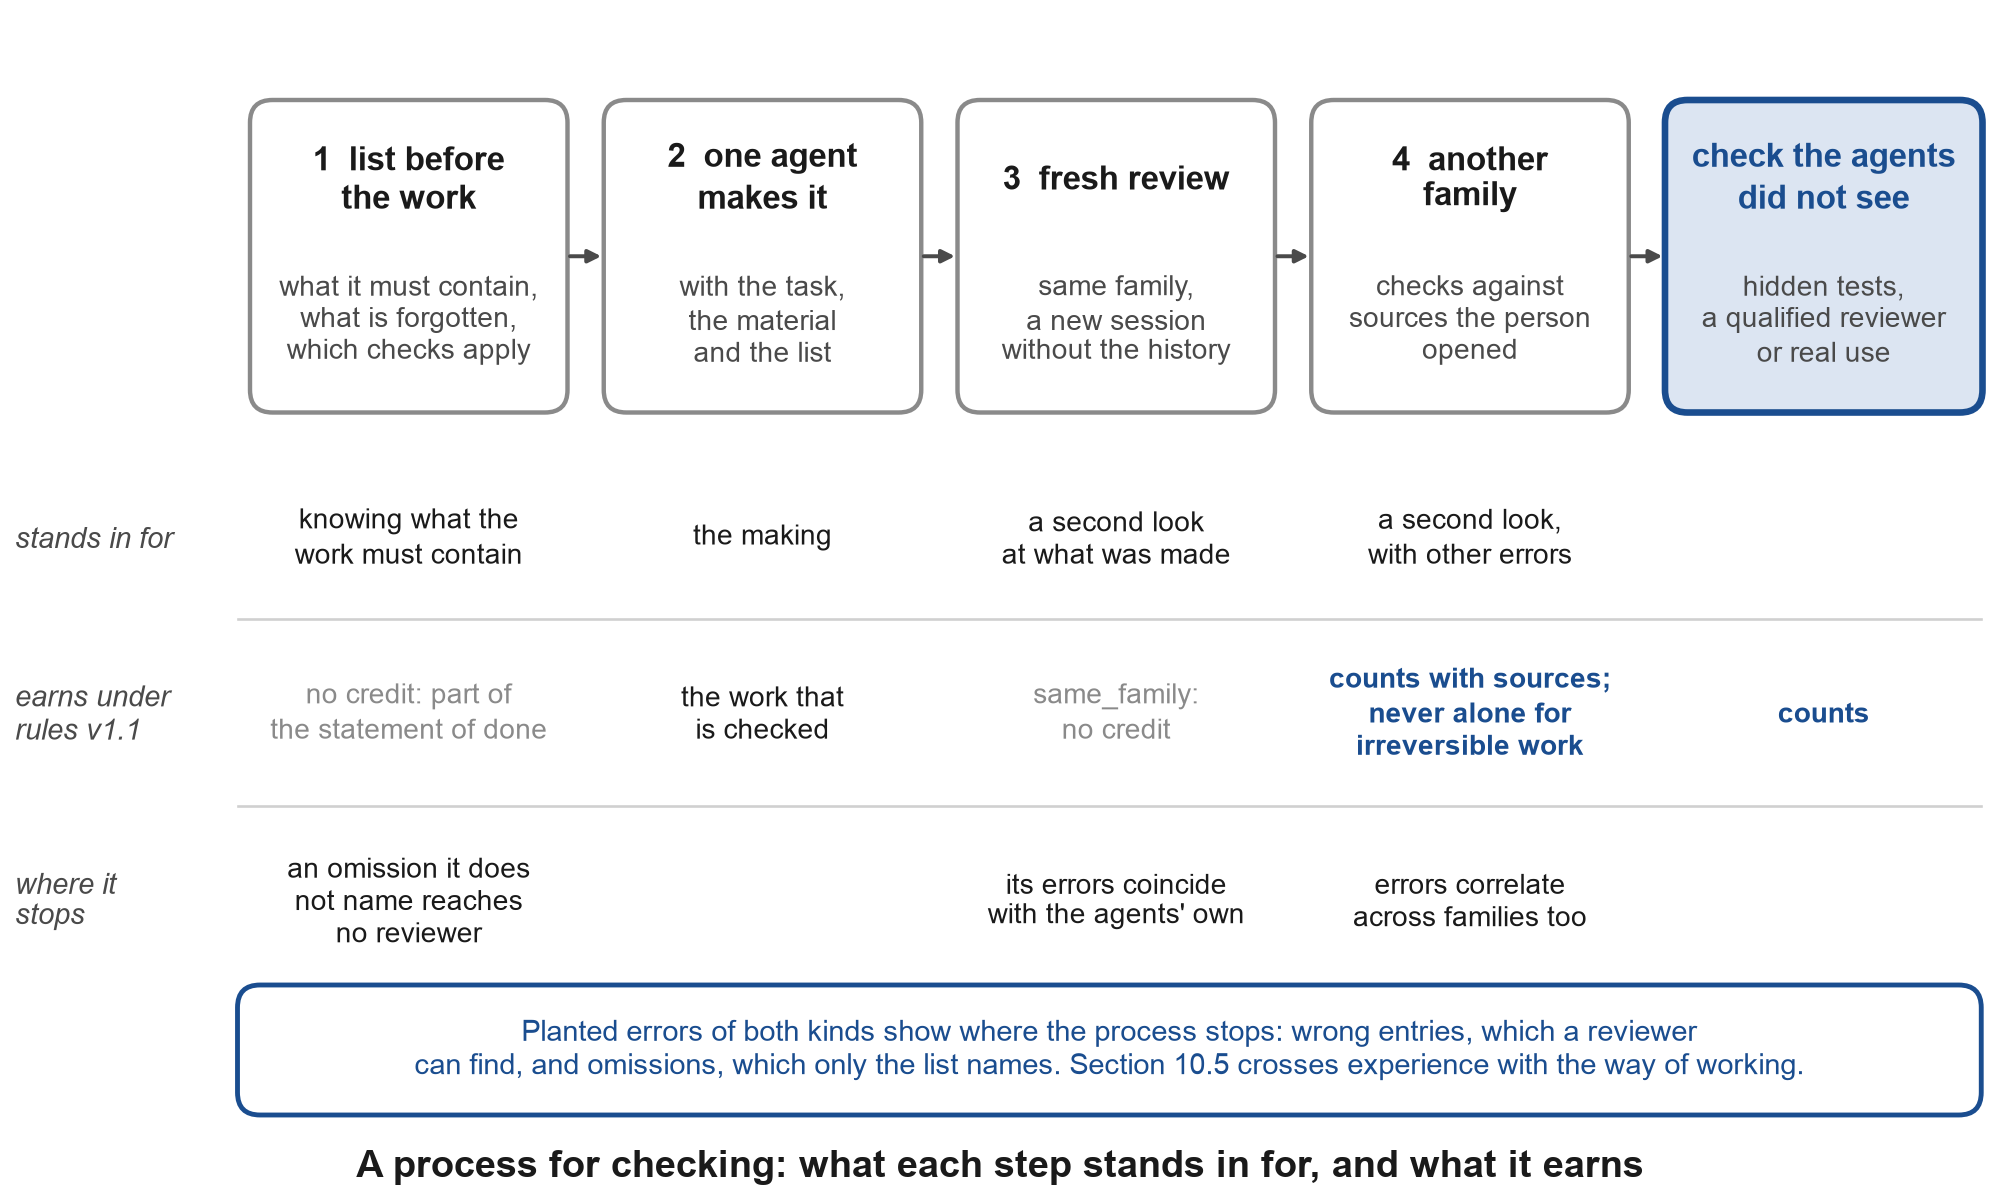
注:4つのステップと各ステップが何に相当するかはセクション6.5のものです。クレジットの行はセクション5.2およびTable A4のスコアリングルールに従っています。同じファミリーのモデルによる新しいコンテキストでのレビューはsame_familyとして記録され、クレジットを獲得しません。ただし、作業を改善する可能性があります。別のファミリーのモデルは、その人が開いたソースに対してチェックする場合のみカウントされ、不可逆的な作業に対して単独でカウントされることはありません。最後の行はFu et al. (2025)の省略とKim et al. (2025)のモデル全体で相関するエラーをまとめています。プロセスをテストする登録予測はありません。セクション10.5は比較を設定しています。図は、コンパニオンリポジトリのfigures/figure_a4_checking_process.pyによって描画されています。これはhorizon.pyから各種類のチェックのクレジットを読みます。各ステップは職業経験の一部を表しています。セクション14はこれをイコライザーのはしごとして返します。
Table A7. 本論文の主張の状態。
| 要素 | どのように保持されているか | 根拠 |
|---|---|---|
| プログラマーおよび他者は現在、委譲および受け入れのタスクとワークフローを共有しています | データはタスクとワークフローのレベルで支持しています。職業全体としては統合されていません | セクション2。2025-2026年のベンダーログと調査 |
| 2つの古いはしごはその作業を測定しません | 観察されました | 新しい測定なしに名前が変更されたはしご(Deloitte)。AIの使用に関する質問がスケールなしにインタビューに入ります |
| トークン数は上級職の測定として失敗します | 初期のケースで観察されました | 2026年の報道(セクション4):Metaの従業員の非公式ランキングは削除されました。およびMetaの後の公式トークン数に対するガイダンス。Amazonのリーダーボードはゲーム化され削除されました。Uberの予算は4か月で費やされました。これは予算イベントです |
| 委譲地平線と増幅ゲインを確認しました | 提案されました。ルールv1.1はデスクテストされました。コンパニオンリポジトリのキャリブレーションプロトコル。登録テストの下での参考時間に関する専門家の合意 | 定義とルール(セクション5)。楽器(付録C)。閾値のデスクテスト(付録E) |
| チェッキングのシェアで設定されたゲインの上限 | モデルとして提供されます。GDPval平均値によって示される | セクション5.5 |
| 背景の中立性 | 仮説。登録されるテスト(F7) | Anthropic (2026e)はそれを指しています。Savva (2026)はライバルです |
| 認定情報の交差点 | 仮説。コンポーネントは別々に日付けられています(パリティF2、追い越しF3、投稿F5、中立性F7) | Lightcast (2026b)は収束する行を示しています。Bone et al. (2025)はAIロールに対してそれに先行します |
| 自己報告ラベルリークで入場を認める門。作業をチェックする門は保持します | モデルとして提供されます。リークは1回、レーター研究のスクリーニングによって示されます | セクション6.2および13。付録G2。Danilova et al. (2021)。Reid et al. (2022)。Serafini et al. (2024, 2026)。Oregon State Board of Bar Examiners (2026) |
| ソフトウェアは最後に交差します | 予測(F6)。表A6の40その他。OSFに登録済み | ドメイン引数(セクション6.3) |
| チェックプロセスは職業の経験の一部に相当することができます | 仮説。登録されていません。プロセスをテストする登録予測はありません。F3b (p = 0.10)は間接的にのみ関連しています。比較はセクション10.5で設定されています | セクション6.5。Dell'Acqua et al. (2026)、McAleese et al. (2024)、Eulerich et al. (2024)、Fox et al. (2026)およびBenchek et al. (2026)一方。Kim et al. (2025)、Chernets (2026b)、Fu et al. (2025)およびVirk and Liu (2025)その他 |
| 第二の境界としての信頼。保証人としてのパートナー職業 | モデルとして提供されます。予測F11およびF12 | セクション7 |
| エージェントを通して作業している非プログラマー | 実行中のコーホートで観察されました。推論なしに記述されました。登録結果は別々に報告されます | セクション11.5。付録G |
Table A8. ラベルで入場を認める門と作業をチェックする門:各がチェックするもの、および観察されたもの。
| ゲート | 何に基づいて入場を認めるか | 観察されたもの | ソース |
|---|---|---|---|
| 研究プラットフォームの参加者フィルタ | ほとんどの答えはその人自身の言葉に基づいて与えられています。年齢と居住国が確認されました | 職業訓練サンプルに入場した60人のうち、11人が取引の初週の問題に誤って答え、そのうち8人は借方と貸方を反転させることによって誤答した | Prolific (2026); Appendix G2 |
| クラウドワークプラットフォームで述べられたプログラミングスキル | 本人の申告 | 42%が研究者の知識問題の基準を満たさなかった | Danilova et al. (2021) |
| Prolificsで報告されたNode.jsでのプログラミング | 本人の申告 | 206人のうち55人がプログラミング問題のすべてに合格した | Reid et al. (2022) |
| テキストまたは画像での静的知識問題 | チャットモデルが提供できる回答 | ChatGPTはプログラマー向けの既存スクリーニング問題を容易に解き、2026年までに抵抗するために設計された静的な視覚問題を突破した | Serafini et al. (2024, 2026) |
| 厳密な時間制限の下でステップバイステップで明かされたオーディオ問題 | 時間的プレッシャー下で与えられた回答 | 2026年でもチャットモデルに対して有効であった | Serafini et al. (2026) |
| ポリシーから削除された学位要件 | 紙から削除されたラベル | 700人に1人未満の採用が変わった。2025年11月の米国のIndeedの求人のうち19.3%が学士号以上を要求しており、1年前より増加した | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| 一度合格した試験による免許 | 一度チェックされた知識 | それ以降ラベルとして機能する | Section 6.2 |
| 免許を持つ監査事務所の署名済み作業の検査 | 署名済み作業、繰り返し再度チェックされたもの | 100人以上の発行体を定期的に監査する事務所については毎年、その他については少なくとも3年ごとに1回 | Sarbanes-Oxley Act of 2002, s. 104 |
| 監督される作業のポートフォリオによる免許 | チェックされた作業、一度;法律学位はまだ必須である | 2026年1月5日までに205人の候補者が申請し、49人がライセンスを取得され、最初は2024年12月であった | Oregon State Board of Bar Examiners (2026) |
| 検証された委譲の地平 | エージェントが見なかったチェックに合格した提供された作業、四半期ごとに確認済み | その後ろにカウントされたランクとチェックの種類、ログに保存された失敗 | Sections 5.2 and 5.3 |
注:行はセクション6.2が引用するケースである。異なる集団から来ており、異なる質問に関するもので、各ゲートがチェックするもののために並べられている。比較のためではなく、レートの比較ではない。第1種のゲートの前に第2種のゲートを追加できる:コンパニオンリポジトリのリファレンスアワーのレーターは职业の1つの質問で認められている(kits/reference-hours-raters.md)、付録G2のレーター研究がそのレーターをスクリーンしたため。kits/trade-screen.mdはそのような質問を書く方法とそれを報告する方法を説明しており、tools/gate_leak.pyはラベルが通す共有を与える、正確な区間で。
附録G. すでに実行している人々:プログラマーではないコホートとProlificレーター研究
この附録は測定の補足であり、その論証の一部ではありません。セクション6.2、6.5および14はG2のスクリーニング結果を例示として引用しています。2026年9月から10月にチャットからエージェント操作に移行した非プログラマーの事例(G1)、および参加者がタスクバンクの参照時間を評価した登録レーター研究(G2)という、人々からの2つの記録を追加します。
G1. チャットからエージェントに移行した非プログラマー
2026年9月6日から、プログラミングの背景がない成人を、普通のメッセージングを通じて段階的にチャットアシスタントから自分のコンピューター上にインストールされ、自分のコンシューマーサブスクリプションから支払われるコーディングエージェントへ、そして複数のモデルとの作業へと導きました。彼らは12以上の職業から来ており、簿記と事務、法律、マーケティングと営業、デザイン、写真とレタッチ、翻訳と編集、音楽、建設、運輸と物流、不動産、ケアワーク、公共管理と非営利コミュニティワークが含まれます。4人は過去または現在のソフトウェア関連の仕事を報告しました。以下の事例は記述的なものです:人々が何をしたか、2026年10月9日までに何が彼らを止めたかを報告し、この論文の主張をテストしたり、比率を計算したりしません。
表G1. 2026年10月9日までにコホートがどこまで進んだか(人数)。
| ステップ | 人数 |
|---|---|
| 記録に含まれる:同意して入力アンケートを提出 | 119 |
| 自分のコンピューターとサブスクリプションにエージェントをインストールして作業を開始 | 35 |
| 成果物を作成した、または自分の作業で少なくとも1つのステップを完了 | 24 |
| 中止した、理由あり | 23 |
| そのうち:自分のコンピューターがない(電話のみ、またはエージェントを実行できないデバイス) | 9 |
| そのうち:サブスクリプションのコスト | 5 |
| そのうち:辞退(持っているものが十分、関心がない、または初心者フレーミングが合わない) | 6 |
| そのうち:健康、家族、または時間 | 2 |
| そのうち:サービスが住んでいる場所で利用できない | 1 |
注:参加者記録および測定の最新サマリーから手作業で計数、各人が記録された最新のイベントを使用。第2行の35人が表G1bの35行であり、第3行の24人がその最初の24行です。成果物は、人がそれを表示したか、エージェントが生成したものを説明したときにカウントされます。後に中止した1人(P60)は両方の行でカウントされます。残りの62人は、その日までにインストールステップを報告なしで受け取ったか、またはまだそれに達していませんでした。
表G1a. 地域と居住国全体のコホート、および2026年10月9日までにそれぞれ何人がエージェントに移行したか。
| 地域と国 | コホート内 | エージェントに移行 |
|---|---|---|
| 北米 | 37 | 10 |
| アメリカ合衆国 | 35 | 10 |
| カナダ | 2 | 0 |
| 西ヨーロッパ | 20 | 7 |
| ドイツ | 12 | 5 |
| アイルランド | 3 | 1 |
| スペイン | 2 | 1 |
| イギリス | 1 | 0 |
| オーストリア | 1 | 0 |
| スイス | 1 | 0 |
| 中央・東ヨーロッパ、名前の付いた国 | 9 | 1 |
| ポーランド | 3 | 0 |
| モルドバ | 2 | 0 |
| ラトビア | 2 | 0 |
| エストニア | 1 | 0 |
| ルーマニア | 1 | 1 |
| 国を開示していない | 53 | 17 |
| 合計 | 119 | 35 |
注:参加者記録の国列から。「国を開示していない」は、研究のプライバシールールの下で国が保留されている参加者と、国を提供しなかった参加者をグループ化しています。
人々がエージェントで何をしたか。表G1bは、2026年10月9日までにチャットアシスタントからエージェント操作に移行していた全員をリストアップし、1行ずつ:彼らが与えたタスクと生成された内容。成果物を作成したか、自分の作業でステップを完了した人々が最初に来て、どこまで進んだかでおおよそ順序付けられています。エージェントをインストールして開始したが、まだ報告された結果がない人々が続きます。職業は記録に示されている通り、中立的な表現で与えられています。短い引用符は参加者自身の言葉です。「(翻訳)」でマークされたものは別の言語で書かれており、私の逐語訳で示されています。
表G1b. これまでに移行した全員(35人、2026年10月9日現在)。
| # | 参加者 | 職業 | 国または地域 | エージェントで何をしたか | 本人の言葉で |
|---|---|---|---|---|---|
| 1 | P20 | 画像処理、レタッチ、写真 | 開示していない | エージェントは彼の目標について尋ね、フォルダとファイルとして月計画を作成しました(トピック別の週、参照ファイル、トラッカー)。その後、ブラウザ自体を操作して9つのAIサービスで彼を登録し、1つの拒否をその進行ファイルに記録しました。彼は11のウェブAIを通じて1つの質問を実行し、結果と制限をファイルに書きました。自分のストック写真では1つのコマンドでメタデータCSVを作成し、それをチェックしました | - |
| 2 | P73 | コンタクトレンズ販売事業 | アイルランド | 別のベンダーから2番目のエージェントをインストール。両方とも彼女の自分のソーシャルメディア計画のコピーを読み、彼女は両者が異なっている点のページを保管しました。各エージェントのルールファイルを作成し、リードミーと作業ログで夕方を終えました | 「トレーニングを続けることができます。」 |
| 3 | P48 | 事務作業とオンライン販売 | 未公開 | 毎週書く文書をテンプレートとチェックリスト付きに変え、次の文書をそれから速く書きました。2番目の労働者が彼女の下書きを盲目的に読みます。2つのAIが全ケースフォルダを読み、3つの最も高額な調査結果を自分で決めました | 「どのAIが優れているかという質問は不正確に定式化されています。」 |
| 4 | P44 | マーケティング、販売、コンサルティング | 未公開 | エージェントタスク(「プロジェクトステータス」、「新規アイテムのインベントリ」、「ドキュメント要約」、「ファイルへのメモ」)を実行するデスクトップボタンを作りました。別のサブスクリプションに2番目のエージェントをインストールし、1つのタスクの共同レビューを実行しました。要約ファイルと2つの完全なレビューです | - |
| 5 | P21 | 非営利コミュニティ組織 | ドイツ | 進捗追跡を備えたスキルと習慣の対話的な1ヶ月間プログラムを構築しました。エージェントがカタログから開始方向を選択し、4週間のプランを作成しました。その後、3つのエージェントセッションを並列で実行しました。数分でのプレゼンテーション、およびリストを監視して一致をメッセンジャーに送信するボット | 「インターネットを検索するか、有料サブスクリプションで妥協するのではなく、あなたの特定のニーズに合わせたツール。」 |
| 6 | P05 | ディレクターのアシスタント、元プログラマー | 米国 | エージェントは彼女のマシンに5つのファイルを作成しました。概要とテーマ別の4週間プランです。後で、Webメッセージングページを通じて76の連絡先のリストに招待を送信し、自分の番号への試験メッセージの後、自動的にクリックしました | 「今後、異なる日常業務を彼らの間で分割し、本当に結果を比較します。」 |
| 7 | P01 | インテリアデザイナーとドラフター、トレーニング中 | スペイン | エージェントに求人ファイルを2回のパスで作成させました。2番目はより広いです。別のチャットボットから2つのレポートと比較しました。同意と相違点は分けて設定されています。彼自身のファイルの正直な読みから彼のCVとポートフォリオを書き直し、彼の専門プロフィールを修正しました | 「それがそれほど深く掘り下げることができ、興味深いが一般的に分離されたデータを作成して分析することができるとき。」 |
| 8 | P18 | インターネットマーケティング | 未公開 | エージェントは彼女のデスクトップを整理しました。ドキュメントを作成し、フォルダに分類し、エラーを見つけて修正しました。後で、彼女自身のトピックに関する電子メールニュースアラートを設定しました | 「私はこのようなことについて聞いていましたが、それが実際に動作しているのを見て、私は本当に確信しました。」 |
| 9 | P19 | 公共管理官 | 未公開 | 彼自身の長い複数冊のテキスト版を1日でプルーフリードしました。1週間で2つの大型プロジェクトを完了しました。現在、翻訳ワークフロー用のプラグインコレクションを構築しています | 「たった1週間で2つの大きなプロジェクトを完了しました...すごい。」 |
| 10 | P35 | 契約、請求書、税関書類 | 米国 | 最初のタスクを音声で行いました。エージェントが彼女のコンピュータのキャッシュをクリアし、アプリを閉じ、予約サイトで予約スロットを見つけました。それ自体を開きます。印刷オンデマンド方向を提案しました。入札書類を支援します。現在ターミナルで実行しています | 「はい、それは機能しました。私たちはそれをしました。」 |
| 11 | P72 | AIで作られた株画像とビデオ | ルーマニア | オーケストレーションツールで多くのAIを通じて1つのタスクを実行し、音声入力を設定し、カタログからフリーランス方向を選択しました | - |
| 12 | P41 | 歯科助手、育児休暇中 | 米国 | エージェントはスケジュール、計画、草案を作成しました。彼女のマシン上で6つのインストーラーのコピーと5つのオフィススイートのコピーを見つけ、余分なものを削除しました。彼女はコミュニティクラスのレッスンを決定し、エージェントはそれをタイプし、参照とリンクを追加し、翻訳して保存し、彼女の言葉で修正しました | 「私は喜んでいます。」 |
| 13 | P24 | 音楽家と詩人 | ドイツ | 1つの画像タスクを11のAIに送信し、結果をギャラリーページ付きのフォルダに保存しました。エージェントに音楽配置の骨格を構築させ、それは彼を失望させました | 「著作権の倫理的側面は私にとって未解決のままです。」 |
| 14 | P102 | ソフトウェア企業を管理 | 未公開 | 到着時に既にエージェントで毎日作業していました。1つの質問を11のAI(10が回答)で実行し、実行ファイルを送信しました。現在、収益カタログを通じて作業しています | - |
| 15 | P40 | 研究エンジニアとWebデベロッパー | 未公開 | 意図的な初心者としてパスを歩きました。ダウンロードフォルダの約100個の緩いファイルをフォルダに分類し、前後のスクリーンショット付き。コース資料に2つの修正を返しました | - |
| 16 | P75 | リモート技術サポート | 未公開 | エージェントは彼のデスクトップにフォルダを作成しました。季節音楽ビデオチャネルの立ち上げプラン(名前、トラックアイデア、タイトル、投稿スケジュール)。ターミナルステップ完了 | - |
| 17 | P60 | ホームケアギビング | 米国 | エージェントからの質問を数個の後、1ヶ月のプランをファイルに分割(寄付者、財務、手紙テンプレート)。後で、初心者フレーミングが基本的すぎることを見つけて去りました | - |
| 18 | P64 | 制服公務員、ロジスティクスおよび供給 | 未公開 | エージェントで月間計画を立てました。これはコンピュータ上にファイルを作成しました。10のAIサービスに登録しました | 「AIは人に適応します。ある意味で、それはお世辞です。」 |
| 19 | P28 | 制服公務員 | 未公開 | エージェントは彼の現在の投稿からのキャリアパスを設定し、彼がそれを断ったとき、彼の以前の取引、時計修理の開発計画(スキル、認定、自分のワークショップ) | - |
| 20 | P14 | 工業用登山者 | 米国 | セットアップ中のエージェントの独自の提案で、小さな反応速度トレーナーである「Reflex Square」を構築しました | 「今のところ、Codeでのコーディングは私の日常生活で必要なものではありません。」 |
| 21 | P67 | 水泳コーチ、また直販 | 未公開 | 彼女が直販で開始したことをエージェントに伝えました。5種類のヘルプを提供し、サンプル製品カードを起草しました | - |
| 22 | P12 | 学生 | ドイツ | 無料のAIサービスに登録し、オーケストレーションフォルダを実行し、エージェントでカタログから4つの方向を選択しました(ジャーナリズム、本、収益化、AIへのより深い潜在)。彼自身のエッセイをそれに与えます | - |
| 23 | P71 | 擁護と公衆衛生 | ドイツ | 自分でプロンプトを作成しました。エージェントがそれを短縮し、他のAIに画像を作成させました。ターミナルステップと、キーストロークを覚えるための独自の追加テストタスクを実行しました | 「タスク完了、次のものを送ってください」 |
| 24 | P22 | 非営利コミュニティ組織 | 非開示 | エージェントでカタログタスクを実行しました(一部サイトはそのサインインをブロックしました)。ターミナルステップを実行してから、エージェント自体に何が行われたかを説明するよう求めました。メールニュースアラートを設定しました | 「完了、次は」(翻訳) |
| 25 | P59 | ビデオグラファー | 米国 | 地元市場で収益性の高い物件リストを見つけるための詳細なブリーフをエージェントに提供しました(チェック、支出なし、利益でランク付け)。結果はまだ表示されていません | 「最初のものがうまく機能するのに、2番目のものが必要な理由は」 |
| 26 | P84 | 非記載 | 非開示 | ターミナルを通じて自分でエージェントをインストールしました。コミュニティ組織用のウェブサイトを構築しています | 「何かしていますが、話し合うべきだと思います」(翻訳) |
| 27 | P66 | レジャー施設の管理者 | 非開示 | コースのためにノートパソコンを購入し、エージェントをインストールして、一般モードからエージェントのタブに移動しました。10個のAIのアカウントを開く段階にあります | 「すべて外国語です、次は何ですか」(翻訳) |
| 28 | P82 | セキュリティ業務。トラック輸送のディスパッチサービスを構築 | 米国 | インストール。別のチャットボットからチャットとプロジェクトを移動して、2つを比較しました | - |
| 29 | P70 | ソーシャルメディア向けの研究とビデオ編集 | 米国 | ルームメイトの助けを借りてエージェントを機能させました。最初に手動でテストファイルを作成した後です | - |
| 30 | P17 | 国際法弁護士 | 非開示 | インストール完了。最初のタスク送信 | 「すべてを実行しました」(翻訳) |
| 31 | P93 | 高齢者ケアの直接支援専門家 | 非開示 | プレーンチャットからエージェントに移動して支払いました。最初のタスク送信 | - |
| 32 | P54 | オーダーメイドケーキの製造 | 非開示 | 新しいノートパソコンにインストールして支払いました。最初のタスク送信 | - |
| 33 | P26 | コンクリート建設 | 米国 | 修理されたノートパソコンにインストールし、その写真を送信しました。最初のタスク送信 | 「次は何ですか」 |
| 34 | P03 | 貿易会社の取締役 | 米国 | P35と一緒にインストール。最初のタスク送信 | - |
| 35 | P45 | 写真とビデオコンテンツ、プログラミングの背景 | ドイツ | 10個のAIでアカウントを開く段階に到達しました。これは機能するエージェントが前提です。詳細は記録されていません | - |
注:参加者記録から編集。行1~24は表G1の3行目です。行25~35は2026年10月9日までにエージェントをインストールし、報告された結果なしで開始しました。「-」は、この期間について参加者の利用可能な言葉が記録に含まれていないことを意味します
新規ユーザーがエージェント指向について話す方法数週間前にチャットアシスタントのみを使用していた人々は、新しい作業を自分の言葉で説明しています。私はエージェントをインストールした35人のための参加者記録と日次観察ノートに記載されている、参加者自身の言い回しによるあらゆる部分を収集しました(32人からの161部分、約1,070語)。また、単語ステムをマッチングすることで、指向するシステムの単語、それに対して行うことの単語、自分自身の単語をカウントしました。カウントは概算であり、「それ」にはツールを指さない一部の用法が含まれています
表G1c新規ユーザーがエージェント指向に使用する言葉(自分の報告における出現回数)
| 言葉が何を示すか | 言葉、カテゴリーに翻訳 | カウント |
|---|---|---|
| 指向するシステム | 「それ」 | 35 |
| モデルまたは製品名(Claude、GPTなど) | 16 | |
| ツール、プログラム、アプリ | 11 | |
| 「AI」、「AI群」 | 9 | |
| エージェント | 1 | |
| アシスタント、ヘルパー、ワーカー | 0 | |
| それに対して行うこと | 設定、インストール、実行 | 10 |
| 質問、問い合わせ、リクエスト | 9 | |
| タスク、命令、プロンプト | 7 | |
| チェック、比較 | 4 | |
| 分割、引き渡し | 2 | |
| 自分自身 | 開発者、初心者 | 5 |
自分の言葉の一部です(英語の引用。「(翻訳)」とマークされたものは別の言語で書かれたもので、翻訳は私によるものです):
- 「単に質問に答えるだけでなく、実際にファイルやドキュメントを扱うことができます」(P18、インターネットマーケティング)
- 「AIを使用する際の最大の過ちの1つは、自信のある答えが自動的に正しいと想定することです」(P20、写真家とレタッチャー、翻訳)
- 「今、本当に開発者のように感じています」(P21、非営利コミュニティ組織)
- 「望むものを得るために、リクエストをどのように説明するかを考え抜く必要があります」(P48、事務作業とオンライン販売、翻訳)
- 「答えは2人への質問のようなものだと思います」(P59、ビデオグラファー)
- 「1回はあるAIが良い助言をします、次回は反対です」(P48、事務作業とオンライン販売、翻訳)
3つの長い部分は、参加者自身の声での移動を示しています。エージェント初日の夜、誰もモデルのコンシルについて彼に示していない前に、インテリアデザイナー訓練中:「それはフォルダを作成しました。ドキュメント付きでもうまく機能しました。開いてい[…]、最後に私は空室と呼ばれる2つのファイルを取得しました。このスペースからそのスペースから、そしてそれらを互いに送信したので、互いの仕事を評価しました」(P01、翻訳。音声メッセージの自動転記から)。産業登山家で、エージェント付きの最初の小さなプログラムを構築した日、すでに次のロールを求めています:「おそらく、ソーシャルネットワークに投稿したり、私に物を思い出させたり、提案を与えてくれるエージェントを構築する方法を学ぶこと」(P14)。そして、非営利コミュニティ業務の参加者は、最初の数週間後:「広大な新しい可能性が開きつつあるのを感じます。何か新しい境界に立っているようです」(P21)
彼らはそのシステムを製品名またはシンプルに「それ」と呼び、「エージェント」とはほぼ決して呼ばず、第3章のマップに記載されたタイトルはいずれも現れません。しかし、タスクの設定、2つの回答の比較、確実なものの確認について語ります。これは測定が数える仕事です。マップのように、機能は名前より前に到着し、これはいかなる主張のテストとしてではなく、説明として提供されます。
同じ人々はまた、別個に事前登録されたプログラム(OSF、DOI 10.17605/OSF.IO/X4EGQ)にも参加しており、その成果はそこで報告されます。
G2. Prolific評定者研究:専門家は基準時間に同意するか?
測定は各仕事を基準時間でサイズ決めし、第5.2章の規則は2人の専門家に盲検で評定させ、推定値が1.5倍以上異なるときは第3者を呼びます。評定者研究は、職業人がそこまで密接に同意するかどうかを問います。これは2026年10月9日にOSFにプリパイロットとして登録されました(DOI 10.17605/OSF.IO/V92R8)。データ収集前であり、同じ日にProlificで始まりました。
デザイン。 2つの独立したサンプル、合計119人の参加者を募集・報酬支給:60人の簿記係(現在の職務:会計士、簿記係、勅許会計士または公認会計士、監査役または税務専門家)および59人のウェブおよびソフトウェア開発者(現在の職務:ソフトウェアエンジニア、ソフトウェア開発者またはウェブ開発者)。すべてイギリス、アメリカ合衆国、アイルランド、カナダ、オーストラリアまたはニュージーランドに住み、Prolific承認率が少なくとも100件の以前の投稿にわたり最低98%であり、1つの研究のみを受けます。各参加者は自分の分野の10つのタスクをタスクバンクv0(BK01からBK10またはWT01からWT10、pilot/task-bank-v0.csvでフリーズされたもの)から評定し、焦点を当てた仕事の時間をAIツールなしで単独で働く資格のある専門家のために、1つのタスク(BK03またはWT03)を再テストとして再び評定し、1つの能力質問と1つの注意チェックに答えます。いずれかに失敗した参加者は除外され報酬支給されます。正の数でない推定値または2000時間を超える推定値は削除されます。
成果。 一次的な:分野ごとに、すべてのタスクにわたる評定者ペアの割合で、その2つの推定値が1.5の比率内に入る割合。キャリブレーションプロトコルで設定された0.70の閾値に対して。二次的な:各評定者の個人的レベルを除去した後の同じ割合、対数時間のICC(2,1)、1.5内の再テスト-テスト割合、および各タスクの中央値推定値と銀行が意図したランクに対して。比較のために、付録Eの4人のモデル評定者はこれら20タスクのペアの56%を1.5内に置きます:簿記タスク10個のうち47%およびウェブタスク10個のうち65%。分析はスクリプトhuman_raters.pyで、データ前にOSF登録に提出され、結果がいかなるものであれ報告されます。
結果。
スクリーニング。 参加者はProlificプロフィール内の職業に基づいて認められ、Prolificのフィルタの背後にあるほとんどの回答は自己報告です(Prolific、2026)。能力質問は取引の設計唯一のチェックでした。簿記サンプルではこれは顧客の銀行に受け取った支払いの複式簿記に関する多肢選択質問でした。そのサンプルに認められた60人のうち、11人(18%)がそれを間違って答え、8人がデビットとクレジットを逆にしました。登録されたように除外され、報酬支給されました。登録されなかった比較で、これら11人はサンプルの他の参加者よりも銀行の大きなタスクを少ない時間で評定しました。Week rungを意図した3つのタスク(BK08からBK10)の中央値は6、6および8時間で、他の49人は8、8および12でした。11人でこれはテストされるべきリードであり、推定ではなく、急いだまたは質問を誤読することは同じトレースを残すでしょう。取引を知らない人はその大きなタスクのすべてのステップを見ません(第6.5章)。ウェブツールサンプルでは同じ比較は繰り返されませんでした。能力質問に失敗した8人の開発者はWeekを意図した3つのタスクの中央値24.5、27.5および19時間を与え、他の50人は20、16および20でしたので、リードは簿記のみに基づいています(以下の探索的分析)。
このセクションのスクリプトはコンパニオンリポジトリ(pilot/)内にあります。prolific_to_long.pyはProlificエクスポートから評定の長いファイルを書きます。各推定値を書かれたとおりに読み、数字がないまたは複数のある回答(範囲など)をテキストとして保持し、登録されたルールがそれを削除できるようにし、すべての回答をリストアップします。プレーンな数字ではないもの。table_g2.pyは登録されたスクリプトの機能を変更しないで呼び出して表G2を印刷し、同じタスクのモデル評定者の横に配置します。screen_compare.pyは上記のスクリーニングの比較を再計算し、正確な間隔とWeekタスクの評定者にわたる順列テストを使用します。
合意。募集枠は2026年10月9日と10日に埋まり、118人の参加者が回答を残しました。60人の簿記係と58人の開発者です。承認され報酬が支払われた1人の開発者の回答は、調査ツールによって保存されませんでした。登録された除外(11人の簿記係と8人の開発者が能力問題に不合格。注意チェックで不合格となった者はなし)の後、49人の簿記係と50人の開発者が残ります。登録された閾値はどちらの分野でも満たされませんでした。簿記係のペアの28%と開発者のペアの25%が1.5の比率内に収まり、0.70に対してです(表G3)。専門家はタスクを一貫して順序付けました。各分野の中央値は、Hourを対象としたタスクからWeekを対象としたタスクへと上昇していますが、時間については2人の評価者の規則が許すものより多く同意しません。各評価者の個人レベルを除去すると、シェアは34%と35%に上昇しただけなので、不同意はレベルを丸め上げたり下げたりする習慣ではなく、仕事そのものについてのものです。対数時間に関するICC(2,1)は簿記で0.34、ウェブツールで0.46でした。評価者の同じタスクの2つの推定値は1.5以内で、53%と74%の場合に同意しました。付録Eの4人のモデル評価者は、同じ20個のタスクで56%で、専門家よりもお互いにより密接に同意しました。これはモデルの精度についてというより専門家のばらつきについてより多くを述べています。開業医に対して銀行は約1段高く位置しています。Dayを対象としたすべてのタスクは2〜7時間の中央値を持ち、これはHourであり、Weekを対象としたすべてのタスクは8〜20時間の中央値を持ち、これはDayです。上記の探索的比較では、除外された11人の簿記係は他の者よりも互いに同意しませんでした(ペアの28%が1.5以内)。結果は評価者ルールの3つの部分を設定します。評価者は測定された時間のタスクで調整され、これは中央値が示すレベルがオフになることを固定します。部分は2人の評価者ではなくパネルの中央値によってサイズされます。この幅のばらつきは、ほとんどのペアを3番目の評価者に送ると思われるためです。タスク銀行は開業医の中央値から再バンディングされ、そのタスクを1段下げます(表G3b)。
表G2。分野別の専門家による参照時間の合意。
| 分野 | 保持 | 除外 | 1.5以内のペア | 評価者レベルを除去した後 | ICC(2,1)、対数時間 | 1.5以内の再テスト |
|---|---|---|---|---|---|---|
| 簿記 | 49 | 11 | 0.283 | 0.335 | 0.335 (49 complete) | 0.531 (n = 49) |
| ウェブツール | 50 | 8 | 0.247 | 0.349 | 0.461 (49 complete) | 0.735 (n = 49) |
注:1.5以内のペアの登録閾値:0.70。どちらの分野でも満たされていません。除外は能力問題の失敗です。注意チェックで不合格となった参加者はいません。ペアは分野の全10タスクで取られています(簿記で11,760、ウェブツールで11,809)。再テストは、BK03またはWT03の評価者の2つの推定値を比較します。登録されたとおりのhuman_raters.pyの出力(DOI 10.17605/OSF.IO/V92R8)。
表G3b。銀行が意図した段に対する各タスクの中央推定値(時間)。
| 意図された段 | 簿記タスク:中央値 | 中央値の段 | ウェブツールタスク:中央値 | 中央値の段 |
|---|---|---|---|---|
| Hour | BK01: 2.0; BK02: 2.0; BK03: 1.5 | Hour | WT01: 1.0; WT02: 1.0; WT03: 2.0 | Hour |
| Day | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | Hour | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | Hour |
| Week | BK08: 8.0; BK09: 8.0; BK10: 12.0 | Day | WT08: 20.0; WT09: 16.0; WT10: 20.0 | Day |
注:保持された評価者の中央値です。8時間未満の中央値はHourに分類され、8〜40時間未満の中央値はDayに分類されます。DayまたはWeekを対象としたすべてのタスクは1段低くなります。
探索的分析。本段落の分析は登録されていません。登録されたローダー、除外基準、テストを再利用しており、スクリプトと出力はコンパニオンリポジトリのpilot/exploratory_prolific.pyとpilot/results/prolific-2026-10/exploratory-output.txtにあります。評価者を再サンプリングすると、主要なシェアの95%区間は0.24~0.33(簿記)および0.21~0.29(Webツール)になります。パネルサイズ(表G4)。各タスクについて、k人の保持評価者から成る2つの互いに素なパネルを2,000回抽出し、その中央値を比較しました。生の推定値では、2つの中央値が1.5以内で一致したのは、パネルごとに15人以上の簿記者または21人以上の開発者からのドローのみで少なくとも70%です。各評価者の個人レベルを除去した場合(これは測定された時間を持つタスクでのキャリブレーションが意図することです)、7人のパネルは0.71と0.69に達し、9人のパネルは0.77と0.76に達しました。同じ段階に到達することは、この尺度が記録することですが、より少ない数が必要です。5人のキャリブレーションされた評価者によるパネルは0.81と0.84のドローでそれを達成しました。セクション5.2の2評価者ルールの下では、3番目の評価者は72%と75%のピースで呼び出されます。経験(表G4b)。回答が完全な98人の保持評価者のうち43人が、自分の分野で10年以上の経験があると報告しました。彼らは互いに、残りの者より密接に一致せず、分野での年数は、評価者が他の者の中央値からどの程度離れているかを予測しませんでした(順位相関+0.18および-0.10、順列p = 0.21および0.47)。経験の豊富な開発者は、他の開発者より高く推定しました(他の者の中央値の1.32倍対0.76倍、p = 0.02)。経験の豊富な簿記者はそうではありませんでした(1.04対1.07、p = 0.88)。タスク。意見の相違はサイズとともに増大します。20個のタスクの中で最も異議のある6つのうち5つは週向けのタスクでした。ここでは24%(簿記)と20%(Webツール)のペアが1.5以内にありました。時間向けのタスクでは31%と27%に対して、週向けのタスクの四分範囲は4~8倍です。速度と単位。最も速い簿記者の四分位数(調査全体で3.6分以下)は、残りの者より密接に一致しました(0.37対0.26)。開発者間では速度は違いがありませんでした(0.24対0.24)。一部のタスクに時間ではなく分で答えることは、どちらのドメインでも違いをもたらしませんでした(0.31対0.31、0.28対0.31)。2人の簿記者が時間向けのタスクに40時間以上を費やしました。これは分を時間として入力しているように見えます。彼らなしの簿記シェアは0.284です。1人の保持された開発者は数字の代わりにテキストを入力したため、彼らの推定値のうち1つだけが分析に入りました。スクリーニング。各評価者の週向けタスクの推定値を自分の時間向けタスクの推定値と比較すると、個人レベルがキャンセルされ、除外された簿記者は大きいタスクを小さいタスクの3.2倍と評価しましたが、保持された簿記者は6.2倍です(順列p = 0.10)。除外された開発者は15.8倍対10.6倍です(p = 0.37)。再テスト。再テスト推定値は25人の簿記者ではじめの推定値より高く、4人では低く、17人の開発者では高く、2人では低かった(両方で正確な符号検定p < 0.001)。幾何平均では約30%であり、これはその間に評価された大きいタスクでのアンカリングと一致しています。これらの結果を合わせると、作業の広がりとその規模は、性急な、経験の浅い、または不十分な評価者のサブグループではなく、ルールが必要とするパネルのサイズを決定します。キャリブレーションされた評価者、ピースごとに5~9人、段階で採点(表G4)。
表G4。タスクごとのk人の評価者による2つの独立したパネル。中央値が1.5以内で一致するドロー数の割合/同じ段階にあるドロー数の割合(探索的)。
| パネルごとの評価者数 | 簿記、生 | 簿記、レベル除去 | Webツール、生 | Webツール、レベル除去 |
|---|---|---|---|---|
| 1 | 0.28 / 0.51 | 0.34 / 0.62 | 0.24 / 0.46 | 0.34 / 0.60 |
| 3 | 0.43 / 0.68 | 0.51 / 0.76 | 0.37 / 0.60 | 0.52 / 0.78 |
| 5 | 0.51 / 0.77 | 0.63 / 0.81 | 0.43 / 0.68 | 0.62 / 0.84 |
| 7 | 0.58 / 0.82 | 0.71 / 0.84 | 0.49 / 0.74 | 0.69 / 0.87 |
| 9 | 0.62 / 0.85 | 0.77 / 0.87 | 0.54 / 0.78 | 0.76 / 0.89 |
| 15 | 0.71 / 0.88 | 0.88 / 0.91 | 0.64 / 0.84 | 0.86 / 0.94 |
| 21 | 0.76 / 0.89 | 0.94 / 0.95 | 0.72 / 0.84 | 0.92 / 0.98 |
注:すべての10個の推定値を持つ保持評価者(ドメインごとに49人)。ドロー当たり2,000回、ドロー内でパネルは互いに素。シード20261011。レベル除去:各評価者の各タスクのすべての評価者の中央値に対する平均対数比は、登録された二次結果のようにサンプルで減算されます。したがって、これらの列は、別のアンカータスクでのキャリブレーションが与える結果の上限推定です。登録されていません。pilot/exploratory_prolific.pyの出力。
表G4b。分野での年数と一致(回答が完全な保持評価者、探索的)。
| ドメイン | グループ | 評価者数 | グループ内で1.5以内のペア | 他の評価者の中央値に対するレベル |
|---|---|---|---|---|
| 簿記 | 10年以上 | 23 | 0.268 | 1.04 |
| 簿記 | 10年以下 | 26 | 0.299 | 1.07(p = 0.88) |
| Webツール | 10年以上 | 20 | 0.297 | 1.32 |
| Webツール | 10年以下 | 29 | 0.242 | 0.76(p = 0.02) |
注:レベルは、同じタスクで評価者の推定値と他の評価者の中央値の幾何平均比です。pは平均対数レベルの差の両側順列検定(5,000順列)です。登録されていません。
引用方法
Chernets, V. (2026). プログラマーの分断を超えて: AIエージェントを通じて構築する人々のための一つの指標 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}