After the Programmer Divide: Ein Maßstab für Menschen, die durch KI-Agenten entwickeln
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Der verifizierte Delegationshorizont, der Verstärkungsgewinn, eine datierte Karte von Rollennamen und 41 registrierte Vorhersagen, die jedes Jahr bis 2031 bewertet werden
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7589918 · DOI 10.2139/ssrn.7589918 · Zenodo 10.5281/zenodo.23267267 · GitHub
Laden Sie dieses Papier herunter
- SSRN (endgültige Fassung): ssrn.com/abstract=7589918 · DOI 10.2139/ssrn.7589918
- Zenodo (archiviert, frei zugänglich): doi.org/10.5281/zenodo.23267266
- OSF (die 41 Vorhersagen, registriert 9. Oktober 2026): doi.org/10.17605/OSF.IO/VW6P9
- GitHub (vollständiger Text als Markdown): github.com/vadimchernets/papers/tree/main/after-the-programmer-divide; Code der Anlage C: github.com/vadimchernets/delegation-horizon
SSRN hält die endgültige Fassung; zitieren Sie diese.
Schlüsselwörter: KI-Agenten; agentenbasierte KI; Nicht-Programmierer; Codierungs-Agenten; Jobtitel; kompetenzbasierte Einstellung; Prinzipal-Agent-Theorie; End-User-Softwaretechnik; KI-Literalität; verifizierter Delegationshorizont; Anmeldepunkt für Berechtigungsnachweise; vorregistrierte Vorhersagen
Zusammenfassung
Ein Buchhalter bittet einen Agenten um ein Abstimmungswerkzeug; ein Entwickler bittet einen, ein Abrechnungssystem zu ändern. Jeder muss eine Tagesarbeit akzeptieren und nachweisen, dass sie hält. Bis Oktober 2026 vergaben auch Anwälte Aufgaben an dieselben Agenten. In etwa 400.000 Sitzungen lag der herstellerverifizierte Erfolg bei codeproduierender Arbeit bei 34 % für Programmierberufe und 29 % für andere, wobei Beruf nicht Ausbildung ist. Keine Karriereleiter sagt, was jemand, der durch Agenten aufbaut, abliefern kann. Ich schlage ein Maß anstelle eines Titels vor. Der verifizierte Delegationshorizont ist das größte kohärente Stück Arbeit in Referenzstunden eines qualifizierten Spezialisten, das eine Person regelmäßig an Agenten übergibt und nach einer unabhängigen Überprüfung, die die Agenten nicht sahen, akzeptiert. Verstärkungsgewinn, akzeptierte Referenzstunden pro Stunde Aufmerksamkeit, ist ein verifizierter Durchsatz, nicht eine kausale Schätzung der Beschleunigung. Beide werden pro Domäne bewertet: Stunde zu Quartal; ein Schreibtischtest korrigierte einen Schwellwert. Drei große Arbeitgeber versuchten Token-Zählungen und gaben sie 2026 auf: ein Ranking wurde entfernt, eine Bestenliste manipuliert, ein Budget aufgebraucht. Überprüfte Arbeit ist schwerer zu manipulieren durch Ausgaben, und jede verbleibende Route erfüllt eine angegebene Verteidigung. Eine datierte Karte verzeichnet rivalisierende Namen (Builder, Agent Manager, Principal und andere), ohne sich festzulegen. Hintergrund-Neutralität ist die Hypothese, dass bei einem gleichen Horizont eine Programmierausbildung die überprüfte Qualität nicht mehr vorhersagt. Der Berechtigungsübergangspunkt ist der Moment, Domäne für Domäne, wenn Produkte von Personen ohne IT-Ausbildung diejenigen von Programmierern unter den gleichen Überprüfungen zu übertreffen beginnen, wonach Abschlüsse und Senioritätsbezeichnungen an Gewicht verlieren. Einundvierzig datierte Vorhersagen, die am 9. Oktober 2026 zum Median von drei blinden Modellprognosen bewertet wurden, sind auf OSF registriert und werden jährlich bis 2031 bewertet; eine nie durchgeführte Studie zählt als Fehler, und Übertreffung in der eigenen Domäne steht auf 0,35.
Zusammenfassung
Bis 2026 verglichen Buchhalter Coding-Agenten so, wie Programmierer das ein Jahr zuvor getan hatten, Rechtsanwälte bauten ihre eigenen Tools damit, und Menschen außerhalb der Softwareentwicklung waren zu einem schnell wachsenden Teil der Nutzer eines Anbieters von Coding-Agenten geworden; in den Aufzeichnungen eines anderen Anbieters, etwa 400.000 Sitzungen, lagen die Berufe, die nicht programmieren, bei der verifizierten Erfolgsquote bei Coding-Arbeiten nur um einige Prozentpunkte hinter Programmierern zurück (34% gegen 29%). Wo die Arbeit geleistet wird, hat sich die Grenze zwischen Programmierern und allen anderen verdünnt. In Jobbezeichnungen, Gehaltsgruppen und Lebensläufen steht sie dort, wo sie stand.
Einige Programmierer und einige Fachleute teilen sich nun einen Arbeitsablauf: Sie übergeben Arbeiten an Agenten und entscheiden, ob sie diese akzeptieren. Aufgaben und Arbeitsabläufe haben sich vor ganzen Berufsgruppen verschmolzen, daher ist die aussagekräftige Frage über eine Person, wie große eine Arbeitsmenge sie übergeben und nachweisen kann, von welcher Seite der alten Grenze auch immer sie kommt. Das Maß, das ich für diese Frage vorschlage, der verifizierte Delegationshorizont, beruht auf einigen Designentscheidungen, und diese Zusammenfassung gibt die Begründung für jede. Die Einheit ist die Zeit, die ein qualifizierter Spezialist benötigt hätte (eine Stunde, ein Tag, eine Woche, ein Monat, ein Quartal), da beide alten Leitern sie ablesen können und keine Übersetzung zwischen Berufen erforderlich ist. Ein Abstimmungstool eines Buchhalters und eine Abrechnungsänderung eines Entwicklers unterliegen der gleichen Regel. Nur Arbeiten, die eine Prüfung bestanden haben, die die Agenten nicht sahen, werden gezählt, und Übereinstimmung zwischen Modellen einer Familie zählt nicht als solche Prüfung, da ihre Fehler korreliert sind. Eine zweite Zahl, Amplifikationsgewinn, erfasst, wie viel geprüfte Arbeit jede Stunde der Aufmerksamkeit der Person erbringt (fehlerhafte Arbeiten kosten dennoch Aufmerksamkeit, und die unbeachtete Zeit der Agenten zählt nicht), so dass jemand, der in kurzen Schleifen neben einem Agenten arbeitet, genauso angerechnet wird wie jemand, der große Arbeitsmengen übergibt. Beide Zahlen werden pro Domäne geführt, aus einem symmetrischen Grund: Ein Anwalt, der in die Softwareentwicklung wechselt, und ein Programmierer, der ins Rechtswesen wechselt, verlieren das gleiche, die Fähigkeit, Arbeiten in einem Bereich anzunehmen, den sie nicht kennen. Die Schwellenwerte werden als Regeln v1.1 versioniert und tischgeprüft, und die Tischprüfung hat bereits eine davon korrigiert (Anhang E).
Die Namen sind nicht festgelegt. Builder, Agentic Engineer, Agent Manager, KI-Operator, Orchestrator und Principal sind alle im Oktober 2026 in Gebrauch, jeder mit einem Besitzer und einem Datum. Ich ordne sie, ohne mich zu entscheiden, so dass derjenige, der gewinnt, auf einer Skala gelesen werden kann: ein Builder bei Week, ein Agent Manager bei Day.
Der Markt hat bereits einen Shortcut versucht. Im Jahr 2026 wurden Token-Zählungen als Maß für Personal bei großen Arbeitgebern versucht und scheiterten innerhalb weniger Monate: Das inoffizielle Ranking eines Mitarbeiters bei Meta wurde entfernt und die offizielle Orientierung des Unternehmens schloss Token-Zählungen später aus, ein Leaderboard bei Amazon wurde mit leeren Aufgaben manipuliert und entfernt, und Uber gab sein jährliches KI-Budget in vier Monaten aus. Eine Zählung von Eingaben belohnt Ausgaben. Eine Zählung akzeptierter Arbeiten, unabhängig überprüft, ist von Grund auf schwerer auf diese Weise zu manipulieren. Die verbleibenden Routen (einfache Prüfungen, großzügige Bewerter, verborgene Hilfe und in Teile zerlegnete Arbeiten) treffen jeweils auf eine Verteidigung in Abschnitt 5.8: Stichprobenaudits, unabhängige Bewerter von Stunden, ein öffentliches Versagensdokument, eine kohärente Arbeitseinheit und gepflanzte Fehler.
Zwei Vorhersagen tragen meine datierte These. Hintergrund-Neutralität sagt, dass auf der gleichen Stufe eine Programmierausbildung die überprüfte Qualität nicht mehr vorhersagt. Der Crossover-Punkt für Anmeldedaten ist der Moment, in einer Domäne, wenn Produkte von Menschen ohne IT-Ausbildung die von Programmierern mit den gleichen Agenten beginnen zu übertreffen, woraufhin ein Abschluss und die Bezeichnungen Junior und Senior an Gewicht verlieren. Qualitätsparität kommt vor diesem Moment, eine Kreuzung von Abschlussanforderungen in Stellenausschreibungen ist sein sichtbares Zeichen, und jeder Teil wird datiert und auf seine eigene Weise getestet. Die Hauptvorhersage läuft gegen aktuelle Meinung, und das Papier sagt dies dort, wo es die Vorhersage angibt. Jede Vorhersage benennt auch das Ergebnis, das sie widerlegen würde, so dass ein Leser im Voraus sehen kann, wie ein Fehler aussehen würde. Alle 41 erscheinen in einer Tabelle mit Wahrscheinlichkeiten, Schwellenwerten, Fallback-Quellen und Enddaten, registriert auf OSF am 9. Oktober 2026 (DOI 10.17605/OSF.IO/VW6P9) und nach der Brier-Regel jedes Jahr bis 2031 bewertet. Siebenundzwanzig lösen sich aus öffentlichen Daten. Vierzehn benötigen Studien, die getrennt registriert werden, bevor Daten erhoben werden, und fehlende oder nicht schlüssige Beweise werden als ungelöst verzeichnet und zählen nicht als Erfolg; eine Studie, die nie durchgeführt wird, ist ein Fehler des Testprogramms und bleibt auf der Scorecard. Die Wahrscheinlichkeiten wurden am 9. Oktober 2026 als Median von drei blinden Modellprognosen festgelegt, die ich annahm, und sind auf OSF registriert; die Wahrscheinlichkeit des Überholens in der eigenen Domäne beträgt 0,35.
Wenn Baukosten gering sind, wird Vertrauen zum knappen Filter. App Stores und Code-Hosts sind überflutet, Plattformen schließen ihre Türen für unbekannte Mitwirkende, und Agenten schreiben zunehmend eine Lösung, anstatt die eines anderen zu übernehmen. Neben der Person, die baut, sind zwei Partnerfunktionen sichtbar: Ein Finisher bringt das Produkt zu Menschen, und ein Garant signiert dafür. Der zweite Name stammt aus einer Beschreibung der Rolle von 2025, und ich schlage auch ein Maß für den Garanten vor.
1. Einleitung
Am 23. September 2026 verglich ein Blog für Buchhalter zwei Coding-Agenten, Claude Code und Codex, bei der Kategorisierung von Transaktionen und der Kontenabstimmung (Growthy, 2026). Ein Jahr zuvor gehörte dieser Vergleich zu Programmierern, und in Programmierer-Threads tut er das immer noch, vollständig mit Lagern und Loyalitäten. Was sich verschob, war der Leser. Die Menschen, die nun zwischen Agenten wählen, führen Bücher, schreiben Verträge und leiten Kampagnen, und die Agenten, zwischen denen sie wählen, sind die, die Softwareentwickler nutzen.
Seit Jahrzehnten hielt die Wirtschaft zwei Karriereleitern. In der Softwareentwicklung waren die Sprossen Junior, Mid-Level, Senior, Staff und Principal, bewertet nach Jahren der Erfahrung und danach, wie viele Ingenieure ein Projekt brauchte. Anderswo waren die Sprossen Analyst, Berater, Manager, Direktor und Partner. Die Leitern trafen sich an der Tür der IT-Abteilung, insofern als ein Fachmann von der zweiten Leiter Software erhielt, indem er sie von jemandem von der ersten in Auftrag gab. In 2025 und 2026 begannen beide Leitern dieselbe Arbeit zu beschreiben. Entwicklern wurde gesagt, dass ihre Haupttätigkeiten Delegation und Verifizierung geworden waren (GitHub, 2025b). Fachleute außerhalb der Softwareentwicklung begannen, mit einem Agenten in einem Terminal oder Fenster auf dem Desktop, die Werkzeuge, Websites und kleinen Anwendungen zu bauen, die sie früher in Auftrag gaben (Bloomberg Law, 2026; OpenAI, 2026). Keine Leiter sagt, was eine solche Person abliefern kann, und keine sagt, wie man einen ehemaligen Entwickler mit einem ehemaligen Analysten vergleicht, die jetzt dieselbe Arbeit machen.
Die folgenden Fragen sind, wie die Menschen auf der zusammengefügten Seite dieser Grenze genannt werden sollten, wie ihr Niveau gemessen werden sollte, wenn ein Grad und Jahre des Dienstes nicht mehr sagen, was sie abliefern können, und wann die Grenze möglicherweise verschwindet. Die letzte erhält ihre Antwort in Form von datierten Prognosen.
Diese Frage hat auch einen datierten Ursprung. Am 8. Oktober 2026 machte ich eine Vorhersage: Innerhalb von ein bis zwei Jahren wird die agentische Fähigkeit so weit wachsen, dass technische Ausbildung nicht mehr nötig ist, und Menschen ohne sie werden bessere Anwendungen, Websites und Produkte bauen, mit Code, der besser ist als der Code von Programmierern. Am selben Abend später fügte ich ein Korollar hinzu. Wenn Produkte von Menschen ohne IT-Ausbildung beginnen, die von IT-Fachleuten zu überflügeln, werden IT-Abschlüsse und die Bezeichnungen Junior und Senior schnell an Gewicht in einem Lebenslauf verlieren. (Beide Aussagen sind aus meinen Notizen von jenem Tag übersetzt.) Die Abschnitte 6 und 11 machen beide zu Vorhersagen mit Daten, Maßstäben, Schwellwerten und Ergebnissen, die sie widerlegen würden. Die zweite Aussage benennt den Moment, den der Rest des Papiers den Glaubwürdigkeits-Wendepunkt nennt.
Das Begleitpapier dieser Serie folgte Nicht-Programmierern von Chat zu Agenten und definierte vier Ebenen danach, wo ein Agent arbeitet und was die Person besitzen muss (Chernets, 2026a). Es zählte eine Transition nur, wenn ein Agent ein Artefakt hervorgebracht hatte, und lehnte es ab, den Manager von Agenten zu einer Jobbezeichnung zu machen, und verwendete den Begriff „für ein Muster von Verhalten statt einer Rolle, gegen die jemand einstellen sollte, weil das Verhalten Beweise hinterlässt und ein Titel nicht" (Chernets, 2026a, Abschnitt 8.4). Das vorliegende Papier beginnt mit dieser Bedingung: Eine Ebene wird gewährt, und jeder Titel kann damit verbunden sein, nur auf Basis von Beweisen, d. h. Arbeit, die Agenten gegeben, von einer Person akzeptiert und durch eine Überprüfung bestätigt wird, die die Agenten nicht sehen.
Abschnitt 3 gibt eine datierte Karte der Namen im Oktober 2026 in Umlauf. Abschnitt 5 gibt die Skala, auf der jeder dieser Namen gelesen werden kann, den verifizierten Delegationshorizont mit seiner zweiten Achse, Verstärkungsgewinn. Abschnitt 6 stellt zwei Hypothesen auf, Hintergrund-Neutralität und der Glaubwürdigkeits-Wendepunkt, und fragt, wie viel der Erfahrung eines Handwerks ein Überprüfungsprozess ersetzen kann. Die Abschnitte 7 und 8 nehmen Vertrauen auf, die Grenze, die sich nicht auflöst, und die zwei Partner-Funktionen neben der Person, die baut. Abschnitt 11 legt datierte Vorhersagen mit Wahrscheinlichkeiten, Schwellwerten und Fallback-Quellen dar, registriert auf OSF und jedes Jahr bis 2031 öffentlich bewertet.
Ich wähle nicht unter den Namen. Der Markt wird wählen, wahrscheinlich innerhalb von Monaten, und ein Papier, das auf ein Wort setzt, ist falsch den Tag, an dem ein anderes Wort gewinnt. Was ein Papier festlegen kann, ist die Skala. Abschnitt 5 definiert sie vollständig; kurz gesagt fragt der verifizierte Delegationshorizont, wie groß ein Stück Arbeit, in den Stunden, die ein qualifizierter Spezialist gebraucht hätte, eine Person regelmäßig Agenten gibt und mit einer unabhängigen Überprüfung hinter der Akzeptanz akzeptiert, und der Verstärkungsgewinn fragt, wie viele solche Stunden jede Stunde der eigenen Aufmerksamkeit der Person ergibt. Beide werden pro Domäne geführt, datiert und auf fünf Sprossen von Stunde bis Quartal platziert. Abbildung 1 stellt die zwei alten Leitern neben diese.
Eine Definition des Glaubwürdigkeits-Wendepunkts dient dem gesamten Papier. In einer Domäne ist es der Moment, in dem Produkte von Menschen ohne IT-Ausbildung, akzeptiert unter denselben unabhängigen Überprüfungen, die von Programmierern beginnen zu überflügeln, die dieselben Agenten nutzen, wonach ein Grad und die Bezeichnungen Junior und Senior ihr Gewicht bei der Einstellung verlieren. Qualitätsparität ist der Schritt vor jenem Moment, und eine Überschreitung der Gradanforderungen in Stellenausschreibungen ist sein sichtbares Zeichen. Hintergrund-Neutralität, die Hypothese, dass Ausbildung aufhört, überprüfte Qualität bei einer gleichen Sprosse vorherzusagen, ist der Mechanismus, der dies erklären würde. Jeder dieser vier Teile trägt seine eigene datierte Vorhersage (Abschnitt 6.2).
Die Beweise stammen aus 2025 und 2026, einer Zeitspanne, in der ein Monat der Agenten-Entwicklung ändert, was ein Maß zählen muss. Eine weit verbreitete Zahl setzt die Neuabsolvent-Einstellung bei großen Technologiefirmen weit unter sein Niveau von 2019. Sie wird weggelassen, ebenso wie Vergleiche mit dem Einstellungshöhepunkt von 2022, da sie eine Welt vor Agenten messen. Serien von vor Agenten treten nur als Vorgänger ein, und die Makroökonomie der Einstellung wird von der LinkedIn-Gegenposition von Abschnitt 2.4 getragen. Ältere Arbeiten treten auch als Theorie, Präzedenz oder Analogie auf: Jaques über die Zeitspanne der Verantwortung, Jensen und Meckling über die Kosten der Delegation, ein Goldrausch und ein Fotograf.
Abbildung 1. Zwei Leitern und ein Maß.
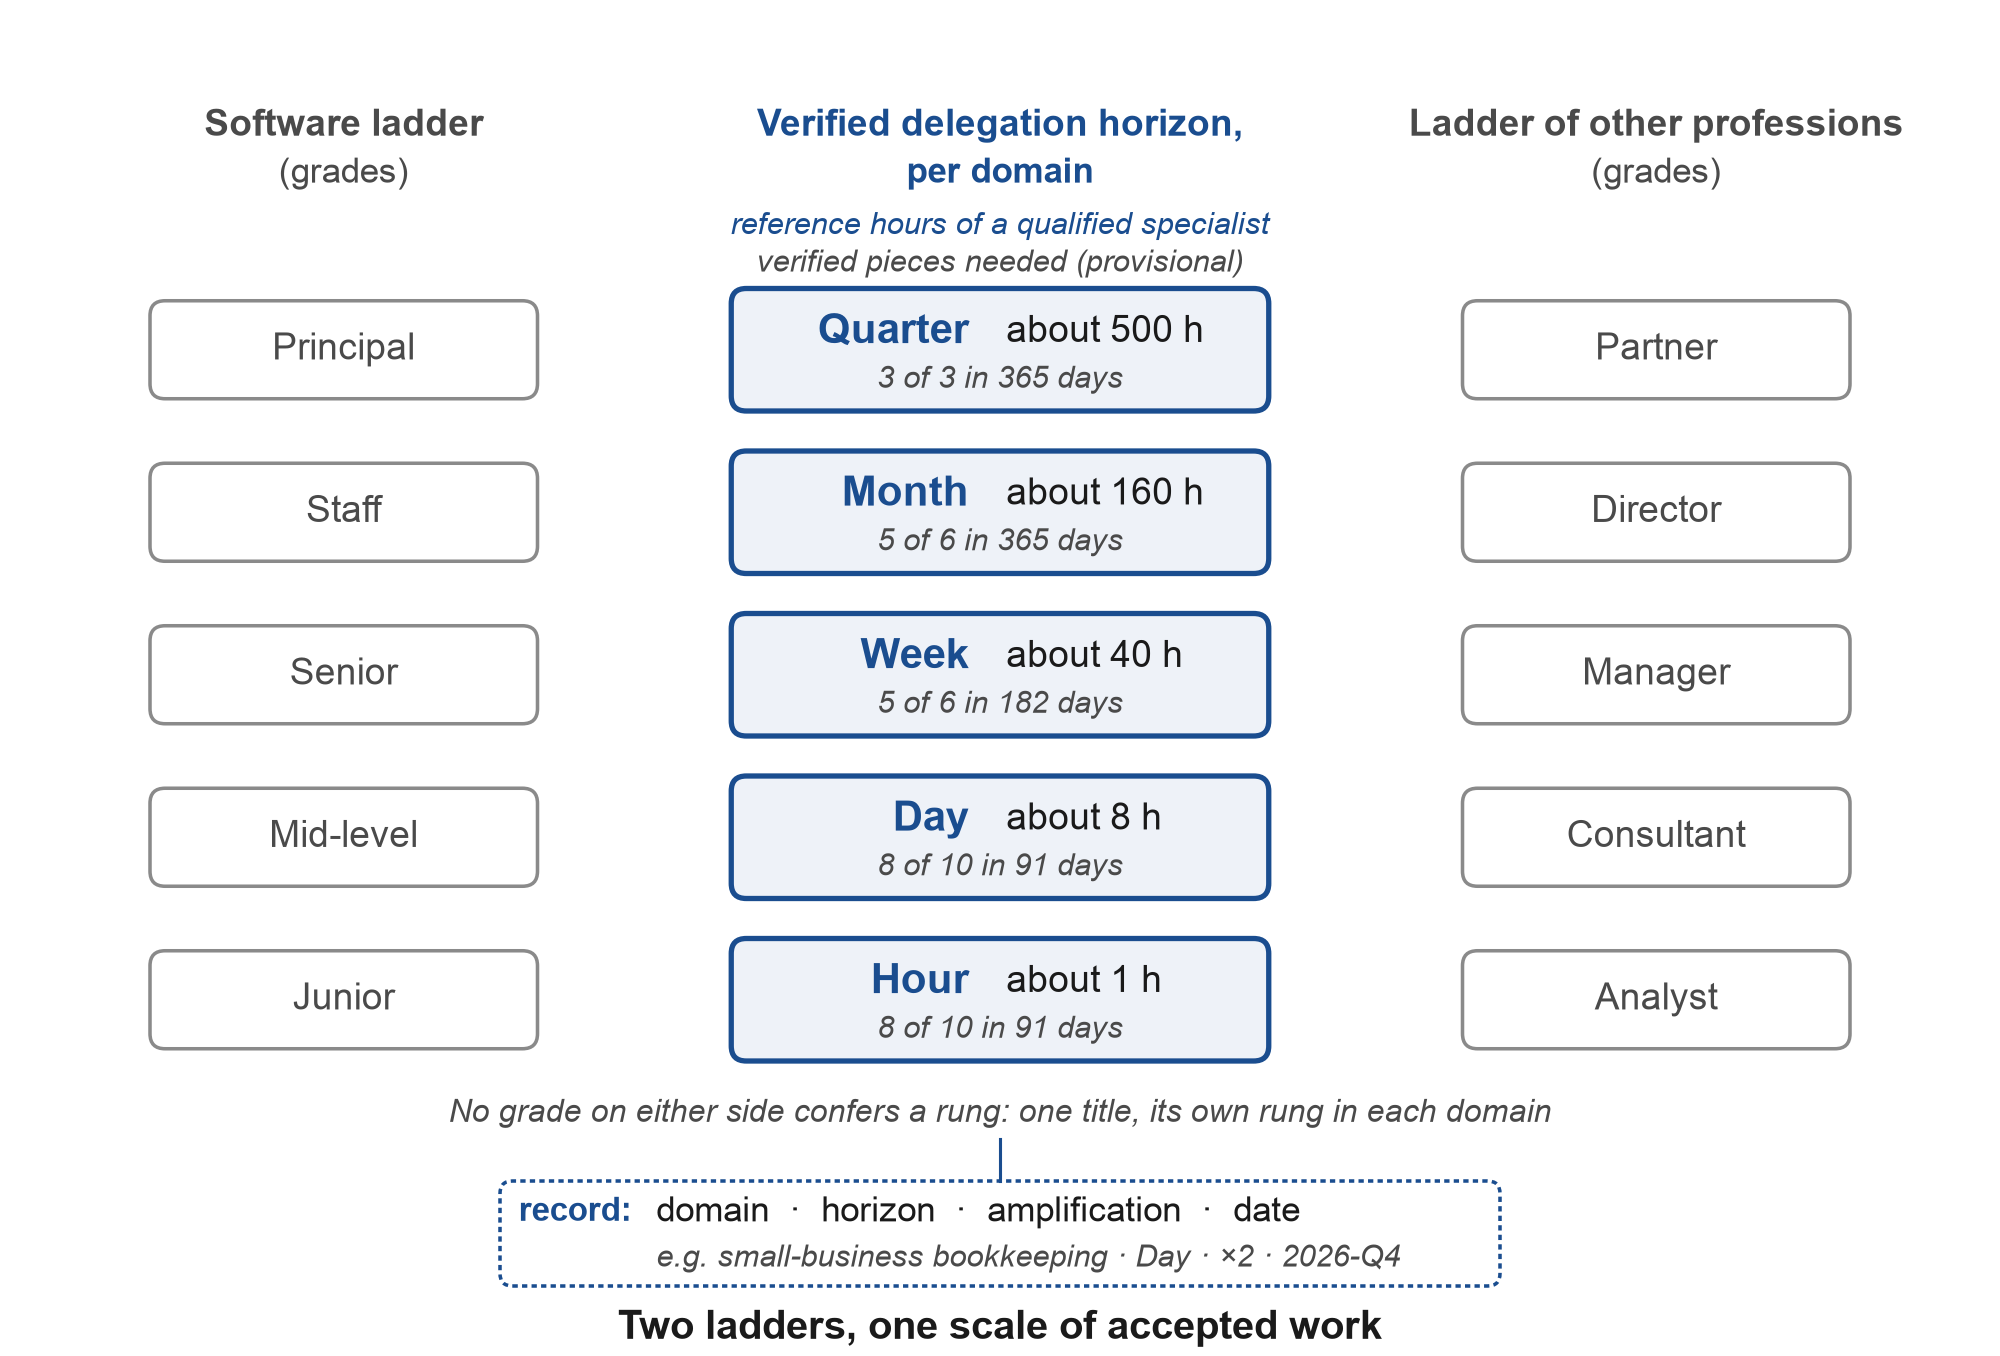
Anmerkung: Die alten Leitern sind nebeneinander gezeichnet und sind absichtlich nicht verbunden: kein Grad auf einer Leiter verleiht eine Sprosse, und dieselbe Person hält eine separate Sprosse in jeder Domäne (Abschnitt 5.2). Die Sprossen werden in Referenzstunden eines qualifizierten Spezialisten gezählt, mit den Zählern und Fenstern von Abschnitt 5.2 (Regeln v1.1). Der angezeigte Datensatz ist der eine, der vom ausgearbeiteten Beispiel von Appendix C4 gedruckt wird.
In diesen Bereichen legt Abschnitt 2 die Konvergenzevidenz dar, und Abschnitt 4 zeigt, wie das erste Maß des Marktes fehlgeschlagen ist, was bei einem Maß dieser Art der Fall ist. Abschnitt 9 prüft, welche Themen aus Programmierergesprächen auf andere Berufe übergreifen, und Abschnitt 10 zieht die Implikationen. Abschnitt 12 sammelt die Evidenz gegen die These, Abschnitt 13 legt ihre Grenzbedingungen dar, und Abschnitt 14 zieht das Fazit.
2. Zwei Welten konvergieren: Evidenz aus 2025 und 2026
2.1 Die Arbeit der Programmiererin, neu beschrieben
Die Anbieter, die an Entwicklerinnen verkaufen, beschreiben die Arbeit der Entwicklerin nun als Anleitung von Agenten. Githubs Darstellung von „der neuen Identität einer Entwicklerin" stellte Delegation und Verifikation in den Mittelpunkt der Arbeit (GitHub, 2025b). Anthropic befragte im August 2025 132 seiner eigenen Ingenieurinnen und Forscherin. Sie berichteten, KI in etwa 60 % ihrer Arbeit einzusetzen und einen selbsteingeschätzten Produktivitätsgewinn von etwa 50 %, und beschrieben sich selbst als immer mehr „Full-Stack". Die meisten sagten, sie könnten nur bis zu einem Fünftel ihrer Arbeit vollständig delegieren, und 27 % der KI-gestützten Arbeit bestand aus Aufgaben, die ohne KI überhaupt nicht durchgeführt worden wären (Anthropic, 2025a). Ein Maßstab, der allein auf vollständiger Delegation basiert, würde daher höchstens ein Fünftel dessen sehen, was die fortgeschrittensten Nutzerinnen der Welt mit KI tun, weshalb Abschnitt 5 eine zweite Achse hinzufügt. Derselbe Bericht nannte ein „Paradoxon der Überwachung": Die Überwachung des Modells erfordert die Programmierfähigkeiten, die atrophieren, wenn alles delegiert wird.
Die Worte folgten der Arbeit. Andrej Karpathy nannte „vibe coding" am 2. Februar 2025 (Karpathy, 2025), Collins machte es zum Wort des Jahres (Collins Dictionary, 2025), und ein Jahr später zog Karpathy zu „agentic engineering" weiter. Bei Sequoias AI Ascent am 30. April 2026 beschrieb er den Unterschied als „vibe coding hebt den Boden an, agentic engineering extrapoliert die Decke" (Karpathy, 2026; Willison, 2026a). Eine wissenschaftliche Arbeit beschrieb die agentic engineer als einen neuen beruflichen Archetyp, bei dem sich die Verantwortung von der Autorenschaft von Code zur Verantwortung für Ergebnisse verschiebt (Alenezi, 2026), und Microsoft beschrieb die Arbeitsmuster bei seinen Kundinnen als Autorin, Editorin, Direktorin und Orchestratorin (Microsoft, 2026b).
2.2 Alle anderen, innerhalb derselben Agenten
Zwei Anbieter berichten von weit verbreiteter Nutzung von Codierungs-Agenten durch Menschen außerhalb der Softwareentwicklung, mit unterschiedlichen Auswahl- und Messgrenzen. OpenAI meldete im Juni 2026, dass die wöchentlichen Nutzerinnen seines Codierungs-Agenten, die keine Entwicklerinnen sind, seit August 2025 um das 137-Fache bei einzelnen Nutzerinnen und um das 189-Fache bei Organisationen gestiegen sind (OpenAI, 2026). Die Basis war niedrig und die Daten stammen vom Anbieter. Derselbe Bericht enthält eine Verteilung, die für Abschnitt 5 relevant ist. In einer Stichprobe von etwa 0,1 % der einzelnen Nutzerinnen des Agenten im Mai 2026 machten 80,6 % mindestens eine Anfrage, deren von-Hand-Dauer, wie von einem Modell geschätzt, 30 Minuten überschritt, 70,2 % mindestens eine über eine Stunde, und 25,6 % mindestens eine über acht Stunden. Dies sind Anteile von Nutzerinnen, die lange Anfragen stellen, mit von einem Modell geschätzten Dauern, was etwas anderes ist als eine Abschlussquote oder ein verifizierter Horizont, und Abschnitt 5 erläutert, warum der Unterschied wichtig ist. Mehr als ein Viertel der Agentenarbeit für Geschäftsfunktionen war Ingenieurarbeit.
Anthropics Studie zu Claude Code, veröffentlicht am 16. Juni 2026, sind die der These am nächsten kommenden öffentlichen Daten (Anthropic, 2026e). Sie analysierte etwa 400.000 Sitzungen von etwa 235.000 Personen zwischen Oktober 2025 und April 2026. Expertise wurde aus Verhalten beurteilt, nach drei Zeichen: wie präzise die Person die Aufgabe angab, was sie überprüft haben wollte, und wer wen korrigierte. Eine Buchhalterin ohne Python-Kenntnisse, die exakte Abstimmungsregeln schrieb und Grenzfälle erfasste, wurde als Expertin bewertet. In Sitzungen, in denen Code produziert wurde, lagen alle zehn größten Berufe hinter Programmiererberufen um nicht mehr als sieben Prozentpunkte bei verifiziertem Erfolg, wobei Erfolg bedeutet, dass etwas erreicht wird, das durch Belege wie bestandene Tests oder committed work gestützt ist. Die Klassifizierung des Anbieters beruht teilweise auf Signalen im Sitzungsprotokoll, wie die ausdrückliche Bestätigung einer Nutzerin, und der Bericht vermerkt, dass die etwas höhere Quote der Managerinnen teilweise widerspiegeln kann, wie sie den Erfolg berichten, daher ist „verified" hier der Begriff des Anbieters, nicht eine unabhängige Überprüfung. Aggregiert über Code-produzierende Sitzungen betrug es 34 % gegenüber 29 % (etwa 30 % gegenüber 26 % über alle Sitzungen), und Management schnitt etwas besser ab als Programmiererinnen. Diese Daten ordnen Menschen nach Beruf und sagen nichts über Bildung: Eine Buchhalterin kann einen Abschluss in Informatik haben, und eine Programmiererin kann keinen haben. Der Bericht kam zu dem Ergebnis, dass „Codierungs-Agenten einen Codierungs-Hintergrund weniger relevant für erfolgreiche Programmierung machen". Personen trafen etwa 70 % der Entscheidungen darüber, was zu tun ist, und der Agent etwa 80 % der Entscheidungen darüber, wie. Ein Satz von Anweisungen einer Expertin löste etwa zwölf Agenten-Aktionen aus, einer Anfängerin etwa fünf.
Dieselbe Verschiebung zeigt sich in Quellen, die nicht von den Unternehmen stammen, die die Agenten verkaufen. Anwältinnen, von Juniorpartnerinnen bis zu Partnerinnen, haben mit Claude Code funktionierende Prototypen ihrer eigenen Tools gebaut, statt auf Anbieter zu warten, und der Anteil der Anwältinnen mit breitem KI-Zugang stieg von 61 % im Jahr 2025 auf 83 % im Jahr 2026 (Bloomberg Law, 2026; Artificial Lawyer, 2026). Buchhalterinnen vergleichen Agenten (Growthy, 2026). Lovable, ein browserbasierter App-Builder, überschritt im September 2026 600 Millionen US-Dollar annualisiertem Umsatz (TechCrunch, 2026a). Nach einer Schätzung verfasste Claude Code etwa 4 % der öffentlichen Commits auf GitHub in frühen Februar 2026 (SemiAnalysis, 2026).
2.3 Die Leitern unter Druck
Arbeitgeberinnen haben angefangen, ihre Leitern umzubenennen, ohne noch zu sagen, was sie ersetzt. Ab 1. Juni 2026 gab Deloitte seinen etwa 181.500 US-Mitarbeiterinnen neue Titel, die nach Jobfamilie organisiert waren, und fügte eine Führungsebene hinzu (Business Insider, 2026). Seine internen Ebenen und Lohnprinzipien blieben bestehen (Fortune, 2026a), also war dies eine Umbenennung mit der unveränderten Messung. LinkedIn wurde berichtet, sein Associate Product Manager Programm durch ein „Associate Product Builder" Programm ersetzt zu haben und eine „Full Stack Builder" Rolle für Menschen aus jeder Funktion geöffnet zu haben (Lenny's Newsletter, 2025). Microsoft zählte 3.233 von 20.000 befragten KI-Nutzerinnen, etwa 16 %, als „Frontier Professionals", die mehrstufige Agenten ausführen und ihre Prozesse neu gestalten (Microsoft, 2026a). Srinivasan und Wei argumentierten im Harvard Business Review im Februar 2026, dass Unternehmen Agent-Managerinnen brauchen, und erwarteten, dass der Titel innerhalb von 12 bis 18 Monaten Standard werden würde (Srinivasan & Wei, 2026). Einige Arbeitgeberinnen gehen weiter und schreiben die neue Rolle in Ausschreibungen: State Street warb für einen „Agentic Product Builder", der immer noch Programmierung erfordert (State Street, 2026). Am 7. Oktober 2026 führte Dust den „AI Operator" als die Person ein, die gemeinsame Agent-Workflows baut und verwaltet (Dust, 2026).
Die Einstellung hat es bemerkt. Der Anteil von Vorstellungsgesprächen, in denen die Verwendung von KI durch Kandidatinnen diskutiert wurde, stieg von 0,33 % im dritten Quartal 2025 auf 4,54 % im zweiten Quartal 2026 (Metaview, 2026). Die Frage ist in die Einstellung eingezogen, bevor es eine Skala für die Antwort gibt.
2.4 Ausschreibungen, Einstellung auf Einstiegsebene und Bildung
US-Stellenausschreibungen, die „agentic AI" erwähnen, stiegen von 151 im Jahr 2024 auf 16.541 im Jahr 2025 (Stanford HAI, 2026). Eine andere Zählung von Lightcast fand mehr als 86.000 Ausschreibungen im Jahr 2025, die Fähigkeiten im Bereich agentic AI erwähnten, eine jährliche Steigerung von 280% bei Erwähnungen dieser Fähigkeiten und ein mittleres beworbenes Gehalt von 153.000 US-Dollar; die Fähigkeiten wurden meist zu bestehenden Stellenbezeichnungen hinzugefügt (Lightcast, 2026a). Der AI Index zählt Ausschreibungen, die den Ausdruck „agentic AI" enthalten, während Lightcasts Blog Ausschreibungen zählt, die agentic skills in seiner eigenen Taxonomie tragen, was die meisten Unterschiede zwischen 16.541 und etwa 86.000 erklärt. Die Zahlen messen unterschiedliche Dinge und werden hier getrennt behandelt.
Die Einstellungen auf Anfängerebene haben sich abgeschwächt, und die Ursache ist umstritten. LinkedIn stellte fest, dass die US-Einstellungen auf Anfängerebene im April bis Juni 2026 um 7,6% gegenüber dem Vorjahr gesunken sind, gegenüber 6,9% für alle Ebenen, und in Berufen, die KI unterstützt, fiel die Einstellung auf Anfängerebene um 9,6% gegenüber 6,5% für alle Ebenen in diesen Berufen (LinkedIn Economic Graph, 2026). LinkedIn selbst führt mehr des Rückgangs auf wirtschaftliche Unsicherheit als auf KI zurück und bemerkt, dass unter den Anfängerrollen diejenigen, die vor KI geschützt sind, in Frankreich, dem Vereinigten Königreich und den Vereinigten Staaten am stärksten sanken. Die Aktualisierung der Stanford-Studie „canaries" vom August 2026 ergab, dass die Beschäftigung von 22- bis 25-Jährigen in KI-exponierten Berufen etwa 19% unter den Erwartungen lag, ohne vergleichbare Lücke für erfahrene Arbeitnehmer, und beschreibt das Ergebnis als deskriptiv (Stanford Digital Economy Lab, 2026a). Zwei weitere Quellen finden denselben Mechanismus. Ökonomen der Federal Reserve Bank of Dallas stellten anhand von Current Population Survey-Mikrodaten fest, dass Beschäftigungsrückgänge im Zusammenhang mit KI-Exposition nur bei jungen Arbeitnehmern auftraten, hauptsächlich durch weniger Menschen, die von außerhalb des Arbeitsmarkts in die Arbeit übergingen, statt durch Entlassungen (Atkinson & Yamco, 2026). In Lebenslaufdaten mit etwa 65 Millionen Arbeitnehmern war die Beschäftigung von Nachwuchskräften in Unternehmen, die generative KI eingeführt haben, etwa 9% niedriger als in Nicht-Adoptern sechs Quartale nach der Einführung, wiederum durch langsamere Einstellungen statt durch Trennungen (Hosseini & Lichtinger, 2026). In der gesamten Wirtschaft stellt das Yale Budget Lab immer noch keine klaren Anzeichen fest, dass KI-exponierte Berufe schlechter abschneiden als vergleichbare nicht-exponierte (Yale Budget Lab, 2026), sodass der Druck an der Anfängerebene liegt, nicht im Beruf als Ganzes. Arbeitgeber erwähnten KI bei 101.743 angekündigten Stellenabbau in der ersten Hälfte von 2026, etwa 23% aller angekündigten Kürzungen (Challenger, Gray & Christmas, 2026).
Die Bildung verändert sich ebenfalls. Neue Bachelorabsolventen in Informatik sanken um 13% in den Fachbereichen der Taulbee-Umfrage 2026, die PhD-verleihende Fachbereiche in Nordamerika erfasst; die Autoren beschreiben dies als die ersten klaren Zeichen einer Schrumpfung in der Rekrutierungspipeline neben Rekordabschlussquoten (Computing Research Association, 2026). Ein Feldexperiment mit 673 deutschen IT-Lehrlingen zeigte Verbesserungen von 26 bis 31 Prozentpunkten bei Aufgaben außerhalb ihrer formalen Ausbildung, wenn sie KI zur Verfügung hatten (Stanford Digital Economy Lab, 2026b). Das gemeinsame Rahmenwerk der OECD und der Europäischen Kommission vom Juni 2026 enthält eine Domäne namens „Manage AI" (OECD & European Commission, 2026).
Tabelle A1 (Anhang F) listet zehn Signale dieser Konvergenz mit ihren Quellen auf und zeigt für jedes, was es zeigt und was es nicht zeigt. Zusammen gelesen zeigen sie auch, wo die Messung fehlt: Anbieter-Daten über Nicht-Entwickler in Coding Agents zeigen Wachstum, nicht die Qualität ihrer Ergebnisse. Die Nähe der Berufe in verifizierten Erfolgsproblemen betrifft den Beruf, nicht den Grad. Umbenannte Karriereleitern und Umfragensegmente sind Titel, keine Messgrößen. Und die schwächere Anfängerebene wird nicht gezeigt, dass sie durch KI verursacht wird.
Diese Signale zeigen mit einiger Sicherheit, dass die Festlegung und Annahme von agent work nun auf beiden Seiten der alten Grenze erfolgt, und dass Arbeitgeber, Schulen und Anbieter begonnen haben, Dinge umzubenennen. Machen Personen außerhalb der Softwareentwicklung diese Arbeit genauso gut wie Programmierer? Die Signale lassen das offen, und sie zeigen auch kein Maß dafür. Abschnitt 5 schlägt das Maß vor, Abschnitt 11 datiert die Frage der Qualität, und Abschnitt 12 legt die Beweise dar, die die Vorhersagen überwinden müssen.
Die Beweise von 2026 trennen Personen, die zeigen können, dass ein Ergebnis richtig ist, von Personen, die das nicht können. Eine Programmierausbildung ist eine Route zu dieser Fähigkeit. Beherrschung eines Feldes, eine Überprüfungsgewohnheit und Werkzeuge zur Überprüfung sind weitere, und die Daten aus Abschnitt 2.2 deuten darauf hin, dass sie öfter für die erste eintreten können, als die alten Leitern annehmen, obwohl nicht noch, dass sie es immer können. Das Maß aus Abschnitt 5 wird gebaut, um diese Aussage zu prüfen.
3. Namen im Umlauf: eine datierte Karte
3.1 Warum ich keinen Namen wähle
Alle paar Wochen im Jahr 2026 schlugen ein Unternehmen oder ein Berater, manchmal auch ein Magazin, einen Namen für die hier beschriebenen Personen vor, und einige dieser Namen werden sich durchsetzen. Da der Sprachgebrauch unsicher ist, tue ich zwei Dinge statt einen Namen zu empfehlen: Ich kartografiere die Namen, die bereits im Umlauf sind, einschließlich derjenigen, die vergeben sind, dokumentiere, wer jeden eingeführt hat, wann und in welchem Sinne, und biete ein Maßstab an, anhand dessen jeder von ihnen gelesen werden kann. Wenn „builder" gewinnt, liest sich der Eintrag „builder at Week"; wenn „agent manager" gewinnt, liest sich der Eintrag „agent manager at Day". Priorität wird für das Maßstab, die Leiter, die Definitionen und die Vorhersagen beansprucht, einschließlich der Begriffe, die sie benennen (verified delegation horizon, amplification gain, credential crossover point), und nicht für einen Rollennamen; die in Abschnitt 3.3 hinzugefügten Rollennamen werden als Kandidaten ohne Priorität angeboten.
3.2 Sechs Schichten
Die Kandidaten konkurrieren nicht alle um einen Platz. Einige benennen eine Fähigkeit, die fast jeder haben wird, andere einen Beruf, ein Maßstab, einen Moment, einen Partner oder ein Signal, das fehlgeschlagen ist. Tabelle A2 (Anhang F) listet die bereits in Gebrauch befindlichen Namen mit ihren Urhebern auf, und im zweiten Teil die in dieser Studie vorgeschlagenen oder hier nur als einfache Beschreibungen verwendeten Namen, zusammen mit Varianten, die in Betracht gezogen und beiseite gelegt wurden, damit ein Leser die ganze Familie sehen kann. Abbildung 2 ordnet die Namen nach Schicht und nach dem Datum ihrer Einführung.
Abbildung 2. Namen im Umlauf, nach Schicht und nach dem Datum ihrer Einführung.
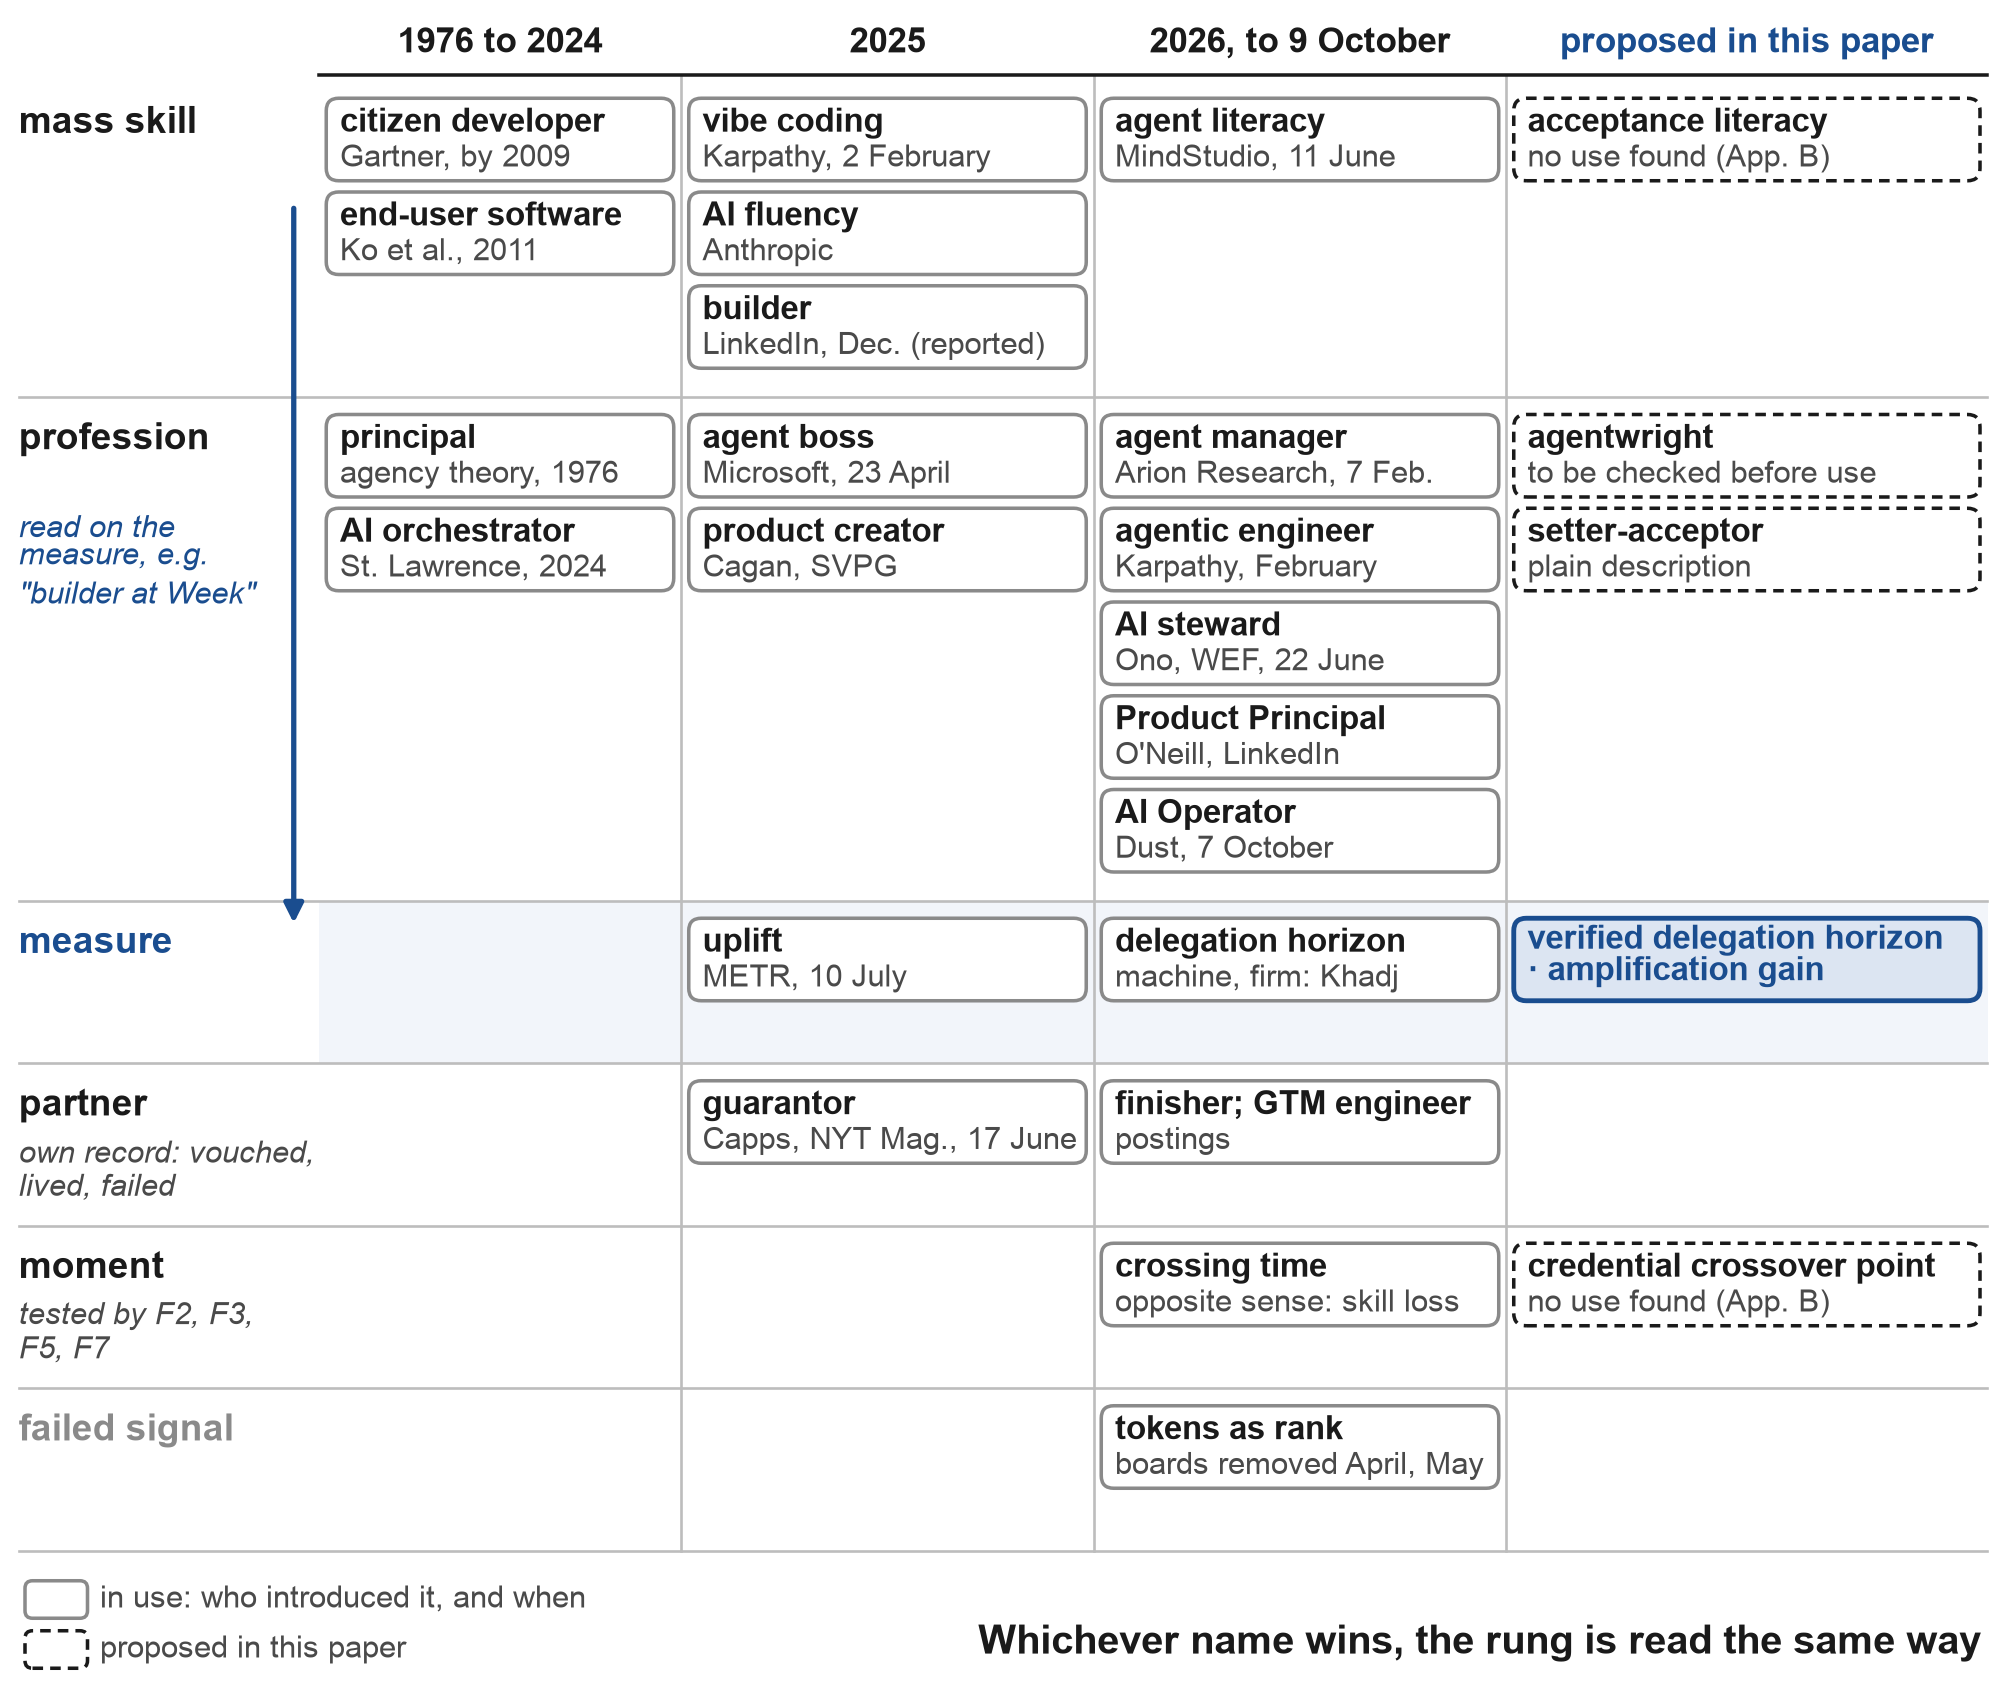
Anmerkung: Urheber und Daten folgen Tabelle A2. Ein Name, dessen Quelle nur ein Jahr angibt, trägt keinen Monat. Die Abbildung ist eine Auswahl; Tabelle A2 listet jeden Kandidaten auf. Nur die Massenfähigkeits- und Berufsschichten werden anhand des Maßstabs gelesen („builder at Week", „agent manager at Day", Abschnitt 3.1). Der Partner hat einen eigenen Eintrag, wie viele Produkte befürwortet wurden, wie lange jedes existierte und wie viele fehlgeschlagen sind (Abschnitt 7.2), und der Moment ist keine Sprosse, sondern wird durch datierte Vorhersagen F2, F3, F5 und F7 getestet (Abschnitt 11.2). „Delegation horizon" in der Maßstab-Reihe ist der Maschinen- oder Firmensinn (Khadj, 2026; Alonso, 2026), nicht das persönliche Maßstab von Abschnitt 5. Die Abbildung enthält kein Urteil darüber, welcher Name sich durchsetzen wird.
3.3 Anmerkungen zur Karte
„Builder" gewinnt wahrscheinlich in der Massen-HR: LinkedIn hat es übernommen, und Journalisten schrieben 2026, dass nun jeder im Silicon Valley ein builder ist (SF Standard, 2026). Es gibt keinen Grund, das Wort zu bekämpfen, da es nichts über Niveau aussagt und das Niveau ist das, was der Maßstab liefert.
Die Managementnamen (agent manager, KI-Operator, orchestrator) sind horizontal: Sie beschreiben die Verwaltung von Agenten allgemein, in keinem bestimmten Bereich. Abschnitt 6.3 gibt den Grund an, warum zu erwarten ist, dass sie dem prompt engineer folgen, einem Titel, der 2023 überall verbreitet war und 2025 als veraltet bezeichnet wurde (Fortune, 2025; TechRepublic, 2025).
„Principal" hat die stärkste Theorie dahinter und die schlechtesten Kollisionen. In der Agenturtheorie ist der principal die Partei, die delegiert und die Kosten der Überwachung trägt (Jensen & Meckling, 1976), und Anthropics Verfassung für ihre Modelle nennt „principals" diejenigen, in deren Namen das Modell handelt (Anthropic, 2026b). Verheul (2026) argumentiert, dass wenn Maschinen die Agenturfunktion erfüllen, Personen in einem Unternehmen nur principal-Positionen halten und die Karriereleiter verschwindet. Ich akzeptiere die Diagnose und schlage eine neue Leiter an ihrer Stelle vor. In Identitäts- und Zugriffsverwaltung benennt „agent principal" jedoch die eigene Identität des Agenten, das Gegenteil des beabsichtigten Sinns, daher sollte die englische Phrase „Agent Principal" nicht für eine Person verwendet werden. O'Neills „Product Principal" ist ein Präzedenzfall in fast diesem Sinne und wird als solcher zitiert, und JetBrains' AIDEs-Rahmen beschreibt bereits Entwickler-Ebenen als Eigenschaften einer principal-agent-Beziehung (Tikhomirov, 2026).
Die hier vorgeschlagenen Namen (agentwright, setter-acceptor, agent director) werden der Familie als Kandidaten hinzugefügt, keiner von ihnen ein Favorit. Agentwright ist in den durchsuchten wissenschaftlichen Datenbanken frei, aber Suchmaschinen teilen es in „Agent Wright" auf, es klingt wie ein Browser-Test-Tool, das Entwickler kennen, und bis Oktober 2026 wurde das Wort bereits für ein Python-Paket und einen Katalog von Agent-Fähigkeiten verwendet, daher bleibt es eine Variante, die einen Qualifizierer benötigen würde.
Eine Beobachtung zur Bedeutung kann ohne Entnahme der Wahl aus dem Markt aufgezeichnet werden. Der Bedeutung nach liegt „principal" dem Beruf von Abschnitt 8 am nächsten, Arbeit für andere mit Verantwortung für das Ergebnis, und „builder" liegt dem Massenskill am nächsten, Arbeit für sich selbst.
4. Warum ein Maßstab: das Jahr, in dem Token als Erfahrungskriterium erprobt wurden
Der Markt wartete nicht auf eine Skala. 2026 erprobte er mehrere, und da sich die Episoden in ihrer Art unterscheiden, werden sie hier in der Reihenfolge ihres Auftretens getrennt behandelt.
Bei Meta entwickelte ein Mitarbeiter ein internes Dashboard mit dem Spitznamen „Claudeonomics", das etwa 85.000 Kollegen nach verbrauchten Token rangierte – mehr als 60 Billionen in dreißig Tagen (Shopifreaks, 2026a). Es war ein Projekt eines einzelnen Mitarbeiters ohne offiziellen Status und wurde im April nach einer Meldung außerhalb des Unternehmens abgeschaltet. Metas offizielle Position entwickelte sich getrennt. Ab Februar war KI-Nutzung ein formaler Teil der Mitarbeiterbewertung, und Anfang September berichteten WIRED und CIO über neue Richtlinien, wonach Meta „wird keine KI-Adoptions-Dashboards oder Token-Zählungen zur Bewertung der Leistung nutzen" und das Label „AI Native" als Kriterium fallen ließ (CIO, 2026b; Shopifreaks, 2026b). Bei Amazon wurde eine Rangliste der Token-Nutzung durch leere Aufgaben manipuliert und im Mai entfernt (CIO, 2026a) – das ist Goodharts Gesetz in seiner reinsten Form: sobald das Maß zum Ziel wird, hört es auf zu messen. Der Fall Uber ist ein Budgetereignis. Das Unternehmen gab sein jährliches KI-Budget in vier Monaten aus und begrenzte Mitarbeiter auf 1.500 Dollar pro Monat (Fortune, 2026b). Im Juli sagte der Geschäftsführer von Cognition, Unternehmen sollten Produktivität messen, nicht KI-Nutzung (Fortune, 2026c).
Die Gegenbeispiele sind ebenso wichtig. Shopify fügt Fragen zur KI-Nutzung seinen Leistungs- und Peer-Bewertungen hinzu (Shopify, 2026), und ein Kommentator erwartet, dass Token-Metriken „herabgestuft, nicht abgeschafft" werden (Kingy AI, 2026). Fragen danach, wie eine Person KI nutzt, sind etwas anderes als eine Rangfolge nach Volumen, und Vorhersage F8 in Abschnitt 11 unterscheidet sie.
Die in Abschnitt 9 untersuchten Entwickler-Threads zeigen denselben Instinkt bei einzelnen Personen. Sie stellen sich vor mit Eingaben: eine monatliche KI-Rechnung von 1.148 Dollar, ein Screenshot eines Abonnements, etwa 330 von etwa 600 abgeschlossenen Pull Requests (eine im Thread als sehr ungefähr beschriebene Einheit), 36 Schritte in drei Tagen aufgebaut. Einer von ihnen veröffentlichte die Einsparungen, die sein Agent für ihn berechnet hatte, ohne die Berechnung zu überprüfen – das ist die Token-Episode, die von einer Person wiederholt wird. Jede dieser Angaben zählt, was ausgegeben oder produziert wurde; was akzeptiert wurde, von wem und nach welcher Prüfung, bleibt unaufgezeichnet.
Ich ziehe eine direkte Lehre für das Maß: zähle Arbeit, und nur Arbeit, die eine Prüfung bestanden hat, die die Agenten nicht sahen. Übereinstimmung zwischen Modellen derselben Familie kann diese Prüfung nicht sein, da ihre Fehler korreliert sind und ihre Übereinstimmung weniger unabhängige Meinungen wert ist, als sie aussieht (Chernets, 2026b). Mehr Token auszugeben kann ein auf diese Weise aufgebautes Maß nicht aufblähen, da nicht akzeptierte Arbeit nichts dazu addiert. Andere Wege, es aufzublähen, bleiben, und Abschnitt 5.8 führt sie zusammen mit ihren Abwehrmechanismen auf.
5. Das Maß: verifizierter Delegationshorizont und Verstärkungsgewinn
5.1 Referenzstunden
Beide Achsen verwenden eine Einheit, die Referenzstunde: die Zeit, die ein qualifizierter Spezialist benötigen würde, um dieselbe Arbeit von Hand zu erledigen. Die Referenz ist bewusst extern. Ob die Person die Arbeit selbst hätte erledigen können, spielt für das Maß keine Rolle, und auch ihr Hintergrund nicht. Ein Buchhaltungs-Abstimmungstool und ein Abrechnungsmodul eines Entwicklers werden beide danach gemessen, welche Zeit ein kompetenter Fachmann dafür aufgewendet hätte.
Referenzstunden stammen aus einer von zwei Quellen. Die eine ist ein gefrorenes Archiv von Aufgaben, deren manuelle Zeiten 2025 und 2026 gemessen wurden; GDPval mit Aufgaben aus 44 Berufen und den Zeiten ihrer Experten zeigt, dass sich ein solches Archiv aufbauen lässt (Patwardhan et al., 2025). Die andere sind zwei unabhängige Bewerter, die die Stunden schätzen, ohne zu wissen, wer die Arbeit erledigt hat; wenn die Bewerter in einem Bereich zu weit auseinander liegen, kann die Referenz stattdessen der Median eines kalibrierten Panels von fünf bis neun Bewertern sein, bewertet nach Stufe (Anlage G2). Ich friere das Archiv bewusst ein, wie das Urmeter einst in einem Tresor bei Paris aufbewahrt wurde, weil in einigen Jahren nur noch wenige Menschen diese Aufgaben von Hand erledigen werden und es nichts mehr zum Vergleichen geben wird. Das Archiv sollte für jede Domäne Aufgaben auf jeder Stufe enthalten, jeweils mit einer schriftlichen Erklärung, was als erledigt zählt, gemessene manuelle Zeiten, die versteckten Kontrollen und einige gepflanzte Fehler, deren Entdeckung Teil der Annahme ist. GDPvals manuelle Zeiten sind verifizierte Selbstberichte von Experten, während seine Überprüfungszeiten gemessen wurden, was der Standard ist, den ein Archiv erfüllen oder verbessern sollte. Um zu vermeiden, dass sich das Maß selbst beurteilt, wird der Horizont anhand eines Aufgabensatzes bewertet und die Qualität, die zum Testen von Hypothesen darüber verwendet wird (Abschnitt 6), anhand eines anderen.
5.2 Der verifizierte Delegationshorizont
Definition. Der verifizierte Delegationshorizont einer Person in einer Domäne ist die größte Arbeitsmenge in Referenzstunden, in der die Person regelmäßig Arbeiten an Agenten übergibt, diese annimmt und durch eine unabhängige Kontrolle bestätigt, die die Agenten nicht gesehen haben.
Die Regel in einem Absatz. Ein delegiertes Werk zählt als verifiziert und trägt zum Horizont bei, nur wenn alle folgenden Bedingungen erfüllt sind. Es wurde mit einer schriftlichen Erklärung festgelegt, was als erledigt zählt, und seine Referenzstunden stammen aus dem Archiv oder von zwei Bewertern. Die Person akzeptierte es als eine kohärente Lieferung: einen Monat Arbeit in 160 EinStunden-Tickets aufgeteilt ist 160 Stunden, während in Etappen durchgeführte und als Ganzes akzeptierte Arbeiten vollständig zählen, nach den Referenzstunden dieses Ganzen. Eine unabhängige Kontrolle bestätigte es, und eine Kontrolle ist unabhängig, wenn sie sich von den Agenten in Daten unterscheidet (Eingaben, die die Agenten nicht produzierten), in Zugriff (die Agenten konnten sie nicht sehen oder bearbeiten) und in Anreizen (wer sie durchführt, gewinnt nichts bei einer Bestätigung). Vier Arten zählen: versteckte Akzeptanztests, ein qualifizierter menschlicher Prüfer, echte Nutzung durch die beabsichtigten Benutzer oder ein KI-Modell einer anderen Familie, das gegen Quellen verifiziert, die die Person offengelegt hat, und ein nachprüfbares Ergebnis liefert. Selbstüberprüfung und Übereinstimmung zwischen KI-Modellen einer Familie zählen nicht, weil ihre blinden Flecken mit den eigenen der Agenten zusammenfallen. Innerhalb des Zeitfensters der Stufe (91 Tage bei Stunde und Tag, 182 bei Woche, 365 bei Monat und Quartal) akzeptierte die Person die erforderliche Anzahl von Werken mindestens dieser Größe, zehn bei Stunde und Tag, sechs bei Woche und Monat und drei bei Quartal, und mindestens acht von zehn bestanden, was fünf von sechs bei Woche und Monat und alle drei bei Quartal bedeutet. Von Woche aufwärts muss mindestens ein dieser Werke gepflanzte Fehler enthalten. Ein übersehener gepflanzter Fehler blockiert von Woche aufwärts für dieses Fenster die Stufen, und das Werk mit ihm zählt weder für eine Stufe noch für einen Verstärkungsgewinn. Wenn ein Fehler nicht rückgängig gemacht werden kann (Geld bewegt, ein Patientenakte, eine Anmeldung, die nicht zurückgezogen werden kann), muss jedes solche Werk bestehen, mit einem versteckten Test oder einem qualifizierten Menschen als Standard-Kontrolle und einem KI-Modell einer anderen Familie als zweite Linie, und die strengere Regel gilt nur für diese Werke. Jede Übergabe wird protokolliert, Ausfälle und abgebrochene Werke eingeschlossen, mit der Aufmerksamkeit, die sie brauchten. Die Stufe wird jedes Quartal erneut bestätigt: bei Woche und höher muss mindestens ein verifiziertes Werk der Größe der Stufe in die letzten 91 Tage fallen, sodass ein Horizont nicht auf Werken ruhen kann, die nahe einem Jahr alt sind. Die folgenden Absätze geben die Gründe für jeden Teil an.
Bewertungsregel. Innerhalb des für jede Stufe festgelegten Zeitfensters (91 Tage für Stunde und Tag, 182 für Woche, 365 für Monat und Quartal) zählt eine Stufe, wenn die Person die erforderliche Anzahl von Werken mindestens dieser Größe in der Domäne akzeptiert hat (zehn für Stunde und Tag, weniger darüber, wie unten festgelegt), und mindestens acht von zehn bestanden eine Kontrolle einer dieser Arten: versteckte Akzeptanztests, ein qualifizierter menschlicher Prüfer, echte Nutzung durch die beabsichtigten Benutzer oder ein KI-Modell einer anderen Familie, das gegen Quellen verifizierte. Selbstüberprüfung und Übereinstimmung zwischen KI-Modellen einer Familie zählen nicht. Wenn Fehler nicht rückgängig gemacht werden können (Geld bewegt, eine Patientenakte, eine Anmeldung, die nicht zurückgezogen werden kann), muss jedes solche Werk bestehen, und der strengere Schwellenwert gilt nur für diese Werke. Für diese Werke ist die Standard-Kontrolle ein versteckter Test oder ein qualifizierter Mensch, mit einem KI-Modell einer anderen Familie als zweite Linie.
Obere Stufen. Eine einzelne Anzahl von zehn würde die oberen Stufen für jeden unerreichbar machen, da zehn Werke von 40 Referenzstunden in drei Monaten 400 Stunden der Arbeit eines Spezialisten sind, und zehn Werke von 500 Stunden sind 5.000. Die Regel verlängert daher das Zeitfenster und senkt die Anzahl, wenn die Stufe steigt: zehn Werke in 91 Tagen für Stunde und Tag, sechs in 182 Tagen für Woche, sechs in 365 Tagen für Monat und drei in 365 Tagen für Quartal, mit demselben Anteil von acht zu zehn (was fünf von sechs bei Woche und Monat und alle drei bei Quartal bedeutet). Eine frühere Version forderte vier von vier bei Monat; der Schreibtischtest in Anlage E zeigte, dass dies Monat schwerer zu verdienen machte als Quartal für eine Person jeglicher Zuverlässigkeit, und die Anzahl wurde geändert. Von Woche aufwärts muss mindestens ein Werk der Größe der Stufe im Fenster gepflanzte Fehler enthalten. Jeder gepflanzte Fehler, den die Person übersieht, blockiert von Woche aufwärts für dieses Fenster die Stufen, und ein Werk mit einem übersehenen gepflanzten Fehler zählt nicht als verifiziert, weder für eine Stufe noch für einen Verstärkungsgewinn. Quartal soll eine seltene Stufe bleiben, und die obigen Anzahlen sind so festgelegt, dass dies der Fall ist.
Jede Übergabe wird protokolliert. Das Protokoll erfasst jedes Stück, das an Agenten übergeben wird, einschließlich derjenigen, die die Überprüfung nicht bestanden haben, und derjenigen, die vor der Überprüfung aufgegeben wurden, und nur ein als eine zusammenhängende Lieferung akzeptiertes Stück zählt für eine Sprosse. Ein Monat Arbeit, aufgeteilt in 160 einstündige Tickets, sind 160 Stunden, nicht ein Monat: Referenzstunden werden für die Lieferung geschätzt, die der Benutzer, der Auftraggeber oder der Prüfer als Ganzes akzeptiert, im Geist von METRs zusammenhängenden Aufgaben. Das Umgekehrte gilt auch: Arbeit, die in Etappen ausgeführt und als eine zusammenhängende Lieferung akzeptiert wird, zählt ganz, nach den Referenzstunden dieser Lieferung, unabhängig davon, wie viele Etappen es brauchte.
Unabhängigkeit. Eine Überprüfung ist unabhängig, wenn sie sich von den Agenten in den Daten unterscheidet (sie verwendet Eingaben, die die Agenten nicht produziert haben), im Zugang (die Agenten konnten sie nicht sehen oder bearbeiten) und in den Anreizen (wer sie durchführt, profitiert nicht von einem erfolgreichen Ergebnis). Ein Modell aus einer anderen Familie bringt Vielfalt bei den Fehlern. Es zählt nur, wenn es gegen Quellen überprüft, die die Person geöffnet hat, und sein Urteil ist eine Eingabe, die überprüft werden kann.
Ein Stück Arbeit verfolgt diesen Weg (Abbildung 3). Eine Aufgabe wird mit einer schriftlichen Aussage darüber festgelegt, was als erledigt zählt. Die Referenzstunden werden aus der Datenbank oder von zwei Bewertern entnommen. Agenten führen die Arbeit durch, während die Person Aufmerksamkeit aufwendet, die protokolliert wird. Die Person akzeptiert, lehnt ab oder gibt das Stück auf, eine unabhängige Überprüfung bestätigt oder widerlegt, und die Zeile des Protokolls wird in diesem Moment geschrieben, wobei das Startdatum als separates Feld beibehalten wird, wo es relevant ist. Wenn ein verzögertes Ergebnis existiert (eine akzeptierte Einreichung, eine Veröffentlichung, die noch nach einem Monat läuft), wird es erfasst, wenn es eintrifft. Der Horizont und der Gewinn werden aus diesen Aufzeichnungen mit einem Datum berechnet.
Abbildung 3. Ein Stück Arbeit, ein Datensatz.
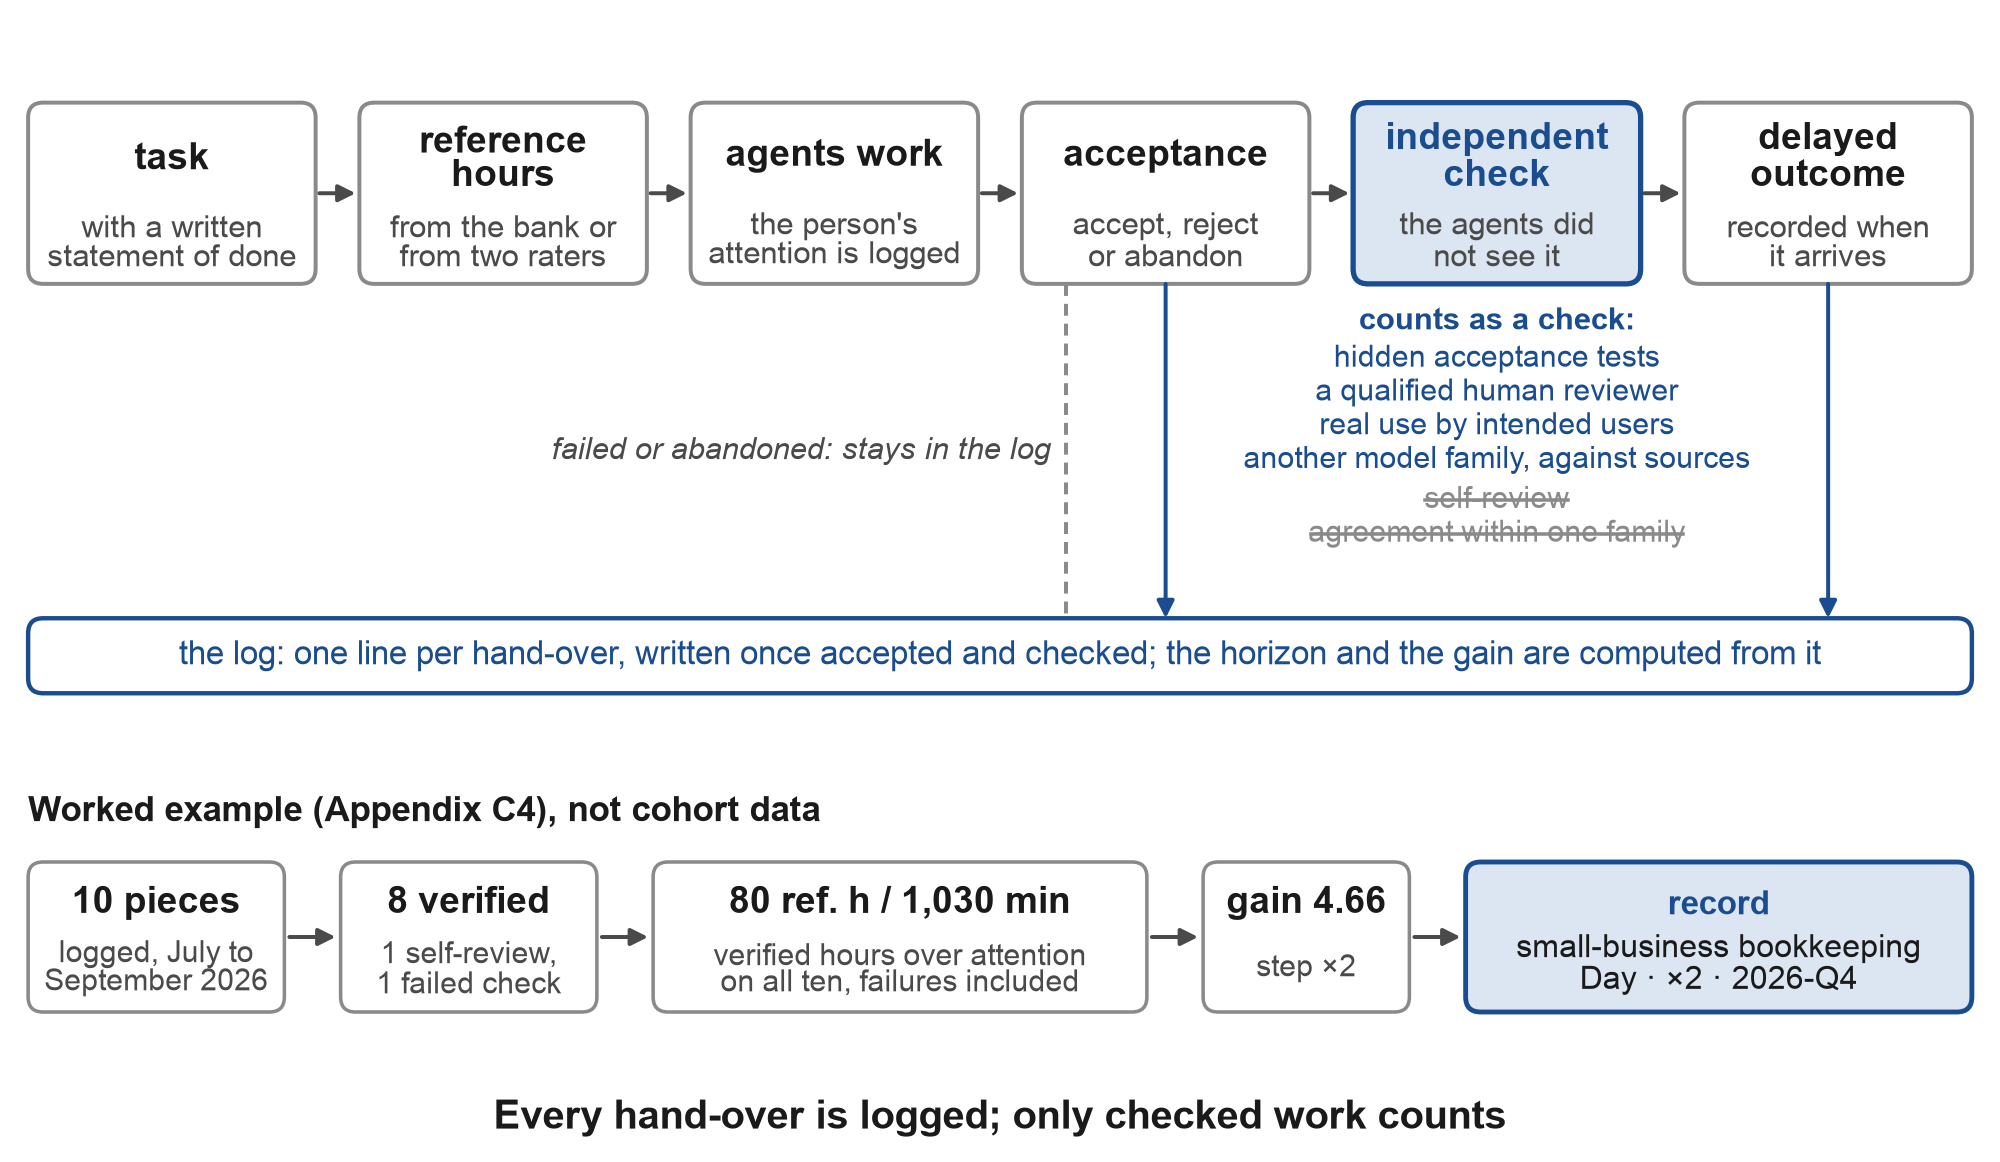
Anmerkung: Die obere Reihe ist der Weg aus Abschnitt 5.2. Die vier Arten unabhängiger Überprüfung sind die der Bewertungsregel. Selbstüberprüfung und Übereinstimmung zwischen Modellen einer Familie zählen nicht. Fehlgeschlagene und aufgegebene Stücke bleiben im Protokoll und addieren ihre Minuten zum Nenner des Verstärkungsgewinns. Die untere Reihe ist das durchgearbeitete Beispiel aus Anhang C4, ein konstruiertes Protokoll, keine Kohortendaten: zehn Stücke, acht überprüft, 80 Referenzstunden gegen 1.030 Minuten Aufmerksamkeit, ein Gewinn von 4,66 (Schritt ×2) und der Datensatz „small-business bookkeeping · Day · ×2 · 2026-Q4".
Erneute Überprüfung. Ein Horizont wird jeden Monat erneut bestätigt. Anthropics Paradoxon der Beaufsichtigung (Abschnitt 2.1) erklärt warum: Ein Horizont, der erreicht wird, während die Überprüfungsfähigkeit nachlässt, ist geliehen, und eine monatliche Überprüfung zeigt, ob er noch hält. Für die Sprossen, deren Fenster länger als ein Monat laufen (Woche, Monat und Quartal), hat die Überprüfung eine konkrete Form: Mindestens ein überprüftes Stück der Größe der Sprosse muss in den letzten 91 Tagen fallen, damit sich eine Sprosse nicht auf Stücke stützen kann, die fast ein Jahr alt sind.
5.3 Die Leiter
Ich benenne die fünf Sprossen in Zeiteinheiten, weil Zeiteinheiten zwischen Berufen keine Übersetzung benötigen, aus Protokollen gelesen werden können und mit der Technologie wachsen, ohne umbenannt zu werden. Tabelle 1 gibt sie mit Beispielen und den Zählungen an, die jede benötigt.
Tabelle 1. Die Leiter des verifizierten Delegationshorizonts.
| Sprosse | Umfang der übergeben und verifizierten Arbeit | Beispiel in der Software | Beispiel anderswo | Benötigte verifizierte Stücke, Fenster |
|---|---|---|---|---|
| Stunde | Etwa 1 Referenzstunde | Ein Skript, eine kleine Reparatur | Antworten aus einem Dokumentenstapel | 8 von 10 in 91 Tagen |
| Tag | Etwa 8 | Eine Funktion, ein kleines internes Tool | Ein Monatsabschlussbericht mit seinen Überprüfungen | 8 von 10 in 91 Tagen |
| Woche | Etwa 40 | Eine Website oder ein internes Tool nach Spezifikation mit nächtlichen Durchläufen | Ein vollständiges Due-Diligence-Paket, ein Kampagnensystem | 5 von 6 in 182 Tagen |
| Monat | Etwa 160, normalerweise in mehreren Streams | Eine Produktveröffentlichung; Akzeptanzregeln, nach denen andere arbeiten | Die Werkzeuge einer Praxis, mit Regeln, die Kollegen anwenden | 5 von 6 in 365 Tagen |
| Quartal | Etwa 500 | Eine Produktlinie mit Live-Benutzern | Eine Servicegruppe, die durch Agenten betrieben wird | 3 von 3 in 365 Tagen |
Anmerkung: Eine Sprosse wird nur nach der Bewertungsregel von Abschnitt 5.2 verdient, separat in jeder Domäne, mit den Zählungen der Regeln v1.1 (Anhang E). Keine Bewertung auf einer alten Leiter verleiht eine Sprosse, und eine Person kann auf Woche in Finanztools und auf Tag in Webanwendungen sein.
Der Datensatz für einen Lebenslauf oder eine HR-Datei enthält die Domäne, den Horizont, die Verstärkung und das Datum, zum Beispiel „small-business bookkeeping · Day · ×2 · 2026-Q4". Das Datum gehört in den Datensatz, weil dieselbe Sprosse ein Jahr später, wenn sich die Technologie weiterentwickelt, etwas anderes bedeutet.
5.4 Verstärkungsgewinn
Nicht jeder, der gut mit Agenten arbeitet, gibt ihnen große Stücke. Einer der Entwickler in Abschnitt 9, der mit vier Maschinen arbeitet, beschreibt drei davon als „einen Schub persönlicher Effizienz" ohne autonomen Agenten darauf. Die autonomen Agenten, die er auch betreibt, „nahmen keine Form an" für tägliche Arbeit, schreibt er, und er bevorzugt „Schub, keine Delegation" (übersetzt). Sein längster Fluss verlief über 36 Etappen über drei Tage, jede Etappe übergeben und bestätigt, dann wurde der Agent gebeten zu bestätigen, dass alles bereitgestellt wurde. Nach der Regel von Abschnitt 5.2 ist diese Bestätigung Selbstüberprüfung, daher zeigt sein Datensatz wie veröffentlicht keine verifizierte Sprosse überhaupt, und der Thread gibt keine Zahlen für seinen Gewinn an. Wo er mit einer unabhängigen Überprüfung stünde, hängt davon ab, was akzeptiert wurde. Wenn die 36 Etappen als eine zusammenhängende Lieferung akzeptiert wurden, zählt der Fluss ganz, nach seinen Referenzstunden, wie die gestaffelte Arbeit von Anhang C, Abschnitt C4, es tut. Wenn jede Etappe für sich selbst akzeptiert wurde, ist jede ein kleines Stück und er steht auf der ersten Achse auf Stunde. Der Beitrag sagt nicht, welches. Doch er erstellt Tools, die Software ersetzen, die er früher kaufen musste, und er benennt den Nenner der zweiten Achse selbst, wenn er Zeit als einzigen Engpass bezeichnet.
Er ist keine Ausnahme. Anthropic berichtete, dass Nutzer mit sechs Monaten oder mehr Erfahrung „viel weniger geneigt waren, größere Verantwortung durch direktive Nutzungsmuster zu delegieren", iterativer mit dem Modell arbeiteten und schwierigere Aufgaben einbrachten, mit einem Erfolg drei bis fünf Punkte höher nach Kontrollen (Anthropic, 2026d). In Claude.ai führte kollaborative Nutzung Automation 52% zu 45% im November 2025 an, und Gespräche waren erfolgreicher als einmalige programmatische Anfragen, 67% gegen 49% (Anthropic, 2026a). Menschen in höher bezahlten Berufen brauchten etwa 1,5-mal so viele Durchläufe, und Frauen automatisierten 7,3 Punkte weniger als Männer im gleichen Beruf (Anthropic, 2026f). In Stanfords Umfrage von 1.500 Arbeitnehmern war die bevorzugteste Anordnung in 47 von 104 Berufen eine gleichberechtigte Partnerschaft zwischen Person und Agent (Shao et al., 2025). Ein Maßstab, der nur auf Delegation basiert, würde daher erfahrenere Nutzer, die höchstverdienenden und Frauen unterrepräsentieren, obwohl nichts in diesen Daten aussagt, dass ihre Arbeit schlechter ist.
Definition. Amplifikationsgewinn ist die Referenzstunden akzeptierter, verifizierter Arbeit geteilt durch die Stunden der Aufmerksamkeit der Person, die daran aufgewendet wurde, in den letzten 91 Tagen in der Domäne, unabhängig vom Fenster der Sprosse der Person. Arbeit mit externer Hilfe (ein Kollege oder Auftragnehmer, der sie außerhalb des Protokolls behebt) wird als solche verzeichnet und trägt nichts zum Zähler bei, während die Minuten der Person daran im Nenner bleiben. Aufmerksamkeit umfasst Planung, Anleitung, Lesen, Prüfung und Behebung. Zeit, die der Agent läuft, während die Person etwas anderes tut, zählt nicht.
Amplifikationsgewinn ist ein verifizierter Durchsatz: akzeptierte, überprüfte Leistung pro Stunde Aufmerksamkeit. Es ist keine kausale Schätzung, wie viel schneller die gleiche Person mit Agenten arbeitet als ohne sie. Ein Gewinn in diesem vergleichenden Sinne braucht einen Ausgangswert, die gleiche Person oder vergleichbare Personen, die die gleiche Art von Arbeit ohne Agenten verrichten, und nur eine vergleichende Studie kann ihn liefern.
Fehlgeschlagene Arbeit trägt nichts zum Zähler bei und alle ihre Minuten zum Nenner, was Selbsttäuschung sichtbar hält. In METRs Versuch 2025 glaubten erfahrene Entwickler, dass KI sie beschleunigt hatte, während Messungen zeigten, dass sie 19% langsamer waren (METR, 2025).
Die Schritte der zweiten Achse sind ×1 („ein Tag für einen Tag"), ×2, ×5 („eine Woche für einen Tag"), ×20 („ein Monat für einen Tag") und ×60 („ein Quartal für einen Tag"). Die beiden Skalen sind unabhängig, so dass ein Schritt auf der einen nicht gleich einer Sprosse auf der anderen ist. Wenn eine Person mehrere Agenten parallel betreibt, wird die Aufmerksamkeit dennoch einmal gezählt, in den eigenen Minuten der Person: eine Stunde, in der man drei Streams beobachtet, ist eine Stunde im Nenner, aufgeteilt auf die einzelnen Teile im Verhältnis zu den gegen jeden protokollierten Minuten. Eine Bewertung wird zusammen mit der Einstellung gemeldet, die sie erzeugt hat (das Modell und die Tools, die Art der Prüfung und die Sprosse der Aufgaben), da die gleiche Person unter einer strengeren Prüfung unterschiedlich bewertet wird.
5.5 Zwei Achsen, vier Profile und eine Obergrenze
Das Platzieren von Personen auf beiden Achsen ergibt vier Profile (Abbildung 4). Ein Lehrling hat einen kurzen Horizont und einen niedrigen Gewinn. Ein Verstärker hat einen kurzen Horizont und einen hohen Gewinn, wie der Erbauer von 36 Stufen, wenn seine Stufen einzeln akzeptiert würden. Ein Delegator hat einen langen Horizont und einen hohen Gewinn. Das vierte Profil, das ich den Aufseher nenne, ist ein langer Horizont mit niedrigem Gewinn: Die Agenten laufen lange, und Prüfung und Überarbeitung verschlingen den Vorteil, so dass es eher ein Warnsignal als eine Sprosse ist.
Die beiden Achsen sind durch eine Obergrenze verbunden. Aufmerksamkeit wird darauf verwendet, ein Arbeitsstück festzulegen und es zu prüfen. Schreiben Sie H für die Referenzstunden eines Stücks, V für die Stunden der Aufmerksamkeit, die seine Prüfung erfordert, und S für die Stunden, die für das Festlegen aufgewendet werden. Dann ist Gewinn G = H / (S + V + Überarbeitung), und so G ≤ H / V. Wenn allein die Prüfung ein Viertel der manuellen Zeit dauert, kann der Gewinn ×4 nicht überschreiten, egal wie lange der Agent unbeaufsichtigt läuft. Nach der gleichen Obergrenze sind die Schritte ×2, ×5, ×20 und ×60 nur offen, wenn die Prüfung nicht mehr als 50%, 20%, 5% und etwa 1,7% der manuellen Zeit ausmacht (Abbildung 4). Dies ist ein vereinfachtes Modell mit angegebenen Rechnungsgrenzen: Es ignoriert den Wert von Arbeit, die die Person überhaupt nicht hätte tun können, es nimmt an, dass die Prüfungszeit mit dem Stück skaliert, und es gilt pro Stück, so dass eine Person, die kleine Stücke preiswert prüft, die für große Stücke berechnete Obergrenze übertreffen kann. Auf wirtschaftlicher Ebene machen Catalini et al. (2026) den gleichen Punkt: Die bindende Einschränkung wird zur „menschlichen Verifikationsbandbreite", und es öffnet sich eine „Messbarkeitslücke" zwischen dem, was Agenten ausführen können, und dem, was Menschen sich leisten können zu verifizieren.
GDPval zeigt, was die Obergrenze in der Praxis bedeutet. In seiner 220-Aufgaben-Gold-Teilmenge berichteten seine Experten (und die Autoren verifiziert) im Durchschnitt 404 Minuten pro Aufgabe von Hand, und die Überprüfung eines Liefergegenstands dauerte gemessene 109 Minuten, etwa 27%, was die Obergrenze nahe ×3,7 für Aufgaben dieser Art setzt. Die Modelle erstellten ihre Entwürfe 90- bis 327-mal schneller als die Experten. Doch in dem Szenario, in dem eine Person das Modell ausprobiert und dann seine Arbeit korrigiert, ergab die Berechnung der Autoren (keine Messung) für GPT-5 eine Beschleunigung von 1,12, wenn das Modell einmal ausprobiert wird, und 1,39, wenn es mehrmals ausprobiert wird, zwei getrennte Spalten der gleichen Tabelle (Patwardhan et al., 2025). Unabhängig von der Geschwindigkeit des Agenten bestimmt der Preis der Prüfung die Obergrenze, und dieser Preis steigt mit der Sprosse, da ein größeres Stück mehr zu überprüfen kostet. Kamara (2026) nennt diese Kosten Verifikationsreibung. Praktizierende in den Diskussionsfäden von Abschnitt 9 bringen es auf eigene Worte: Über einen bestimmten Punkt hinaus unterscheidet sich die Prüfung von Agenten-Code „immer weniger vom Umschreiben von Hand" und kann länger dauern als das Schreiben selbst (übersetzt).
Der gleiche Gewinn kann auf zwei Wegen erreicht werden. Eine lange Leine übergibt ein großes Stück und prüft es am Ende; kurze, schnelle Schleifen übergeben kleine Stücke und prüfen jedes, wenn es ankommt. Meine Hypothese ist, dass die Prüfung kleiner Stücke unterwegs oft billiger ist als die Prüfung eines großen Ergebnisses am Ende, und Anthropics Daten deuten in diese Richtung. Gespräche waren erfolgreicher als einmalige Anfragen, und nach der eigenen Extrapolation der Autoren würden einmalige Anfragen 50% Erfolg bei Aufgaben von etwa 3,5 Stunden erreichen, während Gespräche es bei Aufgaben von etwa 19 Stunden erreichen würden (Anthropic, 2026a). Der Anteil der kollaborativen Nutzung fiel im August 2025 unter Automation und war bis November wieder vorne, 52% zu 45%. Der Weg mit kurzer Schleife ist dem nahe, was die Literatur zur menschlich-KI-Zusammenarbeit untersucht, und Amplifikationsgewinn würdigt ihn so vollständig wie lange Delegation. Vorhersagen F19 bis F21 in Abschnitt 11 testen den Weg mit kurzer Schleife.
Abbildung 4. Zwei Achsen, vier Profile und die Obergrenzen, die Prüfung setzt.
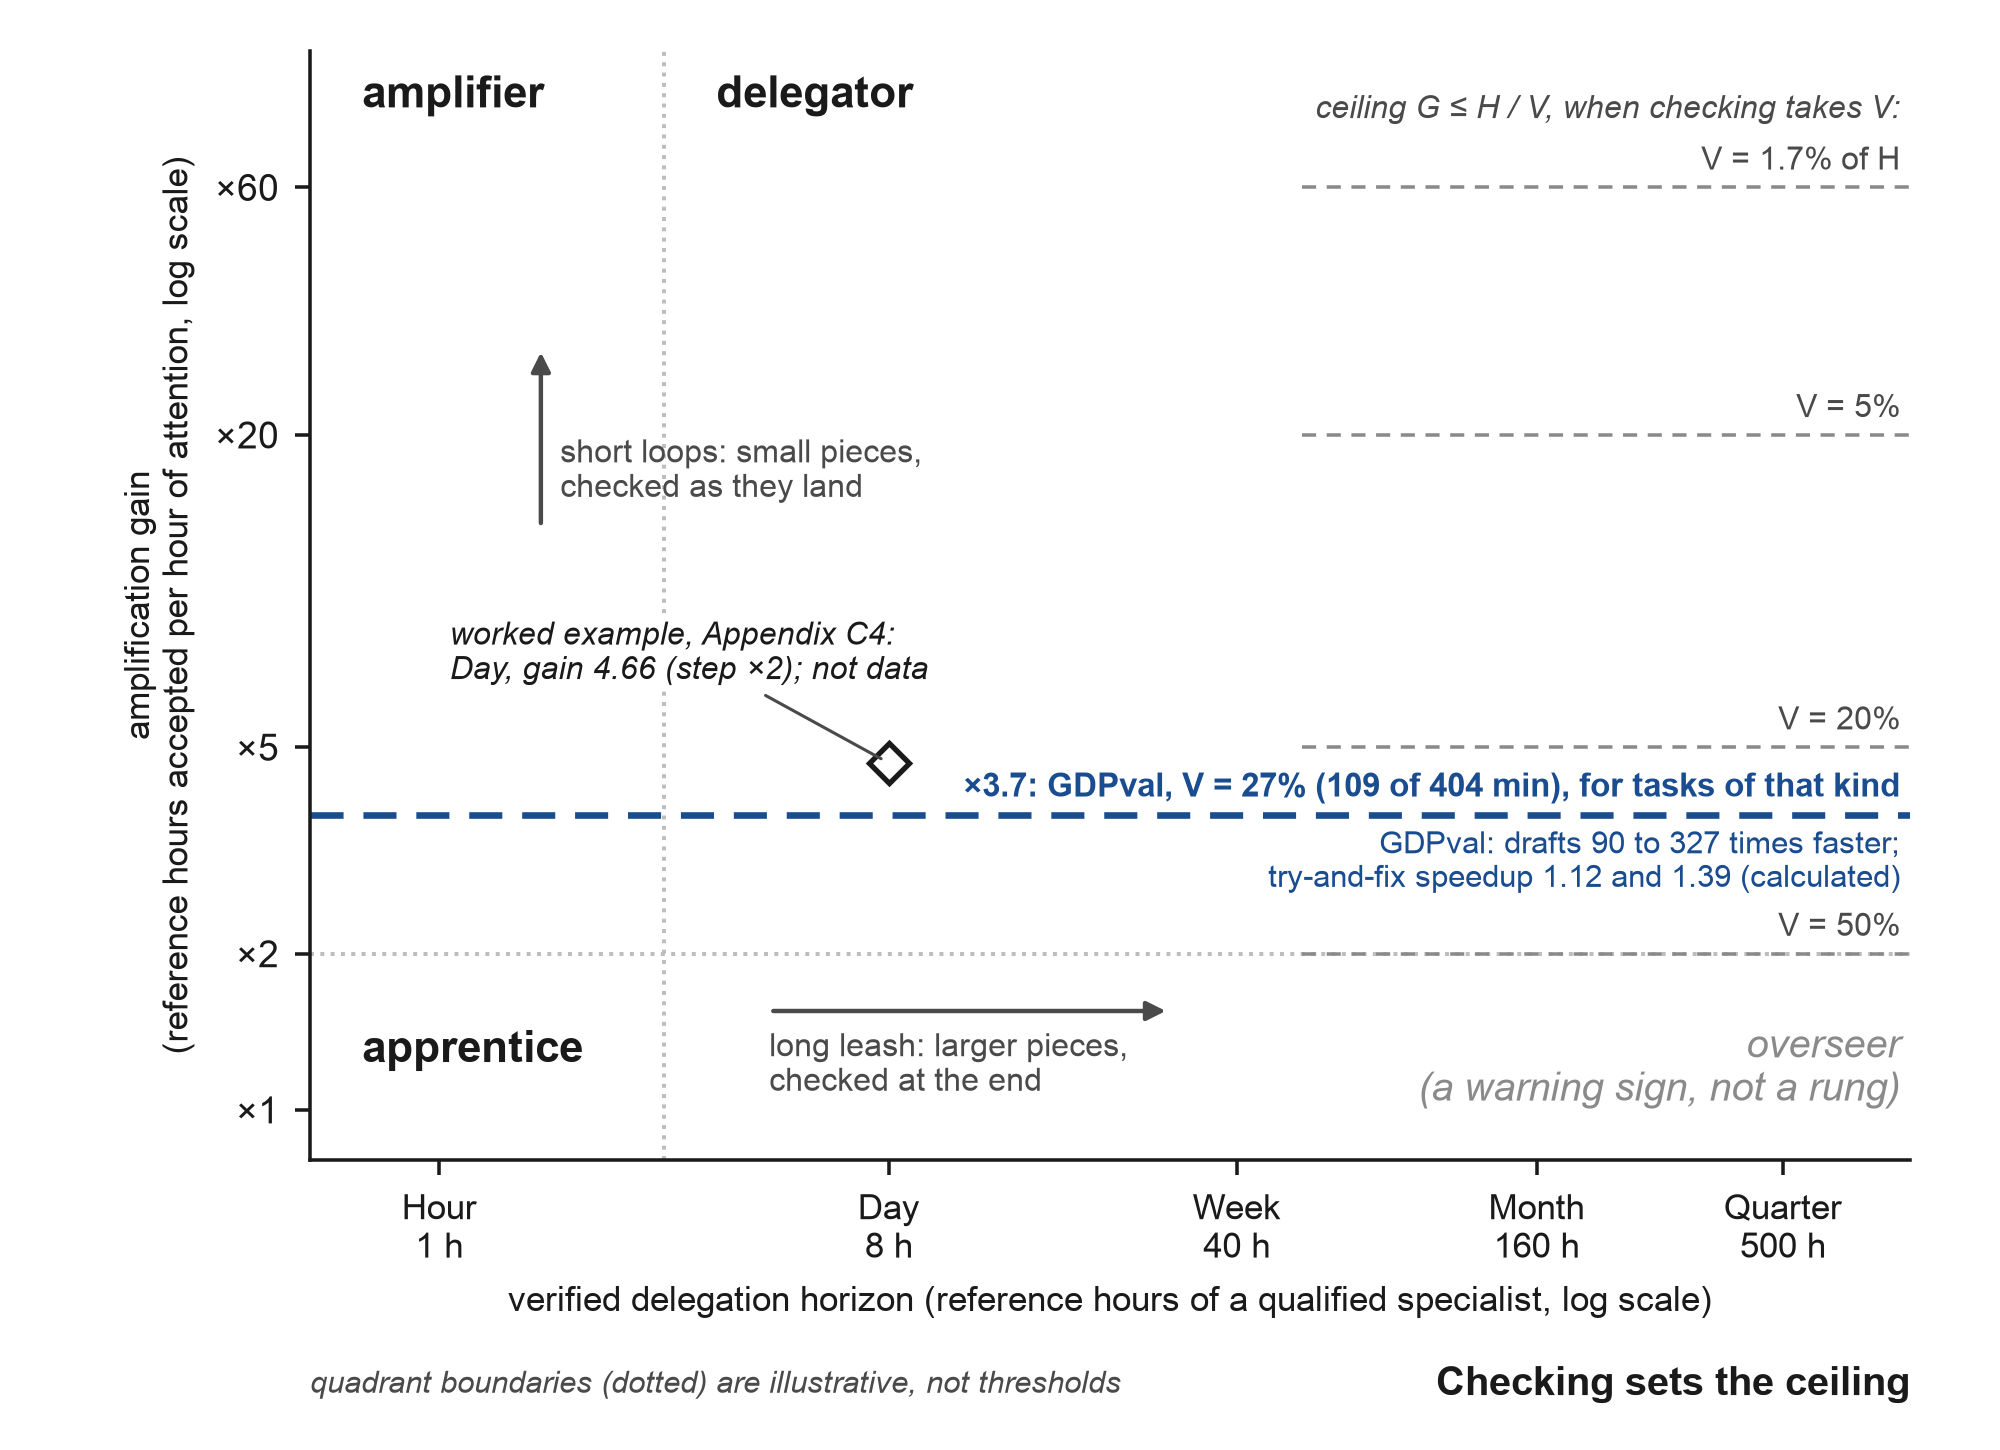
Hinweis: Die Quadranten sind Profile, keine Sprossen, und ihre Grenzen sind illustrativ. Jede graue Linie ist die Grenze G ≤ H / V aus Abschnitt 5.5 für einen gegebenen Anteil der Kontrollzeit V in der manuellen Zeit H. Die Akzentlinie nutzt die Durchschnittswerte von GDPval in seiner 220-Aufgaben-Gold-Teilmenge, 404 Minuten manuell und 109 Minuten Fachbewertung der Modellausgabe (Patwardhan et al., 2025), und gilt für Aufgaben dieser Art. Die Beschleunigungen 1,12 und 1,39 sind eine Berechnung der Autoren, keine Messung. Der Diamant ist das Rechenbeispiel aus Anhang C4, keine Daten. Er liegt über der GDPval-Linie, weil die Obergrenze pro Aufgabentyp berechnet wird, und kleine preiswert überprüfte Teile können eine für große berechnete Obergrenze übertreffen (Abschnitt 5.5). Der Fall von 36 Stufen in Abschnitt 5.4 ist nicht dargestellt: die Anwendung bringt keinen Gewinn und keine unabhängige Kontrolle.
5.6 Woher das Messinstrument stammt und was neu ist
Das Messinstrument hat Vorläufer, und der älteste ist Elliott Jaques, der das Niveau jedes Arbeitsplatzes in jeder Funktion anhand seiner Zeitspanne der Ermessensfreiheit maß: die längste Zeit, die eine Person nach eigenem Urteil arbeitet, bevor jemand das Ergebnis überprüft. Er argumentierte, dass fairer Lohn mit dieser Zeitspanne steigt (Jaques, 1956). Der verifizierte Delegationshorizont trägt die Idee ins Zeitalter von Agenten mit einer Änderung ein. Jaques maß, wie lange eine Person unkontrolliert arbeitet, während dieses Messinstrument zählt, wie viel Arbeit eine Person an Agenten überträgt, akzeptiert und überprüft. Die beiden können auseinandergehen, und seine Schichten, in Monaten und Jahren gezählt, ordnen sich diesen Sprossen nicht zu.
Die Prinzipal-Agent-Theorie ist der zweite Vorläufer. Jensen und Meckling (1976) bewerteten Delegation als Überwachung, Garantie und Residualverlust. Kontrolle ist die Überwachungskosten der Übergabe von Arbeit an einen Agenten, und der Horizont markiert den Punkt, an dem die Kontrolle eines größeren Teils nicht mehr rentabel ist.
METR misst Maschinen auf derselben Achse. Sein Zeithorizont ist die Länge der Aufgabe in menschlichen Stunden, die ein Modell mit einer gegebenen Erfolgsrate erfüllt (Kwa et al., 2025). Im Frühjahr 2026 erreichte das Grenzmodell auf dem Dashboard etwa 17 Stunden bei 50 % Erfolg, obwohl METR selbst warnt, dass Messungen über 16 Stunden mit seinen aktuellen Aufgaben unzuverlässig sind. Der Horizont bei 80 % Erfolg stieg von etwa 1,2 Stunden im Februar 2026 auf etwa 3,1 Stunden im April, zwei Punkte, die das Wachstumstempo zeigen, ohne seine Rate zu messen. Der auf dem Dashboard über Modelle seit 2023 angepasste Trend verdoppelt sich etwa alle 4,2 Monate (128,7 Tage), und das Dashboard war nach dem 8. September 2026 nicht aktualisiert worden, als es zuletzt aufgerufen wurde (METR, 2026c). Die Prognostiker des AI Futures Project arbeiten mit einer Verdoppelungszeit von 4 bis 4,5 Monaten (AI Futures Project, 2026). Akzeptierte Arbeit entspricht dem 80 %-Horizont mehr als dem 50 %-Horizont. Die Lücke zwischen dem, was ein Modell manchmal schafft, und dem, was es zuverlässig schafft, ist die Arbeit der Person, nämlich nachzuweisen, dass ein Ergebnis richtig ist, und es zu verfolgen. Abbildung A3 (Anhang F) setzt diese Maschinenhorizonte gegen die Sprossen.
Die Theorie von 2026 deutet auf dieselbe Lücke hin. Huang, Xiao und Vishnoi (2026) modellieren Delegation unter KI und stellen fest, dass kleine Unterschiede in der Verifizierungsfähigkeit zu großen Unterschieden bei den Ergebnissen führen: KI hilft denen, die kontrollieren, und schadet denen, die zu viel übergeben. Ihr Beitrag wurde auf der ICML 2026 akzeptiert, und sie nennen den Effekt Verifikationsverstärkung. Eine strukturierte Überprüfung von 24 Studien ergab, dass kein validiertes Messinstrument in seinem Fokuskorpus die volle Kombination der erforderlichen Fähigkeiten abdeckt, um Agenten zu überwachen (Umfang, Berechtigungen, Wiederherstellung, unabhängige Überprüfung und evidenzgestützte Abschluss), obwohl einige Messinstrumente Teile davon abdecken (Veri', 2026). DeepMind's Rahmen für intelligente KI-Delegation beschreibt Delegation allgemein und enthält kein Messinstrument auf Personenebene (Tomašev et al., 2026), und die Ökonomie der Delegation hat jetzt ihre eigenen Grenzmodelle (Wang, 2026). Chen und Meng (2026) zeigen, dass generative KI Fähigkeitsunterschiede innerhalb einer Aufgabe komprimiert und Wert auf knappe komplementäre Vermögenswerte verschiebt, und sie fügen hinzu, dass die nach Personen und Aufgaben aufgeschlüsselte Paneldaten, die benötigt werden, um ihre Vorhersagen zu testen, „in großem Umfang noch nicht vorhanden sind". Das von mir vorgeschlagene Messinstrument erzeugt genau diese Art von Daten, da jedes protokollierte Stück eine Person, eine Größe und ein Datum trägt.
Die zweite Achse hat ihre eigenen Nachbarn, und Verstärkungsgewinn ist ihre verifizierte Form auf Personenebene. Engelbart (1962) stellte Computing als Ergänzung der menschlichen Intelligenz dar, und „Superagency" ist McKinseys Wort für dieselbe Hoffnung 2025 (McKinsey, 2025). Der Anthropic Economic Index bewertet Gespräche nach Beschleunigung (Zeit ohne KI geteilt durch Zeit mit ihr) und Agent-Autonomie auf einer Skala von 1 bis 5, beide beurteilt durch ein Modell (Anthropic, 2026a). Stanfords WORKBank bewertet die von Arbeitern bevorzugte menschliche Beteiligung auf einer Skala von H1 bis H5 (Shao et al., 2025). Ein Essay von 2026 definierte Überwachungskapazität als nützliche verifizierte Ausgabe gegen menschliche Anstrengung und lehnte es ausdrücklich ab, ihr eine Zahl zu geben (em360, 2026), und „verstärkte Überwachung" ist ein Begriff der KI-Sicherheit, um Menschen zu helfen, Systeme zu überwachen, die stärker sind als sie selbst. Die Beobachtung eines Suchagenten zeigt dieselbe Verschiebung der menschlichen Zeit zur Kontrolle: der Agent arbeitet 26 Minuten pro Sitzung alleine, während eine einfache Suche 33 Sekunden dauerte (Yang et al., 2026). Auf der Delegationsseite verwenden Khadj (2026) und Alonso (2026) „Delegationshorizont" für das Ausmaß, in dem eine Maschine oder ein Unternehmen delegieren kann, CHI 2026 Arbeiten zu „Entscheidungshorizonten" untersuchen den Verlust von Selbstbestimmung (Universität zu Lübeck, 2026), und Dawson (2026) und Metal Toad (2026) veröffentlichen Praktiken von KI-Delegationsebenen. Keiner dieser Ansätze positioniert eine Person auf einer Ebene anhand von Arbeit, die eine unabhängige Kontrolle bestätigt.
Der nächstverwandte Rahmen wird hier direkt verglichen. Das AIDEs-Rahmenwerk von JetBrains Research (Tikhomirov, 2026) teilt zwei Merkmale mit dem Messinstrument: es behandelt Delegation als eine Prinzipal-Agent-Beziehung und ordnet Delegation in Ebenen ein, fünf davon, beschrieben durch Attribute wie Autonomie und Planung. Es unterscheidet sich in vier Punkten. Sein Thema ist Softwareentwicklung, während der Horizont in jeder Domäne bewertet wird. Seine Ebenen beschreiben, wie Arbeit delegiert wird, während eine Sprosse durch die Größe der Arbeit in Referenzstunden eines qualifizierten Fachmanns festgelegt wird. Es hat keine Regel, dass die Kontrolle unabhängig von den Agenten sein muss, während eine Sprosse nur Teile zählt, die durch eine Kontrolle bestätigt wurden, die die Agenten nicht sahen. Und es hat keine Zählung über ein Zeitfenster und keine zweite Achse, während eine Sprosse einen Durchsatz über ein datiertes Zeitfenster erfordert und Verstärkungsgewinn die Stunden der Aufmerksamkeit hinzufügt. Die Sprache der Agentur ist geteilt; die Einheit, die Unabhängigkeitsregel und der über Software hinausgehende Umfang sind das, was dieses Papier vorschlägt.
Viele Skalen wurden 2025 und 2026 veröffentlicht, und keine der Skalen in Tabelle 2 misst eine Person anhand verifizierter Arbeit. Tabelle 2 ordnet die wichtigsten nach dem, was sie messen; Tabelle A3 (Anhang F) listet jede davon auf.
Tabelle 2. Skalen von 2025 und 2026, gruppiert nach dem, was sie messen.
| Familie | Beispiele | Gemessene Einheit | Platziert eine Person durch verifizierte delegierte Arbeit? |
|---|---|---|---|
| Autonomiestufen von Agenten und Maschinen | Feng et al., 2025; Shapiro, Januar 2026; Memari & Rudolph, 2026; METR, 2025-2026 | Der Agent, das Modell oder die Einrichtung des Teams | Nein |
| Stadien der Praxis eines Entwicklers | Yegge, 2026; Park et al., 2026; Microsoft, Mai 2026 | Praxis, Überwachungsarbeit oder Arbeitsmuster | Nein |
| Delegation durch Organisationen und Firmen | Dawson, 2026; Metal Toad, 2026; Tomašev et al. (DeepMind), Februar 2026; Khadj, 2026 | Eine Organisation, ein Manager, eine Firma oder Delegation allgemein | Nein |
| Entwicklerdelegation als Auftraggeber-Agent-Beziehung | JetBrains Research (Tikhomirov), September 2026 | Eine Delegation eines Entwicklers | Nur Entwickler; keine Unabhängigkeitsregel für Überprüfungen und keine Größeneinheit |
| Kompetenzen- und Literalitätsrahmen | AI Certification Standards, 23. August 2026; Anthropic AI Fluency, 2025b | Kompetenzen oder Literalität | Keine Prüfung, Schwellwerte oder Niveaus |
| Verifizierter Delegationshorizont und Verstärkungsgewinn | Diese Arbeit | Eine Person in einem Bereich | Ja, nach der Regel von Abschnitt 5.2 |
Anmerkung: „Platziert eine Person durch verifizierte delegierte Arbeit" bedeutet, dass die Skala eine Person auf eine Ebene setzt nach der Menge der Arbeit, die an Agenten delegiert und durch eine Überprüfung bestätigt wird, die die Agenten nicht sahen. Der nächste Nachbar ist JetBrains' fünf Ebenen: Sie teilen die Sprache von Auftraggeber und Agent und unterscheiden sich in der Überprüfungsregel (eine unabhängige Überprüfung, die die Agenten nicht sahen) und in der Einheit (Referenzstunden). Tabelle A3 (Anhang F) listet jede Skala separat auf.
Ein Praktiker brachte den Einwand gegen jede persönliche Skala gut vor: „Ihre Autonomiestufe ist eine Eigenschaft des Repositoriums, nicht des Entwicklers und nicht des Modells" (Phoenix, 2026). Ich akzeptiere die Hälfte davon. Ein Horizont gehört zu einer Person, in einem Bereich, unter einem Überprüfungsregime, und ein gut gebautes Repositorium mit versteckten Tests ist Teil dieses Regimes, was ein Grund ist, warum der Horizont pro Bereich und mit einem Datum aufgezeichnet wird.
5.7 Zwei Fragen aus dem Begleitpapier
Das Begleitpapier ließ die Frage offen, warum erfahrene Benutzer weniger delegieren, ob sie verletzt wurden oder ob ihr Urteil das Produkt ist (Chernets, 2026a). Die zweite Achse kann die beiden unterscheiden. Wenn der Anteil der direktiven Nutzung sinkt, während der verifizierte Gewinn steigt, ist das Urteil das Produkt; wenn der Gewinn auch sinkt, wurden sie verletzt. Das Begleitpapier fragte auch, ob das Vokabular der Delegation eine Grammatik oder eine pro Beruf ist. Ich nehme Stellung: Die Grammatik ist eine (Aufgabe setzen, dann auf Evidenz akzeptieren), während das, was als Evidenz zählt, nach Bereich unterschiedlich ist, weshalb die Stufen gemeinsam sind und die Bewertung pro Bereich stattfindet.
Das Instrument von Anhang C meldet einen direktiven Anteil für jede Person und jeden Bereich, gezählt auf Stücke (der Anteil von Stücken, die in einem Stück übergeben werden, gegen Stadien oder gemeinsame Arbeit), sodass ein erster, grober Test auf denselben Aufzeichnungen durchgeführt werden kann, die die Stufen geben. Vorhersage F20 stellt den Test mit einem Datum auf sein registriertes Maß, „der Anteil der Züge einer Person, die Anweisungen geben, anstatt zu überprüfen oder zu bearbeiten, aus dem Protokoll" (Tabelle A6): Dort wird der Anteil über die Züge des Sitzungsprotokolls gezählt, anstatt über die Stücke des Arbeitsprotokols von Anhang C, sodass dies die feinere der beiden Zählungen ist.
5.8 Wie das Maß manipuliert werden kann, und die Abwehrmaßnahmen
Das Zählen akzeptierter, unabhängig überprüfter Arbeit schließt die billigste Route, das Ausgeben, aber eine entschlossene Person oder ein Arbeitgeber, der ein Ziel verfolgt, hat noch andere. Tabelle 3 listet sie mit der Abwehr auf, die die Regeln bieten. Die Abwehrmaßnahmen kosten etwas, und die Kosten sind Teil des Designs: eine geprüfte Stufe ist mehr wert als eine selbst gemeldete, auf die gleiche Weise, dass ein geprüftes Konto mehr wert ist als eine Erklärung.
Tabelle 3. Wege, das Maß zu manipulieren, und die Abwehrmaßnahmen.
| Route | Wie es aussieht | Abwehr |
|---|---|---|
| Einfache Überprüfungen | Versteckte Tests, die eine schwache Lösung besteht; ein Prüfer, der überfliegt | Zufällige Überprüfung eines Anteils akzeptierter Stücke durch einen zweiten unabhängigen Prüfer; gepflanzte Fehler von Week aufwärts; die Art der Überprüfung ist neben der Bewertung gedruckt |
| Aufgaben knapp über einem Schwellwert wählen | Viele Stücke von 8,1 Referenzstunden, um Day zu erreichen | Stufen aus der Verteilung der Größen gelesen, mit der mittleren akzeptierten Größe neben der Stufe gemeldet |
| Großzügige Bewerter von Stunden | Bewerter, die Referenzstunden aufblasen | Zwei Bewerter blind für die Person; Uneinigkeit über einem festen Verhältnis schickt das Stück zur gefrorenen Bank oder einen dritten Bewerter; Aufzeichnungen der Bewerter geprüft |
| Versteckte Hilfe | Ein Kollege oder Auftragnehmer repariert die Arbeit außerhalb des Protokolls | Aufmerksamkeit pro Stück protokolliert; zufällige Interviews oder Wiederholungen; externe Hilfe als ein Feld aufgezeichnet und von der Verstärkung der Person ausgeschlossen |
| Aufschlüsselung | Ein Monat Arbeit in Einheiten-Tickets aufgeteilt | Nur ein kohärentes Lieferergebnis, akzeptiert als Ganzes, zählt zu einer Stufe |
| Verstecken von Ausfällen | Aufgegebene oder fehlgeschlagene Stücke, die aus dem Protokoll weggelassen werden | Jede Übergabe protokolliert, mit ihrem Startdatum, und geschlossen, wenn sie akzeptiert, abgelehnt oder aufgegeben wird; ein öffentliches Fehlerverzeichnis; eine Erfolgsquote, die zu sauber aussieht, löst eine Überprüfung aus |
| Korrelierte Überprüfung | Ein zweites Modell der gleichen Familie stimmt zu | Nicht gezählt (Abschnitt 5.2) |
| Parallele Ströme | Aufmerksamkeit einmal pro Strom gezählt | Aufmerksamkeit einmal pro Person-Minute gezählt (Abschnitt 5.4) |
Die Schwellwerte sind Gestaltungsentscheidungen, versioniert als Regeln v1.1 und geändert nur in einer neuen Version nach Daten. Zehn Stücke in einem Fenster ist die kleinste Anzahl, bei der eine 80%-Bestehensquote etwas bedeutet (acht Bestehensleistungen von zehn). Das 91-Tage-Fenster der unteren Stufen und des erforderlichen aktuellen Stücks bei den oberen stimmt mit der vierteljährlichen Neuverifizierung und dem Tempo überein, in dem sich Werkzeuge ändern. Die Stufenregel ist eine Qualifikationsregel und schätzt nicht die Zuverlässigkeit einer Person. Acht Bestehensleistungen von zehn stimmen mit einer wahren Bestehensquote überein, die etwa zwischen 44 % und 97 % liegt (exaktes 95%-Intervall), und drei von drei mit einer so niedrig wie etwa 37 % (einseitige 95%-Grenze). Die registrierte Kalibrierungsstudie schätzt die Zuverlässigkeit. Der Anteil von 80 % folgt METRs Verwendung des 80%-Horizonts als Niveau zuverlässiger Arbeit, und die Stufen von 1, 8, 40, 160 und 500 Stunden folgen der Arbeitsstunde, dem Tag, der Woche, dem Monat und dem Quartal, sodass sie keine Übersetzung zwischen Berufen benötigen. Ein Schreibtischtest der Schwellwerte überprüfte die Regeln durch Simulation und mit Modellbewertern (Anhang E). Er berechnete, wie oft eine Person bekannter Zuverlässigkeit jede Stufe verdient (Abbildung A2, Anhang E). Bei einer wahren Bestehensquote von 0,8 wird Day in 68 % der Fenster verdient und das gleiche Ergebnis wiederholt sich im nächsten Fenster in 56 %, weshalb der Datensatz die Anzahl neben der Stufe ausdruckt, wie in „Day (8/10)". Es fand auch einen Fehler in der ersten Version der Regeln: vier von vier bei Month war schwerer zu verdienen als drei von drei bei Quarter (41 % gegenüber 51 % bei einer Bestehensquote von 0,8), sodass Month jetzt fünf von sechs in einem Jahr verlangt. Das Verschieben der Anzahl von zehn auf acht oder zwölf oder des Anteils von 0,8 auf 0,7 oder 0,9 ändert das Day-Ergebnis für 8 % bis 11 % der simulierten Protokolle, und das Verschieben beider ändert es um bis zu 22 %. Vier Modellbewerter aus vier Familien, die Referenzstunden blind schätzten, ordneten 30 Aufgaben konsistent (Intraklassenkorrelation 0,89 bei Stundenlogs), aber setzten nur 62 % der Paare innerhalb eines Verhältnisses von 1,5, gegenüber dem Kriterium des Kalibrierungsprotokolls von 70 %, und unterschieden sich um einen Faktor zwei in ihrem Gesamtniveau; mit nur der öffentlichen Kennung einer Aufgabe lag ihre mittlere Schätzung für 3 von 14 Aufgaben innerhalb von 1,5 der gemessenen Menschenzeiten. Modellbewerter können daher nicht die beiden menschlichen Bewerter ersetzen, und die Bewerter der Feldstudie kalibrieren zunächst auf Aufgaben mit gemessenen Zeiten. Das Kalibrierungsprotokoll legt die nächsten Tests im Voraus fest: Übereinstimmung zwischen menschlichen Bewertern (Kriterium: mindestens 70 % der Paare innerhalb von 1,5), Wiederholbarkeit der Stufe einer Person über zwei aufeinanderfolgende Fenster (gewichtetes Kappa mindestens 0,6) und die Fähigkeit einer Stufe, das Bestehen neuer Aufgaben der gleichen Größe vorherzusagen (AUC mindestens 0,7). Sein Protokoll und Registrierungstext befinden sich im Begleitrepository, und ein erster Test mit berufstätigen Fachleuten zu ihrer Übereinstimmung bei Referenzstunden ist registriert und in Anhang G beschrieben.
Tabelle A4 (Anhang F) gibt die Regel für die schwierigen Fälle an, die zuerst auftreten.
Anhang C, Abschnitt C4, arbeitet sich durch ein zehnzeiliges Protokoll einer Person bis zu dem einzelnen Datensatz, den es erzeugt.
6. Hintergrund-Neutralität und der Anmeldepunkt für Qualifikationen
6.1 Hintergrund-Neutralität
Die Hypothese besagt, dass auf einem gleichen verifizierten Erfahrungsniveau in einem Bereich eine Programmierausbildung die Qualität unabhängig überprüfter Arbeit nicht vorhersagt, wenn Bereichskompetenz und Akzeptanzliteralität berücksichtigt werden.
Anthropics Feststellung, dass „die Fähigkeit, die KI Claude zum Erfolg zu lenken, stärker aus der Beherrschung eines Bereichs als aus der Fähigkeit zum Programmieren kommt", ist konsistent mit der Hypothese, testet sie jedoch nicht (Anthropic, 2026e): Seine Daten sortieren Menschen nach Beruf, nicht nach Ausbildung, und die 34%-gegen-29%-Lücke von Abschnitt 2.2 ist eine Lücke zwischen Berufen. Nur die Studie zu F7 testet die Hypothese. Es gibt auch eine starke Gegenalternative. Savva (2026) modelliert KI-gestützte Wissensarbeit als Principal-Agent-Problem und sagt voraus, dass KI Lücken zwischen Menschen bei leichten Aufgaben verengt und bei schwierigen vergrößert. Falls Savva recht hat, wird Hintergrund-Neutralität bei kurzen Aufgaben gelten und bei höheren Ebenen versagen, daher wird die Vorhersage F7 separat bei Tag und bei Woche und darüber bewertet, wo die Hypothese ihrem härtesten Test ausgesetzt ist.
Akzeptanzliteralität ist die Fähigkeit, auf die sich die Hypothese stützt. Sie bedeutet, im Voraus anzugeben, was als erledigt gilt, und es dann zu zeigen: durch einen verborgenen Test, eine zweite Gruppe von KIs, die gegen Quellen überprüft, einen Vergleich mit einer Quelle, die die Person selbst geöffnet hat, oder ein Artefakt anstelle einer Zusicherung. Agent-Literalität umfasst Delegieren, Überprüfen und Verwalten im Allgemeinen (MindStudio, 2026); Akzeptanzliteralität stellt einen Beweisstandard in ihr Zentrum. Sie unterscheidet sich auch von Technologieakzeptanz im Sinne der TAM-Tradition, die untersucht, ob Menschen eine Technologie annehmen, da Akzeptanz hier die Entscheidung ist, eine Arbeit anzunehmen. Die Akzeptanzstatistik des Begleitpapiers wird zur Evidenzeinheit für eine Stufe.
6.2 Der Anmeldepunkt für Qualifikationen
Der Anmeldepunkt für Qualifikationen in einem Bereich ist der Moment, in dem Produkte von Personen ohne IT-Ausbildung, akzeptiert unter denselben unabhängigen Überprüfungen, beginnen, diejenigen von Programmierern, die dieselben Agenten verwenden, zu übertreffen, wonach ein IT-Abschluss und die Bezeichnungen Junior und Senior ihre Vorhersagekraft bei der Einstellung für diesen Bereich verlieren.
Diese Definition ist meine am 8. Oktober 2026 gemachte genaue Vorhersage (Abschnitt 1). Ihre Komponenten sind jeweils beobachtbar und jeweils auf sich selbst datiert, sodass der Moment abgelesen werden kann, wenn sie sich überschneiden. Qualitätsparität ist die Stufe vor dem Moment: In einem Bereich sind Produkte von Personen ohne IT-Ausbildung nicht schlechter als diejenigen von Programmierern mit denselben Agenten, auf denselben Aufgaben, unter verblindeten Überprüfungen (Vorhersage F2). Übertreffung ist der Moment selbst, wenn diese Produkte bei denselben Überprüfungen besser werden (F3, mit den Phasen der Freigabe und Wartung in F4a und F4b). Das Überqueren von Angeboten ist das sichtbare Zeichen, wenn Angebote, die nach agentischen Fähigkeiten fragen, weniger häufig einen Abschluss erfordern als vergleichbare Angebote, die dies nicht tun (F5). Hintergrund-Neutralität ist der Mechanismus, da bei einer gleichen Stufe Ausbildung die überprüfte Qualität nicht mehr vorhersagt (F7).
Der Anmeldepunkt für Qualifikationen in einem Bereich wird anhand des ersten Jahres datiert, in dem in diesem genannten Bereich Übertreffung gezeigt wird (F3) und das Bereichsanalogon des Überqueren von Angeboten erfüllt ist (F5 berechnet auf Angeboten dieses Bereichs; Anhang D). Parität ohne Übertreffung ist die Annäherung an den Punkt, und ein Überqueren von Angeboten ohne Übertreffung würde zeigen, dass Arbeitgeber der Evidenz voraus sind. F2, F3, F5 und F7 bilden daher ein Programm über dieselben benannten Bereiche: Die Bereiche sind in der Registrierung festgelegt, das Experiment von F2, F3 und F7 wird in ihnen durchgeführt, und F5 wird sowohl auf dem gefrorenen Satz von IT-Berufen als auch auf Angeboten jedes dieser Bereiche berechnet. Der Anmeldepunkt für Qualifikationen wird für einen Bereich nur erklärt, wenn die Qualitätsregel (F3) und die Einstellungsregel (das Bereichsanalogon von F5) beide in demselben Bereich erfüllt sind; eine allein erklärt nichts.
Die ersten beiden Komponenten werden durch Experimente mit angepassten Aufgaben getestet (Abschnitt 11). Die dritte kann bereits in Stellenausschreibungen beobachtet werden. Lightcast berichtete im September 2026, dass IT-Angebote, die KI-Fähigkeiten erfordern, immer noch eher einen vierjährigen Abschluss erfordern als IT-Angebote ohne diese. Unter KI-Angeboten sind Abschlussanforderungen jedoch seit 2024 „im klaren Rückgang" gewesen, während sie in anderen IT-Angeboten gestiegen sind (Lightcast, 2026b). Die beiden Linien nähern sich an und haben sich nicht gekreuzt (Abbildung 5). Lightcast definiert KI-Angebote durch mehr als 300 KI-Fähigkeiten, daher beschreiben seine Linien KI-Arbeit im Allgemeinen. Die agentische Teilmenge, die durch eine gefrorene Liste agentischer Fähigkeiten definiert ist (Lightcast, 2026a), ist diejenige, die die Vorhersage verwendet, und ihre Grundlage wird vor der Registrierung genommen.
Die Richtung hat einen Präzedenzfall. Bone, González Ehlinger und Stephany (2025) fanden mit etwa elf Millionen britischen Stellenangeboten bis Mitte 2024, dass Ausbildungsanforderungen in KI-Rollen sanken, und verglichen die Lohnprämien, die an Fähigkeiten und an Abschlüsse gebunden sind. Diese Arbeit dokumentierte kompetenzbasierte Einstellung für KI vor Agenten. Dieses Papier erweitert diese Linie auf agentische Fähigkeiten, mit einem datierten Schwellenwert und einem Vergleich mit angepassten Angeboten, und schlägt vor, Anforderungen in Angeboten mit unabhängig überprüfter Leistung zu verknüpfen, in Tests, die vorregistriert werden sollen. PwCs AI Jobs Barometer meldet dieselbe Richtung in allen Ländern und dient als Fallback-Quelle, wo immer es die gleiche Größe misst (PwC, 2026).
Ein zweiter Indikator ist der Abstand zwischen dem, was Arbeitgeber sagen, und dem, was sie tun. Viele Arbeitgeber entfernten Abschlussanforderungen aus ihren Richtlinien, bevor Agenten ankamen, doch das Burning Glass Institute und die Harvard Business School stellten fest, dass die Änderung weniger als eine von 700 Einstellungen betraf (Burning Glass Institute & Harvard Business School, 2024). Angebote bewegten sich anders: Im November 2025 forderten 19,3% der US-Angebote auf Indeed einen Bachelor-Abschluss oder höher an, erheblich mehr als ein Jahr zuvor (Indeed Hiring Lab, 2026). Eine auf dem Papier entfernte Abschlussanforderung ist eine Richtlinienänderung, und der Anmeldepunkt zeigt sich nur, wenn sich die Einstellung selbst ändert. Eine Audit-Studie, die angepasste Portfolios, die sich nur in der Ausbildung unterscheiden, an echte Angebote sendet, würde dies zuerst sehen, und die Vorhersage F26 setzt eine.
Ein Abschluss gehört zu einer Familie von Toren, die Menschen durch ein Label zulassen: ein Profil auf einer Plattform, eine Berufsbezeichnung, ein Abschluss und teilweise eine Lizenz. Ein Label teilt einem Arbeitgeber über die Arbeit nur insoweit mit, wie das Halten des Labels mit der Fähigkeit einhergeht, die Arbeit zu leisten. Agenten lockern diese Verbindung von einer Seite, da Menschen ohne das Label nun Arbeit hervorbringen, die wie die des Handwerks aussieht (Abschnitt 2.2), und ein Label, das auf dem eigenen Wort einer Person ruht, war schon immer billig zu beanspruchen. Ein Tor, das die Arbeit selbst überprüft, hängt von keinem ab. Die Rater-Studie in Anhang G traf den Unterschied zufällig. Prolific lässt Teilnehmer durch Filter in eine Studie zu, deren Antworten größtenteils selbst angegeben sind, wobei Alter und Wohnland die Hauptausnahmen sind, die es überprüft (Prolific, 2026). Von den 60 Personen, die ihre Filter in die Buchführungsstichprobe ließen, beantworteten 11 eine Frage der ersten Woche des Handwerks falsch (Anhang G2): Das Label ließ sie durch, und eine Frage des Handwerks stoppte sie.
Forscher, die vor Agenten Programmierer auf solchen Plattformen rekrutierten, berichteten von demselben Muster und filterten mit Wissensfragen ihres eigenen Entwurfs: In einer Studie erfüllten 42 % der Programmierer einer Plattform, die Programmierkenntnisse angaben, die Kriterien solcher Fragen nicht (Danilova et al., 2021), und in einer anderen auf Prolific bestanden 55 von 206 Befragten, die Programmierung in Node.js angaben, alle seine Programmierfragen (Reid et al., 2022). Eine Wissensfrage ist selbst ein schwächeres Tor als eine Überprüfung abgegebener Arbeiten, und Sprachmodelle schwächen es auch: In einem simulierten Angriff löste ChatGPT mühelos die bestehenden Screening-Fragen für Programmierer (Serafini et al., 2024), und 2026 kam es auch an den statischen visuellen Fragen vorbei, die dazu entwickelt wurden, dagegen zu widerstehen, während Audiofragen, die ihre Inhalte schrittweise unter strenger Zeitbegrenzung offenbaren, noch bestanden (Serafini et al., 2026). In Einstellungsbegriffen ist der Gewichtsverlust, den die obige Definition für einen Abschluss vorhersagt, ein Tor der ersten Art, das einem Tor der zweiten Art weicht, und der überprüfte Delegationshorizont ist ein Tor der zweiten Art: Er verzeichnet nicht, was eine Person sagt, dass sie ist, sondern was sie abgegeben hat und was eine Überprüfung bestand, die die Agenten nicht sahen.
Lizenzen sitzen zwischen den beiden Arten. Eine Lizenz, die auf einer einmal bestandenen Prüfung ruht, funktioniert von da an als Label; eine Lizenz, deren Inhaber die Arbeit überprüft wird, ist näher an einer Überprüfung. Wirtschaftsprüfungsfirmen, die beim Public Company Accounting Oversight Board in den Vereinigten Staaten registriert sind, werden ihre Prüfungsarbeiten überprüft, jährlich, wenn sie regelmäßig mehr als 100 Emittenten prüfen, und mindestens alle drei Jahre andernfalls, sofern das Board keine andere Regelung durch Vorschrift festlegt (Sarbanes-Oxley Act von 2002, s. 104), ein langsameres Gegenstück für die unterzeichnete Arbeit einer Firma zur Überprüfung, die Abschnitt 5.2 von einem Horizont verlangt. Die Lizenzierung selbst hat begonnen, sich zur zweiten Art zu bewegen. Seit Mai 2024 bietet Oregon Jurastudienabsolventen einen Weg zur Lizenz ohne Anwaltsexamen, die Supervised Practice Portfolio Examination: Über mindestens 675 Stunden beaufsichtigter Praxis reicht der Kandidat acht schriftliche Arbeiten, zwei Kundeninteraktionen und zwei Verhandlungen ein, und Bewerter, die Rubiken des Board of Bar Examiners anwenden, beurteilen, ob jede Mindestkompetenzen zeigt. Bis 5. Januar 2026 hatten sich 205 Kandidaten beworben und 49 waren lizenzierte Anwälte geworden, die ersten im Dezember 2024 (Oregon State Board of Bar Examiners, 2026). Der Jurastudienabschluss ist immer noch erforderlich, daher ersetzt die überprüfte Arbeit die Prüfung, nicht die Schule. In der Buchprüfung ist die Bewegung geringer: Im Mai 2025 genehmigten die AICPA und NASBA Mustergesetze für einen Weg zur CPA-Lizenz, der ein zweites Jahr beruflicher Erfahrung an Stelle von 30 Kreditstunden Studium über einen Bachelor-Abschluss hinaus verlangt, wobei die Prüfung beibehalten wird, und jeder Staat muss sie erlassen, bevor Kandidaten sie nutzen können (Journal of Accountancy, 2025). Was das Gesetz einer Lizenz vorbehält, bleibt eine Grenze des Maßes (Abschnitt 13). Tabelle A8 (Anhang F) stellt die Tore dieses Abschnitts nebeneinander nach dem, was jedes überprüft.
Der Begriff „Credential" hat eine zweite Bedeutung in der KI-Sicherheit, wo er einen geheimen Schlüssel oder Token bezeichnet. Hier bedeutet er einen Abschluss oder ein Zertifikat. Der Ausdruck „credential crossover point" in diesem Sinne ergab bei einer Suche in den wissenschaftlichen Datenbanken am 9. Oktober 2026 keine Treffer (Anhang B).
Abbildung 5. Die Lücke im überprüften Erfolg und die Abschlussanforderung in Stellenausschreibungen: Das Beobachtete und was 2027 testen wird.
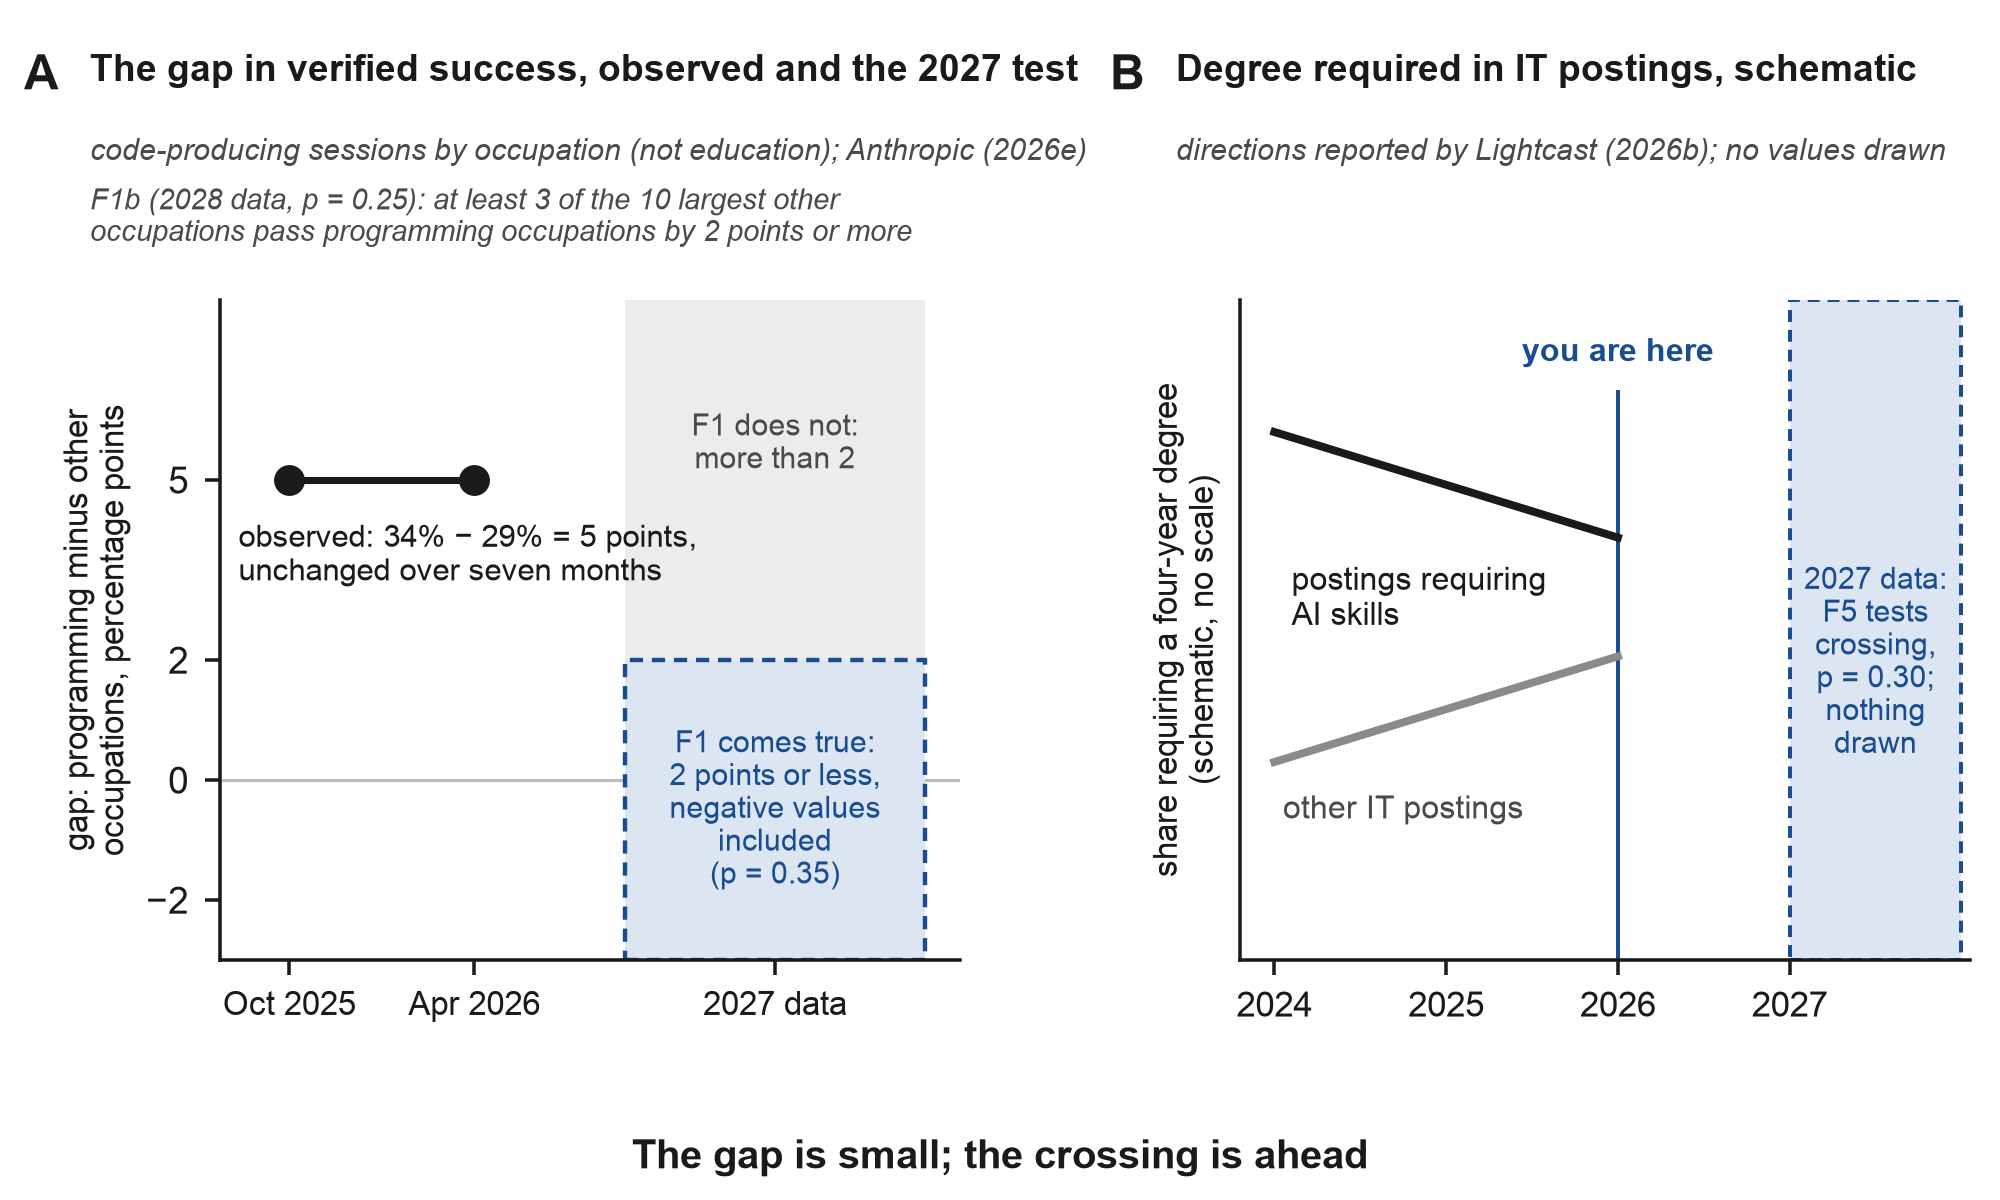
Anmerkung: Panel A nutzt Anthropic (2026e), Code produzierende Sitzungen, 34 % für Programmiertätigkeiten gegenüber 29 % für andere Tätigkeiten, sieben Monate lang unverändert. Beruf ist nicht Ausbildung, und Erfolg bedeutet durch Belege wie Tests oder Commits gestützte Leistung. Das Band ist die Schwelle der Vorhersage F1 (eine Lücke von 2 Punkten oder weniger, negative Werte eingeschlossen, Wahrscheinlichkeit 0,35); F1b (Wahrscheinlichkeit 0,25) ist in Tabelle A6. Panel B zeigt nur die Richtungen, die Lightcast (2026b) bis 2026 gemeldet hat, ohne ihre Werte. Das Fenster für 2027 ist leer gelassen: Keine Kreuzung wird gezogen, da die Vorhersage F5 (Wahrscheinlichkeit 0,30) es entscheiden wird.
6.3 Domänen: Warum der Vorteil des Programmierers horizontal war
Was KI zuerst billig macht, ist das, was horizontal ist, das Gleiche in jeder Branche, und der Mechanismus ist offensichtlich: Eine Fähigkeit, die über Branchen hinweg übertragbar ist, kann ein Universalmodell ihnen allen gleichzeitig zur Verfügung stellen. Dünne Wrapper über einem Modell, Universalsoftware und die allgemeine Fähigkeit, Code zu schreiben, sind alle diesen Weg gegangen. Der Prompt Engineer, der modischste Titel von 2023, wurde 2025 für obsolet erklärt, weil die Fähigkeit in die Tools aufgelöst wurde und Gemeingut wurde (Fortune, 2025). Der alte Vorteil des Programmierers war auch horizontal. Code funktioniert in jeder Branche, daher konnte ein Programmierer für eine Anwaltskanzlei oder ein Krankenhaus arbeiten, ohne eines von beiden zu kennen, und Agents machen Code billig und nehmen diesem Vorteil den Boden weg. Niemand musste Programmierer werden, damit dies geschah. Software wurde eine Vertikale unter vielen (mit Infrastruktur und Sicherheit als nahe Nachbarn), und darin bleiben Programmierer die Stärksten. Dieselbe Logik gilt für Personen wie für Firmen: Eine Person ohne eine Vertikale ist ein Wrapper über KI, ebenso ausgesetzt wie ein dünnes Wrapper-Produkt. Da Agents universelle Software einfacher zu bauen machen, kann alte vertikale Software von zwei Seiten unter Druck geraten, von den Laboren, die die Informationsebene übernehmen, und von Fachleuten, die ihre eigenen Tools bauen. Die Hypothese ist, dass Fachwissen verbunden mit der Fähigkeit, Agent-Arbeit zu akzeptieren, an Wert gewinnt. Vertikalität allein schützt niemanden; Tiefe tut es, das heißt die Fähigkeit, Arbeit in der Domäne zu akzeptieren, die ein Modell oder ein Neuankömmling nicht fälschen kann.
Eine Vertikale hier ist eine Domäne, in der eine Person die Arbeit eines Agents akzeptieren kann, und es kann sein oder nicht, dass Sie einen Abschluss darin haben. Juristische Arbeit zu akzeptieren bedeutet, das Recht gut genug zu kennen, um einen plausibler wirkenden Fehler zu erkennen. Ein Entwickler in den Fäden von Abschnitt 9 sagt es klar: Um zu sehen, dass eine Ausgabe Unsinn ist, müssen Sie mindestens ein wenig vom Feld wissen (übersetzt). Die Annahme bleibt bei der Person, ebenso der Name und die Unterschrift unter einem Ergebnis, der eigene Kontext der Person (Mandanten, Daten, lokale Regeln, Sprache) und die Wartung nach der Veröffentlichung.
Labore kaufen die Informationsebene der Vertikalen. Mercor, das Expertenzeit an KI-Labore verkauft, überschritt im Juni 2026 eine Bruttojahreslaufrate von 2 Milliarden Dollar, indem es die Zeit von Experten wie Radiologen verkaufte (Dealroom, 2026). Die Unternehmensausgaben für vertikale KI-Anwendungen verdreifachten sich 2025 fast auf 3,5 Milliarden Dollar (Menlo Ventures, 2025). Diese Aufteilung gibt dem Domänenexperten zwei Schicksale. Ein Spender verkauft Wissen an ein Labor als Etiketten, und dieses Wissen wird einmal verbraucht. Ein Auftraggeber behält das Wissen in seinem eigenen Produkt und antwortet für das Ergebnis, und das Wissen bleibt wirksam.
Die Konsequenz für das Maß ist, dass sich Horizonte nicht ganz zwischen Domänen übertragen. Ein Anwalt, der in Software wechselt, und ein Programmierer, der in Recht wechselt, verlieren das Gleiche, die Fähigkeit, Arbeit in einem Feld zu akzeptieren, das Sie nicht kennen. Diese Symmetrie ist das, wie das Ende der besonderen Position des Programmierers aussieht, und es kann gemessen werden. Der Schnittpunkt wird auch Domäne für Domäne ankommen. Es sollte zuerst dort ankommen, wo Code billig geworden ist, wo das Überprüfen Fachwissen erfordert, und wo Märkte klein oder lokal sind: Recht, Buchhaltung, Bildung, Klinik-Administration, enge Business-to-Business-Nischen, Märkte in kleineren Sprachen. Software selbst sollte zuletzt kommen. Ein Analyst machte eine verwandte Vorhersage im Februar 2026 und nannte Finanzen „den Kanarienvogel in der Kohlengrube" und erwartete, dass jede verifizierbare Aufgabe bis 2027 der Flugbahn von Finanzen und Buchhaltung folgt (Hwang, 2026). Die Feststellung von Anthropic, dass Management bereits Programmierer bei Codierungssitzungen geringfügig übertrifft, ist ein frühes Zeichen (Anthropic, 2026e). Der Datensatz von Abschnitt 5.3 benennt die Domäne in seinem ersten Feld, und vor jeden Berufsnamen kann eine beliebige Domäne gesetzt werden.
Dieselbe Überlegung sagt das Schicksal von Titeln voraus. Horizontale Titel wie Agent Manager, KI-Operator und Orchestrator beschreiben Personen, die Agents allgemein wrappen. Ein Praktiker erwartet, dass Agent-Management „für die nächsten 18 Monate" währt, bevor KI es auch tut (IT Brew, 2026), während Srinivasan und Wei (2026) erwarten, dass „Agent Manager" innerhalb von 12 bis 18 Monaten ein Standardtitel wird; Vorhersage F9 stellt die beiden Ansichten gegeneinander. Derselbe Artikel zählte 739 Ausschreibungen für KI-Orchesteratoren im Februar 2026, ein Anstieg von 1.294 Prozent, und diese Zahl weist in die andere Richtung. Titel, die an eine Domäne gebunden sind, wie ein „Vertical AI Lead", der für Agent-Bereitstellungen in jeder Vertikalen antwortet (Haize Labs, 2026), sollten schneller wachsen, und Abschnitt 11 setzt eine Vorhersage auf den Vergleich.
6.4 Kinder mit Frontier-Modellen
Ein Einwand geht auf den Kern des Domänenarguments. Ein Frontier-Modell weiß mehr über Biologie als eine Universitätsfakultät. Ein Kind mit einer frischen Idee kann sie einem Agent beschreiben und eine funktionierende Seite oder App über Biologie oder über Autos innerhalb einer Woche haben, ohne überhaupt Spezialisierung. Warum sollten Domänen wichtig sein?
Ein Teil der Prämisse ist bereits wahr. In Peking bauten Sechstklässler im September 2025 ihren eigenen KI-Agent im Unterricht auf einer grafischen Plattform (Xinhua, 2025). Chinas Bildungsministerium setzte sich das Ziel der KI-Ausbildung in praktisch allen Grund- und Sekundarschulen bis 2030 (CSET, 2025). In den Vereinigten Staaten startete ein Dekret vom April 2025 die Presidential AI Challenge, deren Gewinn-Schulprojekte einen Hausaufgabenhelfer, einen Anti-Mobbing-Chatbot und ein Werkzeug für sehbehinderte Schüler umfassten (White House, 2025; EdWeek, 2026). Der Zugang zu Frontier-Agents wird immer noch durch Alter limitiert. Claude ist für Erwachsene, und Konten, die als Minderjährigen gehörig gekennzeichnet wurden, wurden ausgesetzt (MediaNama, 2026). OpenAI führte Altersvorhersage und einen eingeschränkten Modus für Teenager ein (AlternativeTo, 2026). Kinder erreichen Frontier-Modelle eher über Schulplattformen und Teen-Modi als über ein Terminal, und „jede Schule innerhalb eines Jahres" sieht eher wie 2027 bis 2030 aus.
Die tiefere Antwort kommt aus dem Unterschied zwischen Papier und Welt. Auf dem Papier gewinnt das Kind: Frontier-Modelle erzielen Ergebnisse über typischen Experten bei Fragen auf Hochschulniveau, und in einer randomisierten Studie waren Anfänger mit einem Modell bei geschriebenen Biologieaufgaben etwa viermal genauer als Kontrollen (Turner, 2026). In der Welt verschwindet der Vorteil. In einer Studie mit 1.298 Personen, veröffentlicht in Nature Medicine, benannten die Modelle allein die richtige Bedingung in 94,9 Prozent der Fälle, während Personen, die dieselben Modelle verwendeten, dies in weniger als 34,5 Prozent taten, nicht besser als Kontrollen (Nature Portfolio, 2026). In METRs achtköchigem Nassprobentrial mit 153 Anfängern gab der Zugang zu einem Modell keinen signifikanten Gewinn, und etwa 5 Prozent in jeder Gruppe beendeten das ganze Protokoll (METR, 2026a).
Diejenigen, die diesen Einwand erheben, haben recht, dass das alte Vertikale, Jahre des Studiums, an Wert verliert, weil das Wissen kostenlos im Modell vorhanden ist. Was Wissen nicht ersetzen kann, ist die Fähigkeit, ein richtiges Ergebnis von einem plausiblen zu unterscheiden, und der Kontakt zur Realität (Nutzer, Tests, Experimente, Daten), der entscheidet, welches welches ist. Diese Akzeptanzschleife ist die neue Vertikale, und sie löst den scheinbaren Konflikt zwischen „Domänen sind wichtig" und „Kinder brauchen keine Spezialisierung" auf. Eine Vertikale in diesem Sinne ist eine durch Handeln aufgebaute Akzeptanzschleife, und Jahre des Studiums sind eine von mehreren Möglichkeiten, sie aufzubauen. Ein Teenager könnte sie in Wochen aufbauen, durch sein eigenes Produkt und dessen Nutzer, ohne einen Abschluss; ohne sie bleibt eine Woche Agentenarbeit ein überzeugend wirkendes Bild. Kinder sind dann der sauberste Test für Hintergrundneutralität, da sie keinen Abschluss und keine Jahre des Dienens haben, nur die Schleife, und sie brauchen auch jemanden, der für ihr Produkt einstehen kann, den Partner, den Abschnitt 7 nennt. Ob die Schleife so schnell aufgebaut werden kann, ist eine veraltete Frage. Bis Oktober 2026 wurde kein verifizierter Fall eines Teenagers ohne formale Ausbildung gefunden, dessen wissenschaftliches Produkt Nutzer hat und eine unabhängige Überprüfung bestanden hat, und Vorhersage F24 datiert den ersten solchen Fall.
6.5 Anfänger in einem Handwerk, die nach Verfahren prüfen
Abschnitt 6.3 besagt, dass eine Person, die in ein Feld wechselt, das sie nicht kennt, die Fähigkeit verliert, Arbeiten darin zu akzeptieren, und der Einwand von Abschnitt 6.4 hat eine erwachsene Form: Wie viel dieser Fähigkeit kann ein Verfahren wiederherstellen? Nehmen Sie einen Anfänger in der Buchhaltung, ohne deren Ausbildung und Jahre, der in vier Schritten arbeitet. Vor der Arbeit werden mehrere Modelle gefragt, was ein solches Ergebnis enthalten muss, was häufig vergessen wird und welche Prüfungen gelten. Ein Agent führt die Arbeit durch. Ein zweiter überprüft sie in einem frischen Kontext, ohne zu sehen, wie sie erstellt wurde. Ein Modell aus einer anderen Familie prüft sie gegen Quellen, die die Person öffnete. Jeder Schritt steht für etwas ein, das die Erfahrung einst bereitgestellt hat: der Agent für die Erstellung, der frische Reviewer und die zweite Familie für einen zweiten Blick auf das Geleistete, und die im Voraus erstellte Liste für das Wissen, was die Arbeit enthalten muss. Könnte ein solcher Anfänger Arbeit abliefern, die mehr unabhängige Prüfungen besteht als ein erfahrener Buchhalter, der den Output eines Agenten auf den ersten Blick akzeptiert?
Ein Teil der Evidenz spricht für den Anfänger. Erfahrung schützt einen Fachmann nicht, der aufhört zu prüfen. In einem Feldexperiment bei einer Beratungsfirma waren Berater, die ein Modell auf eine Aufgabe anwendeten, die außerhalb seiner Fähigkeit lag, weniger wahrscheinlich eine korrekte Lösung zu erreichen als diejenigen, die ohne eines arbeiteten (Dell'Acqua et al., 2026), und in METRs Versuch glaubten erfahrene Entwickler, sie seien beschleunigt worden, während sie tatsächlich verlangsamt worden waren (Abschnitt 5.4). Den Output eines Agenten auf den ersten Blick zu akzeptieren, ist auch eine schwache Richtlinie in diesem Handwerk: Bei 160 Buchhaltungsaufgaben (Abstimmung von Konten, Abgrenzung von Ausgaben, Buchung von Transaktionen und Erstellung von Berichten), bewertet nach Rubiken, die von Buchhaltungsexperten geschrieben wurden, erfüllte das beste von neun frontier-Modellen durchschnittlich 56 % der Kriterien, und keines erbrachte in mehr als 2,6 % der Aufgaben in allen acht Versuchen ein vollständig korrektes Ergebnis (Benchek et al., 2026). Ein Kritiker kann eingebaut werden: Kritikermodelle, die für diesen Zweck trainiert wurden, fanden mehr Fehler in von Modellen geschriebenem Code als menschliche Auftragnehmer, die für Code-Review bezahlt wurden, obwohl sie auch Fehler meldeten, die es nicht gab, und Auftragnehmer, die mit einem solchen Kritiker arbeiteten, fanden etwa so viele wie der Kritiker allein, während sie weniger falsche meldeten (McAleese et al., 2024), ein Vorgänger aus der Zeit vor Agenten. Die vor der Arbeit erstellte Liste gibt dem Anfänger die erste Hälfte der Akzeptanzalphabetisierung, eine Aussage darüber, was als erledigt gilt (Abschnitt 6.1), und die Modelle, die sie aufstellen, wissen, was die Prüfungen eines Handwerks fragen: GPT-4 bestand mit bearbeiteten Beispielen und Tools wie einem Rechner jeden Abschnitt der CPA-, CMA-, CIA- und EA-Prüfungen mit einer durchschnittlichen Punktzahl von 85,1 % (Eulerich et al., 2024), auch ein Vorgänger aus der Zeit vor Agenten. Das Auflisten an erster Stelle hilft auch bei der Überprüfung: Modellrichter, die eine klinische Notiz mit einer Auslassung kaum besser von einer vollständigen unterscheiden konnten als ein Münzwurf, hatten bessere Ergebnisse, wenn sie zunächst die von der Quelle etablierten Fakten auflisteten und dann die Notiz auf jede prüften, obwohl sie auch dann nur 25 % bis 37 % der Notizen, die eine hatten, kennzeichneten (Fox et al., 2026). Kenntnisse eines bestimmten Kunden kommen aus der Zusammenarbeit mit diesem Kunden, nicht aus einem Abschluss. Wer für das Ergebnis einstehen kann, wird entschieden von wer bereit und vertraut ist, einzustehen (Abschnitt 7.2), außer wo das Gesetz die Unterschrift reserviert (Abschnitt 13).
Ein Teil davon tut es nicht. Nach der Regel von Abschnitt 5.2 ist der frische Reviewer derselben Familie eine Übereinkunft innerhalb einer Familie, die die Arbeit verbessern kann, aber keinen Kredit als Überprüfung verdient, und das Modell einer anderen Familie zählt nur, wenn es gegen Quellen überprüft, die die Person geöffnet hat; wo ein Fehler nicht rückgängig gemacht werden kann, ist es nur eine zweite Linie hinter einem verborgenen Test oder einem qualifizierten Menschen. Übereinstimmung über Familien hinweg ist schwächer als sie aussieht: Über mehr als 350 Modelle hinweg machten größere und genauere Modelle stark korrelierte Fehler, auch wenn ihre Architekturen und Anbieter unterschiedlich waren, obwohl eine gemeinsame Architektur oder ein gemeinsamer Anbieter unter den Faktoren ist, die die Korrelation erhöhen (Kim et al., 2025). Eine zweite Familie ist daher eine bessere Vermutung für eine unabhängige Überprüfung als ein zweites Modell derselben Familie, aber keine Messung der Unabhängigkeit (Chernets, 2026b). Die im Voraus erstellte Liste erfüllt eine engere Grenze. Modelle sind viel schlechter darin, zu bemerken, was in einem Text fehlt, als darin, zu finden, was darin ist, auch wenn das Original daneben liegt (Fu et al., 2025); eine Liste hilft nur insofern, wie sie vollständig ist, und ein fehlender Ertrag ist eine Auslassung, die kein Reviewer sieht. Auch eine Warnung macht einen Außenseiter nicht zu einem Prüfer: Marketing- und Vertriebsfachleute, die aufgefordert wurden, die Analyse einer KI von Marketingdaten zu überprüfen, übersahen kritische Mängel, auch nachdem ihnen wiederholt gesagt worden war, dass die KI Fehler macht; die Analyse als explizite Schritte darzulegen, mit Alternativen für jede Entscheidung, half, obwohl die Teilnehmer oft noch Schwierigkeiten hatten, sich durch diese zu denken (Virk & Liu, 2025). Ein Saldo, das sich einig ist, ist auch kein Beweis. In einem Benchmark eines Buchhaltungssoftware-Herstellers von 2025 gaben Modelle, die aufgefordert wurden, die Bücher eines Unternehmens Monat für Monat abzuschließen, entweder im ersten Monat auf oder häuften Fehler an, und wenn ihre Zahlen nicht mit dem Banksaldo übereinstimmten, zogen einige nicht verwandte Transaktionen heran, um sie zum Stimmen zu bringen (Penrose, 2025, wie von Gigazine, 2025 berichtet). Ein Neuankömmling, der einen Schritt nicht sieht, wird nicht darum bitten, ihn überprüfen zu lassen, es sei denn, die Liste nennt ihn. Der explorative Vergleich von Anhang G2 zeigt, wie groß diese Lücke ohne eine Liste sein kann: Menschen, die eine Frage der ersten Woche des Handels falsch beantwortet haben und ihre Aufgaben nur anhand ihrer Beschreibungen bewertet haben, schätzten ihre größeren Aufgaben auf ein Viertel bis ein Drittel weniger Stunden als die anderen. Ob eine von Modellen erstellte Liste die Lücke schließt, zeigt der Vergleich von Abschnitt 10.5. Als Bild genommen, ist der Prozess eine Leiter von Ausgleichern: Agenten haben einen großen Teil der Herstellung angeglichen, die Liste vor der Arbeit und der Kritiker danach können einen Teil der Überprüfung angleichen, obwohl korrelierte Fehler über Modelle hinweg (Kim et al., 2025) und die Blindheit für Auslassungen (Fu et al., 2025) Grenzen setzen, wie viel, und was übrig bleibt, ist für die Messung zu zeigen. Abbildung A4 (Anhang F) setzt die vier Schritte gegen das, wofür jeder steht, was jeder unter der Regel von Abschnitt 5.2 verdient und wo jeder stoppt, und das begleitende Repository gibt sie als ein Kit für Menschen, die auf diese Weise arbeiten, an (kits/checking-process.md).
Die Messung regelt die Frage nicht im Voraus, und sie fragt nicht, auf welchem Weg die Fähigkeit zu prüfen erworben wurde. Wenn der Prozess des Neuankömmlings Überprüfungen besteht, die die Agenten nicht sahen, mit Auslassungen sowie falschen Einträgen unter den gepflanzten Fehlern, steigt der Horizont des Neuankömmlings wie der eines jeden; wenn nicht, zeigt der Datensatz auch das. Wenn der Rivale von Abschnitt 6.1 recht hat (Savva, 2026), wird der Prozess bei kurzen, gut spezifizierten Aufgaben am besten abschneiden und bei den oberen Sprossen am schlechtesten, wo zu wissen, was ein Stück enthalten muss, am wichtigsten ist, und ein erfahrener Fachmann, der denselben Prozess anwendet, sollte besser abschneiden als entweder. Wenn ein Prozess an die Stelle eines Teils der Erfahrung eines Handels treten kann, verlieren die Bezeichnungen der Erfahrung, Junior und Senior darunter, aus demselben Grund an Gewicht wie Grade, was der Verlust ist, den der Übergangspunkt nennt (Abschnitt 6.2). Kein registrierter Vorhersagetest testet den Prozess: F3b bewertet das Überholen bei Aufgaben außerhalb der eigenen Domäne der Teilnehmer mit 0,10 auf das Domänenargument von Abschnitt 6.3, und trägt nur indirekt zur Frage bei. Abschnitt 10.5 legt einen Vergleich fest, der ihn testen würde.
7. Die zweite Grenze: Vertrauen
7.1 Unauffindbarkeit ist der Normalzustand des Marktes
Was passiert, wenn jeder bauen kann? Die Antwort von 2026 ist, dass das meiste, das gebaut wird, nie gefunden wird. Etwa 560.000 neue Apps erreichten den App Store in der ersten Hälfte von 2026, nahe an den etwa 600.000 des ganzen Jahres 2025, während die Downloads um etwa 2% wuchsen, nach Schätzungen von Sensor Tower, die zuerst von der New York Times berichtet und von sekundären Outlets zusammengefasst wurden (9to5Mac, 2026; Gigazine, 2026). Veröffentlichungen im ersten Quartal waren um etwa 60% gegenüber dem Vorjahr gestiegen (TechCrunch, 2026b). In RevenueCats Bericht von 2026, der Apps mit ihrer Software abdeckt, erreichten 17% der neuen Abonnement-Apps innerhalb von zwei Jahren 1.000 US-Dollar monatliche Einnahmen, gegenüber 19% ein Jahr zuvor, und Apps, die seit 2025 gestartet wurden, verdienten etwa 3% der Abonnement-Einnahmen im Januar 2026 (RevenueCat, 2026; PPC Land, 2026). GitHub meldete 121 Millionen neue Repositories im Octoverse-Jahr bis August 2025, mehr als 230 pro Minute (GitHub, 2025a), und 7,38 Milliarden Commits allein im September 2026, mehr als fünfmal so viele wie ein Jahr zuvor (Celenza, 2026). Diese Zahlen zählen Produktion, nicht Produkte, die Benutzer gefunden haben. Moderatoren des Abschnitts „Show HN" eines großen Entwicklerforums berichteten, dass generierte Projekte den Abschnitt mit Lärm überschwemmten und neue Konten einschränkten (Krebs, 2026). Ein Investor bei Startmate argumentierte im August 2026, dass wenn Bauen billig ist, Vertrieb das ist, was ein Produkt schützt, und beschrieb starke Produkte, die in einer Leere sitzen mit einer Handvoll Benutzer (Batko, 2026).
Die gleiche Form erscheint unter Gründern. Solo-Gründer führten etwa 36% der Startups an, die 2025 auf Carta gegründet wurden, gegenüber 31% im 2024 (Carta, 2026a), und 63% der C-Gesellschaften, die bis jetzt im zweiten Quartal 2026 durch Stripe Atlas gebildet wurden, ein Rekord für diesen Service (Stripe, 2026). Allein zu beginnen ist common geworden; allein zu verdienen nicht. Unter Solo-Gründern auf Atlas fiel der Median-Umsatz in den ersten sechs Monaten 2025 um 23% gegenüber dem Vorjahr, während der Umsatz in der Top-Dezil um 19% anstieg, sodass die Top-Dezil etwa 61-mal den Median verdiente, gegenüber etwa 34-mal vier Jahren zuvor (Stripe, 2026). In Cartas vorherigem Bericht führten Solo-Gründer 30% der 2024 gegründeten Startups an, erhielten aber 14,7% des in gepricten Equity-Runden in jenem Jahr aufgebrachten Geldes (Carta, 2025). Beide Stichproben sind die eigenen Kunden der Anbieter, nicht alle neuen Unternehmen, aber sie zeigen, was dieser Abschnitt beschreibt: Mehr Menschen können beginnen, und die Belohnungen sammeln sich an der Spitze.
Plattformen schützen sich vor der Flut, indem sie diejenigen ausschließen, die keinen Namen haben. Das curl-Projekt beendete sein Bug-Bounty-Programm im Januar 2026 nach Berichten, die von KI generiert wurden und es überschwemmten, „nicht einmal eins von zwanzig" davon real (Stenberg, 2026). GitHub wog ab, Pull Requests auf vertrauenswürdige Mitwirkende zu beschränken (Open Source For You, 2026). Mitchell Hashimoto veröffentlichte Vouch, unter dem ein Neuling nicht zu einem Projekt beitragen kann, es sei denn, ein bestehender Teilnehmer bürgt für ihn (Hashimoto, 2026; Willison, 2026b). Ein Schutz vor einer Flut stoppt auch einen Neuling an der Tür, was das Muster ist, das ein Begleitpapier für automatisierte Aufsicht allgemein beschreibt (Chernets, 2026c). Bürgschaften existieren daher als Mechanismus, und ob es sich zu einem Beruf entwickelt, ist eine Frage für Abschnitt 7.2.
Die neuen Torwächter sind Agenten. In einer Studie von 2.430 Läufen schrieb Claude Code seine eigene Lösung, anstatt ein bestehendes Produkt in 12 von 20 Kategorien zu übernehmen, und wenn es eines übernahm, wählte es die bekannten Namen (Amplifying, 2026). Etwa die Hälfte von Vercels Bereitstellungen wurden bis Juli 2026 von Agenten ausgelöst (Startup Fortune, 2026). Ein kostenloses Produkt auf einem Code-Host konkurriert mit dem, was ein Agent des Benutzers in einer Stunde schreiben kann, und was der Agent nicht für sich selbst schreiben kann, sind Vertrauen, Wartung, ein Standard oder eine Person, die antwortet.
Ein langer Horizont macht keinen Markt. Der Horizont zeichnet auf, was eine Person liefern und beweisen kann, Vertrauen entscheidet, ob jemand außerhalb es nutzen wird, und Unauffindbarkeit ist die Lücke zwischen den beiden. Herbert Simon sah die Ökonomie davon 1971: Ein Überfluss an Information schafft einen Mangel an Aufmerksamkeit (Simon, 1971). Agenten haben die Codierungsbarriere gesenkt, und die obigen Belege zeigen Plattformen und Benutzer, die angesichts der Flut nach neuen Vertrauenssignalen fragen, bevor sie einen Neuling hereinlassen.
7.2 Zwei Partnerberufe
Ein Einwand besagt, dass eine Person, die durch Agenten baut, ohne die Fähigkeit, Menschen zu erreichen, unvollständig ist. Ich lese es anders: Menschen zu erreichen ist eine zweite Achse, und zwei Partnerfunktionen wachsen entlang dieser.
Der Finisher bringt das Produkt zu Menschen, durch Kanäle, Starts und Sichtbarkeit zur KI-Suche. Seine Namen sind bereits vergeben (Growth Engineer, Developer Relations, GTM Engineer, eine Rolle, die 2026 weit verbreitet beworben wurde), und Agenten werden einen Teil davon automatisieren, da Mailings und Starts leicht zu automatisieren sind und Filter werden als Reaktion verhärten.
Der Garant setzt seinen Namen unter ein Produkt und antwortet dafür vor seinem eigenen Kreis. Im Juni 2025 nannte das New York Times Magazine die Rolle „Rechtlicher Garant": „jemand, der die Haftung bereitstellt, die die KI nicht kann" (Capps, 2025). Eine IBM-Schulungsfolie von 1979, die 2017 online gepostet wurde, wobei das Original verloren ging, brachte den Grund in einer Zeile auf den Punkt: „Ein Computer kann niemals zur Rechenschaft gezogen werden" (Willison, 2025a). Neil Lawrence sagte das Gleiche im August 2026: Computer führen Buchhaltung sehr gut durch, „aber sie führen Rechenschaftspflicht nicht gut durch" (Sadki, 2026). Diese Funktion ist am schwierigsten zu automatisieren, denn ihr Wert liegt darin, dass eine Person antwortet. In den Begriffen der Agenturtheorie verkauft der Garant eine Anleihe: ein Versprechen, das durch die eigene Reputation des Garanten gestützt ist, und in reifer Form durch einen Vertrag, der Haftung zuordnet, und durch Versicherung, die sie bepreist (Jensen & Meckling, 1976).
Die Funktion und der Beruf sind getrennte Fragen. Die Funktion existiert überall dort, wo jemand für Arbeit unterzeichnet, die er nicht gemacht hat. Ein Beruf erscheint nur, wenn dieses Unterzeichnen regelmäßig auf seinen eigenen gekauft und bezahlt wird, und Vorhersagen F11 und F12 datieren, wann das geschieht. Der Garant hat auch ein natürliches Maß darin, wie viele Produkte er bürgte, wie lange jedes lebte und wie viele scheiterten, gewichtet nach wie schlecht; das Begleit-Repository berechnet es aus dem Ledger des Garanten, wobei die Schweregewichte von wer auch immer den Datensatz liest, angegeben werden (tools/guarantor_record.py). Der Leitfaden im zweiten Thread von Abschnitt 9 sagt es in vier Worten: Mundpropaganda ist Ruf (übersetzt). Vertrauen sollte auf Dingen ruhen, die überprüft werden können, wie ein früheres Papier in dieser Reihe für agentengesteuerten Handel argumentiert (Chernets, 2026d), und die Aufzeichnung eines Garanten ist eine solche Sache.
Ein dritter Typ erscheint in einem der Fäden von Abschnitt 9: ein Anleiter, der eine Methode verkauft, um ein ganzes Unternehmen auf KI-Agenten zu migrieren. Der Faden zeigt den Verkauf. Ihn als Garant für Organisationen zu lesen, als denjenigen, der der Unternehmensleitung für das Ergebnis Rede und Antwort steht, ist meine Interpretation der Rolle, die er aufbaut.
Die Person, die durch KI-Agenten aufbaut, antwortet nach innen, für das, was sie von KI-Agenten angenommen hat. Der Garant antwortet nach außen, gegenüber Menschen, für das, was freigegeben wurde. Eine Person kann beide Funktionen innehaben, wie ein Hochzeitsfotograf sowohl fotografiert als auch Rechenschaft ablegt, und wenn Produkte zu zahlreich sind, trennen sich die beiden Funktionen, wie es einst bei Autor und Verlag oder Wissenschaftler und Fachjournal der Fall war.
8. Zwei Märkte: der Goldrausch und der Hochzeitsfotograf
1849 strömten Menschenmassen nach Kalifornien, um Gold zu suchen. Der durchschnittliche Tagesertrag eines Bergmanns oder der Tagelohn eines angestellten Bergmanns sank von etwa 20 Dollar im Jahr 1848 auf 16 Dollar im Jahr 1849, 10 Dollar im Jahr 1850 und 6 Dollar im Jahr 1852 (Paul, 1947, S. 349). Bancroft schätzte die pro Bergmann im Jahr 1852 gewonnene Goldmenge auf „nur 600 Dollar, oder kaum 2 Dollar pro Tag", während die Löhne für ungelernte Arbeit zwei- bis dreimal höher waren (Bancroft, 1888, S. 423–424). Sam Brannan, der den Bergleuten ihre Werkzeuge verkaufte, zeigte, dass „der sicherste Weg zu Wohlstand darin bestand, das Bergbaugeschäft anderen zu überlassen" (Andrist, 1962), und Verkäufer von Werkzeugen und Stoffen schnitten gut ab. Das Muster ist 2026 sichtbar. Ein Fünftel oder weniger neuer Abonnement-Apps erreicht 1.000 Dollar pro Monat (Abschnitt 7.1), während die Verkäufer der Tools schnell wachsen: Lovables Umsatz zum Beispiel (TechCrunch, 2026a) und Ubers jährliches KI-Budget, das in vier Monaten ausgegeben wird (Fortune, 2026b), fließen in die Laboratorien.
Risikokapital folgt auf größerer Ebene demselben Weg. KI-Unternehmen erhielten 2025 61% des globalen Risikokapitals, 258,7 Milliarden Dollar von 427,1 Milliarden Dollar, und Megadeals machten etwa 73% des in KI investierten Wertes aus (OECD, 2026). In der ersten Hälfte von 2026 sammelten zwei Laboratorien, OpenAI und Anthropic, etwa 217 Milliarden Dollar zwischen sich, etwa 43% der gesamten Startup-Finanzierung weltweit (Crunchbase News, 2026). Am anderen Ende erreichte das durchschnittliche US-Pre-Seed-Instrument auf Carta im zweiten Quartal 2026 einen Rekord von 276.000 Dollar, während die Anzahl der Instrumente im Jahresvergleich um etwa ein Fünftel sank (Carta, 2026b). Größere Investitionen für weniger Newcomer sind das, was man erwarten würde, wenn das Entwickeln billig geworden ist und das Beurteilen, wer erfolgreich sein wird, nicht. Jemand, der entwickeln kann, ist nicht allein deswegen jemand, der Mittel aufbringen kann.
Die Analogie bricht an einer Stelle auf, und dieser Bruch ist wichtiger als die Übereinstimmung. Der Goldpreis war gesetzlich festgelegt, daher wurde Gold nicht billiger, je mehr abgebaut wurde, und Bergleute verloren, weil die Plazergoldlager erschöpft wurden und die Menge wuchs. Software kann fast kostenlos kopiert werden. Jedes neue Produkt fügt einen nahen Ersatz für die anderen hinzu, und der Preis von nahen Ersatzprodukten fällt gegen die Kopierkosten, die nahe bei null liegen. Das Gold geht nicht zur Neige; es wird zu Sand, außer dort, wo etwas, das nicht kopiert werden kann (Vertrauen, eine Unterschrift, ein gepflegter Dienst), zusammen mit ihm verkauft wird.
Fotografie ist die nähere Analogie. 2026 zählt das US Bureau of Labor Statistics etwa 145.000 Fotografenstellen im Jahr 2025 und prognostiziert einen Rückgang von 1% von 2025 bis 2035, während die vorherige Ausgabe von 2024 bis 2034 ein Wachstum von 2% prognostizierte (Bureau of Labor Statistics, 2025, 2026a). Im Gegensatz zur vorherigen Ausgabe nennt die neue KI: Smartphone-Fotos können den Bedarf an Profis verringern, und Stockfotosammlungen „werden voraussichtlich teilweise durch künstlich erzeugte Bilder ersetzt werden", während die Nachfrage nach Porträts und kommerziellen Arbeiten anhält und die Selbstbeschäftigung wächst (Bureau of Labor Statistics, 2026a). Paare stellen 2026 noch einen Hochzeitsfotografen an und zahlen ihn. Ein Job überlebt als bezahlter Beruf, wenn das Ereignis nicht wiederholt werden kann, wenn ein Fehler nicht rückgängig gemacht werden kann, wenn eine benannte Person für das Ergebnis verantwortlich zeichnen muss, und wenn der Kunde die Qualität vorher nicht beurteilen kann und daher Vertrauen kauft.
Diese Bedingungen spalten den Markt in zwei (Abbildung 6). Telefonschnappschüsse sind Dinge, die Menschen für sich selbst und ihr Team machen: ein Benachrichtigungssystem, ein Ersatz für ein Notizbuch-Tool, die eigene Vertragsprüfung eines Anwalts. Für sich selbst zu schaffen ist Literalität, wie Schreiben, und fast jeder wird das haben. Die Hochzeit ist Arbeit für andere mit Konsequenzen: Produkte, die an Fremde freigegeben werden, Geld, Gesundheit, Recht, Infrastruktur. Arbeit für andere ist der Beruf, definiert durch einen verifizierten Horizont und durch jemanden, der Verantwortung trägt. Zwischen den beiden Märkten steht die Barriere der Unklarheit, und der Garant arbeitet an dieser Barriere.
Diese Aufteilung beantwortet auch die Frage, mit der ich anfing: „Wie sollten diese Menschen genannt werden?" Es gibt zwei Antworten, einen Namen für die Massenfähigkeit und einen anderen für den Beruf, und die Karte von Abschnitt 3 enthält bereits Kandidaten für beide.
Kent Beck fasste die Auswirkung auf alte Seniorität in einem Satz zusammen: „90% meiner Fähigkeiten sind gerade auf null Dollar gefallen und 10% meiner Fähigkeiten sind gerade um das 1000-fache gestiegen" (Willison, 2025b). Einige erfahrene Ingenieure werden zu den Hochzeitsfotografen der Software, angestellt für den kleinen Teil von Systemen, wo ein Fehler nicht rückgängig gemacht werden kann. In den Daten von 2026 zeigt sich die Schwäche in der Beschäftigung bei jüngeren Arbeitern (Stanford Digital Economy Lab, 2026a), daher halte ich die Seite mit älteren Arbeitern als Bild, während Prognose F25 der Seite mit jüngeren Arbeitern folgt.
Abbildung 6. Zwei Märkte, die Mauer der Unklarheit zwischen ihnen und die zwei Partner, die sie überqueren.
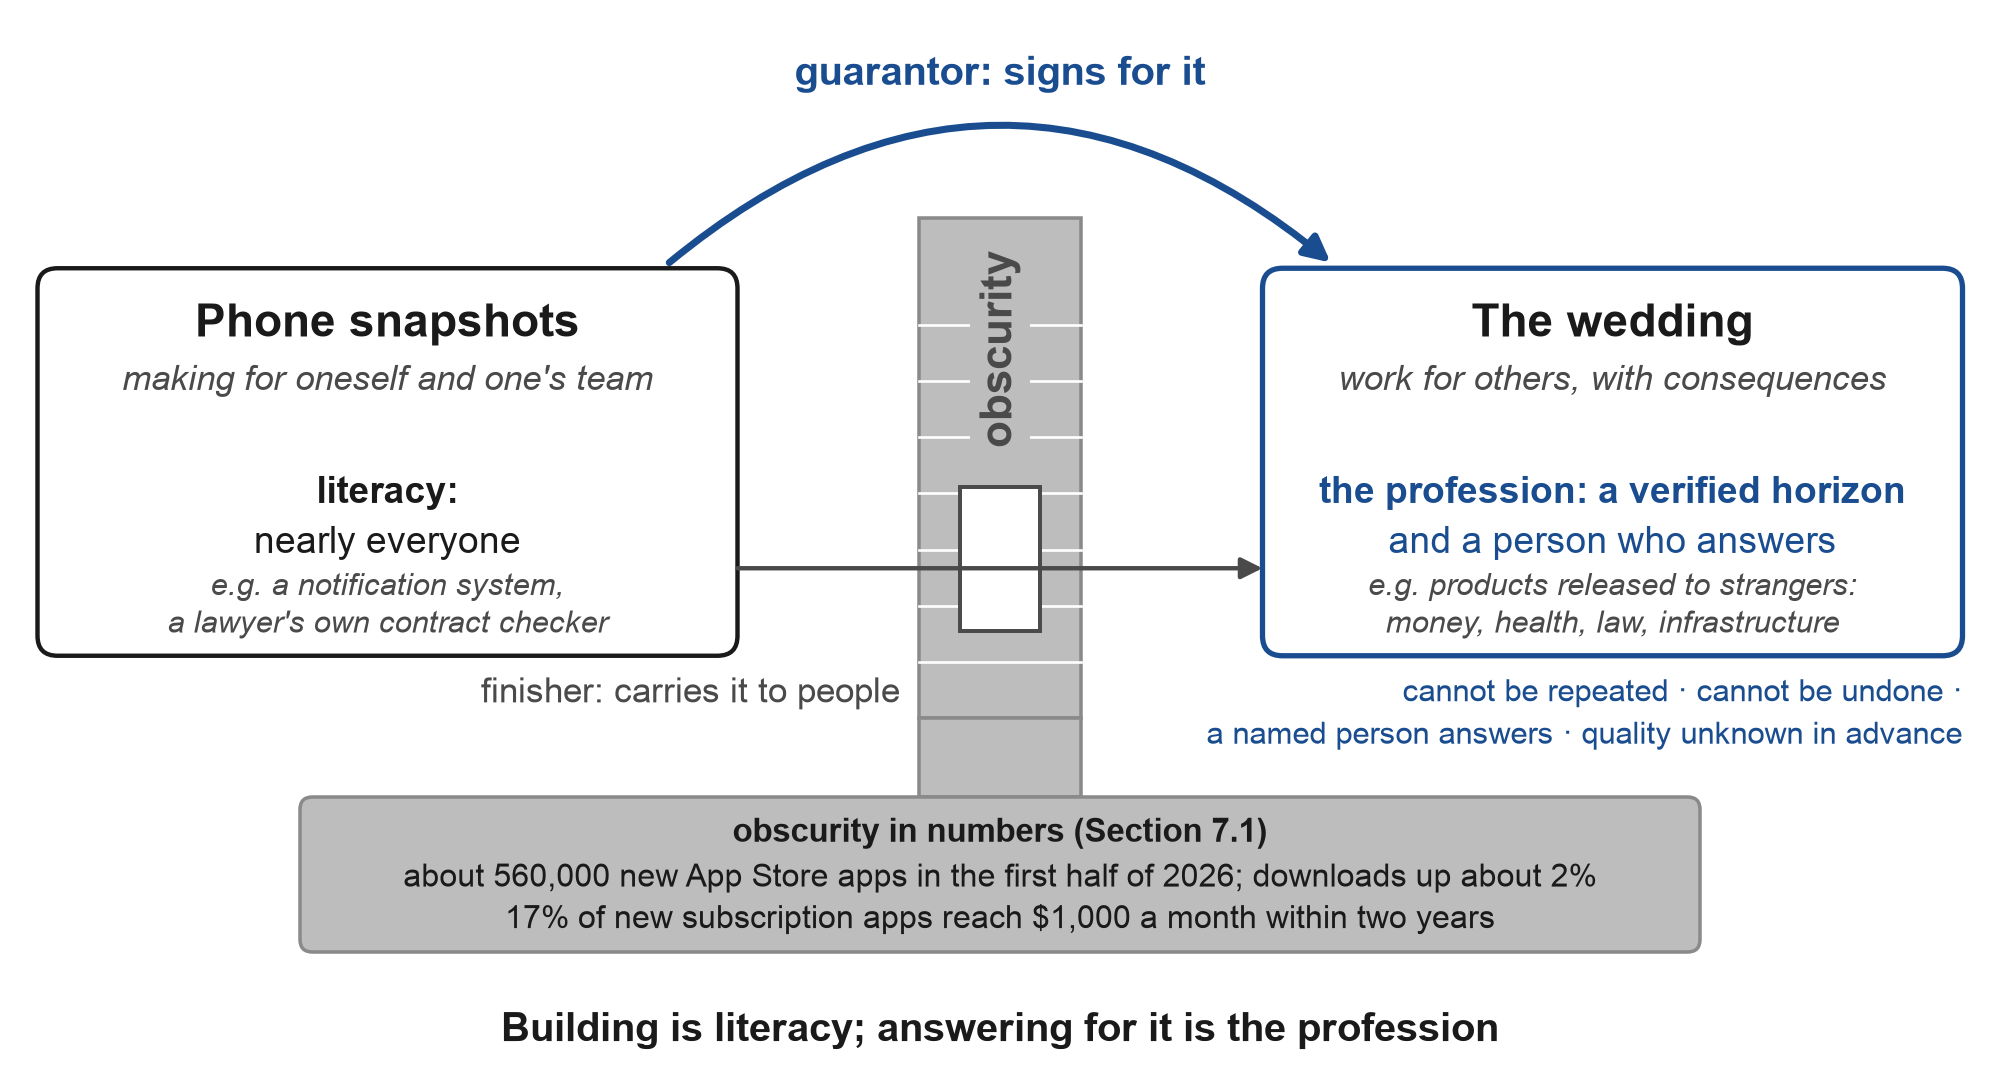
Hinweis: Die beiden Zahlen gehören zur Mauer der Unklarheit, nicht zum Finisher: etwa 560.000 neue App-Store-Apps in der ersten Hälfte von 2026 mit Downloads, die um etwa 2% gestiegen sind (Sensor Tower-Schätzungen, wie von 9to5Mac, 2026, und Gigazine, 2026 berichtet), und 17% neuer Abonnement-Apps erreichten innerhalb von zwei Jahren 1.000 Dollar pro Monat (RevenueCat, 2026). Die Beispiele an jedem Pol sind die von Abschnitt 8. Die vier Bedingungen sind die von Abschnitt 8; der Bogen und die Tür sind die zwei Partnerfunktionen von Abschnitt 7.2.
9. Was aus den Gesprächen von Programmierern übergeht
Die Gespräche von Programmierern im Jahr 2026 könnten die Gespräche jedes Berufsstands im Jahr 2027 sein. Um dies zu überprüfen, habe ich drei öffentliche Diskussionsfäden auf Facebook gelesen, gesammelt am 8. Oktober 2026 (Beiträge und Kommentare; Kommentatoren werden hier nicht namentlich genannt).
Im ersten forderte ein Autor Entwickler, die sagen, dass KI fehlerhaften Code schreibt, auf, einen Fall zu zeigen, bei dem jede gute Praxis angewendet worden war und der Code trotzdem fehlgeschlagen war. Er selbst war sich sicher, dass ein solcher Fall einfach nicht vorkommt. Der Faden entwickelte sich zu einem Streit über Akzeptanz, und ein Teilnehmer fasste es zusammen: Das Problem ist, ob die Produktion so organisiert werden kann, dass das Ergebnis der KI überprüft, akzeptiert und genutzt werden kann (übersetzt). Ein anderer, der an Sicherheitsbehebungen arbeitet, berichtete, dass auch mit Tests und Anweisungen ein starkes Modell oft nicht die richtige Behebung für Schwachstellen oberhalb von 9 auf der CVSS-Skala erzeugt, und dass automatische Überprüfungs- und Behebungsschleifen teuer werden. Ein Manager mit dreißig Jahren in der IT antwortete, dass Programmierer schon immer genau die gleichen Kopfschmerzen bereitet hätten. Ein anderer Kommentator bewertete die neue Aufgabe mit 150 Dollar pro Stunde, dem Satz eines Prüfers, der von KI geschriebenen Code überprüft und korrigiert, und ein dritter beschrieb einen Senior Engineer mit zwanzig Jahren Erfahrung, dem es schwerfiel zu akzeptieren, dass seine Fähigkeiten an Wert verloren hatten.
Im zweiten Faden migriert eine Person, die eigenen Aussagen zufolge weder die eine noch die andere Sprache kennt, eine Plattform mit 650.000 Zeilen von einer Programmiersprache zu einer anderen, mit etwa 330 von etwa 600 Pull Requests erledigt, und gibt 1.148 Dollar pro Monat für KI aus. Sie verkauft eine Methode zum Umzug von Unternehmen auf Agenten und argumentiert, dass Programmierer bei dieser Aufgabe mehr Schaden als Nutzen anrichten. Sie macht sich auch durch öffentliche Ausgaben sichtbar, eine Liste von Projekten, Werbecodes, einen Kurs und eine kostenlose Stunde für größere Firmen. Sie baut praktisch die Rolle des Führers aus Abschnitt 7.2 auf, und sie bekämpft die Dunkelheit mit Inhalten.
Der dritte zeigt eine Person, die für sich selbst auf vier Maschinen aufbaut, mit dem 36-stufigen Ablauf aus Abschnitt 5.4. Sie berichtet, dass keiner ihrer Arbeitsabläufe von vor sechs Monaten bis zu einem Jahr überlebt, dass sie erwartet, sie in drei Monaten erneut zu ändern, und dass sie eine konstante Angst hat, etwas zu verpassen. Die Kommentare streiten sich darüber, welcher Agent zu welchem Lager gehört.
Tabelle A5 (Anhang F) stellt die Themen der Fäden gegen das gegenüber, was bei Menschen außerhalb der Softwareentwicklung im Jahr 2025 und 2026 sichtbar war. Ihre Zeilen sind illustrative Fälle, keine Stichprobe.
Das, was Tabelle A5 zeigt, ist, dass die Funktion übergeht und die Form bleibt. Ein Buchhalter, der lernt, eine Familie von Modellen mit einer anderen zu überprüfen, wird es immer noch „Abstimmungsregeln" und „wer hat es überprüft" nennen, wird kein Wort für ein Gerüst haben und wird die Wahl des Agenten nicht als eine Frage der Identität behandeln. Die Statusmarker der Fäden, die hohe persönliche Rechnung, das Lager und die vier Maschinen bleiben in der obersten Schicht jedes Berufsstands, ganz wie Fotografen über Objektive diskutieren und ihre Kunden nicht.
Das Übergehen kommt auch in Schichten: zuerst das oberste Zehntel oder so eines jeden Berufsstands, dann Ausbildungsprogramme, dann Produkte, die die Einrichtung verstecken. Diese Abfolge ist Diffusionstheorie auf Agenten angewendet, und es wird hier keine Priorität dafür beansprucht; Rogers (2003) ordnete Innovatoren und frühe Anwender zusammen bei etwa einem Sechstel der Anwender. OpenAIs eigener Bericht vermerkt, dass außerhalb des Unternehmens „technische Nutzung der dominante Modus bleibt" (OpenAI, 2026), und Anthropic fand, dass technische Nutzer zuerst kamen und Menschen mit niedrigerbezahlten Aufgaben später (Anthropic, 2026f). Abschnitt 11 gibt das Übergehen von Funktionen als eine Vorhersage an, die überprüft werden kann, indem man Lehrpläne und Beiträge liest.
10. Implikationen
10.1 Für Arbeitgeber und Personalabteilungen
Ein Arbeitgeber, der nach der Arbeitsaufzeichnung bewertet, erfährt mehr aus „Domäne · Horizont · Verstärkung · Datum" als aus „Senior" oder „Manager", und die Aufzeichnung reist zwischen Funktionen. Es folgt ein Einstellungstest: Geben Sie dem Kandidaten eine Tagesaufgabe in seiner eigenen Domäne, die durch Agenten zu erledigen ist, und lassen Sie sie durch eine Überprüfung bestätigt werden, die der Kandidat nicht selbst entworfen hat, mit einigen gepflanzten Fehlern, die der Kandidat finden muss. Jaques' Logik der Bezahlung, unter der gerechte Bezahlung mit der Verantwortungsspanne steigt, liefert eine Ausgangshypothese für die Bezahlung nach verifiziertem Horizont. Ob sie zutrifft, ist eine empirische Frage, und Vorhersage F18 in Abschnitt 11 formuliert sie: Wo Arbeitgeber nach verifizierten Arbeiten bewerten, sollte der Rang Bezahlung und Leistung besser vorhersagen als Berufserfahrung in Jahren.
Das Ranking nach Token-Anzahl ist eine andere Sache, und die Episode aus Abschnitt 4 zeigt, wohin sie führt. Wenn Nutzung überhaupt diskutiert wird, gehört sie in eine Leistungsbewertung wie jede andere Methode auch, als eine Eingabe unter vielen.
Worauf man am Ende achten sollte, ist wen die Organisation tatsächlich einstellt. Eine aus einer Richtlinienseite entfernte Abschlussanforderung ändert von selbst aus wenig (Abschnitt 6.2). Eine Änderung bei wem eingestellt wird, bei gleichem verifiziertem Horizont, ist das, was der Schnittpunkt aus dem Inneren einer Firma aussieht.
10.2 Für Bildung und Schulen
Für Schulen ist die Lektion, Akzeptanz vor Syntax zu lehren. Die Fähigkeiten, die eine Person die Leiter hinauf tragen, zu sagen was als erledigt zählt, eine Überprüfung wählen, die der Agent nicht sehen kann, und einen plausiblen Fehler in seinem eigenen Feld erkennen, können in jeder Disziplin gelehrt werden. Ein Zertifikat ist so viel wert wie seine Überprüfung, daher sollte ein Zertifikat den verifiziertem Horizont angeben, den es bescheinigt, mit der Domäne und dem Datum.
Schulen, die KI-Kompetenz zum Lehrplan hinzufügen, können der „Manage AI"-Domäne des Rahmens der OECD und der Europäischen Kommission einen konkreten Inhalt geben: eine kleine Aufgabe übergeben, eine im Voraus festgelegte Überprüfung, und ein Erwachsener, der für alles verantwortlich ist, das an Fremde weitergegeben wird.
10.3 Für Anbieter und Plattformen
Anbieter können Akzeptanz aus dem Produkt herausbringen. Eine Person sollte in der Lage sein, die Aufgabe, die Eingaben, die Überprüfung und die Entscheidung zur Akzeptanz zu exportieren, damit die Aufzeichnung zu einem Arbeitgeber oder einer Schule reisen kann. Die Nutzung würde dann auf die gleiche Weise gemeldet, durch Zählung von Personen, die verifizierten Arbeiten akzeptierten, anstatt von Personen, die die Anwendung öffneten.
Eine Plattform hat bereits diesen Weg eingeschlagen, von der Anbieterseite aus. Im Januar 2026 begann LinkedIn, verifizierte KI-Fähigkeiten anzuzeigen, die von Lovable, Replit, Descript und Relay.app ausgegeben wurden, basierend darauf, wie ein Mitglied jedes Tool tatsächlich nutzte (LinkedIn, 2026a). Ein solches Abzeichen bescheinigt die Nutzung eines Tools, beurteilt vom Tool-Anbieter selbst gegen Stufen, die der Anbieter setzt; es bescheinigt nicht ein Ergebnis, das von jemandem überprüft wurde, den die Person nicht selbst wählte. Dieselbe Plattform verkauft Agenten an Recruiter, mit agentengestützten Einstellungsprodukten über einer Laufrate von 450 Millionen Dollar jährlich im April 2026 (LinkedIn, 2026b), und gab Mitgliedern im Juli 2026 eine Schaltfläche, um Posts zu melden, die „wie KI-Abfall aussehen" (TechCrunch, 2026c), nachdem der Erkennungsanbieter Pangram schätzte, dass 41 % der langen Posts auf der Website von April bis Juni 2026 völlig generiert waren (The Decoder, 2026). Wenn Text über die eigene Arbeit nichts kostet zu produzieren, sagt ein Profil weniger aus, und eine Aufzeichnung verifizierter Arbeiten, die nicht von einem einzelnen Anbieter abhängt, sagt mehr.
Plattformen, die 2026 ihre Türen vor dem Unbekannten schlossen, wie viele es taten, können eine zweite Tür durch Bürgschaften öffnen. Ein Neuankömmling, dessen Arbeiten eine bekannte Person unterzeichnet, passt, und die Aufzeichnung des Bürgen wächst oder schrumpft mit dem, was danach passiert.
10.4 Für Produkte, die Menschen zu Agenten einführen
Einführungsprodukte trennen normalerweise „Anfänger" und „Programmierer" beim ersten Bildschirm. Das Maß schlägt vor, die zwei Türen durch eine Frage zu ersetzen: Was können Sie bereits an einen Agenten weitergeben und überprüfen, noch nichts, eine Stunde, einen Tag oder eine Woche? Bis sich die Türen zusammenführen, Fragen zur IT-Bildung einmal zu stellen, mit Zustimmung, lässt Hintergrund-Neutralität an den eigenen Benutzern des Produkts getestet werden.
10.5 Für Forscher
Forscher können die Person-nach-Aufgabe-Panels aufbauen, die Chen und Meng (2026) sagen, dass sie nicht existieren, Menschen mit Menschen vergleichen, die die gleichen Agenten unter blinden Überprüfungen nutzen, den Nenner mit der Arbeit angeben, die Überprüfungen nicht bestanden hat, eingeschlossen, und die Referenzbank gefroren und veröffentlicht halten. Das Instrument des Anhangs C tut bereits dies: Es zählt keine Teile, deren Überprüfung als nicht unabhängig aufgezeichnet ist, und meldet beide Achsen mit einem Datum.
Ein Vergleich folgt aus Abschnitt 6.5 und wurde nicht durchgeführt. Bei den gleichen Aufgaben der Bank, unter Überprüfungen, die die Agenten nicht sahen, und mit gepflanzten Fehlern beider Arten, falschen Einträgen und fehlenden, würde es Erfahrung im Handwerk (vorhanden oder abwesend) mit der Arbeitsweise kreuzen (ein Agent, dessen Ausgabe akzeptiert wird, wie sie ist, oder der Überprüfungsprozess aus Abschnitt 6.5). Erfahrung würde durch einen Wissensbildschirm und eine Arbeitsaufzeichnung etabliert, nicht durch ein Profillabel (Abschnitt 6.2), und Teile, deren Fehler nicht rückgängig gemacht werden können, würden durch einen versteckten Test oder einen qualifizierten Menschen überprüft, wie Abschnitt 5.2 erfordert. Auslassungen und falsche Einträge würden getrennt bewertet: Die im Voraus erstellte Liste zielt auf die erste ab und die Prüfer auf die zweite, und die Lücke, die Anhang G2 vorschlägt, ist der ersten Art. Der Vergleich würde zeigen, wie viel Erfahrung eines Handwerks ein Prozess ersetzen kann, und bei welcher Sprosse das aufhört. Ein Vergleich mit Fachleuten, die ohne Agenten arbeiten, würde hier nichts entscheiden, aus dem Grund, der in Abschnitt 11.1 angegeben ist. Die Vorhersagen aus Abschnitt 11 sind eingefroren und enthalten diesen Vergleich nicht, der selbst registriert würde, bevor Daten gesammelt werden. Das Begleit-Repository hält ihn als Protokoll zum Anpassen und Registrieren (kits/process-vs-experience-study.md), mit einem Tool, das die gepflanzten Fehler einer Aufgabe vor der Übergabe versiegelt und falsche Einträge und Auslassungen danach getrennt bewertet (tools/planted.py), und eine Analyse, die die vier Arme druckt und für jede Art von Fehler getrennt, den Effekt des Prozesses unter Neuankömmlingen, den Effekt der Erfahrung unter einem Agenten und deren Wechselwirkung, mit Intervallen, die Menschen resampling durchführen (tools/process_study.py).
11. Datierte Vorhersagen, registriert und bewertet
11.1 Regeln für das Schreiben der Vorhersagen
Ich schrieb die Vorhersagen unter Regeln, die sie überprüfbar halten. Gleiches wird mit Gleichem verglichen: Nicht-Programmierer werden mit Programmierern verglichen, die die gleichen Agenten nutzen, bei den gleichen Aufgaben, mit der gleichen Zeit, denn ein Vergleich mit Programmierern, die ohne KI arbeiten, entscheidet hier nichts.
„Besser" wird in drei Bedeutungen aufgeteilt, von denen jede einzeln getestet wird. Für Code sind die Tests verborgene Tests, Sicherheitsprüfung und eine Änderung, die ein anderer Agent einen Monat später vornimmt, um die Wartbarkeit zu überprüfen. Für ein Produkt ist der Test, ob es Unbekannte erreicht hat und sechs Monate später noch funktioniert. Für den Lebenslauf ist der Test das Gewicht eines Abschlusses in Stellenangeboten. Popularität wird nicht als Maß für „besser" verwendet, denn sie testet Verbreitung, die ein separater Beruf sein kann (Abschnitt 7.2).
Die Vorhersagen hängen auch nicht vom Namen eines Berufszweigs ab. Sie sprechen von „Menschen ohne IT-Ausbildung, die durch Agenten arbeiten", sodass sie überdauern, welcher Name sich durchsetzt.
11.2 Die Vorhersagen
Tabelle 4 zeigt die zehn Kernvorhersagen in kurzer Form; Tabelle A6 (Anhang D) und die Datei predictions/predictions.csv des begleitenden Repositoriums geben alle 41 an, jede mit einem Maß, einer Grundlage aus 2025 oder 2026, Regeln für drei Ergebnisse (eingetroffen, nicht eingetroffen, ungelöst), ein Überprüfungsdatum und ein Enddatum, eine Wahrscheinlichkeit, eine Ausweichquelle und die nächste vorangehende oder Gegenvorhersage. Eine Wahrscheinlichkeit entschuldigt keinen Prognostiker, der sich als falsch herausstellt, aber sie macht den Fehler bewertbar. Eine Vorhersage mit 35%, die fehlschlägt, sagt wenig für sich allein. Ob 35% die richtige Zahl war, zeigt sich nur über die Menge, bei der etwa ein Drittel solcher Vorhersagen wahr werden sollte. Die Brier-Regel (Brier, 1950) gibt einen Gesamtgenauigkeitswert über die Menge, kombiniert Kalibrierung mit der Fähigkeit, zu unterscheiden, was geschieht, von dem, was nicht geschieht. Die Hauptvorhersage läuft gegen die aktuelle Meinung, da Einstellungsdaten immer noch Abschlüsse für KI-Arbeiten bevorzugen, Gartner erwartet, dass die meisten Vibe-codierten Anwendungen eingestellt werden, und Andrew Ng argumentiert, dass tiefes Verständnis von Programmen gewinnt. Die Tabelle setzt anders, mit angegebenen Quoten: Die registrierte Wahrscheinlichkeit des Überholens in der eigenen Domäne (F3) beträgt 0,35. Sie liegt unter einer gleichen Chance, weil die Herstellerdaten Programmierungsberufe immer noch etwa 5 Punkte vorne zeigen (Abschnitt 2.2) und Savva (2026) größere Lücken bei schwierigeren Aufgaben vorhersagt (Abschnitt 6.1), und über 0,25, weil Parität, der Schritt zuvor, mit 0,70 bewertet wird; die unabhängigen Modellforesaster reichten von 0,25 bis 0,55. Abbildung 7 platziert jede Vorhersage in ihrem Überprüfungsjahr und ihrer Wahrscheinlichkeit.
Die Vorhersagen fallen in zwei Gruppen. Satz A (27 Vorhersagen) wird aus öffentlichen Daten und aus den eingefrorenen Abfragen, Listen und Codebüchern in predictions/resolve/ gelöst, sodass jeder es ohne mich bewerten kann. Satz B (14 Vorhersagen: F2, F3, F3b, F4a, F4b, F7, F12, F14, F18, F19, F20, F26, F34, F35) ist ein Forschungsprogramm: Es benötigt Daten, die keine öffentliche Quelle veröffentlicht, und wird nur aus einer Studie gelöst, die separat vor der Datenerfassung registriert wird, mit einem benannten Besitzer, einem Protokoll und einer Powerberechnung. Für die neun Vorhersagen von Satz B, deren Regeln auf einem Intervall geschrieben sind, wendet das begleitende Repositorium die eingefrorenen Regeln „eingetroffen" und „nicht eingetroffen" auf die Schätzungen einer Studie an und druckt die eingefrorenen Worte neben jedem Ergebnis (predictions/set_b.py). Eine Vorhersage von Satz B, deren Protokoll bis zum 30. Juni 2027 nicht registriert ist, wird als nicht durchgeführt erfasst und auf jedem Scorecard als Versagen des Testprogramms aufgeführt. Der Brier-Score wird dann zweimal gemeldet, über gelöste Vorhersagen nur und mit jeder nicht durchgeführten Vorhersage, als wäre die Vorhersage falsch gewesen, sodass eine Studie, die nie durchgeführt wird, nicht aus der Zählung herausfallen kann. Die Experimente von F2, F3 und F3b sind eine Studie mit 1.500 Personen pro Gruppe: Dies gibt etwa 0,8 Power, um einen wahren Vorteil von 5 Punkten zu erkennen (zweiseitig alpha 0,05, bei einem Passanteil nahe 50%, dem am wenigsten günstigen Fall), wobei 400 pro Gruppe ihn nur etwa 30% der Zeit zeigen würde. Für jede studienbezogene Vorhersage ist ein Intervall, das weder die Regel „eingetroffen" noch die Regel „nicht eingetroffen" erfüllt, ungelöst, kein Versagen.
Die Wahrscheinlichkeiten wurden am 9. Oktober 2026 festgelegt. Jede ist der Median von drei verblindeten Vorhersagen durch Modelle von drei Familien (Claude Opus, ein OpenAI-Modell und Gemini), die die gleiche Tabelle ohne Einsicht in meine Zahlen bewertet haben; ich habe diese Mediane als meine Wahrscheinlichkeiten angenommen, sie sind auf OSF registriert, und jede Änderung von meinen früheren Entwürfen ist im Changelog protokolliert. Eine frühere Runde von 4 unabhängigen Modellforesastern von 4 Familien bewertete die Tabelle auch verblinded. Jeder gab eine Referenzklasse, ein einteiliges Argument und eine Wahrscheinlichkeit an, und ihre gepoolte Vorhersage (der geometrische Mittelwert der Quoten) wird neben der registrierten Wahrscheinlichkeit in Tabelle 4 angezeigt, mit der Streuung in der CSV. Wenn sich die registrierte Wahrscheinlichkeit vom Median dieser Runde um mehr als 0,15 unterscheidet (F28 und F32), ist der Grund im Changelog angegeben. Alle Wahrscheinlichkeiten sind bedingt dadurch, dass die Vorhersage gelöst wird, denn der Brier-Score wird über gelöste Vorhersagen berechnet. Der gelöste Anteil wird daneben gemeldet.
Tabelle 4. Zehn Kernvorhersagen mit Schwellwerten, Enddaten und Wahrscheinlichkeiten (alle 41 in Tabelle A6).
| # | Vorhersage | Schwellwert | Enddatum | p | Modelle | Daten |
|---|---|---|---|---|---|---|
| F1 | Die Lücke im verifizierten Erfolg schließt sich in Herstellerdaten | Programmierung minus andere Berufe 2 Punkte oder weniger (jetzt 34% gegen 29%) | 31. Dezember 2028 | 0,35 | 0,39 (0,25 bis 0,65) | öffentlich |
| F2 | Qualitätsparität in der eigenen Domäne | Untere 95%-Grenze von (Nicht-IT minus Programmierer) über minus 10 Punkte; 1.500 pro Gruppe | 8. Oktober 2028 | 0,70 | 0,67 (0,62 bis 0,70) | eigene Studie |
| F3 | Überholung in der eigenen Domäne (der Qualitätswechsel) | Untere 95%-Grenze über Null; gleiche Studie | 8. Oktober 2029 | 0,35 | 0,33 (0,25 bis 0,55) | eigene Studie |
| F5 | Die Kreuzung in Stellenangeboten | Abschlussanteil in agentiven Stellenangeboten unter abgestimmten Stellenangeboten um 2 Punkte oder mehr, zwei aufeinanderfolgende Quartale 2027 | 31. Dezember 2028 | 0,30 | 0,34 (0,25 bis 0,60) | öffentlich |
| F7 | Hintergrund-Neutralität | 90%-Intervall des Quotenverhältnisses für IT-Ausbildung zwischen 0,67 und 1,5, am Tag und in der Woche | 31. Dezember 2029 | 0,42 | 0,43 (0,40 bis 0,48) | eigene Studie |
| F14 | Die beiden Achsen bleiben unterschiedlich | Spearman von Log-Horizont und Log-Gewinn 0,8 oder darunter; Gewinn addiert 0,02 Out-of-Sample-R-Quadrat | 30. September 2028 | 0,52 | 0,49 (0,45 bis 0,50) | eigene Studie |
| F19 | Überprüfung setzt die Obergrenze | Überprüfungsanteil in den Monaten 1 bis 3 übertrifft den Horizont bei der Vorhersage des verifizierten Outputs in den Monaten 4 bis 6 | 30. September 2028 | 0,45 | 0,44 (0,30 bis 0,65) | eigene Studie |
| F26 | Einstellungspraxis folgt | Audit-Studie: Rückruf-Lücke unter 3 Punkte, 95%-Intervall innerhalb von 5 | 31. Dezember 2029 | 0,35 | 0,32 (0,25 bis 0,35) | eigene Studie |
| F27 | Von Agenten erstellte Produkte überdauern die Prognose | Weniger als 50 % einer am 31. Dezember 2026 eingefrorenen Stichprobe wurden Ende 2028 eingestellt (Gartner: 60 %) | 31. März 2029 | 0,32 | 0,35 (0,20 bis 0,55) | öffentlich |
| F28 | Maschinen erreichen Day bei 80 % | METR-80%-Horizont von 8 Stunden oder mehr bis Ende 2027 (3,1 Stunden im April 2026) | 30. Juni 2028 | 0,80 | 0,66 (0,55 bis 0,80) | öffentlich |
Hinweis: p ist die registrierte Wahrscheinlichkeit, dass die Vorhersage wahr wird, vorausgesetzt, sie wird aufgelöst: der Median von drei blinden Modellprognosen vom 9. Oktober 2026, die ich angenommen habe. Modelle: die gepoolte Prognose unabhängiger Modellprognose-Experten, die meine Zahlen nicht sahen (geometrisches Mittel der Quoten), mit deren Spannweite. Daten: öffentlich bedeutet lösbar aus öffentlichen Quellen durch jeden (Set A); eigene Studie bedeutet eine separat vorregistrierte Studie (Set B). Regeln für „wahr geworden", „nicht wahr geworden" und „unaufgelöst", Fallback-Quellen und vorherige Prognosen für alle Vorhersagen finden Sie in Tabelle A6 und in predictions/predictions.csv. Eine Vorhersage ohne vergleichbare Daten bis zu ihrem Enddatum ist unaufgelöst und wird niemals als Erfolg gezählt. Das Programm, registriert auf OSF (Chernets, 2026e), hat keine Hypothesen und stellt keine Fragen zur IT-Ausbildung, kann daher Set B nicht testen.
Abbildung 7. Das Vorhersageregister: jede datierte Vorhersage in ihrem Überprüfungsjahr und angegebene Wahrscheinlichkeit.
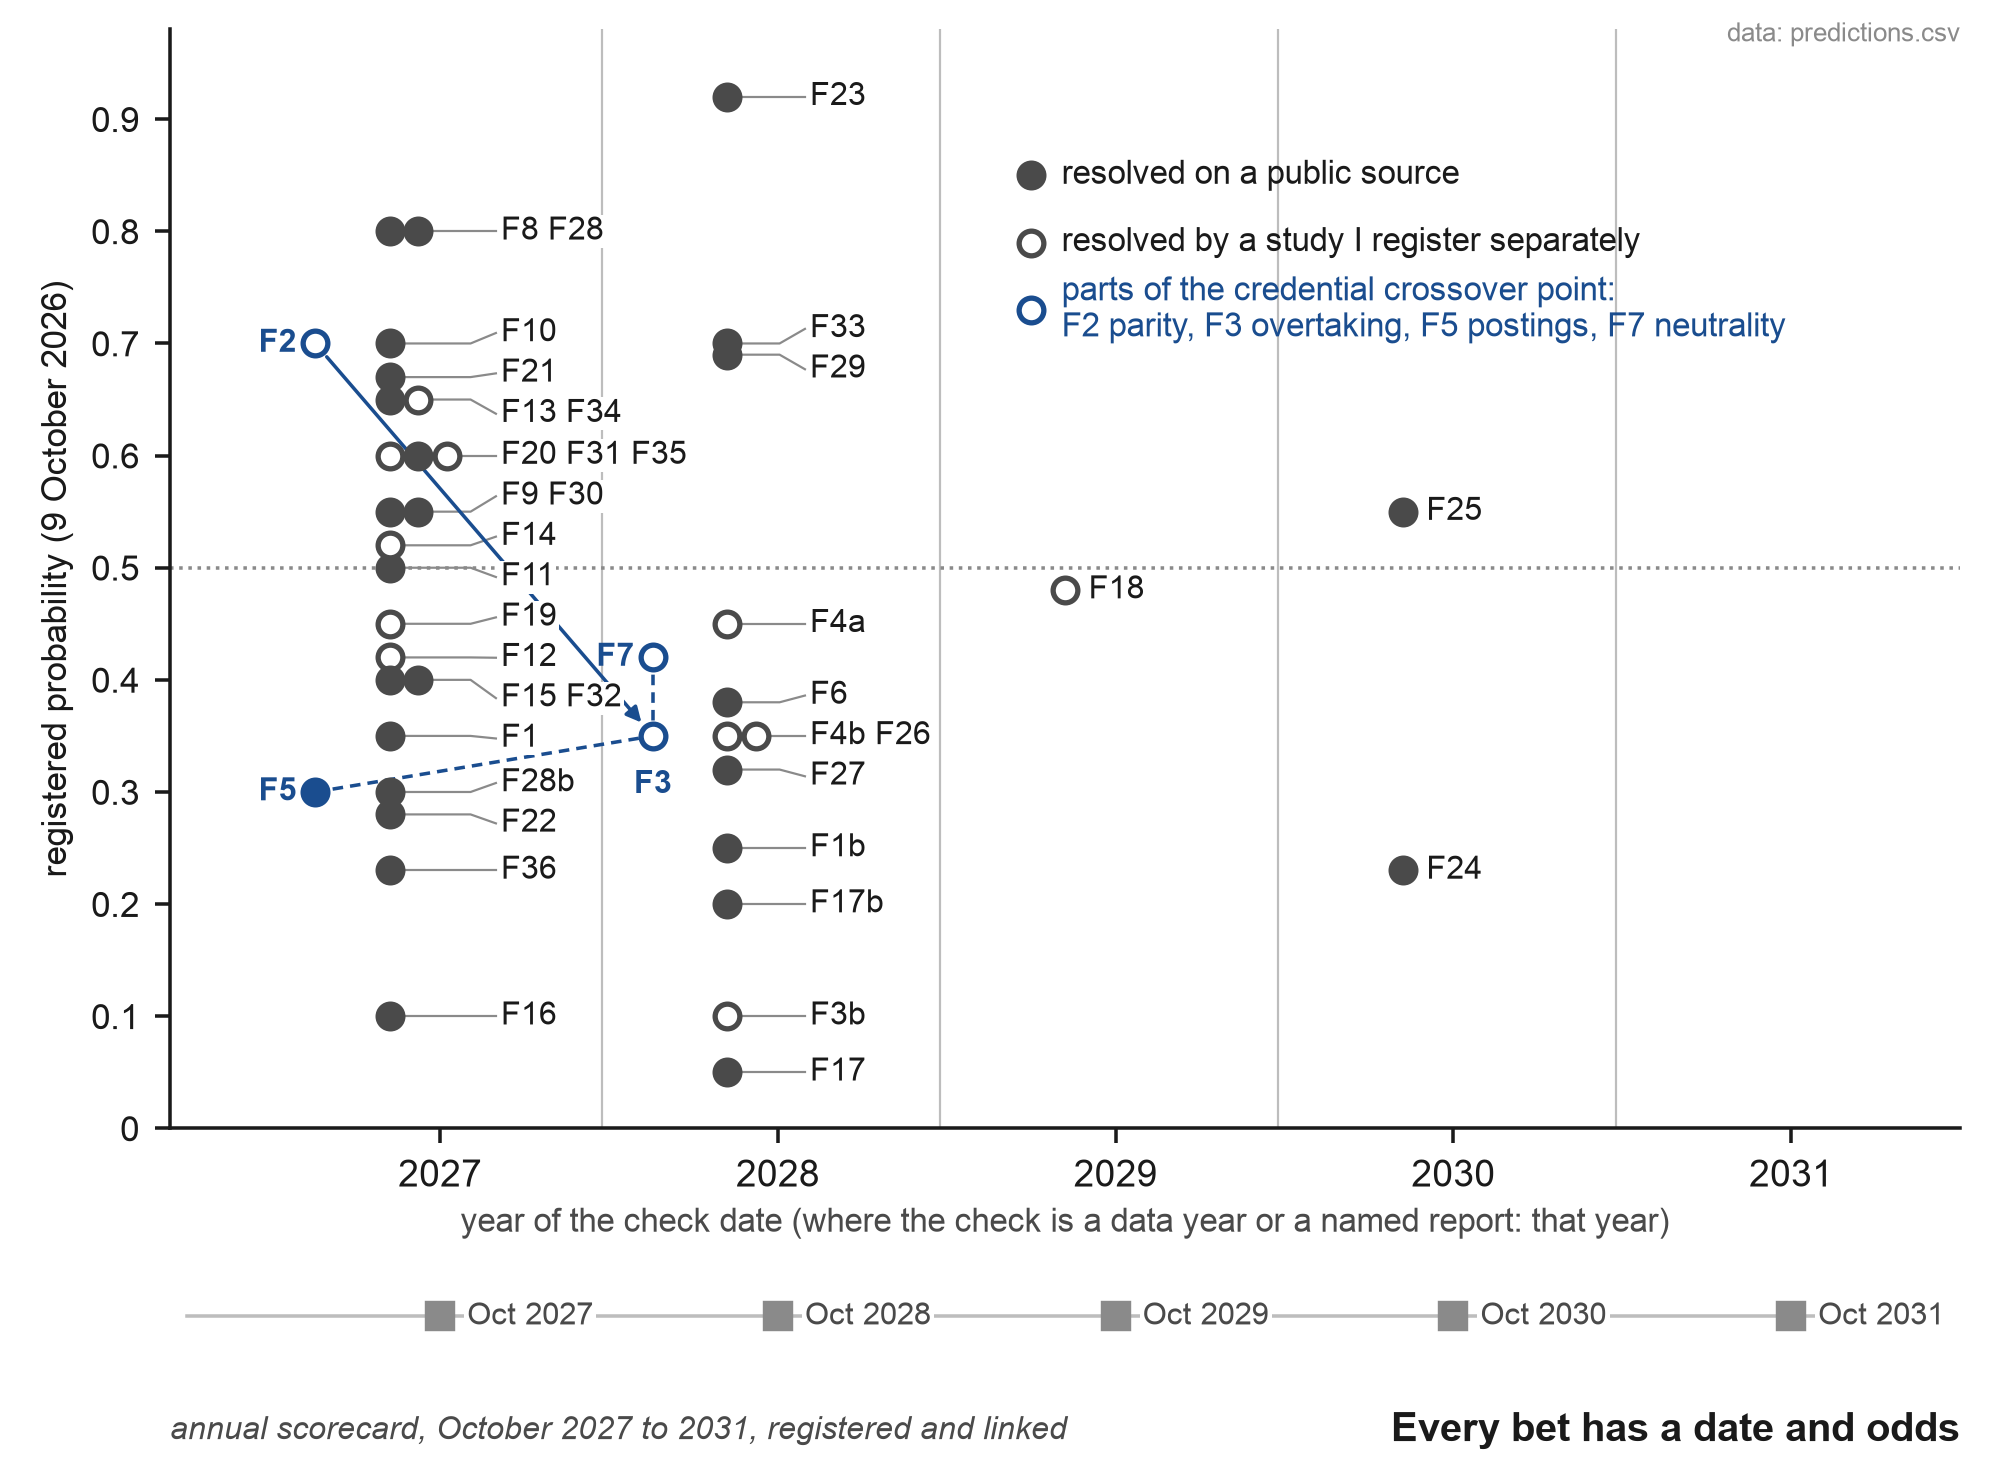
Hinweis: Jeder Marker ist eine der 41 Vorhersagen aus Tabelle A6, angeordnet nach dem Jahr ihres Überprüfungsdatums (wenn die Überprüfung ein Datenjahr oder ein benannter Bericht ist, jenes Jahr) und nach ihrer registrierten Wahrscheinlichkeit. Gefüllte Marker werden in einer öffentlichen Quelle aufgelöst. Hohle Marker werden nur durch eine vor der Datenerfassung separat registrierte Studie aufgelöst. Die vier Teile des Übergangsglaubwürdigkeitspunkts sind in der Akzentfarbe: Qualitätsparität (F2) führt zu Übernahme (F3). Die Kreuzung in den Stellenausschreibungen (F5) ist ihr sichtbares Zeichen und die neutrale Hintergrundinformation (F7) sein Mechanismus. Nur die Parität wird über gleichmäßigen Chancen (0,70) bewertet. Die Übernahme, der Moment selbst, liegt bei 0,35. Quadrate unterhalb der Achse markieren die jährlichen Bewertungsbögen, die auf OSF registriert und vom Oktober 2027 bis 2031 durch DOI verlinkt werden sollen. Die Wahrscheinlichkeiten wurden am 9. Oktober 2026 festgelegt und sind auf OSF registriert.
Eine jährliche Messung begleitet die Vorhersagen, ohne selbst eine Vorhersage zu sein, ein Rennen der Namen: Jedes Jahr zählen die gleichen Abfragen, wie oft jeder Kandidat aus Tabelle A2 in den USA erscheint und in OpenAlex und Crossref erscheint. Die Frage, die früher nur eine langfristige Überprüfung war, ob SOC 2028 einen Beruf für agenten-gesteuerte Arbeit benennen wird, ist nun die Vorhersage F23, mit einer Wahrscheinlichkeit (Bureau of Labor Statistics, 2026b). Am 9. Oktober 2026 hatte das Bureau of Labor Statistics weder eine vorgeschlagene noch eine endgültige SOC-2028-Struktur veröffentlicht; die endgültige Struktur wird 2027 erwartet.
11.3 Vorherige Prognosen
Am 9. Oktober 2026 habe ich Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket und Long Bets durchsucht sowie das offene Web (Unternehmensforschungsseiten, Analystenberichte, arXiv, SSRN und Nachrichten), um datierte Prognosen zu finden, dass Menschen ohne technische Ausbildung, die durch KI-Agenten arbeiten, würden sich Programmierern entsprechen oder diese übertreffen, die die gleichen Agenten verwenden. Keine gefundene trägt ein Datum und ein widerlegendes Ergebnis. Die nächsten sind diese. Gartner prognostizierte 2021, dass bis 2024 80 % der Technologieprodukte und -dienstleistungen von Menschen gebaut würden, die keine Technologiefachleute sind (Gartner, 2021). Mark Cuban sagte 2017, dass er lieber Philosophie-Major sein würde und erwartet, dass kritisches Denken Programmieren übertreffen würde (Black Enterprise, 2017). D. H. Hansson antwortete mit „100 %" im Lex Fridman Podcast vom 26. August 2026, als er gefragt wurde, ob es Probleme gibt, bei denen Programmierer schlechter sind als Nicht-Programmierer bei agentenbasierter Technik (Lex Fridman Podcast, 2026). Anthropic beobachtete im Juni 2026, dass Coding-Agenten einen Coding-Hintergrund weniger relevant machen (Anthropic, 2026e). Prognosen in der entgegengesetzten Richtung existieren. Gartner erwartet, dass bis 2028 60 % der vibe-codierten Anwendungen eingestellt werden (Gartner, 2026, wie von Tray.ai, 2026 zusammengefasst), und erwartete 2024, dass bis 2026 ein Fünftel der Organisationen KI nutzen würde, um ihre Struktur zu vereinfachen (Gartner, 2024). Srinivasan und Wei (2026) erwarten, dass „Agent Manager" innerhalb von 12 bis 18 Monaten zu einem Standardtitel wird. Forrester erwartete, dass 60 % der Fortune-100-Unternehmen einen Leiter für KI-Governance ernennen würden (Forrester, 2025). Die Märkte auf Manifold setzen ein Drittel weniger Junior-Developer-Rollen bis 2030 auf etwa 74 %, und einen Rückgang von mehr als 15 % bei US-Entwicklern von 2023 bis 2028 auf etwa 42 % (Manifold, 2026b; Manifold, 2026c). Auf Manifold stand die Wahrscheinlichkeit, dass es bis 2027 üblich sein wird, dass Nicht-Programmierer kleine Skripte mit KI schreiben, nahe 27 % (Manifold, 2026a), und diese Frage fragt nur nach der Nutzung, ohne ein Qualitätsmass. Die hier vorgestellten Vorhersagen unterscheiden sich von all diesen darin, dass sie Menschen mit Menschen vergleichen, die den gleichen Agenten nutzen, dass sie Bildung zur Variablen machen, und dass sie ein Datum, ein Mss und ein widerlegendes Ergebnis haben. Das Suchenprotokoll befindet sich in Anhang B. Die Einführung in Schichten (Rogers, 2003), Maschinen-Zeit-Horizonte (Kwa et al., 2025) und die Beobachtung, dass Junior-Rollen schrumpfen, sind frühere Arbeiten, und es wird kein Vorrang für sie beansprucht.
11.4 Einfrieren und Bewertung
Wo sollte eine Vorhersage leben, damit niemand, auch nicht ihr Autor, sie stillschweigend ändern kann? Von den Orten, die diese Serie nutzt, friert nur einer ein. Eine OSF-Registrierung kann nicht bearbeitet oder gelöscht werden; sie kann zurückgezogen werden, aber eine Seite mit ihrem Titel, den Daten, der DOI und dem Grund für die Rücknahme bleibt bestehen (OSF, 2026). Zenodo lässt den Hinterleger Dateien 30 Tage nach der Veröffentlichung ändern oder löschen, und danach nur neue Versionen (OpenAIRE, 2025). SSRN ersetzt das PDF bei einer Überarbeitung. Die Vorhersagen werden daher zunächst auf OSF als offene Registrierung registriert und sofort veröffentlicht, ohne Sperrfrist, denn eine Sperrfrist würde den Datensatz verbergen und seine DOI zurückhalten, und eine Priorität, die niemand sehen kann, ist wenig wert.
Am 9. Oktober 2026 wurde die Tabelle auf OSF als eine Reihe von vorregistrierten Vorhersagen registriert (DOI 10.17605/OSF.IO/VW6P9), und das Papier wurde auf SSRN und Zenodo veröffentlicht; Snapshots jeder Baseline-Quelle sind in der Wayback Machine archiviert. Jedes Jahr von 2027 bis 2031 wird am Jahrestag der Registrierung eine Scorecard veröffentlicht, die jede Vorhersage ohne Ausnahme, ihren Status (wahr geworden, nicht wahr geworden, noch nicht fällig, ungelöst, nicht durchgeführt) und die Evidenz auflistet. Sie meldet den Brier-Score über gelöste Vorhersagen insgesamt, nach Menge und nach Familie, wobei verknüpfte Vorhersagen einmal zählen, gruppiert wie in der Familienspalte der registrierten Tabelle (F1 und F1b; F2, F3 und F3b; F4a und F4b; F5, F6 und F33; F9 und F31; F15 und F16; F17 und F17b; F28 und F28b); den Anteil gelöst; eine Worst-Case-Schranke, in der jede Vorhersage nach ihrem Enddatum, die noch ungelöst ist, und jede Vorhersage, die nicht durchgeführt wurde, so bewertet wird, als hätte die Prognose falsch gelegen; den Score mit und ohne die nicht durchgeführten Vorhersagen; und den Brier-Skill-Score gegen drei Referenzen: eine konstante 0,5, die gepoolten Modellierer von Tabelle 4 und den Marktpreis, wo ein Markt am Registrierungstag existierte. Selektive Nichtauflösung kann daher die Punktzahl nicht verbessern. Die Scorecard wird selbst auf OSF registriert, mit der Original-DOI verknüpft, und auf Zenodo eingereicht. Modelle aus mindestens zwei Familien prüfen jede Scorecard unabhängig gegen die eingefrorenen Regeln; wo sie sich uneinig sind, entscheidet die Regel und die Uneinigkeit wird berichtet. Der Registrierungstext befindet sich in Appendix D, und Abbildung A1 (Appendix D) zeigt den vollständigen Kalender der Prüf- und Enddaten. Zwei Verpflichtungen werden fällig, bevor die Bewertung beginnt. Die Stichprobe von KI-gebauten Produkten für F27 wird am 31. Dezember 2026 auf Zenodo eingefroren, und die Baselines von F5 und F30 werden vor der Registrierung berechnet und archiviert. Das Protokoll der F27-Stichprobe, mit einer Voreinstellung für jede Wahl, die die Registrierung offen lässt, und das Werkzeug, das sie mit einem im Voraus festgelegten Seed zieht und versiegelt, befinden sich im Begleit-Repository (kits/f27-sample.md, tools/freeze_sample.py).
Sobald die Vorhersagen registriert sind, werden die öffentlichen auch dort veröffentlicht, wo externe Prognostiker sie bewerten können: fünf Märkte auf Manifold (F5, F8, F10, F11 und F22, die kostenlos zu posten sind; diese fünf wurden gewählt, weil sich jeder auf einer öffentlichen Quelle und einer externen Serie auflöst, die jeder lesen kann, ohne meine eigenen Daten), eine Frage auf Metaculus (die Überkreuzung in Veröffentlichungen, F5), und die Social Science Prediction Platform für die Experimente von F2, F3 und F7, damit Vorhersagen anderer Personen gesammelt werden, bevor die Daten existieren. Prognosemärkte, die Geld auf das Ergebnis handeln, werden nicht verwendet.
11.5 Das Kohorten-Programm
Ich führe ein vorregistriertes Kohorten-Programm durch (OSF, https://osf.io/x4egq, DOI 10.17605/OSF.IO/X4EGQ), das Nicht-Programmierer von Chat zu Agenten zu Orchestrierung begleitet (Chernets, 2026e). Seine erste Kohorte ist eine Machbarkeitsstudie mit einem Arm mit eigenen registrierten Ergebnissen, die in ihrem eigenen Bericht gemeldet werden. Vorhersagen wie F7, F14 und F18 bis F20, die Daten auf Personenebene benötigen, werden in einer später registrierten Kohorte getestet, die für sie vor der Datenerfassung registriert wird, mit einer Frage über IT-Bildung unter ihren eingefrorenen Elementen. Die Datensätze in Appendix C, mit Zustimmung aufbewahrt, sind die natürlichen Daten für diese Kohorte.
12. Die Evidenz, gegen die sich die Vorhersagen wetten
Die Vorhersagen von Abschnitt 11 laufen gegen mehrere Arten von Evidenz aus 2026, und jede von ihnen prägte eine Regel des Maßstabs oder eine Vorhersage.
Die Sicherheit ist nicht mitgewachsen. Über mehr als hundert Modelle hinweg blieb der Anteil des generierten Codes, der Sicherheitstests bestand, in Veracodes 2026-Bericht bei 56% (Veracode, 2026). Diese Tests liefen auf Modellen allein, unter Standardaufforderungen ohne Sicherheitsanweisungen und ohne ein agentisches Gerüst, Werkzeuge oder menschliche Überprüfung, sodass sie das Rohmaterial beschreiben, von dem eine Person ausgeht. Ein passiver Scan von 5.600 öffentlichen Anwendungen, die durch Vibe-Programmierung erstellt wurden, fand über 2.000 Schwachstellen, über 400 freigegebene Geheimnisse und 175 Offenlegungen persönlicher Daten, und ihre Autoren präsentieren diese als untere Grenze (Escape, 2026). Dies ist der Grund, warum F2 eine blinde Sicherheitsüberprüfung umfasst, und warum irreversible Arbeiten jedes Stück bestehen müssen (Abschnitt 5.2).
Tests zu bestehen fällt kurz davor, akzeptiert zu werden. METR bat Betreuer, von Agenten geschriebene Fixes zu überprüfen, die die Tests eines Benchmarks bestanden hatten, und stellte fest, dass etwa die Hälfte nicht so zusammengeführt worden wäre, wie sie waren; die Agenten waren einer früheren Generation ohne Überprüfungsschleife, daher kann der Anteil jetzt niedriger sein (METR, 2026b). Die Bewertungsregel antwortet mit versteckten Tests, qualifizierten Reviewern und echter Nutzung, und F2 fügt eine Wartungsänderung einen Monat später hinzu.
Die Verifikation hängt von Erfahrung ab. In einer Umfrage unter 162 Menschen, die durch Vibe-Programmierung bauen, erkannte jede Gruppe die Risiken von generiertem Code, aber wie sie ihn überprüften, variierte mit der Erfahrung. Die Autoren nennen dies eine Wahrnehmungs-Handlungs-Lücke (Fawzy et al., 2026). Geschäftsnutzer und Anfänger produzieren schnell funktionsfähige Prototypen, während die Code-Qualität ungleichmäßig ist und Überarbeitungen folgen (Gama et al., 2026). Geschäftsnutzer übersahen auch wesentliche Fehler in der Analyse einer KI, selbst nachdem sie gewarnt wurden (Virk & Liu, 2025). Eine randomisierte Studie mit 52 Junior-Ingenieuren, die eine neue Bibliothek erlernen, fand Verständniswerte von 50% mit KI gegen 67% ohne, und keinen signifikanten Geschwindigkeitsgewinn. Diejenigen, die das Modell um Erklärungen baten, erreichten 65% oder mehr, und diejenigen, die den gesamten Code abtraten, erreichten unter 40% (Anthropic, 2026c). Dies ist der stärkste Grund, warum der Maßstab auf Akzeptanzliteralität und eingepflanzte Fehler ruht: die Fähigkeit, die Menschen unterscheidet, ist diejenige, die diese Studien als variabel zeigen.
Es gibt keinen veröffentlichten Vergleich, der Nicht-Programmierer gegen Programmierer setzt, die dieselben Agenten nutzen. Esnaola et al. (2026) stellten fest, dass einige Nicht-Programmierer, die GPT-4o durch ChatGPT nutzten, kleine, gut spezifizierte Programmieraufgaben auf einem Niveau vergleichbar mit Programmierern, die ohne KI arbeiten, lösten, und schneller; die Autoren nennen die Studie explorativ. Die Programmierer arbeiteten ohne KI, sodass das Design keinen Arm mit Programmierern mit KI hatte, und es untersuchte kurze einzelne Aufgaben, nicht nachhaltige Entwicklung; ein Replikationspaket ist öffentlich (Esnaola et al., 2026). In Anthropics Daten hatten Menschen, die neu für eine Aufgabe waren, eine verifizierte Erfolgsquote von 15% gegen 28% bis 33% für erfahrenere Nutzer (Anthropic, 2026e). Dort bedeutet „Anfänger" einen Anfänger bei der Aufgabe, wie von einem Modell beurteilt, und sagt nichts über IT-Ausbildung. Ob diese Lücke Ausbildung oder Vertrautheit mit der Aufgabe widerspiegelt, ist das, was F7 geschrieben wird, um zu trennen. Noch früher erhöhte generative KI bei einem Kundenservice-Unternehmen die Produktivität von Anfänger- und niedrig qualifizierten Agenten am meisten und die der erfahrensten Agenten wenig (Brynjolfsson et al., 2025), ein Vorgänger von vor Agenten. 2024 fand ein Feldexperiment bei Procter & Gamble mit Chat-Modellen heraus, dass Einzelpersonen mit KI Teams ohne KI entsprachen und ausgeglichene Arbeiten unabhängig von ihrem beruflichen Hintergrund produzierten, ein Vorgänger von vor Agenten (Dell'Acqua et al., 2025). F2, F3 und F7 sind konzipiert, um den fehlenden Vergleich bereitzustellen.
Respektierte Stimmen sind mit der starken Version nicht einverstanden. Karpathy hält eine Untergrenze und eine Obergrenze (Abschnitt 2.1). Andrew Ng argumentierte im August 2026, dass Entwickler, die tiefgreifend verstehen, wie Programme funktionieren, diejenigen, die ohne dieses Verständnis Vibe-Programmierung machen, weit übertreffen (Ng, 2026). Einstellungsdaten deuten für jetzt in die gleiche Richtung: Stellenausschreibungen, die KI-Fähigkeiten erfordern, erfordern eher einen vierjährigen Abschluss als vergleichbare Ausschreibungen, die dies nicht tun (Lightcast, 2026b), und LinkedIn führt einen Großteil der Schwäche bei der Einstellung auf Einstiegsniveau auf die Wirtschaft zurück (Abschnitt 2.4). Die Vorhersagen nehmen diese Ansichten als ihre Gegenpartei, mit Quoten, die im Voraus angegeben werden.
13. Umfang und Randbedingungen
Zeit. Die Evidenz reicht bis zum 9. Oktober 2026. Produktfakten werden schnell veralten, daher ist das Maß mit Bezug auf Stunden und Überprüfungen definiert, ohne ein Produkt zu benennen.
Quellen. Ein großer Teil der stärksten Evidenz stammt von Anbietern über ihre eigenen Produkte: OpenAI über seinen Coding-Agenten, Anthropic über seine Sessions. Diese sind als Anbieter-Daten gekennzeichnet und werden für das verwendet, das Anbieter wissen können. Mehrere in der Presse berichtete Episoden, wie die Token-Rankings, beruhen auf Berichten benannter Medienunternehmen und sind als solche zitiert. Sekundäre Quellen (Growthy, Startup Fortune, Shopifreaks) sind in der Wayback Machine archiviert, bevor sie veröffentlicht werden, und der Primärbericht wird zitiert, wann immer er erreichbar war.
Population. Das Argument betrifft Arbeit, die an einem Computer durch Agenten von Menschen geleistet wird, die sie überprüfen können. Menschen ohne einen Computer, den sie kontrollieren, und Arbeit, die überhaupt nicht überprüft werden kann, fallen außerhalb des Maßes.
Was das Maß behauptet. Ein verifizierter Horizont beschreibt, was eine Person unter einem Überprüfungsregime in einem Bereich zu einem bestimmten Datum geliefert hat. Es wird nicht behauptet, dass höher für jede Aufgabe besser ist. Viel Arbeit gehört zu Hour, und die Entscheidung, Arbeit von Hand zu behalten, ist eine legitime Entscheidung. In Bereichen, in denen ein Fehler nicht rückgängig gemacht werden kann, gilt die strengere Schwelle aus Abschnitt 5.2, und einige Arbeit sollte überhaupt nicht an Agenten übergeben werden.
Namen. Die Karte von Abschnitt 3 erfasst die Nutzung, die am 8. und 9. Oktober 2026 gefunden wurde. Namen werden danach angenommen und aufgegeben, weshalb die Karte mit einem jährlichen Namenrennen gekoppelt ist und kein einzelner Name gewählt wird.
Die starke These. Dass Menschen ohne technische Ausbildung bessere Produkte bauen werden als Programmierer wird als eine Reihe von Vorhersagen mit Daten und Schwellen (F2 bis F7) dargelegt. Ich stelle sie als Vorhersage dar, die öffentlich bewertet werden soll.
Durch Gesetz vorbehaltene Handlungen. Wenn das Gesetz eine Handlung einer Lizenz vorbehält, ändert weder das Maß noch der Gewichtsverlust durch Etikett-Tore (Abschnitte 6.2 und 6.5) diese Handlung. Im Vereinigten Königreich darf niemand als Abschlussprüfer tätig sein, der nicht zur Bestellung berechtigt ist, was die Mitgliedschaft in einem anerkannten Aufsichtsorgan und Berechtigung nach dessen Regeln erfordert (Companies Act 2006, ss. 1212 und 1213), und in den Vereinigten Staaten darf nur eine bei der Public Company Accounting Oversight Board registrierte Gesellschaft einen Prüfbericht über einen Emittenten vorbereiten oder ausstellen (Sarbanes-Oxley Act von 2002, s. 102). In der Buchführung sind solche Vorbehalte eng: ein Buchführungsgehilfe in den Vereinigten Staaten ist normalerweise nicht einmal verpflichtet, eine Zertifizierung zu halten (Bureau of Labor Statistics, 2026c). In der Rechtswissenschaft sind sie weiter: England und Wales behalten sich sechs juristische Tätigkeiten vor, darunter die Durchführung von Rechtsstreitigkeiten und Nachlass-Tätigkeiten (Legal Services Act 2007, s. 12). Die Arbeit kann sich daher bewegen, während die Unterschrift bleibt, und der lizenzierte Unterzeichner führt dann die Garantenfunktion von Abschnitt 7.2 in einer Form aus, die das Gesetz bereits bewertet. Wie weit eine Lizenz selbst durch ein Etikett oder durch überprüfte Arbeit zugelassen wird, wird in Abschnitt 6.2 erörtert.
Vor-Agenten-Daten. Reihen von vor 2025 treten nur als Vorgänger ein, weil sie Arbeit ohne Agenten beschreiben. Die Makroökonomie der Einstellung wird durch die LinkedIn-Daten von 2026 getragen (Abschnitt 2.4), die mehr auf die Wirtschaft als auf KI hindeuten.
Status von Behauptungen. Tabelle A7 (Anlage F) wendet die Vertrauenssprache der Serie auf jedes Element an.
14. Fazit
Ein Buchhalter, der KI-Coding-Agenten vergleicht, und eine Juristin, die ihren eigenen Vertragsabwickler entwickelt, arbeiten jetzt so wie eine Entwicklerin, die ein Modul einem Agenten übergibt und das Ergebnis überprüft. Im Jahr 2026 teilen die drei einen Workflow, und keine der alten Karriereleiter kann sagen, welche von ihnen weiter vorangekommen ist. Ein Titel würde es nicht klären, denn jeder im Jahr 2026 vorgeschlagene Titel ist entweder ein Slogan oder jemandes Stellenanzeige, und der Markt hat sich nicht geeinigt. Ein Maßstab kann es klären, sofern er das Richtige misst.
Der hier vorgeschlagene Maßstab wartet nicht darauf, dass der Beruf benannt wird. Er bewertet den Buchhalter, die Juristin und die Entwicklerin auf einer Skala nach dem Umfang der Arbeit, die jede von ihnen an Agenten delegiert hat und überprüft hat – in einer Domäne und zu einem bestimmten Datum – mit einer zweiten Achse für die Menge an überprüfter Arbeit, die eine Stunde ihrer eigenen Aufmerksamkeit gekauft hat. Die Schwellenwerte sind versioniert und am Schreibtisch getestet, und der Schreibtischtest hat bereits einen von ihnen korrigiert; die Regeln benennen die Wege, wie das Protokoll manipuliert werden kann, und eine Verteidigung für jeden; die Obergrenze erklärt, warum die Kosten der Überprüfung das Limit setzen, unabhängig von der Geschwindigkeit des Agenten. Für einen Arbeitgeber, eine Schule oder eine Plattform ändert sich die Frage. Anstatt zu fragen, ob eine Person eine Programmierin ist oder wie viel KI sie verwendet hat, fragen sie nach einem Tag Arbeit im eigenen Bereich dieser Person, der eine Überprüfung bestand, die diese Person nicht selbst entwickelt hat. Jeder Name, den der Markt wählt, kann auf dieser Skala gelesen werden.
Datierte Vorhersagen tragen die These weiter, die diese Arbeit begann. Domäne für Domäne werden Produkte, die von Menschen ohne IT-Ausbildung hergestellt werden, die von Programmiererinnen, die dieselben Agenten verwenden, zu übertrumpfen beginnen. Bei einem gleichen verifizierten Horizont wird eine Programmierausbildung die Qualität überprüfter Arbeit nicht mehr vorhersagen. Und in Stellenanzeigen werden sich die Linien für Abschlussanforderungen kreuzen, zuerst in Domänen, in denen Fachleute die Arbeit selbst akzeptieren können, und zuletzt in Software. Wenn die Scorecards von 2027 und 2028 diesen Vorhersagen widersprechen, werden sie dies öffentlich sagen, mit einem Brier Score. Wenn die Vorhersagen zutreffen, könnten die Wörter junior und senior überleben, mit ihrer Bedeutung hin zum Umfang der Arbeit verschoben, den eine Person nachweisen kann; ob große Arbeitgeber ihre Gehaltsstufen durch ein solches Maßsystem ersetzen, ist selbst eine Vorhersage hier (F17), registriert bei p = 0,05.
Eine Grenze wird bleiben, was immer mit diesen Vorhersagen geschieht. Bauen wird zu einer Schreibfähigkeit, wie Schreiben. Verantwortung für das Gebaute bleibt ein Beruf, und zwischen den beiden steht Unklarheit, der Zustand des Marktes im Jahr 2026, in dem gute Arbeit ungesehen bleibt und Plattformen ihre Türen vor dem Unbekannten schließen. Die Person, die durch Agenten baut, benötigt einen Partner, der für die Arbeit eintritt, oder muss selbst dieser Partner werden, und der Garant wiederum kann danach gemessen werden, wofür sie eintrat und wie viel davon Bestand hatte.
Ein amerikanisches Sprichwort besagt, dass Gott die Menschen schuf und Colonel Colt sie gleich machte. Agenten tun etwas Ähnliches für das Bauen: mit einem können Menschen außerhalb eines Handwerks Arbeiten hervorbringen, die wie die des Handwerks aussehen. Überprüfung ist schwerer zu egalisieren (Abschnitte 5.2 und 12). In der Rater-Studie von Anhang G beantwortete fast einer von fünf Menschen, die auf ihr eigenes Wort hin in die Buchhalter-Stichprobe aufgenommen wurden, eine Frage der ersten Woche des Handwerks falsch, und in einem explorativen Vergleich bewerteten sie die größeren Aufgaben mit weniger Stunden als der Rest (Anhang G2). Ob ein Prozess unabhängiger Überprüfungen für die Überprüfung tun kann, was Agenten für das Bauen getan haben, ist die offene Frage von Abschnitt 6.5. Was die Menschen noch unterscheidet, ist das, was sie überprüfen und akzeptieren können, und das ist das, was der verifizierte Delegationshorizont misst.
Erklärungen
Förderung. Diese Arbeit wurde durch keine externe Förderung unterstützt.
Interessenskonflikte. Der Autor entwickelt Multi-Modell-Orchestrierungsmethoden und hat damit verbundene Patentanmeldungen eingereicht (anhängig; es wurde noch kein Patent erteilt). Der Autor konzipierte das in Abschnitt 11.5 und Anhang G beschriebene vorregistrierte Kohortenprogramm und seine Materialien und entwickelt eine Lehranwendung, die Menschen bei der Arbeit mit KI-Agenten unterstützt. Keine Erkenntnis in diesem Papier hängt von der Implementierung des Autors ab; das Instrument in Anhang C verwendet nur die Python-Standardbibliothek.
Werkzeuge und Überprüfung. KI-Assistenten wurden als Instrumente unter der Anleitung des Autors verwendet; die Ideen, die Forschung und die Schlussfolgerungen stammen vom Autor. Quantitative Aussagen und Zitate wurden gegen primäre Quellen oder archivierte Kopien vom 9. Oktober 2026 oder vom 10. Oktober 2026 für die an diesem Tag hinzugefügten Quellen überprüft, sofern diese abrufbar waren. Wenn nur ein Pressebericht oder eine Seite des Anbieters verfügbar war, wird die Aussage im Text diesem Bericht oder Anbieter zugeordnet. Titel in eckigen Klammern in den Referenzen sind beschreibende Titel für Seiten, deren Überschrift nicht wörtlich erneut gelesen wurde.
Datenverfügbarkeit und Code. Der Code und das Schema von Anhang C, der Schreibtischtest der Schwellwerte (Anhang E) und die Vorhersagedateien werden unter der MIT-Lizenz in einem begleitenden Repository veröffentlicht (https://github.com/vadimchernets/delegation-horizon), archiviert auf Zenodo als Release v1.1.0 (Konzept-DOI 10.5281/zenodo.23267444, die auf die neueste Release auflöst); der in Anhang C gedruckte Code ist identisch mit dem des Repositories, Byte für Byte, und tools/paper_sync.py überprüft dies, das ausgearbeitete Beispiel und die Tabellen 4 und A6 gegen das Repository, wenn seine Tests neben diesem Text ausgeführt werden. Die Vorhersagen der Tabellen 4 und A6 wurden am 9. Oktober 2026 auf OSF registriert (DOI 10.17605/OSF.IO/VW6P9). Die Prolific-Rater-Studie von Anhang G wurde am 9. Oktober 2026 auf OSF registriert, bevor Daten erhoben wurden (DOI 10.17605/OSF.IO/V92R8); das Analyseskript (pilot/human_raters.py) ist bei dieser Registrierung hinterlegt und befindet sich im begleitenden Repository wie hinterlegt, mit dem SHA-256-Hash, den OSF für jede hinterlegte Datei meldet, aufgelistet in pilot/registered-SHA256.txt, zusammen mit den Skripten, die die Prolific-Exporte umwandeln, Tabelle G2 ausgeben und den nicht registrierten Vergleich von G2 ausführen. Die anonymisierten Daten, bei denen Prolific-Kennungen durch einfache Labels ersetzt wurden, werden in denselben Ordner eingefügt. Die Dateien, die bei den Vorhersagen registriert sind, sind mit ihrem SHA-256 in predictions/registered-SHA256.txt, dem auf OSF hinterlegten Manifest aufgelistet, und ein Test des Repositories vergleicht jede einzelne Datei damit.
Ethik. Anhang G berichtet zwei Datenquellen von Personen. Die Prolific-Rater-Studie ist eine anonyme Online-Bewertungsaufgabe: erwachsene Fachleute gaben auf Prolific informierte Zustimmung, bevor sie teilnahmen, wurden über die Plattform bezahlt und gaben keine Namen oder Kontaktdaten an. Der Kohortenbericht fasst, ohne Namen, Orte oder Sprachen, die Unterlagen von Erwachsenen zusammen, die dem vorregistrierten Kohortenprogramm (OSF, DOI 10.17605/OSF.IO/X4EGQ) und der anonymisierten Veröffentlichung zugestimmt haben; die registrierten Ergebnisse des Programms werden separat berichtet. Die Arbeit wurde von einem unabhängigen Forscher ohne Ethikkommission einer Institution durchgeführt. Die in Abschnitt 9 erörterten öffentlichen Diskussionsfäden sind paraphrasiert, und ihre Autoren werden nicht namentlich genannt.
Beitrag des Autors. Alleiniger Autor.
Korrespondenz. [email protected] · ORCID: 0009-0007-4845-3163
References
9to5Mac. (2026). [App Store new apps doubled in the first half of 2026, Sensor Tower data reported by The New York Times]. https://9to5mac.com/?p=1061510
AI Certification Standards. (2026). AI Competence Framework (version of 23 August 2026). https://www.aicertificationstandards.org/framework
AI Futures Project. (2026, April 2). Q1 2026 timelines update. https://blog.aifutures.org/p/q1-2026-timelines-update
aicodex. (2026). AI agent manager vs agent operator. https://www.aicodex.to/articles/ai-agent-manager-vs-agent-operator
Alenezi, M. (2026). From determinism to delegation: AI-native software engineering and the evolution of the agentic engineer. arXiv:2606.28791. https://arxiv.org/abs/2606.28791
Alonso, M. N. (2026). The artificial intelligence economy [working paper, ResearchGate; contains the proposition "A delegation horizon"].
AlternativeTo. (2026, January). OpenAI rolls out age prediction for ChatGPT accounts. https://alternativeto.net/news/2026/1/openai-rolls-out-age-prediction-for-chatgpt-accounts-to-automatically-estimate-your-age/
Andrist, R. K. (1962). Gold! American Heritage, 14(1). https://www.americanheritage.com/content/gold
Amplifying. (2026). What Claude Code actually chooses. https://amplifying.ai/research/claude-code-picks
Anthropic. (2025a, December 2). How AI is transforming work at Anthropic. https://www.anthropic.com/research/how-ai-is-transforming-work-at-anthropic
Anthropic. (2025b). AI Fluency framework (the four Ds). https://aifluencyframework.org/
Anthropic. (2026a, January 15). Anthropic Economic Index report: Economic primitives. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Anthropic. (2026b, January 22). Claude's constitution. https://www.anthropic.com/constitution
Anthropic. (2026c, January 29). [AI assistance and coding skills: a randomised study of junior engineers]. https://www.anthropic.com/research/AI-assistance-coding-skills
Anthropic. (2026d, March 24). Anthropic Economic Index report: Learning curves. https://www.anthropic.com/research/economic-index-march-2026-report
Anthropic. (2026e, June 16). Agentic coding and persistent returns to expertise. https://www.anthropic.com/research/claude-code-expertise
Anthropic. (2026f, June 26). [Anthropic Economic Index report, June 2026]. https://www.anthropic.com/research/economic-index-june-2026-report
Arion Research. (2026, February 7). [The agent manager role]. https://www.arionresearch.com/blog/nfkxv53ktwxqkwtxwm2d03woml1c65
Artificial Lawyer. (2026, January 27). Claude Cowork: the DIY revolution in law. https://www.artificiallawyer.com/2026/01/27/claude-cowork-the-diy-revolution-in-law/
Atkinson, T., & Yamco, S. (2026, January 6). Young workers' employment drops in occupations with high AI exposure. Federal Reserve Bank of Dallas. https://www.dallasfed.org/research/economics/2026/0106
Batko, M. (2026, August 20). [Distribution is the moat]. Startmate. https://startmate.com/writing/distribution-is-the-moat
Benchek, J., et al. (2026). APEX-Accounting. arXiv:2607.27189. https://arxiv.org/abs/2607.27189
Berkeley California Management Review. (2025, July). Rethinking AI agents: A principal-agent perspective. https://cmr.berkeley.edu/2025/07/rethinking-ai-agents-a-principal-agent-perspective/
BetterUp. (2026, May 18). [Workslop research with Stanford]. https://www.betterup.com/blog/workslop-canada
Black Enterprise. (2017). [Mark Cuban on liberal arts and the future of work]. https://www.blackenterprise.com/mark-cuban-right-libreal-arts-key-future/amp/
Bloomberg Law. (2026, April 20). Vibe coding empowers lawyers to influence AI winners, losers. https://news.bloomberglaw.com/legal-exchange-insights-and-commentary/vibe-coding-empowers-lawyers-to-influence-ai-winners-losers
Bone, M., González Ehlinger, E., & Stephany, F. (2025). Skills or degree? The rise of skill-based hiring for AI and green jobs. Technological Forecasting and Social Change. https://doi.org/10.1016/j.techfore.2025.124042
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Bancroft, H. H. (1888). History of California (Vol. 6, 1848-1859). The History Company. https://archive.org/details/historyofcaliforv6banc
Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at work. The Quarterly Journal of Economics, 140(2), 889-942. https://doi.org/10.1093/qje/qjae044
Bureau of Labor Statistics. (2025). Photographers. Occupational Outlook Handbook, 2024-34 edition (archived 19 August 2026). https://web.archive.org/web/20260819060531/https://www.bls.gov/ooh/media-and-communication/photographers.htm
Bureau of Labor Statistics. (2026a). Photographers. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/media-and-communication/photographers.htm (archived copy: https://web.archive.org/web/20261001165113/https://www.bls.gov/ooh/media-and-communication/photographers.htm)
Bureau of Labor Statistics. (2026b). 2028 SOC revision. https://www.bls.gov/soc/2028/2028_soc_revision.htm
Bureau of Labor Statistics. (2026c). Bookkeeping, accounting, and auditing clerks. Occupational Outlook Handbook (updated 27 August 2026). https://www.bls.gov/ooh/office-and-administrative-support/bookkeeping-accounting-and-auditing-clerks.htm
Burning Glass Institute & Harvard Business School. (2024). Skills-based hiring: The long road from pronouncements to practice. https://www.burningglassinstitute.org/research/skills-based-hiring-2024
Business Insider. (2026, January 22). [Deloitte gives US employees new job titles]. https://www.businessinsider.com/deloitte-gives-us-employees-new-job-titles-leader-role-2026-1
Cagan, M. (2025). The era of the product creator. SVPG. https://www.svpg.com/the-era-of-the-product-creator/
Capps, R. (2025, June 17). [New jobs that AI could create]. The New York Times Magazine. https://www.nytimes.com/2025/06/17/magazine/ai-new-jobs.html
Carta. (2025). Solo founders report 2025. https://carta.com/data/solo-founders-report
Carta. (2026a). 2026 founder ownership report. https://carta.com/data/founder-ownership-2026-full-report/
Carta. (2026b). State of pre-seed: Q2 2026. https://carta.com/data/state-of-pre-seed-q2-2026/
Challenger, Gray & Christmas. (2026). [Job cuts report, June 2026]. https://www.challengergray.com/wp-content/uploads/2026/07/Challenger-Report-June2600986996.pdf
Chen, X., & Meng, S. (2026). When AI levels the playing field: Skill homogenization, asset concentration, and two regimes of inequality. arXiv:2603.05565. https://arxiv.org/abs/2603.05565
Catalini, C., Hui, X., & Wu, J. (2026). Some simple economics of AGI. arXiv:2602.20946. https://arxiv.org/abs/2602.20946
Celenza, B. (2026, October 6). Building Git infrastructure for agent-scale development. GitHub Blog. https://github.blog/engineering/architecture-optimization/building-git-infrastructure-for-agent-scale-development/
Chernets, V. (2026a). After Chat: The three transitions between non-programmers and agentic AI. SSRN. https://doi.org/10.2139/ssrn.7520019 (Zenodo: https://doi.org/10.5281/zenodo.22943313)
Chernets, V. (2026b). Agreement is not independent evidence: Auditable multi-model synthesis without an API. SSRN. https://doi.org/10.2139/ssrn.7390698
Chernets, V. (2026c). AI-Watchbird (Sheckley): When automated oversight widens its own mandate and harms what it guards. SSRN. https://doi.org/10.2139/ssrn.7473658
Chernets, V. (2026d). Architectural trust: Why consumer trust in agentic commerce migrates from AI models to verifiable architecture. SSRN. https://doi.org/10.2139/ssrn.7191261
Chernets, V. (2026e). Three steps into agentic AI: A preregistered feasibility study of how non-programmers cross from chatbot to agent to multi-model orchestration (Cohort 1). OSF. https://doi.org/10.17605/OSF.IO/X4EGQ
CIO. (2026a, May 29). Amazon deletes devs' tokenmaxxing leaderboard to minimize costs. https://www.cio.com/article/4178825/amazon-deletes-devs-tokenmaxxing-leaderboard-to-minimize-costs-2.html
CIO. (2026b, September 4). Meta minimizes role of token-maxing in employee evaluations. https://www.cio.com/article/4218661/meta-minimizes-role-of-token-maxing-in-employee-evaluations-2.html
Clark, M. (2026). [Proposal for a Chartered Financial Intelligence Architect]. SSRN.
Collins Dictionary. (2025). Collins Word of the Year 2025. https://blog.collinsdictionary.com/language-lovers/collins-word-of-the-year-2025-ai-meets-authenticity-as-society-shifts/
Companies Act 2006, c. 46, ss. 1212 and 1213 (United Kingdom). Individuals and firms: eligibility for appointment as a statutory auditor; Effect of ineligibility (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2006/46/section/1212 ; https://www.legislation.gov.uk/ukpga/2006/46/section/1213
Computing Research Association. (2026, June). [New CRA Taulbee Survey findings: record degree production alongside a cooling enrollment pipeline]. https://cra.org/crn/2026/06/cra-update-new-cra-taulbee-survey-findings-show-record-degree-production-alongside-a-cooling-enrollment-pipeline/
CSET. (2025). [Translation: China's notice on AI education in primary and secondary schools]. Center for Security and Emerging Technology. https://cset.georgetown.edu/publication/china-primary-secondary-ai-education-notice/
Crunchbase News. (2026, July 2). Crunchbase data: Global startup investment hit record $510B in H1 2026 as AI boom accelerates funding and exits. https://news.crunchbase.com/venture/global-startup-exits-ipo-ma-soar-ai-q2-h1-2026/
Danilova, A., Naiakshina, A., Horstmann, S., & Smith, M. (2021). Do you really code? Designing and evaluating screening questions for online surveys with programmers. 2021 IEEE/ACM 43rd International Conference on Software Engineering (ICSE), 537-548. https://doi.org/10.1109/ICSE43902.2021.00057
Dawson, R. (2026). [Framework: levels of AI delegation in decision making]. https://rossdawson.com/framework-levels-ai-delegation-decision-making
Dealroom. (2026). Mercor doubles to $2B gross revenue run-rate as AI labs buy expert data. https://dealroom.co/news/137121-mercor-doubles-to-2b-gross-revenue-run-rate-as-ai-labs-buy-expert-data/
Dell'Acqua, F., et al. (2025). The cybernetic teammate: A field experiment on generative AI reshaping teamwork and expertise. NBER Working Paper 33641. https://www.nber.org/papers/w33641
Dell'Acqua, F., et al. (2026). Navigating the jagged technological frontier: Field experimental evidence of the effects of artificial intelligence on knowledge worker productivity and quality. Organization Science, 37(2), 403-423. https://doi.org/10.1287/orsc.2025.21838
Digg. (2026). [Your job title is about to change: AI Agent Supervisor]. https://digg.com/aiagentchat/TvbtLF2/your-job-title-is-about-to
Dust. (2026, October 7). [Dust Index: AI strategy beyond models]. https://dust.tt/blog/dust-index-ai-strategy-beyond-models
EdWeek. (2026, June 11). [White House honors AI challenge winners]. https://www.edweek.org/technology/white-house-honors-ai-challenge-winners-as-tech-backlash-grows/2026/06
em360. (2026, September 7). [AI productivity and supervisory capacity]. https://em360tech.com/tech-articles/ai-productivity-supervisory-capacity
Engelbart, D. C. (1962). Augmenting human intellect: A conceptual framework (Summary Report AFOSR-3223). Stanford Research Institute.
Escape. (2026). Methodology: how we discovered vulnerabilities in apps built with vibe coding (accessed 9 October 2026). https://escape.tech/blog/methodology-how-we-discovered-vulnerabilities-apps-built-with-vibe-coding/
Esnaola, L. M., Ramón, H. D., & Lanzarini, L. C. (2026). Can generative AI bridge the gap? A quasi-experimental study of non-programmers with AI vs. programmers without AI. Empirical Software Engineering, 31(3), 75. https://doi.org/10.1007/s10664-026-10813-7 Replication package: https://doi.org/10.5281/zenodo.17803568
Eulerich, M., Sanatizadeh, A., Vakilzadeh, H., & Wood, D. A. (2024). Is it all hype? ChatGPT's performance and disruptive potential in the accounting and auditing industries. Review of Accounting Studies, 29(3), 2318-2349. https://doi.org/10.1007/s11142-024-09833-9
Fawzy, A., Tahir, A., & Blincoe, K. (2026). From prompting to verification: How experience shapes vibe coding practices. arXiv:2605.24521. https://arxiv.org/abs/2605.24521
Feldman, M. Q., & Anderson, C. J. (2024). Non-expert programmers in the generative AI future. CHIWORK 2024 (author version). https://www.feldmanmolly.com/chiwork2024-author-version.pdf
Feng, K. J. K., McDonald, D. W., & Zhang, A. X. (2025). Levels of autonomy for AI agents. arXiv:2506.12469. https://arxiv.org/abs/2506.12469
Flowtivity. (2026, February 24). Your boss will measure you in tokens. https://flowtivity.ai/blog/your-boss-will-measure-you-in-tokens/
Forrester. (2025, October). [Predictions 2026 for AI and technology leadership], as reported by iTWire. https://itwire.com/it-industry-news/strategy/forrester-unveils-2026-predictions-for-ai-and-tech-leadership.html
Fortune. (2025, May 7). [Prompt engineering, a six-figure role, now obsolete]. https://www.fortune.com/2025/05/07/prompt-engineering-200k-six-figure-role-now-obsolete-thanks-to-ai
Fortune. (2026a, January 22). [Deloitte's job title change]. https://www.fortune.com/2026/01/22/deloitte-job-title-change-ai-reshapes-big-4-accounting-consulting-firms
Fortune. (2026b, May 26). [Uber's chief operating officer on AI spending]. https://www.fortune.com/2026/05/26/uber-coo-ai-spending-tokens-claude-code/
Fortune. (2026c, July 7). [Cognition's chief executive on tokenmaxxing]. https://fortune.com/2026/07/07/cognition-ceo-tokenmaxxing-big-tech-carried-away-ai-productivity-gains/
Fox, S., Markham, L., Lail, R., & Karotsieris, M. (2026). LLM judges verify presence, not absence: Omission blindness in AI clinical notes and what recovers it. arXiv:2608.31016. https://arxiv.org/abs/2608.31016
Fu, H. Y., Shrivastava, A., Moore, J., West, P., Tan, C., & Holtzman, A. (2025). AbsenceBench: Language models can't tell what's missing. arXiv:2506.11440. https://arxiv.org/abs/2506.11440
Gama, et al. (2026). [Novice teams building software with AI]. ICSE 2026. arXiv:2512.02750. https://arxiv.org/abs/2512.02750
Gartner. (2009). Gartner Symposium/ITxpo Orlando brochure (use of "citizen developer"). https://www.gartner.com/imagesrv/symposium/pdf/orlando_symposium_conference_brochure.pdf
Gartner. (2021, June 10). Gartner says the majority of technology products and services will be built by professionals outside of IT by 2024. https://www.gartner.com/en/newsroom/press-releases/2021-06-10-gartner-says-the-majority-of-technology-products-and-services-will-be-built-by-professionals-outside-of-it-by-2024
Gartner. (2024, October 22). Gartner unveils top predictions for IT organizations and users in 2025 and beyond. https://www.gartner.com/en/newsroom/press-releases/2024-10-22-gartner-unveils-top-predictions-for-it-organizations-and-users-in-2025-and-beyond
Gartner. (2026). Tyagi, N. Govern vibe coding for citizen developers with self-service platforms (29 June 2026; document 8068765). https://www.gartner.com/en/documents/8068765 (subscriber access; figures cited as summarised by Tray.ai, 2026)
Gigazine. (2025, July 24). What are the results of the 'AccountingBench' benchmark, which tests an AI model for monthly accounting tasks? https://gigazine.net/gsc_news/en/20250724-accountingbench/
Gigazine. (2026, July 21). [Sensor Tower: new App Store apps in the first half of 2026]. https://www.gigazine.net/gsc_news/en/20260721-app-store-new-apps
GitHub. (2025a). Octoverse: A new developer joins GitHub every second as AI leads TypeScript to #1. https://github.blog/news-insights/octoverse/octoverse-a-new-developer-joins-github-every-second-as-ai-leads-typescript-to-1/
GitHub. (2025b, December 8). The new identity of a developer: What changes and what doesn't in the AI era. https://github.blog/news-insights/octoverse/the-new-identity-of-a-developer-what-changes-and-what-doesnt-in-the-ai-era/
Growthy. (2026, September 23). Claude Code vs Codex for bookkeeping. https://growthy.com/blog/claude-code-vs-codex-for-bookkeeping
Haize Labs. (2026). Vertical AI Lead [job posting]. https://job-boards.greenhouse.io/haizelabs/jobs/5173890008
Hashimoto, M. (2026). Vouch [repository]. https://github.com/mitchellh/vouch
HCA Magazine. (2026, July 29). [Atlassian introduces AI wallets for employees]. https://www.hcamag.com/ca/news/general/atlassian-introduces-new-ai-wallets-to-employees/584258
Hosseini, S. M., & Lichtinger, G. (2026, May 6). Generative AI as seniority-biased technological change [Working paper; earlier version SSRN 5425555, 2025]. https://raw.githack.com/s-mahdihosseini/Website/b99fa2962dcc4c165bbc3c41dd283afa99c5ccfb/GenAI_SenBTC_May_2026.pdf
Huang, L., Xiao, W., & Vishnoi, N. K. (2026). Delegation and verification under AI. Accepted at ICML 2026. arXiv:2603.02961. https://arxiv.org/abs/2603.02961
Hwang, J. (2026, February 13). Claude Code is the new Excel. https://nextword.substack.com/p/claude-code-is-the-new-excel
Indeed Hiring Lab. (2026, January 28). Where do college degrees still matter in a "skills-first" job market? https://hiringlab.indeed.com/2026/01/28/where-do-college-degrees-still-matter-in-a-skills-first-job-market/
IT Brew. (2026, June 5). AI orchestrators are the newest in-demand AI role. https://www.itbrew.com/stories/ai-orchestrators-are-the-newest-in-demand-ai-role
Jaques, E. (1956). Measurement of responsibility: A study of work, payment and individual capacity. Tavistock Publications. (Reviewed in Industrial and Labor Relations Review, 10(3), 475. https://doi.org/10.2307/2519792)
Jensen, M. C., & Meckling, W. H. (1976). Theory of the firm: Managerial behavior, agency costs and ownership structure. Journal of Financial Economics, 3(4), 305-360. https://doi.org/10.1016/0304-405X(76)90026-X
Journal of Accountancy. (2025, May 14). AICPA, NASBA approve new CPA licensure path. https://www.journalofaccountancy.com/news/2025/may/aicpa-nasba-approve-new-cpa-licensure-path/
Kamara, S. (2026). Verification friction. SSRN. https://doi.org/10.2139/ssrn.6469865
Karpathy, A. (2025, February 2). [Post introducing "vibe coding"]. X. https://x.com/karpathy/status/1886192184808149383
Karpathy, A. (2026, April 30). Sequoia AI Ascent 2026 [talk notes]. https://karpathy.bearblog.dev/sequoia-ascent-2026/
Khadj, O. J. (2026). The delegation frontier. SSRN. https://doi.org/10.2139/ssrn.7348378
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Accepted at ICML 2025. arXiv:2506.07962. https://arxiv.org/abs/2506.07962
Kingy AI. (2026, May 4). Token spend is coming for your performance review. https://kingy.ai/news/token-spend-is-coming-for-your-performance-review-and-mine/
Ko, A. J., Abraham, R., Beckwith, L., Blackwell, A., Burnett, M., Erwig, M., Scaffidi, C., Lawrance, J., Lieberman, H., Myers, B., Rosson, M. B., Rothermel, G., Shaw, M., & Wiedenbeck, S. (2011). The state of the art in end-user software engineering. ACM Computing Surveys, 43(3), 21. https://doi.org/10.1145/1922649.1922658
Krebs, A. (2026). [Design slop and Show HN]. https://www.adriankrebs.ch/blog/design-slop/
Kwa, T., et al. (2025). Measuring AI ability to complete long tasks. arXiv:2503.14499. https://arxiv.org/abs/2503.14499
Legal Services Act 2007, c. 29, s. 12 (England and Wales). Meaning of "reserved legal activity" and "legal activity" (accessed 10 October 2026). https://www.legislation.gov.uk/ukpga/2007/29/section/12
Lenny's Newsletter. (2025). [Why LinkedIn is replacing PMs]. https://www.lennysnewsletter.com/p/why-linkedin-is-replacing-pms
Lex Fridman Podcast. (2026, August 26). #501, David Heinemeier Hansson [transcript]. https://lexfridman.com/dhh-2-transcript/
Lightcast. (2026a, August 7). Tracking the agentic AI explosion in jobs. https://lightcast.io/resources/blog/tracking-the-agentic-ai-explosion-in-jobs
Lightcast. (2026b, September 9). [Degree requirements still higher for AI jobs]. https://lightcast.io/resources/blog/degree-requirements-ai-jobs
LinkedIn. (2026a, January). LinkedIn gives professionals the edge with verified skills and tools to navigate the job search. https://news.linkedin.com/2026/Professional_Edge_Skills_Verified
LinkedIn. (2026b, April). Q3 earnings and business highlights. https://news.linkedin.com/2026/Q3-Earnings-Highlights
LinkedIn Economic Graph. (2026). AI labor market update, August 2026. https://delivery-p143253-e1476319.adobeaemcloud.com/adobe/assets/urn:aaid:aem:ef153078-1061-4817-82e7-a1c027d7a7d7/original/as/AI-Labor-Market-Update-August-2026-v2.pdf
Manifold. (2026a). [Will it be common for non-programmers to create small scripts using AI by 2027?] (accessed 9 October 2026). https://manifold.markets/jskf/will-it-be-common-for-nonprogrammer-dfc979ea7fec
Manifold. (2026b). [Will the number of junior developer roles fall by a third by 2030?] (accessed 9 October 2026). https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer
Manifold. (2026c). [Will the number of people employed as software developers in the US fall by more than 15% from 2023 to 2028?] (accessed 9 October 2026). https://manifold.markets/MatthewBarnett/will-the-number-of-people-employed
McAleese, N., Pokorny, R. M., Ceron Uribe, J. F., Nitishinskaya, E., Trebacz, M., & Leike, J. (2024). LLM critics help catch LLM bugs. arXiv:2407.00215. https://arxiv.org/abs/2407.00215
McKinsey & Company. (2025, January). Superagency in the workplace: Empowering people to unlock AI's full potential at work. https://www.mckinsey.com/~/media/mckinsey/business%20functions/quantumblack/our%20insights/superagency%20in%20the%20workplace%20empowering%20people%20to%20unlock%20ais%20full%20potential%20at%20work/superagency-in-the-workplace-empowering-people-to-unlock-ais-full-potential-v4.pdf
MediaNama. (2026, April). [Claude users' accounts suspended after being flagged as minors]. https://www.medianama.com/2026/04/223-claude-users-accounts-suspended-flagged-minors/
Memari, M., & Rudolph, G. (2026). The capability ladder. arXiv:2608.07779. https://arxiv.org/abs/2608.07779
Menlo Ventures. (2025). 2025: The state of generative AI in the enterprise. https://menlovc.com/perspective/2025-the-state-of-generative-ai-in-the-enterprise/
Metal Toad. (2026). 6 levels of AI delegation: A framework for AI management. https://www.metaltoad.com/blog/6-levels-of-ai-delegation-a-framework-for-ai-management
Metaview. (2026). [AI use in hiring interviews]. https://www.metaview.ai/resources/blog/ai-baseline-shopify-memo-hiring-process
METR. (2025, July 10). Measuring the impact of early-2025 AI on experienced open-source developer productivity. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
METR. (2026a, February 19). [Five lessons from an AI biology randomised trial]. https://metr.org/blog/2026-02-19-five-lessons-from-ai-biology-rct
METR. (2026b, March 10). Many SWE-bench-passing PRs would not be merged into main. https://metr.org/notes/2026-03-10-many-swe-bench-passing-prs-would-not-be-merged-into-main/
METR. (2026c). Time horizons (dashboard, accessed 9 October 2026). https://metr.org/time-horizons/
METR. (2026d). eval-analysis-public, release time-horizon 1.1, runs.jsonl [Data set]. GitHub. https://github.com/METR/eval-analysis-public (accessed 9 October 2026)
Microsoft. (2025, April 23). 2025: The year the Frontier Firm is born. Work Trend Index. https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born
Microsoft. (2026a, May 5). Agents, human agency and the opportunity for every organization. Work Trend Index 2026. https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
Microsoft. (2026b, May 5). How Frontier Firms are rebuilding the operating model for the age of AI. https://blogs.microsoft.com/blog/2026/05/05/how-frontier-firms-are-rebuilding-the-operating-model-for-the-age-of-ai/
MindStudio. (2026, June 11). What is agent literacy? https://www.mindstudio.ai/blog/what-is-agent-literacy-core-skill-ai-builders
n8n. (2026). AI Product Builder [job posting]. https://jobs.ashbyhq.com/n8n/42e72645-d99a-4545-97b7-53ba3a699893
Nature Portfolio. (2026, February 9). [Press release: people using language models for medical scenarios, Nature Medicine]. https://www.natureasia.com/en/info/press-releases/detail/9231
Ng, A. (2026, August 28). The AI engineering skills map in detail: Software engineering fundamentals. The Batch. https://www.deeplearning.ai/the-batch/the-ai-engineering-skills-map-in-detail-software-engineering-fundamentals
OECD. (2026, February). Venture capital investments in artificial intelligence through 2025. https://www.oecd.org/en/publications/venture-capital-investments-in-artificial-intelligence-through-2025_a13752f5-en/full-report.html
OECD & European Commission. (2026, June). [AI literacy framework for primary and secondary education]. https://ailiteracyframework.org/blog/empowering-learners-for-the-age-of-ai-literacy-framework/
O'Neill, N. (2026). [The Product Principal, LinkedIn post]. https://www.linkedin.com/posts/nicholasoneill_the-product-principal-activity-7445921322486009856-hAwj
Ono, A. (2026, June 22). [Defining the roles of humans and AI]. World Economic Forum. https://www.weforum.org/stories/artificial-intelligence/future-of-work-define-roles-humans-ai/
Open Source For You. (2026, February). GitHub weighs pull request kill switch as AI slop floods open source. https://www.opensourceforu.com/2026/02/github-weighs-pull-request-kill-switch-as-ai-slop-floods-open-source/
OpenAI. (2026, June). How agents are transforming work. https://openai.com/index/how-agents-are-transforming-work/
OpenAIRE. (2025, December 9). Zenodo introduces a new way to manage and correct published records. https://www.openaire.eu/zenodo-introduces-a-new-way-to-manage-and-correct-published-records
Oregon State Board of Bar Examiners. (2026, January 26). Supervised Practice Portfolio Examination: First annual report to the Oregon Supreme Court. https://www.osbar.org/_docs/sppe/2025SPPEAnnualReport.pdf
OSF. (2026). Updating registrations; Addressing fear of scooping on OSF preregistrations (help pages, accessed 9 October 2026). https://help.osf.io/hc/en-us/sections/4414482864279-Updating-Registrations ; https://help.osf.io/article/634-addressing-fear-of-scooping-on-osf-preregistrations
Page, M. J., McKenzie, J. E., Bossuyt, P. M., et al. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, n71. https://doi.org/10.1136/bmj.n71
Park, Y. S., et al. (2026). The work behind delegation: A framework for supervising AI coding agents. arXiv:2609.24234. https://arxiv.org/abs/2609.24234
Paul, R. W. (1947). California gold: The beginning of mining in the Far West. Harvard University Press. https://archive.org/details/in.ernet.dli.2015.177982
Patwardhan, T., et al. (2025). GDPval: Evaluating AI model performance on real-world economically valuable tasks. arXiv:2510.04374. https://arxiv.org/abs/2510.04374
Penrose. (2025). Can LLMs do accounting? [AccountingBench]. https://accounting.penrose.com/ (figures cited as reported by Gigazine, 2025)
Phoenix, J. (2026). [Five levels, gated by verification]. https://understandingdata.com/posts/five-levels-gated-by-verification/
PPC Land. (2026, March 6). The app middle class is dying, and RevenueCat's data shows exactly how fast. https://ppc.land/the-app-middle-class-is-dying-and-revenuecats-data-shows-exactly-how-fast/
Prolific. (2026, July 13). How do I use Prolific's filters? Researcher help centre (accessed 10 October 2026). https://researcher-help.prolific.com/en/articles/445159-how-do-i-use-prolific-s-filters
PwC. (2026). AI Jobs Barometer 2026 (press release). https://www.pwc.com/id/en/media-centre/press-release/2026/english/ai-jobs-barometer-en.html
Reid, B., Wagner, M., d'Amorim, M., & Treude, C. (2022). Software engineering user study recruitment on Prolific: An experience report. RoPES 2022. arXiv:2201.05348. https://arxiv.org/abs/2201.05348
Retool. (2026, February 17). Retool's 2026 Build vs. Buy Report (press release). https://www.businesswire.com/news/home/20260217548274/en/Retools-2026-Build-vs.-Buy-Report-Reveals-35-of-Enterprises-Have-Already-Replaced-SaaS-With-Custom-Software
RevenueCat. (2026). State of subscription apps 2026. https://www.revenuecat.com/state-of-subscription-apps ; https://www.revenuecat.com/sosa-26-insights/
Rogers, E. M. (2003). Diffusion of innovations (5th ed.). Free Press. ISBN 978-0743222099.
Sadki, R. (2026, August 14). [Quotes from the agentic AI summit in Berkeley]. https://redasadki.me/2026/08/14/you-cannot-send-an-ai-agent-to-jail-the-scariest-quotes-from-the-agentic-ai-summit-in-berkeley/
Sarbanes-Oxley Act of 2002, Pub. L. No. 107-204, sections 102 and 104 (15 U.S.C. 7212 and 7214) (United States) (accessed 10 October 2026). https://www.law.cornell.edu/uscode/text/15/7212 ; https://www.law.cornell.edu/uscode/text/15/7214
Savva, N. (2026). Context engineering: A principal-agent theory of AI-augmented knowledge work. SSRN. https://doi.org/10.2139/ssrn.6506600
Search Engine Journal. (2026). Marketers report highest rates of AI brain fry. https://www.searchenginejournal.com/marketers-report-highest-rates-of-ai-brain-fry-report-finds/569110/
SemiAnalysis. (2026, February). Claude Code is the inflection point. https://newsletter.semianalysis.com/p/claude-code-is-the-inflection-point
Serafini, R., Otto, C., Horstmann, S. A., & Naiakshina, A. (2024). ChatGPT-resistant screening instrument for identifying non-programmers. Proceedings of the IEEE/ACM 46th International Conference on Software Engineering (ICSE 2024), 1-13. https://doi.org/10.1145/3597503.3639075
Serafini, R., Weber, N., Yardim, A., Horstmann, S. A., & Naiakshina, A. (2026). Robust methods for developer screening in rapidly evolving AI contexts. Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (CHI '26), 1-18. https://doi.org/10.1145/3772318.3790302
SF Standard. (2026, March 5). [In AI land, everyone's a builder now]. https://sfstandard.com/2026/03/05/engineer-2025-ai-land-everyone-s-builder-now/
Shao, Y., et al. (2025). Future of work with AI agents: Auditing automation and augmentation potential across the U.S. workforce. arXiv:2506.06576. https://arxiv.org/abs/2506.06576
Shapiro, D. (2026, January). The five levels: From spicy autocomplete to the software factory. https://www.danshapiro.com/blog/2026/01/the-five-levels-from-spicy-autocomplete-to-the-software-factory/
Shopifreaks. (2026a). Meta employees compete on an internal AI token leaderboard called Claudeonomics. https://www.shopifreaks.com/meta-employees-compete-on-an-internal-ai-token-leaderboard-called-claudeonomics-that-tracked-60-trillion-tokens-in-30-days/
Shopifreaks. (2026b). Meta stops grading employees on how much AI they use, dropping token counts and AI Native labels from performance reviews (reporting WIRED, 2 September 2026). https://www.shopifreaks.com/meta-stops-grading-employees-on-how-much-ai-they-use-dropping-token-counts-and-ai-native-labels-from-performance-reviews/
Shopify. (2026). AI usage (candidate guide). https://www.shopify.com/careers/candidate-guide/ai-usage
Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, communications, and the public interest (pp. 37-72). Johns Hopkins Press.
Srinivasan, S., & Wei, V. (2026, February 12). To thrive in the AI era, companies need agent managers. Harvard Business Review. https://hbr.org/2026/02/to-thrive-in-the-ai-era-companies-need-agent-managers
Stanford Digital Economy Lab. (2026a, August 12). [Canaries in the coal mine: August 2026 update]. https://digitaleconomy.stanford.edu/news/canariesaug26/
Stanford Digital Economy Lab. (2026b, October 7). Task expansion with generative AI: Experimental evidence on middle-skilled early-career workers. https://digitaleconomy.stanford.edu/publication/task-expansion-with-generative-aiexperimental-evidence-on-middle-skilled-early-career-workers/
Stanford HAI. (2026). AI Index Report 2026, chapter 4: Economy. https://hai.stanford.edu/assets/files/ai_index_report_2026_chapter_4_economy.pdf
Startup Fortune. (2026). Guillermo Rauch says AI agents now trigger more than half of all Vercel deployments. https://startupfortune.com/guillermo-rauch-says-ai-agents-now-trigger-more-than-half-of-all-vercel-deployments/
State Street. (2026). Agentic Product Builder, Senior Associate [job posting]. https://statestreet.wd1.myworkdayjobs.com/en-US/Global/job/Agentic-Product-Builder--Sr-Associate---State-Street-Investment-Managment_R-796094
Stenberg, D. (2026, January 26). The end of the curl bug bounty. https://daniel.haxx.se/blog/2026/01/26/the-end-of-the-curl-bug-bounty/
Stripe. (2026, May 28). Solo founding is at an all-time high: Top performers have these traits in common. https://stripe.com/blog/top-solo-founder-traits
TechCrunch. (2026a, September 24). Lovable's annualized revenue crosses $600M as vibe coding takes off. https://techcrunch.com/2026/09/24/lovables-annualized-revenue-crosses-600m-as-vibe-coding-takes-off/
TechCrunch. (2026b, April 18). The App Store is booming again, and AI may be why. https://techcrunch.com/2026/04/18/the-app-store-is-booming-again-and-ai-may-be-why/
TechCrunch. (2026c, July 30). LinkedIn adds a button to report AI-generated "slop". https://techcrunch.com/2026/07/30/linkedin-adds-a-button-to-report-ai-generated-slop/
TechRepublic. (2025). [Prompt engineering jobs called obsolete]. https://www.techrepublic.com/article/news-prompt-engineering-ai-jobs-obsolete/
The Decoder. (2025, September). AI-generated workslop is costing companies millions and hurting team morale, study finds. https://the-decoder.com/ai-generated-workslop-is-costing-companies-millions-and-hurting-team-morale-study-finds/
The Decoder. (2026, July 12). LinkedIn is the undisputed king of long-form AI slop, according to a study spanning five platforms. https://the-decoder.com/linkedin-is-the-undisputed-king-of-long-form-ai-slop-according-to-a-study-spanning-five-platforms/
The geometry of learning under AI delegation. (2026). [Review of the paper]. https://www.themoonlight.io/fr/review/the-geometry-of-learning-under-ai-delegation
Tikhomirov, S. (2026, September). [The AIDEs framework: levels of delegation in software development]. JetBrains Research. https://blog.jetbrains.com/research/2026/09/aides-framework/
Tomašev, N., Franklin, M., & Osindero, S. (2026). Intelligent AI delegation. arXiv:2602.11865. https://arxiv.org/abs/2602.11865
Tray.ai. (2026). Gartner: Govern vibe coding for citizen developers with self-service platforms [Guide summarising Tyagi, 2026]. https://tray.ai/guides/gartner-govern-vibe-coding/
Turkovic, I. (2026, April 24). [AI job titles in 2026: naming chaos]. https://www.ivanturkovic.com/2026/04/24/ai-job-titles-2026-naming-chaos/
Turner, S. (2026). [An AI biosecurity uplift randomised trial by Scale AI and SecureBio]. https://blog.stephenturner.us/p/ai-biosecurity-uplift-rct
University of Lübeck, Institute for Multimedia and Interactive Systems. (2026). [The cost of convenience: decision horizons, CHI 2026]. https://www.imis.uni-luebeck.de/en/node/11007
Veracode. (2026, July 28). LLMs are getting smarter but not safer: Veracode 2026 GenAI code security report. https://www.veracode.com/news/llms-are-getting-smarter-but-not-safer-veracode-2026-genai-code-security-report-finds-ai-generated-code-security-has-stalled-at-56%25-pass-rate/
Verheul, J. (2026). The principal firm: Organisational form when the agency function is performed by machines. SSRN. https://doi.org/10.2139/ssrn.7235518
Veri', D. (2026). Beyond AI literacy: A structured review and exploratory meta-analysis of measures for competent generative-AI use. arXiv:2609.15624. https://arxiv.org/abs/2609.15624
Virk, Y., & Liu, D. (2025). Non-programmers assessing AI-generated code: A case study of business users analyzing data. VL/HCC 2025. arXiv:2508.06484. https://arxiv.org/abs/2508.06484
Wang, S. (2026). The delegation efficient frontier. SSRN. https://doi.org/10.2139/ssrn.7275801
Washington Monthly. (2026, May 29). [AI and entry-level jobs for college graduates]. https://washingtonmonthly.com/2026/05/29/ai-entry-level-jobs-college-graduates/
White House. (2025, April 23). Advancing artificial intelligence education for American youth. https://www.whitehouse.gov/presidential-actions/2025/04/advancing-artificial-intelligence-education-for-american-youth/
Willison, S. (2025a, February 3). A computer can never be held accountable. https://simonwillison.net/2025/Feb/3/a-computer-can-never-be-held-accountable/
Willison, S. (2025b, June 22). [Kent Beck on skills going to zero and up 1000x]. https://simonwillison.net/2025/Jun/22/kent-beck
Willison, S. (2026a). What is agentic engineering? https://simonwillison.net/guides/agentic-engineering-patterns/what-is-agentic-engineering/
Willison, S. (2026b, February 7). [Vouch]. https://simonwillison.net/2026/Feb/7/vouch/
Writer. (2026). [The AI agent owner]. https://writer.com/blog/ai-agent-owner/
Xinhua. (2025, September 19). [Beijing pupils build AI agents in class]. https://english.news.cn/20250919/740f7bd40ec84b69b9d983e1068a94ac/c.html
Yale Budget Lab. (2026, May 7). AI is probably not (yet) the reason for labor market weakening. https://budgetlab.yale.edu/research/ai-probably-not-yet-reason-labor-market-weakening
Yang, et al. (2026). [How people work with an autonomous search agent]. arXiv:2606.07489. https://arxiv.org/abs/2606.07489
Yegge, S. (2026). Welcome to Gas Town. https://steve-yegge.medium.com/welcome-to-gas-town-4f25ee16dd04
Appendix A. Glossar
Referenzstunde. Die Zeit, die ein qualifizierter Spezialist benötigen würde, um eine Aufgabe von Hand auszuführen, entnommen aus einer eingefrorenen Aufgabenbank oder von zwei unabhängigen Bewertern, die nicht wissen, wer die Arbeit erledigt hat.
Verifizierter Delegationshorizont. Die größte Arbeitsmenge in Referenzstunden, in der eine Person regelmäßig Arbeiten an Agenten überträgt, diese akzeptiert und durch eine unabhängige Überprüfung bestätigt, die die Agenten nicht sahen. Nach Bereich nach der Regel in Abschnitt 5.2 bewertet.
Unabhängige Überprüfung. Verborgene Akzeptanztests, ein qualifizierter menschlicher Prüfer, echte Nutzung durch die vorgesehenen Benutzer oder ein Modell einer anderen Familie, das gegen Quellen überprüft wird und sich von den Agenten in Daten, Zugang und Anreizen unterscheidet. Selbstüberprüfung und Übereinstimmung zwischen Modellen einer Familie sind keine unabhängigen Überprüfungen.
Gepflanzter Fehler. Ein Fehler, der vor der Übergabe in eine Aufgabe eingefügt wird und den die Person fangen muss, entweder ein falscher Eintrag oder das Weglassen von etwas, das die Arbeit enthalten muss. Ein Stück mit einem übersehenen gepflanzten Fehler zählt nicht als verifiziert, und jedes Versäumnis in einem Sprossen-Fenster blockiert die Sprossen ab Woche aufwärts.
Verstärkungsgewinn. Referenzstunden der akzeptierten, verifizierten Arbeit dividiert durch Stunden der Aufmerksamkeit der Person über die letzten 91 Tage im Bereich, fehlgeschlagene Arbeiten in den Nenner einbezogen und Arbeiten mit externer Hilfe aus dem Zähler ausgeschlossen.
Gewinnobergrenze. In einem vereinfachten Modell erfüllt der Verstärkungsgewinn G für ein Stück mit H Referenzstunden, dessen Überprüfung V Stunden Aufmerksamkeit kostet, G ≤ H / V, das heißt, eins dividiert durch den Anteil der manuellen Zeit, den die Überprüfung kostet.
Sprossen. Stunde (etwa 1 Referenzstunde), Tag (etwa 8), Woche (etwa 40), Monat (etwa 160), Quartal (etwa 500). Anzahl und Fenster der Regeln v1.1: zehn Stücke in 91 Tagen für Stunde und Tag, sechs in 182 Tagen für Woche, sechs in 365 Tagen für Monat (fünf davon verifiziert), drei in 365 Tagen für Quartal. Für Woche und darüber mindestens ein verifiziertes Stück der Größe der Sprosse in den letzten 91 Tagen.
Eintrag. Bereich · Horizont · Verstärkung · Datum, zum Beispiel „Buchhaltung für Kleinunternehmen · Tag · ×2 · 2026-Q4".
Akzeptanzliteralität. Die Fähigkeit, im Voraus festzulegen, was als erledigt gilt, und es dann mit einem Nachweis zu zeigen, den ein Agent nicht erfinden kann.
Hintergruntneutralität. Die Hypothese, dass bei gleichem verifiziertem Horizont in einem Bereich eine Programmiererausbildung nicht die Qualität von unabhängig überprüfter Arbeit vorhersagt, wenn Bereichsbeherrschung und Akzeptanzliteralität berücksichtigt werden.
Übergangspunkt der Qualifikation. Der Moment in einem Bereich, in dem Produkte von Personen ohne IT-Ausbildung, die unter denselben Überprüfungen akzeptiert werden, die von Programmierern mit denselben Agenten überholen, wonach Anforderungen an Abschlüsse und die Bezeichnungen Junior und Senior das Gewicht bei der Einstellung verlieren. Ihre Komponenten sind Qualitätsparität (der vorherige Schritt), Überholung (der Moment), die Überkreuzung in Stellenausschreibungen (das Zeichen) und Hintergruntneutralität (der Mechanismus).
Bürge. Eine Person, die für ein Produkt anderer signiert und dafür in ihrem Kreis antwortet, gemessen daran, wie viele Produkte sie befürwortet hat und wie viele hielten.
Fertigsteller. Eine Person, die ein Produkt zu seinen Benutzern bringt.
Zwei Märkte. Anfertigung für sich selbst (Literalität) und Arbeit für andere mit Konsequenzen (Beruf).
Anhang B. Suchprotokoll, 8. und 9. Oktober 2026
Webrecherchen zu Namen und Begriffen wurden am 8. Oktober 2026 mit mehreren KI-Assistenten durchgeführt, die unabhängig und parallel suchten, sowie am 9. Oktober 2026 von einem Assistenten mit erweiterter Websuche. Jede Antwort wurde vollständig mit ihren Quellen gespeichert. Wissenschaftliche Recherchen wurden am 9. Oktober 2026 wie folgt durchgeführt.
| Grundlage | Wonach wird gesucht | Ergebnis für die Begriffe dieser Arbeit |
|---|---|---|
| arXiv (API) | Exakte Phrase, alle Felder | "delegation horizon": 0; "delegation ladder" oder "ladder of delegation": 0; "time span of discretion": 0 |
| Semantic Scholar | Titel und Abstract | Eine Suche lieferte 0 Ergebnisse und eine andere wurde begrenzt (HTTP 429); vor Einreichung zu wiederholen |
| OpenAlex | Titel, Abstract, teilweise Volltext | "credential crossover": 0; "agentwright": nur nicht verwandte Treffer; "background neutrality": nicht verwandt; "acceptance literacy": Arbeiten nur zur Technologieakzeptanz |
| Crossref | Metadaten einschließlich SSRN-Abstracts | "principal" als Beruf: nur Agency-Theorie |
| Europe PMC | Offene Volltexte | Keine exakten Treffer |
| Zenodo | Datensätze und Beschreibungen | Keine Treffer für einen Begriff |
| DOAJ | Open-Access-Zeitschriften | "delegation horizon": vier nicht verwandte Treffer |
| Google Scholar | Volltexte, SSRN | "delegation horizon": 6, verwendet in 2026-Arbeiten für Maschinen oder Unternehmen (Khadj, 2026; Alonso, 2026); "verified delegation horizon", "credential crossover", "credential crossover point" und "agentwright": 0 (am 9. Oktober 2026 ohne Fehler wiederholt); "acceptance literacy", "background neutrality" und "amplification gain": Treffer nur in anderen Bedeutungen |
| DBLP; SSRN-Seiten | Durch Bot-Schutz blockiert (DBLP) oder HTTP 403 zurückgegeben (SSRN); abgedeckt durch Crossref und Scholar |
Frühere Prognosen wurden auf Metaculus, Manifold, Good Judgment Open, Kalshi, Polymarket und Long Bets sowie im offenen Web durchsucht; Metaculus und einige Gartner-Seiten gaben HTTP 403 zurück und wurden durch archivierte oder nachgedruckte Kopien gelesen, wo verfügbar. Die Ergebnisse sind in Abschnitt 11.3 zusammengefasst. Die Berichterstattung folgt Punkt 6 von PRISMA 2020 (Page et al., 2021): Jede Grundlage und das Datum des letzten Zugriffs sind aufgeführt. Ein nicht gefundener Treffer wird als an diesem Datum nicht gefunden gemeldet, und es werden keine Aussagen zu Grundlagen gemacht, die nicht durchsucht wurden.
Anlage C. Das Messinstrument
Diese Anlage stellt ein Forschungsinstrument, ein Datensatzformat und einen Scorer bereit, in der Python-Standardbibliothek unter der MIT-Lizenz. Sie zeigt, wie die Regeln von Abschnitt 5.2 zu Code werden. Es handelt sich nicht um eine Anwendung und trifft keine Entscheidung über eine Person, sondern berechnet nur die beiden Zahlen aus Datensätzen, die die Person oder ein Forscher bereitstellt. Sie beurteilt nicht, ob eine Überprüfung gut gewählt wurde; sie vertraut den Feldern, die ihr gegeben werden. Insbesondere testet sie nicht die Unabhängigkeit. Von den drei Bedingungen in Abschnitt 5.2 (Daten, Zugang und Anreize) liest sie nur die Art der Überprüfung und ob die Agenten sie gesehen haben, und die Unabhängigkeit selbst wird durch die Zufallsprüfung von Tabelle 3 bestätigt.
C1. Der Datensatz
Eine Zeile einer JSON Lines-Datei pro Arbeitspaket, das an Agenten übergeben wird, geschrieben, wenn das Paket akzeptiert, abgelehnt oder aufgegeben wird. Das Datum des Übergabestarts wird im Feld started eingetragen, das von Regeln v1.1 erwartet wird; der Scorer liest trotzdem Zeilen ohne dieses Feld und gibt eine Warnung aus. Pakete, die die Überprüfung nicht bestanden haben oder aufgegeben wurden, bleiben im Protokoll.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-10", "date": "2026-09-14",
 "reference_hours": 8, "reference_basis": "two raters",
 "attention_minutes": 95, "mode": "stages",
 "check": "expert", "agent_saw_check": false, "passed": true,
"irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}| Feld | Bedeutung |
|---|---|
| person | Ein pseudonymer Bezeichner, niemals ein echter Name |
| domain | Der Bereich, in dem die Arbeit akzeptiert wurde |
| date | Datum der Annahme, Ablehnung oder des Abbruchs, wenn die Zeile geschrieben wird (ISO-Format) |
| started | Datum, an dem die Übergabe begann (ISO-Format); ab Regeln v1.1 erwartet, nicht später als date |
| reference_hours | Manuelle Stunden eines qualifizierten Fachmanns für das gesamte Lieferprodukt |
| reference_basis | Woher die Referenz stammt: aus einer benannten Aufgabenbank oder von zwei Bewertern |
| attention_minutes | Die Minuten der Person für Planung, Anweisung, Lesen, Überprüfung und Korrektur |
| mode | one_piece, stages oder together (one_piece zählt zum Richtlinienanteil von Abschnitt 5.7) |
| check | hidden_tests, expert, real_use, other_family_with_sources, same_family, self_review oder none |
| agent_saw_check | Ob die Agenten die Überprüfung sehen konnten (muss false sein, um zu zählen) |
| passed | Ob die Überprüfung bestanden wurde (false für fehlgeschlagene oder abgebrochene Teile) |
| irreversible | Ob ein Fehler in dieser Art von Arbeit nicht rückgängig gemacht werden kann (dieses Teil muss dann bestehen) |
| planted_errors | Wie viele Fehler wurden vor der Übergabe in die Aufgabe eingepflanzt |
| planted_missed | Wie viele davon hat die Person nicht gefangen (jeder Fehler macht das Teil ungeprüft und blockiert Week und höher im Fenster) |
| outside_help | Ob ein Kollege oder Auftragnehmer außerhalb des Protokolls geholfen hat (ein solches Teil trägt nichts zum Zähler des Gewinns bei) |
| task_id, model, tools | Optional: Aufgabenbank-Kennung, die verwendeten Agenten und Modelle sowie deren Werkzeuge (Abschnitt 5.4) |
| checker | Optional: wer oder was die Überprüfung durchgeführt hat, als Rolle, niemals ein echter Name |
| rater_hours | Optional: die Schätzungen der Bewerter hinter reference_hours; wenn es zwei gibt und der größere ist mehr als 1,5-mal so groß wie der kleinere, druckt der Scorer „needs third rater" (Tabelle 3); mit einer dritten Schätzung entscheidet der Median und die Flagge wird nicht gedruckt |
| audit | Optional: none, passed oder failed, das Ergebnis einer zweiten, unabhängigen Überprüfung; ein fehlgeschlagenes Audit macht das Teil ungeprüft |
| revoked | Optional: true, wenn ein verzögertes Ergebnis das Teil widerrufen hat (Tabelle A4); ein widerrufenes Teil ist ungeprüft |
C2. horizon.py
Der folgende Code implementiert Regeln v1.1 und ist identisch, Byte für Byte, mit horizon.py im zugehörigen Repository.
#!/usr/bin/env python3
"""horizon.py: score the verified delegation horizon and the amplification gain.

Teaches: how the rules of Section 5.2 turn a log of work handed to agents into a dated record
"domain . horizon . gain . quarter". Limits: it trusts the fields it is given; it does not
judge whether a check was well chosen or whether the reference hours are fair.
Usage: python3 horizon.py work-log.jsonl --as-of 2026-10-09 [--stable]   Rules v1.1   Licence: MIT
"""
import argparse
import datetime as dt
import json
import math
import sys
import statistics
from collections import Counter, defaultdict

# rung, reference hours, minimum pieces, window in days (provisional; Section 5.8)
RUNGS = [("Quarter", 500.0, 3, 365), ("Month", 160.0, 6, 365), ("Week", 40.0, 6, 182),
         ("Day", 8.0, 10, 91), ("Hour", 1.0, 10, 91)]
PLANTED_FROM = 40.0         # from Week upward a planted error must be in the window
GAIN_STEPS = [60, 20, 5, 2, 1]
GAIN_WINDOW = 91            # gain, directive share and the recent piece of upper rungs (91 days)
PASS_SHARE = 0.8            # 8 of 10; every irreversible piece must pass
INDEPENDENT = {"hidden_tests", "expert", "real_use", "other_family_with_sources"}
RATER_SPREAD = 1.5          # raters further apart than this need a third rater
CHECKS = INDEPENDENT | {"same_family", "self_review", "none"}
MODES = {"one_piece", "stages", "together"}
KEYS = {"person", "domain", "date", "reference_hours", "reference_basis",
        "attention_minutes", "mode", "check", "agent_saw_check", "passed", "irreversible",
        "planted_errors", "planted_missed", "outside_help"}
OPTIONAL = {"started",      # date the hand-over started (expected from v1.1; the line is written at close)
            "task_id", "model", "tools", "checker", "rater_hours", "audit", "revoked"}


def load(path):
    """Every piece handed to agents is a line, including failed and abandoned ones."""
    records, undated = [], 0
    with open(path, encoding="utf-8") as fh:
        for n, line in enumerate(fh, 1):
            if not line.strip():
                continue
            r = json.loads(line)
            if set(r) - OPTIONAL != KEYS:
                sys.exit(f"line {n}: unknown {sorted(set(r) - KEYS - OPTIONAL)}, missing {sorted(KEYS - set(r))}")
            if r["check"] not in CHECKS or r["mode"] not in MODES:
                sys.exit(f"line {n}: check or mode is not one of the allowed values")
            if float(r["reference_hours"]) <= 0 or float(r["attention_minutes"]) < 0:
                sys.exit(f"line {n}: reference hours must be positive, minutes not negative")
            if not 0 <= int(r["planted_missed"]) <= int(r["planted_errors"]):
                sys.exit(f"line {n}: planted_missed must lie between 0 and planted_errors")
            if not isinstance(r["outside_help"], bool) or not isinstance(r.get("revoked", False), bool):
                sys.exit(f"line {n}: outside_help and revoked must be true or false")
            if r.get("audit", "none") not in {"none", "passed", "failed"}:
                sys.exit(f"line {n}: audit must be none, passed or failed")
            if "rater_hours" in r and (len(r["rater_hours"]) < 2 or min(map(float, r["rater_hours"])) <= 0):
                sys.exit(f"line {n}: rater_hours needs two or more positive estimates")
            undated += "started" not in r
            r["date"] = dt.date.fromisoformat(r["date"])
            if "started" in r and dt.date.fromisoformat(r["started"]) > r["date"]:
                sys.exit(f"line {n}: started must not be later than date")
            records.append(r)
    if undated:
        print(f"warning: {undated} lines without started (expected from rules v1.1)", file=sys.stderr)
    return records


def verified(r):
    """A pass counts only if the check was independent, the agents never saw it, no planted error
    was missed, nobody helped off the log, no audit failed and no delayed outcome revoked it.
    Another model family alone never verifies irreversible work."""
    return (r["passed"] is True and r["check"] in INDEPENDENT and r["agent_saw_check"] is False
            and int(r["planted_missed"]) == 0 and not r["outside_help"]
            and not (r["irreversible"] and r["check"] == "other_family_with_sources")
            and r.get("audit") != "failed" and not r.get("revoked", False))


def rung_holds(pieces, hours, minimum, as_of, days):
    start = as_of - dt.timedelta(days=days)
    window = [r for r in pieces if start < r["date"] <= as_of]
    big = [r for r in window if float(r["reference_hours"]) >= hours]
    if len(big) < minimum:
        return False
    if sum(map(verified, big)) / len(big) < PASS_SHARE:
        return False
    if any(r["irreversible"] and not verified(r) for r in big):   # strict rule, these pieces only
        return False
    if hours >= PLANTED_FROM:
        if not any(int(r["planted_errors"]) > 0 for r in big):
            return False
        if any(int(r["planted_missed"]) > 0 for r in window):   # any missed planted error blocks
            return False
    if days > GAIN_WINDOW:                                       # quarterly re-verification
        recent = as_of - dt.timedelta(days=GAIN_WINDOW)
        if not any(verified(r) and r["date"] > recent for r in big):
            return False
    return True


def horizon(pieces, as_of):
    for name, hours, minimum, days in RUNGS:        # from the top rung down
        if rung_holds(pieces, hours, minimum, as_of, days):
            return name
    return "below Hour"


def rung_pieces(pieces, name, as_of):
    """Pieces of the rung's size in its window (Hour's for 'below Hour'): what the count is out of."""
    _, hours, _, days = next(r for r in RUNGS if r[0] == name or (name == "below Hour" and r[0] == "Hour"))
    return [r for r in pieces if as_of - dt.timedelta(days=days) < r["date"] <= as_of
            and float(r["reference_hours"]) >= hours]


def gain(pieces):
    done = math.fsum(float(r["reference_hours"]) for r in pieces
                     if verified(r) and not r["outside_help"])            # outside help excluded
    spent = math.fsum(float(r["attention_minutes"]) for r in pieces) / 60.0   # failures included
    return None if spent == 0 else done / spent


def step(g):
    if g is None:
        return "n/a"
    for s in GAIN_STEPS:
        if g >= s:
            return f"x{s}"
    return "below x1"


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("log")
    ap.add_argument("--as-of", default=dt.date.today().isoformat())
    ap.add_argument("--stable", action="store_true", help="also score 91 days earlier and label the rung")
    args = ap.parse_args()
    as_of = dt.date.fromisoformat(args.as_of)
    longest = max(days for *_, days in RUNGS) + (GAIN_WINDOW if args.stable else 0)
    groups = defaultdict(list)
    for r in load(args.log):
        if as_of - dt.timedelta(days=longest) < r["date"] <= as_of:
            groups[(r["person"], r["domain"])].append(r)
    quarter = f"{as_of.year}-Q{(as_of.month - 1) // 3 + 1}"
    recent_start = as_of - dt.timedelta(days=GAIN_WINDOW)
    for (person, domain), pieces in sorted(groups.items()):
        recent = [r for r in pieces if r["date"] > recent_start]
        g = gain(recent)
        shown = "n/a" if g is None else f"{g:.2f}"
        failed = sum(1 for r in recent if not verified(r))
        directive = (sum(r["mode"] == "one_piece" for r in recent) / len(recent)) if recent else 0.0
        rung = horizon(pieces, as_of)
        counted = rung_pieces(pieces, rung, as_of)
        label = ""
        if args.stable:
            before = horizon(pieces, as_of - dt.timedelta(days=GAIN_WINDOW))
            label = " stable" if before == rung else f" provisional (was {before})"
        print(f"{person}: {domain} . {rung} ({sum(map(verified, counted))}/{len(counted)}){label}"
              f" . {step(g)} . {quarter}  (pieces in last 91 days: {len(recent)}, not verified: {failed};"
              f" gain {shown}; directive share {directive:.0%})")
        kinds = Counter(r["check"] for r in counted).most_common()
        sizes = [float(r["reference_hours"]) for r in recent if r["passed"]]
        median = f"{statistics.median(sizes):.1f} h" if sizes else "n/a"
        spread = any(max(map(float, r["rater_hours"])) / min(map(float, r["rater_hours"])) > RATER_SPREAD
                     for r in pieces if len(r.get("rater_hours", [])) == 2)   # with three, the median decided
        print(f"  checks: {', '.join(f'{k} {v}' for k, v in kinds) or 'none'};"
              f" median accepted size {median}{'; needs third rater' if spread else ''}")


if __name__ == "__main__":
    main()
C3. brier.py
#!/usr/bin/env python3
"""brier.py: score dated predictions by the Brier rule.

Teaches: why one missed prediction made at 35% says little on its own, and why 'unresolved' is
never a success. Input CSV columns: id,probability,outcome (outcome: 1, 0 or unresolved).
Usage: python3 brier.py predictions.csv                                  Licence: MIT
"""
import csv
import sys


def main(path):
    resolved, pending = [], []
    with open(path, newline="", encoding="utf-8") as fh:
        for row in csv.DictReader(fh):
            p = float(row["probability"])
            if not 0.0 <= p <= 1.0:
                sys.exit(f"{row['id']}: probability must lie between 0 and 1")
            outcome = row["outcome"].strip().lower()
            if outcome in ("0", "1"):
                resolved.append((row["id"], p, int(outcome)))
            else:
                pending.append(row["id"])
    for pid, p, o in resolved:
        print(f"{pid}: p={p:.2f} outcome={o} score={(p - o) ** 2:.3f}")
    if resolved:
        mean = sum((p - o) ** 2 for _, p, o in resolved) / len(resolved)
        print(f"Brier score over {len(resolved)} resolved: {mean:.3f} (always saying 0.5 gives 0.250)")
    print("unresolved or not yet due: " + (", ".join(pending) or "none"))


if __name__ == "__main__":
    main(sys.argv[1])
C4. Ein ausgearbeitetes Beispiel
Das Protokoll unten enthält zehn Posten von Buchhaltungsarbeit, die eine Person Agenten zwischen Juli und September 2026 übergeben hat.
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-17", "date": "2026-07-20", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 95, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-24", "date": "2026-07-28", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 80, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-07-29", "date": "2026-08-04", "reference_hours": 12, "reference_basis": "two raters", "attention_minutes": 150, "mode": "one_piece", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-09", "date": "2026-08-11", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 70, "mode": "stages", "check": "self_review", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-13", "date": "2026-08-18", "reference_hours": 10, "reference_basis": "two raters", "attention_minutes": 110, "mode": "together", "check": "real_use", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-21", "date": "2026-08-25", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 120, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": false, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-08-24", "date": "2026-09-01", "reference_hours": 16, "reference_basis": "two raters", "attention_minutes": 180, "mode": "one_piece", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-05", "date": "2026-09-08", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 60, "mode": "stages", "check": "expert", "agent_saw_check": false, "passed": true, "irreversible": true, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-11", "date": "2026-09-15", "reference_hours": 9, "reference_basis": "two raters", "attention_minutes": 90, "mode": "together", "check": "other_family_with_sources", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
{"person": "P07", "domain": "small-business bookkeeping", "started": "2026-09-27", "date": "2026-09-29", "reference_hours": 8, "reference_basis": "two raters", "attention_minutes": 75, "mode": "stages", "check": "hidden_tests", "agent_saw_check": false, "passed": true, "irreversible": false, "planted_errors": 0, "planted_missed": 0, "outside_help": false}
Das Ausführen von python3 horizon.py work-log.jsonl --as-of 2026-10-09 gibt den Datensatz und eine Zeile über die dahinter stehenden Prüfungen aus:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Alle zehn Teile haben mindestens 8 Referenzstunden. Zwei zählen nicht als verifiziert: eines wurde nur durch Selbstkontrolle überprüft, und eines ist bei einer Expertenprüfung durchgefallen. Acht von zehn ist genau der Anteil, den Day verlangt, und das eine irreversible Stück ist bestanden, daher ist die Stufe Day. Week ist unerreichbar, da kein Stück 40 Stunden erreicht. Die verifizierten Stücke addieren sich auf 80 Referenzstunden, gegenüber 1.030 Minuten (etwa 17,2 Stunden) Aufmerksamkeit, die auf alle zehn aufgewendet wurden, Ausfälle eingeschlossen, was einen Gewinn von 4,66 und den Schritt ×2 ergibt. Kein Stück trug gepflanzte Fehler oder externe Hilfe, daher ändert keine dieser Regeln das Ergebnis. Hätte man das fehlgeschlagene Stück aus dem Protokoll gelassen, hätte die Stufe auf neun Stücken geruht und die Anzahl von zehn nicht erfüllt, weshalb Ausfälle im Protokoll gehören. Die Zahl neben der Stufe, 8/10, zeigt, wie knapp das Urteil war (Appendix E), und die zweite Zeile gibt die Art der Prüfung hinter den gezählten Stücken und die mittlere akzeptierte Größe, 9,0 Stunden, an, sodass ein Leser sehen kann, ob der Horizont auf Stücken knapp über einem Schwellenwert ruht (Table 3). Die Aufmerksamkeit der Person, 1.030 Minuten, beträgt etwa 18% der 96 übergebenen Referenzstunden und etwa 21% der 80, die verifiziert wurden. Der Datensatz für einen Lebenslauf lautet „kleine Geschäftsbuchhaltung · Day · ×2 · 2026-Q4".
Das Begleittool tools/explain.py druckt die Gründe hinter dem gleichen Urteil aus denselben Regeln. Acht von zehn Stücken der Day-Größe sind verifiziert und acht sind erforderlich, eine Anzahl, die mit einer echten Erfolgsquote zwischen 44% und 97% konsistent ist (Section 5.8), daher kann kein weiteres fehlgeschlagenes Stück dieser Größe aufgenommen werden. Wenn nichts Neues protokolliert wird, gilt Day bis zum 18. Oktober 2026; am 19. Oktober verlässt das am 20. Juli geschlossene Stück das 91-Tage-Fenster, und neun Stücke der Day-Größe bleiben erhalten, eines zu kurz für die zehn, die Day benötigt. Für Week listet es jede noch fehlende Bedingung auf: sechs Stücke von mindestens 40 Stunden in 182 Tagen, eines davon mit gepflanzten Fehlern und eines in den letzten 91 Tagen verifiziert.
Das erstellte Protokoll trägt auch eine Spur, die Table 3 benennt: fünf seiner zehn Stücke wurden auf exakt 8 Stunden, dem Boden von Day, bewertet, und tools/too_clean.py kennzeichnet es als „audit first", mit der Spur „5 von 10 Stücken liegen knapp über einem Schwellenwert". Ein Flag schickt ein Protokoll zur Audit und entscheidet nichts darüber; der Median von 9,0 Stunden neben der Stufe zeigt das Gleiche einem Leser.
C5. Das Begleit-Repository
Das Begleit-Repository (https://github.com/vadimchernets/delegation-horizon) enthält das Instrument und die Materialien, mit denen Leser jeden Teil des Papiers nutzen können. Die Hauptdateien nach Abschnitt:
| Abschnitt | Dateien | Was sie tun |
|---|---|---|
| 5.2, C1 to C4 | horizon.py, log.schema.json, examples/ |
Scorer, Schema einer Protokollzeile, das bearbeitete Beispiel und die Zeilen, die es drucken muss |
| 5.2, 5.3 | tools/log_piece.py, record_card.py, checker.html |
Schreiben des Protokolls durch Beantwortung von Fragen, eine Datensatzkarte mit der Anzahl hinter der Stufe und die gleiche Bewertung auf einer Offline-Browserseite; beide lesen ein mit Kommas oder Semikola gespeichertes Tabellenkalkulationsprogramm |
| 5.2, 5.8, C4 | tools/explain.py |
Warum ein Protokoll seine Stufe verdient: jede Bedingung, die gilt oder nicht, der Spielraum, der Tag, an dem die Stufe verfällt, wenn nichts Neues protokolliert wird, und was die nächste Stufe benötigt |
| 5.1 | tools/reference_hours.py, kits/reference-hours-raters.md |
Referenzstunden aus den Schätzungen der Bewerter und wie man Bewerter auswählt, zulässt und einweist |
| 5.8, Table 3 | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/ |
Nachvollziehbare Audit-Stichprobe, Flaggen für Protokolle, die zu sauber aussehen, gepflanzte Fehler, die vor der Übergabe versiegelt und nach Art bewertet werden (falscher Eintrag oder Auslassung), Audit- und Anleitungen für gepflanzte Fehler |
| 6.2, 10.3 | tools/verify_record.py |
Die Empfängerseite eines tragbaren Datensatzes: ob das damit versendete Protokoll die Datei ist, die bewertet wurde, ob der Scorer gleich ist, und ob eine erneute Bewertung denselben Datensatz, Feld für Feld, ergibt |
| 6.2 | kits/trade-screen.md, tools/gate_leak.py |
Zulassung von Personen durch eine Frage des Handwerks statt eines Labels und wie viel ein Label durchsickert, mit einem genauen Intervall (11 von 60 in Appendix G2: 9,5% bis 30,4%) |
| 6.5, 10.5 | kits/checking-process.md, kits/process-vs-experience-study.md, tools/process_study.py |
Die vier Schritte von Section 6.5 und was jeder unter der Regel verdient (Figure A4), und der Vergleich von Section 10.5 als Protokoll zur Registrierung, mit seiner Analyse, falsche Einträge und Auslassungen separat |
| 5.8, Appendix E | pilot/ |
Schreibtischtest der Schwellenwerte, eine Bank von 30 Aufgaben, das Kalibrierungsprotokoll mit seinem Registrierungstext und Zustimmungsformular |
| Appendix G2 | pilot/ |
Die registrierte Analyse human_raters.py, wie auf OSF eingereicht, die Konvertierung der Prolific-Exporte, das Skript, das Table G2 mit den registrierten Funktionen druckt, der Vergleich des Screenings und ein synthetischer Export zum Ausführen auf ihnen |
| 7.2 | templates/, tools/guarantor_record.py |
Aufgabenkarte für eine Aufgabenbank, ein Garantenlager und der aus ihm berechnete Garantendatensatz: Produkte, für die garantiert wird, wie viele 6 und 12 Monate hielten, Ausfälle nach Schweregrad |
| 11, Tables 4 and A6, C3 | predictions/, brier.py, tools/power.py |
Die 41 registrierten Vorhersagen mit dem Manifest ihrer Hashes, das auf OSF eingereicht wurde, die Lösungsregeln und Dateien, die Scoring-Tools, die eine nicht durchgeführte Set-B-Vorhersage aufzeichnen und den Brier-Score sowohl ohne als auch mit der Bewertung als falsch berichten (Section 11.2), und die Stichprobengrößen von Section 11.2 |
| 11, Set B | predictions/set_b.py |
Die eingefrorenen Regeln für „wahr geworden" und „nicht wahr geworden" der neun auf einem Intervall geschriebenen Set-B-Vorhersagen, angewendet auf die Schätzungen einer Studie |
| 11.4, F27 | kits/f27-sample.md, tools/freeze_sample.py, tools/liveness.py |
Das Protokoll und die Ziehung der F27-Stichprobe (der geschlossene zuerst registrierte Pool, der Schlüssel danach aus einem öffentlichen Zufallszahlengenerator entnommen), auf Zenodo eingefroren und sein Hash am 31. Dezember 2026 auf OSF registriert, und seine Aktualität an jedem Bewertungsdatum nach F27s Worten |
| C2 to C4, Tables 4 and A6 | tools/paper_sync.py |
Prüft diesen Text gegen das Repository: die Auflistungen Byte für Byte, das ausgearbeitete Beispiel und seine Ausgabe, die Tabellen der Vorhersagen, die Zählungen der Mengen, jede benannte Datei und jede eingebettete Abbildung |
| Appendix D, Appendix F | figures/ |
Die Skripte, die Abbildung A1 aus der Vorhersagetabelle und Abbildung A4 aus den Regeln des Scorers zeichnen |
Dieselben Dateien nach Leser:
| Leser | Beginnen Sie mit | Was es bietet |
|---|---|---|
| Eine Person, die Arbeit an Agenten übergibt | templates/work-log.csv, record_card.py oder checker.html, tools/explain.py |
Ein in einer Tabellenkalkulation geführtes Protokoll, der Datensatz und seine Karte, und was die nächste Stufe benötigt |
| Ein Arbeitgeber oder ein HR-Team | kits/hiring-test/, kits/trade-screen.md, kits/scope-statement.md, tools/explain.py |
Ein bezahlter eintägiger Arbeitstest mit blinder Bewertung, eine Frage des Handwerks an Stelle einer Bezeichnung, was eine Stufe sagt und nicht sagt, und wie nah das Urteil eines Kandidaten war |
| Ein Neuling in einem Handwerk | kits/checking-process.md, kits/acceptance-card.md, kits/planted-errors-guide.md |
Die Schritte von Abschnitt 6.5 und was jeder verdient, „fertig" vor der Übergabe angegeben, und Übung bei gepflanzten Auslassungen |
| Ein Auditor oder ein Garant | audit_sample.py, tools/too_clean.py, tools/planted.py, kits/audit-checklist.md |
Eine Stichprobe zur erneuten Überprüfung, die Spuren eines Protokolls, das zu sauber aussieht, gepflanzte Fehler, deren Siegel zeigt, ob die Liste geändert wurde |
| Ein Forscher | pilot/, kits/matched-task-study.md, kits/process-vs-experience-study.md, tools/power.py, predictions/ |
Der Schreibtischtest, die Bewerterstudien und ihre Skripte, Protokolle für die Vergleiche, Stichprobengrößen und die registrierten Vorhersagen mit ihren Scorercard-Tools |
Anhang D. Registrierungstext für die Vorhersagen (OSF)
Titel. Datierte Vorhersagen zur Arbeit durch KI-Agenten, 2026 bis 2031: eingefrorene Prognosen und jährliche Bewertung.
Typ. Open-Ended Registration, sofort öffentlich, kein Embargo.
Zusammenfassung. Diese Registrierung friert die datierten Vorhersagen ein, die in „After the Programmer Divide: One Measure for People Who Build Through AI Agents" (SSRN 7589918; Zenodo DOI 10.5281/zenodo.23267266) dargelegt sind. Die beigefügte Tabelle gibt für jede Vorhersage an: ihre Formulierung; ihr Maß; eine öffentliche Quelle und eine Fallback-Quelle; eine Basislinie von 2025 oder 2026 mit dem Zugriffsdatum und einem archivierten Snapshot; ein Prüfdatum und ein Enddatum; eine Wahrscheinlichkeit, die zum Zeitpunkt dieser Registrierung festgelegt wurde; und die Schwellenwerte für drei Ergebnisse: wahr geworden, nicht wahr geworden, ungelöst.
Bewertung. Jede Vorhersage wird bei der ersten jährlichen Prüfung an oder nach ihrem Prüfdatum bewertet, zu dem die Daten verfügbar sind, und spätestens an ihrem Enddatum. Aufgelöste Vorhersagen werden nach der Brier-Regel bewertet. Eine Vorhersage ohne vergleichbare Daten bis zu ihrem Enddatum wird als ungelöst erfasst und wird nicht als Erfolg gezählt.
Mengen und Wahrscheinlichkeiten. Menge A wird aus öffentlichen Daten und den Dateien in predictions/resolve/ aufgelöst, deren SHA-256-Hashes in dieser Registrierung aufgelistet sind. Menge B wird nur aus Studien aufgelöst, die separat vor der Datenerhebung registriert wurden; eine Vorhersage aus Menge B, deren Protokoll nicht bis zum 30. Juni 2027 registriert ist, wird als nicht durchgeführt erfasst, als Fehler des Testprogramms; der Brier-Score wird sowohl über aufgelöste Vorhersagen als auch mit jeder nicht durchgeführten Vorhersage als falsch bewertet. Wahrscheinlichkeiten sind bedingt durch die Auflösung. Sie sind der Median von drei blinden Modellprognosen, die am 9. Oktober 2026 erhoben wurden (Claude Opus, ein OpenAI-Modell und Gemini), und wurden vom Autor angenommen; die früheren gepoolten Prognosen von vier Modellen sind als Referenz beigefügt.
Übergangspunkt. F2, F3, F5 und F7 werden in denselben benannten Domänen gemessen: Buchhaltung für Kleinunternehmen sowie rechtliche und Marketing-Dokumente, die zwei Nicht-Software-Domänen der Task Bank (Anhang E); für das Postings-Analogon von F5 bilden sie auf SOC 43-3031, 23-2011 und 13-1161 ab. Die dritte Bank-Domäne, kleine interne Web-Tools, ist die Heimatdomäne der Programmierer und ist keine Übergangspunkt-Domäne. Der Übergangspunkt in einer Domäne ist das erste Jahr, in dem F3 und das Domänen-Analogon von F5 beide in derselben benannten Domäne erfüllt sind; keines der beiden allein erklärt ihn.
Bewertungszusätze. Jeder Scoreboard meldet auch den Anteil der aufgelösten Vorhersagen, den Brier-Score nach Menge und nach Familie, eine Worst-Case-Grenze, die überfällige ungelöste Vorhersagen als falsch bewertet, und den Brier-Geschicklichkeits-Score gegen 0,5, die gepoolten Modellprognose-Steller und Marktpreise.
Jährliche Prüfungen. Jedes Jahr von 2027 bis 2031 veröffentlicht der Autor am Jahrestag dieser Registrierung eine Bewertungskarte, die jede hier registrierte Vorhersage abdeckt. Jede Bewertungskarte wird selbst auf OSF registriert, mit dieser Registrierung durch DOI verlinkt und auf Zenodo hinterlegt.
Festgelegte Regeln. Keine Vorhersage wird entfernt, umformuliert oder mit einem neuen Datum versehen. Alles, was später hinzugefügt wird, wird separat registriert und trägt sein eigenes Datum. Wenn eine benannte Quelle die Veröffentlichung einstellt oder ihre Methode ändert, wird die Fallback-Quelle verwendet, sofern sie dieselbe Größe misst; wenn keine vergleichbare Quelle vorhanden ist, ist die Vorhersage ungelöst.
Unabhängige Überprüfung. Jede Bewertungskarte wird anhand der hier eingefrorenen Regeln von Modellen aus mindestens zwei verschiedenen Familien überprüft. Wenn sie sich widersprechen, entscheidet die Regel und der Widerspruch wird gemeldet. Ein von dem Autor vor der ersten Bewertungskarte benannter menschlicher Schiedsrichter entscheidet Streitigkeiten zwischen den zwei Modellfamilien.
Eigene Daten. Vorhersagen, die auf den Kohortendaten des Autors beruhen, werden nur unter einer separaten Voranmeldung getestet, die vor der Erhebung dieser Daten eingereicht wurde, wie das auf OSF registrierte Programm (DOI 10.17605/OSF.IO/X4EGQ) es für jede Kohorte tut.
Interessenskonflikte. Wie in dem Papier angegeben.
Dateien. Vorhersagetabelle (CSV und Tabelle A6 des beigefügten Papiers); Liste der archivierten Snapshots; predictions/resolve/ (eingefrorene Abfragen, Listen und Codebuch mit Hashes); resolution-rules.md; changelog-v1-v2.md.
Die beigefügte Vorhersagetabelle ist Tabelle A6, und Abbildung A1 zeichnet ihren Kalender.
Abbildung A1. Der Kalender der Prüfungen, 2026 bis 2031.
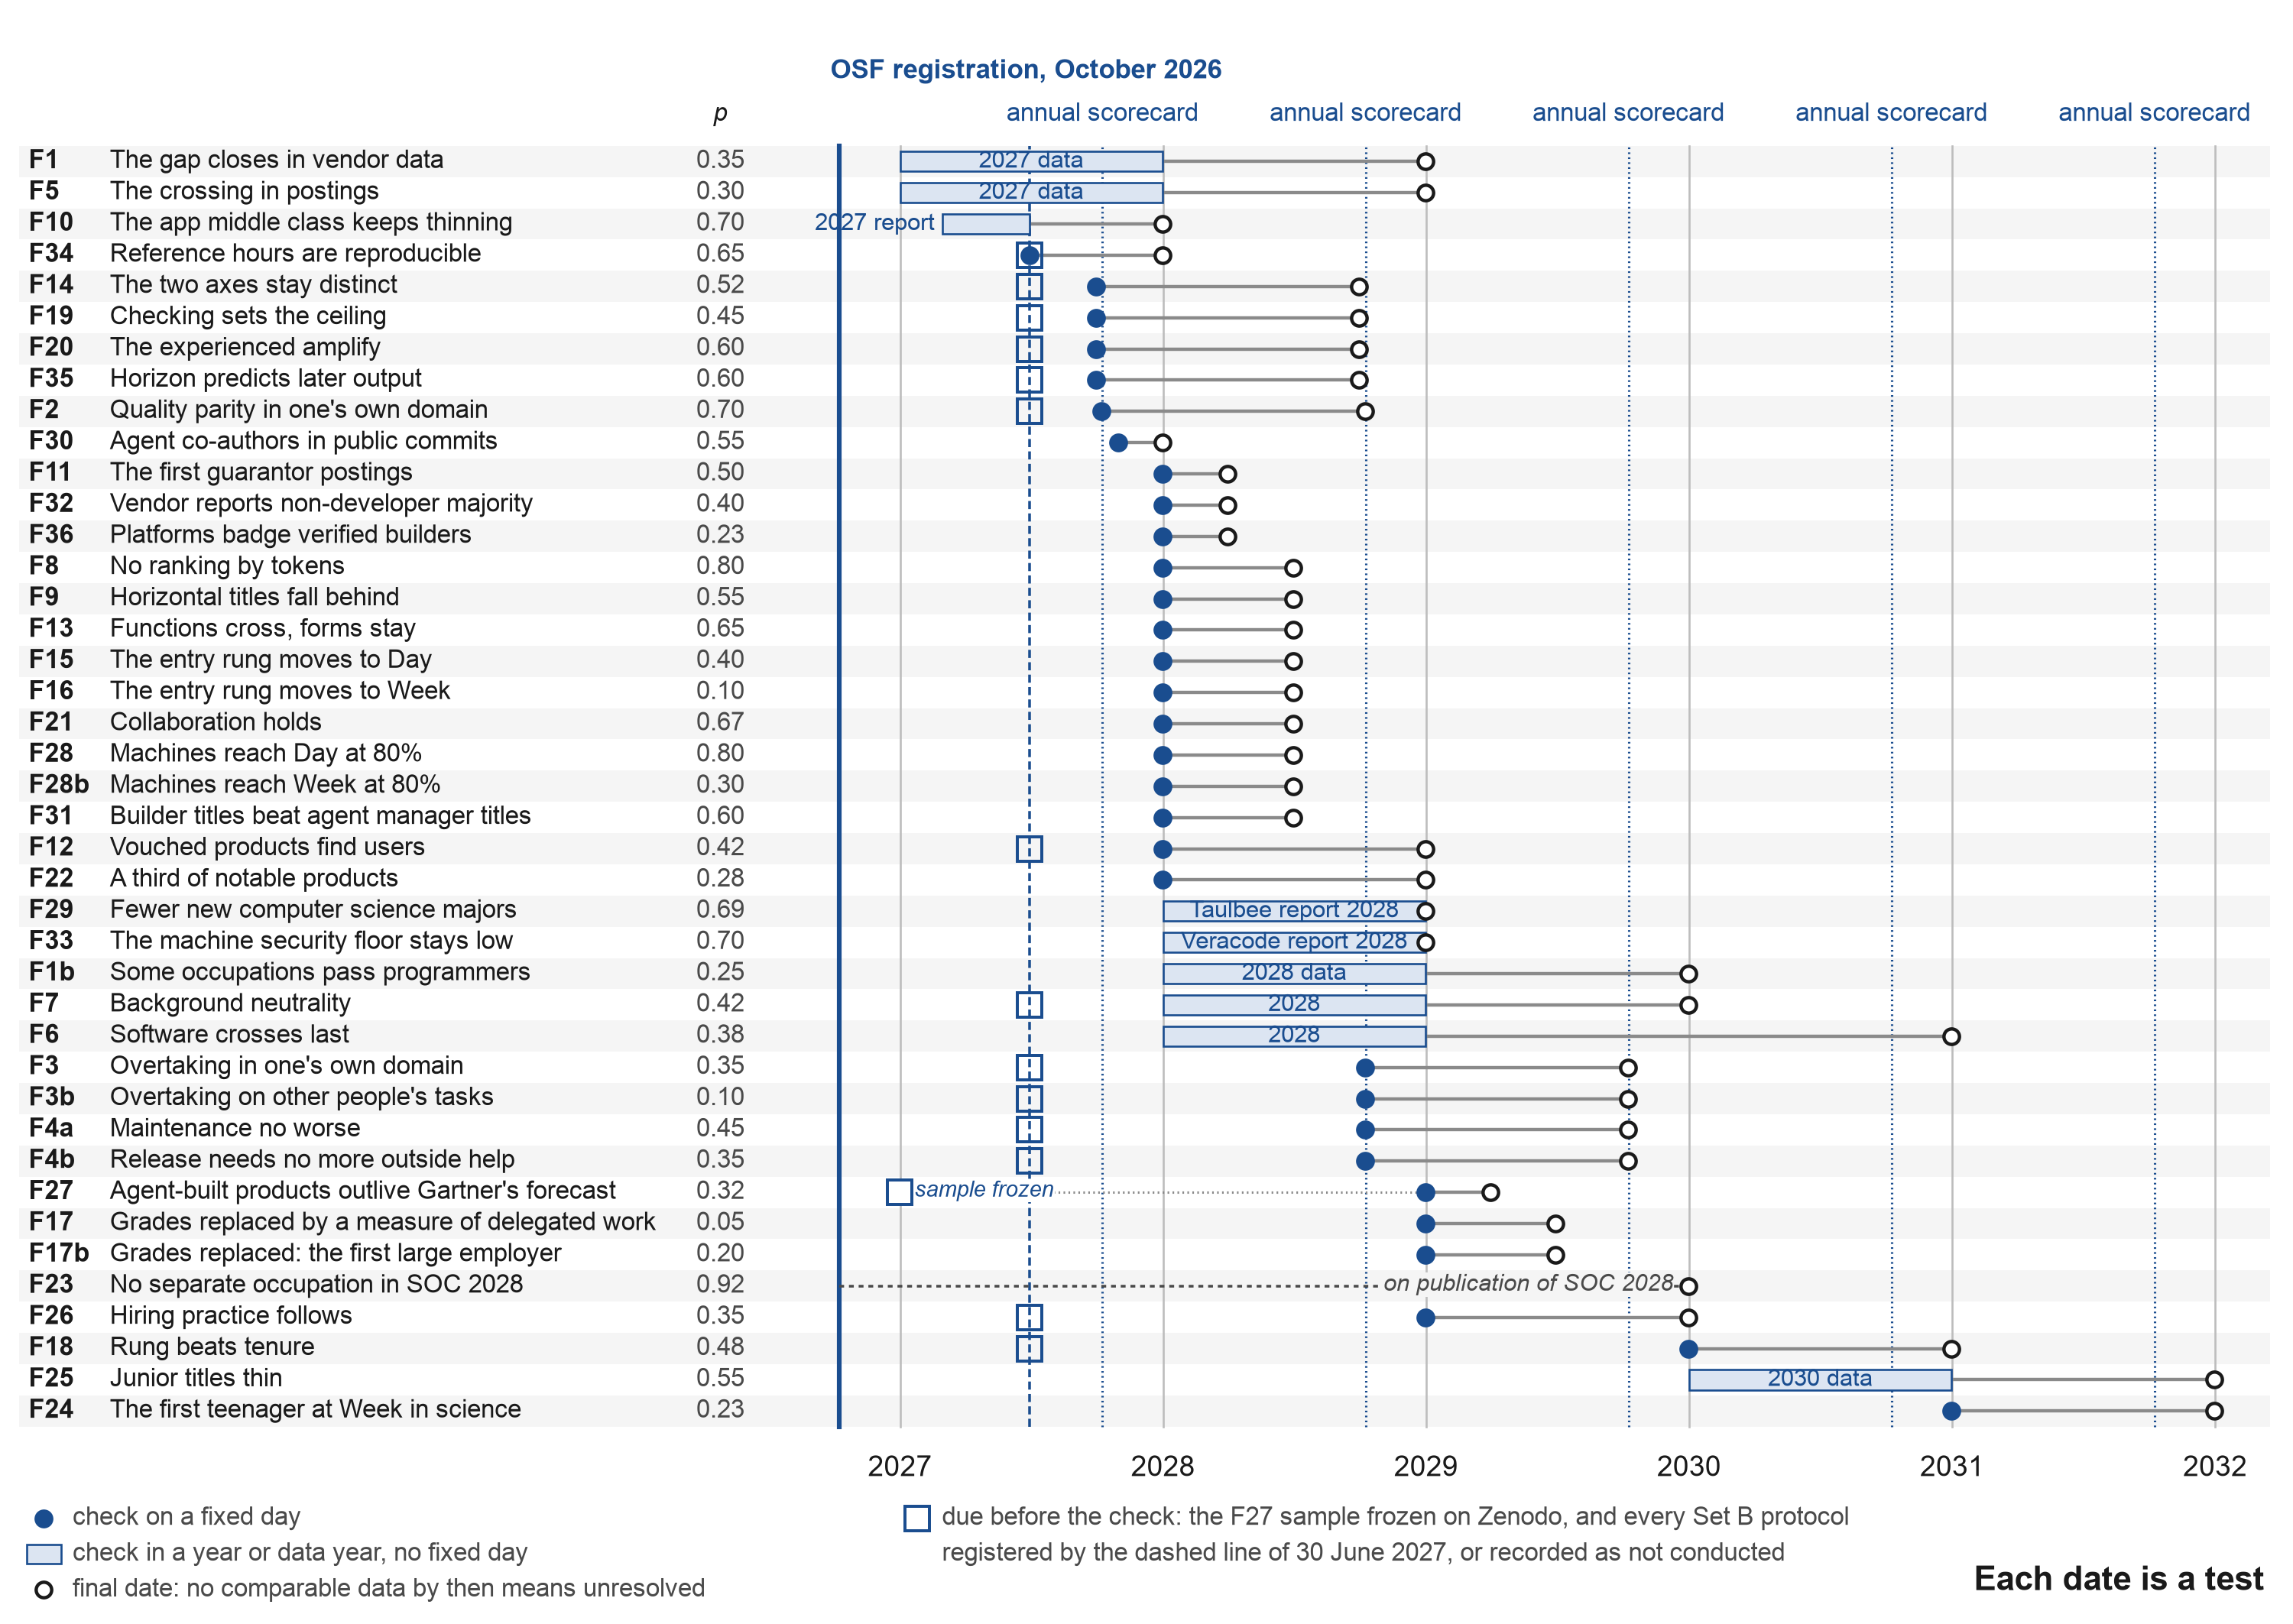
Anmerkung: Eine Zeile pro Vorhersage von Tabelle A6, sortiert nach Prüfdatum, mit ihrer Wahrscheinlichkeit. Ein ausgefüllter Punkt ist eine Prüfung an einem festen Tag. Ein leichter Balken ist eine Prüfung in einem Jahr oder einem Datenjahr ohne festes Datum. Der Ring ist das Enddatum, nach dem eine Vorhersage ohne vergleichbare Daten als ungelöst erfasst wird (Abschnitt 11.4). Gepunktete Linien markieren die jährlichen Bewertungskarten, die von 2027 bis 2031 jedes Oktober auf OSF registriert werden sollen. Ein hohles Quadrat markiert eine Verpflichtung, die vor der Prüfung fällig ist: die F27-Stichprobe, bis zum 31. Dezember 2026 auf Zenodo eingeforen, und am gestrichelten Strich vom 30. Juni 2027 das Protokoll jeder der 14 Set-B-Studien, ohne die die Vorhersage als nicht durchgeführt erfasst wird (Abschnitt 11.2). Die Abbildung wird aus der Vorhersagetabelle selbst durch figures/figure_a1_calendar.py im Begleit-Repository generiert und ändert sich nur damit.
Tabelle A6. Alle 41 datierten Vorhersagen: Mengen, Maße, Schwellenwerte, Wahrscheinlichkeiten, Modellprognosen, Fallbacks und frühere Prognosen.
| # (Menge) | Vorhersage, Maß, Basislinie und Schwellenwert | Daten, Wahrscheinlichkeit, Modellprognosen, Regel für Ungelöst, Fallback und frühere Prognose |
|---|---|---|
| F1 (A) | Die Lücke schließt sich in Herstellerdaten. Verifizierterer Erfolg bei Code-produzierenden Sitzungen, Programmierung gegen andere Berufe: 34% gegen 29%, über sieben Monate unverändert (Anthropic, 2026e). Die Lücke ist die Erfolgsquote der Programmierungsberufe minus die anderer Berufe, mit ihrem Vorzeichen. Wahr geworden, wenn die Lücke in einem vergleichbaren Bericht über 2027-Daten 2 Punkte oder weniger beträgt, negative Werte eingeschlossen; nicht wahr geworden, wenn sie mehr als 2 beträgt. Basislinie: Verifizierterer Erfolg bei Code-produzierenden Sitzungen: Programmierung 34% gegen andere Berufe 29%, über sieben Monate unverändert (Anthropic, 2026e) | Prüfung: Daten 2027. Enddatum: 31. Dezember 2028. p = 0,35; Modelle 0,39 (0,25 bis 0,65). Ungelöst, wenn: Bis zum Enddatum kein Bericht zu Daten 2027 vorliegt oder sich die Sitzungsdefinition geändert hat (wird nie als Erfolg gezählt). Fallback: Beliebiger Herstellerbericht mit verifiziertem Erfolg nach Beruf bei vergleichbaren Sitzungen. Nächste vorherige oder Gegenprognose: Anthropic: Die Lücke „hat sich weder vergrößert noch verringert" |
| F1b (A) | Einige Berufe übertreffen Programmierer. Gleiches Maß wie F1. Die 10 größten Nicht-Programmierungsberufe werden bei der Registrierung als die 10 mit den größten Sitzungsanteilen bei Anthropic (2026e) eingefroren. Ein Beruf übertrifft Programmierung nur, wenn seine Erfolgsquote um 2 Punkte oder mehr höher liegt (eine Marge für Multiplizität über 10 Vergleiche). Erfüllt, wenn mindestens 3 der 10 dies 2028 in den Daten tun. Baseline: Wie F1; Management ist bereits etwas vor Programmierung (Anthropic, 2026e) | Prüfung: Daten 2028. Enddatum: 31. Dezember 2029. p = 0,25; Modelle 0,30 (0,20 bis 0,45). Ungelöst, wenn: Bis zum Enddatum kein Bericht zu Daten 2028 vorliegt oder sich die Sitzungsdefinition geändert hat (wird nie als Erfolg gezählt). Fallback: Wie F1. Nächste vorherige oder Gegenprognose: Management bereits etwas voraus (Anthropic, 2026e) |
| F2 (B) | Qualitätsparität im eigenen Bereich (die Stufe vor dem Schnittpunkt). Gleicher Agent, gleiche Zeit, blinde Annahme und Sicherheitsprüfungen, eine Wartungsänderung durch einen anderen Agent nach einem Monat; eine Studie mit 1.500 Personen pro Gruppe. Erfüllt, wenn die Untergrenze des 95%-Intervalls für (Personen ohne IT-Ausbildung minus Programmierer) über minus 10 Punkte liegt; nicht erfüllt, wenn die Obergrenze unter minus 10 liegt; andernfalls ungelöst. Baseline: Keine öffentliche Baseline; separat vorregistrierte Studie, 1.500 Personen pro Gruppe | Prüfung: 8. Oktober 2027. Enddatum: 8. Oktober 2028. p = 0,70; Modelle 0,67 (0,62 bis 0,70). Ungelöst, wenn: Bis zum Enddatum keine vergleichbaren Daten vorliegen oder ein Intervall, das keine Regel erfüllt (wird nie als Erfolg gezählt). Fallback: Eine unabhängige Studie mit gleichem Design. Nächste vorherige oder Gegenprognose: D. H. Hansson (2026), „100%" (kein Datum, kein Maß); Esnaola et al. (2026) |
| F3 (B) | Überholung im eigenen Bereich (der Schnittpunkt in der Qualität). Wie F2 (1.500 pro Gruppe gibt etwa 0,8 Power, um einen echten Vorteil von 5 Punkten mit einem zweiseitigen Alpha von 0,05 zu erkennen; 400 pro Gruppe würde etwa 0,3 geben). Erfüllt, wenn die Untergrenze des 95%-Intervalls über Null liegt; nicht erfüllt, wenn die Obergrenze unter Null liegt; andernfalls ungelöst. Baseline: Wie F2 | Prüfung: 8. Oktober 2028. Enddatum: 8. Oktober 2029. p = 0,35; Modelle 0,33 (0,25 bis 0,55). Ungelöst, wenn: Bis zum Enddatum keine vergleichbaren Daten vorliegen oder ein Intervall, das keine Regel erfüllt (wird nie als Erfolg gezählt). Fallback: Wie F2. Nächste vorherige oder Gegenprognose: Keine gefunden mit einem Datum |
| F3b (B) | Überholung bei Aufgaben anderer Menschen. Wie F3, aber bei Aufgaben außerhalb des Bereichs der Teilnehmer. Baseline: Wie F2, bei Aufgaben außerhalb des Bereichs der Teilnehmer | Prüfung: 8. Oktober 2028. Enddatum: 8. Oktober 2029. p = 0,10; Modelle 0,13 (0,07 bis 0,35). Ungelöst, wenn: Bis zum Enddatum keine vergleichbaren Daten vorliegen oder ein Intervall, das keine Regel erfüllt (wird nie als Erfolg gezählt). Fallback: Wie F2. Nächste vorherige oder Gegenprognose: Bereichsargument von Abschnitt 6.3 sagt voraus, dass es scheitert |
| F4a (B) | Wartung nicht schlechter. Anteil akzeptierter Produkte, die innerhalb von 12 Monaten aufgegeben werden, nach Ausbildung der Autoren. Erfüllt, wenn die Obergrenze des 95%-Intervalls für die Differenz (Nicht-Programmierer minus Programmierer) unter 10 Punkte liegt. Baseline: Keine öffentliche Baseline; Gartner (Tyagi, 2026, wie von Tray.ai, 2026 zusammengefasst) erwartet, dass 60% der nach Gefühl codierten Anwendungen bis 2028 eingestellt werden, alle Anwendungen gezählt | Prüfung: 8. Oktober 2028. Enddatum: 8. Oktober 2029. p = 0,45; Modelle 0,49 (0,34 bis 0,68). Ungelöst, wenn: Bis zum Enddatum keine vergleichbaren Daten vorliegen oder ein Intervall, das keine Regel erfüllt (wird nie als Erfolg gezählt). Fallback: Produktregister mit Autorenumfragen. Nächste vorherige oder Gegenprognose: Gartner (Tyagi, 2026, wie von Tray.ai, 2026 zusammengefasst): 60% der nach Gefühl codierten Anwendungen bis 2028 eingestellt „da sie den erwartbaren Geschäftswert nicht liefern"; eine breitere Population als F4a, die nur akzeptierte Produkte zählt |
| F4b (B) | Release braucht keine externe Hilfe mehr. Anteil der Produkte, die bei der Freigabe externe technische Hilfe benötigen. Erfüllt, wenn nicht unterlegen bei einer Marge von 10 Punkten; die Lücke wird sich voraussichtlich in der Reihenfolge Prototyp, Freigabe, Wartung schließen. Baseline: Keine öffentliche Baseline | Prüfung: 8. Oktober 2028. Enddatum: 8. Oktober 2029. p = 0,35; Modelle 0,37 (0,22 bis 0,50). Ungelöst, wenn: Bis zum Enddatum keine vergleichbaren Daten vorliegen oder ein Intervall, das keine Regel erfüllt (wird nie als Erfolg gezählt). Fallback: Wie F4a. Nächste vorherige oder Gegenprognose: Gartner (Tyagi, 2026, wie von Tray.ai, 2026 zusammengefasst): 30% der Softwareentwicklungsteams unter „erheblicher Kapazitätsbelastung" durch die Wartung von nach Gefühl codierten Anwendungen, die von Bürgern und Geschäftsbenutzern entwickelt wurden |
| F5 (A) | Die Überkreuzung in Stellenausschreibungen (das sichtbare Zeichen). US-Stellenausschreibungen in einem eingefrorenen Satz von IT-Berufen; agentengesteuerte Fähigkeiten definiert durch die Lightcast Open Skills Taxonomie-Version, die am Registrierungsdatum aktuell ist (Versionsnummer in predictions/resolve/F5.md aufgezeichnet), mit der eingefrorenen Liste agentengesteuerter Fähigkeiten; der Anteil der einen vierjährigen Abschluss in Ausschreibungen mit diesen Fähigkeiten gegen Ausschreibungen ohne sie erfordert, genau abgestimmt nach Beruf (SOC 6-stellig), Seniorität, Bundesstaat und Quartal. Die agentengesteuerte Baseline (2026 Q2 und Q3) wird vor der Registrierung entnommen und archiviert. Erfüllt, wenn die Differenz um 2 Punkte oder mehr negativ ist, wobei das 95%-Intervall Null ausschließt, in zwei aufeinanderfolgenden Quartalen 2027. Baseline: KI-Ausschreibungen sind immer noch eher dazu geneigt, einen Abschluss zu erfordern, aber konvergieren seit 2024 (Lightcast, 2026b); die agentengesteuerte Baseline wird vor der Registrierung entnommen | Prüfung: Daten 2027. Enddatum: 31. Dezember 2028. p = 0,30; Modelle 0,34 (0,25 bis 0,60). Ungelöst, wenn: Bis zum Enddatum keine vergleichbaren Daten vorliegen (wird nie als Erfolg gezählt). Fallback: PwC AI Jobs Barometer, nur wenn es Abschlussanforderungen für Ausschreibungen mit agentengesteuerten Fähigkeiten gegen abgestimmte Ausschreibungen meldet; andernfalls ungelöst. Nächste vorherige oder Gegenprognose: Gartner (2021): Die meisten Technologieprodukte werden 2024 außerhalb der IT gebaut; Bone et al. (2025) zu KI-Fähigkeiten in UK-Ausschreibungen |
| F6 (A) | Software kreuzt zuletzt. Gefrorene Liste von Bereichen: Recht, Buchhaltung und Buchführung, Bildung, Klinische Verwaltung, Marketing, Immobilien, Versicherungen, Personalwesen, Logistik, Softwareentwicklung, IT-Infrastruktur, Sicherheit, Entwicklertools. Reihenfolge der ersten F5-ähnlichen Kreuzungen nach Bereich. Erfüllt, wenn Softwareentwicklung, Infrastruktur, Sicherheit und Entwicklertools alle nach mindestens der Hälfte der anderen Bereiche kreuzen. Ausgangswert: Kein Bereich hat bisher gekreuzt (F5-ähnlicher Vergleich) | Kontrolle: 2028. Enddatum: 31. Dezember 2030. p = 0,38; Modelle 0,37 (0,25 bis 0,55). Ungeklärt, wenn: Weniger als die Hälfte der Nicht-Software-Bereiche auf der gefrorenen Liste bis zum Enddatum gekreuzt haben, oder keine vergleichbare Quelle (wird nie als Erfolg gezählt). Rückgriff: Eine andere Ausschreibungsquelle mit demselben F5-ähnlichen Vergleich nach Bereich; Studien zur Qualität (F2-ähnlich) zählen nicht, und ohne eine solche Quelle bleibt die Vorhersage ungeklärt. Nächste frühere oder Gegenvorhersage: Hwang (2026): Finanzen „der Kanarienvogel in der Kohlenmine" |
| F7 (B) | Hintergrund-Neutralität. Separat registrierte Kohorte mit einer Frage zur IT-Ausbildung; Horizont bewertet auf einem Aufgabensatz, Qualität auf gehaltenen Aufgaben. Odds Ratio des Bestehens unabhängiger Kontrollen, die mit IT-Ausbildung auf gleicher Stufe verbunden sind, unter Kontrolle für Bereichskompetenz und Akzeptanzliteralität. Die Spanne 0,67 bis 1,5 ist ein Odds Ratio von 1,5 in beide Richtungen, etwa ein standardisierter Unterschied von 0,22 (Chinns Umrechnung), konventionell ein kleiner Effekt. Erfüllt, wenn das 90%-Intervall innerhalb von 0,67 bis 1,5 liegt (Äquivalenz), separat an Tag und an Woche und darüber. Ausgangswert: Keine öffentliche Baseline; separat registrierte Kohorte mit einer Frage zur IT-Ausbildung | Kontrolle: 2028. Enddatum: 31. Dezember 2029. p = 0,42; Modelle 0,43 (0,40 bis 0,48). Ungeklärt, wenn: Jede andere Kombination, einschließlich Äquivalenz, die nur auf einer Ebene gezeigt wird, oder keine Daten bis zum Enddatum (wird nie als Erfolg gezählt). Rückgriff: Eine unabhängige Kohorte mit den gleichen Items. Nächste frühere oder Gegenvorhersage: Beobachtung von Anthropic zu Bereichskompetenz; Savva (2026), der Rivale |
| F8 (A) | Keine Rangfolge nach Token. Fortune-500-Arbeitgeber, die Token-Zählungen während 2027 als offizielles Bewertungskriterium verwenden, dokumentiert vom Arbeitgeber oder von zwei unabhängigen Medienquellen (Fragen zur KI-Nutzung zählen nicht). Erfüllt, wenn weniger als zwei solche Arbeitgeber gefunden werden. Ausgangswert: Token-Zählungen wurden 2026 als Bewertungskriterium ausprobiert (Abschnitt 4 des Papiers) | Kontrolle: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,80; Modelle 0,79 (0,60 bis 0,90). Ungeklärt, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Rückgriff: Suche in Wirtschaftsmedienarchiven mit den eingefrorenen Abfragen in predictions/resolve/F8.md. Nächste frühere oder Gegenvorhersage: Kingy AI (2026): „herabgestuft, nicht beendet"; Flowtivity (2026): „unumkehrbar" |
| F9 (A) | Horizontale Titel bleiben zurück. US-Ausschreibungen, gleiche eingefrorene Abfragen (predictions/resolve/F9.md), Q4 2026 und Q4 2027, jede Zählung dividiert durch alle US-Ausschreibungen im gleichen Quartal: Agent Manager, KI-Operator, KI-Orchestrator gegen Titel, die einen Bereich benennen (beispielsweise „Legal KI Lead", „Vertical KI Lead"). Erfüllt, wenn der normalisierte Anteil von Bereichstitelbezeichnungen stärker wächst als der von horizontalen. Ausgangswert: US-Ausschreibungszählungen zu den eingefrorenen Abfragen in Q4 2026 | Kontrolle: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,55; Modelle 0,58 (0,45 bis 0,75). Ungeklärt, wenn: Eine Familie hat weniger als 50 Ausschreibungen in Q4 2026, oder keine Daten bis zum Enddatum (wird nie als Erfolg gezählt). Rückgriff: Indeed- oder LinkedIn-Suchzählungen mit den gleichen Abfragen. Nächste frühere oder Gegenvorhersage: Srinivasan und Wei (2026): „Agent Manager" ein Standard-Titel innerhalb von 12 bis 18 Monaten; IT Brew (2026): „die nächsten 18 Monate" |
| F10 (A) | Die App-Mittelklasse wird weiter ausgedünnt. Anteil neuer Abonnement-Apps, die innerhalb von zwei Jahren 1.000 USD monatliche Einnahmen erreichen, gleiche Maßnahme wie RevenueCat 2026 (17%). Erfüllt, wenn unter 17%. Ausgangswert: 17% der neuen Abonnement-Apps erreichen innerhalb von zwei Jahren 1.000 USD monatliche Einnahmen (RevenueCat, 2026) | Kontrolle: RevenueCat 2027 Bericht. Enddatum: 31. Dezember 2027. p = 0,70; Modelle 0,68 (0,60 bis 0,80). Ungeklärt, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Rückgriff: Sensor Tower oder Appfigures-Umsatzschwellen. Nächste frühere oder Gegenvorhersage: RevenueCats eigener Trend (kein Anspruch erhoben); viele vibe-codierte Apps verdienen durch Anzeigen, die RevenueCat nicht sieht |
| F11 (A) | Die ersten Garantor-Ausschreibungen. Ausschreibungen von Arbeitgebern mit mehr als 1.000 Mitarbeitern in Medizin, Recht, Finanzen oder Bildung, die Unterzeichnung für von KI produzierte Arbeiten und persönliche Verantwortung dafür benennen. Eingefrorene Abfragen in predictions/resolve/F11.md: „sign off" mit „KI-generiert", „verantwortlich für KI-Ausgabe", „KI-Bestätigung", „KI-Garantor"; Ausschreibungen, in denen „Garantor" oder „Berechtigungsnachweis" sich auf Schlüssel oder Zugriffsrechte beziehen, sind ausgeschlossen. Erfüllt, wenn mindestens 10 solche Ausschreibungen von mindestens 5 Arbeitgebern gefunden und archiviert werden. Ausgangswert: Keine solche Ausschreibung zum Zeitpunkt des Schreibens gefunden | Kontrolle: 31. Dezember 2027. Enddatum: 31. März 2028. p = 0,50; Modelle 0,42 (0,25 bis 0,55). Ungeklärt, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Rückgriff: Archivierte Ausschreibungen, die über Google Jobs und LinkedIn gefunden wurden. Nächste frühere oder Gegenvorhersage: Capps (2025), „Rechtsgarant"; Forrester (2025): 60% der Fortune 100 ernennen einen Leiter der KI-Governance |
| F12 (B) | Gebürgte Produkte finden Nutzer. Eigene randomisierte Studie: unter berechtigten Produkten wird ein benannter Garantor zufällig zugewiesen. Anteil, der innerhalb von 90 Tagen zehn nicht verwandte Nutzer erreicht. Erfüllt, wenn der gebürgte Anteil höher ist, wobei das 95%-Intervall Null ausschließt. Ausgangswert: Keine öffentliche Baseline; eigene randomisierte Studie | Kontrolle: 31. Dezember 2027. Enddatum: 31. Dezember 2028. p = 0,42; Modelle 0,43 (0,30 bis 0,60). Ungeklärt, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Rückgriff: Keine. Nächste frühere oder Gegenvorhersage: Hashimotos Vouch (ein Mechanismus, keine Vorhersage) |
| F13 (A) | Funktionen kreuzen, Formen bleiben. Lehrpläne und Beiträge in drei Nicht-IT-Berufen, codiert von zwei Codern mit einem vor dem Codieren veröffentlichten Codebuch (predictions/resolve/F13-codebook.md): Überprüfung, Modellwahl nach Kosten und lange Läufe gelehrt; persönliche Ausgaben und Modellbasis nur bei Top-Tier-Nutzern gefunden. Erfüllt, wenn funktionale Themen Statusthemen um mindestens drei zu eins überwiegen. Ausgangswert: Keine öffentliche Baseline; zwei Coder zu Lehrplänen und Beiträgen in drei Nicht-IT-Berufen | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,65; Modelle 0,69 (0,55 bis 0,82). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Öffentliche Kurskatalogе. Nächste vorherige oder Gegenprognose: Rogers (2003), Schichten der Adoption (kein Vorrang beansprucht) |
| F14 (B) | Die beiden Achsen bleiben unterschiedlich. Korrelation nach Spearman auf Personenebene zwischen logarithmischem Horizont und logarithmischem Gewinn in mindestens 200 Protokollen. Wahr geworden, wenn die Korrelation 0,8 oder darunter liegt und der Gewinn, zum Horizont addiert, das außerstichprobenhafte R-Quadrat für verifizierte Ausgabe sechs Monate später um mindestens 0,02 erhöht. Grundlage: Keine öffentliche Grundlage; mindestens 200 Protokolle | Überprüfung: 30. September 2027. Enddatum: 30. September 2028. p = 0,52; Modelle 0,49 (0,45 bis 0,50). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Keine. Nächste vorherige oder Gegenprognose: Keine gefunden |
| F15 (A) | Die Einstiegsstufe verschiebt sich auf Tag. In einer eingefrorenen Stichprobe von 200 US-amerikanischen Einstiegsstellen und Take-Home-Aufgaben in Software und drei anderen Berufen ist die erste mittlere Aufgabe, bewertet in Referenzstunden durch zwei Bewerter, auf Tag oder höher. Grundlage: Eingefrorene Stichprobe von 200 US-amerikanischen Einstiegsstellen und Take-Home-Aufgaben, bewertet in Referenzstunden durch zwei Bewerter | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,40; Modelle 0,49 (0,30 bis 0,70). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Indeed Hiring Lab Einstiegsebenen-Stichproben. Nächste vorherige oder Gegenprognose: Washington Monthly (2026): „Einstiegspositionen werden immer mehr wie Positionen auf mittlerer Ebene"; METRs angepasster Horizonttrend verdoppelt sich etwa alle 4,2 Monate |
| F16 (A) | Die Einstiegsstufe verschiebt sich auf Woche. Gleiches Maß; Mittelwert bei Woche oder höher. Grundlage: Wie F15 | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,10; Modelle 0,14 (0,06 bis 0,40). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Wie F15. Nächste vorherige oder Gegenprognose: Kwa et al. (2025), Maschinenzeithor izonte (Maschinen, nicht Menschen) |
| F17 (A) | Noten ersetzt durch ein Maß für delegierte Arbeit. Der 50 größten US-amerikanischen Arbeitgeber, die öffentlich Gehaltsstufen durch ein Maß für verifizierte delegierte Arbeit ersetzen. Wahr geworden, wenn mindestens 10. Grundlage: Keine öffentliche Grundlage | Überprüfung: 31. Dezember 2028. Enddatum: 30. Juni 2029. p = 0,05; Modelle 0,05 (0,02 bis 0,20). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Arbeitgeber-Filings und Presse. Nächste vorherige oder Gegenprognose: Gartner (2024): Durch 2026 werden 20% der Organisationen KI nutzen, um Strukturen zu flachen; Microsoft (2025): „Agent Boss" |
| F17b (A) | Noten ersetzt: der erste große Arbeitgeber. Der 50 größten US-amerikanischen Arbeitgeber ersetzt mindestens einer öffentlich Gehaltsstufen durch ein Maß für verifizierte delegierte Arbeit. Grundlage: Keine öffentliche Grundlage | Überprüfung: 31. Dezember 2028. Enddatum: 30. Juni 2029. p = 0,20; Modelle 0,21 (0,05 bis 0,50). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Arbeitgeber-Filings und Presse. Nächste vorherige oder Gegenprognose: Weichere Schwester von F17 |
| F18 (B) | Stufe schlägt Betriebszugehörigkeit. In Arbeitgeber- oder Kohortendaten erklärt verifizierte Stufe mehr Varianz im Gehalt als Jahre der Berufserfahrung (bewertete Leistung wird nur dort verwendet, wo Gehalt nicht verfügbar ist, vor der Analyse festgelegt). Grundlage: Keine öffentliche Grundlage | Überprüfung: 31. Dezember 2029. Enddatum: 31. Dezember 2030. p = 0,48; Modelle 0,52 (0,40 bis 0,60). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Veröffentlichte HR-Analytics. Nächste vorherige oder Gegenprognose: Jaques (1956), Gehalt nach Verantwortungsspanne |
| F19 (B) | Überprüfung setzt die Obergrenze (außerstichprobenhaft). Mindestens 200 Protokolle. Aufmerksamkeitsanteil bei Überprüfung und Horizont, beide gemessen in Monaten 1 bis 3; verifizierte Ausgabe (akzeptierte Stücke in Referenzstunden, nicht die Gewinnformel) in Monaten 4 bis 6. Wahr geworden, wenn bei zurückgehaltenen Personen die Überprüfungsquote eine höhere Partialkorrelation mit später verifizierter Ausgabe hat als der Horizont. Grundlage: Keine öffentliche Grundlage | Überprüfung: 30. September 2027. Enddatum: 30. September 2028. p = 0,45; Modelle 0,44 (0,30 bis 0,65). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Keine. Nächste vorherige oder Gegenprognose: Huang et al. (2026), Verifizierungsverstärkung. v1 verwendete Gewinn, das Horizont nach Konstruktion enthält; v2 sagt ein späteres, separat gemessenes Ergebnis voraus |
| F20 (B) | Die erfahrenen verstärken. Direktivanteil: Anteil der Züge einer Person, die Anweisungen erteilen, statt zu überprüfen oder zu bearbeiten, aus dem Protokoll. Verifizierter Gewinn: akzeptierte Referenzstunden pro Stunde der Aufmerksamkeit der Person. Unter Personen, deren Direktivanteil über sechs Monate fiel, ist der verifizierte Gewinn in Monat 6 mindestens 95% seines Monat-0-Werts für die Mehrheit. Grundlage: Keine öffentliche Grundlage | Überprüfung: 30. September 2027. Enddatum: 30. September 2028. p = 0,60; Modelle 0,62 (0,55 bis 0,70). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Keine. Nächste vorherige oder Gegenprognose: Anthropic (2026d), Lernkurven |
| F21 (A) | Zusammenarbeit hält. Anteil der kollaborativen Nutzung (Augmentierung) in der Claude.ai-Gesprächsstichprobe des Anthropic Economic Index, nicht der API-Stichprobe, bleibt 2027 in jedem veröffentlichten Bericht über 40%. Grundlage: Kollaborative Nutzung 52% gegen Automatisierung 45% im November 2025 (Anthropic, 2026a) | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,67; Modelle 0,68 (0,60 bis 0,75). Ungelöst, wenn: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Fallback: Vergleichbare Anteile in Berichten anderer Anbieter. Nächste vorherige oder Gegenprognose: Anthropic (2026a): 52% gegen 45% im November 2025 |
| F22 (A) | Ein Drittel der bemerkenswerten Produkte. Die 100 Produkte mit den meisten Upvotes über die zwölf monatlichen Product-Hunt-Leaderboards von 2027, Liste eingefroren am 1. Januar 2028. Die aufgelisteten Macher werden kodiert; ein Produkt gilt als ohne Programmiererausbildung erstellt, wenn kein aufgelisteter Macher Programmiererausbildung oder einen früheren Programmiererberuf angibt (selbstgelehrte Menschen mit Programmiererberufen gelten als Programmierer). Zwei Kodierer, blind füreinander. Wahr geworden, wenn mindestens 30 der 100 qualifizieren. Grundlage: Manifold: vibencodierte Software mit 100 Millionen monatlichen Nutzern bis Ende 2026, etwa 28% | Überprüfung: 31. Dezember 2027. Enddatum: 31. Dezember 2028. p = 0,28; Modelle 0,29 (0,14 bis 0,50). Ungelöst wenn: Weniger als 50 der 100 Produkte eine codierbare Aussage haben oder keine Daten bis zum Enddatum vorliegen (nie als Erfolg gezählt). Fallback: Ein zweites gefrorenes Ranking (Hacker News Show HN Top 100 von 2027). Nächste vorherige oder Gegenprognose: Gartner (2021); Manifold: per Gefühl codierte Software mit 100 Millionen monatlichen Nutzern bis Ende 2026, etwa 28 % |
| F23 (A) | Keine separate Berufskategorie in SOC 2028. Die US-Standardberufsklassifizierung für 2028 enthält keine separate Berufskategorie für durch Agenten vermittelte Tätigkeiten. Baseline: SOC 2018 hat keine solche Berufskategorie | Überprüfung: Veröffentlichung von SOC 2028. Enddatum: 31. Dezember 2029. p = 0,92; Modelle 0,93 (0,80 bis 0,98). Ungelöst wenn: Keine vergleichbaren Daten bis zum Enddatum vorliegen (nie als Erfolg gezählt). Fallback: BLS-Überarbeitungsmitteilungen (überprüft am 9. Oktober 2026: noch keine vorgeschlagene oder endgültige Struktur; endgültige Struktur wird 2027 erwartet). Nächste vorherige oder Gegenprognose: Keine gefunden |
| F24 (A) | Der erste Teenager bei Week in Science. Ein wissenschaftliches Produkt ist Software, ein Datensatz oder ein Artikel, der in veröffentlichter Forschung von mindestens zehn nicht verwandten Personen verwendet oder in mindestens einem von Fachleuten begutachteten Artikel zitiert wird. Ein öffentlich dokumentierter Fall einer Person unter 18 Jahren ohne formale Ausbildung, deren wissenschaftliches Produkt solche Nutzer hat und Week unter unabhängiger Überprüfung erhält. Baseline: Kein solcher dokumentierter Fall zum Zeitpunkt der Abfassung | Überprüfung: 31. Dezember 2030. Enddatum: 31. Dezember 2031. p = 0,23; Modelle 0,21 (0,02 bis 0,45). Ungelöst wenn: Nur wenn die Suchquellen nicht verfügbar sind; das Fehlen eines dokumentierten Falls bis zum Enddatum ist nicht. Fallback: Keine. Nächste vorherige oder Gegenprognose: Chinas Ziel der KI-Bildung in allen Schulen bis 2030 (CSET, 2025) |
| F25 (A) | Junior-Titel dünn. Anteil der US-Softwareausschreibungen mit „junior" oder „entry-level" im Titel 2030 gegenüber 2025 bei gleichen Abfragen. Eingetreten wenn um mindestens ein Drittel gesunken. Baseline: Anteil der US-Softwareausschreibungen mit „junior" oder „entry-level" im Titel 2025, gleiche Abfragen | Überprüfung: Daten 2030. Enddatum: 31. Dezember 2031. p = 0,55; Modelle 0,54 (0,45 bis 0,60). Ungelöst wenn: Keine vergleichbaren Daten bis zum Enddatum vorliegen (nie als Erfolg gezählt). Fallback: Indeed Hiring Lab. Nächste vorherige oder Gegenprognose: Manifold: ein Drittel weniger Junior-Developer-Stellen bis 2030, etwa 74 %; US-Entwickler um mehr als 15 % von 2023 bis 2028 zurückgegangen, etwa 42 %; Markt 0,74 (https://manifold.markets/OliverKuperman/will-the-number-of-junior-developer, 9. Oktober 2026 (Junior-SWE-Positionen um mindestens 33 % bis 1. Januar 2030 zurückgegangen; ein verwandtes, aber nicht identisches Maß)) |
| F26 (B) | Einstellungspraxis folgt. Eigene Audit-Studie: abgestimmte Portfolios mit verifizierten Arbeiten, die sich nur in der IT-Ausbildung unterscheiden, wurden an echte Ausschreibungen in zwei Nicht-IT-Bereichen verschickt. Eingetreten wenn sich Callback-Quoten um weniger als 3 Punkte unterscheiden, mit dem 95%-Intervall innerhalb von plus oder minus 5. Baseline: Keine öffentliche Baseline; eigene Audit-Studie | Überprüfung: 31. Dezember 2028. Enddatum: 31. Dezember 2029. p = 0,35; Modelle 0,32 (0,25 bis 0,35). Ungelöst wenn: Keine vergleichbaren Daten bis zum Enddatum vorliegen oder ein Intervall, das keiner Regel entspricht (nie als Erfolg gezählt). Fallback: Keine. Nächste vorherige oder Gegenprognose: Burning Glass Institute und Harvard Business School (2024): weniger als ein Einstellung in 700 änderte sich |
| F27 (A) | Mit Agenten erstellte Produkte übertreffen Gartners Prognose. Eine Stichprobe von mindestens 300 öffentlichen Produkten, die hauptsächlich mit Coding-Agenten erstellt wurden, gestartet Oktober bis Dezember 2026, auf Zenodo bis 31. Dezember 2026 eingeforen; Verfügbarkeit wird durch das Begleitskript überprüft. Eingetreten wenn weniger als 50 % bis 31. Dezember 2028 stillgelegt sind (nicht erreichbar oder nicht 12 Monate lang aktualisiert). Baseline: Gartner (Tyagi, 2026): 60 % der per Gefühl codierten Anwendungen bis 2028 stillgelegt | Überprüfung: 31. Dezember 2028. Enddatum: 31. März 2029. p = 0,32; Modelle 0,35 (0,20 bis 0,55). Ungelöst wenn: Die Stichprobe wurde nicht bis 31. Dezember 2026 eingeforen (nie als Erfolg gezählt). Fallback: Wayback-Machine-Snapshots jedes Produkts. Nächste vorherige oder Gegenprognose: Gartner (Tyagi, 2026): 60 % stillgelegt |
| F28 (A) | Maschinen erreichen Tag bei 80 %. METRs 80%-Zeithorizont für das beste öffentlich verfügbare Modell erreicht 8 Stunden (Tag) bis 31. Dezember 2027. Baseline: Etwa 3,1 Stunden bei 80 % im April 2026 (METR, 2026c; Dashboard nicht nach 8. September 2026 aktualisiert) | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,80; Modelle 0,66 (0,55 bis 0,80). Ungelöst wenn: Weder METR noch der Fallback berichten einen 80%-Horizont bis zum Enddatum (nie als Erfolg gezählt). Fallback: Eine unabhängige Replikation von METRs Methode (beispielsweise Epoch KI). Nächste vorherige oder Gegenprognose: METRs angepasster Horizonttrend verdoppelt sich etwa alle 4,2 Monate |
| F28b (A) | Maschinen erreichen Week bei 80 %. Wie F28, Schwelle 40 Stunden (Week). Baseline: Wie F28 | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,30; Modelle 0,20 (0,10 bis 0,55). Ungelöst wenn: Wie F28. Fallback: Wie F28. Nächste vorherige oder Gegenprognose: Wie F28 |
| F29 (A) | Weniger neue Informatik-Hauptfächer. Neue Undergraduate-Hauptfächer in Informatik, die von der 2028 veröffentlichten CRA-Taulbee-Umfrage gemeldet werden (Studienjahr 2027 bis 2028) gegenüber der 2026 veröffentlichten Umfrage. Baseline: CRA-Taulbee-Umfrage veröffentlicht 2026 | Überprüfung: Taulbee-Bericht 2028. Enddatum: 31. Dezember 2028. p = 0,69; Modelle 0,67 (0,50 bis 0,75). Ungelöst wenn: Keine vergleichbaren Daten bis zum Enddatum vorliegen (nie als Erfolg gezählt). Fallback: NSC Research Center-Einschreibungen nach Hauptfach. Nächste vorherige oder Gegenprognose: CRA-Berichte über fallende Informatik-Einschreibungen 2025 und 2026 |
| F30 (A) | Agent-Mitautoren in öffentlichen Commits. Anteil der öffentlichen Push-Events in GH Archive, deren Commit-Nachrichten einen Agent-Mitautor-Trailer enthalten (gefrorene reguläre Ausdrücke in predictions/resolve/F30.md), September 2027 gegenüber September 2026. Baseline: GH Archive, September 2026, gemessen und archiviert vor Registrierung | Überprüfung: 31. Oktober 2027. Enddatum: 31. Dezember 2027. p = 0,55; Modelle 0,59 (0,40 bis 0,75). Ungelöst wenn: Keine vergleichbaren Daten bis zum Enddatum vorliegen (nie als Erfolg gezählt). Fallback: GitHub Innovation Graph. Nächste vorherige oder Gegenprognose: Keine gefunden |
| F31 (A) | Builder-Titel schlagen Agent-Manager-Titel. US-Ausschreibungen, gefrorene Indeed-Abfragen (predictions/resolve/F31.md), Q4 2027: Titel der Builder-Familie gegen die Agent-Manager-Familie. Baseline: Zählungen in Q4 2026 bei gleichen Abfragen | Überprüfung: 31. Dezember 2027. Enddatum: 30. Juni 2028. p = 0,60; Modelle 0,63 (0,50 bis 0,74). Ungelöst falls: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Ausweichvariante: LinkedIn-Suchanfragen mit denselben Abfragen. Nächste frühere oder Gegenvorhersage: Srinivasan und Wei (2026): „agent manager" ein Standardtitel innerhalb von 12 bis 18 Monaten |
| F32 (A) | Ein Anbieter sagt, dass die meisten Nutzer seines Coding-Agenten keine Entwickler sind. Ein Anbieter eines Coding-Agenten von Anthropic, OpenAI, Google oder GitHub berichtet öffentlich, dass Menschen, die keine Softwareentwickler sind, die Mehrheit der wöchentlichen Nutzer dieses Agenten ausmachen. Basiszustand: Kein solcher Bericht zum Zeitpunkt der Niederschrift | Überprüfung: 31. Dezember 2027. Enddatum: 31. März 2028. p = 0,40; Modelle 0,31 (0,13 bis 0,70). Ungelöst falls: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Ausweichvariante: Wirtschaftliche oder Nutzungsberichte des Anbieters. Nächste frühere oder Gegenvorhersage: App-Builder-Anbieter (Lovable, Replit) beschreiben bereits überwiegend Nutzer ohne Entwicklerhintergrund; dies verlangt dies von allgemeinen Coding-Agenten |
| F33 (A) | Die KI-Sicherheitsuntergrenze bleibt niedrig. Anteil der KI-generierten Code-Beispiele, die Sicherheitstests in Veracodes GenAI-Code-Sicherheitsbericht bestehen. Basiszustand: 56 % Bestehenquote, stagnierend (Veracode, 2026) | Überprüfung: Veracode-Bericht 2028. Enddatum: 31. Dezember 2028. p = 0,70; Modelle 0,67 (0,57 bis 0,80). Ungelöst falls: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Ausweichvariante: Ein vergleichbarer unabhängiger Benchmark zur Sicherheit in generiertem Code. Nächste frühere oder Gegenvorhersage: Veracode: keine Verbesserung der Sicherheit bei neueren Modellen |
| F34 (B) | Referenzstunden sind reproduzierbar. Zwei unabhängige Panels von je drei Bewertern schätzen Referenzstunden für dieselben 50 Aufgaben; Intraklassen-Korrelation (zweiseitig, absolute Übereinstimmung) der log-Stunden. Basiszustand: Schreibtisch-Pilot der Schwellenwerte (Anlage E) | Überprüfung: 30. Juni 2027. Enddatum: 31. Dezember 2027. p = 0,65; Modelle 0,65 (0,40 bis 0,75). Ungelöst falls: Keine vergleichbaren Daten bis zum Enddatum oder ein Intervall, das keine der beiden Regeln erfüllt (wird nie als Erfolg gezählt). Ausweichvariante: Keine. Nächste frühere oder Gegenvorhersage: METRs menschliche Baselines (Maschinen, nicht Menschen) |
| F35 (B) | Horizont sagt späteren Output voraus. Mindestens 200 Logs: Der Horizont zum Zeitpunkt 0 addiert zur Amtszeit und IT-Ausbildung erhöht das außerstichprobenhafte R-Quadrat für verifizierten Output in den Monaten 4 bis 6. Basiszustand: Keine öffentliche Basislinie | Überprüfung: 30. September 2027. Enddatum: 30. September 2028. p = 0,60; Modelle 0,58 (0,45 bis 0,70). Ungelöst falls: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Ausweichvariante: Keine. Nächste frühere oder Gegenvorhersage: Burning Glass Institute und Harvard Business School (2024) |
| F36 (A) | Plattformen bescheinigen verifizierte Entwickler. Mindestens zwei von Upwork, Fiverr, GitHub, Product Hunt, Toptal und Contra führen ein öffentliches Abzeichen oder Profilfeld ein, das unabhängig verifizierten KI-erstellten Arbeiten bescheinigt (kein Fähigkeitsquiz). Basiszustand: Kein solches Abzeichen zum Zeitpunkt der Niederschrift | Überprüfung: 31. Dezember 2027. Enddatum: 31. März 2028. p = 0,23; Modelle 0,24 (0,07 bis 0,70). Ungelöst falls: Keine vergleichbaren Daten bis zum Enddatum (wird nie als Erfolg gezählt). Ausweichvariante: Plattform-Hilfeseiten und archivierte Ankündigungen. Nächste frühere oder Gegenvorhersage: Keine gefunden |
Hinweis: Set A wird aus öffentlichen Daten gelöst; Set B aus separat vorregistrierten Studien (Protokoll bis 30. Juni 2027, andernfalls nicht durchgeführt, was die Scorecard als Fehler des Testprogramms zählt). p ist bedingt durch die Auflösung. Modelle: geometrisches Mittel der Quoten unabhängiger Modellprognosen, die meine Zahlen nicht sahen, mit ihrer Spannweite; einzelne Prognosen in predictions/m2-probabilities.csv. Eintreffen- und Nicht-Eintreffen-Regeln für jede Zeile finden sich in predictions/predictions.csv. In den Zeilen F4a und F4b wird die Gartner-Vorhersage wie in der Referenzliste zitiert, über die Zusammenfassung durch Tray.ai (2026), mit ihren eigenen Worten zitiert; die registrierte Datei gibt dieselbe Vorhersage und dieselben Zahlen kürzer an und zitiert Gartner (Tyagi, 2026).
Anhang E. Schreibtischtest der Schwellenwerte
Dieser Anhang berichtet über den Schreibtischtest der Regeln von Abschnitt 5.2, der am 9. Oktober 2026 durch Simulation und mit Modellbewertern durchgeführt wurde, und legt das Kalibrierungsprotokoll fest, das die nächste Version definiert. Jede Zahl wird von zwei Skripten im Begleit-Repository (pilot/) erzeugt, die den Scorer von Anhang C unverändert aufrufen und nur seine Konstanten austauschen.
E1. Wie oft eine Stufe verdient wird
Für eine Person, deren Teile unabhängig mit einer wahren Wahrscheinlichkeit p bestehen, gibt Tabelle E1 die Chance, jede Stufe mit genau der minimalen Anzahl von Teilen im Fenster zu verdienen. Die Werte sind exakte Binomialwahrscheinlichkeiten; ein Monte-Carlo-Durchlauf durch horizon.py, mit den Teilen verteilt über das Fenster, dem angepflanzten Fehler und dem neuesten Teil vorhanden, stimmt auf 0,01 überein.
Tabelle E1. Wahrscheinlichkeit, eine Stufe zu verdienen, nach wahrer Bestandsquote.
| Regel | p = 0.95 | p = 0.9 | p = 0.8 | p = 0.7 | p = 0.6 |
|---|---|---|---|---|---|
| Stunde und Tag, 8 von 10 in 91 Tagen | 0.99 | 0.93 | 0.68 | 0.38 | 0.17 |
| Woche, 5 von 6 in 182 Tagen | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Monat, erste Version, 4 von 4 in 365 Tagen | 0.81 | 0.66 | 0.41 | 0.24 | 0.13 |
| Monat, aktuell, 5 von 6 in 365 Tagen | 0.97 | 0.89 | 0.66 | 0.42 | 0.23 |
| Quartal, 3 von 3 in 365 Tagen | 0.86 | 0.73 | 0.51 | 0.34 | 0.22 |
Anmerkung: Die Regel ist eine Qualifizierungsregel. Diese Wahrscheinlichkeiten beschreiben die Regel, nicht eine Person.
Es folgen drei Erkenntnisse. Erstens war die erste Version nicht geordnet: Monat bei vier von vier war schwerer zu verdienen als Quartal bei jedem p. Eine Anzahl von vier von fünf hätte den Fehler umgekehrt und Monat leichter gemacht als Tag und Woche bei p = 0.8 (0.74), daher verlangt Monat jetzt fünf von sechs in einem Jahr, etwa 960 Referenzstunden statt 640. Damit sind Tag, Woche, Monat und Quartal bei jedem p von 0.77 und höher vom leichtesten zum schwierigsten geordnet, der Bereich, in dem Qualifizierung wichtig ist. Unterhalb von 0.76 ist Woche bei p = 0.7 leicht einfacher als Tag (0.42 gegen 0.38). Beide werden dann meist abgelehnt, und dies wird berichtet und unverändert gelassen. Keine Anzahl von drei oder mehr Teilen kann gegen drei von drei bei jedem p geordnet werden, weil sich die Kurven kreuzen. Zweitens ist ein Urteil laut: bei p = 0.8 wiederholt sich dasselbe Urteil im nächsten Fenster bei 56% der Fenster bei Tag, 55% bei Woche und Monat und 50% bei Quartal. Der Datensatz druckt daher die Anzahl neben der Stufe („Tag (8/10)"), und ein Bericht kann eine Stufe als stabil kennzeichnen, wenn sie auch im vorherigen Fenster gültig war. Bei p = 0.8 kommt eine Tag, die in zwei aufeinanderfolgenden Fenstern gültig war, in 46% der Fälle vor, daher ist Stabilität ein Etikett, keine Anforderung. Drittens kann eine zuverlässige Person immer noch fehlen: bei p = 0.95 wird Quartal in 14% der Jahre verpasst, was der Preis einer Stufe ist, die auf drei Teilen beruht.
Abbildung A2, Panel A, zeigt diese Wahrscheinlichkeiten gegen p für Regeln v1.1.
E2. Empfindlichkeit gegenüber der Anzahl und dem Anteil
Das Papier versprach zu berichten, wie viele Personen die Stufe wechseln, wenn die Anzahl von zehn auf acht oder zwölf und der Anteil von 0.8 auf 0.7 oder 0.9 wechselt. Die Antwort wird für 10.000 simulierte Protokolle bei Tag gegeben, jeweils mit zwischen 6 und 16 Teilen der Tagsgröße im Fenster und einer wahren Bestandsquote, die gleichmäßig zwischen 0.5 und 1.0 gezogen wird. Die aktuelle Regel (zehn, 0.8) gibt Tag an 30% von ihnen, und Tabelle E2 gibt den Anteil an, deren Urteil sich unter den anderen Regeln ändert.
Tabelle E2. Anteil der simulierten Protokolle, deren Tag-Urteil sich gegen zehn Teile und einen Anteil von 0.8 ändert.
| Minimale Anzahl | Anteil 0.7 | Anteil 0.8 | Anteil 0.9 |
|---|---|---|---|
| 8 | 22% | 8% | 15% |
| 10 | 10% | 0% | 11% |
| 12 | 16% | 9% | 17% |
Anmerkung: Die Grundgesamtheit der Protokolle ist eine Annahme der Simulation. Die Feldstudie von E5 wiederholt diese Analyse an echten Protokollen.
Das Verschieben einer Konstanten um einen Schritt ändert etwa ein Urteil von zehn. Das Verschieben beider ändert bis zu eins von fünf. Der Anteil ist wichtiger als die Anzahl.
E3. Bewerterlärm am Rande einer Stufe
Wenn zwei Bewerter unvoreingenommen sind und 80% ihrer Paare innerhalb eines Verhältnisses von 1,5 liegen, über dem Kriterium von 70% in Abschnitt 5.8, und die Referenz das geometrische Mittel ihrer zwei Schätzungen ist, dann wird ein Teil, dessen wahre Größe 7 Referenzstunden beträgt, 20% der Zeit bei Tagsgröße bewertet, und ein Teil von 9 Stunden fällt 23% der Zeit unter Tagsgröße. Dies ist der Grund, warum der Datensatz die mittlere akzeptierte Größe neben der Stufe meldet (Tabelle 3): Ein Horizont, der auf Teilen gerade über einem Schwellenwert aufgebaut ist, zeigt sich.
E4. Modellbewerter von Referenzstunden
Vier Sprachmodelle aus vier Familien (Anthropic, OpenAI, Google und Moonshot), jeweils allein arbeitend und blind gegenüber den anderen und gegenüber veröffentlichten Zeiten, schätzten die Referenzstunden von 44 Aufgaben am 9. Oktober 2026. Dreißig waren Aufgaben einer neuen Bank in drei risikoarmen Bereichen (kleine Geschäftsbuchhaltung, kleine interne Webtools, rechtliche und Marketingdokumente), jeweils mit einer schriftlichen Fertigstellungserklärung und einer verborgenen Prüfung. Vierzehn waren öffentliche Aufgaben aus METRs Zeithorizont-Daten (METR, 2026d) mit gemessenen menschlichen Grundlinienzeiten von 12 Minuten bis 14,6 Stunden, die den Bewertern nur durch ihre öffentliche Kennung gegeben wurden. Tabelle E3 gibt die Ergebnisse.
Tabelle E3. Übereinstimmung und Genauigkeit von vier blinden Modellbewertern.
| Maßstab | Bank von 30 Aufgaben (Fertigstellungserklärung) | 14 Aufgaben mit gemessenen Zeiten (nur Kennung) |
|---|---|---|
| Paare von Schätzungen innerhalb eines Verhältnisses von 1,5 (6 Bewerterpaare) | 62% (von 27% bis 97% nach Paar) | 35% |
| Intraklassen-Korrelation ICC(2,1), log Stunden | 0.89 | 0.60 |
| Alle vier Bewerter ordnen die Aufgabe der gleichen Stufengröße zu | 60% | 36% |
| Mittelwert der vier innerhalb von 1,5 der gemessenen Zeit | nicht gemessen | 21% (3 von 14) |
| Mittelwert der vier innerhalb von 2 der gemessenen Zeit | nicht gemessen | 43% (6 von 14) |
Anmerkung: Modellbewerter vertreten die zwei menschlichen Bewerter aus Abschnitt 5.1 und sind kein Beweis für diese.
Bei einer vollständigen Fertigstellungsaussage waren sich die Modelle einig, welche Aufgaben größer waren, aber nicht über das Ausmaß: Das geometrische Mittel der Schätzungen eines Bewerters über die Bank betrug 5,1 Stunden und die eines anderen 10,4. Ein fester Versatz dieser Art ist der billigste Fehler, den man beheben kann, weshalb Bewerter in der Feldstudie zunächst an Aufgaben mit gemessenen Zeiten kalibrieren. Bei nur einer Kennung waren Schätzungen von geringem Nutzen, was eine eingefrorene Bank mit hand-gemessenen Zeiten (Abschnitt 5.1) gegenüber Schätzungen aus einem Titel unterstützt. Nach der Regel in Tabelle 3, bei der eine Abweichung über 1,5 ein Stück an einen dritten Bewerter sendet, würden zwei solche Bewerter etwa vier von zehn Stücken an einen dritten senden.
Abbildung A2. Die Sprossen-Regel am Schreibtisch: die Chance, eine Sprosse zu verdienen, und wie sehr sich Modellbewerter bei den Stunden einig sind.
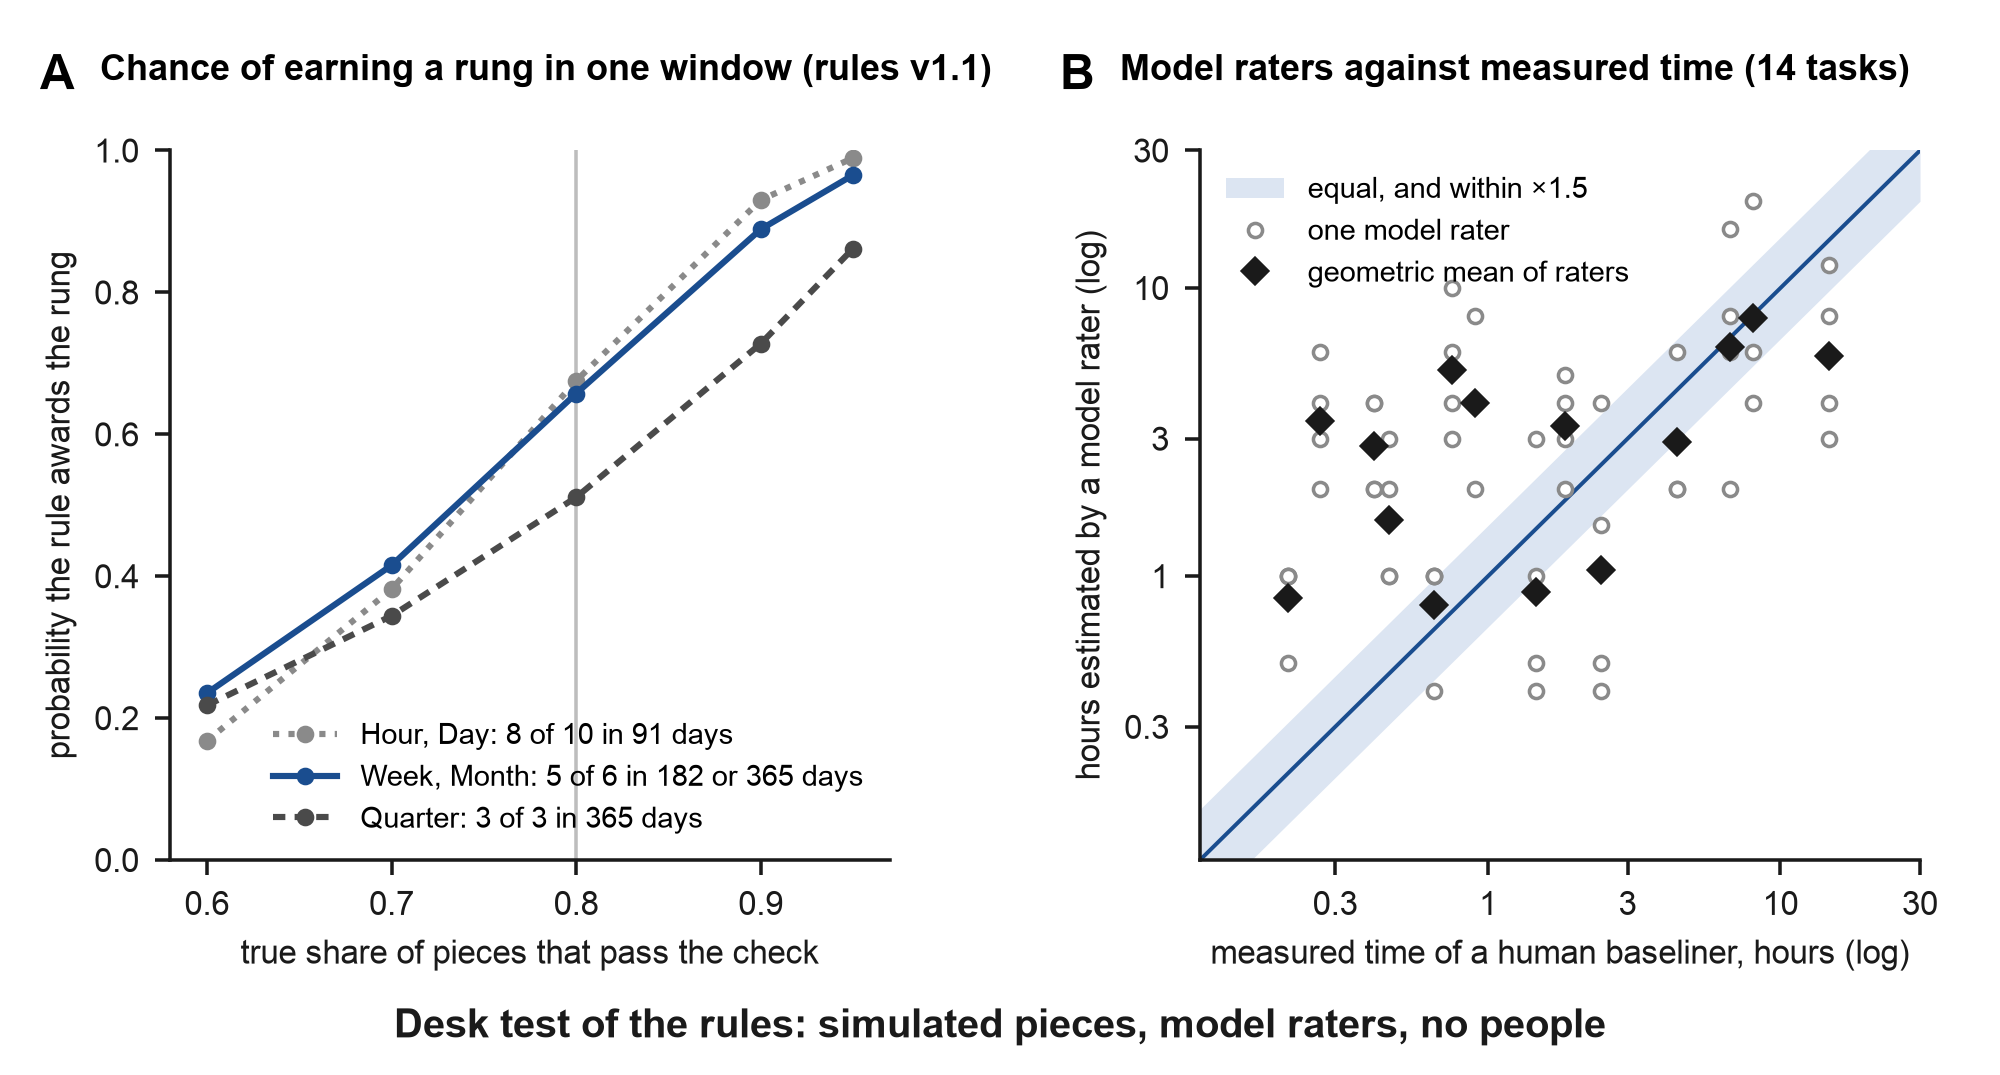
Anmerkung: Ein Schreibtischtest mit simulierten Stücken und Modellbewerten. Panel A gibt für jede Sprosse unter Regeln v1.1 die Wahrscheinlichkeit an, dass die Regel die Sprosse in einem Fenster vergibt, wenn jedes Stück seine Prüfung unabhängig mit dem Anteil auf der horizontalen Achse besteht. Sprossen mit der gleichen Anzahl und der gleichen Anzahl von Bestandenen folgen der gleichen Kurve. Panel B setzt die Referenzstunden, die vier Modellbewerter, jeweils aus einer anderen Familie, für 14 Aufgaben gegenüber der für einen menschlichen Baseline-Bewerter gemessenen Zeit geschätzt haben (METR-Aufgabendaten). Das Band markiert Übereinstimmung innerhalb eines Faktors von 1,5. Der Schreibtischtest, der beide Panels produzierten hat, wird in diesem Anhang beschrieben, und sein Code und seine Ausgaben befinden sich im begleitenden Repository.
E5. Das Kalibrierungsprotokoll
Das Protokoll und der Registrierungstext befinden sich im begleitenden Repository (pilot/pilot-protocol.md, pilot/preregistration-draft.md). Kurz gesagt nehmen 60 Erwachsene teil, 30 mit Software-Hintergrund und 30 ohne, in den drei Bereichen der Bank, über zwei Fenster von 91 Tagen. Alle nutzen die gleichen Agent-Tools, wobei die Versionen protokolliert sind, und die Prüfungen sind versteckte Tests oder zwei blinde Domänenbewerter. Hand-gemessene Zeiten werden für ein Fünftel der Aufgaben der Bank gemessen, jede Übergabe wird mit ihrem Startdatum protokolliert, und ein zufälliges Zehntel der angenommenen Stücke wird überprüft. Die Kriterien werden vor den Daten festgelegt: mindestens 70 % der Paare von menschlichen Schätzungen innerhalb von 1,5, mindestens 60 % der bewerteten Stunden innerhalb von 1,5 der gemessenen, Wiederholbarkeit der Sprosse über die zwei Fenster mit einem gewichteten Kappa von mindestens 0,6, Vorhersage des Bestehens neuer Aufgaben mit einem AUC von mindestens 0,7, weniger als 5 % der Protokollzeilen verloren, und mindestens 95 % der fehlgeschlagenen Übergaben aufgezeichnet. Das Zustimmungsformular ist nur für diese Studie geschrieben und verwendet keine anderen Zustimmungen. Monat und Quartal, irreversible Arbeit und Hochrisikobereiche sind außerhalb dieser sechsmonatigen Feldstudie.
E6. Was der Schreibtischtest klärt und was als Nächstes ansteht
Es zeigt, wie sich die Regeln für eine Person bekannter Zuverlässigkeit verhalten, wo sie inkonsistent waren (eine Inkonsistenz ist jetzt korrigiert), wie empfindlich ein Urteil gegenüber den zwei Konstanten ist, und dass Modellbewerter Aufgaben konsistent ordnen, aber im Ausmaß nicht einig sind. Das Kalibrierungsprotokoll von E5 nimmt auf, was ein Schreibtischtest den Menschen überlässt: wie sie sich unter den Regeln verhalten, ob eine Sprosse für eine echte Person wiederholt wird, und ob sie neue Arbeit vorhersagt; Übereinstimmung unter menschlichen Bewerten wird zuerst getestet (Anhang G). Die Schwellwerte werden daher als Regeln v1.1 am Schreibtisch getestet, und die Kalibrierungsstudie setzt die nächste Version fest.
Zum Reproduzieren: python3 pilot/simulate_rules.py und python3 pilot/rater_agreement.py pilot/results/model-ratings.csv pilot/metr-anchor-tasks.csv (Python 3.9 oder später, nur Standardbibliothek; Seed 20261009).
Appendix F. Ergänzungstabellen und -abbildungen
Objekte mit den Nummern A1, A2 usw. sind Anhang-Objekte. Sie werden in den Abschnitten zitiert, die in jeder Anmerkung genannt sind.
Tabelle A1. Konvergenzsignale, 2025 bis Oktober 2026.
| Signal | Quelle und Datum | Was es zeigt | Was es nicht zeigt |
|---|---|---|---|
| Die Arbeit des Entwicklers wird als Delegation und Verifikation beschrieben | GitHub, 8. Dezember 2025 | Die Darstellung der Rolle durch den Anbieter hat sich verschoben | Dass das Niveau der Entwickler auf diese Weise gemessen wird |
| Nicht-Entwickler innerhalb eines Coding-Agenten wuchsen um das 137-Fache (Einzelpersonen) und um das 189-Fache (Organisationen) | OpenAI, Juni 2026 | Schnelles Wachstum von einer niedrigen Basis aus; ein Viertel der befragten Nutzer stellte mindestens eine Anfrage, die auf mehr als 8 Stunden geschätzt wird | Qualität ihrer Ergebnisse; Daten des Anbieters |
| Die zehn größten Berufe liegen innerhalb von 7 Punkten bei der nachgewiesenen Erfolgsquote bei Code-produzierenden Sitzungen mit Programmierberufen | Anthropic, 16. Juni 2026 | Kleine Lücke zwischen Berufen; Erfolg gestützt durch Belege wie Tests oder Commits; Fachwissen wird durch Verhalten beurteilt | Ausbildung (Beruf ist nicht gleich Abschluss); Qualität bereitgestellter Produkte |
| Anwälte bauen ihre eigenen Tools; breiter KI-Zugang 83 % gegenüber 61 % | Bloomberg Law, 20. April 2026 | Fachexperten bauen, anstatt zu kaufen | Wie lange diese Tools gewartet werden |
| Hierarchiestufe wurde für etwa 181.500 Mitarbeiter umbenannt | Business Insider und Fortune, 22. Januar 2026 | Arbeitgeber ändern Titel | Ein neues Messkriterium (interne Ebenen bleiben erhalten) |
| „Frontier Professionals": 3.233 von 20.000 KI-Nutzern | Microsoft, 5. Mai 2026 | Ein Umfrage-Segment fortgeschrittener Nutzer | Eine Rolle oder eine Einstufung |
| 16.541 Stellenausschreibungen, die 2025 agentic KI erwähnen (151 im Jahr 2024) | Stanford AI Index 2026 | Nachfrage nach dieser Kompetenz in Stellenausschreibungen | Neue Berufe |
| Einstellungen auf Einstiegsniveau fallen stärker als insgesamt | LinkedIn Economic Graph, August 2026 | Eine schwächere Einstiegsstufe Mitte 2026 | Dass KI dies verursacht hat (LinkedIn verweist auf die Wirtschaft) |
| Neue Informatik-Studienanfänger um 13 % gesunken in Fachbereichen mit Promotionsprogrammen | CRA Taulbee, Juni 2026 | Studieren reagieren | Ein langfristiger Trend; alle Institutionen |
| KI-Nutzung wurde in 4,54 % der Interviews im Q2 2026 besprochen (0,33 % im Q3 2025) | Metaview, 2026 | Die Frage hat Eingang in die Personalvermittlung gefunden | Eine Skala für die Antwort |
Anmerkung: Daten von Anbietern sind als solche gekennzeichnet. Ältere Vergleiche (mit 2019 oder 2022) sind nach Regel ausgelassen (Abschnitt 1).
Tabelle A2. Namen im Umlauf und vorgeschlagene Namen nach Ebene, am 9. Oktober 2026. Teil 1: Namen im Gebrauch mit ihren Inhabern und Status. Teil 2: in dieser Studie vorgeschlagene Namen, einfache Beschreibungen und betrachtete Varianten.
| Ebene | Kandidat | Eingeführt von und wann (Teil 1) | Sinn, in dem es verwendet wird | Dafür | Dagegen |
|---|---|---|---|---|---|
| Teil 1 | |||||
| Massenfähigkeit | builder, Full Stack Builder | LinkedIn, Dezember 2025 (berichtet); „jetzt ist jeder ein Builder" (SF Standard, 2026) | Jeder, der etwas baut, aus jeder Funktion | Setzt sich bereits in der Personalverwaltung durch | Sagt nichts über das Niveau aus |
| Massenfähigkeit | vibe coding, vibe coder | Karpathy, 2. Februar 2025 | Bauen ohne den Code zu lesen | Weit verbreitet bekannt | Spöttisch; bezeichnet die untere Grenze |
| Massenfähigkeit | KI-Kompetenz (vier Ds) | Anthropic, 2025b | Delegation, Beschreibung, Urteilsfähigkeit, Sorgfalt | Deckt das Gebiet ab | Kompetenzen ohne Niveaustufen |
| Massenfähigkeit | agent literacy | MindStudio, 11. Juni 2026 | Delegieren, überprüfen, verwalten | Sinnlich nahe | Bereits verwendet; kein Standard des Nachweises |
| Beruf | agentic engineer | Karpathy, Februar 2026; Alenezi, Juni 2026 | Ein Ingenieur, der Agenten lenkt | Das Wort der Ingenieure von 2026 | An Engineering gebunden |
| Beruf | agent boss | Microsoft, 23. April 2025 | Jeder Mitarbeiter, der Agenten verwaltet | Einprägsam | Ein Slogan ohne Messkriterium |
| Beruf | agent manager | Arion Research, 7. Februar 2026; Srinivasan und Wei, Harvard Business Review, 12. Februar 2026 | Eine Rolle, die Agenten in einem Team leitet | Wird als führend berichtet (aicodex, 2026); deren Autoren erwarten, dass es innerhalb von 12 bis 18 Monaten ein Standardtitel wird | Ein Titel für einen horizontalen Manager (Abschnitt 6.3) |
| Beruf | AI Agent Owner; AI Agent Supervisor | Autor, 2026; Digg-Diskussion, 2026 | Eine Person, die für einen bereitgestellten Agenten rechenschaftspflichtig ist | Benennt die Verantwortung | Verwendung nur durch einen einzelnen Anbieter oder ein Forum |
| Beruf | AI orchestrator | St. Lawrence, 2024 Seminar und 2025 Buch; 739 Ausschreibungen im Februar 2026 (IT Brew, 2026) | Ein Geschäftsfachmann, der KI koordiniert | In Stellenausschreibungen | Mehrfach bereits verwendet; horizontal |
| Beruf | AI Operator | Dust, 7. Oktober 2026 | Erstellt und wartet gemeinsame Agent-Workflows | Vertraut | Klingt wie eine Konsole; bei Anthropic ist ein „operator" ein Unternehmen, das auf der API aufbaut (Anthropic, 2026b) |
| Beruf | AI steward, AI work architect | Ono, Weltwirtschaftsforum, 22. Juni 2026 | Der eine legt die Grenzen von KI-Arbeit fest, der andere überprüft die Folgen | Der nächste Vorgänger im Sinn | Zwei Rollen, kein Messkriterium |
| Beruf | product creator | Cagan, SVPG, 2025 | Eine Person, die ein Produkt von der Idee zur Markteinführung trägt | Produktsprache | Bereits verwendet; kein Messkriterium |
| Beruf | Product Principal | O'Neill, LinkedIn-Post, 2026 | Legt Ziele für Agenten fest, akzeptiert und antwortet für das Ergebnis | Fast der Sinn dieses Papiers | In diesem Sinne bereits verwendet; als Präzedenzfall zitieren |
| Beruf | Principal Agentic Context Engineer | Jobtitel gesammelt von Turkovic, 24. April 2026 | Eine Senioritätsstufe in Agent-Arbeit | Zeigt, dass „principal" bereits als Stufe verwendet wird | Grad, keine Profession |
| Profession | AI Product Builder; Agentic Product Builder | n8n-Ausschreibung, 2026; State Street-Ausschreibung, 2026 | Erstellung von Produkten und Überprüfungspraxis erforderlich; Programmierung bevorzugt (n8n) oder erforderlich (State Street) | Zeigt, dass Arbeitgeber die Programmieranforderung in beide Richtungen verschieben | Einzelne Arbeitgebertitel |
| Profession | Chartered Financial Intelligence Architect | Clark, SSRN, 2026 | Eine Profession, die nach einer Branche benannt ist | Zeigt, dass domänengebundene Namen vergeben werden | Ein Vorschlag, eine Branche |
| Profession | principal | Agency theory (Jensen & Meckling, 1976); „principals" in Claudes Verfassung (Anthropic, 2026b); The Principal Firm (Verheul, 2026); principal-agent-Rahmen für KI-Agenten (Berkeley California Management Review, 2025; Tikhomirov, 2026) | Die Partei, in deren Namen ein Agent handelt und die die Kosten der Überprüfung trägt | Theorie dahinter; passt zum Wort „agent" | „Agent principal" in Identitäts- und Zugriffsverwaltung bedeutet die eigene Identität des Agenten, der gegensätzliche Sinn; auch der Grad Principal Engineer |
| Maßstab | delegation horizon (im Sinne von Maschine oder Unternehmen) | Khadj, 2026 (eine frühere Version trug einen „Delegation Horizon Index", 0 bis 100); Alonso, 2026 („a delegation horizon" für Arbeitsketten) | Wie weit eine Maschine oder ein Unternehmen delegieren kann, bevor ein Mensch eingreifen muss | Zeigt, dass der Ausdruck natürlich ist | Maschine oder Unternehmen, nicht eine Person |
| Maßstab | uplift; speedup; autonomy 1 to 5; H1 to H5; supervisory capacity | METR, 2025; Anthropic Economic Index, 2025–2026; Shao et al., 2025; em360, 2026 | Durchschnittliche Gewinne, Beschleunigung auf Gesprächsebene, Agent-Autonomie, bevorzugte menschliche Beteiligung, nützlicher Output pro Aufwand | Etablierte Nachbarn des Verstärkungsgewinns | Messen Sie Aufgaben, Gespräche oder Tools, nicht die überprüfte Leistung einer Person |
| Moment | crossing time | The geometry of learning under AI delegation (2026) | Der Punkt, nach dem das Delegieren an KI durch Fertigkeitsverlust mehr kostet, als es bringt | Form-ähnlich | Gegensätzlicher Sinn: Fertigkeitsverlust, nicht Gewichtung von Anmeldedaten |
| Partner | guarantor | „Legal guarantor" in Capps (2025), New York Times Magazine | Bietet die Schuld, die die KI nicht tragen kann | Exakt | Rechtliche Färbung |
| Partner | finisher; distribution engineer; GTM engineer | GTM engineer in Ausschreibungen, 2026 | Bringt das Produkt zu den Menschen | Wird heute bezahlt | Teilweise automatisierbar (Abschnitt 7) |
| Fehlsignal | tokenmaxxing | Pressegebrauch, 2026 (CIO, 2026a) | Nach verbrauchten Tokens ranken oder konkurrieren | Benennt eine echte Praxis | Keine Profession (Abschnitt 4) |
| Ältere Namen | citizen developer; end-user software engineering; Code Runner, Adaptor, Writer, Builder | Gartner, bis 2009; Ko et al., 2011; Feldman & Anderson, 2024 | Bauen außerhalb der IT; Endbenutzer, die sich Engineeringproblemen stellen | Lange Geschichte | Gebunden an eine Seite der alten Aufteilung |
| Teil 2 | Kandidat | Status | Sinn | Für | Gegen |
| Massenfertigkeit | acceptance literacy | Hier vorgeschlagen; keine Nutzung in den Basen von Anhang B gefunden | Im Voraus sagen, was als erledigt gilt, und es dann zeigen | Benennt den Kern | Eine Fertigkeit, keine Person; muss von der Technologieakzeptanzforschung unterschieden werden |
| Profession | agentwright | Hier vorgeschlagen; keine Nutzung in den Basen von Anhang B gefunden | Derjenige, der Arbeit durch Agenten schafft, wie ein Dramatiker ein Stück schafft | Frei in wissenschaftlichen Basen; trägt Urheberschaft | Suchmaschinen spalten es in „Agent Wright" auf; klingt wie ein Browser-Testing-Tool; teilweise ab Oktober 2026 übernommen (ein Python-Paket und ein Katalog von Agent-Fähigkeiten), daher würde es einen Qualifizierer benötigen |
| Profession | domain orchestrator (legal orchestrator, fintech orchestrator) | Vorgeschlagen in einem früheren Entwurf dieser Studie | Eine Person mit tiefem Fachwissen, die Agentensysteme für diese Domäne zusammensetzt | Bindet die Rolle an ein Segment (Abschnitt 6.3) | „Multi-domain orchestrator" ist ein etablierter Begriff in 5G- und 6G-Netzwerkverwaltung |
| Profession | setter-acceptor; agent director | Einfache Beschreibungen | Stellt die Aufgabe ein und akzeptiert das Ergebnis | Exakt | Eine Beschreibung, kein Name; „director" ist der Rang eines Managers |
| Profession | Agent-Directed Product Creator; Agentic Work Steward; Agentic Work Producer; Outcome Author; Outcome Architect; agent conductor | Varianten, die in den Modellkonsultationen dieser Studie entstanden sind | Variationen über Urheberschaft und Verwaltung von Agentenarbeit | Zeigen Sie den Spektrum der Optionen | Lang oder nahe beieinander stehende Namen (steward, creator, architect) |
| Professions-Leiter | Specifier, Verifier, Domain Orchestrator; setter, acceptor, coordinator, loop owner | Frühe Leitern dieser Studie | Schritte zunehmender Verantwortung für Agentenarbeit | Lesbar | Ersetzt durch Sprossen in Stunden, die keine Übersetzung zwischen Professionen benötigen |
| Maßstab | verified delegation horizon (auch: personal or human delegation horizon) | Hier vorgeschlagen | Größtes verifizierbares Arbeitspaket, das eine Person an Agenten übergibt | Verwurzelt in Jaques und METR | Muss vom Maschinen- und Firmensinn in Teil 1 unterschieden werden |
| Maßstab | amplification gain | Hier vorgeschlagen | Verifizierte Arbeit pro Stunde Aufmerksamkeit | Würdigt Erbauer von Kurzschleifen | Benötigt eine eingefrorene Referenz |
| Moment | credential crossover point | Hier vorgeschlagen; keine Nutzung in den Basen von Anhang B gefunden | Wenn Produkte von Menschen ohne IT-Ausbildung denen von Programmierern unter den gleichen Überprüfungen zu überholen beginnen und Anmeldedaten an Gewicht verlieren | Beobachtbar in Teilen (Abschnitt 6.2) | „Credential" bedeutet auch einen geheimen Schlüssel in der Agent-Sicherheit; definieren Sie bei der ersten Verwendung |
| Moment | Skill Inversion Point; Background Neutrality Point; expertise crossover point; credential decoupling | Varianten in Betracht gezogen | Der gleiche Moment aus der Perspektive von Fähigkeiten, Hintergrund, Fachkompetenz oder Anmeldedaten | Jeder betont einen Teil | Jeder deckt nur einen der Komponenten von Abschnitt 6.2 |
| Partner | co-signer; trust broker; distribution principal | Varianten in Betracht gezogen | Der Partner, der das Produkt unterzeichnet oder trägt | Einfach | Enger als Garant oder Vollender |
| Fehlgeschlagenes Signal | Token-Seniorität (Token als Rang) | Hier für die Episode 2026 verwendeter Begriff | Ranking von Menschen nach verbrauchten Token | Benennt ein reales Ereignis | Keine Profession (Abschnitt 4) |
Anmerkung: Der Status spiegelt Web- und Datenbanksuchen am 8. und 9. Oktober 2026 wider (Anlage B). „Keine Verwendung gefunden" bezieht sich auf die dort an diesen Daten aufgelisteten Grundlagen und sagt nichts über Grundlagen aus, die nicht durchsucht wurden. Varianten in Teil 2 stammen aus den eigenen Entwürfen der Studie und werden aufgelistet, damit die Familie der Optionen sichtbar bleibt.
Tabelle A3. Skalen von 2025 und 2026 und was jede misst (vollständige Liste).
| Skala | Quelle | Gemessene Einheit | Misst eine Person durch verifizierte delegierte Arbeit? |
|---|---|---|---|
| Autonomieebenen für KI-Agenten (Operator bis Beobachter) | Feng et al., 2025 | Der Agent | Nein |
| Fünf Ebenen, von Autovervollständigung zur Software-Fabrik | Shapiro, Januar 2026 | Die Maschine oder die Team-Einrichtung | Nein |
| Acht Stufen der KI-gestützten Entwicklung | Yegge, 2026 | Die Praxis eines Programmierers nach Anzahl der Agenten | Nein |
| The Capability Ladder (Auslöser bis Agent-Team) | Memari & Rudolph, 2026 | Die Automatisierung der Arbeit | Nein |
| Sieben Stufen der Überwachung von Code-Agenten | Park et al., 2026 | Stufen der Überwachungsarbeit | Nein |
| Fünf Delegationsstufen in der Entwicklung (AIDEs) | JetBrains Research (Tikhomirov), September 2026 | Die Delegationsbefugnis eines Entwicklers, formuliert als Principal-Agent-Beziehung | Nur Entwickler; keine Verifikationsregel |
| Ebenen der KI-Delegation in der Entscheidungsfindung | Dawson, 2026; Metal Toad, 2026 | Die Delegationsbefugnis einer Organisation oder eines Managers | Nein |
| Intelligente KI-Delegation | Tomašev et al. (DeepMind), Februar 2026 | Delegation im Allgemeinen | Keine Maßnahme auf Personenebene |
| The delegation frontier (frühe Version: Delegation Horizon Index, 0 bis 100) | Khadj, 2026 | Die Delegationsbefugnis eines Unternehmens oder Agenten | Nein (Maschinen und Unternehmen) |
| Autor, Redakteur, Direktor, Orchestrator | Microsoft, Mai 2026 | Arbeitsmuster | Nein |
| KI-Kompetenz-Rahmen (acht Bereiche, vier Ebenen) | AI Certification Standards, 23. August 2026 | Kompetenzen über Berufe hinweg | Keine Prüfung oder Schwellenwerte |
| KI-Flüssigkeit (vier Ds) | Anthropic, 2025b | Grundlagenwissen | Keine Ebenen |
| Maschinenzeitrahmen | METR, 2025-2026 | Das Modell | Nein (nur Maschinen) |
| Verifizierter Delegationshorizont und Verstärkungsgewinn | Dieses Paper | Eine Person in einem Fachbereich | Ja, nach der Regel von Abschnitt 5.2 |
Anmerkung: „Misst eine Person durch verifizierte delegierte Arbeit" bedeutet, dass die Skala ein Individuum nach der Größe der an Agenten übertragenen und durch eine Kontrolle, die die Agenten nicht sahen, bestätigten Arbeit auf einer Ebene einordnet. JetBrains' Ebenen betreffen, wie viel Entwickler delegieren, und verwenden bereits die Sprache von Principal und Agent. Sie sind die nächsten Nachbarn und ihnen fehlt eine Unabhängigkeitsregel für Kontrollen und eine Größeneinheit.
Tabelle A4. Schwierige Fälle und wie die Regeln sie behandeln.
| Fall | Behandlung |
|---|---|
| Arbeit, die die Person niemals von Hand hätte ausführen können | Referenzstunden stammen trotzdem von einem qualifizierten Spezialisten; die eigene Fähigkeit der Person ist nicht entscheidend |
| Arbeit, deren Qualität sich erst Monate später zeigt | Vorläufig akzeptiert; das verzögerte Ergebnis wird bei Eintreffen aufgezeichnet und kann das Stück widerrufen |
| Ein Fachbereich ohne qualifizierten menschlichen Prüfer in der Nähe | Verborgene Tests oder tatsächliche Nutzung durch beabsichtigte Benutzer; ein Modell aus einer anderen Familie nur mit Quellen, die die Person öffnete |
| Ein blinder Kritiker der gleichen Modellfamilie in einem neuen Kontext | Keine unabhängige Kontrolle: aufgezeichnet als same_family (Anlage C), es bringt keinen Kredit, obwohl es die Arbeit vor einer unabhängigen Kontrolle verbessern kann (Abschnitt 6.5) |
| Ein Team, das Arbeit gemeinsam akzeptiert | Jede Person protokolliert ihre eigene Aufmerksamkeit; das Stück zählt für die Person, die die Annahme unterzeichnete |
| Ein Stück, das die Kontrolle besteht, aber später als falsch befunden wird | Bei der nächsten Überprüfung als gescheitert aufgezeichnet und die Sprosse wird neu bewertet |
| Unumkehrbare Arbeit vermischt mit gewöhnlicher Arbeit | Die strengere Regel gilt nur für die unumkehrbaren Stücke (Abschnitt 5.2) |
Tabelle A5. Themen in Entwickler-Threads und ihre Gegenstücke in anderen Berufen, 2025-2026 (illustrative Fälle).
| Thema in den Threads | Gegenstück außerhalb von Software | Quelle | Übergetreten? |
|---|---|---|---|
| Wer trägt die Schuld für schlechte Ausgaben, das Modell oder wer die Aufgabe gestellt hat | „Workslop": KI-Ausgabe, die die Arbeit auf seinen Empfänger verlagert, etwa zwei Stunden pro Vorfall und 186 USD pro Angestelltem pro Monat; Kollegen beurteilen die Absender als weniger kompetent | The Decoder (2025); BetterUp (2026) | Ja, stark |
| Die Kosten der Kontrolle (150 USD pro Stunde für Überprüfung) | Die gleichen Workslop-Kosten | The Decoder (2025) | Ja |
| Ein starkes Modell plant und überprüft, günstige Modelle führen die Arbeit aus | KI-Budgets nach Rolle bei Atlassian zugeteilt | HCA Magazine (2026) | In Unternehmen |
| Überbelastung, ständiger Werkzeugwechsel, Angst vor dem Verpassen | „KI-Gehirnerschöpfung" von 25-26% der Vermarkter, 19% in HR, 17% in Software berichtet | Search Engine Journal (2026) | Ja, stärker außerhalb der IT |
| Eigene Werkzeuge statt gekaufter Software | Anwälte, die Werkzeuge mit Agenten entwickeln; 35% der befragten Unternehmensgruppen ersetzen einige gekaufte Software durch ihre eigene (Muster des Anbieters) | Artificial Lawyer (2026); Bloomberg Law (2026); Retool (2026) | In der obersten Schicht |
| Agenten vergleichen | Buchhalter, die zwei Code-Agenten vergleichen | Growthy (2026) | Ja |
| Ein Unternehmen auf Agenten ohne Programmierer umstellen | Anwälte und Firmen, die mit Agenten anstelle von Anbietern entwickeln | Bloomberg Law (2026); Artificial Lawyer (2026) | Teilweise; das Beratungsgeschäft selbst wird nur im Thread sichtbar |
| Eine persönliche KI-Rechnung über 1.000 US-Dollar pro Monat als Statusmarker | Kein Statusgegenstück gefunden; die nächsten sind Unternehmenshöchstgrenzen und Zuschüsse (Ubers 1.500-Dollar-Monatshöchstgrenze, Atlassians KI-Wallets) | Fortune (2026b); HCA Magazine (2026); Suche vom 9. Oktober 2026 | Nein, als Status; ja, als Budgetposten |
| Zugehörigkeit zum Lager eines Agenten | Kein Gegenstück gefunden | Suche vom 9. Oktober 2026 | Nein, und nicht erforderlich |
Hinweis: Die Threads sind qualitative Belege, die wegen ihrer Themen ausgewählt wurden, und stellen keine Population dar. „Übergetreten" zeigt an, ob ein Gegenstück in den aufgelisteten Quellen am 9. Oktober 2026 gefunden wurde.
Abbildung A3. Maschinenhorizonte auf der Skala der Sprossen.
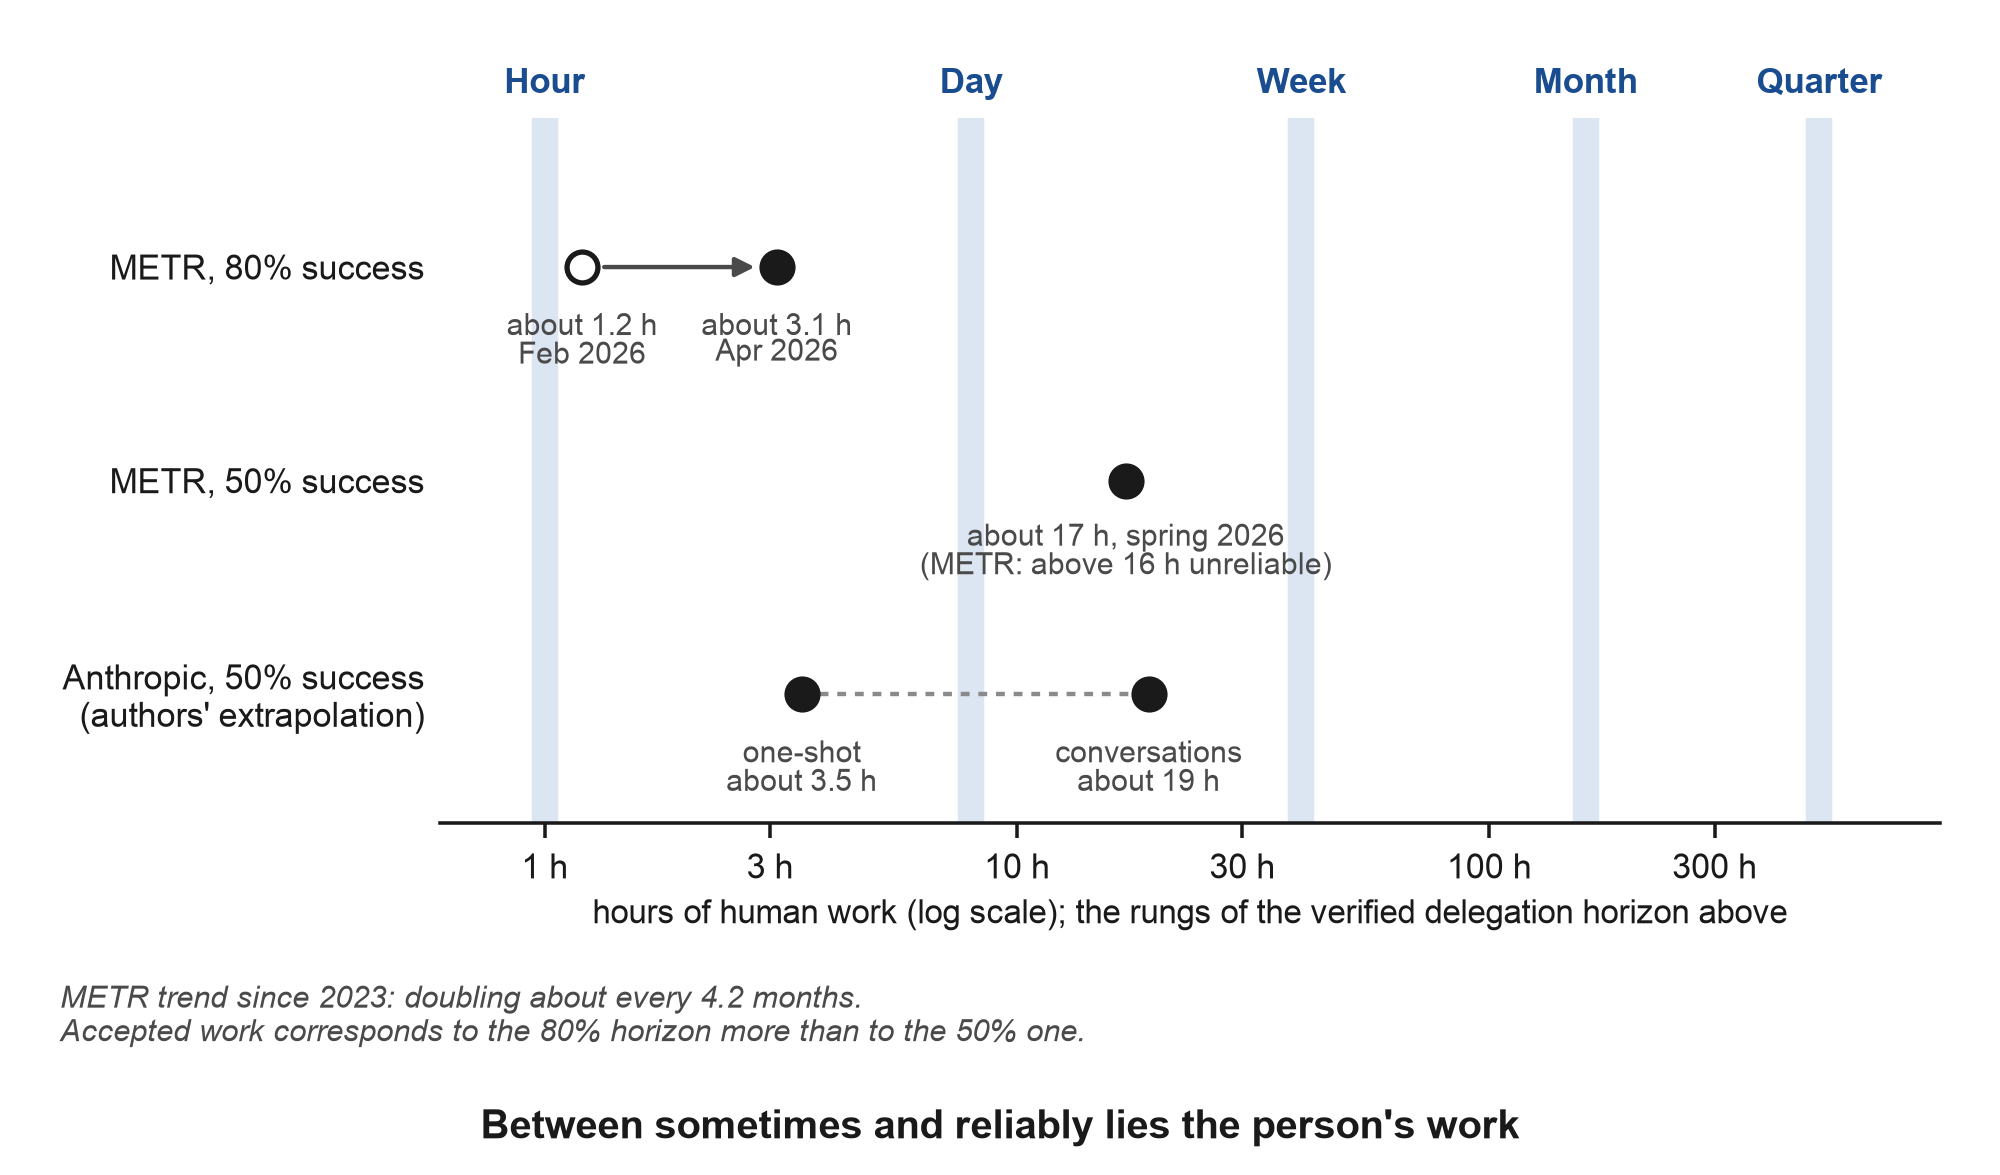
Hinweis: METRs Zeithorizont bei 80 % Erfolgsquote beträgt etwa 1,2 Stunden im Februar 2026 und etwa 3,1 Stunden im April. Bei 50 % Erfolgsquote etwa 17 Stunden im Frühjahr 2026, was METR selbst als unzuverlässig über 16 Stunden bezeichnet (METR, 2026c). Die 50-%-Punkte von Anthropic, etwa 3,5 Stunden für One-Shot-Anfragen und etwa 19 Stunden für Gespräche, sind eine Extrapolation der Autoren (Anthropic, 2026a). Maschinenhorizonte messen Modelle, nicht Menschen. Die schattierten Spalten zeigen nur, wo die Sprossen von Abschnitt 5.3 auf derselben Stundenachse fallen (Abschnitt 5.6).
Abbildung A4. Der Überprüfungsprozess von Abschnitt 6.5: wofür jeder Schritt steht, was er nach der Regel verdient, und wo er stoppt.
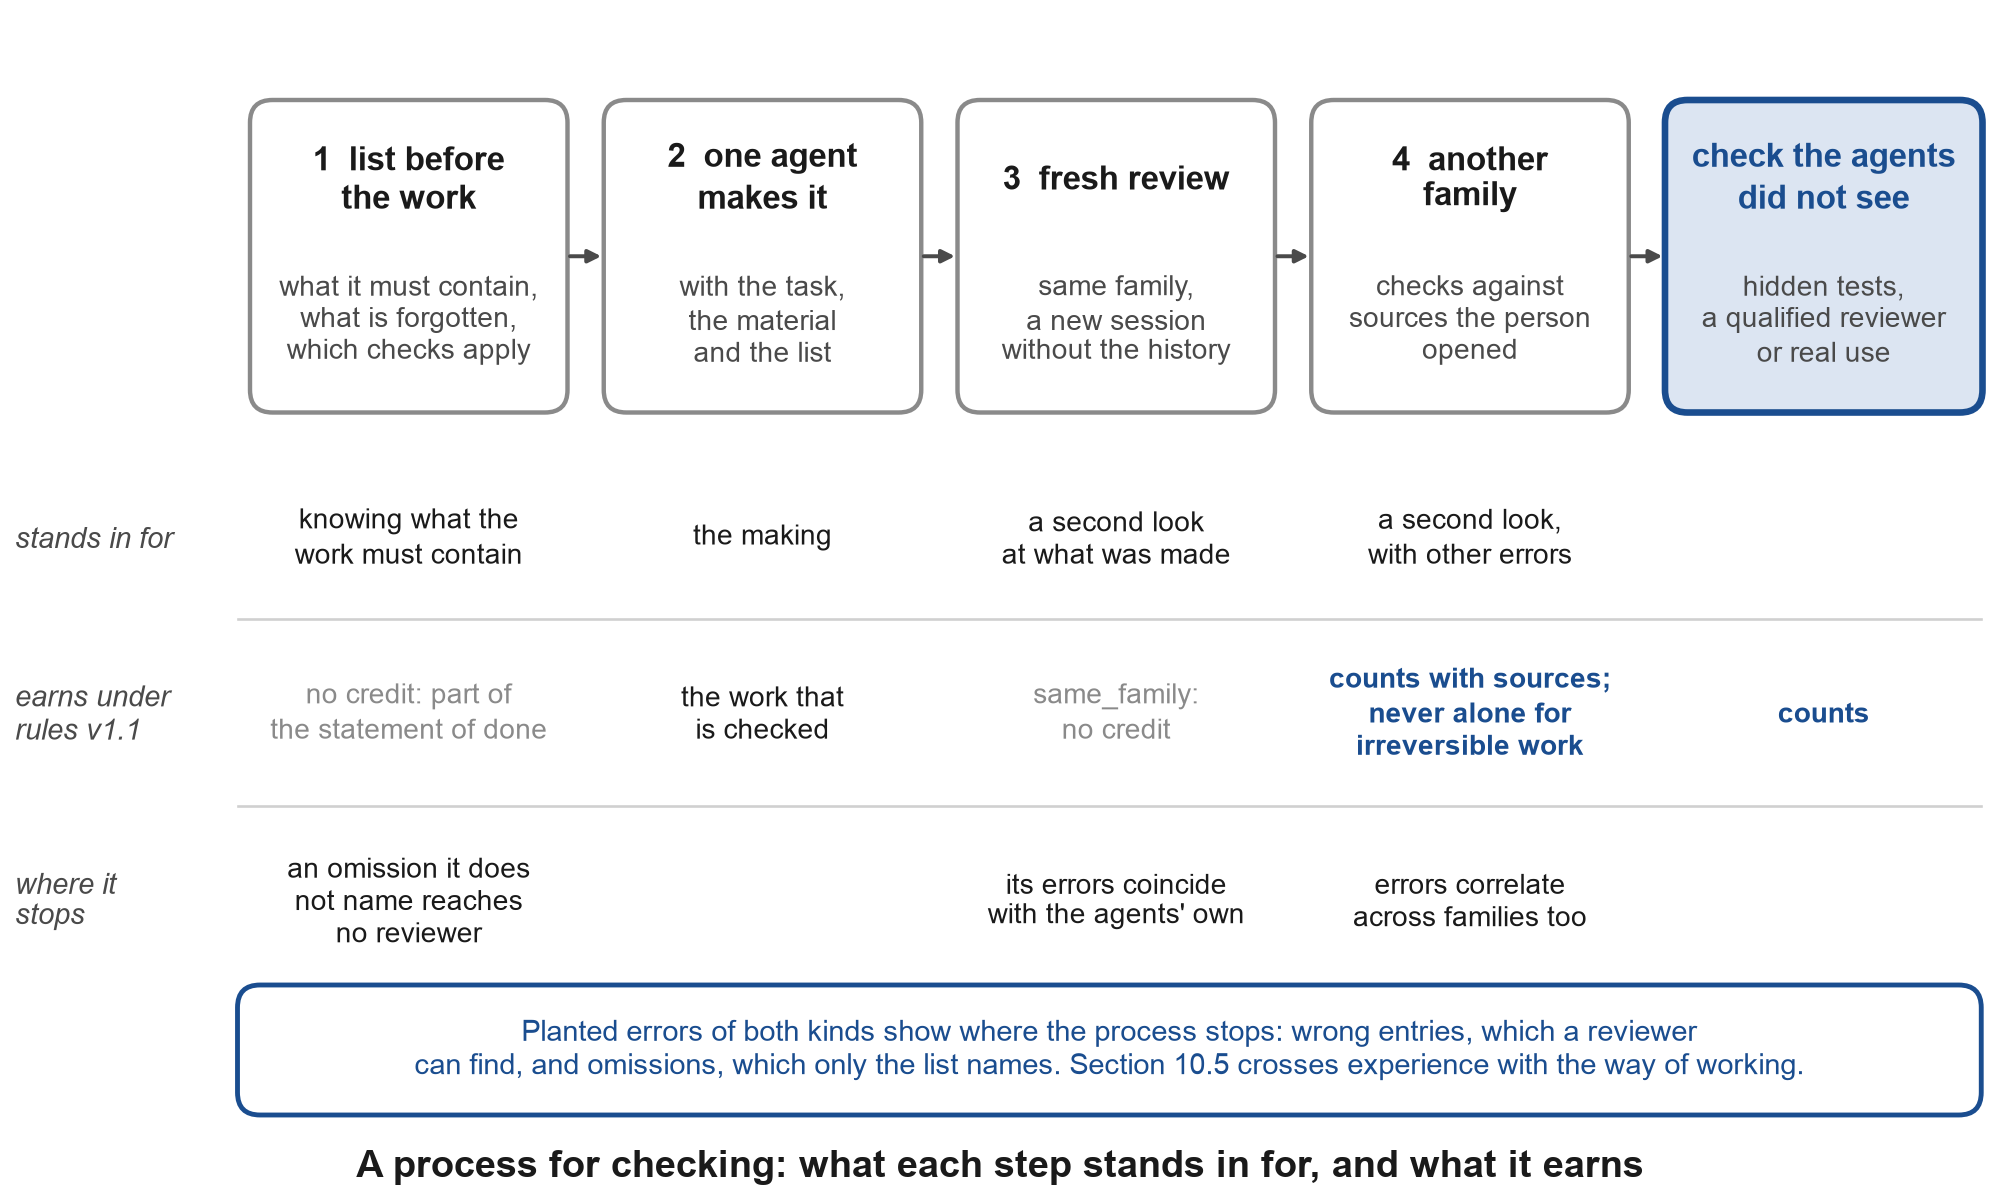
Hinweis: Die vier Schritte und wofür jeder steht, sind die des Abschnitts 6.5. Die Reihe der Gutschrift folgt der Scoringregel von Abschnitt 5.2 und Tabelle A4: Eine Überprüfung durch ein Modell derselben Familie in einem neuen Kontext wird als same_family erfasst und verdient keine Gutschrift, obwohl sie die Arbeit verbessern kann; ein Modell einer anderen Familie zählt nur, wenn es gegen Quellen überprüft, die die Person geöffnet hat, und nie allein für unumkehrbare Arbeit. Die letzte Reihe fasst Fu et al. (2025) zu Auslassungen und Kim et al. (2025) zu Fehlern zusammen, die modellübergreifend korrelieren. Kein registrierter Vorhersagetest überprüft den Prozess; Abschnitt 10.5 legt den Vergleich dar, der dies würde. Die Abbildung wird von figures/figure_a4_checking_process.py im begleitenden Repository gezeichnet, das die Gutschrift jeder Art von Überprüfung aus horizon.py ausliest. Jeder Schritt steht für einen Teil der Erfahrung eines Handwerks; Abschnitt 14 kehrt dazu als Leiter von Ausgleichern zurück.
Tabelle A7. Status der Aussagen in dieser Arbeit.
| Element | Wie es gehalten wird | Grundlage |
|---|---|---|
| Programmierer und andere teilen sich jetzt die Aufgaben und den Arbeitsablauf des Delegierens und Annehmens | Die Daten unterstützen es auf der Ebene von Aufgaben und Arbeitsabläufen; Berufe als Ganzes haben sich nicht vermischt | Abschnitt 2; Anbieter-Logs und Umfragen von 2025–2026 |
| Die beiden alten Leitern messen diese Arbeit nicht | Beobachtet | Umbenannte Leitern ohne ein neues Messinstrument (Deloitte); Frage der KI-Nutzung, die in Interviews ohne Skala auftaucht |
| Token-Zähler versagen als Maß für Anciennität | In frühen Fällen beobachtet | Pressemitteilungen von 2026 (Abschnitt 4): eine inoffizielle Rangfolge eines Mitarbeiters bei Meta, entfernt, und Metas spätere offizielle Anleitung gegen Token-Zähler; ein Leaderboard bei Amazon, gehackt und entfernt; Ubers KI-Budget, das in vier Monaten ausgegeben wurde, ein Budgetereignis |
| Verifizierter Delegierungshorizont und Verstärkungsgewinn | Vorgeschlagen; Regeln v1.1 schreibtisch-getestet; Kalibrierungsprotokoll im begleitenden Repository; Einigung von Fachleuten auf Referenzstunden unter registriertem Test | Definitionen und Regeln (Abschnitt 5); Instrument (Anhang C); Schreibtischtest der Schwellwerte (Anhang E) |
| Gewinnobergrenze durch den Anteil der Überprüfung | Als Modell angeboten; illustriert durch GDPval-Durchschnitte | Abschnitt 5.5 |
| Hintergrund-Neutralität | Hypothese; Tests werden registriert (F7) | Anthropic (2026e) weist darauf hin; Savva (2026) ist eine Alternative |
| Berechtigungsübergangspunkt | Hypothese; Komponenten separat datiert (Parität F2, Übernahme F3, Bewerbungen F5, Neutralität F7) | Lightcast (2026b) zeigt konvergierende Linien; Bone et al. (2025) gehen ihr für KI-Rollen voraus |
| Gatter, die durch ein selbstberichtetes Etikett durchsickern; Gatter, die die Arbeit überprüfen, halten stand | Als Modell angeboten; das Leck wird einmal durch das Screening der Rater-Studie illustriert | Abschnitte 6.2 und 13; Anhang G2; Danilova et al. (2021); Reid et al. (2022); Serafini et al. (2024, 2026); Oregon State Board of Bar Examiners (2026) |
| Software überquert zuletzt | Vorhersage (F6), mit 40 anderen in Tabelle A6, auf der OSF registriert | Domänenargument (Abschnitt 6.3) |
| Ein Überprüfungsprozess kann für einen Teil der Erfahrung eines Handwerks stehen | Hypothese, nicht registriert; kein registrierter Vorhersagetest überprüft ihn, und F3b (p = 0,10) bezieht sich nur indirekt darauf; ein Vergleich wird in Abschnitt 10.5 dargelegt | Abschnitt 6.5; Dell'Acqua et al. (2026), McAleese et al. (2024), Eulerich et al. (2024), Fox et al. (2026) und Benchek et al. (2026) auf der einen Seite; Kim et al. (2025), Chernets (2026b), Fu et al. (2025) und Virk and Liu (2025) auf der anderen |
| Vertrauen als zweite Grenze; Garant als Partnerfachrichtung | Als Modell angeboten; Vorhersagen F11 und F12 | Abschnitt 7 |
| Nicht-Programmierer arbeiten über Agenten | Beobachtet in einer laufenden Kohorte, beschrieben ohne Rückschluss; registrierte Ergebnisse separat berichtet | Abschnitt 11.5; Anhang G |
Tabelle A8. Gatter, die durch ein Etikett zulassen, und Gatter, die die Arbeit überprüfen: was jedes überprüft, und was beobachtet wurde.
| Gatter | Worauf es zulässt | Was beobachtet wurde | Quelle |
|---|---|---|---|
| Ein Teilnehmerfilter einer Forschungsplattform | Antworten überwiegend auf das Wort der Person erhalten; Alter und Wohnland überprüft | Von 60 Personen, die zu einer Buchhaltungs-Stichprobe zugelassen wurden, beantworteten 11 eine Frage des Handwerks der ersten Woche falsch, 8 von ihnen durch Vertauschung von Soll und Haben | Prolific (2026); Appendix G2 |
| Programmierkenntnisse auf einer Crowdwork-Plattform angegeben | Die eigenen Angaben der Person | 42% erfüllten die Kriterien der Wissensfragen der Forschenden nicht | Danilova et al. (2021) |
| Programmierung in Node.js auf Prolific angegeben | Die eigenen Angaben der Person | 55 von 206 bestanden alle Programmierfragen | Reid et al. (2022) |
| Eine statische Wissensfrage in Text oder Bildern | Eine Antwort, die ein Chat-Modell geben kann | ChatGPT löste die bestehenden Screening-Fragen für Programmierer leicht, und 2026 kam es auch an statischen Visualfragen vorbei, die dagegen entwickelt worden waren | Serafini et al. (2024, 2026) |
| Eine Audio-Frage, die schrittweise unter striktem Zeitlimit offengelegt wurde | Eine Antwort unter Zeitdruck gegeben | Hielt 2026 noch gegen ein Chat-Modell stand | Serafini et al. (2026) |
| Eine Abschlussanforderung aus einer Richtlinie entfernt | Ein Label, auf dem Papier entfernt | Weniger als eine Einstellung von 700 änderte sich; 19,3% der US-Ausschreibungen auf Indeed forderten im November 2025 einen Bachelor-Abschluss oder höher, mehr als ein Jahr zuvor | Burning Glass Institute and Harvard Business School (2024); Indeed Hiring Lab (2026) |
| Eine Lizenz durch eine Prüfung, einmal bestanden | Wissen, einmalig überprüft | Funktioniert seitdem als Label | Abschnitt 6.2 |
| Überprüfung der unterzeichneten Arbeit einer lizenzierten Prüfungsfirma | Unterzeichnete Arbeit, immer wieder überprüft | Jedes Jahr für Firmen, die regelmäßig mehr als 100 Emittenten prüfen, mindestens einmal alle drei Jahre sonst | Sarbanes-Oxley Act of 2002, s. 104 |
| Eine Lizenz durch ein Portfolio überwachter Arbeit | Überprüfte Arbeit, einmalig; der Jura-Abschluss ist weiterhin erforderlich | 205 Kandidaten hatten bis zum 5. Januar 2026 beantragt und 49 waren lizenziert, die erste im Dezember 2024 | Oregon State Board of Bar Examiners (2026) |
| Der überprüfte Delegationshorizont | Abgelieferte Arbeit, die eine Überprüfung bestand, die die Agenten nicht sahen, jedes Quartal bestätigt | Eine Stufe mit der Zahl hinter sich und den Arten der Überprüfung, Fehler im Protokoll geführt | Abschnitte 5.2 und 5.3 |
Anmerkung: Die Zeilen sind die Fälle, auf die Abschnitt 6.2 verweist. Sie stammen aus unterschiedlichen Populationen und unterschiedlichen Fragen und werden nebeneinander dargestellt, um zu zeigen, was jedes Gate überprüft, nicht um sie als Quoten zu vergleichen. Ein Gate der zweiten Art kann vor jedem Gate der ersten Art hinzugefügt werden: die Rater der Referenzstunden im begleitenden Repository werden durch eine Frage des Handwerks zugelassen (kits/reference-hours-raters.md), wie die Rater-Studie von Appendix G2 ihre Rater screening. kits/trade-screen.md zeigt auf, wie man eine solche Frage schreibt und berichtet, und tools/gate_leak.py gibt den Anteil, den ein Label durchlässt, mit einem genauen Intervall an.
Anhang G. Menschen, die es bereits tun: eine Kohorte von Nicht-Programmierern und eine Prolific-Rater-Studie
Dieser Anhang ergänzt die Messung und ist nicht Teil ihrer Argumentation; die Abschnitte 6.2, 6.5 und 14 zitieren das Screening-Ergebnis von G2 als Illustration. Er fügt zwei Aufzeichnungen von Menschen hinzu: einen Bericht über Nicht-Programmierer, die im September und Oktober 2026 von Chat zu Agenten übergingen (G1), und eine registrierte Rater-Studie, in der berufstätige Fachleute die Referenzstunden der Task-Bank bewerteten (G2).
G1. Nicht-Programmierer, die von Chat zu Agenten übergingen
Ab dem 6. September 2026 leitete ich Erwachsene ohne Programmierhintergrund Schritt für Schritt und über gewöhnliches Messaging von einem Chat-Assistenten zu einem auf ihrem eigenen Computer installierten Code-Agenten und bezahlt aus ihrem eigenen Consumer-Abonnement an, und dann zur Arbeit mit mehreren Modellen. Sie kamen aus mehr als einem Dutzend Berufen, darunter Buchführung und Büroarbeit, Recht, Marketing und Vertrieb, Design, Fotografie und Retusche, Übersetzung und Lektorat, Musik, Bauwesen, Verkehr und Logistik, Immobilien, Pflegearbeit, öffentliche Verwaltung und gemeinnützige Gemeinschaftsarbeit; vier berichteten von früherer oder gegenwärtiger Arbeit in der Softwareentwicklung. Der nachstehende Bericht ist beschreibend: Er berichtet, was Menschen taten und was sie stoppte, wie bis zum 9. Oktober 2026 aufgezeichnet, und er berechnet keine Rate und testet keinen Anspruch dieses Papiers.
Tabelle G1. Wie weit die Kohorte bis zum 9. Oktober 2026 gekommen war (Personenzahlen).
| Schritt | Personen |
|---|---|
| In der Aufzeichnung: zugestimmt und den Eingangsfragebogen eingereicht | 119 |
| Installierten einen Agenten auf ihrem eigenen Computer und Abonnement und begannen die Arbeit damit | 35 |
| Erstellten ein Artefakt oder vollendeten mindestens einen Schritt an ihrer eigenen Arbeit | 24 |
| Stoppten mit angegeben Grund | 23 |
| davon: keinen eigenen Computer (nur Telefon oder Gerät, das den Agenten nicht ausführen kann) | 9 |
| davon: die Kosten eines Abonnements | 5 |
| davon: lehnten ab (was sie hatten reichte aus, kein Interesse oder der Anfängerschwerpunkt passte nicht) | 6 |
| davon: Gesundheit, Familie oder Zeit | 2 |
| davon: der Dienst war nicht dort verfügbar, wo sie lebten | 1 |
Hinweis: Gezählt von Hand aus der Teilnehmeraufzeichnung und der neuesten Messzusammenfassung, unter Verwendung des fortgeschrittensten Ereignisses, das für jede Person aufgezeichnet ist. Die 35 Personen der zweiten Zeile sind die 35 Zeilen der Tabelle G1b, und die 24 der dritten Zeile sind ihre ersten 24 Zeilen. Ein Artefakt zählt, wenn die Person es zeigte oder beschrieb, was der Agent produzierte; eine Person, die ein Artefakt produzierte, stoppte später (P60) und wird in beiden Zeilen gezählt. Die verbleibenden 62 Personen hatten bis zu diesem Datum entweder den Installationsschritt erhalten, ohne ihn als erledigt zu melden, oder ihn noch nicht erreicht.
Tabelle G1a. Die gesamte Kohorte nach Region und Wohnsitzland und wie viele von jedem bis zum 9. Oktober 2026 zu einem Agenten übergingen.
| Region und Land | In der Kohorte | Übergangen zu einem Agenten |
|---|---|---|
| Nordamerika | 37 | 10 |
| Vereinigte Staaten | 35 | 10 |
| Kanada | 2 | 0 |
| Westeuropa | 20 | 7 |
| Deutschland | 12 | 5 |
| Irland | 3 | 1 |
| Spanien | 2 | 1 |
| Vereinigtes Königreich | 1 | 0 |
| Österreich | 1 | 0 |
| Schweiz | 1 | 0 |
| Mittel- und Osteuropa, benannte Länder | 9 | 1 |
| Polen | 3 | 0 |
| Moldau | 2 | 0 |
| Lettland | 2 | 0 |
| Estland | 1 | 0 |
| Rumänien | 1 | 1 |
| Land nicht angegeben | 53 | 17 |
| Insgesamt | 119 | 35 |
Hinweis: Aus der Landspalte der Teilnehmeraufzeichnung. „Land nicht angegeben" gruppiert Teilnehmer, deren Land gemäß der Datenschutzregel der Studie nicht bekannt gegeben wird, und diejenigen, die keines angegeben haben.
Was Menschen mit einem Agenten taten. Tabelle G1b listet alle auf, die bis zum 9. Oktober 2026 von einem Chat-Assistenten zu einem dirigierten Agenten übergegangen waren, eine Zeile pro Person: welche Aufgabe sie ihm gaben und was es produzierte. Personen, die ein Artefakt produzierten oder einen Schritt an ihrer eigenen Arbeit beendeten, kommen zuerst, grob nach Fortschritt geordnet; diejenigen, die den Agenten installiert hatten und begannen, ohne ein bisher gemeldetes Ergebnis, folgen. Berufe werden wie in der Aufzeichnung in neutraler Formulierung angegeben. Die kurzen Zitate stammen aus eigenen Worten der Teilnehmer aus der Aufzeichnung; diejenigen, die als „(übersetzt)" gekennzeichnet sind, wurden in einer anderen Sprache geschrieben und werden in meiner wörtlichen Übersetzung angegeben.
Tabelle G1b. Alle, die bislang übergegangen sind (35 Personen, Stand 9. Oktober 2026).
| # | Teilnehmer | Beruf | Land oder Region | Was sie mit einem Agenten taten | In ihren eigenen Worten |
|---|---|---|---|---|---|
| 1 | P20 | Bildverarbeitung, Retusche, Fotografie | nicht angegeben | Der Agent fragte nach seinen Zielen und erstellte einen Monatsplan als Ordner und Dateien (Wochen nach Thema, eine Referenzdatei, ein Tracker); er registrierte ihn dann in neun KI-Diensten, indem er selbst den Browser steuerte und den eine Ablehnung in seiner Fortschrittsdatei protokollierte; er leitete eine Frage durch 11 Web-KIs und schrieb Ergebnisse und Grenzen in eine Datei; bei seinen eigenen Fotografien erstellte es eine Metadaten-CSV in einem Befehl und überprüfte sie | - |
| 2 | P73 | Kontaktlinsenfachgeschäft | Irland | Installierte einen zweiten Agenten eines anderen Anbieters; beide lasen eine Kopie ihres eigenen Social-Media-Plans und sie führte eine Seite mit den Punkten auf, in denen sie sich unterschieden; schrieb für jeden Agenten eine Regelsdatei und beendete den Abend mit einer Readme und einem Arbeitsbuch | „Ich kann die Schulung fortsetzen." |
| 3 | P48 | Büroarbeit und Online-Verkauf | nicht offengelegt | Wandelte ein Dokument, das sie jede Woche schreibt, in eine Vorlage mit einer Checkliste um und schrieb das nächste daraus schneller; ein zweiter Mitarbeiter liest ihre Entwürfe unvoreingenommen; ließ zwei KIs einen ganzen Aktienordner lesen und entschied die drei teuersten Erkenntnisse selbst | „Die Frage, welche KI besser ist, ist falsch gestellt." (übersetzt) |
| 4 | P44 | Marketing, Verkauf und Beratung | nicht offengelegt | Erstellte Desktop-Schaltflächen, die Agent-Aufgaben ausführen („Projektstatus", „Bestand neuer Artikel", „Dokumentenzusammenfassung", „Notiz in die Akte"); installierte einen zweiten Agent auf einem anderen Abonnement und führte eine gemeinsame Überprüfung einer Aufgabe durch: eine Zusammenfassungsdatei plus zwei vollständige Überprüfungen | - |
| 5 | P21 | Nichtregierungsorganisation der Zivilgesellschaft | Deutschland | Erstellte ein interaktives einmonatiges Programm mit Fähigkeiten und Gewohnheiten mit Fortschrittsverfolgung; ließ den Agent eine Startrichtung aus dem Katalog wählen und einen vierwöchigen Plan schreiben; führte dann drei Agent-Sitzungen parallel durch: eine Präsentation in Minuten und einen Bot, der Inserate überwacht und Treffer an seinen Messenger sendet | „Ein Werkzeug, das auf Ihre spezifischen Bedürfnisse zugeschnitten ist, anstatt das Internet nach Kompromissen oder kostenpflichtigen Abonnements zu durchsuchen." |
| 6 | P05 | Assistentin einer Direktorin, ehemalige Programmiererin | Vereinigte Staaten | Der Agent erstellte fünf Dateien auf ihrem Computer: einen Überblick und einen vierwöchigen Plan nach Thema; später sendete er Einladungen an eine Liste von 76 Kontakten über eine Webseite für Messaging, wobei er selbst klickte, nachdem er eine Testnachricht an ihre eigene Nummer gesendet hatte | „Von nun an werde ich verschiedene tägliche Aufgaben zwischen ihnen aufteilen und die Ergebnisse wirklich vergleichen." |
| 7 | P01 | Innenarchitekt und Zeichner, in Ausbildung | Spanien | Ließ den Agent in zwei Durchgängen eine Datei mit Stellenausschreibungen erstellen, der zweite breiter als der erste; verglich sie mit zwei Berichten von einem anderen Chatbot, Übereinstimmungen und Abweichungen getrennt; schrieb seinen Lebenslauf und sein Portfolio aus einer ehrlichen Lektüre seiner eigenen Dateien um und überarbeitete sein berufliches Profil | „Wenn es so tief graben kann und interessante, aber im Allgemeinen separate Daten erstellen kann, um sie zu analysieren." (übersetzt) |
| 8 | P18 | Internet-Marketing | nicht offengelegt | Der Agent räumte ihren Desktop auf: erstellte Dokumente, sortierte sie in Ordner, fand Fehler und behob sie; später richtete er E-Mail-Nachrichtenwarnungen zu ihren eigenen Themen ein | „Ich hatte von so etwas gehört, aber es in der Praxis zu sehen, hat mich wirklich überzeugt." |
| 9 | P19 | Beamter der öffentlichen Verwaltung | nicht offengelegt | Korrekturlas eine lange mehrbändige Textausgabe seiner eigenen in einem einzigen Tag; schloss zwei große Projekte in einer Woche ab; baut jetzt eine Plugin-Sammlung für einen Übersetzungs-Workflow auf | „Ich habe zwei große Projekte in nur einer Woche abgeschlossen... wow." (übersetzt) |
| 10 | P35 | Verträge, Rechnungen und Zolldokumente | Vereinigte Staaten | Führte die erste Aufgabe per Sprache durch; der Agent reinigte den Cache ihres Computers, schloss Apps und fand einen Termin auf einer Buchungsseite, indem er diese selbst öffnete; schlug eine Print-on-Demand-Richtung vor; hilft bei Ausschreibungsunterlagen; läuft jetzt im Terminal | „Ja, es hat funktioniert, wir haben es geschafft." (übersetzt) |
| 11 | P72 | Stockbilder und Video mit KI erstellt | Rumänien | Führte eine Aufgabe durch viele KIs mit dem Orchestrationstool durch, richtete Spracheingang ein und wählte freiberufliche Richtungen aus dem Katalog | - |
| 12 | P41 | Zahnarzthelferin, in Elternzeit | Vereinigte Staaten | Der Agent erstellte einen Zeitplan, einen Plan und Entwürfe; fand sechs Kopien seines eigenen Installers und fünf einer Officebündel auf ihrem Computer und entfernte die Extras; sie diktierte eine Lektion für einen Gemeinschaftskurs und der Agent tippte sie, fügte Referenzen und Links hinzu, übersetzte und speicherte sie, dann überarbeitete er sie auf ihre Veranlassung hin | „Ich bin entzückt." |
| 13 | P24 | Musiker und Poet | Deutschland | Sendete eine Bildaufgabe an elf KIs und speicherte die Ergebnisse in einem Ordner mit einer Galerieseite; ließ den Agent das Skelett einer Musikarrangierung bauen, was ihn enttäuschte | „Der ethische Aspekt der Urheberschaft bleibt für mich ungelöst." |
| 14 | P102 | verwaltet ein Softwareunternehmen | nicht offengelegt | Arbeitete bereits täglich in einem Agent bei der Ankunft; führte eine Frage durch 11 KIs aus (10 antworteten) und sendete die Laufdatei; arbeitet jetzt durch den Einnahmekatalog | - |
| 15 | P40 | Research Engineer und Web-Entwickler | nicht offengelegt | Ging den Weg als bewusster Anfänger: etwa hundert lose Dateien in seinem Downloads-Ordner in Ordner sortiert, mit Screenshots vorher und nachher; gab zwei Fixes an das Kursmaterial zurück | - |
| 16 | P75 | Remote-technischer Support | nicht offengelegt | Der Agent erstellte einen Ordner auf seinem Desktop mit einem Startplan für einen saisonalen Musikvideokanal (Namen, Track-Ideen, Titel, ein Posting-Plan); Terminal-Schritt erledigt | - |
| 17 | P60 | häusliche Pflege | Vereinigte Staaten | Nach ein paar Fragen des Agenten ein einmonatiger Plan aufgeteilt in Dateien (Spender, Finanzen, Briefvorlagen); verließ später, da die Anfängerformulierung zu grundlegend war | - |
| 18 | P64 | uniformierter öffentlicher Dienst, Logistik und Versorgung | nicht offengelegt | Erstellte einen Monatsplan mit dem Agent, der die Dateien auf seinem Computer erstellte; registrierte sich bei zehn KI-Diensten | „KI passt sich der Person an. Es schmeichelt, in gewisser Weise." (übersetzt) |
| 19 | P28 | uniformierter öffentlicher Dienst | nicht offengelegt | Der Agent legte Karrierewege von seiner aktuellen Position aus dar und, als er einen ablehnte, einen Entwicklungsplan für seinen früheren Beruf, Uhrenreparatur (Fähigkeiten, Zertifizierung, eigene Werkstatt) | - |
| 20 | P14 | Industriekletterer | Vereinigte Staaten | Baute „Reflex Square", einen kleinen Reaktionsgeschwindigkeits-Trainer, mit dem Agent auf dessen eigenen Vorschlag während des Setups | „Im Moment ist das Codieren in Code nichts, das ich in meinem täglichen Leben brauche." |
| 21 | P67 | Schwimmtrainer, auch direkter Vertrieb | nicht offengelegt | Sagte dem Agent, dass sie im direkten Vertrieb angefangen hatte; er bot fünf Arten von Hilfe an und entwarf eine Beispielprodukt-Karte | - |
| 22 | P12 | Student | Deutschland | Registrierte sich bei den kostenlosen KI-Diensten, führte den Orchestrations-Ordner aus und wählte mit dem Agent vier Richtungen aus dem Katalog (Journalismus, ein Buch, Monetisierung, tiefere Eintauchung in KI); wird ihm seine eigenen Essays geben | - |
| 23 | P71 | Interessenvertretung und öffentliche Gesundheit | Deutschland | Schrieb ihre eigene Eingabeaufforderung; der Agent verkürzte sie und ließ andere KIs die Bilder erstellen; führte den Terminalschritt durch und eine zusätzliche Testaufgabe von sich selbst, um die Tastenanschläge zu merken | "Aufgabe erledigt, schicken Sie die nächste." |
| 24 | P22 | gemeinnützige Gemeinschaftsorganisation | nicht angegeben | Führte die Katalogaufgabe im Agent durch (einige Websites blockierten seine Anmeldung); führte den Terminalschritt durch und bat dann den Agent selbst, zu erklären, was getan worden war; richtete E-Mail-Newsalerts ein | "Erledigt, was kommt als Nächstes?" (übersetzt) |
| 25 | P59 | Videograf | Vereinigte Staaten | Gab dem Agent ein detailliertes Briefing zum Auffinden von profitablen Immobilieninseraten auf seinem lokalen Markt (Überprüfungen, keine Ausgaben, nach Gewinn eingestuft); Ergebnisse noch nicht gezeigt | "Warum brauche ich einen zweiten, wenn der erste funktioniert?" |
| 26 | P84 | nicht angegeben | nicht angegeben | Installierte den Agent selbst über das Terminal; baut eine Website für eine Gemeinschaftsorganisation | "Ich mache etwas, aber ich denke, wir sollten darüber sprechen." (übersetzt) |
| 27 | P66 | Administrator in einer Freizeiteinrichtung | nicht angegeben | Kaufte einen Laptop für den Kurs, installierte den Agent und wechselte vom allgemeinen Modus zum Agent-Tab; beim Schritt zum Öffnen von Konten in zehn KIs | "Alles ist in einer Fremdsprache, was kommt als Nächstes?" (übersetzt) |
| 28 | P82 | Sicherheitsarbeit; Aufbau eines Versandsystems für Spedition | Vereinigte Staaten | Installierte; übertrug seine Chats und Projekte von einem anderen Chatbot, um die beiden zu vergleichen | - |
| 29 | P70 | Recherche und Videobearbeitung für soziale Medien | Vereinigte Staaten | Brachte den Agent mit Hilfe eines Mitbewohners zum Laufen, nachdem er erst von Hand eine Testdatei erstellt hatte | - |
| 30 | P17 | Anwalt für Völkerrecht | nicht angegeben | Installation abgeschlossen; erste Aufgabe gesendet | "Ich habe alles gemacht." (übersetzt) |
| 31 | P93 | Direktbetreuungsfachkraft in der Altenpflege | nicht angegeben | Wechselte vom einfachen Chat zum Agent und zahlte; erste Aufgabe gesendet | - |
| 32 | P54 | stellt Kuchen nach Bestellung her | nicht angegeben | Installierte und zahlte auf einem neuen Laptop; erste Aufgabe gesendet | - |
| 33 | P26 | Betonbau | Vereinigte Staaten | Installierte auf einem reparierten Laptop und sendete ein Foto davon; erste Aufgabe gesendet | "Was kommt als Nächstes?" |
| 34 | P03 | Geschäftsführer eines Außenhandelunternehmens | Vereinigte Staaten | Installierte zusammen mit P35; erste Aufgabe gesendet | - |
| 35 | P45 | Foto- und Videoinhalte, Programmierhintergrund | Deutschland | Erreichte den Schritt zum Öffnen von Konten in zehn KIs, was einen funktionierenden Agent voraussetzt; Details nicht erfasst | - |
Anmerkung: Zusammengestellt aus der Teilnehmerdatenbank. Die Reihen 1 bis 24 sind die dritte Reihe von Tabelle G1; die Reihen 25 bis 35 hatten den Agent bis zum 9. Oktober 2026 installiert und waren ohne gemeldetes Ergebnis gestartet. „–" bedeutet, dass die Aufzeichnung für diese Zeit keine verwendbaren Worte des Teilnehmers enthält.
Wie Anfänger über die Steuerung von Agenten sprechen. Menschen, die wenige Wochen zuvor nur einen Chat-Assistenten genutzt hatten, beschreiben ihre neue Arbeit in eigenen Worten. Ich sammelte jeden Passage, den die Teilnehmerdatenbank und die täglichen Beobachtungsnotizen in einer Teilnehmeraussage für die 35 Personen geben, die einen Agent installiert haben (161 Passages von 32 Personen, etwa 1.070 Wörter), und zählte durch Abgleich von Wortstämmen die Wörter für das System, das sie steuern, für das, was sie daran tun, und für sich selbst; die Zählungen sind grob, und „es" umfasst einige Verwendungen, die sich nicht auf das Werkzeug beziehen.
Tabelle G1c. Wörter, die Anfänger für die Steuerung von Agenten verwenden (Vorkommen in ihren eigenen Berichten).
| Was das Wort benennt | Wörter, in Kategorien übersetzt | Anzahl |
|---|---|---|
| Das System, das sie steuern | „es" | 35 |
| ein Modell- oder Produktname (Claude, GPT, Codex und andere) | 16 | |
| Werkzeug, Programm, App | 11 | |
| „KI", „die KIs" | 9 | |
| Agent | 1 | |
| Assistent, Helfer, Arbeiter | 0 | |
| Was sie damit tun | einrichten, installieren, ausführen | 10 |
| fragen, befragen, anfragen | 9 | |
| Aufgabe, Anweisung, Eingabeaufforderung | 7 | |
| überprüfen, vergleichen | 4 | |
| teilen, übergeben | 2 | |
| Sie selbst | Entwickler, Anfänger | 5 |
Ein paar ihrer eigenen Wörter (Zitate auf Englisch; diejenigen mit der Kennzeichnung „(übersetzt)" waren in einer anderen Sprache geschrieben und die Übersetzung stammt von mir):
- „Es beantwortet nicht nur Fragen, sondern kann tatsächlich mit Dateien und Dokumenten arbeiten." (P18, Internetmarketing)
- „Einer der größten Fehler bei der Verwendung von KI ist die Annahme, dass eine selbstbewusste Antwort automatisch richtig ist." (P20, Fotograf und Retuscheur; übersetzt)
- „Ich fühle mich wirklich wie ein Entwickler jetzt." (P21, gemeinnützige Gemeinschaftsorganisation)
- „Um zu bekommen, was ich will, muss ich überdenken, wie ich die Anfrage formuliere." (P48, Büroarbeit und Online-Vertrieb; übersetzt)
- „Ich denke, die Antwort ist wie eine Frage an zwei Personen." (P59, Videograf)
- „Ein Mal gibt eine KI den besseren Rat, das nächste Mal ist es umgekehrt." (P48, Büroarbeit und Online-Vertrieb; übersetzt)
Drei längere Passages zeigen den Wechsel in der Stimme der Teilnehmer. Ein Innenarchitekt in Ausbildung an seinem ersten Abend mit einem Agent, bevor ihm jemand einen Rat von Modellen gezeigt hatte: „es hat einen Ordner erstellt und arbeitete selbst gut wie mit Dokumenten geöffnet [...] und am Ende bekam ich zwei Dateien mit Namen Stellenangebote von diesem einen Stellenangeboten von jenem einen und nahm sie auch wieder schickte sie sich gegenseitig, so dass sie die Arbeit des anderen bewerteten" (P01, übersetzt, aus einer automatischen Transkription einer Sprachnachricht). Ein Industriekletterer, an dem Tag, an dem er sein erstes kleines Programm mit einem Agent erstellte, fragten bereits nach der nächsten Rolle: „vielleicht lernen, wie man Agenten erstellt, die einen Teil der Arbeit für mich erledigen könnten – in sozialen Netzwerken posten, mich an Dinge erinnern oder mir Vorschläge machen." (P14). Und ein Teilnehmer in gemeinnütziger Gemeinschaftsarbeit, nach seinen ersten Wochen: „Ich spüre ein großes neues Potenzial, das sich öffnet – wie an der Schwelle von etwas Neuem zu stehen." (P21).
Sie bezeichnen das System nach seinem Produktnamen oder einfach „es", fast niemals „Agent", und keiner der Titel auf der Karte aus Abschnitt 3 erscheint; doch sie sprechen davon, Aufgaben zu stellen, zwei Antworten zu vergleichen und eine zuverlässige zu überprüfen, was die Arbeit ist, die das Maß zählt. Wie auf der Karte kommt die Funktion vor einem Namen für sie, und dieser wird als Beschreibung angeboten, nicht als Test einer Behauptung.
Dieselben Menschen nehmen auch an einem separaten vorregistrierten Programm teil (OSF, DOI 10.17605/OSF.IO/X4EGQ), dessen Ergebnisse dort berichtet werden.
G2. Die Prolific-Rater-Studie: stimmen Fachleute in Referenzstunden überein?
Das Maß bemisst jede Arbeit in Referenzstunden, und die Regel aus Abschnitt 5.2 fordert zwei Fachleute auf, ein Stück blind zu bewerten und ruft einen dritten auf, wenn ihre Schätzungen um mehr als den Faktor 1,5 abweichen. Die Rater-Studie fragt, ob berufstätige Fachleute so eng übereinstimmen. Sie wurde auf OSF als Vor-Pilotversuch am 9. Oktober 2026 registriert, bevor Daten erhoben wurden (DOI 10.17605/OSF.IO/V92R8), und wurde am selben Tag auf Prolific gestartet.
Design. Zwei unabhängige Stichproben, insgesamt 119 Teilnehmende rekrutiert und bezahlt: 60 Buchhalter (aktuelle Rolle Buchhalter, Buchhalter, anerkannter oder zertifizierter Buchhalter, Auditor oder Steuerfachmann) und 59 Web- und Softwareentwickler (aktuelle Rolle Softwareentwickler, Softwareentwickler oder Webentwickler). Alle leben im Vereinigten Königreich, den USA, Irland, Kanada, Australien oder Neuseeland, haben eine Prolific-Genehmigungsrate von mindestens 98% über mindestens 100 vorherige Einreichungen und nehmen an nur einer Studie teil. Jede Person bewertet die zehn Aufgaben ihrer eigenen Domäne aus der Aufgabenbank v0 (BK01 bis BK10 oder WT01 bis WT10, wie eingefroren in pilot/task-bank-v0.csv) in Stunden konzentrierter Arbeit für einen qualifizierten Fachmann, der allein ohne KI-Werkzeuge arbeitet, bewertet eine Aufgabe erneut (BK03 oder WT03) als Retest und beantwortet eine Kompetensfrage und eine Aufmerksamkeitsprüfung. Ein Teilnehmer, der eine dieser Prüfungen nicht besteht, wird ausgeschlossen und bezahlt; eine Schätzung, die keine positive Zahl ist oder 2000 Stunden überschreitet, wird verworfen.
Ergebnisse. Primär: pro Domäne der Anteil von Rater-Paaren über alle Aufgaben, deren zwei Schätzungen innerhalb eines Verhältnisses von 1,5 liegen, gegen die im Kalibrierungsprotokoll gesetzte Schwelle von 0,70. Sekundär: derselbe Anteil nach Entfernung des persönlichen Niveaus jedes Raters, ICC(2,1) auf Log-Stunden, der Retest-Anteil innerhalb von 1,5 und die Median-Schätzung jeder Aufgabe gegen die Stufe, die die Bank beabsichtigte. Zum Vergleich: die vier Modell-Rater aus Anhang E setzen 56% ihrer Paare bei diesen 20 Aufgaben innerhalb von 1,5: 47% bei den zehn Buchhaltungsaufgaben und 65% bei den zehn Web-Aufgaben. Die Analyse ist das Skript human_raters.py, eingereicht mit der OSF-Registrierung vor den Daten, und das Ergebnis wird berichtet, wie auch immer es ausfällt.
Ergebnisse.
Screening. Teilnehmende wurden aufgrund des Berufs in ihrem Prolific-Profil zugelassen, und die meisten Antworten hinter Prolific-Filtern sind selbstberichtet (Prolific, 2026), sodass die Kompetensfrage die einzige Überprüfung des Fachs durch das Design war. In der Buchhaltungsstichprobe war es eine Multiple-Choice-Frage zur doppelten Buchung für eine von einem Kunden erhaltene Zahlung auf die Bank. Von den 60 Personen, die in diese Stichprobe aufgenommen wurden, beantworteten 11 (18%) sie falsch, acht von ihnen durch Vertauschung von Soll und Haben, und keiner scheiterte an der Aufmerksamkeitsprüfung; wie registriert, werden sie von den folgenden Ergebnissen ausgeschlossen und wurden bezahlt. In einem nicht registrierten Vergleich bewerteten diese 11 die größeren Aufgaben der Bank mit weniger Stunden als die anderen Teilnehmenden der Stichprobe: ihre Mediane für die drei Aufgaben für die Woche-Stufe (BK08 bis BK10) waren 6, 6 und 8 Stunden, gegenüber 8, 8 und 12 für die anderen 49. Mit 11 Personen ist dies ein zu testender Hinweis, keine Schätzung, und Hast oder eine missverstandene Frage würde eine ähnliche Spur hinterlassen; es passt zur Lesung, dass eine Person, die ein Fach nicht beherrscht, nicht alle Schritte ihrer größeren Aufgaben sieht (Abschnitt 6.5). In der Web-Tools-Stichprobe wiederholte sich derselbe Vergleich nicht: die 8 Entwickler, die ihre Kompetensfrage nicht bestanden, gaben den drei Aufgaben für die Woche Mediane von 24,5, 27,5 und 19 Stunden, gegenüber 20, 16 und 20 für die anderen 50, sodass der Hinweis nur auf Buchhaltung beschränkt bleibt (Explorative Analysen unten).
Die Skripte für diesen Abschnitt befinden sich im Begleitrepository (pilot/). prolific_to_long.py schreibt die lange Datei von Bewertungen aus den Prolific-Exporten; sie liest jede Schätzung wie geschrieben, behält eine Antwort ohne Zahl oder mit mehreren, wie z. B. ein Bereich, als Text bei, damit die registrierte Regel sie verwirft, und listet jede Antwort auf, die keine einfache Zahl ist. table_g2.py druckt Tabelle G2 mit den Funktionen des registrierten Skripts, unverändert aufgerufen, neben den Modell-Ratern bei den gleichen Aufgaben. screen_compare.py berechnet den oben genannten Vergleich des Screenings neu, mit dem genauen Intervall und einem Permutationstest über Rater für die Woche-Aufgaben.
Übereinstimmung. Die Plätze wurden am 9. und 10. Oktober 2026 besetzt, und 118 Teilnehmer gaben Antworten ab, 60 Buchhalter und 58 Entwickler; die Antworten eines Entwicklers, dessen Einreichung genehmigt und bezahlt wurde, wurden vom Umfragetool nicht gespeichert. Nach den registrierten Ausschlüssen (11 Buchhalter und 8 Entwickler scheiterten bei der Kompetenzfrage; niemand scheiterte beim Aufmerksamkeitstest) bleiben 49 Buchhalter und 50 Entwickler. Der registrierte Schwellenwert wurde in keinem Bereich erreicht: 28% der Buchhalterpaare und 25% der Entwicklerpaare lagen innerhalb eines Verhältnisses von 1,5, gegenüber 0,70 (Tabelle G3). Die Fachleute ordneten die Aufgaben konsistent, wobei die Mediane jedes Bereichs von den für Hour bestimmten Aufgaben zu den für Week bestimmten Aufgaben anstiegen, aber sie waren sich bei den Stunden um mehr uneinig, als die Regel für zwei Beurteiler erlaubt. Das Entfernen des persönlichen Niveaus jedes Beurteilers erhöhte den Anteil nur auf 34% und 35%, sodass die Uneinigkeit über die Arbeit selbst besteht und nicht über eine Gewohnheit, auf- oder abzurunden. ICC(2,1) auf Loghours war 0,34 für Buchhaltung und 0,46 für Web-Tools, und die zwei Schätzungen eines Beurteilers für dieselbe Aufgabe stimmten in 53% und 74% der Fälle innerhalb von 1,5 überein. Die vier Modellbeurteiler aus Anhang E erreichten bei denselben 20 Aufgaben 56% und stimmten untereinander enger überein als die Fachleute, was mehr über die Streuung der Fachleute aussagt als über die Genauigkeit der Modelle. Gegenüber Praktizierenden sitzt die Bank etwa eine Stufe höher: jede für Day bestimmte Aufgabe hatte einen Median von 2 bis 7 Stunden, was Hour ist, und jede für Week bestimmte Aufgabe einen Median von 8 bis 20 Stunden, was Day ist. Im obigen explorativen Vergleich stimmten die 11 ausgeschlossenen Buchhalter untereinander nicht besser überein als die anderen (28% der Paare innerhalb von 1,5). Die Ergebnisse legen drei Teile der Beurteilungsregel fest. Beurteiler kalibrieren bei Aufgaben mit gemessenen Zeiten, was die Ebene verankert, die die Mediane als falsch erweisen. Eine Aufgabe wird nach dem Median eines Panels bemessen und nicht nach zwei Beurteilern, da eine Streuung dieser Breite die meisten Paare zu einem dritten Beurteiler schicken würde. Und die Aufgabenbank wird von den Medianen der Praktizierenden neu gebändert, was ihre Aufgaben um eine Stufe senkt (Tabelle G3b).
Tabelle G2. Übereinstimmung von Fachleuten bei Referenzstunden, nach Bereich.
| Bereich | Behalten | Ausgeschlossen | Paare innerhalb von 1,5 | Nach Entfernen der Beurteilungsebene | ICC(2,1), Loghours | Test-Retest innerhalb von 1,5 |
|---|---|---|---|---|---|---|
| Buchhaltung | 49 | 11 | 0.283 | 0.335 | 0.335 (49 vollständig) | 0.531 (n = 49) |
| Web-Tools | 50 | 8 | 0.247 | 0.349 | 0.461 (49 vollständig) | 0.735 (n = 49) |
Anmerkung: Registrierter Schwellenwert für Paare innerhalb von 1,5: 0,70, in keinem Bereich erreicht. Ausschlüsse sind Fehler bei der Kompetenzfrage; kein Teilnehmer scheiterte beim Aufmerksamkeitstest. Paare werden über alle zehn Aufgaben eines Bereichs genommen (11.760 für Buchhaltung, 11.809 für Web-Tools). Test-Retest vergleicht zwei Schätzungen eines Beurteilers von BK03 oder WT03. Ausgabe von human_raters.py wie registriert (DOI 10.17605/OSF.IO/V92R8).
Tabelle G3b. Medianschätzung jeder Aufgabe gegenüber der Stufe, die die Bank beabsichtigte (Stunden).
| Beabsichtigte Stufe | Buchhaltungsaufgabe: Median | Stufe des Medians | Web-Tools-Aufgabe: Median | Stufe des Medians |
|---|---|---|---|---|
| Hour | BK01: 2.0; BK02: 2.0; BK03: 1.5 | Hour | WT01: 1.0; WT02: 1.0; WT03: 2.0 | Hour |
| Day | BK04: 3.0; BK05: 2.0; BK06: 3.0; BK07: 4.0 | Hour | WT04: 7.0; WT05: 6.0; WT06: 4.0; WT07: 4.0 | Hour |
| Week | BK08: 8.0; BK09: 8.0; BK10: 12.0 | Day | WT08: 20.0; WT09: 16.0; WT10: 20.0 | Day |
Anmerkung: Mediane über die behaltenen Beurteiler. Ein Median unter 8 Stunden fällt in Hour und einer von 8 bis unter 40 Stunden in Day. Jede für Day oder Week bestimmte Aufgabe fällt eine Stufe tiefer.
Explorative Analysen. Die Analysen in diesem Abschnitt waren nicht registriert. Sie verwenden das registrierte Loader-, Ausschluss- und Testverfahren, und ihre Skripte und Ausgaben sind pilot/exploratory_prolific.py und pilot/results/prolific-2026-10/exploratory-output.txt im Begleitrepository. Beim Resampling von Bewertern ergeben sich 95%-Intervalle von 0,24 bis 0,33 (Buchhaltung) und 0,21 bis 0,29 (Web-Tools) für den primären Anteil. Panelgröße (Tabelle G4). Für jede Aufgabe wurden 2.000-mal zwei disjunkte Panels mit je k beibehaltenen Bewertern gezogen und ihre Mediane verglichen. Bei rohen Schätzungen stimmten die beiden Mediane in mindestens 70 % der Ziehungen nur bei 15 Buchhältern oder 21 Entwicklern pro Panel innerhalb von 1,5 überein. Wenn das persönliche Niveau jedes Bewerters entfernt wurde, das ist der Zweck der Kalibrierung bei Aufgaben mit gemessenen Zeiten, erreichten Panels mit sieben Personen 0,71 und 0,69, und Panels mit neun Personen 0,77 und 0,76. Um auf der gleichen Stufe zu landen, das ist, was die Maßnahme aufzeichnet, braucht es weniger: fünf kalibrierte Bewerter pro Panel taten dies in 0,81 und 0,84 der Ziehungen. Nach der Zwei-Bewerter-Regel in Abschnitt 5.2 würde ein dritter Bewerter in 72 % und 75 % der Arbeiten hinzugezogen. Erfahrung (Tabelle G4b). 43 der 98 beibehaltenen Bewerter mit vollständigen Antworten meldeten mehr als 10 Jahre Erfahrung in ihrem Bereich. Sie stimmten untereinander nicht enger überein als die übrigen, und die Jahre im Bereich sagten nicht voraus, wie weit ein Bewerter vom Median der anderen entfernt saß (Rangkorrelation +0,18 und –0,10, Permutations-p = 0,21 und 0,47). Erfahrene Entwickler schätzten höher ein als andere Entwickler (1,32 gegenüber 0,76-fach des Medians der anderen, p = 0,02); erfahrene Buchhalter nicht (1,04 gegenüber 1,07, p = 0,88). Aufgaben. Die Uneinigkeit wächst mit der Größe: fünf der sechs am meisten umstrittenen der 20 Aufgaben waren für „Woche" bestimmte Aufgaben, bei denen 24 % (Buchhaltung) und 20 % (Web-Tools) der Paare innerhalb von 1,5 lagen, gegenüber 31 % und 27 % bei den für „Stunde" bestimmten Aufgaben; der Interquartilbereich einer „Woche"-Aufgabe spannte einen Faktor von 4 bis 8. Geschwindigkeit und Einheiten. Das schnellste Viertel der Buchhalter (3,6 Minuten oder weniger für die gesamte Umfrage) stimmte enger überein als die übrigen (0,37 gegenüber 0,26), und bei Entwicklern machte Geschwindigkeit keinen Unterschied (0,24 gegenüber 0,24). Die Beantwortung einiger Aufgaben in Minuten statt Stunden machte in keinem Bereich einen Unterschied (0,31 gegenüber 0,31; 0,28 gegenüber 0,31). Zwei Buchhalter verwandten 40 Stunden oder mehr für eine für „Stunde" bestimmte Aufgabe, was wie eingetippte Minuten statt Stunden aussieht; ohne sie beträgt der Buchaltungsanteil 0,284. Ein beibehaltener Entwickler tippte Text statt Zahlen ein, daher gingen nur eine seiner Schätzungen in die Analyse ein. Screening. Beim Vergleich der Schätzungen jedes Bewerters für die „Woche"-Aufgaben mit seinen eigenen Schätzungen für die „Stunde"-Aufgaben, sodass sich ein persönliches Niveau aufhebt, bewerteten die ausgeschlossenen Buchhalter die größeren Aufgaben 3,2-mal so hoch wie die kleineren gegenüber 6,2-mal für die beibehaltenen (Permutations-p = 0,10), und die ausgeschlossenen Entwickler 15,8-mal gegenüber 10,6 (p = 0,37). Wiederholungsmessung. Die wiederholte Schätzung war für 25 Buchhalter höher und für 4 niedriger, und für 17 Entwickler höher und für 2 niedriger (genauer Vorzeichentest p < 0,001 in beiden Fällen), um etwa 30 % im geometrischen Mittel, was mit einer Verankerung an den größeren, dazwischen bewerteten Aufgaben konsistent ist. Diese Ergebnisse zusammengenommen ordnen die Streuung eher der Arbeit und ihrer Skalierung zu als einer Untergruppe gehetzter, unerfahrener oder unqualifizierter Bewerter, und sie bemessen die Panelogröße, die die Regel benötigt: kalibrierte Bewerter, fünf bis neun pro Arbeitseinheit, bewertet nach Stufe (Tabelle G4).
Tabelle G4. Zwei unabhängige Panels mit je k Bewertern pro Aufgabe: Anteil der Ziehungen, deren Mediane innerhalb von 1,5 übereinstimmen / Anteil auf der gleichen Stufe (explorativ).
| Bewerter pro Panel | Buchhaltung, roh | Buchhaltung, Niveau entfernt | Web-Tools, roh | Web-Tools, Niveau entfernt |
|---|---|---|---|---|
| 1 | 0,28 / 0,51 | 0,34 / 0,62 | 0,24 / 0,46 | 0,34 / 0,60 |
| 3 | 0,43 / 0,68 | 0,51 / 0,76 | 0,37 / 0,60 | 0,52 / 0,78 |
| 5 | 0,51 / 0,77 | 0,63 / 0,81 | 0,43 / 0,68 | 0,62 / 0,84 |
| 7 | 0,58 / 0,82 | 0,71 / 0,84 | 0,49 / 0,74 | 0,69 / 0,87 |
| 9 | 0,62 / 0,85 | 0,77 / 0,87 | 0,54 / 0,78 | 0,76 / 0,89 |
| 15 | 0,71 / 0,88 | 0,88 / 0,91 | 0,64 / 0,84 | 0,86 / 0,94 |
| 21 | 0,76 / 0,89 | 0,94 / 0,95 | 0,72 / 0,84 | 0,92 / 0,98 |
Anmerkung: Beibehaltene Bewerter mit allen zehn Schätzungen (49 pro Bereich); 2.000 Ziehungen pro Aufgabe, Panels disjunkt innerhalb einer Ziehung; Seed 20261011. Niveau entfernt: Das mittlere Logarithmusverhältnis jedes Bewerters zum Median aller Bewerter auf jeder Aufgabe wird in der Stichprobe subtrahiert, wie bei dem registrierten sekundären Ergebnis, daher sind diese Spalten eine obere Schätzung dessen, was Kalibrierung auf separaten Ankeraufgaben ergeben würde. Nicht registriert; Ausgabe von pilot/exploratory_prolific.py.
Tabelle G4b. Jahre im Bereich und Übereinstimmung (beibehaltene Bewerter mit vollständigen Antworten, explorativ).
| Bereich | Gruppe | Bewerter | Paare innerhalb von 1,5 innerhalb der Gruppe | Niveau gegenüber dem Median der anderen |
|---|---|---|---|---|
| Buchhaltung | Mehr als 10 Jahre | 23 | 0,268 | 1,04 |
| Buchhaltung | 10 Jahre oder weniger | 26 | 0,299 | 1,07 (p = 0,88) |
| Web-Tools | Mehr als 10 Jahre | 20 | 0,297 | 1,32 |
| Web-Tools | 10 Jahre oder weniger | 29 | 0,242 | 0,76 (p = 0,02) |
Anmerkung: Niveau ist das geometrische mittlere Verhältnis der Schätzungen eines Bewerters zum Median der anderen Bewerter auf den gleichen Aufgaben; p ist ein zweiseitiger Permutationstest (5.000 Permutationen) der Differenz der mittleren logarithmischen Niveaus. Nicht registriert.
Zitierweise
Chernets, V. (2026). After the Programmer Divide: Ein Maßstab für Menschen, die durch KI-Agenten entwickeln [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7589918
@misc{chernets2026aftertheprogrammerdivide,
  author       = {Chernets, Vadym},
  title        = {{After the Programmer Divide: One Measure for People Who Build Through AI Agents}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7589918},
  url          = {https://doi.org/10.2139/ssrn.7589918}
}