7 डाउनलोड का मतलब क्या है? SSRN रैंकिंग सूर्यास्त के बाद मेट्रिक अंधापन और विद्वतापूर्ण ध्यान की ठंडी शुरुआत
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- रिकॉर्ड का संस्करण: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- संग्रहीत प्रति, उद्धरण योग्य और डाउनलोड योग्य: 10.5281/zenodo.22166896 — अवधारणा DOI, हमेशा नवीनतम संस्करण को हल करता है
- Markdown और PDF के रूप में पूर्ण पाठ: GitHub
- पठनीय HTML: https://polyhelper.ai/research/download-metrics/
समान पाठ चार सतहों पर है ताकि इसे प्राप्त किया जा सके जब उनमें से एक इसकी सेवा नहीं कर सकता। SSRN के पास रिकॉर्ड का संस्करण है; उस का उद्धरण दें।
7 डाउनलोड का क्या मतलब है?
मेट्रिक अंधापन और SSRN रैंकिंग सूर्यास्त के बाद विद्वान ध्यान की कोल्ड स्टार्ट
पांडुलिपि प्रकार: महत्वपूर्ण संश्लेषण, पद्धतिगत ढांचा, और पूर्व-पंजीकरण-तैयार अनुभवजन्य एजेंडा
संस्करण: सितंबर 2026
लेखक: Vadym Chernets, PhD1
संबद्धता: AI systems architect
सारांश
15 जुलाई 2026 को, सामाजिक विज्ञान अनुसंधान नेटवर्क (SSRN) ने अपनी सार्वजनिक रैंकिंग को सेवानिवृत्त किया, कागज, लेखक, और संस्थागत लीग टेबल जो लंबे समय से प्लेटफॉर्म के एकमात्र व्यापक रूप से सुलभ तुलनात्मक ढांचा प्रदान करते थे, जबकि डाउनलोड गणना और उद्धरण सांख्यिकी व्यक्तिगत पत्र और लेखक प्रोफाइल पर रहीं (SSRN ब्लॉग, 15 जुलाई 2026)। परिणाम एक विषम मापन घटना थी: लेखकों ने संख्याओं को रखा और मानदंड को खो दिया। SSRN के काउंटर अर्थहीन नहीं बन गए; वे अपठनीय बन गए। प्रत्येक डाउनलोड गणना एक पैमाने के बिना एक संख्या बन गई।
यह लेख तर्क देता है कि प्रश्न "7 डाउनलोड का क्या मतलब है?" वैज्ञानिकी दृष्टि से गलत तरीके से प्रस्तावित है जब तक कि एक पत्र के संदर्भ वर्ग को निर्दिष्ट नहीं किया जाता। एक कच्ची संचयी उपयोग गणना को पत्र की आयु, क्षेत्र, पोस्टिंग समूह, वितरण एक्सपोजर, और पूर्व लेखक दृश्यता के बिना व्याख्या नहीं की जा सकती। समस्या नई और कम-दृश्यता लेखकों के लिए सबसे तीव्र है, जिनका प्रारंभिक ध्यान विद्वत् रुचि की तुलना में प्लेटफॉर्म आर्किटेक्चर, ई-मेल-अलर्ट वितरण, खोज अनुक्रमण, लेखक प्रतिष्ठा, और ध्यान की हैवी-टेल्ड गतिशीलता द्वारा अधिक आकार का है। हम इस स्थिति को विद्वान ध्यान की कोल्ड स्टार्ट नाम देते हैं। आवश्यकता नई नहीं है: क्षेत्र, आयु और दस्तावेज़ प्रकार के लिए गणना को सामान्य बनाना उद्धरण ग्रंथसूची में लंबे समय से स्थापित अभ्यास है, और उपयोग डेटा के लिए समानांतर प्रश्न डेढ़ दशक पहले पहले से ही उठाया जा रहा था (Kurtz & Bollen, 2010)। उस प्रकार के ग्रंथसूची संकेतक एक ऐसे डेटाबेस को मानते हैं जिसमें क्षेत्र, आयु और प्रकार ज्ञात हैं और संकेतक पाठक की ओर से परिकलित किया जाता है, जबकि एक प्रीप्रिंट प्लेटफॉर्म अपने लेखकों को कोई संदर्भ वर्ग के बिना एक नंगी पूर्णांक, कोई उपकरण, और (जुलाई 2026 के बाद से) कोई तुलनात्मक ढांचा के साथ हाथ देता है। जो गायब है वह विधि नहीं है बल्कि इसका तात्कालिकीकरण है: SSRN एक लेखक के लिए इसे लागू करने वाला कोई उपकरण प्रदान नहीं करता है।
उपलब्ध साक्ष्य दिखाते हैं कि साधारण औसत क्यों गुमराह करते हैं। SSRN नेटवर्क के एकमात्र हाल की प्रकाशित बाहरी बड़े-नमूने अध्ययन में (2,361 विपणन कार्यपत्र), माध्य डाउनलोड 221.3 थे जबकि माध्यिका 87 थी, और माध्य यहां तक कि 75वें प्रतिशतक (206) से भी अधिक था (Jo & Li, 2026)। डाउनलोड वितरण अर्ध-लॉगनॉर्मल हैं और चरम ऊपरी पूंछ के साथ, और एक एकल अनुशासनात्मक नेटवर्क के भीतर औसत डाउनलोड उप-क्षेत्रों में लगभग आठ के कारक से भिन्न होते हैं (Whalen, 2018), इसलिए एक मंच-व्यापी माध्य किसी विशेष पत्र का वर्णन नहीं करता; एक नए पत्र की सामान्यकरण के इस काल्पनिक के विरुद्ध बेंचमार्क करना है। उपलब्ध रूपांतरण साक्ष्य पर, 40 सारांश दृश्यों से 7 डाउनलोड जैसी गणना विफलता का संकेत नहीं देती। यह एक स्क्रीनिंग परिणाम है जिसके चारों ओर एक विस्तृत अंतराल है, और इसे पहुंच, रूपांतरण, आयु और क्षेत्र के माध्यम से पढ़ा जाना चाहिए।
उस साक्ष्य से लेख पोस्ट-रैंकिंग SSRN मेट्रिक्स के लिए एक व्याख्या ढांचा बनाता है, जो जोखिम, सारांश दृश्य, पूर्ण-पाठ डाउनलोड और डाउनस्ट्रीम उपयोग को अलग करता है, और यह एक पहुंच-दर-रूपांतरण निदान जोड़ता है जो अदृश्यता को अस्वीकृति से अलग करता है। एक एकल व्यर्थता संख्या के बजाय यह Cold-Start Scholarly Attention Benchmark (CSAB) का प्रस्ताव देता है, एक बहु-आयामी विकल्प। एक डोज़ियर प्रोटोकॉल इसके साथ जाता है, जिसके तहत हर रिपोर्ट की गई मेट्रिक अपने स्रोत, समय खिड़की, संदर्भ वर्ग और सीमाओं को ले जाती है। लेख तब लापता पैमाने को फिर से बनाने के लिए एक पूर्व-पंजीकरण-तैयार एजेंडा निर्धारित करता है: दिन 1 से दिन 180 तक देखे गए नए SSRN पत्रों का एक भावी पैनल, क्यूरेटेड ईमेल-सतर्क वितरण और Rankings सेवानिवृत्ति का उपयोग करके अर्ध-प्रयोग, एक सामुदायिक-निर्मित प्रतिशतक बेंचमार्क, और AI उत्तर इंजन में प्रीप्रिंट दृश्यमानता का एक ऑडिट। साक्ष्य आधार Appendix E के गैर-प्रतिनिधि आर्काइवल क्रॉस-सेक्शन के साथ उद्धृत अध्ययनों को जोड़ता है; लेख निर्दिष्ट करता है कि लापता बेंचमार्क कैसे फिर से बनाया जा सकता है, और क्यों कोई भी डाउनलोड गणना एक मंच पर इसके संदर्भ के बिना परिचालित नहीं होनी चाहिए जो इसे प्रदान नहीं करता है।
कीवर्ड: डाउनलोड गणना; उपयोग मेट्रिक्स; क्षेत्र सामान्यीकरण; अनुसंधान मूल्यांकन; प्रीप्रिंट्स; वैज्ञानिकी; प्रचार और कार्यकाल; कानूनी विद्वता; altmetrics; Matthew प्रभाव; संचयी लाभ; ध्यान अर्थव्यवस्था; सारांश दृश्य; शिकारी पत्रिकाएं; जनरेटिव इंजन अनुकूलन।
JEL वर्गीकरण: A14; D83; I23; O33; L86
मुख्य बिंदु
कच्चे SSRN डाउनलोड गणना के पास पत्र की आयु, क्षेत्र, पोस्टिंग समूह, वितरण जोखिम और पूर्व लेखक दृश्यमानता के बिना कोई स्थिर व्याख्या नहीं है।
15 जुलाई 2026 की Rankings सूर्यास्त ने मंच के एकमात्र सार्वजनिक तुलनात्मक ढांचे को हटा दिया जबकि हर काउंटर जीवित रहा: लेखकों ने संख्याओं को रखा और मानक खो दिए।
एकमात्र हाल की प्रकाशित बड़े-नमूने वितरण में, डाउनलोड दृढ़ता से दाईं ओर विषम हैं, माध्य 221.3 बनाम माध्यिका 87: "औसत" पत्र निर्माण द्वारा असामान्य है।
पहुंच (सारांश दृश्य) को रूपांतरण (दृश्य प्रति डाउनलोड) से अलग करना अदृश्यता को अस्वीकृति से अलग करता है: विभिन्न निदान जो विभिन्न कार्रवाई की मांग करते हैं।
प्रकाशित दृश्य-से-डाउनलोड रूपांतरण लंगर लगभग 11–19% की एक बैंड में क्लस्टर करते हैं, जिस पर 40 सारांश दृश्यों से 7 डाउनलोड एक स्क्रीनिंग परिणाम के रूप में सीमा के अनुरूप हैं: नहीं, उपलब्ध साक्ष्य पर, विफलता का संकेत।
Cold-Start Scholarly Attention Benchmark (CSAB) एक एकल व्यर्थता संख्या के बजाय सामान्यीकृत पहुंच, डाउनलोड प्रदर्शन, रूपांतरण, गति और डाउनस्ट्रीम सत्यापन रिपोर्ट करता है।
एक पूर्व-निर्दिष्ट, पूर्व-पंजीकरण-तैयार एजेंडा (एक भावी पैनल, दो असामान्य रूप से समय पर अर्ध-प्रयोग जो मंच के अपने सुधारों द्वारा बनाए गए हैं, एक सामुदायिक प्रतिशतक बेंचमार्क, और एक AI उत्तर-इंजन ऑडिट जनरेटिव-इंजन अनुकूलन को साक्ष्य-आधारित माना जा सके) निर्दिष्ट करता है कि लापता पैमाने को कैसे फिर से बनाया जाए।
कार्यक्षेत्र और साक्ष्य अनुशासन
यह लेख एक महत्वपूर्ण संश्लेषण है, एक पद्धतिगत ढांचे और एक पूर्व-पंजीकरण-तैयार अनुभवजन्य एजेंडा के साथ संयुक्त, और एकमात्र नया डेटा जो यह रिपोर्ट करता है वह Appendix E का गैर-प्रतिनिधि आर्काइवल क्रॉस-सेक्शन है। साक्ष्य की तीन श्रेणियां पूरे लेख में अलग रखी जाती हैं, और लेख में हर संख्या अपनी श्रेणी के साथ आती है:
1. सत्यापित अनुमान: प्रकाशित संख्याएं उनके प्राथमिक स्रोत के विरुद्ध जांची गई और उनके नमूने ढांचे और vintage के साथ उद्धृत, या जहां सत्यापन आंशिक है वहां बताए गए सावधानियों के साथ सत्यापित।
2. ऐतिहासिक लंगर: पहले नमूने और सेवानिवृत्त मंच सुविधाएं, बरकरार क्योंकि वे वितरणात्मक संरचना को प्रकट करते हैं, न कि क्योंकि वे 2026 के लिए कैलिब्रेटेड मानदंड बने रहते हैं।
3. वैचारिक और प्रस्तावित आउटपुट: पूर्व-निर्दिष्ट भविष्यवाणियां, बेंचमार्क टेम्पलेट, और अध्ययन डिज़ाइन, स्पष्ट रूप से इस तरह के रूप में लेबल किया गया और कोई संश्लेषित निष्कर्ष नहीं होता है।
व्याख्या क्षमता समस्या, संदर्भ-वर्ग तर्क, और पहुंच–रूपांतरण अपघटन विश्लेषणात्मक दावे हैं जो उपरोक्त साक्ष्य पर बचाव किया जाता है। लेख जो बुनियादी ढांचा प्रस्तावित करता है वह समुदाय के लिए बनाने और मूल्यांकन करने के लिए एक डिज़ाइन के रूप में पेश किया जाता है, एक निपटारे पर नहीं: एक सामुदायिक प्रतिशतक रजिस्ट्री (अनुभाग 8.8), एक लेखक-सामना करने वाला कैलकुलेटर, और अनुभाग 8.10 का ऑर्केस्ट्रेशन आर्किटेक्चर। लेख में कोई निदान दावा किसी भी इसे अपनाए जाने पर निर्भर नहीं करता।
एक क्षेत्र में जिसने अभी अपने सबसे अधिक उपयोग किए जाने वाले सार्वजनिक बेंचमार्क को खो दिया है, दुर्लभ सार्वजनिक अच्छा एक प्रतिलिपि योग्य प्रोटोकॉल है जो कोई भी लेखक, कहीं भी चला सकता है, साथ ही एक संश्लेषण जो मौजूदा संख्याओं की उत्पत्ति और आयु को बताता है।
40-सारांश-दृश्य-और-7-डाउनलोड केस इस पद्धतिगत संश्लेषण के माध्यम से आवर्तक होता है क्योंकि यह तालिका 1 में सूचीबद्ध प्रश्नों को दर्शाता है; निष्कर्ष उद्धृत साक्ष्य पर आराम करते हैं, किसी भी एकल डैशबोर्ड पर नहीं।
तीन नियम संश्लेषण को स्वयं नियंत्रित करते हैं। इकाइयों को दो सामान्य denominators, प्रति पत्र आजीवन डाउनलोड और प्रति पत्र बारह मास डाउनलोड के लिए सामान्यीकृत किया जाता है। ब्रिजिंग केवल तभी किया जाता है जब एक स्रोत स्वयं आवश्यक अनुपात रिपोर्ट करता है, और देशी इकाई हर जगह बरकरार रहती है जहां रूपांतरण ऐसी assumptions की मांग करेगा जो स्रोत समर्थन नहीं करते। हर तथ्य दावे सत्यापन स्तर (प्राथमिक स्रोत के विरुद्ध सत्यापित, बताए गए सावधानियों के साथ सत्यापित, या सत्यापन लंबित) तालिका के स्रोत-विश्वास स्तंभों में दर्ज किया जाता है। जहां स्रोत संघर्ष करते हैं, सबसे प्रमुखता से प्रभावी सूर्यास्त तारीख के बारे में, संघर्ष बाद के आधिकारिक स्रोत के पक्ष में हल किया जाता है और फ़्लैग किया जाता है। प्रत्येक अनुमान अपना स्तर, vintage, और aging caveat कहीं भी फिर से उपयोग किए जाने रखता है।
एक ही नियम स्रोत समावेश को नियंत्रित करता है: एक संदर्भ को तब रखा जाता है जब यह एक विशिष्ट तंत्र, परिणाम, प्लेटफॉर्म तथ्य, मापन चेतावनी, या डिज़ाइन पूर्वनिर्धारित योजना में योगदान देता है; उद्धरण मात्रा एक लक्ष्य नहीं है। पोस्ट करना और पढ़े जाना अलग-अलग उपलब्धियां हैं; यह लेख दूसरे के बारे में है, और इसे मापने के लिए उपकरणों के पतन के बारे में है। एक प्रशंसनीय दिखने वाली तालिका प्रमाण नहीं है, और संदर्भ-मुक्त संख्याओं के बारे में एक लेख में वह नियम पहले लेख को ही बांधता है।
1. परिचय
1.1 चालीस दृश्य, सात डाउनलोड
एक शोधकर्ता पर विचार करें (प्रारंभिक-कैरियर, शायद अनुबद्ध नहीं, या प्लेटफ़ॉर्म के लिए बस नए) जो SSRN को एक सावधानीपूर्वक तैयार किया गया कार्यपत्र अपलोड करते हैं और, कुछ हफ्तों बाद, अगस्त 2026 में, पत्र के सांख्यिकी पैनल को खोलते हैं। डैशबोर्ड "40 सारांश दृश्य" और "7 डाउनलोड" की रिपोर्ट करता है। उस समय, विद्वानों के ध्यान की सांख्यिकी का कार्यसाधक ज्ञान के बिना, लेखक यह नहीं बता सकते कि ये आंकड़े सहकर्मियों द्वारा विनाशकारी अस्वीकृति का मतलब है, एक विशेष पाठ के लिए मानक सांख्यिकीय आधार, या एक असामान्य रूप से मजबूत प्रक्षेपवक्र की शुरुआत। लेखक सहकर्मियों से पूछते हैं: "क्या वह भयानक है?" कोई नहीं कह सकता। न तो डैशबोर्ड, न ही विद्वानों का साहित्य, न ही प्लेटफ़ॉर्म स्वयं एक उत्तर प्रदान करता है, और गणना के पास पढ़ने के लिए कोई पैमाना नहीं है। स्थिति मीट्रिक अंधापन है, अपने स्वयं के काउंटर के सामने खड़े होकर विफलता को सामान्य प्रदर्शन से सफलता से बताने में असमर्थता। यह शब्द यहाँ एक सैद्धांतिक निर्माण के रूप में पेश किया गया है, न कि एक मापा हुआ मात्रा। अध्ययन 4 (अनुभाग 8.6) ठोस संकेतक प्रदान करता है (उन लेखकों का हिस्सा जो कभी भी अपनी गणना को किसी भी बेंचमार्क के विरुद्ध रखने की रिपोर्ट करते हैं, साथ ही कम गणना पहली रीडिंग के वितरण के साथ) ताकि "मीट्रिक अंधापन" किसी ऐसी चीज़ का नाम दे सके जिसे एक पूर्वनिर्धारित सर्वेक्षण अनुमान लगा सकता है।
एक साथी दृश्य, सामुदायिक मंचों में लेखकों द्वारा सुनाया गया और यहाँ एक दृष्टांत के रूप में प्रस्तुत किया गया, अधिक कठोर है। एक शोधकर्ता एक प्रथम प्रीप्रिंट अपलोड करते हैं और डैशबोर्ड को शून्य दृश्य और शून्य डाउनलोड पर रखते हुए देखते हैं, जबकि कुछ दिनों के भीतर, इनबॉक्स पाँच ईमेल देता है जो पांडुलिपि की माँग करने वाली पत्रिकाओं से, सभी शिकारी हैं। नए आने वाले को मिलने वाला एकमात्र जवाब शिकारी पत्रिकाओं से आता है। अनुभाग 7 इस असमरूपता को स्पष्ट परिकल्पना के एक सेट के रूप में विकसित करता है, और अध्ययन 3 (अनुभाग 8.6) इसे समय देने का तरीका निर्दिष्ट करता है। दृश्य सूचना निर्वात का जीवंत समकक्ष है: वैध ध्यान अर्थव्यवस्था इस लेखक को इसके विरुद्ध पढ़ने के लिए कुछ भी नहीं के साथ एक गणना देती है, जबकि परजीवी अर्थव्यवस्था प्रशंसा और कोई पाठक प्रदान करती है।
गर्मियों 2026 तक, एक अनुमानित उत्तर मौजूद था। SSRN की सार्वजनिक रैंकिंग (शीर्ष पत्र, शीर्ष लेखक, और संस्थागत लीग तालिका) एक लेखक को एक दृश्यमान वितरण के भीतर एक गणना का पता लगाने की अनुमति देती थी। 15 जुलाई 2026 को उन रैंकिंगों को सेवानिवृत्त किया गया [149]। सेवानिवृत्ति 12 जून 2026 की घोषणा का पालन किया गया जो "अनुसंधान को अपने लिए बोलने" के बयान के साथ निर्णय को फ्रेम किया [148] और 13 अप्रैल 2026 को घोषित एक पूर्व कौशल पुनः केंद्रित करना, इसके मूल अनुसंधान-साझाकरण मिशन पर प्लेटफ़ॉर्म के संसाधनों को [146]। हटाना असमरूप था: प्रति-पत्र डाउनलोड गणना और उद्धरण आँकड़े "आपकी व्यक्तिगत पत्रों और लेखक प्रोफ़ाइल पर रिकॉर्ड और प्रदर्शित होते रहेंगे" [149], जबकि वितरण जो उन गणनाओं को पैमाना दिया था, चला गया। डैशबोर्ड पर शोधकर्ता की स्थिति को इस प्रकार प्लेटफ़ॉर्म के पूरे उपयोगकर्ता आधार के लिए सामान्यीकृत किया गया था: 1.9 मिलियन से अधिक लेखक और 1.5 मिलियन पत्र [49]।
यह लेख उस स्थिति के बारे में है, और इसके प्रबंध के दो भाग हैं। रैंकिंग का बंद होना संदर्भ को हटाया, डेटा को नहीं। प्रति-पत्र काउंटर सूर्यास्त से बच गए और अभी भी प्रदर्शित होते हैं; तुलनात्मक पैमाना जिसके माध्यम से उन काउंटर को पढ़ा जा सकता था, चला गया है, यह कारण है कि मीट्रिक्स अपठनीय हैं और अर्थहीन नहीं हैं।
दूसरा यह है कि प्रश्न, "7 डाउनलोड का क्या मतलब है?", वैज्ञानिक रूप से तब तक खराब-पद है जब तक सही भाजक और तुलना समूह निर्दिष्ट नहीं होते। उस भाजक की आपूर्ति करना, और इसका उपयोग करने के लिए उपकरण, इस पत्र का कार्य है।
1.2 एक पैमाने के बिना एक संख्या
व्याख्यात्मक समस्या जितनी सरल दिखती है उससे अधिक जटिल है। सात दिनों के बाद दस डाउनलोड और नब्बे दिनों के बाद दस डाउनलोड समान गणनाएँ हैं जिनके अर्थ लगभग निश्चित रूप से भिन्न हैं, और यदि एक पत्र किसी अत्यधिक दृश्यमान संस्थान में एक अंतरराष्ट्रीय रूप से मान्यता प्राप्त प्रोफेसर का नाम रखता है और दूसरा एक पहली बार के लेखक की शुरुआत है, तो वे फिर से भिन्न होते हैं। विद्वतापूर्ण उपयोग मेट्रिक्स फिर भी बिल्कुल इसी संदर्भ-मुक्त रूप में प्रस्तुत की जाती हैं, इसलिए प्रत्येक संख्या अनिवार्य रूप से एक रोर्शच परीक्षण बन जाती है: एक ही "40 दृश्य" एक लेखक में घबराहट और दूसरे में उदासीनता को भड़काते हैं, क्योंकि कोई साझा संदर्भ बिंदु नहीं है।
कच्ची डाउनलोड गणना का अपेक्षित मान सब कुछ के साथ बदलता है जो काउंटर दिखाता नहीं है: पत्र की आयु, इसका क्षेत्र, इसका पोस्टिंग समूह और कैलेंडर वातावरण, इसका वास्तविक वितरण जोखिम, और इसके लेखकों की पूर्व दृश्यमानता। इनमें से प्रत्येक निर्भरता अनुभवजन्य रूप से प्रलेखित है। औसत आजीवन डाउनलोड एक एकल अनुशासनात्मक नेटवर्क के eJournals में लगभग आठ के कारक से भिन्न होते हैं, कॉर्पोरेट और प्रतिभूति कानून में लगभग 438 से कृषि कानून में लगभग 53 तक [168]। कैलेंडर के साथ पहुँच गतिविधि भिन्न होती है, सप्ताहांत में लगभग 11% और पत्रिका-पहुँच डेटा में गर्मी के महीनों में लगभग 50% तक गिरती है [178]। स्थिति और जोखिम सामग्री से स्वतंत्र रूप से महत्वपूर्ण हैं: arXiv घोषणा सूचियों की सबसे दृश्यमान स्थिति में दिखाई देने वाले पत्रों को बाद में काफी अधिक पाठकता और उद्धरण मिले, खगोल विज्ञान में लगभग 83% की माध्यिका उद्धरण लाभ के साथ [72]। प्रतिष्ठित संस्थानों से उत्पन्न विचार कम प्रतिष्ठित संस्थानों से तुलनीय विचारों की तुलना में अधिक तेजी से और व्यापक रूप से प्रसारित होते हैं [111], एक पैटर्न जो स्थिति और ध्यान पर दीर्घकालीन साक्ष्य के अनुरूप है [104][105][140][103]। SSRN पर विशेष रूप से, एक वृद्धिशील शीर्ष-50 सह-लेखक डाउनलोड दरों में एक मापने योग्य प्रीमियम से जुड़ा है [83]। प्लेटफॉर्म की अपनी वितरण मशीनरी काउंटर को भी आकार देती है: लेखक सात वर्गीकरण तक का चयन करते हैं, सुव्यवस्थित विषय-आधारित ईमेल सतर्कताओं में समावेश की गारंटी नहीं है, और उच्च-मात्रा वाले विषयों को 45 दिन तक की देरी का सामना करना पड़ सकता है [53][57]। एक पत्र की शुरुआती गणना कुछ भी नहीं हो सकती यदि इसका प्रासंगिक वितरण अभी तक हुआ है।
प्लेटफॉर्म के गणना नियम एक दूसरी परत जोड़ते हैं जिसे लेखक शायद ही कभी देखते हैं। SSRN अपनी गणनाओं को फ़िल्टर करता है, स्पष्ट रोबोट गतिविधि और एक ही व्यक्ति द्वारा दोहराए गए डाउनलोड को त्याग देता है [144][66][69]; ऐसे फ़िल्टर के बिना, गणना "पाँच गुना या अधिक से" बढ़ी हुई होती [18]। दृश्य और डाउनलोड लगभग स्थिर रूपांतरण से जुड़े हैं, और Black और Caron ने 2006 में सूचित किया कि "सामान्य तौर पर, SSRN वेबसाइट पर तीन सारांश दृश्य एक वास्तविक पत्र डाउनलोड में परिणत होते हैं" [18]। बाद के नमूने रूपांतरण को लगभग 11% और 19% सारांश दृश्यों के बीच रखते हैं [139][172], हाल के विपणन नमूने को औसतन 100 दृश्यों प्रति लगभग 24 डाउनलोड के साथ [83]। एक लेखक जो इस शरीर रचना को जानता है वह पहले से ही शीर्षक के 40 दृश्य और 7 डाउनलोड की जाँच कर सकता है (धारा 5.2 गणना करती है, जो रिपोर्ट किए गए बैंड के अंदर एक विस्तृत-अंतराल स्क्रीनिंग परिणाम के रूप में उतरती है), लेकिन प्लेटफॉर्म पर कुछ भी इसे संप्रेषित नहीं करता है।
कोई बाहरी पैमाना अंतर को भरता नहीं है, जो इसे एक असुविधा नहीं बल्कि एक माप विफलता बनाता है। h-सूचकांक के लिए [79], "क्या एक अच्छा X है" गाइड की एक संपूर्ण शैली मौजूद है [118][128]। SSRN डाउनलोड के लिए, धारा 2.5 ऑडिट को अगस्त 2026 तक किसी भी सार्वजनिक स्रोत में कोई अनुरूप नहीं मिला। बिब्लियोमेट्रिक साहित्य वितरण की रिपोर्ट करता है [85][139][168][83], लेकिन इसे लेखक-सामना करने वाले मानदंडों में अनुवाद नहीं करता है। व्यक्तिगत विद्वानों ने अपने स्वयं के पोर्टफोलियो से रसोई बेंचमार्क की व्यावहारिक व्यवस्था की है [42], और पुस्तकालय गाइड समझाते हैं कि काउंटर क्या हैं बिना यह कहे कि वे क्या मतलब है [161][50]। वह संख्या जो हर लेखक गूगल करता है नहीं मिल सकती है।
1.3 दांव: करियर, चिंता, और बढ़ाने की प्रेरणा
यह अंतर महत्वपूर्ण है क्योंकि संख्याएं परिणामी हैं। SSRN के अपने दस्तावेज़ अपने मेट्रिक्स को उन लोगों के रूप में वर्णित करते हैं "जिनका लेखक पदोन्नति और कार्यकाल प्रयोजनों के लिए उपयोग करते हैं और जिनका संस्थान अपनी नियुक्ति और रैंकिंग गतिविधियों में उपयोग करते हैं" [52]। उपयोग ठोस और प्रलेखित है: एक प्रमुख कानूनी विद्वान ने रिपोर्ट किया कि वह "कुल समय डाउनलोड की कुल संख्या में 3,000 कानूनी लेखकों में से 13वें स्थान पर थे, जिसे कानून स्कूल ने विभिन्न पदोन्नति और संबंधित निर्णयों में ध्यान में रखा है" [12]; कानून-समीक्षा प्रस्तुति मार्गदर्शन कवर लेटर में "SSRN डाउनलोड (यदि बहुत)" और शीर्ष दस सूची उपस्थितियों का उल्लेख करने की सलाह देते हैं [95]; और संस्थानों ने सूर्यास्त से कुछ सप्ताह पहले तक अपनी SSRN स्थिति के बारे में प्रेस विज्ञप्ति जारी की [101]। कुल स्तर पर, SSRN डाउनलोड सौ कानून स्कूलों की उद्धरण-आधारित रैंकिंग के साथ 0.84 पर संबंधित हैं [77], एक स्कूल-स्तरीय संघ जो व्यक्तिगत कागजात या लेखकों तक नहीं उतरता है, खंड 6.2(iii) की पारिस्थितिक-अनुमान सावधानी। कि संस्थान इस तरह के उपायों पर कार्य करते हैं, यह एक अच्छी तरह से प्रलेखित गतिविधि का एक उदाहरण है: सार्वजनिक रैंकिंग प्रतिक्रियाशील हैं, जो उन अभिनेताओं के व्यवहार को पुनर्गठित करती हैं जिन्हें वे वर्णित करने का दावा करते हैं। तंत्र कानून-स्कूल रैंकिंग के लिए विस्तार में स्थापित किया गया था, जहां सामंजस्य और आत्म-पूर्ण भविष्यवाणी ने स्कूलों को उपाय के चारों ओर पुनर्गठित करने के लिए संचालित किया [58][132]। SSRN ने सीधे मुद्रा को मजबूत किया, समय-समय पर शीर्ष 30,000 लेखकों (लगभग 360,000 सूचीबद्ध लेखकों में से शीर्ष 8%) को ईमेल भेजकर उन्हें बताया कि वे "शीर्ष 10% में" थे [161]। "10%" सूचीबद्ध लेखकों का एक हिस्सा है (30,000/360,000 ≈ 8.3%), और 1.9 मिलियन से अधिक के पूर्ण पंजीकृत-लेखक आधार के विरुद्ध समान 30,000 शीर्ष 2% के करीब है, इसलिए वाक्यांश सभी पंजीकर्ताओं के बजाय रैंक किए गए लेखकों का वर्णन करता है। करियर सलाह, इस बीच, चेतावनी देता है कि स्व-प्रकाशित मेट्रिक्स अकेले "संभवतः कानून-स्कूल पदोन्नति और कार्यकाल प्रयोजनों के लिए गिनती नहीं करेंगे" [33], और व्यापक मूल्यांकन साहित्य दोनों को प्रलेखित करता है कि कितनी गहराई से संकेतक-आधारित मूल्यांकन नियुक्ति और कार्यकाल में प्रवेश करता है और यह कितनी खराब तरह से डिज़ाइन किया गया है [110][115][153]। डाउनलोड स्वयं ध्यान उपायों हैं, गुणवत्ता के प्रत्यक्ष उपाय नहीं: प्रारंभिक उपयोग बाद के उद्धरणों की केवल मामूली भविष्यवाणी करता है (0.4 के आसपास सहसंबंध, प्रारंभिक कार्य में भिन्नता के आदेश के 16% की व्याख्या करता है [25], और बाद के अनुमानों में 0.11–0.35 [80]), और अत्यधिक डाउनलोड किए गए और अत्यधिक उद्धृत पत्रों के सेट काफी हद तक भिन्न हैं [108]। संस्थान इन संख्याओं को करियर साक्ष्य के रूप में मानते हैं, भले ही वे कोई पैमाना नहीं करते हैं और विद्वानों के प्रभाव के लिए केवल एक ढीली कड़ी रखते हैं, जो दो सममित दिशाओं में गलत पढ़ने के लिए एक स्थायी निमंत्रण है: पैमाने के बिना, एक लेखक गलत पढ़े गए काउंटर की ताकत पर समय से पहले काम की एक पंक्ति को त्याग सकता है, या एक पत्र को बढ़ावा देने में कम समय और सामाजिक पूंजी खर्च कर सकता है जिसकी संख्या कभी असामान्य नहीं थी। रैंकिंग, अपनी खामियों के बावजूद, इस बारे में बिल्कुल वही आवर्ती निर्णय खिलाया कि क्या किसी पत्र को आगे बढ़ाना वारंट था, और उनकी हटाने ने विकल्प को डेटा के बिना किया जाना था (एक बिंदु जो खंड 6.4 में लिया गया है)।
दांव भावनात्मक भी हैं: जो लेखक डैशबोर्ड पर अनुभव करते हैं वह मेट्रिक चिंता का एक विशिष्ट रूप है, और डाउनलोड की संख्या को जुनूनी तरीके से देखा जाता है। वैज्ञानिक मेट्रिक्स पर्यवेक्षकों ने आत्म-ट्रैकिंग दृश्यता उपकरणों की शैली को 2012 [177] के रूप में जल्दी "आत्मनार्सिसिज्म की तकनीकें" के रूप में वर्णित किया, और एक प्रमुख कानूनी शिक्षाविद् की स्वीकृति कि अपनी गिनती की निगरानी "मेरे लिए क्रैक की तरह" थी (बेनब्रिज, 2007, जैसा कि SSRN गेमिंग व्यवहार पर साहित्य में उद्धृत किया गया है) प्रतीकात्मक हो गया है [44]। एक ही अनुसंधान कार्यक्रम ने प्रायोगिक रूप से यह स्थापित किया कि चिंता क्या उत्पन्न करती है: लेखक अपने पत्रों को स्वयं डाउनलोड करते हैं, गिनती को बढ़ाने के लिए, और शीर्ष-दस सूचियों की दृश्यता सीमा के पास और सहकर्मियों के साथ प्रतिकूल सामाजिक तुलना के तहत सबसे तीव्रता से ऐसा करते हैं [44]। इस तरह के सामाजिक प्रतिक्रिया लूप ध्यान बाजारों की एक सामान्य संपत्ति हैं: प्रारंभिक सामाजिक संकेत असमानता को बढ़ाते हैं और सांस्कृतिक बाजारों में अप्रत्याशितता [131], प्रारंभिक सकारात्मक संकेत पूर्वाग्रह बाद के मूल्यांकन [112], और सफलता क्षेत्र प्रयोगों में सफलता को प्रजनन करती है [162]। सामाजिक मीडिया पर स्व-रिपोर्ट किए गए मील के पत्थर, उच्च प्रदर्शकों की ओर पक्षपाती, उन सभी के लिए तुलना को तीव्र करते हैं जिनका डैशबोर्ड 7 पढ़ता है। सार्वजनिक बेंचमार्क की अनुपस्थिति इस प्रकार चिंता पैदा करती है, गलत व्याख्या को ईंधन देती है, और कृत्रिम मुद्रास्फीति को प्रोत्साहित करती है जो हर किसी के लिए मेट्रिक को कमजोर करती है। समस्या प्रदर्शन से पहले माप का एक है: एक मेट्रिक जो एक साथ दृश्यमान, भावनात्मक रूप से आवेशित, कैरियर-प्रासंगिक, और अव्याख्यात्मक है, माप बुनियादी ढांचे की एक वास्तविक विफलता है, न कि डैशबोर्ड पर घूरने वाले व्यक्ति की एक व्यक्तिगत कमी।
1.4 सबसे अधिक प्रभावित कौन है: इक्विटी आयाम
अपठनीय मेट्रिक्स की लागत समान रूप से वितरित नहीं है। घनी व्यावसायिक नेटवर्क वाले लेखक अनौपचारिक रूप से बेंचमार्क कर सकते हैं; स्थापित लेखकों के पास कागज से कागज तक पूर्व दृश्यमानता होती है। सार्वजनिक मानदंडों की अनुपस्थिति शुरुआती-करियर शोधकर्ताओं, स्वतंत्र और असंबद्ध विद्वानों, संकीर्ण उप-क्षेत्रों में लेखकों, ऐतिहासिक रूप से प्लेटफॉर्म पर प्रमुख अनुशासन के बाहर के लेखकों और अभिजात संस्थानों के बाहर के लेखकों पर सबसे भारी दबाव डालती है। नुकसान संरचनात्मक है और केवल सूचनात्मक नहीं है: SSRN की खोज मशीनरी संस्थागत कार्यपत्र श्रृंखलाओं और सदस्यता ई-जर्नल सतर्कताओं के माध्यम से ध्यान को रूट करती है [57]। एक असंबद्ध शोधकर्ता पोस्ट कर सकता है, लेकिन एक उच्च-यातायात संस्थागत श्रृंखला में एक कागज को बीज नहीं कर सकता, और दृश्यमानता के लिए पूरी तरह से विषय वर्गीकरण पर निर्भर है [168][53]। ऐसे लेखक के लिए संस्थागत जोखिम चैनल प्रभावी रूप से बंद है, इसलिए खोज का वजन खोज और AI परतों पर असमान रूप से पड़ता है। मशीन दृश्यमानता, अनुभाग 8 में परीक्षा की गई, इसलिए केवल एक तकनीकी प्रश्न नहीं है बल्कि एक इक्विटी प्रश्न है। क्षेत्र की सदस्यता अकेले ही गुण के किसी भी निर्णय से पहले प्रत्याशित डाउनलोड को कई गुना बदल देती है [168]। प्रतिष्ठा प्रभाव पहले जोखिम के समय पर काम करते हैं, क्योंकि एक सार्वजनिक SSRN पृष्ठ शीर्षक और सार के साथ लेखक के नाम और संबद्धता प्रदर्शित करता है। डबल-ब्लाइंड समीक्षा अन्यथा कार्य करती है: लेखक पहचान को हटाने से प्रतिष्ठित लेखकों के लिए समीक्षक स्कोर में मापनीय रूप से कमी आती है (5,027 ICLR प्रस्तुतियों के एक अध्ययन में, स्वीकृति निर्णयों पर बहुत कम निर्धारक प्रभाव के साथ) [154], और मूल्यांकन प्रायोगिक रूप से पहचान संकेतों का जवाब देते हैं [64]। ध्यान वितरण के तल पर घटना असमानता के बजाय अनुपस्थिति है: altmetric डेटा में, एक बड़े SDG-केंद्रित नमूने में अध्ययन किए गए सभी क्षेत्रों में अवित्तपोषित अनुसंधान का माध्यिका सामाजिक ध्यान शून्य है [41], और आसन्न खुले मंचों पर ध्यान विकसित अर्थव्यवस्थाओं में आय की तुलना में अधिक असमान है, जिसमें गिनी गुणांक 0.9 से ऊपर है [180]। माध्यिका लेखक के लिए प्रश्न "क्या 7 डाउनलोड खराब है?" एक ऐसे खेल में एकमात्र संकेत को पढ़ने का एक प्रयास है जिसकी प्रणाली संरचनात्मक रूप से असमान अंतराल रखती है, बजाय आत्ममुग्धता के प्रदर्शन के। कोई भी व्याख्या ढांचा जो इस असमानता को अनदेखा करता है, वह अदृश्यता को अस्वीकार के रूप में पढ़कर वंचितों का व्यवस्थित रूप से गलत निदान करेगा। असमानता भविष्य की ओर भी प्रक्षेपित होती है: यदि उभरती हुई AI उत्तर परत वाणिज्यिक जनरेटिव-इंजन अनुकूलन के लिए प्रलेखित ब्रांड और स्थिति पूर्वाग्रहों को विरासत में लेती है [5][164], यह इस असमानता को सुधारने के बजाय पुनरुत्पादित करेगी। यह संभावना असंबद्ध शोधकर्ताओं और वैश्विक दक्षिण के लेखकों के लिए सबसे भारी है, और यह एक कारण है कि अनुभाग 8.6 की मशीन-दृश्यमानता ऑडिट प्लेटफॉर्म जिज्ञासाओं के बजाय इक्विटी एजेंडा के अंतर्गत है।
1.5 व्याख्या की प्रलेखित मांग
पैमाने की मांग काल्पनिक नहीं है। यह विद्वान समुदाय के प्रवचन में सबसे लगातार बने रहने वाले पैटर्न में से एक है, और यह सूर्यास्त से कम से कम एक दशक पहले की है। तालिका 1 लेखक प्रश्नों और चिंताओं के आवर्ती समूहों को सारांशित करती है, प्रत्येक के लिए सबसे मजबूत प्रलेखित साक्ष्य, असुरक्षित शॉर्टकट जो प्रत्येक समूह को आमंत्रित करता है (संक्षिप्त उत्तर जो सहायक दिखता है और गलत है), और इस लेख का वह खंड जो इसका उत्तर देता है।
तालिका 1. व्याख्या की मांग: प्रलेखित समुदाय दर्द समूह (2005–2026)
| # | समूह | लेखक क्या पूछते या रिपोर्ट करते हैं | प्रलेखित साक्ष्य (आत्मविश्वास) | असुरक्षित शॉर्टकट | में संबोधित |
|---|---|---|---|---|---|
| 1 | "क्या मेरी संख्या सामान्य है?" — लापता बेंचमार्क | क्या दी गई डाउनलोड गणना एक तुलनीय पेपर के लिए अच्छी, बुरी, या विशिष्ट है | सार्वजनिक प्रश्न "पेपर डाउनलोड सांख्यिकी का महत्व," Academia StackExchange, 2016 (शीर्षक और तारीख आधिकारिक API के माध्यम से सत्यापित) [3]; SSRN पर पोस्ट करने और इसके मूल्य पर उपयोगकर्ता प्रश्न [126]; कितने डाउनलोड "अच्छे" मायने रखते हैं इस बारे में आवर्ती फोरम धागे (धागे का अस्तित्व पुष्टि की गई; व्यक्तिगत उत्तर स्वतंत्र रूप से सत्यापन योग्य नहीं हैं, और पूरे समय फोरम सामग्री को मांग के कमजोर साक्ष्य के रूप में माना जाता है, डेटा के रूप में नहीं) [B-3]; एक पहली बार के लेखक द्वारा एक नए पोस्ट किए गए कार्यपत्र पर "ईमानदार सलाह" का अनुरोध (Reddit, अप्रैल 2026; तीसरे पक्ष के संग्रह के माध्यम से अस्तित्व सत्यापित) [B-5] | एक सार्वभौमिक कच्ची-गणना सीमा ("N डाउनलोड = अच्छा") | खंड 3, 5–6 |
| 2 | यांत्रिकी भ्रम — दृश्य बनाम डाउनलोड | दृश्य डाउनलोड को क्यों पार करते हैं; क्या कम अनुपात का मतलब एक कमजोर सार है | ऐतिहासिक 3:1 अंगूठे की नियम [18]; रिपोर्ट किया गया रूपांतरण बैंड 11–19% [139][172]; हाल का नमूना माध्य ≈24% [83]; पुस्तकालय मार्गदर्शिकाएँ लेखकों की अनिश्चितता को दस्तावेज़ करती हैं कि काउंटर में क्या शामिल है [161] | स्वचालित दावा कि कम अनुपात का मतलब सार बुरा है | खंड 4–5 |
| 3 | भावना और सामाजिक तुलना | बाध्यकारी जांच; कम और उच्च दोनों गणनाओं पर शर्मिंदगी | "मेरे लिए क्रैक की तरह" (Bainbridge, 2007, जैसा कि [44] में उद्धृत); सामाजिक तुलना के तहत शीर्ष-सूची सीमा के निकट स्व-डाउनलोड करने का प्रायोगिक साक्ष्य [44] | अपने आप को प्लेटफ़ॉर्म-व्यापी माध्य या दृश्यमान सितारों के विरुद्ध बेंचमार्क करना | खंड 1, 5 |
| 4 | कैरियर साक्ष्य — सूर्यास्त के बाद डोजियर में रैंक लाइन को क्या बदलता है | सूर्यास्त के बाद कार्यकाल, पदोन्नति, और नियुक्ति सामग्री में क्या उद्धृत करें | डाउनलोड रैंक "विभिन्न पदोन्नति और संबंधित निर्णयों में ध्यान में लिया जाता है" [12]; शीर्ष-10% सूचना ईमेल [161]; कवर-पत्र सलाह [95]; संस्थागत प्रेस विज्ञप्ति [101]; व्यावहारिक उपयोग का प्लेटफ़ॉर्म विवरण [52] | तारीख, स्रोत, या हर चीज़ के बिना कच्ची संचयी गणना को उद्धृत करना | खंड 6 (तालिका 13) |
| 5 | पोस्टिंग के बाद अनुरोध स्पैम | पोस्ट करने के शीघ्र बाद आने वाले अनुरोधित पत्रिका आमंत्रण | "हर दिन, मुझे इनमें से कम से कम दो ईमेल मिलते हैं" (Reddit r/AskAcademia, 2023; संग्रह के माध्यम से सत्यापित; लेखक ने MDPI पत्रिका में प्रकाशित किया था, SSRN पर नहीं) [127]; कागजात "उदाहरण के लिए SSRN पर पोस्ट किए गए" से पता हार्वेस्टिंग [107]; अनुरोध की मात्रा के ऑडिट [9][84][63]; शैक्षणिक स्पैम के 29 अनुभवजन्य अध्ययनों की पहचान करने वाली व्यवस्थित समीक्षा [61] | एक कुल काउंटर से पाठकों की पहचान या इरादे का अनुमान लगाना | खंड 7 |
| 6 | काउंटर में विश्वास — बॉट, गेमिंग, अचानक गिरावट | क्या संख्याएँ वास्तविक हैं; काउंटर क्यों गिरते हैं | "SSRN बिल्कुल भी अपनी सटीकता को मान्य करने के लिए कुछ नहीं करता" (Goldman, 2005, वर्तमान फ़िल्टर से पहले; एक बाद का अपडेट रिकॉर्ड करता है कि SSRN दोहराए गए समान-स्रोत डाउनलोड को छूट देता है) [66]; SSRN की प्रकाशित डेटा-अखंडता फ़िल्टरिंग [144][66][69]; प्रारंभिक RePEc डेटा में सार दृश्यों का ~74% लेकिन केवल डाउनलोड का ~7% बनाने वाला रोबोट ट्रैफ़िक [99]; 2025–2026 के माध्यम से RePEc पर बड़े पैमाने पर बॉट फ़िल्टरिंग एपिसोड [129] | प्रदर्शित संख्या को अद्वितीय मानव पाठकों की सटीक गणना के रूप में माना जाता है | खंड 4, 9 |
| 7 | निदान — "शून्य डाउनलोड क्यों?" | पहले हफ्तों में शून्य या स्टॉल का क्या मतलब है | सूर्यास्त के बाद लेखक अनिश्चितता सामुदायिक धागों में प्रलेखित (तीसरे पक्ष के संग्रह के माध्यम से अस्तित्व पुष्टि) [B-5]; मंच समर्थन पृष्ठ मेट्रिक्स का वर्णन करते हैं लेकिन, अगस्त 2026 तक, कोई व्याख्यात्मक मार्गदर्शन प्रदान नहीं करते हैं [52][50] (खोज ऑडिट, खंड 2.5) | पूर्व-वितरण शून्य को अस्वीकृति के रूप में माना जाता है | खंड 4–6 |
नोट। केवल एक लाइव या संग्रहीत स्रोत के विरुद्ध स्वतंत्र रूप से सत्यापित उद्धरण ही शब्दशः पुनः प्रस्तुत किए जाते हैं; सभी अन्य समुदाय सामग्री को पुनः कहा जाता है और इसके आत्मविश्वास की स्थिति द्वारा चिह्नित किया जाता है। उपयोगकर्ता पोस्ट को उद्धृत करने की नैतिकता, गोपनीयता और हटाई गई सामग्री की हैंडलिंग सहित, खंड 9 में संबोधित की जाती है।
तालिका 1 में सबसे मजबूत समूह क्रोनिक प्रश्न "क्या मेरी संख्या सामान्य है?" है, जो वर्षों, प्लेटफार्मों और विषयों में आवर्ती होता है। प्लेटफ़ॉर्म के अंदरूनी लोग भी बदले में कोई बेंचमार्क प्रदान नहीं करते हैं, और सार्कास्म जो अक्सर सामुदायिक मंचों पर इसका उत्तर देता है, यह संकेत देता है कि कोई नहीं, अनुभवी उपयोगकर्ताओं सहित, लापता पैमाने को रखता है [B-3]। समूह कारण से भी जुड़े हुए हैं: लापता बेंचमार्क (समूह 1) भावनात्मक भार (समूह 3) का उत्पादन करता है, जो गेमिंग प्रोत्साहन का उत्पादन करता है जो [44] में प्रलेखित है, जो बदले में समूह 6 में जांच किए गए विश्वास को बढ़ाता है। व्याख्यात्मकता को बहाल करना श्रृंखला को इसके मूल पर संबोधित करता है। यह ढांचा डाउनलोड बढ़ाने के लिए नहीं बल्कि अर्थ को बहाल करने के लिए है।
1.6 यह लेख क्या तर्क देता है: आठ स्थितियाँ
ये वे स्थितियाँ हैं जिनका यह लेख बचाव करता है, प्रत्येक को नोट किए गए अनुभाग में तर्क दिया गया है।
1. कच्ची गिनती संदर्भ वर्ग के बिना अनिर्वचनीय है। एक संचयी डाउनलोड गणना का कोई स्थिर अर्थ नहीं है जब तक कि पेपर की आयु, क्षेत्र, पोस्टिंग समूह, वितरण चैनल, और पूर्व लेखक दृश्यमानता पर शर्त न लगाई जाए [83][168][178][53]। यह अनुभाग 5 की संदर्भ-वर्ग समस्या है, और यह "क्या 7 डाउनलोड अच्छे हैं?" को अस्पष्ट रूप से पूछे जाने के रूप में प्रस्तुत करता है।
2. कम पहुँच और कम रूपांतरण अलग-अलग निदान हैं। एक पेपर जिसे कम लोग सामना करते हैं वह एक अलग समस्या प्रस्तुत करता है बनाम एक पेपर जिसे कई लोग देखते हैं लेकिन कम लोग डाउनलोड करते हैं, और विभिन्न कार्रवाई की वारंटी है। अदृश्यता सामग्री की अस्वीकृति नहीं है। अनुभाग 4–5 इस अंतर को एक पहुँच-दर-रूपांतरण निदान (तालिका 9) में विकसित करते हैं, जिसमें "छिपा हुआ हित" विन्यास शामिल है जिसमें मजबूत रूपांतरण कमजोर पहुँच के साथ सहअस्तित्व में है।
3. गिनतियाँ बची रहीं; तुलनात्मक पैमाना नहीं। सूर्यास्त की विषमता (संख्याएँ बरकरार रहीं, मानदंड हटाए गए [149]) पोस्ट-रैंकिंग स्थिति को बिल्कुल वर्णित करती है, और यह एक लंबे समय से अव्यक्त व्याख्या समस्या को एक तत्काल और सार्वभौमिक समस्या में परिवर्तित करती है (अनुभाग 2)।
4. एक प्रतिशतक बेंचमार्क एक जनहित वस्तु है। वह संख्या जिसे प्रत्येक लेखक गूगल करता है और नहीं पा सकता है, वह अनुशासन और पेपर आयु के अनुसार एक प्रतिशतक तालिका है। अनुभाग 5 और 8 यह निर्दिष्ट करते हैं कि समुदाय इसे कैसे बना सकता है और बनाए रख सकता है, अब जब इसे प्लेटफॉर्म से पढ़ा नहीं जा सकता है।
5. अंशांकित मानदंड को पोस्टिंग से देखे गए एक पैनल की आवश्यकता है। प्रकाशित साक्ष्य उम्र के क्रॉस-सेक्शन और एकल स्नैपशॉट से मिलते हैं [139][85][168][83]। एक हाल का बड़ा अध्ययन स्पष्ट रूप से पैनल डेटा को आवश्यक अगले कदम के रूप में पहचानता है [83]। दिन शून्य से अवलोकन के बिना, पहले सप्ताह और पहले महीने के "मानदंड" एक्सट्रापोलेशन हैं और उन्हें इस रूप में लेबल किया जाना चाहिए (अनुभाग 8)।
6. एक बहुआयामी बेंचमार्क एकल दृश्य स्कोर को हराता है। सामान्यीकृत पहुँच, डाउनलोड प्रदर्शन, रूपांतरण, गति, और अनुप्रवाह सत्यापन को अलग-अलग रिपोर्ट करना (CSAB, तालिका 10) निदान संबंधी जानकारी को संरक्षित करता है जिसे कोई समग्र सूचकांक नष्ट कर देता है (अनुभाग 5)।
7. AI उत्तर परत ध्यान का एक नया द्वारपाल बन रही है। खोज स्टैक के ऊपर की ओर माइग्रेट हो रही है, पत्रिका ब्रांड से संग्रह से खोज इंजन से AI उत्तर इंजन तक जो एक एकल प्रतिक्रिया को संश्लेषित करते हैं और कुछ स्रोतों को उद्धृत करते हैं [5][164]। अमेरिकी वयस्कों का एक चौथाई भाग पहले से ही प्रतिदिन AI चैटबॉट का उपयोग करते हैं [121], जबकि इन इंजनों की उद्धरण चैनलों के रूप में विश्वसनीयता विवादित रहती है [82] और विद्वान प्रीप्रिंट दृश्यमानता पर उनमें अभी तक कोई नियंत्रित अध्ययन नहीं है [100]। अनुभाग 8 सुव्यवस्थित ऑडिट प्रोटोकॉल बताता है; पूर्ण ऑडिट को साथी कार्य के लिए आरक्षित है।
8. एक डैशबोर्ड और डोसियर प्रोटोकॉल अभी आवश्यक है। लेखक और समितियाँ नए डेटा अवसंरचना की प्रतीक्षा नहीं कर सकते। अनुभाग 6 डैशबोर्ड को पढ़ने के लिए अंतरिम नियम और डोसियर के लिए एक सात-चरण साक्ष्य प्रोटोकॉल (तालिका 13) प्रदान करता है जिसका शासी आवश्यकता यह है कि प्रत्येक रिपोर्ट की गई संख्या अपने स्रोत, इसकी समय खिड़की, और इसकी सीमाओं को प्रदर्शित करे।
1.7 योगदान
नीचे दी गई सूची उस क्रम में लेख के मौजूदा साहित्य में क्या जोड़ता है, जिस क्रम में खंड इसे विकसित करते हैं।
1. एक निदान। यह प्लेटफॉर्म उपयोग मेट्रिक्स में संदर्भ-वर्ग समस्या की पहचान करता है और अंतर्निहित घटना का नाम देता है: विद्वानों के ध्यान की ठंडी शुरुआत। यह शब्द सिफारिश-प्रणाली साहित्य से अनुकूलित है, जहां एक cold-start आइटम में इसे रखने के लिए आवश्यक इंटरैक्शन इतिहास नहीं होता [133]। इस ठंडी शुरुआत में, नई पत्रें और नए लेखक एक प्रसार प्रणाली में प्रवेश करते हैं जिसमें प्रारंभिक ध्यान काफी हद तक प्लेटफॉर्म वास्तुकला, वितरण, और पूर्व प्रतिष्ठा पर निर्भर करता है, इससे पहले कि पर्याप्त गुणवत्ता अपना पूरा प्रभाव डाल सके [72][111][140][83]। मुख्य दावा अनुभाग 1.1 की खराब-posedness थीसिस है: हेडलाइन प्रश्न का कोई उत्तर नहीं है जब तक इसका हर और तुलना समूह आपूर्ति न किए जाएं।
2. एक समेकित बेंचमार्क मानचित्र। यह सूर्यास्त के बाद से पहली बार (अनुभाग 2.5 ऑडिट, अगस्त 2026), SSRN डाउनलोड और सारांश दृश्यों के लिए हर सत्यापित अनुभवजन्य बेंचमार्क को एक एकल तालिका (तालिका 7) में एकत्रित करता है, स्पष्ट नमूनाकरण फ्रेम, विंटेज, उम्र बढ़ने की चेतावनियों, और हर पंक्ति के लिए एक स्रोत-आत्मविश्वास रेटिंग के साथ। बेंचमार्क बड़े नमूना वितरणात्मक साक्ष्य [83], अर्ध-लॉगनॉर्मल शीर्ष-सूची स्क्रेप [85], कानूनी-विद्वत्ता नमूने [139][168][171][172], और प्लेटफॉर्म एकत्रण [1][49] हैं।
3. एक ध्यान-फनल फ्रेमवर्क नैदानिक के साथ। यह प्रसार को एक्सपोजर, सारांश दृश्य, पूर्ण-पाठ डाउनलोड, और डाउनस्ट्रीम उपयोग में विघटित करता है। फिर यह पहुंच-दर-रूपांतरण मैट्रिक्स (तालिका 9) प्राप्त करता है, जो अदृश्यता को अस्वीकृति से अलग करता है और छिपे हुए-हित कॉन्फ़िगरेशन को शामिल करता है जो कच्चे गणना व्यवस्थित रूप से मुखौटा करती है।
4. व्याख्या साधन। यह बेंचमार्क मानचित्र को एक स्नातक व्याख्या पैमाने (Nascent / Modest / Solid / Strong / Exceptional; तालिका 8) में परिवर्तित करता है, काम के उदाहरणों के साथ एक रूपांतरण बैंड, और कोल्ड-स्टार्ट स्कॉलरली अटेंशन बेंचमार्क (CSAB; तालिका 10), एक बहुआयामी रिपोर्टिंग प्रारूप क्षेत्र, आयु, कोहर्ट, और पूर्व लेखक दृश्यता द्वारा सामान्यीकृत। पैमाने के बैंड तुलनात्मक हैं केवल एक ही क्षेत्र और पत्र आयु के भीतर, क्योंकि क्षेत्र की सदस्यता अकेले प्रत्याशित डाउनलोड को कई गुना स्थानांतरित करती है, और हर सीमा या तो सूचित है या स्पष्ट रूप से लेखकीय अनुमान के रूप में चिह्नित है।
5. एक अभ्यास परत। यह अपने स्वयं के डैशबोर्ड को पढ़ने के नियम, शून्य-डाउनलोड केस के लिए नैदानिक, एक स्थिति-आधारित कार्य तालिका (तालिका 23), शिकारी-आमंत्रण संकेतों की एक परिकल्पना की गई टाइपोलॉजी इस चेतावनी के साथ कि आमंत्रण स्पैम न तो काउंटर को हिलाता है और न ही पाठकता का साक्ष्य देता है (तालिका 14), और सात-चरणीय डोजियर प्रोटोकॉल (तालिका 13) प्रदान करता है।
6. एक पूर्व-पंजीकरण-तैयार अनुसंधान एजेंडा। यह पोस्टिंग से 1, 3, 7, 14, 30, 60, 90, और 180 दिनों में अवलोकन के साथ एक आगामी पैनल निर्दिष्ट करता है, और दो अर्ध-प्रायोगिक डिजाइन: एक भीतर-कागज ध्यान सदमे के रूप में क्यूरेट की गई ईमेल-सतर्क वितरण, और मीट्रिक व्याख्या में एक प्राकृतिक प्रयोग के रूप में रैंकिंग सेवानिवृत्ति। यह आगे एक सामुदायिक-निर्मित प्रतिशत डेटासेट को ताज़ा प्रतिशत के लिए केवल शेष मार्ग के रूप में निर्दिष्ट करता है, AI उत्तर इंजन के लिए एक कॉम्पैक्ट मशीन-दृश्यता ऑडिट प्रोटोकॉल, और इस लेख के अपने डाउनलोड प्रक्षेपवक्र का एक पूर्वनिर्दिष्ट, विशुद्ध रूप से वर्णनात्मक रिकॉर्ड। प्रत्येक अध्ययन कम लागत पर निष्पादनीय है और अनुभाग 9 की पहुंच और नैतिकता सीमा के भीतर, संख्यात्मक भविष्यद्वाणी के साथ पूर्वनिर्दिष्ट बैंड के रूप में कथित किया गया है निष्कर्ष के बजाय।
1.8 लेख का संगठन
लेख का शेष भाग नौ अतिरिक्त खंडों और पाँच परिशिष्टों तक चलता है। खंड 2 घटना और उसके संदर्भ का पुनर्निर्माण करता है: 2026 सुधार पैकेज की पूरी कालक्रम, जो कुछ बना रहा और जो हटाया गया (तालिका 2, चित्र 1), और मंच का संसाधन पुनः आवंटन और पुनः केंद्रीकरण का उल्लिखित तर्क। खंड 3 सत्यापित वितरणात्मक साक्ष्य प्रस्तुत करता है और दिखाता है कि औसत क्यों भ्रामक है। यह माध्य-माध्यिका अंतराल [83], अर्ध-लॉगनॉर्मल पूंछ [85], और अनुशासनात्मक विषमता [168] को कवर करता है (चित्र 2–4, तालिका 3–5), मैथ्यू प्रभाव और संचयी लाभ [104][105][131][162] की सैद्धांतिक पृष्ठभूमि के विरुद्ध (गतिविज्ञान जो अनुदैर्ध्य कैरियर और उद्धरण प्रक्षेपवक्र [120] में सीधे परिमाणित किया गया है), और ध्यान उपाय और गुणवत्ता उपाय [25][80][108][178] के बीच अंतर। खंड 4 काउंटरों के यांत्रिकी की जांच करता है: फ़िल्टरिंग और डेटा अखंडता [144][66], रोबोट और प्रेत ट्रैफ़िक आवश्यक प्रतिवादों के साथ [99][106][129], मंच आर्किटेक्चर (तालिका 6), और मेटाडेटा और संस्करण स्वच्छता। खंड 5 व्याख्या मूल को निर्धारित करता है: संदर्भ-वर्ग तर्क, संघीकृत बेंचमार्क मानचित्र (तालिका 7), व्याख्या पैमाना (तालिका 8), रूपांतरण बैंड, पहुंच-दर-रूपांतरण मैट्रिक्स (तालिका 9), और CSAB (तालिका 10)। खंड 6 लेखकों और मूल्यांकन समितियों के लिए व्यावहारिकता में ढांचे का अनुवाद करता है, जिसमें डोजियर प्रोटोकॉल (तालिका 13) और परिशिष्ट A में, स्थिति-आधारित मार्गदर्शन (तालिका 23) शामिल है। खंड 7 ध्यान अर्थव्यवस्था की परजीवी परत का विश्लेषण करता है, शिकारी अनुरोधों को काल्पनिक दृश्यता संकेत के रूप में माना जाता है, सभी समय और प्रचलन दावे परिकल्पना के रूप में कहे गए हैं [9][61][63][84][107]। खंड 8 पूर्व-पंजीकरण-तैयार अनुभवजन्य एजेंडा को बताता है, जिसमें ध्यान के स्टैक के ऊपर AI उत्तर परत तक के स्थानांतरण और प्रीप्रिंट खोजपूर्णता के लिए इसके निहितार्थ [5][100][82][121][164] का एक सुरुचिपूर्ण उपचार शामिल है। खंड 9 सीमाओं का विस्तार करता है, जिसमें सर्वोत्तम उपलब्ध वितरणात्मक साक्ष्य [83] की एकल-स्रोत विशेषता, 2012–2015 के नमूनों की वृद्धि, और मंच प्रलेखन की अस्थिरता शामिल है। खंड 10 SSRN के लिए नीति सिफारिशों के साथ समाप्त होता है (सबसे महत्वपूर्ण, अनुशासन और पेपर आयु द्वारा गुमनाम प्रतिशतक बैंड एक प्रतिस्थापन के रूप में जो लीग-तालिका प्रतियोगिता को पुनः जीवित किए बिना संदर्भ को पुनः स्थापित करता है) और अनुसंधान समुदाय के लिए।
2. घटना: रैंकिंग सूर्यास्त और उसका संदर्भ
2.1 रैंकिंग क्या थी
SSRN के अधिकांश इतिहास के लिए, इसके उपयोग काउंटर एक सघन तुलनात्मक उपकरण के अंदर बैठे थे। कागज के स्तर पर, प्लेटफॉर्म बारह महीने और सभी समय के डाउनलोड के अनुसार शीर्ष 10,000 सूचियों को बनाए रखता था, साथ ही रोलिंग साठ दिनों की खिड़की पर गणना की गई प्रति-ईजर्नल "हाल के शीर्ष कागजात" सूचियों को भी। लेखक के स्तर पर, यह सभी अनुशासनों और अनुशासनात्मक लीग जैसे शीर्ष 3,000 कानून लेखकों की एक शीर्ष 30,000 सूची को बनाए रखता था, जिसे नए डाउनलोड, कुल डाउनलोड, प्रति पेपर डाउनलोड, और उद्धरणों द्वारा क्रमबद्ध किया जा सकता था। संस्थान के स्तर पर, इसने मासिक लीग तालिकाओं को बनाए रखा जिसमें शीर्ष 350 अमेरिकी कानून स्कूल और शीर्ष 500 अंतरराष्ट्रीय कानून स्कूल शामिल थे [B-9, ऐतिहासिक रैंकिंग पृष्ठ; 15 जुलाई 2026 के बाद से ऐसे सभी URL त्रुटि या प्लेसहोल्डर पृष्ठ लौटाते हैं और केवल संग्रहीत प्रतियों से उद्धृत किए जा सकते हैं]। प्लेटफॉर्म ने सीधे प्रतिशतक प्रतिक्रिया में रैंक का भी अनुवाद किया। जैसा कि वाशिंगटन विश्वविद्यालय गैलाघेर कानून पुस्तकालय के SSRN मेट्रिक्स गाइड में दस्तावेज किया गया था, "SSRN समय-समय पर शीर्ष 30,000 लेखकों को संदेश भेजता है, नए डाउनलोड और सभी समय के डाउनलोड द्वारा, उन्हें यह बताने के लिए कि वे शीर्ष 10% में हैं"। गाइड के अपने "360,000 से अधिक लेखकों" के आंकड़े के विरुद्ध, यह सीमा सूचीबद्ध लेखकों के शीर्ष लगभग 8% के अनुरूप थी (लगभग 360,000 में से 30,000) [161, 14 अगस्त 2026 को एक्सेस किया गया], एक व्यापक ऊपरी स्तर के बजाय एक संकीर्ण अभिजात वर्ग; खंड 1.3 नोट करता है कि पूर्ण पंजीकृत आधार के विरुद्ध समान 30,000 शीर्ष 2% के करीब बैठता है। ये सूचियां और संदेश, प्रभाव में, SSRN डाउनलोड के बारे में कभी भी सार्वजनिक रूप से किए गए एकमात्र प्लेटफॉर्म-प्रदान किए गए, लेखक-सामना वाली प्रतिशतक जानकारी थे।
तुलनात्मक उपकरण सजावटी नहीं था। Black और Caron ने 2006 में प्रस्तावित किया था कि SSRN डाउनलोड कानून-संकाय विद्वान प्रदर्शन के "बीटा" माप के रूप में काम कर सकते हैं, प्रतिष्ठा सर्वेक्षण और उद्धरण गणना को पूरक करते हुए [18]। एक ही संगोष्ठी खंड में प्रस्ताव की एक महत्वपूर्ण परीक्षा है [45]। संस्थागत रूप से प्रस्ताव सफल रहा: डाउनलोड रैंक भर्ती सामग्री, प्रचार फाइलों, और संस्थागत प्रचार में प्रवेश किया। SSRN के स्वयं के समर्थन प्रलेखन इसकी मेट्रिक्स को उन आंकड़ों के रूप में वर्णित करते हैं "जो लेखक पदोन्नति और कार्यकाल के उद्देश्यों के लिए उपयोग करते हैं और जो संस्थाएं अपनी भर्ती और रैंकिंग गतिविधियों में उपयोग करती हैं" [52, 14 अगस्त 2026 को एक्सेस किया गया]। कानून लेखन संस्थान के प्रकाशन मार्गदर्शन ने लेखकों को कानून समीक्षाओं के लिए कवर पत्रों में "SSRN डाउनलोड (यदि बहुत है), SSRN शीर्ष दस डाउनलोड सूचियों पर समावेश" का उल्लेख करने की सलाह दी [95]। जून 2026 में Stephen Bainbridge ने कैरियर फ़ंक्शन को रिकॉर्ड पर रखा: वह "कुल सभी समय के डाउनलोड की संख्या में 3,000 कानूनी लेखकों में से 13वें स्थान पर थे, जिसे कानून स्कूल ने विभिन्न पदोन्नति और संबंधित निर्णयों में ध्यान में रखा है" [12]। SSRN के स्वयं के नेतृत्व ने कानूनी विद्वान संचार के अपने तत्कालीन सीईओ द्वारा एक प्रीप्रिंट में प्लेटफॉर्म के रूपांतरण का दस्तावेज किया है [68]। संस्थाओं ने भी लीग का विपणन किया: जनवरी 2026 तक, Maynooth विश्वविद्यालय ने घोषणा की कि इसके कानून और अपराधविज्ञान स्कूल SSRN शीर्ष 500 अंतरराष्ट्रीय कानून स्कूलों में आयरिश विभागों में पहले स्थान पर थे, 143,500 से अधिक डाउनलोड का हवाला देते हुए [101]। उपकरण की व्यवहार पर पकड़ को Edelman और Larkin के SSRN सर्वर लॉग विश्लेषण में दस्तावेज किया गया है। अध्ययन में पाया गया कि धोखाधड़ी वाली स्व-डाउनलोडिंग उस बहुत ही क्षण में तीव्र हुई जब एक पेपर एक शीर्ष-दस सूची की सीमा के पास पहुंचा, और सामाजिक तुलना को पहचाना, केवल कैरियर दांव के बजाय, हेराफेरी के प्राथमिक चालक के रूप में [44]। एक ही अध्ययन ने 2007 में Bainbridge के लिए जिम्मेदार टिप्पणी को प्रसारित किया, कि अपने डाउनलोड गणना की निगरानी करना "मेरे लिए दरार की तरह था" [44]।
उपकरण का एक दूसरा कार्य था जिसने कम ध्यान आकर्षित किया। उद्धरण और प्रतिष्ठा सर्वेक्षण बहु-वर्ष घड़ियों पर चलते हैं; रैंकिंग ने वास्तविक समय के निकट में प्रतिक्रिया लौटाई, और उन्होंने शुरुआती-कैरियर विद्वानों और प्रतिष्ठित संस्थानों के बाहर लेखकों को दृश्यमान प्रभाव प्रदर्शित करने की अनुमति दी, धीमी और अधिक रूढ़िवादी गेटकीपिंग उपकरणों पर प्रतीक्षा किए बिना। उनकी खामियों के बावजूद, लीग तालिकाएं प्लेटफॉर्म पर हर लेखक के लिए समान रूप से दृश्यमान तुलनात्मक उपकरण थीं। यह आंशिक रूप से है कि क्यों उनका हटाना प्रशंसनीय रूप से सबसे अधिक वजन रखता है, जैसा कि खंड 1.4 तर्क देता है, उन लेखकों पर जिनके पास सबसे कम अनौपचारिक विकल्प हैं। सूर्यास्त के प्रभावों पर कोई प्रत्यक्ष वितरणात्मक सबूत अभी तक मौजूद नहीं है, इसलिए यह एक दिशात्मक अपेक्षा है जिसे RQ1 (खंड 8.5) परीक्षण करता है: दोनों पक्षीय, यह पूछता है कि क्या हटाना ध्यान केंद्रित या बिखरा हुआ है बिना संकेत की प्रस्तावना के।
2.2 2026 रिट्रीट की कालक्रमानुक्रम
15 जुलाई 2026 को रैंकिंग को हटाना 2025 के अंत से शुरू होने वाले प्लेटफॉर्म निर्णयों के एक अनुक्रम का समापन था, जिसे चित्र 1 में सारांशित किया गया है।
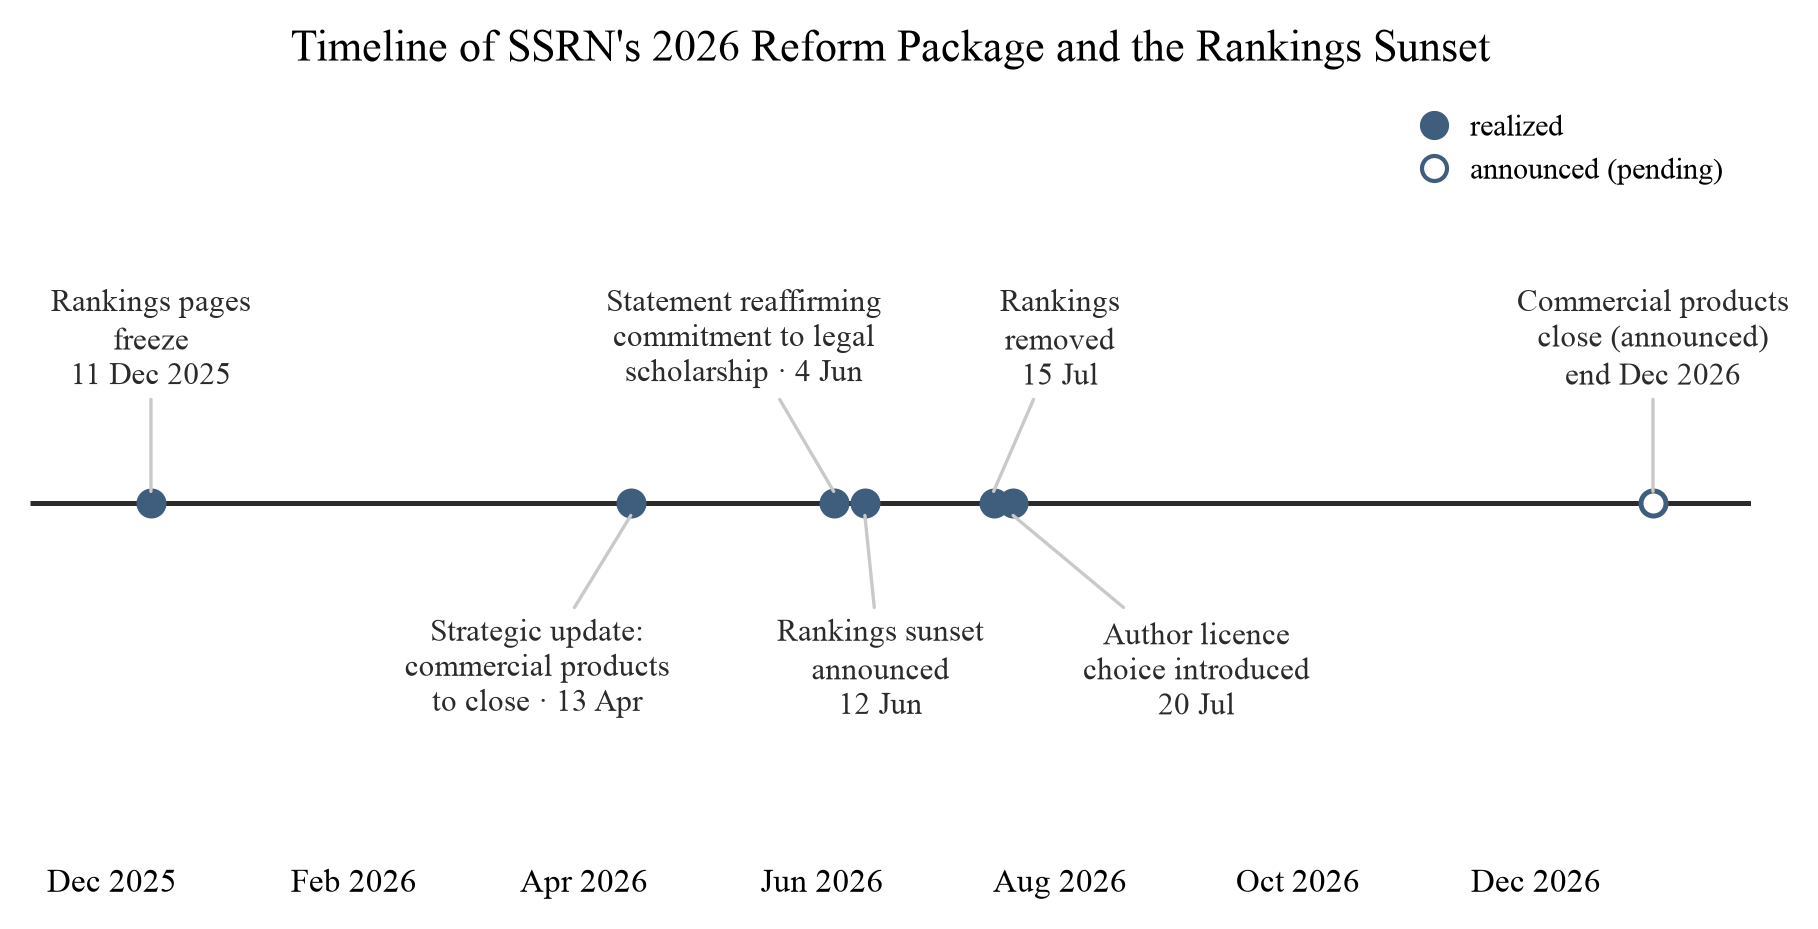
चित्र 1. SSRN के 2026 सुधार पैकेज की समय सारणी। घटनाएँ: eJournal डाउनलोड-रैंकिंग पृष्ठों को फ्रीज करना (11 दिसंबर 2025 से, TaxProf ब्लॉग पोस्ट में 25 जनवरी 2026 में दस्तावेज़ित [B-2]); सभी वाणिज्यिक उत्पादों के 2026 के अंत तक बंद होने की घोषणा करने वाली रणनीतिक अपडेट (13 अप्रैल 2026) [146]; कानूनी विद्वता के लिए SSRN की प्रतिबद्धता की पुष्टि करने वाला सार्वजनिक बयान (4 जून 2026) [147]; रैंकिंग को "1 जुलाई 2026 से" सूर्यास्त करने की घोषणा (12 जून 2026) [148]; रैंकिंग की वास्तविक हटाना (15 जुलाई 2026) [149]; लेखक लाइसेंस विकल्प की शुरूआत (20 जुलाई 2026) [150]; शेष वाणिज्यिक उत्पादों के बंद होने की घोषणा (दिसंबर 2026 के अंत) [146]। स्रोत: [146][147][148][149][150][B-2]।
किसी भी औपचारिक घोषणा से पहले ही गिरावट शुरू हुई। 11 दिसंबर 2025 को प्रति-eJournal डाउनलोड रैंकिंग पृष्ठ अपडेट होना बंद कर दिए। पॉल कैरॉन ने उन रैंकिंग पर निर्मित साप्ताहिक "शीर्ष पाँच नई कर पत्र" विशेषता दो दशक से अधिक समय तक चलाई थी। 25 जनवरी 2026 की एक पोस्ट में उन्होंने दस्तावेज़ित किया कि कर रैंकिंग "12 अक्टूबर 2025 – 11 दिसंबर 2025" की खिड़की पर फ्रीज हो गई थी और लिखा कि "यह SSRN शीर्ष पाँच नई कर पत्र का अंत हो सकता है" [B-2, 25 जनवरी 2026 की पोस्ट के अनुमान के रूप में उद्धृत, किसी SSRN घोषणा के नहीं]।
13 अप्रैल 2026 को, SSRN ने एक "रणनीतिक अपडेट" प्रकाशित किया जिसमें अपने "मुख्य अनुसंधान साझाकरण मिशन" पर नवीनीकृत ध्यान केंद्रित करने और सभी वाणिज्यिक उत्पादों (अनुसंधान पत्र श्रृंखला, प्रायोजित नेटवर्क, साइट सदस्यता, भुगतान किए गए सम्मेलन कार्यवाही, विश्लेषण डैशबोर्ड, नौकरियाँ और घोषणाएँ, और डेटा फ़ीड) के दिसंबर 2026 के अंत तक बंद होने की घोषणा की गई [146]। पुस्तकालय पर्यवेक्षकों ने कुछ दिनों के भीतर परिवर्तन को दर्ज किया [34], और Elsevier की डिजिटल कॉमन्स इकाई ने उन संस्थाओं के लिए माइग्रेशन मार्गदर्शन प्रकाशित किया जिनके अनुसंधान पत्र श्रृंखला संग्रह सेवानिवृत्त किए जा रहे थे [47]।
घोषणा ने कानूनी अकादमी में सार्वजनिक विवाद को भड़काया, जो समुदाय रैंकिंग बुनियादी ढांचे में सबसे अधिक निवेशित था। 3–4 जून 2026 को, Bainbridge ने "सोशल साइंस रिसर्च नेटवर्क ने द शार्क को जंप कर दिया" शीर्षक के तहत व्यापक रूप से पढ़ा गया आलोचना प्रकाशित की, जिसके बाद एक पोस्ट दर्ज की गई कि SSRN ने कागज-श्रृंखला बंद होने के समय और विषय-वस्तु eJournals के संरक्षण के बारे में स्पष्टीकरण के साथ अपनी शिकायतों का जवाब दिया था [12]। 4 जून 2026 को, SSRN ने कानूनी विद्वता के लिए अपनी "चल रही प्रतिबद्धता" पर एक बयान जारी किया, जिसमें वादा किया गया कि eJournal वितरण और ईमेल अलर्ट "अपरिवर्तित रहेंगे" [147]। 7 जून 2026 को, कैरॉन ने "SSRN ने द शार्क को जंप नहीं किया है" शीर्षक के तहत TaxProf ब्लॉग पर Bainbridge को जवाब दिया [B-11]। यह विनिमय प्लेटफॉर्म के तुलनात्मक विशेषताओं को उनके हटाने की पूर्व संध्या पर समुदाय द्वारा क्या माना जाता था इसका एक कॉम्पैक्ट सार्वजनिक रिकॉर्ड है।
12 जून 2026 को, SSRN ने घोषणा की कि यह "1 जुलाई 2026 से रैंकिंग को सूर्यास्त करेगा," यह कहते हुए कि "SSRN में, हम हमेशा माना है कि अनुसंधान को अपने लिए बोलना चाहिए" [148]। शटडाउन पहली बार घोषित समय की तुलना में दो सप्ताह बाद प्रभाव में आया: 15 जुलाई 2026 को, पत्रों, लेखकों और संस्थाओं की रैंकिंग को हटा दिया गया [149]। पाँच दिन बाद, 20 जुलाई 2026 को, एक और सुधार ने लेखक लाइसेंस विकल्प की पसंद की शुरूआत की [150]। घोषित और वास्तविक तारीखों के बीच दो सप्ताह का अंतराल, और घोषणा और निष्पादन के बीच एक महीने की खिड़की, स्वयं विश्लेषणात्मक रूप से प्रासंगिक है: वे एक प्रत्याशा अवधि बनाई गई जिसमें लेखक और संस्थाएं आने वाले परिवर्तन का निरीक्षण कर सकते थे, एक बिंदु जिसे खंड 8 के अर्ध-प्रायोगिक डिजाइन में उठाया गया है।
2.3 आधिकारिक कारण और इसका विकास
सूर्यास्त के लिए बताया गया औचित्य संसाधन आवंटन और प्लेटफॉर्म पुनः फोकस था। जुलाई की घोषणा में समझाया गया कि रैंकिंग "महत्वपूर्ण उत्पाद और विकास संसाधन की आवश्यकता" करती है और निर्णय को तेजी से पोस्टिंग, बेहतर खोजपूर्णता और अनुसंधान अखंडता पर पुनः फोकस के भीतर प्रस्तुत किया। इसमें यह भी कहा गया कि "डाउनलोड गिनती और उद्धरण आंकड़े आपके व्यक्तिगत पत्रों और लेखक प्रोफ़ाइल पर रिकॉर्ड और प्रदर्शित किए जाते रहेंगे" [149]। घोषणा तुलनात्मक सुविधाओं की संभावित वापसी को खुला छोड़ती है: SSRN ने लिखा कि यह "विभिन्न रैंकिंग के विचार पर पुनर्विचार कर सकता है" [149], इसलिए हटाने को स्थायी के रूप में वर्णित नहीं किया जाना चाहिए। रिकॉर्ड में मौन भी मायने रखता है: घोषणाएं निर्णय को मेट्रिक गेमिंग, हेरफेर या रैंकिंग के प्रतिस्पर्धी दुरुपयोग के लिए जिम्मेदार नहीं ठहराती हैं, और ऐसे खाते जो इस तरह के उद्देश्यों की आपूर्ति करते हैं वे प्रकाशित ग्रंथों से परे जाते हैं [148][149]।
आधिकारिक व्याख्या का स्वर घोषणा और लैंडिंग पृष्ठ के बीच विकसित हुआ जो रैंकिंग URL को बदल देता है। जहां जून की पोस्ट संसाधन के बारे में बोली, प्रतिस्थापन पृष्ठ बताता है कि SSRN की "नई दिशा व्यक्तिगत लेखकों और उनके काम को सब कुछ के केंद्र में रखती है," और कि "संस्थाओं और विभागों की एकत्रित लीग तालिकाएं अब उस चित्र में फिट नहीं होती हैं" [B-8; पृष्ठ प्रवेश प्रतिबंध के पीछे प्रस्तुत किया जाता है और ये वाक्यांश खोज-सूचकांक प्रतियों से उद्धृत हैं, इसलिए एक संग्रहीत स्नैपशॉट किसी भी उद्धरण के साथ होना चाहिए]। जून की पोस्ट सूर्यास्त को लागत निर्णय के रूप में प्रस्तुत करती है, प्रतिस्थापन पृष्ठ इसे संस्थागत तुलना से दूर एक सिद्धांतवादी पुनर्निर्देशन के रूप में प्रस्तुत करता है।
SSRN ने लेखकों को पूरी तरह से संदर्भ के लिए एक आधिकारिक संकेत नहीं छोड़ा। संदर्भ के लिए एक पत्र के प्रभाव को मापने पर इसकी सहायता प्रलेखन लेखकों को पत्र-स्तरीय काउंटर (सार दृश्य और डाउनलोड) निर्देशित करता है जो PlumX Metrics द्वारा पूरक है, एक Elsevier altmetrics उत्पाद उद्धरण, उपयोग और सामाजिक-माध्यम संकेतों को एकत्रित करता है [50, 14 अगस्त 2026 को पहुंचा]। PlumX इस प्रकार प्लेटफॉर्म के व्याख्यात्मक संदर्भ के लिए वास्तविक प्रतिस्थापन के रूप में खड़ा है। यह एक आंशिक प्रतिस्थापन है: यह एक व्यक्तिगत पत्र के लिए अतिरिक्त संकेत एकत्रित करता है लेकिन कोई वितरण, प्रतिशतक या सहकर्मी तुलना प्रदान नहीं करता है। ये वे तत्व हैं जो Rankings, चाहे अपूर्ण रूप से, प्रदान किए थे। सेवानिवृत्तियां SSRN के पत्रिका वर्कफ़्लो के साथ एकीकरण तक विस्तृत नहीं होती हैं: First Look प्रोग्राम प्लेटफॉर्म को 1,200 से अधिक Elsevier पत्रिकाओं से जोड़ना जारी रखता है [48][145]। प्लेटफॉर्म का वाणिज्यिक शासन भी इन उत्पाद निर्णयों को एक अत्यधिक केंद्रीकृत विद्वतापूर्ण प्रकाशन बाजार के भीतर रखता है [94]।
2.4 क्या बना रहा और क्या हटाया गया
तालिका 2 प्लेटफॉर्म की सूर्यास्त के बाद की स्थिति को मैप करती है, साथ ही प्रत्येक तत्व के माप निहितार्थ के साथ: प्रत्येक जीवित, लुप्त, या अप्रतिवेदित सुविधा का अर्थ है कि गिनती को पढ़ने का प्रयास करने वाले को क्या मिलेगा। हटाना असमान था। प्रत्येक प्रति-पेपर और प्रति-प्रोफाइल काउंटर बना रहता है। उन काउंटरों पर निर्मित तुलनात्मक उपकरण पूरी तरह से वापस ले लिया गया।
तालिका 2। 15 जुलाई 2026 की रैंकिंग सूर्यास्त के बाद क्या बना रहा और क्या हटाया गया, माप निहितार्थ के साथ। स्रोत: [147][149][161][B-8][B-9]; एक्सपोजर-मशीनरी पंक्तियाँ: [53][57][55][144][66][69]।
| सुविधा | 15 जुलाई 2026 के बाद स्थिति | स्रोत आधार | माप निहितार्थ |
|---|---|---|---|
| प्रति-पेपर डाउनलोड गिनती | बने रहते हैं; पेपर पृष्ठों पर प्रदर्शित | सूर्यास्त की घोषणा में शब्दशः पुष्टि की गई [149] | कच्चा उपयोग अवलोकनीय बना रहता है लेकिन अब इसका अपना कोई संदर्भ वर्ग नहीं है |
| प्रति-पेपर सार दृश्य | बने रहते हैं (सूर्यास्त की घोषणा में शब्दशः नाम नहीं दिया गया, जो "डाउनलोड गिनती और उद्धरण आँकड़े" सूचीबद्ध करता है; दृश्य प्रदर्शित होना जारी रहते हैं) | [149], प्लेटफॉर्म अवलोकन, 14 अगस्त 2026 को एक्सेस किया गया | पहुंच अवलोकनीय बनी रहती है, इसलिए प्रति-पेपर पहुंच–रूपांतरण नैदानिकी (तालिका 9) गणनीय रहती है |
| उद्धरण आँकड़े (पेपर और लेखक प्रोफाइल) | बने रहते हैं | शब्दशः पुष्टि की गई [149] | प्रवाहिक उपयोग अभी भी शुरुआती ध्यान उपायों की पूरक हो सकता है |
| लेखक प्रोफाइल (पेपर, संबद्धता) | बना रहता है | प्लेटफॉर्म अवलोकन, 14 अगस्त 2026 को एक्सेस किया गया | पोर्टफोलियो-स्तरीय एकत्रीकरण संभव बना रहता है, उसी लुप्त भाजक के साथ |
| ई-जर्नल सदस्यता और ईमेल सतर्कता | बने रहते हैं | "अपरिवर्तित जारी रहते हैं," 4 जून 2026 का विवरण [147] | पुश एक्सपोजर चैनल बना रहता है, इसलिए शुरुआती काउंटर आर्किटेक्चर-निर्भर बने रहते हैं (खंड 4.4) |
| विषय वर्गीकरण (1–7, लेखक-चयनित) | बने रहते हैं; ई-जर्नल रूटिंग को चलाते हैं | प्लेटफॉर्म दस्तावेज़ [53] | वर्गीकरण एक संभावित परिणामी एक्सपोजर चर है |
| क्यूरेटेड ई-जर्नल वितरण | जारी रहता है; समावेश "क्यूरेटेड और लक्षित, गारंटीकृत नहीं" | [53][57][147] | वितरण स्थिति और तारीख को पृष्ठभूमि के रूप में नहीं, एक उपचार के रूप में मॉडल किया जाना चाहिए |
| उच्च-मात्रा विषयों में वितरण विलंब | जारी रहता है; 45 दिन तक | [53] | पहले महीने की गिनती पूर्व और पश्च-वितरण प्रणालियों को मिश्रित कर सकती है |
| बाहरी अनुक्रमण (Google, Google Scholar) | जारी रहता है, खोज-इंजन-नियंत्रित समय पर ("6–9 महीने या अधिक") | [55] | एक अंतराल-सेंसर एक्सपोजर प्रक्रिया: एक्सपोजर तारीख सीमांकित है, अवलोकन नहीं |
| संदिग्ध-गतिविधि फ़िल्टरिंग | जारी रहता है | [144][66][69] | गिनती फ़िल्टर की गई घटनाएं हैं, सत्यापित पढ़ना या अनुमोदन नहीं |
| AI-उत्तर पेपर की पुनः प्राप्ति | SSRN द्वारा रिपोर्ट नहीं किया गया | कोई प्लेटफॉर्म रिपोर्टिंग नहीं है; खंड 8.6 | मशीन दृश्यता को एक स्वतंत्र, पुनरावृत्त लेखा परीक्षा की आवश्यकता है (अध्ययन 2) |
| पेपर पृष्ठों पर PlumX मेट्रिक्स | बने रहते हैं; प्रभाव मूल्यांकन के लिए आधिकारिक पॉइंटर | समर्थन दस्तावेज़ [50] | अतिरिक्त प्रति-पेपर संकेत, लेकिन कोई वितरण, प्रतिशतक, या समूह तुलना नहीं (खंड 2.3) |
| शीर्ष पेपर सूचियाँ (शीर्ष 10,000; प्रति-ई-जर्नल सम्मति/सर्व-समय) | हटाया गया; URL एक त्रुटि या सूर्यास्त लैंडिंग पृष्ठ लौटाते हैं | [149][B-8][B-9] | एक प्रमुख तुलनात्मक फ्रेम — और एक संभावित खोज सतह — गायब हो गया |
| शीर्ष लेखक सूचियाँ (शीर्ष 30,000; अनुशासनात्मक लीग) | हटाया गया | [149][B-9] | लेखक-स्तरीय प्रतिशतक स्थिति अब सार्वजनिक रूप से अवलोकनीय नहीं है |
| संस्था-स्तरीय लीग (शीर्ष 350 यू.एस. / शीर्ष 500 अंतर्राष्ट्रीय कानून स्कूल, आदि।) | हटाया गया | [149][B-8][B-9] | प्लेटफॉर्म डेटा से संस्थागत तुलना अब गणना नहीं की जा सकती |
| सार्वजनिक प्रतिशतक फ्रेमिंग (लेखक रैंक, "शीर्ष 10%" स्थिति) | रैंकिंग अवसंरचना के साथ हटाया गया | [149][161] | संदर्भ वर्ग को अब बाहरी रूप से पुनर्निर्मित किया जाना चाहिए (खंड 5, 8) |
| "लेखकों के शीर्ष 10%" सूचना ईमेल | भाग्य आधिकारिक संचार में संबोधित नहीं किया गया है; ईमेल रैंकिंग अवसंरचना से बंधे हुए थे | [161][149] | एक डोजियर-उपयोगी प्रतिशतक संकेत अब आने के लिए माना नहीं जा सकता |
तालिका 2 की शेष पंक्तियाँ बिल्कुल कच्ची गणना और वह एक्सपोज़र तंत्र हैं जो उन्हें खिलाता है: प्लेटफॉर्म पहले जैसी ही दर से संख्याएँ उत्पन्न करना जारी रखता है। हटाई गई पंक्तियाँ बिल्कुल तुलनात्मक फ्रेम का समूह हैं: वितरण, दहलीज़, रैंकिंग और प्रतिशतक संदेश। इस घटना का इसलिए एक सटीक सूचनात्मक संरचना है (डेटा बरकरार, संदर्भ वर्ग वापस लिया गया), और वह संरचना एक दीर्घकालीन गुप्त समस्या को—SSRN संख्या को कैसे पढ़ा जाए—एक तीव्र और सार्वभौमिक समस्या में परिवर्तित करती है। हम उस प्लेटफॉर्म संपत्ति को कहते हैं जो बदली गई बेंचमार्क अस्पष्टता: एक प्लेटफॉर्म की एक श्रेणीबद्ध संपत्ति जो यह बताती है कि क्या यह किसी व्यक्तिगत गणना को स्थित करने के लिए आवश्यक वितरणात्मक आँकड़े (प्रतिशतक, माध्यिकाएँ, सहकर्मी वितरण) प्रकाशित करता है, या केवल कच्ची गणना, माध्य और शीर्ष-N सूचियाँ। 15 जुलाई 2026 को, SSRN ने एक ही कदम में आंशिक पारदर्शिता से लगभग-पूर्ण बेंचमार्क अस्पष्टता में जाना, और लेख के शेष को उस संपत्ति के अपने उपयोगकर्ताओं को क्या खर्च होता है, इसके अध्ययन के रूप में पढ़ा जा सकता है। अस्पष्टता, इस तरह परिभाषित, कम से कम चार आयाम हैं: जनसंख्या कवरेज (प्रकाशित आँकड़े किसका वर्णन करते हैं), संदर्भ-वर्ग सूक्ष्मता (क्या वे क्षेत्र, आयु और सहकर्मी पर शर्त रखते हैं), अस्थायी स्थिरता (क्या परिभाषाएँ और विंडो समय के साथ तुलनीय रहती हैं), और ऑडिट योग्यता (क्या गणना नियम जाँचने के लिए पर्याप्त रूप से सार्वजनिक हैं)। ये चारों आंशिक रूप से स्वतंत्र रूप से चलते हैं: रैंकिंग अस्पष्टता का एक रूप कम कर सकती है जबकि दूसरा बदतर हो सकता है यदि उनके हर और चयन नियम अस्पष्ट हों। वह आंशिक स्वतंत्रता इसलिए है कि अनुभाग 10.4 (आइटम 4 और 8) की प्लेटफॉर्म सिफारिशें प्रकटीकरण को संबोधित करती हैं और केवल तुलनात्मक संख्याओं की वापसी को नहीं। संपत्ति को मापने योग्य बनाने के लिए, प्रत्येक आयाम को एक प्लेटफॉर्म के सार्वजनिक इंटरफेस और प्रलेखन पर लागू एक स्पष्ट क्रमिक चेकलिस्ट पर स्कोर किया जाता है: जनसंख्या कवरेज (0 = केवल कच्ची गणना, 1 = प्लेटफॉर्म-व्यापी सारांश आँकड़े प्रकाशित, 2 = परिभाषित जनसंख्या के लिए वितरणात्मक आँकड़े); संदर्भ-वर्ग सूक्ष्मता (0 = कोई नहीं, 1 = क्षेत्र जैसी एक अक्ष, 2 = संयुक्त क्षेत्र × आयु × सहकर्मी कंडीशनिंग); अस्थायी स्थिरता (0 = गणना परिभाषाएँ और विंडो अनुलेखित या चुपचाप संशोधित, 1 = अनुलेखित, 2 = अनुलेखित और संस्करणीकृत); और ऑडिट योग्यता (0 = गणना नियम अप्रकाशित, 1 = गद्य में वर्णित, 2 = जाँचने योग्य विवरण में प्रकाशित)। एक प्लेटफॉर्म की अस्पष्टता प्रोफाइल तब चार स्कोर का चार-टपल है न कि एक एकल लेबल। यही उपकरण SSRN को सूर्यास्त से पहले और बाद में स्कोर करता है (इसे कवरेज, सूक्ष्मता, और, सेवामुक्त सूचियों के लिए, संदर्भ-वर्ग सूक्ष्मता पर नीचे की ओर ले जाता है), और यह तालिका 6 के क्रॉस-प्लेटफॉर्म तुलना को आभाओं के बजाय स्कोर के रूप में बताए जाने देता है। एक प्लेटफॉर्म कई संख्याएँ प्रदर्शित कर सकता है और लगभग पूरी तरह अस्पष्ट रह सकता है। यह रूब्रिक एक पहला संचालन कार्य है, जिसे परिष्कृत और अंतर-रेटर परीक्षण किया जाना चाहिए, एक पूर्ण सूचकांक नहीं।
2.5 व्याख्या की मांग
जो सवाल सूर्यास्त ने तत्काल उठाया था, वह इससे बहुत पहले से पूछा जा रहा था। तालिका 1 (खंड 1.5) लेखक द्वारा व्याख्या की मांग के प्रलेखित समूहों को एकत्रित करती है, जो सत्यापित स्रोतों तक सीमित है। फोरम सामग्री को वहां मांग के साक्ष्य के रूप में उद्धृत किया जाता है, वितरण के रूप में नहीं, और उपयोगकर्ता पोस्ट से उद्धरण केवल वहां पुनर्प्रस्तुत किए जाते हैं जहां पोस्ट स्वयं स्थित थी (अर्ध-सार्वजनिक फोरम पोस्ट उद्धृत करने की नैतिकता पर खंड 9 में विचार किया गया है)।
जो नकारात्मक दावे अनुसरण करते हैं वे आकस्मिक खोज के बजाय संरचित खोज लेखापरीक्षा पर आधारित हैं, जैसे खंड 1.2, 1.5 (तालिका 1), और 8.8 में समान कथन हैं। प्रोटोकॉल यहां एक बार बताया गया है। हमने अंग्रेजी में 25 से अधिक प्रश्न सूत्रों की एक सूची तैयार की, जिसे छह आशय समूहों में संगठित किया: मानदंड ("कितने SSRN डाउनलोड अच्छे हैं"), परिभाषात्मक ("SSRN डाउनलोड गणना में क्या शामिल है"), सूर्यास्त-पश्चात नेविगेशनल ("SSRN रैंकिंग गई — तुलना करने के लिए कहां"), मूल्यांकनात्मक ("SSRN डाउनलोड के रूप में कार्यकाल साक्ष्य"), निदान ("SSRN पेपर शून्य डाउनलोड क्यों"), और व्यावहारिक ("SSRN डाउनलोड कैसे बढ़ाएं")। प्रत्येक प्रश्न के लिए हमने दर्ज किया कि वर्तमान में कौन इसका उत्तर देता है और कितना अच्छा, मानदंड यह होना कि क्या कोई वापसी किया गया स्रोत मेट्रिक के विवरण या किसी किस्से के बजाय स्नातक, क्षेत्र-संबंधित बेंचमार्क मान प्रदान करता है। सकारात्मक नियंत्रण के रूप में, हमने h-index, ResearchGate स्कोर, और उद्धरण गणना के लिए अनुरूप प्रश्न चलाए, जो [118][128] में प्रलेखित थ्रेसहोल्ड-गाइड शैली को विश्वसनीय रूप से सामने लाते हैं। SSRN डाउनलोड के लिए समान आशय सूत्रों ने सूर्यास्त से पहले या बाद में कोई समतुल्य नहीं सामने लाया। यह अंतराल सबसे व्यापक रूप से परामर्श किए गए समुदाय संदर्भों तक विस्तारित है: प्लेटफॉर्म के विश्वकोश-शैली अवलोकन बताते हैं कि काउंटर क्या हैं लेकिन उनके लिए कोई व्याख्यात्मक मानदंड प्रदान नहीं करते [170]। लेखापरीक्षा जुलाई-अगस्त 2026 में सामान्य-उद्देश्य वेब खोज इंजन और उपभोक्ता AI उत्तर इंजन तक विस्तृत एक कस्टम पाइपलाइन का उपयोग करके आयोजित की गई थी, जो प्रश्न निष्पादन और उत्तर-गुणवत्ता स्कोरिंग को स्वचालित करती है। पूरी प्रश्न सूची लेखक से उपलब्ध है। परिणाम एक नकारात्मक निष्कर्ष है और केवल ऐसा ही दावा किया जाता है: लेखापरीक्षा विंडो तक साक्ष्य की अनुपस्थिति, कवर किए गए भाषाओं और इंजनों में, यह साक्ष्य नहीं कि ऐसा कोई संसाधन मौजूद नहीं हो सकता।
आसन्न मेट्रिक्स के लिए, तालिका 1 (खंड 1.5) में प्रलेखित व्याख्यात्मक मांग लंबे समय से एक जन-दर्शक शैली द्वारा पूरी की गई है: "अच्छा h-index क्या है" दर्जनों स्नातक, क्षेत्र-संबंधित थ्रेसहोल्ड गाइड द्वारा परोसा जाता है [118], और अनुशासन-स्तर उद्धरण मानदंड व्यापक रूप से पढ़े जाने वाले व्याख्यान [128] के विषय हैं। SSRN डाउनलोड के लिए कोई ऐसी शैली नहीं है। बदतर, जो सर्वश्रेष्ठ संरचित गाइड मौजूद था, वॉशिंगटन विश्वविद्यालय के कानून पुस्तकालय पृष्ठ, 15 जुलाई 2026 के बाद शीर्ष लेखकों और शीर्ष पत्रों रैंकिंग का वर्तमान काल में वर्णन करना जारी रखा, जब मांग चरम पर थी तो इसे आंशिक रूप से भ्रामक प्रतीत किया [156, 14 अगस्त 2026 को एक्सेस किया]। सूर्यास्त ने व्याख्या समस्या नहीं बनाई; इसने एकमात्र आंशिक उत्तर को हटा दिया जो पारिस्थितिकी तंत्र के पास था, उस समय जब वितरण की संस्थागत स्मृति क्षय होने लगी।
3. डेटा क्या दिखाता है: माध्य झूठ क्यों बोलता है
3.1 काउंटर क्या मापते हैं और क्या नहीं मापते
शेष काउंटर के किसी भी उपयोग के लिए यह समझना आवश्यक है कि वे क्या मापते हैं। तालिका 3 प्रत्येक मेट्रिक की मापन सामग्री, इसके प्रमुख भ्रामक कारकों और इसकी वैध नैदानिक भूमिका का सारांश प्रस्तुत करता है।
तालिका 3. SSRN मेट्रिक्स क्या मापते हैं — और क्या नहीं मापते।
| मेट्रिक | सबसे निकटतम भौतिक व्याख्या | प्रमुख भ्रामक कारक | उपयुक्त नैदानिक भूमिका |
|---|---|---|---|
| सारांश-पृष्ठ दृश्य | किसी कागज के लैंडिंग पृष्ठ तक पहुंच | खोज जोखिम, मंच प्लेसमेंट, लेखक की प्रतिष्ठा, बाहरी प्रचार, शीर्षक, क्षेत्र का आकार, ऑनलाइन समय | जोखिम / पहुंच |
| पूर्ण-पाठ डाउनलोड | संपूर्ण कागज का निरीक्षण या उपयोग करने का इरादा | दृश्यों को प्रभावित करने वाली सभी चीजें, साथ ही सारांश की गुणवत्ता और प्रासंगिकता तथा डाउनलोड घर्षण | सहभागिता |
| सारांश दृश्य प्रति डाउनलोड | लैंडिंग-पृष्ठ जोखिम से पूर्ण-पाठ अधिग्रहण तक सशर्त संक्रमण | छोटे हर, दोहराया गया व्यवहार, विषम ट्रैफ़िक स्रोत | रूपांतरण |
| उद्धरण | बाद के विद्वत्ता संबंधी दस्तावेजों में अवलोकनीय समावेश | क्षेत्र उद्धरण मानदंड, प्रकाशन विलंब, डेटाबेस कवरेज, आत्म-उद्धरण, स्थिति प्रभाव | डाउनस्ट्रीम विद्वत्ता संबंधी उपयोग |
| Altmetric / PlumX संकेत | व्यापक ऑनलाइन सहभागिता | मंच संरचना और उपयोगकर्ता व्यवहार | पूरक प्रसार साक्ष्य |
तालिका की सामग्री दो समीकरणों के विपरीत में संपीड़ित की जा सकती है। डैशबोर्ड को जो पाठ निरंतर आमंत्रित करता है वह है डाउनलोड = वैज्ञानिक गुणवत्ता। रक्षणीय प्रतिनिधित्व यह है
अवलोकित डाउनलोड = f(Q, E, R, C, T, P, ε),
जहां Q अनुसंधान गुणवत्ता या प्रासंगिकता से संबंधित विशेषताओं को दर्शाता है, E जोखिम को, R प्रतिष्ठा को, C संचार विशेषताओं को, T समय और आयु को, P मंच तंत्र को, और ε अप्रेक्षित प्रभावों को दर्शाता है। यह व्यंजक भ्रामक कारकों को वर्गीकृत करता है; कोई कार्यात्मक रूप या गुणांक निर्दिष्ट नहीं है। वर्गीकरण व्यावहारिक कठिनाई को ठीक बताता है: शोधकर्ता आमतौर पर केवल बाईं ओर अवलोकन करता है।
तालिका के लिए दो सीमा शर्तें लागू होती हैं। काउंटर कच्चे ट्रैफ़िक लॉग नहीं हैं। SSRN कम से कम 2000 के दशक से अपनी गणना को फ़िल्टर करता है: मंच बताता है कि यह एक ही व्यक्ति द्वारा स्पष्ट दोहराए गए डाउनलोड और स्पष्ट रोबोट डाउनलोड को बाहर करता है, "अनियमित गतिविधि के संकेतों" का उपयोग करके, और संदेह के तहत अनाम डाउनलोड लेखक के कुल से बाहर हैं [144]। Black और Caron ने अनुमान लगाया कि ऐसी फ़िल्टरिंग के बिना काउंटर "पाँच गुना या अधिक" से बढ़ जाते [18]। एक गिनती वाला डाउनलोड एक सहभागिता घटना को दर्ज करता है और समर्थन के बारे में कुछ नहीं। काउंटर एक ध्यान प्रक्रिया के चरणों को मापते हैं। उनमें से कोई भी वैज्ञानिक योग्यता को नहीं मापता, और प्रत्येक दृश्यता कारकों से भ्रमित है जो किसी पाठक द्वारा सामग्री का मूल्यांकन करने से पहले काम करते हैं [44][72][144]। ये सीमाएं पठनीयता डेटा के सबसे प्रारंभिक ग्रंथसूची विश्लेषण से मान्यता प्राप्त हैं [91]। चरण एक दूसरे से भी अलग हो सकते हैं, दो परिकल्पित तंत्र के माध्यम से: नीति-प्रासंगिक विषयों पर कागज अभ्यास कर्ताओं द्वारा भारी डाउनलोड किए जा सकते हैं जो पढ़ते हैं लेकिन उद्धरण नहीं देते हैं, जबकि विशेष कागज कुछ डाउनलोड अर्जित कर सकते हैं फिर भी छोटी विशेषज्ञ समुदाय द्वारा लगातार उद्धृत किए जाते हैं जिसे उनकी आवश्यकता है। दोनों पैटर्न दृश्यता को डाउनस्ट्रीम उपयोग से अलग करते हैं, जो यह एक कारण है कि अत्यधिक डाउनलोड किए गए और अत्यधिक उद्धृत कागजों के सेट केवल आंशिक रूप से ओवरलैप करते हैं [108]।
3.2 प्लेटफॉर्म एकत्रीकरण और औसत की कल्पना
SSRN स्वयं द्वारा प्रकाशित एकमात्र वितरण-प्रासंगिक संख्याएँ प्लेटफॉर्म कुल हैं, और डेटा के बारे में सबसे पहली बात यह है कि जब उन कुल को औसत किया जाता है तो क्या होता है। तालिका 4 सत्यापित प्लेटफॉर्म आँकड़ों को उनकी स्थिति तिथियों के साथ संकलित करती है।
तालिका 4. सत्यापित SSRN प्लेटफॉर्म आँकड़े, स्थिति तिथियों और सत्यापन स्थिति के साथ।
| मात्रा | मान | स्थिति तिथि | स्रोत | सत्यापन स्थिति |
|---|---|---|---|---|
| पूर्ण-पाठ पत्र | 1,157,048 | 18 दिसंबर 2023 | ALL-SIS Citation Methods White Paper [1] | प्रकाशित PDF के विरुद्ध सत्यापित |
| सारांश | 1,309,385 | 18 दिसंबर 2023 | [1] | सत्यापित |
| लेखक | 1,479,875 | 18 दिसंबर 2023 | [1] | सत्यापित |
| संचयी डाउनलोड | 256,678,716 | 18 दिसंबर 2023 | [1] | सत्यापित |
| डाउनलोड, अनुवर्ती 12 महीने | 40,642,329 | 18 दिसंबर 2023 | [1] | सत्यापित |
| पूर्ण-पाठ पत्र (पहले का संदर्भ बिंदु) | 571,040 | 6 जुलाई 2016 | [1] | सत्यापित |
| डाउनलोड, अनुवर्ती 12 महीने (पहले का बिंदु) | 12,897,685 | 6 जुलाई 2016 | [1] | सत्यापित |
| प्रीप्रिंट / पत्र; लेखक | "1.5+ मिलियन"; "1.9+ मिलियन" | 2026 उत्पाद पृष्ठ | Elsevier SSRN उत्पाद दस्तावेज़ [49], 14 अगस्त 2026 को एक्सेस किया गया | सत्यापित (गोल विपणन आंकड़े) |
| पत्र; लेखक; डाउनलोड कुल; डाउनलोड 12 महीने | >1.7M; >2.4M; >344M; >54M | 1 नवंबर 2025 | SSRN घोषणा बॉयलरप्लेट [B-6] | परिमाण का क्रम पुष्ट; सटीक दशमलव (344.8M / 54.7M) के लिए उद्धरण से पहले घोषणा की संग्रहीत प्रतियों की आवश्यकता है |
| व्युत्पन्न: प्रति पूर्ण-पाठ पत्र माध्य आजीवन डाउनलोड | ≈222 | दिसंबर 2023 आधार | लेखक-गणना: 256,678,716 ÷ 1,157,048 [1] | सत्यापित आंकड़ों पर अंकगणित |
| व्युत्पन्न: प्रति पत्र प्रति वर्ष माध्य डाउनलोड | ≈35 | दिसंबर 2023 आधार | लेखक-गणना: 40,642,329 ÷ 1,157,048 [1] | सत्यापित आंकड़ों पर अंकगणित |
अंतिम दो पंक्तियाँ लेखक-गणना की गई हैं और इस तरह चिह्नित हैं; SSRN प्रति-पत्र औसत प्रकाशित नहीं करता है। प्लेटफॉर्म-व्यापी कुल स्रोत, तिथि और परिभाषा (पूर्ण-पाठ बनाम कुल पत्र) में भिन्न होते हैं, इसलिए प्रति-पत्र व्युत्पत्ति सुलहे दिसंबर 2023 पूर्ण-पाठ आंकड़ों [1] से ली गई हैं; कच्चे नवंबर 2025 बॉयलरप्लेट [B-6] को केवल डेटा के रूप में ऊपर रखा गया है, संग्रहीत प्रतियों (जैसे, web.archive.org के माध्यम से) के साथ विशेष रूप से उपयोगी है, क्योंकि मूल घोषणा पृष्ठ अब सीधे पुनः प्राप्त नहीं हैं।
सुलहे दिसंबर 2023 के आंकड़ों पर, "औसत" SSRN पत्र ने अपने आजीवन में लगभग 222 डाउनलोड और पिछले वर्ष में लगभग 35 अर्जित किए हैं [1]। यह व्युत्पन्न संख्या एक लेखक के लिए गणना करने योग्य प्लेटफॉर्म-व्यापी मानदंड की सबसे करीबी चीज़ है, और यह व्यवस्थित रूप से भ्रामक है, क्योंकि औसत एकत्रीकरण की कल्पना है। SSRN डाउनलोड वितरण का हर अनुभवजन्य अध्ययन मजबूत सही तिरछापन पाता है: माध्य को एक लंबी ऊपरी पूंछ द्वारा माध्यिका से बहुत ऊपर खींचा जाता है, इसलिए "औसत पत्र" लगभग कोई वास्तविक पत्र वर्णित नहीं करता है। यह अनुभाग उस अंतर का आकार और परिणाम स्थापित करता है। अंशांकन के लिए एक और समुच्चय मायने रखता है। वार्षिक प्लेटफॉर्म डाउनलोड 2000 में लगभग 0.5 मिलियन से 2005 में लगभग 3 मिलियन [18] तक बढ़े, 2016 में 12.9 मिलियन, और 2023 तक 40.6 मिलियन [1]। डाउनलोड-प्रति-पत्र प्रवाह स्वयं बढ़ गया है: 2016 से 2023 तक वार्षिक डाउनलोड लगभग 3.15-गुना बढ़े जबकि पत्र स्टॉक लगभग 2.03-गुना बढ़ा [1], प्रति-पत्र प्रवाह को लगभग 55% तक बढ़ाया। एक पुराना अध्ययन इसलिए एक तुलनीय पत्र को आज अर्जित करने वाली निरपेक्ष संख्याओं को कम करके आंका। इस पूर्वाग्रह को जो दिशा दर्शाती है वह तुलना पर निर्भर करती है: एक निश्चित पुरानी सीमा आज की संख्याओं पर एक निचली सीमा है, जो इसे एक अनुदार, रूढ़िवादी नहीं, पट्टी बनाता है जब इसे एक पूर्ण 2026 स्तर बैंड के रूप में पढ़ा जाता है। विपरीत हेराफेरी समान रूप से अनुमति नहीं है: एक पुरानी सीमा को प्लेटफॉर्म वृद्धि से इसे गुणा करके 2026 मानदंड में "उम्र बढ़ना" नहीं किया जा सकता है, क्योंकि एक बड़ी भंडार एक साथ अंश, हर, लेखकों की संरचना, वितरण चैनलों, बॉट फ़िल्टरिंग और ध्यान के लिए प्रतिस्पर्धा को बदलता है। पूरे उपयोग की जाने वाली विंटेज-पूर्वाग्रह रीडिंग ऊपर एकत्रीकरण प्रवाह-और-स्टॉक अंकगणित पर आधारित है, पुरानी सीमाओं के किसी भी पुनर्मापन पर नहीं। प्लेटफॉर्म की अपनी वर्ष-समीक्षा निरंतर वृद्धि की पुष्टि करती है: 2025 में 250,000 से अधिक नए पत्र पोस्ट किए गए थे (2024 पर 20% ऊपर), वर्ष के दौरान 53 मिलियन से अधिक डाउनलोड के साथ [145]।
3.3 माध्य सामान्य पेपर नहीं है: सीधा प्रमाण
SSRN के लिए सबसे हाल का प्रकाशित वितरणात्मक प्रमाण Jo और Li से आता है, जो SSRN के मार्केटिंग रिसर्च नेटवर्क से 2,361 पेपर का विश्लेषण करते हैं जो 15 अगस्त 2025 को एकत्रित एक क्रॉस-सेक्शनल स्नैपशॉट में है [83]। नीचे दी गई तालिका 5 उनके वर्णनात्मक आँकड़ों को पूरी तरह से पुनः प्रस्तुत करती है, और खंड 5 का समेकित बेंचमार्क नक्शा उन्हें शामिल करता है। माध्य डाउनलोड 221.346 थे, जबकि माध्यिका 87 थी: माध्य लगभग 2.54 गुना माध्यिका है। 95वां प्रतिशतक, 726, माध्यिका से आठ गुना से अधिक है। माध्य यहाँ तक कि 75वें प्रतिशतक (206) को भी पार करता है, जो नमूने में तीन-चौथाई से अधिक पेपर को "औसत पेपर" के नीचे रखता है। एक शोधकर्ता को बताया गया कि इस नेटवर्क में औसत पेपर के कुछ 221 डाउनलोड हैं, तो निष्कर्ष निकालेगा कि 100 डाउनलोड वाला एक पेपर सामान्य से काफी कम है, हालांकि 100 प्रकाशित माध्यिका से एक विस्तृत मार्जिन से अधिक है। चित्र 2 इस संरचना को सीधे प्रदर्शित करता है।
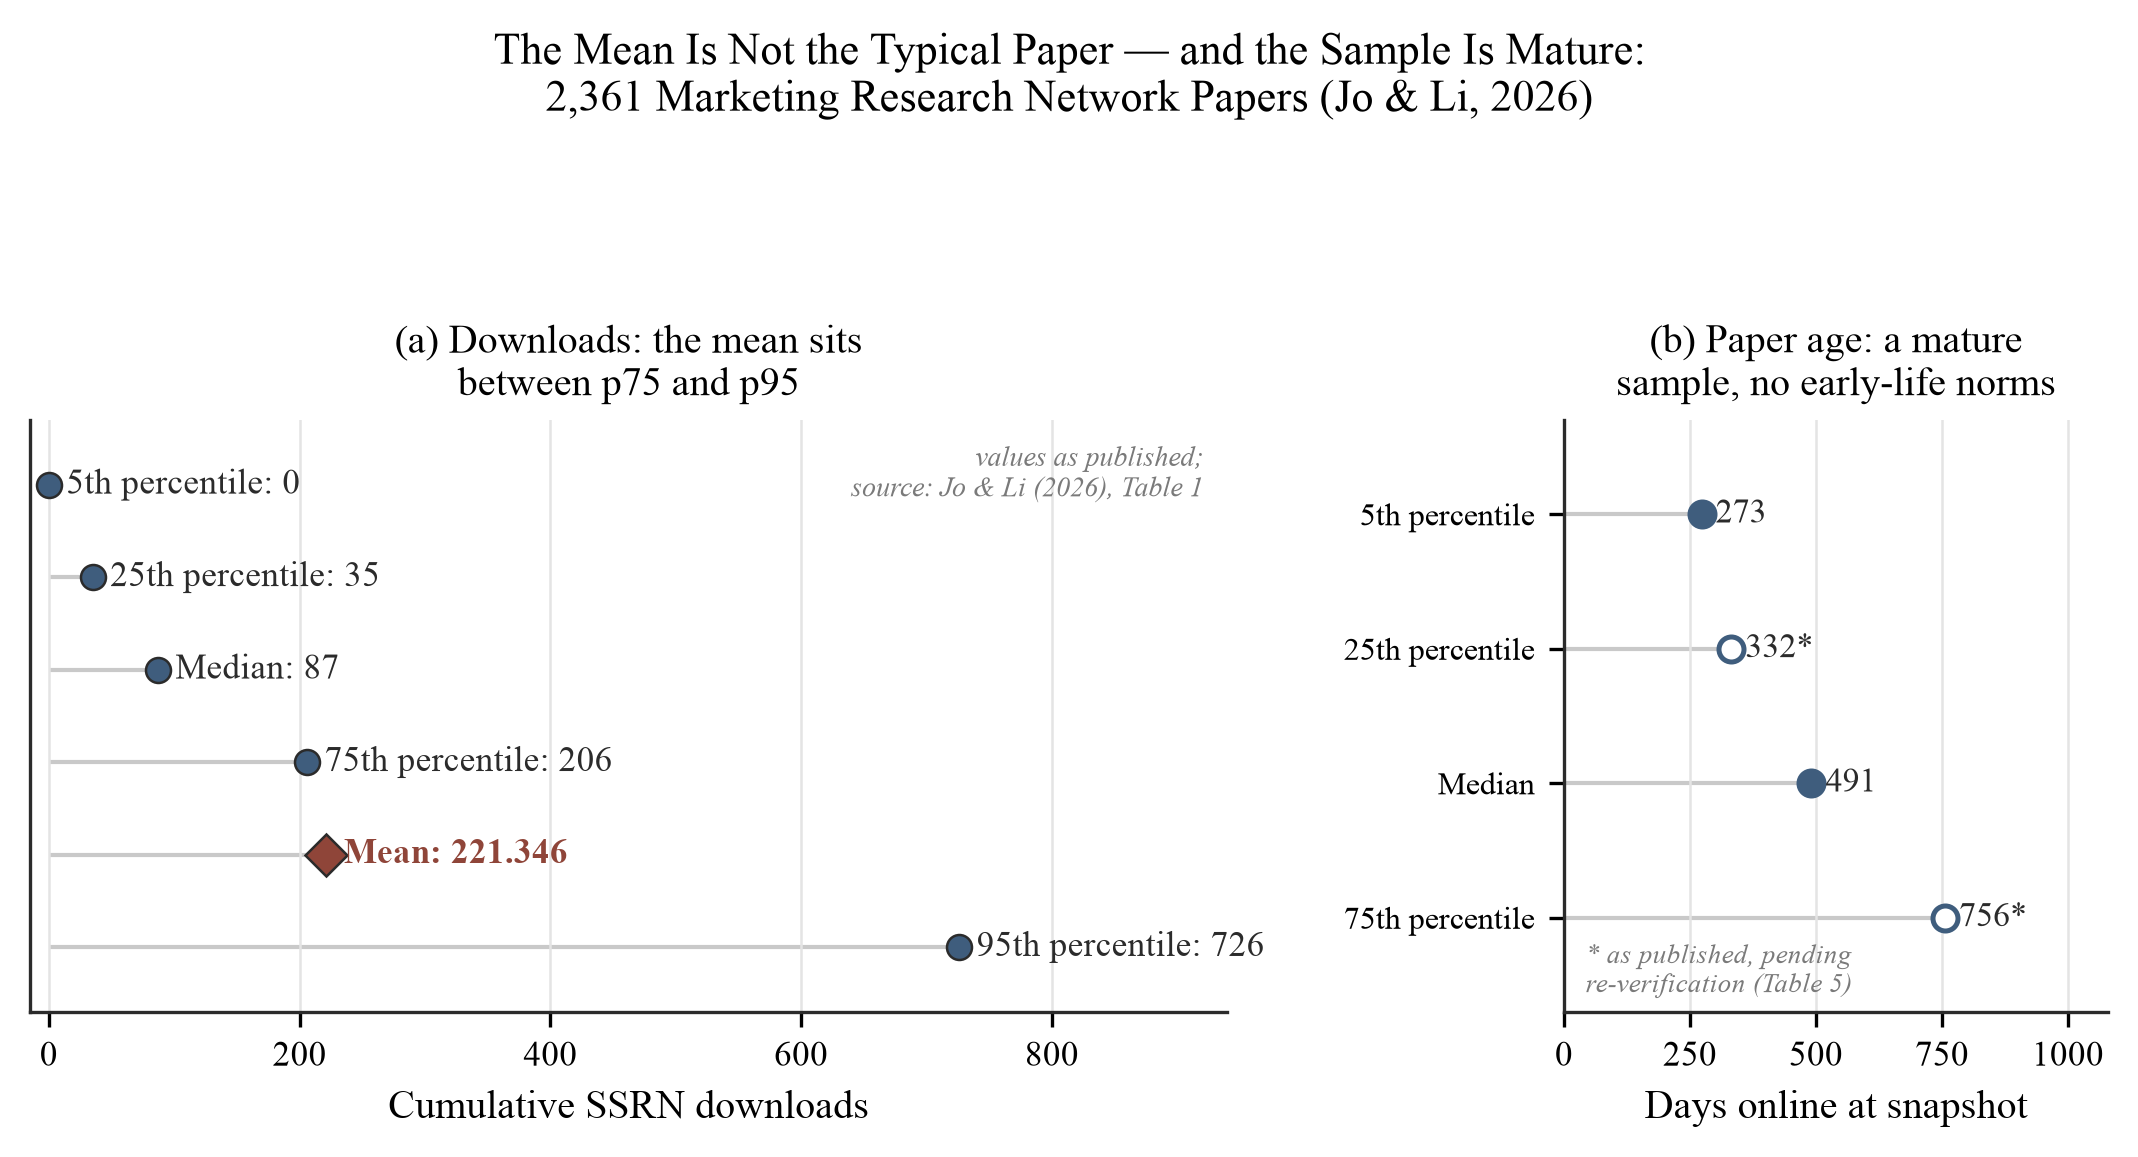
चित्र 2. 2,361 मार्केटिंग रिसर्च नेटवर्क पेपर के लिए प्रकाशित वर्णनात्मक आँकड़े। पैनल (a): डाउनलोड — p5 = 0, p25 = 35, माध्यिका = 87, p75 = 206, माध्य = 221.346, p95 = 726, मूल्य के क्रम में प्लॉट किया गया (ध्यान दें कि माध्य p75 और p95 के बीच गिरता है)। पैनल (b): एक ही नमूने में पेपर की आयु — 5वां प्रतिशतक 273 दिन और माध्यिका 491 दिन स्रोत के विरुद्ध सत्यापित; 25वां (332 दिन) और 75वां (756 दिन) प्रतिशतक "जैसा प्रकाशित है" पुनः प्रस्तुत (तालिका 5)। स्रोत की तालिका 1 में दो मान चिह्नित हैं और "जैसा प्रकाशित है" पुनः प्रस्तुत हैं, लेकिन वे विभिन्न प्रकार की विसंगतियाँ हैं। सारांश-विचार 95वां प्रतिशतक (966) माध्य (611.973; SD 1,100.5) से केवल लगभग 0.32 SD ऊपर बैठता है — एक दाएं-तिरछे गणना के लिए लगभग असंभव जिसका p75 पहले से ही 833 है — तो यह एक संदिग्ध स्रोत त्रुटि है, सबसे प्रशंसनीय रूप से एक टाइपो हालांकि प्रतिलेखन या रूंडिंग दोष को बाहर नहीं किया जा सकता, और सारांश-विचार पंक्ति की अन्य कोशिकाओं को समान सहसंबद्ध त्रुटि से संभावित रूप से प्रभावित माना जाता है (Jo और Li को एक लेखक क्वेरी के लिए चिह्नित, जिनकी प्रतिक्रिया अभी तक उपलब्ध नहीं है)। रूपांतरण 95वां प्रतिशतक (77.7, 27.2 के p75 के विरुद्ध) एक अलग घटना है: खंड 5.2 द्वारा भविष्यवाणी की गई बिल्कुल प्रकार की छोटे-हर अनुपात कलाकृति, सांख्यिकीय असंभावना नहीं। आयु पैनल व्याख्यात्मक सीमा को दृश्यमान करता है: ये परिपक्व-पेपर आँकड़े हैं, और नमूना प्रारंभिक-जीवन मानदंड की आपूर्ति नहीं कर सकता। स्रोत: Jo और Li (2026), तालिका 1 [83]।
तालिका 5 अध्ययन के पूर्ण वर्णनात्मक आँकड़ों को पुनः प्रस्तुत करती है, साथ ही इसके साथी चर और डाउनलोड वितरण भी, क्योंकि यह एकमात्र प्रकाशित SSRN नमूना है जिसमें एक पूर्ण प्रतिशतक पैनल है; इसकी कई कोशिकाएँ इस आलेख में अन्यत्र व्याख्यात्मक कार्य करती हैं। मानक विचलन भारी पूंछ को एक एकल संख्या के रूप में व्यक्त करते हैं: डाउनलोड के लिए 940.9 का SD, 221.3 के माध्य के विरुद्ध। डाउनलोड का 5वां प्रतिशतक बिल्कुल शून्य है, तो एक शून्य काउंटर परिपक्व नमूने की सामान्य श्रेणी के भीतर भी बैठता है। रूपांतरण प्रतिशतक खंड 5.2 के क्रॉस-अध्ययन बैंड को दोनों तरफ से कोष्ठक करते हैं (p25 = 12.1, माध्यिका = 18.9, p75 = 27.2 प्रति 100 विचार)। आयु प्रतिशतक (अंतर-चतुर्थक श्रेणी 332–756 दिन) नमूने की परिपक्वता को ठीक करते हैं, और लेखकत्व और पैकेजिंग पंक्तियाँ खंड 6.4 और 8.3 में खींचे गए सहचर मानदंड प्रदान करती हैं।
तालिका 5. Jo और Li (2026) नमूने के पूर्ण प्रकाशित वर्णनात्मक आँकड़े, "जैसा प्रकाशित है" (N = 2,361 मार्केटिंग रिसर्च नेटवर्क पेपर; 15 अगस्त 2025 का स्नैपशॉट)। सभी मान स्रोत की तालिका 1 से पुनः प्रस्तुत हैं [83]। वितरणात्मक कोर — डाउनलोड और विचार साधन, माध्यिकाएँ, और चतुर्थक; रूपांतरण माध्य और माध्यिका; आयु माध्यिका और 5वां प्रतिशतक — प्रकाशित तालिका के विरुद्ध सत्यापित किया गया है (तालिका 7 देखें)। शेष कोशिकाएँ (मानक विचलन; कोर से परे रूपांतरण और आयु प्रतिशतक; लेखक, पृष्ठ, और सारांश-लंबाई पंक्तियाँ) "जैसा प्रकाशित है" पुनः प्रस्तुत हैं और यहाँ स्वतंत्र रूप से पुनः-व्युत्पन्न नहीं हैं; स्रोत की उपस्थिति, स्थान, और लेखकत्व 14 अगस्त 2026 को Crossref के माध्यम से पुष्टि की गई थी। दो आंतरिक विसंगतियाँ "जैसा प्रकाशित है" की जाती हैं और सुधार के बजाय चिह्नित की जाती हैं, और वे समस्या की एक ही तरह नहीं हैं। सारांश-विचार 95वां प्रतिशतक (966) रिपोर्ट किए गए माध्य (611.973; SD 1,100.5) से केवल लगभग 0.32 SD ऊपर पड़ता है — इतने तिरछे गणना के लिए सांख्यिकीय रूप से लगभग असंभव और पंक्ति के अपने p75 के 833 के साथ असंगत — तो यह एक स्रोत में संदिग्ध टाइपो है; शेष सारांश-विचार कोशिकाएँ सहसंबद्ध त्रुटि से संभावित रूप से प्रभावित होने के लिए चिह्नित हैं और Jo और Li को एक लेखक क्वेरी के आगमन तक पुनः-सत्यापन के लिए अवनत की गई हैं। रूपांतरण 95वां प्रतिशतक (77.704, p75 पर 27.187 के विरुद्ध) इसके बजाय खंड 5.2 द्वारा भविष्यवाणी की गई एक छोटे-हर अनुपात कलाकृति है, एक ही प्रकार की वितरणात्मक विसंगति नहीं।
| चर | माध्य | SD | p5 | p25 | माध्यिका | p75 | p95 |
|---|---|---|---|---|---|---|---|
| डाउनलोड | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| सारांश विचार | 611.973 | 1,100.536 | 151 | 288 | 504 | 833 | 966 ("जैसा प्रकाशित है") |
| 100 सारांश विचार के लिए डाउनलोड | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 ("जैसा प्रकाशित है") |
| SSRN पर उपलब्धता, दिन | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| लेखकों की संख्या | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| पृष्ठों की संख्या | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| सारांश की लंबाई, शब्द | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
अध्ययन की तीन अन्य विशेषताएँ व्याख्या के लिए महत्वपूर्ण हैं। सारांश दृश्य एक उच्च स्तर पर समान विषमता दिखाते हैं: माध्य दृश्य 611.973 थे बनाम 504 की माध्यिका (p5 = 151, p25 = 288, p75 = 833; 966 का p95 "जैसा प्रकाशित" है लेकिन एक संदिग्ध स्रोत टाइपो है, माध्य से केवल ≈0.32 SD ऊपर है और 833 की p75 द्वारा निहित पूंछ के नीचे है, और किसी भी डाउनस्ट्रीम गणना में प्रवेश नहीं करता है; चित्र 2 के नोट देखें), 100 दृश्यों प्रति 23.699 डाउनलोड का प्रकाशित रूपांतरण [83] के साथ। अध्ययन पहुंच को रूपांतरण से अलग भी करता है: लेखकों के Poisson exposure मॉडल में, संस्थागत प्रतिष्ठा ने सारांश दृश्यों के आधार पर डाउनलोड की भविष्यवाणी की (गुणांक 0.192, और तीन-लेखक पत्र के लिए, एक शीर्ष-50-संबद्ध लेखक सारांश दृश्य प्रति अनुमानित 6.6% उच्चतर डाउनलोड दर से मेल खाता है), और यह प्रतिष्ठा प्रीमियम कमजोर हुआ क्योंकि सारांश में AI सहायता बढ़ी (इंटरैक्शन −0.627, p < .01) [83]। SSRN अब जमा करने पर भौतिक generative-AI उपयोग के प्रकटीकरण की आवश्यकता है [54][56]। तो ध्यान स्थिति संकेतों को ट्रैक करता है भले ही पाठक सारांश पृष्ठ पर पहुंच गया हो, जो सीधा प्रमाण है कि डाउनलोड संख्या दृश्यमानता और प्रतिष्ठा प्रभाव को एम्बेड करती है न कि केवल सामग्री मूल्यांकन को। लेखकों द्वारा स्वयं बताई गई सीमा एजेंडा निर्धारित करती है: एक एकल अनुशासनात्मक नेटवर्क की एक एकल स्नैपशॉट ध्यान के समय पथ को नहीं दिखा सकती, और वे स्पष्ट रूप से पैनल डेटा को आवश्यक अगला कदम के रूप में चिन्हित करते हैं [83], वह कदम जिसे खंड 8 में उठाया जाता है।
नमूना एक क्षेत्र में एक नेटवर्क है, एक तारीख को देखा जाता है: ये आंकड़े सार्वभौमिक SSRN बेंचमार्क नहीं हैं, और उनका मूल्य संरचना में निहित है। 2.54 का माध्य/माध्यिका अनुपात और 8 से ऊपर का p95/माध्यिका अनुपात भारी दाएं तिरछेपन के हस्ताक्षर हैं जो SSRN साक्ष्य के प्रत्येक अन्य निकाय में दोहराए जाते हैं, एक अलग अनुशासन और दशक से एक नमूना सहित: कानूनी छात्रवृत्ति के एकमात्र जनगणना-शैली नमूने में, 2012 में कानूनी छात्रवृत्ति नेटवर्क पर पोस्ट किए गए पत्र और दो साल बाद मापे गए (n = 1,107) के पास 63 डाउनलोड की माध्यिका थी बनाम 122.55 की माध्य, केवल दो साल की exposure के बाद लगभग दो गुना अंतर [139]।
3.4 वितरण का आकार: अर्ध-लॉग-सामान्यता और लंबी पूंछ
वितरण की बड़े पैमाने पर शारीरिक संरचना काकुशाद्ज़े द्वारा स्थापित की गई थी, जिन्होंने SSRN की सार्वजनिक शीर्ष सूचियों का विश्लेषण किया: शीर्ष 30,000 सूची पर 29,985 लेखक और उनके साथ जुड़े 367,478 पत्र (2015-vintage रैंकिंग का एक स्क्रैप) [85]। मुख्य निष्कर्ष यह है कि डाउनलोड अर्ध-लॉग-सामान्य हैं, स्तरों में भारी रूप से तिरछे हैं और लॉगेरिथम में लगभग गाऊसी हैं (लॉगेरिथम डाउनलोड के लिए फिट किए गए पैरामीटर प्रति पत्र: माध्य 5.406, मानक विचलन 1.016) [85]। काकुशाद्ज़े लॉग-सामान्यता के व्यावहारिक निष्कर्ष को स्पष्ट रूप से तैयार करते हैं: इस तरह के डेटा पर रैखिक अंकगणित विफल हो जाती है। डाउनलोड के लिए h-सूचकांक का सीधा अनुप्रयोग अनुचित है: डाउनलोड गणना उद्धरण गणना से परिमाण के कई आदेश बड़ी हैं, इसलिए सूचकांक कागजों की संख्या में ढह जाता है। वह इसके बजाय डाउनलोड के लॉगेरिथम के पूर्णांक भाग पर बनाई गई एक सूचकांक का प्रस्ताव करते हैं, k = ⌊ln D⌋ [85]। व्याख्या के लिए इसका अर्थ है कि डाउनलोड में सार्थक अंतर गुणक हैं, योगात्मक नहीं। यह आकार डाउनलोड के लिए विशेष नहीं है: व्यक्तिगत वैज्ञानिक प्रभाव का वितरण स्वयं लगभग लॉग-सामान्य है, जैसा कि सिनात्रा, वांग, डेविले, सॉन्ग और बारबेसी (2016) के Q-मॉडल ने वैज्ञानिक करियर में स्थापित किया है [181], इसलिए गुणक रीडिंग काउंटर मांग में विद्वान ध्यान के लिए मानदंड है, न कि SSRN का कलाकृति।
एक ही डेटासेट ऊपरी वितरण के लिए केवल प्रकाशित थ्रेशहोल्ड लंगर की आपूर्ति करता है। शीर्ष 10,000 पत्र सूची में प्रवेश (प्लेटफॉर्म के पूर्ण पाठ पत्र स्टॉक का लगभग 1.8%, 571,040, जुलाई 2016 [1], कभी-कभी उद्धृत "शीर्ष 1–2%" आंकड़ों के साथ सुसंगत के बजाय ऊपर) को न्यूनतम 160 डाउनलोड की आवश्यकता थी, मध्यिका 805, माध्य 1,800 और अधिकतम 152,242 [85]। शीर्ष 30,000 लेखकों में, न्यूनतम कुल डाउनलोड 129 थे, मध्यिका लेखक कुल 1,626 था, मध्यिका डाउनलोड-प्रति-पत्र 210 था, और अधिकतम, माइकल सी. जेनसेन, 824,762 था [85]। इस अभिजात नमूने के अंदर भी कागज के स्तर पर दुर्लभता बनी रहती है: विश्लेषण किए गए 367,478 पत्रों में से, केवल 112,793 (लगभग 30.7%) के पास अपने लेखकों के लॉग-सूचकांक में योगदान करने के लिए पर्याप्त डाउनलोड थे [85]। प्लेटफॉर्म के सबसे अधिक डाउनलोड किए गए लेखकों द्वारा अधिकांश व्यक्तिगत पत्र मामूली ध्यान आकर्षित करते हैं, और शीर्ष सूचियों के बाहर हिस्सा केवल कम हो सकता है। चित्र 3 प्रकाशित थ्रेशहोल्ड के साथ चिह्नित फिट वितरण को दृश्यमान करता है।
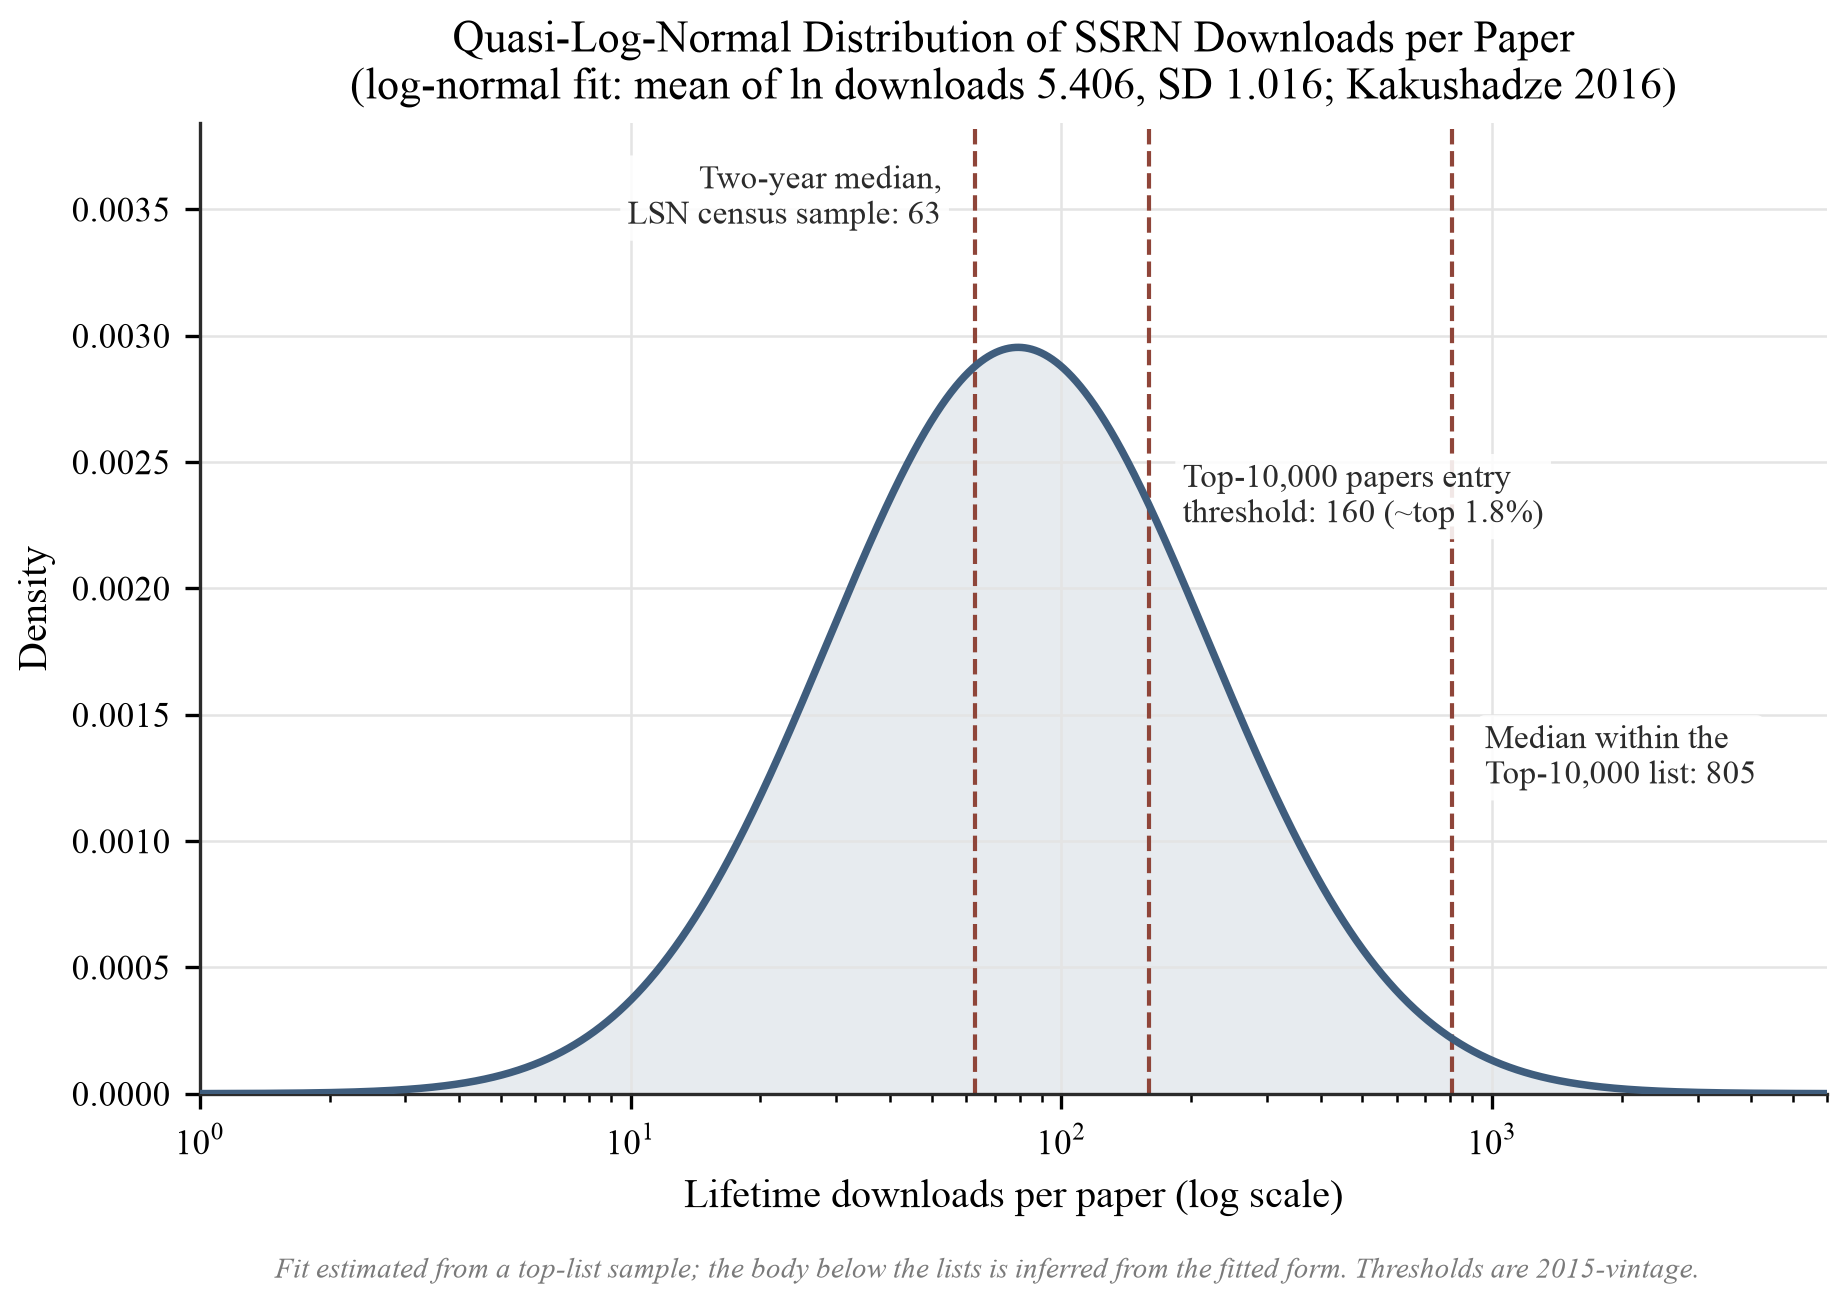
चित्र 3. काकुशाद्ज़े द्वारा रिपोर्ट किए गए पैरामीटर के साथ फिट किया गया लॉग-सामान्य घनत्व (लॉगेरिथम डाउनलोड का माध्य 5.406, SD 1.016) [85]; फिट की गई मध्यिका, exp(5.406) ≈ 223, रिपोर्ट की गई इन-ग्रुप प्रति-पत्र मध्यिका 210 से लगभग 6% ऊपर बैठती है, शीर्ष-सूची वितरण के लिए एक पर्याप्त लेकिन अपूर्ण फिट। धराशायी रेखाएं जनगणना-शैली कानूनी-छात्रवृत्ति नमूने [139] से दो वर्ष की मध्यिका को 63 डाउनलोड के साथ चिह्नित करती हैं, शीर्ष-10,000-पत्र प्रवेश थ्रेशहोल्ड 160 (प्लेटफॉर्म के पूर्ण पाठ पत्र स्टॉक का लगभग 1.8%, जुलाई 2016 में 571,040 [1]), और शीर्ष 10,000 सूची (805) के भीतर मध्यिका [85]। फिट को शीर्ष-सूची नमूने से अनुमानित किया गया है — मोटे तौर पर प्लेटफॉर्म का ऊपरी लेखक दशक — इसलिए सूचियों के नीचे वितरण का शरीर फिट किए गए फॉर्म से अनुमानित किया जाता है बजाय देखे गए; थ्रेशहोल्ड 2015-vintage हैं (तब से मुद्रास्फीति: अनुभाग 5.1)। आकृति के साथ एक मात्रात्मक सावधानी संबंधित है क्योंकि वक्र इसकी निचली पूंछ को पढ़ने के लिए आमंत्रित करता है: इस फिट किए गए घनत्व के तहत निहित निचली-पूंछ द्रव्यमान P(X ≤ 63) ≈ 10.7% और P(X ≤ 10) ≈ 0.1% हैं — 15–30% ≤10-डाउनलोड शेयर के दो से तीन परिमाण नीचे जो अध्ययन 1 (अनुभाग 8.6) एक संपूर्ण-प्लेटफॉर्म संभावना नमूने के लिए भविष्यवाणी करता है। विचलन एक विरोधाभास नहीं है बल्कि फिट के डोमेन का प्रत्यक्ष माप है: ऊपरी लेखक दशक पर अनुमानित घनत्व उस निचली पूंछ को नहीं जानता देख सकता जो कभी देखी नहीं गई, इसलिए जनगणना-शैली मार्कर ([139] की दो-वर्ष की मध्यिका 63; शीर्ष-10,000 प्रवेश 160 और इसकी मध्यिका 805) को फिट किए गए वक्र पर रखे गए बाहरी संदर्भ बिंदु के रूप में प्लॉट किया जाता है, यह दावे नहीं कि फिट उन्हें पुनरुत्पन्न करता है। मार्कर और जहां फिट किए गए वक्र समान मूल्य रखते हैं के बीच की दूरी स्वयं दृश्य सबूत है कि सूचियों के नीचे का शरीर अवलोकन नहीं किया गया है, और इस वक्र से कोई संपूर्ण-प्लेटफॉर्म निचली-पूंछ शेयर पढ़ा नहीं जाना चाहिए।
इन लंगरों को दो चेतावनियों की आवश्यकता है। नमूनाकरण फ्रेम वितरण के शीर्ष पर है, इसलिए काकुशाद्ज़े के आंकड़े पूंछ का वर्णन करते हैं, और सूचियों के नीचे साधारण पत्रों का द्रव्यमान केवल फिट किए गए लॉग-सामान्य फॉर्म के माध्यम से विशेषता है। एट्रिब्यूशन एक एकल लेखक को है: अध्ययन काकुशाद्ज़े (2016), जर्नल ऑफ इनफॉर्मेट्रिक्स [85] है; एक पुनरावर्ती miscitation एक दूसरा लेखक जोड़ता है और इससे बचा जाना चाहिए।
परिशिष्ट E में रिपोर्ट किया गया एक स्वतंत्र संग्रहीय क्रॉस-सेक्शन वितरण के शरीर को सीधे देखता है, 1,360 पत्रों के एक यादृच्छिक सभी-क्षेत्र नमूने पर जिनके सेवानिवृत्ति पूर्व काउंटर सार्वजनिक संग्रहों से पुनः प्राप्त हैं। यह देखे गए वितरण को लगभग लॉग-सामान्य पाता है (लॉग-डाउनलोड का तिरछापन ≈ 0.18), पूंछ पर काकुशाद्ज़े जो फिट कर सकते थे उस आकार को शरीर पर पुष्ट करता है, और यह स्वतंत्र रूप से माध्य-से-मध्यिका अंतराल, रूपांतरण बैंड और क्षेत्र गुणक को पुनरुत्पादित करता है। इसका अपना ऊपर की ओर चयन पूर्वाग्रह चरम निचली पूंछ को कम-देखा जाता है। फिर भी यह एकल आधुनिक संपूर्ण-वितरण लंगर को पुनरुत्पादित करता है जिस पर संश्लेषण अन्यथा झुका हुआ है: पुनर्निर्माण का माध्य (219) 221 की प्रकाशित विपणन-नेटवर्क माध्य के साथ मेल खाता है, इसलिए शीर्षक आकार पूरी तरह से अलग डेटा स्रोत द्वारा भी पुष्ट होता है। (इंटरनेट आर्काइव से ऐतिहासिक वेब डेटा को सत्यापित सामाजिक-विज्ञान पद्धति के रूप में पुनः प्राप्त करने पर, और इसके कवरेज और क्रॉल-आवृत्ति पूर्वाग्रहों पर, अरोड़ा, ली, यूटी एंड शपिरा, 2016, जर्नल ऑफ द एसोसिएशन फॉर इनफॉर्मेशन साइंस एंड टेक्नोलॉजी, 67(8), 1904–1915, doi:10.1002/asi.23503 देखें।)
3.5 दृश्यमान पूँछ द्वारा गलत अंशांकन
खंड 3.2–3.4 की संयुक्त संरचना एक व्यवस्थित मनोवैज्ञानिक त्रुटि की व्याख्या करती है। 2015 के स्क्रैप में सबसे अधिक डाउनलोड किया गया लेखक 824,762 डाउनलोड पर खड़ा था, जो शीर्ष-लेखक समूह के माध्यिका का लगभग 500 गुना (1,626) था, और विशिष्ट पेपर से चार क्रम परिमाण ऊपर [85]। एक अर्ध-लॉग-सामान्य नियम के तहत, जो दूरियाँ महत्वपूर्ण हैं वे गुणक हैं: साधारण-पेपर माध्यिका (दसियों डाउनलोड) से शीर्ष-सूची प्रविष्टि दहलीज (160) तक का चरण उस दहलीज से शीर्ष सूची के माध्यिका (805) तक के चरण से छोटा है, जो बदले में पूँछ अधिकतम [85][139] की दूरी से बौना है। फिर भी संख्याएँ जो सार्वजनिक रूप से प्रसारित होती हैं (मील के पत्थर की घोषणाएँ, "शीर्ष लेखक" प्रोफाइल, संस्थागत प्रेस विज्ञप्तियाँ [101]) लगभग अनन्य रूप से दृश्यमान पूँछ से तैयार की जाती हैं। लेखक इसलिए "अच्छा" को एक संदर्भ वर्ग के विरुद्ध अंशांकित करते हैं जो माध्यिका से सैकड़ों गुना ऊपर स्थित है, जबकि वितरण का द्रव्यमान माध्यिका के पास बैठा है। 7 डाउनलोड की एक डैशबोर्ड रीडिंग तब विफलता के रूप में अनुभव की जाती है भले ही यह पेपर की आयु और क्षेत्र के लिए असाधारण हो। माध्य समान त्रुटि में हल्के रूप में भाग लेता है: जैसा कि खंड 3.3 ने दिखाया, यह 75वें प्रतिशतक के ऊपर बैठा है, इसलिए यहाँ तक कि आधिकारिक-सुनने वाली "औसत" एक पूँछ-दूषित बेंचमार्क है। यह वह अर्थ है जिसमें माध्य झूठ बोलता है: इसे सही तरीके से गणना की जाती है और फिर एक वितरण में एक विशिष्ट मान के लिए गलत किया जाता है जिसका कोई विशिष्ट मान नहीं है।
साक्ष्य के कई अन्य निकाय इस निष्कर्ष को मजबूत करते हैं कि कच्चे काउंटर सामग्री जितना ही दृश्यता संरचना को दर्शाते हैं। ध्यान स्थिति के लिए प्रतिक्रिया करता है: arXiv घोषणा सूचियों में, स्थिति 1 में दिखाई देने वाले पेपर ने astro-ph में लगभग 83% उच्च माध्य उद्धरण अर्जित किए, एक प्रभाव जिसे लेखक काफी हद तक दृश्यता के बजाय स्व-चयन अकेले के लिए जिम्मेदार ठहराते हैं [72]। यह अनुक्रमण विलंब के लिए भी प्रतिक्रिया करता है। SSRN स्वयं नोट करता है कि Google Scholar द्वारा इसकी सामग्री की बाहरी अनुक्रमण खोज इंजन द्वारा नियंत्रित है और "6–9 महीने या उससे अधिक" [54, 14 अगस्त 2026 को एक्सेस किया गया] ले सकते हैं, इसलिए एक युवा पेपर के काउंटर एक प्रमुख खोज चैनल के संचालन शुरू करने से पहले उत्पन्न होते हैं। ध्यान उद्धरणों से डाउनलोड तक भी बहता है: उद्धृत होने से पाठकों (उनके बीच उद्धृत लेखक और उनके स्वयं के नेटवर्क) को उद्धृत पेपर तक आकर्षित करता है, और Granger-कारणता विश्लेषण इस उद्धरण-से-डाउनलोड पथ को लेखों के एक पर्याप्त हिस्से के लिए सक्रिय पाता है [80][39], इसलिए एक काउंटर का हिस्सा इसकी सामग्री पर किसी पाठक के फैसले के बजाय उद्धरण और सहयोग नेटवर्क में एक पेपर की स्थिति को अनुक्रमित करता है। इन तंत्रों में से प्रत्येक दृश्यता संरचना (स्थिति, खोज विलंब, नेटवर्क स्थान) के माध्यम से काउंटर को आकार देता है न कि किसी पाठक के गुणवत्ता के निर्णय के माध्यम से, और डैशबोर्ड संख्या में कोई भी दृश्यमान नहीं है। व्यापक ध्यान अर्थव्यवस्था चरम रूप में एक ही एकाग्रता दिखाती है: सोशल मीडिया में, ध्यान Gini गुणांक 0.90–0.94 तक पहुँचता है, शीर्ष 1% खातों के साथ निचले 99% संयुक्त से अधिक ध्यान प्राप्त करते हैं [180], Simon की कहावत का एक आधुनिक प्रतिध्वनि कि सूचना की संपत्ति ध्यान की गरीबी बनाती है [141]। SSRN पर विद्वतापूर्ण ध्यान, एक हल्के रूप में, तिरछे-प्रसार प्रक्रियाओं के समान परिवार से संबंधित है। SSRN पर सबसे ज्यादा घर वाला दर्शक, अर्थशास्त्री और कानूनी विद्वान, वित्त से संरचना को पहचानेंगे। Bessembinder की 1926–2016 के लिए CRSP डेटा का विश्लेषण पाया कि लगभग $34.8 ट्रिलियन की शुद्ध शेयर-बाजार धन सृष्टि सूचीबद्ध कंपनियों के 4% से कम के लिए जिम्मेदार थी, बहुमत स्टॉक अपने जीवनकाल में Treasury bills को आउटपरफॉर्म करने में विफल रहे [16]। समानांतर को प्रमाण के रूप में नहीं, एक चित्रण के रूप में दिया जाता है: धन में जैसे ध्यान में, कुल कुल एक पतली चरम पूँछ द्वारा उत्पन्न होते हैं, और अपने आप को विशाल द्वारा प्रभुत्व किए गए औसत के विरुद्ध मापना एक श्रेणी त्रुटि है। न ही दुर्लभता काउंटर का उपयोग करने तक सीमित है: बड़े में कानूनी छात्रवृत्ति में, एक 2007 जनगणना में कानून समीक्षा लेखों के 43% को कभी भी उद्धृत नहीं किया गया था, और केवल 2015–2019 समूह के 18% ने पाँच वर्षों के भीतर एक भी उद्धरण को आकर्षित किया [171]।
3.6 द फील्ड मल्टीप्लायर: नॉर्म की अनुशासनात्मक संरचना
वितरण एक नहीं है: यह क्षेत्र से क्षेत्र में भिन्न होता है। व्हेलन के विश्लेषण में लीगल स्कॉलरशिप नेटवर्क के 94 ई-जर्नल्स में वर्गीकृत लगभग एक चौथाई मिलियन पेपर दिखाते हैं कि अनुशासनात्मक आधार एक ही छत्र अनुशासन के भीतर भी लगभग आठ के कारक से भिन्न होता है: प्रति पेपर आजीवन औसत डाउनलोड कॉर्पोरेट, सिक्योरिटीज़ एंड फाइनेंस लॉ में 438.35 से लेकर एग्रीकल्चरल लॉ एंड पॉलिसी में 53.48 तक था [168]। चित्र 4 इस प्रवणता को प्रदर्शित करता है।
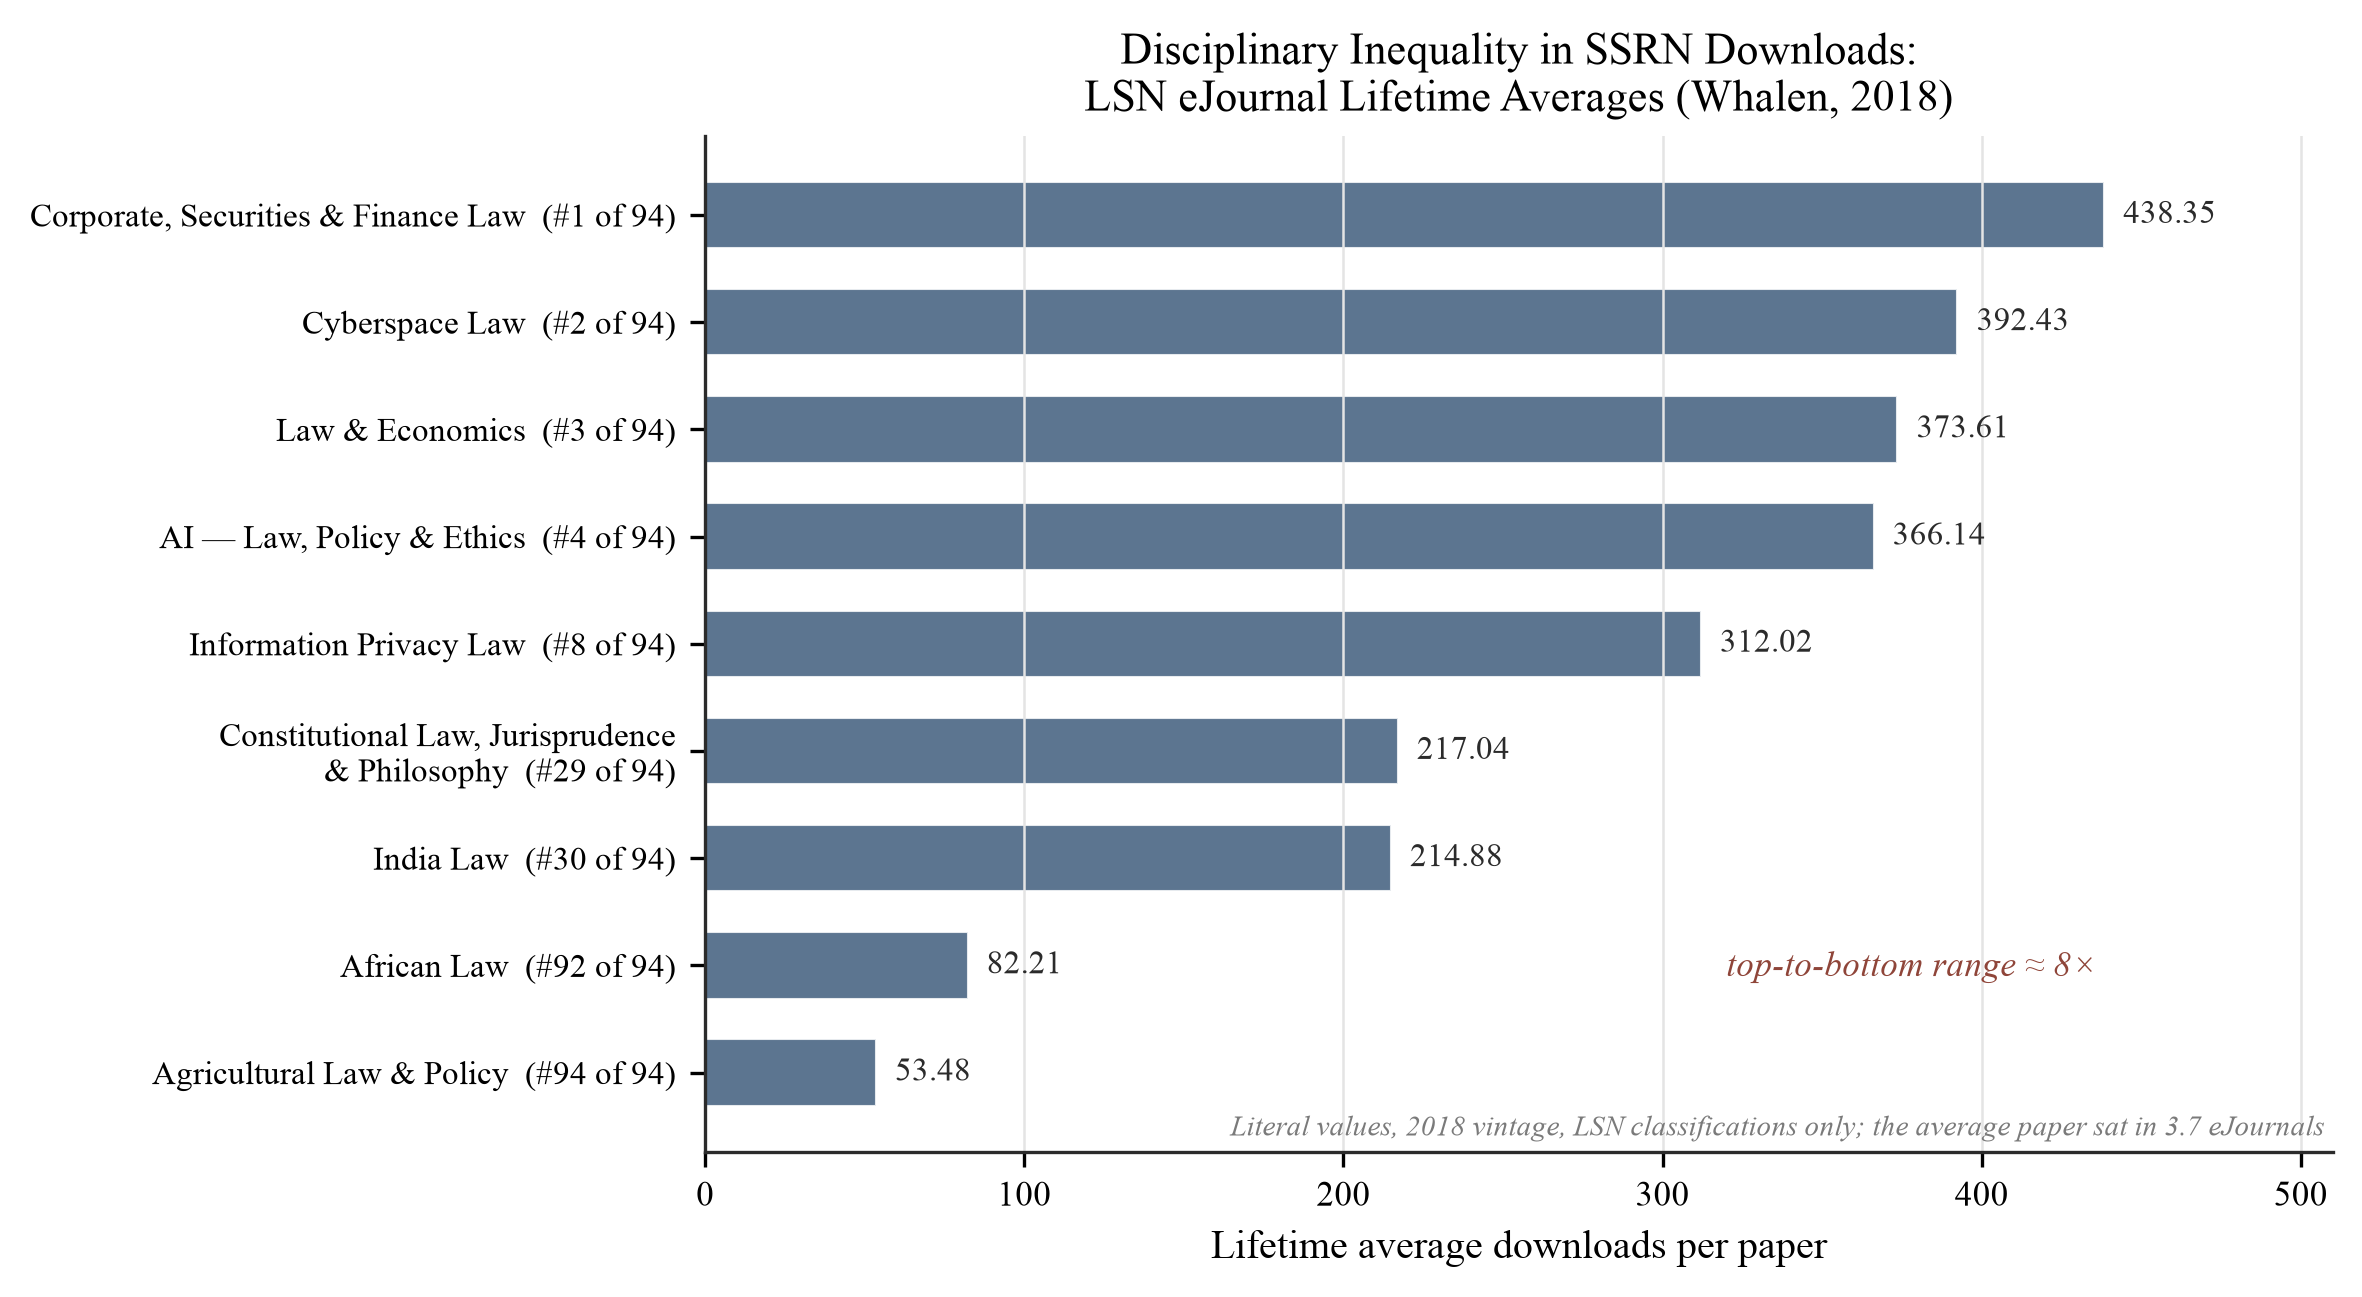
चित्र 4. चयनित LSN ई-जर्नल्स के लिए प्रति पेपर आजीवन औसत डाउनलोड, व्हेलन (2018) [168] से शाब्दिक मान: कॉर्पोरेट, सिक्योरिटीज़ एंड फाइनेंस लॉ 438.35 (रैंक 94 में से 1); साइबरस्पेस लॉ 392.43 (2); लॉ एंड इकोनॉमिक्स 373.61 (3); AI – लॉ, पॉलिसी एंड एथिक्स 366.14 (4); इनफॉर्मेशन प्राइवेसी लॉ 312.02 (8); कॉन्स्टिट्यूशनल लॉ, जुरिस्प्रुडेंस एंड फिलॉसफी 217.04 (29); इंडिया लॉ 214.88 (30); अफ्रीकन लॉ 82.21 (92); एग्रीकल्चरल लॉ एंड पॉलिसी 53.48 (94)। शीर्ष से नीचे की सीमा लगभग आठ गुना है। मान 2018-विंटेज हैं और केवल LSN वर्गीकरण को कवर करते हैं; औसत पेपर को 3.7 ई-जर्नल्स को असाइन किया गया था।
तंत्र योग्यता-आधारित से अधिक संरचनात्मक है: SSRN की खोज वर्गीकरण-आधारित है (ई-जर्नल के सदस्य इसमें वर्गीकृत पेपर के लिए अलर्ट प्राप्त करते हैं), इसलिए किसी पेपर का संबोधनीय दर्शक गण किसी भी गुणवत्ता संकेत के संचालन से पहले उसके क्षेत्र के सदस्य आधार द्वारा निर्धारित होता है। व्हेलन को अतिरिक्त रूप से पता चलता है कि अधिक वर्गीकरण वाले पेपर अधिक डाउनलोड अर्जित करते हैं और शून्य डाउनलोड रिकॉर्ड करने की संभावना कम होती है [168]। फील्ड संरचना उद्धरण संस्कृति के माध्यम से काउंटर को भी आकार देती है: ब्लैक और कैरॉन ने देखा कि डाउनलोड-से-उद्धरण अनुपात क्षेत्र में व्यवस्थित रूप से भिन्न होते हैं क्योंकि कानूनी विद्वता अर्थशास्त्र या वित्त की तुलना में पूर्व कार्य का अधिक पूर्ण रूप से उल्लेख करती है [18], और कानून के भीतर, ध्यान विशेष विषयों और लेखक की विशेषताओं पर केंद्रित होता है: 2012 की जनगणना नमूने में, कॉर्पोरेट और अंतर्राष्ट्रीय कानून विषय, अमेरिकी लेखकत्व, और शीर्ष-20 संबद्धता सभी ने महत्वपूर्ण रूप से उच्च गिनती की भविष्यवाणी की [139], निर्धारक जो समकालीन कानून-पुस्तकालय टिप्पणी में गूँजते हैं [175]। तो एक संख्या जो कॉर्पोरेट कानून में असाधारण नहीं है, कानूनी इतिहास या कृषि कानून में असाधारण हो सकती है, और कोई भी बेंचमार्क या स्केल (अनुभाग 5 में निर्मित एक सहित) को क्षेत्र-सापेक्ष के रूप में पढ़ा जाना चाहिए। इसके लिए उद्धरण पक्ष पर एक अच्छी तरह से स्थापित पूर्वाधार है: राडिक्की, फॉर्च्यूनेटो, और कास्टेलैनो (2008) ने दिखाया कि उद्धरण वितरण केवल तभी एक एकल सार्वभौमिक वक्र पर गिरते हैं जब प्रत्येक पेपर की गणना को उसके क्षेत्र के माध्य द्वारा पुनः स्केल किया जाता है [182], संदर्भ वर्ग का अनुरूप जो यह लेख तर्क देता है कि उपयोग गिनती समान रूप से आवश्यक है।
तीन उदाहरण, पूरी तरह से ऊपर सत्यापित एंकर पर निर्मित, दांव को ठोस बनाते हैं। कृषि कानून में एक लेखक जिसके पेपर में 60 आजीवन डाउनलोड हैं, अपने ई-जर्नल के 53.48 के माध्य से ऊपर बैठे हैं [168], फिर भी, कॉर्पोरेट-कानून गिनती के विरुद्ध कैलिब्रेट करते हुए जो सबसे दृश्यमान रूप से परिचालित होती है, समान संख्या को विफलता के रूप में पढ़ सकते हैं। कॉर्पोरेट और प्रतिभूति कानून में 60 के समान वाले एक लेखक उस क्षेत्र के माध्य 438.35 [168] से बहुत नीचे बैठे हैं। और एक लेखक जिसका विपणन पेपर नेटवर्क माध्यिका के 87 तक पहुंचता है [83] एक परिणाम को कम मूल्यांकन कर सकता है जो, निर्माण के अनुसार, विशिष्ट है। लापता पैमाने की त्रुटि दोनों दिशाओं में चलती है: यह अनुचित निराशा पैदा करती है, और यह सफलता को अस्वीकृत छोड़ देती है।
अनुभाग 3.2–3.6 इस लेख का अनुभवजन्य मूल स्थापित करते हैं। SSRN डाउनलोड वितरण भारी रूप से दाहिनी ओर तिरछा है और लगभग लॉग-सामान्य है, और माध्य न केवल माध्यिका बल्कि 75वें प्रतिशतक से अधिक है। दृश्यमान पूंछ 500 गुना अभिजात माध्यिका तक फैली हुई है और अनौपचारिक कैलिब्रेशन को दूषित करती है; काउंटर प्रतिष्ठा, स्थिति, अनुक्रमण, और क्षेत्र-संरचना प्रभाव को एम्बेड करते हैं जो सामग्री से स्वतंत्र रूप से संचालित होते हैं; और अनुशासनात्मक आधार एक ही विद्वानिक क्षेत्र के भीतर आठ गुना भिन्न होता है। माध्य के विरुद्ध, या पूंछ के विरुद्ध पढ़ी गई कच्ची डाउनलोड गिनती इसलिए निर्माण द्वारा अव्याख्यायित है। एक रक्षणीय पाठ के लिए एक संदर्भ वर्ग की आवश्यकता होती है: क्षेत्र, पेपर की आयु, और कोहोर्ट पर शर्त लगा एक वितरण। रैंकिंग, अपनी सभी खामियों के बावजूद, ऐसे संदर्भ वर्ग की ओर प्लेटफॉर्म की एकमात्र सार्वजनिक इशारा थे, और उनका हटना एक बाहरी वर्ग (अनुभाग 5 की बेंचमार्क मानचित्र और व्याख्या पैमाने) के निर्माण को इस लेख के बाकी हिस्से का केंद्रीय कार्य बनाता है।
4. काउंटर का यांत्रिकी: एक नियम के तहत एक काउंटर
SSRN डैशबोर्ड पर कोई भी संख्या व्याख्या की जा सकती है इससे पहले, यह स्थापित करना आवश्यक है कि वह संख्या वास्तव में क्या रिकॉर्ड करती है। SSRN दो प्राथमिक पेपर-स्तर के उपयोग मेट्रिक्स, सारांश विचार और डाउनलोड, उद्धरण आंकड़े और PlumX संकेतक के साथ प्रदर्शित करता है [50]। 15 जुलाई 2026 को रैंकिंग की सेवानिवृत्ति के बाद, ये काउंटर जगह में रहे: SSRN ने कहा कि "डाउनलोड गिनती और उद्धरण आंकड़े आपके अलग-अलग पेपर और लेखक प्रोफाइल पर रिकॉर्ड और प्रदर्शित किए जाते रहेंगे" [149]। तुलनात्मक पैमाना गायब हो गया, लेकिन डेटा रहा। जो काउंटर रहते हैं, हालांकि, मानव पाठकत्व के कच्चे अवलोकन नहीं हैं: वे प्लेटफॉर्म आर्किटेक्चर, वितरण मशीनरी, गैर-मानव ट्रैफिक, और अखंडता फ़िल्टरिंग का संयुक्त उत्पाद हैं। उन सभी परतों को नीचे अलग किया जाता है, और अनुभाग 5 फिर उनके ऊपर एक व्याख्या रूपरेखा बनाता है।
4.1 एक दृश्य और एक डाउनलोड रिकॉर्ड क्या है, और वे क्या नहीं है
एक सारांश दृश्य किसी पेपर के लैंडिंग पृष्ठ के लिए एक अनुरोध दर्ज करता है। एक डाउनलोड संपूर्ण-पाठ PDF की पुनः प्राप्ति दर्ज करता है। दोनों ही सम्पर्क घटनाएँ हैं; न तो पढ़ने, समझ, समर्थन, या वैज्ञानिक अनुमोदन का प्रत्यक्ष प्रमाण है। यह भेद इस लेख के शेष भाग में किए गए प्रत्येक दावे को सीमित करता है।
SSRN के सार्वजनिक काउंटर साधारण HTTP-अनुरोध लॉग नहीं हैं। प्लेटफॉर्म ने अपने शुरुआती वर्षों से डेटा-अखंडता फ़िल्टरिंग संचालित की है [69] और ने अपने दृष्टिकोण को सार्वजनिक रूप से वर्णित किया है: स्वचालित डाउनलोडिंग, दोहराई गई स्व-डाउनलोडिंग, और गणना में हेराफेरी के प्रयासों को "अनियमित गतिविधि के संकेतों" का उपयोग करके स्क्रीन किया जाता है, और संदिग्ध डाउनलोड (कुछ परिस्थितियों में, अनाम डाउनलोड सहित) लेखक-सामना कुल से बाहर रखे जाते हैं [144]। स्वतंत्र पर्यवेक्षकों ने पहले ही समान व्यवहार दस्तावेज़ किया है: एक ही IP पते से दोहराई गई डाउनलोड को काउंटर को श्रेय नहीं दिया जाता है [66]। डाउनलोड काउंटर इसलिए एक क्यूरेटेड सांख्यिकी है, कच्चे सर्वर लॉग की तुलना में भौतिक रूप से अधिक मजबूत। फ़िल्टरिंग सबसे पहचानने योग्य गैर-मानव और हेराफेरी वाली गतिविधि को हटाता है और अधिक कुछ नहीं। एक काउंटर हमेशा एक नियम के तहत एक काउंटर होता है और एक प्राकृतिक इकाई नहीं है, और नियम बदलते हैं (अनुभाग 4.3)।
4.2 गैर-मानव ट्रैफ़िक और विचारों तथा डाउनलोड के बीच असमरूपता
स्वचालित एजेंट हाल के उद्योग माप में समग्र इंटरनेट ट्रैफ़िक का आधे से अधिक हिस्सा हैं [158]। वह आंकड़ा SSRN के काउंटर पर लागू नहीं किया जा सकता: SSRN सार विचारों या डाउनलोड में बॉट शेयर का कोई प्रकाशित माप नहीं मिला, और SSRN के लिए दिया गया कोई भी विशिष्ट प्रतिशत अप्रमाणित होगा। जो स्थापित किया जा सकता है वह समस्या की संरचना है, दो दिशाओं से अनुमानित: वे तंत्र जो विचारों को अतिरंजित करने की संभावना रखते हैं, और एक पड़ोसी प्लेटफ़ॉर्म का पारदर्शी फ़िल्टरिंग रिकॉर्ड।
कई तंत्र संभवतः गैर-मानव सार विचार उत्पन्न करते हैं। खोज-इंजन क्रॉलर नियमित रूप से नई पोस्ट की गई सार पृष्ठों को अनुक्रमित करते हैं। संस्थागत ईमेल-सुरक्षा प्रणालियां, सबसे प्रमुख रूप से Microsoft Defender for Office 365 में Safe Links, आने वाली मेल में निहित URL को स्कैन करती हैं और पूर्व-प्राप्त करती हैं, जो किसी भी मानव प्राप्तकर्ता द्वारा संदेश खोलने से पहले सर्वर-साइड अनुरोध दर्ज कर सकती हैं [106]। क्योंकि SSRN का प्रमुख वितरण चैनल ईमेल है (अनुभाग 4.4), घोषणा ईमेल की लिंक-स्कैनिंग फैंटम विचारों का संरचनात्मक रूप से संभावित स्रोत है। कोई प्रकाशित अध्ययन सुरक्षा-प्रॉक्सी पूर्व-प्राप्ति के SSRN के विचार काउंटर में योगदान को नहीं मापता, और SSRN स्वयं अपनी मेट्रिक्स का ऑडिट करता है और डाउनलोड काउंट से अनियमित गतिविधि को बाहर करता है [144][66][69], इसलिए प्लेटफ़ॉर्म बहुत अच्छी तरह से ऐसे ट्रैफ़िक का एक बड़ा हिस्सा फ़िल्टर कर रहा हो सकता है, विशेष रूप से डाउनलोड पक्ष पर। दावा कि "अधिकांश SSRN विचार मानव नहीं हैं" अनौपचारिक चर्चा में प्रकट होता है लेकिन कभी भी मापा नहीं गया है।
पारदर्शी मामला RePEc है। इसकी लॉगिंग सेवा, LogEc, अपनी फ़िल्टरिंग पद्धति और फ़िल्टरिंग इतिहास दोनों को प्रकाशित करती है, और रिकॉर्ड यह प्रदर्शित करता है कि गैर-मानव संदूषण कितना गंभीर और कितना असमरूप हो सकता है। जुलाई 2007 तक ही, रोबोट निगरानी प्राप्त RePEc सेवाओं पर लगभग 74% सार विचारों के लिए जिम्मेदार थे लेकिन केवल लगभग 7% डाउनलोड के लिए [99]। फ़िल्टर इतिहास एक हथियार दौड़ का कालक्रम पढ़ता है: जुलाई 2010 में एंटी-मैलवेयर लिंक स्कैनर के विरुद्ध अनुमानशील तर्क जोड़े गए; जनवरी 2017 में एक नए प्रकार की व्यवस्थित बड़े पैमाने पर डाउनलोडिंग को संबोधित किया गया; जनवरी 2022 में पेश की गई DDoS-शमन फ़िल्टर ने 54% सार विचारों को हटा दिया लेकिन केवल 7% डाउनलोड [99]। अक्टूबर 2025 से, RePEc ने AI-संचालित बॉट ट्रैफ़िक की एक वृद्धि का दस्तावेज़ दिया जो मानव उपयोगकर्ताओं का नकल कर रहा था [129]। सितंबर 2025 में, IDEAS के लिए कच्चे ट्रैफ़िक के 99.5% से अधिक को गैर-मानव के रूप में त्यागा गया था [129]। सफाई के बाद, जून 2026 के लिए RePEc रिपोर्ट ने अपनी सेवाओं में लगभग 2.36 मिलियन सार विचार और 238 हज़ार डाउनलोड की गिनती की [129]।
RePEc साक्ष्य SSRN के लिए दो निष्कर्षों का समर्थन करता है। संदूषण निर्माण द्वारा असमरूप है: स्वचालित एजेंट HTML सार पृष्ठों को पूर्ण-पाठ PDF पुनर्प्राप्ति की तुलना में बहुत अधिक आक्रामक रूप से क्रॉल करते हैं, इसलिए जहां फ़िल्टरिंग अधूरी है वहां विचार काउंटर डाउनलोड काउंटर की तुलना में कहीं अधिक बढ़ जाते हैं। वह असमरूपता, 2007 के माप में ~74% विचार लेकिन ~7% डाउनलोड पर रोबोट [99], रिपॉजिटरी ट्रैफ़िक की एक आर्किटेक्चरल संपत्ति है और RePEc की कोई विशेषता नहीं है। विशिष्ट अनुपात स्थानांतरणीय नहीं हैं: SSRN की फ़िल्टरिंग नियम, वितरण मॉडल, और दर्शक अलग हैं, और SSRN समकक्ष फ़िल्टरिंग लॉग प्रकाशित नहीं करता है। अनुभाग 5.2 व्यावहारिक परिणाम विकसित करता है, जो यह है कि विचारों पर बनाए गए अनुपात (जैसे रूपांतरण दर) को मानव एनगेजमेंट गुणवत्ता पर निचली सीमा के रूप में पढ़ा जाना चाहिए, क्योंकि हर पल सबसे प्रदूषित मात्रा है। यह निचली-सीमा दिशा विंटेज-आश्रित है न कि एक कानून: यह तब तक रहता है जब तक दृश्य-पक्ष फ़िल्टरिंग डाउनलोड-पक्ष फ़िल्टरिंग में पिछड़ जाती है, जो ऐतिहासिक रूप से प्रलेखित व्यवस्था है [99], लेकिन यदि प्लेटफ़ॉर्म के विचार फ़िल्टर अपने डाउनलोड फ़िल्टर के साथ पकड़े जाएं, या यदि डाउनलोड-पक्ष संदूषण विचार-पक्ष से तेज़ी से बढ़े (जैसा कि 2025–2026 AI-बॉट एपिसोड ने दोनों को बढ़ाया [129]), तो यह कमजोर या उलट जाएगा। दिशा को जब भी कोई प्लेटफ़ॉर्म अपने गिनती के नियमों को संशोधित करता है तो फिर से जांचा जाना चाहिए।
एक और विचार इन फ़िल्टरिंग व्यवस्थाओं के डिज़ाइन के बाद से उभरा है। फ़िल्टर मानव ध्यान को प्रॉक्सी करने के लिए अभिप्रेत एक गणना से स्वचालित अनुरोधों को हटाने के लिए बनाए गए थे, और वह नियम अभी भी शोर को हटाता है। यह अब जो नहीं कर सकता है वह अनुपरीक्षित रूप से शेष को मानव मानना है, क्योंकि स्वचालित अनुरोध के तीन वर्ग अब वहां बैठते हैं जहां फ़िल्टर ने एक को देखा: मॉडल प्रशिक्षण के लिए पाठ की कटाई करने वाले क्रॉल, एक खोज या उत्तर सेवा के लिए अनुक्रमण के लिए क्रॉलर, और एक प्रणाली वास्तविक समय में एक व्यक्ति की ओर से जो कुछ पूछा है उसके लिए प्राप्त करती है। पहले दो एक ध्यान गणना के लिए शोर रहते हैं। तीसरा एक प्रतिनिधिमंडल कार्य है जिसके पीछे एक मानव है, क्योंकि एक प्रणाली जो उपयोगकर्ता के प्रश्न का उत्तर देने या साहित्य खोज का समर्थन करने के लिए पेपर का पूर्ण पाठ पुनर्प्राप्त करती है, सामग्री की सेवा दी गई है और इसका उपयोग किया गया है, हालांकि कोई व्यक्ति पृष्ठ को कभी लोड नहीं करता। एक स्वचालित अनुरोध स्वयं में यह साक्ष्य नहीं है कि कुछ पढ़ा गया था। प्रॉक्सी कमजोर हो गया है, फ़िल्टर नहीं: मानव बनाम मशीन अब विश्वसनीय रूप से इस लेख को आवश्यकता वाले अंतर को ट्रैक नहीं करता है, जो यह है कि कोई घटना विद्वानों के ध्यान का साक्ष्य है, मानव या प्रतिनिधि।
Project COUNTER ने इसे अपनी रिपोर्टिंग शब्दावली में संबोधित करना शुरू कर दिया है न कि इसके फ़िल्टर में। AI उपयोग पर सर्वोत्तम-प्रैक्टिस मार्गदर्शन, अप्रैल 2026 में जारी किया गया और Release 5.1.1 के लिए 30 जून 2026 को अपडेट किया गया, एक वैकल्पिक Access_Method of Agent को उपलब्ध कराता है, जिसे सामग्री और मेटाडेटा के रूप में परिभाषित किया गया है जिसे एक AI प्रणाली द्वारा प्राप्त किया गया है, AI-विशिष्ट मेट्रिक प्रकारों के साथ, जबकि Release 5.1.1 यह आवश्यकता रखता है कि "पारंपरिक बॉट और क्रॉलर द्वारा उत्पन्न गतिविधि सभी COUNTER रिपोर्ट से बाहर रखी जानी चाहिए" [125]। यंत्र में तीन सीमाएं हैं जो यहां महत्वपूर्ण हैं। यह एक वैकल्पिक विस्तार है, केवल रिपोर्ट में निर्मित जिसे एक प्रदाता उत्पन्न करने का चुनाव करता है और पहले एक प्रदाता के अपने प्लेटफ़ॉर्म पर एम्बेड किए गए AI प्रणालियों पर ध्यान केंद्रित किया गया है न कि इनबाउंड क्रॉलर पर। इसके तत्व "COUNTER रिपोर्ट के किसी भी मानक विचारों में शामिल नहीं किए जाने चाहिए" [125], इसलिए मानक दृश्य एजेंट एक्सेस में अंतर नहीं करेगा यहां तक कि जहां एक प्रदाता मार्गदर्शन लागू करता है। चाहे टैग की गई एजेंट घटनाओं को फिर डिफ़ॉल्ट कुल से हटा दिया जाए या उन्हें अबेल में किया जाए यह कार्यान्वयन का मामला है जिस पर मार्गदर्शन मौन है। यह उस पहुँच को भी वर्गीकृत करता है जो की गई थी न कि उस पहुँच को जो मना की गई थी: मार्गदर्शन कहता है कि "Access_Method Agent के साथ विशेष रूप से जुड़ी कोई भी अस्वीकृति मेट्रिक्स नहीं हैं" [125]। कोई भी इसमें नहीं पहुँचता क्योंकि ऐसा काउंटर कोई भी मामले में एक COUNTER रिपोर्ट नहीं है और कोई भी एक्सेस विधि नहीं ले जाता है; मानक एक एनालॉग है जिसके विरुद्ध इसका आकलन किया जा सकता है, इसका विवरण नहीं।
इनकार परिकल्पना नहीं है, और यह किसी भी गिनती नियम के ऊपर की ओर काम करता है, लेकिन इसके साधन प्रकृति में भिन्न हैं और एक के रूप में काम नहीं करते। एक प्लेटफ़ॉर्म की robots.txt नामित एजेंटों से क्रॉल न करने के लिए कहता है; एक पाठ-और-डेटा-खनन आरक्षण कानूनी स्थिति की पुष्टि करता है; उपयोग की शर्तें संविदात्मक रूप से बाध्य करती हैं; एक चुनौती सेवा उन पृष्ठों को क्लाइंट्स से रोकती है जो इसे पूरा नहीं कर सकते। इनमें से केवल अंतिम प्रवर्तन है। यहाँ अध्ययन किए गए प्लेटफ़ॉर्म पर, जैसा कि 29 अगस्त 2026 को पुनः प्राप्त किया गया था, robots.txt ने तीन एजेंटों (GPTBot, ChatGPT-User और Google-Extended) का नाम दिया और अन्य पर मौन रहा, मौन Robots Exclusion डिफ़ॉल्ट है जिसे अच्छे व्यवहार वाले क्रॉलर अनुमति के रूप में पढ़ते हैं; प्रतिक्रियाओं में EU Digital Single Market Directive के अनुच्छेद 3 के तहत आने वाले उद्देश्यों के लिए खनन की अनुमति देने वाली प्रकाशक की नीति की ओर इशारा करते हुए एक खनन आरक्षण था, और अन्यथा एक लाइसेंस की आवश्यकता होती है; उपयोग की शर्तें पाठ और डेटा खनन और AI प्रशिक्षण पर अधिकार सुरक्षित रखती हैं सिवाय जहाँ एक लेखक ने एक खुला लाइसेंस चुना है, एक विकल्प जो केवल 20 जुलाई 2026 के बाद से उपलब्ध है और सभी अधिकार सुरक्षित के लिए डिफ़ॉल्ट है; और एक एकल अप्रमाणित अनुरोध जो JavaScript इंजन के बिना किया गया था, Cloudflare द्वारा प्रबंधित चुनौती प्राप्त हुई पृष्ठ की जगह। नामित एजेंटों में से एक उपयोगकर्ता द्वारा प्रेरित फेचर है न कि प्रशिक्षण क्रॉलर: यह पूर्ववर्ती पैराग्राफ का प्रतिनिधित्व किया गया वर्ग है। ये सामग्रियाँ प्रकाशित प्रतिबंधों और एक कॉन्फ़िगरेशन अवलोकन को रिकॉर्ड करती हैं। वे यह स्थापित नहीं करती कि कितने अनुरोध, स्वचालित या मानव, अस्वीकार किए गए थे। निर्देशों का अनियमित सम्मान किया जाता है: क्रॉलर व्यवहार के एक बड़े पैमाने पर माप में, कुछ एजेंटों ने पूरी साइट अक्षमताओं का पूर्ण रूप से सम्मान किया जबकि पथ-स्तरीय अक्षमताओं का एक तिहाई से भी कम समय सम्मान किया, और अन्य लोगों ने फाइल को पूरी तरह अनदेखा किया [87]। न ही संपार्श्विक एकतरफा है, क्योंकि चुनौती परिनियोजन अन्यत्र वैध मानव उपयोगकर्ताओं को बाधित करते हैं (एक विश्वविद्यालय पुस्तकालय ने उपयोग के पहले चार महीनों में दो ऐसी घटनाएँ दर्ज की हैं [29])।
ऐतिहासिक विषमता इसलिए केवल आगे नहीं की जा सकती। 2007 की खोज का आराम, अमूर्त दृश्यों का लगभग 74% में रोबोट लेकिन डाउनलोड का लगभग 7% [99], उन क्रॉलर पर निर्भर था जो लैंडिंग पृष्ठ ब्राउज़ करते थे और शायद ही कभी पूर्ण पाठ प्राप्त करते थे। एक सिस्टम जो उत्तर को आधार प्रदान करने के लिए दस्तावेज़ प्राप्त करता है, अमूर्त पर रुकने का कोई कारण नहीं है, इसलिए डाउनलोड पक्ष अब निर्माण द्वारा स्वच्छतर तालिका के रूप में जाना नहीं जाता। जहाँ कच्चे विद्वान ट्रैफ़िक को 2025–26 में मापा गया है वहाँ स्वचालित हिस्सा सीमांत नहीं रहा है, और यह डाउनलोड और विज़िट गणनाओं के भीतर पाया गया है न कि केवल पृष्ठ दृश्यों में: एक सांस्कृतिक-विरासत संग्रह ने संदिग्ध बॉट ट्रैफ़िक हटाए जाने के बाद मार्च 2025 विज़िट गणना को 1,000,000 से 125,000 में संशोधित किया [167]; एक विक्रेता वर्गीकरण ने एक संस्थागत भंडार पर लगभग तीस मिलियन पहुंच अनुरोधों को केवल लगभग एक चौथाई को मानव के रूप में लेबल किया [98]; और एक भंडार ने खुले भंडारों की सर्वेक्षण का जवाब देते हुए अपने स्वयं के बॉट डाउनलोड के कम से कम एक चौथाई को जिम्मेदार ठहराया, कुछ पाँच लाख अनुरोध, ग्यारह नामित AI एजेंटों को [135]। इनमें से कोई भी आंकड़ा यहाँ अध्ययन किए गए प्लेटफ़ॉर्म का माप नहीं है: वे विभिन्न प्लेटफॉर्म से तैयार किए गए हैं जिनमें विभिन्न, कई मामलों में अनुपस्थित, बचाव हैं, और तीनों में से दो विज़िट या अनुरोधों की गणना करते हैं न कि डाउनलोड इवेंट जो एक सार्वजनिक काउंटर प्रदर्शित करता है। वे पूर्व स्थिति के बजाय परिमाण स्थापित करते हैं। वर्तमान वातावरण में किसी भी उपयोग गणना की व्याख्यात्मकता फिल्टर गुणवत्ता का एक कार्य है, और जहाँ एक प्लेटफ़ॉर्म अपनी फ़िल्टरिंग प्रकाशित नहीं करता है, वह गुणवत्ता अनुमोदित नहीं है।
दो पहचान समस्याएँ अनुसरण करती हैं, और वे यौगिक करती हैं। संरचना पहले: एक सार्वजनिक जीवनकाल काउंटर अकेले से, मानव, परंपरागत स्वचालित, और एजेंट-मध्यस्थता इवेंटों के हिस्से अनुमानित नहीं हैं, और प्लेटफ़ॉर्म का अपना दृश्य बेहतर नहीं हो सकता है, क्योंकि स्वचालित क्लाइंट्स को अपने आप को डेस्कटॉप ब्राउज़र के रूप में प्रस्तुत करते हुए देखा गया है [167]। चयन पर, एक काउंटर यह प्रकट नहीं कर सकता कि प्रयास की गई पहुंच के किस हिस्से को प्रदान किया गया, चुनौती दी गई, या किसी भी गिनती नियम के आवेदन से पहले बाहर रखा गया था। प्रकाशित नीतियाँ प्रकट करती हैं कि ऐसी व्यवस्था मौजूद है। वे प्रकट नहीं करती कि वे कितनी बार काम करती हैं, अतीत में कैसे काम करती हैं, या समावेश पर उनका प्रभाव। प्रयास की गई अनुरोधें, चुनौती दी गई अनुरोधें, प्रदान किए गए पूर्ण-पाठ इवेंट, प्रदर्शित डाउनलोड, और एक पुनः प्राप्त पेपर से उत्पन्न उत्तर इसलिए पाँच अलग-अलग जनसंख्या हैं, और उन्हें विनिमेय के रूप में व्यवहार नहीं किया जाना चाहिए। जो अलाइसेंस्ड रहता है वह इस प्लेटफॉर्म के लिए परिमाण या एक शुद्ध संकेत है। अनफ़िल्टर किया हुआ विद्वान उपयोग अब स्वचालित ट्रैफ़िक द्वारा फूला हुआ ज्ञात है, डाउनलोड सहित, लेकिन क्या इस प्लेटफॉर्म की अप्रकाशित फ़िल्टर, चुनौती नियम और क्रॉलर नीतियाँ एक अधिक मानव-भारित अवशेष, एजेंट-मध्यस्थता खोज में एक अंतराल, दोनों या कोई नहीं, अनुमापित है। न ही मिश्रण वर्षों भर स्थिर है जो एक जीवनकाल योग अवधि, जो पूर्व-2024 रोबोट व्यवस्था से लेकर 2025–26 के खरोंच सर्ज तक जुलाई 2026 में पेश किए गए लाइसेंस डिफ़ॉल्ट तक चलता है। सवाल के डाउनस्ट्रीम परिणाम स्वयं प्रलेखित हैं: एक प्रमुख AI क्रॉलर को ब्लॉक करने वाली साइटें, भले ही सामग्री सुलभ रहे, AI उत्तर इंजन द्वारा काफी कम बार पुनः प्राप्त की जाती हैं [70]। किसी भी प्रमुख प्रीप्रिंट सर्वर के लिए एजेंट हिस्से का कोई प्रकाशित अनुमान मौजूद नहीं है, एक छोटे प्रभाव के साक्ष्य के बजाय एक अनुसंधान अंतराल, और धारा 8 में निर्दिष्ट लेखा परीक्षा इसे मापने के लिए डिज़ाइन की गई है। एक सार्वजनिक जीवनकाल योग एक अज्ञात मिश्रण पर एक योग है, प्रयास की गई पहुंच के एक अज्ञात हिस्से से निकाला गया है, दोनों का कोई बाहरी अनुमानक नहीं है और किसी को भी स्थिर के रूप में व्यवहार करने का कोई आधार नहीं है।
4.3 गिरते हुए काउंटर माप घटनाओं के रूप में
जब फिल्टरिंग नियम बदलते हैं तो काउंटर गिर सकते हैं, या पुनः कथित हो सकते हैं, जो फिल्टरिंग रिकॉर्ड का एक और परिणाम है जिसे कोई भी डैशबोर्ड समझाता नहीं है। RePEc की जनवरी 2022 फिल्टर संशोधन ने एक ही कदम में पहले गिने गए अमूर्त दृश्यों का आधा हिस्सा हटा दिया [99]। इसके 2025–2026 AI-bot प्रकरण ने और भी कार्यप्रणालीगत परिवर्तन को बाध्य किया [129]। विक्रेता द्वारा रिपोर्ट किए गए डाउनलोड आंकड़े आम तौर पर गिनती परंपराओं के प्रति संवेदनशील ज्ञात हैं: एक पुस्तकालय-पक्ष ऑडिट में पाया गया कि एक प्रमुख प्रकाशक से डाउनलोड रिपोर्ट तुलनीय प्लेटफॉर्म की तुलना में लगभग दोगुनी थीं, "कम" गिनती रिपोर्ट किए गए आंकड़े का 43% थी [176]। किसी लेखक के SSRN काउंटर में अचानक गिरावट इसलिए एक माप घटना होने की संभावना है, प्लेटफॉर्म पक्ष पर एक फिल्टरिंग या पुनः कथन परिवर्तन, जितना कि एक पाठक घटना है, और इसे कभी भी सहसंबंध के बिना प्रतिष्ठागत नुकसान के रूप में नहीं पढ़ा जाना चाहिए। एक ही तर्क मेट्रिक्स के किसी भी डोस्सियर उपयोग को नियंत्रित करता है, जहां दिनांकित रिकॉर्ड संरक्षित किए जाने चाहिए (एक प्रोटोकॉल अनुभाग 6 में विकसित)। प्लेटफॉर्म की संख्याओं को संशोधित किया जा सकता है, और लेखक का दिनांकित संग्रह संशोधित नहीं किया जा सकता है।
4.4 Push बनाम pull: आर्किटेक्चर अनुपात को आकार देता है
वितरण आर्किटेक्चर अंतिम यांत्रिक परत है। यह प्रमुख रिपॉजिटरी में गुणात्मक रूप से भिन्न होता है और सीधे दृश्य और डाउनलोड के बीच संबंध को आकार देता है। SSRN मुख्य रूप से एक push मॉडल पर काम करता है। प्रस्तुतिकरण पर, लेखक एक से सात विषय वर्गीकरणों के बीच चुनाव करते हैं (औसतन LSN पेपर में 3.7 eJournal असाइनमेंट था [168]), और ये अनुसंधान नेटवर्क में प्लेसमेंट और विषय-विशिष्ट eJournal ईमेल सतर्कताओं के लिए योग्यता निर्धारित करते हैं। सतर्कता में समावेशन "क्यूरेट किया हुआ और लक्षित है, गारंटीकृत नहीं," और उच्च-मात्रा वाले विषयों में वितरण 45 दिन तक का समय ले सकता है [53]। सदस्य ईमेल द्वारा सारांश-स्तर की घोषणाएं प्राप्त करते हैं [57]। हर प्राप्तकर्ता जो किसी घोषणा से क्लिक करते हैं, चाहे केंद्रित रुचि से हो या हल्की जिज्ञासा से, एक सारांश दृश्य दर्ज करता है। इसके विपरीत, arXiv मुख्य रूप से एक pull प्लेटफॉर्म के रूप में काम करता है: एक गैर-लाभकारी रिपॉजिटरी जिसका ट्रैफ़िक सक्रिय रूप से सूचियां और फीड देखने वाले शोधकर्ताओं द्वारा संचालित होता है [11][65], जहां दैनिक घोषणा सूची के भीतर स्थिति भी पठनीयता और उद्धरणों को प्रभावित करती है [72]। RePEc विकेंद्रीकृत संग्रहों से मेटाडेटा एकत्र करता है और ऊपर वर्णित भारी दस्तावेज़ फ़िल्टरिंग लागू करता है [99][129]।
तालिका 6 शासन और खोज यांत्रिकी के एक गुणात्मक स्कीमा के रूप में प्लेटफॉर्म के पार तुलना को सारांशित करती है। तुलनीय क्रॉस-प्लेटफॉर्म ट्रैफ़िक डेटा प्रकाशित रिकॉर्ड में मौजूद नहीं है।
तालिका 6. प्लेटफॉर्म आर्किटेक्चर और उपयोग मेट्रिक्स पर उनका यांत्रिक प्रभाव (गुणात्मक स्कीमा)।
| विशेषता | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| शासन | वाणिज्यिक (Elsevier, मई 2016 से) [46] | गैर-लाभकारी (Cornell विश्वविद्यालय) [11] | विकेंद्रीकृत स्वयंसेवक नेटवर्क [99] |
| प्राथमिक खोज चैनल | Push: लेखक द्वारा चयनित वर्गीकरणों द्वारा संचालित क्यूरेट eJournal ईमेल सतर्कताएं (1–7; उच्च-मात्रा वाले विषयों में वितरण 45 दिन तक) [53][57] | Pull: सूचियों और फीड में इरादे-संचालित दौरे; घोषणाओं के भीतर स्थिति प्रभाव दस्तावेज़ित [11][72] | वितरित संग्रहों का समुच्चय; IDEAS/EconPapers के माध्यम से खोज [99] |
| फ़िल्टरिंग पारदर्शिता | गुणात्मक रूप से वर्णित नीति; कोई सार्वजनिक फ़िल्टरिंग लॉग नहीं [144] | उपयोग मेट्रिक्स के लिए केंद्रीय रूप से प्रकाशित नहीं | पूर्ण रूप से दस्तावेज़ित पद्धति और संशोधन इतिहास (LogEc) [99][129] |
| दृश्य : डाउनलोड अनुपात पर अपेक्षित यांत्रिक प्रभाव | डाउनलोड के सापेक्ष उन्नत दृश्य: ईमेल क्लिक-थ्रू निम्न-इरादे एक्सपोजर से दृश्य दर्ज करते हैं | डाउनलोड में दौरे का उच्च रूपांतरण: ट्रैफ़िक इरादे-संचालित है | अनुपात भारी बॉट ट्रिमिंग के बाद ही सार्थक है; प्रकाशित गिनती फ़िल्टर-पश्चात है [129] |
आर्किटेक्चर लेखक मनोविज्ञान पर असर डालता है, क्योंकि SSRN पर एक उच्च दृश्य-से-डाउनलोड अनुपात काफी हद तक एक डिजाइन परिणाम है: push मॉडल व्यापक, निम्न-इरादे एक्सपोजर उत्पन्न करता है। सारांश स्किमिंग भी वैध विद्वानतापूर्ण व्यवहार है (शोधकर्ता नियमित रूप से पूर्ण पाठ डाउनलोड किए बिना सारांश के माध्यम से क्षेत्रों की निगरानी करते हैं), तो एक दृश्य जो रूपांतरित नहीं होता है वह यह मतलब हो सकता है कि सारांश ने पहले ही अपना सूचनात्मक भार प्रदान कर दिया है, न कि कि यह पाठक को दूर किया। SSRN का अपना ऐतिहासिक अंगूठे का नियम, Black और Caron द्वारा रिपोर्ट किया गया, यह था कि लगभग "तीन सारांश दृश्य … एक वास्तविक पेपर डाउनलोड में परिणत होते हैं" [18]। एक ही लेखकों ने नोट किया कि अखंडता फ़िल्टर के बिना, कच्ची काउंटर "पांच गुना या अधिक के कारक द्वारा" फुलाए जाएंगे [18]। धारा 5.2 इन पुरानी लंगर को आधुनिक मापों के साथ रखती है।
पेपर कैसे प्रस्तुत किया जाता है इसकी दो यांत्रिक विशेषताएं पाठक रुचि के साथ-साथ रूपांतरण को नियंत्रित करती हैं, जो मापा गया रूपांतरण दर को आंशिक रूप से अनुसंधान की बजाय इंटरफेस की एक संपत्ति बनाती है। एक प्लेटफॉर्म का उपयोगकर्ता इंटरफेस है। चाहे पूर्ण पाठ एक इनलाइन, ब्राउज़र-में HTML रेंडरिंग के रूप में या केवल डाउनलोड योग्य PDF के रूप में ऑफर किया जाता है, यह भौतिक रूप से बदलता है कि क्या कोई इच्छुक पाठक कभी डाउनलोड काउंटर को ट्रिगर करता है, क्योंकि एक पाठक जो ब्राउज़र में पूर्ण पाठ का उपभोग करता है वह समान इरादे को संतुष्ट करता है जबकि केवल दृश्य बढ़ाता है। दूसरा दर्शकों की डिवाइस संरचना है। मोबाइल पहुंच डेस्कटॉप के सापेक्ष पूर्ण-पाठ PDF पुनर्प्राप्ति को दबाती है, तो एक पेपर जिसके पाठक मुख्य रूप से फोन पर आते हैं (सोशल-मीडिया लिंक या मोबाइल मेल क्लाइंट से) समान विद्वानतापूर्ण रुचि के लिए व्यवस्थित रूप से कम डाउनलोड और तुलनात्मक रूप से उच्च दृश्य दर्ज करेंगे। दोनों प्रभाव उसी दिशा में खींचते हैं जिस तरह से ऊपर स्थापित हर की यांत्रिक मुद्रास्फीति, और दोनों ही धारा 5.2 के अनुभवजन्य बैंड को एक निश्चित सीमा के बजाय एक प्लेटफॉर्म-सशर्त श्रेणी के रूप में पढ़ने के लिए आगे के कारण हैं: एक प्लेटफॉर्म के इंटरफेस और डिवाइस मिश्रण पर अनुमानित रूपांतरण मानदंड को पुनर्गणना की जानी चाहिए, न कि प्रत्यारोपित किया जाना चाहिए जब या तो बदलता है। उपयोग-मेट्रिक्स साहित्य प्लेटफॉर्म और गिनती सम्मेलनों के बीच डाउनलोड रिपोर्ट की तुलनीयता के बारे में एक ही विश्वसनीयता सावधानी उठाता है [176]।
4.5 पूर्वानुमेय दुष्प्रभाव: समानता स्व-मिलान और मेटाडेटा स्वच्छता
प्रीप्रिंट पोस्टिंग के दो अतिरिक्त यांत्रिक परिणाम पूर्वानुमेय हैं, और दोनों नियमित रूप से अनावश्यक चिंता उत्पन्न करते हैं, इसलिए दोनों बाकी मशीनरी के साथ रखे जाते हैं।
समानता स्व-मिलान। जब SSRN पर पोस्ट किया गया कार्यपत्र बाद में किसी पत्रिका को प्रस्तुत किया जाता है, तो पत्रिका की समानता जांच, अपेक्षित स्थिति में, लेखक के अपने प्रीप्रिंट के साथ लगभग पूर्ण मिलान को चिह्नित करेगी। iThenticate की प्रलेखन व्याख्या के दोनों भागों को स्पष्ट रूप से कहती है: सॉफ़्टवेयर "साहित्यिक चोरी की जांच नहीं करता; यह समानता की जांच करता है," और "यदि आप एक ही लेखक के लिए प्री-प्रिंट मिलान देखते हैं, तो यह साहित्यिक चोरी नहीं है" [81]। तंत्र भी प्रलेखित है। Crossref Posted Content के रूप में पंजीकृत प्रीप्रिंट समानता-जांच तुलना डेटाबेस में शामिल हैं, इसलिए अपने स्वयं के जमा किए गए प्रीप्रिंट के विरुद्ध एक मिलान सिस्टम को डिज़ाइन के अनुसार संचालित करना है [36]। मिलान तब भी सामने आ सकता है जब संपादक प्रीप्रिंट स्रोतों को बाहर करते हैं, क्योंकि माध्यमिक एग्रीगेटर भी भण्डार मेटाडेटा को डुप्लिकेट करके क्रॉल किए जाते हैं [81]। लेखक की प्रतिक्रिया रक्षात्मक के बजाय प्रशासनिक होनी चाहिए: चिह्नित स्रोत को हैंडलिंग संपादक को लेखक के अपने समय-मुहरबंद प्रीप्रिंट के रूप में पहचानें। Crossref और iThenticate मार्गदर्शन यांत्रिक समानता-स्कोर सीमा के बजाय गुणात्मक संपादकीय समीक्षा की सलाह देती है [36][81]। यहाँ कोई संख्यात्मक सीमा निर्दिष्ट नहीं है, क्योंकि स्क्रीनिंग सेवाएं स्वयं किसी को भी अनुमोदित नहीं करती हैं। इस सलाह को जो संयम मानता है वह प्रकाशक नीति में एक प्रलेखित आधार रखता है: एक प्रीप्रिंट सर्वर पर एक कार्यपत्र पोस्ट करना अधिकांश शैक्षणिक पत्रिकाओं की पूर्व-प्रकाशन नीतियों के तहत अनुमत है, हालांकि नीतियां भिन्न होती हैं और लक्ष्य पत्रिका की वर्तमान नीति की जांच की जानी चाहिए; प्रीप्रिंट रुख Sherpa Romeo जैसी रजिस्ट्री में सार्वजनिक रूप से अनुक्रमित हैं। सार्वभौमिक अपवाद चिकित्सा और आसन्न नैदानिक क्षेत्रों में समूहित हैं, जहां कुछ पत्रिकाएं अभी भी पूर्व प्रीप्रिंट पोस्टिंग को प्रतिबंधित या हतोत्साहित करती हैं। उन क्षेत्रों के लेखकों को जमा करने के बजाय पोस्ट करने से पहले लक्ष्य पत्रिका की प्रीप्रिंट नीति की पुष्टि करनी चाहिए।
AI-लेखन पहचान: एक आसन्न झूठी-अलार्म चैनल। एक नई जांच परत एक संरचनात्मक रूप से समान झूठी अलार्म जोखिम रखती है। AI-लेखन डिटेक्टर प्रलेखित झूठी सकारात्मक उत्पन्न करते हैं, और बोझ गैर-मूल अंग्रेजी लेखकों पर असमान रूप से पड़ता है: सात सार्वजनिक रूप से उपलब्ध GPT डिटेक्टरों के Stanford मूल्यांकन में (अध्ययन में Turnitin शामिल नहीं था), गैर-मूल वक्ताओं द्वारा लिखे गए TOEFL निबंधों का औसत 61.3% AI-जनित के रूप में गलत वर्गीकृत किया गया [97]। संस्थागत अभ्यास ने चिंता को पंजीकृत किया है। अगस्त 2023 में Vanderbilt विश्वविद्यालय ने अपने समानता-जांच सॉफ़्टवेयर की AI-पहचान विशेषता को सार्वजनिक रूप से अक्षम कर दिया, इसकी अविश्वसनीयता का हवाला देते हुए: विक्रेता का अपना दावा किया गया झूठी सकारात्मक दर, किसी भी प्रकाशित पहचान पद्धति की अनुपस्थिति, और ऊपर प्रलेखित गैर-मूल अंग्रेजी लेखकों पर समान असमान बोझ [163]। यहाँ रक्षात्मक मुद्रा समानता स्व-मिलान के समानांतर है और विरोधी के बजाय प्रशासनिक है: पांडुलिपि के संस्करण इतिहास और ड्राफ्टिंग रिकॉर्ड को लेखकत्व के समकालीन साक्ष्य के रूप में संरक्षित करें (नीचे संस्करण स्वच्छता के लिए एक अतिरिक्त तर्क), और किसी भी ध्वज का दस्तावेज़ के साथ उत्तर दें बजाय अलार्म के।
संस्करण और मेटाडेटा स्वच्छता। क्योंकि काउंटर प्रति कागज पृष्ठ जमा होते हैं, संशोधन अभ्यास सीधे मीट्रिक अखंडता को प्रभावित करता है। SSRN एक ही कागज पृष्ठ पर संशोधित संस्करण पोस्ट करने का समर्थन करता है, जमा किए गए काउंटरों और अनुक्रमित URL को संरक्षित करता है, जबकि एक कागज को हटाना और इसे फिर से अपलोड करना मेट्रिक्स को रीसेट करता है और मौजूदा लिंक को तोड़ता है (SSRN FAQ; एक समर्थन पृष्ठ संशोधन के अधीन, 14 अगस्त 2026 को एक्सेस किया गया [B-7])। वर्गीकरण विकल्प समान रूप से मीट्रिक परिणाम रखते हैं, क्योंकि वे eJournal रूटिंग निर्धारित करते हैं और इसलिए कागज के प्रमुख जोखिम ईवेंट्स [53]। बाहरी अनुक्रमण लेखकों की अपेक्षा के दीर्घ घड़ी पर चलता है: SSRN बताता है कि Google Scholar अनुक्रमण खोज इंजन द्वारा नियंत्रित है और "6–9 महीने या उससे अधिक" समय ले सकता है [55]। कागज के प्रारंभिक काउंटर इसलिए लगभग पूरी तरह से प्लेटफ़ॉर्म की आंतरिक वितरण मशीनरी द्वारा उत्पन्न होते हैं, जो धारा 5.6 में प्रारंभिक शून्य की व्याख्या को लंगर करता है।
5. एक व्याख्या ढांचा: लापता पैमाने का पुनर्निर्माण
प्रश्न "क्या यह संख्या अच्छी है?" वैज्ञानिक रूप से दुष्ट है जब तक एक तुलना समूह निर्दिष्ट नहीं है। यह अनुभाग प्रकाशित अनुभवजन्य रिकॉर्ड को लापता तुलनात्मक उपकरण में इकट्ठा करता है: स्पष्ट स्रोत आत्मविश्वास (5.1) के साथ एक समेकित बेंचमार्क मानचित्र, एक अनुभवजन्य रूपांतरण बैंड (5.2), एक स्नातक व्याख्या पैमाना (5.3), एक द्वि-आयामी पहुंच–रूपांतरण नैदानिक (5.4), एक बहुआयामी बेंचमार्क विशिष्टता (5.5), और एक अस्थायी पठन प्रोटोकॉल (5.6)। मूल्य उनके नमूने के फ्रेम और आयु के साथ पूरे समय निर्धारित किए जाते हैं। कोई भी 2026 प्लेटफ़ॉर्म के लिए एक अंशांकित प्रतिशतक नहीं है, और सभी को धारा 5.1 के मुद्रास्फीति चेतावनी के अधीन पढ़ा जाना चाहिए।
5.1 एक समेकित बेंचमार्क मानचित्र
तालिका 7 अनुभाग 2.5 ऑडिट में पहचाने गए SSRN उपयोग मेट्रिक्स के लिए प्रकाशित प्रत्येक उपयोगी बेंचमार्क को समेकित करती है, प्रत्येक के साथ इसका नमूनाकरण फ्रेम और स्रोत आत्मविश्वास का स्पष्ट विवरण। क्योंकि एक बेंचमार्क का दुरुपयोग उसी क्षण होता है जब इसे अपने फ्रेम से परे खींचा जाता है, प्रत्येक प्रविष्टि अनुमानात्मक भूमिका का नाम भी देती है जो स्रोत वैध रूप से निभा सकता है और मुख्य सीमा जो इसे बांधती है। साक्ष्य पतला है: मानचित्र पाँच अध्ययनों पर आधारित है जिनके अलग-अलग फ्रेम हैं: 2012 में एक कानूनी नेटवर्क का जनगणना-शैली नमूना [139], 2015 में प्लेटफ़ॉर्म की अपनी शीर्ष सूचियों की एक खुरचन [85], 2025 में एक एकल-नेटवर्क क्रॉस-सेक्शनल स्नैपशॉट [83], प्लेटफ़ॉर्म-स्तरीय एकत्रीकरण [1], और एक उप-क्षेत्र विघटन [168]। ये फ्रेम विनिमेय नहीं हैं: शीर्ष-सूची खुरचन एलीट टेल का वर्णन करते हैं, नेटवर्क जनगणना विशिष्ट पत्रों का वर्णन करते हैं, और प्लेटफ़ॉर्म एकत्रीकरण न तो करते हैं। शामिल प्रत्येक वितरण भी दृढ़ता से दाएं-तिरछा है, इसलिए माध्य व्यवस्थित रूप से माध्यिकाओं से अधिक है और असामान्य पत्रों का वर्णन करते हैं।
तालिका 7. SSRN उपयोग मेट्रिक्स के लिए समेकित बेंचमार्क मानचित्र, नमूनाकरण फ्रेम, स्रोत आत्मविश्वास, अनुमेय अनुमानात्मक भूमिकाएँ, और मुख्य सीमाएँ।
| बेंचमार्क | मान | स्रोत (वर्ष; नमूनाकरण फ्रेम) | स्रोत आत्मविश्वास | अनुमेय अनुमानात्मक भूमिका | मुख्य सीमा |
|---|---|---|---|---|---|
| प्लेटफ़ॉर्म पर ~2 वर्षों के बाद पत्र डाउनलोड की माध्यिका | 63 (माध्य 122.55) | Siems 2016 [139]; n = 1,107 LSN पत्र 2012 की दो खिड़कियों में पोस्ट किए गए, दो साल बाद काउंटर पढ़े गए | मध्यम-उच्च: नमूना और डाउनलोड आंकड़े सत्यापित; केवल कानून; 2012 कोहोर्ट | सामान्य-पत्र वितरण का ऐतिहासिक दृश्य | दो साल की कानूनी-नेटवर्क एंकर, वर्तमान प्लेटफ़ॉर्म-व्यापी मानदंड नहीं |
| ~2 वर्षों के बाद पत्र सार दृश्यों की माध्यिका | 369 (माध्य 564.62; दृश्य–डाउनलोड सहसंबंध 0.852) | Siems 2016 [139] | मध्यम-उच्च: आंकड़े स्रोत की तालिका 1 के विरुद्ध सत्यापित; केवल कानून; 2012 कोहोर्ट | सामान्य-पत्र पहुँच का ऐतिहासिक दृश्य | समान उम्र, एकल-अनुशासन फ्रेम; दृश्य काउंटर अधिक दूषित मात्रा है (अनुभाग 4.2) |
| माध्यिका पत्र डाउनलोड, एकल-नेटवर्क स्नैपशॉट | 87 (माध्य 221.3; p25 = 35; p75 = 206; p95 = 726; माध्यिका पत्र आयु 491 दिन) | Jo & Li 2026 [83]; N = 2,361 मार्केटिंग रिसर्च नेटवर्क पत्र, 15 अगस्त 2025 का स्नैपशॉट | उच्च: प्रकाशित तालिका के विरुद्ध सत्यापित; ध्यान दें विभिन्न प्रकार की दो विसंगतियाँ "जैसा प्रकाशित है" रिपोर्ट की गईं — दृश्य p95 = 966 एक संदिग्ध स्रोत टाइपो है (≈0.32 SD माध्य से ऊपर; पंक्ति पुनः-सत्यापन के लिए डाउनग्रेड की गई), रूपांतरण p95 = 77.7 एक छोटे-भाजक अनुपात कलाकृति है (अनुभाग 5.2); तालिका 5 में पूर्ण पैनल | हाल के क्रॉस-सेक्शनल वितरण और रूपांतरण मॉडल | एक नेटवर्क, एक क्षेत्र, एक तारीख; परिपक्व पत्र; कोई प्रक्षेपवक्र नहीं |
| माध्यिका पत्र सार दृश्य, एकल-नेटवर्क स्नैपशॉट | 504 (माध्य 611.973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 "जैसा प्रकाशित है") | Jo & Li 2026 [83]; ऊपर दिए गए समान नमूना | उच्च: प्रकाशित तालिका के विरुद्ध सत्यापित; p95 मान (966) एक संदिग्ध स्रोत टाइपो है — ≈0.32 SD माध्य से ऊपर — "जैसा प्रकाशित है" पुनरुत्पादित और लेखक प्रश्न की प्रतीक्षा में पुनः-सत्यापन के लिए डाउनग्रेड किया गया | हाल के क्रॉस-सेक्शनल पहुँच वितरण | समान एकल-नेटवर्क, एकल-तारीख फ्रेम |
| दृश्य→डाउनलोड रूपांतरण, अनुभवजन्य बैंड | 11–19% (≈ प्रति 5.3–9 सार दृश्य एक डाउनलोड) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | मध्यम-उच्च: Siems, Willey–Knapp, और Jo & Li आंकड़े स्रोत तालिकाओं के विरुद्ध सत्यापित | सशर्त-सगाई मानदंड (रूपांतरण) | कुछ नमूनाकरण फ्रेम; भाजक बॉट-मुद्रास्फीति योग्य है, इसलिए मापा गया रूपांतरण एक निचली सीमा है जबकि दृश्य अधिक मुद्रास्फीति किए गए काउंटर रहते हैं (अनुभाग 4.2) |
| ऐतिहासिक प्लेटफ़ॉर्म-व्यापी अंगूठे का नियम | ~3 सार दृश्य : 1 डाउनलोड (~33%) | Black & Caron 2006 [18], SSRN की अपनी सांख्यिकी रिपोर्ट करते हुए | मध्यम: शब्दशः सत्यापित; दिनांकित (2006); प्लेटफ़ॉर्म-व्यापी | मेट्रिक शरीर रचना और अखंडता इतिहास | प्रारंभिक प्लेटफ़ॉर्म युग; एक ऊपरी एंकर, वर्तमान मानदंड नहीं |
| प्रवेश थ्रेशोल्ड, समस्त-समय शीर्ष-10,000 पत्र | ≥160 आजीवन डाउनलोड (≈ प्लेटफ़ॉर्म के पूर्ण-पाठ पत्र स्टॉक का शीर्ष 1.8%, जुलाई 2016 में 571,040 [1]); समूह के भीतर माध्यिका 805; माध्य 1,800; अधिकतम 152,242 | Kakushadze 2016 [85]; SSRN शीर्ष सूचियों की खुरचन, 2015; 367,478 पत्र | उच्च: प्रकाशित तालिकाओं के विरुद्ध सत्यापित; शीर्ष-सूची फ्रेम; एकल-लेखक कार्य | वितरण आकार और पूंछ व्यवहार | शीर्ष-सूची चयन; समकालीन माध्यिका पत्र का अनुमान लगाने के लिए अनुपयुक्त |
| प्रवेश थ्रेशोल्ड, शीर्ष-30,000 लेखक | 129 कुल डाउनलोड (न्यूनतम); समूह के भीतर माध्यिका 1,626 कुल; प्रति पत्र माध्यिका 210 डाउनलोड; अधिकतम 824,762 | Kakushadze 2016 [85]; समूह SSRN की अपनी पत्र लेखकों के "शीर्ष 10%" के रूप में वर्णित [161] | उच्च: प्रकाशित तालिकाओं के विरुद्ध सत्यापित | लेखक-पोर्टफोलियो स्तर पर पूंछ व्यवहार | समान शीर्ष-सूची चयन; 2015 विंटेज |
| असंशोधित प्लेटफ़ॉर्म-व्यापी आजीवन माध्य | ~222 प्रति पत्र डाउनलोड (~35 पिछले 12 महीनों में) | दिसंबर 2023 तक प्लेटफ़ॉर्म कुल से गणना की गई: 1,157,048 पूर्ण-पाठ पत्रों में 256,678,716 आजीवन डाउनलोड; ALL-SIS 2024 [1] | मध्यम: व्युत्पन्न एकत्रीकरण; पुराने पत्रों द्वारा यांत्रिक रूप से मुद्रास्फीति; व्यक्तिगत यार्डस्टिक नहीं | प्लेटफ़ॉर्म स्केल का केवल एकत्रीकरण अंशांकन | दो दशकों के जमा होने पर एक औसत; लगभग कोई वास्तविक पत्र का वर्णन नहीं करता (अनुभाग 3.3) |
| एकल अनुशासन के भीतर उप-क्षेत्र प्रसार | ~8× प्रति पत्र माध्य डाउनलोड में (438.35 कॉर्पोरेट/प्रतिभूति/वित्त कानून बनाम 53.48 कृषि कानून) | Whalen 2018 [168]; 94 LSN eJournals, ~250,000 पत्र | मध्यम-उच्च: स्रोत से सत्यापित; 2018; माध्य, माध्यिका नहीं | वर्गीकरण और उप-क्षेत्र विषमता | माध्य, उम्र-मिलान माध्यिका नहीं; केवल कानून; 2018 |
| प्रारंभिक डाउनलोड → बाद के उद्धरण | r ≈ 0.39–0.43 पहले 180 दिनों में (≈ विचरण का 16% व्याख्या की गई) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14,442 | उच्च: सत्यापित; भिन्न प्लेटफ़ॉर्म, स्थानांतरणीयता अनुमानित न कि दिखाई गई | डाउनस्ट्रीम भविष्यसूचक सत्यापन | भिन्न प्लेटफ़ॉर्म और युग; पत्र-स्तरीय सहसंबंध मामूली हैं |
| पहुँच का कैलेंडर संरचना; पहुँच→उद्धरण अंतराल | सप्ताहांत में पहुँच ~11% कम और गर्मी में ~50% कम; लगभग इकाई-लोचदार उद्धरण प्रतिक्रिया पहुँच परिवर्तन के ~9 महीने बाद | Yuret 2026 [178]; सात पत्रिकाओं से >1,500 लेख ~1 वर्ष तक अनुसरण किए गए | उच्च: DOI, स्थान और शीर्षक को Crossref के माध्यम से सत्यापित किया गया (14 अगस्त 2026); सभी चार आंकड़े — सात पत्रिकाओं से 1,500 से अधिक लेख, सप्ताहांत में पहुँच लगभग 11% कम और गर्मी में लगभग 50% कम, और लगभग नौ महीने बाद एक लगभग इकाई-लोचदार उद्धरण प्रतिक्रिया (पहुँच में 10% वृद्धि उद्धरणों में लगभग 10% वृद्धि से जुड़ी होती है) — प्रकाशित लेख सार के विरुद्ध शब्दशः सत्यापित किया गया (Springer, 15 अगस्त 2026) | अस्थायी सामान्यीकरण और भविष्य सूचक सत्यापन — CSAB के पीछे कैलेंडर-सामान्यीकरण एंकर | पत्रिका-पहुँच डेटा, SSRN-विशिष्ट नहीं |
| गणना करने की परंपराओं के लिए गणना की संवेदनशीलता | विक्रेता डाउनलोड रिपोर्ट तुलनीय प्लेटफॉर्म की तुलना में ~2× चल सकती हैं ("अवमूल्यित" गणना रिपोर्ट किए गए आंकड़े का 43%); लेख-स्तरीय मेट्रिक्स के लिए स्पष्ट डेटा-अखंडता जांच की आवश्यकता है | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | मध्यम-उच्च: दोनों स्रोतों को सत्यापित किया गया और खंड 4.1–4.3 में पहले से उद्धृत किया गया | अखंडता और तुलनीयता चेतावनी — किसी भी क्रॉस-प्लेटफॉर्म या क्रॉस-विक्रेता तुलना की परिशुद्धता को सीमित करता है | SSRN बेंचमार्क का सीधा नहीं; कोई SSRN-विशिष्ट लेखा परीक्षा मौजूद नहीं है |
नक्शे की तीन संरचनात्मक रीडिंग अनुसरण करती है।
माध्य विशिष्ट पत्र नहीं है। एकमात्र हाल के प्रकाशित वितरण में माध्य (221.3) माध्यिका का 2.54 गुना (87) है और यहाँ तक कि 75वें प्रतिशतक (खंड 3.3) [83] को भी अधिक करता है। Siems की पहली जनगणना में माध्य माध्यिका का लगभग दोगुना था [139]। प्लेटफॉर्म-स्तरीय माध्य ~222 आजीवन डाउनलोड [1] सभी का सबसे कम उपयुक्त व्यक्तिगत पैमाना है: यह सभी उम्र के पत्रों द्वारा दो दशक के संचय को एकत्र करता है।
हर बेंचमार्क एक विंटेज ले जाता है, और विंटेज पूर्वाग्रह की दिशा तुलना पर निर्भर करती है। वार्षिक प्लेटफॉर्म डाउनलोड 2000 में लगभग 0.5 मिलियन और 2005 में 3 मिलियन [18] से बढ़कर 2016 में 12.9 मिलियन और 2023 में 40.6 मिलियन [1] हो गए, जो 2016 और 2023 के बीच 3.15 गुना वृद्धि है, जबकि कागज स्टॉक उसी अवधि में लगभग 2.03 गुना बढ़ा (571,040 से 1,157,048 [1])। चित्र 5 इस प्रक्षेपवक्र को दर्शाता है। चूंकि डाउनलोड कागज स्टॉक की तुलना में तेजी से बढ़े हैं, प्रति पत्र डाउनलोड प्रवाह लगभग 55% बढ़ गया (लगभग 22.6 से प्रति पत्र प्रति वर्ष लगभग 35.1 [1]), इसलिए एक निश्चित 2015 थ्रेशोल्ड अब एक छोटा हिस्सा दर्शाता है जो एक विशिष्ट पत्र अब कमाता है तुलना में तब। 2026 के लिए एक निरपेक्ष स्तर बैंड के रूप में पढ़ें, एक पुरानी थ्रेशोल्ड जैसे ~160-डाउनलोड शीर्ष-सूची प्रविष्टि इसलिए उदार के बजाय रूढ़िवादी है: इसे साफ़ करना आज 2015 से अधिक चुनिंदा नहीं है, अधिक। पूर्वाग्रह संरचना-निर्भर है। जारी रहने वाली सही विषमता के अंतर्गत प्रतिशतक स्थिति के लिए पुरानी एंकर अभी भी पूंछ को कम बता सकते हैं, लेकिन निरपेक्ष गणना के लिए डाउनलोड मुद्रास्फीति उन्हें नरम बनाता है, इसलिए किसी भी पुरानी थ्रेशोल्ड को इस योग्यता के बिना "रूढ़िवादी तल" के रूप में उद्धृत नहीं किया जाना चाहिए। 2015 थ्रेशोल्ड को बाद के प्लेटफॉर्म वृद्धि से गुणा करना इसी तरह अनुमत नहीं है: लेखक संरचना, वितरण चैनल, फ़िल्टरिंग और ध्यान के लिए प्रतिस्पर्धा सभी डाउनलोड प्रवाह के साथ बदल गई हैं।
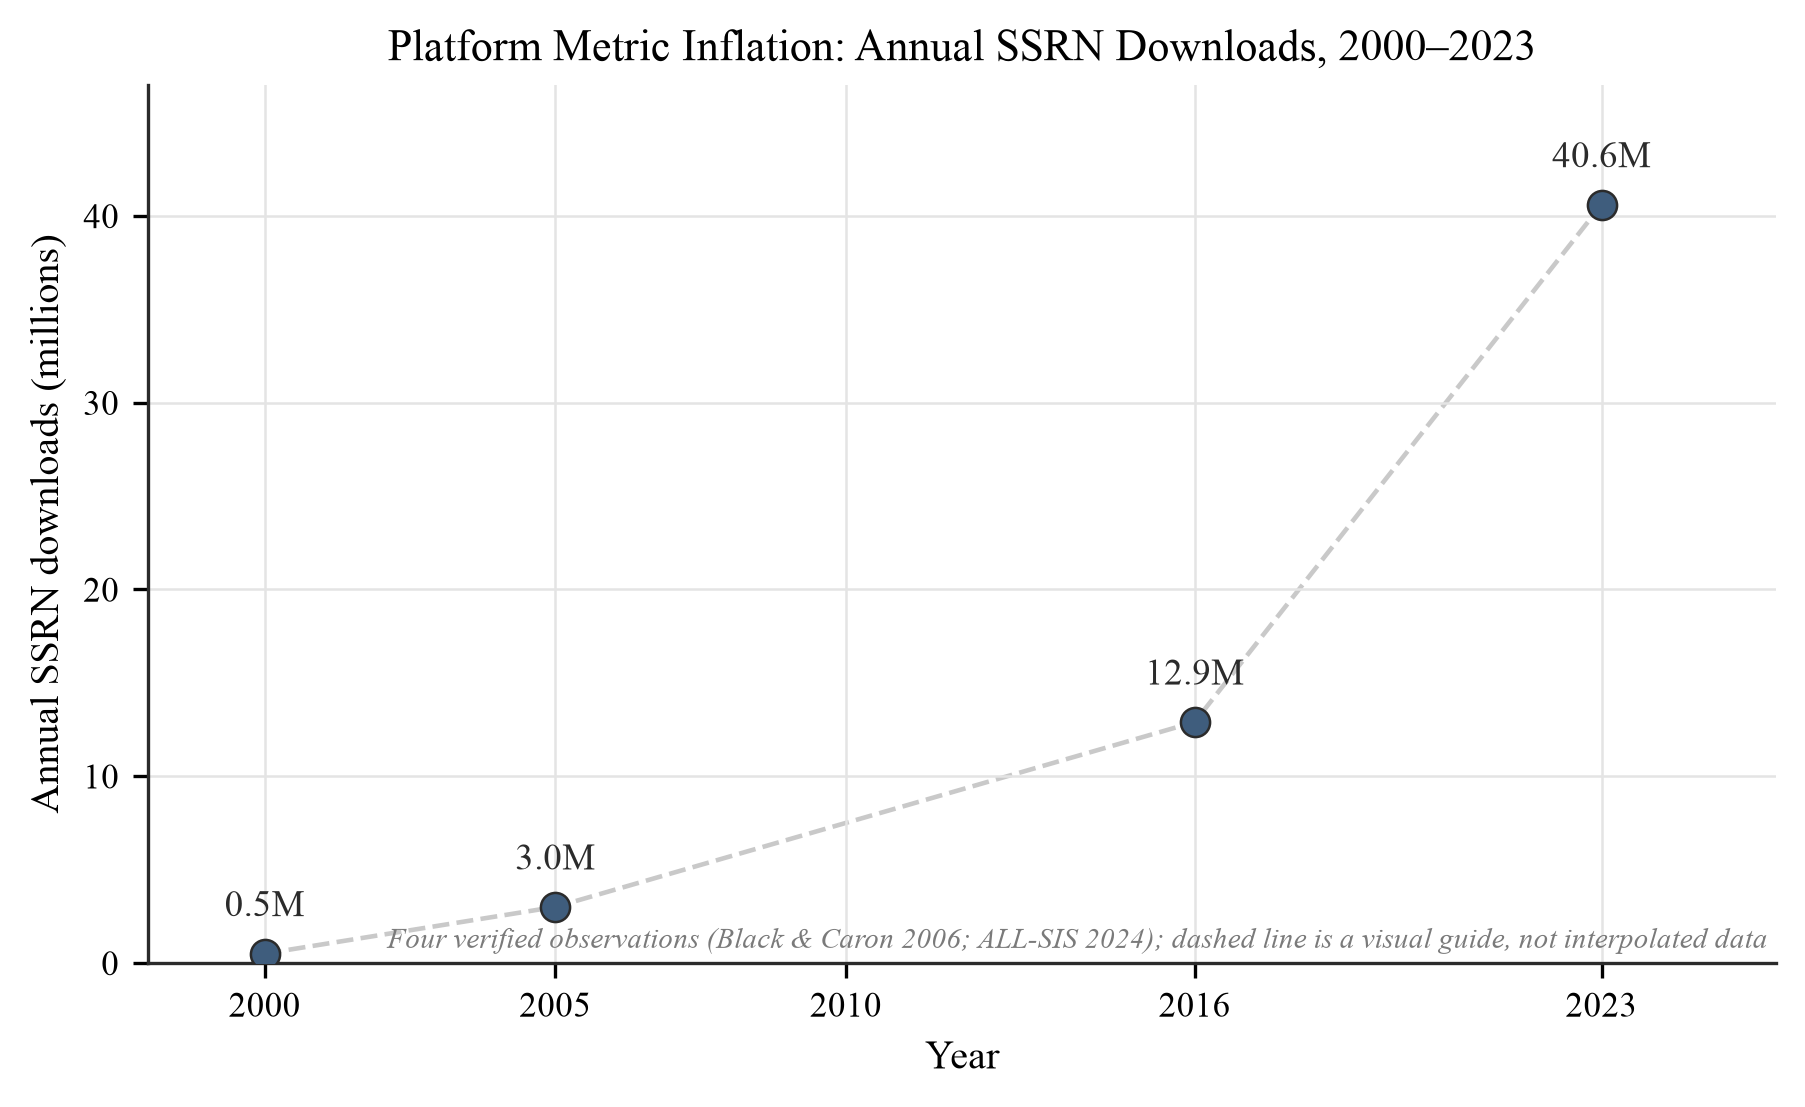
चित्र 5. प्लेटफॉर्म मेट्रिक मुद्रास्फीति, 2000–2023। वार्षिक SSRN डाउनलोड: ~0.5 मिलियन (2000) और ~3 मिलियन (2005) [18]; 12.9 मिलियन (2016) और 40.6 मिलियन (2023) [1]। चूंकि डाउनलोड प्रवाह कागज स्टॉक (2016 से 2023 तक ≈3.15× बनाम ≈2.03× [1]) से तेजी से बढ़ा है, लगभग 55% द्वारा डाउनलोड-प्रति-पेपर प्रवाह को उठाते हुए, निरपेक्ष बेंचमार्क 2012–2015 नमूनों पर अनुमानित 2026 रीडिंग के लिए उदार के बजाय रूढ़िवादी बैंड के रूप में पढ़े जाते हैं। केवल यहाँ सूचीबद्ध चार सत्यापित वर्ष-मान प्लॉट किए जाते हैं; उनके बीच कोई प्रक्षेप नहीं दिया जाता है।
कोई वर्तमान प्रतिशतक स्रोत मौजूद नहीं है। खंड 2.5 लेखा परीक्षा में कोई 2020-पश्चात प्लेटफॉर्म-व्यापी SSRN डाउनलोड का वितरणात्मक अध्ययन की पहचान नहीं की गई थी (2025 एकल-नेटवर्क स्नैपशॉट [83], 2026 में प्रकाशित, एकमात्र हाल के प्रकाशित बाहरी नमूना है), और 15 जुलाई 2026 के बाद प्लेटफॉर्म स्वयं कोई तुलनात्मक डेटा प्रकाशित नहीं करता जिससे प्रतिशतक का पुनर्निर्माण किया जा सके। अंतराल मुद्रा और प्लेटफॉर्म विशिष्टता का है। प्रीप्रिंट ध्यान का वितरण और असमानता अन्य रिपॉजिटरी पर एक परिपक्व अनुसंधान क्षेत्र है (bioRxiv जमा की उद्धरण और altmetric प्रोफ़ाइल पूरे सर्वर में विशेषताएं हैं [62]), और SSRN डाउनलोड की अर्ध-लॉगनॉर्मल आकृति विशेष रूप से 2020 से पहले Kakushadze द्वारा पहले से ही स्थापित की गई थी [85]। जो लापता है वह एक वर्तमान, SSRN-विशिष्ट, पश्चात-सूर्यास्त प्रतिशतक वितरण है। ऊपर दिया गया नक्शा उपलब्ध फ़्रेम से इकट्ठा किया गया है, जो अनुसंधान एजेंडा (खंड 8) में प्रस्तावित सामुदायिक बेंचमार्क डेटासेट के लिए तर्क है।
5.2 रूपांतरण बैंड
डाउनलोड से सार दृश्यों का अनुपात एक मात्र डैशबोर्ड मात्रा है जिसमें एक उचित स्थिर अनुप्रवाह अध्ययन मानदंड है, और लेखक इसे किसी अन्य से अधिक सुसंगत तरीके से गलत पढ़ते हैं। सरलता से पढ़ने पर, प्रत्येक दृश्य जो रूपांतरित नहीं होता वह एक अस्वीकृति के रूप में गिना जाता है, और 40 दृश्य और 7 डाउनलोड वाला एक लेखक "82.5% विफलता दर" को समझता है। वह पढ़ना यांत्रिक और अनुभवजन्य दोनों आधारों पर गलत है।
अनुभाग 4 ने यांत्रिकी स्थापित की: हर (दृश्य) अधिक बॉट-दूषित और अधिक आर्किटेक्चर-फुलाए हुए मात्रा है, क्योंकि पुश-मॉडल ईमेल क्लिक-थ्रू और क्रॉलर ट्रैफ़िक पाठक के इरादे के बिना दृश्य जमा करते हैं, जबकि डाउनलोड काउंटर सक्रिय रूप से ऑडित किया जाता है [144][99][106]। जब तक स्वचालित ट्रैफ़िक डाउनलोड की तुलना में अधिक दृश्यों को फुलाता है, एक मापा गया रूपांतरण दर सच में रुचि रखने वाले मानव आगंतुकों के रूपांतरण पर एक निचली सीमा है; अनुभाग 4.2 व्याख्या करता है कि AI सिस्टम पूर्ण पाठ प्राप्त करते समय वह असममिति अब क्यों मानी नहीं जा सकती, और सीमा तदनुसार कमजोर हो जाती है। अनुभवजन्य रूप से, प्रकाशित माप एक संकीर्ण बैंड में अभिसरित होते हैं। Siems ने LSN जनगणना में प्रति दृश्य डाउनलोड का 0.171 (माध्य 0.187) मध्यिका मापा [139]; Willey और Knapp अपने शीर्ष-लेख समूह में 15% और एकल-उद्धरण लेखों के बीच 11% रूपांतरण की रिपोर्ट करते हैं [172]। Jo और Li के स्नैपशॉट से 100 सार दृश्यों पर 18.9 डाउनलोड की मध्यिका मिलती है [83]। परिणामी अनुभवजन्य बैंड 11–19% है, अर्थात्, लगभग प्रति 5.3–9 सार दृश्य एक डाउनलोड। SSRN का अपना पुरानी नियम ~3 : 1 (~33%) [18] बैंड के ऊपर बैठता है और एक वर्तमान मानदंड के बजाय प्रारंभिक-युग, प्लेटफॉर्म-व्यापी ऊपरी लंगर के रूप में सबसे अच्छा पढ़ा जाता है। एक अनुप्रवाह-डोमेन उदाहरण के रूप में (जनसंख्या और इरादे श्रेणीबद्ध रूप से भिन्न होते हैं), इस सीमा में एक ब्राउज़-टू-कमिट दर उपभोक्ता सॉफ़्टवेयर में उच्च माना जाएगा, जहां विशिष्ट फ्रीमियम मुक्त-से-भुगतान रूपांतरण बेंचमार्क कम एकल अंकों में क्लस्टर करते हैं [10]। यह तुलना केवल चित्र प्रस्तुत करना है, और यह इस अंतर्ज्ञान को पुनः तैयार करता है कि "40 में से 7" अरुचि का संकेत देता है। चित्र 6 अनुमानों को प्लॉट करता है।
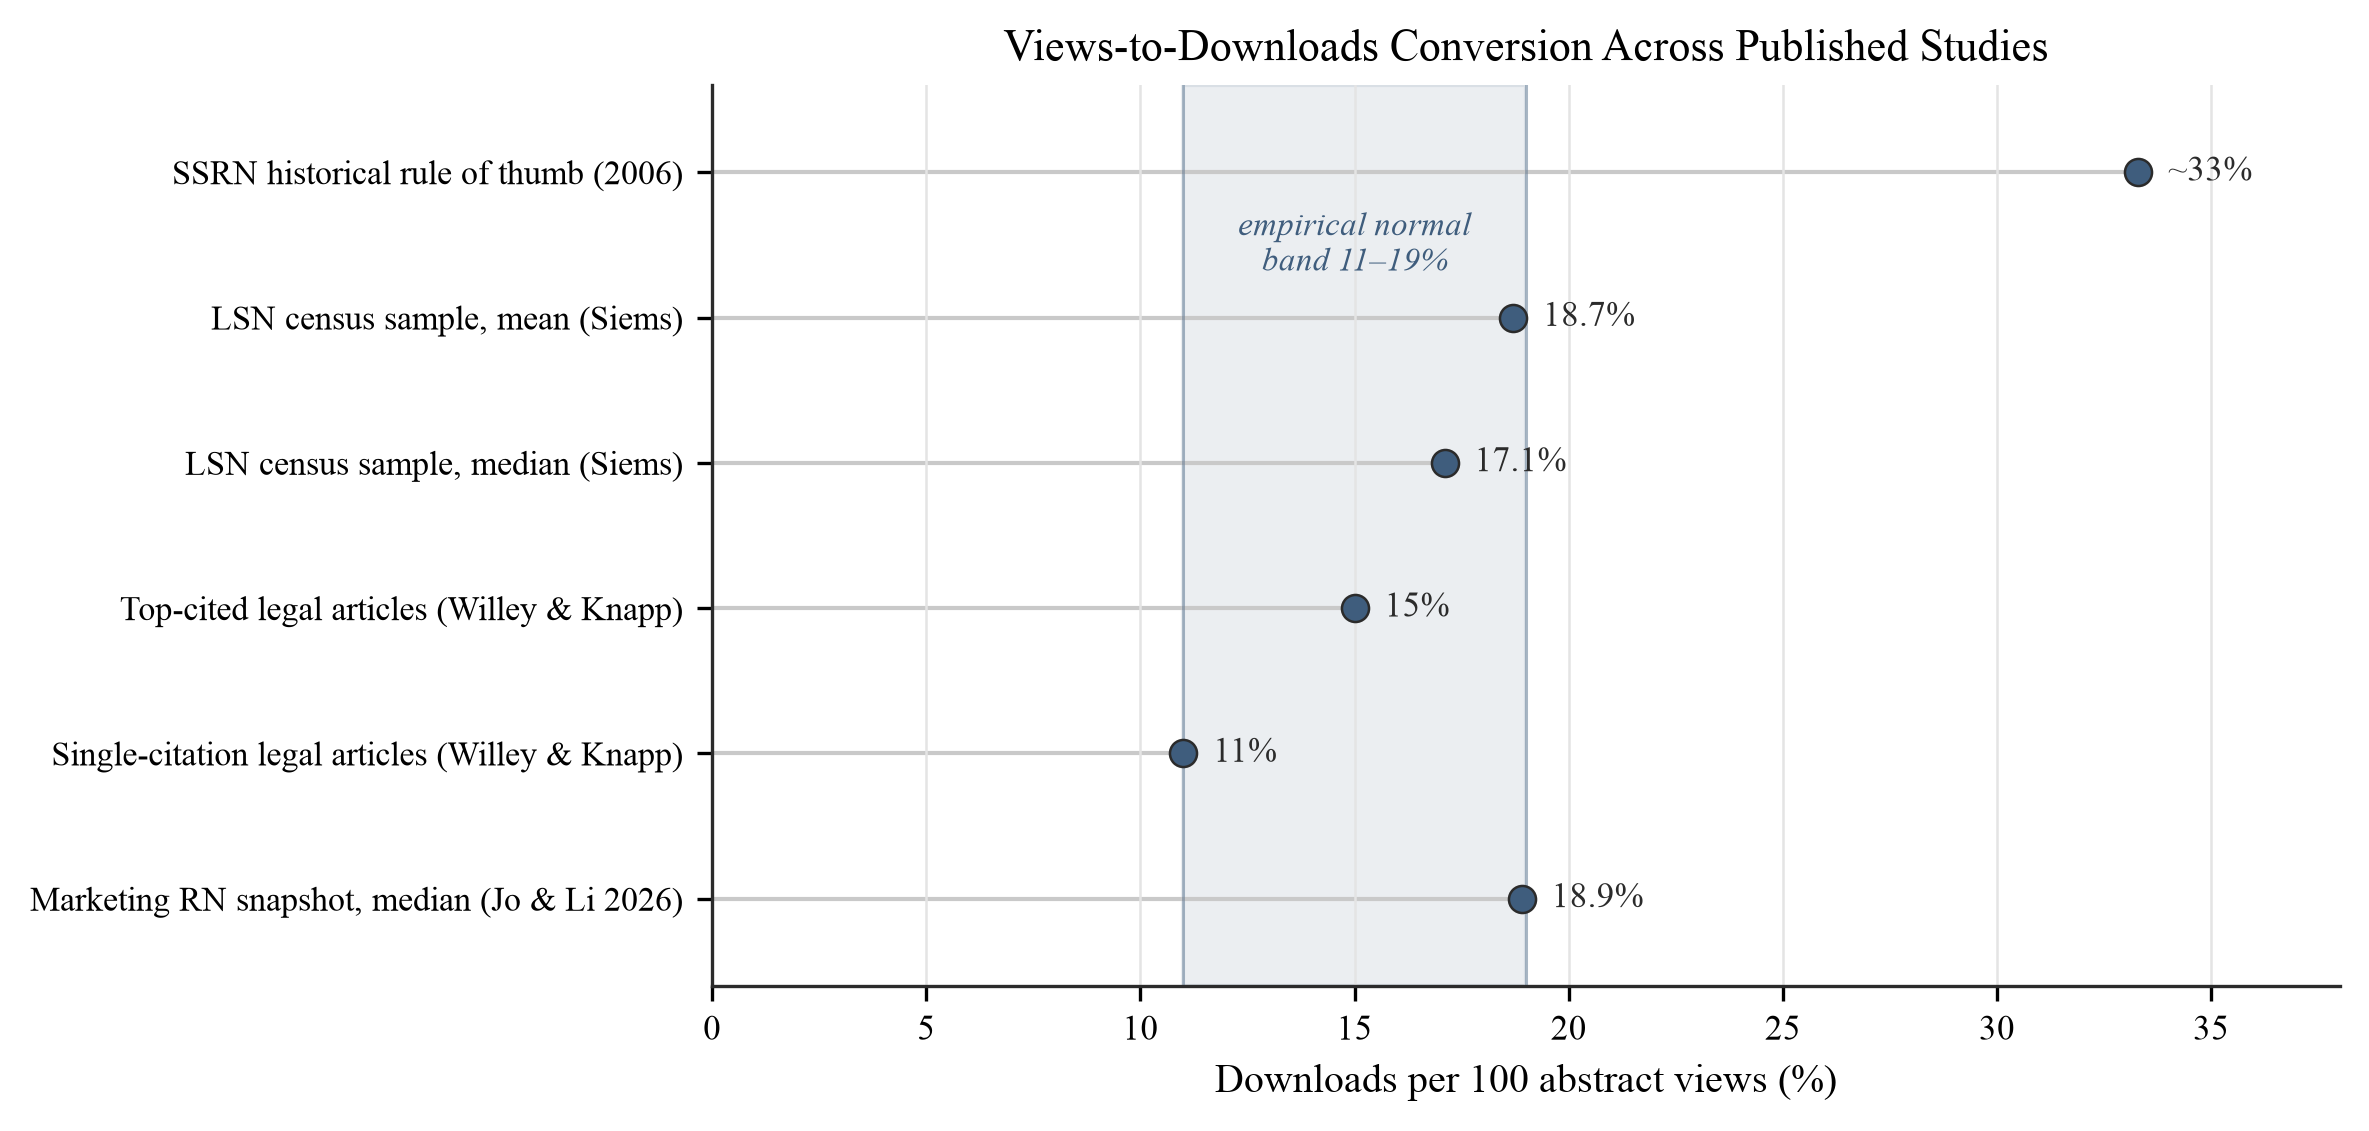
चित्र 6. अध्ययनों में दृश्य-से-डाउनलोड रूपांतरण। प्रकाशित रिकॉर्ड में रूपांतरण अनुमान: SSRN का ऐतिहासिक नियम ~33% (2006 में रिपोर्ट किए गए) [18]; LSN जनगणना माध्य 18.7% और मध्यिका 17.1% [139]; शीर्ष-उद्धृत और एकल-उद्धरण कानूनी लेखों के बीच 15% और 11% [172]; 2025 मार्केटिंग रिसर्च नेटवर्क स्नैपशॉट में 100 सार दृश्यों पर 18.9 डाउनलोड की मध्यिका [83]। छायांकित बैंड 11–19% की अनुभवजन्य सामान्य सीमा को चिह्नित करता है — विषम अनुमानों का एक आवरण (पूर्ण-नेटवर्क मध्यिका साथ में उद्धरण-चयनित उप-नमूने के आंकड़े जिनकी सांख्यिकीय प्रकार स्रोत अनिर्दिष्ट छोड़ता है); Jo और Li नमूना माध्य (23.7 प्रति 100) इसके ऊपर निहित है। सभी मान उद्धृत स्रोतों में प्रकाशित हैं; कोई नए अनुमान पेश नहीं किए गए हैं।
बैंड के सदस्य विभिन्न नमूनों की विभिन्न सांख्यिकी हैं, इसलिए यह विषम बिंदु अनुमानों का आवरण है। Siems (17.1%) और Jo और Li (18.9%) के आंकड़े पूर्ण-नेटवर्क नमूनों की मध्यिका हैं, जबकि Willey और Knapp 15% और 11% उद्धरण-चयनित उप-नमूनों (शीर्ष-उद्धृत बनाम एकल-उद्धरण कानूनी लेख) के लिए रिपोर्ट किए गए हैं, जिनकी सांख्यिकीय प्रकार स्रोत निर्दिष्ट नहीं करता है और जिनका चयन बैंड की निचली सीमा के स्थान को जन्म देता है। ऊपरी सीमा नरम भी है: Jo और Li नमूने में माध्य रूपांतरण, 100 दृश्यों पर 23.7 डाउनलोड [83], बैंड के ऊपर निहित है, और यह उस नमूने के कुल साधनों के अनुपात से तीव्रता से विचलित होता है (221.346 ÷ 611.973 = 100 प्रति 36.2)। कि 36.2 का एक अनुपात-साधन 23.7 के माध्य-अनुपात से बहुत ऊपर बैठता है वह ही निदान है। क्योंकि साधनों का अनुपात बीजगणितीय रूप से प्रति-कागज रूपांतरण दरों का दृश्य-भारित औसत है, इसका अनभारित माध्य-अनुपात से अधिक होना पहुंच और रूपांतरण के बीच एक सकारात्मक सहविचरण का अर्थ है: उच्च-दृश्य कागज कुछ हद तक उच्च दरों पर रूपांतरित होते हैं, न कि कम। पढ़ना रूढ़िवादी है: छोटे-हर की फुलाई अनभारित माध्य-अनुपात को ऊपर की ओर धकेल देगी, इस क्रम के खिलाफ काम करते हुए, इसलिए फिर भी इसे ऊपर देखना सकारात्मक-निर्भरता निष्कर्ष को अधिक मजबूत बनाता है, कम नहीं।
बैंड इस लेख का केंद्रीय कार्य-उदाहरण प्रदान करता है। प्रकाशित लंगरों पर, 40 सार दृश्यों वाले एक पेपर को लगभग 4–8 डाउनलोड देने की अपेक्षा की जाएगी। शीर्षक के "7 डाउनलोड", 40 दृश्यों पर, 17.5% का एक रूपांतरण है, एक बिंदु अनुमान जो बैंड के अंदर उतरता है लेकिन इस हर पर व्यापक अनिश्चितता रखता है। 7 में से 40 पर सटीक 95% क्लोप्पर–पियर्सन अंतराल लगभग 7.3% से लगभग 32.8% तक चलता है, बैंड के दोनों ओर से होकर: केवल 40 दृश्यों के साथ अनुमान को बैंड की चौड़ाई तक समाधान नहीं किया जा सकता, इसलिए पढ़ना एक स्क्रीनिंग परिणाम है, एक वर्गीकरण नहीं। दो चीजें आगे उदाहरण को सीमित करती हैं। हर छोटा है (नीचे दर्ज की गई अस्थिरता), और तुलना आयु-मेल नहीं है: लगभग दिन 20 पर 40 दृश्य एक प्रारंभिक-जीवन पढ़ना है, जबकि लंगर मध्यिका परिपक्व नमूनों से आते हैं (Siems दो वर्षों पर [139], Jo और Li माध्य कागज आयु 491 दिन [83] पर), और पदों 1 और 5 और अनुभाग 5.6 तर्क देते हैं कि प्रारंभिक-जीवन संपर्क एक भिन्न शासन है, इसलिए आयु अक्ष संरेखित नहीं है। रक्षणीय पढ़ना इसलिए यह है कि 17.5% क्रॉस-अध्ययन बैंड के साथ एक स्क्रीनिंग परिणाम के रूप में सुसंगत है, एक सटीक जनसंख्या शतांश नहीं, और "आराम से अंदर" नहीं। ऐसी एक आकृति जो संकट का कारण बनती है वह वह पैमाने की अनुपस्थिति को प्रतिबिंबित करती है वाचकता की अनुपस्थिति को नहीं। अंतर्निहित लंगरों की विंटेज और दायरा अनुभाग 9 में निर्धारित किए गए हैं।
छोटे हर बड़ी संख्या अनुपात को अस्थिर बनाते हैं। दो views और एक download वाले paper का nominal conversion 50% है, लेकिन उस अनुमान के लिए 500 views पर निर्मित अनुमान से अधिक विश्वास की आवश्यकता नहीं है; किसी भी public-facing benchmarking के लिए, empirical-Bayes shrinkage reference-class rate की ओर छोटे हर को extreme scores से रोकना चाहिए (Sections 8.3 और 8.8)। Band दोनों दिशाओं में diagnostic के रूप में भी काम करता है। Conversion जो band से नीचे है, एक non-trivial denominator पर, आमतौर पर title–abstract–text mismatch को इंगित करता है: readers आते हैं, abstract पढ़ते हैं, और चले जाते हैं, एक actionable communication problem (title और abstract को फिर से लिखें), research पर कोई verdict नहीं। Conversion जो band से ऊपर है, वह traffic को signal करता है जिसे abstract browsing explain नहीं करता (media pickup, course adoption, या viral circulation) और यह जांचने के लिए prompt करना चाहिए कि views कहां से originate करते हैं। न ही deviation, अपने आप में, research quality के बारे में कुछ भी स्थापित करता है। एक further qualification एक finding की तुलना में एक hypothesis है। Conversion fields में systematically vary हो सकता है audience reading style के property के रूप में individual papers के नहीं: large fields "window-shopping" behavior को exhibit कर सकते हैं, कई abstract visits और कुछ downloads के साथ, जबकि small, highly engaged communities अधिक rates पर convert करते हैं। ऊपर का band इसे resolve करने के लिए बहुत कम frames से estimated है, इसलिए Study 1 (Section 8.6) अपने outputs में field-stratified conversion को शामिल करता है।
एक diagnostic, कभी एक target नहीं: anti-gaming constraint। Conversion band शक्तिशाली है क्योंकि इसे एक norm के रूप में पढ़ा जा सकता है, और उस शक्ति में एक hazard है। Goodhart's Law कहता है कि एक measure जो एक target के रूप में adopted किया जाता है, एक अच्छा measure नहीं रह जाता है [67], एक principle जो Campbell's Law के साथ parallel है, social indicators के corruption पर decision-making के लिए use किए जाने पर [27]। यदि 11–19% band, या Section 5.5 के benchmark framework का कोई भी component, एक promotion threshold के रूप में adopted किया जाता ("papers को conversion band के अंदर बैठना चाहिए count करने के लिए"), तो ratio तुरंत observation के बजाय optimization का object बन जाता। Attack concrete और cheap है: क्योंकि denominator अधिक manipulable quantity है (Section 4.2), abstract views के coordinated inflation को downloads के अनुपात में fixed proportion में रखा जा सकता है ratio को band के अंदर रखने के लिए और एक engineered signal को statistically indistinguishable organic conversion से बनाया जा सकता है। Framework का answer एक matter of definition है। Conversion band, reach–conversion diagnostic (Section 5.4), और CSAB components (Section 5.5) एक diagnostic vector हैं, कभी एक target नहीं, और कोई component भी एक promotion criterion के रूप में read नहीं किया जा सकता। जो machinery gaming को resist करती है, वह design में built है: band को एक lower bound के रूप में stated किया जाता है क्योंकि इसका denominator bot-inflatable है, तो reading construction द्वारा inflation के विरुद्ध conservative है; Section 8.3 की anomaly protocol flag, न कि delete है, इसलिए एक engineered spike को silently absorbed होने की बजाय preserved और visible बनाया जाता है; और Section 4.1 की integrity filtering पहले से ही सबसे detectable coordinated activity को screen करती है। Diagnosis के रूप में read किए जाने पर, band gaming को एक out-of-band या internally inconsistent signature के रूप में expose करता है; एक target के रूप में read किया जाता है, यह exactly उस coordination को invite करता जिसे detect किया जाना है। यह position framework को established research-assessment reform consensus के साथ align करता है: San Francisco Declaration on Research Assessment (DORA), जो single-number और journal-brand proxies को reject करता है assessment की तरफ research के own content पर [8], और Leiden Manifesto, जिसके principles caution करते हैं exactly इस substitution के विरुद्ध एक easy indicator की expert judgment के लिए [78]।
Downloads का कोई public audit trail नहीं है: band को एक floor के रूप में पढ़ने का एक further reason। Citations और downloads के बीच एक structural asymmetry gaming concern को sharpen करता है। एक citation एक public, inspectable trace छोड़ता है: citing document exist करता है, discoverable है, और check किया जा सकता है, तो citation manipulation principle में auditable है किसी भी third party द्वारा। एक download counter ऐसा कोई public trail नहीं छोड़ता। यह platform के servers पर एक private tally है, कोई external record नहीं कि कौन से requests को counted, filtered, या restated किया गया, जो इसे covert gaming के लिए uniquely exposed छोड़ता है जिसे कोई outside observer बाद में reconstruct नहीं कर सकता। यह exposure एक independent reason है, denominator के bot-contamination के beyond, measured conversion rate को एक lower bound के रूप में treat करने की तुलना में एक point estimate (Section 4.2 caveat subject को AI retrieval पर), और हमेशा counter को pair करने के लिए anomaly protocol और documented integrity filtering के साथ जिस पर framework rely करता है (Section 4.1)। Audit trail की absence distrust करने का एक reason नहीं है counter को; यह conservatively read करने का एक reason है और flag-not-delete discipline को insist करने का जो एक manipulated reading को detectable रखता है (Section 8.3)।
Band एक calibration target है, constant नहीं। एक consequence follow करता है कि कैसे 11–19% figure, और हर CSAB threshold, को quoted किया जाना चाहिए: वे quantities हैं calibrated होने के लिए field के द्वारा, और platform के द्वारा (Sections 4.4, 5.5)। उस calibration के लिए mechanism पहले से ही specified है: field-stratified Study 1 (Section 8.6) को deliver करने के लिए designed किया गया है per-field conversion और download distributions जो framework को require करता है और consume करने के लिए built है। जब तक Study 1 report नहीं करता, Appendix E का archival cross-section एक field-resolved estimate supply करता है। Fourteen fields के across जो कम से कम बीस papers hold करते हैं, median conversion Energy में 0.134 से Computer Science में 0.195 तक चलता है, लगभग 1.5 times का एक spread, और paper age को fixed रखते हुए यह 0.134 से 0.224 तक चलता है, लगभग 1.7 times। Three- से fivefold field spread downloads में set against, conversion दोनों quantities में अधिक portable है, जो इसे एक diagnostic के रूप में usable बनाता है। Age वह dimension है जिसे यह survive नहीं करता: हर field के within जो test करने के लिए large enough है, conversion जैसे-जैसे papers older हो जाते हैं, गिरता है, Spearman coefficients −0.14 से −0.41 तक के साथ eight fields में जो कम से कम चालीस papers hold करते हैं। एक conversion band quoted जिसके बिना एक paper age है, वह कम काम कर रहा है जितना यह appear करता है।
5.3 क्रमिक व्याख्या पैमाना
Post-Rankings लेखकों में सबसे स्पष्ट रूप से एक क्रमिक पैमाना नहीं है, जो h-index व्याख्या मार्गदर्शकों के स्थापित प्रारूप [118] में है, जो कच्चे काउंटरों को सादी-भाषा बैंड में परिवर्तित करता है। अनुभाग 5.1–5.2 इसके लिए सामग्री प्रदान करते हैं। तालिका 8 चार मात्राओं के लिए प्रस्तावित पैमाना प्रस्तुत करती है: कागज-स्तर के आजीवन डाउनलोड, प्रथम-माह डाउनलोड, दृश्य-से-डाउनलोड रूपांतरण, और लेखक-स्तर के कुल डाउनलोड।
तालिका 8. SSRN मेट्रिक्स के लिए प्रस्तावित व्याख्या पैमाना। बैंड 2012–2015 साक्ष्य [139][85][18][172] को संश्लेषित करते हैं; क्योंकि डाउनलोड-प्रति-कागज प्रवाह तब से बढ़ गया है (अनुभाग 5.1), उनकी निरपेक्ष सीमाएं 2026 के लिए उदार बैंड के रूप में सबसे अच्छी तरह पढ़ी जाती हैं, न कि रूढ़िवादी बैंड के रूप में, और किसी भी स्थिति में एक सन्निकटन के रूप में। प्रथम-माह स्तंभ पैमाने की एक क्रमबद्ध सीढ़ी नहीं है बल्कि एक पूर्व-पंजीकृत भविष्यवाणी है जो व्यापक अनिश्चितता के साथ है, Study 1 के संभावित पैनल द्वारा परीक्षण के लिए (अनुभाग 8.6); इसकी कोशिकाओं को सीमाओं या प्रचार सीढ़ियों के रूप में नहीं पढ़ा जाना चाहिए (पाठ देखें)। 10,000 पर Strong/Exceptional सीमा एक लेखक का अनंतिम अनुमान है: अनुभाग 2.5 लेखापरीक्षा में पहचान किया गया कोई प्रकाशित स्रोत 10,000 डाउनलोड को प्रतिशतक से जोड़ता नहीं है। Nascent बैंड कोई नई संख्याएँ प्रस्तुत नहीं करता है: इसकी सीमा 63 की मौजूदा दो-वर्ष की माध्यिका एंकर है [139]। बैंड सीमाएँ गोल संख्याओं पर निर्धारित हैं और मोटे तौर पर एक पूरी बैंड चौड़ी रखी गई हैं: अखंडता साहित्य द्वारा स्थापित सटीकता सीमा (अनुभाग 3.1, 4.1–4.3) बेहतर ग्रेडेशन को असत्य रूप से सटीक बनाती है, इसलिए बैंड की स्थूलता डिज़ाइन के अनुसार है। सादी-भाषा निर्णय स्तंभ डाउनलोड पैमाने का वर्णन करता है और रूपांतरण स्तंभ में स्थानांतरित नहीं होता है: 18.9% माध्यिका रूपांतरण "Solid" के बजाय सामान्य है, और 27.2% p75 "Strong" नहीं है। आजीवन-डाउनलोड सीमाएँ निर्माण के अनुसार गैर-अतिव्यापी हैं (Nascent 63 के नीचे, Modest 63–159, Solid 160 और ऊपर); जहां तालिका उच्च पंक्तियों के बीच एक साझा समापन बिंदु प्रिंट करती है — Solid और Strong के बीच 800, और संगत रूपांतरण और लेखक-स्तर की कटऑफ — अंतराल आधा-खुला है, प्रत्येक साझा मान उच्च बैंड से संबंधित है। दोनों आजीवन सीमा मान स्वयं असंगत संदर्भ वर्गों से निकाले गए हैं: 63 एक एकल-अनुशासन कानूनी-छात्रवृत्ति जनगणना [139] के लिए दो-वर्ष की खिड़की माध्यिका है, जबकि 160 पूरे-प्लेटफॉर्म शीर्ष-सूची [85] के लिए एक सर्वकालीन, आजीवन प्रवेश सीमा है। वे इसलिए विभिन्न घड़ियों पर बैठते हैं (एक निश्चित दो-वर्ष के कागज की आयु बनाम अनबाउंडेड आजीवन संचय) और विभिन्न आबादियों का वर्णन करते हैं (एक क्षेत्र बनाम सभी क्षेत्र), इसलिए उन्हें एक एकल निरपेक्ष सीढ़ी में मिलाना विभिन्न आयु, क्षेत्र और चयन नियमों के साथ संदर्भ वर्गों का एक संयोजन है — एक सीमा जो Study 1 के क्षेत्र- और आयु-विशिष्ट प्रतिशतक को हटाने के लिए डिज़ाइन किया गया है। इन एंकरों की एक संरचनात्मक सीमा जोर देने योग्य है: क्योंकि उपलब्ध संदर्भ बिंदु दो-वर्ष की माध्यिका (63 [139]) और प्लेटफॉर्म की ऊपरी पूंछ पर क्लस्टर करते हैं, पाँच मौखिक बैंड में से चार — Modest, Solid, Strong, और Exceptional — माध्यिका पर या ऊपर कागज का वर्णन करते हैं, इसलिए पैमाना माध्यिका से ऊपर घना है और 50वें-से-98वें-प्रतिशतक श्रेणी में केवल कमजोर रूप से भेदभाव करता है जिसमें अधिकांश कागज वास्तव में गिरते हैं। यह संपीड़न शीर्ष-पूंछ साक्ष्य पर एंकरिंग का प्रत्यक्ष परिणाम है; माध्यिका से साधारण को अलग करना Study 1 के क्षेत्र- और आयु-विशिष्ट प्रतिशतक की प्रतीक्षा करता है। पैमाना सचित्र है, न कि मानक: किसी भी बैंड सीमा को किसी भी कार्यकाल, नियोजन, या पदोन्नति निर्णय में पास/फेल सीमा के रूप में प्रवेश नहीं करना चाहिए जब तक Study 1 (अनुभाग 8.6) का संभावित पैनल इन पुरानी निरपेक्ष एंकरों को बदलने के लिए क्षेत्र- और आयु-विशिष्ट प्रतिशतक को कैलिब्रेट नहीं कर लेता।
| बैंड | कागज: आजीवन डाउनलोड | कागज: प्रथम-माह डाउनलोड (अनुमानित) | रूपांतरण (डाउनलोड / दृश्य) | लेखक: कुल डाउनलोड | सादी-भाषा निर्णय |
|---|---|---|---|---|---|
| Nascent | 63 [139] की दो-वर्ष की माध्यिका से नीचे | — (कोई अलग एंकर नहीं; पाठ देखें) | — (हर बार आमतौर पर बहुत छोटा; अनुभाग 5.2) | — | बहुत जल्द, या क्षेत्र माध्यिका से नीचे — युवा और विशेषज्ञ कागजों के लिए सांख्यिकीय मानदंड; पहले जोखिम का निदान करें (अनुभाग 5.4, 5.6), गुणवत्ता नहीं |
| Modest | 63–159 | <15 | <11% | <~130 | प्लेटफॉर्म के विशिष्ट; माध्यिका बैंड |
| Solid | 160–800 | 15–50 | 11–19% | ~130–1,600 | ऐतिहासिक शीर्ष-सूची प्रवेश पर या उससे परे |
| Strong | 800–10,000 | 50–250 | 19–30% | 1,600–10,000 | ऐतिहासिक शीर्ष सूचियों के विशिष्ट |
| Exceptional | >10,000 (लेखक का अनंतिम अनुमान) | >250 | >30% | >10,000 (लेखक का अनंतिम अनुमान) | साधारण विद्वानों के प्रचलन की प्रलेखित श्रेणी से परे |
प्रत्येक आंतरिक एंकर एक प्रकाशित थ्रेसहोल्ड से जुड़ा होता है। नेसेंट बैंड 63 [139] के दो-वर्षीय LSN माध्यिका के नीचे के क्षेत्र को कवर करता है। वह क्षेत्र जनसंख्या में समृद्ध है, विषम नहीं है: पूर्वनिर्धारित अध्ययन 1 बैंड (अनुभाग 8.6) प्रत्याशा करते हैं कि प्लेटफ़ॉर्म के कागजों का एक पर्याप्त शेयर, कथित भविष्य कहनेवाला बैंड के तहत 15–30% के क्रम में, दस या उससे कम जीवनकाल डाउनलोड हैं, इसलिए एक पैमाना जिसका सबसे निचला बैंड माध्यिका के पास शुरू होता था, प्लेटफ़ॉर्म के सबसे अधिक संख्यात्मक कागजों को छोड़ देता, इस लेख के नायक सहित, पूरी तरह से पैमाने के बाहर। नेसेंट निर्णय गैर-मूल्यांकनकारी है। क्षेत्र माध्यिका के नीचे, और विशेष रूप से युवा कागज की आयु पर, काउंटर गुणवत्ता का कोई निर्णय नहीं देता है, और पहला निदान चरण एक्सपोज़र है (अनुभाग 5.4 और 5.6) सामग्री के बजाय। मॉडेस्ट बैंड 63 [139] के दो-वर्षीय LSN माध्यिका पर लंगर डाला गया है। "मॉडेस्ट" माध्यिका बैंड है: विशिष्टता विफलता नहीं है। मॉडेस्ट/सॉलिड सीमा (~160 जीवनकाल डाउनलोड) Kakushadze प्रवेश बिंदु से सभी समय के शीर्ष-10,000 कागजों में है, लगभग प्लेटफ़ॉर्म के पूर्ण-पाठ कागज स्टॉक के शीर्ष 1.8% (571,040, जुलाई 2016 [1]) [85]। संचालन के अनुसार, एक "सॉलिड" पेपर एक शीर्ष-सूची पेपर है। सॉलिड/स्ट्रॉंग सीमा (~800) उस अभिजात समूह (805) [85] के भीतर माध्यिका है: यह उन कागजों को अलग करता है जो केवल ऐतिहासिक अभिजात वर्ग में प्रवेश करते हैं उन कागजों से जो इसके विशिष्ट हैं। पोर्टफोलियो पैमाने पर लेखक-स्तर का स्तंभ इस तर्क को प्रतिबिंबित करता है: समूह जिसे SSRN के अपने सूचनाओं ने लेखकों के शीर्ष 10% के रूप में वर्णित किया [161] में कुल डाउनलोड की प्रवेश न्यूनतम 129 था और आंतरिक माध्यिका 1,626 [85] था। क्योंकि हर लेखक-स्तरीय एंकर उस रैंक की गई सूची से तैयार किया गया है, लेखक स्तंभ लेखक वितरण की ऊपरी पूंछ का वर्णन करता है न कि विशिष्ट लेखक का। ~130 सीमा के नीचे एक लेखक केवल "मॉडेस्ट" नहीं है: वह लेखक ऐतिहासिक रूप से रैंक किए गए समूह के बाहर पूरी तरह से गिरता है, इसलिए स्तंभ के निचले बैंड "ऐतिहासिक अभिजात के नीचे" के रूप में पढ़ते हैं, सभी लेखकों के बीच एक अंशांकित स्थिति के रूप में नहीं। यह वही शीर्ष-पूंछ एंकरिंग है जो कागज-स्तरीय पैमाने को संपीड़ित करता है; लेखक स्तंभ के एंकर अध्ययन 1 के पोर्टफोलियो-स्तरीय प्रतिशत की प्रतीक्षा करते हैं। रूपांतरण स्तंभ अनुभाग 5.2 का अंतर-अध्ययन बैंड है। स्ट्रॉंग/असाधारण सीमा 10,000 पर कोई प्रकाशित प्रतिशत एंकर नहीं है और एक परिमाण-का-क्रम क्षितिज के रूप में रखी गई है।
पहले महीने का स्तंभ एक अलग स्थिति है। यह एक पूर्वपंजीकृत भविष्य कहना है, व्यापक अनिश्चितता के साथ एक झूठा होने योग्य पूर्वानुमान जिसे अध्ययन 1 (अनुभाग 8.6) परीक्षण करने के लिए डिज़ाइन किया गया है, और कोई भी पहला महीना सेल थ्रेसहोल्ड या व्याख्यात्मक रूंग के रूप में उपयोग नहीं किया जा सकता है। प्रकाशित साहित्य में कोई सीधा पहला-महीना बेंचमार्क मौजूद नहीं है, इसलिए स्तंभ एक माप के बजाय एक प्रक्षेपण है, डाउनलोड की दस्तावेज़ की गई प्रारंभिक एकाग्रता से एक्सट्रपलेट किया गया है (ध्यान स्पाइक्स पहले सप्ताह में क्लस्टर करते हैं, विशेष रूप से बाहरी कवरेज [18][116][138] के तहत) जीवनकाल थ्रेसहोल्ड के ऊपर। विशिष्ट सीमाएं एक प्रकाशित एंकर से प्राप्त होती हैं: Kakushadze की शीर्ष-सूची नमूने में, लगभग प्लेटफ़ॉर्म के पूर्ण-पाठ कागज स्टॉक के शीर्ष 1.8% (571,040, जुलाई 2016 [1]), माध्यिका बारह महीने डाउनलोड गणना 247 [85] थी। ~250 से ऊपर का पहला महीना इसलिए प्लेटफ़ॉर्म के ऐतिहासिक अभिजात की वार्षिक मानदंड से अधिक होगा, इसलिए असाधारण सीमा, जबकि 15–50 पहले-महीने डाउनलोड, यदि बनाए रखा जाता है, तो ~160 जीवनकाल प्रवेश थ्रेसहोल्ड पर प्रक्षेप करता है, इसलिए ठोस। ये सेल एक एकल ऐतिहासिक एंकर से प्रक्षेप हैं और तालिका के सबसे कमजोर सेल हैं; यदि उद्धृत किया जाता है, तो वे यह व्युत्पत्ति ले जाते हैं।
पैमाने के उपयोग पर दो सावधानियां शासन करती हैं। विषय योग्यता वैकल्पिक नहीं है: एक एकल अनुशासन के भीतर, कागज प्रति माध्य डाउनलोड सबडिवीजन (Corporate/Securities/Finance Law में 438.35 बनाम Agricultural Law में 53.48) [168] में लगभग आठ गुना अलग-अलग होते हैं, इसलिए हर बैंड विवरण को एक क्षेत्र लेबल ले जाना चाहिए। ये जीवनकाल माध्य हैं और कागज की आयु के लिए समायोजित नहीं हैं, और परिशिष्ट E का संग्रह क्रॉस-सेक्शन दिखाता है कि यह क्यों महत्वपूर्ण है: एक क्षेत्र का स्पष्ट स्तर इसमें से नमूना किए गए कागजों की आयु प्रोफ़ाइल के साथ चलता है, और आयु को स्थिर रखने से स्प्रेड को लगभग तीन से पाँच गुना तक सीमित कर देता है। दूसरा यह है कि इस स्थान में प्रस्तावित वैकल्पिक एकल-संख्या आधार (अनुपात-आधारित सापेक्ष-प्रदर्शन सूचकांक (एक कागज के डाउनलोड को एक मेल खाते समूह की माध्यिका से विभाजित), ⌊ln D⌋ पर आधारित लॉगरिदमिक टियर आधार, और मौखिक स्कोरकार्ड निर्णय ("तेज़ शुरुआत / स्थिर रुचि / धीमी शुरुआत")) को अंशांकित लेखक आधार के रूप में यहाँ समाहित किया जाता है, क्योंकि कोई भी सत्यापित संख्यात्मक बैंड नहीं है। लॉगरिदमिक अंतर्ज्ञान स्वयं ध्वनि है और शब्दों में रखने के लिए लायक है: एक अर्ध-लॉगनॉर्मल वितरण [85] के तहत, 7 से 20 डाउनलोड में जाना दृश्यमानता में एक प्राकृतिक-लॉग इकाई की एक पारी है, और इसे 13 क्लिक के संयोजन के रूप में पढ़ना उसे मिस करता है।
पैमाना यह भी समझाता है कि क्यों लेखक व्यवस्थित रूप से अपने स्वयं के काउंटरों का गलत निर्णय करते हैं। संख्याएं जो मील के पत्थर, प्रोफाइल और घोषणाओं में परिचलित होती हैं, जैसा कि अनुभाग 3.5 ने दस्तावेज़ किया, दृश्यमान पूंछ से माध्यिका के सैकड़ों गुना आते हैं, जबकि वितरण का समूह LSN माध्यिका 63 के पास बैठता है, और अर्ध-लॉगनॉर्मल कानून के तहत रंगों के बीच की दूरियां गुणक हैं, योगात्मक नहीं। चित्र 7 इन मानों (सामान्य-कागज माध्यिका, प्रवेश थ्रेसहोल्ड, अभिजात माध्यिका, पूंछ) को लॉगरिदमिक पैमाने पर एक बेंचमार्क सीढ़ी के रूप में व्यवस्थित करता है।
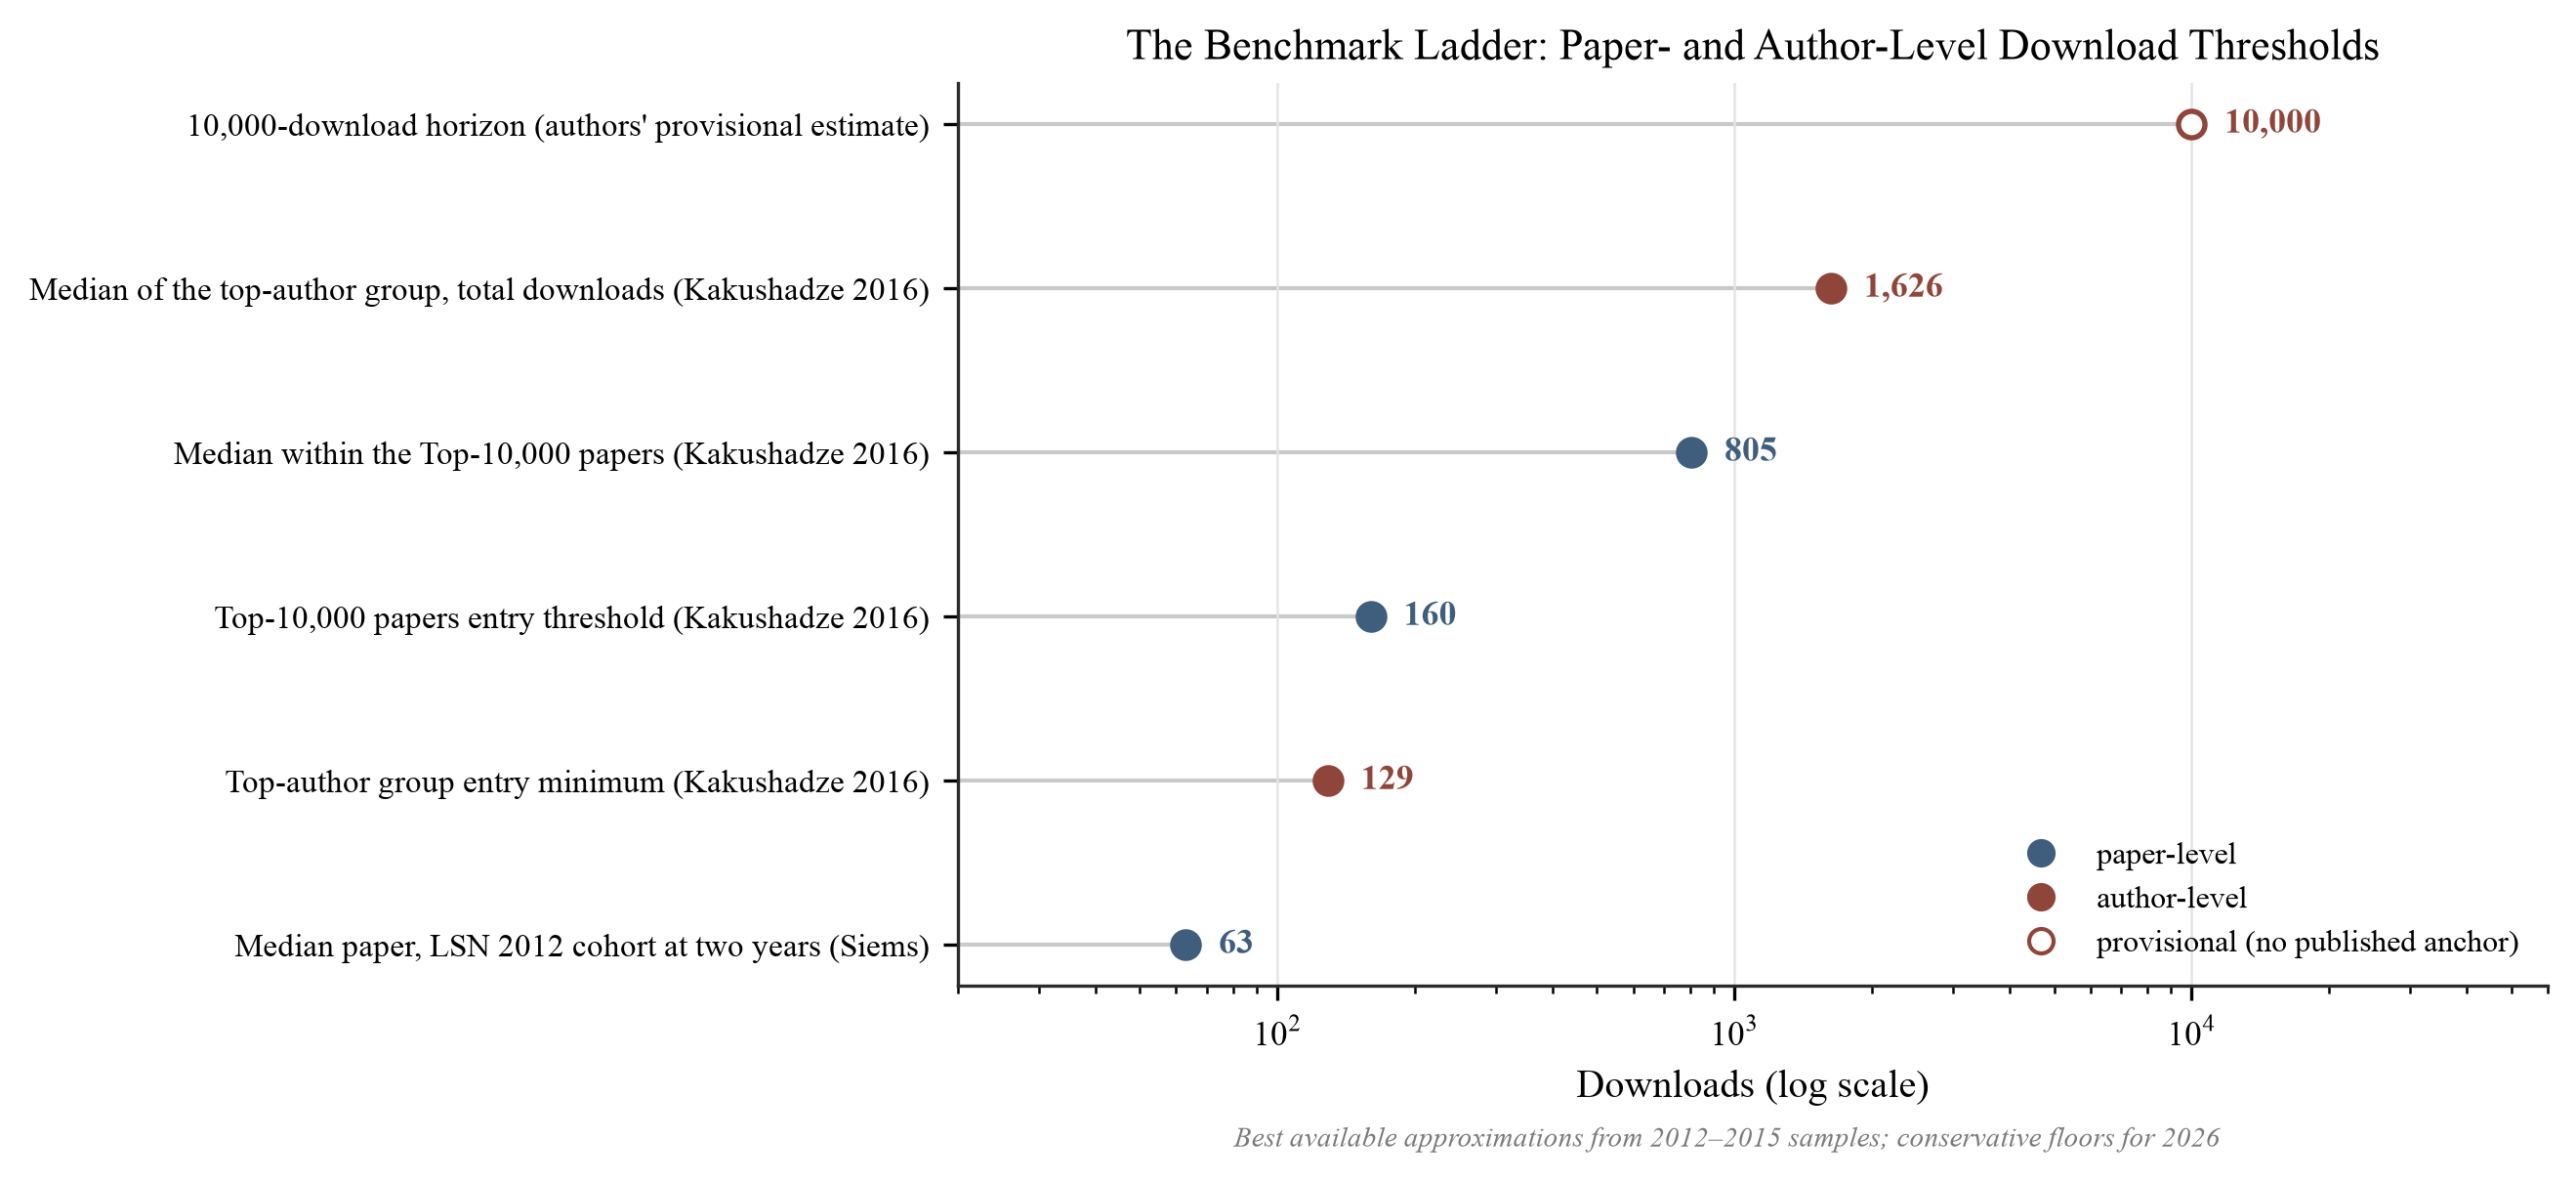
चित्र 7. बेंचमार्क सीढ़ी। लॉगरिदमिक पैमाने पर कागज- और लेखक-स्तरीय डाउनलोड थ्रेसहोल्ड: LSN दो-वर्षीय माध्यिका 63 [139]; शीर्ष-लेखक प्रवेश न्यूनतम 129 और शीर्ष-कागज प्रवेश ~160 [85]; शीर्ष-10,000 कागजों के भीतर माध्यिका 805 [85]; शीर्ष-लेखक समूह की माध्यिका 1,626 [85]; 10,000-डाउनलोड क्षितिज (लेखक का अनंतिम अनुमान, कोई प्रकाशित प्रतिशत एंकर नहीं)। 63 की दो-वर्षीय माध्यिका के नीचे का क्षेत्र तालिका 8 के नेसेंट बैंड के अनुरूप है। मान 2012–2015 नमूने हैं (तब से मुद्रास्फीति: अनुभाग 5.1)।
5.4 पहुँच बनाम रूपांतरण: एक द्विआयामी निदान
एक एकल गणना, भले ही बंडित हो, उन विभिन्न तंत्रों के बीच अंतर नहीं कर सकती जो इसे उत्पन्न करते हैं। खंड 4 के यांत्रिकी का एक निहितार्थ है जो व्यवहार में सबसे अधिक महत्वपूर्ण है: दृश्यमानता विफलता और सामग्री गैर-प्रतिक्रिया विभिन्न निदान हैं: एक पेपर बहुत कम डाउनलोड किया जा सकता है क्योंकि कुछ पाठकों ने इसका सामना किया, या क्योंकि जिन्होंने इसका सामना किया वे पूर्ण पाठ में गिरावट आई। तालिका 9 दोनों सामान्यीकृत आयामों को पार करती है।
तालिका 9. पहुँच–रूपांतरण निदान मैट्रिक्स। पहुँच और रूपांतरण का मूल्यांकन तुलनीय कागजात के संदर्भ वर्ग के भीतर प्रतिशतक के रूप में किया जाता है (समान क्षेत्र, पोस्टिंग समूह, पेपर आयु, और पूर्व लेखक दृश्यमानता; खंड 5.5), वर्ग माध्यिका को सीमा के रूप में। वर्तमान साक्ष्य पर कोई पूर्ण संख्यात्मक कटऑफ रक्षणीय नहीं है, और कोई नहीं दिया गया है। 2×2 प्रदर्शन पठनीयता के लिए वर्ग माध्यिका में प्रत्येक अक्ष को द्विभाजित करता है; अंतर्निहित पहुँच और रूपांतरण प्रतिशतक निरंतर हैं (खंड 5.4), और तीसरे भाग जैसे बारीक विभाजन उपलब्ध हैं।
| कम रूपांतरण | उच्च रूपांतरण | |
|---|---|---|
| कम पहुँच | "कोल्ड स्टार्ट" (कम पहुँच, कम रूपांतरण)। पेपर न तो व्यापक रूप से सामना किया जाता है और न ही एक्सपोजर के बाद बार-बार डाउनलोड किया जाता है। डेटा यह स्थापित नहीं करता कि अंतर्निहित अनुसंधान कमजोर है; वे केवल यह स्थापित करते हैं कि प्रसार शुरू नहीं हुआ है। | "छिपी हुई रुचि" (कम पहुँच, उच्च रूपांतरण)। जो पाठक पेपर का सामना करते हैं वे अच्छी तरह प्रतिक्रिया देते हैं, लेकिन बहुत कम इसका सामना करते हैं। खोजक्षमता प्राथमिक देखने योग्य बाधा है — एक वितरण समस्या, सामग्री समस्या नहीं। |
| उच्च पहुँच | "ध्यान बिना ग्रहण के" (उच्च पहुँच, कम रूपांतरण)। शीर्षक, विषय, या मंच प्लेसमेंट दौरों को आकर्षित करने के लिए प्रतीत होता है, लेकिन कुछ दर्शक पूर्ण पाठ प्राप्त करते हैं। निदान से पहले एक दूषित भाजक को नियम से बाहर करें: संचार बेमेल: उच्च पहुँच फैंटम दृश्य वास्तविक ध्यान के बजाय हो सकती है, क्योंकि दृश्य दो काउंटर में से अधिक प्रदूषित हैं (खंड 4.2) — पारदर्शी RePEc/LogEc रिकॉर्ड में, रोबोट सार दृश्यों का लगभग 74% लेकिन केवल लगभग 7% डाउनलोड [99] के लिए जिम्मेदार हैं, इसलिए अनफ़िल्टर्ड गैर-मानव यातायात बिल्कुल यह उच्च-पहुँच, कम-रूपांतरण हस्ताक्षर उत्पन्न करता है। केवल एक बार बॉट-मुद्रास्फीत दृश्य को बाहर रखा जाता है, जब अवशिष्ट डेटा दर्शक फिट और शीर्षक–सारांश संचार की जांच करने के लिए वारंट करते हैं। | "मजबूत प्रारंभिक प्रसार" (उच्च पहुँच, उच्च रूपांतरण)। पेपर तुलनात्मक रूप से बड़े दर्शकों तक पहुँचता है और एक्सपोजर को पूर्ण-पाठ रुचि में परिवर्तित करता है। |
चार चतुर्भुज को प्रसार पैटर्न द्वारा लेबल किया जाता है जो दोनों प्रतिशतक दिखाते हैं (कोल्ड स्टार्ट, छिपी हुई रुचि, ध्यान बिना ग्रहण के, मजबूत प्रारंभिक प्रसार)। लेबल प्रसार पैटर्न का वर्णन करते हैं, अनुसंधान स्वयं नहीं, और जो परिचालन की दृष्टि से महत्वपूर्ण है वह तंत्रों का पृथक्करण है; न तो कम-पहुँच चतुर्भुज अनुसंधान गुणवत्ता के बारे में अनुमान की अनुमति देते हैं, एक बिंदु जो इन मेट्रिक्स के किसी भी मूल्यांकन उपयोग पर सीधे असर डालता है। कम-प्रसार चतुर्भुज इस लेख के अपने निदान का नाम लेता है, कोल्ड स्टार्ट। मैट्रिक्स व्यावहारिक रूप से मूल्यवान है क्योंकि उपयुक्त हस्तक्षेप चतुर्भुज द्वारा भिन्न होता है: एक छिपी हुई रुचि उम्मीदवार को वितरण (वर्गीकरण समीक्षा, घोषणा समय, बाहरी दृश्यमानता) की आवश्यकता होती है, जबकि ध्यान बिना ग्रहण के संचार मरम्मत (शीर्षक और सारांश) या यातायात ऑडिट के लिए बुलाता है। चित्र 8 समतल को एक टेम्पलेट के रूप में प्रस्तुत करता है।
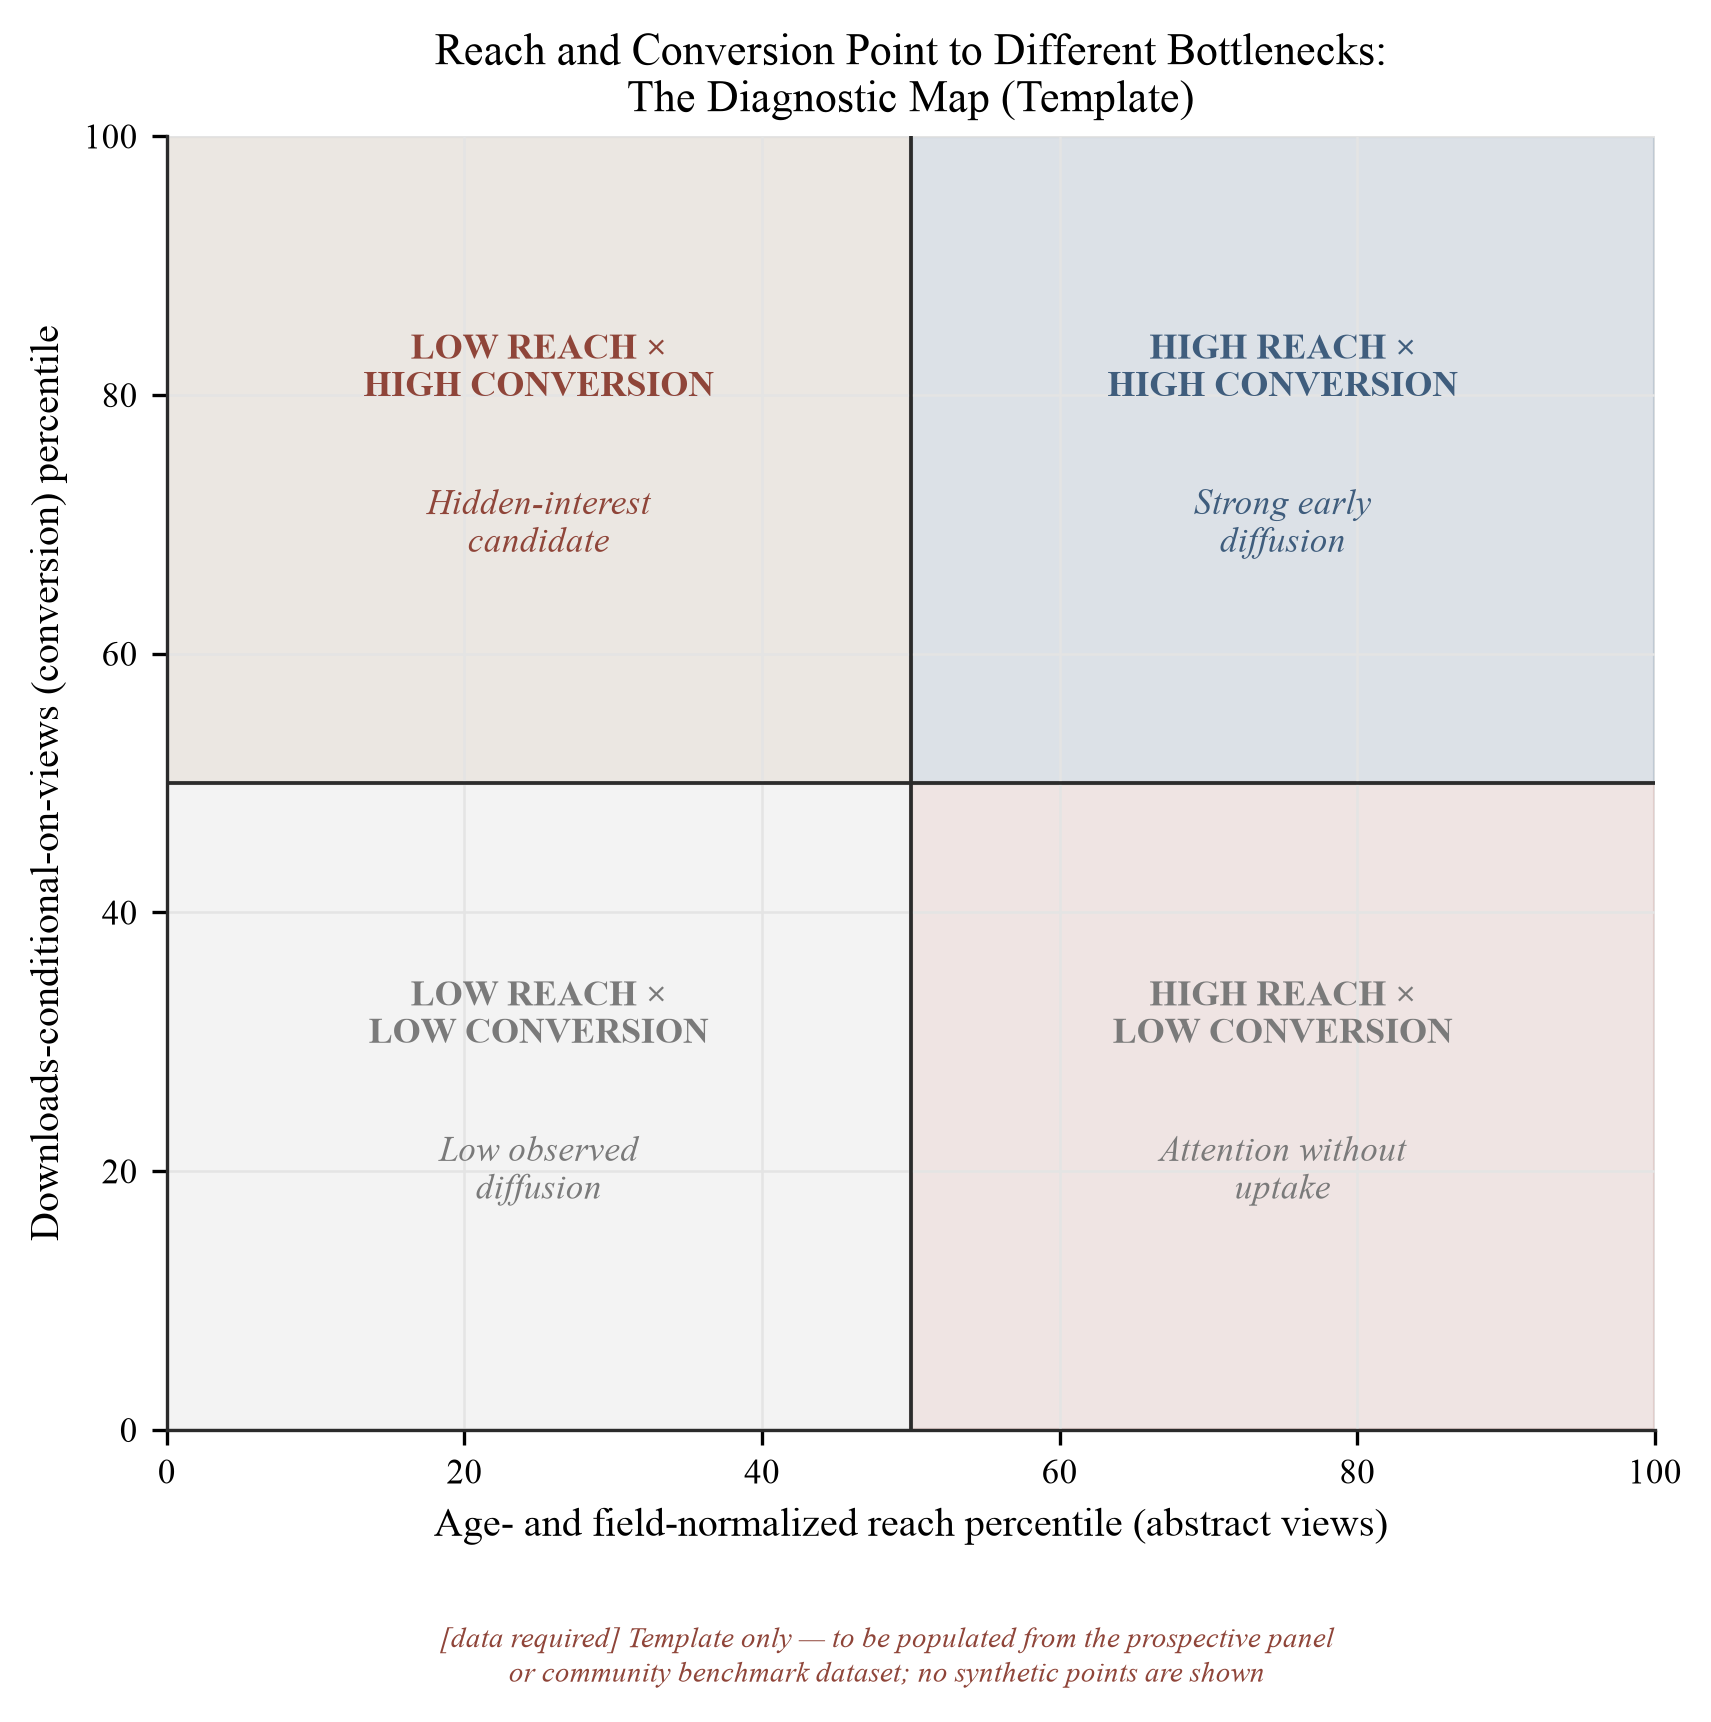
चित्र 8. पहुँच–रूपांतरण मानचित्र। आयु-, क्षेत्र-, समूह-, और दृश्यमानता-सामान्यीकृत दृश्य प्रतिशतक (पहुँच, क्षैतिज) और डाउनलोड-सशर्त-दृश्य प्रतिशतक (रूपांतरण, ऊर्ध्वाधर) द्वारा कागजात की स्थिति के लिए टेम्पलेट, तालिका 9 (कोल्ड स्टार्ट, छिपी हुई रुचि, ध्यान बिना ग्रहण के, मजबूत प्रारंभिक प्रसार) के साथ चतुर्भुज। ऊपरी-बाएं चतुर्भुज उन पत्रों की पहचान करता है जिनके पास माध्य-के-बाद रूपांतरण माध्य से नीचे की पहुँच है, एक वर्ग जो कच्ची डाउनलोड गणना व्यवस्थित रूप से कम मूल्यांकन करता है। कोई अनुभवजन्य मान दिखाए नहीं गए हैं; मानचित्र खंड 8 के संभावी पैनल या सामुदायिक बेंचमार्क डेटासेट से भरा जाना है।
5.5 एक शीर्षक संख्या से एक बेंचमार्क तक: CSAB आयाम
पूर्ववर्ती प्रत्येक उपखंड कच्चे काउंटर की एक विफलता मोड को ठीक करता है, और Cold-Start Scholarly Attention Benchmark (CSAB) वह एकीकरण है: एक रिपोर्टिंग ढांचा जो एकल शीर्षक संख्या को पाँच सामान्यीकृत घटकों से बदलता है (तालिका 10)। सामान्यीकरण चर (कागज की आयु, क्षेत्र, पोस्टिंग समूह, और पूर्व लेखक दृश्यता) प्रत्येक अनुभवजन्य रूप से प्रेरित हैं: संचयी मेट्रिक्स यांत्रिक रूप से आयु के साथ बढ़ते हैं; क्षेत्र के मानदंड माध्य में परिमाण के एक क्रम तक भिन्न होते हैं [168]; कैलेंडर स्थितियाँ ध्यान में मापने योग्य परिवर्तन करती हैं (लेख पहुँच सप्ताहांत में ~11% और गर्मी के महीनों में ~50% गिरती है [178]); और एक प्लेटफ़ॉर्म नवागंतुक को एक स्थापित लेखक जैसा प्रारंभिक दर्शक नहीं मिलता है [83]। कोई भी प्रतिशतक की गणना करने से पहले एक जनसंख्या सम्मेलन तय किया जाना चाहिए। एक संचयी काउंटर विषम जीवित रहने वाले कागज के स्टॉक पर परिभाषित है (कागज कभी-कभार वापस ले लिए जाते हैं, विलीन हो जाते हैं, या बाद के संस्करणों द्वारा प्रतिस्थापित हो जाते हैं), इसलिए हर CSAB प्रतिशतक अवलोकन तिथि पर जीवित रहने वाले स्टॉक के बारे में एक कथन है। अध्ययन 1 (खंड 8.6) समावेश नियम (संस्करण प्रबंधन, वापसी, और डुप्लिकेट समाधान) को पूर्वनिर्दिष्ट करता है बजाय संदर्भ जनसंख्या को निहित छोड़ने के।
दो केंद्रीय घटक एक सघन परिभाषा को स्वीकार करते हैं। कागज i के लिए आयु τ पर (पोस्टिंग के बाद से दिन), क्षेत्र f में, पोस्टिंग समूह c, और पूर्व-दृश्यता स्तर s:
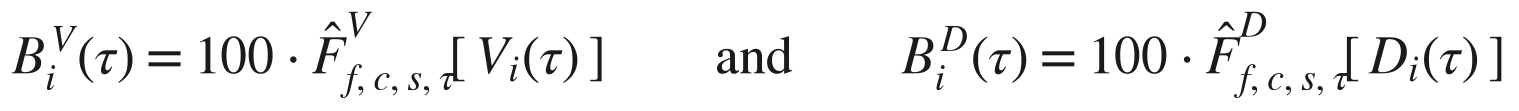
जहाँ V_i(τ) और D_i(τ) संचयी सारांश दृश्य और डाउनलोड हैं और F̂^V, F̂^D उन गणनाओं के अनुभवजन्य वितरण कार्य हैं f, c, s, और τ द्वारा परिभाषित संदर्भ वर्ग के भीतर। परिभाषा अनुमानक को ठीक करती है, एक कथित संदर्भ वर्ग के भीतर एक प्रतिशतक। कोई भी F̂ आज नहीं लिखा जा सकता है, क्योंकि संदर्भ वितरण मौजूद नहीं हैं (खंड 5.1)। यह सूत्र वह विनिर्देश है जिसे अध्ययन 1 और खंड 8 के पैनल का अनुमान लगाने के लिए डिज़ाइन किया गया है, और समान संकेतन खंड 8.9 के भविष्यसूचक-सत्यापन डिज़ाइन के माध्यम से ले जाया जाता है। प्रतिशतक और संदर्भ-वर्ग सामान्यीकरण स्वयं एक स्थापित ग्रंथसूची पद्धति है: प्रतिशतक क्षेत्र, दस्तावेज़ प्रकार, और प्रकाशन वर्ष के लिए प्रकाशन की गणना को सामान्य बनाने का एक मानक तरीका है [22], क्षेत्र- और समय-सामान्यीकरण के लिए समर्पित प्रक्रियाओं के साथ शून्य द्वारा प्रभावित संकेतक [23], बिल्कुल वह शासन जो एक डाउनलोड काउंटर कब्जा करता है। उपयोग मेट्रिक्स को विशेष रूप से (डाउनलोड और दृश्य नहीं बल्कि उद्धरण) एक संदर्भ वर्ग के विरुद्ध सामान्य बनाना समान रूप से परिपक्व कार्य की एक पंक्ति है: उपयोग-ग्रंथसूची साहित्य ने लंबे समय से डाउनलोड-आधारित प्रभाव को एक वितरण के रूप में माना है जो उपयोगकर्ता समुदाय की विशेषताओं और नमूनाकरण फ्रेम पर निर्भर है [92][19], और जर्नल-उपयोग-कारक कार्यक्रम COUNTER-अनुगामी डेटा से बिल्कुल ऐसे सामान्यीकृत उपयोग संकेतक बनाए गए [137]। उपयोग गणना का मानकीकरण स्वयं एक परिपक्व अभिक्रेता ढांचे का विषय है, COUNTER Code of Practice [125]। क्षेत्र-सामान्यीकृत पठनीयता संकेतक altmetrics साहित्य [179] में एक तुलनीय स्थापित पूर्वाभास रखते हैं। विधि इसलिए स्थापित है। यहाँ का योगदान SSRN डाउनलोड पर इसका अनुप्रयोग और एक post-Rankings वातावरण के लिए एक आयु-, क्षेत्र-, और समूह-स्तरीय संदर्भ वर्ग का निर्माण है।
अनुमानक स्वच्छ है, लेकिन कोई भी F̂ फिट होने से पहले तीन क्रियान्वयन प्रश्न हल किए जाने चाहिए। पहला सबसे महत्वपूर्ण है, क्योंकि यह इस बात के बारे में है कि बेंचमार्क के लिए क्या है। संदर्भ वर्ग को पूर्व लेखक दृश्यता (स्तर s) पर कंडीशन करना सही है जब प्रश्न निदान है: "यह कागज तुलनीय लेखकों द्वारा तुलनीय कागजों के बीच कैसे कर रहा है?" यह बिल्कुल गलत है जब प्रश्न H1–H3 की इक्विटी प्रश्न है, क्योंकि पूर्व दृश्यता द्वारा सामान्य बनाना नवागंतुक-बनाम-स्थापित अंतर को घटाता है जो इक्विटी फ्रेम मापने के लिए मौजूद है। एक within-s प्रतिशतक cold-start नुकसान का पता नहीं लगा सकता है, क्योंकि नुकसान निर्माण द्वारा कंडीशन हो गया है। ढांचा इसलिए CSAB के दो अलग उपयोग को अलग करता है जिन्हें कभी एक संख्या में नहीं मिलाया जा सकता है। एक वर्णनात्मक बेंचमार्क के रूप में यह एक पूर्ण रूप से स्तरीकृत संदर्भ वर्ग (जिसमें s शामिल है) के भीतर एक लेखक की स्थिति की रिपोर्ट करता है, जो एक व्यक्तिगत लेखक डैशबोर्ड पर चाहता है। H1–H3 के लिए एक समायोजित अनुमानक के रूप में यह कंडीशनिंग सेट से पूर्व दृश्यता को हटाता है और इसके बजाय इसे रुचि के भविष्यवक्ता के रूप में मानता है, इसे हटाने के बजाय ढाल को मापता है। दो उत्तर भिन्न हैं, वे विभिन्न प्रश्नों का उत्तर देते हैं, और कोई भी रिपोर्ट जो एक दृश्यता-सामान्यीकृत प्रतिशतक प्रस्तुत करती है उसे यह बताना चाहिए कि यह दोनों में से कौन सा है। एक दूसरा प्रश्न नमूना आकार है। क्षेत्र × समूह × दृश्यता स्तर × आठ आयु बिंदुओं द्वारा स्तरीकरण करने से 3,000–5,000 कागजों की संभाव्यता नमूना तेजी से समाप्त हो जाता है (खंड 8.6): पूर्ण रूप से पार किए गए सेल गणना हजारों में चलती है, इसलिए अधिकांश सेल छोटे या खाली हैं। Empirical-Bayes सिकुड़न व्यापक संदर्भ वर्गों की ओर इसी कारण के लिए नाम दिया गया है (खंड 8.3, 8.8), लेकिन सिकुड़न को इसके स्वयं के विनिर्देश की आवश्यकता है: न्यूनतम पदानुक्रमिक संरचना (व्यापक क्षेत्र के भीतर क्षेत्र, मोटे आयु बैंड के भीतर आयु) और एक पूर्वनिर्दिष्ट न्यूनतम-सेल नियम अनुमान के लिए, जिसके नीचे एक सेल एक कच्चे प्रतिशतक की रिपोर्ट करने के बजाय अपने माता-पिता से उधार लेता है। यह अनुमान-पक्ष न्यूनतम-सेल नियम गोपनीयता-संचालित न्यूनतम-सेल नियम से अलग है और तर्क देने के लिए कठोर है जो सार्वजनिक रिलीज़ को नियंत्रित करता है परिशिष्ट D में; दोनों विभिन्न उद्देश्यों की पूरी करते हैं और अलग से निर्दिष्ट हैं। अंतिम प्रश्न momentum (तालिका 10) है, जिसे एक अनुमानित सामान्यीकृत स्थिति में परिवर्तन के रूप में परिभाषित किया गया है। एक अनुमानित मात्रा में एक परिवर्तन स्कोर माध्य की ओर प्रतिगमन को आमंत्रित करता है: एक कागज जो दिन 7 पर आंशिक रूप से अनुमान शोर द्वारा ऊपर उतरता है विशुद्ध रूप से सांख्यिकीय कारणों के लिए दिन 30 तक गिरने का प्रवृत्ति होगा। Momentum इसलिए अंतर्निहित प्रक्षेपवक्र के एक स्पष्ट मॉडल की आवश्यकता है (उदाहरण के लिए, अंतर्निहित स्थिति का एक सिकुड़न या empirical-Bayes अनुमान इसकी माप त्रुटि प्रसारित की गई) बजाय दो प्रतिशतक स्नैपशॉट के कच्चे अंतर के, और कच्चा अंतर रिपोर्ट किया जाता है, यदि बिल्कुल, केवल मॉडल की गई मात्रा के एक वर्णनात्मक साथी के रूप में।
सारणी 10. कोल्ड-स्टार्ट स्कॉलरली अटेंशन बेंचमार्क (CSAB): एक संख्या के बजाय पाँच आयाम। इन आयामों के लिए एक प्रतिलिपि योग्य वाक्य-स्तरीय रिपोर्टिंग टेम्पलेट परिशिष्ट B में प्रदान किया गया है।
| आयाम | मीट्रिक | मुख्य प्रश्न | व्याख्या |
|---|---|---|---|
| पहुँच | आयु/क्षेत्र/समूह/नवागंतुक-सामान्यीकृत दृश्य प्रतिशतक | क्या प्रासंगिक दर्शकों ने पेपर का सामना किया? | खोजयोग्यता |
| डाउनलोड प्रदर्शन | सामान्यीकृत संचयी डाउनलोड प्रतिशतक | तुलनीय पेपरों की तुलना में कितने पूर्ण-पाठ अधिग्रहण हुए? | समग्र प्रारंभिक प्रसार |
| रूपांतरण | दृश्य के अवसरों पर सशर्त डाउनलोड (अनुभाग 5.2) | क्या उजागर किए गए पाठकों ने पूर्ण पाठ की मांग की? | सशर्त संलग्नता |
| गति | सामान्यीकृत स्थिति या अंतराल-स्तरीय अटेंशन में परिवर्तन | क्या प्रसार त्वरित हो रहा है, स्थिर है, या क्षीण हो रहा है? | अस्थायी प्रक्षेपवक्र |
| अनुप्रवाह सत्यापन | प्रारंभिक मीट्रिक्स पर सशर्त बाद का उद्धरण या उपयोग | क्या प्रारंभिक अटेंशन ने बाद के विद्वत ग्रहण की भविष्यद्वाणी की? | भविष्यसूचक वैधता |
यह ढाँचा "सफलता" के किसी भी सार्वभौमिक कच्चे थ्रेशहोल्ड को अस्वीकार करता है। सफलता को एक विश्लेषणात्मक उद्देश्य के सापेक्ष परिभाषित किया जाना चाहिए: खोजयोग्यता के लिए, समान आयु और क्षेत्र के पेपरों के बीच उच्च पहुँच प्रतिशतक; पाठक ग्रहण के लिए, संपर्क पर सशर्त संदर्भ-वर्ग-ऊपर रूपांतरण; प्रसार के लिए, दोनों का संयुक्त वितरण; वैज्ञानिक प्रभाव के लिए, अनुप्रवाह उद्धरण या प्रलेखित उपयोग। आखिरी उद्देश्य के लिए अकेले प्रारंभिक उपयोग अपर्याप्त है, क्योंकि प्रारंभिक डाउनलोड बाद के उद्धरण विचरण के केवल लगभग 16% की व्याख्या करते हैं [25]। यह शीर्षक उदाहरण की व्याख्या को सटीक बनाता है। सात डाउनलोड "अच्छे" हैं केवल उस हद तक कि सात डाउनलोड पेपर को अपने जीवन चक्र के समान चरण में अन्यथा तुलनीय पेपरों के बीच असामान्य रूप से उच्च रखते हैं। एक दिन-7 मूल्य और एक दिन-180 मूल्य को एक ही बेंचमार्क पर मूल्यांकन नहीं किया जा सकता।
चार डिज़ाइन विकल्प लीडन घोषणापत्र के आठवें सिद्धांत का पालन करते हैं: कि मात्रात्मक संकेतक उनके पीछे की मान्यताओं की ताकत से आगे नहीं निकलने दिए जाने चाहिए, और कि झूठी सटीकता स्वयं माप की विफलता है [78]। यह ढाँचा बैंड रिपोर्ट करता है, बिंदु स्कोर नहीं (सारणी 8); यह CSAB को एक लक्ष्य के बजाय एक निदान वेक्टर के रूप में ठीक करता है (अनुभाग 5.2); यह अपनी आउटपुट आकृतियाँ, पहुँच–रूपांतरण मानचित्र (चित्र 8) और बेंचमार्क प्रशंसक (चित्र 14), कोई संख्यात्मक पैमाना के बिना खींचता है, ताकि एक आकार को एक अंशांकित मूल्य के लिए गलत न समझा जाए; और यह प्रत्येक संख्या को जो उपयोग करता है उसे एक सत्यापन स्तर और पुरातन से जोड़ता है (सारणी 7)। इनमें से प्रत्येक सटीकता को रोकता है कि साक्ष्य समर्थन नहीं कर सकता, जैसा कि DORA अनुसंधान मूल्यांकन को मांगता है जब यह एकल-संख्या और पत्रिका-ब्रांड प्रॉक्सी को एक पेपर की सामग्री के पदार्थपूर्ण मूल्यांकन के लिए अस्वीकार करता है [8]। CSAB को एक स्कोर में वापस लाना दोनों दस्तावेज़ों द्वारा चेतावनी दी गई बिल्कुल झूठी सटीकता को फिर से शुरू करेगा।
एक लेखक के लिए, CSAB रिपोर्टिंग नंगी पंक्ति "डाउनलोड: 12" को इसके जैसी किसी चीज़ से प्रतिस्थापित करेगी: 14 दिनों के बाद 12 डाउनलोड: तुलनीय पेपरों के बीच समग्र डाउनलोड प्रतिशतक: 67वाँ; पहुँच प्रतिशतक: 39वाँ; रूपांतरण प्रतिशतक: 81वाँ; व्याख्या: उच्च सशर्त रुचि, माध्यिका-नीचे संपर्क। इस नकली-अप में हर संख्या सचित्र है, क्योंकि अनुभाग 8 के संदर्भ वितरण का अनुमान लगाए जाने तक कोई ऐसे प्रतिशतक मौजूद नहीं हैं, और इनमें से कोई भी मूल्य एक बेंचमार्क के रूप में उद्धृत नहीं किया जा सकता, लेकिन प्रारूप दिखाता है कि विघटन क्या खरीदता है। वही कच्चा गणना जो एक अविभेदित निराशा के रूप में पढ़ता है एक विशिष्ट निदान में विघटित हो जाता है: पाठक जो पेपर का सामना करते हैं असामान्य रूप से अच्छी तरह से प्रतिक्रिया करते हैं, लेकिन बहुत कम का सामना करते हैं, इसलिए संकेतित हस्तक्षेप वितरण है, संशोधन नहीं। काम किया गया उदाहरण सारणी 9 के "छिपी रुचि" चतुर्थांश का CSAB समकक्ष है। परिशिष्ट B इस प्रारूप को एक प्रतिलिपि योग्य रिपोर्टिंग टेम्पलेट के रूप में ठीक करता है जिसके प्रतिशतक क्षेत्र अनुभाग 8 वितरण मौजूद होने तक खाली रहते हैं।
5.6 पढ़ने के प्रक्षेपवक्र: एक्सपोजर एक उपचार है, पृष्ठभूमि शोर नहीं
ढांचे का अंतिम घटक अस्थायी है: एक नई तरह से पोस्ट किया गया पेपर एक सजातीय ध्यान वातावरण में नहीं प्रवेश करता है। यह विभिन्न एक्सपोजर व्यवस्थाओं से गुजरता है (पोस्टिंग → आंतरिक खोज → ईमेल वितरण → बाहरी अनुक्रमण → नेटवर्क प्रसार), और एक संचयी कुल इन व्यवस्थाओं को एक संख्या में ढह देता है। व्यवस्था की सीमाएं खंड 4 की मशीनरी द्वारा निर्धारित की जाती हैं: eJournal वितरण क्यूरेटेड है और उच्च-मात्रा विषयों में 45 दिन तक ले सकता है [53], और बाहरी खोज अनुक्रमण 6–9 महीने या उससे अधिक समय ले सकता है [55]।
सबसे चिंता पैदा करने वाली डैशबोर्ड स्थिति सीधे इससे अनुसरण करती है: पहले सप्ताह में शून्य डाउनलोड सामान्य पूर्व-वितरण है, अस्वीकृति नहीं। घोषणा चक्र चलने से पहले, पेपर अपने मुख्य दर्शकों को अभी तक उजागर नहीं किया गया है। जल्दी शून्य के लिए नैदानिक अनुक्रम प्रशासनिक है: पुष्टि करें कि पेपर सार्वजनिक रूप से पोस्ट किया गया है; eJournal असाइनमेंट की पुष्टि करें; घोषणा चक्र का इंतजार करें; केवल तभी काउंटर पढ़ें। इसके विपरीत, पहले महीने की गणना, एक बार वितरण हो जाने के बाद, सबसे शुरुआती और सबसे शोर वाली अग्रणी संकेतक है: जल्दी डाउनलोड बाद के उद्धरणों के साथ लगभग r ≈ 0.4 [25] पर सहसंबंधित होते हैं, जानकारीपूर्ण लेकिन एक निर्णय से बहुत दूर, और जल्दी स्पाइक अक्सर एक्सपोजर इवेंट (ब्लॉग या मीडिया कवरेज) होते हैं स्थायी रुचि के बजाय [116][138]।
क्योंकि संचयी गणनाओं का पूर्वव्यापी स्क्रैपिंग दिन 3 या दिन 30 पर एक पेपर क्या था इसका पुनर्निर्माण नहीं कर सकता है, प्रक्षेपवक्र-आधारित व्याख्या (और खंड 8 के पैनल अनुसंधान एजेंडा) के लिए एक मानकीकृत ग्रिड पर जन्म से अवलोकन की आवश्यकता होती है। तालिका 11 न्यूनतम अनुसूची को निर्दिष्ट करती है। यह व्यक्तिगत लेखकों के लिए एक स्व-ट्रैकिंग टेम्पलेट के रूप में भी कार्य करता है। एक प्रक्षेपवक्र को तालिका 11 ग्रिड के 60- और 90-दिन की पढ़ाई पर केवल अस्थायी रूप से वर्गीकृत किया जाता है और 180-दिन की पढ़ाई पर आत्मविश्वास के साथ, कभी दिन 7 पर नहीं।
तालिका 11. SSRN पेपर के लिए न्यूनतम अनुदैर्ध्य अवलोकन अनुसूची।
| पेपर की आयु | अवलोकन का मूल उद्देश्य |
|---|---|
| दिन 1 | तत्काल मंच एक्सपोजर |
| दिन 3 | बहुत जल्दी खोज |
| दिन 7 | पहले सप्ताह की बेंचमार्क (अधिकांश पेपर के लिए अपेक्षित मूल्य: शून्य पर या निकट, पूर्व-वितरण) |
| दिन 14 | शुरुआती स्थिरीकरण |
| दिन 30 | पहले महीने की बेंचमार्क |
| दिन 60 | वितरण और खोज परिपक्वता (eJournal चक्र पूर्ण [53]) |
| दिन 90 | माध्यम-रन जल्दी प्रसार |
| दिन 180 | डाउनस्ट्रीम प्रभाव माप की ओर संक्रमण |
जहां संभव हो, पहले 45 दिनों में दैनिक अवलोकन बेहतर है, क्योंकि ईमेल वितरण उस विंडो के भीतर परिवर्तनीय समय पर हो सकता है [53]। इस ग्रिड पर अंतराल-स्तरीय पढ़ाई डैशबोर्ड को एक स्थिर निर्णय से एक प्रक्षेपवक्र में परिवर्तित करती है, एकमात्र रूप जिसमें जल्दी SSRN मेट्रिक्स रक्षणीय जानकारी प्रदान करते हैं।
खंड 4 और 5 एक लेखक के प्रश्न को जो वह उत्तर नहीं दे सकता ("क्या 7 डाउनलोड अच्छे हैं?") चार से बदलते हैं जो प्रकाशित रिकॉर्ड समर्थन कर सकता है: गणना बेंचमार्क मानचित्र और इसके विंटेज के विरुद्ध कहां बैठती है (5.1, 5.3); क्या रूपांतरण अनुभवजन्य बैंड के अंदर है (5.2); रीच-कन्वर्सन प्लेन का कौन सा चतुर्भुज पेपर को ग्रहण करता है (5.4); और अवलोकन ग्रिड पर प्रक्षेपवक्र क्या दिखाता है (5.6)? इनमें से कोई भी प्रश्न सेवामुक्त रैंकिंग की आवश्यकता नहीं है, लेकिन सभी को तुलनात्मक डेटा की आवश्यकता है जिसके संग्रह का यह लेख के अंतिम खंड प्रस्ताव देते हैं।
6. लेखकों के लिए एक व्यावहारिक खेल पुस्तिका
खंड 5 की बेंचमार्क मानचित्र (तालिका 7) गायब पैमाने को पुनः स्थापित करता है, और यह खंड लेखक के लिए काम में डालता है जो 15 जुलाई 2026 के बाद सांख्यिकी पैनल खोलता है और संदर्भ के बिना गणना देखता है [148][149]। इसमें बदले में चार कार्य हैं: अपने काउंटर का अवलोकन करने की दिनचर्या (6.1–6.2), रैंकिंग जो प्रदान करते थे तुलनात्मक ढांचे के स्थान (6.3), लीवर जो दृश्यता में वैध रूप से सुधार कर सकते हैं (6.4), और काउंटर को रक्षणीय कैरियर साक्ष्य में परिवर्तित करने की एक प्रोटोकॉल (6.5–6.6)। यहां उपयोग किया गया हर संख्यात्मक लंगर एक प्रकाशित स्रोत का पता लगाता है जिसमें एक स्पष्ट नमूना फ्रेम और समय विंडो हो; तालिका 7 उन्हें समेकित करता है। लेखक समुदाय में प्रचलित प्रथाएं जिनके पास कोई साक्ष्य समर्थन नहीं है जहां वे दिखाई देते हैं वहां अनुपलब्ध चिह्नित किए जाते हैं और परीक्षण के लिए उम्मीदवार परिकल्पना के रूप में परिशिष्ट A के अंत में एकत्र किए जाते हैं।
तालिका 12 खेल पुस्तिका के मूल को सात प्रश्नों की एक प्रोटोकॉल में संपीड़ित करता है, क्रम में पूछा जाता है, प्रत्येक को संरक्षित करने के लिए साक्ष्य और उत्तर वैध रूप से लाइसेंस कर सकता है सबसे मजबूत निष्कर्ष के साथ युग्मित किया जाता है। खंड 6.1–6.2 इस प्रोटोकॉल को दिनचर्या और पढ़ने के नियमों में विस्तारित करते हैं, और तालिका 23 (परिशिष्ट A) इसके परिस्थितिगत साथी के रूप में रहती है, लेखकों द्वारा वास्तव में सामना की जाने वाली डैशबोर्ड स्थितियों द्वारा अनुक्रमित।
तालिका 12. एक SSRN काउंटर की व्याख्या के लिए एक लेखक प्रोटोकॉल: सात प्रश्न, संरक्षित करने के लिए साक्ष्य, और अनुमत निष्कर्ष। कोई चरण एक काउंटर को एक गुणवत्ता स्कोर के रूप में नहीं मानता है; अंतिम स्तंभ बताता है कि प्रत्येक उत्तर क्या समर्थन कर सकता है इसकी सीमा।
| चरण | प्रश्न | संरक्षित करने के लिए साक्ष्य | अनुमत निष्कर्ष |
|---|---|---|---|
| 1 | जब गणना का अवलोकन किया गया था तो पेपर कितना पुराना था? | दिनांकित स्क्रीनशॉट या निर्यात, साथ ही पोस्टिंग की तारीख | एक समय-विशिष्ट अवलोकन, जीवनकाल निर्णय नहीं |
| 2 | क्या क्यूरेटेड वितरण और बाहरी अनुक्रमण हुआ था? | वितरण सूचना और तारीख जहां उपलब्ध हो; खोज-अनुक्रमण स्थिति | पूर्व बनाम बाद-एक्सपोजर व्यवस्था की पहचान (खंड 5.6) |
| 3 | विचार, डाउनलोड, और रूपांतरण एक साथ क्या हैं? | दोनों काउंटर और हर | एक रीच-बनाम-सशर्त-एनगेजमेंट निदान (तालिका 9), एक एकल निर्णय नहीं |
| 4 | सबसे संकीर्ण रक्षणीय संदर्भ वर्ग क्या है? | क्षेत्र, समूह, पेपर आयु, नवागंतुक स्थिति, वर्गीकरण इतिहास | केवल उस वर्ग के भीतर सापेक्ष खड़ा (खंड 5.5) |
| 5 | क्या प्रक्षेपवक्र बदल रहा है? | तालिका 11 की निश्चित आयु पर दोहराए गए अवलोकन | गति या पठार, एक्सपोजर इवेंट के अधीन — "गुणवत्ता" का त्वरण नहीं |
| 6 | क्या कोई डाउनस्ट्रीम पुष्टि है? | उद्धरण, सार्थक संपर्क, प्रकाशन या प्रलेखित उपयोग | ग्रहण के स्तरित साक्ष्य, गुणवत्ता का प्रमाण नहीं |
| 7 | क्या दावे को पुनः प्रस्तुत किया जा सकता है? | स्रोत, तारीख, गणना नियम, संग्रहीत रिकॉर्ड | एक लेखा-परीक्षा योग्य रिपोर्ट, एक असमर्थित मील का पत्थर नहीं |
6.1 एक माप दिनचर्या
व्याख्या अनुशासित रिकॉर्डिंग से शुरू होती है, क्योंकि SSRN केवल वर्तमान संचयी गणना प्रदर्शित करता है और लेखक के नियंत्रण में कोई इतिहास नहीं है। पोस्टिंग के दिन से लागू किए गए छह कदम, न्यूनतम रिकॉर्ड का उत्पादन करते हैं जो बाद के प्रत्येक अनुमान के लिए आवश्यक है।
1. काउंटर और उनके अनुपात दोनों को रिकॉर्ड करें। निश्चित अंतराल पर सार दृश्य, डाउनलोड और डाउनलोड-से-दृश्य रूपांतरण अनुपात पर ध्यान दें। तालिका 11 (दिन 1, 3, 7, 14, 30, 60, 90, 180) का अवलोकन ग्रिड प्रत्येक पठन का कार्यक्रम और उद्देश्य निर्दिष्ट करता है। प्रत्येक अंतराल पर एक दिनांकित स्क्रीनशॉट रिकॉर्ड का एकमात्र संस्करण है जो लेखक नियंत्रित करता है, क्योंकि जब फ़िल्टरिंग नियम बदलते हैं तो प्लेटफ़ॉर्म काउंटर को पुनः बताया जा सकता है [144][69]। संचयी रिकॉर्ड एक संस्करणित प्रमाण पैकेट है: पांडुलिपि संस्करण, इसके मेटाडेटा और वर्गीकरण, दिनांकित डैशबोर्ड स्नैपशॉट, वितरण नोटिस, लेखक की अपनी प्रचार घटनाओं का दिनांकित लॉग (एक पोस्ट किया गया धागा, एक बातचीत, एक मेलिंग-सूची घोषणा), और बाद में उद्धरण और पदार्थपूर्ण संपर्क। प्रचार लॉग महत्वपूर्ण है क्योंकि प्रचार जोखिम उपचार हैं। अपनी स्वयं की प्रचार की दिनांकित रिकॉर्ड के बिना, एक लेखक एक जैविक वृद्धि को स्व-उत्पन्न से अलग नहीं कर सकता है, और न ही कोई भी दावे का ऑडिट कर सकता है (अनुभाग 8.3)।
2. पोस्टिंग के बाद के समय से सामान्य करें। प्रारंभिक प्रदर्शन को कच्ची संचयी गणना के रूप में नहीं, बल्कि पहले तीन से छह महीने में प्रति माह डाउनलोड के रूप में व्यक्त करें। एक तीन महीने की पुरानी पेपर की तुलना पुरानी कार्य के सर्वकालिक कुल से की गई, व्यवस्थित रूप से भ्रामक निष्कर्ष देती है, क्योंकि काउंटर एक पेपर के जीवनकाल पर एक प्लेटफ़ॉर्म पर जमा होते हैं जिसकी वार्षिक डाउनलोड मात्रा 2016 में लगभग 12.9 मिलियन से बढ़कर 2023 में 40.6 मिलियन हो गई है [1]।
3. कभी भी अवलोकन विंडो को मिक्स न करें। एक साप्ताहिक गणना की तुलना बारह महीने के औसत से नहीं की जा सकती है, और 90 दिन की गणना की तुलना जीवनकाल कुल से नहीं की जा सकती है। इस प्लेबुक में हर तुलना समान विंडो को जोड़ी जाती है। इस नियम के उल्लंघन रैंकिंग सांख्यिकी के प्रि-सूर्यास्त उपयोग में सबसे आम व्याख्यात्मक त्रुटियों के बीच थे [161]।
4. पेपर को अपने अनुशासनात्मक पड़ोस में रखें, प्लेटफ़ॉर्म के विरुद्ध नहीं। औसत डाउनलोड प्रति पेपर कानूनी छात्रवृत्ति नेटवर्क eJournals अकेले में लगभग आठ के कारक से भिन्न हैं (कॉर्पोरेट/प्रतिभूतियां/वित्त में 438.35 बनाम कृषि कानून में 53.48, 2018 डेटा) [168]। एक गणना जो एक उप-क्षेत्र में असाधारण नहीं है, दूसरे में असाधारण है। प्रासंगिक संदर्भ वर्ग पेपर का अपना eJournal या विषय नेटवर्क है, जिसे समान पेपर आयु पर जांचा गया है।
5. छोटी संख्याओं की एकल छोटी गणना पर अधिक व्याख्या न करें। अखंडता साहित्य उपयोग काउंटर की परिशुद्धता पर एक सीमा रखता है: प्रकाशक-रिपोर्ट किए गए डाउनलोड तुलनीय प्लेटफार्मों की दोहरी हो सकती है [176], प्लेटफ़ॉर्म फ़िल्टर कच्चे ट्रैफ़िक का एक बड़ा हिस्सा त्यागते हैं [99][129][144], और इस तरह के फ़िल्टर के बिना SSRN के अपने काउंटर "पाँच या अधिक के एक कारक से" फुलाए जाएंगे [18]। तुलनीय संख्याओं के बीच छोटे अंतर इसलिए कोई जानकारी नहीं रखते।
6. प्रारंभिक आंकड़ों पर प्रतिक्रिया करने के बजाय लंबे समय तक जमा होने पर निगरानी करें। वर्किंग-पेपर प्लेटफार्मों पर ध्यान जल्दी केंद्रित होता है [116][28] (बाद की खोज NBER के बजाय SSRN डेटा से निकलती है), लेकिन खोज परतें धीरे-धीरे परिपक्व होती हैं: SSRN रिपोर्ट करता है कि Google Scholar अनुक्रमण "6–9 महीने या उससे अधिक" लगता है [55]। पाठकता, इसके अलावा, एक साथ कई समय स्केल पर क्षय होती है, और पढ़ना और उद्धरण को एक ही अस्थायी प्रक्रिया का पालन नहीं करना पड़ता है [91], इसलिए अपने स्वयं के वक्र का कोई भी एकल "आधा जीवन" पठन सुरक्षित नहीं है। एक प्रक्षेपवक्र को तालिका 11 ग्रिड के 60–90 दिन के पठन पर अनंतिम रूप से वर्गीकृत किया जा सकता है और 180 दिन पर अधिक आत्मविश्वास के साथ, कभी भी दिन-7 पठन पर नहीं।
6.2 डैशबोर्ड को पढ़ने के पाँच नियम
उस रिकॉर्ड के साथ, खंड 5 का वितरणात्मक साक्ष्य दिन-प्रतिदिन डैशबोर्ड को पढ़ने के पाँच नियमों तक आता है।
(i) माध्यिका की तुलना करें, माध्य या दृश्यमान तारों की नहीं। साधारण पत्रों का एकमात्र जनगणना-शैली नमूना दो वर्षों के बाद माध्यिका को 63 डाउनलोड और 369 सारांश दृश्य पर रखता है (LSN, 2012 में पोस्ट किए गए पत्र) [139]। एक हाल के प्रकाशित नमूने में माध्यिका 87 डाउनलोड है, जबकि 221.3 का माध्य है जो 75वें प्रतिशतक से भी ऊपर है (खंड 3.3) [83]। जो मील के पत्थर के आंकड़े प्रचलित हैं, वे दृश्यमान पूंछ से आते हैं, जिसके 2015 के अधिकतम डाउनलोड सैकड़ों हजारों तक पहुंचे (खंड 3.5) [85]; एक लेखक जो उनके विरुद्ध अंशांकन करता है, वह एक अर्ध-लॉग-सामान्य वितरण की पूंछ के विरुद्ध अंशांकन कर रहा है, जो गलत अंशांकन की गारंटी देता है। दिसंबर 2023 के समुच्चय से गणना की गई प्रति पत्र ~ 222 आजीवन डाउनलोड का मंच-व्यापी औसत [1] व्यक्तिगत मापदंड के रूप में उतना ही अनुपयोगी है।
(ii) रूपांतरण अनुपात की जांच करें, केवल गिनती की नहीं। स्वतंत्र माप लगभग 11–19% डाउनलोड प्रति सारांश दृश्य की सामान्य बैंड पर अभिसरण करते हैं: LSN नमूने का 18.7% माध्य और 17.1% माध्यिका [139], और कानूनी-उद्धरण अध्ययनों की 15% (शीर्ष-उद्धृत लेख) और 11% (एकल-उद्धरण लेख) आंकड़े [172]। SSRN का दीर्घस्थायी तीन-दृश्य-प्रति-डाउनलोड का अंगूठे का नियम [18] उस बैंड के भीतर की बजाय उसके ऊपर है। हाल के मार्केटिंग-नेटवर्क नमूने 100 दृश्यों के प्रति 23.7 डाउनलोड के माध्य के साथ थोड़ा ऊपर बैंड में हैं [83]। चित्र 6 अनुमानों को एक साथ प्लॉट करता है। खंड 5.2 के केंद्रीय कार्य किए गए उदाहरण को नियम के माध्यम से चलाएं: शीर्षक के 40 सारांश दृश्य और 7 डाउनलोड 17.5% में परिवर्तित होते हैं, एक बिंदु अनुमान के रूप में बैंड के भीतर, लेकिन एक विस्तृत 95% Clopper–Pearson अंतराल (≈7.3–32.8%) के साथ। n = 40 पर पढ़ना न विफलता है और न ही एक सटीक प्रतिशतक: एक साधारण रूपांतरण के अनुरूप स्क्रीनिंग परिणाम। बैंड से बहुत नीचे रूपांतरण सारांश और पत्र के बीच एक बेमेल के अनुरूप है, जहां पाठक आते हैं, सारांश को पढ़ते हैं, और चले जाते हैं। यह कार्यान्वयन योग्य है, और कार्य शीर्षक और सारांश को संशोधित करना है। बैंड से बहुत ऊपर रूपांतरण ऐसी ट्रैफिक को संकेत देता है जिसे सारांश ब्राउजिंग समझा नहीं सकता, जैसे मीडिया या समुच्चयकर्ता कवरेज से सीधे लिंक, और यह जांच करने के लिए प्रेरित करना चाहिए कि दृश्य कहां से आते हैं। दोनों पाठ स्क्रीनिंग निदान हैं: कोई भी अध्ययन सारांश गुणवत्ता के लिए कम रूपांतरण से अनुमान को कारणात्मक रूप से मान्य नहीं किया है, और निदान को अपने पत्र के बारे में एक परिकल्पना के रूप में दर्ज किया जाना चाहिए।
(iii) पहले महीने के डाउनलोड को सबसे प्रारंभिक, और सबसे शोर वाले, उद्धरण संकेत के रूप में मानें। आरंभिक डाउनलोड arXiv डेटा में लगभग r ≈ 0.4 पर बाद के उद्धरणों के साथ सहसंबंधित होते हैं, जिसे मूल लेखक स्वयं केवल लगभग 16% की व्याख्यायित विचरण में अनुवाद करते हैं [25]। रिकॉर्ड पर सबसे प्रारंभिक ऐसा संकेत जैवचिकित्सा है: BMJ में प्रकाशन के बाद पहले सप्ताह में ऑनलाइन हिट गिनती बाद के वर्षों में जमा किए गए उद्धरणों के साथ लगभग 0.50 पर सहसंबंधित [119]। कानूनी छात्रवृत्ति में, ब्लैक और केरोन ने पत्र-स्तर के डाउनलोड-उद्धरण सहसंबंध 0.50 के क्रम में रिपोर्ट किया, एक सौ कनिष्ठ कानून प्रोफेसरों के नमूने में लगभग 0.55 तक बढ़ रहा [18]। क्षेत्रों और क्षितिज में पत्र-स्तर के सहसंबंध लगभग 0.1 से 0.6 तक होते हैं [80][25], और arXiv डाउनलोड गणना एक बार समकालीन ट्विटर ध्यान नियंत्रित होने के बाद सांख्यिकीय महत्व के रूप में खो जाती हैं [138]। समुच्चय स्तर पर संबंध कसना: एक सौ कानून स्कूलों की डाउनलोड-आधारित और उद्धरण-आधारित रैंकिंग के बीच 0.84 [77], और एक पत्रिका के अपने विश्लेषण में छह महीने की PDF डाउनलोड और बाद के उद्धरणों के बीच R = 0.724 [114]। ये समुच्चय आंकड़े यह तय नहीं करते हैं कि कोई भी एकल पत्र कहां समाप्त होगा, और डाउनलोड का पहला महीना बाद के उद्धरणों के बारे में एक प्रारंभिक संकेत है।
(iv) सप्ताह एक में शून्य डाउनलोड सामान्य पूर्व-वितरण है, अस्वीकृति नहीं। एक नया पोस्ट किया गया पत्र केवल मध्यस्थता को साफ़ करने, विषय eJournals में वर्गीकृत करने, और घोषणा चक्र में प्रवेश करने के बाद ध्यान अर्जित करता है। SSRN का अपना दस्तावेज़ वर्गीकरण को गारंटीकृत के बजाय क्यूरेटेड के रूप में वर्णित करता है, भारी भरे विषयों के लिए 45 दिन तक की देरी के साथ [53], और eJournal वितरण और ईमेल सतर्कता को सूर्यास्त के बाद अपरिवर्तित रहने के लिए स्पष्ट रूप से पुष्टि की गई [147][57]। निदान क्रम चलता है: पुष्टि करें कि पत्र सार्वजनिक रूप से पोस्ट किया गया है, eJournal वर्गीकरण की पुष्टि करें, घोषणा चक्र की प्रतीक्षा करें, और उसके बाद ही काउंटर को पढ़ें। खोज इंजन के माध्यम से खोज बाद में भी आती है [55]।
(v) एक गिरती या सपाट काउंटर फ़िल्टरिंग को प्रतिबिंबित कर सकती है, पाठकों को खोई गई नहीं। SSRN सार्वजनिक रूप से दस्तावेज़ करता है कि यह स्पष्ट दोहराव डाउनलोड, रोबोट डाउनलोड, और अन्य अनियमित गतिविधि को त्याग देता है [144][66][69]। RePEc/LogEc अनुभव दिखाता है कि ऐसे सुधार कितने बड़े हो सकते हैं: जुलाई 2007 में रोबोट सारांश दृश्यों का लगभग 74% लेकिन डाउनलोड का केवल लगभग 7% का प्रतिनिधित्व करते थे [99], और सितंबर 2025 में 99.5% से अधिक कच्ची IDEAS ट्रैफिक AI-बॉट हस्तक्षेप के बीच त्याग दी गई [129]। एक अचानक गिरावट, या एक पुनर्कथन, इसलिए पाठकों को खोई गई गतिविधि की तुलना में एक माप घटना होने की संभावना है, और इसे सहसंबंध के बिना प्रतिष्ठा नुकसान के रूप में कभी नहीं पढ़ा जाना चाहिए।
6.3 रैंकिंग के बिना बेंचमार्किंग
रैंकिंग एक तुलनात्मक ढांचा प्रदान करती थी। आज एक लेखक के पास इसके लिए तीन विकल्प हैं, जो कम से अधिक काम के क्रम में हैं।
माइक्रो-बेंचमार्क। सबसे सीधा विकल्प एक संदर्भ समूह है जिसे आप स्वयं बनाते हैं: तुलनीय संस्थानों में समकक्षों द्वारा तीन से पाँच पद्धतिगत रूप से तुलनीय पत्र चिन्हित करें, जो एक ही महीने में पोस्ट किए गए हों, और अपने स्वयं के समान तालिका 11 शेड्यूल पर उनके सार्वजनिक काउंटरों को ट्रैक करें। परिणाम बिल्कुल सही संदर्भ वर्ग के विरुद्ध एक स्थानीयकृत प्रतिशतक आधारभूमि है, जो निर्माण द्वारा क्षेत्र, पत्र की आयु और प्लेटफॉर्म युग के लिए मेल खाती है, जहाँ सेवानिवृत्त रैंकिंग सभी आयु और क्षेत्रों के पत्रों की तुलना एक ही लीग में करती थी। यह एक प्रस्तावित प्रक्रिया है जो केवल सार्वजनिक प्रति-पत्र गणना का उपयोग करती है, और इसे किसी भी डॉसियर उपयोग में ऐसे के रूप में दर्ज किया जाना चाहिए। यह समकक्ष साहित्य से कुछ परिचितता भी मानता है जो सबसे अलग-थलग नए आने वाले, वे लेखक जिन पर कोल्ड-स्टार्ट स्थिति सबसे अधिक प्रभाव डालती है, के पास नहीं हो सकता है। उनके लिए अनुभाग 10.4 (अनाम प्रतिशतक बैंड) का प्लेटफॉर्म-पक्षीय समाधान संरचनात्मक सुधार है, क्योंकि इसके लिए स्व-असेंबल किए गए नेटवर्क का उपयोग करने की आवश्यकता नहीं है।
एक सापेक्ष कार्यक्षमता अनुपात। एक ही तर्क को एक एकल संख्या के रूप में व्यक्त किया जा सकता है: एक पत्र के डाउनलोड का एक दिए गए आयु पर एक मेल खाने वाली कोहोर्ट के माध्यिका डाउनलोड के लिए अनुपात, अर्थात् एक ही अनुशासन, एक ही पत्र आयु, और जहाँ संभव हो एक ही पत्र प्रकार। 1.0 का अनुपात कोहोर्ट के लिए बिल्कुल माध्यिका दृश्यता का मतलब है, और 1.0 से ऊपर या नीचे के मान तदनुसार पढ़े जाते हैं। सूचकांक एक मेल खाने वाली कोहोर्ट के भीतर पत्रों को क्रमबद्ध करता है; प्रतिशतक बैंड संदर्भ वितरण की प्रतीक्षा करते हैं। प्रकाशित माध्यिकाएँ जिनसे एक कोहोर्ट आधारभूमि बनाई जा सकती है, वे पुरानी और संकीर्ण हैं (2012 में पोस्ट किए गए कानूनी छात्रवृत्ति के लिए दो वर्षों में 63 डाउनलोड [139], 2025 में देखे गए विपणन पत्रों के लिए 87 [83]), और अनुपात मानों को प्रतिशतक पर मैप करने के लिए पूर्ण वितरण की आवश्यकता होती है, केवल माध्यिका नहीं। उस वितरण के बिना अनुपात बैंड को प्रतिशतक लेबल निर्दिष्ट करना झूठी सटीकता पैदा करता है। अनुभाग 8 का पूर्व-पंजीकृत एजेंडा बैंड का अंशांकन शामिल करता है; तब तक अनुपात एक क्रमांकन डिवाइस है, न कि एक ग्रेडिंग पैमाना। दो और सावधानियाँ डिवाइस को सीमांकित करती हैं। इसे छोटी गणना पर बिल्कुल भी कंप्यूट नहीं किया जाना चाहिए, क्योंकि अनुभाग 5.2 की छोटी-हर अस्थिरता अनुपात के अंश पर और एक पतली कोहोर्ट माध्यिका पर भी लागू होती है, और अनुभवजन्य-बेयेस सिकुड़न (अनुभाग 8.3, 8.8) जहाँ कहीं भी ऐसा अनुपात सार्वजनिक रूप से रिपोर्ट किया जाता है वहाँ उपयुक्त मरम्मत है। एक दिया गया अनुपात एक निश्चित प्रतिशतक में अनुवाद नहीं करता है: "कोहोर्ट माध्यिका का दोगुना" विभिन्न आकृतियों के वितरण में विभिन्न प्रतिशतक स्थितियों के अनुरूप है, इसलिए अनुपात एक कोहोर्ट के भीतर पत्रों को क्रमबद्ध करता है लेकिन उन कोहोर्ट या युगों में तुलना नहीं कर सकता है जिनके वितरणात्मक आकार भिन्न हैं।
प्रक्षेपवक्र के लिए निर्णय भाषा। सामुदायिक-सामना करने वाले उपकरणों ने एक पत्र के प्रारंभिक प्रक्षेपवक्र को तीन गुणात्मक निर्णयों (तेज शुरुआत, स्थिर रुचि, धीमी शुरुआत) में वर्गीकृत करने का प्रस्ताव दिया है जैसे कि कच्ची संख्याओं का एक मानवीय विकल्प। शब्दावली को बनाए रखना लायक है, क्योंकि यह एक गणना को एक प्रक्षेपवक्र के बारे में एक बयान में परिवर्तित करता है, और "धीमी शुरुआत" स्पष्ट रूप से विफलता का पर्यायवाची नहीं है। इन निर्णयों के लिए मूल रूप से प्रस्तावित थ्रेसहोल्ड मेल न खाने वाली समय windows की तुलना पर और एक प्लेटफॉर्म-व्यापी "नेटवर्क औसत" आंकड़े पर निर्भर करते थे जो सार्वजनिक मीट्रिक के रूप में मौजूद नहीं है: SSRN कोई सार्वजनिक स्व-सेवा API या सांख्यिकी समापन बिंदु नहीं देता है [51], और निकटतम ऐतिहासिक मीट्रिक ("प्रति पत्र नई डाउनलोड," एक लेखक-स्तर की रैंकिंग आंकड़ा) रैंकिंग के साथ सेवानिवृत्त हुआ था ([B-9], इस चेतावनी के साथ उद्धृत कि ऐतिहासिक रैंकिंग पृष्ठ अब सुलभ नहीं हैं)। निर्णय को असाइन करें, तब, केवल मेल खाने वाली तुलना से: माइक्रो-बेंचमार्क समूह या ऊपर कोहोर्ट-माध्यिका अनुपात, 60-90 दिन के निशान से पहले नहीं पढ़ा जाता है।
जो भी विकल्प उपयोग किया जाता है, बाहरी त्रिकोणीकरण इसे मजबूत करता है। Crossref और OpenAlex [35][124] से उद्धरण-स्तर डेटा और SSRN पृष्ठों पर प्रदर्शित PlumX संकेतक [50] एक अलग प्रश्न का उत्तर देते हैं, दृश्यता के बजाय डाउनस्ट्रीम उपयोग के बारे में। Overton जैसा एक नीति-उद्धरण उपकरण एक पत्र को सरकार और संस्थागत दस्तावेजों में उद्धृत किया जा रहा है यह मैप करके नीति और अभ्यास तक समान त्रिकोणीकरण को बढ़ाता है [187], जो SSRN के कानून, अर्थशास्त्र और नीति आधार के अनुरूप है। इन परतों को तालिका 10 के CSAB ढांचे में काउंटरों के साथ संयुक्त रूप से परीक्षा की जाती है और तालिका 9 के पहुँच-रूपांतरण निदान। Altmetric संकेतक एक और त्रिकोणीकरण परत हैं। शुरुआत से ही जल्दी ध्यान संकेत के रूप में परिकल्पित [123][122], वे उद्धरणों से अलग पैटर्न का पालन करते हैं [74][20] और क्षेत्र सामान्यीकरण को स्वीकार करते हैं [21]। वे स्वचालित मुद्रास्फीति के लिए भी असुरक्षित हैं [75] और सिद्धांत-निर्देशित व्याख्या की आवश्यकता होती है न कि सतह-मूल्य पठन [76]।
6.4 वैध दृश्यमानता में सुधार
सूर्यास्त से पहले, रैंकिंग्स ने एक आवर्ती लेखक निर्णय के लिए कच्चा लेकिन वास्तविक प्रतिक्रिया प्रदान की: क्या किसी पेपर को आगे बढ़ाना प्रयास के लायक था (अनुभाग 1.3)। सूर्यास्त के बाद, यह निर्णय यहाँ एकत्रित लीवर और डायग्नोस्टिक्स से लिया जाना है। निर्धारक साहित्य लेखक के नियंत्रण में लीवर के एक छोटे समूह की पहचान करता है और प्लेटफॉर्म नियमों के अनुरूप है। प्रत्येक दृश्यमानता पर कार्य करता है, गुणवत्ता पर नहीं, और कोई भी पेपर की सामग्री को नहीं बदलता। तीव्र प्रसार और शीघ्र प्रतिक्रिया प्रीप्रिंट पोस्टिंग के स्वीकृत उद्देश्य हैं जो प्रीप्रिंट्स पर पद्धतिगत साहित्य में हैं [24], और वैध दृश्यमानता के लिए एक प्लेबुक उस कथित कार्य का उपयोग करता है।
पैकेजिंग। LSN नमूने में, शीर्षक विशेषताएँ, सार की लंबाई और विषय सार्थकता ध्यान के साथ महत्वपूर्ण रूप से जुड़ी हुई थीं, लेखक की अपनी सावधानी के साथ कि ऐसे चर अप्राप्य गुणवत्ता के लिए प्रॉक्सी हो सकते हैं [139]। कानूनी-उद्धरण अध्ययनों में, शीर्ष-दशमलव पेपर निचले-दशमलव पेपर्स की तुलना में अधिक कीवर्ड और लंबे सार रखते थे [172] (विशिष्ट गणना मूल के विरुद्ध सत्यापन की प्रतीक्षा करती है)। सार पृष्ठ रूपांतरण सतह है जिस पर नियम (ii) कार्य करता है, इसलिए जब रूपांतरण लगातार बैंड से नीचे बैठता है तो शीर्षक और सार पहली चीजें हैं जिन्हें संशोधित करना है। कोई भी ऐसा संशोधन प्रतिश्रुति और सामग्री के बीच संरेखण का लक्ष्य रखता है, न कि अंधाधुंध ट्रैफिक का: पहले से स्पष्ट सार को क्लिक बढ़ाने के लिए फिर से लिखना इसकी परिशुद्धता को नुकसान पहुँचा सकता है, और असंगत आगंतुकों को आकर्षित करके यह रूपांतरण को बैंड से दूर ले जा सकता है।
वर्गीकरण। अधिक eJournals में वर्गीकृत पेपर्स 2018 LSN विश्लेषण में अधिक डाउनलोड और कम शून्य-डाउनलोड परिणाम औसत करते थे [168]। SSRN एक पेपर के लिए एक से सात वर्गीकरणों की अनुमति देता है और समावेश को तैयार करता है [53]। एक लोकप्रिय सामुदायिक परिशोधन, अपरिष्कृत क्योंकि कोई भी अध्ययन वर्गीकरण रणनीतियों की तुलना नहीं करता, वर्गीकरणों को तीन तक सीमित करता है, एक मूल, एक व्यापक और एक अंतःविषय eJournal के रूप में चुना गया; वह सलाह परिशिष्ट A की परीक्षणीय परिकल्पनाओं के बीच है।
वितरण और बाहरी ध्यान। eJournal ईमेल सतर्कता प्लेटफॉर्म का मुख्य पुश चैनल रहती है और सूर्यास्त के बाद जारी रहती है [147][57][152]। प्लेटफॉर्म से बाहर, ब्लॉग कवरेज ने प्रश्न के एक अनुभवजन्य परीक्षण में तीव्र प्रारंभिक डाउनलोड स्पाइक्स का उत्पादन किया [116], दृश्यमान सूची स्थिति ने arXiv स्थितीय अध्ययनों में पठनीयता और उद्धरण बढ़ाए [72], और सम्मेलन भागीदारी एक कठोर-प्रायोगिक अध्ययन में एक रद्द किए गए राजनीति-विज्ञान बैठक के चारों ओर निर्मित एक पेपर के लिए अतिरिक्त 17–26 डाउनलोड के साथ जुड़ा था ([B-4], APSA 2012 की सावधानी के साथ उद्धृत, SSRN-अर्थशास्त्र नमूना नहीं)। चिकित्सक गाइड कानूनी विद्वता के लिए आगे वितरण उपकरण एकत्र करते हैं [169]। शीघ्र खुली प्रसार के लिए मामला स्वतंत्र रूप से स्थापित है: खुली पहुंच के एक यादृच्छिकीकृत परीक्षण ने अधिक डाउनलोड लेकिन कोई अल्पकालिक उद्धरण लाभ नहीं पाया [37], जबकि समूह और क्षेत्र अध्ययन मोटे तौर पर 10% से दोगुनी के उद्धरण लाभों की रिपोर्ट करते हैं [59][86][17][93], अमेरिकी कानून पत्रों के लिए +53% सहित [40], और कानूनी उद्धरणों की एक लेखा परीक्षा पाई कि 87% सबसे अधिक-उद्धृत लेख SSRN पर उपलब्ध थे बनाम 44–46% कम-उद्धृत लेखों का, सबसे अधिक-उद्धृत समूह के 95% को उनके प्रकाशन के वर्ष में या उससे पहले SSRN पर पोस्ट किया गया था [172]। प्रीप्रिंट जमा arXiv पर उच्चतर उद्धरण के साथ जुड़ा है, और कम प्रकाशक-साइट डाउनलोड के साथ [38], और bioRxiv डाउनलोड जर्नल परिणामों के साथ संबंधित हैं [62]। सभी bioRxiv प्रीप्रिंट्स की जनगणना में, डाउनलोड गणना उस जर्नल के प्रभाव कारक के साथ संबंधित हैं जिसमें एक प्रीप्रिंट बाद में प्रकाशित होता है (Kendall τb = 0.59), एक संबंध जिसकी कार्यकारिता की दिशा अज्ञात है [2]। मशीन आविष्कार परतें (खोज इंजन और उत्पादक उत्तर इंजन) अनुभाग 8 की लेखा परीक्षा ढांचे और तालिका 20 [5][164] के विशेषता-लेखा परीक्षा एजेंडे में अलग से माना जाता है।
संस्करण स्वच्छता। एक ही SSRN पृष्ठ पर अपलोड किए गए संशोधन संचित काउंटर्स और स्थिर URL को सुरक्षित रखते हैं, जबकि हटाने और पुनः पोस्ट करने से मेट्रिक्स शून्य हो जाते हैं ([B-7], समर्थन-पृष्ठ शब्दावली परिवर्तन के साथ सावधानी के साथ उद्धृत और जमा के समय पुनः सत्यापित किया जाना चाहिए)। आगे का सामुदायिक दावा कि दिन 3 पर एक छोटा संशोधन पुनः-घोषणा और ध्यान की एक "दूसरी लहर" को ट्रिगर करता है, अनिर्धारित है, और यह परिशिष्ट A में अपरिष्कृत प्रथाओं के बीच बैठता है। पहचान को समान देखभाल की आवश्यकता है। SSRN लेखक प्रोफ़ाइल को एक सत्यापित ORCID iD से जोड़ना पेपर्स और उनके काउंटर्स को सही व्यक्ति से जुड़ा रखता है न कि एक समान नाम से, और यह लेखक-विवेचन समस्या के विरुद्ध एक कम लागत वाली सुरक्षा है कि अनुभाग 8.3 की पैनल डिजाइन अन्यथा सांख्यिकीय रूप से हल करनी चाहिए ([B-7], समान पुनः-सत्यापन सावधानी)।
क्या नहीं करना है। आत्म-डाउनलोडिंग और संबंधित हेराफेरी SSRN के अपने सर्वर लॉग्स में प्रलेखित हैं, शीर्ष-सूची थ्रेशोल्ड के पास तीव्र हैं, और सामाजिक तुलना द्वारा संचालित थीं [44]। प्लेटफॉर्म की धोखाधड़ी फिल्टर सार्वजनिक हैं [144][69], और इस इतिहास से अवगत मूल्यांकन समितियाँ असमर्थित दावों को कम करती हैं। तो गेमिंग साहित्य अखंडता एक के साथ एक व्यावहारिक चेतावनी ले जाता है: हेराफेरी की गई गणनाएँ पहचानने योग्य और प्रतिष्ठात्मक रूप से महंगी हैं। चित्र 9 अनुकृत डेटा पर मुद्दे पर सार्थक हस्ताक्षर को दर्शाता है। जैविक ध्यान एक लंबी पूंछ के साथ एक प्रारंभिक शिखर के रूप में जमा होता है, जबकि हेराफेरी इस तरह की केंद्रित स्पाइक्स का उत्पादन करती है कि अखंडता फिल्टर ध्वज करने के लिए डिज़ाइन किए गए हैं [144][69]।
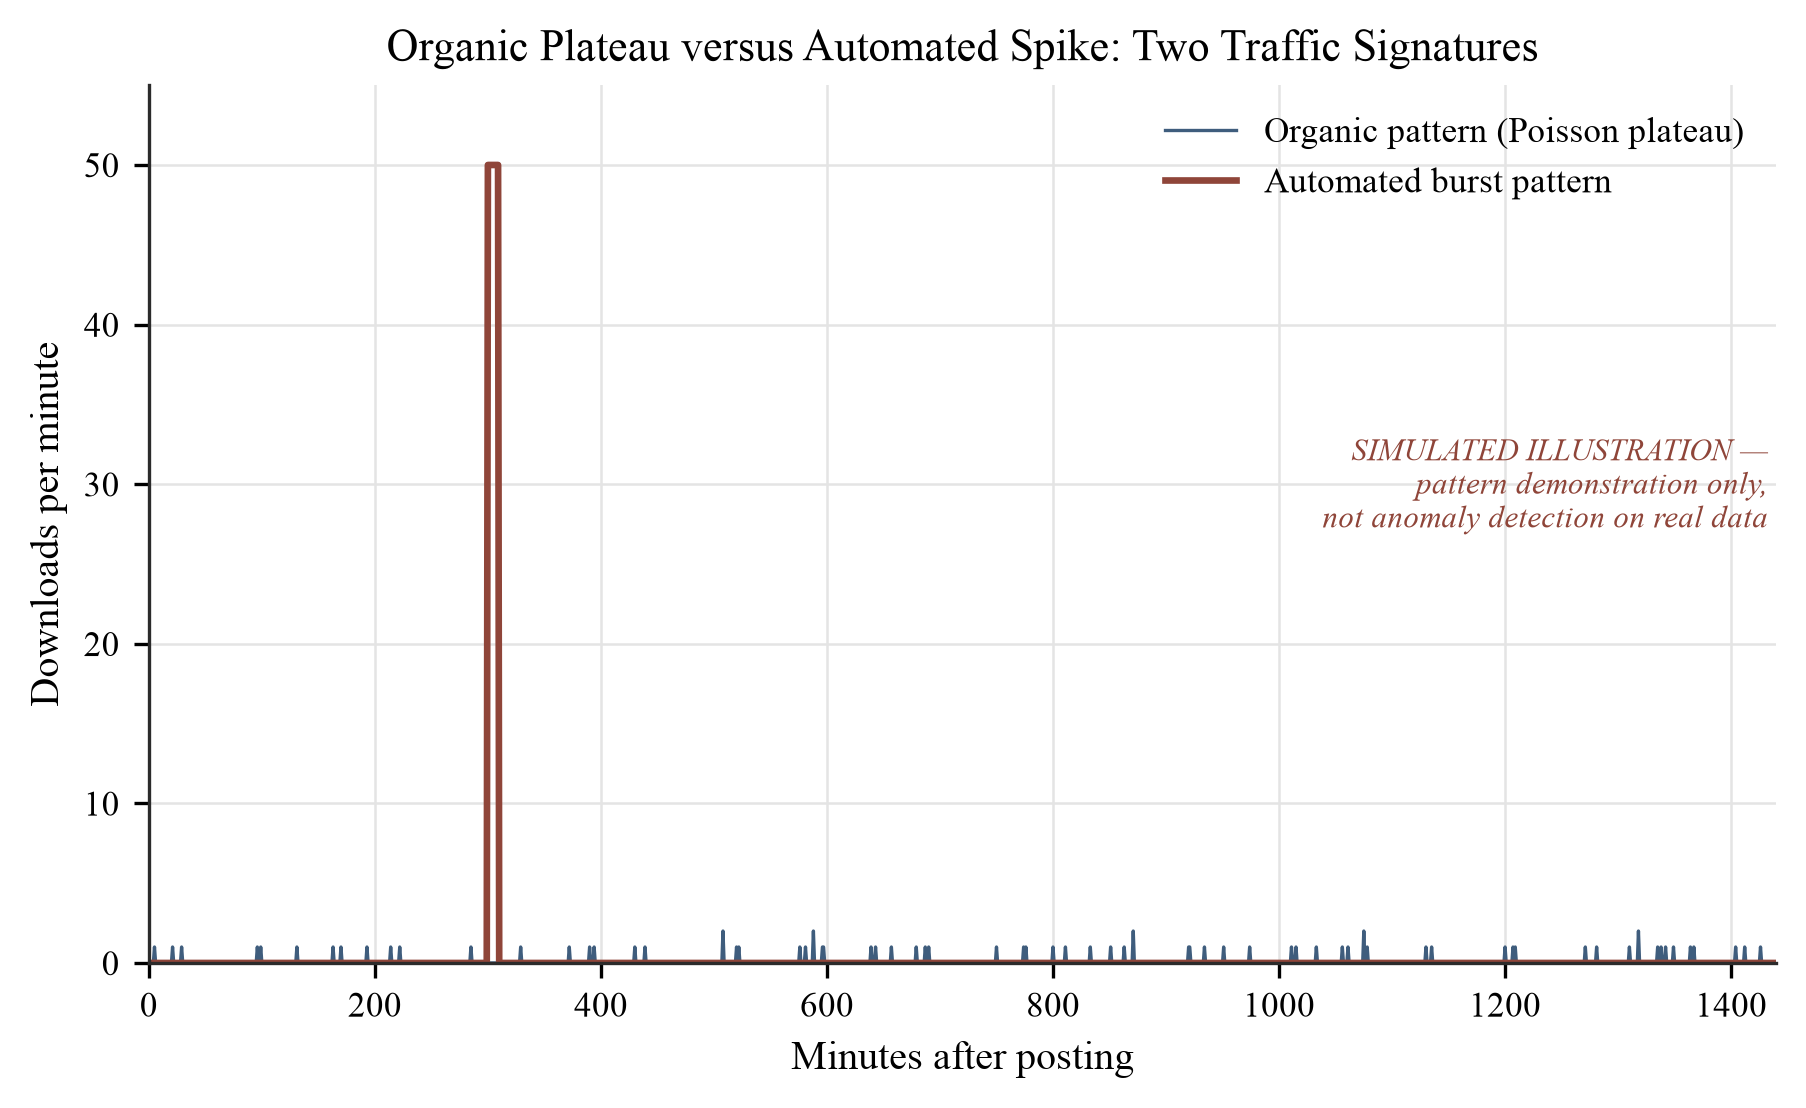
चित्र 9. जैविक संचय बनाम एक हेराफेरी स्पाइक। एक चिकनी जैविक डाउनलोड प्रक्षेपवक्र एक अचानक एकल-दिवसीय स्पाइक के विपरीत जो आत्म-डाउनलोडिंग की विशेषता है, अनुभाग 6.4 की हेराफेरी चेतावनी और अनुभाग 4 [44][69][144] की अखंडता चर्चा को प्रेरित करता है। सभी डेटा दिखाए गए हैं अनुकृत; SSRN के लिए कोई अनुभवजन्य विसंगति-पहचान डेटासेट मौजूद नहीं है।
6.5 प्रतिकार्यकर्ताओं को कैरियर साक्ष्य में परिवर्तित करना: डोसियर प्रोटोकॉल
सूर्यास्त से पहले, रैंक-आधारित SSRN साक्ष्य एक मानकीकृत डोसियर घटक था। एक लेखक की सार्वजनिक रैंक सीधे प्रचार फ़ाइलों में प्रविष्ट हुई: "कुल सभी समय डाउनलोड की कुल संख्या में 3,000 कानूनी लेखकों में से 13 वां स्थान, जिसे कानून स्कूल ने विभिन्न प्रचार और संबंधित निर्णयों में ध्यान में रखा है" [12]। कवर-लेटर गाइड ने डाउनलोड गणना और शीर्ष दस सूची दिखावट का हवाला देने की सलाह दी [95], चिकित्सक मार्गदर्शन ने एक साथ सावधान किया कि स्व-पोस्ट किया गया काम "संभवतः कानून-स्कूल प्रचार और कार्यकाल के उद्देश्यों के लिए नहीं गिना जाएगा" [33], और प्लेटफ़ॉर्म के अपने दस्तावेज़ ने अपनी मेट्रिक्स को ऐसे डेटा के रूप में वर्णित किया "जिसे लेखक प्रचार और कार्यकाल के उद्देश्यों के लिए उपयोग करते हैं और जिसे संस्थान अपनी भर्ती और रैंकिंग गतिविधियों में उपयोग करते हैं" [52]। इन सभी कलाकृतियों ने एक सार्वजनिक तुलनात्मक ढांचे को प्रतिमानित किया जो अब मौजूद नहीं है [149]। काउंटर का मूल्यांकनकारी उपयोग इसके पहले प्रस्ताव से विवादित था: Black और Caron के 2006 के मामले ने डाउनलोड को "बीटा" के रूप में विद्वानों के प्रदर्शन का एक उपाय [18] होने के लिए तर्क दिया था, जिसका उत्तर एक ही संगोष्ठी खंड में Eisenberg की SSRN-आधारित रैंकिंग क्या मान्य रूप से माप सकते हैं इसकी आलोचना से दिया गया था [45]। एक डोसियर जो डाउनलोड का हवाला देता है वह अनुत्तरित बहस को विरासत में लेता है। तालिका 13 जो बनी हुई है उससे रक्षाकर्म साक्ष्य का पुनर्निर्माण करने के लिए एक सात-चरणीय प्रोटोकॉल निर्धारित करती है, और इसकी नियंत्रणकारी आवश्यकता, तीसरे और चौथे स्तंभों में लागू होती है, यह है कि एक डोसियर में उद्धृत प्रत्येक संख्या को अपने स्रोत, अपनी समय खिड़की, और इसकी सीमाओं के साथ यात्रा करनी चाहिए। एक अनुवादित दावा जो असंगठित परिशुद्धता में कठोर हो जाता है वह कोई दावा नहीं करने से बदतर है।
तालिका 13। कार्यकाल, प्रचार, और भर्ती डोसियर में SSRN मेट्रिक्स के लिए सूर्यास्त-उपरांत साक्ष्य प्रोटोकॉल। प्रत्येक चरण कार्रवाई का नाम देता है, इसकी समय खिड़की के साथ साक्ष्य का आधार, किसी भी संख्या के साथ प्रकट किए जाने वाली सीमा, बचने के लिए विरोधी-पैटर्न, और चरण जो सबसे मजबूत निष्कर्ष दे सकता है।
| चरण | कार्रवाई | साक्ष्य का आधार (स्रोत; समय खिड़की) | प्रकट करने के लिए सीमाएं | बचें | अनुमेय निष्कर्ष |
|---|---|---|---|---|---|
| 1. संरक्षित करें | तालिका 11 अंतराल पर और किसी भी प्रस्तुतिकरण से पहले प्रत्येक पेपर के सांख्यिकी पैनल और लेखक प्रोफ़ाइल के दिनांकित स्क्रीनशॉट संग्रहीत करें; उन्हें वितरण सूचनाओं और लेखक की अपनी प्रचार घटनाओं की दिनांकित लॉग के साथ एक साथ रखें, धारा 6.1 के संस्करण किए गए साक्ष्य पैकेट में। | प्रति-पेपर काउंटर सूर्यास्त से बचते हैं ([148][149]; 2026)। काउंटर को जब फ़िल्टरिंग नियम बदलते हैं तब पुनः कहा जा सकता है ([144][69]; 2018 से प्रलेखित)। | एक दिनांकित व्यक्तिगत अभिलेख लेखक के नियंत्रण के तहत एकमात्र सत्य का संस्करण है; प्लेटफ़ॉर्म संख्याएं संशोधनीय हैं और कोई सार्वजनिक इतिहास मौजूद नहीं है। | "पेपर के पास X डाउनलोड हैं" — तारीख या हर घटक के बिना उद्धृत। | जो प्लेटफ़ॉर्म ने दिखाया उसका एक दिनांकित, ऑडिट योग्य रिकॉर्ड — एक आजीवन निर्णय नहीं, एक समय-विशिष्ट अवलोकन। |
| 2. अनुवाद करें | तालिका 8 का उपयोग करके गणना को बैंड भाषा में परिवर्तित करें (उदा., "2015 शीर्ष-10,000 पत्रों सूची की ~160 प्रविष्टि थ्रेसहोल्ड के ऊपर आजीवन डाउनलोड, अर्थात् प्लेटफ़ॉर्म के पूर्ण-पाठ पेपर स्टॉक का लगभग शीर्ष 1.8%, जुलाई 2016 में 571,040 [1], उस समय"), हमेशा स्रोत, नमूना, और वर्ष का नाम देते हुए; परिशिष्ट B का CSAB टेम्पलेट वाक्य-स्तर का प्रारूप प्रदान करता है, इसके प्रतिशतक क्षेत्रों के साथ एक संदर्भ पैनल मौजूद होने तक खाली छोड़े गए। | पेपर-स्तर थ्रेसहोल्ड: प्रविष्टि ≥160, इन-ग्रुप माध्यिका 805 (शीर्ष-सूची स्क्रेप; 2015) [85]। लेखक-स्तर: प्रविष्टि न्यूनतम 129 कुल डाउनलोड, इन-ग्रुप माध्यिका 1,626 (समान स्क्रेप) [85]। विशिष्ट-पेपर लंगर: माध्यिका 63 दो वर्षों में (LSN; 2012→2014) [139]; माध्यिका 87 (विपणन नेटवर्क; स्नैपशॉट 2025) [83]। | सभी थ्रेसहोल्ड 2012–2015 नमूनों से व्युत्पन्न होते हैं (तब से मुद्रास्फीति [1]: धारा 5.1); 2015 फ्रेम केवल शीर्ष सूचियों को कवर करता है; दो माध्यिका लंगर एकल-अनुशासन हैं। बैंड भाषा को एक पंजीकृत प्रतिशतक के रूप में पुनः कहा नहीं जाना चाहिए। | सार्वभौमिक लेबल जैसे "उत्कृष्ट" एक पुरानी कच्ची थ्रेसहोल्ड पर लटके हुए हैं। | नामित नमूना, क्षेत्र, और वर्ष के भीतर सापेक्ष खड़े — कुछ भी व्यापक नहीं। |
| 3. त्रिभुज करें | SSRN काउंटर को स्वतंत्र उद्धरण साक्ष्य के साथ जोड़ी: Google Scholar, कानून के लिए HeinOnline, अर्थशास्त्र के लिए RePEc, खुले उद्धरण परतों के रूप में Crossref/OpenAlex, SSRN पर प्रदर्शित PlumX। | स्कूल-स्तर SSRN-डाउनलोड और HeinOnline-उद्धरण रैंकिंग 0.84 पर संबंधित होते हैं (100 यू.एस. कानून स्कूल; 2019) [77]; पेपर-स्तर डाउनलोड–उद्धरण सहसंबंध क्षेत्र और क्षितिज के आधार पर ~0.1–0.6 चलाते हैं [80][25]; खुले उद्धरण बुनियादी ढांचा [35][124]; PlumX [50]। | 0.84 आंकड़ा एक स्कूल-स्तर सहसंबंध है और किसी भी व्यक्तिगत पेपर या लेखक तक नहीं उतरता है (पारिस्थितिक-अनुमान सावधानी, धारा 6.2(iii)); डाउनलोड मांग को मापते हैं, पढ़ना या अनुमोदन नहीं; पेपर-स्तर सहसंबंध मामूली हैं, और अत्यधिक डाउनलोड किए गए और अत्यधिक उद्धृत सेट केवल आंशिक रूप से ओवरलैप करते हैं [108]। अभिसरण उद्धरण साक्ष्य, काउंटर अकेले नहीं, प्रभाव दावे को ले जाता है। | एक डाउनलोड को अनुमोदन या सत्यता के बराबर करना। | ग्रहण का स्तरित साक्ष्य, गुणवत्ता का प्रमाण नहीं। |
| 4. क्षेत्र-सामान्य करें | अनुशासनात्मक ढांचे को स्पष्ट रूप से कहें (उदा., "कॉर्पोरेट-कानून छात्रवृत्ति के भीतर, जहां eJournal मतलब कानूनी उप-क्षेत्रों में लगभग आठ के कारक से भिन्न होते हैं")। | उप-क्षेत्र मतलब 438.35 बनाम 53.48 डाउनलोड/पेपर (LSN eJournals; 2018) [168]; डाउनलोड-से-उद्धरण अनुपात स्वयं क्षेत्र-संरचित हैं [18]। | प्रसार अनुमान केवल कानून है और 2018 को दिनांकित है; किसी भी थ्रेसहोल्ड की क्रॉस-अनुशासनात्मक स्थानांतरण को सावधानी की आवश्यकता है, और एक क्षेत्र योग्यता के बिना प्रतिशतक भाषा अनिर्वचनीय है। | एक नया पेपर एक बहु-वर्षीय संचयी कुल के साथ तुलना करना, या क्षेत्रों में एक थ्रेसहोल्ड प्रत्यारोपित करना। | एक क्षेत्र- और आयु-योग्य तुलना — कभी भी एक सार्वभौमिक ग्रेड नहीं। |
| 5. पूरक करें | संस्थागत-भंडार और अन्य वितरण चैनलों को SSRN के साथ-साथ उद्धृत करें। | SSRN काउंटर अन्य सेवाओं से एक ही पेपर के डाउनलोड के बारे में कुछ नहीं कहते हैं [161]; 2026 सुधारों ने संस्थागत वितरण के लिए माइग्रेशन पथ को भंडार-आधारित श्रृंखला बनाया [47][146]। | कोई भी एकल प्लेटफ़ॉर्म का काउंटर एक पेपर के कुल परिसंचरण को नहीं मापता है; डोसियर दावा पेपर के बारे में है, एक काउंटर के बारे में नहीं। | एक प्लेटफ़ॉर्म के काउंटर को पेपर के कुल परिसंचरण के रूप में प्रस्तुत करना। | पेपर के परिसंचरण के बारे में एक दावा, प्रत्येक चैनल के काउंटर को अलग से नाम दिया गया। |
| 6. अखंडता | किसी भी उद्धृत गणना के साथ प्लेटफ़ॉर्म के गिनती नियम को बताएं, और दिनांकित आर्काइव रखें जो संख्या को प्रदर्शित के रूप में प्रलेखित करता है। | फ़िल्टरिंग और पुनः कथन प्रलेखित प्लेटफ़ॉर्म व्यवहार हैं ([144][69][66]; चल रहा है); विक्रेता द्वारा रिपोर्ट किए गए डाउनलोड सांख्यिकी गिनती सम्मेलनों पर निर्भर करते हैं ([69][176]; 2015–2019)। | काउंटर फ़िल्टर किए गए, संशोधन योग्य अनुमान हैं; कोई सार्वजनिक पुनः कथन इतिहास मौजूद नहीं है, इसलिए लेखक की दिनांकित आर्काइव एकमात्र स्थिर रिकॉर्ड है। | काउंटर को अद्वितीय मानव पाठकों की सटीक संख्या के रूप में मानना। | एक निर्दिष्ट नियम के तहत एक निर्दिष्ट तारीख पर एक फ़िल्टर किया गया अनुमान — पाठकों की जनगणना नहीं। |
| 7. विशेषज्ञ मूल्यांकन | कार्य के योगदान और कठोरता के गुणात्मक मूल्यांकन के लिए संदर्भ के रूप में हर मीट्रिक लाइन प्रस्तुत करें, कभी भी इसके प्रतिस्थापन के रूप में नहीं। | मीट्रिक्स प्रसार के चरणों को मापते हैं, वैधता को नहीं (खंड 3.1, 5.5); अत्यधिक डाउनलोड किए गए और अत्यधिक उद्धृत सेट केवल आंशिक रूप से ओवरलैप करते हैं [108]। | कोई भी उपयोग मीट्रिक, सामान्यीकृत या कच्चा, यह मूल्यांकन नहीं करता कि क्या अनुसंधान सही या महत्वपूर्ण है। | सहकर्मी निर्णय के लिए मीट्रिक प्रतिस्थापन। | विशेषज्ञ समीक्षा के साथ संदर्भात्मक साक्ष्य — गुणवत्ता का दावा समीक्षा के साथ है, संख्या के साथ नहीं। |
अवॉइड कॉलम प्रोटोकॉल के विरोधी पैटर्न को एकत्र करता है। दो चेतावनियाँ प्रोटोकॉल को पूरी तरह से सीमित करती हैं। एक डाउनलोड निष्क्रिय मांग रिकॉर्ड करता है न कि पढ़ने, समर्थन, या गुणवत्ता की, और गणना छात्रवृत्ति के समान रूप से प्रचार गतिविधि (ब्लॉग कवरेज, सामयिक शीर्षक, विषयगत लहरें) के प्रति प्रतिक्रिया करती है [116][139][138]। समितियां जो हेरफेर रिकॉर्ड [44] जानती हैं, बिना समर्थन की संख्याओं को छूट देंगी, और जो सामग्री ऐसी छूट से बची है वह ठीक वही है जो प्रोटोकॉल की आवश्यकता है: दिनांकित स्क्रीनशॉट, स्रोत जुड़े बैंड भाषा, क्षेत्र योग्यताएं, और त्रिकोणीकरण।
6.6 संवेदना अनुसारी
पोस्टिंग का एक प्रलेखित दुष्प्रभाव है जिसकी कोई डैशबोर्ड रिपोर्ट नहीं करता: प्रीप्रिंट प्लेटफॉर्म से नामों, संबद्धताओं और पत्र शीर्षकों की कटाई द्वारा उत्पादित शिकारी पत्रिकाओं और सम्मेलनों से अनचाहे आमंत्रण [107][159]। मात्रा आसन्न ऑडिट में पर्याप्त है, जहां विशेषता अध्ययन आमंत्रण धाराओं को दस्तावेज़ित करते हैं जो प्रति शैक्षणिक प्रति पाक्षिक दर्जनों से लेकर प्रति विशेषता समूह प्रति माह हजारों तक होती है (अनुभाग 7.2) [9][84][63]। सर्वेक्षित मामलों के लगभग 41% में एक शिकारी पत्रिका के साथ पहला संपर्क एक अनचाहा ईमेल है [32]। अनुभाग 7 और तालिका 14 इस घटना का विश्लेषण करते हैं। प्लेबुक के लिए परिणाम चार निर्देशों तक सीमित हैं। दृश्यमानता के एक डिफ़ॉल्ट परिणाम के रूप में आमंत्रणों की अपेक्षा करें, और कभी भी उनकी मात्रा को विद्वानों की मान्यता के रूप में न पढ़ें: प्रेषक दृश्यमानता को यांत्रिकी से लक्षित करते हैं, योग्यता को चयनात्मक रूप से नहीं [159][63]। एक समर्पित पते के माध्यम से पत्राचार को रूट करें ताकि कटाई प्राथमिक इनबॉक्स को दूषित न करे; एक व्यापक रूप से दोहराई जाने वाली पुनर्परिभाषा, पोस्टिंग के बाद पहले दो सप्ताह के लिए प्रोफाइल ईमेल पते को छिपाना, एक अपरीक्षित अभ्यास है (परिशिष्ट A)। कभी भुगतान न करें, क्योंकि व्यवसाय मॉडल शुल्क है, जिसमें ऑडिट किए गए शिकारी आउटलेट में लेख-प्रसंस्करण शुल्क $25 से $1,800 तक है [136]। पैसा छोटा दांव है: समान मूल्यांकन समितियां जो डॉसियर की जांच करती हैं (अनुभाग 6.5) ग्रंथ सूची भी पढ़ती हैं, और प्रकाशन सूची पर एक ज्ञात शिकारी स्थान एक प्रतिष्ठात्मक लागत लगाता है जो किसी भी शुल्क से अधिक समय तक रहता है। Cabells Predatory Reports जैसी एक बनाए हुए स्क्रीनिंग सेवा के विरुद्ध किसी भी आमंत्रण स्थल को सत्यापित करें ([B-1]; Beall की सूची जनवरी 2017 के बाद अपडेट नहीं की गई है और इसे लाइव स्रोत के रूप में उपयोग नहीं किया जाना चाहिए), और Think. Check. Submit. की जांच सूची के विरुद्ध [159]। कटाई तंत्र एक गुणात्मक स्क्रीन भी प्रदान करता है: एक पत्रिका जो प्रीप्रिंट की पोस्टिंग के कुछ दिनों के भीतर एक आमंत्रण भेजती है, किसी भी मानवीय पाठकता के गठन से पहले, अत्यंत संभावना नहीं है कि वह वैध हो। यह एक अनुमानी है; कोई अध्ययन इसकी घटना को नहीं मापा है [63]।
6.7 प्लेबुक का दायरा
प्लेबुक के एंकर 2012 से 2015 तक के हैं और कानून और विपणन-भारी हैं [139][85][83][1]। तब से डाउनलोड-प्रति-पेपर प्रवाह बढ़ गया है (खंड 5.1)। ताज़ा, क्षेत्र-स्तरीकृत प्रतिशत डेटा अभी तक मौजूद नहीं हैं; उनका संग्रह, प्लेटफ़ॉर्म द्वारा या समुदाय द्वारा, खंड 8 और 10 का विषय है। प्लेबुक गलतफहमी को कम करता है, और यह गुणवत्ता को मापता नहीं है। चार नियम इसके उपयोग को यांत्रिक बनाते हैं: मेल खाने वाले मामलों की तुलना करें, अवलोकन विंडो को स्थिर रखें, प्रत्येक संख्या के लिए एक स्रोत संलग्न करें, और एक परिकल्पना को परिकल्पना के रूप में लेबल करें।
7. परजीवी ध्यान परत: दृश्यता और शिकारी अनुरोध
अब तक विकसित व्याख्यात्मक ढाँचा ध्यान को एक एकल फ़नल के रूप में मानता है जो एक्सपोजर से सार दृश्य से डाउनलोड तक डाउनस्ट्रीम उपयोग तक चलता है। हालांकि, एक प्रीप्रिंट पोस्ट करने का जीवित अनुभव अक्सर "ध्यान" की एक दूसरी धारा को शामिल करता है जो पूरी तरह से एक अलग चैनल के माध्यम से आती है: पत्रिकाओं, सम्मेलनों और संदिग्ध वैधता की संपादकीय सेवाओं से अनुरोधित ईमेल आमंत्रण [14][61][117][142]। उस दूसरी धारा का एक वैचारिक विवरण इसके प्रलेखित पैमाने के लिए ऑडिट साक्ष्य के साथ अनुसरण करता है।
7.1 ध्यान का द्विस्तरीय मॉडल
पोस्ट-पोस्टिंग पर्यावरण को यहाँ एक द्विस्तरीय ध्यान अर्थव्यवस्था (चित्र 10) के रूप में माना जाता है। स्तर 1 वह वैध फनल है जिसका वर्णन खंड 4 और 6 में किया गया है: eJournal वितरण, सारांश दृश्य, डाउनलोड और अंतिम विद्वत्तापूर्ण उपयोग। स्तर 2 एक परजीवी स्तर है, शिकारी प्रकाशकों और सेवा प्रदाताओं का एक पारिस्थितिकतंत्र जो समान सार्वजनिक ढांचे (शीर्षक, सारांश, लेखक के नाम और संबद्धता) पर निर्भर करता है और लेखकों को भुगतान करने वाले ग्राहकों में परिवर्तित करने का लक्ष्य रखता है, उनके काम को पढ़ने के लिए नहीं। अनुरोध-ऑडिट साहित्य जीवनचक्र का दस्तावेज़ बनाता है। सार्वजनिक प्रीप्रिंट मेटाडेटा (SSRN शीर्षक, सारांश, लेखक के नाम और संबद्धता) काटा जाता है [107][159], नकली आमंत्रण जो पेपर के लिए वैध आह्वान को दर्शाते हैं, भेजे जाते हैं [61][63], और जो लेखक संलग्न होते हैं उन्हें भुगतान करने वाले ग्राहकों में परिवर्तित किया जाता है। आर्थिक इंजन भी प्रलेखित है: अनुमानित शिकारी पत्रिकाओं में लेख प्रसंस्करण शुल्क औसतन लगभग $178 है, जिसकी रिपोर्ट की गई सीमा $25–$1,800 है [136]।
दोनों स्तरों के बीच असंतुलन व्याख्या के लिए महत्वपूर्ण है। स्तर 1 को एक मानव पाठक की आवश्यकता है कि वह पेपर को नोटिस करे, खोले और मूल्य दे, जबकि स्तर 2 को केवल यह आवश्यक है कि पेपर का मेटाडेटा मशीन-पठनीय बन जाए। इसलिए एक प्रीप्रिंट सिद्धांत रूप में परजीवी स्तर द्वारा पूरी तरह से संसाधित हो सकता है जबकि वैध स्तर में प्रभावी रूप से अपठित रहता है। यह प्लेटफॉर्म के लगभग-शून्य-डाउनलोड पेपर की स्थिति है, "भूतिया पेपर," जिसे मशीनें संसाधित करते हैं और मनुष्य प्रभावी रूप से नहीं पढ़ते हैं।
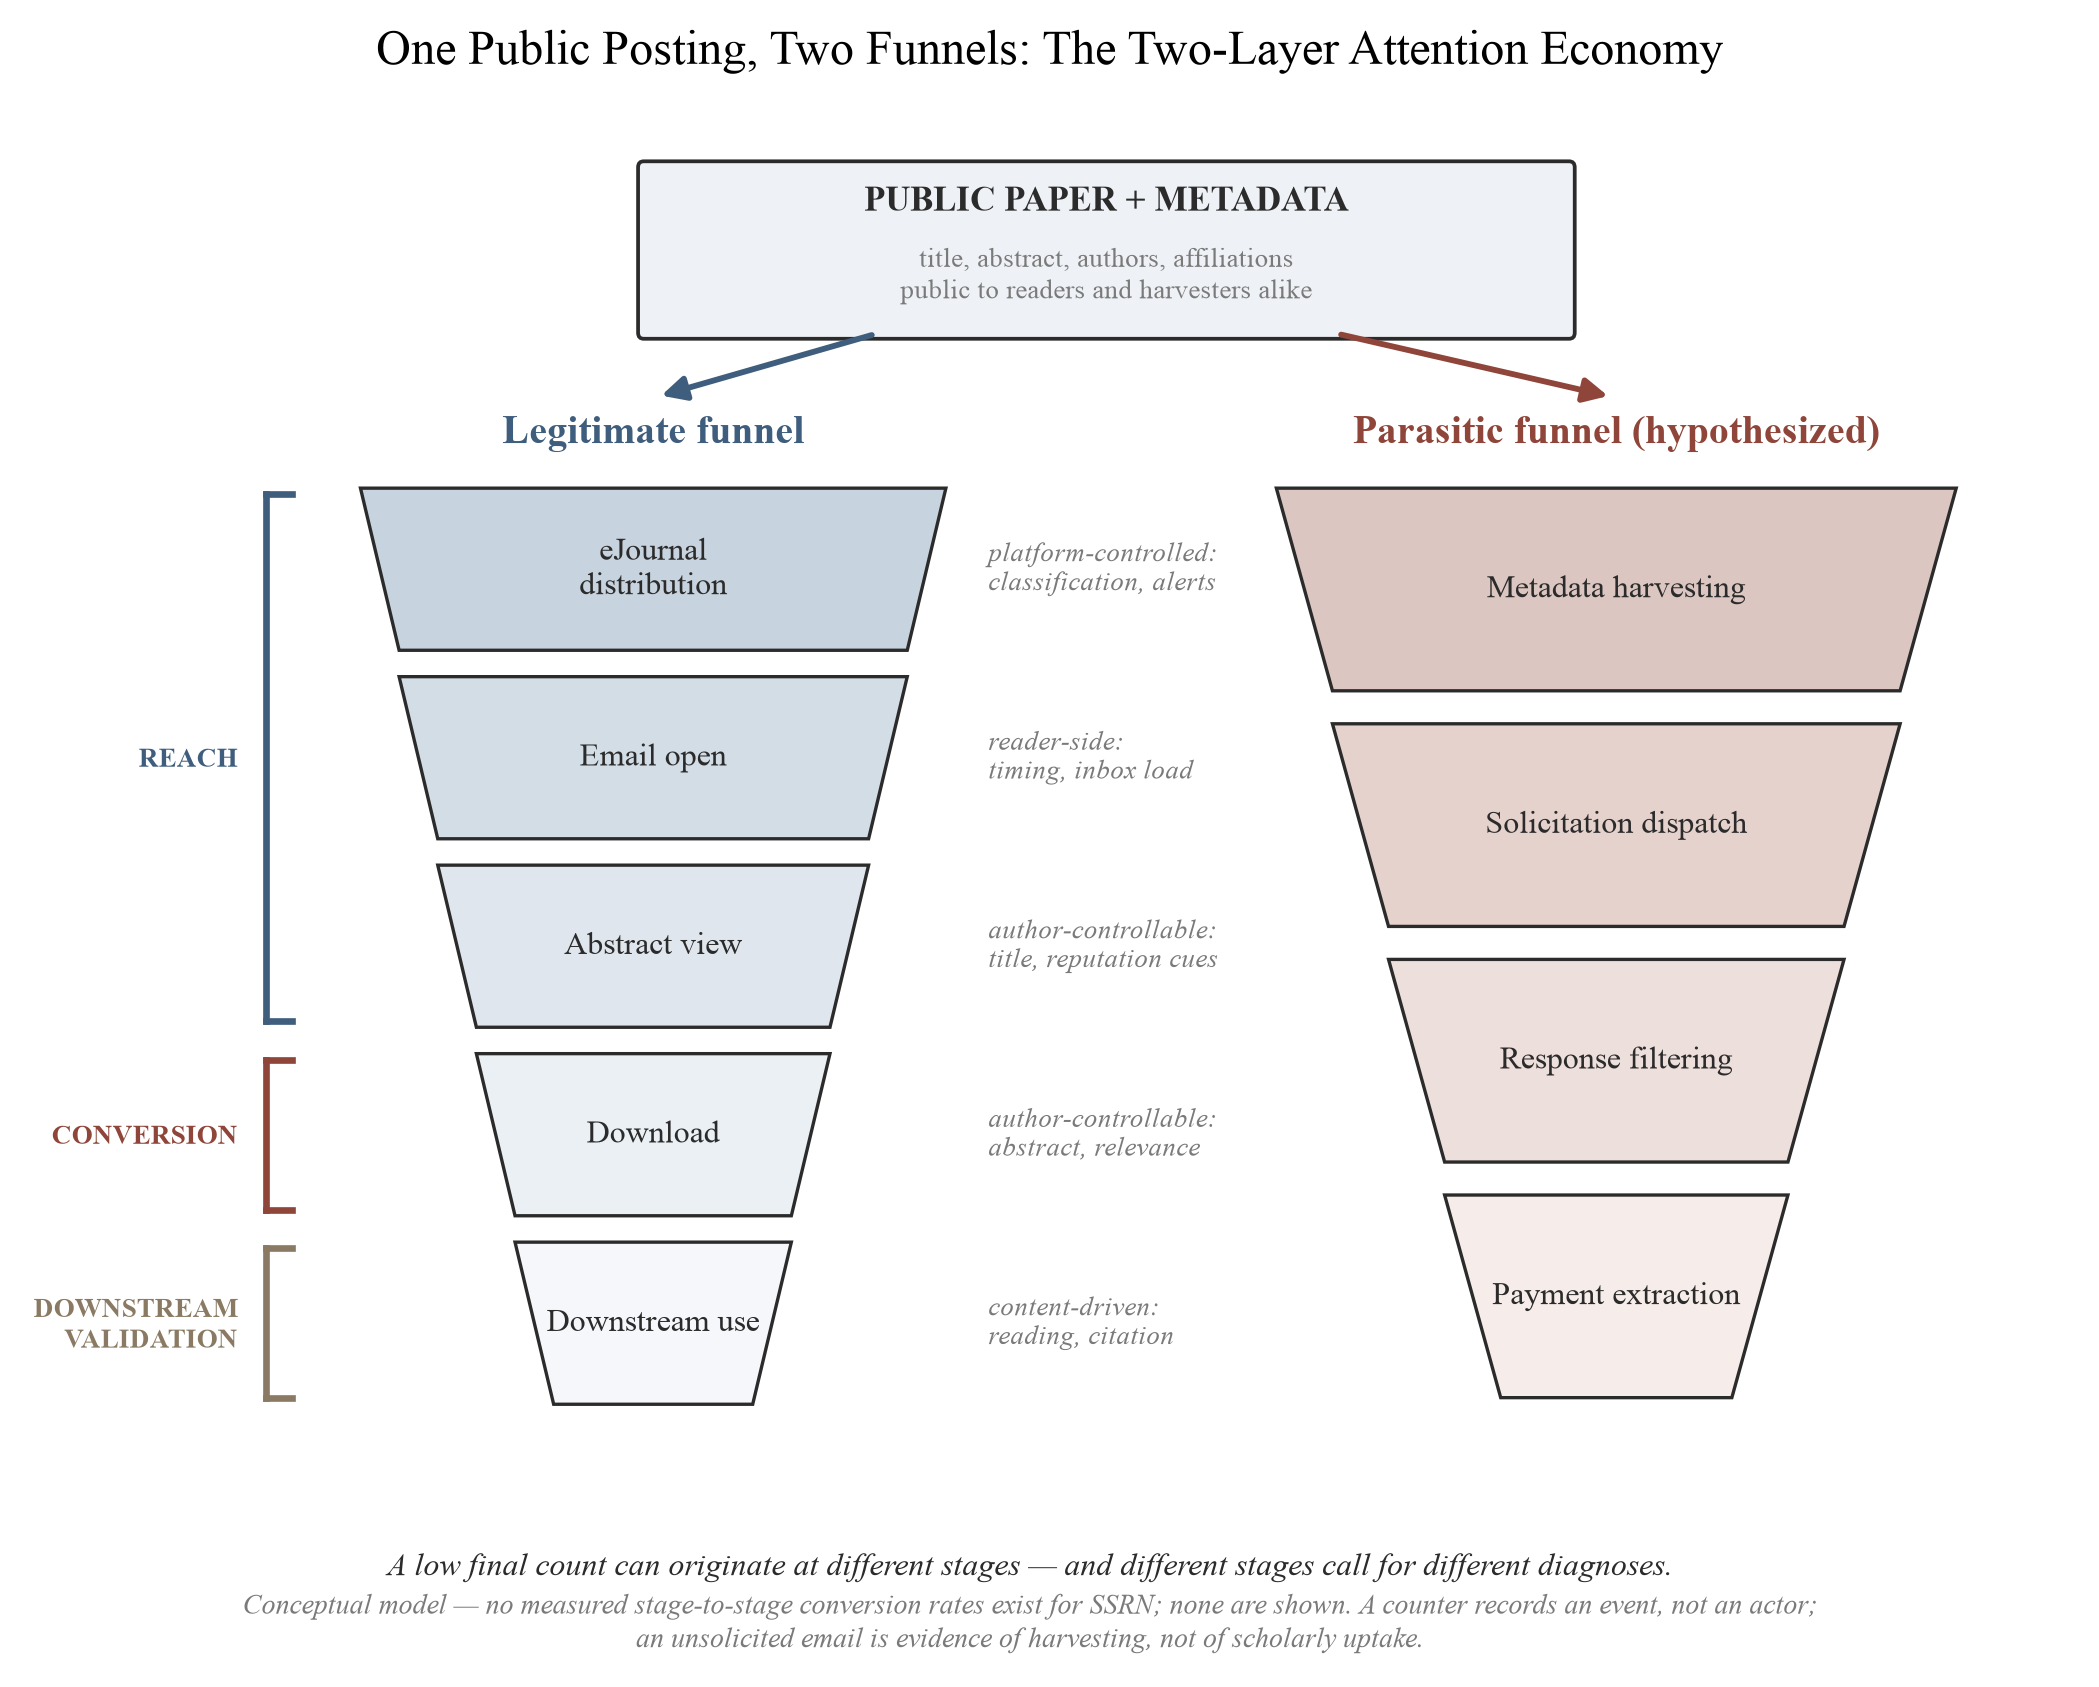
चित्र 10। द्विस्तरीय ध्यान अर्थव्यवस्था का वैचारिक मॉडल। दोनों फनल को गुणात्मक चरण अनुक्रमों के रूप में दिखाया गया है; कोई चरण-दर-चरण रूपांतरण दर प्रदर्शित नहीं की गई है क्योंकि SSRN के लिए ऐसी कोई दर मापी नहीं गई है। परजीवी फनल अनुरोध-ऑडिट साहित्य के आधार पर एक परिकल्पित पुनर्निर्माण है [61][63][107][159] (खंड 7.3)।
7.2 शिकारी आमंत्रण का प्रलेखित पैमाना
यह कि शिकारी आमंत्रण एक बड़े पैमाने की घटना है, इसमें कोई संदेह नहीं है। एक 2026 की समीक्षा ने शैक्षणिक स्पैम के उन्नीस अनुभवजन्य अध्ययनों की पहचान की, जो रणनीति की एक प्रतिष्ठित सूची पर अभिसरित होते हैं: चापलूसीपूर्ण आमंत्रण, झूठे संपादकीय दावे, और संदिग्ध मेट्रिक्स और अनुक्रमण अभिकथन [61]। मापी गई मात्राएँ पर्याप्त हैं। चौदह शैक्षणिक नेत्र रोग विशेषज्ञों को एक ही 30-दिन की अवधि में 383 अद्वितीय प्रकाशकों से 1,813 आमंत्रण ईमेल प्राप्त हुए, जो 696 अद्वितीय पत्रिकाओं में विस्तृत थे [84]। शैक्षणिक रेडियोलॉजिस्ट दो सप्ताह की अवधि में औसतन 20.7 पांडुलिपि निमंत्रण और 4.1 वक्ता निमंत्रण प्राप्त करते हैं [9]। एक खोजपूर्ण लेखा परीक्षा ने 2023–24 में एक एकल यूरोलॉजिस्ट द्वारा प्राप्त 422 आमंत्रण ईमेल का सूचीकरण किया [63], और विद्वान प्रकाशन में एक केस स्टडी ने 391 दिनों में पत्रिकाओं से 1,024 स्पैम ईमेल दर्ज किए [89]। प्रीप्रिंट पोस्टिंग के बाद के एक वर्ष लंबे एकल-शोधकर्ता अवलोकन ने 256 पत्रिकाओं से 875 निमंत्रण दर्ज किए, जिनमें से 76% क्यूरेटेड ब्लॉकलिस्ट पर दिखाई दिए, एक सशर्त स्रोत, जिसे यहाँ इस चेतावनी के साथ उद्धृत किया गया है कि पोस्टिंग के बाद आगमन विलंब को नहीं मापा गया [B-10]। आमंत्रण प्रदर्शनीय रूप से परिवर्तित भी होता है। उन लेखकों में जिन्होंने अनुमानित शिकारी पत्रिकाओं में प्रकाशित किया था, 41% ने बताया कि पत्रिका के साथ उनका पहला संपर्क एक अनुरोधित ईमेल निमंत्रण था [32], और आमंत्रण कार्पोरा का सामग्री विश्लेषण चापलूसीपूर्ण भाषा, जाली समय सीमा, और अस्पष्ट विषयगत दायरे को आवर्ती प्रेरण उपकरण के रूप में दस्तावेज करता है [96]।
न ही सबूत चिकित्सा तक सीमित है। सामाजिक विज्ञान में, अनुशासन में SSRN के अपने आधार के बहुत करीब, शैक्षणिक विज्ञान में तीन शोधकर्ताओं को तीन महीने के भीतर 210 अनुरोधित पत्रिका निमंत्रण प्राप्त हुए, जो 139 पत्रिकाओं और 37 प्रकाशकों तक पहुँचे, जिनमें से अधिकांश शिकारी के रूप में वर्गीकृत हैं; मोटे तौर पर आधे निमंत्रण प्राप्तकर्ताओं की विशेषज्ञता के क्षेत्रों के बाहर थे, मेटाडेटा-संचालित के बजाय पाठकत्व-संचालित लक्ष्य का हस्ताक्षर [155]। बोझ इस लेख के नायक, प्रारंभिक-करियर लेखक पर सबसे पहले पड़ता है। एक प्रारंभिक-करियर शैक्षणिक का एक अनुदैर्ध्य स्व-लेखा परीक्षा लगभग आठ वर्षों में 1,280 शिकारी आमंत्रण (990 पत्रिकाओं से, 220 सम्मेलनों से, और 70 अन्य प्रकार के) दर्ज किए, साथ ही सदस्यता समाप्त करने के प्रलेखित और अधिकांश असफल प्रयास [160]।
साक्ष्य के इस आधार की दो विशेषताओं को ध्यान में रखना चाहिए। सबसे बड़ी लेखा परीक्षा चिकित्सा से आती हैं, और ऊपर दिए गए सामाजिक-विज्ञान लेखा परीक्षा, जबकि अनुशासन में SSRN के करीब, छोटे हैं; किसी भी साहित्य से कोई मात्रा SSRN लेखकों में प्रत्यारोपित नहीं की जा सकती। इस लेख के लिए निर्णायक, इनमें से कोई भी अध्ययन एक प्रीप्रिंट पोस्टिंग घटना के सापेक्ष आमंत्रण का समय नहीं मापता। उदाहरण के लिए [63] में लेखा परीक्षा ने सामग्री और मूल का सूचीकरण किया लेकिन SSRN गतिविधि के आगमन समय को जोड़ा नहीं। परजीवी परत को पोस्टिंग के कार्य से जोड़ने वाला प्रत्येक दावा इसलिए एक तंत्र परिकल्पना है, एक निष्कर्ष नहीं।
7.3 परिकल्पित लक्ष्यीकरण तंत्र
नव-पोस्ट किए गए प्रीप्रिंट तक पहुंचने के लिए, परजीवी स्तर को पहले इसे खोजना होगा। नीचे दिए गए तंत्र साहित्य में आंशिक समर्थन के साथ परिकल्पनाएं हैं; कोई कॉर्पस अनुरोधों को SSRN पोस्टिंग से जोड़ता नहीं है।
H-S1 (मेटाडेटा संचयन)। शिकारी ऑपरेशन सार्वजनिक सारांश पृष्ठों और नए-पेपर सूचियों से शीर्षक, लेखक नाम और अनुबंध खोदते हैं। व्यवहारकर्ता और सलाहकारी स्रोत इस व्यवहार का वर्णन करते हैं: शिकारी पत्रिकाओं को प्रीप्रिंट सर्वर को स्कैन करने और अनुरोध भेजने के लिए रिपोर्ट किया जाता है जो पेपर के शीर्षक को संदर्भित करते हैं [159]। एक कानूनी-छात्रवृत्ति टिप्पणी बताती है कि विनंती करने वाले "मौजूदा विद्वानों के कागजात, उदाहरण के लिए SSRN पर पोस्ट किए गए ईमेल, नाम, संबद्धता आदि एकत्र करते हैं" [107], और एक कानून-पुस्तकालय मार्गदर्शिका प्रीप्रिंट पोस्टिंग को "शिकारी प्रकाशकों से स्पैम में वृद्धि से जोड़ता है जो शोधकर्ताओं को एक शुल्क के लिए अपने लेख को पुनः प्रकाशित करने का अनुरोध करते हैं" [117]। एक मापी गई नियमितता तंत्र को फिट करती है। रेडियोलॉजी ऑडिट में, विशेषता ऑडिट सक्रिय रूप से प्रकाशन लेखकों के बीच उच्च अनुरोध मात्रा की रिपोर्ट करते हैं [9], जो किसी एकल पोस्टिंग घटना की तुलना में लेखक के संचयी ग्रंथ सूची सतह से संचयन के अनुरूप है। अध्ययन 3 (अनुभाग 8.6) तदनुसार फोकल पोस्टिंग के साथ लेखक-स्तर के जोखिम नियंत्रणों को रिकॉर्ड करता है।
H-S2 (संपर्क अधिग्रहण)। अनुरोध के लिए एक ईमेल पता आवश्यक है। SSRN सारांश पृष्ठों में ऐतिहासिक रूप से लेखक संपर्क जानकारी शामिल थी [151], और पते कागजात स्वयं, संस्थागत पृष्ठों और पूर्व प्रकाशनों के माध्यम से भी संचलित होते हैं। SSRN वर्तमान में लेखक ईमेल को संग्रहणीय रूप में उजागर करता है या नहीं, यह अनपरीक्षित है; सुसज्जित अनुरोध-लॉगिंग अध्ययन इसे मापने के लिए निर्दिष्ट है। किसी दिए गए अनुरोध के लिए अधिग्रहण चैनल अप्रकट है।
H-S3 (वितरण पिग्गीबैकिंग)। eJournal डाइजेस्ट और RSS-प्रकार के फीड नई-पेपर मेटाडेटा को सदस्यों को पुनर्वितरित करते हैं [57][51]। इन चैनलों की सदस्यता लेने वाला एक परजीवी अभिनेता खोद के बिना संरचित लीड प्राप्त करेगा। कोई भी ऑडिट इस मार्ग को सत्यापित नहीं करता है।
पोस्टिंग से लक्ष्यीकृत होने तक का कारणात्मक श्रृंखला अनुभवजन्य रूप से स्थापित नहीं किया गया है; अनुभाग 8 इन तंत्रों की एक पूर्व-पंजीकृत परीक्षा निर्दिष्ट करता है: ताजा पोस्ट किए गए कागजात के लिए ज्ञात पोस्टिंग टाइमस्टैम्प के विरुद्ध अनुरोध आगमन को लॉग करना।
7.4 आमंत्रण संकेतों की एक परिकल्पित वर्गीकरण
यदि अनुभाग 7.3 के लक्ष्यीकरण तंत्र काम करते हैं, तो आमंत्रण के विभिन्न वर्गों को किसी पत्र की मशीन दृश्यता के बारे में विभिन्न जानकारी ले जानी चाहिए। तालिका 14 इसे एक परिकल्पित वर्गीकरण के रूप में प्रस्तुत करती है, इसकी रणनीति श्रेणियाँ प्रलेखित प्रेरण रणनीतियों पर आधारित हैं: क्रेडेंशियल बेमेल और ऑफ-लक्ष्य व्यक्तिगतकरण [9][63], काल्पनिक समय सीमा और चापलूसी [96], झूठे मीट्रिक और अनुक्रमण दावे [61], और प्रलेखित एपीसी बाजार के विरुद्ध छिपी हुई फीस [136]। अंतिम स्तंभ अनुमानपूर्ण है और अप्रमाणित है। तालिका कोई प्रचलन प्रतिशत और कोई आगमन-समय अनुमान नहीं देती है।
तालिका 14. प्रीप्रिंट पोस्टिंग के बाद शिकारी आमंत्रण संकेतों की एक परिकल्पित वर्गीकरण। उदाहरण के रूप में दिए गए वाक्यांश आमंत्रण ऑडिट में प्रलेखित पैटर्न के सचित्र, आविष्कृत पुनर्निर्माण हैं [9][61][96], न कि किसी विशिष्ट संदेश से सीधे उद्धरण।
| आमंत्रण पैटर्न | विवरण | सचित्र वाक्यांश | दृश्यता के बारे में परिकल्पित जानकारी |
|---|---|---|---|
| सामान्य संबोधन, कोई पत्र संदर्भ नहीं | विशिष्ट पत्र या क्षेत्र का कोई उल्लेख नहीं के साथ स्वचालित निमंत्रण | "प्रिय सम्मानित शोधकर्ता, अपना मूल्यवान कार्य प्रस्तुत करें…" | कम: संबोधन किसी भी स्रोत से प्राप्त हो सकता है; पत्र ही देखा गया, इसका कोई सबूत नहीं |
| क्रेडेंशियल बेमेल | पत्र से असंबंधित किसी क्षेत्र में विशेषज्ञता का हवाला देने वाला निमंत्रण [9] | "आपकी क्वांटम भौतिकी में विशेषज्ञता को देखते हुए…" (किसी कानून पत्र के लिए) | कम से कोई नहीं: बल्क हार्वेस्टिंग को मेटाडेटा पार्सिंग के बिना इंगित करता है |
| लक्षित, शीर्षक-संदर्भित | विशिष्ट प्रीप्रिंट और विषयगत रूप से आसन्न स्थान का नाम देने वाला निमंत्रण [159] | "आपका हाल का पत्र '[सटीक शीर्षक]' हमारी पत्रिका के लिए उपयुक्त होगा…" | अधिक (परिकल्पित): पत्र का मेटाडेटा प्रेषक तक पहुँचा, जो सफल अनुक्रमण और स्क्रैपर अभिगम का अर्थ है |
| चापलूसी व्यक्तिगतकरण | विशिष्ट कार्य की प्रशंसा "अग्रणी" या "सम्मानित" के रूप में [96] | "आपका अग्रणी योगदान…" | शीर्षक अभिगम से परे कोई नहीं: प्रशंसा टेम्पलेट की है, पढ़ी नहीं गई |
| काल्पनिक तात्कालिकता और मीट्रिक्स | आविष्कृत समय सीमा, तारांकित "प्रभाव कारक," अनुक्रमण दावे [61][96] | "प्रभाव कारक 4.2*; 7 दिनों के भीतर प्रस्तुत करें" | कोई नहीं: लक्ष्य पत्र से स्वतंत्र प्रेरण डिवाइस |
| छिपी हुई फीस | APC देर से या केवल अनुलग्नकों में प्रकट; बाजार श्रेणी $25–$1,800 [136] | निमंत्रण निकाय से अनुपस्थित फीस | कोई नहीं: मूल्य निर्धारण रणनीति, दृश्यता संकेत नहीं |
| सम्मेलन निमंत्रण, पत्र-संदर्भित | संदिग्ध सम्मेलन में प्रस्तुत करने या प्रस्तुत करने के लिए निमंत्रण, अक्सर विशिष्ट पत्र का नाम देते हुए; वक्ता निमंत्रण शैक्षणिक स्पैम का एक मापा घटक हैं [61][9] | "हम आपको अपने पत्र '[सटीक शीर्षक]' को मुख्य वक्ता के रूप में प्रस्तुत करने के लिए आमंत्रित करते हैं…" | लक्षित आमंत्रण के समान (परिकल्पित): पत्र का मेटाडेटा प्रेषक तक पहुँचा; पर्याप्त पढ़ने का कोई सबूत नहीं |
| भुगतान किए गए लेखक सेवाएँ | तेजी से सहकर्मी समीक्षा, अनुवाद, या संपादन सेवाओं के प्रस्ताव जो ताजा पोस्ट किए गए प्रीप्रिंट पर लक्षित हैं [61][84] | "आपके नए प्रीप्रिंट के लिए तेजी से समीक्षा और पेशेवर भाषा पॉलिशिंग…" | कोई स्थापित नहीं: सेवा स्पैम नई-पोस्टिंग मेटाडेटा को ट्रैक करता है, पत्र सामग्री नहीं |
चापलूसी की पंक्तियाँ एक मनोवैज्ञानिक आयाम रखती हैं जिसे यांत्रिक पढ़ना अस्पष्ट करता है। टेम्पलेट की हुई प्रशंसा एक लेखक पर उतरती है जो एक ठहरे हुए काउंटर को देख रहा हो सकता है, जिसके लिए आमंत्रण अब तक पोस्टिंग ने प्राप्त किया एकमात्र "सत्यापन" है। दो-परत मॉडल इस प्रकार एक क्रूर व्युत्क्रम की भविष्यवाणी करता है जिसमें एक नए प्रीप्रिंट के पहले प्रतिक्रियाशील अक्सर शिकारी होते हैं न कि पाठक (अनुभाग 7.5), और एक नए आने वाले को यह गलत पढ़ सकता है कि स्पैम ब्याज है क्योंकि अभी तक कोई वैध संकेत नहीं आया है। एक लेखक जो हुक की अपेक्षा करता है, इसे छूट दे सकता है।
तालिका 14 आने वाले संदेशों को पढ़ती है कि वे किसी पत्र की दृश्यता के बारे में क्या प्रकट कर सकते हैं। उन संदेशों को वैसे भी कोड करने के लिए कैसे है यह पूरक प्रश्न है, और यह वैध विद्वत्तापूर्ण संपर्क और उच्च-जोखिम वाले आमंत्रण के बीच एक अंतर पर टिकी हुई है। तालिका 15 इस अंतर को एक छः-संकेत वर्गीकरण के रूप में प्रस्तुत करती है जिसका अंतिम स्तंभ कोडिंग सावधानियाँ रखता है: प्रत्येक संकेत संभाव्य है और कोई भी अपने आप में प्रमाण नहीं है। वर्गीकरण अध्ययन 3 कोडबुक का ढाँचा भी है (अनुभाग 8.6), क्योंकि वैध संपर्क के एक सकारात्मक वर्ग के बिना एक आमंत्रण अध्ययन अनुभाग 7.5 की परिकल्पना करने वाली विषमता को नहीं माप सकता है।
तालिका 15. वैध विद्वत्तापूर्ण संपर्क को उच्च-जोखिम वाले आमंत्रण से अलग करना: छः संकेत कोडिंग सावधानियों के साथ। एक परिकल्पित कोडिंग स्कीम, सत्यापित वर्गीकारक नहीं। तालिका 14 की दृश्यता स्तंभ एक अलग प्रश्न पूछती है और अप्रभावित है: एक ही संदेश को दोनों ग्रिड पर कोड किया जा सकता है।
| संकेत | वैध विद्वत्तापूर्ण संपर्क | उच्च-जोखिम वाला आमंत्रण | कोडिंग सावधानी |
|---|---|---|---|
| विशिष्टता | किसी ठोस तर्क, विधि, या परिणाम को संलग्न करता है | शीर्षक या कीवर्ड डाले गए सामान्य प्रशंसा | विशिष्टता की नकल की जा सकती है |
| स्थान पहचान | सत्यापन योग्य पत्रिका, संपादक, संस्था, या सम्मेलन इतिहास | अस्पष्ट स्वामित्व, प्रतिलिपि किया हुआ ब्रांडिंग, अप्राप्य बोर्ड | नए स्थान स्वचालित रूप से शिकारी नहीं हैं |
| अनुरोध | पर्याप्त प्रश्न, सहयोग, या पारदर्शी निमंत्रण | काम से असंबंधित तत्काल प्रस्तुति या भुगतान अनुरोध | अकेली फीस निर्णायक नहीं है; पारदर्शिता मायने रखती है |
| समय | कोई भी समय; अक्सर वास्तविक पढ़ने के बाद | सार्वजनिक पोस्टिंग के तुरंत बाद तेजी से टेम्पलेट संपर्क | अस्थायी निकटता हार्वेस्टिंग स्रोत को साबित नहीं करती है |
| भाषा | विषय-विशिष्ट और पेशेवर रूप से जवाबदेह | चापलूसी, झूठी परिचितता, कृत्रिम तात्कालिकता, अस्पष्ट दायरा | भाषा सुविधाएँ संभाव्य हैं, प्रमाण नहीं |
| सत्यापन | स्वतंत्र रूप से सत्यापन योग्य संपर्क विवरण और नीतियाँ | टूटी हुई पहचानकर्ता, झूठे मीट्रिक्स, भ्रामक अनुक्रमण दावे | प्रलेखित मानदंड के तहत मानव समीक्षा आवश्यक है |
व्यावहारिक रूप से यह टाइपोलॉजी एक स्क्रीनिंग ह्यूरिस्टिक प्रदान करती है न कि एक निदान: एक जर्नल सॉलिसिटेशन जो पोस्टिंग के बाद के प्रथम दिनों में आती है, इससे पहले कि वैध वितरण चैनल प्रामाणिक रूप से काम कर सकें, बहुत संभव है कि वह शिकारी हो। वैध उच्च-प्रभाव जर्नल को केवल-पोस्ट किए गए पांडुलिपियों के लेखकों को कोल्ड-कॉल करने की रिपोर्ट नहीं दी जाती है [174], जबकि शिकारी स्थलों का प्रथम-संपर्क मोड प्रारंभिक अनुरोधित आमंत्रण है [32][174]। हम व्यावहारिक चर्चाओं में कभी-कभी प्रस्तावित विशिष्ट कटऑफ (लगभग पहले 96 घंटों में किसी भी जर्नल ईमेल को प्रारंभिक रूप से शिकारी मानना) को सत्यापन के लिए लंबित एक लेखक ह्यूरिस्टिक के रूप में आगे बढ़ाते हैं। कोई अध्ययन उस अंतराल वितरण को नहीं मापा है जो ऐसी सीमा को कैलिब्रेट करेगा। तालिका 15 की समय चेतावनी स्वयं ह्यूरिस्टिक पर लागू होती है: अस्थायी निकटता संदेह को बढ़ाता है लेकिन यह साबित नहीं करता कि भेजने वाले ने इस विशेष पोस्टिंग को हार्वेस्ट किया है, क्योंकि पता प्रीप्रिंट के पहले भी हो सकता है, इसलिए 96-घंटे की स्क्रीन इनबॉक्स को क्रमबद्ध करती है न कि साक्ष्य को।
7.5 स्पैम विरोधाभास और गति असमरूपता
दो-स्तरीय मॉडल से परजीवी स्तर के बारे में दो और प्रस्ताव अनुसरण करते हैं।
स्पैम विरोधाभास। यदि लक्षित अभिनंदन को सफल मेटाडेटा संग्रह की आवश्यकता है, तो पोस्ट-Rankings वातावरण में अनुपस्थिति शिकारी स्पैम की प्लेटफॉर्म अदृश्यता का मजबूत संकेतक हो सकती है इसकी उपस्थिति किसी और चीज़ का है। एक पत्र जो कभी भी परजीवी स्तर को भी ट्रिगर नहीं करता वह मशीन-पठनीय वितरण की न्यूनतम पट्टी को साफ़ करने में विफल हो सकता है। इस उलटाव का विश्लेषणात्मक आकर्षण, स्पैम को अनिच्छुक और विषाक्त इंडेक्सिंग प्रॉक्सी के रूप में, एक अपरिहार्य उपद्रव को एक मुफ़्त अवलोकन उपकरण में बदल देता है। इसकी नैदानिक शक्ति वर्तमान में केवल एक परिकल्पना है: अभिनंदन प्राप्ति और किसी भी दृश्यता मीट्रिक के बीच सहसंबंध कभी नहीं मापा गया है, और तालिका 14 की सामान्य-अभिनंदन पंक्तियाँ दिखाती हैं कि कच्चे स्पैम वॉल्यूम सिद्धांत में भी एक शोरगुल सिग्नल होंगे।
शिकारी पाठकों से पहले आते हैं। वैध फ़नल संस्थागत अंतराल पर संचालित होता है: eJournal समावेश संपादित होता है गारंटीकृत नहीं, उच्च-मात्रा वर्गीकरण के लिए 45 दिन तक की देरी की सूचना दी गई है [53], और Google Scholar इंडेक्सिंग छह से नौ महीने या उससे अधिक समय लेती है [55]। पहले सप्ताह में शून्य-के-पास डाउनलोड सामान्य पूर्व-वितरण के अनुरूप हैं अस्वीकृति के बजाय (अनुभाग 6)। परजीवी स्तर, यदि यह प्रोग्रामेटिक रूप से मेटाडेटा संग्रह करता है, तो इन अंतरालों में से कोई का सामना नहीं करता है। हम इसलिए परिकल्पना करते हैं कि एक लेखक के लिए जिसकी संपर्क जानकारी प्राप्य है, पहली शिकारी अभिनंदन के लिए अपेक्षित समय जो एक पोस्टिंग को जिम्मेदार ठहराया जा सकता है पहली वास्तविक विद्वान संपर्क के लिए अपेक्षित समय से कम है, ताकि अज्ञात लेखक परजीवी स्तर से मिलें वैध से पहले। विकृतिकरण प्रत्यक्ष है: वास्तविक संपर्क लगातार अभिनंदन से पहले होता है।
दिनों और हफ्तों में मापी गई प्रलेखित अभिनंदन मात्रा [9][84], वितरण यांत्रिकी के विरुद्ध सप्ताह और महीनों में मापी गई [55][53], परिकल्पना को प्रशंसनीय बनाते हैं। केवल अनुभाग 8 में निर्दिष्ट लॉगिंग अध्ययन इसे परीक्षण कर सकता है, क्योंकि मौजूदा कॉर्पस पोस्टिंग घटनाओं के लिए समय-लॉक नहीं थे [63]।
7.6 परजीवी परत लेखक को क्या नहीं बताती है
तीन सीमांत कथन इस खंड के निष्कर्षों को सीमित करते हैं।
पहला, आमंत्रण ईमेल प्लेटफॉर्म के काउंटरों को नहीं बढ़ाता है। लेखक को भेजा गया निमंत्रण कोई सार दृश्य उत्पन्न नहीं करता है और न ही पेपर की कोई डाउनलोड करता है। जहां तक स्क्रैपर्स सार पृष्ठों पर जाते हैं, SSRN कहता है कि यह अपने डाउनलोड गणना से अनियमित और स्वचालित गतिविधि को फ़िल्टर करता है [66][69][144]। स्पैम वॉल्यूम इसलिए कभी भी पाठकता का प्रमाण नहीं है, और एक आमंत्रण-भरा इनबॉक्स जो एकल-अंकीय डाउनलोड के साथ सह-अस्तित्व रखता है, इसमें कोई विरोधाभास नहीं है: दोनों परतें विभिन्न चीजों को गिनती हैं।
दूसरा, परजीवी परत भी उन लेखकों पर सबसे कठिन पड़ती है जो इसकी लागतों को अवशोषित करने के लिए सबसे कम सुसज्जित हैं: प्रारंभिक-कैरियर और गैर-मूल अंग्रेजी शोधकर्ता विशेष रूप से आमंत्रण के लिए असुरक्षित के रूप में नोट किए जाते हैं [142]। खंड 6 का व्यावहारिक प्रोटोकॉल इसलिए इनबॉक्स स्वच्छता (किसी भी आमंत्रण देने वाले स्थान की ब्लॉकलिस्ट स्क्रीनिंग, अनुरोधित आमंत्रणों के लिए गैर-प्रतिक्रिया, विलुप्त सूचियों के बजाय संरक्षित सेवाओं के माध्यम से सत्यापन) को एक अलग चिंता के बजाय मीट्रिक व्याख्या के हिस्से के रूप में मानता है। शिकारी स्थलों की स्वचालित स्क्रीनिंग स्वयं एक सक्रिय अनुसंधान दिशा है [157]।
तीसरा, प्रारंभिक दृश्यता का एक और दुष्प्रभाव है, जिसका सामना लेखकों को एक स्पष्ट आरोप के रूप में करना पड़ता है: बाद की पत्रिका प्रस्तुति पर, समानता-जांच सॉफ़्टवेयर पांडुलिपि और इसके स्वयं के SSRN पूर्ववर्ती के बीच एक लगभग पूर्ण मिलान को फ़्लैग करेगा, क्योंकि प्रीप्रिंट Crossref Posted Content कॉर्पस में अनुक्रमित हैं जो iThenticate [36] द्वारा उपयोग किए जाते हैं। विक्रेता का दस्तावेज़ स्पष्ट है कि एक समान-लेखक प्रीप्रिंट मिलान एक अपेक्षित परिणाम है न कि साहित्यिक चोरी [81]। उपयुक्त प्रतिक्रिया प्रीप्रिंट को संपादक को प्रकट करना है, इसे वापस लेना नहीं।
परजीवी परत वह जगह है जहां इस लेख का केंद्रीय दावा देखना सबसे आसान है: Rankings सूर्यास्त के बाद, कच्चे संकेत (डाउनलोड, दृश्य, और अब यहां तक कि स्पैम) केवल तभी व्याख्याकार अर्थ रखते हैं जब उन्हें उत्पन्न करने वाली तंत्र निर्दिष्ट की जाती है। वह विनिर्देश वैध परत के लिए आंशिक रूप से उपलब्ध है, और परजीवी परत के लिए यह अभी भी एक अनुसंधान कार्यक्रम है।
8. एक पूर्व-पंजीकरण के लिए तैयार अनुसंधान एजेंडा: लापता संदर्भ वर्ग का पुनर्निर्माण
पूर्ववर्ती खंडों ने SSRN ध्यान मीट्रिक्स पर सत्यापन योग्य साक्ष्य को संश्लेषित किया और post-Rankings वातावरण के लिए एक व्याख्या ढांचा प्रस्तावित किया। यह खंड ढांचे के खुले प्रश्नों का अनुभवजन्य रूप से उत्तर देने के लिए एक पूर्व-पंजीकरण-तैयार एजेंडा है। यह डिज़ाइन से, कोई परिणाम नहीं रिपोर्ट करता है: पूर्वनिर्धारित, विकृत बैंड बजाय निष्कर्ष। नीचे प्रत्येक डिज़ाइन, परिकल्पना और भविष्यवाणी बैंड Open Science Framework पर किसी भी डेटा संग्रह से पहले पंजीकृत होने के लिए तैयार है, विश्लेषण कोड के साथ जारी किया गया है। 15 जुलाई 2026 [149] पर SSRN Rankings की सेवानिवृत्ति, 12 जून 2026 [148] को घोषित की गई और प्रारंभिक पहले का लक्ष्य तारीख के साथ और एक व्यापक प्लेटफॉर्म पुनः ध्यान केंद्रित [146] में एम्बेड की गई, इस एजेंडा को असामान्य रूप से समय-संवेदनशील बनाता है: नीचे दिए गए कुछ डिज़ाइन एक असंतुलन का दोहन करते हैं जिसका पूर्व-अवधि हर महीने के साथ पीछे हटता है, और उनमें से एक, खंड 8.8 का प्रतिशतक रजिस्ट्री, एक माप अंतराल को संबोधित करता है जो सूर्यास्त स्वयं बाहरी पर्यवेक्षकों के लिए स्थायी बना दिया।
8.1 डिज़ाइन सिद्धांत
चार सिद्धांत एजेंडे को नियंत्रित करते हैं।
जन्म से अवलोकन। संचयी काउंटरों का पूर्वदर्शी खुरचना यह पुनर्निर्माण नहीं कर सकता कि किसी पेपर के पास दिन 3, दिन 7, या दिन 30 पर क्या था। इसलिए, किसी भी विश्वसनीय बेंचमार्क पैनल को पोस्टिंग पर पेपरों को नामांकित करना चाहिए और मानकीकृत आयु पर उनके काउंटरों को रिकॉर्ड करना चाहिए: दिन 1, 3, 7, 14, 30, 60, 90, और 180 (तालिका 11), पहले 45 दिनों के दौरान दैनिक अवलोकन बेहतर है, क्योंकि SSRN बताता है कि भारी सदस्यता वाले विषयों में सतर्कता वितरण में 45 दिन तक का समय लग सकता है [53]। यह सिद्धांत रिसाव के खिलाफ भी सुरक्षा देता है: पूर्व-लेखक प्रतिष्ठा उपाय को फोकल पोस्टिंग तारीख पर फ्रीज़ किया जाना चाहिए ताकि भविष्य की सफलता बेसलाइन सहसंबंधों को दूषित न कर सके। इसका साथी अनुशासन, अनुभाग 5.6 से आगे किया गया, यह है कि वितरण, अनुक्रमण, और प्रचार घटनाएं नीचे दिए गए डिज़ाइनों में दिनांकित उपचार के रूप में प्रवेश करती हैं और कभी भी अप्रतिरूपित संदर्भ के रूप में नहीं।
पहुंच और रूपांतरण का पृथक्करण। अनुभाग 5 (तालिका 9) के नैदानिक तर्क का पालन करते हुए, नीचे दिया गया प्रत्येक डिज़ाइन सार दृश्यों और डाउनलोड को अलग-अलग परिणामों के रूप में रिकॉर्ड करता है और डाउनलोड को दृश्यों पर सशर्त मॉडल करता है। कम पहुंच और कम रूपांतरण विभिन्न निदान हैं: पाठक की विचार सेट में प्रवेश करने में विफलता बनाम एक्सपोजर के बाद गैर-अधिग्रहण। उन्हें एकल गिनती में एकत्र करना वह जानकारी त्याग देता है जिसकी एक लेखक को आवश्यकता है।
वितरणात्मक परिणाम, केवल साधन नहीं। क्योंकि प्लेटफ़ॉर्म ध्यान भारी-पूंछ वाला है [83][85][180], हस्तक्षेप और प्लेटफ़ॉर्म परिवर्तन वितरण के आकार को बदल सकते हैं जबकि इसका माध्य लगभग अपरिवर्तित रहता है। परिणामों में इसलिए ध्यान का गिनी गुणांक, शीर्ष-1% और शीर्ष-10% डाउनलोड शेयर, शून्य पर या उसके पास कागजात का हिस्सा, और अन्य मीडिया में ध्यान-असमानता माप की परंपरा में नौसिखिया-से-स्थापित ध्यान अनुपात शामिल हैं [180]।
जाँचपरीक्षा। प्रत्येक परिकल्पना एक पहचान रणनीति और एक कथित शर्त के साथ युग्मित है जिसके तहत यह विफल हो जाती है। यह ढांचा स्वयं अस्वीकृति के लिए उजागर है: यदि आयु- और क्षेत्र-सामान्यीकृत प्रारंभिक मेट्रिक्स नमूने से परे कच्ची गिनती (RQ3 नीचे) को पार नहीं करते हैं, तो सामान्यीकरण के दावे किए गए माप लाभ को अस्वीकार या सीमित किया जाना चाहिए। जाँचपरीक्षा भी परिमाणात्मक है: पूरे एजेंडा में नमूना आकार को ब्याज की सबसे छोटी प्रभाव आकार के विरुद्ध शक्ति सिमुलेशन द्वारा अंतिम रूप दिया जाना है। पाँच परिकल्पनाओं, तीन अनुसंधान प्रश्नों, और पाँच प्रस्तावों के एक कार्यक्रम के लिए बहुलता रणनीति पूर्वपंजीकरण पर प्रतिबद्ध है, और पुष्टिकारी और अन्वेषणात्मक विश्लेषण अग्रिम में इस तरह लेबल किए जाते हैं। क्षरण (वापस लिए गए, विलीन, या भौतिक रूप से संशोधित कागजात) को ट्रैक किया जाता है और रिपोर्ट किया जाता है, चुप्पी से न गिरा कर, कार्यक्रम की प्रत्येक अनुभवजन्य रिपोर्ट में एक कोहोर्ट प्रवाह आरेख के साथ (अनुभाग 8.8)।
8.2 परिकल्पनाएँ और प्रस्ताव
यह ढाँचा प्रारंभिक ध्यान के आबंटन से संबंधित पाँच परिकल्पनाएँ और तीन अनुसंधान प्रश्न, तथा इसकी संरचना से संबंधित पाँच प्रस्ताव उत्पन्न करता है। तालिका 16 परिकल्पनाओं, अनुसंधान प्रश्नों और प्रस्तावों को समर्पित डिज़ाइन (P2, P3b, P4) के साथ एक परिणाम, एक विपरीतता और एक पसंदीदा डिज़ाइन से जोड़ता है; P1 और P3 तालिका 17 में अध्ययन 1 और 2 द्वारा समर्थित हैं।
H1 (ठंडी शुरुआत की हानि)। क्षेत्र, पोस्टिंग समूह, अवलोकनीय विषय, दस्तावेज़ की विशेषताओं और कैलेंडर स्थितियों की शर्त पर, पूरी तरह से मंच के नए उपयोगकर्ताओं द्वारा लिखे गए पत्र कम प्रारंभिक सारांश-पृष्ठ दृश्य प्राप्त करते हैं उन पत्रों की तुलना में जिनके पास कम से कम एक पहले से दृश्यमान SSRN लेखक है। केंद्रीय परिणाम दृश्य है न कि प्रति दृश्य डाउनलोड, क्योंकि H1 दर्शक निर्माण से संबंधित है, न कि रूपांतरण से।
H2 (प्रतिष्ठा और एक्सपोजर)। संस्थागत और लेखक की प्रतिष्ठा पूर्व मंच गतिविधि और अवलोकनीय पत्र की विशेषताओं को नियंत्रित करने के बाद प्रारंभिक सारांश-पृष्ठ पहुँच की सकारात्मक भविष्यवाणी करती है, स्थिति-ध्यान साहित्य [104][105][111][140][60] को प्रीप्रिंट प्रसार के पहले चरण तक विस्तारित करती है।
H3 (प्रतिष्ठा और सशर्त रूपांतरण)। संस्थागत प्रतिष्ठा सारांश-पृष्ठ एक्सपोजर की शर्त पर पूर्ण-पाठ डाउनलोड की सकारात्मक भविष्यवाणी करती है। Jo और Li विपणन में इस पैटर्न के अनुरूप हाल के क्षेत्र-विशिष्ट साक्ष्य प्रदान करते हैं, तीन-लेखक पत्र में एक शीर्ष-50 लेखक के लिए डाउनलोड दर में लगभग +6.6% की प्रतिष्ठा प्रीमियम [83], लेकिन एक व्यापक अनुदैर्ध्य परीक्षण आवश्यक रहता है। संयुक्त रूप से, H2 और H3 पैनल की मुख्य अनुमानीय को परिभाषित करते हैं: प्रतिष्ठा ढाल का एक पहुँच-बनाम-रूपांतरण अपघटन, अर्थात् डाउनलोड में प्रतिष्ठा-संबंधित असमानता के अवलोकित अंश का वह हिस्सा जो सारांश-पृष्ठ दौरे से पहले (एक्सपोजर) बनाम उसके बाद (सशर्त रूपांतरण) उत्पन्न होता है। एक निष्कर्ष कि ढाल का अधिकांश हिस्सा किसी भी पाठक के द्वारा सारांश को देखने से पहले बनता है, असमानता को खोज यांत्रिकी में स्थित करेगा न कि सामग्री मूल्यांकन में, सीधे मापने योग्य रूप में।
H4 (संचार एक समानकारी के रूप में)। अधिक सारांश स्पष्टता और सूचनात्मक दक्षता पहले से कम-दृश्यमानता वाले लेखकों में सशर्त रूपांतरण में बड़े सुधार के साथ जुड़ी हुई हैं, जो पहले से ही दृश्यमान लेखकों की तुलना में। H4 एकमात्र परिकल्पना है जिसका उपचार पूरी तरह से लेखक के नियंत्रण के भीतर है। इसे पूर्वनिर्दिष्ट पाठ्य उपायों और अलग से, ऑनलाइन-क्षेत्र-प्रयोग मानकों [30] के अनुसार डिज़ाइन किए गए एक यादृच्छिक सारांश प्रयोग के साथ परीक्षण किया जाना चाहिए। इसे केवल स्वचालित "AI-लिखित" वर्गीकरणकर्ताओं पर निर्भर नहीं करना चाहिए, जो अपनी स्वयं की माप अनिश्चितता प्रस्तुत करते हैं।
H5 (एक्सपोजर शॉक की दृढ़ता)। बहिर्जात या अर्ध-बहिर्जात प्रारंभिक एक्सपोजर शॉक तत्काल एक्सपोजर विंडो से परे ऊँचे बाद के ध्यान की भविष्यवाणी करते हैं: विद्वानों-मंच की अनुरूपता सफलता-प्रजनन-सफलता गतिशीलता का दस्तावेज़ प्रायोगिक रूप से अन्यत्र [112][131][162] और arXiv पर स्थितीय एक्सपोजर प्रभाव [72][73]।
RQ1। क्या 15 जुलाई 2026 को Rankings की सेवानिवृत्ति ने ध्यान की एकाग्रता, वितरण या प्रतिष्ठा ढाल को बदल दिया? दोनों विरोधी भविष्यवाणियाँ समान रूप से प्रशंसनीय हैं, और प्रश्न को दो-पक्षीय छोड़ा गया है: रैंकिंग को हटाने से लोकप्रियता-प्रतिक्रिया लूप को कम किया जा सकता है [112][131], या यह इसके बजाय पहले से मौजूद लेखक नेटवर्क पर निर्भरता को बढ़ा सकता है एक खोज सतह को हटाने से जिसके माध्यम से अज्ञात पत्र दृश्यमान हो सकते थे एक बार जब वे ध्यान आकर्षित करना शुरू कर देते थे।
RQ2। क्या क्यूरेटेड ईमेल-सतर्कता वितरण नए उपयोगकर्ताओं के लिए या स्थापित लेखकों के लिए अधिक आनुपातिक ध्यान लाभ उत्पन्न करता है?
RQ3। क्या दिन 7 और 30 पर देखी गई सामान्यीकृत प्रारंभिक मेट्रिक्स कच्चे संचयी डाउनलोड की तुलना में बाद के विद्वानों उद्धरण या प्रकाशन परिणामों की बेहतर भविष्यवाणी करती हैं?
प्रस्ताव ढाँचे के संरचनात्मक दावों को खंडनीय रूप में पुनः स्थापित करते हैं:
P1 (विषमता और अदृश्य बहुमत)। SSRN पत्रों के एक यादृच्छिक स्तरीकृत नमूने पर, आजीवन डाउनलोड का वितरण भारी-पूँछ वाला और दाएँ-विषम है जैसे कि माध्यिका माध्य से आधे से कम है, और पत्रों का एक पर्याप्त हिस्सा दस या अधिक आजीवन डाउनलोड रखता है। खंडक: माध्यिका ≥ 0.5 × माध्य, या एक नगण्य ≤10-डाउनलोड हिस्सा। विपणन-नेटवर्क अनुपात का प्रकाशित माध्य से माध्यिका (लगभग 2.54) [83] और 2015 शीर्ष-सूची डेटा का अर्ध-लॉगनॉर्मल फ़िट [85] P1 को मंच पर बड़े पैमाने पर प्रेरित करते हैं लेकिन प्रतिष्ठित नहीं करते हैं।
P2 (वर्गीकरण सतह को नियंत्रित करता है)। भंडार परत के भीतर, eJournal वर्गीकरणों की संख्या डाउनलोड के साथ सकारात्मक रूप से जुड़ी हुई है और शून्य-निकट डाउनलोड की संभावना के साथ नकारात्मक रूप से जुड़ी हुई है, आयु और नेटवर्क को नियंत्रित करते हुए, Whalen के 2018 अनुप्रस्थ पैटर्न [168] का एक प्रतिकृति और अपडेट मंच की क्यूरेटेड वितरण यांत्रिकी [53][57] के तहत। खंडक: नियंत्रणों के बाद कोई महत्वपूर्ण संबंध नहीं। वर्गीकरण गणना स्वयं संभावित रूप से अंतर्जातीय है: व्यापक प्रासंगिकता के पत्र अधिक वर्गीकरण और अधिक पाठक दोनों प्राप्त कर सकते हैं, इसलिए अनुप्रस्थ संबंध किसी भी सतह प्रभाव को अधिक बताता है। पसंदीदा पहचान इसलिए उपलब्ध होने पर पत्र-के-भीतर वर्गीकरण परिवर्तन है, अनुप्रस्थ अनुमान स्पष्ट रूप से एक ऊपरी सीमा के रूप में रिपोर्ट की गई है।
P3 (मशीन दृश्यता कम है और सुविधा-निर्भर है)। प्रश्नों के लिए निर्मित जहाँ एक विशिष्ट SSRN प्रीप्रिंट सर्वोत्तम उपलब्ध स्रोत है, उपभोक्ता AI उत्तर इंजन मामलों के अल्पसंख्यक में प्रीप्रिंट का ही हवाला देते हैं, और मशीन दृश्यता प्रलेखित जनक-इंजन-अनुकूलन कारकों [5][164] के अनुरूप सुविधाओं के साथ बढ़ती है। खंडक: प्रीप्रिंट सुविधाओं की परवाह किए बिना अधिकांश समय का हवाला दिया जाता है, या कोई सुविधा दृश्यता की भविष्यवाणी नहीं करती है।
P3b (एक मशीन-परत Matthew प्रभाव)। विशेषज्ञ-मान्य प्रश्न प्रासंगिकता की शर्त पर, अधिक पूर्व वेब और विद्वानों दृश्यमानता वाले पत्र AI उत्तर प्रणालियों द्वारा अधिक बार उद्धृत किए जाते हैं अन्यथा तुलनीय ठंडी शुरुआत के पत्रों की तुलना में। समानता वैकल्पिक के तहत, जनक इंजन प्रासंगिकता पर पूर्व दृश्यमानता के प्रीमियम के बिना पुनः प्राप्त करते हैं और P3b अस्वीकार किया जाता है, एक परिणाम जिसके तहत मशीन परत मानव खोज परतों H1–H3 की तुलना में अधिक समानवादी होगी, कम नहीं। खंडक: मिलान प्रश्न प्रासंगिकता पर कोई दृश्यता ढाल नहीं। P3b H1–H3 की संचयी-लाभ पंक्ति को खोज स्टैक के शीर्ष तक विस्तारित करता है। इसका परीक्षण करने के लिए अध्ययन 2 (अनुभाग 8.6) में निर्दिष्ट पूर्व-दृश्यता सहवेरिएट और प्रश्न स्तरीकरण की आवश्यकता है।
P4 (शिकारी पाठकों से पहले आते हैं)। एक नई तरह से पोस्ट किए गए प्रीप्रिंट के लिए जिसके ग्रंथ-सूची मेटाडेटा और संपर्क मार्ग को पोस्ट किए गए दस्तावेज़ या संबंधित सार्वजनिक पृष्ठों से प्राप्त किया जा सकता है, पहली शिकारी माँग के लिए अपेक्षित समय पहले असली विद्वतापूर्ण संपर्क के लिए अपेक्षित समय से कम है। असत्यकारक: असली संपर्क विश्वसनीय रूप से शिकारी माँग से पहले आता है। P4 को प्राप्त करने योग्यता के आधार पर सशर्त रूप से कहा जाता है क्योंकि वर्तमान मंच इंटरफेस पर लेखक संपर्क विवरण की सार्वजनिक दृश्यता स्थापित नहीं की गई है। प्राप्त करने की तंत्र को सामान्य रूप से प्रीप्रिंट भंडारों के लिए दस्तावेज़ित किया गया है [107][159][151], और अनचाहे ईमेल शिकारी पत्रिका के साथ माँगे गए लेखकों के पर्याप्त हिस्से के लिए पहला संपर्क हैं [32]। इसलिए एट्रिब्यूशन के लिए इनबॉक्स समय के अनुमान के बजाय अध्ययन 3 के वाद्य डिज़ाइन की आवश्यकता है।
तालिका 16. परिकल्पनाएँ, शोध प्रश्न, और पहचान की रणनीतियाँ।
| प्रश्न | प्राथमिक परिणाम | मुख्य तुलना | पसंदीदा डिज़ाइन |
|---|---|---|---|
| H1: नए आने वाले का नुकसान | वर्धमान दृश्य | नए आने वाले बनाम स्थापित | पदानुक्रमित अनुदैर्ध्य गणना मॉडल |
| H2: प्रतिष्ठा और पहुँच | वर्धमान दृश्य | उच्च बनाम निम्न पूर्व प्रतिष्ठा | सहसंयोजक-समायोजित पैनल + मिलान संवेदनशीलता विश्लेषण |
| H3: प्रतिष्ठा और रूपांतरण | दृश्यों पर सशर्त डाउनलोड | उच्च बनाम निम्न प्रतिष्ठा | नकारात्मक-द्विपद/Poisson जोखिम मॉडल |
| H4: संचार समानांतरकारी | सशर्त डाउनलोड संभावना/दर | स्पष्टता × पूर्व दृश्यता | प्रेक्षणीय पाठ मॉडल + यादृच्छिकृत प्रतिकृति |
| H5: संचयी ध्यान | प्रभाव-बाद दृश्य/डाउनलोड | जोखिम प्रभाव बनाम प्रभाव-पूर्व प्रक्षेपवक्र | कागज़-के-भीतर घटना अध्ययन |
| RQ1: रैंकिंग सेवानिवृत्ति | दैनिक ध्यान; Gini; शीर्ष शेयर; क्षेत्र द्वारा नई-पोस्टिंग मात्रा | पहले रैंकिंग-उजागर बनाम तुलना क्षेत्र | बाधित/घटना-अध्ययन डिज़ाइन |
| RQ2: ईमेल वितरण | दैनिक दृश्य/डाउनलोड | वितरण से पहले बनाम बाद में | कागज़-के-भीतर घटना अध्ययन (वितरण × नए आने वाले) |
| RQ3: भविष्यसूचक वैधता | 6/12/18-माह उद्धरण | सामान्यीकृत बनाम कच्चे शुरुआती मेट्रिक्स | नमूना-बाहर भविष्यसूचक तुलना |
| P2: वर्गीकरण सतह को नियंत्रित करता है | डाउनलोड; लगभग-शून्य डाउनलोड की संभावना | वर्गीकरण गणना; कागज़-के-भीतर वर्गीकरण परिवर्तन जहाँ उपलब्ध है | पैनल प्रतिगमन + कागज़-के-भीतर परिवर्तन डिज़ाइन |
| P3b: मशीन-परत Matthew प्रभाव | उत्तर प्रणाली द्वारा सीधा उद्धरण | उच्च बनाम निम्न पूर्व दृश्यता मिलान क्वेरी प्रासंगिकता पर | दोहराया गया बहुस्तरीय पुनः प्राप्ति लेखापरीक्षा (अध्ययन 2) |
| P4: शिकारी पाठकों से पहले | प्रथम-के-लिए समय और कोडित इनबाउंड संदेशों की दर | पोस्टिंग-पूर्व बनाम पोस्टिंग-बाद की खिड़कियाँ; शिकारी बनाम असली संपर्क | वाद्य संभावित समूह + घटना-इतिहास मॉडल (अध्ययन 3) |
नोट। सभी पंक्तियाँ संभावित डिज़ाइन हैं। कोई भी निष्पादित नहीं किया गया है। परिणाम, तुलना, बहिष्करण नियम, और संदर्भ वर्ग डेटा संग्रह से पहले पूर्व-पंजीकृत होने हैं।
8.3 मुख्य पैनल
संदर्भ डिजाइन एक बहु-अनुशासनात्मक समूह है जिसमें नई तरह से पोस्ट की गई SSRN पेपर हैं जिन्हें पोस्टिंग के बाद कम से कम बारह महीनों तक देखा जाता है, तालिका 11 के अनुसार अनुसूचित किया जाता है। कागज के स्तर पर डेटासेट शीर्षक, सारांश, लेखक नाम और क्रम, संबद्धताएं, पोस्टिंग तारीख, वर्गीकरण, कीवर्ड, पृष्ठ गणना, DOI (जहां उपलब्ध हो), संशोधन इतिहास, सार्वजनिक सारांश दृश्य, सार्वजनिक डाउनलोड, और बाद के उद्धरण संकेतकों का सबसे प्रारंभिक उपलब्ध संस्करण संरक्षित करता है, जिसमें लेखक-पहचान मिलान खुली ग्रंथसूची बुनियादी ढांचे के विरुद्ध [35][124] स्केल पर अनुमानित प्रतिष्ठा का उपयोग करने से पहले एक यादृच्छिक उप-नमूने पर मैन्युअल रूप से मान्य किया जाता है। नवागंतुक स्थिति को इस प्रकार परिभाषित किया जाता है कि फोकल पेपर पर कोई भी लेखक फोकल पोस्टिंग से पहले दिनांकित SSRN पेपर नहीं रखता है, संवेदनशीलता परिभाषाएं पूर्व कागज गणना और पूर्व-पोस्टिंग उद्धरण स्टॉक पर आधारित होती हैं। संस्थागत प्रतिष्ठा इस परिभाषा का हिस्सा नहीं है: क्योंकि प्रतिष्ठा स्वयं H2 और H3 में एक व्याख्यात्मक चर है, इसे नवागंतुक स्थिति में शामिल करना प्लेटफॉर्म नवीनता को पूर्व लेखक दृश्यमानता के साथ यांत्रिक रूप से भ्रमित करेगा और उन परिकल्पनाओं को समाप्त करेगा जिन्हें डिजाइन अलग करने का इरादा रखता है। प्रतिष्ठा इसलिए मॉडल में केवल एक अलग सहसंयोजक के रूप में प्रवेश करती है। पूर्व दृश्यमानता के आधार पर सामान्यीकरण को इक्विटी के आधार पर संगत देखभाल के साथ संभाला जाना चाहिए: पूर्व-दृश्यमानता आधारभूत को बहुत आक्रामक रूप से घटाना एक जूनियर लेखक की वास्तविक प्रारंभिक सफलता को दंडित करेगा और सांख्यिकीय रूप से मिटा देगा, बजाय उजागर करने के, सीमांत और ग्लोबल-साउथ लेखकों का कोई भी व्यवस्थित कम-जोखिम। ढांचे का उत्तर यह है कि असमानता जहां बनती है वहां माप करें बजाय इसे शुद्ध करने के: पहुंच बनाम रूपांतरण अपघटन स्थानीयकृत करता है कि क्या दृश्यमानता अंतर जोखिम पर या रूपांतरण पर उत्पन्न होता है, और प्रतिष्ठा एक सहसंयोजक के रूप में प्रवेश करती है जिसे समझा जाना चाहिए, शोर के रूप में नहीं जिसे चुपचाप भिन्न किया जाए। प्रतिष्ठा का ध्यान पर वितरणात्मक प्रभाव अर्ध-प्रयोगों का एक प्राथमिक परिणाम है (खंड 8.4–8.5)। कैलेंडर नियंत्रण सप्ताह के दिन, वर्ष के सप्ताह, शैक्षणिक सीजन, और तारीख निर्धारित प्रभाव शामिल हैं। सप्ताहांत और मौसमी भिन्नता लेख पहुंच में दस्तावेज (गतिविधि सप्ताहांत पर लगभग 11% कम और हाल के सात-पत्रिका पैनल में गर्मियों में 50% कम [178]) किसी भी उच्च-आवृत्ति उपयोग अध्ययन में उनके लोप को न्यायसंगत बनाता है। पूर्ण पैनल परिवर्तनीय शब्दकोश (लगभग दो दर्जन क्षेत्रों के क्रम में, केवल संचयी गणना के बजाय अंतराल वृद्धि सहित, सहमति के साथ वितरण तारीख, 6, 12, और 18 महीनों पर उद्धरण स्टॉक, और संशोधन संख्या) परिशिष्ट C (तालिका C1) में निर्दिष्ट है, और एक ही स्कीमा फाइल पूर्व-पंजीकरण सामग्री (खंड 8.8; घोषणाएं) के साथ जमा की जाती है।
पहुंच को वृद्धिशील दृश्यों के लिए एक पदानुक्रमित नकारात्मक-द्विपद प्रक्रिया के रूप में मॉडल किया जाता है, जिसमें क्षेत्र-दर-आयु प्रभाव, कैलेंडर प्रभाव, और कागज-स्तर की विषमता होती है। सशर्त रूपांतरण को वृद्धिशील डाउनलोड के रूप में मॉडल किया जाता है जिसमें लॉग वृद्धिशील दृश्य जोखिम के रूप में होते हैं, ताकि एक लैंडिंग-पृष्ठ यात्रा प्राप्त करना और उस यात्रा को रूपांतरित करना सांख्यिकीय रूप से अलग हों। संक्षिप्त रूप में, कागज i के लिए अंतराल t में:
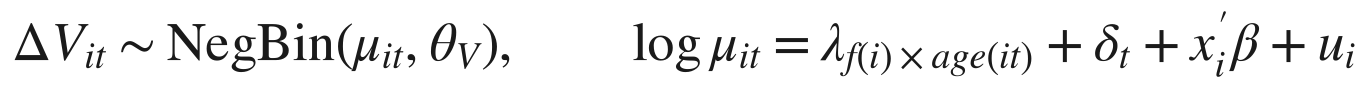

जहां λ_{f×age} क्षेत्र-दर-आयु प्रभाव हैं, δ_t कैलेंडर-तारीख प्रभाव, u_i और w_i कागज-स्तर की विषमता, और दूसरे समीकरण में लॉग-दृश्य ऑफसेट डाउनलोड को लैंडिंग-पृष्ठ जोखिम पर सशर्त बनाता है। नवागंतुक × स्पष्टता इंटरएक्शन γ_3 H4 परीक्षा है। ये समीकरण पूर्व-निर्दिष्ट अनुमानों और पहुंच से रूपांतरण के अलगाव को ठीक करते हैं, और पदानुक्रमित संरचना बिल्कुल अनुभवजन्य-बेयस आंशिक पूलिंग को निष्पादित करती है कि खंड 5.2 और 8.8 को किसी भी विरल कोशिका का प्रतिशत प्रकाशित करने से पहले की आवश्यकता होती है। x_i में विषय नियंत्रण शीर्षक–सारांश एम्बेडिंग से निर्मित किए जाते हैं जो पूर्व-पंजीकरण पर जमे हुए और समूहीकृत होते हैं, कोई भी परिणाम देखे जाने से पहले, ताकि विषयगत संरचना परिणामों को ट्यून न कर सके। क्योंकि कागज एक साथ सात वर्गीकरणों तक पर कब्जा कर सकते हैं, वर्गीकरण प्रभाव प्रत्येक कागज को एकल क्षेत्र में जबरदस्ती करने के बजाय एकाधिक-सदस्यता पदानुक्रमित संरचनाओं के साथ अनुमानित किए जाते हैं। क्योंकि पेपर निश्चित प्रभाव समय-अपरिवर्तनीय स्थिति उपायों को अवशोषित करते हैं, आधारभूत नवागंतुक और प्रतिष्ठा प्रभाव पत्रों के बीच अनुमानित किए जाते हैं, जबकि पेपर निश्चित प्रभाव वितरण घटनाओं जैसे अंतःपेपर उपचारों के लिए आरक्षित होते हैं। अतिविक्षेप और अतिरिक्त शून्य औपचारिक रूप से परीक्षण किए जाते हैं, बाधा और शून्य-मुद्रास्फीति विकल्प जहां न्यायसंगत हो वहां रिपोर्ट किए जाते हैं, और भारी पूंछ को सफल कागजों को हटाने के बजाय मात्रात्मक और मजबूत अनुमान द्वारा संभाला जाता है। डेटा-सफाई नियम स्वयं पूर्व-निर्दिष्ट होते हैं न कि विवेकाधीन, और विसंगति प्रोटोकॉल झंडा, हटाएं नहीं है। पूर्व-निर्दिष्ट संकेत सूची कवर करती है: कागज के अपने इतिहास के विरुद्ध एक अंतराल चरम, डाउनलोड में कोई गति के साथ एक दृश्य स्पाइक, रूपांतरण में एक विच्छेद, दोहराई गई समान टाइमस्टैम्प, और एक प्लेटफॉर्म-पक्ष पुनः विवरण। एक चिह्नित अंतराल कभी भी संग्रह से हटाया नहीं जाता है: इसे एक कारण कोड के साथ बनाए रखा जाता है, और हर शीर्षक परिणाम चार-परत संवेदनशीलता सीढ़ी पर रिपोर्ट किया जाता है: (i) अपरिवर्तित काउंटर; (ii) केवल प्लेटफॉर्म-पुष्टि अमान्य गतिविधि को छोड़कर; (iii) मजबूत या विंसोराइज्ड अनुमान; (iv) सभी चिह्नित अंतराल को छोड़कर, ताकि कोई भी निष्कर्ष केवल एक परत पर जीवित रहे वह नाजुक के रूप में दिखाई दे। थ्रेशहोल्ड देखे गए वितरण के विरुद्ध अंशांकित किए जाते हैं न कि पहले से निर्धारित किए जाएं। जहां पार्टनर लॉग उपलब्ध हैं, रेफरर, उपयोगकर्ता-एजेंट, और भूगोल क्षेत्र न्यूजलेटर, ब्लॉग, प्रीफेच, और क्रॉलर ट्रैफ़िक को अलग करते हैं। SSRN [116] पर दस्तावेज़ ब्लॉग-संचालित डाउनलोड स्पाइक यह दर्शाता है कि एक चरम मान अक्सर कंटामिनेशन के बजाय जैविक सफलता क्यों है। विसंगति पहचान एक माप उपकरण है। यह असुविधाजनक सफलता को त्यागने का लाइसेंस नहीं देता है।
समान अनुशासन अस्थायी संरचना पर लागू होता है। पैनल सीमांत ध्यान को संचयी ध्यान से अलग करता है: अंतराल डाउनलोड ΔD के कोहॉर्ट वक्र, और किसी कागज़ के 180-दिन के डाउनलोड का वह हिस्सा जो प्रत्येक आयु द्वारा संचित होता है, बजाय केवल आजीवन कुल के। यह क्षय पर कोई एकल घातीय अर्ध-जीवन नहीं लागू करता, क्योंकि पाठकशीलता एक साथ कई समयमान पर क्षय होती है [91]। आयु वक्र इसलिए डिफ़ॉल्ट रूप से स्प्लाइन या अपरामित्रिक अनुमानकर्ताओं के साथ फिट किए जाते हैं, लॉगरिदमिक परिवर्तनों का उपयोग संरचना का अध्ययन करने के लिए किया जाता है और कच्ची गिनती बेंचमार्क रिपोर्टिंग के लिए बनाए रखी जाती है। मजबूती को एक ही तरह से संभाला जाता है: प्रतिष्ठा को कई वैकल्पिक उपायों के माध्यम से परिचालित किया जाता है न कि एकल रैंकिंग सीमा के, नवागंतुक स्थिति को क्रमिक रूप से कड़ी परिभाषाओं के तहत फिर से परीक्षण किया जाता है, और परिणाम विंसोराइज़्ड-संवेदनशीलता जांच और मात्रा अनुमानों के साथ पूर्ण-वितरण प्लॉट के साथ रिपोर्ट किए जाते हैं।
क्योंकि कोई सार्वजनिक SSRN API नहीं है [134][51], डेटा संग्रह तीन मार्गों से आगे बढ़ता है, प्राथमिकता के क्रम में: SSRN/Elsevier को एक औपचारिक डेटा अनुरोध या साझेदारी; लेखक-सहमति वाले डैशबोर्ड निर्यात, जिसमें भाग लेने वाले लेखक सूचित सहमति के तहत अपने स्वयं के सांख्यिकी-पैनल डेटा का योगदान करते हैं, जिस मध्यवर्ती स्तर पर धारा 8.8 की रजिस्ट्री पहले से ही निर्भर करती है; और दर-सीमित, robots.txt-सम्मानजनक सार्वजनिक पृष्ठों का प्रति-कागज़ नमूना, जिसकी तकनीकी व्यवहार्यता मौजूदा ओपन-सोर्स संग्रह उपकरणों द्वारा स्थापित है [134]। डिज़ाइन बल्क स्क्रैपिंग को बाहर करता है जो सेवा की शर्तों का उल्लंघन करेगी, और यह कोई अप्रलेखित एंडपॉइंट को एक स्थिर API के रूप में प्रस्तुत नहीं करता। पहुँच बाधाओं पर धारा 9 में एक सीमा के रूप में चर्चा की जाती है।
8.4 अर्ध-प्रयोग I: ईमेल-सतर्कता वितरण एक ध्यान आघात के रूप में
अनुभाग 8.4 और 8.5 एक विश्लेषणात्मक मॉड्यूल बनाते हैं, जो समान पैनल कोहर्ट पर दो प्लेटफॉर्म-पक्षीय हस्तक्षेपों को पूरक उपचार के रूप में अध्ययन करते हैं। सतर्कता वितरण एक जोखिम सतह जोड़ता है, रैंकिंग सेवानिवृत्ति एक को हटाती है, और दोनों को वितरणात्मक परिणामों के एक सामान्य सेट के विरुद्ध पढ़ा जाता है (नवागंतुक हिस्सा, प्रतिष्ठा प्रवणता, ध्यान गिनी, शीर्ष हिस्से)। SSRN की सतर्कता तंत्र विश्लेषणात्मक रूप से मूल्यवान है क्योंकि पोस्टिंग और वितरण को एक साथ होने की आवश्यकता नहीं है। कागजात पहले सार्वजनिक रूप से उपलब्ध हो जाते हैं, और पात्र कार्य बाद में क्यूरेट किए गए ईजर्नल सतर्कताओं के माध्यम से वितरित किए जाते हैं जिनका समय भिन्न होता है और गारंटीकृत नहीं है [53][57]। अपने वितरण-स्थिति तिथियां प्रदान करने के लिए सहमत लेखकों के लिए, एक अंतर-कागज़ात ईवेंट अध्ययन वितरण तिथि के चारों ओर ध्यान पथ का अनुमान लगा सकता है, प्रत्येक कागज़ात अपने स्वयं के नियंत्रण के रूप में काम करता है ताकि विषय आकर्षण, लेखक पहचान और संस्था में स्थिर अंतर को अवशोषित किया जा सके। विनिर्देश मानक ईवेंट-अध्ययन रूप है: परिणाम Y_it (अंतराल दृश्य या डाउनलोड) के लिए,
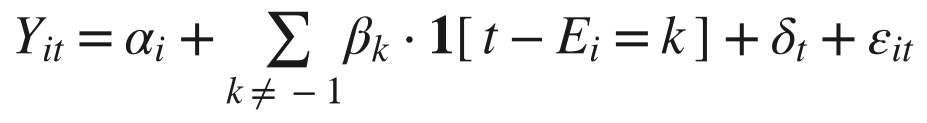
जहाँ E_i कागज़ात i की वितरण तिथि है, α_i कागज़ात निश्चित प्रभाव हैं, δ_t कैलेंडर-तिथि प्रभाव हैं, और β_k, k = −1 पूर्व-वितरण संदर्भ अवधि के लिए सामान्यीकृत, ईवेंट के चारों ओर ध्यान पथ का पता लगाते हैं। समीकरण पूर्वपंजीकरण के लिए अनुमानकर्ता को निर्दिष्ट करती है। मुख्य विषमपूर्ण प्रभाव Distribution × Newcomer के साथ अंतःक्रिया है, जिसका अनुमान β_k को नवागंतुक स्थिति के साथ अंतःक्रिया करके लगाया जाता है। यदि सतर्कताएं नवागंतुकों की पहुंच में असमान रूप से सुधार करती हैं, तो क्यूरेट किए गए वितरण एक प्लेटफॉर्म-स्तरीय समानताकारक के रूप में कार्य करते हैं; यदि लाभ प्रतिष्ठित लेखकों को असमान रूप से मिलते हैं, तो वितरण मौजूदा प्रतिष्ठा लाभों को बढ़ाता है (RQ2)। पूर्व साक्ष्य कि असतत जोखिम ईवेंट (arXiv पर सामने-स्थिति सूचियाँ [72][73], SSRN कागज़ात के ब्लॉग कवरेज [116]) तीव्र प्रारंभिक ध्यान स्पाइक्स उत्पन्न करते हैं, यह दर्शाता है कि डिज़ाइन का एक पहचानने योग्य पहला चरण है। पूर्वनिर्दिष्ट विनिर्देश वितरण तिथि के चारों ओर वैकल्पिक ईवेंट विंडोज़ भी शामिल करता है और जल्दी से वितरित किए गए कागज़ात बनाम लंबी वर्गीकरण कतार के बाद अलग रिपोर्टिंग, क्योंकि 45-दिन की देरी [53] अन्यथा एक एकल ईवेंट समय में विषमपूर्ण जोखिम इतिहास को मिलाती है। कागज़ात निश्चित प्रभाव केवल समय-अपरिवर्तनीय आकर्षण को अवशोषित करते हैं, इसलिए तीन डिज़ाइन शर्तें भार-वहन कर रही हैं। वितरण समय क्यूरेट किया जाता है, यादृच्छिक नहीं: प्लेटफॉर्म चुनता है कि यह कौन से पात्र कागज़ात वितरित करता है और कब [53][57]। ईवेंट तिथि इसलिए विषयीयता पर समय-भिन्न चयन करती है (एक कागज़ात जो सप्ताह वितरित किया जाता है जब एक विषय प्रासंगिक हो जाता है, शांत सप्ताह में वितरित एक ही कागज़ात से अलग होता है), और यह चयन कागज़ात निश्चित प्रभावों को जीवित रखता है, जो कारण है कि विनिर्देश वितरण विलंब पर शर्त रखती है और वितरण-समय स्तरों को अलग से रिपोर्ट करती है। वितरण-स्थिति तिथियाँ भी केवल सहमत लेखकों के लिए देखी जाती हैं, इसलिए अनुमान नमूना पैनल का एक स्व-चयनित उपसमूह है। सहमति स्थिति इसलिए रिकॉर्ड की जाती है, और ईवेंट-अध्ययन नमूना को अवलोकन योग्य सहसंयोजकों पर पूर्ण कोहर्ट से तुलना की जाती है; चयन बाह्य वैधता को सीमित करता है। और लेखक अपनी सतर्कता के लिए अपनी स्वयं की प्रचार का समय निर्धारण कर सकते हैं: एक समन्वित आत्म-प्रचार स्पाइक एक वितरण प्रभाव के रूप में प्रच्छन्न होगा। एक दिनांकित लेखक-प्रचार लॉग (अनुभाग 6.1 का संस्करणित साक्ष्य पैकेट) इसलिए इस डिज़ाइन की आवश्यकता है: इसके बिना एक जैविक वितरण स्पाइक को एक आत्म-उत्पन्न से अलग नहीं किया जा सकता है, और अनुभाग 8.3 की विसंगति सीढ़ी किसी भी स्पाइक को हटाने के बजाय झंडी लगाती है जो दर्ज आत्म-प्रचार के साथ मेल खाता है।
8.5 अर्ध-प्रयोग II: रैंकिंग सेवानिवृत्ति एक प्राकृतिक प्रयोग के रूप में
15 जुलाई 2026 की सूर्यास्त [149] एक दूसरे विश्लेषण की अनुमति देती है यदि संग्रहीत रैंकिंग पृष्ठों से ऐतिहासिक रैंकिंग एक्सपोज़र का पुनर्निर्माण किया जा सकता है। डिज़ाइन के दो विशेषताएं एक स्वच्छ एकल-तारीख इवेंट अध्ययन को कमजोर करती हैं। उपचार एक तारीख पर नहीं आया: प्रति-ईजर्नल रैंकिंग पृष्ठ 11 दिसंबर 2025 से अपडेट होना बंद कर दिया (खंड 2.2 [B-2]), 15 जुलाई 2026 को हटाने से लगभग सात महीने पहले, तो रैंकिंग खोज सतह की वापसी एक स्टैगर्ड प्रक्रिया के रूप में बेहतर तरीके से मॉडल की जाती है, लाइव पृष्ठों का एक पहला-चरण फ्रीज़ उसके बाद उनकी अंतिम हटाई, न कि एक एकल सामान्य इवेंट तारीख के रूप में। विनिर्देश इसलिए कम से कम दो इवेंट समय (दिसंबर फ्रीज़ और जुलाई हटाई) रखता है, स्टैगर्ड फॉर्म प्राथमिक मॉडल के रूप में और एकल-तारीख फिट इसके विरुद्ध परीक्षा की जा रही है। "पूर्व में रैंकिंग-एक्सपोज़्ड" विषयों को प्लेटफ़ॉर्म की संरचना से मान नहीं लिया जा सकता: रैंकिंग प्लेटफ़ॉर्म-व्यापी थी, इसलिए अंतर एक्सपोज़र अंतर्जात है और इसे उन क्षेत्रों को नामकरण करके संचालित नहीं किया जाता है जो "महसूस" किए गए रैंक किए गए हैं। एक्सपोज़र को मापा जाना चाहिए, निर्दिष्ट नहीं: उदाहरण के लिए, इंटरनेट आर्काइव के माध्यम से पुनः प्राप्त संग्रहीत रैंकिंग पृष्ठों से, किसी क्षेत्र के पेपर का हिस्सा जो कभी सार्वजनिक शीर्ष सूचियों में प्रवेश किया या किसी क्षेत्र की उपस्थिति की घनत्व प्रति-ईजर्नल पृष्ठों पर। क्या आर्काइव प्रत्येक क्षेत्र के रैंकिंग पृष्ठों को पर्याप्त रूप से घनी रूप से कवर करता है एक उपयोगी एक्सपोज़र माप उपज करने के लिए अभी तक स्थापित नहीं है; डिज़ाइन एक्सपोज़र माप के साथ घनत्व की रिपोर्ट करता है। इस तरह मापे गए एक्सपोज़र के साथ, एक पेपर-स्तर की इवेंट-स्टडी विनिर्देश फ्रीज़ और हटाई की तारीखों के चारों ओर उच्च- और कम-एक्सपोज़र क्षेत्रों में ध्यान के प्रक्षेपवक्र की तुलना करता है: खंड 8.4 का समीकरण इवेंट-टाइम शर्तों पर अकेले के बजाय Exposure_f × EventTime_k इंटरैक्शन पर रुचि के गुणांक के साथ। सबसे जानकारीपूर्ण परिणाम वितरणात्मक हैं (खंड 8.1)। रैंकिंग तंत्र माध्य को लगभग बरकरार रखते हुए ध्यान की एकाग्रता को बदल सकता है, और क्योंकि किसी भी प्रभाव को पहले से ही दृश्यमान पूंछ पेपर में एकाग्र करने की उम्मीद है जो सूचियों को आबाद करते हैं, क्षेत्र-माध्य परिणाम निर्माण द्वारा कम शक्तिशाली हैं। गिनी गुणांक, शीर्ष-शेयर उपाय, नए आने/स्थापित अनुपात, और प्रतिष्ठा ढाल इसलिए प्राथमिक परिणाम हैं, RQ1 की दो-पक्षीय भविष्यवाणी के साथ, और खंड 8.1 की शक्ति सिमुलेशन इन वितरणात्मक आंकड़ों पर लक्षित होनी चाहिए, न कि माध्य ध्यान पर, या अध्ययन गलत अनुमानक पर शक्ति की कमी के लिए शून्य घोषित किया जा सकता है।
दो नामित, दिशात्मक भविष्यवाणियां दो-पक्षीय RQ1 को तीक्ष्ण करती हैं इसे प्रतिस्थापित किए बिना, दोनों पूर्व-निर्दिष्ट विषमता परीक्षण। दृश्यता-खड़ी परिकल्पना यह मानती है कि पूर्व में रैंकिंग-एक्सपोज़्ड क्षेत्रों में सूर्यास्त-पूर्व पोस्टिंग समूह मिलान पूर्व-सूर्यास्त समूहों की तुलना में प्रारंभिक पहुंच में एक असतत गिरावट का अनुभव करते हैं, क्योंकि एक खोज सतह एक ज्ञात तारीख पर हटा दी गई थी। एक मुआवजे की परिकल्पना के तहत, यदि रैंकिंग कमजोर खोज पारिस्थितिकी तंत्र वाले क्षेत्रों के लिए एक मुआवजे की दृश्यता तंत्र के रूप में कार्य करती थी, तो उनकी हटाई का प्रभाव कम ईजर्नल सदस्यता आधार वाले क्षेत्रों में सबसे बड़ा होना चाहिए, व्हेलन ढाल की निचली सीमा [168]।
एक सस्ता द्वितीयक परिणाम डिज़ाइन को ध्यान के आवंटन से प्लेटफ़ॉर्म के स्वास्थ्य तक विस्तारित करता है: क्षेत्र द्वारा नई पोस्टिंग की मात्रा, 15 जुलाई 2026 से पहले और बाद की खिड़कियों में। यदि रैंकिंग पोस्ट करने के लिए प्रोत्साहन का हिस्सा आपूर्ति करती थी, तो उनकी सेवानिवृत्ति नई प्रस्तुतियों को ठंडा कर सकती थी। यह ऊपर दिए गए ध्यान परिणामों से अलग एक व्यवहार संबंधी परिणाम है, सार्वजनिक नई-पेपर सूचियों से प्लेटफ़ॉर्म की अपनी 2025 में 250,000 से अधिक नए पेपर की तुलना [145] से अवलोकन योग्य है, और "शार्क कूद" विवाद का एक सीधा अनुभवजन्य उत्तर खंड 2.2 [12][B-11] में दर्ज है। भविष्यवाणी RQ1 की तरह दो-पक्षीय रहती है, और पोस्टिंग-मात्रा परिणाम अध्ययन 4 सर्वेक्षण ("नई अपलोड से बचना") के आइटम (3) से जुड़ता है।
विश्लेषण अर्ध-प्रयोगात्मक है। पांच खतरे भौतिक हैं। एक घोषणा और प्रत्याशा प्रभाव है: सेवानिवृत्ति की घोषणा 12 जून 2026 को 1 जुलाई के प्रारंभिक लक्ष्य के साथ की गई थी और 15 जुलाई को निष्पादित किया गया था, तो एक सत्य प्रत्याशा खिड़की मौजूद थी और स्थानांतरित हुई [148][149]। एक समूह समवर्ती 2026 प्लेटफ़ॉर्म परिवर्तन सूर्यास्त की कैलेंडर साझा करते हैं और इसे किसी भी एकल इवेंट तारीख द्वारा अलग नहीं किया जा सकता: 13 अप्रैल 2026 को घोषित रणनीतिक पुनर्फोकस, दिसंबर के अंत के माध्यम से चलने वाली वाणिज्यिक अनुसंधान पत्र श्रृंखला की सेवानिवृत्ति 2026, और 20 जुलाई 2026 को लेखक-लाइसेंस परिवर्तन, हटाई के पांच दिन बाद [146][150]। क्योंकि ये हस्तक्षेप जुलाई की खिड़की को ओवरलैप करते हैं, एक एकल सामान्य इवेंट तारीख उनके संयुक्त प्रभाव को अकेले सूर्यास्त को जिम्मेदार ठहराएगी। पहचान इसलिए ऊपर के स्टैगर्ड टाइमिंग पर निर्भर करती है (दिसंबर फ्रीज़ सभी से पहले होती है), प्लेसेबो तारीखों पर, और एक रैंकिंग वापसी के लिए विशिष्ट वितरणात्मक हस्ताक्षर पर, और डिज़ाइन रिपोर्ट करता है कि कौन से सह-समय परिवर्तन अलग नहीं रहते हैं। फिर ग्रीष्मकालीन ध्यान गर्त है: जुलाई के मध्य में विद्वानों की पहुंच में प्रलेखित मौसमी गिरावट के साथ मेल खाता है, पहुंच गर्मी के महीनों में 50% के क्रम में गिरती है [178], इसलिए हटाई की तारीख में एक क्रॉस-क्षेत्र विपरीत सूर्यास्त को एक क्षेत्र की अपनी ग्रीष्मकालीन मौसमीता के साथ भ्रमित करता है, जो अनुशासन द्वारा भिन्न होता है। कैलेंडर-तारीख निश्चित प्रभाव केवल सामान्य मौसमी घटक को अवशोषित करते हैं। डिज़ाइन इसलिए क्षेत्र-विशिष्ट मौसमी आधारभूत (क्षेत्र प्रति एक पूर्व-वर्ष समान-खिड़की तुलना) की आवश्यकता है। उच्च- और कम-एक्सपोज़र क्षेत्रों के बीच गैर-यादृच्छिक अंतर एक और खतरा है, ऊपर दिए गए मापे-एक्सपोज़र परिचालन द्वारा और मिलान तुलना समूहों द्वारा संबोधित किया गया है। शेष खतरा भविष्यसूचक है: SSRN ने कहा है कि यह रैंकिंग को फिर से देख सकता है, इसलिए अवलोकन खिड़की के दौरान एक आंशिक पुनरुस्थापन एक दूसरी इवेंट शुरू करेगा। डिज़ाइन किसी भी ऐसी पुनरुस्थापन को पोस्ट-अवधि के लिए एक सेंसरिंग बिंदु के रूप में मानने और इसे एक अलग उपचार के रूप में मॉडल करने का पूर्व-पंजीकरण करता है न कि इसे सूर्यास्त विपरीत में मोड़ने के। सभी रिपोर्टिंग में, इवेंट समय को तीन नामित अवधियों में विभाजित किया जाता है, घोषणा (12 जून 2026 से), संक्रमण, और सेवानिवृत्ति (15 जुलाई 2026 से), ताकि प्रत्याशा प्रभाव अनुमानित हों। पूर्व-निर्दिष्ट डिज़ाइन इसलिए इवेंट-टाइम पूर्व-प्रवृत्ति परीक्षण, वैकल्पिक बैंडविड्थ, प्लेसेबो तारीखें, क्षेत्र-विशिष्ट समय प्रवृत्तियां और क्षेत्र-विशिष्ट मौसमी आधारभूत, और संवेदनशीलता विश्लेषण घोषणा-से-सेवानिवृत्ति संक्रमण अवधि को बाहर करते हुए शामिल हैं। चित्रा 11 दोनों इवेंट अध्ययनों के इच्छित आउटपुट को डिज़ाइन टेम्पलेट के रूप में प्रस्तुत करता है।
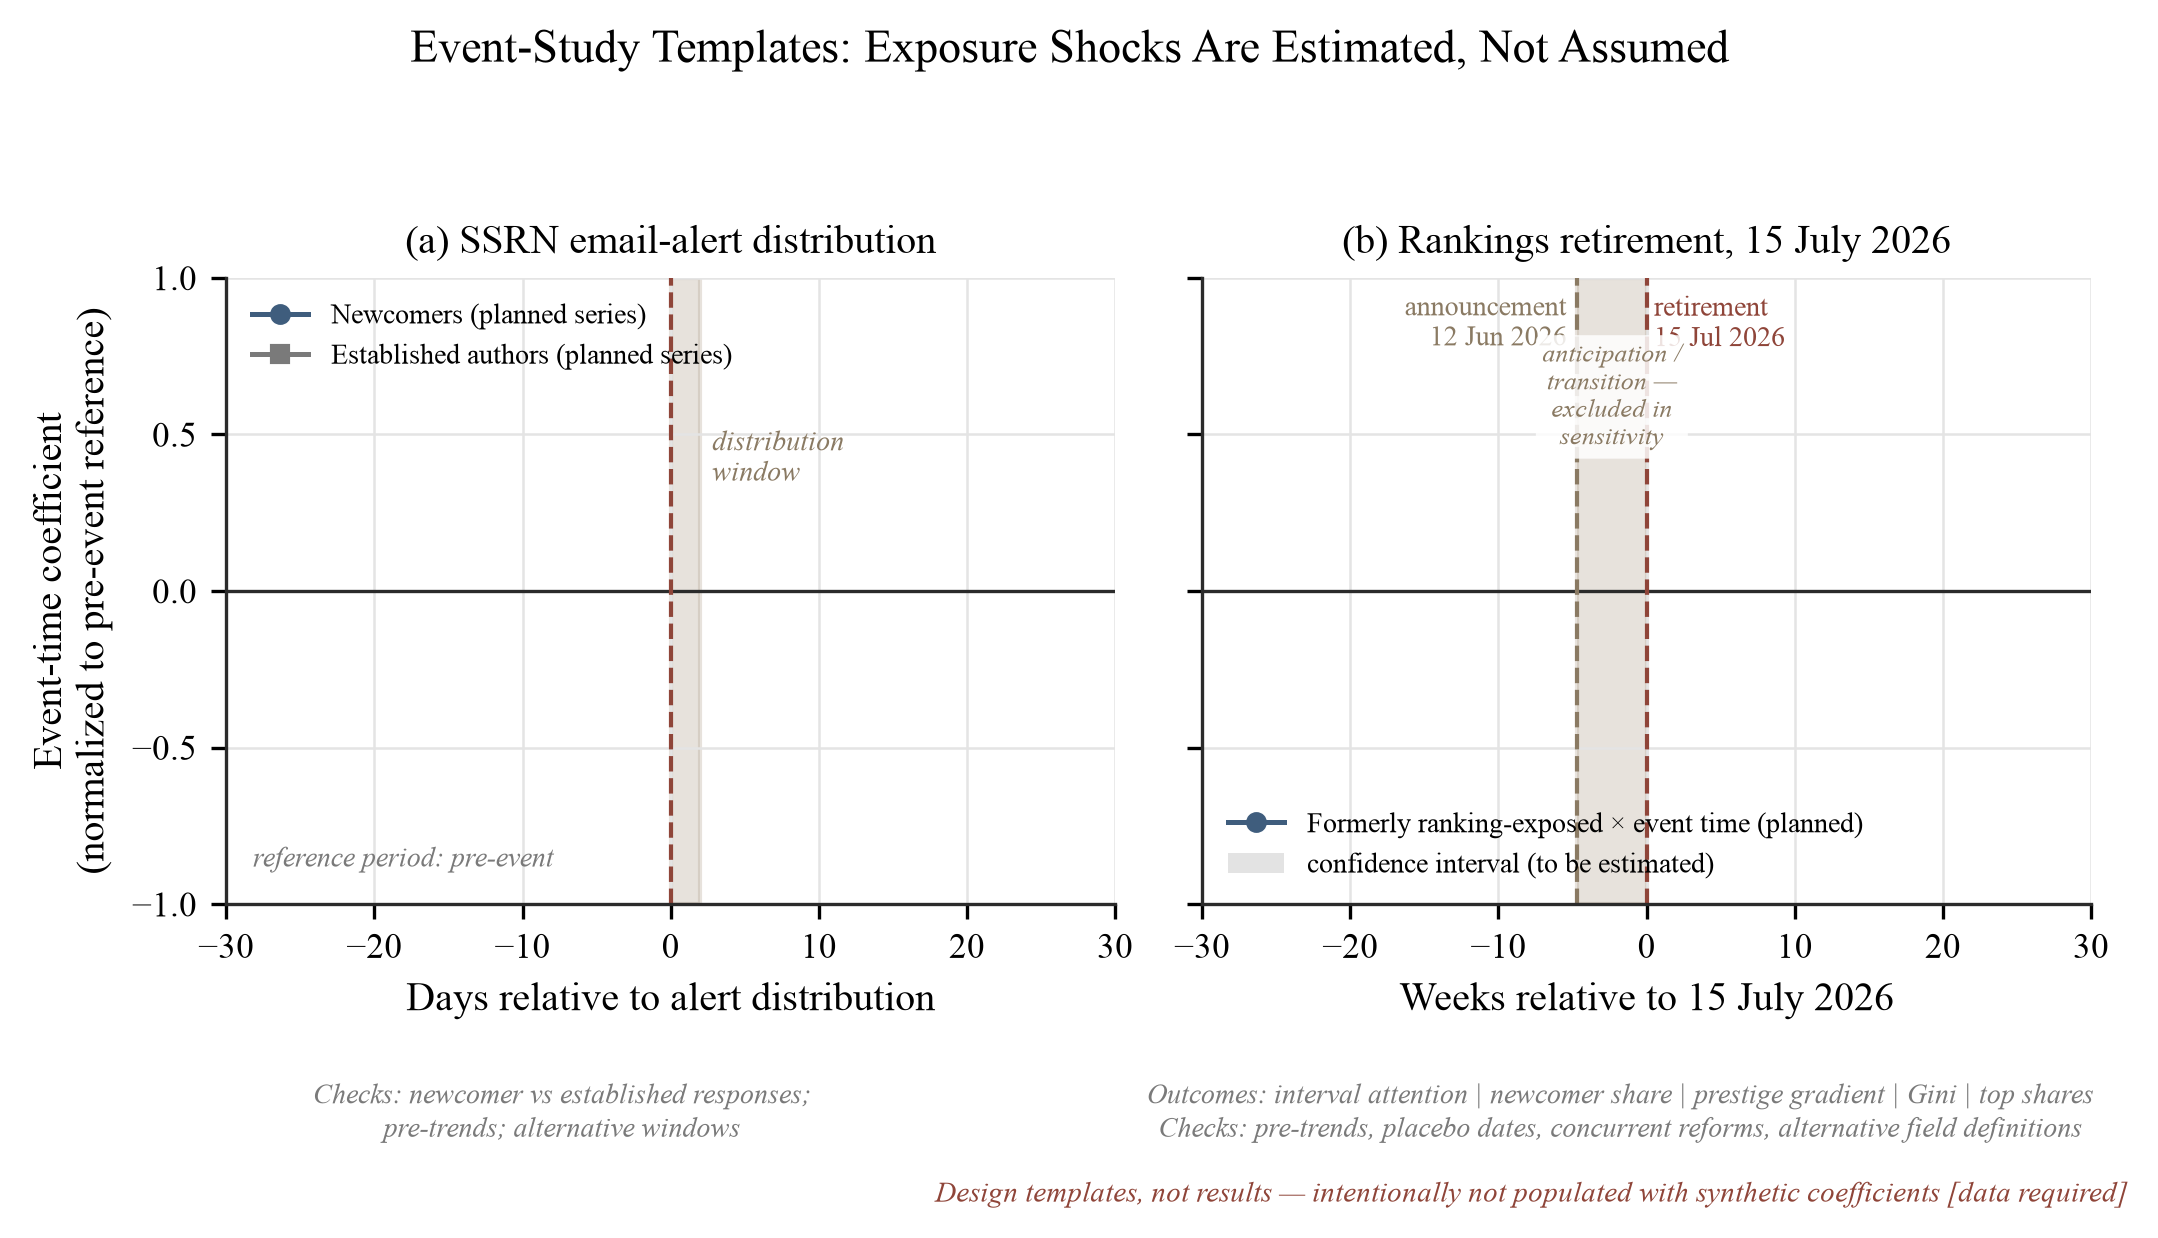
चित्र 11. दोनों प्लेटफॉर्म अर्ध-प्रयोगों के लिए ईवेंट-अध्ययन डिज़ाइन टेम्पलेट। अनुभागों 8.4–8.5 के डिज़ाइन के लिए पूर्वनिर्दिष्ट ईवेंट-अध्ययन आउटपुट: (a) ईमेल-सतर्कता वितरण के चारों ओर ध्यान, नए लेखकों बनाम स्थापित लेखकों, वितरण विंडो को छायांकित किया गया क्योंकि सतर्कताएं एक तात्कालिक के रूप में नहीं, एक विंडो के रूप में आती हैं; (b) रैंकिंग सेवानिवृत्ति के चारों ओर ध्यान और असमानता परिणाम, घोषणा (12 जून 2026) और सेवानिवृत्ति (15 जुलाई 2026) दोनों तारीखें चिह्नित हैं और प्रत्याशा/संक्रमण अवधि को छायांकित किया गया है — पूर्वनिर्दिष्ट संवेदनशीलता विश्लेषणों में बाहर की गई विंडो। वितरणात्मक परिणाम (अंतराल ध्यान, नए सदस्य शेयर, प्रतिष्ठा प्रवणता, गिनी, शीर्ष शेयर) और आवश्यक जांचें आकृति पर ही कथित हैं। गुणांक पूर्व-ईवेंट संदर्भ अवधि के लिए सामान्यीकृत हैं; छायांकित भूरे क्षेत्र आत्मविश्वास अंतराल को दर्शाते हैं। ये पैनल डिज़ाइन टेम्पलेट हैं; कोई अनुभवजन्य मान नहीं दिखाए गए हैं, और जनरेशन कोड पूर्वपंजीकरण सामग्रियों के साथ जारी किया जाएगा।
8.6 चार पूर्वनिर्दिष्ट अध्ययन
मुख्य पैनल के साथ, चार अध्ययन निर्दिष्ट हैं और तालिका 17 में संक्षेपित हैं। दोनों सार्वजनिक-डेटा अध्ययन (1 और 2) किसी भी शोधकर्ता द्वारा प्रतिबंधित-पहुँच अनुमतियों के बिना, धारा 9 में उल्लिखित पहुँच सीमाओं के भीतर (प्लेटफॉर्म की सेवा की शर्तों के तहत दर-सीमित संग्रह) का प्रयास किया जा सकता है। दोनों मानव-विषय अध्ययन (3 और 4) को प्रतिभागियों की आवश्यकता है और घोषणापत्र में बताई गई नैतिकता अनुमोदन के तहत आगे बढ़ते हैं। ये सभी चारों एक बहु-वर्षीय पैनल के परिपक्व होने के बाद के बजाय तुरंत बेंचमार्क शून्य को भरना शुरू करने के लिए मौजूद हैं।
तालिका 17. चार पूर्वनिर्दिष्ट अध्ययन।
| अध्ययन 1 | अध्ययन 2 | अध्ययन 3 | अध्ययन 4 | |
|---|---|---|---|---|
| अनुसंधान प्रश्न | माध्यिका/प्रतिशतक डाउनलोड वितरण क्या है? | क्या AI उत्तर इंजन प्रीप्रिंट का ही हवाला देते हैं? | पाठक या शिकारी पहले? | लेखक अपने स्वयं के काउंटर को कैसे पढ़ते हैं? |
| डेटा | 3,000–5,000 स्तरीकृत SSRN पेपर आईडी | 100–200 विशिष्ट प्रश्न × ~5 इंजन | 2 उपकरणित पोस्टिंग, 90-दिन की इनबाउंड लॉग | पूर्वपंजीकृत लेखक सर्वेक्षण, चार निश्चित-शब्दांकन आइटम |
| विधि | माध्यिका, गिनी, क्षय वक्र, वर्गीकरण-गणना प्रतिगमन | पुनः प्राप्ति कोडिंग + लॉजिस्टिक प्रतिगमन | प्रति-चैनल उपनाम ट्रैकिंग + संदेश कोडिंग | बंद-रूप प्रश्नावली + वर्णनात्मक शेयर |
| प्राथमिक परिणाम | माध्यिका; ≤10-डाउनलोड शेयर; ध्यान गिनी | मशीन दृश्यमानता V | t_पाठक बनाम t_शिकारी | कभी भी किसी भी बेंचमार्क से काउंटर की तुलना नहीं करने वाले शेयर; "7 डाउनलोड" के लिए पहली-पठन वितरण |
| विकृत भविष्यवाणी | माध्यिका < 0.5 × माध्य; गिनी 0.75–0.90 | परीक्षणों के 10–35% में प्रीप्रिंट का हवाला दिया गया | t_शिकारी < t_पाठक | बहुमत कभी किसी भी बेंचमार्क से तुलना नहीं करने की रिपोर्ट करते हैं |
| मुख्य वितरण | सार्वजनिक, मशीन-पठनीय आयु-, क्षेत्र-, और समूह-स्तरीकृत प्रतिशतक बेंचमार्क तालिकाएँ | पुनः प्राप्ति-और-एट्रिब्यूशन ऑडिट प्रोटोकॉल एक समय-मुद्रांकित स्नैपशॉट के साथ पुनरुत्पादनीय | पूर्व-पोस्टिंग बेसलाइन और कोडिंग कोडबुक के साथ खुली उपकरणित-पोस्टिंग प्रोटोकॉल | लेखक व्याख्याओं और रिपोर्ट किए गए व्यवहार परिवर्तन का प्रलेखित वितरण |
| डिज़ाइन विफल होता है यदि | सामान्यीकरण कच्ची गणना पर स्थिरता या नमूना-बाहर भविष्यवाणी में सुधार नहीं करता है | विशेषताएँ क्वेरी प्रासंगिकता, इंजन, और तारीख से परे कुछ भी भविष्यवाणी नहीं करती हैं | बेसलाइन और जोखिम नियंत्रण के बाद कोई पोस्ट-पोस्टिंग असंतोष नहीं है, या अविश्वसनीय कोडिंग है | भर्ती या आत्म-चयन वर्णनात्मक शेयरों को भी अव्याख्यायित छोड़ देता है |
| संसाधन प्रोफ़ाइल | सार्वजनिक डेटा; मानक स्क्रैपिंग और सांख्यिकी | सार्वजनिक AI-इंजन क्वेरी; मैनुअल कोडिंग | दो उपकरणित पोस्टिंग; इनबॉक्स लॉगिंग (IRB) | गुमनाम लेखक सर्वेक्षण (IRB) |
नोट। प्रत्येक अध्ययन डेटा संग्रह से पहले OSF पर पंजीकृत किया जाना चाहिए, कोड जारी किया जाना चाहिए।
अध्ययन 1: "माध्यिका की शारीरिकी।" अध्ययन 3,000–5,000 SSRN सार आईडी का एक यादृच्छिक स्तरीकृत नमूना लेता है, एक योजना श्रेणी, अंतिम N पूर्वनिर्दिष्ट भविष्यवाणी बैंड के विरुद्ध शक्ति सिमुलेशन द्वारा निर्धारित किया जाता है और सबसे छोटा ब्याज के प्रभाव (धारा 8.1)। स्तरीकरण पोस्टिंग वर्ष और नेटवर्क द्वारा है, और प्रति-पेपर जीवनकाल डाउनलोड, सार दृश्य, पोस्टिंग तारीख, और वर्गीकरण गणना धारा 8.3 के पहुँच मार्गों के माध्यम से एकत्र किए जाते हैं। अनुमानक: माध्यिका जीवनकाल डाउनलोड; शून्य और दस या उससे कम डाउनलोड वाले पेपर के शेयर; बूटस्ट्रैप विश्वास अंतराल के साथ ध्यान गिनी; दृश्य-से-डाउनलोड रूपांतरण दर, समग्र रूप से अनुमानित और नेटवर्क द्वारा स्तरीकृत (धारा 5.2 की दर्शक-पठन-शैली परिकल्पना की एक परीक्षा); डाउनलोड क्षय वक्र; और वर्गीकरण गणना पर लॉग डाउनलोड का एक प्रतिगमन वर्ष और नेटवर्क निश्चित प्रभाव के साथ (P2 की एक प्रत्यक्ष परीक्षा [168])। पूर्वनिर्दिष्ट भविष्यवाणी बैंड (माध्यिका जीवनकाल डाउनलोड मोटे तौर पर 30–80, ≤10-डाउनलोड शेयर 15–30%, गिनी 0.75–0.90) धारा 5 की दिनांकित एंकरों [83][85][139] और आसन्न माध्यमों में ध्यान-गिनी परिमाण [180] से एक्सट्रपोलेशन हैं, अग्रिम में बताए गए हैं ताकि अध्ययन उन्हें विकृत कर सके। अध्ययन 1 धारा 8.8 में चर्चा किए गए प्रतिशतक बेंचमार्क का अनुभवजन्य बीज है।
अध्ययन 2: "क्या मशीनें आपको पढ़ती हैं?" सूचना खोज का एक बढ़ता हुआ हिस्सा अब उत्पादक इंटरफेस पर शुरू होता है: लगभग आधे अमेरिकी वयस्क AI चैटबॉट का उपयोग करने की रिपोर्ट करते हैं, और लगभग एक चौथाई उन्हें दैनिक उपयोग करते हैं [121], जिनमें से एक महत्वपूर्ण अल्पसंख्यक पहले से ही सुविधा नमूनों में एक चैटबॉट को अपने पहले खोज इंजन के रूप में मानते हैं [4]। परिचय (धारा 1.6) ने इसे खोज गेटकीपर का एक ऊपर की ओर प्रवासन के रूप में विचारा (जर्नल ब्रांड → रिपोजिटरी → खोज इंजन → AI उत्तर परत) प्रत्येक चरण के साथ नियंत्रण को लेखक से आगे स्थानांतरित कर रहे हैं और किसी भी सार्वजनिक बेंचमार्क से आगे (चित्र 12)। क्या शीर्ष परत प्रीप्रिंट को बिल्कुल भी पुनः प्राप्त करती है, यह अज्ञात है: उत्पादक-इंजन-अनुकूलन साहित्य अब तक ब्रांड और वाणिज्य पर ध्यान केंद्रित कर रहा है [5][100][164], और AI खोज के ऑडिट समाचार एट्रिब्यूशन से संबंधित हैं बजाय विद्वानपूर्ण स्रोतों के [82]। वे ऑडिट नई गेटकीपर की विश्वसनीयता के बारे में संदेह करते हैं: Tow Center ऑडिट में (आठ इंजनों में 1,600 क्वेरी), इंजन ने सामूहिक रूप से 60% से अधिक परीक्षणों में सही सूचना को पुनः प्राप्त करने में विफल रहे, सर्वश्रेष्ठ प्रदर्शनकर्ता (Perplexity) 37% समय गलत उत्तर दिया और सबसे बुरा (Grok-3) 94%, और वे आमतौर पर अनुचित आत्मविश्वास के साथ गलती करते हैं बजाय उत्तर देने से इनकार करते हैं [82], समाचार-एट्रिब्यूशन परीक्षण से आंकड़े, विद्वानपूर्ण खोज से नहीं। AI उत्तर इंजन में विद्वानपूर्ण प्रीप्रिंट दृश्यमानता का कोई नियंत्रित अध्ययन अगस्त 2026 तक मौजूद नहीं था [100]। योगदान दो आसन्न कार्य की पंक्तियों के विरुद्ध बैठता है। उत्पादक-इंजन-अनुकूलन अध्ययन यह लेख ब्रांड और वाणिज्यिक पृष्ठों की दृश्यमानता को मापते और हेराफेरी करते हैं [5][164], विद्वानपूर्ण कलाकृतियों के पुनः प्राप्ति नहीं। एक अलग शाखा दिखाती है कि जब भाषा मॉडल सभी पर संदर्भ उत्पन्न करते हैं, तो वे पहले से ही अत्यधिक उद्धृत कार्य को उद्धृत करने की मानव प्रवृत्ति को पुन: उत्पन्न और प्रशस्त करते हैं, एक Matthew प्रभाव को मशीन परत में विस्तारित करते हैं [7], जो तंत्र P3b है (धारा 8.2) परीक्षण। न ही शाखा ने नियंत्रित क्वेरी प्रासंगिकता के तहत वैज्ञानिक प्रीप्रिंट की खोजशीलता की जांच की है, और विशेष रूप से एक प्लेटफॉर्म रैंकिंग सतह हटाने के बाद उनकी पुनः प्राप्यता, जो अध्ययन 2 अलग करता है।
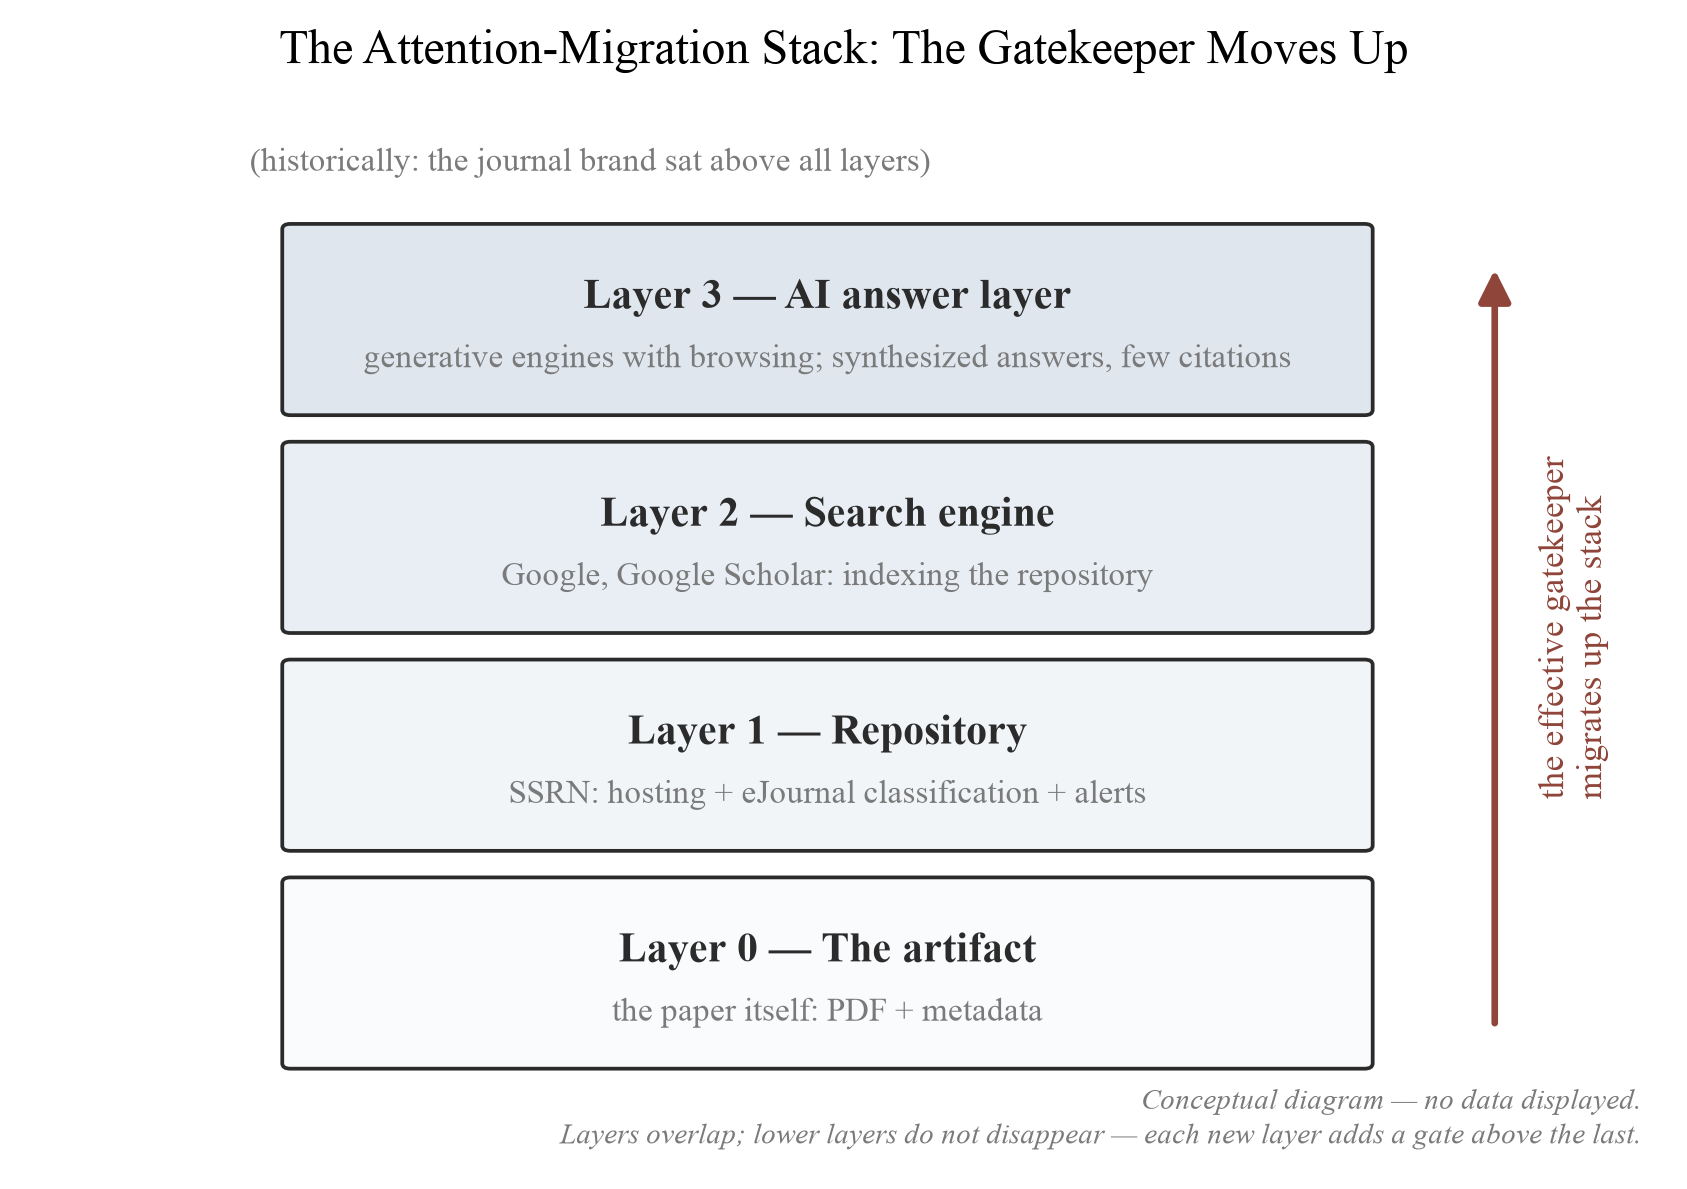
Figure 12. ध्यान-प्रवासन स्टैक। एक पूर्ण पांडुलिपि से पाठक के ध्यान तक की स्तरित पथ। प्रवासन थीसिस मानती है कि प्रभावी गेटकीपर — वह परत जो यह तय करती है कि कौन सी कलाकृतियों को ध्यान मिले — समय के साथ ऊपर की ओर चली गई है, जर्नल ब्रांड से होते हुए रिपॉजिटरी और सर्च इंजन से लेकर AI उत्तर परत तक; प्रत्येक ऊपर की ओर चाल नियंत्रण को लेखक से और आगे किसी भी सार्वजनिक बेंचमार्क से दूर ले जाती है। स्टैक एक वैचारिक मॉडल है।
अध्ययन 2 100–200 विशेष प्रश्न बनाता है, प्रत्येक इस तरह तैयार किया जाता है कि एक विशिष्ट SSRN प्रीप्रिंट सर्वोत्तम उपलब्ध स्रोत है, एक प्रासंगिकता दावा जिसे अंधे विशेषज्ञ रेटर द्वारा सत्यापित किया जाता है न कि क्वेरी लेखकों द्वारा स्वयं-प्रमाणित किया जाता है। यह ब्राउज़िंग सक्षम करके प्रमुख उपभोक्ता AI सिस्टम को क्वेरी करता है और परिणाम को छह परस्पर अनन्य श्रेणियों में कोड करता है: (1) फोकल प्रीप्रिंट स्वयं उद्धृत; (2) प्रकाशित संस्करण या एक ही पेपर का दर्पण उद्धृत, एक मामला जिसे एक मोटे योजना गायब के रूप में गलत वर्गीकृत करेगी; (3) द्वितीयक कवरेज बिना पेपर के उद्धृत; (4) एक अलग लेकिन रक्षणीय स्रोत उद्धृत; (5) कोई पता लगाने योग्य स्रोत नहीं; और (6) इंजन से इनकार (Figure 13)। प्रत्येक उत्तर के लिए जो फोकल पेपर या इसके संस्करण को उद्धृत करता है, एक बाइनरी attribution-fidelity फ्लैग अतिरिक्त रूप से रिकॉर्ड करता है कि क्या उत्तर में दावा वास्तव में उद्धृत स्रोत द्वारा समर्थित है। दृश्यमानता और निष्ठा अलग से रिपोर्ट की जाती हैं और कभी भी एक एकल स्कोर में नहीं जोड़ी जाती हैं, क्योंकि एक इंजन एक पेपर को प्रमुखता से उद्धृत कर सकता है जबकि इसे गलत बता रहा है (उद्धरण लॉन्ड्रिंग) या इसकी सामग्री को बिना किसी उद्धरण के पुन: प्रस्तुत कर सकता है (जिम्मेदारी के बिना प्रभाव)। पुष्टिकारी प्रतिगमन लॉजिस्टिक रहता है, "फोकल पेपर या इसके संस्करण उद्धृत" के विरुद्ध सभी अन्य परिणामों के विरुद्ध, मानक त्रुटियों के साथ क्लस्टर किए गए, या अधिमानतः एक पार किया गया यादृच्छिक-प्रभाव संरचना फिट की गई, प्रेक्षणों की गैर-स्वतंत्रता का सम्मान करने के लिए जो एक इंजन, एक क्वेरी, या एक फोकल पेपर साझा करते हैं, क्योंकि इंजन के पार क्वेरी किया गया समान पेपर और पेपर के पार क्वेरी किया गया समान इंजन प्रत्येक सहसंबद्ध परिणाम प्रेरित करते हैं जो भोली स्वतंत्र-परीक्षण त्रुटियां कम करेंगी। औपचारिक रूप से, लेखापरीक्षा का अनुमानक M_pqe है: क्वेरी q के प्रतिक्रिया में इंजन e द्वारा पेपर p के उद्धृत होने की संभावना। M_pqe अकेले पेपर की संपत्ति नहीं है, क्योंकि यह क्वेरी, इंजन, तारीख और मॉडल संस्करण में भिन्न होता है, इसलिए संकेतन अनुमानक को परिभाषित करता है और प्रत्येक टाइमस्टैम्प रन को इसकी तारीख में M_pqe का अनुमान माना जाता है। इंजन नमूना उपभोक्ता चैटबॉट्स से परे उदीयमान विद्वान पुनः प्राप्ति परत तक विस्तारित होना चाहिए (Consensus, Elicit, Scite, और Semantic Scholar जैसे उपकरण, जो अकादमिक कॉर्पस पर आधारित हैं और वास्तविक पेपर उद्धृत करते हैं), क्योंकि एक प्रीप्रिंट उपभोक्ता इंजन के लिए अदृश्य हो सकता है लेकिन फिर भी अनुशासन-विशिष्ट द्वारा सतह पर आ सकता है, और दोनों परतों के बीच विचलन स्वयं रुचि का परिणाम है। मशीन दृश्यमानता को फिर Table 18 में संचालनीकृत पेपर सुविधाओं पर प्रतिगमन किया जाता है, जिसमें P3b के लिए आवश्यक prior-visibility सहसंयोजक शामिल है: प्रत्येक पेपर का पूर्व-लेखापरीक्षा वेब और विद्वान पदचिह्न, क्वेरी निर्माण पर फ्रीज किया गया। क्वेरी नमूना prior visibility द्वारा स्तरीकृत है ताकि cold-start पेपर डिजाइन द्वारा प्रतिनिधित्व किए जाएं। क्योंकि जेनरेटिव इंजन गैर-स्थिर हैं, डिजाइन एक टाइमस्टैम्प किए गए प्राथमिक स्नैपशॉट के साथ एक स्क्रिप्टेड पुनः रन प्रोटोकॉल को जोड़ता है जो अन्य दोहरा सकते हैं। तीन आगे audit-hygiene आवश्यकताएं पूर्वनिर्दिष्ट हैं: नकारात्मक नियंत्रण (प्रतिष्ठित लेकिन अप्रासंगिक पेपर, शीर्षक वेरिएंट, और संकेत जो फोकल कार्य को नहीं पुनः प्राप्त करना चाहिए) अविवेकी उद्धरण को पहचान योग्य बनाते हैं; प्रत्येक क्वेरी रिकॉर्ड किए गए सत्र स्थिति (स्वच्छ बनाम logged-in सत्र; इंजन, मॉडल संस्करण, तारीख और भूगोल) के तहत समकक्ष संकेत वेरिएंट में चलता है, ताकि prompt- और session-विशिष्ट कलाकृतियों को स्थिर पुनः प्राप्ति व्यवहार से अलग किया जा सके; और परिणामों का एक यादृच्छिक सबसेट double-coded है, inter-rater समझौते के साथ रिपोर्ट किया गया। पूर्ण चरण-दर-चरण लेखापरीक्षा चेकलिस्ट पूर्वपंजीकरण सामग्री के साथ जमा की गई है। अध्ययन की प्रधान इनपुट शोधकर्ता समय है (100–200 प्रश्नों का अंधा प्रासंगिकता सत्यापन और double-coding) के बजाय प्रतिबंधित-access डेटा या विशेष बुनियादी ढांचे। एक अध्ययन जिसे बाजार दरों पर विशेषज्ञ-rater समय के लिए भुगतान करना चाहिए उस श्रम के लिए स्पष्ट रूप से बजट करना चाहिए। पूर्वनिर्दिष्ट भविष्यवाणी यह है कि प्रीप्रिंट स्वयं परीक्षणों के एक अल्पसंख्यक में उद्धृत है (band 10–35%), संरचित-सार और प्रकाशित-संस्करण सुविधाएं दृश्यमानता बढ़ाती हैं (P3)। अध्ययन 2 पांच एजेंडा आइटम में से एक प्रोटोकॉल है। विद्वान मशीन दृश्यमानता की एक पूर्ण लेखापरीक्षा, cross-engine और cross-repository तुलना सहित, एक नियोजित साथी पेपर का विषय है।
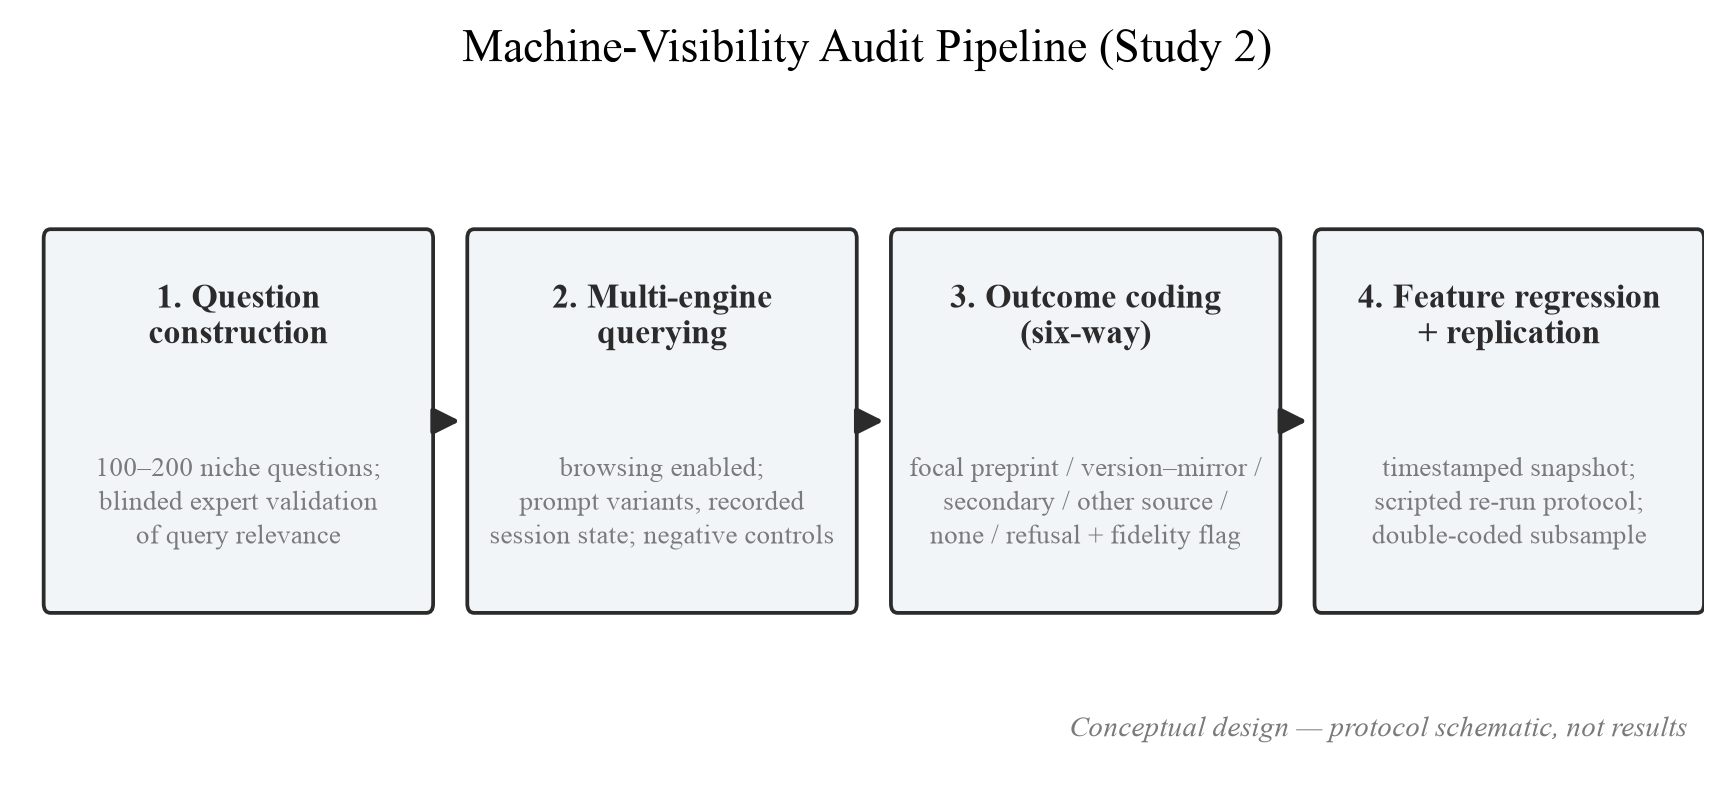
Figure 13. मशीन-दृश्यमानता लेखापरीक्षा पाइपलाइन (अध्ययन 2)। चार-चरण अध्ययन 2 पाइपलाइन। छह-तरफा कोडिंग फोकल प्रीप्रिंट के उद्धरण को इसके प्रकाशित संस्करण या दर्पण से अलग करती है — अनुपस्थिति का गलत वर्गीकरण रोकना — और attribution-fidelity फ्लैग "क्या इसे उद्धृत किया गया था" को "क्या इसे सच्चाई से उद्धृत किया गया था" से अलग रखता है। स्नैपशॉट-प्लस-प्रतिकृति संरचना मॉडल non-stationarity को संबोधित करती है: प्राथमिक स्नैपशॉट को तारीख दी गई है, और पुनः-रन प्रोटोकॉल किसी भी शोधकर्ता को बाद की तारीख में लेखापरीक्षा को पुन: प्रस्तुत करने की अनुमति देता है।
Table 18. मशीन-दृश्यमानता सुविधाओं का संचालन (अध्ययन 2)।
| चर | परिभाषा | कोडिंग |
|---|---|---|
| DOI उपस्थित | पेपर पृष्ठ एक पंजीकृत DOI को उजागर करता है | 1/0 |
| शीर्षक प्रकार | वर्णनात्मक बनाम संकेत शीर्षक | descriptive = 1 |
| सारांश संरचना | संरचित/सांख्यिकीय-समृद्ध बनाम narrative | structured = 1 |
| आयु | पहली पोस्टिंग के बाद से महीने | integer |
| वर्गीकरण गणना | निर्दिष्ट eJournals की संख्या | integer |
| माध्यमिक कवरेज | ≥1 अनुक्रमित ब्लॉग/समाचार उल्लेख मौजूद है | 1/0 |
| प्रकाशित संस्करण | एक पत्रिका संस्करण रिकॉर्ड का विद्यमान है | 1/0 |
| पूर्व दृश्यमानता | पत्र और उसके लेखकों की पूर्व-लेखापरीक्षा वेब और विद्वानों की उपस्थिति, प्रश्न निर्माण के समय स्थिर (P3b) | स्तरीकृत क्रमिक |
| परिणाम V | केंद्रीय पत्र के लिए पुनः प्राप्ति परिणाम | छः श्रेणियाँ: केंद्रीय प्रीप्रिंट / प्रकाशित संस्करण या दर्पण / केवल माध्यमिक / अन्य रक्षणीय स्रोत / कोई पता न चल सके / अस्वीकार; साथ ही उद्धृत मामलों के लिए बाइनरी आरोपण-निष्ठा ध्वज |
नोट। विशेषता चुनाव विद्वान कलाकृतियों के लिए प्रलेखित जनरेटिव-इंजन-अनुकूलन कारकों [5][164] को अनुकूलित करते हैं। इस तरह का सबसे बड़ा लेखापरीक्षा, छः AI-आधारित इंजनों में लगभग 252,000 परीक्षणों के क्रम पर, विषयगत प्रासंगिकता और पुनः प्राप्त संदर्भ के भीतर सूची स्थिति को पहले उद्धृत किए जाने के प्रमुख चालकों के रूप में चिन्हित किया गया [164]। सूची स्थिति इसलिए अध्ययन 2 के लिए एक अलग, हस्तांतरणीय परिकल्पना है, और परिणाम-सूची स्थिति को कहीं भी रिकॉर्ड किया जाना चाहिए जहाँ यह प्रेक्षणीय है।
तालिका 19 वर्णन के एक अलग स्तर पर तालिका 18 को पूरक करती है। तालिका 18 पत्र-स्तर की विशेषताओं को संचालित करती है जिनके प्रभाव अध्ययन 2 का अनुमान लगाते हैं, जबकि तालिका 19 लेखापरीक्षा के माप निर्माणों को निर्दिष्ट करती है: क्या मापा जाता है, किन नियंत्रणों के तहत, और किस प्राथमिक वैधता खतरे के विरुद्ध। प्रत्येक निर्माण मशीन परत के बारे में एक अलग दावा है, और प्रत्येक खतरा उस विशिष्ट तरीके को नाम देता है जिससे एक भोली लेखापरीक्षा गलत होगी।
तालिका 19। मशीन-दृश्यमानता लेखापरीक्षा के माप निर्माण (अध्ययन 2)।
| निर्माण | परिचालन उपाय | आवश्यक नियंत्रण | प्राथमिक खतरा |
|---|---|---|---|
| प्रत्यक्ष मशीन दृश्यमानता | केंद्रीय प्रीप्रिंट उत्तर में उद्धृत या जुड़ा हुआ | प्रश्न की प्रासंगिकता, इंजन, तारीख, सत्र स्थिति | मॉडल और सूचकांक प्रवाह |
| स्रोत प्रतिस्थापन | प्रकाशित संस्करण, दर्पण, या माध्यमिक कवरेज प्रीप्रिंट के बजाय उद्धृत | संस्करण मिलान, DOI, शीर्षक वेरिएंट | अनुपस्थिति के रूप में गलत वर्गीकरण |
| उद्धरण स्थिति | उत्तर के भीतर केंद्रीय उद्धरण की रैंक और प्रमुखता | उत्तर की लंबाई और उद्धरण गणना | इंटरफ़ेस-विशिष्ट प्रस्तुति |
| आरोपण निष्ठा | उत्तर में दावा उद्धृत पत्र द्वारा सटीक रूप से समर्थित है | अंधा दावा–स्रोत सत्यापन | उद्धरण लॉन्ड्रिंग या मतिभ्रम |
| प्रश्न संवेदनशीलता | समान प्रश्न वाक्यांशों में परिणामों में भिन्नता | यादृच्छिक संकेत वेरिएंट | संकेत-विशिष्ट कलाकृतियाँ |
| प्रतिलिपि क्षमता | बाद की तारीख पर या स्वच्छ पुनः चलने पर समान परिणाम | संग्रहीत प्रोटोकॉल और सिस्टम मेटाडेटा | इंजन गैर-स्थिरता |
वाणिज्यिक GEO साहित्य से सबसे रक्षणीय हस्तांतरण एक विशेषता-लेखापरीक्षा एजेंडा है, प्रचारक पकिस्तान नहीं: तालिका 20 उम्मीदवार विशेषताओं की सूची देती है जिनका मशीन दृश्यमानता के साथ संबंध अध्ययन 2 की पुष्टि या खंडन करने के लिए डिज़ाइन किया गया है। प्रत्येक पंक्ति एक स्थापित रणनीति के बजाय एक परिकल्पना है, और पुनः प्राप्ति के साथ जुड़ी एक विशेषता अभी भी कागज़ परिपक्वता, विषय लोकप्रियता, या पूर्व दृश्यमानता के लिए एक प्रॉक्सी हो सकती है एक लीवर के बजाय।
तालिका 20। मशीन दृश्यमानता के लिए विशेषता-लेखापरीक्षा एजेंडा (अध्ययन 2 के लिए परिकल्पनाएं, सिफारिशें नहीं)।
| उम्मीदवार विशेषता | परिकल्पित तंत्र | समर्थन साक्ष्य |
|---|---|---|
| एक DOI पंजीकृत करें | स्थिर पहचानकर्ता पुनः प्राप्ति और उद्धरण मिलान में सहायता करता है | [164] |
| संरचित, सांख्यिकी-समृद्ध सारांश | सांख्यिकी जोड़ ने वाणिज्यिक बेंचमार्क में जनरेटिव दृश्यमानता को ~40% तक बढ़ाया | [5] |
| वर्णनात्मक, प्रासंगिकता-घने शीर्षक | विषयगत प्रासंगिकता AI उत्तरों में उद्धरण का शीर्ष चालक है | [164] |
| अधिकतम सटीक ईजर्नल वर्गीकरण | अधिक वर्गीकरण अधिक डाउनलोड, कम शून्य के साथ जुड़े हुए हैं | [168] |
| ≥1 माध्यमिक कवरेज की वस्तु सुरक्षित करें | इंजन अक्सर प्राथमिक स्रोतों पर माध्यमिक कवरेज का हवाला देते हैं | [82] |
अध्ययन 3: "पहले कौन आता है?" एक सुसज्जित-पोस्टिंग प्रोटोकॉल P4 को सीधे परीक्षण करता है। दो वास्तविक कार्यशील पत्र प्रत्येक एक्सपोजर चैनल के लिए अद्वितीय प्लस-संबोधित ईमेल उपनाम का उपयोग करके पोस्ट किए जाते हैं, जिसमें एक 90-दिवसीय इनबाउंड लॉग होता है जो उसी उपनाम पर दो से चार सप्ताह की एक पूर्व-पोस्टिंग आधारभूत खिड़की से पहले होता है। एक आधारभूत के बिना, अनुरोध मात्रा में वृद्धि को पोस्टिंग के लिए बिल्कुल भी जिम्मेदार नहीं ठहराया जा सकता, क्योंकि शैक्षणिक स्पैम एक उच्च पृष्ठभूमि दर के विरुद्ध लगातार आता है। प्रत्येक संदेश को प्रकाशित अनुरोध हस्ताक्षर [96] और संचयी ब्लॉकलिस्ट-प्रकार के मानदंड का उपयोग करके सत्य शैक्षणिक संपर्क या परभक्षी अनुरोध के रूप में कोडित किया जाता है, खंड 7.2 [9][84][63][61] में समीक्षा किए गए विशेषता ऑडिट में प्रलेखित उच्च पृष्ठभूमि दर के विरुद्ध। परिणाम पहले सत्य संपर्क के समय और पोस्टिंग के लिए विशेषता योग्य पहले परभक्षी अनुरोध के समय की तुलना है। P4 के अनुसार पूर्वनिर्धारित भविष्यवाणी यह है कि अनुरोध सत्य संपर्क से पहले आता है। लॉन्च से पहले दो माप नियम निर्धारित किए जाते हैं। आधारभूत और पोस्ट-पोस्टिंग खिड़कियां लंबाई में असमान होती हैं (लगभग दो से चार सप्ताह बनाम नब्बे दिन), इसलिए तुलना आगमन दरों (प्रति उपनाम-दिन घटनाएं) और जीवित रहने वाले कार्यों की होती है, कभी भी कच्ची घटना गणना की नहीं, जो खिड़की विषमता अन्यथा विकृत करेगी। और पहले संपर्क तक का समय निर्माण द्वारा दाईं ओर सेंसर किया जाता है: दो पत्रों के साथ, एक उपनाम जो 90-दिवसीय खिड़की के भीतर कोई सत्य संपर्क प्राप्त नहीं करता है, एक सेंसर किया गया, शून्य नहीं, अवलोकन प्राप्त करता है, इसलिए सेंसरिंग नियम पूर्वनिर्धारित है। अवलोकन 90 दिनों पर दाईं ओर सेंसर किए जाते हैं, बिना घटना वाले उपनाम सेंसर किए गए समय को जीवित रहने के अनुमान में योगदान देते हैं, न कि छोड़े जाने या तत्काल के रूप में कोडित किए जाने, और N = 2 के साथ परिणामी वक्र बिंदु अनुमानों के रूप में नहीं बल्कि उनकी सटीक छोटे-नमूना अनिश्चितता के साथ रिपोर्ट किए जाते हैं। वितरित-प्रतिकृति डिजाइन का कारणात्मक अनुमान है पोस्टिंग के बाद अनुरोध के खतरे में परिवर्तन (किसी भी डाउनलोडर की पहचान नहीं), मेल खाते पूर्व- और पोस्ट-पोस्टिंग खिड़कियों पर जीवित रहने/घटना-इतिहास विधियों के साथ अनुमानित। क्योंकि एक लेखक की दृश्यमान उत्पादकता संभवतः अनुरोध मात्रा की स्वतंत्र रूप से भविष्यवाणी करती है (अनुरोध एक लेखक के जमा हुए सार्वजनिक आउटपुट से कटाई किया जाता है, इसलिए खंड 7.2 के विशेषता ऑडिट में प्रलेखित उच्च पृष्ठभूमि दरें उस आउटपुट के साथ स्केल करती हैं), वितरित प्रतिकृतियों को लेखक-स्तर की एक्सपोजर नियंत्रण (पूर्व पोस्टिंग, प्रकाशन मात्रा, और सार्वजनिक संपर्क सतह) को फोकल घटना के साथ रिकॉर्ड करना चाहिए। यह एक N = 2 सुसज्जित केस स्टडी है, एक तंत्र का प्रमाण और एक खुली प्रोटोकॉल जो वितरित प्रतिकृति को आमंत्रित करती है, जो सामूहिक रूप से एक संचालित अनुमान प्राप्त करेगी। N = 2 सुसज्जा की व्यावहारिकता, प्रसार नहीं और कारणात्मक परिमाण नहीं प्रदर्शित करता है। अध्ययन 1, 2, और 4 के विपरीत, जो पूर्वनिर्धारित प्रभाव आकारों के विरुद्ध संचालित होते हैं, अध्ययन 3 एक व्यावहारिकता पायलट और खुली प्रतिकृति प्रोटोकॉल है।
कोडिंग फ्रेम लॉन्च से पहले निर्धारित किया जाता है। इनबाउंड संदेशों को सात प्रकारों में कोडित किया जाता है: पत्रिका अनुरोध, सम्मेलन निमंत्रण, सहकर्मी-समीक्षा अनुरोध, संपादकीय-बोर्ड निमंत्रण, पुस्तक-अध्याय निमंत्रण, वाणिज्यिक सेवा प्रस्ताव, और सत्य शैक्षणिक पत्राचार, एक द्विआधारी परभक्षी/सत्य विभाजन से व्यापक फ्रेम। प्रत्येक रिकॉर्ड एक न्यूनतम क्षेत्र सेट वहन करता है: टाइमस्टैम्प, प्राप्त करने वाला उपनाम (चैनल), स्थान नाम, शुल्क प्रकटीकरण, फोकल पत्र की विशिष्टता, तात्कालिकता भाषा, रखी गई स्क्रीनिंग सेवाओं के विरुद्ध सत्यापन परिणाम, और कोडर आत्मविश्वास। सीमांत मामलों और वैध निम्न-प्रतिष्ठा स्थानों को तदर्थ निर्णय के बजाय पूर्वनिर्धारित नियमों द्वारा नियंत्रित किया जाता है। एक नया या अस्पष्ट स्थान स्वचालित रूप से परभक्षी नहीं है। एक यादृच्छिक उप-नमूने को अंतर-रेटर समझौते के साथ दोहरा-कोडित किया जाता है जिसे रिपोर्ट किया जाता है। केवल समग्र गणना जारी की जाती है (खंड 9; घोषणाएं), और पूर्ण कोडबुक को पूर्वपंजीकरण के साथ जमा किया जाता है। अनुरोध मात्रा पाठकता का प्रमाण नहीं है, और अनुरोध सार्वजनिक काउंटर को नहीं हिलाता है: SSRN की अखंडता प्रणाली आधिकारिक गणनाओं से विसंगत स्वचालित गतिविधि को बाहर करती है [144], और इनबॉक्स से डैशबोर्ड तक का कोई अनुमान किसी भी दिशा में अनुमति नहीं है।
अध्ययन 4: "लेखक अपने काउंटर को कैसे पढ़ते हैं।" एक पूर्वनिर्दिष्ट लेखक सर्वेक्षण तालिका 1 में दर्ज की गई मांग के फोरम साक्ष्य को सीधे माप में परिवर्तित करता है। यह उपकरण चार निश्चित-शब्दांकन आइटम से बना है: (1) "क्या आपने कभी अपने SSRN डाउनलोड की तुलना किसी बेंचमार्क या मानदंड से की है?", जिसमें प्रतिक्रिया विकल्प एक विशिष्ट प्रकाशित संख्या, एक अनुशासन-विशिष्ट तालिका, अनौपचारिक साथी तुलना और कभी नहीं को अलग करते हैं; (2) "जब आप अपने डैशबोर्ड पर '7 डाउनलोड' देखते हैं, तो आपका पहला विचार क्या है?", जिसमें विकल्प अनुमानित विफलता, बताने के लिए बहुत जल्दी, यह कोई विचार नहीं है कि सामान्य क्या है, और अपेक्षित या ठीक है; (3) "क्या जुलाई 2026 रैंकिंग सूर्यास्त ने आपके प्रीप्रिंट व्यवहार को बदल दिया?", जिसमें सांख्यिकी की जांच बंद करना, नई अपलोड से बचना, अपलोड करना लेकिन कम बार जांच करना, और कोई प्रभाव नहीं के विकल्प हैं; और (4) "क्या आप सोचते हैं कि नियुक्ति और कार्यकाल समितियां SSRN मेट्रिक्स को समझती हैं?". पूर्वनिर्दिष्ट भविष्यवाणियां यह हैं कि उत्तरदाताओं का बहुमत कभी भी अपने काउंटर की तुलना किसी भी बेंचमार्क से नहीं करने की रिपोर्ट करता है, और एक कम गिनती का पहला पाठ अनुमानित विफलता की ओर झुकता है न कि बहुत जल्दी पढ़ने की ओर जो अनुभाग 5.6 दिखाता है कि आमतौर पर सही डिफ़ॉल्ट है। नमूना-आकार का लक्ष्य, भर्ती चैनल, और विश्लेषण कोड पंजीकरण पर तय किए गए हैं। संलग्न और प्रशंसनीय रूप से अधिक चिंतित, लेखकों की ओर स्व-चयन नमूने को सीमित करता है, जैसा कि यह अनुभाग 8.8 रजिस्ट्री को करता है। निश्चित-विकल्प प्रारूप एक गुणात्मक साथी शाखा को भी स्वीकार करता है: सार्वजनिक लेखक प्रश्नों की पूर्वनिर्दिष्ट विषयगत कोडिंग (स्पष्ट समावेश मानदंड और अंतर-कोडर विश्वसनीयता के साथ, अनुभाग 9 में बताई गई उद्धरण नैतिकता के तहत) और अर्ध-संरचित साक्षात्कार कि लेखक कैसे पढ़ते हैं, और अपने काउंटर के बारे में महसूस करते हैं, मीट्रिक प्रस्तुति के मानवीय परिणामों तक पहुंचते हैं कि बंद-रूप आइटम नहीं कर सकते। एक डिजाइन सीमा केंद्रीय निर्माण पर है। केवल SSRN लेखकों को दिए गए चार निश्चित आइटम एक स्तर बेंचमार्क-मुक्त पाठ को मापते हैं, एक विपरीतता नहीं, और एक स्तर अपने आप से लेख के दावा किए गए मार्ग को बेंचमार्क अस्पष्टता से मीट्रिक अंधापन तक की पहचान नहीं कर सकता। SSRN पर एक उच्च कभी-तुलना नहीं किए गए शेयर एक सामान्य उदासीनता के साथ समान रूप से संगत है जिसका काउंटर से कोई लेना-देना नहीं है और न ही मंच अस्पष्टता है। विभेदक और कारण कर्षण इसलिए एक तुलना स्थिति की आवश्यकता है: विभिन्न बेंचमार्क एक्सपोज़र वाले मंचों पर पोस्ट करने वाले लेखकों को दिया गया समान उपकरण, arXiv (समर्थन- और सूचीबद्ध-आधारित, अपनी स्वयं की दृश्यता सतहों के साथ) और OSF Preprints, "SSRN लेखक अपने काउंटर को कैसे पढ़ते हैं" को "क्या लेखक अधिक- और कम-अपारदर्शी मंचों पर अपने काउंटर को अलग तरीके से पढ़ते हैं" में बदल देता है, जो विपरीतता है जो अस्पष्टता-से-अंधापन दावा वास्तव में भविष्यवाणी करता है। क्रॉस-मंच भुजा अध्ययन 4 के भाग के रूप में पूर्वनिर्दिष्ट है; इसके बिना एक एकल-मंच परिणाम SSRN का वर्णनात्मक रहेगा बजाय तंत्र का परीक्षण के। अध्ययन 4 तब अनुभाग 1 और 5 के व्याख्यात्मक दावों को सीधे परीक्षण करता है, यह मापता है कि लेखक अपने काउंटर का क्या अर्थ मानते हैं बजाय काउंटर क्या हैं।
8.7 अनुच्छेद अपने आप में एक प्रयोग के रूप में
इस अनुच्छेद का अपना डाउनलोड प्रक्षेपवक्र भी पूर्वनिर्धारित है। इसके काउंटर पोस्टिंग के 30, 90 और 180 दिनों के बाद रिकॉर्ड किए जाएंगे और एक बार वह माध्यिका ज्ञात हो जाने के बाद Study 1 माध्यिका के विरुद्ध रिपोर्ट किए जाएंगे। रिकॉर्ड वर्णनात्मक है और इसमें कोई व्याख्या नियम नहीं हैं, क्योंकि दोनों दिशात्मक पाठ थीसिस को प्रशंसा देंगे, और एक उपकरण जिस पर हर परिणाम तर्क की पुष्टि करता है, कुछ नहीं परखता; संख्याएं जैसे ही वे आएंगी प्रकाशित की जाएंगी। एक पाठ अनुच्छेद के ढांचे के विरुद्ध कटा होगा: एक प्रक्षेपवक्र जो क्षेत्र-और-आयु माध्यिका पर बैठा है, न तो उन्नत है और न ही दबा हुआ है, यह संकेत देता है कि आत्मनिर्देशी डिज़ाइन इस एकल मामले में कोई मापने योग्य खोजपूर्णता लाभ प्रदान नहीं करता है। प्रतिवर्तनीयता से बचा नहीं जा सकता, क्योंकि यह पत्र एक मेट्रिक का अध्ययन करता है जो वह स्वयं अर्जित करेगा; सूचीबद्ध लीवर का मूल्यांकन खंड 8 में प्रत्यक्ष परीक्षणों द्वारा किया जाता है, इस रिकॉर्ड द्वारा नहीं।
8.8 प्रतिशतक बेंचमार्क एक सार्वजनिक वस्तु के रूप में
इस एजेंडा जो सबसे उपयोगी कलाकृति का उत्पादन कर सकता है वह प्रीप्रिंट डाउनलोड के लिए एक प्रतिशतक तालिका है, वह संख्या जो हर लेखक खोजता है और नहीं पा सकता है। प्लेटफॉर्म ने ऐतिहासिक रूप से माध्य और शीर्ष-N सूचियाँ प्रकाशित की हैं लेकिन माध्यिकाएँ या प्रतिशतक नहीं, और 15 जुलाई 2026 के बाद से यह केवल प्रति-पत्र और प्रति-लेखक गणना प्रदर्शित करता है बिना किसी तुलनात्मक संदर्भ के [149]। h-सूचकांक और इसी तरह के संकेतकों के लिए यह मास-दर्शकों की एक विधा है "क्या X अच्छा है?" गाइड [118][128]; अनुभाग 2.5 ऑडिट ने SSRN डाउनलोड के लिए कोई समतुल्य नहीं पाया। ऐसी तालिका के लिए कच्चे माल वर्षों से प्रिंट में मौजूद हैं [18][83][85][139][168], और जो अनुपस्थित है वह उन वितरणों को एक लेखक-सामना करने वाले पैमाने में अनुवाद करना है।
सूर्यास्त के बाद, पूर्ण-प्लेटफॉर्म प्रतिशतकों का बाहरी संग्रहण अब संभव नहीं है: शीर्ष सूचियाँ जिन्होंने वितरणीय सीमाएँ लीक कीं वे पूंछ में एकमात्र सार्वजनिक खिड़की थीं, और वे चली गई हैं [149]। दो पूरक मार्ग बने रहते हैं। एक अध्ययन 1 का स्तरीकृत नमूना है, जो कागज स्तर पर प्लेटफॉर्म प्रतिशतक प्रदान करता है। दूसरा मार्ग स्व-रिपोर्ट किए गए काउंटर की एक क्राउडसोर्स रजिस्ट्री है: एक स्वेच्छिक सामुदायिक डेटासेट जिसमें लेखक दिनांकित डैशबोर्ड स्नैपशॉट (पत्र आयु, क्षेत्र, सार दृश्य, डाउनलोड) का योगदान करते हैं, सूर्यास्त पूर्व वितरणों की संस्थागत स्मृति क्षय होने से पहले संकलित किया गया है। डोसियर प्रोटोकॉल (तालिका 13) का संरक्षण चरण, यदि बड़े पैमाने पर अपनाया जाता है, तो ठीक ऐसी रजिस्ट्री का बीज है। आविष्कार करने के बजाय विस्तार के लिए एक कार्यशील पूर्वजो भी है। IRUS (Jisc) पहले से ही मानकीकृत, COUNTER-अनुरूप आइटम-स्तरीय उपयोग आँकड़े, Total_Item_Requests समेत, भाग लेने वाली संस्थागत भंडारों में एकत्रित करता है [185], जो यह दर्शाता है कि बहु-संस्था उपयोग एकीकरण संचालनात्मक रूप से संभव है। एक प्रीप्रिंट रजिस्ट्री वह स्थापित मॉडल है जिसे यहाँ महत्वपूर्ण संदर्भ-वर्ग चर (क्षेत्र, पोस्टिंग कोहोर्ट, और कैरियर चरण) को वहन करने के लिए चौड़ा किया गया है। एक उत्तर अमेरिकी समकक्ष, CC-PLUS, संघ [188] में COUNTER 5 उपयोग की स्वचालित SUSHI कटाई के साथ, खुले-स्रोत अवसंरचना के रूप में समान क्षमता प्रदान करता है, तो एक रजिस्ट्री शुरुआत से कमीशन किए जाने के बजाय एक कार्यशील प्लेटफॉर्म को विस्तारित कर सकती है। इस तरह की एक रजिस्ट्री मध्य-2010 के नमूने [85][139] के बाद से पहली ताजा, बहु-अनुशासन डाउनलोड वितरण का गठन करेगी। ज्ञात कमजोरियाँ स्व-चयन लगे हुए और संभवतः औसत-ऊपर लेखकों की ओर, दिनांकित स्क्रीनशॉट की आवश्यकता न होने तक अपरीक्षणीय स्व-रिपोर्ट, और छोटे क्षेत्रों में कवरेज अंतराल हैं। इससे व्युत्पन्न प्रतिशतकों को इसलिए स्पष्ट चयन सावधानियों के साथ प्रकाशित किया जाना चाहिए और, जहाँ संभव हो, अध्ययन 1 संभाव्यता नमूने के विरुद्ध अंशांकित किया जाना चाहिए, और विरल क्षेत्र-दर-आयु कोशिकाओं को अनुभवजन्य-Bayes संकुचन के तहत व्यापक संदर्भ वर्गों की ओर बताया जाना चाहिए बजाय अस्थिर कच्चे प्रतिशतकों के (अनुभाग 5.2, 8.3)। रजिस्ट्री प्रोटोकॉल और सत्यापन नियमों को पूर्वपंजीकरण सामग्रियों के साथ प्रकाशित किया जाएगा, और योगदान प्रारूप यहाँ निर्धारित है: एक रजिस्ट्री रिकॉर्ड परिशिष्ट C (पहचान, समय, उपयोग, जोखिम, और ऑडिट डोमेन) के पैनल स्कीमा का एक परिभाषित सबसेट है, ताकि स्व-रिपोर्ट किए गए रिकॉर्ड अध्ययन 1 पैनल के साथ विलीन रहें बजाय एक असंगत दूसरे डेटासेट के रूप में जमा होने के।
रजिस्ट्री के आउटपुट प्रारूप इसके प्रोटोकॉल के साथ पूर्वनिर्दिष्ट हैं, और दो कलाकृतियाँ प्रतिबद्ध हैं। एक एक अनुवाद तालिका है जो एक एकल संख्या (कहें 10, 40, या 100 डाउनलोड) लेती है और प्रत्येक कवर किए गए क्षेत्र के लिए, इसकी प्रतिशतक स्थिति और तालिका 8 का सादा-भाषा बैंड लौटाती है; इसके साथ, "क्या 7 डाउनलोड अच्छे हैं?" का उत्तर अनुमान लगाने के बजाय अंततः देखा जा सकता है। दूसरी एक प्रतिशतक "प्रशंसक" आकृति है जो 25वें, 50वें, 75वें, और 95वें प्रतिशतक डाउनलोड वक्रों को पत्र आयु, क्षेत्र और नएकम स्तर के कार्य के रूप में रेखांकित करती है: वह प्रारूप जिसमें एक बेंचमार्क "दिन X पर सामान्य कितना है" का उत्तर देता है (आकृति 14; [डेटा आवश्यक]: किसी भी कलाकृति को सिंथेटिक मानों के साथ आबाद नहीं किया जा सकता है)। या तो मार्ग (संभाव्यता नमूना या रजिस्ट्री) से प्रत्येक प्रतिशतक रिलीज परिशिष्ट D की पारदर्शिता विनिर्देश के अंतर्गत प्रकाशित होता है, इसके न्यूनतम-कक्ष गोपनीयता नियमों सहित, ताकि यह बेंचमार्क जो इस एजेंडा प्रस्ताव करता है वह अस्पष्टता को पुन: उत्पादित न करे जिसे इसे ठीक करने के लिए डिज़ाइन किया गया था। डेटा के शीर्ष एक पतली स्व-सेवा परत है, एक सार्वजनिक ऑनलाइन कैलकुलेटर जिसमें एक लेखक क्षेत्र, पत्र आयु, और काउंटर प्रविष्ट करता है और एक प्रतिशतक बैंड और एक मौखिक फैसला प्राप्त करता है। यह अनुभाग 6.3 की बेकैलिब्रेटेड स्कोरकार्ड-शैली के अनुमानों को एक अंशांकित उपकरण में बदल देगा एक बार, और केवल एक बार, जब संदर्भ वितरण मौजूद हों। अनुभाग 8.10 एक बहु-मॉडल आर्किटेक्चर का प्रस्ताव करता है जिसके माध्यम से ऐसी सेवा का संचालन और अद्यतन रखा जा सकता है। वही स्व-सेवा परत रिपोर्टिंग प्रोटोकॉल को किराए और कार्यकाल समितियों पर एक नया कार्यभार लागू करने से रखता है, क्योंकि प्रति-संख्या सामान्यीकरण जो डोसियर प्रारूप (तालिका 13) माँगता है वह कैलकुलेटर (यह अनुभाग) द्वारा निर्वहन किया जाता है और, बड़े पैमाने पर, आर्केस्ट्रेशन परत (अनुभाग 8.10) द्वारा। इसका यथार्थवादी परिनियोजन पथ मौजूदा अनुसंधान-सूचना प्लंबिंग, अर्थात् वर्तमान अनुसंधान सूचना प्रणालियों (CRIS) और ORCID-जुड़े प्रोफाइलों के माध्यम से चलता है, ताकि एक बेंचमार्क पठन एक पत्र की पहचानकर्ताओं से हाथ से संकलित होने के बजाय उत्पादित हो सके। एक प्राकृतिक क्रॉस-प्लेटफॉर्म विस्तार एक समानांतर-जमा प्रोटोकॉल है जो SSRN, arXiv (जहाँ क्षेत्र-उपयुक्त), और OSF Preprints पर एक ही पत्र के प्रक्षेपवक्र की तुलना करता है, एक प्रत्यक्ष परीक्षण कि क्या तालिका 8 के बैंड पुश- और खींच-आर्किटेक्चर के बीच स्थानांतरित होते हैं (तालिका 6)।
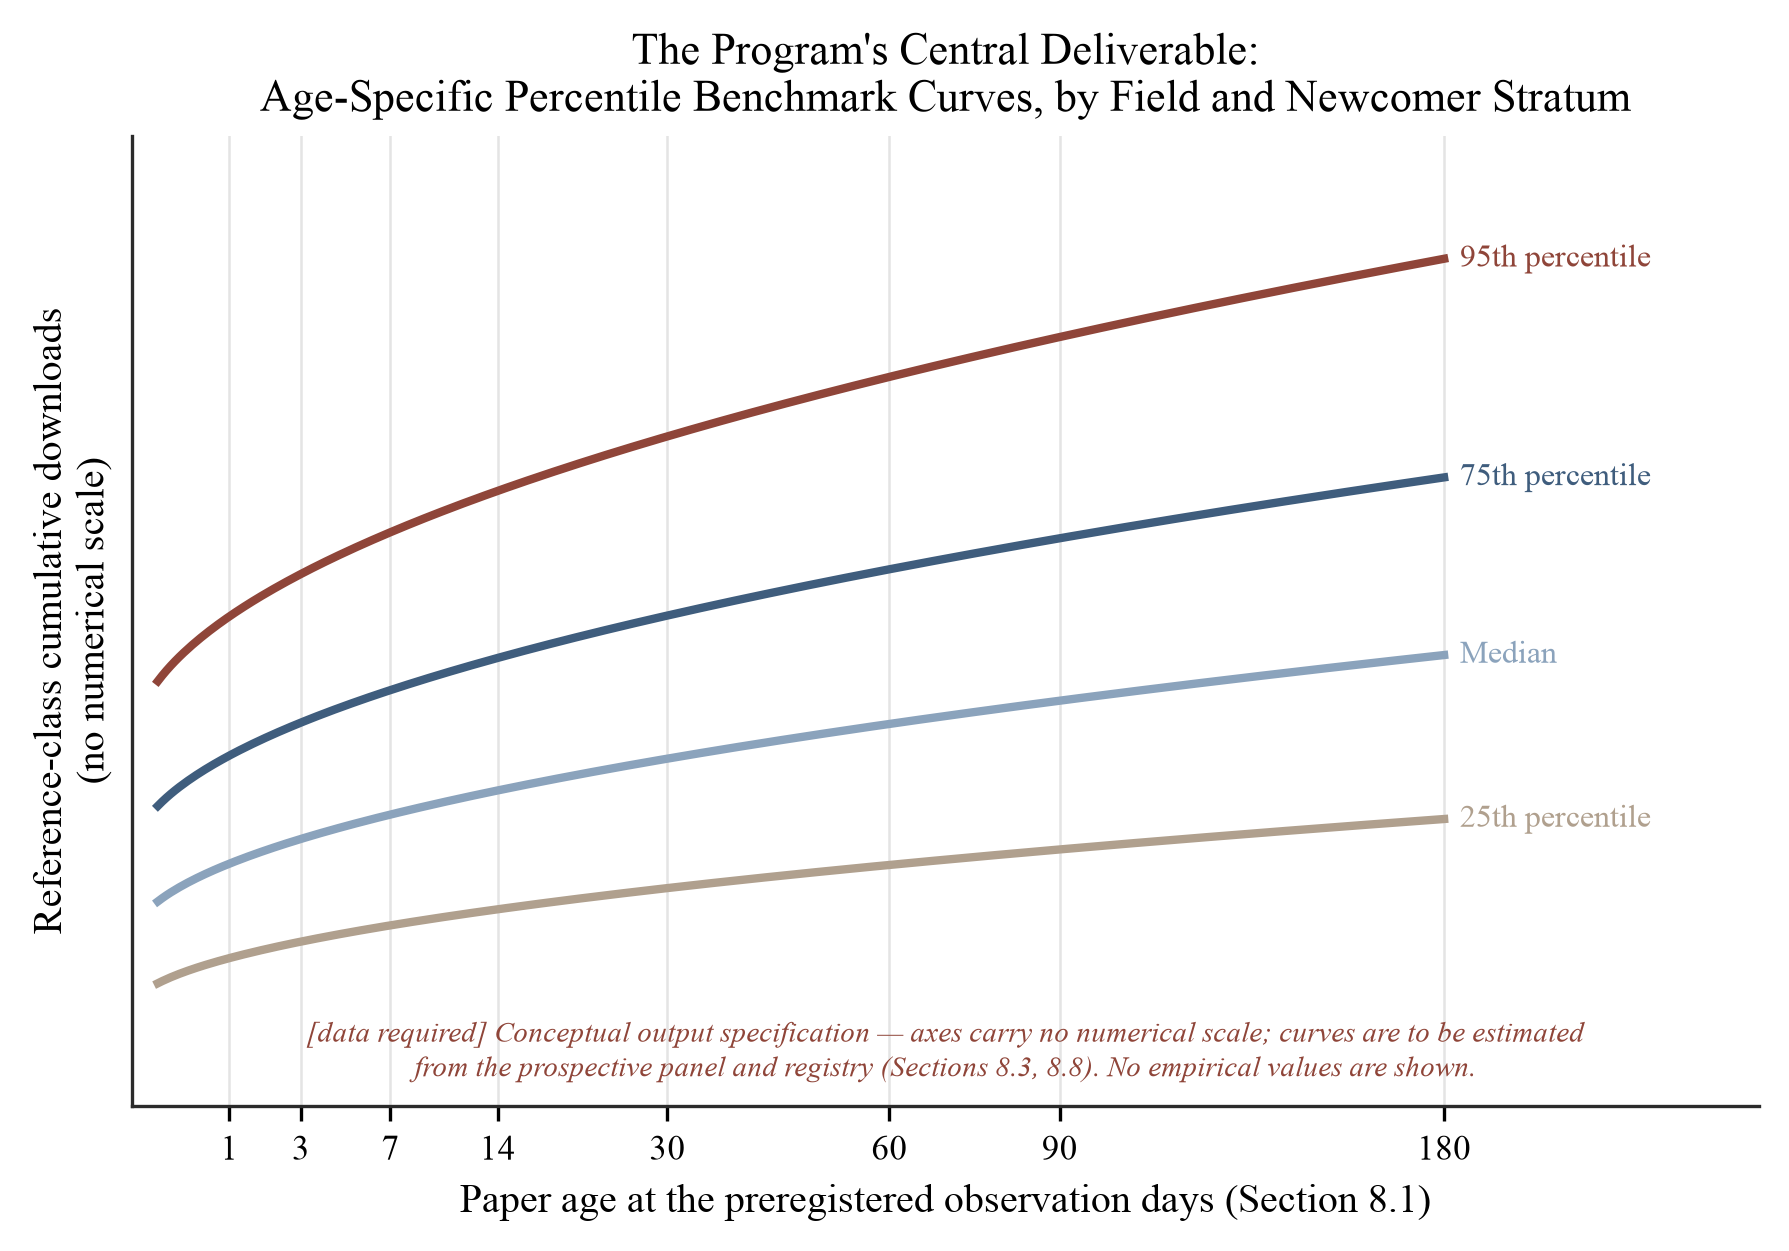
आकृति 14. आयु-विशिष्ट बेंचमार्क प्रशंसक: कार्यक्रम की केंद्रीय डिलीवरेबल। प्रतिशतक डाउनलोड वक्र (25वें, 50वें, 75वें, और 95वें) पत्र आयु के कार्य के रूप में, अनुभाग 8.1 के पूर्वनिर्दिष्ट अवलोकन दिनों पर मूल्यांकित किया गया और अध्ययन 1 नमूने और सामुदायिक रजिस्ट्री से क्षेत्र और नएकम स्तर द्वारा अनुमानित किया जाना है। अक्ष कोई संख्यात्मक पैमाना नहीं ले जाते; आकृति एक वैचारिक आउटपुट विनिर्देश है, और यह अनुभाग 10.4 की प्लेटफॉर्म सिफारिश और ऊपर वर्णित सार्वजनिक कैलकुलेटर दोनों के पीछे प्रदर्शन प्रारूप है।
कार्यक्रम का हर अनुभवजन्य लेख एक न्यूनतम रिपोर्टिंग पैकेज के प्रति प्रतिबद्ध है: एक कोहोर्ट प्रवाह आरेख; कच्चे और सामान्यीकृत वितरण एक दूसरे के बगल में; पहुंच और रूपांतरण अलग से रिपोर्ट किया गया; एक्सपोजर इतिहास; धारा 8.3 की चार-स्तरीय सीढ़ी पर विसंगति-संवेदनशीलता परिणाम; शून्य और विपरीत परिणाम पुष्टि के समान प्रमुखता के साथ रिपोर्ट किए गए; और एक मशीन-पठनीय बेंचमार्क तालिका, वह स्थिति जिसके तहत अध्ययन 1 का आउटपुट वास्तव में ऊपर वर्णित सार्वजनिक कैलकुलेटर को आगे बढ़ा सकता है। कार्यक्रम लेखों के सारांश सत्यापित अनुमानों को पूर्वनिर्धारित अपेक्षाओं से अलग करते हैं।
8.9 भविष्यसूचक सत्यापन
एजेंडा का समष्टिगत परीक्षण (RQ3) पूछता है कि क्या सामान्यीकरण अपनी जटिलता के योग्य है। प्रारंभिक उपयोग और बाद के उद्धरण विभिन्न सेटिंग्स में सकारात्मक लेकिन अपूर्ण रूप से जुड़े हुए हैं: पत्रिका-स्तरीय ग्रेंजर विश्लेषणों में 0.11–0.35 के क्रम में सहसंबंध [80], प्रारंभिक arXiv समूहों में लगभग 0.4, जहाँ r ≈ 0.4 केवल लगभग 16% विचरण की व्याख्या करता है [25], रसायन विज्ञान प्रीप्रिंट्स के लिए दो दशक पहले रिपोर्ट किए गए तुलनीय संबंध [26], पत्रिका और पेपर स्तरों पर सामान्य रूप से डाउनलोड के लिए [71], RePEc उपयोग डेटा में [31], और bioRxiv समूहों में [62], और मेगा-जर्नल उपयोग में मध्यम रैंक सहसंबंध [102]। अत्यधिक डाउनलोड किए गए और अत्यधिक उद्धृत समुच्चय केवल आंशिक रूप से ओवरलैप करते हैं [108][39]। हाल ही के पैनल साक्ष्य विलंब के साथ पहुंच को उद्धरणों से जोड़ते हैं: एक सात-पत्रिका पैनल में संबंध लगभग इकाई-लोचदार था, पहुंच में 10% वृद्धि के साथ लगभग नौ महीने बाद उद्धरणों में मोटे तौर पर 10% वृद्धि जुड़ी थी [178]। अनुभाग 5.5 के संकेतन में, समष्टिगत तुलना का अनुमान लगाता है
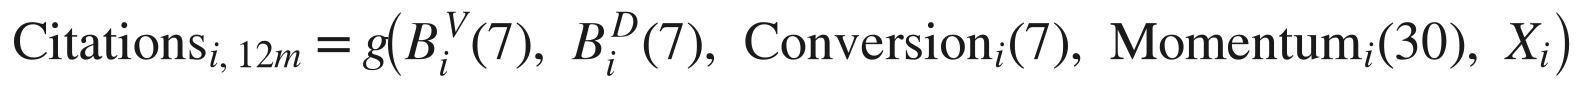
g के साथ लचीले ढंग से फिट किया गया और केवल नमूने के बाहर मूल्यांकन किया गया। समीकरण तय करता है कि कौन से सामान्यीकृत इनपुट कच्ची गणना के विरुद्ध प्रतिस्पर्धा करते हैं। आयु-, क्षेत्र-, और समूह-सामान्यीकृत दिन-7 और दिन-30 मेट्रिक्स से 6-, 12-, और 18-महीने के उद्धरणों की भविष्यवाणी करने वाले मॉडल को कच्चे संचयी डाउनलोड अकेले का उपयोग करने वाले मॉडल के साथ नमूने के बाहर तुलना की जानी चाहिए (क्रॉस-सत्यापित संभावना, अंशांकन, रैंक सहसंबंध, और भविष्यसूचक त्रुटि द्वारा), Kleinberg et al. [88] के अर्थ में एक भविष्यसूचक नीति समस्या। एक विशेष रूप से सूचनात्मक परिणाम यह होगा कि कच्ची गणना स्थापित लेखकों का समर्थन करती है जबकि सामान्यीकृत कोल्ड-स्टार्ट उपाय बाद के उद्धरण ग्रहण की बेहतर भविष्यवाणी करते हैं। वह पैटर्न इसका अर्थ होगा कि कच्ची प्रारंभिक गणना क्या मापती है उसका एक हिस्सा प्रारंभिक अवसर है न कि बाद की बौद्धिक मांग। यदि सामान्यीकरण भविष्यसूचक जानकारी जोड़ने में विफल रहता है, तो ढांचे का माप दावा अस्वीकार कर दिया जाता है या तदनुसार संकीर्ण किया जाता है।
Figure 15 एजेंडा को एक साथ खींचता है। एक संभावित समूह चार अध्ययनों और दो प्लेटफॉर्म अर्ध-प्रयोगों को समानांतर में खिलाता है, और प्रत्येक मॉड्यूल संस्करण सार्वजनिक आउटपुट के एक ही सेट में जमा होता है। वह साझा संरचना एजेंडा को एक अनुसंधान कार्यक्रम बनाती है।
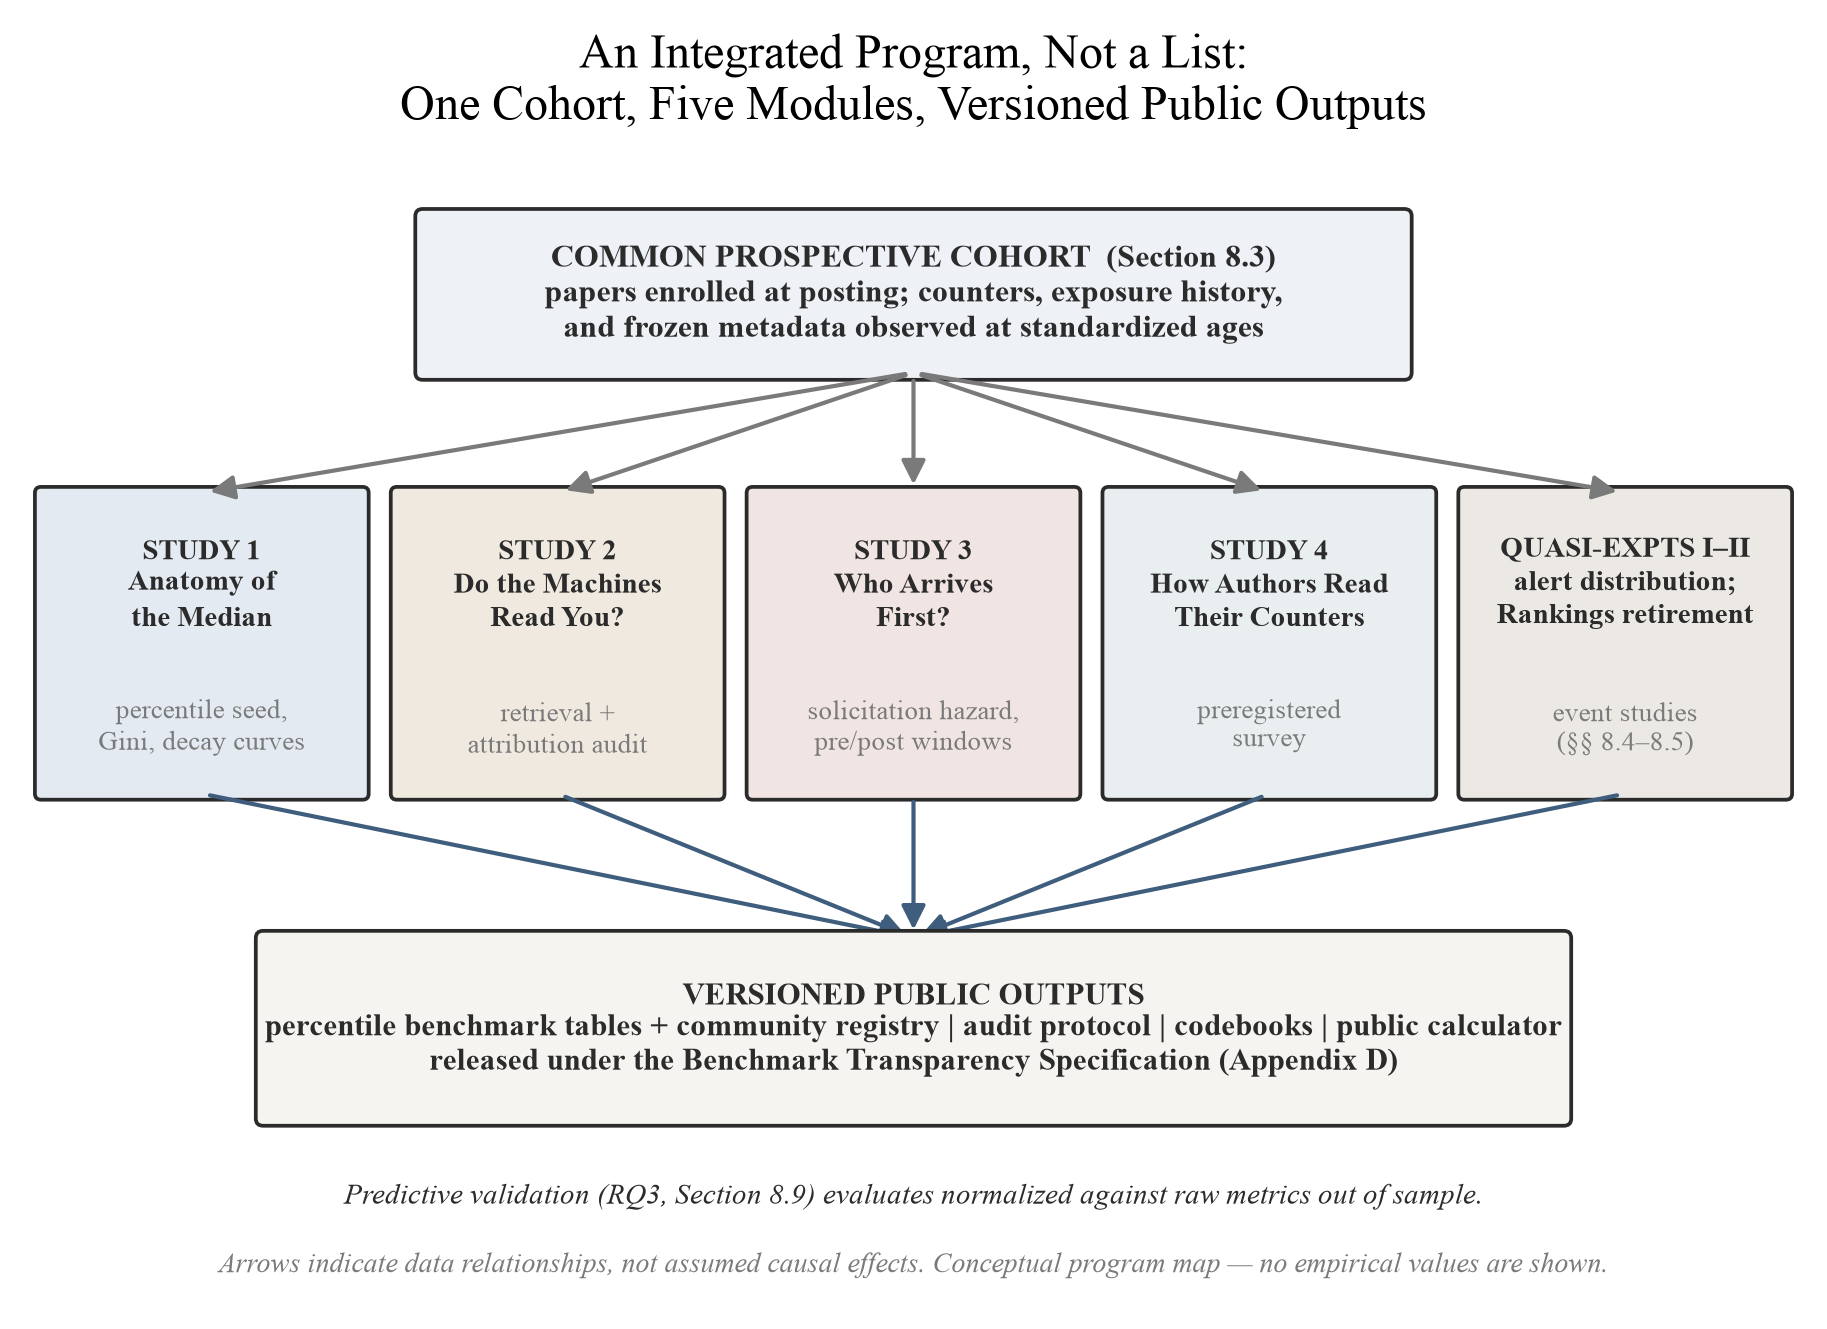
Figure 15. एकीकृत अनुसंधान कार्यक्रम। एक संभावित समूह (अनुभाग 8.3) चार अध्ययनों (अनुभाग 8.6) और दो प्लेटफॉर्म अर्ध-प्रयोगों (अनुभाग 8.4–8.5) को खिलाता है; सभी मॉड्यूल संस्करण सार्वजनिक आउटपुट में जमा होते हैं — प्रतिशतक बेंचमार्क तालिकाएं और सामुदायिक रजिस्ट्री (अनुभाग 8.8), ऑडिट प्रोटोकॉल, कोडिंग कोडबुक्स, और सार्वजनिक कैलकुलेटर — परिशिष्ट D की बेंचमार्क पारदर्शिता विशिष्टता के तहत जारी किए गए, जबकि भविष्यसूचक सत्यापन (अनुभाग 8.9) परिणामी बेंचमार्क का नमूने के बाहर मूल्यांकन करता है। तीर डेटा संबंधों को इंगित करते हैं, न कि मानी गई कारणात्मक प्रभावों को।
8.10 एक डिजाइन प्रस्ताव: आयोजित सीमांत मॉडल को बेंचमार्क की डिलीवरी परत के रूप में
एक बार का प्रकाशन एजेंडा के आउटपुट की आवश्यकताओं को पूरा नहीं कर सकता। प्रतिशत तालिकाएं, सामुदायिक रजिस्ट्री, CSAB रिपोर्टिंग प्रारूप (खंड 5.5; परिशिष्ट B), और सार्वजनिक कैलकुलेटर (खंड 8.8) को सभी को बिखरे हुए और क्षय हो रहे स्रोतों से इकट्ठा किया जाना चाहिए, दावे दर दावे को सत्यापित किया जाना चाहिए, गिनती के नियमों और प्लेटफॉर्म की विशेषताओं के परिवर्तन के साथ वर्तमान रखा जाना चाहिए, और व्यक्तिगत लेखकों को कैलिब्रेटेड भाषा में दिया जाना चाहिए। उस डिलीवरी-और-रखरखाव परत के लिए एक संभावित आर्किटेक्चर विशेषीकृत सीमांत AI मॉडलों की एक आयोजित पाइपलाइन है (सिस्टम की एक क्लास जिसे लेखक विकसित करता है; प्रतिस्पर्धी हितों को देखें)। इस उप-खंड में सब कुछ एक डिजाइन प्रस्ताव है। कोई कार्यान्वयन मौजूद नहीं है, कोई अनुभवजन्य प्रदर्शन दावा नहीं किया जाता है, और नीचे कहीं भी सटीकता, लागत, या समय बचाए गए आंकड़े का कोई आंकड़ा नहीं दिया गया है।
एक आयोजित प्रणाली का एक विकल्प एक एकल सर्वज्ञानी मॉडल है। एक लेखक जो एक उपभोक्ता चैटबॉट से पूछता है "क्या 7 डाउनलोड अच्छा है?" एक प्रवाहपूर्ण, अपरीक्षणीय दावा प्राप्त करता है, विफलता का तरीका जो उत्तर-इंजन ऑडिट दस्तावेज़ करते हैं, जिसमें सिस्टम अनुचित आत्मविश्वास के साथ त्रुटि करते हैं बजाय उत्तर देने से इनकार करने के [82]। इसके नीचे एक संरचनात्मक समस्या निहित है। मीट्रिक व्याख्या विभिन्न, आंशिक रूप से प्रतिकूल उद्देश्यों के साथ उप-कार्यों में विघटित होती है। साक्ष्य प्राप्त करना और तारीख देना, गैर-मानव या विषम ट्रैफ़िक के लिए एक काउंटर की जांच करना, आयु, क्षेत्र, समूह और पूर्व दृश्यमानता की एक संदर्भ वर्ग के विरुद्ध स्क्रीन किए गए काउंट को सामान्य करना, सामान्यीकृत स्थिति को बंधित भाषा में अनुवाद करना, और रिलीज़ से पहले उस अनुवाद को चुनौती देना एक ही कार्य नहीं है, और एक घटक जो एक के लिए अनुकूलित है एक और का एक खराब न्यायाधीश है। जो मॉडल एक आश्वस्त करने वाली पाठ का मसौदा तैयार करता है वह यह नहीं होना चाहिए कि क्या अंतर्निहित संख्या दूषित है, और मॉडल जो डोजियर भाषा का मसौदा तैयार करता है वह यह प्रमाणित नहीं करना चाहिए कि भाषा अतिशयोक्ति से बचती है। संगठित सिद्धांत इसलिए ज्ञानमीमांसा श्रम का एक विभाजन है: पीढ़ी और सत्यापन को स्वतंत्र उद्देश्यों के साथ अलग-अलग घटकों को सौंपा जाता है, और असहमति को संरक्षित और रिपोर्ट किया जाता है। स्वतंत्र रूप से संकेतित या आर्किटेक्चरल रूप से विशिष्ट मूल्यांकनकर्ताओं का अभिसरण सत्य नहीं है, हालांकि यह एक एकल मॉडल की प्रवाहिता की तुलना में एक पाठ के लिए मजबूत आधार है, एक डिजाइन अंतर्ज्ञान जो प्रायोगिक साक्ष्य के अनुरूप है कि भाषा-मॉडल उदाहरणों के बीच बहु-एजेंट बहस ने तथ्यात्मक वैधता में मापने योग्य सुधार किया है और एक मॉडल की तुलना में अकेले उत्तर देने वाले विभ्रम को कम किया है [43]। जहां मूल्यांकनकर्ता विचलित होते हैं, विचलन स्वयं नैदानिक जानकारी है, जैसे कि इस लेख के स्वयं के संश्लेषण नियमों में विरोधाभासी स्रोतों को शोर की तुलना में संकेत के रूप में माना गया था (दायरा और साक्ष्य अनुशासन)। दो डिजाइन सावधानियां उस अंतर्ज्ञान को कम करती हैं। घटकों के बीच समझौता स्वयं साक्ष्य नहीं है: यह साझा प्रशिक्षण डेटा, साझा पुनः प्राप्ति परिणामों, सामान्य संकेत मान्यताओं, या आयोजक के माध्यम से संदूषण से उत्पन्न हो सकता है। विभिन्न विक्रेताओं से तैयार मॉडल परिवार वैज्ञानिक रूप से स्वतंत्र नहीं हैं, और स्वतंत्रता को इंजीनियर किया जाना चाहिए, अलग-अलग निर्देशों के माध्यम से, घटकों के बीच प्रतिबंधित जानकारी प्रवाह, संरक्षित मध्यवर्ती आउटपुट, और साक्ष्य के विरुद्ध मूल्यांकन कि कोई जनरेटिंग घटक संपादित करने की अनुमति नहीं है। सत्यापन भी केवल इसलिए विश्वसनीय नहीं हो जाता क्योंकि एक दूसरा मॉडल इसे निष्पादित करता है: दावे जो विवादित हैं या परिणामस्वरूप मानव उपयोगकर्ता द्वारा अंतर्निहित स्रोत की जांच की आवश्यकता है।
चित्र 16 प्रस्तावित पाइपलाइन दिखाता है, और तालिका 21 इसे कार्य द्वारा विघटित करती है। प्रसंस्करण एक मुक्त-रूप संकेत से नहीं, बल्कि एक जमे हुए केस फ़ाइल से शुरू होता है: काउंटर अपनी अवलोकन तारीखों के साथ, कागज की आयु, घोषित क्षेत्र और उम्मीदवार संदर्भ समूह, जोखिम इतिहास, और लेखक का वास्तविक प्रश्न। लापता इनपुट लापता रहते हैं, और सिस्टम एक अनुपस्थित प्रतिशत वितरण का निर्माण नहीं कर सकता, एक हर का अनुमान नहीं लगा सकता, या एक देखे गए संख्या के स्थान पर एक मॉडल-उत्पन्न संख्या को स्वीकार नहीं कर सकता। सूचना का प्रवाह तब व्याख्यात्मक अनुक्रम को पुनः उत्पन्न करता है जिसे लेख पूरे समय बचाव करता है: कच्चे काउंटर → अखंडता जांच → संदर्भ-वर्ग सामान्यीकरण → बाधा के तहत व्याख्या। एक निगरानी घटक काउंटर, प्लेटफॉर्म दस्तावेज़, और तारीख प्रदान किए गए रजिस्ट्री रिकॉर्ड पुनः प्राप्त करता है, ताकि हर डाउनस्ट्रीम मान एक संग्रहीत स्रोत के लिए ट्रेस किया जा सके। हर तथ्यात्मक आउटपुट एक दावा बहीखाता में एक प्रविष्टि के रूप में घटकों के बीच यात्रा करता है। प्रत्येक प्रविष्टि दावे, इसके सहायक स्रोत या डेटा फ़ील्ड, एक स्थिर लोकेटर, पुनः प्राप्ति समय, किसी भी लागू परिवर्तन, इसके संदर्भ वर्ग, और इसकी सत्यापन स्थिति को रिकॉर्ड करती है, ताकि कोई अनुमर्थित आउटपुट चुप्पी से एक बाद के चरण का एक आधार नहीं बन सके। अखंडता जांच दस्तावेजित बॉट फ़िल्टरिंग और AI-क्रॉलर संदूषण की पृष्ठभूमि के विरुद्ध पारंपरिक समय-श्रृंखला विसंगति पहचान को लागू करती है (एक कार्य सांख्यिकीय तरीकों के लिए, मुक्त-पाठ पीढ़ी नहीं) [129][144]। यह जहां तक संभव हो दिनांकित जोखिम घटनाओं के लिए प्रक्षेपवक्र ब्रेक को जिम्मेदार ठहराता है (खंड 5.6)। सामान्यीकरण एक उपकरण के रूप में आह्वान किया गया निर्धारक सांख्यिकीय कोड द्वारा किया जाता है: प्रतिशत स्थिति खंड 8.3 के सिकुड़न नियमों के तहत संस्करणीकृत अध्ययन 1 और रजिस्ट्री तालिकाओं के विरुद्ध गणना की जाती है। प्रतिशत अंकगणित कभी मुक्त-पाठ पीढ़ी को सौंपा नहीं जाता। केवल तभी एक दुभाषिया मॉडल लेखक-सामना पाठ का मसौदा तैयार करता है, तालिका 8 की बैंड भाषा, तालिका 9 के पहुंच-बनाम-रूपांतरण निदान, और परिशिष्ट B के CSAB टेम्पलेट तक सीमित, प्रत्येक संख्या के साथ स्रोत, विंटेज, और आत्मविश्वास स्तर संलग्न। एक अलग सत्यापनकर्ता और आलोचक रिलीज़ से पहले प्रत्येक दावे को इसके दर्ज साक्ष्य के विरुद्ध जांचते हैं, प्रत्येक को सत्यापित, प्रतिद्वंद्वी, अनुमर्थित, या मूल्यांकन योग्य नहीं के रूप में रिपोर्ट करते हैं, चार विशिष्ट राज्य जो कभी एक एकल सिंथेटिक आत्मविश्वास स्कोर में संपीड़ित नहीं होते हैं। दो बाधाएं ढांचे से अपरिवर्तित हैं। कोई भी सिफारिश निदान किए गए बाधा पर सशर्त है, क्योंकि पहुंच-सीमित और रूपांतरण-सीमित कागजात विभिन्न कार्यों की वारंटी देते हैं (तालिका 9), और एक प्रणाली जो उन्हें अलग नहीं बता सकती है वह कुछ भी नहीं कहना चाहिए बजाय सामान्य सलाह देने के। दूसरी बाधा यह है कि एक जारी की गई सिफारिश एक परिकल्पना है: यह भविष्यद्वाणी करता है कि यदि निदान सही है तो कौन सी तंत्र चलना चाहिए, और बाद के अवलोकन उस भविष्यद्वाणी का परीक्षण करते हैं। प्रणाली का उद्देश्य कार्य तदनुसार संकीर्ण है: एक कागज और इसके उपयुक्त संदर्भ वर्ग के बीच पहचाने जाने योग्य व्याख्यात्मक घर्षण को हटाएं, और कभी भी किसी काउंटर के अधिकतमकरण नहीं, एक सीमा प्लेटफॉर्म की अखंडता और जनरेटिव-AI नीतियों द्वारा तय की गई है [54][144] और खंड 3 के गेमिंग इतिहास द्वारा [44]।
तालिका 21. प्रस्तावित ऑर्केस्ट्रेशन परत का कार्यात्मक विघटन: फ़ंक्शन, घटक प्रकार, प्रमुख विफलता मोड, और तंत्र जो इसे स्वतंत्र रूप से सत्यापित करता है। प्रत्येक पंक्ति श्रम विभाजन के कार्यक्षम होने के बारे में एक परिकल्पना है।
| फ़ंक्शन | मॉडल या घटक प्रकार | प्रमुख विफलता मोड | स्वतंत्र सत्यापन तंत्र |
|---|---|---|---|
| ऑर्केस्ट्रेशन और प्रोवेनेंस | फ़्रोज़न केस फ़ाइल और दावा बहीखाता बनाए रखने वाला टास्क राउटर | एक प्रारंभिक अघोषित धारणा बाद के प्रत्येक चरण की एक आधार के रूप में प्रचारित होती है | कोई भी अस्वीकृत आउटपुट एक विश्वसनीय आधार नहीं बन सकता; स्रोत, परिवर्तन, पुनर्प्राप्ति समय, और अनिश्चितता प्रत्येक हस्तांतरण पर संरक्षित |
| साक्ष्य अधिग्रहण और निगरानी | पुनः-चलाने के शेड्यूल पर टूल-उपयोग करने वाला पुनर्प्राप्ति मॉडल; खुले उद्धरण बुनियादी ढांचे के विरुद्ध ग्रंथ सूची मिलान [35][124] | निर्मित, गलत या चुनिंदा रूप से पुनः प्राप्त स्रोत | दिनांकित प्रोवेनेंस लॉग; प्रत्येक मान एक संग्रहीत स्नैपशॉट तक ट्रेस करने योग्य; यादृच्छिक उप-नमूना एक दूसरे घटक द्वारा स्वतंत्र रूप से फिर से प्राप्त; विफल खोजें और विपरीत परिणाम दर्ज किए गए, छोड़े नहीं गए |
| अखंडता स्क्रीनिंग | गैर-जनरेटिव समय-श्रृंखला विसंगति का पता लगाना [129][144] | एक स्पाइक "बॉट" — या "रीडर" — बिना किसी पहचान के लिए सबूत के रूप में लेबल किया गया | विसंगति फ्लैग कुल के साथ-साथ प्रकाशित (अनुभाग 8.8); धारा 8.3 की चार-परत मजबूती सीढ़ी पर संवेदनशीलता की रिपोर्ट की गई; विसंगति को एक फ्लैग के रूप में माना जाता है, कभी भी पहचान दावे के रूप में नहीं |
| संदर्भ-वर्ग सामान्यीकरण | एक उपकरण के रूप में आह्वान किया गया निर्धारक सांख्यिकीय कोड | सुविधाजनक साथियों को एक मान्य तुलना जनसंख्या के लिए गलत किया जाता है | संस्करणीकृत सार्वजनिक बेंचमार्क तालिकाओं के विरुद्ध पुनः संगणना (परिशिष्ट D); क्षेत्र, आयु, समूह, पूर्व दृश्यता, और स्रोत विंटेज बताए गए या मॉड्यूल संयम; कोई मुक्त-पाठ अंकगणित रिकॉर्ड में स्वीकार नहीं किया गया |
| व्याख्या ड्राफ्टिंग | तालिका 8 बैंड भाषा और CSAB टेम्पलेट (परिशिष्ट B) के लिए विवश सामान्यवादी भाषा मॉडल | प्रवाहशील अतिकथन — निश्चितता, दायरा, या कारणात्मक स्थिति जो साक्ष्य लाइसेंस से परे है | दर्ज किए गए साक्ष्य के विरुद्ध एक अलग सत्यापनकर्ता द्वारा दावा-स्तर की जांच; प्रत्येक दावा सत्यापित, विवादित, असमर्थित, या आकलनीय नहीं के रूप में रिपोर्ट किया गया; असमर्थित वाक्य अस्वीकार किए गए, नरम नहीं किए गए |
| प्रतिकूल समीक्षा | ड्राफ्टर के लिए प्रतिकूल उद्देश्यों वाला आलोचक मॉडल | अनुष्ठान समीक्षा, या एक सिंथेटिक सर्वसम्मति जो भौतिक असहमति को छुपाती है | संरचित असहमति रिपोर्ट — साक्ष्य स्थिति, मूल्यांकनकर्ता पैटर्न, निर्णय संवेदनशीलता (क्या विवाद निदान को बदलता है या केवल इसके शब्दों को), अवशिष्ट अनिश्चितता — एकीकृत किए बिना, एक आत्मविश्वास संख्या में कभी संपीड़ित नहीं |
| आमंत्रण छंटाई | तालिकाओं 14–15 के कोडिंग फ्रेम पर विशेषज्ञ वर्गीकृत | एक श्रेणीबद्ध "शिकारी" फैसला जो साक्ष्य से आगे निकल जाता है और प्रतिष्ठामूलक नुकसान का जोखिम उठाता है | केवल फ्लैग-और-समीक्षा, कभी भी स्वतः-हटाना नहीं और कभी भी एक प्रकाशित आरोप नहीं; लेबल किए गए सेट पर त्रुटि दरें दर्ज की गई; AI पाठ वर्गीकरण की दस्तावेजित सीमाएं और पूर्वाग्रह स्वीकार किए गए [157][97] |
| बेंचमार्क रखरखाव | सभी घटकों का शेड्यूल किया गया ऑर्केस्ट्रेशन | मूक बहाव: पुरानी स्रोत, या बिना ट्रेस के अधिलेखित रिलीज | परिशिष्ट D के तहत संस्करणीकृत, दिनांकित रिलीज; संशोधन दर्ज किए गए, कभी चुप्पी से अधिलेखित नहीं — एक जीवंत बेंचमार्क मानचित्र बजाय एक स्थिर स्नैपशॉट के |
| अंतिम व्याख्या और कोई भी कैरियर उपयोग | मानव लेखक | स्वचालन पूर्वाग्रह और जिम्मेदारी का प्रसार | किसी भी बाहरी उपयोग से पहले अनिवार्य मानव साइन-ऑफ; डोसियर भाषा तालिका 13 प्रोटोकॉल का पालन करती है, स्रोत, समय विंडो, और सीमाओं के साथ संलग्न |
दो सीमाएं विशेष्टता को पूरा करती हैं। एक अनुमति सीमा है: पढ़ने-केवल पहुंच डिफ़ॉल्ट है, और परत मसौदा तैयार करती है लेकिन कभी निष्पादित नहीं करती। यह स्वायत्त रूप से एक पांडुलिपि को संपादित नहीं कर सकता, मंच मेटाडेटा को बदल सकता है, विद्वानों या स्थानों से संपर्क कर सकता है, सार्वजनिक रूप से पोस्ट कर सकता है, या एक आमंत्रण संदेश को हटा सकता है, और किसी भी कार्यान्वित वर्कफ़्लो को मानव जिम्मेदारी और लागू मंच और सबमिशन नीतियों के प्रकटीकरण दायित्वों को संरक्षित करना चाहिए [54][56][144]। दूसरा एक संयम सीमा है: शून्य आउटपुट एक वैध (अक्सर सही) परिणाम है, और प्रत्येक चरण एक दोषपूर्ण इनपुट को आगे पास करने के बजाय रुक सकता है। अनिवार्य संयम ट्रिगर में एक लापता या असमर्थनीय संदर्भ वर्ग शामिल है; पढ़ने के लिए केंद्रीय एक अप्रमाणित स्रोत; प्रस्तावित सूत्रीकरण पत्र के दावों को संरक्षित करता है या नहीं इसके बारे में अनसुलझी असहमति; किसी विशुद्ध वर्णनात्मक पैटर्न से कारणात्मक निष्कर्ष के लिए किसी भी अनुरोध या एक सत्यापित भविष्यवाणी डेटासेट के बिना उद्धरण या कैरियर परिणामों की भविष्यवाणी (अनुभाग 8.9); और ध्यान में हेराफेरी, खरीद, सिमुलेट, या अन्यथा बढ़ाने के लिए किसी भी अनुरोध। वह अंतिम ट्रिगर परत को मीट्रिक-गेमिंग उपकरण बनने से रोकता है जिसका इतिहास धारा 3 दस्तावेजों [44][69][144]। एक अंतिम अलगाव एजेंडा की दो साक्ष्य धाराओं को नियंत्रित करता है। धारा 8.6 और 8.8 की संस्करणीकृत प्रतिशतक तालिकाएं परत का एकमात्र प्रशासनीय सामान्यीकरण स्रोत हैं, जबकि अध्ययन 2 की मशीन-दृश्यता ऑडिट एक अलग पुनर्प्राप्ति-और-आरोपण जांच को खिलाती है। मशीन पुनर्प्राप्ति मानव ध्यान की एक प्रतिशतक नहीं है, और परत दोनों को मिश्रित नहीं कर सकती।
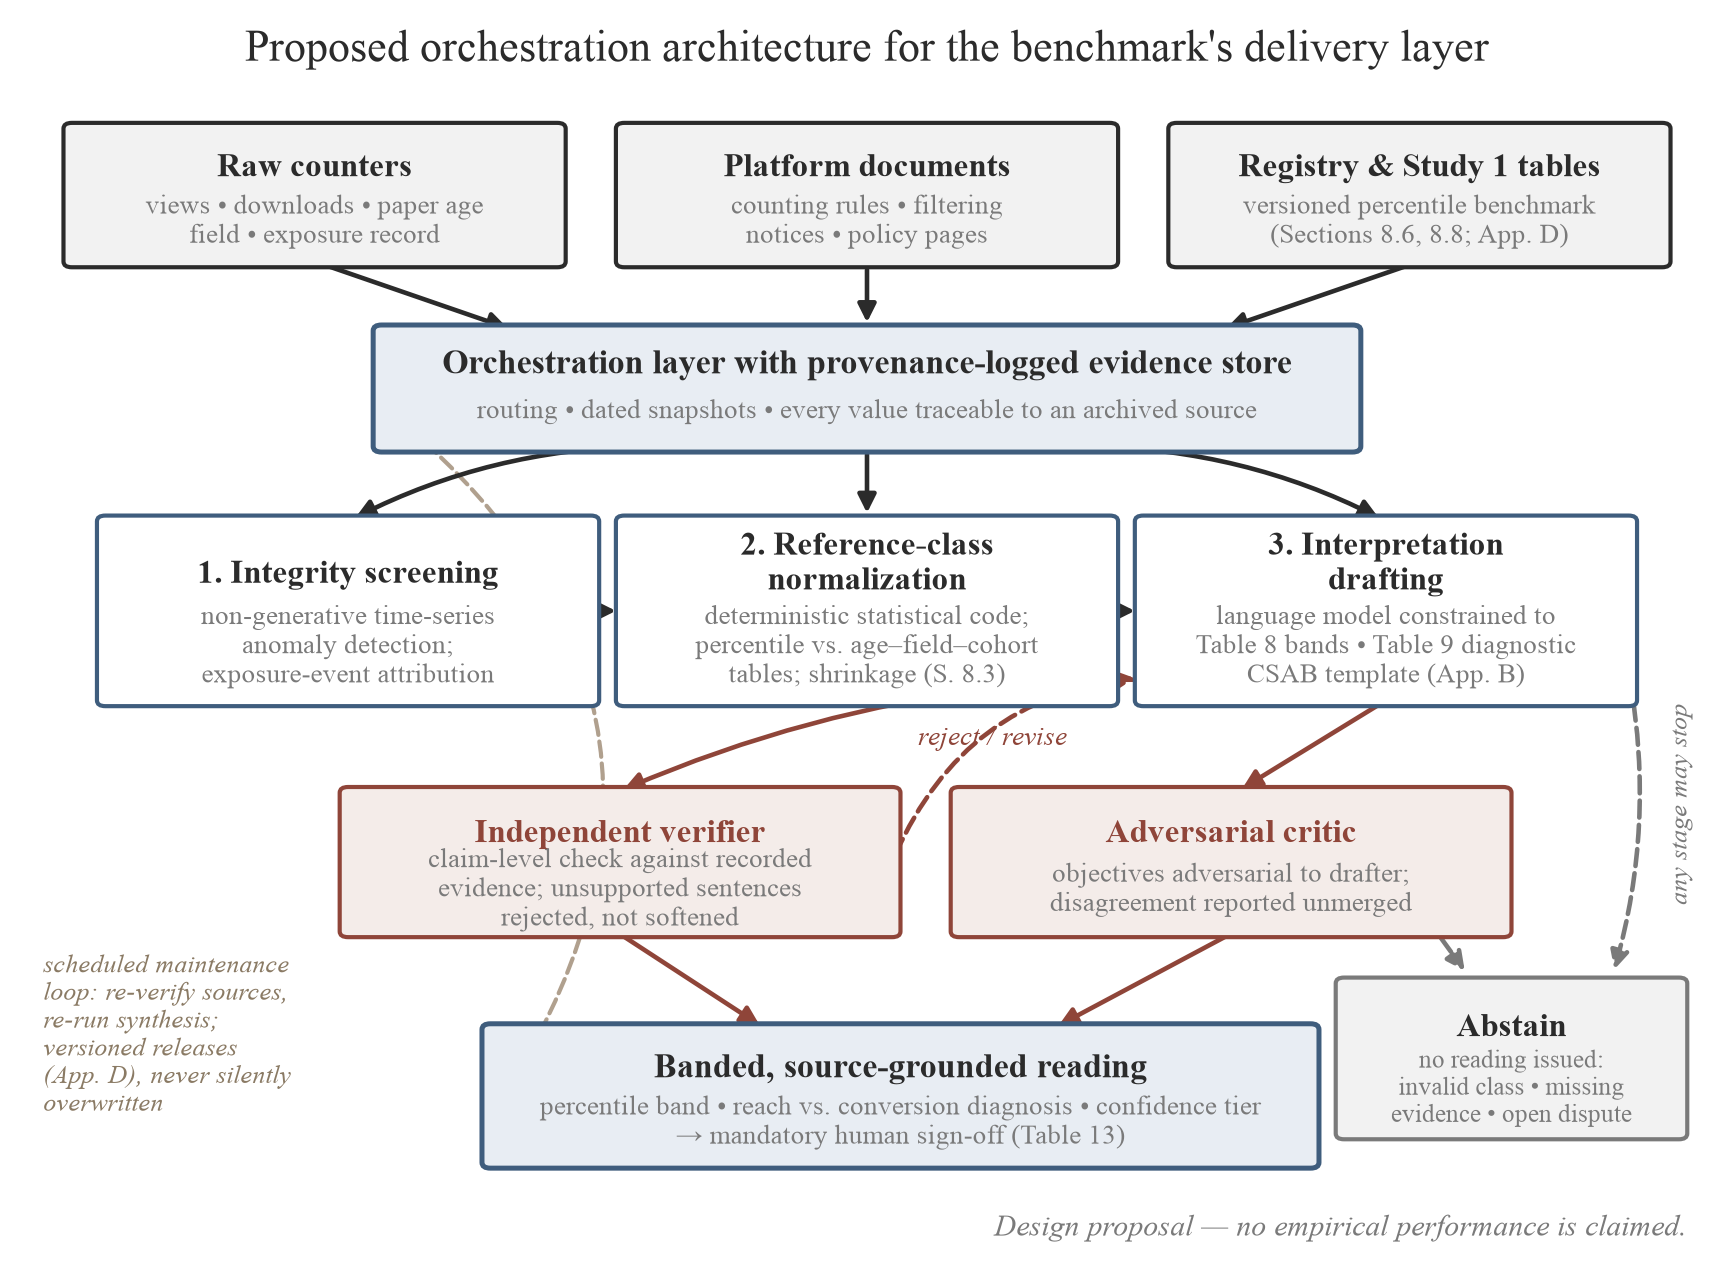
चित्र 16. बेंचमार्क की डिलीवरी परत के लिए प्रस्तावित ऑर्केस्ट्रेशन आर्किटेक्चर (अनुभाग 8.10; तालिका 21)। विशेषज्ञ घटक साक्ष्य अधिग्रहण, अखंडता स्क्रीनिंग, सामान्यीकरण, और व्याख्या को अलग करते हैं, जनरेशन और रिलीज़ के बीच स्वतंत्र सत्यापन के साथ, हर चरण पर एक संयम पथ उपलब्ध है, और धारा 8.8 की संस्करणीकृत बेंचमार्क को बनाए रखने वाली एक शेड्यूल किया गया लूप।
एक ही अनुशासन यह निर्धारित करता है कि परत को निदान मिलने के बाद क्या करने की अनुमति है। तालिका 22 कार्य नीति को निर्धारित करती है: प्रत्येक देखी गई पैटर्न (पहुंच और रूपांतरण को संवेग के साथ संयुक्त रूप से पढ़ी गई, तालिका 9–10 की शब्दावली में) एक अनंतिम निदान, अनुमति प्राप्त सहायता का एक सीमित रूप, वह तंत्र परीक्षा जो निदान को पुष्ट या कमजोर कर सकती है, और वह अनुमान या कार्य जो निषिद्ध है, से मानचित्रित होता है। तंत्र-परीक्षण स्तंभ उपरोक्त कथन को क्रियान्वित करता है कि एक जारी की गई सिफारिश एक परिकल्पना है। यदि एक वर्गीकरण सुधार एक पहुंच बाधा को हटाने के लिए माना जाता है, तो जो परिणाम मायने रखता है वह आयु-समायोजित पहुंच है, और कुल डाउनलोड के बारे में एक पूर्वदृश्य आख्यान इसके स्थान पर नहीं खड़ा होगा। एक विफल भविष्यवाणी को एक विफल हस्तक्षेप के रूप में रिकॉर्ड किया जाता है और निदान को लौटाया जाता है, कभी भी अधिक अनुकूल सफलता उपाय के विरुद्ध पुनः स्कोर नहीं किया जाता है। पूरा अनुक्रम इस प्रकार एक लूप में बंद हो जाता है: माप → सत्यापन → सामान्यीकरण → निदान → प्रस्ताव → आलोचना और सत्यापन → निर्णय → अवलोकन → अद्यतन या रुकें (चित्र 17)। उस लूप के भीतर मानवीय निर्णय सत्यापन और किसी भी कार्य के बीच खड़ा है, निर्णय-बाद के अवलोकन केस फ़ाइल में लौटते हैं, और संयम पथ जब भी साक्ष्य अपर्याप्त हो तो चक्र को समाप्त करता है। लूप जटिलता को भी नियंत्रित करता है: जब साक्ष्य केवल संरक्षण और निरीक्षण का समर्थन करता है, या जब लेखक पुस्तिका का एक नियतात्मक नियम (अनुभाग 6) पहले से ही प्रश्न का उत्तर देता है, तो ऑर्केस्ट्रेशन कुछ नहीं जोड़ता है और चलना नहीं चाहिए।
तालिका 22. प्रस्तावित ऑर्केस्ट्रेशन परत के लिए निदान-से-कार्य नीति। पैटर्न को तालिका 9 के प्रतिशत सम्मेलनों के तहत एक रक्षणीय संदर्भ वर्ग के भीतर पढ़ा जाता है; प्रत्येक पंक्ति एक नीति परिकल्पना है, और कोई भी सेल एक अनुभवजन्य आवृत्ति का दावा नहीं करता है।
| देखी गई पैटर्न (पहुंच, रूपांतरण, संवेग) | अनंतिम निदान | अनुमति प्राप्त सहायता | तंत्र परीक्षा | निषिद्ध अनुमान या कार्य |
|---|---|---|---|---|
| कम पहुंच, उच्च रूपांतरण, स्थिर या बढ़ते हुए | एक खोज क्षमता बाधा पैटर्न के साथ पांडुलिपि-ग्रहण बाधा की तुलना में अधिक सुसंगत है ("छिपी हुई रुचि," तालिका 9) | पहचानकर्ता, वर्गीकरण, मेटाडेटा, अनुक्रमण, और शीर्षक खोज क्षमता का अंकेक्षण करें; सीमित, वास्तव में प्रासंगिक वितरण | एक मेटाडेटा या वर्गीकरण परिवर्तन के बाद, क्या पहुंच बढ़ती है जबकि रूपांतरण स्थिर रहता है? | केवल इसे अधिक प्रचारणात्मक बनाने के लिए एक अच्छी तरह से परिवर्तित सारांश को फिर से लिखना |
| उच्च पहुंच, कम रूपांतरण, स्थिर या गिरते हुए | संचार असमानता, दर्शकों की असमानता, और कम-इरादे के जोखिम प्रतिस्पर्धी व्याख्या हैं ("उपस्थिति ग्रहण के बिना") | शीर्षक–सारांश संरेखण, गुंजाइश स्पष्टता, और दर्शकों का फिट परीक्षा करें; केवल दावा-संरक्षण विकल्प | क्या तुलनीय जोखिम के तहत रूपांतरण बदलता है, प्रत्येक संशोधन पर निष्ठा जांच के साथ? | बेतरतीब प्रचार में वृद्धि; यह निष्कर्ष कि पाठकों ने विज्ञान को अस्वीकार कर दिया |
| कम पहुंच, कम रूपांतरण | अपर्याप्त रूप से पहचाना गया: कमजोर जोखिम, गलत संदर्भ वर्ग, मेटाडेटा विफलता, संचार घर्षण, या आला मांग सभी फिट करते हैं ("ठंडी शुरुआत") | पहले संदर्भ वर्ग और जोखिम रिकॉर्ड को मान्य करें; फिर मेटाडेटा और संचार को अलग से अंकेक्षण करें | एक बार में एक मापने योग्य तंत्र बदलें; शून्य परिणाम को संरक्षित करें | कम उपयोग से कम गुणवत्ता का अनुमान लगाना; एक एकल-कारण निर्णय लौटाना |
| उच्च पहुंच, उच्च रूपांतरण, बढ़ते हुए | कथित वर्ग के सापेक्ष मजबूत प्रारंभिक प्रसार | प्रामाणिकता को संरक्षित करें; निश्चित आयु पर निगरानी करें; कारण के बिना कुछ न बदलें | क्या पैटर्न जोखिम घटना के बाद और विसंगति संवेदनशीलता के तहत बना रहता है? | आगे प्रवर्धन का निर्माण; ध्यान को गुणवत्ता के प्रमाण के रूप में व्यवहार करना |
| उच्च पहुंच, उच्च रूपांतरण, तीव्रता से गिरती हुई वृद्धि | घटना-संचालित ध्यान, सामान्य क्षय, या संतृप्ति (अनुभाग 5.6) | जोखिम घटना की पहचान करें; संचयी कुल नहीं, अंतराल वृद्धि की तुलना करें | क्या क्षय आयु-मिलान वाली प्रक्षेप पथ से घटना के अनुसार भिन्न है? | गिरती हुई वृद्धि को वैज्ञानिक विफलता कहना — संचयी गणना दर के संदर्भ में लगभग हमेशा समतल हो जाती है |
| कम पहुंच, उच्च रूपांतरण, गिरती हुई वृद्धि | सशर्त रुचि वास्तविक हो सकती है जबकि निरंतर जोखिम कमजोर है | अंकेक्षण करें कि वितरण या अनुक्रमण समाप्त हुआ है या नहीं; सीमित, प्रासंगिक चैनलों की पहचान करें | क्या पुनर्स्थापित जोखिम बिना रूपांतरण को कमजोर किए पहुंच को बढ़ाता है? | दावों को व्यापक बनाना या अधिक दर्शकों का पीछा करने के लिए तकनीकी विशिष्टता को हटाना |
| उच्च पहुंच, कम रूपांतरण, बढ़ते हुए जोखिम | आगमन आनुपातिक पूर्ण-पाठ ग्रहण के बिना बढ़ रहे हैं | कम-इरादे ट्रैफिक (अनुभाग 4.2), दर्शकों की असमानता, और प्रस्तुति स्पष्टता का परीक्षा करें | क्या रूपांतरण तुलनीय जोखिम के तहत दावा-विश्वस्त प्रस्तुति परिवर्तन में प्रतिक्रिया करता है? | केवल फनल के शीर्ष को अनुकूल करना; प्रत्येक दृश्य को मानव पाठक के रूप में गिनना |
| पुनर्कथित प्रतिकार, अस्पष्टीकृत स्पाइक, अमान्य समूह, या लापता हर के साथ कोई भी पैटर्न | मेट्रिक वर्तमान में वांछित स्तर पर व्याख्या योग्य नहीं है | स्नैपशॉट को संरक्षित करें; संवेदनशीलता विश्लेषण चलाएं; दावे को संकीर्ण करें; संयम करें | क्या पाठन विवादित अंतराल के बहिष्करण, या एक बेहतर संदर्भ वर्ग को जीवित रखता है? | साक्ष्य के बिना ट्रैफिक को मानव या स्वचालित करार देना; एक निर्मित हर से एक प्रतिशत उत्सर्जन करना |
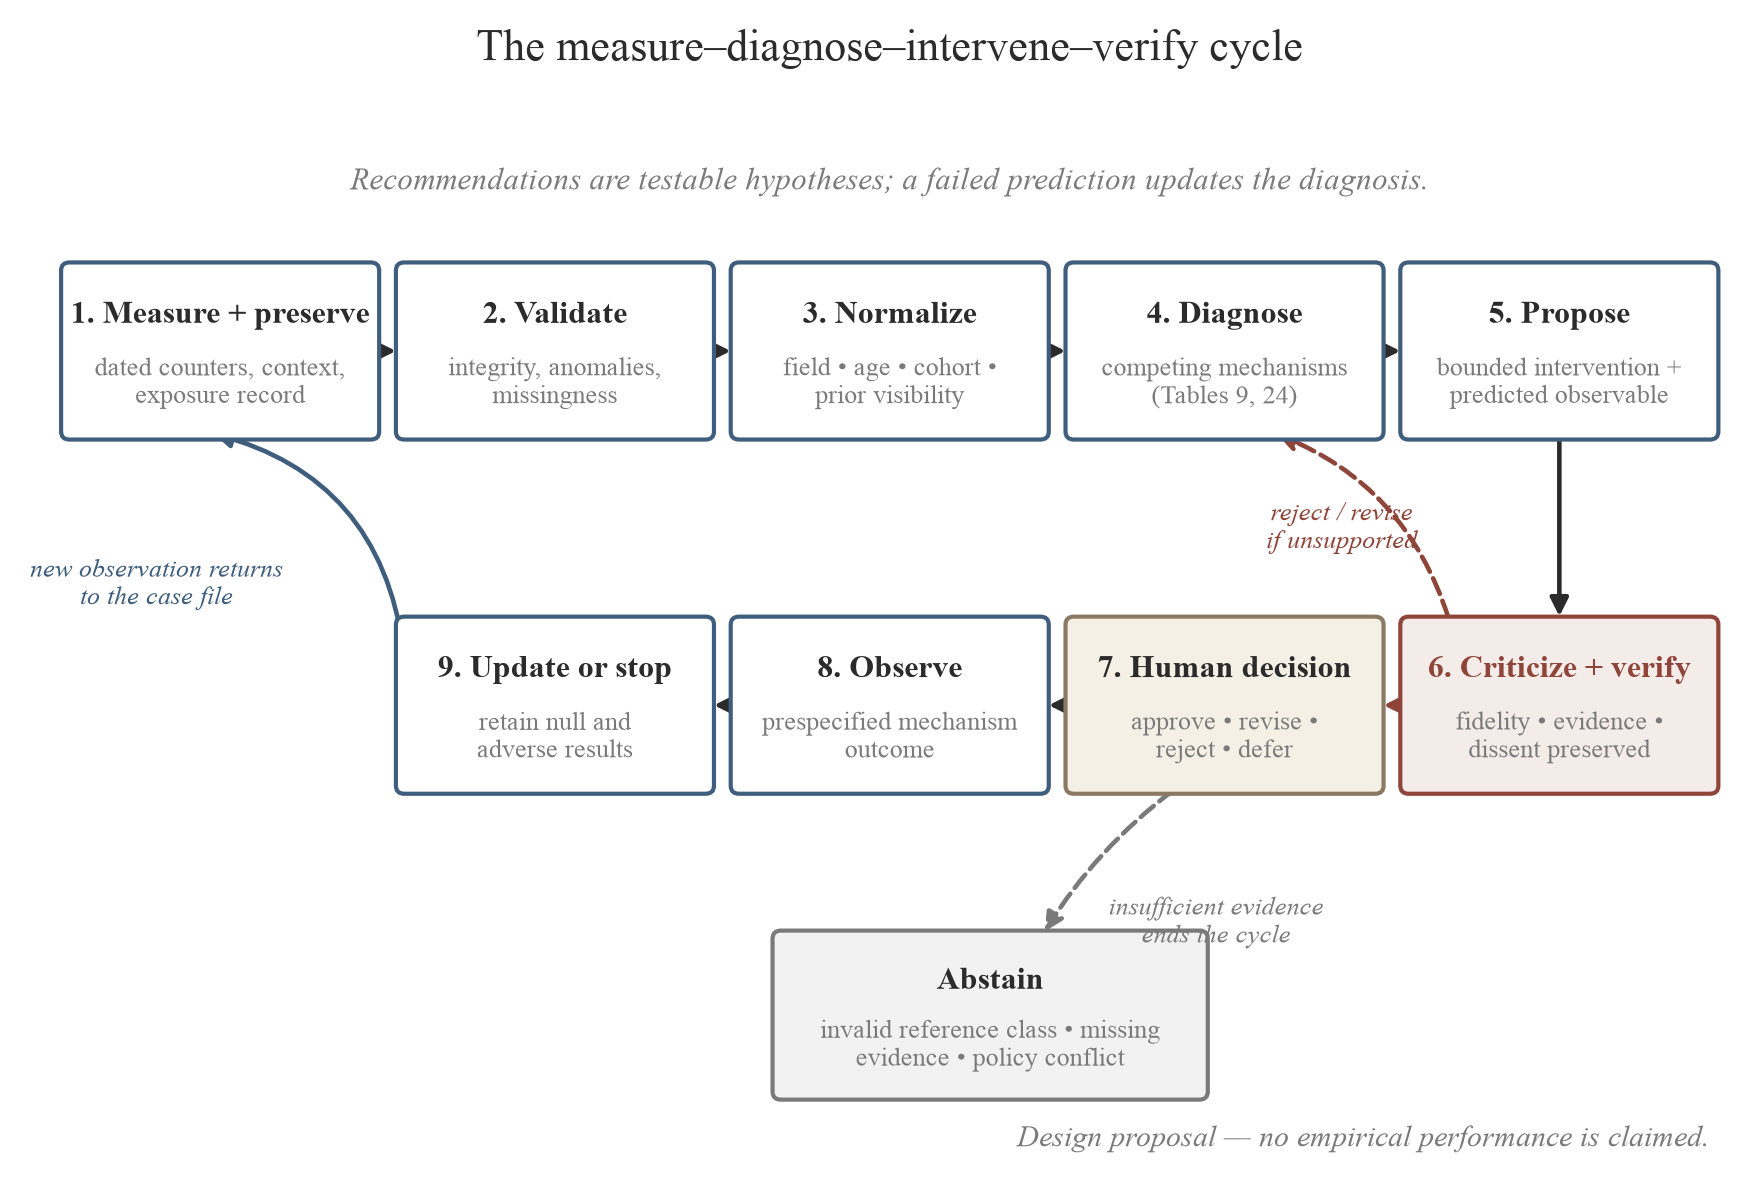
चित्र 17. माप–निदान–हस्तक्षेप–सत्यापन चक्र (अनुभाग 8.10; तालिका 22)। सिफारिशें लूप को केवल परीक्षण योग्य परिकल्पनाओं के रूप में छोड़ती हैं: प्रत्येक उस तंत्र का नाम देती है जिसे वह स्थानांतरित करने का इरादा रखती है और बाद का अवलोकन जो निदान को पुष्ट या कमजोर कर सकता है। विफल भविष्यवाणियां निदान में लौटती हैं और अंकेक्षण रिकॉर्ड में रहती हैं; मानवीय निर्णय सत्यापन और किसी भी कार्य के बीच खड़ा है; और संयम पथ चक्र को समाप्त करता है जब भी कोई रक्षणीय संदर्भ वर्ग या पर्याप्त साक्ष्य नहीं है। चक्र साक्ष्य-संरक्षण व्याख्या को अनुकूल करता है, कच्चा ध्यान नहीं।
चार सीमाएँ इस प्रस्ताव को बाँधती हैं। पीढ़ीकरण पुनरुद्धार नहीं है। कोई भी मॉडल, चाहे कितना भी संगठित हो, उन प्रतिशतक वितरणों को पुनः उत्पन्न नहीं कर सकता जो अवलोकनीय होना बंद हो गए जब शीर्ष सूचियों को हटाया गया था [149], और परत केवल एक सन्निकटन बनाए रख सकती है, अनुभाग 5 की रूढ़िवादी-तल की चेतावनियों के साथ बरकरार। न ही संगठन एक डाउनलोडर की पहचान कर सकता है, काउंटर से अकेले मानव ट्रैफिक को स्वचालित ट्रैफिक से अलग कर सकता है (अनुभाग 4.2), अनुरोध मात्रा को पाठकता के प्रमाण में परिवर्तित कर सकता है (अनुभाग 7.6), सहसंबद्ध मॉडल आउटपुट को "एजेंट" के रूप में पुनः लेबल करके स्वतंत्र बना सकता है, सहकर्मी निर्णय को प्रतिस्थापित कर सकता है, या शोधकर्ता से वर्कफ़्लो को जिम्मेदारी हस्तांतरित कर सकता है। आर्केस्ट्रेटर को स्वयं एक लेखा परीक्षक की आवश्यकता है। एक तैनात व्याख्या परत इस स्टैक में एक नया गेटकीपर बन जाती है जिसे यह लेख मैप करता है (चित्र 12), और इसे उस अपारदर्शिता को विरासत में नहीं लेना चाहिए जिसे मरम्मत के लिए बनाया गया था: तर्क ट्रेस और प्रोवेनेंस लॉग निरीक्षण के लिए खुले होने चाहिए, और परत के स्वयं के पुनर्प्राप्ति और व्याख्या व्यवहार को अध्ययन 2 के अनुशासन के साथ लेखा परीक्षित किया जाना चाहिए (टाइमस्टैम्प किए गए स्नैपशॉट साथ ही एक लिपिबद्ध प्रतिलिपि प्रोटोकॉल), क्योंकि मॉडल गैर-स्थिरता प्रत्येक आउटपुट को एक दिनांकित अनुमान बनाती है, कभी भी एक टिकाऊ मूल्य नहीं। लागत और समानता। ऐसी पाइपलाइन का संचालन निःशुल्क नहीं है, और एक भुगतान व्याख्या परत इस ढांचे के केंद्र में रहने वाले कम-संसाधन और असंबद्ध लेखकों को बाहर कर देगी। AI पाठ वर्गीकारकों के ज्ञात पूर्वाग्रह गैर-मूल अंग्रेजी लेखकों के विरुद्ध [97] बिना कमजोरी के, ऐसा ही करेंगे। झूठी सटीकता अवशिष्ट जोखिम है। एक परत जो विश्वास स्तरों के बिना बैंडेड फैसले जारी करती है, अनुभाग 3 में निदान किए गए ठीक उसी गलत अंशांकन को स्वचालित करेगी: कोई तुलनात्मक पैमाना के साथ एक गणना एक अनिश्चितता के साथ जुड़ी एक फैसले से बदल दी गई। आर्किटेक्चर स्वयं एक खंडनीय वस्तु है और उन शर्तों पर एजेंडे में है, सरल सहायता के विरुद्ध मूल्यांकन किया गया है और इसके आरेख की परिष्कृतता से अनुमानित नहीं है। उपयुक्त डिज़ाइन श्रेणीबद्ध है। रोपित अस्पष्टताओं वाले यथार्थवादी केस पैकेट (अमान्य उद्धरण, काउंटर पुनः कथन, असमर्थनीय समूह, वास्तव में सीमावर्ती अनुरोध) स्थितियों में यादृच्छिकृत होते हैं जो एक बार में एक घटक जोड़ते हैं: इस लेख की तालिकाओं की मैनुअल प्रोटोकॉल (सही आधारभूत, क्योंकि एक गैर-AI विधि पहले से मौजूद है), एक एकल सामान्यवादी मॉडल, समान मॉडल पुनर्प्राप्ति और नियतात्मक गणना के साथ, पीढ़ीकरण और स्वतंत्र आलोचना, और पूर्ण शासित पाइपलाइन। संक्षेप जो सत्यापक, नियतात्मक कैलकुलेटर, असहमति की दृश्यता, या मानव द्वार को हटाते हैं, तो अलग करते हैं कि कौन सी शासन सामग्री अपनी लागत कमाती है। परिणाम अलग-अलग स्कोर किए जाते हैं, कभी नहीं एक समग्र के रूप में: दावा और उद्धरण निष्ठा; संदर्भ-वर्ग वैधता; लेखक विश्वास का अंशांकन (अध्ययन 4 का उपकरण) और अस्पष्ट मामलों पर उपयुक्त संयम; शोधकर्ता का समय और निरीक्षण बोझ; शासन विफलताएं (स्वायत्त बाहरी कार्य, मेट्रिक-गेमिंग सलाह, श्रेणीबद्ध स्थान आरोप); और, लेख के ठंडे-शुरुआत तर्क के लिए केंद्रीय, पूर्व लेखक दृश्यता और नए लोग की स्थिति द्वारा लाभ की विषमता, क्योंकि एक परत जो मुख्य रूप से पहले से दृश्यमान लेखकों की मदद करती है असमानता को पुनः उत्पन्न करेगी जिसे कम करने के लिए डिज़ाइन किया गया था। शून्य और प्रतिकूल समानता के परिणाम रिपोर्ट योग्य निष्कर्ष हैं। मॉडल संस्करण, संकेत, उपकरण अनुमतियां, और स्रोत स्नैपशॉट संग्रहीत हैं, क्योंकि एक गैर-स्थिर प्रणाली में प्रत्येक परिणाम एक दिनांकित अनुमान है। दो अनुमानपत्र पूरे समय अलग रहते हैं: व्याख्या गुणवत्ता पर प्रभाव और बाद के प्रसार पर प्रभाव। एक परत जो निदान में सुधार करती है बिना डाउनलोड को स्थानांतरित किए एक सफलता है, जबकि जो दावों को विकृत करते हुए डाउनलोड बढ़ाती है एक शासन विफलता है। डिज़ाइन विफल हो जाता है यदि शासित पाइपलाइन सबूत सटीकता और अंशांकन पर एक मजबूत एकल मॉडल से बेहतर प्रदर्शन नहीं करती है: "कई मॉडल" योगदान नहीं है, और परीक्षण के तहत परिकल्पना ज्ञानमीमांसा श्रम का विभाजन है। प्रस्ताव AI-सहायता प्राप्त व्याख्या के लिए एक परीक्षणीय भूमिका निर्दिष्ट करता है। AI एक लेखक को एक संख्या का बेहतर प्रश्न पूछने में सहायता कर सकता है; केवल सत्यापित सबूत इसका उत्तर दे सकते हैं।
9. सीमाएँ
इस लेख के दावे नीचे दी गई सीमाओं द्वारा बाँधे गए हैं, जिनमें से प्रत्येक उस कलाकृति से जुड़ी है जिसे यह बाधित करती है।
साक्ष्य आधार की उम्र और संरचना। बेंचमार्क मानचित्र में पुरानी वितरणात्मक प्रशिक्षण (तालिका 7) 2012 और 2015 के बीच एकत्र किए गए नमूनों पर निर्भर करती है और कानूनी छात्रवृत्ति द्वारा प्रमुख [85][139]; एक हाल का प्रविष्टि नीचे चर्चा की गई एकल-नेटवर्क स्नैपशॉट है [83]। व्याख्या पैमाने की बैंड (तालिका 8) 2026 के लिए कम सख्त के बजाय रूढ़िवादी पूर्ण बैंड के रूप में सबसे अच्छी तरह से पढ़ी जाती हैं (अनुभाग 5.1)। मंच-व्यापी वार्षिक डाउनलोड मात्रा मध्य-2010 और 2020 के बीच कई गुना बढ़ी [1][143], डाउनलोड-प्रति-पेपर प्रवाह को उठा कर और एक निर्धारित पुरानी सीमा को आज की तुलना में नरम पट्टी बना दिया जब इसका अनुमान लगाया गया था। कोई गुणक सुधार इसको ठीक नहीं कर सकता, क्योंकि वृद्धि अंश, हर, और संरचना को एक साथ बदलती है (अनुभाग 3.2)। तालिका 8 की बैंड पुनः स्केल किए गए मानदंड के बजाय कुल अंकगणित से व्युत्पन्न सन्निकटन हैं। SSRN डाउनलोड का कोई पोस्ट-2020 मंच-व्यापी वितरणात्मक अध्ययन पहचाना नहीं गया।
एकल-स्रोत समसामयिक साक्ष्य। यहाँ उपयोग किया गया एकमात्र हाल का वितरणात्मक साक्ष्य एक अनुशासित नेटवर्क का एक एकल प्रकाशित स्नैपशॉट है: 15 अगस्त 2025 को देखे गए 2,361 मार्केटिंग पत्र [83]। यह विषमता और एक सशर्त प्रतिष्ठा प्रीमियम प्रदर्शित करता है, लेकिन यह मंच-व्यापी बेंचमार्क स्थापित नहीं करता है, और इसकी प्रकाशित तालिका के दो आंतरिक मान एक सावधानी नोट के साथ "प्रकाशित के रूप में" पुनः उत्पादित हैं। इस स्रोत से अन्य SSRN नेटवर्क के लिए सामान्यीकरण एक्सट्रपोलेशन हैं। परिशिष्ट E एक स्वतंत्र, सभी-क्षेत्र संग्रह क्रॉस-सेक्शन (n = 1,360) जोड़कर इस निर्भरता को कम करता है जो विषमता, माध्य-से-माध्यिका अंतराल, रूपांतरण बैंड, क्षेत्र गुणक, और देखे गए निकाय पर लॉग-सामान्यता को पुनः उत्पादित करता है। यह अपना स्वयं का ऊर्ध्वमुखी चयन पूर्वाग्रह रखता है और अनुशासनों में वितरण के आकार की पुष्टि करता है। अनुभाग 8 का एजेंडा अभी भी मंच-प्रतिनिधि बेंचमार्क को लक्षित करता है।
शीर्ष-सूची पूर्वाग्रह। 2015 बड़े-नमूने की फिटिंग केवल शीर्ष सूचियों को कवर करती है (मोटे तौर पर लेखकों और उनके पत्रों के ऊपरी दशमलव [85]), इसलिए अभिजात सूचियों के नीचे वितरण का निकाय एक फिट किए गए लॉगनॉर्मल से अनुमानित किया जाता है बजाय देखे गए। उस फिटिंग से व्युत्पन्न प्रतिशतक कथन मॉडल-आधारित हैं।
काउंटर शब्दार्थ अस्थिर हैं। विचार और डाउनलोड के रिकॉर्ड समय के साथ बदलते रहे हैं और इंटरफ़ेस पुनर्डिजाइन और विकसित बॉट फ़िल्टरिंग के साथ बदलते रहेंगे। प्लेटफॉर्म की अखंडता प्रणाली कुछ संदिग्ध गतिविधि को आधिकारिक गणना से बाहर करती है [144][66][69], और आसन्न RePEc/LogEc बुनियादी ढांचा रोबोट ट्रैफिक के ऐतिहासिक पैमाने और हाल के AI-क्रॉलर लहरों दोनों को दस्तावेज़ करता है जिसके लिए कच्चे ट्रैफिक के अधिकांश को छोड़ने की आवश्यकता थी [99][129]। धारा 5 में उद्धृत रूपांतरण मानदंड इसलिए विंटेज-विशिष्ट मात्राएं हैं, और वर्षों में काउंटर की तुलना व्यवहारगत और फ़िल्टरिंग परिवर्तनों को मिश्रित करती है। सामान्य वेब-बॉट आंकड़े [158] को SSRN की फ़िल्टर की गई गणना में किसी भी दिशा में बढ़ाया नहीं जा सकता।
प्लेटफॉर्म अस्थिरता और स्रोत बहाव। रैंकिंग सेवानिवृत्ति एक व्यापक 2026 उत्पाद पुनर्संरचना में एम्बेड की गई है [146][149][150], इसलिए कोई भी विश्लेषण 15 जुलाई 2026 को एक पृथक हस्तक्षेप के रूप में नहीं मानना चाहिए। यह खतरा धारा 8.5 के डिजाइन में निर्मित है लेकिन पूरी तरह समाप्त नहीं किया जा सकता। प्लेटफॉर्म सहायता पृष्ठ बिना नोटिस के संशोधित किए जाते हैं; सभी ऐसे पृष्ठ यहां एक्सेस तिथि के साथ उद्धृत हैं, और उद्धृत प्लेटफॉर्म भाषा को औपचारिक प्रस्तुति से पहले संग्रहीत प्रतियों के विरुद्ध पुनः सत्यापित किया जाना चाहिए।
कोई प्रतिशतक डेटा नहीं। कोई सार्वजनिक पूर्ण-प्लेटफॉर्म प्रतिशतक डेटा कभी भी अस्तित्व में नहीं रहे हैं, और 15 जुलाई 2026 के बाद कोई भी प्लेटफॉर्म-प्रतिनिधि प्रतिशतक ढांचा बाहरी रूप से एकत्र नहीं किया जा सकता, क्योंकि रैंकिंग जो पहले शीर्ष-सूची सीमाएं लीक करती थीं उन्हें हटा दिया गया है [149]। एक नमूना-आधारित संदर्भ वितरण अभी भी संग्रहीत कैप्चर से इकट्ठा किया जा सकता है, और परिशिष्ट E एक की रिपोर्ट करता है; यह वितरण के आकार को ठीक करता है और प्लेटफॉर्म प्रतिशतक प्रदान नहीं करता है। रुचि की कुछ मात्राएं (उदाहरण के लिए, "शीर्ष 10%" लेखक अधिसूचना ईमेल [161] का भाग्य) आधिकारिक रूप से दस्तावेज़ित नहीं हैं, और हम सार्वजनिक ढांचे से उनके गायब होने पर ध्यान देते हैं बिना उनकी समाप्ति पर जोर दिए।
उपयोग पाठन नहीं है, और न ही गुणवत्ता है। एक डाउनलोड सावधानीपूर्वक पढ़ने, सतही निरीक्षण, संग्रह भंडारण, या कोई भी उपयोग नहीं से पहले हो सकता है। डाउनलोड अनुसंधान गुणवत्ता का सीधा संकेतक नहीं हैं और उद्धरणों का गारंटीकृत कारणात्मक स्रोत नहीं हैं: डाउनलोड-उद्धरण सहयोग सकारात्मक है लेकिन विषम है (क्षेत्र, एकत्रीकरण के स्तर और क्षितिज के आधार पर मोटे तौर पर 0.1 से 0.6 [18][25][39][80][102][108]) और अत्यधिक डाउनलोड किए गए और अत्यधिक उद्धृत जनसंख्या केवल आंशिक रूप से ओवरलैप करते हैं [108]। उद्धरण स्वयं सकारात्मक, नकारात्मक, साधारण, या रणनीतिक हो सकते हैं, और उद्धरण प्रक्रिया उपन्यास कार्य के विरुद्ध व्यवस्थित रूप से पक्षपाती है [166]। इस लेख में कुछ भी मीट्रिक प्रतिस्थापन को विशेषज्ञ निर्णय के लिए लाइसेंस नहीं देता; ढांचे का रक्षणीय उपयोग निदान और वर्णनात्मक है।
अप्रेक्षणीय जोखिम और गैर-यादृच्छिक प्रतिष्ठा। हर जोखिम अप्रेक्षणीय नहीं है: पाठक ईमेल, सोशल मीडिया, खोज परिणामों और पत्राचार में शीर्षक का सामना करते हैं इससे पहले कि कोई भी सारांश-पृष्ठ दृश्य दर्ज किया जाता है, और अच्छी तरह से नेटवर्क किए गए लेखक प्रतिष्ठा और गुणवत्ता दोनों के साथ सहसंबद्ध ऑफ-प्लेटफॉर्म जोखिम उत्पन्न करते हैं। प्रेक्षणीय प्रतिष्ठा गुणांक इसलिए स्थिति-आधारित ध्यान को संसाधन, विषय और नेटवर्क में वास्तविक अंतर के साथ मिश्रित करते हैं [111][140]। लेखक-पहचान संकेतों के प्रायोगिक हेराफेरी [154][64] प्लेटफॉर्म अवलोकन की पूरक लेकिन प्रतिस्थापन नहीं करता। फील्ड वर्गीकरण आंशिक रूप से लेखक द्वारा चयनित है, और कागजात कई श्रेणियां घेरते हैं, एकल-क्षेत्र असाइनमेंट जटिल करते हैं।
एजेंडा की सीमाएं। धारा 8.4–8.5 की अर्ध-प्रायोगिक डिजाइन घोषणा प्रभाव, समवर्ती प्लेटफॉर्म परिवर्तन, और गैर-यादृच्छिक क्षेत्र अंतर का सामना करती हैं। वे अर्ध-प्रायोगिक के रूप में लेबल किए जाते हैं क्योंकि एक प्लेटफॉर्म-व्यापी घटना कोई अनुपचारित नियंत्रण समूह प्रदान नहीं करती है। अध्ययन 2 का स्नैपशॉट उन इंजनों के साथ उम्र बढ़ेगा जो यह ऑडिट करता है, और इसका प्रतिकृति प्रोटोकॉल गैर-स्थिरता को कम करता है लेकिन हटाता नहीं है। अध्ययन 3 एक N = 2 केस अध्ययन है जिसका मूल्य तंत्र और प्रोटोकॉल है, जनसंख्या अनुमान नहीं, और इसका विशेषता तर्क सार्वजनिक ईमेल दृश्यता के किसी भी दावे के बजाय प्रति-चैनल उपनाम पर निर्भर करता है। भीड़-सूचीबद्ध रजिस्ट्री धारा 8.8 में कहीं गई आत्म-चयन और सत्यापन समस्याएं विरासत में लेती है। सभी डिजाइनों के लिए डेटा एक्सेस प्लेटफॉर्म सहयोग या सेवा की शर्तों के भीतर दर-सीमित संग्रह पर निर्भर करता है [134][51]; न तो गारंटीकृत है।
ग्रंथ सूची की व्यापकता। ग्रंथ सूची व्यापक है क्योंकि लेख एक संश्लेषण है; उद्धृत अधिकांश अध्ययन फ़्रेम, क्षेत्र और डिजाइन सीमाएं साझा करते हैं, और समुदाय पोस्ट बिना जनसंख्या मापदंड स्थापित किए अनुभव दस्तावेज़ करते हैं। एक दावे का सबूत इसका सत्यापन स्तर और नमूनाकरण फ्रेम है, न कि इसके पीछे संदर्भों की संख्या।
बैंड कैलिब्रेशन लक्ष्य हैं, स्थिरांक नहीं। 11–19% रूपांतरण बैंड और CSAB सीमाएं क्षेत्र और प्लेटफॉर्म द्वारा अंशांकित की जाने वाली मात्राएं हैं, विद्वान व्यवहार के सार्वभौमिक स्थिरांक नहीं (धारा 4.4, 5.2)। उनका वर्तमान रूप एक एकल क्रॉस-क्षेत्र बैंड है, जिसे प्रति-क्षेत्र वितरण द्वारा प्रतिस्थापित किया जाना है जो ढांचे को आवश्यकता है जब क्षेत्र-स्तरीय अध्ययन 1 (धारा 8.6) रिपोर्ट करता है।
SSRN से परे सामान्यीकरण के लिए प्रत्यारोपण नहीं, पुनः कैलिब्रेशन की आवश्यकता है। यहां निदान की गई व्याख्याकारिता समस्या (सार्वजनिक तुलनात्मक पैमाने के बिना प्रदर्शित उपयोग काउंटर) और पहुंच-बनाम-रूपांतरण तर्क जो इसकी मरम्मत करता है SSRN के लिए विशिष्ट नहीं है; वे किसी भी प्रीप्रिंट सर्वर पर लागू होते हैं जो उपयोग गणना दिखाता है, जिसमें bioRxiv, medRxiv, arXiv, और OSF Preprints [11][62][2][24] शामिल हैं। जो स्थानांतरित नहीं होता वह विशिष्ट 11–19% बैंड या CSAB सीमाएं हैं। क्यूरेशन, वितरण आर्किटेक्चर, और इंटरफ़ेस सर्वरों में भिन्न होता है: arXiv की इरादा-संचालित खींचना ट्रैफिक और इसकी ईमेल घोषणा सूचियां SSRN की क्यूरेटेड पुश सतर्कताओं (तालिका 6) के विरुद्ध। संख्यात्मक एंकर इसलिए उन्हें उद्धृत करने से पहले प्रत्येक प्लेटफॉर्म पर पुनः अनुमानित किए जाने चाहिए। ढांचे पोर्टेबल है; इसका अंशांकन स्थानीय है। धारा 8.8 का समानांतर-जमा प्रोटोकॉल यह सीधा अनुभवजन्य परीक्षण है कि SSRN बैंड कितनी दूर यात्रा करते हैं। उस पुनः कैलिब्रेशन के पैमाने को कम करना आसान है: bioRxiv के सभी-कॉर्पस माध्यिका डाउनलोड (लगभग 279, और जीनोमिक्स में लगभग 496 [2]) आर्काइवल क्रॉस-सेक्शन के माध्यिका 60 का कई गुना है परिशिष्ट E में: समग्र रूप से लगभग पांच गुना और जीनोमिक्स में लगभग आठ गुना। तुलना केवल संकेतात्मक है। bioRxiv आंकड़ा एक संपूर्ण-कॉर्पस जनगणना से आता है, जबकि 60 एक संग्रहीत नमूने से आता है जो कब्जा किए गए पृष्ठों को अधिक-प्रतिनिधित्व करता है, आयु और क्षेत्रों को मिश्रित करता है जिनकी संरचना आयु के साथ बदलती है, और आयु को पूरे वर्षों तक हल करता है। अंतराल की दिशा पढ़ने के लिए सुरक्षित है; इसका आकार नहीं है।
नैतिकता। इस लेख का सामुदायिक-प्रवचन भाग स्व-चयनित सार्वजनिक पोस्ट से मिलकर बना है जिनका उपयोग केवल माँग के साक्ष्य के रूप में किया जाता है, कभी भी प्रतिनिधि भावना के रूप में नहीं, और केवल वहीं उद्धृत किए जाते हैं जहाँ कोई जीवंत, सत्यापन योग्य स्रोत मौजूद है। उपयोगकर्ता पोस्ट को अर्ध-सार्वजनिक फोरम सामग्री को उद्धृत करने की नैतिकता पर ध्यान देकर उद्धृत किया जाता है, जिसमें वे मामले शामिल हैं जहाँ लेखकों की अपेक्षाओं के विरुद्ध पहचाना जा सकता है वहाँ शाब्दिक उद्धरण के स्थान पर पुनर्कथन किया जाता है, जो गुणात्मक साक्ष्य के लिए पारदर्शिता मानदंडों के अनुरूप है [6]। अध्ययन 3 केवल अनुरोधित नहीं किए गए संदेश दर्ज करता है जो उपकरण लगे लेखक को भेजे गए हैं और प्रेषकों द्वारा स्वेच्छा से प्रदान किए गए से परे कोई तीसरी पक्ष की व्यक्तिगत जानकारी एकत्र नहीं करता है। अध्ययन 4 केवल सूचित सहमति के तहत स्वेच्छा से, गुमनाम प्रश्नावली प्रतिक्रियाएँ एकत्र करता है। पैनल डिजाइन सार्वजनिक रूप से प्रदर्शित काउंटर और ग्रंथ सूची मेटाडेटा का उपयोग करता है, और गैर-सार्वजनिक डैशबोर्ड जानकारी (जैसे वितरण-स्थिति तिथियाँ) का कोई भी संग्रह सूचित लेखक सहमति और, जहाँ लागू हो, संस्थागत समीक्षा की आवश्यकता है। दो अध्ययन जिनमें मानव प्रतिभागी और प्रतिभागी-उत्पन्न डेटा शामिल हैं, अध्ययन 4 (लेखक सर्वेक्षण) और अध्ययन 3 (उपकरण लगी पोस्टिंग इनबॉक्स लॉगिंग के साथ) हैं। क्योंकि दोनों मानव-विषय अनुसंधान हैं, दोनों को प्रासंगिक संस्थागत समीक्षा बोर्ड या अनुसंधान-नैतिकता समिति द्वारा अनुमोदन के लिए प्रस्तुत किए जाएँगे और किसी भी डेटा संग्रह शुरू होने से पहले प्रतिभागियों की सूचित सहमति के तहत आयोजित किए जाएँगे, और इनबॉक्स लॉग में निहित व्यक्तिगत डेटा किसी भी विश्लेषण या रिपोर्टिंग से पहले एकत्रित और विमुक्त-पहचान किए जाते हैं। यह प्रोटोकॉल निष्पादन की एक पूर्वशर्त है और घोषणाओं में पुनः प्रस्तुत किया गया है।
10. निष्कर्ष और नीति सिफारिशें
10.1 विश्लेषण ने क्या स्थापित किया
15 जुलाई 2026 को SSRN Rankings की सेवानिवृत्ति ने एकमात्र सार्वजनिक तुलनात्मक पैमाने को हटा दिया [149]। काउंटर हर पेपर और प्रोफ़ाइल पर बने रहे, जिससे ऐसी मेट्रिक्स रह गईं जो अर्थहीन के बजाय अपठनीय थीं। इस नुकसान के विरुद्ध यह लेख प्रत्येक सत्यापन योग्य अनुभवजन्य एंकर को स्पष्ट विंटेज और आत्मविश्वास चेतावनियों के साथ एक बेंचमार्क मानचित्र में संकलित करता है (तालिका 7), एक व्याख्या ढांचा, पाँच-बैंड पैमाना, पहुँच–रूपांतरण अपघटन, और डोजिएर प्रोटोकॉल (तालिकाएँ 8, 9, 13) बनाता है, जो काउंटर को निदान में अनुवाद करता है, और अनुभाग 8 के पूर्व-पंजीकरण-तैयार एजेंडा को निर्धारित करता है, जो निर्दिष्ट करता है कि लुप्त वितरण को कैसे पुनर्निर्मित किया जा सकता है।
तर्क के केंद्र में आने वाली क्रियाविधि इसमें आती है:
कोई नहीं जानता कि सात डाउनलोड का अर्थ क्या है यह जाने बिना कि सात डाउनलोड किससे तुलना में हैं, और 15 जुलाई 2026 के बाद प्लेटफ़ॉर्म अब "किससे" का उत्तर नहीं देता।
योगदान किस्म में भिन्न हैं। संदर्भ-वर्ग समस्या का नाम देना निदान वाला है: एक कच्चा गणना कोई सवाल का जवाब तब तक नहीं देता जब तक उम्र, क्षेत्र, समूह, और एक्सपोज़र इसके तुलना समूह को परिभाषित न करें। instrumental योगदान बेंचमार्क मानचित्र और CSAB है, जो एक भावनात्मक रूप से सार्थक लेकिन वैज्ञानिक रूप से अस्पष्ट संख्या को एक व्याख्यात्मक निदान में सामान्यीकृत करता है। प्लेबुक और डोजिएर प्रोटोकॉल व्यावहारिक योगदान हैं, जो लेखकों और समितियों को आज काउंटर पर काम करने देते हैं उन्हें गलत पढ़े बिना। नीति के संदर्भ में योगदान गुमनाम प्रतिशतक बैंड है: तुलनात्मक संदर्भ एक ऐसे रूप में बहाल किया गया है जो किसी को भी चिन्हित नहीं करता है और किसी लीग टेबल को पुनर्जीवित नहीं करता है।
संकलित साक्ष्य पर, इस लेख के शीर्षक में सवाल तब तक खराब-प्रश्नित है जब तक एक संदर्भ वर्ग निर्दिष्ट न हो। हर उपलब्ध एंकर के विरुद्ध, छोटी गणनाएँ प्लेटफ़ॉर्म के सांख्यिकीय मानदंड हैं न कि कार्य पर फैसला। 40 सारांश दृश्यों और 7 डाउनलोड वाला एक पेपर, एक स्क्रीनिंग परिणाम के रूप में, अनुभाग 5 के अनुभवजन्य रूपांतरण बैंड के साथ संगत है [139][172][83], जबकि पुरानी तीन-दृश्य-प्रति-डाउनलोड की अंगूठे की सामान्य नियम [18] उस बैंड के बजाय उसके ऊपर बैठता है। केवल जनगणना-शैली नमूने में माध्यिका पेपर दो साल में 63 डाउनलोड जमा किए [139], और 2015 शीर्ष-10,000 सूची में प्रवेश, मोटे तौर पर प्लेटफ़ॉर्म के पूर्ण-पाठ पेपर स्टॉक के शीर्ष 1.8% (571,040, जुलाई 2016 [1]) में, 160 आजीवन डाउनलोड की आवश्यकता थी [85]। एक अर्ध-लॉग-सामान्य ध्यान व्यवस्था के तहत, अधिकांश लेखक निर्माण द्वारा सीढ़ी के निचले पायदानों पर खड़े हैं। माध्यिका प्रीप्रिंट एक log-normal वितरण की लंबी पूंछ में रहता है जिसे इसका लेखक नहीं देख सकता, और इसे वर्गीकरण तंत्र द्वारा सतहीकृत किया जाता है जो संबद्ध को अनुकूल करते हैं। इसे शिकारियों द्वारा साथियों द्वारा पढ़े जाने से पहले माँगा जाता है, और इसने अब रैंकिंग खो दी है जो एक बार इसे स्थित करता था। पैमाना एक पेपर को उस सीढ़ी पर कहीं स्थित करता है, और सवाल जो संकट ले जाता है वह लुप्त पैमाने द्वारा उत्पादित होता है संख्या द्वारा नहीं।
इसमें कुछ भी एक प्लेटफ़ॉर्म के लिए विशिष्ट नहीं है, और घटना अभूतपूर्व नहीं है। ResearchGate ने अगस्त 2022 में अपने स्वयं के भारी समीक्षित समग्र RG Score को सेवानिवृत्त किया [130], मजबूत पद्धति संबंधी आलोचना के बाद [90], और 2022–2023 में दर्जनों अमेरिकी कानून स्कूलों ने, Yale और Harvard के नेतृत्व में, अमेरिकी News कानून-स्कूल रैंकिंग से अलग हो गए [13]। एक विवादास्पद उपाय को सेवानिवृत्त करना एक सौंदर्य प्रसाधन कार्य नहीं है, क्योंकि उपाय कभी भी एक निष्क्रिय वर्णन नहीं था: कानून-स्कूल रैंकिंग से उत्पन्न प्रतिक्रिया साहित्य दिखाता है कि एक सार्वजनिक रैंकिंग उन लोगों के व्यवहार को पुनर्गठित करता है जिन्हें यह रैंक करता है [58][132], तो दोनों इसका आरोपण और इसकी हटाना आचरण को बदलते हैं न कि केवल रिपोर्ट किए जाने वाली चीज़ को बदलते हैं। एक काउंटर और इसका तुलनात्मक फ्रेम संयुक्त रूप से एक मेट्रिक हैं, और फ्रेम को सेवानिवृत्त करते हुए काउंटर को रखना हर उपयोगकर्ता को एक गणना के साथ इसके विरुद्ध पढ़ने के लिए कुछ भी नहीं रखता है। व्याख्यात्मकता, एक सार्वजनिक वितरण की उपलब्धता एक सार्वजनिक काउंटर के लिए, को किसी भी संकेतक के पहले-श्रेणी के गुणवत्ता आयाम के रूप में व्यवहार किया जाना चाहिए, वैधता और विश्वसनीयता के साथ। मेट्रिक्स अपने व्याख्या संरचना को जीवित रखती हैं, और संदर्भ के बिना एक मेट्रिक शोर है, decontextualized संख्याओं के संदेहपूर्ण पढ़ने के सामान्य अनुशासन का एक उदाहरण [15]। समान मेट्रिक संदर्भ के साथ एक अंशांकन है जो लेखकों को सशक्त बनाता है, विद्वान संचार में सुधार करता है, और उन भंडारों में विश्वास को बनाए रखता है जो इसे प्रदर्शित करते हैं।
यह ढांचा अपने उपयोगकर्ता की कुछ साधारण आदतें माँगता है। समान के साथ तुलना करें, और पहुँच को रूपांतरण से अलग रखें। प्रक्षेपवक्र पढ़ें न कि कुल, हर संख्या को दिनांकित मानें, और कोई गणना अपने स्रोत, विंडो, और सीमाओं के बिना यात्रा न करने दें।
10.2 लेखकों के लिए सिफारिशें
लेखक अभी कार्य कर सकते हैं, नए डेटा की प्रतीक्षा किए बिना। पेपर-स्तरीय काउंटरों के दिनांकित स्क्रीनशॉट लें, जो संदर्भ को संरक्षित करते हैं: सूर्यास्त के बाद वे स्थिति का एकमात्र रिकॉर्ड हैं जो लेखक के नियंत्रण में रहता है, और वे अनुभाग 8.8 की सामुदायिक रजिस्ट्री को आरंभ करते हैं। काउंट केवल उनके फ्रेम के साथ रिपोर्ट करें (आयु, क्षेत्र, कोहोर्ट, और स्रोत), तालिका 13 के डोजियर प्रोटोकॉल का पालन करते हुए, जिसमें प्रत्येक संख्या अपना स्रोत, समय विंडो, और सीमाएं ले जाती है। डैशबोर्ड को भावनात्मक रूप से नहीं, बल्कि नैदानिक रूप से पढ़ें: पहुंच को रूपांतरण से अलग करें (तालिका 9), पहले सप्ताह में शून्य-डाउनलोड को सामान्य पूर्व-वितरण व्यवहार के रूप में मानें [53], और सहकर्मियों द्वारा एक ही महीने में पोस्ट किए गए तीन से पाँच पेपर के विरुद्ध बेंचमार्क करें, न कि दृश्यमान पूंछ के विरुद्ध, जिसकी परिचलन करने वाली मील के पत्थर की संख्याएं भारी-पूंछ वाली व्यवस्था के तहत गलत अंशांकन की गारंटी देती हैं [85][180]। अनुरोध ईमेल को स्क्रैपिंग घटना के रूप में मानें, न कि मान्यता के रूप में, और न ही काउंटरों के बारे में साक्ष्य के रूप में [61][107][144]।
10.3 मूल्यांकनकर्ताओं के लिए सिफारिशें
जिन संस्थानों ने SSRN डाउनलोड को मूल्यांकन मुद्रा के रूप में आयात किया [12][18][161][52], उनके सामने अब एक प्रशासनिक प्रश्न है क्योंकि मुद्रा का सार्वजनिक पैमाना समाप्त हो गया है। कच्ची डाउनलोड संख्या को नियुक्ति, पदोन्नति या कार्यकाल की फाइलों में शामिल नहीं होना चाहिए: वे ठीक उसी सीमा पर हेराफेरी की जाती हैं जहां यह महत्वपूर्ण है [44], वे एक ही नेटवर्क के भीतर उप-क्षेत्रों में आठ गुना तक भिन्न होती हैं [168], और वे अब मानदंड-अपारदर्शी हैं। न्यूनतम रूप से रक्षणीय इकाई एक परिभाषित समूह (समान क्षेत्र, समान आयु बैंड, समान पोस्टिंग अवधि) के भीतर एक प्रतिशतक है जिसके साथ इसका स्रोत और विंटेज हो, और उपयोग साक्ष्य उद्धरण, सहकर्मी आकलन और वास्तविक निर्णय के पूरक के रूप में काम करना चाहिए, न कि उनके स्थान पर [108][109][110]। स्थापित अनुसंधान-मूल्यांकन सुधार सर्वसम्मति उसी सिद्धांत पर काम करती है। DORA का मूल निर्देश अनुसंधान स्वयं का मूल्यांकन करने के स्थान पर एक एकल संख्या या स्थान प्रॉक्सी का उपयोग न करना है [8], और Leiden Manifesto जोर देता है कि मात्रात्मक मूल्यांकन गुणात्मक विशेषज्ञ निर्णय को प्रतिस्थापित करने के बजाय समर्थन करे [78]। Metric Tide समीक्षा इस जोर को पुष्ट करती है, ऐसे संकेतकों की मांग करती है जो मजबूत, विनम्र, पारदर्शी, विविध और प्रतिबिंबित हों और विशेषज्ञ आकलन के स्थान पर उसके समर्थन में उपयोग किए जाएं [173], जैसा कि अधिक हाल की CoARA Agreement on Reforming Research Assessment भी करती है, जिसके कई सौ हस्ताक्षरकर्ता संगठन गुणात्मक मूल्यांकन के लिए प्रतिबद्ध हैं जो जिम्मेदार मात्रात्मक उपयोग द्वारा समर्थित है, प्रतिस्थापित नहीं [183]। यह संपूर्ण सर्वसम्मति एक डाउनलोड काउंटर पर पूर्ण बल के साथ लागू होती है जिसका सार्वजनिक पैमाना हटा दिया गया है। Metric Tide के पाँच आयामों में से दो यहाँ प्रस्तावित विधि पर सीधा प्रभाव डालते हैं: विविधता वह क्षेत्र-सामान्यीकरण है जिस पर यह लेख जोर देता है, और प्रतिबिंबन अनुभाग 8.7 का रुख है, जिसमें लेख अपने स्वयं के ध्यान को मापता है। समीक्षा का REF-सामना करने वाला उत्तराधिकारी वर्तमान UK अभ्यास में समान पाँच सिद्धांतों को ले जाता है [184]। यह सर्वसम्मति स्वयं संस्थागत जीवन में मीट्रिक अतिरेक की व्यापक आलोचना की एक अभिव्यक्ति है [113]। मूल्यांकन समितियों को तालिका 13 (साक्ष्य का संदर्भित, आख्यात्मक रूप जिसे UK का Résumé for Research and Innovation (R4RI) जैसे उदीयमान मूल्यांकन प्रारूप ले जाने के लिए बनाए गए हैं [186]) प्रारूप की अपेक्षा करनी चाहिए और स्वीकार करनी चाहिए, न कि सेवामुक्त "शीर्ष 10%" रैंकिंग भाषा के। संयुक्त राज्य अमेरिका में समान dossier-भाषा लीवर Higher Education Leadership Initiative for Open Scholarship (HELIOS Open) का ध्यान केंद्र है, जो विश्वविद्यालयों के साथ पदोन्नति और कार्यकाल मानदंडों को फिर से लिखने के लिए काम करता है [189]; यहाँ निर्दिष्ट संदर्भित उपयोग लाइन ठीक वही ठोस रूब्रिक है जो अक्सर ऐसे सुधारों में कमी होती है।
10.4 प्लेटफॉर्म के लिए सिफारिशें
रैंकिंग को प्रतिस्थापन संदर्भ के बिना सेवानिवृत्त करना एक खामी वाले संकेत को कोई संकेत न देने के लिए व्यापार करता है। परिणाम लेखक के आराम के पार पहुंचते हैं। चाहे सूर्यास्त नई प्रस्तुतियों को ठंडा करता है, खंड 8.5 में निर्दिष्ट पोस्टिंग-वॉल्यूम परिणाम, प्लेटफॉर्म के अपने स्वास्थ्य के बारे में एक खुला अनुभवजन्य प्रश्न है। ढांचा एक ठोस उत्पाद दिशा का सुझाव देता है जो SSRN ने सेवानिवृत्त करने के लिए चुने गए लीग-टेबल उपकरण को फिर से नहीं बनाता है [149]:
1. अनुशासन और पेपर आयु के आधार पर अनाम प्रतिशतक बैंड। प्रत्येक पेपर के डाउनलोड और दृश्य स्थिति को अपने अनुशासन-दर-आयु समूह के भीतर एक मोटे प्रतिशतक बैंड के रूप में प्रदर्शित करें: जानकारी जो प्रत्येक लेखक को चाहिए, एक ऐसे रूप में प्रकाशित जो किसी को भी पहचानता नहीं है, कोई लीडरबोर्ड नहीं बनाता है, और शीर्ष-एन सूचियों की विजेता-ले-सभी गतिविधि को कम करता है। प्रतिशतक संदर्भ गोपनीयता संरक्षित करते हुए पठनीयता को बहाल करता है। लक्ष्य प्रदर्शन प्रारूप चित्र 14 के आयु-विशिष्ट बेंचमार्क पंखे के बिल्कुल समान है।
2. समय-सामान्यीकृत प्रदर्शन। केवल आजीवन गणना के बजाय आयु-मिलान तुलना दिखाएं, ताकि एक 14-दिन-पुराने पेपर की कभी भी अंतर्निहित रूप से उस काम के साथ तुलना न की जाए जो वर्षों से ध्यान जमा करता रहा है।
3. पहुंच और रूपांतरण को अलग करें। सार दृश्य और डाउनलोड को अलग संकेत के रूप में रिपोर्ट करें उनके अनुपात के साथ, बजाय एक एकल-संख्या पाठन को आमंत्रित करने के जो अदृश्यता को अस्वीकृति के साथ मिलाता है।
4. पारदर्शी संदर्भ वर्ग। किसी भी तुलनात्मक संकेत को जनसंख्या, क्षेत्र, अवधि और आयु बैंड को बताना चाहिए जिसके विरुद्ध यह तुलना करता है; एक अनलेबल "शीर्ष X%" वैज्ञानिक रूप से निरर्थक है। परिशिष्ट D दस प्रकटीकरण क्षेत्र निर्दिष्ट करता है जो एक संस्करणित प्रतिशतक रिलीज को ले जाना चाहिए, जनसंख्या और समूह परिभाषाओं से लेकर न्यूनतम-सेल गोपनीयता नियमों और एक उद्धृत संस्करण इतिहास तक।
5. संचयी लाभ के लिए ऑडिट डिज़ाइन। वर्गीकरण, सतर्कता वितरण, खोज रैंकिंग, और दृश्यमान लोकप्रियता संकेत दुर्लभ ध्यान आवंटित करते हैं और उनके वितरणात्मक प्रभावों के लिए मूल्यांकन किया जाना चाहिए। खंड 8.4–8.5 के अनुभवजन्य डिज़ाइन ऐसे ऑडिट के लिए सीधे उपयोग योग्य हैं।
6. सुविधाओं को सेवानिवृत्त करते समय व्याख्यात्मक अवशेष के लिए योजना बनाएं। जब तुलनात्मक सुविधाओं को हटाया जाता है, तो व्याख्यात्मक नुकसान का आकलन किया जाना चाहिए और डेटा माइग्रेशन के समान देखभाल के साथ कम किया जाना चाहिए, संग्रहीत वितरण, प्रकाशित सारांश प्रतिशतक, या समुदाय को एक स्पष्ट हस्तांतरण के माध्यम से, क्योंकि एक मीट्रिक जो पढ़ा नहीं जा सकता सूचित नहीं कर सकता।
7. फसल-प्रतिरोधी संपर्क यांत्रिकी, खंड 7 में प्रलेखित दृश्यमानता की अनुरोध बाह्यता को कम करते हुए [107][159]। एक ठोस उम्मीदवार: पोस्टिंग के बाद पहले 48–72 घंटों के लिए लेखक संपर्क मार्गों के सार्वजनिक जोखिम में देरी या अस्पष्टता, वह खिड़की जिसमें वैध वितरण आमतौर पर अभी तक शुरू नहीं हुआ है लेकिन प्रोग्रामेटिक फसल सबसे संभावित है। किसी भी ऐसे उपाय का प्रभाव अनुभवजन्य रूप से मूल्यांकन किया जाना चाहिए, न कि माना। व्यापार-बंद वास्तविक है, क्योंकि संपर्क जानकारी को छिपाने से ठीक उन नए लोगों को भी नुकसान हो सकता है जो प्रत्यक्ष प्रतिक्रिया पर निर्भर हैं।
8. एक सार्वजनिक फ़िल्टरिंग लॉग और प्रलेखित वितरण यांत्रिकी। एक LogEc-शैली का रिकॉर्ड प्रकाशित करें कि अखंडता फ़िल्टर क्या त्याग करते हैं, और दस्तावेज़ कैसे eJournal वितरण और डाइजेस्ट चयन संचालित होते हैं। आसन्न RePEc/LogEc बुनियादी ढांचा प्रदर्शित करता है कि ऐसी पारदर्शिता पैमाने पर संभव है [99][129], जबकि SSRN वर्तमान में अपने फ़िल्टर का वर्णन करता है बिना उनका इतिहास प्रकाशित किए [144] (तालिका 6)। जब फ़िल्टरिंग प्रलेखित किया जाता है, तो एक काउंटर के पुनर्विवरण को माप घटनाओं के रूप में पढ़ा जा सकता है न कि प्रतिष्ठा संबंधी घटनाओं के रूप में।
9. जोखिम इतिहास को स्पष्ट बनाएं। एक पेपर पृष्ठ या लेखक डैशबोर्ड को सार्वजनिक पोस्टिंग, वर्गीकरण असाइनमेंट, क्यूरेट वितरण, अनुक्रमण पुष्टि, और प्रमुख काउंटर पुनर्विवरण के बीच अंतर करना चाहिए, ताकि एक लेखक "अभी तक उजागर नहीं" को "उजागर लेकिन परिवर्तित नहीं" से अलग कर सके। यह खंड 5.6 के जोखिम-शासन पाठ का प्लेटफॉर्म-पक्ष समकक्ष है, और सबसे चिंता-उत्पादक डैशबोर्ड स्थिति, प्रारंभिक शून्य के लिए सस्ता उपचार है।
10.5 अनुसंधान समुदाय के लिए सिफारिशें
समुदाय को प्लेटफ़ॉर्म की प्रतीक्षा करने की आवश्यकता नहीं है। अनुभाग 8.8 की रजिस्ट्री (दिनांकित, स्व-रिपोर्ट किए गए डैशबोर्ड स्नैपशॉट जो एक खुले प्रोटोकॉल के तहत योगदान दिए गए हैं) एक दशक में पहला ताज़ा डाउनलोड वितरण तैयार कर सकती है। तालिका 17 के दो सार्वजनिक-डेटा अध्ययन (1 और 2) अनुभाग 9 में नोट की गई पहुंच सीमाओं के भीतर किसी भी शोधकर्ता द्वारा निष्पादित हैं, जबकि दोनों प्रतिभागी अध्ययन (3 और 4) को स्वेच्छासेवकों और घोषणाओं में कहे गए नैतिकता अनुमोदन की आवश्यकता है। वैज्ञानिकमिति को मीट्रिक व्याख्या को अपने विषय वस्तु के रूप में मानना चाहिए: वर्तमान मामला, जिसमें एक दशक के काउंटर अपने एकमात्र सार्वजनिक पैमाने से आगे निकल गए, संभवतः अंतिम नहीं होगा। यंत्रीकृत-पोस्टिंग प्रोटोकॉल का वितरित प्रतिकृति, प्रतिशतक तालिकाओं (और उन पर निर्मित सार्वजनिक लेखक-सामना करने वाले कैलकुलेटर, अनुभाग 8.8 और 8.10) का समुदाय रखरखाव, और प्लेटफ़ॉर्म परिवर्तनों का व्याख्यात्मक-प्रभाव मूल्यांकन सभी अपने आप में अनुसंधान योगदान हैं, और उनमें से प्रत्येक इस लेख के मरम्मत कार्य को रोकथाम में परिवर्तित करता है।
10.6 समापन
"मेरे सात डाउनलोड का क्या मतलब है?" यह प्रश्न इस लेख के माध्यम से चलता है क्योंकि यह प्रश्न प्लेटफॉर्म के लगभग दो मिलियन लेखकों को 15 जुलाई 2026 को पकड़े हुए छोड़ा गया था [49][149]। यहाँ एकत्र किया गया उत्तर न तो आश्वस्ति है और न ही चिंता बल्कि अंशांकन है। यह संख्या उपलब्ध रूपांतरण साक्ष्य के अनुरूप है लेकिन एक स्क्रीनिंग परिणाम बनी हुई है; चिंता लुप्त पैमाने द्वारा निर्मित है, जिसे साहित्य से आंशिक रूप से पुनः बनाया जा सकता है, जैसा कि अनुभाग 3-6 ने किया है, और आंशिक रूप से नए डेटा से, जैसा कि अनुभाग 8 निर्दिष्ट करता है।
लेख उस प्रश्न के साथ खुलता है जो हर लेखक को पकड़े हुए छोड़ा जाता है:
"मेरे 7 डाउनलोड का मतलब क्या है?"
यह ढाँचा इसे इसके साथ प्रतिस्थापित करता है:
"यह पेपर समान आयु, क्षेत्र, समूह और वितरण इतिहास वाले तुलनीय पेपरों में कहाँ खड़ा है? क्या इसकी बाधा पहुँच है या रूपांतरण? और क्या इसे उन प्रणालियों के माध्यम से प्राप्त और श्रेय दिया जा रहा है जिनके माध्यम से पाठक अब अनुसंधान की खोज करते हैं?"
यह एक ऐसा प्रश्न है जिसका उत्तर विज्ञान मापन दे सकता है, और इस लेख ने निर्दिष्ट किया है कि कैसे।
काउंटर जो दर्ज करते हैं वह घटनाएँ हैं, और केवल घटनाएँ हैं। दृश्य डाउनलोड नहीं हैं; डाउनलोड पठन नहीं हैं; एक माध्य एक मानक नहीं है; एक काउंटर एक निर्णय नहीं है; आग्रह मान्यता नहीं है; AI पुनः प्राप्ति विश्वस्त गुणारोपण नहीं है; और एक पैमाने के बिना एक संख्या सूचना नहीं है।
जब तक प्लेटफॉर्म एक काउंटर को इसके संदर्भ से अलग दिखाते हैं, तब तक लेखक, मूल्यांकनकर्ता और प्लेटफॉर्म वितरणात्मक तथ्यों को व्यक्तिगत निर्णयों के रूप में पढ़ते रहेंगे। ओपन एक्सेस ने जो लड़ाई लड़ी (पोस्ट करने और बिना मूल्य बाधाओं के डाउनलोड करने का अधिकार) और इसे जीतने में, एक लड़ाई को उजागर किया जो उसने कभी नहीं लड़ी: ध्यान का आवंटन। लेखक क्षेत्र, आयु और रूपांतरण के साथ काउंटर पढ़ सकते हैं। SSRN की मेट्रिक्स अभी भी मूल्य रखती हैं, लेकिन केवल एक लेखक के लिए जो समझता है कि उनका क्या मतलब है।
परिशिष्ट A. स्थिति → कार्य मार्गदर्शिका
तालिका 23 अनुभाग 4-6 को उन स्थितियों में संघनित करती है जो लेखक सबसे अधिक बार रिपोर्ट करते हैं [161][127][139]। इसका मध्य स्तंभ केवल वह कथन करता है जो एकत्र किए गए साक्ष्य को स्रोतों और खिड़कियों के साथ लाइसेंस देते हैं। चेतावनियों का स्तंभ उस सीमा को वहन करता है जो प्रत्येक पठन के साथ होनी चाहिए। यहाँ प्रकट होने वाली संख्याएँ मुख्य पाठ की तालिका 6-7 और चित्र 6 की संख्याएँ हैं।
तालिका 23. स्थिति → साक्ष्य क्या कहता है → क्या करें।
| # | आपकी स्थिति | साक्ष्य क्या कहता है | क्या करें | स्रोत और चेतावनियाँ |
|---|---|---|---|---|
| 1 | "पहले महीने में 7 डाउनलोड और 40 सार दृश्य।" | रूपांतरण 17.5% है, एक बिंदु अनुमान के रूप में 11-19% की क्रॉस-अध्ययन बैंड के भीतर, हालाँकि 7/40 पर 95% Clopper-Pearson अंतराल (≈7.3-32.8%) चौड़ा है और बैंड को फैलाता है; माध्यिका LSN पेपर ने केवल दो साल बाद 63 डाउनलोड तक पहुँचा, और माध्यिका विपणन पेपर 16 महीने की माध्यिका आयु पर 87 पर था — परिपक्व-नमूना लंगर, दिन-20 पठन के लिए आयु-मिलान नहीं। एक व्यापक अंतराल वाला स्क्रीनिंग परिणाम, विफलता का साक्ष्य नहीं। | तालिका 11 अवलोकन अनुसूची जारी रखें; दिन 60-90 से पहले प्रक्षेपवक्र को वर्गीकृत न करें। | बैंड: [18][139][172]; माध्यिकाएँ: [139] (2012 LSN), [83] (2025 विपणन)। सभी लंगर एकल-अनुशासन और पुरानी हैं; 7/40 रूपांतरण एक व्यापक-अंतराल स्क्रीनिंग अनुमान है, परिपक्व लंगर के लिए आयु-मिलान नहीं। |
| 2 | "पहले सप्ताह में शून्य डाउनलोड।" | सामान्य पूर्व-वितरण: वर्गीकरण क्यूरेट किया जाता है और लोड किए गए विषयों के लिए 45 दिन तक ले सकता है; eJournal सतर्कताएँ प्रारंभिक दृश्य चलाती हैं और सूर्यास्त के बाद जारी रहती हैं; Google Scholar अनुक्रमण 6-9 महीने या उससे अधिक समय लेता है। | सार्वजनिक पोस्टिंग की पुष्टि करें; eJournal वर्गीकरण की पुष्टि करें; जाँचें कि क्या पेपर इसके सटीक शीर्षक के तहत अनुक्रमित है — सबसे सस्ता उपलब्ध अनुक्रमण परीक्षण; घोषणा चक्र को समाप्त होने दें; तब ही काउंटर पढ़ें। | [53][147][57][55]। समर्थन-पृष्ठ शब्दावली परिवर्तन; पहुँच तिथियों के साथ पुनः-सत्यापित करें। |
| 3 | "कई दृश्य, कुछ डाउनलोड — रूपांतरण 11% से बहुत नीचे।" | एक सार-पाठ असंगति के अनुरूप: पाठक आते हैं और सार पर निकल जाते हैं। पैकेजिंग चर (शीर्षक, सार, कीवर्ड) ध्यान लीवर हैं जो काउंटर के साथ सबसे मजबूती से जुड़े हुए हैं। | शीर्षक और सार को संशोधित करें; अगली खिड़की पर रूपांतरण को पुनः-अवलोकन करें, फिर आगे के परिवर्तन करें। | [139][168][172]। कारण पठन "कम रूपांतरण = कमजोर सार" एक स्क्रीनिंग परिकल्पना है, एक सत्यापित निदान नहीं। |
| 4 | "बैंड से बहुत अधिक रूपांतरण, या अचानक दृश्य वृद्धि।" | ट्रैफिक जो सार ब्राउज़िंग नहीं समझाता है — मीडिया या एकत्रकर्ता लिंक, या गैर-मानव ट्रैफिक जिसे फ़िल्टर ने अभी तक हटाया नहीं है। | बाहरी स्रोत (कवरेज, मेलिंग सूचियाँ) की पहचान करें; सहसंबंध के बिना वृद्धि को पाठकता के रूप में उद्धृत न करें। | [116][138][144][102 — Safe Links प्री-फेच तंत्र, इस चेतावनी के साथ कि SSRN की अपनी फ़िल्टरिंग पहले से ही ऐसे ट्रैफिक को बाहर कर सकती है]। |
| 5 | "मेरा काउंटर गिरा, या संख्याओं को पुनः स्थापित किया गया।" | प्लेटफॉर्म काउंटर को संशोधित करते हैं जब फ़िल्टरिंग नियम बदलते हैं; RePEc ने प्रलेखित एपिसोड में कच्चे ट्रैफिक का बहुमत त्याग दिया (2007 में दृश्यों का ≈74% रोबोट; सितंबर 2025 में IDEAS ट्रैफिक का >99.5%)। | इसे एक माप घटना के रूप में मानें; अपनी दिनांकित स्क्रीनशॉट की जाँच करें; इसे सहसंबंध के बिना खोई हुई पाठकता के रूप में रिपोर्ट न करें। | [144][69][99][129][66]। |
| 6 | "रैंकिंग्स चली गई हैं और मुझे पता नहीं कि मैं कहाँ खड़ा हूँ।" | कोई सार्वजनिक प्रतिशतक ढाँचा नहीं रहता, और कोई प्लेटफॉर्म-प्रतिनिधि नहीं बाहर से एकत्र किया जा सकता। परिशिष्ट E का आर्काइवल क्रॉस-सेक्शन एक नमूना-आधारित संदर्भ वितरण प्रदान करता है, और मेल खाने वाली तुलना प्लेटफॉर्म प्रतिशतक के लिए प्रतिस्थापन है। | 3-5 समकक्ष पेपरों का एक सूक्ष्म-बेंचमार्क बनाएँ जिन्हें एक ही महीने में पोस्ट किया गया था और अपनी स्वयं की अनुसूची पर उन्हें ट्रैक करें; वैकल्पिक रूप से अपने डाउनलोड का अनुपात एक मेल खाने वाली समूह माध्यिका की गणना करें। | [149][51]; लंगर [139][83][85]। अनुपात के पास कोई अंशांकित व्याख्या बैंड नहीं है (अनुभाग 6.3)। |
| 7 | "एक समिति मेरी गणना देखेगी।" | डॉसिएर में रैंक लाइनें प्रलेखित अभ्यास हैं, और उनका तुलनात्मक ढाँचा गायब है; बैंड भाषा स्रोतों, क्षेत्र योग्यताओं और उद्धरण त्रिकोणीकरण के साथ वह सहन करती है जहाँ कच्ची गणना नहीं होती। | तालिका 13 का सात-चरण प्रोटोकॉल लागू करें: संरक्षित, अनुवाद, त्रिकोणीकरण, क्षेत्र-सामान्य करें, पूरक, अखंडता, विशेषज्ञ मूल्यांकन। | [12][95][33][52][77][108]. डाउनलोड माँग को मापते हैं, गुणवत्ता को नहीं; हेरफेर इतिहास [44] मूल्यांकनकर्ताओं को ज्ञात है। |
| 8 | "मैंने पोस्ट करने के दिनों बाद शिकारी आमंत्रण आने लगे।" | प्रीप्रिंट प्लेटफॉर्म से कटाई का एक प्रलेखित उप-उत्पाद; आसन्न ऑडिट प्रति पखवाड़े प्रति शिक्षाविद् दर्जनों आमंत्रणों की रिपोर्ट करते हैं। मात्रा स्क्रैपर्स को दृश्यमानता का संकेत देती है, न कि पाठकों द्वारा मान्यता का। | कभी भुगतान न करें; Cabells और Think. Check. Submit. के माध्यम से स्थान सत्यापित करें; एक समर्पित पते के माध्यम से पत्राचार भेजें; टाइपोलॉजी के लिए तालिका 14 देखें। | [107][159][9][84][63][32][136]; [B-1] (2017 से Beall की सूची निरस्त)। समय नियमितताएँ अमापित हैं; "पोस्टिंग के दिनों बाद" स्क्रीन गुणात्मक है। |
| 9 | "एक पत्रिका की समानता जाँच ने मेरी प्रस्तुति को मेरे स्वयं के SSRN प्रीप्रिंट से मेल खाते हुए चिह्नित किया।" | जाँच प्रणाली डिज़ाइन के अनुसार कार्य कर रही है: Crossref Posted Content के रूप में पंजीकृत प्रीप्रिंट तुलना कार्पस का हिस्सा हैं, और iThenticate का मार्गदर्शन बताता है कि समान-लेखक प्रीप्रिंट मिलान साहित्यिक चोरी नहीं है। एक कार्यपत्र पोस्ट करना अधिकांश पत्रिकाओं की पूर्व-प्रकाशन नीतियों द्वारा अनुमत है, लेकिन नीतियाँ भिन्न होती हैं और लक्ष्य पत्रिका की जाँच की जानी चाहिए; मुख्य अपवाद चिकित्सा और नैदानिक क्षेत्रों में हैं। | चिह्नित स्रोत को हैंडलिंग संपादक को अपने स्वयं के टाइम-स्टैम्प किए गए प्रीप्रिंट के रूप में पहचानें; प्रीप्रिंट को वापस न लें; चिकित्सा और नैदानिक स्थलों के लिए, Sherpa Romeo रजिस्ट्री के माध्यम से प्रस्तुति से पहले लक्ष्य पत्रिका की प्रीप्रिंट नीति जाँचें (उदाहरण के लिए)। | [81][36]; खंड 4.5। पत्रिका नीतियाँ भिन्न होती हैं और बदलती हैं; सामान्य नियम पर भरोसा करने के बजाय लक्ष्य पत्रिका की वर्तमान नीति सत्यापित करें। |
| 10 | "रैंकिंग चली गई — क्या मुझे अपने पेपर को ResearchGate या Academia.edu में स्थानांतरित करना चाहिए?" | कोई पश्च-सूर्यास्त लेखक प्रवास प्रलेखित नहीं है; डाउनलोड काउंटर प्लेटफार्मों में स्थानांतरणीय नहीं हैं; और तुलनीय प्लेटफार्म समान व्याख्यात्मकता समस्या रखते हैं — ResearchGate ने अगस्त 2022 में पद्धतिगत आलोचना के बाद अपने स्वयं के समग्र RG स्कोर को सेवानिवृत्त किया। | SSRN रिकॉर्ड को रखें और स्थानांतरित करने के बजाय पूरक करें: एक संस्थागत या विषय भंडार में एक ही पेपर जमा करें (तालिका 13, चरण 5), दिनांकित काउंटर स्नैपशॉट संरक्षित करें, और कहीं और हटाएँ-और-फिर से पोस्ट न करें, जो जमा किए गए काउंटर को जब्त करता है। | [130][90][149]; [47][146] (भंडार पूरक); [161] (एक प्लेटफार्म का काउंटर अन्य चैनलों के बारे में कुछ नहीं कहता); [B-7] (हटाएँ-और-फिर से पोस्ट मेट्रिक्स को रीसेट करता है)। प्रलेखित प्रवास की अनुपस्थिति साक्ष्य की अनुपस्थिति है, स्थिरता का प्रमाण नहीं। |
अपरीक्षित सामुदायिक प्रथाएँ (अनुभाग 8 एजेंडा के लिए उम्मीदवार परिकल्पनाएँ)। निम्नलिखित सिफारिशें लेखक समुदायों में प्रचलित हैं और व्यावहारिक मार्गदर्शन के पहले के मसौदों में दिखाई देती हैं; कोई अध्ययन उन्हें समर्थन नहीं करता, और उन्हें यहाँ परीक्षण योग्य परिकल्पनाओं के रूप में दर्ज किया गया है और निष्कर्षों के रूप में उद्धृत नहीं किया जा सकता: (a) eJournal वर्गीकरणों को तीन (एक मुख्य, एक व्यापक, एक अंतःविषय) पर सीमित करना [53][168] के बजाय अनुमत सात में से अधिक का उपयोग करना; (b) SSRN कार्यपत्रों को उद्धृत करना ताकि उनके लेखकों को Google Scholar सतर्कताओं के माध्यम से सूचित किया जाए और पारस्परिकता के साथ ध्यान दिया जाए; (c) कटाई को कम करने के लिए पोस्टिंग के बाद पहले चौदह दिनों के लिए प्रोफ़ाइल ईमेल पते को छिपाना; (d) दिन 3 पर एक मामूली संशोधन अपलोड करना पुनः-घोषणा को ट्रिगर करने के लिए (SSRN केवल दस्तावेज़ करता है कि स्थान-संशोधन काउंटर और URL को संरक्षित करते हैं [B-7]); (e) "96 घंटों में आमंत्रण शिकारी है" स्क्रीन से जुड़ी कोई संख्यात्मक घटना; (f) पेपर में उद्धृत तीन से पाँच लेखकों को प्रत्यक्ष आउटरीच (एक संक्षिप्त संदेश जो उनके SSRN काम के हवाले को नोट करता है) पहले वैध दर्शकों के लिए एक चैनल के रूप में, प्रचार के बजाय साधारण विद्वत्तापूर्ण संचार के रूप में तैयार किया गया। प्रत्येक अनुभाग 8 के अवलोकन डिज़ाइन के साथ गलत साबित होने योग्य है; परीक्षण तक, उनका उचित उद्धरण रूप "सामुदायिक प्रथा, अपरीक्षित" है।
तालिका 24 पुस्तिका को कालानुक्रमिक रूप से फिर से सॉर्ट करती है। प्रत्येक सेल एक अनुभाग और उसके स्रोतों को वापस इंगित करता है। समयरेखा दृश्य लेखकों द्वारा वास्तव में पूछे जाने वाले प्रश्न का उत्तर देता है ("मैं अभी क्या करूँ?") उस क्रम में जिसमें स्थितियाँ उत्पन्न होती हैं, और तालिका 23 की स्थिति-अनुक्रमित को पूरक करता है।
तालिका 24. पुस्तिका एक समयरेखा के रूप में: तीन चरण × तीन अक्ष। सभी सेल अनुभागों 4–7 में पहले से ही कथित साक्ष्य और निर्देशों को सारांशित करते हैं; अपरीक्षित सामुदायिक प्रथाएँ बाहर रखी जाती हैं (ऊपर सूची देखें)।
| चरण | प्लेटफार्म यांत्रिकी और माप | दर्शक और वितरण | विनती रक्षा |
|---|---|---|---|
| पोस्टिंग से पहले | शीर्षक और सार को रूपांतरण सतह के रूप में मानें और तदनुसार उन्हें तैयार करें (§6.4; [139][172]); eJournal वर्गीकरण की योजना बनाएँ — सात तक अनुमत हैं, और अधिक वर्गीकरण अधिक डाउनलोड और कम शून्य से जुड़े हैं [53][168] | अपने स्वयं के पेपर के साथ ट्रैक करने के लिए 3–5-पेपर सूक्ष्म-बेंचमार्क कोहर्ट की पहचान करें (§6.3) | मेटाडेटा सार्वजनिक होने से पहले एक समर्पित पते के माध्यम से पत्राचार भेजें (§6.6) |
| पोस्टिंग में | सार्वजनिक पोस्टिंग और eJournal वर्गीकरण की पुष्टि करें; तालिका 11 ग्रिड का दिन-1 आधार रिकॉर्ड करें (§6.1) | eJournal ईमेल सतर्कताएँ प्लेटफार्म का प्रमुख पुश चैनल हैं और सूर्यास्त के बाद जारी रहती हैं [147][57] | दृश्यमानता के एक डिफ़ॉल्ट परिणाम के रूप में विनती की अपेक्षा करें, योग्यता का संकेत नहीं (§6.6; [159][63]) |
| पहले सप्ताह (दिन 1–45) | एक प्रारंभिक शून्य को पूर्व-वितरण के रूप में पढ़ें, अस्वीकृति नहीं (§6.2 नियम iv; [53]); तालिका 11 अनुसूची पर काउंटर लॉग करें; दिन 60–90 से पहले कक्षा को वर्गीकृत न करें (§6.3) | जहाँ उचित हो वहाँ वैध बाहरी लीवर लागू करें — ब्लॉग और सूची कवरेज मापने योग्य प्रारंभिक स्पाइक्स का उत्पादन किया (§6.4; [116][72]) | कभी भुगतान न करें; किसी भी आमंत्रण स्थल को स्क्रीन करें ([B-1]; Think. Check. Submit. [159]); आमंत्रणों को तालिका 14 टाइपोलॉजी के विरुद्ध जाँचें; स्पैम मात्रा को पाठकता के रूप में कभी न पढ़ें (§7.6) |
परिशिष्ट B. CSAB रिपोर्टिंग टेम्पलेट
एक न्यूनतम लेखक- या मूल्यांकनकर्ता-मुखी CSAB कथन (अनुभाग 5.5; तालिका 10) रिपोर्ट करता है:
[X] दिन की पेपर आयु में, पेपर के [V] सारांश दृश्य और [D] सत्यापित डाउनलोड थे। [परिभाषित क्षेत्र / कोहर्ट / नए उपयोगकर्ता संदर्भ वर्ग] के संबंध में, इसका पहुंच प्रतिशतक [RV] था, इसका डाउनलोड प्रतिशतक [RD] था, और इसका संकुचन-समायोजित रूपांतरण प्रतिशतक [RC] था। पेपर को उस अवलोकन तक [प्राप्त / प्राप्त नहीं] क्यूरेटेड वितरण की प्रलेखित प्राप्ति थी। [आयु 1] और [आयु 2] के बीच, इसकी सामान्यीकृत स्थिति [बढ़ी / स्थिर रही / गिरी]। ये संकेतक प्रसार का वर्णन करते हैं और अनुसंधान गुणवत्ता या शुद्धता स्थापित नहीं करते हैं।
जब तक एक समकालीन संदर्भ पैनल का अनुमान नहीं लगाया जा चुका है (खंड 5.5, 8.3), प्रतिशतक क्षेत्रों को खाली रहना चाहिए: कोई भी मान अंतर्ज्ञान से, प्लेटफॉर्म-व्यापी साधनों से, या पुराने नमूनों से नहीं दर्ज किया जा सकता। ऐतिहासिक एंकरों को टेम्पलेट के साथ रिपोर्ट किया जा सकता है: 2012 LSN दो साल में 63 डाउनलोड की माध्यिका [139] और 2025 Marketing-network माध्यिका 87 [83], प्रत्येक अपने नमूने, क्षेत्र और आयु के साथ कहा जाता है, लेकिन कभी भी लापता संदर्भ वर्ग के लिए प्रतिस्थापित नहीं किया जाता। टेम्पलेट dossier प्रोटोकॉल के Translate चरण का वाक्य-स्तरीय समकक्ष है (तालिका 13, चरण 2)।
परिशिष्ट C. पैनल चर शब्दकोश
तालिका C1 खंड 8.3 के मुख्य पैनल के लिए न्यूनतम पेपर-अंतराल रिकॉर्ड को बताता है: खंड 5.5 के CSAB अनुमानों और खंड 8.4–8.5 के प्लेटफॉर्म-घटना विश्लेषणों को पुन: उत्पन्न करने के लिए सबसे छोटी स्कीमा। सार्वजनिक रिलीज़ जहां लिंकेज विश्लेषणात्मक रूप से आवश्यक नहीं है, वहां प्रत्यक्ष पहचानकर्ताओं को स्थिर अध्ययन कुंजियों से बदलते हैं, और रजिस्ट्री योगदान (खंड 8.8) इस स्कीमा के सबसेट का उपयोग करते हैं जो वहां दर्शाया गया है।
तालिका C1. मुख्य पैनल के लिए न्यूनतम पेपर-अंतराल डेटा स्कीमा।
| डोमेन | चर | परिभाषा या प्रारूप |
|---|---|---|
| पहचान | paper_id | स्थिर अध्ययन पहचानकर्ता |
| पहचान | ssrn_abstract_id | प्लेटफॉर्म पहचानकर्ता; सार्वजनिक रिलीज़ में हैश किया गया या प्रतिबंधित |
| समय | posted_at | पहली सार्वजनिक पोस्टिंग तारीख |
| समय | observed_at | मेट्रिक अवलोकन समय मुहर (तालिका 11 ग्रिड) |
| समय | paper_age_days | पहली पोस्टिंग के बाद से दिन |
| उपयोग | abstract_views_cum | सार्वजनिक संचयी सारांश-पृष्ठ दृश्य |
| उपयोग | downloads_cum | सार्वजनिक संचयी सत्यापित डाउनलोड |
| उपयोग | views_interval, downloads_interval | पूर्ववर्ती वैध अवलोकन से वृद्धि |
| एक्सपोजर | classification_ids | अवलोकन के समय सक्रिय सभी eJournal वर्गीकरण |
| एक्सपोजर | distributed_status, distributed_at | क्यूरेटेड-वितरण संकेतक और तारीख, जहां सहमति दी गई है |
| एक्सपोजर | search_indexed | प्रोटोकॉल-परिभाषित बाहरी सूचकांक स्थिति (सटीक-शीर्षक परीक्षण) |
| पेपर | title_frozen, abstract_frozen, keywords, page_count, doi | सबसे पहले देखे गए पांडुलिपि मेटाडेटा, पहली अवलोकन पर फ्रोज़न |
| पेपर | authors_frozen, affiliations_frozen | पहली अवलोकन पर लेखक नाम, क्रम और संबद्धताएं |
| संस्करण | revision_id, revision_at, material_change_flag | सामग्री-परिवर्तन संकेतक के साथ संस्करण इतिहास |
| लेखक | author_count, platform_newcomer, prior_ssrn_papers | टीम संरचना और पूर्व-पोस्टिंग प्लेटफॉर्म इतिहास (खंड 8.3 परिभाषाएं) |
| प्रतिष्ठा | prior_citations, prior_works, institution_measure | focal पोस्टिंग से पहले फ्रोज़न और क्षेत्र-सामान्यीकृत |
| कैलेंडर | day_of_week, week, season, holiday_flag | पूर्वनिर्धारित समय नियंत्रण [178] |
| डाउनस्ट्रीम | citations_6m, citations_12m, citations_18m, publication_status | बाद की सत्यापन परिणाम स्रोत और तारीख के साथ (खंड 8.9 क्षितिज) |
| ऑडिट | collection_method, source_url, quality_flag | प्रोवेनेंस, पहुंच मार्ग, और विसंगति प्रलेखन (ध्वज, हटाएं नहीं; खंड 8.3) |
परिशिष्ट D. बेंचमार्क पारदर्शिता विशिष्टि
खंड 8.8 के प्रतिशतक बेंचमार्क को बनाए रखने के लिए, और इस लेख द्वारा आलोचना की गई बेंचमार्क अपारदर्शिता को पुन: उत्पन्न करने से रोकने के लिए कोई भी उत्तराधिकारी प्लेटफॉर्म या समुदाय द्वारा बनाए गए (खंड 10.4, सिफारिशें 1 और 4), हर प्रतिशतक रिलीज़ एक संस्करणित साथी के साथ प्रकाशित किया जाता है जो निर्दिष्ट करता है:
1. पात्र पेपर जनसंख्या, नेटवर्क, दस्तावेज़ प्रकार, और बहिष्कार;
2. पोस्टिंग-कोहर्ट तारीखें और अवलोकन आयु;
3. क्षेत्र-असाइनमेंट नियम, एकाधिक वर्गीकरणों के उपचार सहित;
4. रिलीज़ के समय प्रभाव में दृश्यों, डाउनलोड, अद्वितीय अभिनेताओं, दोहराव, और सत्यापित ट्रैफिक की परिभाषाएं;
5. माध्यिका, अंतरचतुर्थक श्रेणी, P10/P25/P75/P90/P95, शून्य हिस्सा, Gini गुणांक, और शीर्ष हिस्से;
6. हर रिपोर्ट किए गए संदर्भ वर्ग के लिए नमूना आकार और अनिश्चितता अंतराल;
7. लापता डेटा, निकासी, संशोधन, मर्ज, और काउंटर पुनः विवरण की हैंडलिंग;
8. किसी भी समायोजन में शामिल वितरण और बाहरी-प्रचार चर;
9. गोपनीयता और न्यूनतम-सेल नियम: खंड 8.8 के क्राउडसोर्स रजिस्ट्री के लिए, जहां छोटे क्षेत्र-दर-आयु कोशिकाएं अन्यथा व्यक्तिगत योगदानकर्ताओं की पहचान कर सकती हैं, यह आइटम डेटा-सुरक्षा कानून द्वारा शासित एक बाध्यकारी बाधा है (यूके में, UK GDPR और Data Protection Act 2018), औपचारिकता नहीं। प्रकटीकरण नियंत्रण सरल गुमनामीकरण से परे k-गुमनामी या पतली कोशिकाओं के लिए शोर-जोड़े गए (अंतर्निहित रूप से निजी) एकीकरण तक विस्तारित होना चाहिए, और एक अनुमत-उपयोग नियम रजिस्ट्री को व्याख्या के लिए बाध्य करना चाहिए, मूल्यांकन के लिए इसके उपयोग को मना करना चाहिए, किराया, पदोन्नति, संसाधन आवंटन, या किसी भी सार्वजनिक लीडरबोर्ड में पुनः असेंबली;
10. एक संस्करण इतिहास और रिलीज़ के लिए एक स्थायी, उद्धृत संदर्भ।
कोई समग्र स्कोर इन घटकों को प्रतिस्थापित नहीं कर सकता। एक कोहर्ट माध्यिका के लिए सरल अनुपात (खंड 6.3 का अनकैलिब्रेटेड फॉलबैक) अस्थिर हो सकता है जब हर सेल छोटा हो और गलत तरीके से सुझा सकता है कि "माध्यिका का दो गुना" विभिन्न आकार के क्षेत्रों में एक निश्चित प्रतिशतक में मैप करता है। लेखक-सामना रिपोर्टिंग इसलिए खंड 8.3 में पहले से निर्दिष्ट अनुभवजन्य-Bayes संकुचन के तहत प्रतिशतक अनुमानों का उपयोग करती है, जबकि कच्चे वितरण ऑडिट के लिए उपलब्ध रहते हैं।
परिशिष्ट E. डाउनलोड वितरण का एक स्वतंत्र संग्रहीय अनुप्रस्थ-काट
हाल के संपूर्ण-वितरण साक्ष्य के लिए खंड 3 और 5 का संश्लेषण एक एकल प्रकाशित स्नैपशॉट [83] पर निर्भर करता है। यह परिशिष्ट इस लेख के लिए इकट्ठा किया गया एक स्वतंत्र, पुनरुत्पादनीय अनुप्रस्थ-काट रिपोर्ट करता है जो केवल सार्वजनिक डेटा का उपयोग करके और कोई विशेषाधिकार प्राप्त मंच पहुंच के बिना, क्षेत्रों में वितरणात्मक संरचना की पुष्टि करता है। यह एक बार का संग्रहीय पुनर्निर्माण है जिसमें एक ज्ञात ऊपर की ओर पूर्वाग्रह है, आकार की पुष्टि के रूप में प्रस्तुत किया गया है, खंड 8.6 के पूर्वनिर्धारित पैनल से अलग, जो पोस्टिंग से पेपर को आगे देखता है।
विधि। SSRN पेपर का एक यादृच्छिक नमूना OpenAlex से तेइस स्वतंत्र यादृच्छिक बीजों के पार खींचा गया था। प्रत्येक नमूने वाले पेपर के लिए पूर्व-सेवानिवृत्ति डाउनलोड और सारांश-दृश्य काउंटर को इंटरनेट आर्काइव में पेपर के सबसे हाल के कैप्चर से पढ़ा गया था, Wayback Machine के सार्वजनिक उपलब्धता समापन बिंदु के माध्यम से खोजा गया था, लाइव साइट से नहीं, जो पहुंच-संरक्षित है (खंड 4) और अब तुलनात्मक फ्रेम प्रकाशित नहीं करता है। संग्रहीय प्रतियों से काउंटर पढ़ना मंच को क्वेरी करने के बजाय प्रक्रिया को दर-सीमित, मंच के प्रति सम्मानजनक और रिलीज़ किए गए पहचानकर्ताओं से पुनरुत्पादनीय रखता है। क्योंकि प्रति-पेपर काउंटर Rankings सूर्यास्त को अपरिवर्तित रहा, और केवल तुलनात्मक Rankings वापस ले लिया गया, 15 जुलाई 2026 के बाद दिनांकित कैप्चर पेपर की संचयी गणना की वैध पढ़ाई बनी रहती है। स्नैपशॉट इसलिए सूर्यास्त-पूर्व विंडो तक सीमित नहीं थे, और कैप्चर तारीख को केवल पेपर की आयु की गणना करने के लिए बरकरार रखा जाता है। कैप्चर जो एक अंतरस्टिशियल बॉट-चुनौती के बजाय पृष्ठ सामग्री लौटाते थे, को त्याग दिया गया था। 2,600 नमूने वाले पेपर में से, 64% के पास एक प्रयोग्य संग्रहीय कैप्चर था और 52% ने एक मशीन-पठनीय डाउनलोड गणना दी, n = 1,360 पेपर दिए जो पच्चीस क्षेत्रों में फैले हुए थे, उनमें चौदह में कम से कम बीस पेपर, और पोस्टिंग वर्ष से दो दशक से अधिक की पेपर आयु। डेटासेट appendixE-wayback-downloads.csv के रूप में रिलीज़ किया गया है और https://doi.org/10.5281/zenodo.22285871 पर जमा किया गया है, जहां एक ही फाइल study1-wayback-downloads.csv नाम को ले जाती है। नमूने के दो गुण इससे क्या पढ़ा जा सकता है इसे सीमित करते हैं। पोस्टिंग तारीखें एक वर्ष और कोई महीना नहीं ले जाती हैं: 1,360 रिकॉर्ड में से 1,358 को 1 जनवरी पर मुहर लगाई गई है, क्योंकि OpenAlex SSRN पोस्टिंग को वर्ष रिज़ॉल्यूशन पर रिपोर्ट करता है। आयु इसलिए कैप्चर वर्ष घटा पोस्टिंग वर्ष के रूप में गणना की जाती है, पूर्ण वर्षों में रिपोर्ट की जाती है, और कोई भी छोटी पट्टी रक्षा योग्य नहीं है। कैप्चर समय में भी केंद्रित हैं: 688 में से, नमूने का आधा, 25 अप्रैल और 7 मई 2025 के बीच एक एकल क्रॉल में आते हैं, और 81.5 प्रतिशत 2025 में आते हैं, इसलिए यहां एक पेपर की आयु अपने पोस्टिंग वर्ष के पुनर्कथन के करीब चलती है और दोनों को अलग नहीं किया जा सकता। इनमें से पहला हटाने योग्य है। पोस्टिंग लाइन "पोस्ट किया गया: DD Mon YYYY" एक ही संग्रहीय कैप्चर में दिखाई देती है, इसलिए पूर्ण तारीखें उन्हें पुनः-पार्स करके पुनः प्राप्त की जा सकती हैं, जो लाइव साइट पर पहुंच गेट को रोकता नहीं है। तालिका E1 इस क्षति को स्पष्ट करता है।
तालिका E1. संग्रहीय अनुप्रस्थ-काट का निर्माण और प्रत्येक चरण पर क्षति।
| चरण | पेपर | प्रारंभिक का % | पिछले का % |
|---|---|---|---|
| यादृच्छिक रूप से नमूना किए गए OpenAlex रिकॉर्ड (SSRN Electronic Journal) | 2,600 | 100.0 | — |
| प्रयोग्य इंटरनेट आर्काइव कैप्चर स्थित | ≈1,660 | 63.8 | 63.8 |
| कैप्चर में एक मशीन-पठनीय डाउनलोड गणना थी | 1,360 | 52.3 | 81.9 |
| अंतिम विश्लेषणात्मक नमूना | 1,360 | 52.3 | 100.0 |
परिणाम। क्रॉस-सेक्शन प्रकाशित एंकर द्वारा दावा किए गए प्रत्येक गुणात्मक विशेषता को पुनरुत्पादित करता है (तालिका E4)। डाउनलोड भारी रूप से दाईं ओर विषम हैं: माध्य 219, माध्यिका 60 (95% बूटस्ट्रैप CI 55–69), माध्य-से-माध्यिका अनुपात 3.65, माध्य 75वें प्रतिशतक (158) से अधिक है। इनमें एक भारी ऊपरी पूंछ भी है (95वां प्रतिशतक 816, माध्यिका से तेरह गुना से अधिक; Gini 0.75, 95% CI 0.71–0.78)। लघुगणक में वितरण लगभग सममित है (ln डाउनलोड की विषमता ≈ 0.18), जो वितरण के देखे गए निकाय पर अनुमानित लॉग-सामान्यता के अनुरूप है, यह गुण कि Kakushadze केवल शीर्ष सूचियों पर फिट कर सकते हैं (खंड 3.4)। डाउनलोड-से-दृश्य रूपांतरण में 16.2% की माध्यिका और 17.3% का माध्य है, जो 11–19% क्रॉस-अध्ययन बैंड के अंदर है (खंड 5.2)। माध्यिका डाउनलोड समान पेपर आयु पर विभिन्न क्षेत्रों में भिन्न होते हैं। आयु बैंड को निश्चित रखते हुए, सबसे अधिक और सबसे कम क्षेत्र माध्यिका के बीच का प्रसार लगभग तीन से लगभग पांच गुना चलता है, सटीक आंकड़ा बैंड और पतली-नमूना क्षेत्रों के उपचार पर निर्भर करता है। सभी आयु में एकत्रित प्रसार लगभग बारहगुना तक पहुंचता है, और वह बड़ी आंकड़ा नमूने की बदलती संरचना को वहन करता है: Engineering तीन साल और उससे कम आयु के पेपर का 21 से 27 प्रतिशत और नौ साल और उससे अधिक आयु के पेपर का अधिकतम 5 प्रतिशत प्रदान करता है, जबकि Economics समान समूहों का 9 से 12 प्रतिशत और 37 से 54 प्रतिशत प्रदान करता है, और एक Economics पेपर की माध्यिका आयु यहां नौ साल है Engineering के लिए एक साल के विरुद्ध। दिशा खंड 3.6 के क्षेत्र गुणक के साथ सहमत है। परिमाण तुलनीय नहीं हैं, क्योंकि वह गुणक एक एकल अनुशासन के 94 उप-क्षेत्रों में जीवनकाल माध्य पर निर्भर करता है और यह प्रसार 25 अनुशासनों में माध्यिका पर निर्भर करता है, और न ही आयु के लिए समायोजित है। माध्यिका डाउनलोड पुरानी आयु बैंड में अधिक होते हैं, अधिकांश आसन्न बैंड के बीच गैर-अतिव्यापी 95% बूटस्ट्रैप आत्मविश्वास अंतराल (पोस्टिंग वर्ष में माध्यिका 12, दस साल से परे 172), जो आयु निर्भरता है जो संदर्भ-वर्ग तर्क को प्रेरित करता है। एक एकल क्षेत्र के भीतर अंतर पहले तीन या चार साल में केंद्रित है: पांच-से-दस बैंड और दस-से-परे बैंड के बीच यह महत्व तक नहीं पहुंचता है (Economics के लिए Mann-Whitney p = 0.57, Social Sciences के लिए 0.82, Business के लिए 0.23)। एकत्रित ढाल का लगभग एक चौथाई आयु के बजाय क्षेत्र संरचना है। इस नमूने में आयु पोस्टिंग वर्ष के पुनर्कथन के करीब भी चलता है, क्योंकि आधी कैप्चर 25 अप्रैल और 7 मई 2025 के बीच एक क्रॉल में ली गईं और 81.5 प्रतिशत 2025 में गिरती हैं, इसलिए आयु और cohort को यहां अलग नहीं किया जा सकता है और बैंड किसी भी एकल पेपर के पथ के बजाय स्तर की रिपोर्ट करते हैं। नमूना माध्य (219) प्रकाशित विपणन-नेटवर्क माध्य (221) के साथ मेल खाता है [83], जबकि नमूना माध्यिका (60) जनगणना-शैली कानूनी माध्यिका (63) के स्तर पर बैठता है [139]। तालिका E2 पेपर आयु के अनुसार डाउनलोड वितरण देता है और तालिका E3 क्षेत्र के अनुसार, दोनों 95% बूटस्ट्रैप आत्मविश्वास अंतराल और नमूना आकार के साथ। आत्मविश्वास अंतराल सबसे छोटे क्षेत्रों के लिए सबसे चौड़े होते हैं, जिसका कारण यह है कि क्षेत्र प्रसार को एकल सटीक गुणक के बजाय लगभग एक परिमाण के क्रम के रूप में वर्णित किया जाता है। लेख के उद्घाटन केस को नमूने के विरुद्ध सीधे पढ़ा जा सकता है। 30 से 50 सारांश विचार ले जाने वाले दो साल से कम पुराने पेपर के बीच, वह बैंड जिसमें केस गिरता है, माध्यिका डाउनलोड गणना 7 है, 4 से 11 (n = 42) की अंतराल चतुर्थक श्रेणी के साथ। शीर्षक में केस इसके दृश्य बैंड और आयु के लिए विशिष्ट केस है। पोस्टिंग वर्ष में नमूने का 35 प्रतिशत 7 डाउनलोड या उससे कम का रिकॉर्ड करता है, माध्यिका सारांश-दृश्य गणना 66 है, और केस का स्वयं का 17.5 प्रतिशत रूपांतरण नमूने के 57वें प्रतिशतक पर बैठता है। खंड 5.2 का 11–19% रूपांतरण बैंड पेपर के बजाय माध्यिका का एक बैंड है: नमूने का 41 प्रतिशत इसके अंदर गिरता है, 23 प्रतिशत नीचे और 36 प्रतिशत ऊपर। आधा नमूना, 51 प्रतिशत, जनगणना-शैली कानूनी माध्यिका 63 [139] से नीचे बैठता है, जो उभरते हुए श्रेणी को वितरण के आबादी वाले भाग में रखता है।
तालिका E2। संग्रह क्रॉस-सेक्शन में पेपर आयु के अनुसार डाउनलोड वितरण।
| पेपर आयु | n | माध्यिका [95% CI] | माध्य | IQR (P25–P75) |
|---|---|---|---|---|
| पोस्टिंग वर्ष | 203 | 12 [11–14] | 33 | 5–21 |
| 1 वर्ष | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 वर्ष | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 वर्ष | 188 | 130 [110–151] | 384 | 72–374 |
| 10 वर्ष और उससे अधिक | 341 | 172 [157–189] | 453 | 96–336 |
| सभी पेपर | 1,360 | 60 [55–69] | 219 | 23–158 |
तालिका E3। संग्रह क्रॉस-सेक्शन में क्षेत्र (n ≥ 20 वाले क्षेत्र) के अनुसार डाउनलोड वितरण।
| क्षेत्र (n ≥ 20) | n | माध्यिका [95% CI] | माध्य | IQR |
|---|---|---|---|---|
| Economics | 285 | 150 [134–169] | 443 | 76–302 |
| Business | 161 | 150 [126–188] | 335 | 72–330 |
| Psychology | 24 | 107 [35–192] | 179 | 32–229 |
| Social Sciences | 241 | 85 [78–117] | 219 | 45–189 |
| Decision Sciences | 32 | 74 [56–158] | 615 | 49–260 |
| Computer Science | 63 | 42 [36–73] | 167 | 26–104 |
| Medicine | 40 | 42 [24–59] | 81 | 22–66 |
| Agric. & Biological Sci. | 36 | 31 [24–57] | 65 | 23–67 |
| Biochemistry | 21 | 30 [23–37] | 38 | 20–38 |
| Environmental Science | 72 | 26 [18–32] | 44 | 14–50 |
| Engineering | 196 | 24 [20–26] | 46 | 13–46 |
| Physics & Astronomy | 21 | 23 [15–38] | 112 | 13–45 |
| Materials Science | 55 | 18 [15–25] | 26 | 11–36 |
| Energy | 21 | 12 [11–22] | 25 | 11–22 |
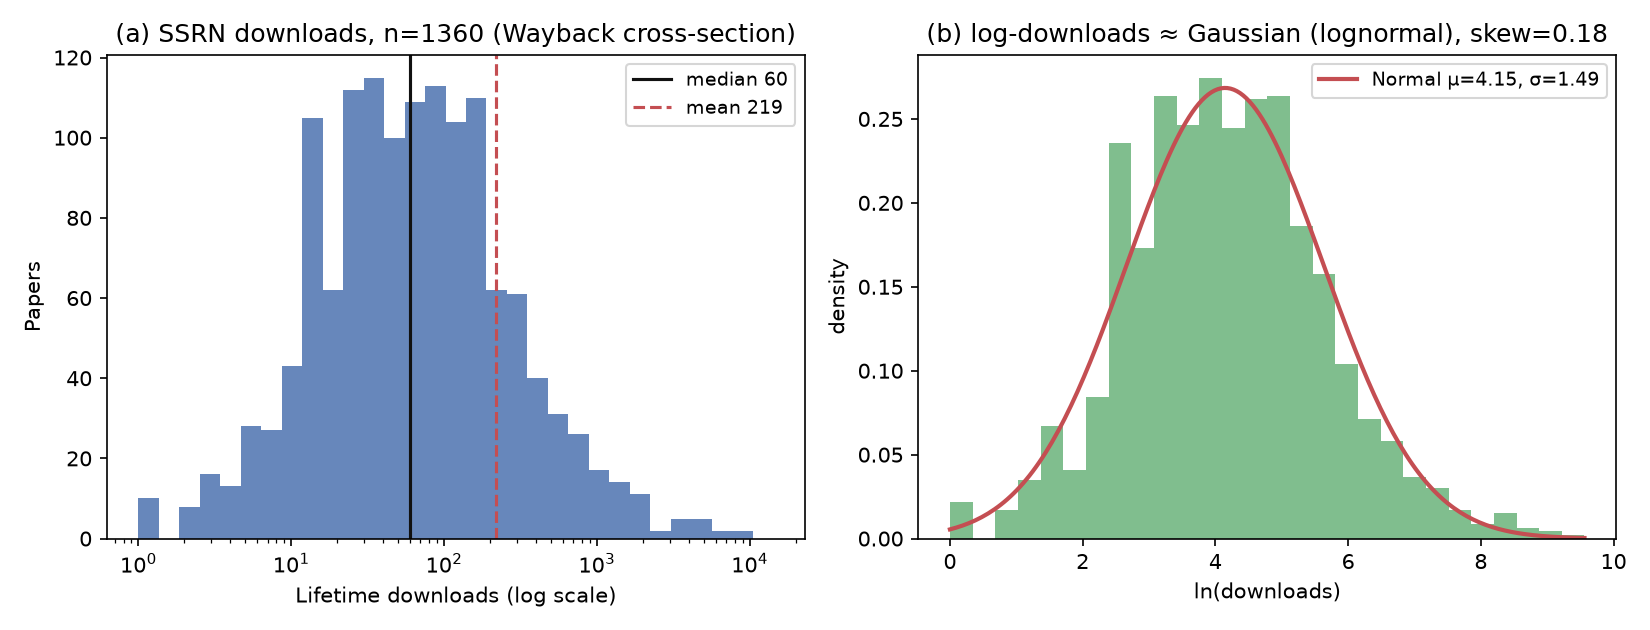
चित्र E1. (a) लॉगरिदमिक पैमाने पर डाउनलोड वितरण माध्य और माध्यिका चिह्नित; (b) ln(डाउनलोड) का हिस्टोग्राम एक फिट किए गए सामान्य घनत्व के साथ। लॉग-डाउनलोड की विषमता ≈ 0.18। n = 1,360।
तालिका E4. प्रकाशित एंकर बनाम स्वतंत्र आर्काइवल क्रॉस-सेक्शन (n = 1,360)।
| विशेषता | प्रकाशित एंकर | आर्काइवल क्रॉस-सेक्शन |
|---|---|---|
| माध्य डाउनलोड | 221 (विपणन) [83] | 219 |
| माध्यिका डाउनलोड | 87 (विपणन) [83]; 63 (कानून) [139] | 60 |
| माध्य / माध्यिका | 2.54 [83] | 3.65 |
| 95वां प्रतिशतक / माध्यिका | > 8 [83] | 13.6 |
| डाउनलोड-से-दृश्य रूपांतरण | 11–19% बैंड (§5.2) | 16.2% माध्यिका |
| क्षेत्र प्रसार (माध्यिकाएं) | ≈ 8× क्षेत्र माध्य, आयु-समायोजित नहीं [168] | ≈ 3–5× समान आयु पर; 12.5× पूलित |
| वितरणात्मक आकार | लॉग-सामान्य, केवल पूंछ [85] | लॉग-विषमता 0.18 (अवलोकित निकाय) |
क्रॉस-सेक्शन क्या स्थापित करता है। क्रॉस-सेक्शन वितरण के आकार और अनुशासन के पार इसकी केंद्रीय और ऊपरी संरचना की पुष्टि करता है, एक स्वतंत्र सर्व-क्षेत्र नमूने पर जो किसी भी एकल प्रकाशित SSRN स्नैपशॉट की तुलना में क्षेत्र कवरेज में बहुत व्यापक है। यह प्लेटफॉर्म-प्रतिनिधि प्रतिशतक का अनुमान नहीं लगाता है, और इसके निर्माण की दो विशेषताएं इसे ऊपर की ओर पूर्वाग्रह करती हैं। आर्काइव किए गए कैप्चर दृश्यमान पृष्ठों का अधिक प्रतिनिधित्व करते हैं, इसलिए डाउनलोड-भारी पत्र अधिक संभवतः कैप्चर किए जाते हैं। एक पत्र केवल तभी नमूने में प्रवेश करता है जब इसके पास एक पठनीय काउंटर वहन करने वाला एक आर्काइव किया गया पृष्ठ होता है, जो चरम निचली पूंछ को सेंसर करता है: नमूने का दस या उससे कम डाउनलोड वाले पत्रों का हिस्सा (लगभग 10%) तदनुसार 15–30% से बहुत कम है जो खंड 3.4 और 8.6 निष्पक्ष संपूर्ण-प्लेटफॉर्म नमूने के लिए प्रत्याशा करते हैं, और उस शेयर के अनुमान के रूप में नहीं पढ़ा जाना चाहिए। फिर भी नमूने की माध्यिका (60) प्रकाशित कानूनी (63) और विपणन (87) माध्यिकाओं पर या उसके नीचे है यह इंगित करता है कि ऊपर की ओर पूर्वाग्रह केंद्रीय द्रव्यमान के लिए मामूली है और विषमता और भारी-पूंछ निष्कर्ष यदि कुछ भी हो तो रूढ़िवादी हैं। अंशांकित बेंचमार्क के लिए उपयुक्त साधन खंड 10 में अनुशंसित प्लेटफॉर्म-प्रतिनिधि प्रतिशतक बैंड और खंड 8.6 का पूर्वपंजीकृत पैनल बने हुए हैं; यह क्रॉस-सेक्शन इस बात की पुष्टि करता है कि वह संरचना जो वे मापेंगे वह है जो यह लेख वर्णन करता है। अध्ययन 1 की तीन भविष्यवाणी बैंड जो पहले से खंड 8.6 में निर्धारित हैं इस नमूने के विरुद्ध पढ़ी जा सकती हैं, इसके ऊपर की ओर पूर्वाग्रह को ध्यान में रखते हुए। 60 डाउनलोड की नमूना माध्यिका 30 से 80 की भविष्यवाणी की हुई रेंज के अंदर बैठता है। 0.75 का ध्यान गिनी 0.75 से 0.90 की भविष्यवाणी की हुई रेंज के निचले किनारे पर बैठता है, जो दिशा नमूना पूर्वाग्रह भविष्यवाणी करता है, क्योंकि सेंसर की गई निचली पूंछ मापा असमानता को संपीड़ित करता है। 0.27 का माध्यिका-से-माध्य अनुपात 0.5 की भविष्यवाणी की गई सीमा से नीचे है। इनमें से कोई भी संभावप्रवर्तनीय डिज़ाइन को मान्य नहीं करता है, जिसका मूल्य यह है कि यह पोस्टिंग से एक संभाव्यता नमूने पर पत्रों का अवलोकन करता है; यह दर्ज करता है कि बैंड अप्रशंसनीय रूप से निर्धारित नहीं किए गए थे।
घोषणाएं
डेटा उपलब्धता। यहां पुनः प्रस्तुत किए गए प्रत्येक संश्लेषित एंकर पाठ और तालिकाओं में उद्धृत प्रकाशित स्रोतों का पता लगाते हैं, नमूना फ्रेम और सत्यापन स्थिति उपयोग के बिंदु पर कही गई है, और कोई नई जनसंख्या-प्रतिनिधि डेटासेट लेख के बेंचमार्क दावों को रेखांकित नहीं करती है। इस लेख के लिए उत्पादित एकमात्र मूल डेटासेट खंड E का स्वतंत्र आर्काइवल क्रॉस-सेक्शन है, 1,360 पत्रों का एक यादृच्छिक सर्व-क्षेत्र नमूना जिसके पूर्व-सेवानिवृत्ति काउंटर सार्वजनिक आर्काइव से पुनः प्राप्त किए गए थे, appendixE-wayback-downloads.csv के रूप में जारी किए गए (एक खंड E डेटासेट, संभावप्रवर्तनीय अध्ययन 1 नहीं) विश्लेषण कोड के साथ, ताकि प्रक्रिया को फिर से चलाया जा सके और विस्तारित किया जा सके; यह वितरण के आकार की पुष्टि करता है और प्लेटफॉर्म-प्रतिनिधि बेंचमार्क नहीं है। डेटासेट https://doi.org/10.5281/zenodo.22285871 पर CC BY 4.0 के तहत जमा किया गया है, जहां समान फ़ाइल का नाम study1-wayback-downloads.csv है, और यह एक खुले उपकरण के साथ आती है जो एक डाउनलोड काउंट को इसके विरुद्ध पढ़ता है जबकि पत्र की आयु और क्षेत्र दोनों पर कंडीशनिंग करता है, https://github.com/vadimchernets/ssrn-benchmark पर (MIT लाइसेंस, केवल Python मानक पुस्तकालय)। जो पाठक अपने स्वयं के काउंटर को इस संदर्भ वर्ग में रखना चाहते हैं वे विश्लेषण को पुनः निर्माण करने के बजाय उस उपकरण को चला सकते हैं। खंड 8 की पूर्वपंजीकरण-तैयार एजेंडा के लिए सामग्री, पैनल चर शब्दकोश (खंड C, तालिका C1) सहित और खोज-ऑडिट क्वेरी सूची, पूर्वपंजीकरण पर जमा करने के लिए तैयार है (खंड 8.8); रजिस्ट्री योगदान खंड 8.8 में परिभाषित स्कीमा सबसेट का पालन करते हैं, और बेंचमार्क प्रोग्राम से कोई भी प्रतिशतक रिलीज़ खंड D की पारदर्शिता विनिर्देश के तहत प्रकाशित होता है। खंड B की CSAB रिपोर्टिंग टेम्पलेट को स्वतंत्र रूप से पुनः उपयोग किया जा सकता है, इसके रिक्त-प्रतिशतक नियम के अधीन। 24 अगस्त 2026 को SSRN समर्थन (टिकट 260824-003051) के साथ सेवानिवृत्त रैंकिंग द्वारा निहित समग्र संदर्भ वर्ग के लिए एक औपचारिक अनुरोध दायर किया गया था — माध्यिका, अंतःचतुर्थक रेंज, और डाउनलोड की दशमलव बैंड क्षेत्र और पत्र आयु द्वारा विभाजित, कोई प्रति-पत्र पहचानकर्ता के साथ नहीं; इसका परिणाम (अनुदान, इनकार, या गैर-प्रतिक्रिया) एक बाद के संशोधन में रिपोर्ट किया जाएगा।
इस लेख तक खुली पहुंच। इस पांडुलिपि की एक खुली लाइसेंस प्राप्त प्रति https://doi.org/10.5281/zenodo.22166896 पर जमा की गई है (CC BY 4.0), जहां पूर्ण पाठ सीधे और किसी भी पहुंच चुनौती के बिना पुनः प्राप्त है। जमा SSRN पर विहित रिकॉर्ड के कारण प्रदान किया जाता है जो बॉट-शमन के पीछे परोसा जाता है जो JavaScript इंजन के बिना क्लाइंट को अस्वीकार करता है, एक स्थिति जिसे खंड 4.2 में प्रलेखित किया गया है; पाठक, संदर्भ प्रबंधक और स्वचालित क्लाइंट जो विहित प्रति तक नहीं पहुंच सकते हैं जमा से समान पाठ प्राप्त कर सकते हैं। साथी पत्र https://doi.org/10.5281/zenodo.22166995 और https://doi.org/10.5281/zenodo.22168724 पर समान शर्तों पर जमा किए गए हैं।
कोड उपलब्धता। अपेंडिक्स ई के स्वतंत्र संग्रहीय क्रॉस-सेक्शन के लिए संचयन और विश्लेषण कोड इसके डेटासेट के साथ https://github.com/vadimchernets/ssrn-benchmark पर जारी किया गया है, ताकि प्रक्रिया को पुनः प्राप्त किया जा सके और संदर्भ वर्ग को कच्चे काउंटरों से पुनः प्राप्त किया जा सके। लेख अन्यथा विश्लेषण कोड की आवश्यकता वाले कोई परिणाम रिपोर्ट नहीं करता है; खंड 8 के अनुभवजन्य डिज़ाइन के लिए आकृति-जनन टेम्पलेट पूर्वपंजीकरण सामग्रियों के साथ एक ऑनलाइन अपेंडिक्स के रूप में जारी किए जाएंगे।
नैतिकता। खंड 8 के अनुभवजन्य डिज़ाइन सार्वजनिक रूप से प्रदर्शित पेपर-स्तर के काउंटर और ग्रंथसूची मेटाडेटा पर निर्भर करते हैं; गैर-सार्वजनिक डैशबोर्ड जानकारी, वितरण-स्थिति तारीखों, या ईमेल संदेशों के किसी भी संग्रह के लिए सूचित सहमति और, जहां लागू हो, संस्थागत समीक्षा की आवश्यकता है (खंड 9 देखें)। दो डिज़ाइन जो मानव-विषय अनुसंधान का गठन करते हैं, अध्ययन 4 (लेखक सर्वेक्षण) और अध्ययन 3 (इनबॉक्स लॉगिंग के साथ यंत्रीकृत पोस्टिंग), संस्थागत समीक्षा बोर्ड या अनुसंधान-नैतिकता-समिति अनुमोदन के लिए प्रस्तुत किए जाएंगे और किसी भी डेटा संग्रह शुरू होने से पहले प्रतिभागियों की सूचित सहमति के तहत आयोजित किए जाएंगे। संदेश डेटासेट किसी भी रिपोर्टिंग से पहले एकत्रित और विलग किए जाते हैं, और सामुदायिक पोस्ट केवल तभी उद्धृत किए जाते हैं जब एक लाइव, सत्यापन योग्य स्रोत मौजूद हो, और ऐसे स्थानों पर पुनर्कथन जहां लेखकों को उनकी अपेक्षाओं के विरुद्ध पहचाना जा सकता है। डेटा संग्रह प्लेटफार्मों की सेवा की शर्तों द्वारा अनुमत साधनों तक सीमित है: डिज़ाइन सार्वजनिक रूप से प्रदर्शित काउंटर और ग्रंथसूची मेटाडेटा का उपयोग करते हैं और ऐसी कोई स्क्रैपिंग नहीं करते हैं जो प्लेटफार्म की सेवा की शर्तों का उल्लंघन करे, और बड़े पैमाने पर या गैर-सार्वजनिक डेटा की आवश्यकता वाला कोई भी डिज़ाइन स्वचालित निष्कर्षण के बजाय एक औपचारिक डेटा अनुरोध और कानूनी समीक्षा के माध्यम से आगे बढ़ता है। अर्ध-सार्वजनिक फोरम सामग्री के उद्धरण योगदानकर्ता सहमति और पुनः-पहचान जोखिम पर ध्यान देते हैं, जो कारण है कि ऐसी सामग्री को शब्दशः पुनः प्रस्तुत करने के बजाय पुनर्कथन किया जाता है जहां कहीं भी एक लेखक को उनकी अपेक्षाओं के विरुद्ध पहचाना जा सकता है। लेख किसी विशिष्ट पत्रिका या प्रकाशक को "शिकारी" के रूप में लेबल नहीं करता है; स्थान स्क्रीनिंग मान्य, पारदर्शी मानदंड लागू करता है, जो किसी भी वर्गीकरण को रक्षणीय रखता है और मानहानि से बचता है।
स्वीकृतियाँ। लेखक स्टेफानी हॉस्टीन को महत्वपूर्ण टिप्पणियों के लिए धन्यवाद देते हैं, जो अगस्त 2026 में ईमेल द्वारा भेजी गई थीं, जिससे खंड 4.2 में संशोधन हुए, और विंसेंट लेरिवियर, जिनके प्रश्न ने पत्राचार में – कौन सा एकल सामान्यीकरण एक लेखक को सबसे पहले जोर देना चाहिए, और तर्क के बजाय डेटा देखने पर उनके जोर ने अपेंडिक्स ई में रिपोर्ट किए गए आर्काइवल क्रॉस-सेक्शन को प्रेरित किया।
प्रतिस्पर्धी हित। लेखक खंड 8.10 में चर्चा की गई बहु-मॉडल ऑर्केस्ट्रेशन विधियों का विकासकर्ता है, जो खुली और पुनः उत्पादक हैं, एक ऐसा हित जिसे पाठकों को तौलना चाहिए। लेखक लंबित पेटेंट आवेदनों पर एक नामित आवेदक है, न कि दी गई पेटेंट पर, AI ऑर्केस्ट्रेशन और बहु-मॉडल सत्यापन प्रणालियों को कवर करता है जिसका उस खंड में चर्चा की गई है। खंड 8.10 में प्रस्तावित ऑर्केस्ट्रेशन-लेयर वितरण डिज़ाइन एक वैचारिक विशेषज्ञता है जिस पर लेख के निष्कर्ष किसी पर निर्भर नहीं करते हैं। खंड 8.10 को पूरी तरह से हटाया जा सकता है बिना लेख के कहीं और किसी निदान, परिणाम, या सिफारिश को बदले।
उपकरण और सत्यापन। AI सहायकों का उपयोग लेखक के निर्देशन में उपकरण के रूप में किया गया था; विचार, अनुसंधान और निष्कर्ष लेखक के हैं। सभी परिमाणात्मक दावे और उद्धरण लेखक द्वारा उनके प्राथमिक स्रोतों या संग्रहीत प्रतियों के विरुद्ध सत्यापित किए गए थे; लेखक सामग्री के लिए पूर्ण जिम्मेदारी वहन करते हैं।
संदर्भ
पाठ में [B-n] (प्लेटफार्म पृष्ठ, फोरम धागे, ब्लॉग पोस्ट, और अन्य सहायक सामग्री) के रूप में उद्धृत स्रोत नीचे "अतिरिक्त स्रोत" के तहत अलग से सूचीबद्ध हैं। एक्सेस-डेटेड प्लेटफार्म पृष्ठ अस्थिर हैं और संग्रहीत प्रतियों के विरुद्ध पुनः-सत्यापित किए जाने चाहिए।
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Predatory publishers are corrupting open access. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). Do stocks outperform Treasury bills? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). Open access versus subscription journals: a comparison of scientific impact. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Ranking Law Schools: Using SSRN to Measure Scholarly Performance. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Usage impact factor: The effects of sample characteristics on usage-based impact metrics. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). Do altmetrics point to the broader impact of research? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). How to normalize Twitter counts? A first attempt based on journals in the Twitter Index. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). The use of percentiles and percentile rank classes in the analysis of bibliometric data: Opportunities and limits. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Normalization of zero-inflated data: An empirical analysis of a new indicator family and its use with altmetrics data. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Ten simple rules to consider regarding preprint submission. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Earlier Web usage statistics as predictors of later citation impact. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). The role of electronic preprints in chemical communication: Analysis of citation, usage, and acceptance in the journal literature. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Assessing the impact of planned social change. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Congestion on the information superhighway: Inefficiencies in economics working papers. Journal of Public Economics, 225, 104978 (also NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Mitigating Aggressive Crawler Traffic in the Age of Generative AI: A Collaborative Approach from the University of North Carolina at Chapel Hill Libraries. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Online field experiments. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Downloads vs. citations in economics: relationships, contributing factors and beyond. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informatics), Madrid.
[32] Cobey, K. D., et al. (2019). Knowledge and motivations of researchers publishing in presumed predatory journals. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Showcase Your Scholarship, Part Three: Self-Publishing". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Social Science Research Network (SSRN) Ending Commercial Products". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. REST API documentation. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Similarity Check documentation. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Open access publishing, article downloads, and citations: randomised controlled trial. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). Does the arXiv lead to higher citations and reduced publisher downloads for mathematics articles? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Revisiting the relationship between downloads and citations: a perspective from papers with different citation patterns in the case of the Lancet. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). The Open Access Advantage for American Law Reviews. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). The funding effect on citation and social attention: the UN Sustainable Development Goals (SDGs) as a case study. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "How many reads does a typical academic article get?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Social Comparisons and Deception Across Workplace Hierarchies: Field and Experimental Evidence. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulated since 2009)
[45] Eisenberg, T. (2006). Assessing the SSRN-Based Law School Rankings. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier Acquires the Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (also LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (product page). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (product page). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "शोधकर्ता किसी पत्र के प्रभाव को कैसे माप सकते हैं?" https://www.elsevier.support/ssrn/answer/gauge-impact (accessed 14.08.2026)
[51] Elsevier/SSRN Support. "SSRN पर RSS और डेटा फीड्स क्या हैं". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "SSRN क्या है?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (accessed 14.08.2026)
[53] Elsevier/SSRN Support. वर्गीकरण और वितरण। https://www.elsevier.support/ssrn/answer/classification-distribution (accessed 14.08.2026)
[54] Elsevier/SSRN Support. जनरेटिव AI नीति। https://www.elsevier.support/ssrn/answer/AI (accessed 14.08.2026)
[55] Elsevier/SSRN Support. Google / Google Scholar अनुक्रमण। https://www.elsevier.support/ssrn/answer/google-scholar (accessed 14.08.2026)
[56] Elsevier/SSRN Support. प्रस्तुतिकरण दिशानिर्देश / शुरुआत करें। https://www.elsevier.support/ssrn/answer/get-started (accessed 14.08.2026)
[57] Elsevier/SSRN Support. सदस्यता (eJournal मेलिंग)। https://www.elsevier.support/ssrn/answer/subscriptions ; also https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). रैंकिंग और प्रतिक्रियाशीलता: कैसे सार्वजनिक उपाय सामाजिक दुनिया को फिर से बनाते हैं। American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). खुली पहुंच लेखों का उद्धरण लाभ। PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). विज्ञान में मैथ्यू प्रभाव और विचारों का क्रमिक प्रसार। Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). शैक्षणिक स्पैम की पहचान और इससे निपटने की सिफारिशें: एक साहित्य समीक्षा। European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (published 8 May 2026)
[62] Fraser, N., et al. (2020). bioRxiv प्रीप्रिंट्स, उद्धरणों और altmetrics के बीच संबंध। Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). विश्वास करें, लेकिन सत्यापित भी करें: शिकारी पत्रिकाओं और प्रकाशकों के आमंत्रणों की एक अन्वेषणात्मक लेखा-परीक्षा। ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). एकल- बनाम दोहरी-अंध समीक्षा पर लेखक की विशेषताओं का प्रभाव: वैज्ञानिक सारांशों और प्रकाशनों में तुलनात्मक अध्ययनों की एक व्यवस्थित समीक्षा। Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv को 20 साल। Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN और डाउनलोड सांख्यिकी" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "SSRN पर अपडेट", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). मौद्रिक प्रबंधन की समस्याएं: यू.के. का अनुभव। In Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Reprinted in C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). विद्वत्तापूर्ण अनुसंधान में डिजिटल वकील की विकसित शिक्षा। SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). लेख-स्तर के मेट्रिक्स में डेटा अखंडता का प्रश्न। PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). जनरेटिव AI खोज को कैसे बाधित करता है: Google Search, Gemini, और AI Overviews का एक अनुभवजन्य अध्ययन। arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). पत्रिका और कागज के स्तर पर डाउनलोड और उद्धरणों के बीच संबंध, और भाषा का प्रभाव। Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). arXiv में उद्धरण और पठनीयता पर स्थितीय प्रभाव। JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). अंतिम लेकिन कम नहीं: arXiv में उद्धरण और पठनीयता पर अतिरिक्त स्थितीय प्रभाव। JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). विद्वत्तापूर्ण कागजों की सोशल मीडिया मेट्रिक्स की विशेषता। PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). ट्विट्स प्रभाव संकेतक के रूप में: Twitter पर स्वचालित "bot" खातों के प्रभावों की जांच। JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). "altmetrics" की व्याख्या: उद्धरण और सामाजिक सिद्धांतों के लेंस के माध्यम से सोशल मीडिया पर दृश्य कार्य। In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). 100 अमेरिकी कानून विद्यालयों के शैक्षणिक प्रभाव की रैंकिंग। Jurimetrics, 60(1), 1–39 (Fall 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). बिबलियोमेट्रिक्स: अनुसंधान मेट्रिक्स के लिए लेडेन घोषणापत्र। Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). किसी व्यक्ति के वैज्ञानिक अनुसंधान उत्पादन को मापने के लिए एक सूचकांक। PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). डाउनलोड और उद्धरण गणना के बीच संबंध पर: Granger-causality अनुमान का एक परिचय। Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. गाइड: "समानता रिपोर्ट को समझना"; "प्रीप्रिंट्स"। https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, March 6). AI खोज में एक उद्धरण समस्या है। Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). क्या AI ज्ञान प्रसार में प्रतिष्ठा प्रीमियम को कम कर सकता है? SSRN विपणन कार्यपत्रों से साक्ष्य। Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). नेत्र विज्ञान में विधिसंगत पत्रिकाओं से आमंत्रणों का विश्लेषण। American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — "1813 ईमेल" आंकड़े का स्रोत
[85] Kakushadze, Z. (2016). SSRN डाउनलोड के लिए एक सूचकांक। Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). ओपन एक्सेस का प्रभाव (AEA Conference 2014)। https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). स्क्रेपर्स चुनिंदा रूप से robots.txt निर्देशों का सम्मान करते हैं: एक बड़े पैमाने पर अनुभवजन्य अध्ययन से साक्ष्य। Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). भविष्यवाणी नीति समस्याएं। American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). विद्वत्तापूर्ण प्रकाशन में स्पैमिंग: एक केस स्टडी। JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). वैज्ञानिक प्रतिष्ठा के एक माप के रूप में ResearchGate Score पर एक आलोचनात्मक दृष्टि। Presented at ASCW'15 (Quantifying and Analysing Scholarly Communication on the Web), Web Science Conference 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (लोकप्रिय संस्करण: "The ResearchGate Score: a good example of a bad metric," LSE Impact Blog, 9 Dec 2015)
[91] Kurtz, M. J., et al. (2005). लेख पाठकीयता सूचना के ग्रंथसूची गुण। JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). उपयोग ग्रंथसूची विज्ञान। Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). क्या ओपन एक्सेस उद्धरण लाभ वास्तविक है? ओपन एक्सेस और सदस्यता-आधारित लेखों के उद्धरणों की एक व्यवस्थित समीक्षा। PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). डिजिटल युग में शैक्षणिक प्रकाशकों का अल्पाधिकार। PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "प्रकाशन सुझाव" (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). विधिसंगत नर्सिंग पत्रिकाओं और प्रकाशकों से ईमेल आमंत्रणों की विशेषताएं। The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT डिटेक्टर गैर-देशी अंग्रेजी लेखकों के खिलाफ पूर्वाग्रहित हैं। Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). अतिथि पोस्ट — प्रेम, मृत्यु और रोबोट: विद्वत्तापूर्ण संस्करण। The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. LogEc के बारे में (ट्रैफिक-फ़िल्टरिंग पद्धति)। https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). जनरेटिव इंजनों में दृश्यता का अनुकूलन: जनरेटिव इंजन अनुकूलन की एक गंभीर समीक्षा (2023–2026)। arXiv:2607.14035 (15 July 2026 को प्रस्तुत)। https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). "Maynooth University का कानून और अपराध विज्ञान स्कूल सामाजिक विज्ञान अनुसंधान नेटवर्क में पहले स्थान पर है…"। https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). एक ओपन एक्सेस मेगा-पत्रिका में उपयोग और उद्धरणों के बीच संबंध। Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). हार्वर्ड और शिकागो मैथ्यू प्रभाव का साक्ष्य। Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). विज्ञान में मैथ्यू प्रभाव। Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). विज्ञान में मैथ्यू प्रभाव, II: संचयी लाभ और बौद्धिक संपत्ति का प्रतीकवाद। Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. "Microsoft Defender for Office 365 में सुरक्षित लिंक"। https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ UrlClickEvents में क्लिक पर Microsoft Q&A; + असत्य खुलने पर Suped)
[107] Milanovic, M. EJIL:Talk! "शैक्षणिक स्पैम [अपडेट किया गया]"। https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). वैज्ञानिक-विद्वत्तापूर्ण पत्रिकाओं में पूर्ण पाठ डाउनलोड और उद्धरण वितरण पर। JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Applied Evaluative Informetrics। Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). नियुक्ति, प्रचार और कार्यकाल के लिए वैज्ञानिकों का आकलन। PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). प्रतिष्ठा वैज्ञानिक विचारों के प्रसार में ज्ञानमीमांसात्मक असमानता को चलाती है। EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). सामाजिक प्रभाव पूर्वाग्रह: एक यादृच्छिक प्रयोग। Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). The Tyranny of Metrics। Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (अनुसंधान आकलन/मेट्रिक्स)। https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). क्या ब्लॉग SSRN डाउनलोड को प्रभावित करते हैं? Volokh और Slashdot प्रभावों का अनुभवजन्य परीक्षण। U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. "प्रकाशित करें — कानून समीक्षा सदस्यों के लिए मार्गदर्शन"। https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "एक अच्छा h-index क्या है?" https://paperpile.com/g/what-is-a-good-h-index/ (समान गाइड: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). ऑनलाइन "हिट काउंट्स" और बाद के उद्धरणों के बीच संबंध: BMJ में अनुसंधान पत्रों का आगामी अध्ययन। BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). शैक्षणिक करियर में प्रतिष्ठा और प्रभाव। PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (archived copy at web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 June 2026 (Release 5.1 published 5 May 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (guidance for R5.1.1, updated 30 June 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmed via the pullpush.io archive)
[128] Remler, D. (2014, April 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (also scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, April 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Working-paper version: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary Stats announcement. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (post author: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRN to Sunset Rankings from July 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). SSRN Ranking has sunsetted as of 15 July 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (PDF copy, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Subscription page. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). क्या डबल-ब्लाइंड पीयर रिव्यू पूर्वाग्रह को कम करता है? शीर्ष कंप्यूटर विज्ञान सम्मेलन से साक्ष्य। JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (दूसरे लेखक का उपनाम Crossref के अनुसार: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). शिकारी पत्रिकाएं और प्रकाशक: शैक्षिक विज्ञान में शोधकर्ताओं के लिए अकादमिक स्पैम की विशेषताएं और प्रभाव। Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN ई-जर्नल रैंकिंग औसत डाउनलोड प्रति पेपर द्वारा" (2018, May), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN ने शार्क को नहीं छोड़ा है" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). क्या AI शिकारी पत्रिकाओं का पता लगा सकता है? FT50 पत्रिकाओं का मामला। SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). 2025 Imperva बैड बॉट रिपोर्ट। https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, February 4). "क्या कोई पत्रिका आपके प्रीप्रिंट में रुचि रखती है? पत्रिका के अनुरोधों में सार को तुष से अलग करना"। https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). प्रारंभिक कैरियर अकादमिया में शिकारी ईमेल का विश्लेषण और रोकथाम के प्रयास। Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library। LibGuide "SSRN मेट्रिक्स" (29 Sep 2025 को अपडेट किया गया)। https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ पृष्ठ p=9061269 ईजर्नल्स पर)
[162] van de Rijt, A., et al. (2014). सफलता-प्रजनन-सफलता गतिविधि के क्षेत्र प्रयोग। PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). AI पहचान पर मार्गदर्शन और हम Turnitin के AI डिटेक्टर को क्यों अक्षम कर रहे हैं। 16 अगस्त 2023 को प्रकाशित। https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (15 अगस्त 2026 को एक्सेस किया गया)।
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). क्या उद्धृत होता है: AI उत्तर इंजन में प्रतिस्पर्धी GEO। SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Drake कृषि कानून जर्नल का विस्तार: द ग्रीन इश्यू। Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). विज्ञान में नवीनता के खिलाफ पूर्वाग्रह। Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, June). क्या AI बॉट्स सांस्कृतिक विरासत को ऑफलाइन नॉक कर रहे हैं? GLAM-E Lab (NYU Engelberg Center / University of Exeter)। https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, May 3). SSRN ई-जर्नल्स और डाउनलोड। https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). वितरण, चर्चा और डाउनलोड में सुधार के लिए उपकरण... SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (U. Detroit Mercy Law Review में प्रकाशित)
[170] Wikipedia: "Social Science Research Network"; "सहकर्मी-समीक्षा नीति द्वारा अकादमिक पत्रिकाओं की सूची"; "प्रीप्रिंट"। https://en.wikipedia.org/wiki/Social_Science_Research_Network और संबंधित पृष्ठ।
[171] Willey, R., & Knapp, M. (2021). कानूनी छात्रवृत्ति के लिए उद्धरण कैसे बढ़ाएं। Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). कानूनी छात्रवृत्ति के लिए उद्धरण पर SSRN का प्रभाव और इसे कैसे अधिकतम करें। University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). द मेट्रिक टाइड: अनुसंधान मूल्यांकन और प्रबंधन में मेट्रिक्स की भूमिका की स्वतंत्र समीक्षा की रिपोर्ट। HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). अनुरोधित नहीं किए गए अनुरोध: संभावित शिकारी पत्रिकाओं से अनुरोधित ईमेल की पहचान की गई विशेषताएं और पुस्तकालयाध्यक्षों की भूमिका। Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, September 21). "कौन से कानूनी लेख SSRN पर सबसे अधिक ध्यान आकर्षित करते हैं"। https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). क्या डाउनलोड रिपोर्ट विश्वसनीय रूप से पत्रिका उपयोग को मापते हैं? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). उपयोगकर्ता, आत्मकामिता और नियंत्रण — 21वीं सदी में विद्वत्तापूर्ण प्रकाशनों के प्रभाव को ट्रैक करना। SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). लेख एक्सेस: उद्धरण के लिए लिंक, सप्ताहांत प्रभाव और मौसमी। Scientometrics (23.07.2026 को प्रकाशित)। DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Mendeley पठन उच्च उद्धृत प्रकाशनों की पहचान करने के लिए एक फ़िल्टरिंग उपकरण के रूप में। Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). सोशल मीडिया में ध्यान असमानता। arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). व्यक्तिगत वैज्ञानिक प्रभाव के विकास को मापना। Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). उद्धरण वितरण की सार्वभौमिकता: वैज्ञानिक प्रभाव का एक उद्देश्यपूर्ण उपाय की ओर। PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). अनुसंधान आकलन में सुधार पर समझौता। Coalition for Advancing Research Assessment। https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). मेट्रिक टाइड को काम में लगाना: ब्रिटेन के जिम्मेदार अनुसंधान आकलन के लिए संकेतक, बुनियादी ढांचे और प्राथमिकताएं। Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). रिपोजिटरियों के लिए मानकीकृत, COUNTER-अनुरूप उपयोग आंकड़े। https://irus.jisc.ac.uk
[186] यूके रिसर्च एंड इनोवेशन (2024)। रिसर्च एंड इनोवेशन के लिए रेज्यूमे (R4RI): मार्गदर्शन। https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton। नीति बुद्धिमत्ता उपकरण। https://www.overton.io
[188] CC-PLUS। लाइब्रेरी उपयोग आंकड़ों के लिए सहायक संगठनों द्वारा सहयोग करने वाला मंच (खुला स्रोत SUSHI/COUNTER-5 हार्वेस्टिंग; IMLS-द्वारा वित्तपोषित, PALCI आदि)। https://www.cc-plus.org/
[189] HELIOS Open। उच्च शिक्षा नेतृत्व खुली छात्रवृत्ति के लिए पहल। https://www.heliosopen.org/
अतिरिक्त स्रोत
पाठ में [B-n] के रूप में उद्धृत अतिरिक्त स्रोत: प्लेटफॉर्म पृष्ठ, फोरम थ्रेड, ब्लॉग पोस्ट, और अन्य सामग्रियां जो विशिष्ट पाठ-में बिंदुओं का समर्थन करती हैं। प्लेटफॉर्म पृष्ठ अस्थिर हैं और संग्रहीत प्रतियों के विरुद्ध पुनः सत्यापित किए जाने चाहिए।
[B-1] Cabells Predatory Reports (सक्रिय शिकारी-पत्रिका स्क्रीनिंग सेवा); Beall's List (केवल संग्रहीत; जनवरी 2017 के बाद से अपडेट नहीं किया गया)।
[B-2] Caron, P. TaxProf Blog (2026, 25 जनवरी)। "The SSRN Top Five New Tax Papers Ranking Is Broken"। https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), SSRN डाउनलोड और लेखक रैंकिंग पर चर्चा थ्रेड (उदा। /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads)। गुमनाम मंच; केवल इस बात के प्रमाण के रूप में उद्धृत कि ऐसी चर्चाएं मौजूद हैं।
[B-4] de Leon, F. L. L., & McQuillin, B. (2020)। The Role of Conferences on the Pathway to Academic Impact। Journal of Human Resources, 55(1), 164। https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, थ्रेड 1seeyq3 (6 अप्रैल 2026, "I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, थ्रेड 13w6zjw (31 मई 2023, "SSRN Approval Time is Absurd")। अस्तित्व तीसरे पक्ष के Reddit संग्रह के माध्यम से पुष्टि की गई।
[B-6] SSRN — घोषणाओं का सांख्यिकीय बॉयलरप्लेट (उदा। https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) और अप्रैल 2018 की घोषणा (04132018ann002)। प्लेटफॉर्म पृष्ठ; संग्रहीत प्रतियों के विरुद्ध सत्यापित करें। संग्रहीत प्रति: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (29 दिसंबर 2025 का स्नैपशॉट; 15 अगस्त 2026 को एक्सेस किया गया)।
[B-7] SSRN FAQ — संस्करण और ORCID। https://www.ssrn.com/index.cfm/en/faq/ (2026 में एक्सेस किया गया; संग्रहीत प्रति के विरुद्ध सत्यापित करें)।
[B-8] SSRN — "SSRN has Sunset Rankings" लैंडिंग पृष्ठ। https://www.ssrn.com/ssrn/rankings-sunset। संग्रहीत प्रति: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (19 जुलाई 2026 का स्नैपशॉट; 15 अगस्त 2026 को एक्सेस किया गया)।
[B-9] SSRN — hq.ssrn.com / papers.ssrn.com/topten पर ऐतिहासिक रैंकिंग पृष्ठ: Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 days), "Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10)। ऐतिहासिक पृष्ठ; 15 जुलाई 2026 के बाद से ये URL 403/प्लेसहोल्डर प्रतिक्रियाएं देते हैं — संग्रहीत प्रतियों के माध्यम से उद्धृत करें। Top 10,000 Papers पृष्ठ की संग्रहीत प्रति: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (14 जुलाई 2026 का स्नैपशॉट, सूर्यास्त से एक दिन पहले; 15 अगस्त 2026 को एक्सेस किया गया)।
[B-10] Teixeira da Silva, J. A. (2024/2025)। Spam, unwanted or unsolicited emails following the publication of preprints (वर्ष-लंबा अवलोकन: 256 पत्रिकाओं से 875 आमंत्रण, ब्लॉकलिस्ट से 76%)। DOI 10.1080/10875301.2025.2550600; ResearchGate प्रकाशन 384286174।
[B-11] Caron, P. TaxProf Blog (2026, 7 जून)। "SSRN Has Not Jumped the Shark"। https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (Bainbridge [12] का उत्तर; सितंबर 2026 को एक्सेस किया गया)।
पत्राचार: [email protected]।↩︎
कैसे उद्धृत करें
Chernets, V. (2026)। 7 डाउनलोड का मतलब क्या है? SSRN रैंकिंग सूर्यास्त के बाद मेट्रिक अंधापन और विद्वतापूर्ण ध्यान की ठंडी शुरुआत [Preprint]। SSRN। https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}