Was bedeuten 7 Downloads? Metrik-Blindheit und der Kaltstart wissenschaftlicher Aufmerksamkeit nach dem Sonnenuntergang der SSRN-Rankings
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- Veröffentlichte Fassung: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- Archivierte Kopie, zitierbar und herunterladbar: 10.5281/zenodo.22166896 — Konzept-DOI, immer auf die neueste Version verweisend
- Volltext als Markdown und PDF: GitHub
- Lesbare HTML-Version: https://polyhelper.ai/research/download-metrics/
Der gleiche Text befindet sich auf vier Plattformen, damit er erreichbar ist, wenn eine davon nicht verfügbar ist. SSRN enthält die veröffentlichte Fassung; zitieren Sie diese.
Was bedeuten 7 Downloads?
Metrische Blindheit und der Kaltstart wissenschaftlicher Aufmerksamkeit nach dem Ende der SSRN-Rankings
Manuskripttyp: Kritische Synthese, methodologischer Rahmen und vorregistrierungsbereite empirische Agenda
Version: September 2026
Autor: Vadym Chernets, PhD1
Affiliation: KI-Systemarchitekt
Zusammenfassung
Am 15. Juli 2026 stellte das Social Science Research Network (SSRN) seine öffentlichen Rankings ein – die Papier-, Autoren- und Institutionen-Ranglisten, die lange Zeit den einzigen weit zugänglichen Vergleichsrahmen der Plattform bereitgestellt hatten –, während Download-Zählungen und Zitierstatistiken auf einzelnen Papieren und Autorenprofilen erhalten blieben (SSRN Blog, 15. Juli 2026). Das Ergebnis war ein asymmetrisches Messereignis: Autoren behielten die Zahlen und verloren die Norm. SSRNs Zähler wurden nicht bedeutungslos; sie wurden unleserlich. Jede Download-Zählung wurde zu einer Zahl ohne Skala.
Dieser Artikel argumentiert, dass die Frage „Was bedeuten 7 Downloads?" wissenschaftlich unzulänglich gestellt ist, bis die Referenzklasse eines Papiers spezifiziert wird. Eine rohe kumulative Nutzungszählung kann nicht ohne Alter des Papiers, Fachgebiet, Veröffentlichungskohort, Verteilungsexposition und vorherige Sichtbarkeit des Autors interpretiert werden. Das Problem ist am akutesten für neue Papiere und Autoren mit niedriger Sichtbarkeit, deren frühe Aufmerksamkeit weniger durch wissenschaftliches Interesse als durch Plattformarchitektur, E-Mail-Alert-Verteilung, Suchindexierung, Autorenansehen und die breitgeschwänzte Dynamik von Aufmerksamkeit geprägt wird. Wir bezeichnen diesen Zustand als den Kaltstart wissenschaftlicher Aufmerksamkeit. Die Anforderung ist nicht neu: Das Normalisieren von Zählungen nach Fachgebiet, Alter und Dokumenttyp ist in der Zitationsbibliometrik seit langem etablierte Praxis, und die parallele Frage für Nutzungsdaten wurde bereits vor anderthalb Jahrzehnten gestellt (Kurtz & Bollen, 2010). Bibliometrische Indikatoren dieser Art setzen eine Datenbank voraus, in der Fachgebiet, Alter und Typ bekannt sind und der Indikator im Namen des Lesers berechnet wird, während eine Preprint-Plattform ihren Autoren eine nackte ganze Zahl ohne Referenzklasse, ohne Werkzeuge und (seit Juli 2026) ohne Vergleichsrahmen übergibt. Was fehlt, ist nicht die Methode, sondern ihre Umsetzung: SSRN stellt kein Instrument bereit, das sie für einen Autor anwendet.
Die verfügbaren Belege zeigen, warum einfache Durchschnitte irreführend sind. In der einzigen kürzlich veröffentlichten externen Großstichprobenstudie eines SSRN-Netzwerks (2.361 Marketing-Arbeitspapiere) betrug der Mittelwert der Downloads 221,3, während der Median 87 war, und der Mittelwert überschritt sogar das 75. Perzentil (206) (Jo & Li, 2026). Download-Verteilungen sind quasi-logarithmisch mit extremen oberen Ausläufern, und innerhalb eines einzelnen disziplinären Netzwerks unterscheiden sich die durchschnittlichen Downloads zwischen Teilbereichen um ungefähr den Faktor acht (Whalen, 2018), sodass ein plattformweiter Mittelwert kein Papier besonders beschreibt; die Bewertung eines neuen Papiers anhand davon bedeutet die Kalibrierung gegen eine Aggregationsfiction. Basierend auf den verfügbaren Konversionsnachweisen zeigt eine Kennzahl wie 7 Downloads aus 40 Abstract-Ansichten keinen Misserfolg an. Es ist ein Screening-Ergebnis mit einem breiten Konfidenzintervall um es, und es muss durch Reichweite, Konversion, Alter und Bereich gelesen werden.
Aus diesen Belegen entwickelt der Artikel ein Interpretationsrahmenwerk für Post-Rankings-SSRN-Metriken, das Exposition, Abstract-Ansicht, Volltext-Download und nachgelagerte Nutzung trennt, und es fügt eine Reichweiten-Konversionsdiagnose hinzu, die Unsichtbarkeit von Ablehnung unterscheidet. Anstelle einer einzelnen Vanity-Kennzahl schlägt er die Cold-Start Scholarly Attention Benchmark (CSAB) vor, eine mehrdimensionale Alternative. Ein Dossier-Protokoll begleitet ihn, unter dem jede gemeldete Metrik ihre Quelle, das Zeitfenster, die Referenzklasse und die Einschränkungen trägt. Der Artikel beschreibt dann eine preregistrierungsbereite Agenda zum Wiederaufbau der fehlenden Skala: ein prospektives Paneel neuer SSRN-Papiere, beobachtet von Tag 1 bis Tag 180, Quasi-Experimente unter Verwendung kuratierter E-Mail-Alert-Verteilung und die Rankings-Stilllegung selbst, ein von der Gemeinschaft erstellter Perzentil-Benchmark und eine Prüfung der Preprint-Sichtbarkeit in KI-Antwort-Engines. Die Evidenzbasis kombiniert die zitierten Studien mit dem nicht repräsentativen Archiv-Querschnitt von Appendix E; der Artikel gibt an, wie der fehlende Benchmark wiederaufgebaut werden kann, und warum keine Download-Anzahl ohne ihren Kontext auf einer Plattform zirkulieren sollte, die ihn nicht liefert.
Schlüsselbegriffe: Download-Zahlen; Nutzungsmetriken; Feldnormalisierung; Forschungsbewertung; Preprints; Wissenschaftometrie; Beförderung und Tenure; Rechtswissenschaft; Altmetriken; Matthew-Effekt; kumulative Vorteil; Aufmerksamkeitswirtschaft; Abstract-Ansichten; raubkopierte Zeitschriften; generative Engine-Optimierung.
JEL-Klassifizierung: A14; D83; I23; O33; L86
Highlights
Rohe SSRN-Download-Zahlen haben keine stabile Interpretation ohne Papieralter, Bereich, Posting-Kohorte, Verteilungsexposition und frühere Autor-Sichtbarkeit.
Die Rankings-Stilllegung vom 15. Juli 2026 entfernte den einzigen öffentlichen Vergleichsrahmen der Plattform, während jeder Zähler überlebte: Autoren behielten die Zahlen und verloren die Norm.
In der einzigen kürzlich veröffentlichten Großstichprobenverteilung sind Downloads stark rechtsschief, Mittelwert 221,3 gegenüber Median 87: das „durchschnittliche" Papier ist per Konstruktion untypisch.
Das Trennen von Reichweite (Abstract-Ansichten) von Konversion (Downloads pro Ansicht) unterscheidet Unsichtbarkeit von Ablehnung: unterschiedliche Diagnosen, die unterschiedliches Handeln erfordern.
Die veröffentlichten Ansichten-zu-Downloads-Konversionsanker gruppieren sich in einem Band von ungefähr 11–19%, auf das 7 Downloads aus 40 Abstract-Ansichten konsistent mit dem Bereich als Screening-Ergebnis ist: nicht, basierend auf den verfügbaren Belegen, ein Zeichen von Misserfolg.
Die Cold-Start Scholarly Attention Benchmark (CSAB) meldet normalisierte Reichweite, Download-Performance, Konversion, Dynamik und nachgelagerte Validierung anstelle einer einzelnen Vanity-Kennzahl.
Eine vorgegebene, preregistrierungsbereite Agenda (ein prospektives Paneel, zwei ungewöhnlich rechtzeitig von den Reformen der Plattform selbst geschaffene Quasi-Experimente, ein Community-Perzentil-Benchmark und eine KI-Antwort-Engine-Prüfung, erforderlich bevor generative-Engine-Optimierung als evidenzbasiert behandelt werden kann) gibt an, wie die fehlende Skala wiederaufgebaut werden kann.
Umfang und Evidenzdisziplin
Dieser Artikel ist eine kritische Synthese, kombiniert mit einem methodologischen Rahmenwerk und einer preregistrierungsbereiten empirischen Agenda, und die einzigen neuen Daten, die er meldet, sind der nicht repräsentative Archiv-Querschnitt von Appendix E. Drei Klassen von Belegen werden durchgehend getrennt, und jede Zahl im Artikel kommt mit ihrer Klasse:
1. Verifizierte Schätzungen: veröffentlichte Zahlen, überprüft gegen ihre primäre Quelle und zitiert mit ihrem Stichprobenrahmen und Alter, oder verifiziert mit angegebenen Vorbehalten, wo die Verifizierung teilweise ist.
2. Historische Ankerpunkte: frühere Stichproben und stillgelegte Plattformfunktionen, beibehalten, weil sie die Verteilungsstruktur offenbaren, nicht weil sie kalibrierte Normen für 2026 bleiben.
3. Konzeptionelle und vorgeschlagene Ausgaben: vorgegebene Vorhersagen, Benchmark-Vorlagen und Studiendesigns, ausdrücklich als solche gekennzeichnet und enthaltend keine synthetischen Ergebnisse.
Das Interpretierungsproblem, das Referenzklassen-Argument und die Reichweiten-Konversions-Zerlegung sind analytische Ansprüche, die auf den obigen Belegen verteidigt werden. Die Infrastruktur, die der Artikel vorschlägt, wird als Design für die Gemeinschaft zum Aufbau und zur Evaluierung angeboten, nicht als feststehende Vorgabe: ein Community-Perzentil-Register (Abschnitt 8.8), ein für Autoren bestimmter Rechner, und die Orchestrierungsarchitektur von Abschnitt 8.10. Kein diagnostischer Anspruch im Artikel hängt davon ab, dass einer davon angenommen wird.
In einem Bereich, der gerade seinen am häufigsten verwendeten öffentlichen Benchmark verloren hat, ist das knappe öffentliche Gut ein replizierbares Protokoll, das jeder Autor, überall, ausführen kann, zusammen mit einer Synthese, die die Herkunft und das Alter vorhandener Zahlen angibt.
Der Fall mit 40 Abstract-Ansichten und 7 Downloads tritt in dieser methodologischen Synthese wiederholt auf, weil er die in Tabelle 1 aufgelisteten Fragen veranschaulicht; die Schlussfolgerungen basieren auf den zitierten Belegen, nicht auf irgendeinem einzelnen Dashboard.
Drei Regeln regieren die Synthese selbst. Einheiten werden auf zwei gemeinsame Nenner normalisiert, Lebenszeit-Downloads pro Papier und Zwölf-Monats-Downloads pro Papier. Überbrückung wird nur durchgeführt, wenn eine Quelle selbst das erforderliche Verhältnis meldet, und die native Einheit wird beibehalten, überall dort wo die Konversion Annahmen erfordern würde, die die Quellen nicht unterstützen. Jede Tatsachenbehauptung trägt eine Verifikationsstufe (verifiziert gegen die primäre Quelle, verifiziert mit angegebenen Vorbehalten, oder Verifizierung ausstehend) in den Quellen-Vertrauensspalten der Tabellen aufgezeichnet. Wenn Quellen sich widersprechen, besonders über das geltende Stilllegungsdatum, wird der Konflikt zugunsten der späteren offiziellen Quelle gelöst und gekennzeichnet. Jede Schätzung behält ihre Stufe, ihr Alter und ihren Aging-Vorbehalt überall dort, wo sie wiederverwendet wird.
Eine einzelne Regel bestimmt die Quellenauswahl: Eine Referenz wird beibehalten, wenn sie einen eigenständigen Mechanismus, ein Ergebnis, eine Plattformtatsache, eine Messprognose oder ein Designpräzedenzfall beträgt; Zitierquantität ist kein Ziel. Posten und gelesen werden sind unterschiedliche Leistungen; dieser Artikel handelt von der zweiten und vom Zusammenbruch der Instrumente zu ihrer Messung. Eine plausibel aussehende Tabelle ist kein Beweis, und in einem Artikel über kontextfreie Zahlen bindet diese Regel den Artikel selbst zuerst.
1. Einleitung
1.1 Vierzig Aufrufe, sieben Downloads
Stellen Sie sich einen Forschenden vor (früh in der Karriere, vielleicht unabhängig affiliiert oder einfach neu auf der Plattform), der ein sorgfältig vorbereitetes Arbeitspapier auf SSRN hochlädt und einige Wochen später, im August 2026, das Statistik-Panel des Papiers öffnet. Das Dashboard zeigt „40 Abstract Views" und „7 Downloads" an. Zu diesem Zeitpunkt kann der Autor oder die Autorin ohne praktisches Wissen über die Statistik wissenschaftlicher Aufmerksamkeit nicht feststellen, ob diese Zahlen eine katastrophale Ablehnung durch Fachkollegen bedeuten, eine standardmäßige statistische Baseline für einen spezialisierten Text oder der Beginn einer ungewöhnlich starken Karriere. Der Autor oder die Autorin fragt Kollegen und Kolleginnen: „Ist das schlecht?" Niemand kann es sagen. Weder das Dashboard noch die wissenschaftliche Literatur noch die Plattform selbst liefert eine Antwort, und die Zahl hat keine Skala, an der sie gemessen werden könnte. Diese Situation wird als Metrik-Blindheit bezeichnet – die Unfähigkeit, vor den eigenen Zählern, Fehler von normaler Leistung von Erfolg zu unterscheiden. Der Begriff wird hier als theoretisches Konstrukt eingeführt, nicht als gemessene Größe. Studie 4 (Abschnitt 8.6) liefert den konkreten Indikator (der Anteil der Autoren und Autorinnen, die angeben, ihre eigene Zahl noch nie gegen einen Vergleichswert gesetzt zu haben, zusammen mit der Verteilung der ersten Lesevorgänge, die eine niedrige Zahl auslöst), so dass „Metrik-Blindheit" etwas bezeichnet, das eine vorregistrierte Umfrage schätzen kann.
Eine verwandte Szene, die von Autoren und Autorinnen in Community-Foren erzählt und hier als veranschaulichende Anekdote angeboten wird, ist deutlicher. Ein Forschender oder eine Forschende lädt einen ersten Preprint hoch und beobachtet, dass das Dashboard bei null Aufrufen und null Downloads stehen bleibt, während der Posteingang innerhalb weniger Tage fünf E-Mails von Zeitschriften mit Anfragen zum Manuskript liefert, alle von Raubzeitschriften. Die einzige Antwort, die der oder die Newcomer erhält, kommt von Raubzeitschriften. Abschnitt 7 entwickelt diese Asymmetrie als eine Reihe expliziter Hypothesen, und Studie 3 (Abschnitt 8.6) spezifiziert deren zeitliche Koordination. Die Szene ist das gelebte Gegenstück zum Informationsvakuum: die legitime Aufmerksamkeitsökonomie gibt diesem Autor oder dieser Autorin eine Zahl, ohne etwas zum Ablesen zu haben, während die parasitäre die Schmeichelei liefert und keine Leser.
Bis zum Sommer 2026 gab es eine ungefähre Antwort. Die öffentlichen Rankings von SSRN (Top Papers, Top Authors und institutionelle Ranglisten) ermöglichten es einem Autor oder einer Autorin, eine Zahl innerhalb einer sichtbaren Verteilung zu lokalisieren. Am 15. Juli 2026 wurden diese Rankings eingestellt [149]. Die Einstellung folgte einer Ankündigung vom 12. Juni 2026, die die Entscheidung mit der Aussage rahmte, dass „Forschung für sich selbst sprechen sollte" [148], und einer früheren strategischen Neuausrichtung, die am 13. April 2026 angekündigt wurde, der Ressourcen der Plattform auf ihre Kernaufgabe der Forschungsfreigabe [146]. Die Entfernung war asymmetrisch: pro-Paper Download-Zählungen und Zitierungsstatistiken „werden weiterhin auf Ihren einzelnen Papieren und Ihrem Autorenprofil aufgezeichnet und angezeigt" [149], während die Verteilung, die diesen Zählungen eine Skala gegeben hatte, weg war. Die Situation des Forschenden am Dashboard wurde dadurch auf die gesamte Benutzerbasis der Plattform verallgemeinert: mehr als 1,9 Millionen Autoren und Autorinnen und 1,5 Millionen Papiere [49].
Dieser Artikel behandelt diese Situation, und seine These hat zwei Teile. Die Abschaltung der Rankings entfernte den Kontext, nicht die Daten. Die Pro-Paper-Zähler überlebten den Sunset und werden noch angezeigt; die Vergleichsskala, durch die diese Zähler gelesen werden konnten, ist verschwunden, weshalb die Metriken unlesbar sind und nicht bedeutungslos.
Das zweite ist, dass die Frage „was bedeuten 7 Downloads?" wissenschaftlich nicht korrekt gestellt ist, bis der richtige Nenner und die Vergleichsgruppe spezifiziert sind. Die Bereitstellung dieses Nenners und der Instrumente zu seiner Verwendung ist die Aufgabe dieses Papiers.
1.2 Eine Zahl ohne Maßstab
Das Interpretationsproblem sieht einfacher aus, als es ist. Zehn Downloads nach sieben Tagen und zehn Downloads nach neunzig Tagen sind identische Zählwerte, deren Bedeutungen sich mit großer Sicherheit unterscheiden, und sie unterscheiden sich erneut, wenn ein Paper den Namen eines international anerkannten Professors einer hochsichtbaren Institution trägt und das andere das Debüt eines Erstautors ist. Wissenschaftliche Nutzungsmetriken werden dennoch genau in dieser kontextfreien Form präsentiert, weshalb jede Zahl unweigerlich zum Rorschach-Test wird: dieselben „40 Aufrufe" rufen bei einem Autor Panik hervor und bei einem anderen Gleichgültigkeit, da es keinen gemeinsamen Bezugspunkt gibt.
Der Erwartungswert einer rohen Download-Zahl ändert sich mit allem, was der Zähler nicht zeigt: das Alter des Papers, sein Fachgebiet, seine Posting-Kohorte und sein Kalenderumfeld, seine tatsächliche Verteilungsexposition und die frühere Sichtbarkeit seiner Autoren. Jede dieser Abhängigkeiten ist empirisch dokumentiert. Durchschnittliche Lifetime-Downloads unterscheiden sich um ungefähr einen Faktor von acht über die eJournals eines einzelnen Fachnetzwerks hinweg, von etwa 438 im Unternehmens- und Wertpapierrecht bis etwa 53 im Agrarrecht [168]. Die Zugriffstätigkeit variiert mit dem Kalender selbst, fällt an Wochenenden um etwa 11 % und in den Sommermonaten um etwa 50 % in Journal-Zugriffsdaten [178]. Position und Exposition sind unabhängig vom Inhalt wichtig: Papers an der sichtbarsten Position von arXiv-Ankündigungslisten erhielten anschließend erheblich höhere Leserzahlen und Zitationen, mit mittleren Zitationsgewinnen von etwa 83 % in der Astrophysik [72]. Ideen von prestigeträchtigen Institutionen verbreiten sich schneller und breiter als vergleichbare Ideen von weniger prestigeträchtigen [111], ein Muster, das mit langjährigen Befunden zu Status und Aufmerksamkeit übereinstimmt [104][105][140][103]. Auf SSRN speziell ist ein zusätzlicher Top-50-Koautor mit einer messbaren Prämie bei Download-Raten verbunden [83]. Die eigene Verteilungsmaschinerie der Plattform beeinflusst auch den Zähler: Autoren können bis zu sieben Klassifizierungen auswählen, die Aufnahme in kuratierte themenbasierte E-Mail-Benachrichtigungen ist nicht garantiert, und hochvolumige Themen können Verzögerungen von bis zu 45 Tagen erfahren [53][57]. Der frühe Zähler eines Papers kann nichts anderes widerspiegeln als ob die relevante Verteilung bereits stattgefunden hat.
Die Zählregeln der Plattform fügen eine zweite Schicht hinzu, die Autoren selten sehen. SSRN filtert seine Zähler und verwirft scheinbare Robot-Aktivität und wiederholte Downloads derselben Person [144][66][69]; ohne solche Filter würden die Zählwerte „um einen Faktor von fünf oder mehr" aufgeblasen [18]. Aufrufe und Downloads sind durch eine ungefähr stabile Umwandlung verbunden, und Black und Caron berichteten 2006, dass „allgemein drei Abstract-Aufrufe auf der SSRN-Website einen tatsächlichen Paper-Download ergeben" [18]. Spätere Stichproben setzen die Umwandlung zwischen ungefähr 11 % und 19 % der Abstract-Aufrufe [139][172], wobei eine neuere Marketing-Stichprobe durchschnittlich etwa 24 Downloads pro 100 Aufrufe zeigt [83]. Ein Autor, der diese Anatomie kennt, kann bereits die 40 Aufrufe und 7 Downloads des Titels überprüfen (Abschnitt 5.2 führt die Berechnung durch, die innerhalb der berichteten Spanne als breites Screening-Ergebnis landet), aber nichts auf der Plattform kommuniziert dies.
Kein externer Maßstab schließt die Lücke, was dies zu einem Messfehler und nicht zu einer Unannehmlichkeit macht. Für den h-Index [79] existiert ein ganzes Genre von „Was ist eine gute X"-Leitfäden [118][128]. Für SSRN-Downloads fand die Revision in Abschnitt 2.5 bis August 2026 keine Entsprechung in einer öffentlichen Quelle. Die bibliometrische Literatur berichtet Verteilungen [85][139][168][83], aber keine übersetzt sie in Normen für Autoren. Einzelne Wissenschaftler haben sich ad-hoc-Benchmarks aus ihren eigenen Portfolios improvisiert [42], und Leitfäden der Bibliotheken erklären, was die Zähler sind, ohne zu sagen, was sie bedeuten [161][50]. Die Zahl, nach der jeder Autor googelt, kann nicht gefunden werden.
1.3 Die Einsätze: Karrieren, Angst und der Anreiz zur Aufblähung
Die Lücke ist wichtig, weil die Zahlen Konsequenzen haben. SSRNs eigene Dokumentation beschreibt seine Metriken als solche, „die Autoren für Beförderungs- und Leistungsschutzverfahren nutzen und die Institutionen in ihren Einstellungs- und Ranking-Aktivitäten verwenden" [52]. Die Nutzung ist konkret und dokumentiert: Ein prominenter Rechtswissenschaftler berichtete, dass er „unter 3.000 Rechtswissenschaftlern insgesamt mit Platz 13 in der Gesamtzahl aller Downloads rangiert wurde, was die Law School bei verschiedenen Beförderungs- und damit verbundenen Entscheidungen berücksichtigt hat" [12]; Leitfäden für die Einreichung von Rechtszeitschriften raten, „SSRN-Downloads (falls viele)" und Platzierungen in den Top-Ten-Listen in Anschreiben zu erwähnen [95]; und Institutionen gaben Pressemitteilungen zu ihren SSRN-Bewertungen bis zu Wochen vor dem Sunset ab [101]. Auf aggregierter Ebene korrelieren SSRN-Downloads mit 0,84 mit zitiergestützten Rankings von hundert Law Schools [77], eine Assoziation auf Schulebene, die sich nicht auf einzelne Arbeiten oder Autoren überträgt – die ökologische Inferenzvorsicht aus Abschnitt 6.2(iii). Dass Institutionen auf solche Maßstäbe überhaupt einwirken, ist ein Beispiel für eine gut dokumentierte Dynamik: Öffentliche Rankings sind reaktiv und gestalten das Verhalten der Akteure um, deren Eigenschaften sie angeblich beschreiben. Der Mechanismus wurde im Detail für Law-School-Rankings nachgewiesen, wo Kommensurabilität und selbsterfüllende Prophezeiung Schulen dazu trieben, ihre Organisation um die Messgröße herum umzugestalten [58][132]. SSRN verstärkte die Währung direkt, indem es regelmäßig den Top 30.000 Autoren (ungefähr die Top 8% von etwa 360.000 aufgelisteten Autoren) E-Mails schickte, um ihnen zu sagen, dass sie „in den Top 10%" waren [161]. Die „10%" sind ein Anteil der aufgelisteten Autoren (30.000/360.000 ≈ 8,3%), und gegen die vollständige registrierte Autorenbasis von mehr als 1,9 Millionen [49] sind dieselben 30.000 näher an den Top 2%, sodass die Formulierung die eingestuften Autoren und nicht alle Registrierten beschreibt. Karriereratschläge warnen unterdessen, dass nur selbstveröffentlichte Metriken allein „wahrscheinlich nicht für Law-School-Beförderungs- und Leistungsschutzverfahren zählen" [33], und die breitere Evaluierungsliteratur dokumentiert sowohl, wie tief indikatorbasierte Bewertungen in die Einstellung und das Leistungsschutzverfahren eindringen, als auch wie schlecht sie oft gestaltet sind [110][115][153]. Downloads selbst sind Aufmerksamkeitsmaße, keine direkten Qualitätsmaße: Die frühe Nutzung sagt spätere Zitierungen nur moderat voraus (Korrelationen um 0,4, was etwa 16% der Varianz in frühen Arbeiten erklärt [25], und 0,11–0,35 in späteren Schätzungen [80]), und die Mengen der stark heruntergeladenen und stark zitierten Arbeiten unterscheiden sich erheblich [108]. Institutionen behandeln diese Zahlen als Karrierenachweis, obwohl sie weder einen Maßstab noch nur eine lockere Verbindung zur wissenschaftlichen Auswirkung haben, was eine ständige Einladung zu Fehlinterpretationen in zwei symmetrischen Richtungen ist: Ohne einen Maßstab kann ein Autor eine Arbeitslinie verfrüht aufgrund einer falsch gelesenen Zähler aufgeben oder knappe Zeit und soziales Kapital auf die Bewerbung eines Papers verwenden, dessen Zahlen nie anomal waren. Die Rankings, welche Mängel sie auch hatten, lieferten genau diese wiederkehrende Entscheidung darüber, ob eine weitere Bewerbung eines Papers gerechtfertigt war, und ihre Entfernung ließ die Entscheidung ohne Daten getroffen werden (ein Punkt, der in Abschnitt 6.4 behandelt wird).
Die Einsätze sind auch emotional: Was Autoren im Dashboard erleben, ist eine besondere Form von Metrik-Angst, und die Download-Anzahl wird zwanghaft beobachtet. Wissenschaftler der Szientometrie beschrieben das Genre der Selbstverfolgung-Sichtbarkeitswerkzeuge bereits 2012 als „Technologien des Narzissmus" [177], und das Geständnis eines prominenten Rechtswissenschaftlers, dass die Überwachung seiner Anzahl für ihn „wie Crack" war (Bainbridge, 2007, wie in der Literatur zum SSRN-Gaming-Verhalten zitiert), ist emblematisch geworden [44]. Das gleiche Forschungsprogramm etablierte experimentell, was die Angst bewirkt: Autoren laden ihre eigenen Papers herunter, um die Anzahl zu erhöhen, und tun dies am intensivsten in der Nähe der Sichtbarkeitsschwellen der Top-Ten-Listen und unter ungünstigen sozialen Vergleichen mit Kollegen [44]. Soziale Rückkopplungsschleifen dieser Art sind eine allgemeine Eigenschaft von Aufmerksamkeitsmärkten: Frühe soziale Signale verstärken Ungleichheit und Unvorhersehbarkeit in Kulturbranchen [131], anfängliche positive Signale beeinflussen nachfolgende Bewertungen [112], und Erfolg führt zu Erfolg in Feldexperimenten [162]. Selbstberichtete Meilensteine in sozialen Medien, die zu Gunsten von Hochleistern verzerrt sind, verschärfen den Vergleich für jeden, dessen Dashboard 7 anzeigt. Die Abwesenheit einer öffentlichen Benchmark erzeugt also Angst, fördert Fehlinterpretation und schafft Anreize für die künstliche Aufblähung, die die Metrik für alle untergräbt. Das Problem ist eines der Messung, bevor es eines der Leistung ist: Eine Metrik, die gleichzeitig sichtbar, emotional belastet, karriererelevant und nicht interpretierbar ist, ist ein echtes Versagen der Messinfrastruktur, keine persönliche Unzulänglichkeit der Person, die auf dem Dashboard starrt.
1.4 Wer wird am meisten geschädigt: die Gerechtigkeitsdimension
Die Kosten unlesbarer Metriken sind nicht gleichmäßig verteilt. Autoren mit dichten beruflichen Netzwerken können sich informell vergleichen; etablierte Autoren bringen vorherige Sichtbarkeit von Paper zu Paper mit. Das Fehlen öffentlicher Normen wiegt am schwersten auf Forschern in frühen Karrierephasen, unabhängigen und nicht angegliederten Wissenschaftlern, Autoren in engen Teilbereichen, Autoren außerhalb der historisch dominanten Disziplinen auf der Plattform und Autoren außerhalb von Elite-Institutionen. Der Nachteil ist strukturell und nicht nur informativ: SSRNs Discovery-Mechanismus leitet Aufmerksamkeit durch institutionelle Working-Paper-Serien und Abonnement-eJournal-Benachrichtigungen [57]. Ein nicht angegliedierter Forscher kann ein Paper hochladen, kann es aber nicht in eine hochfrequentierte institutionelle Serie einbringen und ist vollständig von der Sachklassifikation für die Sichtbarkeit abhängig [168][53]. Für solch einen Autor ist der institutionelle Expositionskanal faktisch geschlossen, daher fällt das Gewicht der Entdeckung unverhältnismäßig stark auf die Such- und KI-Schichten. Machine Visibility, untersucht in Abschnitt 8, ist daher eine Gerechtigkeitsfrage und nicht nur eine technische. Allein die Zugehörigkeit zu einem Fachbereich verschiebt die erwarteten Downloads um ein Vielfaches, bevor überhaupt ein Leistungsurteil einfließt [168]. Prestigeeffekte wirken im Moment der ersten Exposition, weil eine öffentliche SSRN-Seite Autorennamen und Zugehörigkeiten neben Titel und Abstract anzeigt. Double-Blind-Review funktioniert anders: Das Entfernen von Autorenidentitäten senkt messbar die Bewertungen von Gutachtern für renommierte Autoren (in einer Studie von 5.027 ICLR-Einreichungen, mit einem viel weniger eindeutigen Effekt auf Annahmebeschlüsse) [154], und Bewertungen reagieren experimentell auf Identitätssignale [64]. Am unteren Ende der Aufmerksamkeitsverteilung ist das Phänomen eher Abwesenheit als Ungleichheit: In Altmetrik-Daten liegt die mediane soziale Aufmerksamkeit für nicht finanzierte Forschung bei Null in allen in einer großen auf SDGs fokussierten Stichprobe untersuchten Feldern [41], und Aufmerksamkeit auf angrenzenden offenen Plattformen ist ungleicher verteilt als Einkommen in entwickelten Volkswirtschaften, mit Gini-Koeffizienten über 0,9 [180]. Für den mittleren Autor ist die Frage „sind 7 Downloads schlecht?" ein Versuch, das einzige Signal zu lesen, das das System zurückgibt, in einem Spiel mit strukturell ungleichen Chancen, statt einer Zurschaustellung von Eitelkeit. Jedes Interpretationsgerüst, das diese Asymmetrie ignoriert, wird die Benachteiligten systematisch falsch diagnostizieren, indem es Unsichtbarkeit als Ablehnung liest. Die Asymmetrie projiziert sich auch nach vorne: Falls die entstehende KI-Antwortschicht die für die Optimierung kommerzieller generativer Engines dokumentierten Marken- und Positiionsverzerrungen erbt [5][164], wird sie diese Ungleichheit reproduzieren statt zu beheben. Diese Aussicht wiegt am schwersten auf nicht angegliederten Forschern und auf Autoren im Globalen Süden, und sie ist einer der Gründe, warum das Machine-Visibility-Audit in Abschnitt 8.6 zur Gerechtigkeitsagenda und nicht zu Plattformkuriosheiten gehört.
1.5 Der dokumentierte Bedarf an Interpretation
Der Bedarf an einer Skala ist nicht hypothetisch. Er gehört zu den hartnäckigsten Mustern in der Diskurswissenschaftlichen Gemeinschaft und liegt mindestens ein Jahrzehnt vor dem Sunset. Tabelle 1 fasst die wiederkehrenden Cluster von Autorenfragen und -bedenken zusammen, mit dem stärksten dokumentierten Nachweis für jeden, der unsicheren Abkürzung, zu dem jeder Cluster einlädt (die kurze Antwort, die hilfreich aussieht und falsch ist), und dem Abschnitt dieses Artikels, der darauf antwortet.
Tabelle 1. Der Bedarf an Interpretation: dokumentierte Schmerzcluster der Gemeinschaft (2005–2026)
| # | Cluster | Was Autoren fragen oder berichten | Dokumentierter Nachweis (Konfidenz) | Unsicherer Abkürzung | Behandelt in |
|---|---|---|---|---|---|
| 1 | „Ist meine Zahl normal?" — der fehlende Benchmark | Ob eine gegebene Download-Anzahl gut, schlecht oder typisch für ein vergleichbares Papier ist | Öffentliche Frage „Importance of paper download statistics," Academia StackExchange, 2016 (Titel und Datum durch offizielle API verifiziert) [3]; Benutzerfragen zum Posten auf SSRN und seinen Wert [126]; wiederkehrende Forum-Threads, die fragen, wie viele Downloads als „gut" gelten (Thread-Existenz bestätigt; einzelne Antworten nicht unabhängig überprüfbar, und Forum-Material wird durchweg als schwacher Nachweis des Bedarfs behandelt, nicht als Daten) [B-3]; die Bitte eines Erstautors um „ehrliche Ratschläge" zu einem neu geposteten Arbeitspapier (Reddit, April 2026; Existenz durch Archive von Drittanbietern verifiziert) [B-5] | Ein universeller Schwellenwert für Rohzahlen („N Downloads = gut") | Abschnitte 3, 5–6 |
| 2 | Mechanik-Verwirrung — Aufrufe versus Downloads | Warum Aufrufe Downloads übersteigen; ob ein niedriges Verhältnis ein schwaches Abstract bedeutet | Historische 3:1-Faustregel [18]; gemeldetes Konvertierungsband 11–19 % [139][172]; kürzlicher Stichprobenmittelwert ≈24 % [83]; Bibliothekshandbücher dokumentieren die Unsicherheit der Autoren über das, was die Zähler einschließen [161] | Die automatische Behauptung, dass ein niedriges Verhältnis bedeutet, dass das Abstract schlecht ist | Abschnitte 4–5 |
| 3 | Emotion und sozialer Vergleich | Zwanghaftes Überprüfen; Verlegenheit bei sowohl niedrigen als auch hohen Zählen | „Wie Crack für mich" (Bainbridge, 2007, zitiert in [44]); experimentelle Evidenz von Selbst-Downloads in der Nähe von Top-Listen-Schwellenwerten unter sozialem Vergleich [44] | Sich selbst am plattformweiten Mittelwert oder den sichtbaren Stars benchmarken | Abschnitte 1, 5 |
| 4 | Karrierebeweis — was die Rangzeile in einer Mappe ersetzt | Was in Lebenszyklus-, Beförderungs- und Einstellungsmaterialien nach dem Sunset zitiert werden soll | Downloads-Rang „in verschiedenen Beförderungs- und verwandten Entscheidungen berücksichtigt" [12]; Top-10%-Benachrichtigungsmails [161]; Bewerbungsschreiben-Ratschläge [95]; institutionelle Pressemitteilungen [101]; Plattformbeschreibung der evaluativen Verwendung [52] | Ein Rohzahlkumulat ohne Datum, Quelle oder Nenner zitieren | Abschnitt 6 (Tabelle 13) |
| 5 | Post-Posting-Anforderungs-Spam | Unaufgeforderte Zeitschrifteneinladungen, die bald nach dem Posting ankommen | „Jeden Tag erhalte ich mindestens zwei dieser E-Mails" (Reddit r/AskAcademia, 2023; durch Archive verifiziert; der Autor hatte in einer MDPI-Zeitschrift veröffentlicht, nicht auf SSRN) [127]; Adressensammlung aus Arbeiten „z. B. auf SSRN gepostet" [107]; Audits des Anforderungsvolumens [9][84][63]; eine systematische Überprüfung, die 29 empirische Studien über akademischen Spam identifiziert [61] | Die Identität oder Absicht von Lesern aus einem aggregierten Zähler ableiten | Abschnitt 7 |
| 6 | Vertrauen in die Zähler — Bots, Gaming, plötzliche Tropfen | Ob die Zahlen real sind; warum Zähler fallen | „SSRN unternimmt absolut nichts, um ihre Genauigkeit zu überprüfen" (Goldman, 2005, vor den aktuellen Filtern; eine spätere Aktualisierung vermerkt, dass SSRN wiederholte Zugriffe aus derselben Quelle diskontiert) [66]; SSRNs veröffentlichte Datenintegritätsfilterung [144][66][69]; Robot-Datenverkehr, der etwa 74 % der Abstract-Aufrufe, aber nur etwa 7 % der Downloads in frühen RePEc-Daten ausmacht [99]; großflächige Bot-Filtrungsepisoden auf RePEc bis 2025–2026 [129] | Die angezeigte Zahl als genaue Zählung eindeutiger menschlicher Leser behandeln | Abschnitte 4, 9 |
| 7 | Diagnose — „warum null Downloads?" | Was eine Null oder ein Stillstand in den ersten Wochen bedeutet | Post-Sunset-Autorenunsicherheit dokumentiert in Community-Threads (Existenz durch Archive von Drittanbietern bestätigt) [B-5]; Plattform-Support-Seiten beschreiben die Metriken, bieten aber ab August 2026 keine Interpretationshilfe an [52][50] (Suchaudit, Abschnitt 2.5) | Eine Vor-Verteilungs-Null als Ablehnung behandeln | Abschnitte 4–6 |
Hinweis. Nur Zitate, die unabhängig gegen eine Live- oder archivierte Quelle verifiziert wurden, werden wörtlich wiedergegeben; alle anderen Community-Materialien werden paraphrasiert und durch ihren Konfidenzstatus gekennzeichnet. Die Ethik des Zitierens von Benutzerbeiträgen, einschließlich Anonymisierung und Umgang mit gelöschtem Inhalt, wird in Abschnitt 9 behandelt.
Der stärkste Cluster in Tabelle 1 ist die chronische Frage „ist meine Zahl normal?", die über Jahre, Plattformen und Disziplinen hinweg wiederkehrt. Selbst Plattform-Insider bieten keinen Benchmark im Gegenzug an, und die Sarkasmus, der sie oft in Community-Foren beantwortet, signalisiert, dass niemand, nicht einmal erfahrene Nutzer, die fehlende Skala besitzt [B-3]. Die Cluster sind auch kausal verbunden: der fehlende Benchmark (Cluster 1) erzeugt die emotionale Last (Cluster 3), die den in [44] dokumentierten Gaming-Anreiz erzeugt, was wiederum das in Cluster 6 untersuchte Vertrauen untergräbt. Die Wiederherstellung der Interpretierbarkeit behandelt die Kette an ihrer Wurzel. Das Framework zielt nicht darauf ab, Downloads zu erhöhen, sondern Bedeutung wiederherzustellen.
1.6 Was dieser Artikel argumentiert: acht Positionen
Dies sind die Positionen, die der Artikel verteidigt, jede wird in dem angegebenen Abschnitt argumentiert.
1. Rohe Zahlen sind ohne Referenzklasse nicht interpretierbar. Eine kumulative Download-Zahl hat keine stabile Bedeutung ohne Konditionierung auf Papieralter, Feld, Posting-Kohorte, Verteilungskanal und vorherige Sichtbarkeit des Autors [83][168][178][53]. Dies ist das Referenzklassen-Problem von Abschnitt 5, und es macht die Frage „sind 7 Downloads gut?" so wie gestellt unzulässig.
2. Niedrige Reichweite und niedrige Konversion sind unterschiedliche Diagnosen. Ein Papier, das wenige Menschen begegnen, stellt ein anderes Problem dar als ein Papier, das viele Menschen ansehen, aber wenige herunterladen, und erfordert andere Maßnahmen. Unsichtbarkeit ist nicht Ablehnung von Inhalten. Abschnitte 4–5 entwickeln diese Unterscheidung zu einer Reichweite-nach-Konversion-Diagnostik (Tabelle 9), einschließlich der Konfiguration „verstecktes Interesse", bei der starke Konversion mit schwacher Reichweite koexistiert.
3. Die Zähler blieben erhalten; die komparative Skala nicht. Die Asymmetrie des Sonnenuntergangs (Zahlen beibehalten, Normen entfernt [149]) beschreibt die Post-Rankings-Bedingung exakt und wandelt ein lange latentes Interpretabilitätsproblem in ein dringendes und universelles um (Abschnitt 2).
4. Ein Perzentil-Benchmark ist ein öffentliches Gut. Die Zahl, die jeder Autor googelt und nicht findet, ist eine Perzentiltabelle nach Disziplin und Papieralter. Abschnitte 5 und 8 erklären, wie die Gemeinschaft eine erstellen und pflegen kann, jetzt, wo sie nicht mehr von der Plattform abgelesen werden kann.
5. Kalibrierte Normen erfordern ein Panel, das vom Posting an beobachtet wird. Veröffentlichte Evidenz besteht aus alternden Querschnitten und einzelnen Momentaufnahmen [139][85][168][83]. Die eine neueste große Studie identifiziert ausdrücklich Paneldaten als notwendigen nächsten Schritt [83]. Ohne Beobachtung ab Tag eins sind Normen der ersten Woche und des ersten Monats Extrapolationen und müssen als solche gekennzeichnet werden (Abschnitt 8).
6. Ein multidimensionaler Benchmark schlägt eine einzelne Eitelkeitsmetrik. Das separate Berichten von normalisierter Reichweite, Download-Performance, Konversion, Momentum und nachgelagerter Validierung (CSAB, Tabelle 10) bewahrt Diagnose-Informationen, die jeder zusammengesetzte Index zerstört (Abschnitt 5).
7. Die KI-Antwortstufe wird zu einem neuen Gatekeeper der Aufmerksamkeit. Die Entdeckung wandert den Stack hinauf, von Zeitschriftenmarke zu Repository zu Suchmaschine zu KI-Antwortsystemen, die eine einzelne Antwort synthetisieren und eine Handvoll Quellen zitieren [5][164]. Ein Viertel der US-amerikanischen Erwachsenen nutzt bereits täglich KI-Chatbots [121], während die Zuverlässigkeit dieser Systeme als Zitierkanäle umstritten bleibt [82] und noch keine kontrollierte Studie zur Sichtbarkeit wissenschaftlicher Preprints in ihnen existiert [100]. Abschnitt 8 beschreibt das kompakte Audit-Protokoll; die vollständige Audit ist für Begleitarbeiten reserviert.
8. Ein Dashboard- und Dossier-Protokoll ist jetzt erforderlich. Autoren und Komitees können nicht auf neue Dateninfrastruktur warten. Abschnitt 6 bietet Interimsregeln zum Lesen eines Dashboards und ein siebenschrittiges Evidenz-Protokoll für Dossiers (Tabelle 13), dessen Hauptanforderung ist, dass jede berichtete Zahl ihre Quelle, ihr Zeitfenster und ihre Einschränkungen anzeigt.
1.7 Beiträge
Die nachfolgende Liste zeigt, was der Artikel zur bestehenden Literatur beiträgt, in der Reihenfolge, in der die Abschnitte dies entwickeln.
1. Eine Diagnose. Sie identifiziert das Referenzklassen-Problem in Plattformnutzungsmetriken und benennt das zugrunde liegende Phänomen: der Cold Start der wissenschaftlichen Aufmerksamkeit. Der Begriff ist aus der Recommender-Systems-Literatur übernommen, wo ein Cold-Start-Element die Interaktionsverlauf benötigt, um es einzuordnen [133]. Bei diesem Cold Start treten neue Arbeiten und neue Autoren in ein Diffusionssystem ein, in dem frühe Aufmerksamkeit wesentlich von der Plattformarchitektur, Verteilung und vorherigem Ruf abhängt, bevor inhaltliche Qualität ihre volle Wirkung entfalten kann [72][111][140][83]. Die zentrale These ist die Ill-Posedness-These von Abschnitt 1.1: Die Leitfrage hat keine Antwort, bis ihr Nenner und Vergleichsgruppe festgelegt sind.
2. Eine konsolidierte Benchmark-Karte. Sie stellt erstmals seit der Abschaltung (Abschnitt 2.5 Audit, August 2026) jeden verifizierten empirischen Benchmark für SSRN-Downloads und Abstract-Ansichten in einer einzigen Tabelle (Tabelle 7) zusammen, mit expliziten Stichprobenrahmen, Jahrgängen, Alterungsvorbehälten und einer Quellenzuverlässigkeitsbewertung für jede Zeile. Die Benchmarks sind die Großstichproben-Verteilungsevidenz [83], die Quasi-Lognormal-Top-List-Scrapes [85], Stichproben der Rechtswissenschaft [139][168][171][172] und Plattformaggregate [1][49].
3. Ein Aufmerksamungs-Trichter-Rahmen mit Diagnostiken. Er zerlegt die Diffusion in Exposition, Abstract-Ansicht, Volltext-Download und nachgelagerte Nutzung. Anschließend leitet er die Reach-by-Conversion-Matrix (Tabelle 9) her, die Unsichtbarkeit von Ablehnung trennt und die Hidden-Interest-Konfiguration einbezieht, die rohe Zahlen systematisch verbergen.
4. Interpretationsinstrumente. Sie konvertiert die Benchmark-Karte in eine abgestufte Interpretationsskala (Nascent / Modest / Solid / Strong / Exceptional; Tabelle 8), ein Konversionsband mit ausgearbeiteten Beispielen und den Cold-Start Scholarly Attention Benchmark (CSAB; Tabelle 10), ein mehrdimensionales Berichtformat normalisiert nach Feld, Alter, Kohorte und vorheriger Autorensichtbarkeit. Die Skalen-Bereiche sind nur innerhalb desselben Feldes und Alters der Arbeit vergleichbar, da die Zugehörigkeit zum Feld allein die erwarteten Downloads um ein Vielfaches verändert, und jede Grenze ist entweder belegt oder explizit als Autorenestimate markiert.
5. Eine Praxis-Schicht. Sie bietet Regeln zum Lesen des eigenen Dashboards, Diagnostiken für den Null-Download-Fall, eine situationsbasierte Aktionstabelle (Tabelle 23), eine hypothetisierte Typologie von Raubtier-Akquisitionssignalen mit dem Vorbehalt, dass Akquisitions-Spam weder die Zähler bewegt noch Lesbarkeit nachweist (Tabelle 14), und das siebenschritte-Dossier-Protokoll (Tabelle 13).
6. Eine Preregistration-bereite Forschungsagenda. Sie spezifiziert ein prospektives Panel mit Beobachtung bei 1, 3, 7, 14, 30, 60, 90 und 180 Tagen nach dem Posten und zwei Quasi-Experimente: kuratierte E-Mail-Alert-Verteilung als Within-Paper-Aufmerksamkeitsschock und der Rankings-Ruhestand als natürliches Experiment in der Metrik-Interpretierbarkeit. Sie spezifiziert weiter einen Gemeinschafts-aufgebauten Perzentil-Datensatz als einzige verbleibende Route zu frischen Perzentilen, ein kompaktes Machine-Visibility-Audit-Protokoll für KI-Antwort-Engines und ein vorab festgelegtes, rein deskriptives Protokoll dieser Artikel-eigenen Download-Trajektorie. Jede Studie ist mit niedrigen Kosten und innerhalb der Zugangs- und Ethikgrenzen von Abschnitt 9 durchführbar, mit numerischen Vorhersagen, die als vorspezifizierte Bands statt Erkenntnisse angegeben werden.
1.8 Gliederung des Artikels
Der Rest des Artikels umfasst neun weitere Abschnitte und fünf Anhänge. Abschnitt 2 rekonstruiert das Ereignis und seinen Kontext: die vollständige Chronologie des Reformpakets 2026, was erhalten bleibt und was entfernt wurde (Tabelle 2, Abbildung 1), und die von der Plattform angegebene Begründung der Ressourcenumverteilung und Neuausrichtung. Abschnitt 3 präsentiert die verifizierten Verteilungsbelege und zeigt, warum der Durchschnitt irreführend ist. Er behandelt die Mittel-Median-Lücke [83], den quasi-logarithmischen Schwanz [85] und disziplinäre Heterogenität [168] (Abbildungen 2–4, Tabellen 3–5), vor dem theoretischen Hintergrund des Matthäus-Effekts und kumulativen Vorteils [104][105][131][162] (Dynamiken, die direkt in Längsschnittstudien von Karrieren und Zitationstraditionen quantifiziert wurden [120]), und der Unterscheidung zwischen Aufmerksamkeitsmaßen und Qualitätsmaßen [25][80][108][178]. Abschnitt 4 untersucht die Mechanik der Zähler: Filterung und Datenintegrität [144][66], Robot- und Phantom-Traffic mit den erforderlichen Gegenargumenten [99][106][129], Plattformarchitekturen (Tabelle 6) sowie Metadaten und Versionskontrolle. Abschnitt 5 legt den Interpretationskern dar: das Referenzklassen-Argument, die konsolidierte Benchmark-Karte (Tabelle 7), die Interpretationsskala (Tabelle 8), die Konvertierungsbande, die Reichweiten-nach-Konvertierungs-Matrix (Tabelle 9) und CSAB (Tabelle 10). Abschnitt 6 übersetzt den Rahmen in die Praxis für Autoren und Evaluierungskomitees, einschließlich des Dossier-Protokolls (Tabelle 13) und in Anhang A situationsspezifische Leitlinien (Tabelle 23). Abschnitt 7 analysiert die parasitäre Schicht der Aufmerksamkeitsökonomie, räuberische Aufforderungen als hypothesierte Sichtbarkeitssignale, wobei alle Zeit- und Häufigkeitsansprüche als Hypothesen formuliert sind [9][61][63][84][107]. Abschnitt 8 gibt die Preregistration-bereite empirische Agenda an, einschließlich einer kompakten Behandlung der Migration der Aufmerksamkeit nach oben im Stack zur KI-Antwortsschicht und ihrer Auswirkungen auf die Entdeckbarkeit von Preprints [5][100][82][121][164]. Abschnitt 9 behandelt Einschränkungen, einschließlich des monobibliothekalen Charakters der besten verfügbaren Verteilungsbelege [83], des Alterns der Stichproben von 2012–2015 und der Instabilität der Plattformdokumentation. Abschnitt 10 schließt mit politischen Empfehlungen für SSRN (an erster Stelle anonyme Perzentilbänder nach Disziplin und Papieralter als Ersatz, der Kontext wiederherstellt, ohne den Liga-Tisch-Wettbewerb wiederzubeleben) und für die Forschungsgemeinschaft.
2. Das Ereignis: Das Sunset der Rankings und sein Kontext
2.1 Was waren die Rankings
Während des größten Teils der Geschichte von SSRN befanden sich die Nutzungszähler in einem dichten Vergleichsapparat. Auf der Papierebene führte die Plattform Top-10.000-Listen nach zwölf-Monats- und All-Time-Downloads zusammen mit „recent top papers"-Listen pro eJournal, berechnet über rollende Fenster von sechzig Tagen. Auf der Autorenebene führte sie eine Top-30.000-Liste über alle Disziplinen und fachspezifische Ligen wie die Top-3.000-Juristen-Autoren, sortierbar nach neuen Downloads, Gesamt-Downloads, Downloads pro Papier und Zitationen. Auf der Institutionsebene führte sie monatliche Ranglisten, einschließlich der Top 350 US-amerikanischen Law Schools und der Top 500 International Law Schools [B-9, Archivseiten der Rankings; alle derartigen URLs sind seit dem 15. Juli 2026 fehlerhaft oder zeigen eine Platzhalterseite und können nur aus archivierten Kopien zitiert werden]. Die Plattform übersetzte auch Rang in direktes Perzentil-Feedback. Wie der Leitfaden der University of Washington Gallagher Law Library zu SSRN-Metriken dokumentierte, „schickt SSRN in regelmäßigen Abständen Nachrichten an die Top-30.000-Autoren nach neuen Downloads und nach All-Time-Downloads, um sie darauf hinzuweisen, dass sie unter den besten 10% sind". Gegenüber der eigenen Angabe des Leitfadens von „über 360.000 Autoren" entsprach diese Schwelle ungefähr den besten 8% der aufgelisteten Autoren (30.000 von etwa 360.000) [161, abgerufen am 14. August 2026], eine breite obere Schicht eher als eine enge Elite; Abschnitt 1.3 merkt an, dass gegenüber der vollständigen registrierten Basis dieselben 30.000 näher an den besten 2% sitzen. Diese Listen und Nachrichten waren praktisch die einzigen von der Plattform bereitgestellten, autorengericht Perzentil-Informationen über SSRN-Downloads, die je veröffentlicht wurden.
Der Vergleichsapparat war nicht dekorativ. Black und Caron schlugen 2006 vor, dass SSRN-Downloads als „Beta"-Maßstab der Forschungsleistung von Jurafakultäten dienen könnten, ergänzend zu Reputationsumfragen und Zitationsrechnungen [18]. Derselbe Tagungsband enthält eine kritische Untersuchung des Vorschlags [45]. Institutionell war der Vorschlag erfolgreich: Download-Ränge traten in Einstellungsmaterialien, Beförderungsakten und institutionelle Publizität ein. SSRNs eigene Support-Dokumentation beschreibt ihre Metriken als Zahlen, „die Autoren für Beförderungs- und Tenurierungszwecke nutzen und die Institutionen in ihren Einstellungs- und Ranking-Aktivitäten nutzen" [52, abgerufen am 14. August 2026]. Der Veröffentlichungsleitfaden des Legal Writing Institute riet Autoren, „SSRN-Downloads (falls viele), Aufnahme auf SSRN-Top-Ten-Download-Listen" in Begleitschreiben an Law Reviews zu erwähnen [95]. Im Juni 2026 brachte Stephen Bainbridge die Karrierefunktion zu Protokoll: er war „an 13. Stelle von 3.000 Juristen-Autoren nach Gesamt-All-Time-Downloads raniert, was die Law School bei verschiedenen Beförderungs- und verwandten Entscheidungen berücksichtigt hat" [12]. SSRNs eigene Führung dokumentierte die Transformation der Plattform der rechtswissenschaftlichen Kommunikation in einem Preprint ihres damaligen CEO [68]. Institutionen vermarkteten die Ligen ebenfalls: noch im Januar 2026 kündigte die Maynooth University an, dass ihre School of Law and Criminology den ersten Platz unter den irischen Abteilungen in den SSRN Top 500 International Law Schools belegte, mit mehr als 143.500 Downloads [101]. Der Griff des Apparats auf Verhalten wird in Edelmans und Larkins Analyse von SSRN-Serverprotokollen dokumentiert. Die Studie stellte fest, dass betrügerisches Selbst-Downloading sich genau in dem Moment intensivierte, als sich ein Papier der Grenze einer Top-10-Liste näherte, und identifizierte sozialen Vergleich, nicht nur Karriereumsätze, als primären Treiber der Manipulation [44]. Dieselbe Studie verbreitete die Bemerkung, die Bainbridge 2007 zugeschrieben wird, dass die Überwachung der eigenen Download-Zählungen „wie Rauschgift für mich" war [44].
Der Apparat hatte eine zweite Funktion, die weniger Aufmerksamkeit auf sich zog. Zitationen und Reputationsumfragen arbeiten auf mehrjährigen Uhren; die Rankings gaben Feedback in nahezu Echtzeit zurück, und sie ließen Nachwuchswissenschaftler und Autoren außerhalb prestigeträchtiger Institutionen sichtbare Auswirkungen direkt demonstrieren, ohne auf langsamere und konservativere Gatekeeping-Instrumente zu warten. Was auch immer ihre Mängel waren, die Ligatafeln waren das einzige Vergleichsinstrument, das jedem Autor auf der Plattform gleich sichtbar war. Das ist teilweise der Grund, warum ihre Entfernung plausibel, wie Abschnitt 1.4 argumentiert, am stärksten auf den Autoren lasten dürfte, die die wenigsten informellen Substitute haben. Es gibt noch keine direkten Verteilungsbeweise zu den Auswirkungen des Sonnenuntergangs, daher ist dies eine Richtungserwartung, die RQ1 (Abschnitt 8.5) testet: zweiseitig fragt es, ob die Entfernung Aufmerksamkeit konzentrierte oder zerstreute, ohne das Vorzeichen vorauszusetzen.
2.2 Chronologie des 2026er Retreats
Die Entfernung der Rankings am 15. Juli 2026 war der Höhepunkt einer Reihe von Plattformentscheidungen, die Ende 2025 begannen und in Abbildung 1 zusammengefasst sind.
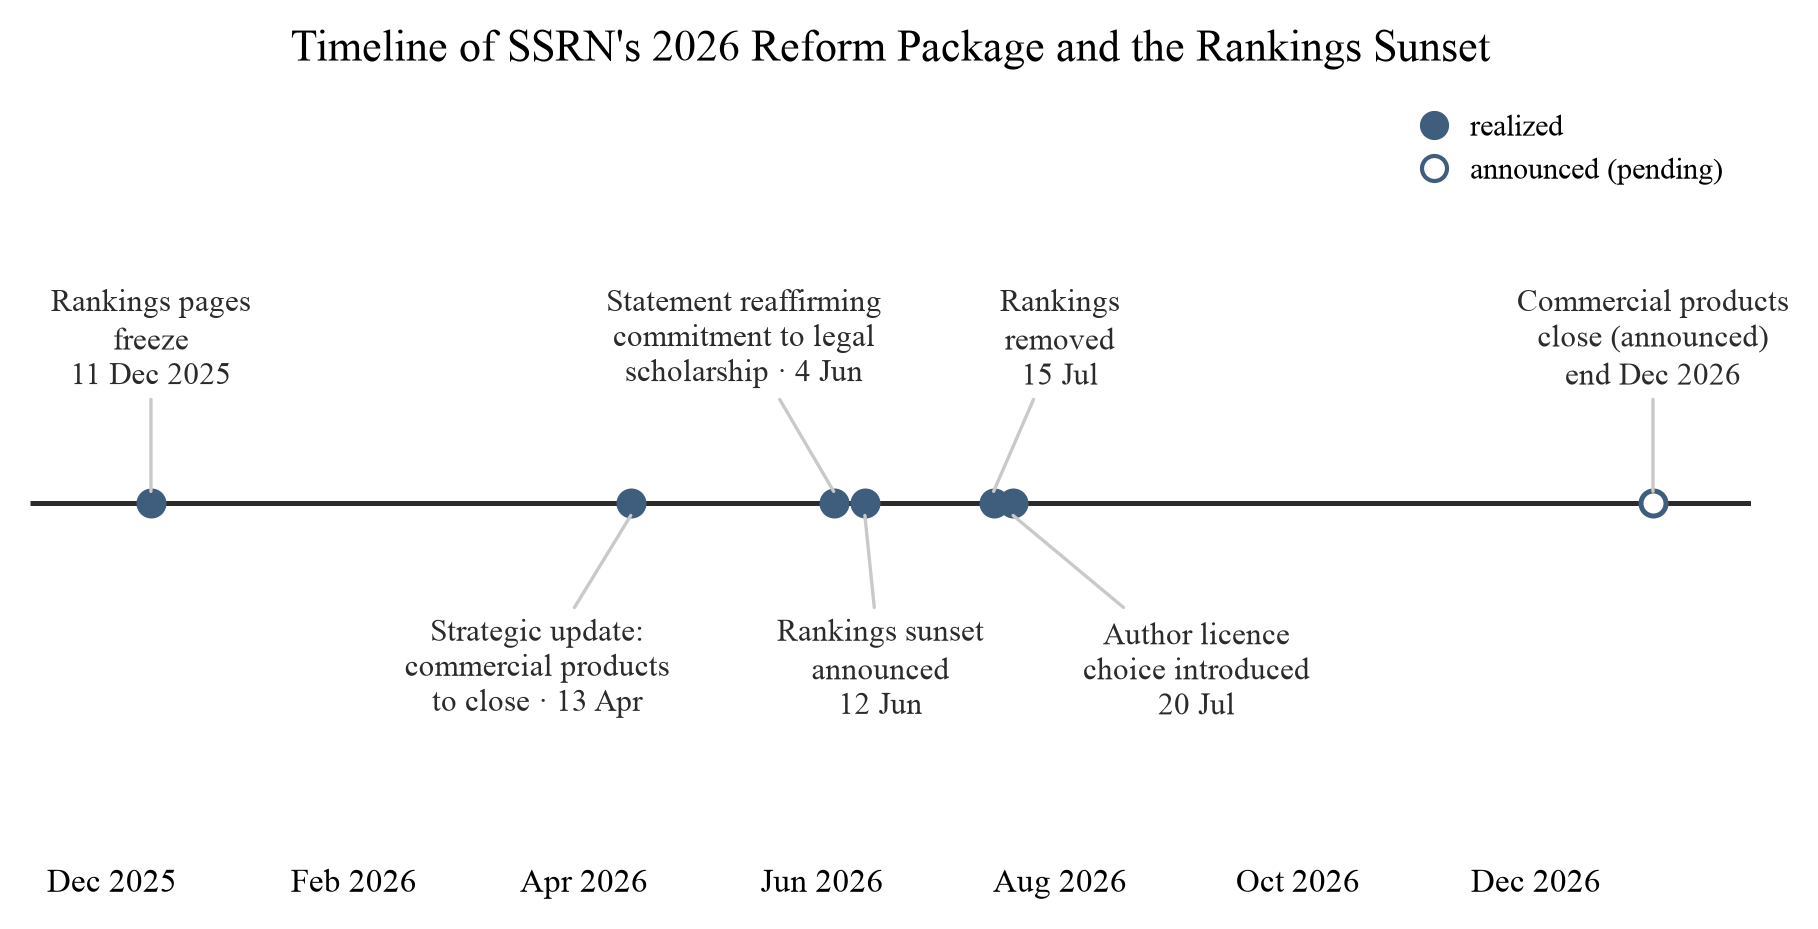
Abbildung 1. Zeitstrahl von SSRNs 2026er Reformpaket. Ereignisse: Einfrieren der eJournal-Download-Ranking-Seiten (ab 11. Dezember 2025, dokumentiert in einem TaxProf-Blog-Beitrag vom 25. Januar 2026 [B-2]); strategische Aktualisierung mit Ankündigung der Schließung aller kommerziellen Produkte bis Ende 2026 (13. April 2026) [146]; öffentliche Erklärung, die SSRNs Engagement für juristische Literatur bekräftigt (4. Juni 2026) [147]; Ankündigung, dass Rankings ab „1. Juli 2026" eingestellt würden (12. Juni 2026) [148]; tatsächliche Entfernung der Rankings (15. Juli 2026) [149]; Einführung der Lizenzwahl für Autoren (20. Juli 2026) [150]; angekündigte Schließung der verbleibenden kommerziellen Produkte (Ende Dezember 2026) [146]. Quellen: [146][147][148][149][150][B-2].
Der Verschleiß begann bereits vor einer formellen Ankündigung. Am 11. Dezember 2025 stellten die eJournal-Download-Ranking-Seiten mit Aufteilung pro eJournal ihre Aktualisierung ein. Paul Caron hatte über zwei Jahrzehnte lang eine wöchentliche „Top Five New Tax Papers"-Rubrik erstellt, die auf diesen Rankings basierte. In einem Beitrag vom 25. Januar 2026 dokumentierte er, dass die Tax-Rankings auf dem Zeitfenster „12. Okt. 2025 – 11. Dez. 2025" eingefroren waren, und schrieb, dass „dies möglicherweise das Ende von SSRNs Top Five New Tax Papers" sei [B-2, zitiert als Paraphrase des Beitrags vom 25. Januar 2026, nicht einer SSRN-Ankündigung].
Am 13. April 2026 veröffentlichte SSRN ein „Strategic Update", in dem eine erneuerte Ausrichtung auf seine „core research sharing mission" und die Schließung aller kommerziellen Produkte (Research Paper Series, Sponsored Networks, Site Subscriptions, kostenpflichtige Konferenzproceedings, Analyse-Dashboards, Stellenangebote und Ankündigungen sowie Daten-Feeds) bis Ende Dezember 2026 angekündigt wurden [146]. Bibliothekenbeobachter registrierten die Änderung innerhalb von Tagen [34], und Elseviers Digital Commons-Einheit veröffentlichte Migrationsleitfäden für Institutionen, deren Research Paper Series-Sammlungen eingestellt wurden [47].
Die Ankündigung provozierte öffentliche Kontroversen in der juristische Akademie, der Gemeinschaft, die am meisten in die Ranking-Infrastruktur investiert war. Am 3.–4. Juni 2026 veröffentlichte Bainbridge eine vielgelesene Kritik unter dem Titel „The Social Science Research Network Has Jumped the Shark", gefolgt von einem Beitrag, in dem vermerkt wurde, dass SSRN auf seine Beschwerden mit Klarstellungen zum Zeitpunkt der Schließung der Papierserie und zum Erhalt der Fachzeitschriften-eJournals reagiert hatte [12]. Am 4. Juni 2026 gab SSRN eine Erklärung zu seinem „andauernden Engagement für juristische Literatur" ab und versprach, dass eJournal-Verteilungen und E-Mail-Benachrichtigungen „unverändert fortgesetzt" würden [147]. Am 7. Juni 2026 antwortete Caron Bainbridge auf TaxProf Blog unter dem Titel „SSRN Has Not Jumped the Shark" [B-11]. Der Austausch ist eine prägnante öffentliche Dokumentation dessen, wofür die Gemeinschaft die Vergleichsfunktionen der Plattform zum Zeitpunkt ihrer Entfernung als wertvoll erachtete.
Am 12. Juni 2026 kündigte SSRN an, dass es Rankings „ab 1. Juli 2026" einstellen würde, und erklärte, dass „bei SSRN immer der Glaube bestanden hat, dass Forschung für sich selbst sprechen sollte" [148]. Die Abschaltung erfolgte zwei Wochen später als zunächst angekündigt: Am 15. Juli 2026 wurden die Rankings von Papieren, Autoren und Institutionen entfernt [149]. Fünf Tage später, am 20. Juli 2026, führte eine weitere Reform die Lizenzwahl für Autoren ein [150]. Die zweiwöchige Lücke zwischen den angekündigten und tatsächlichen Terminen sowie das einmonatige Zeitfenster zwischen Ankündigung und Umsetzung sind selbst analytisch relevant: Sie schufen einen Antizipationszeitraum, in dem Autoren und Institutionen die kommende Änderung beobachten konnten – ein Aspekt, der im Quasi-Experimentaldesign von Abschnitt 8 behandelt wird.
2.3 Die offizielle Begründung und ihre Entwicklung
Die angegebene Rechtfertigung für die Abschaltung war Ressourcenzuteilung und eine Neuausrichtung der Plattform. Die Ankündigung im Juli erklärte, dass Rankings „erhebliche Ressourcen für Produktentwicklung und Entwicklung" erforderten, und ordnete die Entscheidung in eine Neuausrichtung auf schnelleres Posten, bessere Auffindbarkeit und Forschungsintegrität ein. Sie besagte auch, dass „Download-Zahlen und Zitierstatistiken weiterhin auf Ihren einzelnen Papieren und Ihrem Autorenprofil aufgezeichnet und angezeigt werden" [149]. Die Ankündigung lässt die Möglichkeit einer Rückkehr vergleichender Funktionen offen: SSRN schrieb, dass es „die Idee verschiedener Rankings neu überdenken könnte" [149], daher sollte die Entfernung nicht als dauerhaft beschrieben werden. Das Fehlen von Aussagen in den Dokumenten ist ebenso bedeutsam: Die Ankündigungen führen die Entscheidung nicht auf Metrik-Gaming, Manipulation oder wettbewerbsmäßigen Missbrauch der Rankings zurück, und Berichte, die solche Motive anführen, gehen über die veröffentlichten Texte hinaus [148][149].
Der Ton der offiziellen Erklärung entwickelte sich zwischen der Ankündigung und der Seite, die die Ranking-URLs ersetzte. Während der Juni-Beitrag von Ressourcen sprach, besagt die Ersatzseite, dass SSRNs „neue Ausrichtung Einzelautoren und ihre Arbeiten in den Mittelpunkt von allem stellt, was wir tun", und dass „aggregierte Ranglisten von Institutionen und Abteilungen nicht mehr in dieses Bild passen" [B-8; die Seite ist hinter Zugriffsbeschränkungen verfügbar und diese Sätze sind Zitate aus Suchindex-Kopien, daher sollte ein archiviertes Snapshot bei jeder Zitierung beigefügt werden]. Der Juni-Beitrag stellt die Abschaltung als Kostentscheidung dar, die Ersatzseite als eine grundsätzliche Neuausrichtung weg von institutionellem Vergleich ganz allgemein.
SSRN ließ Autoren nicht ganz ohne offizielle Hinweise auf Kontext. Seine Support-Dokumentation zur Bewertung der Auswirkungen eines Papers verweist Autoren auf Paper-Ebenen-Zähler (Abstract-Aufrufe und Downloads), ergänzt durch PlumX Metrics, ein Elsevier-Altmetrics-Produkt, das Zitier-, Nutzungs- und Social-Media-Signale aggregiert [50, abgerufen am 14. August 2026]. PlumX fungiert daher als de-facto-Ersatz der Plattform für interpretativen Kontext. Es ist ein teilweiser Ersatz: Er aggregiert zusätzliche Signale für ein einzelnes Paper, liefert aber keine Verteilung, Perzentile oder Kohorten-Vergleich. Dies sind die Elemente, die die Rankings, allerdings unvollkommen, bereitgestellt hatten. Die Einstellungen erstrecken sich nicht auf SSRNs Integration mit Journal-Workflows: Das First-Look-Programm verbindet die Plattform weiterhin mit mehr als 1.200 Elsevier-Journals [48][145]. Die kommerzielle Governance der Plattform ordnet diese Produktentscheidungen auch in einen hochkonzentrierten Markt für wissenschaftliches Publizieren ein [94].
2.4 Was bleibt und was wurde entfernt
Tabelle 2 zeigt den Zustand der Plattform nach Sonnenuntergang zusammen mit der Messbarkeitsbedeutung jedes Elements: was jedes überlebende, verschwundene oder nicht gemeldete Merkmal für jeden bedeutet, der versucht, eine Anzahl zu erfassen. Die Entfernung war asymmetrisch. Alle Pro-Paper- und Pro-Profil-Zähler bleiben erhalten. Der auf diesen Zählern aufgebaute Vergleichsapparat wurde vollständig zurückgezogen.
Tabelle 2. Was bleibt und was wurde nach dem Rankings-Sonnenuntergang vom 15. Juli 2026 entfernt, mit Messbarkeitsbedeutungen. Quellen: [147][149][161][B-8][B-9]; Exposure-Machinery-Reihen: [53][57][55][144][66][69].
| Merkmal | Status nach dem 15. Juli 2026 | Quellengrundlage | Messbarkeitsbedeutung |
|---|---|---|---|
| Pro-Paper-Download-Zähler | Bleiben; auf Papierseiten angezeigt | Wörtlich bestätigt in der Sonnenuntergang-Ankündigung [149] | Rohe Nutzung bleibt beobachtbar, trägt aber jetzt keine eigene Referenzklasse |
| Pro-Paper-Abstraktaufrufe | Bleiben (in der Sonnenuntergang-Ankündigung nicht wörtlich genannt, die „Download-Zähler und Zitierstatistiken" auflistet; Aufrufe werden weiterhin angezeigt) | [149], Plattformbeobachtung, zugegriffen am 14. August 2026 | Die Reichweite bleibt beobachtbar, sodass Pro-Paper-Reichweiten-Konversions-Diagnostiken (Tabelle 9) weiterhin berechenbar bleiben |
| Zitierstatistiken (Paper und Autorenprofil) | Bleiben | Wörtlich bestätigt [149] | Die nachgelagerte Nutzung kann frühe Aufmerksamkeitsmaße immer noch ergänzen |
| Autorenprofil (Papers, Zugehörigkeiten) | Bleibt | Plattformbeobachtung, zugegriffen am 14. August 2026 | Die Aggregation auf Portfolioebene bleibt möglich, mit demselben fehlenden Nenner |
| eJournal-Abonnements und E-Mail-Benachrichtigungen | Bleiben | „Bleiben unverändert", Stellungnahme vom 4. Juni 2026 [147] | Der Push-Exposure-Kanal bleibt bestehen, sodass frühe Zähler weiterhin architekturabhängig bleiben (Abschnitt 4.4) |
| Themeneinstufungen (1–7, autorgewählt) | Bleiben; steuern eJournal-Routing | Plattformdokumentation [53] | Die Klassifizierung ist eine potenziell folgenreiche Expositionsvariable |
| Kuratierte eJournal-Verteilung | Setzt sich fort; Einbeziehung „kuratiert und gezielt, nicht garantiert" | [53][57][147] | Der Verteilungsstatus und das Datum sollten als Behandlung modelliert werden, nicht als Hintergrund |
| Verteilungsverzögerung bei hochvolumigen Themen | Setzt sich fort; bis zu 45 Tage | [53] | Die Zähler des ersten Monats können vor und nach der Verteilung vermischte Regime aufweisen |
| Externe Indexierung (Google, Google Scholar) | Setzt sich fort, nach Zeitplan der Suchmaschine („6–9 Monate oder länger") | [55] | Ein intervallzensierter Expositionsprozess: das Expositionsdatum ist begrenzt, nicht beobachtet |
| Filterung verdächtiger Aktivitäten | Setzt sich fort | [144][66][69] | Zähler sind gefilterte Ereignisse, nicht verifiziertes Lesen oder Billigung |
| KI-Antworterabruf von Papers | Wird von SSRN nicht gemeldet | Keine Plattformberichterstattung existiert; Abschnitt 8.6 | Die Maschinensichtbarkeit erfordert ein unabhängiges, wiederholtes Audit (Studie 2) |
| PlumX-Metriken auf Papierseiten | Bleiben; offizieller Hinweis auf Wirkungsbeurteilung | Support-Dokumentation [50] | Zusätzliche Pro-Paper-Signale, aber keine Verteilung, Perzentil oder Kohortevergleich (Abschnitt 2.3) |
| Top-Papers-Listen (Top 10.000; pro eJournal aktuell/ganzzeitig) | Entfernt; URLs geben einen Fehler oder die Sonnenuntergang-Landingpage zurück | [149][B-8][B-9] | Ein wichtiger Vergleichsrahmen – und eine mögliche Entdeckungsfläche – ist verschwunden |
| Top-Autoren-Listen (Top 30.000; disziplinarische Ligen) | Entfernt | [149][B-9] | Die Autorenperzentil-Position auf Ebene ist nicht mehr öffentlich beobachtbar |
| Institutionelle Ligen (Top 350 U.S. / Top 500 Internationale Jura-Schulen, usw.) | Entfernt | [149][B-8][B-9] | Der institutionelle Vergleich kann nicht mehr aus Plattformdaten berechnet werden |
| Öffentliche Perzentil-Rahmung (Autoren-Rang, „Top-10%-Positionierung") | Mit der Rankings-Infrastruktur entfernt | [149][161] | Die Referenzklasse muss jetzt extern neu aufgebaut werden (Abschnitte 5, 8) |
| Benachrichtigungs-E-Mails „Top 10% der Autoren" | Schicksal nicht in offiziellen Mitteilungen angesprochen; die E-Mails waren an die Rankings-Infrastruktur gebunden | [161][149] | Ein dossierverwendbares Perzentil-Signal kann nicht mehr als angekommen angenommen werden |
Die verbleibenden Zeilen in Tabelle 2 sind genau die Rohdaten und die Expositionsmaschinerie, die sie speist: Die Plattform produziert weiterhin Zahlen in der gleichen Rate wie zuvor. Die entfernten Zeilen sind genau die Menge der Vergleichsrahmen: Verteilungen, Schwellenwerte, Ränge und Perzentil-Mitteilungen. Das Ereignis hat daher eine präzise informationelle Struktur (Daten beibehalten, Referenzklasse entzogen), und diese Struktur wandelt ein langjähriges latentes Problem, wie man eine SSRN-Nummer liest, in ein akutes und universelles um. Wir nennen die Plattformeigenschaft, die sich geändert hat, Benchmark-Opazität: eine abgestufte Eigenschaft einer Plattform, die beschreibt, ob sie die Verteilungsstatistiken veröffentlicht, die nötig sind, um einen einzelnen Zähler zu situieren (Perzentile, Mediane, Kohortentverteilungen), oder nur Rohdaten, Mittelwerte und Top-N-Listen. Am 15. Juli 2026 wechselte SSRN in einem einzigen Schritt von partieller Transparenz zu nahezu vollständiger Benchmark-Opazität, und der Rest des Artikels kann als eine Studie darüber gelesen werden, was diese Eigenschaft seine Nutzer kostet. Opazität, so definiert, hat mindestens vier Dimensionen: Populationsabdeckung (wen die veröffentlichten Statistiken beschreiben), Referenzklassen-Granularität (ob sie nach Feld, Alter und Kohorte konditionieren), zeitliche Stabilität (ob Definitionen und Fenster über die Zeit vergleichbar bleiben) und Nachvollziehbarkeit (ob die Zählregeln öffentlich genug sind, um sie zu überprüfen). Die vier laufen teilweise unabhängig: Rankings können eine Form von Opazität reduzieren, während sie eine andere verschärfen, wenn ihre Nenner und Auswahlregeln unklar sind. Diese teilweise Unabhängigkeit ist der Grund, warum die Plattformempfehlungen von Abschnitt 10.4 (Punkte 4 und 8) sich selbst auf die Offenlegung beziehen und nicht nur auf die Rückkehr von Vergleichszahlen. Um die Eigenschaft messbar zu machen, wird jede Dimension auf einer expliziten ordinalen Checkliste bewertet, die auf die öffentliche Schnittstelle und Dokumentation einer Plattform angewendet wird: Populationsabdeckung (0 = nur Rohdaten, 1 = plattformweite Zusammenfassungsstatistiken veröffentlicht, 2 = Verteilungsstatistiken für definierte Populationen); Referenzklassen-Granularität (0 = keine, 1 = eine Achse wie Feld, 2 = gemeinsame Feld-×-Alter-×-Kohorte-Konditionierung); zeitliche Stabilität (0 = Zähldefinitionen und Fenster undokumentiert oder stillschweigend überarbeitet, 1 = dokumentiert, 2 = dokumentiert und versioniert); und Nachvollziehbarkeit (0 = Zählregeln unveröffentlicht, 1 = in Prosa beschrieben, 2 = in überprüfbaren Details veröffentlicht). Das Opazitätsprofil einer Plattform ist dann das Vier-Tupel der Scores statt eines einzelnen Labels. Das gleiche Instrument bewertet SSRN vor und nach dem Sunset (wobei es diesen bei Abdeckung, Granularität und, für die pensionierten Listen, Referenzklassen-Granularität nach unten verschiebt), und es ermöglicht, dass die plattformübergreifenden Vergleiche von Tabelle 6 als Scores statt als Eindrücke formuliert werden. Eine Plattform kann viele Zahlen anzeigen und dennoch fast völlig opak bleiben. Die Rubrik ist eine erste Operationalisierung, die verfeinert und zwischen Ratern getestet werden soll, keine fertige Messgröße.
2.5 Die Nachfrage nach Interpretation
Die Frage, die der Sonnenuntergang dringend machte, wurde lange vorher schon gestellt. Tabelle 1 (Abschnitt 1.5) fasst die dokumentierten Cluster der Autorennachfrage nach Interpretation zusammen, beschränkt auf verifizierte Quellen. Forummaterial wird dort als Beleg für Nachfrage angeführt, nicht für Verteilungen, und Zitate aus Benutzerbeiträgen werden nur dort wiedergegeben, wo der Beitrag selbst lokalisiert wurde (die Ethik des Zitierens von halböffentlichen Forumsbeiträgen wird in Abschnitt 9 behandelt).
Die negativen Aussagen, die folgen, beruhen auf einer strukturierten Suchprüfung statt auf beiläufigem Suchen, ebenso wie die parallelen Aussagen in den Abschnitten 1.2, 1.5 (Tabelle 1) und 8.8. Das Protokoll wird hier einmal dargelegt. Wir konstruierten ein Inventar von mehr als 25 Abfrageformulierungen in Englisch, organisiert in sechs Intentionscluster: normativ („wie viele SSRN-Downloads sind gut"), definitional („was beinhaltet ein SSRN-Download-Count"), post-sunset-navigational („SSRN-Rankings weg — wo vergleichen"), evaluativ („SSRN-Downloads als Tenure-Evidenz"), diagnostisch („SSRN-Papier null Downloads warum") und praktisch („wie man SSRN-Downloads erhöht"). Für jede Abfrage dokumentierten wir, wer sie derzeit beantwortet und wie gut, wobei das Kriterium war, ob eine zurückgegebene Quelle abgestufte, feldbedingte Benchmarkwerte bietet, anstatt eine Beschreibung der Metrik oder eine Anekdote. Als positive Kontrolle führten wir analoge Abfragen für den h-Index, die ResearchGate-Bewertung und Zitatzahlen durch, die zuverlässig das in [118][128] dokumentierte Schwellenwert-Leitfaden-Genre aufdecken. Die gleichen Intentionsformulierungen für SSRN-Downloads deckten kein Äquivalent auf, weder vor noch nach dem Sonnenuntergang. Die Lücke erstreckt sich auf die am häufigsten konsultierten Gemeinschaftsreferenzen: enzyklopädisch-artige Übersichten über die Plattform beschreiben, was die Counter sind, bieten aber keine Interpretationsnormen dafür [170]. Die Prüfung wurde im Juli–August 2026 durchgeführt, wobei eine benutzerdefinierte Pipeline verwendet wurde, die Suchmaschinen für allgemeine Zwecke und Antwort-Engines für Verbraucher umfasste, mit Automatisierung der Abfrageausführung und Bewertung der Antwortqualität. Die vollständige Abfrageliste ist vom Autor erhältlich. Das Ergebnis ist ein negatives Befund und wird nur als solcher behauptet: Abwesenheit von Belegen zum Zeitpunkt des Prüffensters, in den abgedeckten Sprachen und Engines, kein Beweis, dass keine solche Ressource existieren kann.
Für benachbarte Metriken wurde die in Tabelle 1 (Abschnitt 1.5) dokumentierte Interpretationsnachfrage lange durch ein Massenmedien-Genre erfüllt: „was ist ein guter h-Index" wird von Dutzenden abgestufter, feldgebundener Schwellenwert-Leitfäden bedient [118], und Disziplin-Zitationsnormen sind Gegenstand weit gelesener Erklärungen [128]. Für SSRN-Downloads gibt es kein solches Genre. Schlimmer noch, der beste strukturierte Leitfaden, der existierte, die Seite der Universität Washington-Rechtsbibliothek, fuhr nach dem 15. Juli 2026 fort, die Top-Autoren und Top-Papers-Rankings im Präsens zu beschreiben, was ihn teilweise irreführend machte, genau als die Nachfrage ihren Höhepunkt erreichte [156, abgerufen 14. August 2026]. Der Sonnenuntergang schuf nicht das Interpretationsproblem; er entfernte die einzige Teilantwort, die das Ökosystem hatte, zu dem Zeitpunkt, als das institutionelle Gedächtnis an die Verteilungen zu verfallen begann.
3. Was die Daten zeigen: Warum der Mittelwert lügt
3.1 Was die Zähler messen und was nicht
Jede Verwendung der erhaltenen Zähler setzt eine Darlegung voraus, was sie messen. Tabelle 3 fasst den Messinhalt jeder Metrik, ihre wichtigsten Störfaktoren und die diagnostische Rolle zusammen, die sie legitim spielen kann.
Tabelle 3. Was SSRN-Metriken messen – und was nicht.
| Metrik | Nächste inhaltliche Interpretation | Wichtigste Störfaktoren | Angemessene diagnostische Rolle |
|---|---|---|---|
| Aufrufe der Zusammenfassungsseite | Reichweite zur Landingpage einer Arbeit | Suchpräsenz, Platzierung auf der Plattform, Autorenreputation, externe Promotion, Titel, Feldgröße, Online-Zeit | Sichtbarkeit / Reichweite |
| Volltext-Downloads | Absicht, die vollständige Arbeit zu prüfen oder zu nutzen | Alles, was Aufrufe beeinflusst, plus Qualität und Relevanz der Zusammenfassung und Download-Reibung | Engagement |
| Downloads pro Aufruf der Zusammenfassung | Bedingte Übergänge von Sichtbarkeit der Landingpage zu Volltext-Akquisition | Kleine Nenner, wiederholtes Verhalten, heterogene Verkehrsquellen | Konvertierung |
| Zitationen | Beobachtbare Aufnahme in später entstandene wissenschaftliche Dokumente | Zitationsnormen des Fachs, Publikationsverzögerung, Datenbankabdeckung, Selbstzitation, Statuseffekte | Nachgelagerte wissenschaftliche Nutzung |
| Altmetric / PlumX Signale | Breitere Online-Engagement | Plattformzusammensetzung und Nutzerverhalten | Zusätzliche Verbreitungsevidenz |
Der Inhalt der Tabelle kann in einen Kontrast zwischen zwei Gleichungen verdichtet werden. Die Lesart, die das Dashboard stillschweigend vorschlägt, ist Downloads = Wissenschaftliche Qualität. Die vertretbare Darstellung ist
Beobachtete Downloads = f(Q, E, R, C, T, P, ε),
wobei Q Merkmale bezüglich Forschungsqualität oder Relevanz bezeichnet, E Sichtbarkeit, R Reputation, C Kommunikationsmerkmale, T Zeit und Alter, P Plattformmechanismen und ε unbeobachtete Einflüsse. Der Ausdruck klassifiziert die Störfaktoren; es wird keine funktionale Form oder kein Koeffizient angegeben. Die Klassifizierung beschreibt die praktische Schwierigkeit genau: Der Forscher beobachtet normalerweise nur die linke Seite.
Zwei Randbedingungen gelten für die Tabelle. Die Zähler sind keine reinen Verkehrsprotokolle. SSRN hat seine Zählungen mindestens seit den 2000er Jahren gefiltert: Die Plattform gibt an, dass sie offensichtliche wiederholte Downloads durch dieselbe Person und offensichtliche Robot-Downloads ausschließt, unter Verwendung von „Zeichen für unregelmäßige Aktivität", und dass verdächtige anonyme Downloads aus der Gesamtsumme des Autors ausgeschlossen werden [144]. Black und Caron schätzten, dass die Zähler ohne solche Filterung „um einen Faktor von fünf oder mehr" inflationiert würden [18]. Ein gezählter Download verzeichnet ein Engagement-Ereignis und nichts über Billigung. Die Zähler messen Stufen eines Aufmerksamkeitsprozesses. Keine von ihnen misst wissenschaftliche Verdienste, und jede wird durch Sichtbarkeitsfaktoren verzerrt, die wirken, bevor ein Leser den Inhalt bewertet [44][72][144]. Diese Grenzen sind seit den frühesten bibliometrischen Analysen von Leserdaten bekannt [91]. Die Stufen können sich auch voneinander entkoppeln, durch zwei angenommene Mechanismen: Arbeiten zu politisch relevanten Themen können von Praktikern stark heruntergeladen werden, die lesen, aber nicht zitieren, während spezialisierte Arbeiten wenig heruntergeladen werden können, aber von der kleinen Fachwelt, die sie benötigt, zitiert werden. Jedes Muster trennt Sichtbarkeit von nachgelagerter Nutzung, was ein Grund dafür ist, dass sich die Mengen der am meisten heruntergeladenen und am meisten zitierten Arbeiten nur teilweise überschneiden [108].
3.2 Plattformaggregate und die Fiktion des Durchschnitts
Die einzigen verteilungsrelevanten Zahlen, die SSRN selbst veröffentlicht, sind Plattformtotale, und das Erste, das bei den Daten auffällt, ist das, was passiert, wenn diese Totale gemittelt werden. Tabelle 4 sammelt die verifizierten Plattformstatistiken mit ihren Stichtagen.
Tabelle 4. Verifizierte SSRN-Plattformstatistiken mit Stichtagen und Verifizierungsstatus.
| Menge | Wert | Stand vom | Quelle | Verifizierungsstatus |
|---|---|---|---|---|
| Volltextarbeiten | 1.157.048 | 18. Dezember 2023 | ALL-SIS Citation Methods White Paper [1] | Verifiziert anhand der veröffentlichten PDF |
| Abstracts | 1.309.385 | 18. Dezember 2023 | [1] | Verifiziert |
| Autoren | 1.479.875 | 18. Dezember 2023 | [1] | Verifiziert |
| Kumulierte Downloads | 256.678.716 | 18. Dezember 2023 | [1] | Verifiziert |
| Downloads, letzte 12 Monate | 40.642.329 | 18. Dezember 2023 | [1] | Verifiziert |
| Volltextarbeiten (früherer Referenzpunkt) | 571.040 | 6. Juli 2016 | [1] | Verifiziert |
| Downloads, letzte 12 Monate (früherer Punkt) | 12.897.685 | 6. Juli 2016 | [1] | Verifiziert |
| Preprints / Arbeiten; Autoren | „1,5+ Millionen"; „1,9+ Millionen" | 2026-Produktseite | Elsevier SSRN Produktdokumentation [49], aufgerufen am 14. August 2026 | Verifiziert (gerundete Marketingzahlen) |
| Arbeiten; Autoren; Downloads insgesamt; Downloads 12 Mo | >1,7M; >2,4M; >344M; >54M | 1. November 2025 | SSRN-Ankündigungsvorlage [B-6] | Größenordnung bestätigt; die genauen Dezimalzahlen (344,8M / 54,7M) erfordern archivierte Kopien der Ankündigung vor dem Zitieren |
| Abgeleitet: durchschnittliche Downloads pro Volltext-Arbeit während der Lebensdauer | ≈222 | Dezember 2023 Basis | Von Autoren berechnet: 256.678.716 ÷ 1.157.048 [1] | Arithmetik basierend auf verifizierten Zahlen |
| Abgeleitet: durchschnittliche Downloads pro Arbeit pro Jahr | ≈35 | Dezember 2023 Basis | Von Autoren berechnet: 40.642.329 ÷ 1.157.048 [1] | Arithmetik basierend auf verifizierten Zahlen |
Die letzten beiden Zeilen sind von Autoren berechnet und entsprechend gekennzeichnet; SSRN veröffentlicht keine Durchschnittswerte pro Arbeit. Plattformweite Totale unterscheiden sich nach Quelle, Datum und Definition (Volltext vs. Gesamtarbeiten), daher werden die Pro-Arbeit-Ableitungen aus den abgestimmten Dezember-2023-Volltextzahlen [1] entnommen; die rohen Daten der Ankündigungsvorlage von November 2025 [B-6] werden oben als Daten beibehalten, die ausschließlich zusammen mit archivierten Kopien (z. B. über web.archive.org) nutzbar sind, da die ursprünglichen Ankündigungsseiten nicht mehr direkt abrufbar sind.
Nach den abgestimmten Dezember-2023-Zahlen hat die „durchschnittliche" SSRN-Arbeit in ihrer Lebensdauer etwa 222 Downloads erreicht und in den vergangenen 12 Monaten etwa 35 [1]. Diese abgeleitete Zahl ist das dem plattformweiten Standard am nächsten kommende, das ein Autor berechnen kann, und sie ist systematisch irreführend, da der Durchschnitt eine Fiktion der Aggregation ist. Jede empirische Untersuchung der SSRN-Download-Verteilung findet starke Rechtsschiefe: der Mittelwert wird durch einen langen oberen Schweif weit über den Median hinausgezogen, sodass die „durchschnittliche Arbeit" fast keine tatsächliche Arbeit beschreibt. Der Rest dieses Abschnitts etabliert die Größe und Konsequenzen dieser Lücke. Ein weiteres Aggregat ist für die Kalibrierung wichtig. Jährliche Plattform-Downloads wuchsen von etwa 0,5 Millionen im Jahr 2000 auf etwa 3 Millionen im Jahr 2005 [18], 12,9 Millionen im Jahr 2016 und 40,6 Millionen bis 2023 [1]. Der Download-pro-Arbeit-Fluss selbst ist gestiegen: Jährliche Downloads wuchsen etwa um das 3,15-fache von 2016 bis 2023, während der Arbeitsspeicherbestand etwa um das 2,03-fache wuchs [1], was den Pro-Arbeit-Fluss um etwa 55% erhöhte. Eine ältere Studie würde somit die absoluten Zahlen unterschätzen, die eine vergleichbare Arbeit heute verdienen würde. Die Richtung dieser Tendenz hängt vom Vergleich ab: eine feste alte Schwelle ist eine Untergrenze für heutige Zahlen, was sie zu einer nachsichtigen, nicht einer konservativen Schwelle macht, wenn sie als absolutes 2026-Niveauband gelesen wird. Die umgekehrte Manipulation ist gleichermaßen unzulässig: eine alte Schwelle kann nicht durch Multiplikation mit dem Plattformwachstum in eine 2026-Norm „alterungsgerecht" gemacht werden, da ein größeres Repository gleichzeitig den Zähler, den Nenner, die Zusammensetzung der Autoren, die Verteilungskanäle, die Bot-Filterung und den Wettbewerb um Aufmerksamkeit verändert. Die im gesamten Text verwendete Lesart der Altersverzerrung basiert auf der oben genannten aggregierten Fluss- und Bestandsarithmetik, nicht auf einer Reskalierung alter Schwellen. Der eigene Jahresrückblick der Plattform bestätigt anhaltendes Wachstum: Mehr als 250.000 neue Arbeiten wurden 2025 eingereicht (20% mehr als 2024), mit über 53 Millionen Downloads im Jahr [145].
3.3 Der Mittelwert ist nicht das typische Paper: Direkte Evidenz
Die jüngsten veröffentlichten Verteilungsevidenzen für SSRN stammen von Jo und Li, die 2.361 Papers aus SSRNs Marketing Research Network in einer einzigen Querschnittsaufnahme vom 15. August 2025 analysieren [83]. Tabelle 5 unten reproduziert ihre deskriptiven Statistiken vollständig, und die konsolidierte Benchmark-Karte von Abschnitt 5 bezieht sie ein. Die mittleren Downloads betrugen 221.346 gegenüber einem Median von 87: Der Mittelwert liegt ungefähr 2,54-mal über dem Median. Das 95. Perzentil, 726, ist mehr als achtmal so hoch wie der Median. Der Mittelwert überschreitet sogar das 75. Perzentil (206), was bedeutet, dass mehr als drei Viertel der Papers in der Stichprobe unter dem „durchschnittlichen Paper" liegen. Ein Forscher, dem mitgeteilt wird, dass das durchschnittliche Paper in diesem Netzwerk etwa 221 Downloads hat, würde den Schluss ziehen, dass ein Paper mit 100 Downloads erheblich unter dem Normalbereich liegt, obwohl 100 den veröffentlichten Median bei weitem überschreitet. Abbildung 2 zeigt diese Struktur unmittelbar.
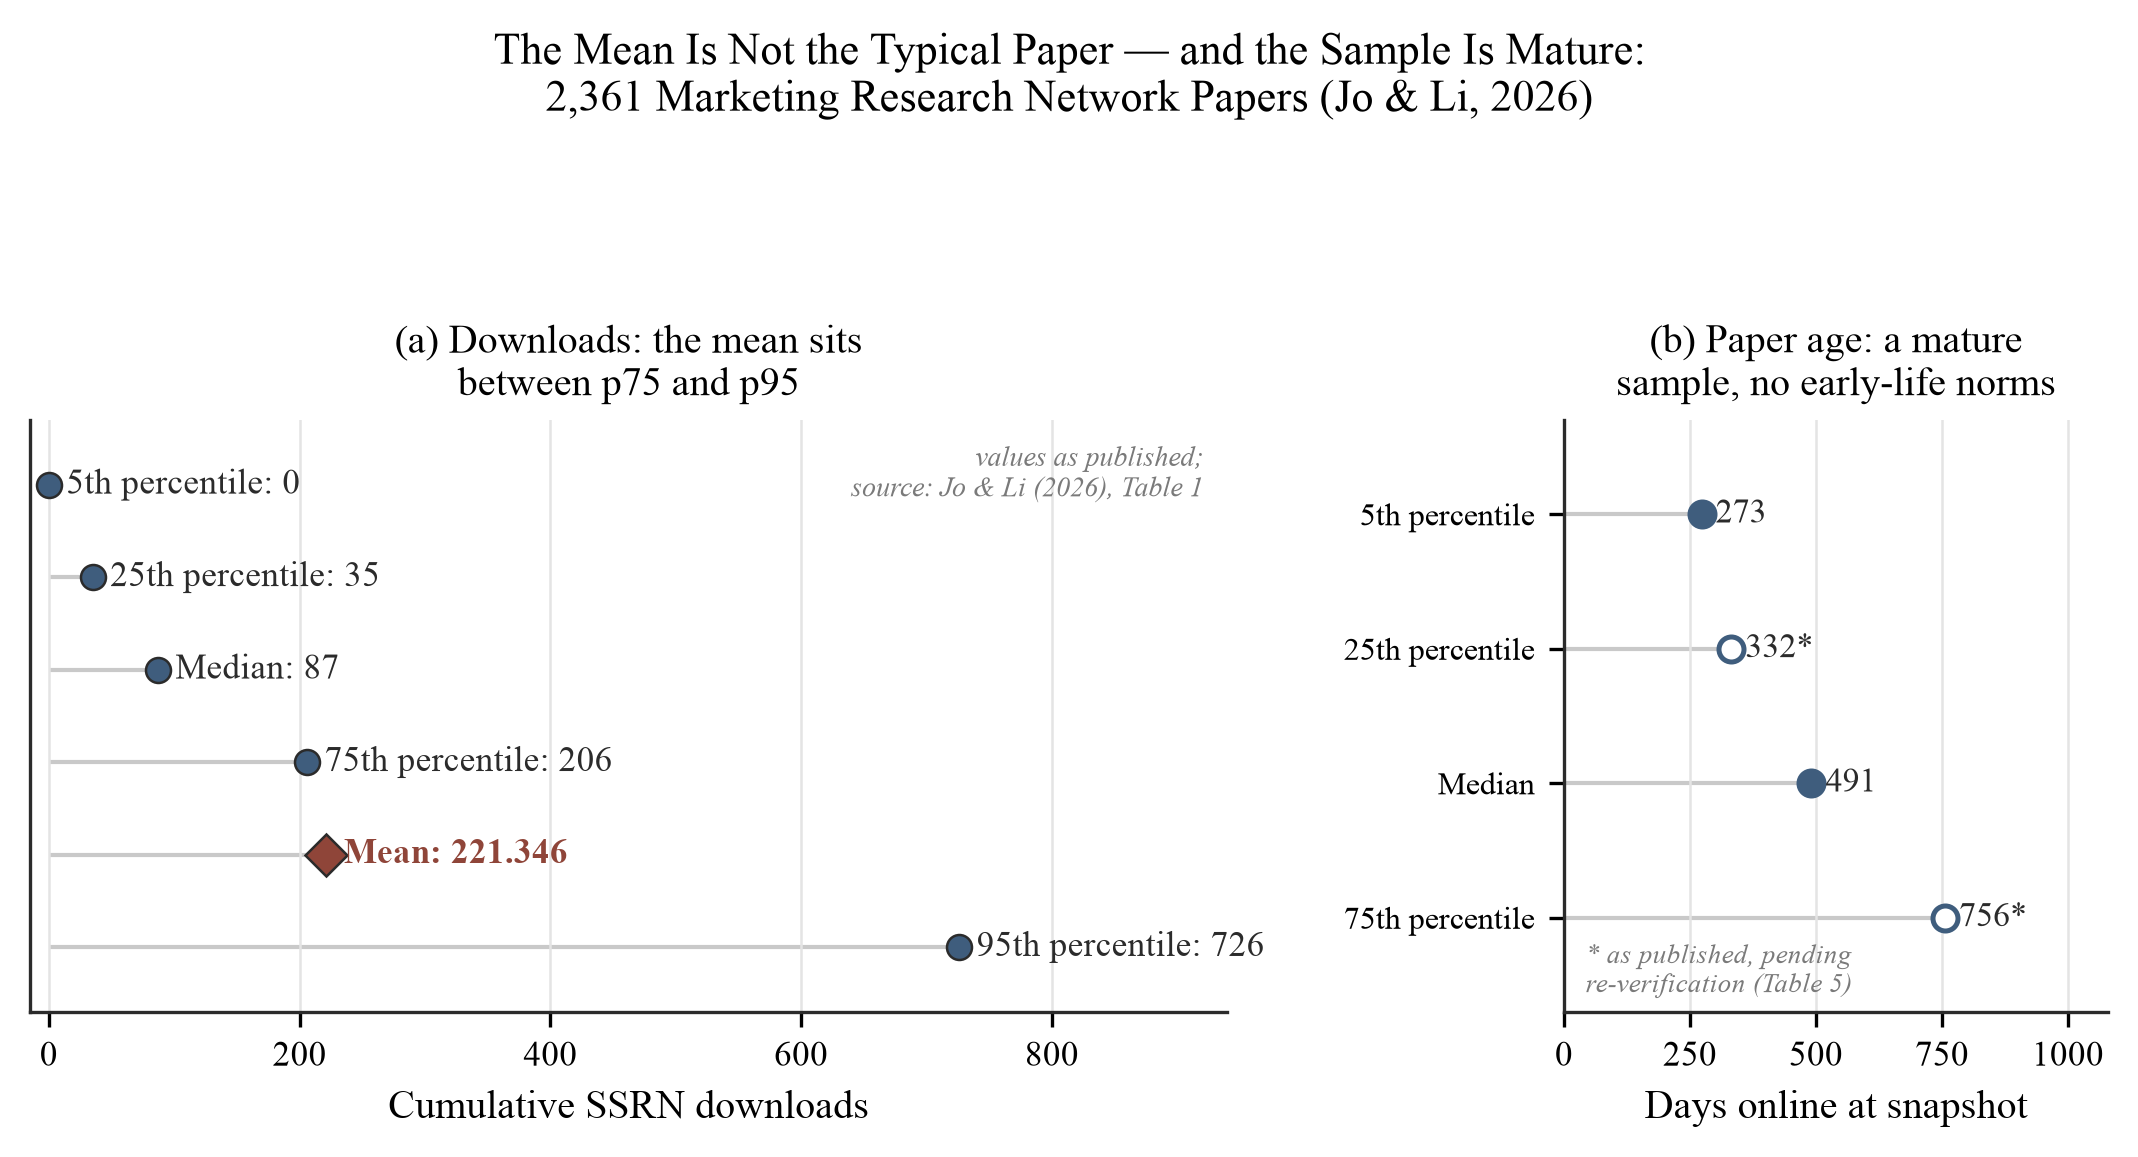
Abbildung 2. Veröffentlichte deskriptive Statistiken für 2.361 Marketing Research Network Papers. Panel (a): Downloads — p5 = 0, p25 = 35, Median = 87, p75 = 206, Mittelwert = 221.346, p95 = 726, aufgelistet nach Wert (beachten Sie, dass der Mittelwert zwischen p75 und p95 liegt). Panel (b): Paper-Alter in derselben Stichprobe — 5. Perzentil 273 Tage und Median 491 Tage gegen die Quelle verifiziert; das 25. (332 Tage) und 75. (756 Tage) Perzentil reproduziert „wie veröffentlicht" (Tabelle 5). Zwei Werte in der Tabelle 1 der Quelle sind gekennzeichnet und „wie veröffentlicht" reproduziert, sind aber Anomalien verschiedener Art. Das 95. Perzentil der Abstract-Ansichten (966) liegt nur etwa 0,32 SD über dem Mittelwert (611.973; SD 1.100,5) — nahezu unmöglich für eine rechtsschief verteilte Zählung, deren p75 bereits 833 ist — daher ist es ein vermuteter Quellfehler, höchstwahrscheinlich ein Tippfehler, obwohl ein Transkriptions- oder Rundungsfehler nicht ausgeschlossen werden kann, und die übrigen Zellen der Zeile der Abstract-Ansichten werden als möglicherweise durch denselben korrelierten Fehler betroffene behandelt (zur Autorenabfrage bei Jo und Li gekennzeichnet, deren Antwort noch nicht verfügbar ist). Das 95. Perzentil der Konversion (77,7 gegenüber 27,2 bei p75) ist ein anderes Phänomen: ein Artefakt von Klein-Nenner-Verhältnissen genau der Art, die Abschnitt 5.2 vorhersagt, keine statistische Unmöglichkeit. Das Alters-Panel macht die interpretative Grenze sichtbar: Dies sind Statistiken für mature Papers, und die Stichprobe kann keine Normen für frühe Phasen liefern. Quelle: Jo und Li (2026), Tabelle 1 [83].
Tabelle 5 reproduziert die vollständigen deskriptiven Statistiken der Studie, ihre zugehörigen Variablen sowie die Download-Verteilung, da dies die einzige veröffentlichte SSRN-Stichprobe mit einem vollständigen Perzentil-Panel ist; mehrere ihrer Zellen leisten interpretative Arbeit an anderer Stelle in diesem Artikel. Die Standardabweichungen geben den schweren Schwanz als eine einzige Zahl an: eine SD von 940,9 gegenüber einem Mittelwert von 221,3 für Downloads. Das 5. Perzentil der Downloads ist genau null, daher sitzt ein Nullzähler auch in der normalen Bandbreite einer Stichprobe von mature Papers. Die Konversion-Perzentile begrenzen die Querschnitt-Bandbreite von Abschnitt 5.2 von beiden Seiten (p25 = 12,1, Median = 18,9, p75 = 27,2 pro 100 Ansichten). Die Alters-Perzentile (Interquartilbereich 332–756 Tage) bestimmen die Reife der Stichprobe, und die Autorenschaft und Verpackungs-Zeilen liefern die in den Abschnitten 6.4 und 8.3 verwendeten Kovariate-Normen.
Tabelle 5. Vollständige veröffentlichte deskriptive Statistiken der Stichprobe Jo und Li (2026), „wie veröffentlicht" (N = 2.361 Marketing Research Network Papers; Aufnahme vom 15. August 2025). Alle Werte sind aus der Tabelle 1 der Quelle reproduziert [83]. Der Verteilungskern — die Download- und View-Mittelwerte, Mediane und Quartile; der Konversions-Mittelwert und Median; das Alters-Median und 5. Perzentil — wurde gegen die veröffentlichte Tabelle verifiziert (siehe Tabelle 7). Die restlichen Zellen (die Standardabweichungen; die Konversions- und Alters-Perzentile jenseits des Kerns; die Autoren-, Seiten- und Abstract-Längen-Zeilen) sind „wie veröffentlicht" reproduziert und wurden hier nicht unabhängig neu abgeleitet; die Existenz, der Veranstaltungsort und die Autorenschaft der Quelle wurden über Crossref am 14. August 2026 bestätigt. Zwei interne Anomalien werden „wie veröffentlicht" getragen und gekennzeichnet statt korrigiert, und sie sind nicht dasselbe Problem. Das 95. Perzentil der Abstract-Ansichten (966) liegt nur etwa 0,32 SD über dem gemeldeten Mittelwert (611.973; SD 1.100,5) — statistisch nahezu unmöglich für eine so schief verteilte Zählung und inkonsistent mit dem p75 der Zeile von 833 — daher ist es ein vermuteter Tippfehler in der Quelle; die übrigen Zellen der Abstract-Ansichten sind als möglicherweise durch ein korreliertes Fehler betroffenes gekennzeichnet und auf Neuverifizierung bei ausstehender Autorenabfrage bei Jo und Li herabgestuft. Das 95. Perzentil der Konversion (77.704 gegenüber 27.187 bei p75) ist stattdessen ein Artefakt von Klein-Nenner-Verhältnissen, das von Abschnitt 5.2 vorhergesagt wird, keine Verteilungsanomalie derselben Art.
| Variable | Mittelwert | SD | p5 | p25 | Median | p75 | p95 |
|---|---|---|---|---|---|---|---|
| Downloads | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| Abstract-Ansichten | 611.973 | 1.100,536 | 151 | 288 | 504 | 833 | 966 („wie veröffentlicht") |
| Downloads pro 100 Abstract-Ansichten | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 („wie veröffentlicht") |
| Verfügbarkeit auf SSRN, Tage | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| Anzahl der Autoren | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| Anzahl der Seiten | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| Abstract-Länge, Wörter | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
Drei weitere Merkmale der Studie sind für die Interpretation relevant. Abstrakt-Aufrufe zeigen die gleiche Asymmetrie auf höherer Ebene: Die mittleren Aufrufe betrugen 611.973 gegenüber einem Median von 504 (p5 = 151, p25 = 288, p75 = 833; das p95 von 966 wird „wie veröffentlicht" wiedergegeben, ist aber ein vermuteter Tippfehler in der Quelle, nur ≈0,32 SD über dem Mittelwert und unter dem durch ein p75 von 833 implizierten Schwanz, und geht in keine nachgelagerte Berechnung ein; siehe die Anmerkung zu Abbildung 2), mit einer veröffentlichten Umrechnung von 23.699 Downloads pro 100 Aufrufe [83]. Die Studie unterscheidet auch zwischen Reichweite und Umrechnung: In dem Poisson-Expositionsmodell der Autoren sagte institutionelle Prestige Downloads voraus, bedingt auf Abstrakt-Aufrufe (Koeffizient 0,192, und für ein Drei-Autoren-Paper entsprach ein Top-50-verbundener Autor einer geschätzten 6,6 % höheren Download-Rate pro Abstrakt-Aufruf), und diese Prestige-Prämie schwächte sich ab, wenn die KI-Unterstützung in Abstracts zunahm (Interaktion −0,627, p < ,01) [83]. SSRN selbst verlangt nun die Offenlegung wesentlicher generativer KI-Nutzung bei der Einreichung [54][56]. Die Aufmerksamkeit verfolgt also Statussignale, selbst nachdem ein Leser auf der Abstrakt-Seite gelandet ist, was direkte Evidenz dafür ist, dass Download-Zahlen Sichtbarkeits- und Reputationseffekte widerspiegeln, anstatt der Inhaltsbeurteilung allein. Die Limitation, die die Autoren selbst formulieren, setzt die Agenda: Ein einzelner Schnappschuss eines einzelnen disziplinären Netzwerks kann Zeitpfade von Aufmerksamkeit nicht offenbaren, und sie identifizieren explizit Paneldaten als den erforderlichen nächsten Schritt [83], den Schritt, der in Abschnitt 8 unternommen wird.
Die Stichprobe ist ein Netzwerk in einem Feld, beobachtet an einem Datum: Diese Zahlen sind keine universellen SSRN-Richtwerte, und ihr Wert liegt in der Struktur. Das Mittelwert-Median-Verhältnis von 2,54 und das p95-Median-Verhältnis über 8 sind Signaturen einer starken Rechtsschiefe, die in jedem anderen Datenbestand von SSRN-Evidenz auftritt, einschließlich einer Stichprobe aus einer anderen Disziplin und einem anderen Jahrzehnt: In der einzigen zensusstilartigen Stichprobe der rechtswissenschaftlichen Literatur hatten Arbeiten, die 2012 in das Juristische Netzwerk für Literatur eingefügt und zwei Jahre später gemessen wurden (n = 1.107), einen Median von 63 Downloads gegenüber einem Mittelwert von 122,55, eine fast zweifache Lücke nach nur zwei Jahren Exposition [139].
3.4 Die Form der Verteilung: Quasi-Lognormalität und der lange Schwanz
Die großskalige Anatomie der Verteilung wurde von Kakushadze etabliert, der SSRNs öffentliche Top-Listen analysierte: 29.985 Autoren auf der Top-30.000-Liste und die 367.478 damit verbundenen Arbeiten (ein Web-Scrape von Rankings aus dem Jahr 2015) [85]. Die zentrale Erkenntnis ist, dass Downloads quasi-lognormalverteilt sind, stark schief mit einem langen oberen Schwanz in den Rohdaten und annähernd gaußverteilt im Logarithmus (angepasste Parameter für ln Downloads pro Arbeit: Mittelwert 5,406, Standardabweichung 1,016) [85]. Kakushadze zieht die praktische Schlussfolgerung der Lognormalität explizit: lineare Arithmetik funktioniert bei solchen Daten nicht. Eine direkte Anwendung des h-Index auf Downloads ist uninformativ: Download-Zahlen sind Größenordnungen höher als Zitatzahlen, sodass der Index auf die Anzahl der Arbeiten zusammenfällt. Er schlägt stattdessen einen Index vor, der auf dem ganzzahligen Teil des Logarithmus der Downloads aufbaut, k = ⌊ln D⌋ [85]. Für die Interpretation bedeutet dies, dass bedeutungsvolle Unterschiede in Downloads multiplikativ, nicht additiv sind. Diese Form ist nicht eigentümlich für Downloads: die Verteilung der individuellen wissenschaftlichen Wirkung ist selbst annähernd lognormal, wie das Q-Modell von Sinatra, Wang, Deville, Song und Barabási (2016) über wissenschaftliche Karrieren etablierte [181], sodass die multiplikative Lesart, die die Zähler fordern, die Norm für wissenschaftliche Aufmerksamkeit ist, nicht ein Artefakt von SSRN.
Derselbe Datensatz liefert die einzigen veröffentlichten Schwellenwert-Ankerpunkte für die obere Verteilung. Die Aufnahme in die Top-10.000-Arbeiten-Liste (ungefähr die besten 1,8 % des vollständigen Papierbestands der Plattform, 571.040, Juli 2016 [1], konsistent mit und nicht über den manchmal zitierten „besten 1–2%"-Zahlen) erforderte mindestens 160 Downloads, mit einem Median von 805, einem Mittelwert von 1.800 und einem Maximum von 152.242 [85]. Unter den Top-30.000-Autoren betrugen die minimalen Gesamt-Downloads 129, der Median der Autoren betrug 1.626, der Median Downloads-pro-Arbeit war 210, und das Maximum, Michael C. Jensen, war 824.762 [85]. Knappheit persistiert auf der Arbeit-Ebene auch innerhalb dieser Elite-Stichprobe: von den 367.478 analysierten Arbeiten hatten nur 112.793 (ungefähr 30,7 %) genug Downloads, um überhaupt zu ihrem Log-Index der Autoren beizutragen [85]. Die meisten einzelnen Arbeiten der am meisten heruntergeladenen Autoren der Plattform erhalten bescheidene Aufmerksamkeit, und außerhalb der Top-Listen kann der Anteil nur niedriger sein. Abbildung 3 visualisiert die angepasste Verteilung mit den markierten veröffentlichten Schwellenwerten.
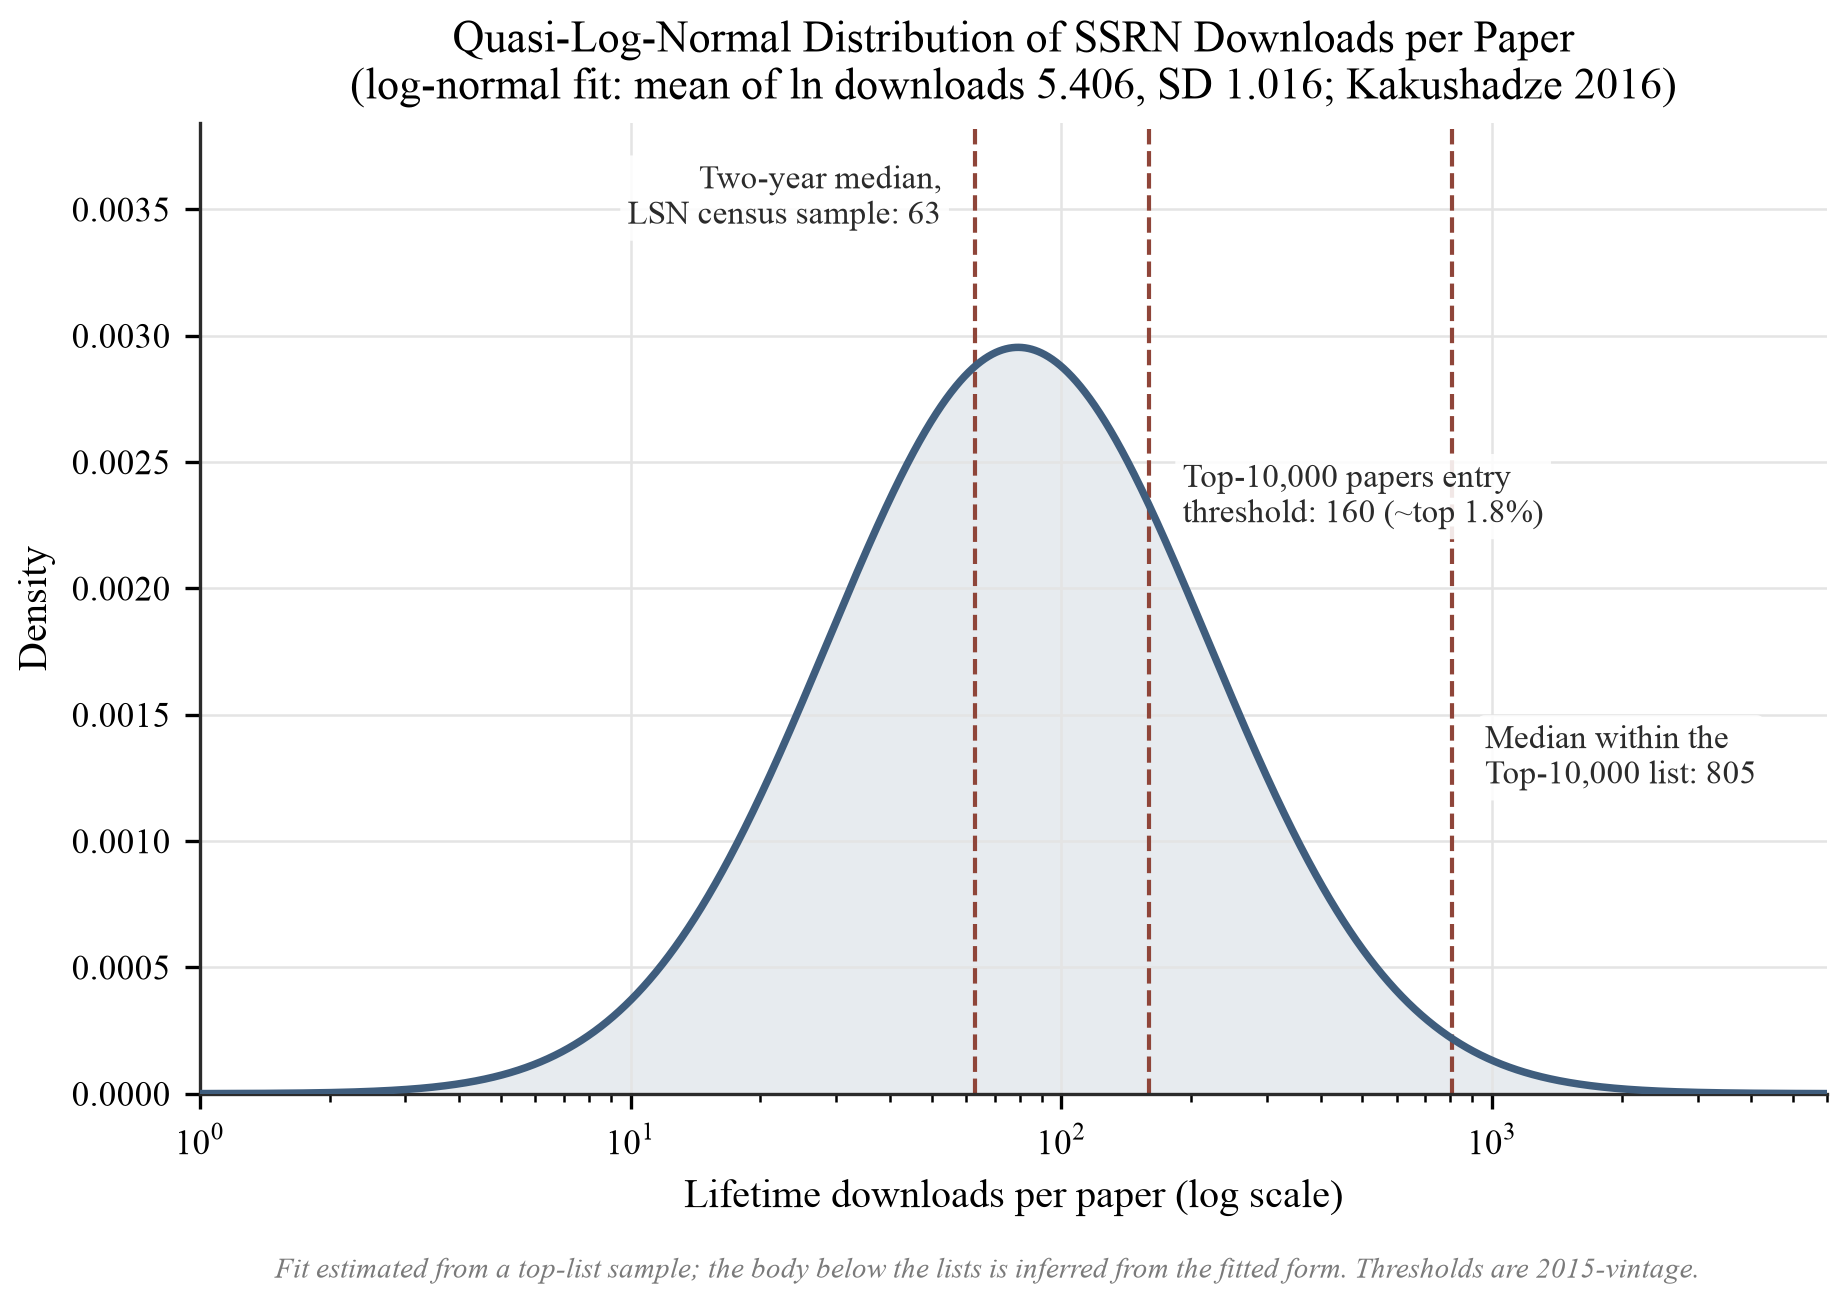
Abbildung 3. Lognormale Dichte angepasst mit den von Kakushadze berichteten Parametern (Mittelwert von ln Downloads 5,406, SD 1,016) [85]; der angepasste Median, exp(5,406) ≈ 223, liegt etwa 6 % über dem berichteten Ingroup-Median pro Arbeit von 210, eine angemessene, aber unvollkommene Anpassung an die Top-List-Verteilung. Gestrichelte Linien kennzeichnen den Zwei-Jahres-Median von 63 Downloads aus der zensusähnlichen rechtswissenschaftlichen Stichprobe [139], den Eingangsschwellenwert der Top-10.000-Arbeiten von 160 (ungefähr die besten 1,8 % des vollständigen Papierbestands der Plattform, 571.040 im Juli 2016 [1]), und den Median innerhalb der Top-10.000-Liste (805) [85]. Die Anpassung wird aus einer Top-List-Stichprobe geschätzt — ungefähr das obere Autoren-Dezil der Plattform — sodass der Körper der Verteilung unterhalb der Listen aus der angepassten Form abgeleitet wird, statt beobachtet zu werden; die Schwellenwerte stammen aus 2015 (Inflation seitdem: Abschnitt 5.1). Eine quantitative Vorsichtsmaßnahme gehört zur Abbildung, weil die Kurve dazu einlädt, ihren unteren Schwanz zu lesen: unter dieser angepassten Dichte betragen die implizierten Schwanzmassen P(X ≤ 63) ≈ 10,7 % und P(X ≤ 10) ≈ 0,1 % — zwei bis drei Größenordnungen unter dem 15–30% ≤10-Download-Anteil, den Studie 1 (Abschnitt 8.6) für eine Ganz-Plattform-Wahrscheinlichkeitsstichprobe vorhersagt. Die Divergenz ist kein Widerspruch, sondern ein direktes Maß der Anpassungs-Domäne: eine Dichte, die auf dem oberen Autoren-Dezil geschätzt wird, kann den unteren Schwanz nicht beschreiben, den Sie nie beobachtet hat, sodass die zensusähnlichen Marker ([139]s Zwei-Jahres-Median von 63; der Top-10.000-Eintrag von 160 und sein Median von 805) als externe Referenzpunkte auf die angepasste Kurve gelegt werden, nicht als Behauptungen, dass die Anpassung sie reproduziert. Der Abstand zwischen den Markern und dem Ort, an den die angepasste Kurve die gleichen Werte platziert, ist selbst der visuelle Beweis, dass der Körper unterhalb der Listen unbeobachtet ist, und es sollte kein Ganz-Plattform-Schwanz-Anteil aus dieser Kurve abgelesen werden.
Diese Ankerpunkte bedürfen zwei Vorbehalte. Der Stichprobenrahmen ist die Oberseite der Verteilung, daher beschreiben Kakushadzes Statistiken den Schwanz, und die Masse der gewöhnlichen Arbeiten unterhalb der Listen wird nur durch die angepasste Lognormalform charakterisiert. Die Zuschreibung geht auf einen einzelnen Autor: die Studie ist Kakushadze (2016), Journal of Informetrics [85]; eine wiederkehrende Fehlzitierung fügt einen zweiten Autor hinzu und sollte vermieden werden.
Ein unabhängiger archivarischer Querschnitt, der in Anhang E berichtet wird, beobachtet den Körper der Verteilung direkt auf einer zufälligen feldübergreifenden Stichprobe von 1.360 Arbeiten, deren Zähler vor ihrer Stilllegung aus öffentlichen Archiven wiederhergestellt werden. Es findet die beobachtete Verteilung annähernd lognormal (Schiefe von log-Downloads ≈ 0,18) und bestätigt damit auf dem Körper die Form, die Kakushadze nur auf dem Schwanz anpassen konnte, und es reproduziert unabhängig die Mittelwert-zu-Median-Lücke, das Umwandlungsband und den Feldmultiplikator. Seine eigene Aufwärtsselektionsverzerrung lässt den extremen unteren Schwanz unterbeobachtet. Es reproduziert jedoch den einzigen modernen Ganz-Verteilungs-Ankerpunkt, auf den die Synthese andernfalls angewiesen ist: der Mittelwert der Rekonstruktion (219) stimmt mit dem veröffentlichten Marketing-Netzwerk-Mittelwert von 221 überein, sodass die charakteristische Form durch eine völlig separate Datenquelle ebenfalls bestätigt wird. (Zum Wiederherstellen historischer Web-Daten aus dem Internet Archive als validierte sozialwissenschaftliche Methode sowie zu ihrer Abdeckung und Crawl-Häufigkeitsverzerrungen siehe Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503.)
3.5 Fehlkalibrierung durch den sichtbaren Tail
Die gemeinsame Struktur der Abschnitte 3.2–3.4 erklärt einen systematischen psychologischen Fehler. Der meistgeladene Autor im Scraping von 2015 stand bei 824.762 Downloads, etwa 500-mal höher als der Median der Top-Autor-Gruppe selbst (1.626), und vier Größenordnungen über einem typischen Paper [85]. Unter einem quasi-logarithmisch-normalen Gesetz sind die relevanten Abstände multiplikativ: Der Schritt vom Median des Ordinary-Paper (Dutzende Downloads) zur Schwelle der Top-Liste (160) ist kleiner als der Schritt von dieser Schwelle zum Median der Top-Liste (805), der wiederum vom Abstand zum Maximum des Tails in den Schatten gestellt wird [85][139]. Doch die Zahlen, die öffentlich zirkulieren (Meilenstein-Ankündigungen, „Top-Autor"-Profile, Pressemitteilungen von Institutionen [101]), stammen fast ausschließlich aus dem sichtbaren Tail. Autoren kalibrieren daher „gut" gegen eine Referenzklasse, die hunderte Male über dem Median liegt, während die Masse der Verteilung beim Median sitzt. Eine Dashboard-Anzeige von 7 Downloads wird dann als Misserfolg empfunden, auch wenn sie für das Alter und die Disziplin des Papers unremarkabel ist. Der Mittelwert beteiligt sich an demselben Fehler in milderer Form: wie Abschnitt 3.3 zeigte, liegt er über dem 75. Perzentil, sodass selbst der offiziell klingende „Durchschnitt" ein tail-kontaminierter Maßstab ist. Das ist der Sinn, in dem der Mittelwert lügt: Er wird korrekt berechnet und dann mit einem typischen Wert in einer Verteilung verwechselt, die keinen typischen Wert hat.
Mehrere weitere Evidenzkörper verstärken die Schlussfolgerung, dass rohe Zähler die Sichtbarkeitsstruktur mindestens so sehr widerspiegeln wie den Inhalt. Aufmerksamkeit reagiert auf Position: In arXiv-Ankündigungslisten verdienen Papers an Position 1 ungefähr 83 % höhere mediane Zitationen in astro-ph, ein Effekt, den die Autoren substanziell der Sichtbarkeit statt nur der Selbstselektion zuschreiben [72]. Sie reagiert auch auf Indexierungsverzögerungen. SSRN selbst vermerkt, dass die externe Indexierung seines Inhalts durch Google Scholar von den Suchmaschinen kontrolliert wird und „6–9 Monate oder länger" dauern kann [54, abgerufen am 14. August 2026], sodass die Zähler eines jungen Papers generiert werden, bevor ein wichtiger Entdeckungskanal zu operieren begonnen hat. Aufmerksamkeit fließt auch rückwärts von Zitationen zu Downloads: Zitiert zu werden zieht Leser (darunter die zitierten Autoren und ihre eigenen Netzwerke) zum zitierenden Paper, und die Granger-Kausalitätsanalyse findet diesen Zitations-zu-Downloads-Pfad für einen erheblichen Anteil von Artikeln aktiv [80][39], sodass Teil eines Zählers die Position eines Papers im Zitierungs- und Kooperationsnetzwerk indiziert statt eines Lesers Urteil über seinen Inhalt. Jeder dieser Mechanismen formt den Zähler durch Sichtbarkeitsstruktur (Position, Entdeckungsverzögerung, Netzwerkposition) statt durch Urteil eines Lesers über Qualität, und keiner ist in der Dashboard-Zahl sichtbar. Die breitere Aufmerksamkeitswirtschaft zeigt dieselbe Konzentration in extremer Form: in sozialen Medien erreichen Aufmerksamkeits-Gini-Koeffizienten 0,90–0,94, wobei die oberen 1 % der Konten mehr Aufmerksamkeit erhalten als die unteren 99 % zusammen [180], ein modernes Echo von Simons Diktum, dass ein Überfluss an Information eine Armut an Aufmerksamkeit schafft [141]. Wissenschaftliche Aufmerksamkeit auf SSRN gehört in milderer Form zu derselben Familie schief-verteilter Diffusionsprozesse. Das auf SSRN heimische Publikum, Ökonomen und Rechtswissenschaftler, werden die Struktur aus der Finanzwirtschaft erkennen. Bessembinders Analyse von CRSP-Daten für 1926–2016 fand, dass die ungefähr 34,8 Billionen USD an Netto-Aktienmärkte-Vermögensschaffung auf weniger als 4 % der börsennotierten Unternehmen zurückzuführen waren, die meisten Aktien nicht über ihre Lebensdauer hinweg Treasury-Bills zu übertreffen schafften [16]. Die Parallele wird als Illustration angeboten, nicht als Beweis: In Vermögen wie in Aufmerksamkeit werden Gesamtsummen durch einen dünnen extremen Tail generiert, und sich selbst gegen einen von Riesen dominierten Durchschnitt zu messen, ist ein Kategorienfehler. Auch Knappheit ist nicht auf Nutzungszähler begrenzt: In der Rechtswissenschaft insgesamt waren 43 % der Law-Review-Artikel in einer Zählung von 2007 niemals zitiert, und nur 18 % der Kohorte von 2015–2019 zog innerhalb von fünf Jahren eine einzelne Zitation an [171].
3.6 Der Feldmultiplikator: Disziplinarische Struktur der Norm
Die Verteilung ist nicht eine Verteilung: sie unterscheidet sich von Feld zu Feld. Whalens Analyse von knapp einer Viertelmillion Arbeiten, klassifiziert in die 94 eJournals des Legal Scholarship Network, zeigt, dass die disziplinarische Basislinie um etwa einen Faktor acht variiert, selbst innerhalb einer einzigen Dachkategorie: Die durchschnittlichen Lebenszeit-Downloads pro Arbeit reichten von 438,35 im Bereich Corporate, Securities & Finance Law bis 53,48 im Bereich Agricultural Law & Policy [168]. Abbildung 4 zeigt den Gradienten.
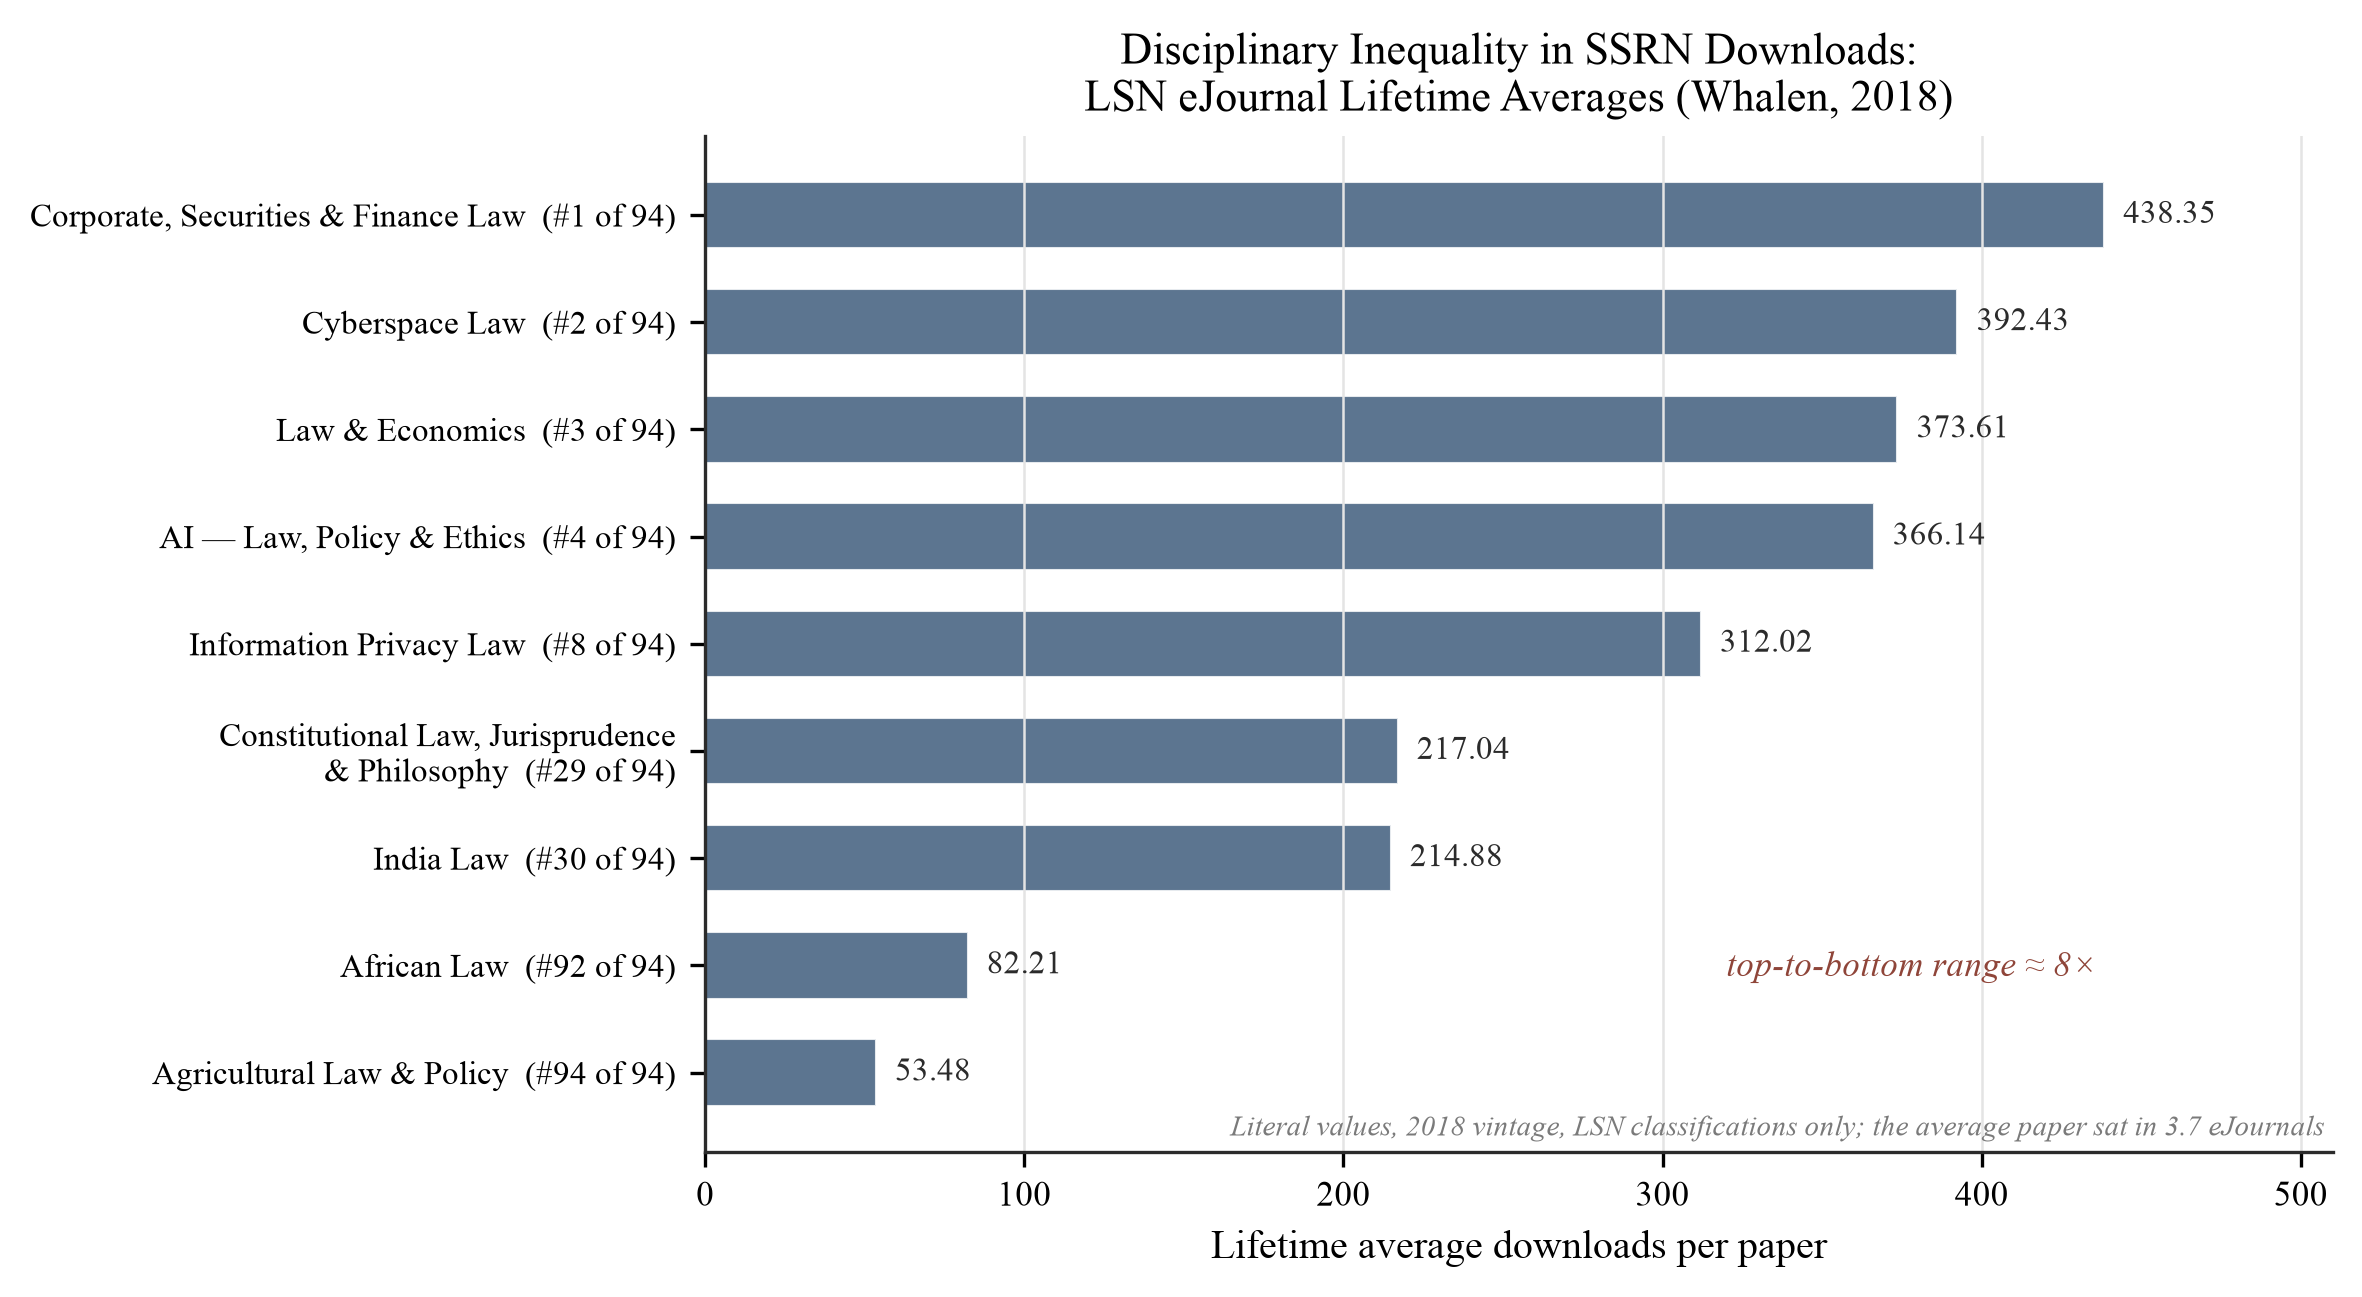
Abbildung 4. Durchschnittliche Lebenszeit-Downloads pro Arbeit für ausgewählte LSN eJournals, Literal-Werte aus Whalen (2018) [168]: Corporate, Securities & Finance Law 438,35 (Rang 1 von 94); Cyberspace Law 392,43 (2); Law & Economics 373,61 (3); KI – Law, Policy & Ethics 366,14 (4); Information Privacy Law 312,02 (8); Constitutional Law, Jurisprudence & Philosophy 217,04 (29); India Law 214,88 (30); African Law 82,21 (92); Agricultural Law & Policy 53,48 (94). Die Spanne von oben nach unten ist ungefähr achtfach. Die Werte stammen aus 2018 und decken nur LSN-Klassifizierungen ab; die durchschnittliche Arbeit wurde 3,7 eJournals zugeordnet.
Der Mechanismus ist strukturell statt meritokratisch: SSRNs Discovery ist klassifizierungsbasiert (Abonnenten eines eJournal erhalten Benachrichtigungen für Arbeiten, die ihm zugeordnet sind), daher wird das adressierbare Publikum einer Arbeit durch die Abonnentenbasis ihres Feldes festgelegt, bevor ein Qualitätssignal wirkt. Whalen stellt zudem fest, dass Arbeiten mit mehr Klassifizierungen mehr Downloads erhalten und weniger wahrscheinlich null Downloads verzeichnen [168]. Die Feldstruktur formt auch die Zähler durch Zitierkultur: Black und Caron beobachteten, dass Download-zu-Zitierquoten systematisch über Felder hinweg variieren, weil die juristische Fachliteratur vorherige Arbeiten vollständiger zitiert als Wirtschaftswissenschaften oder Finanzwissenschaften [18], und innerhalb des Rechts konzentriert sich die Aufmerksamkeit auf bestimmte Themen und Autorenmerkmale: In der Volkszählung von 2012 sagten Themen aus Corporate und International Law, US-Autorschaft und Top-20-Zugehörigkeit alle signifikant höhere Zählungen voraus [139], Bestimmungsfaktoren, die in gleichzeitigen Kommentaren aus juristischen Bibliotheken widergespiegelt werden [175]. Daher kann eine Zahl, die im Corporate Law unremarkabel ist, im Rechtsgeschichte oder Agricultural Law außergewöhnlich sein, und jede Benchmark oder Skala (einschließlich der in Abschnitt 5 konstruierten) muss als feldrelativ gelesen werden. Es gibt einen gut etablierten Präzedenzfall hierfür auf der Zitierseite: Radicchi, Fortunato und Castellano (2008) zeigten, dass Zitierverteilungen sich nur auf eine einzelne universelle Kurve zusammenziehen, nachdem die Zahl jeder Arbeit um den Mittelwert ihres Feldes neu skaliert wurde [182], das Analogon der Referenzklasse, die dieser Artikel argumentiert, dass Nutzungszählungen gleichermaßen erfordern.
Drei Beispiele, ganz auf den verifizierten Ankern oben aufgebaut, machen die Einsätze konkret. Ein Autor im Bereich Agricultural Law, dessen Arbeit 60 Lebenszeit-Downloads hält, sitzt über dem Mittelwert seines eJournal von 53,48 [168], kann aber, kalibriert gegen die Corporate-Law-Zählungen, die am sichtbarsten zirkulieren, dieselbe Zahl als Fehlschlag lesen. Ein Autor im Bereich Corporate and Securities Law mit denselben 60 sitzt weit unter dem Mittelwert dieses Feldes von 438,35 [168]. Und ein Autor, dessen Marketing-Arbeit den Netzwerk-Median von 87 erreicht [83], kann ein Ergebnis unterbewerten, das per Konstruktion typisch ist. Der Fehler der fehlenden Skala läuft in beide Richtungen: Er erzeugt ungerechtfertigte Verzweiflung, und er lässt Erfolg unerkannt.
Abschnitte 3.2–3.6 etablieren den empirischen Kern dieses Artikels. Die SSRN-Download-Verteilung ist stark rechtsschief und ungefähr lognormal, und der Mittelwert überschreitet nicht nur den Median, sondern auch das 75. Perzentil. Der sichtbare Schwanz reicht bis zu 500-facher Elite-Mediane und kontaminiert informelle Kalibrierung; die Zähler enthalten Prestige-, Positions-, Indexierungs- und Feldstruktur-Effekte, die unabhängig vom Inhalt wirken; und die disziplinarische Basislinie variiert um das Achtfache innerhalb einer einzigen wissenschaftlichen Domäne. Eine rohe Download-Zahl, gelesen gegen den Mittelwert oder gegen den Schwanz, ist daher per Konstruktion uninterpretierbar. Eine verteidigbare Lesart erfordert eine Referenzklasse: eine Verteilung konditioniert auf Feld, Alter der Arbeit und Kohorte. Die Rankings waren trotz ihrer Mängel die einzige öffentliche Geste der Plattform zu einer solchen Referenzklasse, und ihre Entfernung macht die Konstruktion einer externen (die Benchmark-Karte und Interpretationsskala von Abschnitt 5) zur zentralen Aufgabe des Rests dieses Artikels.
4. Die Mechanik der Zähler: Ein Zähler unter einer Regel
Bevor eine beliebige Zahl auf einem SSRN-Dashboard interpretiert werden kann, ist es notwendig, festzustellen, was diese Zahl tatsächlich erfasst. SSRN zeigt zwei primäre Paper-Level-Nutzungsmetriken an, Abstract-Ansichten und Downloads, zusammen mit Zitierstatistiken und PlumX-Indikatoren [50]. Nach der Einstellung des Rankings am 15. Juli 2026 blieben diese Zähler an Ort und Stelle: SSRN erklärte, dass „Download-Zählungen und Zitierstatistiken weiterhin auf Ihren einzelnen Arbeiten und Autorenprofilen aufgezeichnet und angezeigt werden" [149]. Die vergleichende Skala verschwand, aber die Daten blieben. Die verbleibenden Zähler sind jedoch keine rohen Beobachtungen der menschlichen Lektüre: Sie sind das gemeinsame Produkt von Plattformarchitektur, Distributionsmaschinerie, nicht-menschlichem Traffic und Integritätsfilterung. Jede dieser Schichten wird unten auseinander genommen, und Abschnitt 5 konstruiert dann einen Interpretationsrahmen darauf.
4.1 Was ein View und ein Download-Datensatz sind und was nicht
Ein Abstract-View registriert eine Anfrage auf der Landingpage eines Papers. Ein Download erfasst den Abruf der vollständigen PDF-Datei. Beide sind Engagement-Events; keines ist ein direkter Beweis für das Lesen, das Verständnis, die Billigung oder die wissenschaftliche Genehmigung. Diese Unterscheidung bestimmt jeden Anspruch, der in der restlichen Teile dieses Artikels gemacht wird.
SSRNs öffentliche Zähler sind keine einfachen HTTP-Request-Logs. Die Plattform hat seit ihren frühen Jahren Datenintegritätsfilterung betrieben [69] und hat ihren Ansatz öffentlich beschrieben: automatisiertes Herunterladen, wiederholtes Selbst-Herunterladen und Versuche, die Zähler zu manipulieren, werden mit Hilfe von „Hinweisen auf irreguläre Aktivität" gefiltert, und verdächtige Downloads (einschließlich, unter bestimmten Umständen, anonymer Downloads) werden aus den autorenseitigen Gesamtsummen ausgeschlossen [144]. Unabhängige Beobachter dokumentierten das gleiche Verhalten früher: wiederholte Downloads von einer einzelnen IP-Adresse werden nicht dem Zähler gutgeschrieben [66]. Der Download-Zähler ist daher eine kuratierte Statistik, materiell robuster als ein rohes Server-Log. Die Filterung entfernt die erkennbarste nicht-menschliche und manipulative Aktivität und nichts mehr. Ein Zähler ist immer ein Zähler unter einer Regel und keine natürliche Einheit, und die Regeln ändern sich (Abschnitt 4.3).
4.2 Nichtmenschlicher Datenverkehr und die Asymmetrie zwischen Aufrufen und Downloads
Automatisierte Agenten machen in aktuellen Messungen der Industrie mehr als die Hälfte des gesamten Internetverkehrs aus [158]. Diese Zahl lässt sich auf die Zähler von SSRN nicht übertragen: es wurde keine veröffentlichte Messung des Bot-Anteils bei SSRN-Abstraktaufrufen oder Downloads ermittelt, und jeder spezifische Prozentsatz für SSRN wäre unbegründet. Was sich feststellen lässt, ist die Struktur des Problems, das von zwei Seiten her angegangen wird: die Mechanismen, die Aufrufe plausibel aufblähen, und die transparente Filterungshistorie einer benachbarten Plattform.
Mehrere Mechanismen erzeugen plausibel nichtmenschliche Abstraktaufrufe. Suchmaschinen-Crawler indexieren routinemäßig neu veröffentlichte Abstraktseiten. Institutionelle E-Mail-Sicherheitssysteme, allen voran Safe Links in Microsoft Defender für Office 365, scannen und fetchen URLs aus eingehenden E-Mails vor, was Server-seitige Anfragen registrieren kann, bevor ein menschlicher Empfänger die Nachricht öffnet [106]. Da der Hauptverteilungskanal von SSRN E-Mail ist (Abschnitt 4.4), ist Link-Scanning von Ankündigungsemails eine strukturell plausible Quelle von Phantom-Aufrufen. Keine veröffentlichte Studie misst den Beitrag des Sicherheits-Proxy-Prefetchings zu SSRNs Aufrufen, und SSRN selbst prüft seine Metriken und schließt unregelmäßige Aktivitäten aus den Download-Zählungen aus [144][66][69], so dass die Plattform einen wesentlichen Anteil solchen Verkehrs filtern könnte, insbesondere auf der Download-Seite. Die Aussage, dass „die meisten SSRN-Aufrufe nicht menschlich sind", erscheint in informellen Diskussionen, wurde aber nie gemessen.
Der transparente Fall ist RePEc. Sein Logging-Service LogEc veröffentlicht sowohl seine Filtermethodik als auch seine Filterhistorie, und die Dokumentation zeigt, wie schwerwiegend und wie asymmetrisch nichtmenschliche Kontamination sein kann. Bereits im Juli 2007 machten Roboter etwa 74 % der Abstraktaufrufe auf überwachten RePEc-Services aus, aber nur etwa 7 % der Downloads [99]. Die Filterhistorie liest sich als eine Chronologie eines Wettrüstens: Heuristiken gegen Anti-Malware-Link-Scanner wurden im Juli 2010 hinzugefügt; ein neuer Typ systematischen Massen-Downloads wurde im Januar 2017 behoben; DDoS-Mitigationsfilter, die im Januar 2022 eingeführt wurden, entfernten 54 % der Abstraktaufrufe, aber nur 7 % der Downloads [99]. Seit Oktober 2025 dokumentierte RePEc einen Anstieg von KI-gesteuerten Bot-Traffic, der sich als menschliche Benutzer ausgibt [129]. Im September 2025 wurden mehr als 99,5 % des Rohverkehrs zu IDEAS als nichtmenschlich verworfen [129]. Nach Bereinigung zählte der RePEc-Bericht für Juni 2026 etwa 2,36 Millionen Abstraktaufrufe und 238.000 Downloads über seine Services [129].
Die RePEc-Evidenz unterstützt zwei Schlussfolgerungen für SSRN. Die Kontamination ist konstruktionsbedingt asymmetrisch: automatisierte Agenten durchsuchen HTML-Abstraktseiten viel aggressiver als sie vollständige PDF-Abrufe durchführen, so dass Aufrufen-Zähler dort, wo die Filterung unvollkommen ist, viel mehr aufgebläht werden als Download-Zähler. Diese Asymmetrie, Roboter bei etwa 74 % der Aufrufe, aber etwa 7 % der Downloads in der 2007-Messung [99], ist eine architektonische Eigenschaft des Repository-Verkehrs und keine Eigenheit von RePEc. Die spezifischen Anteile sind nicht übertragbar: SSRNs Filterregeln, Verteilungsmodell und Publikum unterscheiden sich, und SSRN veröffentlicht ein gleichwertiges Filterungsprotokoll nicht. Abschnitt 5.2 entwickelt die praktische Konsequenz, nämlich dass Verhältnisse, die auf Aufrufen aufgebaut sind (wie die Konversionsrate), als untere Grenzen für die menschliche Engagement-Qualität gelesen werden müssen, da der Nenner die stärker kontaminierte Größe ist. Diese Untergrenze-Richtung ist vintage-abhängig, kein Naturgesetz: sie gilt, während die Filterung auf der Aufrufen-Seite der Filterung auf der Download-Seite hinterherhinkt, was das dokumentierte historische Regime ist [99], würde aber abschwächen oder umkehren, wenn die Aufrufen-Filter einer Plattform mit ihren Download-Filtern aufgeholt hätten, oder wenn die Download-seitige Kontamination schneller anstieg als die Aufrufen-Seite (wie die KI-Bot-Episode von 2025–2026 beide anhob [129]). Die Richtung ist zu überprüfen, wann immer eine Plattform ihre Zählregeln überarbeitet.
Eine weitere Überlegung ist seit der Entwicklung dieser Filterungsregime entstanden. Die Filter wurden gebaut, um automatisierte Anfragen aus einer Zählung zu entfernen, die die menschliche Aufmerksamkeit abbildet, und diese Regel entfernt immer noch Rauschen. Was sie nicht mehr ungeprüft tun kann, ist den Rest als menschlich zu behandeln, da drei Klassen automatisierter Anfragen jetzt dort sitzen, wo der Filter eine sah: Durchsuchungen, die Text für das Training von Modellen sammeln, Crawler, die für einen Such- oder Antwortdienst indexieren, und Abrufe, die ein System in Echtzeit in Auftrag einer Person tätigt, die etwas erfragt hat. Die ersten beiden bleiben Rauschen für eine Aufmerksamkeitszählung. Die dritte ist ein delegierter Akt mit einem Menschen dahinter, da ein System, das den vollständigen Text einer Arbeit abruft, um eine Benutzerfrage zu beantworten oder eine Literaturrecherche zu unterstützen, den Inhalt bereitgestellt und verwendet wurde, obwohl keine Person je die Seite geladen hat. Eine automatisierte Anfrage ist nicht von selbst ein Beweis dafür, dass etwas gelesen wurde. Der Proxy ist schwächer geworden, nicht der Filter: Mensch gegen Maschine verfolgt nicht mehr zuverlässig die Unterscheidung, die dieser Artikel benötigt, nämlich ob ein Ereignis Anzeichen von wissenschaftlicher Aufmerksamkeit ist, menschlich oder delegiert.
Projekt COUNTER hat begonnen, dies in seinem Berichtsvokabular statt in seinem Filter zu adressieren. Best-Practice-Anleitung zur KI-Nutzung, ausgestellt im April 2026 und aktualisiert am 30. Juni 2026 für Release 5.1.1, stellt eine optionale Access_Method von Agent zur Verfügung, definiert als Inhalte und Metadaten, auf die durch ein KI-System zugegriffen wird, zusammen mit KI-spezifischen Metrik-Typen, während Release 5.1.1 weiterhin verlangt, dass „von herkömmlichen Bots und Crawlern erzeugte Aktivität AUS allen COUNTER-Berichten AUSGESCHLOSSEN werden MUSS" [125]. Das Instrument hat drei Grenzen, die hier wichtig sind. Es ist eine optionale Erweiterung, die nur in Berichten produziert wird, die ein Provider zu generieren wählt, und zielt zunächst auf KI-Systeme ab, die in die Plattform eines Providers eingebettet sind, statt auf eingehende Crawler. Seine Elemente „DÜRFEN NICHT in irgendwelche Standard-Ansichten der COUNTER-Berichte einbezogen werden" [125], so dass eine Standardansicht auch dort Agent-Zugriff nicht unterscheidet, wo ein Provider die Anleitung umsetzt. Ob markierte Agent-Ereignisse dann aus Standard-Summen entfernt oder unmarkiert in ihnen mitgeführt werden, ist eine Implementierungsfrage, zu der die Anleitung schweigt. Es klassifiziert auch Zugriff, der bereitgestellt wurde, und nicht Zugriff, der verweigert wurde: die Anleitung besagt, dass „es keine speziell für Access_Method Agent zugeordneten Ablehnungsmetriken gibt" [125]. Nichts davon erreicht überhaupt einen nackten öffentlichen Zähler, da dieser kein COUNTER-Bericht ist und keine Zugriffsmethode trägt; der Standard ist ein Analogon, an dem er beurteilt werden kann, keine Beschreibung davon.
Verweigerung ist auch nicht hypothetisch und wirkt sich upstream von jeder Zählregel aus, aber ihre Instrumente unterscheiden sich grundlegend und handeln nicht als Einheit. Die robots.txt einer Plattform bittet benannte Agenten, nicht zu crawlen; eine Text-und-Datenmining-Reservierung bekräftigt eine rechtliche Position; Nutzungsbedingungen binden vertraglich; ein Challenge-Dienst verweigert die Seite Clients, die ihn nicht erfüllen können. Nur das letzte ist Durchsetzung. Auf der hier untersuchten Plattform, wie am 29. August 2026 abgerufen, benannte robots.txt drei Agenten (GPTBot, ChatGPT-User und Google-Extended) und war zu anderen stillschweigend, wobei Stille das Robots-Exclusion-Standard ist, das gut arbeitende Crawler als Erlaubnis lesen; Antworten trugen eine Mining-Reservierung, die auf die Richtlinie des Herausgebers verweist, die Mining für Zwecke gemäß Artikel 3 der EU-Richtlinie über den digitalen Binnenmarkt erlaubt und andernfalls eine Lizenz erfordert; Nutzungsbedingungen behalten sich Rechte an Text- und Data-Mining sowie KI-Training vor, außer wenn ein Autor sich für eine offene Lizenz entschieden hat, eine Option, die nur seit 20. Juli 2026 verfügbar ist und standardmäßig alle Rechte vorbehält; und eine einzelne nicht authentifizierte Anfrage ohne JavaScript-Engine erhielt eine von Cloudflare verwaltete Herausforderung anstelle der Seite. Einer der benannten Agenten ist der vom Benutzer ausgelöste Abrufer und nicht ein Trainings-Crawler: Das ist die delegierte Klasse des vorherigen Absatzes. Diese Materialien dokumentieren veröffentlichte Einschränkungen und eine Konfigurationsbeobachtung. Sie belegen nicht, wie viele Anfragen, automatisiert oder menschlich, abgelehnt wurden. Richtlinien werden ungleichmäßig befolgt: In einer großangelegten Messung des Crawler-Verhaltens respektierten einige Agenten Ganzseitensperrungen vollständig, während sie Pfad-Ebenen-Sperrungen weniger als ein Drittel der Zeit einhielten, und andere ignorierten die Datei ganz [87]. Die Nebenwirkung ist auch nicht einseitig, da Challenge-Einsätze anderswo legitime menschliche Nutzer beeinträchtigt haben (eine Universitätsbibliothek verzeichnete in den ersten vier Monaten der Nutzung zwei solche Zwischenfälle [29]).
Die historische Asymmetrie kann daher nicht einfach beibehalten werden. Der Komfort des Ergebnisses von 2007, Robots bei ungefähr 74% der abstrakten Aufrufe, aber etwa 7% der Downloads [99], beruhte auf Crawlern, die Landingpages durchsuchten und selten Volltext abriefen. Ein System, das Dokumente abruft, um eine Antwort zu begründen, hat keinen Grund, beim Abstract zu stoppen, daher ist die Download-Seite nicht mehr bekannt, die sauberere Statistik nach Konstruktion zu sein. Wo rohes wissenschaftliches Datenverkehr 2025–26 gemessen wurde, war der automatisierte Anteil nicht marginal, und er wurde in Download- und Besuchszahlen anstelle nur von Seitenaufrufen gefunden: eine Kulturerbsammlung überarbeitete eine Besuchszahl vom März 2025 von 1.000.000 auf 125.000, nachdem vermuteter Bot-Verkehr entfernt wurde [167]; eine Anbieterklassifizierung von etwa dreißig Millionen Zugriffsanfragen auf einem institutionellen Repository kennzeichnete nur etwa ein Viertel davon als menschlich [98]; und ein Repository, das auf eine Umfrage von offenen Repositories reagierte, schrieb mindestens ein Viertel seiner eigenen Bot-Downloads, einige eine halbe Million Anfragen, elf benannten KI-Agenten zu [135]. Keine dieser Zahlen ist eine Messung der hier untersuchten Plattform: Sie stammen von verschiedenen Plattformen mit verschiedenen, in mehreren Fällen fehlenden Verteidigungsmechanismen, und zwei der drei zählen Besuche oder Anfragen anstelle der Download-Ereignisse, die ein öffentlicher Counter anzeigt. Sie etablieren die vorherige Bedingung statt eine Größenordnung. In der gegenwärtigen Umgebung ist die Interpretierbarkeit jeder Nutzungsstatistik eine Funktion der Filterqualität, und wenn eine Plattform ihre Filterung nicht veröffentlicht, ist diese Qualität nicht überprüft.
Zwei Identifikationsprobleme folgen, und sie verstärken sich gegenseitig. Zusammensetzung zuerst: Aus einem öffentlichen Lebenszeit-Counter allein sind die Anteile von menschlich, konventionell automatisiert und agentenvermittelten Ereignissen nicht schätzbar, und die eigene Ansicht der Plattform kann nicht besser sein, da automatisierte Clients beobachtet wurden, wie sie sich als Desktop-Browser präsentierten [167]. Bei der Auswahl kann ein Counter nicht offenbaren, welcher Anteil des versuchten Zugriffs bereitgestellt, herausgefordert oder ausgeschlossen wurde, bevor eine Zählregel angewendet wurde. Veröffentlichte Richtlinien offenbaren, dass solche Mechanismen existieren. Sie offenbaren nicht, wie oft sie funktionieren, wie sie in der Vergangenheit funktioniert haben oder ihre Auswirkung auf die Aufnahme. Versuchte Anfragen, herausgeforderte Anfragen, bediente Volltext-Ereignisse, angezeigte Downloads und aus einem abgerufenen Papier generierte Antworten sind daher fünf verschiedene Populationen, und sie dürfen nicht als austauschbar behandelt werden. Was unlizenziert bleibt, ist eine Größenordnung oder ein Nettozeichen für diese Plattform. Ungefilterte wissenschaftliche Nutzung ist bekannt dafür, dass sie durch automatisierten Verkehr aufblähbar ist, einschließlich Downloads, aber ob die unveröffentlichten Filter, Challenge-Regeln und Crawler-Richtlinien dieser Plattform einen stärker menschlich gewichteten Rest hinterlassen, eine Lücke in der agentenvermittelten Erkennung, beides oder keines, ist unmessen. Das Gemisch ist auch nicht stabil über die Jahre hinweg, die ein Lebenszeit-Gesamtwert umfasst, die sich von einem Robot-Regime vor 2024 durch die Scrape-Welle 2025–26 zu einem Lizenz-Standard erstrecken, der im Juli 2026 eingeführt wurde. Die nachgelagerten Konsequenzen der Frage sind selbst dokumentiert: Websites, die einen großen KI-Crawler blockieren, werden von KI-Antwortsystemen deutlich seltener abgerufen, selbst wenn der Inhalt zugänglich bleibt [70]. Es gibt keine veröffentlichte Schätzung des KI-Anteils für einen großen Preprint-Server, eine Forschungslücke statt eines Beweises für einen kleinen Effekt, und die in Abschnitt 8 angegebene Prüfung soll ihn messen. Ein öffentlicher Lebenszeit-Gesamtwert ist eine Summe über ein unbekanntes Gemisch, gezogen aus einem unbekannten Anteil versuchter Zugriffe, ohne externen Schätzer für einen von beiden und ohne Grundlage dafür, einen von beiden als stationär zu behandeln.
4.3 Fallende Zähler als Messereignisse
Zähler können auch fallen oder neu festgelegt werden, wenn sich Filterregeln ändern – eine weitere Folge des Filterdatensatzes, den kein Dashboard erklärt. Die Filterrevision von RePEc im Januar 2022 entfernte in einem einzigen Schritt die Hälfte der zuvor gezählten Abstract-Aufrufe [99]. Ihr KI-Bot-Ereignis 2025–2026 erzwang weitere methodische Änderungen [129]. Von Anbietern gemeldete Download-Statistiken sind allgemein bekannt dafür, dass sie empfindlich gegenüber Zählkonventionen sind: Eine Audit auf Bibliotheksseite stellte fest, dass Download-Berichte von einem großen Verlag ungefähr doppelt so hoch ausfielen wie auf vergleichbaren Plattformen, mit „deflationierten" Zählungen bei 43 % der gemeldeten Zahl [176]. Ein plötzlicher Rückgang in den SSRN-Zählern eines Autors ist daher genauso wahrscheinlich ein Messereignis, eine Filterungs- oder Neufestlegungsänderung auf der Plattformseite, wie ein Leseereignis, und sollte niemals ohne Bestätigung als Reputationsverlust interpretiert werden. Die gleiche Logik gilt für jede dossiergestützte Nutzung von Metriken, bei der datierte Aufzeichnungen bewahrt werden sollten (ein in Abschnitt 6 entwickeltes Protokoll). Die Zahlen der Plattform können überarbeitet werden, und das datierte Archiv des Autors kann nicht überarbeitet werden.
4.4 Push versus Pull: Die Architektur bestimmt das Verhältnis
Die Distributionsarchitektur ist die letzte mechanische Schicht. Sie unterscheidet sich qualitativ zwischen den großen Repositories und bestimmt direkt das Verhältnis zwischen Views und Downloads. SSRN arbeitet überwiegend nach einem Push-Modell. Bei der Einreichung wählen Autoren zwischen einer und sieben Fachklassifizierungen aus (das durchschnittliche LSN-Paper hatte 3,7 eJournal-Zuordnungen [168]), und diese bestimmen die Platzierung in Forschungsnetzwerken und die Berechtigung für themenbezogene eJournal-E-Mail-Benachrichtigungen. Die Aufnahme in eine Benachrichtigung ist „kuratiert und gezielt, nicht garantiert", und die Verbreitung in hochvolumigen Themen kann bis zu 45 Tage dauern [53]. Abonnenten erhalten Abstract-Level-Ankündigungen per E-Mail [57]. Jeder Empfänger, der auf eine Ankündigung klickt – sei es aus fokussiertem Interesse oder milder Neugier – registriert einen Abstract-View. arXiv funktioniert dagegen überwiegend als Pull-Plattform: ein gemeinnütziges Repository, dessen Datenverkehr von Forschern getrieben wird, die aktiv Listungen und Feeds besuchen [11][65], wo selbst die Position in einer täglichen Ankündigungsliste messbar Leserzahlen und Zitationen beeinflusst [72]. RePEc aggregiert Metadaten aus dezentralisierten Archiven und wendet die oben beschriebene intensive dokumentierte Filterung an [99][129].
Tabelle 6 fasst den Vergleich über Plattformen als qualitatives Schema der Governance- und Discovery-Mechaniken zusammen. Vergleichbare plattformübergreifende Verkehrsdaten existieren nicht in der veröffentlichten Literatur.
Tabelle 6. Plattformarchitekturen und ihre mechanische Auswirkung auf Nutzungsmetriken (qualitatives Schema).
| Merkmal | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| Governance | Kommerziell (Elsevier, seit Mai 2016) [46] | Gemeinnützig (Cornell University) [11] | Dezentralisiertes Freiwilligennetzwerk [99] |
| Primärer Discovery-Kanal | Push: kuratierte eJournal-E-Mail-Benachrichtigungen, gesteuert durch von Autoren ausgewählte Klassifizierungen (1–7; Verbreitung bis zu 45 Tage bei hochvolumigen Themen) [53][57] | Pull: intentionsgesteuerte Besuche von Listungen und Feeds; Positionseffekte innerhalb von Ankündigungen dokumentiert [11][72] | Aggregation verteilter Archive; Discovery über IDEAS/EconPapers [99] |
| Transparenz der Filterung | Richtlinie qualitativ beschrieben; kein öffentliches Filterungsprotokoll [144] | Nicht zentral für Nutzungsmetriken veröffentlicht | Vollständig dokumentierte Methodik und Revisionsverlauf (LogEc) [99][129] |
| Erwartete mechanische Auswirkung auf das View:Download-Verhältnis | Erhöhte Views relativ zu Downloads: E-Mail-Durchklicks registrieren Views aus Low-Intent-Exposition | Höhere Konvertierung von Besuchen in Downloads: der Datenverkehr ist intentionsgesteuert | Verhältnis bedeutsam nur nach intensivem Bot-Trimming; veröffentlichte Zählungen sind nachgelagert gefiltert [129] |
Die Architektur wirkt sich auf die Autorenpsychologie aus, da ein hohes View-zu-Download-Verhältnis auf SSRN in erheblichem Maße ein Designergebnis ist: das Push-Modell erzeugt breite, Low-Intent-Exposition. Abstract-Skimming ist auch legitimes wissenschaftliches Verhalten (Forscher überwachen Felder routinemäßig über Abstracts, ohne vollständige Texte herunterzuladen), daher kann ein View, das sich nicht konvertiert, bedeuten, dass das Abstract bereits seine Informationsleistung erbracht hat, statt dass es den Leser abgestoßen hat. SSRNs eigene historische Faustregel, von Black und Caron berichtet, lautete, dass ungefähr „drei Abstract-Views … zu einem tatsächlichen Paper-Download führen" [18]. Dieselben Autoren stellten fest, dass ohne Integritätsfilter Rohdaten um „das Fünffache oder mehr" aufgeblasen würden [18]. Abschnitt 5.2 stellt diese veralteten Ankerpunkte neben modernen Messungen.
Zwei mechanische Merkmale der Präsentation eines Papers bestimmen die Konvertierung neben dem Leserinteresse, was die gemessene Konvertierungsrate teilweise zu einer Eigenschaft der Schnittstelle als auch der Forschung macht. Das eine ist die Benutzeroberfläche der Plattform. Ob der vollständige Text als inline, im Browser gerendertes HTML oder nur als herunterladbare PDF angeboten wird, ändert materiell, ob ein interessierter Leser jemals den Download-Zähler auslöst, da ein Leser, der den vollständigen Text im Browser konsumiert, die gleiche Absicht erfüllt, während er nur Views erhöht. Das andere ist die Gerätzusammensetzung des Publikums. Mobiler Zugriff drückt den vollständigen Text-PDF-Abruf relativ zu Desktop, sodass ein Paper, dessen Leser überwiegend auf Telefonen ankommen (von einem Social-Media-Link oder einem mobilen Mail-Client), systematisch niedrigere Downloads und vergleichsweise höhere Views bei identischem wissenschaftlichem Interesse registrieren wird. Beide Effekte ziehen in die gleiche Richtung wie die mechanische Aufblähung des Nenners, die oben bereits etabliert wurde, und beide sind weitere Gründe, das empirische Band von Abschnitt 5.2 als plattformabhängigen Bereich statt als feste Schwelle zu lesen: eine Konvertierungsnorm, die auf der Schnittstelle und Gerätemischung einer Plattform geschätzt wird, sollte umkalibriert werden, statt transplantiert zu werden, wenn sich eine der beiden ändert. Die Literatur zu Nutzungsmetriken wirft dieselbe Zuverlässigkeitswarnung zur Vergleichbarkeit von Download-Berichten über Plattformen und Zählkonventionen auf [176].
4.5 Vorhersehbare Nebenwirkungen: Ähnlichkeits-Selbstübereinstimmungen und Metadaten-Hygiene
Zwei weitere mechanische Folgen des Preprint-Postings sind vorhersehbar, und beide erzeugen routinemäßig unnötige Besorgnis, daher gehören beide zum Rest des Mechanismus.
Die Ähnlichkeits-Selbstübereinstimmung. Wenn ein Arbeitspapier, das auf SSRN veröffentlicht wurde, später bei einer Zeitschrift eingereicht wird, wird das Ähnlichkeits-Screening der Zeitschrift im erwarteten Fall eine nahezu vollständige Übereinstimmung mit dem eigenen Preprint des Autors kennzeichnen. Die Dokumentation von iThenticate besagt beide Hälften der Interpretation explizit: Die Software „prüft nicht auf Plagiarismus; sie prüft auf Ähnlichkeit" und „wenn Sie eine Preprint-Übereinstimmung für denselben Autor sehen, ist dies kein Plagiarismus" [81]. Der Mechanismus ist ebenfalls dokumentiert. Preprints, die als Crossref Posted Content registriert sind, sind in den Vergleichsdatenbanken zur Ähnlichkeitsprüfung enthalten, daher ist eine Übereinstimmung mit dem eigenen hinterlegten Preprint das System, das wie vorgesehen funktioniert [36]. Übereinstimmungen können sogar dann zutage treten, wenn Redakteure Preprint-Quellen ausschließen, da auch sekundäre Aggregatoren, die Repository-Metadaten duplizieren, durchsucht werden [81]. Die Antwort des Autors sollte administrativ statt defensiv sein: Teilen Sie der Redaktion mit, dass die gekennzeichnete Quelle das eigene zeitgestempelte Preprint des Autors ist. Die Orientierungshilfen von Crossref und iThenticate empfehlen eine qualitative redaktionelle Überprüfung statt mechanischer Ähnlichkeits-Score-Schwellen [36][81]. Hier wird keine numerische Schwelle angegeben, da von den Screening-Diensten selbst keine empfohlen wird. Die Gelassenheit, die dieser Rat voraussetzt, hat eine dokumentierte Grundlage in der Verlegerpolitik: Das Posten eines Arbeitspapiers auf einem Preprint-Server ist unter den Vorveröffentlichungsrichtlinien der meisten akademischen Zeitschriften zulässig, obwohl die Richtlinien unterschiedlich sind und die aktuelle Richtlinie der Zielzeitschrift überprüft werden sollte; Preprint-Positionen sind öffentlich in Registern wie Sherpa Romeo indexiert. Die relevanten Ausnahmen konzentrieren sich in der Medizin und angrenzenden klinischen Bereichen, wo einige Zeitschriften das vorherige Preprint-Posting immer noch einschränken oder entmutigen. Autoren in diesen Bereichen sollten die Preprint-Richtlinie der Zielzeitschrift vor dem Posten statt nach der Einreichung überprüfen.
KI-Schreibenerkennung: ein benachbarter Falschalarm-Kanal. Eine neuere Screening-Ebene birgt ein strukturell ähnliches Risiko für Falschalarme. KI-Schreibenerkenner erzeugen dokumentierte Falschpositiva, und die Last fällt überproportional auf nicht-englische Muttersprachler: In einer Stanford-Bewertung von sieben öffentlich verfügbaren GPT-Detektoren (die Studie umfasste nicht Turnitin) wurden durchschnittlich 61,3 % der TOEFL-Aufsätze von nicht-englischen Muttersprachlern fälschlicherweise als KI-generiert klassifiziert [97]. Die institutionelle Praxis hat die Besorgnis registriert. Im August 2023 deaktivierte die Vanderbilt University öffentlich die KI-Erkennungsfunktion ihrer Ähnlichkeitsprüfungssoftware und führte deren Unzuverlässigkeit an: die von dem Anbieter selbst beanspruchte Falschpositivquote, das Fehlen einer veröffentlichten Erkennungsmethodik und dieselbe oben dokumentierte überproportionale Last für nicht-englische Muttersprachler [163]. Die defensive Haltung hier entspricht der Ähnlichkeits-Selbstübereinstimmung und ist administrativ statt adversativ: Bewahren Sie die Versionsverlauf und Entwurfsunterlagen des Manuskripts als zeitgenössische Beweise für die Urheberschaft auf (ein weiteres Argument für die unten beschriebene Versionshygiene), und beantworten Sie jede Kennzeichnung mit Dokumentation statt Besorgnis.
Versionskontrolle und Metadaten-Hygiene. Da sich Zähler pro Papierseite ansammeln, wirkt sich die Überarbeitungspraxis direkt auf die Metrik-Integrität aus. SSRN unterstützt das Posten überarbeiteter Versionen auf derselben Papierseite und bewahrt die angesammelten Zähler und die indexierte URL, während das Löschen eines Papiers und das erneute Hochladen die Metriken zurücksetzen und bestehende Links unterbrechen (SSRN FAQ; eine Support-Seite, die geändert werden kann, aufgerufen am 14. August 2026 [B-7]). Klassifizierungsentscheidungen haben ebenfalls Metrik-Konsequenzen, da sie das eJournal-Routing und daher die wichtigsten Belichtungsereignisse des Papiers bestimmen [53]. Externe Indizierung läuft auf einer längeren Zeitachse als Autoren erwarten: SSRN gibt an, dass die Google Scholar-Indizierung von der Suchmaschine gesteuert wird und „6–9 Monate oder länger" dauern kann [55]. Die frühen Zähler eines Papiers werden daher fast vollständig durch die interne Verteilungsmaschinerie der Plattform erzeugt, was die Interpretation früher Nullen in Abschnitt 5.6 verankert.
5. Ein Interpretations-Framework: Wiederherstellung der fehlenden Skala
Die Frage „ist diese Zahl gut?" ist wissenschaftlich nicht korrekt formuliert, bis eine Vergleichsgruppe angegeben wird. Dieser Abschnitt stellt das veröffentlichte empirische Archiv in den fehlenden vergleichenden Apparat zusammen: eine konsolidierte Benchmark-Karte mit expliziter Quellenvertrauensangabe (5.1), ein empirisches Umwandlungsband (5.2), eine abgestufte Interpretationsskala (5.3), eine zweidimensionale Reichweiten-Umwandlungsdiagnose (5.4), eine multidimensionale Benchmark-Spezifikation (5.5) und ein zeitliches Leseprotokoll (5.6). Werte werden durchgehend mit ihren Stichprobenrahmen und Altersangaben angegeben. Keiner ist ein kalibriertes Perzentil für die 2026-Plattform, und alle sollten unter Berücksichtigung der Inflationswarnung von Abschnitt 5.1 gelesen werden.
5.1 Eine konsolidierte Benchmark-Karte
Tabelle 7 konsolidiert jeden verwendbaren veröffentlichten Benchmark für SSRN-Nutzungsmetriken, die in der Audit-Prüfung 2.5 identifiziert wurden, jeweils mit seinem Stichprobenrahmen und einer expliziten Angabe des Quellenvertrauens. Da ein Benchmark missbraucht wird, sobald er über seinen Rahmen hinaus gestreckt wird, benennt jeder Eintrag auch die Inferenzrolle, die die Quelle legitim spielen kann, und die Hauptbeschränkung, die sie begrenzt. Die Evidenz ist dünn: Die Karte stützt sich auf fünf Studien mit unterschiedlichen Rahmen: eine zensusähnliche Stichprobe eines rechtlichen Netzwerks im Jahr 2012 [139], ein Scrape der eigenen Top-Listen der Plattform im Jahr 2015 [85], eine Querschnittsaufnahme eines einzelnen Netzwerks im Jahr 2025 [83], Gesamtaggregate auf Plattformebene [1] und eine Subfeld-Zerlegung [168]. Diese Rahmen sind nicht austauschbar: Top-List-Scrapes beschreiben den Elite-Schwanz, Netzwerk-Zensus beschreibt typische Arbeiten, und Plattform-Aggregate beschreiben weder noch. Jede beteiligte Verteilung ist auch stark rechtsschief, daher übersteigen Mittelwerte systematisch Mediane und beschreiben atypische Arbeiten.
Tabelle 7. Konsolidierte Benchmark-Karte für SSRN-Nutzungsmetriken mit Stichprobenrahmen, Quellenvertrauen, zulässigen Inferenzrollen und Hauptbeschränkungen.
| Benchmark | Wert | Quelle (Jahr; Stichprobenrahmen) | Quellenvertrauen | Zulässige Inferenzrolle | Hauptbeschränkung |
|---|---|---|---|---|---|
| Mediane Paper-Downloads nach ~2 Jahren auf der Plattform | 63 (Mittelwert 122,55) | Siems 2016 [139]; n = 1.107 LSN-Papers, die in zwei 2012-Fenster gepostet wurden, Zähler zwei Jahre später gelesen | Mittel-hoch: Stichprobe und Download-Zahlen verifiziert; nur Recht; 2012-Kohorte | Historische Sicht auf die Verteilung durchschnittlicher Papers | Ein Zwei-Jahres-Anker für rechtliche Netzwerke, keine aktuelle plattformweite Norm |
| Mediane Paper-Abstract-Aufrufe nach ~2 Jahren | 369 (Mittelwert 564,62; Aufrufe–Downloads-Korrelation 0,852) | Siems 2016 [139] | Mittel-hoch: Zahlen gegen Tabelle 1 der Quelle verifiziert; nur Recht; 2012-Kohorte | Historische Sicht auf die Reichweite durchschnittlicher Papers | Gleicher altersgebundener, einfach-disziplinärer Rahmen; Aufrufs-Zähler sind die kontaminierte Größe (Abschnitt 4.2) |
| Mediane Paper-Downloads, Querschnittsaufnahme eines einzelnen Netzwerks | 87 (Mittelwert 221,3; p25 = 35; p75 = 206; p95 = 726; Median-Alter des Papers 491 Tage) | Jo & Li 2026 [83]; N = 2.361 Marketing Research Network-Papers, Aufnahme vom 15. August 2025 | Hoch: gegen die veröffentlichte Tabelle verifiziert; beachten Sie zwei Anomalien verschiedener Art, die „wie veröffentlicht" berichtet werden — Aufrufe p95 = 966 ist ein vermuteter Quellendruckfehler (≈0,32 SD über dem Mittelwert; Zeile für Neuverifikation herabgestuft), Umwandlung p95 = 77,7 ist ein Artefakt kleiner Nenner (Abschnitt 5.2); vollständiges Panel in Tabelle 5 | Aktuelle Querschnittsverteilung und Umwandlungsmodell | Ein Netzwerk, ein Feld, ein Datum; ausgereifte Papers; keine Trajektorien |
| Mediane Paper-Abstract-Aufrufe, Querschnittsaufnahme eines einzelnen Netzwerks | 504 (Mittelwert 611,973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 „wie veröffentlicht") | Jo & Li 2026 [83]; gleiche Stichprobe wie oben | Hoch: gegen die veröffentlichte Tabelle verifiziert; der Wert p95 (966) ist ein vermuteter Quellendruckfehler — ≈0,32 SD über dem Mittelwert — wiedergegeben „wie veröffentlicht" und für Neuverifikation bis zur Autorenabfrage herabgestuft | Aktuelle Querschnitts-Reichweiten-Verteilung | Gleicher Rahmen für einzelnes Netzwerk und einzelnes Datum |
| Aufrufe→Downloads-Umwandlung, empirisches Band | 11–19% (≈ ein Download pro 5,3–9 Abstract-Aufrufe) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | Mittel-hoch: Siems-, Willey–Knapp- und Jo & Li-Zahlen gegen die Quelltabellen verifiziert | Konditionalisierte-Engagement-Norm (Umwandlung) | Wenige Stichprobenrahmen; der Nenner ist bot-aufblähbar, daher ist die gemessene Umwandlung eine Untergrenze, während Aufrufe die stärker aufgeblähte Größe bleiben (Abschnitt 4.2) |
| Historische plattformweite Faustregel | ~3 Abstract-Aufrufe : 1 Download (~33%) | Black & Caron 2006 [18], berichtend SSRNs eigene Statistik | Mittel: wörtlich verifiziert; veraltet (2006); plattformweit | Metriken-Anatomie und Integritätsgeschichte | Frühe Plattform-Ära; ein oberer Anker, keine aktuelle Norm |
| Einstiegsschwelle, All-Time Top-10.000-Papers | ≥160 Lebenszeit-Downloads (≈ obere 1,8% des vollständigen Papier-Bestands der Plattform, 571.040 im Juli 2016 [1]); Median innerhalb der Gruppe 805; Mittelwert 1.800; Maximum 152.242 | Kakushadze 2016 [85]; Scrape von SSRN-Top-Listen, 2015; 367.478 Papers | Hoch: gegen die veröffentlichten Tabellen verifiziert; Top-List-Rahmen; Einzelautor-Werk | Verteilungsform und Tail-Verhalten | Top-List-Auswahl; ungeeignet zur Schätzung des zeitgenössischen Median-Papers |
| Einstiegsschwelle, Top-30.000-Autoren | 129 Gesamtdownloads (Minimum); Median innerhalb der Gruppe 1.626 Gesamtdownloads; Median 210 Downloads pro Paper; Maximum 824.762 | Kakushadze 2016 [85]; die Gruppe SSRNs eigene Briefe, die als die „oberen 10%" der Autoren [161] beschrieben werden | Hoch: gegen die veröffentlichten Tabellen verifiziert | Tail-Verhalten auf der Autoren-Portfolio-Ebene | Gleiche Top-List-Auswahl; 2015-Vintage |
| Unadjustierter plattformweiter Lebenszeit-Mittelwert | ~222 Downloads pro Paper (~35 in den letzten 12 Monaten) | Berechnet aus Plattform-Gesamtwerten ab Dezember 2023: 256.678.716 Lebenszeit-Downloads über 1.157.048 Volltext-Papers; ALL-SIS 2024 [1] | Mittel: abgeleitetes Aggregat; mechanisch aufgebläht durch alte Papers; kein persönlicher Maßstab | Aggregat-Kalibrierung der Plattformgröße nur | Ein Durchschnitt über zwei Jahrzehnte der Ansammlung; beschreibt fast kein echtes Paper (Abschnitt 3.3) |
| Subfeld-Spread innerhalb einer einzelnen Disziplin | ~8× in mittleren Downloads pro Paper (438,35 Corporate/Securities/Finance Law gegenüber 53,48 Agricultural Law) | Whalen 2018 [168]; 94 LSN eJournals, ~250.000 Papers | Mittel-hoch: aus der Quelle verifiziert; 2018; Mittelwerte, keine Mediane | Klassifikation und Subfeld-Heterogenität | Mittelwerte, keine altersabgestimmten Mediane; nur Recht; 2018 |
| Frühe Downloads → spätere Zitationen | r ≈ 0,39–0,43 über die ersten 180 Tage (≈16% der erklärten Varianz) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14.442 | Hoch: verifiziert; andere Plattform, Übertragbarkeit angenommen statt gezeigt | Nachgelagerte Validierungsprognose | Unterschiedliche Plattform und Ära; Korrelationen auf Paper-Ebene sind bescheiden |
| Kalenderstruktur des Zugriffs; Zugriff→Zitierungsverzögerung | Zugriffe ~11% niedriger am Wochenende und ~50% niedriger im Sommer; ≈unit-elastische Zitierungsreaktion ~9 Monate nach einer Zugriffsänderung | Yuret 2026 [178]; >1.500 Artikel aus sieben Zeitschriften über ~1 Jahr verfolgt | Hoch: DOI, Veröffentlichungsort und Titel via Crossref verifiziert (14. August 2026); alle vier Zahlen — mehr als 1.500 Artikel aus sieben Zeitschriften, Zugriffe etwa 11% niedriger am Wochenende und etwa 50% niedriger im Sommer, und eine ungefähr unit-elastische Zitierungsreaktion (ein 10%iger Anstieg der Zugriffe verbunden mit etwa 10% mehr Zitierungen) etwa neun Monate später — wörtlich gegen die veröffentlichte Artikel-Zusammenfassung verifiziert (Springer, 15. August 2026) | Zeitliche Normalisierung und prädiktive Validierung — die Kalender-Normalisierungsanker hinter CSAB | Zeitschriften-Zugriffsdaten, nicht SSRN-spezifisch |
| Empfindlichkeit der Zählungen gegenüber Zählkonventionen | Anbieter-Download-Berichte können ~2× denen vergleichbarer Plattformen entsprechen („deflationierte" Zählungen bei 43% der gemeldeten Zahl); Artikel-Kennzahlen erfordern explizite Datenintegritätsprüfung | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | Mittel-hoch: beide Quellen verifiziert und bereits in den Abschnitten 4.1–4.3 zitiert | Integritäts- und Vergleichbarkeitswarnung — begrenzt die Genauigkeit jedes plattformübergreifenden oder herstellerübergreifenden Vergleichs | Kein direkter SSRN-Vergleichswert; es existiert keine SSRN-spezifische Prüfung |
Es folgen drei strukturelle Lesarten der Karte.
Der Mittelwert ist nicht das typische Papier. In der einzigen kürzlich veröffentlichten Verteilung ist der Mittelwert (221,3) 2,54-mal so groß wie der Median (87) und überschreitet sogar das 75. Perzentil (Abschnitt 3.3) [83]. In Siems' früherem Zensus war der Mittelwert ungefähr doppelt so groß wie der Median [139]. Der Plattform-Mittelwert von ~222 Downloads im Laufe der Zeit [1] ist das am wenigsten geeignete persönliche Maßstab überhaupt: Er aggregiert zwei Jahrzehnte der Akkumulation durch Papiere aller Altersgruppen.
Jeder Vergleichswert hat ein Vintage, und die Richtung der Vintage-Verzerrung hängt vom Vergleich ab. Die jährlichen Plattform-Downloads wuchsen von etwa 0,5 Millionen im Jahr 2000 und 3 Millionen im Jahr 2005 [18] auf 12,9 Millionen im Jahr 2016 und 40,6 Millionen im Jahr 2023 [1], ein 3,15-facher Anstieg zwischen 2016 und 2023, während der Papierbestand über denselben Zeitraum etwa 2,03-fach wuchs (571.040 auf 1.157.048 [1]). Abbildung 5 zeigt diese Entwicklung. Da Downloads schneller wuchsen als der Papierbestand, stieg der Download-Fluss pro Papier um etwa 55% (von etwa 22,6 auf etwa 35,1 pro Papier pro Jahr [1]), sodass eine feste Schwelle von 2015 jetzt einen kleineren Anteil dessen darstellt, was ein typisches Papier verdient, als damals. Als absolutes Niveauband für 2026 gelesen, ist eine alte Schwelle wie der ~160-Download-Top-Listen-Eintrag daher nachgiebig statt konservativ: Sie zu überschreiten ist heute weniger selektiv als 2015, nicht mehr. Die Verzerrung ist zusammensetzungsabhängig. Für Perzentil-Position unter fortbestehender Rechtsschiefe können die alten Anker den Schwanz möglicherweise immer noch unterschätzen, aber für absolute Zählungen macht die Download-Inflation sie weich, daher sollte keine alte Schwelle ohne diese Einschränkung als „konservativer Boden" zitiert werden. Eine 2015-Schwelle mit nachfolgendem Plattformwachstum zu multiplizieren ist ebenfalls unzulässig: Zusammensetzung der Autoren, Vertriebskanäle, Filterung und Wettbewerb um Aufmerksamkeit änderten sich alle zusammen mit dem Download-Fluss.
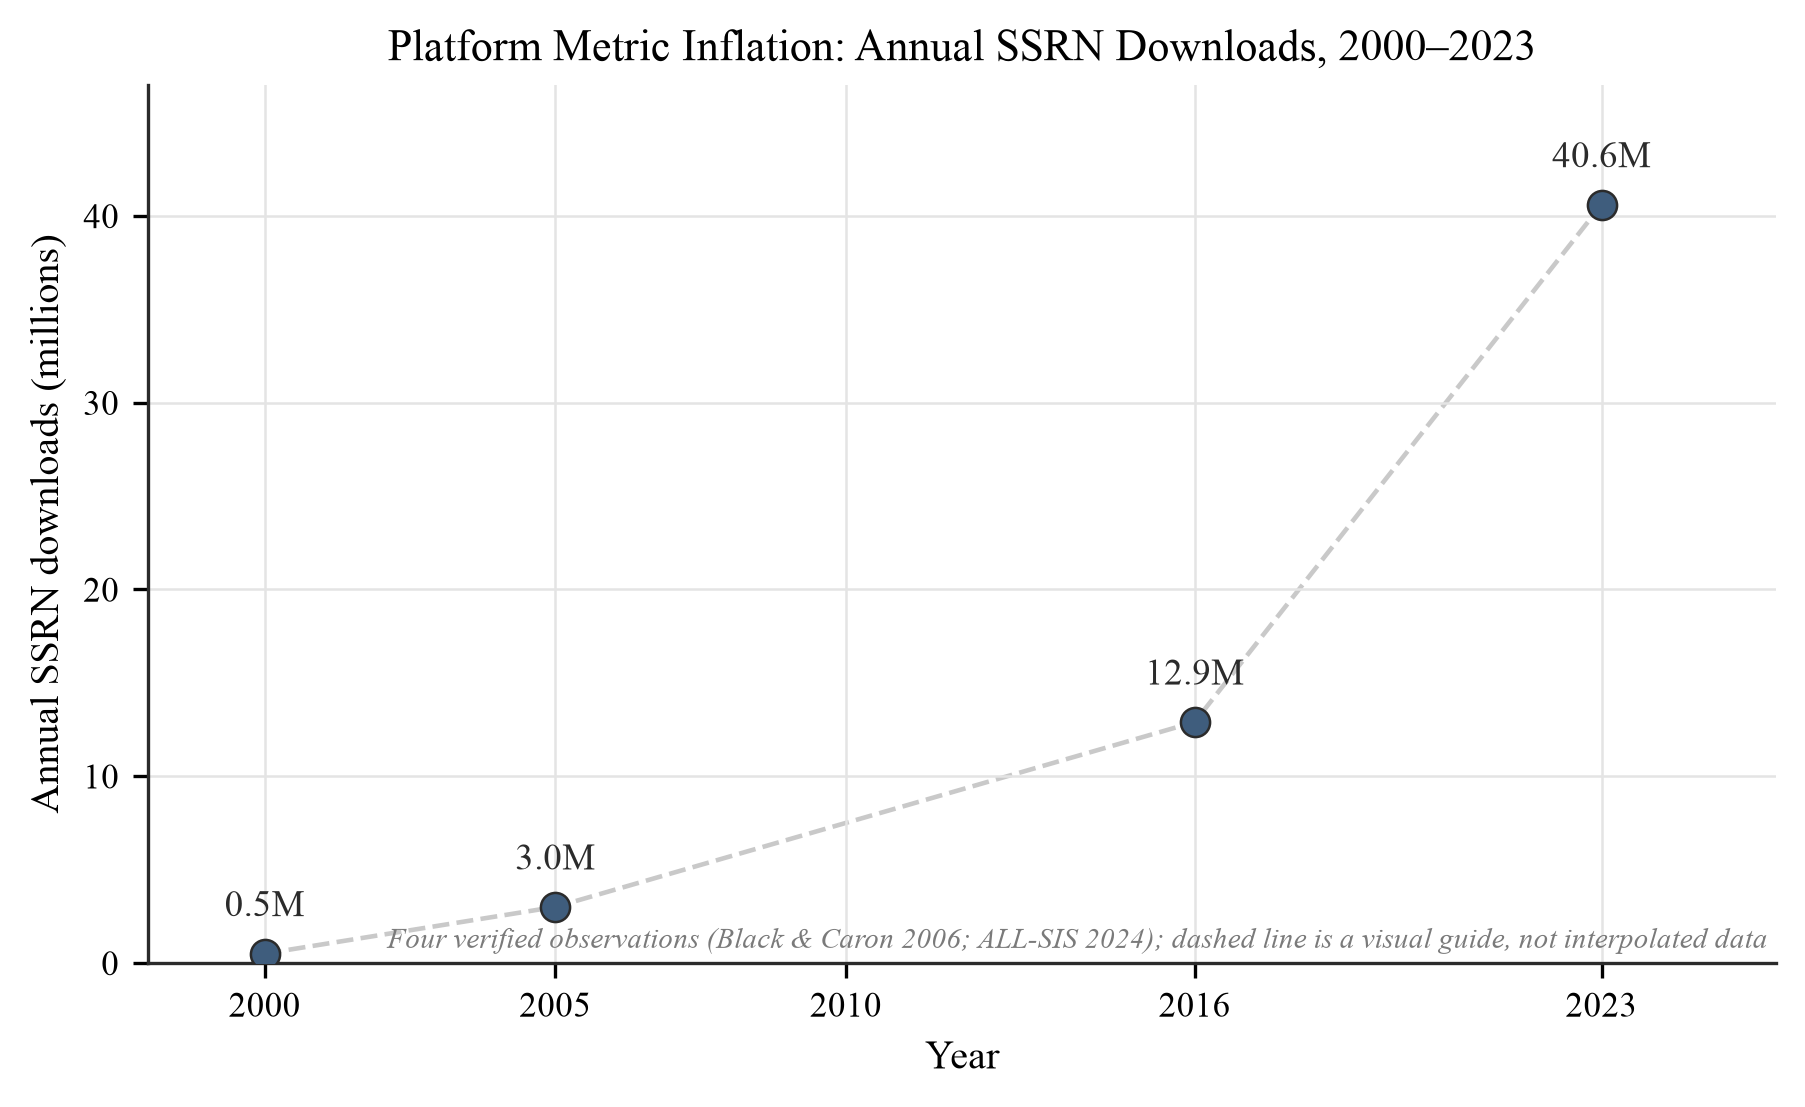
Abbildung 5. Plattform-Metrik-Inflation, 2000–2023. Jährliche SSRN-Downloads: ~0,5 Millionen (2000) und ~3 Millionen (2005) [18]; 12,9 Millionen (2016) und 40,6 Millionen (2023) [1]. Da der Download-Fluss schneller wuchs als der Papierbestand (≈3,15× versus ≈2,03× von 2016 bis 2023 [1]), Hebung des Download-pro-Papier-Flusses um etwa 55%, lesen sich absolute Vergleichswerte, die auf 2012–2015-Stichproben geschätzt sind, für 2026-Lesungen als nachgiebige statt konservative Bänder. Nur die vier verifizierten hier aufgelisteten Jahreswerte sind dargestellt; es ist keine Interpolation zwischen ihnen gemeint.
Es existiert keine aktuelle Perzentil-Quelle. In der Prüfung in Abschnitt 2.5 wurde keine post-2020 plattformweite Verteilungsstudie von SSRN-Downloads identifiziert (der 2025 Single-Network-Schnappschuss [83], 2026 veröffentlicht, ist die einzige kürzlich veröffentlichte externe Stichprobe), und nach dem 15. Juli 2026 veröffentlicht die Plattform selbst keine Vergleichsdaten, aus denen Perzentile rekonstruiert werden könnten. Die Lücke ist eine der Aktualität und Plattformspezifität. Die Verteilung und Ungleichheit der Preprint-Aufmerksamkeit ist ein reifes Forschungsgebiet in anderen Repositories (das Zitierungs- und Altmetrik-Profil von bioRxiv-Hinterlegungen wurde über den gesamten Server charakterisiert [62]), und die quasi-lognormale Form von SSRN-Downloads spezifisch war bereits vor 2020 von Kakushadze [85] etabliert. Was fehlt, ist eine aktuelle, SSRN-spezifische, post-Sonnenuntergang-Perzentilverteilung. Die obige Karte wird aus den verfügbaren Rahmen zusammengestellt, was das Argument für den in der Forschungsagenda vorgeschlagenen Community-Benchmark-Datensatz ist (Abschnitt 8).
5.2 Das Konversionsbachmaß
Das Verhältnis von Downloads zu Abstract-Aufrufen ist die einzige Dashboard-Größe mit einer hinreichend stabilen studienübergreifenden Norm, und Autoren missverstehen es konsistenter als jede andere. Naiv gelesen, zählt jede Ansicht, die nicht zu einem Download führt, als Ablehnung, und ein Autor mit 40 Ansichten und 7 Downloads nimmt eine „82,5%-Ausfallquote" wahr. Diese Lesart ist sowohl mechanisch als auch empirisch falsch.
Abschnitt 4 legte die Mechanik dar: Der Nenner (Ansichten) ist die stärker durch Bots kontaminierte und die stärker durch Architektur aufgeblasene Größe, da Push-Modell-E-Mail-Klicks und Crawler-Traffic Ansichten anhäufen, ohne Leserabsicht zu implizieren, während der Download-Zähler aktiv überprüft wird [144][99][106]. Solange automatisierter Traffic die Ansichten mehr aufbläht als Downloads, ist eine gemessene Konversionsquote eine untere Grenze der Konversion von wirklich interessierten menschlichen Besuchern; Abschnitt 4.2 erläutert, warum diese Asymmetrie dort nicht mehr angenommen werden kann, wo KI-Systeme Volltext abrufen, und die Grenze wird entsprechend schwächer. Empirisch konzentrieren sich die veröffentlichten Messungen auf ein enges Bachmaß. Siems maß ein Verhältnis von Mediandownloads pro Ansicht von 0,171 (Mittelwert 0,187) in der LSN-Volkszählung [139]; Willey und Knapp berichten von einer Konversion von 15 % in ihrer Top-Artikel-Gruppe und 11 % bei einfach zitierten Artikeln [172]. Jo und Lis Momentaufnahme ergeben einen Medianwert von 18,9 Downloads pro 100 Abstract-Ansichten [83]. Das resultierende empirische Bachmaß liegt bei 11–19 %, d. h. ungefähr ein Download pro 5,3–9 Abstract-Ansichten. SSRNs eigene veraltete Faustregel von ca. 3:1 (ca. 33 %) [18] liegt über dem Bachmaß und wird am besten als frühe, plattformweite obere Verankerung verstanden als eine aktuelle Norm. Als bereichsübergreifende Illustration (die Populationen und Absichten unterscheiden sich grundlegend) würde eine Browse-zu-Commit-Quote in dieser Spanne in Consumer-Software als hoch angesehen, wo typische Freemium-Free-to-Paid-Konversions-Benchmarks in den unteren einstelligen Prozentbereich fallen [10]. Der Vergleich ist nur illustrativ und rerahmt die Intuition, dass „7 von 40" Desinteresse signalisiert. Abbildung 6 zeigt die Schätzungen.
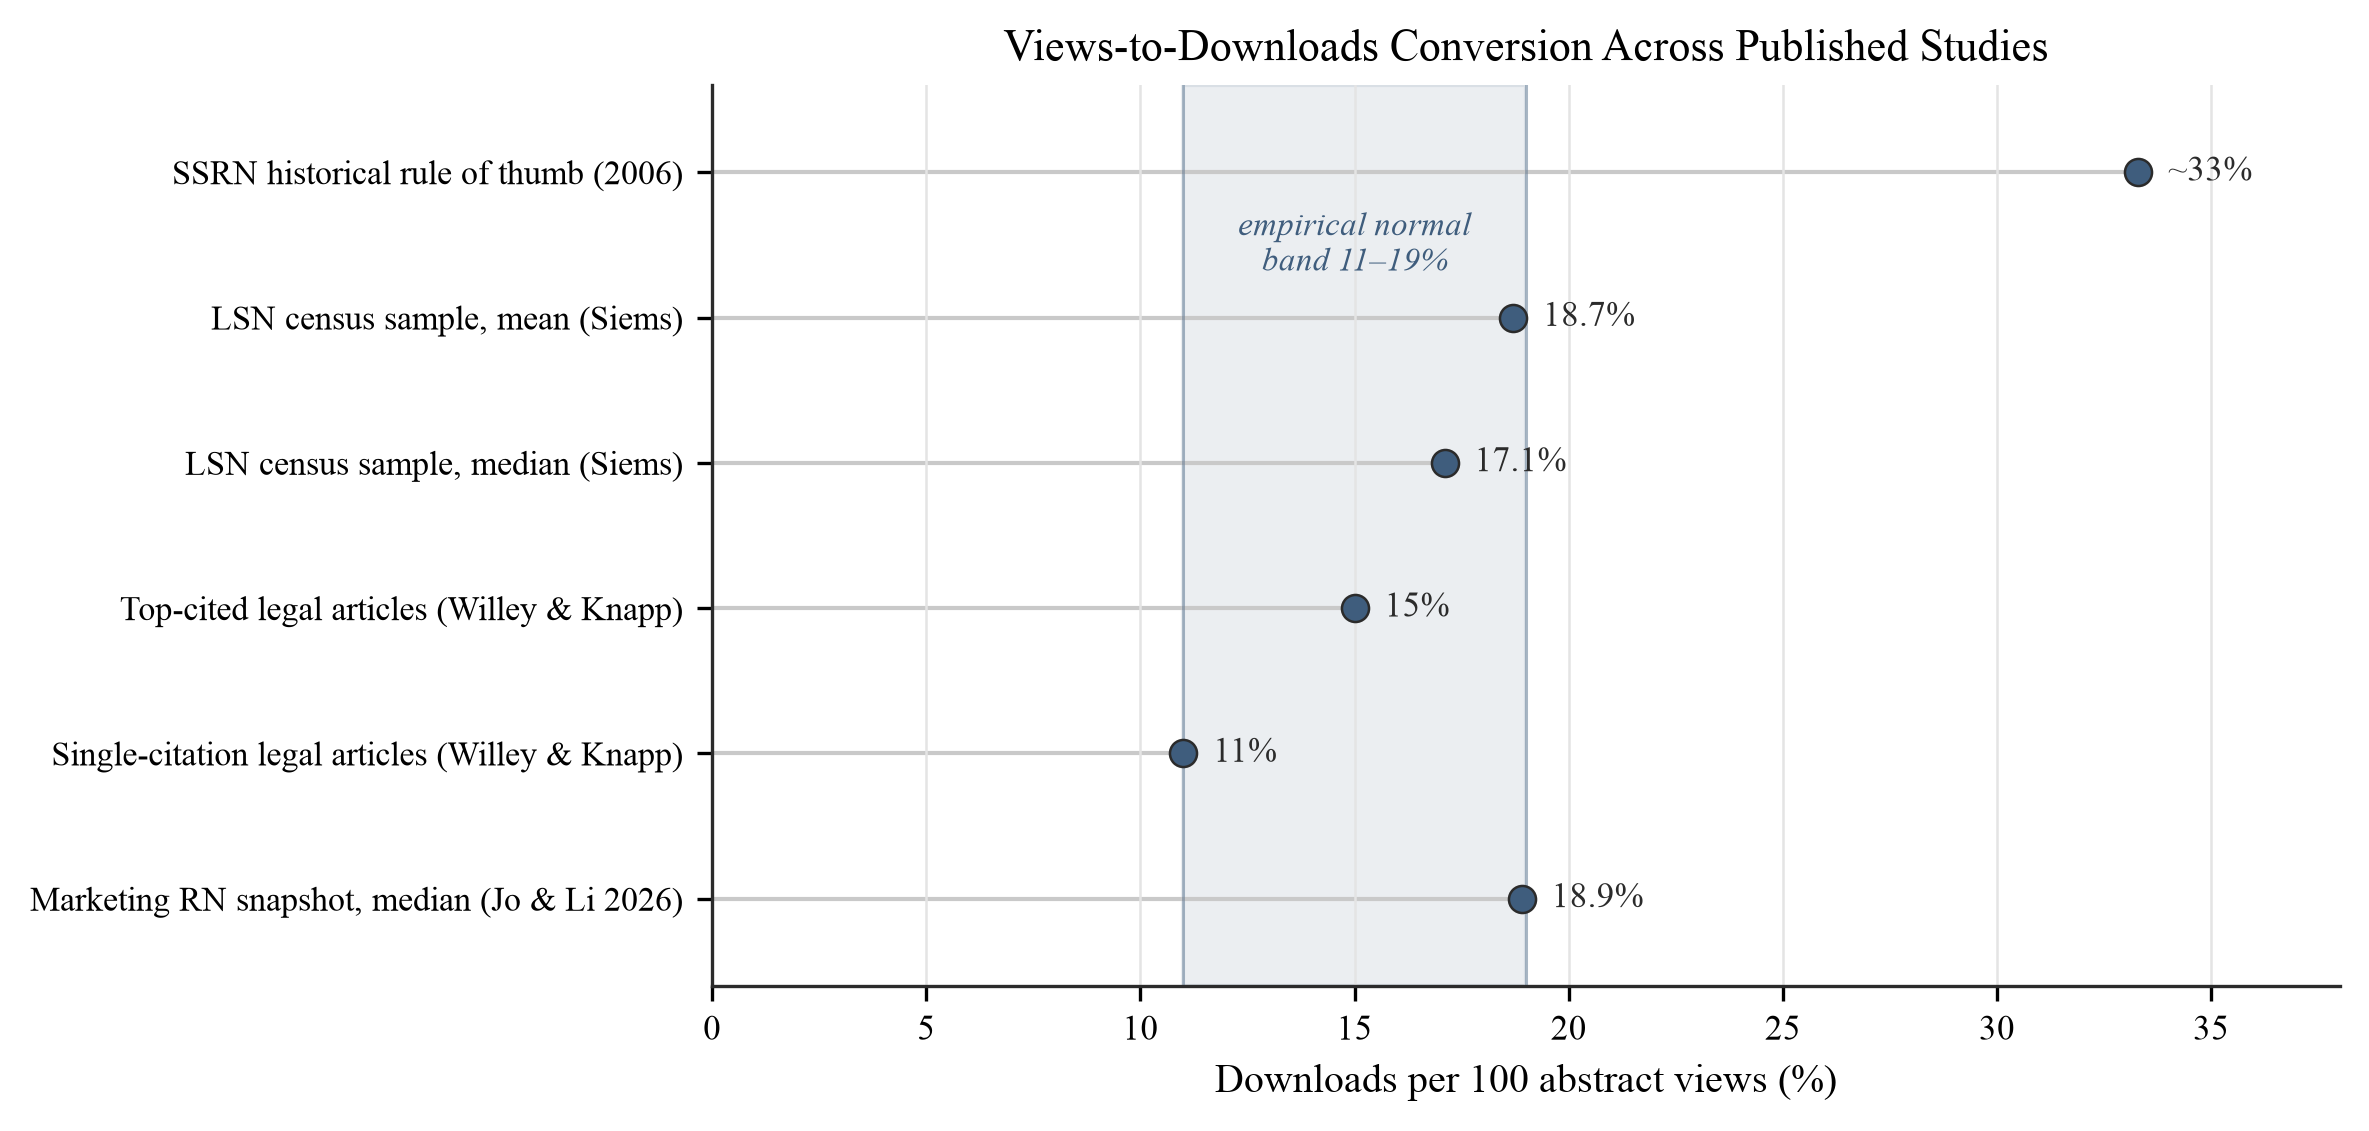
Abbildung 6. Ansichts-zu-Downloads-Konversion in Studien. Konversionsschätzungen in der veröffentlichten Literatur: SSRNs historische Faustregel von ca. 33 % (wie 2006 berichtet) [18]; LSN-Volkszählung Mittelwert 18,7 % und Median 17,1 % [139]; 15 % unter am häufigsten zitierten und 11 % unter einfach zitierten Rechtsartikeln [172]; Median 18,9 Downloads pro 100 Abstract-Ansichten in der Momentaufnahme des 2025 Marketing Research Network [83]. Das schraffierte Bachmaß kennzeichnet den empirischen Normalbereich von 11–19 % – ein Umschlag heterogener Schätzungen (vollständige Netzwerk-Mediane neben zitatgesteuerten Teilstichproben-Zahlen, deren Statistiktyp die Quelle nicht spezifiziert); das Jo- und Li-Beispielmittel (23,7 pro 100) liegt über ihm. Alle Werte sind wie in den zitierten Quellen veröffentlicht; es werden keine neuen Schätzungen eingeführt.
Die Mitglieder des Bachmaßes sind unterschiedliche Statistiken verschiedener Stichproben, daher ist es die Umhüllung heterogener Punktschätzungen. Die Siems-Zahlen (17,1 %) und Jo- und Li-Zahlen (18,9 %) sind Mediane von Vollnetzwerk-Stichproben, während die Willey-und-Knapp-Werte von 15 % und 11 % für zitatgesteuerte Teilstichproben gemeldet werden (am häufigsten zitiert gegenüber einfach zitierten Rechtsartikeln), deren Statistiktyp die Quelle nicht spezifiziert und deren Auswahl der Grund dafür ist, dass die untere Kante des Bachmaßes dort sitzt, wo sie ist. Die obere Kante ist noch viel weicher: Die durchschnittliche Konversion in der Jo- und Li-Stichprobe von 23,7 Downloads pro 100 Ansichten [83] liegt über dem Bachmaß und weicht stark von dem Verhältnis der aggregierten Mittel dieser Stichprobe ab (221.346 ÷ 611.973 = 36,2 pro 100). Dass ein Verhältnis-der-Mittel von 36,2 so weit über einem Mittel-der-Verhältnisse von 23,7 liegt, ist selbst aufschlussreich. Da das Verhältnis-der-Mittel algebraisch der ansichtsgewichtete Durchschnitt der Pro-Paper-Konversionsquoten ist, impliziert sein Überschuss des ungewichteten Mittels-der-Verhältnisse eine positive Kovarianz zwischen Reichweite und Konversion: Paper mit höherer Ansicht konvertieren mit etwas höheren Quoten, nicht niedrigeren. Die Lesart ist konservativ: eine Inflation durch kleine Nenner würde das ungewichtete Mittel-der-Verhältnisse aufwärts drücken und gegen diese Ordnung arbeiten, daher macht das Beobachten des Verhältnisses-der-Mittel über ihm trotzdem die Schlussfolgerung der positiven Abhängigkeit robuster, nicht weniger robust.
Das Bachmaß liefert das zentrale durchgearbeitete Beispiel dieses Artikels. Auf den veröffentlichten Ankern sollte eine Arbeit mit 40 Abstract-Ansichten etwa 4–8 Downloads ergeben. Die „7 Downloads" des Titels bei 40 Ansichten entsprechen einer Konversion von 17,5 %, einer Punktschätzung, die innerhalb des Bachmaßes liegt, aber bei diesem Nenner eine breite Unsicherheit aufweist. Das exakte 95%-Clopper-Pearson-Intervall auf 7 von 40 reicht von etwa 7,3 % bis etwa 32,8 %, das Bachmaß auf beiden Seiten überquerend: Bei nur 40 Ansichten kann die Schätzung nicht auf die Breite des Bachmaßes aufgelöst werden, daher ist die Lesart ein Screening-Ergebnis, keine Klassifizierung. Zwei Dinge beschränken das Beispiel weiter. Der Nenner ist klein (die unten erwähnte Instabilität), und der Vergleich ist nicht altersabgestimmt: 40 Ansichten bei ungefähr Tag 20 ist eine Früh-Lebens-Lesart, während die Anker-Mediane aus reifen Stichproben stammen (Siems bei zwei Jahren [139], Jo und Li bei einem medianen Papieralter von 491 Tagen [83]), und die Positionen 1 und 5 sowie Abschnitt 5.6 argumentieren, dass die Früh-Lebens-Exposition ein anderes Regime ist, daher ist die Altersachse nicht ausgerichtet. Die verteidigbare Lesart ist daher, dass 17,5 % mit dem studienübergreifenden Bachmaß als Screening-Ergebnis konsistent ist, nicht als genaue Populationspercentil, und nicht „komfortabel darin". Die Besorgnis, die eine solche Zahl verursacht, spiegelt das Fehlen einer Skala wider, nicht das Fehlen von Lesern. Der Umfang und die Qualität der zugrunde liegenden Anker sind in Abschnitt 9 dargelegt.
Kleine Nenner machen das Verhältnis instabil. Ein Paper mit zwei Aufrufen und einem Download hat eine nominale Konversionsrate von 50 %, aber diese Schätzung verdient nicht mehr Vertrauen als eine auf der Grundlage von 500 Aufrufen; für jede öffentliche Benchmarking sollte empirische-Bayes-Schrumpfung in Richtung der Referenzklassenrate verhindern, dass kleine Nenner zu extremen Werten führen (Abschnitte 8.3 und 8.8). Das Band funktioniert auch als Diagnose in beide Richtungen. Konversion weit unterhalb des Bands bei einem nicht trivialen Nenner deutet normalerweise auf ein Titel-Abstract-Text-Mismatch hin: Leser kommen an, lesen das Abstract und gehen, ein umsetzbares Kommunikationsproblem (Titel und Abstract umschreiben), keine Aussage über die Forschungsqualität. Konversion weit oberhalb des Bands signalisiert Traffic, den Abstract-Browsing nicht erklärt (Medienpräsenz, Kursadoption oder virale Verbreitung) und sollte eine Überprüfung anstoßen, woher die Aufrufe stammen. Keine der beiden Abweichungen stellt von selbst etwas über die Forschungsqualität fest. Eine weitere Einschränkung ist eine Hypothese statt ein Ergebnis. Konversion kann systematisch über Felder variieren als eine Eigenschaft des Lesestils der Zielgruppe statt einzelner Paper: große Felder können „Window-Shopping"-Verhalten zeigen, mit vielen Abstract-Besuchen und wenigen Downloads, während kleine, hochgradig engagierte Gemeinschaften höhere Konversionsraten aufweisen. Das Band oben wird aus zu wenigen Bildern geschätzt, um dies aufzulösen, daher umfasst Studie 1 (Abschnitt 8.6) feldgestratifizierte Konversion unter ihren Ausgaben.
Eine Diagnose, niemals ein Ziel: die Anti-Gaming-Einschränkung. Das Konversionsband ist kraftvoll, weil es als Norm gelesen werden kann, und diese Macht birgt eine Gefahr. Goodharts Gesetz besagt, dass eine Maßnahme, die als Ziel angenommen wird, aufhört, ein gutes Maß zu sein [67], ein Prinzip, das sich in Campbells Gesetz zur Korruption von Sozialnormalen spiegelt, die für Entscheidungsfindung verwendet werden [27]. Wenn das 11–19 %-Band oder eine Komponente des Benchmark-Rahmens von Abschnitt 5.5 als Beförderungsschwelle angenommen würde („Papers sollten im Konversionsband liegen, um zu zählen"), würde das Verhältnis sofort zu einem Optimierungsobjekt statt einer Beobachtung. Der Angriff ist konkret und billig: da der Nenner die manipulierbarere Größe ist (Abschnitt 4.2), würde eine koordinierte Aufblähung von Abstract-Aufrufen in festem Verhältnis zu Downloads das Verhältnis im Band halten und ein technisch erzeugtes Signal statistisch von organischer Konversion nicht unterscheidbar machen. Die Antwort des Rahmens ist eine Definitionsfrage. Das Konversionsband, die Reach-Konversions-Diagnose (Abschnitt 5.4) und die CSAB-Komponenten (Abschnitt 5.5) sind ein Diagnosevektor, niemals ein Ziel, und keine Komponente darf als Beförderungskriterium gelesen werden. Die Maschinerie, die gegen Gaming resistiert, ist in das Design eingebaut: das Band wird als untere Grenze angegeben, weil sein Nenner bot-aufblähbar ist, daher ist die Lesart von Konstruktion aus konservativ gegen Aufblähung; das Anomalie-Protokoll von Abschnitt 8.3 ist Flagge, nicht Löschen, daher wird ein technisch erzeugter Spike bewahrt und sichtbar gemacht statt stillschweigend absorbiert; und die Integritätsfilterung von Abschnitt 4.1 filtert bereits die am leichtesten erkennbare koordinierte Aktivität. Als Diagnose gelesen, entblößt das Band Gaming als eine Out-of-Band- oder intern inkonsistente Signatur; als Ziel gelesen, würde es genau die Koordination einladen, die es erkennen soll. Diese Position richtet den Rahmen nach dem etablierten Forschungsbewertungsreform-Konsens aus: die San Francisco Declaration on Research Assessment (DORA), die Single-Number- und Journal-Brand-Proxies zugunsten einer Bewertung auf dem Inhalt der Forschung selbst ablehnt [8], und das Leiden Manifesto, dessen Prinzipien genau vor dieser Substitution eines leichten Indikators für Expertenjudgment warnen [78].
Downloads haben keine öffentliche Audit-Spur: ein weiterer Grund, das Band als Untergrenze zu lesen. Eine strukturelle Asymmetrie zwischen Zitierungen und Downloads verschärft die Gaming-Sorge. Eine Zitierung hinterlässt eine öffentliche, inspizierbare Spur: das zitierende Dokument existiert, ist auffindbar und kann überprüft werden, daher ist eine Zitierungsmanipulation von Grundsatz aus von jeder dritten Partei nachvollziehbar. Ein Download-Zähler hinterlässt keine solche öffentliche Spur. Es ist eine private Buchhaltung auf den Servern der Plattform, ohne externe Aufzeichnung darüber, welche Anfragen gezählt, gefiltert oder neu angepasst wurden, was ihn einzigartig gegenüber verdecktem Gaming exponiert, das kein außenstehender Beobachter später rekonstruieren kann. Diese Exposition ist ein eigenständiger Grund, über die Bot-Kontamination des Nenners hinaus, die gemessene Konversionsrate als untere Grenze statt Punktschätzung zu behandeln (unter Vorbehalt des Vorbehalts von Abschnitt 4.2 zur KI-Abruf), und den Zähler immer mit dem Anomalie-Protokoll und der dokumentierten Integritätsfilterung zu koppeln, auf die der Rahmen sich stützt (Abschnitt 4.1). Das Fehlen einer Audit-Spur ist kein Grund, dem Zähler zu misstrauen; es ist ein Grund, ihn konservativ zu lesen und auf der Flagge-nicht-Löschen-Disziplin zu bestehen, die eine manipulierte Lesart erkennbar hält (Abschnitt 8.3).
Das Band ist ein Kalibrierungsziel, keine Konstante. Daraus folgt eine Konsequenz für die Darstellung der 11–19 %-Zahl und jedes CSAB-Schwellenwerts: sie sind Größen, die nach Feld und nach Plattform zu kalibrieren sind (Abschnitte 4.4, 5.5). Der Mechanismus für diese Kalibrierung ist bereits angegeben: Studie 1 mit Feldstratifizierung (Abschnitt 8.6) ist so gestaltet, dass sie die Pro-Feld-Konversions- und Download-Verteilungen liefert, die der Rahmen erfordert, und ist so konstruiert, diese zu verarbeiten. Bis Studie 1 berichtet, liefert der Archivquerschnitt von Anhang E eine feldaufgelöste Schätzung. Über die vierzehn Felder mit mindestens zwanzig Papers hinweg liegt die mediane Konversion von 0,134 in Energy bis 0,195 in Computer Science, eine Spanne von etwa 1,5 fach, und bei festgehaltener Paper-Alter läuft sie von 0,134 bis 0,224, etwa 1,7 fach. Gegen die drei- bis fünffache Feldspanne in Downloads selbst ist Konversion die portablere der beiden Größen, was sie als Diagnose nutzbar macht. Alter ist die Dimension, die sie nicht überdauert: in jedem Feld, das groß genug ist zum Testen, fällt Konversion, wenn Papers älter werden, mit Spearman-Koeffizienten von −0,14 bis −0,41 über die acht Felder mit mindestens vierzig Papers. Ein Konversionsband ohne Paper-Alter zitiert leistet weniger Arbeit, als es den Anschein hat.
5.3 Die gestaffelte Interpretationsskala
Den Autoren von Post-Rankings fehlt am deutlichsten eine gestaffelte Skala in dem etablierten Format von h-Index-Interpretationsleitfäden [118], die Rohzahlen in verständliche Bereiche umwandelt. Die Abschnitte 5.1–5.2 liefern die Zutaten dafür. Tabelle 8 präsentiert die vorgeschlagene Skala für vier Größen: Lebenszeitdownloads auf Papierebene, Downloads im ersten Monat, Ansichten-zu-Downloads-Umwandlung und Gesamtdownloads auf Autorenebene.
Tabelle 8. Vorgeschlagene Interpretationsskala für SSRN-Metriken. Die Bereiche synthetisieren Belege aus 2012–2015 [139][85][18][172]; da der Download-pro-Papier-Fluss seitdem gestiegen ist (Abschnitt 5.1), sollten ihre absoluten Schwellwerte für 2026 eher als nachsichtige als als konservative Bereiche gelesen werden, und in jedem Fall als Annäherung. Die Spalte für den ersten Monat ist keine kalibrierte Stufe der Skala, sondern eine vorregistrierte Vorhersage mit großer Unsicherheit, die durch das prospektive Gremium von Studie 1 getestet werden soll (Abschnitt 8.6); ihre Zellen dürfen nicht als Schwellwerte oder Beförderungsstufen gelesen werden (siehe Text). Die Grenze Stark/Außergewöhnlich bei 10.000 ist eine vorläufige Schätzung des Autors: keine in der Prüfung in Abschnitt 2.5 identifizierte veröffentlichte Quelle verknüpft 10.000 Downloads mit einem Perzentil. Der Nascent-Bereich führt keine neuen Zahlen ein: seine Obergrenze ist der bestehende Zwei-Jahres-Median-Anker von 63 [139]. Bereichsgrenzen sind auf runde Zahlen gesetzt und ungefähr eine volle Bereichsbreite breit: die durch die Integritätsliteratur etablierte Präzisionsgrenze (Abschnitte 3.1, 4.1–4.3) macht feinere Abstufungen spurlos präzise, daher ist die Grobheit der Bereiche beabsichtigt. Die Spalte „Urteil in verständlicher Sprache" beschreibt die Downloads-Skala nur und überträgt sich nicht auf die Konversionsspalte: eine 18,9%-Median-Konversion ist gewöhnlich, nicht „Solide", und ein 27,2%-p75 ist nicht „Stark". Die Lebenszeitdownload-Grenzen überlappen sich konstruktionsbedingt nicht (Nascent unter 63, Modest 63–159, Solid 160 und darüber); wo die Tabelle einen gemeinsamen Endpunkt zwischen den höheren Zeilen druckt – 800 zwischen Solid und Strong und die entsprechenden Konversions- und Autorenebenen-Cutoffs – ist das Intervall halboffenes Ende, jeder gemeinsame Wert gehört zum höheren Bereich. Die beiden Lebenszeitgrenzwerte werden selbst aus nicht vergleichbaren Referenzklassen gezogen: 63 ist ein Zwei-Jahres-Fenster-Median für eine Volkszählung der Rechtswissenschaft eines einzelnen Fachbereichs [139], während 160 ein zeitlich unbegrenzter, lebenslanges Einstiegsschwellwert für die gesamte Plattform-Top-Liste [85] ist. Sie sitzen daher auf verschiedenen Uhren (ein festes Zwei-Jahres-Papieralter im Vergleich zur unbegrenzten lebenslangen Ansammlung) und beschreiben verschiedene Populationen (ein Feld im Vergleich zu allen Feldern), daher ist das Zusammenfassen zu einer einzigen absoluten Leiter eine Kombination von Referenzklassen mit unterschiedlichen Altersangaben, Feldern und Auswahlregeln – eine Einschränkung, die die Feld- und altersgerechten Perzentile von Studie 1 entfernen sollen. Eine strukturelle Grenze dieser Anker verdient Betonung: Da die verfügbaren Referenzpunkte bei dem Zwei-Jahres-Median (63 [139]) und im oberen Ende der Plattform konzentriert sind, beschreiben vier der fünf verbalen Bereiche – Modest, Solid, Strong und Exceptional – Papiere am oder über dem Median, daher ist die Skala über dem Median dicht und unterscheidet nur schwach über die breite 50.–98. Perzentilbereich, in dem die meisten Papiere tatsächlich fallen. Diese Kompression ist eine direkte Folge der Verankerung an Top-Tail-Belegen; die Unterscheidung des Gewöhnlichen vom bloß über dem Median wird auf die Feld- und altersgerechten Perzentile von Studie 1 warten. Die Skala ist illustrativ, nicht normativ: keine Bereichsgrenze sollte als Pass/Fail-Schwellwert in eine Amtszeit-, Einstellungs- oder Beförderungsentscheidung eintreten, bis das prospektive Gremium von Studie 1 (Abschnitt 8.6) Feld- und altersgerechte Perzentile kalibriert hat, um diese veralteten absoluten Anker zu ersetzen.
| Bereich | Papier: Lebenszeitdownloads | Papier: Downloads im ersten Monat (extrapoliert) | Konversion (Downloads / Ansichten) | Autor: Gesamtdownloads | Urteil in verständlicher Sprache |
|---|---|---|---|---|---|
| Nascent | Unter dem Zwei-Jahres-Median von 63 [139] | — (kein separater Anker; siehe Text) | — (Nenner typischerweise zu klein; Abschnitt 5.2) | — | Zu früh oder unter dem Feldmedian – die statistische Norm für junge und Nischenpapiere; diagnostizieren Sie zuerst die Belichtung (Abschnitte 5.4, 5.6), nicht die Qualität |
| Modest | 63–159 | <15 | <11% | <~130 | Typisch für die Plattform; der Median-Bereich |
| Solid | 160–800 | 15–50 | 11–19% | ~130–1.600 | Am oder jenseits des historischen Top-Listen-Eintrags |
| Strong | 800–10.000 | 50–250 | 19–30% | 1.600–10.000 | Typisch für die historischen Top-Listen |
| Exceptional | >10.000 (vorläufige Schätzung des Autors) | >250 | >30% | >10.000 (vorläufige Schätzung des Autors) | Jenseits des dokumentierten Bereichs der gewöhnlichen wissenschaftlichen Zirkulation |
Jede innere Ankermarke ist an einen veröffentlichten Schwellenwert gebunden. Das Nascent-Band deckt die Region unterhalb des Zwei-Jahres-LSN-Medians von 63 [139] ab. Diese Region ist bevölkerungsreich, nicht anomal: die vordefinierten Study-1-Bänder (Abschnitt 8.6) erwarten, dass ein erheblicher Anteil der Plattformartikel, in der Größenordnung von 15–30% unter dem angegebenen Vorhersageband, zehn oder weniger Lifetime-Downloads hat, sodass eine Skala, deren unteres Band nahe dem Median beginnt, die zahlreichsten Artikel der Plattform, einschließlich dieses Artikels als Protagonist, ganz außerhalb der Skala lassen würde. Das Nascent-Urteil ist nicht evaluativ. Unterhalb des Feldmedians und besonders bei jungem Alter des Artikels erteilt der Zähler kein Qualitätsurteil, und der erste Diagnoseschritt ist Sichtbarkeit (Abschnitte 5.4 und 5.6) statt Inhalt. Das Modest-Band ist am Zwei-Jahres-LSN-Median von 63 [139] verankert. „Modest" ist das Median-Band: Typikalität ist keine Niederlage. Die Modest/Solid-Grenze (~160 Lifetime-Downloads) ist der Kakushadze-Einstiegspunkt für die zeitlose Top-10.000-Artikel, ungefähr die oberen 1,8% des vollständigen Papierbestands der Plattform (571.040, Juli 2016 [1]) [85]. Operativ ist ein „Solid"-Artikel ein Top-List-Artikel. Die Solid/Strong-Grenze (~800) ist der Median innerhalb dieser Elite-Gruppe (805) [85]: Sie trennt Artikel, die lediglich in die historische Elite eintreten, von Artikeln, die typischerweise darin vertreten sind. In der Portfolio-Skala spiegelt die Spalte auf Autorenebene diese Logik wider: die Gruppe, die SSRN selbst in seinen Mitteilungen als die oberen 10% der Autoren beschrieben hat [161], hatte ein Eingangsminimum von 129 Gesamtdownloads und einen internen Median von 1.626 [85]. Da jede Ankermarke auf Autorenebene aus dieser Rangliste entnommen ist, beschreibt die Autoren-Spalte den oberen Rand der Autorenverteilung statt des typischen Autors. Ein Autor unterhalb der ~130-Grenze ist nicht nur „Modest": Dieser Autor fällt ganz außerhalb der historisch bewerteten Gruppe, sodass die unteren Bänder der Spalte als „unterhalb der historischen Elite" zu lesen sind, nicht als eine kalibrierte Position unter allen Autoren. Dies ist dieselbe Top-Tail-Verankerung, die die Skala auf Artikelebene komprimiert; die Anker der Autoren-Spalte warten auf die Portfolio-Ebenen-Perzentile von Study 1. Die Umwandlungs-Spalte ist das durchstudie-übergreifende Band aus Abschnitt 5.2. Die Strong/Exceptional-Grenze bei 10.000 trägt keine veröffentlichte Perzentil-Ankermarke und wird als Größenordnungs-Horizont beibehalten.
Die Spalte „Erster Monat" hat einen anderen Status. Sie ist eine vorregistrierte Vorhersage, eine überprüfbare Prognose mit großer Unsicherheit, die Study 1 (Abschnitt 8.6) testen soll, und keine Zelle des ersten Monats darf als Schwellenwert oder interpretative Stufe verwendet werden. Es gibt keine direkte Referenz für den ersten Monat in der veröffentlichten Literatur, daher ist die Spalte eher eine Projektion als eine Messung, die aus der dokumentierten frühen Konzentration von Downloads (Aufmerksamkeitsspitzen konzentrieren sich in den ersten Wochen, besonders unter externer Berichterstattung [18][116][138]) auf die obigen Lifetime-Schwellenwerte extrapoliert wird. Die spezifischen Grenzen stammen von einer veröffentlichten Ankermarke: In Kakushadzhe's Top-List-Stichprobe, ungefähr den oberen 1,8% des vollständigen Papierbestands der Plattform (571.040, Juli 2016 [1]), betrug die mediane Zwölf-Monats-Download-Anzahl 247 [85]. Ein erster Monat über ~250 würde daher die Jahresnorm der historischen Elite der Plattform übertreffen, daher die Exceptional-Grenze, während 15–50 Downloads im ersten Monat, wenn aufrechterhalten, sich auf den ~160 Lifetime-Eintrittschwellenwert projizieren würden, daher Solid. Diese Zellen sind Projektionen aus einer einzigen historischen Ankermarke und sind die schwächsten Zellen der Tabelle; wenn zitiert, tragen sie diese Ableitung.
Zwei Vorbehalte regeln die Verwendung der Skala. Der Disziplinqualifizierer ist nicht optional: innerhalb einer einzelnen Disziplin unterscheiden sich die durchschnittlichen Downloads pro Artikel um etwa einen Faktor von acht über Teilbereiche hinweg (438,35 im Unternehmensrecht/Wertpapierrecht/Finanzrecht gegenüber 53,48 im Agrarrecht) [168], daher sollte jede Band-Aussage ein Feldlabel tragen. Dies sind Lifetime-Mittelwerte und sind nicht für das Alter des Artikels angepasst, und der Archiv-Querschnitt von Anhang E zeigt, warum das wichtig ist: das vermeintliche Niveau eines Feldes bewegt sich mit dem Altersprofil der aus ihm entnommenen Artikel, und wenn das Alter konstant gehalten wird, verengt sich die Spanne auf ungefähr drei bis fünf mal. Das Zweite ist, dass alternative Single-Number-Heuristiken, die in diesem Bereich vorgeschlagen wurden (verhältnisbasierte Indices der relativen Leistung (Downloads eines Artikels geteilt durch den Median einer übereinstimmenden Kohorte), logarithmische Tier-Heuristiken basierend auf ⌊ln D⌋ und verbale Scorecard-Urteile („schneller Start / gleichmäßiges Interesse / langsamer Start")) hier als nicht kalibrierte Autoren-Heuristiken subsumiert sind, da keine validierten numerischen Bänder hat. Die logarithmische Intuition selbst ist sound und wert, in Worten beibehalten zu werden: unter einer quasi-lognormalen Verteilung [85] ist der Wechsel von 7 zu 20 Downloads eine Verschiebung einer natürlichen Logarithmus-Einheit in der Sichtbarkeit, und es als Addition von 13 Klicks zu lesen, verfehlt das.
Die Skala erklärt auch warum Autoren ihre eigenen Zähler systematisch falsch einschätzen. Die Zahlen, die in Meilensteinen, Profilen und Ankündigungen zirkulieren, stammen, wie Abschnitt 3.5 dokumentierte, aus einem sichtbaren Tail, der hunderte Male über dem Median liegt, während die Masse der Verteilung nahe dem LSN-Median von 63 sitzt, und unter dem quasi-lognormalen Gesetz sind die Abstände zwischen Stufen multiplikativ, nicht additiv. Abbildung 7 ordnet diese Werte (Median des Regelartikels, Eintrittschwellenwerte, Elite-Mediane, Tail) als eine Referenz-Leiter auf einer logarithmischen Skala an.
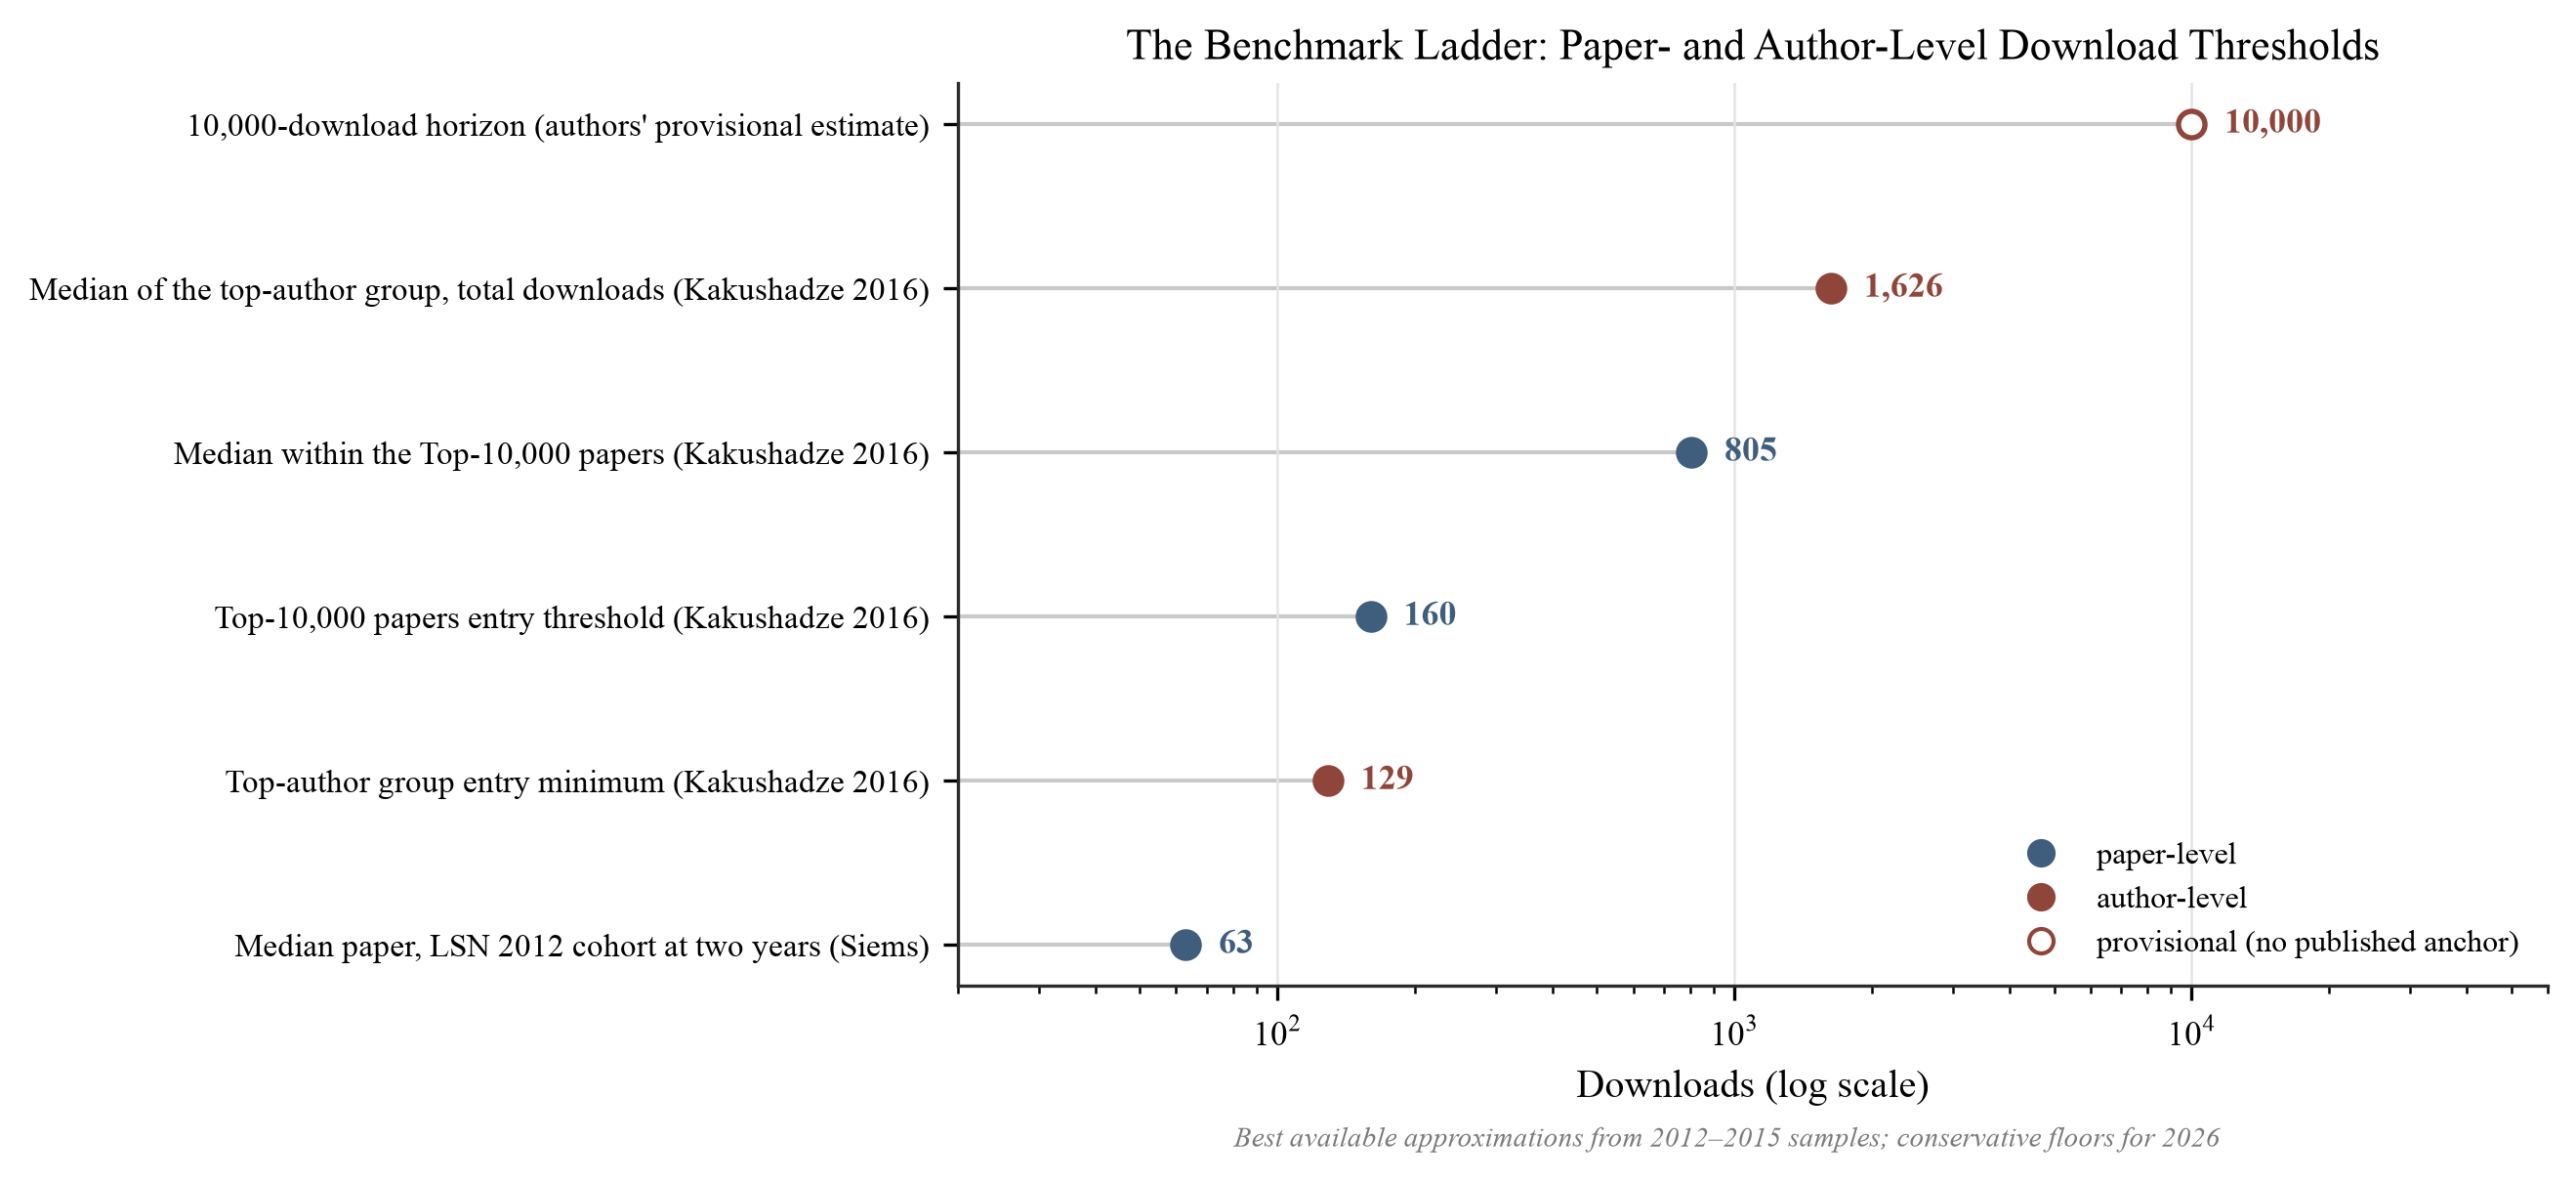
Abbildung 7. Die Referenz-Leiter. Download-Schwellenwerte auf Artikel- und Autorenebene auf einer logarithmischen Skala: LSN Zwei-Jahres-Median 63 [139]; Einstiegsminimum für Top-Autoren 129 und Top-Artikel-Eintritt ~160 [85]; Median innerhalb der Top-10.000-Artikel 805 [85]; Median der Top-Autoren-Gruppe 1.626 [85]; der 10.000-Download-Horizont (vorläufige Schätzung des Autors, keine veröffentlichte Perzentil-Ankermarke). Die Region unterhalb des Zwei-Jahres-Medians von 63 entspricht dem Nascent-Band von Tabelle 8. Werte stammen aus Stichproben von 2012–2015 (Inflation seitdem: Abschnitt 5.1).
5.4 Reichweite versus Konversion: eine zweidimensionale Diagnose
Eine einzelne Zählung, auch eine gebündelte, kann zwischen den verschiedenen Mechanismen, die sie erzeugen, nicht unterscheiden. Die Mechanik von Abschnitt 4 hat eine Implikation, die in der Praxis am wichtigsten ist: Sichtbarkeitsfehler und Inhaltsfehlreaktionen sind unterschiedliche Diagnosen: Ein Paper kann wenig heruntergeladen werden, weil nur wenige Leser es angetroffen haben, oder weil diejenigen, die es angetroffen haben, den vollständigen Text abgelehnt haben. Tabelle 9 kreuzt die beiden normalisierten Dimensionen.
Tabelle 9. Reichweiten–Konversions-Diagnose-Matrix. Reichweite und Konversion werden als Perzentile innerhalb einer Referenzklasse vergleichbarer Papers (gleiches Feld, Posting-Kohorte, Paper-Alter und vorherige Sichtbarkeit des Autors; Abschnitt 5.5) bewertet, wobei der Klassenmedian als Grenze dient. Absolute numerische Grenzwerte sind auf Grundlage aktueller Erkenntnisse nicht zu rechtfertigen und werden nicht angegeben. Die 2×2-Darstellung dichotomisiert jede Achse am Klassenmedian zur Lesbarkeit; die zugrunde liegende Reichweiten- und Konversions-Perzentile sind kontinuierlich (Abschnitt 5.4), und feinere Unterteilungen wie Terzile sind verfügbar.
| Niedrige Konversion | Hohe Konversion | |
|---|---|---|
| Niedrige Reichweite | „Kalter Start" (niedrige Reichweite, niedrige Konversion). Das Paper wird weder weit verbreitet angetroffen noch häufig nach der Exposition heruntergeladen. Die Daten legen nicht fest, ob die zugrunde liegende Forschung schwach ist; sie legen nur fest, dass die Diffusion nicht begonnen hat. | „Verborgenes Interesse" (niedrige Reichweite, hohe Konversion). Leser, die das Paper antreffen, reagieren gut, aber zu wenige treffen es an. Auffindbarkeit ist der primäre beobachtbare Engpass – ein Verteilungsproblem, kein Inhaltsproblem. |
| Hohe Reichweite | „Aufmerksamkeit ohne Übernahme" (hohe Reichweite, niedrige Konversion). Der Titel, das Thema oder die Platzierung auf der Plattform scheint Besuche anzuziehen, aber nur wenige Besucher erhalten den vollständigen Text. Schließen Sie einen kontaminierten Nenner aus, bevor Sie eine Kommunikationsfehlanpassung diagnostizieren: hohe Reichweite kann Phantom-Aufrufe statt echte Aufmerksamkeit sein, da Aufrufe der stärker verschmutzte der beiden Zähler sind (Abschnitt 4.2) – im transparenten RePEc/LogEc-Datensatz machten Roboter etwa 74 % der Abstract-Aufrufe aus, aber nur etwa 7 % der Downloads [99], daher führt ungefilterte Nicht-Mensch-Traffic zu genau dieser Signatur mit hoher Reichweite und niedriger Konversion. Nur wenn bot-aufgeblasene Aufrufe ausgeschlossen sind, rechtfertigen die verbleibenden Daten die Untersuchung von Zielgruppenpassung und Titel–Abstract-Kommunikation. | „Starke frühe Diffusion" (hohe Reichweite, hohe Konversion). Das Paper erreicht ein vergleichsweise großes Publikum und setzt Exposition in Interesse am vollständigen Text um. |
Die vier Quadranten sind nach dem Diffusionsmuster benannt, das die beiden Perzentile zeigen (kalter Start, verborgenes Interesse, Aufmerksamkeit ohne Übernahme, starke frühe Diffusion). Die Etiketten beschreiben ein Diffusionsmuster, nicht die Forschung selbst, und operativ zählt die Unterscheidung von Mechanismen; weder ein Quadrant mit niedriger Reichweite rechtfertigt eine Folgerung über Forschungsqualität, ein Punkt, der direkt auf jede bewertende Verwendung dieser Kennzahlen zutrifft. Der Quadrant mit niedriger Diffusion trägt den Namen der eigenen Diagnose dieses Artikels, den kalten Start. Die Matrix ist praktisch wertvoll, weil die angemessene Intervention nach Quadrant unterschiedlich ist: ein Kandidat mit verborgenem Interesse benötigt Verbreitung (Klassifizierungsüberprüfung, Ankündigungszeitpunkt, externe Sichtbarkeit), während Aufmerksamkeit ohne Übernahme eine Kommunikationsreparatur (Titel und Abstract) oder eine Traffic-Überprüfung erfordert. Abbildung 8 stellt die Ebene als Vorlage dar.
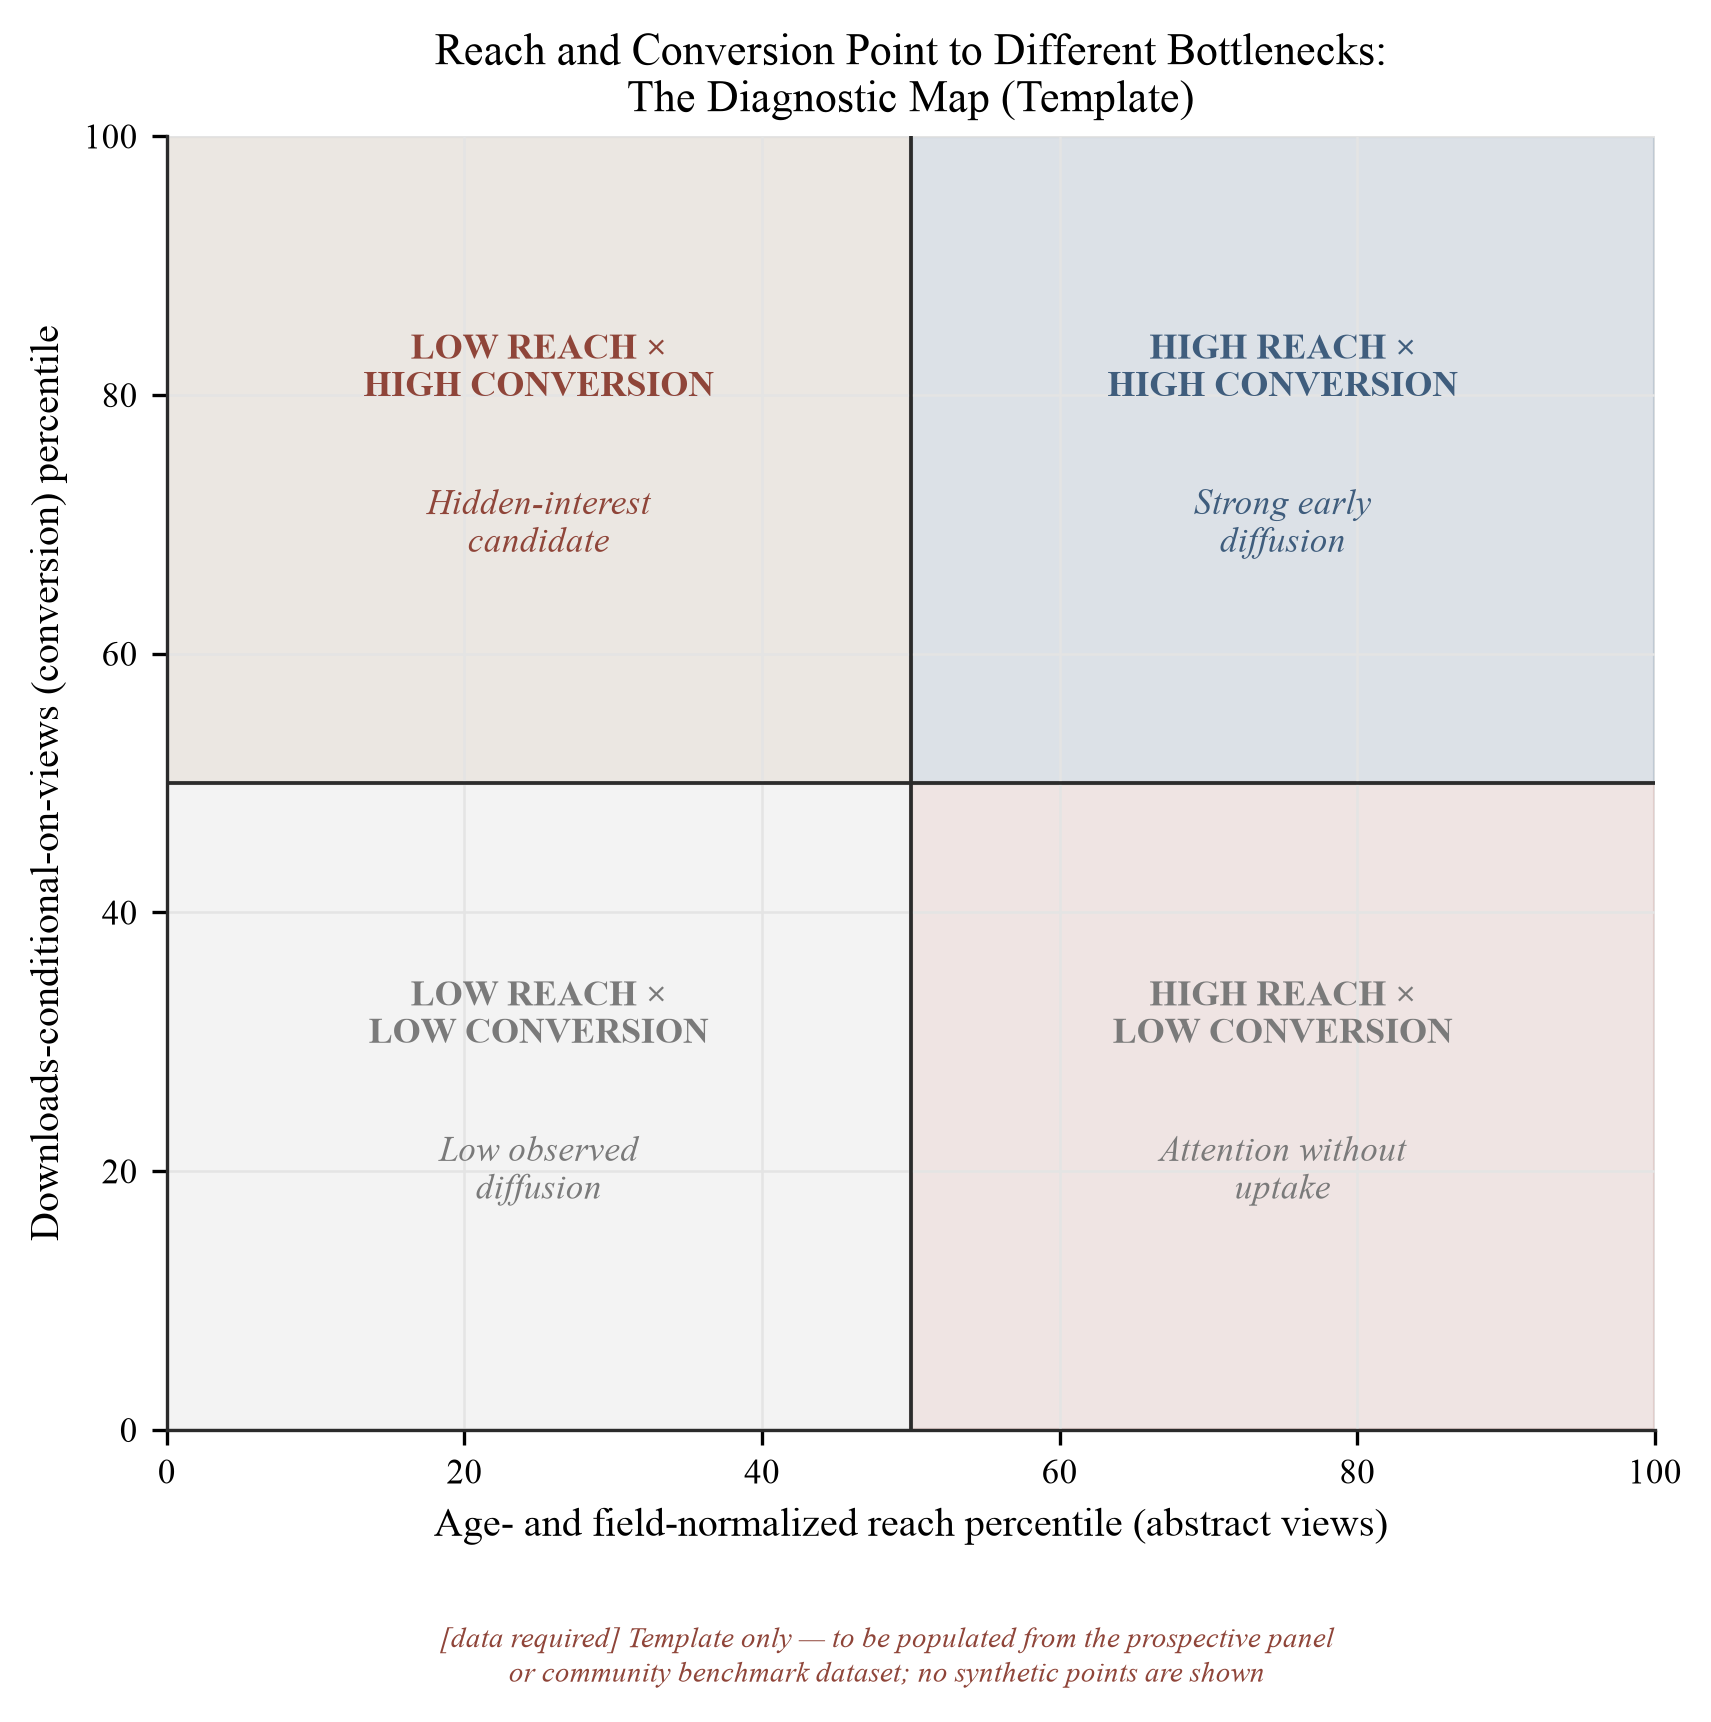
Abbildung 8. Die Reichweiten–Konversions-Karte. Vorlage zur Positionierung von Papers nach Alter-, Feld-, Kohorten- und Sichtbarkeits-normalisierten Aufrufs-Perzentilen (Reichweite, horizontal) und Downloads-bedingt-auf-Aufrufe-Perzentilen (Konversion, vertikal), mit Quadranten wie in Tabelle 9 (kalter Start, verborgenes Interesse, Aufmerksamkeit ohne Übernahme, starke frühe Diffusion). Der obere linke Quadrant identifiziert Papers mit überdurchschnittlicher Konversion trotz unterdurchschnittlicher Reichweite, eine Klasse, die rohe Download-Zählungen systematisch unterbewertet. Es werden keine empirischen Werte angezeigt; die Karte soll aus dem prospektiven Panel oder Community-Benchmark-Datensatz von Abschnitt 8 gefüllt werden.
5.5 Von einer Schlagzahl zu einem Benchmark: die CSAB-Dimensionen
Jeder der vorherigen Unterabschnitte behebt einen Fehlermodus des rohen Zählers, und die Cold-Start Scholarly Attention Benchmark (CSAB) ist diese Integration: ein Berichtsrahmen, der die einzelne Schlagzahl durch fünf normalisierte Komponenten ersetzt (Tabelle 10). Die Normalisierungsvariablen (Papieralter, Feld, Posting-Kohorte und vorherige Autorenvisibilität) sind jeweils empirisch motiviert: kumulative Metriken nehmen mechanisch mit dem Alter zu; Feldnormen unterscheiden sich um bis zu eine Größenordnung im Mittelwert [168]; Kalenderbedingungen verschieben die Aufmerksamkeit messbar (Artikelzugriffe fallen ~11% an Wochenenden und ~50% in den Sommermonaten [178]); und ein Plattformneuling sieht sich nicht mit derselben Anfangsöffentlichkeit konfrontiert wie ein etablierter Autor [83]. Eine Populationskonvention muss festgelegt werden, bevor irgendein Perzentil berechnet wird. Ein kumulativer Zähler ist über einen Papierbestand mit heterogenem Überleben definiert (Papiere werden gelegentlich zurückgezogen, zusammengeführt oder durch neuere Versionen ersetzt), daher ist jedes CSAB-Perzentil eine Aussage über den zum Beobachtungszeitpunkt verbleibenden Bestand. Studie 1 (Abschnitt 8.6) gibt die Einschlussregel (Versionskontrolle, Rückzüge und Duplikatauflösung) vor, anstatt die Referenzpopulation implizit zu lassen.
Die beiden zentralen Komponenten lassen sich kompakt definieren. Für Papier i im Alter τ (Tage seit dem Posting), im Feld f, Posting-Kohorte c und Prior-Visibilitätsschicht s:
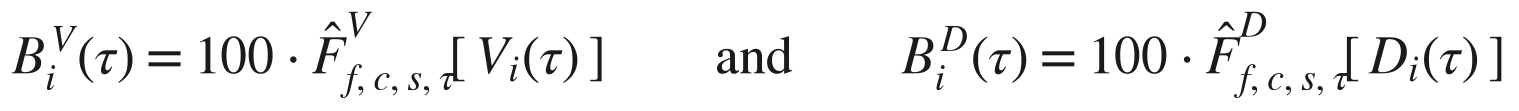
wobei V_i(τ) und D_i(τ) kumulative Abstract-Ansichten und Downloads sind und F̂^V, F̂^D die empirischen Verteilungsfunktionen dieser Zählungen innerhalb der durch f, c, s und τ definierten Referenzklasse sind. Die Definition fixiert den Schätzwert, ein Perzentil innerhalb einer angegebenen Referenzklasse. Kein F̂ kann heute aufgeschrieben werden, da die Referenzverteilungen nicht existieren (Abschnitt 5.1). Die Formel ist die Spezifikation, die Studie 1 und die Diskussion in Abschnitt 8 schätzen sollen, und dieselbe Notation wird bis zum prädiktiven Validierungsdesign von Abschnitt 8.9 durchgeführt. Perzentil- und Referenzklassen-Normalisierung ist selbst eine etablierte bibliometrische Methode: Perzentile sind ein Standardweg zur Normalisierung der Zählungen einer Publikation für Feld, Dokumenttyp und Publikationsjahr [22], mit speziellen Verfahren für die Feld- und Zeitnormalisierung von Indikatoren, die von Nullen dominiert werden [23], genau das Regime, das ein Download-Zähler einnimmt. Die Normalisierung von Nutzungsmetriken spezifisch (Downloads und Ansichten statt Zitationen) gegen eine Referenzklasse ist ebenfalls eine etablierte Forschungslinie: die Nutzungsbibliometrie-Literatur hat lange den Download-basierten Impact als eine Verteilung behandelt, die an die Merkmale der Benutzergemeinschaft und des Stichprobenrahmens angepasst werden muss [92][19], und Journal-Usage-Factor-Programme bauten genau solche normalisierten Nutzungsindikatoren aus COUNTER-konformen Daten [137]. Die Standardisierung der Nutzungszählung selbst ist Gegenstand einer etablierten Praktiker-Infrastruktur, des COUNTER Code of Practice [125]. Feldnormalisierte Lesbarkeits-Indikatoren haben ein vergleichbares etabliertes Vorbild in der Altmetrics-Literatur [179]. Die Methode ist daher etabliert. Der Beitrag hier liegt in ihrer Anwendung auf SSRN-Downloads und der Konstruktion einer nach Alter, Feld und Kohorte geschichteten Referenzklasse für eine Post-Rankings-Umgebung.
Der Schätzwert ist sauber, aber drei Operationalisierungsfragen müssen geklärt werden, bevor irgendein F̂ angepasst wird. Die erste ist am folgenreichsten, da sie sich auf das bezieht, wofür der Benchmark ist. Die Konditionierung der Referenzklasse auf vorherige Autorenvisibilität (die Schicht s) ist korrekt, wenn die Frage diagnostisch ist: „Wie geht es diesem Papier unter vergleichbaren Papieren von vergleichbar sichtbaren Autoren?" Es ist genau falsch, wenn die Frage die Gerechtigkeitsfrage von H1–H3 ist, da die Normalisierung durch vorherige Visibilität die Newcomer-gegenüber-etabliert-Lücke abzieht, die der Gerechtigkeitsrahmen messen soll. Ein Within-s-Perzentil kann Cold-Start-Nachteil nicht erkennen, da der Nachteil durch Konstruktion konditioniert wurde. Der Rahmen trennt daher zwei unterschiedliche Verwendungen von CSAB, die niemals in eine Zahl zusammengefasst werden dürfen. Als deskriptiver Benchmark meldet er die Position eines Autors innerhalb einer vollständig geschichteten Referenzklasse (einschließlich s), was einzelne Autoren im Dashboard wünschen. Als angepasster Schätzwert für H1–H3 lässt er vorherige Visibilität aus der Konditionierungsmenge fallen und behandelt sie stattdessen als den Prädiktor von Interesse, misst den Gradienten, anstatt ihn zu entfernen. Die beiden Antworten unterscheiden sich, sie beantworten unterschiedliche Fragen, und jeder Bericht, der ein Visibilitäts-normalisiertes Perzentil präsentiert, muss angeben, welcher der beiden es ist. Eine zweite Frage ist die Stichprobengröße. Die Schichtung nach Feld × Kohorte × Visibilitätsschicht × acht Alterspunkte erschöpft schnell eine Wahrscheinlichkeitsstichprobe von 3.000–5.000 Papieren (Abschnitt 8.6): die vollständig gekreuzte Zellenanzahl läuft in die Tausende, daher sind die meisten Zellen winzig oder leer. Empirische Bayes-Schrumpfung hin zu breiteren Referenzklassen ist aus diesem Grund benannt (Abschnitte 8.3, 8.8), aber Schrumpfung erfordert ihre eigene Spezifikation: eine minimale hierarchische Struktur (Feld innerhalb breiter Bereich, Alter innerhalb groben Alterbandes) und eine vorab festgelegte Mindestzellen-Regel zur Schätzung, unter der eine Zelle von ihrer übergeordneten Zelle borgt, anstatt ein rohes Perzentil zu berichten. Diese Mindestzellen-Regel auf der Schätzungsseite unterscheidet sich von und ist strenger zu argumentieren als die datenschutzgesteuerte Mindestzellen-Regel, die die öffentliche Veröffentlichung in Anhang D regelt; die beiden erfüllen unterschiedliche Zwecke und sind separat spezifiziert. Die letzte Frage ist Momentum (Tabelle 10), definiert als die Änderung einer geschätzten normalisierten Position. Ein Änderungsscore in einer geschätzten Größe lädt zur Regression zum Mittelwert ein: ein Papier, das am Tag 7 teilweise durch Schätzungsrauschen hoch landet, wird bis zum Tag 30 rein aus statistischen Gründen dazu neigen zu fallen. Momentum erfordert daher ein explizites Modell der zugrunde liegenden Trajektorie (zum Beispiel eine Schrumpfungs- oder empirische Bayes-Schätzung der latenten Position mit propagiertem Messfehler), anstelle einer rohen Differenz zweier Perzentil-Schnappschüsse, und die rohe Differenz wird, wenn überhaupt, nur als deskriptive Begleiterin zur modellierten Größe gemeldet.
Tabelle 10. Die Cold-Start Scholarly Attention Benchmark (CSAB): fünf Dimensionen statt einer Zahl. Eine kopierbare Reporting-Vorlage auf Satzebene für diese Dimensionen wird in Anhang B bereitgestellt.
| Dimension | Metrik | Kernfrage | Interpretation |
|---|---|---|---|
| Reichweite | Nach Alter/Feld/Kohorte/Neueinsteiger normalisiertes Ansicht-Perzentil | Sind relevante Zielgruppen auf das Papier gestoßen? | Auffindbarkeit |
| Download-Leistung | Normalisiertes kumulatives Download-Perzentil | Wie viele Volltext-Akquisitionen erfolgten im Vergleich zu vergleichbaren Papieren? | Gesamte frühe Verbreitung |
| Konvertierung | Downloads unter der Bedingung von Ansicht-Chancen (Abschnitt 5.2) | Suchten exponierte Leser den Volltext? | Bedingte Bindung |
| Dynamik | Änderung der normalisierten Position oder Aufmerksamkeit auf Intervallebene | Beschleunigt sich die Verbreitung, ist sie stabil oder verblasst sie? | Zeitliche Trajektorie |
| Nachgelagerte Validierung | Spätere Zitierung oder Verwendung unter der Bedingung früher Metriken | Sagten frühe Aufmerksamkeit und spätere wissenschaftliche Übernahme voraus? | Prädiktive Validität |
Das Framework lehnt jeden universellen Rohschwellwert von „Erfolg" ab. Erfolg muss relativ zu einem analytischen Zweck definiert werden: für Auffindbarkeit, ein hohes Reichweiten-Perzentil unter Papieren desselben Alters und Feldes; für Leseraufnahme, überdurchschnittliche Konvertierung unter der Bedingung von Exposition; für Verbreitung, die gemeinsame Verteilung der beiden; für wissenschaftliche Einflussnahme, nachgelagerte Zitierungen oder dokumentierte Verwendung. Frühe Nutzung allein ist für letzteren Zweck unzureichend, da frühe Downloads nur etwa 16 % der späteren Zitierungsvarianz erklären [25]. Das macht die Interpretation des Titelbeispiels genau. Sieben Downloads sind „gut" nur insoweit, als sieben Downloads das Papier ungewöhnlich hoch unter ansonsten vergleichbaren Papieren in derselben Phase ihres Lebenszyklus platzieren. Ein Tag-7-Wert und ein Tag-180-Wert können nicht auf derselben Benchmark bewertet werden.
Vier Designentscheidungen folgen dem achten Grundsatz des Leiden Manifesto: dass quantitative Indikatoren nicht den Umfang der ihnen zugrundeliegenden Annahmen überbieten dürfen, und dass falsche Präzision selbst ein Messfehler ist [78]. Das Framework berichtet Bänder, nicht Punktwerte (Tabelle 8); es legt CSAB als diagnostischen Vektor fest, nicht als Ziel (Abschnitt 5.2); es zeichnet seine Ausgabefiguren, die Reichweiten–Konvertierungs-Karte (Abbildung 8) und den Benchmark-Fächer (Abbildung 14), ohne numerische Skala, sodass eine Form nicht mit einem kalibrierten Wert verwechselt werden kann; und es versieht jede Zahl, die es verwendet, mit einer Verifizierungsebene und einem Datum (Tabelle 7). Jedes dieser verzichtet auf Präzision, die die Evidenz nicht unterstützen kann, wie DORA es von der Forschungsbewertung verlangt, wenn es Ein-Zahlen- und Journal-Marken-Proxys für die inhaltliche Bewertung eines Papiers ablehnt [8]. Das Zusammenfallen von CSAB in eine Punktzahl würde genau die falsche Präzision wieder einführen, vor der beide Dokumente warnen.
Für einen Autor würde CSAB-Reporting die bloße Zeile „Downloads: 12" mit etwa folgendem ersetzen: 12 Downloads nach 14 Tagen: Gesamt-Download-Perzentil unter vergleichbaren Papieren: 67. Perzentil; Reichweiten-Perzentil: 39. Perzentil; Konvertierungs-Perzentil: 81. Perzentil; Interpretation: hohes bedingtes Interesse, unterdurchschnittliche Exposition. Jede Zahl in diesem Muster ist illustrativ, da solche Perzentile erst existieren, wenn die Referenzverteilungen von Abschnitt 8 geschätzt werden, und keine dieser Werte darf als Benchmark zitiert werden, aber das Format zeigt, was die Zerlegung bringt. Der gleiche Rohzähler, der als undifferenzierter Fehlschlag wirkt, löst sich in eine spezifische Diagnose auf: Leser, die auf das Papier treffen, reagieren ungewöhnlich gut, aber zu wenige treffen darauf, sodass die angezeigte Maßnahme Verbreitung ist, nicht Überarbeitung. Das ausgearbeitete Beispiel ist das CSAB-Gegenstück des Quadranten „verborgenes Interesse" von Tabelle 9. Anhang B legt dieses Format als kopierbare Reporting-Vorlage fest, deren Perzentilfelder leer bleiben, bis die Abschnitt-8-Verteilungen existieren.
5.6 Leseverlauf: Exposition ist eine Intervention, keine Hintergrundvariable
Die letzte Komponente des Rahmens ist zeitlich: Ein neu eingestelltes Papier tritt nicht in eine homogene Aufmerksamkeitsumgebung ein. Es durchläuft unterschiedliche Expositionsregime (Posting → interne Entdeckung → E-Mail-Verbreitung → externe Indexierung → Netzwerkdiffusion), und eine kumulative Summe fasst diese Regimes in eine Zahl zusammen. Die Regimegrenzen werden durch die Maschinerie von Abschnitt 4 festgelegt: eJournal-Verbreitung ist kuratiert und kann in hochvolumigen Themen bis zu 45 Tage dauern [53], und externe Suchmaschinenindexierung kann 6–9 Monate oder länger dauern [55].
Der am meisten Besorgnis erregendste Dashboard-Zustand folgt unmittelbar daraus: Null Downloads in Woche eins ist normales Vor-Verbreitungs-Verhalten, keine Ablehnung. Bevor der Ankündigungszyklus abgelaufen ist, ist das Papier noch nicht der Öffentlichkeit ausgesetzt worden, auf die es abzielt. Die diagnostische Abfolge für ein frühes Null ist verwaltungstechnisch: bestätigen, dass das Papier öffentlich eingestellt ist; eJournal-Zuordnung bestätigen; den Ankündigungszyklus abwarten; erst dann die Zähler ablesen. Umgekehrt sind die Zählerstände im ersten Monat, sobald die Verbreitung stattgefunden hat, der früheste und am meisten Rauschen behaftete führende Indikator: frühe Downloads korrelieren mit späteren Zitationen mit ungefähr r ≈ 0,4 [25], informativ aber weit entfernt von einem Urteil, und frühe Spitzen sind häufig Expositionsereignisse (Blog- oder Medienberichterstattung) statt dauerhaftes Interesse [116][138].
Da retrospektive Bereinigung kumulativer Zählerstände nicht rekonstruieren kann, was ein Papier am Tag 3 oder Tag 30 hatte, erfordert die trajektorienbasierte Interpretation (und die Forschungsagenda der Panels in Abschnitt 8) Beobachtung ab der Geburt auf einem standardisierten Raster. Tabelle 11 gibt den Mindeststundenplan an. Sie dient auch als Selbstverfolgungsvorlage für einzelne Autoren. Eine Trajektorie wird nur vorläufig bei den 60- und 90-Tage-Ablesungen des Tabelle-11-Rasters und mit Sicherheit bei der 180-Tage-Ablesung klassifiziert, niemals am Tag 7.
Tabelle 11. Mindestens längsfristige Beobachtungsplan für SSRN-Papiere.
| Alter des Papiers | Kernzweck der Beobachtung |
|---|---|
| Tag 1 | Unmittelbare Plattformexposition |
| Tag 3 | Sehr frühe Entdeckung |
| Tag 7 | Benchmark für die erste Woche (Erwartungswert für die meisten Papiere: bei oder nahe Null, vor Verbreitung) |
| Tag 14 | Frühe Stabilisierung |
| Tag 30 | Benchmark für den ersten Monat |
| Tag 60 | Verbreitungs- und Suchreifen (eJournal-Zyklen abgeschlossen [53]) |
| Tag 90 | Mittelfristige frühe Diffusion |
| Tag 180 | Übergang zur Messung nachgelagerter Auswirkungen |
Sofern möglich, ist tägliche Beobachtung über die ersten 45 Tage vorzuziehen, da E-Mail-Verbreitung innerhalb dieses Fensters zu unterschiedlichen Zeiten erfolgen kann [53]. Ablesungen auf Intervallniveau auf diesem Raster verwandeln das Dashboard von einem statischen Urteil in eine Trajektorie, die einzige Form, in der frühe SSRN-Metriken verteidigbare Informationen enthalten.
Die Abschnitte 4 und 5 ersetzen die Frage, die ein Autor nicht beantworten kann („sind 7 Downloads gut?"), durch vier, die der veröffentlichte Datensatz unterstützen kann: Wo sitzt der Zählerstand gegen die Benchmark-Karte und ihre Jahrgänge (5.1, 5.3); liegt die Konvertierung innerhalb des empirischen Bandes (5.2); in welchem Quadranten der Reichweiten-Konvertierungs-Ebene befindet sich das Papier (5.4); und was zeigt die Trajektorie auf dem Beobachtungsraster (5.6)? Keine dieser Fragen erfordert die eingestellten Rankings, aber alle erfordern die vergleichenden Daten, deren Sammlung die abschließenden Abschnitte dieses Artikels vorschlagen.
6. Ein praktisches Spielbuch für Autoren
Die Benchmark-Karte von Abschnitt 5 (Tabelle 7) stellt die fehlende Skala wieder her, und dieser Abschnitt setzt sie in die Praxis um für den Autor, der das Statistik-Panel nach 15. Juli 2026 öffnet und Zählerstände ohne Kontext sieht [148][149]. Es hat nacheinander vier Aufgaben: eine Routine zum Beobachten der eigenen Zähler (6.1–6.2), Ersatz für den Vergleichsrahmen, den die Rankings früher lieferten (6.3), Hebel, die die Sichtbarkeit legitim verbessern können (6.4), und ein Protokoll für die Umwandlung von Zählern in verteidigbare Karrierenachweise (6.5–6.6). Jeder hier verwendete numerische Anker lässt sich auf eine veröffentlichte Quelle mit einem expliziten Stichprobenrahmen und Zeitfenster zurückführen; Tabelle 7 fasst sie zusammen. In der Autorengemeinschaft zirkulierende Praktiken, die keine evidenzgestützte Grundlage haben, werden überall dort als unverifiziert gekennzeichnet und als Kandidatenhypothesen zum Testen am Ende von Anhang A gesammelt.
Tabelle 12 komprimiert den Kern des Spielbuchs in ein Protokoll von sieben Fragen, der Reihe nach gestellt, jede gepaart mit den wert erhaltenden Nachweisen und der stärksten Schlussfolgerung, die die Antwort legitim lizenzieren kann. Die Abschnitte 6.1–6.2 entfalten dieses Protokoll in Routinen und Lesungsregeln, und Tabelle 23 (Anhang A) bleibt sein situativer Begleiter, indexiert nach den Dashboard-Zuständen, denen Autoren tatsächlich begegnen.
Tabelle 12. Ein Autorenprotokoll zur Interpretation eines SSRN-Zählers: sieben Fragen, die zu bewahrenden Nachweise und die zulässige Schlussfolgerung. Kein Schritt behandelt einen Zähler als Qualitätsscore; die letzte Spalte gibt die Obergrenze an, was jede Antwort unterstützen kann.
| Schritt | Frage | Zu bewahrende Nachweise | Zulässige Schlussfolgerung |
|---|---|---|---|
| 1 | Wie alt war das Papier, als der Zähler beobachtet wurde? | Datierter Screenshot oder Export, plus das Posting-Datum | Eine zeitspezifische Beobachtung, nicht ein Lebensurteil |
| 2 | Hatte kuratierte Verbreitung und externe Indexierung stattgefunden? | Verbreitungsmitteilung und Datum, falls verfügbar; Suchmaschinenindexierungs-Status | Identifizierung des Vor- versus Post-Expositions-Regimes (Abschnitt 5.6) |
| 3 | Was sind Aufrufe, Downloads und Konvertierung zusammen? | Beide Zähler und der Nenner | Eine Reichweiten-versus-bedingtes-Engagement-Diagnose (Tabelle 9), nicht ein einzelnes Urteil |
| 4 | Was ist die engste verteidigbare Referenzklasse? | Feld, Kohorte, Alter des Papiers, Neuling-Status, Klassifikationsgeschichte | Relative Stellung nur innerhalb dieser Klasse (Abschnitt 5.5) |
| 5 | Ändert sich die Trajektorie? | Wiederholte Beobachtungen bei den festen Alterungspunkten von Tabelle 11 | Dynamik oder Plateau, unterworfen Expositionsereignissen — nicht Beschleunigung von „Qualität" |
| 6 | Gibt es nachgelagerte Bestätigung? | Zitationen, substanzielle Kontakte, Veröffentlichung oder dokumentierte Nutzung | Geschichtete Evidenz der Aufnahme, kein Qualitätsnachweis |
| 7 | Kann der Anspruch reproduziert werden? | Quelle, Datum, Zählregel, archivierter Datensatz | Ein nachprüfbarer Bericht, kein unbegründeter Meilenstein |
6.1 Eine Messerroutine
Die Interpretation beginnt mit disziplinierter Aufzeichnung, da SSRN nur aktuelle kumulative Zählerstände anzeigt und keine Verlaufshistorie unter der Kontrolle des Autors bereitstellt. Sechs Schritte, vom Veröffentlichungstag an angewandt, erzeugen die minimale Dokumentation, die jede spätere Schlussfolgerung erfordert.
1. Beide Zähler und deren Verhältnis aufzeichnen. Notieren Sie Abstraktaufrufe, Downloads und die Umwandlungsquote Downloads-zu-Aufrufen in festen Intervallen. Das Beobachtungsraster von Tabelle 11 (Tage 1, 3, 7, 14, 30, 60, 90, 180) gibt den Zeitplan und den Zweck jeder Messung vor. Ein datierter Screenshot bei jedem Intervall ist die einzige Dokumentationsversion, die der Autor kontrolliert, da Plattformzähler neu festgelegt werden können, wenn sich Filterregeln ändern [144][69]. Die sich ansammelnde Dokumentation ist ein versioniertes Evidenzpaket: die Manuskriptversion, ihre Metadaten und Klassifizierungen, datierte Dashboard-Snapshots, Verteilungshinweise, ein datiertes Protokoll der eigenen Promotionsmaßnahmen des Autors (ein Forenbeitrag, ein Vortrag, eine Mailing-List-Ankündigung) und spätere Zitierungen und sachliche Kontakte. Das Promotionsprotokoll ist wichtig, da Promotionen Expositionsbehandlungen sind. Ohne ein datiertes Protokoll der eigenen Öffentlichkeitsarbeit kann ein Autor einen organischen Anstieg nicht von einem selbst generierten unterscheiden, und auch niemand, der den Anspruch prüft (Abschnitt 8.3).
2. Nach Zeit seit Veröffentlichung normalisieren. Drücken Sie frühe Leistung als Downloads pro Monat in den ersten drei bis sechs Monaten aus, nicht als rohe kumulative Zählung. Ein drei Monate altes Papier im Vergleich zu den Gesamtsummen älterer Arbeiten führt zu systematisch irreführenden Schlussfolgerungen, da sich Zähler über die Lebensdauer eines Papiers auf einer Plattform ansammeln, deren jährliches Download-Volumen von etwa 12,9 Millionen im Jahr 2016 auf 40,6 Millionen im Jahr 2023 gewachsen ist [1].
3. Beobachtungsfenster niemals mischen. Eine wöchentliche Zählung darf nicht gegen einen Zwölf-Monats-Durchschnitt verglichen werden, und eine 90-Tage-Zählung darf nicht gegen Gesamtsummen verglichen werden. Jeder Vergleich in diesem Ratgeber setzt gleiche Fenster mit gleichen Fenstern ins Verhältnis. Verstöße gegen diese Regel gehörten zu den häufigsten Interpretationsfehlern bei der vorherigen Nutzung von Ranking-Statistiken [161].
4. Ordnen Sie das Papier in seiner fachlichen Nachbarschaft ein, nicht gegen die Plattform. Die durchschnittlichen Downloads pro Papier unterschieden sich um einen Faktor von etwa acht nur in den Legal Scholarship Network eJournals (438,35 in Corporate/Securities/Finance gegenüber 53,48 in Agricultural Law, Daten von 2018) [168]. Eine Zählung, die in einem Unterbereich unremarkabel ist, ist in einem anderen außergewöhnlich. Die relevante Referenzklasse ist das eigene eJournal oder Subjectnetzwerk des Papiers, untersucht im gleichen Papieralter.
5. Kleine einzelne Zähler nicht überinterpretieren. Die Integritätsliteratur setzt eine Obergrenze für die Präzision von Nutzungszählern: von Verlegern gemeldete Downloads können doppelt so hoch ausfallen wie vergleichbare Plattformen [176], Plattformfilter verwerfen einen großen Teil des rohen Verkehrs [99][129][144], und ohne solche Filter würden SSSRNs eigene Zähler um „einen Faktor von fünf oder mehr" erhöht [18]. Kleine Unterschiede zwischen vergleichbaren Zahlen tragen daher keine Information in sich.
6. Überwachen Sie die langfristige Akkumulation, anstatt auf frühe Zahlen zu reagieren. Die Aufmerksamkeit auf Working-Paper-Plattformen konzentriert sich früh [116][28] (die letztere Feststellung stammt eher aus NBER- als aus SSRN-Daten), aber Discovery-Layer reifen langsam: SSRN meldet, dass die Google-Scholar-Indexierung „6–9 Monate oder länger" dauert [55]. Die Lesbarkeit verringert sich darüber hinaus auf mehreren Zeitskalen gleichzeitig, und Lesen und Zitieren müssen nicht dem gleichen zeitlichen Prozess folgen [91], daher ist keine einzelne „Halbwertszeit"-Lesung der eigenen Kurve sicher. Eine Trajektorie kann provisorisch bei den 60–90-Tage-Lesungen des Rasters von Tabelle 11 klassifiziert werden und mit mehr Sicherheit bei 180 Tagen, niemals bei der 7-Tage-Lesung.
6.2 Fünf Regeln zum Lesen des Dashboards
Mit dieser Aufzeichnung zur Hand lässt sich die Verteilungsevídenz aus Abschnitt 5 auf fünf Faustregeln zum täglichen Lesen eines Dashboards reduzieren.
(i) Vergleichen Sie mit Medianen, nicht mit Mittelwerten oder sichtbaren Spitzenwerten. Die einzige zensusähnliche Stichprobe gewöhnlicher Arbeiten setzt den Median bei 63 Downloads und 369 Abstract-Aufrufen nach zwei Jahren an (LSN, Arbeiten von 2012 veröffentlicht) [139]. In der einen kürzlich veröffentlichten Stichprobe liegt der Median bei 87 Downloads gegenüber einem Mittelwert von 221,3, der sogar über dem 75. Perzentil liegt (Abschnitt 3.3) [83]. Die Meilensteinzahlen, die zirkulieren, stammen aus dem sichtbaren Schwanz, dessen 2015er Maxima in die Hunderttausende von Downloads gingen (Abschnitt 3.5) [85]; ein Autor, der sich daran kalibriert, kalibriert sich gegen den Schwanz einer quasi-logarithmischen Verteilung, was Fehlkalibrierung garantiert. Der plattformweite Durchschnitt von ~222 Lifetime-Downloads pro Arbeit, berechnet aus Aggregaten vom Dezember 2023 [1], ist genauso unbrauchbar als persönliches Messinstrument.
(ii) Prüfen Sie die Konversionsquote, nicht nur die Zahl. Unabhängige Messungen konvergieren auf eine normale Spanne von ungefähr 11–19% Downloads pro Abstract-Aufruf: der Mittelwert der LSN-Stichprobe von 18,7% und der Median von 17,1% [139] sowie die Zahlen von 15% (meistzitierte Artikel) und 11% (Artikel mit einer Zitation) aus den Rechtszitationsstudien [172]. SSRNs langjährige Daumenregel von drei Aufrufen pro Download [18] liegt eher über als innerhalb dieser Spanne. Die kürzliche Marketing-Network-Stichprobe liegt leicht über dieser Spanne, mit einem Mittelwert von 23,7 Downloads pro 100 Aufrufe [83]. Abbildung 6 zeigt die Schätzungen zusammen. Führen Sie das zentrale ausgearbeitete Beispiel aus Abschnitt 5.2 durch die Regel: die 40 Abstract-Aufrufe und 7 Downloads des Titels ergeben 17,5%, innerhalb der Spanne als Punktschätzung, aber mit einem breiten 95%-Clopper–Pearson-Intervall (≈7,3–32,8%). Bei n = 40 ist die Ablesung weder Misserfolg noch eine genaue Perzentilangabe: ein Screening-Ergebnis, das mit gewöhnlicher Konversion konsistent ist. Eine Konversion weit unter der Spanne ist konsistent mit einer Diskrepanz zwischen Abstract und Arbeit, wobei Leser ankommen, das Abstract lesen und gehen. Das ist umsetzbar, und die Maßnahme ist die Überarbeitung von Titel und Abstract. Eine Konversion weit über der Spanne signalisiert Datenverkehr, den das Abstract-Browsing nicht erklärt, wie direkte Links von Medien oder Aggregator-Berichterstattung, und sie sollte einen Überprüfung anregen, woher die Aufrufe stammen. Beide Lesarten sind Screening-Diagnostiken: keine Studie hat die Inferenz von niedriger Konversion auf Abstract-Qualität kausal validiert, und die Diagnose sollte als Hypothese über die eigene Arbeit verzeichnet werden.
(iii) Behandeln Sie Downloads im ersten Monat als das früheste und lauteste Zitationssignal. Frühe Downloads korrelieren mit späteren Zitationen mit ungefähr r ≈ 0,4 in den arXiv-Daten, was die ursprünglichen Autoren selbst nur auf etwa 16% der erklärten Varianz übersetzen [25]. Das früheste solche Signal in der Aufzeichnung ist biomedizinisch: Online-Hit-Zahlen in der ersten Woche nach Veröffentlichung im BMJ korrelierten ungefähr mit 0,50 mit Zitationen, die in den folgenden Jahren gesammelt wurden [119]. In der Rechtswissenschaft berichteten Black und Caron von Paper-ebenen-Downloads–Zitationen-Korrelationen in der Größenordnung von 0,50, ansteigend auf etwa 0,55 in einer Stichprobe von hundert Junior-Rechtsprofessoren [18]. Über Felder und Horizonte hinweg liegen die Paper-ebenen-Korrelationen bei ungefähr 0,1 bis 0,6 [80][25], und arXiv-Download-Zahlen verlieren statistische Signifikanz als Prädiktoren, sobald zeitgenössische Twitter-Aufmerksamkeit kontrolliert wird [138]. Auf aggregierter Ebene wird die Assoziation enger: 0,84 zwischen Download-basierten und Zitationsbaserten Rankings von hundert Rechtsschulen [77] und R = 0,724 zwischen sechsmonatigen PDF-Downloads und späteren Zitationen in der eigenen Analyse einer Zeitschrift [114]. Diese aggregierten Zahlen klären nicht, wo ein einzelnes Paper enden wird, und ein erster Monat von Downloads ist ein frühes Signal über spätere Zitationen.
(iv) Null Downloads in Woche eins ist normale Prä-Verteilung, keine Ablehnung. Ein neu veröffentlichtes Paper erhält Aufmerksamkeit erst, nachdem es die Moderation durchlaufen hat, in Fach-eJournals klassifiziert wurde und in den Ankündigungszyklus eintritt. SSRNs eigene Dokumentation beschreibt die Klassifizierung als kuratiert statt garantiert, mit Verzögerungen von bis zu 45 Tagen für stark belastete Themen [53], und eJournal-Verteilungen und E-Mail-Warnungen wurden ausdrücklich bestätigt, um nach dem Sonnenuntergang unverändert fortzubestehen [147][57]. Die Diagnose-Sequenz läuft: Bestätigen Sie, dass das Paper öffentlich veröffentlicht ist, bestätigen Sie die eJournal-Klassifizierung, warten Sie den Ankündigungszyklus ab, und lesen Sie die Zähler erst danach. Entdeckung durch Suchmaschinen kommt später noch [55].
(v) Ein fallender oder flacher Zähler kann Filterung widerspiegeln, nicht verlorene Leserschaft. SSRN dokumentiert öffentlich, dass es anscheinend wiederholte Downloads, Robot-Downloads und andere unregelmäßige Aktivitäten verwirft [144][66][69]. Die RePEc/LogEc-Erfahrung zeigt, wie groß solche Korrektionen sein können: im Juli 2007 machten Robots ungefähr 74% der Abstract-Aufrufe aus, aber nur etwa 7% der Downloads [99], und im September 2025 wurde mehr als 99,5% des rohen IDEAS-Datenverkehrs inmitten von KI-Bot-Interferenz verworfen [129]. Ein plötzlicher Rückgang oder eine Neudarstellung ist daher ebenso wahrscheinlich ein Messereignis wie ein Lesereschaft-Ereignis, und er sollte ohne Bestätigung nie als Reputationsverlust gelesen werden.
6.3 Benchmarking ohne Rankings
Die Rankings lieferten einen Vergleichsrahmen. Ein Autor hat heute drei Ersatzmöglichkeiten dafür, geordnet von weniger zu mehr Aufwand.
Mikro-Benchmarks. Der direkteste Ersatz ist eine Referenzgruppe, die man selbst aufbaut: Identifizieren Sie drei bis fünf methodologisch vergleichbare Arbeiten von Kollegen an vergleichbaren Institutionen, die im selben Monat veröffentlicht wurden, und verfolgen Sie deren öffentliche Zähler nach dem gleichen Zeitplan wie in Tabelle 11 für die eigene Arbeit. Das Ergebnis ist eine lokalisierte Perzentil-Basislinie gegen genau die richtige Referenzklasse, konstruktionsbedingt nach Feld, Alter der Arbeit und Plattform-Ära abgestimmt, während die ausrangierten Rankings Arbeiten aller Alter und Felder in einer einzigen Liga verglichen. Es ist ein vorgeschlagenes Verfahren, das nur öffentliche pro-Arbeit-Zähler nutzt, und es sollte als solches bei jeglicher Dossierbenutzung aufgezeichnet werden. Es setzt auch eine gewisse Vertrautheit mit einer Peer-Literatur voraus, die die isoliertesten Neulinge, genau die Autoren, die die Cold-Start-Bedingung am meisten betrifft, möglicherweise nicht haben. Für diese ist das plattformseitige Remedium von Abschnitt 10.4 (anonyme Perzentil-Bänder) die strukturelle Lösung, da es kein selbst zusammengestelltes Netzwerk erfordert.
Ein relatives Leistungsverhältnis. Die gleiche Logik kann als eine einzelne Zahl ausgedrückt werden: das Verhältnis der Downloads einer Arbeit in einem bestimmten Alter zum Median-Download einer passenden Kohorte, das heißt dieselbe Disziplin, das gleiche Alter der Arbeit und wenn möglich der gleiche Arbeitstyp. Ein Verhältnis von 1,0 bedeutet genau mittlere Sichtbarkeit für die Kohorte, und Werte über oder unter 1,0 werden entsprechend gelesen. Der Index ordnet Arbeiten innerhalb einer abgestimmten Kohorte; Perzentil-Bänder warten auf die Referenzverteilung. Die veröffentlichten Mediane, aus denen eine Kohorte-Basislinie aufgebaut werden könnte, sind veraltet und eng (63 Downloads nach zwei Jahren für juristische Arbeiten, die 2012 veröffentlicht wurden [139], 87 für Marketing-Arbeiten, die 2025 beobachtet wurden [83]), und die Zuordnung von Verhältniswerten zu Perzentilen erfordert die vollständige Verteilung, nicht nur den Median. Die Zuweisung von Perzentil-Etiketten zu Verhältnis-Bändern ohne diese Verteilung erzeugt falsche Präzision. Die vorregistrierte Agenda von Abschnitt 8 umfasst die Kalibrierung der Bänder; bis dahin ist das Verhältnis ein Ordnungsgerät, keine Bewertungsskala. Zwei weitere Vorsichtsmaßnahmen begrenzen das Gerät. Es sollte überhaupt nicht bei kleinen Zählungen berechnet werden, da die Instabilität mit kleinem Nenner von Abschnitt 5.2 auf den Zähler des Verhältnisses und auf einen dünnen Kohorte-Median gleichermaßen angewendet wird, und empirical-Bayes-Schrumpfung (Abschnitte 8.3, 8.8) ist die angemessene Reparatur überall dort, wo ein solches Verhältnis öffentlich gemeldet wird. Ein gegebenes Verhältnis lässt sich nicht in ein festes Perzentil übersetzen: „doppelt der Kohorte-Median" entspricht verschiedenen Perzentil-Positionen in Verteilungen verschiedener Formen, daher ordnet das Verhältnis Arbeiten innerhalb einer Kohorte, kann aber nicht über Kohorten oder Ären hinweg verglichen werden, deren Verteilungsformen sich unterscheiden.
Urteilssprache für Trajektorien. Community-facing Tools haben vorgeschlagen, die frühe Trajektorie einer Arbeit in drei qualitative Urteile zu klassifizieren (schneller Start, stetiges Interesse, langsamer Start) als humane Alternative zu rohen Zahlen. Das Vokabular ist es wert, beibehalten zu werden, da es einen Zähler in eine Aussage über eine Trajektorie umwandelt, und „langsamer Start" ist explizit kein Synonym für Misserfolg. Die ursprünglich für diese Urteile vorgeschlagenen Schwellwerte beruhten auf Vergleichen von nicht abgestimmten Zeitfenstern und auf einer plattformweiten „Netzwerk-Durchschnitts"-Statistik, die nicht als öffentliche Metrik existiert: SSRN bietet keine öffentliche Self-Service-API oder Statistics-Endpunkte [51], und die nächste historische Metrik („New Downloads Per Paper", eine Autoren-Level-Ranking-Statistik) wurde mit den Rankings außer Kraft gesetzt ([B-9], zitiert mit dem Vorbehalt, dass die historischen Ranking-Seiten nicht mehr zugänglich sind). Weisen Sie Urteile also nur aus abgestimmten Vergleichen zu: die Mikro-Benchmark-Gruppe oder das Kohorte-Median-Verhältnis oben, gelesen nicht früher als zum 60–90-Tage-Punkt.
Welcher Ersatz auch verwendet wird, externe Triangulation stärkt ihn. Citation-Layer-Daten von Crossref und OpenAlex [35][124] und die PlumX-Indikatoren, die auf SSRN-Seiten angezeigt werden [50], beantworten eine andere Frage, über nachgelagerte Nutzung statt Sichtbarkeit. Ein Policy-Citation-Tool wie Overton erweitert dieselbe Triangulation auf Policy und Practice Reach durch Mapping, wo eine Arbeit in Regierungs- und Institutionsdokumenten zitiert wird [187], was SSRNs Basis in Recht, Wirtschaft und Policy passt. Diese Ebenen werden gemeinsam mit den Zählern im CSAB-Framework von Tabelle 10 und den Reach-Conversion-Diagnostiken von Tabelle 9 untersucht. Altmetric-Indikatoren sind eine weitere Triangulations-Ebene. Von Anfang an als frühe Aufmerksamkeitssignale konzipiert [123][122], folgen sie Mustern, die sich von Zitationen unterscheiden [74][20], und ermöglichen Feldnormalisierung [21]. Sie sind auch anfällig für automatisierte Inflation [75] und erfordern theoriegestützte Interpretation statt oberflächlicher Lesart [76].
6.4 Verbesserung der legitimen Sichtbarkeit
Vor dem Sunset lieferten die Rankings rohes, aber echtes Feedback für eine wiederkehrende Autorenentscheidung: ob sich eine weitere Promotion eines Papiers lohnte (Abschnitt 1.3). Nach dem Sunset muss diese Entscheidung anhand der hier zusammengestellten Hebel und Diagnosen getroffen werden. Die Determinantenliteratur identifiziert eine kleine Menge von Hebeln unter der Kontrolle des Autors und im Einklang mit den Plattformregeln. Jeder wirkt auf die Sichtbarkeit ein, nicht auf die Qualität, und keiner ändert den Inhalt des Papiers. Schnelle Verbreitung und frühes Feedback gehören zu den anerkannten Zielen des Preprint-Posting in der methodologischen Literatur über Preprints [24], und ein Spielplan für legitime Sichtbarkeit nutzt diese erklärte Funktion.
Verpackung. In der LSN-Stichprobe waren Titelmerkmale, Zusammenfassungslänge und Themensalienz signifikant mit Aufmerksamkeit verbunden, mit der eigenen Vorsicht des Autors, dass solche Variablen für nicht beobachtbare Qualität stehen könnten [139]. In den juristischen Zitierungsstudien trugen die Top-Dezil-Papiere mehr Schlüsselwörter und längere Zusammenfassungen als die Bottom-Dezil-Papiere [172] (die genauen Zahlen warten auf Überprüfung anhand des Originals). Die Zusammenfassungsseite ist die Konversionsoberfläche, auf die Regel (ii) einwirkt, daher sind Titel und Zusammenfassung die ersten Dinge, die überarbeitet werden sollten, wenn die Konversion hartnäckig unter dem Band liegt. Jede solche Überarbeitung zielt auf Ausrichtung zwischen Versprechen und Inhalt ab, nicht auf unterschiedslosen Traffic: eine bereits klare Zusammenfassung umzuschreiben, um Klicks zu maximieren, kann ihre Präzision beschädigen und durch die Anziehung von nicht passenden Besuchern kann die Konversion eher vom Band weg als darauf zu gedrückt werden.
Klassifizierung. Papiere, die in mehr eJournals klassifiziert wurden, erzielten in der 2018-LSN-Analyse durchschnittlich mehr Downloads und weniger Null-Download-Ergebnisse [168]. SSRN erlaubt ein bis sieben Klassifizierungen pro Papier und kuratiert die Aufnahme [53]. Eine beliebte Community-Verbesserung, unüberprüft, weil keine Studie Klassifizierungsstrategien vergleicht, begrenzt die Klassifizierungen auf drei, ausgewählt als ein Kern-, ein breites und ein interdisziplinäres eJournal; dieser Rat gehört zu den überprüfbaren Hypothesen des Anhangs A.
Verbreitung und externe Aufmerksamkeit. Die eJournal-E-Mail-Benachrichtigung bleibt der wichtigste Push-Kanal der Plattform und bleibt post-sunset bestehen [147][57][152]. Außerhalb der Plattform erzeugte Blog-Berichterstattung in dem einen empirischen Test der Frage scharfe frühe Download-Spitzen [116], sichtbare Listenposition erhöhte die Lesbarkeit und Zitate in den arXiv-Positionsstudien [72], und die Konferenzteilnahme war in einer Quasi-Experiment-Studie um einen abgesagten politikwissenschaftlichen Meeting mit zusätzlichen 17–26 Downloads pro Papier verbunden ([B-4], zitiert mit der Vorsicht, dass die Einstellung APSA 2012 ist, nicht eine SSRN-Wirtschaftsstichprobe). Praktikerleitfäden sammeln weitere Verbreitungswerkzeuge für juristische Gelehrsamkeit [169]. Der Fall für frühe offene Verbreitung ist unabhängig etabliert: ein randomisierter Test des offenen Zugangs fand mehr Downloads, obwohl kein kurzfristiger Zitiergewinn [37], während Kohorten- und Feldstudien Zitiervorteile von ungefähr 10% bis zweifach berichten [59][86][17][93], einschließlich +53% für amerikanische Rechtszeitschriften [40], und eine Überprüfung juristischer Zitate stellte fest, dass 87% der am meisten zitierten Artikel auf SSRN verfügbar waren gegenüber 44–46% der wenig zitierten Artikel, mit 95% der am meisten zitierten Gruppe auf SSRN in oder vor ihrem Publikationsjahr gepostet [172]. Preprint-Hinterlegung ist mit höheren Zitierungen und niedrigeren Publisher-Site-Downloads auf arXiv verbunden [38], und bioRxiv-Downloads korrelieren mit Journalergebnissen [62]. In der Volkszählung aller bioRxiv-Preprints korrelieren Download-Zahlen mit dem Impact Factor der Zeitschrift, in der ein Preprint später veröffentlicht wird (Kendall τb = 0,59), eine Assoziation, deren Kausalitätsrichtung unbekannt ist [2]. Machine-Discovery-Schichten (Suchmaschinen und generative Antwortsysteme) werden separat im Audit-Framework von Abschnitt 8 und der Feature-Audit-Agenda von Tabelle 20 behandelt [5][164].
Versionshygiene. Überarbeitungen, die auf die gleiche SSRN-Seite hochgeladen werden, bewahren die angesammelten Zähler und die stabile URL, während das Löschen und erneute Posten die Metriken auf Null zurücksetzen ([B-7], zitiert mit der Vorsicht, dass die Wording auf der Support-Seite sich im Laufe der Zeit ändert und bei der Einreichung erneut überprüft werden sollte). Die weitere Community-Behauptung, dass eine kleinere Überarbeitung am Tag 3 eine Neuankündigung und eine „zweite Welle" der Aufmerksamkeit auslöst, ist undokumentiert und sitzt unter den unüberprüften Praktiken in Anhang A. Die Identität benötigt die gleiche Sorgfalt. Das Verlinken einer verifizierten ORCID-ID mit dem SSRN-Autorenprofil hält Papiere und ihre Zähler an der richtigen Person statt an einem Namensvetter angebracht, und es ist ein kostengünstiger Schutz gegen das Autor-Disambiguierungs-Problem, das das Panel-Design von Abschnitt 8.3 sonst statistisch lösen muss ([B-7], gleiches Überprüfungsvorbehalt).
Was nicht zu tun ist. Selbst-Downloads und verwandte Manipulationen sind in SSRNs eigenen Server-Protokollen dokumentiert, intensiviert in der Nähe von Top-Listen-Schwellwerten, und wurden durch sozialen Vergleich angetrieben [44]. Die öffentlichen Fraud-Filter der Plattform sind öffentlich [144][69], und Bewertungskomitees, die sich dieser Geschichte bewusst sind, diskontieren unbegründete Behauptungen. Daher trägt die Gaming-Literatur eine praktische Warnung neben der Integritäts-eine: manipulierte Zahlen sind erkennbar und reputationsmäßig teuer. Abbildung 9 zeigt die zeitliche Signatur in Frage an simulierten Daten. Organische Aufmerksamkeit sammelt sich als frühes Peak mit langem Schwanz an, während Manipulation konzentrierte Spitzen erzeugt, genau die Art, die Integritätsfilter flaggen sollen [144][69].
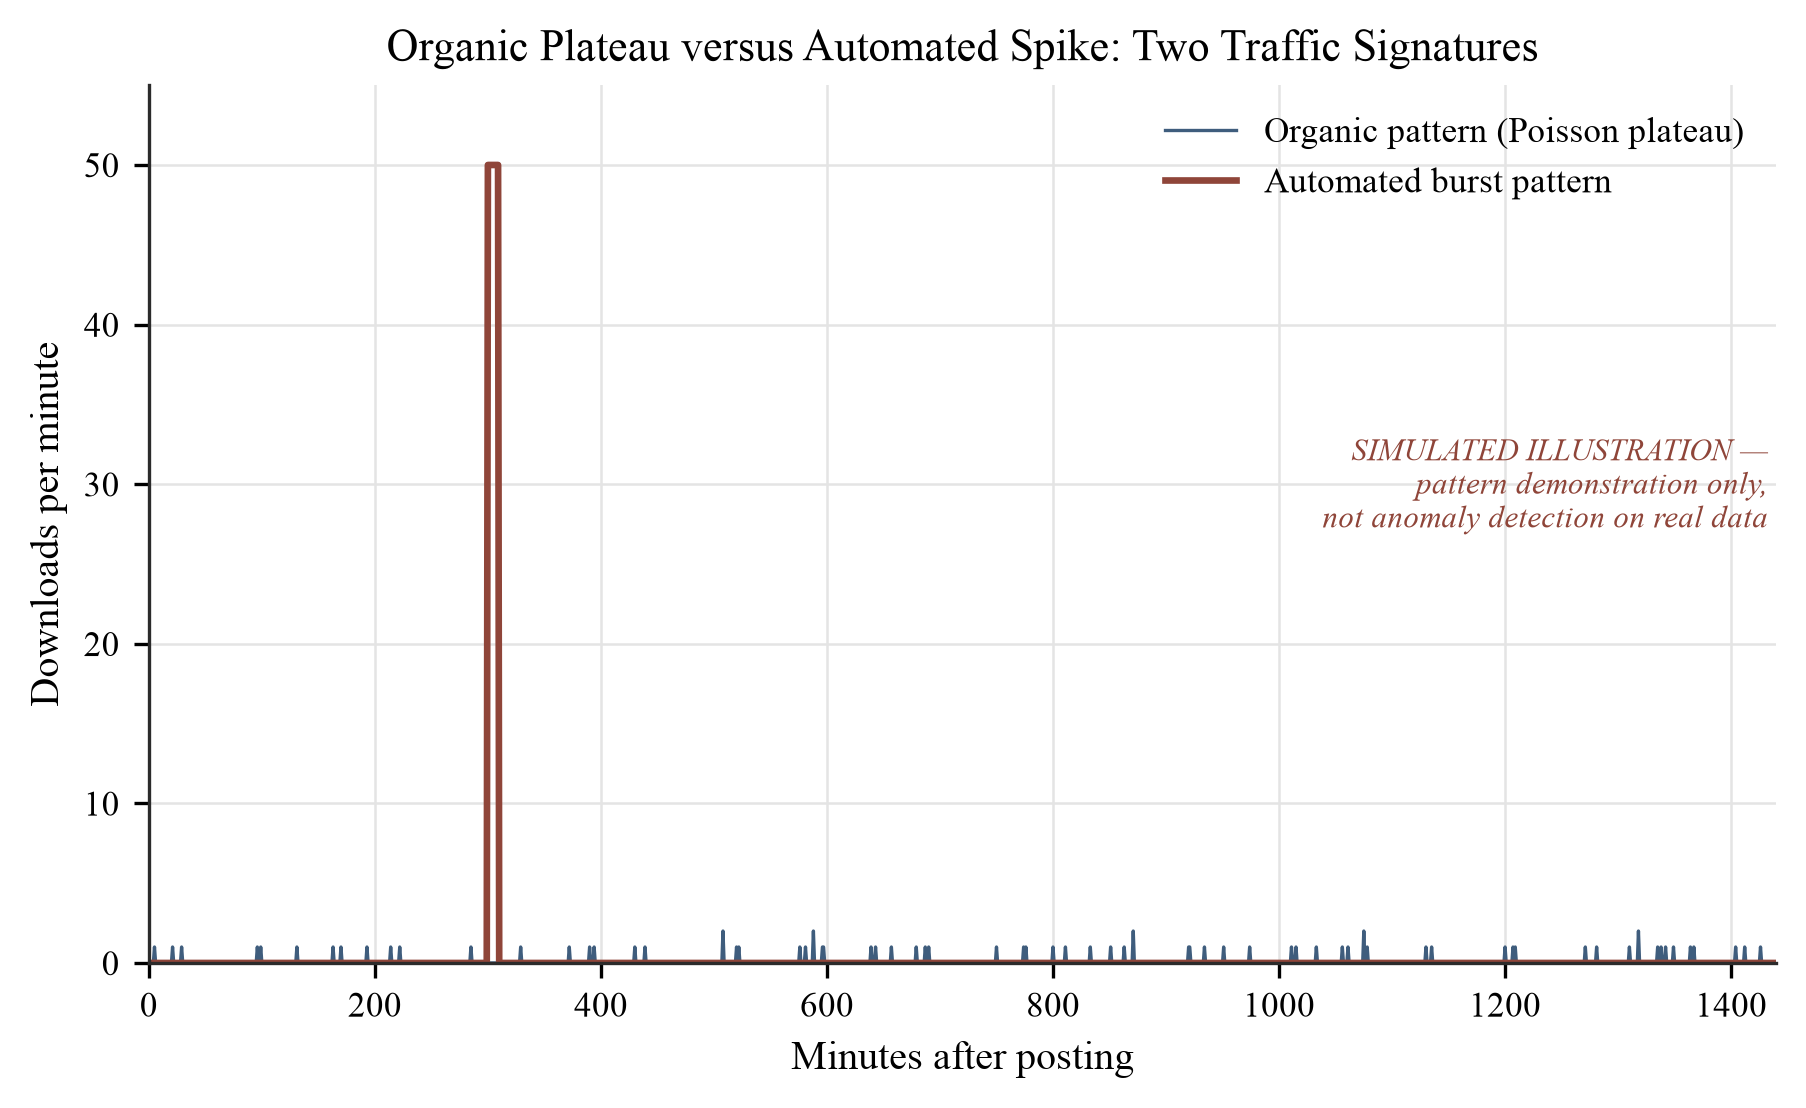
Abbildung 9. Organische Akkumulation versus Manipulationsspitze. Eine glatte organische Download-Trajektorie im Gegensatz zu einer abrupten eintägigen Spitze, die für Selbst-Downloads charakteristisch ist und die Manipulationswarnung von Abschnitt 6.4 und die Integritätsdiskussion von Abschnitt 4 motiviert [44][69][144]. Alle angezeigten Daten sind simuliert; es gibt keinen empirischen Anomalieerkennung-Datensatz für SSRN.
6.5 Zähler in Karrierenachweis umwandeln: das Dossier-Protokoll
Vor dem Sonnenuntergang war rankingbasierter SSRN-Nachweis eine standardisierte Dossier-Komponente. Der öffentliche Rang eines Autors ging direkt in Beförderungsdossiers ein: „rangiert an 13. Stelle von insgesamt 3.000 juristischen Autoren nach der Gesamtzahl aller Downloads, die die Rechtsfakultät bei verschiedenen Beförderungs- und verwandten Entscheidungen berücksichtigt hat" [12]. Anleitung für Bewerbungsschreiben rieten dazu, Download-Zahlen und Platzierungen in Top-Ten-Listen zu zitieren [95], gleichzeitig warnten praktische Anleitungen, dass selbst veröffentlichte Arbeiten „wahrscheinlich nicht für Beförderungs- und Tenure-Zwecke an Rechtsfakultäten zählen" [33], und die eigene Dokumentation der Plattform beschrieb ihre Metriken als Daten, „die Autoren für Beförderungs- und Tenure-Zwecke und die Institutionen bei ihren Einstellungs- und Ranking-Aktivitäten nutzen" [52]. Jedes dieser Artefakte setzte einen öffentlichen Vergleichsrahmen voraus, der nicht mehr existiert [149]. Die evaluative Nutzung der Zähler war zudem von ihrem ersten Vorschlag an umstritten: Black und Carons Fall von 2006 für Downloads als „Beta"-Maß für wissenschaftliche Leistung [18] wurde im selben Symposiumsband durch Eisenbergs Kritik an dem beantwortet, was SSRN-basierte Rankings gültig messen können [45]. Ein Dossier, das Downloads zitiert, erbt diese ungelöste Debatte. Tabelle 13 legt ein siebenstufiges Protokoll dar, um nachweisbare Nachweise aus dem zu rekonstruieren, was bleibt, und ihre bestimmende Anforderung, angewendet in der dritten und vierten Spalte, ist, dass jede in einem Dossier zitierte Zahl mit ihrer Quelle, ihrem Zeitfenster und ihren Einschränkungen reisen muss. Ein übersetzter Anspruch, der sich zu unquellenbewiesener Präzision verhärtet, ist schlimmer als gar kein Anspruch.
Tabelle 13. Nachsonnenuntergangs-Nachweisprotokoll für SSRN-Metriken in Tenure-, Beförderungs- und Einstellungsdossiers. Jeder Schritt benennt die Aktion, die Beweisgrundlage mit ihrem Zeitfenster, die Einschränkung, die neben jeder Zahl offengelegt werden muss, das zu vermeidende Anti-Pattern und die stärkste Schlussfolgerung, die der Schritt lizenzieren kann.
| Schritt | Aktion | Beweisgrundlage (Quelle; Zeitfenster) | Offenzulegende Einschränkungen | Zu vermeiden | Zulässige Schlussfolgerung |
|---|---|---|---|---|---|
| 1. Bewahren | Archivieren Sie datierte Screenshots des Statistik-Panels jedes Papers und des Autorenprofils in den Abständen von Tabelle 11 und vor jeder Einreichung; stellen Sie diese zusammen mit Verteilungshinweisen und einem datierten Protokoll der eigenen Beförderungsereignisse des Autors in das versionierte Nachweispaket von Abschnitt 6.1. | Pro-Paper-Zähler überdauern den Sonnenuntergang ([148][149]; 2026). Zähler können neu angegeben werden, wenn sich die Filterregeln ändern ([144][69]; seit 2018 dokumentiert). | Ein datiertes persönliches Archiv ist die einzige Fassung, die unter der Kontrolle des Autors steht; Plattformzahlen sind überarbeitbar und es gibt keine öffentliche Chronologie. | „Das Paper hat X Downloads" – zitiert ohne Datum oder Nenner. | Ein datiertes, prüfbares Protokoll dessen, was die Plattform angezeigt hat – eine zeitspezifische Beobachtung, nicht ein Lebensurteil. |
| 2. Übersetzen | Konvertieren Sie Zähler in Bandsprache unter Verwendung von Tabelle 8 (z. B. „Lebensdauer-Downloads über der ~160-Eintrags-Schwelle der Top-10.000-Papier-Liste von 2015, d. h. ungefähr die oberen 1,8 % des vollständigen Papierbestands der Plattform, 571.040 im Juli 2016 [1], zu dieser Zeit"), wobei Sie immer Quelle, Stichprobe und Jahr benennen; die CSAB-Vorlage von Anhang B liefert das Satzformat, wobei die Perzentil-Felder leer gelassen werden, bis ein Referenzpanel existiert. | Papierstufen-Schwellen: Eintrag ≥160, Gruppen-Median 805 (Top-List-Scrape; 2015) [85]. Autorenstufe: Eintrag Minimum 129 Gesamtdownloads, Gruppen-Median 1.626 (gleicher Scrape) [85]. Typische Papier-Ankerpunkte: Median 63 nach zwei Jahren (LSN; 2012→2014) [139]; Median 87 (Marketing-Netzwerk; Schnappschuss 2025) [83]. | Alle Schwellen stammen aus Stichproben von 2012–2015 (Inflation seitdem [1]: Abschnitt 5.1); der 2015-Rahmen deckt nur Top-Listen ab; die beiden Median-Ankerpunkte sind einzeldisziplinarisch. Bandsprache darf nicht als kalibriertes Perzentil umformuliert werden. | Universelle Bezeichnungen wie „ausgezeichnet" an einer alten rohen Schwelle. | Relative Stellung innerhalb der benannten Stichprobe, des Feldes und des Jahres – nichts Umfassenderes. |
| 3. Triangulieren | Verbinden Sie SSRN-Zähler mit unabhängigen Zitationsnachweis: Google Scholar, HeinOnline für Jura, RePEc für Wirtschaftswissenschaften, Crossref/OpenAlex als offene Zitationsschichten, PlumX wie auf SSRN angezeigt. | Schul-Level-SSRN-Download- und HeinOnline-Zitationsrankings korrelieren bei 0,84 (100 U.S. Rechtsfakultäten; 2019) [77]; Download-Zitationskorrelationen auf Papierebene laufen ~0,1–0,6 je nach Feld und Horizont [80][25]; offene Zitationsinfrastruktur [35][124]; PlumX [50]. | Die Abbildung von 0,84 ist eine Schul-Level-Korrelation und geht nicht auf einzelne Paper oder Autoren über (ökologische Inferenz-Vorsicht, Abschnitt 6.2(iii)); Downloads messen Nachfrage, nicht Lektüre oder Billigung; Paper-Level-Korrelationen sind bescheiden, und stark heruntergeladene und stark zitierte Sets überlappen sich nur teilweise [108]. Konvergente Zitationsnachweis, nicht nur der Zähler, trägt den Impact-Anspruch. | Ein Download mit Billigung oder Korrektheit gleichzusetzen. | Geschichtete Nachweise der Aufnahme, nicht Qualitätsbeweis. |
| 4. Felddiskriminieren | Geben Sie den disziplinarischen Rahmen explizit an (z. B. „innerhalb der Unternehmensrechtswissenschaft, wo eJournal-Mittel sich in juristischen Unterbereichen um etwa einen Faktor von acht unterscheiden"). | Unterfeld-Mittel 438,35 vs. 53,48 Downloads/Papier (LSN eJournals; 2018) [168]; Download-zu-Zitations-Verhältnisse sind selbst feldstrukturiert [18]. | Die Spread-Schätzung ist nur auf Jura beschränkt und stammt von 2018; Cross-Disziplinar-Übertrag jeder Schwelle erfordert Vorsicht, und Perzentil-Sprache ohne Feldqualifizierer ist nicht interpretierbar. | Vergleich eines neuen Papers mit einer mehljährigen kumulativen Summe, oder Transplantation einer Schwelle über Felder hinweg. | Ein feld- und altersqualifizierter Vergleich – nie eine universelle Bewertung. |
| 5. Ergänzen | Zitieren Sie Institutional-Repository und andere Verteilungskanäle neben SSRN. | SSRN-Zähler sagen nichts über Downloads desselben Papers von anderen Diensten [161]; die 2026-Reformen machten Repository-basierte Reihen zum Migrationspfad für institutionelle Verteilung [47][146]. | Kein Plattform-Zähler misst die Gesamtzirkulation eines Papers; der Dossier-Anspruch geht um das Paper, nicht um einen Zähler. | Einen Plattform-Zähler als die Gesamtzirkulation des Papers darstellen. | Eine Aussage über die Verbreitung des Papiers, wobei der Zähler jedes Kanals separat benannt wird. |
| 6. Integrität | Geben Sie die Zählregel der Plattform neben einer zitierten Anzahl an, und bewahren Sie das datierte Archiv auf, das die angezeigte Zahl dokumentiert. | Filterung und Neuformulierung sind dokumentiertes Plattformverhalten ([144][69][66]; laufend); von Anbietern gemeldete Download-Statistiken sind von Zählkonventionen abhängig ([69][176]; 2015–2019). | Zähler sind gefilterte, überarbeitbare Schätzungen; es gibt keinen öffentlichen Reformulierungsverlauf, daher ist das datierte Archiv des Autors der einzige stabile Datensatz. | Zähler als genaue Zahlen eindeutiger menschlicher Leser behandeln. | Eine gefilterte Schätzung unter einer angegebenen Regel zu einem angegebenen Datum – keine Erfassung der Leser. |
| 7. Fachbewertung | Präsentieren Sie jede Metrikzeile als Kontext für die qualitative Bewertung des Beitrags und der Rigorosität der Arbeit, nie als ihr Ersatz. | Metriken messen Phasen der Diffusion, nicht Validität (Abschnitte 3.1, 5.5); stark heruntergeladene und stark zitierte Mengen überlappen sich nur teilweise [108]. | Keine Nutzungsmetrik, normalisiert oder roh, bewertet, ob die Forschung korrekt oder wichtig ist. | Metriksubstitution für Fachurteil. | Kontextueller Nachweis begleitend zu Fachbewertung – die Qualitätsaussage ruht bei der Bewertung, nicht bei der Zahl. |
Die Spalte „Vermeiden" sammelt die Antimuster des Protokolls. Zwei Warnungen begrenzen das Protokoll als Ganzes. Ein Download dokumentiert passive Nachfrage statt Lesen, Unterstützung oder Qualität, und Zähler reagieren auf Publizitätsdynamiken (Blog-Berichterstattung, prägnante Titel, sachliche Wellen) genauso wie auf Wissenschaft [116][139][138]. Ausschüsse, die das Manipulationsprotokoll kennen [44], werden unbegründete Zahlen diskontieren, und die Bestandteile, die solch ein Diskontieren überstehen, sind genau die, die das Protokoll verlangt: datierte Screenshots, Band-Sprache mit beigefügten Quellen, Feldqualifizierer und Triangulation.
6.6 Das Sollizitations-Korollar
Das Posten hat eine dokumentierte Nebenwirkung, die kein Dashboard meldet: unaufgeforderte Einladungen von Raubzeitschriften und Konferenzen, erzeugt durch das Erfassen von Namen, Affiliationen und Papiertiteln von Preprint-Plattformen [107][159]. Das Volumen ist erheblich in benachbarten Audits, wo Spezialistenstudien Einladungsströme von Dutzenden pro Akademiker pro Woche bis zu Tausenden pro Spezialgruppe pro Monat dokumentieren (Abschnitt 7.2) [9][84][63]. Der erste Kontakt mit einer Raubzeitschrift ist eine unaufgeforderte E-Mail in etwa 41 % der befragten Fälle [32]. Abschnitt 7 und Tabelle 14 analysieren das Phänomen. Für das Playbook reduzieren sich die Konsequenzen auf vier Anweisungen. Erwarten Sie Sollizitationen als Standardfolge der Sichtbarkeit, und lesen Sie niemals ihr Volumen als wissenschaftliche Anerkennung: Die Absender zielen mechanisch auf Sichtbarkeit ab, nicht selektiv auf Verdienste [159][63]. Leiten Sie Korrespondenz über eine dedizierte Adresse, damit das Erfassen den primären Posteingang nicht kontaminiert; eine weit verbreitete Verbesserung, die die Profiladresse in den ersten zwei Wochen nach dem Posten verbirgt, ist eine unverifiedte Praxis (Anlage A). Zahlen Sie niemals, da das Geschäftsmodell die Gebühr ist, wobei die Gebühren für die Artikelverarbeitung in geprüften Raubzeitschriften zwischen 25 und 1.800 US-Dollar liegen [136]. Das Geld ist der kleinere Einsatz: Dieselben Bewertungskommissionen, die Dossiers überprüfen (Abschnitt 6.5), lesen auch Bibliografien, und ein bekannter Raubzeitschrifteneintrag auf einer Publikationsliste verursacht Reputationskosten, die länger andauern als jede Gebühr. Überprüfen Sie alle einladenden Veranstaltungen gegen einen verwalteten Screening-Service wie Cabells Predatory Reports ([B-1]; Bealls Liste wurde seit Januar 2017 nicht aktualisiert und darf nicht als Live-Quelle verwendet werden) und gegen die Checklisten von Think. Check. Submit. [159]. Der Erfassungsmechanismus liefert auch eine qualitative Siebung: Eine Zeitschrift, die innerhalb von Tagen nach dem Posten eines Preprints eine Einladung verschickt, bevor eine menschliche Leserschaft plausibel hätte entstehen können, ist überwiegend unwahrscheinlich, legitim zu sein. Das ist eine Heuristik; keine Studie hat deren Häufigkeit gemessen [63].
6.7 Umfang des Playbooks
Die Anker des Playbooks stammen aus den Jahren 2012 bis 2015 und sind rechts- und marketingorientiert [139][85][83][1]. Der Download-pro-Paper-Fluss ist seitdem gestiegen (Abschnitt 5.1). Frische, feldstratifizierte Perzentildaten existieren noch nicht; deren Erfassung durch die Plattform oder durch die Gemeinschaft ist Gegenstand der Abschnitte 8 und 10. Das Playbook reduziert Fehlinterpretationen und misst nicht die Qualität. Vier Regeln machen seine Verwendung mechanisch: vergleichen Sie angepasste Fälle, halten Sie das Beobachtungsfenster konstant, fügen Sie jeder Zahl eine Quelle bei, und kennzeichnen Sie eine Hypothese als Hypothese.
7. Die parasitäre Aufmerksamkeitsschicht: Sichtbarkeit und räuberische Werbung
Das bisher entwickelte interpretative Rahmenwerk behandelt Aufmerksamkeit als einen einzelnen Trichter, der von der Exposition zur abstrakten Ansicht zum Download bis zur nachgelagerten Nutzung verläuft. Die gelebte Erfahrung beim Hochladen eines Preprints umfasst jedoch häufig einen zweiten Strom von „Aufmerksamkeit", der über einen völlig anderen Kanal ankommt: unaufgeforderte E-Mail-Einladungen von Zeitschriften, Konferenzen und Redaktionsdiensten fragwürdiger Legitimität [14][61][117][142]. Es folgt eine konzeptionelle Darstellung dieses zweiten Stroms zusammen mit Prüfbelegen für seine dokumentierte Größenordnung.
7.1 Ein zweischichtiges Aufmerksamkeitsmodell
Die Post-Posting-Umgebung wird hier als zweischichtige Aufmerksamkeitsökonomie (Abbildung 10) behandelt. Schicht 1 ist der in den Abschnitten 4 und 6 beschriebene legitime Trichter: eJournal-Verteilung, Abstract-Aufrufe, Downloads und schließlich wissenschaftliche Nutzung. Schicht 2 ist eine parasitäre Schicht, ein Ökosystem räuberischer Verlage und Dienstleister, das von derselben öffentlichen Infrastruktur (Titel, Abstracts, Autorennamen und Zugehörigkeiten) lebt und darauf abzielt, Autoren in zahlende Kunden umzuwandeln, nicht ihre Arbeiten zu lesen. Die Fachliteratur zur Aufforderungs- und Prüfpraxis dokumentiert den Lebenszyklus. Öffentliche Preprint-Metadaten (SSRN-Titel, Abstracts, Autorennamen und Zugehörigkeiten) werden gesammelt [107][159], mimische Einladungen, die legitime Calls for Papers widerspiegeln, werden versendet [61][63], und Autoren, die sich einlassen, werden in zahlende Kunden umgewandelt. Das Wirtschaftsmodell ist ebenfalls dokumentiert: Artikel-Bearbeitungsgebühren bei angenommenen räuberischen Zeitschriften betragen durchschnittlich etwa 178 USD, mit einem gemeldeten Bereich von 25–1.800 USD [136].
Die Asymmetrie zwischen den beiden Schichten ist für die Interpretation wichtig. Schicht 1 erfordert, dass ein menschlicher Leser die Arbeit bemerkt, öffnet und wertet, während Schicht 2 nur erfordert, dass die Metadaten des Papers maschinenlesbar werden. Ein Preprint kann daher grundsätzlich vollständig von der parasitären Schicht verarbeitet werden, während er in der legitimen Schicht praktisch ungelesen bleibt. Das ist die Situation der Near-Zero-Download-Papers der Plattform, der „Ghost Papers", die von Maschinen verarbeitet werden, von Menschen aber faktisch nicht gelesen werden.
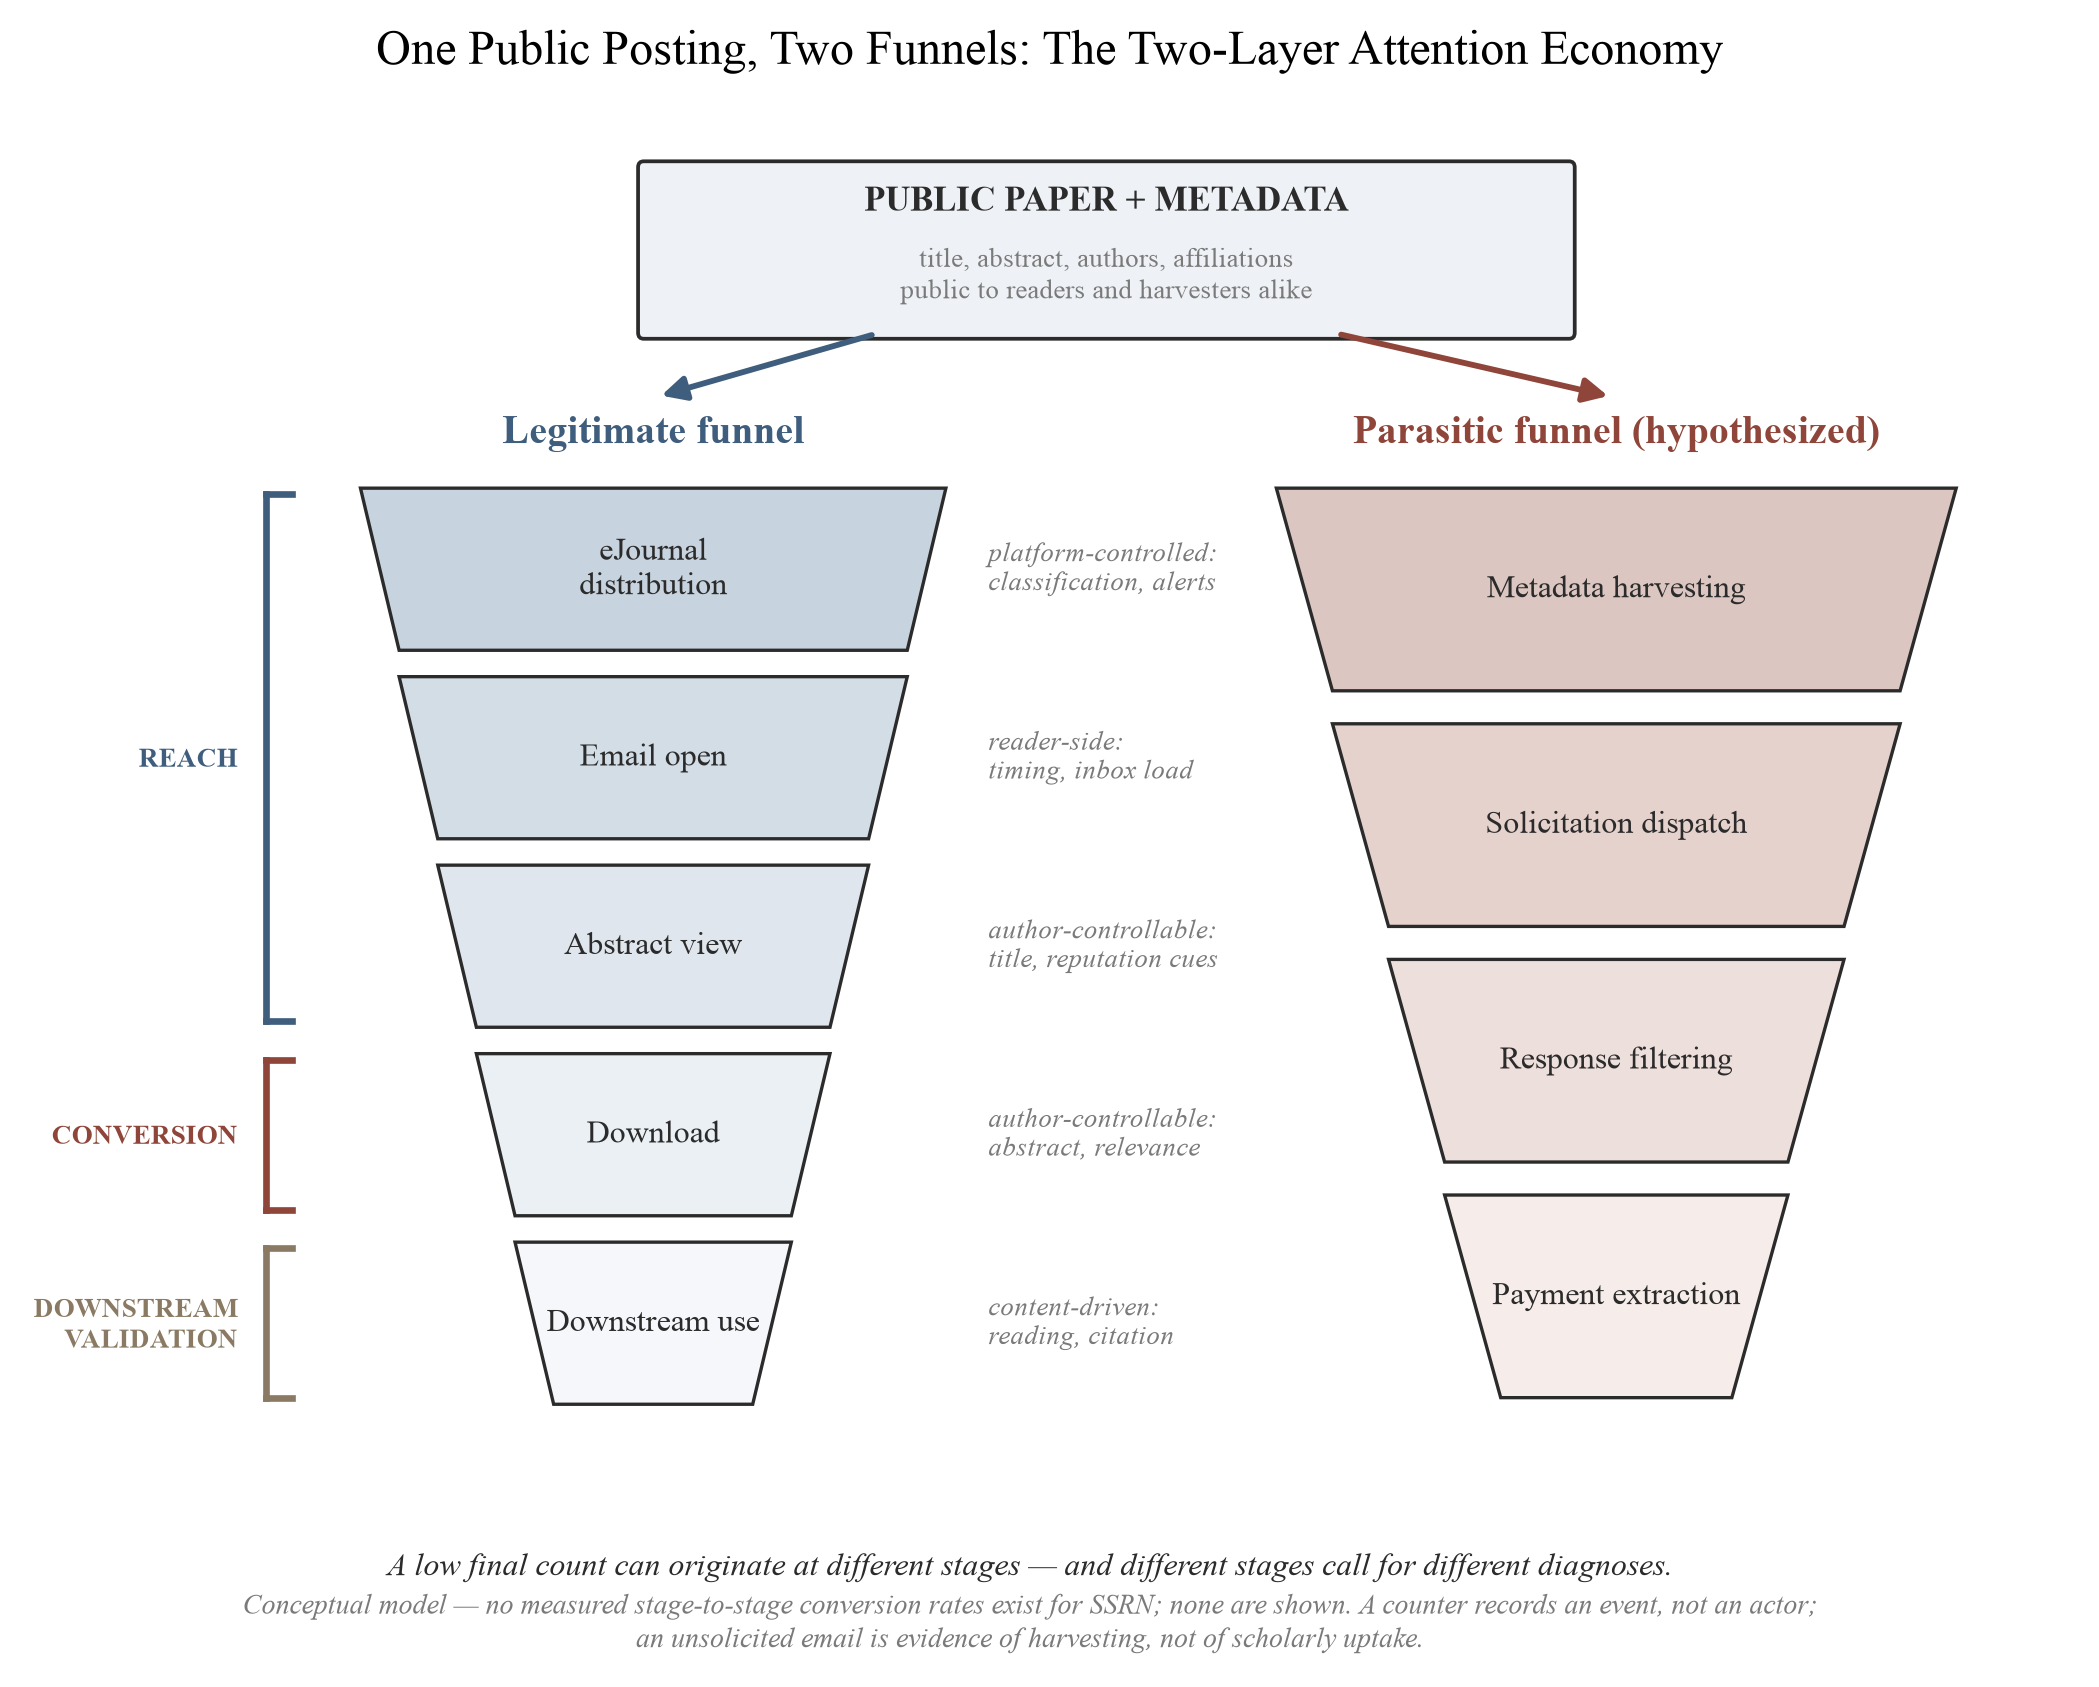
Abbildung 10. Konzeptionelles Modell der zweischichtigen Aufmerksamkeitsökonomie. Beide Trichter werden als qualitative Stufenfolgen dargestellt; keine Umwandlungsraten von Stufe zu Stufe werden angezeigt, da solche Raten für SSRN nicht gemessen wurden. Der parasitäre Trichter ist eine hypothetische Rekonstruktion basierend auf der Fachliteratur zur Aufforderungs- und Prüfpraxis [61][63][107][159] (Abschnitt 7.3).
7.2 Das dokumentierte Ausmaß räuberischer Anfragen
Dass räuberische Anfragen ein großflächiges Phänomen darstellen, ist unbestritten. Eine Übersichtsarbeit aus dem Jahr 2026 identifizierte neunundzwanzig empirische Studien zu akademischem Spam und konvergierte auf ein Repertoire von Taktiken: schmeichelhafte Anfragen, falsche redaktionelle Behauptungen und zweifelhafte Metriken sowie Indexierungsaussagen [61]. Die gemessenen Volumen sind erheblich. Vierzehn akademische Ophthalmologen erhielten 1.813 Anfrage-E-Mails von 383 einzigartigen Verlagen, die sich über 696 einzigartige Zeitschriften erstreckten, innerhalb eines einzelnen 30-Tage-Fensters [84]. Akademische Radiologen erhielten im Durchschnitt 20,7 Manuskripteinladungen und 4,1 Rednereinladungen über einen Zeitraum von zwei Wochen [9]. Eine explorative Überprüfung katalogisierte 422 Anfrage-E-Mails, die von einem einzelnen Urologen über 2023–24 empfangen wurden [63], und eine Fallstudie im wissenschaftlichen Verlagswesen protokollierte 1.024 Spam-E-Mails von Zeitschriften über 391 Tage [89]. Eine einjährige Einzelbeobachtung eines Forschers nach dem Posten von Preprints verzeichnete 875 Einladungen von 256 Zeitschriften, von denen 76 % auf kuratierten Blocklisten erschienen, eine bedingte Quelle, die hier mit der Einschränkung zitiert wird, dass Ankunftsverzögerungen nach dem Posten nicht gemessen wurden [B-10]. Anfragen führen nachweislich zu Konversionen. Unter Autoren, die in vermeintlich räuberischen Zeitschriften veröffentlicht hatten, berichteten 41 %, dass ihr erster Kontakt mit der Zeitschrift eine unaufgeforderte E-Mail-Einladung war [32], und Inhaltsanalysen von Anfrage-Korpora dokumentieren schmeichelhafte Sprache, erfundene Fristen und vage thematische Geltungsbereiche als wiederkehrende Überzeugungsmechanismen [96].
Auch sind die Belege nicht auf die Medizin beschränkt. In den Sozialwissenschaften, disziplinär dem eigenen Fundament von SSRN viel näher, erhielten drei Forscher in den Erziehungswissenschaften 210 unaufgeforderte Zeitschrifteinladungen innerhalb von drei Monaten, zurückzuführen auf 139 Zeitschriften und 37 Verlage, von denen die meisten als räuberisch klassifizierbar sind; etwa die Hälfte der Einladungen lag außerhalb der Fachgebiete der Empfänger, das Kennzeichen metadatengestützter statt lesergestützter Ausrichtung [155]. Die Belastung fällt am frühesten auf den Protagonisten dieses Artikels, den Autor in der frühen Karrierephase. Eine längsfristige Selbstüberprüfung eines akademischen Frühkarriere-Forschers protokollierte 1.280 räuberische Anfragen (990 von Zeitschriften, 220 von Konferenzen und 70 sonstiger Art) über etwa acht Jahre hinweg, zusammen mit dokumentierten und weitgehend erfolgslosen Versuchen, sich abzumelden [160].
Zwei Merkmale dieser Evidenzbasis müssen berücksichtigt werden. Die größten Überprüfungen stammen aus der Medizin, und die oben erwähnten Überprüfungen aus den Sozialwissenschaften sind zwar disziplinär näher an SSRN, aber kleiner; kein Volumen aus beiden Literaturen kann auf SSRN-Autoren übertragen werden. Entscheidend für diesen Artikel ist, dass keine dieser Studien das Timing von Anfragen in Bezug auf ein Preprint-Posting-Ereignis gemessen hat. Die Überprüfung in [63] katalogisierte beispielsweise Inhalt und Herkunft, verknüpfte aber Ankunftszeiten nicht mit SSRN-Aktivität. Jeder Anspruch, der die parasitäre Schicht mit dem Akt des Postens verbindet, ist daher eine Mechanismushypothese, kein Befund.
7.3 Hypothetische Zielungsmechanismen
Um einen neu veröffentlichten Preprint zu erreichen, muss die parasitäre Schicht ihn zunächst lokalisieren. Die folgenden Mechanismen sind Hypothesen mit teilweiser Unterstützung in der Literatur; kein Korpus verbindet Anfragen mit SSRN-Veröffentlichungen.
H-S1 (Metadaten-Harvesting). Predatorische Operationen scrapen öffentliche Abstract-Seiten und Neu-Paper-Auflistungen nach Titeln, Autorennamen und Zugehörigkeiten. Praktiker und beratende Quellen beschreiben dieses Verhalten: Predatorische Zeitschriften sollen Preprint-Server durchsuchen und unaufgeforderte Einladungen verschicken, die den Titel des Papers referenzieren [159]. Ein Kommentar zur Rechtsgelehrsamkeit besagt, dass Anfragende „E-Mail-Adressen, Namen, Zugehörigkeiten usw. durch das Durchsuchen vorhandener wissenschaftlicher Arbeiten sammeln, z. B. solcher, die auf SSRN veröffentlicht sind" [107], und ein Ratgeber einer Gesetzesbibliothek verbindet die Veröffentlichung von Preprints mit „einem Anstieg von Spam von predatorischen Verlagen, die Forschende auffordern, ihre Artikel gegen eine Gebühr erneut zu veröffentlichen" [117]. Eine gemessene Regelmäßigkeit entspricht dem Mechanismus. Bei der Radiologie-Audit berichten die Spezialitäts-Audits über hohe Anfragevolumina unter aktiv publizierenden Autorschaften [9], was mit dem Harvesting aus der kumulativen bibliographischen Oberfläche einer Autorschaft vereinbar ist, anstatt von einem einzelnen Veröffentlichungsereignis. Studie 3 (Abschnitt 8.6) dokumentiert dementsprechend Kontrollen auf Autor-Ebene neben der fokalen Veröffentlichung.
H-S2 (Kontaktakquisition). Anfragen erfordern eine E-Mail-Adresse. SSRN-Abstract-Seiten enthielten historischerweise Kontaktinformationen der Autoren [151], und Adressen zirkulieren auch in den Papieren selbst, auf institutionellen Seiten und in früheren Veröffentlichungen. Ob SSRN derzeit Autoren-E-Mails in harvestbarer Form bereitstellt, ist ungetestet; die instrumentierte Anfrage-Logging-Studie ist so konzipiert, dass sie dies misst. Der Akquisitionskanal für eine beliebige Anfrage ist unbeobachtet.
H-S3 (Verteilungs-Trittbrettfahren). eJournal-Digeste und RSS-ähnliche Feeds verteilen neue-Paper-Metadaten an Abonnenten [57][51]. Ein parasitärer Akteur, der diese Kanäle abonniert hat, würde strukturierte Leads ohne Scraping erhalten. Keine Audit hat diese Route verifiziert.
Die kausale Kette von der Veröffentlichung zum Zielwerden wurde nicht empirisch etabliert; Abschnitt 8 spezifiziert einen vorab registrierten Test dieser Mechanismen: Protokollierung von Anfragenankünften gegen bekannte Veröffentlichungszeitstempel für frisch veröffentlichte Papiere.
7.4 Eine hypothetische Typologie von Anwerbungssignalen
Wenn die Zielungsmechanismen von Abschnitt 7.3 wirken, sollten unterschiedliche Klassen von Anwerbung unterschiedliche Informationen über die maschinelle Sichtbarkeit eines Papers vermitteln. Tabelle 14 zeigt dies als hypothetische Typologie, deren Strategiekategorien in dokumentierten Überzeugungstaktiken verankert sind: Qualifikationsmismatch und fehlzielgerichtete Personalisierung [9][63], erfundene Fristen und Schmeichelei [96], falsche Metrik- und Indexierungsansprüche [61] und verborgene Gebühren gegenüber einem dokumentierten APC-Markt [136]. Die letzte Spalte ist inferenziell und ungetestet. Die Tabelle gibt keine Prävalenzprozentsätze und keine Ankunftszeitschätzungen an.
Tabelle 14. Eine hypothetische Typologie von räuberischen Anwerbungssignalen nach dem Hochladen von Preprints. Beispielformulierungen sind illustrativ, erfundene Umschreibungen von Mustern, die in Anwerbungsprüfungen dokumentiert sind [9][61][96], nicht wörtliche Zitate aus einer bestimmten Nachricht.
| Anwerbungsmuster | Beschreibung | Illustrative Formulierung | Hypothetische Information über Sichtbarkeit |
|---|---|---|---|
| Generische Anrede, kein Papierrreferenz | Automatisierte Einladung ohne Erwähnung des spezifischen Papers oder Fachbereichs | „Liebe geschätzte Forscherin/Forscher, reichen Sie Ihre wertvolle Arbeit ein…" | Niedrig: Die Anrede kann aus jeder Quelle stammen; kein Nachweis, dass das Paper selbst gesehen wurde |
| Qualifikationsmismatch | Einladung, die Expertise in einem zum Paper unverwandten Gebiet zitiert [9] | „Angesichts Ihrer Expertise in Quantenphysik…" (zu einem Jura-Paper) | Niedrig bis keine: deutet auf Massenabfrage ohne Metadaten-Parsing hin |
| Zielgerichtet, titelreferenzierend | Einladung, die das spezifische Preprint und einen thematisch benachbarten Ort nennt [159] | „Ihr kürzlich erschienenes Paper ‚[genauer Titel]' würde zu unserem Journal passen…" | Höher (hypothetisiert): Die Metadaten des Papers erreichten den Absender, was auf erfolgreiche Indexierung und Scraper-Zugriff hindeutet |
| Schmeichelhafte Personalisierung | Lob der spezifischen Arbeit als „bahnbrechend" oder „angesehen" [96] | „Ihr bahnbrechender Beitrag…" | Nichts über Titelverstehen hinaus: Lob ist vorlage, nicht gelesen |
| Erfundene Dringlichkeit und Metriken | Erfundene Fristen, gekennzeichnete „Impact Factors", Indexierungsansprüche [61][96] | „Impact Factor 4,2*; Einreichung innerhalb von 7 Tagen" | Nichts: Überzeugungsgerät unabhängig vom Ziel-Paper |
| Verborgene Gebühren | APC spät oder nur in Anhängen offengelegt; Marktbereich 25–1.800 USD [136] | Gebühr fehlt im Nachrichtentext | Nichts: Preisstrategie, nicht Sichtbarkeitssignal |
| Konferenzeinladung, Paper-referenzierend | Einladung, auf einer fragwürdigen Konferenz zu präsentieren oder einzureichen, oft mit Nennung des spezifischen Papers; Sprechereinladungen sind eine gemessene Komponente akademischer Spam [61][9] | „Wir laden Sie ein, Ihr Paper ‚[genauer Titel]' als Hauptvortrag auf… zu präsentieren" | Wie bei zielgerichteter Anwerbung (hypothetisiert): Die Metadaten des Papers erreichten den Absender; kein Nachweis substantieller Lektüre |
| Bezahlte Autorenserivces | Angebote für beschleunigte Fachbegutachtung, Übersetzung oder Lektorat, die auf einem kürzlich hochgeladenen Preprint angeboten werden [61][84] | „Schnelle Überprüfung und professionelle Sprachpolitur für Ihr neues Preprint…" | Nichts etabliert: Service-Spam verfolgt neue Posting-Metadaten, nicht Paper-Inhalt |
Die Schmeichel-Reihen tragen eine psychologische Dimension, die die mechanische Lesart verdunkelt. Vorlagen-Lob trifft auf eine Autorin/einen Autor, die/der auf einen stagnierenden Zähler starrt, für den die Anwerbung die einzige „Validierung" ist, die der Beitrag bisher erhalten hat. Das Zwei-Ebenen-Modell sagt somit eine grausame Umkehrung voraus, bei der die ersten Antwortenden auf ein neues Preprint häufig Raubtiere statt Leserinnen/Leser sind (Abschnitt 7.5), und eine Neuankömmling kann Spam als Interesse falsch auslegen, weil noch kein legitimes Signal angekommen ist. Eine Autorin/Ein Autor, die/der den Köder erwartet, kann ihn diskontieren.
Tabelle 14 liest eingehende Nachrichten für das, was sie über die Sichtbarkeit eines Papers offenbaren könnten. Die Frage, wie diese Nachrichten überhaupt codiert werden, ist die ergänzende Frage, und sie beruht auf einer bisher impliziten Unterscheidung zwischen legitimer wissenschaftlicher Kontakt und höheres Risiko aufweisender Anwerbung. Tabelle 15 legt diese Unterscheidung als sechssignaltypologie dar, deren letzte Spalte die Codierungsvorsichtsmaßnahmen trägt: Jedes Signal ist probabilistisch und keines ist selbstverständlich ein Nachweis. Die Typologie ist auch das Gerüst des Study-3-Codebuchs (Abschnitt 8.6), da eine Anwerbungsstudie ohne eine positive Klasse legitimer Kontakte die Asymmetrie, die Abschnitt 7.5 hypothetisiert, nicht messen kann.
Tabelle 15. Trennung legitimen wissenschaftlichen Kontakts von höheres Risiko aufweisender Anwerbung: sechs Signale mit Codierungsvorsichtsmaßnahmen. Ein hypothetisches Codierungsschema, kein validierter Klassifizierer. Die Sichtbarkeitsspalte von Tabelle 14 stellt eine andere Frage und ist unberührt: dieselbe Nachricht kann auf beiden Gittern codiert werden.
| Signal | Legitimer wissenschaftlicher Kontakt | Höheres Risiko aufweisende Anwerbung | Codierungsvorsichtsmaßnahme |
|---|---|---|---|
| Spezifität | Nimmt ein konkretes Argument, eine Methode oder ein Ergebnis auf | Generisches Lob mit eingefügtem Titel oder Stichwörtern | Spezifität kann nachgeahmt werden |
| Identität des Ortes | Überprüfbares Journal, Herausgeber, Institution oder Konferenzgeschichte | Unklar Eigentümerschaft, kopierte Markengestaltung, unüberprüfbarer Beirat | Neue Orte sind nicht automatisch räuberisch |
| Anfrage | Inhaltliche Frage, Zusammenarbeit oder transparente Einladung | Dringende Einreichungs- oder Zahlungsanfrage ohne Bezug zur Arbeit | Gebühren allein sind nicht entscheidend; Transparenz ist wichtig |
| Zeitpunkt | Beliebiger Zeitpunkt; folgt oft tatsächlicher Lektüre | Schneller vorlagenkontakt bald nach öffentlicher Veröffentlichung | Zeitliche Nähe beweist die Abfragequelle nicht |
| Sprache | Themenspezifisch und beruflich verantwortlich | Schmeichelei, falsche Vertrautheit, künstliche Dringlichkeit, vager Umfang | Sprachmerkmale sind probabilistisch, nicht Nachweis |
| Überprüfung | Unabhängig überprüfbare Kontaktdetails und Richtlinien | Fehlerhafte Identifizierer, falsche Metriken, irreführende Indexierungsansprüche | Menschliche Überprüfung nach dokumentierten Kriterien ist erforderlich |
In der Praxis liefert die Typologie eher eine Screening-Heuristik als eine Diagnose: Eine Zeitschriftenaufforderung, die in den ersten Tagen nach dem Hochladen eintrifft, bevor legitime Vertriebskanäle plausibel tätig geworden sind, ist sehr wahrscheinlich räuberisch. Seriöse hochimpaktive Zeitschriften werden nicht berichtet, um Autoren von gerade hochgeladenen Manuskripten anzurufen [174], während frühe unaufgeforderte Einladungen der dokumentierte erste Kontaktmodus räuberischer Veranstaltungsorte sind [32][174]. Wir schlagen die spezifische Schwelle vor, die manchmal in Praktikerdiskussionen vorgeschlagen wird (jede Zeitschriften-E-Mail in etwa den ersten 96 Stunden als vermutlich räuberisch behandeln), als eine Autor-Heuristik unter Vorbehalt der Validierung. Keine Studie hat die Verzögerungsverteilung gemessen, die einen solchen Schwellenwert kalibrieren würde. Die zeitliche Vorsicht von Tabelle 15 gilt für die Heuristik selbst: zeitliche Nähe erregt Verdacht, beweist aber nicht, dass der Absender diesen bestimmten Beitrag geerntet hat, da die Adresse dem Preprint vollständig vorausgehen kann, so dass das 96-Stunden-Screening Posteingänge und nicht Beweise sortiert.
7.5 Das Spam-Paradoxon und die Geschwindigkeitsasymmetrie
Zwei weitere Aussagen über die parasitäre Schicht folgen aus dem Zwei-Schichten-Modell.
Das Spam-Paradoxon. Wenn gezielte Anfragen eine erfolgreiche Metadaten-Erfassung erfordern, dann kann in der Post-Rankings-Umgebung die Abwesenheit von räuberischem Spam ein stärkerer Indikator für Plattform-Unsichtbarkeit sein als seine Präsenz für etwas anderes ist. Ein Paper, das nicht einmal die parasitäre Schicht auslöst, könnte es versäumt haben, die minimale Hürde der maschinenlesbaren Verbreitung zu überschreiten. Die analytische Attraktivität dieser Umkehrung, bei der Spam als unwilliger und toxischer Proxy für Indexierung fungiert, besteht darin, dass sie eine unvermeidliche Unannehmlichkeit in ein kostenloses Beobachtungsinstrument verwandelt. Seine diagnostische Aussagekraft ist derzeit nur eine Hypothese: die Korrelation zwischen Anfrage-Empfang und einer beliebigen Sichtbarkeitskennzahl ist nie gemessen worden, und die Reihen generischer Anfragen in Tabelle 14 zeigen, warum rohes Spam-Volumen auch grundsätzlich ein verrauschtes Signal wäre.
Räuber treffen vor Lesern ein. Der legitime Trichter arbeitet mit institutionellen Verzögerungen: eJournal-Aufnahme wird kuratiert und nicht garantiert, mit Verzögerungen von bis zu 45 Tagen, die für Klassifikationen mit hohem Volumen berichtet werden [53], und die Google-Scholar-Indexierung dauert sechs bis neun Monate oder länger [55]. Nahe Null Downloads in der ersten Woche sind konsistent mit normaler Vor-Verbreitung statt Ablehnung (Abschnitt 6). Die parasitäre Schicht sieht sich bei programmatischer Metadaten-Erfassung keinen dieser Verzögerungen gegenüber. Wir vermuten daher, dass für einen Autor, dessen Kontaktinformationen erhältlich sind, die erwartete Zeit bis zur ersten räuberischen Anfrage aufgrund eines Postings kürzer ist als die erwartete Zeit bis zum ersten echten wissenschaftlichen Kontakt, sodass der unbekannte Autor die parasitäre Schicht vor der legitimen treffen würde. Der Falsifizierer ist direkt: echter Kontakt geht zuverlässig voraus Anfragen.
Dokumentierte Anfrage-Volumen gemessen in Tagen und Wochen [9][84], gegenüber Verbreitungsmechaniken gemessen in Wochen und Monaten [55][53], machen die Hypothese plausibel. Nur die in Abschnitt 8 angegebene Logging-Studie kann sie testen, da die vorhandenen Corpora nicht zeitgebunden an Posting-Ereignisse waren [63].
7.6 Was die parasitäre Schicht einem Autor nicht verrät
Drei Grenzaussagen begrenzen die Schlussfolgerungen dieses Abschnitts.
Erstens, Aufforderungs-E-Mails bewegen die Zähler der Plattform nicht. Eine Einladung, die an den Autor gesendet wird, erzeugt keine abstrakte Ansicht und keinen Download des Papers. Soweit Scraper abstrakte Seiten besuchen, gibt SSRN an, dass es unregelmäßige und automatisierte Aktivitäten aus seinen Download-Zählen filtert [66][69][144]. Spam-Volumen ist daher niemals ein Beweis für Lesbarkeit, und ein Posteingang voller Aufforderungen, der mit einstelligen Downloads koexistiert, beinhaltet keinen Widerspruch: die beiden Schichten zählen unterschiedliche Dinge.
Zweitens, die parasitäre Schicht trifft auch am härtesten die Autoren, die am wenigsten ausgerüstet sind, ihre Kosten zu tragen: Forscher in der frühen Karrierephase und Nicht-Muttersprachler werden als besonders anfällig für Aufforderungen erwähnt [142]. Das praktische Protokoll von Abschnitt 6 behandelt daher Inbox-Hygiene (Blocklist-Screening aller auffordernd tätigen Veranstaltungsorte, Nichtreaktion auf unaufgeforderte Einladungen, Verifizierung durch kurierte Dienste anstelle von defekten Listen) als Teil der Metrik-Interpretation statt als separate Angelegenheit. Automatisiertes Screening von räuberischen Veranstaltungsorten ist selbst eine aktive Forschungsrichtung [157].
Drittens hat die frühe Sichtbarkeit einen weiteren Nebeneffekt, dem Autoren als scheinbarer Vorwurf begegnen: Bei später erfolgter Zeitschrifteneinreichung wird eine Ähnlichkeitsprüfungssoftware eine nahezu vollständige Übereinstimmung zwischen dem Manuskript und seinem eigenen SSRN-Vorläufer kennzeichnen, da Preprints im von iThenticate genutzten Crossref Posted Content Corpus indiziert sind [36]. Die Dokumentation des Anbieters macht explizit deutlich, dass eine Übereinstimmung mit einem Preprint desselben Autors ein erwartetes Ergebnis ist und kein Plagiat [81]. Die angemessene Reaktion ist, den Preprint dem Editor offenzulegen, nicht ihn zurückzuziehen.
Die parasitäre Schicht ist der Ort, an dem die zentrale Aussage dieses Artikels am leichtesten zu erkennen ist: Nach dem Sunset der Rankings tragen rohe Signale (Downloads, Aufrufe und nun sogar Spam) interpretierbare Bedeutung nur dann, wenn der Mechanismus, der sie generiert hat, spezifiziert ist. Diese Spezifikation ist für die legitime Schicht teilweise verfügbar, und für die parasitäre Schicht ist sie noch ein Forschungsprogramm.
8. Ein preregistrierungsfähiges Forschungsprogramm: Wiederaufbau der fehlenden Referenzklasse
Die vorhergehenden Abschnitte synthetisierten die überprüfbaren Evidenzen zu SSRN-Aufmerksamkeitsmetriken und schlugen einen Interpretationsrahmen für die Post-Rankings-Umgebung vor. Dieser Abschnitt ist eine preregistrierungsfähige Agenda zur empirischen Beantwortung der offenen Fragen des Rahmens. Er berichtet designbedingt keine Ergebnisse: vorspezifizierte, falsifizierbare Bänder statt Befunde. Jedes Design, jede Hypothese und jedes Vorhersageband unten ist bereit, vor der Datenerfassung im Open Science Framework registriert zu werden, mit Analysecode, der gleichzeitig freigegeben wird. Die Einstellung der SSRN Rankings am 15. Juli 2026 [149], angekündigt am 12. Juni 2026 mit einem anfänglich früheren Zieldatum [148] und eingebettet in eine breitere Plattformumausrichtung [146], macht diese Agenda ungewöhnlich zeitkritisch: Einige der Designs unten nutzen eine Diskontinuität aus, deren Vorperiode mit jedem Monat abnimmt, und eines davon, das Perzentil-Register von Abschnitt 8.8, adressiert eine Messlücke, die der Sunset selbst für externe Beobachter dauerhaft gemacht hat.
8.1 Designprinzipien
Vier Prinzipien bestimmen die Agenda.
Beobachtung von Anfang an. Das nachträgliche Scrapen kumulativer Zähler kann nicht rekonstruieren, welche Werte ein Paper am Tag 3, Tag 7 oder Tag 30 hatte. Jedes glaubwürdige Benchmark-Panel muss daher Papers bei der Veröffentlichung registrieren und ihre Zähler in standardisierten Abständen erfassen: Tage 1, 3, 7, 14, 30, 60, 90 und 180 (Tabelle 11), wobei tägliche Beobachtungen in den ersten 45 Tagen vorzuziehen sind, da SSRN angibt, dass die Alertverteilung bei stark abonnierten Themen bis zu 45 Tage dauern kann [53]. Dieses Prinzip schützt auch vor Leckage: Reputationsmessungen des ursprünglichen Autors müssen zum Veröffentlichungsdatum eingefroren werden, damit zukünftiger Erfolg nicht die Baseline-Kovariate kontaminieren kann. Die Begleitdisziplin, die aus Abschnitt 5.6 übernommen wird, ist, dass Verteilungs-, Indexierungs- und Promotionsereignisse in den nachfolgenden Designs als datierte Behandlungen eingehen und niemals als unmodellierter Kontext.
Trennung von Reichweite und Konversion. Gemäß der diagnostischen Logik von Abschnitt 5 (Tabelle 9) erfasst jedes nachfolgende Design Abstract-Aufrufe und Downloads als unterschiedliche Ergebnisse und modelliert Downloads bedingt durch Aufrufe. Geringe Reichweite und geringe Konversion sind unterschiedliche Diagnosen: Nichteintritt in die Überlegungsmenge des Lesers versus Nichterwerbung nach Exposition. Das Zusammenfassen in eine einzelne Zahl verwirft die Information, die ein Autor benötigt.
Verteilungsergebnisse, nicht nur Mittelwerte. Da die Plattformaufmerksamkeit stark linksverteilt ist [83][85][180], können Interventionen und Plattformänderungen die Form der Verteilung verändern, während der Mittelwert nahezu unverändert bleibt. Die Ergebnisse umfassen daher den Gini-Koeffizienten der Aufmerksamkeit, die Top-1%- und Top-10%-Download-Anteile, den Anteil von Papers bei oder nahe Null und Quoten der Aufmerksamkeit von Neuankömmlingen zu etablierten Akteuren, in der Tradition der Aufmerksamkeitsungleichheitsmessung in anderen Medien [180].
Falsifizierbarkeit. Jede Hypothese ist mit einer Identifikationsstrategie und einer angegebenen Bedingung gepaart, unter der sie fehlschlägt. Der Rahmen selbst ist einer Ablehnung ausgesetzt: Wenn normalisierte frühe Metriken nach Alter und Feld rohes Zählwerk außerhalb der Stichprobe nicht übertreffen (RQ3 unten), sollte der behauptete Messvorteil der Normalisierung abgelehnt oder eingeengt werden. Falsifizierbarkeit ist auch quantitativ: Stichprobenumfänge in der gesamten Agenda sind durch Leistungssimulation gegen die kleinsten Effektgrößen von Interesse zu finalisieren. Die Multiplikitätsstrategie für ein Programm von fünf Hypothesen, drei Forschungsfragen und fünf Propositionen wird bei der Vorregistrierung festgelegt, und bestätigende und explorative Analysen werden im Voraus als solche gekennzeichnet. Ausfälle (zurückgezogene, zusammengefasste oder wesentlich überarbeitete Papers) werden nachverfolgt und gemeldet, anstatt stillschweigend gelöscht zu werden, mit einem Kohortenflussdiagramm in jedem empirischen Bericht des Programms (Abschnitt 8.8).
8.2 Hypothesen und Forschungsfragen
Das Rahmenwerk generiert fünf Hypothesen und drei Forschungsfragen zur Allokation früher Aufmerksamkeit sowie fünf Propositionen zu deren Struktur. Tabelle 16 verbindet die Hypothesen, die Forschungsfragen und die Propositionen mit dedizierten Designs (P2, P3b, P4) zu einem Ergebnis, einem Kontrast und einem bevorzugten Design; P1 und P3 werden durch Studien 1 und 2 in Tabelle 17 gestützt.
H1 (Cold-Start-Nachteil). Unter Kontrolle von Feld, Posting-Kohorte, beobachtbarem Thema, Dokumentmerkmalen und Kalenderbedingungen erhalten Arbeiten, die ausschließlich von Plattform-Neulingen verfasst wurden, weniger initiale Abstract-Seitenaufrufe als Arbeiten mit mindestens einem zuvor sichtbaren SSRN-Autor. Das zentrale Ergebnis ist Aufrufe statt Downloads pro Aufruf, da H1 die Publikumsbildung und nicht die Konversion betrifft.
H2 (Prestige und Exposition). Institutionelles und Autoren-Prestige sagen frühe Abstract-Seitenerreichbarkeit positiv voraus, nach Kontrolle von vorheriger Plattformaktivität und beobachtbaren Papiermerkmalen, und erweitern die Status-Aufmerksamkeits-Literatur [104][105][111][140][60] auf die erste Phase der Preprint-Verbreitung.
H3 (Prestige und bedingte Konversion). Institutionelles Prestige sagt vollständige Textdownloads positiv voraus, bedingt auf Abstract-Seitenexposition. Jo und Li liefern jüngste feldspezifische Evidenz, die konsistent mit diesem Muster im Marketing ist – eine Prestige-Prämie von etwa +6,6 % in der Download-Rate für ein Drei-Autoren-Papier mit einem Top-50-Autor [83] –, aber ein breiterer Längsschnitttest bleibt notwendig. Gemeinsam definieren H2 und H3 den Schlagzeilenschätzwert des Panels: eine Erreichbarkeits-versus-Konversions-Zerlegung des Prestige-Gradienten, also der Anteil der beobachteten Prestige-bezogenen Ungleichheit bei Downloads, der vor dem Abstract-Seitenbesuch (Exposition) versus danach (bedingte Konversion) entsteht. Ein Befund, dass sich der Großteil des Gradienten vor der Abstract-Einsicht durch irgendeinen Leser bildet, würde die Ungleichheit in Entdeckungsmechaniken statt in Inhaltsbewertung lokalisieren, in direkt messbarer Form.
H4 (Kommunikation als Ausgleich). Größere Abstract-Klarheit und Informationseffizienz sind mit größeren Verbesserungen der bedingten Konversion bei Autoren mit niedriger vorheriger Sichtbarkeit verbunden als bei bereits sichtbaren Autoren. H4 ist die einzige Hypothese, deren Intervention vollständig in der Kontrolle des Autors liegt. Sie sollte mit vorspezifizierten Textmaßnahmen und separat mit einem randomisierten Abstract-Experiment getestet werden, das nach Online-Feldexperiment-Standards konzipiert ist [30]. Sie sollte sich nicht ausschließlich auf automatisierte „KI-geschriebene" Klassifizierer verlassen, die ihre eigene Messunsicherheit einführen.
H5 (Persistenz von Expositionsschocks). Exogene oder quasi-exogene frühe Expositionsschocks sagen erhöhte nachfolgende Aufmerksamkeit über das unmittelbare Expositionsfenster hinaus voraus: das gelehrte-Plattform-Analogon zu Erfolg-erzeugt-Erfolg-Dynamiken, die anderswo experimentell dokumentiert sind [112][131][162], und zu Positionsexpositionseffekten auf arXiv [72][73].
RQ1. Hat die Pensionierung von Rankings am 15. Juli 2026 die Konzentration, Verteilung oder den Prestige-Gradienten der Aufmerksamkeit verändert? Zwei gegensätzliche Vorhersagen sind beide plausibel, und die Frage bleibt zweiseitig: Das Entfernen von Rankings kann Popularitäts-Rückkopplungsschleifen abschwächen [112][131], oder es kann stattdessen die Abhängigkeit von vorbestehenden Autoren-Netzwerken erhöhen, indem eine Entdeckungsfläche entfernt wird, durch die unbekannte Arbeiten sichtbar werden konnten, sobald sie Aufmerksamkeit zu erhalten begannen.
RQ2. Erzeugt kuratierte E-Mail-Alert-Verteilung größere proportionale Aufmerksamkeitsgewinne für Neulinge oder für etablierte Autoren?
RQ3. Sagen normalisierte frühe Metriken, die an Tag 7 und 30 beobachtet werden, später gelehrte Zitationen oder Publikationsergebnisse besser voraus als rohe kumulative Downloads?
Die Propositionen formulieren die strukturellen Aussagen des Rahmenwerks in falsifizierbarer Form neu:
P1 (Schiefe und die unsichtbare Mehrheit). Über eine zufällig geschichtete Stichprobe von SSRN-Arbeiten ist die Verteilung der Lifetime-Downloads rechtsschief mit schweren Enden, derart dass der Median weniger als die Hälfte des Mittelwerts ist, und ein wesentlicher Anteil von Arbeiten zehn oder weniger Lifetime-Downloads hat. Falsifizierer: Median ≥ 0,5 × Mittelwert oder ein vernachlässigbarer Anteil ≤10-Download. Das veröffentlichte Marketing-Netzwerk-Verhältnis von Mittelwert zu Median (etwa 2,54) [83] und die quasi-lognormale Anpassung der 2015-Top-Listen-Daten [85] motivieren, etablieren aber nicht P1 für die Plattform insgesamt.
P2 (Klassifizierung bestimmt Sichtbarmachung). Innerhalb der Repository-Schicht ist die Anzahl der eJournal-Klassifizierungen positiv mit Downloads verbunden und negativ mit der Wahrscheinlichkeit von nahe-Null-Downloads, unter Kontrolle von Alter und Netzwerk, eine Replikation und Aktualisierung von Whalens 2018-Querschnittsmuster [168] unter den kuratierten Verteilungsmechaniken der Plattform [53][57]. Falsifizierer: keine signifikante Assoziation nach Kontrollen. Die Klassifizierungszahl ist selbst potenziell endogen: Arbeiten mit breiterer Relevanz können sowohl mehr Klassifizierungen erhalten als auch mehr Leser anziehen, daher überwertet die Querschnittsassoziation jeden Sichtbarmachungseffekt. Die bevorzugte Identifizierung ist daher innerhalb-Papier-Klassifizierungsänderungen, sofern verfügbar, mit dem Querschnittsschätzwert explizit als obere Grenze berichtet.
P3 (Maschinelle Sichtbarkeit ist niedrig und merkmalsabhängig). Bei Anfragen, die so konstruiert sind, dass ein spezifisches SSRN-Preprint die beste verfügbare Quelle ist, zitieren Consumer-KI-Antwortsysteme das Preprint selbst nur in einer Minderheit von Fällen, und die maschinelle Sichtbarkeit steigt mit Merkmalen analog zu dokumentierten generativen-Engine-Optimierungsfaktoren [5][164]. Falsifizierer: Preprints werden unabhängig von Merkmalen in der Mehrheit der Fälle zitiert, oder kein Merkmal sagt Sichtbarkeit voraus.
P3b (Ein maschineller-Schicht-Matthew-Effekt). Unter Kontrolle von Experten-validierter Anfragerelevanz werden Arbeiten mit größerer vorheriger Web- und gelehrter Sichtbarkeit von KI-Antwortsystemen häufiger zitiert als ansonsten vergleichbare Cold-Start-Arbeiten. Unter der Chancengleichheitsalternative rufen generative Motoren nach Relevanz ab, ohne eine Prämie auf vorherige Sichtbarkeit, und P3b wird abgelehnt, ein Ergebnis, unter dem die Maschinenschicht egalitärer wäre als die menschlichen Entdeckungsschichten von H1–H3, nicht weniger. Falsifizierer: kein Sichtbarkeitsgradient bei abgestimmter Anfragerelevanz. P3b erweitert die kumulative-Vorteil-Linie von H1–H3 zur Spitze des Entdeckungs-Stapels. Es zu testen erfordert die vorherige-Sichtbarkeits-Kovariate und Anfrageschichtung, die in Studie 2 (Abschnitt 8.6) spezifiziert sind.
P4 (Raubtiere kommen vor Lesern an). Für ein neu veröffentlichtes Preprint, dessen bibliografische Metadaten und Kontaktweg aus dem veröffentlichten Dokument oder zugehörigen öffentlichen Seiten gewonnen werden können, ist die erwartete Zeit bis zur ersten räuberischen Anfrage, die der Veröffentlichung zuzuordnen ist, kürzer als die erwartete Zeit bis zum ersten echten wissenschaftlichen Kontakt. Falsifizierer: echter Kontakt geht der räuberischen Anfrage zuverlässig voraus. P4 wird unter der Bedingung formuliert, dass die Gewinnung möglich ist, da die öffentliche Sichtbarkeit von Autorenkontaktdetails auf der aktuellen Plattformoberfläche nicht etabliert ist. Der Gewinnungsmechanismus selbst ist für Preprint-Repositorien allgemein dokumentiert [107][159][151], und unaufgeforderte E-Mails sind der erste Kontakt mit einer räuberischen Zeitschrift für einen erheblichen Anteil der angesprochenen Autoren [32]. Die Zuordnung erfordert daher das instrumentierte Design von Studie 3 und nicht nur eine Schlussfolgerung aus dem Inbox-Timing.
Tabelle 16. Hypothesen, Forschungsfragen und Identifikationsstrategien.
| Frage | Primäres Ergebnis | Hauptkontrast | Bevorzugtes Design |
|---|---|---|---|
| H1: Neuling-Nachteil | Inkrementelle Ansichten | Neuling vs. etabliert | Hierarchisches longitudinales Zählmodell |
| H2: Prestige und Reichweite | Inkrementelle Ansichten | Höheres vs. niedrigeres früheres Prestige | Kovariaten-angepasstes Panel + abgestimmte Sensitivitätsanalyse |
| H3: Prestige und Konversion | Downloads unter Berücksichtigung von Ansichten | Höheres vs. niedrigeres Prestige | Negativ-binomiales/Poisson-Expositionsmodell |
| H4: Kommunikations-Equalizer | Bedingte Download-Wahrscheinlichkeit/Rate | Klarheit × frühere Sichtbarkeit | Beobachtungsmodell für Texte + randomisierte Replikation |
| H5: kumulative Aufmerksamkeit | Ansichten/Downloads nach Schock | Expositionsschock vs. Vorschock-Trajektorie | Ereignisstudie innerhalb des Papers |
| RQ1: Rückzug aus Rankings | Tägliche Aufmerksamkeit; Gini; Top-Anteile; Volumen neuer Veröffentlichungen nach Feld | Früher ranking-exponiert vs. Vergleichsfelder | Unterbrochenes/ereignisbasiertes Design |
| RQ2: E-Mail-Verteilung | Tägliche Ansichten/Downloads | Vor vs. nach Verteilung | Ereignisstudie innerhalb des Papers (Verteilung × Neuling) |
| RQ3: prädiktive Validität | Zitationen nach 6/12/18 Monaten | Normalisiert vs. rohe frühe Metriken | Vorhersagevergleich außerhalb der Stichprobe |
| P2: Klassifikation steuert Anzeige | Downloads; Wahrscheinlichkeit von Downloads nahe Null | Klassifikationsanzahl; Klassifikationsänderungen innerhalb des Papers, falls verfügbar | Panel-Regression + Design mit innerhalb des Papers erfolgter Änderung |
| P3b: Matthew-Effekt auf Maschinenebene | Direkte Zitierung durch Antwortsystem | Hohe vs. niedrige frühere Sichtbarkeit bei abgestimmter Abfragerelevanz | Wiederholte mehrstufige Abrufprüfung (Studie 2) |
| P4: Raubtiere vor Lesern | Zeit bis erste und Rate kodierter eingehender Nachrichten | Fenster vor vs. nach Veröffentlichung; räuberischer vs. echter Kontakt | Instrumentierte prospektive Kohorte + Ereignisverlauf-Modell (Studie 3) |
Anmerkung. Alle Zeilen sind prospektive Designs. Keines wurde ausgeführt. Ergebnisse, Kontraste, Ausschlussregeln und Referenzklassen sind vor der Datenerfassung zu preregistrieren.
8.3 Das Kernpanel
Das Referenzdesign ist eine multidisziplinäre Kohorte von kürzlich auf SSRN veröffentlichten Arbeiten, die mindestens zwölf Monate nach der Veröffentlichung beobachtet werden, gemäß dem Zeitplan von Tabelle 11. Auf Papierebene bewahrt der Datensatz die früheste verfügbare Version von Titel, Abstract, Autorennamen und -reihenfolge, Affiliationen, Veröffentlichungsdatum, Klassifizierungen, Schlüsselwörter, Seitenzahl, DOI soweit verfügbar, Versionsverlauf, öffentliche Abstract-Aufrufe, öffentliche Downloads und nachfolgende Zitationsindikatoren auf, mit einer manuell validierten Autor-Identitätsabgleichung gegen offene bibliografische Infrastruktur [35][124] an einer Zufallsstichprobe, bevor abgeleiteter Ruf in großem Maßstab verwendet wird. Der Neuling-Status ist definiert als kein Autor des betrachteten Papers mit einem vor der betrachteten Veröffentlichung datierten SSRN-Paper, mit Sensitivitätsdefinitionen basierend auf vorherigen Papieranzahlen und Zitationsbestand vor Veröffentlichung. Institutionelles Ansehen ist nicht Teil dieser Definition: Da Ansehen selbst eine erklärende Variable in H2 und H3 ist, würde seine Einbeziehung in den Neuling-Status die Plattformneuerung mechanisch mit vorheriger Autorensichtbarkeit verwechseln und die Hypothesen zusammenfallen, die das Design trennen soll. Ansehen tritt daher in die Modelle nur als distinct Kovariate ein. Die Normalisierung durch vorherige Sichtbarkeit muss mit entsprechender Sorgfalt aus Gerechtigkeitsgründen behandelt werden: Eine zu aggressive Subtraktion einer Baseline vorheriger Sichtbarkeit würde den echten frühen Erfolg eines jungen Autors bestrafen und würde statistisch eher löschen als aufdecken, etwaige systematische Unterexposition marginalisierter und Autoren aus dem Globalen Süden. Die Antwort des Rahmens ist, zu messen, wo Ungleichheit entsteht, statt sie herauszurechnen: Die Reichweite-versus-Konversions-Zerlegung lokalisiert, ob eine Sichtbarkeitslücke bei der Exposition oder bei der Konversion entsteht, und Ansehen tritt als Kovariate auf, um verstanden zu werden, nicht als Rauschen, das stillschweigend differenziert wird. Die Verteilungswirkung des Ansehens auf Aufmerksamkeit ist ein primäres Ergebnis der Quasi-Experimente (Abschnitte 8.4–8.5). Kalenderkontrollen umfassen Wochentag, Woche des Jahres, akademische Jahreszeit und Datum-Fixeffekte. Die dokumentierte Wochenend- und Saisonvariation im Artikelzugriff (Aktivität ungefähr 11 % niedriger an Wochenenden und 50 % niedriger im Sommer in einem kürzlichen Sieben-Journal-Panel [178]) macht ihre Auslassung in jeder hochfrequenten Nutzungsstudie schwer zu rechtfertigen. Das vollständige Panel-Variablenwörterbuch (in der Größenordnung von zwei Dutzend Feldern, einschließlich Intervallzuwächsen statt nur kumulativer Zähler, das Verteilungsdatum wo eingewilligt, Zitationsbestände bei 6, 12 und 18 Monaten und Revisionsnummer) ist in Anhang C (Tabelle C1) spezifiziert, und die gleiche Schemadatei ist mit den Preregistrations-Materialien (Abschnitt 8.8; Erklärungen) hinterlegt.
Reichweite wird als hierarchischer negativ-binomischer Prozess für inkrementelle Aufrufe mit Feld-nach-Alter-Effekten, Kalendereffekten und Papier-Ebenen-Heterogenität modelliert. Bedingte Konversion wird als inkrementelle Downloads mit Log-inkrementellen Aufrufen als Exposition modelliert, so dass die Erlangung eines Landing-Page-Besuchs und die Umwandlung dieses Besuchs statistisch getrennt sind. In kompakter Form für Paper i im Intervall t:
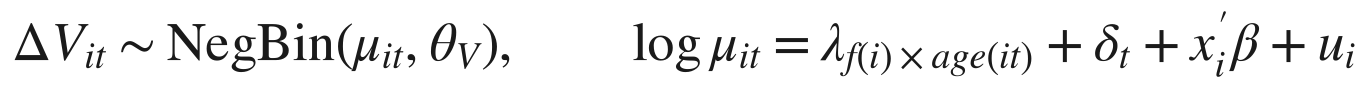

wobei λ_{f×age} Feld-nach-Alter-Effekte sind, δ_t Kalender-Datums-Effekte, u_i und w_i Papier-Ebenen-Heterogenität, und der Log-Aufrufe-Offset in der zweiten Gleichung Downloads bedingt auf Landing-Page-Exposition macht. Die Neuling × Klarheit Wechselwirkung γ_3 ist der H4-Test. Diese Gleichungen fixieren die vorspezifizierten Estimanden und die Trennung von Reichweite von Konversion, und die hierarchische Struktur führt genau das empirische-Bayes-Partial-Pooling durch, das Abschnitte 5.2 und 8.8 erfordern, bevor ein Perzentil aus spärlichen Zellen veröffentlicht wird. Themkontrollen in x_i sind aus Titel–Abstract-Embeddings konstruiert, die zum Zeitpunkt der Preregistration eingefroren und geclustert wurden, bevor ein Ergebnis beobachtet wird, so dass die thematische Zusammensetzung nicht auf Ergebnisse abgestimmt werden kann. Da Papers bis zu sieben Klassifizierungen gleichzeitig belegen, werden Klassifizierungseffekte mit Multiple-Membership-Hierarchischen Strukturen geschätzt, statt jedes Paper in ein einzelnes Feld zu zwingen. Da Paper-Fixeffekte zeitinvariante Statusmaße absorbieren, werden Baseline-Neuling- und Ansehen-Effekte zwischen Papieren geschätzt, während Paper-Fixeffekte für Within-Paper-Behandlungen wie Verteilungsereignisse reserviert sind. Überdispersion und überschüssige Nullen werden formal getestet, Hurdle- und Zero-Inflated-Alternativen wo gerechtfertigt berichtet, und der schwere Schwanz durch Quantil- und robuste Schätzung behandelt statt durch Löschen erfolgreicher Papers. Datenbereinigungsregeln sind selbst vorspezifiziert statt diskretionär, und das Anomalie-Protokoll ist kennzeichnen, nicht löschen. Die vorspezifizierte Signal-Liste umfasst: ein Intervall-Extrem gegen die eigene Geschichte des Papers, ein Aufrufe-Spike ohne Bewegung in Downloads, eine Diskontinuität in Konversion, wiederholte identische Zeitstempel und eine Plattformseiten-Neubewertung. Ein gekennzeichnetes Intervall wird niemals aus dem Archiv entfernt: es wird mit einem Ursachencode beibehalten, und jedes Schlagzeilenergebnis wird auf einer vierschichtigen Sensitivitätsleiter berichtet: (i) unmodifizierte Zähler; (ii) ausschließlich plattformbestätigter ungültiger Aktivität; (iii) robuste oder winsorisierte Schätzung; (iv) ausschließlich gekennzeichneter Intervalle, so dass jede Schlussfolgerung, die nur auf einer Ebene überlebt, als fragil sichtbar wird. Schwellwerte werden gegen die beobachtete Verteilung kalibriert statt a priori festgelegt. Wo Partner-Logs verfügbar sind, unterscheiden Referrer-, User-Agent- und Geografie-Felder Newsletter-, Blog-, Prefetch- und Crawler-Verkehr. Die dokumentierten Blog-getriebenen Download-Spikes auf SSRN [116] veranschaulichen, warum ein extremer Wert oft organischer Erfolg statt Verunreinigung ist. Anomalieerkennung ist ein Messinstrument. Sie lizenziert nicht das Verwerfen unbequemen Erfolgs.
Dieselbe Disziplin gilt für die zeitliche Struktur. Das Panel unterscheidet zwischen marginaler und kumulativer Aufmerksamkeit: Kohortenkurven von Intervall-Downloads ΔD und der Anteil der 180-Tage-Downloads eines Papers, die in jedem Alter kumuliert werden, anstatt nur Gesamtlebenszyklen zu lesen. Es legt keine einzelne exponentielle Halbwertszeit für den Rückgang fest, da die Leserschaft auf mehreren Zeitskalen gleichzeitig abnimmt [91]. Alterskurven werden daher standardmäßig mit Splines oder nichtparametrischen Schätzern angepasst, wobei logarithmische Transformationen zur Untersuchung der Struktur verwendet werden und Rohdaten für die Benchmark-Berichterstattung beibehalten werden. Robustheit wird auf die gleiche Weise behandelt: Prestige wird durch mehrere alternative Maßnahmen operationalisiert, anstatt einen einzigen Ranking-Schwellenwert zu verwenden, der Newcomer-Status wird unter progressiv strengeren Definitionen erneut getestet, und die Ergebnisse werden mit Winsorized-Sensitivitätschecks und vollständigen Verteilungsdiagrammen neben den Quantilschätzungen berichtet.
Da es keine öffentliche SSRN-API gibt [134][51], erfolgt die Datenerfassung auf drei Wegen, in der Reihenfolge der Präferenz: eine formale Datenanfrage an oder Partnerschaft mit SSRN/Elsevier; von Autoren genehmigte Dashboard-Exporte, bei denen teilnehmende Autoren ihre eigenen Statistik-Panel-Daten unter informierter Zustimmung beitragen, die mittlere Ebene, auf die sich das Verzeichnis von Abschnitt 8.8 bereits stützt; und ratenbegrenzte, robots.txt-respektierende Sampling von öffentlichen Seiten pro Paper, deren technische Machbarkeit durch bestehende Open-Source-Erfassungswerkzeuge etabliert ist [134]. Das Design schließt Bulk-Scraping aus, das gegen die Nutzungsbedingungen verstoßen würde, und stellt keinen nicht dokumentierten Endpunkt als stabile API dar. Zugriffsbeschränkungen werden in Abschnitt 9 als Limitation diskutiert.
8.4 Quasi-Experiment I: E-Mail-Alert-Verteilung als Aufmerksamkeitsschock
Die Abschnitte 8.4 und 8.5 bilden ein analytisches Modul, das zwei plattformseitige Interventionen als komplementäre Behandlungen einer gleichen Panel-Kohorte untersucht. Die Alert-Verteilung fügt eine Expositionsfläche hinzu, die Rankings-Einstellung entfernte eine, und beide werden gegen einen gemeinsamen Satz von Verteilungsergebnissen gemessen (Anteil der Neulinge, Prestige-Gradient, Aufmerksamkeits-Gini, Top-Anteile). SSRNs Alert-Mechanismus ist analytisch wertvoll, weil Veröffentlichung und Verteilung nicht zusammenfallen müssen. Arbeiten werden zunächst öffentlich verfügbar, und förderfähige Arbeiten werden später über kuratierte eJournal-Alerts verteilt, deren zeitliche Abfolge variabel und nicht garantiert ist [53][57]. Für Autoren, die ihre Verteilungsstatusdaten zur Verfügung stellen, kann eine Within-Paper-Ereignisstudie den Aufmerksamkeitsverlauf um das Verteilungsdatum herum schätzen, wobei jede Arbeit als ihre eigene Kontrolle dient, so dass stabile Unterschiede in Themenattraktivität, Autorenidentität und Institution absorbiert werden. Die Spezifikation hat die standardmäßige Ereignisstudienform: für das Ergebnis Y_it (Intervallaufrufe oder Downloads),
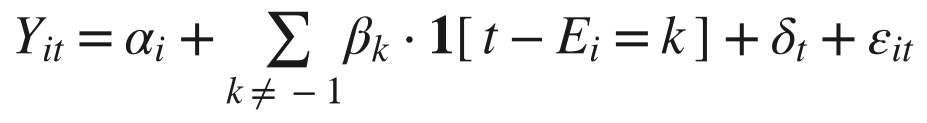
wobei E_i das Verteilungsdatum von Arbeit i ist, α_i Paper-Fixeffekte sind, δ_t Kalender-Datums-Effekte, und die β_k, normalisiert auf den k = −1 Vor-Verteilungs-Referenzzeitraum, den Aufmerksamkeitsverlauf um das Ereignis nachzeichnen. Die Gleichung spezifiziert den Schätzwert für die Vorregistrierung. Der wichtigste heterogene Effekt ist die Wechselwirkung Verteilung × Neuling, geschätzt durch Wechselwirkung der β_k mit dem Neulings-Status. Wenn Alerts die Reichweite von Neulingen überproportional verbessern, fungiert die kuratierte Verteilung als Gleichmacher auf Plattformebene; wenn Gewinne überproportional an renommierte Autoren gehen, verstärkt die Verteilung bestehende Reputationsvorteile (FO2). Vorherige Evidenz, dass diskrete Expositionsereignisse (Front-Positionen-Auflistungen auf arXiv [72][73], Blog-Berichterstattung über SSRN-Arbeiten [116]) scharfe frühe Aufmerksamkeitsspitzen erzeugen, weist darauf hin, dass das Design eine erkennbare erste Stufe hat. Die vorgegebene Spezifikation umfasst auch alternative Ereignisfenster um das Verteilungsdatum und separate Berichte für schnell verteilte Arbeiten im Vergleich zu solchen nach einer langen Klassifizierungswarteschlange, da die bis zu 45-tägige Verzögerung [53] sonst heterogene Expositionsgeschichten zu einer einzigen Ereigniszeit mischt. Paper-Fixeffekte absorbieren nur zeitinvariante Attraktivität, daher sind drei Designbedingungen tragend. Die Verteilungszeit wird kuratiert, nicht zufällig: Die Plattform wählt aus, welche förderfähigen Arbeiten sie verteilt und wann [53][57]. Das Ereignisdatum trägt daher eine zeitlich variierende Selektion auf Topikalität (eine Arbeit, die in der Woche verteilt wird, in der ein Thema präsent wird, unterscheidet sich von derselben Arbeit, die in einer ruhigen Woche verteilt wird), und diese Selektion übersteht Paper-Fixeffekte, weshalb die Spezifikation die Verteilungsverzögerung konditioniert und separate Strata der Verteilungszeit meldet. Verteilungsstatusdaten werden auch nur für zustimmende Autoren beobachtet, daher ist die Schätzstichprobe eine selbstgewählte Teilmenge des Panels. Der Zustimmungsstatus wird daher aufgezeichnet, und die Ereignisstichprobe wird mit der vollständigen Kohorte auf beobachtbare Kovariaten verglichen; die Selektion begrenzt die externe Validität. Und Autoren können ihre eigene Publizität auf den Alert timen: Ein koordinierter Selbstpromotionstrom würde sich als Verteilungseffekt tarnen. Ein datiertes Autor-Promotionsprotokoll (das versionierte Evidenzpaket von Abschnitt 6.1) ist daher eine Voraussetzung dieses Designs: Ohne es kann ein organischer Verteilungsspitzenwert nicht von einem selbst erzeugten unterschieden werden, und die Anomalie-Leiter von Abschnitt 8.3 kennzeichnet statt zu löschen jeden Spitzenwert, der mit protokollierter Selbstpromotion zusammenfällt.
8.5 Quasi-Experiment II: Die Einstellung der Rankings als natürliches Experiment
Die Abschaltung am 15. Juli 2026 [149] ermöglicht eine zweite Analyse, wenn die historische Ranking-Exposition aus archivierten Ranking-Seiten rekonstruiert werden kann. Zwei Merkmale des Designs schwächen eine saubere Ereignisstudie mit einem einzigen Stichtag. Die Behandlung trat nicht an einem Stichtag ein: Die Ranking-Seiten pro eJournal stellten am 11. Dezember 2025 (Abschnitt 2.2 [B-2]) auf Aktualisierung ein, etwa sieben Monate vor der Entfernung am 15. Juli 2026, daher wird der Rückzug der Ranking-Erkennungsfläche besser als gestaffelter Prozess modelliert – eine erste Phase der Einfrierung der Live-Seiten gefolgt von ihrer endgültigen Entfernung – als als ein einziger gemeinsamer Ereignisdatum. Die Spezifikation umfasst daher mindestens zwei Ereigniszeitpunkte (die Dezember-Einfrierung und die Juli-Entfernung), wobei die gestaffelte Form das primäre Modell ist und die Passung mit einzelnem Stichtag dagegen getestet wird. Auch kann nicht davon ausgegangen werden, dass „ehemals Ranking-exponierte" Disziplinen aus der Plattformstruktur abgeleitet werden: Die Rankings waren plattformweit, daher ist die differentielle Exposition endogen und wird nicht dadurch operationalisiert, dass Felder benannt werden, die sich „rangiert" anfühlten. Die Exposition muss gemessen, nicht zugewiesen werden: zum Beispiel aus archivierten Ranking-Seiten, die über das Internet Archive wiedergewonnen wurden, als der Anteil der Arbeiten eines Feldes, die jemals in die öffentlichen Top-Listen eingingen, oder die Dichte der Präsenz eines Feldes auf den pro-eJournal-Seiten. Ob das Archiv die Ranking-Seiten jedes Feldes ausreichend dicht abdeckt, um eine brauchbare Expositionsmessung zu ermöglichen, ist noch nicht etabliert; das Design meldet diese Dichte zusammen mit der Expositionsmessung. Mit so gemessener Exposition vergleicht eine Ereignisstudie auf Papierebene die Aufmerksamkeitsverlauf in Feldern mit hoher und niedriger Exposition um die Einfrierungs- und Entfernungsdaten: die Gleichung von Abschnitt 8.4 mit Koeffizienten von Interesse auf Exposure_f × EventTime_k-Wechselwirkungen statt auf die Ereigniszeitbegriffe allein. Die informativsten Ergebnisse sind verteilungsbezogen (Abschnitt 8.1). Der Ranking-Mechanismus könnte die Aufmerksamkeitskonzentration verändern und dabei Mittelwerte nahezu unverändert lassen, und da sich jede Wirkung voraussichtlich in den bereits sichtbaren Tail-Papieren konzentriert, die die Listen bevölkerten, sind Ergebnisse auf Feldebene mittelwert konstruktionsbedingt unterstärkt. Gini-Koeffizienten, Top-Share-Maßstäbe, Neuling/etablierte Verhältnisse und Prestige-Gradienten sind daher die primären Ergebnisse, mit der zweiseitigen Vorhersage von RQ1, und die Leistungssimulation von Abschnitt 8.1 muss auf diese verteilungsbezogenen Statistiken ausgerichtet sein, nicht auf durchschnittliche Aufmerksamkeit, oder die Studie riskiert, wegen mangelnder Leistung beim falschen Schätzwert für null erklärt zu werden.
Zwei benannte, direktionale Vorhersagen verschärfen die zweiseitige RQ1, ohne sie zu ersetzen, beide davon vordefinierte Heterogenitätstests. Die Sichtbarkeitsklippen-Hypothese besagt, dass Post-Abschaltungs-Kohorten in ehemals Ranking-exponierten Feldern einen diskreten Rückgang der frühen Reichweite im Vergleich zu angepassten Vor-Abschaltungs-Kohorten erfahren, weil eine Erkennungsfläche an einem bekannten Datum entfernt wurde. Unter einer Kompensationshypothese sollte, wenn die Rankings als Kompensationsmechanismus für Sichtbarkeit in Feldern mit schwachen Erkennungs-Ökosystemen funktionierten, die Auswirkung ihrer Entfernung in Feldern mit kleinen eJournal-Abonnementbasen am größten sein, am unteren Ende des Whalen-Gradienten [168].
Ein kostengünstiges sekundäres Ergebnis erweitert das Design von der Aufmerksamkeitsverteilung auf die Gesundheit der Plattform selbst: das Volumen neuer Beiträge nach Feld in Zeitfenstern vor und nach dem 15. Juli 2026. Wenn die Rankings Teil des Anreizes zum Posten lieferten, könnte ihre Einstellung neue Einreichungen abschrecken. Das ist ein Verhaltensresultat, das sich von den Aufmerksamkeitsergebnissen oben unterscheidet, beobachtbar aus öffentlichen Neupapierlisten gegenüber der eigenen Basislinie der Plattform von mehr als 250.000 neuen Papieren im Jahr 2025 [145], und eine direkte empirische Antwort auf die gleichzeitige „jumped the shark"-Polemik, die in Abschnitt 2.2 [12][B-11] verzeichnet ist. Die Vorhersage wird wie RQ1 zweiseitig gelassen, und das Beitragsvoluemen-Ergebnis verbindet sich mit Punkt (3) der Umfrage zu Studie 4 („Vermeidung neuer Uploads").
Die Analyse ist quasi-experimentell. Fünf Bedrohungen sind material. Eine ist Ankündigungs- und Antizipationseffekte: Die Einstellung wurde am 12. Juni 2026 mit einem anfänglichen Zieldatum von 1. Juli angekündigt und am 15. Juli ausgeführt, daher existierte ein echtes Antizipationsfenster und verschob sich [148][149]. Ein Cluster gleichzeitiger 2026-Plattformänderungen teilt den Kalender der Abschaltung und kann von ihm durch kein einzelnes Ereignisdatum getrennt werden: die strategische Umausrichtung, angekündigt am 13. April 2026, die Einstellung der kommerziellen Research Paper Series, die bis Ende Dezember 2026 läuft, und die Autorenlizenzenänderung vom 20. Juli 2026, fünf Tage nach der Entfernung [146][150]. Da diese Interventionen das Juli-Fenster überlagern, würde ein einziger gemeinsamer Ereignisdatum ihre kombinierte Wirkung allein der Abschaltung zuschreiben. Die Identifikation stützt sich daher auf die gestaffelte Timing oben (die Dezember-Einfrierung geht allen voraus), auf Placebo-Daten und auf die verteilungsbezogene Signatur, die für einen Ranking-Rückzug spezifisch ist, und das Design berichtet, welche zeitgleichen Änderungen ungetrennt bleiben. Dann gibt es das Sommeraufmerksamkeitstief: Mitte Juli fällt mit dem dokumentierten saisonalen Rückgang des wissenschaftlichen Zugangs zusammen, wobei der Zugang in den Sommermonaten um etwa 50 % fällt [178], daher verwechselt ein feldübergreifender Kontrast, der über das Entfernungsdatum läuft, die Abschaltung mit der eigenen Sommersaisonnalität eines Feldes, die sich je nach Disziplin unterscheidet. Kalender-Stichtag-Fixeffekte absorbieren nur die gemeinsame saisonale Komponente. Das Design erfordert daher feldbezogene saisonale Baselines (ein Vergleich des gleichen Fensters des Vorjahres pro Feld). Nicht-zufällige Unterschiede zwischen Feldern mit hoher und niedriger Exposition sind eine weitere Bedrohung, angegangen durch die oben gemessene Expositionsoperationalisierung und durch abgestimmte Vergleichsgruppen. Die verbleibende Bedrohung ist prospektiv: SSRN hat angekündigt, dass es Rankings möglicherweise erneut überprüfen kann, daher würde eine Teilerneuerung während des Beobachtungsfensters einen zweiten Ereignis einführen. Das Design preregistriert, jede solche Erneuerung als Zensurpunkt für die Nach-Periode zu behandeln und sie als eine distinkte Behandlung zu modellieren, statt sie in den Abschaltungskontrast einzufalten. In aller Berichterstattung wird die Ereigniszeit in drei benannte Zeiträume partitioniert: Ankündigung (ab 12. Juni 2026), Übergang und Einstellung (ab 15. Juli 2026), so dass Antizipationseffekte geschätzt werden. Das vordefinierte Design umfasst daher Ereigniszeit-Vor-Trend-Tests, alternative Bandbreiten, Placebo-Daten, feldbezogene Zeittrends und feldbezogene saisonale Baselines sowie Sensitivitätsanalysen, die den Ankündigungs-zu-Einstellungs-Übergangszeitraum ausschließen. Abbildung 11 präsentiert die beabsichtigten Ausgaben beider Ereignisstudien als Designvorlagen.
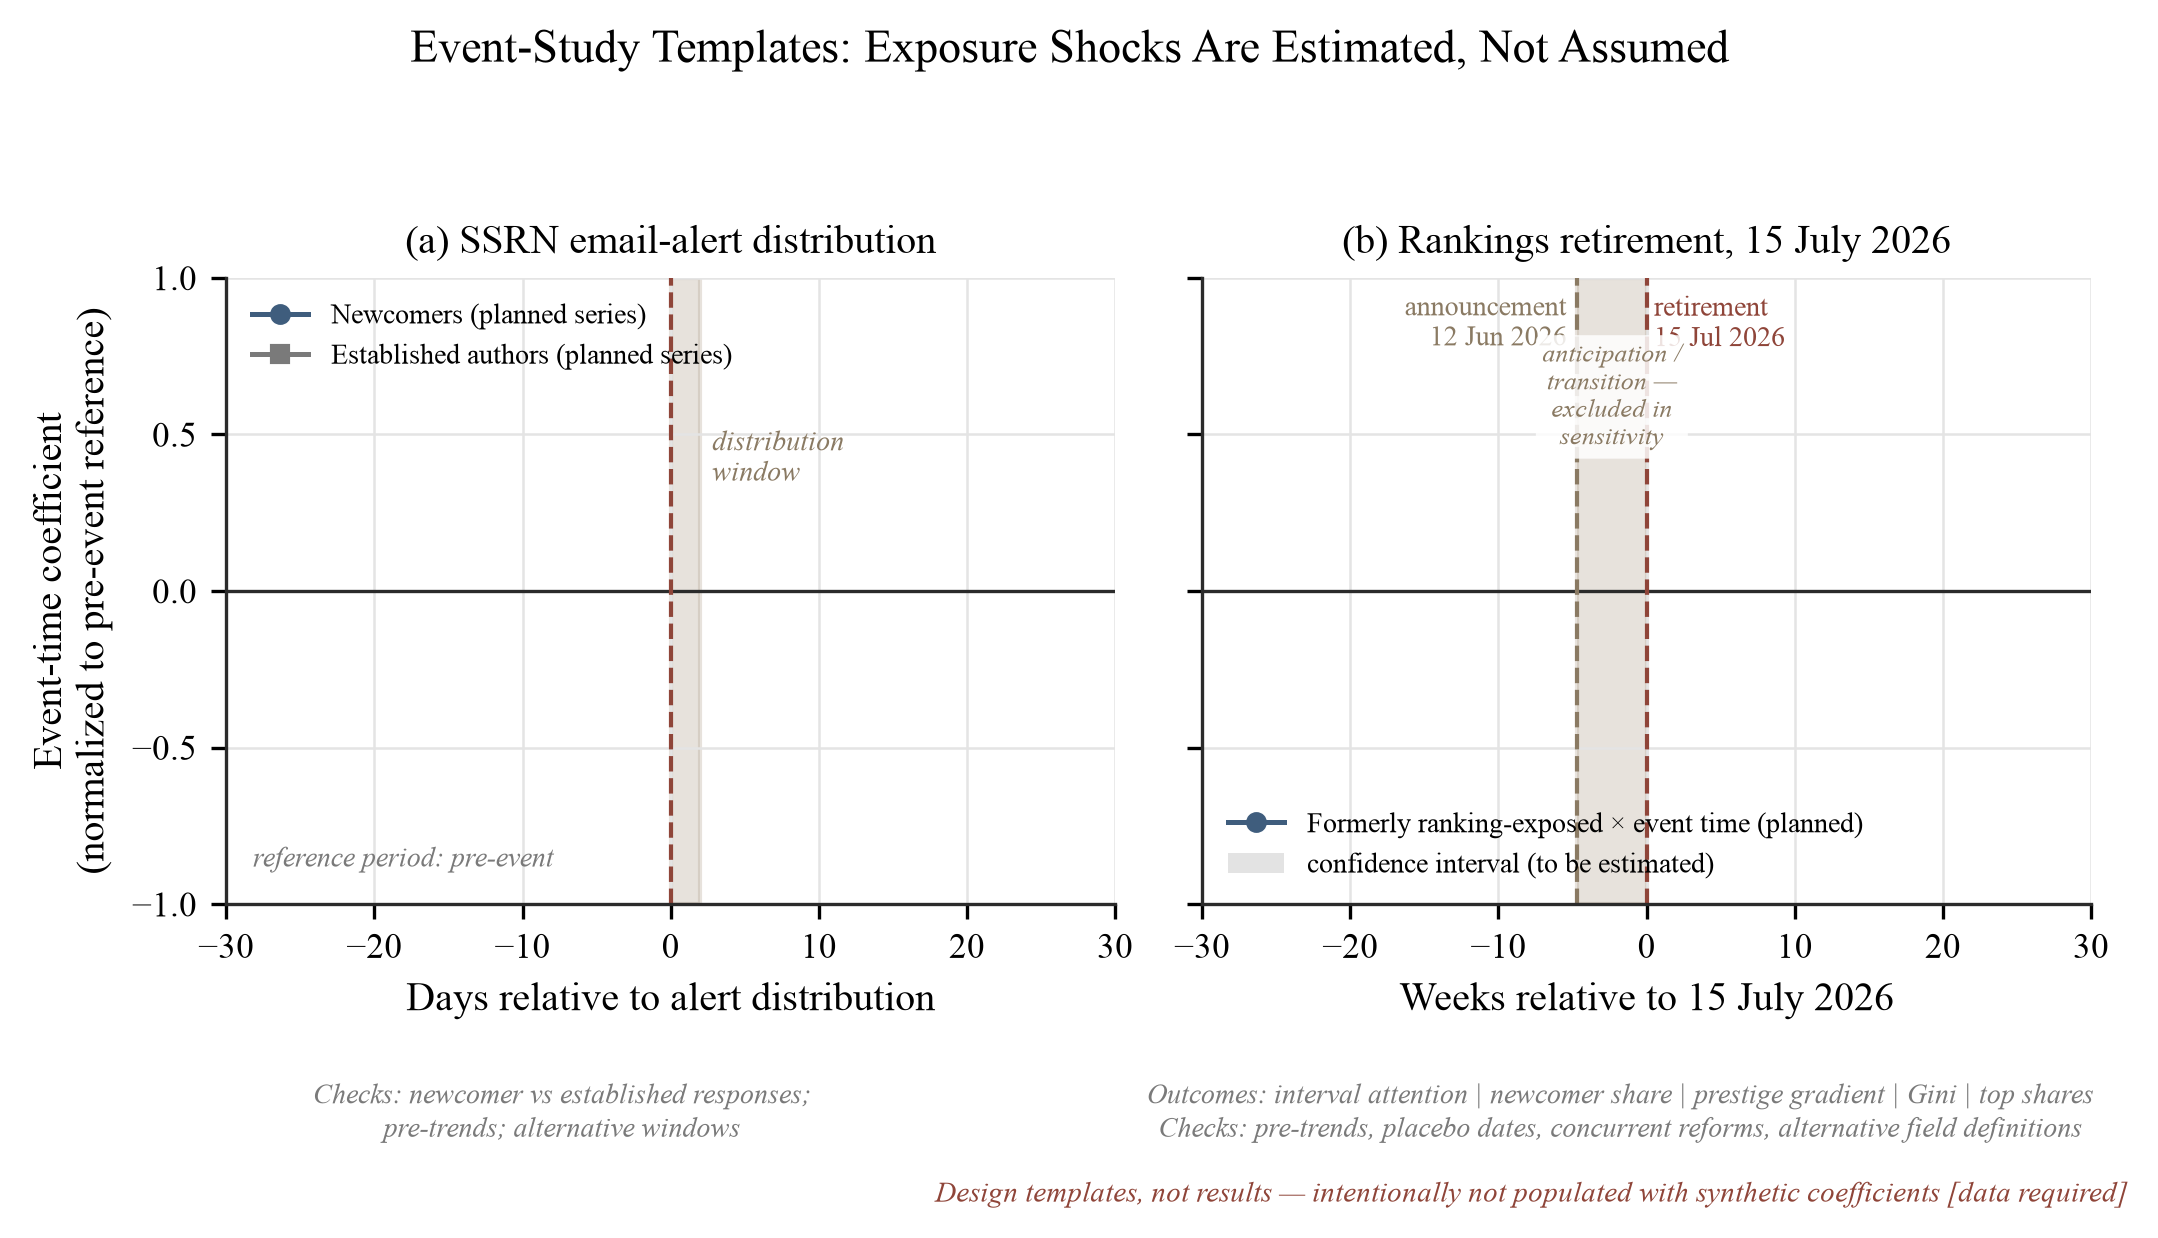
Abbildung 11. Event-Study-Design-Vorlagen für die zwei Plattform-Quasi-Experimente. Vorspezifizierte Event-Study-Outputs für die Designs der Abschnitte 8.4–8.5: (a) Aufmerksamkeit um die E-Mail-Benachrichtigungsverteilung, neue versus etablierte Autoren, mit dem Verteilungsfenster schattiert, da Benachrichtigungen als Fenster ankommen, nicht als Moment; (b) Aufmerksamkeit und Ungleichheitsergebnisse um die Rankings-Stilllegung, mit sowohl dem Ankündigungsdatum (12. Juni 2026) als auch dem Stilllegungsdatum (15. Juli 2026) markiert und der Erwartungs-/Übergangszeitraum schattiert — das Fenster ausgeschlossen in den vorspezifizierten Sensitivitätsanalysen. Die Verteilungsergebnisse (Interval-Aufmerksamkeit, Newcomer-Anteil, Prestige-Gradient, Gini, Top-Anteile) und erforderliche Überprüfungen sind in der Abbildung selbst angegeben. Koeffizienten sind auf den Vor-Event-Referenzzeitraum normalisiert; schattierte graue Regionen bezeichnen Konfidenzintervalle. Diese Panels sind Design-Vorlagen; es werden keine empirischen Werte angezeigt, und der Generierungscode wird mit den Preregistrierungsmaterialien veröffentlicht.
8.6 Vier vorspezifizierte Studien
Neben dem Kernpanel werden vier Studien spezifiziert und in Tabelle 17 zusammengefasst. Die beiden öffentlichen Datenstudien (1 und 2) können von jedem Forscher ohne Zugriffsbeschränkungen versucht werden, innerhalb der in Abschnitt 9 beschriebenen Zugriffsgrenzen (ratenbegrenzte Erfassung gemäß den Geschäftsbedingungen der Plattform). Die beiden Human-Subjects-Studien (3 und 4) erfordern Teilnehmer und erfolgen unter den in den Declarations angegebenen ethischen Genehmigungen. Alle vier existieren, um das Benchmark-Vakuum sofort zu füllen, anstatt nach der Reifung eines mehrjährigen Panels zu warten.
Tabelle 17. Die vier vorspezifizierten Studien.
| Studie 1 | Studie 2 | Studie 3 | Studie 4 | |
|---|---|---|---|---|
| Forschungsfrage | Wie lautet die mediane/Perzentil-Downloadverteilung? | Zitieren KI-Antwortsysteme den Preprint selbst? | Leser oder Raubtier zuerst? | Wie lesen Autoren ihre eigenen Zähler? |
| Daten | 3.000–5.000 stratifizierte SSRN-Paper-IDs | 100–200 Nischenfragen × ~5 Engines | 2 instrumentierte Postings, 90-Tage-Eingangsverlauf | Vorregistrierte Autorenumfrage, vier Items mit fester Formulierung |
| Methode | Median, Gini, Abklingkurven, Klassifikationszahl-Regression | Abruf-Kodierung + logistische Regression | Pro-Kanal-Alias-Verfolgung + Nachrichtenkodierung | Geschlossener Fragebogen + deskriptive Anteile |
| Primäres Ergebnis | Median; ≤10-Download-Anteil; Aufmerksamkeits-Gini | Maschinenvisibilität V | t_leser vs. t_raubtier | Anteil, der niemals Zähler mit einem Benchmark vergleicht; Erstleseverteiling für „7 Downloads" |
| Falsifizierbare Vorhersage | Median < 0,5 × Mittelwert; Gini 0,75–0,90 | Preprint in 10–35 % der Versuche zitiert | t_raubtier < t_leser | Mehrheit berichtet, niemals mit einem Benchmark verglichen zu haben |
| Hauptlieferable | Öffentliche, maschinenlesbare, nach Alter, Feld und Kohorte stratifizierte Perzentil-Benchmark-Tabellen | Reproduzierbares Abruf- und Attributions-Audit-Protokoll mit zeitgestempeltem Snapshot | Offenes instrumentiertes Posting-Protokoll mit Pre-Posting-Baseline und Kodier-Codebuch | Dokumentierte Verteilung von Autoreninterpretationen und berichteter Verhaltensänderung |
| Das Design schlägt fehl, wenn | Normalisierung verbessert die Stabilität oder Out-of-Sample-Vorhersage nicht gegenüber rohen Zähler | Features vorhersagen nichts über Abfrageigenschaft, Engine und Datum hinaus | Keine Post-Posting-Diskontinuität nach Baseline und Exposurekontrollen oder unzuverlässige Kodierung | Rekrutierung oder Selbstselektionsbias macht sogar die deskriptiven Anteile uninterpretierbar |
| Ressourcenprofil | Öffentliche Daten; standardisiertes Web-Scraping und Statistik | Öffentliche KI-Engine-Abfragen; manuelle Kodierung | Zwei instrumentierte Postings; Inbox-Logging (IRB) | Anonyme Autorenumfrage (IRB) |
Anmerkung. Jede Studie muss vor der Datenerfassung auf OSF registriert werden, mit veröffentlichtem Code.
Studie 1: „Anatomie des Medians." Die Studie zieht eine zufällig stratifizierte Stichprobe von 3.000–5.000 SSRN-Abstract-IDs, ein Planungsbereich, wobei das endgültige N durch Powersimulation gegen die vorspezifizierten Vorhersagebänder und die kleinsten Effekte von Interesse (Abschnitt 8.1) festgelegt wird. Die Stratifizierung erfolgt nach Posting-Jahr und Netzwerk, und pro Paper Lebensdauer-Downloads, Abstract-Ansichten, Posting-Datum und Klassifikationszahl werden durch die Zugriffswege von Abschnitt 8.3 erfasst. Estimands: Lebensdauer-Downloads-Median; Anteile von Papieren mit null und mit zehn oder weniger Downloads; die Aufmerksamkeits-Gini mit Bootstrap-Konfidenzintervallen; die Ansicht-zu-Download-Konversionsrate, geschätzt insgesamt und stratifiziert nach Netzwerk (ein Test der Hypothese der Publikum-Lesestil aus Abschnitt 5.2); Download-Abklingkurven; und eine Regression des Log-Downloads auf die Klassifikationszahl mit Jahr- und Netzwerk-Effekten (ein direkter Test von P2 [168]). Die vorspezifizierten Vorhersagebänder (Lebensdauer-Downloads-Median ungefähr 30–80, ein ≤10-Download-Anteil von 15–30 %, Gini 0,75–0,90) sind Extrapolationen aus den datierten Ankern von Abschnitt 5 [83][85][139] und aus Aufmerksamkeits-Gini-Größen in benachbarten Medien [180], im Voraus angegeben, damit die Studie sie falsifizieren kann. Studie 1 ist der empirische Kern des in Abschnitt 8.8 erörterten Perzentil-Benchmarks.
Studie 2: „Lesen die Maschinen Sie?" Ein wachsender Anteil der Informationssuche beginnt jetzt bei generativen Schnittstellen: Etwa die Hälfte der US-Amerikaner gibt an, KI-Chatbots zu nutzen, und etwa ein Viertel nutzt sie täglich [121], wobei eine substanzielle Minderheit einen Chatbot bereits als erste Suchmaschine in Convenience-Samples behandelt [4]. Die Einleitung (Abschnitt 1.6) konzeptualisierte dies als Aufwärtsmigration des Discovery-Torwächters (Journal-Marke → Repository → Suchmaschine → KI-Antwortschipper) mit jedem Schritt, der die Kontrolle weiter weg vom Autor und weiter weg von jedem öffentlichen Benchmark verlegt (Abbildung 12). Ob die oberste Ebene Preprints überhaupt abruft, ist unbekannt: Die Literatur zur generativen-Engine-Optimierung hat sich bisher auf Marken und Commerce konzentriert [5][100][164], und Audits der KI-Suche haben sich auf News-Zuschreibung anstelle von wissenschaftlichen Quellen bezogen [82]. Diese Audits raten zur Skepsis gegenüber der Zuverlässigkeit des neuen Torwächters: Im Tow Center Audit (1.600 Abfragen über acht Engines) konnten die Engines kumulativ korrekte Informationen in mehr als 60 % der Versuche nicht abrufen, wobei der beste Performer (Perplexity) 37 % der Zeit falsch antwortete und der schlechteste (Grok-3) 94 %, und sie irrten typischerweise mit unbegründetem Vertrauen anstatt abzulehnen [82], Zahlen aus einem News-Zuschreibungstest, nicht aus einer wissenschaftlichen Suche. Keine kontrollierte Studie zur Sichtbarkeit wissenschaftlicher Preprints in KI-Antwortsystemen existierte ab August 2026 [100]. Der Beitrag steht im Kontext zweier benachbarter Forschungslinien. Die generativen-Engine-Optimierungsstudien, auf denen dieser Artikel aufbaut, messen und manipulieren die Sichtbarkeit von Marken und kommerziellen Seiten [5][164], nicht den Abruf wissenschaftlicher Artefakte. Ein separater Strang zeigt, dass Sprachmodelle, wenn sie überhaupt Referenzen generieren, die menschliche Tendenz, bereits stark zitierte Arbeiten zu zitieren, reproduzieren und verstärken, wodurch ein Matthew-Effekt in die Maschinenebene erweitert wird [7], was der Mechanismus P3b (Abschnitt 8.2) testet. Keiner dieser Stränge hat die Auffindbarkeit wissenschaftlicher Preprints unter kontrollierter Abfragerelevanz untersucht, und speziell ihre Abrufbarkeit nach der Entfernung einer Plattform-Ranking-Oberfläche, was das Objekt ist, das Studie 2 isoliert.
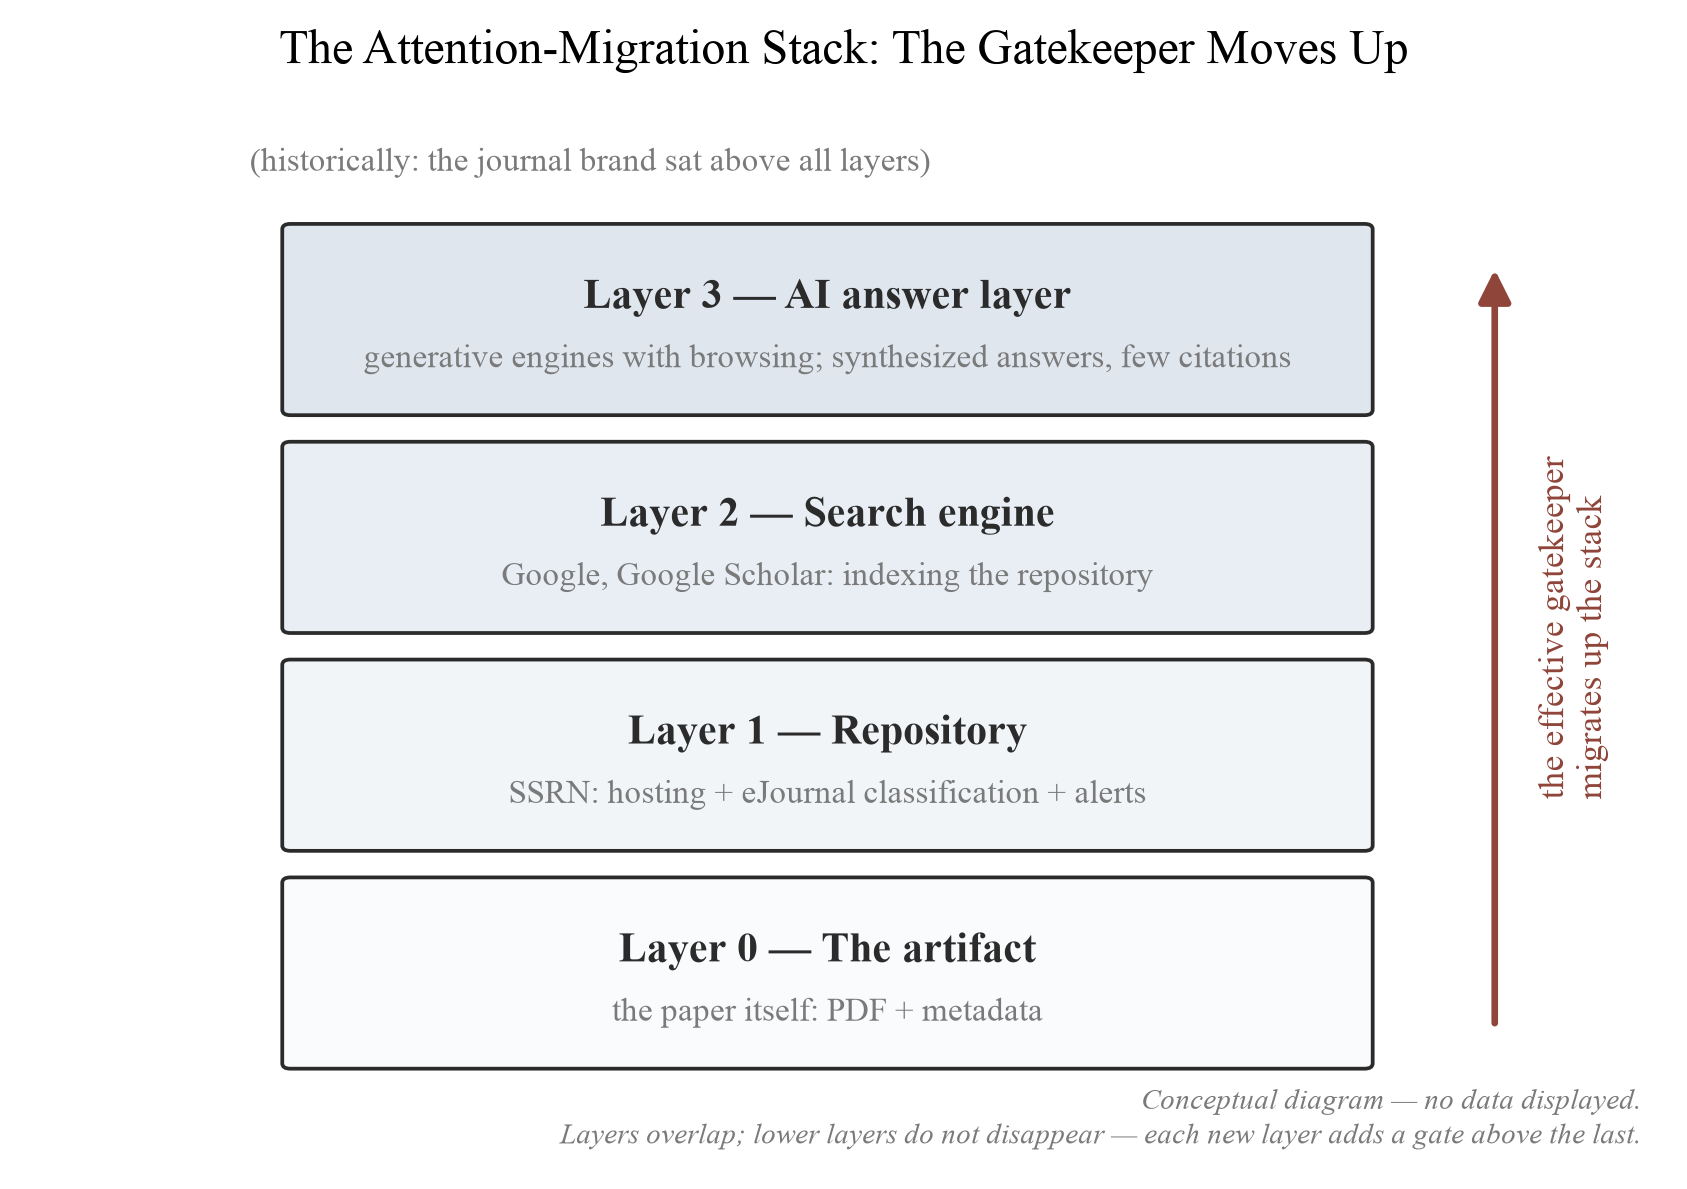
Abbildung 12. Der Aufmerksamkeits-Migrations-Stack. Der geschichtete Pfad von einem fertiggestellten Manuskript zur Aufmerksamkeit eines Lesers. Die Migrationsthese besagt, dass sich der effektive Gatekeeper – die Schicht, die entscheidet, welche Artefakte Aufmerksamkeit erhalten – im Laufe der Zeit nach oben verschoben hat, vom Journal-Brand über Repository und Suchmaschine zur KI-Antwortschicht; jede Aufwärtsbewegung verlagert die Kontrolle weiter vom Autor und weiter weg von jedem öffentlichen Benchmark. Der Stack ist ein konzeptionelles Modell.
Studie 2 konstruiert 100–200 Nischen-Fragen, von denen jede so gestaltet ist, dass ein spezifisches SSRN-Preprint die beste verfügbare Quelle ist, ein Relevanzanspruch, der von verblindeten Experten validiert wird, anstatt von den Autoren der Anfrage selbst zertifiziert zu werden. Sie fragt große Verbraucher-KI-Systeme mit aktiviertem Browsing ab und kodiert das Ergebnis in sechs sich gegenseitig ausschließende Kategorien: (1) das fokale Preprint selbst zitiert; (2) die veröffentlichte Version oder ein Mirror desselben Papers zitiert, ein Fall, den ein gröberes Schema als Abwesenheit fehlklassifizieren würde; (3) Sekundärberichterstattung zitiert ohne das Paper; (4) eine andere, aber verteidigbare Quelle zitiert; (5) keine nachverfolgbare Quelle; und (6) Engine-Ablehnung (Abbildung 13). Für jede Antwort, die das fokale Paper oder eine Version davon zitiert, zeichnet ein binäres Zuordnungs-Treue-Flag zusätzlich auf, ob die Aussage in der Antwort tatsächlich durch die zitierte Quelle gestützt wird. Sichtbarkeit und Treue werden separat berichtet und niemals in eine einzige Punktzahl zusammengefasst, da eine Engine ein Paper prominent zitieren kann, während sie es mischarakterisiert (Zitations-Wäsche), oder seinen Inhalt ohne jede Zitation reproduzieren kann (Einfluss ohne Zuordnung). Die bestätigende Regression bleibt logistisch, auf den Kontrast „fokales Paper oder seine Version zitiert" versus alle anderen Ergebnisse, mit geclusterten Standardfehlern oder bevorzugt einer Crossed-Random-Effects-Struktur, um die Nicht-Unabhängigkeit von Beobachtungen zu respektieren, die einen Motor, eine Anfrage oder ein fokales Paper teilen, da dasselbe Paper, das über Motoren abgefragt wird, und derselbe Motor, der über Papers abgefragt wird, jeweils korrelierte Ergebnisse induzieren, die naive unabhängige Versuchsfehler unterschätzen würden. Formal ist der Schätzbereich der Audit M_pqe: die Wahrscheinlichkeit, dass Paper p von Engine e als Reaktion auf Anfrage q zitiert wird. M_pqe ist keine Eigenschaft des Papers allein, da es über Anfragen, Engines, Daten und Modellversionen variiert, also definiert die Notation den Schätzbereich und jeder mit Zeitstempel versehene Lauf wird als Schätzung von M_pqe zu seinem Datum gelesen. Die Engine-Stichprobe sollte über Verbraucher-Chatbots hinaus zur entstehenden wissenschaftlichen Abruf-Schicht reichen (Tools wie Consensus, Elicit, Scite und Semantic Scholar, die in akademischen Korpora verankert sind und echte Papers zitieren), da ein Preprint, das für Verbraucher-Engines unsichtbar ist, immer noch von disziplinspezifischen Engine gefunden werden kann, und die Divergenz zwischen den beiden Schichten ist selbst ein Ergebnis von Interesse. Maschinenensichtbarkeit wird dann auf Paper-Merkmale regrediert, die in Tabelle 18 operationalisiert sind, einschließlich der Prior-Sichtbarkeitkovariable, die P3b erfordert: des Web- und wissenschaftlichen Fußabdrucks jedes Papers vor dem Audit, eingefroren bei der Anfragekonstruktion. Die Anfrage-Stichprobe wird nach Prior-Sichtbarkeit geschichtet, damit Kalt-Start-Papers von Design vertreten sind. Da generative Engines nicht-stationär sind, koppelt das Design einen mit Zeitstempel versehenen primären Snapshot mit einem Skript-Wiederholungsprotokoll, das andere wiederholen können. Drei weitere Audit-Hygiene-Anforderungen sind vorspezifiziert: negative Kontrollen (prestigeträchtige, aber irrelevante Papers, Titel-Varianten und Anfragen, die die fokale Arbeit nicht abrufen sollten) machen wahllose Zitation erkennbar; jede Anfrage läuft in äquivalenten Prompt-Varianten unter aufgezeichnetem Sitzungszustand (saubere versus angemeldete Sitzungen; Engine, Modellversion, Datum und Geografie), sodass Prompt- und Sitzungs-spezifische Artefakte vom stabilen Abrufverhalten zu unterscheiden sind; und eine zufällige Unterstichprobe von Ergebnissen wird doppelt kodiert, mit berichteter Inter-Rater-Übereinstimmung. Die vollständige Schritt-für-Schritt-Audit-Checkliste wird mit den Vorregistrierungsmaterialien hinterlegt. Der Hauptinput der Studie ist die Zeit des Forschers (die verblindete Relevanzvalidierung von 100–200 Fragen und die doppelte Kodierung) statt eingeschränkt zugänglicher Daten oder spezialisierter Infrastruktur. Eine Studie, die für Expert-Rater-Zeit zu Marktpreisen bezahlen muss, sollte diese Arbeitszeit explizit einplanen. Die vorspezifizierte Vorhersage ist, dass das Preprint selbst in einer Minderheit von Versuchen zitiert wird (Band 10–35%), wobei strukturierte Abstrakt- und veröffentlichte Versionsmerkmale die Sichtbarkeit erhöhen (P3). Studie 2 ist ein Protokoll unter fünf Agenda-Punkten. Ein vollständiger Audit der wissenschaftlichen Maschinenensichtbarkeit, einschließlich Cross-Engine- und Cross-Repository-Vergleiche, ist Gegenstand eines geplanten Begleitpapers.
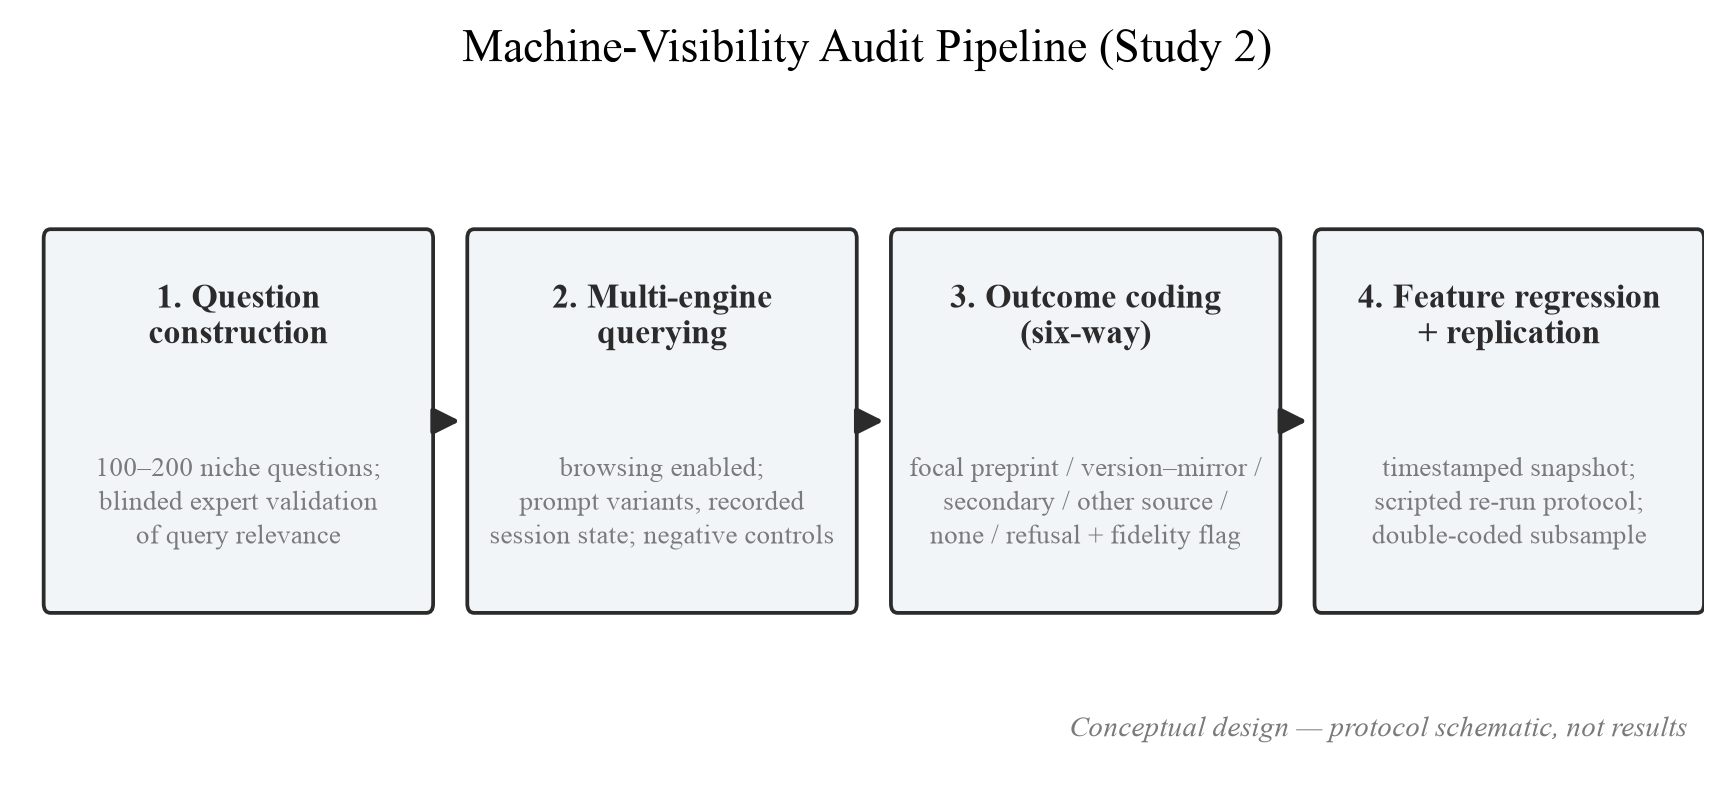
Abbildung 13. Die Maschinenensichtbarkeits-Audit-Pipeline (Studie 2). Die vierschrittige Studie-2-Pipeline. Die sechsfache Kodierung trennt Zitation des fokalen Preprints von der Zitation seiner veröffentlichten Version oder eines Mirrors – was die falsche Klassifizierung von Abwesenheit verhindert – und das Zuordnungs-Treue-Flag hält „wurde es zitiert" von „wurde es korrekt zitiert" unterschieden. Die Snapshot-Plus-Replikations-Struktur adressiert Model-Non-Stationarität: Der primäre Snapshot ist datiert, und das Wiederholungsprotokoll ermöglicht es jedem Forscher, den Audit zu einem späteren Zeitpunkt zu reproduzieren.
Tabelle 18. Operationalisierung von Maschinenensichtbarkeitsmerkamlen (Studie 2).
| Variable | Definition | Kodierung |
|---|---|---|
| DOI vorhanden | Paper-Seite legt einen registrierten DOI frei | 1/0 |
| Titel-Typ | Deskriptiver vs. allusiver Titel | deskriptiv = 1 |
| Abstrakt-Struktur | Strukturiert/statistikreich vs. narrativ | strukturiert = 1 |
| Alter | Monate seit erstem Posten | integer |
| Klassifizierungsanzahl | Anzahl zugewiesener eJournals | integer |
| Sekundärberichterstattung | ≥1 indizierter Blog/Nachrichtenbeitrag vorhanden | 1/0 |
| Veröffentlichte Version | Eine Journalversion als Originalveröffentlichung existiert | 1/0 |
| Vorherige Sichtbarkeit | Digitale Sichtbarkeit vor der Prüfung im Web und in wissenschaftlichen Datenbanken des Papers und seiner Autoren, eingefroren zum Zeitpunkt der Anfrageerstellung (P3b) | stratifizierte Ordinalskala |
| Ergebnis V | Abrufergebnis für das fokussierte Paper | Sechs Kategorien: fokussiertes Preprint / Veröffentlichte Version oder Spiegelung / Nur Sekundärquellen / Andere vertretbare Quelle / Keine nachverfolgbar / Verweigerung; plus binäres Attributions-Treue-Flag für zitierte Fälle |
Anmerkung. Die Auswahl der Merkmale passt dokumentierte Optimierungsfaktoren für generative Engines [5][164] auf wissenschaftliche Artefakte an. Die größte derartige Prüfung mit etwa 252.000 Versuchen über sechs KI-basierte Engines identifizierte thematische Relevanz und Listenposition innerhalb des abgerufenen Kontexts als die führenden Treiber dafür, zuerst zitiert zu werden [164]. Die Listenposition ist daher eine separate, übertragbare Hypothese für Studie 2, und die Ergebnislistenposition sollte überall dort verzeichnet werden, wo sie beobachtbar ist.
Tabelle 19 ergänzt Tabelle 18 auf einer anderen Beschreibungsebene. Tabelle 18 operationalisiert die Paper-Merkmale, deren Effekte Studie 2 schätzt, während Tabelle 19 die Messkonstrukte der Prüfung spezifiziert: Was wird gemessen, unter welchen Kontrollen und gegen welche primäre Gültigkeitsbedrohung. Jedes Konstrukt ist eine eigenständige Aussage über die Machine-Layer, und jede Bedrohung benennt die spezifische Weise, auf die eine naive Prüfung schiefgehen würde.
Tabelle 19. Messkonstrukte der Machine-Visibility-Prüfung (Studie 2).
| Konstrukt | Operationales Messinstrument | Erforderliche Kontrollen | Primäre Bedrohung |
|---|---|---|---|
| Direkte Machine-Sichtbarkeit | Fokussiertes Preprint wird in der Antwort zitiert oder verlinkt | Anfragerelevanz, Engine, Datum, Sitzungszustand | Modell- und Index-Drift |
| Quellenersetzung | Veröffentlichte Version, Spiegelung oder Sekundärabdeckung wird statt des Preprints zitiert | Versionsabgleich, DOI, Titelvarianten | Falsche Klassifizierung als Abwesenheit |
| Zitierposition | Rang und Prominenz des fokussierten Zitats innerhalb der Antwort | Antwortlänge und Zitatzahl | Interface-spezifische Darstellung |
| Attributions-Treue | Aussage in der Antwort wird genau durch das zitierte Paper gestützt | Verblindete Aussage-Quellen-Verifikation | Zitationsverwäschung oder Halluzination |
| Anfragensensibilität | Variation der Ergebnisse über äquivalente Anfragenformulierungen | Randomisierte Prompt-Varianten | Prompt-spezifische Artefakte |
| Replizierbarkeit | Gleiches Ergebnis zu einem späteren Datum oder bei neuem Durchlauf | Archiviertes Protokoll und Systemmetadaten | Engine-Nichtstationarität |
Die verteidigbarste Übertragung aus der kommerziellen GEO-Literatur ist eine Merkmal-Prüfungs-Agenda, keine Förderungsanleitung: Tabelle 20 führt Kandidatenmerkmale auf, deren Assoziation mit Machine-Sichtbarkeit Studie 2 bestätigen oder widerlegen soll. Jede Zeile ist eine Hypothese statt einer etablierten Taktik, und ein Merkmal, das mit Abruf assoziiert ist, könnte dennoch ein Proxy für Paper-Reife, Themen-Popularität oder vorherige Sichtbarkeit sein, statt ein Hebel.
Tabelle 20. Merkmal-Prüfungs-Agenda für Machine-Sichtbarkeit (Hypothesen für Studie 2, keine Empfehlungen).
| Kandidatenmerkmal | Hypothetischer Mechanismus | Unterstützende Evidenz |
|---|---|---|
| DOI registrieren | Stabile Kennung hilft bei Abruf und Zitationsabgleich | [164] |
| Strukturiertes, statistikreiches Abstract | Statistikhinzufügung erhöhte generative Sichtbarkeit um bis zu ~40% in kommerziellen Benchmarks | [5] |
| Beschreibender, relevanzreicher Titel | Thematische Relevanz ist ein Top-Treiber von Zitation in KI-Antworten | [164] |
| Genaue eJournal-Klassifizierungen maximieren | Mehr Klassifizierungen assoziiert mit mehr Downloads, weniger Nullen | [168] |
| ≥1 Element Sekundärabdeckung sichern | Engines zitieren oft Sekundärabdeckung über Primärquellen | [82] |
Studie 3: „Who Arrives First?" (Wer kommt zuerst an?) Ein Protokoll mit instrumentiertem Posting testet P4 direkt. Zwei echte Arbeitspapiere werden mithilfe eindeutiger Plus-Adressen-E-Mail-Aliase pro Expositionskanal gepostet, mit einem 90-Tage-Eingangsprotokoll, dem ein Baseline-Fenster von zwei bis vier Wochen auf denselben Aliasen vorausgeht. Ohne eine Baseline können Steigerungen des Solicitation-Volumens überhaupt nicht dem Posting zugeordnet werden, da akademischer Spam kontinuierlich gegen eine hohe Hintergrundrate ankommt. Jede Nachricht wird anhand veröffentlichter Solicitation-Signaturen [96] und kuratierter Blocklist-Kriterien als echte wissenschaftliche Kontaktaufnahme oder räuberische Solicitation kodiert, gegen die hohen Hintergradraten, die in den Spezialaudits in Abschnitt 7.2 dokumentiert sind [9][84][63][61]. Das Ergebnis ist der Vergleich von Zeit bis zum ersten echten Kontakt und Zeit bis zur ersten räuberischen Solicitation, die dem Posting zuzuordnen ist. Die vorspezifizierte Vorhersage gemäß P4 lautet, dass Solicitation dem echten Kontakt vorausgeht. Zwei Messregeln sind vor dem Start festgelegt. Das Baseline- und Post-Posting-Fenster sind unterschiedlich lang (ungefähr zwei bis vier Wochen gegenüber neunzig Tagen), daher ist der Vergleich von Ankunftsraten (Ereignisse pro Alias-Tag) und von Überlebensfunktionen, niemals von rohen Ereigniszahlen, die durch die Fensterasymmetrie verzerrt würden. Und die Zeit bis zum ersten Kontakt ist konstruktionsbedingt rechts-zensiert: Mit zwei Papieren ergibt ein Alias, der innerhalb des 90-Tage-Fensters keinen echten Kontakt erhält, eine zensierte, keine Null-Beobachtung, daher ist die Zensierungsregel vorspezifiziert. Beobachtungen sind bei 90 Tagen rechts-zensiert, Aliase ohne Ereignis tragen zensierte Zeit zur Überlebensschätzung bei, anstatt gelöscht oder als sofort kodiert zu werden, und mit N = 2 werden die resultierenden Kurven mit ihrer exakten Kleinprobe-Unsicherheit gemeldet, anstatt als Punktschätzer. Der kausale Schätzwert des verteilten Replikationsdesigns ist die Änderung der Hazard von Solicitation nach dem Posting (nicht die Identität eines Downloader), geschätzt mit Überlebens-/Ereignishistorie-Methoden auf abgestimmten Pre- und Post-Posting-Fenstern. Da die sichtbare Produktivität eines Autors das Solicitation-Volumen unabhängig von jedem einzelnen Posting plausibel vorhersagt (Solicitation wird aus der kumulierten öffentlichen Ausgabe eines Autors geerntet, daher skalieren die hohen Hintergradraten, die in den Spezialaudits von Abschnitt 7.2 dokumentiert sind, mit dieser Ausgabe), müssen verteilte Replikationen Expositionskontrollvariablen auf Autorenebene (vorherige Postings, Publikationsvolumen und öffentliche Kontaktfläche) neben dem Focal-Ereignis aufzeichnen. Dies ist eine N = 2 instrumentierte Fallstudie, ein Mechanismusnachweis und ein offenes Protokoll, das verteilte Replikation einlädt, was kollektiv eine angemessen gepowerte Schätzung ergeben würde. N = 2 zeigt die Machbarkeit der Instrumentierung, nicht die Prävalenz und nicht die kausale Magnitude. Im Gegensatz zu den Studien 1, 2 und 4, die gegen vorspezifizierte Effektgrößen gepowert sind, ist Studie 3 ein Machbarkeitspilot und ein offenes Replikationsprotokoll.
Der Kodierungsrahmen ist vor dem Start festgelegt. Eingangspostfachnachrichten werden in sieben Typen kodiert: Journal-Solicitation, Konferenzeinladung, Peer-Review-Anfrage, Editorial-Board-Einladung, Buchkapitel-Einladung, kommerzielles Serviceangebot und echte wissenschaftliche Korrespondenz – ein breiterer Rahmen als eine binäre Aufteilung in räuberisch/echt. Jeder Datensatz enthält einen Mindestsatz von Feldern: Zeitstempel, empfangender Alias (Kanal), Venuename, Gebührenoffenlegung, Spezifität zum Focal Paper, Dringlichkeitssprache, Überprüfungsergebnis gegen verwaltete Screening-Services und Kodiervertrauen. Grenzfälle und legitime minderwertige Venues werden durch vorspezifizierte Regeln statt ad-hoc-Urteilen geregelt. Ein neues oder obskures Venue ist nicht automatisch räuberisch. Eine zufällige Teilstichprobe wird doppelt kodiert, mit gemeldeter Inter-Rater-Übereinstimmung. Nur aggregierte Zählwerte werden freigegeben (Abschnitt 9; Declarations), und das vollständige Codebuch wird mit der Vorregistrierung hinterlegt. Solicitation-Volumen ist kein Beweis für Lesbarkeit, und Solicitation bewegt die öffentlichen Zähler nicht: SSRNs Integritätssystem schließt anomale automatisierte Aktivitäten aus amtlichen Zählen aus [144], und keine Schlussfolgerung vom Postfach zum Dashboard ist in beide Richtungen zulässig.
Studie 4: „Wie Autorinnen und Autoren ihre Zähler lesen." Eine vorgegebene Autorenumfrage wandelt die Forumevidenz der in Tabelle 1 erfassten Nachfrage in direkte Messung um. Das Instrument umfasst vier Fragen mit festem Wortlaut: (1) „Haben Sie Ihre SSRN-Downloads jemals mit einem Richtwert oder einer Norm verglichen?", mit Antwortkategorien, die zwischen einer spezifischen veröffentlichten Zahl, einer fachdisziplinspezifischen Tabelle, informellem Peergruppenvergleich und niemals unterscheiden; (2) „Wenn Sie „7 Downloads" auf Ihrem Dashboard sehen, was ist Ihr erster Gedanke?", mit Optionen, die zwischen vermuteter Misserfolgsbewertung, noch zu früh zum Beurteilen, keine Idee, was normal ist, und erwartet oder in Ordnung spannen; (3) „Hat die Änderung der Rankings-Einstellung im Juli 2026 Ihr Preprint-Verhalten beeinflusst?", mit Optionen zum Beenden von Statistikprüfungen, Vermeidung neuer Uploads, Hochladen, aber weniger häufige Überprüfung, und keine Auswirkung; und (4) „Glauben Sie, dass Einstellungs- und Tenure-Komitees SSRN-Metriken verstehen?". Die vorgegebenen Vorhersagen sind, dass eine Mehrheit der Befragten berichtet, ihre Zähler niemals mit einer Benchmark verglichen zu haben, und dass erste Lesarten einer niedrigen Zahl eher zur Inferenz von Misserfolgsbewertung als zur frühen Lesart neigen, die Abschnitt 5.6 zeigt, ist normalerweise die korrekte Standardannahme. Stichprobenumfangsziel, Rekrutierungskanäle und Analysencode sind bei der Registrierung festgelegt. Selbstauswahl hin zu engagierten und vermutlich ängstlicheren Autorinnen und Autoren begrenzt die Stichprobe, wie es auch die Registrierung in Abschnitt 8.8 tut. Das Format mit Mehrfachauswahl ermöglicht auch einen qualitativen Begleitstrang: vorgegebene thematische Kodierung öffentlicher Autorenfragen (mit expliziten Einschlusskriterien und Inter-Coder-Reliabilität unter den in Abschnitt 9 angegebenen Zitierethiken) und semi-strukturierte Interviews darüber, wie Autorinnen und Autoren ihre Zähler lesen und sich dazu fühlen, wobei die menschlichen Folgen der Metrikpräsentation erreicht werden, die geschlossene Fragen nicht können. Eine Gestaltungsgrenze bezieht sich auf das zentrale Konstrukt. Vier festgelegte Fragen, die nur SSRN-Autorinnen und -Autoren gestellt werden, messen eine Ebene des Lesens ohne Benchmarks, nicht einen Kontrast, und eine Ebene kann von selbst nicht den im Artikel behaupteten Weg von Benchmark-Undurchsichtigkeit zu Metrik-Blindheit identifizieren. Ein hoher Nie-verglichen-Anteil auf SSRN ist ebenso konsistent mit einer allgemeinen Indifferenz gegenüber Zählern, die nichts mit der Plattformundurchsichtigkeit zu tun hat. Diskriminante und kausale Griffigkeit erfordern daher eine Vergleichsbedingung: das gleiche Instrument, das Autorinnen und Autoren verabreicht wird, die auf Plattformen mit unterschiedlicher Benchmark-Transparenz posten, arXiv (endorsement- und auflistungsbasiert, mit eigenen Sichtbarkeitsflächen) und OSF Preprints, verwandelt „wie SSRN-Autorinnen und -Autoren ihre Zähler lesen" in „ob Autorinnen und Autoren auf mehr und weniger undurchsichtigen Plattformen ihre Zähler unterschiedlich lesen", was der Kontrast ist, den der Opacity-to-Blindness-Anspruch tatsächlich vorhersagt. Der plattformübergreifende Arm ist als Teil von Studie 4 vorgegebenermaßen geplant; ohne ihn würde ein Ergebnis auf einer einzelnen Plattform beschreibend für SSRN bleiben, anstatt einen Test des Mechanismus darzustellen. Studie 4 testet dann die Interpretationsansprüche der Abschnitte 1 und 5 direkt, misst, was Autorinnen und Autoren glauben, dass ihre Zähler bedeuten, anstatt was die Zähler sind.
8.7 Der Artikel als eigenes Experiment
Die Download-Trajektorie dieses Artikels ist ebenfalls vorspezifiziert. Die Zähler werden 30, 90 und 180 Tage nach der Veröffentlichung erfasst und gegen den Median aus Studie 1 berichtet, sobald dieser Median bekannt ist. Der Datensatz ist deskriptiv und enthält keine Interpretationsregeln, da beide direktionalen Lesarten die These begünstigen würden und ein Verfahren, bei dem jedes Ergebnis das Argument bestätigt, nichts testet; die Zahlen werden veröffentlicht, wie sie anfallen. Eine Lesart würde gegen die Rahmung des Artikels sprechen: Eine Trajektorie auf dem Niveau des Feld- und Altersmedians, weder erhöht noch unterdrückt, würde anzeigen, dass selbstreferenzielles Design in diesem einzelnen Fall keinen messbaren Vorteil bei der Auffindbarkeit bietet. Die Reflexivität lässt sich nicht vermeiden, da diese Arbeit eine Metrik untersucht, die sie selbst akkumulieren wird; die katalogisierten Hebel werden durch die direkten Tests in Abschnitt 8 bewertet, nicht durch diesen Datensatz.
8.8 Die Perzentil-Benchmark als öffentliches Gut
Das nützlichste Artefakt, das diese Agenda produzieren kann, ist eine Perzentiltabelle für Preprint-Downloads – die Zahl, die jeder Autor sucht und nicht finden kann. Die Plattform hat historisch Mittelwerte und Top-N-Listen veröffentlicht, aber keine Mediane oder Perzentile, und seit dem 15. Juli 2026 zeigt sie nur noch Pro-Paper- und Pro-Autor-Zählungen ohne jeden Vergleichskontext [149]. Für den h-Index und ähnliche Indikatoren gibt es ein Massengenre von gestuften „Ist X gut?"-Leitfäden [118][128]; die Prüfung in Abschnitt 2.5 fand keine Entsprechung für SSRN-Downloads. Die Rohmaterialien für eine solche Tabelle existieren seit Jahren in Druck [18][83][85][139][168], und es fehlt die Übersetzung dieser Verteilungen in eine autorenseitige Skala.
Nach dem Sunset ist die externe Erfassung vollständiger Plattform-Perzentile nicht mehr möglich: die Top-Listen, die Verteilungsschwellwerte durchgesickert haben, waren das einzige öffentliche Fenster zum Schwanz, und sie sind weg [149]. Zwei komplementäre Wege bleiben. Einer ist die geschichtete Stichprobe von Studie 1, die Plattform-Perzentile auf Papierebene liefert. Der andere Weg ist ein crowdgesourctes Register von selbstberichteten Zählern: ein freiwilliger Community-Datensatz, in dem Autoren datierte Dashboard-Snapshots (Papieralter, Feld, abstrakte Ansichten, Downloads) beitragen, zusammengestellt, bevor die institutionelle Erinnerung an die Vor-Sunset-Verteilungen weiter verblasst. Der Erhaltungsschritt des Dossier-Protokolls (Tabelle 13), wenn in großem Maßstab übernommen, ist der Samen genau eines solchen Registers. Es gibt auch ein funktionierendes Vorbild zum Erweitern, nicht zum Erfinden. IRUS (Jisc) aggregiert bereits standardisierte, COUNTER-konforme Item-Level-Nutzungsstatistiken, Total_Item_Requests darunter, über teilnehmende institutionelle Repositories [185], was zeigt, dass Multi-Institution-Nutzungsaggregation operativ durchführbar ist. Ein Preprint-Register ist dieses etablierte Modell verbreitert, um die Referenzklassen-Variablen zu tragen, die hier wichtig sind (Feld, Posting-Kohorte und Karrierephase). Ein nordamerikanisches Gegenstück, CC-PLUS, bietet die gleiche Kapazität als Open-Source-Infrastruktur mit automatisiertem SUSHI-Harvesting von COUNTER 5-Nutzung über Konsortien [188], sodass ein Register eine funktionierende Plattform erweitern kann, anstatt von Grund auf in Auftrag gegeben zu werden. Ein Register dieser Art würde die erste frische, multidisziplinäre Download-Verteilung seit den Mid-2010er-Stichproben darstellen [85][139]. Die bekannten Schwächen sind Selbstselektionsbias gegenüber engagierten und wahrscheinlich überdurchschnittlichen Autoren, unüberprüfbare Selbstberichte, es sei denn, datierte Screenshots sind erforderlich, und Abdeckungslücken in kleinen Feldern. Aus ihr abgeleitete Perzentile müssen daher mit expliziten Auswahlvorbehalten veröffentlicht werden und, wo möglich, kalibriert gegen die Wahrscheinlichkeitsstichprobe von Studie 1, und spärliche Feld-nach-Alter-Zellen müssen unter empirischem Bayes-Shrinkage zu breiteren Referenzklassen statt als instabile Roh-Perzentile berichtet werden (Abschnitte 5.2, 8.3). Das Register-Protokoll und die Verifikationsregeln werden mit den Preregistrierungsmaterialien veröffentlicht, und das Beitragsformat ist hier festgelegt: Ein Register-Datensatz ist eine definierte Teilmenge des Panel-Schemas von Anhang C (die Identität-, Timing-, Nutzungs-, Expositions- und Audit-Domänen), sodass selbstberichtete Datensätze mit dem Studienpanel 1 zusammenführbar bleiben, statt sich als inkompatibles zweites Dataset anzusammeln.
Die Ausgabeformate des Registers sind zusammen mit seinem Protokoll vorspezifiziert, und zwei Artefakte sind festgelegt. Eines ist eine Übersetzungstabelle, die eine einzelne Zahl (sagen wir 10, 40 oder 100 Downloads) nimmt und für jedes abgedeckte Feld seine Perzentilposition und das Klartext-Band von Tabelle 8 zurückgibt; damit kann die Antwort auf „Sind 7 Downloads gut?" endlich nachgeschlagen statt geraten werden. Das andere ist eine Perzentil-„Fächer"-Abbildung, die die 25., 50., 75. und 95. Perzentil-Download-Kurven als Funktionen des Papieralters, nach Feld und Anfänger-Schicht, darstellt: das Format, in dem eine Benchmark „wie viel ist normal am Tag X" beantwortet (Abbildung 14; [Daten erforderlich]: keines der Artefakte darf mit synthetischen Werten gefüllt werden). Jede Perzentil-Veröffentlichung aus beiden Routen (der Wahrscheinlichkeitsstichprobe oder dem Register) wird unter der Transparenzspezifikation von Anhang D veröffentlicht, einschließlich ihrer Mindest-Zellenschutzregeln, sodass die Benchmark, die diese Agenda vorschlägt, nicht die Undurchsichtigkeit reproduziert, die sie heilen sollte. Oben auf die Daten gehört eine dünne Self-Service-Schicht, ein öffentlicher Online-Rechner, in den ein Autor Feld, Papieralter und Zähler eingibt und ein Perzentil-Band und ein verbales Urteil erhält. Es würde die unkalibrieren Scorecard-artigen Heuristiken von Abschnitt 6.3 in ein kalibriertes Instrument umwandeln, einmal und nur einmal, wenn die Referenzverteilungen existieren. Abschnitt 8.10 schlägt eine Multi-Modell-Architektur vor, durch die ein solcher Service betrieben und aktuell gehalten werden könnte. Diese gleiche Self-Service-Schicht verhindert, dass das Berichtsprotokoll eine neue Arbeitslast auf Einstellungs- und Tenure-Komitees auferlegt, da die Pro-Nummer-Normalisierung, die das Dossier-Format (Tabelle 13) verlangt, vom Rechner (dieser Abschnitt) und, in großem Maßstab, von der Orchestration-Schicht (Abschnitt 8.10) gelöst wird. Sein realistischer Bereitstellungspfad führt durch existierende Forschungsinformations-Rohre, nämlich aktuelle Forschungsinformationssysteme (CRIS) und ORCID-verknüpfte Profile, sodass ein kalibriertes Reading aus den Identifiern eines Papers produziert statt von Hand zusammengestellt werden kann. Eine natürliche plattformübergreifende Erweiterung ist ein Parallel-Deposit-Protokoll, das die gleiche Papier-Trajektorie auf SSRN, arXiv (wo feldgerecht) und OSF Preprints vergleicht, ein direkter Test, ob die Bänder von Tabelle 8 zwischen Push- und Pull-Architekturen (Tabelle 6) übertragbar sind.
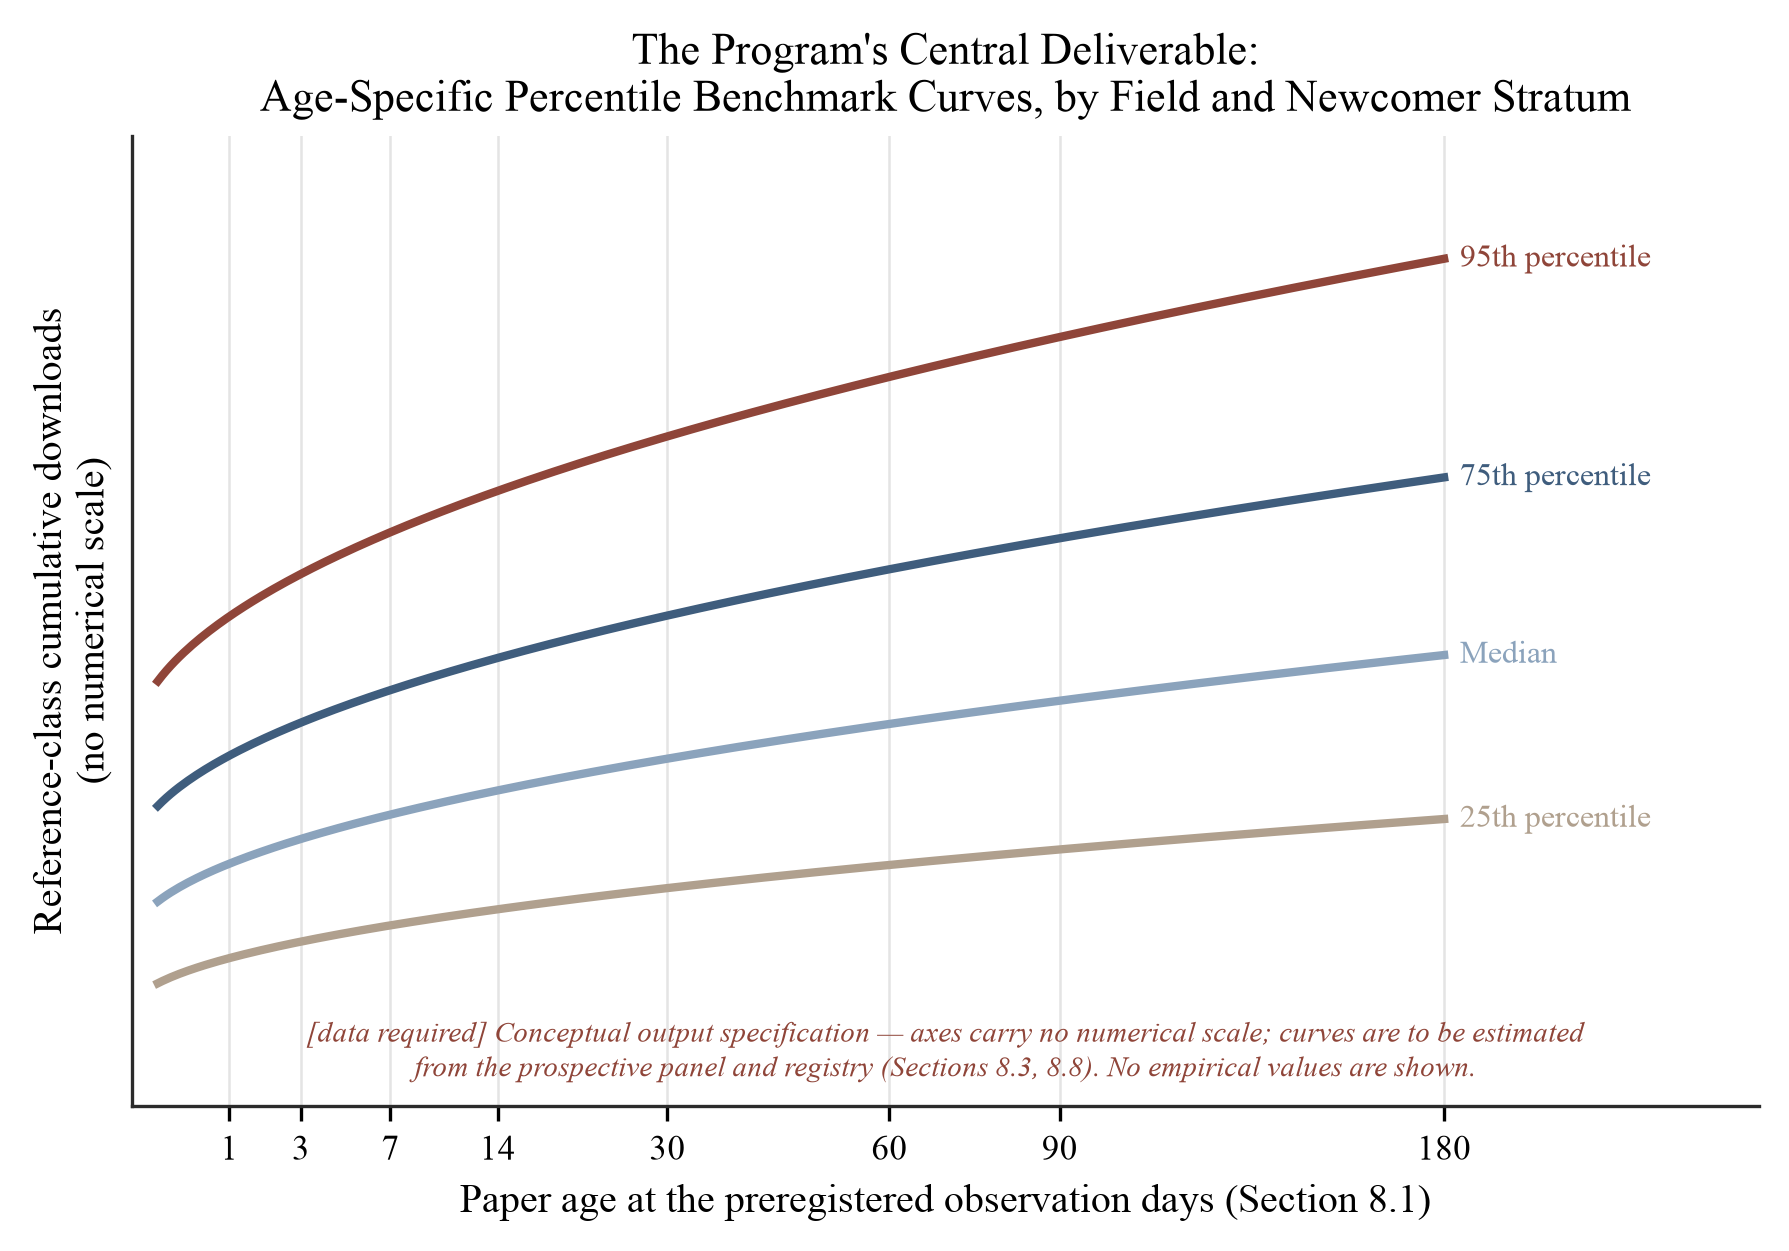
Abbildung 14. Der altersgerechte Benchmark-Fächer: die zentrale Liefervorgabe des Programms. Perzentil-Download-Kurven (25., 50., 75. und 95.) als Funktionen des Papieralters, evaluiert an den vorspezifizierten Beobachtungstagen von Abschnitt 8.1 und geschätzt nach Feld und Anfänger-Schicht aus der Studienstichprobe 1 und dem Community-Register. Die Achsen tragen keine numerische Skala; die Abbildung ist eine konzeptuelle Ausgabespezifikation, und sie ist das Anzeigeformat hinter sowohl der Plattform-Empfehlung von Abschnitt 10.4 als auch des oben beschriebenen öffentlichen Rechners.
Jeder empirische Artikel des Programms verpflichtet sich zu einem Mindestumfang an Berichtserstattung: ein Flussdiagramm der Kohorte; Roh- und normalisierte Verteilungen nebeneinander; Reichweite und Konversion separat berichtet; Expositionshistorien; Anomalie-Sensitivitätsergebnisse auf der vier-schichtigen Leiter von Abschnitt 8.3; Null- und gegenteilige Ergebnisse mit der gleichen Prominenz wie Bestätigungen berichtet; und eine maschinenlesbare Benchmark-Tabelle, die Bedingung, unter der die Ausgabe von Studie 1 tatsächlich den oben beschriebenen öffentlichen Rechner speisen kann. Abstracts von Programmartikeln unterscheiden verifizierte Schätzungen von vordefinierten Erwartungen.
8.9 Prädiktive Validierung
Der Summativer Test der Agenda (RQ3) fragt, ob die Normalisierung ihre Komplexität rechtfertigt. Frühe Nutzung und spätere Zitationen sind über Einstellungen hinweg positiv, aber unvollkommen miteinander verbunden: Korrelationen in der Größenordnung von 0,11–0,35 in Granger-Analysen auf Journalebene [80], ungefähr 0,4 in frühen arXiv-Kohorten, wobei r ≈ 0,4 nur etwa 16 % der Varianz erklärt [25], mit vergleichbaren Assoziationen, die für Chemiepräprints vor zwei Jahrzehnten berichtet wurden [26], für Downloads auf Journal- und Papierebene allgemein [71], in RePEc-Nutzungsdaten [31] und in bioRxiv-Kohorten [62], sowie moderate Rangkorrelationen bei Mega-Journal-Nutzung [102]. Die stark heruntergeladenen und stark zitierten Mengen überlappen sich nur teilweise [108][39]. Neueste Panelbelege verknüpfen Zugang mit Zitationen mit einer Verzögerung: in einem Siebenjournal-Panel betrug die Assoziation ungefähr Einheitselastizität, wobei eine 10%ige Steigerung der Zugriffe mit ungefähr einer 10%igen Steigerung der Zitationen etwa neun Monate später verbunden war [178]. In der Notation von Abschnitt 5.5 schätzt der summative Vergleich
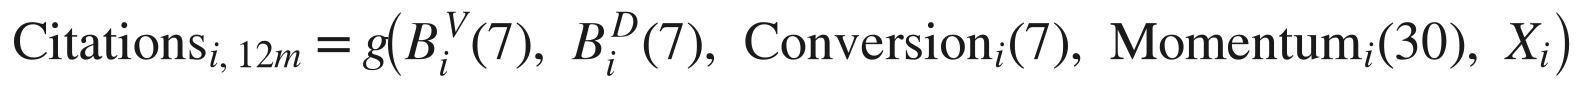
mit g flexibel angepasst und nur außerhalb der Stichprobe bewertet. Die Gleichung legt fest, welche normalisierten Eingaben gegen rohe Zählungen konkurrieren. Modelle, die 6-, 12- und 18-Monats-Zitationen aus nach Alter, Feld und Kohorte normalisierten 7- und 30-Tage-Metriken vorhersagen, sollten außerhalb der Stichprobe (durch kreuzvalidierte Wahrscheinlichkeit, Kalibrierung, Rangkorrelation und Vorhersagefehler) mit Modellen verglichen werden, die allein rohe kumulative Downloads verwenden, ein Vorhersagepolitik-Problem im Sinne von Kleinberg et al. [88]. Ein besonders informativer Ausgang wäre, dass rohe Zählungen etablierte Autoren bevorzugen, während normalisierte Cold-Start-Maße die spätere Zitationsübernahme besser vorhersagen. Dieses Muster würde implizieren, dass ein Teil dessen, was rohe frühe Zähler messen, die anfängliche Gelegenheit eher als die nachfolgende intellektuelle Nachfrage ist. Wenn die Normalisierung keine Vorhersageinformationen hinzufügt, wird der Messuranspruch des Rahmens entsprechend abgelehnt oder eingeengt.
Abbildung 15 fasst die Agenda zusammen. Eine prospektive Kohorte speist die vier Studien und die zwei Plattform-Quasi-Experimente parallel, und jedes Modul lagert sich in denselben Satz versionierter öffentlicher Ausgaben ein. Diese gemeinsame Struktur macht die Agenda zu einem Forschungsprogramm.
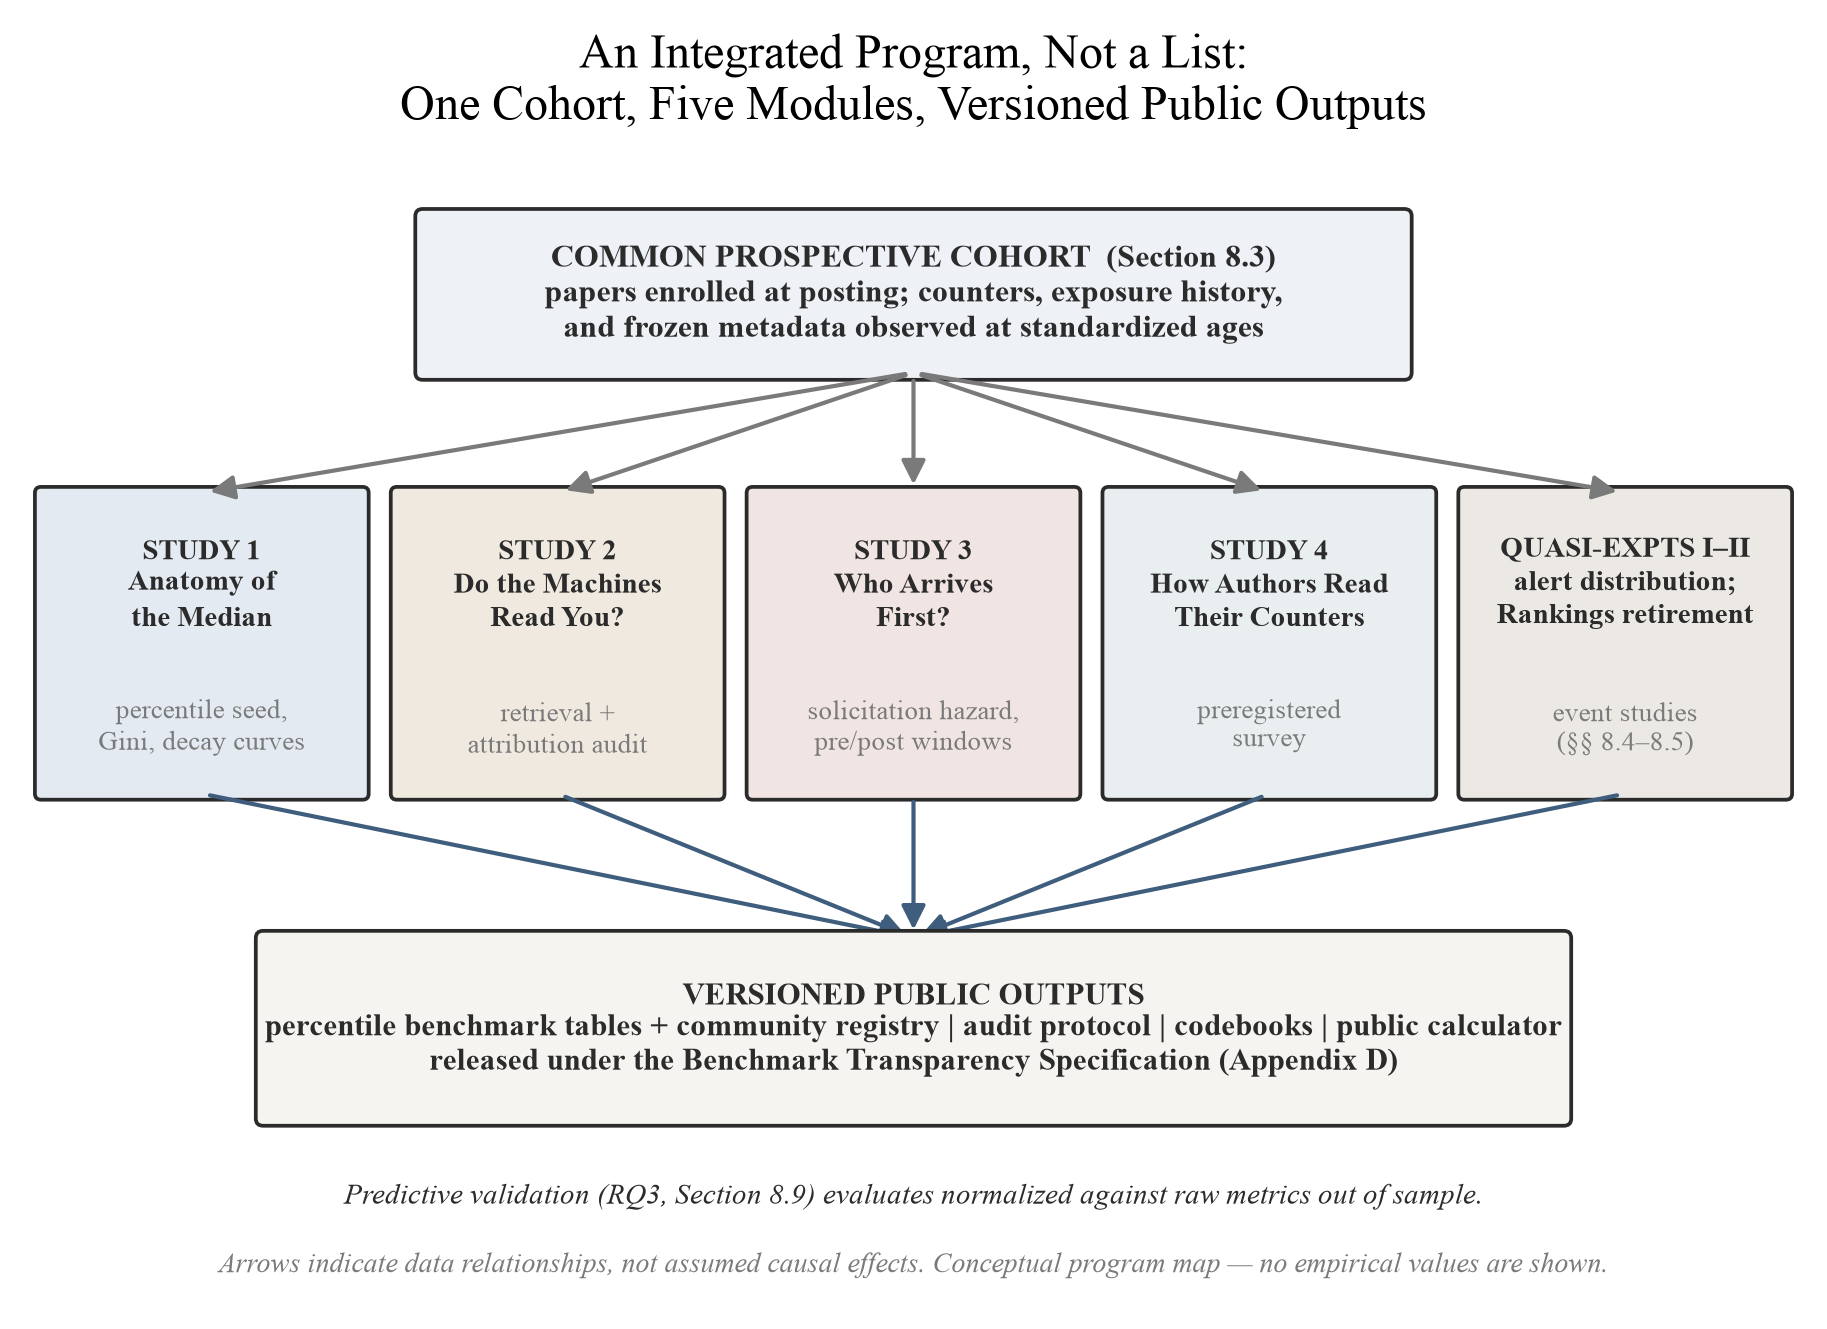
Abbildung 15. Das integrierte Forschungsprogramm. Eine prospektive Kohorte (Abschnitt 8.3) speist die vier Studien (Abschnitt 8.6) und die zwei Plattform-Quasi-Experimente (Abschnitte 8.4–8.5); alle Module lagern sich in versionierte öffentliche Ausgaben ein – die Perzentil-Benchmark-Tabellen und das Community-Register (Abschnitt 8.8), das Audit-Protokoll, die Kodierungscodebücher und der öffentliche Rechner – veröffentlicht unter der Benchmark-Transparenzspezifikation von Anhang D, während die prädiktive Validierung (Abschnitt 8.9) den resultierenden Benchmark außerhalb der Stichprobe bewertet. Pfeile zeigen Datenbeziehungen an, nicht angenommene Kausaleffekte.
8.10 Ein Designvorschlag: orchestrierte Frontier-KI-Modelle als Lieferschicht des Benchmarks
Eine einmalige Veröffentlichung kann nicht liefern, was die Ergebnisse der Agenda erfordern. Die Perzentiltabellen, das Community-Register, das CSAB-Berichtsformat (Abschnitt 5.5; Anhang B) und der öffentliche Rechner (Abschnitt 8.8) müssen alle aus verstreuten und verfallenden Quellen zusammengestellt, Anspruch für Anspruch überprüft, aktuell gehalten werden, wenn sich Zählregeln und Plattformfunktionen ändern, und in kalibrierter Sprache an einzelne Autoren geliefert werden. Eine Kandidaten-Architektur für diese Liefer- und Wartungsschicht ist eine orchestrierte Pipeline spezialisierter Frontier-KI-Modelle (eine Klasse von System, die der Autor entwickelt; siehe Konkurrierende Interessen). Alles in diesem Unterabschnitt ist ein Designvorschlag. Es existiert keine Implementierung, keine empirische Leistung wird beansprucht, und keine Angabe für Genauigkeit, Kosten oder eingesparte Zeit wird nachfolgend behauptet.
Eine Alternative zu einem orchestrierten System ist ein einzelnes generalistisches Modell. Ein Autor, der einen Consumer-Chatbot fragt „sind 7 Downloads gut?", erhält eine flüssige, nicht überprüfbare Behauptung, den Fehlermodus, den die Audits der Antwortsysteme dokumentieren, bei dem Systeme mit unbegründetem Vertrauen irren, anstatt abzulehnen zu antworten [82]. Darunter liegt ein strukturelles Problem. Die Metrikinterpretation zerlegt sich in Untergaben mit unterschiedlichen, teilweise gegensätzlichen Zielen. Das Beschaffen und Datieren des Nachweises, das Überprüfen eines Zählers auf nicht-menschlichen oder anomalen Verkehr, das Normalisieren des überprüften Zählers gegen eine Referenzklasse von Alter, Feld, Kohorte und vorheriger Sichtbarkeit, das Übersetzen der normalisierten Position in Sprachbänder und das Anfechten dieser Übersetzung vor der Veröffentlichung sind nicht dieselbe Aufgabe, und eine für eine optimierte Komponente ist ein schlechter Richter für eine andere. Das Modell, das eine beruhigende Lesart entwirft, sollte nicht die einzige Autorität sein, ob die zugrunde liegende Zahl kontaminiert ist, und das Modell, das Dossier-Sprache entwirft, sollte nicht bestätigen, dass die Sprache Übermaßnahmen vermeidet. Das Organisationsprinzip ist daher eine Aufteilung der epistemischen Arbeit: Generierung und Überprüfung werden separaten Komponenten mit unabhängigen Zielen zugewiesen, und Uneinigkeit wird bewahrt und berichtet, anstatt weggemittelt zu werden. Konvergenz unabhängig aufgeforderten oder architektonisch unterschiedlichen Bewertern ist nicht Wahrheit, obwohl sie einen stärkeren Grund für eine Lesart darstellt als die Flüssigkeit eines einzelnen Modells, eine Designintuition, die mit experimentellen Belegen konsistent ist, dass Multiagentur-Debatten zwischen Sprachmodell-Instanzen die faktische Gültigkeit messbar verbessert und Halluzination relativ zu einem einzelnen Modell, das allein antwortet, reduziert [43]. Wo Bewerter divergieren, ist die Divergenz selbst diagnostische Information, genau wie widersprüchliche Quellen in den Syntheseregeln dieses Artikels als Signal und nicht als Rauschen behandelt wurden (Umfang und Beweisdisziplin). Zwei Designvorsichtsmaßnahmen dämpfen diese Intuition. Übereinstimmung zwischen Komponenten ist nicht selbst Beweis: Sie kann aus gemeinsamen Trainingsdaten, gemeinsamen Abrufergebnissen, gemeinsamen Prompt-Annahmen oder Kontamination durch den Orchestrator selbst entstehen. Modellfamilien von verschiedenen Anbietern sind nicht wissenschaftlich unabhängig, und Unabhängigkeit muss durch separate Anweisungen, eingeschränkten Informationsfluss zwischen Komponenten, bewahrte Zwischenausgaben und Bewertung gegen Belege, dass keine generierende Komponente berechtigt ist zu bearbeiten, hergestellt werden. Überprüfung wird auch nicht zuverlässig, weil ein zweites Modell sie durchführt: Ansprüche, die umstritten oder folgenreich sind, erfordern Inspektionen der zugrunde liegenden Quelle durch den menschlichen Benutzer.
Abbildung 16 zeigt die vorgeschlagene Pipeline, und Tabelle 21 zerlegt sie nach Funktion. Die Verarbeitung beginnt mit einer eingefrorenen Fallakte, nicht mit einem freien Prompt: die Zähler mit ihren Beobachtungsdaten, Papieralter, deklariertem Feld und kandidaten Referenzkohorten, Belastungsgeschichte und der eigentlichen Frage des Autors. Fehlende Eingaben bleiben fehlend, und das System darf keine fehlende Perzentilverteilung herstellen, einen Nenner imputieren oder eine modellgenerierte Zahl an Stelle einer beobachteten akzeptieren. Der Informationsfluss reproduziert dann die interpretive Sequenz, die der Artikel durchgehend verficht: Rohe Zähler → Integritätsprüfung → Referenzklassen-Normalisierung → Interpretation unter Beschränkung. Eine Überwachungskomponente ruft Zähler, Plattformdokumente und Registrierungsdatensätze mit datiertem Ursprung ab, damit jeder nachgelagerte Wert auf eine archivierte Quelle zurückgeführt werden kann. Jede faktische Ausgabe wird zwischen Komponenten als Eintrag in ein Anspruchsregister übertragen. Jeder Eintrag verzeichnet den Anspruch, seine unterstützende Quelle oder sein Datenfeld, einen stabilen Locator, die Abrufzeit, jede angewendete Transformation, seine Referenzklasse und seinen Überprüfungsstatus, so dass keine unsupported Ausgabe stillschweigend zur Prämisse einer späteren Phase werden kann. Die Integritätsprüfung wendet konventionelle Zeitreihen-Anomalieerkennung (eine Aufgabe für statistische Methoden, nicht freie Textgenerierung) gegen den dokumentierten Hintergrund der Bot-Filterung und KI-Crawler-Kontamination an [129][144]. Es schreibt Trajektoriebruch datierten Belastungsereignissen zu, wenn das Belastungsregister dies zulässt (Abschnitt 5.6). Die Normalisierung wird durch deterministischen statistischen Code durchgeführt, der als Tool aufgerufen wird: Perzentilpositionen werden gegen die versionierten Tabellen aus Studie 1 und Registry unter den Schrumpfungsregeln von Abschnitt 8.3 berechnet. Die Perzentilrechenschaft wird niemals an freie Textgenerierung delegiert. Erst dann entwirft ein Interpreter-Modell die autorenfassliche Lesart, beschränkt auf die Sprachbänder von Tabelle 8, die Reichweiten-gegen-Umwandlungs-Diagnostik von Tabelle 9 und die CSAB-Vorlage von Anhang B, mit Quelle, Alter und Vertrauensebene an jede Zahl angeheftet. Ein separater Verifier und Kritiker überprüfen jeden Anspruch gegen seinen aufgezeichneten Beweis vor Veröffentlichung, wobei jeder als verifiziert, umstritten, unsupported oder nicht bewertbar berichtet wird, vier unterschiedliche Zustände, die niemals in einen einzigen synthetischen Vertrauenswert komprimiert werden. Zwei Beschränkungen übertragen sich aus dem Framework unverändert. Jede Empfehlung ist bedingt durch den diagnostizierten Engpass, da reichweiten-limitierte und umwandlungs-limitierte Papiere unterschiedliche Maßnahmen rechtfertigen (Tabelle 9), und ein System, das sie nicht unterscheiden kann, sollte nichts sagen, anstatt generische Ratschläge auszugeben. Die andere Beschränkung ist, dass eine veröffentlichte Empfehlung eine Hypothese ist: Sie sagt voraus, welcher Mechanismus sich bewegen sollte, wenn die Diagnose richtig ist, und nachfolgende Beobachtungen testen diese Vorhersage. Die Zielfunktion des Systems ist entsprechend eng: Entfernen Sie identifizierbare interpretive Reibung zwischen einem Papier und seiner angemessenen Referenzklasse, und niemals die Maximierung eines Zählers, eine Grenze, die durch die Integritäts- und generativen KI-Richtlinien der Plattform [54][144] und durch die Gaming-Geschichte von Abschnitt 3 [44] festgelegt ist.
Tabelle 21. Funktionale Dekomposition der vorgeschlagenen Orchestrierungsschicht: Funktion, Komponententyp, primärer Fehlermodus und der Mechanismus, der ihn unabhängig überprüft. Jede Zeile ist eine Hypothese über eine funktionsfähige Arbeitsteilung.
| Funktion | Modell oder Komponententyp | Primärer Fehlermodus | Unabhängiger Verifizierungsmechanismus |
|---|---|---|---|
| Orchestrierung und Nachverfolgung | Task-Router, der die eingefrorene Aktendatei und das Anspruchsregister verwaltet | Eine frühe unbegründete Annahme wird als Prämisse jeder späteren Phase weitergegeben | Keine unverifizierte Ausgabe darf eine vertrauenswürdige Prämisse werden; Quelle, Transformation, Abrufszeit und Unsicherheit bei jedem Handoff bewahrt |
| Evidenzerfassung und Überwachung | Werkzeugnutzendes Abrufmodell nach einem Wiederholungsplan; bibliografisches Matching gegen offene Zitierungsinfrastruktur [35][124] | Gefälschte, nicht übereinstimmende oder selektiv abgerufene Quellen | Datengestempeltes Nachverfolgungsprotokoll; jeder Wert rückverfolgbar zu einer archivierten Momentaufnahme; zufällige Substichprobe unabhängig von einer zweiten Komponente erneut abgerufen; fehlgeschlagene Suchen und gegensätzliche Ergebnisse aufgezeichnet, nicht verworfen |
| Integritätsprüfung | Nicht-generative Anomalieerkennung in Zeitreihen [129][144] | Ein Spitzenwert als „Bot" – oder „Leser" – ohne Beweis für eine der beiden Identitäten gekennzeichnet | Anomalieflaggen neben Aggregaten veröffentlicht (Abschnitt 8.8); Empfindlichkeit auf der vierschichtigen Robustheitsleiter von Abschnitt 8.3 berichtet; Anomalie als Flag behandelt, niemals als Identitätsanspruch |
| Referenzklassen-Normalisierung | Deterministischer statistischer Code, der als Werkzeug aufgerufen wird | Bequeme Peers, die mit einer gültigen Vergleichspopulation verwechselt werden | Neuberechnung gegen die versionierten öffentlichen Benchmarktabellen (Appendix D); Feld, Alter, Kohorte, vorherige Sichtbarkeit und Quellenalter angegeben oder das Modul enthält sich; kein Freitext-Rechnen in den Datensatz aufgenommen |
| Entwurf der Interpretation | Allgemeines Sprachmodell, beschränkt auf Bandsprache von Tabelle 8 und die CSAB-Vorlage (Appendix B) | Fließende Überaussage – Sicherheit, Umfang oder kausaler Status jenseits dessen, was die Evidenz zulässt | Anspruchsgerechte Überprüfung durch einen separaten Prüfer gegen die aufgezeichnete Evidenz; jeder Anspruch als verifiziert, umstritten, unbegründet oder nicht bewertbar berichtet; unbegründete Sätze abgelehnt, nicht abgeschwächt |
| Adversarische Überprüfung | Kritikermodell mit Zielen, die denen des Verfassers entgegengesetzt sind | Rituelle Kritik oder ein synthetischer Konsens, der wesentliche Uneinigkeit verbirgt | Strukturierter Uneinigkeitsbericht – Evidenzstatus, Evaluatormuster, Entscheidungsempfindlichkeit (ändert der Streit die Diagnose oder nur ihre Formulierung), verbleibende Unsicherheit – ungemergt geliefert, niemals in eine Konfidenzziffer zusammengefasst |
| Anfragensortierung | Spezialisierter Klassifikator über den Kodierungsrahmen von Tabellen 14–15 | Ein kategorisches Urteil „räuberisch", das die Evidenz übersteigt und Reputationsschaden riskiert | Nur Flag-and-Review, niemals Auto-Delete und niemals eine veröffentlichte Anschuldigung; Fehlerraten auf beschrifteten Sätzen berichtet; dokumentierte Grenzen und Vorurteile der KI-Textklassifikation anerkannt [157][97] |
| Benchmark-Verwaltung | Geplante Orchestrierung aller Komponenten | Stilles Abdriften: veraltete Quellen oder Releases, die ohne Spur überschrieben werden | Versionierte, datierte Releases unter Appendix D; Überarbeitungen protokolliert, niemals still überschrieben – eine lebende Benchmark-Karte statt eines statischen Snapshots |
| Endgültige Interpretation und jede Karrierenutzung | Menschlicher Autor | Automatisierungsneigung und Verantwortungsdiffusion | Obligatorisches menschliches Sign-off vor jeder externen Nutzung; Dossierspache folgt dem Protokoll von Tabelle 13, mit Quelle, Zeitfenster und Einschränkungen angehängt |
Zwei Grenzen vervollständigen die Spezifikation. Eine ist eine Berechtigungsgrenze: Lesezugriff ist die Standardeinstellung, und die Schicht entwirft, führt aber nie aus. Sie darf ein Manuskript nicht autonom bearbeiten, Plattformmetadaten nicht ändern, Wissenschaftler oder Veranstaltungsorte nicht kontaktieren, nicht öffentlich posten oder eine Anfragenachricht nicht löschen, und jeder implementierte Workflow muss die menschliche Verantwortung und Offenlegungsverpflichtungen der geltenden Plattform und Einreichungsrichtlinien bewahren [54][56][144]. Die andere ist eine Enthaltungsgrenze: die Nullausgabe ist ein legitimes (oft das richtige) Ergebnis, und jede Phase kann anhalten, anstatt fehlerhafte Eingaben weiterzuleiten. Obligatorische Enthaltungstrigger umfassen eine fehlende oder nicht zu rechtfertigende Referenzklasse; eine nicht überprüfbare Quelle, die zentral für die Lesart ist; ungelöste Uneinigkeit darüber, ob eine vorgeschlagene Formulierung die Ansprüche des Papiers bewahrt; jede Anfrage für eine kausale Schlussfolgerung aus einem rein beschreibenden Muster oder für eine Vorhersage von Zitationen oder Karriereergebnissen ohne einen validierten Vorhersagedatensatz (Abschnitt 8.9); und jede Anfrage, Aufmerksamkeit zu manipulieren, zu kaufen, zu simulieren oder anderweitig zu erhöhen. Dieser letzte Trigger verhindert, dass die Schicht zum Metrik-Gaming-Instrument wird, dessen Geschichte Abschnitt 3 dokumentiert [44][69][144]. Eine letzte Trennung regelt die zwei Evidenzströme der Agenda. Die versionierten Perzentiltabellen der Abschnitte 8.6 und 8.8 sind die einzige zulässige Normalisierungsquelle der Schicht, während die Audit der Maschinensichtbarkeit von Studie 2 eine separate Abruf-und-Attributionsprüfung speist. Maschinenabfrage ist keine Perzentile der menschlichen Aufmerksamkeit, und die Schicht darf die beiden nicht vermischen.
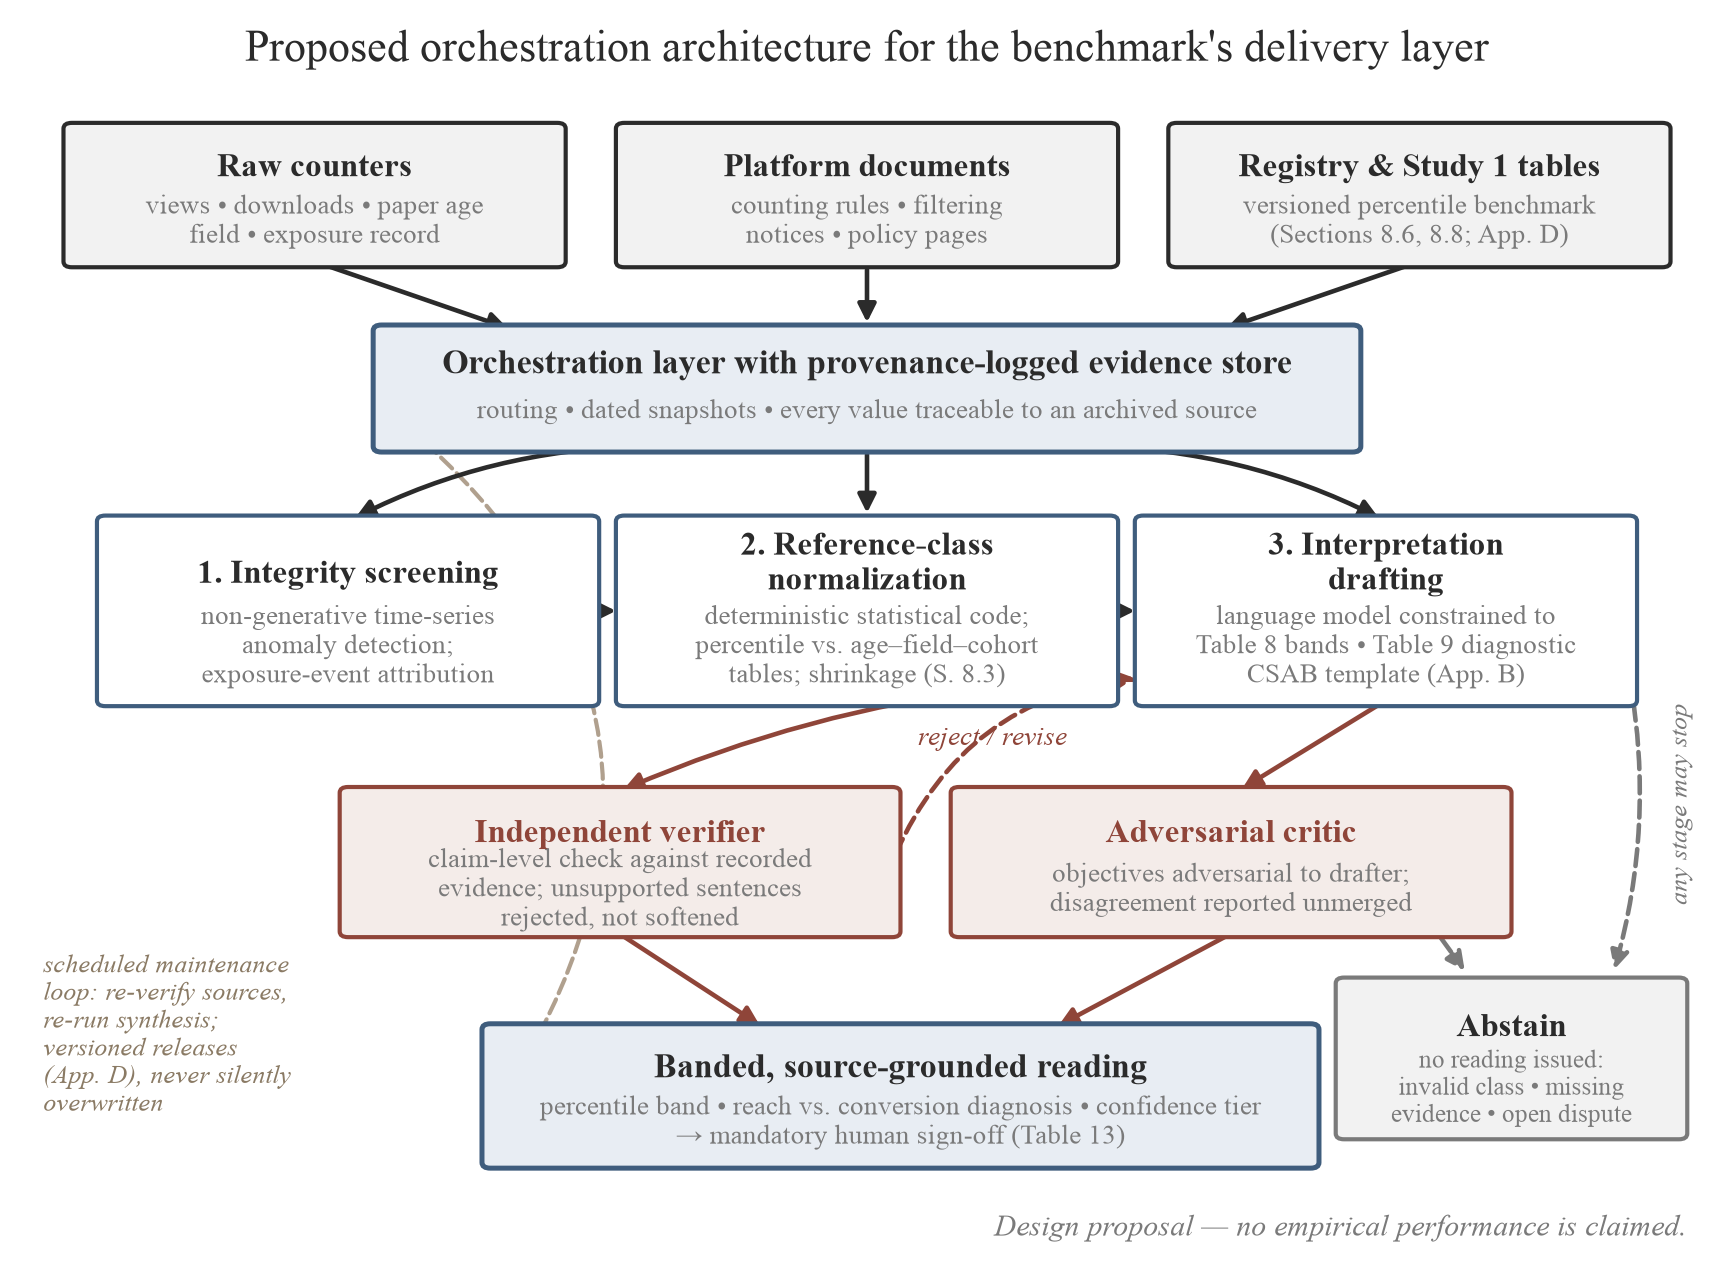
Abbildung 16. Vorgeschlagene Orchestrierungsarchitektur für die Bereitstellungsschicht des Benchmarks (Abschnitt 8.10; Tabelle 21). Spezialisierte Komponenten trennen Evidenzerfassung, Integritätsprüfung, Normalisierung und Interpretation, mit unabhängiger Verifizierung zwischen Generierung und Freigabe interponiert, ein Enthaltungsweg bei jeder Phase verfügbar und eine geplante Schleife, die den versionierten Benchmark von Abschnitt 8.8 verwaltet.
Die gleiche Fachdisziplin schränkt ein, was die Schicht tun darf, sobald sie eine Diagnose hat. Tabelle 22 legt die Aktionsrichtlinie fest: Jedes beobachtete Muster (Reichweite und Konversion zusammen mit Momentum gelesen, in der Begrifflichkeit der Tabellen 9–10) wird einer provisorischen Diagnose zugeordnet, einer beschränkten Form zulässiger Unterstützung, dem Mechanismustest, der die Diagnose bestätigen oder abschwächen könnte, und der Schlussfolgerung oder Aktion, die verboten bleibt. Die Spalte Mechanismustest operationalisiert die oben genannte Regel, dass eine freigelegte Empfehlung eine Hypothese ist. Wenn eine Klassifizierungskorrektur einen Reichweittenengpass beseitigen soll, ist das Ergebnis, das zählt, die altersgerechte Reichweite, und eine retrospektive Erzählung über insgesamt Downloads kann dafür nicht eintreten. Eine gescheiterte Vorhersage wird als gescheiterte Intervention aufgezeichnet und zurück zur Diagnose zurückgeführt, niemals neu bewertet anhand einer schmeichelhafteren Erfolgsmessung. Die gesamte Sequenz schließt sich dadurch zu einer Schleife: messen → validieren → normalisieren → diagnostizieren → vorschlagen → kritisieren und verifizieren → entscheiden → beobachten → aktualisieren oder stoppen (Abbildung 17). Innerhalb dieser Schleife steht die menschliche Entscheidung zwischen Verifikation und jeder Aktion, Beobachtungen nach der Entscheidung kehren zur Aktendatei zurück, und der Verzichtsweg beendet den Zyklus immer dann, wenn die Evidenz unzureichend ist. Die Schleife kontrolliert auch Komplexität: Wenn die Evidenz nur Bewahrung und Überwachung unterstützt oder wenn eine deterministische Regel aus dem Autorenspielplan (Abschnitt 6) die Frage bereits beantwortet, trägt die Orchestration nichts bei und sollte nicht ausgeführt werden.
Tabelle 22. Diagnose-zu-Aktion-Richtlinie für die vorgeschlagene Orchestrationsschicht. Muster werden innerhalb einer verteidigbaren Referenzklasse unter den Perzentilkonventionen von Tabelle 9 gelesen; jede Zeile ist eine Richtlinienhypothese, und keine Zelle behauptet eine empirische Häufigkeit.
| Beobachtetes Muster (Reichweite, Konversion, Momentum) | Provisorische Diagnose | Zulässige Unterstützung | Mechanismustest | Verbotene Schlussfolgerung oder Aktion |
|---|---|---|---|---|
| Niedrige Reichweite, hohe Konversion, stabil oder steigend | Ein Auffindungsenpasss ist konsistenter mit dem Muster als ein Manuskript-Aufnahmengengpass („verborgenes Interesse", Tabelle 9) | Prüfung von Identifikatoren, Klassifizierungen, Metadaten, Indexierung und Titel-Auffindbarkeit; begrenzte, genuinely relevante Verteilung | Steigt die Reichweite nach einer Metadaten- oder Klassifizierungsänderung, während die Konversion gleich bleibt? | Umschreiben einer gut konvertierenden Zusammenfassung nur, um sie werblicher zu gestalten |
| Hohe Reichweite, niedrige Konversion, stabil oder fallend | Kommunikationsmissverhältnis, Publikumsmissverhältnis und Exposition mit geringer Absicht sind konkurrierende Erklärungen („Aufmerksamkeit ohne Aufnahme") | Test von Titel-Abstract-Ausrichtung, Umfangsklarheit und Publikumspassung; nur anspruchserhaltende Alternativen | Ändert sich die Konversion unter vergleichbarer Exposition mit einer Treuekontrolle bei jeder Überarbeitung? | Erhöhung wahlloser Bewerbung; Schlussfolgerung, dass Leser die Wissenschaft ablehnten |
| Niedrige Reichweite, niedrige Konversion | Unteridentifiziert: schwache Exposition, falsche Referenzklasse, Metadatenfehler, Kommunikationsreibung oder Nischennachfrage passen alle („Kaltstart") | Validieren Sie zunächst die Referenzklasse und das Expositionsdatensatz; prüfen Sie dann Metadaten und Kommunikation separat | Ändern Sie jeweils einen messbaren Mechanismus; bewahren Sie das Nullergebnis | Ableitung niedriger Qualität aus niedriger Nutzung; Rückgabe eines Einzelursachenurteils |
| Hohe Reichweite, hohe Konversion, steigend | Starke frühe Verbreitung relativ zur angegebenen Klasse | Bewahrung der Herkunft; Überwachung im festen Alter; keine Änderung ohne Grund | Bleibt das Muster nach dem Expositionsereignis und unter Anomalie-Sensitivität erhalten? | Herstellung weiterer Verstärkung; Behandlung von Aufmerksamkeit als Qualitätsbeweis |
| Hohe Reichweite, hohe Konversion, stark fallende Inkremente | Ereignisgesteuerte Aufmerksamkeit, gewöhnlicher Verfall oder Sättigung (Abschnitt 5.6) | Identifizierung des Expositionsereignisses; Vergleich von Intervallinkrementen, nicht kumulativen Gesamtsummen | Unterscheidet sich der Verfall von altersgerechten Trajektorien unter Bedingung des Ereignisses? | Fallende Inkremente als wissenschaftliches Versagen bezeichnen – kumulative Zählungen flachen fast immer in Ratenbegriffen ab |
| Niedrige Reichweite, hohe Konversion, fallende Inkremente | Bedingtes Interesse kann real sein, während fortgesetzte Exposition schwach ist | Prüfung, ob Verteilung oder Indexierung beendet wurde; Identifikation begrenzter, relevanter Kanäle | Erhöht wiederhergestellte Exposition die Reichweite ohne Verschlechterung der Konversion? | Verbreiterung von Ansprüchen oder Entfernung technischer Spezifität, um ein breiteres Publikum zu erreichen |
| Hohe Reichweite, niedrige Konversion, steigende Exposition | Ankunftsrate wächst ohne proportionale Volltext-Aufnahme | Test von Traffic mit geringer Absicht (Abschnitt 4.2), Publikumsmissverhältnis und Präsentationsklarheit | Reagiert die Konversion auf eine anspruchsgetreuere Präsentationsänderung unter vergleichbarer Exposition? | Optimierung nur der Trichterspitze; Zählung jedes Aufrufs als menschlicher Leser |
| Jedes Muster mit einem wiederholten Gegenargument, unerklärtem Anstieg, ungültigem Kohort oder fehlender Nenner | Die Metrik ist derzeit nicht auf der gewünschten Ebene interpretierbar | Bewahrung von Schnappschüssen; Durchführung von Sensitivitätsanalysen; Eingrenzung des Anspruchs; Verzicht | Überlebt die Lesart den Ausschluss des umstrittenen Intervalls oder eine bessere Referenzklasse? | Kennzeichnung von Traffic als human oder automatisiert ohne Evidenz; Ausgabe eines Perzentils aus einer erfundenen Nenner |
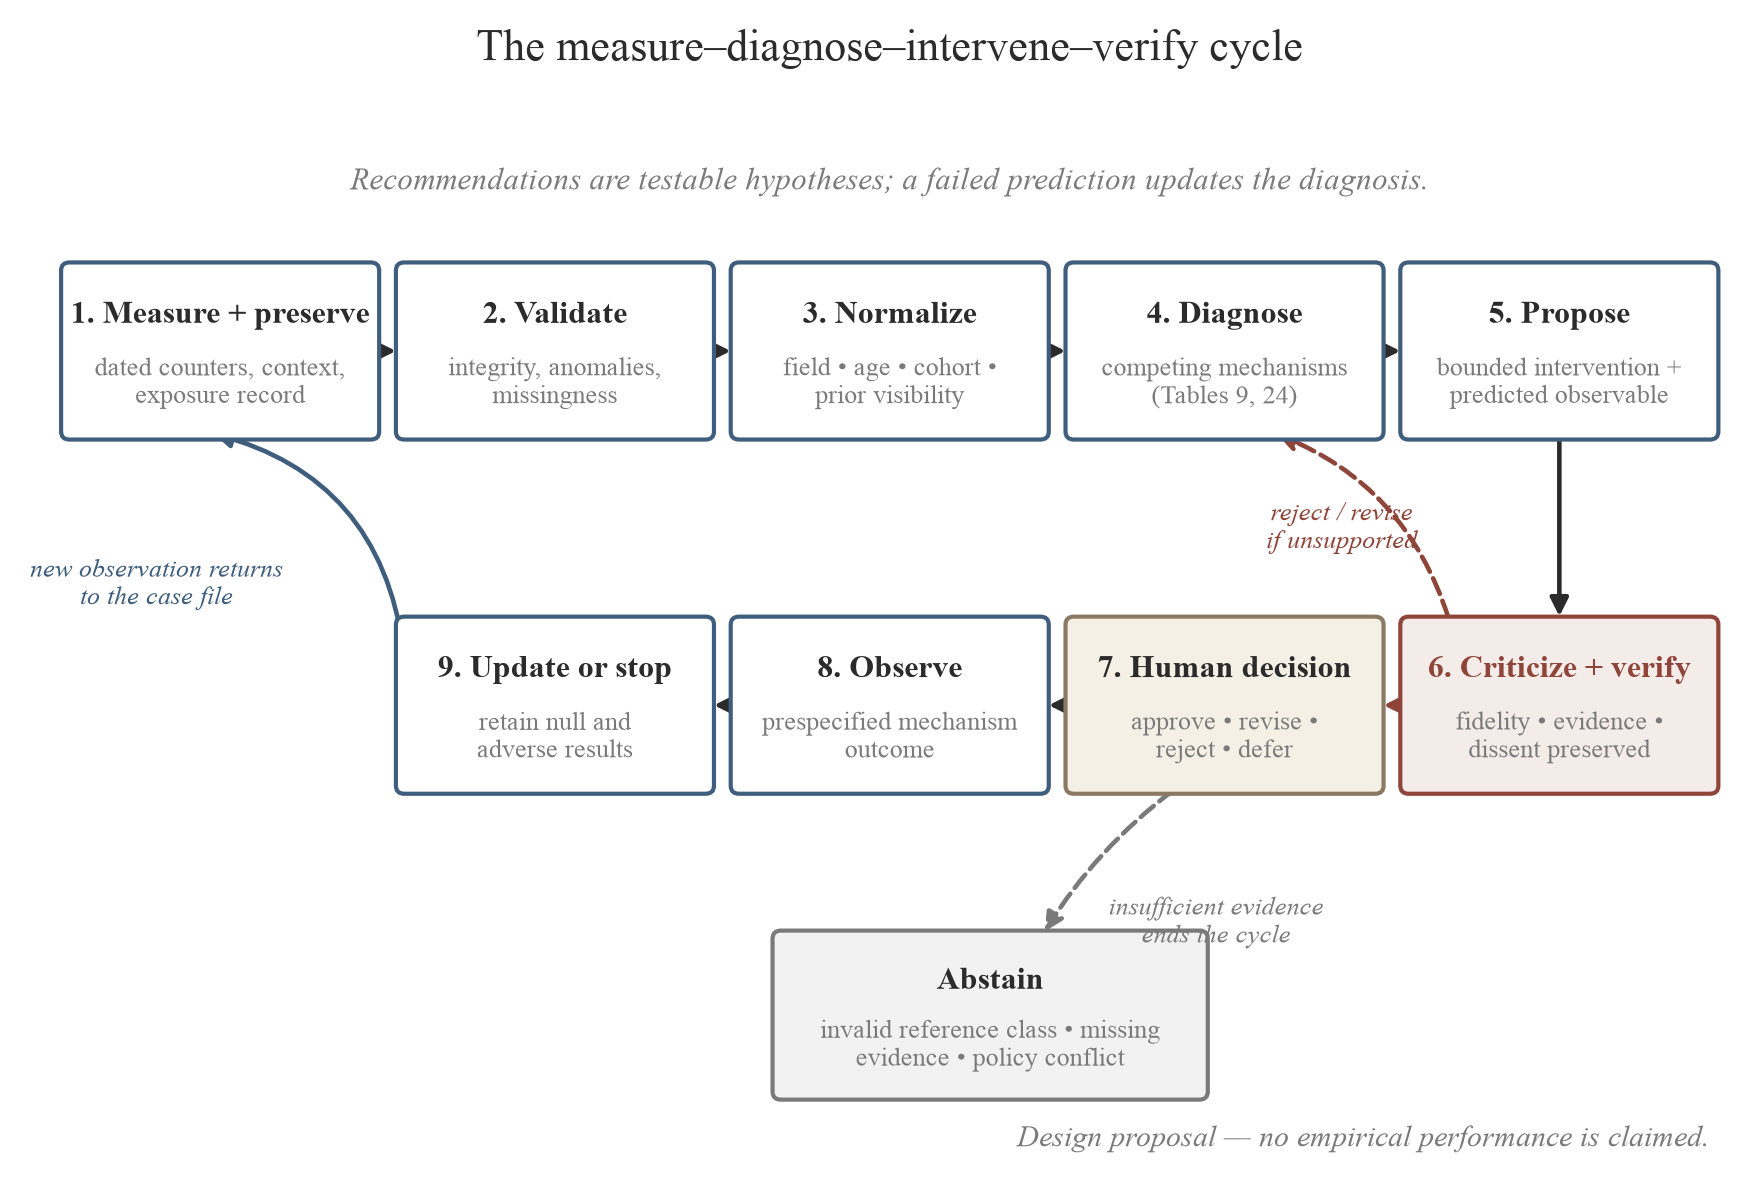
Abbildung 17. Der Mess–Diagnose–Intervention–Verifikations-Zyklus (Abschnitt 8.10; Tabelle 22). Empfehlungen verlassen die Schleife nur als testbare Hypothesen: Jede nennt den Mechanismus, den sie verschieben soll, und die nachfolgende Beobachtung, die die Diagnose bestätigen oder abschwächen könnte. Gescheiterte Vorhersagen kehren zur Diagnose zurück und bleiben im Prüfprotokoll; die menschliche Entscheidung steht zwischen Verifikation und jeder Aktion; und der Verzichtsweg beendet den Zyklus immer dann, wenn keine verteidigbare Referenzklasse oder ausreichende Evidenz vorhanden ist. Der Zyklus optimiert evidenzbewahrende Interpretation, nicht reine Aufmerksamkeit.
Vier Grenzen beschränken den Vorschlag. Generierung ist keine Wiederherstellung. Kein Modell, wie sehr es auch orchestriert ist, kann die Perzentilverteilungen regenerieren, die aufhörten, beobachtbar zu sein, als die Top-Listen entfernt wurden [149], und die Schicht kann nur eine Approximation bewahren, wobei die konservativen Untergrenzvorbehalte von Abschnitt 5 erhalten bleiben. Die Orchestrierung kann auch nicht einen Downloader identifizieren, menschlichen von automatisiertem Datenverkehr anhand von Zählern allein unterscheiden (Abschnitt 4.2), Anfragesvolumen in Hinweise auf Leseverhalten umwandeln (Abschnitt 7.6), korrelierte Modellausgaben durch Umbenennung in „Agenten" unabhängig machen, Fachurteil ersetzen oder die Verantwortung vom Forscher auf einen Arbeitsablauf übertragen. Der Orchestrator selbst benötigt einen Prüfer. Eine bereitgestellte Interpretationsschicht wird zu einem neuen Gatekeeper im Stapel, den dieser Artikel abbildet (Abbildung 12), und sie darf nicht die Undurchsichtigkeit erben, zu deren Behebung sie gebaut wurde: Nachverfolgungsspuren und Herkunftsprotokolle müssen zur Überprüfung offen sein, und das Verhalten der Schicht bei Abruf und Interpretation sollte mit der Strenge von Studie 2 geprüft werden (zeitgestempelte Momentaufnahmen plus ein Replikationsprotokoll mit Skript), denn die Nicht-Stationarität von Modellen macht jede Ausgabe zu einer datierten Schätzung, niemals zu einem dauerhaften Wert. Kosten und Gerechtigkeit. Die Ausführung einer solchen Pipeline ist nicht kostenlos, und eine kostenpflichtige Interpretationsschicht würde Autoren mit geringen Ressourcen und unabhängig tätige Autoren ausschließen, auf die sich dieses Rahmenwerk konzentriert. Die bekannten Verzerrungen von KI-Textklassifizierer gegen Autoren, deren Muttersprache nicht Englisch ist [97], würden dasselbe bewirken, wenn sie nicht abgemildert werden. Falsche Präzision ist das verbleibende Risiko. Eine Schicht, die abgestufte Urteile ohne Konfidenzebenen ausgibt, würde die in Abschnitt 3 diagnostizierte Fehlkalibrierung automatisieren: eine Zählung ohne Vergleichsskala ersetzt durch ein Urteil ohne angehängte Unsicherheit. Die Architektur ist selbst ein widerlegbares Objekt und gehört auf die Tagesordnung auf dieser Basis, bewertet gegen einfachere Unterstützung und nicht aus der Raffinesse ihres Diagramms abgeleitet. Das passende Design ist abgestuft. Realistische Fallpakete mit eingebauten Mehrdeutigkeiten (ungültige Zitate, Gegendarstellungen, nicht vertretbare Gruppen, echte Grenzfälle von Anfragen) werden zufällig auf Bedingungen verteilt, die eine Zutat nach der anderen hinzufügen: das manuelle Protokoll der Tabellen dieses Artikels (die korrekte Baseline, da eine Nicht-KI-Methode bereits existiert), ein einzelnes verallgemeinertes Modell, dasselbe Modell mit Abruf und deterministischer Berechnung, Generierung plus unabhängige Kritik, und die vollständige verwaltete Pipeline. Ablationen, die den Verifizierer, den deterministischen Rechner, die Sichtbarkeit von Meinungsverschiedenheiten oder das menschliche Gate entfernen, isolieren dann, welche Verwaltungszutat ihre Kosten verdient. Ergebnisse werden separat bewertet, niemals als ein Composite: Anspruchs- und Zitationstreue; Referenzklassenvalidität; Kalibrierung der Überzeugungen von Autoren (Instrument der Studie 4) und angemessene Enthaltung bei mehrdeutigen Fällen; Forscherzeit und Überwachungsbelastung; Verwaltungsfehler (autonome externe Maßnahmen, Ratschläge zur Metrik-Spielerei, kategorische Veranstaltungsvorwürfe); und, zentral für das Cold-Start-Argument des Artikels, Heterogenität des Nutzens nach bisheriger Sichtbarkeit von Autoren und Neulingsstatus, da eine Schicht, die hauptsächlich bereits sichtbaren Autoren hilft, die Ungleichheit reproduzieren würde, die sie verringern sollte. Null- und nachteilige Gerechtigkeitsergebnisse sind berichtsfähige Befunde. Modellversionen, Eingabeaufforderungen, Werkzeugberechtigungen und Quellen-Momentaufnahmen werden archiviert, denn in einem nicht-stationären System ist jedes Ergebnis eine datierte Schätzung. Zwei Schätzer bleiben durchgehend separat: der Effekt auf die Interpretationsqualität und der Effekt auf die nachfolgende Verbreitung. Eine Schicht, die die Diagnose verbessert, ohne Downloads zu erhöhen, ist ein Erfolg, während eine, die Downloads erhöht und dabei Ansprüche verzerrt, ein Verwaltungsversagen ist. Das Design schlägt fehl, wenn die verwaltete Pipeline ein starkes einzelnes Modell nicht in Bezug auf Beweisgenauigkeit und Kalibrierung übertrifft: „mehrere Modelle" ist nicht die Beitrag, und die Hypothese unter Test ist die Aufteilung der epistemischen Arbeit. Der Vorschlag gibt eine testbare Rolle für KI-gestützte Interpretation an. Die KI kann einem Autor helfen, eine bessere Frage zu einer Zahl zu stellen; nur überprüfte Belege können sie beantworten.
9. Einschränkungen
Die Ansprüche dieses Artikels sind durch die folgenden Einschränkungen begrenzt, jede an das Artefakt gebunden, das sie beschränkt.
Alterung und Zusammensetzung der Evidenzbasis. Die älteren Verteilungsanker in der Benchmarkkarte (Tabelle 7) beruhen auf Proben, die zwischen 2012 und 2015 erhoben wurden und von Rechtswissenschaft dominiert werden [85][139]; der einzige aktuelle Eintrag ist die in diesem Abschnitt erörterte Einzelnetzwerk-Momentaufnahme [83]. Die Banden der Interpretationsskala (Tabelle 8) sind am besten als nachgiebig statt konservativ absolute Banden für 2026 zu lesen (Abschnitt 5.1). Das jährliche Plattform-Downloadvolumen wuchs zwischen Mitte der 2010er Jahre und den 2020er Jahren um ein Vielfaches [1][143], erhöhte den Download-pro-Paper-Fluss und machte einen festen alten Schwellenwert heute zu einer weicheren Grenze als zum Zeitpunkt der Schätzung. Keine multiplikative Korrektur kann dies beheben, da das Wachstum Zähler, Nenner und Zusammensetzung gleichzeitig verändert (Abschnitt 3.2). Die Banden von Tabelle 8 sind Approximationen, die aus aggregierter Arithmetik abgeleitet sind statt neu skalierter Normen. Es wurde keine Verteilungsstudie der SSRN-Downloads auf Plattformebene nach 2020 identifiziert.
Zeitgenössische Belege aus einer einzigen Quelle. Der einzige aktuelle Verteilungsbeweis, der hier verwendet wird, ist eine einzige veröffentlichte Momentaufnahme eines disziplinarischen Netzwerks: 2.361 Marketingarbeiten beobachtet am 15. August 2025 [83]. Sie zeigt Schiefe und eine bedingte Prestigiumprämie, etabliert aber keine Plattform-Benchmarks, und zwei interne Werte ihrer veröffentlichten Tabelle werden „wie veröffentlicht" mit einem Vorbehalt reproduziert. Verallgemeinerungen von dieser Quelle auf andere SSRN-Netzwerke sind Extrapolationen. Anlage E verringert diese Abhängigkeit durch Hinzufügung eines unabhängigen, feldübergreifenden archivierten Querschnitts (n = 1.360), der die Schiefe, die Mittelwert-zu-Median-Lücke, die Umwandlungsband, den Feldmultiplikator und die Lognormalität im beobachteten Text reproduziert. Dies hat eine eigene Aufwärtsselektionsverzerrung und bestätigt die Form der Verteilung über Disziplinen hinweg. Die Tagesordnung von Abschnitt 8 zielt immer noch auf den Plattform-repräsentativen Benchmark ab.
Top-Listen-Verzerrung. Die große Stichprobe aus 2015 umfasst nur die Top-Listen (ungefähr das obere Dezil der Autoren und ihrer Arbeiten [85]), daher wird der Körper der Verteilung unter den Elite-Listen aus einer angepassten Lognormalen anstelle von beobachtet abgeleitet. Perzentilaussagen, die von dieser Anpassung abgeleitet werden, sind modellgestützt.
Zählersemantik ist instabil. Was Aufrufe und Downloads aufzeichnen, hat sich im Laufe der Zeit geändert und wird sich mit Schnittstellen-Redesigns und sich entwickelnden Bot-Filtern weiterhin ändern. Das Integritätssystem der Plattform schließt einige verdächtige Aktivitäten aus den offiziellen Zählungen aus [144][66][69], und die benachbarte RePEc/LogEc-Infrastruktur dokumentiert sowohl das historische Ausmaß des Robot-Verkehrs als auch die jüngsten KI-Crawler-Wellen, die das Verwerfen der überwiegenden Mehrheit des unverarbeiteten Verkehrs erforderten [99][129]. Die in Abschnitt 5 zitierten Konversionsnormen sind daher Jahrgangs-spezifische Größen, und Vergleiche von Zählern über Jahre hinweg vermischen Verhaltens- und Filteränderungen. Allgemeine Web-Bot-Statistiken [158] können nicht auf SSRNs gefilterte Zähler in beide Richtungen extrapoliert werden.
Plattformvolatilität und Quellendrift. Die Verabschiedung der Rankings ist in eine umfassendere Produktumgestaltung 2026 eingebettet [146][149][150], daher sollte keine Analyse den 15. Juli 2026 als isolierte Intervention behandeln. Diese Bedrohung ist in das Design von Abschnitt 8.5 eingebaut, kann aber nicht vollständig beseitigt werden. Plattform-Support-Seiten werden ohne Ankündigung überarbeitet; alle solchen Seiten sind hier mit Zugriffsdaten zitiert, und zitierte Plattformsprache sollte vor formeller Einreichung gegen archivierte Kopien erneut überprüft werden.
Keine Perzentildaten. Es haben nie öffentliche Perzentildaten für die gesamte Plattform existiert, und nach dem 15. Juli 2026 kann extern kein plattformrepräsentativer Perzentilrahmen gesammelt werden, da die Rankings, die zuvor Schwellenwerte der Top-Liste durchsickern ließen, entfernt wurden [149]. Ein stichprobenbasierter Referenzverteilungsrahmen kann immer noch aus archivierten Erfassungen zusammengestellt werden, und Anhang E berichtet einen; er fixiert die Form der Verteilung und liefert nicht die Plattform-Perzentile. Einige Größen von Interesse (beispielsweise das Schicksal der Benachrichtigungsmails für die Top-10%-Autoren [161]) sind offiziell undokumentiert, und wir vermerken ihr Verschwinden aus dem öffentlichen Rahmen, ohne deren Beendigung zu behaupten.
Nutzung ist nicht Leserschaft, und beides ist nicht Qualität. Ein Download kann sorgfältigem Lesen, flüchtiger Inspektion, Archivspeicherung oder gar keiner Nutzung vorausgehen. Downloads sind kein direkter Indikator für Forschungsqualität und keine garantierte kausale Quelle von Zitationen: Die Downloads-Zitationen-Assoziation ist positiv, aber heterogen (grob 0,1 bis 0,6 je nach Feld, Aggregationsniveau und Horizont [18][25][39][80][102][108]) und die hoch heruntergeladenen und hoch zitierten Populationen überlappen sich nur teilweise [108]. Zitationen selbst können positiv, negativ, oberflächlich oder strategisch sein, und der Zitationsprozess ist systematisch gegen neuartige Arbeiten verzerrt [166]. Nichts in diesem Artikel ermächtigt die Metrik-Substitution für Expertenjudgement; die defensible Verwendung des Rahmens ist diagnostisch und deskriptiv.
Nicht beobachtbare Exposition und nicht-zufälliges Prestige. Nicht jede Exposition ist beobachtbar: Leser begegnen Titeln in E-Mails, sozialen Medien, Suchergebnissen und Korrespondenz, bevor eine Abstract-Seiten-Ansicht protokolliert wird, und gut vernetzte Autoren generieren eine Off-Plattform-Exposition, die mit sowohl Prestige als auch Qualität korreliert. Beobachtungsprestige-Koeffizienten mischen daher statusbasierte Aufmerksamkeit mit echten Unterschieden bei Ressourcen, Themen und Netzwerken [111][140]. Experimentelle Manipulation von Autor-Identitätssignalen [154][64] ergänzt, ersetzt aber nicht die Plattformbeobachtung. Die Feldklassifizierung ist teilweise autorgewählt, und Arbeiten nehmen mehrere Kategorien ein, was einzelne Feldzuweisungen erschwert.
Grenzen der Agenda selbst. Die quasi-experimentellen Designs von Abschnitt 8.4–8.5 sehen sich Ankündigungseffekten, gleichzeitigen Plattformänderungen und nicht-zufälligen Feldunterschieden gegenüber. Sie werden als quasi-experimentell bezeichnet, weil ein plattformweites Ereignis keine unbehandelte Kontrollgruppe bietet. Die Momentaufnahme von Studie 2 wird mit den von ihr audtierten Engines altern, und sein Replikationsprotokoll mildert, entfernt aber nicht die Nichtstationarität. Studie 3 ist eine N = 2 Fallstudie, deren Wert Mechanismus und Protokoll ist, keine Populationsschätzung, und seine Zuschreibungslogik hängt von Pro-Kanal-Aliasen ab, nicht von irgendeinem Anspruch auf öffentliche E-Mail-Sichtbarkeit. Die Crowdsourced-Registry erbt Selbstselektions- und Verifikationsprobleme, die in Abschnitt 8.8 dargelegt sind. Der Datenzugriff für alle Designs hängt entweder von Plattformkooperation oder ratenlimitierter Sammlung innerhalb von Nutzungsbedingungen ab [134][51]; keines ist garantiert.
Breite der Bibliografie. Die Bibliografie ist umfassend, weil der Artikel eine Synthese ist; viele der zitierten Studien teilen Rahmenbedingungen, Felder und Design-Grenzen, und Community-Beiträge dokumentieren Erfahrung ohne Feststellung von Populationsparametern. Die Evidenz einer Aussage ist ihre Verifizierungsstufe und ihr Stichprobenrahmen, nicht die Anzahl der Referenzen dahinter.
Bänder sind Kalibrierungsziele, keine Konstanten. Das 11–19%-Konversionsband und die CSAB-Schwellenwerte sind Größen, die nach Feld und Plattform kalibriert werden müssen, keine universellen Konstanten des wissenschaftlichen Verhaltens (Abschnitte 4.4, 5.2). Ihre gegenwärtige Form ist ein einzelnes feldübergreifendes Band, das durch die feldstratifizierten Verteilungen ersetzt werden soll, die der Rahmen erfordert, wenn Studie 1 (Abschnitt 8.6) berichtet.
Verallgemeinerung über SSRN erfordert Rekalibrierung, nicht Verpflanzung. Das hier diagnostizierte Interpretierungsproblem (Nutzungszähler ohne öffentliche vergleichbare Skala angezeigt) und die Reichweiten-gegen-Konversionslogik, die es repariert, sind nicht spezifisch für SSRN; sie gelten für jeden Preprint-Server, der Nutzungszählungen anzeigt, einschließlich bioRxiv, medRxiv, arXiv und OSF Preprints [11][62][2][24]. Was nicht übertragen wird, ist das spezifische 11–19%-Band oder die CSAB-Schwellenwerte. Kuration, Verteilungsarchitektur und Benutzeroberfläche unterscheiden sich zwischen Servern: arXivs absichtsorientierter Pull-Verkehr und seine E-Mail-Ankündigungslisten gegen SSRNs kuratierte Push-Benachrichtigungen (Tabelle 6). Die numerischen Ankerpunkte müssen daher auf jeder Plattform neu geschätzt werden, bevor sie dort zitiert werden. Der Rahmen ist tragbar; seine Kalibrierung ist lokal. Das Parallel-Hinterlegungsprotokoll von Abschnitt 8.8 ist der direkte empirische Test, wie weit die SSRN-Bänder reichen. Die Skala dieser Rekalibrierung ist leicht zu unterschätzen: bioRxivs Median-Download aller Corpora (etwa 279 und grob 496 in Genomik [2]) ist mehrfach der Median von 60 in der archivierten Querschnitt von Anhang E: grob fünfmal insgesamt und etwa achtmal in Genomik. Der Vergleich ist nur indikativ. Die bioRxiv-Zahl stammt aus einer Ganz-Corpus-Zählung, während die 60 aus einer Archivstichprobe stammt, die erfasste Seiten überrepräsentiert, Alter und Felder mischt, deren Zusammensetzung sich mit dem Alter verschiebt, und Alter auf ganze Jahre löst. Die Richtung der Lücke ist sicher zu lesen; ihre Größe nicht.
Ethik. Der Community-Diskurs-Strang dieses Artikels besteht aus selbstausgewählten öffentlichen Beiträgen, die nur als Nachweis der Nachfrage verwendet werden, nie als repräsentative Stimmung, und zitiert werden nur dort, wo eine live, überprüfbare Quelle existiert. Nutzerbeiträge werden unter Beachtung der Ethik des Zitierens von halböffentlichen Forumsinhalten zitiert, einschließlich Paraphrase anstelle von wörtlichem Zitat, wo Autoren gegen ihre Erwartungen identifiziert werden könnten, konsistent mit Transparenznormen für qualitative Evidenz [6]. Study 3 protokolliert nur Nachrichten, die unaufgefordert an den instrumentierten Autor gesendet wurden, und erhebt keine Drittpartei-Personendaten über das hinaus, das Absender freiwillig bereitstellen. Study 4 erhebt nur freiwillige, anonymisierte Fragebogenantworten unter informierter Zustimmung. Das Panel-Design verwendet öffentlich angezeigte Zähler und bibliografische Metadaten, und jede Erfassung nicht-öffentlicher Dashboard-Informationen (wie Verteilungsstatusdaten) erfordert informierte Zustimmung des Autors und, soweit anwendbar, institutionelle Überprüfung. Die beiden Studien, die an menschlichen Teilnehmern und von Teilnehmern generierten Daten beteiligt sind, sind Study 4 (die Autorenbefragung) und Study 3 (instrumentiertes Posten mit Posteingang-Protokollierung). Da beide Forschung mit menschlichen Probanden sind, werden beide zur Genehmigung durch das zuständige institutional review board oder die forschungsethische Kommission eingereicht und unter informierter Zustimmung der Teilnehmer durchgeführt bevor irgendwelche Datenerfassungen beginnen, und Personendaten in den Posteingang-Protokollen werden vor jeder Analyse oder Berichterstattung aggregiert und anonymisiert. Dieses Protokoll ist eine Voraussetzung für die Ausführung und wird in den Erklärungen wiedergegeben.
10. Fazit und politische Empfehlungen
10.1 Was die Analyse etabliert hat
Die Einstellung der SSRN Rankings am 15. Juli 2026 entfernte die einzige öffentliche Vergleichsskala [149]. Zähler blieben auf jedem Paper und Profil erhalten, was Metriken hinterließ, die unleserlich statt bedeutungslos waren. Gegen diesen Verlust stellt dieser Artikel jeden verifizierbaren empirischen Ankerpunkt in eine Benchmark-Karte mit expliziten Vintage- und Konfidenz-Vorbehalten zusammen (Tabelle 7), errichtet ein Interpretationsgerüst, die Fünf-Band-Skala, die Reach-Conversion-Dekomposition und das Dossier-Protokoll (Tabellen 8, 9, 13), das Zähler in Diagnosen übersetzt, und legt die Preregistration-bereite Agenda von Abschnitt 8 dar, die angibt, wie die fehlenden Verteilungen wiederaufgebaut werden können.
Der Mechanismus im Kern des Arguments läuft auf Folgendes hinaus:
Niemand weiß, was sieben Downloads bedeuten, ohne zu wissen, sieben Downloads im Vergleich zu was, und nach dem 15. Juli 2026 beantwortet die Plattform „im Vergleich zu was" nicht mehr.
Die Beiträge unterscheiden sich in ihrer Art. Die Benennung des Referenzklasse-Problems ist der diagnostische: eine rohe Zählung beantwortet keine Frage, bis Alter, Gebiet, Kohorte und Exposition ihre Vergleichsgruppe definieren. Der instrumentelle Beitrag ist die Benchmark-Karte und CSAB, die eine emotional prägnant, aber wissenschaftlich mehrdeutige Zahl in eine interpretierbare Diagnose normalisieren. Das Playbook und das Dossier-Protokoll sind der praktische Beitrag, der Autoren und Komitees ermöglicht, heute auf Zähler zu handeln, ohne sie falsch zu lesen. In politischer Hinsicht ist der Beitrag das anonymisierte Perzentilband: komparativer Kontext, wiederhergestellt in einer Form, die niemanden identifiziert und keine Liga wieder belebt.
Auf der zusammengetragenen Evidenz ist die Frage im Titel dieses Artikels schlecht gestellt, bis eine Referenzklasse angegeben wird. Gegen jeden verfügbaren Ankerpunkt sind kleine Zählungen die statistische Norm der Plattform statt ein Urteil über die Arbeit. Ein Paper mit 40 Abstract-Aufrufen und 7 Downloads ist konsistent, als Screening-Ergebnis, mit dem empirischen Conversion-Band von Abschnitt 5 [139][172][83], während die ältere Faustregel drei-Aufrufe-pro-Download [18] über diesem Band sitzt statt darin. Das Median-Paper in der einzigen volkszählungsähnlichen Stichprobe sammelte 63 Downloads in zwei Jahren [139], und der Eintritt in die Top-10.000-Liste von 2015, ungefähr die besten 1,8 % des Volltext-Paper-Bestands der Plattform (571.040, Juli 2016 [1]), erforderte 160 lebenslange Downloads [85]. Unter einem quasi-lognormalen Aufmerksamkeitsregime stehen die meisten Autoren konstruktionsbedingt auf den unteren Sprossen der Leiter. Das Median-Preprint lebt im Long Tail einer Log-Normal-Verteilung, die sein Autor nicht sehen kann, und es wird von Klassifizierungsmechaniken an die Oberfläche gebracht, die Zugehörige bevorzugen. Es wird von Raubtieren angefordert, bevor es von Peers gelesen wird, und es hat jetzt die Rangfolge verloren, die es einst lokalisierte. Die Skala platziert ein Paper irgendwo auf dieser Leiter, und der Stress, den die Frage trägt, wird durch die fehlende Skala statt durch die Zahl erzeugt.
Nichts daran ist besonderlich für eine Plattform, und das Ereignis ist nicht beispiellos. ResearchGate stellte seinen eigenen stark kritisierten zusammengesetzten RG Score im August 2022 ein [130], nach anhaltendem methodologischem Kritik [90], und 2022–2023 zogen sich Dutzende von U.S. Law Schools, angeführt von Yale und Harvard, aus den U.S. News-Law-School-Rankings zurück [13]. Das Zurückziehen eines umstrittenen Maßes ist kein kosmetischer Akt, denn das Maß war nie eine passive Beschreibung: die Reaktivitätsliteratur, die sich aus den Law-School-Rankings entwickelte, zeigt, dass eine öffentliche Rangfolge das Verhalten derer, die sie rankt, umgestaltet [58][132], also ändern sowohl ihre Einführung als auch ihre Entfernung das Verhalten statt lediglich zu ändern, was berichtet wird. Ein Zähler und sein komparativer Rahmen sind gemeinsam eine Metrik, und das Zurückziehen des Rahmens bei Beibehaltung des Zählers lässt jeden Benutzer einen Zähler halten, gegen den nichts gelesen werden kann. Interpretierbarkeit, die Verfügbarkeit einer öffentlichen Verteilung für einen öffentlichen Zähler, sollte als Qualitätsdimension erster Ordnung jedes Indikators behandelt werden, neben Validität und Zuverlässigkeit. Metriken überdauern ihre interpretative Infrastruktur, und eine Metrik ohne Kontext ist Rauschen, ein Beispiel der allgemeinen Disziplin der skeptischen Lesart entkontextualisierter Zahlen [15]. Die gleiche Metrik mit Kontext ist eine Kalibrierung, die Autoren befähigt, wissenschaftliche Kommunikation verbessert und Vertrauen in die Repositories aufrechterhält, die sie anzeigen.
Das Gerüst verlangt von seinem Benutzer einige gewöhnliche Gewohnheiten. Vergleichen Sie Gleiches mit Gleichem, und halten Sie Reichweite von Conversion getrennt. Lesen Sie Trajektorien statt Summen, behandeln Sie jede Zahl als datiert, und lassen Sie keinen Zähler ohne seine Quelle, sein Fenster und seine Einschränkungen reisen.
10.2 Empfehlungen für Autorinnen und Autoren
Autorinnen und Autoren können jetzt handeln, ohne auf neue Daten zu warten. Erstellen Sie datierte Screenshots von Zählern auf Papierebene, die den Kontext bewahren: Nach dem Sunset sind sie die einzige unter der Kontrolle der Autorin oder des Autors verbleibende Aufzeichnung des Status und bereichern das Gemeinschafts-Register von Abschnitt 8.8. Berichten Sie Zählungen nur zusammen mit ihrem Kontext (Alter, Fachbereich, Kohorte und Quelle), nach dem Dossier-Protokoll von Tabelle 13, in dem jede Zahl ihre Quelle, ihren Zeitraum und ihre Einschränkungen trägt. Lesen Sie das Dashboard diagnostisch und nicht emotional: unterscheiden Sie Reichweite von Konversion (Tabelle 9), behandeln Sie null Downloads in der ersten Woche als normales Verhalten vor der Verbreitung [53], und vergleichen Sie mit drei bis fünf Arbeiten von Kolleginnen und Kollegen, die im selben Monat veröffentlicht wurden, anstatt mit dem sichtbaren Ende, dessen zirkulierende Meilensteinnummern Fehlkalibrierung in einem Heavy-Tail-Regime garantieren [85][180]. Behandeln Sie Anfrage-E-Mails als Scraping-Phänomen, nicht als Anerkennung, und nicht als Beweise über die Zähler [61][107][144].
10.3 Empfehlungen für Evaluatoren
Institutionen, die SSRN-Downloads als Evaluierungswährung importiert haben [12][18][161][52], stehen vor einer Governance-Frage, da die öffentliche Skala dieser Währung nun nicht mehr vorhanden ist. Rohe Download-Zahlen sollten nicht in Einstellungs-, Beförderungs- oder Berufungsverfahren aufgenommen werden: Sie werden genau an den Schwellwerten manipuliert, die zählen [44], sie variieren um das Achtfache über Teilgebiete hinweg innerhalb eines einzelnen Netzwerks [168], und sie sind nun nicht mehr anhand von Benchmarks nachvollziehbar. Die minimal vertretbare Einheit ist ein Perzentil innerhalb einer definierten Kohorte (gleiches Feld, gleiche Altersgruppe, gleicher Veröffentlichungszeitraum), begleitet von ihrer Quelle und ihrem Erhebungsjahr, und die Nutzungsevidenz sollte Zitationen, Peer-Bewertung und sachliches Urteil ergänzen, anstatt sie zu ersetzen [108][109][110]. Der etablierte Konsens zur Reform der Forschungsbewertung funktioniert nach diesem Prinzip. DORAs Kernrichtlinie besagt, dass nicht eine einzelne Zahl oder ein Publikationsvenue-Proxy als Ersatz für die Bewertung der Forschung selbst verwendet werden sollte [8], und das Leiden-Manifest besteht darauf, dass quantitative Bewertung die qualitative Expertenbeurteilung unterstützen, nicht ersetzen sollte [78]. Die Metric-Tide-Überprüfung verstärkt diesen Standpunkt und fordert Indikatoren, die robust, bescheiden, transparent, vielfältig und reflexiv sind und zur Unterstützung der Expertenbewertung herangezogen werden, anstatt sie zu ersetzen [173], ebenso wie die neuere CoARA-Vereinbarung zur Reformierung der Forschungsbewertung, deren mehrere hundert unterzeichnende Organisationen sich zu qualitativer Bewertung verpflichten, die durch verantwortungsvolle quantitative Nutzung unterstützt wird, anstatt diese zu ersetzen [183]. Der gesamte Konsens gilt in vollem Umfang für einen Download-Zähler, dessen öffentliche Skala entfernt worden ist. Zwei der fünf Dimensionen der Metric Tide sind direkt auf die hier vorgeschlagene Methode anwendbar: Vielfalt ist die Feld-Normalisierung, auf die dieser Artikel besteht, und Reflexivität ist die Haltung von Abschnitt 8.7, in dem der Artikel seine eigene Aufmerksamkeit misst. Der an den REF gerichtete Nachfolger der Überprüfung trägt die gleichen fünf Prinzipien in die aktuelle britische Praxis ein [184]. Dieser Konsens ist selbst ein Ausdruck der breiteren Kritik an der Metrik-Übergriffigkeit im institutionellen Leben [113]. Evaluierungskomitees sollten das Protokollformat von Tabelle 13 (die kontextualisierte, narrative Form der Evidenz, die aufkommende Bewertungsformate wie das britische Résumé for Research and Innovation (R4RI) tragen [186]) anstelle der veralteten Rangierungssprache „top 10 %" erwarten und akzeptieren. In den Vereinigten Staaten ist der gleiche Dossiersprachenhebel der Fokus der Higher Education Leadership Initiative for Open Scholarship (HELIOS Open), die mit Universitäten zusammenarbeitet, um Beförderungs- und Berufungskriterien umzuschreiben [189]; die hier festgelegte kontextualisierte Nutzungszeile ist genau die konkrete Richtlinie, der solchen Reformen oft fehlt.
10.4 Empfehlungen für die Plattform
Die Einstellung der Rankings ohne Ersatzkontext tauscht ein fehlerhaftes Signal gegen kein Signal aus. Die Folgen gehen über das Wohlbefinden der Autor:innen hinaus. Ob der Sunset neue Einreichungen abschreckt, das in Abschnitt 8.5 angegebene Ergebnis des Posting-Volumens, ist eine offene empirische Frage zur Gesundheit der Plattform selbst. Das Framework impliziert eine konkrete Produktrichtung, die den Liga-Tabellen-Apparat, den SSRN eingestellt hat, nicht nachbildet [149]:
1. Anonymisierte Perzentilbänder nach Disziplin und Papieralter. Zeigen Sie die Download- und Ansichtsposition jedes Papiers als grobes Perzentilband innerhalb seiner Disziplin-nach-Alter-Kohorte an: Informationen, die jede:r Autor:in benötigt, veröffentlicht in einer Form, die niemanden identifiziert, keine Rangliste erstellt und die „Winner-take-all"-Dynamik von Top-N-Listen reduziert. Der Perzentilkontext wahrt die Privatsphäre und stellt die Lesbarkeit wieder her. Das Zielanzeigeformat ist genau der altersspezifische Benchmark-Fächer von Abbildung 14.
2. Zeitnormalisierte Anzeige. Zeigen Sie altersgerechte Vergleiche statt nur Lifetime-Zählungen, sodass ein 14 Tage altes Papier nie implizit mit Arbeiten verglichen wird, die sich über Jahre hinweg Aufmerksamkeit angesammelt haben.
3. Reichweite von Konversion trennen. Melden Sie abstrakte Ansichten und Downloads als unterschiedliche Signale mit ihrem Verhältnis, statt eine einzelne Zahlenablesung einzuladen, die Unsichtbarkeit mit Ablehnung vermischt.
4. Transparente Referenzklassen. Jeder vergleichende Indikator sollte die Population, das Feld, den Zeitraum und die Altersgruppe angeben, mit der er verglichen wird; ein unlabeliertes „Top X%" ist wissenschaftlich uninformativ. Anhang D gibt die zehn Offenlegungsfelder an, die eine versionierte Perzentil-Freigabe enthalten sollte, von Populations- und Kohortendefinitionen bis hin zu Datenschutzregeln für Mindestzellenzahl und einer zitierfähigen Versionsverlauf.
5. Audit-Design für kumulative Vorteile. Klassifizierung, Warnverteilung, Suchranking und sichtbare Popularitätssignale vergeben knappe Aufmerksamkeit und sollten auf ihre Verteilungseffekte hin bewertet werden. Die empirischen Designs der Abschnitte 8.4–8.5 können direkt für einen solchen Audit verwendet werden.
6. Planen Sie für interpretive Restbestände bei der Einstellung von Funktionen. Wenn vergleichende Funktionen entfernt werden, sollte der interpretive Verlust mit der gleichen Sorgfalt bewertet und gemindert werden wie eine Datenmigration, durch archivierte Verteilungen, veröffentlichte zusammenfassende Perzentile oder eine explizite Übergabe an die Community, da eine Metrik, die nicht gelesen werden kann, nicht informieren kann.
7. Erntewiderstandsfähige Kontaktmechanik, die die in Abschnitt 7 dokumentierte Sollizitations-Externalität der Sichtbarkeit reduziert [107][159]. Ein konkreter Kandidat: Verzögern oder verschleieren Sie die öffentliche Exposition von Autor:innenkontaktrouten für etwa die ersten 48–72 Stunden nach der Veröffentlichung, das Fenster, in dem legitime Verbreitung typischerweise noch nicht begonnen hat, aber programmgesteuerte Ernte am wahrscheinlichsten ist. Die Auswirkung einer solchen Maßnahme sollte empirisch bewertet werden, nicht angenommen. Der Trade-off ist real, da das Verbergen von Kontaktinformationen auch genau denjenigen Newcomern schaden könnte, die auf direktes Feedback angewiesen sind.
8. Ein öffentliches Filterungsprotokoll und dokumentierte Verteilungsmechanik. Veröffentlichen Sie ein LogEc-ähnliches Protokoll dessen, was die Integritätsfilter verwerfen, und dokumentieren Sie, wie eJournal-Verteilung und Digest-Auswahl funktionieren. Die benachbarte RePEc/LogEc-Infrastruktur zeigt, dass solche Transparenz im Großmaßstab machbar ist [99][129], während SSRN seine Filter derzeit ohne Veröffentlichung ihrer Verlauf beschreibt [144] (Tabelle 6). Wenn die Filterung dokumentiert ist, können Restatements eines Zählers als Messereignisse statt als Reputationsereignisse gelesen werden.
9. Machen Sie die Expositionsgeschichte lesbar. Eine Papierseite oder ein Autor:innen-Dashboard sollte öffentliches Posting, Klassifizierungszuweisung, kuratierte Verbreitung, Indexierungsbestätigung und große Zählrestatements unterscheiden, damit eine:r Autor:in „noch nicht exponiert" von „exponiert aber nicht konvertiert" trennen kann. Dies ist die plattformseitige Entsprechung der Expositions-Regime-Lesart von Abschnitt 5.6 und die billigste Behandlung für den am meisten angsteinflößenden Dashboard-Zustand, die frühe Null.
10.5 Empfehlungen für die Forschungsgemeinschaft
Die Gemeinschaft muss nicht auf die Plattform warten. Das Register aus Abschnitt 8.8 (datierte, selbstberichtete Dashboard-Snapshots, die unter einem offenen Protokoll beigetragen werden) kann die erste neue Download-Verteilung in einem Jahrzehnt produzieren. Die beiden Studien mit öffentlichen Daten in Tabelle 17 (1 und 2) sind von jedem Forscher innerhalb der in Abschnitt 9 angegebenen Zugriffsgrenzen durchführbar, während die beiden Teilnehmerstudien (3 und 4) Freiwillige und die in den Deklarationen angegebenen Ethikgenehmigungen erfordern. Die Szientometrie sollte die Interpretierbarkeit von Metriken als Teil ihres Themas behandeln: Der vorliegende Fall, in dem ein Jahrzehnt von Zählern ihre einzige öffentliche Skala überlebte, ist wahrscheinlich nicht der letzte. Verteilte Replikation des instrumentierten Posting-Protokolls, gemeinschaftliche Verwaltung von Perzentiltabellen (und des öffentlichen autorenseitigen Rechners, der auf ihnen aufgebaut ist, Abschnitte 8.8 und 8.10), und interpretative Wirkungsbewertung von Plattformänderungen sind alle Forschungsbeiträge in ihrem eigenen Recht, und jeder von ihnen wandelt diese Reparaturarbeit des Artikels in Prävention um.
10.6 Abschluss
Die Frage „Was bedeuten meine sieben Downloads?" durchzieht diesen Artikel, weil es die Frage ist, die die knapp zwei Millionen Autoren der Plattform am 15. Juli 2026 zurückhielten [49][149]. Die hier zusammengestellte Antwort ist weder Beruhigung noch Alarm, sondern Kalibrierung. Die Zahl stimmt mit den verfügbaren Konversionsevidenzen überein, bleibt aber ein Screening-Ergebnis; die Besorgnis wird durch die fehlende Skalierung hergestellt, die teilweise aus der Literatur, wie die Abschnitte 3–6 taten, und teilweise aus neuen Daten, wie Abschnitt 8 spezifiziert, wiederhergestellt werden kann.
Der Artikel begann mit der Frage, die jeden Autor zurückhält:
„Was bedeuten meine 7 Downloads?"
Das Rahmenwerk ersetzt sie mit dieser:
„Wo steht dieses Papier unter vergleichbaren Papieren des gleichen Alters, Feldes, der gleichen Kohorte und Verteilungsgeschichte? Ist seine Begrenzung Reichweite oder Konversion? Und wird es durch die Systeme abgerufen und zitiert, durch die Leser nun Forschung entdecken?"
Das ist eine Frage, die die Szientometrie beantworten kann, und dieser Artikel hat spezifiziert, wie.
Was die Zähler aufzeichnen, sind Ereignisse, und nur Ereignisse. Aufrufe sind nicht Downloads; Downloads sind nicht Lesen; ein Mittelwert ist keine Norm; ein Zähler ist kein Urteil; Aufforderung ist keine Anerkennung; KI-Abruf ist keine treue Zuschreibung; und eine Zahl ohne Skalierung ist keine Information.
Solange Plattformen einen Zähler getrennt von seinem Kontext anzeigen, werden Autoren, Bewerter und Plattformen Verteilungsfakten weiterhin als persönliche Urteile lesen. Open Access gewann den Kampf, den es führte (das Recht zu posten und ohne Preisbarrieren herunterzuladen), und exponierte dabei einen Kampf, den es nie führte: die Verteilung von Aufmerksamkeit. Autoren können Zähler mit Feld, Alter und Konversion lesen. SSRNs Metriken behalten Wert, aber nur für einen Autor, der versteht, was sie bedeuten.
Anhang A. Situation → Maßnahmenleitfaden
Tabelle 23 verdichtet die Abschnitte 4–6 in die Situationen, über die Autoren am häufigsten berichten [161][127][139]. Ihre mittlere Spalte gibt nur an, wofür die zusammengestellte Evidenz belegt ist, mit Quellen und Zeitfenstern. Die Spalte „Vorbehalte" trägt die Einschränkung, die jede Lesart begleiten muss. Die hier angegebenen Zahlen sind die der Tabellen 6–7 und Abbildung 6 des Haupttextes.
Tabelle 23. Situation → Was die Evidenz sagt → Was zu tun ist.
| # | Ihre Situation | Was die Evidenz sagt | Was zu tun ist | Quellen und Vorbehalte |
|---|---|---|---|---|
| 1 | „7 Downloads und 40 Abstract-Aufrufe im ersten Monat." | Konversion beträgt 17,5 %, innerhalb der disziplinübergreifenden Spanne von 11–19 % als Punktschätzung, obwohl das 95%-Clopper-Pearson-Intervall auf 7/40 (≈7,3–32,8 %) breit ist und die Spanne überlagert; das mediane LSN-Papier erreichte 63 Downloads erst nach zwei Jahren, und das mediane Marketing-Papier stand bei 87 mit einem Medianalter von 16 Monaten – Anker für reife Stichproben, nicht altersgerecht für eine Lesung am Tag 20. Ein Screening-Ergebnis mit breitem Intervall, kein Versagensbeweis. | Setzen Sie den Beobachtungsplan von Tabelle 11 fort; klassifizieren Sie die Trajektorie frühestens am Tag 60–90. | Spanne: [18][139][172]; Mediane: [139] (2012 LSN), [83] (2025 Marketing). Alle Anker sind einzeldisziplinar und gealtert; die 7/40-Konversion ist eine Screening-Schätzung mit breitem Intervall, nicht altersgerecht zu den reifen Ankern. |
| 2 | „Null Downloads in der ersten Woche." | Normale Vor-Verteilung: Klassifizierung wird kuratiert und kann für beladene Themen bis zu 45 Tage dauern; eJournal-Benachrichtigungen treiben frühe Aufrufe an und setzen sich nach dem Sunset fort; die Google Scholar-Indizierung dauert 6–9 Monate oder länger. | Bestätigen Sie die öffentliche Veröffentlichung; bestätigen Sie die eJournal-Klassifizierung; prüfen Sie, ob das Papier unter seinem exakten Titel indiziert ist – der günstigste verfügbare Indexierungstest; warten Sie den Ankündigungszyklus ab; nur dann lesen Sie die Zähler. | [53][147][57][55]. Support-Seite Wortlaut ändert sich; erneut mit Zugriffsdaten überprüfen. |
| 3 | „Viele Aufrufe, wenige Downloads – Konversion deutlich unter 11 %." | Konsistent mit einem Abstract-Text-Mismatch: Leser kommen an und gehen beim Abstract. Verpackungsvariablen (Titel, Abstract, Schlüsselwörter) sind die Aufmerksamkeitshebel, die am robustesten mit Zählern verbunden sind. | Überarbeiten Sie Titel und Abstract; beobachten Sie die Konversion über das nächste Fenster, bevor Sie weitere Änderungen vornehmen. | [139][168][172]. Die kausale Lesart „niedrige Konversion = schwacher Abstract" ist eine Screening-Hypothese, keine validierte Diagnose. |
| 4 | „Konversion weit über der Spanne, oder ein plötzlicher Aufrufe-Anstieg." | Verkehr, den Abstract-Browsing nicht erklärt – Medien- oder Aggregator-Links oder nicht-menschlicher Verkehr, den Filter noch nicht entfernt haben. | Identifizieren Sie die externe Quelle (Berichterstattung, Mailinglisten); zitieren Sie den Anstieg nicht als Leserschar ohne Bestätigung. | [116][138][144][102 – Safe Links Pre-Fetch-Mechanismus, mit dem Vorbehalt, dass SSRNs eigene Filterung möglicherweise bereits solchen Verkehr ausschließt]. |
| 5 | „Mein Zähler ist gesunken, oder die Zahlen wurden neu angegeben." | Plattformen überarbeiten Zähler, wenn sich Filterregeln ändern; RePEc verwarf die große Mehrheit des Rohverkehrs in dokumentierten Episoden (Roboter ≈74 % der Aufrufe 2007; >99,5 % des IDEAS-Verkehrs im September 2025). | Behandeln Sie es als Messereignis; überprüfen Sie Ihre datierten Screenshots; melden Sie es nie als verlorene Leserschar ohne Bestätigung. | [144][69][99][129][66]. |
| 6 | „Die Rankings sind weg und ich weiß nicht, wo ich stehe." | Kein öffentlicher Perzentil-Rahmen bleibt erhalten, und keiner, der plattformrepräsentativ ist, kann extern gesammelt werden. Der Archiv-Querschnitt von Anhang E liefert eine stichprobenbasierte Referenzverteilung, und die angepasste Vergleichung bleibt der Ersatz für Plattform-Perzentile. | Bauen Sie eine Mikro-Benchmark von 3–5 Peer-Papieren, die im selben Monat gepostet wurden, und verfolgen Sie diese nach Ihrem eigenen Plan; berechnen Sie optional das Verhältnis Ihrer Downloads zu einem Kohorten-Median. | [149][51]; Anker [139][83][85]. Das Verhältnis hat keine kalibrierten Interpretationsspannen (Abschnitt 6.3). |
| 7 | „Ein Komitee wird meine Zählungen sehen." | Ranglinien in Dossiers sind dokumentierte Praxis, und ihr Vergleichsrahmen ist weg; Sprachenband mit Quellen, Feldqualifizierern und Zitationsdreiecksbildung übersteht die Prüfung, wo rohe Zählungen das nicht tun. | Wenden Sie das Sieben-Schritte-Protokoll von Tabelle 13 an: bewahren, übersetzen, triangulieren, feldnormalisieren, ergänzen, Integrität, Expertenbeurteilung. | [12][95][33][52][77][108]. Downloads messen die Nachfrage, nicht die Qualität; die Manipulationsgeschichte [44] ist den Evaluatoren bekannt. |
| 8 | „Räuberische Einladungen begannen Tage nach meinem Posting anzukommen." | Ein dokumentiertes Nebenprodukt der Abschöpfung von Preprint-Plattformen; angrenzende Audits melden Dutzende von Einladungen pro Woche pro Akademiker. Das Volumen signalisiert Sichtbarkeit für Scraper, nicht Anerkennung durch Leser. | Zahlen Sie nie; verifizieren Sie Venues über Cabells und Think. Check. Submit.; leiten Sie die Korrespondenz über eine dedizierte Adresse; siehe Tabelle 14 für die Typologie. | [107][159][9][84][63][32][136]; [B-1] (Bealls Liste seit 2017 nicht mehr vorhanden). Zeitliche Regelmäßigkeiten sind nicht gemessen; der „Tage-nach-Posting"-Screen ist qualitativ. |
| 9 | „Eine Ähnlichkeitsprüfung einer Zeitschrift hat meine Einreichung als Übereinstimmung mit meinem eigenen SSRN-Preprint gekennzeichnet." | Das Screening-System funktioniert wie beabsichtigt: Preprints, die als Crossref Posted Content registriert sind, sind Teil des Vergleichskorpus, und die Anleitung von iThenticate besagt, dass eine Preprint-Übereinstimmung desselben Autors kein Plagiat ist. Das Veröffentlichen eines Arbeitspapiers ist bei den meisten Richtlinien zur vorherigen Veröffentlichung von Zeitschriften zulässig, die Richtlinien sind jedoch unterschiedlich, und die Zielzeitschrift sollte überprüft werden; die Hauptausnahmen sind in Medizin und klinischen Bereichen. | Identifizieren Sie die gekennzeichnete Quelle dem Handhabungseditor als Ihren eigenen, zeitgestempelten Preprint; ziehen Sie den Preprint nicht zurück; für medizinische und klinische Venues überprüfen Sie die Preprint-Richtlinie der Zielzeitschrift (z. B. über die Sherpa Romeo-Registrierung) vor der Einreichung. | [81][36]; Abschnitt 4.5. Die Richtlinien von Zeitschriften sind unterschiedlich und ändern sich; überprüfen Sie die aktuelle Richtlinie der Zielzeitschrift, anstatt sich auf die allgemeine Regel zu verlassen. |
| 10 | „Die Rankings sind weg – sollte ich meine Papiere zu ResearchGate oder Academia.edu verschieben?" | Nach dem Sonnenuntergang ist keine Autorenmigration dokumentiert; Download-Zähler sind nicht zwischen Plattformen übertragbar; und die Vergleichsplattformen haben das gleiche Interpretabilitätsproblem – ResearchGate stellte seinen eigenen zusammengesetzten RG Score im August 2022 nach methodologischer Kritik ein. | Behalten Sie den SSRN-Datensatz und ergänzen Sie ihn statt umzuziehen: Deponieren Sie die gleiche Arbeit in einem institutionellen oder thematischen Repository (Tabelle 13, Schritt 5), bewahren Sie datierte Zähler-Snapshots auf und löschen und posten Sie nicht woanders erneut, was angesammelte Zähler aufgibt. | [130][90][149]; [47][146] (Repository-Ergänzung); [161] (ein Zähler einer Plattform sagt nichts über andere Kanäle aus); [B-7] (Löschen und erneutes Posten setzt Metriken zurück). Das Fehlen dokumentierter Migration ist das Fehlen von Belegen, kein Stabilitätsbeweis. |
Unverifizierte Gemeinschaftspraktiken (Kandidatenhypothesen für die Agenda in Abschnitt 8). Die folgenden Empfehlungen zirkulieren in Autorengemeinden und erscheinen in früheren Entwürfen praktischer Leitfäden; keine Studie unterstützt sie, und sie werden hier als testbare Hypothesen aufgezeichnet und dürfen nicht als Erkenntnisse zitiert werden: (a) Begrenzung der eJournal-Klassifizierungen auf drei (ein Kern-, ein breites, ein interdisziplinäres) anstatt mehr der zulässigen sieben [53][168]; (b) Zitieren von SSRN-Arbeitspapieren, damit ihre Autoren über Google Scholar-Benachrichtigungen benachrichtigt werden und Aufmerksamkeit erwidern; (c) Verbergen der Profil-E-Mail-Adresse in den ersten vierzehn Tagen nach dem Posten, um die Abschöpfung zu verringern; (d) Hochladen einer kleineren Überarbeitung am Tag 3, um eine erneute Ankündigung auszulösen (SSRN dokumentiert nur, dass In-Place-Revisionen Zähler und URL beibehalten [B-7]); (e) jegliche numerische Inzidenz, die an den „Einladung innerhalb von 96 Stunden ist räuberisch"-Screen angehängt ist; (f) direkte Kontaktaufnahme mit drei bis fünf im Papier zitierten Autoren (eine kurze Nachricht, die die Zitierung ihrer SSRN-Arbeit beachtet) als Kanal zu einem ersten legitimen Publikum, dargestellt als gewöhnliche wissenschaftliche Kommunikation statt Werbung. Jede ist mit den Beobachtungsentwürfen von Abschnitt 8 falsifizierbar; bis getestet, ist ihre ordnungsgemäße Zitierform „Gemeinschaftspraxis, unverifiziert".
Tabelle 24 sortiert das Playbook chronologisch um. Jede Zelle verweist auf einen Abschnitt und seine Quellen. Die Timeline-Ansicht beantwortet die Frage, die Autoren tatsächlich stellen („Was soll ich jetzt tun?"), in der Reihenfolge, in der die Situationen entstehen, und ergänzt die situationsindexierte Tabelle 23.
Tabelle 24. Das Playbook als Timeline: drei Phasen × drei Achsen. Alle Zellen fassen Belege und Anweisungen zusammen, die bereits in den Abschnitten 4–7 angegeben sind; unverifizierte Gemeinschaftspraktiken sind ausgenommen (siehe die obige Liste).
| Phase | Plattformmechanik und Messung | Publikum und Verteilung | Anfragenabwehr |
|---|---|---|---|
| Vor dem Posten | Behandeln Sie den Titel und die Zusammenfassung als Konversionsfläche und verfassen Sie sie entsprechend (§6.4; [139][172]); planen Sie eJournal-Klassifizierungen – bis zu sieben sind zulässig, und mehr Klassifizierungen sind mit mehr Downloads und weniger Nullen verbunden [53][168] | Identifizieren Sie die 3–5-Paper-Mikro-Benchmark-Kohorte, um sie neben Ihrer eigenen Arbeit zu verfolgen (§6.3) | Leiten Sie die Korrespondenz über eine dedizierte Adresse ein, bevor die Metadaten öffentlich werden (§6.6) |
| Beim Posten | Bestätigen Sie öffentliches Posten und eJournal-Klassifizierung; notieren Sie die Tag-1-Basislinie des Tabelle-11-Gitters (§6.1) | eJournal-E-Mail-Benachrichtigungen sind der Hauptübertragungskanal der Plattform und werden nach dem Sonnenuntergang fortgesetzt [147][57] | Erwarten Sie Anfragen als Standard-Konsequenz der Sichtbarkeit, nicht als Signal von Verdienst (§6.6; [159][63]) |
| Erste Wochen (Tag 1–45) | Lesen Sie eine frühe Null als Vor-Distribution, nicht Ablehnung (§6.2 Regel iv; [53]); protokollieren Sie Zähler nach dem Tabelle-11-Zeitplan; klassifizieren Sie die Trajektorie nicht früher als Tag 60–90 (§6.3) | Wenden Sie legitime externe Hebel an, wo angebracht – Blog- und Listenabdeckung erzeugte messbare frühe Spitzen (§6.4; [116][72]) | Zahlen Sie nie; prüfen Sie alle einladenden Venues ([B-1]; Think. Check. Submit. [159]); überprüfen Sie Einladungen gegen die Tabelle-14-Typologie; lesen Sie das Spam-Volumen nie als Leserschaft (§7.6) |
Anhang B. CSAB-Berichtsvorlage
Eine minimale Autor- oder Evaluator-gegenüber stehende CSAB-Erklärung (Abschnitt 5.5; Tabelle 10) meldet:
Im Alter von [X Tagen] hatte das Papier [V] Abstract-Aufrufe und [D] validierte Downloads. Bezogen auf [definiertes Feld / Kohorte / Referenzklasse für Neukunden] betrug sein Erreichtungs-Perzentil [RV], sein Download-Perzentil [RD] und sein schrumpfungsbereinigtes Konvertierungs-Perzentil [RC]. Das Papier [hatte / hatte nicht] dokumentierte kuratierte Verbreitung bis zu dieser Beobachtung erhalten. Zwischen [Alter 1] und [Alter 2] änderte sich seine normalisierte Position [stieg / blieb stabil / fiel]. Diese Indikatoren beschreiben die Diffusion und begründen weder Forschungsqualität noch Korrektheit.
Bis ein zeitgenössisches Referenzpanel geschätzt worden ist (Abschnitte 5.5, 8.3), müssen die Perzentilfelder leer bleiben: Kein Wert darf aus Intuition, aus plattformweiten Mittelwerten oder aus gealterten Stichproben eingegeben werden. Historische Anker können neben der Vorlage berichtet werden: der 2012er LSN-Median von 63 Downloads nach zwei Jahren [139] und der 2025er Marketing-Netzwerk-Median von 87 [83], jeweils mit seiner Stichprobe, seinem Feld und seinem Alter angegeben, aber niemals als Ersatz für die fehlende Referenzklasse. Die Vorlage ist das Satz-Ebenen-Gegenstück zu Schritt „Translate" des Dossier-Protokolls (Tabelle 13, Schritt 2).
Anhang C. Panel-Variablenwörterbuch
Tabelle C1 gibt den minimalen Paper-Intervall-Datensatz für das Kern-Panel von Abschnitt 8.3 an: das kleinste Schema, das ausreicht, um die CSAB-Schätzungen von Abschnitt 5.5 und die Plattformereignis-Analysen von Abschnitten 8.4–8.5 zu reproduzieren. Öffentliche Freigaben ersetzen direkte Identifikatoren durch stabile Studienschlüssel überall dort, wo eine Verknüpfung analytisch nicht erforderlich ist, und Registry-Beiträge (Abschnitt 8.8) nutzen die dort angegebene Teilmenge dieses Schemas.
Tabelle C1. Minimales Paper-Intervall-Datenschema für das Kern-Panel.
| Domäne | Variable | Definition oder Format |
|---|---|---|
| Identität | paper_id | Stabiler Studienidentifizierer |
| Identität | ssrn_abstract_id | Plattformidentifizierer; in öffentlichen Freigaben gehashed oder eingeschränkt |
| Timing | posted_at | Erstes öffentliches Veröffentlichungsdatum |
| Timing | observed_at | Metrik-Beobachtungszeitstempel (Tabelle 11 Gitter) |
| Timing | paper_age_days | Tage seit der ersten Veröffentlichung |
| Nutzung | abstract_views_cum | Öffentliche kumulative Abstract-Seitenaufrufe |
| Nutzung | downloads_cum | Öffentliche kumulative validierte Downloads |
| Nutzung | views_interval, downloads_interval | Steigerungen gegenüber der vorherigen gültigen Beobachtung |
| Exposition | classification_ids | Alle eJournal-Klassifizierungen, die zum Zeitpunkt der Beobachtung aktiv sind |
| Exposition | distributed_status, distributed_at | Indikator und Datum der kuratierten Verbreitung, sofern zugestimmt |
| Exposition | search_indexed | Protokolldefinierter externer Indexstatus (Exact-Title-Test) |
| Papier | title_frozen, abstract_frozen, keywords, page_count, doi | Zuerst beobachtete Manuskriptmetadaten, eingeforen bei der ersten Beobachtung |
| Papier | authors_frozen, affiliations_frozen | Autorennamen, Reihenfolge und Zugehörigkeiten bei der ersten Beobachtung |
| Versionierung | revision_id, revision_at, material_change_flag | Versionsgeschichte mit Indikator für wesentliche Änderungen |
| Autoren | author_count, platform_newcomer, prior_ssrn_papers | Teamstruktur und Pre-Posting-Plattformhistorie (Definitionen in Abschnitt 8.3) |
| Ruf | prior_citations, prior_works, institution_measure | Vor der fokalen Veröffentlichung eingeforen und feldnormalisiert |
| Kalender | day_of_week, week, season, holiday_flag | Vordefinierte zeitliche Kontrollen [178] |
| Nachgelagert | citations_6m, citations_12m, citations_18m, publication_status | Spätere Validierungsergebnisse mit Quelle und Datum (Horizonte in Abschnitt 8.9) |
| Audit | collection_method, source_url, quality_flag | Herkunft, Zugangsweg und Anomaliendokumentation (Flag, nicht löschen; Abschnitt 8.3) |
Anhang D. Benchmark-Transparenzspezifikation
Um das Perzentil-Benchmark von Abschnitt 8.8 und jeden Nachfolger, der von der Plattform oder der Gemeinschaft verwaltet wird (Abschnitt 10.4, Empfehlungen 1 und 4), davon abzuhalten, die in diesem Artikel kritisierte Benchmark-Intransparenz zu reproduzieren, wird jede Perzentil-Freigabe mit einer versionierten Begleitdokumentation veröffentlicht, die Folgendes spezifiziert:
1. die berechtigte Papierpopulation, Netzwerke, Dokumenttypen und Ausschlüsse;
2. Posting-Kohortendaten und Beobachtungsalter;
3. die Feldvergabemethode, einschließlich der Behandlung mehrfacher Klassifizierungen;
4. die Definitionen von Aufrufen, Downloads, eindeutigen Akteuren, Wiederholungen und validiertem Traffic, die bei Freigabe gelten;
5. den Median, den Interquartilbereich, P10/P25/P75/P90/P95, den Nullanteil, den Gini-Koeffizienten und die Top-Anteile;
6. Stichprobenumfänge und Unsicherheitsintervalle für jede gemeldete Referenzklasse;
7. die Behandlung von Fehlwerten, Rückzügen, Überarbeitungen, Fusionen und Gegenangaben;
8. die in einer Anpassung enthaltenen Verteilungs- und externe Promotionsvariablen;
9. Datenschutz- und Mindestzellregeln: Für das crowdsourcing-basierte Registry von Abschnitt 8.8, wo kleine Feld-nach-Alter-Zellen andernfalls einzelne Mitwirkende identifizieren könnten, ist dieser Punkt eine verbindliche Beschränkung, die durch Datenschutzgesetze geregelt wird (im Vereinigten Königreich durch UK GDPR und den Data Protection Act 2018), keine Formalität. Die Offenlegungskontrolle sollte über einfache Anonymisierung hinaus zu k-Anonymität oder rausch-hinzugefügten (differenziell privaten) Aggregaten für schwache Zellen führen, und eine Nutzungsregel sollte das Registry an Interpretation statt Evaluation binden und seine Nutzung für Einstellung, Beförderung, Ressourcenallokation oder Wiederherstellung in ein öffentliches Ranking verbieten;
10. eine Versionsgeschichte und eine permanente, zitierbare Referenz für die Freigabe.
Kein zusammengesetzter Score darf diese Komponenten ersetzen. Einfache Verhältnisse zum Kohortenmedian (der unkalibrierte Fallback von Abschnitt 6.3) können instabil sein, wenn die Nennerzelle klein ist, und können fälschlicherweise suggerieren, dass „das Doppelte des Medians" auf ein festes Perzentil über unterschiedlich geformte Felder abbildet. Das autorenseitige Reporting verwendet daher Perzentilschätzungen unter dem empirischen-Bayes-Schrumpfung, die bereits für schwache Zellen in Abschnitt 8.3 spezifiziert ist, während Rohverteilungen für Audit verfügbar bleiben.
Anhang E. Ein unabhängiger archivarischer Querschnitt der Download-Verteilung
Für aktuelle Belege der Gesamtverteilung stützt sich die Synthese der Abschnitte 3 und 5 auf einen einzigen veröffentlichten Snapshot [83]. Dieser Anhang präsentiert einen unabhängigen, reproduzierbaren Querschnitt, der für diesen Artikel zusammengestellt wurde und die Verteilungsstruktur über Fachbereiche hinweg bestätigt, wobei nur öffentliche Daten verwendet werden und kein privilegierter Plattformzugriff erforderlich ist. Es handelt sich um eine einmalige archivarische Rekonstruktion mit einer bekannten Aufwärtsverzerrung, die als Bestätigung der Form angeboten wird und sich vom vorregistrierten Panel von Abschnitt 8.6 unterscheidet, das Arbeiten prospektiv ab dem Zeitpunkt des Postens beobachtet.
Methode. Eine Zufallsstichprobe von SSRN-Arbeiten wurde aus OpenAlex gezogen (Quelle S4210172589, „SSRN Electronic Journal") über dreiundzwanzig unabhängige Zufallssamen. Für jede gesampelte Arbeit wurden die Download- und Abstract-View-Zähler aus der neuesten Erfassung der Arbeit im Internet Archive gelesen, die über den öffentlichen Verfügbarkeitsendpunkt der Wayback Machine gefunden wurde, nicht von der Live-Website, die zugangsgeschützt ist (Abschnitt 4) und keine Vergleichsrahmen mehr veröffentlicht. Das Lesen der Zähler aus archivierten Kopien statt aus Abfragen der Plattform hält das Verfahren ratenbegrenzt, respektiert die Plattform und ist anhand der veröffentlichten Kennungen reproduzierbar. Da die Pro-Paper-Zähler den Rankings-Sonnenuntergang unverändert überstanden haben und nur die vergleichenden Rankings zurückgezogen wurden, bleibt eine Erfassung vom 15. Juli 2026 oder später ein gültiges Lesen der kumulativen Zähler einer Arbeit. Snapshots waren daher nicht auf das Fenster vor dem Sonnenuntergang beschränkt, und das Erfassungsdatum wird nur zur Berechnung des Papieralters beibehalten. Erfassungen, die eine Zwischenseite mit Bot-Challenge statt Seiteninhalt zurückgaben, wurden verworfen. Von 2.600 gesampelten Arbeiten hatten 64% eine verwendbare archivierte Erfassung und 52% ergaben einen maschinenlesbaren Download-Zähler, was n = 1.360 Arbeiten über fünfundzwanzig Fachbereiche ergibt, vierzehn davon mit mindestens zwanzig Arbeiten, und Papieralter von Jahr der Veröffentlichung bis zu über zwei Jahrzehnten. Der Datensatz wird als appendixE-wayback-downloads.csv veröffentlicht und bei https://doi.org/10.5281/zenodo.22285871 hinterlegt, wo dieselbe Datei den Namen study1-wayback-downloads.csv trägt. Zwei Eigenschaften der Stichprobe beschränken, was daraus gelesen werden kann. Posting-Daten tragen ein Jahr und keinen Monat: 1.358 der 1.360 Datensätze sind mit 1. Januar gestempelt, da OpenAlex SSRN-Postings auf Jahresauflösung meldet. Das Alter wird daher als Erfassungsjahr minus Posting-Jahr berechnet, in ganzen Jahren angegeben, und kein kürzeres Intervall ist verteidigbar. Erfassungen sind auch zeitlich konzentriert: 688 von ihnen, die Hälfte der Stichprobe, fallen in einen einzigen Crawl zwischen 25. April und 7. Mai 2025, und 81,5 Prozent fallen in 2025, sodass das Alter einer Arbeit hier nahe bei einer Umformulierung ihres Posting-Jahres liegt und die beiden nicht getrennt werden können. Das erste ist behebbar. Die Posting-Zeile „Posted: DD Mon YYYY" erscheint in denselben archivierten Erfassungen, sodass vollständige Daten durch erneutes Parsen wiederhergestellt werden können, was das Zugangstor der Live-Website nicht verhindert. Tabelle E1 macht diese Abnutzung explizit.
Tabelle E1. Konstruktion des archivarischen Querschnitts und Abgang in jeder Phase.
| Phase | Arbeiten | % der Anfangssumme | % der vorherigen |
|---|---|---|---|
| Zufällig gesampelte OpenAlex-Datensätze (SSRN Electronic Journal) | 2.600 | 100,0 | — |
| Verwendbare Internet-Archive-Erfassung gefunden | ≈1.660 | 63,8 | 63,8 |
| Erfassung trug einen maschinenlesbaren Download-Zähler | 1.360 | 52,3 | 81,9 |
| Endgültige analytische Stichprobe | 1.360 | 52,3 | 100,0 |
Ergebnisse. Der Querschnitt reproduziert jedes qualitative Merkmal, das die veröffentlichten Anker behaupten (Tabelle E4). Downloads sind stark rechtsschief verteilt: Mittelwert 219, Median 60 (95%-Bootstrap-KI 55–69), Mittelwert-zu-Median-Verhältnis 3,65, wobei der Mittelwert das 75. Perzentil (158) übersteigt. Sie tragen auch einen schweren oberen Schwanz (95. Perzentil 816, mehr als dreizehnmal der Median; Gini 0,75, 95%-KI 0,71–0,78). Im Logarithmus ist die Verteilung nahezu symmetrisch (Schiefe von ln Downloads ≈ 0,18), konsistent mit näherungsweise logarithmischer Normalität im beobachteten Kern der Verteilung, eine Eigenschaft, die Kakushadze nur auf den oberen Listen anpassen konnte (Abschnitt 3.4). Die Download-zu-View-Konversion hat einen Median von 16,2 % und einen Mittelwert von 17,3 %, innerhalb des 11–19%-Bandes über Studien (Abschnitt 5.2). Mediane Downloads unterscheiden sich zwischen Feldern im gleichen Papieralter. Wenn die Altersgruppe festgehalten wird, liegt die Spanne zwischen dem höchsten und dem niedrigsten Feldmedian zwischen etwa drei und etwa fünf mal, wobei die genaue Zahl von der Gruppe und der Behandlung dünn beprobter Felder abhängt. Zusammengefasst über alle Altersgruppen erreicht die Spanne etwa das Zwölffache, und diese größere Zahl trägt die sich ändernde Zusammensetzung der Stichprobe: Ingenieurwissenschaften liefern 21 bis 27 Prozent der Papiere im Alter von drei Jahren und jünger und höchstens 5 Prozent derjenigen neun Jahre und älter, während Wirtschaft 9 bis 12 Prozent und 37 bis 54 Prozent derselben Gruppen liefert, und das Medianalter eines Wirtschaftspapiers beträgt hier neun Jahre gegen ein Jahr für Ingenieurwissenschaften. Die Richtung stimmt mit dem Feldmultiplikator von Abschnitt 3.6 überein. Die Größenordnungen sind nicht vergleichbar, da dieser Multiplikator auf lebenslangen Mittelwerten über 94 Unterdisziplinen einer einzelnen Disziplin beruht und diese Spanne auf Medianen über 25 Disziplinen, und keiner ist altersbereinigt. Mediane Downloads sind in den älteren Altersgruppen höher, mit sich nicht überlappenden 95%-Bootstrap-Konfidenzintervallen zwischen den meisten benachbarten Gruppen (Median 12 im Veröffentlichungsjahr, 172 nach zehn Jahren), was die Altersabhängigkeit ist, die das Referenzklassen-Argument motiviert. Innerhalb eines einzelnen Feldes konzentriert sich der Unterschied auf die ersten drei oder vier Jahre: zwischen der Fünf-bis-Zehn-Gruppe und der Über-Zehn-Gruppe erreicht es nicht statistische Signifikanz (Mann-Whitney p = 0,57 für Wirtschaft, 0,82 für Sozialwissenschaften, 0,23 für Betriebswirtschaft). Etwa ein Viertel des gepoolten Gradienten ist Feldzusammensetzung statt Alter. Alter in dieser Stichprobe läuft auch eng an einer Umformulierung des Veröffentlichungsjahrs, da die Hälfte der Erfassungen in einem Crawl zwischen 25. April und 7. Mai 2025 durchgeführt wurden und 81,5 Prozent in 2025 fallen, daher können Alter und Kohorte hier nicht getrennt werden und die Gruppen berichten Niveaus statt der Bahn eines einzelnen Papiers. Der Stichprobenmittelwert (219) stimmt mit dem veröffentlichten Marketing-Netzwerk-Mittelwert (221) überein [83], während der Stichprobenmedian (60) auf dem Niveau des Zensus-ähnlichen rechtlichen Medians (63) liegt [139]. Tabelle E2 gibt die Download-Verteilung nach Papieralter und Tabelle E3 nach Feld, beide mit 95%-Bootstrap-Konfidenzintervallen und Stichprobengrößen. Konfidenzintervalle sind breitesten für die kleinsten Felder, weshalb die Feldspanne als ungefähr eine Größenordnung statt ein einzelnes genaues Vielfaches beschrieben wird. Der Eröffnungsfall des Artikels kann direkt gegen die Stichprobe gelesen werden. Unter Papieren unter zwei Jahren alt mit 30 bis 50 Abstract-Views, die Gruppe, in die dieser Fall fällt, beträgt die mediane Download-Zählung 7, mit einem Interquartilbereich von 4 bis 11 (n = 42). Der Fall im Titel ist der typische Fall für sein View-Band und Alter. Im Veröffentlichungsjahr verzeichnen 35 Prozent der Stichprobe 7 Downloads oder weniger, die mediane Abstract-View-Zählung beträgt 66, und die eigene Konversion des Falls von 17,5 Prozent liegt beim 57. Perzentil der Stichprobe. Das 11–19%-Konversionsband von Abschnitt 5.2 ist ein Band von Medianen statt von Papieren: 41 Prozent der Stichprobe fällt darin, 23 Prozent darunter und 36 Prozent darüber. Die Hälfte der Stichprobe, 51 Prozent, liegt unter dem Zensus-ähnlichen rechtlichen Median von 63 [139], was die entstehende Spanne in den bevölkerten Teil der Verteilung platziert.
Tabelle E2. Download-Verteilung nach Papieralter im Archiv-Querschnitt.
| Papieralter | n | Median [95%-KI] | Mittelwert | IQR (P25–P75) |
|---|---|---|---|---|
| Veröffentlichungsjahr | 203 | 12 [11–14] | 33 | 5–21 |
| 1 Jahr | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 Jahre | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 Jahre | 188 | 130 [110–151] | 384 | 72–374 |
| 10 Jahre und älter | 341 | 172 [157–189] | 453 | 96–336 |
| Alle Papiere | 1.360 | 60 [55–69] | 219 | 23–158 |
Tabelle E3. Download-Verteilung nach Feld (Felder mit n ≥ 20) im Archiv-Querschnitt.
| Feld (n ≥ 20) | n | Median [95%-KI] | Mittelwert | IQR |
|---|---|---|---|---|
| Wirtschaft | 285 | 150 [134–169] | 443 | 76–302 |
| Betriebswirtschaft | 161 | 150 [126–188] | 335 | 72–330 |
| Psychologie | 24 | 107 [35–192] | 179 | 32–229 |
| Sozialwissenschaften | 241 | 85 [78–117] | 219 | 45–189 |
| Entscheidungswissenschaften | 32 | 74 [56–158] | 615 | 49–260 |
| Informatik | 63 | 42 [36–73] | 167 | 26–104 |
| Medizin | 40 | 42 [24–59] | 81 | 22–66 |
| Landw. & Biologische Wiss. | 36 | 31 [24–57] | 65 | 23–67 |
| Biochemie | 21 | 30 [23–37] | 38 | 20–38 |
| Umweltwissenschaft | 72 | 26 [18–32] | 44 | 14–50 |
| Ingenieurwissenschaften | 196 | 24 [20–26] | 46 | 13–46 |
| Physik & Astronomie | 21 | 23 [15–38] | 112 | 13–45 |
| Materialwissenschaft | 55 | 18 [15–25] | 26 | 11–36 |
| Energie | 21 | 12 [11–22] | 25 | 11–22 |
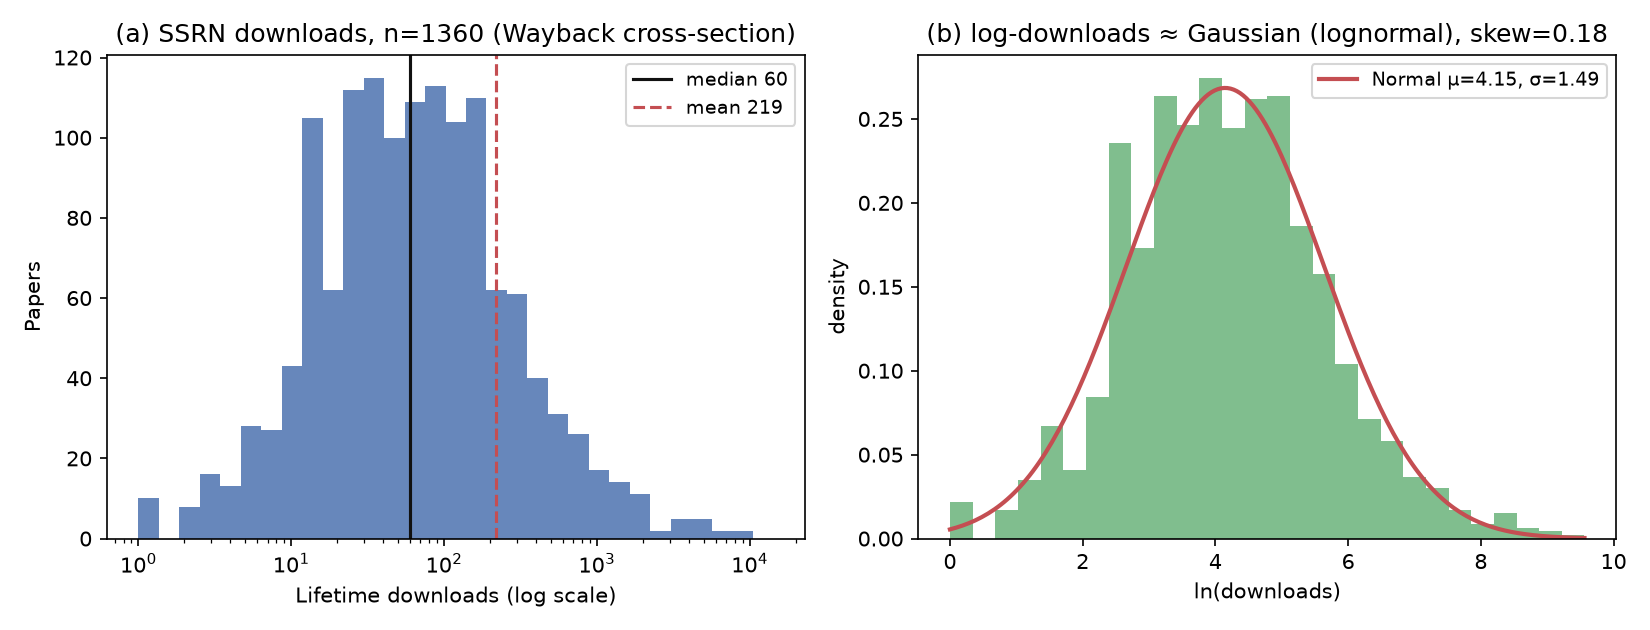
Abbildung E1. (a) Die Download-Verteilung auf logarithmischer Skala mit markiertem Mittelwert und Median; (b) ein Histogramm von ln(Downloads) mit angepasster Normalverteilung. Schiefe der Log-Downloads ≈ 0,18. n = 1.360.
Tabelle E4. Veröffentlichte Anker gegenüber dem unabhängigen Archiv-Querschnitt (n = 1.360).
| Merkmal | Veröffentlichter Anker | Archiv-Querschnitt |
|---|---|---|
| Mittlere Downloads | 221 (Marketing) [83] | 219 |
| Median Downloads | 87 (Marketing) [83]; 63 (Recht) [139] | 60 |
| Mittelwert / Median | 2,54 [83] | 3,65 |
| 95. Perzentil / Median | > 8 [83] | 13,6 |
| Download-zu-View-Konversion | 11–19% Bereich (§5.2) | 16,2% Median |
| Feldverteilung (Mediane) | ≈ 8× Feldmittelwerte, nicht altersbereinigt [168] | ≈ 3–5× bei gleichem Alter; 12,5× gepooled |
| Verteilungsform | logarithmisch-normal, nur Schwanz [85] | Log-Schiefe 0,18 (beobachteter Rumpf) |
Was der Querschnitt belegt. Der Querschnitt bestätigt die Form der Verteilung und ihre zentrale und obere Struktur über Disziplinen hinweg auf einer unabhängigen feldübergreifenden Gesamtstichprobe, die eine viel breitere Feldabdeckung aufweist als jede einzelne veröffentlichte SSRN-Momentaufnahme. Er schätzt keine plattformrepräsentativen Perzentile, und zwei Merkmale seiner Konstruktion weisen ihn aufwärts. Archivierte Erfassungen überrepräsentieren sichtbare Seiten, daher sind Download-intensive Arbeiten eher erfasst worden. Eine Arbeit gelangt auch nur in die Stichprobe, wenn sie eine archivierte Seite mit einem lesbaren Zähler hatte, was den extremen unteren Schwanz zensiert: Der Anteil der Stichprobe an Arbeiten mit zehn oder weniger Downloads (etwa 10%) liegt daher weit unter den 15–30%, die die Abschnitte 3.4 und 8.6 für eine unverzerrte Gesamtstichprobe der Plattform erwarten, und darf nicht als Schätzung dieses Anteils gelesen werden. Dass der Stichprobenmedian (60) trotzdem auf oder unter den veröffentlichten Medianen für Recht (63) und Marketing (87) liegt, deutet darauf hin, dass die Aufwärtsverzerrung für die zentrale Masse bescheiden ist und dass die Schiefe- und Heavy-Tail-Schlussfolgerungen, falls überhaupt, konservativ sind. Für kalibrierte Bezugswerte bleiben die angemessenen Instrumente die in Abschnitt 10 empfohlenen plattformrepräsentativen Perzentilebänder und das vorgregistrierte Panel von Abschnitt 8.6; dieser Querschnitt bestätigt, dass die Struktur, die sie messen würden, die ist, die dieser Artikel beschreibt. Drei der Vorhersagebänder, die Studie 1 im Voraus festlegt (Abschnitt 8.6), können anhand dieser Stichprobe gelesen werden, wobei ihre Aufwärtsverzerrung zu berücksichtigen ist. Der Stichprobenmedian von 60 Downloads liegt innerhalb des vorhergesagten Bereichs von 30 bis 80. Der Aufmerksamkeits-Gini-Koeffizient von 0,75 liegt an der unteren Grenze des vorhergesagten Bereichs von 0,75 bis 0,90, was die Richtung ist, die die Stichprobenverzerrung vorhersagt, da der zensierte untere Schwanz die gemessene Ungleichheit komprimiert. Das Median-zu-Mittelwert-Verhältnis von 0,27 liegt unter der vorhergesagten Obergrenze von 0,5. Nichts davon validiert das prospektive Design, dessen Wert darin liegt, dass es Arbeiten ab dem Posting auf einer Wahrscheinlichkeitsstichprobe beobachtet; es zeigt auf, dass die Bänder nicht implausibel gesetzt wurden.
Erklärungen
Datenverfügbarkeit. Jeder hier reproduzierte synthetisierte Anker lässt sich auf die im Text und in den Tabellen zitierten veröffentlichten Quellen zurückführen, wobei Stichprobenrahmenbedingungen und Verifizierungsstatus am Verwendungspunkt angegeben sind, und es gibt keinen neuen bevölkerungsrepräsentativen Datensatz, der den Benchmark-Ansprüchen des Artikels zugrunde liegt. Der einzige für diesen Artikel erstellte ursprüngliche Datensatz ist der unabhängige Archiv-Querschnitt von Anhang E, eine zufällige feldübergreifende Stichprobe von 1.360 Arbeiten, deren Zähler vor dem Ruhestand aus öffentlichen Archiven wiederhergestellt wurden, veröffentlicht als appendixE-wayback-downloads.csv (ein Anhang-E-Datensatz, nicht die prospektive Studie 1) mit dem Analysecode, damit das Verfahren erneut ausgeführt und erweitert werden kann; es bestätigt die Form der Verteilung und ist kein plattformrepräsentativer Benchmark. Der Datensatz wird hinterlegt unter https://doi.org/10.5281/zenodo.22285871 unter CC BY 4.0, wo dieselbe Datei den Namen study1-wayback-downloads.csv trägt, und sie wird mit einem offenen Tool ausgeliefert, das einen Download-Zähler dagegen liest und dabei sowohl das Alter der Arbeit als auch das Feld berücksichtigt, unter https://github.com/vadimchernets/ssrn-benchmark (MIT-Lizenz, nur Python-Standardbibliothek). Leser, die ihren eigenen Zähler in diese Referenzklasse einordnen möchten, können dieses Tool verwenden, anstatt die Analyse zu rekonstruieren. Materialien für die Vorgregistrierungs-Agenda von Abschnitt 8, einschließlich des Panel-Variablenwörterbuchs (Anhang C, Tabelle C1) und des Suchprüfungs-Abfrageverzeichnisses, sind für die Hinterlegung bei der Vorgregistrierung vorbereitet (Abschnitt 8.8); Registry-Beiträge folgen der in Abschnitt 8.8 definierten Schema-Teilmenge, und jede Perzentil-Veröffentlichung aus dem Benchmark-Programm wird unter der Transparenzspezifikation von Anhang D veröffentlicht. Die CSAB-Berichtsvorlage von Anhang B kann frei wiederverwendet werden, vorbehaltlich ihrer Blank-Perzentil-Regel. Am 24. August 2026 wurde eine formelle Anfrage an den SSRN-Support (Ticket 260824-003051) eingereicht, um die aggregierte Referenzklasse zu erhalten, die die eingestellten Rankings implizierten — Median, Interquartilbereich und Dezilbänder von Downloads, stratifiziert nach Feld und Alter der Arbeit, ohne Pro-Arbeit-Identifizierer; sein Ergebnis (Bewilligung, Ablehnung oder Nichtreaktion) wird in einer späteren Überarbeitung mitgeteilt.
Offener Zugang zu diesem Artikel. Eine unter einer offenen Lizenz verbreitete Kopie dieses Manuskripts wird unter https://doi.org/10.5281/zenodo.22166896 (CC BY 4.0) hinterlegt, wobei der vollständige Text direkt und ohne Zugriffshürde abrufbar ist. Das Deposit wird bereitgestellt, weil der kanonische Datensatz auf SSRN hinter einer Bot-Abwehr bereitgestellt wird, die Clients ohne JavaScript-Engine ablehnt, eine in Abschnitt 4.2 dokumentierte Bedingung; Leser, Referenzverwaltungsprogramme und automatisierte Clients, die das kanonische Exemplar nicht erreichen können, können denselben Text aus dem Deposit erhalten. Die Begleitarbeiten werden zu denselben Bedingungen unter https://doi.org/10.5281/zenodo.22166995 und https://doi.org/10.5281/zenodo.22168724 hinterlegt.
Codeverfügbarkeit. Der Harvestings- und Analysecode für den unabhängigen archivierten Querschnitt in Anhang E wird zusammen mit seinem Datensatz unter https://github.com/vadimchernets/ssrn-benchmark veröffentlicht, sodass das Verfahren reproduziert und die Referenzklasse aus den rohen Zählern neu abgeleitet werden kann. Der Artikel berichtet anderweitig über keine Ergebnisse, die Analysecode erfordern; Figurengenerations-Templates für die empirischen Designs in Abschnitt 8 sollen als Online-Anhang beigefügt werden, der die Vorregistrierungsmaterialien begleitet.
Ethik. Die empirischen Designs in Abschnitt 8 stützen sich auf öffentlich angezeigte Zähler auf Papierebene und bibliografische Metadaten; jede Erfassung nicht öffentlicher Dashboard-Informationen, Verteilungsstatusdaten oder E-Mail-Nachrichten erfordert informierte Zustimmung und, falls zutreffend, institutionelle Überprüfung (siehe Abschnitt 9). Die beiden Designs, die Menschenversuche darstellen, Studie 4 (die Umfrage unter Autoren) und Studie 3 (instrumentiertes Posten mit Posteingangsprotokollierung), werden zur Genehmigung durch Institutional Review Boards oder Forschungsethikkommissionen eingereicht und unter informierter Zustimmung der Teilnehmer durchgeführt, bevor die Datenerfassung beginnt. Nachrichtendatensätze werden vor jeder Berichterstellung aggregiert und de-identifiziert, und Community-Beiträge werden nur zitiert, wenn eine live, überprüfbare Quelle vorhanden ist, mit Paraphrase, wenn Autoren gegen ihre Erwartungen identifiziert werden könnten. Die Datenerfassung beschränkt sich auf Mittel, die durch die Nutzungsbedingungen der Plattformen zulässig sind: Die Designs verwenden öffentlich angezeigte Zähler und bibliografische Metadaten und verwenden kein Scraping, das gegen die Nutzungsbedingungen einer Plattform verstoßen würde, und jedes Design, das Massen- oder nicht öffentliche Daten erfordert, erfolgt durch eine formale Datenanfrage und rechtliche Überprüfung statt durch automatisierte Extraktion. Die Zitierung von halböffentlichen Foruminhalten achtet die Zustimmung der Mitwirkenden und das Wiederidentifizierungsrisiko, weshalb solches Material paraphrasiert statt wörtlich reproduziert wird, wo immer ein Autor gegen ihre Erwartungen identifiziert werden könnte. Der Artikel kennzeichnet kein bestimmtes Journal oder Verlagsunternehmen als „räuberisch"; die Überprüfung von Veranstaltungsorten wendet validierte, transparente Kriterien an, die jede Klassifizierung verteidigbar macht und Diffamation vermeidet.
Danksagungen. Der Autor dankt Stefanie Haustein für kritische Kommentare, die per E-Mail im August 2026 versendet wurden und zu Überarbeitungen von Abschnitt 4.2 führten, und Vincent Larivière, dessen Frage in der Korrespondenz – welche einzelne Normalisierung ein Autor zunächst fordern sollte, und sein Bestehen darauf, Daten statt Argumenten zu sehen – den in Anhang E berichteten archivierten Querschnitt veranlasste.
Interessenskonflikte. Der Autor ist der Entwickler der in Abschnitt 8.10 besprochenen Multi-Model-Orchestrierungsmethoden, die offen und reproduzierbar sind, ein Interesse, das die Leser abwägen sollten. Der Autor ist benannter Antragsteller für ausstehende Patentanmeldungen, keine erteilten Patente, die KI-Orchestrierung und Multi-Model-Validierungssysteme der in jenem Abschnitt besprochenen Art abdecken. Das in Abschnitt 8.10 vorgeschlagene Orchestrierungs-Layer-Lieferdesign ist eine konzeptionelle Spezifikation, auf der keine Befunde dieses Artikels beruhen. Abschnitt 8.10 könnte vollständig gelöscht werden, ohne dass sich eine Diagnose, ein Ergebnis oder eine Empfehlung an anderer Stelle im Artikel ändert.
Tools und Überprüfung. KI-Assistenten wurden als Instrumente unter der Anleitung des Autors eingesetzt; die Ideen, Forschung und Schlussfolgerungen sind die des Autors. Alle quantitativen Aussagen und Zitierungen wurden vom Autor gegen ihre primären Quellen oder archivierten Kopien überprüft; der Autor trägt alleinige Verantwortung für den Inhalt.
Literaturverzeichnis
Quellen, die im Text als [B-n] zitiert werden (Plattformseiten, Forumthreads, Blog-Beiträge und andere Unterstützungsmaterialien), werden unten separat unter „Zusätzliche Quellen" aufgeführt. Plattformseiten mit Zugriffsdatum sind instabil und sollten gegen archivierte Kopien neu überprüft werden.
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Predatory publishers are corrupting open access. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). Do stocks outperform Treasury bills? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). Open access versus subscription journals: a comparison of scientific impact. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Ranking Law Schools: Using SSRN to Measure Scholarly Performance. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Usage impact factor: The effects of sample characteristics on usage-based impact metrics. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). Do altmetrics point to the broader impact of research? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). How to normalize Twitter counts? A first attempt based on journals in the Twitter Index. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). The use of percentiles and percentile rank classes in the analysis of bibliometric data: Opportunities and limits. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Normalization of zero-inflated data: An empirical analysis of a new indicator family and its use with altmetrics data. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Ten simple rules to consider regarding preprint submission. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Earlier Web usage statistics as predictors of later citation impact. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). The role of electronic preprints in chemical communication: Analysis of citation, usage, and acceptance in the journal literature. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Assessing the impact of planned social change. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Congestion on the information superhighway: Inefficiencies in economics working papers. Journal of Public Economics, 225, 104978 (also NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Mitigating Aggressive Crawler Traffic in the Age of Generative AI: A Collaborative Approach from the University of North Carolina at Chapel Hill Libraries. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Online field experiments. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Downloads vs. citations in economics: relationships, contributing factors and beyond. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). Knowledge and motivations of researchers publishing in presumed predatory journals. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "Showcase Your Scholarship, Part Three: Self-Publishing". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "Social Science Research Network (SSRN) Ending Commercial Products". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. REST API documentation. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Similarity Check documentation. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Open access publishing, article downloads, and citations: randomised controlled trial. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). Does the arXiv lead to higher citations and reduced publisher downloads for mathematics articles? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Revisiting the relationship between downloads and citations: a perspective from papers with different citation patterns in the case of the Lancet. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). The Open Access Advantage for American Law Reviews. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). The funding effect on citation and social attention: the UN Sustainable Development Goals (SDGs) as a case study. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "How many reads does a typical academic article get?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Social Comparisons and Deception Across Workplace Hierarchies: Field and Experimental Evidence. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (circulated since 2009)
[45] Eisenberg, T. (2006). Assessing the SSRN-Based Law School Rankings. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier Acquires the Social Science Research Network (SSRN)…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (also LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (Produktseite). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (Produktseite). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "How can researchers gauge a paper's impact?" https://www.elsevier.support/ssrn/answer/gauge-impact (abgerufen 14.08.2026)
[51] Elsevier/SSRN Support. "What are RSS and Data Feeds on SSRN". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "What is SSRN?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (abgerufen 14.08.2026)
[53] Elsevier/SSRN Support. Klassifizierung und Verbreitung. https://www.elsevier.support/ssrn/answer/classification-distribution (abgerufen 14.08.2026)
[54] Elsevier/SSRN Support. KI-Richtlinie. https://www.elsevier.support/ssrn/answer/AI (abgerufen 14.08.2026)
[55] Elsevier/SSRN Support. Google / Google Scholar-Indexierung. https://www.elsevier.support/ssrn/answer/google-scholar (abgerufen 14.08.2026)
[56] Elsevier/SSRN Support. Richtlinien für Einreichungen / Erste Schritte. https://www.elsevier.support/ssrn/answer/get-started (abgerufen 14.08.2026)
[57] Elsevier/SSRN Support. Abonnements (eJournal-Mailings). https://www.elsevier.support/ssrn/answer/subscriptions ; auch https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (veröffentlicht 8. Mai 2026)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. In Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Reprinted in C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (Fall 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Guides: "Understanding the Similarity Report"; "Preprints". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, March 6). KI-Suche hat ein Zitationsproblem. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). Kann KI die Reputationsprämie bei der Wissensdiffusion reduzieren? Evidence from SSRN marketing working papers. Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). An Analysis of Solicitations From Predatory Journals in Ophthalmology. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — Quelle der Zahl „1813 E-Mails"
[85] Kakushadze, Z. (2016). An index for SSRN downloads. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). The Effect of Open Access (AEA Conference 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). Scrapers selectively respect robots.txt directives: evidence from a large-scale empirical study. Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). Prediction policy problems. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). Spamming in Scholarly Publishing: A Case Study. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). A critical look at the ResearchGate Score as a measure of scientific reputation. Presented at ASCW'15 (Quantifying and Analysing Scholarly Communication on the Web), Web Science Conference 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (populäre Version: „The ResearchGate Score: a good example of a bad metric," LSE Impact Blog, 9 Dez 2015)
[91] Kurtz, M. J., et al. (2005). The bibliometric properties of article readership information. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). Usage bibliometrics. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). Is the open access citation advantage real? A systematic review of the citation of open access and subscription-based articles. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). The oligopoly of academic publishers in the digital era. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "Publishing Tips" (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). Characteristics of e-mail solicitations from predatory nursing journals and publishers. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). Guest Post — Love, Death & Robots: Scholarly Edition. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. About LogEc (traffic-filtering methodology). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026). arXiv:2607.14035 (submitted 15 July 2026). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). "Maynooth University's School of Law and Criminology ranks first…". https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). The relationship between usage and citations in an open access mega-journal. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). Evidence of a Harvard and Chicago Matthew Effect. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). The Matthew effect in science. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). The Matthew effect in science, II: Cumulative advantage and the symbolism of intellectual property. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. "Safe Links in Microsoft Defender for Office 365". https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ Microsoft Q&A on clicks in UrlClickEvents; + Suped on false opens)
[107] Milanovic, M. EJIL:Talk! "Academic Spam [UPDATED]". https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). On full text download and citation distributions in scientific-scholarly journals. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Applied Evaluative Informetrics. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). Assessing scientists for hiring, promotion, and tenure. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). Prestige drives epistemic inequality in the diffusion of scientific ideas. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). Social influence bias: A randomized experiment. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). The Tyranny of Metrics. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (research assessment/metrics). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). Do Blogs Influence SSRN Downloads? Empirically Testing the Volokh and Slashdot Effects. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. "Get Published — Guide for Law Review Members". https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "What is a good h-index?" https://paperpile.com/g/what-is-a-good-h-index/ (similar guides: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). Relation between online "hit counts" and subsequent citations: prospective study of research papers in the BMJ. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). Reputation and impact in academic careers. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, Juni 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (archived copy at web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 Juni 2026 (Release 5.1 published 5 Mai 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (guidance for R5.1.1, updated 30 Juni 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmed via the pullpush.io archive)
[128] Remler, D. (2014, April 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (also scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, Juni 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, April 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Working-paper version: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary Stats announcement. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, Juni 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, Dezember 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (post author: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, Juni 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, Juni 12). SSRN to Sunset Rankings from July 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, Juli 15). SSRN Ranking has sunsetted as of 15 Juli 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, Juli 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (PDF copy, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Subscription page. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). Reduziert Doppelblind-Peer-Review Voreingenommenheit? Evidenz von einer Top-Informatikkonferenz. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (second author's surname per Crossref: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). Räuberische Zeitschriften und Verlage: Charakteristiken und Auswirkungen von akademischem Spam auf Forschende in Erziehungswissenschaften. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN e-Journal Rankings By Average Downloads Per Paper" (2018, May), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN Has Not Jumped the Shark" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). Kann KI räuberische Zeitschriften erkennen? Der Fall der FT50-Zeitschriften. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). 2025 Imperva Bad Bot Report. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, February 4). "Interessiert sich eine Zeitschrift für Ihr Preprint? Die Spreu vom Weizen in den Aufforderungen zur Einreichung von Arbeiten trennen". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). Analyse räuberischer E-Mails in der frühen akademischen Karriere und Präventionsversuche. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN Metrics" (updated 29 Sep 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ page p=9061269 on eJournals)
[162] van de Rijt, A., et al. (2014). Feldexperimente zur Dynamik von Erfolg schafft Erfolg. PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). Leitlinien zur KI-Erkennung und warum wir Turnitins KI-Detektor deaktivieren. Published 16 August 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (accessed 15 August 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). Was wird zitiert: Wettbewerbsfähiges GEO in KI-Antwortsystemen. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Erweiterung des Drake Journal of Agricultural Law: The Green Issue. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). Voreingenommenheit gegen Neuheit in der Wissenschaft. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, June). Verdrängen KI-Bots das Kulturerbe vom Netz? GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, May 3). SSRN e-Journals und Downloads. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). Werkzeuge zur Verbesserung der Verbreitung, Diskussion und Downloads… SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (published in U. Detroit Mercy Law Review)
[170] Wikipedia: "Social Science Research Network"; "List of academic journals by preprint policy"; "Preprint". https://en.wikipedia.org/wiki/Social_Science_Research_Network and related pages.
[171] Willey, R., & Knapp, M. (2021). Wie man Zitationen zu rechtswissenschaftlichen Arbeiten erhöht. Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). Auswirkungen von SSRN auf Zitationen zu rechtswissenschaftlichen Arbeiten und wie man diese maximiert. University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). The Metric Tide: Bericht der unabhängigen Überprüfung der Rolle von Metriken in der Forschungsbewertung und -verwaltung. HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). Unaufgeforderte Aufforderungen: Identifizierung von Charakteristiken unaufgeförderter E-Mails von möglicherweise räuberischen Zeitschriften und die Rolle von Bibliothekarinnen und Bibliothekaren. Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, September 21). "Welche rechtswissenschaftlichen Artikel erzeugen die meiste Aufmerksamkeit auf SSRN". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). Messen Downloadberichte zuverlässig die Zeitschriftennutzung? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). Nutzerinnen und Nutzer, Narzissmus und Kontrolle – Verfolgung der Auswirkungen wissenschaftlicher Publikationen im 21. Jahrhundert. SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). Artikelzugriffe: Verknüpfungen zu Zitationen, Wochenendeffekte und Saisonalität. Scientometrics (published 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Mendeley-Lesbarkeit als Filterwerkzeug zur Identifikation stark zitierter Publikationen. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). Aufmerksamkeitsungleichheit in sozialen Medien. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). Quantifizierung der Entwicklung individueller wissenschaftlicher Auswirkungen. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). Universalität von Zitierverteilungen: Hin zu einem objektiven Maß für wissenschaftliche Auswirkungen. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). The Agreement on Reforming Research Assessment. Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). Nutzen der Metric Tide: Indikatoren, Infrastrukturen und Prioritäten für verantwortungsvolle Forschungsbewertung im Vereinigten Königreich. Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). Standardisierte, COUNTER-konforme Nutzungsstatistiken für Repositorien. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). Résumé for Research and Innovation (R4RI): Leitfaden. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. Das Policy-Intelligence-Tool. https://www.overton.io
[188] CC-PLUS. Consortia Collaborating on a Platform for Library Usage Statistics (Open-Source-SUSHI/COUNTER-5-Harvesting; von IMLS finanziert, PALCI u. a.). https://www.cc-plus.org/
[189] HELIOS Open. Higher Education Leadership Initiative for Open Scholarship. https://www.heliosopen.org/
Zusätzliche Quellen
Zusätzliche Quellen, die im Text als [B-n] zitiert werden: Plattformseiten, Forumsbeiträge, Blogbeiträge und andere Materialien, die bestimmte Aussagen im Text unterstützen. Plattformseiten sind instabil und sollten anhand archivierter Kopien überprüft werden.
[B-1] Cabells Predatory Reports (aktiver Service zur Überprüfung von Raubzeitschriften); Beall's List (nur archiviert; seit Januar 2017 nicht aktualisiert).
[B-2] Caron, P. TaxProf Blog (2026, 25. Januar). „The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), Diskussionsbeiträge zu SSRN-Downloads und Autorenrankings (z. B. /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads). Anonymes Forum; zitiert nur als Nachweis, dass solche Diskussionen existieren.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, Beitrag 1seeyq3 (6. April 2026, „I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, Beitrag 13w6zjw (31. Mai 2023, „SSRN Approval Time is Absurd"). Existenz durch Archive von Drittanbietern bestätigt.
[B-6] SSRN — statistische Standardvorlage von Ankündigungen (z. B. https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) und die Ankündigung vom April 2018 (04132018ann002). Plattformseiten; überprüfen Sie anhand archivierter Kopien. Archivierte Kopie: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (Snapshot vom 29. Dezember 2025; abgerufen am 15. August 2026).
[B-7] SSRN FAQ — Versionsverwaltung und ORCID. https://www.ssrn.com/index.cfm/en/faq/ (abgerufen 2026; überprüfen Sie anhand einer archivierten Kopie).
[B-8] SSRN — Landingpage „SSRN has Sunset Rankings". https://www.ssrn.com/ssrn/rankings-sunset. Archivierte Kopie: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (Snapshot vom 19. Juli 2026; abgerufen am 15. August 2026).
[B-9] SSRN — historische Rankingseiten auf hq.ssrn.com / papers.ssrn.com/topten: Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 days), „Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10). Historische Seiten; seit dem 15. Juli 2026 geben diese URLs 403/Platzhalter-Antworten zurück – zitieren Sie anhand archivierter Kopien. Archivierte Kopie der Seite Top 10,000 Papers: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (Snapshot vom 14. Juli 2026, dem Tag vor der Einstellung; abgerufen am 15. August 2026).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (year-long observation: 875 invitations from 256 journals, 76% from blocklists). DOI 10.1080/10875301.2025.2550600; ResearchGate publication 384286174.
[B-11] Caron, P. TaxProf Blog (2026, 7. Juni). „SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (Antwort auf Bainbridge [12]; abgerufen September 2026).
Korrespondenz: [email protected].↩︎
Zitierweise
Chernets, V. (2026). Was bedeuten 7 Downloads? Metrik-Blindheit und der Kaltstart wissenschaftlicher Aufmerksamkeit nach dem Sonnenuntergang der SSRN-Rankings [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}