Que signifient 7 téléchargements ? Cécité métrique et démarrage à froid de l'attention scientifique après le coucher du soleil des classements SSRN
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, PhD, architecte de systèmes IA · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- Version officielle : SSRN 7296358 · DOI 10.2139/ssrn.7296358
- Copie archivée, citables et téléchargeable : 10.5281/zenodo.22166896 — DOI de concept, pointe toujours vers la dernière version
- Texte complet en Markdown et PDF : GitHub
- HTML lisible : https://polyhelper.ai/research/download-metrics/
Le même texte est sur quatre surfaces pour qu'on puisse y accéder quand l'une d'elles ne peut pas le servir. SSRN détient la version officielle ; citez celle-ci.
Que signifie 7 téléchargements ?
Cécité métrique et démarrage à froid de l'attention savante après le coucher du soleil des classements SSRN
Type de manuscrit : Synthèse critique, cadre méthodologique et agenda empirique prêt pour la préenregistrement
Version : septembre 2026
Auteur : Vadym Chernets, PhD1
Affiliation : architecte de systèmes IA
Résumé
Le 15 juillet 2026, le Social Science Research Network (SSRN) a supprimé ses classements publics, les tableaux de classement des articles, des auteurs et des institutions qui avaient longtemps fourni le seul cadre comparatif largement accessible de la plateforme, tandis que les décomptes de téléchargements et les statistiques de citations sont restés sur les articles individuels et les profils d'auteurs (SSRN Blog, 15 juillet 2026). Le résultat a été un événement de mesure asymétrique : les auteurs ont conservé les chiffres et ont perdu la norme. Les compteurs de SSRN n'ont pas perdu leur sens ; ils sont devenus illisibles. Chaque décompte de téléchargements est devenu un nombre sans échelle.
Cet article soutient que la question « Que signifie 7 téléchargements ? » est scientifiquement mal posée jusqu'à ce que la classe de référence d'un article soit spécifiée. Un décompte brut et cumulatif de l'utilisation ne peut pas être interprété sans l'âge de l'article, le domaine, la cohorte de publication, l'exposition de la distribution et la visibilité antérieure de l'auteur. Le problème est le plus aigu pour les nouveaux articles et les auteurs peu visibles, dont l'attention précoce est façonnée moins par l'intérêt savant que par l'architecture de la plateforme, la distribution des alertes par courrier électronique, l'indexation des moteurs de recherche, le prestige de l'auteur et les dynamiques à queue lourde de l'attention. Nous appelons cette condition le démarrage à froid de l'attention savante. L'exigence n'est pas nouvelle : la normalisation des décomptes par domaine, âge et type de document est une pratique établie de longue date en bibliométrie de citation, et la question parallèle pour les données d'utilisation se posait déjà il y a une décennie et demie (Kurtz & Bollen, 2010). Les indicateurs bibliométriques de ce type supposent une base de données dans laquelle le domaine, l'âge et le type sont connus et l'indicateur est calculé pour le compte du lecteur, tandis qu'une plateforme de prépublication remet à ses auteurs un simple entier sans classe de référence, sans outils et (depuis juillet 2026) sans cadre comparatif du tout. Ce qui manque, ce n'est pas la méthode, mais son instanciation : SSRN ne fournit aucun instrument qui l'applique pour un auteur.
Les preuves disponibles montrent pourquoi les simples moyennes induisent en erreur. Dans la seule étude externe récente à grand échantillon d'un réseau SSRN (2 361 articles de recherche en marketing), les téléchargements moyens étaient 221,3 tandis que la médiane était 87, et la moyenne dépassait même le 75e percentile (206) (Jo & Li, 2026). Les distributions de téléchargements sont quasi-lognormales avec des queues supérieures extrêmes, et au sein d'un seul réseau disciplinaire les téléchargements moyens diffèrent d'environ un facteur huit selon les sous-domaines (Whalen, 2018), si bien qu'une moyenne à l'échelle de la plateforme ne décrit aucun article en particulier ; comparer un nouvel article à celle-ci, c'est étalonner contre une fiction d'agrégation. Sur la base des preuves de conversion disponibles, un nombre tel que 7 téléchargements sur 40 consultations de résumé n'indique pas un échec. C'est un résultat de tri avec un large intervalle autour de lui, et il doit être lu à travers la portée, la conversion, l'âge et le domaine.
À partir de cette preuve, l'article construit un cadre d'interprétation pour les métriques SSRN post-classements, qui sépare l'exposition, la consultation du résumé, le téléchargement du texte intégral et l'utilisation aval, et il ajoute un diagnostic portée-par-conversion qui distingue l'invisibilité du rejet. À la place d'un seul nombre de vanité, il propose le Cold-Start Scholarly Attention Benchmark (CSAB), une alternative multidimensionnelle. Un protocole de dossier l'accompagne, en vertu duquel chaque métrique rapportée porte sa source, sa fenêtre temporelle, sa classe de référence et ses limites. L'article énonce ensuite un agenda prêt pour la préregistration pour reconstruire l'échelle manquante : un panel prospectif de nouveaux articles SSRN observés du jour 1 au jour 180, des quasi-expériences utilisant la distribution de alertes électroniques curées et le retrait des classements lui-même, un benchmark de percentile construit par la communauté, et un audit de la visibilité des prépublications dans les moteurs de réponse IA. La base de preuves combine les études citées avec la coupe transversale archivale non représentative de l'appendice E ; l'article spécifie comment le benchmark manquant peut être reconstruit, et pourquoi aucun décompte de téléchargement ne devrait circuler sans son contexte sur une plateforme qui n'en fournit aucun.
Mots-clés : décomptes de téléchargements ; métriques d'utilisation ; normalisation par domaine ; évaluation de la recherche ; prépublications ; scientométrie ; promotion et titularisation ; droit ; altmétriques ; effet Matthieu ; avantage cumulatif ; économie de l'attention ; consultations de résumé ; revues prédatrices ; optimisation des moteurs génératifs.
Classification JEL : A14 ; D83 ; I23 ; O33 ; L86
Points clés
Les décomptes de téléchargements bruts SSRN n'ont pas d'interprétation stable sans l'âge de l'article, le domaine, la cohorte de publication, l'exposition à la distribution et la visibilité préalable de l'auteur.
Le coucher de soleil des classements du 15 juillet 2026 a supprimé le seul cadre comparatif public de la plateforme tandis que chaque compteur a survécu : les auteurs ont conservé les chiffres et perdu la norme.
Dans la seule distribution à grand échantillon publiée récemment, les téléchargements sont fortement asymétriques à droite, moyenne 221,3 par rapport à médiane 87 : l'article « moyen » est atypique par construction.
La séparation de la portée (consultations de résumé) de la conversion (téléchargements par consultation) distingue l'invisibilité du rejet : des diagnostics différents qui justifient des actions différentes.
Les ancres de conversion consultations-téléchargements publiées se regroupent dans une bande d'environ 11–19 %, sur laquelle 7 téléchargements à partir de 40 consultations de résumé est cohérent avec la gamme en tant que résultat de tri : pas, sur la base des preuves disponibles, un signe d'échec.
Le Cold-Start Scholarly Attention Benchmark (CSAB) rapporte la portée normalisée, la performance de téléchargement, la conversion, la dynamique et la validation aval au lieu d'un seul nombre de vanité.
Un agenda préspécifié, prêt pour la préregistration (un panel prospectif, deux quasi-expériences inhabituellement opportunes créées par les propres réformes de la plateforme, un benchmark de percentile communautaire et un audit des moteurs de réponse IA requis avant que l'optimisation des moteurs génératifs puisse être traitée comme fondée sur des preuves) spécifie comment reconstruire l'échelle manquante.
Champ d'application et discipline de la preuve
Cet article est une synthèse critique, combinée à un cadre méthodologique et un agenda empirique prêt pour la préregistration, et les seules données nouvelles qu'il rapporte sont la coupe transversale archivale non représentative de l'appendice E. Trois classes de preuves sont maintenues séparées tout au long, et chaque chiffre de l'article voyage avec sa classe :
1. Estimations vérifiées : chiffres publiés vérifiés par rapport à leur source primaire et cités avec leur cadre d'échantillonnage et leur millésime, ou vérifiés avec des réserves énoncées où la vérification est partielle.
2. Ancres historiques : échantillons antérieurs et fonctionnalités de plateforme retirées, retenus parce qu'ils révèlent la structure distributionnelle, non parce qu'ils restent des normes d'étalonnage pour 2026.
3. Résultats conceptuels et proposés : prédictions préspécifiées, modèles de benchmark et plans d'étude, explicitement étiquetés comme tels et ne contenant aucune conclusion synthétique.
Le problème d'interprétabilité, l'argument de classe de référence et la décomposition portée–conversion sont des affirmations analytiques défendues sur la base des preuves ci-dessus. L'infrastructure que l'article propose est offerte comme une conception que la communauté peut construire et évaluer, non comme une prescription établie : un registre de percentile communautaire (section 8.8), une calculatrice côté auteur et l'architecture d'orchestration de la section 8.10. Aucune affirmation de diagnostic de l'article ne dépend de l'adoption d'une quelconque d'entre elles.
Dans un domaine qui vient de perdre son benchmark public le plus utilisé, le bien public rare est un protocole reproductible que tout auteur, n'importe où, peut exécuter, ainsi qu'une synthèse qui énonce la provenance et l'âge des chiffres existants.
Le cas de 40 consultations de résumé et 7 téléchargements revient à plusieurs reprises dans cette synthèse méthodologique parce qu'il illustre les questions cataloguées dans le tableau 1 ; les conclusions reposent sur les preuves citées, non sur un seul tableau de bord.
Trois règles régissent la synthèse elle-même. Les unités sont normalisées à deux dénominateurs communs, téléchargements au cours de la vie par article et téléchargements sur douze mois par article. Le pontage n'est effectué que lorsqu'une source elle-même rapporte le rapport requis, et l'unité native est conservée partout où la conversion exigerait des hypothèses que les sources ne soutiennent pas. Chaque affirmation de fait porte un niveau de vérification (vérifiée par rapport à la source primaire, vérifiée avec des réserves énoncées ou en attente de vérification) enregistré dans les colonnes de confiance des sources des tableaux. Lorsque les sources sont en conflit, notamment sur la date effective du coucher de soleil, le conflit est résolu en faveur de la source officielle ultérieure et signalé. Chaque estimation conserve son niveau, son millésime et sa réserve de vieillissement partout où elle est réutilisée.
Une seule règle gouverne l'inclusion des sources : une référence est conservée lorsqu'elle contribue un mécanisme distinct, un résultat, un fait de plateforme, un avertissement de mesure, ou un précédent de conception ; la quantité de citations n'est pas un objectif. Publier et être lu sont des accomplissements différents ; cet article traite du second, et de l'effondrement des instruments permettant de le mesurer. Un tableau d'apparence plausible n'est pas une preuve, et dans un article sur les chiffres sans contexte, cette règle lie d'abord l'article lui-même.
1. Introduction
1.1 Quarante consultations, sept téléchargements
Considérez un chercheur (en début de carrière, peut-être sans affiliation, ou simplement nouveau sur la plateforme) qui télécharge un document de travail soigneusement préparé sur SSRN et, quelques semaines plus tard, en août 2026, ouvre le panneau de statistiques de son document. Le tableau de bord indique « 40 consultations du résumé » et « 7 téléchargements ». À ce moment, sans une connaissance pratique des statistiques de l'attention scientifique, l'auteur ne peut pas dire si ces chiffres signifient un rejet catastrophique par les pairs, une base statistique standard pour un texte spécialisé, ou le début d'une trajectoire inhabituellement forte. L'auteur demande à ses collègues : « C'est terrible ? » Personne ne peut répondre. Ni le tableau de bord, ni la littérature scientifique, ni la plateforme elle-même ne fournissent de réponse, et le décompte n'a pas d'échelle par rapport à laquelle le lire. Cette condition s'appelle cécité métrique, l'incapacité, face à ses propres compteurs, de distinguer l'échec de la performance normale du succès. Le terme est introduit ici comme une construction théorique, non comme une quantité mesurée. L'étude 4 (section 8.6) fournit l'indicateur concret (la part des auteurs qui déclarent n'avoir jamais situé leur propre décompte par rapport à un repère quelconque, ainsi que la distribution des premières lectures qu'un faible décompte suscite) afin que « cécité métrique » désigne quelque chose qu'une enquête préenregistrée peut estimer.
Une scène complémentaire, rapportée par des auteurs dans les forums communautaires et présentée ici comme une anecdote illustrative, est plus frappante. Un chercheur télécharge une première prépublication et regarde le tableau de bord rester à zéro consultation et zéro téléchargement, tandis que, en quelques jours, la boîte de réception reçoit cinq courriels de revues sollicitant le manuscrit, tous prédateurs. La seule réponse que le novice reçoit provient de revues prédatrices. La section 7 développe cette asymétrie comme un ensemble d'hypothèses explicites, et l'étude 3 (section 8.6) spécifie comment la temporiser. La scène est le pendant vécu du vide informatif : l'économie de l'attention légitime donne à cet auteur un décompte sans rien pour le lire, tandis que celle parasite fournit des flatteries et pas de lecteurs.
Jusqu'à l'été 2026, une réponse approximative existait. Les classements publics de SSRN (Meilleurs articles, Meilleurs auteurs et tableaux de classement institutionnels) permettaient à un auteur de situer un décompte dans une distribution visible. Le 15 juillet 2026, ces classements ont été supprimés [149]. La suppression a suivi une annonce du 12 juin 2026 qui encadrait la décision avec l'affirmation que « la recherche devrait parler d'elle-même » [148] et une réorientation stratégique antérieure, annoncée le 13 avril 2026, des ressources de la plateforme vers sa mission de partage des recherches fondamentales [146]. La suppression était asymétrique : les décomptes de téléchargements par article et les statistiques de citation « continueront à être enregistrés et affichés sur vos articles individuels et votre profil d'auteur » [149], tandis que la distribution qui avait donné une échelle à ces décomptes était disparue. La situation du chercheur au tableau de bord a ainsi été généralisée à l'ensemble de la base d'utilisateurs de la plateforme : plus de 1,9 million d'auteurs et 1,5 million d'articles [49].
Cet article porte sur cette situation, et sa thèse comporte deux parties. L'arrêt des classements a supprimé le contexte, non les données. Les compteurs par article ont survécu au coucher de soleil et sont toujours affichés ; l'échelle comparative par laquelle ces compteurs pouvaient être lus est disparue, ce qui explique pourquoi les métriques sont illisibles et non dénuées de sens.
La seconde partie est que la question « que signifient 7 téléchargements ? » est scientifiquement mal posée jusqu'à ce que le dénominateur correct et le groupe de comparaison approprié soient spécifiés. Fournir ce dénominateur, ainsi que les instruments pour l'utiliser, est la tâche de cet article.
1.2 Un nombre sans échelle
Le problème interprétatif semble plus simple qu'il ne l'est. Dix téléchargements après sept jours et dix téléchargements après quatre-vingt-dix jours sont des comptages identiques dont les significations diffèrent presque certainement, et elles diffèrent à nouveau si un article porte le nom d'un professeur mondialement reconnu dans une institution très visible et l'autre est le premier ouvrage d'un auteur débutant. Les métriques d'utilisation savante sont néanmoins présentées exactement sous cette forme sans contexte, de sorte que chaque nombre devient inévitablement un test de Rorschach : les mêmes « 40 vues » provoquent la panique chez un auteur et l'indifférence chez un autre, car il n'existe pas de point de référence partagé.
La valeur attendue d'un comptage brut de téléchargements change avec tout ce que le compteur ne montre pas : l'âge de l'article, son domaine, sa cohorte d'affichage et son environnement calendaire, son exposition réelle de distribution, et la visibilité antérieure de ses auteurs. Chacune de ces dépendances est documentée empiriquement. Les téléchargements moyens sur la durée de vie diffèrent d'environ un facteur de huit dans les eJournals d'un seul réseau disciplinaire, d'environ 438 en droit des sociétés et des valeurs mobilières à environ 53 en droit agricole [168]. L'activité d'accès varie avec le calendrier lui-même, diminuant d'environ 11 % les fins de semaine et d'environ 50 % pendant les mois d'été dans les données d'accès aux revues [178]. La position et l'exposition importent indépendamment du contenu : les articles apparaissant dans la position la plus visible des listes d'annonces arXiv ont ensuite obtenu un lectorat et des citations considérablement plus élevés, avec des gains médians de citation d'environ 83 % en astrophysique [72]. Les idées provenant d'institutions prestigieuses se diffusent plus rapidement et largement que les idées comparables provenant d'institutions moins prestigieuses [111], un modèle cohérent avec des preuves de longue date sur le statut et l'attention [104][105][140][103]. Sur SSRN spécifiquement, un co-auteur supplémentaire dans les cinquante premiers est associé à une prime mesurable dans les taux de téléchargement [83]. La machinerie de distribution de la plateforme façonne également le compteur : les auteurs sélectionnent jusqu'à sept classifications, l'inclusion dans les alertes de courrier électronique basées sur des sujets organisés n'est pas garantie, et les sujets à volume élevé peuvent faire face à des retards d'environ 45 jours [53][57]. Le compteur précoce d'un article peut ne refléter rien d'autre que le fait que sa distribution pertinente s'est produite ou non.
Les règles de comptage de la plateforme ajoutent une deuxième couche que les auteurs voient rarement. SSRN filtre ses compteurs, éliminant l'activité apparente de robots et les téléchargements répétés par la même personne [144][66][69] ; sans de tels filtres, les comptages seraient gonflés « d'un facteur de cinq ou plus » [18]. Les vues et les téléchargements sont liés par une conversion approximativement stable, et Black et Caron ont signalé, en 2006, que « en général, trois vues de résumé sur le site Web SSRN aboutissent à un téléchargement réel d'article » [18]. Les échantillons ultérieurs placent la conversion entre environ 11 % et 19 % des vues de résumé [139][172], avec un échantillon marketing récent faisant en moyenne environ 24 téléchargements pour 100 vues [83]. Un auteur qui connaît cette anatomie peut déjà vérifier les 40 vues et 7 téléchargements du titre (la section 5.2 effectue le calcul, qui se situe dans la bande signalée comme un résultat de sélection à intervalle large), mais rien sur la plateforme ne le communique.
Aucune échelle externe ne comble l'écart, ce qui en fait un échec de mesure et non un inconvénient. Pour l'indice h [79], un genre entier de guides « quel est un bon X » existe [118][128]. Pour les téléchargements SSRN, l'audit de la section 2.5 n'a trouvé aucun équivalent en août 2026 dans une source publique. La littérature bibliométrique signale des distributions [85][139][168][83], mais aucune d'elles ne les traduit en normes visibles pour les auteurs. Des chercheurs individuels ont improvisé des repères de cuisine à partir de leurs propres portefeuilles [42], et les guides des bibliothèques expliquent ce que sont les compteurs sans dire ce qu'ils signifient [161][50]. Le nombre que chaque auteur recherche ne peut pas être trouvé.
1.3 Les enjeux : carrières, anxiété et incitation à l'inflation
L'écart importe parce que les chiffres ont des conséquences. La documentation propre de SSRN décrit ses métriques comme celles « que les auteurs utilisent à des fins de promotion et de permanence, et que les institutions utilisent dans leurs activités d'embauche et de classement » [52]. L'utilisation est concrète et documentée : un éminent spécialiste du droit a signalé être « classé 13e sur 3 000 auteurs juridiques au total en nombre de téléchargements de tous les temps, ce que la faculté de droit a pris en compte dans diverses décisions de promotion et connexes » [12] ; les guides de soumission aux revues juridiques conseillent de mentionner « les téléchargements SSRN (s'il y en a beaucoup) » et les apparitions dans les listes des dix premiers dans les lettres de présentation [95] ; et les institutions ont publié des communiqués de presse sur leurs classements SSRN jusqu'à quelques semaines avant la fermeture [101]. Au niveau global, les téléchargements SSRN sont corrélés à 0,84 avec les classements fondés sur les citations de cent facultés de droit [77], une association au niveau de l'école qui ne descend pas aux articles ou aux auteurs individuels, la mise en garde de l'inférence écologique de la section 6.2(iii). Le fait que les institutions agissent sur de telles mesures est une instance d'une dynamique bien documentée : les classements publics sont réactifs, remodelant le comportement des acteurs mêmes qu'ils prétendent décrire. Le mécanisme a été établi en détail pour les classements des facultés de droit, où la commensuration et la prophétie autoréalisatrice ont poussé les écoles à se réorganiser autour de la mesure [58][132]. SSRN a renforcé directement la monnaie, en envoyant périodiquement des messages électroniques aux 30 000 meilleurs auteurs (environ 8 % des 360 000 auteurs répertoriés) pour leur dire qu'ils figuraient « dans les 10 % les meilleurs » [161]. Le « 10 % » est une part des auteurs répertoriés (30 000/360 000 ≈ 8,3 %), et contre la base complète des auteurs inscrits de plus de 1,9 million [49], les mêmes 30 000 sont plus proches des 2 % les meilleurs, de sorte que la formulation décrit les auteurs classés plutôt que tous les inscrits. Les conseils en matière de carrière, en revanche, avertissent que les seules métriques auto-publiées « probablement ne compteront pas aux fins de promotion et de permanence à la faculté de droit » [33], et la littérature d'évaluation plus large documente à la fois la profondeur de la pénétration de l'évaluation basée sur les indicateurs dans l'embauche et la permanence, et son caractère souvent mal conçu [110][115][153]. Les téléchargements eux-mêmes sont des mesures d'attention, non des mesures directes de la qualité : l'utilisation précoce ne prédit que modestement les citations ultérieures (corrélations autour de 0,4, expliquant de l'ordre de 16 % de la variance dans les travaux précoces [25], et 0,11–0,35 dans les estimations ultérieures [80]), et les ensembles des articles très téléchargés et très cités diffèrent sensiblement [108]. Les institutions traitent ces chiffres comme des preuves de carrière même s'ils n'ont pas d'échelle et ne sont que faiblement liés à l'impact savant, ce qui est une invitation permanente à une mauvaise lecture dans deux directions symétriques : sans échelle, un auteur peut abandonner prématurément une ligne de travail sur la base d'un compteur mal lu, ou consacrer du temps et du capital social précieux à la promotion d'un article dont les chiffres n'ont jamais été anormaux. Les classements, quels que soient leurs défauts, ont alimenté exactement cette décision récurrente quant à savoir si la promotion ultérieure d'un article était justifiée, et leur suppression a laissé le choix à faire sans données (un point abordé à la section 6.4).
Les enjeux sont aussi émotionnels : ce que les auteurs vivent au tableau de bord est une forme distinctive d'anxiété métrique, et les comptages de téléchargements sont surveillés de manière compulsive. Les observateurs scientométriques ont décrit le genre d'outils d'auto-suivi de la visibilité comme des « technologies du narcissisme » dès 2012 [177], et l'admission d'un éminent universitaire en droit que la surveillance de ses comptages était « comme du crack pour moi » (Bainbridge, 2007, tel que cité dans la littérature sur les comportements de manipulation de SSRN) est devenue emblématique [44]. Le même programme de recherche a établi expérimentalement ce que l'anxiété produit : les auteurs se téléchargent leurs propres articles pour gonfler les comptages, et le font de manière la plus intense près des seuils de visibilité des listes des dix meilleurs et sous une comparaison sociale défavorable avec les pairs [44]. Les boucles de rétroaction sociale de ce type sont une propriété générale des marchés d'attention : les premiers signaux sociaux amplifient l'inégalité et l'imprévisibilité dans les marchés culturels [131], les signaux positifs initiaux biaisent les évaluations ultérieures [112], et le succès engendre le succès dans les expériences sur le terrain [162]. Les jalons auto-signalés sur les réseaux sociaux, biaisés en faveur des grands performers, aiguisent la comparaison pour tous ceux dont le tableau de bord affiche 7. L'absence d'un point de référence public crée ainsi de l'anxiété, alimente les malentendus et incite à l'inflation artificielle qui mine la métrique pour tous. Le problème est un problème de mesure avant d'être un problème de performance : une métrique à la fois visible, chargée émotionnellement, pertinente pour la carrière et inintelligible est une véritable défaillance de l'infrastructure de mesure, non une insuffisance personnelle de la personne qui regarde le tableau de bord.
1.4 Qui est le plus touché : la dimension d'équité
Les coûts des métriques illisibles ne sont pas distribués équitablement. Les auteurs possédant des réseaux professionnels denses peuvent établir des comparaisons de manière informelle ; les auteurs établis conservent une visibilité préalable d'un article à l'autre. L'absence de normes publiques pèse plus lourdement sur les chercheurs en début de carrière, les chercheurs indépendants et non affiliés, les auteurs dans des sous-domaines étroits, les auteurs issus de disciplines historiquement moins dominantes sur la plateforme, et les auteurs issus d'institutions non élitaires. Le désavantage est structurel et non simplement informatif : le mécanisme de découverte de SSRN achemine l'attention par le biais de séries de documents de travail institutionnels et d'alertes de revues électroniques par abonnement [57]. Un chercheur non affilié peut publier, mais ne peut pas placer un article dans une série institutionnelle à fort trafic, et dépend entièrement de la classification par sujet pour sa visibilité [168][53]. Pour un tel auteur, le canal d'exposition institutionnel est effectivement fermé, de sorte que le poids de la découverte repose de manière disproportionnée sur les couches de recherche et d'IA. La visibilité mécanique, examinée à la section 8, est donc une question d'équité et non simplement une question technique. L'appartenance au domaine seul modifie les téléchargements attendus de plusieurs fois avant que tout jugement de mérite n'intervienne [168]. Les effets de prestige opèrent au moment de la première exposition, car une page SSRN publique affiche les noms et affiliations des auteurs aux côtés du titre et du résumé. L'examen en aveugle fonctionne différemment : le retrait des identités des auteurs abaisse mesurément les scores des examinateurs pour les auteurs prestigieux (dans une étude de 5 027 soumissions à l'ICLR, avec un effet beaucoup moins déterminé sur les décisions d'acceptation) [154], et les évaluations réagissent aux signaux d'identité de manière expérimentale [64]. Au bas de la distribution de l'attention, le phénomène est l'absence plutôt que l'inégalité : dans les données altmétriques, l'attention sociale médiane de la recherche non financée est zéro dans tous les domaines étudiés dans un grand échantillon axé sur les ODD [41], et l'attention sur les plateformes ouvertes adjacentes est plus inégale que le revenu dans les économies développées, avec des coefficients de Gini supérieurs à 0,9 [180]. Pour l'auteur médian, la question « 7 téléchargements, c'est mauvais ? » est une tentative de lire le seul signal que le système retourne, dans un jeu dont les chances sont structurellement inégales, plutôt qu'un affichage de vanité. Tout cadre d'interprétation qui ignore cette asymétrie diagnostiquera systématiquement les désavantagés en lisant l'invisibilité comme un rejet. L'asymétrie se projette également vers l'avant : si la couche de réponse émergente de l'IA hérite des biais de marque et de position documentés pour l'optimisation des moteurs de génération commerciale [5][164], elle reproduira plutôt que ne remédiera à cette inégalité. Cette perspective pèse plus lourdement sur les chercheurs non affiliés et sur les auteurs du Sud global, et c'est l'une des raisons pour lesquelles l'audit de visibilité mécanique de la section 8.6 appartient au programme d'équité plutôt qu'aux curiosités de plateforme.
1.5 La demande documentée d'interprétation
La demande d'une échelle n'est pas hypothétique. C'est l'un des modèles les plus persistants dans le discours de la communauté universitaire, et elle précède le coucher du soleil d'au moins une décennie. Le tableau 1 résume les groupes récurrents de questions et de préoccupations des auteurs, avec la preuve documentée la plus solide pour chacun, le raccourci dangereux que chaque groupe invite (la réponse brève qui semble utile et qui est fausse), et la section de cet article qui y répond.
Tableau 1. La demande d'interprétation : groupes de difficultés documentés de la communauté (2005–2026)
| # | Groupe | Ce que les auteurs demandent ou signalent | Preuve documentée (confiance) | Raccourci dangereux | Traité dans |
|---|---|---|---|---|---|
| 1 | « Mon chiffre est-il normal ? » — l'étalon manquant | Si un nombre de téléchargements donné est bon, mauvais ou typique pour un article comparable | Question publique « Importance of paper download statistics », Academia StackExchange, 2016 (titre et date vérifiés via API officielle) [3] ; questions d'utilisateurs sur la publication sur SSRN et sa valeur [126] ; discussions récurrentes demandant combien de téléchargements comptent comme « bons » (existence du fil confirmée ; les réponses individuelles ne sont pas indépendamment vérifiables, et le matériel du forum est traité partout comme une preuve faible de la demande, non comme des données) [B-3] ; demande d'un auteur novice pour un « conseil honnête » sur un article de travail nouvellement publié (Reddit, avril 2026 ; existence vérifiée via archives tiers) [B-5] | Un seuil de décompte brut universel (« N téléchargements = bon ») | Sections 3, 5–6 |
| 2 | Confusion mécanique — vues par rapport aux téléchargements | Pourquoi les vues dépassent les téléchargements ; si un ratio faible signifie un résumé faible | Règle empirique historique 3:1 [18] ; bande de conversion rapportée 11–19 % [139][172] ; moyenne d'échantillon récente ≈24 % [83] ; les guides des bibliothèques documentent l'incertitude des auteurs sur ce que les compteurs incluent [161] | L'affirmation automatique qu'un ratio faible signifie que le résumé est mauvais | Sections 4–5 |
| 3 | Émotion et comparaison sociale | Vérification compulsive ; embarras tant pour les chiffres bas que élevés | « Like crack to me » (Bainbridge, 2007, cité dans [44]) ; preuve expérimentale d'auto-téléchargement près des seuils de liste supérieure sous comparaison sociale [44] | Se comparer à soi-même par rapport à la moyenne à l'échelle de la plateforme ou aux stars visibles | Sections 1, 5 |
| 4 | Preuve de carrière — ce qui remplace la ligne de classement dans un dossier | Quoi citer dans les documents de titularisation, de promotion et d'embauche après le coucher du soleil | Les téléchargements sont « pris en compte dans diverses décisions de promotion et apparentées » [12] ; e-mails de notification des 10 % supérieurs [161] ; conseils en lettre de motivation [95] ; communiqués de presse institutionnels [101] ; description de la plateforme de l'utilisation évaluative [52] | Citer un décompte cumulatif brut sans date, source ou dénominateur | Section 6 (Tableau 13) |
| 5 | Spam de sollicitation après publication | Invitations de journaux non sollicitées arrivant peu après la publication | « Tous les jours, je reçois au moins deux de ces e-mails » (Reddit r/AskAcademia, 2023 ; vérifié via archive ; l'auteur avait publié dans une revue MDPI, pas sur SSRN) [127] ; récolte d'adresses à partir d'articles « par exemple ceux publiés sur SSRN » [107] ; audits du volume de sollicitation [9][84][63] ; un examen systématique identifiant 29 études empiriques sur le spam universitaire [61] | Déduire l'identité ou l'intention des lecteurs à partir d'un compteur agrégé | Section 7 |
| 6 | Confiance dans les compteurs — bots, jeux, chutes soudaines | Si les chiffres sont réels ; pourquoi les compteurs chutent | « SSRN does absolutely zero to validate their accuracy » (Goldman, 2005, antérieur aux filtres actuels ; une mise à jour ultérieure enregistre que SSRN réduit les téléchargements répétés de la même source) [66] ; filtrage de l'intégrité des données publié par SSRN [144][66][69] ; le trafic des robots représentant ≈74 % des vues des résumés mais seulement ≈7 % des téléchargements dans les premières données RePEc [99] ; les grands épisodes de filtrage des bots sur RePEc jusqu'en 2025–2026 [129] | Traiter le nombre affiché comme un décompte exact de lecteurs humains uniques | Sections 4, 9 |
| 7 | Diagnostiques — « pourquoi zéro téléchargement ? » | Ce qu'un zéro ou une stagnation signifie dans les premières semaines | Incertitude de l'auteur après le coucher du soleil documentée dans les discussions de la communauté (existence confirmée via archives tiers) [B-5] ; les pages d'assistance de la plateforme décrivent les métriques mais, en août 2026, n'offrent aucune orientation interprétative [52][50] (audit de recherche, section 2.5) | Traiter un zéro pré-distribution comme un rejet | Sections 4–6 |
Note. Seules les citations indépendamment vérifiées par rapport à une source en direct ou archivée sont reproduites textuellement ; tout autre matériel communautaire est paraphrasé et marqué par son état de confiance. L'éthique de citer les messages des utilisateurs, y compris l'anonymisation et le traitement du contenu supprimé, est abordée à la section 9.
Le groupe le plus fort du tableau 1 est la question chronique « mon chiffre est-il normal ? », qui revient au cours des années, des plates-formes et des disciplines. Même les initiés de la plateforme n'offrent aucun point de référence en retour, et le sarcasme qui y répond souvent dans les forums communautaires signale que personne, y compris les utilisateurs expérimentés, ne possède l'échelle manquante [B-3]. Les groupes sont également causalement liés : l'étalon manquant (groupe 1) produit la charge émotionnelle (groupe 3), qui produit l'incitation aux jeux documentée dans [44], ce qui à son tour érode la confiance examinée dans le groupe 6. Restaurer l'interprétabilité aborde la chaîne à sa racine. Le cadre vise non pas à augmenter les téléchargements, mais à restaurer le sens.
1.6 Ce que cet article avance : huit positions
Ce sont les positions que l'article défend, chacune argumentée dans la section indiquée.
1. Les décomptes bruts sont ininterprétables sans classe de référence. Un décompte cumulatif de téléchargements n'a pas de signification stable sans tenir compte de l'âge de l'article, du domaine, de la cohorte de mise en ligne, du canal de distribution et de la visibilité antérieure de l'auteur [83][168][178][53]. C'est le problème de la classe de référence de la section 5, et il rend la question « 7 téléchargements, c'est bien ? » mal posée telle qu'elle est formulée.
2. La faible portée et la faible conversion sont des diagnostics différents. Un article que peu de personnes rencontrent pose un problème différent d'un article que beaucoup de personnes consultent mais que peu téléchargent, et justifie une action différente. L'invisibilité n'est pas un rejet du contenu. Les sections 4–5 développent cette distinction en un diagnostic portée-par-conversion (tableau 9), incluant la configuration « intérêt caché » dans laquelle une conversion forte coexiste avec une portée faible.
3. Les compteurs ont survécu ; l'échelle comparative non. L'asymétrie du coucher de soleil (les nombres conservés, les normes supprimées [149]) décrit exactement la condition post-Classements, et elle convertit un problème d'interprétabilité longtemps latent en un problème urgent et universel (section 2).
4. Un indice percentile est un bien public. Le nombre que chaque auteur cherche sur internet et ne trouve pas est un tableau de percentiles par discipline et par âge de l'article. Les sections 5 et 8 précisent comment la communauté peut en construire et en maintenir un, maintenant que celui-ci ne peut plus être lu sur la plateforme.
5. Les normes calibrées exigent un panel observé depuis la mise en ligne. Les preuves publiées consistent en coupes transversales vieillis et instantanés uniques [139][85][168][83]. L'une des rares études récentes de grande envergure identifie explicitement les données de panel comme l'étape suivante nécessaire [83]. Sans observation à partir du jour zéro, les normes de « première semaine » et de « premier mois » sont des extrapolations et doivent être étiquetées comme telles (section 8).
6. Un indice multidimensionnel surpasse un score de vanité unique. Le signalement séparé de la portée normalisée, de la performance des téléchargements, de la conversion, de l'élan et de la validation aval (CSAB, tableau 10) préserve l'information diagnostique que tout indice composite détruit (section 5).
7. La couche de réponse IA devient un nouveau gardien de l'attention. La découverte migre vers le haut de la pile, de la marque de la revue au référentiel au moteur de recherche aux moteurs de réponse IA qui synthétisent une réponse unique et citent une poignée de sources [5][164]. Un quart des adultes américains utilisent déjà des chatbots IA quotidiennement [121], tandis que la fiabilité de ces moteurs comme canaux de citation reste contestée [82] et aucune étude contrôlée de la visibilité des préimpressions savantes en leur sein n'existe encore [100]. La section 8 énonce le protocole d'audit compact ; l'audit complet est réservé au travail d'accompagnement.
8. Un protocole de tableau de bord et de dossier est nécessaire maintenant. Les auteurs et les comités ne peuvent pas attendre une nouvelle infrastructure de données. La section 6 fournit des règles provisoires pour lire un tableau de bord et un protocole de preuve en sept étapes pour les dossiers (tableau 13) dont l'exigence directrice est que chaque nombre signalé affiche sa source, sa fenêtre temporelle et ses limites.
1.7 Contributions
La liste ci-dessous énumère ce que l'article ajoute à la littérature existante, dans l'ordre selon lequel les sections la développent.
1. Un diagnostic. Il identifie le problème de classe de référence dans les métriques d'utilisation des plateformes et nomme le phénomène sous-jacent : le démarrage à froid de l'attention scientifique. Le terme est adapté de la littérature sur les systèmes de recommandation, où un élément en démarrage à froid manque de l'historique d'interaction nécessaire pour le placer [133]. Dans ce démarrage à froid, les nouveaux articles et les nouveaux auteurs entrent dans un système de diffusion où l'attention précoce dépend largement de l'architecture de la plateforme, de la distribution et de la réputation antérieure avant que la qualité substantielle puisse exercer son plein effet [72][111][140][83]. L'affirmation centrale est la thèse du mal-posé de la section 1.1 : la question centrale n'a pas de réponse tant que son dénominateur et son groupe de comparaison ne sont pas fournis.
2. Une carte de référence consolidée. Elle rassemble, pour la première fois depuis le coucher du soleil (audit de la section 2.5, août 2026), chaque référence empirique vérifiée pour les téléchargements et les vues de résumés SSRN dans un seul tableau (tableau 7), avec des cadres d'échantillonnage explicites, des millésimes, des avertissements de vieillissement et une évaluation de la confiance dans la source pour chaque ligne. Les références comprennent la preuve distributionnelle à grand échantillon [83], les extractions de listes supérieures quasi-lognormales [85], les échantillons de jurisprudence [139][168][171][172] et les agrégats de plateforme [1][49].
3. Un cadre d'entonnoir d'attention avec diagnostics. Il décompose la diffusion en exposition, vue de résumé, téléchargement de texte intégral et utilisation en aval. Il dérive ensuite la matrice d'atteinte par conversion (tableau 9), qui sépare l'invisibilité du rejet et inclut la configuration d'intérêt caché que les comptages bruts masquent systématiquement.
4. Instruments d'interprétation. Il convertit la carte de référence en une échelle d'interprétation graduée (Naissant / Modeste / Solide / Fort / Exceptionnel ; tableau 8), une bande de conversion avec des exemples travaillés, et l'indice de démarrage à froid de l'attention scientifique (CSAB ; tableau 10), un format de rapport multidimensionnel normalisé par domaine, âge, cohorte et visibilité antérieure de l'auteur. Les bandes de l'échelle sont comparables uniquement au sein du même domaine et du même âge du document, car l'appartenance au domaine seule modifie les téléchargements attendus plusieurs fois, et chaque limite est soit sourcée, soit explicitement marquée comme estimation de l'auteur.
5. Une couche pratique. Elle fournit des règles pour lire son propre tableau de bord, des diagnostics pour le cas de zéro téléchargement, un tableau d'actions basé sur la situation (tableau 23), une typologie hypothétique de signaux de sollicitation prédatrice avec la mise en garde que le courrier indésirable de sollicitation ne modifie ni les compteurs ni n'apporte la preuve de la lecture (tableau 14), et le protocole de dossier en sept étapes (tableau 13).
6. Un programme de recherche prêt à la préenregistrement. Il spécifie un panel prospectif avec observation à 1, 3, 7, 14, 30, 60, 90 et 180 jours après la publication, et deux plans quasi-expérimentaux : distribution d'alerte électronique organisée comme choc d'attention intra-article, et la suppression des classements comme expérience naturelle dans l'interprétabilité des métriques. Il spécifie en outre un ensemble de données de centiles construit par la communauté comme seule route restante vers de nouveaux centiles, un protocole d'audit compact de la visibilité des machines pour les moteurs de réponse IA, et un enregistrement préspécifié, purement descriptif, de la trajectoire de téléchargement propre de cet article. Chaque étude est exécutable à faible coût et dans les limites d'accès et d'éthique de la section 9, avec des prédictions numériques énoncées comme bandes préspécifiées plutôt que comme des résultats.
1.8 Organisation de l'article
Le reste de l'article comprend neuf sections supplémentaires et cinq annexes. La section 2 reconstitue l'événement et son contexte : la chronologie complète du paquet de réforme 2026, ce qui persiste et ce qui a été supprimé (tableau 2, figure 1), et la justification affichée par la plateforme concernant la réaffectation des ressources et la réorientation. La section 3 présente les preuves distributionnelles vérifiées et explique pourquoi la moyenne est trompeuse. Elle couvre l'écart moyenne-médiane [83], la queue quasi-lognormale [85], et l'hétérogénéité disciplinaire [168] (figures 2-4, tableaux 3-5), replacées dans le contexte théorique de l'effet Matthieu et de l'avantage cumulatif [104][105][131][162] (dynamiques qui ont été quantifiées directement dans les carrières longitudinales et les trajectoires de citation [120]), et la distinction entre les mesures d'attention et les mesures de qualité [25][80][108][178]. La section 4 examine la mécanique des compteurs : le filtrage et l'intégrité des données [144][66], le trafic robotisé et fantôme avec les contre-arguments nécessaires [99][106][129], les architectures de plateforme (tableau 6), et l'hygiène des métadonnées et du versionnage. La section 5 expose le cœur de l'interprétation : l'argument de classe de référence, la carte de référence consolidée (tableau 7), l'échelle d'interprétation (tableau 8), la bande de conversion, la matrice portée par conversion (tableau 9), et CSAB (tableau 10). La section 6 traduit le cadre en pratique pour les auteurs et les comités d'évaluation, notamment le protocole de dossier (tableau 13) et, en annexe A, des conseils situationnels (tableau 23). La section 7 analyse la couche parasitaire de l'économie de l'attention, les sollicitations prédatrices traitées comme des signaux de visibilité hypothétiques, avec toutes les affirmations concernant le calendrier et la prévalence énoncées comme des hypothèses [9][61][63][84][107]. La section 8 énonce l'agenda empirique prêt pour la préenregistrement, incluant un traitement compact de la migration de l'attention vers le haut de la pile jusqu'à la couche de réponse IA et ses implications pour la découverte de préimpression [5][100][82][121][164]. La section 9 détaille les limites, notamment le caractère de source unique des meilleures preuves distributionnelles disponibles [83], le vieillissement des échantillons de 2012-2015, et l'instabilité de la documentation de plateforme. La section 10 conclut avec des recommandations politiques pour SSRN (avant tout, des bandes de centile anonymes par discipline et âge du document comme remplacement qui restaure le contexte sans relancer la compétition des classements) et pour la communauté de recherche.
2. L'événement : le coucher de soleil des classements et son contexte
2.1 Quels étaient les classements
Pendant la majeure partie de l'histoire de SSRN, ses compteurs d'utilisation se trouvaient à l'intérieur d'un appareil comparatif dense. Au niveau des articles, la plateforme maintenait des listes des 10 000 meilleurs par téléchargements sur douze mois et cumulés, ainsi que des listes de « documents récents les plus consultés » par eJournal calculées sur des fenêtres glissantes de soixante jours. Au niveau des auteurs, elle maintenait une liste des 30 000 meilleurs dans toutes les disciplines et des ligues disciplinaires telles que les 3 000 meilleurs auteurs en droit, triables par nouveaux téléchargements, téléchargements cumulés, téléchargements par article et citations. Au niveau des institutions, elle maintenait des tableaux mensuels incluant les 350 meilleures facultés de droit américaines et les 500 meilleures facultés de droit internationales [B-9, pages de classement historiques ; toutes ces URL ont renvoyé une erreur ou une page d'espace réservé depuis le 15 juillet 2026 et ne peuvent être citées que à partir de copies archivées]. La plateforme traduisait également le classement en retours de percentile directs. Comme l'a documenté le guide de la bibliothèque Gallagher Law de l'Université de Washington sur les métriques SSRN, « SSRN envoie périodiquement des messages aux 30 000 meilleurs auteurs, par nouveaux téléchargements et par téléchargements cumulés, pour leur faire savoir qu'ils se situent dans les 10 % les meilleurs ». Selon le chiffre du guide lui-même de « plus de 360 000 auteurs », ce seuil correspondait à environ les 8 % des auteurs répertoriés (30 000 sur environ 360 000) [161, consulté le 14 août 2026], une couche supérieure large plutôt qu'une élite étroite ; la section 1.3 note que par rapport à la base enregistrée complète, ces mêmes 30 000 se situent plus près des 2 % les meilleurs. Ces listes et messages étaient, en effet, les seules informations de percentile destinées aux auteurs fournies par la plateforme concernant les téléchargements SSRN jamais rendues publiques.
L'appareil comparatif n'était pas décoratif. Black et Caron ont proposé en 2006 que les téléchargements SSRN pourraient servir de mesure « bêta » de la performance académique des facultés de droit, complétant les enquêtes de réputation et les comptages de citations [18]. Le même volume de symposium contient un examen critique de la proposition [45]. Institutionnellement, la proposition a réussi : les classements de téléchargements sont entrés dans les matériaux d'embauche, les dossiers de promotion et la publicité institutionnelle. La documentation d'assistance de SSRN elle-même décrit ses métriques comme des chiffres « que les auteurs utilisent à des fins de promotion et de titularisation et que les institutions utilisent dans leurs activités d'embauche et de classement » [52, consulté le 14 août 2026]. Le guide de publication du Legal Writing Institute conseillait aux auteurs de mentionner « les téléchargements SSRN (s'il y en a beaucoup), l'inclusion dans les listes des 10 meilleurs téléchargements SSRN » dans les lettres d'accompagnement adressées aux revues juridiques [95]. En juin 2026, Stephen Bainbridge a mis la fonction de carrière sur le dossier : il était « classé 13e sur 3 000 auteurs juridiques en nombre total de téléchargements cumulés, que la faculté de droit a pris en compte dans diverses décisions de promotion et connexes » [12]. Le leadership de SSRN a lui-même documenté la transformation de la plateforme de la communication savante juridique dans une prépublication de son alors-directeur général [68]. Les institutions ont également commercialisé les ligues : jusqu'en janvier 2026, l'Université Maynooth a annoncé que son École de droit et de criminologie était classée première parmi les départements irlandais dans les 500 meilleures facultés de droit internationales de SSRN, citant plus de 143 500 téléchargements [101]. L'emprise de l'appareil sur le comportement est documentée dans l'analyse des journaux serveur SSRN par Edelman et Larkin. L'étude a révélé que l'auto-téléchargement trompeur s'intensifiait au moment précis où un article s'approchait de la limite d'une liste des dix meilleurs, et a identifié la comparaison sociale, plutôt que les enjeux de carrière seuls, comme principal moteur de la manipulation [44]. La même étude a circulé la remarque, attribuée à Bainbridge en 2007, que surveiller ses comptages de téléchargements était « comme du crack pour moi » [44].
L'appareil avait une deuxième fonction qui a attiré moins d'attention. Les citations et les enquêtes de réputation fonctionnent sur des horloges de plusieurs années ; les classements renvoyaient des retours en quasi-temps réel, et ils permettaient aux chercheurs en début de carrière et aux auteurs en dehors des institutions prestigieuses de démontrer directement un impact visible, sans attendre les instruments de contrôle plus lents et plus conservateurs. Quels que soient leurs défauts, les tableaux de ligues étaient le seul appareil comparatif également visible pour chaque auteur sur la plateforme. C'est en partie pour cette raison que leur suppression pèse plausiblement le plus lourdement, comme l'argue la section 1.4, sur les auteurs qui ont les moins de substituts informels. Aucune preuve distributive directe sur les effets du coucher de soleil n'existe encore, il s'agit donc d'une attente directionnelle que RQ1 (section 8.5) teste : bilatérale, elle demande si la suppression a concentré ou dispersé l'attention sans présupposer le signe.
2.2 Chronologie de la retraite 2026
La suppression des classements le 15 juillet 2026 était l'aboutissement d'une série de décisions de plateforme commencées à la fin de 2025, résumées à la figure 1.
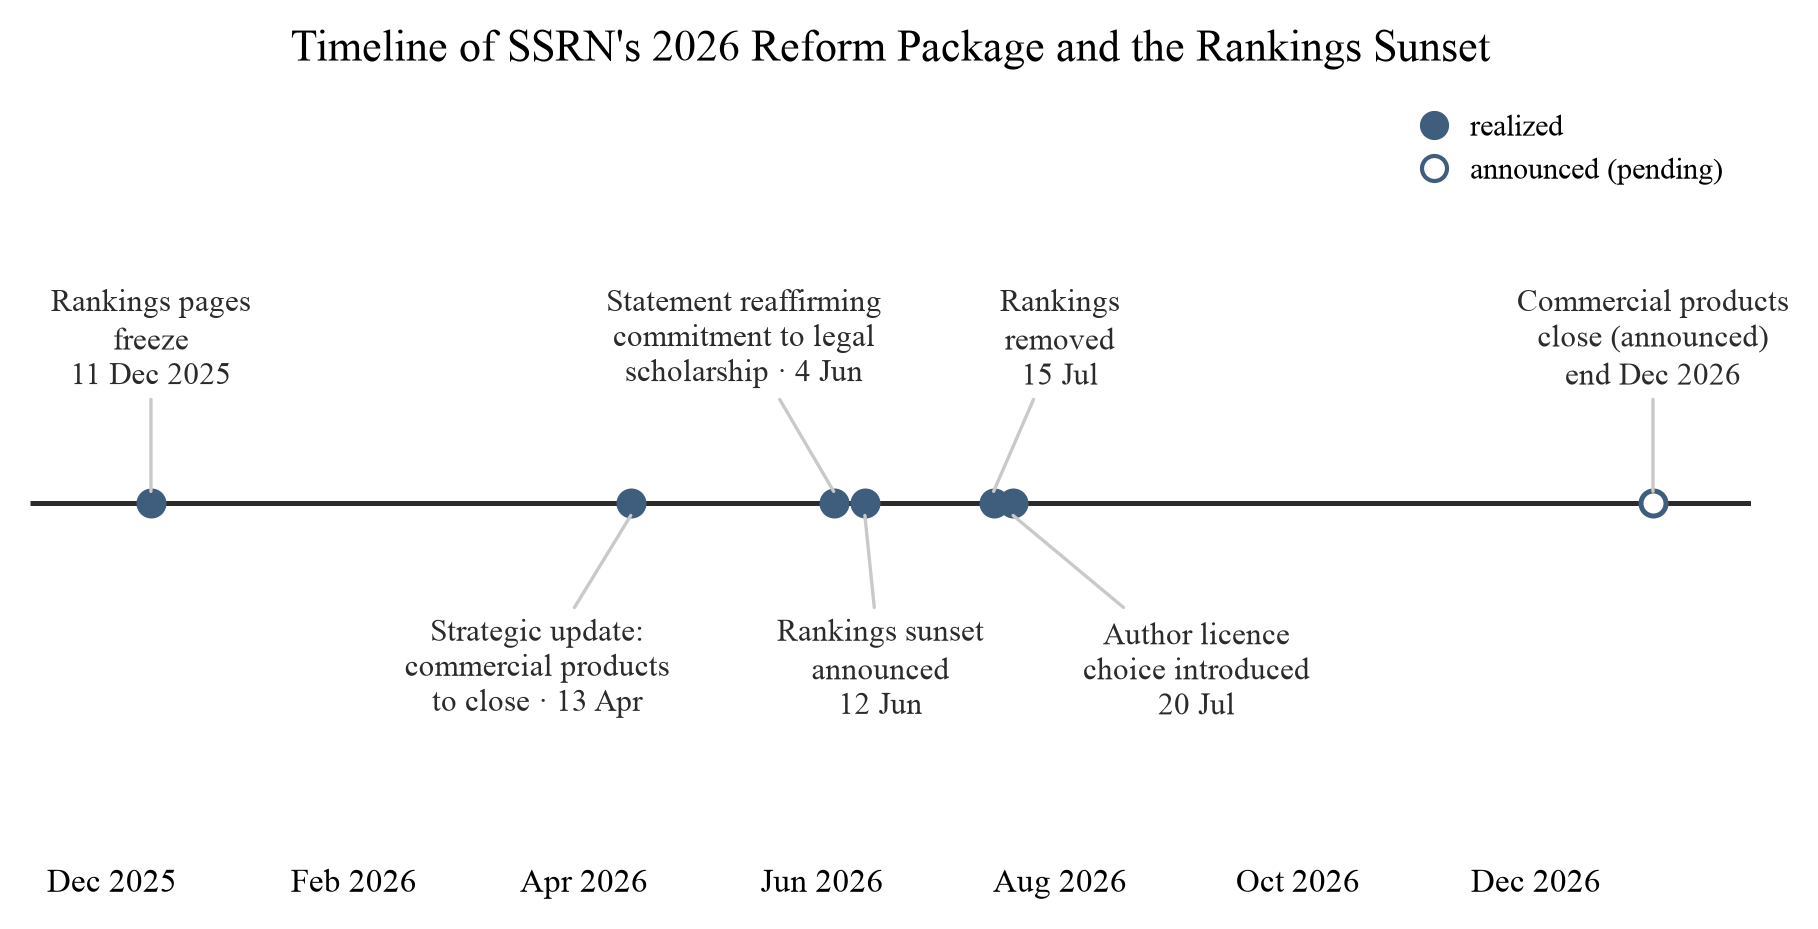
Figure 1. Chronologie du plan de réforme 2026 de SSRN. Événements : gel des pages de classement des téléchargements de revues électroniques (à partir du 11 décembre 2025, documenté dans un article du TaxProf Blog du 25 janvier 2026 [B-2]) ; mise à jour stratégique annonçant la fermeture de tous les produits commerciaux d'ici la fin de 2026 (13 avril 2026) [146] ; déclaration publique réaffirmant l'engagement de SSRN envers la recherche juridique (4 juin 2026) [147] ; annonce de la suppression des classements « à partir du 1er juillet 2026 » (12 juin 2026) [148] ; suppression effective des classements (15 juillet 2026) [149] ; introduction du choix de licence pour les auteurs (20 juillet 2026) [150] ; fermeture annoncée des produits commerciaux restants (fin décembre 2026) [146]. Sources : [146][147][148][149][150][B-2].
La dégradation a commencé avant toute annonce officielle. Le 11 décembre 2025, les pages de classement des téléchargements par revue électronique ont cessé de se mettre à jour. Paul Caron avait animé une rubrique hebdomadaire « Top Five New Tax Papers » fondée sur ces classements pendant plus de deux décennies. Dans un article du 25 janvier 2026, il a documenté que les classements fiscaux s'étaient figés sur la période « 12 oct. 2025 – 11 déc. 2025 » et a écrit que « cela pourrait être la fin de la rubrique SSRN Top Five New Tax Papers » [B-2, cité comme une paraphrase de l'article du 25 janvier 2026, et non d'une annonce de SSRN].
Le 13 avril 2026, SSRN a publié une « mise à jour stratégique » annonçant un recentrage sur sa « mission centrale de partage de la recherche » et la fermeture de tous les produits commerciaux (Research Paper Series, Sponsored Networks, Site Subscriptions, actes de conférences payants, tableaux de bord d'analyse, offres d'emploi et annonces, et flux de données) d'ici la fin de décembre 2026 [146]. Les observateurs des bibliothèques ont enregistré le changement en quelques jours [34], et l'unité Digital Commons d'Elsevier a publié des conseils de migration pour les institutions dont les collections Research Paper Series étaient en cours de suppression [47].
L'annonce a provoqué une controverse publique dans la communauté juridique, celle-ci étant la plus investie dans l'infrastructure de classement. Les 3-4 juin 2026, Bainbridge a publié une critique très lue intitulée « The Social Science Research Network Has Jumped the Shark », suivie d'un article notant que SSRN avait répondu à ses plaintes par des clarifications sur le calendrier des fermetures de série de documents et la préservation des revues électroniques thématiques [12]. Le 4 juin 2026, SSRN a émis une déclaration sur son « engagement continu envers la recherche juridique », promettant que les distributions de revues électroniques et les alertes par courrier électronique « resteraient inchangées » [147]. Le 7 juin 2026, Caron a répondu à Bainbridge sur le TaxProf Blog sous le titre « SSRN Has Not Jumped the Shark » [B-11]. L'échange constitue un récit public compact de ce que la communauté considérait comme valeur comparative des fonctionnalités de la plateforme à la veille de leur suppression.
Le 12 juin 2026, SSRN a annoncé qu'il « supprimerait les classements à partir du 1er juillet 2026 », déclarant que « chez SSRN, nous avons toujours cru que la recherche devrait parler d'elle-même » [148]. L'arrêt a pris effet deux semaines plus tard que prévu : le 15 juillet 2026, les classements des articles, des auteurs et des institutions ont été supprimés [149]. Cinq jours plus tard, le 20 juillet 2026, une nouvelle réforme a introduit le choix de licence pour les auteurs [150]. L'écart de deux semaines entre les dates annoncées et réelles, et la période d'un mois entre l'annonce et la mise en œuvre, sont en eux-mêmes analytiquement pertinents : ils ont créé une période d'anticipation au cours de laquelle les auteurs et les institutions pouvaient observer le changement à venir, point repris dans la conception quasi expérimentale de la section 8.
2.3 La justification officielle et son évolution
La justification affichée pour l'arrêt était l'allocation des ressources et la réorientation de la plateforme. L'annonce de juillet expliquait que les classements « nécessitent des ressources importantes en produits et en développement » et encadrait la décision dans une réorientation vers un partage plus rapide, une meilleure détectabilité et l'intégrité de la recherche. Elle déclarait aussi que « les nombres de téléchargements et les statistiques de citation continueront à être enregistrés et affichés sur vos articles individuels et sur votre profil d'auteur » [149]. L'annonce laisse ouverte la possibilité d'un retour des fonctionnalités comparatives : SSRN a écrit qu'il « pourrait revisiter l'idée de divers classements » [149], donc le retrait ne doit pas être décrit comme permanent. Le silence dans le dossier a aussi son importance : les annonces n'attribuent pas la décision aux jeux de métriques, à la manipulation ou à l'utilisation concurrentielle abusive des classements, et les récits qui fournissent de tels motifs vont au-delà des textes publiés [148][149].
Le ton de l'explication officielle a évolué entre l'annonce et la page d'accueil qui a remplacé les URL des classements. Là où le message de juin parlait de ressources, la page de remplacement indique que la « nouvelle direction » de SSRN « met les auteurs individuels et leurs travaux au cœur de tout ce que nous faisons », et que « les tableaux comparatifs agrégés des institutions et des départements ne correspondent plus à cette vision » [B-8 ; la page est servie derrière des restrictions d'accès et ces phrases sont citées à partir de copies d'index de recherche, de sorte qu'une copie archivée devrait accompagner toute citation]. Le message de juin présente l'arrêt comme une décision de coûts, la page de remplacement comme une réorientation principes loin de la comparaison institutionnelle tout court.
SSRN n'a pas laissé les auteurs entièrement sans pointeur officiel vers le contexte. Sa documentation d'assistance sur l'évaluation de l'impact d'un article oriente les auteurs vers les compteurs au niveau de l'article (vues d'abstraits et téléchargements) complétés par PlumX Metrics, un produit d'altmétrique Elsevier agrégeant les signaux de citations, d'utilisation et de médias sociaux [50, consulté le 14 août 2026]. PlumX apparaît ainsi comme le remplacement de facto de la plateforme pour le contexte interprétatif. C'est un remplacement partiel : il agrège des signaux supplémentaires pour un article individuel mais ne fournit pas de distribution, de percentile ou de comparaison de cohorte. Ce sont les éléments que les Classements, aussi imparfaitement, avaient fournis. Les retraits ne s'étendent pas à l'intégration de SSRN avec les flux de travail des revues : le programme First Look continue de connecter la plateforme à plus de 1 200 revues Elsevier [48][145]. La gouvernance commerciale de la plateforme situe aussi ces décisions produits dans un marché hautement concentré de l'édition savante [94].
2.4 Ce qui subsiste et ce qui a été supprimé
Le tableau 2 cartographie l'état post-coucher du soleil de la plateforme, ainsi que l'implication de mesure de chaque élément : ce que signifie chaque fonctionnalité survivante, disparue ou non signalée pour quiconque essaie de lire un comptage. La suppression a été asymétrique. Tous les compteurs par article et par profil survivent. L'appareil comparatif construit sur ces compteurs a été entièrement retiré.
Tableau 2. Ce qui subsiste et ce qui a été supprimé après le coucher du soleil des classements du 15 juillet 2026, avec implications de mesure. Sources : [147][149][161][B-8][B-9] ; lignes de machinerie d'exposition : [53][57][55][144][66][69].
| Fonctionnalité | Statut après le 15 juillet 2026 | Base de source | Implication de mesure |
|---|---|---|---|
| Comptages de téléchargement par article | Subsistent ; affichés sur les pages d'article | Confirmés textuellement dans l'annonce de coucher du soleil [149] | L'utilisation brute reste observable mais ne porte plus de classe de référence propre |
| Vues d'abrégés par article | Subsistent (non nommées textuellement dans l'annonce de coucher du soleil, qui énumère « comptages de téléchargement et statistiques de citation » ; les vues continuent à être affichées) | [149], observation de plateforme, accédé le 14 août 2026 | La portée reste observable, donc les diagnostiques de portée-conversion par article (tableau 9) restent calculables |
| Statistiques de citation (article et profil d'auteur) | Subsistent | Confirmées textuellement [149] | L'utilisation en aval peut toujours compléter les mesures d'attention précoce |
| Profil d'auteur (articles, affiliations) | Subsiste | Observation de plateforme, accédé le 14 août 2026 | L'agrégation au niveau du portefeuille reste possible, avec le même dénominateur manquant |
| Abonnements aux revues électroniques et alertes par courriel | Subsistent | « Continuent sans changement », déclaration du 4 juin 2026 [147] | Le canal d'exposition par notification persiste, donc les compteurs précoces restent dépendants de l'architecture (section 4.4) |
| Classifications par sujet (1–7, sélectionnées par l'auteur) | Subsistent ; pilotent le routage des revues électroniques | Documentation de plateforme [53] | La classification est une variable d'exposition potentiellement conséquente |
| Distribution de revue électronique curatoriale | Continue ; l'inclusion est « curatoriale et ciblée, non garantie » | [53][57][147] | Le statut de distribution et la date doivent être modélisés comme un traitement, non comme contexte |
| Délai de distribution dans les sujets à haut volume | Continue ; jusqu'à 45 jours | [53] | Les comptages du premier mois peuvent mélanger les régimes pré- et post-distribution |
| Indexation externe (Google, Google Scholar) | Continue, selon le calendrier contrôlé par le moteur de recherche (« 6–9 mois ou plus ») | [55] | Un processus d'exposition avec censure par intervalle : la date d'exposition est limitée, non observée |
| Filtrage des activités suspectes | Continue | [144][66][69] | Les comptages sont des événements filtrés, non une lecture ou un appui vérifiés |
| Récupération d'articles par des réponses IA | Non signalée par SSRN | Aucune signalisation de plateforme n'existe ; section 8.6 | La visibilité des machines nécessite un audit indépendant et répété (étude 2) |
| Métriques PlumX sur les pages d'article | Subsistent ; pointeur officiel pour l'évaluation d'impact | Documentation d'assistance [50] | Signaux supplémentaires par article, mais pas de distribution, de percentile ou de comparaison de cohorte (section 2.3) |
| Listes des meilleurs articles (Top 10 000 ; récents/tous les temps par revue électronique) | Supprimés ; les URL renvoient une erreur ou la page d'atterrissage de coucher du soleil | [149][B-8][B-9] | Un cadre comparatif majeur — et une surface de découverte possible — a disparu |
| Listes des meilleurs auteurs (Top 30 000 ; ligues disciplinaires) | Supprimés | [149][B-9] | La position de percentile au niveau des auteurs n'est plus observable publiquement |
| Ligues au niveau institutionnel (Top 350 universités américaines / Top 500 facultés de droit internationales, etc.) | Supprimés | [149][B-8][B-9] | La comparaison institutionnelle ne peut plus être calculée à partir des données de plateforme |
| Cadrage public de percentile (rang d'auteur, positionnement « top 10 % ») | Supprimé avec l'infrastructure de classements | [149][161] | La classe de référence doit maintenant être reconstruite en externe (sections 5, 8) |
| Courriels de notification « Top 10 % des auteurs » | Le sort n'est pas abordé dans les communications officielles ; les courriels étaient liés à l'infrastructure de classements | [161][149] | Un signal de percentile utilisable dans un dossier ne peut plus être supposé arriver |
Les lignes restantes du tableau 2 sont exactement les compteurs bruts et la machinerie d'exposition qui les alimente : la plateforme continue de produire des nombres au même taux qu'auparavant. Les lignes supprimées sont exactement l'ensemble des cadres comparatifs : distributions, seuils, classements et messages de percentile. L'événement a donc une structure informationnelle précise (données conservées, classe de référence retirée), et cette structure convertit un problème latent de longue date, comment lire un numéro SSRN, en un problème aigu et universel. Nous appelons la propriété de plateforme qui a changé opacité de référence : une propriété graduée d'une plateforme décrivant si elle publie les statistiques distributionnelles nécessaires pour situer un compte individuel (percentiles, médianes, distributions de cohorte), ou seulement des compteurs bruts, des moyennes et des listes des N premiers. Le 15 juillet 2026, SSRN s'est déplacé en une seule étape d'une transparence partielle à une opacité de référence quasi complète, et le reste de l'article peut être lu comme une étude du coût de cette propriété pour ses utilisateurs. L'opacité, ainsi définie, a au moins quatre dimensions : couverture de la population (qui décrivent les statistiques publiées), granularité de la classe de référence (si elles conditionnent sur le domaine, l'âge et la cohorte), stabilité temporelle (si les définitions et fenêtres restent comparables dans le temps) et auditabilité (si les règles de comptage sont publiques assez pour être vérifiées). Les quatre fonctionnent partiellement indépendamment : les classements peuvent réduire une forme d'opacité tout en en aggravant une autre si leurs dénominateurs et règles de sélection sont peu clairs. C'est cette indépendance partielle qui explique pourquoi les recommandations de plateforme de la section 10.4 (points 4 et 8) traitent de la divulgation elle-même et non seulement du retour des nombres comparatifs. Pour rendre la propriété mesurable, chaque dimension est notée sur une liste de contrôle ordinale explicite appliquée à l'interface publique et à la documentation d'une plateforme : couverture de la population (0 = compteurs bruts seulement, 1 = statistiques récapitulatives à l'échelle de la plateforme publiées, 2 = statistiques distributionnelles pour les populations définies) ; granularité de la classe de référence (0 = aucune, 1 = un axe tel que le domaine, 2 = conditionnement conjoint domaine × âge × cohorte) ; stabilité temporelle (0 = définitions et fenêtres de comptage non documentées ou révisées silencieusement, 1 = documentées, 2 = documentées et versionnées) ; et auditabilité (0 = règles de comptage non publiées, 1 = décrites en prose, 2 = publiées avec détails vérifiables). Le profil d'opacité d'une plateforme est alors le quadruplet de scores plutôt qu'une étiquette unique. Le même instrument note SSRN avant et après le coucher de soleil (le déplaçant vers le bas sur la couverture, la granularité, et, pour les listes supprimées, la granularité de la classe de référence), et il permet aux comparaisons interplateformes du tableau 6 d'être énoncées comme des scores plutôt que comme des impressions. Une plateforme peut afficher de nombreux nombres et rester presque complètement opaque. La rubrique est une première opérationnalisation, à affiner et à tester entre évaluateurs, et non un index définitif.
2.5 La demande d'interprétation
La question que le coucher de soleil a rendue urgente était posée bien avant lui. Le tableau 1 (section 1.5) rassemble les groupes documentés de demandes d'auteurs pour l'interprétation, limités aux sources vérifiées. Le matériel du forum y est cité comme preuve de demande, non de distributions, et les citations des messages d'utilisateurs ne sont reproduites que lorsque le message lui-même a été localisé (l'éthique de citer des messages de forum semi-publics est abordée à la section 9).
Les affirmations négatives qui suivent reposent sur un audit de recherche structuré plutôt que sur une recherche casual, tout comme les énoncés parallèles aux sections 1.2, 1.5 (tableau 1) et 8.8. Le protocole est énoncé ici une fois. Nous avons construit un inventaire de plus de 25 formulations de requêtes en anglais, organisées en six groupes d'intention : normatif (« combien de téléchargements SSRN c'est bon »), définitionnel (« qu'inclut un décompte de téléchargements SSRN »), navigationnel post-coucher de soleil (« classements SSRN disparus — où comparer »), évaluatif (« téléchargements SSRN comme preuve de titularisation »), diagnostique (« article SSRN zéro téléchargements pourquoi ») et pratique (« comment augmenter les téléchargements SSRN »). Pour chaque requête, nous avons enregistré qui y répond actuellement et à quel point bien, le critère étant si une source retournée offre des valeurs de référence graduées et conditionnées par domaine plutôt qu'une description de la métrique ou une anecdote. Comme contrôle positif, nous avons exécuté des requêtes analogues pour l'indice h, le score ResearchGate et les décomptes de citations, qui remontent de manière fiable le genre de guide de seuil documenté dans [118][128]. Les mêmes formulations d'intention pour les téléchargements SSRN n'ont fait remonter aucun équivalent, avant ou après le coucher de soleil. L'écart s'étend aux références communautaires les plus largement consultées : les aperçus de style encyclopédie de la plateforme décrivent ce que sont les compteurs mais n'offrent pas de normes interprétatives pour eux [170]. L'audit a été menée en juillet-août 2026 en utilisant un pipeline personnalisé couvrant les moteurs de recherche web à usage général et les moteurs de réponses IA grand public, automatisant l'exécution des requêtes et l'évaluation de la qualité des réponses. La liste complète des requêtes est disponible auprès de l'auteur. Le résultat est une conclusion négative et n'est revendiquée que comme telle : absence de preuve au moment de la fenêtre d'audit, dans les langues et moteurs couverts, non preuve qu'aucune telle ressource ne peut exister.
Pour les métriques voisines, la demande interprétative documentée au tableau 1 (section 1.5) a longtemps été satisfaite par un genre de grand public : « quel est un bon indice h » est servi par des dizaines de guides de seuils graduées et conditionnées par domaine [118], et les normes de citation au niveau disciplinaire sont le sujet d'explications largement lues [128]. Pour les téléchargements SSRN il n'existe pas un tel genre. Pire encore, le meilleur guide structuré qui existait, la page de la bibliothèque juridique de l'Université de Washington, a continué après le 15 juillet 2026 à décrire les classements Top Authors et Top Papers au temps présent, le rendant partiellement trompeur juste quand la demande a atteint son apogée [156, consulté le 14 août 2026]. Le coucher de soleil n'a pas créé le problème d'interprétation ; il a supprimé la seule réponse partielle que l'écosystème avait, au moment où la mémoire institutionnelle des distributions a commencé à se désagréger.
3. Ce que les données montrent : pourquoi la moyenne ment
3.1 Ce que les compteurs mesurent et ce qu'ils ne mesurent pas
Toute utilisation des compteurs subsistants présuppose un compte rendu de ce qu'ils mesurent. Le tableau 3 résume le contenu de mesure de chaque métrique, ses principaux facteurs de confusion et le rôle diagnostique qu'elle peut légitimement jouer.
Tableau 3. Ce que les métriques SSRN mesurent — et ce qu'elles ne mesurent pas.
| Métrique | Interprétation substantive la plus proche | Principaux facteurs de confusion | Rôle diagnostique approprié |
|---|---|---|---|
| Vues de la page de résumé | Portée de la page d'accueil d'un article | Exposition de recherche, positionnement sur la plateforme, réputation de l'auteur, promotion externe, titre, taille du domaine, durée en ligne | Exposition / portée |
| Téléchargements du texte intégral | Intention d'examiner ou d'utiliser l'article complet | Tous les facteurs affectant les vues, plus la qualité et la pertinence du résumé et les frictions de téléchargement | Engagement |
| Téléchargements par vue de résumé | Transition conditionnelle de l'exposition de la page d'accueil à l'acquisition du texte intégral | Petits dénominateurs, comportement de répétition, sources de trafic hétérogènes | Conversion |
| Citations | Incorporation observable dans des documents savants ultérieurs | Normes de citation du domaine, délai de publication, couverture de la base de données, auto-citation, effets de statut | Utilisation savante en aval |
| Signaux Altmetric / PlumX | Engagement en ligne plus large | Composition de la plateforme et comportement des utilisateurs | Preuve de diffusion complémentaire |
Le contenu du tableau peut être compressé en un contraste de deux équations. La lecture que le tableau de bord vous invite silencieusement à faire est Téléchargements = Qualité scientifique. La représentation défendable est
Téléchargements observés = f(Q, E, R, C, T, P, ε),
où Q désigne les caractéristiques liées à la qualité ou la pertinence de la recherche, E l'exposition, R la réputation, C les caractéristiques de communication, T le temps et l'ancienneté, P les mécanismes de plateforme, et ε les influences non observées. L'expression classe les facteurs de confusion ; aucune forme fonctionnelle ou coefficient n'est spécifié. La classification énonce exactement la difficulté pratique : le chercheur n'observe ordinairement que le côté gauche.
Deux conditions aux limites s'appliquent au tableau. Les compteurs ne sont pas des journaux de trafic bruts. SSRN a filtré ses comptages au moins depuis les années 2000 : la plateforme déclare qu'elle exclut les téléchargements répétés apparents par la même personne et les téléchargements de robots apparents, en utilisant des « indices d'activité irrégulière », et que les téléchargements anonymes suspects sont exclus du total de l'auteur [144]. Black et Caron ont estimé que sans un tel filtrage les compteurs seraient gonflés « d'un facteur cinq ou plus » [18]. Un téléchargement enregistré signale un événement d'attention et rien sur l'approbation. Les compteurs mesurent les étapes d'un processus d'attention. Aucun d'eux ne mesure le mérite scientifique, et chacun est confondus par des facteurs de visibilité qui opèrent avant que tout lecteur n'évalue le contenu [44][72][144]. Ces limites ont été reconnues depuis les plus anciennes analyses bibliométriques des données de lecture [91]. Les étapes peuvent également se découpler l'une de l'autre, par deux mécanismes supposés : les articles sur des sujets pertinents pour les politiques peuvent être massivement téléchargés par des praticiens qui lisent mais ne citent pas, tandis que les articles spécialisés peuvent obtenir peu de téléchargements tout en étant cités régulièrement par la petite communauté d'experts qui en a besoin. L'un ou l'autre schéma sépare la visibilité de l'utilisation en aval, ce qui est une raison pour laquelle les ensembles d'articles très téléchargés et très cités ne se chevauchent que partiellement [108].
3.2 Les agrégats de plateforme et la fiction de la moyenne
Les seuls chiffres pertinents pour la distribution que SSRN elle-même publie sont les totaux de plateforme, et la première chose à remarquer concernant les données est ce qui se passe lorsque ces totaux sont moyennés. Le tableau 4 rassemble les statistiques vérifiées de plateforme SSRN avec leurs dates de référence.
Tableau 4. Statistiques vérifiées de plateforme SSRN, avec dates de référence et statut de vérification.
| Quantité | Valeur | Au | Source | Statut de vérification |
|---|---|---|---|---|
| Articles en texte intégral | 1,157,048 | 18 Dec 2023 | ALL-SIS Citation Methods White Paper [1] | Vérifié par rapport au PDF publié |
| Résumés | 1,309,385 | 18 Dec 2023 | [1] | Vérifié |
| Auteurs | 1,479,875 | 18 Dec 2023 | [1] | Vérifié |
| Téléchargements cumulés | 256,678,716 | 18 Dec 2023 | [1] | Vérifié |
| Téléchargements, 12 derniers mois | 40,642,329 | 18 Dec 2023 | [1] | Vérifié |
| Articles en texte intégral (point de référence antérieur) | 571,040 | 6 Jul 2016 | [1] | Vérifié |
| Téléchargements, 12 derniers mois (point antérieur) | 12,897,685 | 6 Jul 2016 | [1] | Vérifié |
| Prépublications / articles ; auteurs | « 1,5+ million » ; « 1,9+ million » | 2026 product page | Elsevier SSRN product documentation [49], accessed 14 Aug 2026 | Vérifié (chiffres marketing arrondis) |
| Articles ; auteurs ; total téléchargements ; téléchargements 12 mo | >1,7M ; >2,4M ; >344M ; >54M | 1 Nov 2025 | SSRN announcement boilerplate [B-6] | Ordre de grandeur corroboré ; les décimales exactes (344,8M / 54,7M) nécessitent des copies archivées de l'annonce avant citation |
| Dérivé : moyenne des téléchargements à vie par article en texte intégral | ≈222 | Dec 2023 basis | Author-computed: 256,678,716 ÷ 1,157,048 [1] | Arithmétique sur des chiffres vérifiés |
| Dérivé : moyenne des téléchargements par article par an | ≈35 | Dec 2023 basis | Author-computed: 40,642,329 ÷ 1,157,048 [1] | Arithmétique sur des chiffres vérifiés |
Les deux dernières lignes sont calculées par l'auteur et étiquetées comme telles ; SSRN ne publie pas de moyennes par article. Les totaux à l'échelle de la plateforme diffèrent selon la source, la date et la définition (texte intégral par rapport au total des articles), ainsi les dérivations par article sont tirées des chiffres en texte intégral réconciliés de décembre 2023 [1] ; le contenu brut de novembre 2025 [B-6] est conservé ci-dessus comme données uniquement, utilisable exclusivement avec des copies archivées (par exemple, via web.archive.org), puisque les pages d'annonce originales ne sont plus directement récupérables.
Sur les chiffres réconciliés de décembre 2023, l'article SSRN « moyen » a généré environ 222 téléchargements au cours de sa durée de vie et environ 35 au cours de l'année passée [1]. Ce chiffre dérivé est la chose qui se rapproche le plus d'une norme à l'échelle de la plateforme qu'un auteur puisse calculer, et il est systématiquement trompeur, car la moyenne est une fiction de l'agrégation. Chaque étude empirique de la distribution des téléchargements SSRN constate une forte asymétrie à droite : la moyenne est tirée bien au-delà de la médiane par une longue queue supérieure, donc l'« article moyen » ne décrit presque aucun article réel. Le reste de cette section établit l'importance et les conséquences de cet écart. Un autre agrégat importe pour l'étalonnage. Les téléchargements annuels de la plateforme sont passés de quelque 0,5 million en 2000 à quelque 3 millions en 2005 [18], 12,9 millions en 2016, et 40,6 millions en 2023 [1]. Le flux de téléchargements par article a lui-même augmenté : les téléchargements annuels ont augmenté d'environ 3,15 fois de 2016 à 2023 tandis que le stock d'articles a augmenté d'environ 2,03 fois [1], soulevant le flux par article d'environ 55 %. Une étude plus ancienne sous-estime donc les comptages absolus qu'un article comparable gagnerait aujourd'hui. La direction vers laquelle pointe ce biais dépend de la comparaison : un seuil ancien fixe est une limite inférieure sur les comptages d'aujourd'hui, ce qui en fait un bar bienveillant, non conservateur, lorsqu'il est lu comme une bande de niveau absolue de 2026. La manipulation inverse est tout aussi illégale : un seuil ancien ne peut pas être « vieilli » en une norme de 2026 en le multipliant par la croissance de la plateforme, car un référentiel plus grand change simultanément le numérateur, le dénominateur, la composition des auteurs, les canaux de distribution, le filtrage des bots et la concurrence pour l'attention. La lecture du biais de millésime utilisée partout repose sur l'arithmétique aggregate du flux et du stock ci-dessus, non sur un quelconque ajustement des anciens seuils. L'examen annuel de la plateforme elle-même confirme une croissance continue : plus de 250 000 nouveaux articles ont été postés en 2025 (en hausse de 20 % par rapport à 2024), avec plus de 53 millions de téléchargements au cours de l'année [145].
3.3 La moyenne n'est pas l'article typique : preuve directe
Les preuves distributionnelles publiées les plus récentes pour SSRN proviennent de Jo et Li, qui analysent 2 361 articles du Marketing Research Network de SSRN dans un instantané transversal unique collecté le 15 août 2025 [83]. Le tableau 5 ci-dessous reproduit l'intégralité de leurs statistiques descriptives, et la carte de référence consolidée de la section 5 les intègre. Les téléchargements moyens s'élevaient à 221,346 contre une médiane de 87 : la moyenne est environ 2,54 fois supérieure à la médiane. Le 95e percentile, 726, dépasse plus de huit fois la médiane. La moyenne dépasse même le 75e percentile (206), ce qui place plus des trois quarts des articles de l'échantillon en dessous de l'« article moyen ». Un chercheur à qui l'on dirait que l'article moyen de ce réseau compte environ 221 téléchargements concluerait qu'un article ayant 100 téléchargements est sensiblement en dessous de la normale, bien que 100 dépasse largement la médiane publiée. La figure 2 illustre directement cette structure.
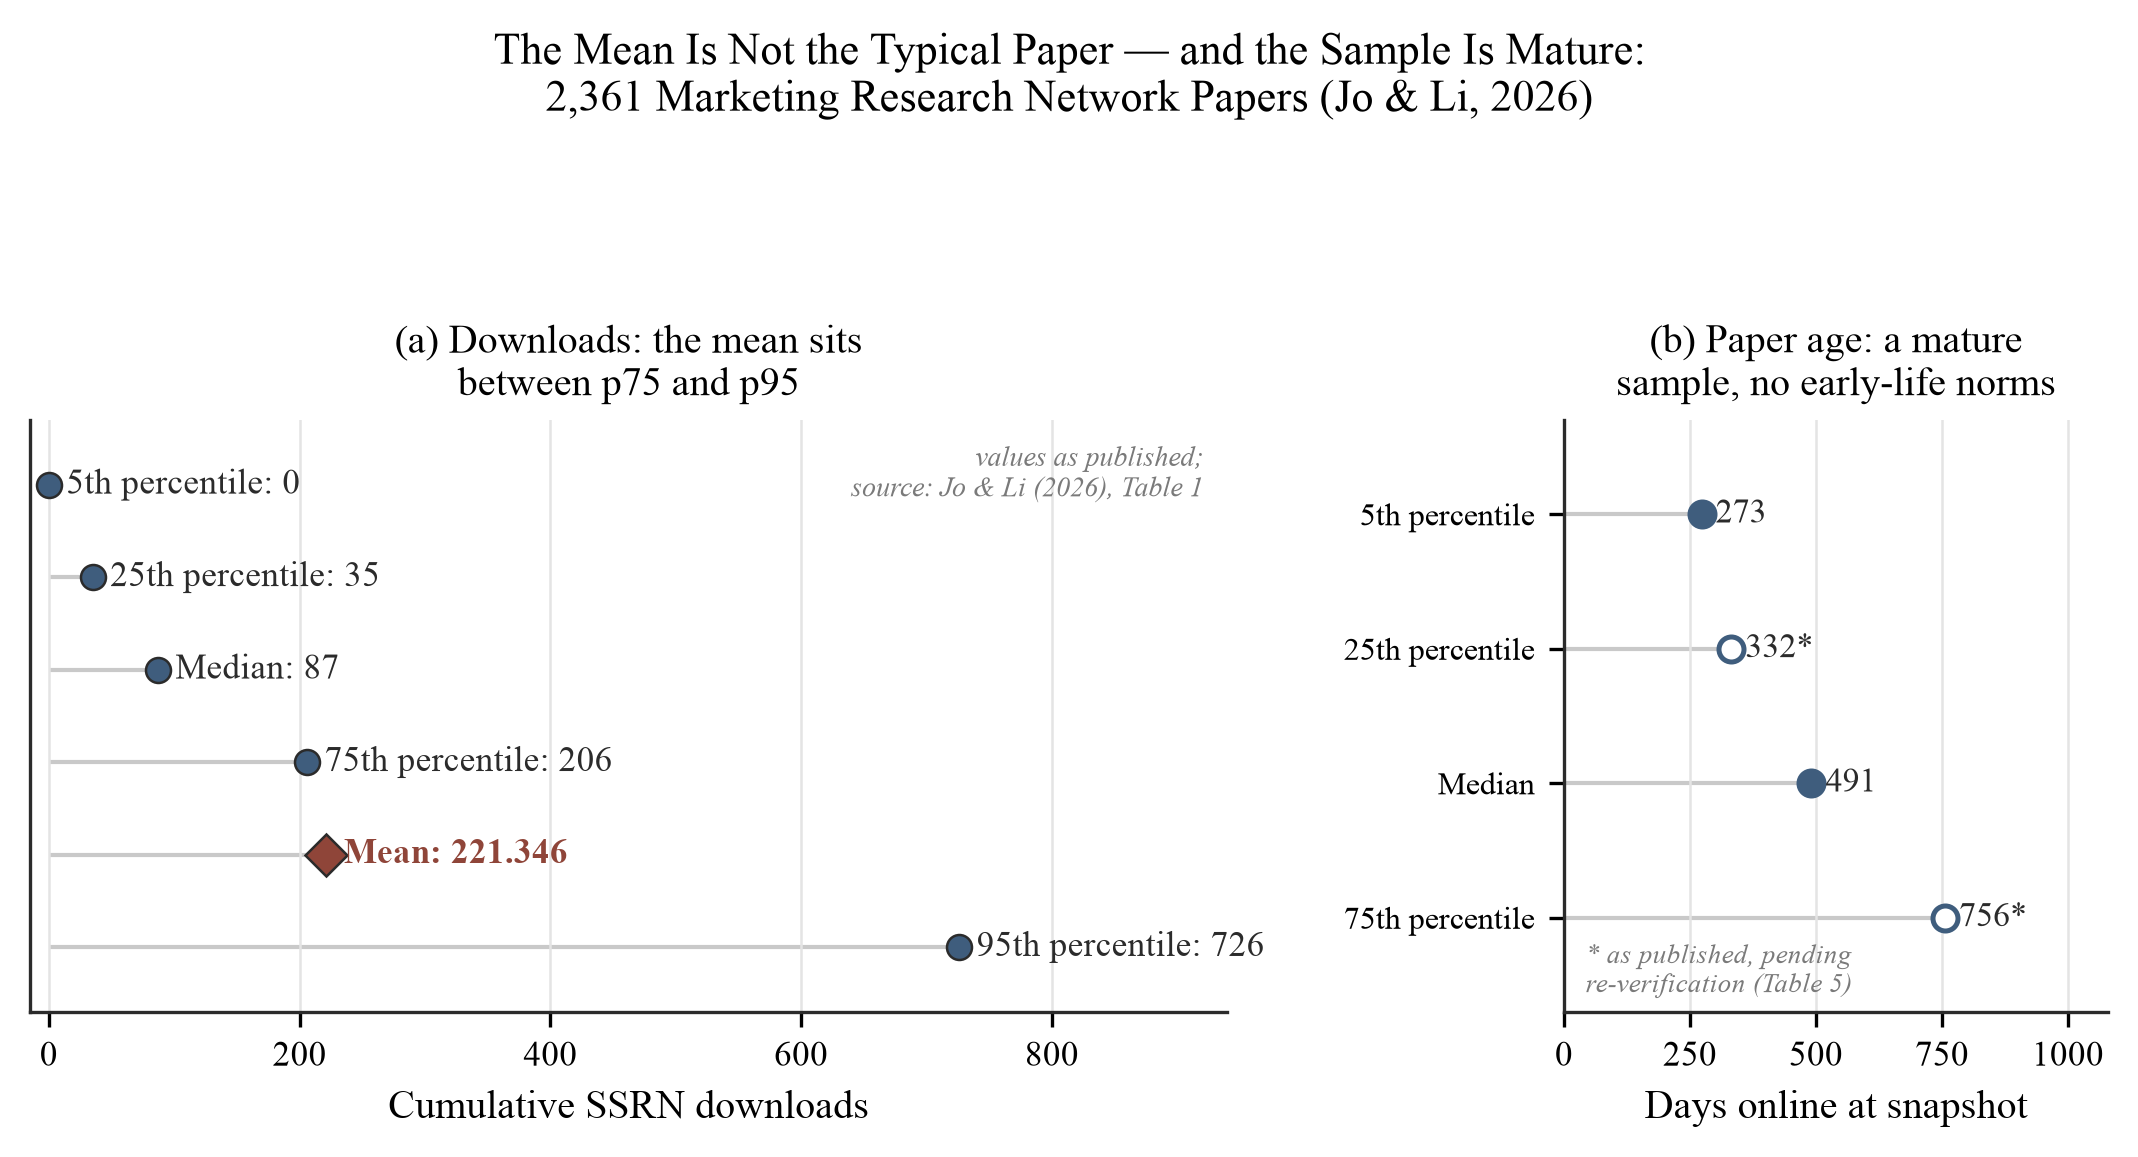
Figure 2. Statistiques descriptives publiées pour 2 361 articles du Marketing Research Network. Panneau (a) : téléchargements — p5 = 0, p25 = 35, médiane = 87, p75 = 206, moyenne = 221,346, p95 = 726, tracés par ordre de valeur (note : la moyenne se situe entre p75 et p95). Panneau (b) : âge de l'article dans le même échantillon — 5e percentile 273 jours et médiane 491 jours vérifiés par rapport à la source ; les 25e (332 jours) et 75e (756 jours) percentiles reproduits « tels que publiés » (tableau 5). Deux valeurs du tableau 1 de la source sont signalées et reproduites « telles que publiées », mais ce sont des anomalies de nature différente. Le 95e percentile des vues d'abstract (966) se situe seulement à environ 0,32 écart-type au-dessus de la moyenne (611,973 ; écart-type 1 100,5) — quasiment impossible pour un décompte asymétrique vers la droite dont le p75 est déjà 833 — c'est donc une erreur source soupçonnée, très probablement une faute de frappe bien qu'une erreur de transcription ou d'arrondi ne puisse être exclue, et les autres cellules de la ligne des vues d'abstract sont traitées comme potentiellement affectées par la même erreur corrélée (signalées pour une requête adressée aux auteurs Jo et Li, dont la réponse n'est pas encore disponible). Le 95e percentile de conversion (77,7, contre 27,2 au p75) est un phénomène différent : un artefact de ratio à petit dénominateur exactement du type que prédit la section 5.2, non une impossibilité statistique. Le panneau d'âge rend visible la limite interprétative : ce sont des statistiques d'articles matures, et l'échantillon ne peut fournir des normes de début de vie. Source : Jo et Li (2026), tableau 1 [83].
Le tableau 5 reproduit les statistiques descriptives complètes de l'étude, ses variables associées ainsi que la distribution des téléchargements, car c'est le seul échantillon SSRN publié avec un panneau de percentiles complet ; plusieurs de ses cellules effectuent un travail interprétatif ailleurs dans cet article. Les écarts-types énoncent la queue lourde en un seul nombre : un écart-type de 940,9 contre une moyenne de 221,3 pour les téléchargements. Le 5e percentile des téléchargements est exactement zéro, donc un compteur à zéro se situe dans la plage normale même d'un échantillon mature. Les percentiles de conversion encadrent la bande inter-études de la section 5.2 des deux côtés (p25 = 12,1, médiane = 18,9, p75 = 27,2 pour 100 vues). Les percentiles d'âge (écart interquartile 332–756 jours) fixent la maturité de l'échantillon, et les lignes d'auteure et d'emballage fournissent les normes covariées utilisées aux sections 6.4 et 8.3.
Tableau 5. Statistiques descriptives publiées complètes de l'échantillon Jo et Li (2026), « telles que publiées » (N = 2 361 articles du Marketing Research Network ; instantané du 15 août 2025). Toutes les valeurs sont reproduites du tableau 1 de la source [83]. Le noyau distributionnel — les moyennes, médianes et quartiles des téléchargements et vues ; la moyenne et médiane de conversion ; la médiane d'âge et le 5e percentile — a été vérifié par rapport au tableau publié (voir tableau 7). Les cellules restantes (les écarts-types ; les percentiles de conversion et d'âge au-delà du noyau ; les lignes auteurs, pages et longueur d'abstract) sont reproduites « telles que publiées » et n'ont pas été redérivées indépendamment ici ; l'existence, le lieu et l'auteure de la source ont été confirmés via Crossref le 14 août 2026. Deux anomalies internes sont reportées « telles que publiées » et signalées plutôt que corrigées, et ce ne sont pas le même type de problème. Le 95e percentile des vues d'abstract (966) se situe seulement à environ 0,32 écart-type au-dessus de la moyenne rapportée (611,973 ; écart-type 1 100,5) — statistiquement quasi-impossible pour un décompte aussi asymétrique et incompatible avec le p75 propre de la ligne (833) — c'est donc une faute de frappe soupçonnée dans la source ; les cellules restantes des vues d'abstract sont signalées comme potentiellement affectées par une erreur corrélée et rétrogradées pour révérification en attente d'une requête adressée aux auteurs Jo et Li. Le 95e percentile de conversion (77,704, contre 27,187 au p75) est au lieu un artefact de ratio à petit dénominateur prédit par la section 5.2, non une anomalie distributionnelle du même type.
| Variable | Moyenne | Écart-type | p5 | p25 | Médiane | p75 | p95 |
|---|---|---|---|---|---|---|---|
| Téléchargements | 221,346 | 940,855 | 0 | 35 | 87 | 206 | 726 |
| Vues d'abstract | 611,973 | 1 100,536 | 151 | 288 | 504 | 833 | 966 (« tels que publiés ») |
| Téléchargements pour 100 vues d'abstract | 23,699 | 20,118 | 0 | 12,105 | 18,944 | 27,187 | 77,704 (« tels que publiés ») |
| Disponibilité sur SSRN, jours | 550,210 | 230,557 | 273 | 332 | 491 | 756 | 955 |
| Nombre d'auteurs | 2,578 | 1,705 | 1 | 1 | 2 | 3 | 5 |
| Nombre de pages | 32,734 | 29,186 | 1 | 13 | 27 | 46 | 75 |
| Longueur d'abstract, mots | 182,274 | 71,641 | 87 | 137 | 178 | 217 | 295 |
Trois caractéristiques supplémentaires de l'étude importent pour l'interprétation. Les vues d'abstraits montrent la même asymétrie à un niveau supérieur : les vues moyennes étaient de 611.973 contre une médiane de 504 (p5 = 151, p25 = 288, p75 = 833 ; le p95 de 966 est reproduit « tel que publié » mais est une source de typage suspectée, seulement ≈0.32 écart-type au-dessus de la moyenne et en dessous de la queue impliquée par un p75 de 833, et n'entre dans aucun calcul en aval ; voir la note à la Figure 2), avec une conversion publiée de 23.699 téléchargements pour 100 vues [83]. L'étude sépare également la portée de la conversion : dans le modèle d'exposition de Poisson des auteurs, le prestige institutionnel prédisait les téléchargements conditionnels aux vues d'abstraits (coefficient 0.192, et pour un article à trois auteurs, un auteur affilié au top 50 correspondait à un taux de téléchargement estimé 6.6 % plus élevé par vue d'abstract), et cette prime de prestige s'affaiblissait à mesure que l'assistance par IA dans les abstraits augmentait (interaction −0.627, p < .01) [83]. SSRN lui-même exige maintenant la divulgation de l'utilisation substantielle d'IA générative à la soumission [54][56]. Ainsi l'attention suit les signaux de statut même après qu'un lecteur a accédé à la page d'abstract, ce qui est une preuve directe que les comptages de téléchargements incorporent les effets de visibilité et de réputation plutôt que l'évaluation du contenu seul. La limitation que les auteurs énoncent eux-mêmes fixe l'agenda : un instantané unique d'un seul réseau disciplinaire ne peut pas révéler les trajectoires temporelles de l'attention, et ils identifient explicitement les données de panel comme l'étape suivante requise [83], l'étape prise en charge à la Section 8.
L'échantillon est un réseau dans un domaine, observé à une date : ces chiffres ne sont pas des repères universels de SSRN, et leur valeur réside dans la structure. Le rapport moyen/médian de 2.54 et le rapport p95/médian au-dessus de 8 sont des signatures de forte asymétrie droite qui réapparaissent dans tous les autres corpus de preuves SSRN, y compris un échantillon d'une discipline et décennie différentes : dans le seul échantillon de style recensement de l'érudition juridique, les articles postés sur le Legal Scholarship Network en 2012 et mesurés deux ans plus tard (n = 1,107) avaient une médiane de 63 téléchargements contre une moyenne de 122.55, un écart près de deux fois supérieur après seulement deux ans d'exposition [139].
3.4 La forme de la distribution : quasi-lognormalité et queue longue
L'anatomie à grande échelle de la distribution a été établie par Kakushadze, qui a analysé les listes publiques les plus consultées de SSRN : 29 985 auteurs dans la liste des 30 000 premiers et les 367 478 articles qui y sont attachés (un scrape des classements de 2015) [85]. La conclusion centrale est que les téléchargements suivent une distribution quasi-lognormale, fortement asymétrique avec une longue queue supérieure en niveaux et approximativement gaussienne en logarithme (paramètres ajustés pour ln téléchargements par article : moyenne 5,406, écart-type 1,016) [85]. Kakushadze tire explicitement le corollaire pratique de la lognormalité : l'arithmétique linéaire échoue sur de telles données. Une application directe de l'indice h aux téléchargements est non informative : les nombres de téléchargements sont des ordres de grandeur plus importants que les nombres de citations, de sorte que l'indice se réduit au nombre d'articles. Il propose à la place un indice construit sur la partie entière du logarithme des téléchargements, k = ⌊ln D⌋ [85]. Pour l'interprétation, cela signifie que les différences significatives dans les téléchargements sont multiplicatives, non additives. Cette forme n'est pas particulière aux téléchargements : la distribution de l'impact scientifique individuel suit elle-même une distribution approximativement lognormale, comme l'a établi le modèle Q de Sinatra, Wang, Deville, Song et Barabási (2016) sur les carrières scientifiques [181], de sorte que la lecture multiplicative que les compteurs exigent est la norme pour l'attention savante, non un artefact de SSRN.
Le même ensemble de données fournit les seules valeurs seuil publiées pour la distribution supérieure. L'entrée dans la liste des 10 000 premiers articles (approximativement les 1,8 % supérieurs du stock complet de texte intégral de la plateforme, 571 040, juillet 2016 [1], cohérent plutôt que supérieur aux chiffres des « 1–2 % supérieurs » parfois cités) nécessitait un minimum de 160 téléchargements, avec une médiane de 805, une moyenne de 1 800 et un maximum de 152 242 [85]. Parmi les 30 000 auteurs les plus importants, le nombre minimum de téléchargements totaux était 129, la médiane des auteurs était 1 626, la médiane des téléchargements par article était 210, et le maximum, Michael C. Jensen, était 824 762 [85]. La rareté persiste au niveau des articles même dans cet échantillon d'élite : sur les 367 478 articles analysés, seuls 112 793 (approximativement 30,7 %) avaient suffisamment de téléchargements pour contribuer à l'indice logarithmique de leurs auteurs [85]. La plupart des articles individuels des auteurs les plus téléchargés de la plateforme attirent une attention modeste, et en dehors des listes les plus consultées, la part ne peut être que plus faible. La figure 3 visualise la distribution ajustée avec les seuils publiés marqués.
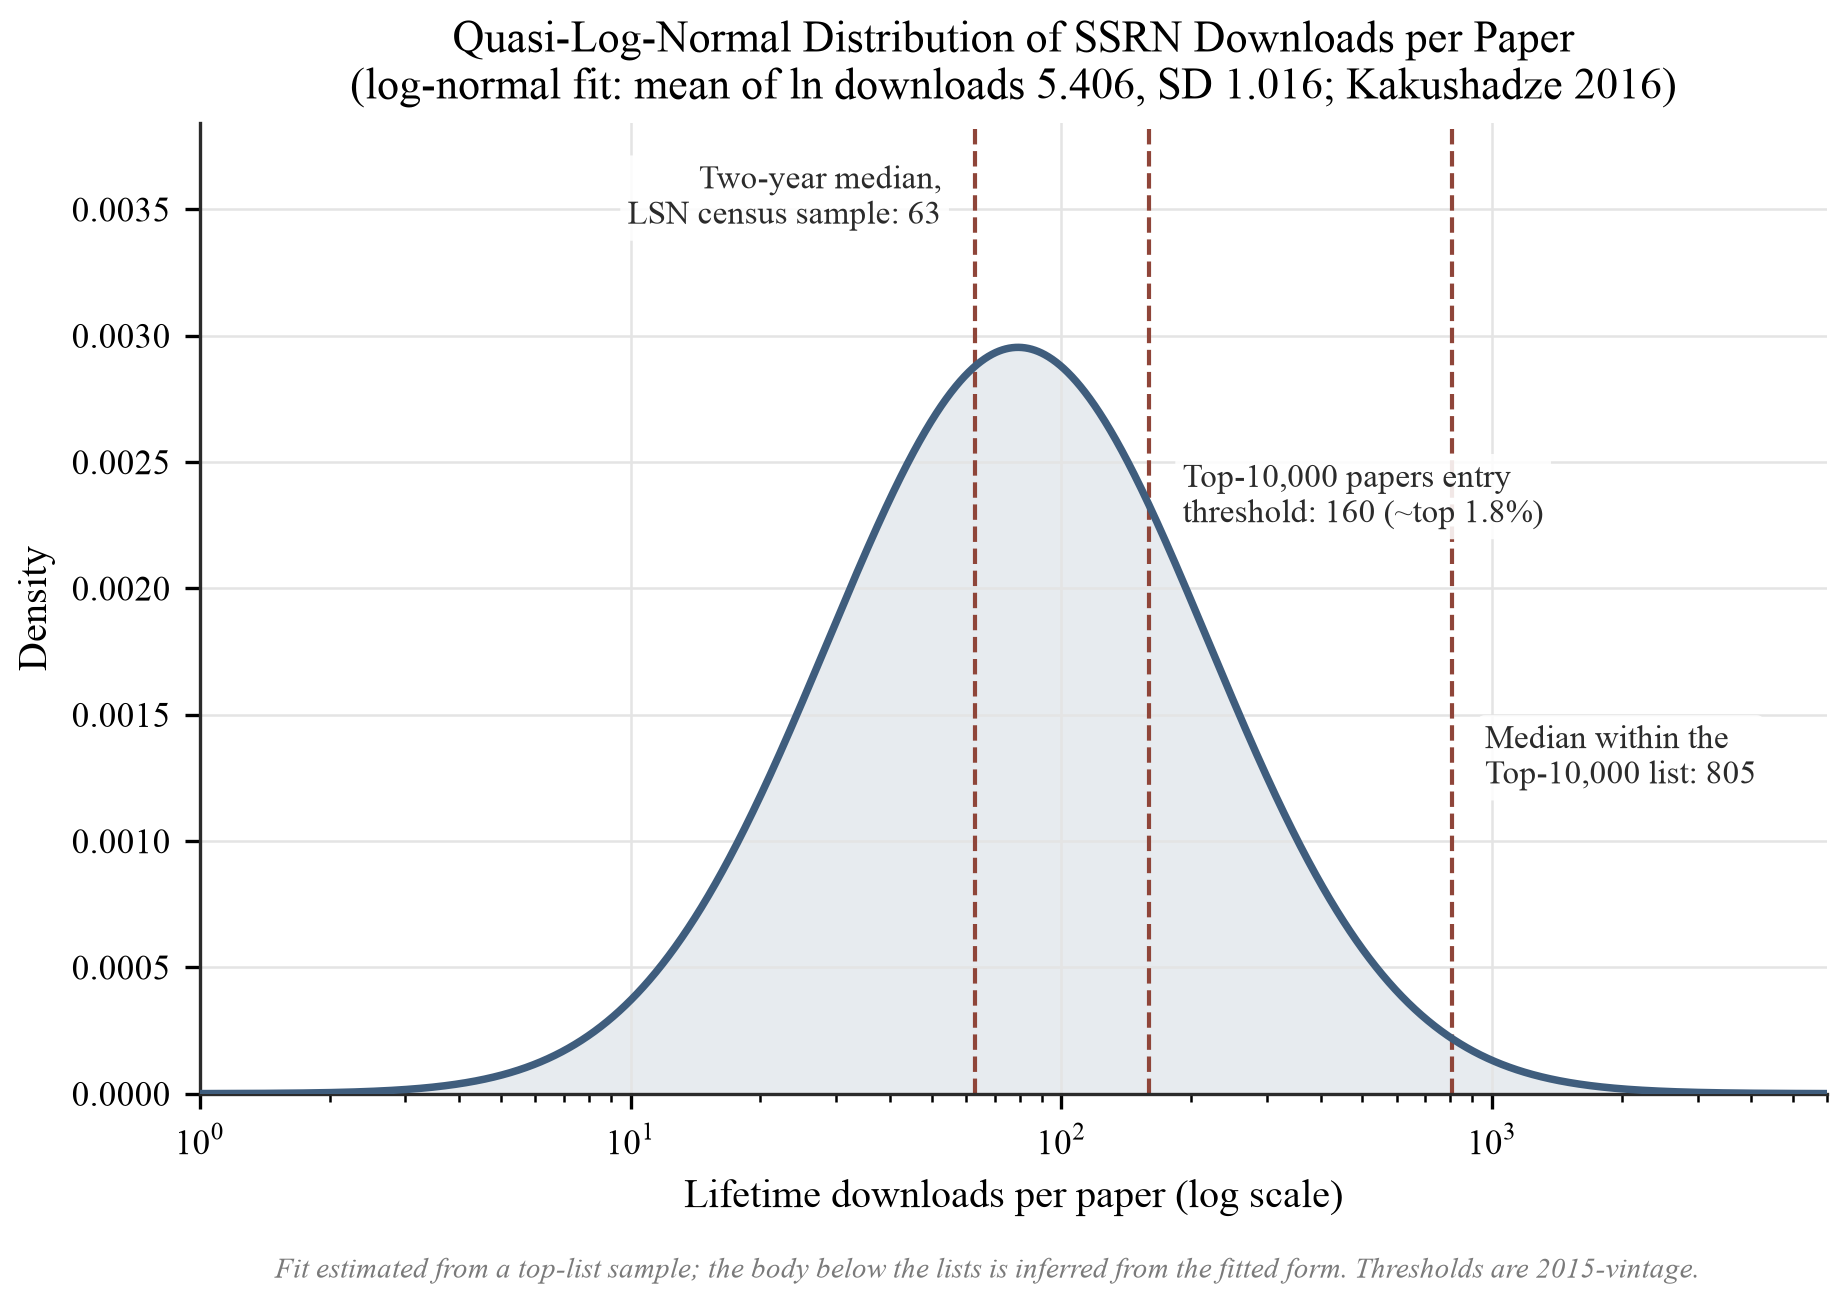
Figure 3. Densité lognormale ajustée avec les paramètres rapportés par Kakushadze (moyenne de ln téléchargements 5,406, ÉT 1,016) [85] ; la médiane ajustée, exp(5,406) ≈ 223, se situe environ 6 % au-dessus de la médiane rapportée en groupe par article de 210, un ajustement adéquat mais imparfait à la distribution de la liste la plus consultée. Les lignes en pointillés marquent la médiane biennale de 63 téléchargements de l'échantillon de jurisprudence de style recensement [139], le seuil d'entrée des 10 000 premiers articles de 160 (approximativement les 1,8 % supérieurs du stock complet de texte intégral de la plateforme, 571 040 en juillet 2016 [1]), et la médiane au sein de la liste des 10 000 premiers (805) [85]. L'ajustement est estimé à partir d'un échantillon de liste la plus consultée — approximativement la décile d'auteurs supérieure de la plateforme — de sorte que le corps de la distribution sous les listes est déduit de la forme ajustée plutôt qu'observé ; les seuils sont de 2015 (inflation depuis : section 5.1). Une mise en garde quantitative accompagne la figure car la courbe invite à lire sa queue inférieure : sous cette densité ajustée, les masses de queue basse impliquées sont P(X ≤ 63) ≈ 10,7 % et P(X ≤ 10) ≈ 0,1 % — deux à trois ordres de grandeur en dessous de la part de 15–30 % ≤10 téléchargements que l'étude 1 (section 8.6) prédit pour un échantillon de probabilité de la plateforme entière. La divergence n'est pas une contradiction mais une mesure directe du domaine de l'ajustement : une densité estimée sur la décile d'auteurs supérieure ne peut pas décrire la queue basse qu'elle n'a jamais observée, de sorte que les marqueurs de style recensement ([139]'s médiane biennale de 63 ; l'entrée des 10 000 premiers de 160 et sa médiane de 805) sont tracés comme des points de référence externes posés sur la courbe ajustée, non comme des affirmations que l'ajustement les reproduit. La distance entre les marqueurs et l'endroit où la courbe ajustée place les mêmes valeurs est elle-même la preuve visuelle que le corps sous les listes n'est pas observé, et aucune part de queue basse de plateforme entière ne devrait être lue de cette courbe.
Ces ancrages nécessitent deux mises en garde. Le cadre d'échantillonnage est le haut de la distribution, de sorte que les statistiques de Kakushadze décrivent la queue, et la masse d'articles ordinaires sous les listes n'est caractérisée que par la forme lognormale ajustée. L'attribution est à un seul auteur : l'étude est Kakushadze (2016), Journal of Informetrics [85] ; une miscitation récurrente ajoute un deuxième auteur et devrait être évitée.
Une coupe transversale archivistique indépendante rapportée à l'annexe E observe directement le corps de la distribution, sur un échantillon aléatoire tous domaines de 1 360 articles dont les compteurs de pré-retraite sont récupérés dans les archives publiques. Elle constate que la distribution observée est approximativement lognormale (asymétrie des ln téléchargements ≈ 0,18), corroborant sur le corps la forme que Kakushadze ne pouvait ajuster que sur la queue, et elle reproduit indépendamment l'écart entre la moyenne et la médiane, la bande de conversion et le multiplicateur de domaine. Son propre biais de sélection à la hausse laisse la queue basse extrême sous-observée. Elle reproduit néanmoins l'ancre de distribution entière moderne unique sur laquelle la synthèse s'appuie autrement : la moyenne de la reconstruction (219) coïncide avec la moyenne du réseau de marketing publiée de 221, de sorte que la forme générale est corroborée par une source de données entièrement distincte également. (Sur la récupération de données Web historiques de la Internet Archive comme méthode validée de sciences sociales, et sur ses biais de couverture et de fréquence d'exploration, voir Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503.)
3.5 Étalonnage erroné par la queue visible
La structure conjointe des sections 3.2–3.4 explique une erreur psychologique systématique. L'auteur le plus téléchargé dans l'extraction de 2015 s'élevait à 824 762 téléchargements, soit environ 500 fois la médiane du groupe des auteurs les plus en vue (1 626), et quatre ordres de grandeur au-dessus de l'article typique [85]. Selon une loi quasi-log-normale, les distances qui importent sont multiplicatives : l'écart entre la médiane des articles ordinaires (des dizaines de téléchargements) et le seuil d'entrée de la liste des meilleurs (160) est inférieur à l'écart entre ce seuil et la médiane de la liste des meilleurs (805), qui est à son tour éclipsé par la distance jusqu'au maximum de la queue [85][139]. Or les chiffres qui circulent publiquement (annonces de jalons, profils des « auteurs les plus en vue », communiqués de presse institutionnels [101]) sont tirés presque exclusivement de la queue visible. Les auteurs étalonnent donc « bon » par rapport à une classe de référence située des centaines de fois au-dessus de la médiane, tandis que la masse de la distribution se situe près de la médiane. Un tableau de bord affichant 7 téléchargements est alors ressenti comme un échec, même s'il n'a rien de remarquable pour l'âge et le domaine de l'article. La moyenne participe à la même erreur sous une forme plus douce : comme l'a montré la section 3.3, elle se situe au-dessus du 75e percentile, de sorte que même la « moyenne » officielle est un indice contaminé par la queue. C'est le sens dans lequel la moyenne ment : elle est calculée correctement, puis prise pour une valeur typique dans une distribution qui n'a pas de valeur typique.
Plusieurs autres corps de preuves renforcent la conclusion que les compteurs bruts reflètent la structure de visibilité au moins autant que le contenu. L'attention répond à la position : dans les listes d'annonces arXiv, les articles apparaissant en position 1 ont obtenu environ 83 % de citations médianes plus élevées en astro-ph, un effet que les auteurs attribuent largement à la visibilité plutôt qu'à l'auto-sélection seule [72]. Elle répond aussi au délai d'indexation. SSRN lui-même note que l'indexation externe de son contenu par Google Scholar est contrôlée par les moteurs de recherche et peut prendre « 6 à 9 mois ou plus » [54, consulté le 14 août 2026], de sorte que les compteurs d'un article jeune sont générés avant qu'un canal de découverte majeur n'ait commencé à fonctionner. L'attention s'écoule également rétroactivement des citations aux téléchargements : être cité attire les lecteurs (parmi lesquels les auteurs cités et leurs propres réseaux) vers l'article citant, et l'analyse de causalité de Granger trouve ce chemin des citations vers les téléchargements actif pour une part importante d'articles [80][39], de sorte qu'une partie d'un compteur indexe la position d'un article dans le réseau de citations et de collaboration plutôt que le verdict d'un lecteur sur son contenu. Chacun de ces mécanismes façonne le compteur par la structure de visibilité (position, délai de découverte, localisation du réseau) plutôt que par le jugement d'un lecteur sur la qualité, et aucun n'est visible dans le nombre du tableau de bord. L'économie de l'attention plus large montre la même concentration sous une forme extrême : sur les médias sociaux, les coefficients de Gini de l'attention atteignent 0,90–0,94, les 1 % supérieurs des comptes recevant plus d'attention que les 99 % inférieurs réunis [180], un écho moderne du dicton de Simon selon lequel une richesse d'informations crée une pauvreté d'attention [141]. L'attention savante sur SSRN appartient, sous une forme plus douce, à la même famille de processus de diffusion asymétriques. Le public le plus à l'aise sur SSRN, les économistes et les juristes, reconnaîtra la structure de la finance. L'analyse par Bessembinder des données CRSP pour 1926–2016 a révélé que les environ 34,8 billions de dollars de création de richesse nette du marché boursier étaient attribuables à moins de 4 % des sociétés cotées, la majorité des actions n'ayant pas dépassé les bons du Trésor au cours de leur durée de vie [16]. Le parallèle est offert à titre d'illustration, non de preuve : dans la richesse comme dans l'attention, les totaux globaux sont générés par une fine queue extrême, et se mesurer par rapport à une moyenne dominée par des géants est une erreur catégorique. La rareté ne se limite pas aux compteurs d'utilisation : dans l'ensemble de l'érudition juridique, 43 % des articles des revues de droit dans un recensement de 2007 n'ont jamais été cités, et seuls 18 % de la cohorte 2015–2019 ont attiré une citation dans les cinq ans [171].
3.6 Le multiplicateur de domaine : structure disciplinaire de la norme
La distribution n'est pas une distribution unique : elle varie d'un domaine à l'autre. L'analyse de Whalen portant sur près d'un quart de million d'articles classés dans les 94 revues électroniques du Legal Scholarship Network montre que la ligne de base disciplinaire varie d'un facteur d'environ huit, même au sein d'une seule discipline générale : les téléchargements moyens par article au cours de la vie variaient de 438,35 en droit des sociétés, des valeurs mobilières et de la finance à 53,48 en droit et politique agricoles [168]. La figure 4 illustre ce gradient.
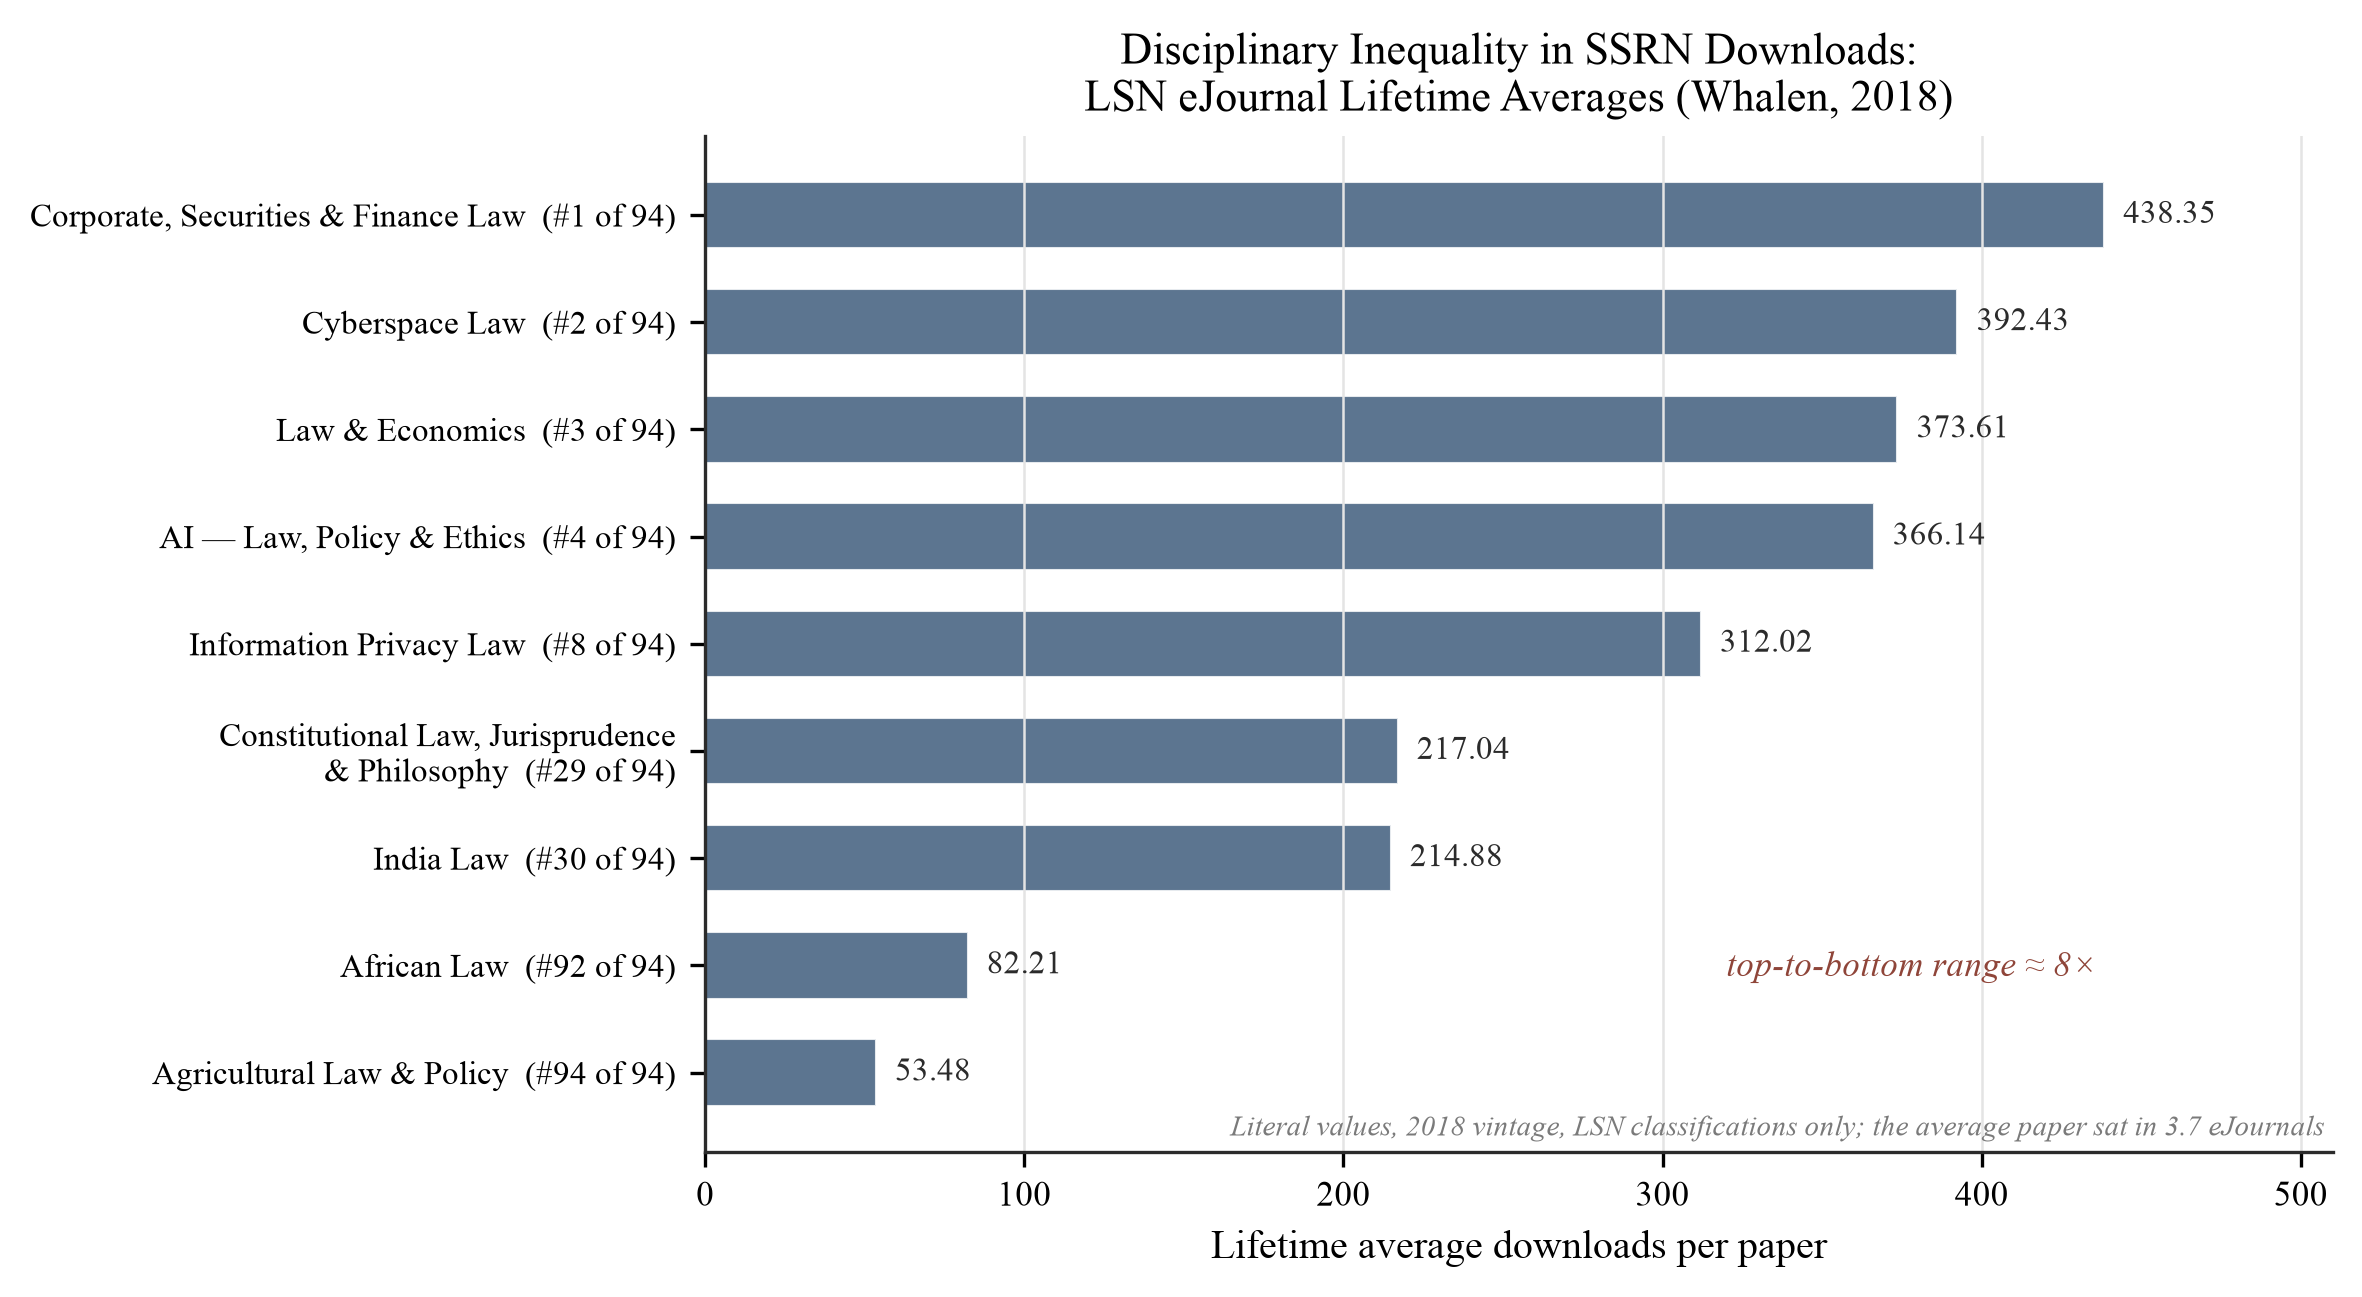
Figure 4. Téléchargements moyens par article au cours de la vie pour les revues électroniques LSN sélectionnées, valeurs littérales de Whalen (2018) [168] : Droit des sociétés, des valeurs mobilières et de la finance 438,35 (rang 1 sur 94) ; Droit de l'espace numérique 392,43 (2) ; Droit et économie 373,61 (3) ; IA – Droit, politique et éthique 366,14 (4) ; Droit de la protection des données personnelles 312,02 (8) ; Droit constitutionnel, jurisprudence et philosophie 217,04 (29) ; Droit indien 214,88 (30) ; Droit africain 82,21 (92) ; Droit et politique agricoles 53,48 (94). L'étendue du haut vers le bas est approximativement d'un facteur huit. Les valeurs datent de 2018 et couvrent uniquement les classifications LSN ; l'article moyen a été classé dans 3,7 revues électroniques.
Le mécanisme est structurel plutôt que méritocratique : la découverte sur SSRN est basée sur la classification (les abonnés à une revue électronique reçoivent des alertes pour les articles classés dans celle-ci), de sorte que l'audience adressable d'un article est fixée par la base d'abonnés du domaine avant que tout signal de qualité n'entre en jeu. Whalen constate en outre que les articles ayant plus de classifications obtiennent plus de téléchargements et sont moins susceptibles d'enregistrer zéro téléchargement [168]. La structure du domaine façonne également les compteurs par la culture de citation : Black et Caron ont observé que les rapports téléchargements-citations varient systématiquement d'un domaine à l'autre parce que l'érudition juridique cite les travaux antérieurs plus complètement que l'économie ou la finance [18], et au sein du droit, l'attention se concentre sur des sujets et des caractéristiques d'auteurs particuliers : dans l'échantillon du recensement de 2012, les sujets du droit des sociétés et du droit international, l'auteurship américain et l'affiliation aux 20 premières institutions prédisaient tous des comptages significativement plus élevés [139], des déterminants qui se retrouvent dans les commentaires contemporains des bibliothèques juridiques [175]. Ainsi, un nombre qui n'est pas remarquable en droit des sociétés peut être exceptionnel en histoire du droit ou en droit agricole, et tout repère ou échelle (y compris celui construit à la section 5) doit être lu comme relatif au domaine. Il existe un précédent bien établi pour cela du côté des citations : Radicchi, Fortunato et Castellano (2008) ont montré que les distributions de citations s'effondrent sur une seule courbe universelle seulement après que le comptage de chaque article soit rééchelonné par la moyenne de son domaine [182], l'analogue de la classe de référence que cet article soutient que les comptages d'utilisation requièrent également.
Trois exemples, construits entièrement sur les ancres vérifiées ci-dessus, rendent les enjeux concrets. Un auteur en droit agricole dont l'article a 60 téléchargements au cours de la vie se situe au-dessus de la moyenne de sa revue électronique de 53,48 [168], pourtant, en calibrant par rapport aux comptages du droit des sociétés qui circulent le plus visiblement, peut lire le même nombre comme un échec. Un auteur en droit des sociétés et des valeurs mobilières avec les mêmes 60 se situe bien en dessous de la moyenne de ce domaine de 438,35 [168]. Et un auteur dont l'article de marketing atteint la médiane du réseau de 87 [83] peut sous-évaluer un résultat qui est, par construction, typique. L'erreur de l'échelle manquante fonctionne dans les deux sens : elle produit un désespoir injustifié, et elle laisse le succès non reconnu.
Les sections 3.2–3.6 établissent le noyau empirique de cet article. La distribution des téléchargements SSRN est fortement asymétrique à droite et approximativement log-normale, et la moyenne dépasse non seulement la médiane mais le 75e percentile. La queue visible s'étend à 500 fois les médianes d'élite et contamine l'étalonnage informel ; les compteurs intègrent les effets de prestige, de position, d'indexation et de structure de domaine qui opèrent indépendamment du contenu ; et la ligne de base disciplinaire varie d'un facteur huit au sein d'un seul domaine d'érudition. Un comptage brut de téléchargement lu par rapport à la moyenne, ou par rapport à la queue, est donc intrinsèquement ininterprétable. Une lecture défendable nécessite une classe de référence : une distribution conditionnée par le domaine, l'âge de l'article et la cohorte. Les classements, malgré tous leurs défauts, étaient le seul geste public de la plateforme vers une telle classe de référence, et leur suppression rend la construction d'une classe externe (la carte comparative et l'échelle d'interprétation de la section 5) la tâche centrale du reste de cet article.
4. La mécanique des compteurs : un compteur sous une règle
Avant que tout nombre sur un tableau de bord SSRN puisse être interprété, il est nécessaire d'établir ce que ce nombre enregistre réellement. SSRN affiche deux métriques d'utilisation primaires au niveau des articles, les consultations d'abrégés et les téléchargements, aux côtés des statistiques de citations et des indicateurs PlumX [50]. Après le retrait des classements le 15 juillet 2026, ces compteurs sont restés en place : SSRN a déclaré que « les comptages de téléchargements et les statistiques de citations continueront à être enregistrés et affichés sur vos articles individuels et votre profil d'auteur » [149]. L'échelle comparative a disparu, mais les données sont restées. Les compteurs qui demeurent, cependant, ne sont pas des observations brutes de la lecture humaine : ils sont le produit conjoint de l'architecture de la plateforme, de la machinerie de distribution, du trafic non humain et du filtrage d'intégrité. Chacune de ces couches est démontée ci-dessous, et la section 5 construit ensuite un cadre d'interprétation sur elles.
4.1 Qu'est-ce qu'une vue et un enregistrement de téléchargement, et ce qu'ils ne sont pas
Une vue abstraite enregistre une demande d'accès à la page de présentation d'un article. Un téléchargement enregistre la récupération du PDF du texte intégral. Les deux sont des événements d'engagement ; aucun n'est une preuve directe de lecture, de compréhension, d'approbation ou d'approbation scientifique. Cette distinction encadre chaque affirmation formulée dans le reste de cet article.
Les compteurs publics de SSRN ne sont pas de simples journaux de requêtes HTTP. La plateforme a appliqué un filtrage d'intégrité des données depuis ses débuts [69] et a décrit publiquement son approche : les téléchargements automatisés, les auto-téléchargements répétés et les tentatives de manipulation des comptages sont filtrés à l'aide d'« indices d'activité irrégulière », et les téléchargements suspects (notamment, dans certaines circonstances, les téléchargements anonymes) sont exclus des totaux affichés aux auteurs [144]. Des observateurs indépendants ont documenté le même comportement antérieurement : les téléchargements répétés à partir d'une seule adresse IP ne sont pas crédités au compteur [66]. Le compteur de téléchargements est donc une statistique organisée, matériellement plus robuste qu'un journal brut du serveur. Le filtrage supprime l'activité non humaine et manipulatrice la plus détectable et rien de plus. Un compteur est toujours un compteur selon une règle et non une unité naturelle, et les règles changent (section 4.3).
4.2 Le trafic non humain et l'asymétrie entre les vues et les téléchargements
Les agents automatisés représentent plus de la moitié du trafic internet global selon les mesures récentes de l'industrie [158]. Ce chiffre ne peut pas être transposé aux compteurs de SSRN : aucune mesure publiée de la part des robots dans les vues ou téléchargements d'abstracts SSRN n'a été identifiée, et tout pourcentage spécifique affirmé pour SSRN manquerait de fondement. Ce qui peut être établi, c'est la structure du problème, approchée sous deux angles : les mécanismes qui gonflent vraisemblablement les vues, et l'historique de filtrage transparent d'une plateforme voisine.
Plusieurs mécanismes peuvent vraisemblablement générer des vues non humaines d'abstracts. Les robots des moteurs de recherche indexent régulièrement les pages d'abstracts récemment publiées. Les systèmes de sécurité email institutionnels, en particulier Safe Links dans Microsoft Defender for Office 365, analysent et pré-chargent les URLs contenues dans les emails entrants, ce qui peut générer des requêtes côté serveur avant que tout destinataire humain n'ouvre le message [106]. Parce que le principal canal de distribution de SSRN est l'email (Section 4.4), l'analyse des liens dans les emails d'annonce est une source structurellement plausible de vues fantômes. Aucune étude publiée ne mesure la contribution du pré-chargement par proxy de sécurité aux compteurs de vues de SSRN, et SSRN lui-même audite ses métriques et exclut les activités irrégulières des comptages de téléchargements [144][66][69], de sorte que la plateforme filtre probablement une part substantielle de ce trafic, particulièrement du côté des téléchargements. L'affirmation que « la plupart des vues SSRN ne sont pas humaines » apparaît dans les discussions informelles mais n'a jamais été mesurée.
Le cas transparent est celui de RePEc. Son service de journalisation, LogEc, publie à la fois sa méthodologie de filtrage et son historique de filtrage, et l'historique montre combien la contamination non humaine peut être sévère et asymétrique. Dès juillet 2007, les robots représentaient environ 74 % des vues d'abstracts sur les services RePEc supervisés mais seulement environ 7 % des téléchargements [99]. L'historique des filtres se lit comme la chronologie d'une course aux armements : des heuristiques contre les scanners de liens anti-malware ont été ajoutées en juillet 2010 ; un nouveau type de téléchargement de masse systématique a été traité en janvier 2017 ; les filtres d'atténuation des attaques par déni de service introduits en janvier 2022 ont supprimé 54 % des vues d'abstracts mais seulement 7 % des téléchargements [99]. À partir d'octobre 2025, RePEc a documenté une vague de trafic de robots dirigés par l'IA se faisant passer pour des utilisateurs humains [129]. En septembre 2025, plus de 99,5 % du trafic brut vers IDEAS a été rejeté comme non humain [129]. Après nettoyage, le rapport RePEc pour juin 2026 a comptabilisé environ 2,36 millions de vues d'abstracts et 238 mille téléchargements sur ses services [129].
Les données de RePEc soutiennent deux inférences pour SSRN. La contamination est asymétrique par construction : les agents automatisés parcourent les pages HTML d'abstracts bien plus agressivement qu'ils n'exécutent des récupérations complètes de PDF en texte intégral, de sorte que les compteurs de vues gonflent bien plus que les compteurs de téléchargements là où le filtrage est imparfait. Cette asymétrie, robots à ~74 % des vues mais ~7 % des téléchargements dans la mesure de 2007 [99], est une propriété architecturale du trafic de dépôt et non une particularité de RePEc. Les proportions spécifiques ne sont pas transférables : les règles de filtrage de SSRN, le modèle de distribution et l'audience diffèrent, et SSRN ne publie pas un journal de filtrage équivalent. La section 5.2 développe la conséquence pratique, qui est que les ratios construits sur les vues (comme le taux de conversion) doivent être lus comme des bornes inférieures de la qualité de l'engagement humain, parce que le dénominateur est la quantité la plus contaminée. Cette direction de borne inférieure dépend de l'année plutôt que d'être une loi : elle s'applique tant que le filtrage côté vues est à la traîne du filtrage côté téléchargements, ce qui est le régime historiquement documenté [99], mais elle s'affaiblirait ou s'inverserait si les filtres côté vues d'une plateforme rattrapaient ses filtres côté téléchargements, ou si la contamination côté téléchargements augmentait plus vite que côté vues (comme l'épisode des robots IA de 2025-2026 a augmenté les deux [129]). La direction doit être vérifiée à nouveau chaque fois qu'une plateforme révise ses règles de comptage.
Une considération supplémentaire a émergé depuis la conception de ces régimes de filtrage. Les filtres ont été construits pour éliminer les requêtes automatisées d'un comptage destiné à faire la proxy de l'attention humaine, et cette règle supprime toujours le bruit. Ce qu'elle ne peut plus faire sans examen est de traiter ce qui reste comme humain, parce que trois classes de requêtes automatisées se trouvent désormais là où le filtre n'en voyait qu'une : les parcours qui recueillent du texte pour l'entraînement des modèles, les robots d'indexation pour un service de recherche ou de réponse, et les récupérations qu'un système effectue en temps réel au nom d'une personne qui lui a posé une question. Les deux premiers restent du bruit pour un comptage d'attention. Le troisième est un acte délégué avec un humain derrière, puisqu'un système qui récupère le texte intégral d'un article pour répondre à la question d'un utilisateur ou soutenir une recherche bibliographique a reçu le contenu et l'a utilisé, bien qu'aucune personne n'ait jamais chargé la page. Une requête automatisée n'est pas en elle-même la preuve que quelque chose a été lu. La proxy s'est affaiblie, pas le filtre : humain par rapport à machine ne suit plus de manière fiable la distinction dont cet article a besoin, qui est de savoir si un événement constitue une preuve d'attention savante, humaine ou déléguée.
Le Project COUNTER a commencé à traiter cela dans son vocabulaire de rapportage plutôt que dans son filtre. L'orientation des bonnes pratiques sur l'utilisation de l'IA, émise en avril 2026 et mise à jour le 30 juin 2026 pour la Release 5.1.1, met à disposition une Access_Method optionnelle d'Agent, définie comme le contenu et les métadonnées accédés par un système d'IA, ainsi que des types de métriques spécifiques à l'IA, tandis que la Release 5.1.1 continue d'exiger que « l'activité générée par les robots et les robots d'indexation traditionnels DOIT être exclue de tous les rapports COUNTER » [125]. L'instrument a trois limites qui importent ici. C'est une extension optionnelle, produite uniquement dans les rapports qu'un fournisseur choisit de générer et destinée en premier lieu aux systèmes d'IA intégrés à la propre plateforme d'un fournisseur plutôt qu'aux robots d'indexation entrants. Ses éléments « NE DOIVENT PAS être inclus dans les vues Standard de COUNTER Reports » [125], de sorte qu'une vue standard ne distinguera pas l'accès par agent même si un fournisseur met en œuvre l'orientation. Que les événements d'agent marqués soient ensuite supprimés des totaux par défaut ou y figurent sans étiquette est une question de mise en œuvre sur laquelle l'orientation est silencieuse. Elle classe également l'accès qui a été fourni et non l'accès qui a été refusé : l'orientation déclare que « il n'y a pas de métriques de refus associées spécifiquement à Access_Method Agent » [125]. Rien de cela n'atteint un compteur public nu en tout cas, puisqu'un tel compteur n'est pas un COUNTER report et ne porte aucune méthode d'accès ; la norme est un analogue auquel il peut être jugé, pas une description de celui-ci.
Le refus n'est pas davantage hypothétique, et il opère en amont de toute règle de comptage, mais ses instruments diffèrent en nature et ne fonctionnent pas comme un seul. Le fichier robots.txt d'une plateforme demande aux agents nommés de ne pas explorer ; une réserve de fouille textuelle et de données-minière affirme une position juridique ; les conditions d'utilisation lient contractuellement ; un service de défi refuse la page aux clients qui ne peuvent pas le relever. Seul le dernier est une application. Sur la plateforme étudiée ici, telle qu'elle a été récupérée le 29 août 2026, robots.txt nommait trois agents (GPTBot, ChatGPT-User et Google-Extended) et restait silencieux sur les autres, le silence étant la valeur par défaut de l'Exclusion Robots que les explorateurs bien comportés lisent comme une permission ; les réponses contenaient une réserve de fouille pointant vers la politique de l'éditeur, qui autorise la fouille aux fins relevant de l'article 3 de la Directive du Marché unique numérique de l'UE et exige une licence autrement ; les conditions d'utilisation réservent les droits sur la fouille textuelle et de données-minière et la formation des IA sauf si un auteur a choisi une licence ouverte, une option disponible seulement depuis le 20 juillet 2026 et s'établissant par défaut à tous droits réservés ; et une seule requête non authentifiée faite sans moteur JavaScript a reçu un défi géré par Cloudflare plutôt que la page. L'un des agents nommés est le récupérateur déclenché par l'utilisateur plutôt qu'un explorateur d'entraînement : c'est la classe déléguée du paragraphe précédent. Ces matériaux enregistrent les restrictions publiées et une observation de configuration. Ils n'établissent pas le nombre de requêtes, automatisées ou humaines, qui ont été rejetées. Les directives sont honorées inégalement : dans une mesure à grande échelle du comportement des explorateurs, certains agents respectaient complètement les interdictions au niveau du site entier tout en honorant les interdictions au niveau des chemins moins d'un tiers du temps, et d'autres ignoraient entièrement le fichier [87]. Les dommages collatéraux ne sont pas non plus unidirectionnels, puisque les déploiements de défis ont perturbé les utilisateurs humains légitimes ailleurs (une bibliothèque universitaire a enregistré deux tels incidents dans les quatre premiers mois d'utilisation [29]).
L'asymétrie historique ne peut donc simplement être reportée. Le confort de la conclusion de 2007, des robots sur environ 74 % des vues abstraites mais environ 7 % des téléchargements [99], reposait sur des explorateurs qui feuilletaient les pages de destination et récupéraient rarement le texte intégral. Un système qui récupère des documents pour fonder une réponse n'a aucune raison de s'arrêter à l'abstract, de sorte que le côté des téléchargements n'est plus connu pour être le décompte plus fiable par construction. Lorsque le trafic universitaire brut a été mesuré en 2025-26, la part automatisée n'a pas été marginale, et elle a été trouvée à l'intérieur des téléchargements et des comptages de visites plutôt que seulement dans les vues de pages : une collection de patrimoine culturel a révisé un décompte de visite de mars 2025 de 1 000 000 à 125 000 après suppression du trafic de bots soupçonné [167] ; une classification de vendeur d'environ trente millions de requêtes d'accès dans un dépôt institutionnel n'a étiqueté qu'environ un quart d'entre elles comme humaines [98] ; et un dépôt répondant à une enquête sur les dépôts ouverts a attribué au moins un quart de ses propres téléchargements de bots, environ un demi-million de requêtes, à onze agents IA nommés [135]. Aucune de ces chiffres n'est une mesure de la plateforme étudiée ici : elles sont tirées de plateformes différentes avec différentes défenses, dans plusieurs cas absentes, et deux des trois comptent les visites ou les requêtes plutôt que les événements de téléchargement qu'un compteur public affiche. Elles établissent la condition préalable plutôt qu'une magnitude. Dans l'environnement actuel, l'interprétabilité de tout décompte d'utilisation est une fonction de la qualité du filtre, et là où une plateforme ne publie pas son filtrage, cette qualité est non vérifiée.
Deux problèmes d'identification en découle, et ils se composent. La composition d'abord : à partir d'un seul compteur public sur toute la durée, les parts des événements humains, automatisés conventionnels et médiatisés par un agent ne sont pas estimables, et la vision propre de la plateforme ne vaut pas mieux, puisque les clients automatisés ont été observés se présentant comme des navigateurs de bureau [167]. Sur la sélection, un compteur ne peut pas révéler quelle part de l'accès tenté a été servie, contestée ou exclue avant qu'une règle de comptage ne s'applique. Les politiques publiées divulguent que de tels mécanismes existent. Elles ne divulguent pas la fréquence à laquelle ils opèrent, comment ils ont opéré par le passé, ou leur effet sur l'inclusion. Les requêtes tentées, les requêtes contestées, les événements de service en texte intégral, les téléchargements affichés et les réponses générées à partir d'un document récupéré sont donc cinq populations différentes, et elles ne doivent pas être traitées comme interchangeables. Ce qui reste sans licence est une magnitude ou un signe net pour cette plateforme. L'utilisation universitaire non filtrée est maintenant connue pour être gonflable par le trafic automatisé, les téléchargements compris, mais si les filtres non publiés de cette plateforme, les règles de défi et les politiques d'exploration laissent un reste plus pondéré par l'humain, un écart dans la découverte médiatisée par un agent, les deux ou ni l'un ni l'autre, n'est pas mesuré. Le mélange n'est pas stable non plus au cours des années qu'un total sur toute la durée s'étend, qui s'exécutent d'un régime de robot pré-2024 à travers la montée en grappillage de 2025-26 à une valeur par défaut de licence introduite en juillet 2026. Les conséquences en aval de la question sont elles-mêmes documentées : les sites bloquant un grand explorateur IA sont récupérés significativement moins souvent par les moteurs de réponse IA même lorsque le contenu reste accessible [70]. Aucune estimation publiée de la part de l'agent n'existe pour aucun grand serveur de prépublication, une lacune de recherche plutôt qu'une preuve d'un petit effet, et l'audit spécifié à la section 8 est conçu pour la mesurer. Un total public sur toute la durée est une somme sur un mélange inconnu, tiré d'une part inconnue d'accès tenté, sans estimateur externe de l'un ou de l'autre et sans base pour traiter l'un ou l'autre comme stationnaire.
4.3 Les compteurs en baisse comme événements de mesure
Les compteurs peuvent aussi baisser ou être rectifiés lorsque les règles de filtrage changent, une conséquence supplémentaire du registre de filtrage qu'aucun tableau de bord n'explique. La révision du filtre de RePEC en janvier 2022 a supprimé la moitié des consultations abstraites précédemment comptabilisées en une seule étape [99]. Son épisode de bot IA de 2025-2026 a forcé d'autres changements méthodologiques [129]. Les statistiques de téléchargement rapportées par les fournisseurs sont, de façon plus générale, connues pour être sensibles aux conventions de comptage : un audit côté bibliothèque a révélé que les rapports de téléchargement d'un grand éditeur s'élevaient à peu près deux fois plus que sur les plateformes comparables, avec des comptes « dégonflés » à 43 % du chiffre signalé [176]. Une baisse soudaine des compteurs SSRN d'un auteur est donc tout aussi susceptible d'être un événement de mesure, un changement de filtrage ou de rectification côté plateforme, qu'un événement de lectorat, et elle ne devrait jamais être lue comme une perte de réputation sans corroboration. Le même raisonnement régit toute utilisation de métriques dans un dossier, où les enregistrements datés doivent être conservés (un protocole développé à la section 6). Les chiffres de la plateforme peuvent être révisés, et les archives datées de l'auteur ne peuvent pas être révisées.
4.4 Push versus pull : l'architecture façonne le ratio
L'architecture de distribution constitue la dernière couche mécanique. Elle diffère qualitativement selon les grands référentiels et façonne directement la relation entre les vues et les téléchargements. SSRN fonctionne principalement selon un modèle de push. À la soumission, les auteurs choisissent entre une et sept classifications thématiques (l'article LSN moyen comportait 3,7 affectations d'eJournal [168]), et celles-ci déterminent le placement dans les réseaux de recherche et l'éligibilité pour les alertes eJournal spécifiques aux sujets. L'inclusion dans une alerte est « curée et ciblée, non garantie », et la distribution dans les sujets à fort volume peut prendre jusqu'à 45 jours [53]. Les abonnés reçoivent des annonces au niveau du résumé par courrier électronique [57]. Chaque destinataire qui clique sur une annonce, par intérêt focalisé ou simple curiosité, enregistre une vue de résumé. arXiv, en contraste, fonctionne principalement comme une plateforme de pull : un référentiel à but non lucratif dont le trafic est animé par les chercheurs qui visitent activement les listes et les flux [11][65], où même la position dans une liste d'annonces quotidienne affecte mesurément la lecture et les citations [72]. RePEc agrège les métadonnées à partir d'archives décentralisées et applique le filtrage documenté lourd décrit ci-dessus [99][129].
Le tableau 6 résume la comparaison entre les plateformes en tant que schéma qualitatif des mécaniques de gouvernance et de découverte. Les données de trafic comparables entre les plateformes n'existent pas dans la littérature publiée.
Tableau 6. Architectures de plateforme et leur effet mécanique sur les métriques d'utilisation (schéma qualitatif).
| Caractéristique | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| Gouvernance | Commerciale (Elsevier, depuis mai 2016) [46] | À but non lucratif (Université Cornell) [11] | Réseau décentralisé de bénévoles [99] |
| Canal de découverte principal | Push : alertes eJournal curées pilotées par les classifications choisies par les auteurs (1–7 ; distribution jusqu'à 45 jours dans les sujets à fort volume) [53][57] | Pull : visites intentionnelles aux listes et flux ; effets positionnels dans les annonces documentés [11][72] | Agrégation d'archives distribuées ; découverte via IDEAS/EconPapers [99] |
| Transparence du filtrage | Politique décrite qualitativement ; aucun journal de filtrage public [144] | Non publié centralement pour les métriques d'utilisation | Méthodologie entièrement documentée et historique des révisions (LogEc) [99][129] |
| Effet mécanique attendu sur le ratio vue : téléchargement | Vues élevées par rapport aux téléchargements : les clics de courrier électronique enregistrent les vues provenant d'une exposition à faible intention | Conversion plus élevée des visites en téléchargements : le trafic est intentionnel | Le ratio n'a de sens qu'après un épuration importante des bots ; les nombres publiés sont post-filtrage [129] |
L'architecture influe sur la psychologie de l'auteur, car un ratio élevé de vues par rapport aux téléchargements sur SSRN est en grande partie un résultat de conception : le modèle de push génère une exposition large et à faible intention. L'examen des résumés est également un comportement érudit légitime (les chercheurs surveillent régulièrement les domaines par le biais de résumés sans télécharger les textes intégraux), de sorte qu'une vue qui ne se convertit pas peut signifier que le résumé a déjà fourni sa charge informationnelle plutôt qu'il n'a repoussé le lecteur. La règle empirique historique propre à SSRN, rapportée par Black et Caron, était qu'environ « trois vues de résumé … aboutissent à un téléchargement réel d'article » [18]. Les mêmes auteurs ont noté que sans filtres d'intégrité, les compteurs bruts seraient gonflés « d'un facteur de cinq ou plus » [18]. La section 5.2 place ces ancres datées à côté des mesures modernes.
Deux caractéristiques mécaniques de la façon dont un article est présenté régissent la conversion aux côtés de l'intérêt du lecteur, ce qui rend le taux de conversion mesuré partiellement une propriété de l'interface plutôt que de la recherche. L'une est l'interface utilisateur de la plateforme. Le fait que le texte intégral soit proposé sous forme de rendu HTML en ligne dans le navigateur ou seulement en tant que PDF téléchargeable change matériellement si un lecteur intéressé déclenche jamais le compteur de téléchargement, car un lecteur qui consomme le texte intégral dans le navigateur satisfait la même intention tout en ne augmentant que les vues. L'autre est la composition des appareils du public. L'accès mobile déprime la récupération du PDF en texte intégral par rapport à l'ordinateur de bureau, de sorte qu'un article dont les lecteurs arrivent principalement sur des téléphones (à partir d'un lien de média social ou d'un client de messagerie mobile) enregistrera systématiquement des téléchargements plus faibles et des vues comparativement plus élevées pour un intérêt érudit identique. Les deux effets tirent dans la même direction que le gonflement mécanique du dénominateur déjà établi ci-dessus, et les deux sont d'autres raisons de lire la bande empirique de la section 5.2 comme une plage conditionnelle à la plateforme plutôt qu'un seuil fixe : une norme de conversion estimée sur l'interface d'une plateforme et le mélange d'appareils doit être recalibrée plutôt que transplantée lorsque l'un ou l'autre change. La littérature sur les métriques d'utilisation soulève la même mise en garde sur la fiabilité concernant la comparabilité des rapports de téléchargement entre les plateformes et les conventions de comptage [176].
4.5 Conséquences prévisibles : auto-correspondances de similarité et hygiène des métadonnées
Deux autres conséquences mécaniques du dépôt de prépublications sont prévisibles, et toutes deux génèrent régulièrement une alarme inutile, elles appartiennent donc au reste du mécanisme.
L'auto-correspondance de similarité. Quand un working paper déposé sur SSRN est ensuite soumis à une revue, le contrôle de similarité de la revue signalera, comme attendu, une correspondance quasi-totale avec la prépublication de l'auteur. La documentation d'iThenticate énonce explicitement les deux volets de l'interprétation : le logiciel « ne vérifie pas le plagiat ; il vérifie la similarité », et « si vous voyez une correspondance de prépublication pour le même auteur, ce n'est pas du plagiat » [81]. Le mécanisme est également documenté. Les prépublications enregistrées comme Crossref Posted Content sont incluses dans les bases de données de comparaison du contrôle de similarité, de sorte qu'une correspondance avec sa propre prépublication déposée est le système fonctionnant comme prévu [36]. Les correspondances peuvent surgir même quand les éditeurs excluent les sources de prépublication, parce que les agrégateurs secondaires dupliquant les métadonnées de dépôt sont aussi analysés [81]. La réponse de l'auteur devrait être administrative plutôt que défensive : identifier la source signalée à l'éditeur responsable comme la prépublication horodatée de l'auteur. Les conseils de Crossref et iThenticate recommandent un examen éditorial qualitatif plutôt que des seuils de score de similarité mécanique [36][81]. Aucun seuil numérique n'est spécifié ici, puisqu'aucun n'est approuvé par les services de contrôle eux-mêmes. L'assurance que ce conseil présuppose a une base documentée dans la politique de l'éditeur : le dépôt d'un working paper sur un serveur de prépublication est autorisé selon les politiques de publication antérieure de la plupart des revues académiques, bien que les politiques varient et la politique actuelle de la revue cible devrait être vérifiée ; les positions sur les prépublications sont indexées publiquement dans des registres tels que Sherpa Romeo. Les exceptions notables s'agglomèrent en médecine et dans les domaines cliniques adjacents, où certaines revues restreignent ou découragent encore le dépôt antérieur de prépublication. Les auteurs dans ces domaines devraient vérifier la politique de prépublication de la revue cible avant le dépôt plutôt qu'après la soumission.
Détection d'écriture par l'IA : un canal de fausse alarme adjacent. Une couche de contrôle plus récente comporte un risque structurellement similaire de fausse alarme. Les détecteurs d'écriture par l'IA produisent des faux positifs documentés, et le fardeau pèse de manière disproportionnée sur les rédacteurs dont l'anglais n'est pas la langue maternelle : dans une évaluation de Stanford de sept détecteurs GPT disponibles publiquement (l'étude n'incluait pas Turnitin), une moyenne de 61,3 % des essais TOEFL rédigés par des locuteurs non natifs ont été mal classifiés comme générés par l'IA [97]. La pratique institutionnelle a enregistré la préoccupation. En août 2023, l'Université Vanderbilt a publiquement désactivé la fonction de détection d'IA de son logiciel de contrôle de similarité, citant son manque de fiabilité : le taux de faux positifs revendiqué par le fournisseur, l'absence de toute méthodologie de détection publiée, et le même fardeau disproportionné sur les rédacteurs dont l'anglais n'est pas la langue maternelle documenté ci-dessus [163]. La posture défensive ici parallèle l'auto-correspondance de similarité et est administrative plutôt qu'adversariale : préserver l'historique des versions du manuscrit et les enregistrements de rédaction comme preuve contemporaine de paternité (un argument supplémentaire pour l'hygiène de versioning ci-dessous), et répondre à tout signalement par une documentation plutôt que par l'alarme.
Hygiène de versioning et des métadonnées. Parce que les compteurs s'accumulent par page de document, la pratique de révision affecte directement l'intégrité des métriques. SSRN supporte le dépôt de versions révisées sur la même page de document, préservant les compteurs accumulés et l'URL indexée, alors que la suppression d'un document et son re-dépôt réinitialise les métriques et brise les liens existants (FAQ SSRN ; une page d'assistance sujette à révision, consultée le 14 août 2026 [B-7]). Les choix de classification ont également des conséquences sur les métriques, puisqu'ils déterminent le routage d'eJournal et donc les principaux événements d'exposition du document [53]. L'indexation externe fonctionne selon une horloge plus longue que les auteurs ne l'attendent : SSRN déclare que l'indexation par Google Scholar est contrôlée par le moteur de recherche et peut prendre « 6 à 9 mois ou plus » [55]. Les compteurs initiaux d'un document sont donc générés presque entièrement par la machinerie de distribution interne de la plateforme, ce qui ancre l'interprétation des zéros initiaux dans la section 5.6.
5. Un cadre d'interprétation : Reconstruction de l'échelle manquante
La question « ce nombre est-il bon ? » est scientifiquement mal posée jusqu'à ce qu'un groupe de comparaison soit spécifié. Cette section assemble le dossier empirique publié dans l'appareil comparatif manquant : une carte de référence consolidée avec confiance explicite des sources (5.1), une bande de conversion empirique (5.2), une échelle d'interprétation graduée (5.3), un diagnostic bidimensionnel de portée-conversion (5.4), une spécification de référence multidimensionnelle (5.5), et un protocole de lecture temporelle (5.6). Les valeurs sont énoncées partout avec leurs cadres d'échantillonnage et leurs âges. Aucune n'est un percentile étalonné pour la plateforme 2026, et tous doivent être lus sous réserve de la mise en garde sur l'inflation de la section 5.1.
5.1 Une carte de référence consolidée
Le tableau 7 consolide tous les référentiels publiés exploitables pour les métriques d'utilisation de SSRN identifiés lors de l'audit de la section 2.5, chacun avec son cadre d'échantillonnage et une déclaration explicite de la confiance dans la source. Un référentiel est mal utilisé dès qu'on l'étend au-delà de son cadre, aussi chaque entrée nomme-t-elle également le rôle inférentiel que la source peut légitimement jouer et la limitation principale qui le borne. Les preuves sont minces : la carte repose sur cinq études avec des cadres distincts : un échantillon de type recensement d'un réseau juridique en 2012 [139], un scrape des listes de premier plan de la plateforme en 2015 [85], un instantané transversal d'un seul réseau en 2025 [83], des agrégats au niveau de la plateforme [1], et une décomposition d'un sous-domaine [168]. Ces cadres ne sont pas interchangeables : les scrapes de listes de premier plan décrivent l'élite, les recensements de réseaux décrivent les articles typiques, et les agrégats de plateforme ne décrivent ni l'un ni l'autre. Toute distribution impliquée est également fortement asymétrique à droite, de sorte que les moyennes dépassent systématiquement les médianes et décrivent des articles atypiques.
Tableau 7. Carte de référence consolidée pour les métriques d'utilisation de SSRN, avec cadres d'échantillonnage, confiance dans la source, rôles inférentiels permissibles et limitations principales.
| Référentiel | Valeur | Source (année ; cadre d'échantillonnage) | Confiance dans la source | Rôle inférentiel permissible | Limitation principale |
|---|---|---|---|---|---|
| Téléchargements médians d'articles après ~2 ans sur la plateforme | 63 (moyenne 122,55) | Siems 2016 [139] ; n = 1 107 articles LSN publiés dans deux périodes de 2012, compteurs lus deux ans plus tard | Moyen-élevé : exemple et chiffres de téléchargement vérifiés ; domaine du droit uniquement ; cohorte 2012 | Vue historique de la distribution des articles ordinaires | Un ancrage de réseau juridique de deux ans, non une norme actuelle à l'échelle de la plateforme |
| Affichages médians d'articles après ~2 ans | 369 (moyenne 564,62 ; corrélation affichages-téléchargements 0,852) | Siems 2016 [139] | Moyen-élevé : chiffres vérifiés par rapport au tableau 1 de la source ; domaine du droit uniquement ; cohorte 2012 | Vue historique de la portée des articles ordinaires | Même cadre ancien et monodisciplinaire ; les compteurs d'affichage sont la quantité la plus contaminée (section 4.2) |
| Téléchargements médians d'articles, instantané d'un seul réseau | 87 (moyenne 221,3 ; p25 = 35 ; p75 = 206 ; p95 = 726 ; âge médian des articles 491 jours) | Jo & Li 2026 [83] ; N = 2 361 articles du Marketing Research Network, instantané du 15 août 2025 | Élevé : vérifiés par rapport au tableau publié ; noter deux anomalies de natures différentes rapportées « telles que publiées » — les affichages p95 = 966 sont un typage source soupçonné (≈0,32 SD au-dessus de la moyenne ; ligne dégradée pour re-vérification), conversion p95 = 77,7 est un artefact de petit dénominateur (section 5.2) ; panel complet au tableau 5 | Distribution transversale récente et modèle de conversion | Un réseau, un domaine, une date ; articles matures ; aucune trajectoire |
| Affichages médians d'articles, instantané d'un seul réseau | 504 (moyenne 611,973 ; p5 = 151 ; p25 = 288 ; p75 = 833 ; p95 = 966 « tels que publiés ») | Jo & Li 2026 [83] ; même échantillon que ci-dessus | Élevé : vérifiés par rapport au tableau publié ; la valeur p95 (966) est un typage source soupçonné — ≈0,32 SD au-dessus de la moyenne — reproduite « telle que publiée » et dégradée pour re-vérification en attente de demande aux auteurs | Distribution récente transversale de la portée | Même cadre d'un seul réseau et d'une seule date |
| Conversion affichages→téléchargements, bande empirique | 11–19% (≈ un téléchargement pour 5,3–9 affichages d'articles) | Siems 2016 [139] ; Willey & Knapp 2022/23 [172] ; Jo & Li 2026 [83] | Moyen-élevé : chiffres de Siems, Willey–Knapp et Jo & Li vérifiés par rapport aux tableaux des sources | Norme d'engagement conditionnel (conversion) | Peu de cadres d'échantillonnage ; le dénominateur est gonflable par les robots, de sorte que la conversion mesurée est une limite inférieure tandis que les affichages restent le compteur le plus gonflé (section 4.2) |
| Règle empirique historique à l'échelle de la plateforme | ~3 affichages d'articles : 1 téléchargement (~33%) | Black & Caron 2006 [18], rapportant la statistique propre de SSRN | Moyen : vérifiée textuellement ; datée (2006) ; à l'échelle de la plateforme | Anatomie des métriques et historique de l'intégrité | Ère ancienne de la plateforme ; un ancrage supérieur, non une norme actuelle |
| Seuil d'entrée, articles Top-10 000 de tous les temps | ≥160 téléchargements sur durée de vie (≈ top 1,8% du stock complet d'articles en texte intégral de la plateforme, 571 040 en juillet 2016 [1]) ; médiane au sein du groupe 805 ; moyenne 1 800 ; max 152 242 | Kakushadze 2016 [85] ; scrape des listes de premier plan de SSRN, 2015 ; 367 478 articles | Élevé : vérifiés par rapport aux tableaux publiés ; cadre de listes de premier plan ; travail d'un auteur unique | Forme de distribution et comportement de la queue | Sélection de listes de premier plan ; inadapté pour estimer l'article médian contemporain |
| Seuil d'entrée, Top-30 000 auteurs | 129 téléchargements totaux (minimum) ; médiane au sein du groupe 1 626 totaux ; médiane 210 téléchargements par article ; max 824 762 | Kakushadze 2016 [85] ; le groupe que SSRN elle-même a décrit dans ses lettres comme les « top 10 % » des auteurs [161] | Élevé : vérifiés par rapport aux tableaux publiés | Comportement de la queue au niveau du portefeuille d'auteur | Même sélection de listes de premier plan ; millésime 2015 |
| Moyenne non ajustée à l'échelle de la plateforme sur durée de vie | ~222 téléchargements par article (~35 au cours des 12 mois suivants) | Calculé à partir des totaux de la plateforme en décembre 2023 : 256 678 716 téléchargements sur durée de vie sur 1 157 048 articles en texte intégral ; ALL-SIS 2024 [1] | Moyen : agrégat dérivé ; mécaniquement gonflé par les anciens articles ; non un étalon personnel | Étalonnage agrégé de l'échelle de la plateforme uniquement | Une moyenne sur deux décennies d'accumulation ; décrit presque aucun article réel (section 3.3) |
| Étendue du sous-domaine au sein d'une seule discipline | ~8× en téléchargements moyens par article (438,35 Corporate/Securities/Finance Law vs 53,48 Agricultural Law) | Whalen 2018 [168] ; 94 eRevues LSN, ~250 000 articles | Moyen-élevé : vérifiés à partir de la source ; 2018 ; moyennes, non médianes | Classification et hétérogénéité du sous-domaine | Moyennes, non médianes appariées en âge ; domaine du droit uniquement ; 2018 |
| Premiers téléchargements → citations ultérieures | r ≈ 0,39–0,43 au cours des 180 premiers jours (≈16 % de variance expliquée) | Brody, Harnad & Carr 2006 [25] ; arXiv (HEP), N = 14 442 | Élevé : vérifiés ; plateforme différente, transférabilité supposée plutôt que démontrée | Validation prédictive ultérieure | Plateforme et ère différentes ; les corrélations au niveau des articles sont modestes |
| Structure calendaire de l'accès ; délai accès→citation | Les accès sont ~11 % plus faibles les week-ends et ~50 % plus faibles en été ; réponse de citation ≈élastique unitaire ~9 mois après un changement d'accès | Yuret 2026 [178] ; >1 500 articles de sept revues suivis ~1 an | Élevée : DOI, lieu de publication et titre vérifiés via Crossref (14 août 2026) ; les quatre chiffres — plus de 1 500 articles de sept revues, les accès environ 11 % plus faibles les week-ends et environ 50 % plus faibles en été, et une réponse de citation approximativement élastique unitaire (une augmentation de 10 % des accès associée à environ une augmentation de 10 % des citations) environ neuf mois plus tard — vérifiés textuellement par rapport au résumé de l'article publié (Springer, 15 août 2026) | Normalisation temporelle et validation prédictive — l'ancrage de normalisation calendaire derrière CSAB | Données d'accès aux revues, non spécifiques à SSRN |
| Sensibilité des comptages aux conventions de comptage | Les rapports de téléchargement des fournisseurs peuvent atteindre ~2× ceux des plates-formes comparables (comptages « dégonflés » à 43 % du chiffre rapporté) ; les métriques au niveau des articles exigent un dépistage explicite de l'intégrité des données | Wood-Doughty et al. 2019 [176] ; Gordon et al. 2015 [69] | Moyen-élevée : les deux sources vérifiées et déjà citées dans les sections 4.1–4.3 | Avertissement d'intégrité et de comparabilité — limite la précision de toute comparaison inter-plates-formes ou inter-fournisseurs | Pas un repère SSRN direct ; aucun audit spécifique à SSRN n'existe |
Trois lectures structurelles de la carte suivent.
La moyenne n'est pas l'article typique. Dans la seule distribution récemment publiée, la moyenne (221,3) est 2,54 fois la médiane (87) et dépasse même le 75e percentile (section 3.3) [83]. Dans le recensement antérieur de Siems, la moyenne était environ deux fois la médiane [139]. La moyenne au niveau de la plate-forme de ~222 téléchargements de durée de vie [1] est le moins approprié de tous les critères d'étalonnage personnel : elle agrège deux décennies d'accumulation par des articles de tous âges.
Chaque repère porte un millésime, et la direction du biais de millésime dépend de la comparaison. Les téléchargements annuels de la plate-forme sont passés d'environ 0,5 million en 2000 et 3 millions en 2005 [18] à 12,9 millions en 2016 et 40,6 millions en 2023 [1], une augmentation de 3,15 fois entre 2016 et 2023, tandis que le stock d'articles a augmenté d'environ 2,03 fois au cours de la même période (571 040 à 1 157 048 [1]). La figure 5 trace cette trajectoire. Parce que les téléchargements ont augmenté plus vite que le stock d'articles, le flux de téléchargements par article a augmenté d'environ 55 % (d'environ 22,6 à environ 35,1 par article par an [1]), donc un seuil fixe de 2015 représente maintenant une plus petite part de ce qu'un article typique gagne que ce n'était le cas à l'époque. Lue comme une bande de niveau absolu pour 2026, un ancien seuil tel que l'entrée de liste supérieure ~160-téléchargements est donc indulgente plutôt que conservatrice : la dépasser est moins sélectif aujourd'hui qu'en 2015, non plus. Le biais dépend de la composition. Pour la position de percentile sous asymétrie continue à droite, les anciens repères peuvent encore sous-estimer la queue, mais pour les comptages absolus, l'inflation de téléchargements les rend souples, donc aucun ancien seuil ne devrait être cité comme un « plancher conservateur » sans cette qualification. Multiplier un seuil de 2015 par la croissance ultérieure de la plate-forme est également illicite : la composition des auteurs, les canaux de distribution, le filtrage et la concurrence pour l'attention ont tous changé parallèlement au flux de téléchargements.
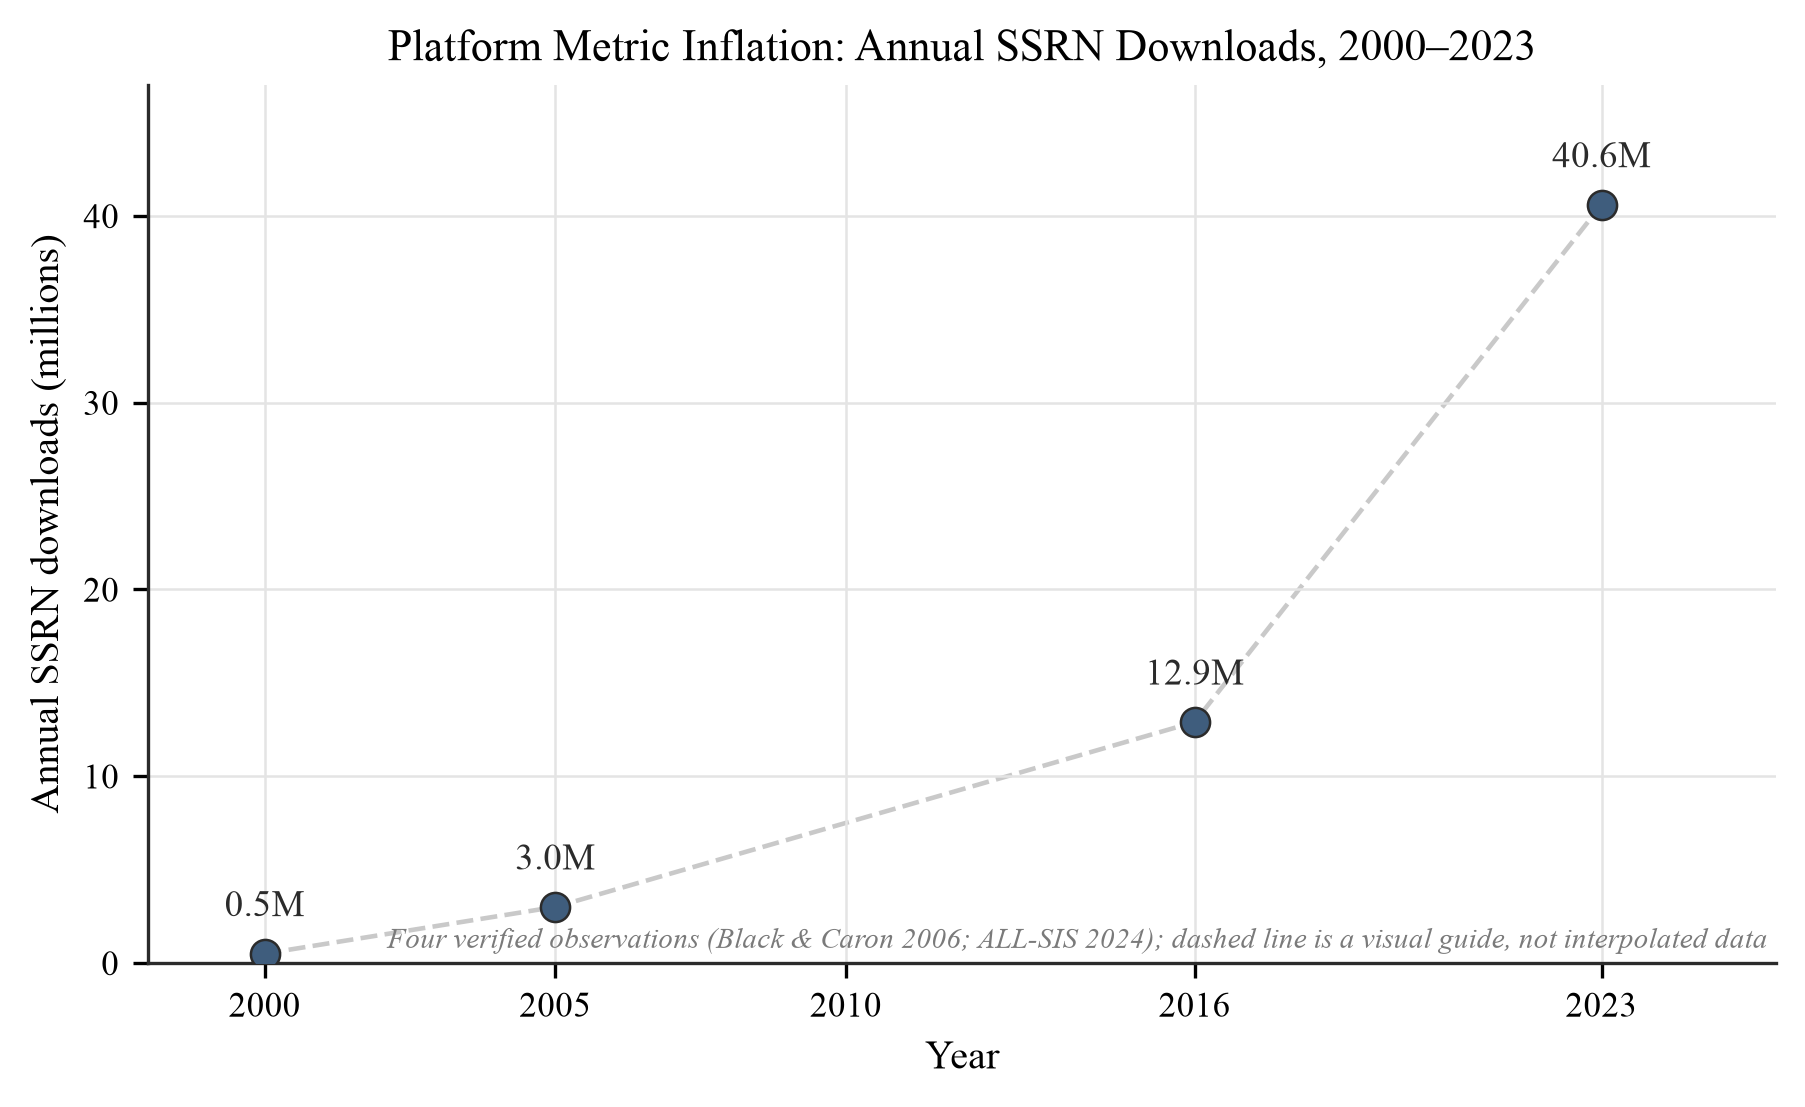
Figure 5. Inflation des métriques de la plate-forme, 2000–2023. Téléchargements annuels SSRN : ~0,5 million (2000) et ~3 millions (2005) [18] ; 12,9 millions (2016) et 40,6 millions (2023) [1]. Parce que le flux de téléchargements a augmenté plus vite que le stock d'articles (≈3,15× contre ≈2,03× de 2016 à 2023 [1]), augmentant le flux de téléchargements par article d'environ 55 %, les repères absolus estimés sur des échantillons de 2012–2015 se lisent comme des bandes indulgentes plutôt que conservatrices pour les lectures de 2026. Seules les quatre valeurs d'année vérifiées énumérées ici sont tracées ; aucune interpolation entre elles n'est impliquée.
Aucune source de percentile actuelle n'existe. Aucune étude distributionnelle à l'échelle de la plate-forme post-2020 des téléchargements SSRN n'a été identifiée dans l'audit de la section 2.5 (l'instantané de réseau unique de 2025 [83], publié en 2026, est le seul échantillon externe récemment publié), et après le 15 juillet 2026, la plate-forme elle-même ne publie aucune donnée comparative à partir de laquelle les percentiles pourraient être reconstruit. L'écart porte sur l'actualité et la spécificité de la plate-forme. La distribution et l'inégalité de l'attention aux préimpression est un domaine de recherche mature sur d'autres référentiels (le profil de citation et d'altmétrique des dépôts bioRxiv a été caractérisé sur l'ensemble du serveur [62]), et la forme quasi-lognormale des téléchargements SSRN spécifiquement avait déjà été établie avant 2020 par Kakushadze [85]. Ce qui manque, c'est une distribution de percentile actuelle, spécifique à SSRN, post-coucher de soleil. La carte ci-dessus est assemblée à partir des cadres disponibles, ce qui est l'argument pour l'ensemble de données de repère communautaire proposé dans l'agenda de recherche (section 8).
5.2 La bande de conversion
Le ratio des téléchargements par rapport aux consultations de résumé est la seule grandeur du tableau de bord ayant une norme inter-études raisonnablement stable, et les auteurs le mal-interprètent de façon plus cohérente que toute autre grandeur. Lu naïvement, chaque consultation qui ne se convertit pas compte comme un refus, et un auteur avec 40 consultations et 7 téléchargements perçoit un « taux d'échec de 82,5 %. » Cette lecture est erronée tant sur le plan mécanique qu'empirique.
La section 4 a établi les mécanismes : le dénominateur (consultations) est la grandeur la plus contaminée par les bots et la plus gonflée par l'architecture, puisque les clics dans les e-mails en modèle push et le trafic des robots d'exploration accumulent des consultations sans impliquer une intention de lecture, tandis que le compteur de téléchargements est activement audité [144][99][106]. Tant que le trafic automatisé gonfle davantage les consultations que les téléchargements, un taux de conversion mesuré constitue une limite inférieure de la conversion des véritables visiteurs humains intéressés ; la section 4.2 explique pourquoi cette asymétrie ne peut plus être supposée lorsque les systèmes IA récupèrent le texte intégral, et la limite s'affaiblit en conséquence. Empiriquement, les mesures publiées convergent vers une bande étroite. Siems a mesuré un ratio médian de téléchargements par consultation de 0,171 (moyenne 0,187) dans le recensement LSN [139] ; Willey et Knapp rapportent une conversion de 15 % dans leur groupe d'articles les plus consultés et de 11 % parmi les articles à une seule citation [172]. L'instantané de Jo et Li donne une médiane de 18,9 téléchargements pour 100 consultations de résumé [83]. La bande empirique résultante est de 11–19 %, c'est-à-dire environ un téléchargement pour 5,3–9 consultations de résumé. La règle empirique ancienne de SSRN d'environ 3 : 1 (~33 %) [18] se situe au-dessus de la bande et est mieux comprise comme une ancre supérieure précoce à l'échelle de la plateforme plutôt que comme une norme actuelle. À titre d'illustration inter-domaines (les populations et les intentions diffèrent catégoriquement), un taux de consultation-à-validation dans cette plage serait considéré comme élevé dans les logiciels grand public, où les points de référence typiques de conversion freemium gratuit vers payant se situent dans la partie inférieure des chiffres simples [10]. La comparaison est illustrative uniquement, et elle reformule l'intuition selon laquelle « 7 sur 40 » signale un manque d'intérêt. La figure 6 représente les estimations.
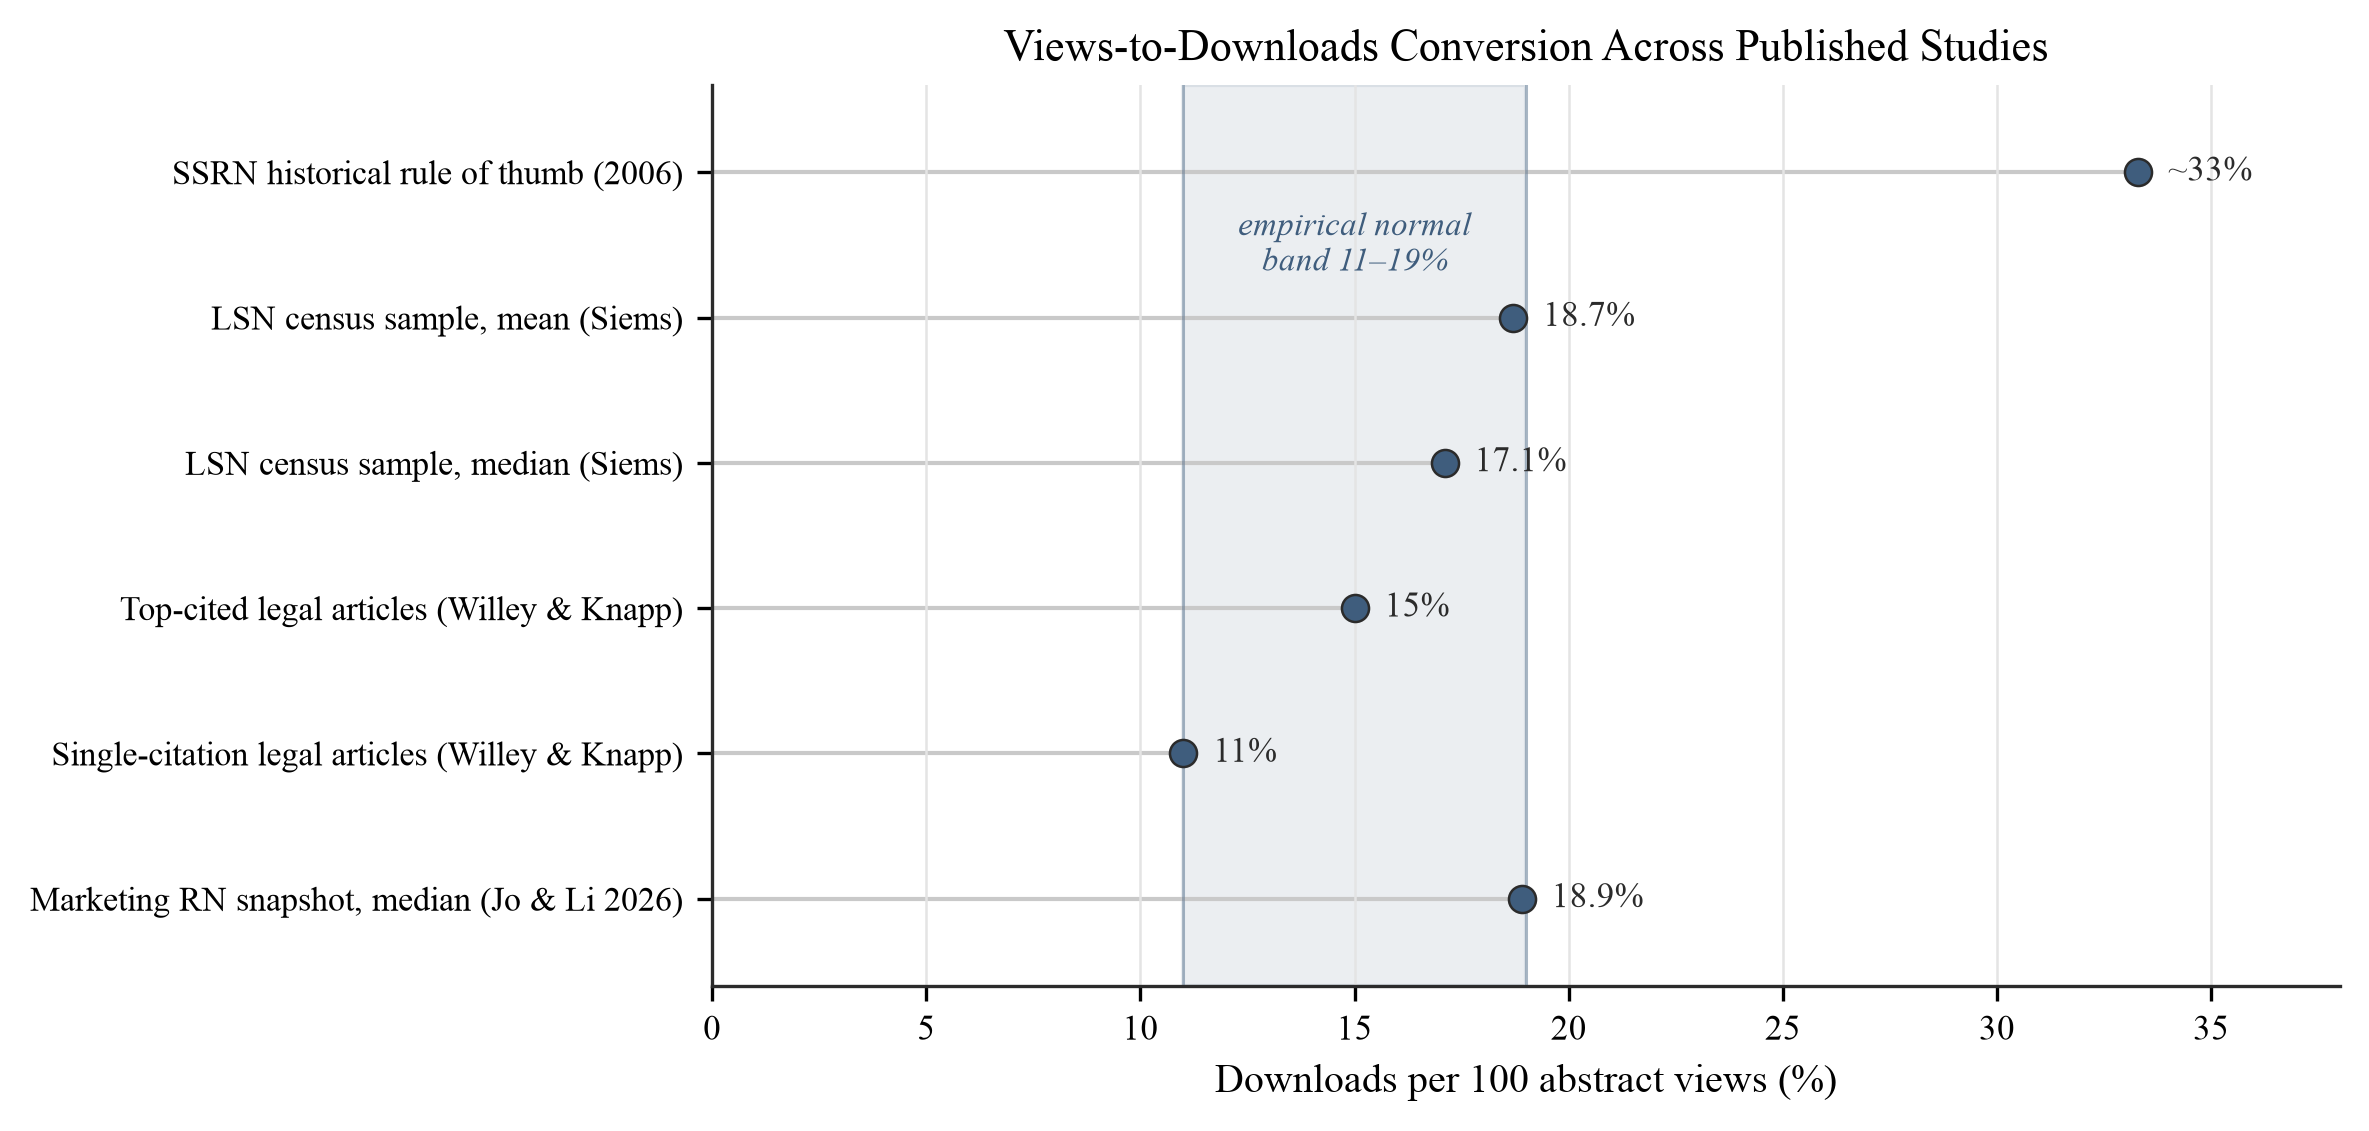
Figure 6. Conversion consultations-vers-téléchargements dans les différentes études. Estimations de conversion dans l'ensemble des publications : règle empirique historique de SSRN d'environ 33 % (telle que rapportée en 2006) [18] ; moyenne du recensement LSN de 18,7 % et médiane de 17,1 % [139] ; 15 % parmi les articles les plus cités et 11 % parmi les articles juridiques à citation unique [172] ; médiane de 18,9 téléchargements pour 100 consultations de résumé dans l'instantané 2025 du Marketing Research Network [83]. La bande ombrée marque la plage empirique normale de 11–19 % — une enveloppe d'estimations hétérogènes (médianes du réseau entier aux côtés de chiffres d'échantillons sélectionnés par citation dont la source ne précise pas le type de statistique) ; la moyenne de l'échantillon Jo et Li (23,7 pour 100) se situe au-dessus. Toutes les valeurs sont telles que publiées dans les sources citées ; aucune nouvelle estimation n'est introduite.
Les membres de la bande sont des statistiques différentes d'échantillons différents, de sorte que c'est l'enveloppe d'estimations ponctuelles hétérogènes. Les chiffres de Siems (17,1 %) et Jo et Li (18,9 %) sont des médianes d'échantillons du réseau entier, tandis que les 15 % et 11 % de Willey et Knapp sont rapportés pour des sous-échantillons sélectionnés par citation (articles juridiques les plus cités par rapport à citation unique), dont la source ne précise pas le type de statistique et dont la sélection est la raison pour laquelle le bord inférieur de la bande se situe où il est. Le bord supérieur est encore plus flou : la conversion moyenne dans l'échantillon Jo et Li, 23,7 téléchargements pour 100 consultations [83], se situe au-dessus de la bande, et elle diverge fortement du ratio des moyennes agrégées de cet échantillon (221,346 ÷ 611,973 = 36,2 pour 100). Le fait qu'un ratio-des-moyennes de 36,2 se situe si loin au-dessus d'une moyenne-des-ratios de 23,7 est en lui-même diagnostique. Parce que le ratio-des-moyennes est algébriquement la moyenne pondérée par les consultations des taux de conversion par article, son dépassement de la moyenne-des-ratios non pondérée implique une covariance positive entre la portée et la conversion : les articles avec plus de consultations se convertissent à des taux quelque peu plus élevés, non plus bas. La lecture est conservative : l'inflation à petit dénominateur pousserait la moyenne-des-ratios non pondérée vers le haut, fonctionnant contre ce classement, de sorte qu'observer le ratio-des-moyennes au-dessus de celui-ci de toute façon rend la conclusion de dépendance positive plus robuste, non moins.
La bande fournit l'exemple travaillé central de cet article. Sur les ancres publiées, un article avec 40 consultations de résumé devrait générer environ 4–8 téléchargements. Les « 7 téléchargements » du titre, sur 40 consultations, est une conversion de 17,5 %, une estimation ponctuelle qui se situe à l'intérieur de la bande mais porte une incertitude large à ce dénominateur. L'intervalle exact de Clopper–Pearson à 95 % sur 7 de 40 s'étend d'environ 7,3 % à environ 32,8 %, chevauchant la bande des deux côtés : avec seulement 40 consultations, l'estimation ne peut pas être résolue à la largeur de la bande, de sorte que la lecture est un résultat de criblage, non une classification. Deux éléments limitent davantage l'exemple. Le dénominateur est petit (l'instabilité notée ci-dessous), et la comparaison n'est pas appariée en âge : 40 consultations à environ le jour 20 est une lecture de début de vie, tandis que les médianes de référence proviennent d'échantillons matures (Siems à deux ans [139], Jo et Li à un âge médian de l'article de 491 jours [83]), et les positions 1 et 5 et la section 5.6 soutiennent que l'exposition en début de vie est un régime différent, de sorte que l'axe de l'âge n'est pas aligné. La lecture défendable est donc que 17,5 % est cohérent avec la bande inter-études en tant que résultat de criblage, non un percentile de population précis, et non « confortablement à l'intérieur » de celle-ci. La détresse qu'une telle figure provoque reflète l'absence d'une échelle plutôt que l'absence de lectorat. Le millésime et la portée des ancres sous-jacentes sont énoncés à la section 9.
Les petits dénominateurs rendent le ratio instable. Un article avec deux vues et un téléchargement a une conversion nominale de 50 %, mais cette estimation ne mérite pas plus de confiance qu'une construction basée sur 500 vues ; pour tout benchmarking public, un rétrécissement empirique-Bayes vers le taux de la classe de référence devrait empêcher les petits dénominateurs de produire des scores extrêmes (sections 8.3 et 8.8). La bande fonctionne aussi comme un diagnostic dans les deux sens. Une conversion bien en dessous de la bande, sur un dénominateur non trivial, indique généralement une inadéquation titre–résumé–texte : les lecteurs arrivent, lisent le résumé, et partent, un problème de communication exploitable (réécrire le titre et le résumé), non un jugement sur la recherche. Une conversion bien au-dessus de la bande signale un trafic que la consultation d'abstraits n'explique pas (couverture médiatique, adoption pédagogique, ou circulation virale) et devrait inciter à vérifier l'origine des vues. Aucun des deux écarts, en lui-même, n'établit rien sur la qualité de la recherche. Une qualification ultérieure est une hypothèse plutôt qu'une conclusion. La conversion peut varier systématiquement selon les domaines en tant que propriété du style de lecture du public plutôt que des articles individuels : les grands domaines peuvent exhiber un comportement de « lèche-vitrines », avec de nombreuses visites d'abstraits et peu de téléchargements, tandis que les petites communautés fortement engagées convertissent à des taux plus élevés. La bande ci-dessus est estimée à partir de trop peu de frames pour résoudre cela, aussi l'Étude 1 (section 8.6) inclut la conversion stratifiée par domaine parmi ses résultats.
Un diagnostic, jamais une cible : la contrainte anti-manipulation. La bande de conversion est puissante parce qu'elle peut être lue comme une norme, et ce pouvoir comporte un risque. La loi de Goodhart veut qu'une mesure adoptée comme cible cesse d'être une bonne mesure [67], un principe parallélisé par la loi de Campbell sur la corruption des indicateurs sociaux utilisés pour la prise de décision [27]. Si la bande de 11–19 %, ou toute composante du cadre de benchmark de la section 5.5, était adoptée comme seuil de promotion (« les articles doivent se situer à l'intérieur de la bande de conversion pour compter »), le ratio deviendrait immédiatement un objet d'optimisation plutôt que d'observation. L'attaque est concrète et peu coûteuse : parce que le dénominateur est la quantité la plus manipulable (section 4.2), une inflation coordonnée des vues d'abstraits en proportion fixe des téléchargements maintiendrait le ratio à l'intérieur de la bande et rendrait un signal d'ingénierie statistiquement indistinguible d'une conversion organique. La réponse du cadre relève de la définition. La bande de conversion, le diagnostic portée–conversion (section 5.4), et les composantes CSAB (section 5.5) constituent un vecteur diagnostique, jamais une cible, et aucune composante ne peut être lue comme un critère de promotion. La machinerie qui résiste à la manipulation est intégrée à la conception : la bande est énoncée comme une limite inférieure parce que son dénominateur est gonflable par bot, donc la lecture est conservative contre l'inflation par construction ; le protocole d'anomalie de la section 8.3 est signaler, non supprimer, donc un pic d'ingénierie est préservé et rendu visible plutôt que silencieusement absorbé ; et le filtrage d'intégrité de la section 4.1 dépiste déjà l'activité coordonnée la plus détectable. Lue comme diagnostic, la bande expose la manipulation comme une signature hors bande ou internement incohérente ; lue comme une cible, elle inviterait exactement la coordination qu'elle est censée détecter. Cette position aligne le cadre avec le consensus établi de la réforme de l'évaluation de la recherche : la Déclaration de San Francisco sur l'évaluation de la recherche (DORA), qui rejette les proxies à nombre unique et de marque de journal en faveur d'une évaluation sur le contenu propre de la recherche [8], et le Manifeste de Leiden, dont les principes mettent en garde contre exactement cette substitution d'un indicateur facile au jugement expert [78].
Les téléchargements n'ont pas de piste d'audit publique : une raison supplémentaire de lire la bande comme un plancher. Une asymétrie structurelle entre les citations et les téléchargements aiguise la préoccupation relative à la manipulation. Une citation laisse une trace publique, inspectable : le document citant existe, est découvrable, et peut être vérifié, de sorte que la manipulation des citations est en principe auditable par tout tiers. Un compteur de téléchargements ne laisse aucune piste publique. C'est un décompte privé sur les serveurs de la plateforme, sans dossier externe de quelles demandes ont été comptabilisées, filtrées, ou retraitées, ce qui le rend uniquement exposé à une manipulation secrète qu'aucun observateur extérieur ne peut reconstituer après coup. Cette exposition est une raison indépendante, au-delà de la contamination par bot du dénominateur, de traiter le taux de conversion mesuré comme une limite inférieure plutôt qu'une estimation ponctuelle (sous réserve de la mise en garde de la section 4.2 sur la récupération par IA), et toujours d'associer le compteur au protocole d'anomalie et au filtrage d'intégrité documenté sur lequel le cadre s'appuie (section 4.1). L'absence de piste d'audit n'est pas une raison de méfier du compteur ; c'est une raison de le lire de manière conservative et d'insister sur la discipline signaler-non-supprimer qui garde une lecture manipulée détectable (section 8.3).
La bande est une cible de calibrage, non une constante. Une conséquence en découle pour la manière dont le chiffre de 11–19 %, et chaque seuil CSAB, devrait être cité : ce sont des quantités à calibrer par domaine, et par plateforme (sections 4.4, 5.5). Le mécanisme pour ce calibrage est déjà spécifié : l'Étude 1 stratifiée par domaine (section 8.6) est conçue pour fournir les distributions par domaine de conversion et de téléchargement que le cadre exige et est construite pour consommer. Jusqu'à ce que l'Étude 1 soit rapportée, la coupe transversale d'archivage de l'Appendice E fournit une estimation résolue par domaine. Sur les quatorze domaines contenant au moins vingt articles, la conversion médiane s'étend de 0,134 en Énergie à 0,195 en Informatique, un écart d'environ 1,5 fois, et en maintenant l'âge du papier constant, elle s'étend de 0,134 à 0,224, environ 1,7 fois. Rapporté à l'écart de trois à cinq fois par domaine dans les téléchargements eux-mêmes, la conversion est la plus portable des deux quantités, ce qui est ce qui la rend utile comme diagnostic. L'âge est la dimension qu'elle ne survit pas : dans chaque domaine suffisamment grand pour être testé, la conversion diminue à mesure que les articles vieillissent, avec des coefficients de Spearman allant de −0,14 à −0,41 sur les huit domaines contenant au moins quarante articles. Une bande de conversion citée sans un âge du papier fait moins de travail qu'elle ne le paraît.
5.3 L'échelle d'interprétation graduée
Les auteurs de Post-Rankings manquent très visiblement d'une échelle graduée, dans le format établi des guides d'interprétation de l'indice h [118], qui convertit les compteurs bruts en bandes en langage clair. Les sections 5.1–5.2 en fournissent les ingrédients. Le tableau 8 présente l'échelle proposée pour quatre grandeurs : les téléchargements totaux au niveau du document, les téléchargements du premier mois, la conversion vues-téléchargements, et les téléchargements totaux au niveau de l'auteur.
Tableau 8. Échelle d'interprétation proposée pour les métriques SSRN. Les bandes synthétisent les preuves de 2012–2015 [139][85][18][172] ; comme le flux de téléchargements par document a augmenté depuis (section 5.1), leurs seuils absolus doivent être lus comme des bandes cléments plutôt que conservateurs pour 2026, et en tout cas comme une approximation. La colonne du premier mois n'est pas un échelon calibré de l'échelle mais une prédiction préenregistrée comportant une large incertitude, à tester par le groupe prospectif de l'étude 1 (section 8.6) ; ses cellules ne doivent pas être lues comme des seuils ou des échelons de promotion (voir texte). La limite Solide/Exceptionnel à 10 000 est une estimation provisoire de l'auteur : aucune source publiée identifiée dans l'audit de la section 2.5 n'associe 10 000 téléchargements à un percentile. La bande Naissante n'introduit aucun nouveau chiffre : son plafond est l'ancre médiane existante de deux ans de 63 [139]. Les limites de bande sont fixées à des nombres ronds et maintenues à une largeur grossièrement égale à une bande complète : la précision établie par la littérature d'intégrité (sections 3.1, 4.1–4.3) rend les gradations plus fines spurieusement précises, donc la grossièreté des bandes est intentionnelle. La colonne du verdict en langage clair décrit l'échelle des téléchargements uniquement et ne s'étend pas à la colonne de conversion : une conversion médiane de 18,9 % est ordinaire plutôt que « Solide », et un p75 de 27,2 % n'est pas « Solide ». Les limites de téléchargement au cours de la vie ne se chevauchent pas par construction (Naissante en dessous de 63, Modeste 63–159, Solide 160 et plus) ; où le tableau imprime un point final partagé entre les lignes supérieures — 800 entre Solide et Solide, et les seuils de conversion et de niveau auteur correspondants — l'intervalle est semi-ouvert, chaque valeur partagée appartenant à la bande supérieure. Les deux valeurs de limite de vie sont elles-mêmes tirées de classes de référence incommensurables : 63 est une médiane sur une fenêtre de deux ans pour un recensement de bourse juridique d'une seule discipline [139], tandis que 160 est un seuil d'entrée de liste supérieure de toute la plateforme au cours de la vie [85]. Elles se situent donc sur des horloges différentes (un âge de document fixe de deux ans par rapport à une accumulation de vie illimitée) et décrivent des populations différentes (un champ par rapport à tous les champs), de sorte que leur regroupement dans une seule échelle absolue est une combinaison de classes de référence avec des âges, des champs et des règles de sélection différents — une limitation que les percentiles spécifiques aux champs et à l'âge de l'étude 1 sont conçus pour éliminer. Une limite structurelle de ces ancrages mérite l'emphase : parce que les points de référence disponibles se regroupent à la médiane de deux ans (63 [139]) et dans la queue supérieure de la plateforme, quatre des cinq bandes verbales — Modeste, Solide, Solide et Exceptionnel — décrivent des documents à ou au-dessus de la médiane, donc l'échelle est dense au-dessus de la médiane et discrimine faiblement à travers la large plage 50e-98e percentile dans laquelle la plupart des documents tombent réellement. Cette compression est une conséquence directe de l'ancrage sur les preuves de la queue supérieure ; résoudre l'ordinaire du simplement au-dessus de la médiane attend les percentiles spécifiques aux champs et à l'âge de l'étude 1. L'échelle est illustrative, non normative : aucune limite de bande ne doit entrer dans une décision de titularisation, d'embauche ou de promotion comme seuil de réussite/échec jusqu'à ce que le groupe prospectif de l'étude 1 (section 8.6) ait calibré des percentiles spécifiques aux champs et à l'âge pour remplacer ces ancrages absolus datés.
| Bande | Document : téléchargements au cours de la vie | Document : téléchargements du premier mois (extrapolés) | Conversion (téléchargements / vues) | Auteur : téléchargements totaux | Verdict en langage clair |
|---|---|---|---|---|---|
| Naissante | En dessous de la médiane de deux ans de 63 [139] | — (pas d'ancre séparée ; voir texte) | — (dénominateur généralement trop petit ; section 5.2) | — | Trop tôt, ou en dessous de la médiane du champ — la norme statistique pour les documents jeunes et de niche ; diagnostiquer d'abord l'exposition (sections 5.4, 5.6), non la qualité |
| Modeste | 63–159 | <15 | <11 % | <~130 | Typique de la plateforme ; la bande médiane |
| Solide | 160–800 | 15–50 | 11–19 % | ~130–1 600 | À ou au-delà de l'entrée de la liste supérieure historique |
| Robuste | 800–10 000 | 50–250 | 19–30 % | 1 600–10 000 | Typique des listes supérieures historiques |
| Exceptionnel | >10 000 (estimation provisoire de l'auteur) | >250 | >30 % | >10 000 (estimation provisoire de l'auteur) | Au-delà de la gamme documentée de la circulation scientifique ordinaire |
Chaque ancre intérieure est liée à un seuil publié. La bande Nascent couvre la région en dessous de la médiane LSN sur deux ans de 63 [139]. Cette région est densément peuplée, non anomale : les bandes Study 1 préspécifiées (Section 8.6) anticipent qu'une part substantielle des articles de la plateforme, de l'ordre de 15–30 % selon la bande de prédiction énoncée, ont dix téléchargements ou moins au cours de leur vie, donc une échelle dont la bande la plus basse commencerait près de la médiane laisserait les articles les plus nombreux de la plateforme, dont celui-ci est le protagoniste, entièrement en dehors de l'échelle. Le verdict Nascent est non évaluatif. En dessous de la médiane du domaine, et particulièrement au jeune âge d'un article, le compteur n'autorise aucun jugement de qualité, et la première étape diagnostique est l'exposition (Sections 5.4 et 5.6) plutôt que le contenu. La bande Modest est ancrée à la médiane LSN sur deux ans de 63 [139]. « Modest » est la bande médiane : la typicité n'est pas un échec. La limite Modest/Solid (~160 téléchargements au cours de la vie) est le point d'entrée Kakushadze aux articles du Top-10,000 de tous les temps, approximativement le top 1,8 % du stock d'articles en texte intégral de la plateforme (571 040, juillet 2016 [1]) [85]. Opérationnellement, un article « Solid » est un article de liste supérieure. La limite Solid/Strong (~800) est la médiane au sein de ce groupe d'élite (805) [85] : elle sépare les articles qui ne font qu'entrer dans l'élite historique des articles typiques de celle-ci. Sur l'échelle de portefeuille, la colonne au niveau auteur reflète cette logique : le groupe que les propres notifications de SSRN décrivaient comme le top 10 % des auteurs [161] avait un minimum d'entrée de 129 téléchargements au total et une médiane interne de 1 626 [85]. Parce que chaque ancre au niveau auteur est tirée de cette liste classée, la colonne auteur décrit la queue supérieure de la distribution des auteurs plutôt que l'auteur typique. Un auteur en dessous de la limite ~130 n'est pas simplement « Modest » : cet auteur se situe entièrement en dehors du groupe historiquement classé, donc les bandes inférieures de la colonne se lisent comme « en dessous de l'élite historique », non comme une position calibrée parmi tous les auteurs. C'est le même ancrage de queue supérieure qui compresse l'échelle au niveau article ; les ancres de la colonne auteur attendent les percentiles au niveau portefeuille de Study 1. La colonne conversion est la bande multi-études de la Section 5.2. La limite Strong/Exceptional à 10 000 ne porte aucune ancre de percentile publié et est conservée comme horizon d'ordre de grandeur.
La colonne du premier mois a un statut différent. C'est une prédiction préenregistrée, une prévision falsifiable avec une large incertitude que Study 1 (Section 8.6) est conçue pour tester, et aucune cellule du premier mois ne peut être utilisée comme seuil ou échelon interprétatif. Aucune référence directe du premier mois n'existe dans la littérature publiée, donc la colonne est une projection plutôt qu'une mesure, extrapolée de la concentration documentée des téléchargements au début (les pics d'attention se regroupent dans les premières semaines, particulièrement sous couverture externe [18][116][138]) vers les seuils de vie utile ci-dessus. Les limites spécifiques dérivent d'une ancre publiée : dans l'échantillon de liste supérieure de Kakushadze, approximativement le top 1,8 % du stock d'articles en texte intégral de la plateforme (571 040, juillet 2016 [1]), le nombre médian de téléchargements sur douze mois était 247 [85]. Un premier mois au-dessus de ~250 dépasserait donc la norme annuelle de l'élite historique de la plateforme, d'où la limite Exceptional, tandis que 15–50 téléchargements au premier mois, s'ils se maintenaient, se projettent sur le seuil d'entrée de la vie utile ~160, d'où Solid. Ces cellules sont des projections à partir d'une seule ancre historique et sont les cellules les plus faibles du tableau ; si elles sont citées, elles portent cette dérivation.
Deux réserves gouvernent l'utilisation de l'échelle. Le qualificatif disciplinaire n'est pas optionnel : au sein d'une seule discipline, les téléchargements moyens par article diffèrent d'environ un facteur huit selon les sous-domaines (438,35 en Droit des Sociétés/des Valeurs/Financier contre 53,48 en Droit Agricole) [168], donc chaque énoncé de bande devrait porter une étiquette de domaine. Ce sont des moyennes de la vie utile et ne sont pas ajustées en fonction de l'âge de l'article, et la section archivale de l'Appendice E montre pourquoi cela importe : le niveau apparent d'un domaine évolue avec le profil d'âge des articles échantillonnés à partir de celui-ci, et en maintenant l'âge constant réduit l'écart à environ trois à cinq fois. Le second est que les heuristiques à nombre unique alternatif proposées dans cet espace (indices de performance relative basés sur le ratio (les téléchargements d'un article divisés par la médiane d'une cohorte appariée), heuristiques de niveaux logarithmiques basées sur ⌊ln D⌋, et verdicts de fiche d'évaluation verbale (« démarrage rapide / intérêt régulier / démarrage lent »)) sont subsumées ici comme heuristiques auteur non calibrées, car aucune n'a validé les bandes numériques. L'intuition logarithmique elle-même est solide et vaut la peine d'être conservée en termes verbaux : sous une distribution quasi-lognormale [85], passer de 7 à 20 téléchargements est un décalage d'une unité de logarithme naturel en visibilité, et le lire comme l'addition de 13 clics manque cela.
L'échelle explique aussi pourquoi les auteurs jugent systématiquement mal leurs propres compteurs. Les nombres qui circulent dans les jalons, les profils et les annonces proviennent, comme l'a documenté la Section 3.5, d'une queue visible des centaines de fois supérieure à la médiane, tandis que la masse de la distribution se situe près de la médiane LSN de 63, et selon la loi quasi-lognormale les distances entre les échelons sont multiplicatives, non additives. La Figure 7 arrange ces valeurs (médiane d'article ordinaire, seuils d'entrée, médianes d'élite, queue) comme une échelle de référence sur une échelle logarithmique.
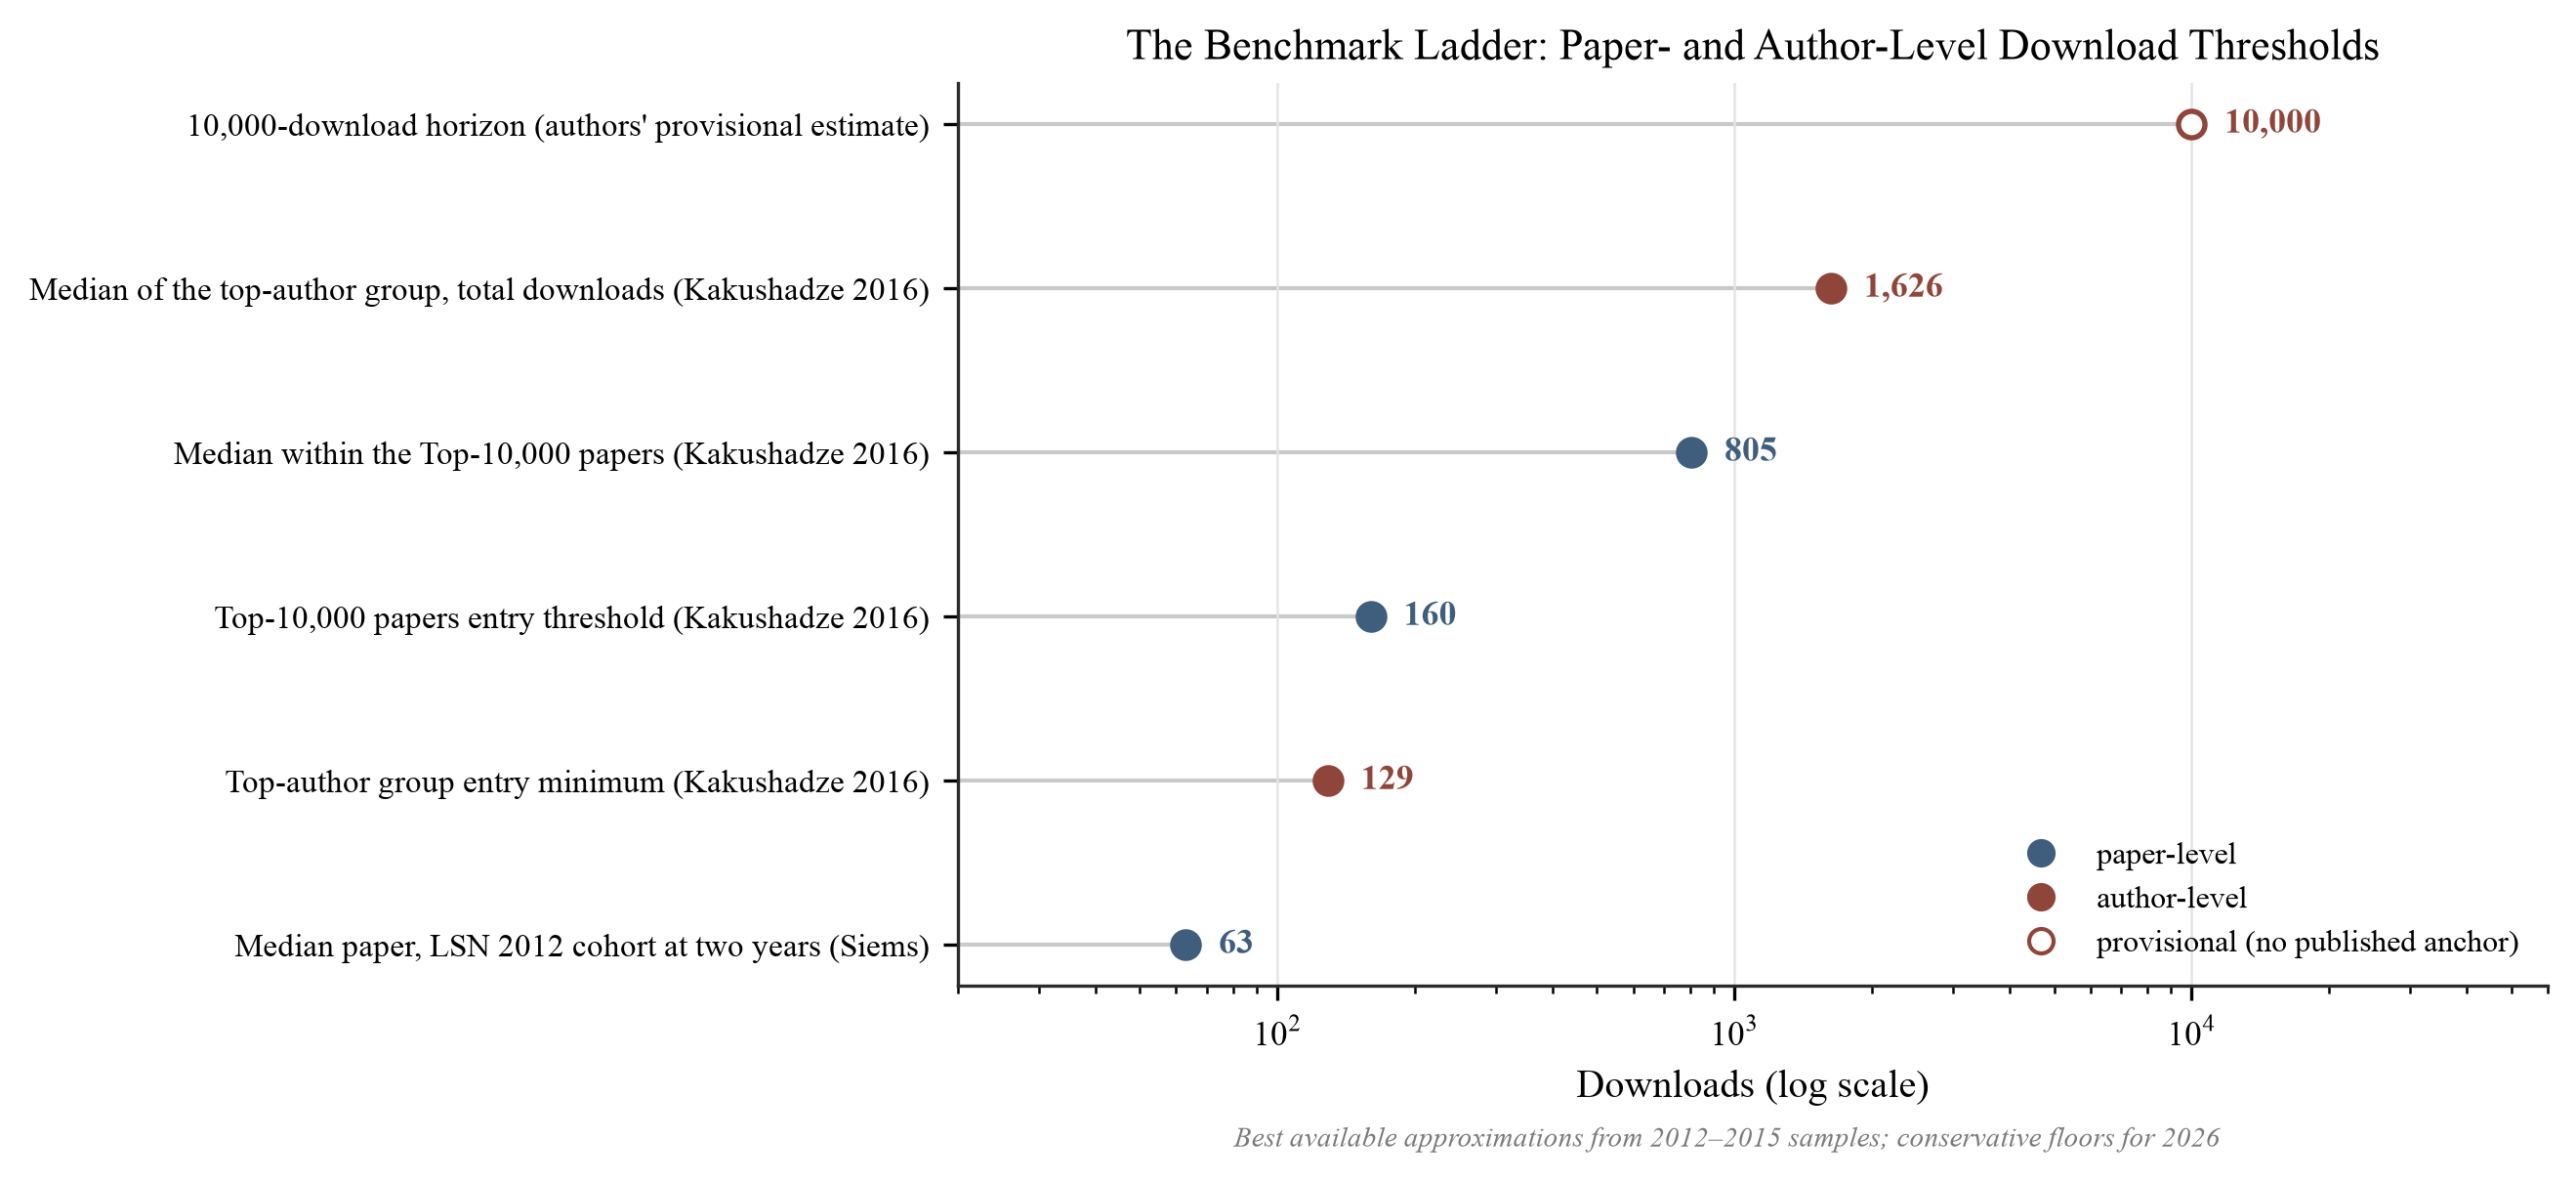
Figure 7. L'échelle de référence. Seuils de téléchargement au niveau article et auteur sur une échelle logarithmique : médiane LSN sur deux ans 63 [139] ; minimum d'entrée auteur supérieur 129 et entrée article supérieure ~160 [85] ; médiane au sein des articles Top-10,000 805 [85] ; médiane du groupe auteur supérieur 1 626 [85] ; horizon de 10 000 téléchargements (estimation provisoire de l'auteur, aucune ancre de percentile publiée). La région en dessous de la médiane sur deux ans de 63 correspond à la bande Nascent du Tableau 8. Les valeurs proviennent des échantillons de 2012–2015 (inflation depuis : Section 5.1).
5.4 Portée versus conversion : un diagnostic bidimensionnel
Un simple décompte, même regroupé, ne peut pas distinguer entre les différents mécanismes qui le produisent. La mécanique de la section 4 a une implication qui importe le plus dans la pratique : l'échec de visibilité et la non-réponse au contenu sont des diagnostics différents : un article peut être peu téléchargé parce que peu de lecteurs l'ont rencontré, ou parce que ceux qui l'ont rencontré ont refusé le texte intégral. Le tableau 9 croise les deux dimensions normalisées.
Tableau 9. Matrice de diagnostic portée–conversion. La portée et la conversion sont évaluées comme percentiles dans une classe de référence d'articles comparables (même domaine, cohorte de dépôt, âge de l'article et visibilité antérieure de l'auteur ; section 5.5), avec la médiane de la classe comme limite. Aucun seuil numérique absolu n'est défendable sur la base des données actuelles, et aucun n'est donné. L'affichage 2×2 dichotomise chaque axe à la médiane de la classe pour la lisibilité ; les percentiles sous-jacents de portée et de conversion sont continus (section 5.4), et des partitions plus fines comme les terciles sont disponibles.
| Conversion faible | Conversion élevée | |
|---|---|---|
| Portée faible | « Démarrage à froid » (portée faible, conversion faible). L'article n'est ni largement rencontré ni fréquemment téléchargé après exposition. Les données n'établissent pas si la recherche sous-jacente est faible ; elles établissent seulement que la diffusion n'a pas commencé. | « Intérêt caché » (portée faible, conversion élevée). Les lecteurs qui rencontrent l'article réagissent bien, mais trop peu le rencontrent. La découverte est le goulot d'étranglement observable principal — un problème de distribution, non un problème de contenu. |
| Portée élevée | « Attention sans adoption » (portée élevée, conversion faible). Le titre, le sujet ou le positionnement sur la plateforme semble attirer des visites, mais peu de visiteurs obtiennent le texte intégral. Écartez un dénominateur contaminé avant de diagnostiquer un défaut de communication : la portée élevée peut être des vues fantômes plutôt qu'une véritable attention, car les vues sont le plus pollué des deux compteurs (section 4.2) — dans le dossier transparent RePEc/LogEc, les robots représentaient environ 74 % des affichages de résumés mais seulement environ 7 % des téléchargements [99], de sorte que le trafic non humain non filtré produit exactement cette signature de portée élevée et conversion faible. Ce n'est qu'une fois que les vues gonflées par les robots sont exclues que les données résiduelles justifient d'enquêter sur l'ajustement du public et la communication titre–résumé. | « Diffusion précoce forte » (portée élevée, conversion élevée). L'article atteint un public comparativement large et convertit l'exposition en intérêt pour le texte intégral. |
Les quatre quadrants sont étiquetés selon le motif de diffusion que montrent les deux percentiles (démarrage à froid, intérêt caché, attention sans adoption, diffusion précoce forte). Les étiquettes décrivent un motif de diffusion, non la recherche elle-même, et ce qui importe opérationnellement est la séparation des mécanismes ; aucun quadrant de faible portée n'autorise une inférence sur la qualité de la recherche, un point qui a des incidences directes sur tout usage évaluatif de ces métriques. Le quadrant de faible diffusion prend le nom du diagnostic de cet article, le démarrage à froid. La matrice a une valeur pratique car l'intervention appropriée diffère selon le quadrant : un candidat d'intérêt caché a besoin de distribution (révision de la classification, calendrier d'annonce, visibilité externe), alors que l'attention sans adoption exige une réparation de la communication (titre et résumé) ou un audit du trafic. La figure 8 rend le plan comme un modèle.
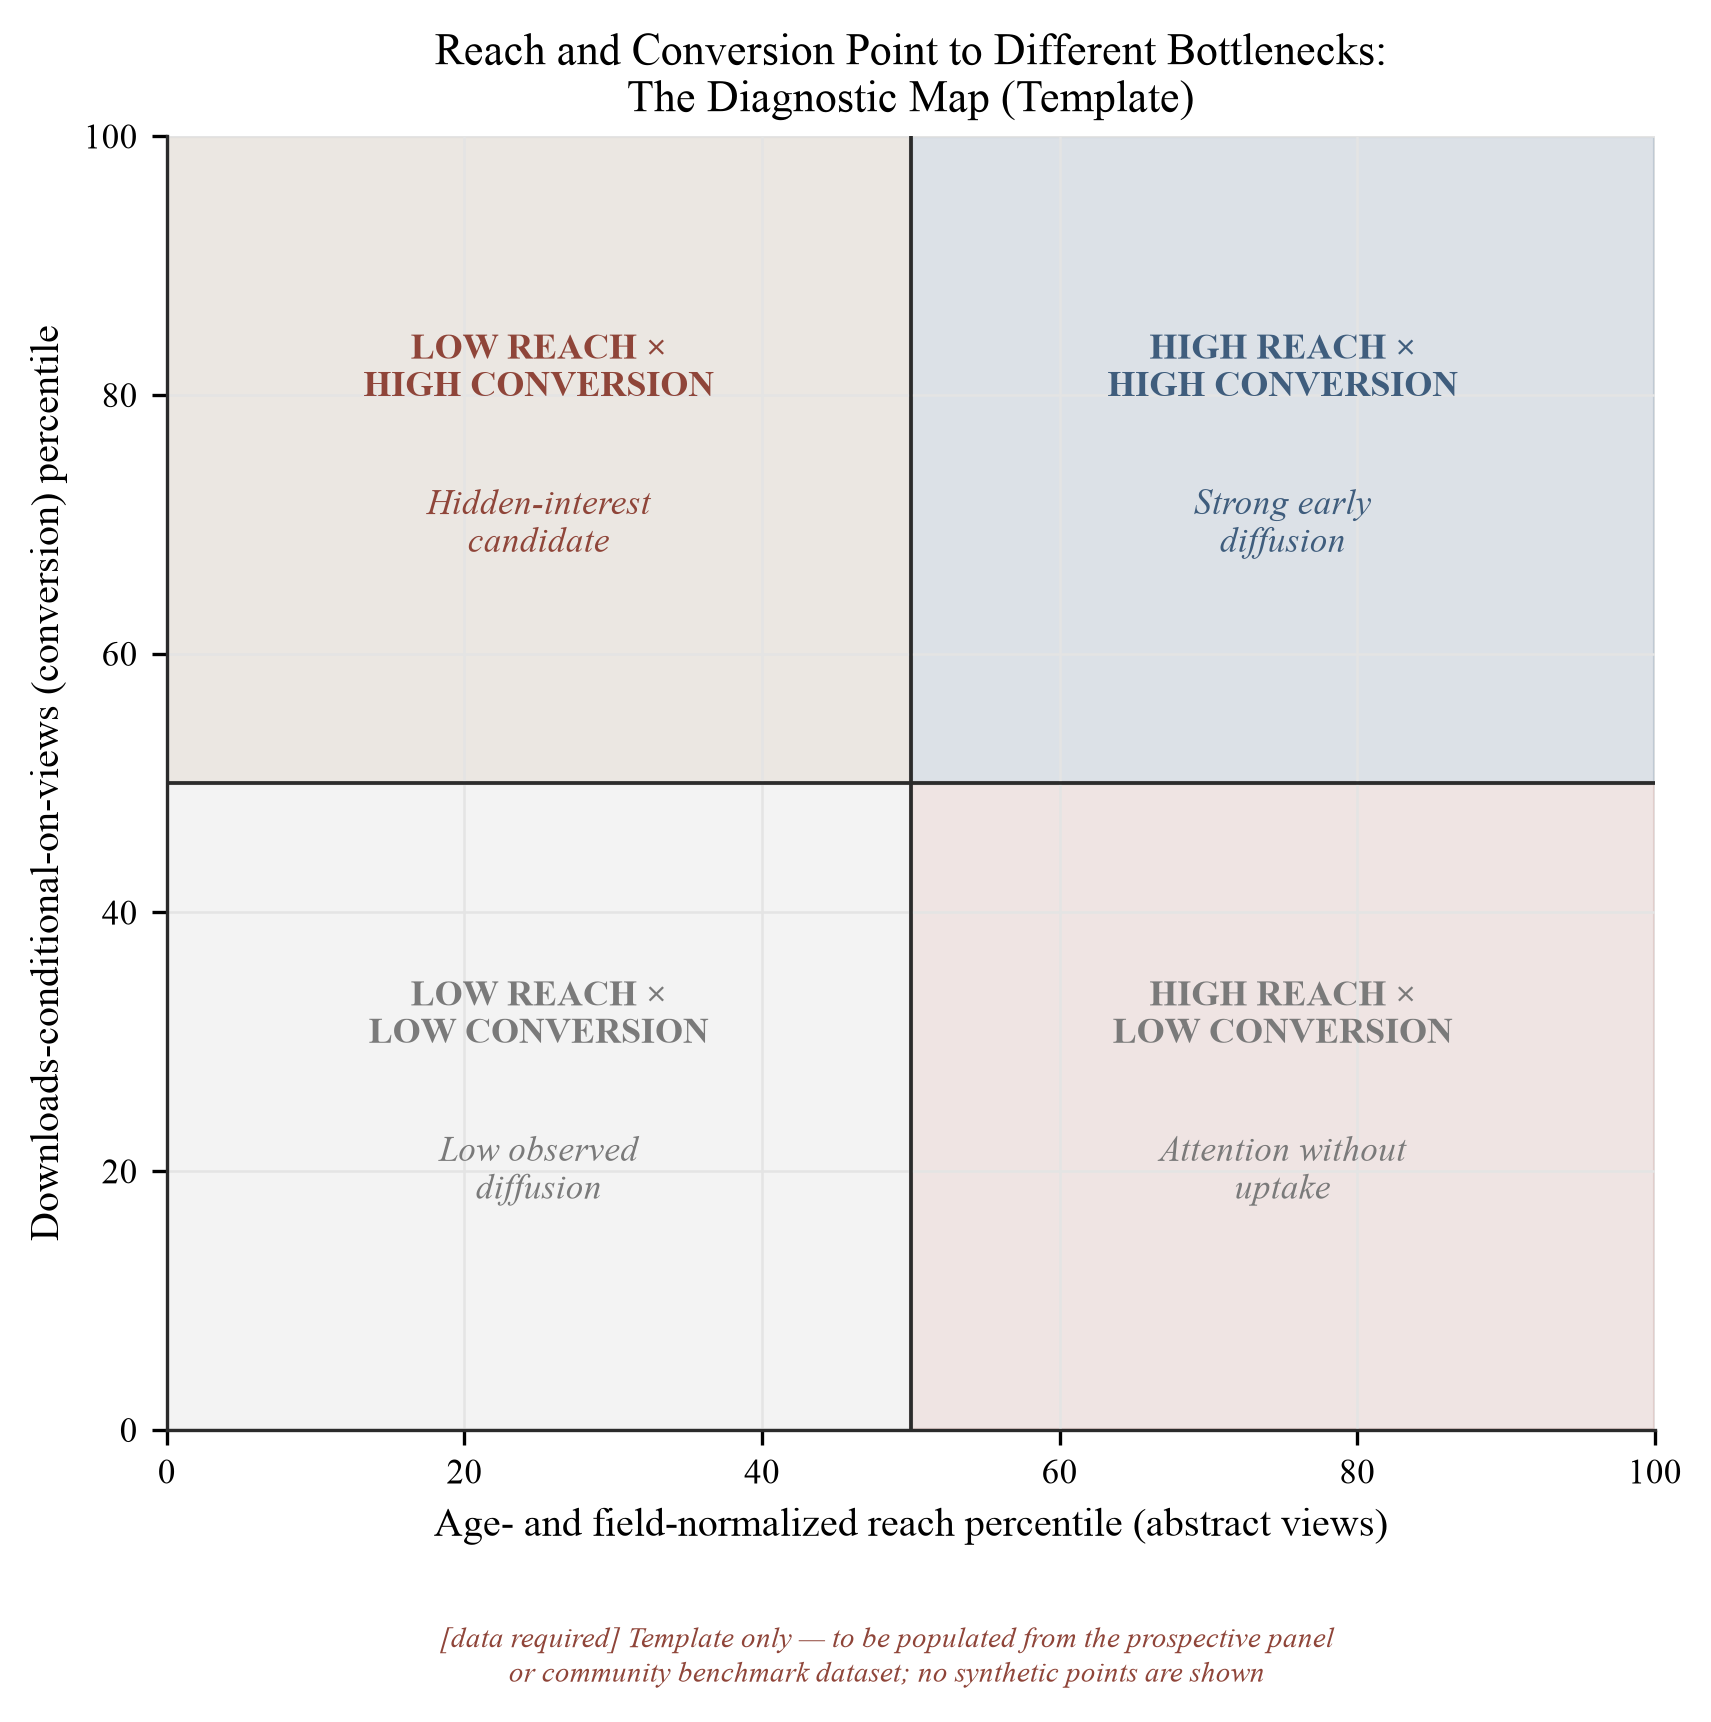
Figure 8. La carte portée–conversion. Modèle pour positionner les articles par percentile de vues normalisé par âge, domaine, cohorte et visibilité antérieure de l'auteur (portée, horizontale) et percentile de téléchargements-conditionnels-aux-vues (conversion, verticale), avec quadrants comme dans le tableau 9 (démarrage à froid, intérêt caché, attention sans adoption, diffusion précoce forte). Le quadrant en haut à gauche identifie les articles avec une conversion supérieure à la médiane malgré une portée inférieure à la médiane, une classe que les comptages bruts de téléchargements systématiquement sous-évaluent. Aucune valeur empirique n'est indiquée ; la carte doit être remplie à partir de l'panel prospectif ou de l'ensemble de données de référence communautaire de la section 8.
5.5 D'un chiffre-clé à un repère : les dimensions du CSAB
Chacune des sous-sections précédentes corrige un mode de défaillance du compteur brut, et le Cold-Start Scholarly Attention Benchmark (CSAB) en est l'intégration : un cadre de rapport qui remplace le chiffre-clé unique par cinq composantes normalisées (Tableau 10). Les variables de normalisation (âge de l'article, domaine, cohorte de publication et visibilité antérieure de l'auteur) sont chacune motivées empiriquement : les métriques cumulatives augmentent mécaniquement avec l'âge ; les normes des domaines diffèrent jusqu'à un ordre de magnitude dans la moyenne [168] ; les conditions calendaires modifient l'attention de manière mesurable (l'accès aux articles chute ~11% les week-ends et ~50% en été [178]) ; et un nouveau venu sur la plateforme ne fait pas face au même public initial qu'un auteur établi [83]. Une convention de population doit être fixée avant que tout percentile ne soit calculé. Un compteur cumulatif est défini sur un stock d'articles présentant une survie hétérogène (les articles sont occasionnellement retirés, fusionnés ou remplacés par des versions ultérieures), donc chaque percentile du CSAB est une affirmation sur le stock survivant à la date d'observation. L'Étude 1 (Section 8.6) préspécifie la règle d'inclusion (gestion des versions, retraits et résolution des doublons) plutôt que de laisser la population de référence implicite.
Les deux composantes centrales admettent une définition compacte. Pour l'article i d'âge τ (jours depuis la publication), dans le domaine f, la cohorte de publication c et la strate de visibilité antérieure s :
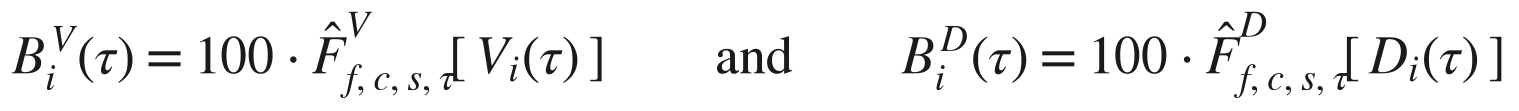
où V_i(τ) et D_i(τ) sont les vues et téléchargements cumulatifs du résumé et F̂^V, F̂^D sont les fonctions de distribution empirique de ces comptages dans la classe de référence définie par f, c, s et τ. La définition fixe l'estimande, un percentile au sein d'une classe de référence déclarée. Aucun F̂ ne peut être écrit aujourd'hui, car les distributions de référence n'existent pas (Section 5.1). La formule est la spécification que l'Étude 1 et le panel de la Section 8 sont conçus pour estimer, et la même notation se prolonge jusqu'à la conception de validation prédictive de la Section 8.9. La normalisation par percentile et classe de référence est elle-même une méthode bibliométrique établie : les percentiles sont un moyen standard de normaliser les comptages d'une publication pour le domaine, le type de document et l'année de publication [22], avec des procédures dédiées pour la normalisation des domaines et du temps des indicateurs dominés par des zéros [23], exactement le régime qu'occupe un compteur de téléchargements. Normaliser les métriques d'utilisation spécifiquement (téléchargements et vues plutôt que citations) par rapport à une classe de référence est également un domaine d'étude mature : la littérature bibliométrique d'utilisation a longtemps traité l'impact basé sur les téléchargements comme une distribution à conditionner selon les caractéristiques de la communauté d'utilisateurs et du plan d'échantillonnage [92][19], et les programmes de facteur d'utilisation des revues construisaient exactement de tels indicateurs d'utilisation normalisés à partir de données conformes au COUNTER [137]. La standardisation du comptage d'utilisation lui-même est le sujet d'une infrastructure de praticiens mature, le Code de pratique du COUNTER [125]. Les indicateurs de lisibilité normalisés par domaine ont un précédent établi comparable dans la littérature altmétrique [179]. La méthode est donc établie. La contribution ici est son application aux téléchargements de SSRN et la construction d'une classe de référence stratifiée par âge, domaine et cohorte pour un environnement post-classements.
L'estimande est clair, mais trois questions d'opérationnalisation doivent être résolues avant que tout F̂ ne soit ajusté. La première est la plus conséquente, car elle concerne à quoi sert le repère pour. Conditionner la classe de référence sur la visibilité antérieure de l'auteur (la strate s) est correct lorsque la question est diagnostique : « comment cet article s'en tire-t-il par rapport à des articles comparables d'auteurs comparablement visibles ? » C'est exactement faux lorsque la question est celle d'équité des H1–H3, car normaliser par la visibilité antérieure soustrait l'écart débutant-par-rapport-établi que le cadre d'équité existe pour mesurer. Un percentile intra-s ne peut pas détecter le désavantage du démarrage à froid, car le désavantage a été conditionné par construction. Le cadre sépare donc deux usages distincts du CSAB qui ne doivent jamais être réduits à un seul chiffre. En tant que repère descriptif, il rapporte la position d'un auteur au sein d'une classe de référence entièrement stratifiée (incluant s), ce qu'un auteur individuel souhaite au tableau de bord. En tant qu'estimande ajusté pour H1–H3, il supprime la visibilité antérieure de l'ensemble de conditionnement et la traite plutôt comme le prédicteur d'intérêt, mesurant le gradient plutôt que de l'éliminer. Les deux réponses diffèrent, elles répondent à des questions différentes, et tout rapport qui présente un percentile normalisé par la visibilité doit indiquer lequel des deux il est. Une deuxième question est la taille de l'échantillon. La stratification par domaine × cohorte × strate de visibilité × huit points d'âge épuise rapidement un échantillon probabiliste de 3 000–5 000 articles (Section 8.6) : le comptage des cellules complètement croisées atteint les milliers, donc la plupart des cellules sont minuscules ou vides. La réduction empirique-Bayes vers des classes de référence plus larges est nommée pour cette raison (Sections 8.3, 8.8), mais la réduction nécessite sa propre spécification : une structure hiérarchique minimale (domaine dans un domaine large, âge dans une tranche d'âge grossière) et une règle de cellule minimale préspécifiée pour l'estimation, au-dessous de laquelle une cellule emprunte à son parent plutôt que de rapporter un percentile brut. Cette règle de cellule minimale côté estimation est distincte de, et plus stricte à raisonner que, la règle de cellule minimale motivée par la vie privée qui gouverne la publication publique en Appendice D ; les deux servent des objectifs différents et sont spécifiées séparément. La dernière question est le momentum (Tableau 10), défini comme le changement dans une position normalisée estimée. Un score de changement dans une quantité estimée invite à la régression vers la moyenne : un article qui atterrit haut au jour 7 en partie par du bruit d'estimation aura tendance à chuter au jour 30 pour des raisons purement statistiques. Le momentum nécessite donc un modèle explicite de la trajectoire sous-jacente (par exemple, une estimation de rétrécissement ou empirique-Bayes de la position latente avec sa propagation d'erreur de mesure) plutôt qu'une différence brute de deux instantanés de percentile, et la différence brute est rapportée, le cas échéant, uniquement comme compagnon descriptif de la quantité modélisée.
Tableau 10. L'indice de référence d'attention savante au démarrage à froid (CSAB) : cinq dimensions au lieu d'un seul chiffre. Un modèle de rapport au niveau de la phrase, reproductible pour ces dimensions, est fourni en Annexe B.
| Dimension | Métrique | Question centrale | Interprétation |
|---|---|---|---|
| Portée | Percentile de vues normalisé par âge/domaine/cohorte/nouveaux venus | Les publics pertinents ont-ils rencontré l'article ? | Découvrabilité |
| Performance de téléchargement | Percentile cumulatif de téléchargement normalisé | Combien d'acquisitions de texte intégral se sont produites par rapport aux articles comparables ? | Diffusion précoce globale |
| Conversion | Téléchargements conditionnels aux opportunités de vues (Section 5.2) | Les lecteurs exposés ont-ils cherché le texte intégral ? | Engagement conditionnel |
| Momentum | Changement dans la position normalisée ou l'attention au niveau d'intervalle | La diffusion s'accélère-t-elle, se stabilise-t-elle ou s'estompe-t-elle ? | Trajectoire temporelle |
| Validation en aval | Citation ou utilisation ultérieure conditionnée aux métriques précoces | L'attention précoce a-t-elle prédit l'adoption savante ultérieure ? | Validité prédictive |
Le cadre rejette tout seuil brut universel de « succès ». Le succès doit être défini par rapport à un objectif analytique : pour la découvrabilité, un percentile de portée élevé parmi les articles du même âge et domaine ; pour l'adoption par les lecteurs, une conversion au-dessus de la classe de référence conditionnée à l'exposition ; pour la diffusion, la distribution conjointe des deux ; pour l'influence scientifique, les citations ou l'utilisation documentée en aval. L'utilisation précoce seule est insuffisante à cette dernière fin, puisque les téléchargements précoces n'expliquent que de l'ordre de 16 % de la variance de citation ultérieure [25]. Cela rend l'interprétation de l'exemple du titre exacte. Sept téléchargements est « bon » seulement dans la mesure où sept téléchargements place l'article inhabituellement haut parmi les autres articles comparables au même stade de leur cycle de vie. Une valeur au jour 7 et une valeur au jour 180 ne peuvent pas être évaluées sur le même indice de référence.
Quatre choix de conception suivent le huitième principe du Manifeste de Leyde : selon lequel les indicateurs quantitatifs ne doivent pas dépasser la force des hypothèses qui les sous-tendent, et selon lequel la fausse précision elle-même constitue un échec de la mesure [78]. Le cadre rapporte des bandes, non des scores ponctuels (Tableau 8) ; il fixe le CSAB en tant que vecteur diagnostique plutôt que cible (Section 5.2) ; il dessine ses figures de sortie, la carte portée–conversion (Figure 8) et l'éventail d'indice de référence (Figure 14), sans échelle numérique, de sorte qu'une forme ne puisse pas être confondue avec une valeur calibrée ; et il attache un niveau de vérification et un millésime à chaque chiffre qu'il utilise (Tableau 7). Chacun de ceux-ci retient la précision que les preuves ne peuvent pas soutenir, comme le demande la DORA dans l'évaluation de la recherche en rejetant les proxies à chiffre unique et de marque de revue pour l'évaluation substantive du contenu d'un article [8]. Réduire le CSAB à un seul score réintroduirait exactement la fausse précision que les deux documents déconseillent.
Pour un auteur, le rapport CSAB remplacerait la simple ligne « Téléchargements : 12 », par quelque chose comme ceci : 12 téléchargements après 14 jours : percentile de téléchargement global parmi les articles comparables : 67e ; percentile de portée : 39e ; percentile de conversion : 81e ; interprétation : intérêt conditionnel élevé, exposition inférieure à la médiane. Chaque chiffre de cette composition est illustratif, puisqu'aucun de ces percentiles n'existe jusqu'à ce que les distributions de référence de la Section 8 soient estimées, et aucune de ces valeurs ne peut être citée en tant qu'indice de référence, mais le format montre ce que la décomposition apporte. Le même décompte brut qui se lit comme une déception indifférenciée se résout en un diagnostic spécifique : les lecteurs qui rencontrent l'article réagissent inhabituellement bien, mais trop peu le rencontrent, de sorte que l'intervention indiquée est la distribution, non la révision. L'exemple travaillé est l'homologue CSAB du quadrant « intérêt caché » du Tableau 9. L'Annexe B fixe ce format en tant que modèle de rapport reproductible dont les champs de percentile restent vierges jusqu'à ce que les distributions de la Section 8 existent.
5.6 Trajectoires de lecture : l'exposition est un traitement, non un bruit de fond
La composante finale du cadre est temporelle : un article nouvellement publié n'entre pas dans un environnement d'attention homogène. Il traverse des régimes d'exposition distincts (publication → découverte interne → distribution par courriel → indexation externe → diffusion en réseau), et un total cumulatif réduit ces régimes à un seul nombre. Les limites des régimes sont fixées par la machinerie de la section 4 : la distribution par eJournal est curée et peut prendre jusqu'à 45 jours dans les sujets à fort volume [53], et l'indexation par moteur de recherche externe peut prendre 6 à 9 mois ou plus [55].
L'état du tableau de bord le plus générateur d'anxiété découle directement de ceci : zéro téléchargement la première semaine est normal avant distribution, non un rejet. Avant que le cycle d'annonce ne soit terminé, l'article n'a pas encore été exposé à son public principal. La séquence diagnostique pour un zéro précoce est administrative : confirmer que l'article est publiquement affiché ; confirmer l'attribution à eJournal ; attendre la fin du cycle d'annonce ; seulement ensuite lire les compteurs. Inversement, les compteurs du premier mois, une fois la distribution effectuée, sont l'indicateur avancé le plus précoce et le plus bruyant : les téléchargements précoces sont corrélés aux citations ultérieures à environ r ≈ 0,4 [25], informatif mais loin d'un verdict, et les pics précoces sont fréquemment des événements d'exposition (couverture médiatique ou de blog) plutôt qu'un intérêt durable [116][138].
Puisque le raclage rétrospectif des compteurs cumulatifs ne peut pas reconstituer ce qu'un article avait le jour 3 ou le jour 30, l'interprétation basée sur la trajectoire (et l'agenda de recherche du panel de la section 8) nécessite l'observation dès la naissance sur une grille standardisée. Le tableau 11 précise l'horaire minimum. Il sert aussi de modèle d'auto-suivi pour les auteurs individuels. Une trajectoire n'est classée que provisoirement aux lectures 60 et 90 jours de la grille du tableau 11 et avec confiance à la lecture de 180 jours, jamais au jour 7.
Tableau 11. Programme minimum d'observation longitudinale pour les articles SSRN.
| Âge de l'article | Objectif principal de l'observation |
|---|---|
| Jour 1 | Exposition immédiate de la plateforme |
| Jour 3 | Découverte très précoce |
| Jour 7 | Référence de la première semaine (valeur attendue pour la plupart des articles : à zéro ou près de zéro, avant distribution) |
| Jour 14 | Stabilisation précoce |
| Jour 30 | Référence du premier mois |
| Jour 60 | Maturation de la distribution et de la recherche (cycles eJournal terminés [53]) |
| Jour 90 | Diffusion précoce à moyen terme |
| Jour 180 | Transition vers la mesure de l'impact en aval |
Dans la mesure du possible, l'observation quotidienne au cours des 45 premiers jours est préférable, car la distribution par courriel peut se produire à des moments variables dans cette fenêtre [53]. Les lectures au niveau des intervalles sur cette grille convertissent le tableau de bord d'un verdict statique en une trajectoire, la seule forme dans laquelle les métriques SSRN précoces portent une information défendable.
Les sections 4 et 5 remplacent la question à laquelle un auteur ne peut pas répondre (« 7 téléchargements, c'est bien ? ») par quatre que le dossier publié peut soutenir : où le compteur se situe-t-il par rapport à la carte de référence et à ses versions (5.1, 5.3) ; la conversion se situe-t-elle dans la bande empirique (5.2) ; quel quadrant du plan portée-conversion l'article occupe-t-il (5.4) ; et que montre la trajectoire sur la grille d'observation (5.6) ? Aucune de ces questions ne nécessite les Classements retirés, mais elles nécessitent toutes les données comparatives dont la collection les sections finales de cet article proposent.
6. Un guide pratique pour les auteurs
La carte de référence de la section 5 (tableau 7) restaure l'échelle manquante, et cette section la met en pratique pour l'auteur qui ouvre le panneau de statistiques après le 15 juillet 2026 et voit des compteurs sans contexte [148][149]. Elle a quatre tâches à son tour : une routine pour observer ses propres compteurs (6.1-6.2), des substituts au cadre comparatif que les classements avaient l'habitude de fournir (6.3), des leviers qui peuvent légitimement améliorer la visibilité (6.4), et un protocole pour convertir les compteurs en preuves professionnelles défendables (6.5-6.6). Chaque ancre numérique utilisée ici remonte à une source publiée avec un cadre d'échantillonnage explicite et une fenêtre de temps ; le tableau 7 les consolide. Les pratiques circulant dans la communauté des auteurs qui n'ont aucun soutien probant sont marquées comme non vérifiées partout où elles apparaissent et sont rassemblées, en tant qu'hypothèses candidates pour les tests, à la fin de l'annexe A.
Le tableau 12 compresse le cœur du guide en un protocole de sept questions, posées dans l'ordre, chacun associé aux preuves qui valent la peine d'être conservées et à la conclusion la plus forte que la réponse peut légitimement autoriser. Les sections 6.1-6.2 développent ce protocole en routines et règles de lecture, et le tableau 23 (annexe A) reste son compagnon situationnel, indexé par les états de tableau de bord que les auteurs rencontrent réellement.
Tableau 12. Un protocole d'auteur pour interpréter un compteur SSRN : sept questions, les preuves à préserver et la conclusion permissible. Aucune étape ne traite un compteur comme un score de qualité ; la colonne finale indique le plafond de ce que chaque réponse peut soutenir.
| Étape | Question | Preuves à préserver | Conclusion permissible |
|---|---|---|---|
| 1 | Quel âge avait l'article au moment de l'observation du compteur ? | Capture d'écran ou export datée, plus la date de publication | Une observation ponctuelle dans le temps, non un verdict de durée de vie |
| 2 | La distribution curée et l'indexation externe avaient-elles eu lieu ? | Avis et date de distribution le cas échéant ; statut de l'index de recherche | Identification du régime pré- ou post-exposition (section 5.6) |
| 3 | Que sont les vues, les téléchargements et la conversion ensemble ? | Les deux compteurs et le dénominateur | Un diagnostic portée-engagement-conditionnel (tableau 9), non un verdict unique |
| 4 | Quelle est la classe de référence la plus étroite défendable ? | Domaine, cohorte, âge de l'article, statut de nouveau venu, historique de classification | Position relative uniquement au sein de cette classe (section 5.5) |
| 5 | La trajectoire change-t-elle ? | Observations répétées aux âges fixes du tableau 11 | Momentum ou plateau, soumis aux événements d'exposition — non une accélération de la « qualité » |
| 6 | Y a-t-il corroboration en aval ? | Citations, contacts substantiels, publication ou utilisation documentée | Preuves en couches de l'adoption, non une preuve de qualité |
| 7 | La réclamation peut-elle être reproduite ? | Source, date, règle de comptage, enregistrement archivé | Un rapport vérifiable, non un jalon non étayé |
6.1 Une routine de mesure
L'interprétation commence par l'enregistrement discipliné, car SSRN n'affiche que les comptages cumulatifs actuels et aucun historique sous le contrôle de l'auteur. Six étapes, appliquées à partir du jour de la publication, produisent l'enregistrement minimal que toute inférence ultérieure exige.
1. Enregistrez les deux compteurs et leur rapport. Notez les vues d'abstracts, les téléchargements et le rapport de conversion téléchargements-vers-vues à intervalles fixes. La grille d'observation du Tableau 11 (jours 1, 3, 7, 14, 30, 60, 90, 180) spécifie l'horaire et le but de chaque lecture. Une capture d'écran datée à chaque intervalle est la seule version d'enregistrement que l'auteur contrôle, car les compteurs de plateforme peuvent être réajustés lorsque les règles de filtrage changent [144][69]. L'enregistrement cumulatif est un paquet de preuves versionnées : la version du manuscrit, ses métadonnées et classifications, des captures d'écran du tableau de bord datées, des avis de distribution, un journal daté des événements de promotion propres à l'auteur (un fil posté, une présentation, une annonce de liste de diffusion), ainsi que les citations et contacts ultérieurs substantifs. Le journal de promotion importe car les promotions sont des traitements d'exposition. Sans un enregistrement daté de sa propre publicité, un auteur ne peut pas distinguer un pic organique d'un pic autoengendré, et personne auditant la revendication ne le peut non plus (Section 8.3).
2. Normalisez par le temps écoulé depuis la publication. Exprimez les performances précoces sous forme de téléchargements par mois au cours des trois à six premiers mois plutôt que sous la forme d'un comptage cumulatif brut. Un article âgé de trois mois comparé aux totaux historiques du travail plus ancien produit des conclusions systématiquement trompeuses, car les compteurs s'accumulent au cours de la durée de vie d'un article sur une plateforme dont le volume annuel de téléchargements est passé d'environ 12,9 millions en 2016 à 40,6 millions en 2023 [1].
3. Ne mélangez jamais les fenêtres d'observation. Un comptage hebdomadaire ne peut pas être comparé à une moyenne de douze mois, et un comptage de 90 jours ne peut pas être comparé aux totaux historiques. Chaque comparaison dans ce playbook associe des fenêtres semblables avec des fenêtres semblables. Les violations de cette règle figuraient parmi les erreurs interprétatives les plus courantes dans l'utilisation précédant le coucher du soleil des statistiques de classement [161].
4. Situez l'article dans son voisinage disciplinaire, non contre la plateforme. Les téléchargements moyens par article ont différé d'approximativement un facteur de huit dans les seules revues du Réseau de bourses juridiques (438,35 en Droit des sociétés/Valeurs mobilières/Finance versus 53,48 en Droit agricole, données de 2018) [168]. Un comptage qui est remarquable dans un sous-domaine est exceptionnel dans un autre. La classe de référence pertinente est la propre revue de l'article ou le réseau thématique, examiné au même âge de l'article.
5. Ne surinterprétez pas les petits comptages isolés. La littérature sur l'intégrité fixe un plafond à la précision des compteurs d'utilisation : les téléchargements rapportés par les éditeurs peuvent atteindre le double de ceux des plateformes comparables [176], les filtres de plateforme écartent une grande part du trafic brut [99][129][144], et sans de tels filtres les compteurs propres de SSRN seraient gonflés « d'un facteur cinq ou plus » [18]. Les petites différences entre les nombres comparables ne comportent donc aucune information.
6. Surveillez l'accumulation à long terme plutôt que de réagir aux premiers chiffres. L'attention sur les plateformes de documents de travail se concentre tôt [116][28] (le dernier résultat provient de données du NBER plutôt que de SSRN), mais les couches de découverte arrivent lentement : SSRN rapporte que l'indexation de Google Scholar prend « 6–9 mois ou plus » [55]. La lecture, en outre, décroît selon plusieurs échelles temporelles à la fois, et la lecture et la citation ne doivent pas nécessairement suivre le même processus temporel [91], donc aucune lecture simple de « demi-vie » de sa propre courbe n'est sûre. Une trajectoire peut d'abord être classée provisoirement aux lectures des jours 60–90 de la grille du Tableau 11 et avec plus de confiance à 180 jours, jamais à la lecture du jour 7.
6.2 Cinq règles pour lire le tableau de bord
Avec ce dossier en main, les preuves distributionnelles de la section 5 se résument à cinq règles pratiques pour lire un tableau de bord au jour le jour.
(i) Comparer par rapport aux médianes, non aux moyennes ni aux étoiles visibles. Le seul échantillon de style recensement d'articles ordinaires place la médiane à 63 téléchargements et 369 affichages de résumés après deux ans (LSN, articles publiés 2012) [139]. Dans le seul échantillon publié récent, la médiane est de 87 téléchargements, par rapport à une moyenne de 221,3 qui se situe au-dessus même du 75e percentile (section 3.3) [83]. Les chiffres repères qui circulent proviennent de la queue visible, dont les maxima de 2015 s'élevaient à des centaines de milliers de téléchargements (section 3.5) [85] ; un auteur qui s'étalonne par rapport à eux s'étalonne par rapport à la queue d'une distribution quasi-lognormale, ce qui garantit un mauvais étalonnage. La moyenne à l'échelle de la plateforme d'environ 222 téléchargements permanents par article calculée à partir des agrégations de décembre 2023 [1] est tout aussi inutilisable comme repère personnel.
(ii) Vérifier le ratio de conversion, non seulement le nombre. Les mesures indépendantes convergent vers une bande normale d'environ 11–19 % de téléchargements par affichage de résumé : la moyenne de 18,7 % et la médiane de 17,1 % de l'échantillon LSN [139], et les chiffres de 15 % (articles les plus cités) et 11 % (articles à une citation) des études de citation juridique [172]. La règle empirique de trois affichages par téléchargement de longue date de SSRN [18] se situe au-dessus de cette bande plutôt qu'en son sein. L'échantillon récent du réseau Marketing se situe légèrement au-dessus de cette bande, avec une moyenne de 23,7 téléchargements pour 100 affichages [83]. La figure 6 trace ensemble les estimations. Exécuter l'exemple travaillé central de la section 5.2 à travers la règle : les 40 affichages de résumés et 7 téléchargements du titre se convertissent en 17,5 %, à l'intérieur de la bande en tant qu'estimation ponctuelle, mais avec un intervalle de Clopper–Pearson à 95 % large (≈7,3–32,8 %). À n = 40, la lecture n'est pas un échec et n'est pas un percentile précis : un résultat de dépistage cohérent avec une conversion ordinaire. Une conversion bien en dessous de la bande est cohérente avec un décalage entre le résumé et l'article, où les lecteurs arrivent, lisent le résumé et s'en vont. C'est exploitable, et l'action est de réviser le titre et le résumé. Une conversion bien au-dessus de la bande signale un trafic que la navigation dans les résumés n'explique pas, comme les liens directs à partir de couverture médiatique ou d'agrégateurs, et elle devrait inciter à vérifier l'origine des affichages. Les deux lectures sont des diagnostics de dépistage : aucune étude n'a causalement validé l'inférence d'une faible conversion à la qualité du résumé, et le diagnostic doit être enregistré comme une hypothèse sur son propre article.
(iii) Traiter les téléchargements du premier mois comme le plus précoce, et le plus bruyant, signal de citation. Les téléchargements précoces corrèlent avec les citations ultérieures à environ r ≈ 0,4 dans les données arXiv, que les auteurs originaux eux-mêmes traduisent en seulement environ 16 % de la variance expliquée [25]. Le signal précoce le plus ancien enregistré est biomédical : les compteurs de visites en ligne dans la première semaine suivant la publication dans le BMJ ont corrélé à environ 0,50 avec les citations accumulées au cours des années suivantes [119]. En matière de jurisprudence, Black et Caron ont signalé des corrélations téléchargements-citations au niveau de l'article de l'ordre de 0,50, montant à environ 0,55 dans un échantillon de cent professeurs de droit junior [18]. Dans les domaines et les horizons, les corrélations au niveau de l'article varient d'environ 0,1 à 0,6 [80][25], et les compteurs de téléchargement arXiv perdent leur signification statistique en tant que prédicteurs une fois que l'attention Twitter contemporaine est contrôlée [138]. Au niveau agrégé, l'association se resserre : 0,84 entre les classements basés sur les téléchargements et ceux basés sur les citations de cent écoles de droit [77], et R = 0,724 entre les téléchargements de PDF de six mois et les citations ultérieures dans l'analyse propre d'une revue [114]. Ces chiffres agrégés ne règlent pas la question de l'endroit où aboutira un article unique, et un premier mois de téléchargements est un signal précoce sur les citations ultérieures.
(iv) Zéro téléchargement dans la première semaine est une pré-distribution normale, non un rejet. Un article nouvellement publié n'attire l'attention qu'après avoir passé la modération, être classé dans les eJournals de sujet, et entrer dans le cycle d'annonce. La documentation propre de SSRN décrit la classification comme curée plutôt que garantie, avec des délais jusqu'à 45 jours pour les sujets fortement chargés [53], et les distributions d'eJournal et les alertes par courrier électronique ont été explicitement confirmées comme continuant inchangées après le coucher du soleil [147][57]. La séquence de diagnostic s'exécute comme suit : confirmer que l'article est publié publiquement, confirmer la classification eJournal, attendre le cycle d'annonce, et lire les compteurs uniquement après cela. La découverte par les moteurs de recherche arrive encore plus tard [55].
(v) Un compteur en baisse ou plat peut refléter un filtrage, non une perte de lectorat. SSRN documente publiquement qu'il rejette les téléchargements apparents en double, les téléchargements robots, et autres activités irrégulières [144][66][69]. L'expérience RePEc/LogEc montre l'ampleur de telles corrections : en juillet 2007, les robots représentaient environ 74 % des affichages de résumés mais seulement environ 7 % des téléchargements [99], et en septembre 2025, plus de 99,5 % du trafic brut d'IDEAS a été rejeté au milieu de l'interférence des bots IA [129]. Une chute soudaine, ou une restatement, est donc aussi susceptible d'être un événement de mesure qu'un événement de lectorat, et elle ne devrait jamais être lue comme une perte de réputation sans corroboration.
6.3 L'évaluation comparative sans classements
Les classements fournissaient un cadre comparatif. Un auteur dispose aujourd'hui de trois substituts, ordonnés du moins au plus gourmand en travail.
Micro-évaluations. Le remplacement le plus direct est un groupe de référence qu'on se constitue soi-même : identifier trois à cinq articles méthodologiquement comparables de pairs d'institutions comparables, postés le même mois, et suivre leurs compteurs publics selon le même calendrier que le tableau 11 pour les siens. Le résultat est une base de référence de percentile localisée par rapport à exactement la bonne classe de référence, assortie par construction du domaine, de l'âge de l'article et de l'époque de la plateforme, où les classements retraités comparaient des articles de tous âges et domaines dans une seule ligue. C'est une procédure proposée qui utilise uniquement les comptages publics par article, et elle doit être enregistrée comme telle dans toute utilisation en dossier. Elle suppose aussi une certaine familiarité avec une littérature de pairs que les nouveaux venus les plus isolés, précisément les auteurs les plus affectés par la condition de démarrage à froid, pourraient ne pas avoir. Pour eux, le remède côté plateforme de la section 10.4 (bandes de percentile anonymes) est le correctif structurel, car il ne nécessite aucun réseau auto-assemblé pour être utilisé.
Un ratio de performance relative. La même logique peut s'exprimer sous la forme d'un seul nombre : le ratio entre les téléchargements d'un article à un âge donné et les téléchargements médians d'une cohorte appariée, c'est-à-dire la même discipline, le même âge de l'article, et si possible le même type d'article. Un ratio de 1,0 signifie exactement une visibilité médiane pour la cohorte, et les valeurs supérieures ou inférieures à 1,0 se lisent en conséquence. L'indice ordonne les articles au sein d'une cohorte appariée ; les bandes de percentile attendent la distribution de référence. Les médianes publiées à partir desquelles une base de cohorte pourrait être construite sont vieillies et étroites (63 téléchargements à deux ans pour les articles juridiques postés en 2012 [139], 87 pour les articles de marketing observés en 2025 [83]), et cartographier les valeurs de ratio sur les percentiles nécessite la distribution complète, pas seulement la médiane. Attribuer des étiquettes de percentile aux bandes de ratio sans cette distribution produit une fausse précision. L'agenda préenregistré de la section 8 inclut l'étalonnage des bandes ; en attendant, le ratio est un dispositif d'ordonnancement, non une échelle de notation. Deux autres mises en garde limitent le dispositif. Il ne doit pas être calculé du tout sur de petits comptages, car l'instabilité à petit dénominateur de la section 5.2 s'applique au numérateur du ratio et à une médiane de cohorte mince également, et le rétrécissement empirique-Bayes (sections 8.3, 8.8) est la réparation appropriée partout où un tel ratio est rapporté publiquement. Un ratio donné ne se traduit pas par un percentile fixe : « deux fois la médiane de la cohorte » correspond à des positions de percentile différentes dans les distributions de formes différentes, donc le ratio ordonne les articles au sein d'une cohorte mais ne peut être comparé entre les cohortes ou les époque dont les formes distributionnelles diffèrent.
Langage de verdict pour les trajectoires. Les outils destinés à la communauté ont proposé de classer la trajectoire précoce d'un article en trois verdicts qualitatifs (démarrage rapide, intérêt constant, démarrage lent) comme alternative bienveillante aux nombres bruts. Le vocabulaire vaut la peine d'être conservé, car il convertit un comptage en énoncé sur une trajectoire, et « démarrage lent » n'est explicitement pas un synonyme d'échec. Les seuils initialement proposés pour ces verdicts reposaient sur des comparaisons de fenêtres temporelles sans correspondance et sur une statistique « moyenne du réseau » à l'échelle de la plateforme qui n'existe pas en tant que métrique publique : SSRN n'offre aucune API en libre-service ou point de terminaison de statistiques publics [51], et la métrique historique la plus proche (« Nouveaux téléchargements par article », une statistique de classement au niveau de l'auteur) a été supprimée avec les classements ([B-9], citée avec la mise en garde que les pages de classement historiques ne sont plus accessibles). Attribuez des verdicts, alors, seulement à partir de comparaisons appariées : le groupe de micro-évaluation ou le ratio de médiane de cohorte ci-dessus, lus au plus tôt à la marque de 60–90 jours.
Quel que soit le substitut utilisé, la triangulation externe le renforce. Les données de couche citation de Crossref et OpenAlex [35][124] et les indicateurs PlumX affichés sur les pages SSRN [50] répondent à une question différente, sur l'utilisation en aval plutôt que sur la visibilité. Un outil de citation politique comme Overton étend la même triangulation à la portée politique et pratique en cartographiant où un article est cité dans les documents gouvernementaux et institutionnels [187], ce qui convient à la base juridique, économique et politique de SSRN. Ces couches sont examinées conjointement avec les compteurs dans le cadre CSAB du tableau 10 et les diagnostics de portée-conversion du tableau 9. Les indicateurs Altmetric constituent une couche de triangulation supplémentaire. Conçus dès le départ comme des signaux d'attention précoce [123][122], ils suivent des schémas distincts des citations [74][20] et admettent une normalisation par domaine [21]. Ils sont également vulnérables à l'inflation automatisée [75] et nécessitent une interprétation guidée par la théorie plutôt qu'une lecture au pied de la lettre [76].
6.4 Améliorer la visibilité légitime
Avant le coucher du soleil, les classements fournissaient un retour d'information brut mais réel pour une décision d'auteur récurrente : savoir si une promotion supplémentaire d'un article valait l'effort (Section 1.3). Après le coucher du soleil, cette décision doit être prise à partir des leviers et des diagnostiques assemblés ici. La littérature sur les déterminants identifie un petit ensemble de leviers sous le contrôle de l'auteur et cohérents avec les règles de la plateforme. Chacun agit sur la visibilité, non sur la qualité, et aucun ne change ce que contient l'article. La dissémination rapide et les retours d'information précoces figurent parmi les objectifs reconnus de la mise en ligne de préimpressions dans la littérature méthodologique sur les préimpressions [24], et un plan d'action pour la visibilité légitime utilise cette fonction déclarée.
Présentation. Dans l'échantillon LSN, les caractéristiques du titre, la longueur du résumé et la saillance du sujet étaient significativement associés à l'attention, avec la mise en garde propre à l'auteur que de telles variables peuvent être des substituts pour une qualité inobservable [139]. Dans les études de citations juridiques, les articles du premier décile portaient plus de mots-clés et de résumés plus longs que les articles du dernier décile [172] (les comptes spécifiques attendent une vérification par rapport à l'original). La page du résumé est la surface de conversion sur laquelle la règle (ii) opère, donc lorsque la conversion se situe persistemment en dessous de la bande, le titre et le résumé sont les premières choses à réviser. Toute révision de ce type vise un alignement entre la promesse et le contenu, non un trafic indiscriminé : réécrire un résumé déjà clair pour maximiser les clics peut endommager sa précision, et en attirant des visiteurs mal assortis, cela peut éloigner la conversion de la bande plutôt que de la rapprocher.
Classification. Les articles classés dans plus d'eJournals ont enregistré en moyenne plus de téléchargements et moins de résultats sans téléchargement dans l'analyse LSN de 2018 [168]. SSRN permet une à sept classifications par article et en organise l'inclusion [53]. Un affinement communautaire populaire, non vérifié car aucune étude ne compare les stratégies de classification, limite les classifications à trois, choisies comme une eJournal principale, une large et une interdisciplinaire ; ce conseil figure parmi les hypothèses testables de l'Appendice A.
Distribution et attention externe. L'alerte par courrier électronique de l'eJournal reste le principal canal de diffusion de la plateforme et se poursuit après le coucher du soleil [147][57][152]. En dehors de la plateforme, la couverture de blog a produit des pics de téléchargement précoces nets dans le seul test empirique de la question [116], la position visible a accru la lecture et les citations dans les études positionnelles d'arXiv [72], et la participation à des conférences était associée à 17–26 téléchargements supplémentaires par article dans une étude quasi-expérimentale construite autour d'une réunion annulée de science politique ([B-4], citée avec la mise en garde que le cadre est APSA 2012, non un échantillon SSRN-économie). Les guides de praticiens rassemblent d'autres outils de distribution pour l'érudition juridique [169]. Le cas de la dissémination ouverte précoce est établi indépendamment : un essai randomisé d'accès ouvert a trouvé plus de téléchargements bien qu'aucun gain de citation à court terme [37], tandis que les études de cohorte et les études de domaine rapportent des avantages de citation d'environ 10 % à deux fois [59][86][17][93], y compris +53 % pour les revues juridiques américaines [40], et un audit des citations juridiques a constaté que 87 % des articles les plus cités étaient disponibles sur SSRN contre 44–46 % des articles peu cités, avec 95 % du groupe le plus cité publié sur SSRN dans ou avant leur année de publication [172]. Le dépôt de préimpression est associé à des citations plus élevées et à des téléchargements de sites d'éditeurs plus faibles sur arXiv [38], et les téléchargements bioRxiv corrèlent avec les résultats du journal [62]. Dans le recensement de toutes les préimpressions bioRxiv, les comptes de téléchargement corrèlent avec le facteur d'impact du journal dans lequel une préimpression est ultérieurement publiée (τb de Kendall = 0,59), une association dont la direction de causalité est inconnue [2]. Les couches de découverte automatique (moteurs de recherche et moteurs de réponse génératifs) sont traitées séparément dans le cadre d'audit de la Section 8 et l'agenda d'audit des fonctionnalités du Tableau 20 [5][164].
Hygiène du versionnage. Les révisions mises en ligne sur la même page SSRN préservent les compteurs accumulés et l'URL stable, tandis que la suppression et la republication réinitialisent les mesures à zéro ([B-7], citée avec la mise en garde que le libellé de la page d'assistance change au fil du temps et doit être reverifié à la soumission). L'affirmation supplémentaire de la communauté qu'une révision mineure au jour 3 déclenche une re-annonce et une « deuxième vague » d'attention n'est pas documentée, et elle figure parmi les pratiques non vérifiées de l'Appendice A. L'identité a besoin du même soin. Lier un identifiant ORCID vérifié au profil d'auteur SSRN maintient les articles et leurs compteurs attachés à la bonne personne plutôt qu'à un homonyme, et c'est une garde à faible coût contre le problème de désambiguïsation d'auteur que la conception du panneau de la Section 8.3 doit autrement résoudre statistiquement ([B-7], même caveat de re-vérification).
Ce qu'il ne faut pas faire. L'auto-téléchargement et la manipulation connexe sont documentés dans les propres journaux de serveurs de SSRN, intensifiés près des seuils des listes les plus consultées, et ont été motivés par la comparaison sociale [44]. Les filtres de fraude de la plateforme sont publics [144][69], et les comités d'évaluation conscients de cet historique remettent en question les affirmations non étayées. Ainsi, la littérature sur le jeu porte un avertissement pratique aux côtés d'un avertissement sur l'intégrité : les comptes manipulés sont détectables et coûteux en termes de réputation. La Figure 9 illustre la signature temporelle en question sur des données simulées. L'attention organique s'accumule comme un pic précoce avec une longue queue, tandis que la manipulation produit des pics concentrés exactement du type que les filtres d'intégrité sont conçus pour signaler [144][69].
Figure 9. Accumulation organique par rapport à un pic de manipulation. Une trajectoire de téléchargement organique lisse contrastée avec un pic unique d'une journée caractéristique de l'auto-téléchargement, motivant l'avertissement de manipulation de la Section 6.4 et la discussion d'intégrité de la Section 4 [44][69][144]. Toutes les données affichées sont simulées ; aucun ensemble de données de détection d'anomalie empirique n'existe pour SSRN.
6.5 Conversion des compteurs en preuves de carrière : le protocole du dossier
Avant le coucher du soleil, la preuve fondée sur le classement SSRN était une composante standardisée du dossier. Le classement public d'un auteur entrait directement dans les dossiers de promotion : « classé 13e sur 3 000 auteurs juridiques au total en nombre de téléchargements de tous les temps, ce que l'école de droit a pris en compte dans diverses décisions de promotion et connexes » [12]. Les guides de lettre de couverture conseillaient de citer les compteurs de téléchargements et les apparitions dans les listes Top Ten [95], les conseils aux praticiens avertissaient simultanément que les travaux auto-publiés « ne compteront probablement pas aux fins de promotion et permanence à l'école de droit » [33], et la documentation propre de la plateforme décrivait ses indicateurs comme des données « que les auteurs utilisent à des fins de promotion et permanence et que les institutions utilisent dans leurs activités d'embauche et de classement » [52]. Chacun de ces artefacts présupposait un cadre de comparaison publique qui n'existe plus [149]. L'utilisation évaluative des compteurs a été contestée dès sa première proposition, d'ailleurs : le dossier de 2006 de Black et Caron en faveur des téléchargements comme mesure « bêta » de la performance scientifique [18] a reçu une réponse dans le même volume du symposium par la critique d'Eisenberg sur ce que les classements fondés sur SSRN peuvent validement mesurer [45]. Un dossier qui cite les téléchargements hérite de ce débat non résolu. Le tableau 13 énonce un protocole en sept étapes pour reconstruire des preuves défendables à partir de ce qui reste, et son exigence directrice, appliquée dans la troisième et la quatrième colonnes, est que chaque nombre cité dans un dossier doit s'accompagner de sa source, de sa fenêtre temporelle et de ses limitations. Une affirmation traduite qui se durcit en une précision sans source est pire qu'aucune affirmation du tout.
Tableau 13. Protocole de preuve post-coucher du soleil pour les indicateurs SSRN dans les dossiers de permanence, promotion et embauche. Chaque étape nomme l'action, le fondement probant avec sa fenêtre temporelle, la limitation qui doit être divulguée aux côtés de tout nombre, l'anti-modèle à éviter et la conclusion la plus solide que l'étape peut autoriser.
| Étape | Action | Fondement probant (source ; fenêtre temporelle) | Limitations à divulguer | À éviter | Conclusion admissible |
|---|---|---|---|---|---|
| 1. Préserver | Archiver des captures d'écran datées du panneau de statistiques de chaque article et du profil d'auteur aux intervalles du tableau 11 et avant toute soumission ; les assembler, avec les avis de distribution et un journal daté des événements de promotion propres à l'auteur, dans le paquet de preuves versionnées de la section 6.1. | Les compteurs par article survivent au coucher du soleil ([148][149] ; 2026). Les compteurs peuvent être réaffirmés lorsque les règles de filtrage changent ([144][69] ; documenté depuis 2018). | Une archive personnelle datée est la seule version officielle sous le contrôle de l'auteur ; les chiffres de la plateforme sont révisables et aucun historique public n'existe. | « L'article a X téléchargements » — cité sans date ni dénominateur. | Un enregistrement daté et vérifiable de ce que la plateforme affichait — une observation spécifique au moment, non un verdict à vie. |
| 2. Traduire | Convertir les compteurs en langage de bande utilisant le tableau 8 (par exemple, « téléchargements à vie au-dessus du seuil d'entrée d'environ 160 de la liste Top-10 000 articles de 2015, c'est-à-dire approximativement les 1,8 % supérieurs du stock complet d'articles en texte intégral de la plateforme, 571 040 en juillet 2016 [1], à ce moment »), en nommant toujours la source, l'échantillon et l'année ; le modèle CSAB de l'appendice B fournit le format au niveau de la phrase, avec ses champs de centile laissés en blanc jusqu'à l'existence d'un groupe de référence. | Seuils au niveau de l'article : entrée ≥160, médiane intra-groupe 805 (scrape de la liste supérieure ; 2015) [85]. Au niveau de l'auteur : minimum d'entrée 129 téléchargements totaux, médiane intra-groupe 1 626 (même scrape) [85]. Ancres d'articles typiques : médiane 63 à deux ans (LSN ; 2012→2014) [139] ; médiane 87 (réseau Marketing ; snapshot 2025) [83]. | Tous les seuils découlent d'échantillons de 2012–2015 (inflation depuis [1] : section 5.1) ; le cadre de 2015 couvre uniquement les listes supérieures ; les deux ancres de médiane sont monodisciplinaires. Le langage de bande ne doit pas être réaffirmé comme un centile calibré. | Des étiquettes universelles telles que « excellent » appliquées à un ancien seuil brut. | Position relative dans l'échantillon, le domaine et l'année nommés — rien de plus large. |
| 3. Trianguler | Appairer les compteurs SSRN avec des preuves de citation indépendantes : Google Scholar, HeinOnline pour le droit, RePEc pour l'économie, Crossref/OpenAlex comme couches de citation ouvertes, PlumX tel qu'affiché sur SSRN. | Les classements SSRN-téléchargement et HeinOnline-citation au niveau de l'école corrèlent à 0,84 (100 écoles de droit américaines ; 2019) [77] ; les corrélations téléchargement–citation au niveau de l'article s'exécutent à ~0,1–0,6 selon le domaine et l'horizon [80][25] ; infrastructure de citation ouverte [35][124] ; PlumX [50]. | Le chiffre de 0,84 est une corrélation au niveau de l'école et ne descend à aucun article ou auteur individuel (mise en garde par inférence écologique, section 6.2(iii)) ; les téléchargements mesurent la demande, non la lecture ou l'approbation ; les corrélations au niveau de l'article sont modestes, et les ensembles fortement téléchargés et fortement cités ne se chevauchent que partiellement [108]. Les preuves de citation convergentes, non le compteur seul, portent l'affirmation d'impact. | Assimiler un téléchargement à une approbation ou une exactitude. | Preuves en couches de l'adoption, non preuve de qualité. |
| 4. Normaliser par domaine | Énoncer explicitement le cadre disciplinaire (par exemple, « dans la bourse de droit des sociétés, où les moyennes de eJournal diffèrent d'environ un facteur huit selon les sous-domaines juridiques »). | Moyennes du sous-domaine 438,35 vs. 53,48 téléchargements/article (eJournals LSN ; 2018) [168] ; les ratios téléchargements-citations sont eux-mêmes structurés par domaine [18]. | L'estimation de propagation est spécifique au droit et datée de 2018 ; le transfert transdisciplinaire d'un seuil quelconque nécessite de la prudence, et le langage centile sans un qualificateur de domaine est ininterprétable. | Comparer un nouvel article avec un total cumulatif de plusieurs années, ou transplanter un seuil entre domaines. | Une comparaison qualifiée par domaine et par âge — jamais une note universelle. |
| 5. Compléter | Citer les canaux de distribution de référentiels institutionnels et autres aux côtés de SSRN. | Les compteurs SSRN ne disent rien sur les téléchargements du même article à partir d'autres services [161] ; les réformes de 2026 ont fait des séries basées sur le référentiel le chemin de migration pour la distribution institutionnelle [47][146]. | Aucun compteur d'une seule plateforme ne mesure la circulation totale d'un article ; l'affirmation du dossier concerne l'article, non un compteur. | Présenter le compteur d'une plateforme comme la circulation totale de l'article. | Une affirmation concernant la circulation de l'article, avec un compteur distinct pour chaque canal. |
| 6. Intégrité | Énoncez la règle de comptage de la plateforme aux côtés de tout décompte cité, et conservez l'archive datée qui documente le nombre tel qu'affiché. | Le filtrage et la reformulation sont un comportement documenté de la plateforme ([144][69][66]; en cours); les statistiques de téléchargement déclarées par le fournisseur dépendent des conventions de comptage ([69][176]; 2015–2019). | Les compteurs sont des estimations filtrées et révisables; aucun historique de reformulation publique n'existe, l'archive datée de l'auteur est donc le seul dossier stable. | Traiter les compteurs comme des nombres exacts de lecteurs humains uniques. | Une estimation filtrée selon une règle énoncée à une date donnée — pas un recensement des lecteurs. |
| 7. Évaluation d'experts | Présentez chaque ligne de métrique comme contexte pour l'évaluation qualitative de la contribution et de la rigueur du travail, jamais comme son remplacement. | Les métriques mesurent les étapes de diffusion, non la validité (sections 3.1, 5.5); les ensembles très téléchargés et très cités ne se chevauchent que partiellement [108]. | Aucune métrique d'utilisation, normalisée ou brute, n'évalue si la recherche est correcte ou importante. | La substitution de métriques au jugement d'experts. | Preuve contextuelle accompagnant l'examen d'experts — l'affirmation de qualité repose sur l'examen, non sur le nombre. |
La colonne Éviter recense les anti-modèles du protocole. Deux avertissements encadrent le protocole dans son ensemble. Un téléchargement enregistre une demande passive plutôt qu'une lecture, une approbation ou une qualité, et les décomptes réagissent aux dynamiques de publicité (couverture médiatique, titres saillants, vagues thématiques) autant qu'à la production scientifique [116][139][138]. Les comités qui connaissent le dossier de manipulation [44] remettront en question les nombres non appuyés, et les éléments qui survivent à cette remise en question sont précisément ceux que le protocole exige : des captures d'écran datées, un langage mesuré assorti de sources, des qualificatifs de domaine et une triangulation.
6.6 Le corollaire de la sollicitation
L'affichage produit un effet secondaire documenté qu'aucun tableau de bord ne signale : des invitations non sollicitées provenant de revues et conférences prédatrices, générées par la moisson de noms, d'affiliations et de titres d'articles à partir de plateformes de prépublications [107][159]. Le volume est considérable dans les audits adjacents, où des études spécialisées documentent des flux d'invitations allant de quelques douzaines par universitaire tous les quinze jours à des milliers par groupe de spécialité par mois (Section 7.2) [9][84][63]. Le premier contact avec une revue prédatrice est un courriel non sollicité dans environ 41 % des cas enquêtés [32]. La Section 7 et le Tableau 14 analysent le phénomène. Pour le livret, les conséquences se réduisent à quatre instructions. Attendez-vous à des sollicitations comme une conséquence par défaut de la visibilité, et ne lisez jamais leur volume comme une reconnaissance savante : les envoyeurs ciblent la visibilité mécaniquement, non le mérite sélectivement [159][63]. Acheminez la correspondance par une adresse dédiée afin que la moisson ne contamine pas une boîte de réception principale ; un raffinement très répandu consistant à masquer l'adresse électronique du profil pendant les deux premières semaines suivant l'affichage est une pratique non vérifiée (Appendice A). Ne payez jamais, car le modèle économique repose sur les frais, les frais de traitement des articles dans les revues prédatrices auditées s'échelonnant de 25 à 1 800 dollars [136]. L'argent est l'enjeu le plus faible : les mêmes comités d'évaluation qui examinent les dossiers (Section 6.5) lisent également les bibliographies, et une revue prédatrice connue sur une liste de publications impose un coût réputationnel qui dépasse la durée de validité de tout frais. Vérifiez tout lieu d'invitation par rapport à un service de dépistage maintenu tel que Cabells Predatory Reports ([B-1] ; la liste de Beall n'a pas été mise à jour depuis janvier 2017 et ne doit pas être utilisée comme source en direct), et par rapport aux listes de contrôle de Think. Check. Submit. [159]. Le mécanisme de moisson fournit également un filtre qualitatif : une revue qui envoie une invitation dans les jours suivant l'affichage d'une prépublication, avant que toute lecture humaine plausible n'ait pu se former, est extrêmement improbable d'être légitime. C'est une heuristique ; aucune étude n'en a mesuré l'incidence [63].
6.7 Portée du playbook
Les ancres du playbook datent de 2012 à 2015 et sont très axées sur le droit et le marketing [139][85][83][1]. Le flux de téléchargements par article a augmenté depuis (Section 5.1). Des données de centile fraîches et stratifiées par domaine n'existent pas encore ; leur collecte, par la plateforme ou par la communauté, fait l'objet des sections 8 et 10. Le playbook réduit les malinterprétations, et il ne mesure pas la qualité. Quatre règles rendent son utilisation mécanique : comparer les cas appariés, maintenir la fenêtre d'observation constante, joindre une source à chaque nombre, et étiqueter une hypothèse comme hypothèse.
7. La couche d'attention parasite : visibilité et sollicitation prédatrice
Le cadre interprétatif développé jusqu'à présent traite l'attention comme un seul entonnoir allant de l'exposition à la vue abstraite au téléchargement à l'utilisation en aval. L'expérience concrète de la mise en ligne d'une prépublication comprend cependant fréquemment un deuxième flux d'« attention » qui arrive par un canal entièrement différent : des invitations par courriel non sollicitées provenant de revues, de conférences et de services éditoriaux de légitimité douteuse [14][61][117][142]. Un compte rendu conceptuel de ce deuxième flux suit, ainsi que les preuves d'audit de son ampleur documentée.
7.1 Un modèle à deux niveaux de l'attention
L'environnement post-publication est traité ici comme une économie de l'attention à deux niveaux (Figure 10). Le niveau 1 est l'entonnoir légitime décrit aux sections 4 et 6 : distribution via eJournal, consultations de résumés, téléchargements et utilisation savante ultérieure. Le niveau 2 est un niveau parasitaire, un écosystème d'éditeurs et de prestataires prédateurs qui se nourrissent de la même infrastructure publique (titres, résumés, noms d'auteurs et affiliations) et visent à convertir les auteurs en clients payants, non à lire leurs travaux. La littérature sur les sollicitations-audits documente le cycle de vie. Les métadonnées publiques des prépublications (titres SSRN, résumés, noms d'auteurs et affiliations) sont moissonnées [107][159], des invitations mimétiques qui reflètent les appels à communications légitimes sont envoyées [61][63], et les auteurs qui réagissent sont convertis en clients payants. Le moteur économique est aussi documenté : les frais de traitement des articles dans les revues présumées prédatrices s'élèvent en moyenne à environ 178 $, avec une plage rapportée de 25 $–1 800 $ [136].
L'asymétrie entre les deux niveaux importe pour l'interprétation. Le niveau 1 nécessite qu'un lecteur humain remarque, ouvre et valorise l'article, tandis que le niveau 2 ne nécessite que les métadonnées de l'article soient lisibles par machine. Une prépublication peut donc en principe être entièrement traitée par le niveau parasitaire tout en restant effectivement non lue dans le niveau légitime. C'est la situation des articles à téléchargement quasi nul de la plateforme, les « articles fantômes », que les machines traitent et que les humains ne lisent effectivement pas.
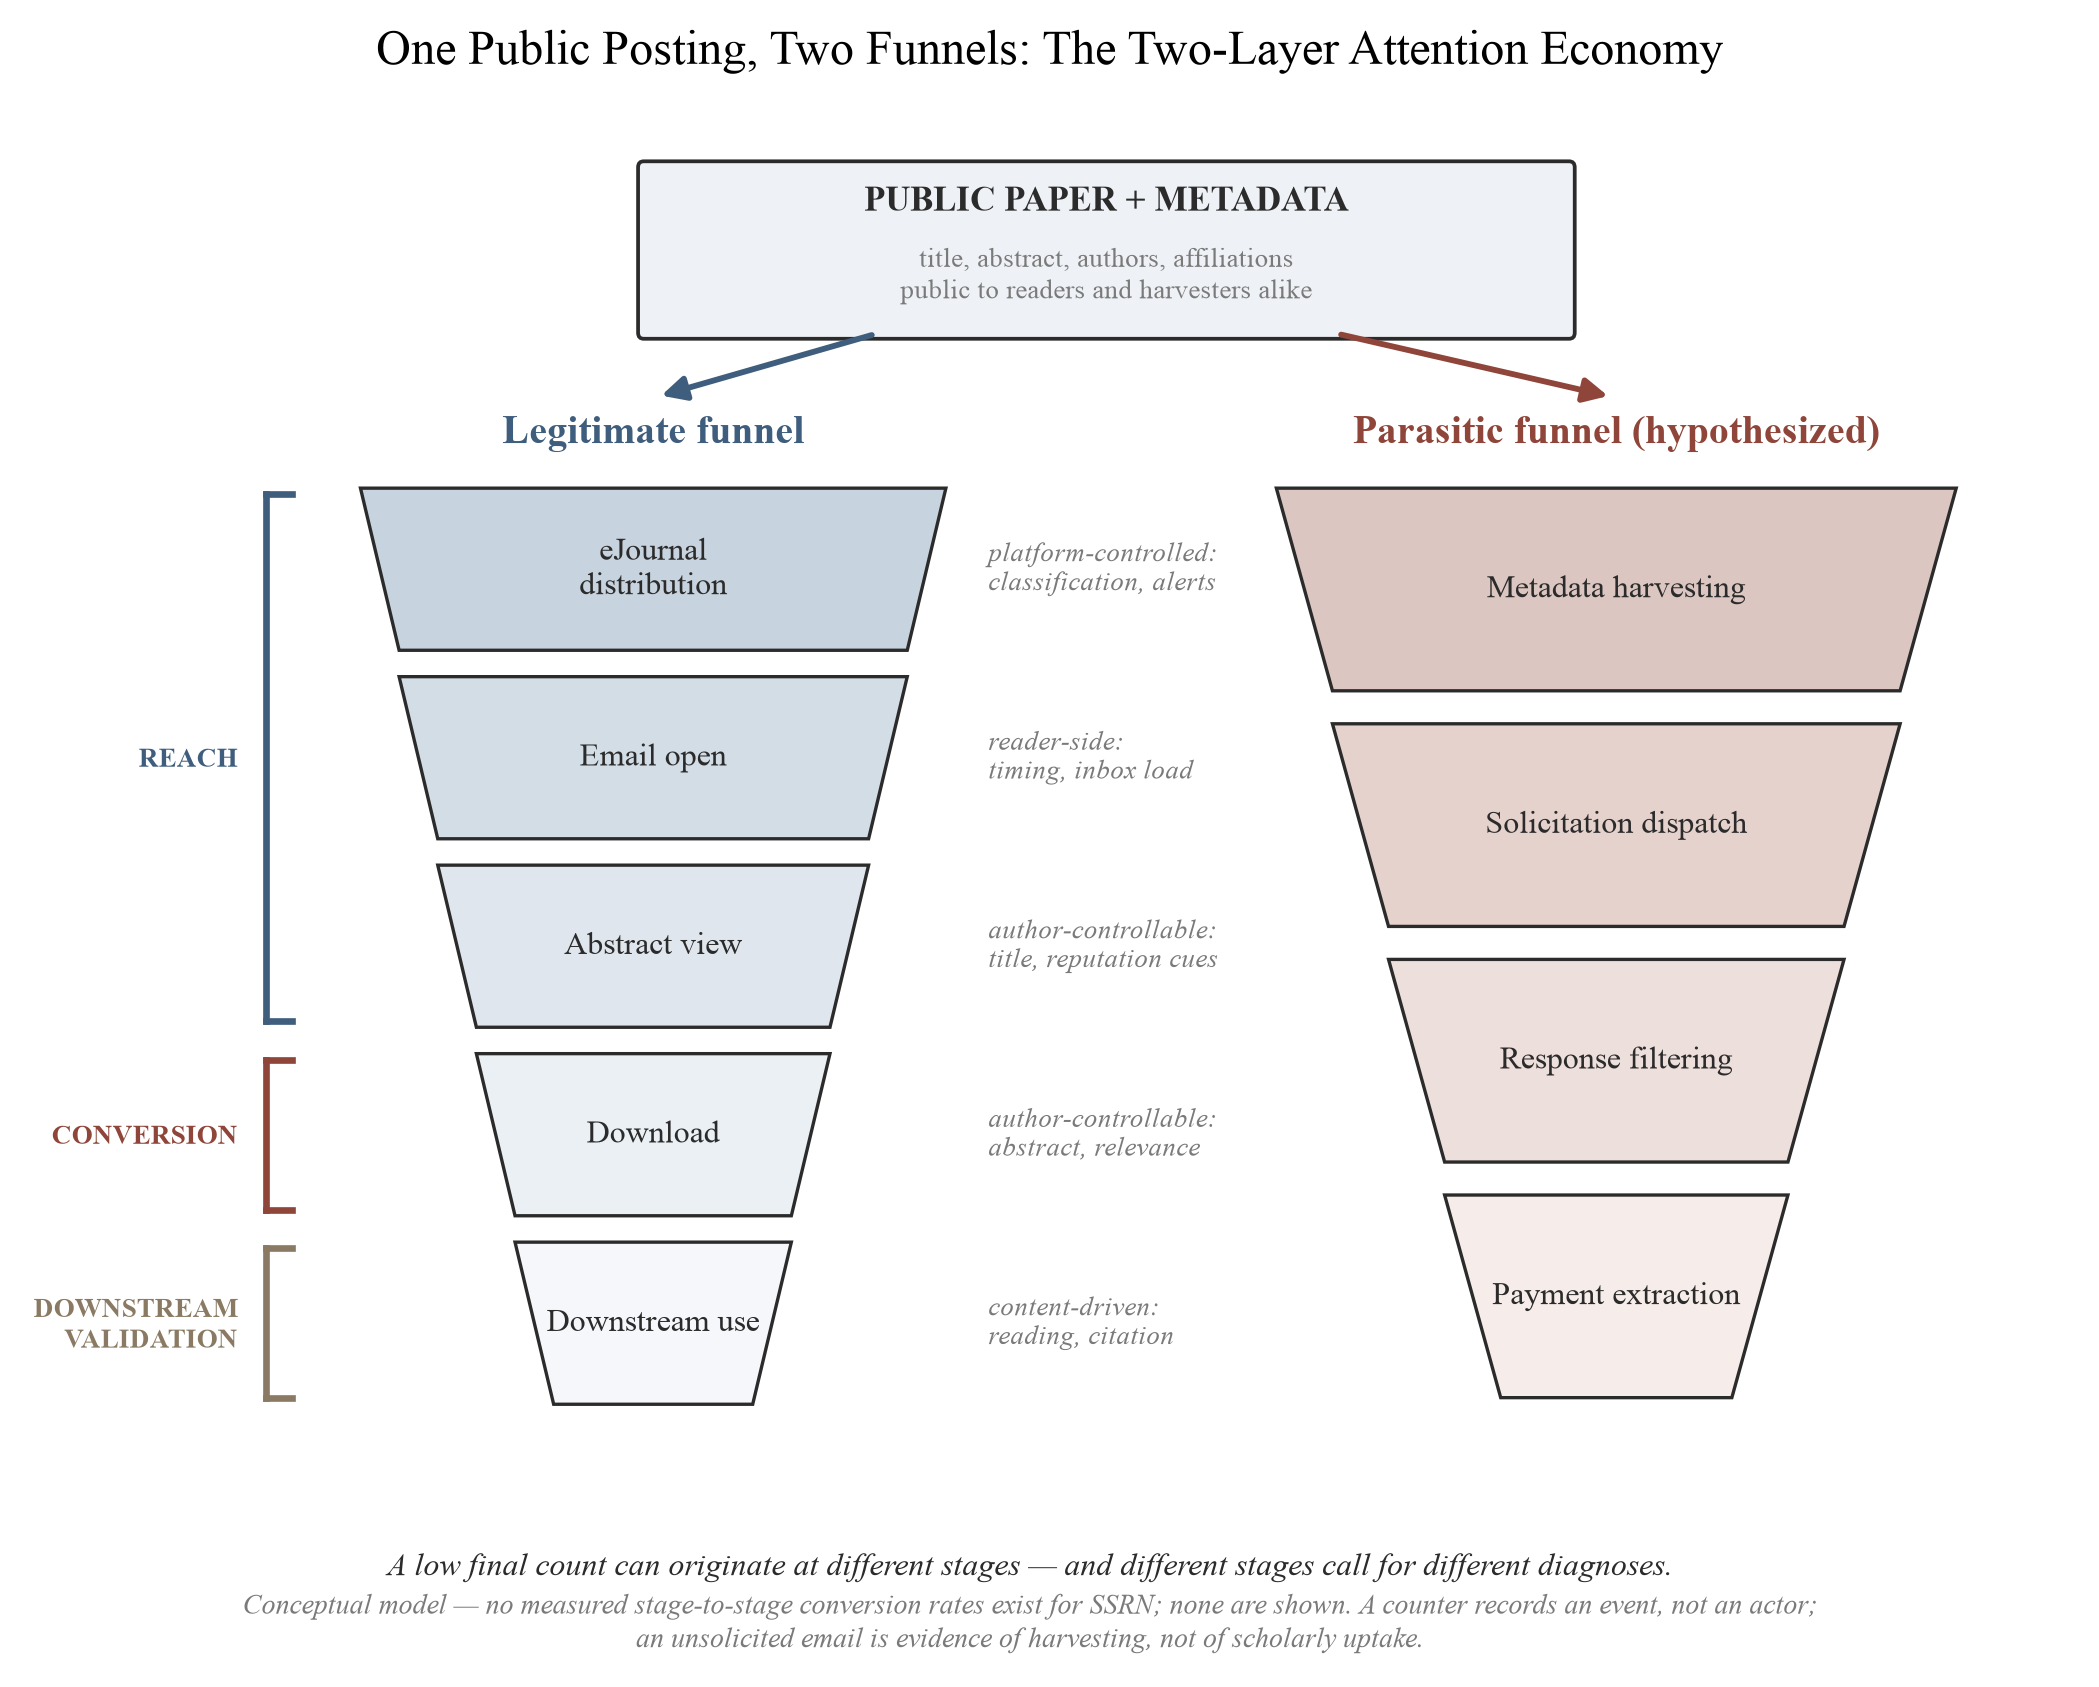
Figure 10. Modèle conceptuel de l'économie de l'attention à deux niveaux. Les deux entonnoirs sont présentés comme des séquences d'étapes qualitatives ; aucun taux de conversion d'étape en étape n'est affiché car aucun tel taux n'a été mesuré pour SSRN. L'entonnoir parasitaire est une reconstruction hypothétique basée sur la littérature sur les sollicitations-audits [61][63][107][159] (section 7.3).
7.2 L'ampleur documentée des sollicitations prédatrices
Le fait que la sollicitation prédatrice soit un phénomène à grande échelle ne fait aucun doute. Un examen de 2026 a identifié vingt-neuf études empiriques sur le spam académique, convergeant vers un répertoire de tactiques : sollicitation flatteuse, fausses revendications éditoriales et assertions douteuses concernant les métriques et l'indexation [61]. Les volumes mesurés sont substantiels. Quatorze ophtalmologistes académiques ont reçu 1 813 emails de sollicitation de la part de 383 éditeurs uniques, couvrant 696 journaux uniques, sur une fenêtre de 30 jours [84]. Les radiologues académiques ont reçu en moyenne 20,7 invitations de manuscrits et 4,1 invitations en tant qu'orateurs sur une période de deux semaines [9]. Un audit exploratoire a catalogué 422 emails de sollicitation reçus par un seul urologue entre 2023–24 [63], et une étude de cas en édition savante a enregistré 1 024 emails de spam en provenance de journaux sur 391 jours [89]. Une observation sur un an d'un seul chercheur suite à des mises en ligne de prépublications a enregistré 875 invitations de la part de 256 journaux, dont 76 % figuraient sur des listes de blocage organisées, une source conditionnelle citée ici avec la réserve que les délais d'arrivée après mise en ligne n'ont pas été mesurés [B-10]. La sollicitation convertit également de façon démontrable. Parmi les auteurs qui avaient publié dans des journaux présumés prédateurs, 41 % ont signalé que leur premier contact avec le journal était une invitation par email non sollicitée [32], et les analyses de contenu des corpus de sollicitation documentent le langage flatteur, les délais fictifs et la portée thématique vague comme des dispositifs de persuasion récurrents [96].
Les preuves ne sont pas non plus limitées à la médecine. Dans les sciences sociales, disciplinairement beaucoup plus proches de la base propre de SSRN, trois chercheurs en sciences de l'éducation ont reçu 210 invitations de journaux non sollicitées en trois mois, retracées auprès de 139 journaux et 37 éditeurs, dont la plupart classables comme prédateurs ; environ la moitié des invitations se situaient en dehors des domaines d'expertise des destinataires, la signature d'un ciblage axé sur les métadonnées plutôt que sur la lecture [155]. Le fardeau pèse en premier lieu sur le protagoniste de cet article, l'auteur en début de carrière. Un auto-audit longitudinal d'un universitaire en début de carrière a enregistré 1 280 sollicitations prédatrices (990 en provenance de journaux, 220 de conférences et 70 d'autres types) sur environ huit ans, ainsi que des tentatives documentées et en grande partie infructueuses de se désabonner [160].
Deux caractéristiques de cette base de preuves doivent être gardées à l'esprit. Les plus grands audits proviennent de la médecine, et les audits en sciences sociales ci-dessus, bien que disciplinairement plus proches de SSRN, sont plus modestes ; aucun volume de l'une ou l'autre littérature ne peut être transposé aux auteurs de SSRN. Décisif pour cet article, aucune de ces études n'a mesuré le moment des sollicitations par rapport à un événement de mise en ligne de prépublication. L'audit dans [63], par instance, a catalogué le contenu et la provenance mais n'a pas lié les temps d'arrivée à l'activité de SSRN. Toute affirmation reliant la couche parasitaire à l'acte de mise en ligne est donc une hypothèse de mécanisme, et non une conclusion.
7.3 Mécanismes de ciblage hypothétiques
Pour atteindre une prépublication fraîchement postée, la couche parasitaire doit d'abord la localiser. Les mécanismes ci-dessous sont des hypothèses partiellement soutenues par la littérature ; aucun corpus ne lie les sollicitations aux postages SSRN.
H-S1 (moissonnage de métadonnées). Les opérations prédatrices extraient les pages de résumés publics et les listes de nouveaux articles pour obtenir les titres, noms d'auteurs et affiliations. Des sources praticiennes et consultatives décrivent ce comportement : les journaux prédateurs sont signalés comme scannant les serveurs de prépublications et envoyant des invitations non sollicitées qui font référence au titre de l'article [159]. Un commentaire de jurisprudence en droit indique que les solliciteurs « collectent les courriels, noms, affiliations etc en parcourant les articles savants existants, par exemple ceux postés sur SSRN » [107], et un guide de bibliothèque juridique relie le postage de prépublications à « une augmentation du spam provenant des éditeurs prédateurs qui sollicitent les chercheurs de republier leurs articles contre rémunération » [117]. Une régularité mesurée s'ajuste au mécanisme. Dans l'audit en radiologie, les audits de spécialité signalent des volumes de sollicitation élevés parmi les auteurs publiants actifs [9], cohérent avec le moissonnage à partir de la surface bibliographique cumulative d'un auteur plutôt qu'à partir d'un quelconque événement de postage unique. L'étude 3 (section 8.6) enregistre en conséquence les contrôles d'exposition au niveau de l'auteur aux côtés du postage focal.
H-S2 (acquisition de contacts). La sollicitation nécessite une adresse de courriel. Les pages de résumé SSRN incluaient historiquement les informations de contact des auteurs [151], et les adresses circulent également par les articles eux-mêmes, les pages institutionnelles et les publications antérieures. Si SSRN expose actuellement les courriels des auteurs sous une forme moissonnage est untesté ; l'étude de journalisation des sollicitations instrumentalisées est spécifiée pour le mesurer. Le canal d'acquisition pour toute sollicitation donnée n'est pas observé.
H-S3 (parasitage de la distribution). Les digests eJournal et les flux de type RSS redistribuent les métadonnées de nouveaux articles aux abonnés [57][51]. Un acteur parasitaire abonné à ces canaux recevrait des pistes structurées sans moissonnage. Aucun audit n'a vérifié cet itinéraire.
La chaîne causale du postage à l'exposition au ciblage n'a pas été empiriquement établie ; la section 8 spécifie un test pré-enregistré de ces mécanismes : enregistrement des arrivées de sollicitations par rapport aux horodatages de postage connus pour les articles fraîchement postés.
7.4 Une typologie hypothétique des signaux de sollicitation
Si les mécanismes de ciblage de la section 7.3 fonctionnent, différentes classes de sollicitations devraient véhiculer des informations différentes sur la visibilité machine d'un article. Le tableau 14 présente cela comme une typologie hypothétique, ses catégories stratégiques ancrées dans des tactiques de persuasion documentées : inadéquation des qualifications et personnalisation hors cible [9][63], délais artificiels et flatterie [96], fausses revendications métriques et d'indexation [61], et frais dissimulés face à un marché des APC documenté [136]. La dernière colonne est inférentielle et non testée. Le tableau ne donne ni pourcentages de prévalence ni estimations de délai d'arrivée.
Tableau 14. Une typologie hypothétique des signaux de sollicitation prédatrice suivant la publication d'une prépublication. Les phrasings exemplaires sont illustratifs, des paraphrases inventées de modèles documentés dans les audits de sollicitation [9][61][96], pas des citations textuelles de tout message spécifique.
| Modèle de sollicitation | Description | Phrasing illustratif | Information hypothétique sur la visibilité |
|---|---|---|---|
| Adresse générique, sans référence à l'article | Invitation automatisée sans mention de l'article ou du domaine spécifique | « Cher chercheur estimé, soumettez votre travail précieux… » | Faible : l'adresse peut provenir de n'importe quelle source ; aucune preuve que l'article lui-même a été consulté |
| Inadéquation des qualifications | Invitation citant une expertise dans un domaine sans lien avec l'article [9] | « Compte tenu de votre expertise en physique quantique… » (à un article juridique) | Faible à nul : indique une moisson en masse sans analyse des métadonnées |
| Ciblé, faisant référence au titre | Invitation mentionnant la prépublication spécifique et un lieu topiquement adjacent [159] | « Votre article récent '[titre exact]' conviendrait à notre revue… » | Plus élevé (hypothétique) : les métadonnées de l'article ont atteint l'expéditeur, impliquant une indexation réussie et un accès aux données collectées |
| Personnalisation flatteuse | Éloge du travail spécifique comme « révolutionnaire » ou « estimé » [96] | « Votre contribution révolutionnaire… » | Aucune au-delà de l'accès au titre : l'éloge est modélisé, non lu |
| Urgence et métriques fabriquées | Délais inventés, « facteurs d'impact » astérisqués, revendications d'indexation [61][96] | « Facteur d'impact 4,2* ; soumission dans 7 jours » | Aucune : dispositif de persuasion indépendant de l'article cible |
| Frais dissimulés | APC divulgué tardivement ou uniquement en pièce jointe ; gamme de marché 25–1 800 $ [136] | Frais absents du corps de l'invitation | Aucune : stratégie tarifaire, non signal de visibilité |
| Invitation à une conférence, avec référence à l'article | Invitation à présenter ou à soumettre à une conférence douteuse, souvent mentionnant l'article spécifique ; les invitations de conférenciers sont une composante mesurée du spam académique [61][9] | « Nous vous invitons à présenter votre article '[titre exact]' comme conférencier principal à… » | Comme pour la sollicitation ciblée (hypothétique) : les métadonnées de l'article ont atteint l'expéditeur ; aucune preuve de lecture substantielle |
| Services aux auteurs rémunérés | Offres d'examen accéléré, traduction ou services d'édition proposés à une prépublication fraîchement publiée [61][84] | « Examen en voie rapide et polissage linguistique professionnel pour votre nouvelle prépublication… » | Aucune établie : le spam de services suit les métadonnées de nouvelles publications, non le contenu de l'article |
Les lignes flatteuses comportent une dimension psychologique que la lecture mécanique obscurcit. La louange modélisée atteint un auteur qui regarde peut-être un compteur stagnant, pour qui la sollicitation est la seule « validation » que la publication a produite jusqu'à présent. Le modèle à deux niveaux prédit ainsi une inversion cruelle dans laquelle les premiers répondants à une nouvelle prépublication sont fréquemment des prédateurs plutôt que des lecteurs (section 7.5), et un nouvel arrivant peut mal interpréter le spam comme un intérêt car aucun signal légitime n'est encore arrivé. Un auteur qui s'attend à l'hameçon peut le rejeter.
Le tableau 14 lit les messages entrants pour ce qu'ils pourraient révéler sur la visibilité d'un article. Comment coder ces messages du tout est la question complémentaire, et elle tourne autour d'une distinction laissée implicite jusqu'à présent, entre le contact savant légitime et la sollicitation à risque plus élevé. Le tableau 15 définit cette distinction comme une typologie à six signaux dont la dernière colonne porte les mises en garde de codage : chaque signal est probabiliste et aucun ne constitue une preuve en soi. La typologie est également le squelette du codebook de l'étude 3 (section 8.6), car une étude de sollicitation sans une classe positive de contact savant légitime ne peut pas mesurer l'asymétrie que la section 7.5 hypothétise.
Tableau 15. Séparer le contact savant légitime de la sollicitation à risque plus élevé : six signaux avec mises en garde de codage. Un schéma de codage hypothétique, non un classifieur validé. La colonne visibilité du tableau 14 pose une question différente et n'en est pas affectée : le même message peut être codé sur les deux grilles.
| Signal | Contact savant légitime | Sollicitation à risque plus élevé | Mise en garde de codage |
|---|---|---|---|
| Spécificité | Engage un argument, une méthode ou un résultat concret | Éloge générique avec le titre ou les mots-clés insérés | La spécificité peut être imitée |
| Identité du lieu | Historique vérifié de journal, éditeur, institution ou conférence | Propriété peu claire, marque copiée, conseil non vérifiable | Les nouveaux lieux ne sont pas automatiquement prédateurs |
| Demande | Question substantive, collaboration ou invitation transparente | Demande de soumission ou de paiement urgente sans lien avec le travail | Les frais seuls ne sont pas décisifs ; la transparence compte |
| Moment | N'importe quel moment ; suit souvent la lecture réelle | Contact rapide et modélisé peu après la publication publique | La proximité temporelle ne prouve pas la source de la moisson |
| Langage | Spécifique au sujet et professionnellement responsable | Flatterie, fausse familiarité, urgence artificielle, portée vague | Les caractéristiques linguistiques sont probabilistes, non des preuves |
| Vérification | Coordonnées et politiques indépendamment vérifiables | Identifiants brisés, fausses métriques, revendications d'indexation trompeuses | L'examen humain selon des critères documentés est requis |
En pratique, la typologie produit une heuristique de tri plutôt qu'un diagnostic : une sollicitation de journal arrivant dans les premiers jours suivant le dépôt, avant que les canaux de distribution légitimes aient plausiblement opéré, est très probablement prédatrice. Les revues légitimes à haut impact ne sont pas signalées comme contactant à froid les auteurs de manuscrits fraîchement postés [174], tandis que l'invitation précoce non sollicitée est le mode de premier contact documenté des revues prédatrices [32][174]. Nous proposons comme heuristique d'auteur le seuil spécifique parfois avancé dans les discussions entre praticiens (traiter tout courrier de journal dans approximativement les premières 96 heures comme présomptivlement prédateur) en attente de validation. Aucune étude n'a mesuré la distribution des délais qui permettrait d'étalonner un tel seuil. La mise en garde sur le temps du Tableau 15 s'applique à l'heuristique elle-même : la proximité temporelle suscite la suspicion mais ne prouve pas que l'expéditeur a récolté ce dépôt particulier, puisque l'adresse peut antédater la prépublication entièrement, donc le tri sur 96 heures classe les boîtes de réception plutôt que la preuve.
7.5 Le paradoxe du spam et l'asymétrie de vitesse
Deux propositions supplémentaires concernant la couche parasite découlent du modèle à deux couches.
Le paradoxe du spam. Si la sollicitation ciblée nécessite une extraction de métadonnées réussie, alors dans l'environnement post-Rankings l'absence de spam prédateur peut être un indicateur plus fort de l'invisibilité de la plateforme que sa présence ne l'est de quoi que ce soit d'autre. Un article qui ne déclenche jamais ne serait-ce que la couche parasite a peut-être échoué à franchir le seuil minimal de distribution lisible par machine. L'attrait analytique de cette inversion, où le spam sert de mandataire involontaire et toxique pour l'indexation, est qu'elle transforme un désagrément inévitable en instrument d'observation gratuit. Son pouvoir diagnostique n'est pour l'instant qu'une hypothèse : la corrélation entre la réception de sollicitations et toute métrique de visibilité n'a jamais été mesurée, et les lignes de sollicitation générique du tableau 14 montrent pourquoi le volume brut de spam serait un signal bruyant en principe.
Les prédateurs arrivent avant les lecteurs. L'entonnoir légitime fonctionne selon des délais institutionnels : l'inclusion dans eJournal est curée plutôt que garantie, avec des délais pouvant atteindre 45 jours signalés pour les classifications à grand volume [53], et l'indexation par Google Scholar prend six à neuf mois ou plus [55]. Un nombre quasi nul de téléchargements la première semaine est compatible avec une pré-distribution normale plutôt qu'un rejet (section 6). La couche parasite, si elle extrait les métadonnées par programme, ne connaît aucun de ces délais. Nous émettons donc l'hypothèse que pour un auteur dont les informations de contact sont accessibles, le temps prévu jusqu'à la première sollicitation prédatrice attribuable à une publication est plus court que le temps prévu jusqu'au premier contact universitaire véritablement savant, de sorte que l'auteur inconnu rencontrerait la couche parasite avant la couche légitime. Le falsificateur est direct : le contact véritablement savant précède toujours la sollicitation.
Les volumes de sollicitation documentés mesurés en jours et en semaines [9][84], comparés à la mécanique de distribution mesurée en semaines et en mois [55][53], rendent l'hypothèse plausible. Seule l'étude de journalisation spécifiée à la section 8 peut la tester, car les corpora existants n'ont pas été verrouillés dans le temps par rapport aux événements de publication [63].
7.6 Ce que la couche parasitaire ne dit pas à un auteur
Trois énoncés limites bornent les conclusions de cette section.
D'abord, l'email de sollicitation ne fait pas bouger les compteurs de la plateforme. Une invitation envoyée à l'auteur ne génère aucune vue abstraite et aucun téléchargement du document. Dans la mesure où les racleurs visitent les pages d'abstract, SSRN affirme qu'il filtre les activités irrégulières et automatisées de ses comptages de téléchargement [66][69][144]. Le volume de pourriel n'est donc jamais une preuve de lecture, et une boîte de réception remplie de sollicitations coexistant avec des téléchargements en un chiffre n'implique aucune contradiction : les deux couches comptent des choses différentes.
Deuxièmement, la couche parasitaire affecte aussi le plus durement les auteurs les moins équipés pour absorber ses coûts : les chercheurs en début de carrière et non anglophones sont signalés comme particulièrement vulnérables à la sollicitation [142]. Le protocole pratique de la section 6 traite donc l'hygiène de la boîte de réception (filtrage par liste noire de tout lieu de sollicitation, non-réponse aux invitations non sollicitées, vérification par des services curés plutôt que des listes défuntes) comme faisant partie de l'interprétation des métriques plutôt que comme une préoccupation séparée. Le filtrage automatisé des lieux prédateurs est lui-même une direction de recherche active [157].
Troisièmement, la visibilité précoce a un autre effet secondaire que les auteurs rencontrent comme une accusation apparente : lors d'une soumission ultérieure à un journal, le logiciel de vérification de similarité signalera une correspondance presque complète entre le manuscrit et son propre prédécesseur SSRN, puisque les prépublications sont indexées dans le corpus Crossref Posted Content utilisé par iThenticate [36]. La documentation du fournisseur affirme explicitement qu'une correspondance de prépublication du même auteur est un résultat attendu et non du plagiat [81]. La réponse appropriée est de divulguer la prépublication à l'éditeur, non de la retirer.
La couche parasitaire est l'endroit où l'affirmation centrale de cet article est la plus facile à voir : après le coucher du soleil des classements, les signaux bruts (téléchargements, vues, et maintenant même le pourriel) ne portent un sens interprétable que si le mécanisme qui les a générés est spécifié. Cette spécification est partiellement disponible pour la couche légitime, et pour la couche parasitaire, c'est encore un programme de recherche.
8. Un agenda de recherche prêt pour la préregistration : reconstituer la classe de référence manquante
Les sections précédentes ont synthétisé les preuves vérifiables sur les métriques d'attention de SSRN et proposé un cadre d'interprétation pour l'environnement post-classements. Cette section est un agenda prêt pour la préregistration permettant de répondre empiriquement aux questions ouvertes du cadre. Elle ne rapporte aucun résultat, par conception : des bandes préspécifiées et falsifiables plutôt que des résultats. Chaque conception, hypothèse et bande de prédiction ci-dessous est prête à être enregistrée sur l'Open Science Framework avant toute collecte de données, avec le code d'analyse publié en même temps. La retraite des classements SSRN le 15 juillet 2026 [149], annoncée le 12 juin 2026 avec une date cible initialement antérieure [148] et inscrite dans une redéfinition plus large de la plateforme [146], rend cet agenda exceptionnellement sensible au temps : certaines des conceptions ci-dessous exploitent une discontinuité dont la période pré- recule chaque mois, et l'une d'elles, le registre des centiles de la section 8.8, aborde un écart de mesure que le coucher du soleil lui-même a rendu permanent pour les observateurs externes.
8.1 Principes de conception
Quatre principes gouvernent l'agenda.
Observation dès la publication. L'extraction rétroactive de compteurs cumulatifs ne peut pas reconstituer ce qu'un article avait au jour 3, au jour 7 ou au jour 30. Tout panel d'évaluation crédible doit donc inscrire les articles à leur publication et enregistrer leurs compteurs à des âges standardisés : jours 1, 3, 7, 14, 30, 60, 90 et 180 (Tableau 11), l'observation quotidienne étant préférable pendant les 45 premiers jours, car SSRN indique que la distribution des alertes dans les sujets très abonnés peut prendre jusqu'à 45 jours [53]. Ce principe protège également contre les fuites : les mesures de réputation des auteurs antérieurs doivent être figées à la date de publication focale afin que le succès futur ne puisse pas contaminer les covariables de base. Son discipline complémentaire, reprise de la section 5.6, est que les événements de distribution, d'indexation et de promotion entrent dans les conceptions ci-dessous en tant que traitements datés et jamais en tant que contexte non modélisé.
Séparation de la portée et de la conversion. Suivant la logique diagnostique de la section 5 (Tableau 9), chaque conception ci-dessous enregistre les vues et les téléchargements d'abstraits en tant que résultats distincts et modélise les téléchargements conditionnés aux vues. Une faible portée et une faible conversion sont des diagnostics différents : l'incapacité à entrer dans l'ensemble de considération du lecteur par rapport à la non-acquisition après exposition. Les regrouper dans un seul décompte élimine l'information dont un auteur a besoin.
Résultats distributionnels, pas seulement des moyennes. Parce que l'attention sur la plateforme est à queue lourde [83][85][180], les interventions et les changements de plateforme peuvent modifier la forme de la distribution tout en laissant sa moyenne pratiquement inchangée. Les résultats incluent donc le coefficient de Gini de l'attention, les parts de téléchargement du top 1% et du top 10%, la part d'articles à ou près de zéro, et les ratios d'attention des nouveaux venus par rapport aux établis, dans la tradition de la mesure des inégalités d'attention dans d'autres médias [180].
Réfutabilité. Chaque hypothèse est appairée avec une stratégie d'identification et une condition explicite sous laquelle elle échoue. Le cadre lui-même est exposé au rejet : si les mesures précoces normalisées par l'âge et le domaine ne surpassent pas les décomptes bruts hors échantillon (RQ3 ci-dessous), l'avantage de mesure revendiqué de la normalisation devrait être rejeté ou réduit. La réfutabilité est aussi quantitative : les tailles d'échantillon dans l'ensemble de l'agenda doivent être finalisées par simulation de puissance par rapport aux plus petites tailles d'effet d'intérêt. La stratégie de multiplicité pour un programme de cinq hypothèses, trois questions de recherche et cinq propositions est engagée à la pré-inscription, et les analyses confirmatoires et exploratoires sont étiquetées comme telles à l'avance. L'attrition (articles retirés, fusionnés ou matériellement révisés) est suivie et rapportée plutôt que silencieusement abandonnée, avec un diagramme de flux de cohorte dans chaque rapport empirique du programme (section 8.8).
8.2 Hypothèses et propositions
Le cadre génère cinq hypothèses et trois questions de recherche concernant l'allocation de l'attention précoce, et cinq propositions concernant sa structure. Le tableau 16 relie les hypothèses, les questions de recherche et les propositions à des plans dédiés (P2, P3b, P4) à un résultat, un contraste et un plan préféré ; P1 et P3 sont portés par les études 1 et 2 du tableau 17.
H1 (Désavantage du démarrage à froid). Conditionné par domaine, cohorte de publication, sujet observable, caractéristiques du document et conditions calendaires, les articles rédigés entièrement par de nouveaux venus sur la plateforme reçoivent moins de consultations initiales de la page abstraite que les articles comportant au moins un auteur SSRN précédemment visible. Le résultat central est les consultations plutôt que les téléchargements par consultation, car H1 concerne la formation de l'audience et non la conversion.
H2 (Prestige et exposition). Le prestige institutionnel et celui de l'auteur prédisent positivement la portée initiale de la page abstraite après contrôle de l'activité antérieure sur la plateforme et des caractéristiques observables de l'article, étendant la littérature sur l'attention au statut [104][105][111][140][60] au premier stade de la diffusion des prépublications.
H3 (Prestige et conversion conditionnelle). Le prestige institutionnel prédit positivement le téléchargement de texte intégral conditionné à l'exposition de la page abstraite. Jo et Li fournissent des preuves récentes spécifiques au domaine cohérentes avec ce modèle en Marketing, une prime de prestige d'environ +6,6 % dans le taux de téléchargement pour un article de trois auteurs avec un auteur parmi les 50 premiers [83], mais un test longitudinal plus large reste nécessaire. Conjointement, H2 et H3 définissent l'estimande phare du panel : une décomposition exposition-versus-conversion du gradient de prestige, c'est-à-dire la fraction de l'inégalité liée au prestige observée dans les téléchargements qui apparaît avant la visite de la page abstraite (exposition) par rapport à après celle-ci (conversion conditionnelle). Une constatation selon laquelle la majeure partie du gradient se forme avant que le lecteur n'ait vu l'abstrait localiserait l'inégalité dans la mécanique de la découverte plutôt que dans l'évaluation du contenu, sous une forme directement mesurable.
H4 (La communication comme facteur d'égalisation). Une plus grande clarté abstraite et efficacité informationnelle sont associées à des améliorations plus importantes de la conversion conditionnelle chez les auteurs à faible visibilité antérieure que chez les auteurs déjà visibles. H4 est la seule hypothèse dont le traitement se situe entièrement sous le contrôle de l'auteur. Elle doit être testée avec des mesures textuelles préspécifiées et, séparément, une expérience abstraite aléatoire conçue selon les normes des expériences en ligne [30]. Elle ne doit pas s'appuyer uniquement sur des classificateurs « rédigés par IA » automatisés, qui introduisent leur propre incertitude de mesure.
H5 (Persistance des chocs d'exposition). Les chocs d'exposition précoce exogènes ou quasi-exogènes prédisent une attention accrue ultérieure au-delà de la fenêtre d'exposition immédiate : l'analogue sur la plateforme savante de la dynamique du succès engendre le succès documentée expérimentalement ailleurs [112][131][162] et des effets d'exposition positionnelle sur arXiv [72][73].
RQ1. Le retrait du 15 juillet 2026 de Rankings a-t-il modifié la concentration, la distribution ou le gradient de prestige de l'attention ? Deux prédictions opposées sont toutes deux plausibles, et la question est laissée bilatérale : la suppression des classements peut atténuer les boucles de rétroaction de popularité [112][131], ou elle peut au lieu de cela accroître la dépendance aux réseaux d'auteurs préexistants en supprimant une surface de découverte par laquelle les articles inconnus pourraient devenir visibles une fois qu'ils commenceraient à attirer l'attention.
RQ2. La distribution des alertes électroniques curées produit-elle des gains d'attention proportionnels plus importants pour les nouveaux venus ou pour les auteurs établis ?
RQ3. Les métriques précoces normalisées observées aux jours 7 et 30 prédisent-elles mieux les résultats ultérieurs de citations savantes ou de publication que les téléchargements cumulatifs bruts ?
Les propositions reformulent les affirmations structurelles du cadre sous une forme réfutable :
P1 (Asymétrie et majorité invisible). Sur un échantillon aléatoire stratifié d'articles SSRN, la distribution des téléchargements au cours de la vie est à queue lourde et asymétrique à droite de sorte que la médiane est inférieure à la moitié de la moyenne, et une part substantielle d'articles a dix téléchargements ou moins au cours de la vie. Réfutateur : médiane ≥ 0,5 × moyenne, ou une part négligeable ≤10 téléchargements. Le ratio Marketing-réseau publié de moyenne à médiane (approximativement 2,54) [83] et l'ajustement quasi-lognormal des données de la liste des meilleurs [85] de 2015 motivent mais n'établissent pas P1 pour la plateforme dans son ensemble.
P2 (La classification gouverne l'affichage). Au sein de la couche de référentiel, le nombre de classifications eJournal est positivement associé aux téléchargements et négativement associé à la probabilité de téléchargements quasi nuls, contrôlant l'âge et le réseau, une réplication et mise à jour du modèle transversal de Whalen de 2018 [168] selon la mécanique de distribution curée de la plateforme [53][57]. Réfutateur : aucune association significative après contrôles. Le nombre de classifications est lui-même potentiellement endogène : les articles de plus large pertinence peuvent à la fois recevoir plus de classifications et attirer plus de lecteurs, de sorte que l'association transversale surestime tout effet d'affichage. L'identification préférée est donc les changements de classification intra-article si disponibles, avec l'estimée transversale rapportée explicitement comme limite supérieure.
P3 (La visibilité machine est faible et dépend des caractéristiques). Pour les requêtes construites de sorte qu'une prépublication SSRN spécifique soit la meilleure source disponible, les moteurs de réponse IA de consommateur citent la prépublication elle-même dans une minorité de cas, et la visibilité machine augmente avec des caractéristiques analogues aux facteurs d'optimisation de moteur génératif documentés [5][164]. Réfutateur : les prépublications sont citées la plupart du temps indépendamment des caractéristiques, ou aucune caractéristique ne prédit la visibilité.
P3b (Un effet Matthieu au niveau machine). Conditionné à la pertinence validée par un expert, les articles ayant une visibilité web et savante antérieure plus grande sont cités par les systèmes de réponse IA plus souvent que les articles comparables au démarrage à froid. Selon l'alternative équité, les moteurs génératifs récupèrent sur la pertinence sans prime sur la visibilité antérieure et P3b est rejeté, un résultat dans lequel la couche machine serait plus égalitaire que les couches de découverte humaines de H1–H3, non moins. Réfutateur : aucun gradient de visibilité à pertinence de requête appariée. P3b étend la ligne d'avantage cumulatif de H1–H3 au sommet de la pile de découverte. Son test nécessite la covariable de visibilité antérieure et la stratification de requête spécifiées dans l'étude 2 (section 8.6).
P4 (Les prédateurs arrivent avant les lecteurs). Pour une prépublication nouvellement postée dont les métadonnées bibliographiques et la route de contact peuvent être extraites du document posté ou des pages publiques associées, le temps attendu jusqu'à la première sollicitation prédatrice attribuable au postage est plus court que le temps attendu jusqu'au premier contact savant véritable. Falsificateur : le contact véritable précède régulièrement la sollicitation prédatrice. P4 est énoncé sous condition d'extractibilité car la visibilité publique des coordonnées de l'auteur sur l'interface actuelle de la plateforme n'est pas établie. Le mécanisme d'extraction lui-même est documenté pour les dépôts de prépublications en général [107][159][151], et l'courrier électronique non sollicité est le premier contact avec une revue prédatrice pour une part substantielle des auteurs sollicités [32]. L'attribution exige donc la conception instrumentée de l'Étude 3 plutôt que l'inférence à partir du seul chronométrage des boîtes de réception.
Tableau 16. Hypothèses, questions de recherche et stratégies d'identification.
| Question | Résultat principal | Contraste principal | Conception préférée |
|---|---|---|---|
| H1 : désavantage des nouveaux venus | Vues supplémentaires | Nouveaux venus vs. établis | Modèle de comptage longitudinal hiérarchique |
| H2 : prestige et portée | Vues supplémentaires | Prestige antérieur plus élevé vs. plus faible | Panel ajusté pour covariables + analyse de sensibilité appariée |
| H3 : prestige et conversion | Téléchargements conditionnés aux vues | Prestige plus élevé vs. plus faible | Modèle d'exposition binomiale négative/Poisson |
| H4 : égalisateur de communication | Probabilité/taux de téléchargement conditionnel | Clarté × visibilité antérieure | Modèle textuel observationnel + réplication randomisée |
| H5 : attention cumulative | Vues/téléchargements après choc | Choc d'exposition vs. trajectoire antérieure au choc | Étude d'événement intra-article |
| RQ1 : retraite des classements | Attention quotidienne ; Gini ; parts les plus élevées ; volume de nouvelles publications par domaine | Anciennement exposés au classement vs. domaines de comparaison | Conception d'étude d'événement interrompue |
| RQ2 : distribution par courriel | Vues/téléchargements quotidiens | Avant vs. après la distribution | Étude d'événement intra-article (Distribution × Nouveaux venus) |
| RQ3 : validité prédictive | Citations à 6/12/18 mois | Métriques précoces normalisées vs. brutes | Comparaison prédictive hors échantillon |
| P2 : la classification gouverne la surfacisation | Téléchargements ; probabilité de téléchargements quasi nuls | Comptage de classification ; changements de classification intra-article où disponibles | Régression de panel + conception de changement intra-article |
| P3b : effet Matthew au niveau machine | Citation directe par système de réponse | Visibilité antérieure élevée vs. faible à pertinence de requête appariée | Audit de récupération multiniveaux répété (Étude 2) |
| P4 : prédateurs avant lecteurs | Délai jusqu'au premier message codé et taux de messages entrants codés | Fenêtres avant et après postage ; contact prédateur vs. véritable | Cohorte prospective instrumentée + modèle d'historique des événements (Étude 3) |
Note. Toutes les lignes sont des conceptions prospectives. Aucune n'a été exécutée. Les résultats, les contrastes, les règles d'exclusion et les classes de référence doivent être préenregistrés avant la collecte de données.
8.3 Le panneau central
Le plan de référence est une cohorte multidisciplinaire d'articles SSRN récemment publiés suivis pendant au moins douze mois à partir de leur publication, observés selon le calendrier du tableau 11. Au niveau de l'article, l'ensemble de données conserve la version la plus ancienne disponible du titre, du résumé, des noms des auteurs et de leur ordre, des affiliations, de la date de publication, des classifications, des mots-clés, du nombre de pages, du DOI le cas échéant, de l'historique des révisions, des vues publiques du résumé, des téléchargements publics et des indicateurs de citation ultérieurs, avec une correspondance de l'identité des auteurs par rapport à l'infrastructure bibliographique ouverte [35][124] validée manuellement sur un sous-échantillon aléatoire avant que la réputation déduite soit utilisée à grande échelle. Le statut de nouveau venu est défini comme aucun auteur de l'article focal n'ayant d'article SSRN daté avant la publication focale, avec des définitions de sensibilité basées sur les décomptes d'articles antérieurs et le stock de citations avant publication. Le prestige institutionnel ne fait pas partie de cette définition : parce que le prestige est lui-même une variable explicative dans H2 et H3, l'intégrer au statut de nouveau venu confondrait mécaniquement la nouveauté de la plateforme avec la visibilité antérieure de l'auteur et effondrerait les hypothèses que le plan est censé séparer. Le prestige n'entre donc dans les modèles que comme une covariable distincte. La normalisation par visibilité antérieure doit être traitée avec un soin correspondant sur le plan de l'équité : soustraire un baseline de visibilité antérieure trop agressivement pénaliserait le vrai succès précoce d'un auteur junior et effacerait statistiquement, plutôt que d'exposer, toute sous-exposition systémique des auteurs marginalisés et du Sud global. La réponse du cadre est de mesurer où se forment les inégalités plutôt que de les éliminer : la décomposition portée-versus-conversion localise si un écart de visibilité surgit à l'exposition ou à la conversion, et le prestige entre comme une covariable à comprendre, non comme du bruit à éliminer silencieusement. L'effet distributionnel du prestige sur l'attention est un résultat principal des quasi-expériences (sections 8.4–8.5). Les contrôles calendaires incluent le jour de la semaine, la semaine de l'année, la saison académique et les effets fixes de date. La variation documentée de fin de semaine et saisonnière dans l'accès aux articles (l'activité est approximativement 11 % plus basse les week-ends et 50 % plus basse en été dans un panel récent de sept revues [178]) rend difficile à justifier leur omission dans toute étude d'utilisation haute fréquence. Le dictionnaire complet des variables du panneau (de l'ordre de deux douzaines de champs, incluant les incréments d'intervalle plutôt que seulement des décomptes cumulatifs, la date de distribution où consentie, les stocks de citations à 6, 12 et 18 mois, et le numéro de révision) est spécifié dans l'appendice C (tableau C1), et le même fichier schéma est déposé avec les matériaux de préenregistrement (section 8.8 ; Déclarations).
La portée est modélisée comme un processus binomial négatif hiérarchique pour les vues supplémentaires, avec des effets champ-par-âge, des effets calendaires et de l'hétérogénéité au niveau de l'article. La conversion conditionnelle est modélisée comme des téléchargements supplémentaires avec les vues supplémentaires en log comme exposition, de sorte que gagner une visite de page de destination et convertir cette visite sont statistiquement séparés. Sous forme compacte, pour l'article i dans l'intervalle t :
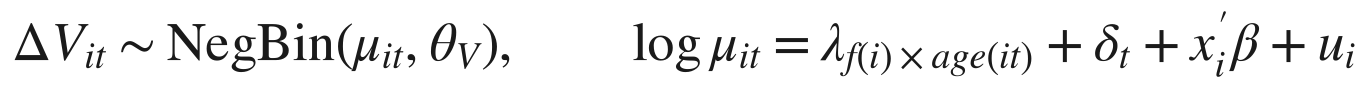

où λ_{f×age} sont des effets champ-par-âge, δ_t des effets de date calendaire, u_i et w_i de l'hétérogénéité au niveau de l'article, et le décalage des vues en log dans la deuxième équation rend les téléchargements conditionnels à l'exposition de la page de destination. L'interaction Nouveau venu × Clarté γ_3 est le test H4. Ces équations fixent les estimands préspécifiés et la séparation de la portée par rapport à la conversion, et la structure hiérarchique effectue exactement le regroupement partiel par Bayes empiriques que les sections 5.2 et 8.8 requièrent avant que le percentile d'une cellule creuse soit publié. Les contrôles thématiques dans x_i sont construits à partir des plongements titre–résumé gelés et groupés à la préenregistrement, avant que n'importe quel résultat soit observé, de sorte que la composition thématique ne peut pas être ajustée aux résultats. Parce que les articles occupent jusqu'à sept classifications simultanément, les effets de classification sont estimés avec des structures hiérarchiques à adhésion multiple plutôt que de forcer chaque article dans un seul champ. Parce que les effets fixes de l'article absorbent les mesures de statut invariantes dans le temps, les effets de base du nouveau venu et du prestige sont estimés entre les articles, tandis que les effets fixes de l'article sont réservés aux traitements au sein de l'article comme les événements de distribution. La surdispersion et les zéros excessifs sont formellement testés, les alternatives de hurdle et zéro-gonflées sont rapportées où justifiées, et la queue lourde est gérée par une estimation quantile et robuste plutôt que par la suppression des articles réussis. Les règles de nettoyage des données sont elles-mêmes préspécifiées plutôt que discrétionnaires, et le protocole d'anomalie est signaler, ne pas supprimer. La liste de signaux préspécifiée couvre : un intervalle extrême par rapport à l'historique propre de l'article, un pic de vues sans mouvement dans les téléchargements, une discontinuité dans la conversion, des horodatages identiques répétés, et une restatement côté plateforme. Un intervalle signalé n'est jamais supprimé de l'archive : il est conservé avec un code de raison, et chaque résultat principal est rapporté sur une échelle de sensibilité à quatre niveaux : (i) compteurs non modifiés ; (ii) excluant seulement l'activité invalide confirmée par la plateforme ; (iii) estimation robuste ou winsorisée ; (iv) excluant tous les intervalles signalés, de sorte que toute conclusion survivant sur un seul niveau soit visible comme fragile. Les seuils sont calibrés par rapport à la distribution observée plutôt que fixés a priori. Où les journaux des partenaires sont disponibles, les champs de référent, d'agent utilisateur et de géographie distinguent le trafic de bulletin d'information, de blog, de préchargement et d'explorateur. Les pics de téléchargement entraînés par les blogs documentés sur SSRN [116] illustrent pourquoi une valeur extrême est souvent un succès organique plutôt qu'une contamination. La détection d'anomalies est un outil de mesure. Elle ne justifie pas de rejeter un succès gênant.
La même discipline s'applique à la structure temporelle. Le panneau distingue l'attention marginale de l'attention cumulative : les courbes de cohorte des téléchargements par intervalle ΔD, et la part des téléchargements sur 180 jours d'un article accumulée à chaque âge, plutôt que de lire uniquement les totaux de durée de vie. Il n'impose pas une seule demi-vie exponentielle unique à la décroissance, puisque la lecture décroît sur plusieurs échelles de temps à la fois [91]. Les courbes d'âge sont donc ajustées par défaut avec des splines ou des estimateurs non paramétriques, les transformations logarithmiques étant utilisées pour étudier la structure et les comptages bruts étant conservés pour la publication des références. La robustesse est traitée de la même manière : le prestige est opérationnalisé par plusieurs mesures alternatives plutôt qu'un seuil de classement unique, le statut de débutant est testé à nouveau selon des définitions progressivement plus strictes, et les résultats sont rapportés avec des vérifications de sensibilité winsorisées et des tracés de distribution complète aux côtés des estimations de quantile.
Parce qu'il n'existe pas d'API publique SSRN [134][51], la collecte de données s'effectue par trois voies, par ordre de préférence : une demande formelle de données ou un partenariat avec SSRN/Elsevier ; les exportations de tableau de bord consenties par les auteurs, dans lesquelles les auteurs participants contribuent leurs propres données du panneau de statistiques sous consentement éclairé, le niveau intermédiaire sur lequel s'appuie déjà le registre de la section 8.8 ; et l'échantillonnage limité par débit et respectant robots.txt des pages publiques par article, dont la faisabilité technique est établie par les outils de collecte open source existants [134]. La conception exclut le scraping en masse qui violerait les conditions de service, et elle ne représente aucun point de terminaison non documenté comme une API stable. Les contraintes d'accès sont discutées comme une limitation à la section 9.
8.4 Quasi-expérience I : la distribution d'alertes par courriel comme choc attentionnel
Les sections 8.4 et 8.5 forment un module analytique unique, étudiant deux interventions côté plateforme comme des traitements complémentaires appliqués à la même cohorte de panel. La distribution d'alertes ajoute une surface d'exposition, le retrait des classements en supprime une, et les deux sont évaluées par rapport à un ensemble commun de résultats distributionnels (part des nouveaux venus, gradient de prestige, indice de Gini de l'attention, parts du top). Le mécanisme d'alerte de SSRN est analytiquement précieux car la publication et la distribution ne doivent pas coïncider. Les articles deviennent d'abord accessibles au public, et les travaux admissibles sont ensuite distribués par des alertes de revues électroniques curatoriales dont le calendrier varie et n'est pas garanti [53][57]. Pour les auteurs consentant à fournir leurs dates de statut de distribution, une étude d'événement intra-article peut estimer le chemin de l'attention autour de la date de distribution, chaque article servant de son propre contrôle afin que les différences stables dans l'attrait thématique, l'identité de l'auteur et l'institution soient absorbées. La spécification suit la forme standard d'étude d'événement : pour le résultat Y_it (consultations ou téléchargements d'intervalles),
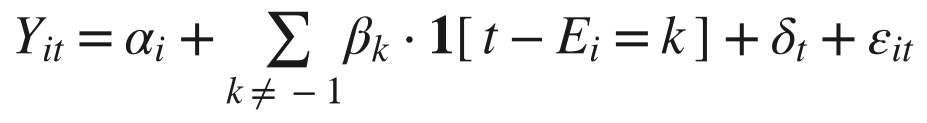
où E_i est la date de distribution de l'article i, α_i sont les effets fixes des articles, δ_t les effets fixes de la date calendaire, et les β_k, normalisés à la période de référence k = −1 pré-distribution, tracent le chemin de l'attention autour de l'événement. L'équation spécifie l'estimand pour la préinscription. L'effet hétérogène clé est l'interaction Distribution × Nouveau venu, estimée en interagissant les β_k avec le statut de nouveau venu. Si les alertes améliorent de manière disproportionnée la portée des nouveaux venus, la distribution curatoriale fonctionne comme un égalisateur au niveau de la plateforme ; si les gains s'accumulent de manière disproportionnée pour les auteurs prestigieux, la distribution amplifie les avantages de réputation existants (RQ2). Les preuves antérieures que les événements d'exposition discrets (listes en position d'accueil sur arXiv [72][73], couverture par blog des articles SSRN [116]) produisent des pics d'attention précoces nets indiquent que la conception a un premier étage détectable. La spécification préspécifiée comprend également des fenêtres d'événement alternatives autour de la date de distribution et des rapports distincts pour les articles distribués rapidement par rapport à ceux distribués après une longue file de classification, car le délai pouvant aller jusqu'à 45 jours [53] mélange autrement des historiques d'exposition hétérogènes en un seul temps d'événement. Les effets fixes des articles n'absorbent que l'attrait invariant dans le temps, de sorte que trois conditions de conception sont essentielles. Le calendrier de distribution est curatié, non aléatoire : la plateforme sélectionne quels articles admissibles elle distribue et quand [53][57]. La date d'événement porte donc une sélection variant dans le temps selon la pertinence thématique (un article distribué la semaine où un sujet devient pertinent diffère du même article distribué dans une semaine calme), et cette sélection persiste après les effets fixes des articles, ce qui justifie que la spécification soit conditionnée sur la latence de distribution et que les strates de calendrier de distribution soient rapportées séparément. Les dates de statut de distribution sont également observées uniquement pour les auteurs consentants, de sorte que l'échantillon d'estimation est un sous-ensemble auto-sélectionné du panel. Le statut de consentement est donc enregistré, et l'échantillon d'étude d'événement est comparé à la cohorte complète selon les covariables observables ; la sélection limite la validité externe. Et les auteurs peuvent chronométrer leur propre publicité sur l'alerte : un pic de promotion autonome coordonné se ferait passer pour un effet de distribution. Un journal de promotion d'auteur daté (le paquet de preuves versionnées de la section 6.1) est donc une exigence de cette conception : sans lui, un pic de distribution organique ne peut pas être séparé d'un pic généré de manière autonome, et l'échelle d'anomalies de la section 8.3 signale plutôt que supprime tout pic qui coïncide avec une auto-promotion enregistrée.
8.5 Quasi-expérience II : le retrait des classements comme expérience naturelle
Le coucher de soleil du 15 juillet 2026 [149] permet une deuxième analyse si l'exposition historique aux classements peut être reconstruite à partir des pages de classements archivées. Deux caractéristiques du plan affaiblissent une étude d'événement à date unique nette. Le traitement n'est pas arrivé à une seule date : les pages de classement par eJournal ont cessé de se mettre à jour à partir du 11 décembre 2025 (section 2.2 [B-2]), environ sept mois avant le retrait du 15 juillet 2026, de sorte que le retrait de la surface de découverte des classements est mieux modélisé comme un processus échelonné, un gel d'abord des pages en direct suivi de leur suppression définitive, que comme une date d'événement commun unique. La spécification porte donc au moins sur deux moments d'événement (le gel de décembre et le retrait de juillet), avec la forme échelonnée comme modèle principal et l'ajustement à date unique testé contre celui-ci. On ne peut pas non plus supposer les disciplines « anciennement exposées au classement » à partir de la structure de la plateforme : les classements étaient à l'échelle de la plateforme, donc l'exposition différentielle est endogène et n'est pas opérationnalisée en nommant des domaines qui « semblaient » classés. L'exposition doit être mesurée, non attribuée : par exemple, à partir des pages de classements archivées récupérées via la Internet Archive, comme la part des articles d'un domaine qui ont jamais entré les listes publiques du haut ou la densité de la présence d'un domaine sur les pages par eJournal. Le fait que l'archive couvre suffisamment densément les pages de classements de chaque domaine pour produire une mesure d'exposition utilisable n'est pas encore établi ; le plan rapporte cette densité parallèlement à la mesure d'exposition. Avec l'exposition ainsi mesurée, une spécification d'étude d'événement au niveau des articles compare les trajectoires d'attention dans les domaines à exposition élevée et faible autour des dates de gel et de retrait : l'équation de la section 8.4 avec les coefficients d'intérêt sur les interactions Exposure_f × EventTime_k plutôt que sur les termes d'événement seuls. Les résultats les plus informatifs sont distributionnels (section 8.1). Le mécanisme de classement pourrait changer la concentration de l'attention tout en laissant les moyennes pratiquement intactes, et parce que tout effet devrait se concentrer dans les articles de queue déjà visibles qui peuplaient les listes, les résultats au niveau du domaine moyen sont insuffisants par construction. Les coefficients de Gini, les mesures de part supérieure, les rapports nouveaux/établis et les gradients de prestige sont donc les résultats principaux, avec la prédiction bidirectionnelle de la RQ1, et la simulation de puissance de la section 8.1 doit être ciblée sur ces statistiques distributionnelles, non sur l'attention moyenne, ou l'étude risque d'être déclarée nulle faute de puissance sur le mauvais estimand.
Deux prédictions nommées et directionnelles affinent la RQ1 bidirectionnelle sans la remplacer, toutes deux des tests d'hétérogénéité préspécifiés. L'hypothèse de falaise de visibilité stipule que les cohortes de publication après le coucher de soleil dans les domaines anciennement exposés au classement connaissent une baisse discrète de la portée précoce par rapport aux cohortes avant le coucher de soleil appariées, car une surface de découverte a été supprimée à une date connue. Selon une hypothèse compensatoire, si les classements fonctionnaient comme un mécanisme de visibilité compensatoire pour les domaines ayant des écosystèmes de découverte faibles, l'effet de leur suppression devrait être le plus important dans les domaines avec de petites bases d'abonnement eJournal, l'extrémité inférieure du gradient de Whalen [168].
Un résultat secondaire bon marché étend le plan de l'allocation de l'attention à la santé de la plateforme elle-même : le volume de nouveaux articles par domaine, dans les fenêtres avant et après le 15 juillet 2026. Si les classements fournissaient une partie de l'incitation à publier, leur retrait pourrait refroidir les nouveaux envois. C'est un résultat comportemental distinct des résultats d'attention ci-dessus, observable à partir des listes de nouveaux articles publics par rapport à la ligne de base propre de la plateforme de plus de 250 000 nouveaux articles en 2025 [145], et une réponse empirique directe à la polémique contemporaine « jumped the shark » enregistrée à la section 2.2 [12][B-11]. La prédiction est laissée bidirectionnelle, comme la RQ1, et le résultat du volume de publication se connecte à l'élément (3) du sondage Study 4 (« éviter les nouveaux téléchargements »).
L'analyse est quasi-expérimentale. Cinq menaces sont matérielles. L'une est les effets d'annonce et d'anticipation : le retrait a été annoncé le 12 juin 2026 avec un objectif initial du 1er juillet et exécuté le 15 juillet, donc une fenêtre d'anticipation authentique existait et s'est décalée [148][149]. Un groupe de changements de plateforme concomitants de 2026 partage le calendrier du coucher de soleil et ne peut pas en être séparé par une seule date d'événement : la refocalisation stratégique annoncée le 13 avril 2026, le retrait de la série commerciale Research Paper Series jusqu'à la fin décembre 2026, et le changement de licence auteur du 20 juillet 2026, cinq jours après le retrait [146][150]. Parce que ces interventions chevauchent la fenêtre de juillet, une seule date d'événement commun attribuerait leur effet combiné au coucher de soleil seul. L'identification s'appuie donc sur le calendrier échelonné ci-dessus (le gel de décembre précède chacun d'eux), sur les dates de contrôle et sur la signature distributionnelle spécifique à un retrait de classement, et le plan rapporte les changements concomitants qui restent non séparés. Ensuite, il y a le creux d'attention estivale : la mi-juillet coïncide avec le déclin saisonnier documenté de l'accès savant, les accès chutant de l'ordre de 50 % pendant les mois d'été [178], de sorte qu'un contraste entre champs exécuté à travers la date de retrait confond le coucher de soleil avec la saisonnalité estivale propre d'un domaine, qui diffère selon la discipline. Les effets fixes de la date du calendrier absorbent uniquement la composante saisonnière commune. Le plan requiert donc des lignes de base saisonnières spécifiques aux domaines (une comparaison de fenêtre de même année antérieure par domaine). Les différences non aléatoires entre les domaines à exposition élevée et faible constituent une menace supplémentaire, traitée par l'opérationnalisation de l'exposition mesurée ci-dessus et par des groupes de comparaison appariés. La menace restante est prospective : SSRN a déclaré qu'elle pourrait réexaminer les classements, donc une réinstauration partielle au cours de la fenêtre d'observation introduirait un deuxième événement. Le plan préenregistre le traitement de toute réinstauration de ce type comme un point de censure pour la période post et la modélise comme un traitement distinct plutôt que de la fusionner dans le contraste de coucher de soleil. Dans tous les rapports, le temps d'événement est partitionné en trois périodes nommées, annonce (à partir du 12 juin 2026), transition, et retrait (à partir du 15 juillet 2026), de sorte que les effets d'anticipation sont estimés. Le plan préspécifié inclut donc des tests de pré-tendance en temps d'événement, des bandwidths alternatifs, des dates de contrôle, des tendances temporelles spécifiques aux domaines et des lignes de base saisonnières spécifiques aux domaines, et des analyses de sensibilité excluant la période de transition entre annonce et retrait. La figure 11 présente les résultats prévus des deux études d'événement comme modèles de conception.
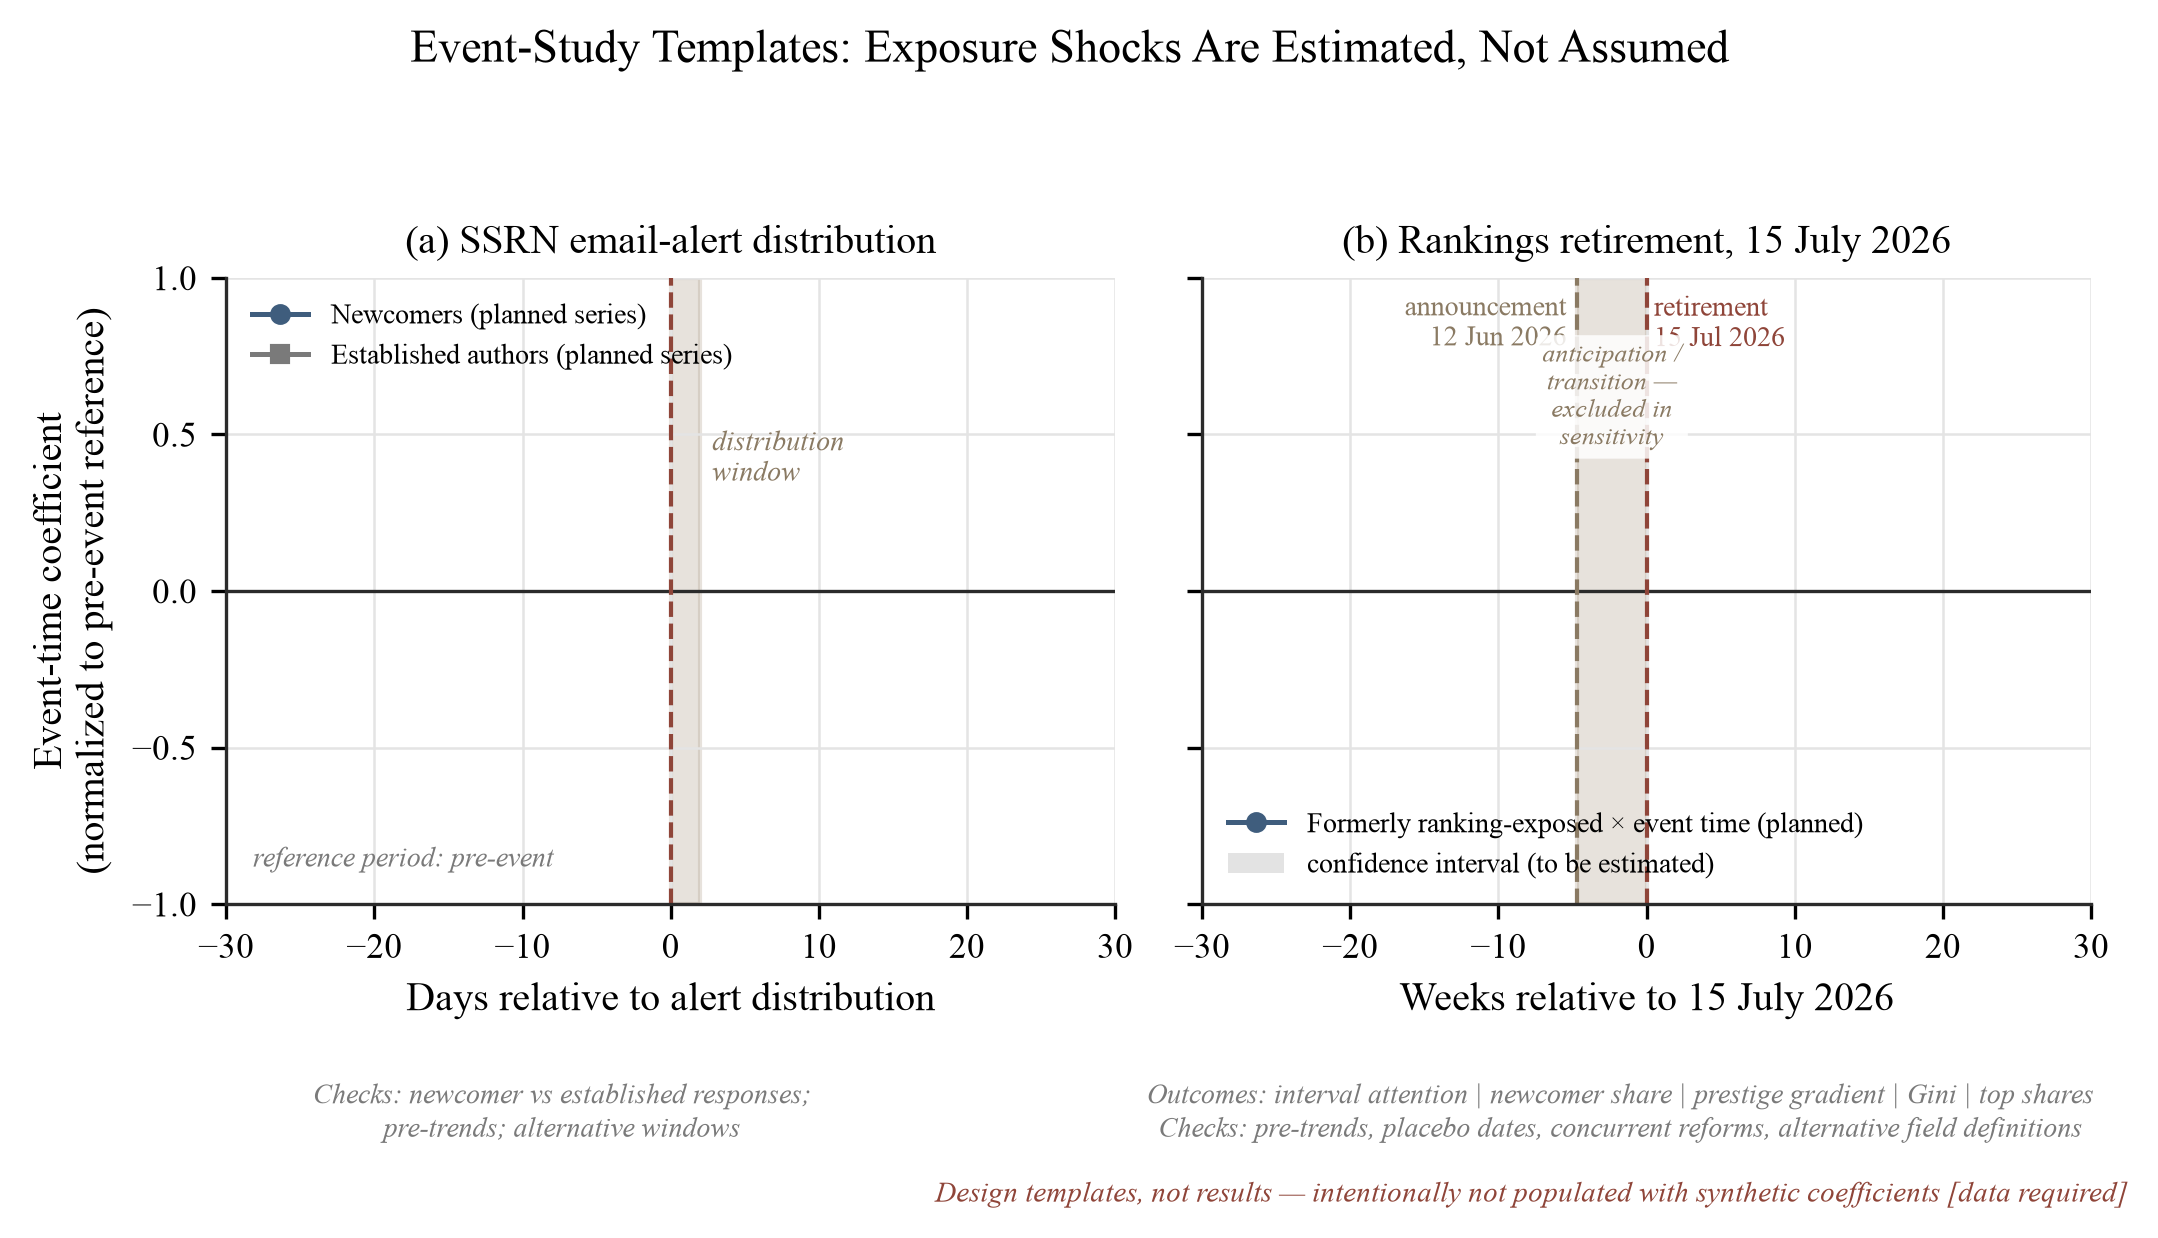
Figure 11. Modèles de conception d'études événementielles pour les deux quasi-expériences de plateforme. Résultats d'études événementielles préspécifiés pour les conceptions des sections 8.4–8.5 : (a) attention autour de la distribution d'alertes par courriel, nouveaux auteurs par rapport aux auteurs établis, avec la fenêtre de distribution ombrée parce que les alertes arrivent sous la forme d'une fenêtre, non d'un instant ; (b) attention et résultats d'inégalité autour de la retraite du classement, avec à la fois les dates d'annonce (12 juin 2026) et de retraite (15 juillet 2026) marquées et la période d'anticipation/transition ombrée — la fenêtre exclue dans les analyses de sensibilité préspécifiées. Les résultats distributionnels (attention par intervalle, part des nouveaux venus, gradient de prestige, Gini, parts des meilleurs) et les vérifications requises sont indiqués sur la figure elle-même. Les coefficients sont normalisés à la période de référence antérieure à l'événement ; les régions ombrées en gris désignent les intervalles de confiance. Ces panneaux sont des modèles de conception ; aucune valeur empirique n'est affichée, et le code de génération sera publié avec les matériaux de préenregistrement.
8.6 Quatre études préspécifiées
Aux côtés du panel principal, quatre études sont spécifiées et résumées dans le Tableau 17. Les deux études sur données publiques (1 et 2) peuvent être entreprises par tout chercheur sans permissions d'accès restreint, dans les limites d'accès indiquées à la Section 9 (collecte limitée en débit selon les conditions de service de la plateforme). Les deux études sur sujets humains (3 et 4) nécessitent des participants et procèdent selon les approbations éthiques énoncées dans les Déclarations. Les quatre existent pour commencer à combler le vide de référence immédiatement plutôt qu'après la maturation d'un panel sur plusieurs années.
Tableau 17. Les quatre études préspécifiées.
| Étude 1 | Étude 2 | Étude 3 | Étude 4 | |
|---|---|---|---|---|
| Question de recherche | Quelle est la distribution médiane/centile des téléchargements ? | Les moteurs de réponse IA citent-ils la prépublication elle-même ? | Lecteur ou prédateur en premier ? | Comment les auteurs lisent-ils leurs propres compteurs ? |
| Données | 3 000–5 000 identifiants de documents SSRN stratifiés | 100–200 questions de niche × ~5 moteurs | 2 postages instrumentés, journal entrant de 90 jours | Enquête auprès des auteurs préenregistrée, quatre éléments à formulation fixe |
| Méthode | Médiane, Gini, courbes de décroissance, régression de comptage de classification | Codage de la récupération + régression logistique | Suivi d'alias par canal + codage des messages | Questionnaire de forme fermée + parts descriptives |
| Résultat principal | Médiane ; part ≤10 téléchargements ; Gini d'attention | Visibilité machine V | t_lecteur vs. t_prédateur | Part ne comparant jamais les compteurs à aucune référence ; distribution de première lecture pour « 7 téléchargements » |
| Prédiction falsifiable | médiane < 0,5 × moyenne ; Gini 0,75–0,90 | Prépublication citée dans 10–35 % des essais | t_prédateur < t_lecteur | La majorité rapporte ne jamais comparer à aucune référence |
| Livrable principal | Tableaux de référence centiles lisibles par machine, publics, stratifiés par âge, domaine et cohorte | Protocole d'audit de récupération et d'attribution reproductible avec une capture temporalisée | Protocole de postage instrumenté ouvert avec baseline avant postage et codebook de codage | Distribution documentée des interprétations des auteurs et du changement de comportement rapporté |
| La conception échoue si | La normalisation n'améliore pas la stabilité ou la prédiction hors-échantillon par rapport aux comptages bruts | Les caractéristiques ne prédisent rien au-delà de la pertinence de la requête, du moteur et de la date | Aucune discontinuité après-postage après contrôles de baseline et d'exposition, ou codage peu fiable | Le recrutement ou l'auto-sélection rend même les parts descriptives non interprétables |
| Profil de ressources | Données publiques ; scraping et statistiques standards | Requêtes publiques de moteur IA ; codage manuel | Deux postages instrumentés ; journalisation de boîte de réception (IRB) | Enquête anonyme auprès des auteurs (IRB) |
Note. Chaque étude doit être enregistrée sur OSF avant la collecte de données, avec code publié.
Étude 1 : « Anatomie de la Médiane ». L'étude tire un échantillon aléatoire stratifié de 3 000–5 000 identifiants de résumé SSRN, une plage de planification, le N final étant fixé par simulation de puissance par rapport aux bandes de prédiction préspécifiées et aux plus petits effets d'intérêt (Section 8.1). La stratification est par année de postage et réseau, et par téléchargements de durée de vie par document, vues de résumé, date de postage et comptage de classification sont collectés par les routes d'accès de la Section 8.3. Estimands : téléchargements médians de durée de vie ; parts de documents avec zéro et avec dix ou moins de téléchargements ; Gini d'attention avec intervalles de confiance de bootstrap ; taux de conversion vues-vers-téléchargements, estimés globalement et stratifiés par réseau (un test de l'hypothèse de style de lecture du public de la Section 5.2) ; courbes de décroissance de téléchargement ; et une régression du journal des téléchargements sur le comptage de classification avec effets fixes d'année et de réseau (un test direct de P2 [168]). Les bandes de prédiction préspécifiées (téléchargements médians de durée de vie environ 30–80, une part ≤10 téléchargements de 15–30 %, Gini 0,75–0,90) sont des extrapolations des ancrages datés de la Section 5 [83][85][139] et des ampleurs de Gini d'attention dans les médias adjacents [180], énoncées à l'avance pour que l'étude puisse les falsifier. L'Étude 1 est la graine empirique de la référence centile discutée à la Section 8.8.
Étude 2 : « Les Machines Vous Lisent-Elles ? » Une part croissante de la recherche d'information commence maintenant aux interfaces génératives : environ la moitié des adultes américains rapportent utiliser des chatbots IA, et environ un quart les utilisent quotidiennement [121], une minorité substantielle les traitant déjà comme leur premier moteur de recherche dans les échantillons de convenance [4]. L'introduction (Section 1.6) a conceptualisé ceci comme une migration vers le haut du gardien de la découverte (marque de journal → référentiel → moteur de recherche → couche de réponse IA) avec chaque étape relocalisé le contrôle plus loin de l'auteur et plus loin de toute référence publique (Figure 12). Si la couche supérieure récupère des prépublications du tout est inconnue : la littérature d'optimisation pour moteur générative s'est jusqu'à présent concentrée sur les marques et le commerce [5][100][164], et les audits de recherche IA se sont préoccupés de l'attribution d'actualités plutôt que de sources savantes [82]. Ces audits conseillent le scepticisme quant à la fiabilité du nouveau gardien : dans l'audit du Tow Center (1 600 requêtes sur huit moteurs), les moteurs collectivement ont échoué à récupérer les informations correctes dans plus de 60 % des essais, le meilleur performer (Perplexity) répondant incorrectement 37 % du temps et le pire (Grok-3) 94 %, et ils se sont typiquement trompés avec une confiance injustifiée plutôt que de refuser de répondre [82], chiffres d'un test d'attribution d'actualités, non de recherche savante. Aucune étude contrôlée de la visibilité des prépublications savantes dans les moteurs de réponse IA n'existait en août 2026 [100]. La contribution s'oppose à deux lignes de travail adjacentes. Les études d'optimisation pour moteur générative sur lesquelles cet article s'appuie mesurent et manipulent la visibilité des marques et des pages commerciales [5][164], non la récupération d'artefacts savants. Un brin séparé montre que quand les modèles de langage génèrent des références du tout, ils reproduisent et amplifient la tendance humaine à citer le travail déjà hautement cité, étendant un effet Matthieu dans la couche machine [7], qui est le mécanisme P3b (Section 8.2) teste. Aucun brin n'a examiné la découvrabilité des prépublications scientifiques sous pertinence de requête contrôlée, et spécifiquement leur récupérabilité après une surface de classement de plateforme est supprimée, qui est l'objet l'Étude 2 isole.
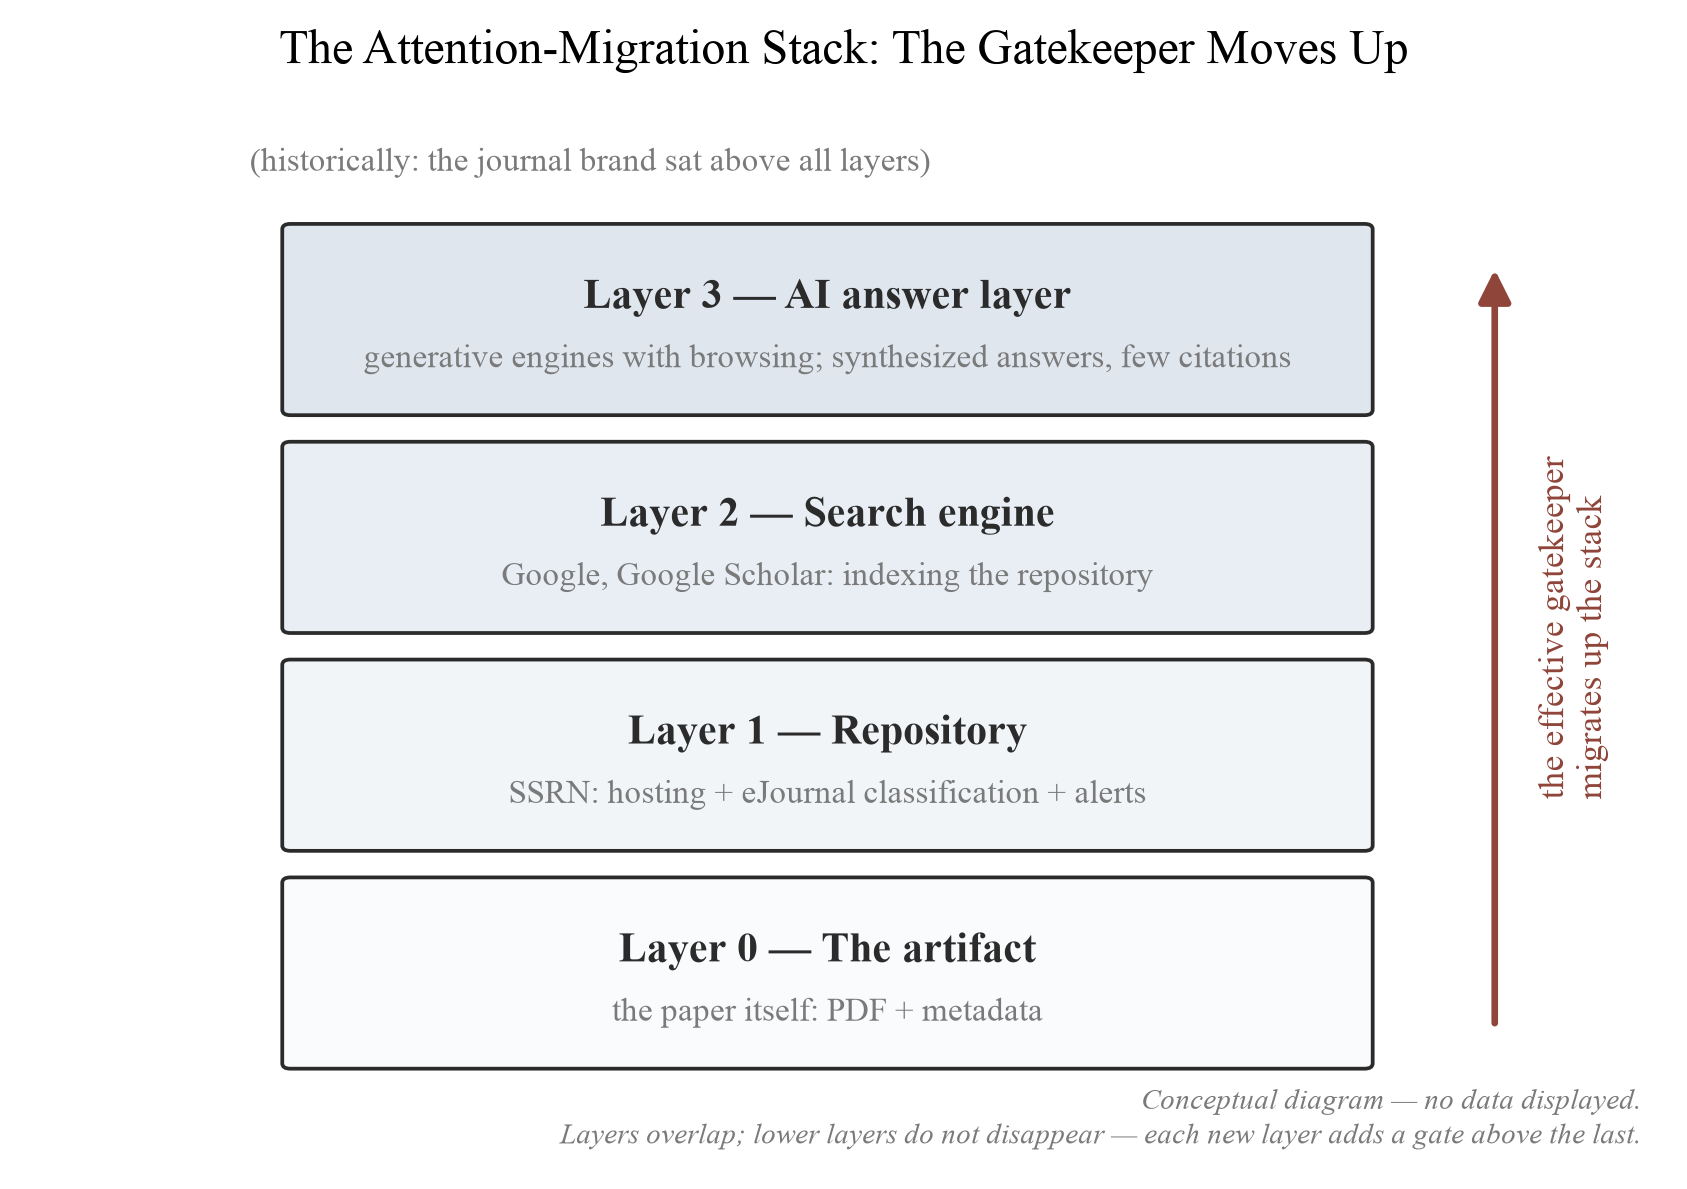
Figure 12. La pile de migration d'attention. Le chemin stratifié d'un manuscrit terminé à l'attention d'un lecteur. La thèse de migration soutient que le gardien efficace — la couche qui décide quels artefacts reçoivent l'attention — s'est déplacé vers le haut au fil du temps, de la marque de la revue à travers le dépôt et le moteur de recherche à la couche de réponse IA ; chaque mouvement vers le haut déplace le contrôle plus loin de l'auteur et plus loin de tout benchmark public. La pile est un modèle conceptuel.
L'étude 2 construit 100–200 questions de niche, chacune conçue de sorte qu'une prépublication SSRN spécifique soit la meilleure source disponible, une revendication de pertinence validée par des évaluateurs experts en aveugle plutôt que d'être auto-certifiée par les auteurs de la requête. Elle interroge les principaux systèmes IA grand public avec navigation activée et code le résultat dans six catégories mutuellement exclusives : (1) la prépublication focale elle-même citée ; (2) la version publiée ou un miroir du même article cité, un cas qu'un schéma plus grossier classerait à tort comme absence ; (3) couverture secondaire citée sans l'article ; (4) une source différente mais défendable citée ; (5) aucune source traçable ; et (6) refus du moteur (Figure 13). Pour chaque réponse qui cite l'article focal ou une version de celui-ci, un drapeau binaire fidélité-attribution enregistre en outre si l'affirmation dans la réponse est réellement soutenue par la source citée. La visibilité et la fidélité sont rapportées séparément et ne sont jamais fusionnées en un seul score, car un moteur peut citer un article de manière bien en vue tout en le déformant (blanchiment de citation) ou reproduire son contenu sans aucune citation (influence sans attribution). La régression confirmatoire reste logistique, sur le contraste « article focal ou sa version citée » par rapport à tous les autres résultats, avec des erreurs standard regroupées, ou de préférence une structure d'effets aléatoires croisés ajustée, pour respecter la non-indépendance des observations qui partagent un moteur, une requête ou un article focal, puisque le même article interrogé dans tous les moteurs et le même moteur interrogé dans tous les articles induisent chacun des résultats corrélés que les erreurs d'essais indépendants naïfs sousestimeraient. Formellement, l'estimand de l'audit est M_pqe : la probabilité que l'article p soit cité par le moteur e en réponse à la requête q. M_pqe n'est pas une propriété de l'article seul, puisqu'il varie selon les requêtes, les moteurs, les dates et les versions de modèles, donc la notation définit l'estimand et chaque exécution horodatée est lue comme une estimation de M_pqe à sa date. L'échantillon de moteurs devrait s'étendre au-delà des chatbots grand public à la couche émergente de récupération savante (des outils tels que Consensus, Elicit, Scite et Semantic Scholar, qui sont ancrés dans des corpus académiques et citent de vrais articles), puisqu'une prépublication invisible pour les moteurs grand public peut toujours être surfacée par les moteurs disciplinaires, et la divergence entre les deux couches est elle-même un résultat d'intérêt. La visibilité machine est ensuite régression sur les caractéristiques de l'article opérationnalisées dans le Tableau 18, y compris la covariable de visibilité antérieure que P3b nécessite : l'empreinte web et savante pré-audit de chaque article, gelée au moment de la construction de la requête. L'échantillon de requêtes est stratifié par visibilité antérieure de sorte que les articles de démarrage à froid sont représentés par construction. Parce que les moteurs génératifs sont non-stationnaires, la conception associe un instantané horodaté primaire à un protocole de ré-exécution scénairisé que d'autres peuvent reproduire. Trois exigences supplémentaires de propreté d'audit sont prédéfinies : les contrôles négatifs (articles prestigieux mais non pertinents, variantes de titre et invites qui ne devraient pas récupérer l'article focal) rendent la citation indiscriminée détectable ; chaque requête s'exécute dans des variantes d'invite équivalentes sous un état de session enregistré (sessions propres par rapport à sessions connectées ; moteur, version de modèle, date et géographie), de sorte que les artefacts spécifiques à l'invite et à la session sont séparables du comportement de récupération stable ; et un sous-ensemble aléatoire de résultats est codé en double, avec accord inter-évaluateurs rapporté. La liste de contrôle complète d'audit étape par étape est déposée avec les matériaux de préenregistrement. L'entrée principale de l'étude est le temps des chercheurs (la validation de pertinence en aveugle de 100–200 questions et le codage en double) plutôt que des données d'accès restreint ou une infrastructure spécialisée. Une étude qui doit payer le temps d'évaluateurs experts aux tarifs du marché devrait budgétiser explicitement ce travail. La prédiction prédéfinie est que la prépublication elle-même est citée dans une minorité d'essais (bande 10–35 %), avec des caractéristiques de résumé structuré et de version publiée augmentant la visibilité (P3). L'étude 2 est un protocole parmi cinq points d'agenda. Un audit complet de la visibilité machine savante, y compris des comparaisons inter-moteurs et inter-dépôts, est le sujet d'un document compagnon prévu.
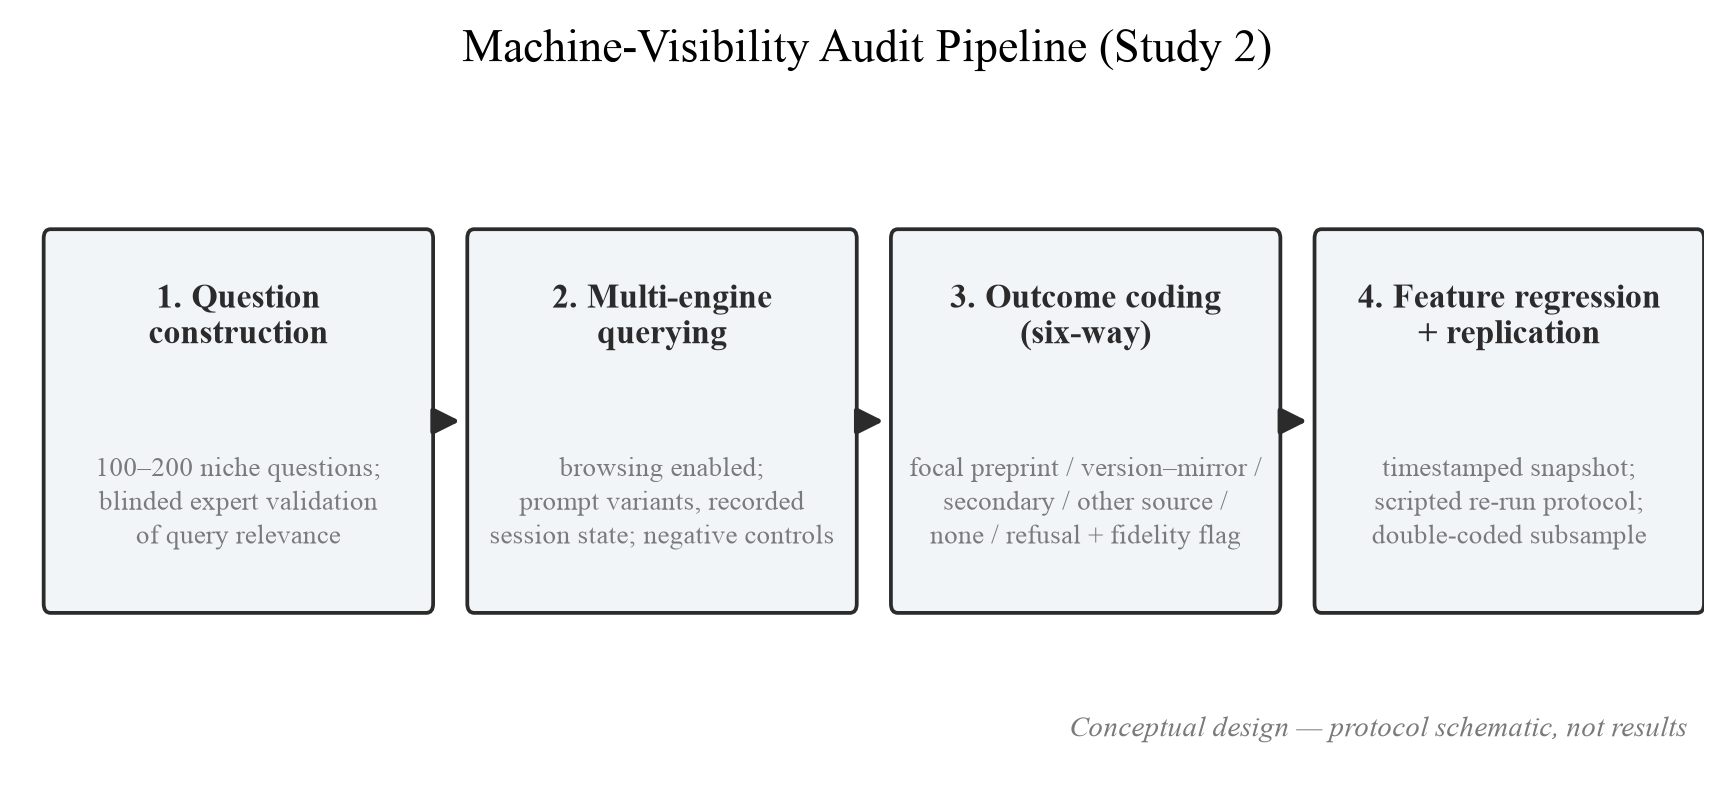
Figure 13. Le pipeline d'audit de visibilité machine (Étude 2). Le pipeline en quatre étapes de l'étude 2. Le codage à six voies sépare la citation de la prépublication focale de la citation de sa version publiée ou miroir — empêchant la fausse classification d'absence — et le drapeau de fidélité d'attribution garde « a-t-elle été citée » distinct de « a-t-elle été citée fidèlement ». La structure instantané-plus-réplication aborde la non-stationnarité du modèle : l'instantané primaire est horodaté, et le protocole de ré-exécution permet à tout chercheur de reproduire l'audit à une date ultérieure.
Tableau 18. Opérationnalisation des caractéristiques de visibilité machine (Étude 2).
| Variable | Définition | Codage |
|---|---|---|
| DOI présent | La page de l'article expose un DOI enregistré | 1/0 |
| Type de titre | Titre descriptif vs. allusif | descriptif = 1 |
| Structure de résumé | Structuré/riche en statistiques vs. narratif | structuré = 1 |
| Âge | Mois depuis la première publication | entier |
| Nombre de classifications | Nombre d'eRevues assignées | entier |
| Couverture secondaire | ≥1 mention indexée de blog/actualité existe | 1/0 |
| Version publiée | Une version de journal officiel existe | 1/0 |
| Visibilité antérieure | Empreinte web et savante antérieure à l'audit du document et de ses auteurs, gelée au moment de la construction de la requête (P3b) | ordinal stratifié |
| Résultat V | Résultat de récupération pour le document focal | six catégories : prépublication focal / version publiée ou miroir / secondaire uniquement / autre source défendable / aucune traçable / refus ; plus indicateur binaire de fidélité d'attribution pour les cas cités |
Note. Les choix de caractéristiques adaptent les facteurs d'optimisation des moteurs de génération documentés [5][164] aux artefacts savants. Le plus grand audit de ce type, portant sur environ 252 000 essais sur six moteurs basés sur les IA, a identifié la pertinence thématique et la position dans la liste au sein du contexte récupéré comme les principaux moteurs d'être cité en premier [164]. La position dans la liste est donc une hypothèse distincte et transférable pour l'Étude 2, et la position dans la liste de résultats doit être enregistrée partout où elle est observable.
Le tableau 19 complète le tableau 18 à un niveau de description différent. Le tableau 18 opérationnalise les caractéristiques au niveau du document dont l'Étude 2 estime les effets, tandis que le tableau 19 spécifie les construits de mesure de l'audit : ce qui est mesuré, sous quels contrôles, et contre quelle menace principale à la validité. Chaque construit est une affirmation distincte sur la couche machine, et chaque menace désigne la façon spécifique dont un audit naïf échouerait.
Tableau 19. Construits de mesure de l'audit de visibilité machine (Étude 2).
| Construit | Mesure opérationnelle | Contrôles requis | Menace principale |
|---|---|---|---|
| Visibilité machine directe | Prépublication focal citée ou liée dans la réponse | Pertinence de la requête, moteur, date, état de session | Dérive du modèle et de l'index |
| Substitution de source | Version publiée, miroir, ou couverture secondaire citée à la place de la prépublication | Appariement de version, DOI, variantes de titre | Fausse classification comme absence |
| Position de citation | Rang et proéminence de la citation focal dans la réponse | Longueur de réponse et nombre de citations | Présentation spécifique à l'interface |
| Fidélité d'attribution | L'affirmation dans la réponse est précisément soutenue par le document cité | Vérification en aveugle affirmation–source | Blanchiment de citation ou hallucination |
| Sensibilité à la requête | Variation des résultats entre formulations de requête équivalentes | Variantes d'invite aléatoires | Artefacts spécifiques à l'invite |
| Reproductibilité | Même résultat à une date ultérieure ou une réexécution nette | Protocole archivé et métadonnées système | Non-stationnarité du moteur |
Le transfert le plus défendable de la littérature commerciale sur l'OGM est un agenda d'audit de caractéristiques, non une recette promotionnelle : le tableau 20 énumère les caractéristiques candidates dont l'association avec la visibilité machine l'Étude 2 est conçue pour confirmer ou réfuter. Chaque ligne est une hypothèse plutôt qu'une tactique établie, et une caractéristique associée à la récupération peut quand même être un indicateur de la maturité du document, de la popularité du sujet, ou de la visibilité antérieure plutôt qu'un levier.
Tableau 20. Agenda d'audit de caractéristiques pour la visibilité machine (hypothèses pour l'Étude 2, non des recommandations).
| Caractéristique candidate | Mécanisme hypothétisé | Preuve justificative |
|---|---|---|
| Enregistrer un DOI | L'identifiant stable facilite la récupération et l'appariement des citations | [164] |
| Résumé structuré, riche en statistiques | L'ajout de statistiques a augmenté la visibilité générative de jusqu'à ~40 % dans les benchmarks commerciaux | [5] |
| Titre descriptif, dense en pertinence | La pertinence thématique est un principal moteur de citation dans les réponses IA | [164] |
| Maximiser les classifications eJournal précises | Plus de classifications associées à plus de téléchargements, moins de zéros | [168] |
| Obtenir ≥1 élément de couverture secondaire | Les moteurs citent souvent la couverture secondaire plutôt que les sources primaires | [82] |
Étude 3 : « Qui arrive en premier ? » Un protocole de dépôt instrumentalisé teste P4 directement. Deux véritables articles de travail sont déposés en utilisant des alias de courrier électronique à adresse plus unique par canal d'exposition, avec un journal entrant de 90 jours précédé d'une fenêtre de base de deux à quatre semaines sur les mêmes alias. Sans base de référence, une augmentation du volume de sollicitation ne peut pas être attribuée au dépôt du tout, puisque le spam académique arrive continuellement sur un taux de fond élevé. Chaque message est codé comme un contact savant authentique ou une sollicitation prédatrice en utilisant des signatures de sollicitation publiées [96] et des critères de type liste de blocage conservée, par rapport aux taux de fond élevés documentés dans les audits de spécialité examinés à la section 7.2 [9][84][63][61]. Le résultat est la comparaison du délai jusqu'au premier contact authentique et du délai jusqu'à la première sollicitation prédatrice attribuables au dépôt. La prédiction préspécifiée, selon P4, est que la sollicitation précède le contact authentique. Deux règles de mesure sont fixées avant le lancement. Les fenêtres de base et post-dépôt ont des longueurs inégales (environ deux à quatre semaines par rapport à quatre-vingt-dix jours), donc la comparaison porte sur les taux d'arrivée (événements par alias-jour) et sur les fonctions de survie, jamais sur les nombres d'événements bruts, que l'asymétrie de fenêtre distordrait autrement. Et le délai jusqu'au premier contact est censuré à droite par construction : avec deux articles, un alias qui ne reçoit aucun contact authentique dans la fenêtre de 90 jours donne une observation censurée, non zéro, donc la règle de censure est préspécifiée. Les observations sont censurées à droite à 90 jours, les alias sans événement contribuent le temps censuré à l'estimation de survie plutôt que d'être supprimés ou codés comme immédiats, et avec N = 2, les courbes résultantes sont signalées avec leur incertitude d'échantillon réduit exact plutôt que comme des estimations ponctuelles. L'estimand causal du plan de réplication distribuée est le changement du risque de sollicitation après le dépôt (non l'identité de tout téléchargeur), estimé avec des méthodes de survie/historique des événements sur des fenêtres pré- et post-dépôt appariées. Parce que la productivité visible d'un auteur prédit plausiblement le volume de sollicitation indépendamment de tout dépôt unique (la sollicitation est récoltée à partir de la production publique accumulée d'un auteur, donc les taux de fond élevés documentés dans les audits de spécialité de la section 7.2 s'ajustent à cette production), les réplications distribuées doivent enregistrer les contrôles d'exposition au niveau de l'auteur (dépôts antérieurs, volume de publication et surface de contact public) aux côtés de l'événement focal. C'est une étude de cas instrumentalisée N = 2, une preuve de mécanisme et un protocole ouvert invitant la réplication distribuée, qui collectivement produirait une estimation alimentée. N = 2 démontre la faisabilité de l'instrumentation, non la prévalence et non l'ampleur causale. Contrairement aux études 1, 2 et 4, qui sont alimentées contre les ampleurs d'effet préspécifiées, l'étude 3 est un pilote de faisabilité et un protocole de réplication ouvert.
Le cadre de codage est fixé avant le lancement. Les messages entrants sont codés en sept types : sollicitation de journal, invitation à une conférence, demande d'examen par les pairs, invitation à un comité de rédaction, invitation à un chapitre de livre, offre de service commercial et correspondance savante authentique, un cadre plus large qu'une division prédatrice/authentique binaire. Chaque enregistrement porte un ensemble de champs minimum : horodatage, alias récepteur (canal), nom du lieu, divulgation de frais, spécificité au document focal, langage d'urgence, résultat de vérification par rapport aux services de filtrage maintenus, et confiance du codeur. Les cas limites et les lieux légitimes de faible prestige sont régis par des règles préspécifiées plutôt que par un jugement ad hoc. Un lieu nouveau ou obscur n'est pas automatiquement prédateur. Un sous-ensemble aléatoire est double-codé avec accord inter-évaluateurs signalé. Seuls les décomptes globaux sont publiés (section 9 ; Déclarations), et le codebook complet est déposé avec l'enregistrement préalable. Le volume de sollicitation n'est pas une preuve de lecture, et la sollicitation ne modifie pas les compteurs publics : le système d'intégrité de SSRN exclut l'activité automatisée anormale des décomptes officiels [144], et aucune inférence de la boîte de réception au tableau de bord n'est autorisée dans l'une ou l'autre direction.
Étude 4 : « Comment les auteurs lisent leurs compteurs. » Une enquête auprès d'auteurs préspécifiée convertit la preuve de la demande du forum enregistrée dans le tableau 1 en une mesure directe. L'instrument comprend quatre éléments à libellé fixe : (1) « Avez-vous jamais comparé vos téléchargements SSRN à un repère ou une norme ? », avec des options de réponse distinguant un nombre publié spécifique, un tableau spécifique à la discipline, une comparaison informelle entre pairs, et jamais ; (2) « Quand vous voyez « 7 téléchargements » sur votre tableau de bord, quelle est votre première pensée ? », avec des options s'étendant de l'échec déduit, trop tôt pour le dire, aucune idée de ce qui est normal, et attendu ou acceptable ; (3) « Le coucher de soleil du classement de juillet 2026 a-t-il changé votre comportement en matière de prépublication ? », avec des options pour arrêter de consulter les statistiques, éviter les nouveaux téléchargements, télécharger mais consulter moins souvent, et aucun effet ; et (4) « Pensez-vous que les comités d'embauche et de titularisation comprennent les métriques SSRN ? ». Les prédictions préspécifiées sont qu'une majorité de répondants rapportent n'avoir jamais comparé leurs compteurs à un repère, et que les premières lectures d'un faible nombre penchent vers l'échec déduit plutôt que vers la lecture trop précoce que la section 5.6 montre être généralement la valeur par défaut correcte. L'objectif de taille d'échantillon, les canaux de recrutement et le code d'analyse sont fixés à l'enregistrement. L'auto-sélection vers des auteurs engagés, et plausiblement plus anxieux, limite l'échantillon, comme le fait le registre de la section 8.8. Le format à choix fixes admet également un volet compagnon qualitatif : codage thématique préspécifié des questions publiques d'auteurs (avec des critères d'inclusion explicites et une fiabilité inter-codeurs, selon l'éthique des citations énoncée à la section 9) et des entretiens semi-structurés sur la façon dont les auteurs lisent leurs compteurs et ce qu'ils en ressentent, abordant les conséquences humaines de la présentation des métriques que les éléments fermés ne peuvent pas capturer. Une limite de conception porte sur le construit central. Quatre éléments fixes administrés aux auteurs SSRN seuls mesurent un niveau de lecture sans repère, non un contraste, et un niveau ne peut à lui seul identifier le chemin revendiqué par l'article, de l'opacité des repères à la cécité métrique. Une part élevée de jamais comparés sur SSRN est tout aussi compatible avec une indifférence générale aux compteurs qui n'a rien à voir avec l'opacité de la plateforme. La traction discriminante et causale nécessite donc une condition de comparaison : le même instrument administré aux auteurs qui publient sur des plateformes ayant une exposition à différents repères, arXiv (basé sur l'approbation et l'énumération, avec ses propres surfaces de visibilité) et OSF Preprints, transforme « comment les auteurs SSRN lisent leurs compteurs » en « si les auteurs sur des plateformes plus ou moins opaques lisent leurs compteurs différemment », ce qui est le contraste que la revendication opacité-vers-cécité prédit réellement. Le volet interplateforme est préspécifié comme faisant partie de l'étude 4 ; sans lui, un résultat monoplateforme resterait descriptif de SSRN plutôt qu'un test du mécanisme. L'étude 4 teste alors directement les revendications interprétatives des sections 1 et 5, mesurant ce que les auteurs croient que leurs compteurs signifient plutôt que ce que les compteurs sont.
8.7 L'article comme sa propre expérience
La trajectoire de téléchargement propre de cet article est également préspécifiée. Ses compteurs seront enregistrés à 30, 90 et 180 jours après la publication et rapportés à la médiane de l'Étude 1 une fois cette médiane connue. L'enregistrement est descriptif et ne comporte aucune règle d'interprétation, car les deux lectures directionnelles flatteraient la thèse, et un dispositif sur lequel chaque résultat confirme l'argument ne teste rien ; les chiffres seront publiés tels qu'ils arrivent. Une lecture s'opposerait au cadrage de l'article : une trajectoire se situant à la médiane du domaine et de l'âge, ni élevée ni supprimée, indiquerait que la conception autoréférentielle ne confère aucun avantage de découvrabilité mesurable dans ce seul cas. La réflexivité ne peut être évitée, puisque cet article étudie une métrique qu'il accumulerait lui-même ; les leviers catalogués sont évalués par les tests directs de la section 8, non par cet enregistrement.
8.8 L'indice de percentile comme bien public
L'artefact le plus utile que cet agenda puisse produire est un tableau de percentiles pour les téléchargements de prépublications, le chiffre que chaque auteur recherche et ne peut pas trouver. La plateforme a historiquement publié des moyennes et des listes des N premiers, mais pas de médianes ou de percentiles, et depuis le 15 juillet 2026, elle n'affiche que des comptages par article et par auteur sans aucun contexte comparatif [149]. Pour l'indice h et les indicateurs similaires, il existe un genre de guides « X est-il bon ? » destinés à un large public [118][128] ; l'audit de la section 2.5 n'a trouvé aucun équivalent pour les téléchargements SSRN. Les matériaux bruts pour un tel tableau existent en version imprimée depuis des années [18][83][85][139][168], et ce qui manque est la traduction de ces distributions en une échelle destinée aux auteurs.
Après la fermeture, la collecte externe de percentiles de l'ensemble de la plateforme n'est plus possible : les listes de haut classement qui ont révélé les seuils de distribution étaient la seule fenêtre publique sur la queue, et elles ont disparu [149]. Deux voies complémentaires subsistent. L'une est l'échantillon stratifié de l'étude 1, qui produit des percentiles de plateforme au niveau des articles. L'autre voie est un registre participatif de compteurs auto-déclarés : un ensemble de données communautaire volontaire dans lequel les auteurs contribuent des captures d'écran du tableau de bord datées (âge de l'article, domaine, vues du résumé, téléchargements), rassemblées avant que la mémoire institutionnelle des distributions antérieures à la fermeture ne s'effondre davantage. L'étape de préservation du protocole du dossier (tableau 13), si elle est adoptée à grande échelle, est la semence d'exactement un tel registre. Il existe également un précédent fonctionnel à étendre plutôt qu'à inventer. IRUS (Jisc) agrège déjà des statistiques d'utilisation standardisées, conformes à COUNTER, au niveau des articles, notamment Total_Item_Requests, sur les référentiels institutionnels participants [185], ce qui montre que l'agrégation d'utilisation multi-institution est opérationnellement réalisable. Un registre de prépublications est ce modèle établi élargi pour porter les variables de classe de référence qui importent ici (domaine, cohorte de publication et étape de carrière). Un homologue nord-américain, CC-PLUS, fournit la même capacité en tant qu'infrastructure open-source, avec récolte SUSHI automatisée de COUNTER 5 d'utilisation entre consortiums [188], de sorte qu'un registre peut étendre une plateforme fonctionnelle au lieu d'être commandé à partir de zéro. Un registre de ce type constituerait la première distribution de téléchargement fraîche, multidisciplinaire, depuis les échantillons des années 2010 [85][139]. Les faiblesses connues sont l'auto-sélection vers les auteurs engagés et probablement au-dessus de la médiane, les auto-déclarations non vérifiables à moins que des captures d'écran datées ne soient exigées, et les lacunes de couverture dans les petits domaines. Les percentiles qui en découlent doivent donc être publiés avec des avertissements explicites de sélection et, si possible, être calibrés par rapport à l'échantillon de probabilité de l'étude 1, et les cellules clairsemées par domaine et âge doivent être rapportées sous rétrécissement empirique-Bayes vers des classes de référence plus larges plutôt que comme des percentiles bruts instables (sections 5.2, 8.3). Le protocole du registre et les règles de vérification seront publiés avec les matériaux de préenregistrement, et le format de contribution est fixé ici : un enregistrement du registre est un sous-ensemble défini du schéma de panneau de l'appendice C (les domaines d'identité, de chronologie, d'utilisation, d'exposition et d'audit), de sorte que les enregistrements auto-déclarés restent fusionnables avec le panneau de l'étude 1 plutôt que de s'accumuler en tant que deuxième ensemble de données incompatible.
Les formats de sortie du registre sont préspécifiés avec son protocole, et deux artefacts sont engagés. L'un est un tableau de traduction qui prend un seul nombre (par exemple 10, 40 ou 100 téléchargements) et retourne, pour chaque domaine couvert, sa position de percentile et la bande en langage clair du tableau 8 ; avec lui, la réponse à « 7 téléchargements, c'est bien ? » peut enfin être consultée plutôt que devinée. L'autre est une figure de « ventail » de percentiles traçant les courbes de téléchargement du 25e, 50e, 75e et 95e percentile en fonction de l'âge de l'article, par domaine et strate de nouveaux venus : le format dans lequel un indice de référence répond à « combien est normal le jour X » (figure 14 ; [données requises] : aucun artefact ne peut être rempli avec des valeurs synthétiques). Chaque publication de percentile de l'une ou l'autre voie (l'échantillon de probabilité ou le registre) est publiée selon la spécification de transparence de l'appendice D, y compris ses règles de confidentialité à cellule minimale, de sorte que l'indice de référence que cet agenda propose ne reproduit pas l'opacité qu'il a été conçu pour guérir. Au-dessus des données appartient une fine couche en libre-service, un calculateur en ligne public dans lequel un auteur saisit le domaine, l'âge de l'article et les compteurs et reçoit une bande de percentile et un verdict verbal. Il transformerait les heuristiques de style scorecard non calibrées de la section 6.3 en un instrument calibré une fois, et une seule fois, les distributions de référence existent. La section 8.10 propose une architecture multi-modèle par laquelle un tel service pourrait être exploité et maintenu à jour. Cette même couche en libre-service empêche le protocole de rapports d'imposer une nouvelle charge de travail aux commissions d'embauche et de titularisation, puisque la normalisation par nombre que le format du dossier (tableau 13) demande est déchargée par la calculatrice (cette section) et, à grande échelle, par la couche d'orchestration (section 8.10). Son chemin de déploiement réaliste passe par la plomberie de recherche existante, à savoir les systèmes d'information de recherche actuels (CRIS) et les profils liés à ORCID, de sorte qu'une lecture avec indice de référence puisse être produite à partir des identifiants d'un article plutôt que assemblée à la main. Une extension multi-plateforme naturelle est un protocole de dépôt parallèle comparant la trajectoire du même article sur SSRN, arXiv (le cas échéant) et OSF Preprints, un test direct de savoir si les bandes du tableau 8 se transfèrent entre architectures push et pull (tableau 6).
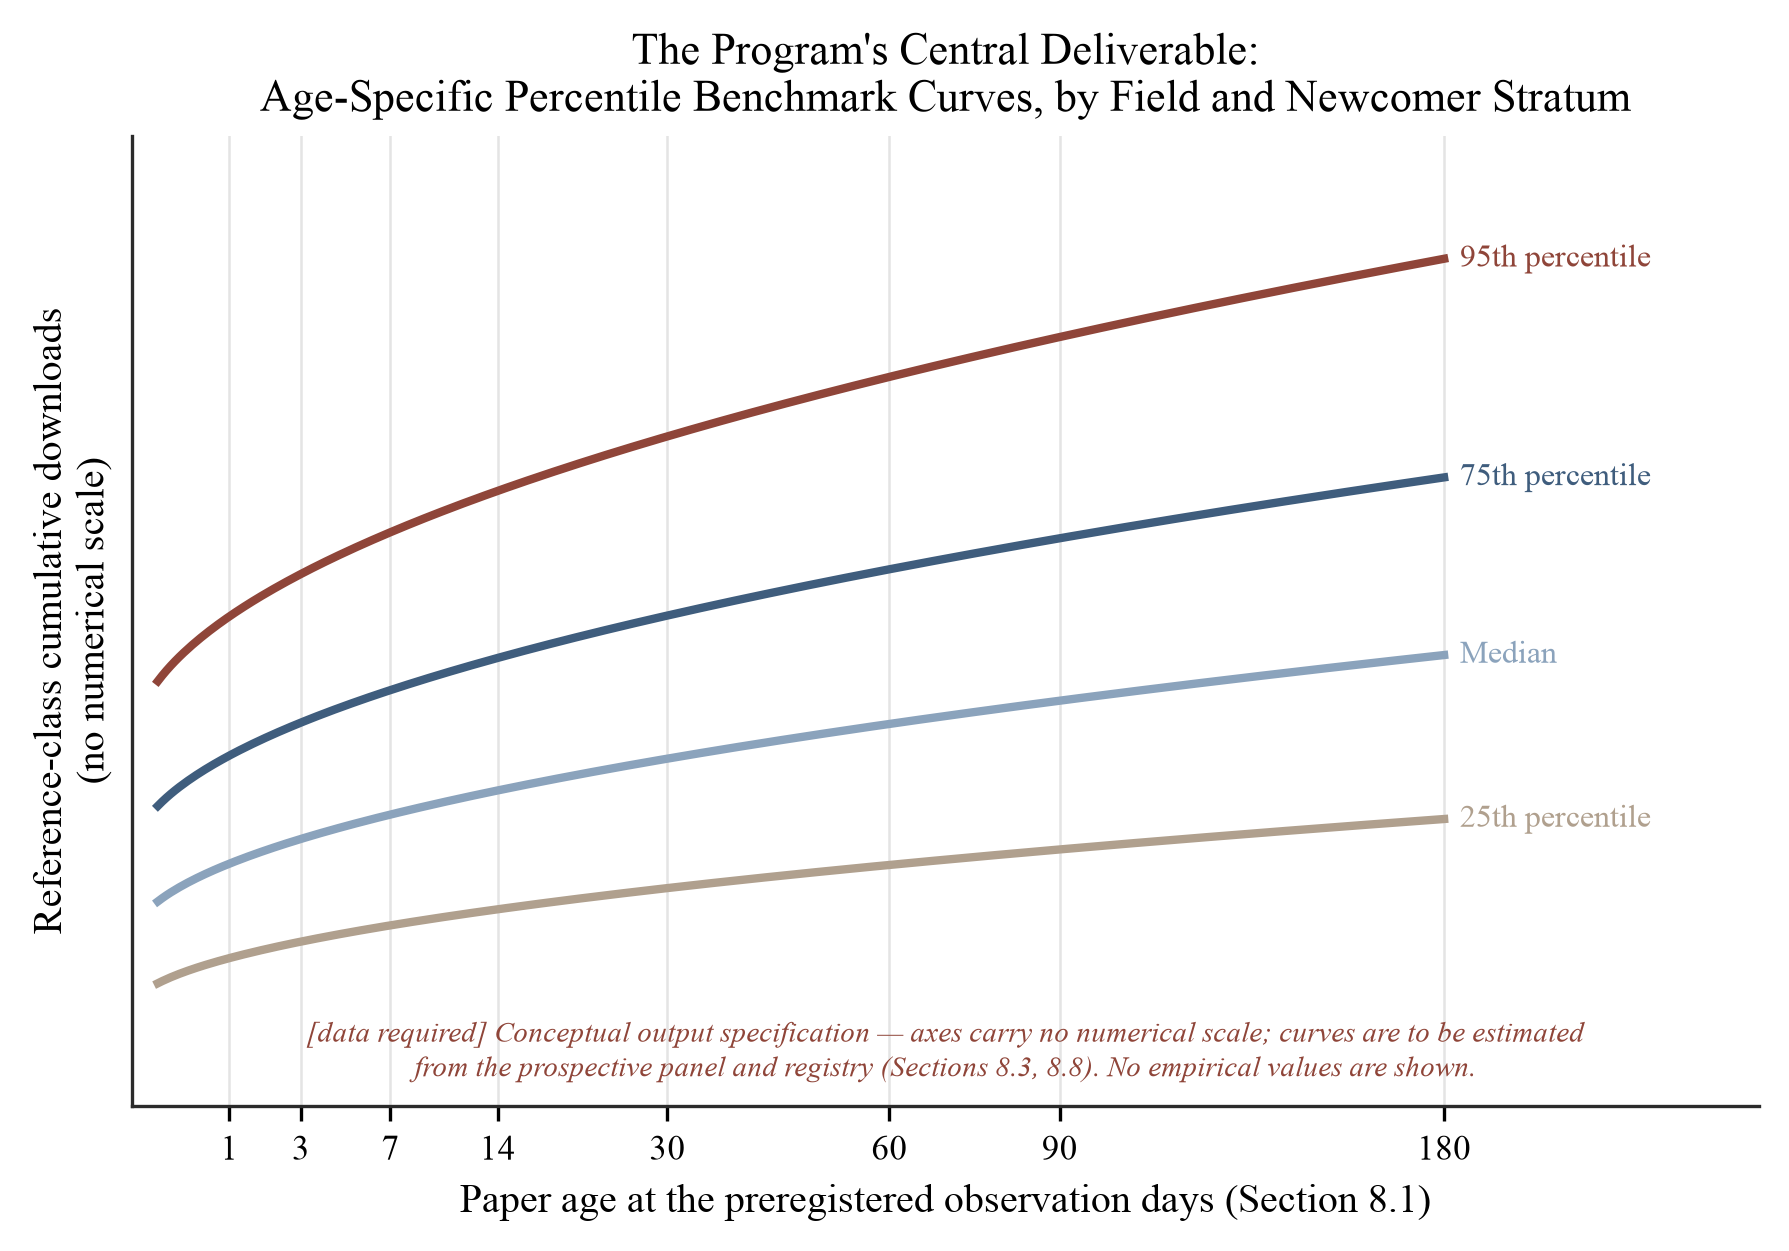
Figure 14. L'indice de référence spécifique à l'âge : le produit livrable central du programme. Courbes de téléchargement des percentiles (25e, 50e, 75e et 95e) en fonction de l'âge de l'article, évaluées aux jours d'observation préspécifiés de la section 8.1 et à estimer par domaine et strate de nouveaux venus à partir de l'échantillon de l'étude 1 et du registre communautaire. Les axes ne portent pas d'échelle numérique ; la figure est une spécification de sortie conceptuelle, et c'est le format d'affichage derrière la recommandation de plateforme de la section 10.4 et la calculatrice publique décrite ci-dessus.
Chaque article empirique du programme s'engage à un package de rapport minimum : un diagramme de flux de cohorte ; des distributions brutes et normalisées côte à côte ; la portée et la conversion rapportées séparément ; les historiques d'exposition ; les résultats de sensibilité aux anomalies sur l'échelle à quatre niveaux de la section 8.3 ; les résultats nuls et contraires rapportés avec la même importance que les confirmations ; et un tableau d'évaluation lisible par machine, la condition selon laquelle le résultat de l'étude 1 peut effectivement alimenter la calculatrice publique décrite ci-dessus. Les résumés des articles du programme distinguent les estimations vérifiées des attentes préspécifiées.
8.9 Validation prédictive
Le test sommatif de l'agenda (RQ3) demande si la normalisation justifie sa complexité. L'usage précoce et les citations ultérieures sont positivement mais imparfaitement associés dans différents contextes : corrélations de l'ordre de 0,11–0,35 dans les analyses de Granger au niveau des revues [80], environ 0,4 dans les cohortes précoces d'arXiv, où r ≈ 0,4 n'explique que environ 16 % de la variance [25], avec des associations comparables rapportées pour les préimpressions de chimie deux décennies auparavant [26], pour les téléchargements aux niveaux de la revue et de l'article en général [71], dans les données d'usage de RePEc [31], et dans les cohortes de bioRxiv [62], et des corrélations de rang modérées dans l'usage des méga-revues [102]. Les ensembles hautement téléchargés et hautement cités ne se chevauchent que partiellement [108][39]. Des preuves récentes de panel relient l'accès aux citations avec un décalage : dans un panel de sept revues, l'association était approximativement d'élasticité unitaire, avec une augmentation de 10 % des accès associée à une augmentation d'environ 10 % des citations environ neuf mois plus tard [178]. Dans la notation de la section 5.5, la comparaison sommatif estime
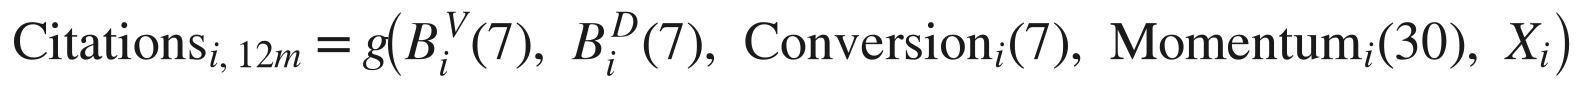
avec g ajusté de manière flexible et évalué uniquement hors de l'échantillon. L'équation fixe quelles entrées normalisées concurrencent les décomptes bruts. Les modèles prédisant les citations à 6, 12 et 18 mois à partir des métriques de jour 7 et jour 30 normalisées par l'âge, le domaine et la cohorte doivent être comparés hors de l'échantillon (par probabilité validée par croisement, calibrage, corrélation de rang et erreur prédictive) avec des modèles utilisant les téléchargements cumulatifs bruts seuls, un problème de politique prédictive au sens de Kleinberg et al. [88]. Un résultat particulièrement informatif serait que les décomptes bruts favorisent les auteurs établis tandis que les mesures de cold-start normalisées prédisent mieux l'adoption des citations ultérieures. Ce modèle implique que ce que les compteurs précoces bruts mesurent en partie, c'est l'opportunité initiale plutôt que la demande intellectuelle ultérieure. Si la normalisation ne parvient pas à ajouter d'information prédictive, la prétention à la mesure du cadre est rejetée ou restreinte en conséquence.
La figure 15 rassemble l'agenda. Une cohorte prospective alimente les quatre études et les deux quasi-expériences de plateforme en parallèle, et chaque module débouche dans le même ensemble de sorties publiques versionnées. Cette structure partagée fait de l'agenda un programme de recherche.
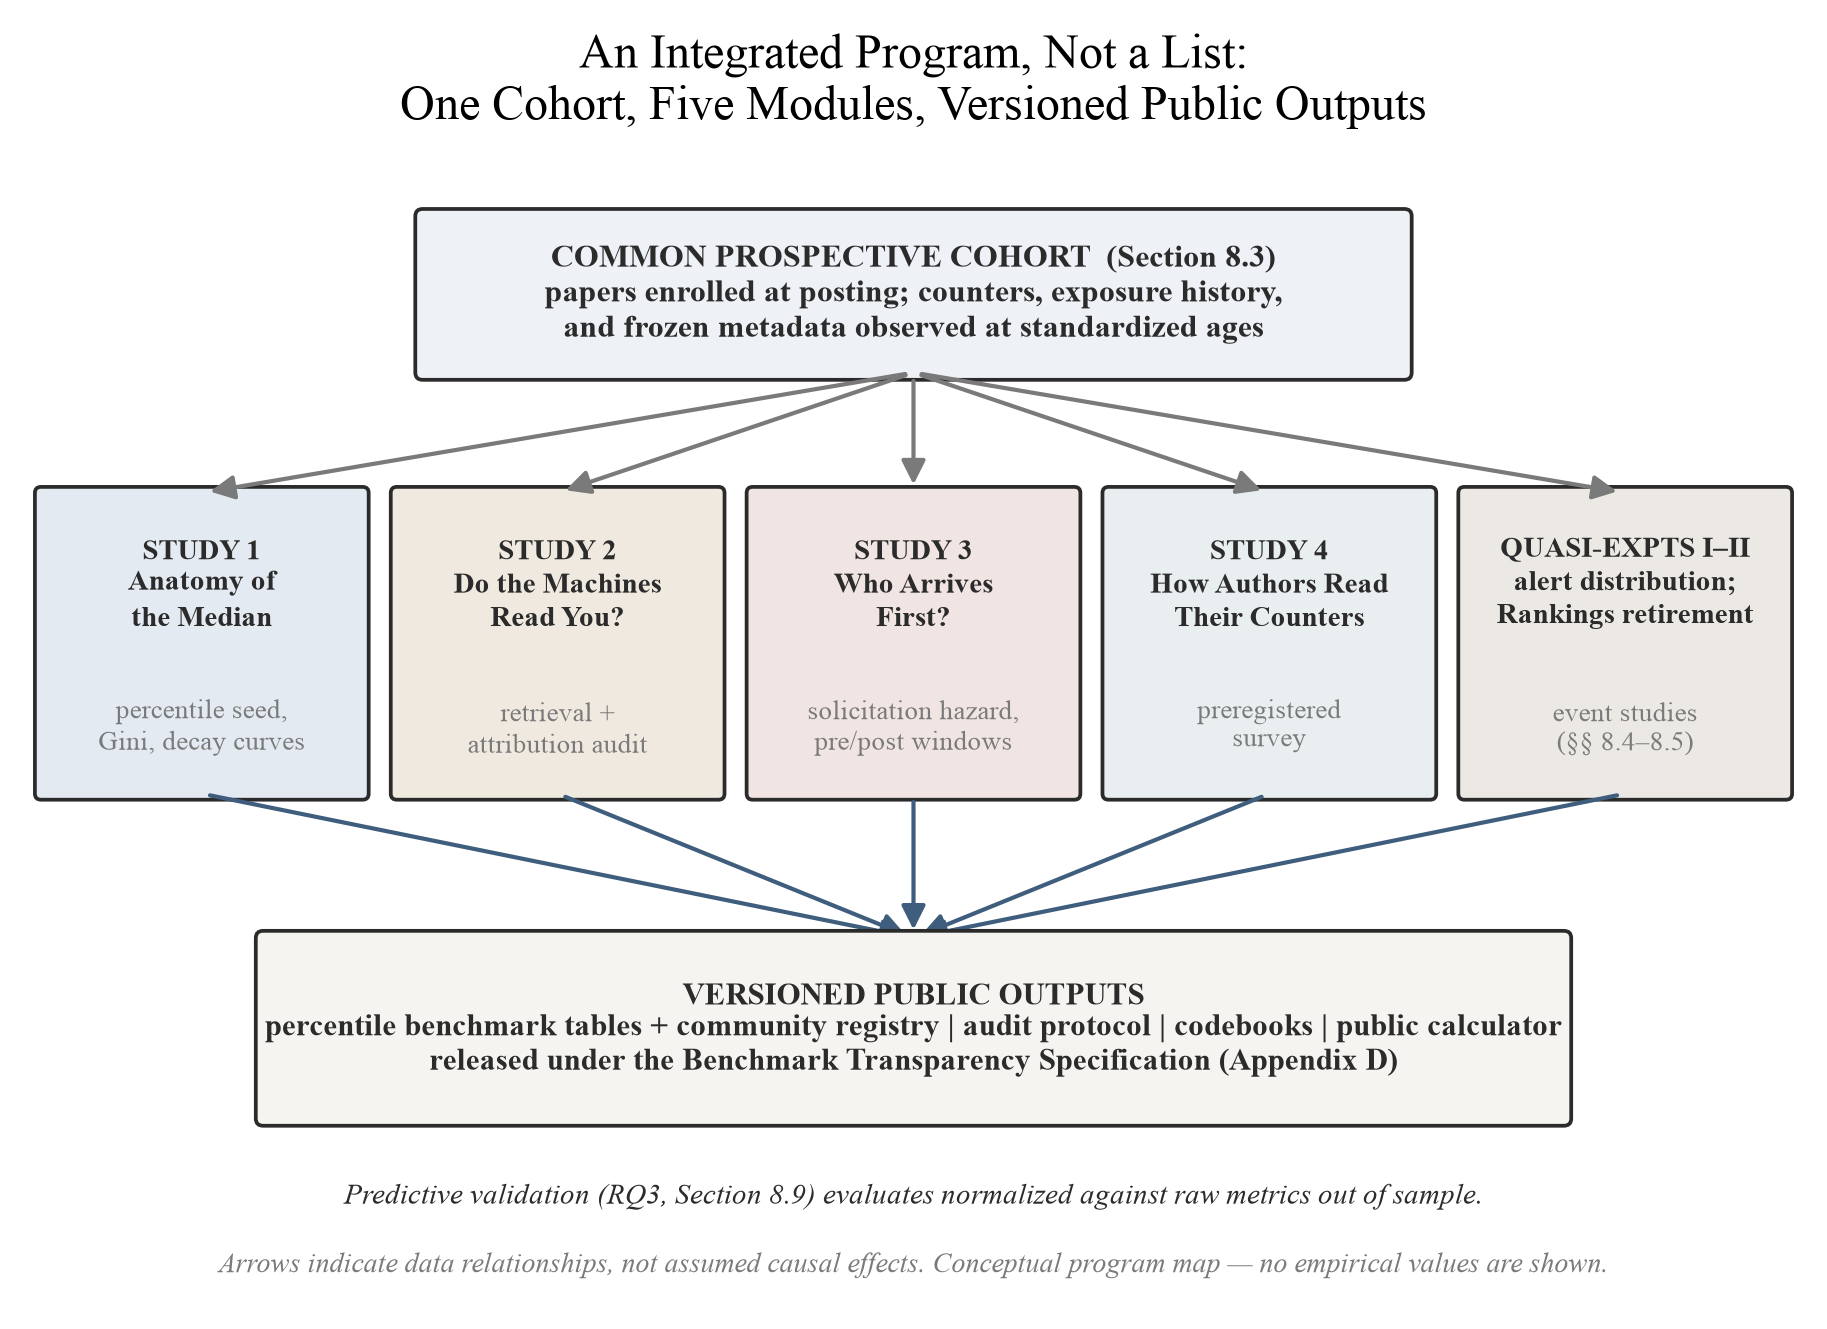
Figure 15. Le programme de recherche intégré. Une cohorte prospective (section 8.3) alimente les quatre études (section 8.6) et les deux quasi-expériences de plateforme (sections 8.4–8.5) ; tous les modules débouchent dans des sorties publiques versionnées — les tableaux de référence en percentiles et le registre communautaire (section 8.8), le protocole d'audit, les codebooks de codification et la calculatrice publique — publiés selon la Spécification de transparence des référentiels de l'annexe D, tandis que la validation prédictive (section 8.9) évalue le référentiel résultant hors de l'échantillon. Les flèches indiquent les relations de données, non les effets causaux supposés.
8.10 Une proposition de conception : les modèles de frontière orchestrés comme couche de livraison des benchmarks
Une publication ponctuelle ne peut pas fournir ce que les résultats de l'agenda exigent. Les tableaux de percentiles, le registre communautaire, le format de rapport CSAB (Section 5.5 ; Appendice B), et la calculatrice publique (Section 8.8) doivent tous être assemblés à partir de sources dispersées et dégradées, vérifiés affirmation par affirmation, tenus à jour à mesure que les règles de comptage et les caractéristiques des plateformes changent, et livrés aux auteurs individuels dans un langage calibré. Une architecture candidate pour cette couche de livraison et de maintenance est un pipeline orchestré d'IA de frontière spécialisées (une classe de système que l'auteur développe ; voir Conflits d'intérêts). Tout ce qui suit dans cette sous-section est une proposition de conception. Aucune implémentation n'existe, aucune performance empirique n'est revendiquée, et aucun chiffre d'exactitude, de coût ou de temps économisé n'est affirmé nulle part ci-dessous.
Une alternative à un système orchestré est un modèle généraliste unique. Un auteur qui demande à un chatbot grand public « 7 téléchargements, c'est bien ? » reçoit une affirmation fluide et invérifiable, le mode de défaillance que les audits des moteurs de réponse documentent, dans lequel les systèmes se trompent avec une confiance injustifiée au lieu de refuser de répondre [82]. En dessous se trouve un problème structurel. L'interprétation des métriques se décompose en sous-tâches avec des objectifs différents et partiellement antagonistes. Acquérir et dater les preuves, examiner un compteur pour détecter le trafic non humain ou anormal, normaliser le compteur examiné par rapport à une classe de référence d'âge, de domaine, de cohorte et de visibilité antérieure, traduire la position normalisée en langage balisé, et contester cette traduction avant la publication ne sont pas la même tâche, et un composant optimisé pour l'une est un mauvais juge de l'autre. Le modèle qui rédige une lecture rassurante ne devrait pas être la seule autorité pour déterminer si le nombre sous-jacent est contaminé, et le modèle qui rédige le langage du dossier ne devrait pas certifier que le langage évite l'exagération. Le principe organisateur est donc une division du travail épistémique : la génération et la vérification sont assignées à des composants distincts avec des objectifs indépendants, et le désaccord est préservé et signalé plutôt que moyenné. La convergence d'évaluateurs indépendamment sollicités ou architecturalement distincts n'est pas la vérité, bien qu'elle soit un fondement plus solide pour une lecture qu'une fluence d'un modèle unique, une intuition de conception cohérente avec les preuves expérimentales selon lesquelles un débat multiagent entre instances de modèles de langage améliore mesurément la validité factuelle et réduit les hallucinations par rapport à un modèle unique répondant seul [43]. Lorsque les évaluateurs divergent, la divergence elle-même est une information diagnostique, tout comme les sources conflictuelles ont été traitées comme un signal plutôt que du bruit dans les règles de synthèse propres de cet article (Scope et Evidence Discipline). Deux mises en garde de conception tempèrent cette intuition. L'accord entre composants n'est pas en soi une preuve : il peut résulter de données d'entraînement partagées, de résultats de récupération partagés, d'hypothèses de prompt communes, ou de contamination par l'orchestrateur lui-même. Les familles de modèles provenant de fournisseurs différents ne sont pas scientifiquement indépendantes, et l'indépendance doit être conçue, par des instructions distinctes, un flux d'information restreint entre composants, des résultats intermédiaires préservés, et une évaluation par rapport à des preuves qu'aucun composant générateur n'est autorisé à éditer. La vérification ne devient pas non plus fiable simplement parce qu'un deuxième modèle l'effectue : les affirmations qui sont contestées ou conséquentes nécessitent l'inspection de la source sous-jacente par l'utilisateur humain.
La Figure 16 montre le pipeline proposé, et le Tableau 21 le décompose par fonction. Le traitement commence à partir d'un fichier de cas figé, et non d'un prompt libre : les compteurs avec leurs dates d'observation, l'âge du document, le domaine déclaré et les cohortes de référence candidates, l'historique d'exposition, et la question réelle de l'auteur. Les entrées manquantes restent manquantes, et le système ne peut pas fabriquer une distribution de percentiles absente, imputer un dénominateur, ou accepter un nombre généré par un modèle à la place d'un nombre observé. Le flux d'information reproduit ensuite la séquence interprétative que l'article défend dans l'ensemble : compteurs bruts → examen de l'intégrité → normalisation par classe de référence → interprétation sous contrainte. Un composant de surveillance récupère les compteurs, les documents de plateforme et les enregistrements du registre avec une provenance datée, afin que chaque valeur en aval soit traçable jusqu'à une source archivée. Chaque résultat factuel se déplace entre les composants comme une entrée dans un registre de réclamations. Chaque entrée enregistre la réclamation, sa source de support ou son champ de données, un localisateur stable, le moment de la récupération, toute transformation appliquée, sa classe de référence, et son état de vérification, afin qu'aucune résultat non soutenu ne puisse silencieusement devenir une prémisse d'une étape ultérieure. L'examen de l'intégrité applique la détection d'anomalies des séries chronologiques conventionnelles (une tâche pour les méthodes statistiques, pas la génération de texte libre) par rapport à l'arrière-plan documenté du filtrage des bots et de la contamination par les crawlers IA [129][144]. Il attribue les ruptures de trajectoire aux événements d'exposition datés quand l'enregistrement d'exposition le permet (Section 5.6). La normalisation est effectuée par du code statistique déterministe invoqué comme un outil : les positions de percentile sont calculées par rapport aux tableaux d'Étude 1 versionnés et aux tables de registre selon les règles de rétrécissement de la Section 8.3. L'arithmétique des percentiles n'est jamais déléguée à la génération de texte libre. Ce n'est qu'alors qu'un modèle interprète rédige la lecture destinée à l'auteur, limitée au langage balisé du Tableau 8, au diagnostic portée-conversion du Tableau 9, et au modèle CSAB de l'Appendice B, avec la source, l'ancienneté et le niveau de confiance attachés à chaque nombre. Un vérificateur et un critique distincts vérifient chaque affirmation par rapport à ses preuves enregistrées avant publication, signalant chacune comme vérifiée, contestée, non soutenue, ou non évaluable, quatre états distincts qui ne sont jamais comprimés en un seul score de confiance synthétique. Deux contraintes sont reprises du cadre inchangé. Toute recommandation est conditionnelle au goulot d'étranglement diagnostiqué, puisque les documents limités en portée et en conversion méritent des actions différentes (Tableau 9), et un système qui ne peut pas les distinguer devrait ne rien dire au lieu d'émettre des conseils génériques. L'autre contrainte est qu'une recommandation publiée est une hypothèse : elle prédit quel mécanisme devrait se déplacer si le diagnostic est correct, et les observations ultérieures testent cette prédiction. La fonction objective du système est donc correspondamment étroite : éliminer les frictions interprétatives identifiables entre un document et sa classe de référence appropriée, et jamais la maximisation d'un compteur, une limite fixée par les politiques d'intégrité et d'IA générative de la plateforme [54][144] et par l'historique du gaming de la Section 3 [44].
Tableau 21. Décomposition fonctionnelle de la couche d'orchestration proposée : fonction, type de composant, mode de défaillance principal et mécanisme qui le vérifie indépendamment. Chaque ligne est une hypothèse concernant une division du travail viable.
| Fonction | Type de modèle ou de composant | Mode de défaillance principal | Mécanisme de vérification indépendante |
|---|---|---|---|
| Orchestration et provenance | Routeur de tâches maintenant le dossier gelé et le registre des réclamations | Une hypothèse non fondée précoce se propage en tant que prémisse de chaque étape ultérieure | Aucune sortie non vérifiée ne peut devenir une prémisse de confiance ; la source, la transformation, le délai de récupération et l'incertitude sont préservés à chaque transfert |
| Acquisition de preuves et surveillance | Modèle de récupération utilisant des outils selon un calendrier de réexécution ; correspondance bibliographique par rapport à l'infrastructure de citation ouverte [35][124] | Sources fabriquées, mal appariées ou sélectivement récupérées | Journal de provenance daté ; chaque valeur traçable jusqu'à un instantané archivé ; sous-échantillon aléatoire réextraire indépendamment par un deuxième composant ; recherches échouées et résultats contraires enregistrés, non supprimés |
| Contrôle d'intégrité | Détection d'anomalies de séries temporelles non générative [129][144] | Un pic étiqueté « bot » — ou « lecteur » — sans preuve de l'une ou l'autre identité | Les drapeaux d'anomalie sont publiés aux côtés des agrégats (section 8.8) ; la sensibilité est signalée sur l'échelle de robustesse à quatre niveaux de la section 8.3 ; l'anomalie est traitée comme un drapeau, jamais comme une affirmation d'identité |
| Normalisation de la classe de référence | Code statistique déterministe invoqué en tant qu'outil | Des pairs de commodité confondus avec une population de comparaison valide | Recalcul par rapport aux tables d'étalonnage public versionnées (appendice D) ; le domaine, l'âge, la cohorte, la visibilité préalable et l'ancienneté de la source sont énoncés ou le module s'abstient ; aucune arithmétique en texte libre n'est acceptée dans le dossier |
| Rédaction d'interprétation | Modèle de langue généraliste limité au langage de bande du tableau 8 et au modèle CSAB (appendice B) | Suraffirmation fluide — certitude, portée ou statut causal au-delà de ce que les preuves autorisent | Vérification au niveau de la réclamation par un vérificateur distinct par rapport aux preuves enregistrées ; chaque réclamation signalée comme vérifiée, contestée, non fondée ou non évaluable ; les phrases non fondées sont rejetées, non adoucies |
| Examen contradictoire | Modèle critique avec des objectifs contradictoires avec le rédacteur | Critique rituelle, ou un consensus synthétique qui masque un désaccord substantiel | Rapport de désaccord structuré — statut des preuves, modèle d'évaluateur, sensibilité de la décision (le différend change-t-il le diagnostic ou seulement sa formulation), incertitude résiduelle — livré non fusionné, jamais réduit à un seul chiffre de confiance |
| Tri des sollicitations | Classificateur spécialisé selon le cadre de codage des tableaux 14–15 | Un verdict catégorique « prédateur » qui dépasse les preuves et risque de porter atteinte à la réputation | Marquage et révision uniquement, jamais suppression automatique et jamais accusation publiée ; les taux d'erreur sont signalés sur les ensembles étiquetés ; les limites et biais documentés de la classification de texte par IA sont reconnus [157][97] |
| Maintenance des étalons | Orchestration programmée de tous les composants | Dérive silencieuse : sources obsolètes, ou versions écrasées sans trace | Versions datées et datées en vertu de l'appendice D ; les révisions sont enregistrées, jamais silencieusement écrasées — une carte d'étalonnage vivante plutôt qu'un instantané statique |
| Interprétation finale et tout usage pour la carrière | Auteur humain | Biais d'automatisation et diffusion de la responsabilité | Approbation obligatoire par l'humain avant tout usage externe ; le langage du dossier suit le protocole du tableau 13, avec la source, la fenêtre temporelle et les limitations jointes |
Deux limites complètent la spécification. L'une est une limite de permission : l'accès en lecture seule est le défaut, et la couche brouille mais n'exécute jamais. Elle ne peut pas modifier autonomement un manuscrit, modifier les métadonnées de la plateforme, contacter des chercheurs ou des lieux, publier publiquement ou supprimer un message de sollicitation, et tout flux de travail implémenté doit préserver la responsabilité humaine et les obligations de divulgation des politiques de plateforme et de soumission applicables [54][56][144]. L'autre est une limite d'abstention : la sortie nulle est un résultat légitime (souvent correct), et chaque étape peut s'arrêter plutôt que de transmettre une entrée défectueuse. Les déclencheurs d'abstention obligatoires incluent une classe de référence manquante ou indéfendable ; une source invérifiable centrale à la lecture ; désaccord non résolu quant à savoir si une formulation proposée préserve les affirmations du document ; toute demande de conclusion causale à partir d'un schéma purement descriptif ou de prédiction des citations ou des résultats de carrière sans un ensemble de données de prédiction validé (section 8.9) ; et toute demande de manipuler, acheter, simuler ou autrement gonfler l'attention. Ce dernier déclencheur empêche la couche de devenir l'instrument de jeu de mesures dont la section 3 documente l'histoire [44][69][144]. Une dernière séparation régit les deux flux de preuves du programme. Les tableaux de centile versionnés des sections 8.6 et 8.8 sont la seule source de normalisation admissible de la couche, tandis que l'audit de visibilité des machines de l'étude 2 alimente une vérification de récupération et d'attribution distincte. La récupération automatique n'est pas un centile de l'attention humaine, et la couche ne peut pas mélanger les deux.
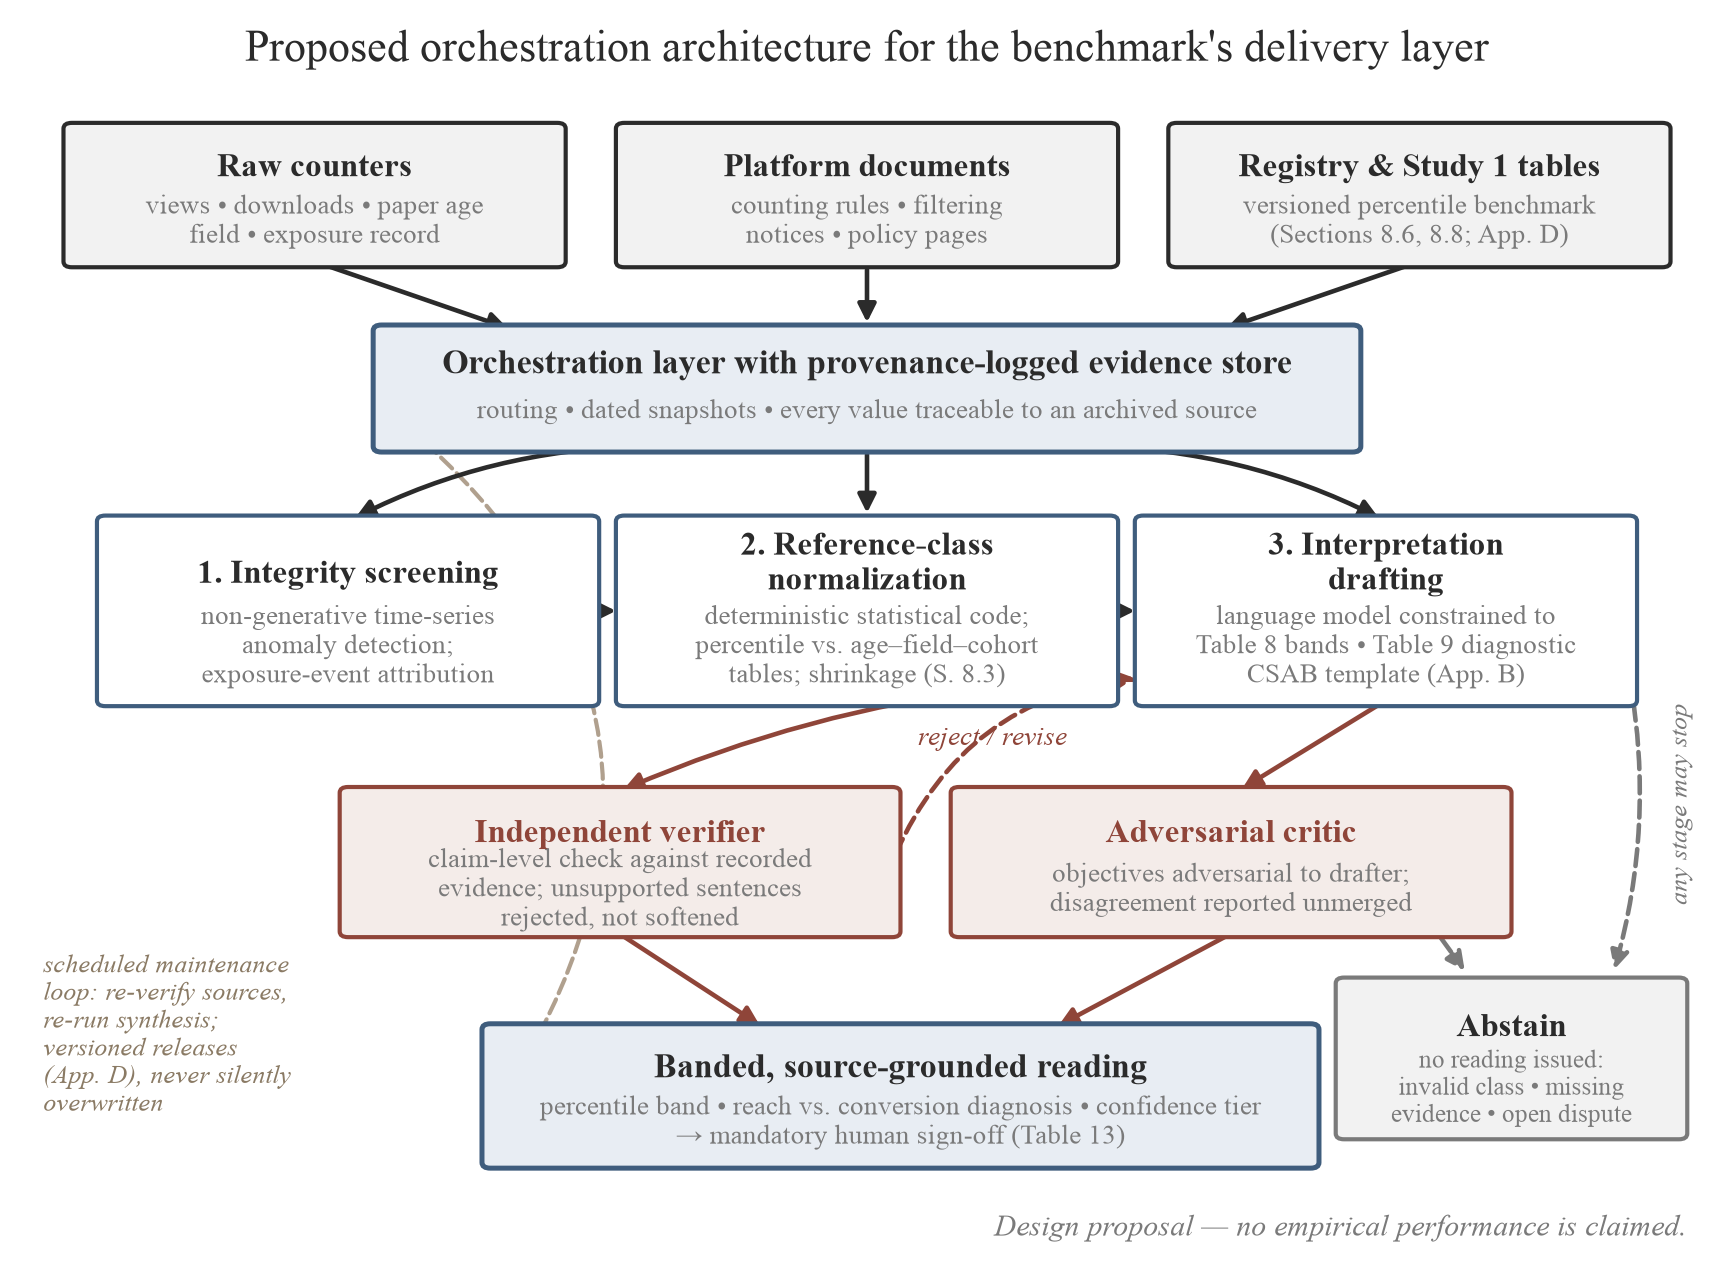
Figure 16. Architecture d'orchestration proposée pour la couche de livraison de l'étalon (section 8.10 ; tableau 21). Les composants spécialisés séparent l'acquisition de preuves, le contrôle d'intégrité, la normalisation et l'interprétation, avec vérification indépendante interposée entre la génération et la libération, un chemin d'abstention disponible à chaque étape et une boucle programmée maintenant l'étalon versionnée de la section 8.8.
La même discipline délimite ce que la couche peut faire une fois qu'elle a un diagnostic. Le tableau 22 fixe la politique d'action : chaque motif observé (portée et conversion lus conjointement avec le momentum, dans le vocabulaire des tableaux 9–10) correspond à un diagnostic provisoire, une forme limitée d'assistance permissible, le test de mécanisme qui pourrait corroborer ou affaiblir le diagnostic, et l'inférence ou l'action qui reste interdite. La colonne test de mécanisme opérationalise la règle énoncée ci-dessus selon laquelle une recommandation diffusée est une hypothèse. Si une correction de classification est supposée éliminer un goulot d'étranglement de portée, le résultat qui compte est la portée ajustée par l'âge, et un récit rétrospectif concernant les téléchargements totaux ne pourra pas s'y substituer. Une prédiction échouée est enregistrée comme une intervention échouée et retournée au diagnostic, jamais redéfinie par rapport à une mesure de succès plus flatteuse. La séquence complète se ferme ainsi en une boucle : mesurer → valider → normaliser → diagnostiquer → proposer → critiquer et vérifier → décider → observer → mettre à jour ou arrêter (figure 17). Au sein de cette boucle, la décision humaine se situe entre la vérification et toute action, les observations post-décision reviennent au dossier, et le chemin d'abstention termine le cycle chaque fois que les preuves sont insuffisantes. La boucle contrôle aussi la complexité : lorsque les preuves ne soutiennent que la préservation et le suivi, ou lorsqu'une règle déterministe du carnet de l'auteur (section 6) répond déjà à la question, l'orchestration n'ajoute rien et ne devrait pas s'exécuter.
Tableau 22. Politique de diagnostic à action pour la couche d'orchestration proposée. Les motifs sont lus dans une classe de référence défendable selon les conventions de percentile du tableau 9 ; chaque ligne est une hypothèse de politique, et aucune cellule n'affirme une fréquence empirique.
| Motif observé (portée, conversion, momentum) | Diagnostic provisoire | Assistance permissible | Test de mécanisme | Inférence ou action interdite |
|---|---|---|---|---|
| Portée faible, conversion élevée, stable ou croissante | Un goulot d'étranglement de découvrabilité est plus cohérent avec le motif qu'un goulot d'étranglement d'adoption de manuscrit (« intérêt caché », tableau 9) | Auditer les identifiants, classifications, métadonnées, indexation et découvrabilité du titre ; distribution limitée et véritablement pertinente | Après une modification de métadonnées ou de classification, la portée augmente-t-elle tandis que la conversion se maintient ? | Réécrire un résumé hautement convertissant simplement pour le rendre plus promotionnel |
| Portée élevée, conversion faible, stable ou décroissante | Inadéquation de la communication, inadéquation du public et exposition à faible intention sont des explications concurrentes (« attention sans adoption ») | Tester l'alignement titre–résumé, la clarté de la portée et l'adéquation du public ; alternatives préservant les affirmations uniquement | La conversion change-t-elle sous une exposition comparable, avec une vérification de fidélité à chaque révision ? | Augmenter la promotion indiscriminée ; conclure que les lecteurs ont rejeté la science |
| Portée faible, conversion faible | Sous-identifié : exposition faible, mauvaise classe de référence, défaillance des métadonnées, friction de communication ou demande de niche tous s'ajustent (« démarrage à froid ») | Valider d'abord la classe de référence et l'enregistrement d'exposition ; puis auditer les métadonnées et la communication séparément | Modifier un seul mécanisme mesurable à la fois ; préserver le résultat nul | Déduire une faible qualité d'une faible utilisation ; rendre un verdict de cause unique |
| Portée élevée, conversion élevée, croissante | Diffusion précoce forte par rapport à la classe déclarée | Préserver la provenance ; surveiller à des âges fixes ; ne rien changer sans raison | Le motif persiste-t-il après l'événement d'exposition et sous sensibilité aux anomalies ? | Fabriquer une amplification supplémentaire ; traiter l'attention comme preuve de qualité |
| Portée élevée, conversion élevée, incréments décroissants fortement | Attention liée à un événement, décroissance ordinaire ou saturation (section 5.6) | Identifier l'événement d'exposition ; comparer les incréments d'intervalle, non les totaux cumulatifs | La décroissance diffère-t-elle des trajectoires appariées par l'âge conditionnées à l'événement ? | Appeler l'échec scientifique les incréments décroissants — les nombres cumulatifs s'aplatissent presque toujours en termes de taux |
| Portée faible, conversion élevée, incréments décroissants | L'intérêt conditionnel peut être réel tandis que l'exposition continue est faible | Auditer si la distribution ou l'indexation ont pris fin ; identifier des canaux limités et pertinents | L'exposition restaurée augmente-t-elle la portée sans dégrader la conversion ? | Élargir les affirmations ou supprimer la spécificité technique pour poursuivre un public plus large |
| Portée élevée, conversion faible, exposition croissante | Les arrivées augmentent sans adoption proportionnelle du texte intégral | Tester le trafic à faible intention (section 4.2), l'inadéquation du public et la clarté de la présentation | La conversion répond-elle à un changement de présentation fidèle aux affirmations sous exposition comparable ? | Optimiser uniquement le haut de l'entonnoir ; compter chaque vue comme un lecteur humain |
| Tout motif avec un compteur restaté, un pic inexpliqué, une cohorte invalide ou un dénominateur manquant | La métrique n'est actuellement pas interprétable au niveau souhaité | Préserver les instantanés ; exécuter des analyses de sensibilité ; restreindre l'affirmation ; s'abstenir | La lecture survit-elle à l'exclusion de l'intervalle contesté ou à une meilleure classe de référence ? | Qualifier le trafic humain ou automatisé sans preuve ; émettre un percentile à partir d'un dénominateur fabriqué |
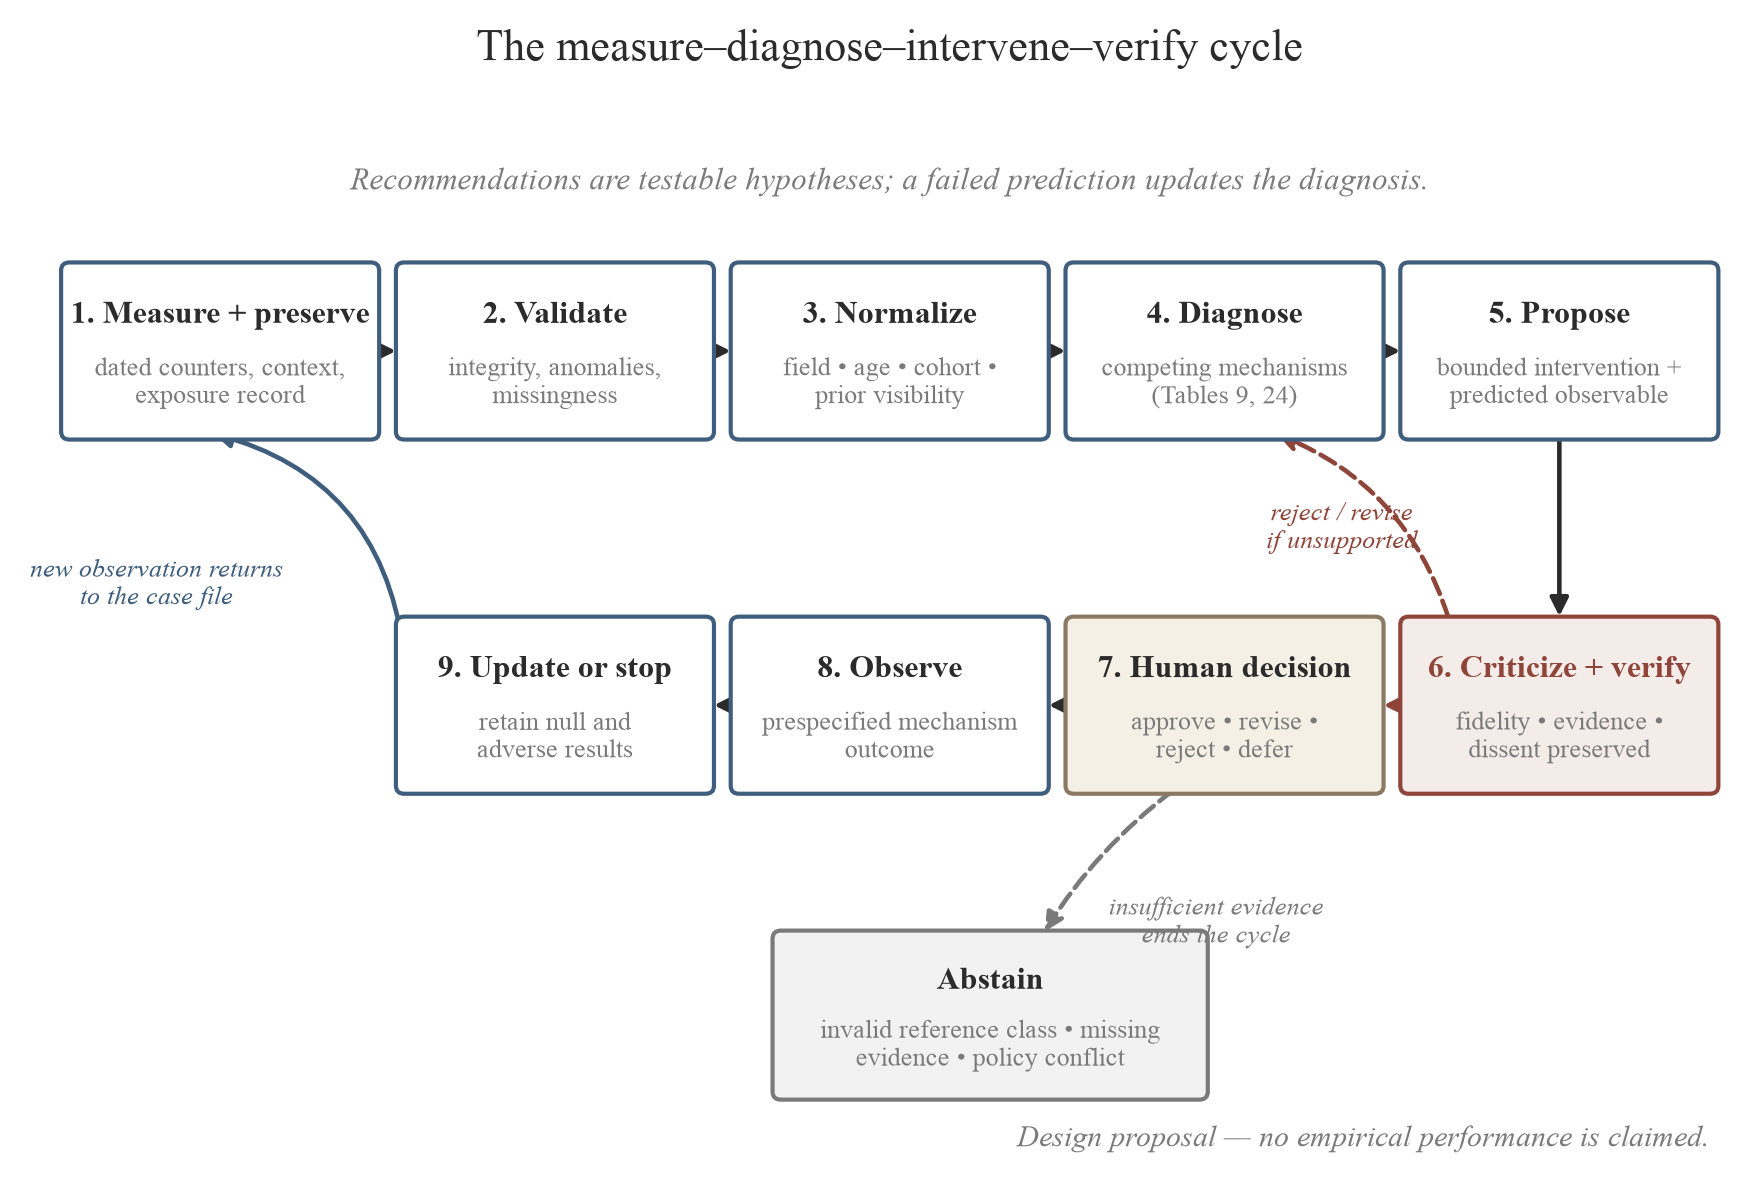
Figure 17. Le cycle mesurer–diagnostiquer–intervenir–vérifier (section 8.10 ; tableau 22). Les recommandations quittent la boucle uniquement comme hypothèses testables : chacune nomme le mécanisme qu'elle a l'intention de déplacer et l'observation ultérieure qui pourrait corroborer ou affaiblir le diagnostic. Les prédictions échouées reviennent au diagnostic et restent dans l'enregistrement d'audit ; la décision humaine se situe entre la vérification et toute action ; et le chemin d'abstention termine le cycle chaque fois qu'aucune classe de référence défendable ou preuve suffisante n'existe. Le cycle optimise l'interprétation préservant les preuves, non l'attention brute.
Quatre limitations encadrent la proposition. La génération n'est pas la récupération. Aucun modèle, si bien orchestré soit-il, ne peut régénérer les distributions de percentiles qui ont cessé d'être observables quand les listes de classement ont été supprimées [149], et la couche ne peut maintenir qu'une approximation, avec les réserves de plancher conservateur de la section 5 intactes. L'orchestration ne peut pas non plus identifier un téléchargeur, distinguer le trafic humain du trafic automatisé à partir des compteurs seuls (section 4.2), convertir le volume de sollicitation en preuve de lecture (section 7.6), rendre indépendants les résultats corrélés du modèle en les rebaptisant « agents », remplacer le jugement des pairs ou transférer la responsabilité du chercheur à un flux de travail. L'orchestrateur lui-même a besoin d'un auditeur. Une couche d'interprétation déployée devient un nouveau gardien dans la pile que cet article cartographie (figure 12), et elle ne doit pas hériter de l'opacité qu'elle a été construite pour réparer : les traces de raisonnement et les journaux de provenance doivent être ouverts à l'inspection, et le comportement de récupération et d'interprétation de la couche elle-même doit être audité avec la discipline de l'étude 2 (instantanés horodatés plus un protocole de réplication scriptée), car la non-stationnarité du modèle fait de chaque résultat une estimation datée, jamais une valeur durable. Coût et équité. L'exploitation d'un tel pipeline n'est pas gratuite, et une couche interprétative payante exclurait les auteurs peu dotés en ressources et non affiliés que ce cadre centre. Les biais connus des classificateurs de texte IA contre les rédacteurs non natifs en anglais [97] feraient la même chose, sans atténuation. La fausse précision est le risque résiduel. Une couche qui émet des verdicts par bandes sans niveaux de confiance automatiserait le mal-étalonnage même diagnostiqué à la section 3 : un décompte sans échelle comparative remplacé par un verdict sans incertitude attachée. L'architecture est elle-même un objet falsifiable et appartient à l'agenda à ce titre, évaluée par rapport à une assistance plus simple et non déduite de la sophistication de son diagramme. La conception appropriée est graduée. Des paquets de cas réalistes avec des ambiguïtés plantées (citations non valides, reformulations de contre-arguments, cohortes indéfendables, sollicitations véritablement limites) sont randomisés dans des conditions qui ajoutent un ingrédient à la fois : le protocole manuel des tableaux de cet article (le bon paramètre de référence, puisqu'une méthode sans IA existe déjà), un seul modèle généraliste, le même modèle avec récupération et calcul déterministe, génération plus critique indépendante, et le pipeline gouverné complet. Les ablations qui suppriment le vérificateur, le calculateur déterministe, la visibilité du désaccord ou la porte humaine isolent alors quel ingrédient de gouvernance mérite son coût. Les résultats sont notés séparément, jamais comme un composite : fidélité des affirmations et des citations ; validité de classe de référence ; étalonnage des convictions des auteurs (instrument de l'étude 4) et abstention appropriée sur les cas ambigus ; temps du chercheur et charge de surveillance ; défaillances de gouvernance (actions externes autonomes, conseils de jeu des métriques, accusations catégoriques de lieu ; et, central à l'argument du démarrage à froid de l'article, hétérogénéité des avantages selon la visibilité antérieure de l'auteur et le statut de nouveau venu, car une couche qui aide principalement des auteurs déjà visibles reproduirait l'inégalité qu'elle était conçue pour réduire. Les résultats d'équité nuls et adverses sont des conclusions rapportables. Les versions de modèles, les invites, les permissions d'outils et les instantanés de source sont archivés, car dans un système non-stationnaire chaque résultat est une estimation datée. Deux estimands restent séparés tout au long : l'effet sur la qualité de l'interprétation et l'effet sur la diffusion ultérieure. Une couche qui améliore le diagnostic sans augmenter les téléchargements est un succès, tandis qu'une qui augmente les téléchargements tout en déformant les affirmations est une défaillance de gouvernance. La conception échoue si le pipeline gouverné ne surpasse pas un modèle unique fort sur la précision des preuves et l'étalonnage : « plusieurs modèles » n'est pas la contribution, et l'hypothèse testée est la division du travail épistémique. La proposition spécifie un rôle testable pour l'interprétation assistée par IA. L'IA peut aider un auteur à poser une meilleure question à un nombre ; seules les preuves vérifiées peuvent y répondre.
9. Limitations
Les affirmations de cet article sont délimitées par les limitations ci-dessous, chacune attachée à l'artefact qu'elle contraint.
Vieillissement et composition de la base de preuves. Les ancres distributionnelles plus anciennes dans la carte de référence (tableau 7) reposent sur des échantillons collectés entre 2012 et 2015 et dominés par les études juridiques [85][139] ; la seule entrée récente est l'instantané d'un seul réseau discuté ci-dessous [83]. Les bandes de l'échelle d'interprétation (tableau 8) se lisent mieux comme des bandes absolues indulgentes plutôt que conservatrices pour 2026 (section 5.1). Le volume de téléchargement annuel à l'échelle de la plateforme a augmenté plusieurs fois entre le milieu des années 2010 et les années 2020 [1][143], augmentant le flux de téléchargement par article et rendant un seuil ancien fixe une barre plus douce aujourd'hui que quand il a été estimé. Aucune correction multiplicative ne peut réparer cela, car la croissance change simultanément le numérateur, le dénominateur et la composition (section 3.2). Les bandes du tableau 8 sont des approximations dérivées de l'arithmétique agrégée plutôt que des normes remises à l'échelle. Aucune étude distributionnelle à l'échelle de la plateforme post-2020 des téléchargements SSRN n'a été identifiée.
Preuves contemporaines d'une seule source. La seule preuve distributionnelle récente utilisée ici est un instantané publié unique d'un réseau disciplinaire : 2 361 articles Marketing observés le 15 août 2025 [83]. Il démontre l'asymétrie et une prime de prestige conditionnelle, mais il n'établit pas les repères à l'échelle de la plateforme, et deux valeurs internes de son tableau publié sont reproduites « comme publié » avec une note d'avertissement. Les généralisations de cette source à d'autres réseaux SSRN sont des extrapolations. L'appendice E réduit cette dépendance en ajoutant une section transversale archivale indépendante et tous domaines confondus (n = 1 360) qui reproduit l'asymétrie, l'écart moyenne-médiane, la bande de conversion, le multiplicateur de domaine et la log-normalité sur le corps observé. Elle porte son propre biais de sélection à la hausse et corrobore la forme de la distribution dans les disciplines. L'agenda de la section 8 cible toujours le repère représentatif de la plateforme.
Biais de liste de classement. L'ajustement de grand échantillon de 2015 couvre uniquement les listes de classement (à peu près le décile supérieur des auteurs et leurs articles [85]), donc le corps de la distribution sous les listes d'élite est déduit d'une lognormale ajustée plutôt qu'observé. Les affirmations de percentile dérivées de cet ajustement sont basées sur un modèle.
La sémantique des compteurs est instable. Ce que les vues et téléchargements enregistrent a changé au fil du temps et continuera de changer avec les redesigns d'interface et l'évolution des filtres de bots. Le système d'intégrité de la plateforme exclut certaines activités suspectes des comptages officiels [144][66][69], et l'infrastructure adjacente RePEc/LogEc documente à la fois l'ampleur historique du trafic robotisé et les vagues récentes de crawlers IA qui ont nécessité de rejeter la majorité écrasante du trafic brut [99][129]. Les normes de conversion citées à la section 5 sont donc des quantités spécifiques à une année, et les comparaisons de compteurs entre années confondent des changements de comportement et de filtrage. Les statistiques générales de bots web [158] ne peuvent pas être extrapolées aux compteurs filtrés de SSRN dans aucune direction.
Volatilité de la plateforme et dérive des sources. La retraite des classements s'inscrit dans une restructuration produit plus large en 2026 [146][149][150], donc aucune analyse ne doit traiter le 15 juillet 2026 comme une intervention isolée. Cette menace est intégrée à la conception de la section 8.5 mais ne peut pas être complètement éliminée. Les pages d'assistance de la plateforme sont révisées sans notification ; toutes ces pages sont citées ici avec des dates d'accès, et le langage cité de la plateforme doit être reverifié par rapport à des copies archivées avant toute soumission formelle.
Aucune donnée de centile. Aucune donnée de centile publique de plateforme complète n'a jamais existé, et après le 15 juillet 2026, aucun cadre de centile représentatif de la plateforme ne peut être collecté en externe, car les classements qui révélaient précédemment les seuils des listes principales ont été supprimés [149]. Une distribution de référence basée sur un échantillon peut toujours être assemblée à partir de captures archivées, et l'appendice E en rapporte une ; elle fixe la forme de la distribution et ne livrera pas de centiles de plateforme. Certaines quantités d'intérêt (par exemple, le sort des courriels de notification « top 10% » des auteurs [161]) ne sont officiellement pas documentées, et nous notons leur disparition du cadre public sans affirmer leur interruption.
L'utilisation n'est pas la lecture, et ni l'une ni l'autre n'est la qualité. Un téléchargement peut précéder une lecture attentive, un examen superficiel, un stockage archivé, ou aucune utilisation du tout. Les téléchargements ne sont pas un indicateur direct de la qualité de la recherche et ne sont pas une source causale garantie de citations : l'association téléchargements–citations est positive mais hétérogène (à peu près 0,1 à 0,6 selon le domaine, le niveau d'agrégation et l'horizon [18][25][39][80][102][108]) et les populations très téléchargées et très citées ne se chevauchent que partiellement [108]. Les citations elles-mêmes peuvent être positives, négatives, perfectionnistes, ou stratégiques, et le processus de citation est systématiquement biaisé contre les travaux novateurs [166]. Rien dans cet article ne vous autorise à substituer les métriques au jugement d'expert ; l'usage défendable du cadre est diagnostique et descriptif.
Exposition inobservable et prestige non aléatoire. Toute exposition n'est pas observable : les lecteurs rencontrent des titres dans les courriels, les réseaux sociaux, les résultats de recherche et la correspondance avant que toute vue de la page abstraite ne soit enregistrée, et les auteurs bien connectés génèrent une exposition hors plateforme corrélée à la fois au prestige et à la qualité. Les coefficients de prestige observationnels mélangent donc l'attention basée sur le statut avec les différences authentiques en ressources, sujets et réseaux [111][140]. La manipulation expérimentale des signaux d'identité d'auteur [154][64] complète mais ne remplace pas l'observation de plateforme. La classification du domaine est partiellement auto-sélectionnée, et les articles occupent plusieurs catégories, ce qui complique les attributions à champ unique.
Limitations de l'agenda lui-même. Les conceptions quasi-expérimentales des sections 8.4–8.5 font face à des effets d'annonce, des changements de plateforme concurrents, et des différences de champ non aléatoires. Elles sont étiquetées quasi-expérimentales parce qu'un événement à l'échelle de la plateforme n'offre aucun groupe de contrôle non traité. L'instantané de l'étude 2 vieillira avec les moteurs qu'elle audite, et son protocole de réplication atténue mais n'élimine pas la non-stationnarité. L'étude 3 est une étude de cas N = 2 dont la valeur est le mécanisme et le protocole, non une estimation de population, et sa logique d'attribution dépend des alias par canal plutôt que de toute affirmation concernant la visibilité des courriels publics. Le registre participatif hérite les problèmes d'auto-sélection et de vérification énoncés à la section 8.8. L'accès aux données pour tous les modèles dépend soit de la coopération de la plateforme, soit de la collecte limitée par débit selon les conditions de service [134][51] ; aucun des deux n'est garanti.
Ampleur de la bibliographie. La bibliographie est large parce que l'article est une synthèse ; de nombreuses études citées partagent les cadres, les domaines et les limites de conception, et les publications communautaires documentent l'expérience sans établir les paramètres de population. La preuve d'une affirmation est son niveau de vérification et son cadre d'échantillonnage, non le nombre de références derrière elle.
Les bandes sont des cibles d'étalonnage, non des constantes. La bande de conversion 11–19 % et les seuils CSAB sont des quantités à étalonner par domaine et par plateforme, non des constantes universelles du comportement savant (sections 4.4, 5.2). Leur forme actuelle est une bande unique inter-domaines, à remplacer par les distributions par domaine que le cadre exige lorsque l'étude 1 stratifiée par domaine (section 8.6) rapportera.
La généralisation au-delà de SSRN nécessite un réétalonage, non une transplantation. Le problème d'interprétabilité diagnostiqué ici (compteurs d'utilisation affichés sans échelle comparative publique) et la logique portée–conversion qui le répare ne sont pas spécifiques à SSRN ; ils s'appliquent à tout serveur de préimpressions qui affiche les comptages d'utilisation, y compris bioRxiv, medRxiv, arXiv, et OSF Preprints [11][62][2][24]. Ce qui ne se transfère pas est la bande spécifique 11–19 % ou les seuils CSAB. La curation, l'architecture de distribution et l'interface diffèrent entre serveurs : le trafic de tirage piloté par l'intention d'arXiv et ses listes d'annonces par courriel par rapport aux alertes de poussée curée de SSRN (tableau 6). Les ancres numériques doivent donc être ré-estimées sur chaque plateforme avant d'être citées là. Le cadre est portable ; son étalonnage est local. Le protocole de dépôt parallèle de la section 8.8 est le test empirique direct de la distance que les bandes de SSRN parcourent. L'ampleur de cet réétalonage est facile à sous-estimer : le téléchargement médian de l'ensemble du corpus de bioRxiv (environ 279, et à peu près 496 en génomique [2]) est plusieurs fois la médiane de 60 dans la coupe archivale de l'appendice E : à peu près cinq fois au total et environ huit fois en génomique. La comparaison est indicative seulement. Le chiffre bioRxiv provient d'un recensement de l'ensemble du corpus, tandis que le 60 provient d'un échantillon archivé qui sur-représente les pages capturées, mélange les âges et domaines dont la composition change avec l'âge, et résout l'âge en années entières. La direction de l'écart est sûre à lire ; sa taille ne l'est pas.
Éthique. La composante du discours communautaire de cet article se compose de messages publics auto-sélectionnés utilisés uniquement comme preuve de demande, jamais comme sentiment représentatif, et cités uniquement lorsqu'une source vivante et vérifiable existe. Les messages des utilisateurs sont cités en tenant compte de l'éthique de la citation du contenu de forum semi-public, y compris la paraphrase à la place de la citation textuelle lorsque les auteurs pourraient être identifiés contrairement à leurs attentes, conformément aux normes de transparence pour les preuves qualitatives [6]. L'étude 3 enregistre uniquement les messages envoyés sans sollicitation à l'auteur instrumenté et ne recueille aucune donnée personnelle tierce au-delà de ce que les expéditeurs offrent volontairement. L'étude 4 recueille uniquement des réponses aux questionnaires volontaires et anonymisées en vertu du consentement éclairé. La conception du panel utilise les compteurs affichés publiquement et les métadonnées bibliographiques, et toute collecte d'informations non publiques du tableau de bord (telles que les dates de statut de distribution) nécessite le consentement éclairé de l'auteur et, le cas échéant, l'examen institutionnel. Les deux études qui impliquent des participants humains et des données générées par les participants sont l'étude 4 (l'enquête auprès des auteurs) et l'étude 3 (message instrumenté avec enregistrement de la boîte de réception). Parce que les deux sont des recherches impliquant des sujets humains, les deux seront soumises pour approbation par le comité d'éthique de la recherche institutionnel pertinent ou le comité d'éthique de la recherche et menées en vertu du consentement éclairé des participants avant le début de toute collecte de données, et les données personnelles contenues dans les journaux de la boîte de réception sont agrégées et désidentifiées avant toute analyse ou rapport. Ce protocole est une précondition d'exécution et est reproduit dans les Déclarations.
10. Conclusion et recommandations politiques
10.1 Ce que l'analyse a établi
Le retrait des classements SSRN le 15 juillet 2026 a supprimé l'unique échelle comparative publique [149]. Les compteurs sont restés sur chaque article et profil, ce qui a laissé des métriques illisibles plutôt qu'insignifiantes. Pour pallier cette perte, cet article rassemble chaque ancrage empirique vérifiable dans une carte comparative avec des réserves explicites de date de référence et de confiance (tableau 7), construit un cadre d'interprétation, l'échelle à cinq bandes, la décomposition couverture–conversion, et le protocole de dossier (tableaux 8, 9, 13), qui traduit les compteurs en diagnostics, et énonce le programme prêt à la préenregistrement de la section 8, qui spécifie comment les distributions manquantes peuvent être reconstruites.
Le mécanisme au cœur de l'argument se ramène à ceci :
Personne ne sait ce que sept téléchargements signifient sans savoir sept téléchargements comparés à quoi, et après le 15 juillet 2026 la plateforme ne répond plus « à quoi ».
Les contributions diffèrent par leur nature. Nommer le problème de classe de référence est la contribution diagnostique : un comptage brut ne répond à aucune question tant que l'âge, le domaine, la cohorte et l'exposition ne définissent pas son groupe de comparaison. La contribution instrumentale est la carte comparative et CSAB, qui normalisent un nombre émotionnellement saillant mais scientifiquement ambigu en un diagnostic interprétable. Le manuel et le protocole de dossier sont la contribution pratique, permettant aux auteurs et aux comités d'agir sur les compteurs aujourd'hui sans les mal interpréter. En termes de politique, la contribution est la bande de percentile anonymisée : contexte comparatif rétabli sous une forme qui n'identifie personne et ne ravive aucun classement.
Sur la base des preuves rassemblées, la question du titre de cet article est mal posée jusqu'à ce qu'une classe de référence soit spécifiée. Par rapport à chaque ancrage disponible, les comptages faibles sont la norme statistique de la plateforme plutôt qu'un jugement sur le travail. Un article avec 40 consultations du résumé et 7 téléchargements est cohérent, comme résultat de criblage, avec la bande de conversion empirique de la section 5 [139][172][83], tandis que la règle de trois vues par téléchargement plus ancienne [18] se situe au-dessus de cette bande plutôt qu'à l'intérieur de celle-ci. L'article médian dans le seul échantillon de style recensement a accumulé 63 téléchargements en deux ans [139], et l'entrée dans la liste des 10 000 premiers en 2015, approximativement le premier 1,8 % du stock complet de textes intégraux de la plateforme (571 040, juillet 2016 [1]), exigeait 160 téléchargements au cours de la vie [85]. Selon un régime d'attention quasi-lognormal, la plupart des auteurs se situent par construction sur les échelons inférieurs de l'échelle. L'article préimprimé médian réside dans la longue traîne d'une distribution log-normale que son auteur ne peut pas voir, et il est surfacé par des mécaniques de classification qui favorisent les affiliés. Il est sollicité par des prédateurs avant d'être lu par des pairs, et il a maintenant perdu le classement qui le situe autrefois. L'échelle place un article quelque part sur cette échelle, et la détresse que porte la question est produite par l'échelle manquante plutôt que par le nombre.
Rien de cela n'est particulier à une plateforme, et l'événement n'est pas sans précédent. ResearchGate a retiré son propre indice RG Score composite lourdement critiqué en août 2022 [130], après une critique méthodologique soutenue [90], et en 2022–2023 des dizaines de facultés de droit américaines, menées par Yale et Harvard, se sont retirées des classements des écoles de droit du U.S. News [13]. Le retrait d'une mesure contestée n'est pas un acte cosmétique, car la mesure n'a jamais été une description passive : la littérature sur la réactivité qui a découlé des classements des écoles de droit montre qu'un classement public remodèle le comportement de ceux qu'il classe [58][132], de sorte que son imposition et son retrait changent la conduite plutôt que de simplement changer ce qui est rapporté. Un compteur et son cadre comparatif sont conjointement une métrique, et retirer le cadre tout en gardant le compteur laisse chaque utilisateur tenir un comptage sans rien pour le lire. L'interprétabilité, la disponibilité d'une distribution publique pour un compteur public, doit être traitée comme une dimension de qualité de première classe de tout indicateur, aux côtés de la validité et de la fiabilité. Les métriques survivent à leur infrastructure interprétative, et une métrique sans contexte est du bruit, une instance de la discipline générale de la lecture sceptique des nombres décontextualisés [15]. La même métrique avec contexte est un étalonnage qui autonomise les auteurs, améliore la communication savante, et soutient la confiance dans les référentiels qui l'affichent.
Le cadre demande quelques habitudes ordinaires à son utilisateur. Comparez les choses similaires entre elles, et gardez la couverture séparée de la conversion. Lisez les trajectoires plutôt que les totaux, traitez chaque nombre comme daté, et ne laissez aucun comptage voyager sans sa source, sa fenêtre et ses limitations.
10.2 Recommandations à l'intention des auteurs
Les auteurs peuvent agir dès maintenant, sans attendre de nouvelles données. Prenez des captures d'écran datées des compteurs au niveau de l'article, qui préservent le contexte : après le coucher de soleil, ce sont les seuls enregistrements de classement qui restent sous le contrôle de l'auteur, et ils alimentent le registre communautaire de la section 8.8. Rapportez les comptages uniquement avec leur cadre (âge, domaine, cohorte et source), en suivant le protocole du dossier du tableau 13, dans lequel chaque nombre porte sa source, sa fenêtre temporelle et ses limitations. Lisez le tableau de bord de manière diagnostique plutôt qu'émotionnelle : séparez la portée de la conversion (tableau 9), traitez un zéro téléchargement la première semaine comme un comportement normal antérieur à la distribution [53], et comparez-vous à trois à cinq articles de collègues postés le même mois plutôt qu'à la queue visible, dont les chiffres de jalons circulants garantissent un mauvais calibrage sous un régime à queue lourde [85][180]. Traitez le courriel de sollicitation comme un phénomène de scraping, non comme une reconnaissance, et non comme une preuve concernant les compteurs [61][107][144].
10.3 Recommandations pour les évaluateurs
Les institutions qui ont importé les téléchargements SSRN comme devise d'évaluation [12][18][161][52] font face à une question de gouvernance maintenant que l'échelle publique de cette devise a disparu. Les nombres bruts de téléchargements ne doivent pas entrer dans les dossiers d'embauche, de promotion ou de titularisation : ils sont manipulés précisément aux seuils qui importent [44], ils varient jusqu'à huit fois selon les sous-domaines au sein d'un seul réseau [168], et ils sont désormais opaques en termes de référence. L'unité minimalement défendable est un percentile au sein d'une cohorte définie (même domaine, même tranche d'âge, même période d'affichage) accompagné de sa source et de son millésime, et les preuves d'utilisation doivent compléter plutôt que substituer les citations, l'évaluation par les pairs et le jugement substantif [108][109][110]. Le consensus établi de la réforme de l'évaluation de la recherche fonctionne selon ce principe. L'injonction centrale de DORA est de ne pas utiliser un seul nombre ou un substitut de lieu comme substitut à l'évaluation de la recherche elle-même [8], et le Manifeste de Leiden insiste sur le fait que l'évaluation quantitative doit soutenir, non supplanter, le jugement d'experts qualitatifs [78]. L'examen Metric Tide renforce cette insistance, appelant à des indicateurs qui sont robustes, humbles, transparents, diversifiés et réflexifs et utilisés en soutien de l'évaluation par des experts plutôt que comme substitut à celle-ci [173], tout comme l'Accord CoARA plus récent sur la réforme de l'évaluation de la recherche, dont plusieurs centaines d'organisations signataires s'engagent à l'évaluation qualitative soutenue par, non pas supplantée par, l'utilisation quantitative responsable [183]. Le consensus entier s'applique de plein droit à un compteur de téléchargements dont l'échelle publique a été supprimée. Deux des cinq dimensions de Metric Tide s'appliquent directement à la méthode proposée ici : la diversité est la normalisation au niveau du domaine que cet article insiste pour, et la réflexivité est la posture de la section 8.7, dans laquelle l'article mesure sa propre attention. Le successeur de cet examen axé sur le REF porte les mêmes cinq principes dans la pratique actuelle du Royaume-Uni [184]. Ce consensus est lui-même une expression de la critique plus large du dépassement métrique dans la vie institutionnelle [113]. Les comités d'évaluation doivent s'attendre à et accepter le format de protocole du tableau 13 (la forme contextualisée et narrative des preuves que les formats d'évaluation émergents tels que le Résumé pour la recherche et l'innovation (R4RI) du Royaume-Uni sont construits pour transporter [186]) à la place du langage de classement « top 10 % » retiré. Aux États-Unis, le même levier du langage du dossier est l'objet de l'Initiative pour le leadership en enseignement supérieur en faveur d'une science ouverte (HELIOS Open), qui travaille avec les universités pour réécrire les critères de promotion et de titularisation [189] ; la ligne d'utilisation contextualisée spécifiée ici est exactement la rubrique concrète que ces réformes manquent souvent.
10.4 Recommandations pour la plateforme
Retirer les classements sans contexte de remplacement échange un signal défectueux contre l'absence de signal. Les conséquences vont au-delà du confort des auteurs. Que le coucher de soleil refroidisse les nouvelles soumissions, le résultat de volume d'affichage spécifié à la section 8.5, est une question empirique ouverte sur la santé de la plateforme elle-même. Le cadre implique une direction de produit concrète qui ne recréerait pas l'appareil de tableau des classements que SSRN a choisi de retirer [149] :
1. Bandes de percentiles anonymisées par discipline et âge du document. Afficher le statut de téléchargement et de consultation de chaque document sous la forme d'une bande de percentile grossière au sein de sa cohorte discipline-par-âge : information dont chaque auteur a besoin, publiée sous une forme qui n'identifie personne, ne crée aucun classement et réduit la dynamique du gagnant-emporte-tout des listes Top-N. Le contexte de percentile préserve la confidentialité tout en restaurant la lisibilité. Le format d'affichage cible est exactement l'éventail de référence spécifique à l'âge de la figure 14.
2. Affichage normalisé dans le temps. Montrer les comparaisons ajustées à l'âge plutôt que les seuls totaux cumulés, de sorte qu'un document de 14 jours ne soit jamais implicitement comparé à des travaux qui ont accumulé l'attention pendant des années.
3. Séparer la portée de la conversion. Signaler les consultations abstraites et les téléchargements comme des signaux distincts avec leur rapport, plutôt que d'inviter une lecture à un seul nombre qui confond l'invisibilité avec le rejet.
4. Classes de référence transparentes. Tout indicateur comparatif devrait indiquer la population, le domaine, la période et la bande d'âge qu'il compare ; un « top X% » sans étiquette n'est pas scientifiquement informatif. L'annexe D spécifie les dix champs de divulgation qu'une version de percentile avec historique devrait inclure, des définitions de population et de cohorte aux règles de confidentialité des cellules minimales et un historique des versions citable.
5. Audit de la conception pour l'avantage cumulatif. La classification, la distribution des alertes, le classement de la recherche et les signaux de popularité visibles allouent l'attention rare et devraient être évalués pour leurs effets distributifs. Les conceptions empiriques des sections 8.4–8.5 sont directement utilisables pour un tel audit.
6. Plan pour les résidus interprétatifs lors du retrait des fonctionnalités. Quand les fonctionnalités comparatives sont supprimées, la perte interprétative devrait être évaluée et atténuée avec le même soin que la migration de données, par le biais des distributions archivées, des percentiles de synthèse publiés ou d'un passage explicite à la communauté, car une métrique qui ne peut pas être lue ne peut pas informer.
7. Mécanique de contact résistante à la moisson, réduisant l'externalité de sollicitation de la visibilité documentée à la section 7 [107][159]. Un candidat concret : retarder ou obscurcir l'exposition publique des itinéraires de contact des auteurs pendant environ les 48–72 premières heures après la publication, la fenêtre au cours de laquelle la distribution légitime n'a généralement pas encore commencé mais la moisson programmatique est la plus probable. L'effet de toute telle mesure devrait être évalué empiriquement, non supposé. L'arbitrage est réel, car masquer les informations de contact pourrait également désavantager exactement les nouveaux venus qui dépendent des commentaires directs.
8. Un journal de filtrage public et une mécanique de distribution documentée. Publiez un registre de style LogEc de ce que les filtres d'intégrité rejettent, et documentez le fonctionnement de la distribution eJournal et de la sélection du résumé. L'infrastructure RePEc/LogEc adjacente démontre que cette transparence est réalisable à l'échelle [99][129], tandis que SSRN décrit actuellement ses filtres sans publier leur historique [144] (tableau 6). Quand le filtrage est documenté, les restatements d'un compteur peuvent être lus comme des événements de mesure plutôt que comme des événements de réputation.
9. Rendre l'historique d'exposition lisible. Une page de document ou un tableau de bord d'auteur devrait distinguer la publication publique, l'attribution de classification, la distribution organisée, la confirmation d'indexation et les restatements de compteur majeurs, de sorte qu'un auteur puisse séparer « pas encore exposé » de « exposé mais non converti ». Ceci est la contrepartie côté plateforme de la lecture du régime d'exposition de la section 5.6, et le traitement le moins coûteux pour l'état de tableau de bord le plus producteur d'anxiété, le zéro initial.
10.5 Recommandations pour la communauté de recherche
La communauté n'a pas besoin d'attendre la plateforme. Le registre de la section 8.8 (instantanés de tableaux de bord autodéclarés et datés, contribués selon un protocole ouvert) peut produire la première distribution de téléchargement nouvelle en une décennie. Les deux études de données publiques du tableau 17 (1 et 2) sont exécutables par tout chercheur dans les limites d'accès notées à la section 9, tandis que les deux études avec participants (3 et 4) nécessitent des bénévoles et les approbations éthiques énoncées dans les Déclarations. La scientométrie devrait traiter l'interprétabilité des mesures comme faisant partie de son domaine : le cas présent, dans lequel une décennie de compteurs a survécu à leur seule échelle publique, est peu susceptible d'être le dernier. La réplication distribuée du protocole de publication instrumentée, la maintenance communautaire des tableaux de percentiles (et de la calculatrice publique destinée aux auteurs construite sur ceux-ci, sections 8.8 et 8.10), et l'évaluation de l'impact interprétatif des changements de plateforme sont tous des contributions de recherche à part entière, et chacun d'eux convertit le travail de réparation de cet article en prévention.
10.6 Conclusion
La question « que signifient mes sept téléchargements ? » traverse cet article parce que c'est la question que les près de deux millions d'auteurs de la plateforme se posaient le 15 juillet 2026 [49][149]. La réponse assemblée ici n'est ni rassurant ni alarmant, mais un calibrage. Le nombre est cohérent avec les preuves de conversion disponibles, mais reste un résultat de dépistage ; l'anxiété est produite par l'échelle manquante, qui peut être reconstruite, en partie à partir de la littérature, comme l'ont fait les sections 3–6, et en partie à partir de nouvelles données, comme le précise la section 8.
L'article s'ouvre sur la question que se pose chaque auteur :
« Que signifient mes 7 téléchargements ? »
Le cadre la remplace par celle-ci :
« Où cet article se situe-t-il parmi les articles comparables du même âge, du même domaine, de la même cohorte et du même historique de distribution ? Sa limite est-elle la portée ou la conversion ? Et est-il recherché et cité par les systèmes par lesquels les lecteurs découvrent désormais la recherche ? »
C'est une question à laquelle la scientométrie peut répondre, et cet article a spécifié comment.
Ce que les compteurs enregistrent, ce sont des événements, et seulement des événements. Les consultations ne sont pas des téléchargements ; les téléchargements ne sont pas la lecture ; une moyenne n'est pas une norme ; un compteur n'est pas un verdict ; la sollicitation n'est pas la reconnaissance ; la récupération par l'IA n'est pas une attribution fidèle ; et un nombre sans échelle n'est pas une information.
Tant que les plateformes affichent un compteur en dehors de son contexte, les auteurs, les évaluateurs et les plateformes continueront à lire les faits distributionnels comme des verdicts personnels. L'accès ouvert a remporté la bataille qu'il menait (le droit de publier et de télécharger sans barrières tarifaires) et, en la remportant, a exposé une bataille qu'il n'a jamais menée : l'allocation de l'attention. Les auteurs peuvent lire les compteurs en fonction du domaine, de l'âge et de la conversion. Les métriques de SSRN conservent leur valeur, mais seulement pour un auteur qui comprend ce qu'elles signifient.
Appendice A. Situation → Guide d'action
Le tableau 23 condense les sections 4–6 dans les situations que les auteurs signalent le plus fréquemment [161][127][139]. Sa colonne du milieu énonce uniquement ce que les preuves assemblées autorisent, avec les sources et les fenêtres. La colonne des réserves comporte la limitation qui doit accompagner chaque lecture. Les nombres apparaissant ici sont ceux des tableaux 6–7 et de la figure 6 du texte principal.
Tableau 23. Situation → ce que disent les preuves → ce qu'il faut faire.
| # | Votre situation | Ce que disent les preuves | Ce qu'il faut faire | Sources et réserves |
|---|---|---|---|---|
| 1 | « 7 téléchargements et 40 consultations d'abstract le premier mois. » | La conversion est de 17,5 %, dans la bande inter-études de 11–19 % comme une estimation ponctuelle, bien que l'intervalle de Clopper–Pearson à 95 % sur 7/40 (≈7,3–32,8 %) soit large et chevauche la bande ; l'article LSN médian n'a atteint 63 téléchargements qu'après deux ans, et l'article marketing médian se tenait à 87 à un âge médian de 16 mois — des ancrages d'échantillon mûr, non appariés à une lecture du jour 20. Un résultat de dépistage avec un intervalle large, pas une preuve d'échec. | Poursuivez le calendrier d'observation du tableau 11 ; classifiez la trajectoire au plus tôt aux jours 60–90. | Bande : [18][139][172] ; médianes : [139] (2012 LSN), [83] (2025 Marketing). Tous les ancrages sont mono-disciplinaires et vieillis ; la conversion 7/40 est une estimation de dépistage à intervalle large, non appariée aux ancrages mûrs. |
| 2 | « Zéro téléchargement la première semaine. » | Pré-distribution normale : la classification est organisée et peut prendre jusqu'à 45 jours pour les sujets chargés ; les alertes eJournal génèrent des consultations précoces et persistent après la fin de vie ; l'indexation de Google Scholar prend 6–9 mois ou plus. | Confirmez l'affichage public ; confirmez la classification eJournal ; vérifiez si l'article est indexé sous son titre exact — le test d'indexation le moins coûteux disponible ; attendez le cycle d'annonce ; lisez ensuite les compteurs. | [53][147][57][55]. Modifications de la formulation de la page d'assistance ; vérifiez à nouveau avec les dates d'accès. |
| 3 | « Nombreuses consultations, peu de téléchargements — conversion bien inférieure à 11 %. » | Cohérent avec une inadéquation abstract–texte : les lecteurs arrivent et partent au niveau de l'abstract. Les variables d'emballage (titre, abstract, mots-clés) sont les leviers d'attention les plus robustement associés aux compteurs. | Révisez le titre et l'abstract ; réobservez la conversion sur la fenêtre suivante avant d'autres modifications. | [139][168][172]. La lecture causale « conversion basse = abstract faible » est une hypothèse de dépistage, pas un diagnostic validé. |
| 4 | « Conversion bien au-delà de la bande, ou un pic de consultation soudain. » | Trafic que la navigation par abstract n'explique pas — liens de médias ou d'agrégateurs, ou trafic non-humain que les filtres n'ont pas encore supprimé. | Identifiez la source externe (couverture, listes de diffusion) ; ne citez pas le pic comme lectorat sans corroboration. | [116][138][144][102 — Mécanisme de pré-récupération Safe Links, avec la réserve que le propre filtrage de SSRN exclut peut-être déjà ce trafic]. |
| 5 | « Mon compteur a baissé, ou les nombres ont été reformulés. » | Les plateformes révisent les compteurs lorsque les règles de filtrage changent ; RePEc a jeté la grande majorité du trafic brut lors d'épisodes documentés (robots ≈74 % des consultations en 2007 ; >99,5 % du trafic IDEAS en septembre 2025). | Traitez-le comme un événement de mesure ; vérifiez vos captures d'écran datées ; ne le signalez jamais comme une lectorat perdu sans corroboration. | [144][69][99][129][66]. |
| 6 | « Les classements ont disparu et je ne sais pas où je me situe. » | Aucun cadre de centile public ne subsiste, et aucun cadre représentatif de la plateforme ne peut être collecté en externe. La section transversale archivée de l'appendice E fournit une distribution de référence basée sur un échantillon, et la comparaison appariée reste le substitut aux centiles de la plateforme. | Construisez un micro-benchmark de 3–5 articles pairs publiés le même mois et suivez-les selon votre propre calendrier ; optionnellement, calculez le ratio de vos téléchargements à la médiane d'une cohorte appariée. | [149][51] ; ancrages [139][83][85]. Le ratio n'a pas de bandes d'interprétation calibrées (section 6.3). |
| 7 | « Un comité verra mes comptages. » | Les lignes de classement dans les dossiers sont une pratique documentée, et leur cadre comparatif a disparu ; le langage des bandes avec sources, qualificatifs de domaine et triangulation par citation résiste à l'examen là où les comptages bruts ne résistent pas. | Appliquez le protocole en sept étapes du tableau 13 : préserver, traduire, trianguler, normaliser par domaine, compléter, intégrité, évaluation experte. | [12][95][33][52][77][108]. Les téléchargements mesurent la demande, non la qualité ; l'historique de manipulation [44] est connu des évaluateurs. |
| 8 | « Les invitations prédatrices ont commencé à arriver quelques jours après ma publication. » | Un sous-produit documenté du moissonnage à partir de plateformes de prépublications ; les audits connexes signalent des dizaines d'invitations par quinzaine par chercheur. Le volume signale la visibilité aux racleurs, non la reconnaissance par les lecteurs. | Ne jamais payer ; vérifiez les venues via Cabells et Think. Check. Submit. ; acheminez la correspondance via une adresse dédiée ; voir le tableau 14 pour la typologie. | [107][159][9][84][63][32][136] ; [B-1] (liste de Beall inexistante depuis 2017). Les régularités temporelles ne sont pas mesurées ; le filtre « quelques jours après publication » est qualitatif. |
| 9 | « Le contrôle de similarité d'une revue a signalé ma soumission comme correspondant à ma propre prépublication SSRN. » | Le système de criblage fonctionne comme prévu : les prépublications enregistrées en tant que Crossref Posted Content font partie du corpus de comparaison, et les conseils d'iThenticate indiquent qu'une correspondance de prépublication d'un même auteur n'est pas du plagiat. La publication d'un document de travail est autorisée par les politiques de publication antérieure de la plupart des revues, mais les politiques varient et la revue cible doit être vérifiée ; les principales exceptions concernent les domaines médicaux et cliniques. | Identifiez la source signalée au rédacteur en charge comme votre propre prépublication horodatée ; ne retirez pas la prépublication ; pour les venues médicales et cliniques, vérifiez la politique de prépublication de la revue cible (p. ex., via le registre Sherpa Romeo) avant la soumission. | [81][36] ; section 4.5. Les politiques des revues varient et changent ; vérifiez la politique actuelle de la revue cible plutôt que de vous fier à la règle générale. |
| 10 | « Les classements ont disparu — devrais-je déplacer mes articles vers ResearchGate ou Academia.edu ? » | Aucune migration d'auteurs post-fermeture n'est documentée ; les compteurs de téléchargements ne sont pas transférables entre les plateformes ; et les plateformes de comparaison posent le même problème d'interprétabilité — ResearchGate a retiré son propre score RG composite en août 2022 après une critique méthodologique. | Conservez l'enregistrement SSRN et complétez plutôt que de relocaliser : déposez le même article dans un référentiel institutionnel ou thématique (tableau 13, étape 5), préservez les captures de compteurs datées, et ne supprimez pas et republier ailleurs, ce qui perd les compteurs accumulés. | [130][90][149] ; [47][146] (complément de référentiel) ; [161] (un compteur d'une plateforme ne dit rien sur les autres canaux) ; [B-7] (supprimer et republier réinitialise les métriques). L'absence de migration documentée est une absence de preuve, non une preuve de stabilité. |
Pratiques communautaires non vérifiées (hypothèses candidates pour l'agenda de la section 8). Les recommandations suivantes circulent dans les communautés d'auteurs et apparaissent dans les versions antérieures des guides pratiques ; aucune étude ne les soutient, et elles sont enregistrées ici comme des hypothèses testables et ne doivent pas être citées comme des résultats : (a) limiter les classifications eJournal à trois (un cœur, un large, un interdisciplinaire) plutôt que d'utiliser davantage des sept autorisées [53][168] ; (b) citer les documents de travail SSRN afin que leurs auteurs soient notifiés via les alertes Google Scholar et répondent avec de l'attention ; (c) masquer l'adresse e-mail du profil pendant les quatorze premiers jours après la publication pour réduire le moissonnage ; (d) télécharger une révision mineure le jour 3 pour déclencher une ré-annonce (SSRN documente uniquement que les révisions sur place préservent les compteurs et l'URL [B-7]) ; (e) toute incidence numérique attachée au filtre « invitation dans les 96 heures est prédatrice » ; (f) le contact direct avec trois à cinq auteurs cités dans l'article (un bref message notant la citation de leur travail SSRN) comme canal d'accès à un premier public légitime, encadré comme une communication savante ordinaire plutôt que comme une promotion. Chacun est réfutable selon les plans d'observation de la section 8 ; jusqu'à ce qu'ils soient testés, leur forme de citation appropriée est « pratique communautaire, non vérifiée ».
Le tableau 24 réorganise le manuel chronologiquement. Chaque cellule renvoie à une section et à ses sources. La vue chronologique répondre à la question que se posent réellement les auteurs (« que dois-je faire maintenant ? ») dans l'ordre chronologique d'apparition des situations, et complète le tableau 23 indexé par situation.
Tableau 24. Le manuel sous forme de chronologie : trois phases × trois axes. Tous les résumés des cellules résument les preuves et les instructions déjà énoncées dans les sections 4-7 ; les pratiques communautaires non vérifiées sont exclues (voir la liste ci-dessus).
| Phase | Mécanismes de plateforme et mesure | Public et distribution | Défense contre les sollicitations |
|---|---|---|---|
| Avant la publication | Traiter le titre et l'abstrait comme la surface de conversion et les rédiger en conséquence (§6.4 ; [139][172]) ; planifier les classifications eJournal — jusqu'à sept sont autorisées, et davantage de classifications sont associées à davantage de téléchargements et moins de zéros [53][168] | Identifiez la cohorte de micro-benchmark de 3-5 articles à suivre aux côtés de votre propre article (§6.3) | Acheminez la correspondance via une adresse dédiée avant que les métadonnées ne deviennent publiques (§6.6) |
| À la publication | Confirmez la publication publique et la classification eJournal ; enregistrez la ligne de base du jour 1 de la grille du tableau 11 (§6.1) | Les alertes e-mail eJournal sont le principal canal de poussée de la plateforme et se poursuivent après la fermeture [147][57] | Attendez-vous à des sollicitations comme conséquence par défaut de la visibilité, non comme un signal de mérite (§6.6 ; [159][63]) |
| Premières semaines (jours 1-45) | Lisez un zéro précoce comme une pré-distribution, non un rejet (§6.2 règle iv ; [53]) ; enregistrez les compteurs selon le calendrier du tableau 11 ; classifiez la trajectoire au plus tôt le jour 60-90 (§6.3) | Appliquez des leviers externes légitimes où approprié — la couverture par des blogs et des listes a produit des pics initiaux mesurables (§6.4 ; [116][72]) | Ne jamais payer ; cribler tout lieu d'invitation ([B-1] ; Think. Check. Submit. [159]) ; vérifiez les invitations par rapport à la typologie du tableau 14 ; ne lisez jamais le volume de spam comme de la lecture (§7.6) |
Appendice B. Modèle de rapport CSAB
Une déclaration CSAB minimale destinée aux auteurs ou aux évaluateurs (section 5.5 ; tableau 10) rapporte :
À l'âge X jours du manuscrit, celui-ci avait [V] consultations d'abstract et [D] téléchargements validés. Relativement à [domaine / cohorte / classe de référence des nouveaux venus], son percentile de portée était [RV], son percentile de téléchargement [RD], et son percentile de conversion ajusté par la contraction [RC]. Le manuscrit [avait / n'avait pas] reçu de distribution curée documentée à cette observation. Entre l'âge [age 1] et l'âge [age 2], sa position normalisée [a augmenté / s'est stabilisée / a diminué]. Ces indicateurs décrivent la diffusion et n'établissent ni la qualité ni l'exactitude de la recherche.
Jusqu'à ce qu'un panel de référence contemporain ait été estimé (sections 5.5, 8.3), les champs de percentile doivent rester vides : aucune valeur ne peut être entrée par intuition, à partir de moyennes au niveau de la plateforme, ou à partir d'échantillons antérieurs. Les ancres historiques peuvent être rapportées aux côtés du modèle : la médiane 2012 du LSN de 63 téléchargements à deux ans [139] et la médiane 2025 du réseau Marketing de 87 [83], chacune avec son échantillon, son domaine et son âge indiqués, mais jamais substituées à la classe de référence manquante. Le modèle est l'équivalent au niveau de la phrase de l'étape Translate du protocole du dossier (tableau 13, étape 2).
Appendice C. Dictionnaire des variables du panel
Le tableau C1 énonce l'enregistrement minimum d'intervalle de manuscrit pour le panel principal de la section 8.3 : le plus petit schéma suffisant pour reproduire les estimations CSAB de la section 5.5 et les analyses des événements de plateforme des sections 8.4–8.5. Les versions publiques remplacent les identifiants directs par des clés d'étude stables partout où la liaison n'est pas analytiquement nécessaire, et les contributions de registre (section 8.8) utilisent le sous-ensemble de ce schéma indiqué là.
Tableau C1. Schéma de données minimal d'intervalle de manuscrit pour le panel principal.
| Domaine | Variable | Définition ou format |
|---|---|---|
| Identité | paper_id | Identifiant d'étude stable |
| Identité | ssrn_abstract_id | Identifiant de plateforme ; hashé ou restreint dans les versions publiques |
| Chronométrage | posted_at | Date de première publication publique |
| Chronométrage | observed_at | Horodatage d'observation de métrique (grille du tableau 11) |
| Chronométrage | paper_age_days | Jours depuis la première publication |
| Utilisation | abstract_views_cum | Consultations publiques cumulatives de la page abstract |
| Utilisation | downloads_cum | Téléchargements publiques cumulatifs validés |
| Utilisation | views_interval, downloads_interval | Incréments depuis l'observation valide précédente |
| Exposition | classification_ids | Toutes les classifications eJournal actives à l'observation |
| Exposition | distributed_status, distributed_at | Indicateur et date de distribution curée, le cas échéant |
| Exposition | search_indexed | Statut d'index externe défini par le protocole (test de titre exact) |
| Manuscrit | title_frozen, abstract_frozen, keywords, page_count, doi | Métadonnées de manuscrit observées en premier lieu, figées à la première observation |
| Manuscrit | authors_frozen, affiliations_frozen | Noms, ordre et affiliations des auteurs à la première observation |
| Versioning | revision_id, revision_at, material_change_flag | Historique de version avec un indicateur de changement matériel |
| Auteurs | author_count, platform_newcomer, prior_ssrn_papers | Structure de l'équipe et historique de plateforme antérieur à la publication (définitions de la section 8.3) |
| Réputation | prior_citations, prior_works, institution_measure | Figés avant la publication focal et normalisés par domaine |
| Calendrier | day_of_week, week, season, holiday_flag | Contrôles temporels prédéfinis [178] |
| Aval | citations_6m, citations_12m, citations_18m, publication_status | Résultats de validation ultérieurs avec source et date (horizons de la section 8.9) |
| Audit | collection_method, source_url, quality_flag | Provenance, itinéraire d'accès et documentation d'anomalie (drapeau, non suppression ; section 8.3) |
Appendice D. Spécification de transparence des points de référence
Pour éviter que le point de référence de percentile de la section 8.8, et tout successeur maintenu par la plateforme ou par la communauté (section 10.4, recommandations 1 et 4), ne reproduisent l'opacité de point de référence dont cet article critique, chaque version de percentile est publiée avec une spécification compagne versionnée précisant :
1. la population de manuscrits admissible, les réseaux, les types de documents et les exclusions ;
2. les dates de cohorte de publication et les âges d'observation ;
3. la règle d'assignation de domaine, y compris le traitement des classifications multiples ;
4. les définitions des consultations, téléchargements, acteurs uniques, répétitions et trafic validé en vigueur à la version ;
5. la médiane, l'écart interquartile, P10/P25/P75/P90/P95, la part zéro, le coefficient de Gini et les parts supérieures ;
6. les tailles d'échantillon et les intervalles d'incertitude pour chaque classe de référence rapportée ;
7. la gestion des données manquantes, retraits, révisions, fusions et retraits de compteur ;
8. les variables de distribution et de promotion externe incluses dans tout ajustement ;
9. règles de confidentialité et de cellule minimale : pour le registre participatif de la section 8.8, où les petites cellules de domaine par âge pourraient autrement identifier les contributeurs individuels, cet élément est une contrainte contraignante régie par la loi sur la protection des données (au Royaume-Uni, le RGPD du Royaume-Uni et la Loi de 2018 sur la protection des données), non une formalité. Le contrôle de divulgation doit s'étendre au-delà de la simple anonymisation à la k-anonymité ou à des agrégats ajoutés du bruit (différentiellement privés) pour les cellules minces, et une règle d'utilisation autorisée doit lier le registre à l'interprétation plutôt qu'à l'évaluation, interdisant son utilisation pour l'embauche, la promotion, l'allocation de ressources, ou le réassemblage en tout classement public ;
10. un historique de version et une référence permanent et citable pour la version.
Aucun score composite ne peut remplacer ces composants. Les simples ratios à une médiane de cohorte (le recours non calibré de la section 6.3) peuvent être instables lorsque la cellule du dénominateur est petite et peuvent faussement suggérer que « deux fois la médiane » correspond à un percentile fixe dans les domaines de formes différentes. La production orientée vers les auteurs utilise donc des estimations de percentile selon le rétrécissement empirique de Bayes déjà spécifié pour les cellules clairsemées de la section 8.3, tandis que les distributions brutes restent disponibles pour l'audit.
Appendice E. Une coupe transversale archivistique indépendante de la distribution des téléchargements
Pour les preuves récentes de la distribution complète, la synthèse des sections 3 et 5 s'appuie sur un seul instantané publié [83]. Cette appendice rapporte une coupe transversale indépendante et reproductible assemblée pour cet article qui corrobore la structure distributionnelle entre les domaines, en utilisant uniquement des données publiques et sans accès privilégié à la plateforme. Il s'agit d'une reconstruction archivistique ponctuelle présentant un biais ascendant connu, offerte comme corroboration de la forme, distincte du panel préenregistré de la section 8.6, qui observe les articles de manière prospective à partir de leur mise en ligne.
Méthode. Un échantillon aléatoire d'articles SSRN a été tiré d'OpenAlex (source S4210172589, « SSRN Electronic Journal ») selon vingt-trois germes aléatoires indépendants. Pour chaque article échantillonné, les compteurs de téléchargements avant le retrait et d'affichages d'abstracts ont été lus à partir de la capture la plus récente de l'article dans Internet Archive, localisée via le point de terminaison de disponibilité publique de la Wayback Machine, plutôt que depuis le site actif, qui est protégé par un portail d'accès (section 4) et ne publie plus de cadres comparatifs. La lecture des compteurs à partir de copies archivées plutôt que l'interrogation de la plateforme permet de maintenir la procédure à un débit limité, respectueuse de la plateforme et reproductible à partir des identifiants publiés. Étant donné que les compteurs par article ont survécu à l'extinction du classement sans modification, et seuls les classements comparatifs ont été retirés, une capture datée après le 15 juillet 2026 reste une lecture valide des comptages cumulatifs d'un article. Les instantanés n'ont donc pas été limités à la fenêtre antérieure à l'extinction, et la date de capture est conservée uniquement pour calculer l'âge de l'article. Les captures qui ont renvoyé un défi bot interstitiel au lieu du contenu de la page ont été supprimées. Sur 2 600 articles échantillonnés, 64 % disposaient d'une capture archivée utilisable et 52 % ont fourni un comptage de téléchargement lisible par machine, donnant n = 1 360 articles couvrant vingt-cinq domaines, quatorze d'entre eux comptant au moins vingt articles, et des âges d'articles allant de l'année de mise en ligne à plus de deux décennies. L'ensemble de données est publié en tant qu'appendixE-wayback-downloads.csv et déposé à https://doi.org/10.5281/zenodo.22285871, où le même fichier porte le nom study1-wayback-downloads.csv. Deux propriétés de l'échantillon limitent ce qui peut en être déduit. Les dates de mise en ligne comportent une année et aucun mois : 1 358 des 1 360 enregistrements sont horodatés 1er janvier, car OpenAlex rapporte les publications SSRN à résolution annuelle. L'âge est donc calculé comme année de capture moins année de publication, rapporté en années entières, et aucune bande plus courte n'est défendable. Les captures sont également concentrées dans le temps : 688 d'entre elles, soit la moitié de l'échantillon, s'inscrivent dans un seul crawl entre le 25 avril et le 7 mai 2025, et 81,5 % s'inscrivent en 2025, donc l'âge d'un article ici se rapproche d'une reformulation de son année de publication et les deux ne peuvent pas être séparés. Le premier est supprimable. La ligne de publication « Posted: DD Mon YYYY » apparaît dans les mêmes captures archivées, les dates complètes peuvent donc être récupérées en les réanalysant, ce que le portail d'accès sur le site actif ne peut pas empêcher. Le tableau E1 explicite cette attrition.
Tableau E1. Construction de la coupe transversale archivistique et attrition à chaque étape.
| Étape | Articles | % de l'initial | % du précédent |
|---|---|---|---|
| Enregistrements OpenAlex échantillonnés aléatoirement (SSRN Electronic Journal) | 2 600 | 100,0 | — |
| Capture Internet Archive utilisable localisée | ≈1 660 | 63,8 | 63,8 |
| Capture avec comptage de téléchargement lisible par machine | 1 360 | 52,3 | 81,9 |
| Échantillon analytique final | 1 360 | 52,3 | 100,0 |
Résultats. La coupe transversale reproduit chaque caractéristique qualitative que les ancres publiées affirment (Tableau E4). Les téléchargements sont fortement asymétriques vers la droite : moyenne 219, médiane 60 (IC d'amorçage 95 % : 55–69), rapport moyenne-sur-médiane 3,65, la moyenne dépassant le 75e percentile (158). Ils présentent également une queue supérieure lourde (95e percentile 816, plus de treize fois la médiane ; Gini 0,75, IC 95 % : 0,71–0,78). Dans le logarithme, la distribution est proche de la symétrie (asymétrie du ln des téléchargements ≈ 0,18), cohérente avec une lognormalité approximative sur le corps observé de la distribution, propriété que Kakushadze n'a pu ajuster que sur les listes supérieures (section 3.4). La conversion téléchargement-vers-consultation a une médiane de 16,2 % et une moyenne de 17,3 %, à l'intérieur de la bande inter-études 11–19 % (section 5.2). Les téléchargements médians diffèrent selon les domaines au même âge du document. En maintenant la bande d'âge fixe, l'écart entre la médiane de domaine la plus élevée et la plus basse varie d'environ trois à environ cinq fois, le chiffre exact dépendant de la bande et du traitement des domaines faiblement échantillonnés. Combinés sur tous les âges, l'écart atteint environ douze fois, et ce chiffre plus important reflète la composition changeante de l'échantillon : l'Ingénierie fournit 21 à 27 pour cent des documents âgés de trois ans et moins et au maximum 5 pour cent de ceux âgés de neuf ans et plus, tandis que l'Économie fournit 9 à 12 pour cent et 37 à 54 pour cent des mêmes groupes, et l'âge médian d'un document en Économie ici est neuf ans contre un an pour l'Ingénierie. La direction s'accorde avec le multiplicateur de domaine de la section 3.6. Les magnitudes ne sont pas comparables, car ce multiplicateur repose sur les moyennes sur toute la vie de 94 sous-domaines d'une seule discipline et cet écart sur les médianes de 25 disciplines, et ni l'un ni l'autre n'est ajusté en fonction de l'âge. Les téléchargements médians sont plus élevés dans les bandes d'âge plus anciennes, avec des intervalles de confiance d'amorçage 95 % non superposés entre la plupart des bandes adjacentes (médiane 12 l'année du dépôt, 172 au-delà de dix ans), ce qui est la dépendance à l'âge qui motive l'argument de classe de référence. Au sein d'un seul domaine, la différence est concentrée dans les trois ou quatre premières années : entre la bande cinq-à-dix ans et la bande au-delà-de-dix ans, elle n'atteint pas la significativité (Mann-Whitney p = 0,57 pour l'Économie, 0,82 pour les Sciences sociales, 0,23 pour les Affaires). Environ un quart du gradient groupé est composition de domaine plutôt qu'âge. L'âge dans cet échantillon s'éxécute également proche d'une reformulation de l'année de dépôt, puisque la moitié des captures ont été prises dans un seul crawl entre le 25 avril et le 7 mai 2025 et 81,5 pour cent tombent en 2025, donc l'âge et la cohorte ne peuvent pas être séparés ici et les bandes rapportent des niveaux plutôt que le chemin d'un quelconque document unique. La moyenne de l'échantillon (219) coïncide avec la moyenne du réseau de marketing publié (221) [83], tandis que la médiane de l'échantillon (60) se situe au niveau de la médiane juridique de style recensement (63) [139]. Le tableau E2 donne la distribution des téléchargements par âge du document et le tableau E3 par domaine, tous deux avec des intervalles de confiance d'amorçage 95 % et des tailles d'échantillon. Les intervalles de confiance sont les plus larges pour les plus petits domaines, ce qui explique pourquoi l'écart de domaine est décrit comme à peu près un ordre de magnitude plutôt qu'un multiple précis unique. Le cas d'ouverture de l'article peut être lu directement par rapport à l'échantillon. Parmi les documents de moins de deux ans portant 30 à 50 consultations de résumé, la bande dans laquelle ce cas s'inscrit, le nombre de téléchargements médians est 7, avec une plage interquartile de 4 à 11 (n = 42). Le cas du titre est le cas typique de sa bande d'affichage et de son âge. L'année du dépôt, 35 pour cent de l'échantillon enregistre 7 téléchargements ou moins, le nombre médian de consultations de résumé est 66, et la conversion propre du cas de 17,5 pour cent se situe au 57e percentile de l'échantillon. La bande de conversion 11–19 % de la section 5.2 est une bande de médianes plutôt que de documents : 41 pour cent de l'échantillon tombe à l'intérieur, 23 pour cent en dessous et 36 pour cent au-dessus. La moitié de l'échantillon, 51 pour cent, se situe en dessous de la médiane juridique de style recensement de 63 [139], ce qui place la gamme naissante dans la partie peuplée de la distribution.
Tableau E2. Distribution des téléchargements par âge du document dans la coupe transversale archivistique.
| Âge du document | n | Médiane [IC 95 %] | Moyenne | IQR (P25–P75) |
|---|---|---|---|---|
| année du dépôt | 203 | 12 [11–14] | 33 | 5–21 |
| 1 an | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4 ans | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9 ans | 188 | 130 [110–151] | 384 | 72–374 |
| 10 ans et plus | 341 | 172 [157–189] | 453 | 96–336 |
| Tous les documents | 1 360 | 60 [55–69] | 219 | 23–158 |
Tableau E3. Distribution des téléchargements par domaine (domaines avec n ≥ 20) dans la coupe transversale archivistique.
| Domaine (n ≥ 20) | n | Médiane [IC 95 %] | Moyenne | IQR |
|---|---|---|---|---|
| Économie | 285 | 150 [134–169] | 443 | 76–302 |
| Affaires | 161 | 150 [126–188] | 335 | 72–330 |
| Psychologie | 24 | 107 [35–192] | 179 | 32–229 |
| Sciences sociales | 241 | 85 [78–117] | 219 | 45–189 |
| Sciences de la décision | 32 | 74 [56–158] | 615 | 49–260 |
| Informatique | 63 | 42 [36–73] | 167 | 26–104 |
| Médecine | 40 | 42 [24–59] | 81 | 22–66 |
| Agric. & Sci. biologiques | 36 | 31 [24–57] | 65 | 23–67 |
| Biochimie | 21 | 30 [23–37] | 38 | 20–38 |
| Sciences de l'environnement | 72 | 26 [18–32] | 44 | 14–50 |
| Ingénierie | 196 | 24 [20–26] | 46 | 13–46 |
| Physique & Astronomie | 21 | 23 [15–38] | 112 | 13–45 |
| Science des matériaux | 55 | 18 [15–25] | 26 | 11–36 |
| Énergie | 21 | 12 [11–22] | 25 | 11–22 |
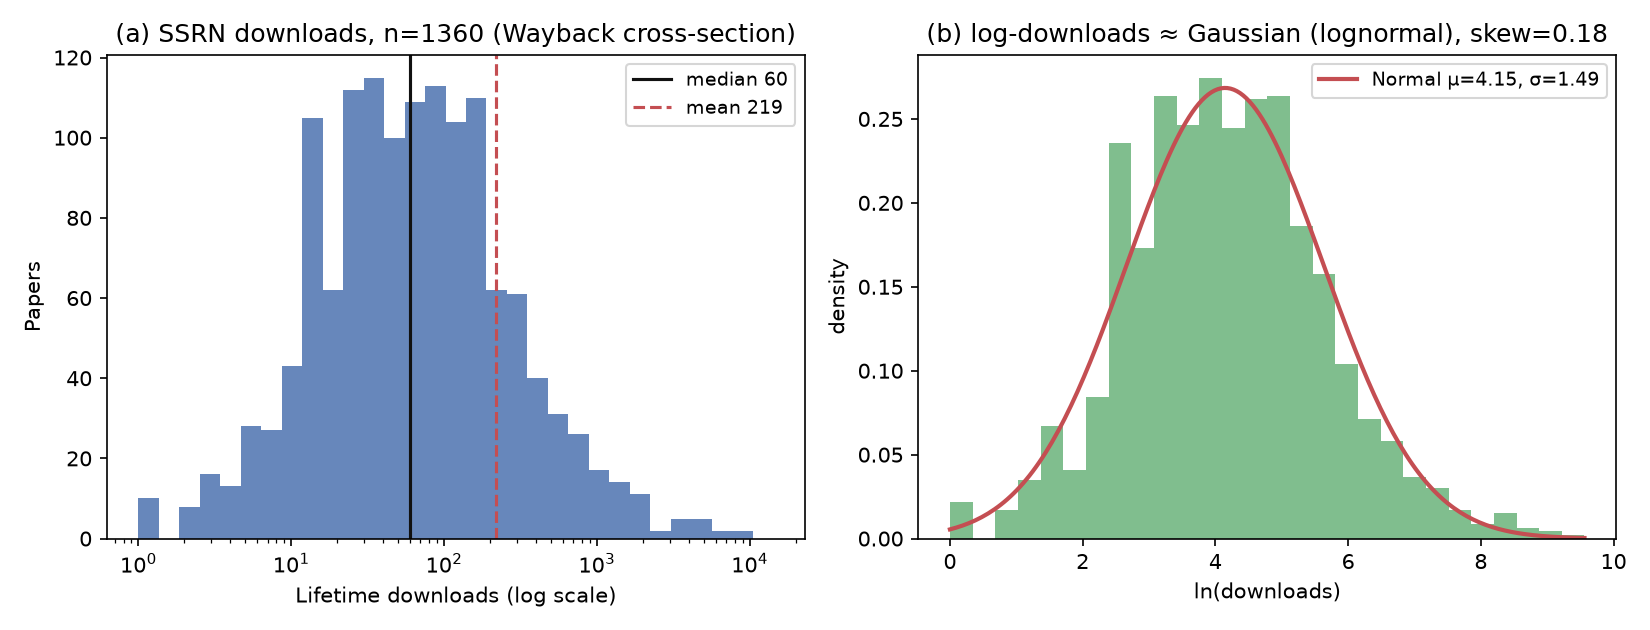
Figure E1. (a) La distribution des téléchargements sur une échelle logarithmique avec la moyenne et la médiane marquées ; (b) un histogramme de ln(téléchargements) avec une densité normale ajustée. L'asymétrie des log-téléchargements ≈ 0,18. n = 1 360.
Tableau E4. Ancres publiées par rapport à l'échantillon transversal archivistique indépendant (n = 1 360).
| Caractéristique | Ancre publiée | Échantillon transversal archivistique |
|---|---|---|
| Moyenne des téléchargements | 221 (marketing) [83] | 219 |
| Médiane des téléchargements | 87 (marketing) [83] ; 63 (droit) [139] | 60 |
| Moyenne / médiane | 2,54 [83] | 3,65 |
| 95e percentile / médiane | > 8 [83] | 13,6 |
| Conversion téléchargement-consultation | Bande 11–19 % (§5.2) | 16,2 % médiane |
| Dispersion par discipline (médianes) | ≈ 8× moyennes par discipline, non ajustées par âge [168] | ≈ 3–5× à âge égal ; 12,5× regroupées |
| Forme de la distribution | log-normale, queue uniquement [85] | log-asymétrie 0,18 (corps observé) |
Ce que l'échantillon transversal établit. L'échantillon transversal corrobore la forme de la distribution et sa structure centrale et supérieure par disciplines, sur un échantillon indépendant couvrant l'ensemble des disciplines et beaucoup plus large en couverture disciplinaire que n'importe quel instantané SSRN publié unique. Il n'estime pas les percentiles représentatifs de la plateforme, et deux caractéristiques de sa construction le biaisent vers le haut. Les captures archivistiques surreprésentent les pages visibles, de sorte que les articles téléchargés massivement sont plus susceptibles d'être capturés. Un article n'entre dans l'échantillon que s'il possédait une page archivistique portant un compteur lisible, ce qui censure la queue extrême inférieure : la part de l'échantillon d'articles avec dix téléchargements ou moins (environ 10 %) est en conséquence bien inférieure aux 15–30 % que les sections 3.4 et 8.6 anticipent pour un échantillon entier sans biais de la plateforme, et ne doit pas être interprétée comme une estimation de cette part. Que la médiane de l'échantillon (60) se situe néanmoins au niveau ou en dessous des médianes juridique (63) et marketing (87) publiées indique que le biais vers le haut est modeste pour la masse centrale et que les conclusions sur l'asymétrie et la queue lourde sont, le cas échéant, conservatrices. Pour des points de référence calibrés, les instruments appropriés restent les bandes de percentiles représentatifs de la plateforme recommandées à la section 10 et le panel préenregistré de la section 8.6 ; cet échantillon transversal corrobore que la structure qu'ils mesureraient est celle que cet article décrit. Trois des bandes de prédiction que l'étude 1 fixe à l'avance (section 8.6) peuvent être lues par rapport à cet échantillon, en tenant compte de son biais vers le haut. La médiane de l'échantillon de 60 téléchargements se situe dans la plage prédite de 30 à 80. Le coefficient de Gini d'attention de 0,75 se situe sur le bord inférieur de la plage prédite de 0,75 à 0,90, ce qui est la direction que le biais d'échantillonnage prédit, puisque la queue basse censurée comprime l'inégalité mesurée. Le ratio médiane-sur-moyenne de 0,27 est inférieur au plafond prédit de 0,5. Aucun de ceci ne valide la conception prospective, dont la valeur est qu'elle observe les articles à partir de l'envoi sur un échantillon probabiliste ; il enregistre que les bandes n'ont pas été définies de manière implausible.
Déclarations
Disponibilité des données. Chaque ancre synthétisée reproduite ici est traçable aux sources publiées citées dans le texte et les tableaux, avec les cadres d'échantillonnage et le statut de vérification indiqués au point d'utilisation, et aucun nouveau jeu de données représentatif de la population ne sous-tend les affirmations de référence de l'article. Le seul jeu de données original généré pour cet article est l'échantillon transversal archivistique indépendant de l'appendice E, un échantillon aléatoire couvrant l'ensemble des disciplines de 1 360 articles dont les compteurs avant retrait ont été récupérés dans des archives publiques, diffusé en tant qu'appendixE-wayback-downloads.csv (un ensemble de données de l'appendice E, et non l'étude 1 prospective) avec le code d'analyse, de sorte que la procédure peut être réexécutée et étendue ; il corrobore la forme de la distribution et n'est pas un point de référence représentatif de la plateforme. L'ensemble de données est déposé sur https://doi.org/10.5281/zenodo.22285871 sous CC BY 4.0, où le même fichier porte le nom study1-wayback-downloads.csv, et il est fourni avec un outil ouvert qui lit un nombre de téléchargements par rapport à celui-ci tout en tenant compte à la fois de l'âge et du domaine du document, sur https://github.com/vadimchernets/ssrn-benchmark (licence MIT, bibliothèque standard Python uniquement). Les lecteurs qui souhaitent placer leur propre compteur dans cette classe de référence peuvent exécuter cet outil plutôt que de reconstruire l'analyse. Les matériaux pour l'agenda prêt à la préenregistrement de la section 8, y compris le dictionnaire des variables du panel (appendice C, tableau C1) et l'inventaire des requêtes d'audit de recherche, sont préparés pour le dépôt à la préenregistrement (section 8.8) ; les contributions au registre suivent le sous-ensemble de schéma défini à la section 8.8, et toute version percentile du programme de référence est publiée selon les spécifications de transparence de l'appendice D. Le modèle de rapport CSAB de l'appendice B peut être réutilisé librement, sous réserve de sa règle de percentile vierge. Le 24 août 2026, une demande formelle a été adressée au support SSRN (ticket 260824-003051) pour la classe de référence agrégée que les classements retirés impliquaient — médiane, plage interquartile et bandes déciles des téléchargements stratifiés par domaine et âge du document, sans identifiants par document ; son résultat (approbation, refus ou non-réponse) sera signalé dans une révision ultérieure.
Accès ouvert à cet article. Une copie sous licence ouverte de ce manuscrit est déposée sur https://doi.org/10.5281/zenodo.22166896 (CC BY 4.0), où le texte complet est récupérable directement et sans défi d'accès. Le dépôt est fourni car l'enregistrement canonique sur SSRN est servi derrière une atténuation des bots qui décline les clients sans moteur JavaScript, une condition documentée à la section 4.2 ; les lecteurs, les gestionnaires de références et les clients automatisés qui ne peuvent pas accéder à la copie canonique peuvent obtenir le même texte à partir du dépôt. Les articles connexes sont déposés aux mêmes conditions sur https://doi.org/10.5281/zenodo.22166995 et https://doi.org/10.5281/zenodo.22168724.
Disponibilité du code. Le code de moissonnage et d'analyse de la coupe transversale archivale indépendante de l'Annexe E est publié aux côtés de son ensemble de données à https://github.com/vadimchernets/ssrn-benchmark, afin que la procédure puisse être reproduite et la classe de référence redérivée à partir des compteurs bruts. L'article ne rapporte par ailleurs aucun résultat nécessitant un code d'analyse ; les modèles de génération de figures pour les designs empiriques de la Section 8 seront publiés en tant qu'annexe en ligne accompagnant les matériaux de préenregistrement.
Éthique. Les designs empiriques de la Section 8 s'appuient sur les compteurs au niveau des articles affichés publiquement et les métadonnées bibliographiques ; toute collecte d'informations de tableaux de bord non publiques, de dates de statut de distribution ou de messages électroniques exige le consentement éclairé et, le cas échéant, un examen institutionnel (voir Section 9). Les deux designs qui constituent une recherche impliquant des sujets humains, l'Étude 4 (l'enquête auprès des auteurs) et l'Étude 3 (affichage instrumenté avec enregistrement des boîtes de réception), seront soumis pour approbation d'un comité d'examen institutionnel ou d'un comité d'éthique de la recherche et menés selon le consentement éclairé des participants avant toute collecte de données. Les ensembles de données de messages sont agrégés et dé-identifiés avant tout rapportage, et les messages communautaires sont cités uniquement lorsqu'une source vivante et vérifiable existe, avec paraphrase lorsque les auteurs pourraient être identifiés contre leurs attentes. La collecte de données est limitée aux moyens autorisés par les conditions d'utilisation des plates-formes : les designs utilisent les compteurs affichés publiquement et les métadonnées bibliographiques et n'emploient aucun scraping qui violerait les conditions d'utilisation d'une plate-forme, et tout design nécessitant des données en masse ou non publiques procède par une demande de données formelle et un examen juridique plutôt que par extraction automatisée. La citation de contenu de forums semi-publics tient compte du consentement des contributeurs et du risque de ré-identification, ce qui explique pourquoi ce matériel est paraphrasé plutôt que reproduit mot pour mot partout où un auteur pourrait être identifié contre ses attentes. L'article ne qualifie aucune revue ou éditeur spécifique de « prédateur » ; le filtrage des lieux applique des critères validés et transparents, ce qui rend tout classement défendable et évite la diffamation.
Remerciements. L'auteur remercie Stefanie Haustein pour ses commentaires critiques, envoyés par courriel en août 2026, qui ont conduit à des révisions de la Section 4.2, et Vincent Larivière, dont la question en correspondance — quelle seule normalisation un auteur devrait insister pour obtenir en premier, et son insistance à voir les données plutôt que l'argument — a suscité la coupe transversale archivale rapportée en Annexe E.
Conflits d'intérêts. L'auteur est le développeur des méthodes d'orchestration multi-modèles discutées dans la Section 8.10, qui sont ouvertes et reproductibles, un intérêt que les lecteurs doivent considérer. L'auteur est un demandeur nommé sur des demandes de brevets en attente, non des brevets accordés, couvrant l'orchestration d'IA et les systèmes de validation multi-modèles du type discuté dans cette section. Le design de livraison de la couche d'orchestration proposé dans la Section 8.10 est une spécification conceptuelle sur laquelle aucune des conclusions de l'article ne repose. La Section 8.10 pourrait être supprimée en entier sans modifier aucun diagnostic, résultat ou recommandation ailleurs dans l'article.
Outils et vérification. Les assistants IA ont été utilisés comme instruments sous la direction de l'auteur ; les idées, la recherche et les conclusions sont celles de l'auteur. Toutes les affirmations quantitatives et citations ont été vérifiées par l'auteur par rapport à leurs sources primaires ou à des copies archivées ; l'auteur assume l'entière responsabilité du contenu.
Références
Les sources citées dans le texte sous la forme [B-n] (pages de plates-formes, fils de discussion, articles de blog et autres matériels de soutien) sont énumérées séparément ci-dessous sous « Sources supplémentaires ». Les pages de plates-formes avec dates d'accès sont instables et doivent être re-vérifiées par rapport aux copies archivées.
[1] AALL / ALL-SIS (2024, 14 juin). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, 28 mai). « Importance of paper download statistics ». https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025 ; enquête menée en mai 2025). « Using ChatGPT as a search engine ». https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900 ; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381 ; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002 ; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). « The Social Science Research Network Has Jumped the Shark » (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; « SSRN Responds to My Complaints With Changes and/or Clarifications » (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, 16 novembre). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). Les éditeurs prédateurs corrompent l'accès ouvert. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). Les actions surpassent-elles les bons du Trésor ? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). L'accès ouvert par rapport aux revues d'abonnement : une comparaison de l'impact scientifique. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). Classement des écoles de droit : utiliser SSRN pour mesurer la performance académique. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). Facteur d'impact d'utilisation : les effets des caractéristiques de l'échantillon sur les mesures d'impact basées sur l'utilisation. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). Les altmétries pointent-elles vers l'impact plus large de la recherche ? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). Comment normaliser les comptes Twitter ? Une première tentative basée sur les revues dans l'indice Twitter. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). L'utilisation des percentiles et des classes de rangs de percentiles dans l'analyse des données bibliométriques : possibilités et limites. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). Normalisation des données à inflation de zéros : une analyse empirique d'une nouvelle famille d'indicateurs et son utilisation avec des données altmétriques. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). Dix règles simples à considérer concernant la soumission de préimpressions. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). Les statistiques d'utilisation du Web antérieures comme prédicteurs de l'impact des citations ultérieures. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). Le rôle des préimpressions électroniques dans la communication chimique : analyse des citations, de l'utilisation et de l'acceptation dans la littérature des revues. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). Évaluer l'impact des changements sociaux planifiés. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). Congestion sur l'autoroute de l'information : inefficacités dans les documents de travail en économie. Journal of Public Economics, 225, 104978 (aussi NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). Atténuer le trafic agressif des robots d'exploration à l'ère de l'IA générative : une approche collaborative des bibliothèques de l'Université de Caroline du Nord à Chapel Hill. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). Expériences sur le terrain en ligne. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). Téléchargements par rapport aux citations en économie : relations, facteurs contributifs et au-delà. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informatics), Madrid.
[32] Cobey, K. D., et al. (2019). Connaissances et motivations des chercheurs publiant dans des revues présumées prédatrices. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). « Montrez votre recherche, partie trois : auto-édition ». https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). « Social Science Research Network (SSRN) Ending Commercial Products ». https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. Documentation de l'API REST. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Documentation de Similarity Check. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). Publication en accès ouvert, téléchargements d'articles et citations : essai contrôlé randomisé. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). arXiv mène-t-il à des citations plus élevées et à une réduction des téléchargements par les éditeurs pour les articles de mathématiques ? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). Revisiter la relation entre téléchargements et citations : une perspective depuis les articles de la Lancet avec différents motifs de citations. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). L'avantage de l'accès ouvert pour les revues de droit américaines. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). L'effet du financement sur les citations et l'attention sociale : les objectifs de développement durable des Nations unies (ODD) comme étude de cas. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). « Combien de lectures un article universitaire typique reçoit-il ? » https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). Comparaisons sociales et tromperie dans les hiérarchies organisationnelles : preuves de terrain et expérimentales. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (en circulation depuis 2009)
[45] Eisenberg, T. (2006). Évaluer les classements des écoles de droit basés sur SSRN. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). « Elsevier acquiert le Social Science Research Network (SSRN)… ». PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (aussi LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. « SSRN Research Paper Series Sunset — DC Options ». https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. « SSRN First Look » (page produit). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. « SSRN for Authors and Researchers » (page produit). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. « Comment les chercheurs peuvent-ils évaluer l'impact d'un article ? » https://www.elsevier.support/ssrn/answer/gauge-impact (consulté le 14.08.2026)
[51] Elsevier/SSRN Support. « Qu'est-ce que les flux RSS et les flux de données sur SSRN ». https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. « Qu'est-ce que SSRN ? » https://www.elsevier.support/ssrn/answer/what-is-ssrn (consulté le 14.08.2026)
[53] Elsevier/SSRN Support. Classification et distribution. https://www.elsevier.support/ssrn/answer/classification-distribution (consulté le 14.08.2026)
[54] Elsevier/SSRN Support. Politique relative à l'IA générative. https://www.elsevier.support/ssrn/answer/AI (consulté le 14.08.2026)
[55] Elsevier/SSRN Support. Google / Indexation Google Scholar. https://www.elsevier.support/ssrn/answer/google-scholar (consulté le 14.08.2026)
[56] Elsevier/SSRN Support. Directives de soumission / Commencer. https://www.elsevier.support/ssrn/answer/get-started (consulté 14.08.2026)
[57] Elsevier/SSRN Support. Abonnements (envois de revues électroniques). https://www.elsevier.support/ssrn/answer/subscriptions ; voir aussi https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Avantage de citation des articles en accès ouvert. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Effets Matthieu dans la science et diffusion en série des idées. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifier le pourriel académique et recommandations pour le traiter : une revue de la littérature. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (publié 8 mai 2026)
[62] Fraser, N., et al. (2020). La relation entre les prépublications bioRxiv, les citations et les altmétriques. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Faire confiance, mais vérifier : audit exploratoire des sollicitations de revues et d'éditeurs prédateurs. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact des caractéristiques de l'auteur sur les résultats de l'évaluation par les pairs en simple ou double aveugle : revue systématique d'études comparatives dans les résumés et publications scientifiques. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. « SSRN and Download Statistics » (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; « Update on SSRN », https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problèmes de gestion monétaire : l'expérience du Royaume-Uni. In Papers in Monetary Economics, Vol. I. Sydney : Reserve Bank of Australia. Réimprimé dans C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). Londres : Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). La question de l'intégrité des données dans les mesures au niveau des articles. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relation entre les téléchargements et les citations au niveau des revues et des articles, et l'influence de la langue. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Effets positionnels sur les citations et les lectures sur arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). En dernier lieu, mais non le moins important : effets positionnels supplémentaires sur les citations et les lectures sur arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (Fall 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. Guides: « Understanding the Similarity Report » ; « Preprints ». https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, March 6). Les IA de recherche ont un problème de citation. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). Les IA peuvent-elles réduire la prime de réputation dans la diffusion des connaissances ? Données probantes provenant des documents de travail marketing de SSRN. Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). An Analysis of Solicitations From Predatory Journals in Ophthalmology. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — source de la figure « 1813 emails »
[85] Kakushadze, Z. (2016). Un indice pour les téléchargements sur SSRN. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). L'effet de l'accès ouvert (Conférence AEA 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). Les robots respectent sélectivement les directives robots.txt : preuves d'une étude empirique à grande échelle. Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). Problèmes de politique de prédiction. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). Le spam dans la publication académique : une étude de cas. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). Un regard critique sur le score ResearchGate comme mesure de la réputation scientifique. Presented at ASCW'15 (Quantifying and Analysing Scholarly Communication on the Web), Web Science Conference 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (version populaire : « Le score ResearchGate : un bon exemple de mauvaise métrique », LSE Impact Blog, 9 Dec 2015)
[91] Kurtz, M. J., et al. (2005). Les propriétés bibliométriques des informations de lisibilité des articles. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). Bibliométrie d'utilisation. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). L'avantage de citation en accès ouvert est-il réel ? Un examen systématique de la citation des articles en accès ouvert et sur abonnement. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). L'oligopole des éditeurs académiques à l'ère numérique. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. « Publishing Tips » (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). Caractéristiques des messages électroniques provenant de revues et d'éditeurs prédateurs en sciences infirmières. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). Les détecteurs de GPT sont biaisés contre les auteurs anglophones non natifs. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). Billet invité — Love, Death & Robots : Édition académique. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. À propos de LogEc (méthodologie de filtrage du trafic). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). Optimiser la visibilité dans les moteurs génératifs : un examen critique de l'optimisation pour moteurs génératifs (2023–2026). arXiv:2607.14035 (submitted 15 July 2026). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). « Maynooth University's School of Law and Criminology ranks first… ». https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). The relationship between usage and citations in an open access mega-journal. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). Evidence of a Harvard and Chicago Matthew Effect. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). L'effet Matthieu dans la science. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). The Matthew effect in science, II: Cumulative advantage and the symbolism of intellectual property. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. « Safe Links in Microsoft Defender for Office 365 ». https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ Microsoft Q&A on clicks in UrlClickEvents; + Suped on false opens)
[107] Milanovic, M. EJIL:Talk! « Academic Spam [UPDATED] ». https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). On full text download and citation distributions in scientific-scholarly journals. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). Applied Evaluative Informetrics. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). Évaluation des scientifiques pour l'embauche, la promotion et la titularisation. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). Prestige drives epistemic inequality in the diffusion of scientific ideas. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). Social influence bias: A randomized experiment. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). The Tyranny of Metrics. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (research assessment/metrics). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). Do Blogs Influence SSRN Downloads? Empirically Testing the Volokh and Slashdot Effects. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. « Get Published — Guide for Law Review Members ». https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. « What is a good h-index? » https://paperpile.com/g/what-is-a-good-h-index/ (guides similaires : Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). Relation between online "hit counts" and subsequent citations: prospective study of research papers in the BMJ. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). Reputation and impact in academic careers. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (archived copy at web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 June 2026 (Release 5.1 published 5 May 2023). https://www.countermetrics.org/ ; « Best Practice on AI Usage » (guidance for R5.1.1, updated 30 June 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. « À quel point recommanderiez-vous ou décourageriez-vous la publication d'un document de travail académique sur SSRN… ». https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 « Spam sans fin depuis la publication d'un article il y a quelques mois ». https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmed via the pullpush.io archive)
[128] Remler, D. (2014, April 23). 90 % des articles académiques ne sont-ils vraiment jamais cités ? Examen de la littérature sur les citations académiques. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: « How RePEc counts views and downloads » (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; « AI issues in RePEc » (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; « RePEc in June 2026 » (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). « Suppression du RG Score ». https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Étude expérimentale de l'inégalité et de l'imprévisibilité dans un marché culturel artificiel. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). La discipline du classement : couplage étroit et changement organisationnel. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Méthodes et mesures pour les recommandations de démarrage à froid. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (also scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). L'impact des bots et des robots d'IA sur les référentiels ouverts : Résultats d'une enquête COAR, avril 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). « Predatory » open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). La faisabilité du développement et de la mise en œuvre de facteurs d'utilisation des revues : un projet de recherche parrainé par l'UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). Comment la communauté scientifique réagit aux prépublications nouvellement soumises. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Version de travail : « What Determines SSRN Downloads », SSRN abstract_id=2836950 ; Durham : https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Statut, qualité et attention : qu'y a-t-il dans un nom (manquant) ? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). E-mails inattendus pour soumettre vos travaux : spam ou offres légitimes ? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). Annonce eLibrary Stats. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). Ce que SSRN signifie quand nous parlons d'intégrité des données. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). Bilan 2025 : comment SSRN a amélioré l'accès aux prépublications et à la recherche en phase précoce. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). Mise à jour stratégique de SSRN : renouvellement de l'accent sur la mission centrale de partage de la recherche (auteur du message : S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). L'engagement continu de SSRN envers la recherche juridique. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRN cessera les classements à partir du 1er juillet 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). Le classement SSRN a cessé à partir du 15 juillet 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRN vous permettra désormais de choisir la licence qui convient à vos travaux. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. FAQ historique (copie PDF, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Page d'abonnement. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). La révision par les pairs en double aveugle réduit-elle les biais ? Données probantes d'une conférence majeure en informatique. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (nom de famille du deuxième auteur selon Crossref : « Barry Danfa »)
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). Revues et éditeurs prédateurs : caractéristiques et impact du pourriel académique sur les chercheurs en sciences de l'éducation. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.) : « Classements des revues électroniques SSRN par téléchargements moyens par article » (2018, mai), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; « SSRN ne s'est pas discrédité » (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). L'IA peut-elle détecter les revues prédateurs ? Le cas des revues FT50. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). Rapport 2025 sur les mauvais robots d'Imperva. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, 4 février). « La revue s'intéresse-t-elle à votre prépublication ? Séparer le bon grain de l'ivraie dans les sollicitations de revues ». https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). Analyse des courriels prédateurs dans l'académie en début de carrière et tentatives de prévention. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] Bibliothèque de droit Gallagher de l'Université de Washington. Guide de ressources « Métriques SSRN » (mis à jour le 29 septembre 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ page p=9061269 sur les revues électroniques)
[162] van de Rijt, A., et al. (2014). Expériences de terrain sur la dynamique du succès qui engendre le succès. PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Université Vanderbilt, Brightspace (Centre pour l'enseignement / Bureau des technologies innovantes) (2023). Conseils sur la détection d'IA et raisons pour lesquelles nous désactivons le détecteur d'IA de Turnitin. Publié le 16 août 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (consulté le 15 août 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). Ce qui est cité : Concurrence géolocalisée dans les moteurs de réponse IA. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Expansion de la Drake Journal of Agricultural Law : le numéro vert. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). Biais contre la nouveauté en sciences. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, juin). Les robots IA mettent-ils le patrimoine culturel hors ligne ? Laboratoire GLAM-E (Centre NYU Engelberg / Université d'Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, 3 mai). Revues électroniques SSRN et téléchargements. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). Outils pour améliorer la distribution, la discussion et les téléchargements… SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (publié dans U. Detroit Mercy Law Review)
[170] Wikipédia : « Social Science Research Network » ; « Liste des revues universitaires selon leur politique de prépublication » ; « Prépublication ». https://en.wikipedia.org/wiki/Social_Science_Research_Network et pages connexes.
[171] Willey, R., & Knapp, M. (2021). Comment augmenter les citations de la littérature juridique. Ohio State Technology Law Journal, 18. SSRN 3801190; PDF : https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). L'impact de SSRN sur les citations de la littérature juridique et comment le maximiser. University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). La marée des métriques : rapport de l'examen indépendant du rôle des métriques dans l'évaluation et la gestion de la recherche. HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). Sollicitations non sollicitées : identification des caractéristiques des courriels non sollicités en provenance de revues potentiellement prédateurs et le rôle des bibliothécaires. Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, Bibliothèque de droit UW–Madison (2016, 21 septembre). « Quels articles juridiques génèrent le plus d'attention sur SSRN ». https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). Les rapports de téléchargement mesurent-ils de manière fiable l'utilisation des revues ? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). Utilisateurs, narcissisme et contrôle — suivi de l'impact des publications savantes au XXIe siècle. Fondation SURF, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). Accès aux articles : liens vers les citations, effets de fin de semaine et saisonnalité. Scientometrics (publié le 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). Lecteurs Mendeley comme outil de filtrage pour identifier les publications hautement citées. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). Inégalité d'attention dans les médias sociaux. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). Quantification de l'évolution de l'impact scientifique individuel. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). Universalité des distributions de citations : vers une mesure objective de l'impact scientifique. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). L'accord sur la réforme de l'évaluation de la recherche. Coalition pour l'avancement de l'évaluation de la recherche. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). Exploiter la marée des métriques : indicateurs, infrastructures et priorités pour l'évaluation responsable de la recherche au Royaume-Uni. Institut de recherche sur la recherche. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). Statistiques d'utilisation standardisées et conformes à COUNTER pour les dépôts. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). Résumé for Research and Innovation (R4RI): guidance. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. L'outil d'intelligence politique. https://www.overton.io
[188] CC-PLUS. Consortia Collaborating on a Platform for Library Usage Statistics (moissonnage SUSHI/COUNTER-5 open-source ; financé par l'IMLS, PALCI et al.). https://www.cc-plus.org/
[189] HELIOS Open. Higher Education Leadership Initiative for Open Scholarship. https://www.heliosopen.org/
Sources supplémentaires
Sources supplémentaires citées dans le texte comme [B-n] : pages de plateforme, fils de discussion de forums, articles de blog et autres matériaux qui soutiennent des points spécifiques dans le texte. Les pages de plateforme sont instables et doivent être revérifiées par rapport à des copies archivées.
[B-1] Cabells Predatory Reports (service actif de dépistage des revues prédatrices) ; Beall's List (archivé uniquement ; non mis à jour depuis janvier 2017).
[B-2] Caron, P. TaxProf Blog (2026, 25 janvier). « The SSRN Top Five New Tax Papers Ranking Is Broken ». https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), fils de discussion sur les téléchargements et les classements d'auteurs sur SSRN (par exemple, /topic/ssrn-downloads-and-views ; /topic/top-10-of-authors-on-ssrn-by-downloads). Forum anonyme ; cité uniquement comme preuve que de telles discussions existent.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, fil 1seeyq3 (6 avr 2026, « I've uploaded a working paper to SSRN… honest advice ») ; Reddit r/academia, fil 13w6zjw (31 mai 2023, « SSRN Approval Time is Absurd »). Existence confirmée via des archives Reddit tierces.
[B-6] SSRN — boilerplate statistique des annonces (par exemple https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) et l'annonce d'avril 2018 (04132018ann002). Pages de plateforme ; vérifiez par rapport aux copies archivées. Copie archivée : https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (instantané 29 décembre 2025 ; consulté 15 août 2026).
[B-7] SSRN FAQ — versioning et ORCID. https://www.ssrn.com/index.cfm/en/faq/ (consulté 2026 ; vérifiez par rapport à une copie archivée).
[B-8] SSRN — page d'accueil « SSRN has Sunset Rankings ». https://www.ssrn.com/ssrn/rankings-sunset. Copie archivée : https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (instantané 19 juillet 2026 ; consulté 15 août 2026).
[B-9] SSRN — pages de classement historiques sur hq.ssrn.com / papers.ssrn.com/topten : Top 10,000 Papers (TRN_gID=10), Top 30,000 Authors (TRN_gID=7), Top 3,000 Law Authors, Top 350 U.S. Law Schools, Top 500 International Law Schools, Eigenfactor, Recent Top Papers (60 days), « Ranking Data Explained » (ranking_data_explain.cfm?id=6 / id=10). Pages historiques ; depuis le 15 juillet 2026, ces URL retournent des réponses 403/placeholder — citez via des copies archivées. Copie archivée de la page Top 10,000 Papers : https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (instantané 14 juillet 2026, la veille du coucher de soleil ; consulté 15 août 2026).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (observation sur un an : 875 invitations de 256 revues, 76 % provenant de listes de blocage). DOI 10.1080/10875301.2025.2550600 ; publication ResearchGate 384286174.
[B-11] Caron, P. TaxProf Blog (2026, 7 juin). « SSRN Has Not Jumped the Shark ». https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (réponse à Bainbridge [12] ; consulté septembre 2026).
Correspondance : [email protected].↩︎
Comment citer
Chernets, V. (2026). Que signifient 7 téléchargements ? Cécité métrique et démarrage à froid de l'attention scientifique après le coucher du soleil des classements SSRN [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}