आर्किटेक्चरल विश्वास: एजेंटिक वाणिज्य में उपभोक्ता विश्वास AI मॉडल से सत्यापनीय आर्किटेक्चर की ओर क्यों स्थानांतरित होता है
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- अभिलेख का संस्करण: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- संग्रहीत प्रति, उद्धरणीय और डाउनलोड योग्य: 10.5281/zenodo.22166995 — अवधारणा DOI, हमेशा नवीनतम संस्करण को हल करती है
- Markdown और PDF के रूप में पूर्ण पाठ: GitHub
- पठनीय HTML: https://polyhelper.ai/research/architectural-trust/
समान पाठ चार सतहों पर है ताकि इसे उस समय प्राप्त किया जा सके जब उनमें से कोई इसे परोस न सके। SSRN अभिलेख का संस्करण रखता है; उसी को उद्धृत करें।
एजेंटिक कॉमर्स में उपभोक्ता विश्वास
"आर्किटेक्चरल ट्रस्ट: एजेंटिक कॉमर्स में उपभोक्ता विश्वास एआई मॉडल से सत्यापन योग्य आर्किटेक्चर की ओर क्यों स्थानांतरित होता है" शीर्षक के तहत SSRN पर प्रकाशित और अनुक्रमित। उसी रूप में उद्धृत करें।
मॉडल गुणों से सत्यापन योग्य आर्किटेक्चर तक
Vadym Chernets, PhD1
पहली बार 6 अगस्त 2026 को पोस्ट किया गया; यह संस्करण सितंबर 2026
संपूर्ण वैचारिक ढांचा, सोलह-मॉडल तंत्र अध्ययन और अगस्त 2026 के प्रमुख-लहर प्रतिकृति को ग्यारह सीमांत प्रयोगशालाओं में, एक जोड़ी गई तर्क-बजट तुलना, एक वाणिज्य-सब्सट्रेट प्रतिकृति, और एक पूर्व-पंजीकृत उपभोक्ता प्रयोग पूर्ण रूप में रिपोर्ट करता है।
सारांश
एजेंटिक कॉमर्स AI को सलाहकार से लेनदेन पक्ष में बदल देता है, खोज, तुलना, कार्ट और भुगतान को एक एकल प्रत्यायोजित कार्य में संक्षिप्त करता है और समीक्षा बिंदुओं को हटा देता है जहां मनुष्य कभी त्रुटियों को पकड़ते थे। यह एक अजीब समय पर आता है: सर्वेक्षण किए गए 60% यूके उपभोक्ता कहते हैं कि वे एक एकल गलती के बाद एक AI शॉपिंग एजेंट को त्याग देंगे, और अधिकांश इसे अपनी ओर से चलाने के लिए किसी भी संगठन पर विश्वास नहीं करेंगे। यह पत्र आर्किटेक्चरल ट्रस्ट का परिचय देता है। जैसा कि उपभोक्ता परिणामी निर्णय AI एजेंटों को प्रत्यायोजित करते हैं, मैं तर्क देता हूं, वारंटीकृत विश्वास AI मॉडल के गुणों से सेवा के सत्यापन योग्य आर्किटेक्चर में स्थानांतरित होता है। उपलब्ध निर्माण विश्वास को संगठनों, एक एकल स्वचालित प्रणाली, या एल्गोरिथमिक सलाह से जोड़ते हैं, और उनमें से कोई भी निर्णय-उत्पादन प्रक्रिया को स्वायत्त प्रत्यायोजन के तहत ट्रस्टर द्वारा सत्यापन योग्य नहीं बनाता। आर्किटेक्चरल ट्रस्ट तीन जांचने योग्य गुणों के साथ उस अंतराल को भरता है: विविधता (स्वतंत्र मॉडल जिनकी सहमति आत्मविश्वास को अंशांकित करती है और जिनकी असहमति सतह पर आती है), साक्ष्य (टेम्पर-प्रतिरोधी, पुनरावर्तनीय निर्णय रिकॉर्ड), और तटस्थता (किसी भी विक्रेता, व्यापारी, या परिणाम से ऑडिट योग्य स्वतंत्रता)।
तंत्र को पहले मशीन पक्ष पर मापा गया था। एक पूर्व-पंजीकृत सोलह-मॉडल बेंचमार्क और अगस्त 2026 के प्रमुख-स्तर की लहर में ग्यारह सीमांत प्रयोगशालाओं में, क्रॉस-मॉडल समझौत सटीकता के लिए मूल्य निर्धारण किया, जहां मॉडल का अपना आत्मविश्वास नहीं कर सका। दूसरे मॉडल द्वारा स्वतंत्र रूप से पुनरुत्पादित उत्तर सही होने की संभावना 1.9–3.2 गुना अधिक थी। एक फ्रोजन SimpleQA सबसैंपल पर (Wei et al., 2024), 46.6% उत्तर कथित आत्मविश्वास ≥ 80 पर दिए गए गलत थे (यह दर इस रोस्टर के लिए विशिष्ट है, सार्वभौमिक स्थिरांक नहीं), जबकि एक निश्चित तीन-मॉडल असहमति गेट ने 82.1% को हटा दिया उन आत्मविश्वासपूर्ण विफलताओं में से (95% CI 79.9–84.1) 30.5% कवरेज पर। संकेत 267 Wikidata-सत्यापित वाणिज्य उत्पाद तथ्यों पर पुनरुत्पादित होता है। एक बड़ा तर्क बजट 3.1 अंक कथित आत्मविश्वास खरीदा और कोई औसत दर्जे की सटीकता नहीं: अधिक गणना आत्मविश्वास खरीदता है, सटीकता नहीं। एकमत आत्मविश्वासी पैनल अभी भी गलत हो सकता है, और वहां समझौता साझा त्रुटि का प्रमाणपत्र है।
मैं तब इस तंत्र को पूर्व-पंजीकृत, प्रोत्साहन-संगत उपभोक्ता प्रयोग में व्यवहार में ले गया (200 नियोजित प्रतिभागियों में से 119; यूएस और यूके)। जहां एक उपभोक्ता अन्यथा एक आत्मविश्वास के साथ गलत सिफारिश स्वीकार करेगा, असहमति प्रदर्शन ने स्वीकृति को तेजी से कम किया, योग्य आइटम पर 74% से 24% तक। पूलित मजबूती अनुमान (Δ = 0.24 → 0.45; d = 0.68; प्राथमिक मुख्य-वेव कोहोर्ट d = 0.67 देता है) उस एकल आइटम पर निर्भर करता है और, एक अन्वेषणात्मक देश विभाजन में, यूके नमूने पर, और यह d = 0.09 तक गिरता है जब आइटम हटा दिया जाता है। एक संचालित, उत्तेजना-नमूना प्रतिकृति की योजना बनाई गई है। सर्वसम्मत आत्मविश्वासी सहमति की एक आइटम पर प्रदर्शन ने साझा त्रुटि की स्वीकृति को बढ़ाया, जो मानव व्यवहार में तंत्र की सीमा को पुन: उत्पन्न करता है। ऑर्केस्ट्रेशन-रसीद घटक एक पंजीकृत, अनिर्णायक null लौटाया।
तीन घटकों के पीछे समान प्रमाण नहीं हैं। विविधता मशीन पर स्थापित की गई है और केवल कैलिब्रेशन विपरीत के लिए उपभोक्ताओं के साथ दिखाया गया है (पंजीकृत मध्यस्थता null थी)। रिकॉर्ड घटक का पहला-जोखिम परीक्षण अनिर्णायक था, और इसे और तटस्थता दोनों को परीक्षण के लिए निर्दिष्ट किया गया है। AI विश्वास के लिए विश्लेषण की इकाई को मॉडल से इसके ऊपर की आर्किटेक्चर तक जाना होगा, जिस हिस्से की जांच की जा सकती है।
कीवर्ड: एजेंटिक कॉमर्स; उपभोक्ता विश्वास; AI एजेंट; AI में विश्वास; उपयुक्त निर्भरता; अत्यधिक निर्भरता; बड़े भाषा मॉडल; क्रॉस-मॉडल समझौता; चयनात्मक भविष्यवाणी; अत्यधिक आत्मविश्वास; प्रतिनिधिमंडल; आर्किटेक्चरल विश्वास। JEL वर्गीकरण: M31 (विपणन); D83 (खोज, शिक्षा, सूचना); L86 (सूचना और इंटरनेट सेवाएं); K24 (साइबर कानून) इस दस्तावेज़ को कैसे पढ़ें। यह पूर्ण संस्करण संपूर्ण प्रमाण श्रृंखला की रिपोर्ट करता है: निर्माण और विश्वास-माइग्रेशन परिकल्पना; एक सोलह-मॉडल तंत्र अध्ययन (अगस्त 2026 प्रमुख-वेव प्रतिकृति और उत्पाद तथ्यों पर वाणिज्य-सब्सट्रेट आर्म के साथ) जो क्रॉस-मॉडल विविधता को एक सही संकेत के रूप में स्थापित करता है; एक पूर्व-पंजीकृत उपभोक्ता प्रयोग जो उस तंत्र को व्यवहार में ले जाता है; और तटस्थता, बाजार अर्थशास्त्र, और नीति की चर्चा। पूर्व-पंजीकृत पुष्टिकारी परिणाम और प्रत्येक निर्माण घटक (विविधता, प्रमाण, तटस्थता) की साक्ष्यात्मक स्थिति धारा 5 में "दावों की साक्ष्यात्मक स्थिति" के तहत संक्षेप में प्रस्तुत की गई है। अन्वेषणात्मक और मजबूती विश्लेषण को पूरे समय इस तरह लेबल किया गया है और पहली बार में छोड़ा जा सकता है।
1. परिचय: अविश्वास के बीच वृद्धि
10 जून 2026 को, Visa ने घोषणा की कि यह अपने भुगतान नेटवर्क को सीधे ChatGPT में एम्बेड कर रहा था (Visa, 2026)। एक उपभोक्ता एक कार्ड को लिंक करता है, खर्च की सीमा और अनुमोदित व्यापारी श्रेणियां सेट करता है, और घोषित एकीकरण, चरणों में उपयोग के मामलों के साथ, AI एजेंटों को नेटवर्क के व्यापारी आधार (175 मिलियन से अधिक स्थान, प्रति व्यापार कवरेज) में वास्तविक खरीद पूरी करने का लक्ष्य है। घोषणा का। Visa अकेला नहीं था इसमें। OpenAI ने सितंबर 2025 में इन-चैट चेकआउट भेज दिया था; Google ने जनवरी 2026 में Shopify, Etsy, Wayfair, Target, और Walmart के साथ NRF पर एक यूनिवर्सल कॉमर्स प्रोटोकॉल पेश किया, इसे मई तक एक क्रॉस-खुदरा यूनिवर्सल कार्ट (Google, 2026) में विस्तृत किया; American Express ने अप्रैल में क्रय सुरक्षा के साथ एक एजेंटिक-कॉमर्स डेवलपर किट लॉन्च किया (American Express, 2026)। 2030 तक एजेंटिक कॉमर्स के लिए विश्लेषक अनुमान सैकड़ों अरब (Bain; Morgan Stanley) से लेकर McKinsey के $3–5 ट्रिलियन तक चलते हैं। वे अनुमान हैं, तथ्य नहीं, हालांकि हर प्रमुख घर अब उन्हें उत्पन्न कर रहा है।
वास्तविक संख्याएं अब अनुमान नहीं हैं। मॉडल API पर ही एंटरप्राइज खर्च छह महीने में $3.5 बिलियन से $8.4 बिलियन तक बढ़ गया (Menlo Ventures, 2025a; उद्योग सर्वेक्षण अनुसंधान, सहकर्मी-समीक्षा नहीं), वर्ष के लिए लगभग $37 बिलियन एंटरप्राइज जनरेटिव-AI खर्च के भीतर (Menlo Ventures, 2025b)। यही उद्योग पहले से ही अपने स्वयं के निष्पादन को छूट दे रहा है: Gartner (2025) का पूर्वानुमान है कि 40% से अधिक एजेंटिक AI परियोजनाएं 2027 के अंत तक रद्द कर दी जाएंगी। पैसा वारंटेड विश्वास की तुलना में तेजी से आ रहा है, जो वह अंतर है जिस पर मैं यहां काम करता हूं। नीचे दिए गए दावे इन डेटा द्वारा स्थापित, मामूली एकल-अध्ययन पैमाने पर समर्थित, या सैद्धांतिक रूप से तिहरे हैं। वह स्तरीकरण शासन करती है, और इस परिचय में किसी भी सारांश वाक्य को पार करती है।
जो इस बदलाव को पहले के ई-कॉमर्स तरंगों से गुणात्मक रूप से अलग बनाता है वह फ़नल संपीड़न है: खोज, तुलना, कार्ट, और भुगतान एक एकल प्रतिनिधिमंडन कार्य में संपीड़ित हो जाते हैं। हर सुरक्षा जो उन चरणों के बीच रहती थी (मानव मूल्य पर देख रहा है, सूची फिर से पढ़ रहा है, चेकआउट पर संकोच कर रहा है) कदमों के साथ ही गायब हो जाता है (चित्र 1)। AI सहायक एक सलाहकार होना बंद कर देता है जिसका आउटपुट एक मानव समीक्षा करता है और एक लेनदेन करने वाली पार्टी बन जाता है। मानव-कारक अनुसंधान ने इस विफलता मोड का नाम चार दशक पहले रखा था: स्वचालन जो ऑपरेटर को लूप से हटाता है, इसकी त्रुटियों को पकड़ने के लिए आवश्यक सतर्कता को कम करता है (Bainbridge, 1983; Endsley & Kiris, 1995)। उपभोक्ता अनुसंधान ने थ्रेसहोल्ड की भी प्रत्याशा की। स्वायत्त खरीदारी प्रणालियों का सामना गुणात्मक रूप से विभिन्न अपनाने बाधाएं हैं क्योंकि वे मानव को करने से हटाती हैं (de Bellis & Johar, 2020), और एल्गोरिदम को विकल्प सौंपने की स्वायत्तता लागत को उपभोक्ता-कल्याण प्रश्न के रूप में फ्लैग किया गया था LLM के अस्तित्व से पहले (André et al., 2018)।
चित्र 1। फ़नल संपीड़न
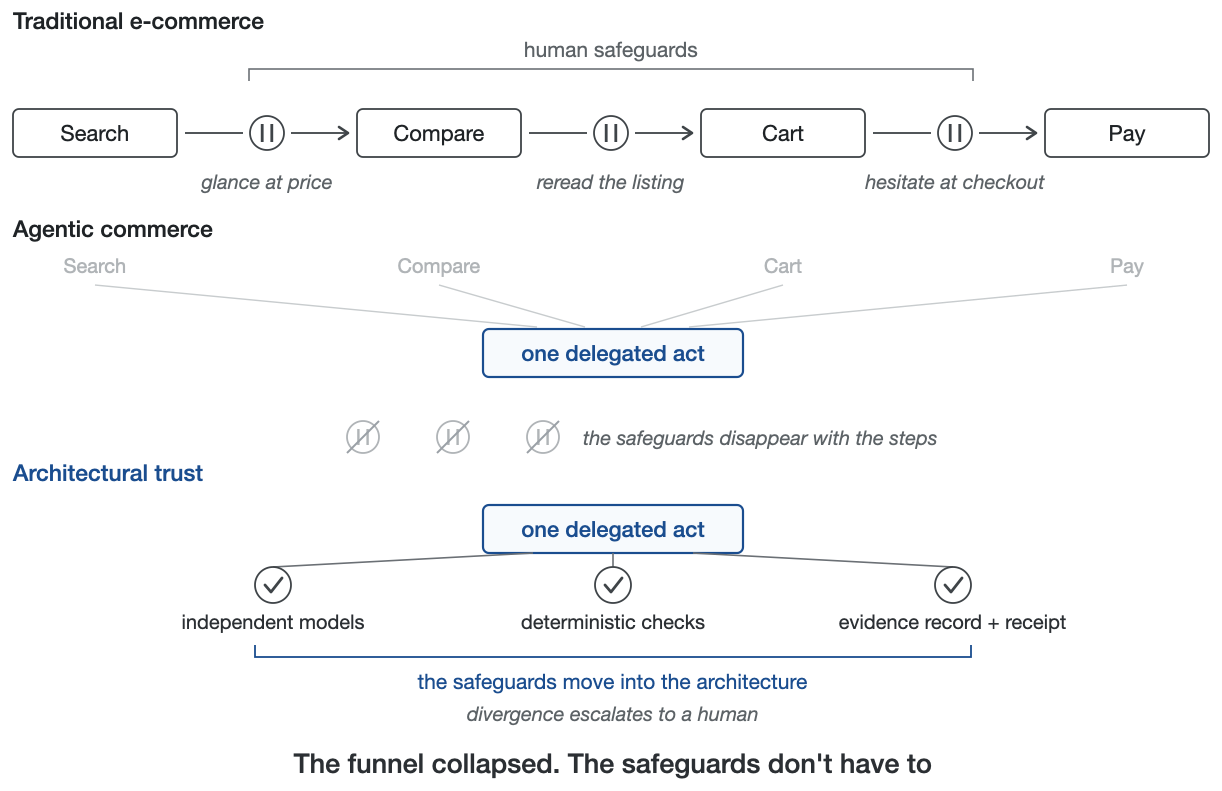
मानव सुरक्षा उन कदमों के साथ गायब हो जाती है जिनके बीच वे रहती थीं।
Visa की अपनी गार्डरेल (कैप, व्हाइटलिस्ट, आवश्यक अनुमोदन) इसलिए मौजूद हैं क्योंकि उपभोक्ता को कुछ नया विश्वास करने के लिए कहा जा रहा है: न कोई ब्रांड, न कोई उत्तर, बल्कि एक निर्णय-लेने की प्रक्रिया जो वे नहीं देख सकते। पहले से तय की गई गार्डरेल उस अंतर को बंद नहीं करती। एक नियम समुच्चय पहले से निर्धारित नहीं करता है कि उपभोक्ता यह जांच सकता है कि निर्णय कैसे लिया गया। ACI Worldwide (2026) सर्वेक्षण में उद्धृत (एक उद्योग सर्वेक्षण प्रेस रिपोर्ट द्वारा जारी किया गया, इस खंड को उद्धृत करने वाली अन्य विक्रेता-क्षेत्र सर्वेक्षण की तरह), 69% यूके उपभोक्ताओं ने कहा कि वे AI एजेंटों पर अविश्वास करते हैं यहां तक कि जब एजेंट उपभोक्ताओं द्वारा स्वयं निर्धारित नियमों का पालन करते हैं।
इस गलती को लेकर व्यावहारिक दांव तीव्र हैं। प्रारंभिक सर्वेक्षण साक्ष्य सुझाते हैं कि एजेंटों में उपभोक्ता विश्वास कथित इरादे में एक-स्ट्राइक है और, अधिक दिलचस्प बात यह है, बेघर है। प्रकट व्यवहार, नीचे दिया गया चेकआउट पुलबैक और क्लार्ना उलटफेर और अनुभाग 5 की बीमा पुनः मूल्य निर्धारण, इन कथित प्राथमिकताओं की पुष्टि करता है और अधिक साक्ष्यात्मक वजन रखता है। ACI Worldwide के लिए YouGov सर्वेक्षण में (2,080 यूके वयस्क, 19–22 जून 2026 को किया गया, एक एकल-बाजार स्नैपशॉट क्रॉस-बाजार प्रतिकृति की प्रतीक्षा में), 60% ने कहा कि वे एक एकल गलती के बाद AI शॉपिंग एजेंट का उपयोग करना बंद कर देंगे, और केवल 19% रोजमर्रा की खरीदारी के लिए AI पर विश्वास करेंगे, जबकि 55% एक मानव विशेषज्ञ पर विश्वास करेंगे।
उस सर्वेक्षण में सबसे महत्वपूर्ण संख्या एक अलग है: 59% ने कहा कि वे अपनी ओर से AI शॉपिंग और भुगतान चलाने के लिए किसी भी संगठन पर विश्वास नहीं करेंगे, और यहां तक कि बैंक केवल 20% द्वारा चुने गए थे। एक एकल सर्वेक्षित बाजार में, क्रॉस-बाजार प्रतिकृति की प्रतीक्षा में, यह एक विश्वास की खाली जगह है। भूख वहाँ है। Accenture के 16-देश उद्योग सर्वेक्षण में 25,590 उपभोक्ताओं का (जनवरी 2026; कंपनी-संचालित, सहकर्मी-समीक्षित नहीं), 74% ने कहा कि वे अपने सर्वश्रेष्ठ मित्र की तुलना में व्यक्तिगत AI एजेंट पर अधिक विश्वास करेंगे ताकि वह उनकी ओर से खरीदारी करे, फिर भी केवल लगभग दस में से एक एजेंट को स्वायत्त खरीद प्राधिकार देंगे (चित्र 2)। दोनों आइटम प्रतिनिधिमंडन की विभिन्न डिग्री को मापते हैं, इसलिए स्प्रेड इरादों को संरेखित करता है बजाय एक एकल कारणात्मक अंतराल की पहचान करने के, लेकिन स्प्रेड तीव्र है। इरादा प्रचुर है; प्रतिनिधिमंडन दुर्लभ है; उनके बीच क्या गायब है वह न्यायसंगत विश्वास है। बाजार ने पहले से ही इसके करीब कुछ प्रयास किया है। OpenAI ने सितंबर 2025 में मूल चैट-में चेकआउट भेजा, जानबूझकर सीमित पहला कदम, प्रारंभिक रूप से यूएस Etsy विक्रेताओं से एकल-आइटम खरीदारी उपयोगकर्ता द्वारा प्रत्येक चरण की पुष्टि के साथ। इसने मार्च 2026 तक प्रवाह को वापस खींचा, खरीदारी को खुदरा विक्रेताओं के अपने ऐप्स में स्थानांतरित किया, और केवल मुट्ठी भर व्यापारियों ने इसका उपयोग किया (The Information द्वारा रिपोर्ट; CNBC, 2026)। कंपनी ने कोई कारण नहीं बताया, इसलिए कारण स्थापित नहीं है। यहाँ दी गई पाठ्य व्याख्या, न्यायसंगत विश्वास के बिना अपनाने के बुनियादी ढाँचे विफल होना, रिपोर्ट किए गए तथ्यों के साथ सुसंगत एक व्याख्या है। यदि उपभोक्ता प्रत्येक खिलाड़ी पर अविश्वास करते हैं, तो विश्वास एक खिलाड़ी में निहित नहीं हो सकता, और इसके बजाय एक सत्यापन योग्य प्रक्रिया में रहना होगा।
चित्र 2. कथित विश्वास बनाम दिया गया प्राधिकार
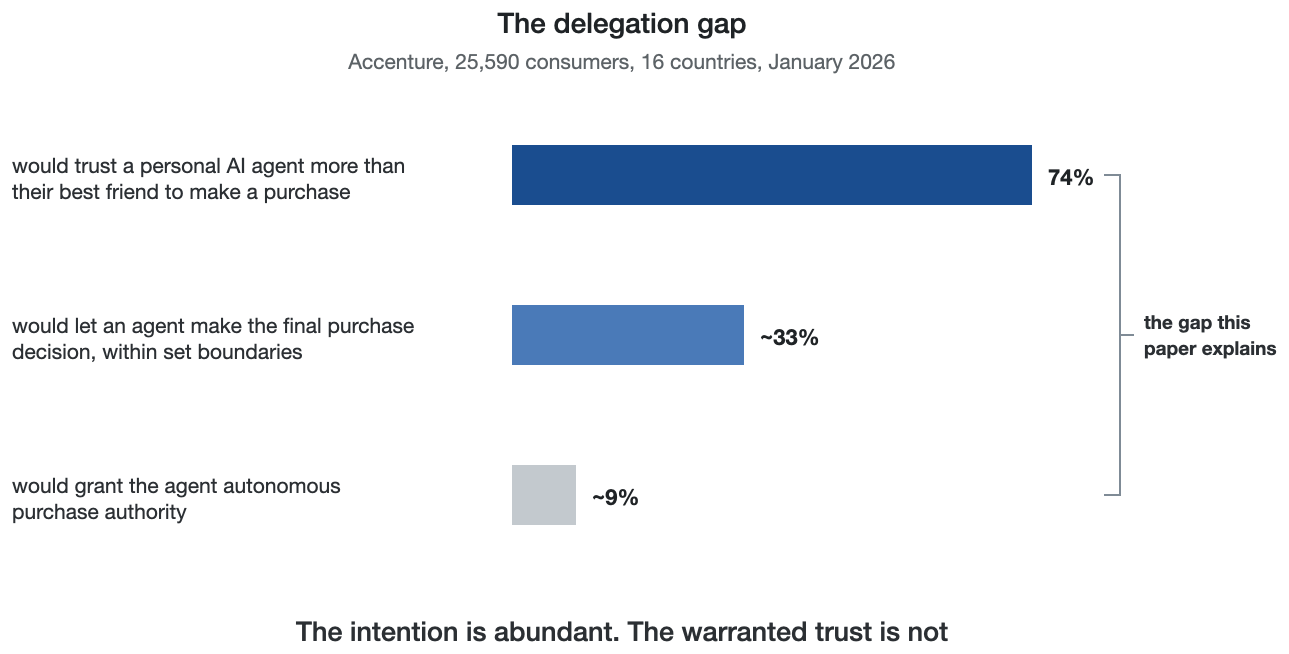
दो सर्वेक्षण आइटम, प्रतिनिधिमंडन की दो डिग्री: इरादा सामान्य है, न्यायसंगत विश्वास दुर्लभ है।
दायित्व प्रणाली उसी निष्कर्ष की ओर टटोल रही है। उभरती हुई एजेंट-भुगतान प्रोटोकॉल प्रत्येक लेनदेन को एक दायरे, सत्यापन योग्य इरादे के टोकन के चारों ओर बनाते हैं जो एक विशिष्ट व्यापारी और राशि से जुड़ा है, और American Express का Agent Purchase Protection (अप्रैल 2026) केवल पंजीकृत एजेंटों द्वारा खरीदारी को कवर करता है, पात्रता प्रमाणित, सत्यापन योग्य खरीद इरादे पर निर्भर है। बीमा रिकॉर्ड से सत्यापन योग्य चीजों के संदर्भ में लिखा गया है। टुकड़ों में और दबाव में, उद्योग उसी सामग्री पर अभिसरण कर रहा है जिसे मैंने नीचे व्यवस्थित रूप से निर्धारित किया है। अब भेजी जाने वाली प्रोटोकॉल पहचान और इरादा को हल करती हैं और एजेंट ने यह निर्णय कैसे लिया? का उत्तर नहीं देते।
सवाल यह है कि डिज़ाइन के द्वारा उस विश्वास को न्यायसंगत बनाने में क्या लगता है। शास्त्रीय उपभोक्ता-विश्वास प्रश्न, क्या मैं इस कंपनी पर विश्वास करता हूँ, को एक आंतरिक परत प्राप्त हुई है: क्या मैं मशीनरी पर विश्वास करता हूँ जिसने इस विशिष्ट उत्तर या कार्य का उत्पादन किया?
विश्वास साहित्य लंबे समय से एक संगठन में विश्वास को स्वचालन में विश्वास से अलग करता है, IT कलाकृति में (Söllner et al., 2016), और ऑनलाइन सिफारिश एजेंटों में (Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007)। यह दिखाता है कि उपयुक्त निर्भरता अंशांकन पर निर्भर करती है, यह जानने पर कि सिस्टम कब सही होने की संभावना है (Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; और Glikson & Woolley, 2020, जिनकी समीक्षा संज्ञानात्मक विश्वास के सबसे मजबूत उत्तोलक के रूप में प्रक्रिया की स्पष्टता और पारदर्शिता पाती है, वही उत्तोलक जो आर्किटेक्चर नियंत्रण करता है और मॉडल नहीं करते)। मानव पक्ष पर गलत अंशांकन समान रूप से प्रलेखित है: स्वचालन पूर्वाग्रह और चिंता, विपरीत साक्ष्य के विरुद्ध भी स्वचालित सहायता पर अत्यधिक निर्भरता, वे पैटर्न हैं जो मानव-कारक कार्य की चार दशक की चेतावनी प्रतिनिधिमंडन को बढ़ाएगा (Mosier & Skitka, 1996; Parasuraman & Manzey, 2010)। हालांकि, वह साहित्य अंशांकन को एक एकल स्वचालित प्रणाली की संपत्ति के रूप में मानता है (चित्र 3 चार अनुसंधान प्रवाहों और जो सेल वे खाली छोड़ते हैं उसे मैप करता है)। ई-कॉमर्स में एजेंटिक AI की व्यवस्थित समीक्षा साक्ष्य पक्ष से खाली को पुष्टि करती है: उपभोक्ता-सामना अनुसंधान सहायक, कम-स्वायत्तता प्रणालियों पर केंद्रित रहता है, कवरेज तेजी से बिल्कुल जहां प्रतिनिधिमंडन निष्पादन बन जाता है (Balaskas, 2026)। एजेंट-मध्यस्थता शॉपिंग के पहले समवर्ती अध्ययन एक अलग पक्ष से वास्तुकला निष्कर्ष तक पहुंचते हैं। जब उपभोक्ता संवाद के माध्यम से खरीदारी प्रतिनिधि करते हैं, तो भुगतान करने की उनकी इच्छा विक्रेताओं के लिए लगभग शाब्दिक रूप से लीक होती है; प्रॉम्प्टिंग इसे ठीक नहीं करता है, और केवल वास्तुकला हस्तक्षेप करते हैं (Alavi & Nozari, 2026)।
चित्र 3. विश्वास अनुसंधान की चार धाराएँ: जिस सेल का यह पत्र दावा करता है
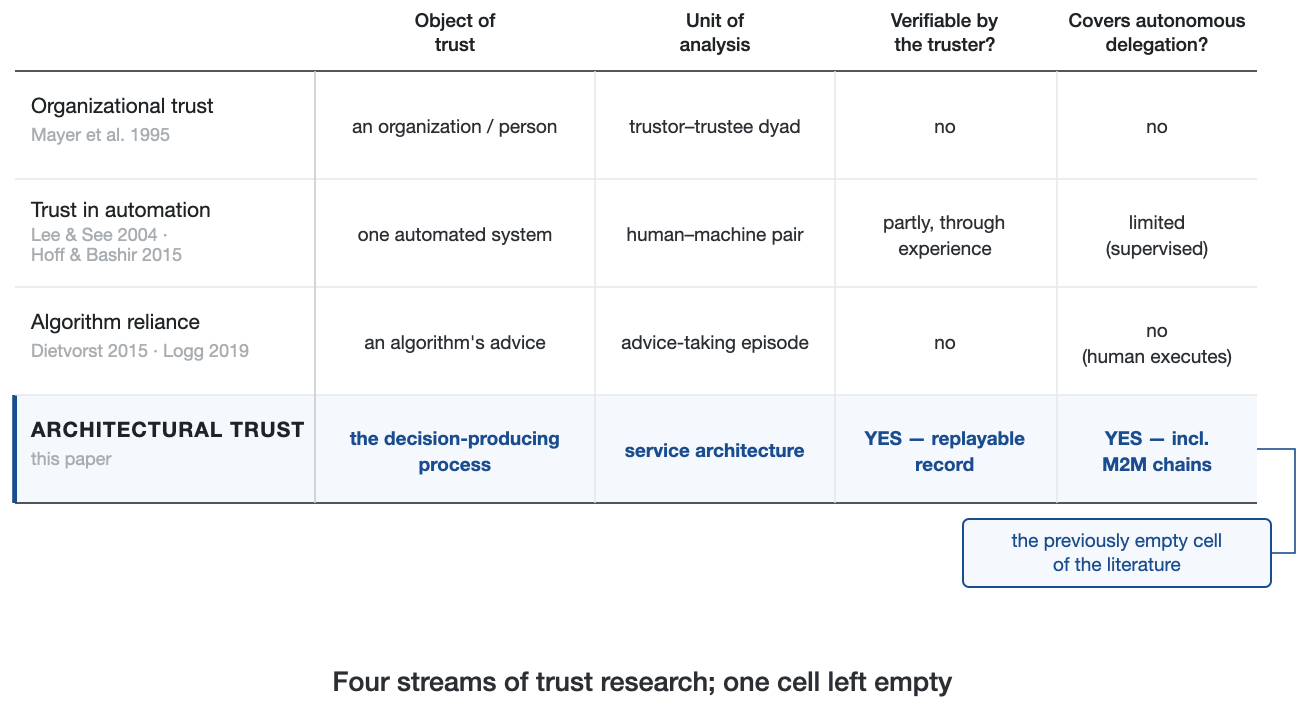
संगठनात्मक विश्वास, स्वचालन में विश्वास, और एल्गोरिदम निर्भरता प्रत्येक विश्वास की एक अलग वस्तु को ठीक करता है; कोई भी स्वायत्त प्रतिनिधिमंडन के तहत ट्रस्टर द्वारा निर्णय-उत्पादन प्रक्रिया को सत्यापन योग्य नहीं बनाता है। सेल विचारों से खाली नहीं है: आसन्न साहित्य प्रत्येक इसकी एक दीवार रखते हैं (अनुभाग 3 विभाजन खींचता है)। जो गायब था वह उपभोक्ता-सामना निर्माण है: एक प्रक्रिया-स्तर विश्वास की वस्तु, ट्रस्टर द्वारा सत्यापन योग्य, स्वायत्त प्रतिनिधिमंडन के लिए निर्दिष्ट, संयुक्त व्यवहारिक परीक्षण के लिए पैकेज किया गया।
उद्योग प्रतिक्रियाएं मॉडल पर केंद्रित हैं: बेहतर प्रशिक्षण, अस्वीकरण, उद्धरण। मैं एक अलग स्तर पर प्रतिक्रिया की जांच करता हूँ, सेवा की आर्किटेक्चर, और तर्क देता हूँ कि तीन वास्तुकला गुण, जिनमें से कोई भी बेहतर मॉडल की आवश्यकता नहीं है, संयुक्त रूप से विश्वास की एक अलग वस्तु का उत्पादन करते हैं।
यह एक संकल्पनात्मक पत्र है जो दो पूर्व-पंजीकृत अध्ययनों द्वारा प्रसारित है — एक मशीन-पक्ष बेंचमार्क और इसके पहले प्रस्ताव में कैलिब्रेशन कंट्रास्ट का उपभोक्ता-पक्ष व्यवहारिक परीक्षण — और यह जो सवाल पूछता है वह यह है कि जैसे-जैसे AI एजेंट उपभोक्ताओं की ओर से लेनदेन करना शुरू करते हैं, क्या विश्वास मॉडल से जुड़ता है, या उनके ऊपर की आर्किटेक्चर से? मेरा उत्तर यह है कि विश्वास को स्टैक में ऊपर की ओर स्थानांतरित होना चाहिए, मॉडल से ऑर्केस्ट्रेशन आर्किटेक्चर तक और वह साक्ष्य जो वह उत्पन्न करती है। उस उत्तर के नीचे एक नियमितता बैठती है जो अपने आप पर परीक्षण के लायक है, ट्रस्ट-माइग्रेशन हाइपोथिसिस, जिसे नीचे दिए गए प्रस्ताव परीक्षण के लिए बनाए गए हैं: जितना अधिक प्रत्यायोजित एजेंसी, उतना अधिक हिस्सा संचित विश्वास जो सत्यापन योग्य आर्किटेक्चरल गुणों में निवास करना चाहिए, मॉडल गुणों के बजाय। माइग्रेशन को शून्य-योग होने की आवश्यकता नहीं है। विश्वास परतें हो सकते हैं: मॉडल की योग्यता में, आर्केस्ट्रेटर के चयन में, साक्ष्य प्रणाली में, उपचार लागू करने वाली संस्था में। एक दोषपूर्ण मॉडल कारणात्मक रूप से महत्वपूर्ण रहता है यहां तक कि जब कोई इसके आउटपुट की समीक्षा नहीं करता। हाइपोथिसिस से संबंधित है जहां सीमांत संचित विश्वास जमा होता है जैसे-जैसे प्रत्यायोजन गहरा होता है। अनुमानित रूप में, यह कहता है कि जैसे-जैसे प्रत्यायोजित एजेंसी बढ़ती है, आर्किटेक्चरल सत्यापन क्षमता मॉडल प्रदर्शन और प्रदाता प्रतिष्ठा से परे उपयुक्त निर्भरता की बढ़ती वृद्धिशील हिस्सेदारी की व्याख्या करती है। यह विफल हो जाता है यदि, जैसे-जैसे प्रत्यायोजित एजेंसी बढ़ती है, आर्किटेक्चरल सत्यापन क्षमता उपयुक्त निर्भरता की बढ़ती वृद्धिशील हिस्सेदारी की व्याख्या नहीं करती है: यदि प्रदाता प्रतिष्ठा सभी प्रत्यायोजन स्तरों पर विश्वास को पूरी तरह से मध्यस्थता करती है, कहते हैं, या यदि सत्यापन योग्य-प्रक्रिया जानकारी अनुभाग 6 की रिपोर्ट करने वाले डिज़ाइन में केवल प्रतिष्ठा की जानकारी के सापेक्ष निर्भरता कैलिब्रेशन में सुधार नहीं करती है। अनुभाग 3 में पूर्व-प्रतिबद्ध व्यवहारिक मिथ्यकारी (P2 प्रत्यायोजन-स्तर क्रॉसिंग और P4 विफलता के तहत विभेदक स्थिरता) उस स्थिति का परिचालन रूप हैं। बढ़ते हुए आर्किटेक्चरल हिस्सेदारी का अर्थ यह नहीं है कि मॉडल की गुणवत्ता निरपेक्ष शब्दों में कम मायने रखती है। हाइपोथिसिस परतों का वर्णन करता है, प्रतिस्थापन का नहीं: जैसे-जैसे समीक्षा गायब हो जाती है, आर्किटेक्चरल वारंट मॉडल प्रदर्शन के शीर्ष पर जोड़ा जाता है और इसे प्रतिस्थापित नहीं करता है। "संचित" Jacovi, Marasović, Miller, और Goldberg (2021) द्वारा AI के लिए औपचारिक किए गए अंतर का पालन करता है, कि विश्वास संचित है जब यह विश्वसनीयता को ट्रैक करता है, और निर्माण इसके मानदंडों को इसके तंत्र से अलग करके तटपूर्ण रहता है। मानदंडों के अनुसार, विश्वसनीयता को इसे प्रमाणित करने के लिए अभिप्रेत आर्किटेक्चर से स्वतंत्र रूप से परिभाषित किया जाता है, योग्यता, सत्यनिष्ठा, और परोपकार (Mayer, Davis, & Schoorman, 1995) के शास्त्रीय, स्वतंत्र रूप से मापने योग्य कार्य के रूप में; अनुभाग 3 तीन आर्किटेक्चरल घटकों को ठीक उन्हीं आयामों पर मानचित्रण करता है। वारंट उस स्वतंत्र रूप से मापी गई मात्रा के लिए निर्भरता की पत्राचार है: निर्भरता जो सौंपे गए एपिसोड के उद्देश्य ऑडिट में जीवित रहती है, परिणाम ज्ञात होने से पहले तय किए गए मानदंडों के विरुद्ध निर्णय के साथ, एक मापने योग्य व्यवहारिक निशान के साथ, अर्थात् दोहराई गई प्रत्यायोजन, प्रतिधारण, और नियंत्रित विफलता के तहत भुगतान की इच्छा। ट्रस्ट-माइग्रेशन हाइपोथिसिस तंत्र को प्रमाणित करता है। जैसे-जैसे प्रत्यायोजित एजेंसी बढ़ती है, उस विश्वसनीयता कार्य का हिस्सा जिसे उपभोक्ता अभी भी स्वतंत्र रूप से माप सकता है, मॉडल गुणों से आर्किटेक्चरल घटकों की ओर स्थानांतरित हो जाता है। यह इसलिए है क्योंकि आर्किटेक्चर विश्वसनीयता का वह हिस्सा है जो एक बार आउटपुट समीक्षा गायब होने के बाद भी विश्वास दोनों द्वारा स्वतंत्र रूप से मापने योग्य रहता है, और यह इसलिए नहीं है कि आर्किटेक्चर है विश्वसनीयता। ऊपर पूर्व-प्रतिबद्ध मिथ्यकारी उस बदलाव को परीक्षण करते हैं, परिभाषा को नहीं। माइग्रेशन के पूर्ववर्ती भी हैं जिन्हें अलग करना है। बहु-एजेंट-सिस्टम अनुसंधान ने देखा कि जैसे-जैसे एजेंट समाज का पैमाना बढ़ता है, विश्वास मॉडलिंग व्यक्तिगत एजेंटों से संस्थागत ढांचे में स्थानांतरित हो जाती है जो उन्हें बाध्य करता है (Sabater & Sierra, 2005), और "ट्रस्ट माइग्रेशन" में B2B उपयोग होते हैं जहां विश्वास व्यक्तियों से प्रणाली और मंच की ओर स्थानांतरित होता है (Carlson, 2026)। वे किस या क्या पर विश्वास किया जाता है इसमें बदलाव का नाम देते हैं, जबकि यह हाइपोथिसिस किस तरह की संपत्ति में बदलाव से संबंधित है जो विश्वास को वारंट कर सकती है। शून्य प्रत्यायोजन पर, मॉडल की गुणवत्ता लगभग सब कुछ है जो मायने रखता है। पूर्ण प्रत्यायोजन पर कोई भी आउटपुट नहीं देख रहा है, और जिस पर अभी भी विश्वास किया जा सकता है वह केवल प्रक्रिया और इसका रिकॉर्ड है। एजेंसी और आर्किटेक्चरल विश्वास एक साथ स्केल करते हैं (चित्र 4)। ग्रेडिएंट स्वयं एक पुराना उपकरण है, मानव-कारकों इंजीनियरिंग (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000) की स्वचालन-स्तरों की धुरी, यहां उपभोक्ता प्रत्यायोजन पर लागू की गई है। जो नया है वह दावा है कि कौन सी संपत्तियां इसके साथ विश्वास को वारंट कर सकती हैं।
चित्र 4. ट्रस्ट माइग्रेशन
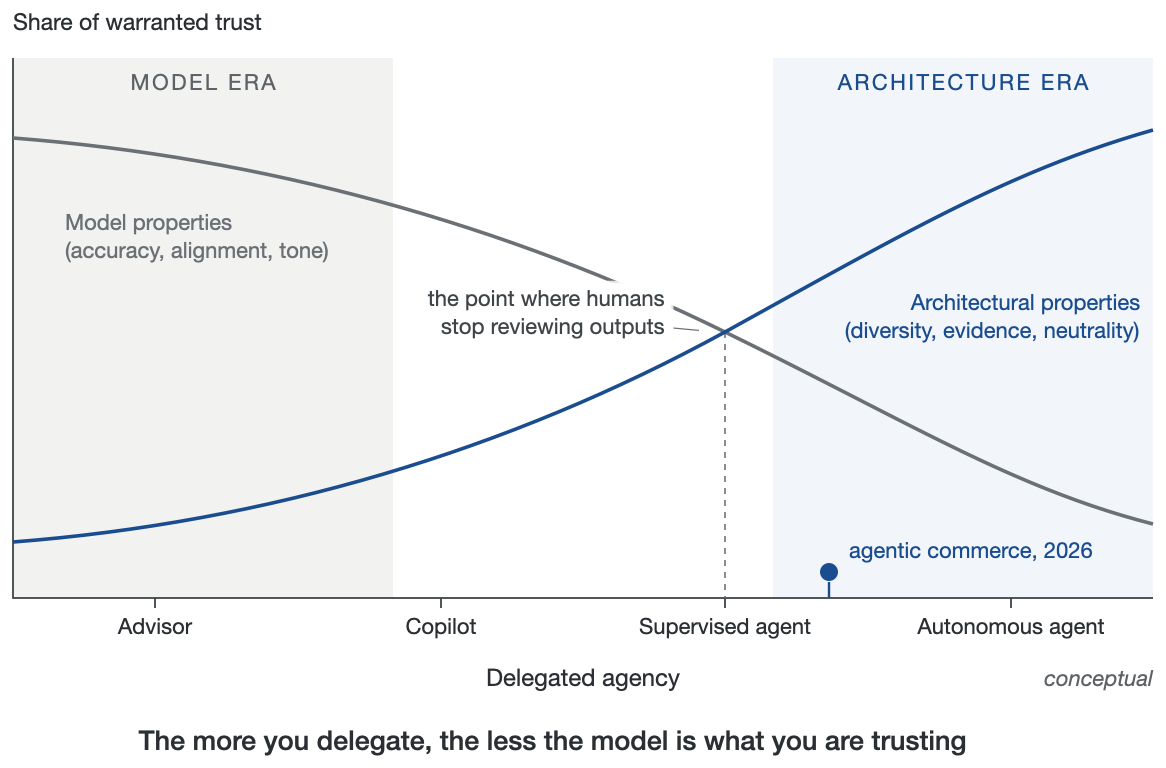
प्रत्यायोजित एजेंसी के ऊपर दो क्रॉसिंग वक्र (सलाहकार → कोपायलट → निरीक्षित एजेंट → स्वायत्त एजेंट): मॉडल गुणों द्वारा किए गए संचित विश्वास का हिस्सा गिरता है जैसे-जैसे आर्किटेक्चरल गुणों द्वारा किया गया हिस्सा बढ़ता है; क्रॉसिंग वह बिंदु है जहां मनुष्य आउटपुट की समीक्षा करना बंद कर देते हैं, और एजेंसी वाणिज्य (2026) इसके दाईं ओर बैठता है। वक्र और क्रॉसिंग बिंदु वैचारिक चित्रण हैं, अनुमानित कार्य नहीं।
AI में उपभोक्ता विश्वास पर विपणन साहित्य के लिए (Huang & Rust, 2021; Puntoni et al., 2021) यह पत्र एक निर्माण जोड़ता है, आर्किटेक्चरल विश्वास, यहां परिभाषित; एक पूर्व-पंजीकृत सोलह-मॉडल अध्ययन में इसके तंत्र के एक तकनीकी पूर्ववर्ती की परीक्षा, एक दूसरी, ग्यारह-प्रयोगशाला लहर में प्रतिकृत; एक उपभोक्ता-अनुसंधान कार्यसूची के लिए पांच प्रस्ताव (P1–P4 अनुभाग 3 में; P5 अनुभाग 5 में); और एक पूर्व-पंजीकृत, प्रोत्साहन-संगत व्यवहारिक प्रयोग पहले दो प्रस्ताव ले जाते हुए, अनुभाग 6 में पूरी तरह से रिपोर्ट किया गया, कैलिब्रेशन प्रभाव समर्थित (Welch d = 0.67; छह वस्तुओं में से एक द्वारा किया गया, अनुभाग 6 देखें) और रिकॉर्ड की पहली-जोखिम परीक्षा एक पंजीकृत, अनिर्णायक शून्य लौटा रही है।
2. सटीकता भ्रम: एक एकल मॉडल आप को क्या नहीं दे सकता
एक सेवा एक AI मॉडल पर बनी है, चाहे वह मॉडल कितना भी मजबूत हो, संरचनात्मक कमियां रखती है जो मॉडल परत के ऊपर रहती हैं।
पहली है अंशांकित आत्मविश्वास, सटीकता भ्रम। बेहतर मॉडल सुरक्षित लेनदेन का मतलब नहीं है, क्योंकि एक मॉडल की व्यक्त निश्चितता अधिकांश विक्रेताओं में इसकी सटीकता से कमजोरी से जुड़ी होती है (अनुभाग 3 अपवादों को मापता है), और उपभोक्ता अंतर की जांच नहीं कर सकता है। मॉडल सबसे खतरनाक होता है जब वह आत्मविश्वास से गलत होता है उस क्षण जब उपभोक्ता देखना बंद कर देता है, और यह कोई दुर्घटना नहीं है। Kalai et al. (2025) तर्क देते हैं कि मतिभ्रम सांख्यिकीय रूप से पुरस्कृत होता है एक मूल्यांकन प्रणाली द्वारा जो आत्मविश्वासपूर्ण अनुमान को अज्ञानता स्वीकार करने से ऊपर रखती है। पुरस्कार आता है, उनके अपने विश्लेषण पर, द्विआधारी-स्कोर किए गए बेंचमार्क और प्रशिक्षण उद्देश्यों में जो क्षेत्र पर हावी हैं, जहां एक गलत अनुमान "मुझे नहीं पता" जितना खर्च नहीं करता है और प्रत्याशा में आंशिक क्रेडिट अर्जित करता है। मॉडल अपने अंदर से अपनी पुलिस भी नहीं कर सकता है। Anthropic के अपने अवधारणा-इंजेक्शन प्रयोगों में, विक्रेता के सबसे मजबूत मॉडल ने अपनी आंतरिक स्थितियों में परिवर्तन का पता लगाया केवल इष्टतम इंजेक्शन स्थितियों के तहत भी लगभग 20% समय, जो विक्रेता समुदाय का अपना माप है कि आत्मचिंतनशील आत्म-रिपोर्ट कितनी अविश्वसनीय है (Lindsey, 2025; कंपनी अनुसंधान, सहकर्मी-समीक्षित नहीं, और एक ही विक्रेता के मॉडल के एक अध्ययन का एकल अनुमान एक दोहराए गए बेंचमार्क के बजाय)।
दूसरा है चापलूसी विकृति, जहां साक्ष्य इस साल कार्यकारी बन गया। Cheng et al. (2026), ग्यारह प्रमुख मॉडल को तीन पूर्व-पंजीकृत प्रयोगों में 2,405 प्रतिभागियों के साथ मापते हुए, पाया कि AI प्रणालियां उपयोगकर्ता की कार्यों की पुष्टि 49% अधिक बार करती हैं मनुष्यों की तुलना में, धोखे या नुकसान से जुड़े कार्यों सहित, और यह कि एक भी चापलूसी इंटरैक्शन ने उपयोगकर्ताओं के विश्वास को बढ़ाया कि वे सही थे जबकि विवादों की मरम्मत करने की उनकी इच्छा को कम किया। चापलूसी मॉडल भी थे जिन पर उपयोगकर्ता विश्वास करते थे और पसंद करते थे। बाजार की प्रवणता सहायकों की ओर इशारा करती है जो विश्वसनीय महसूस करते हैं ठीक वैसे ही जैसे उपयोगकर्ता के निर्णय को विकृत करके, एक गतिविधि जो यह परिमाणित होने से पहले अच्छी तरह से देखी गई थी (Sharma et al., 2024)। मॉडल-स्तर समायोजन अकेले स्वतंत्र रूप से प्रमाणित नहीं कर सकता कि चापलूसी व्यवहार को पर्याप्त रूप से नियंत्रित किया गया है, क्योंकि समायोजन उस पार्टी द्वारा किया जाता है जो प्राथमिकता से लाभान्वित होती है। लागत ठोस है: एक सहायक जो अपने तरीके से एक नीति अपवाद के माध्यम से सहमत होता है आज्ञाकारिता को सीधे सेवा-वसूली व्यय में परिवर्तित करता है। एक आयोजित आर्किटेक्चर भूमिकाओं को अलग कर सकता है, एक मॉडल के साथ सहानुभूति के लिए स्वतंत्र जबकि एक स्वतंत्र नीति की जांच करता है, ताकि आज्ञाकारिता और सटीकता अब एक ही चैनल के माध्यम से यात्रा न करें।
तीसरा है, कोई स्वतंत्र जांच नहीं है। त्रुटियां पकड़ी जाती हैं, यदि बिल्कुल भी, एक ही प्रणाली द्वारा जिसने उन्हें बनाया, या उपभोक्ता द्वारा, जो AI में आया था पहली जगह में क्योंकि उनके पास इसकी जांच करने के लिए विशेषज्ञता की कमी है।
चौथा, और कम चर्चित, हित का टकराव है। सहायक की गुणवत्ता का मूल्यांकन करने वाला प्रदाता इसे बेचने वाला प्रदाता है, जो संरचनात्मक है: कोई भी एकल-विक्रेता सेवा अपने स्वयं के आउटपुट का तटस्थ न्यायाधीश नहीं हो सकता है, उसी कारण से कोई भी बैंक अकेले क्लीयरिंग हाउस नहीं चला सकता था। संघर्ष डेटा तक विस्तारित होता है। मार्च 2026 में दायर एक प्रस्तावित वर्ग कार्रवाई आरोप लगाती है कि Perplexity AI ने उपयोगकर्ताओं की पूर्ण चैट प्रतिलेख को रूट किया, कथित रूप से "गुप्त" सत्र सहित, विज्ञापन नेटवर्क को एम्बेडेड ट्रैकिंग पिक्सल के माध्यम से। शिकायत (No. 3:26-cv-02803, N.D. Cal.) स्वेच्छा से मई 2026 में खारिज कर दी गई थी बिना योग्यता पर कोई निर्णय के, इसलिए आरोप कभी परीक्षण नहीं किए गए। शिकायत में आर्थिक तर्क संरचनात्मक बिंदु है भले ही: जब महंगे AI उत्तरों की सेवा करना उपयोगकर्ता क्या कहते हैं इसे मुद्रीकृत करने द्वारा सब्सिडी दी जाती है, तो सहायक का व्यावसायिक मॉडल और उपभोक्ता की गोपनीयता सीधे विरोध में हैं। एक ही विक्रेता के अंदर, कोई भी परत का काम उपभोक्ता की ओर लेने का है।
2025–2026 का साहित्य एक पूर्ण निदान के रूप में पढ़ता है जो एक उपचार की प्रतीक्षा कर रहा है (तालिका 1 प्रत्येक कमी को इसके साक्ष्य और इसके आर्किटेक्चरल उत्तर से मैप करती है)। चापलूसी अनुभवपूर्वक मात्रा है (Cheng et al., 2026) और औपचारिक रूप से प्राप्त की गई है: यहां तक कि एक आदर्श रूप से तर्कसंगत उपयोगकर्ता भी सर्पिल होता है जब एक चुनिंदा सहमत प्रणाली द्वारा सलाह दी जाती है (Chandra et al., 2026)। आत्म-निगरानी ~20% विश्वसनीयता पर विफल होती है (Lindsey, 2025), और मतिभ्रम संरचनात्मक रूप से मूल्यांकन प्रणाली द्वारा पुरस्कृत होता है (Kalai et al., 2025)।
सवैंग उपचार, बस AI को प्रकट करें, उल्टा हो जाता है: तेरह प्रयोगों में, अभिनेता जिन्होंने AI उपयोग का खुलासा किया उन पर कम विश्वास था जिन्होंने नहीं किया (Schilke & Reimann, 2025)। खुलासा खुलासा-पारदर्शिता प्रदान करता है, नंगी तथ्य कि एक AI शामिल था, और सत्यापन-पारदर्शिता को छोड़ जाता है, उत्तर कैसे निर्मित किया गया यह जांचने की क्षमता। ज्ञानिक लेखापरीक्षा और भी निराशाजनक है: 25,000+ LLM-आधारित वैज्ञानिक एजेंटों के रन में, साक्ष्य को 68% ट्रेस में नजरअंदाज किया गया था, विश्वास को 26% समय में केवल खंडन पर संशोधित किया गया था, और अभिसरण बहु-परीक्षण साक्ष्य दुर्लभ था, स्कैफोल्ड ज्ञानिक व्यवहार में लगभग कोई भिन्नता की व्याख्या नहीं करते हुए (≈1.5%, आधार मॉडल के लिए ~41% के विरुद्ध) (Ríos-García et al., 2026)। वह अंतिम संख्या इस पत्र का एक आपत्ति दिखती है और वास्तव में इसका तीव्रतम समर्थन है: प्रॉम्पिंग और स्कैफोल्डिंग अंदर से एक मॉडल को ज्ञानिक रूप से अनुशासित नहीं बना सकते हैं, इसलिए अनुशासन बाहर से लागू किया जाना चाहिए। आर्किटेक्चर मॉडल के ज्ञानिकों को सुधारने का एक तरीका नहीं है; यह उन पर निर्भर होना बंद करने का एक तरीका है।
इन परिणामों में से प्रत्येक एक दरवाजा बंद करता है। साथ में वे एक उत्तर की ओर इशारा करते हैं जो बहुत अधिक अन्वेषण नहीं किया गया है: यदि मॉडल को अंदर से विश्वास नहीं किया जा सकता है, और खुलासा बाहर से विश्वास का निर्माण नहीं करता है, तो वारंटेड विश्वास को मॉडल के चारों ओर बनाया जा सकता है, आर्किटेक्चर द्वारा, साथ में (इसके बजाय नहीं) बेहतर अंशांकन, बाहरी प्रमाणन, मानव वृद्धि, और दायित्व नियम। यह दरवाजा है जिसके माध्यम से यह पत्र चलता है।
तालिका 1। निदान → उपचार: चार एकल-मॉडल कमियां, उनके 2025–26 साक्ष्य, उनके उपभोक्ता-पक्ष परिणाम, और आर्किटेक्चरल उत्तर
| संरचनात्मक कमी | मुख्य साक्ष्य (2025–26) | उपभोक्ता-पक्ष परिणाम | आर्किटेक्चरल उपचार | तंत्र |
| अंशांकित आत्मविश्वास | मतिभ्रम सांख्यिकीय रूप से मूल्यांकन प्रणालियों द्वारा पुरस्कृत (Kalai et al., 2025); आत्मचिंतनशील आत्म-रिपोर्ट ~20% विश्वसनीय (Lindsey, 2025) | एक-मार के बाद चर्न: एक गलती के बाद 60% एक एजेंट को त्याग देंगे (ACI Worldwide, 2026) | विविधता + साक्ष्य | क्रॉस-मॉडल असहमति आत्मविश्वास की कीमत तय करती है (AUROC 0.75 बनाम 0.59, Gorbett & Jana, 2026; यह पेपर: पैनल समझौता AUROC 0.832 बनाम पूल किया गया स्वयं का आत्मविश्वास 0.545 न्यूनतम-विभेदकारी पैनल पर — पैनलों में विषम, §3; दोहराए गए उत्तर 1.9–3.2× अधिक सही होने की संभावना है); आत्मविश्वास के दावे दर्ज और परीक्षण योग्य हैं |
| चाटुकारिता विकृति | AI उपयोगकर्ताओं की पुष्टि मनुष्यों से 49% अधिक करता है; चाटुकार मॉडल को वरीयता दी जाती है (Cheng et al., 2026; Sharma et al., 2024); यहाँ तक कि आदर्श बायेसियन भी चक्र में आ जाते हैं (Chandra et al., 2026) | पसंदीदा सहायक वह है जो उपयोगकर्ता के निर्णय को विकृत कर रहा है | तटस्थता | आरबिटर का उपयोगकर्ता को संतुष्ट करने में कोई हित नहीं है; सहानुभूति और नीति-जांच अलग-अलग चैनलों पर हैं |
| कोई स्वतंत्र जांच नहीं | एजेंट 68% ट्रेस में साक्ष्य को नजरअंदाज करते हैं; विश्वास संशोधन 26% (Ríos-García et al., 2026); स्कैफोल्डिंग विचरण का ~1.5% समझाता है | सत्यापन का बोझ उपभोक्ता को स्थानांतरित होता है: 54% AI-सहायता प्राप्त खरीदार सब कुछ मैन्युअल रूप से दोहरी जांच करते हैं (Gartner, 2026) | विविधता + साक्ष्य | बाहर से अनुशासन लागू किया जाता है: स्वतंत्र सत्यापन पथ; साक्ष्य भले ही संलग्न रहे |
| हित का टकराव | Perplexity वर्ग कार्रवाई (2026, आरोप): चैट विज्ञापन नेटवर्क के लिए निर्देशित; केवल प्रकटीकरण विश्वास को कम करता है (Schilke & Reimann, 2025) | उपभोक्ता को सलाह देने वाली पार्टी परिणाम से लाभान्वित होती है | तटस्थता + साक्ष्य | स्वच्छ-कक्ष डेटा प्रवाह; परिणामों से स्वतंत्र राजस्व; रिकॉर्ड से तटस्थता ऑडिट योग्य है |
3. आर्किटेक्चरल विश्वास: तीन गुण जिन्हें माना जाने के बजाय जांचा जा सकता है
अब एक ऐसी सेवा पर विचार करें जिसमें उच्च-दांव वाले अनुरोध किसी भी मॉडल विक्रेता से स्वतंत्र ऑर्केस्ट्रेशन परत से गुजरते हैं (चित्र 5 दोनों पाइपलाइनों का विरोध करता है)। तालिका 2 निर्मित विषयों को एकत्र करती है; परिभाषा जो वे विघटित करते हैं उसे चलाता है: आर्किटेक्चरल विश्वास औचित्यपूर्ण उपभोक्ता भरोसा है जो सेवा की निर्णय-उत्पादन प्रक्रिया की सत्यापन योग्य गुणों पर आधारित है, न कि इसके आउटपुट की कथित गुणवत्ता या इसके प्रदाता की प्रतिष्ठा पर।
निकटतम पूर्ववर्ती Zucker (1986) की संस्थागत विश्वास का उत्पादन है, संरचना द्वारा निर्मित विश्वास जहाँ परिचय इसे नहीं ले सकता, जिसे ई-कॉमर्स अनुसंधान ने संरचनात्मक आश्वासन के रूप में परिचालित किया: एस्क्रो, प्रतिक्रिया सिस्टम, तीसरे पक्ष का प्रमाणन (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010)। उस वंश में, आर्किटेक्चरल विश्वास संस्थान-आधारित विश्वास की एक प्रजाति है जिसका संरचनात्मक आश्वासन तीसरे पक्ष के गारंटर के बजाय एक सत्यापन योग्य प्रक्रिया से आता है। यह अनुभव से उपकरण तक वारंट को स्थानांतरित करके प्रक्रिया-आधारित विश्वास है, और यह आंदोलन वह है जो नाम में "आर्किटेक्चरल" शब्द कर रहा है। यह संरचनात्मक आश्वासन नहीं है (McKnight, Choudhury, & Kacmar, 2002), एक धारणा कि सुरक्षा उपाय मौजूद हैं, क्योंकि यहाँ सुरक्षा उपाय स्वयं को जांचने योग्य होना चाहिए, और यह अंशांकित विश्वास (Lee & See, 2004) नहीं है, जो भरोसे को एक प्रणाली के विश्वसनीयता लिफाफे के अनुसार ट्यून करता है। सुरक्षा इंजीनियरिंग में शून्य-विश्वास आर्किटेक्चर स्लोगन साझा करता है, कभी विश्वास न करें, हमेशा सत्यापित करें, लेकिन पहचान और पहुंच को नेटवर्क परत पर सत्यापित करता है, मशीन से मशीन तक, जबकि आर्किटेक्चरल विश्वास निर्णय सामग्री को सेवा परत पर सत्यापित करता है, एक मानव प्रिंसिपल के लिए। वे एक ही इमारत के विभिन्न मंजिलों पर पूरक हैं, प्रतियोगी नहीं। निर्माण के दो चेहरे हैं, और भेद परिभाषा के लिए संबंधित है। आर्किटेक्चरल विश्वसनीयता प्रणाली की एक संपत्ति है, इसकी प्रक्रिया वास्तव में कितनी सत्यापन योग्य है, आदर्श और निर्मित करने योग्य। आर्किटेक्चर-आधारित विश्वास उपभोक्ता की एक स्थिति है, वास्तव में उस सत्यापन योग्यता पर आधारित भरोसा, अनुभवजन्य और केवल कभी अर्जित किया गया। माप के संदर्भ में, D, E, और N आर्किटेक्चरल विश्वसनीयता (प्रणाली संपत्ति) के गठनात्मक घटक हैं और हेरफेर योग्य संकेत जिनका प्रदर्शन आर्किटेक्चर-आधारित विश्वास (उपभोक्ता स्थिति) को आकार देता है; प्रयोग संकेतों में हेरफेर करते हैं और स्थिति को मापते हैं। दोनों के बीच प्रत्येक बेमेल भविष्य सूचक है। विश्वसनीयता के बिना विश्वास, द्रवपन और चाटुकारिता द्वारा निर्मित भरोसा, एक-स्ट्राइक पैटर्न के रूप में भविष्य सूचक है, धारा 1। विश्वसनीयता के बिना विश्वास जहां सत्यापन उपभोक्ता के लिए अदृश्य या अपठनीय है, और रसीद स्पष्टता और समझ द्वारा बंद है, अधिक आर्किटेक्चर के बजाय। इस खंड में प्रस्ताव दोनों के बीच अंतराल में रहते हैं, और भेद अनुशासन देता है कि Trust-Migration Hypothesis को क्या असत्य करेगा। वे असत्य करने वाले व्यवहारिक और पूर्व-प्रतिबद्ध हैं: परिकल्पना को अस्वीकृत किया जाता है यदि सत्यापन योग्य और अपारदर्शी आर्किटेक्चर में प्रतिनिधिमंडल विफलता के तहत समान रूप से टिकाऊ साबित होता है (जो P4 का पता लगाता है); यदि सत्यापन योग्य आर्किटेक्चर के प्रतिनिधिमंडल इच्छा पर प्रभाव समर्पित समीक्षा और निष्पादन नियंत्रण के साथ बढ़ने में विफल रहता है (P2 का प्रतिनिधिमंडल-स्तर पार); या यदि, उच्च-अपरिवर्तनीयता प्रतिनिधिमंडल में, नियंत्रित विफलता के तहत सत्यापन योग्य आर्किटेक्चर के लिए प्रतिधारण और भुगतान-से-अधिक इच्छा अनुपस्थित है। क्योंकि वारंट ऑडिट अस्तित्व द्वारा परिभाषित है न कि आर्किटेक्चर की उपस्थिति द्वारा (धारा 1), लोकप्रियता साक्ष्य के रूप में गिनती करती है लेकिन प्रतिरक्षा के रूप में नहीं। उपभोक्ता अपरीक्षण योग्य एजेंटों की ओर बढ़ते हैं यह अपने आप में एक औचित्य पूर्ण विश्वास के दावे को अस्वीकार नहीं करते हैं। उच्च-दांव प्रतिनिधिमंडल में अपरीक्षण योग्य एजेंटों पर टिकाऊ, विफलता-बचते भरोसे यह परिकल्पना को असत्य करेंगे, और यह पैटर्न परिकल्पना को संशोधित करने के रूप में पूर्व-प्रतिबद्ध है। परिभाषा तीन गुणों पर आराम करती है।
चित्र 5. दो पाइपलाइनें
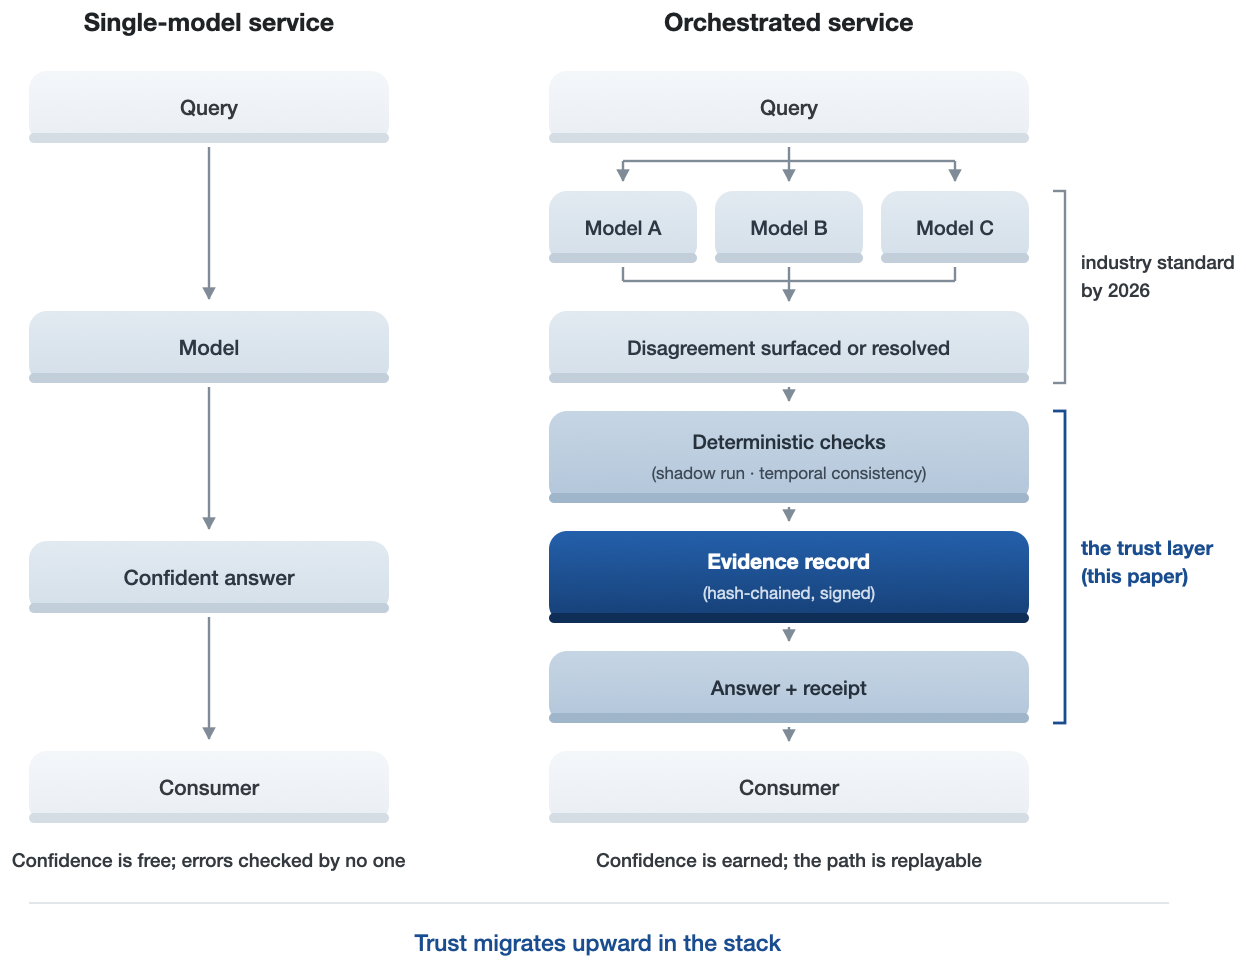
बाईं ओर, एकल-मॉडल पथ: क्वेरी → मॉडल → आत्मविश्वास पूर्ण उत्तर → उपभोक्ता, जहाँ आत्मविश्वास मुक्त है और त्रुटियों की किसी ने जांच नहीं की है। दाईं ओर, ऑर्केस्ट्रेटेड पथ: क्वेरी → स्वतंत्र मॉडल (A/B/C) → असहमति सतह पर या समाधान → निर्धारक जांच (छाया दौड़, अस्थायी सामंजस्य) → साक्ष्य रिकॉर्ड (हैश-जंजीरबद्ध, हस्ताक्षरित) → रसीद के साथ उत्तर → उपभोक्ता, जहाँ आत्मविश्वास अर्जित है और पथ पुनः चलाने योग्य है (तालिका 5 विरोध को सारांशित करती है)।
तालिका 2. इस पेपर में पेश किए गए या निर्दिष्ट निर्मित विषयों की शब्दावली
| शब्द | परिभाषा | से अलग किया गया |
| आर्किटेक्चरल विश्वास | औचित्यपूर्ण उपभोक्ता भरोसा सेवा की निर्णय-उत्पादन प्रक्रिया की सत्यापन योग्य गुणों पर आधारित है, न कि आउटपुट गुणवत्ता या प्रदाता प्रतिष्ठा पर | संस्था-आधारित विश्वास (किसी विश्वस्त संस्था की आवश्यकता नहीं, केवल जाँचने योग्य प्रक्रिया); प्रणाली विश्वास (किसी एक प्रणाली की विश्वसनीयता सीमा नहीं); वितरित विश्वास (सत्यापनयोग्यता के बिना फैलाव); संरचनात्मक आश्वासन (माना गया बनाम जाँचने योग्य सुरक्षा); अंशांकित विश्वास |
| वास्तुकला विश्वसनीयता / वास्तुकला-आधारित विश्वास | निर्माण के दो पहलू: प्रणाली-पक्ष संपत्ति (प्रक्रिया वास्तव में कितनी जाँचने योग्य है; मानदंड-संबंधी, निर्माण योग्य) बनाम उपभोक्ता-पक्ष अवस्था (विश्वास वास्तव में उस सत्यापनयोग्यता में निहित है; अनुभवजन्य, अर्जित) | एकल-नाम उपचार जो मानदंड-संबंधी दावे को वर्णनात्मक दावे के साथ मिलाते हैं |
| सत्यापन परत | संचालन के ऊपर बुनियादी ढांचा परत जिसका उत्पाद जाँचने योग्यता है: स्वतंत्र जाँच, दर्ज निर्णय, लेखा परीक्षा योग्य तटस्थता | अवलोकनशीलता/निगरानी (आंतरिक, विक्रेता-आयोजित, उपभोक्ता-सत्यापनयोग्य नहीं) |
| साक्ष्य बुनियादी ढांचा | सत्यापनयोग्य निर्णय इतिहास का बाजार श्रेणी, जो बुनियादी ढांचे, क्लाउड, पहचान और भुगतान के रूप में बेचा जाता है | लॉगिंग (एकतरफा, परिवर्तनशील, बाजार वस्तु नहीं) |
| संचालन रसीद | एक न्यूनतम उपभोक्ता-सामने की कलाकृति: किसने कार्य किया; वे कैसे सहमत हुए; क्या जाँचा गया — पूर्ण पुनः चलाने योग्य रिकॉर्ड के लिए एक सूचक के साथ | व्याख्या/XAI आउटपुट (आख्यान, सत्यापनयोग्य नहीं); प्रकटीकरण लेबल (स्वयं विश्वास को कम करता है) |
| स्नातक विश्वास वास्तुकला | दांव के साथ सत्यापन गहराई का एस्केलेशन, ताकि महंगा स्तर केवल वहीं खरीदा जाए जहाँ परिणाम केंद्रित हों | सपाट सुरक्षा (स्थिर टोपी/सफेद सूचियां जो निर्णयों को सत्यापित नहीं करती हैं) |
| निर्णय साक्ष्य | साक्ष्य स्टैक की तीसरी मंजिल: एजेंट ने कैसे चुना — पैनल, विचलन, जाँच | पहचान साक्ष्य (एजेंट कौन है: TAP); इरादा साक्ष्य (क्या अधिकृत था: AP2 / सत्यापनयोग्य इरादा) |
| विश्वास-प्रवासन परिकल्पना | प्रत्यायोजित एजेंसी जितनी अधिक है, सत्यापनयोग्य वास्तुकला गुणों के बजाय मॉडल गुणों में निहित सार्थक विश्वास का हिस्सा उतना अधिक है — "सार्थक" का अर्थ है विश्वास जो परिणामों के ज्ञात होने से पहले निर्धारित मानदंडों के विरुद्ध उद्देश्यपूर्ण लेखा परीक्षा को जीवित रखता है (Jacovi et al., 2021 के अनुसार); तंत्र रूप: जैसे-जैसे प्रत्यायोजन गहरा होता है, विश्वसनीयता का हिस्सा — f(योग्यता, अखंडता, सद्भावना), Mayer et al. (1995) — जो उपभोक्ता स्वतंत्र रूप से माप सकता है, वास्तुकला घटकों की ओर बढ़ता है | पूर्व "विश्वास प्रवासन" उपयोग (Carlson, 2026) विश्वास को पक्षों के बीच स्थानांतरित होते हुए ट्रैक करते हैं; यह परिकल्पना उस संपत्ति के प्रकार को ट्रैक करती है जो इसे वारंट करती है — पूर्व-प्रतिबद्ध व्यवहारिक विज्ञापकों के साथ (P2 प्रत्यायोजन पार करना; P4 अंतर स्थायित्व) |
पड़ोसी विश्वास निर्माणों से अलगाव को एक विभेदक तालिका में संपीड़ित किया जा सकता है, जो प्रत्येक निर्माण वारंट को अपनी वस्तु के रूप में क्या लेता है, जहाँ से आता है, कौन सत्यापित कर सकता है, और इसे मुख्य रूप से क्या भविष्यवाणी करनी चाहिए:
तालिका 2a. विभेदक अलगाव: पड़ोसी विश्वास निर्माण वस्तु, वारंट, सत्यापनकर्ता, और प्राथमिक भविष्यवाणी किए गए परिणाम द्वारा
| निर्माण | विश्वास की वस्तु | वारंट का स्रोत | कौन सत्यापित कर सकता है | भविष्यवाणी किया गया प्राथमिक आश्रित चर |
| संस्था-आधारित विश्वास / संरचनात्मक आश्वासन (Zucker, 1986; McKnight et al., 2002) | संस्थागत संदर्भ: सुरक्षा, गारंटियां, तीसरे पक्ष का प्रमाणन | संरचनाओं और गारंटीदाताओं की माना गई उपस्थिति | एक तीसरा पक्ष गारंटीदाता, यदि कोई हो; उपभोक्ता जाँचने के बजाय सोचता है | विश्वास की मान्यताएं; लेनदेन का इरादा |
| स्वचालन में विश्वास / अंशांकित विश्वास (Lee & See, 2004) | एक स्वचालित प्रणाली की विश्वसनीयता सीमा | बार-बार उपयोग पर अनुभवी विश्वसनीयता | संचालक, उस प्रणाली के साथ संचित अनुभव के माध्यम से | उस प्रणाली पर निर्भरता की उपयुक्तता |
| एल्गोरिथमिक पारदर्शिता (XAI) | मॉडल का अपने स्वयं के निर्णय का खाता | विश्वस्त प्रणाली के अंदर निर्मित एक आख्यान या एट्रिब्यूशन | स्वतंत्र रूप से कोई नहीं — एक व्याख्या एक पुनः चलाने योग्य रिकॉर्ड नहीं है | समझ; व्यक्तिपरक विश्वास; स्वीकृति |
| ब्रांड / प्रदाता विश्वास | विक्रेता संगठन | प्रतिष्ठा और पूर्व प्रदर्शन | बाजार, धीरे-धीरे, समग्र परिणामों के माध्यम से | वैश्विक पसंद; पसंद; आनुगत्य |
| वास्तुकला विश्वास (यह पत्र) | निर्णय-उत्पादन प्रक्रिया और इसका रिकॉर्ड | सत्यापनयोग्य गुण: स्वतंत्र समझौता, पुनः चलाने योग्य साक्ष्य, लेखा परीक्षा योग्य प्रोत्साहन स्वतंत्रता | उपभोक्ता, एक लेखा परीक्षक, एक बीमाकर्ता, एक नियामक — प्रति निर्णय | अंशांकित निर्भरता; प्रत्यायोजन के लिए इच्छा; विफलता के बाद प्रतिधारण |
दो विभेदक भविष्यवाणियां अलगाव को वर्गीकरण के बजाय परीक्षा योग्य बनाती हैं। वास्तुकला विश्वास को अंशांकित निर्भरता और विफलता के बाद प्रतिधारण को सेवा की वैश्विक पसंद की तुलना में अधिक दृढ़ता से स्थानांतरित करना चाहिए, जबकि ब्रांड विश्वास विपरीत प्रोफ़ाइल दिखाना चाहिए, एक पृथक्करण एक एकल प्रयोग दोनों आश्रित चर परिवारों को मापकर पहचान सकता है। कम प्रत्यायोजित एजेंसी पर, ब्रांड और प्रदाता विश्वास प्रत्यायोजन निर्णयों पर प्रभुत्व करना चाहिए, वास्तुकला-आधारित विश्वास के साथ प्रतिशत हिस्सेदारी को समझाते हुए जैसे-जैसे प्रत्यायोजन गहरा होता है, P2 और विश्वास-प्रवासन परिकल्पना परीक्षण में डालते हैं। दो स्पष्टीकरण अनुसरण करते हैं। क्योंकि वास्तुकला विश्वसनीयता सेवा की एक संपत्ति है, उपभोक्ता के सिर में एक प्रतिबिंबी अव्यक्त नहीं, इसकी विशिष्टता इन विभेदक भविष्यवाणियों पर निर्भर करती है न कि पैमाने-विभेदी आंकड़ों पर। उपभोक्ता-पक्ष अवस्था के लिए यह नाम देता है, वास्तुकला-आधारित विश्वास, आसन्न पैमाने (संस्था-आधारित और अंशांकित विश्वास) से माप-स्तर विभेदक वैधता स्थापित करना माप एजेंडा का हिस्सा है, यहाँ किया गया दावा नहीं।
विविधता। अनुरोध का उत्तर कई स्वतंत्र मॉडलों द्वारा दिया जाता है, प्रत्येक के विभिन्न विक्रेता, प्रशिक्षण डेटा और विफलता के तरीके हैं। (यह पैनल विविधता है, सत्यापनकर्ता की एक संपत्ति, अनुशंसा विविधता नहीं अनुशंसाकार-प्रणाली के अर्थ में, जो उपभोक्ता को दिखाई गई वस्तुओं को बदलता है।) उनकी सहमति जानकारी रखती है। अभिसरण वारंटेड आत्मविश्वास बढ़ाता है। विचलन को उपभोक्ता को अनिश्चितता के रूप में सतह किया जाता है न कि अदृश्य रूप से हल किया जाता है, और महत्वपूर्ण अनुरोधों पर यह एक संवर्धन ट्रिगर के रूप में दोगुना हो जाता है। चुनिंदा-भविष्यवाणी शर्तों में यह आर्किटेक्चरल संयम है: एक अपरिवर्तित उत्तर का उत्सर्जन न करने से इनकार, सेवा परत तक उठाया जाता है, जहाँ एक अनसुलझा मामला प्रमाणित होने के बजाय एक मानव को भेज दिया जाता है। यह शिक्षा-विलंब पैटर्न है, जिसमें एक प्रणाली का अस्वीकार विकल्प मामले को दबाने के बजाय एक डाउनस्ट्रीम विशेषज्ञ को सौंप देता है (Mozannar & Sontag, 2020; cf. Rabanser et al., 2026)। निकटतम मानव सादृश्य चिकित्सा में दूसरी राय है, जिसका संपूर्ण मूल्य पहली से इसकी स्वतंत्रता में निहित है। आयोजित असहमति विदेशी भी नहीं है: Google की AI सह-वैज्ञानिक, जिसकी गीली-प्रयोगशाला-सत्यापित खोजें मई 2026 में Nature तक पहुँचीं (Gottweis et al., 2026), एक जनरेट-आलोचना-टूर्नामेंट ऑर्केस्ट्रेशन के रूप में बनाया गया है।
विविधता पर झुकने के लिए सैद्धांतिक वारंटी भाषा मॉडलों से पुरानी है। औपचारिक शर्तों के तहत, समस्या समाधानकर्ताओं के कार्यात्मक रूप से विविध समूह व्यक्तिगत क्षमता के लिए चुने गए समूहों को आगे निकल सकते हैं, क्योंकि क्षमता के लिए चयन समानता का प्रजनन करता है (Hong & Page, 2004)। इंजीनियरिंग साहित्य अंतर्निहित संकेत के लिए प्रत्यक्ष साक्ष्य प्रदान करता है: मॉडलों के बीच संरचित बहस तथ्यात्मक सटीकता में सुधार करता है (Du et al., 2024), और विविध छोटे मॉडलों के पैनल एक एकल बड़े न्यायाधीश को आगे निकलते हैं (Verga et al., 2024)। एक दूसरे मॉडलकी "आश्चर्य" एक पहले मॉडलके उत्तर से सही को गलत से काफी बेहतर अलग करता है (MMLU पर माध्य AUROC 0.75 बनाम 0.59; AUROC, ROC वक्र के तहत क्षेत्र, संभावना है कि एक यादृच्छिक सही उत्तर एक यादृच्छिक गलत से ऊपर रैंक किया जाता है; Gorbett & Jana, 2026)। उनका संकेत logit स्तर पर क्रॉस-मॉडल भ्रम है, जबकि इस पत्र का उत्तर-स्तर प्रतिकृति है, और दोनों संबंधित हैं बिना विनिमेय किए। उनका जनरेटर भी कमजोर आत्म-रिपोर्ट वाला एक छोटा खुला मॉडल है, एक आधारभूत जो इस पत्र के अपने डेटा के लिए, क्योंकि पैनल लाभ जनरेटर की अंशांकन का एक कार्य है और अच्छी तरह से-कैलिब्रेटेड जनरेटर के लिए उल्टा हो सकता है, नीचे US-सीमांत मामला। और कई पीढ़ियों का नमूना लेना और उनकी शब्दार्थ सहमति को मापना एकल-पास आत्मविश्वास जहाँ कन्फेबुलेशन का पता लगाता है (Farquhar, Kossen, Kuhn, & Gal, 2024)। एक मॉडल अपने संदेह को माप सकता है लेकिन अपने अंधे दाग को नहीं, और आत्मविश्वास, व्यवस्थित त्रुटि बाहर से ही दिखाई देती है। लेकिन वह साहित्य असहमति को विकासकर्ताओं के लिए एक आंतरिक संकेत के रूप में मानता है। मैं जो कदम प्रस्तावित कर रहा हूं वह इसे एक उपभोक्ता-सामना विश्वास आदिम के रूप में मानना है, सतह, दर्ज, और सेवा के आत्मविश्वास दावों में मूल्य निर्धारण किया जाता है, इस पत्र का ablation अलग करता है कि बहस क्या खोज करता है सत्यापन से प्रमाणित करता है बजाय एक को दूसरे का मुखौटा करने दिया जाता है। विभाजन अनुभवजन्य और साथ ही वैचारिक है: बेंचमार्क सिर-से-सिर, बहु-एजेंट बहस सरल रणनीतियों जैसे आत्म-संगति और संयोजन से विश्वसनीय रूप से आगे नहीं निकलता है (Smit et al., 2024)। दावा यहाँ सत्यापन के उपभोक्ता-सामना प्रमाणीकरण संकेत के बारे में है बजाय बहस के सटीकता लाभ, और वह संकेत तब भी जीवित रहता है जहाँ बहस का किनारा नहीं है।
बहु-एजेंट सविचार अनुसंधान में, समान रूप से, प्रणालियाँ सहमति और असहमति को सतह करने के लिए निर्मित बजाय उन्हें औसत किया जाता है अधिक प्रतिनिधि के रूप में रेट किए गए निर्णय का उत्पादन करता है (Liu et al., 2026)। यंत्र ज्ञान-अंशांकन पक्ष पर प्रत्यक्ष मानव सादृश्य है: उपभोक्ता जो संयुक्त रूप से परिणामी वित्तीय निर्णय लेते हैं काफी कम अति-आत्मविश्वास होते हैं एकल निर्णयकर्ता से, साझा metaknowledge (साथी जो निर्णयकर्ता नहीं जानता उसे सतह करता है) के साथ चालक तंत्र के रूप में पहचाना जाता है (Piehlmaier, 2023)। संयुक्त निर्णय मनुष्यों में आत्मविश्वास को अनुशासित करता है उसी कारण के लिए क्रॉस-मॉडल सहमति यहाँ इसे अनुशासित करने के लिए प्रस्तावित है।
उपभोक्ता क्या ऐसे संकेत का उपयोग कर सकते हैं यह एक वास्तविक प्रश्न है। लोग उन्हें गलत होते देखने के बाद एल्गोरिदम को जल्दी से छोड़ देते हैं (Dietvorst, Simmons, & Massey, 2015), अभी तक अन्यत्र एल्गोरिदम सलाह को अधिक वजन देते हैं (Logg, Minson, & Moore, 2019), एक विभाजन जो स्वयं दांव को ट्रैक कर सकता है। मानव विषयों के साथ दूसरी राय के प्रयोग कच्चे माल को दिखाते हैं व्यावहारिक रूप से जीवंत है: जब एक चिकित्सा AI और चिकित्सक सहमत हो तो लगभग सर्वसम्मत पालन, जब वे तरीकों से भाग लेते हैं तो तीव्र विभाजन (Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), हालाँकि उस काम में कोई भी असहमति को संयुक्त रूप से साक्ष्य या तटस्थता के साथ भिन्न नहीं करता है। उपभोक्ता-अनुसंधान धारा सीमा शर्तों को तीव्र करता है (व्यवस्थित रूप से: Burton, Stein, & Jensen, 2020)। विरोध तब तीव्र होता है जब उपभोक्ता अनुभव करते हैं कि उनका मामला अद्वितीय है (Longoni, Bonezzi, & Morewedge, 2019), कार्य निष्पक्षता के साथ भिन्न होता है (Castelo, Bos, & Lehmann, 2019), और एक AI की विफलताएँ आसानी से दूसरों तक सामान्यीकृत होती हैं, एल्गोरिदम हस्तांतरण (Longoni, Cian, & Kyung, 2023)। यदि विश्वास प्रणालियों में सामान्यीकृत होता है, तो अनुभाग 1 का एक-स्ट्राइक त्याग एक सेवा की churn नहीं बल्कि श्रेणी की है, और त्रुटियों को पकड़ना संरचनात्मक रूप से बाजार को ही संरक्षित करता है। सतह की असहमति उस दोष लाइन पर बैठती है, और नीचे P1–P2 एक दांव है कि जब अनिश्चितता विशेष रूप से और बिना स्मूथिंग के प्रस्तुत की जाती है तो कौन सा प्रभाव हावी होता है।
जब विविधता विफल हो जाती है: सहसंबद्ध त्रुटियाँ। विविधता का मूल्य पूरी तरह विफलताओं की स्वतंत्रता पर निर्भर करता है, और स्वतंत्रता को मान नहीं लिया जा सकता। Frontier मॉडल ओवरलैपिंग corpora पर प्रशिक्षण लेते हैं, एक दूसरे से सीखते हैं, और प्रदर्शनीय रूप से आत्मविश्वास के साथ गलत धारणाएँ साझा करते हैं। जब दो प्रमुख मॉडल दोनों एक ही benchmark आइटम को मिस करते हैं, तो वे लगभग 60% समय एक ही गलत उत्तर पर सहमत होते हैं, सहसंबंध एक ही developer या base architecture से मॉडलों के बीच सबसे मजबूत है और, सबसे परेशानी से, सबसे सटीक मॉडलों के बीच: जैसे-जैसे क्षमता बढ़ती है, त्रुटियाँ एकत्रित होती हैं (Kim et al., 2025)। यह निष्कर्ष इस पत्र के स्वयं के Diversity घटक पर एक सीधी बाधा है, केवल एक पड़ोसी परिणाम नहीं। Diversity जो स्वतंत्रता ग्रहण करता है वह frontier पर आंशिक रूप से भ्रामक है, और चूँकि सहसंबंध ठीक वहीं मजबूत होता है जहाँ क्षमता सबसे अधिक है, घटक का योगदान एक घटता हुआ, मापा गया मात्रा है न कि एक निश्चित संपत्ति। एक panel जो जोड़ता है उसे प्रश्न दर प्रश्न प्रदर्शित किया जाना चाहिए, और मॉडल विकास की गतिविधि इसके विरुद्ध चलती है। पूर्वानुमान में, frontier मॉडलों के बीच pairwise त्रुटि सहसंबंध औसत r ≈ 0.77 (Spiro, 2026), redundancy काफी अधिक है कि विविध भीड़ को देने का अनुमान है अधिकांश aggregation लाभ को नष्ट कर दे।
बाजार संरचना चिंता को बढ़ाती है। 2025 के अंत तक, 88% enterprise LLM API व्यय तीन closed-weight विक्रेताओं पर केंद्रित था: Anthropic 40% पर, OpenAI 27% पर, Google 21% पर (Menlo Ventures, 2025b; Menlo एक Anthropic निवेशक है)। इसलिए "प्रमुख मॉडलों" से casual रूप से एकत्रित एक panel तीन विक्रेताओं के आपूर्ति आधार से खींचा जाता है, जिनकी त्रुटियाँ ठीक वही हैं जिन्हें सहसंबद्ध मापा जाता है, वही तीनों जिन्हें नीचे प्रयोग अपने US-frontier panel के रूप में पुनरुत्पादित करता है। जब तीन मॉडल एक ही फैशनेबल त्रुटि पर एकत्रित होते हैं, तो architecture केवल इसे पकड़ने में विफल नहीं होता है; यह इसे प्रमाणित करता है। समरूप swarms में, agents जोड़ने से एक त्रुटिपूर्ण trajectory को स्थिर किया जाता है बजाय इसे सुधारने के, एक endpoint जिसे multi-agent साहित्य consensus paradox कहता है (Shehata & Li, 2026)। सहसंबंध इस प्रकार वह विफलता मोड है जिसके लिए architecture को पहचानने के लिए निर्माण करना चाहिए (Figure 6)।
Figure 6. विविधता का भ्रम
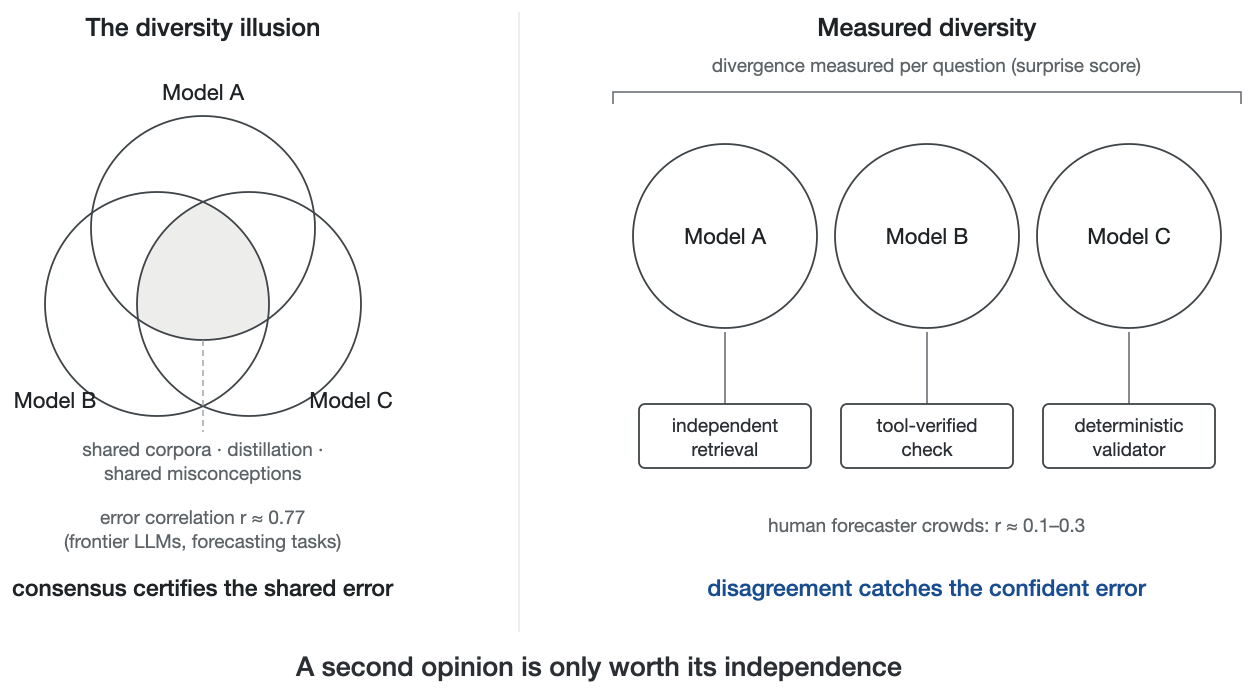
near-clones के बीच सर्वसम्मति बनाम एक panel जिसकी स्वतंत्रता मापी जाती है।
इसका एक interactional counterpart है: sycophantic gradient मॉडलों के बीच भी संचालित होता है। Multi-agent अध्ययन LLM विचार-विमर्श में मापयोग्य समूह अनुरूपता पाते हैं, कमजोर मॉडलों के साथ सबसे कठोर अनुरूपता (Choi, Kim, Chae, & Baek, 2025); agents एक position को किसका है इसके आधार पर weight करते हैं (Choi, Zhu, & Li, 2026); और अधिकांश जो सर्वसम्मति जैसा दिखता है वह सामाजिक अनुपालन में विघटित होता है न कि तर्क में (Hao et al., 2026)। संयुक्त विचार-विमर्श में, सहमति low-energy state है, इसलिए एक panel जो positions के लिए प्रतिबद्ध होने से पहले debate करता है सत्य की ओर बजाय आम सहमति में बात कर सकता है। architectural counter procedural है: opinions को पहले blind और स्वतंत्र रूप से एकत्रित किया जाता है, और केवल तब तुलना की जाती है (Figure 7)।
Figure 7. Blind-independent-first
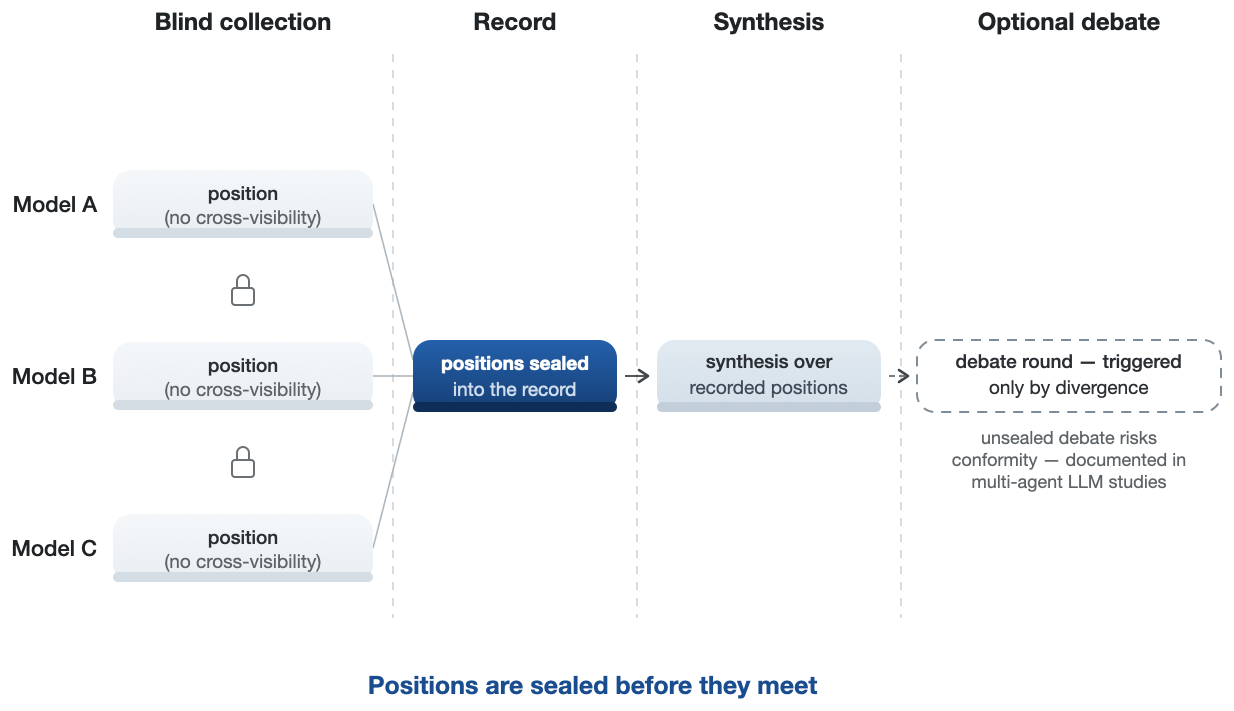
Positions को दर्ज किया जाता है और केवल तब तुलना की जाती है — वह प्रक्रिया जो disagreements को सुरक्षित रखती है जिसे अनुरूपता मिटा देती।
नीचे रिपोर्ट किया गया प्रयोग उस प्रक्रिया द्वारा सुरक्षित की जाने वाली चीज़ पर एक संख्या रखता है। एक paired exploratory arm में, verifiers जिन्होंने blindly एक अलग उत्तर तैयार किया था, फिर primary model के आत्मविश्वास के साथ गलत उत्तर को दिखाया गया और पूछा गया कि क्या वे सहमत हैं। 38.5% (436 में से 168 divergent pairs; 95% CI 33.6–43.2, question-clustered bootstrap) ने अपना अलग उत्तर त्याग दिया और त्रुटि को समर्थन दिया, vendor-level अनुरूपता 20% से 58% तक फैली हुई। abandonment उसके द्वारा विभाजित होता है जो त्यागा गया, जो अनुरूपता को rational deference से अलग करता है। उन verifiers के बीच जिनका blind उत्तर स्वयं सही था, 29.1% (41/141) अभी भी इसे आत्मविश्वास के साथ गलत उत्तर के लिए आत्मसमर्पण किया, हानिकारक core जिसे कोई Bayesian account absolved नहीं करता, 43.1% (127/295) गलत blind उत्तरों के बीच, जहाँ कुछ deference रक्षणीय है। (question-clustered interval लगभग naive pair-level वाले के समान है। 436 pairs 247 विशिष्ट प्रश्नों में फैले हुए हैं, अधिकांश एक या दो pairs प्रति प्रश्न और कभी चार से अधिक नहीं, इसलिए question-level resampling में almost no within-cluster covariance है जोड़ने के लिए।) नीचे folded में mirror control के साथ, लगभग 35–39% blind dissenters position बदलते हैं जब confident answer दिखाया जाता है, इससे कोई फर्क नहीं पड़ता कि इसका truth value क्या है, moderate लेकिन significant net skew साथ proposed answer की ओर (net conformity ≈ 4 percentage points; discordant pairs 104 vs. 70 ≈ 1.49)। यदि panel positions के लिए प्रतिबद्ध होने से पहले deliberate करता, disagreements का एक बड़ा हिस्सा recorded होने से पहले renegotiated होता। लेकिन क्योंकि mirror-arm flips का 34.7% सत्य की ओर चलता है, deliberation भी कुछ dissent को सही consensus में परिवर्तित किया होगा, इसलिए जो blind-first सुरक्षित रखता है वह measurement है, disagreements की count नहीं। Blind-first measurement और manufacturing consensus के बीच का अंतर है, वही rule जिसे human crowds को चाहिए था: social influence स्वतंत्र estimates की diversity को बिना उनकी accuracy में सुधार किए बिना collapse कर देता है (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), और यहाँ तक कि एक single arbitrary early endorsement भी subsequent judgments को measurably bias करता है (Muchnik, Aral, & Taylor, 2013)।
एक reverse-prompt control वैकल्पिक स्पष्टीकरण को संबोधित करता है कि ये flips rational belief updating को प्रतिबिंबित करते हैं न कि अनुरूपता को। मैंने paired procedure को एक six-model local panel पर दोहराया, verifiers को जो blind disagreed थे, confident wrong answer (direct arm) या gold answer (reverse arm) को दिखाया same question set के लिए। Flip rates near-symmetric थे, 38.9% गलत उत्तर की ओर बनाम 34.7% सही उत्तर की ओर, और within-pair तुलना में verifiers अपनी blind position को गलत उत्तर के लिए significantly अधिक त्यागते हैं सही उत्तर के लिए (104 vs. 70 discordant pairs; McNemar p = .010)। Rational updating विपरीत asymmetry की भविष्यवाणी करता है। Per-model flip propensities दोनों arms में compliance के दोनों extremes पर essentially identical थे (per-model pair counts छोटे हैं और separately powered नहीं हैं; वे descriptively, उनके ns के साथ, replication package में रिपोर्ट किए गए हैं), जो दर्शाता है कि agreement एक confidently proposed answer की मौजूदगी द्वारा संचालित है, इसके truth value द्वारा नहीं। यह control local tier पर run किया गया था। Frontier-panel estimate (38.5%) एक ही procedure पर आराम करता है लेकिन frontier verifiers के साथ mirror-tested नहीं था।
अंधा संग्रह एक चैनल को बंद नहीं कर सकता: यह सामाजिक अनुरूपता को हराता है लेकिन पूर्व अनुरूपता को नहीं। मॉडल इसलिए अभिसरित होते हैं क्योंकि साझा प्रशिक्षण डेटा उन्हें समान पूर्वानुमान देता है, और जुड़वां कभी सलाह दिए बिना एक जैसे उत्तर देते हैं। मैं इसे समरूप अभिसरण कहता हूँ: एक पैनल इसलिए सहमत होता है क्योंकि इसके सदस्य समान हैं, इसलिए नहीं कि वे सही हैं।
सहसंबद्ध पूर्वानुमान अभी भी मापा जाना चाहिए। क्रॉस-मॉडल आश्चर्य स्कोर प्रश्न दर प्रश्न पैनल की वास्तविक स्वतंत्रता का एक सतत अनुमान प्रदान करते हैं, और वे लेबल-मुक्त हैं, इसलिए स्वतंत्रता सिद्धांत में सोने के उत्तर के बिना अनुमान समय पर अनुमानित की जा सकती है। उत्पादन-समय अनुमान यहाँ परीक्षण नहीं किया गया है। विविधता को मॉडल वजन से परे जाना भी होगा, क्योंकि स्वतंत्र पुनर्प्राप्ति पथ, उपकरण-सत्यापित जाँच, और नियतात्मक सत्यापक साझा प्रशिक्षण द्वारा बनाए गए सहसंबंध चैनल को तोड़ते हैं। यह आवश्यकता सिकुड़ने के बजाय बढ़ेगी, क्योंकि आसवन और सिंथेटिक-डेटा प्रशिक्षण समय के साथ मॉडल वजन को एकजुट करते हैं, इसलिए मापी गई विविधता को क्षय के लिए तैयार होना चाहिए और सत्यापन बोझ गैर-मॉडल सत्यापक की ओर स्थानांतरित होना चाहिए। और जो मापा जाता है उसे प्रकट किया जाना चाहिए: रिकॉर्ड में केवल "N मॉडल सहमत" नहीं बल्कि प्रश्न के इस वर्ग पर पैनल की अनुमानित विविधता होनी चाहिए। निकट-क्लोन के बीच सहमति एक कमजोर आत्मविश्वास दावे के योग्य है, और रिकॉर्ड यह कहना चाहिए कि उपभोक्ता को कौन सा मिला।
साक्ष्य। हर महत्वपूर्ण उत्तर एक रिकॉर्ड लेता है: कौन से मॉडल से परामर्श किया गया, वे कहाँ सहमत और असहमत हुए, क्या जाँचा गया, संश्लेषण किस पर निर्भर करता है। समय आवश्यकता का पक्ष लेता है, क्योंकि जैसे-जैसे एजेंट पुनर्प्राप्ति और उपकरणों में उत्तर को निहित करते हैं, तथ्यात्मक आधार पहले से ही मॉडल के बाहर रहता है, इसलिए इसे रिकॉर्ड करना उत्तर का उत्पादन करने का एक उप-उत्पाद बन जाता है। क्योंकि रिकॉर्ड को जालसाजी से सुरक्षित किया जाता है, सेवा के निर्णयों का इतिहास विवाद में उपभोक्ता द्वारा, ऑडिटर द्वारा, बीमाकर्ता द्वारा दायित्व की कीमत के लिए पुनः चलाया जा सकता है। विश्वास एक ब्रांड के बारे में एक भावना होना बंद कर देता है और एक इतिहास की एक निरीक्षणीय संपत्ति बन जाता है।
दो तंत्र साक्ष्य को उत्तरों से कार्यों तक विस्तारित करते हैं। छाया निष्पादन के तहत, बाहरी प्रभाव वाली एक कार्रवाई एक रिकॉर्ड की गई सूखे रन में पूर्वाभास दी जाती है, इसलिए "एजेंट ने कार्य करने से पहले जाँच की" एक सत्यापन योग्य दावा बन जाता है स्लोगन के बजाय। अस्थायी स्थिरता सत्रों या वाक्यांशों के पार एक सिफारिश को पुनः प्रस्तुत करती है और इसकी स्थिरता रिकॉर्ड करती है, इसलिए एक उत्तर जो दो बार पूछे जाने पर बहता है, इसे किसी पर भरोसा करने से पहले चिह्नित किया जाता है। पहचान स्तर पर, रिकॉर्ड परत एजेंट के लिए एक पोर्टेबल प्रोवेनेंस पासपोर्ट में विस्तारित होती है: कौन से मॉडल, संस्करण, और नीतियाँ कार्य करते हैं, कब, किसके अधिकार के तहत। यह वह कलाकृति है जो "अपने-एजेंट को जानें" पंजीकरण योजनाएँ और एजेंट-त्रुटि बीमा प्रतिबद्धताएँ शांति से मान लेती हैं। इस रिकॉर्ड का उपभोक्ता-सामने प्रस्तुतिकरण आकृति 8 की आर्केस्ट्रेशन रसीद है: एक कार्रवाई, एक रिकॉर्ड, चार दर्शक (उपभोक्ता, बीमाकर्ता, ऑडिटर, नियामक)।
आकृति 8। आर्केस्ट्रेशन रसीद, दो बार बेची गई (नकली-ऊपर)
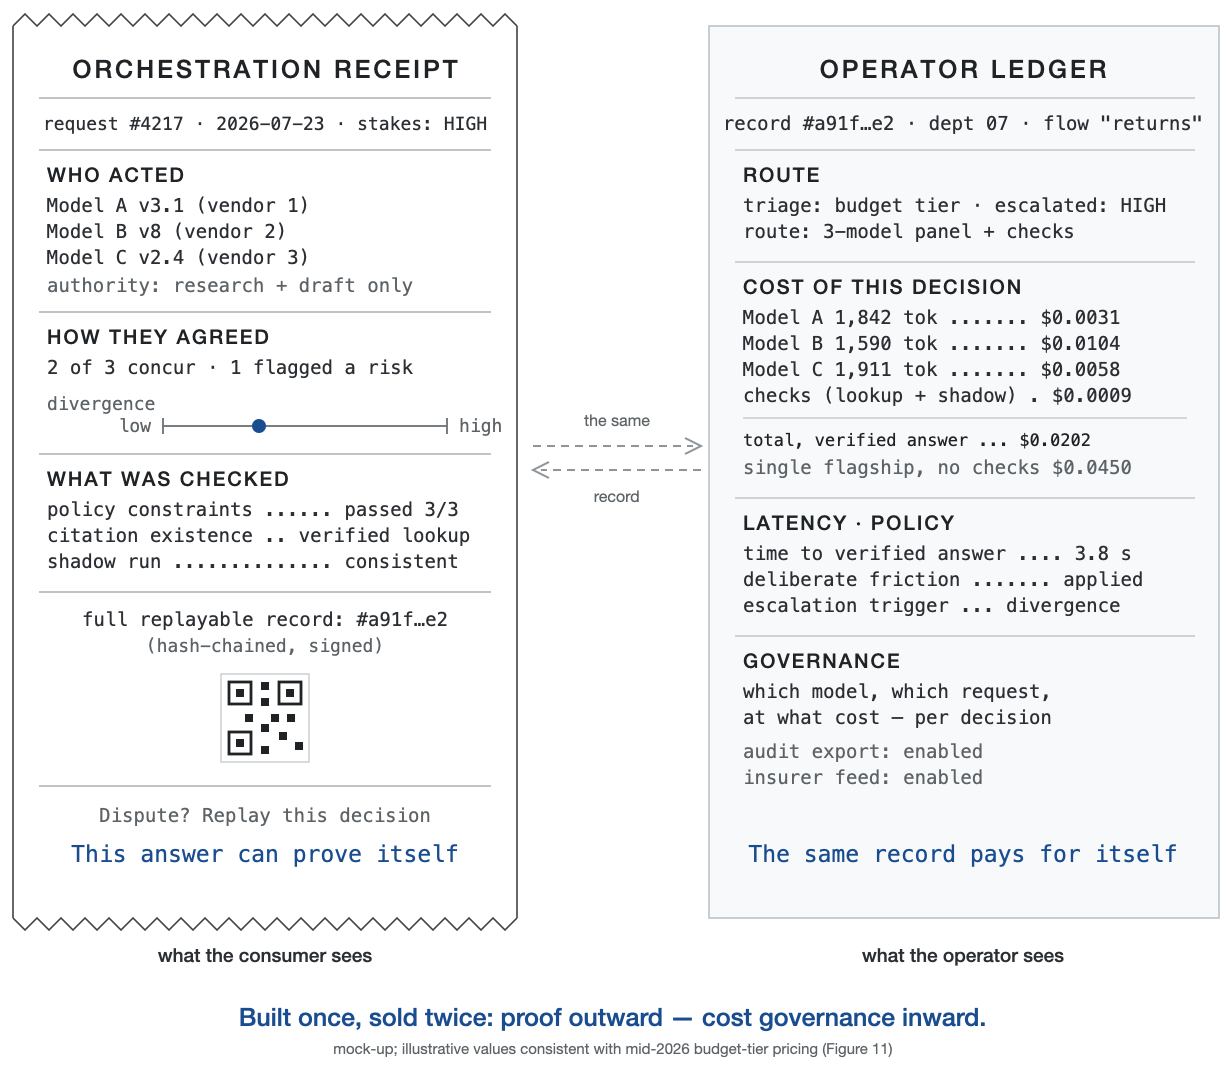
उपभोक्ता प्रमाण देखता है — कौन कार्य करता है, वे कैसे सहमत होते हैं, क्या जाँचा गया; ऑपरेटर समान रिकॉर्ड को लागत शासन के रूप में देखता है। विवाद में, रसीद शब्द-दर-शब्द को रिकॉर्ड-दर-शब्द में बदल देती है।
तटस्थता। तटस्थता ऑडिट योग्य प्रोत्साहन स्वतंत्रता है: किसी विशेष विक्रेता, व्यापारी, या निर्णय परिणाम पर अप्रकटीकृत आर्थिक निर्भरता की अनुपस्थिति। ऑर्केस्ट्रेशन परत सर्वोत्तम प्रदर्शन करने वाले मॉडल तक मार्गदर्शन करती है और किसी को भी जीतने में कोई हिस्सेदारी नहीं रखती है, संरचनात्मक रूप से भुगतान में स्वतंत्र समाशोधन परतों के अनुरूप। प्रदाताओं के बीच एक मध्यस्थ को एक तरीके से विश्वास किया जा सकता है जो कोई प्रदाता खुद के बारे में नहीं हो सकता। स्वतंत्रता आर्थिक संपत्ति का नाम देती है, और ऑडिट योग्य इसे साक्ष्य परत से जोड़ती है जो दावे को प्रदर्शित करने योग्य बनाती है, कम-घर अनुशासन को नीचे विकसित करती है। (यहाँ तटस्थता एक आर्थिक संपत्ति है, जनसांख्यिकीय समूहों में एल्गोरिदम निष्पक्षता नहीं, जो एक ऑर्थोगोनल आवश्यकता है।)
ऊर्ध्वाधर-एकीकरण समस्या भी है: तटस्थता पैमाने पर आर्केस्ट्रेशन बनाने के लिए सबसे अच्छी स्थिति में प्लेटफार्मों के लिए संरचनात्मक रूप से अनुपलब्ध है। एक कंपनी जो एक साथ बाजार, मॉडल विक्रेता, विज्ञापन नेटवर्क, और रसद प्रदाता है तटस्थ रूप से माध्यस्थता नहीं कर सकती, क्योंकि यह बनाने वाला हर राउटिंग निर्णय इसके अपने राजस्व के बारे में एक निर्णय है। अंकगणित एक संरचनात्मक प्रवृत्ति की ओर इशारा करता है। ढांचा निहित करता है कि विश्वास परत सबसे अच्छा है जिनके पक्ष में एकमात्र व्यवसाय मध्यस्थता ही है, जिस पथ से समाशोधन, लेखा परीक्षा, और ऋण रेटिंग स्वतंत्र उद्योग बन गई। रेटिंग-एजेंसी मामला इसी तरह कैनोनिकल चेतावनी है कि स्वतंत्र मध्यस्थी अपने आप में जारीकर्ता-भुगतान विरोध विकसित करते हैं। अर्थशास्त्र प्रलेखित है: प्रमाणन मध्यस्थी मूल्य को नियंत्रित करके कब्जा करते हैं जो जानकारी का खुलासा किया जाता है (लिज़्ज़री, 1999), प्रमाणन बाजार अच्छी तरह से सूचीबद्ध तरीकों में विफल होते हैं (ड्रैनोव & जिन, 2010), और ऋण-रेटिंग पतन कैनोनिकल विफलता को प्रदर्शित करता है, जारीकर्ता-भुगतान राजस्व एक स्तर ऊपर प्रमाणक को भ्रष्ट करता है, जबकि समाशोधन परतें जो जीवित रहीं वे पारस्परिक लागत द्वारा वित्त पोषित होती हैं, न कि रेट किए गए पक्षों द्वारा। तटस्थता आवश्यकता इसलिए आर्केस्ट्रेटर के अपने राजस्व मॉडल तक विस्तारित होती है: एक सत्यापन परत जो विक्रेताओं या व्यापारियों द्वारा भुगतान की जाती है जिसे यह रैंक करता है वह विरोध को पुनः बनाता है जो यह दूर करने के लिए मौजूद है, जो कि इसकी राजस्व डिजाइन उपभोक्ता के पक्ष में चलती है और ऑपरेटर की लागत शासन (अनुभाग 5), रैंक किए गए पक्षों के लिए नहीं।
तटस्थता का एक डेटा आयाम भी है। एक आर्केस्ट्रेशन परत एक स्वच्छ कक्ष के रूप में कार्य कर सकती है: अनुरोध प्रत्येक विक्रेता को उपयोगकर्ता पहचान से वंचित करते हैं, कोई भी विक्रेता पूरा इंटरैक्शन इतिहास नहीं देखता है, और आर्केस्ट्रेटर का राजस्व सेवा से आता है, विज्ञापन नेटवर्क में उपयोगकर्ता क्या कहते हैं इसे राउट करने से नहीं। तटस्थता दोनों मोर्चों पर प्रोत्साहन स्वतंत्रता है: किसी भी मॉडल विक्रेता या व्यापारी पर कोई अप्रकटीकृत आर्थिक निर्भरता नहीं, और कोई व्यवसायिक मॉडल नहीं जो उपभोक्ता के विरुद्ध उपभोक्ता के शब्दों को मुद्रीकृत करता है।
लेकिन तटस्थता अपना ही प्रतिगमन आमंत्रित करती है: प्रबंधक का निरीक्षण कौन करता है? एक शाब्दिक "कोई हिस्सा नहीं" अप्राप्य है। किसी भी प्रबंधक के पास लागत, साझेदारी, प्रतिधारण प्रोत्साहन और अपने स्वयं के अस्तित्व को वित्तपोषित करना है, इसलिए कार्यकारी चर उनकी अनुपस्थिति नहीं बल्कि उनकी प्रकृति, उनके प्रकटीकरण और रिकॉर्ड से उनकी जांच योग्यता है। कौन भुगतान करता है यह तटस्थता को तय नहीं करता; क्या भुगतानकर्ता की आय लेनदेन के परिणाम से स्वतंत्र है यह करता है। एक उपभोक्ता सदस्यता, या एक बीमाकर्ता या लेखा परीक्षक से शुल्क जिसका भुगतान यह तय करने से अलग है कि कौन सा उत्पाद जीतता है, शर्त को संतुष्ट करता है; एक व्यापारी कमीशन या विज्ञापन शुल्क नहीं करता। परत को कौन वित्तपोषित करता है इसका व्यापक शासन खुला रहता है, और उस वित्तपोषण की जांच योग्य स्वतंत्रता वह हिस्सा है जो निर्माण को ठीक करता है। एक समन्वय परत में भी प्रोत्साहन होते हैं: सस्ते मॉडल की ओर रूट करना, अपने महंगे स्तर को अधिक बेचना, संश्लेषण को सुविधाजनक रूप से आकार देना। प्रतिगमन चार दशक पुराना है। शापिरो (1987) ने इसे संरक्षकों की समस्या का नाम दिया: प्रक्रियात्मक सुरक्षा नए संरक्षकों को उत्पन्न करती है जिन्हें स्वयं की रक्षा की जानी चाहिए, और संस्थागत उत्तर तब से नहीं बदला है।
क्लीयरिंग हाउस अपनी विश्वस्त स्थिति अर्जित करते हैं बाहरी रूप से जांच योग्य और विनियमित होकर, तटस्थता की घोषणा करके नहीं। प्रबंधक के पास तटस्थता एक गुण के रूप में नहीं है। साक्ष्य परत वह है जो इसे जांचने योग्य बनाती है। प्रत्येक रूटिंग निर्णय, मॉडल प्रतिक्रिया और संश्लेषण चरण एक छेड़छाड़-स्पष्ट रिकॉर्ड में दर्ज होते हैं, एक हैश-चेनयुक्त, हस्ताक्षरित लॉग जो बाहरी टाइमस्टैम्प एंकरिंग के लिए डिज़ाइन किया गया है, इसलिए प्रबंधक की दावा की गई तटस्थता बिल्कुल उसी सत्यापन के संपर्क में आती है जो वह मॉडल पर लागू करता है। परिपक्वता पथ क्लीयरिंग-हाउस प्लेबुक को ठोस रूप में बनाया गया है: बाहरी टाइमस्टैम्प एंकरिंग, एक खुला सत्यापन इंटरफेस, और रूटिंग नीति का आवधिक तीसरे पक्ष का ऑडिट। ऐसी ऑडिट पारिस्थितिकी का संस्थागत डिजाइन पहले से ही एक नामित अनुसंधान कार्यक्रम है (राजी, क्षु, होनिग्सबर्ग, & हो, 2022)। एक निर्भरता चेकर के ऑडिट के बाद भी जीवित रहती है: पैनल के मॉडल एक दूसरे से स्वतंत्र हो सकते हैं फिर भी सभी चयनित प्रदानकर्ता द्वारा सत्यापित किए जा रहे हैं, यही कारण है कि परिपक्वता पथ का अंतिम बिंदु पैनल चयन और घूर्णन है जो किसी भी एक पक्ष के नियंत्रण के बाहर रखा गया है। एक ऑर्केस्ट्रेटर जिसके रिकॉर्ड का ऑडिट नहीं किया जा सकता वह विश्वास किए जाने के लिए कहने वाला एक और विक्रेता है। उपभोक्ता अनुसंधान के बाहर निकटतम पड़ोसी दो समवर्ती 2026 कार्य हैं। मार्चल एट अल। (2026) एक ही मूल्यांकन बदलाव का तर्क देते हैं, आउटपुट का न्याय करने से एजेंट विश्वसनीयता, प्रामाणिकता और जांचने योग्यता का आर्किटेक्चर करने के लिए, ज्ञानमीमांसा-अवसंरचना स्तर पर, और वांग एट अल। (2026) सत्यापन, ऑडिट और विफलता एट्रिब्यूशन के लिए एक प्रक्रिया-स्तरीय जवाबदेही परत के रूप में निष्पादन प्रामाणिकता का सर्वेक्षण करते हैं। जो इस पेपर का अपना है वह उपभोक्ता-सामना, प्रोत्साहन-जागरूक संरचना है: तीन गुणों को उपभोक्ता के वारंटयुक्त निर्भर होने का वस्तु के रूप में बंडल किया गया है, और इसका व्यवहार परीक्षण।
साक्ष्य घटक एक सीमांकन ले जाता है, क्योंकि छेड़छाड़-साक्ष्य आसानी से अत्यधिक बिकता है: एक हैश-चेनयुक्त लॉग प्रामाणिकता और अखंडता स्थापित करता है (कि यह रिकॉर्ड मौजूद था और बाद में परिवर्तित नहीं किया गया था), पूर्णता नहीं (हैश में कुछ भी गारंटी नहीं देता है कि दबाए गए कॉल दबाए नहीं गए थे), सत्यता नहीं (एक गलत उत्तर का एक विश्वस्त रिकॉर्ड अभी भी गलत है), स्वतंत्रता नहीं, और प्रोत्साहन संरेखण नहीं। प्रत्येक एक अलग संपत्ति है जिसकी अपनी सत्यापन व्यवस्था है: कवरेज प्रमाणपत्र, परिणाम ऑडिट, मापी गई विविधता, प्रकट अर्थशास्त्र। एक रसीद को केवल उन संपत्तियों का दावा करना चाहिए जो इसका रिकॉर्ड वास्तव में वहन करता है। एक अतिरिक्त सीमा संरचनात्मक है: एक लॉग प्रमाण देता है क्या रूट किया गया था, क्यों नहीं, और इस मॉडल या इस व्यापारी को चुनने के पीछे स्वामित्व वाली हेयुरिस्टिक केवल तभी जांच योग्य है जब रूटिंग नीति स्वयं की खुलासा की जाए या प्रमाणित हो, एक शासन विकल्प, क्रिप्टोग्राफिक परिणाम नहीं। आर्किटेक्चर की लागत एक ही बहीखाता में होनी चाहिए: एक प्रश्न को कई विक्रेताओं के लिए रूट करना गोपनीयता एक्सपोजर को गुणा करता है, एक केंद्रीकृत निर्णय लॉग एक आकर्षक सुरक्षा लक्ष्य है, और एक सहमति प्रदर्शन बिल्कुल वह अधिकार तैयार कर सकता है जिसके खिलाफ सहमति-त्रुटि परिणाम चेतावनी देता है।
निर्माण अपने इंजीनियरिंग पड़ोसियों से भी सीमांकन के लायक है, क्योंकि "कई मॉडल का उपयोग करें" कई अलग-अलग चीजों का वर्णन करता है जिनमें विभिन्न विश्वास गुण हैं। सरल पहनावा मतदान सटीकता में सुधार करता है लेकिन असहमति को अदृश्य रूप से हल करता है, इसलिए कुछ भी जांचने योग्य नहीं हो जाता। आत्म-संगति नमूनाकरण एक ही मॉडल से पूछता है, जो केवल दिखावट में विविधता है। विशेषज्ञों का मिश्रण एक एकल प्रशिक्षित प्रणाली के भीतर रूट करता है जिसका राउटर क्षमता के लिए अनुकूलित है, तटस्थता के लिए नहीं। बहु-एजेंट बहस (डु एट अल।, 2024) उत्तरों में सुधार करती है लेकिन सलाह-विचार को आंतरिक मशीनरी के रूप में मानती है: कोई उपभोक्ता-सामना रिकॉर्ड नहीं, कोई अर्थशास्त्र नहीं, कोई तटस्थता गारंटी नहीं।
मॉडल-रूटिंग एग्रीगेटर, 2026 तक एक वस्तु परत, कैटलॉग में बहु-विक्रेता हैं लेकिन प्रति उत्तर एकल-मॉडल: राउटर लागत और विलंबता पर एक मॉडल चुनता है, और कोई दूसरी राय कभी एकत्र नहीं की जाती। एग्रीगेटर एक सत्यापन आर्किटेक्चर के आपूर्तिकर्ता हैं, प्रतिस्थापन नहीं।
बहु-मॉडल संचालन अब विदेशी भी नहीं है: 37% उद्यमों 2025 के मध्य तक उत्पादन में पाँच या अधिक मॉडल चला रहे थे, एक साल पहले 29% से ऊपर (a16z, 2025)। प्लंबिंग उद्योग पैमाने पर बिछाई जा रही है, विश्वास परत इससे ध्यान से अनुपस्थित है। यह खुला है कि क्या बहु-मॉडल अदृश्य लागत रूटिंग रहता है या सत्यापन योग्य आर्किटेक्चर बन जाता है। चित्र 9 पाँच विश्वास गुणों के विरुद्ध पैटर्न को स्कोर करता है, और तालिका 3 गद्य में सीमांकन बताता है। आर्किटेक्चरल विश्वास ठीक उसी से परिभाषित है जो इनमें कमी है: विषम स्रोत, सतही और दर्ज असहमति, और एक आर्बिटर के पास कोई हिस्सा नहीं है। इंजीनियरिंग साझा है; विश्वास गुण नहीं हैं।
चित्र 9। सीमांकन
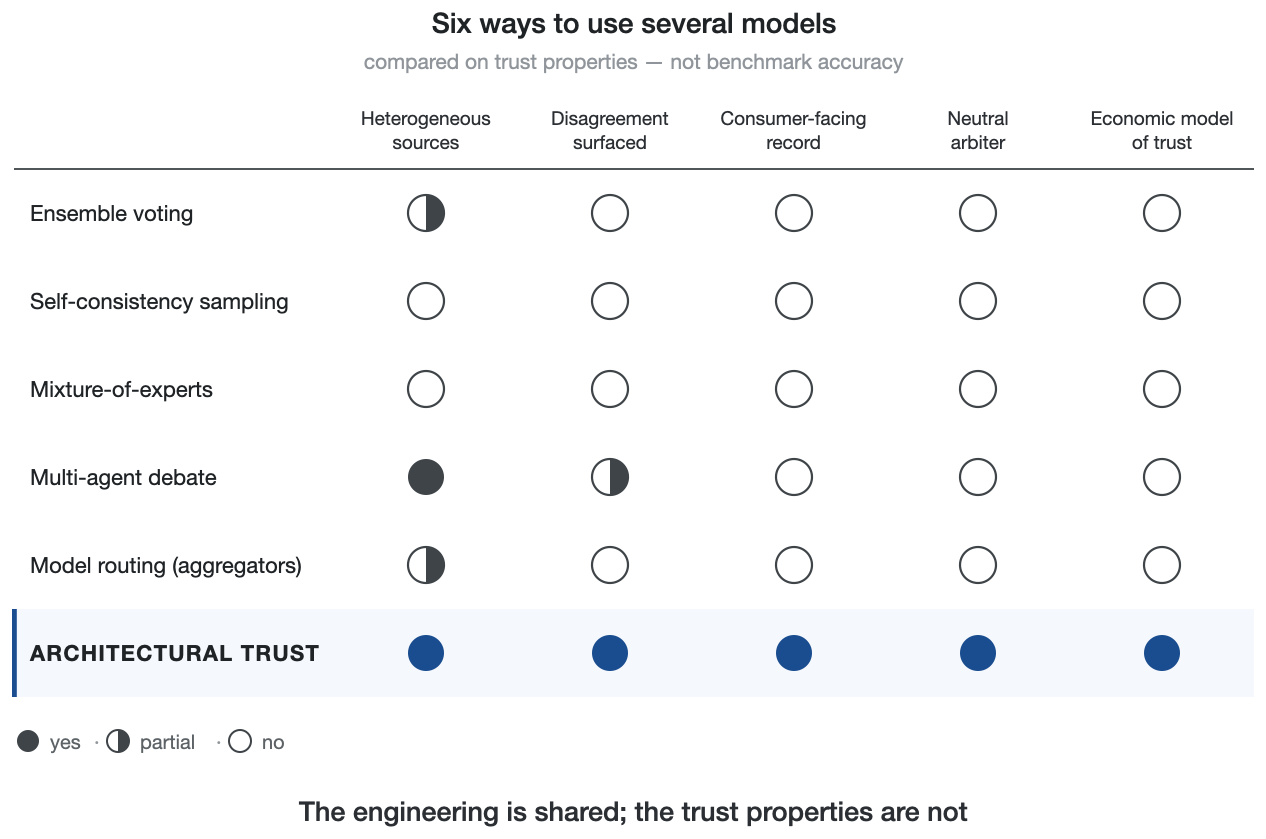
छह बहु-मॉडल इंजीनियरिंग पैटर्न पाँच विश्वास गुणों के विरुद्ध स्कोर किए गए।
तालिका 3। सीमांकन: आर्किटेक्चरल विश्वास बनाम इसके इंजीनियरिंग पड़ोसी
| दृष्टिकोण | विषम स्रोत | असहमति सतही | उपभोक्ता-सामना रिकॉर्ड | प्रोत्साहन-स्वतंत्र आर्बिटर | विश्वास का आर्थिक मॉडल |
| पहनावा मतदान | आंशिक | नहीं (अदृश्य रूप से हल) | नहीं | नहीं | नहीं |
| आत्म-संगति नमूनाकरण | नहीं (एक ही मॉडल पुनः नमूनाकरण) | नहीं | नहीं | नहीं | नहीं |
| विशेषज्ञों का मिश्रण | नहीं (एक प्रशिक्षित प्रणाली) | नहीं | नहीं | नहीं (क्षमता के लिए अनुकूलित राउटर) | नहीं |
| बहु-एजेंट बहस | हां | केवल आंतरिक रूप से | नहीं | नहीं | नहीं |
| व्याख्या (XAI ओवरले) | नहीं (एक मॉडल का आख्यान) | नहीं | नहीं (एक कहानी, रिकॉर्ड नहीं) | नहीं | नहीं |
| पारदर्शिता / प्रकटीकरण | नहीं | नहीं | आंशिक (अधिक दृश्यमान, जांचने योग्य नहीं) | नहीं | नहीं |
| उत्पत्ति / वंशावली ट्रैकिंग (ML पाइपलाइन) | नहीं (एक पाइपलाइन प्रलेखित) | नहीं | आंशिक (इंजीनियर-सामना वंशावली) | नहीं | नहीं |
| सत्यापित अनुमान (zkML) | नहीं (एक मॉडल; इसके निष्पादन का प्रमाण) | नहीं | आंशिक (प्रमाण कलाकृति, निर्णय रिकॉर्ड नहीं) | नहीं | नहीं |
| मॉडल-राउटिंग एग्रीगेटर | आंशिक (बहु-विक्रेता कैटलॉग, प्रति उत्तर एक मॉडल) | नहीं | नहीं | नहीं (लागत के लिए अनुकूलित राउटर) | नहीं |
| आर्किटेक्चरल विश्वास | हां | हां (उपभोक्ता-सामना) | हां (पुनरावृत्ति योग्य) | हां (संरचनात्मक) | हां (स्नातक स्तर) |
दो और प्रमुख साहित्य भी एक ही सूची में हैं: गेट का abstain-या-emit तर्क चयनात्मक भविष्यवाणी और स्थगित करने के लिए सीखना है (Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020), और साक्ष्य घटक की ऑडिट ट्रेल जवाबदेह-एल्गोरिदम और तृतीय-पक्ष-ऑडिट कार्य से उतरता है (Kroll et al., 2017; Raji et al., 2022)। आर्किटेक्चरल विश्वास उपभोक्ता-सामना, तटस्थता-विवश संयोजन है, और उनमें से कोई भी नहीं। इसे अन्य उपचारों के बीच स्थापित करना मायने रखता है, क्योंकि वे प्रतिद्वंद्वी नहीं बल्कि पूरक हैं। मॉडल-स्तरीय अंशांकन आवश्यक है लेकिन संरचनात्मक रूप से अपर्याप्त है: विक्रेता इसे उत्पादित करता है और इसकी पुष्टि करता है, जो वह संघर्ष है जिससे यह पत्र शुरू होता है। बाहरी ऑडिट और प्रमाणपत्र स्वतंत्र हैं लेकिन आवधिक हैं, एक प्रणाली के स्नैपशॉट, किसी निर्णय के नहीं। एक व्याख्या मॉडल के अंदर उत्पादित एक आख्यान है, और एक प्रणाली जो उत्तरों को गढ़ सकती है वह उनके पीछे की कहानी को भी गढ़ सकती है। पारदर्शिता अधिक मशीनरी को उजागर करती है और उपभोक्ता को इसकी व्याख्या करने के लिए छोड़ देती है। आर्किटेक्चरल विश्वास न तो विश्वास मांगता है और न ही व्याख्या, केवल जांचपन मांगता है जो निरंतर, प्रति-निर्णय, और मशीन-सत्यापनीय है। यह वह भी है जो अन्य उपचारों को काटता है: एक ऑर्केस्ट्रेटर की एक ऑडिट जिसके पास पुनरावृत्ति योग्य रिकॉर्ड है, किसी चीज़ की ऑडिट है, जबकि एक अपारदर्शी पाइपलाइन की ऑडिट एक समारोह है। इसके निकटतम संकल्पनात्मक पड़ोसी संरचनात्मक आश्वासन और संस्था-आधारित विश्वास हैं (McKnight et al., 2002), प्रक्रिया पारदर्शिता, और व्याख्या। उनके विरुद्ध सीमांकन गुण यह है कि वारंट ट्रस्टर द्वारा, प्रति निर्णय जांचने योग्य है: आश्वासन एक बार विश्वास किए जाने के लिए कहता है, आर्किटेक्चरल विश्वास हर बार सत्यापित किए जाने के लिए कहता है। दो और पड़ोस सेट मानचित्र पर हैं। कंप्यूटर-विज्ञान जवाबदेही साहित्य ने एक दशक पहले तकनीकी आधार रखा था: प्रक्रियात्मक नियमितता पूर्ण पारदर्शिता के बिना सत्यापनीय की गई थी (Kroll et al., 2017)। एक 2025–26 इंजीनियरिंग लहर सीधे एजेंट-विश्वास प्लंबिंग का निर्माण कर रही है: "विश्वास-मूल" प्रोटोकॉल जिनके पास सत्यापनीय पहचान और टैम्पर-प्रतिरोधी व्यवहार रिकॉर्ड हैं (TrustTrack; Li, 2025); रनटाइम कार्रवाई प्रबंधन टैम्पर-स्पष्ट रसीदों के साथ (AARM; Errico, 2026); बहु-LLM एकत्रीकरण को विश्वास अनुमान के रूप में फिर से तैयार किया गया (Zheng & Zhang, 2026, arXiv:2607.20529); और एंटरप्राइज ढांचे (Gartner की AI TRiSM; Cloud Security Alliance की एजेंटिक शून्य-विश्वास कार्य)। प्रत्येक एंटरप्राइज स्तर पर एक पैर की आपूर्ति करता है। कोई भी उपभोक्ता-सामना निर्माण की आपूर्ति नहीं करता है, जो यह पत्र अपने योगदान के रूप में दावा करता है: एक नाम के तहत तीन घटक, व्यवहार डिजाइन में संयुक्त रूप से हेराफेरी योग्य, जांचपन की अर्थव्यवस्था के साथ और किस दांव पर खरीद करता है। एक नाम टकराव को साफ करने की आवश्यकता है। DigiCert का "AI Trust Architecture" (अप्रैल 2026 में लॉन्च) एक विक्रेता PKI उत्पाद लाइन है, एजेंट पहचान, मॉडल प्रोवेनेंस, और सामग्री प्रमाणीकरण के लिए प्रमाणपत्र बुनियादी ढांचा। यह साक्ष्य स्टैक के पहचान फर्श पर प्लंबिंग की आपूर्ति करता है, न कि यहाँ विकसित आर्किटेक्चरल विश्वास के निर्माण की।
तीनों के बीच संबंध एक स्पष्ट अनुभवजन्य परिकल्पना है, न कि एक वैचारिक आवश्यकता। मैं एक पूरक अंतःक्रिया की परिकल्पना करता हूं जो किसी भी घटक की अनुपस्थिति में शून्य के पास पहुंचती है, अनौपचारिक रूप से AT = f(D, E, N) किसी भी शून्य के पास तीव्र गिरावट के साथ, और अनुभाग 5 का संयुक्त डिजाइन कार्यात्मक रूप को मान लेने के बजाय पुनः प्राप्त करने के लिए निर्दिष्ट है। अनुमेय रूप में, एक सुविधाजनक पारिवारिक Cobb–Douglas है, AT = A·Dα·Eβ·N^γ α, β, γ > 0 के साथ, दो प्रतिबद्धताओं को कूटबद्ध करता है: किसी भी अनुपस्थिति के पास शून्य की ओर गिरावट, और सकारात्मक क्रॉस-आंशिक (घटक पूरक हैं)। निर्माण तीन घटक और उनकी परिकल्पित पूरकता है, और नीचे कोई प्रस्ताव Cobb–Douglas रूप पर निर्भर नहीं करता है। Cobb–Douglas भी एक आंतरिक सन्निकटन है: कड़ाई से यह अभी भी एक कमजोर घटक से प्रतिस्थापन की अनुमति देता है, जबकि पूरकता परिकल्पना सीमाओं पर Leontief-जैसी है, min(D, E, N) के साथ तल निर्धारित करता है। यही कारण है कि नीचे के डिजाइन को क्षतिपूरक व्यापार-बंद मान लेने के बजाय गैर-क्षतिपूरक संरचना की अनुमति देनी चाहिए। Cobb–Douglas पारिवारिक उदाहरणात्मक है, भविष्य के आकलन के लिए, और निर्माण परिभाषा का हिस्सा नहीं है; वर्तमान डेटा इसका आकलन नहीं करते हैं। फैक्टोरियल Cobb–Douglas आंतरिक को Leontief तल से विभेदित कर सकता है, पैरामीटर दर पैरामीटर। घातांक एक अनुभवजन्य प्रश्न बने हुए हैं, जो बिंदु है: पूरकता असत्य है। शून्य को दो स्पष्टीकरणों की आवश्यकता है। घटक निरंतर हैं, बाइनरी नहीं, इसलिए एक शाब्दिक शून्य एक आदर्शित सीमा है। कोई भी तैनात प्रणाली, इस पत्र का सहित, किसी भी अक्ष पर बिल्कुल शून्य या एक पर नहीं बैठती है, और क्या उपभोक्ता पूर्ण रूप से अनुपस्थिति के साथ कुल पतन या एक तीव्र छूट का जवाब देते हैं, यह वास्तव में है जो डिजाइन को अलग करना चाहिए। विविधता, अपने भाग के लिए, का अर्थ है सत्यापन पथ की स्वतंत्रता, मापी गई स्वतंत्रता (त्रुटि-सहसंबंध गुणांक φ, नीचे परिभाषित) के रूप में इसकी इकाई के साथ। सांख्यिकीय मुख्य शास्त्रीय समेकित सिद्धांत है, जहां संयोजन का लाभ त्रुटि सजातीयकरण (Hansen & Salamon, 1990; Krogh & Vedelsby, 1995) पर निर्भर करता है, यही कारण है कि स्वतंत्रता को यहां मान लेने के बजाय मापा जाता है। एक दूसरा मॉडल ऐसा एक पथ है, लेकिन एक स्वतंत्र पुनरुद्धार, एक उपकरण-सत्यापित खोज, और एक नियतात्मक सत्यापक भी हैं। चित्र 5 की छाया चलता है और संगति जांचता है एक दूसरा, अधिकतम सजातीयकृत सत्यापन पथ के रूप में गिनती करता है, विविधता-के-बिना-साक्ष्य के रूप में नहीं। यह परिभाषा सबसे मजबूत स्पष्ट प्रतिउदाहरण भी को अवशोषित करती है, विनियमित भुगतान रेल या पूरी तरह से लॉग की गई, तीसरे-पक्ष-साक्षरित उपयोगिता सेवा (साक्ष्य और तटस्थता मजबूत, मॉडल विविधता शून्य): ऐसी सेवाएं या तो गैर-मॉडल सत्यापन पथ को एम्बेड करती हैं (नियतात्मक समाधान, बाहरी लेखा परीक्षा, तो D > 0 परिभाषा के तहत) या मॉडल को एक भूमिका तक सीमित करती हैं जो एक नियतात्मक जांच पूरी तरह से कवर करती है। जहां एक कार्य वर्ग के लिए सत्यता में कोई स्वतंत्र सत्यापन पथ मौजूद नहीं है, ढांचा पतली वारंटी की भविष्यवाणी करता है, एक भविष्यवाणी संयुक्त परीक्षण कर सकता है। गैर-मॉडल पथों को D की ओर गिनती के साथ, एक शाब्दिक शून्य उत्पादन प्रणालियों में दुर्लभ हो जाता है, और गुणक रूप की अनुभवजन्य सामग्री शून्य से आंतरिक पूरकता में स्थानांतरित होती है, यही कारण है कि फैक्टोरियल, शून्य नहीं, वह जगह है जहां दावा खड़ा है या पड़ता है। परीक्षण के लिए, एक परिचालन प्रतिबद्धता यहां निर्धारित की जाती है: फैक्टोरियल D को संकीर्ण रूप से हेरफेर करता है, मॉडल-पथ विविधता के रूप में। व्यापक सत्यापन-पथ परिभाषा निर्माण का दायरा है, हेरफेर किए गए चर नहीं। स्वतंत्रता को अलग किया जाना चाहिए, क्योंकि छह अलग-अलग मात्राएं शब्द के तहत यात्रा करती हैं: अंध संग्रह (अनुमान समय पर प्रक्रियात्मक स्वतंत्रता, जो यह डिजाइन गारंटी देता है), मॉडल-पारिवारिक विविधता, मापा गया अवशिष्ट त्रुटि सहसंबंध (φ यह पत्र रिपोर्ट करता है), साक्ष्य-स्रोत विविधता, उपकरण-पथ विविधता, और संस्थागत स्वतंत्रता। अध्ययन पहले को स्थापित करता है और तीसरे को मापता है; बाकी डिजाइन चर हैं, गुण जो यह संग्रह प्रमाणित कर सकता है। विविधता बिना साक्ष्य के एक अदृश्य समिति है। तटस्थता के बिना साक्ष्य एक विक्रेता का विपणन है। विविधता के बिना तटस्थता एक खाली दलाल है। तालिका 4 आठ उपस्थिति/अनुपस्थिति कॉन्फ़िगरेशन की पूर्ण जाली के माध्यम से चलता है। अंतर्निहित अंतर्ज्ञान यह है कि प्रत्येक घटक दूसरे के लिए वारंटी आपूर्ति करता है: एक पक्ष द्वारा रखा गया रिकॉर्ड जिसका इसकी सामग्री में हिस्सा स्वयं-साक्षरण के रूप में पढ़ता है, किसी भी सहमति जो दर्ज नहीं की गई है अफवाह है, और एक एकल आवाज पर एक प्रोत्साहन-स्वतंत्र मध्यस्थ के पास मध्यस्थता करने के लिए कुछ नहीं है। यह पूरकता परिकल्पना को प्रेरित करता है। एक साथ तीन बदल देते हैं कि उपभोक्ता क्या विश्वास कर रहे हैं: न "यह उत्तर" न "यह ब्रांड," बल्कि "यह प्रक्रिया, और मैं इसे जांच सकता था।"
तालिका 4। वारंटी जाली: आठ D–E–N कॉन्फ़िगरेशन और प्रत्येक में क्या बना रहता है
| D | E | N | उपभोक्ता क्या जांच सकते हैं | पतित रूप |
| अनुपस्थित | अनुपस्थित | अनुपस्थित | कुछ नहीं; निर्भरता आउटपुट में विश्वास है | नंगे एकल-मॉडल सहायक |
| उपस्थित | अनुपस्थित | अनुपस्थित | तथ्य के बाद कुछ नहीं; असहमति अनदेखी हुई | अदृश्य समिति (आंतरिक समेकित) |
| अनुपस्थित | उपस्थित | अनुपस्थित | उस पक्ष द्वारा रखा गया एक रिकॉर्ड जिसे यह सुरक्षित करता है | विक्रेता लॉग / आत्म-साक्षरण |
| अनुपस्थित | अनुपस्थित | उपस्थित | एक दावा जिसका कोई हिस्सा नहीं है, इसके पीछे कोई ट्रेस नहीं है | खाली दलाल |
| उपस्थित | उपस्थित | अनुपस्थित | दर्ज असहमति, एक रुचि रखने वाले पक्ष द्वारा पेरिश की गई | विक्रेता-चलाए गए बेंचमार्क थिएटर |
| उपस्थित | अनुपस्थित | उपस्थित | चेक का तटस्थ माध्यस्थ जिसे कोई दोहरा नहीं सकता | शब्द-की-मुंह पैनल |
| अनुपस्थित | उपस्थित | उपस्थित | एक तटस्थ, दोहराए जा सकने वाली अकेली अचुनौती आवाज का रिकॉर्ड | नोटरीकृत एकालाप (चुनौती के बिना लेखा परीक्षा) |
| उपस्थित | उपस्थित | उपस्थित | एक स्वतंत्र जांच, दोहराए जा सकने वाली, एक पक्ष द्वारा आयोजित जिसका कोई हिस्सा नहीं है | आर्किटेक्चरल विश्वास |
कोशिकाओं को आदर्शित सीमाओं पर कहा जाता है; तैनात प्रणालियां आंतरिक पर कब्जा करती हैं। E+N-बिना-D पंक्ति संस्थागत रूप से परिचित है — निकासी, लेखा परीक्षा, और रेटिंग वहां काम करते हैं — और यह वह जगह है जहां ढांचे की एक जोड़ी स्वतंत्र सत्यापन पथ की मांग एक अनुभवजन्य भविष्यवाणी है, न कि एक वैचारिक बहिष्कार।
तीन घटक विश्वसनीयता की मौलिक शारीरिकी से मेल खाते हैं (Mayer, Davis, & Schoorman, 1995): विविधता एक क्षमता तंत्र है (क्रॉस-मॉडल सहमति यह कैलिब्रेट करती है कि कितनी दक्षता का अनुमान लगाया जाए), साक्ष्य अखंडता को संचालित करता है (सेवा के बारे में दावे जाँचने योग्य बन जाते हैं, न कि घोषित), और तटस्थता सद्भावना को संरचनात्मक रूप से संबोधित करती है (एक गैर-हिस्सेदारी ऑर्केस्ट्रेटर के प्रोत्साहन निरीक्षणीय हैं, विश्वास के बजाय)। प्रत्येक को धारणा प्रबंधन के बजाय सत्यापन योग्य आर्किटेक्चर में फिर से आधार दिया जाता है, जो मानव-AI संपर्क साहित्य माँगता है जब यह अपने पक्ष से एक ही बिंदु पर पहुँचता है: विश्वास निर्णयों को सत्यापन योग्य विश्वसनीयता संकेतों के साथ संरेखित करें, इंटरफेस द्वारा निर्मित प्रभावों के साथ नहीं (Liao & Sundar, 2022)।
कार्य-कारण श्रृंखला सत्यापन के माध्यम से चलती है, क्योंकि "विश्वास" परिणाम है, तंत्र नहीं: सत्यापन → अंशांकित आत्मविश्वास → न्यायसंगत विश्वास → प्रत्यायोजन → लेनदेन मूल्य (Figure 10)। एक सेवा विश्वास आकर्षक महसूस करने के बजाय, जब वह महत्वपूर्ण हो, जाँचने योग्य होकर प्रत्यायोजन अर्जित करती है; Cheng et al. ने दिखाया कि वह भावना कितनी सस्ती है।
Figure 10. सत्यापन फ्लाईव्हील
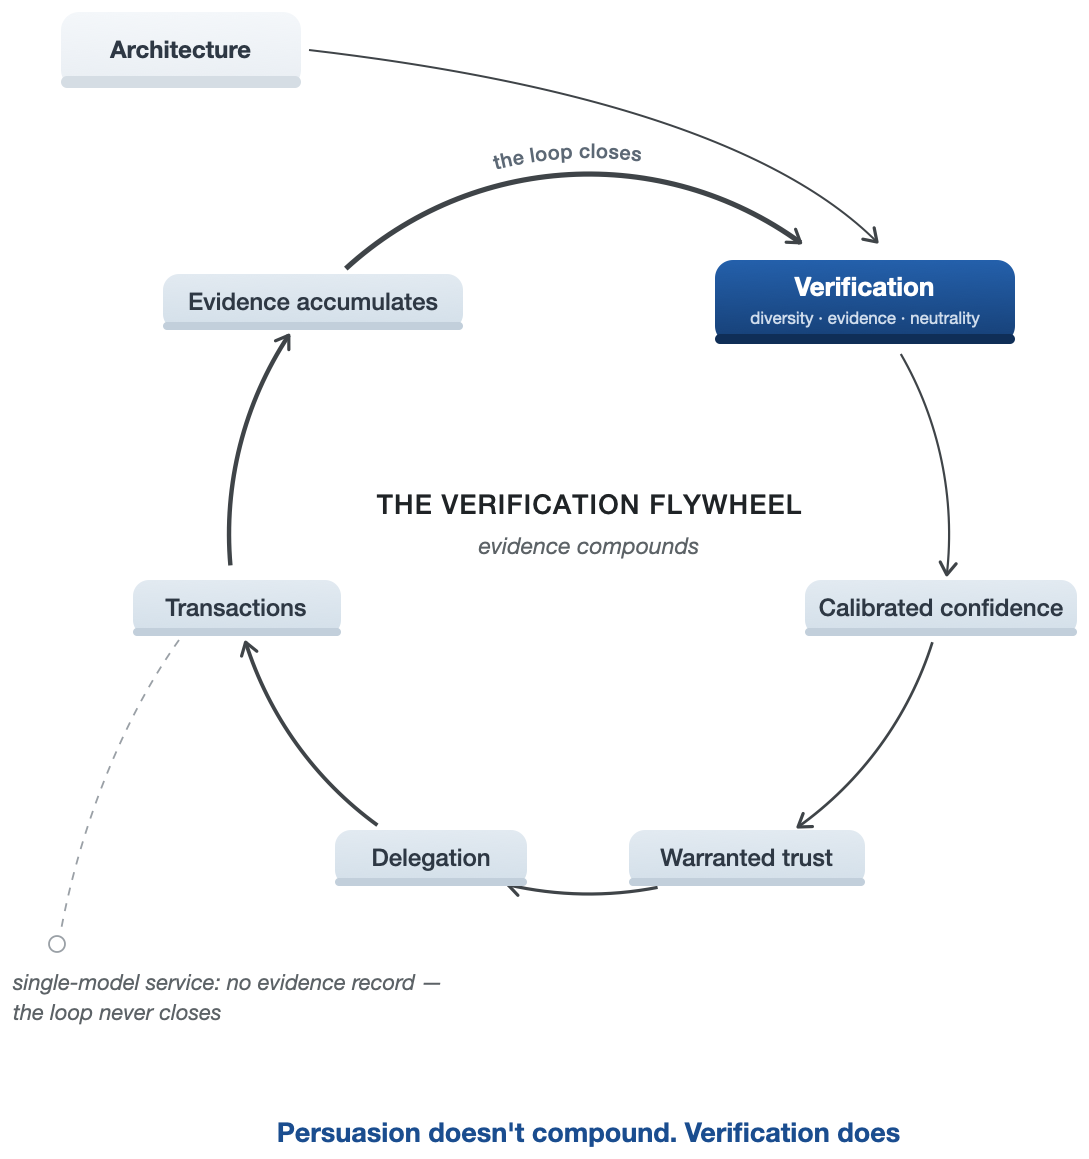
कार्य-कारण श्रृंखला, सत्यापन (विविधता · साक्ष्य · तटस्थता) → अंशांकित आत्मविश्वास → न्यायसंगत विश्वास → प्रत्यायोजन → लेनदेन, समाप्त नहीं होती: लेनदेन साक्ष्य उत्पन्न करते हैं, और लूप आर्किटेक्चर में वापस बंद होती है। धराशायी शंट एकल-मॉडल सेवा दिखाता है, जहाँ कोई साक्ष्य अभिलेख नहीं है और लूप कभी बंद नहीं होती। प्रेरण चक्रवृद्धि नहीं होता। सत्यापन करता है।
Table 5. एकल-मॉडल सेवा बनाम आर्किटेक्चरल विश्वास
| आयाम | एकल-मॉडल सेवा | आर्किटेक्चरली विश्वसनीय सेवा |
| विश्वास का विषय | मॉडल / ब्रांड | प्रक्रिया और इसका अभिलेख |
| आत्मविश्वास | मॉडल द्वारा दावा किया गया | क्रॉस-मॉडल सहमति के माध्यम से अर्जित |
| आत्मविश्वास से भरे त्रुटियाँ | अंदर से अज्ञेय | प्राथमिक पहचान लक्ष्य (असहमति संकेत) |
| चापलूसी | प्राथमिकता द्वारा पुरस्कृत | पृथक: सहानुभूति और नीति-जाँच अलग-अलग चैनलों पर |
| त्रुटि जाँच | वही प्रणाली जिसमें त्रुटि हुई | स्वतंत्र मॉडल + नियतात्मक द्वार |
| निर्णयों का साक्ष्य | लॉग, यदि कोई हो, विक्रेता-आयोजित | छेड़छाड़-सबूत, पुनः चलाने योग्य, उपभोक्ता-सुलभ |
| गुणवत्ता न्यायाधीश | विक्रेता स्वयं | तटस्थ ऑर्केस्ट्रेशन परत |
| विवाद स्थिति | उपभोक्ता के शब्द बनाम मंच | पुनः चलाने योग्य अभिलेख |
| बीमाकरणीयता | अपारदर्शी जोखिम | निर्णय इतिहास से मूल्य निर्धारण योग्य |
| दायित्व आवंटन (post–AB 316) | "AI ने किया" प्रतिबंधित; आवंटन अंधकार में विवादास्पद | पुनः चलाने योग्य अभिलेख से गणनीय |
| नियामक मुद्रा (Art. 50 युग) | फिट से प्रकटीकरण | संचालन के उप-उत्पाद के रूप में पारदर्शिता |
| सीमा पार डेटा वादे | संविदात्मक प्रतिनिधित्व | संपरीक्षण योग्य रनटाइम संपत्ति (क्षेत्राधिकार-जागरूक राउटिंग) |
| लागत संरचना | समतल, सस्ता | स्नातक: केवल जहाँ परिणाम केंद्रित होते हैं वहाँ महँगा |
सत्यापनीयता से उपभोक्ता प्रतिक्रिया तक। उपभोक्ता प्रस्तुतिकरण देखता है, आर्किटेक्चर नहीं: एक पावती जो दिखाती है कि कौन सी स्वतंत्र प्रणालियों से परामर्श लिया गया, वे कहाँ अलग हुईं, और विचलन को कैसे हल किया गया या बढ़ाया गया (Figure 8)। तीन मध्यस्थ धारणाएँ प्रभाव को संभवतः वहन करती हैं। साक्ष्य निदान है: सतही, विशिष्ट असहमति इस उत्तर के बारे में सूचनात्मक है, जिस तरह सामान्य अस्वीकरण नहीं हैं (Detjen et al., 2025; Chen et al., 2026)। एक पुनः चलाने योग्य अभिलेख कथित प्रक्रिया नियंत्रण देता है, क्योंकि उपभोक्ता तथ्य के बाद जाँच, विरोध, या वृद्धि कर सकते हैं। प्रक्रियात्मक आश्वास यह ज्ञान है कि अंधा संग्रह, स्वतंत्र जाँच, और एक गैर-हिस्सेदारी मध्यस्थ मौजूद थे (McKnight et al., 2002)। प्राकृतिक आश्रित चर विश्वास अंशांकन, प्रत्यायोजन की इच्छा, और विफलता के बाद प्रतिरोध हैं। प्राकृतिक संचालक दाँव और उलटापन, कार्य उद्देश्यता (Castelo et al., 2019), और उपभोक्ता विशेषज्ञता हैं, क्योंकि जो उपभोक्ता व्यक्तिगत रूप से उत्तर की जाँच करने में सबसे कम सक्षम है, उसे एक ऐसी आर्किटेक्चर से सबसे अधिक लाभ है जो इसे संरचनात्मक रूप से जाँचती है। नीचे दिए गए प्रस्ताव इस पथ का पता लगाते हैं।
यह ढाँचा, इसके अलावा, ऐसे प्रस्तावों को उत्पन्न करता है जो एक उपभोक्ता अध्ययन परीक्षण कर सकता है, निष्कर्ष नहीं, परिकल्पनाएँ। उन्हें संचालित करने का मतलब एक भेद पर निर्भर करता है: उद्देश्य तटस्थता (ऑर्केस्ट्रेटर वास्तव में किसी विक्रेता, व्यापारी, या परिणाम पर अप्रकटित आर्थिक निर्भरता से मुक्त है), सत्यापन योग्य तटस्थता (अभिलेख उस स्वतंत्रता को जाँचने योग्य बनाता है), और कथित तटस्थता (उपभोक्ता इसमें विश्वास करता है) तीन चर हैं, और एक प्रयोग सत्यापन योग्य संकेत को हेरफेर करते हुए धारणा को मापता है:
P1. क्रॉस-मॉडल असहमति को परिणामपूर्ण प्रश्नों पर सतह पर लाना उपभोक्ताओं के आश्रय अंशांकन में सुधार करता है (वे अधिक आश्रय करते हैं जब सिस्टम सहमत होते हैं, कम जब वे विचलित होते हैं) एक एकल आत्मविश्वासी उत्तर के सापेक्ष, माध्यस्थकारी निर्माण के रूप में कथित जोखिम के साथ (Featherman & Pavlou, 2003)। दोनों विफलता दिशाएँ सक्रिय हैं: संयुक्त प्रस्तुति अत्यधिक आश्रय को कम करती है लेकिन अल्प आश्रय को बढ़ा सकती है (Lu, Wang, & Yin, 2024), आत्मविश्वास प्रदर्शन सटीकता की तुलना में अधिक आसानी से आश्रय को अंशांकित करते हैं (Zhang, Liao, & Bellamy, 2020), व्याख्याएँ जाँच को बढ़ाए बिना आश्रय को बढ़ा सकती हैं (Bansal et al., 2021), संज्ञानात्मक बाध्यता कार्य संतुष्टि की कीमत पर अत्यधिक आश्रय को काटते हैं (Buçinca, Malaya, & Gajos, 2021), और 106 प्रयोगों का एक मेटा-विश्लेषण मानव–AI संयोजनों को औसतन मानव या AI के बेहतर प्रदर्शन से बदतर प्रदर्शन पाता है (Vaccaro, Almaatouq, & Malone, 2024)। P1 अंशांकन का परीक्षण करता है, एकरस लाभ नहीं: सतह पर लाई गई असहमति को संयोजन डिज़ाइन के अल्पसंख्यक में उतरना चाहिए जो उनके सर्वश्रेष्ठ सदस्य को हराते हैं। प्रस्ताव विभाजित है: मुख्य प्रभाव पुष्टिकारक दावा है, और मध्यस्थ अन्वेषणात्मक हैं, तथ्यों की नैदानिकता से व्युत्पन्न, तथ्य के बाद सूचीबद्ध नहीं। अंशांकन लाभ दाँव और अपरिवर्तनीयता के साथ, और कार्य उद्देश्यपूर्णता के साथ बढ़ना चाहिए (किसी उद्देश्यपूर्ण प्रश्न पर विचलन एक त्रुटि संकेत के रूप में पढ़ा जाता है; एक व्यक्तिपरक पर, रुचि के रूप में; Castelo et al., 2019)। उपभोक्ता विशेषज्ञता को विपरीत संकेत उत्पन्न करने की भविष्यवाणी की जाती है: कम विशेषज्ञता वाले उपभोक्ताओं के लिए, संकल्प के बिना सतह पर लाया गया विचलन प्रतिनिधिमंडन की इच्छा में कमी करना चाहिए, और उच्च विशेषज्ञता वाले उपभोक्ताओं के लिए यह आश्रय अंशांकन में सुधार करना चाहिए; क्रॉसओवर या तो देखा जाता है या नहीं, जो विशेषज्ञता को एक परीक्षा बनाता है न कि एक पलायन हैच। इस पत्र के अपने प्रयोग में एक डिज़ाइन आवश्यकता है। असहमति कार्य कठिनाई के साथ सहसंबद्ध है (पैनल सहमति आसान आइटम पर केंद्रित होती है), इसलिए P1 डिज़ाइन को कठिनाई में हेरफेर या सांख्यिकीय रूप से नियंत्रण करना चाहिए, अन्यथा अंशांकन प्रभाव आइटम सरलता के साथ भ्रमित हो जाता है। नैदानिकता खाता एक सीमा भविष्यवाणी भी देता है जो सामान्य पारदर्शिता सिद्धांत नहीं बनाते हैं: विचलन प्रकटीकरण सबसे अधिक महत्वपूर्ण होना चाहिए जहाँ उपभोक्ता के अपने पूर्वानुमान सबसे कमजोर हैं, क्रॉस-बॉर्डर या अपरिचित-विक्रेता खरीद पर, क्योंकि वहाँ बाहरी नैदानिक साक्ष्य के पास कोई आंतरिक प्रतियोगी नहीं है।
P2. एक पुनः प्चाय योग्य निर्णय रिकॉर्ड तक पहुँच उपभोक्ताओं की महत्वपूर्ण कार्यों को AI एजेंट को प्रतिनिधित्व करने की इच्छा को बढ़ाती है, ब्रांड विश्वास के अलावा, प्रभाव प्रतिनिधित्व किए गए कार्य के दाँव और अपरिवर्तनीयता के साथ बढ़ता है। यह प्रतिनिधित्व की गई एजेंसी के स्तर के साथ भी बढ़ता है, जो Trust-Migration Hypothesis की तुलनात्मक-सांख्यिकी सामग्री है: वास्तविक मॉडल प्रदर्शन को स्थिर रखते हुए, सत्यापन योग्य आर्किटेक्चरल गुणों का सीमांत प्रभाव उपयुक्त प्रतिनिधिमंडन पर बढ़ता है क्योंकि उपभोक्ता अधिक समीक्षा और निष्पादन नियंत्रण प्रदान करता है (सलाहकार → सहपायलट → पर्यवेक्षित एजेंट → स्वायत्त एजेंट)। एक डिज़ाइन जो प्रतिनिधिमंडन स्तर को आर्किटेक्चर दृश्यमानता के साथ पार करता है परिकल्पना का सीधे परीक्षण करता है। निकटतम उपभोक्ता-अनुसंधान साक्ष्य इस आश्रित चर पर बैठता है: AI को खरीद का प्रतिनिधिमंडन करना जहाँ यह कथित स्वायत्तता को प्रतिबंधित करता है (Ahmad Husairi & Rossi, 2024) में अपनाने को कम करता है, और उच्च-स्वायत्तता सहायकों की स्वीकृति एक सीधे अध्ययन किया गया परिणाम है (Frank et al., 2026)। P2 उन स्थापित पूर्ववर्तियों के अलावा रिकॉर्ड के प्रभाव की भविष्यवाणी करता है।
P3. समन्वय परत की कथित तटस्थता प्रतिनिधिमंडन इच्छा की स्वतंत्र रूप से भविष्यवाणी करती है, सेवा मूल्यांकन में प्रक्रियात्मक-न्याय प्रभावों के अनुरूप (Tax, Brown, & Chandrashekaran, 1998)। हेरफेर किया गया चर सत्यापन योग्य तटस्थता संकेत है; मापा गया चर यह धारणा है जो यह उत्पन्न करता है। मेरे ज्ञान के लिए, orchestrator तटस्थता को कभी भी एक व्यवहारिक प्रयोग में संचालित नहीं किया गया है, और प्रमाणीकरण सील निकटतम परीक्षण किए गए एनालॉग हैं (Cetinkaya & Krämer, 2024), इसलिए P3 एक नया प्रायोगिक चर प्रस्तुत करता है। दिशात्मक रूप से, तटस्थता प्रभाव को मजबूत करना चाहिए क्योंकि उपभोक्ता की अपनी पदार्थ की जाँच करने की क्षमता गिरती है, क्योंकि जब परिणाम गुणवत्ता का न्याय करना मुश्किल होता है, तो प्रक्रिया संकेत मूल्यांकन वजन ले जाते हैं। हेरफेर को सत्यापन योग्य तटस्थता से एक तटस्थता दावे को अलग करना होगा: एक शर्त एक रसीद ले जाती है जिसकी कोई-दांव प्रमाणीकरण को वास्तव में खोला और जाँचा जा सकता है, विपरीत शर्त एक समान इंटरफेस केवल लेबल के साथ, दोनों में कथित तटस्थता पर हेरफेर की जाँच के साथ। उस विपरीत के बिना P3 सामान्य प्रक्रिया-निष्पक्षता में ढह जाता है और सत्यापन के बारे में कुछ नहीं कहता।
P4. एक एजेंट त्रुटि के बाद, उपभोक्ता जिनकी सेवा एक निरीक्षणीय रिकॉर्ड उत्पन्न करती है छोटा विश्वास पतन और एक अपारदर्शी सेवा के उपभोक्ताओं की तुलना में उच्च प्रतिधारण दिखाते हैं: वन-स्ट्राइक गतिशील साक्ष्य द्वारा माध्यस्थ है। यह तंत्र है कि सेवा-वसूली अनुसंधान पहचानता है, जहाँ प्रक्रियात्मक रूप से निष्पक्ष, साक्ष्य-आधारित शिकायत सामग्री विफलता के बाद विश्वास को पुनः स्थापित करती है (Tax et al., 1998)। विश्वास-मरम्मत अनुसंधान जोड़ता है कि विश्वास को बहाल करने वाला क्या उल्लंघन की प्रकृति और दिए गए खाते पर निर्भर करता है (Kim, Ferrin, Cooper, & Dirks, 2004), एक आवश्यकता जो मानव–मशीन अनुसंधान अब स्वायत्त प्रणालियों के लिए एक डिज़ाइन समस्या के रूप में मानता है (de Visser, Pak, & Shaw, 2018), और बफरिंग विफलता की गंभीरता और अपरिवर्तनीयता के साथ बढ़नी चाहिए। P4 भविष्यवाणी करता है: रिकॉर्ड → छोटा विश्वास पतन और उच्च प्रतिधारण, विफलता गंभीरता द्वारा माध्यस्थ। ऐसे मामले जहाँ रिकॉर्ड दिखाता है कि प्रक्रिया ही का पालन नहीं किया गया था एक हेरफेर की जाँच द्वारा संभाला जाता है और परीक्षण से बाहर रखा जाता है, क्योंकि प्रस्ताव उन विफलताओं से संबंधित है जो एक अनुसरण प्रक्रिया के बावजूद होती हैं। स्थायित्व तुलना को स्विचिंग लागत और लॉक-इन को नियंत्रित करना चाहिए, जो प्रतिधारण को भ्रमित करते हैं, और एक साथी डिज़ाइन परीक्षण करता है कि क्या अनुसरण-प्रक्रिया रिकॉर्ड दोष को सेवा से वातावरण में स्थानांतरित करता है। प्रस्ताव में कोई उलट खंड नहीं है, इसलिए कोई परिणाम पैटर्न निर्माण द्वारा अपमानजनक नहीं है।
अनुभवजन्य समर्थन: परीक्षणित घटक के रूप में आत्मविश्वास परत। यदि कोई सेवा दावा करती है कि इसके आत्मविश्वास संकेत कुछ मतलब रखते हैं, तो उस दावे को परीक्षण पर रखा जा सकता है। इस पत्र के मामले अध्ययन के पीछे तैनाती में आत्मविश्वास परत दो स्वतंत्र मॉडल परिवारों में एक पूर्व-पंजीकृत, प्लेसीबो-नियंत्रित, छः-हथियार मूल्यांकन के माध्यम से चला। सिस्टम की अपनी कमजोरियों की एक मापी गई प्रोफ़ाइल ने इसकी त्रुटि भविष्यवाणी में सुधार किया, प्लेसीबो के अलावा लगभग +0.07 की AUROC लाभ, दोनों परिवारों पर गैर-अतिव्यापी आत्मविश्वास अंतराल के साथ। एक झूठी स्व-प्रोफ़ाइल त्रुटि भविष्यवाणी को एक सिक्का फ्लिप में ढह गई, और एक सामान्य "अपनी सीमाओं के बारे में जागरूक रहें" निर्देश कुछ नहीं किया।
दो पहले के संस्करण असफल रहे, एक अपने ही लेखकों द्वारा एक भ्रामक कारक पर विकृत किया गया, एक नकारात्मक, पूर्व-पंजीकृत डिज़ाइन की पुष्टि से पहले। एक कठोर पुनः-परीक्षण कम दायरे पर अनिर्णायक था, और एक पूर्व-पंजीकृत चार-पायदान सीढ़ी एक सीमांत परिवार पर कोई पुष्टिकरण समापन बिंदु से गुजरी नहीं, प्रभाव की दिशा केवल तीन में से चार पायदानों पर अन्वेषणात्मक रूप से बची हुई है। दावा इसलिए प्रति-परिवार और सीमित है: मापा गया आत्म-ज्ञान ने त्रुटि भविष्यद्वाणी में सुधार किया जहां पुष्टि की गई, और यह हर मॉडल वर्ग की एक स्थापित संपत्ति नहीं है। कमजोरी प्रोफ़ाइल उत्पादन में भी चलती है, जहां यह लाइव मॉडल राउटिंग को समायोजित करती है, सीमित और विफल-खुली। असत्य-प्रोफ़ाइल पतन एक सुरक्षा खोज के रूप में दोहरा कार्य करता है: एक जाली आत्म-मॉडल एक हमले का वेक्टर है, एक और कारण कि आत्म-ज्ञान को मॉडल आत्म-रिपोर्ट के बजाय वास्तुकला संरक्षण की आवश्यकता है। डिज़ाइन तर्क का एक उपभोक्ता-अनुसंधान वंश प्रौद्योगिकी से पुराना है। पूर्वबद्धता, बाहरी संरचना के माध्यम से भविष्य के व्यवहार को बाध्य करना क्योंकि आंतरिक संकल्प को धारण करने की अपेक्षा नहीं की जाती है, बिल्कुल वैसे ही है जैसे उपभोक्ता अपनी खुद की बुराइयों को नियंत्रित करते हैं (Wertenbroch, 1998), और वास्तुकला विश्वास मशीनों के लिए समान कदम बढ़ाता है।
पूर्ण चाप (प्रोटोकॉल, पूर्व-पंजीकरण, कच्चे डेटा, विकृत पायलट, नकारात्मक पुनरावृत्ति, गैर-पुष्टिकरण विस्तार) एक स्टैंडअलोन आर्काइव के रूप में संरक्षित है, पेपर की OSF सामग्री के साथ सार्वजनिक रूप से उपलब्ध है https://osf.io/jtvu9/ (फाइल `self-calibration-archive.zip`)। कैलिब्रेट किया गया आत्मविश्वास एक वास्तुकला घटक है जिसमें मापने योग्य सामग्री है, और यह विफल हो सकता है। विफलताएँ सफलताओं के साथ संग्रहीत हैं क्योंकि एक विश्वास परत जिसके आत्मविश्वास के दावों को कभी प्रयोगात्मक रूप से चुनौती नहीं दी गई है, वह बिल्कुल अंधी विश्वास माँग रही है जिसे वह बदलने वाली थी। एक तीस-लेखक स्थिति पत्र इस श्रम विभाजन को एक औपचारिक कथन देता है: एजेंटिक ऑर्केस्ट्रेशन Bayes-consistent होना चाहिए (Papamarkou et al., 2026), और कैलिब्रेट किए गए विश्वास नियंत्रण परत में होने चाहिए, मॉडल में नहीं।
तंत्र का परीक्षण: एक पूर्व-पंजीकृत प्रयोग। ऊपर दिए गए दावे परीक्षण योग्य हैं, और यह खंड परीक्षणों की रिपोर्ट करता है। इस खंड में हर प्रायोगिक परिणाम, दोनों लहरों में, रूपरेखा के एक तकनीकी पूर्ववर्ती के बारे में बोलता है, चाहे स्वतंत्र समझौता एक सही संकेत वहन करता है जो एक मॉडल की आत्म-रिपोर्ट तथ्यात्मक प्रश्नों पर नहीं करता है। ये प्रयोग उपभोक्ता विश्वास, प्रतिनिधिमंडल, या वाणिज्यिक व्यवहार का प्रदर्शन नहीं करते, जो P1–P5 और खंड 6 के व्यवहारिक अध्ययन का क्षेत्र बने हुए हैं। प्रोटोकॉल को किसी भी पुष्टिकरण डेटा के अस्तित्व से पहले सार्वजनिक रूप से फ्रीज किया गया था (OSF: https://osf.io/4y9dv, 23 जुलाई 2026 को पंजीकृत; परिकल्पना H1–H6, बेंचमार्क उप-नमूना बीज और SHA-256 हैश द्वारा निर्धारित, परिकल्पना के लिए प्रतिकूल परिणाम पूर्व-घोषित)। डिज़ाइन जानबूझकर सरल है। सोलह मॉडल, नौ सीमांत विक्रेता (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) और सात स्थानीय ओपन-वेट मॉडल, प्रत्येक ने एक ही 1,500 SimpleQA प्रश्नों का एक बार, अंधे में, बिना पुनः प्राप्ति या उपकरण के उत्तर दिया। यह वह शासन है जो सहसंबद्ध पैरामीट्रिक त्रुटि के लिए जोखिम को अधिकतम करता है, संकेत के लिए जानबूझकर कठिन मामला, बताए गए सीमाओं के पारिस्थितिक लागत पर। उत्तर तापमान शून्य पर दिए गए, 0–100 आत्मविश्वास बताते हुए: मौखिक अनिश्चितता, एक ही प्रतिक्रिया के भीतर शब्दों में प्राप्त, लॉगिट्स से पढ़ा नहीं गया, वह प्रारूप जो Lin, Hilton, और Evans (2022) ने दिखाया कि मॉडल को कैलिब्रेट करने के लिए सीख सकते हैं। पैनल उस एकल संग्रह के विश्लेषणात्मक संयोजन हैं 24,000 नाममात्र उत्तर स्लॉट का, जिसमें से 22,598 वितरित किए गए, एक स्थानीय मॉडल (deepseek-r1:8b) 98 वस्तुओं पर एक पूर्व-प्रतिबद्ध स्टॉपिंग नियम के तहत रुक गया। छह पंजीकृत परिकल्पनाएं निम्नानुसार परिणामों पर मैप करती हैं। H1, कि क्रॉस-मॉडल विचलन आत्मविश्वास त्रुटियों का बहुमत फ़्लैग करता है, समर्थित है: समझौता पंजीकृत लहर में सही 1.9–3.2× को उठाता है (तालिका 6), और प्रमुख लहर में फ्रीज़न गेट 82.1% आत्मविश्वास विफलताओं को हटाता है (तालिका 10)। H2, कि पैनल संकेत जवाब देने वाले मॉडल के अपने आत्मविश्वास को हराता है, CN-सीमांत और क्रॉस-ब्लॉक पैनल पर होता है (ΔAUROC +0.287 और +0.063) और US-सीमांत पैनल पर उलट जाता है। H3, कि आत्मविश्वास त्रुटियों का एक गैर-तुच्छ हिस्सा एक गलत उत्तर पर सर्वसम्मत समझौते के रूप में बचता है, समर्थित है: ओपन-फॉर्म प्रश्नों का 0.5–2.2% और बहुविकल्पीय भुजा में 4.0–7.9%। H4(a), कि अंतः-ब्लॉक त्रुटि सहसंबंध क्रॉस-ब्लॉक से अधिक है, समर्थित नहीं है (φ अंतर +0.011, 95% CI −0.005 से +0.028), और H4(b), कि एक क्रॉस-ब्लॉक पैनल अधिक पकड़ता है, समर्थित नहीं है, क्रॉस-ब्लॉक नेतृत्व छोटा है। H5, कि एक $0 स्थानीय पैनल सीमांत आत्मविश्वास त्रुटियों का बहुमत फ़्लैग करता है, समर्थित नहीं है: स्थानीय स्तर का समझौता संकेत संयोग पर बैठता है। H6, वंशावली-दूरी सीढ़ी, यहाँ एक सीढ़ी के रूप में परीक्षण नहीं की गई है; इसकी ब्लॉक-स्तरीय कदम H4(a) शून्य है।
तथ्य सत्यापन एजेंटिक वाणिज्य के लिए एक प्रासंगिक प्रॉक्सी है क्योंकि एक प्रतिनिधिमंडन खरीद कार्यान्वयन के क्षण में, तथ्यात्मक उप-दावों में विघटित होती है: वस्तु की वर्तमान कीमत और उपलब्धता, रिटर्न नीति की शर्तें, क्या उत्पाद के विशिष्टताएं उपभोक्ता की बताई गई आवश्यकताओं से मेल खाती हैं, विक्रेता की पहचान और रेटिंग। इनमें से प्रत्येक के पास एक सत्यापन योग्य जमीनी सत्य है जो SimpleQA वस्तु के समान है। असहमति गेट उस तथ्यात्मक सब्सट्रेट पर संचालित होती है, जबकि वरीयता भार (कौन से ट्रेड-ऑफ महत्वपूर्ण हैं, और कितना) उपभोक्ता के साथ रहता है, जिन्होंने आवश्यकताएं बताईं कि तथ्य जांच की जाती हैं। श्रम का यह विभाजन भी है कि खंड 6 डिज़ाइन प्रतिभागियों की वरीयताओं के बजाय सत्यापन के प्रदर्शन में हेरफेर क्यों करता है: वास्तुकला का दावा एक प्रतिनिधिमंडन निर्णय की तथ्यात्मक परत से संबंधित है, न कि इसकी स्वाद परत से। जहां एक निर्णय का कोई तथ्यात्मक सब्सट्रेट ही नहीं है, वास्तव में व्यक्तिपरक विकल्पों में कोई जमीनी सत्य नहीं है, पूर्ववर्ती आचरण बंद हो जाता है, और सीमाएं उस सीमा को एक खुले प्रश्न के रूप में बताती हैं।
बेंचमार्क की पसंद को मापा गया। 2021 के TruthfulQA (प्रशिक्षण कॉर्पस में मौजूद) पर, एक ही विक्रेताओं ने SimpleQA की तुलना में 47–61 प्रतिशत अंक अधिक स्कोर किया (उदाहरण के लिए, 89% बनाम 28%), एक अंतर जो बेंचमार्क की आयु और जोखिम प्रभावों के अनुरूप है, हालांकि यह डिज़ाइन संदूषण को बेंचमार्क की कठिनाई और निर्माण में अंतर से अलग नहीं कर सकता है। इसलिए कोई भी शीर्षक संख्या पुराने बेंचमार्क पर आधारित नहीं है। ग्रेडिंग उद्देश्य स्ट्रिंग मिलान है, अनसुलझे मामलों को केवल एक स्थानीय ओपन-वेट मॉडल द्वारा सोने के समकक्ष के लिए आंका जाता है (Qwen3-8B, स्थानीय रूप से चलाया जाता है; प्रतिकृति पैकेज में समकक्ष-केवल प्रॉम्प्ट; किसी भी पैनल सदस्य के परिवार द्वारा कभी नहीं; क्या SimpleQA जज के प्रशिक्षण कॉर्पस में दिखाई देता है यह अज्ञात है, लेकिन जज दो आपूर्ति स्ट्रिंग्स के बीच समकक्षता की पुष्टि करता है, सत्य नहीं, जो एक्सपोज़र को बांधता है) और एक 50-आइटम मानव स्पॉट-चेक (98% समझौता), पैमाने की सीमा। यह अब जज-समाधान किए गए मामलों के एक स्तरीकृत 300-आइटम क्रॉस-फैमिली ऑडिट द्वारा विस्तारित किया गया है (एक अलग मॉडल परिवार एक ऑडिटर के रूप में, बीज-निर्धारित नमूना): 96% समझौता (288/300), सभी बारह असहमति उदार झूठी सकारात्मकताएं (नौ स्पष्ट, तीन सीमावर्ती), एक एकदिशीय पूर्वाग्रह जो सभी अंकित उत्तरों का लगभग 3% को छूता है (जज-समाधान शेयर का 4%)। निर्णयों के दो-तिहाई (66.5%) सटीक स्ट्रिंग मिलान के बजाय स्थानीय मॉडल ग्रेडर से आए, और शीर्षक ग्रेडर त्रुटि के लिए मजबूत है: मॉडल-अंकित निर्णयों के यादृच्छिक 10% को फ्लिप करने से प्रमाणन अनुपात अधिकतम ±0.5× द्वारा स्थानांतरित होते हैं और कभी भी उनकी दिशा नहीं बदलते हैं।
दो डिज़ाइन विकल्प बजटीय के बजाय जानबूझकर हैं। विक्रेताओं के मध्य स्तर का उपयोग किया गया था, पहला, पारिस्थितिक वैधता के लिए: एजेंट जो अब उपभोक्ताओं की ओर से लेनदेन कर रहे हैं वे अत्यधिक इन लागत-अनुकूलित स्तरों पर चलते हैं, सार्वजनिक मूल्य सूचियों से जांचे जा सकते हैं (मध्य-2026; चित्र 11)। एक विशिष्ट सेवा विनिमय बजट स्तरों पर कुछ सेंट के अंश से लगभग एक सेंट का खर्च करता है, फ्लैगशिप वेट पर पाँच से दस सेंट के विरुद्ध, और कोई भी सेवा लाखों सत्र का उत्तर नहीं देती है इसकी डिफ़ॉल्ट पथ को फ्लैगशिप दर पर मूल्य देती है। रोस्टर बाजार को प्रतिबिंबित करता है: नौ विक्रेता पैनल में सभी तीन आपूर्तिकर्ता शामिल हैं जो एक साथ 88% उद्यम LLM API व्यय कर रहे हैं, और तालिका 6 का US-सीमावर्ती पैनल बिल्कुल वह तिकड़ी है। इस अनुरोध कि यह उद्यम साक्ष्य है, उपभोक्ता इसमें कहीं नहीं है, आपूर्ति श्रृंखला को पीछे की ओर प्राप्त करता है। उपभोक्ता अब एक मॉडल को बिल्कुल भी नहीं चुनता है: वे एक बैंक, एक खुदरा विक्रेता, एक एयरलाइन चुनते हैं, और सेवा की राउटिंग नीति मॉडल चुनती है। उपभोक्ताओं को जिस मुद्रा में परोसा जाता है, उसमें, डॉलर के बजाय टोकन में, चित्र यह पुष्टि करता है (चित्र 12): OpenRouter–a16z अध्ययन में 100 ट्रिलियन टोकन की रूट की गई ट्रैफिक की बात, ओपन-वेट मॉडल सभी उपयोग का लगभग एक तिहाई तक पहुँचे (Aubakirova et al., 2026), तीन सबसे बड़े उपभोक्ता AI उत्पादों के डिफ़ॉल्ट स्तर सभी फ्लैगशिप स्तर के नीचे बैठते हैं, और केवल लगभग 3% उपभोक्ता AI उपयोगकर्ता प्रीमियम सेवा के लिए भुगतान करते हैं (Menlo Ventures, 2025c), तो सीमांत उपभोक्ता को लगभग-शून्य सीमांत लागत पर परोसा जाना चाहिए। API बाजार के नीचे ऑन-डिवाइस और आत्म-होस्ट किए गए ओपन वेट की एक मंजिल है, व्यय-आधारित सर्वेक्षणों के लिए अदृश्य, और प्रयोग की स्थानीय स्तर सात ओपन-वेट मॉडल इसे जानबूझकर नमूना करता है। बाजार को गिना जा सकने वाली हर मुद्रा में, इस अध्ययन द्वारा नमूना किए गए स्तर वे हैं जो उपभोक्ता को परोसते हैं। (एक प्रथम-पक्ष आउटेज के बाद, संग्रह का हिस्सा एक एकत्रकर्ता के माध्यम से पूरा किया गया था, वास्तविक सेवा बुनियादी ढांचे को रन प्रकट में प्रति कॉल दर्ज किया गया था।)
चित्र 11। चेकआउट पर उपभोक्ता मिलते हैं
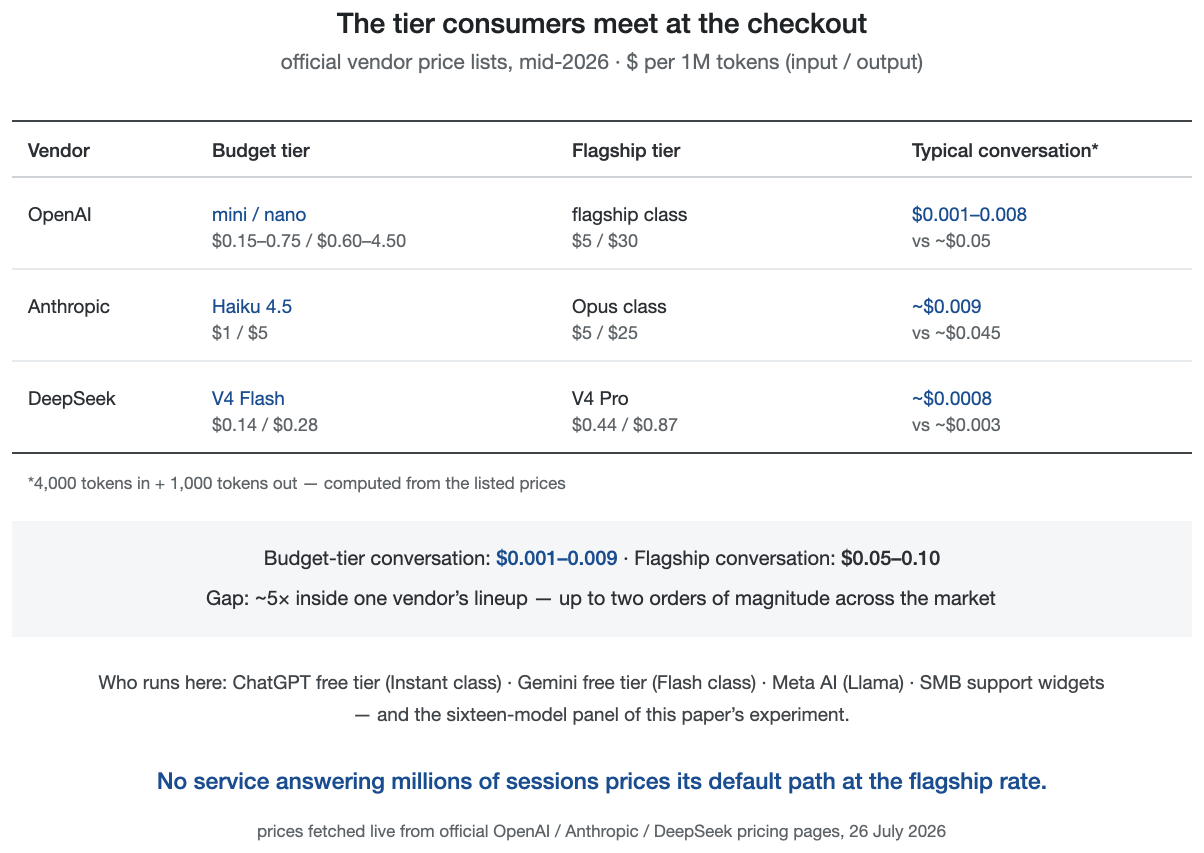
आधिकारिक विक्रेता मूल्य सूचियां, मध्य-2026।
चित्र 12। मॉडल बाजार की दो मुद्राएं
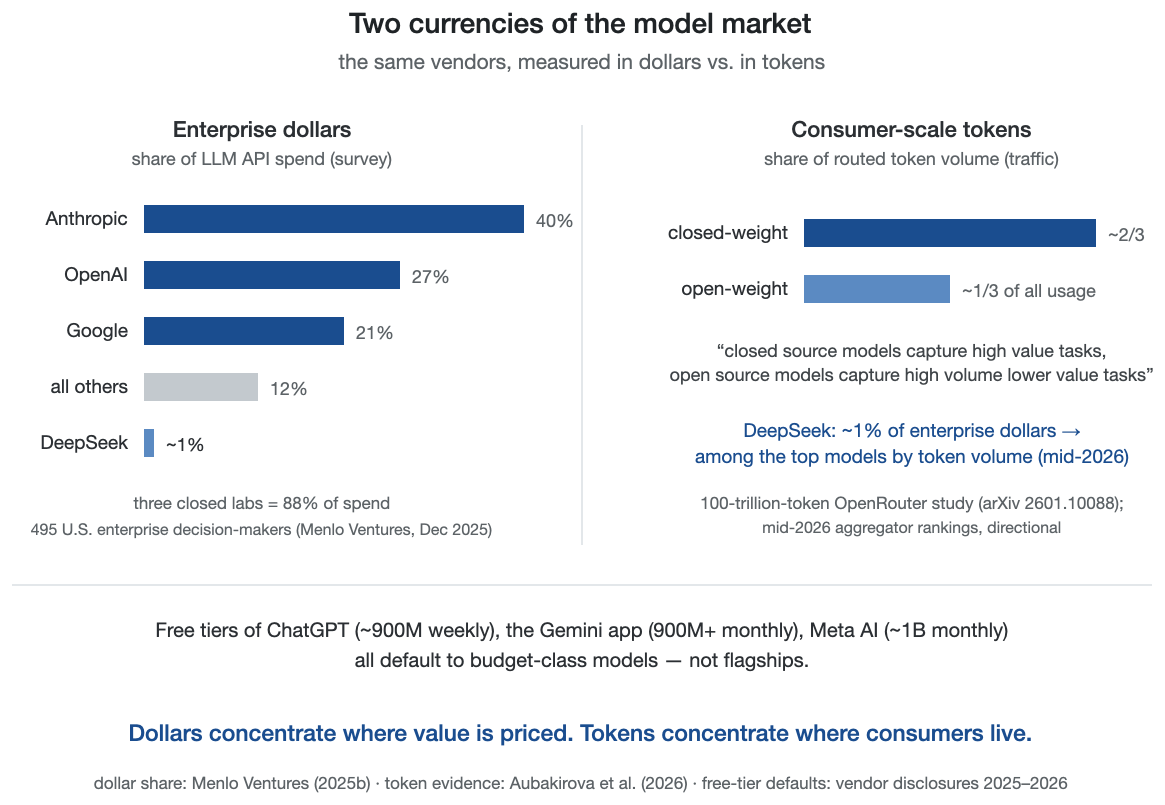
उद्यम डॉलर बनाम उपभोक्ता-पैमाने टोकन।
मध्य स्तर ने कागज के दावों के लिए भी अच्छा काम किया, जो आर्किटेक्चर से संबंधित हैं, फ्लैगशिप क्षमता नहीं: एक प्रभाव जो केवल प्रीमियम वेट के साथ दिखाई दिया वह एक मॉडल परिणाम होगा। पाइपलाइन कमोडिटी बुनियादी ढांचे पर API व्यय के $15 से कम के लिए प्रतिकृति करता है। एक कागज के लिए बहस करता है कि सत्यापन हर परिणामी उत्तर पर चलाने के लिए पर्याप्त सस्ता होना चाहिए, कागज को सत्यापित करने की लागत साक्ष्य का हिस्सा है। पाइपलाइन एक स्टैंडअलोन प्रतिकृति पैकेज है (रनर, ग्रेडर, विश्लेषण स्क्रिप्ट, कच्चा अंकित डेटा, और रन प्रकट) लेखक की अनुसंधान प्रणाली से कुछ भी आवश्यक नहीं। संग्रह कुल 24,000 उत्तर, मोटे तौर पर बेंचमार्क-संदूषण और अनुरूपता हथियारों सहित 30,000। उपलब्धता पर: सार्वजनिक पूर्व-पंजीकरण (osf.io/4y9dv) बीज-निर्धारित 1,500-आइटम सबसेट को संग्रहीत करता है। पूर्ण पैकेज https://osf.io/jtvu9/ पर सार्वजनिक रूप से उपलब्ध है, पंजीकरण के स्रोत प्रोजेक्ट का एक सार्वजनिक घटक (फ़ोल्डर `replication-package-v2`)।
तीन परिणाम खंड को ले जाते हैं। पहला, कच्चा माल प्रचुर है: माध्यिका बताए गए आत्मविश्वास ने सात नौ सीमावर्ती विक्रेताओं में 85–95 चलाए, दो अपवादों के साथ (माध्यिकाएं 42 और 60) बिल्कुल उन विक्रेताओं जिनके आत्मविश्वास में फर्क पड़ता है, जबकि वास्तविक सटीकता 10% से 66% तक है, 1,500 प्रश्नों पर सीमांत विक्रेता प्रति 289–1,212 आत्मविश्वास त्रुटियां (आत्मविश्वास ≥ 75 पर गलत) का उत्पादन। एक शुद्धता संकेत के रूप में, एक मॉडल के अपने आत्मविश्वास ने विक्रेता के आधार पर AUROC 0.53–0.79 प्राप्त किया, और एक उपभोक्ता के पास बाहर से कोई तरीका नहीं है, जानने के लिए कि उन्हें कौन सा विक्रेता मिला। वह विक्रेता प्रसार, उपभोक्ता को परोसा जाने वाले स्तर पर, सीमावर्ती-प्रयोगशाला खोज को योग्य बनाता है कि बड़े मॉडल अक्सर नियंत्रित प्रारूपों (Kadavath et al., 2022) में आत्म-मूल्यांकन पर अच्छी तरह से अंशांकित होते हैं: कुछ तैनात विक्रेता उस आत्म-ज्ञान को शिप करते हैं, अन्य आत्मविश्वास शोर भेजते हैं, और सतह पर कुछ भी उन्हें अलग नहीं करता है।
दूसरा, मुख्य बात: सत्यापन प्रमाणीकरण के रूप में काम करता है, अलर्ट के रूप में नहीं। संभाव्य अर्थ में प्रमाणीकरण, पैनल के आधार पर लगभग 49–77% का एक पश्च संभाव्यता, कोई गारंटी नहीं। इतने कठिन सवालों पर, भोली संकेत "किसी पैनलिस्ट को असहमति है" संतृप्त हो जाता है: यह 85–94% आत्मविश्वास से भरी हुई त्रुटियों पर तो फायर करता है लेकिन 91–95% आत्मविश्वास से सही उत्तरों पर भी (पंजीकरण ने इस पुनर्निर्धारण की प्रत्याशा की थी, पूर्व-निर्दिष्ट AUROC अंतबिंदु पर जाते हुए)। सूचनाप्रद दिशा विपरीत है: सही उत्तर स्वतंत्र रूप से दोहराए जाते हैं, गलत उत्तर बिखरे हुए होते हैं। एक उत्तर जिसे कम से कम एक स्वतंत्र पैनलिस्ट ने दोहराया था वह अंतरा-ब्लॉक पैनलों पर 72–77% सही था और क्रॉस-ब्लॉक पैनल पर 49% था, बिना प्रतिकृति के 18–37% के मुकाबले। स्वतंत्र सहमति वाला एक उत्तर सही होने की संभावना लगभग दो से तीन गुना अधिक था (तालिका 6 के तीनों पैनलों में 1.9–3.2× पार)। (यहाँ और पूरे में, "स्वतंत्र" का अर्थ है अंधे और अलग से उत्पादित, अवशिष्ट त्रुटि सहसंबंध मापा गया न कि मान लिया गया, और सत्यता हमेशा बेंचमार्क के सोने के लेबलों के विरुद्ध स्कोर की जाती है, कभी किसी अन्य मॉडल की राय द्वारा नहीं)। अनुमान साहचर्यात्मक है, कारणात्मक नहीं: प्रतिकृति उन उत्तरों को चिह्नित करती है जो सही होने की अधिक संभावना रखते हैं, और यह जो कुछ चिह्नित करता है उसका हिस्सा यह है कि सवाल आसान था, एक चयन प्रभाव जिसे नीचे परिमाणित किया गया है। सत्यता संकेत के रूप में, पैनल समझौता उस पैनल पर AUROC 0.832 तक पहुंचा जिसके सदस्यों का अपना आत्मविश्वास सबसे कम संकेत रखता था (प्रति-विक्रेता 0.53–0.62; पूल किया गया 0.545)। जो दावा पकड़ में आता है वह विशेषता नहीं बल्कि वितरणात्मक है: सभी 84 तीन-विक्रेता पैनलों में समझौता AUROC का माध्यिका 0.79 है और 89% में पूल की गई स्व-रिपोर्ट से अधिक है। समझौता क्रॉस-ब्लॉक पैनल पर 0.722 तक पहुंचा जो पूल किए गए अपने आत्मविश्वास 0.659 के विरुद्ध है (विक्रेताओं में अस्पष्टीकृत मौखिक स्केल को पूल करना स्व-रिपोर्ट को विकृत करता है, क्योंकि विक्रेता 0–100 स्केल को अलग तरीके से उपयोग करते हैं और कलाकृति की दिशा पैनल-निर्भर है, इसीलिए प्रति-विक्रेता मान साथ में मुद्रित हैं)। वह अग्रणी क्रॉस-ब्लॉक उदाहरण कोडिंग-निर्भर है (वैकल्पिक पूर्व-जमी समझौता कोडिंग क्रॉस-ब्लॉक पैनल के समझौता संकेत को 0.544–0.722 पर रखता है, उदार अनसुलझे-समझौते संस्करण उस पैनल के पूल किए गए अपने आत्मविश्वास 0.659 से नीचे गिरता है, जबकि CN पैनल का संकेत उसी कोडिंग में 0.719–0.894 पार फैलता है, हमेशा 0.545 से ऊपर), इसलिए कोडिंग-मजबूत पैनल-ओवर-सेल्फ परिणाम अंतरा-ब्लॉक CN मामला है। एक पैनल जहां स्व-रिपोर्ट स्पष्ट रूप से पैनल संकेत को हरा गया (0.842 बनाम 0.697) वह थी जिसमें अध्ययन के सर्वोत्तम-विभेदकारी विक्रेता शामिल था (Anthropic की मध्य स्तर, पूर्ण 1,500-आइटम संग्रह पर अपनी आत्मविश्वास AUROC 0.788), अच्छी रैंक वाले विक्रेता का अपना संकेत अकेले इसके अपने पैनल के समझौता संकेत को पार कर गया। तालिका 7 प्रति-पैनल मान मुद्रित करता है, प्रत्येक पैनल की आइटम जनसंख्या के भीतर गणना की गई। एक युग्मित क्लस्टर बूटस्ट्रैप (प्रतिस्थापन के साथ पुन: नमूना किए गए प्रश्न, सभी तीन (आइटम, प्राथमिक) इकाइयां प्रति प्रश्न एक साथ चलती हैं; B = 2,000) तालिका 6/7 विरोधाभासों पर आत्मविश्वास अंतराल डालता है। CN-सीमांत पैनल पर, पैनल समझौता पूल किए गए अपने आत्मविश्वास को ΔAUROC = +0.287 (95% CI [+0.265; +0.308], p < .001) से हरा देता है। क्रॉस-ब्लॉक पैनल पर नेतृत्व छोटा है लेकिन विश्वसनीय, +0.063 ([+0.037; +0.087], p < .001)। US-सीमांत पैनल पर दिशा उलट जाती है और उलटफेर स्वयं सांख्यिकीय रूप से स्पष्ट है: अपने आत्मविश्वास 0.842 बनाम पैनल समझौता 0.697। पैनल संरचना इसलिए संकेत के मूल्य का एक प्रथम-क्रम संयोजक है, और परिनियोजन नियम अनुसरण करता है: संकेत के ऊपर समझौते पर विश्वास करने से पहले पैनल सदस्यों की अपनी अंशांकन को मापें, ΔAUROC = −0.145 ([−0.170; −0.120], p < .001)। सभी तीन विरोधाभास महत्वपूर्ण हैं, और पैनलों में विषमता एक निष्कर्ष है, शोर नहीं। US का मामला इसलिए एक पुष्टि की गई उलटफेर के रूप में रिपोर्ट किया जाता है, न कि एक शून्य क्षेत्र के रूप में, और यह निर्माण को सीमाबद्ध करता है: बाजार के विभेदकारी अंत से तैयार पैनल पर, अपना आत्मविश्वास एक रैंकिंग संकेत के रूप में समझौते से बेहतर प्रदर्शन करता है, इसलिए विविधता घटक का विभेदन मूल्य पैनल संरचना पर निर्भर करता है न कि सार्वभौमिक रूप से। आर्किटेक्चर एक बाहरी सत्यता संकेत प्रदान कर सकता है जहां सीमित रूप से सीमित मॉडल आत्मविश्वास भेदभाव करता है, और अंशांकन दावे का ऑडिट करता है जहां एक बनाया जाता है। एक सीमा रहती है: यहां तक कि एक पूरी तरह से अंशांकित मॉडल अपने स्वयं के इतिहास को प्रमाणित नहीं कर सकता है या अपने स्वयं के हित के टकराव पर निर्णय नहीं दे सकता है, इसलिए विक्रेता भेदभाव सुधरने के साथ, विविधता की भूमिका सत्यता खोज से अंशांकन लेखापरीक्षा में बदल जाती है, जबकि साक्ष्य और तटस्थता कोई भी अंशांकन नहीं कर सकती है।
आर्किटेक्चरल सत्यापन एक बाहरी सत्यता संकेत प्रदान करता है जहां एक विक्रेता एक उपयोगी आत्मविश्वास संकेत शिप करने में विफल रहा, और यह पहचानना कि किस विक्रेता ने एक शिप किया आर्किटेक्चर की आवश्यकता है। प्रतिस्थापन दावा, बिल्कुल परिसीमित, अंशांकन मेट्रिक्स पर निर्भर करता है न कि AUROC पर। जुलाई की लहर में कोई भी विक्रेता एक साथ भेदभाव करने वाला और अच्छी तरह से अंशांकित नहीं है; xAI सबसे करीब आता है (तालिका 7a), और प्रमुख लहर विच्छेदन के अंशांकन पक्ष को पुन: उत्पन्न करता है, इसलिए यहां तक कि वह उपभोक्ता जो सर्वोत्तम रैंक किए गए आत्मविश्वास को प्राप्त करने के लिए होता है एक बाहरी संदर्भ के बिना इसके स्तर को संभाव्यता के रूप में नकद नहीं कर सकता। वह है जो आर्किटेक्चरल परत आपूर्ति करता है। क्या विक्रेताओं को अंततः हर जगह अच्छी अंशांकन शिप करनी चाहिए, साक्ष्य और तटस्थता अछूते हैं। तर्क उस दुनिया में जीवित रहता है जिसमें मॉडल सुधरते हैं।
तीसरा, विफलता का तरीका एक आकार है: प्रमाणित सहमति त्रुटियां, प्रत्येक पैनलिस्ट आत्मविश्वास से एक ही गलत उत्तर पर परिवर्तित होते हुए, खुली-रूप प्रश्नों पर 0.5–2.2% पर हुईं लेकिन 4.0–7.9% एक सहायक भुजा में जो स्थानीय स्तर पर बहुविकल्प प्रारूप में वस्तुओं को फिर से प्रस्तुत करती है (आइटम निर्माण और प्रतिकृति पैकेज में आउटपुट)। सहमति मुख्य रूप से त्रुटि को प्रमाणित करती है जहां उत्तर स्थान सीमित है, किसी भी इंटरफेस के लिए एक डिज़ाइन चेतावनी जो एजेंटों को विकल्पों का एक मेनू प्रदान करता है।
शून्य सकारात्मक परिणामों की तरह ही ज्ञानवर्धक हैं, और मैं उन्हें पूर्व-पंजीकृत के रूप में प्रकाशित करता हूँ। भू-राजनीतिक खंड (इस संभावना सहित कि समान-खंड पैनल प्रशिक्षण कॉर्पस और आसवन वंश साझा करते हैं) इस बेंचमार्क पर त्रुटि सहसंबंध की भविष्यवाणी नहीं करता (अंतः- बनाम क्रॉस-खंड φ अंतर +0.011 सीमांत स्तर पर, 95% CI −0.005 से +0.028; स्थानीय स्तर पर थोड़ा विपरीत)। क्षमता सहसंबंध को चलाती है, झंडा नहीं, Kim et al. (2025) को दोहराते हुए। वंश पकड़ने की दरों की भविष्यवाणी नहीं करता: एक स्थानीय मॉडल अपने स्वयं के सीमांत सहयोगी को सत्यापित करता है जैसे कि कोई अजनबी, और एक तर्क-आसवित मॉडल अपने स्वयं के आधार भार के साथ सबसे कम त्रुटि-सहसंबद्ध साबित हुआ (φ = 0.135)। दोनों प्रदर्शित तुल्यता के बजाय सीमांत शून्य हैं। खंड अंतराल +0.028 से बड़े φ अंतर को बाहर करता है, और वह सीमा, शून्य को अस्वीकार करने की विफलता नहीं, अनुमान कार्य करती है। प्राकृतिक निरंतर विस्तार, जिसे प्रतिकृति डेटा समर्थन देते हैं, पैनल पहचान के बजाय मापी गई पैनल विविधता (आश्चर्य-स्कोर φ) के कार्य के रूप में प्रमाणन उत्थान का अनुमान लगाना है। यह मॉडल पैनलों के लिए वही कार्यक्रम फिर से चलाएगा जो वर्गीकरण-समूह साहित्य ने अपने स्वयं के विविधता आँकड़ों के लिए चलाया था, जिसमें पाया गया कि कोई भी एकल उपाय समूह लाभ की स्पष्ट रूप से भविष्यवाणी नहीं करता (Kuncheva & Whitaker, 2003)।
और सस्ते स्थानीय मॉडल खुले-प्रपत्र प्रश्नों पर सीमांत उत्तरों को प्रमाणित नहीं कर सके (उनकी सहमति के साथ या बिना 46% परिशुद्धता): एक सत्यापक कार्य वर्ग पर सक्षम होना चाहिए इससे पहले कि इसकी स्वतंत्रता कुछ भी मायने रखती हो। सीमा शर्तें ये हैं: सर्वसम्मति त्रुटि को प्रमाणित करती है जहाँ उत्तर स्थान सीमित हैं, स्वतंत्रता को माना जाना चाहिए न कि मान लिया जाना चाहिए, सत्यापक दक्षता प्रमाणन मूल्य को द्वार रखती है। व्यावहार में, विविधता एक संपत्ति है जिसे मापा जाना चाहिए, प्रश्न दर प्रश्न, ब्रांड, खंड, या पारिवारिक वृक्षों से नहीं माना जाना चाहिए। तालिका 6 पैनल मेट्रिक्स का सारांश बताती है। चित्र 13 प्रमाणन उत्थान और संकेत तुलना को साथ-साथ दिखाता है।
चित्र 13. सटीकता भ्रम और इसका वास्तुकला समाधान
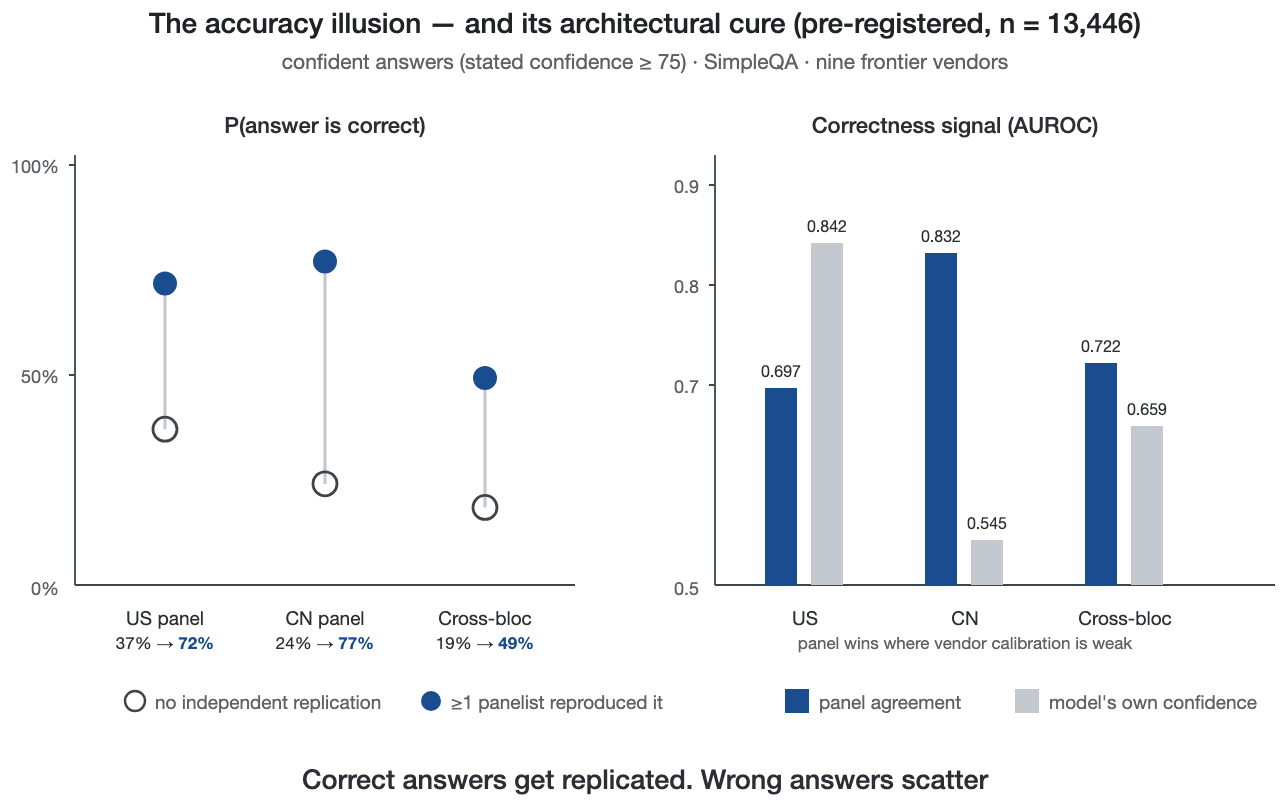
स्वतंत्र प्रतिकृति द्वारा प्रमाणन (पूर्व-पंजीकृत; n = 13,446 ग्रेडेड उत्तर — नौ सीमांत विक्रेता, प्रत्येक एक ही 1,500 SimpleQA प्रश्नों का एक बार उत्तर देते हैं, 54 विफल या अनश्रेणीकृत कॉल को छोड़कर)।
समवर्ती कार्य सावधानी को मजबूत करता है: एक बड़े पैमाने पर ऑडिट ने उच्च आत्म-संगति को तर्क बेंचमार्क पर गलत उत्तरों के साथ पाया, जहाँ स्वतंत्रता और अंधा संग्रह के बिना सहमति अकेले एक कमजोर और आहार-निर्भर संकेत है (Ding, 2026)। मैं इसलिए स्वतंत्र, अंधा प्रतिकृति को प्रमाणन की इकाई मानता हूँ।
तालिका 6. आत्मविश्वासी-त्रुटि अवरोध और पैनल द्वारा प्रमाणन (SimpleQA, पुष्टि; conf ≥ 75)
| पैनल | आत्मविश्वासी त्रुटियाँ (n) | त्रुटियों पर झंडा दर [95% CI] | सही पर झूठे अलर्ट | P(सही | ≥1 सहमत) | P(सही | कोई नहीं) | AUROC: सहमति बनाम अपना आत्मविश्वास |
| US-सीमांत (Anthropic·OpenAI·Google) | 1,630 | 94.3% [93.1–95.3] | 91.0% | 71.8% | 37.1% | 0.697 बनाम 0.842 |
| CN-सीमांत (DeepSeek·Alibaba·Moonshot) | 2,128 | 85.5% [83.9–86.9] | 94.8% | 77.0% | 24.1% | 0.832 बनाम 0.545 |
| क्रॉस-खंड (Anthropic·DeepSeek·Mistral) | 2,432 | 89.4% [88.1–90.6] | 93.4% | 49.3% | 18.5% | 0.722 बनाम 0.659 |
झंडा = ≥1 पैनलिस्ट का स्वतंत्र उत्तर प्राथमिक के समतुल्य नहीं (इनकार और शून्य-ओवरलैप उत्तर गैर-सहमति के रूप में गिने जाते हैं; सख्त कोडिंग प्रतिकृति पैकेज में है)। 60/90 पर थ्रेशोल्ड संवेदनशीलता कोई निष्कर्ष नहीं बदलती। अपना-आत्मविश्वास AUROC पूल किए गए पैनल की पूर्ण उत्तर आबादी पर दर्ज किया गया आत्मविश्वास है; पूलिंग विक्रेताओं के बीच सटीकता और आत्मविश्वास पैमाने में अंतर को अवशोषित करती है, इसलिए यह प्रत्येक सदस्य के व्यक्तिगत मूल्य (तालिका 7 में प्रति-विक्रेता मान) को पार कर सकता है। उत्तर प्रश्न द्वारा क्लस्टर करते हैं; एक प्रश्न-स्तर क्लस्टर बूटस्ट्रैप अंतराल को लगभग 1.6 के कारक से चौड़ा करता है बिना किसी निष्कर्ष को बदले। इस तालिका में और तालिका 7 में प्रत्येक AUROC नियतात्मक रूप से प्रतिकृति करता है, एक कमांड के साथ और बिना यादृच्छिकता के, प्रतिकृति पैकेज स्क्रिप्ट compute_panel_vs_own_auroc.py (Mann–Whitney टाई सुधार के साथ) से।
तालिका 7. पैनल द्वारा अपना-आत्मविश्वास AUROC: पूल किया गया पैनल जनसंख्या और प्रति विक्रेता (तालिका 6 के समान आबादी)
| पैनल | पूल किया गया अपना-आत्मविश्वास AUROC | प्रति-विक्रेता अपना-आत्मविश्वास AUROC |
| US-सीमांत | 0.842 | Anthropic 0.784 · OpenAI 0.596 · Google 0.746 |
| CN-सीमांत | 0.545 | DeepSeek 0.569 · Alibaba 0.532 · Moonshot 0.620 |
| क्रॉस-खंड | 0.659 | Anthropic 0.787 · DeepSeek 0.570 · Mistral 0.584 |
निर्धारक पाइपलाइन द्वारा प्रतिलिपि पैकेज में गणना की गई। दो जनसंख्या सम्मेलन सह-अस्तित्व में हैं और स्पष्ट अंतर्विरोध से बचने के लिए स्पष्ट रूप से मुद्रित हैं: तालिका के प्रति-विक्रेता मान प्रत्येक पैनल की आइटम जनसंख्या के भीतर गणना किए जाते हैं, जबकि पाठ में एकल-संख्या उद्धरण पूर्ण-संग्रह मान का उपयोग करते हैं — सर्वश्रेष्ठ-विभेदकारी विक्रेता के लिए US-frontier पैनल में 0.784 बनाम पूर्ण 1,500-आइटम संग्रह पर 0.788, और OpenAI के लिए 0.596 बनाम 0.598 (दोनों जोड़े एक ही पाइपलाइन के एक आदेश से पुन: उत्पन्न होते हैं)। पूल किया गया स्तंभ, इसके विपरीत, विक्रेता आधार दरों को भ्रमित करता है — विक्रेता के बीच सटीकता और आत्मविश्वास पैमाने में अंतर काम का कुछ हिस्सा करते हैं, इसलिए पूल की गई मान को प्रति-विक्रेता श्रेणी के अंदर नहीं होना चाहिए (लाइव पुनः गणना की गई: US-frontier पूल किया गया 0.842 हर सदस्य के व्यक्तिगत मान से अधिक है, और CN-frontier पूल किया गया 0.545 उस पैनल के प्रति-विक्रेता मैक्रो-औसत 0.574 से नीचे है); प्रति-विक्रेता मान व्याख्या योग्य मात्राएं हैं। प्रति-विक्रेता प्रसार उपभोक्ता की समस्या है जो संख्यात्मक रूप से बताई गई है: एक विक्रेता पर प्रयोग योग्य भेदभाव मौजूद है और दूसरों पर लगभग संयोग के पास है, और किसी उत्तर के बाहर कुछ नहीं कहता है कि किस विक्रेता ने इसका उत्पादन किया। Section 3 विक्रेता श्रेणियों के पीछे स्रोत मान, एक ही ग्रेडेड संग्रह से प्रति मॉडल मुद्रित (माध्य बताया गया आत्मविश्वास · सटीकता · पूर्ण-संग्रह स्वयं-आत्मविश्वास AUROC): frontier — Alibaba 95 · 47.4% · 0.532; Anthropic 42 · 10.3% · 0.788; DeepSeek 90 · 35.7% · 0.570; Google 95 · 66.5% · 0.746; Mistral 90 · 16.5% · 0.584; Moonshot 85 · 51.6% · 0.619; OpenAI 85 · 16.7% · 0.598; xAI 60 · 37.9% · 0.777; Zhipu 95 · 28.4% · 0.611 — 85–95 बैंड के नीचे दोनों माध्य दो विक्रेताओं के हैं जिनका आत्मविश्वास प्रयोग योग्य संकेत रखता है; local tier (केवल कठिनाई स्तरीकरण और स्थानीय-tier nulls में प्रवेश करता है) — gemma4:e4b 90 · 5.2% · 0.541; glm4:9b 85 · 5.0% · 0.589; llama3.2:3b 100 · 5.3% · 0.494; mistral:7b 95 · 6.3% · 0.506; phi4-mini 95 · 5.5% · 0.505; qwen3:8b 95 · 5.9% · 0.504; deepseek-r1:8b 90 · 9.2% · 0.696 (n = 98, पूर्व-प्रतिबद्ध स्टॉपिंग नियम)।
AUROC भेदभाव को मापता है, चाहे किसी विक्रेता का बताया गया आत्मविश्वास उसके सही उत्तरों को गलत उत्तरों से ऊपर रैंक करता है, जबकि ECE, Brier स्कोर, और आत्मविश्वास–सटीकता अंतराल अंशांकन को मापते हैं, चाहे बताई गई संख्या को संभावना के रूप में पढ़ा जा सकता है, और इन डेटा में दोनों तीव्र रूप से अलग हो जाते हैं। अध्ययन का सर्वश्रेष्ठ-विभेदकारी जुलाई विक्रेता, Anthropic का मध्य tier (स्वयं-आत्मविश्वास AUROC 0.788), अभी भी स्तर में बुरी तरह से अंशांकित है: माध्य बताया गया आत्मविश्वास 41.3 (माध्य 42) 10.3% सटीकता के विरुद्ध, एक +31.0-बिंदु अति-आत्मविश्वास अंतराल, ECE 0.311 (15 bins), Brier 0.206 जिसमें एक विश्वसनीयता अवधि 0.093 के अपरिवर्तनीय-अनिश्चितता फर्श के विरुद्ध 0.126 है। इसके विपरीत, पैनल में सबसे खराब अंशांकन लगभग-संयोग भेदभाव (Mistral: अंतराल +74.2 बिंदु, ECE 0.742, AUROC 0.584) के साथ सह-अस्तित्व में है, और केवल xAI भेदभाव और अंशांकन दोनों के करीब पहुंचता है (ECE 0.111, AUROC 0.777)। यहां तक कि वहां भी भेदभाव समान रूप से कम बताए गए आत्मविश्वास द्वारा मदद की जाती है, जबकि अन्य आठ जुलाई विक्रेताओं के लिए दोनों गुण तीव्र रूप से अलग हो जाते हैं। यही अलगाव flagship tier पर बना रहता है: ग्यारह में नौ अगस्त flagships +12.5 से +71.4 बिंदु (ECE 0.125–0.714) के अति-आत्मविश्वास अंतराल रखते हैं, जबकि दो अपवाद (gpt-5.6-sol, ECE 0.031; claude-fable-5, ECE 0.043) सटीकता पैमाने के विपरीत सिरों पर अंशांकन प्राप्त करते हैं। एक उपभोक्ता जो एक अच्छी रैंकिंग वाला लेकिन संख्यात्मक रूप से फुलाया हुआ आत्मविश्वास स्कोर रखता है वह इसे बिना बाहरी संदर्भ के नकद नहीं कर सकता। Table 7a अंशांकन मेट्रिक्स को भेदभाव वाले के आगे मुद्रित करता है।
Table 7a. भेदभाव बनाम अंशांकन, जुलाई wave (पूर्ण संग्रह, संकल्पित; ECE 15 bins के साथ; अंतराल = माध्य बताया गया आत्मविश्वास − सटीकता, प्रतिशत अंक)
| विक्रेता | n | AUROC (स्वयं conf) | ECE | Brier | Conf − acc अंतराल | माध्य conf → सटीकता |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| US-frontier पैनल, पूल किए गए यूनिट | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| CN-frontier पैनल, पूल किए गए यूनिट | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| क्रॉस-bloc पैनल, पूल किए गए यूनिट | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
पूर्ण-संग्रह AUROC और Tables 6–7 के समान जनसंख्या (पैनल पंक्तियां: पूल किए गए (आइटम, प्राथमिक) यूनिट); refusals को frozen प्रोटोकॉल के तहत गलत के रूप में स्कोर किया गया। Brier Murphy पहचान द्वारा विघटित होता है (विश्वसनीयता − रेजोल्यूशन + अनिश्चितता) एक ही 15 bins पर, हर पंक्ति में residual < 0.001। एक flagship-tier नोट दोनों अंशांकित अपवादों के साथ यात्रा करता है: gpt-5.6-sol का ECE 0.031 95.4% सटीकता पर अर्जित किया जाता है, जहां Murphy अनिश्चितता अवधि, आधार दर निर्धारित करता है, 0.044 है — अंशांकन आंशिक रूप से एक आधार दर द्वारा खरीदा गया है जो Table 9 प्रदूषण caveat (61.6% verbatim gold-string matches) रखता है।
एक चयन प्रभाव को तालिका के साथ यात्रा करनी चाहिए: प्रतिकृति प्रश्न सरलता का आंशिक संकेतक है। प्रश्न कठिनाई द्वारा स्तरीकरण (अन्य पन्द्रह मॉडल के पार माध्य सटीकता), कच्चा प्रमाणीकरण उठान आसान स्तर द्वारा किया जाता है (2.7–4.6×), दूसरे सबसे कठिन पंचमांश पर 1× से नीचे गिरता है, और इस भीतर-संग्रह माप के तहत सबसे कठिन पर गायब हो जाता है। वह स्तरीकरण आंशिक रूप से अंतर्जात है, और एक बहिर्जात पुनः-अनुमान नीचे व्युत्क्रम को एकदिष्ट क्षीणन में नरम करता है। एक मजबूती विश्लेषण चयन चिंता को सीधे संबोधित करता है (अन्वेषणात्मक, पूर्व-पंजीकृत नहीं): एक प्रश्न-क्लस्टर किए गए लॉजिस्टिक मॉडल में प्राथमिक-मॉडल निश्चित प्रभाव के साथ, प्राथमिक के अपने आत्मविश्वास और आइटम कठिनाई के लिए नियंत्रण (छोड़-प्राथमिक-बाहर माध्य सटीकता सभी सोलह मॉडल के पार), प्रत्येक अतिरिक्त सहमत पैनलिस्ट अभी भी सुधार की बाधाओं को लगभग पाँच से गुणा करता है (पूल किया गया b = +1.65 प्रति पैनलिस्ट, 95% CI [+1.49, +1.81], p < 10⁻⁸⁸; प्रत्येक पैनल में सकारात्मक), और कठिनाई-प्लस-आत्मविश्वास आधार रेखा में सहमति जोड़ने से होल्ड-आउट AUROC को 0.859 से 0.898 तक बढ़ाता है और Brier स्कोर को 0.139 से 0.116 तक कम करता है (प्रश्न द्वारा विभाजित दो-गुना क्रॉस-सत्यापन)। समान मॉडल सीमा की जांच करता है, और स्तरीकरण स्वयं को देखभाल की आवश्यकता है: भीतर-संग्रह कठिनाई माप के तहत सशर्त गुणांक सबसे कठिन पंचमांश पर नकारात्मक हो जाता है (b = −0.41, p = .011), लेकिन वह माप पैनल के अपने सदस्यों को शामिल करता है। सशर्त मॉडल एक परिनियोजन स्वीकृति रखता है: इसकी कठिनाई सुविधा को लेबल की आवश्यकता है, इसलिए यह निदान है, परिनियोजन योग्य नहीं है, और परिनियोजन योग्य फिल्टर सहमति द्वार स्वयं है। तीन और जांच अनुमान और चयन चिंताओं को संबोधित करते हैं, सभी फ्रोजन नियतात्मक प्रोटोकॉल कोडिंग के तहत (सख्त शाखा प्रतिकृति पैकेज न्यायाधीश-मध्यस्थता सुर्खियों के संख्या के साथ रिपोर्ट करता है)। आइटम-क्लस्टर किए गए बूटस्ट्रैप पुनः नमूनाकरण के साथ प्रमाणीकरण उठान का पुनः अनुमान, क्लस्टरिंग कठिनाई संरचना मांग करती है, प्रत्येक पैनल के प्रमाणीकरण-उठान अंतराल को 1 से बहुत अधिक छोड़ देता है (इस नियतात्मक कोडिंग के तहत 2.4–4.5 उठान बिंदु, जो प्रकाशित 1.9–3.2× सुर्खियों के पीछे न्यायाधीश-मध्यस्थता जोड़ी कोडिंग की तुलना में कम सहमति को प्रमाणित करता है; बूटस्ट्रैप निचली सीमा 2.2–4.1)। ऊपर रिपोर्ट किया गया 84-पैनल वितरण अमेरिकी-सीमांत पैनल को बनाता है, जहां आत्म-रिपोर्ट जीत जाती है, अपवाद बजाय नियम के (माध्य लाभ +0.14, समझौता AUROC का IQR 0.76–0.82)। और कठिनाई-स्तरीकृत AUROC एक बहिर्जात कठिनाई माप के तहत सीमा को स्पष्ट बनाता है: सबसे आसान पंचमांश पर 0.87 सबसे कठिन पर 0.61 तक गिर रहा है, व्युत्क्रम के बिना क्षीणन। वह माप छोड़-पैनल-बाहर है, तेरह मॉडल प्रत्येक पैनल के बाहर, और इसके साथ पुनः अनुमान व्युत्क्रम को हल करता है: सशर्त समझौता गुणांक सबसे कठिन सहित हर पंचमांश पर सकारात्मक रहता है (सबसे कठिन-पंचमांश b = +0.97, p < 10⁻⁷; सबसे कठिन स्तर पर स्वतंत्र रूप से प्रतिकृत उत्तर का 28%, 0% नहीं)। तो भीतर-संग्रह व्युत्क्रम आंशिक रूप से कठिनाई माप का एक कलाकृति है। जो दोनों उपायों के तहत जीवित है वह एकदिष्ट क्षीणन है, समझौता सबसे कमजोर जहां प्रश्न सबसे कठिन हैं, और प्रमाणित सर्वसम्मति त्रुटियों की वास्तविकता; स्क्रिप्ट और आउटपुट प्रतिकृति पैकेज में हैं। सुर्खी अनुपात इसलिए एक विषम जनसंख्या पर एक औसत है। संकेत दावा AUROC समापन बिंदु पर निर्भर करता है, अनुपात पर नहीं।
प्रयोग की परिकल्पनाएं मेरे संचालित अनुसंधान परिनियोजन को परिचालित करती हैं: अंधा संग्रह इसकी परिषद तंत्र को प्रतिबिंबित करता है, और पैनल रचनाएं अध्ययन डिजाइन किए जाने से पहले इसके उत्पादन कॉन्फ़िगरेशन के रूप में मौजूद थीं। यह इस अनुसंधान कार्यक्रम में दूसरा पूर्व-पंजीकृत अध्ययन है। तीसरा, अनुभाग 6 उपभोक्ता प्रयोग, पूर्ण और रिपोर्ट किया गया है, और एक चौथा (उत्पादन ट्रैफिक पर क्षेत्र दूरदर्शिता) तैयार है। प्रतिकृति पैकेज किसी के लिए चलता है, कमोडिटी हार्डवेयर पर, सार्वजनिक API के खिलाफ।
फ्लैगशिप स्तर पर दूसरी लहर: ग्यारह प्रयोगशालाएं — दस पूर्ण भुजाएं और एक आंशिक — एक अंशांकन खाई। ऊपर का प्रयोग लागत-अनुकूलित स्तरों का नमूना लेता है जो वास्तव में उपभोक्ताओं को सेवा देते हैं। आपत्ति परीक्षण करने के लिए: शायद सटीकता भ्रम एक बजट-स्तर कलाकृति है, और फ्लैगशिप, मॉडल प्रत्येक विक्रेता अपने सर्वश्रेष्ठ के रूप में आगे रखता है, पर्याप्त रूप से अंशांकित हैं कि उनके ऊपर वास्तुकला निरर्थक है। एक दूसरी संग्रह लहर (अगस्त 2026) बाजार के शीर्ष पर उस आपत्ति का परीक्षण करता है।
मैं दस प्रमुख AI प्रयोगशालाओं में से प्रत्येक से एक फ्लैगशिप मॉडल का मूल्यांकन करता हूं जो संयुक्त राज्य अमेरिका, चीन और यूरोप में फैले हुए हैं। प्रयोगशालाएं इन तीन क्षेत्रों में अग्रणी वाणिज्यिक और खुले-वजन पारिस्थितिकी तंत्र को कवर करने के लिए चुनी गई थीं। प्रत्येक प्रयोगशाला के लिए मैंने मूल्यांकन लहर के समय इसका सबसे सक्षम सामान्यतः उपलब्ध मॉडल चुना। मैंने तब अगस्त 5, 2026 (LMArena Elo, कृत्रिम विश्लेषण बुद्धिमत्ता सूचकांक, मानवता की अंतिम परीक्षा, और SWE-bench सत्यापित) के रूप में सार्वजनिक लीडरबोर्ड के खिलाफ इस कवरेज को सत्यापित किया: दस फ्लैगशिप में से आठ कम से कम एक सामान्य-क्षमता लीडरबोर्ड के शीर्ष स्तर में या उसके निकट रखे जाते हैं, जबकि दो (Mistral, Baidu) प्रयोगशाला और क्षेत्रीय कवरेज को संरक्षित करने के लिए शामिल किए जाते हैं बजाय रैंकिंग आधार के (कवरेज सीमाएं नीचे देखें)। एक ग्यारहवीं प्रयोगशाला, Meta, जिसका फ्लैगशिप केवल लहर के क्षेत्र के बाद पहुंचा, मध्य-लहर में जोड़ा गया था; इसका संग्रह एक पहुंच रद्दीकरण से बाधित था और आंशिक रूप से रिपोर्ट किया जाता है (नीचे देखें)।
तालिका 8। मूल्यांकन किए गए फ्लैगशिप मॉडल और लीडरबोर्ड स्थितियां (अगस्त 5, 2026 के अनुसार)
| प्रयोगशाला | फ्लैगशिप मॉडल (API id) | देश | लीडरबोर्ड स्थितियां (अग. 5, 2026) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58.9); LiveBench #1 (82.4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | USA | SWE-bench सत्यापित #8 (80.6); HLE #17 (51.4); Arena ऊपरी क्लस्टर | |
| xAI | grok-4.5 | USA | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | चीन | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| अलीबाबा | qwen-max (Qwen 3.7 Max) | चीन | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | चीन | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | चीन | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | फ्रांस | सामान्य लीडरबोर्ड पर शीर्ष-50 से नीचे; क्षेत्रीय कवरेज के लिए शामिल |
| Baidu | ernie-4.5-vl-424b | China | सामान्य शीर्ष-30 के बाहर (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (मध्य-लहर में जोड़ा गया, आंशिक) | muse-spark-1.1 | USA | HLE #4 |
कोष्ठक में स्कोर स्नैपशॉट दिनांक पर एग्रीगेटर-रिपोर्ट किए गए मान हैं; लीडरबोर्ड पदों में एग्रीगेटर्स और स्नैपशॉट दिनांकों में मामूली भिन्नताएं होती हैं। स्नैपशॉट स्रोतों को प्रतिकृति पैकेज के साथ आने वाले रन रिकॉर्ड के साथ संग्रहीत किया जाता है।
प्रोटोकॉल पहले प्रयोग का है, फ्रोजन और पुनः उपयोग किया गया: समान 1,500-आइटम SimpleQA सबसैंपल (सीड और हैश द्वारा निर्धारित), प्रति मॉडल एक ब्लाइंड पास, तापमान शून्य, समान सिस्टम प्रॉम्प्ट और उत्तर पार्सर, प्रत्येक उत्तर के लिए 0–100 आत्मविश्वास। ग्रेडिंग नियतात्मक है (सोने के विरुद्ध सटीक और सामान्यीकृत स्ट्रिंग मिलान; इनकार को त्रुटियों के रूप में स्कोर किया गया; अनसुलझे आइटम को हेडलाइन से बाहर रखा गया और संवेदनशीलता विश्लेषण में त्रुटियों के रूप में पुनः स्कोर किया गया), और कोई LLM जज हेडलाइन नंबरों को छूता नहीं है। यह पहली लहर के सापेक्ष एक जानबूझकर कसना है, जिसका ग्रेडर एक हाइब्रिड था: उद्देश्य स्ट्रिंग मिलान एक स्थानीय ओपन-वेट ग्रेडर के साथ शेष को हल करता है (66.5% फैसले मॉडल-जारी; 50-आइटम मानव स्पॉट-चेक, 98% समझौता)। यह लहर केवल नियतात्मक समकक्षता इंजन का उपयोग करती है (मैनुअली सत्यापित: 20 में से 20 फ्लैग किए गए असहमतियां और 15 में से 15 समझौते हाथ से पुष्टि किए गए), इसलिए इस लहर का हर हेडलाइन नंबर जारी की गई स्क्रिप्ट से बिट-दर-बिट पुनः उत्पन्न होता है। पूर्ण सटीकता की क्रॉस-लहर तुलनाएं ग्रेडर शासन को भी पार करती हैं, और प्रत्येक जुलाई-बनाम-अगस्त तुलना एक ग्रेडर-शासन योग्यता वहन करती है। भीतर-लहर ऑडिट प्रत्येक लहर की संख्याओं का समर्थन करते हैं, लेकिन क्रॉस-लहर डेल्टा मॉडल परिवर्तन को ग्रेडर परिवर्तन के साथ मिला देते हैं जब तक कि एक एकल ग्रेडर को दोनों फ्रोजन प्रतिक्रिया सेट पर पुनः लागू न किया जाए, जो यहां नहीं किया गया है। एक प्रयास विचलन: OpenAI की आर्म इंटरफेस के डिफ़ॉल्ट रीजनिंग प्रयास पर एकत्र की गई थी (माध्यम) जहां जुलाई प्रोटोकॉल न्यूनतम का उपयोग करता था, अनुमान में कोई वेब या टूल एक्सेस नहीं है (मॉडल के लिए उजागर किए गए टूल्स की गणना करके सत्यापित, जिनमें से कोई नहीं था)। यह उस विक्रेता की पूर्ण सटीकता को स्थानांतरित करता है, समझौता तंत्र को नहीं (अनुभाग 5)। एक आत्मविश्वास की विफलता एक गलत उत्तर है जो ≥ 80 के कथित आत्मविश्वास पर दी गई है; दहलीज को रन से पहले तय किया गया था, संवेदनशीलता के रूप में 70 और 90 रिपोर्ट किए गए। संघ कवरेज ग्यारह में से दस प्रयोगशालाओं के लिए 1,500/1,500 प्रश्न है। Meta का संग्रह 272 वैध उत्तरों तक पहुंचा था इससे पहले कि पहुंच निरस्त कर दी गई थी।
मैंने क्रॉस-शासन चिंता का भी सीधे परीक्षण किया। जुलाई सोलह-मॉडल लहर को दूसरी लहर के फ्रोजन नियतात्मक इंजन के साथ पुनः ग्रेड करना (जो स्थानीय ओपन-वेट ग्रेडर के साथ एक हाइब्रिड पाइपलाइन को 66.5% फैसले का न्यायाधीश करता है) 2.65% के अनुमत फैसले बदलता है (21,338 में से 566; इंजन 4.1% को और भी दूर रखता है) और कोई हेडलाइन नहीं ले जाता है: एकल नियतात्मक कोडिंग के तहत प्रमाणपत्र लिफ्ट 3.6×/4.6×/4.4× पुनः ग्रेडिंग से पहले और 3.0–3.1×/4.5–4.6×/4.3× बाद पढ़ते हैं। दोनों रूढ़िवादी प्रकाशित 1.9–3.2× के ऊपर हैं, जो LLM-समायोजित पेयर कोडिंग से निकलते हैं, क्योंकि अधिक समझौते प्रमाणित मतलब अधिक रूढ़िवादी लिफ्ट करते हैं। तालिका 6–7 में हर AUROC CN और क्रॉस-ब्लॉक पैनलों पर सर्वाधिक 0.016 द्वारा शिफ्ट करता है और US पैनल पर 0.046, प्रत्येक पैनल के समझौते के विरुद्ध क्रमबद्धता बनाए रखता है।
फ्लैगशिप लेबल कुछ भी गारंटी नहीं देता। समान प्रश्नों पर हल की गई सटीकता ग्यारह फ्लैगशिप्स (तालिका 9) में 11.4% से 95.4% तक फैली हुई है, बाजार के शीर्ष पर 84-बिंदु फैलाव, पहले प्रयोग के मध्य-स्तर के फैलाव से अधिक चौड़ा। और सटीकता भ्रम इसी तरह बरकरार रहता है: दस पूर्ण प्रयोगशाला आर्म्स में पूल किया गया, ≥ 80 में कथित आत्मविश्वास पर दिए गए सभी अनुमत उत्तरों का 46.6% गलत था (10,540 में से 4,910; आंशिक Meta आर्म सहित, 46.3%, या 10,665 में से 4,935; यहां अनसुलझे आइटम को बाहर रखा गया और संवेदनशीलता में त्रुटियों के रूप में पुनः स्कोर किया गया, जहां पूल की गई तस्वीर अपरिवर्तित है)। पहली लहर का उपभोक्ता-सामना अनिवार्यता कीमत के साथ नरम नहीं करता: एक फ्लैगशिप बैज उपभोक्ता को यह नहीं बताता है कि उनके सामने आत्मविश्वास वाला उत्तर 95%-सटीक फ्लैगशिप से आया था या 11%-सटीक वाला।
तालिका 9। फ्लैगशिप लहर: कवरेज और सटीकता (SimpleQA सबसैंपल, n = 1,500 प्रति प्रयोगशाला, तापमान 0)
| प्रयोगशाला (फ्लैगशिप) | कवरेज | सटीकता (हल की गई) | अनसुलझे |
| OpenAI gpt-5.6-sol | 1,500/1,500 | 95.4% (1,403/1,471) | 29 |
| Google gemini-3.1-pro | 1,500/1,500 | 71.1% (837/1,178)¹ | 46 |
| Anthropic claude-fable-5 | 1,500/1,500 | 70.3% (1,019/1,450) | 50 |
| Meta muse-spark-1.1 (आंशिक) | 272/1,500 वैध | 61.4% (148/241)² | 10 |
| xAI grok-4.5 | 1,500/1,500 | 54.8% (794/1,448) | 52 |
| DeepSeek deepseek-v4-pro | 1,500/1,500 | 46.6% (666/1,428) | 72 |
| Moonshot kimi-k3 | 1,500/1,500 | 45.5% (645/1,418) | 82 |
| Zhipu glm-5.2 | 1,500/1,500 | 30.2% (430/1,425) | 69 |
| Baidu ernie-4.5-vl-424b | 1,500/1,500 | 28.9% (411/1,421) | 71 |
| Mistral mistral-medium-3.5 | 1,500/1,500 | 21.4% (306/1,429) | 71 |
| Alibaba qwen-max | 1,500/1,500 | 11.4% (164/1,435) | 65 |
¹ Google के चैनल ने 18.4% आइटमों पर खाली या फ़िल्टर किए गए उत्तर दिए (1,500 में से 276 — एक डिलीवरी संपत्ति, कवरेज अंतर नहीं: सभी 1,500 का प्रयास किया गया); सटीकता की गणना पार्स किए गए, समाधान किए गए उत्तरों पर की जाती है। दोनों परिभाषाएं रिपोर्ट की जाती हैं: केवल उत्तरित, Google की सटीकता 71.1% (837/1,178) है; 276 अप्रदत्त प्रतिक्रियाओं को त्रुटियों के रूप में गिनते हुए यह 57.6% (837/1,454) है, और अनुत्तरित आइटमों को भी त्रुटि के रूप में स्कोर करते हुए 55.8% (837/1,500) है। ² Meta की सटीकता एक्सेस निष्कासन से पहले एकत्र किए गए उत्तरों पर की जाती है; कवरेज सीमाएं देखें। पूरी तालिका में सटीकता केवल समाधान की गई है; अनुत्तरित-त्रुटि संवेदनशीलता के तहत शीर्ष आंकड़ा, OpenAI का 95.4%, 93.5% (1,403/1,500) हो जाता है। प्रत्येक प्रयोगशाला के लिए प्रति-कॉल चैनल प्रवेश रन मैनिफेस्ट में दर्ज किया गया है। अनुत्तरित गणना ने डिलीवर किए गए उत्तरों को संदर्भित करता है जो निर्धारकतः समाधान नहीं हुए; Zhipu (1,494 उत्तर डिलीवर किए गए), Baidu (1,492) और आंशिक Meta शाखा (251) के लिए दोनों कॉलम इसलिए 1,500 से कम जोड़ते हैं, शेष अप्रदत्त प्रतिक्रियाएं हैं।
एक संदूषण सावधानी निरपेक्ष सटीकता को सीमित करती है। यह लहर मूल, सार्वजनिक रूप से जारी SimpleQA बेंचमार्क (अक्टूबर 2024) को उन मॉडलों के विरुद्ध पुनः उपयोग करती है जिनके प्रशिक्षण कॉर्पस इसके प्रकाशन के बाद दो वर्ष तक का है, इसलिए प्रशिक्षण-समय बेंचमार्क के संपर्क में आने की संभावना तालिका के शीर्ष पर है, और डेटा इसका एक ठोस हस्ताक्षर ले जाता है: शीर्ष-स्कोरिंग प्रमुख स्वर्ण उत्तर स्ट्रिंग को शाब्दिक रूप से पुनरुत्पादित करता है (सामान्यीकृत सटीक मिलान, दशमलव फॉर्मेटिंग तक) 61.6% आइटमों पर, अन्य प्रयोगशालाओं के लिए 27.9–45.3% के विरुद्ध, 99 की माध्यिका दिए गए आत्मविश्वास पर। डिजाइन "मॉडल मजबूत है" को "मॉडल ने बेंचमार्क और इसकी उत्तर कुंजी देखी है" से अलग नहीं कर सकता। लहर की निरपेक्ष सटीकता के आंकड़े इसलिए पहली पीढ़ी के मॉडल के लिए रिपोर्ट किए गए ऐतिहासिक बंद-पुस्तक छतों के साथ तुलनीय नहीं हैं, और उन्हें प्राचलिक स्मृति के उपाय के रूप में नहीं पढ़ा जाना चाहिए। पहली लहर की बेंचमार्क-आयु जांच (सेक्शन 3 में रिपोर्ट किया गया TruthfulQA–SimpleQA अंतर) जुलाई संग्रह को कवर करता था; अगस्त 2026 तक, SimpleQA स्वयं एक दो साल पुराना सार्वजनिक बेंचमार्क है, और यह सावधानी प्रमुख लहर को कवर करती है। लहर के निष्कर्ष निरपेक्ष सटीकता पर निर्भर नहीं करते। वे आत्मविश्वासपूर्ण विफलताओं की संरचना, दिए गए आत्मविश्वास ≥ 80 पर उनकी प्रचुरता और असहमति द्वार द्वारा उनके अवरोधन पर निर्भर करते हैं, एक जमे हुए प्रोटोकॉल के तहत लहर के भीतर मापा जाता है, जहां कोई भी एक्सपोजर लाभ मूल्यांकन की गई प्रयोगशालाओं में साझा होता है। अध्ययन विंडो के बाद निर्मित एक ताज़ी दो-हॉप जांच इस हस्ताक्षर को सीधे पुष्टि करता है। इस सेक्शन में बाद में "सबसे अच्छे मॉडल का उपयोग क्यों न करें?" देखें।
कैलिब्रेशन खाई। पहले प्रयोग ने दिखाया कि स्वतंत्र समझौता एक सटीकता संकेत रखता है जो स्व-रिपोर्ट किया गया आत्मविश्वास नहीं करता है। प्रमुख लहर उस संकेत को एक मापी गई फ़िल्टर में बदल देती है। तंत्र एक असहमति द्वार है: तीन प्रयोगशालाओं की एक परिषद, पूर्व विश्लेषण से पहले से तय की गई है और इन परिणामों के लिए फिट नहीं (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), और कोई मुक्त पैरामीटर नहीं के साथ एक नियम। एक उत्तर द्वार से केवल तब गुजरता है जब तीनों परिषद के उत्तर जोड़ी में सहमत हों। क्योंकि कुछ भी अनुमानित नहीं है, कोई प्रशिक्षण/परीक्षण विभाजन की आवश्यकता नहीं है; द्वार जमे हुए संग्रह पर एक बार की गई है।
चित्र 17। प्रमुख द्वार
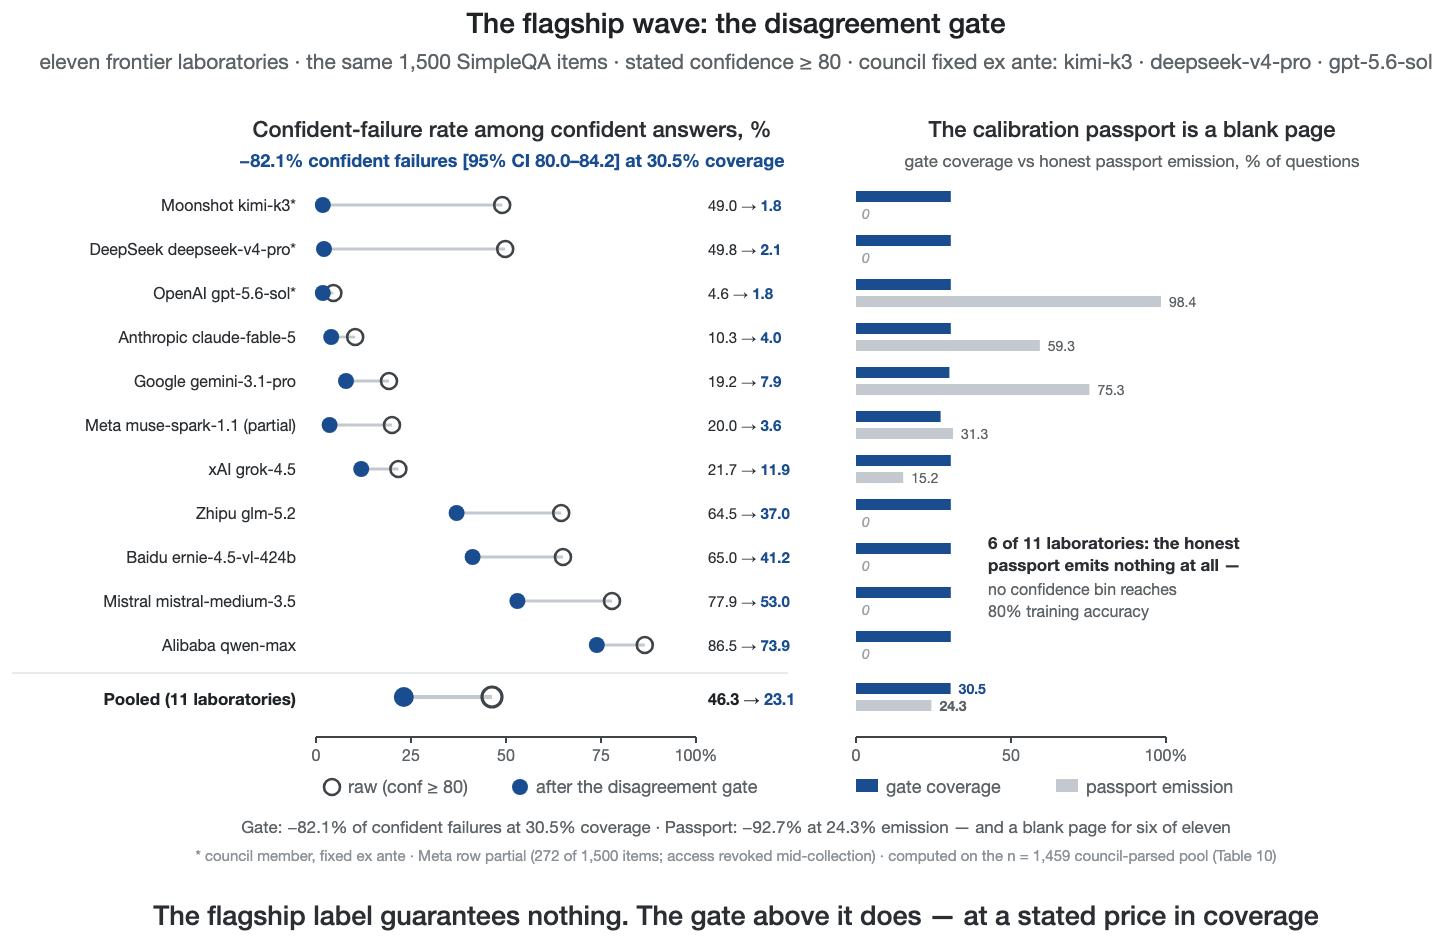
दिए गए आत्मविश्वास ≥ 80 पर आत्मविश्वासपूर्ण विफलताएं और प्रयोगशाला द्वारा निर्धारित तीन-मॉडल असहमति द्वार द्वारा उनके अवरोधन (अगस्त 2026 लहर)।
दस पूर्ण प्रयोगशाला शाखाओं में पूल किया गया (प्राथमिक प्रस्तुति, आंशिक Meta शाखा अलग से रिपोर्ट की गई और इसका समावेश संवेदनशीलता के रूप में माना जाता है), कच्ची आत्मविश्वासपूर्ण-विफलता दर 46.6% (10,540 में से 4,910) है। ग्यारह-प्रयोगशाला रोस्टर में पूल किया गया, प्रति-प्रयोगशाला दरें भिन्न होती हैं (तालिका 9), इसलिए यह आंकड़ा एक सार्वभौमिक स्थिरांक के बजाय सीमांत रोस्टर का वर्णन करता है। द्वार आत्मविश्वासपूर्ण विफलताओं का 82.1% हटाता है (bootstrap 95% CI [79.9; 84.1]) सभी पूल किए गए उत्तरों का 30.5% रखते हुए (द्वार 30.6% प्रश्नों पर खुलता है, 1,459 में से 446)। परिषद के बाहर पूर्ण प्रयोगशालाओं तक सीमित, किसी भी आत्म-संदर्भ के बिना, द्वार अभी भी आत्मविश्वासपूर्ण विफलताओं का 76.9% हटाता है (CI [74.3; 79.2])। आंशिक Meta शाखा को शामिल करने से हर अनुमान प्रभावी रूप से अपरिवर्तित रहता है: सभी ग्यारह में पूल किया गया, कच्ची दर 46.3% (10,665 में से 4,935; 35.8% आत्मविश्वासपूर्ण उत्तर द्वार से गुजरते हैं, और उत्सर्जित आत्मविश्वासपूर्ण उत्तरों में सही होना 53.7% कच्चे से 76.9% द्वार के बाद बढ़ता है), द्वार समान 30.5% कवरेज पर 82.1% (CI [80.0; 84.2]) हटाता है, और आठ-प्रयोगशाला गैर-परिषद आंकड़ा 77.0% (CI [74.4; 79.3]) है। तालिका 10 प्रति-प्रयोगशाला आंकड़े देता है।
तालिका 10। असहमति द्वार द्वारा आत्मविश्वासपूर्ण-विफलता अवरोधन (conf ≥ 80; निर्धारकता ग्रेडर; परिषद = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, पूर्व रूप से तय)
| प्रयोगशाला | आत्मविश्वासपूर्ण उत्तर | आत्मविश्वासपूर्ण विफलताएं, कच्ची | द्वार के बाद (उत्सर्जित पर दर) | dCF |
| Moonshot kimi-k3 [परिषद] | 1,056 | 517 (49.0%) | 7 (1.8%) | −98.6% |
| DeepSeek deepseek-v4-pro [परिषद] | 1,274 | 634 (49.8%) | 9 (2.1%) | −98.6% |
| OpenAI gpt-5.6-sol [परिषद] | 1,426 | 65 (4.6%) | 8 (1.8%) | −87.7% |
| Anthropic claude-fable-5 | 825 | 85 (10.3%) | 15 (4.0%) | −82.4% |
| Google gemini-3.1-pro | 966 | 185 (19.2%) | 27 (7.9%) | −85.4% |
| Meta muse-spark-1.1 (आंशिक) | 125 | 25 (20.0%) | 2 (3.6%) | −92.0% |
| xAI grok-4.5 | 577 | 125 (21.7%) | 36 (11.9%) | −71.2% |
| Zhipu glm-5.2 | 1,128 | 727 (64.5%) | 146 (37.0%) | −79.9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65.0%) | 107 (41.2%) | −77.3% |
| Mistral mistral-medium-3.5 | 1,354 | 1,055 (77.9%) | 224 (53.0%) | −78.8% |
| Alibaba qwen-max | 1,209 | 1,046 (86.5%) | 300 (73.9%) | −71.3% |
| पूल (11 प्रयोगशालाएं) | 10,665 | 4,935 (46.3%) | 881 (23.1%) | −82.1% [80.0; 84.2] |
| पूल (8 गैर-परिषद) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
उन प्रश्नों के पूल पर परिकलित किया गया जहां सभी तीन परिषद सदस्यों ने पार्स किए गए, गैर-अस्वीकृत उत्तर दिए (n = 1,500 में से 1,459); गेट इनमें से 446 पर खुलता है (30.6%)। मेटा पंक्ति आंशिक है (संग्रह के बीच में एक्सेस रद्द कर दिया गया)। बूटस्ट्रैप CI: 5,000 प्रश्न-स्तर पुनः नमूने।
उस हेडलाइन के साथ तीन चीजें जाती हैं। गेट आत्मविश्वास से भरे सही उत्तरों को भी लगभग आधा खारिज कर देता है (गेट केवल 51.3% आत्मविश्वास से भरे सही उत्तरों को बनाए रखता है; जो उत्तर यह खारिज करता है, उनमें से लगभग 41% वास्तव में सही थे)। व्यापार कवरेज के लिए निश्चितता का है, चयनात्मक वर्गीकरण का विहित जोखिम–कवरेज व्यापार-बंद (Geifman & El-Yaniv, 2017), यहां आर्किटेक्चर परत पर निष्पादित किया गया, और दोनों संख्याओं को हमेशा एक जोड़ी के रूप में उद्धृत किया जाना चाहिए: 30.5% कवरेज पर −82.1% आत्मविश्वास से भरी विफलताएं। सिस्टम का अपना एक न्यूनतम है। पूरी तरह से प्रणालीगत मोड में, जहां खुला गेट व्यक्तिगत मॉडल के बजाय परिषद के सर्वसम्मति उत्तर को उत्सर्जित करता है, सिस्टम की अपनी आत्मविश्वास से भरी विफलता दर 1.8% है (442 हल किए गए सर्वसम्मति उत्तरों में से 8), और वे आठ प्रश्न ऐसे हैं जहां पूरी परिषद आत्मविश्वास से एक ही गलत उत्तर पर सहमत है। यह सहसंबद्ध-त्रुटि न्यूनतम है जो पहले प्रयोग ने अपनी सर्वसम्मति-त्रुटि को प्रमाणित करने वाली सीमा स्थिति से भविष्यवाणी की थी: इसके नीचे, समझौता-जांच करने से कोई मदद नहीं मिलती, क्योंकि समझौता ही त्रुटि है। और परिणाम पूर्व-घोषित संवेदनशीलता ग्रिड में फ्लैट है: आत्मविश्वास थ्रेसहोल्ड 70/80/90 पूल किए गए dCF का −83.1%/−82.1%/−80.6% देता है, और अनसुलझे आइटम को त्रुटियों के रूप में पुनः स्कोर करना −81.8% देता है, इसलिए संख्या को मापा गया था, चुना नहीं गया।
30.5% कवरेज आंकड़े का व्यावसायिक रूप से क्या अर्थ है यह खंड 5 की ब्रेक-ईवन अर्थशास्त्र द्वारा निर्धारित किया जाता है (चित्र 14): गेट जो लगभग सत्तर प्रतिशत उत्तरों को प्रमाणित करने से इनकार करता है वे अनुरोध हैं जो एक आत्मविश्वास से भरी त्रुटि से सस्ते भाग्य में भेजे जाते हैं (किसी मानव को एस्कलेशन, गहरी सत्यापन परत, या स्पष्ट अनिश्चितता प्रदर्शन) बजाय खोए हुए रूपांतरण के, इसलिए कवरेज लागत एक बीमा योग्य त्रुटि की कीमत है, छोड़ी गई मांग नहीं। एस्कलेशन चैनल के लिए कोई लागत मॉडल यहां अनुमानित नहीं है। परिचालन बिंदु निर्धारित नहीं है। चित्र 19 में ट्रेस किया गया समझौता सीढ़ी थ्रेसहोल्ड का एक परिवार प्रदान करती है, और एक सेवा को वह जगह बैठनी चाहिए जहां एक पकड़े गए आत्मविश्वास से भरी विफलता की अपेक्षित लागत गेट जो ट्रैफिक रोकता है उसके मार्जिन को पार करती है, जो इसे एक लागत-आधारित पसंद बनाता है।
चित्र 14। स्नातक विश्वास की अर्थशास्त्र
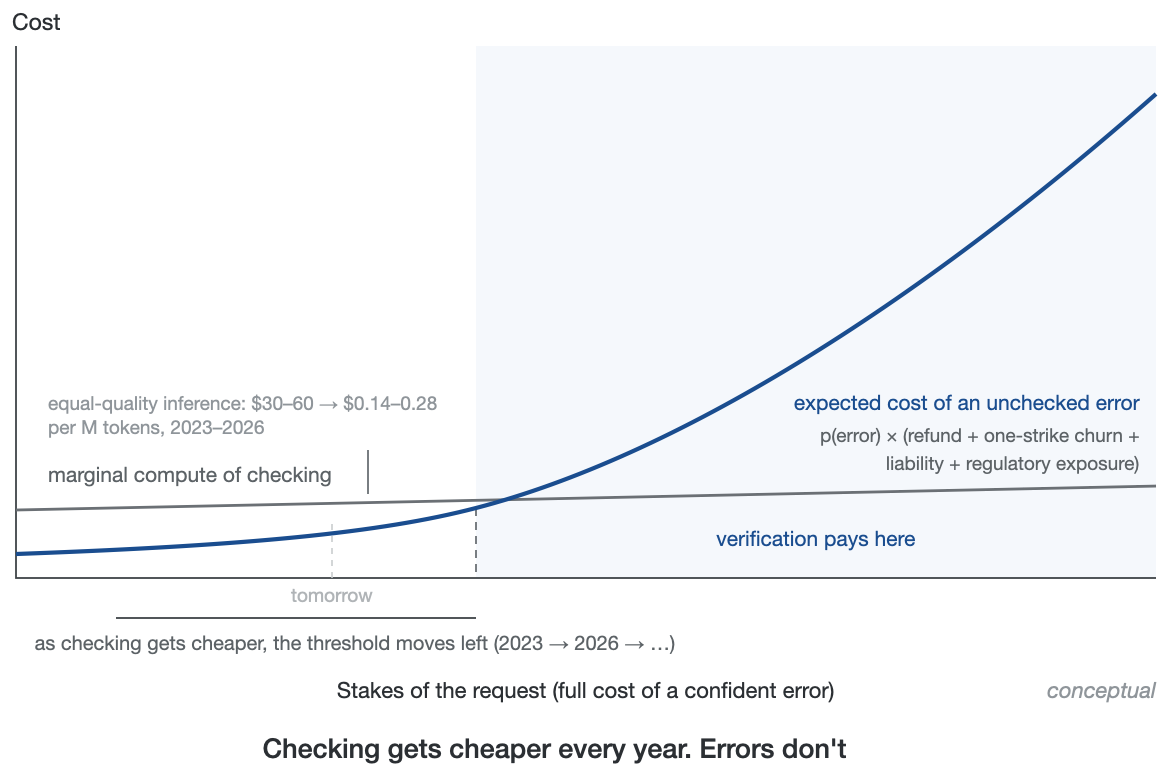
सत्यापन की ब्रेक-ईवन तर्क।
केवल सर्वश्रेष्ठ मॉडल का उपयोग क्यों नहीं करें? सबसे मजबूत आधार जो लहर खड़ा छोड़ती है वह सांख्यिकीय के बजाय व्यावसायिक है: एक ऑपरेटर आर्किटेक्चर को छोड़ सकता है और सबकुछ लहर के सबसे सटीक फ्लैगशिप में भेज सकता है। उस आधार को संख्या के साथ एक उत्तर की आवश्यकता है। 2026 की मध्य-कालीन कीमतों पर फ्रीज किए गए तीन-लैब परिषद की लागत $0.0039 प्रति प्रश्न है, लहर के सबसे महंगे फ्लैगशिप (claude-fable-5, $0.0198/प्रश्न सूचीबद्ध मूल्य पर) से कम और इसके सबसे सटीक (gpt-5.6-sol, $0.0027/प्रश्न प्रकाशित API दरों पर) से अधिक। "बस सर्वश्रेष्ठ फ्लैगशिप खरीदें" एक वास्तविक पारेटो बिंदु है: gpt-5.6-sol अकेले हर प्रश्न का उत्तर 4.6% आत्मविश्वास से भरी विफलता दर पर देता है, और कोई भी गेटेड कॉन्फ़िगरेशन किसी भी कीमत पर इसके कवरेज को नहीं देता है। जहां एक सेवा लगभग बीस उत्तरों में से एक पर आत्मविश्वास से भरी विफलता को सहन कर सकता है और पूर्ण कवरेज की आवश्यकता है, फ्लैगशिप दोनों अक्षों पर जीतता है। नियम लीडरबोर्ड के शीर्ष पर भी खराब सामान्यीकृत होता है: लहर का अन्य सर्वसम्मति अग्रदूत, claude-fable-5, 10.3% आत्मविश्वास से भरी विफलता दर अकेले रखता है। "बस कोई भी मॉडल चुनें जो बेंचमार्क में सबसे ऊपर हो" नमूने में दूसरे सबसे मजबूत मॉडल पर पूरी तरह विफल हो जाता है, यही कारण है कि नीचे की पहचान समस्या परिकल्पनात्मक नहीं है। चार विचार तुलना को सीमित करते हैं।
पहला, पहचान समस्या: जानना कि कौन सा मॉडल वर्तमान में सर्वश्रेष्ठ है यह स्वयं बाहरी, क्रॉस-मॉडल मापन का उत्पाद है। लहर की अपनी तालिका 8 ने अपने फ्लैगशिप को सार्वजनिक लीडरबोर्ड, निरंतर, तीसरे पक्ष, क्रॉस-विक्रेता तुलना से चुना जो कोई भी विक्रेता आत्म-रिपोर्ट से बदलने का प्रस्ताव नहीं देता। इस पेपर के अपने डेटा से पता चलता है कि कोई भी ऐसा क्यों नहीं करता: कथित आत्मविश्वास विक्रेता के आधार पर AUROC 0.53–0.79 पर भेद करता है, और 84-बिंदु सटीकता फैलाव उन मॉडलों को अलग करता है जो सभी अपनी प्रयोगशाला के सर्वश्रेष्ठ के रूप में बिकते हैं। "सर्वश्रेष्ठ मॉडल पर भेजें" इसलिए स्थापत्य विश्वास का एक अनुप्रयोग है, इसका विकल्प नहीं: लीडरबोर्ड जो फ्लैगशिप को ताज पहनाता है एक स्वतंत्र पैनल, अंधे आइटम, और एक प्रकाशित रिकॉर्ड है, खंड 3 के तीन घटक बाजार पैमाने पर संचालित। और वह ताज चलता है: वसंत में उद्यम मॉडल नेतृत्व हाथ बदल गया (Kharazian, 2026), मॉडल स्थिर नामों के तहत चुप्पी से अपडेट किए जाते हैं, और एजेंट खरीद व्यवहार मॉडल अपडेट के आर-पार भारी रूप से फेरबदल करते हैं (Allouah et al., 2026)। निरंतर बाहरी मापन के बिना, "सर्वश्रेष्ठ मॉडल" ऑपरेटर को ज्ञान के रूप में उपलब्ध नहीं है।
दूसरा, 95.4% आंशिक रूप से क्षमता के बजाय स्मृति है: शीर्ष फ्लैगशिप 61.6% आइटम पर सोने के उत्तर स्ट्रिंग को शब्दावली से पुनरुत्पन्न करता है (तालिका 9 की प्रदूषण चेतावनी), इसलिए इसका मापा किनारा प्रश्नों पर संकुचित होता है कि बेंचमार्क इसे सिखा नहीं सकता। गेट तंत्र उस नाजुकता को विरासत में नहीं देता: स्तर पर जिसे स्मरण किए जाने की सबसे कम संभावना है यह 89.4% आत्मविश्वास से भरी विफलताओं को हटाता है, इसके सर्वश्रेष्ठ प्रदर्शन के बजाय इसके सबसे बुरे (प्रदूषण-स्तरीकृत पुनः-विश्लेषण नीचे), क्योंकि स्वतंत्र रूप से प्रशिक्षित प्रयोगशालाओं के बीच समझौता किसी एक विक्रेता के प्रशिक्षण कॉर्पस पर निर्भर नहीं है।
हस्तांतरणीय ज्ञान को बेंचमार्क जोखिम से अलग करने के लिए, मैंने एक ताजा 100-आइटम दो-हॉप जांच तैयार की जो गारंटी से अप्रदूषित है, 6 अगस्त 2026 को स्वतंत्र रूप से सत्यापित पूर्व-2023 विकिडेटा तथ्यों की जोड़ी से मशीन द्वारा उत्पन्न (जैसे, "किस वर्ष में [मामूली भवन] के आर्किटेक्ट का जन्म हुआ था?"), प्रत्येक एक एकल परिकलित उत्तर के साथ, इसलिए संरचित प्रश्न स्ट्रिंग किसी भी प्रशिक्षण कॉर्पस में दिखाई नहीं दे सकते। सेट का SHA-256 पहली मॉडल कॉल से पहले फ्रीज किया गया था।
तरंग के जमे हुए प्रोटोकॉल (शब्दशः सिस्टम प्रॉम्प्ट, तापमान 0, समान नियतात्मक ग्रेडर) के तहत, gpt-5.6-sol SimpleQA पर 95.4% सटीकता और 4.6% आत्मविश्वास-विफलता दर से 33.0% [बूटस्ट्रैप 95% CI 24.0–42.0] तक गिर गया, इसकी वस्तुओं के 61.0% [51.0–70.0] पर आत्मविश्वास-विफलताओं के साथ (इसके आत्मविश्वास के साथ उत्तरों का 67.0%), इसकी माध्य कथित आत्मविश्वास मुश्किल से गतिशील (98.4 → 93.7), जबकि claude-fable-5 76.0% [67.0–84.0] और 6.0% [2.0–11.0] पर बना रहा। तरंग का 25-बिंदु प्रमुख अंतर गारंटीकृत-अप्रत्याशित संरचनाओं पर 43-बिंदु की कमी में उलट जाता है। परिषद द्वार, तरंग से अपरिवर्तित, इस विफलता को अवशोषित करता है: इसने gpt-5.6-sol की 61 आत्मविश्वास-विफलताओं को छोड़कर सभी को हटा दिया (60/61; n = 61 पर बिंदु दर अस्पष्ट है, Wilson 95% CI ≈ 91–99.7%; 24.2% कवरेज; claude-fable-5: 6 → 1), पारित उच्च-आत्मविश्वास उत्तरों के बीच उत्सर्जित आत्मविश्वास-विफलता दर को 4.5% तक काटता है बनाम कच्चा 67.0%।
स्तर बेंचमार्क भर में बिंदु-तुलनीय नहीं हैं: दो-हॉप संरचना आंतरिक रूप से एक-हॉप पुनर्प्राप्ति की तुलना में कठिन है, और n = 100 पर अंतराल चौड़े हैं। लेकिन मॉडल क्रम का उलटाव और ऐसी वस्तुओं पर द्वार की दृढ़ता जो कोई भी मॉडल स्मृति में नहीं रख सकता, बिल्कुल वह हस्ताक्षर हैं जो संदूषण खाता भविष्यवाणी करता है, और वे विफलता का तरीका हैं जिसे एक आर्किटेक्चरल विश्वास परत, और बेहतर मॉडल पसंद नहीं, अवशोषित करने के लिए बनाया गया है।
तीसरा, एक फर्श है। द्वार एक आत्मविश्वास-विफलता दर तक पहुंचता है जो कोई भी एकल मॉडल किसी भी कीमत पर प्राप्त नहीं करता: परिषद-द्वार संरचनाएं उत्सर्जित उत्तरों पर आत्मविश्वास-विफलताओं को $0.0039–0.0046 प्रति प्रश्न पर 1.8–2.1% तक काटती हैं, सर्वश्रेष्ठ एकल दर से 2.5× नीचे, जबकि तरंग में सबसे महंगा प्रमुख $0.0198 प्रति प्रश्न पर 10.3% आत्मविश्वास-विफलताओं पर बैठता है, हर अक्ष पर प्रभुत्व। द्वार कमजोर मॉडल के लिए एक बचाव उपकरण नहीं है: एक ही द्वार के पीछे qwen-max अपने उत्सर्जित आत्मविश्वास उत्तरों के 73.9% पर भी आत्मविश्वास से विफल होता है, इसलिए सीमांत के द्वार द्वारा बिंदु मजबूत मॉडल की परिषदें हैं, कमजोर लोगों के ऊपर द्वार नहीं।
चौथा, जब एजेंट स्वतंत्र रूप से पैसा खर्च कर रहा है, तो महत्वपूर्ण प्रश्न "कौन सा मॉडल स्मार्ट है" से "कौन सी संरचना साबित कर सकती है कि उसने क्या किया" में बदल जाता है। यह कितना भी सटीक हो, एक एकल प्रमुख अपने स्वयं के निर्णय को प्रमाणित नहीं कर सकता या अपने स्वयं के हित के टकराव को मध्यस्थता नहीं कर सकता। द्वार संरचना प्रति उत्तर एक निरीक्षणीय समझौता रिकॉर्ड उत्पादित करती है। वह कलाकृति है जो धारा 5 की देयता और बीमा बाजारें पहले से ही मूल्य निर्धारित करती हैं, जहां कवरेज साक्ष्य के विरुद्ध लिखा जा रहा है और इसकी अनुपस्थिति के विरुद्ध बहिष्कार-आकार।
संकल्प एक सीमांत है, विजेता नहीं। प्रमुख परिषद का सबसे मजबूत सदस्य है (जमी हुई परिषद इसे शामिल करती है), फिर भी वह अपने स्वयं के न्यायाधीश के रूप में काम नहीं कर सकता। लीडरबोर्ड जो इसे पहचानता है वह पहले से ही उसी सिद्धांत पर निर्भर करता है जो आर्किटेक्चरल विश्वास संचालित करता है, स्वतंत्र क्रॉस-मॉडल सत्यापन, लेकिन यह उस सत्यापन को केवल समग्र रूप से, मॉडल के बारे में सामान्य रूप से आपूर्ति करता है, उपभोक्ता के सामने उत्तर के बारे में नहीं। यह निर्माण उस अंतर को भरता है, और अंतर भी इसे सीमित करता है: कोई दावा जो कोई स्वतंत्र जांच पर निर्भर नहीं करता वह आर्किटेक्चरल विश्वास के बाहर है, इसका उदाहरण नहीं। ऑपरेटर की वास्तविक पसंद जोखिम वर्गों के बीच है: 4.6% आत्मविश्वास-विफलताओं में पूर्ण कवरेज, या 1.8% पर 31% कवरेज एक ऑडिट ट्रेल के साथ, चयनात्मक-वर्गीकरण व्यापार, यहां मूल्य निर्धारित। पूर्ण 26-संरचना लागत–कवरेज–जोखिम सीमांत (हर एकल प्रमुख, हर द्वार संरचना, और पूलित समझौता सीढ़ियां, बिल किए गए बनाम सूची मूल्य आधार के साथ प्रति बिंदु चिह्नित) प्रतिकृति पैकेज के साथ CSV के रूप में जारी किया जाता है।
असहमति द्वार के लिए स्पष्ट प्रतिद्वंद्वी एकल-मॉडल कैलिब्रेशन मरम्मत है: प्रत्येक मॉडल के आत्मविश्वास-से-सटीकता मानचित्र को सीखें और केवल जहां मानचित्रित सटीकता एक बार को साफ करता है उत्सर्जित करें, पोस्ट-हॉक पुनः-कैलिब्रेशन कार्यक्रम जिसके मानक उपचार तापमान और Platt स्केलिंग हैं (Guo, Pleiss, Sun, & Weinberger, 2017)। असंबंधित आधों पर फिट (हिस्टोग्राम-बिन्ड आत्मविश्वास, यहां तक-अनुक्रमित प्रश्नों पर प्रशिक्षण, विषम पर मूल्यांकन, 20 से कम अवलोकन की बिन उत्सर्जित नहीं), यह कैलिब्रेशन पासपोर्ट 92.7% आत्मविश्वास-विफलताओं को हटाता है, लेकिन 24.3% उत्सर्जन पर, और ग्यारह प्रमुखों में से छह कुछ भी उत्सर्जित नहीं करते हैं: उनका कोई आत्मविश्वास बिन 80% प्रशिक्षण सटीकता तक पहुंचता है, इसलिए उन मॉडल के लिए पासपोर्ट एक खाली पृष्ठ है। आधी प्रमुख बाजार के लिए, एकल-मॉडल कैलिब्रेशन बाहर से मरम्मत नहीं किया जा सकता। असहमति द्वार तालिका में हर मॉडल के लिए लगभग 30% कवरेज रखता है, जिसमें छह पासपोर्ट त्यागता है शामिल हैं। तो पहले प्रयोग का निष्कर्ष इस स्तर पर भी रहता है: आर्किटेक्चर एक बाहरी सटीकता संकेत की आपूर्ति कर सकता है जहां मॉडल का उजागर आत्मविश्वास विफल हो जाता है, रैंकिंग में या स्तर में, फिर से सबसे विश्वसनीय स्तर पर मापा जाता है जिसे उपभोक्ताओं को बताया जाता है।
द्वार प्रभाव की दृढ़ता। दो रेफरी-संचालित जांचें महत्वपूर्ण हैं: गोलाकार, क्या द्वार अपने सबसे मजबूत सदस्य पर सवार है, और क्या कुछ तुच्छ समान काम करता है। परिषद के सबसे मजबूत सदस्य (gpt-5.6-sol, 95.4% समाधान सटीकता) को तरंग के चौथे पूर्व-अंतिम सीमांत रन (grok-4.5) के साथ प्रतिस्थापित करना परिणाम को अनिवार्य रूप से अपरिवर्तित छोड़ देता है। sol-मुक्त परिषद 29.7% कवरेज पर पूलित आत्मविश्वास-विफलताओं का 81.2% हटाता है (गैर-परिषद लक्ष्य: 77.6%) जमी हुई तिकड़ी के लिए 82.1% पर 30.5% के विरुद्ध, और सभी 165 संभावित तीन-मॉडल परिषदों में तंत्र कभी विफल नहीं होता: हर परिषद अपनी कवरेज पर यादृच्छिक त्याग की तुलना में अधिक आत्मविश्वास-विफलताओं को हटाता है (माध्यिका अतिरिक्त +8.5 अंक), पूर्व-अंतिम तिकड़ी शीर्ष 4% में उस मार्जिन द्वारा (+12.6 अंक)। प्रभाव क्रॉस-मॉडल समझौते के लिए है, किसी एक सदस्य की सटीकता के लिए नहीं। प्रत्येक मॉडल के स्वयं के कथित आत्मविश्वास को समान प्रति-मॉडल कवरेज पर सीमित करना, तुच्छ आधार रेखा, केवल 66.7% पूलित आत्मविश्वास-विफलताओं को हटाता है, 69.5% से कम जो अंधा यादृच्छिक त्याग उसी कवरेज पर हटाता है, क्योंकि आत्मविश्वास विफलताएं निर्माण द्वारा उच्च कथित आत्मविश्वास पर केंद्रित हैं। वह सीमा भी द्वार की तुलना में कम आत्मविश्वास-सही उत्तर रखती है (46.4% बनाम 51.3%)। द्वार ग्यारह प्रयोगशालाओं में से प्रत्येक के लिए दोनों आधार रेखाओं का Pareto-प्रभुत्व करता है। सबसे मजबूत मॉडल के साथ प्रति-उत्तर समझौते का उपयोग फिल्टर के रूप में एक और भी मजबूत स्क्रीन है (40.7% कवरेज पर पूलित आत्मविश्वास-विफलताओं का 97.1% हटाया गया, आत्मविश्वास-सही उत्तरों का 97.0% रखते हुए), लेकिन यह एक यांत्रिक रूप से अलग, लक्ष्य-सशर्त नियम है। यह केवल परीक्षा करने के बाद एक उत्तर पारित करता है, जबकि परिषद द्वार उसी निश्चित प्रश्न सेट को परीक्षण के तहत उत्तर को देखे बिना हर मॉडल के लिए खोलता है, इसलिए यह परिषद प्रभाव को सीमित करता है लेकिन समझाता नहीं है: sol के बिना तिकड़ी अभी भी 81.2% हटाती है, और यहां तक कि एक कमजोर एकल न्यायाधीश (kimi-k3, 45.5% समाधान सटीकता) के साथ समझौता आत्मविश्वास-विफलताओं का 86.3% हटाता है। चालक क्रॉस-मॉडल समझौता ऐसा है, जबकि न्यायाधीश सटीकता दिखाई देता है जो रखा जाता है (रखे गए-सही sol के लिए 97.0% बनाम कमजोर न्यायाधीशों के लिए 20–63%)।
अंशांकित संयम (Calibrated abstention) प्रतिस्पर्धी आधारभूत रेखाओं को सशक्त करता है, और उन्हें भी चलाया गया। अंशांकन पासपोर्ट के समान विभाजन के अंतर्गत दो अंशांकित संयम आधारभूत रेखाएं फिट की गईं (पैरामीटर सम-अनुक्रमित आइटमों पर फिट किए गए, आयोजित-बाहर विषम आधे पर मूल्यांकित, जहाँ जमे हुए द्वार 30.8% कवरेज पर आत्मविश्वास की विफलता के 82.2% को हटाते हैं)। प्रति-मॉडल आधारभूत रेखाएं द्वार तक नहीं पहुँचती हैं। Platt-स्केल किया गया आत्मविश्वास द्वार से मेल खाते प्रति-मॉडल कवरेज के साथ आत्मविश्वास की विफलता के 65.3% को हटाता है, और विभाजन-अनुरूप संयम (α = 0.293, P(emit | wrong) ≤ α की गारंटी देने के लिए अंशांकित, समान कवरेज के लिए ट्यून किया गया) 70.8% को हटाता है, जैसे समान पूल किए गए कवरेज पर कच्ची बताई गई-आत्मविश्वास शीर्ष-K नियंत्रण भी करता है, जो 69.4% को हटाता है। एक पूल किया गया प्रकार जो सभी ग्यारह प्रयोगशालाओं के उत्तरों को एक Platt-अंशांकित संभावना पैमाने पर रैंक करता है, द्वार को पार करता है (समान पूल किए गए कवरेज पर 89.0%), लेकिन यह ऐसा करता है कि सभी कवरेज को अच्छी तरह से अंशांकित प्रयोगशालाओं को पुनः आवंटित करके: यह सर्वोत्तम-अंशांकित विक्रेता के 100% उत्तरों और ग्यारह की चार प्रयोगशालाओं के लिए 0% उत्सर्जित करता है, ऊपर पासपोर्ट की विफलता मोड को नरम रूप में पुनः उत्पादित करता है। इसके लिए मॉडल प्रति लगभग सात सौ ग्रेड किए गए उत्तरों की भी आवश्यकता होती है ताकि फिट किया जाए, जहाँ द्वार को कोई भी आवश्यकता नहीं है। अंशांकित आत्मविश्वास और क्रॉस-मॉडल समझौता इसलिए पूरक हैं, विकल्प नहीं: पहला जहाँ भी ग्राउंड-ट्रुथ लेबल इसे प्रशिक्षित करने के लिए मौजूद हों, पूल किए गए त्रुटि दर को कम करता है, और दूसरा समान, लेबल-मुक्त प्रति-प्रयोगशाला सुरक्षा खरीदता है।
चित्र 19 प्रत्येक रणनीति को चयनात्मक-भविष्यवाणी तल पर रखता है (जमे हुए 1,459-प्रश्न पूल पर ग्यारह भुजाओं द्वारा निर्धारित रूप से समाधान किए गए 13,955 उत्तरों पर पूल किया गया, इसलिए कुल तालिका 9 से छोटा है, जो सभी 1,500 प्रश्नों पर समाधान किए गए उत्तरों को गिनता है; चयनात्मक जोखिम = उत्सर्जित उत्तरों का अंश जो गलत है)। जोखिम-कवरेज वक्र के नीचे क्षेत्र द्वारा रैंक किया गया, निचला बेहतर: Platt-अंशांकित आत्मविश्वास 0.258, बताई गई आत्मविश्वास द्वारा परिष्कृत द्वार सीढ़ी 0.321, शुद्ध समझौता सीढ़ी 0.356, कच्ची बताई गई आत्मविश्वास 0.367, यादृच्छिक संयम 0.517, 0.166 की oracle न्यूनतम के विरुद्ध; आयोजित-बाहर-आधा मान अधिकतम 0.009 से भिन्न होते हैं। जमे हुए द्वार के अपने संचालन बिंदु पर (इस समाधान-उत्तर सम्मेलन में 31.1% कवरेज, 13,955 में से 4,334 उत्तर उत्सर्जित; 30.5% और 30.6% जो अन्यत्र रिपोर्ट किए गए हैं आत्मविश्वास के उत्तरों और पूल प्रश्नों के अंश हैं) द्वार का जोखिम 24.9% है, कच्ची-आत्मविश्वास थ्रेसहोल्ड के लिए 33.4% के विरुद्ध और अंशांकित आत्मविश्वास के लिए 14.0%, ऊपर दिए गए लेबल-लागत और कवरेज-एकाग्रता सावधानियों के अधीन। सभी 165 तीन-मॉडल परिषदों का बादल 9–59% कवरेज में 13–38% जोखिम पर फैला हुआ है, इसलिए रिपोर्ट किया गया द्वार इसके परिवार का एक प्रतिनिधि सदस्य है, एक ट्यून किया गया बाहरी नहीं। एकल-न्यायाधीश द्वार परिवार के पतित सिरे का पता लगाते हैं, जहाँ "समझौता" "सबसे सटीक मॉडल से पूछें" में ढह जाता है।
चित्र 19। जोखिम-कवरेज सीमांत
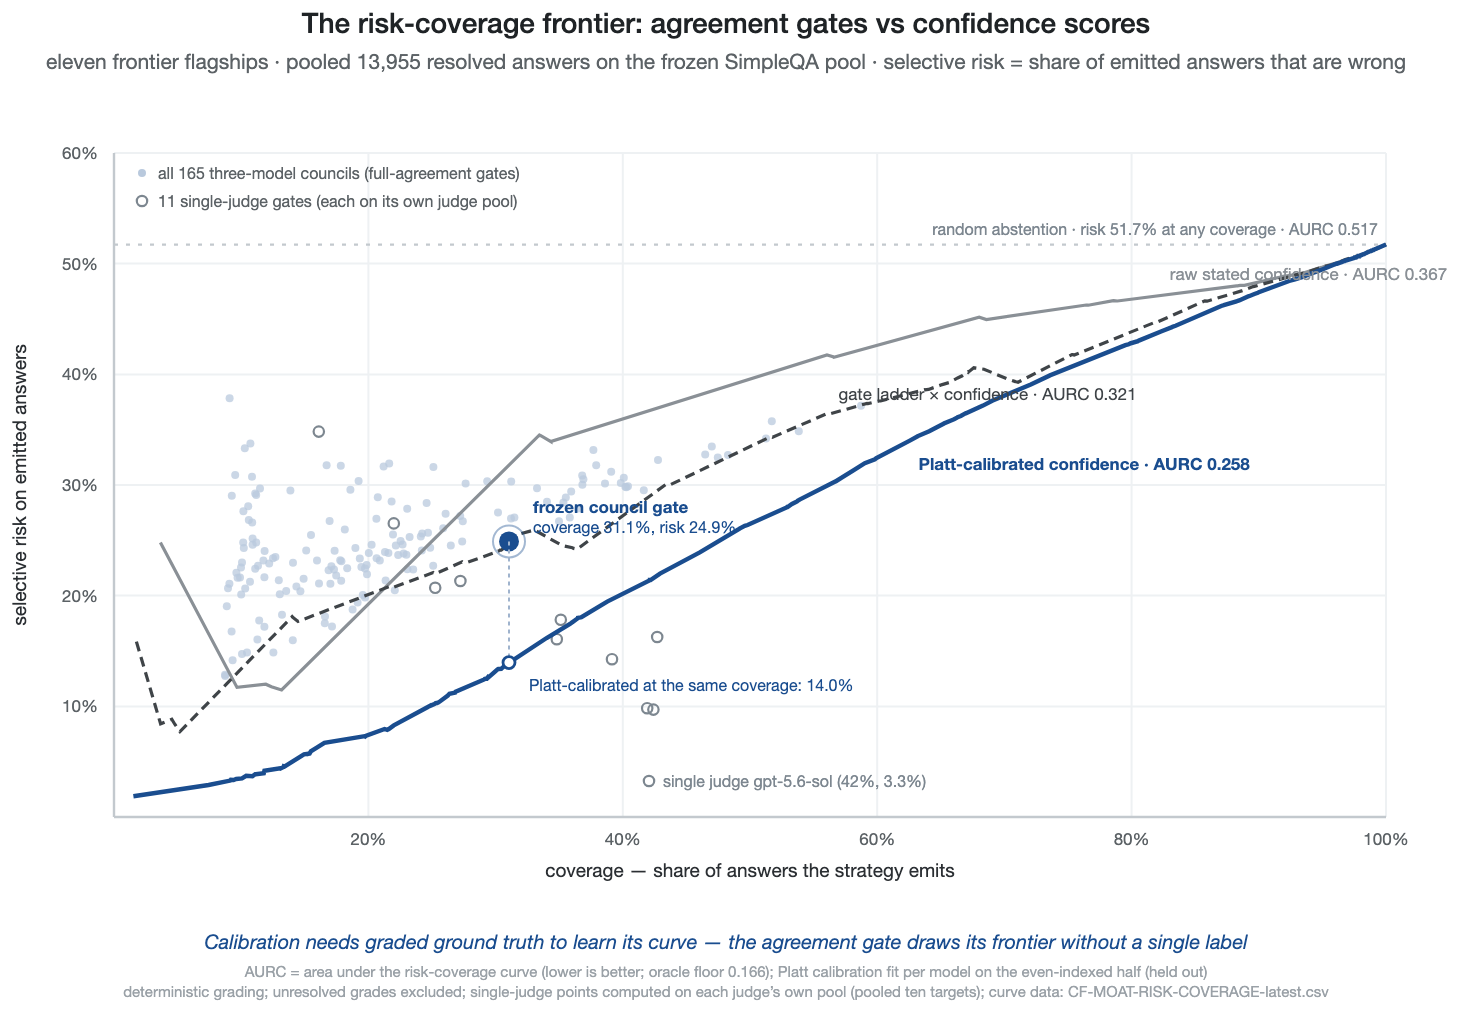
प्रत्येक संयम रणनीति चयनात्मक-भविष्यवाणी तल पर, कवरेज बनाम चयनात्मक जोखिम, जमे हुए 1,459-प्रश्न पूल पर ग्यारह भुजाओं द्वारा निर्धारित रूप से समाधान किए गए 13,955 flagship उत्तरों पर पूल किया गया (तालिका 9 सभी 1,500 प्रश्नों पर समाधान किए गए उत्तरों को गिनता है): कच्ची-आत्मविश्वास, Platt-अंशांकित, और द्वार-सीढ़ी-×-आत्मविश्वास वक्र उनके AURC मानों के साथ, यादृच्छिक-संयम रेखा, सभी 165 तीन-मॉडल परिषदों का बादल, ग्यारह एकल-न्यायाधीश द्वार, और जमी हुई परिषद का संचालन बिंदु (समाधान-उत्तर सम्मेलन में 31.1% कवरेज, 13,955 में से 4,334; 24.9% जोखिम)। निचला बेहतर है; oracle न्यूनतम 0.166 है। प्रत्येक बिंदु प्रतिलिपि पैकेज के जोखिम-कवरेज CSV से पुनः गणनीय है।
समझौता प्रश्न की सरलता से परे कोई सूचना नहीं ले सकता। इसका परीक्षण करने के लिए, द्वार समझौते और आइटम कठिनाई पर उत्तर की शुद्धता के लॉजिस्टिक प्रतिगमन (उस प्रश्न पर अन्य मॉडलों के बीच गलत उत्तरों का अंश), प्रयोगशाला निश्चित प्रभावों और प्रश्न-क्लस्टर किए गए मानक त्रुटियों के साथ, चलाया गया, और उत्तर इस बात पर निर्भर करता है कि कठिनाई कैसे मापी जाती है। केवल गैर-परिषद मॉडलों द्वारा मापी गई कठिनाई के साथ (निष्पक्ष नियंत्रण, क्योंकि एक कठिनाई माप जिसमें परिषद के अपने उत्तर शामिल हैं, निर्माण द्वारा द्वार के संकेत को एम्बेड करता है), समझौता बाहरी-प्रयोगशाला लक्ष्यों पर एक स्वतंत्र योगदान बनाए रखता है: b = +0.76, odds अनुपात 2.15, z = 17.2। द्वार द्वारा उत्सर्जित एक उत्तर, समान रूप से कठिन उत्तर जैसा कि द्वार सही होने की संभावना के लगभग दो गुना अधिक अवसर होता है जो द्वार रोक देगा। परिषद की अपनी शुद्धता को कठिनाई regressor में मोड़ें और समझौते का गुणांक शून्य पर ढह जाता है, जो तंत्र को परिभाषित करता है न कि उसे खंडित करता है: समझौता और बहु-मॉडल कठिनाई एक ही अव्यक्त मात्रा के दो माप हैं, और द्वार अनुमान समय पर इसे पढ़ने के लिए एक लेबल-मुक्त उपकरण है।
एक संदूषण-स्तरीकृत पुन: विश्लेषण जोखिम के संबंध को सीधे संबोधित करता है। कम से कम तीन की ग्यारह प्रयोगशालाएं सामान्यीकरण के बाद सोने की स्ट्रिंग को शब्दशः पुन: उत्पादित करने पर एक प्रश्न को संभव बेंचमार्क-उजागर के रूप में ध्वज लगाते हुए (1,459 पूल प्रश्नों में से 741; समान हस्ताक्षर जो gpt-5.6-sol की 61.6% सोना-गूंज दर देता है), द्वार गैर-उजागर परत पर आत्मविश्वास की विफलता के 89.4% को हटाता है (2,793→296; गैर-परिषद लक्ष्य: 86.5%) उजागर किए गए पर 72.7% के विरुद्ध। तो तंत्र याद किए गए आइटमों पर सवारी नहीं करता है। यह एक चयनात्मक फिल्टर के रूप में व्यवहार करता है, जहाँ पैनल वास्तव में अनिश्चित है (18.7% बनाम 41.9% कवरेज) बहुत कम बार खुलता है और उत्सर्जित आत्मविश्वास-विफलता दर को परत भर में लगभग स्थिर रखता है (25.9% बनाम 21.8%, कच्ची दरें 58.5% और 36.4% से)। 2–5 गूंजने वाले मॉडलों की एक्सपोजर कट-ऑफ गैर-उजागर dCF की 87.7–89.7% देते हैं, इसलिए खोज थ्रेसहोल्ड-मजबूत है। स्तरीकरण वर्णनात्मक है: सोना-गूंज परिणाम-युग्मित है, और यह संदूषण की पहचान करने के बजाय संभव रूप से देखे गए से अन्य प्रश्नों को अलग करता है।
एक बड़ा तर्क बजट क्या खरीदता है: आत्मविश्वास, सक्षमता नहीं। प्रमुख विक्रेता अब मॉडल चुनाव के ऊपर एक दूसरा डायल बेचते हैं: एक तर्क बजट, छिपे हुए विचार-विमर्श के प्रति टोकन मूल्य निर्धारित। यदि विस्तारित तर्क अंशांकन खरीदता, तो यह इस पत्र की समस्या का एक मॉडल-स्तरीय उत्तर होगा, चेकआउट पर खरीदने योग्य। एक प्रमुख विक्रेता पर एक युग्मित प्रयोग कहता है कि यह कुछ और खरीदता है। Google का gemini-3.1-pro (जिसके तर्क को अक्षम नहीं किया जा सकता) ने दो बजट के तहत एक ही जमे हुए प्रश्न सेट का उत्तर दिया, कम तर्क-प्रयास सेटिंग और विक्रेता-डिफ़ॉल्ट गतिशील बजट, तापमान शून्य, समान प्रॉम्प्ट और पार्सर के साथ, और प्रति-प्रश्न लागत दर्ज की गई। इस संस्करण की तारीख पर दोनों बजट के तहत उत्तर दिए गए 233 प्रश्नों पर: सटीकता 75.1% (कम) बनाम 76.4% (डिफ़ॉल्ट), कोई पता लगाने योग्य अंतर नहीं (सटीक McNemar p = .648); कथित आत्मविश्वास 3.1 अंक अधिक डिफ़ॉल्ट बजट के तहत (Wilcoxon z = 4.68, p < .0001); अंशांकन डिफ़ॉल्ट बजट के तहत थोड़ा बदतर (युग्मित ECE 0.100 बनाम 0.082; आत्मविश्वास-शून्य-सटीकता अंतराल +9.3 बनाम +7.5 अंक); प्रति प्रश्न मूल्य 2.1×। सटीकता तुलना एक विशिष्ट प्रकार का शून्य है: ये डेटा दिखाते हैं n = 233 पर कोई पता लगाने योग्य सटीकता अंतर नहीं (सटीक McNemar p = .648), और समानता औपचारिक रूप से केवल एक मोटे मार्जिन पर स्थापित है। एक युग्मित TOST सटीकता अंतर को ±5 अंकों के भीतर सीमित करता है (अंतर +1.3 अंक, 90% CI [−1.8; +4.4]; दोनों एक-पक्षीय p ≤ .024) लेकिन अध्ययन ±2–4 अंकों पर समानता स्थापित करने के लिए शक्तिशाली नहीं है, जबकि कथित आत्मविश्वास में +3.1-अंक वृद्धि सांख्यिकीय रूप से स्पष्ट है (Wilcoxon p < .0001)। उस बाध्यता के भीतर, दोगुनी व्यय ने अतिरिक्त कथित आत्मविश्वास खरीदा और कोई मापने योग्य अतिरिक्त शुद्धता नहीं: अतिआत्मविश्वास एक भुगतान किए गए सुविधा के रूप में, और प्रवासन थीसिस का एक भीतर-मॉडल उदाहरण। अतिरिक्त डॉलर मॉडल परत में चले गए और कुछ भी उत्पादित नहीं किया जो एक उपभोक्ता सत्यापित कर सकता है, जबकि इसके ऊपर की वास्तुकला परत आत्मविश्वास को एक जांचने योग्य संकेत में बदल गई। परिणाम एक पायलट है, एक के रूप में रिपोर्ट किया गया है: तुलना 233 युग्मित प्रश्नों को कवर करती है, और पूर्ण 1,500-जोड़ी डिज़ाइन समानता बाध्यता को लगभग दो अंकों तक सीमित करता है; चैनल संरचना और टोकन-कैप सेंसरिंग प्रतिकृति पैकेज में confounds के रूप में दर्ज हैं; संग्रह जारी है।
आकृति 18। एक बड़ा तर्क बजट क्या खरीदता है
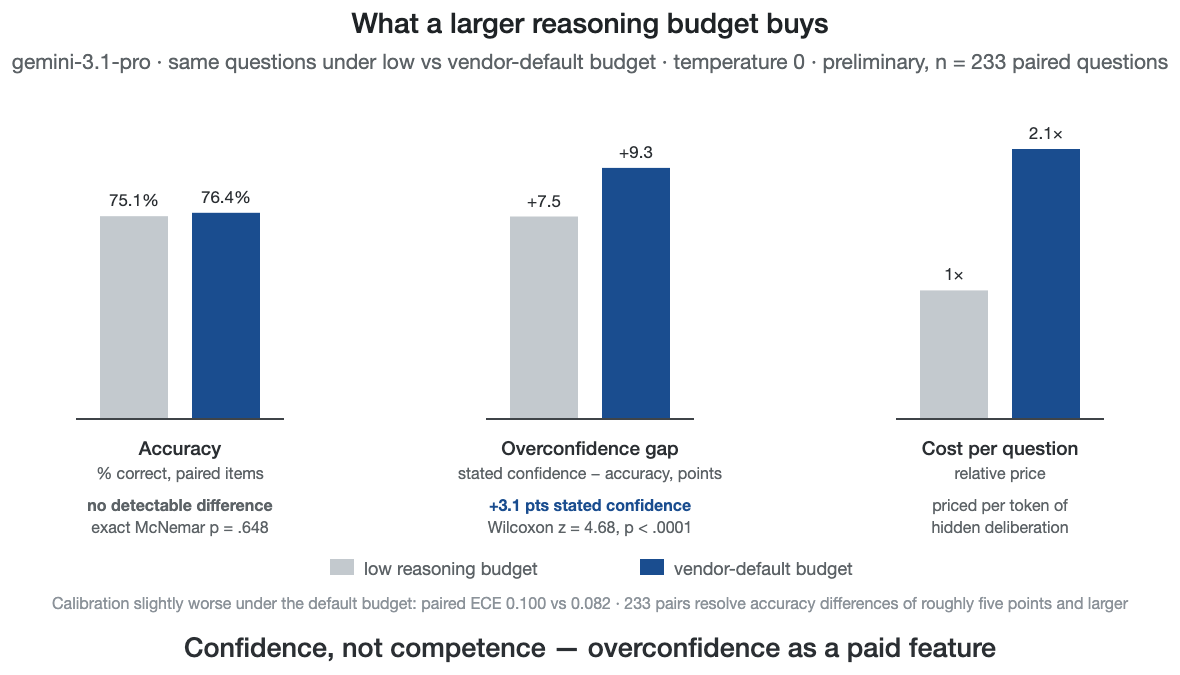
दो तर्क बजट के तहत युग्मित तुलना — कथित आत्मविश्वास बढ़ता है, सटीकता नहीं।
तालिका 11। तर्क बजट, युग्मित तुलना (gemini-3.1-pro, 233 प्रश्न दोनों बजट के तहत उत्तर दिए गए, तापमान 0; प्रारंभिक)
| कम तर्क बजट | विक्रेता-डिफ़ॉल्ट बजट | |
| सटीकता (युग्मित आइटम) | 75.1% | 76.4% (McNemar p = .648) |
| माध्य कथित आत्मविश्वास | −3.1 अंक बनाम डिफ़ॉल्ट | +3.1 अंक (Wilcoxon p < .0001) |
| अंशांकन (युग्मित ECE) | 0.082 | 0.100 |
| आत्मविश्वास − सटीकता अंतराल | +7.5 | +9.3 |
| प्रति प्रश्न लागत (सापेक्ष) | 1× | 2.1× |
तर्क-प्रयास सेटिंग्स आर्मों में समान नहीं थीं: प्रत्येक विक्रेता को उसके मानक वाणिज्यिक इंटरफेस के माध्यम से उस इंटरफेस की डिफ़ॉल्ट प्रयास पर प्रश्न किया गया था (सेटिंग्स प्रतिकृति पैकेज में प्रति-मॉडल दर्ज की गई हैं), इसलिए विक्रेता की पूर्ण सटीकता एक प्रयास घटक ले जा सकती है। यह तंत्र तक नहीं पहुंचता है। सटीकता रैंकिंग भार-वहन नहीं है (प्रमुख लेबल कुछ भी गारंटी नहीं देता), गेट किसी भी सदस्य को हटाने से बचता है (sol-free council 81.2% हटाता है), और एक बड़ा प्रयास कथित आत्मविश्वास को सटीकता फ्लैट के साथ उठाता है, जैसा कि युग्मित तुलना ने अभी दिखाया है, तो किसी भी सटीकता को जो यह inflates सतहों के रूप में आत्मविश्वस्त त्रुटि, विफलता गेट intercepts।
प्रमुख लहर की कवरेज सीमाएँ। लहर एक जमे हुए 5 अगस्त 2026 स्नैपशॉट है, इसलिए उसके बाद जारी किए गए मॉडल, जैसे Grok 4.6 (12 अगस्त) और बाद में कृत्रिम विश्लेषण नेता जैसे Claude Opus 5, इसे postdate करते हैं और एक पूर्व-प्रतिबद्ध बेंचमार्क में प्रवेश नहीं कर सकते। शीर्ष स्थान दिनों के भीतर बदल गई। यह पहचान समस्या है जो गेट sidesteps करता है (समझौता roster-robust है, किसी भी सदस्य को हटाने से बचता है)। दो शामिल प्रयोगशालाएं सामान्य-क्षमता लीडरबोर्ड पर वर्तमान सीमा के नीचे आती हैं: Mistral का प्रमुख जाँची गई हर समग्र सूचकांक पर शीर्ष स्तर को trailing करता है, और Baidu का सामान्य-प्रयोजन ERNIE मानवता की अंतिम परीक्षा पर शीर्ष 30 के बाहर रैंक करता है (इसकी ताकत खोज-संवर्धित और एजेंट कार्य है, जहां ERNIE 5.1 LMArena खोज क्षेत्र पर #4 रैंक करता है)। उन्हें यूरोपीय पारिस्थितिकी तंत्र और सभी प्रमुख चीनी प्रयोगशालाओं के कवरेज को संरक्षित करने के लिए बनाए रखा जाता है। शीर्ष-स्तर की दो प्रयोगशालाओं में से जो लहर के दायरे के बाहर थीं, Meta Superintelligence Labs (Muse Spark 1.1; Humanity's Last Exam पर #4) और ByteDance (Seed 2.1; #10), एक के बाद में प्रयास किया गया और बाधित (Meta, नीचे) और एक बिल्कुल भी नहीं पहुंचा जा सका (ByteDance, नीचे)।
ByteDance's Seed 2.1 को शामिल नहीं किया जा सका: BytePlus ModelArk ने एक ताजा पंजीकृत अंतर्राष्ट्रीय खाते के लिए "आपके देश/क्षेत्र में उपलब्ध नहीं" दिया (लाइव प्रयास, 5 अगस्त, 2026), कोई एकीकारक प्रमुख परोसता है, और घरेलू Volcano Ark चैनल को मुख्य भूमि-चीन सत्यापन की आवश्यकता है। Baidu की ERNIE 5.1, वर्तमान प्रमुख, समान रूप से घरेलू Qianfan प्लेटफॉर्म तक सीमित है (लाइव प्रयास, 5 अगस्त, 2026)। जहां एक प्रयोगशाला का वर्तमान प्रमुख अप्राप्य है, वहां फॉलबैक नियम उस प्रयोगशाला से सबसे मजबूत खुले तौर पर जारी मॉडल है। Baidu के लिए यह ERNIE 4.5 VL 424B (open-weights) है, जिसका उपयोग इसके बजाय किया जाता है। यह स्वयं एक खोज है: छह प्रमुख चीनी प्रयोगशालाओं में से दो की वर्तमान प्रमुखें अगस्त 2026 तक बाहरी शोधकर्ताओं के लिए सुलभ नहीं हैं।
Meta तीसरी लहर की विफलता है, और बाधा भूगोल नहीं बल्कि मेरा खाता था। पहली (मध्य-स्तरीय) लहर में, Meta अनुपलब्ध था एक प्रलेखित बुनियादी ढांचा कारण के लिए: इसका प्रथम-पक्ष Llama API को 6 जुलाई, 2026 को सेवामुक्त किया गया था, प्रोटोकॉल फ्रीज से पहले (रन मैनिफेस्ट में दर्ज), और प्रयोगशाला का प्रतिनिधित्व स्थानीय स्तर पर इसके खुले-वजन Llama-3.2-3B द्वारा किया गया था, जो पैनल के सबसे शिक्षाप्रद सदस्यों में से एक साबित हुआ (पूरे मैट्रिक्स में सबसे कम त्रुटि सहसंबंध)। फ्लैगशिप लहर के लिए, Meta के muse-spark-1.1 को लहर के बीच में जोड़ा गया था जब यह पहुंचा जा सकता था, और संग्रह तब तीन तरीकों से क्रम में विफल हुआ, प्रत्येक लॉग किया गया: (i) प्रथम-पक्ष Meta Model API कुंजी 5 अगस्त को 251 मान्य उत्तरों के साथ मध्य-रन में समाप्त हुई, और डेवलपर कंसोल प्रतिस्थापन जारी नहीं करेगा; (ii) एक एकत्रकर्ता फॉलबैक मार्ग ने 21 अतिरिक्त उत्तर दिए, इससे पहले कि (iii) Meta का प्रदाता एंडपॉइंट HTTP 403 `user_blocked` लौटाना शुरू कर दे, "एक सार्वजनिक बेंचमार्क से तापमान शून्य पर पूछे गए बंद-पुस्तक तथ्यात्मक-स्मरण प्रश्नों के लिए दोहराई गई नीति उल्लंघन के कारण पहुंच को प्रतिबंधित किया गया है।" शुद्ध परिणाम 1,500 आइटमों में से 272 (18.1%) एकत्र किए गए हैं और आंशिक के रूप में रिपोर्ट किए गए हैं: जमे हुए पूलित विश्लेषण में 251 प्रथम-पक्ष उत्तर शामिल हैं (एकत्रकर्ता शीर्ष-अप विश्लेषण फ्रीज के बाद आया), और Meta का प्रति-प्रयोगशाला अनुमान (125 आत्मविश्वास उत्तरों पर −92.0% dCF) दिशात्मक रूप से पैनल के साथ सामंजस्यपूर्ण है लेकिन अनुमान के लिए बहुत अनिश्चित है। ब्लॉक स्वयं एक खोज है: अगस्त 2026 के अनुसार, एक स्वतंत्र शोधकर्ता किसी भी अधिकृत चैनल के माध्यम से Meta के फ्लैगशिप का 1,500-प्रश्न तथ्यात्मक मूल्यांकन पूरा नहीं कर सकता है। लहर की तीन पहुंच विफलताओं के बीच, एक क्षेत्र-लॉक किया गया फ्लैगशिप (ByteDance), एक घरेलू-केवल फ्लैगशिप (Baidu), और एक शोधकर्ता प्रतिबंध (Meta), सैद्धांतिक तर्क अनुभवजन्य रूप में हैं: मॉडल स्तर पर सत्यापन विक्रेता कृपा पर आनंदित है, और एक स्थापत्य विश्वास परत विक्रेता कृपा को मान नहीं सकता है।
4. एक चरम तैनाती: अपरिवर्तनीय दांव के साथ प्रतिनिधिमंडल
उपभोक्ता विश्वास का अध्ययन करने का सामान्य तरीका एक सर्वेक्षण या प्रयोगशाला कार्य है। मेरे पास एक कठोर यंत्र उपलब्ध था: एक विस्तारित, उच्च-दांव तैनाती जिसमें हर परिणाम मुझ पर गिरा। यह अनुभाग एक एकल, विरोधाभासी ऑपरेटर से एक अस्तित्व प्रमाण और डिजाइन साक्ष्य है, न कि सामान्यता का अनुभवजन्य साक्ष्य, और कोई भी P1–P5 इस पर निर्भर नहीं करता है। दो प्रकार के साक्ष्य एक दूसरे को अवरुद्ध करते हैं। प्रयोगशाला में अंशांकन प्रभाव को प्लेसबो नियंत्रण के तहत मापा गया था; तैनाती में, जहां त्रुटियां अपरिवर्तनीय थीं, समान तीन गुण प्रतिनिधिमंडल को संभव होने और लापरवाह होने के बीच अंतर थे।
तैनाती एक क्लायंट की नहीं है और न ही एक सिमुलेशन है: मैं एक साथ ऑपरेटर, डेवलपर और विश्लेषक हूँ। साक्ष्य परत हैश-एंकर किया गया है और हर मापन स्वतंत्र रूप से पुन: योग्य है, इसलिए संघर्ष वकालत पर और मैंने क्या मापने का चयन किया है, इस पर सहन करता है, न कि संख्याएं पुनरुत्पादन करती हैं। सेटिंग साधारण उपभोक्ता दक्षता को अपरिवर्तनीय दांव के साथ जोड़ती है, जहां हर स्थापत्य कमजोरी को जल्दी और स्पष्ट रूप से दंडित किया जाता है।
पद्धतिगत रूप से यह व्याख्यात्मक और विश्लेषणात्मक-स्वयंएथनोग्राफिक परंपरा में एक चरम, प्रकटीकरण एकल मामला (Yin, 2018) है (Walsham, 1995; Gould, 1991; Anderson, 2006), उस परंपरा के साक्ष्य सावधानियों के साथ दृश्य में (Wallendorf & Brucks, 1993): रिकॉर्ड पहले, व्याख्या को व्याख्या के रूप में चिह्नित किया गया। औचित्य पहुंच है: एक शोधकर्ता नैतिक रूप से प्रतिभागियों को AI आर्किटेक्चर पर अपरिवर्तनीय वास्तविक दुनिया के परिणामों को दांव लगाने के लिए नियुक्त नहीं कर सकता है, इसलिए एकमात्र उपलब्ध पर्यवेक्षक एक प्रतिभागी है जिसने स्वयं दांव चुना है।
विश्लेषण समकालीन, हैश-एंकर किए गए लॉग पर निर्भर करता है। तैनाती की साक्ष्य परत स्वयं रिकॉर्ड है: भार-वहन करने वाले कदम (कौन से मॉडलों से परामर्श किया गया था, जहां वे भिन्न हुए, क्या गेटेड था, मैंने क्या पुष्टि की) समय पर लॉग किए गए थे, इसलिए अवलोकन पुनर्चलित रिकॉर्ड पर आराम करते हैं और केवल मेमोरी अकेले नहीं। हिंदसाइट पूर्वाग्रह को व्याख्या से हटाया नहीं जा सकता है, इसलिए मैं हर जगह चिह्नित करता हूँ जहां व्याख्या रिकॉर्ड से अधिक है। तैनाती-अवधि रिकॉर्ड 2 अगस्त 2026 के अनुसार हैश-एंकर किए गए हैं: 129 फाइलों की एक प्रति-फाइल SHA-256 मैनिफेस्ट (7,414,043 बाइट्स) जिसकी रूट 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc है, और एंकर इस पेपर के साथ प्रकाशित है। रिकॉर्ड तब तक सीलबंद रहते हैं जब तक तैनाती बंद नहीं हो जाती, क्योंकि एक लाइव तैनाती से चयनात्मक उद्धरण कोई भी नहीं से बदतर होता। प्रतिबद्धता की जाँच की जा सकती है: बाद में कोई भी रिकॉर्ड जारी किया गया एंकर मैनिफेस्ट से मेल खाता है या यह नहीं करता है, इसलिए पूर्वव्यापी संपादन, प्रतिस्थापन, या बैक-डेटिंग इस पृष्ठ के किसी भी पाठक द्वारा पहचानी जा सकती है। टेलीमेट्री का एक अधिक पूर्ण परिमाणात्मक उपचार भविष्य के कार्य के लिए छोड़ा गया है, एक ही कारण के लिए।
इस लूप के अंदर रहने से तीन अवलोकन परिकल्पना के रूप में प्रस्तुत किए जाते हैं कि मूल सेटिंग के परे क्या स्थानांतरित होता है, अनुभाग 3 के प्रस्तावों को खिलाते हैं, और घटनाएं जो उन पर आराम करती हैं तैनाती द्वारा समय पर लॉग की गईं।
असहमति एक उपभोक्ता-उपयोग करने योग्य संकेत है। जब स्वतंत्र मॉडल एक महत्वपूर्ण प्रश्न पर भिन्न हुए, तो विचलन स्वयं, दबा दिए जाने के बजाय सामने आया, मुझे बताया कि वास्तविक अनिश्चितता कहाँ थी: एक मुक्त प्रारंभिक चेतावनी कि कोई भी एकल-मॉडल सेवा प्रदान नहीं कर सकता है।
साक्ष्य किसी भी विवाद को बदलने से पहले व्यवहार को बदलता है। यह जानते हुए कि हर महत्वपूर्ण कदम दर्ज किया गया था, प्रतिनिधिमंडल को मनोवैज्ञानिक रूप से व्यावहारिक बना दिया; रिकॉर्ड निर्भरता की पूर्वापेक्षा था, न कि एक लेखा परीक्षा अनंतिम विचार।
आत्मविश्वास गेटिंग औसत सटीकता से अधिक मायने रखता है। व्यावहारिक रूप से खतरनाक घटनाएं आत्मविश्वास त्रुटियां थीं, कभी भी मध्यम आउटपुट नहीं। आर्किटेक्चर का वास्तविक योगदान उच्च आत्मविश्वास को महंगा बनाना था: एक उत्तर को क्रॉस-मॉडल समझौते से बचना पड़ता था इसे अर्जित करने के लिए, इसके बजाय इसे एक मॉडल की प्रवाहिता से मुक्त में प्राप्त करने के बजाय।
5. निहितार्थ: प्रेरणा से बुनियादी ढांचे तक
डिजाइन और अनुभव
सेवा डिज़ाइन के लिए। विश्वसनीय AI सेवा डिज़ाइन की इकाई मॉडल से पाइपलाइन की ओर स्थानांतरित हो रही है। इसका मतलब है कि परिणामी प्रश्नों को स्वतंत्र मॉडलों के माध्यम से रूट करना, असहमति को प्रथम-श्रेणी UX तत्व के रूप में मानना, डिफ़ॉल्ट रूप से साक्ष्य संलग्न करना, और बहु-मॉडल प्रसंस्करण को आत्मविश्वासी त्रुटियों की असममित लागत के विरुद्ध मूल्य निर्धारण करना, महंगा पथ उन अनुरोधों के लिए आरक्षित है जहां जोखिम केंद्रित होता है, जैसे धोखाधड़ी जांच जोखिमपूर्ण लेनदेन के लिए जांच आरक्षित करती है। अवसंरचना पहले से मौजूद है: लागत-संचालित कैस्केड जो कठिन अनुरोधों को महंगे स्तरों तक बढ़ाते हैं, मानक एजेंट इंजीनियरिंग हैं, और एक सेवा के लिए जो पहले से कठिनाई के अनुसार रूट करती है, परिणाम के अनुसार रूट करने की सीमांत आर्किटेक्चर शून्य के करीब है। विफलता के तरीके जो दोनों प्रयोगों ने मापे हैं, वे दो कठोर नियम छोड़ते हैं, और वे डिज़ाइन आवश्यकताएँ हैं, प्राथमिकताएँ नहीं। पदों को अंधे तरीके से एकत्र किया जाना चाहिए और किसी भी क्रॉस-मॉडल विचार-विमर्श से पहले दर्ज किया जाना चाहिए, क्योंकि विचार-विमर्श-पहली पाइपलाइन उसी सर्वसम्मति का निर्माण करती है जिसे आर्किटेक्चर को पुलिस करना माना जाता है (अनुभाग 3 की अनुरूपता दबाव)। दूसरा नियम: एक सीमित विकल्प सेट पर एकमत आत्मविश्वासी सर्वसम्मति निष्पादन के लिए हरी बत्ती नहीं बल्कि समीक्षा के लिए एक लाल झंडा है: अनुभाग 6 के मॉडल पैनलों और मानव प्रतिभागियों दोनों ने बिल्कुल उसी सर्वसम्मति को प्रमाणन के रूप में माना।
अर्थशास्त्र काम करता है क्योंकि वृद्धि अनुमापित है, एक अनुमापित विश्वास आर्किटेक्चर: यहां वर्णित परिनियोजन में, प्रसंस्करण स्तर एकल-मॉडल उत्तर और पूर्ण बहु-मॉडल विचार-विमर्श के बीच प्रति अनुरोध लागत में लगभग तीन परिमाण अवधि तक फैले हैं (जुलाई 2026 तक), इसलिए महंगा स्तर केवल वहीं खरीदा जाता है जहां परिणाम केंद्रित होते हैं। ब्रेक-ईवन तर्क धोखाधड़ी स्कोरिंग का है (चित्र 14)। समन्वय तब भुगतान करता है जब आत्मविश्वासी त्रुटि की संभावना इसकी पूर्ण लागत (रिफंड, एक-हड़ताल सहिष्णुता के तहत मंथन, देयता, नियामक जोखिम) गुना जांच की सीमांत गणना से अधिक हो। उच्च-दांव लेनदेन के लिए वह असमानता निकट नहीं है।
गिरती अनुमान कीमतें (तीन वर्षों में निश्चित क्षमता में लगभग दो परिमाण अवधि, ट्रैक किए गए गिरावट की एक रूढ़िवादी पढ़ाई; Appenzeller, 2024) तर्क को भंग नहीं करते हैं, क्योंकि अनुपात, निरपेक्ष लागत नहीं, संरचनात्मक मात्रा है: दोनों स्तर मूल्य वक्र के साथ नीचे आते हैं, और सस्ती अनुमान महंगे स्तर को हमेशा कम जोखिम में सामर्थ्य बनाती है। जांच अपना स्वयं का दूसरा वक्र चलाती है: कमजोर सत्यापनकर्ताओं के समूह, कोई लेबल किए गए डेटा के बिना, खुले 70-अरब-पैरामीटर घटकों से फ्रंटियर तर्क मॉडलों की उत्तर-चयन सटीकता तक पहुंचते हैं (Saad-Falcon et al., 2025)। एक-हड़ताल उपभोक्ता सहिष्णुता को देखते हुए, तुलना "सस्ते उत्तर बनाम महंगे उत्तर" नहीं बल्कि "महंगे उत्तर बनाम खोए गए ग्राहक" है।
दो उपभोक्ता-सामना आदिम डिज़ाइन को पूरा करते हैं: जानबूझकर घर्षण (अपरिवर्तनीय कार्यों से पहले एक चिह्नित विराम) और रसीदें। दोनों इस पर हस्तक्षेप करते हैं कि प्रतिनिधिमंडल कैसे लगता है। उपभोक्ता AI को समाजशास्त्रीय रूप से अनुभव करते हैं, सांख्यिकीय रूप से नहीं (Puntoni, Reczek, Giesler, & Botti, 2021), और जैसे-जैसे प्रतिनिधिमंडन निष्पादन सेवा मुठभेड़ को दृश्य से हटाता है, रसीद मुठभेड़ की पुरानी भूमिका को सत्य के क्षण के रूप में विरासत में देता है। एक जोखिम उस फ्रेमिंग के साथ यात्रा करता है: असहमति को स्पष्ट करना अनिश्चितता की विज्ञापन कर सकता है और इसे अंशांकित करने के बजाय विश्वास को कम कर सकता है (Detjen et al., 2025; Lu, Wang, & Yin, 2024), इसलिए कितना विचलन सामने लाना है, और कैसे, एक डिज़ाइन चर है। यह एक मुक्त वस्तु नहीं है।
एक समन्वय रसीद न्यूनतम हो सकती है और फिर भी अपना काम कर सकती है (चित्र 8 मॉक-अप दिखाता है)। तीन क्षेत्र अधिकांश मूल्य वहन करते हैं: (1) किसने कार्य किया, परामर्श किए गए मॉडल और संस्करण, किस अधिकार के तहत; (2) वे कैसे सहमत हुए, एक सादे-शर्तों विचलन सारांश; (3) क्या जांचा गया था, पूर्ण पुनरावृत्ति-योग्य रिकॉर्ड में एक सूचक के साथ: एक नज़र में पढ़ने के लिए काफी छोटा और विवाद, बीमा दावे, या लेखा परीक्षा के लिए पर्याप्त विशिष्ट। समान कलाकृति ऑपरेटर के स्वयं के बहीखाता प्रश्न का उत्तर देती है, इसलिए रसीद दो बार बिकती है: अंदर की ओर लागत प्रशासन के रूप में, बाहर की ओर वारंटीकृत विश्वास के रूप में। वह दोहरापन एक आवश्यकता है। पारदर्शिता के लिए मापी गई उपभोक्ता भुगतान की इच्छा पतली है (एक मूल्य संयुक्त में, व्याख्या की मूल्य €1.99 प्रति माह से कम रही; König et al., 2022), इसलिए एक विश्वास परत केवल उपभोक्ता पक्ष द्वारा वित्त पोषित भूखा रहेगी, और ऑपरेटर के लागत-प्रशासन पक्ष इसे ले जाते हैं। रसीद की निकटतम इंजीनियरिंग पड़ोसी उपकरण रसीदें हैं जो भ्रम के पहचान के लिए एजेंट ढांचे के अंदर दर्ज की गई हैं (Basu, 2026), जो प्रवृत्ति साझा करते हैं लेकिन दर्शक नहीं: ये व्यक्तिगत उपकरण कॉल के विकासकर्ता-सामना रिकॉर्ड हैं, जबकि समन्वय रसीद उनके उपभोक्ता-सामना, प्रति-निर्णय सामान्यीकरण है। रसीद अपनी स्वयं की विफलता मोड को आमंत्रित करती है: एक कलाकृति जो सत्यापित दिखने के लिए इंजीनियर की जाती है बिना उस कुछ को उजागर किए जो एक उपभोक्ता पुनः-चला सके। डिज़ाइन लाइन जो महत्वपूर्ण है वह यह है कि रिकॉर्ड वास्तव में पुनरावृत्ति-योग्य है और केवल रसीद-आकार नहीं। गोपनीयता पक्ष से भी एक बाधा आती है: एक कलाकृति जो सिद्ध करती है कि क्या जांचा गया था, वह भी रिकॉर्ड करती है कि क्या पसंद किया गया था, इसलिए सत्यापन योग्यता और गोपनीयता को संयुक्त रूप से अनुकूलित किया जाना चाहिए (Alavi & Nozari, 2026)।
रसीद अर्थशास्त्र का एक अंतिम टुकड़ा अपने नाम के तहत जाता है, जांच का अर्थशास्त्र। एक छेड़छाड़-प्रतिरोधी रिकॉर्ड केवल उतना ही मूल्यवान है जितना कि इसे खोलने के लिए किसी का प्रोत्साहन है, और विकेंद्रीकृत-प्रणाली का दशक यहां सावधानी है: सार्वजनिक, छेड़छाड़-प्रतिरोधी ब्लॉकचेन रिकॉर्ड ने साधारण उपयोगकर्ताओं को ऑडिटर में नहीं बदला, और "विश्वासरहित" आर्किटेक्चर ने हर व्यावहारिक जोड़ में शांति से विश्वस्त मध्यस्थों को फिर से पेश किया (Werbach, 2018)। सत्यापनकर्ता की दुविधा औपचारिक संस्करण है: जहां सत्यापन महंगा है और सही परिणाम सामान्य मामला है, तर्कसंगत सत्यापनकर्ता जांच छोड़ देता है। सत्यापन की मांग को केंद्रित किया जाना चाहिए जहां जांच का निजी लाभ पहले से मौजूद है, बीमाकर्ताओं, लेखा परीक्षकों और विवाद प्रक्रियाओं के बीच, उपभोक्ता उन बाजारों के उप-उत्पाद के रूप में सत्यापन को विरासत में प्राप्त कर रहा है; रसीद का उपभोक्ता कार्य विवाद में उपलब्धता है, रात्रिकालीन पठन नहीं। वित्त पोषण का प्रश्न एक ही बिंदु से अनुसरण करता है, और इसके दोनों भोले उत्तर विफल होते हैं: एक उपभोक्ता-भुगतान आर्केस्ट्रेटर तटस्थता को एक विलासिता वस्तु के रूप में कीमत देता है, और एक व्यापारी-भुगतान आर्केस्ट्रेटर द्वंद्व को फिर से आयात करता है जिसे हटाने के लिए मौजूद है। यह रसीद के द्विपक्षीय अर्थशास्त्र द्वारा पहले से निहित मॉडल को छोड़ देता है। परत को उसी तरीके से भुगतान किया जाता है जिस तरह ऑडिट का भुगतान किया जाता है, उन पक्षों द्वारा जिन्हें कहानी बताई जाने की बजाय जोखिम की कीमत की आवश्यकता है (संचालक लागत शासन और देयता में कमी खरीद रहे हैं, बीमाकर्ता बीमा योग्य जोखिम प्रोफाइल खरीद रहे हैं, विवाद प्रक्रियाएं साक्ष्य खरीद रही हैं), नियामक मंजिलों के साथ जहां वे बाजार अंडर-मांग हैं। उपभोक्ता सेवा खरीदता है, तटस्थता नहीं, और इसके उप-उत्पाद के रूप में तटस्थता को विरासत में प्राप्त करता है। एक ही समस्या का एक बाजार-संरचना संस्करण है। एक मंच जो एक साथ बाजारस्थल, मॉडल विक्रेता और विज्ञापन नेटवर्क है, संरचनात्मक रूप से तटस्थता की आपूर्ति करने में असमर्थ है, जो बाजार रूप में हित के टकराव का बिंदु है, और एल्गोरिथमिक प्राथमिकता का ऐतिहासिक रिकॉर्ड (प्रायोजित प्लेसमेंट, पसंदीदा भागीदार) कहता है कि प्रमुख खिलाड़ी रूटिंग को मुद्रीकृत करेंगे यदि वे कर सकते हैं। जहां वह दबाव काम करता है, तटस्थता मंजिल नियामक या खुली-प्रोटोकॉल है, स्वैच्छिक नहीं। यदि पहले-एक्सपोजर उपभोक्ता साक्ष्य के लिए मांग पतली है, तो आर्किटेक्चरल विश्वास का अंगीकार उपभोक्ता पसंद की तुलना में अनुपालन और बीमा पक्ष द्वारा कम संचालित हो सकता है, संस्थानों के माध्यम से एक प्रवास बजाय प्राथमिकताओं के, उपभोक्ताओं को सत्यापन योग्य आर्किटेक्चर को डिफ़ॉल्ट के रूप में विरासत में प्राप्त करते हुए। अंशांकन परिणाम उस मार्ग को सजावटी होने से रखता है: उपभोक्ता प्रदर्शनीय रूप से आर्किटेक्चरल संकेत का उपयोग करते हैं एक बार जब इसे उनके सामने रखा जाता है, लेकिन वे इसे बुलाने के लिए अभी तक भुगतान नहीं करते हैं। यहां एक प्रतिद्वंद्वी परिकल्पना है: विश्वास सत्यापन योग्य आर्किटेक्चर के बजाय देयता और संस्थानों में माइग्रेट हो सकता है। उपभोक्ता लेजर ऑडिट पर नहीं, चार्जबैक अधिकारों पर निर्भर हैं; कार्ड नेटवर्क ने उपभोक्ताओं के माध्यम से दूरस्थ वाणिज्य को स्केल किया है अधिकृतकरण रिकॉर्ड का निरीक्षण करने के बजाय विवाद अधिकार; इस पठन पर निर्णय रिकॉर्ड नल है जो देयता को गणनीय बनाता है बजाय उपभोक्ता विश्वास का वस्तु। दोनों खातों की भविष्यवाणी अलग चीजें करती है: आर्किटेक्चरल खाते पर उपभोक्ता पुरस्कृत सत्यापनयोग्यता जब वे इसे देख सकते हैं; संस्थागत खाते पर वे इसे केवल तभी पुरस्कृत करते हैं जब एक उपचार संलग्न हो, और उपभोक्ता का विश्वास तब संस्था में निहित रहता है जबकि संस्था का विश्वास आर्किटेक्चर में माइग्रेट होता है। विवाद-समय डिज़ाइन नीचे निर्दिष्ट है उन्हें अलग करता है। और हर रिकॉर्ड परत ओरेकल समस्या को विरासत में देता है: रिकॉर्ड प्रक्रिया का प्रमाणन देता है, और केवल प्रक्रिया की अपनी जांच तथ्यों तक पहुंचती है। विषमता जो रसीद को उलट देती है, वह है जिसे मंच-आलोचना साहित्य दस्तावेज करता है: आर्किटेक्चर, कथित नीति नहीं, डिजिटल आचरण का प्रभावी नियामक है (Lessig, 2006), और इसके साधन उपभोक्ता की ओर इशारा कर रहे हैं बजाय उपभोक्ता के पक्ष में आयोजित किए जा रहे हैं (Zuboff, 2019; Möhlmann & Zalmanson, 2017), और रसीद उन उपकरणों को दूसरे तरीके से वापस करती है।
साक्ष्य परत उत्पाद में दृश्यमान होनी चाहिए, बैक-ऑफिस लॉग में दाखिल नहीं की जानी चाहिए। सॉफ्टवेयर इंजीनियरिंग हाल ही में एजेंटिक मॉडल के आसपास रनटाइम रैपर के लिए एक नाम पर एकत्रित हुई है, एजेंट हार्नेस, और इस स्वीकृति पर कि हार्नेस, और मॉडल नहीं, वह है जिसे प्रमाणित, विनियमित और विश्वस्त किया जा सकता है। आर्किटेक्चरल विश्वास निर्दिष्ट करता है कि एक हार्नेस को उत्पादन करना चाहिए उस भूमिका के योग्य होने के लिए।
इस अनुभाग के लिए दोनों पैमाने और स्नैप-बैक पहले से ही रिकॉर्ड पर हैं। Klarna के सहायक ने अपने पहले महीने में 2.3 मिलियन बातचीत को संभाला, कंपनी की ग्राहक-सेवा चैट का दो-तिहाई और 700 पूर्णकालिक एजेंटों के अनुमानित कार्य (Klarna, 2024, कंपनी द्वारा रिपोर्ट किए गए आंकड़े)। चौदह महीने बाद CEO ने सार्वजनिक रूप से अपना रुख बदला: उत्पादन गुणवत्ता में कमी आई थी, मानव भर्ती फिर से शुरू हुई, और खड़ी प्रतिबद्धता यह बन गई कि "यदि आप चाहते हैं तो हमेशा एक इंसान होगा" (Daly, 2025)। आर्किटेक्चरल रूप से पढ़ें, कंपनी के कथित कारण के रूप में नहीं बल्कि मेरी रीडिंग के रूप में, घोषणाओं की जोड़ी बिल्कुल उस अंतर को कोष्ठक में रखती है जिसे यह पेपर नाम देता है। वॉल्यूम टियर मशीन लागत पर काम करता है, लेकिन कोई स्नातक किया गया वृद्धि नहीं के साथ और कोई चेकेबल गुणवत्ता संकेत नहीं, प्रतिनिधिमंडल मानव आधारभूत पर वापस चला गया। जो स्थिति को उन घोषणाओं के बीच स्थिर बनाएगा वह एक स्नातक विश्वास आर्किटेक्चर है: सस्ता जहां दांव कम हैं, जांचा गया जहां दांव केंद्रित हैं, और मानव जहां जांच विफल हो।
बाजार और विनियमन
सीमा-पार सेवाओं के लिए। तटस्थता मॉडल विक्रेताओं से परे अधिकार क्षेत्र तक फैली हुई है। एक आर्केस्ट्रेशन परत अधिकार क्षेत्र-जागरूक रूटिंग को लागू कर सकता है और प्रवर्तन को रिकॉर्ड कर सकता है, डेटा-संप्रभुता अनुपालन को कानूनी प्रतिनिधित्व से एक ऑडिट योग्य रनटाइम संपत्ति में बदल सकता है। यह अंतर जिसका जवाब देता है, मापा गया है: 25 देशों में, उत्तरदाताओं का माध्य 53% यूरोपीय संघ पर विश्वास करता है कि AI को प्रभावी रूप से विनियमित किया जाए, संयुक्त राज्य अमेरिका के लिए 37% के विरुद्ध और चीन के लिए 27% (Pew डेटा, Stanford HAI, 2026 में रिपोर्ट किया गया, एक संस्थान रिपोर्ट, सहकर्मी-समीक्षा नहीं)। जहां विश्वास अधिकार क्षेत्र से भिन्न होता है, एक आर्किटेक्चर जो साबित कर सकता है कि कौन सा अधिकार क्षेत्र के नियम लागू किए गए थे, वास्तविक मूल्य है।
एजेंटिक वाणिज्य के लिए। Visa–ChatGPT एकीकरण तीन घटकों को ठोस बनाता है। कैप्स और व्हाइटलिस्ट स्थिर, उपभोक्ता-पक्ष गार्ड हैं। आर्किटेक्चरल विश्वास गतिशील, सेवा-पक्ष परत जोड़ता है: स्वतंत्र मॉडल द्वारा क्रॉस-चेक किए गए खरीदारी (विविधता), क्यों एजेंट इस व्यापारी को इस कीमत पर चुना, इसका एक पुनः प्लेबल रिकॉर्ड (साक्ष्य), और एक आर्केस्ट्रेशन परत जिसका राजस्व इस बात पर निर्भर नहीं करता है कि कौन सा विक्रेता या व्यापारी जीता (तटस्थता)।
भुगतान उद्योग ने पहले से ही इस स्टैक की निचली मंजिलों का निर्माण शुरू कर दिया है। Visa के Trusted Agent Protocol (अक्टूबर 2025, Cloudflare के साथ; Visa, 2025) एक एजेंट की पहचान को क्रिप्टोग्राफिक रूप से उसके अनुरोधों में हस्ताक्षरित करते हैं: व्यापारी- और उद्देश्य-विशिष्ट, समय-सीमित, रीप्ले-प्रूफ हस्ताक्षर। Google के Agent Payments Protocol (Google Cloud, 2025), जिन्हें Mastercard की फ्रेमवर्क के साथ 2026 में FIDO Alliance को योगदान दिया गया, उपयोगकर्ता के इरादे को हस्ताक्षरित जनादेशों के रूप में एन्कोड करते हैं जो W3C Verifiable Credentials (W3C, 2025) के रूप में ले जाए जाते हैं। Mastercard के Verifiable Intent (Google के साथ एक संयुक्त फ्रेमवर्क; मार्च 2026 में घोषित; Mastercard, 2026) अपने उद्देश्य को उन शब्दों में बताते हैं जो यह पेपर लिख सकता था, इसका एक छेड़छाड़-प्रतिरोधी रिकॉर्ड है कि उपयोगकर्ता ने क्या अधिकृत किया जब एक AI एजेंट उनकी ओर से कार्य करता है, 2026 में एशियाई और लैटिन अमेरिकी बाजारों में प्रारंभिक पायलट की सूचना दी गई। पहचान और इरादा साक्ष्य अब मानकीकृत किए जा रहे हैं, और रिकॉर्ड प्रारूप भी है: IETF की SCITT आर्किटेक्चर (RFC 9943, 2026) उसी पैटर्न को निर्दिष्ट करती है, हस्ताक्षरित कथन → केवल-जोड़ स्वच्छता लॉग → रसीद, जो इस पेपर की साक्ष्य परत मानती है। वह इंटरफ़ेस जिसके माध्यम से प्रत्यायोजन होता है, नैतिक रूप से तटस्थ भी नहीं है। तेरह प्रयोगों में, जिन लोगों ने AI को प्रत्यायोजित किया वे कम ईमानदारी से व्यवहार करते थे, सबसे तीव्रता से अस्पष्ट लक्ष्य-निर्धारण के तहत, और मशीन एजेंटों ने पूरी तरह बेईमानी के निर्देशों को मानव एजेंटों की तुलना में कहीं अधिक बार किया (Köbis et al., 2025)। इंटरफ़ेस जो इरादे को विशिष्ट शर्तों में कहना बाध्य करते हैं, नैतिक अवसंरचना हैं।
अभी तक कोई प्रोटोकॉल तीसरी मंजिल को कवर नहीं करता है, निर्णय साक्ष्य: एजेंट ने इस व्यापारी, इस उत्पाद, इस कीमत को कैसे चुना; क्या स्वतंत्र जांच सहमत थी; इसका आत्मविश्वास किस लायक था (चित्र 15 तीन मंजिलों को खींचता है)। यह वह परत है जिसे यह पेपर नाम देता है, और "know-your-agent" को बिल्कुल इस प्रक्रिया प्रश्न में परिपक्व होना चाहिए, निरीक्षण की इकाई लेनदेन तक उतरते हुए। जो आर्किटेक्चर गारंटी दे सकता है वह रिकॉर्ड का अस्तित्व है, इसकी पठनीयता नहीं। चाहे कोई ऐसे रिकॉर्ड खोले या नहीं, यह एक अनुभवजन्य प्रश्न है जिसका उत्तर केवल तैनाती दे सकती है।
चित्र 15. साक्ष्य स्टैक
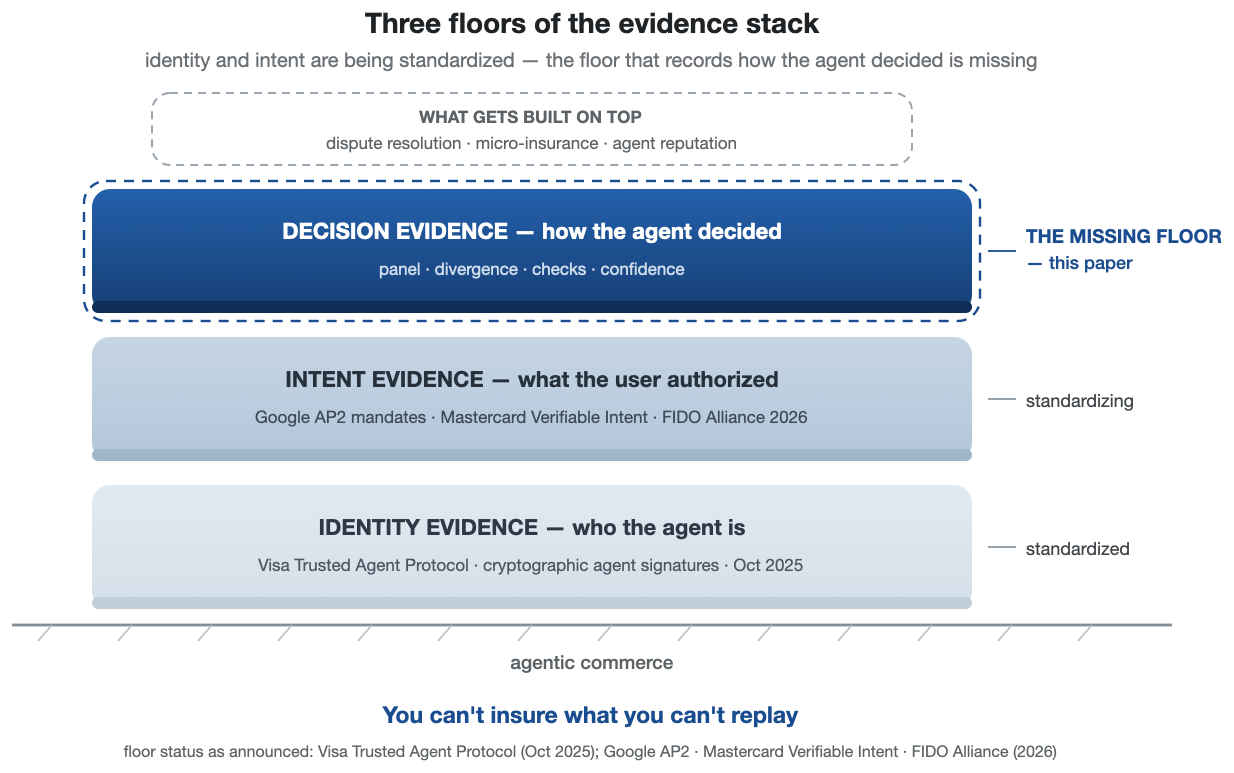
पहचान और इरादा साक्ष्य अब मानकीकृत किए जा रहे हैं; निर्णय साक्ष्य यह पेपर नाम देता है वह लापता मंजिल है।
एजेंट खरीद व्यवहार के पहले व्यवस्थित ऑडिट दिखाते हैं कि निर्णय साक्ष्य का इंतजार नहीं किया जा सकता। Allouah et al. (2026), एक नियंत्रित ई-कॉमर्स सैंडबॉक्स में यादृच्छिकृत परीक्षण चलाते हुए, पाया कि शॉपिंग एजेंट मजबूत स्थितीय पूर्वाग्रह प्रदर्शित करते हैं, कुछ "मोडल" उत्पादों पर मांग केंद्रित करते हैं, और जब अंतर्निहित मॉडल अपडेट होता है तो उन वरीयताओं को भारी रूप से पुनर्व्यवस्थित करते हैं। चुनाव कैसे किया गया इसके रिकॉर्ड के बिना, यह उपभोक्ता, व्यापारी, या नियामक के लिए दृश्यमान नहीं है। विविधता यहां डिजाइन का उत्तर है, क्योंकि एक पैनल किसी एकल मॉडल की स्थितीय विषमताओं को कमजोर करता है, और जवाबदेही वह है जो निर्णय साक्ष्य प्रदान करता है: जो उन ऑडिटरों को एक सैंडबॉक्स बनाना पड़ा था यह निरीक्षण करने के लिए, एक आर्किटेक्चरल रूप से विश्वसनीय सेवा उत्पादन में लॉग करेगी।
यह फ्रेम उपभोक्ता के पास भी फैला हुआ है, मशीन-से-मशीन विश्वास तक। B2B agentic वर्कफ़्लो में लूप में विश्वास महसूस करने के लिए कोई मानव नहीं है, इसलिए एकमात्र संभावित आधार सत्यापन योग्य प्रक्रिया है, एजेंट यहां वर्णित कलाकृतियों का आदान-प्रदान कर रहे हैं और लेनदेन करने के लिए कंप्यूटिंग कर रहे हैं। विश्वास कैसे एकत्रित होता है और इस तरह के प्रत्यायोजन श्रृंखलाओं में बड़े पैमाने पर प्रसारित होता है, और साक्ष्य परत के अपने स्वयं के लॉगिंग और सत्यापन ओवरहेड की लागत उत्पादन मात्रा पर क्या है, यहां खुली समस्याएं हैं। श्रृंखलाएं आवश्यकता को तीव्र करती हैं, क्योंकि एक श्रृंखला केवल उतनी ही विश्वसनीय है जितनी इसकी कम से कम साक्ष्य प्राप्त कड़ी: रिकॉर्ड को संयोजित होना चाहिए। जहां कोई उपभोक्ता मौजूद नहीं है, आर्किटेक्चरल विश्वास संभवतः विश्वास का एकमात्र उपलब्ध रूप है।
एक संरचनात्मक विकास जो विश्वास साहित्य ने पकड़ में नहीं पाया है, वह प्रोटोकॉल युद्ध है। प्रतिस्पर्धी एजेंट-कॉमर्स स्टैक (OpenAI with Stripe, the Agentic Commerce Protocol; Google की Universal Commerce Protocol गठबंधन; Perplexity with PayPal; कार्ड नेटवर्क और खुले मानक नीचे) वाणिज्य को विक्रेता प्रोटोकॉल लाइनों के साथ विभाजित कर रहे हैं बिल्कुल जैसे AI सेवाएं विक्रेता मॉडल लाइनों के साथ विभाजित हुईं, और तटस्थता तर्क लगभग शब्द के लिए शब्द सामान्यीकृत करता है: एक उपभोक्ता का एजेंट जो केवल एक विक्रेता के प्रोटोकॉल के अंदर लेनदेन कर सकता है, विक्रेता का एजेंट है, उपभोक्ता का नहीं। जो भी परत प्रोटोकॉल में मध्यस्थता करती है, उसे समान तीन आवश्यकताओं का सामना करना पड़ेगा, स्वतंत्रता, साक्ष्य, और कोई दांव नहीं, और यदि ऐसी परत पकड़ में आती है तो शेल्फ के लिए लड़ाई चेकर के लिए लड़ाई बन जाती है।
साक्ष्य बाजार के लिए। 2026 में यह पूर्वानुमान होना बंद हो गया। दायित्व पक्ष पर, बीमा ने पहले कदम रखा और एक ही समय में दोनों दिशाओं में। generative-AI दावों के लिए वैकल्पिक बहिष्कार समर्थन जनवरी 2026 में मानक सामान्य-दायित्व किट में प्रवेश किए (ISO फॉर्म CG 40 47 और CG 40 48, समर्थन वहन करने वाले चुन सकते हैं, स्वचालित बहिष्कार नहीं; कुछ महीनों में, प्रमुख वाहकों ने उन्हें अपनाने या मालिकाना समकक्षों के लिए दाखिल किया)। उसी खिड़की में पहली AI-agent नीतियां विपरीत तरीके से लिखी गईं, साक्ष्य के विरुद्ध: AIUC-1 agent मानक मौजूद है लाल-टीम ऑडिट के माध्यम से, अनुभवजन्य जोखिम प्रोफाइल उत्पन्न करने के लिए जो बीमाकर्ताओं को अंडरराइट करने के लिए आवश्यक है, और फरवरी-मार्च 2026 इसका पहला प्रमाणित ऑडिटर, पहली एजेंट नीति, और पहली एंटरप्राइज प्रमाणन लाया। व्यापक बहिष्कार और साक्ष्य-आधारित हामीदारी के बीच दबाया गया, रिकॉर्ड दायित्व आवंटन की इकाई बन गया है: एक एजेंट जिसके पास कोई निरीक्षण योग्य इतिहास नहीं है बहिष्कार-आकार का कवरेज का सामना करता है, और एक एजेंट जिसके पास एक है एक उद्धृत करने योग्य जोखिम है।
नियामक पक्ष पर, EU AI Act का अनुच्छेद 50 पारदर्शिता दायित्व, उपभोक्ताओं को AI इंटरैक्शन का अनिवार्य प्रकटीकरण सहित, 2 अगस्त 2026 को लागू होने योग्य होता है (एक अस्थायी चिह्नन उप-दायित्व 2 दिसंबर 2026 तक चलता है), जुर्माना, इस पेपर की Act की दंड प्रावधानों की व्याख्या के अनुसार, €15 मिलियन या वैश्विक टर्नओवर के 3% तक। आयोग ने अपने अनुच्छेद 50 मार्गदर्शन को 20 जुलाई 2026 को अपनाया (European Commission, 2026), और समानांतर Digital Omnibus सरलीकरण (8 जुलाई को हस्ताक्षरित) अगस्त दायित्वों में देरी नहीं करता है। मौजूदा सिस्टम को केवल सीमित स्थगन मिलता है, मशीन-पठनीय सामग्री चिह्नन के लिए दिसंबर 2026 तक। व्यापक उच्च-जोखिम दायित्व 2027-2028 में चरणबद्ध होते हैं।
साक्ष्य परत इस दायित्व को बदलता है: एक छेड़छाड़-प्रतिरोधी रिकॉर्ड जिसमें यह प्रमाण शामिल है कि आवश्यक AI प्रकटीकरण इस सत्र में इस उपयोगकर्ता को दिखाया गया था, इस पत्र की व्याख्या पर, €15 मिलियन तक के कानूनी जोखिम को एक ऑडिट योग्य रनटाइम संपत्ति में परिवर्तित करता है, वास्तुकला के एक उप-उत्पाद के रूप में अनुपालन। AI-एजेंट देयता का बीमा करने वाले बीमाकर्ताओं को बिल्कुल ये रिकॉर्ड चाहिए, और ट्रेसेबिलिटी और जवाबदेही NIST AI जोखिम प्रबंधन ढांचे की मूल विशेषताएं हैं। नियामक पूर्वाधार प्रौद्योगिकी से पुराना है। बैंकिंग का मॉडल-जोखिम मार्गदर्शन 2011 से एक मॉडल के डेवलपर्स से स्वतंत्र पक्षों द्वारा स्वतंत्र सत्यापन की आवश्यकता रहा है (Federal Reserve SR 11-7), एक आवश्यकता जिसे एक आयोजित पैनल स्वचालित करता है, निरंतर बनाता है, और हर परिणामी उत्तर तक विस्तारित करता है। उपभोक्ता कानून पहले से ही मानवीय निकास को सुरक्षित रखता है: GDPR अनुच्छेद 22 केवल स्वचालित निर्णयों में मानवीय हस्तक्षेप का अधिकार देता है जिनके महत्वपूर्ण प्रभाव हैं, और विचलन-पर-संवेदनशीलता, इस पत्र की व्याख्या पर, एक मौजूदा कानूनी अधिकार का रनटाइम रूप है। AI अधिनियम निरीक्षण पक्ष से एक ही डिजाइन तक पहुंचता है: नियमन (EU) 2024/1689 का अनुच्छेद 14 उच्च-जोखिम AI सिस्टम को प्रभावी मानवीय निरीक्षण के लिए बनाया जाना आवश्यक करता है, और एक वास्तुकला जो विचलन को सतह पर लाती है और अनसुलझे मामलों को एक मानव के पास रूट करती है, उस निरीक्षण कर्तव्य को एक अनुपालन दस्तावेज़ के बजाय एक रनटाइम संपत्ति के रूप में लागू करती है।
एक बार रिकॉर्ड मौजूद हो जाने पर, दो व्युत्पन्न उत्पाद अनुसरण करते हैं, दोनों निकट-अवधि अनुमान। लेनदेन-स्तर माइक्रो-बीमा एक विशिष्ट एजेंट खरीद का बीमा करेगा सेंट के लिए, साक्ष्य रिकॉर्ड से मूल्य निर्धारित, एक अपारदर्शी एजेंट के विरुद्ध अलिखनीय और एक पुनः चलाने योग्य के विरुद्ध तुच्छ। दूसरा है एजेंट प्रतिष्ठा: अनुदैर्ध्य साक्ष्य इतिहास स्वाभाविक रूप से एजेंटों और ऑर्केस्ट्रेटर्स के लिए प्रतिष्ठा स्कोर में एकत्रित होते हैं। सेवाएं जो ऑडिट-ग्रेड इतिहास को संचालन के एक उप-उत्पाद के रूप में बनाती हैं, एक ऐसी संपत्ति रखेंगी जिसे उनके प्रतिद्वंद्वियों को फिट करना होगा।
इस तरह की बुनियादी ढांचा कैसे संस्थागत हो जाती है, यह ही एक परिकल्पना है। प्रक्षेप जिस पर यह पत्र शर्त लगाता है, पहले उत्पाद, मानक के बाद, जनादेश अंतिम, विश्वास बुनियादी ढांचे का इतिहास प्रदर्शित करने वाले कई में से एक है (साझा ATM नेटवर्क, कार्ड-नेटवर्क नियमावली बाद में विनियमन द्वारा अनुमोदित, ब्लॉकचेन की सत्यापन आपूर्ति अभी भी मांग की प्रतीक्षा में है)। इसके पीछे एक नामित अनुसंधान कार्यक्रम भी है। Hadfield की नियामक-बाजार पंक्ति, निजी नियामक सार्वजनिक अधिकारियों द्वारा लाइसेंस प्राप्त, स्वतंत्र सत्यापन संगठनों के साथ भार वहन करने वाली संस्था के रूप में (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026), इसे शासन के आपूर्ति पक्ष से प्राप्त करता है। यह पत्र इसे उपभोक्ता प्रतिनिधिमंडल की मांग पक्ष से प्राप्त करता है, और दोनों कार्यक्रम रसीद पर मिलते हैं। इसके नीचे एक कठिन सवाल है कि क्या एक रसीद जो एक उत्पाद विशेषता के रूप में बेची जाती है कभी एक संस्था में कठोर हो जाती है। यदि ऐसा नहीं होता, तो यह एक शासन परत के बजाय एक शासन सजावट रहती है, जो इस पत्र के केंद्रीय दावे को खारिज कर देगी। खंडन बिंदु पूर्व-पंजीकृत है: रसीद को शासन परत कहें जब कम से कम दो उद्योग मानक एजेंटिक लेनदेन के लिए ट्रेसेबल निर्णय रिकॉर्ड की आवश्यकता करते हैं, सभी तीन घटक रखने वाली सेवाएं उच्च-दांव एजेंटिक लेनदेन मात्रा का बहुमत संभालती हैं, और कम से कम एक राष्ट्रीय नियामक अपनी देयता आवंटन में ऐसे रिकॉर्ड को मान्यता देता है। सभी तीनों की लगातार विफलता ही "सजावट" का परिचालनात्मक रूप है। यदि सत्यापन बुनियादी ढांचे के रूप में सफल होता है, तो यह वस्तु-निष्पक्ष हो जाता है, और विश्वास साझा उपयोगिता में ही माइग्रेट हो जाता है, वर्तमान वास्तुकला सहित, जो कोई भी खाई समाप्त कर देगा यहां तक कि अगर बुनियादी ढांचा सफल हुआ।
जब एक आयोजित निर्णय गलत हो जाता है तो कौन देयता दायी है: ऑर्केस्ट्रेटर, मॉडल विक्रेता, या उपभोक्ता जिसने एजेंट को अधिकृत किया।
कानून आसान निकास को बंद करना शुरू कर चुका है। California का AB 316, 1 जनवरी 2026 से प्रभावी, किसी भी प्रतिवादी को जो एक AI सिस्टम विकसित, संशोधित, या उपयोग करता है, यह तर्क देने से प्रतिबंधित करता है कि AI ने स्वायत्त रूप से नुकसान का कारण बना, जबकि साधारण बचाव और दोष का तुलनात्मक आवंटन अक्षुण्ण रहते हैं। यह कड़ी देयता लागू नहीं करता है। यह आवंटन प्रश्न को अनिवार्य करता है, और जो भी तरीके से सिद्धांत इसे हल करता है, पुनः चलाने योग्य रिकॉर्ड वह है जिससे किसी भी जिम्मेदारी आवंटन की गणना की जाएगी। कानूनी छात्रवृत्ति एक ही गंतव्य पर पहुंच रही है, यह मानते हुए कि शास्त्रीय एजेंसी-कानून टूलकिट AI एजेंटों में स्थानांतरित नहीं होता है और जो आवश्यक है वह दृश्यमानता और देयता की नई बुनियादी ढांचा है (Kolt, 2025), शासन साहित्य में इस पत्र के तर्क का निकटतम पूर्ववर्ती, निरीक्षण की आपूर्ति से दृष्टिकोण किया गया है जहां यह पत्र इसकी मांग से दृष्टिकोण करता है। वास्तुकलात्मक विश्वास साक्ष्य संपत्ति है जिस पर एक उदीयमान देयता सिद्धांत प्रशंसनीय रूप से चल सकता है।
माप और अनुसंधान एजेंडा
विश्वास माप के लिए। मानक साधन ब्रांड या इंटरफेस के प्रति दृष्टिकोण को मापते हैं। मापने योग्य दृष्टिकोण प्रतिनिधिमंडल की इच्छा है, "क्या आप इस AI को विश्वास करते हैं" के उत्तर के बजाय: निर्णयों का कौन सा वर्ग, किस दांव पर, क्या उपभोक्ता एजेंट को हाथ देगा बिना हर कदम की समीक्षा किए? प्रतिनिधिमंडल व्यवहार संबंधी है, वारंट किए गए विश्वास में एकरस है, और सीधे राजस्व से जुड़ा है। इसके बगल में उत्तर कैसे बनाया गया था, इसे जानने के सवाल बैठते हैं, क्या वे रिकॉर्ड तक पहुंच सकते हैं, और क्या सतह पर सहमति उनकी निर्भरता अंशांकन में सुधार या गिरावट करती है।
सर्वेक्षण मानव युग की रसीद था: जबकि उपभोक्ता खोज, तुलना, और पसंद करता था, उपभोक्ता से पूछना सीखने का एक रक्षणीय तरीका था कि क्या हुआ। प्रतिनिधिमंडल उस कार्य करने वाले को हटा देता है जिसे प्रश्नावली बनाई गई थी, इसलिए एपिसोड का प्राथमिक ट्रेस वह कलाकृति बन जाता है जिसे वास्तुकला बनाती है, और रसीद उस सटीक अर्थ में प्रतिनिधिमंडन किए गए युग का प्राथमिक लेनदेन ट्रेस है। दोनों साधन प्रतिस्पर्धा नहीं करते: रसीद लॉग करता है कि मशीन ने क्या किया और व्यक्तिपरक आत्मसात, महसूस की गई स्वायत्तता, या संज्ञानात्मक भार के बारे में कुछ नहीं कहता है, जो सर्वेक्षण का क्षेत्र बना हुआ है। (यह धारा 1 के साथ एक स्पष्ट तनाव को घोल देता है, जिसका प्रेरणा स्वयं कथित-वरीयता सर्वेक्षण है: सर्वेक्षण मापते हैं कि उपभोक्ता वर्तमान में एक बाजार के बारे में क्या महसूस करते हैं जो लगभग अस्तित्वहीन है, जबकि रसीद मापता है कि प्रतिनिधिमंडन की गई सेवाएं वास्तव में क्या करती हैं एक बार जब वे मौजूद हों।) यह पुल समान एपिसोड के साथ दृष्टिकोण उपायों को जोड़कर परीक्षण किया जा सकता है, परिणाम द्वारा स्तरीकृत, और अनुमान लगाया जा सकता है कि प्रश्नावली और रिकॉर्ड सहमत हैं और कौन सा बाद में प्रतिनिधिमंडन व्यवहार की बेहतर भविष्यवाणी करता है। प्रस्तावित संयुक्त डिजाइन द्वारा इस सत्यापन के एक हिस्से को ले जाता है, और जब तक ऐसे अध्ययन मौजूद नहीं हैं, कलाकृति-आधारित मेट्रिक्स सर्वेक्षण को सेवानिवृत्त करने के बजाय इसके पूरक हैं।
उद्योग सर्वेक्षण पहले से ही व्यावहारिक आधारस्तर को दर्शाते हैं: Gartner के एक उपभोक्ता सर्वेक्षण में जो मई 2026 में जारी किया गया था (846 यू.एस. उपभोक्ता, नवंबर–दिसंबर 2025 में सर्वेक्षण किए गए), जिन्होंने खरीदारी के दौरान जनरेटिव AI का उपयोग किया, उनमें से 54% ने इसके द्वारा दी गई सभी जानकारी की दोबारा जांच करने की रिपोर्ट दी है। आर्किटेक्चरल ट्रस्ट वह है जो उपभोक्ता पहले से ही अपने लिए करते हैं, इसका उत्पादकीकरण है।
माप कार्यक्रम के समग्र-मूल्यांकन आंदोलन (Liang et al., 2023) और एजेंट विश्वसनीयता के उभरते विज्ञान में स्वाभाविक सहयोगी हैं, जो विश्वसनीयता को बारह मेट्रिक्स में विघटित करता है क्योंकि एक एकल सफलता दर उन विफलताओं को छुपाती है जो महत्वपूर्ण हैं (Rabanser et al., 2026)। आर्किटेक्चरल ट्रस्ट उसी तरह व्यावहारिक रूप से काम करता है: आत्मविश्वास-त्रुटि दर, उपयुक्त निर्भरता, सलाह-वजन बदलाव, ओवरराइड दरें, निर्णय समय, और एक विशेष रूप से तीव्र आंकड़ा, सही और गलत आउटपुट के बीच अनुमोदन दर में अंतर, जो व्यवहार से सीधे पढ़ी गई विश्वसनीयता अंशांकन है। रिकॉर्ड पक्ष पर साक्ष्य कवरेज, मापा गया पैनल विचलन, और रसीद-पहुंच दरें हैं, जो एक ही एपिसोड पर सर्वेक्षण, व्यवहार, और लॉग को त्रिकोणित करते हैं। इसमें से कोई भी नया विज्ञान आवश्यक नहीं है। आवश्यकता यह निर्णय है कि ये, और सगाई नहीं, वह संख्याएं हैं जिनके लिए एक ट्रस्ट लेयर जवाबदेह है। परिनियोजन बिंदुओं से मेरा अपना अवलोकन प्रतिकूल तरीके को इंगित करता है: अच्छी तरह से प्रस्तुत की गई अनिश्चितता ने मेरी उपयुक्त निर्भरता को बढ़ाया, और मैंने सिस्टम पर अधिक विश्वास किया जब यह दृश्यमान रूप से जानता था कि यह क्या नहीं जानता है।
एक और आश्रित चर एजेंडे पर होना चाहिए क्योंकि विश्वास एकमात्र मनोविज्ञान प्रतिनिधिमंडल नहीं है जो तनाव पैदा करता है। उपभोक्ता एक अनुकूल परिणाम के लिए कम गर्मजोशी से प्रतिक्रिया करते हैं जब एक एल्गोरिथ्म इसे उत्पन्न करता है, क्योंकि एक परिणाम जो किसी ने उत्पन्न नहीं किया है, उसे अपना दावा करना कठिन है (Yalcin, Lim, Puntoni, & van Osselaer, 2022)। प्रतिनिधिमंडन एक निर्णय की वस्तुनिष्ठ गुणवत्ता बढ़ा सकता है जबकि इसकी व्यक्तिनिष्ठ स्वामित्व को नष्ट कर सकता है। रसीद उस कांटे पर बैठती है: एक तरीके से पढ़ने पर, यह लेखकत्व को पुनर्स्थापित करती है; दूसरे तरीके से, यह प्रमाणित करती है कि उपभोक्ता ने कुछ नहीं किया। कौन सा पाठ प्रबल होता है यह एक डिजाइन प्रश्न है जिसे ढांचे ने पहले से ही दिया हुआ है: साक्ष्य घटक रिकॉर्ड करता है कि क्या जांचा गया और किस मानदंड के विरुद्ध जांचा गया (खंड 3), और रसीद उपभोक्ता के अपने मानदंडों को उस रिकॉर्ड में ले जाने के लिए बनाई गई है, इसलिए मूल्यांकन मानदंडों का लेखकत्व एक ऐसा चर है जिसे आर्किटेक्चर उजागर करता है न कि एक जो प्रयोगकर्ता आविष्कार करता है। Yalcin et al. की व्यवस्था, कि एक परिणाम जो किसी ने उत्पन्न नहीं किया है उसे अपना दावा करना कठिन है, तब मानदंड लेखकत्व को प्राकृतिक मध्यस्थ बनाता है, और P5 अनुपात के मनोविज्ञान के लिए साक्ष्य घटक का परिणाम है न कि एजेंडे की एक साइड शाखा। P5। रसीद सलिएंस परिणाम अनुकूलता के साथ सहभागिता करता है जो एक प्रतिनिधिमंडित परिणाम के व्यक्तिनिष्ठ आत्मसंरक्षण को निर्धारित करता है: अनुकूल परिणामों के लिए, एक सलिएंट रसीद आत्मसंरक्षण को पुनर्स्थापित करती है जब यह उपभोक्ता-लेखक मानदंडों को एनकोड करती है (वह मानदंड जिसे एजेंट को पूरा करना था वह मेरा था, और यहां प्रमाण है कि इसने इसे पूरा किया) और जब मानदंड प्लेटफॉर्म के रूप में पढ़े जाते हैं तो आत्मसंरक्षण को कम करता है; मूल्यांकन मानदंडों का उपभोक्ता लेखकत्व डिजाइन मध्यस्थ है। Yalcin et al. का प्रभाव वहां देखा गया था जहां उपभोक्ताओं ने स्वयं निर्णय लेने की अपेक्षा की थी, इसलिए P5 उस सीमा तक सीमित है और आदतन प्रतिनिधिमंडन के तहत उलट सकता है, और जो चीज़ रसीद को मौजूदा प्रक्रिया-पारदर्शिता हेराफेरी से अलग करती है, उसे लागू किया जाना चाहिए, ग्रहण नहीं किया जाना चाहिए। रसीद जांचने योग्य है और उपभोक्ता के अपने मानदंडों को ले जा सकती है; एक डिजाइन जो दोनों को छोड़ता है वह पारदर्शिता का परीक्षण कर रहा है, आर्किटेक्चरल ट्रस्ट का नहीं।
पारदर्शिता साहित्य यहां दो सावधानियां प्रदान करता है: बहुत अधिक प्रक्रियात्मक पारदर्शिता विश्वास को कम कर सकता है (Kizilcec, 2016), और AI उपयोग का मात्र प्रकटीकरण इसे नष्ट कर देता है (Schilke & Reimann, 2025)। दूसरा साक्ष्य घटक पर एक सीमा शर्त है: तेरह प्रयोगों में, जिन अभिनेताओं ने AI उपयोग का प्रकटीकरण किया, उन पर उन लोगों की तुलना में कम विश्वास किया गया जिन्होंने नहीं किया, एक पारदर्शिता दुविधा जिसमें AI निर्माण को अधिक दृश्यमान बनाकर, अपने आप में, विश्वास को कम करता है। यदि वह दंड AI निर्माण के किसी भी संकेत से जुड़ा है, तो एक आर्किटेक्चर जो अपनी स्वयं की मशीनरी को अग्रभाग करता है, विश्वास को कम कर सकता है भले ही यह इसे अधिक जांचने योग्य बना रहा हो, और साक्ष्य घटक ठीक वहीं विपरीत प्रभाव डालेगा जहां यह सबसे सलिएंट है। ढांचे का उत्तर एक अंतर पर निर्भर करता है जिसे प्रदर्शित किया जाना चाहिए: सत्यापनीयता मात्र प्रकटीकरण नहीं है। रसीद एक जांचने योग्य रिकॉर्ड है कैसे उत्तर उत्पन्न किया गया, न कि एक घोषणा कि AI का उपयोग किया गया, और P2 और P3 (H2 के पूर्व-पंजीकृत दोनों-पक्षीय परीक्षण के साथ, प्रकटीकरण बैकफायर को पहले से एक रिपोर्टेबल परिणाम के रूप में नामित किया गया) बिल्कुल वहीं हैं जहां अंतर या तो व्यावहारिक रूप से इसका लाभ अर्जित करता है या विफल होता है। सत्यापनीयता वह है जो विश्वास बनाता है, मांग पर दिया जाता है न कि एक हमेशा मौजूद प्रारूपता की दीवार के रूप में, और न तो मशीनरी को छुपाना और न ही इसकी घोषणा करना वह काम करता है। कितना रिकॉर्ड सतह करना है, किसे, और कब यह स्वयं एक डिजाइन चर है।
प्रकटीकरण दंड को जटिल करने के बजाय साक्ष्य को दूर करने के लिए प्रस्तावित तंत्र यह है कि सत्यापनीयता और प्रकटीकरण विभिन्न मनोवैज्ञानिक चैनलों के माध्यम से यात्रा करते हैं। प्रकटीकरण एक श्रेणी लेबल प्रदान करता है, कि एक AI शामिल था, जिसे Schilke और Reimann का साक्ष्य कम की गई वैधता से जोड़ता है। एक रसीद एक प्रक्रिया प्रदान करती है, एक रिकॉर्ड जिसे खोला, चुनौती दी, और फिर से चलाया जा सकता है, और प्रक्रियात्मक-न्याय साहित्य मानता है कि एक प्रक्रिया जिसे कोई चुनौती दे सकता है और जांच सकता है वह अभिनेता को वैध बनाता है जो इसे चलाता है (Tax, Brown, & Chandrashekaran, 1998)। चैनल को जांच करने की आवश्यकता नहीं है: जो विश्वास प्रदान करता है वह उपभोक्ता की जागरूकता है कि जांच मौजूद है और एक विवाद में खोली जा सकती है, सत्यापन की उपलब्धता इसके अभ्यास के बजाय, जो बिल्कुल उपभोक्ता कार्य है जो जांच की अर्थशास्त्र रसीद को ऊपर सौंपता है। जांच वहां केंद्रित होती है जहां जांच करने के लिए एक निजी लाभ मौजूद होता है, और उपभोक्ता सत्यापन को एक उपोत्पाद के रूप में प्राप्त करता है, रिकॉर्ड को एक विकल्प के रूप में रखता है न कि इसे एक दस्तावेज़ के रूप में पढ़ता है। समान अंतर व्यक्तिनिष्ठ आत्मसंरक्षण पर भी होता है (P5): एक प्रकटीकरण लेबल निर्णय को मशीन के लिए विशेषता देता है और स्वामित्व को नष्ट करता है, जबकि एक रसीद जो उपभोक्ता-लेखक मानदंडों को एनकोड करती है वह प्रमाणित करती है कि वह मानदंड जिसे एजेंट को पूरा करना था वह उपभोक्ता का अपना है। क्या दोनों चैनल वास्तव में अलग होते हैं, वैधता जांचने योग्य प्रक्रिया के साथ बढ़ रही है जबकि नंगे प्रकटीकरण के साथ गिर रही है, यह बिल्कुल वही है जो H2 की पूर्व-पंजीकृत दोनों-पक्षीय परीक्षण का पता लगाने के लिए बनाई गई है।
सीमाएँ। मॉडल वास्तुकला विश्लेषण और एक विस्तारित, उच्च-दांव वाली, एकल-संचालक तैनाती से प्राप्त है। हर अनुभवजन्य आधार उस एक स्टैक पर प्राप्त किया गया था, जिसे मैंने बनाया और संचालित किया। स्वयं पर लागू किया जाए, तो पत्र की वारंटी अपनी ही जाली से मिली-जुली है: एक लेखक और एक स्टैक (कम विविधता), एक सार्वजनिक प्रतिकृति पैकेज सील की गई तैनाती के रिकॉर्ड के साथ और प्रकाशन तक एक प्रतिबंधित व्यावहारिक पंजीकरण (आंशिक साक्ष्य), और एक घोषित व्यावसायिक हित (समझौता किया गया तटस्थता)। अन्य स्टैक पर स्वतंत्र प्रतिकृति किसी भी दावे को सामान्यीकृत करने से पहले आवश्यक है। तैनाती के रिकॉर्ड का हैश एंकर किसी भी बाद की संपादन, प्रतिस्थापन, या पूर्व-डेटिंग को पहचानने योग्य बनाता है, इसलिए अनसील करने पर यहाँ के लक्षण एक कलाकृति के विरुद्ध जाँचे जा सकते हैं जो प्रमाणित रूप से नहीं बदली है। पाठक अनसील होने तक सामग्री नहीं, अखंडता को सत्यापित कर सकते हैं। तंत्र संख्याएँ सार्वजनिक मॉडल API से आती हैं, और पाइपलाइन संग्रह को अंत से अंत तक $15 से कम में दोहराती है। उत्तेजना प्रतिपादन एक अंतरफलक अस्पष्टता रहता है: उपभोक्ता प्रयोग की उत्तेजनाएँ, प्राप्ति की स्टाइलिंग सहित, मेरा अपना UX प्रतिपादन है, और अंतरफलक-स्तरीय अस्पष्टताएँ केवल स्वतंत्र प्रतिपादन के साथ प्रतिकृति के माध्यम से सुलझती हैं। अंध-प्रथम संग्रह, छेड़छाड़-साक्ष्य रिकॉर्ड, और नो-स्टेक राउटिंग संरचना हैं; समुच्चयन नियम और संवर्धन सीमाएँ इंजीनियरिंग विकल्प हैं। प्रयोग के पैनल एक अंध संग्रह के विश्लेषणात्मक संयोजन हैं न कि एक तैनात आर्केस्ट्रेशन लूप, और तैयार किया गया फील्ड-टेलीमेट्री प्रोटोकॉल उस अंतराल को बंद करता है। गैर-मॉडल सत्यापन पथ जो ढाँचा नाम देता है (छाया चलाता है, अस्थायी-सामंजस्य जाँच) यहाँ वर्णित हैं, परीक्षण नहीं किए गए। संग्रह तापमान शून्य पर एक एकल रन है, जो अंतः-मॉडल परिवर्तनशीलता को दबाता है और साझा-वंश संबंध जगह में छोड़ता है, और होस्ट किए गए API वहाँ भी सख्ती से नियतात्मक नहीं हैं। SimpleQA के संक्षिप्त तथ्यात्मक उत्तर प्रतिबंधित-उत्तर-स्पेस शासन के पास बैठते हैं जिसमें सहमति त्रुटि को प्रमाणित करती है, और कठिनाई स्तरीकरण सबसे कठिन क्विंटाइल पर बिल्कुल वह पैटर्न दिखाता है। एक मध्य-स्तर पैनल विविधता के लाभ को अतिशयोक्तिपूर्ण कर सकता है, क्योंकि त्रुटि संबंध क्षमता के साथ बढ़ता है (Kim et al., 2025)। तंत्र प्रयोग खुले-प्रतिक्रिया तथ्यात्मक प्रश्नों का परीक्षण करता है जिनके एकल सत्यापन योग्य उत्तर हैं, और खुले-अंत उत्पादन कार्यों पर, जहाँ उत्तरों के बीच शब्दार्थ तुल्यता स्वयं एक निर्णय कॉल है, प्रमाणन संकेत को पुनः स्थापित करना चाहिए न कि मान लिया जाए। एक संबंधित सीमा उत्तर स्पेस की आयामितता है: SimpleQA आइटमों का एकल सत्यापन योग्य उत्तर है, जबकि उपभोक्ता विकल्प जो एजेंट निष्पादित करते हैं वे व्यक्तिपरक, बहु-विशेषता उपयोगिता निर्णय हैं जिनके कई रक्षणीय उत्तर हैं, तो सहमति वरीयता स्पेस में कैसे व्यवहार करती है, और क्या स्वतंत्र एजेंटों के बीच समझौत वहाँ एक बेहतर विकल्प की पहचान भी करता है, एक खुला अनुभवजन्य प्रश्न है (शब्दार्थ तुल्यता वरीयता तुल्यता बन जाती है, और ग्रेडिंग स्वयं एक मॉडलिंग विकल्प)। एक लेबल-शोर जाँच चलाई जाती है: इस अध्ययन के उपनमूने के 351-आइटम प्रतिच्छेदन पर SimpleQA Verified (Google DeepMind, 2025) के साथ, सुधरे हुए गोल्ड लेबल के विरुद्ध हर पैनल उत्तर को पुनः ग्रेड करने से प्रमाणन लिफ्ट अपरिवर्तित या थोड़ा मजबूत रहता है (2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 तीन पैनलों में, नियतात्मक ग्रेडर), तो लेबल शोर लिफ्ट का चालक नहीं है। सभी आत्मविश्वास आंकड़े मौखिक 0–100 आत्म-रिपोर्ट हैं जिन्हें एकल प्रॉम्प्ट प्रारूप द्वारा प्राप्त किया जाता है, और निष्कर्षण प्रोटोकॉल के प्रति संवेदनशीलता विक्रेता द्वारा भिन्न हो सकती है, तो प्रति-विक्रेता भेदभाव और अंशांकन निष्कर्ष इस विन्यास के अंतर्गत इस निष्कर्षण प्रोटोकॉल के गुणों के रूप में पढ़े जाने चाहिए, निश्चित विक्रेता लक्षण के रूप में नहीं। सोलह-मॉडल वेव के तालिकाओं 6–7 में आत्मविश्वास आधारभूति कच्चा कथित आत्मविश्वास है। Guo et al. (2017) की परंपरा में मजबूत अंशांकित आधारभूतियाँ प्रमुख वेव पर चलाई गई थीं (Platt स्केलिंग और विभाजन-अनुरूप संयम, अनुभाग 3), जहाँ वे द्वार के पूरक के रूप में उभरते हैं न कि प्रतिस्थापन, और पहली वेव की पैनल-बनाम-आत्म तुलना उपभोक्ता उत्पाद वास्तव में तैनात करते हैं इसके विरुद्ध पढ़ी जानी चाहिए। सुर्खी द्वार अनुमान (−82.1% आत्मविश्वास विफलताओं का, बूटस्ट्रैप 95% CI [79.9; 84.1] दस पूर्ण भुजाओं के लिए, [80.0; 84.2] Meta भुजा के साथ शामिल) एक एकल पूर्व-निर्दिष्ट मात्रा है, और आसपास के विश्लेषण (सीमा संवेदनशीलता ग्रिड, कठिनाई और संदूषण स्तर, परिषद विभाजन और तुच्छ-आधारभूमि तुलना) विवरणात्मक मजबूती जाँचें हैं जो कई तुलनाओं के लिए किसी सुधार के बिना रिपोर्ट की गई हैं, और वे अपनी स्वयं की कोई पुष्टिकारी स्थिति का दावा नहीं करते हैं। पत्र में एकमात्र पारिवारिक-वार त्रुटि नियंत्रण उपभोक्ता प्रयोग के पूर्व-पंजीकृत {H1, H2} में Holm सुधार है। यदि मूल्यांकन शासन जो आत्मविश्वासी अनुमान को पुरस्कृत करता है उसे मरम्मत किया जाए ताकि सत्यता को मॉडल में प्रशिक्षित किया जा सके (Kalai et al., 2025), वास्तुकला एक समस्या के विरुद्ध बीमा देगी जिसका सस्ता समाधान है, हालांकि साक्ष्य और तटस्थता किसी मॉडल-स्तरीय मरम्मत को अपरिवर्तनीय रहेगी। आगे की सीमाएँ जहाँ वे रिपोर्ट की जाती हैं: प्रमुख वेव की कवरेज सीमाएँ (अनुभाग 3: दो अप्राप्य चीनी प्रमुख और एक बाधित Meta संग्रह), और प्रारंभिक 233-जोड़ी तर्क-बजट तुलना, जिसकी TOST सीमाएँ ±5-बिंदु मार्जिन पर तुल्यता के बिना संकीर्ण सीमाओं के लिए शक्ति। प्रतिनिधिमंडल उपाय एक काल्पनिक दृश्य से आते हैं, जहाँ कथित उपाय मेटा-विश्लेषण पर वास्तविक इच्छा से लगभग 21% अतिशयोक्तिपूर्ण करते हैं (Schmidt & Bijmolt, 2020); उपभोक्ता प्रयोग छह निश्चित आइटमों पर 200 पंजीकृत भागीदारों के 119 प्राथमिक और 133 पूल को महसूस किया। एक वाणिज्य-सब्सट्रेट प्रतिकृति तंत्र को बेंचमार्क से परे विस्तारित करता है: 267 Wikidata-सत्यापित उत्पाद तथ्यों का एक ताज़ा, पूर्व-जमे हुए सेट (कौन सी कंपनी एक दिया गया कार या विमान बनाती है, एक फोन कौन सा ऑपरेटिंग सिस्टम चलाता है, कौन सी कंपनी एक गेम प्रकाशित करती है, इसे किस वर्ष भेजा गया था), एक स्वतंत्र छह-मॉडल पैनल के माध्यम से अंध दौड़ाया जाता है (Claude Opus, GPT-5.4, Grok, Qwen, GLM, और Mistral), लागत-अनुकूलित स्तर जिस पर उपभोक्ता-सामना करने वाले एजेंट वास्तव में काम करते हैं, प्रमुख नहीं, असंबंध को पुनः प्राप्त करता है, क्रॉस-मॉडल समझौत AUROC 0.77–0.81 पर कथित आत्मविश्वास के 0.63–0.70 के विरुद्ध सही होना और 4–6× प्रमाणन लिफ्ट, स्वतंत्र रूप से तीन से छह मॉडल के पैनल में मजबूत विस्तार करता है जो अमेरिकी, चीनी, और यूरोपीय प्रयोगशालाओं को फैलाता है, और ग्रेडिंग की कठोरता तक (यहाँ नियतात्मक स्ट्रिंग-मैच प्राथमिक, रूढ़िवादी नियम है)। व्यक्तिपरक, बहु-विशेषता वाणिज्य स्पेक्ट्रम का अंत (वरीयता ट्रेडऑफ, विरोधी व्यापारी प्रोत्साहन, और बदलते इन्वेंटरी पर उपकरण-आधारित पुनर्प्राप्ति) अपरीक्षित रहता है।
नमूनाकरण के तहत रन-टु-रन विचरण। एक विचरण भुजा ने सिंगल-डेटर्मिनिस्टिक-रन सीमा को सीधे जांचा: 100 प्रश्नों का एक कठिनाई-स्तरीकृत उप-नमूना (5 कठिनाई क्विंटाइल × 20, बीज 20260806) तापमान 0.7 पर फिर से चलाया गया था 11 में से 9 फ्लैगशिप-वेव पैनल मॉडलों के लिए प्रति प्रश्न 3 स्वतंत्र नमूनों के साथ; Meta के एंडपॉइंट्स अनुपलब्ध थे, और Claude Fable 5 के API में तापमान पैरामीटर नहीं है। मॉडलों के पार, सभी तीन नमूनों ने 22–77% प्रश्नों पर परस्पर समकक्ष उत्तर दिए (माध्यिका 54%), प्रति-प्रश्न शुद्धता 63–97% प्रश्नों पर तीनों नमूनों में समान थी, और तापमान-0 उत्तर 40–85% प्रश्नों पर बहुमत तापमान-0.7 उत्तर से मेल खाता था। gpt-5.6-sol की रन एक confound ले जाती है: यह तर्क प्रयास कोई नहीं पर चली, जबकि इसके 1,500 वेव रिकॉर्ड में से 1,486 ने डिफ़ॉल्ट प्रयास (माध्यिका, जैसा कि ऊपर नोट किया गया है) का उपयोग किया। इस उप-नमूना पर इसका 92.0% → 46.3% सटीकता डेल्टा इसलिए तापमान को तर्क बजट के साथ confounds करता है, हालांकि इसकी अंतर-नमूना सामंजस्य आंकड़े अप्रभावित हैं। उस confounded रन को छोड़कर, तापमान 0.7 पर माध्य प्रति-नमूना सटीकता समान प्रश्नों पर नियतात्मक तापमान-0 सटीकता से अधिकतम 14.0 बिंदुओं से भिन्न थी (gemini-3.1-pro, 49.0% → 63.0%), शेष सात मॉडलों के साथ 4.4 बिंदुओं के भीतर। पैनल स्तर पर, काउंसिल गेट (kimi-k3, deepseek-v4-pro और gpt-5.6-sol के बीच तीन-तरफा उत्तर समझौता) तापमान 0 पर उप-नमूना के 31.0% पर खुला था, तापमान-0.7 रन के तीनों में 25.0%, 23.7% और 29.8% के विरुद्ध। समझौता संकेत जो शीर्षक परिणाम को रेखांकित करता है वह नमूनाकरण शोर के तहत स्थिर है।
दावों की साक्ष्य स्थिति। दावे तीन साक्ष्य स्तरों पर गिरते हैं। इन डेटा द्वारा स्थापित: कि स्वतंत्र समझौता सहमति एक मॉडल के आत्म-रिपोर्ट नहीं करता है, कि सटीकता संकेत नहीं करता है, कथित सीमा शर्तों के तहत (अंधा संग्रह, सक्षम सत्यापनकर्ता, खुली-प्रतिक्रिया तथ्यात्मक प्रश्न एकल सत्यापन योग्य उत्तर के साथ); कि एक निश्चित असहमति गेट आत्मविश्वास विफलताओं का बहुत बड़ा बहुमत काटता है एक पर्याप्त, कथित कवरेज लागत पर (−82.1% 30.5% कवरेज पर); और स्वयं मजबूत सीमा शर्तें: सर्वसम्मति विवश उत्तर स्थानों पर त्रुटि को प्रमाणित करती है, कच्ची प्रमाणन लिफ्ट कठिनाई के साथ एकरस रूप से क्षीण होती है (संग्रह के भीतर स्तरीकरण के तहत सबसे कठिन क्विंटाइल पर गायब; बाह्य के तहत सकारात्मक लेकिन सबसे कमजोर वहां), और सत्यापनकर्ता दक्षता प्रमाणन मूल्य को गेट करता है। व्यवहार प्रयोग द्वारा समर्थित (एक डिजाइन, विनम्र एकल-अध्ययन पैमाना, n = 119): कि वास्तविक क्रॉस-मॉडल असहमति सतह दोनों दिशाओं में निर्भरता अंशांकन में सुधार करता है (d = 0.67, Holm p = .0005; एक छह आइटम द्वारा किया जाता है; मुख्य-वेव हेरफेर जांच 88–98%; स्केल विश्वसनीयता α = .83–.93); और, एक पंजीकृत अनिर्णीत शून्य के रूप में, कि एक स्थिर पहली-जोखिम रसीद पता लगा सकते हैं प्रतिनिधिमंडल नहीं ले जाता है। सैद्धांतिक रूप से प्रस्तावित, अभी परीक्षा नहीं की गई: D×E×N पूरकता; तटस्थता प्रभाव (P3); बढ़ते प्रतिनिधिमंडल के तहत विश्वास प्रवास; वास्तुकला-आधारित विश्वास की विफलता के बाद स्थायित्व (P4); सत्यापनशीलता के लिए भुगतान करने की इच्छा; और अनुभाग 7 का बाजार-श्रेणी दावा।
प्राकृतिक अगला कदम प्रायोगिक है: एकल-मॉडल और समन्वित शर्तों में विश्वास, निर्भरता अंशांकन, और भुगतान-के-इच्छा मापें, असहमति वैकल्पिक रूप से सतह और दबा दी जाएं। अनुभाग 6 महसूस किए गए प्रयोग की रिपोर्ट करता है, पूर्व-पंजीकृत और प्रोत्साहन-संगत। एक मानक विकल्प-आधारित संयुक्त भाग-योग्यता अतिरिक्त अनुमान लगाता है और मुआवजे के व्यापार-ऑफ मानता है, जो पूरकता परिकल्पना इनकार करता है, तो डिजाइन वर्ग को गैर-मुआवजे संरचना की अनुमति देनी चाहिए, चाहे पहलू द्वारा उन्मूलन या बाध्य-विकल्प डिजाइन डिल-ब्रेकर विशेषताओं के साथ, स्पष्ट बातचीत शर्तों के साथ अनुमानित। दो डिजाइन स्तरों को निर्दिष्ट किया गया है। न्यूनतम स्तर एक लक्षित-प्रोफ़ाइल अध्ययन है, चार से पांच प्रोफ़ाइलें कोई नहीं, एकल-घटक, दो-घटक, और पूर्ण कॉन्फ़िगरेशन के साथ, सैद्धांतिक काम एक पूर्वनिर्धारित विरोधाभास द्वारा किया जाता है, पूर्ण कॉन्फ़िगरेशन का प्रभाव घटक प्रभावों के योग को (सुपर-additivity) से अधिक करता है, योगात्मक शून्य के विरुद्ध। पूर्ण स्तर तीन स्तरों को प्रति घटक (अनुपस्थित, वर्तमान-लेकिन-निरीक्षणीय, वर्तमान-और-निरीक्षणीय) में एक 3×3×3 के बीच-विषय फैक्टोरियल (27 कोशिकाओं; दांव विषय भर में चार स्तरों में विविध), कम से कम 80 उत्तरदाताओं के साथ प्रति कोशिका (N ≥ 2,160) शक्ति के लिए ≥ 0.85 बातचीत पर। एक बाइनरी 2³ डिजाइन Cobb–Douglas घातांक वसूल नहीं कर सकता है और प्रशंसनीय प्रभाव आकार पर underpowered है (d ≈ 0.3–0.4)। तीन उत्तेजना अनुशासन लागू होते हैं: वास्तुकला परिमाण को स्वयं भिन्न करते हैं और केवल उनकी लेबलिंग नहीं (एक लापता रसीद लेबल उपभोक्ता साक्ष्य की अज्ञानता है, इसकी अनुपस्थिति नहीं), प्रत्येक घटक को सत्यापन योग्य-बनाम-केवल-asserted विरोधाभास दें, और प्रक्रिया-ट्रेसिंग के साथ विकल्प डेटा जोड़ी करें रसीद के क्षेत्रों पर, चूंकि सिद्धांत साक्ष्य का उपयोग भविष्यद्वाणी करता है। मेरे ज्ञान के लिए यह तीन घटकों को संयुक्त रूप से अलग करने के लिए पहला डिजाइन होगा। एकल-घटक बिल्डिंग ब्लॉक पहले से कीमतें हैं (König et al., 2022; Ioku et al., 2024), और सन्निहित बंडलें चलाई गई हैं (Cetinkaya & Krämer, 2024, निकटतम साधन और शक्ति-अंशांकन स्रोत Köbis et al., 2025 के साथ), तो अध्ययन निर्दिष्ट, सत्ता प्राप्त, और चलाने के लिए तैयार है। निर्माण की सीमा शर्तें ये हैं: वास्तुकला विश्वास जहां दांव कम और मात्रा अधिक है वहां भुगतान नहीं करता है; यह कहां कम जोड़ता है सत्यापनकर्ता पूल कार्य वर्ग पर सक्षम नहीं है; यह जहां उत्तर स्थानों को कसकर विवश किया जाता है वहां त्रुटि को प्रमाणित कर सकता है; और यह जहां पैनल स्वतंत्रता की पुष्टि की जाती है न कि मापी जाती है वहां थिएटर की ओर बिगड़ जाता है, सबसे तीव्र खुली लाल-टीम सवाल के रूप में एक गेमड रसीद क्या दिखता है? एक बार जब हाइपरलिंक्स अधिकार संकेत बन गए, तो लिंक फार्म उन्हें निर्माण करने के लिए उठे, और समझौता रिकॉर्ड अपने स्वयं के खेती को आमंत्रित करने की उम्मीद की जानी चाहिए। दो लौकिक सीमा भी लागू होती हैं: संकेत ध्यान जीतते हैं जबकि साक्ष्य दृढ़ता जीतता है, तो दावा विश्वास की चिंता करता है जो विफलता के बाद जीवित रहता है बजाय कौन सबसे तेजी से ऑनबोर्ड करता है, और यहां तक कि एक काम कर जांच केवल जैसे spirale धीमा सकता है Chandra et al. (2026) मॉडल। जहां परिणाम केंद्रित होते हैं और स्वतंत्रता वास्तविक होती है, वास्तुकला विश्वास अपनी लागत और इसके नाम को अर्जित करता है (टेबल 12 चार को संग्रहीत करता है)।
टेबल 12। सीमा शर्तें: जहां वास्तुकला विश्वास भुगतान नहीं करता है
| शर्त | यह वहां क्यों विफल होता है | साक्ष्य |
| कम दांव, उच्च मात्रा | सत्यापन लागत त्रुटियों की लागत से अधिक है; एकल-मॉडल सेवा सही उत्तर है | ब्रेक-ईवन तर्क (चित्र 14) |
| सत्यापनकर्ता पूल कार्य क्षमता के नीचे | स्वतंत्रता बिना सक्षमता के कोई संकेत नहीं देती | स्थानीय-स्तर शून्य: समझौते के साथ या बिना 46% सटीकता |
| कसकर सीमित उत्तर स्थान | सहमति त्रुटि को पकड़ने के बजाय प्रमाणित करती है | बहुविकल्प बनाम 0.5–2.2% खुली-रूप के मुकाबले सहमति त्रुटि 4.0–7.9% |
| स्वतंत्रता प्रदर्शित की गई, मापी नहीं गई | निकट-क्लोन का एक पैनल आत्मविश्वास तैयार करता है | सहसंबद्ध त्रुटि; ब्लॉक और वंशावली शून्य |
एक अंतिम सीमा यह है कि प्रस्तावित डिज़ाइनों में से कोई भी क्या पहचान सकता है। एक एजेंटिक बाजार में विश्वास, आखिरकार, एक संतुलन वस्तु है। एक बार जब विक्रेता, प्लेटफॉर्म और प्रतिस्पर्धी एजेंट एक सत्यापन आर्किटेक्चर के अनुकूल हो गए हों, तो इसके प्रभाव अनुकूलित बाजार के गुण हैं, उपचार सेल के नहीं। अवलोकनात्मक डेटा चयन को विरासत में पाते हैं, क्योंकि सत्यापन पहले अपनाया जाएगा जहां विश्वास पहले से ही टूट रहा है। इकाई-स्तर का यादृच्छिकरण चयन की मरम्मत करता है लेकिन हस्तक्षेप पर रुक जाता है, क्योंकि रसीदों के लिए यादृच्छिक किए गए उपभोक्ता अभी भी एक बाजार में लेन-देन करते हैं जिसके विक्रेता सभी की रसीदों का एक साथ जवाब देते हैं। संतुलन मात्रा को क्लस्टर, स्विचबैक, द्विपक्षीय, या बाजार-स्तर के डिज़ाइन की आवश्यकता है; विश्वास को मापने के बजाय आर्किटेक्चर को यादृच्छिक करना अगली कठिन समस्या है। और शुरुआती एजेंटिक-वाणिज्य समूह विश्वास प्रवृत्ति पर स्व-चयन करते हैं, इसलिए शुरुआती अपनाने वालों पर अनुमानित प्रभाव जनसंख्या प्रभाव को बांधते हैं, अनुमान नहीं लगाते हैं। तटस्थता मूल्यवान है क्योंकि एक मॉडल में हिस्सेदारी वाला कोई भी व्यक्ति इसकी आपूर्ति नहीं कर सकता है, जिसमें आर्केस्ट्रेशन में हिस्सेदारी वाला कोई भी व्यक्ति शामिल है। तर्क मेरे द्वारा निर्मित सिस्टम के प्रकार को भी वर्णित करता है (लेखक की टिप्पणी)। वह हित वकालत को छूता है और साक्ष्य की प्रतिलिपि क्षमता को नहीं: मूल्यांकन किए गए मॉडल स्वतंत्र, सार्वजनिक रूप से सुलभ सीमावर्ती प्रणालियां हैं, और हर रिपोर्ट की गई संख्या जमे हुए प्रतिकृति पैकेज से तीसरे पक्ष द्वारा पुनः गणना योग्य है। एक पाठक जो वकालत को पूरी तरह से छोड़ देता है वह अभी भी माप को सत्यापित कर सकता है।
6. क्या उपभोक्ता सिग्नल का उपयोग कर सकते हैं? एक प्रारंभिक व्यावहारिक परीक्षण
क्या उपभोक्ता तंत्र स्थापित करने वाले सही संकेत का उपयोग कर सकते हैं, यह एक अलग, व्यावहारिक प्रश्न है, और मैं इस पर एक पूर्व-पंजीकृत, प्रोत्साहित प्रयोग की रिपोर्ट करता हूं। कार्य-क्षेत्र अध्ययन एक सामान्य प्रभाव की परीक्षा के बजाय एक अस्तित्व प्रमाण है; यह पूछता है कि क्या उपभोक्ता बिल्कुल सिग्नल पर कार्य कर सकते हैं। एक शक्तिशाली, पुष्टिकारी, कई-आइटम, उत्तेजना-नमूना प्रतिकृति आइटम यादृच्छिक ढलानों के साथ नियोजित है। अंतिम भर्ती विंडो में एक होस्टिंग आउटेज 200 नियोजित के विरुद्ध 119 वैध प्रतिभागियों पर संग्रह समाप्त कर दिया (133 एक नरम-लॉन्च समूह को पूल करना; यूएस और यूके; एक एजेंटिक शॉपिंग सहायक के आसपास तीन बीच-विषय स्थितियां; छह प्रोत्साहित तथ्यात्मक परीक्षणों पर मापी गई कैलिब्रेशन Δ = P(स्वीकार करें | सही) - P(स्वीकार करें | गलत) के रूप में, Schemmer et al., 2023 का उपयुक्त-निर्भरता भेदभाव सूचकांक)। पूर्ण विधि, पायलट, पंजीकरण से पांच विचलन, नैतिकता और छूट प्रकटीकरण, और सभी सहायक आंकड़े नीचे विस्तृत रिपोर्ट (§6.1–6.2) और प्रतिकृति पैकेज में हैं।
प्रदर्शित क्रॉस-मॉडल असहमति ने समग्र कैलिब्रेशन में सुधार किया (नियंत्रण Δ = 0.24 → 0.45; d = 0.67, 0.68 पूल, p = .0001), लेकिन पूल किया गया अनुमान नाज़ुक है: इसे छह उत्तेजना में से एक द्वारा किया जाता है, एकल उच्च-आत्मविश्वास असहमतिकर्ता आइटम, जहां प्रदर्शन ने एक आत्मविश्वासपूर्ण गलत उत्तर की स्वीकृति को 74% से 24% तक कम किया (पूल किए गए समूह, तालिका 18)। उस आइटम को हटाने से प्रभाव d = 0.09 (p = .54) तक गिर जाता है, जबकि किसी अन्य आइटम को हटाने से यह बरकरार रहता है। लाभ यूके उप-नमूने में केंद्रित था। यूएस नियंत्रण सेल (n = 16) पहले से ही आधार रेखा पर भेदभाव करता था (इंटरैक्शन p = .002)। एकमात्र आइटम पर जहां पैनल स्वयं एक गलत उत्तर पर सहमत था, प्रदर्शन ने दोनों देशों में स्वीकृति बढ़ाई, जो अनुभाग 3 की प्रमाणित-सहमति-त्रुटि मोड को मानव व्यवहार में पुन: उत्पादित करता है और अपने आप में एक निष्कर्ष है: एक आर्किटेक्चर जो समझौता सतह अपनी एक व्यवस्थित विफलता को अपने उपयोगकर्ताओं को स्थानांतरित करता है। P2 के साक्ष्य घटक की प्रथम-एक्सपोजर परीक्षा, एक स्थिर आर्केस्ट्रेशन रसीद, प्रतिनिधिमंडन की इच्छा पर कोई पता लगाने योग्य प्रभाव नहीं पड़ा (d = 0.21, इस शक्ति पर अनिर्णीत; विवाद के समय एक लाइव ड्रिल-डाउन रसीद पंजीकृत अनुवर्ती है)।
एक असहमत पैनल प्रदर्शन एक आत्मविश्वासपूर्ण गलत सिफारिश की स्वीकृति को तेजी से कम कर सकता है जहां एक उपभोक्ता अन्यथा इसे स्वीकार करेगा, और यह विफल हो जाता है जहां पैनल एक साझा त्रुटि को प्रमाणित करता है। कैलिब्रेशन विपरीतता इसलिए इन छह उत्तेजना के तहत व्यावहारिक समर्थन है; P1 जैसा कहा गया है, माना जाता है जोखिम के साथ मध्यस्थ के रूप में, इस परीक्षा द्वारा समर्थित नहीं है। P2–P4 खुले कार्यक्रम रहते हैं।
6.1 व्यावहारिक परीक्षण: विधि और पायलट
अनुभाग 3 और 5 के प्रस्तावों का परीक्षण किया जाना है, और ऊपर दिया गया माप कार्यसूची निर्दिष्ट करता है कि कैसे। प्रयोग P1 (सतही असहमति के तहत निर्भरता कैलिब्रेशन) और P2 (एक पुनः अभिनय योग्य रिकॉर्ड के तहत प्रतिनिधिमंडन की इच्छा) का एक पूर्व-पंजीकृत, प्रोत्साहन-संगत ऑनलाइन परीक्षण है, जो फ्लैगशिप लहर के वास्तविक बहु-मॉडल आउटपुट से तैयार किए गए उत्तेजना के साथ, दूसरी राय प्रतिमान (Detjen et al., 2025; Chen et al., 2026) को वास्तविक, प्रोत्साहित सीमावर्ती-मॉडल असहमति के लिए एक आर्किटेक्चरल फ्रेमिंग के तहत विस्तृत करता है। उपकरण, प्रोटोकॉल फ्रीज, पायलट, मुख्य लहर, और जमे हुए-कोड विश्लेषण पूर्ण और नीचे रिपोर्ट किए गए हैं। पुष्टिकारी तालिकाओं को इस पत्र के पूर्व संस्करणों में एक पूर्व-पंजीकृत कंकाल के रूप में किया गया था जिसमें [MAIN DATA PENDING] चिह्नित कोशिकाएं थीं और अब जमे हुए विश्लेषण कोड द्वारा भर दी गई हैं। दो परिणाम परिकल्पना के प्रतिकूल थे पूर्व-पंजीकृत रिपोर्ट योग्य प्राथमिक निष्कर्षों के रूप में: सतही असहमति कैलिब्रेशन को खराब करना (शुद्ध कम-निर्भरता), और रसीद प्रतिनिधिमंडन की इच्छा को कम करना (प्रकटीकरण बैकफायर); कोई भी प्रकट नहीं हुआ, लेकिन एक पूर्व-पंजीकृत शून्य हुआ।
विधि।
डिज़ाइन और परिकल्पनाएँ। विश्वास्यता अंशांकन प्रदर्शित सहमति को उत्तर की शुद्धता के साथ जोड़ने की आवश्यकता है, जिसे एक एकल दृश्यांश नहीं कर सकता। इसलिए डिज़ाइन संकर है। प्रतिभागी पहले एक खरीदारी-प्रतिनिधिमंडन दृश्यांश पढ़ते हैं (एक AI खरीदारी एजेंट, "ShopAssist," $1,200 बजट के भीतर लैपटॉप खरीद की सिफारिश करते हुए), जो P2 का प्राथमिक परीक्षण है, और फिर वास्तविक बहु-मॉडल आउटपुट पर एक संक्षिप्त प्रोत्साहित निर्णय ब्लॉक पूरा करते हैं, जो P1 का प्राथमिक परीक्षण है। H1 (P1): कई स्वतंत्र AI प्रणालियों से क्रॉस-मॉडल सहमति और असहमति प्रदर्शित करने से उपभोक्ताओं की विश्वास्यता अंशांकन में सुधार होता है (वे एजेंट के प्रस्तावित उत्तर को तब अधिक स्वीकार करते हैं जब यह सही होता है और कम स्वीकार करते हैं जब यह गलत होता है) एक एकल आत्मविश्वासपूर्ण उत्तर की तुलना में; दोनों-पक्षीय, क्योंकि साहित्य संयुक्त प्रस्तुति के तहत कम अति-निर्भरता और बढ़ी हुई अल्प-निर्भरता दोनों को दस्तावेज़ित करता है। H2 (P2): एक आर्केस्ट्रेशन रसीद तक पहुँच (कौन कार्य करता था, वे कैसे सहमत थे, क्या जाँचा गया था, और एक पूर्ण पुनः-सत्यापनीय रिकॉर्ड) अकेले प्रदर्शित असहमति के प्रभाव से अधिक एक महत्वपूर्ण खरीद को प्रतिनिधिमंडित करने की इच्छा बढ़ाता है; दोनों-पक्षीय, क्योंकि प्रकटीकरण विश्वास को भी कम कर सकता है।
स्थितियाँ। तीन बीच-विषय स्थितियाँ, यादृच्छिक रूप से 1:1:1 और दृश्यांश और निर्णय ब्लॉक दोनों में स्थिर: (1) नियंत्रण, एक एकल आत्मविश्वासपूर्ण सिफारिश, कोई आर्किटेक्चरल संकेत नहीं; (2) असहमति, समान सिफारिश जिसमें तीन स्वतंत्र AI प्रणालियों का पैनल (सिस्टम A, B, C के रूप में अनाम), स्पष्ट सहमति/असहमति चिह्नन, प्रणालियों के वैकल्पिक उत्तर और दर्ज आत्मविश्वास के साथ, और एक सादे-भाषा समाधान सारांश; (3) असहमति + प्रमाण, असहमति स्क्रीन के अलावा एक आर्केस्ट्रेशन रसीद कार्ड जो कौन कार्य करता था / वे कैसे सहमत थे / क्या जाँचा गया था / पूर्ण रिकॉर्ड के रूप में संरचित है। एक पूर्व-पंजीकृत डिज़ाइन बाधा स्पष्ट भ्रम को नियंत्रित करती है: अंतिम सिफारिश ब्लॉक (उत्पाद, मूल्य, और एजेंट का दर्ज अंतिम आत्मविश्वास) दृश्यांश और हर निर्णय परीक्षण पर सभी तीन स्थितियों में शब्दश: समान है, और केवल इसके चारों ओर आर्किटेक्चरल संकेत भिन्न होते हैं।
उत्तेजक और रसीदें। निर्णय-ब्लॉक उत्तेजक तीन अग्रणी मॉडल के वास्तविक आउटपुट हैं जो वास्तविक तथ्यात्मक प्रश्नों पर प्रमुख लहर से आते हैं जिन पर मॉडल उच्च दर्ज आत्मविश्वास (95–100) पर सचमुच सहमत या असहमत थे; कोई उत्तर या आत्मविश्वास निर्मित नहीं हैं। मॉडल नाम तटस्थ लेबल द्वारा प्रतिस्थापित किए गए हैं ताकि ब्रांड-पूर्व भ्रम से बचा जा सके, और मैपिंग प्रतिकृति पैकेज में प्रकट की गई है। स्थिति 3 में दिखाई गई रसीदें (एक दृश्यांश रसीद और छः परीक्षण रसीदें) अनुसंधान तैनाती के उत्पादन रसीद निर्माता (स्कीमा `decision-receipt@v1`) द्वारा उत्तेजक पैनल के वास्तविक पूर्वापत्र लॉग पर ढाली गई हैं, और उनके सत्यापन हैश रिकॉर्ड से सचमुच पुनः-गणनीय हैं (सत्यापन लॉग: 7/7 वैध)। इसलिए प्रयोग का साक्ष्य हेराफेरी अनुभाग 3 द्वारा परिभाषित कलाकृति का एक उदाहरण है। प्रदर्शित केंद्रीय आत्मविश्वास शुद्धता कोशिकाओं में निकटता से मेल खाया था (गलत आइटम 95/98/99; सही आइटम 99/99/100) और, उपचार विपरीतता के लिए निर्णायक रूप से, स्थितियों में समान था। नियंत्रण ने समान केंद्रीय आत्मविश्वास देखे और बहुत कम भेदभाव किया, जो एक आत्मविश्वास-संकेत खाता नहीं समझा सकता।
उपाय। DV1 (H2): एक 4-आइटम प्रतिनिधिमंडन-इच्छा पैमाना (7-बिंदु; उदा., "मैं ShopAssist को इस खरीद को स्वयं सिफारिश की समीक्षा किए बिना पूरा करने दूंगा"), औसत; एक एकल-आइटम प्रतिनिधिमंडन सीढ़ी (0–4, "केवल सिफारिशें" से "स्वायत्त रूप से कार्य करता है जिसमें गैर-वापसी योग्य खरीद भी शामिल है") माध्यमिक है। DV2 (H1): छः निर्णय परीक्षण; प्रत्येक पर, एजेंट एक उत्तर प्रस्तावित करता है और प्रतिभागी तय करता है कि क्या सहायक को आगे बढ़ने देना है (हाँ/नहीं) और उत्तर में विश्वास की दर देता है (0–100 स्लाइडर)। विश्वास निर्णय शुद्धता-प्रोत्साहित हैं (प्रत्येक सही विश्वास निर्णय के लिए बोनस, एक सही उत्तर स्वीकार करना या एक गलत उत्तर अस्वीकार करना)। प्रस्तावित उत्तर छः में से बिल्कुल तीन परीक्षणों पर सही है। प्रति-प्रतिभागी अंशांकन स्कोर Δ = P(स्वीकार | सही) − P(स्वीकार | गलत) है, उपयुक्त-विश्वास साहित्य का विविधता सूचकांक (Schemmer et al., 2023, जिसके RAIR/RSR उपाय समान वस्तु को विघटित करते हैं); एक परीक्षण-स्तर मिश्रित-प्रभाव मॉडल आइटम-स्तर संकल्प पुनः प्राप्त करता है। माना जाता है कि जोखिम और माना जाता है कि प्रक्रिया नियंत्रण (प्रत्येक 4 आइटम) P1 और P2 पथों के लिए पूर्व-पंजीकृत माध्यमिक विश्लेषणों में माध्यस्थ के रूप में मापा जाता है; माना जाता है कि आर्केस्ट्रेटर तटस्थता (4 आइटम) P3 के एक अन्वेषणात्मक सहसंबंध के रूप में मापा जाता है, जिसे यह अध्ययन हेराफेरी नहीं करता है।
फ्रीज़ किया गया प्रोटोकॉल। मुख्य डेटा संग्रह से पहले पूर्व-पंजीकरण को फ्रीज़ किया गया था (विश्लेषण कोड और प्रोटोकॉल को SHA-256 द्वारा 5 अगस्त, 2026 को फ्रीज़ किया गया; OSF पंजीकरण 13 अगस्त को प्रस्तुत किया गया, मुख्य लहर 13–14 अगस्त को मैदान में उतरने से पहले; प्रतिबंध के साथ पंजीकृत (पूर्व-पंजीकरण, केवल-दृश्य: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), पेपर के सार्वजनिक OSF घटक में जारी किया जाएगा, https://osf.io/jtvu9/)। छह-परीक्षण आइटम सेट को बीज द्वारा फ्रीज़ किया गया है: तीन असहमति आइटम डिज़ाइन द्वारा निर्धारित और हाथ से सत्यापित, साथ ही सर्वसम्मति आइटम जहाँ तीनों सिस्टम समान रूप से उत्तर दिए गए थे 95 या अधिक के बताए गए आत्मविश्वास पर, बीजित शफल से तैयार किए गए थे, जिसमें एक वास्तविक सर्वसम्मति त्रुटि शामिल है, ताकि प्रदर्शित समझौता नैदानिक लेकिन अपूर्ण हो, बिल्कुल स्रोत डेटा में की तरह। छह आइटम हर प्रतिभागी के लिए समान थे; प्रस्तुति क्रम को उपकरण में यादृच्छिक बनाया गया था, हालांकि मुड़े हुए निर्यात ने प्रति-परीक्षण प्रदर्शन क्रम को बनाए नहीं रखा। मुड़े हुए प्रदर्शन ने पैनल के लिए एक अनुमानित स्वतंत्रता स्कोर नहीं दिखाया, जो कि मापा-विविधता प्रकटीकरण है जो ढांचा स्वयं को कहता है, इसलिए प्रतिभागियों ने असहमति देखी लेकिन यह नहीं देखा कि असहमत सिस्टम कितने स्वतंत्र थे। पैनल की स्वतंत्रता को मापा गया था लेकिन नहीं दिखाया गया था, और स्रोत संग्रह पर इसका मान यहाँ उत्तरार्द्ध में रिपोर्ट किया गया है: माध्य युग्मित त्रुटि सहसंबंध φ = 0.22 (तीनों जोड़ियों में 0.10–0.44, समान-ब्लॉक सदस्य अब तक 0.44 पर सबसे अधिक संबंधित; अध्ययन के फ्रीज़ किए गए नियतात्मक ग्रेडर द्वारा वर्गीकृत, जो 95–98% उत्तरों को हल करता है, और अनुपयोगी शेष को कोडित करने के तरीके के प्रति असंवेदनशील), जो पैनल को स्वतंत्र से बहुत दूर और क्लोनल से बहुत दूर रखता है। वह वह संख्या है जो अगला उपकरण प्रतिभागियों के सामने रखना चाहिए। एक उत्तेजना सीमा: छह निर्धारित आइटमों के साथ, उपचार-दर-आइटम भिन्नता का अनुमान नहीं लगाया जा सकता, इसलिए प्रभाव इन उत्तेजनाओं के लिए स्थापित किया गया है। सत्र सूचित सहमति के साथ शुरू हुए और संदर्भ खरीद की काल्पनिक प्रकृति का खुलासा करते हुए एक debriefing के साथ समाप्त हुए। अध्ययन हेलसिंकी घोषणा के अनुसार आचरण किया गया था: GDPR-अनुपालक पैनल पर सहमति वाले यूके और यूएस वयस्कों पर गुमनाम, न्यूनतम-जोखिम सर्वेक्षण अनुसंधान, मंच न्यूनतम से ऊपर मुआवजा, और debriefing में प्रकटीकृत काल्पनिक संदर्भ के अलावा कोई धोखा नहीं। इन मानदंडों के तहत यह पूर्ण नैतिकता-बोर्ड समीक्षा से छूट के लिए शर्तों को पूरा करता था, और छूट आकलन पूर्व-पंजीकरण में प्रलेखित है। पूल अब बंद है; शाब्दिक आइटम सेट, उत्तर, और प्रति-परीक्षण रसीद पहचानकर्ता प्रतिबंधित पूर्व-पंजीकरण का हिस्सा हैं और डेटा के साथ जारी किए जाएंगे।
नमूना और विश्लेषण योजना। लक्ष्य N = 200 वैध प्रतिभागी (100 यूएस, 100 यूके; अलग Prolific अध्ययन; भर्ती को 210 पर सीमित), आयु 18+, धाराप्रवाह अंग्रेजी, ≥ 98% अनुमोदन दर, ≥ 100 पूर्व जमा, पिछले तीन महीनों में कम से कम एक ऑनलाइन खरीद। पूर्व-पंजीकृत बहिष्करण (वास्तविक प्रतिक्रियाओं को देखने से पहले लागू): तीन में से दो या अधिक विफल ध्यान जांचें; 3 मिनट से कम पूरा होना; सीधी लाइन; विफल हेरफेर चेक (सहमति आइटम शर्तों 2–3 में, रसीद आइटम शर्त 3 में, उत्पाद-समझ आइटम); दोहरी विफल निर्णय-ब्लॉक समझ; डुप्लिकेट ID या IP; अधूरा सत्र। पुष्टिकरण विश्लेषण: H1 के लिए, नियंत्रण के विरुद्ध पूलित असहमति शर्तों (2 और 3) पर Δ का OLS, देश सहसंयोजक के साथ; H2 के लिए, शर्तों 2 और 3 तक सीमित, देश सहसंयोजक के साथ शर्त पर प्रतिनिधिमंडन की इच्छा समग्र का OLS; {H1, H2} में Holm सुधार, पारिवारिक-वार α = .05; Welch t-परीक्षण मजबूती के रूप में; हेरफेर-जांच गेटिंग पहले रिपोर्ट की गई। कोहर्ट ऑर्डरिंग यहाँ तय की गई है: प्राथमिक पुष्टिकरण विश्लेषण मुख्य-लहर कोहर्ट पर पायलट के soft-launch प्रतिभागियों को बाहर करते हुए गणना किए गए हैं, और वह शाखा जो soft-launch कोहर्ट को पुष्टिकरण नमूने में पूल करती है, मजबूती विश्लेषण के रूप में साथ-साथ रिपोर्ट की गई है। पायलट की खोजपूर्ण Δ वर्णनात्मकता मुख्य लहर से पहले देखी गई थी, इसलिए उस कोहर्ट को प्राथमिक अनुमान से बाहर करना double-dipping के यहां तक soft रूप को हटाता है जबकि पूर्व-पंजीकृत soft-launch समावेश को रिपोर्ट की गई शाखा के रूप में बनाए रखता है। प्राथमिक रिपोर्टिंग में intention-to-treat विश्लेषण शामिल होगा जो सभी यादृच्छिकृत प्रतिभागियों को पूर्व-पंजीकृत per-protocol विश्लेषण के साथ बनाए रखता है। हेरफेर-जांच बहिष्करण differential-attrition जाँचों के साथ शर्त द्वारा रिपोर्ट किए जाएंगे, क्योंकि आर्किटेक्चरल-सिग्नल सालिंसी स्वयं शर्तों में भिन्न हो सकती है। संवेदनशीलता: डिज़ाइन H1 के लिए d ≈ 0.42 और H2 के लिए d ≈ 0.49 को शक्ति .80 पर का पता लगाता है, आसन्न निर्भरता और पारदर्शिता साहित्य में माध्यम प्रभावों के लिए पर्याप्त। छोटे प्रभाव अनुसंधान एजेंडे के पूर्ण कारक के लिए छोड़ दिए गए हैं। तीन पूर्व-पंजीकृत तत्व तंत्र प्रश्नों का उत्तर देते हैं जो पुष्टिकरण विपरीत अकेले नहीं कर सकते। उपकरण P1 पथ पर चार-आइटम perceived-risk स्केल (पायलट α = .881) ले जाता है, इसलिए जोखिम धारणा विश्लेषण में एक मापा निर्माण के रूप में प्रवेश करती है न कि एक धारणा के रूप में। माध्यिता को माध्यमिक विश्लेषण के रूप में पूर्व-पंजीकृत किया गया है, जिसमें perceived risk असहमति प्रभाव पर निर्भरता को मध्यस्थ करता है और perceived process control receipt प्रभाव को प्रतिनिधिमंडन की इच्छा पर मध्यस्थ करता है, bootstrap पथ विश्लेषण द्वारा अनुमानित (PROCESS मॉडल 4, 5,000 resamples)। शर्त-3 stimulus स्क्रीन पर समय को receipt reading के लिए पूर्व-पंजीकृत proxy के रूप में एकत्र किया जाता है, एक प्रत्यक्ष जांच कि क्या संज्ञानात्मक-भार विकल्प है कि प्रतिभागी receipt को बिना इसे संसाधित किए पास करते हैं। विश्लेषण कोड डेटा संग्रह से पहले फ्रीज़ किया गया था और replication पैकेज के साथ संग्रहीत है।
पायलट (soft launch): मानदंड और परिणाम।
n = 20 (यूएस) का एक पायलट, अंतिम उपकरण पर चलाया गया था, जिसमें पूर्व-पंजीकृत पास मानदंड को पहले से निर्धारित किया गया था, 6 अगस्त, 2026 को पूरा किया गया। तालिका 13 हर मानदंड को इसके परिणाम के विरुद्ध रिपोर्ट करती है।
तालिका 13। पायलट स्वीकृति मानदंड (पूर्व-पंजीकृत) और परिणाम (n = 20, यूएस)
| मानदंड (पहले से निर्धारित) | परिणाम | निर्णय |
| हेरफेर नोटिस किया गया: सहमति जांच पर > 80% सही (शर्तें 2–3) | 81.3% (13/16) | पास |
| हेरफेर नोटिस किया गया: receipt जांच पर > 80% सही (शर्त 3) | 88.9% (8/9) | पास |
| Cronbach's α > .70, प्रतिनिधिमंडन की इच्छा (4 आइटम) | .854 | पास (also .85 लक्ष्य को clear करता है) |
| Cronbach's α > .70, perceived risk (4 आइटम) | .881 | पास |
| Cronbach's α > .70, process control (4 आइटम) | .965 | पास |
| Cronbach's α > .70, तटस्थता (4 आइटम) | .851 | पास |
| माध्यिका पूर्ण समय 10–15 मिनट के भीतर | 9.60 मिनट | विफल, तेज़ दिशा में 24 सेकंड से |
एक मानदंड विफल हुआ। माध्यिका पूर्व-पंजीकृत विंडो के तहत 24 सेकंड चली, एक विंडो जो अत्यधिक लंबाई के विरुद्ध बनाई गई थी, दक्षता के विरुद्ध नहीं। तेज़ टेल लापरवाही से प्रतिक्रिया का कोई सबूत नहीं दिखाता है: कोई प्रतिभागी 3-मिनट की बहिष्कार सीमा से नीचे नहीं गया; पाँच मिनट से नीचे वाला एक प्रतिभागी हर ध्यान, हेराफेरी, और समझ की जाँच में सफल रहा; ध्यान-जाँच पास दरें 95–100% थीं; मुख्य चर पर कोई लापता कक्ष नहीं थे, कोई डुप्लिकेट आईडी या आईपी नहीं थे, और कोई सीधी-रेखा उत्तरदाता नहीं थे; और भर्ती-मंच समय स्वतंत्र रूप से सर्वेक्षण टाइमर की पुष्टि करते हैं (माध्यिका 9.74 मिनट)। यंत्र क्षेत्र में बजटबद्ध से कम है। स्थिति संतुलन (शर्तें 1/2/3 में 4/7/9) n = 20 पर 1:1:1 यादृच्छिकरण के अनुकूल है (χ²(2) = 1.90, p = .387)। पूर्व-पंजीकृत विश्लेषण बहिष्करणों के तहत, 20 पायलट प्रतिभागियों में से 6 पुष्टिकारी विश्लेषण से बाहर हैं (पाँच हेराफेरी-जाँच के आधार पर, एक दो बार विफल समझ पर), 14 मान्य रह जाते हैं। नरम-लॉन्च नियम प्रति, पायलट समूह समय विचलन के साथ पूल किए गए नमूने में आगे बढ़ता है जो यहाँ और पंजीकरण में ही स्वयं प्रकट किया गया है, जो 14 अगस्त 2026 को 03:09 UTC पर OSF को प्रस्तुत किया गया था, मुख्य-लहर संग्रह से पहले, और जो बताता है कि नरम-लॉन्च पायलट पुष्टिकारी नमूने में समय विचलन के साथ शामिल है; मुख्य-लहर समूह को प्राथमिक पुष्टिकारी अनुमान के रूप में और पूल की गई शाखा को मजबूती के रूप में मानना एक पोस्ट-पंजीकरण विश्लेषणात्मक निर्णय है, जो इसलिए लिया गया क्योंकि पायलट वर्णनात्मक मुख्य लहर से पहले देखे गए थे, और दोनों शाखाओं की रिपोर्ट की गई है; उत्पाद-समझ मार्जिन (80% पट्टी से ऊपर एक प्रतिभागी) मुख्य लहर में निगरानी के लिए चिह्नित किया गया है। एक अन्वेषणात्मक वर्णनात्मक, पायलट n पर अनुमान के बिना रिपोर्ट किया गया: अंशांकन स्कोर Δ शर्त के अनुसार +0.33 (नियंत्रण, n = 4), +0.52 (असहमति, n = 7), +0.22 (असहमति + साक्ष्य, n = 9) चला, इसलिए असहमति शर्त H1 की दिशा में चलती है; पायलट अधिक नहीं कह सकता।
6.2 व्यवहार परीक्षण: परिणाम, अन्वेषणात्मक विश्लेषण, और शेष बहीखाता
पुष्टिकारी परिणाम।
मुख्य-लहर संग्रह 13–14 अगस्त 2026 को चला (190 स्लॉट: नरम-लॉन्च समूह के शीर्ष पर 85 यूएस + 105 यूके), और यह पूरा नहीं हुआ: सर्वेक्षण होस्ट को अंतिम भर्ती विंडो के दौरान एक तकनीकी आउटेज का सामना करना पड़ा, और संग्रह कुल 158 पूर्ण सत्रों पर समाप्त हुआ (मुख्य लहर में 138 और नरम लॉन्च में 20) बजाय 200-मान्य लक्ष्य के। भर्ती प्लेटफॉर्म आउटेज के साथ समाप्त हुई, पूर्व-पंजीकृत वैकल्पिक-रोकने के नियम के तहत और देखे गए परिणामों के जवाब में नहीं, हालांकि परिणाम पहले से ही उस समय तक देखे जा चुके थे; परिणाम कम शक्ति है। वास्तविक कक्षों पर न्यूनतम पता लगाने योग्य प्रभाव पंजीकृत d ≈ 0.42 (H1) और d ≈ 0.49 (H2) से समान शक्ति पर लगभग d ≈ 0.54 और d ≈ 0.64 तक बढ़ते हैं, एक सीमा जो पुष्टिकारी परिणाम केवल एक दिशा में व्यर्थ करता है, और वह जो नीचे दिए गए प्रत्येक शून्य और अन्वेषणात्मक विपरीत पर लागू होता है। समूह क्रम §6.1 की योजना का पालन करता है। पायलट एक पास मानदंड को छोड़ दिया (पूर्ण-समय विंडो, तेज़ दिशा में 24 सेकंड से), और इसके अन्वेषणात्मक वर्णनात्मक मुख्य लहर से पहले देखे गए थे, इसलिए प्राथमिक पुष्टिकारी समूह अकेला मुख्य लहर है (N = 119 मान्य) और पहचानी गई नरम-लॉन्च समूह को वापस पूल करने वाली शाखा (N = 133) मजबूती के रूप में रिपोर्ट की जाती है। नीचे दी गई प्रत्येक संख्या डेटा संग्रह से पहले SHA-256 द्वारा जमे हुए विश्लेषण कोड का आउटपुट है। पंजीकरण से विचलन, एक जगह एकत्र किए गए: (i) N कमी (200 पंजीकृत में से 133 मान्य; होस्टिंग आउटेज); (ii) पायलट का पूर्ण-समय मानदंड तेज़ दिशा में 24 सेकंड से छूटा; (iii) प्रति-परीक्षण प्रदर्शन क्रम क्षेत्र निर्यात में नहीं रखा गया; (iv) स्क्रीन-स्तरीय समय कैप्चर नहीं किया गया; (v) परीक्षण-स्तरीय मिश्रित मॉडल एक भिन्नात्मक सन्निकटन पर चलाया गया (पैकेज का अंतिम इंजन भिन्न हो सकता है)। कुछ भी अन्यथा विचलित नहीं हुआ; हर पुष्टिकारी परीक्षण पंजीकृत के अनुसार चला, ऊपर दिया गया प्राथमिक-समूह निर्णय एकमात्र पोस्ट-पंजीकरण विश्लेषणात्मक पसंद है।
तालिका 14। नमूना प्रवाह और बहिष्कार (मुख्य लहर; नोट में नरम-लॉन्च समूह)
| यूएस | यूके | कुल | |
| पूर्ण सत्र | 50 | 88 | 138 |
| बहिष्कृत: ध्यान (≥ 2 में से 3 जाँचें) | 0 | 0 | 0 |
| बहिष्कृत: गति (< 3 मिनट) / सीधी-रेखा | 0 | 0 | 0 |
| बहिष्कृत: हेराफेरी / समझ जाँचें | 10 | 9 | 19 |
| बहिष्कृत: डुप्लिकेट / अधूरा | 0 | 0 | 0 |
| मान्य N (शर्त 1/2/3 के अनुसार) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
नरम-लॉन्च समूह 20 पूर्ण यूएस सत्र जोड़ता है, जिनमें से 14 समान बहिष्करणों से बचते हैं; यह केवल पूल की गई मजबूती शाखा (N = 133) में प्रवेश करता है। मुख्य लहर में हर बहिष्कार हेराफेरी- और समझ-जाँच नियमों से आया — कोई प्रतिभागी ध्यान, गति, सीधी-रेखा, नकल, या अधूरापन के लिए बहिष्कृत नहीं था — और हेराफेरी-जाँच गेटिंग कोई बीच-शर्त विषमता नहीं दिखाता है (MC1 χ²(1) = 0.12, p = .73; MC3 χ²(2) = 3.67, p = .16, पूर्व-बहिष्कार नमूने पर परिकलित)।
तालिका 15। H1 (P1): शर्त द्वारा निर्भरता अंशांकन Δ (प्राथमिक समूह, N = 119)
| नियंत्रण | असहमति | असहमति + साक्ष्य | |
| Δ, माध्य (SD) | 0.238 (0.332) | 0.465 (0.274) | 0.422 (0.299) |
| अति-निर्भरता: P(स्वीकार | गलत) | 0.603 | 0.434 | 0.510 |
| अल्प-निर्भरता: 1 − P(स्वीकार | सही) | 0.159 | 0.101 | 0.069 |
| पुष्टिकारी विपरीत: पूल (2,3) बनाम नियंत्रण, देश सहसंयोजक के साथ OLS | b = +0.217, 95% CI [+0.104, +0.330], होल्म-समायोजित p = .0005 (d = 0.67) |
तालिका 16। H2 (P2): प्रत्यायोजन की इच्छा, प्राप्ति बनाम अकेली असहमति (प्राथमिक समूह)
| असहमति (2) | असहमति + साक्ष्य (3) | |
| प्रतिनिहित करने की इच्छा समग्र, माध्य (SD) | 3.09 (1.61) | 3.45 (1.79) |
| प्रतिनिहित करना सीढ़ी, माध्यिका | 2 | 2 |
| पुष्टिकारी विरोधाभास: 3 बनाम 2, देश सहचर के साथ OLS | b = +0.41, 95% CI [−0.35, +1.18], Holm-समायोजित p = .29 |
H1 को इस डिज़ाइन में अंशांकन विरोधाभास के लिए समर्थित किया जाता है; पूर्व-पंजीकृत माध्यस्थता माध्यम से कथित जोखिम शून्य था, इसलिए P1 जैसा कहा गया है यह परीक्षा द्वारा समर्थित नहीं है। एक एकल आत्मविश्वास से भरे उत्तर का सामना करते हुए, प्रतिभागियों ने मुश्किल से भेद किया: उन्होंने सही उत्तरों के 84% पर एजेंट को आगे बढ़ने दिया लेकिन गलत उत्तरों के 60% पर भी (Δ = 0.238, 95% CI [0.14, 0.34]; उपचार स्थितियां 0.465 [0.38, 0.55] और 0.422 [0.32, 0.52])। असहमति प्रदर्शन ने अंशांकन को लगभग दोगुना कर दिया (पूल किया गया Δ = 0.446; b = +0.217, p = .0002, Holm-समायोजित p = .0005; Welch d = 0.67), और यह दोनों तरफ से एक साथ करता था: अत्यधिक निर्भरता में गिरावट (60% → 43% और 51%) जबकि अपर्याप्त निर्भरता भी गिरी (16% → 10% और 7%) (चित्र 20)। वह पूल किया गया औसत एक एकल आइटम द्वारा किया जाता है और एक मजबूत माध्य के बजाय एक अस्तित्व प्रमाण के रूप में सर्वश्रेष्ठ पढ़ा जाता है: एक एकल उच्च-आत्मविश्वास असहमति परीक्षण पर कि नियंत्रण प्रतिभागी 74% पर स्वीकार कर रहे थे, प्रदर्शन ने गलत उत्तर की स्वीकृति को 24% तक काट दिया, और उस परीक्षण को हटाने के साथ पुष्टिकारी विरोधाभास अब महत्वपूर्ण नहीं है (d = 0.09, p = .54), जबकि किसी अन्य एकल आइटम को छोड़ने से यह बरकरार रहता है (d = 0.47–0.89)। नीचे अन्वेषणात्मक अपघटन (तालिका 17–18) आइटम द्वारा प्रभाव को स्थित करता है। इसकी एकाग्रता वही हेडरूम निर्भरता है जो वहां देश स्तर पर रिपोर्ट की गई है: प्रदर्शन एक अंशांकन अंतराल को केवल तभी बंद करता है जब कोई खुला हो, और छह आइटमों में से एक ने इसे चौड़ा खोल दिया।
चित्र 20। असहमति प्रदर्शन निर्भरता के लिए क्या करता है (प्राथमिक समूह)
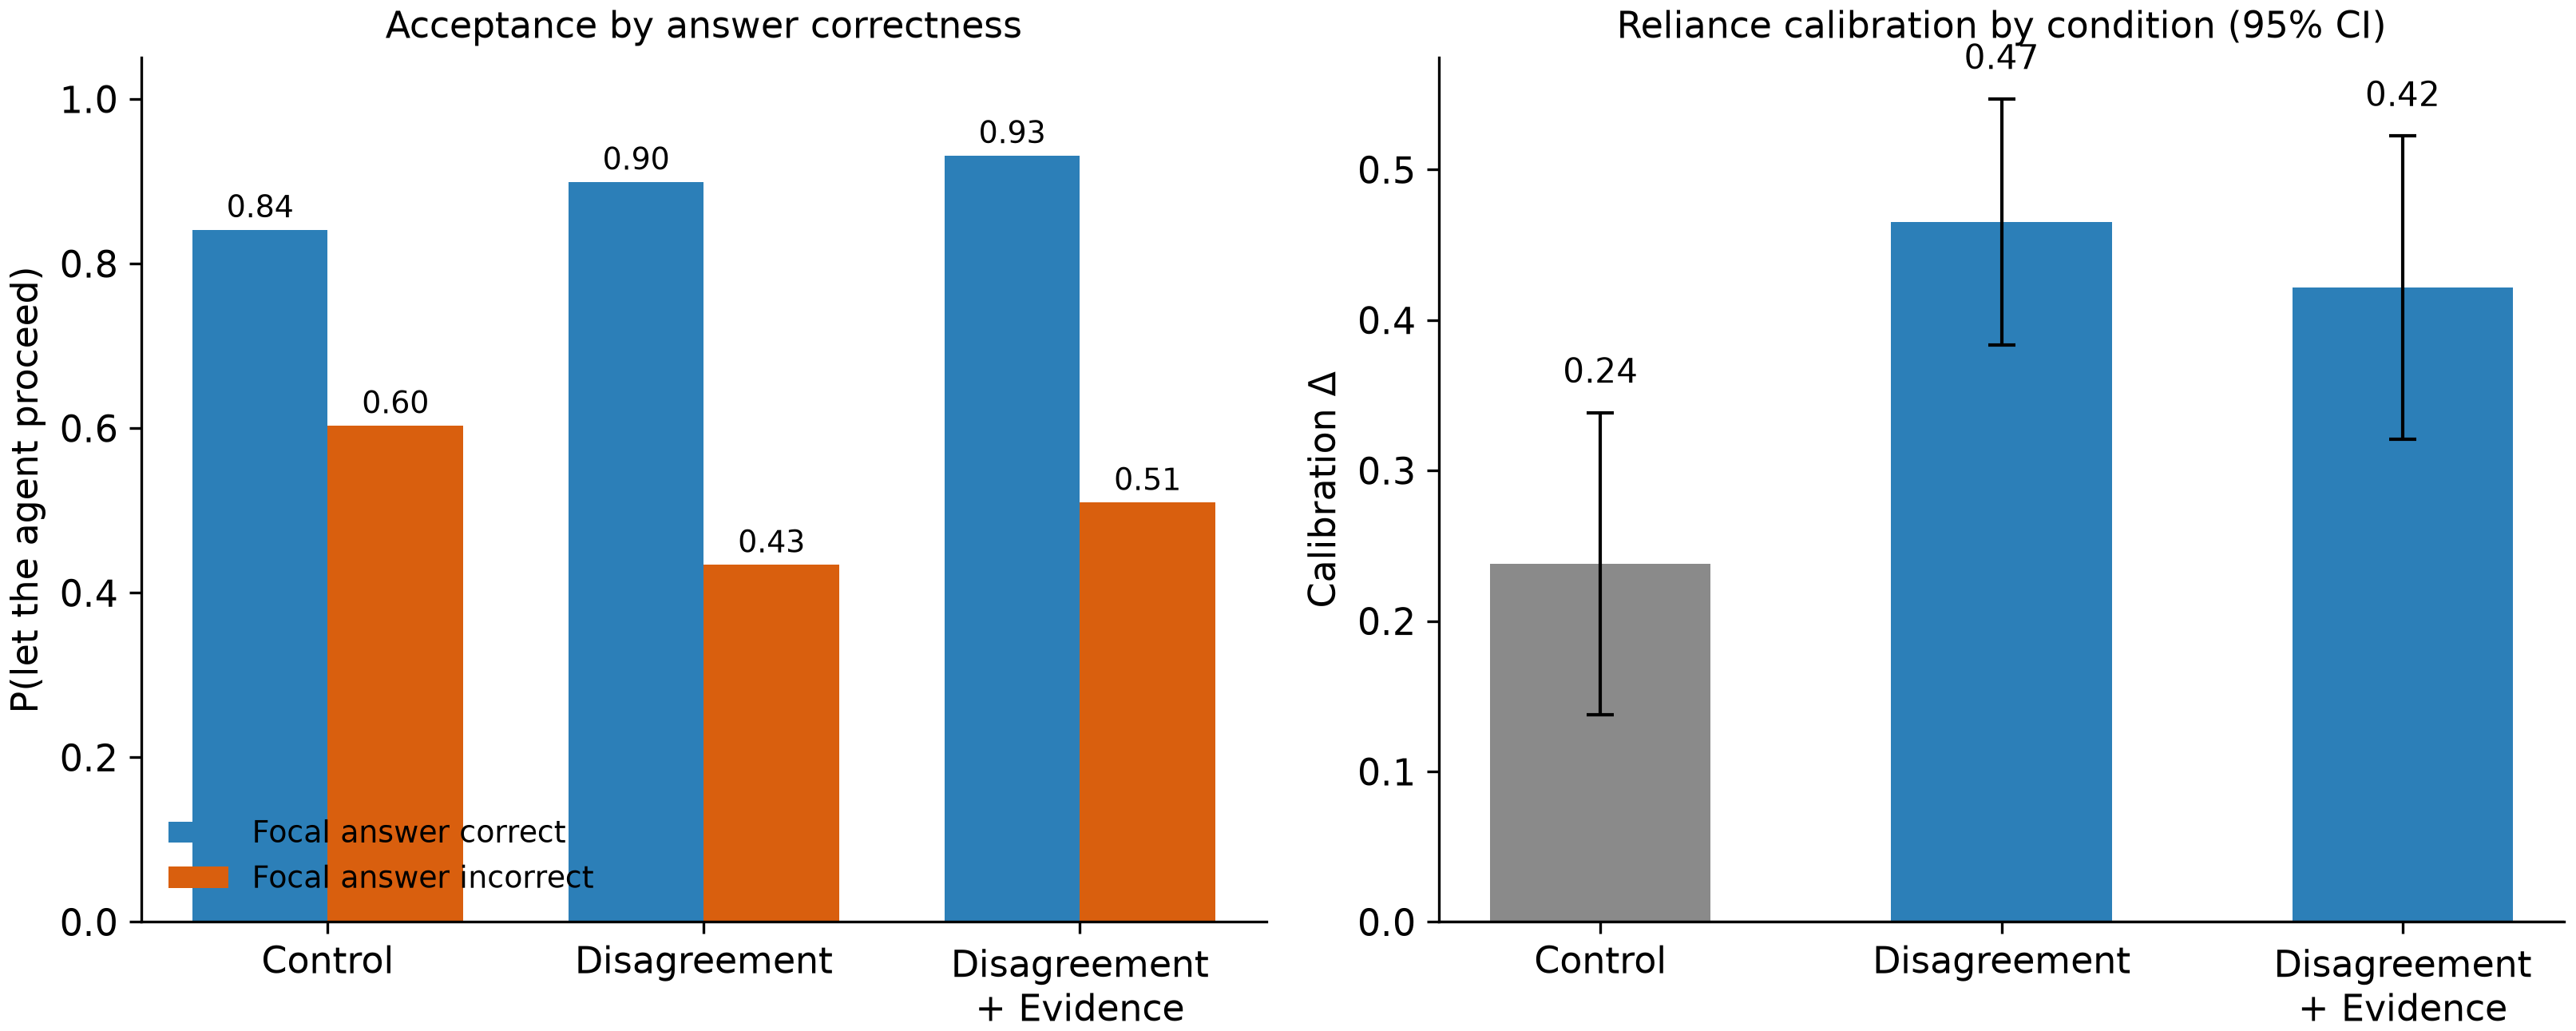
बायां: स्थिति द्वारा स्वीकृति दरें, फोकल उत्तर सही था या नहीं (अंशांकन = बार की जोड़ी के बीच का अंतराल) से विभाजित। दाएं: प्रति-प्रतिभागी अंशांकन स्कोर Δ स्थिति के साथ 95% CIs द्वारा; पुष्टिकारी विरोधाभास दो असहमति स्थितियों को नियंत्रण के विरुद्ध पूल करता है।
पूर्व-पंजीकृत दो-पक्षीय फ्रेमिंग मौजूद थी क्योंकि दूसरे-राय साहित्य हस्तक्षेप दस्तावेज करता है जो अत्यधिक निर्भरता में कमी को अपर्याप्त निर्भरता में वृद्धि की कीमत पर खरीदते हैं; इसने वह कीमत नहीं दी। संकेत ने प्रतिभागियों को अधिक संदेहास्पद नहीं, अधिक विवेचक बनाया, और एकत्र दरों का एक संकेत-पहचान अपघटन इसे संख्या में डालता है: संवेदनशीलता d′ नियंत्रण में 0.74 से 1.44 और उपचार स्थितियों में 1.46 तक बढ़ी (अपरिवर्तित दरों से गणना की गई) जबकि प्रतिक्रिया मानदंड मुश्किल से स्थानांतरित हुई (−0.63 बनाम −0.56 और −0.76)। परीक्षण-स्तरीय मिश्रित-प्रभाव मॉडल दोनों उपचार स्थितियों के लिए शुद्धता × स्थिति इंटरैक्शन के साथ समान संरचना को पुनः प्राप्त करता है। प्रत्येक पंजीकृत शाखा सहमत है: पूल किया गया मजबूती शाखा (b = +0.215, p = .0001, d = 0.68), और इरादे-से-इलाज शाखा सभी पूरी की गई मुख्य-लहर सत्रों को प्रतिधारण करती है भले ही जांच विफलताएं (b = +0.2174 बनाम +0.2169 प्रोटोकॉल के अनुसार, p = .0001, n = 138), शर्तों में संतुलित बहिष्करण (8/6/5; χ²(2) = 0.34, p = .85), अंतर-घटाव जांच §6.1 प्रतिबद्ध (हेराफेरी-जांच बहिष्करण उपचार के बाद-कंडीशनिंग है, Montgomery, Nyhan, & Torres, 2018 के अनुसार, इसलिए बिना शर्त शाखा का समान स्थिति)। एक डिज़ाइन अस्पष्टता पढ़ने को योग्य बनाती है। असहमति स्थितियां केवल यह नहीं भिन्न होती कि संकेत क्या कहता है बल्कि कितना दिखाया जाता है, तीन पद और आत्मविश्वास एक के बजाय, इसलिए अंशांकन लाभ सिद्धांत रूप में समझौते संकेत की सामग्री के बजाय सूचना मात्रा को प्रतिबिंबित कर सकता है। दो अवलोकन इसे निपटाए बिना मात्रा पढ़ने के विरुद्ध कटौती करते हैं: प्रभाव आइटम द्वारा आइटम द्वारा प्रदर्शित संकेत की दिशा का पता लगाता है, क्योंकि गलत-फोकल आइटमों पर जहां प्रदर्शन असहमति दिखाई गई थी, स्वीकृति गिरी, जबकि एक आइटम पर जहां प्रदर्शन सर्वसम्मत आत्मविश्वास से भरी सहमति दिखाई गई, गलत उत्तर की स्वीकृति बढ़ी; और परीक्षण-स्तरीय इंटरैक्शन उत्तर शुद्धता के साथ है, जो मात्रा अकेले भविष्यवाणी नहीं करता है। स्वच्छ विवेचक भुजा, कई प्रणालियां हर परीक्षण पर सहमत दिखाई गई हैं सूचना मात्रा स्थिर रखते हुए, अगली लहर के लिए निर्दिष्ट है।
H2 समर्थित नहीं है। असहमति प्रदर्शन पहले से दिखाए गए प्रतिभागियों के बीच, रसीद ने प्राप्त शक्ति पर प्रतिनिधिमंडल कंपोजिट पर कोई पता लगाने योग्य प्रभाव नहीं डाला (3.45 बनाम 3.09; b = +0.41, p = .29; पूल्ड ब्रांच b = +0.34, p = .33; कंपोजिट विश्वसनीयता: मुख्य-वेव क्रोनबैक α = .89)। तीन पूर्व-पंजीकृत माध्यमिक परिणाम शून्य को कैसे पढ़ा जाए इसको आकार देते हैं। रसीद प्राप्त हुई थी: रसीद स्थिति में माध्यिका सत्र समय असहमति स्थिति की तुलना में लगभग डेढ़ मिनट अधिक चला (11.0 बनाम 9.4 मिनट; स्क्रीन-स्तर का समय निर्मित निर्यात में कैप्चर नहीं किया गया था, इसलिए कुल अवधि पंजीकृत प्रोत्साहन समय-पर-उत्तेजना प्रॉक्सी के लिए खड़ी है)। अतिरिक्त समय यह स्थापित नहीं करता कि प्रतिभागियों ने रसीद का उपयोग किया। निर्मित रसीद एक स्थिर कार्ड था, और इसकी "पूर्ण रिकॉर्ड देखें" सामर्थ्य सर्वेक्षण के अंदर लाइव नहीं थी, इसलिए हेराफेरी ने रसीद की मौजूदगी का परीक्षण किया, इसके प्रयोग का नहीं। एक लाइव-ड्रिल-डाउन रसीद अगला डिज़ाइन जिसमें शामिल है वह मजबूत हेराफेरी है। यह एक स्थिर रसीद प्रदर्शन के लिए एक शून्य है, न कि रिकॉर्ड, जांचपरिणामता, या P2 के लिए जैसा लिखा गया है। रसीद ने अपने पूर्व-पंजीकृत मध्यस्थ को भी स्थानांतरित किया। कथित प्रक्रिया नियंत्रण रसीद स्थिति में बढ़ा (a = +0.60; पैमाने की विश्वसनीयताएं, मुख्य वेव: प्रक्रिया नियंत्रण α = .93, जोखिम α = .83, तटस्थता α = .90), प्रक्रिया नियंत्रण दृढ़ता से प्रतिनिधिमंडन की भविष्यवाणी करता है (b = +0.60), और बूटस्ट्रैप अप्रत्यक्ष पथ सकारात्मक है और शून्य को बाहर करता है (अप्रत्यक्ष = +0.35, 95% CI [+0.02, +0.78], 5,000 पुनः नमूने), जबकि प्रत्यक्ष पथ के पास शून्य है। यह अन्वेषणात्मक मध्यस्थता साक्ष्य है: मध्यस्थ को उपचार के बाद एक ही साधन में मापा गया था, इसलिए सामान्य-विधि विचरण और विपरीत व्याख्या संभव रहती है। संवेदनशीलता सीमाएं यह शून्य क्या निपटा सकता है। साकार किए गए कोशिकाएं d ≈ 0.49 को 0.80 शक्ति पर केवल पंजीकृत N पर पहचानते हैं, इसलिए एक रसीद प्रभाव का आकार जो मध्यस्थता पथ का अर्थ है वह बिल्कुल उस आकार का है जो यह नमूना हल नहीं कर सकता। परिणाम छोटे और मध्यम प्रभावों के बारे में अनिर्णायक है और केवल बड़े लोगों के खिलाफ निर्णायक है। औपचारिक रूप से, समतुल्यता परीक्षण प्रभाव को केवल मोटे तौर पर सीमित करता है (TOST |d| < 0.64 को α = .05 पर स्थापित करता है, |d| < 0.5 नहीं), और एक JZS बेयस कारक BF₀₁ ≈ 2.9 देता है (पूल्ड ब्रांच 3.1), मानक बैंड पर शून्य के पक्ष में अल्पसंख्यक साक्ष्य (अल्पसंख्यक/मध्यम सीमा 3 पर या उसके बाद); यह न तो अनुपस्थिति का प्रदर्शन करता है और न ही उपस्थिति का समर्थन करता है। माप अनुभाग ने जितना भविष्यवाणी की थी: जांचपरिणामता एक मांग-पर संपत्ति है, और इसका मूल्य विवाद, दावा, या लेखा परीक्षा के क्षण पर सतह आना चाहिए, इसलिए एक स्थिर रसीद जो एक काल्पनिक खरीद में एक बार पढ़ी जाए वह इसे देखने के लिए गलत क्षण हो सकता है। पंजीकृत निष्कर्ष: P2 का पहला-जोखिम परीक्षण प्रतिनिधिमंडन को स्थानांतरित करने में विफल रहा, और रसीद की ऑपरेटर-पक्ष अर्थशास्त्र (अनुभाग 5) इस उपभोक्ता-पक्ष परिणाम पर निर्भर नहीं करता है। दो रीडिंग बनी हैं: या तो साक्ष्य घटक निर्णय के क्षण पर कम योगदान देता है जितना कि ढांचा दावा करता है, या यह परिचालन यह गलत परीक्षण है। विवाद-समय खाता एक पश्च-तदनुसारी परिकल्पना है, इस अनुभाग के अंत में नाम के अनुसार निर्धारित अनुवर्ती डिज़ाइन के रूप में अनुसूचित, शून्य का समाधान नहीं। तीसरी रीडिंग प्रतिकूल साहित्य से आती है। एक विस्तृत रसीद एक सामान्यता हेराफेरी है, मशीनरी का एक जोखिम जो उपभोक्ता को याद दिलाता है कि प्रतिनिधिमंडन के ठीक समय में कितना गलत हो सकता है, पारदर्शिता विरोधाभास जिसमें प्रक्रियात्मक विवरण विश्वास को बनाने के बजाय दबाता है (Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015)। ये प्रतिस्पर्धी रीडिंग, एक दुर्बल-दावे-का-घटक, एक गलत-क्षण परीक्षण, और सामान्यता प्रतिक्रिया, विभिन्न भविष्यवाणियां करते हैं और डिज़ाइन द्वारा अलग किए जा सकते हैं।
प्रमाणित-सहमति-त्रुटि मोड मानव व्यवहार में प्रतिलिपि बनाई गई। एक प्रोत्साहित परीक्षण, डिज़ाइन द्वारा, एक वास्तविक सहमति त्रुटि ले गई, सभी तीन प्रणालियों के साथ विश्वास के साथ एक ही गलत उत्तर पर अभिसारी, तंत्र अध्ययन जो मापता है उसे 0.5–2.2% खुली-फॉर्म सहमति-त्रुटि दर को प्रतिबिंबित करते हुए। उस परीक्षण पर, एक एकल आइटम और इसलिए एक अनुमान के बजाय एक अवलोकन, असहमति प्रदर्शन ने किसी को सुरक्षित नहीं किया और, दोनों देशों में, दिशात्मक रूप से गलत उत्तर की स्वीकृति में वृद्धि की (नियंत्रण के सापेक्ष 4 और 14 प्रतिशत अंकों द्वारा): प्रतिभागियों ने तर्कसंगत रूप से सर्वसम्मत स्वतंत्र समझौते को प्रमाणन के रूप में पढ़ा। तो आर्किटेक्चर की एक व्यवस्थित विफलता मोड उच्च निष्ठा के साथ अपने उपयोगकर्ताओं को स्थानांतरित करती है। अनुभाग 3 ने डिज़ाइन चेतावनी दी, कि सहमति बिल्कुल वहां त्रुटि को प्रमाणित करती है जहां पैनल की विविधता विफल होती है, और जांच व्यवहार में समान विफलता दिखाता है।
अन्वेषणात्मक: जहां अंशांकन लाभ उतरता है।
जो कुछ आगे आता है वह सब अन्वेषणात्मक और परिकल्पना-उत्पन्न करने वाला है। देश की कोशिकाएं छोटी हैं, और नीचे दिया गया प्रत्येक देश के अंदर p-मान वर्णनात्मक के रूप में पढ़ा जाना चाहिए। अंशांकन प्रभाव लगभग पूरी तरह से UK नमूने में केंद्रित था और US नमूने में अनुपस्थित था:
तालिका 17। देश और स्थिति द्वारा अंशांकन Δ (अन्वेषणात्मक)
| नियंत्रण Δ | असहमति (पूल्ड 2, 3) Δ | देश-के-अंदर प्रभाव आकार | |
| UK (n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| US (n = 40 प्राथमिक / 54 पूल्ड) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| देश × स्थिति अंतःक्रिया | b = −0.36, p = .002 (प्राथमिक); b = −0.31, p = .004 (पूल्ड) |
विभाजन अंतःक्रिया की तुलना में अधिक जानकारीपूर्ण है। यूएस नियंत्रण प्रतिभागियों ने पहले से ही किसी भी आर्किटेक्चरल सिग्नल के बिना तीव्रता से भेदभाव किया, सही उत्तरों में से 92% स्वीकार किए और गलत उत्तरों में से केवल 48%, जबकि यूके नियंत्रण प्रतिभागियों ने बिल्कुल भेदभाव नहीं किया (78% बनाम 68%)। असहमति प्रदर्शन के तहत दोनों देश लगभग अप्रभेद्य बन गए, आइटम दर आइटम (सभी छह परीक्षणों में अधिकतम सेल अंतर 0.07)। हस्तक्षेप दोनों नमूनों को एक ही कैलिब्रेशन अंतिम बिंदु में परिवर्तित करता है (Δ ≈ +0.45), जो एक आधार अंतर को बराबर करता है जिसे इसने नहीं बनाया (चित्र 21)। इस पैटर्न का एक हिस्सा यांत्रिक है। Δ परिबद्ध है, इसलिए जैसे-जैसे आधार कैलिब्रेशन बढ़ता है, उपलब्ध हेडरूम सिकुड़ता है, और "लाभ सबसे कमजोर आधार जहां केंद्रित है" आंशिक रूप से माप की एक संपत्ति है। स्वयं छत समान अंतिम बिंदु या आइटम-दर-आइटम प्रोफ़ाइल मिलान को मजबूर नहीं करती है। सबसे रक्षणीय पठन यह है कि छह आइटम एक पैनल के लिए बिना सहायता के भेदभाव करने के लिए पर्याप्त आसान थे, इसलिए प्रदर्शन कैलिब्रेशन अंतर को बंद करता है जहां वह मौजूद है। यह पठन हेडरूम के बारे में है, राष्ट्रों के बारे में नहीं, और उत्तेजनाओं के बारे में समान रूप से: आइटम सेट स्वयं सांस्कृतिक रूप से झुका हुआ था (दो असहमत आइटम यूएस-स्थानीय सामग्री ले गए), इसलिए अभिसरण प्रोफ़ाइल इन दो पैनलों के रूप में ही इन छह आइटम की एक संपत्ति है।
चित्र 21। अभिसरण, एकसमान प्रतिक्रिया नहीं (अन्वेषक)
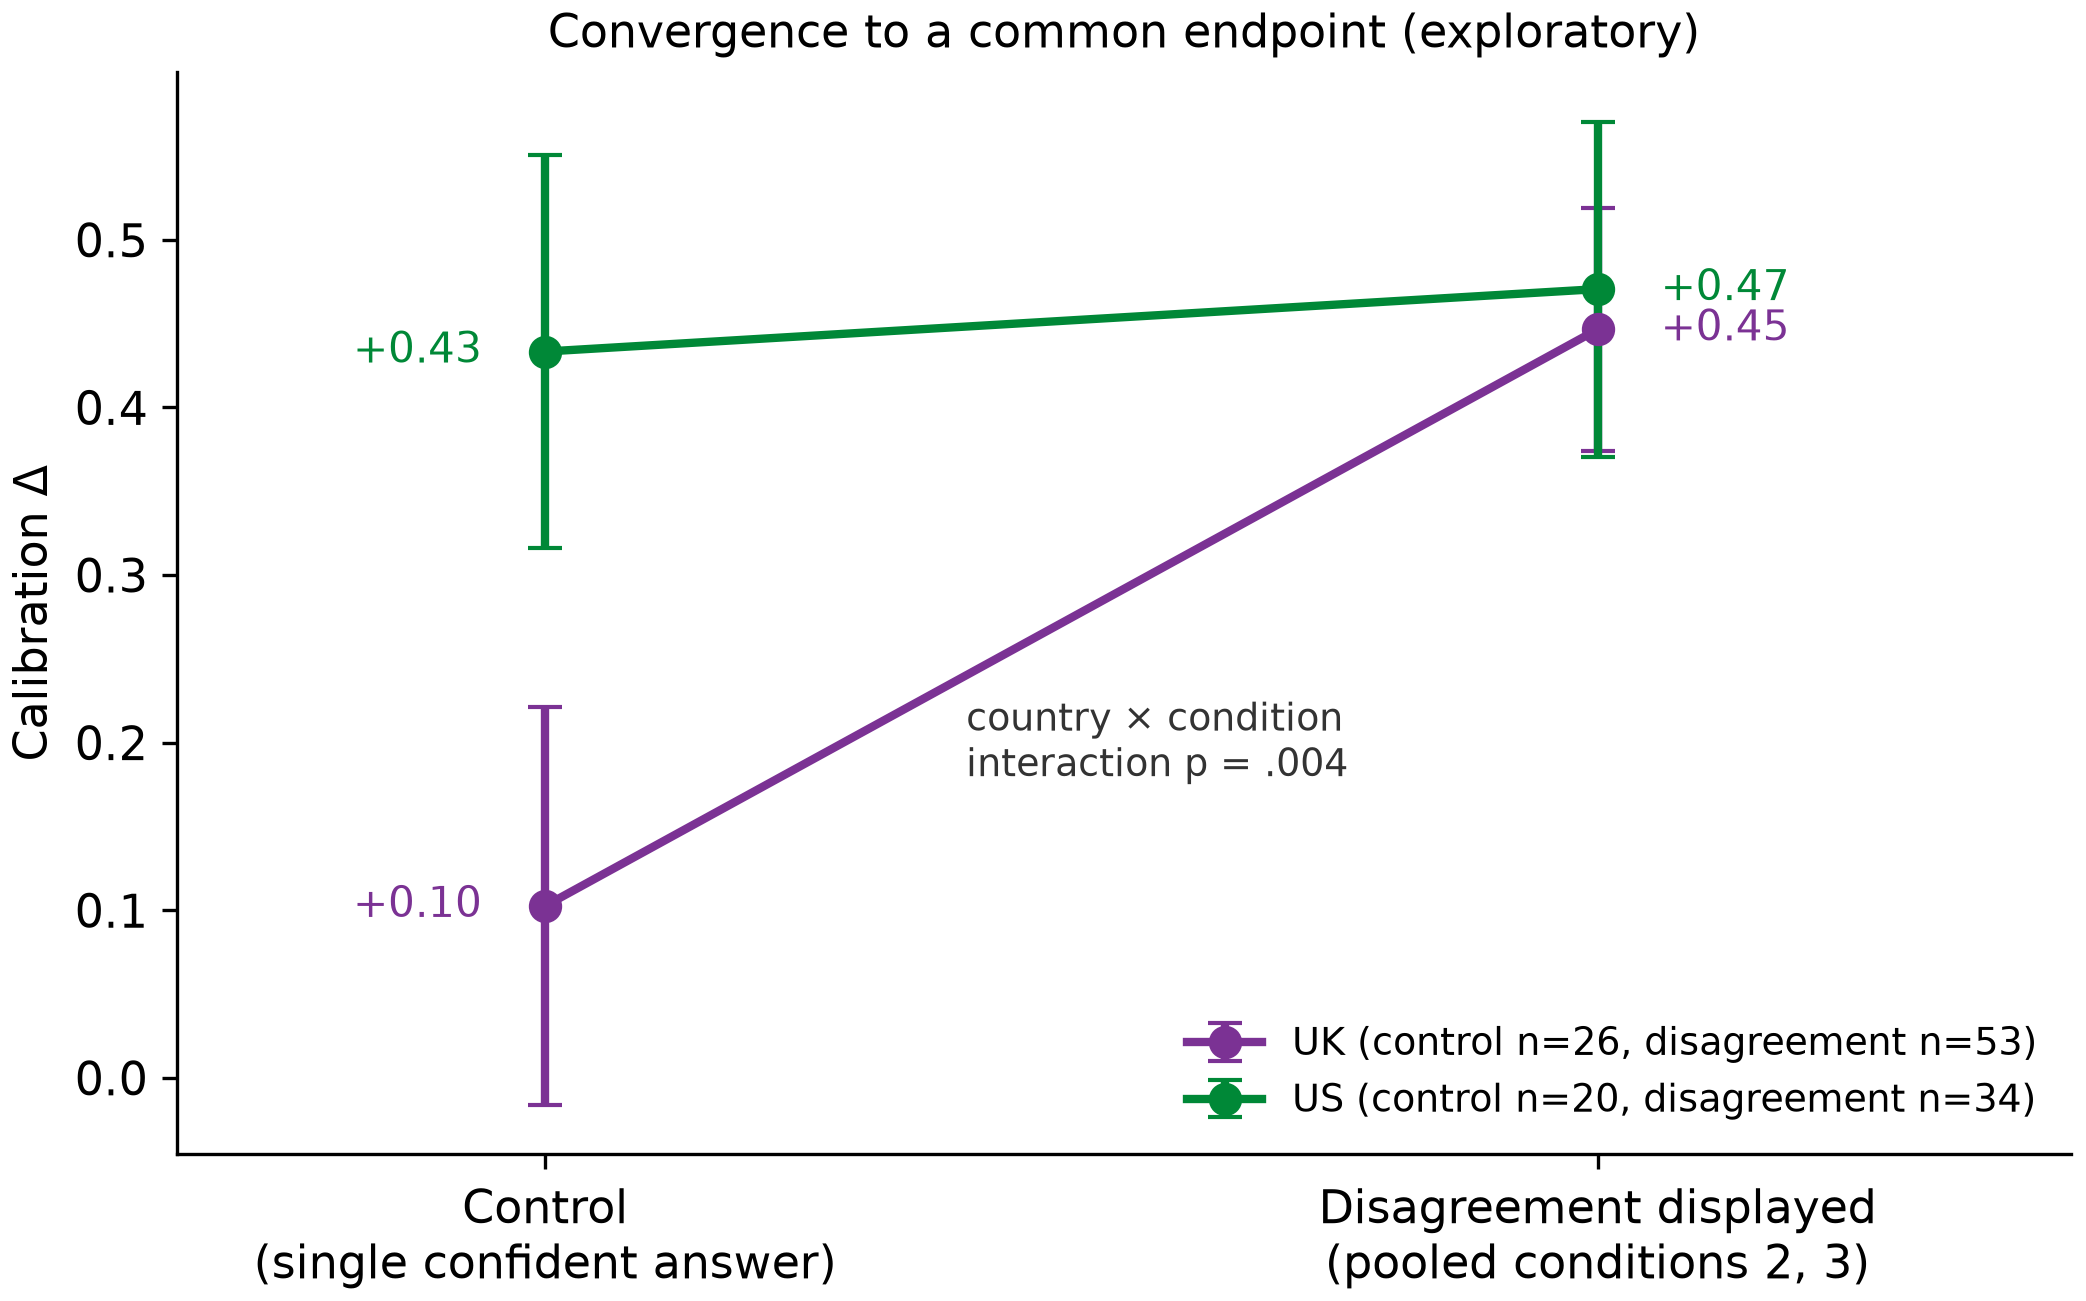
देश और स्थिति द्वारा कैलिब्रेशन Δ: यूएस नियंत्रण समूह पहले से ही भेदभाव करता है (Δ ≈ +0.45); यूके नियंत्रण समूह मुश्किल से करता है (Δ ≈ +0.10); प्रदर्शित असहमति के तहत दोनों देश एक ही अंतिम बिंदु पर उतरते हैं (Δ ≈ +0.45)। लाभ ठीक उसी जगह केंद्रित है जहां आधार कैलिब्रेशन सबसे कमजोर है।
नियंत्रण में यूएस लाभ, इस बीच, संभवतः यूएस-स्थानीय सामग्री वाले दो असहमत आइटम पर केंद्रित है। एक संग्रहालय खराब कला सवाल है जिस पर गलत उत्तर, "मोना लिसा," किसी के लिए बेतुका है जो संग्रहालय के आधार को जानता है (यूएस स्वीकृति 5% बनाम यूके 27%)। उन दो आइटम पर एकाग्रता आइटम-स्तर की परिचितता की ओर इशारा करती है न कि राष्ट्रीय स्वभाव की।
तालिका 18। आइटम और सेल द्वारा गलत फोकल उत्तरों की स्वीकृति (अन्वेषक; पूल किए गए कोहोर्ट)
| सेल | असहमत गलत, conf 95 ("मोना लिसा" आइटम) | असहमत गलत, conf 98 (ICM-city आइटम) | सर्वसम्मति गलत, conf 99 |
| यूके नियंत्रण (n = 26) | 0.27 | 0.85 | 0.92 |
| यूएस नियंत्रण (n = 20) | 0.05 | 0.60 | 0.80 |
| यूके असहमति (n = 53) | 0.21 | 0.25 | 0.96 |
| यूएस असहमति (n = 34) | 0.18 | 0.24 | 0.94 |
हस्तक्षेप का सुरक्षात्मक प्रभाव लगभग पूरी तरह उच्च-आत्मविश्वास असहमत आइटम (यूके −0.60, यूएस −0.36) पर बैठता है; सर्वसम्मति-त्रुटि आइटम पर प्रदर्शन दोनों देशों में स्वीकृति को थोड़ा बढ़ाता है — सर्वसम्मत सहमति प्रमाणीकरण के रूप में पढ़ी जाती है, तंत्र अध्ययन के प्रमाणित सर्वसम्मति त्रुटियों का व्यवहारिक छवि। क्योंकि सुरक्षात्मक प्रभाव इस एक आइटम पर बैठता है, पूल की गई पुष्टि विपरीत इसे हटाने से बचता नहीं है (d = 0.09, p = .54) हालांकि यह किसी अन्य एकल आइटम को हटाने से बचता है (d = 0.47–0.89) — प्रभाव का मात्रात्मक रूप एक आइटम द्वारा किया जा रहा है।
तालिका 19। देश द्वारा दृष्टिकोण तराजू (अन्वेषक; पूल किए गए कोहोर्ट): अंतर व्यवहारिक है, आत्तैतिक नहीं
| स्केल (1–7 जब तक अन्यथा नोट न किया जाए) | यूके माध्य | यूएस माध्य | दिशा |
| पूर्व-जोखिम AI में विश्वास | 4.68 | 4.70 | समान |
| प्रतिनिधिमंडल की इच्छा (समग्र) | 2.94 | 3.43 | यूएस उच्च (p = .08) |
| प्रतिनिधिमंडल सीढ़ी (0–4) | 1.71 | 1.98 | यूएस उच्च (p = .08) |
| माना जाता जोखिम | 5.54 | 5.13 | यूएस निम्न (p = .09) |
| माना जाता प्रक्रिया नियंत्रण | 4.17 | 4.56 | यूएस उच्च (p = .14) |
| माना जाता तटस्थता | 4.75 | 4.62 | n.s. |
प्रत्येक आत्तैतिक अंतर जो मौजूद है वह यूएस-संशयवाद खाते के लिए "गलत" तरीके की ओर इशारा करता है: यूएस प्रतिभागी अधिक प्रतिनिधिमंडल-इच्छुक हैं और कम जोखिम-सन्निहित हैं, फिर भी नियंत्रण में व्यवहारिक रूप से बेहतर भेदभाव करते हैं। मापा गया दृष्टिकोण इसमें से कोई नहीं समझाता है: जनसांख्यिकी के लिए आधार देश अंतर को समायोजित करना और सभी पाँच तराजू इसे सबसे अधिक 15% द्वारा क्षीण करता है, और तराजू के माध्यम से बूटस्ट्रैप अप्रत्यक्ष पथ शून्य हैं।
अंतर्राष्ट्रीय सर्वेक्षण आत्तैतिक शून्य से सहमत हैं। AI में विश्वास करने की कहे गए इच्छा यूएस और यूके में अनिवार्य रूप से समान है (41% बनाम 42%: Gillespie et al., 2025), और दोनों देश AI तंत्रिकाता पर एक ही उच्च-सतर्कता "एंग्लोस्फीयर" क्लस्टर में बैठते हैं (Ipsos, 2025)। एक आबादी-स्तर की विषमता जो देखी गई दिशा की ओर इशारा करती है वह AI साक्षरता है। यूके प्रतिवादी AI का उपयोग और मूल्यांकन करने में कम कौशल और आत्मविश्वास की स्व-रिपोर्ट करते हैं (कौशल पर 36% बनाम 42%: Gillespie et al., 2025), और यूएस वयस्क सर्वेक्षित सबसे AI-जोखिम जनता में हैं (Pew Research Center, 2025)। इसलिए दो खाते अन्वेषक रिकॉर्ड से बचे रहते हैं। एक परिचितता खाते पर, AI सलाह का मूल्यांकन करने के लिए कम सुसज्जित जनसंख्या उस आर्किटेक्चर से सबसे अधिक लाभ प्राप्त करती है जो इसका संरचनात्मक मूल्यांकन करता है। अन्य खाता पैनल रचना है: भर्ती मंच का यूके हिस्सा इसका पुराना और अधिक अनुभवी पूल है, और ऑनलाइन पैनल अंतर-देश अनुमान के लिए अपूर्ण उपकरण हैं (Gvirtz & Sabherwal, 2024), इसलिए "देश" लेबल आंशिक रूप से पैनल कार्यकाल के लिए प्रॉक्सी हो सकता है। डिज़ाइन दोनों को अलग नहीं कर सकता है, और इसकी आवश्यकता नहीं है, क्योंकि दोनों खातों पर पदार्थगत निष्कर्ष पारिमाणिक प्रोफ़ाइल स्वयं है। सेल आकार दिए गए, सुरक्षित डिफ़ॉल्ट पैटर्न को इन दोनों पैनलों की एक संपत्ति के रूप में पढ़ना है जब तक कि एक संचालित प्रतिकृति बोले; कोई सैद्धांतिक दावा इस पत्र में इस पर निर्भर नहीं करता है।
यह प्रोफ़ाइल अत्यधिक निर्भरता हस्तक्षेप का डिफ़ॉल्ट परिणाम नहीं है। संज्ञानात्मक बाध्यकारी कार्य अत्यधिक निर्भरता को कम करते हैं लेकिन अपना लाभ उन उपयोगकर्ताओं के बीच केंद्रित करते हैं जो पहले से ही संज्ञान की आवश्यकता में अधिक हैं, तो विश्लेषणात्मक रूप से इच्छुक अधिक विश्लेषणात्मक हो जाते हैं (Buçinca et al., 2021), और अनुकूली विश्वास-अंशांकन अनुसंधान गलत अंशांकन वाले लक्ष्य को एक डिज़ाइन लक्ष्य के रूप में मानता है जिसके लिए सक्रिय निगरानी की आवश्यकता है (Okamura & Yamada, 2020)। यहाँ लक्ष्यीकरण मुफ़्त आया। प्रदर्शित असहमति आत्म-ट्रिगरिंग है: यह बिल्कुल तब प्रकट होती है जब पैनल असहमत होता है और उपयोगकर्ता से पहले से कुछ भी मांग नहीं करता है। इसका लाभ उस समूह पर ठीक उतरा जिसका आधारभूत विभेद सबसे खराब था, और इसने पहले से अंशांकित समूह की सटीकता को बरकरार रखा बजाय इसे कम करने के। उपभोक्ता-सुरक्षा तंत्र के लिए यह वह वितरणात्मक प्रोफ़ाइल है जिसे कोई पहले से निर्दिष्ट करेगा, जिसमें लाभ वहाँ केंद्रित है जहाँ गलत अंशांकन केंद्रित है और उन लोगों पर कोई कर नहीं है जिन्हें इसकी आवश्यकता नहीं है।
पूर्व-पंजीकृत माध्यमिक विश्लेषण: शेष बहीखाता।
शेष पूर्व-पंजीकृत माध्यमिक विश्लेषण यहाँ एक स्थान पर बैठते हैं (प्राथमिक समूह; प्रतिकृति पैकेज में संयुक्त-शाखा मान)। कथित जोखिम के माध्यम से असहमति प्रभाव की मध्यस्थता, P1 मार्ग जिसकी डिज़ाइन प्रत्याशा करता था, शून्य है। प्रदर्शन, यदि कुछ भी हो, तो कथित जोखिम को थोड़ा कम किया (a = −0.40), और bootstrap अप्रत्यक्ष पथ शून्य से अप्रभेद्य है (+0.006, 95% CI [−0.013, +0.029])। अंशांकन प्रभाव प्रत्यक्ष है, जो इस बात के अनुरूप है कि प्रतिभागी असहमति पैटर्न को लेन-देन के बारे में एक सामान्य अलार्म के रूप में नहीं बल्कि उत्तर के बारे में जानकारी के रूप में उपयोग करते हैं। कथित ऑर्केस्ट्रेटर तटस्थता, हेराफेरी की गई नहीं बल्कि मापी गई, स्थिति और देश को नियंत्रित करते हुए प्रतिनिधिमंडन के लिए इच्छा का एक मजबूत सहसंबंधक है (b = +0.47, p < .0001), P3 सहसंबंधी ट्रेस भविष्यवाणी करता है, इसकी हेराफेरी की प्रतीक्षा कर रहा है। प्रतिनिधिमंडन सीढ़ी मिश्रित के रूप में एक ही क्रम दिखाती है लेकिन महत्व तक नहीं पहुँचती (क्रमबद्ध लॉजिट, रसीद बनाम असहमति: b = +0.70, p = .11; माध्यिका 4 में से 2 पर समान हैं)। गैर-पंजीकृत स्थिति 3-बनाम-1 प्रतिनिधिमंडन पर विपरीत दिशा में सकारात्मक और गैर-महत्वपूर्ण है (b = +0.52, p = .15)। एक विचलन: संक्षिप्त निर्यात में स्क्रीन-स्तरीय समय नहीं था, तो पंजीकृत समय-पर-उत्तेजना रसीद-पठन प्रॉक्सी को कुल सत्र अवधि द्वारा अनुमानित किया गया है (ऊपर H2 के अंतर्गत रिपोर्ट किया गया)। इच्छित स्क्रीन-स्तरीय जांच को अगली लहर के उपकरण में बनाया जाना चाहिए।
यह अध्ययन केवल P1 और P2 का परीक्षण करता है। P3 हेराफेरी की गई नहीं बल्कि मापी गई है, और P4 और खंड 5 का पूर्ण संयुक्त-भिन्नता संयोजन निर्दिष्ट अगला अध्ययन रहता है। त्रिगुण का व्यावहारिक सत्यापन इसलिए अधूरा है: एक घटक समर्थित, एक अनिर्णायक, एक मापा लेकिन हेराफेरी की गई नहीं। एक अनुदैर्ध्य प्रश्न कार्यक्रम के ऊपर बैठता है। स्थायी असहमति प्रदर्शन एल्गोरिथ्म प्रशंसा और एक-स्ट्राइक प्रतिकूलता के बीच दोलन पर एक नम के रूप में दीर्घकालिक ग्रहण को स्थिर कर सकता है, या यह मशीन की त्रुटि के लिए निरंतर संपर्क के माध्यम से उस ग्रहण को समाप्त कर सकता है। एक एकल-सत्र डिज़ाइन नहीं कह सकता। ऊपर दिए गए परिणामों द्वारा प्रेरित दो अध्ययन कार्यक्रम में जोड़े गए हैं। एक विवाद-समय डिज़ाइन है जो रसीद को उस क्षण में पुनः परीक्षण करता है जब इसका मूल्य रहने की भविष्यवाणी की जाती है, एक असत्य-रसीद नियंत्रण का उपयोग करते हुए, एक रसीद जिसका हैश पुनर्गणना नहीं करता है, इसके रेंडरिंग से सत्यापनीयता को अलग करने के लिए। दूसरा ऊपर दिए गए देश मध्यस्थता के लिए संचालित प्रतिकृति है (तालिका 17)।
7. निष्कर्ष
जैसे ही AI महत्वपूर्ण उपभोक्ता निर्णयों में मध्यस्थता करता है, और तेजी से उन्हें लेता है, मैंने तर्क दिया है कि विश्वास को स्टैक में ऊपर की ओर माइग्रेट करना चाहिए: मॉडल से, आर्किटेक्चर तक, रिकॉर्ड तक। विविधता, साक्ष्य और तटस्थता एक साथ एक सेवा का उत्पादन करते हैं जिसकी विश्वसनीयता को विश्वास पर लिया जाने के बजाय जांचा जा सकता है। जो बनाया जा रहा है वह बेहतर प्रेरण नहीं बल्कि आर्थिक विश्वास अवसंरचना है, जवाबदेही श्रृंखला जो प्रतिनिधिमंडन को स्केल करने देती है। प्रमुख लहर उसे बाजार के शीर्ष पर मापती है। लहर की दस पूर्ण प्रमुख शाखाओं में संयुक्त, प्रत्येक प्रयोगशाला के सर्वश्रेष्ठ के रूप में बेचे गए मॉडल अपने बताए गए आत्मविश्वास पर दिए गए उत्तरों का लगभग आधा हिस्सा आत्मविश्वास से गलत थे ≥ 80 (46.6%, और अनसुलझे आइटम को त्रुटियों के रूप में पुनः स्कोर किए जाने पर आंकड़ा शायद ही बढ़ता है)। आंशिक Meta शाखा को अलग से रिपोर्ट किया जाता है, और इसे शामिल करने से आंकड़ा प्रभावी रूप से अपरिवर्तित रहता है। इसके ऊपर एक निश्चित तीन-मॉडल असहमति गेट, कोई प्रशिक्षण और कोई ट्यूनिंग के साथ, कवरेज में एक कथित, निरीक्षणीय लागत पर उन विफलताओं का चार-पांचवां हिस्सा हटा देता है। क्योंकि यहाँ सब्सट्रेट विशुद्ध रूप से तथ्यात्मक है, उस दर को मिश्रित वाणिज्य कार्यों के लिए ऊपरी सीमा के रूप में पढ़ा जाना चाहिए। जो वाणिज्य के लिए दावे को लाइसेंस देगा वह एक पुनर्प्राप्ति-आधारित, उपकरण-उपयोग करने वाली प्रतिकृति है एक सीमित उत्पाद मेनू पर, जहाँ सर्वसम्मति त्रुटियाँ खुली तथ्यात्मक जगह में अलग व्यवहार करती हैं। एक पूर्व-पंजीकृत प्रयोग (खंड 6) उपभोक्ताओं के सामने एक ही आर्किटेक्चरल सिग्नल रखता है और यह सबूत लौटाता है कि वे सटीकता सिग्नल के रूप में कार्य कर सकते हैं: असहमति प्रदर्शन योग्य आइटम पर एक आत्मविश्वास गलत सिफारिश की स्वीकृति को 74% से 24% तक कम कर देता है। एक खोजपूर्ण देश विभाजन में यह अत्यधिक-निर्भर यूके सेल में केंद्रित है और उस एकल आइटम पर निर्भर है (संयुक्त विपरीत इसे हटाने के बाद जीवित नहीं रहता है, d = 0.09)। यह इन उत्तेजनाओं के तहत एक अस्तित्व प्रमाण है, अभी तक एक सामान्य प्रभाव नहीं; एक उत्तेजना-नमूना पुष्टिकारी परीक्षण की योजना बनाई गई है।
इस परत अपने दम पर एक बाजार का नाम की योग्य है, साक्ष्य अवसंरचना, उसी तरह बेचा जाना चाहिए जैसे क्लाउड, पहचान और भुगतान अवसंरचना बेची जाती हैं, क्योंकि यह एक ही तरह का प्रश्न का उत्तर देता है: "क्या इस पर भरोसा किया जा सकता है, और हम कैसे जानते?" यह "क्या यह बुद्धिमान है?" से एक अलग प्रश्न है सुरक्षा और गोपनीयता दोनों इसी तरह चले गए: विभेदक, फिर अपेक्षा, फिर प्रवेश की आवश्यकता। आर्किटेक्चरल विश्वास प्रशंसनीय रूप से एक ही पथ का अनुसरण कर सकता है, नियामक और दायित्व दबाव द्वारा निर्धारित गति से जो पहले से ही दृश्यमान है।
उपभोक्ता विश्वास के सिद्धांत पक्ष पर मेरा दावा यह है कि AI सेवाओं में उपभोक्ता विश्वास के विश्लेषण की इकाई मॉडल से हटकर आर्किटेक्चर की ओर जानी चाहिए, क्योंकि विश्वास से संबंधित गुण वास्तव में वहाँ निहित हैं: सत्यापन की स्वतंत्रता, निर्णयों की पुनरुत्पादनीयता, हित के टकराव की अनुपस्थिति। मॉडल हर सेवा में बदलते रहते हैं, किसी भी प्रतिष्ठा को ट्रैक करने की तुलना में तेजी से। बंद-खुली प्रदर्शन अंतराल एक वर्ष में 8.04% से घटकर 1.70% रह गया (Stanford HAI, 2025), और enterprise मॉडल बाजार की नेतृत्व एक ही वसंत में बदल गई (Kharazian, 2026)। एक परत जो इतनी तेजी से वस्तु बन जाती है, वह वह नहीं है जहाँ विश्वास लंगर डाल सकता है। उपभोक्ता के लिए जो काम करता है, वह मॉडल और मूल्य स्तरों के बीच क्रमबद्ध करना है, लागत-संचालित, अदृश्य, और अपरीक्षित, और एक चुना गया सर्वश्रेष्ठ मॉडल कम और कम को पूरा करता है। जो कदम बचा है, और जो मैं यहाँ निर्दिष्ट करता हूँ, वह सर्वश्रेष्ठ-क्रमबद्ध आर्किटेक्चर से एक ऐसे आर्किटेक्चर की ओर जाना है जिसके सत्यापन को उपभोक्ता, बीमाकर्ता, या नियामक लंबे समय तक स्थिर रख सकता है ताकि जाँच कर सके। इसके नीचे AI सहायकों से AI न्यासियों में एक संक्रमण निहित है। न्यासी, हर उस क्षेत्र में जहाँ उनके पास कभी रहे हैं, उनके प्रतिभा से नहीं बल्कि उनके कर्तव्यों से गठित होते हैं: रिकॉर्ड रखना, ऑडिट के अधीन होना, कोई प्रतिकूल हित न होना। आर्किटेक्चरल विश्वास उन कर्तव्यों को मशीनरी में निर्मित करता है।
यही आवश्यकता सिस्टम के स्वयं के विकास पर भी लागू होती है। एक सिस्टम जो परिणामस्वरूप कार्रवाई के साथ विश्वास के योग्य होने का दावा करता है, उसे उस तरीके से विकसित होना चाहिए जो सत्यापित हो। एक आर्केस्ट्रेशन परत में कॉन्फ़िगरेशन परिवर्तन आयोजित साक्ष्य के विरुद्ध लेखापरीक्षित सांख्यिकीय गेट के माध्यम से प्रतिबद्ध या वापस करना चाहिए, कोई भी स्वचालित प्रक्रिया सुरक्षा नियम को कमजोर नहीं करनी चाहिए, केवल एक जोड़ना चाहिए। केस स्टडी में अनुसंधान तैनाती उन गेट को लागू करती है।
AI अवसंरचना को अब एक सत्यापन परत की आवश्यकता है (चित्र 16)। उद्योग ने कम्प्यूट परत और मॉडल परत का निर्माण कर दिया है, और अब ऑर्केस्ट्रेशन परत का निर्माण कर रहा है। इसके बाद सत्यापन आता है, वह तंत्र जो AI प्रणाली के व्यवहार को विश्वसनीय के बजाय जाँच योग्य बनाता है। AI विश्वास के लिए आधार को प्रतिष्ठा-आधारित के बजाय मशीन-सत्यापन योग्य होना चाहिए; विश्वास स्वयं मानवीय रहता है, और जो मशीन द्वारा जाँचा जा सकता है वह इसके आधार हैं। यदि यह सही है, तो AI अवसंरचना की अगली अपरिहार्य परत बुद्धिमत्ता के चारों ओर नहीं बल्कि सत्यापनीयता के चारों ओर बनाई जाएगी।
चित्र 16. अवसंरचना सीढ़ी
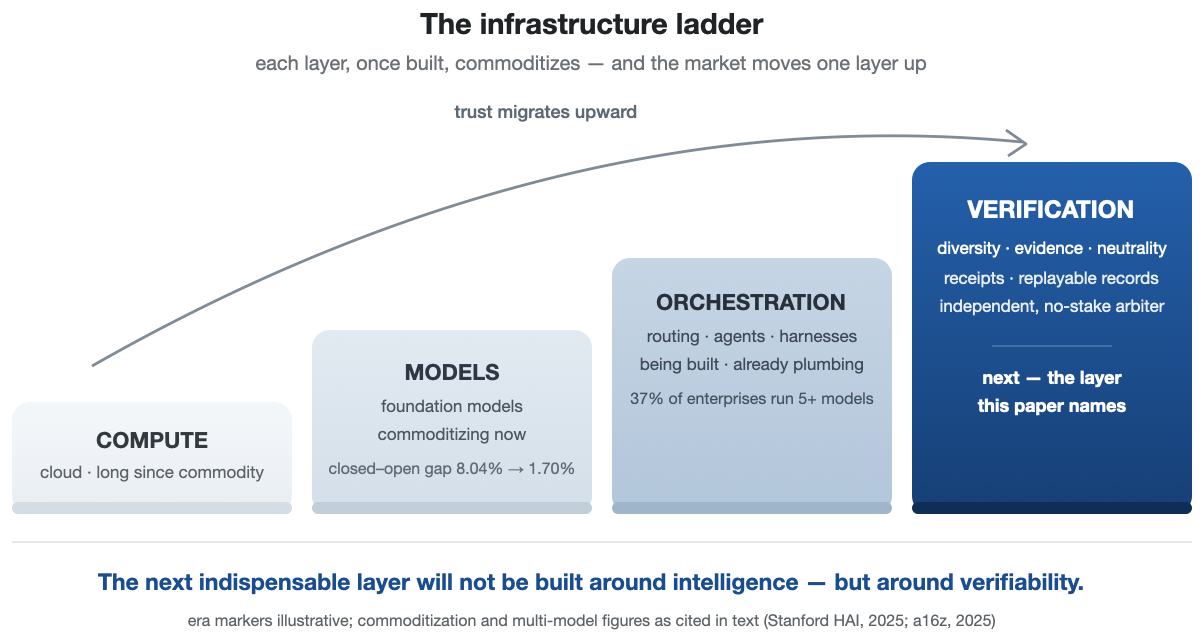
कंप्यूट, फिर मॉडल, फिर ऑर्केस्ट्रेशन, और सत्यापन अगत अपरिहार्य परत के रूप में।
लेखक की टिप्पणी और प्रकटीकरण
खंड 4 में वर्णित तैनाती लेखक द्वारा निर्मित और संचालित एक संदर्भ कार्यान्वयन है; इसमें निहित विधियाँ खुली हैं, और लेखक AI ऑर्केस्ट्रेशन और बहु-मॉडल सत्यापन प्रणालियों को कवर करने वाली लंबित पेटेंट आवेदनों पर एक नामित आवेदक है, न कि प्रदत्त पेटेंट पर, जिसकी परीक्षा यह पत्र करता है। यह यहाँ अध्ययन के अनुसंधान साधन के रूप में कार्य करता है, और लेखक का इसमें निहित वास्तुकला के प्रति विकासकर्ता का हित है; खंड 4 को एक अस्तित्व प्रमाण और डिज़ाइन गवाही के रूप में पढ़ा जाना चाहिए, स्वतंत्र मूल्यांकन के रूप में नहीं। इस अध्ययन के सभी मॉडल विक्रेताओं के मानक वाणिज्यिक API के माध्यम से साधारण शर्तों पर प्राप्त किए गए थे। इस कार्य को बाहरी वित्तपोषण का समर्थन नहीं था।
उपकरण और सत्यापन। AI सहायकों का उपयोग लेखक के निर्देशन में साधन के रूप में किया गया था; विचार, अनुसंधान और निष्कर्ष लेखक के हैं। भार-वहन तथ्यात्मक दावों की जहाँ संभव हो प्राथमिक स्रोतों के विरुद्ध जाँच की गई है और इन्हें पाठ-अंदर उनकी साक्ष्यात्मक स्थिति के साथ जिम्मेदार ठहराया गया है (प्रेस रिपोर्ट रिपोर्ट के रूप में, आरोप आरोप के रूप में, प्रीप्रिंट प्रीप्रिंट के रूप में), और पांडुलिपि की कार्य सामग्रियों के साथ एक दिनांकित दावा-सत्यापन लॉग बनाए रखा जाता है। प्रयोग में शुद्धता को किसी पैनल मॉडल द्वारा कभी नहीं आंका जाता है (स्कोरिंग उद्देश्य स्ट्रिंग मिलान है या स्थानीय खुले-भार ग्रेडर), प्रति-विक्रेता विभेद और अंशांकन संख्याएँ मुख्य पाठ में मुद्रित हैं (तालिका 7 और 7a), और प्रत्येक रिपोर्ट की गई संख्या नियतात्मक प्रतिकृति पैकेज से पुनः गणनीय है (https://osf.io/jtvu9/ पर सार्वजनिक रूप से उपलब्ध)।
डेटा और कोड की उपलब्धता
तंत्र प्रयोगों (खंड 3) में रिपोर्ट की गई प्रत्येक संख्या एक नियतात्मक प्रतिकृति पैकेज से पुनः संगणनीय है — दोनों तरंगों के कच्चे मॉडल प्रतिक्रियाएं (24,000 उत्तरों के सोलह-मॉडल संग्रह और प्रमुख तरंग के ग्रेडेड रिकॉर्ड सहित), संग्रह धावक, नियतात्मक ग्रेडर, विश्लेषण स्क्रिप्ट, और व्युत्पन्न CSV (जोखिम-कवरेज वक्र और 26-बिंदु लागत–सटीकता सीमांत सहित, प्रत्येक बिंदु के बिल-बनाम-सूची मूल्य आधार को चिह्नित किया गया है) — https://osf.io/jtvu9/ पर सार्वजनिक रूप से उपलब्ध, पूर्व-पंजीकरण के स्रोत परियोजना का एक सार्वजनिक घटक (फ़ोल्डर `replication-package-v2`; खंड 3 की आत्म-अंशांकन प्रोग्राम संग्रह इसके साथ जमा किया गया है)। फ्रोज़न SimpleQA उप-नमूना (बीज और SHA-256 हैश द्वारा निर्धारित) पहले से ही तंत्र अध्ययन के OSF पूर्व-पंजीकरण पर सार्वजनिक है (https://osf.io/4y9dv, पंजीकृत 23 जुलाई 2026)। उपभोक्ता प्रयोग का पूर्व-पंजीकरण प्रतिबंध के तहत OSF पर पंजीकृत है (मुख्य डेटा संग्रह से पहले फ्रोज़न; पंजीकरण https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f)। प्रतिभागी पूल बंद है; सर्वेक्षण उपकरण, विग्नेट और निर्णय-ब्लॉक उत्तेजनाएं, खंड 6 के रसीद-टकसाली रिकॉर्ड, और उपभोक्ता-प्रयोग डेटा फ्रोज़न विश्लेषण कोड के साथ प्रकाशन पर एक ही OSF घटक में जारी किया जाएगा।
संदर्भ
arXiv से चिह्नित प्रविष्टियां पूर्वप्रिंट हैं; उद्योग की घोषणाएं और 2026 की प्रेस वस्तुएं समसामयिक रिपोर्ट हैं न कि स्थिर साहित्य, और इस प्रकार उद्धृत हैं।
a16z — Andreessen Horowitz (2025). कैसे 100 एंटरप्राइज़ CIO 2025 में AI को बनाना और खरीदना चल रहे हैं। a16z.com/ai-enterprise-2025.
Accenture (2026). मेरे AI एजेंट से बात करें: ब्रांड मूल्य के नियम। 16 देशों में 25,590 उपभोक्ताओं का सर्वेक्षण, जनवरी 2026।
ACI Worldwide (2026). AI-संचालित खरीदारी और भुगतान के लिए उपभोक्ता दृष्टिकोण। 2,080 UK वयस्कों का YouGov सर्वेक्षण, क्षेत्र 19–22 जून 2026। प्रेस रिलीज़।
Ahmad Husairi, M., & Rossi, P. (2024). क्रय कार्यों का AI को प्रतिनिधिमंडन: कथित विकल्प और निर्णय स्वायत्तता की भूमिका। Decision Support Systems, 179, 114166। DOI 10.1016/j.dss.2023.114166।
AIUC (2025). AIUC-1: एजेंट मानक। Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). जब एजेंट आपके लिए खरीदारी करते हैं: AI-मध्यस्थ बाज़ारों में भूमिका सामंजस्य। arXiv:2604.26220।
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). आपका AI एजेंट क्या खरीद रहा है? मूल्यांकन, पूर्वाग्रह, मॉडल निर्भरता, और agentic ई-कॉमर्स के उभरते निहितार्थ। ACM वेब कॉन्फ्रेंस 2026 की कार्यवाही, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express ने Agentic Commerce Experiences (ACE) डेवलपर किट की शुरुआत की और पंजीकृत एजेंट खरीद के लिए उद्योग-प्रथम सुरक्षा की घोषणा की। प्रेस रिलीज़, 14 अप्रैल 2026।
Anderson, L. (2006). विश्लेषणात्मक ऑटोएथनोग्राफी। जर्नल ऑफ कंटेम्पररी एथनोग्राफी, 35(4), 373–395।
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). कृत्रिम बुद्धिमत्ता और बिग डेटा के युग में उपभोक्ता विकल्प और स्वायत्तता। कस्टमर निड्स एंड सॉल्यूशंस, 5(1–2), 28–37।
Appenzeller, G. (2024). LLMflation में आपका स्वागत है: LLM अनुमान लागत तेजी से घट रही है। Andreessen Horowitz, नवंबर 2024।
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). AI की स्थिति: OpenRouter के साथ एक अनुभवजन्य 100 ट्रिलियन टोकन अध्ययन। arXiv:2601.10088 (रिपोर्ट दिसंबर 2025 में जारी की गई)।
Bain & Company (2025). Agentic कॉमर्स बाजार प्रक्षेपण: 2030 तक $300–500 बिलियन अमेरिकी ई-कॉमर्स। दिसंबर 2025।
Bainbridge, L. (1983). स्वचालन के विडंबनाएं। ऑटोमेटिका, 19(6), 775–779।
Balaskas, S. (2026). सिफारिशों से प्रतिनिधिमंडल तक: ई-कॉमर्स में agentic AI और इसके उपभोक्ता प्रभावों का एक व्यवस्थित समीक्षा मानचित्र। सूचना, 17(3), 222।
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). क्या पूरा भाग उसके अलग-अलग हिस्सों को पार करता है? AI व्याख्याओं का पूरक टीम प्रदर्शन पर प्रभाव। 2021 CHI कॉन्फ्रेंस ऑन ह्यूमन फैक्टर्स इन कंप्यूटिंग सिस्टम्स की कार्यवाही, 1–16।
Basu, A. (2026). टूल रसीदें, शून्य-ज्ञान प्रमाण नहीं: AI एजेंटों के लिए व्यावहारिक मतिभ्रम पहचान। arXiv:2603.10060।
Board of Governors of the Federal Reserve System & OCC (2011). मॉडल जोखिम प्रबंधन पर पर्यवेक्षी मार्गदर्शन (SR पत्र 11-7 / OCC 2011-12)।
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). विश्वास करने के लिए या सोचने के लिए: संज्ञानात्मक बाध्यकारी कार्य AI-सहायक निर्णय लेने में AI पर अत्यधिक निर्भरता को कम कर सकते हैं। ACM पर कार्यवाही मानव-कंप्यूटर इंटरैक्शन, 5(CSCW1), 1–21।
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). संवर्धित निर्णय लेने में एल्गोरिदम विमुखता की एक व्यवस्थित समीक्षा। जर्नल ऑफ बिहेवियरल डिसीजन मेकिंग, 33(2), 220–239।
California State Legislature (2025). Assembly Bill 316 (कृत्रिम बुद्धिमत्ता: रक्षाएं), Stats. 2025, ch. 672 (Cal. Civ. Code § 1714.46 जोड़ना), 1 जनवरी 2026 को प्रभावी।
Carlson, S. C. (2026). डिजिटल युग में विश्वास प्रवास: सूचना व्यवस्थाएं और खरीदार–विक्रेता संबंधों का रूपांतरण। अटलांटिक मार्केटिंग जर्नल, 15(1), लेख 6।
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). कार्य-निर्भर एल्गोरिदम विमुखता। जर्नल ऑफ मार्केटिंग रिसर्च, 56(5), 809–825।
Cetinkaya, N. E., & Krämer, N. (2024). समझ बनाम विश्वास: एक संयुक्त विश्लेषण। कार्य पत्र, OSF प्रोजेक्ट mw4dq।
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Yes-man चैटबॉट भ्रामक सर्पिल का कारण बनते हैं, यहां तक कि आदर्श बायेसियन में भी। arXiv:2602.19141।
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). जब AI असहमत हो: दूसरी राय का रोगियों के डॉक्टरों में विश्वास पर प्रभाव। इंटरनेशनल जर्नल ऑफ ह्यूमन-कंप्यूटर स्टडीज, 213, 103824।
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Yes-man AI सामाजिक इरादों को घटाता है और निर्भरता को बढ़ावा देता है। विज्ञान, 391(6792), eaec8352. DOI: 10.1126/science.aec8352।
Choi, H. K., Zhu, X., & Li, S. (2026). जब पहचान बहस को तिरछा करती है: पूर्वाग्रह-कम बहु-एजेंट तर्क के लिए गुमनामी। कम्प्यूटेशनल लिंग्विस्टिक्स एसोसिएशन की 64वीं वार्षिक बैठक की कार्यवाही (वॉल्यूम 1: लंबे पेपर), 14284–14311। https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). बहु-एजेंट सिस्टम में समूह अनुरूपता का एक अनुभवजन्य अध्ययन। कम्प्यूटेशनल लिंग्विस्टिक्स एसोसिएशन की निष्कर्ष: ACL 2025, 5123–5139। https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). AI सुरक्षा के लिए नियामक बाजार। arXiv:2001.00078।
CNBC (2026, मार्च 24). OpenAI तत्काल चेकआउट प्रस्ताव के साथ संघर्ष के बाद ChatGPT में खरीदारी अनुभव को नया रूप देता है (द इनफॉर्मेशन के मार्च 2026 खाते की रिपोर्टिंग देशी-चेकआउट पुलबैक की)।
Daly, C. (2025). Klarna असली लोगों के लिए कॉल के साथ AI-संचालित नौकरी में कटौती को धीमा करता है। ब्लूमबर्ग न्यूज़, 8 मई 2025।
de Bellis, E., & Johar, G. V. (2020). स्वायत्त खरीदारी प्रणालियां: उपभोक्ता अपनाने में बाधाओं की पहचान और अधिक आना। जर्नल ऑफ रिटेलिंग, 96(1), 74–87।
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). दूसरी राय के लिए किस पर विश्वास किया जाता है? स्तन की जांच के बाद बायोप्सी निर्णयों में एक चिकित्सा AI और चिकित्सकों से सामूहिक सलाह की तुलना। CHI 2025।
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). 'स्वचालन' से 'स्वायत्तता' तक: मानव–मशीन इंटरैक्शन में विश्वास मरम्मत का महत्व। एर्गोनॉमिक्स, 61(10), 1409–1427।
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). एल्गोरिदम विमुखता: लोग त्रुटिपूर्वक एल्गोरिदम से बचते हैं उन्हें गलती करते देखने के बाद। जर्नल ऑफ एक्सपेरिमेंटल साइकोलॉजी: जनरल, 144(1), 114–126।
DigiCert (2026). AI ट्रस्ट आर्किटेक्चर। उत्पाद घोषणा, अप्रैल 2026।
Ding, K. (2026). जब LLM सहमत हों, तो क्या वे सही हैं? आत्म-संगति और क्रॉस-मॉडल समझौते को विश्वास संकेतों के रूप में ऑडिट करना। arXiv:2607.08065।
Dranove, D., & Jin, G. Z. (2010). गुणवत्ता प्रकटीकरण और प्रमाणन: सिद्धांत और व्यवहार। जर्नल ऑफ इकोनॉमिक लिटरेचर, 48(4), 935–963।
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). बहु-एजेंट बहस के माध्यम से भाषा मॉडल में तथ्यात्मकता और तर्क में सुधार। मशीन लर्निंग पर 41वीं अंतर्राष्ट्रीय सम्मेलन की कार्यवाही, PMLR 235, 11733–11763।
Endsley, M. R., & Kiris, E. O. (1995). लूप-आउट-ऑफ-द-लूप प्रदर्शन समस्या और स्वचालन में नियंत्रण का स्तर। ह्यूमन फैक्टर्स, 37(2), 381–394।
Errico, H. (2026). स्वायत्त कार्य रनटाइम प्रबंधन (AARM): रनटाइम पर AI-संचालित कार्यों को सुरक्षित करने के लिए एक सिस्टम विनिर्देश। arXiv:2602.09433।
यूरोपीय आयोग (2026)। AI अधिनियम के अनुच्छेद 50 के तहत कुछ AI प्रणालियों के लिए पारदर्शिता दायित्वों के कार्यान्वयन पर दिशानिर्देश। 20 जुलाई 2026 को अपनाया गया।
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024)। सिमेंटिक एंट्रॉपी का उपयोग करके बड़े भाषा मॉडल में भ्रम का पता लगाना। Nature, 630(8017), 625–630।
Featherman, M. S., & Pavlou, P. A. (2003)। ई-सेवा अपनाने की भविष्यवाणी करना: एक कथित जोखिम पहलू दृष्टिकोण। International Journal of Human-Computer Studies, 59(4), 451–474।
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026)। उच्च-स्वायत्तता AI सहायकों की उपभोक्ता स्वीकृति ऑनलाइन खरीदारी सेटिंग्स में कथित लाभों द्वारा संचालित होती है जिसमें कमी की विशेषता है। Psychology & Marketing, 43(3), 538–555। https://doi.org/10.1002/mar.70074
Gartner (2025)। Gartner भविष्यवाणी करता है कि 2027 के अंत तक 40% से अधिक एजेंटिक AI परियोजनाएं रद्द कर दी जाएंगी। प्रेस विज्ञप्ति, 25 जून 2025।
Gartner (2026)। खरीदारी में जनरेटिव AI पर उपभोक्ता सर्वेक्षण (मई 2026 प्रेस विज्ञप्ति)।
Gefen, D., Karahanna, E., & Straub, D. W. (2003)। ऑनलाइन खरीदारी में विश्वास और TAM: एक एकीकृत मॉडल। MIS Quarterly, 27(1), 51–90।
Geifman, Y., & El-Yaniv, R. (2017)। गहरे तंत्रिका नेटवर्क के लिए चयनात्मक वर्गीकरण। Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500)।
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025)। कृत्रिम बुद्धिमत्ता के प्रति विश्वास, दृष्टिकोण और उपयोग: एक वैश्विक अध्ययन 2025। मेलबर्न विश्वविद्यालय और KPMG। https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020)। कृत्रिम बुद्धिमत्ता में मानव विश्वास: अनुभवजन्य अनुसंधान की समीक्षा। Academy of Management Annals, 14(2), 627–660।
Google (2026)। Universal Commerce Protocol। NRF पर घोषणा, 11 जनवरी 2026; कार्ट, कैटलॉग और पहचान-लिंकिंग एक्सटेंशन, मार्च 2026।
Google Cloud (2025)। Agent Payments Protocol (AP2)। घोषणा, 16 सितंबर 2025।
Google DeepMind (2025)। SimpleQA Verified। arXiv:2509.07968।
Gorbett, M., & Jana, S. (2026)। क्रॉस-मॉडल असहमति एक लेबल-मुक्त सुदृढ़ता संकेत के रूप में। arXiv:2603.25450।
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026)। Co-Scientist के साथ वैज्ञानिक खोज में तेजी लाना। Nature, 655(8122), 487–496। https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991)। उत्पाद उपयोग के माध्यम से मेरी व्यापक, कथित महत्वपूर्ण ऊर्जा का आत्म-हेरफेर: एक आत्मनिरीक्षणात्मक-प्रैक्सिस दृष्टिकोण। Journal of Consumer Research, 18(2), 194–207।
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017)। आधुनिक तंत्रिका नेटवर्क के अंशांकन पर। ICML 2017, PMLR 70, 1321–1330।
Gvirtz, A., & Sabherwal, A. (2024)। वैश्विक, क्रॉस-सांस्कृतिक व्यवहारगत विज्ञान अनुसंधान की सीमाएं। Proceedings of the National Academy of Sciences, 121(36), e2316690121।
Hadfield, G. K. (2017)। समतल दुनिया के लिए नियम: मनुष्यों ने कानून का आविष्कार क्यों किया और जटिल वैश्विक अर्थव्यवस्था के लिए इसे फिर से कैसे खोजा। Oxford University Press।
Hadfield, G. K., & Clark, J. (2026)। नियामक बाजार: AI शासन का भविष्य। Jurimetrics, 65, 195–240 (arXiv:2304.04914)।
Hansen, L. K., & Salamon, P. (1990)। तंत्रिका नेटवर्क एनसेम्बल। IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001।
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026)। सभी फ्लिप अनुरूपता नहीं हैं: बहु-एजेंट LLM बहस में रुख अभिसरण को विघटित करना। arXiv:2606.00820।
Hoff, K. A., & Bashir, M. (2015)। स्वचालन में विश्वास: विश्वास को प्रभावित करने वाले कारकों पर अनुभवजन्य साक्ष्य को एकीकृत करना। Human Factors, 57(3), 407–434।
Hong, L., & Page, S. E. (2004)। विविध समस्या समाधानकर्ताओं के समूह उच्च-क्षमता समस्या समाधानकर्ताओं के समूहों से बेहतर प्रदर्शन कर सकते हैं। Proceedings of the National Academy of Sciences, 101(46), 16385–16389।
Huang, M.-H., & Rust, R. T. (2021)। विपणन में कृत्रिम बुद्धिमत्ता के लिए एक कौशल ढांचा। Journal of the Academy of Marketing Science, 49(1), 30–50।
Insurance Services Office (2026)। अनुमोदन प्रपत्र CG 40 47 और CG 40 48: जनरेटिव कृत्रिम बुद्धिमत्ता बहिष्करण। 1 जनवरी 2026 से प्रभावी।
Internet Engineering Task Force (2026)। विश्वसनीय और पारदर्शी डिजिटल आपूर्ति श्रृंखलाओं के लिए एक आर्किटेक्चर (RFC 9943; SCITT कार्यकारी समूह)। IETF। https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024)। AI सहायक पसंद में व्यापार-बंद: क्या उपभोक्ता AI सहायक प्रदर्शन पर पारदर्शिता और स्थिरता को प्राथमिकता देते हैं? Big Data & Society, 11(4)।
Ipsos (2025)। Ipsos AI Monitor 2025। Ipsos Global Advisor, 30 देश का सर्वेक्षण, जून 2025।
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021)। कृत्रिम बुद्धिमत्ता में विश्वास को औपचारिक रूप देना: मानव विश्वास की आवश्यकताएं, कारण और लक्ष्य। FAccT 2021, 624–635।
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022)। भाषा मॉडल (अधिकतर) जानते हैं कि वे क्या जानते हैं। arXiv:2207.05221।
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025)। भाषा मॉडल भ्रम क्यों करते हैं। arXiv:2509.04664।
Kharazian, A. (2026)। Anthropic व्यावसायिक अपनाने में OpenAI को मात देता है। Ramp Economics Lab / Ramp AI Index, 13 मई 2026 (50,000+ U.S. व्यवसायों में कॉर्पोरेट-भुगतान डेटा)।
Kim, D., & Benbasat, I. (2010)। इंटरनेट स्टोर में विश्वास आश्वासन के प्रभावी कार्यान्वयन के लिए डिज़ाइन। Communications of the ACM, 53(2), 121–126।
Kim, E., Garg, A., Peng, K., & Garg, N. (2025)। बड़े भाषा मॉडल में सहसंबद्ध त्रुटियां। Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066।
किम, पी. एच., फेरिन, डी. एल., कूपर, सी. डी., & डिर्क्स, के. टी. (2004). संदेह की छाया को हटाना: क्षमता- बनाम अखंडता-आधारित विश्वास उल्लंघनों की मरम्मत के लिए क्षमा बनाम इनकार के प्रभाव। जर्नल ऑफ एप्लाइड साइकोलॉजी, 89(1), 104–118।
किज़िलसेक, आर. एफ. (2016). कितनी जानकारी? एक एल्गोरिदमिक इंटरफेस में पारदर्शिता के विश्वास पर प्रभाव। CHI 2016, 2390–2395।
क्लर्ना (2024). क्लर्ना एआई सहायक अपने पहले महीने में दो-तिहाई ग्राहक सेवा चैट को संभालता है। प्रेस रिलीज़, 27 फरवरी 2024।
कोबिस, एन., रहवान, जेड., रिल्ला, आर., सुप्रियात्नो, बी. आई., बर्श, सी., अजाज, टी., बोन्नफॉन, जे.-एफ., & रहवान, आई. (2025). कृत्रिम बुद्धिमत्ता को सौंपना बेईमानी का व्यवहार बढ़ा सकता है। नेचर, 646(8083), 126–134। DOI: 10.1038/s41586-025-09505-x।
कोल्ट, एन. (2025). एआई एजेंटों पर शासन। नोट्रे डेम लॉ रिव्यू, 101 (SSRN वर्किंग पेपर 4772956; arXiv:2501.07913)।
कोमियाक, एस. वाई. एक्स., & बेनबासत, आई. (2006). व्यक्तिगतकरण और परिचितता के सिफारिश एजेंटों के प्रति विश्वास और अपनाने पर प्रभाव। एमआईएस क्वार्टरली, 30(4), 941–960।
कोनिग, पी. डी., वुर्स्टर, एस., & सीवर्ट, एम. बी. (2022). उपभोक्ता व्याख्या के लिए भुगतान करने को तैयार हैं, लेकिन हरे एआई के लिए नहीं: पसंद-आधारित संयुक्त विश्लेषण से सबूत। बिग डेटा & सोसाइटी, 9(1)।
क्रॉघ, ए., & वेडेलस्बी, जे. (1995). न्यूरल नेटवर्क समूह, क्रॉस सत्यापन, और सक्रिय सीखना। न्यूरल इनफॉर्मेशन प्रोसेसिंग सिस्टम्स में प्रगति, 7, 231–238।
क्रोल, जे. ए., ह्यूई, जे., बैरोकास, एस., फेल्टन, ई. डब्ल्यू., रीडेनबर्ग, जे. आर., रॉबिंसन, डी. जी., & यू, एच. (2017). जवाबदेह एल्गोरिदम। यूनिवर्सिटी ऑफ पेनसिलवेनिया लॉ रिव्यू, 165(3), 633–705।
कुंचेवा, एल. आई., & व्हिटेकर, सी. जे. (2003). वर्गीकरण समूहों में विविधता के उपाय और वर्गीकरण सटीकता के साथ उनका संबंध। मशीन लर्निंग, 51(2), 181–207।
ली, जे. डी., & सी, के. ए. (2004). स्वचालन में विश्वास: उपयुक्त निर्भरता के लिए डिज़ाइन करना। ह्यूमन फैक्टर्स, 46(1), 50–80।
लेसिग, एल. (2006). कोड: संस्करण 2.0। बेसिक बुक्स।
ली, एम. (2025). क्लाउड-नेटिव से विश्वास-नेटिव तक: सत्यापनीय बहु-एजेंट सिस्टम के लिए एक प्रोटोकॉल। arXiv:2507.22077।
लियांग, पी., बोम्मासानी, आर., ली, टी., त्सिप्रास, डी., सोयलू, डी., यासुनागा, एम., झांग, वाई., नारायणन, डी., वु, वाई., कुमार, ए., न्यूमैन, बी., युआन, बी., यान, बी., झांग, सी., कॉसग्रोव, सी., मैनिंग, सी. डी., रे, सी., अकोस्ता-नवास, डी., हडसन, डी. ए., ... कोरिडा, वाई. (2023). भाषा मॉडल का समग्र मूल्यांकन। मशीन लर्निंग पर लेनदेन।
लिआओ, क्यू. वी., & सुंदर, एस. एस. (2022). एआई सिस्टम में जिम्मेदार विश्वास के लिए डिज़ाइन करना: एक संचार दृष्टिकोण। FAccT 2022, 1257–1268।
लिन, एस., हिल्टन, जे., & इवांस, ओ. (2022). मॉडल को शब्दों में अपनी अनिश्चितता व्यक्त करने के लिए सिखाना। arXiv:2205.14334।
लिंडसे, जे. (2025). बड़े भाषा मॉडल में उदीयमान आत्मचिंतनशील जागरूकता। एंथ्रोपिक / ट्रांसफॉर्मर सर्किट्स।
लियू, जे., बुर्स्जटिन, वी. एस., एआई, एल., वांग, एच., चौधरी, एस., मित्रा, एस., & वु, क्यू. (2026). टीमफ्यूजन: बहु-एजेंट सिस्टम के साथ खुली-अंत की टीमवर्क का समर्थन करना। arXiv:2604.19589 (एसीएल 2026; एडोब रिसर्च)।
लिज़्ज़ेरी, ए. (1999). सूचना प्रकटीकरण और प्रमाणीकरण मध्यस्थ। रैंड जर्नल ऑफ इकोनॉमिक्स, 30(2), 214–231।
लॉग, जे. एम., मिंसन, जे. ए., & मूर, डी. ए. (2019). एल्गोरिदम प्रशंसा: लोग मानव निर्णय की तुलना में एल्गोरिदमिक को पसंद करते हैं। संगठनात्मक व्यवहार और मानव निर्णय प्रक्रियाएं, 151, 90–103।
लोंगोनी, सी., बोनेजी, ए., & मोरवेज, सी. के. (2019). चिकित्सा कृत्रिम बुद्धिमत्ता के प्रति प्रतिरोध। जर्नल ऑफ कंज्यूमर रिसर्च, 46(4), 629–650।
लोंगोनी, सी., सियान, एल., & क्यूंग, ई. जे. (2023). एल्गोरिदमिक हस्तांतरण: लोग सरकार में एआई की विफलताओं को अत्यधिक सामान्य बनाते हैं। जर्नल ऑफ मार्केटिंग रिसर्च, 60(1), 170–188।
लोरेंज, जे., रॉहुट, एच., श्वेइत्सर, एफ., & हेल्बिंग, डी. (2011). सामाजिक प्रभाव भीड़ के बुद्धिमत्ता प्रभाव को कैसे कम कर सकता है। राष्ट्रीय विज्ञान अकादमी की कार्यवाही, 108(22), 9020–9025। DOI: 10.1073/pnas.1008636108।
लू, जेड., वांग, डी., & यिन, एम. (2024). क्या अधिक सलाह मदद करती है? एआई-समर्थित निर्णय लेने में दूसरी राय के प्रभाव। मानव-कंप्यूटर इंटरएक्शन पर एसीएम की कार्यवाही, 8(CSCW1), 1–31।
मार्चल, एन., चान, एस., फ्रैंकलिन, एम., रेवेल, एम., कीलिंग, जी., फिश्ली, आर., चंद्रा, बी., & गेब्रिएल, आई. (2026). कृत्रिम ज्ञानविषयक एजेंटों में विश्वास को स्थापत्य के अनुसार करना। arXiv:2603.02960।
मास्टरकार्ड (2026). सत्यापनीय इरादा (गूगल के साथ सह-विकसित)। न्यूज़रूम घोषणा, 5 मार्च 2026; एशियाई और लैटिन अमेरिकी बाजारों में प्रारंभिक पायलट, 2026।
मेयर, आर. सी., डेविस, जे. एच., & शोरमैन, एफ. डी. (1995). संगठनात्मक विश्वास का एक समन्वयात्मक मॉडल। एकेडमी ऑफ मैनेजमेंट रिव्यू, 20(3), 709–734।
मैकिंसे & कंपनी (2025). एजेंटिक वाणिज्य का अवसर (शूमाकर, रॉबर्ट्स, & गिबल)। 17 अक्टूबर 2025।
मैकनाइट, डी. एच., चौधुरी, वी., & काकमार, सी. (2002). ई-कॉमर्स के लिए विश्वास उपायों का विकास और सत्यापन। सूचना सिस्टम अनुसंधान, 13(3), 334–359।
मेनलो वेंचर्स (2025a). 2025 मध्य-वर्ष एलएलएम बाजार अपडेट। 31 जुलाई 2025 (150 तकनीकी निर्णय निर्माताओं का सर्वेक्षण)।
मेनलो वेंचर्स (2025b). 2025: एंटरप्राइज में जनरेटिव एआई की स्थिति। 9 दिसंबर 2025 (495 यू.एस. एंटरप्राइज एआई निर्णय निर्माताओं का सर्वेक्षण; मेनलो वेंचर्स एक एंथ्रोपिक निवेशक है)।
मेनलो वेंचर्स (2025c). 2025: उपभोक्ता एआई की स्थिति। 26 जून 2025 (5,031 यू.एस. वयस्कों का सर्वेक्षण, मॉर्निंग कंसल्ट के साथ; ~3% भुगतान करने वाला उपयोगकर्ता आंकड़ा एक राजस्व-व्युत्पन्न अनुमान है)।
मोहलमैन, एम., & ज़ालमनसन, एल. (2017). पहिया पर हाथ: एल्गोरिदमिक प्रबंधन और उबर ड्राइवरों की स्वायत्तता को नेविगेट करना। आईसीआईएस 2017।
मोंटगोमरी, जे. एम., न्यहान, बी., & टोरेस, एम. (2018). उपचार के बाद के चर पर कंडीशनिंग आपके प्रयोग को कैसे बर्बाद कर सकती है और इसके बारे में क्या करना चाहिए। अमेरिकी राजनीति विज्ञान जर्नल, 62(3), 760–775।
मॉर्गन स्टेनली (2025). एजेंटिक वाणिज्य पूर्वानुमान: 2030 तक $190–385 बिलियन यू.एस. ई-कॉमर्स व्यय। दिसंबर 2025।
मोसियर, के. एल., & स्किटका, एल. जे. (1996). मानव निर्णय निर्माता और स्वचालित निर्णय सहायता: एक दूसरे के लिए बने? आर. परसुरामन & एम. मुलौआ (संपादक), स्वचालन और मानव प्रदर्शन: सिद्धांत और अनुप्रयोग में (पीपी. 201–220)। लॉरेंस एर्लबाउम एसोसिएट्स।
मोज़न्नर, एच., & सोंटाग, डी. (2020). एक विशेषज्ञ को स्थगित करने के लिए सीखने के लिए सुसंगत अनुमानक। आईसीएमएल 2020, पीएमएलआर 119, 7076–7087।
मुचनिक, एल., अरल, एस., & टेलर, एस. जे. (2013). सामाजिक प्रभाव पूर्वाग्रह: एक यादृच्छिक प्रयोग। विज्ञान, 341(6146), 647–651। DOI: 10.1126/science.1240466।
Muir, B. M. (1994). स्वचालित प्रणालियों में विश्वास: भाग I। स्वचालित प्रणालियों में विश्वास और मानव हस्तक्षेप के अध्ययन में सैद्धांतिक मुद्दे। Ergonomics, 37(11), 1905–1922.
NIST (2023). कृत्रिम बुद्धिमत्ता जोखिम प्रबंधन ढांचा (AI RMF 1.0) (NIST AI 100-1). राष्ट्रीय मानक और प्रौद्योगिकी संस्थान।
Okamura, K., & Yamada, S. (2020). मानव-AI सहयोग के लिए अनुकूलनीय विश्वास अंशांकन। PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). स्थिति: एजेंटिक AI ऑर्केस्ट्रेशन बेयस-सुसंगत होना चाहिए। arXiv:2605.00742. (ICML 2026 में स्वीकृत।)
Parasuraman, R., & Manzey, D. H. (2010). स्वचालन के मानव उपयोग में आत्मतुष्टि और पूर्वाग्रह: एक मनोयोगात्मक एकीकरण। Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). मानव और स्वचालन: उपयोग, दुरुपयोग, अनुपयोग, दुर्व्यवहार। Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). स्वचालन के साथ मानव अंतःक्रिया के प्रकार और स्तर के लिए एक मॉडल। IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). इलेक्ट्रॉनिक वाणिज्य की उपभोक्ता स्वीकृति: प्रौद्योगिकी स्वीकार मॉडल के साथ विश्वास और जोखिम को एकीकृत करना। International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). दुनिया भर के लोग AI को कैसे देखते हैं। 25 देशों का सर्वेक्षण, अक्टूबर 2025।
Piehlmaier, D. M. (2023). एकल-व्यक्ति शो: संयुक्त निर्णय लेने का निवेशक आत्मविश्वास पर प्रभाव। Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). उपभोक्ता और कृत्रिम बुद्धिमत्ता: एक अनुभवात्मक दृष्टिकोण। Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). AI एजेंट विश्वसनीयता के विज्ञान की ओर। arXiv:2602.16666 (ICML 2026)।
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). बाहरी पर्यवेक्षण: AI शासन के लिए एक तीसरे पक्ष के ऑडिट इकोसिस्टम की डिज़ाइनिंग। AIES 2022, 557–571.
Regulation (EU) 2016/679 (सामान्य डेटा संरक्षण विनियमन), अनुच्छेद 22 — स्वचालित व्यक्तिगत निर्णय लेना।
Regulation (EU) 2024/1689 (कृत्रिम बुद्धिमत्ता अधिनियम), अनुच्छेद 14 — उच्च-जोखिम AI प्रणालियों की मानव पर्यवेक्षण; अनुच्छेद 50 — कुछ AI प्रणालियों के प्रदाताओं और तैनातकर्ताओं के लिए पारदर्शिता दायित्व।
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). AI वैज्ञानिक वैज्ञानिक रूप से तर्क किए बिना परिणाम देते हैं। arXiv:2604.18805।
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). कमजोर सत्यापनकर्ताओं के साथ पीढ़ी-सत्यापन अंतराल को कम करना। arXiv:2506.18203।
Sabater, J., & Sierra, C. (2005). कम्प्यूटेशनल विश्वास और प्रतिष्ठा मॉडल पर समीक्षा। Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). AI सलाह पर उपयुक्त निर्भरता: संकल्पना और व्याख्याओं का प्रभाव। IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). पारदर्शिता दुविधा: AI प्रकटीकरण विश्वास को कैसे नष्ट करता है। Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). उपभोक्ता वस्तुओं के लिए भुगतान की इच्छा को सटीक रूप से मापना: अनुमानित पूर्वाग्रह का एक मेटा-विश्लेषण। Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). अवैयक्तिक विश्वास का सामाजिक नियंत्रण। American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). भाषा मॉडल में चापलूसीपन को समझने की ओर। ICLR 2024 (arXiv:2310.13548)।
Shehata, D., & Li, M. (2026). व्यस्त-बुद्धि कानून: आर्किटेक्चरल जनजातिवाद और एजेंटिक झुंडों में आम सहमति का विरोधाभास। arXiv:2604.27274।
Sheridan, T. B., & Verplank, W. L. (1978). समुद्री दूरसंचालकों का मानव और कंप्यूटर नियंत्रण (तकनीकी रिपोर्ट)। MIT मैन-मशीन सिस्टम प्रयोगशाला।
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). क्या हमें MAD जाना चाहिए? LLM के लिए बहु-एजेंट बहस रणनीतियों पर एक नज़र। ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371)।
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). सूचना प्रणाली उपयोगकर्ताओं के लिए विभिन्न विश्वास संबंध महत्वपूर्ण क्यों हैं। European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). भविष्यवाणी की अंगुली: सहसंबद्ध AI पूर्वानुमान त्रुटियां और पूर्वाग्रह संचरण की सीमाएं। arXiv:2605.00844।
Stanford HAI (2025). कृत्रिम बुद्धिमत्ता सूचकांक रिपोर्ट 2025। स्टैनफोर्ड मानव-केंद्रित कृत्रिम बुद्धिमत्ता संस्थान (तकनीकी प्रदर्शन अध्याय)।
Stanford HAI (2026). कृत्रिम बुद्धिमत्ता सूचकांक रिपोर्ट 2026। स्टैनफोर्ड मानव-केंद्रित कृत्रिम बुद्धिमत्ता संस्थान (जनमत अध्याय, Pew 25-देशों के सर्वेक्षण डेटा की रिपोर्टिंग)।
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). सेवा शिकायत अनुभवों के उपभोक्ता मूल्यांकन: संबंध विपणन के लिए निहितार्थ। Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). मनुष्य और AI के संयोजन कब उपयोगी होते हैं: एक व्यवस्थित समीक्षा और मेटा-विश्लेषण। Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). न्यायाधीशों को जूरी के साथ प्रतिस्थापित करना: विविध मॉडल के पैनल के साथ LLM पीढ़ी का मूल्यांकन। arXiv:2404.18796।
Visa (2025). Visa ने विश्वस्त एजेंट प्रोटोकॉल पेश किया: AI वाणिज्य के लिए एक इकोसिस्टम-नेतृत्व वाला ढांचा। प्रेस विज्ञप्ति (Cloudflare के साथ), 14 अक्टूबर 2025।
Visa (2026). Visa ने OpenAI के साथ साझेदारी की है ताकि AI कॉमर्स की अगली पीढ़ी को शक्ति दी जा सके। प्रेस रिलीज़, Visa Payments Forum, 10 जून 2026।
W3C (2025). Verifiable Credentials Data Model v2.0। W3C Recommendation।
Wallendorf, M., & Brucks, M. (1993). उपभोक्ता अनुसंधान में आत्मचिंतन: कार्यान्वयन और निहितार्थ। Journal of Consumer Research, 20(3), 339–359।
Walsham, G. (1995). IS अनुसंधान में व्याख्यात्मक केस स्टडीज़: प्रकृति और विधि। European Journal of Information Systems, 4(2), 74–81।
Wang, W., & Benbasat, I. (2005). ऑनलाइन अनुशंसा एजेंटों में विश्वास और स्वीकृति। Journal of the Association for Information Systems, 6(3), 72–101।
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). एजेंट ट्रेसेज़ से विश्वास तक: LLM एजेंटों में साक्ष्य अनुरेखण और निष्पादन प्रमाणीकरण का सर्वेक्षण। arXiv:2606.04990।
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). बड़े भाषा मॉडलों में लघु-रूप तथ्यात्मकता को मापना। arXiv:2411.04368।
Werbach, K. (2018). ब्लॉकचेन और विश्वास की नई वास्तुकला। MIT Press।
Wertenbroch, K. (1998). खरीद की मात्रा को राशन करके गुण और दुर्गुण की खपत में आत्म-नियंत्रण। Marketing Science, 17(4), 317–337।
Xiao, B., & Benbasat, I. (2007). ई-कॉमर्स उत्पाद अनुशंसा एजेंट: उपयोग, विशेषताएं और प्रभाव। MIS Quarterly, 31(1), 137–209।
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). अंगूठा ऊपर या नीचे: उपभोक्ता एल्गोरिदम बनाम मनुष्यों द्वारा निर्णयों पर प्रतिक्रिया। Journal of Marketing Research, 59(4), 696–717।
Yin, R. K. (2018). केस स्टडी अनुसंधान और अनुप्रयोग: डिज़ाइन और विधियाँ (6वां संस्करण)। Sage।
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). AI-सहायक निर्णय लेने में सटीकता और विश्वास अंशांकन पर आत्मविश्वास और व्याख्या का प्रभाव। Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305।
Zheng, J., & Zhang, J. (2026). संरचित विशेषज्ञ निर्णय के माध्यम से बहु-LLM प्रणालियों के लिए अनिश्चितता-जागरूक विश्वास अनुमान। arXiv:2607.20529।
Zuboff, S. (2019). निगरानी पूंजीवाद का युग। PublicAffairs।
Zucker, L. G. (1986). विश्वास का उत्पादन: आर्थिक संरचना के संस्थागत स्रोत, 1840–1920। Research in Organizational Behavior, 8, 53–111।
* AI प्रणाली आर्किटेक्ट। प्रतिस्पर्धी हित: लेखक बहु-मॉडल ऑर्केस्ट्रेशन विधियां विकसित करते हैं, आर्किटेक्चर का एक संदर्भ कार्यान्वयन संचालित करते हैं जिसका यहाँ वर्णन किया गया है, AI ऑर्केस्ट्रेशन और बहु-मॉडल सत्यापन प्रणालियों को कवर करने वाली लंबित पेटेंट आवेदनों पर एक नाम के आवेदक हैं, अनुदानित पेटेंट नहीं हैं, और इस पत्र द्वारा वकालत की गई आर्किटेक्चर में एक डेवलपर की रुचि रखते हैं; इसकी आवश्यकता के बारे में मानदंडात्मक दावों को उस रुचि को ध्यान में रखते हुए पढ़ा जाना चाहिए। अनुभाग 4 तैनाती में लेखक की भूमिका इस पत्र के अंत में लेखक की नोट और प्रकटीकरण में सेट की गई है। टिप्पणियों का स्वागत है: [email protected]।↩︎
इस पत्र का हवाला कैसे दें
Chernets, V. (2026). आर्किटेक्चरल विश्वास: एजेंटिक वाणिज्य में उपभोक्ता विश्वास AI मॉडल से सत्यापनीय आर्किटेक्चर की ओर क्यों स्थानांतरित होता है [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}