7개의 다운로드가 의미하는 바는 무엇인가? 지표 맹목성과 SSRN 랭킹 종료 후 학술적 주목의 냉각 시작
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- 기록 버전: SSRN 7296358 · DOI 10.2139/ssrn.7296358
- 보관된 사본, 인용 가능 및 다운로드 가능: 10.5281/zenodo.22166896 — 개념 DOI, 항상 최신 버전으로 확인됨
- 마크다운 및 PDF 전체 텍스트: GitHub
- 읽기 가능한 HTML: https://polyhelper.ai/research/download-metrics/
동일한 텍스트가 4개의 서면에 있으므로 그 중 하나가 제공할 수 없을 때 도달할 수 있습니다. SSRN이 기록 버전을 보유하고 있습니다. 그것을 인용합니다.
7 다운로드가 무엇을 의미합니까?
SSRN 순위 종료 후 지표 맹점과 학술 관심의 콜드 스타트
원고 유형: 비판적 종합, 방법론적 프레임워크 및 사전등록 준비된 경험적 의제
버전: 2026년 9월
저자: Vadym Chernets, PhD1
소속: AI systems architect
초록
2026년 7월 15일, 사회 과학 연구 네트워크(SSRN)는 논문, 저자 및 기관 리그 테이블인 공개 순위를 폐지했으며, 이는 오랫동안 플랫폼의 유일하게 널리 접근 가능한 비교 프레임을 제공했지만, 다운로드 수 및 인용 통계는 개별 논문 및 저자 프로필에 남아 있습니다(SSRN 블로그, 2026년 7월 15일). 결과는 비대칭적 측정 사건이었습니다. 저자는 숫자는 유지하고 규범을 잃었습니다. SSRN의 카운터는 무의미해지지 않았습니다. 읽을 수 없게 되었습니다. 모든 다운로드 수는 척도가 없는 숫자가 되었습니다.
본 논문은 "7 다운로드가 무엇을 의미합니까?"라는 질문이 논문의 참조 클래스가 명시될 때까지 과학적으로 부정확하게 제기된다고 주장합니다. 원본 누적 사용 수는 논문의 나이, 분야, 게시 코호트, 분포 노출 및 이전 저자 가시성 없이는 해석할 수 없습니다. 문제는 새로운 논문과 낮은 가시성 저자에게 가장 심각합니다. 이들의 초기 관심은 학술적 관심보다는 플랫폼 아키텍처, 이메일 알림 배포, 검색 인덱싱, 저자 명성 및 관심의 무거운 꼬리 역학에 의해 형성됩니다. 우리는 이 조건을 학술 관심의 콜드 스타트라고 명명합니다. 요구사항은 새로운 것이 아닙니다. 분야, 나이 및 문서 유형에 대한 계수 정규화는 인용 서지학에서 오래 정착된 관행입니다. 사용 데이터에 대한 병렬 질문은 이미 15년 반 전에 제기되었습니다(Kurtz & Bollen, 2010). 그러한 종류의 서지 지표는 분야, 나이 및 유형이 알려진 데이터베이스를 가정하며 지표는 독자를 대신하여 계산되는 반면, 사전 인쇄 플랫폼은 저자에게 참조 클래스, 도구 없이 순수 정수를 제공합니다. 2026년 7월 이후 비교 프레임도 없습니다. 누락된 것은 방법이 아니라 그 인스턴스화입니다. SSRN은 저자를 위해 이를 적용하는 도구를 제공하지 않습니다.
이용 가능한 증거는 단순 평균이 오도하는 이유를 보여줍니다. SSRN 네트워크의 최근 발표된 외부 대표본 연구(2,361개 마케팅 워킹페이퍼)에서만 평균 다운로드는 221.3이었고 중앙값은 87이었으며, 평균은 75백분위수(206)를 초과했습니다(Jo & Li, 2026). 다운로드 분포는 극단적 상위 꼬리를 가진 준로그정규분포이며, 단일 학문 네트워크 내에서 평균 다운로드는 세부 분야에 따라 대략 8배 정도 차이가 납니다(Whalen, 2018). 따라서 플랫폼 전체 평균은 특정 논문을 설명하지 않으며, 새로운 논문을 이에 대해 벤치마킹하는 것은 집계라는 허구에 대해 보정하는 것입니다. 이용 가능한 전환 증거에 따르면, 40개 초록 조회에서 7건의 다운로드라는 수치는 실패를 나타내지 않습니다. 이는 주변에 넓은 신뢰 구간을 가진 선별 결과이며, 도달도, 전환율, 논문 나이, 분야를 통해 읽어야 합니다.
그 증거로부터 본 논문은 순위 이후 SSRN 지표에 대한 해석 틀을 구축하며, 이는 노출, 초록 조회, 전문 다운로드, 후속 활용을 분리하고, 무시당함을 거절과 구분하는 도달도-전환율 진단을 추가합니다. 단일 허영 수치 대신 Cold-Start Scholarly Attention Benchmark(CSAB)라는 다차원 대안을 제안합니다. 이를 동반하는 문서 프로토콜에서는 모든 보고된 지표가 그 출처, 시간 범위, 참조 집단, 제한 사항을 전달합니다. 본 논문은 그 후 누락된 척도를 재구축하기 위한 사전등록 준비 완료 의제를 제시합니다: 1일차부터 180일차까지 새로운 SSRN 논문을 관찰하는 전망적 패널, 선별된 이메일 경보 배포와 순위 폐기 자체를 활용한 준실험, 커뮤니티 구축 백분위수 벤치마크, AI 답변 엔진의 사전인쇄 가시성 감사. 증거 기반은 인용된 연구와 부록 E의 비대표성 아카이브 단면을 결합합니다. 본 논문은 누락된 벤치마크가 어떻게 재구축될 수 있는지, 그리고 왜 어떤 다운로드 수도 맥락 없이 그것을 제공하지 않는 플랫폼에서 유포되어서는 안 되는지를 명시합니다.
키워드: 다운로드 수; 사용 지표; 분야 정규화; 연구 평가; 사전인쇄; 계량서지학; 승진과 임용; 법학 학문; 대체지표; 마태복음 효과; 누적 이점; 주의 경제; 초록 조회; 약탈적 저널; 생성 엔진 최적화.
JEL 분류: A14; D83; I23; O33; L86
핵심 내용
원본 SSRN 다운로드 수는 논문 나이, 분야, 게시 코호트, 배포 노출도, 이전 저자 가시성 없이 안정적인 해석을 갖지 않습니다.
2026년 7월 15일의 순위 폐기는 플랫폼의 유일한 공개 비교 틀을 제거했으나 모든 카운터는 남았습니다: 저자들은 수치를 유지하고 규범을 잃었습니다.
최근 발표된 유일한 대표본 분포에서 다운로드는 강한 우측 편향이며, 평균 221.3 대 중앙값 87입니다: "평균" 논문은 구성상 비정형적입니다.
도달도(초록 조회)를 전환율(조회당 다운로드)과 분리하면 무시당함을 거절과 구분합니다: 서로 다른 진단으로 서로 다른 조치를 필요로 합니다.
발표된 조회수-다운로드 전환 앵커는 대략 11–19% 대역에 군집하며, 40개 초록 조회에서 7건의 다운로드는 선별 결과로서 범위와 일치합니다: 이용 가능한 증거에 따르면 실패의 신호가 아닙니다.
Cold-Start Scholarly Attention Benchmark(CSAB)는 단일 허영 수치 대신 정규화된 도달도, 다운로드 성능, 전환율, 모멘텀, 후속 검증을 보고합니다.
사전 지정되고 사전등록 준비 완료된 의제(전망적 패널, 플랫폼 자체의 개혁에 의해 생성된 두 개의 특히 시의적절한 준실험, 커뮤니티 백분위수 벤치마크, 생성 엔진 최적화가 증거 기반으로 취급되기 전에 필요한 AI 답변 엔진 감사)는 누락된 척도를 재구축하는 방법을 명시합니다.
범위 및 증거 규율
본 논문은 비판적 종합이며, 방법론적 틀과 사전등록 준비 완료된 실증적 의제를 함께 제시하고, 보고하는 유일한 새로운 데이터는 부록 E의 비대표성 아카이브 단면입니다. 세 가지 증거 범주는 전체에 걸쳐 분리되어 있으며, 본 논문의 모든 수치는 그 범주와 함께 이동합니다:
1. 검증된 추정치: 발표된 수치는 그들의 1차 출처와 비교하여 검토되고 표본 프레임과 시점을 명시하여 인용되거나, 검증이 부분적인 경우 명시된 주의사항과 함께 검증됩니다.
2. 역사적 앵커: 이전 표본과 폐기된 플랫폼 기능으로, 분포 구조를 드러내기 때문에 유지되지만 2026년의 보정된 규범으로 남아있기 때문이 아닙니다.
3. 개념적 및 제안된 산출물: 사전 지정된 예측, 벤치마크 템플릿, 연구 설계로, 명시적으로 그렇게 표시되며 합성 발견을 포함하지 않습니다.
해석 가능성 문제, 참조 집단 논증, 도달도-전환율 분해는 위의 증거에 대해 방어된 분석적 주장입니다. 본 논문이 제안하는 인프라는 정착된 규정이 아니라 커뮤니티가 구축하고 평가할 설계로 제시됩니다: 커뮤니티 백분위수 레지스트리(섹션 8.8), 저자 대면 계산기, 섹션 8.10의 조율 아키텍처. 본 논문의 어떤 진단 주장도 이들이 채택되는 것에 의존하지 않습니다.
방금 가장 많이 사용되는 공개 벤치마크를 잃은 분야에서, 희소한 공공선은 어떤 저자든지 어디서든 실행할 수 있는 복제 가능한 프로토콜이며, 기존 수치의 출처와 나이를 명시하는 종합입니다.
40-초록-조회-그리고-7-다운로드 사례는 본 방법론적 종합을 통해 반복되는데, 이는 표 1에 목록된 질문들을 예시하기 때문입니다. 결론은 인용된 증거에 근거하며, 어떤 단일 대시보드에도 근거하지 않습니다.
세 가지 규칙이 종합 자체를 지배합니다. 단위는 두 가지 공통 분모인 논문당 생애주기 다운로드와 논문당 12개월 다운로드로 정규화됩니다. 브리징은 출처 자체가 필요한 비율을 보고하는 경우에만 수행되며, 전환이 출처가 지원하지 않는 가정을 요구할 곳마다 원래 단위가 유지됩니다. 모든 사실적 주장은 표의 출처-신뢰도 열에 기록된 검증 계층(1차 출처 대비 검증, 명시된 주의사항과 함께 검증, 또는 검증 대기 중)을 전달합니다. 출처가 충돌하는 경우, 특히 효과적 폐기 날짜에 대해, 충돌은 나중의 공식 출처에 유리하게 해결되고 표시됩니다. 각 추정치는 재사용되는 곳마다 그 계층, 시점, 나이 증가 주의사항을 유지합니다.
소스 포함을 지배하는 단일 규칙이 있습니다: 참고문헌은 서로 다른 메커니즘, 결과, 플랫폼 사실, 측정 경고 또는 설계 선례에 기여할 때 유지됩니다. 인용 수량은 목표가 아닙니다. 게시와 읽혀지는 것은 다른 성취입니다. 이 글은 두 번째에 관한 것이며, 이를 측정하기 위한 도구들의 붕괴에 관한 것입니다. 그럴듯해 보이는 표는 증거가 아니며, 문맥 없는 숫자에 관한 글에서 그 규칙은 먼저 글 자체에 적용됩니다.
1. 서론
1.1 40회 조회, 7회 다운로드
연구자(초기 경력, 혹은 소속이 없거나, 단순히 플랫폼이 처음인)를 생각해 봅시다. 이 연구자가 정성을 들여 준비한 작업 논문을 SSRN에 업로드하고, 몇 주 후인 2026년 8월에 논문의 통계 패널을 열어봅니다. 대시보드는 "40회 초록 조회"와 "7회 다운로드"를 보고합니다. 이 시점에서, 학술적 관심의 통계에 대한 실무적 이해가 없으면, 저자는 이 수치가 동료들의 치명적인 거부를 의미하는지, 전문적인 텍스트에 대한 표준적인 통계 기준선인지, 아니면 비상할 정도로 강한 궤적의 시작인지 알 수 없습니다. 저자가 동료들에게 묻습니다: "그게 끔찍한 거예요?" 아무도 답할 수 없습니다. 대시보드도, 학술 문헌도, 플랫폼 자체도 답을 제공하지 않으며, 그 수치는 읽을 수 있는 척도가 없습니다. 이 상황을 지표 맹목성이라 부릅니다. 이는 자신의 카운터 앞에 서 있으면서도 실패와 정상적인 성과, 그리고 성공을 구별할 수 없는 무능함입니다. 이 용어는 여기서 측정된 량이 아니라 이론적 구성물로 소개됩니다. 연구 4(8.6절)는 구체적인 지표(자신의 카운트를 어떤 벤치마크와도 비교해 본 적이 없다고 보고하는 저자들의 비율, 그리고 낮은 카운트가 유발하는 첫 독회의 분포)를 제공하므로 "지표 맹목성"은 사전 등록된 설문 조사가 추정할 수 있는 것을 이름 붙입니다.
커뮤니티 포럼에서 저자들이 이야기한 동반 장면이 있으며, 이것은 설명적 일화로 제시됩니다. 더욱 극명합니다. 연구자가 첫 번째 사전 인쇄본을 업로드하고 대시보드가 0 조회와 0 다운로드로 유지되는 것을 지켜보는 한편, 며칠 내에 수신함에는 모두 약탈적인 저널 5곳에서 원고를 청탁하는 이메일이 들어옵니다. 신규 이용자가 받는 유일한 답변은 약탈적 저널로부터 옵니다. 7절은 이 비대칭성을 명시적 가설 집합으로 발전시키며, 연구 3(8.6절)은 이를 시간 설정하는 방법을 명시합니다. 이 장면은 정보의 공백의 살아있는 대응물입니다: 합법적인 관심 경제는 이 저자에게 읽을 것이 없는 카운트를 제공하는 반면, 기생하는 경제는 아첨을 제공하고 독자는 없습니다.
2026년 여름까지, 대략적인 답변이 존재했습니다. SSRN의 공개 순위(상위 논문, 상위 저자, 기관 순위표)는 저자가 카운트를 보이는 분포 내에 위치시킬 수 있게 했습니다. 2026년 7월 15일에 그 순위들이 폐기되었습니다 [149]. 폐기는 "연구는 스스로 말해야 한다"는 성명으로 결정을 프레임 지은 2026년 6월 12일 발표 [148] 그리고 플랫폼의 리소스를 핵심 연구 공유 사명에 재집중하겠다는 2026년 4월 13일 발표 [146]를 따랐습니다. 철회는 비대칭적이었습니다: 논문별 다운로드 수와 인용 통계는 "계속 기록되고 당신의 개별 논문과 저자 프로필에 표시됩니다" [149]인 반면, 그 카운트들에 척도를 부여했던 분포는 사라졌습니다. 대시보드의 연구자의 상황은 따라서 플랫폼의 전체 사용자 기반에 일반화되었습니다: 190만 명 이상의 저자와 150만 개의 논문 [49].
이 논문은 그 상황에 관한 것이며, 논문의 주장은 두 부분으로 나뉩니다. 순위 종료는 맥락을 제거했지, 데이터를 제거하지 않았습니다. 논문별 카운터는 종료 시점을 생존했으며 여전히 표시됩니다; 그 카운터들을 읽을 수 있게 했던 비교 척도는 사라졌으며, 이것이 지표들이 읽을 수 없고 무의미하지 않은 이유입니다.
두 번째는 "7회 다운로드가 무엇을 의미하는가?"라는 질문은 올바른 분모와 비교 집단이 명시될 때까지 과학적으로 잘못된 것입니다. 그 분모와 이를 사용하기 위한 도구를 제공하는 것이 이 논문의 과제입니다.
1.2 척도 없는 숫자
해석의 문제는 보이는 것보다 복잡합니다. 7일 후 10회 다운로드와 90일 후 10회 다운로드는 동일한 수치이지만 그 의미는 거의 확실히 다르며, 한 논문이 국제적으로 인정받는 교수의 이름을 가진 저명한 기관의 논문이고 다른 하나가 첫 저자의 데뷔작이라면 그 의미는 다시 달라집니다. 그럼에도 불구하고 학술 이용 지표는 정확히 이러한 맥락이 제거된 형태로 제시되므로, 모든 숫자는 필연적으로 로르샤흐 검사가 됩니다. 동일한 "40회 조회"는 한 저자에게는 공황을 일으키고 다른 저자에게는 무관심을 일으키는데, 이는 공유된 참조점이 없기 때문입니다.
원본 다운로드 수의 기댓값은 카운터가 표시하지 않는 모든 것과 함께 변합니다. 논문의 나이, 분야, 게시 동료 및 달력 환경, 실제 배포 노출, 저자의 선행 가시성입니다. 이러한 각 종속성은 경험적으로 문서화되어 있습니다. 평균 생애 다운로드는 단일 학문 네트워크의 eJournals 전반에 걸쳐 대략 8배 차이가 나며, 회사법 및 증권법의 약 438회에서 농업법의 약 53회입니다[168]. 접근 활동은 달력 자체에 따라 변하며, 주말에는 약 11%, 저널 접근 데이터에서 여름 개월에는 약 50% 감소합니다[178]. 위치와 노출은 내용과 관계없이 중요합니다. arXiv 공지 목록의 가장 눈에 띄는 위치에 나타나는 논문은 이후 상당히 높은 가독성과 인용을 얻었으며, 천체물리학에서 중앙값 인용 증가는 약 83%입니다[72]. 저명한 기관에서 비롯된 아이디어는 덜 저명한 기관의 비교 가능한 아이디어보다 더 빠르고 광범위하게 확산됩니다[111]. 이는 지위와 주의에 대한 오랫동안 지속된 증거와 일치하는 패턴입니다[104][105][140][103]. SSRN에서 특히, 증분 상위 50명 공동저자는 다운로드 요금에서 측정 가능한 프리미엄과 관련이 있습니다[83]. 플랫폼 자체의 배포 메커니즘도 카운터를 형성합니다. 저자는 최대 7개 분류를 선택할 수 있고, 큐레이션된 주제 기반 이메일 알림에 포함되는 것은 보장되지 않으며, 대량 주제는 최대 45일의 지연에 직면할 수 있습니다[53][57]. 논문의 초기 카운트는 관련 배포가 일어났는지 여부만 반영할 수 있습니다.
플랫폼의 계산 규칙은 저자가 거의 보지 못하는 두 번째 계층을 추가합니다. SSRN은 카운터를 필터링하여 분명한 로봇 활동과 동일 인물의 반복 다운로드를 버립니다[144][66][69]. 이러한 필터 없이 수치는 "5배 이상" 부풀려집니다[18]. 조회수와 다운로드는 대략 안정적인 변환으로 연결되며, Black과 Caron은 2006년에 "일반적으로 SSRN 웹사이트의 3개 초록 조회는 1회의 실제 논문 다운로드로 이어집니다"라고 보고했습니다[18]. 이후 샘플은 초록 조회의 대략 11%에서 19% 사이의 변환을 보여주며[139][172], 최근 마케팅 샘플은 100회 조회당 약 24회 다운로드를 평균으로 합니다[83]. 이 구조를 아는 저자는 이미 제목의 40회 조회와 7회 다운로드를 확인할 수 있습니다(섹션 5.2에서 계산을 수행하며, 보고된 범위 내에 광범위한 구간 선별 결과로 들어갑니다). 하지만 플랫폼의 어느 것도 이를 전달하지 않습니다.
외부 척도가 격차를 채우지 못하므로, 이는 불편함이 아닌 측정 실패입니다. h-지수의 경우[79], "좋은 X가 무엇인가"에 대한 가이드의 전체 장르가 존재합니다[118][128]. SSRN 다운로드의 경우, 섹션 2.5 감사는 2026년 8월 현재 공개 소스에서 유사한 것을 찾지 못했습니다. 문헌계량학 문헌은 분포를 보고합니다[85][139][168][83]. 하지만 이 중 어느 것도 그것을 저자 대면 규범으로 번역하지 않습니다. 개별 학자는 자신의 포트폴리오에서 임시방편의 기준을 고안했으며[42], 도서관 가이드는 카운터가 무엇인지 설명하되 그것이 무엇을 의미하는지는 말하지 않습니다[161][50]. 모든 저자가 구글링하는 숫자는 찾을 수 없습니다.
1.3 위험 요소: 커리어, 불안감, 부풀리기의 인센티브
이 격차가 중요한 이유는 그 숫자들이 실질적인 영향을 미치기 때문입니다. SSRN의 자체 문서는 그 지표들을 "저자들이 승진 및 종신 목표로 사용하며, 기관들이 채용 및 순위 활동에서 사용하는" 것으로 설명합니다 [52]. 사용은 구체적이고 문서화되어 있습니다: 저명한 법학자 한 명은 "전체 누적 다운로드 수 기준으로 3,000명의 법학 저자 중 13위로 순위가 매겨졌으며, 법학대학원은 여러 승진 및 관련 결정에서 이를 고려했다"고 보고했습니다 [12]; 법학 저널 투고 안내서는 추천서에서 "SSRN 다운로드(많은 경우)"와 상위 10개 목록 등재를 언급할 것을 조언합니다 [95]; 그리고 기관들은 SSRN이 폐지되기 몇 주 전까지 그들의 SSRN 순위에 대해 보도자료를 발표했습니다 [101]. 집계 수준에서 SSRN 다운로드는 백 개의 법학대학원의 인용도 기반 순위와 0.84의 상관관계를 보입니다 [77]. 이는 제6.2(iii)절의 생태학적 추론 주의에서 개별 논문이나 저자에게 내려가지 않는 학교 수준의 연관성입니다. 기관들이 그러한 지표에 작용한다는 것 자체가 잘 문서화된 동역학의 한 사례입니다: 공개 순위는 반응형이며, 그들이 설명하려고 하는 바로 그 행위자들의 행동을 재형성합니다. 이 메커니즘은 법학대학원 순위에서 상세하게 확립되었습니다. 여기서 공약화와 자기충족적 예언은 학교들이 이 지표 주위로 재정리하도록 했습니다 [58][132]. SSRN은 상위 30,000명의 저자(약 360,000명 등재 저자의 약 8%)에게 정기적으로 이메일을 보내 그들이 "상위 10%에" 있다고 알려줌으로써 통화를 직접 강화했습니다 [161]. "10%"는 등재된 저자들의 점유율입니다(30,000/360,000 ≈ 8.3%). 그리고 190만 명 이상의 전체 등록 저자 기반에 대해 [49] 같은 30,000은 상위 약 2%에 더 가깝습니다. 따라서 표현은 모든 등록자가 아닌 순위가 매겨진 저자들을 설명합니다. 한편, 커리어 조언은 자체 발행된 지표들만으로는 "아마도 법학대학원 승진 및 종신 목적으로 계산되지 않을 것"이라고 경고합니다 [33]. 더 광범위한 평가 문헌은 지표 기반 평가가 채용 및 종신 결정에 얼마나 깊이 침투하는지, 그리고 그것이 얼마나 부실 설계되어 있는지 문서화합니다 [110][115][153]. 다운로드 자체는 품질의 직접적인 척도가 아닌 주의 척도입니다: 초기 사용은 이후 인용을 겨우 적당히 예측합니다(초기 작업에서 약 0.4의 상관관계로, 분산의 약 16%를 설명하고 [25], 이후 추정에서 0.11–0.35 [80]). 그리고 높은 다운로드 수와 높은 인용 논문의 집합은 상당히 다릅니다 [108]. 기관들은 이 숫자들을 척도가 없고 학문적 영향과의 느슨한 연결만 있음에도 불구하고 커리어 증거로 취급합니다. 이것은 두 가지 대칭적 방향으로의 오독을 향한 상시적 초대입니다: 척도가 없으면, 저자는 오독된 카운터의 강도로 미리 작업 라인을 포기하거나, 그 숫자들이 결코 비정상적이지 않았던 논문을 홍보하는 데 귀중한 시간과 사회 자본을 소비할 수 있습니다. 순위는 그들의 결함이 무엇이든, 논문의 추가 홍보가 정당한지에 대한 바로 그 반복되는 결정에 정확히 피드를 제공했으며, 그들의 제거는 그 선택이 데이터 없이 이루어지도록 남겼습니다(제6.4절에서 다루는 포인트입니다).
위험 요소는 또한 정서적입니다: 저자들이 대시보드에서 경험하는 것은 distinctive한 형태의 지표 불안감이며, 다운로드 수는 강박적으로 감시됩니다. 과학계량학 관찰자들은 자체 추적 가시성 도구 장르를 이미 2012년에 "자기애의 기술"로 설명했으며 [177], 한 저명한 법학 교수의 그의 수를 모니터링하는 것이 "나에게 마약 같다"는 인정(Bainbridge, 2007, SSRN 게이밍 행동 문헌에서 인용)이 상징적이 되었습니다 [44]. 같은 연구 프로그램은 불안감이 생산하는 것을 실험적으로 확립했습니다: 저자들은 자신의 논문을 자체 다운로드하여 수를 부풀리며, 상위 10개 목록의 가시성 임계값 근처에서 그리고 동료들과의 불리한 사회적 비교 아래에서 가장 강하게 그렇게 합니다 [44]. 이러한 종류의 사회적 피드백 루프는 주의 시장의 일반적인 속성입니다: 초기 사회적 신호는 문화 시장의 불평등과 예측 불가능성을 증폭시키며 [131], 초기 긍정적 신호는 이후 평가에 편향을 부여하고 [112], 성공은 현장 실험에서 성공을 낳습니다 [162]. 소셜 미디어의 자체 보고 마일스톤은 고성과자들을 향해 편향되어 있으며, 대시보드가 7을 읽는 모든 사람에 대한 비교를 심화시킵니다. 공개 벤치마크의 부재는 따라서 불안감을 창출하고, 오독을 부추기며, 모두를 위해 지표를 훼손하는 인위적 부풀리기에 인센티브를 제공합니다. 문제는 성능이 문제이기 전에 측정의 문제입니다: 동시에 가시적이고, 감정적으로 충전되며, 커리어와 관련이 있고, 해석 불가능한 지표는 대시보드를 응시하는 사람의 개인적 결함이 아닌, 측정 인프라의 진정한 실패입니다.
1.4 가장 피해를 입는 사람: 공정성 차원
읽기 어려운 메트릭의 비용은 균등하게 분배되지 않습니다. 광범위한 전문가 네트워크를 가진 저자들은 비공식적으로 벤치마킹할 수 있으며, 확립된 저자들은 논문에서 논문으로 이전 가시성을 유지합니다. 공개 규범의 부재는 초기 경력 연구자, 독립적이고 소속 없는 학자, 좁은 하위 분야의 저자, 플랫폼에서 역사적으로 지배적이었던 학문 분야 외의 저자, 그리고 엘리트 기관 외의 저자에게 가장 큰 부담을 줍니다. 이러한 불이익은 구조적이며 단순한 정보 부족이 아닙니다. SSRN의 발견 체계는 기관 워킹페이퍼 시리즈와 구독 eJournal 알림을 통해 주목을 유도합니다 [57]. 소속 없는 연구자는 논문을 올릴 수 있지만, 높은 트래픽의 기관 시리즈에 논문을 올릴 수 없으며, 가시성을 위해 전적으로 주제 분류에 의존합니다 [168][53]. 이러한 저자에게 기관 노출 채널은 사실상 폐쇄되어 있으므로, 발견의 무게는 검색 및 AI 계층에 불균형적으로 떨어집니다. 섹션 8에서 검토하는 기계 가시성은 따라서 단순한 기술적 문제가 아니라 공정성 문제입니다. 분야 소속만으로도 메릿에 대한 어떤 판단이 들어가기 전에 예상 다운로드가 수 배 변합니다 [168]. 명성 효과는 첫 노출 순간에 작동합니다. 공개 SSRN 페이지는 저자 이름과 소속을 제목 및 초록과 함께 표시하기 때문입니다. 이중 맹검 심사는 다르게 작동합니다. 저자 신원을 제거하면 명성 저자에 대한 심사자 점수를 현저히 낮추고(5,027개의 ICLR 제출에 대한 한 연구에서, 수락 결정에 대한 영향은 훨씬 덜 결정적임) [154], 평가는 신원 신호에 실험적으로 반응합니다 [64]. 주목 분포의 하단에서 그 현상은 부등식이 아니라 부재입니다. 알트메트릭 데이터에서, 자금을 지원받지 못한 연구의 중앙 사회적 주목은 연구된 대규모 SDG 초점 표본의 모든 분야에서 0입니다 [41]. 인접한 공개 플랫폼의 주목은 선진국의 소득보다 더 불평등하며, 지니 계수가 0.9 이상입니다 [180]. 중간값 저자에게 "7 다운로드가 나쁜가?"라는 질문은 허영의 표시가 아니라, 구조적으로 불균형한 게임에서 시스템이 반환하는 유일한 신호를 읽으려는 시도입니다. 이러한 비대칭성을 무시하는 모든 해석 프레임워크는 보이지 않음을 거부로 읽음으로써 체계적으로 불리한 입장에 있는 사람들을 잘못 진단할 것입니다. 이 비대칭성은 또한 전방으로 투영됩니다. 신흥 AI 답변 계층이 상용 생성 엔진 최적화에 대해 문서화된 브랜드 및 위치 편향을 상속한다면 [5][164], 이는 이러한 불평등을 해결하기보다는 재현할 것입니다. 그 전망은 소속 없는 연구자와 글로벌 남반부의 저자에게 가장 큰 부담을 줍니다. 그것이 섹션 8.6의 기계 가시성 감시가 플랫폼의 호기심이 아니라 공정성 의제에 속하는 이유 중 하나입니다.
1.5 해석에 대한 문서화된 수요
척도에 대한 수요는 가정적인 것이 아닙니다. 이는 학술 커뮤니티 담론에서 가장 지속적인 패턴 중 하나이며, 서비스 종료보다 최소 10년 전부터 존재해 왔습니다. 표 1은 저자들의 반복되는 질문과 우려의 클러스터, 각각에 대한 가장 강력한 문서화된 증거, 각 클러스터가 초래하는 위험한 지름길(도움이 되어 보이지만 잘못된 단답), 그리고 이에 대응하는 본 논문의 섹션을 요약합니다.
표 1. 해석에 대한 수요: 문서화된 커뮤니티 고충 클러스터 (2005–2026)
| # | 클러스터 | 저자들이 묻거나 보고하는 것 | 문서화된 증거 (신뢰도) | 위험한 지름길 | 다루는 섹션 |
|---|---|---|---|---|---|
| 1 | "내 수치가 정상인가?" — 누락된 벤치마크 | 주어진 다운로드 수가 유사한 논문에 비해 좋은지, 나쁜지, 또는 전형적인지 여부 | 공개 질문 "Importance of paper download statistics," Academia StackExchange, 2016 (제목과 날짜는 공식 API를 통해 확인됨) [3]; SSRN에 게시하는 것과 그 가치에 대한 사용자 질문 [126]; 몇 개의 다운로드가 "좋다"고 할 수 있는지 묻는 반복되는 포럼 스레드 (스레드 존재는 확인되었으나 개별 댓글은 독립적으로 검증 불가능하며, 포럼 자료는 수요의 약한 증거로 취급되며 데이터로서가 아님) [B-3]; 새로 게시된 워킹 페이퍼에 대한 "솔직한 조언"을 요청하는 첫 저자의 요청 (Reddit, 2026년 4월; 제3자 아카이브를 통해 존재 확인됨) [B-5] | 보편적인 원시 수 임계값 ("N개 다운로드 = 좋음") | 섹션 3, 5–6 |
| 2 | 메커니즘 혼동 — 조회수 대 다운로드 | 조회수가 다운로드를 초과하는 이유; 낮은 비율이 약한 초록을 의미하는지 여부 | 역사적 3:1 경험칙 [18]; 보고된 전환 범위 11–19% [139][172]; 최근 표본 평균 ≈24% [83]; 도서관 안내서에 문서화된 저자들의 카운터 포함 내용에 대한 불확실성 [161] | 낮은 비율이 초록이 나쁘다는 자동 주장 | 섹션 4–5 |
| 3 | 감정과 사회 비교 | 강박적 확인; 낮은 수와 높은 수 모두에 대한 당혹감 | "내게는 마약 같아요" (Bainbridge, 2007, [44]에서 인용됨); 사회 비교 상황에서 상위 목록 임계값 근처의 자체 다운로드에 대한 실험 증거 [44] | 플랫폼 전체 평균 또는 가시적인 스타들과 자신을 벤치마킹하기 | 섹션 1, 5 |
| 4 | 경력 증거 — 서비스 종료 후 경력 기술서의 순위 라인을 대체하는 것 | 서비스 종료 후 재임용, 승진 및 채용 자료에서 인용할 것 | 다운로드 순위 "다양한 승진 및 관련 결정에서 고려됨" [12]; 상위 10% 알림 이메일 [161]; 추천서 조언 [95]; 기관 보도자료 [101]; 플랫폼 평가 사용 설명 [52] | 날짜, 출처 또는 분모 없이 원시 누적 수치 인용하기 | 섹션 6 (표 13) |
| 5 | 게시 후 권유 스팸 | 게시 직후 도착하는 원치 않는 저널 초대 | "매일 최소 두 개의 이메일을 받습니다" (Reddit r/AskAcademia, 2023; 아카이브를 통해 확인됨; 저자는 SSRN이 아닌 MDPI 저널에 게시했음) [127]; "예를 들어 SSRN에 게시된" 논문에서 주소 수집 [107]; 권유 볼륨 감사 [9][84][63]; 학술 스팸의 29개 실증 연구를 식별하는 체계적 검토 [61] | 집계 카운터에서 독자의 신원이나 의도 추론하기 | 섹션 7 |
| 6 | 카운터에 대한 신뢰 — 봇, 조작, 급락 | 숫자가 실제인지 여부; 카운터가 떨어지는 이유 | "SSRN은 정확성을 검증하기 위해 절대 아무것도 하지 않습니다" (Goldman, 2005, 현재 필터보다 먼저; 후속 업데이트는 SSRN이 반복되는 동일 출처 다운로드를 할인한다고 기록함) [66]; SSRN의 공표된 데이터 무결성 필터링 [144][66][69]; 초기 RePEc 데이터에서 로봇 트래픽이 초록 조회의 약 74%를 차지하지만 다운로드의 7%만 차지 [99]; 2025–2026년 동안 RePEc의 대규모 봇 필터링 에피소드 [129] | 표시된 수치를 고유 인간 독자의 정확한 수로 취급하기 | 섹션 4, 9 |
| 7 | 진단 — "왜 다운로드가 0인가?" | 처음 몇 주 동안 0 또는 정체가 의미하는 바 | 서비스 종료 후 저자의 불확실성이 커뮤니티 스레드에 문서화됨 (제3자 아카이브를 통해 존재 확인됨) [B-5]; 플랫폼 지원 페이지는 메트릭을 설명하지만 2026년 8월 현재 해석 지침을 제공하지 않음 [52][50] (검색 감사, 섹션 2.5) | 배포 전 0을 거부로 취급하기 | 섹션 4–6 |
참고. 라이브 또는 아카이브된 출처에 대해 독립적으로 검증된 인용문만 그대로 재현됩니다; 다른 모든 커뮤니티 자료는 의역되며 신뢰도 상태로 표시됩니다. 사용자 게시물 인용의 윤리, 익명화 및 삭제된 콘텐츠 처리는 섹션 9에서 다룹니다.
표 1에서 가장 강력한 클러스터는 만성적인 질문 "내 수치가 정상인가?"이며, 이는 여러 해, 플랫폼 및 학문 분야에 걸쳐 반복됩니다. 플랫폼 내부자들도 반대로 벤치마크를 제공하지 않으며, 커뮤니티 포럼에서 이에 자주 답하는 풍자는 경험 많은 사용자를 포함한 아무도 누락된 척도를 소유하지 않음을 신호합니다 [B-3]. 클러스터들은 또한 인과 관계로 연결되어 있습니다: 누락된 벤치마크 (클러스터 1)가 감정적 부담을 야기하고 (클러스터 3), 이는 [44]에 문서화된 조작 인센티브를 야기하며, 이는 차례로 클러스터 6에서 탐구된 신뢰를 훼손합니다. 해석 가능성을 복원하면 근본에서 연쇄를 해결합니다. 이 프레임워크는 다운로드를 증가시키려는 것이 아니라 의미를 복원하는 것을 목표로 합니다.
1.6 이 논문의 주장: 여덟 가지 입장
다음은 논문이 옹호하는 입장들이며, 각각은 지적된 절에서 논증됩니다.
1. 원시 수치는 참고 집단 없이는 해석할 수 없습니다. 누적 다운로드 수는 논문 연령, 분야, 게시 코호트, 배포 채널, 그리고 이전 저자 가시성을 조건으로 하지 않으면 안정적인 의미를 갖지 못합니다[83][168][178][53]. 이것이 제5절의 참고 집단 문제이며, "7회 다운로드가 좋은가?"라는 질문을 있는 그대로 제시된 형태로는 잘 정의되지 않은 것으로 만듭니다.
2. 낮은 도달률과 낮은 전환율은 서로 다른 진단입니다. 적은 수의 사람들이 접하는 논문은 많은 사람들이 보지만 적은 수가 다운로드하는 논문과는 다른 문제를 제시하며, 다른 조치가 필요합니다. 비가시성은 내용의 거부가 아닙니다. 제4~5절은 이 구분을 도달률 대비 전환 진단(표 9)으로 발전시키며, 강한 전환율이 약한 도달률과 공존하는 "숨겨진 관심" 구성을 포함합니다.
3. 카운터는 남았으나, 비교 척도는 남지 않았습니다. 일몰의 비대칭성(수치는 유지되고 규범은 제거됨[149])은 순위 이후 조건을 정확히 설명하며, 오랫동안 잠복된 해석 가능성 문제를 긴급하고 보편적인 것으로 전환합니다(제2절).
4. 백분위 벤치마크는 공공재입니다. 모든 저자가 검색하지만 찾을 수 없는 수치는 학문분야와 논문 연령별 백분위 표입니다. 제5절과 제8절은 커뮤니티가 더 이상 플랫폼에서 읽을 수 없게 된 지금 이를 구축하고 유지하는 방법을 명시합니다.
5. 보정된 규범은 게시부터 관찰된 패널이 필요합니다. 발표된 증거는 노화된 횡단면 자료와 단일 스냅샷으로 구성됩니다[139][85][168][83]. 하나의 최근 대규모 연구는 명시적으로 패널 데이터를 필요한 다음 단계로 식별합니다[83]. 0일차부터의 관찰 없이, 첫째 주와 첫째 달의 "규범"은 외삽이며 그러한 것으로 표시되어야 합니다(제8절).
6. 다차원 벤치마크가 단일 허영 점수를 능가합니다. 정규화된 도달률, 다운로드 성과, 전환, 모멘텀, 그리고 후속 검증을 별도로 보고(CSAB, 표 10)하면 모든 복합 지수가 파괴하는 진단 정보를 보존합니다(제5절).
7. AI 답변 계층이 주목도의 새로운 문지기가 되고 있습니다. 발견은 저널 브랜드에서 저장소로, 검색 엔진으로, 단일 응답을 종합하고 극소수의 출처를 인용하는 AI 답변 엔진으로 스택을 따라 이동하고 있습니다[5][164]. 미국 성인의 4분의 1이 이미 매일 AI 챗봇을 사용하고 있습니다[121]. 그러나 이러한 엔진의 인용 채널로서의 신뢰성은 여전히 논쟁 중이며[82] 이들 엔진 내에서 학술 선행논문 가시성에 대한 통제된 연구는 아직 존재하지 않습니다[100]. 제8절은 간단한 감시 프로토콜을 기술하며, 전체 감시는 함께하는 작업으로 남겨집니다.
8. 대시보드와 도서관 프로토콜이 지금 필요합니다. 저자와 위원회는 새로운 데이터 인프라를 기다릴 수 없습니다. 제6절은 대시보드를 읽기 위한 임시 규칙과 도서관을 위한 7단계 증거 프로토콜(표 13)을 제공하며, 그 지배하는 요구사항은 보고된 모든 수치가 그 출처, 시간 창, 그리고 한계를 표시하는 것입니다.
1.7 기여도
아래 목록은 논문이 기존 문헌에 추가하는 내용을 섹션이 전개하는 순서대로 정리한 것입니다.
1. 진단. 플랫폼 사용 지표의 참조 집단 문제를 파악하고 기저 현상을 명명합니다: 학술적 관심의 콜드 스타트. 이 용어는 추천 시스템 문헌에서 콜드 스타트 항목이 이를 배치하는 데 필요한 상호작용 이력이 부족한 경우를 의미하는 것에서 차용되었습니다 [133]. 이 콜드 스타트에서 새로운 논문과 새로운 저자들은 초기 관심이 실질적 질이 완전한 영향을 미치기 전에 플랫폼 아키텍처, 배포, 선행 평판에 크게 의존하는 확산 체계에 진입합니다 [72][111][140][83]. 핵심 주장은 1.1절의 부적절성 논제입니다: 제목 질문은 분모와 비교 집단이 제공될 때까지 답을 가질 수 없습니다.
2. 통합 벤치마크 지도. 2026년 8월 종료(2.5절 감시) 이후 처음으로 SSRN 다운로드 및 초록 조회에 대한 모든 검증된 실증 벤치마크를 단일 표(표 7)로 수집하며, 모든 행에 명시적 표본틀, 시점, 노후화 주의사항, 출처 신뢰도 평가를 포함합니다. 벤치마크는 대표본 분포 증거 [83], 준로그정규 상위 목록 스크래핑 [85], 법학 표본 [139][168][171][172], 플랫폼 집계 [1][49]입니다.
3. 진단 기능이 있는 관심-깔때기 프레임워크. 확산을 노출, 초록 조회, 전문 다운로드, 후속 사용으로 분해합니다. 그런 다음 도달-전환 매트릭스(표 9)를 도출하며, 이는 비가시성을 거부와 분리하고 원시 수치가 체계적으로 숨기는 숨겨진 관심 구성을 포함합니다.
4. 해석 도구. 벤치마크 지도를 단계적 해석 척도(신생/적절/견고/강력/뛰어남; 표 8), 작동 사례가 포함된 전환 대역, 냉시작 학술적 관심 벤치마크(CSAB; 표 10)로 변환합니다. 이는 분야, 연령, 코호트, 선행 저자 가시성으로 정규화된 다차원 보고 형식입니다. 분야 소속만으로도 예상 다운로드가 수배 변하고 모든 경계가 출처가 있거나 명시적으로 저자 추정으로 표시되어 있으므로 척도의 대역은 동일 분야 및 논문 연령 내에서만 비교됩니다.
5. 실행 계층. 자신의 대시보드 읽기 규칙, 제로 다운로드 경우에 대한 진단, 상황 기반 실행 표(표 23), 약탈적 권유 신호의 가설 유형론(청탁 스팸이 카운터를 움직이지도 않고 읽음을 증명하지도 않는다는 주의; 표 14), 그리고 7단계 문서 프로토콜(표 13)을 제공합니다.
6. 사전등록 준비 완료된 연구 의제. 게시 후 1, 3, 7, 14, 30, 60, 90, 180일에 관찰하는 prospective 패널을 규정하고, 두 가지 준실험 설계를 제시합니다: 논문 내 관심 충격으로서의 큐레이트된 이메일 알림 배포, 그리고 순위 폐지를 지표 해석 가능성에 대한 자연 실험으로. 또한 새로운 백분위수로 가는 유일한 남은 경로인 커뮤니티 구축 백분위수 데이터셋, AI 회신 엔진을 위한 간결한 기계 가시성 감시 프로토콜, 그리고 본 논문의 자체 다운로드 궤적에 대한 사전지정된 순수 기술적 기록을 규정합니다. 각 연구는 낮은 비용으로 실행 가능하며 9절의 접근성 및 윤리 제한 내에 있으며, 수치 예측은 결과가 아닌 사전지정된 대역으로 명시됩니다.
1.8 논문의 구성
본 논문의 나머지 부분은 9개의 추가 섹션과 5개의 부록으로 구성됩니다. 섹션 2에서는 사건과 그 맥락을 재구성합니다: 2026 개혁 패키지의 전체 연대기, 유지된 것과 제거된 것(표 2, 그림 1), 그리고 자원 재배분과 재초점화라는 플랫폼의 명시된 취지입니다. 섹션 3에서는 검증된 분포 증거를 제시하고 평균이 왜 오도적인지 보여줍니다. 평균-중앙값 간격 [83], 준로그정규 꼬리 [85], 학문 분야의 이질성 [168] (그림 2–4, 표 3–5)을 다루며, 매튜 효과와 누적 우위 [104][105][131][162]의 이론적 배경 (종단적 커리어와 인용 궤적에서 직접 정량화된 역학 [120])과 주목도 측정과 질 측정 간의 구별 [25][80][108][178]을 배경으로 합니다. 섹션 4에서는 카운터의 작동 메커니즘을 검토합니다: 필터링과 데이터 무결성 [144][66], 필요한 반박 논거와 함께 봇과 허위 트래픽 [99][106][129], 플랫폼 아키텍처 (표 6), 메타데이터와 버전 관리 위생입니다. 섹션 5에서는 해석의 핵심을 제시합니다: 참조 클래스 논거, 통합 벤치마크 맵 (표 7), 해석 척도 (표 8), 전환 대역, 도달-전환 매트릭스 (표 9), CSAB (표 10). 섹션 6에서는 저자와 평가 위원회를 위해 프레임워크를 실무에 적용합니다. 여기에는 도서관 프로토콜 (표 13)과 부록 A의 상황별 지침 (표 23)이 포함됩니다. 섹션 7에서는 주목도 경제의 기생층을 분석합니다. 약탈적 권유를 가설적 가시성 신호로 취급하며, 모든 시간 및 유병률 주장은 가설로 제시합니다 [9][61][63][84][107]. 섹션 8에서는 사전등록 준비 완료 실증 의제를 제시합니다. 여기에는 AI 답변층으로의 주목도 이동과 사전 인쇄 발견 가능성에 대한 그 함의에 대한 간결한 처리를 포함합니다 [5][100][82][121][164]. 섹션 9에서는 제한 사항을 자세히 설명합니다. 여기에는 최고의 이용 가능한 분포 증거의 단일 출처 특성 [83], 2012–2015 샘플의 노후화, 플랫폼 문서의 불안정성이 포함됩니다. 섹션 10에서는 SSRN을 위한 정책 권고사항(가장 중요하게는, 리그 테이블 경쟁을 부활시키지 않으면서 맥락을 복원하는 대체재로서의 학문 분야 및 논문 연령별 익명 백분위 대역)과 연구 공동체를 위한 권고사항으로 결론을 맺습니다.
2. 사건: 랭킹 일몰 및 그 맥락
2.1 랭킹이 무엇이었는가
SSRN의 대부분의 역사에서 사용 카운터는 밀도 높은 비교 기구 내에 위치했습니다. 논문 수준에서 플랫폼은 12개월 및 누적 다운로드 상위 10,000개 목록과 롤링 60일 윈도우에서 계산된 저널당 "최근 상위 논문" 목록을 유지했습니다. 저자 수준에서 플랫폼은 모든 분야와 상위 3,000명 법학 저자와 같은 분야별 리그에 걸쳐 상위 30,000개 목록을 유지했으며, 새로운 다운로드, 총 다운로드, 논문당 다운로드 및 인용으로 정렬할 수 있었습니다. 기관 수준에서 플랫폼은 상위 350개 미국 법학대학원 및 상위 500개 국제 법학대학원을 포함한 월간 리그 테이블을 유지했습니다 [B-9, 역사적 랭킹 페이지; 2026년 7월 15일 이후 모든 그러한 URL은 오류 또는 자리 표시자 페이지를 반환했으며 보관된 사본에서만 인용할 수 있습니다]. 플랫폼은 또한 순위를 직접 백분위수 피드백으로 변환했습니다. University of Washington Gallagher Law Library의 SSRN 지표 안내서가 문서화한 바와 같이, "SSRN은 주기적으로 새로운 다운로드 및 누적 다운로드 기준으로 상위 30,000명의 저자에게 메시지를 보내 상위 10%에 있다는 것을 알립니다". 안내서 자체 "360,000명 이상의 저자" 수치에 대비하면, 그 임계값은 목록된 저자의 대략 상위 8% (약 360,000명 중 30,000명)에 해당했으며, 이는 좁은 엘리트가 아닌 광범위한 상위 계층입니다 [161, 2026년 8월 14일 접근]; 섹션 1.3은 전체 등록 기반에 대비하면 동일한 30,000은 상위 약 2% 근처에 있다고 언급합니다. 이러한 목록과 메시지는 사실상 SSRN 다운로드에 대해 공개된 유일한 플랫폼 제공 저자 대면 백분위수 정보였습니다.
비교 기구는 장식적이지 않았습니다. Black과 Caron은 2006년 SSRN 다운로드가 평판 조사 및 인용 수를 보완하는 법학 교수진 학술적 성과의 "베타" 척도로 사용될 수 있음을 제안했습니다 [18]. 동일한 심포지엄 권에는 이 제안에 대한 비판적 검토가 포함되어 있습니다 [45]. 제도적으로 이 제안은 성공했습니다: 다운로드 순위는 채용 자료, 승진 파일 및 기관 홍보물에 포함되었습니다. SSRN 자체 지원 문서는 그 지표를 저자들이 "승진 및 종신권 목적으로 사용하고 기관이 채용 및 랭킹 활동에서 사용하는" 수치로 설명합니다 [52, 2026년 8월 14일 접근]. Legal Writing Institute의 출판 지침은 저자들에게 법 평론에 대한 표지 편지에 "SSRN 다운로드 (많은 경우), SSRN 상위 10개 다운로드 목록 포함"을 언급하도록 조언했습니다 [95]. 2026년 6월 Stephen Bainbridge는 경력 기능을 기록했습니다: 그는 "누적 다운로드 수 기준으로 3,000명의 법학 저자 중 13위로 랭크되었으며, 법학대학원은 다양한 승진 및 관련 결정에서 이를 고려했습니다" [12]. SSRN 자체 리더십은 당시 CEO가 작성한 전인본에서 플랫폼의 법학 학술 커뮤니케이션 변환을 문서화했습니다 [68]. 기관들도 리그를 마케팅했습니다: 2026년 1월 말까지 Maynooth University는 법학 및 범죄학 학교가 SSRN 상위 500개 국제 법학대학원에서 아일랜드 부서 중 1위를 차지했다고 발표했으며, 143,500회 이상의 다운로드를 인용했습니다 [101]. 기구의 행동에 대한 영향력은 Edelman과 Larkin의 SSRN 서버 로그 분석에 문서화되어 있습니다. 연구는 논문이 상위 10개 목록의 경계에 접근할 때 정확히 그 순간에 기만적인 자체 다운로드가 심화되었으며, 사회적 비교를 경력 위험뿐만 아니라 조작의 주요 동인으로 파악했습니다 [44]. 동일한 연구는 2007년 Bainbridge에 귀속된 발언을 유포했으며, 다운로드 수를 모니터링하는 것이 "나에게 크랙 같다"고 했습니다 [44].
기구는 덜 주목받은 두 번째 기능을 가지고 있었습니다. 인용과 평판 조사는 수년 주기로 움직입니다. 랭킹은 거의 실시간으로 피드백을 반환했으며, 초기 경력 학자와 명성 높은 기관 외부의 저자들이 느리고 더욱 보수적인 게이트키핑 도구를 기다리지 않고 직접 가시적인 영향을 시연할 수 있게 해주었습니다. 그 결함이 무엇이든 리그 테이블은 플랫폼의 모든 저자에게 동등하게 가시적인 유일한 비교 장치였습니다. 이것은 섹션 1.4가 주장하는 바와 같이 그들의 제거가 가장 무거운 무게를 두는 이유의 일부입니다. 가장 비공식적인 대체물이 가장 적은 저자들에게 말입니다. 일몰 효과에 대한 직접적인 분포 증거는 아직 존재하지 않으므로 이는 RQ1 (섹션 8.5)이 테스트하는 방향 기대입니다: 양측이며, 부호를 전제하지 않고 제거가 주의를 집중시켰는지 분산시켰는지를 묻습니다.
2.2 2026년 리트릿의 연대기
2026년 7월 15일 랭킹 제거는 2025년 말부터 시작된 일련의 플랫폼 결정의 정점이었으며, 그림 1에 요약되어 있습니다.
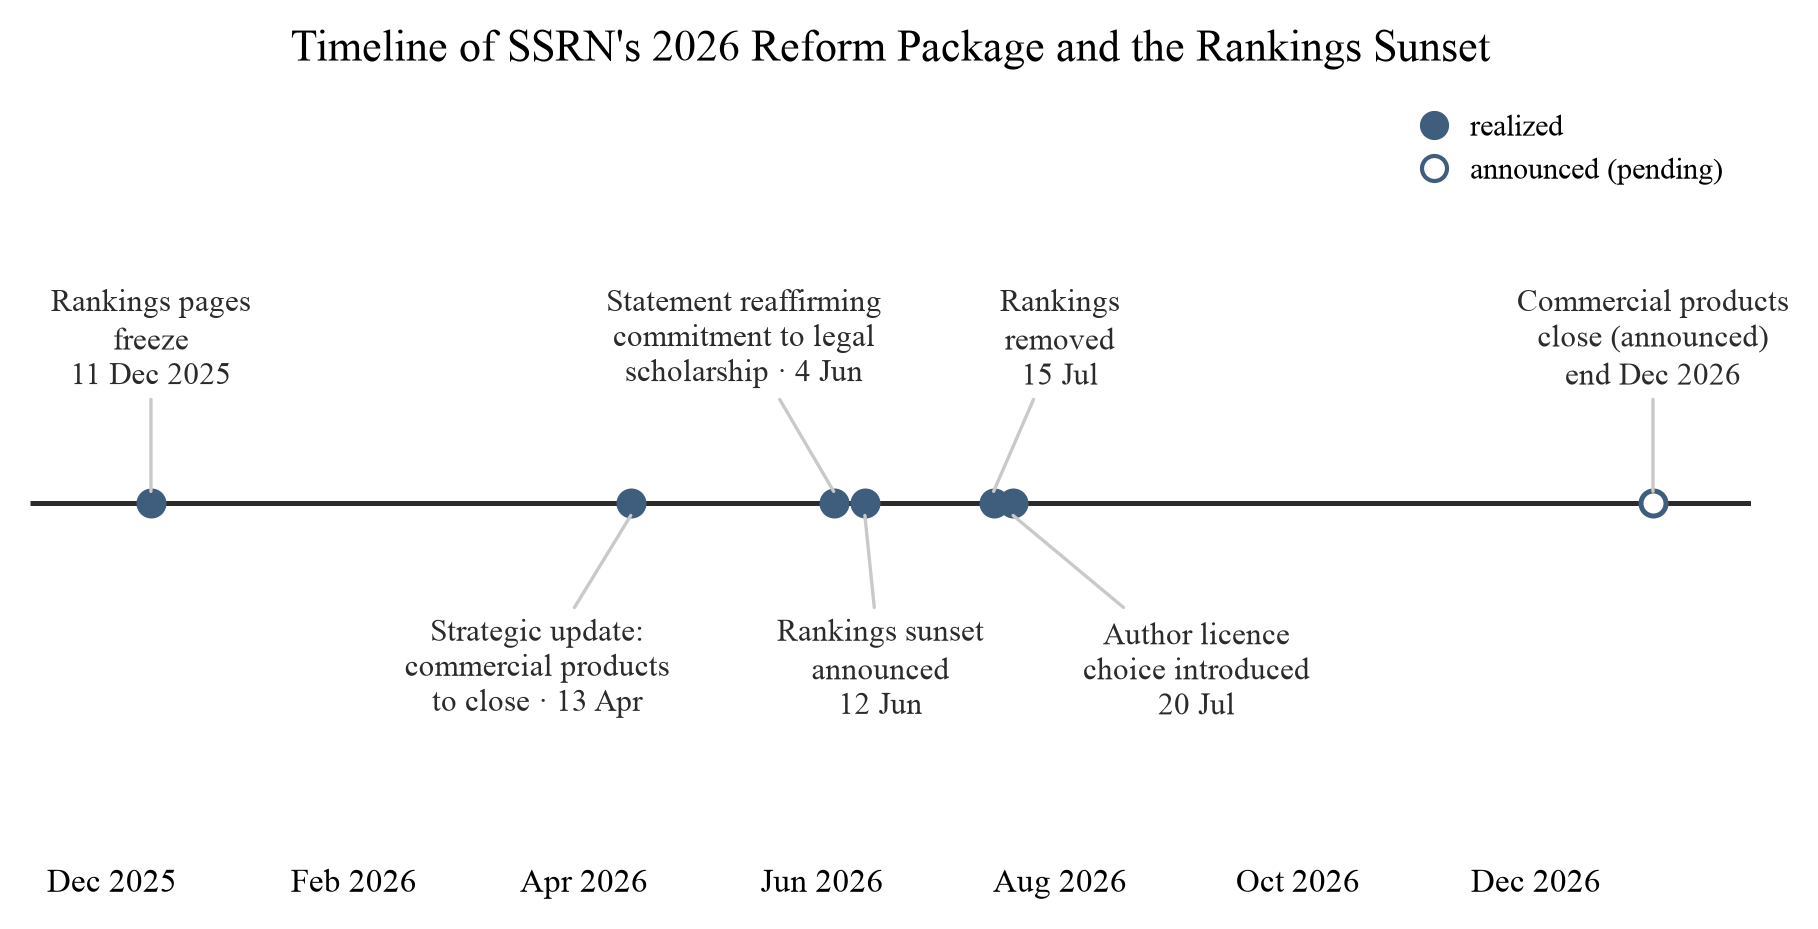
그림 1. SSRN의 2026년 개혁 패키지 타임라인. 이벤트: eJournal 다운로드 순위 페이지 동결(2025년 12월 11일부터, 2026년 1월 25일 TaxProf Blog 게시물에 기록됨 [B-2]); 2026년 말까지 모든 상업 제품 폐지를 발표하는 전략적 업데이트(2026년 4월 13일) [146]; 법학 학문에 대한 SSRN의 약속을 재확인하는 공개 성명(2026년 6월 4일) [147]; 랭킹이 "2026년 7월 1일부터" 폐지될 것이라는 발표(2026년 6월 12일) [148]; 랭킹의 실제 제거(2026년 7월 15일) [149]; 저자 라이선스 선택 도입(2026년 7월 20일) [150]; 나머지 상업 제품의 폐지 발표(2026년 12월 말) [146]. 출처: [146][147][148][149][150][B-2].
성능 저하는 공식 발표 전에 시작되었습니다. 2025년 12월 11일 eJournal당 다운로드 순위 페이지의 업데이트가 중단되었습니다. Paul Caron은 그러한 순위에 기반한 주간 "상위 5개 신규 세금 논문" 기능을 20년 이상 운영해왔습니다. 2026년 1월 25일의 게시물에서 그는 세금 순위가 "2025년 10월 12일 – 2025년 12월 11일" 기간에 동결되었음을 기록하고 "이것이 SSRN 상위 5개 신규 세금 논문의 끝일 수 있다"고 썼습니다 [B-2, SSRN 발표가 아닌 2026년 1월 25일 게시물의 의역으로 인용됨].
2026년 4월 13일 SSRN은 "핵심 연구 공유 사명"에 대한 재집중과 상업 제품(Research Paper Series, Sponsored Networks, Site Subscriptions, 유료 회의 절차, 분석 대시보드, 채용 공고 및 공지, 데이터 피드)의 2026년 12월 말까지의 폐지를 발표하는 "전략적 업데이트"를 발표했습니다 [146]. 도서관 관찰자들은 수 일 내에 변화를 기록했으며 [34], Elsevier의 Digital Commons 부서는 Research Paper Series 컬렉션이 폐지되는 기관들을 위한 마이그레이션 지침을 발표했습니다 [47].
그 발표는 순위 인프라에 가장 투자한 공동체인 법학계에서 공개적 논쟁을 촉발했습니다. 2026년 6월 3–4일 Bainbridge는 "The Social Science Research Network Has Jumped the Shark"라는 제목 아래 널리 읽힌 비판을 발표했으며, 그 뒤를 SSRN이 그의 불만에 대해 논문 시리즈 폐지 시기와 주제별 eJournal 보존에 대한 설명으로 대응했음을 기록한 게시물이 따랐습니다 [12]. 2026년 6월 4일 SSRN은 법학 학문에 대한 "지속적인 약속"에 관한 성명을 발표했으며, eJournal 배포 및 이메일 알림이 "변함없이 계속될" 것이라고 약속했습니다 [147]. 2026년 6월 7일 Caron은 TaxProf Blog에서 "SSRN Has Not Jumped the Shark"라는 제목 아래 Bainbridge에 회신했습니다 [B-11]. 이 교환은 그 제거 직전에 커뮤니티가 플랫폼의 비교 특징이 무엇의 가치가 있는지에 대한 간결한 공개 기록입니다.
2026년 6월 12일 SSRN은 "2026년 7월 1일부터 랭킹을 폐지"할 것이라고 발표했으며, "SSRN에서 우리는 항상 연구는 자신을 위해 말해야 한다고 믿어왔습니다"라고 밝혔습니다 [148]. 종료는 처음 발표된 것보다 2주일 늦게 적용되었습니다: 2026년 7월 15일 논문, 저자, 기관의 순위가 제거되었습니다 [149]. 5일 후인 2026년 7월 20일 추가 개혁으로 저자의 라이선스 선택이 도입되었습니다 [150]. 발표된 날짜와 실제 날짜 사이의 2주 간격과 발표와 실행 사이의 한 달 기간의 창은 그 자체로 분석적으로 관련이 있습니다: 저자와 기관이 다가올 변화를 관찰할 수 있는 예상 기간을 만들었으며, 이는 제8장의 준실험 설계에서 다루어집니다.
2.3 공식 근거 및 그 변화
선셋의 명시된 정당화는 리소스 할당과 플랫폼 재집중이었습니다. 7월 공지사항은 랭킹이 "상당한 제품 및 개발 리소싱을 필요로 한다"고 설명했으며, 더 빠른 게시, 더 나은 검색 가능성, 그리고 연구 무결성에 대한 재집중으로 결정을 프레임화했습니다. 또한 "다운로드 수 및 인용 통계는 계속해서 개별 논문 및 저자 프로필에 기록되고 표시될 것입니다"라고 명시했습니다 [149]. 공지사항은 비교 기능의 가능한 복귀를 열어두었습니다. SSRN은 "다양한 랭킹의 아이디어를 다시 검토할 수 있다"고 작성했으므로 [149], 제거를 영구적인 것으로 설명해서는 안 됩니다. 기록에서의 침묵도 중요합니다. 공지사항은 메트릭 게이밍, 조작 또는 랭킹의 경쟁적 오용으로 결정을 귀속시키지 않으며, 그러한 동기를 제공하는 계정은 공개된 텍스트를 넘어갑니다 [148][149].
공식 설명의 톤은 공지사항과 랭킹 URL을 대체한 랜딩 페이지 사이에서 변화했습니다. 6월 게시물이 리소싱에 대해 언급한 곳에서, 대체 페이지는 SSRN의 "새로운 방향이 개별 저자와 그들의 작업을 모든 것의 중심에 놓는다"고 명시하고 "기관 및 부서의 집계된 리그 테이블은 더 이상 그 그림에 맞지 않는다"고 합니다 [B-8; 페이지는 접근 제한 뒤에서 제공되며 이 구절은 검색 색인 사본에서 인용되므로 아카이브된 스냅샷이 모든 인용을 동반해야 합니다]. 6월 게시물은 선셋을 비용 결정으로 제시하고, 대체 페이지는 기관 비교에서 원칙적으로 방향을 돌린 것으로 제시합니다.
SSRN은 저자에게 문맥에 대한 공식적인 포인터를 완전히 남기지 않았습니다. 논문의 영향도를 측정하는 것에 관한 지원 문서는 저자를 논문 수준의 카운터(초록 조회 및 다운로드)와 인용, 사용 및 소셜 미디어 신호를 집계하는 Elsevier 알트메트릭스 제품인 PlumX Metrics로 안내합니다 [50, 2026년 8월 14일 접근]. PlumX는 따라서 플랫폼의 해석적 문맥을 위한 실질적 대체재로 서 있습니다. 부분적인 대체입니다. 개별 논문에 대한 추가 신호를 집계하지만 분포, 백분위수 또는 집단 비교를 제공하지 않습니다. 그것들은 랭킹(완벽하지는 않더라도)이 제공했던 요소입니다. 폐지는 SSRN의 저널 워크플로우와의 통합으로까지 확장되지 않습니다. First Look 프로그램은 계속해서 플랫폼을 1,200개 이상의 Elsevier 저널과 연결합니다 [48][145]. 플랫폼의 상업적 거버넌스는 또한 이러한 제품 결정을 고도로 집중된 학술 출판 시장 내에 위치시킵니다 [94].
2.4 남은 것과 제거된 것
표 2는 플랫폼의 일몰 후 상태를 매핑하며, 각 요소의 측정 함의를 나타냅니다. 즉, 생존한 기능, 사라진 기능, 또는 미보고 기능 각각이 횟수를 읽으려는 사람에게 무엇을 의미하는지를 보여줍니다. 제거는 비대칭적이었습니다. 모든 논문별 및 프로필별 카운터는 유지되었습니다. 이러한 카운터를 기반으로 구축된 비교 장치는 완전히 철수되었습니다.
표 2. 2026년 7월 15일 Rankings 일몰 이후 남은 것과 제거된 것, 그리고 측정 함의. 출처: [147][149][161][B-8][B-9]; 노출 메커니즘 행: [53][57][55][144][66][69].
| 기능 | 2026년 7월 15일 이후 상태 | 출처 기반 | 측정 함의 |
|---|---|---|---|
| 논문별 다운로드 횟수 | 유지; 논문 페이지에 표시됨 | 일몰 공지에서 원문 그대로 확인됨 [149] | 원시 사용량은 여전히 관찰 가능하지만 이제 자체 참조 클래스를 가지지 않음 |
| 논문별 초록 조회 | 유지됨 (일몰 공지에서 "다운로드 횟수 및 인용 통계"를 나열하며 명시적으로 언급되지 않았으나, 조회는 계속 표시됨) | [149], 플랫폼 관찰, 2026년 8월 14일 접근 | 도달 범위는 여전히 관찰 가능하므로 논문별 도달 범위-전환 진단(표 9)은 계산 가능함 |
| 인용 통계 (논문 및 저자 프로필) | 유지 | 원문 그대로 확인됨 [149] | 후속 사용은 여전히 초기 주목도 측정을 보완할 수 있음 |
| 저자 프로필 (논문, 소속) | 유지됨 | 플랫폼 관찰, 2026년 8월 14일 접근 | 포트폴리오 수준 집계는 여전히 가능하며, 같은 누락된 분모를 가짐 |
| eJournal 구독 및 이메일 알림 | 유지 | "변경 없이 계속," 2026년 6월 4일 성명 [147] | 푸시 노출 채널이 지속되므로 초기 카운터는 여전히 아키텍처 의존적임 (섹션 4.4) |
| 주제 분류 (1–7, 저자 선택) | 유지됨; eJournal 라우팅을 운영함 | 플랫폼 설명서 [53] | 분류는 잠재적으로 중요한 노출 변수임 |
| 큐레이션된 eJournal 배포 | 계속됨; 포함은 "큐레이션되고 목표화되며, 보장되지 않음" | [53][57][147] | 배포 상태 및 날짜는 배경이 아닌 처리로 모델화해야 함 |
| 고용량 주제의 배포 지연 | 계속됨; 최대 45일 | [53] | 첫 달의 카운트는 배포 전후 체계를 혼합할 수 있음 |
| 외부 인덱싱 (Google, Google Scholar) | 계속됨, 검색 엔진 제어 타이밍에 따라 ("6–9개월 이상") | [55] | 구간 중도절단된 노출 프로세스: 노출 날짜는 경계지어지지만 관찰되지 않음 |
| 의심 활동 필터링 | 계속됨 | [144][66][69] | 카운트는 필터링된 사건이며, 검증된 읽기 또는 지지가 아님 |
| AI 답변 논문 검색 | SSRN에서 보고되지 않음 | 플랫폼 보고가 존재하지 않음; 섹션 8.6 | 머신 가시성은 독립적인 반복 감시가 필요함 (연구 2) |
| 논문 페이지의 PlumX 지표 | 유지됨; 영향력 평가를 위한 공식 포인터 | 지원 설명서 [50] | 추가 논문별 신호이지만, 배포, 백분위수, 또는 동료군 비교 없음 (섹션 2.3) |
| 상위 논문 목록 (상위 10,000; eJournal별 최신/전체 기간) | 제거됨; URL은 오류 또는 일몰 랜딩 페이지를 반환함 | [149][B-8][B-9] | 주요 비교 프레임 — 그리고 가능한 발견 표면 — 이 사라짐 |
| 상위 저자 목록 (상위 30,000; 학문적 리그) | 제거됨 | [149][B-9] | 저자 수준의 백분위수 위치는 더 이상 공개적으로 관찰 가능하지 않음 |
| 기관 수준의 리그 (상위 350개 미국 / 상위 500개 국제 법학교 등) | 제거됨 | [149][B-8][B-9] | 기관 비교는 더 이상 플랫폼 데이터에서 계산될 수 없음 |
| 공개 백분위수 표현 (저자 순위, "상위 10%" 포지셔닝) | 순위 인프라와 함께 제거됨 | [149][161] | 참조 클래스는 이제 외부에서 재구축되어야 함 (섹션 5, 8) |
| "저자 상위 10%" 알림 이메일 | 운명이 공식 커뮤니케이션에서 다루어지지 않음; 이메일은 순위 인프라에 연결되어 있음 | [161][149] | 도움말에 사용 가능한 백분위수 신호는 더 이상 도착한다고 가정될 수 없음 |
표 2의 존속 행은 정확히 원시 카운터와 이를 공급하는 노출 메커니즘입니다: 플랫폼은 이전과 동일한 속도로 계속해서 숫자를 생성합니다. 제거된 행은 정확히 비교 프레임의 집합입니다: 분포, 임계값, 순위, 백분위 메시지. 따라서 이 사건은 정밀한 정보 구조를 가지고 있으며(데이터 유지, 참조 클래스 제거), 그 구조는 오래된 잠재적 문제인 SSRN 숫자를 읽는 방법을 급성이며 보편적인 것으로 전환합니다. 우리는 변경된 플랫폼 속성을 벤치마크 불투명성이라고 부릅니다: 플랫폼이 개별 카운트를 상황화하는 데 필요한 분포 통계(백분위, 중앙값, 코호트 분포)를 공개하는지 또는 원시 카운터, 평균 및 상위-N 목록만 공개하는지를 설명하는 플랫폼의 등급화된 속성입니다. 2026년 7월 15일, SSRN은 한 단계로 부분적 투명성에서 거의 완전한 벤치마크 불투명성으로 이동했으며, 이 글의 나머지 부분은 그 속성이 사용자에게 어떤 비용을 초래하는지에 대한 연구로 읽을 수 있습니다. 이렇게 정의된 불투명성은 최소한 네 가지 차원을 가집니다: 인구 범위(공개된 통계가 설명하는 대상), 참조 클래스 세분화(필드, 나이, 코호트에 조건을 부여하는지 여부), 시간 안정성(정의와 기간이 시간에 따라 비교 가능하게 유지되는지 여부), 감사 가능성(계산 규칙이 확인할 수 있을 정도로 공개되는지 여부). 네 가지는 부분적으로 독립적으로 작동합니다: 순위는 분자와 선택 규칙이 불명확한 경우 한 형태의 불투명성을 줄이면서 다른 형태를 악화시킬 수 있습니다. 이러한 부분적 독립성이 섹션 10.4의 플랫폼 권장사항(항목 4 및 8)이 비교 숫자의 반환뿐 아니라 공개 자체를 다루는 이유입니다. 속성을 측정 가능하게 하기 위해, 각 차원은 플랫폼의 공개 인터페이스와 문서에 적용된 명시적 서수 체크리스트로 채점합니다: 인구 범위(0 = 원시 카운트만, 1 = 플랫폼 전체 요약 통계 공개, 2 = 정의된 인구에 대한 분포 통계); 참조 클래스 세분화(0 = 없음, 1 = 필드 같은 하나의 축, 2 = 필드 × 나이 × 코호트 결합 조건); 시간 안정성(0 = 계산 정의와 기간 미문서화 또는 자동 수정, 1 = 문서화됨, 2 = 문서화 및 버전 관리됨); 감사 가능성(0 = 계산 규칙 미공개, 1 = 산문으로 기술됨, 2 = 확인 가능한 상세로 공개됨). 플랫폼의 불투명성 프로필은 단일 레이블이 아니라 네 개의 점수로 구성된 튜플입니다. 동일한 도구는 SSRN을 선설 전후로 채점하며(범위, 세분화, 그리고 폐지된 목록의 경우 참조 클래스 세분화에서 이를 하향 이동), 표 6의 교차 플랫폼 비교가 인상이 아닌 점수로 표현되도록 합니다. 플랫폼은 많은 숫자를 표시하면서도 거의 완전히 불투명할 수 있습니다. 이 기준은 정제되어야 하고 평가자 간 테스트되어야 할 첫 번째 운영화이며, 완성된 지수가 아닙니다.
2.5 해석에 대한 수요
석양이 시급하게 만든 질문은 그보다 훨씬 전부터 제기되고 있었습니다. 표 1(섹션 1.5)은 검증된 출처로 제한된 저자의 해석 수요에 대한 문서화된 클러스터를 모아놓았습니다. 포럼 자료는 분포의 증거가 아니라 수요의 증거로 인용되며, 사용자 게시물의 인용문은 게시물 자체가 위치한 곳에서만 재현됩니다(준공개 포럼 게시물 인용의 윤리는 섹션 9에서 다룹니다).
뒤따르는 부정적 주장들은 무작위 검색이 아닌 구조화된 검색 감시를 기반으로 하며, 섹션 1.2, 1.5(표 1), 8.8의 병렬 진술도 마찬가지입니다. 프로토콜은 여기서 한 번만 설명합니다. 우리는 6개의 의도 클러스터로 구성된 25개 이상의 영어 쿼리 공식화 인벤토리를 구축했습니다: 규범적("SSRN 다운로드 몇 개가 좋은가"), 정의적("SSRN 다운로드 수에 포함되는 것은 무엇인가"), 일몰 후 탐색("SSRN 순위 사라짐 — 비교할 곳"), 평가적("tenure 증거로서의 SSRN 다운로드"), 진단적("SSRN 논문 다운로드 0인 이유"), 실용적("SSRN 다운로드를 늘리는 방법"). 각 쿼리에 대해 현재 누가 이에 답하고 얼마나 잘 답하는지 기록했으며, 기준은 반환된 출처가 메트릭 설명이나 일화가 아닌 단계별, 분야별 조건 벤치마크 값을 제공하는지 여부였습니다. 긍정적 대조 대상으로, h-지수, ResearchGate 점수, 인용 수에 대한 유사 쿼리를 실행했으며, 이들은 [118][128]에 기록된 임계값-가이드 장르를 안정적으로 표시합니다. SSRN 다운로드에 대한 동일한 의도 공식화는 일몰 전후로 동등한 것을 표시하지 않았습니다. 격차는 가장 널리 참조되는 커뮤니티 참고문헌까지 확장됩니다: 플랫폼의 백과사전식 개요는 카운터가 무엇인지 설명하지만 이에 대한 해석적 규범을 제공하지 않습니다 [170]. 감시는 일반 목적 웹 검색 엔진과 소비자 AI 답변 엔진에 걸쳐 있는 커스텀 파이프라인을 사용하여 2026년 7월-8월에 수행되었으며, 쿼리 실행과 답변 품질 채점을 자동화했습니다. 전체 쿼리 목록은 저자로부터 입수할 수 있습니다. 그 결과는 부정적 발견이며 그 자체로만 주장됩니다: 감시 창, 포함된 언어 및 엔진 기준으로 증거의 부재이지, 그러한 리소스가 존재할 수 없다는 증명이 아닙니다.
인접 메트릭의 경우, 표 1(섹션 1.5)에 문서화된 해석적 수요는 오랫동안 대중 장르로 충족되었습니다: "좋은 h-지수란 무엇인가"는 수십 개의 단계별, 분야별 조건 임계값 가이드로 제공되며 [118], 분야별 인용 규범은 널리 읽히는 설명의 주제입니다 [128]. SSRN 다운로드의 경우 그러한 장르가 없습니다. 더 나쁜 것은, 존재했던 가장 잘 구조화된 가이드인 워싱턴 대학교 법률 도서관 페이지가 2026년 7월 15일 이후에도 상위 저자 및 상위 논문 순위를 현재형으로 설명하여 수요가 절정에 달했을 때 부분적으로 오도한다는 것입니다 [156, 2026년 8월 14일 접근]. 일몰이 해석 문제를 야기하지 않았습니다. 그것은 생태계가 가지고 있던 유일한 부분적 답을 제거했으며, 분포의 제도적 기억이 쇠퇴하기 시작했을 바로 그 순간입니다.
3. 데이터가 보여주는 것: 평균이 거짓인 이유
3.1 카운터가 측정하는 것과 측정하지 않는 것
기존 카운터의 사용은 모두 카운터가 무엇을 측정하는지에 대한 설명을 전제로 합니다. 표 3은 각 지표의 측정 내용, 주요 교란 요인, 그리고 이것이 정당하게 수행할 수 있는 진단 역할을 요약합니다.
표 3. SSRN 지표가 측정하는 것과 측정하지 않는 것.
| 지표 | 가장 가까운 실질적 해석 | 주요 교란 요인 | 적절한 진단 역할 |
|---|---|---|---|
| 초록 페이지 조회 | 논문 랜딩 페이지로의 도달 | 검색 노출, 플랫폼 배치, 저자 평판, 외부 홍보, 제목, 분야 규모, 온라인 기간 | 노출 / 도달 |
| 전체 텍스트 다운로드 | 전체 논문을 검토하거나 사용하려는 의도 | 조회에 영향을 미치는 모든 것, 그리고 초록 품질, 적절성, 다운로드 마찰 | 참여 |
| 초록당 다운로드 수 | 랜딩 페이지 노출에서 전체 텍스트 획득으로의 조건부 전환 | 작은 분모, 반복 행동, 이질적인 트래픽 출처 | 전환 |
| 인용 | 이후 학문적 문서에 대한 관찰 가능한 통합 | 분야 인용 규범, 출판 지연, 데이터베이스 범위, 자기인용, 지위 효과 | 하류 학문적 사용 |
| Altmetric / PlumX 신호 | 더 넓은 온라인 참여 | 플랫폼 구성 및 사용자 행동 | 보완적 확산 증거 |
표의 내용은 두 개의 식 대조로 압축할 수 있습니다. 대시보드가 무언의 초대로 제시하는 해석은 다운로드 = 과학적 품질입니다. 방어 가능한 표현은
관찰된 다운로드 = f(Q, E, R, C, T, P, ε),
입니다. 여기서 Q는 연구 품질 또는 적절성과 관련된 특성, E는 노출, R은 평판, C는 통신 특성, T는 시간과 나이, P는 플랫폼 메커니즘, ε는 관찰되지 않은 영향을 나타냅니다. 이 식은 교란 요인을 분류합니다. 함수 형태나 계수는 명시되지 않습니다. 이 분류는 실제적 어려움을 정확하게 나타냅니다. 즉, 연구자는 일반적으로 좌변만 관찰합니다.
표에 두 가지 경계 조건이 적용됩니다. 카운터는 원시 트래픽 로그가 아닙니다. SSRN은 최소한 2000년대 이래로 자신의 카운트를 필터링했습니다. 플랫폼은 "불규칙한 활동의 신호"를 사용하여 같은 사람의 명백한 반복 다운로드와 명백한 로봇 다운로드를 제외하며, 의심스러운 익명 다운로드를 저자의 총계에서 제외한다고 명시합니다[144]. Black과 Caron은 이러한 필터링 없이 카운터가 "5배 이상 부풀려질" 것으로 추정했습니다[18]. 계산된 다운로드는 참여 이벤트를 기록하며 승인에 대해서는 아무것도 기록하지 않습니다. 카운터는 주의 프로세스의 단계를 측정합니다. 어느 것도 과학적 가치를 측정하지 않으며, 각각은 독자가 내용을 평가하기 전에 작동하는 가시성 요인에 의해 교란됩니다[44][72][144]. 이러한 한계는 독서 데이터의 가장 초기 문헌계량학 분석 이래로 인식되어 왔습니다[91]. 단계들은 두 가지 가설된 메커니즘을 통해 서로 분리될 수도 있습니다. 정책 관련 주제의 논문은 인용하지 않고 읽는 실무자들에 의해 많이 다운로드될 수 있으며, 전문화된 논문은 다운로드가 적지만 필요한 소규모 전문가 커뮤니티에 의해 꾸준히 인용될 수 있습니다. 어느 패턴이든 가시성을 하류 사용과 분리하며, 이는 다운로드가 많은 논문과 인용도가 높은 논문의 집합이 부분적으로만 겹치는 이유 중 하나입니다[108].
3.2 플랫폼 집계와 평균의 허구
SSRN이 자체적으로 발행하는 유일한 유통 관련 수치는 플랫폼 전체 합계이며, 이 데이터에서 가장 먼저 주목할 점은 그러한 합계를 평균화했을 때 무엇이 일어나는지입니다. 표 4는 검증된 플랫폼 통계를 기준 날짜와 함께 정리합니다.
표 4. 검증된 SSRN 플랫폼 통계, 기준 날짜 및 검증 상태 포함.
| 수량 | 값 | 기준 | 출처 | 검증 상태 |
|---|---|---|---|---|
| 전문 논문 | 1,157,048 | 2023년 12월 18일 | ALL-SIS Citation Methods White Paper [1] | 발행된 PDF에 대해 검증됨 |
| 초록 | 1,309,385 | 2023년 12월 18일 | [1] | 검증됨 |
| 저자 | 1,479,875 | 2023년 12월 18일 | [1] | 검증됨 |
| 누적 다운로드 | 256,678,716 | 2023년 12월 18일 | [1] | 검증됨 |
| 지난 12개월 다운로드 | 40,642,329 | 2023년 12월 18일 | [1] | 검증됨 |
| 전문 논문 (과거 기준점) | 571,040 | 2016년 7월 6일 | [1] | 검증됨 |
| 지난 12개월 다운로드 (과거 시점) | 12,897,685 | 2016년 7월 6일 | [1] | 검증됨 |
| 프리프린트 / 논문; 저자 | "150만 이상"; "190만 이상" | 2026 제품 페이지 | Elsevier SSRN 제품 문서 [49], 2026년 8월 14일 접근 | 검증됨 (반올림된 마케팅 수치) |
| 논문; 저자; 다운로드 총계; 다운로드 12개월 | >170만; >240만; >3억 4,400만; >5,400만 | 2025년 11월 1일 | SSRN 공지 보일러플레이트 [B-6] | 수준의 크기는 입증됨; 정확한 소수점(3억 4,480만 / 5,470만)에는 인용 전 공지의 보관된 복사본 필요 |
| 파생: 전문 논문당 평생 다운로드 평균 | ≈222 | 2023년 12월 기준 | 저자 계산: 256,678,716 ÷ 1,157,048 [1] | 검증된 수치에 대한 산술 |
| 파생: 논문당 연간 다운로드 평균 | ≈35 | 2023년 12월 기준 | 저자 계산: 40,642,329 ÷ 1,157,048 [1] | 검증된 수치에 대한 산술 |
마지막 두 행은 저자가 계산한 것이며 그렇게 표시됩니다; SSRN은 논문당 평균을 발행하지 않습니다. 플랫폼 전체 합계는 출처, 날짜, 정의(전문 vs. 전체 논문)에 따라 다르므로, 논문당 파생값은 조정된 2023년 12월 전문 수치에서 취합니다 [1]; 원래 2025년 11월 보일러플레이트 [B-6]는 위에 데이터로만 보관되며, 원래 공지 페이지가 더 이상 직접 검색 불가능하므로 보관된 복사본(예: web.archive.org를 통해)과 함께만 사용 가능합니다.
조정된 2023년 12월 수치에서, "평균" SSRN 논문은 평생 대략 222회, 지난 1년간 대략 35회의 다운로드를 기록했습니다 [1]. 이 파생 수치는 저자가 계산할 수 있는 가장 가까운 플랫폼 전체 규범이며, 이는 체계적으로 오도적입니다. SSRN 다운로드 분포에 대한 모든 실증 연구는 강한 우측 편향을 발견합니다: 평균은 긴 상위 꼬리에 의해 중앙값보다 훨씬 높게 끌어올려지므로, "평균 논문"은 거의 실제 논문을 설명하지 않습니다. 이 절의 나머지 부분은 그 차이의 규모와 결과를 입증합니다. 보정을 위해 한 가지 더 중요한 집계가 있습니다. 연간 플랫폼 다운로드는 2000년의 대략 50만에서 2005년 대략 300만으로 [18], 2016년 1,290만으로, 2023년까지 4,060만으로 증가했습니다 [1]. 논문당 다운로드 흐름 자체도 증가했습니다: 연간 다운로드는 2016년에서 2023년 사이에 약 3.15배 증가했지만 논문 재고는 약 2.03배 증가했으며 [1], 논문당 흐름을 약 55% 높였습니다. 따라서 더 오래된 연구는 오늘날 비슷한 논문이 얻을 절대 수치를 과소평가합니다. 이 편향이 가리키는 방향은 비교에 따라 달라집니다: 고정된 오래된 임계값은 오늘날 수치의 하한선이며, 이는 절대 2026년 수준 대역으로 읽힐 때 보수적인 것이 아니라 관대한 기준입니다. 역의 조작도 마찬가지로 허용되지 않습니다: 오래된 임계값은 플랫폼 성장을 곱함으로써 2026년 규범으로 "나이를 먹을" 수 없습니다. 더 큰 저장소는 동시에 분자, 분모, 저자의 구성, 배포 채널, 봇 필터링, 및 관심의 경쟁을 변경하기 때문입니다. 전체적으로 사용된 빈티지 편향 읽기는 오래된 임계값의 재조정이 아닌 위의 집계 흐름 및 재고 산술에 기반합니다. 플랫폼 자체의 연간 검토는 계속된 성장을 확인합니다: 2025년에 250,000편 이상의 신규 논문이 게시되었으며 (2024년 대비 20% 증가), 그 해 5,300만 회 이상의 다운로드가 있었습니다 [145].
3.3 평균은 전형적인 논문이 아닙니다: 직접적 증거
SSRN에 대한 가장 최근의 공표된 분포 증거는 Jo와 Li에서 비롯되었으며, 이들은 2025년 8월 15일에 수집한 단일 횡단면 스냅샷에서 SSRN의 마케팅 연구 네트워크의 2,361개 논문을 분석합니다 [83]. 아래의 표 5는 이들의 기술통계량을 완전히 재현하고 있으며, 제5절의 통합 벤치마크 맵은 이들을 포함합니다. 평균 다운로드는 221.346이었으며 중앙값은 87입니다: 평균은 중앙값의 약 2.54배입니다. 95 백분위수인 726은 중앙값의 8배 이상입니다. 평균은 75 백분위수(206)를 초과하며, 이는 샘플의 논문 중 3/4 이상이 "평균 논문"보다 아래에 있다는 의미입니다. 이 네트워크에서 평균 논문이 약 221개의 다운로드를 가지고 있다고 들은 연구자는 100번의 다운로드를 가진 논문이 정상보다 상당히 낮다고 결론지을 것이지만, 100은 공표된 중앙값을 훨씬 큰 폭으로 초과합니다. 그림 2는 이 구조를 직접 나타냅니다.
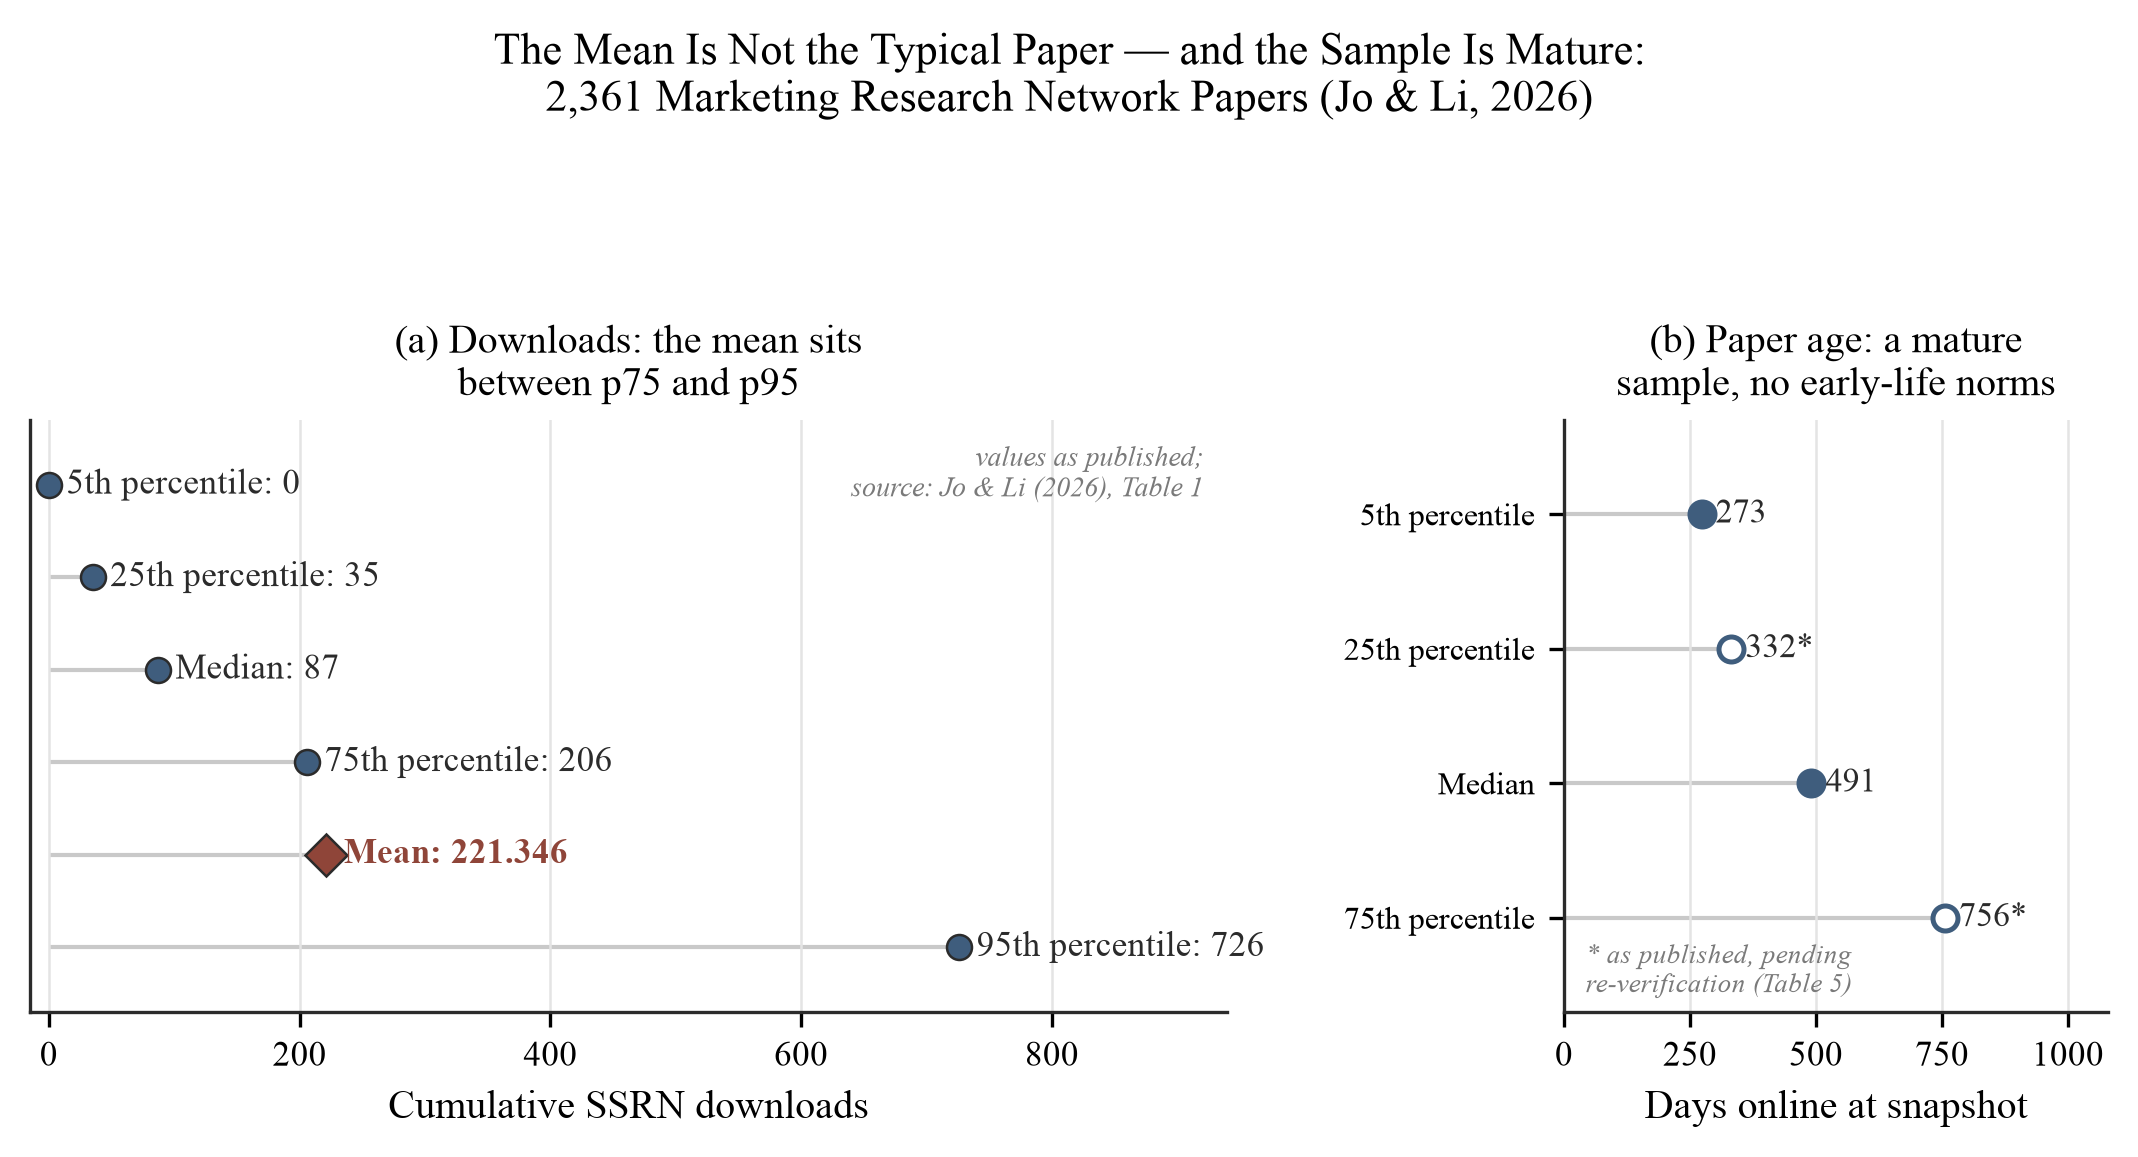
그림 2. 2,361개의 마케팅 연구 네트워크 논문의 공표된 기술통계량. 패널 (a): 다운로드 — p5 = 0, p25 = 35, 중앙값 = 87, p75 = 206, 평균 = 221.346, p95 = 726, 값의 순서로 표시됨 (평균이 p75와 p95 사이에 위치함을 주목). 패널 (b): 동일 샘플의 논문 나이 — 5 백분위수 273일 및 중앙값 491일은 출처에 대해 검증되었으며, 25 백분위수(332일) 및 75 백분위수(756일)는 "공표된 대로" 재현됨 (표 5). 출처의 표 1에 있는 두 값은 표시되고 "공표된 대로" 재현되었지만, 이들은 서로 다른 종류의 이상입니다. 초록 조회수 95 백분위수(966)는 평균(611.973; 표준편차 1,100.5)보다 약 0.32 SD만 위에 있습니다 — 오른쪽으로 치우친 계수에 있어 통계적으로 거의 불가능하며 p75가 이미 833인 행과 불일치합니다 — 따라서 이는 의심되는 출처 오류이며, 가장 그럴듯하게는 오타이지만 필사 또는 반올림 오류를 배제할 수 없으며, 초록 조회수 행의 다른 셀들은 동일한 상관 오류의 영향을 받을 가능성이 있는 것으로 취급됩니다 (Jo와 Li에 대한 저자 쿼리로 표시되었으며, 그들의 응답은 아직 이용할 수 없습니다). 변환 95 백분위수(77.7, p75의 27.2에 대비)는 다른 현상입니다: 제5.2절이 예측하는 정확히 같은 종류의 작은 분모 비율 아티팩트이며, 통계적 불가능이 아닙니다. 나이 패널은 해석적 한계를 명확히 합니다: 이들은 성숙한 논문 통계이며, 샘플은 초기 생명 규범을 제공할 수 없습니다. 출처: Jo와 Li (2026), 표 1 [83].
표 5는 연구의 완전한 기술통계량, 그 동반 변수뿐만 아니라 다운로드 분포를 재현합니다. 왜냐하면 이것이 완전한 백분위수 패널을 가진 유일한 공표된 SSRN 샘플이기 때문입니다; 이 논문의 여러 셀은 해석적 역할을 합니다. 표준편차는 무거운 꼬리를 단일 숫자로 나타냅니다: 다운로드의 평균 221.3에 대한 표준편차 940.9입니다. 다운로드의 5 백분위수는 정확히 0이므로, 0 카운터는 성숙한 샘플의 정상 범위 내에도 있습니다. 변환 백분위수는 제5.2절의 교차 연구 밴드를 양쪽 모두에서 괄호로 묶습니다 (p25 = 12.1, 중앙값 = 18.9, p75 = 100 조회당 27.2). 나이 백분위수(사분위수 범위 332–756일)는 샘플의 성숙도를 고정하며, 저자 및 패키징 행들은 제6.4절 및 제8.3절에서 그려진 공변량 규범을 제공합니다.
표 5. Jo와 Li (2026) 샘플의 완전한 공표된 기술통계량, "공표된 대로" (N = 2,361개 마케팅 연구 네트워크 논문; 2025년 8월 15일의 스냅샷). 모든 값은 출처의 표 1에서 재현되었습니다 [83]. 분포 핵심 — 다운로드 및 조회 평균, 중앙값, 사분위수; 변환 평균 및 중앙값; 나이 중앙값 및 5 백분위수 — 는 공표된 표에 대해 검증되었습니다 (표 7 참조). 나머지 셀들 (표준편차; 핵심을 넘어선 변환 및 나이 백분위수; 저자, 페이지 및 초록 길이 행)은 "공표된 대로" 재현되었으며 여기서 독립적으로 재계산되지 않았습니다; 출처의 존재, 장소 및 저자 정보는 2026년 8월 14일에 Crossref를 통해 확인되었습니다. 두 가지 내부 이상은 "공표된 대로" 유지되고 수정되지 않고 표시되었으며, 이들은 동일한 종류의 문제가 아닙니다. 초록 조회수 95 백분위수(966)는 보고된 평균(611.973; 표준편차 1,100.5)보다 약 0.32 SD만 위에 있습니다 — 그렇게 치우친 계수에 통계적으로 거의 불가능하며 행의 자체 p75인 833과 불일치합니다 — 따라서 이는 출처의 의심되는 오타이며; 나머지 초록 조회수 셀들은 상관 오류의 영향을 받을 가능성이 있는 것으로 표시되고 Jo와 Li에 대한 저자 쿼리 대기 중에 재검증으로 등급을 낮추었습니다. 변환 95 백분위수(77.704, p75의 27.187에 대비)는 대신 제5.2절에서 예측한 작은 분모 비율 아티팩트이며, 동일한 종류의 분포 이상이 아닙니다.
| 변수 | 평균 | 표준편차 | p5 | p25 | 중앙값 | p75 | p95 |
|---|---|---|---|---|---|---|---|
| 다운로드 | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| 초록 조회수 | 611.973 | 1,100.536 | 151 | 288 | 504 | 833 | 966 ("공표된 대로") |
| 100개 초록 조회당 다운로드 | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704 ("공표된 대로") |
| SSRN 가용성, 일 | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| 저자 수 | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| 페이지 수 | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| 초록 길이, 단어 | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
이 연구의 해석을 위해 중요한 세 가지 추가 특징이 있습니다. 초록 조회수는 더 높은 수준에서 동일한 비대칭성을 보여줍니다: 평균 조회수는 611.973이었고 중앙값은 504였습니다(p5 = 151, p25 = 288, p75 = 833; p95 966은 "출판된 그대로" 재현되었지만 의심되는 출판 오류이며, 평균보다 약 0.32 SD만 높고 p75 833이 암시하는 꼬리보다 낮으며, 하위 계산에 포함되지 않습니다; Figure 2의 주석을 참조하세요), 출판된 100회 조회당 23.699회 다운로드 전환율이 있습니다[83]. 이 연구는 또한 도달 범위와 전환을 분리합니다: 저자들의 푸아송 노출 모형에서 기관 명성은 초록 조회수를 조건으로 다운로드를 예측했으며(계수 0.192, 그리고 3명 저자 논문의 경우 상위 50개 소속 저자 1명은 초록 조회당 추정 6.6% 높은 다운로드율에 해당), 이 명성 프리미엄은 초록의 AI 보조가 증가함에 따라 약화되었습니다(상호작용 −0.627, p < .01)[83]. SSRN은 이제 제출 시 실질적인 생성형 AI 사용 공개를 요구합니다[54][56]. 따라서 관심은 독자가 초록 페이지에 도달한 후에도 상태 신호를 추적하며, 이는 다운로드 수가 내용 평가만이 아니라 가시성 및 평판 효과를 포함한다는 직접적인 증거입니다. 저자들이 직접 제시한 제한은 의제를 설정합니다: 단일 분야의 단일 네트워크의 단일 스냅샷은 관심의 시간 경로를 드러낼 수 없으며, 그들은 명시적으로 패널 데이터를 필요한 다음 단계로 식별합니다[83]. 이는 Section 8에서 다루어진 단계입니다.
표본은 한 시점에 관찰된 한 분야의 한 네트워크입니다: 이 수치는 보편적인 SSRN 벤치마크가 아니며, 그 가치는 구조에 있습니다. 평균/중앙값 비율 2.54와 위의 p95/중앙값 비율은 모든 다른 SSRN 증거의 본문에서 반복되는 무거운 오른쪽 왜도의 특징이며, 다른 분야와 시대의 표본을 포함합니다: 법학 논문의 유일한 센서스 스타일 표본에서, 2012년 법학 학술 네트워크에 게시되고 2년 후 측정된 논문(n = 1,107)은 중앙값 63회 다운로드 대비 평균 122.55회 다운로드를 기록했으며, 단 2년의 노출 후 거의 2배 격차입니다[139].
3.4 분포의 형태: 준로그정규성과 긴 꼬리
분포의 대규모 구조는 SSRN의 공개 상위 목록을 분석한 Kakushadze에 의해 확립되었습니다: 상위 30,000 목록에 있는 29,985명의 저자와 이들에 연결된 367,478개의 논문 (2015년형 순위의 스크랩) [85]. 핵심 발견은 다운로드가 준로그정규분포를 따르며, 수준에서는 심하게 왜곡되어 긴 상단 꼬리를 가지고 있고, 로그에서는 대략 정규분포를 따른다는 것입니다 (논문당 ln 다운로드의 적합 모수: 평균 5.406, 표준편차 1.016) [85]. Kakushadze는 로그정규성의 실질적 결론을 명시적으로 도출합니다: 이러한 데이터에는 선형 산술이 작동하지 않습니다. 다운로드에 h-지수를 직접 적용하는 것은 정보가 부족합니다: 다운로드 수는 인용 수보다 크기가 훨씬 크므로, 지수는 논문 수로 축소됩니다. 대신 다운로드의 로그 정수 부분으로 구축된 지수를 제안합니다, k = ⌊ln D⌋ [85]. 해석상 이는 다운로드의 의미 있는 차이가 덧셈적이 아니라 곱셈적임을 의미합니다. 이 형태는 다운로드에만 특이한 것이 아닙니다: 개인적 과학적 영향의 분포 자체는 Sinatra, Wang, Deville, Song, 그리고 Barabási (2016)의 Q-모델이 과학적 경력 전반에 걸쳐 확립한 대로 대략 로그정규분포입니다 [181]. 따라서 카운터가 요구하는 곱셈적 해석은 SSRN의 인공물이 아니라 학술적 관심의 규범입니다.
동일한 데이터세트는 상단 분포의 유일한 공개된 임계값 기준점을 제공합니다. 상위 10,000 논문 목록 (플랫폼의 전체 텍스트 논문 스톡의 약 상위 1.8%, 571,040, 2016년 7월 [1], 때때로 인용되는 "상위 1–2%" 수치와 일치하거나 그 이상)에 진입하려면 최소 160개의 다운로드가 필요했고, 중앙값은 805, 평균은 1,800, 최대값은 152,242였습니다 [85]. 상위 30,000 저자 중에서 최소 총 다운로드는 129, 중앙값 저자 총액은 1,626, 중앙값 논문당 다운로드는 210, 최대값인 Michael C. Jensen은 824,762였습니다 [85]. 희소성은 이 엘리트 표본 내의 논문 수준에서도 지속됩니다: 분석된 367,478개의 논문 중 112,793개 (약 30.7%)만이 저자의 로그-지수에 전혀 기여할 만큼 충분한 다운로드를 가지고 있었습니다 [85]. 플랫폼의 가장 많이 다운로드된 저자들의 개별 논문 대부분은 겸손한 관심을 끌고, 상위 목록 밖에서는 비율이 더 낮을 수만 있습니다. 그림 3은 공개된 임계값이 표시된 적합 분포를 시각화합니다.
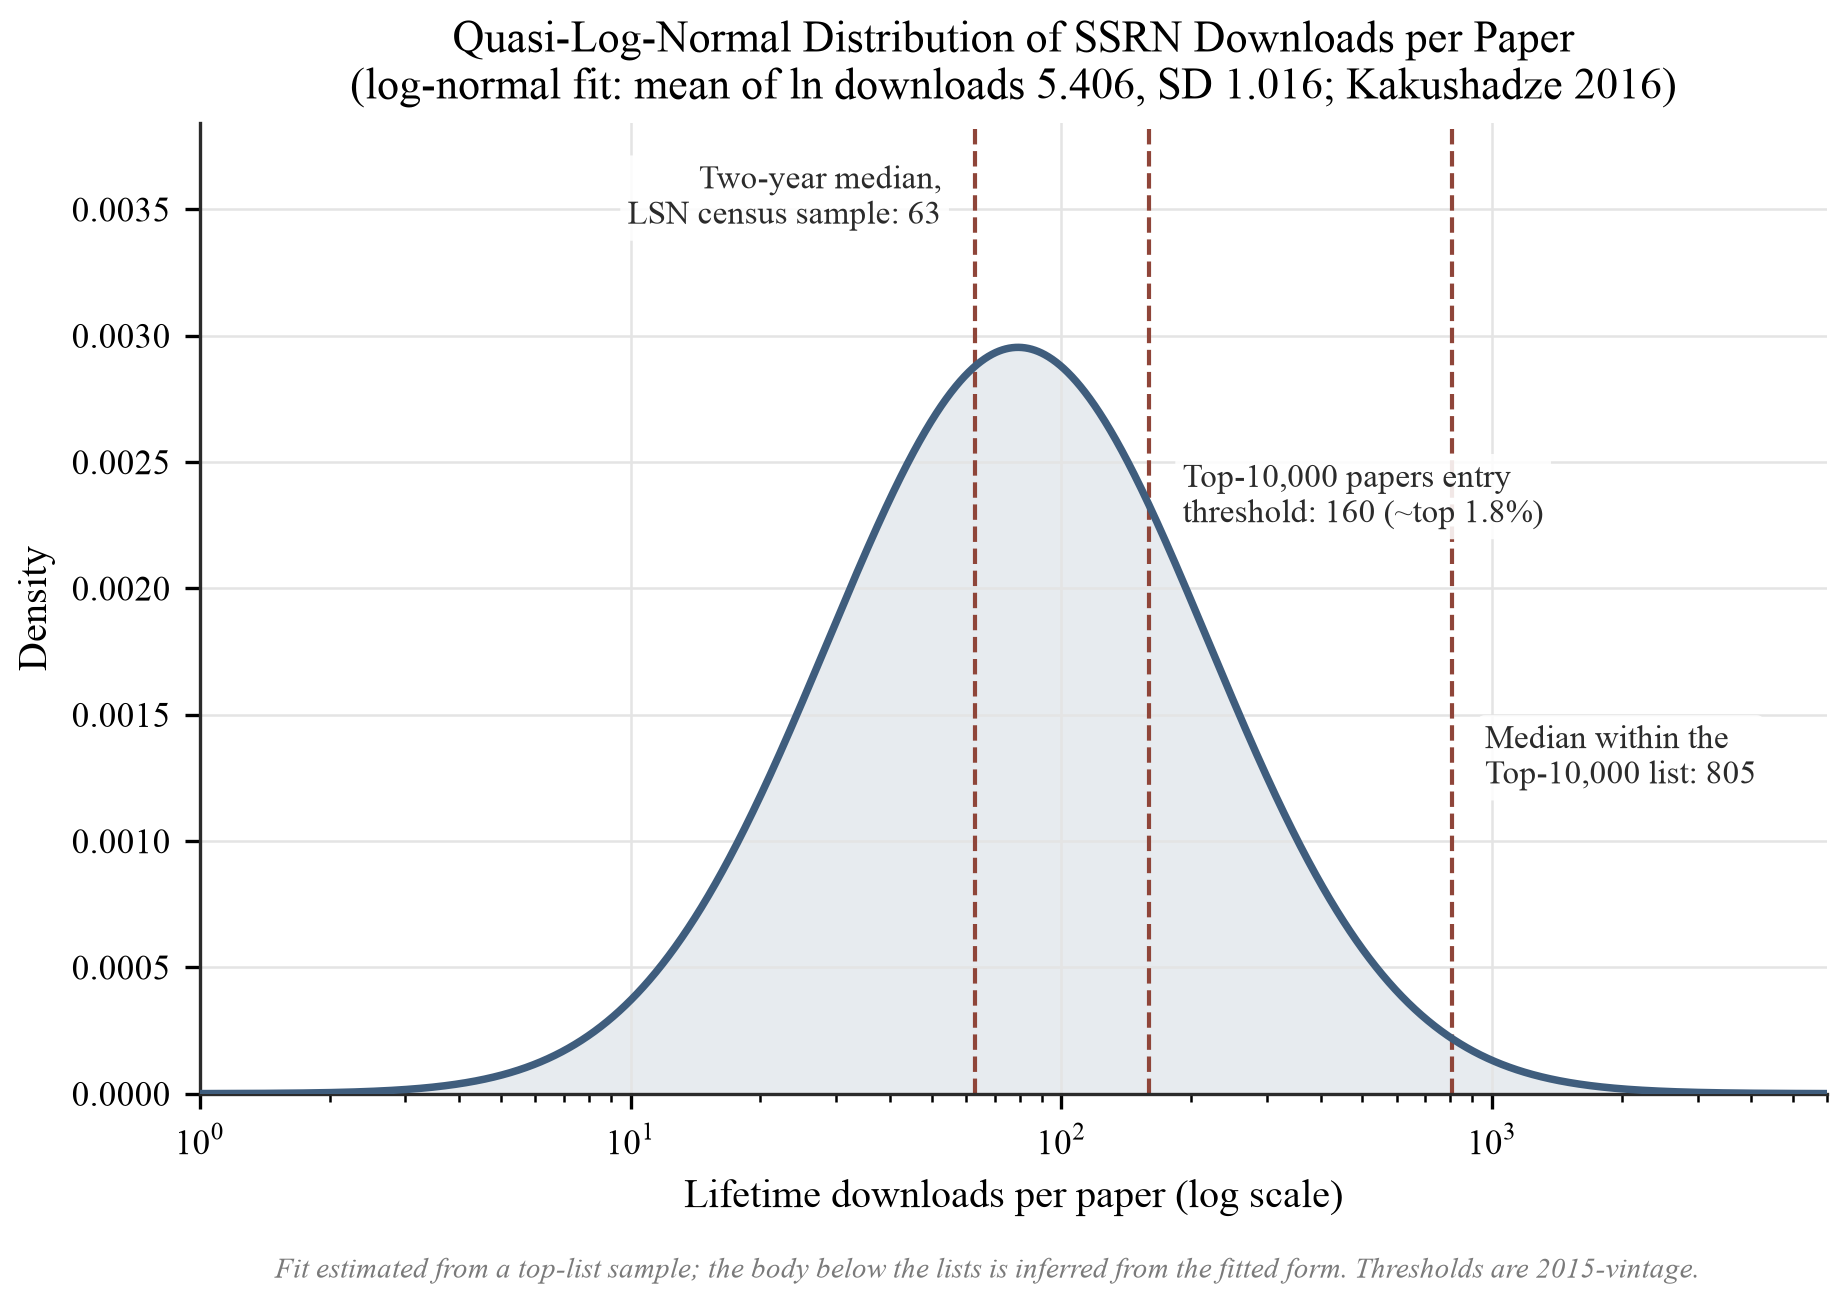
그림 3. Kakushadze가 보고한 모수로 적합된 로그정규 밀도 (ln 다운로드의 평균 5.406, SD 1.016) [85]; 적합 중앙값 exp(5.406) ≈ 223은 보고된 그룹 내 논문당 중앙값 210보다 약 6% 높으며, 상위-목록 분포에 대한 적절하지만 불완전한 적합입니다. 파선은 인구조사 방식의 법률 학문 표본의 2년 중앙값인 63개 다운로드 [139], 상위 10,000-논문 진입 임계값인 160 (2016년 7월의 플랫폼 전체 텍스트 논문 스톡 약 상위 1.8%, 571,040 [1]), 그리고 상위 10,000 목록 내의 중앙값 (805) [85]을 표시합니다. 적합은 상위-목록 표본 — 대략 플랫폼의 상위 십분위수 저자 —에서 추정되므로, 목록 아래의 분포 본체는 관찰되지 않고 적합 형식에서 추론됩니다; 임계값은 2015년형입니다 (이후 인플레이션: 섹션 5.1). 그림은 낮은 꼬리를 읽는 것을 초대하기 때문에 정량적 주의가 필요합니다: 이 적합 밀도 하에서 암시된 낮은 꼬리 질량은 P(X ≤ 63) ≈ 10.7% 및 P(X ≤ 10) ≈ 0.1% — 연구 1 (섹션 8.6)이 전체 플랫폼 확률 표본에 대해 예측하는 15–30% ≤10-다운로드 공유보다 2~3 자릿수 아래입니다. 이 차이는 모순이 아니라 적합의 도메인에 대한 직접적인 척도입니다: 상위 저자 십분위수에서 추정된 밀도는 관찰하지 못한 낮은 꼬리를 설명할 수 없으므로, 인구조사 방식의 마커 ([139]의 2년 중앙값 63; 상위 10,000 진입 160 및 중앙값 805)는 적합 곡선에 외부 참조점으로 도표됩니다, 적합이 이들을 재현한다는 주장이 아닙니다. 마커와 적합 곡선이 동일한 값을 배치하는 곳 사이의 거리는 목록 아래의 본체가 관찰되지 않았다는 시각적 증거이며, 이 곡선에서 전체 플랫폼 낮은 꼬리 공유를 읽어서는 안 됩니다.
이 기준점에는 두 가지 주의사항이 필요합니다. 표본 프레임은 분포의 상단이므로, Kakushadze의 통계는 꼬리를 설명하고, 목록 아래의 일반적인 논문의 대량은 적합된 로그정규 형식을 통해서만 특성화됩니다. 저작은 단일 저자에게 귀속됩니다: 연구는 Kakushadze (2016), Journal of Informetrics [85]입니다; 반복되는 잘못된 인용은 두 번째 저자를 추가하며 피해야 합니다.
부록 E에서 보고된 독립적인 보관 횡단면은 분포의 본체를 직접 관찰합니다, 퇴직 전 카운터가 공개 보관소에서 복구된 1,360개 논문의 무작위 전 분야 표본에 대해. 관찰된 분포는 대략 로그정규분포 (로그-다운로드의 왜도 ≈ 0.18)를 발견하며, Kakushadze가 꼬리에만 적합할 수 있었던 형태를 본체에서 확증하고, 독립적으로 평균-중앙값 격차, 변환 대역, 그리고 분야 승수를 재현합니다. 자체의 상향 선택 편향은 극단적인 낮은 꼬리를 과소 관찰하게 합니다. 그럼에도 불구하고, 종합이 다른 방식으로 의존하는 유일한 현대 전체 분포 기준점을 재현합니다: 재구성의 평균 (219)은 공개된 마케팅 네트워크 평균 221과 일치하므로, 핵심 형태는 완전히 별도의 데이터 소스로도 확증됩니다. (인터넷 보관소에서 역사적 웹 데이터 복구를 검증된 사회 과학 방법으로, 그리고 그 커버리지 및 크롤 빈도 편향에 대해, Arora, Li, Youtie & Shapira, 2016, Journal of the Association for Information Science and Technology, 67(8), 1904–1915, doi:10.1002/asi.23503을 참조하세요.)
3.5 가시적 꼬리에 의한 보정 오류
3.2–3.4절의 결합 구조는 체계적인 심리적 오류를 설명합니다. 2015년 스크래핑에서 가장 많이 다운로드된 저자는 824,762회 다운로드에 도달했는데, 이는 상위 저자 그룹의 중앙값(1,626)의 약 500배이며, 전형적인 논문의 4자리 수 위[85]입니다. 준대수정규분포법칙 하에서 중요한 거리는 곱셈적입니다. 일반적인 논문 중앙값(수십 회 다운로드)에서 최상위 목록 진입 임계값(160)으로의 단계가 그 임계값에서 최상위 목록의 중앙값(805)으로의 단계보다 작으며, 이는 다시 꼬리 최댓값으로의 거리에 비해 왜소합니다[85][139]. 그러나 공개적으로 유통되는 수치들(이정표 발표, "상위 저자" 프로필, 기관 보도자료[101])은 거의 전적으로 가시적 꼬리에서 추출됩니다. 따라서 저자들은 "좋음"을 중앙값보다 수백 배 위에 있는 참조 집단을 기준으로 보정하는 반면, 분포의 대부분은 중앙값 근처에 앉아 있습니다. 7회 다운로드를 읽는 대시보드는 논문의 나이와 분야에서 특별하지 않은 곳에서도 실패로 경험됩니다. 평균은 동일한 오류에 더 완화된 형태로 참여합니다. 3.3절에서 보았듯이, 그것은 75백분위수 위에 앉아 있으므로, 공식적으로 들리는 "평균"조차도 꼬리-오염된 벤치마크입니다. 이것이 평균이 거짓말하는 의미입니다. 그것은 올바르게 계산되고 나서 전형적인 값이 없는 분포의 전형적인 값으로 잘못 인식됩니다.
추가적인 여러 증거 본문들이 원시 카운터가 내용만큼이나 가시성 구조를 반영한다는 결론을 강화합니다. 주의는 위치에 반응합니다. arXiv 공지 목록에서 위치 1에 나타나는 논문들은 astro-ph에서 약 83% 더 높은 중앙값 인용을 얻었으며, 저자들은 이 효과를 자기선택만이 아닌 가시성에 상당히 기인시킵니다[72]. 또한 인덱싱 지연에도 반응합니다. SSRN 자체는 Google Scholar에 의한 자신의 콘텐츠의 외부 인덱싱이 검색 엔진에 의해 제어되며 "6–9개월 이상"이 걸릴 수 있음을 지적합니다[54, 2026년 8월 14일 접속], 따라서 새 논문의 카운터는 주요 발견 채널이 작동을 시작하기 전에 생성됩니다. 주의는 또한 인용에서 다운로드로 역방향으로 흐릅니다. 인용되는 것은 독자(인용된 저자들과 그들의 자신의 네트워크 포함)를 인용 논문으로 끌어당기며, Granger-인과분석은 이 인용-다운로드 경로가 기사의 상당 부분에서 활성임을 발견합니다[80][39], 따라서 카운터의 일부는 논문의 콘텐츠에 대한 독자의 평결보다는 인용 및 협력 네트워크에서의 논문의 위치를 인덱싱합니다. 이러한 각 메커니즘은 독자의 질 판단을 통해서가 아니라 가시성 구조(위치, 발견 지연, 네트워크 위치)를 통해 카운터를 형성하며, 어느 것도 대시보드 수치에 보이지 않습니다. 더 광범위한 주의 경제는 동일한 집중을 극단적 형태로 보여줍니다. 소셜 미디어에서 주의 지니 계수는 0.90–0.94에 도달하며, 상위 1%의 계정이 하위 99%를 합친 것보다 더 많은 주의를 받습니다[180], Simon의 정보의 부는 주의의 빈곤을 만든다는 격언의 현대적 메아리입니다[141]. SSRN의 학문적 주의는 더 완화된 형태로 동일한 계열의 비뚤어진 확산 프로세스에 속합니다. SSRN에서 가장 친숙한 청중인 경제학자들과 법학 학자들은 금융에서 이 구조를 인식할 것입니다. Bessembinder의 1926–2016년 CRSP 데이터 분석은 약 $34.8조의 순 주식시장 부의 창출이 상장 회사의 4% 미만에 기인하며, 대부분의 주식이 그들의 생애에 걸쳐 재무부 채권을 능가하지 못함을 발견했습니다[16]. 평행선은 증명이 아니라 설명으로 제시됩니다. 부에서와 마찬가지로 주의에서도, 총계는 얇은 극단적 꼬리에 의해 생성되며, 거인들이 지배하는 평균을 기준으로 자신을 측정하는 것은 범주 오류입니다. 또한 부족은 사용 카운터에만 국한되지 않습니다. 대법원 학문 전체에서, 2007년 한 조사의 법률 검토 기사 중 43%는 전혀 인용되지 않았으며, 2015–2019년 코호트의 18%만이 5년 내에 단일 인용을 받았습니다[171].
3.6 필드 승수: 규범의 학문적 구조
분포는 하나의 분포가 아닙니다. 필드마다 다릅니다. Whalen의 Legal Scholarship Network의 94개 eJournal로 분류된 약 25만 개 논문 분석에 따르면, 단일 우산 학문 내에서도 학문적 기준선이 대략 8배 정도 변합니다. 논문당 평생 다운로드 수는 Corporate, Securities & Finance Law의 438.35에서 Agricultural Law & Policy의 53.48까지 범위를 보였습니다 [168]. Figure 4는 이 기울기를 보여줍니다.
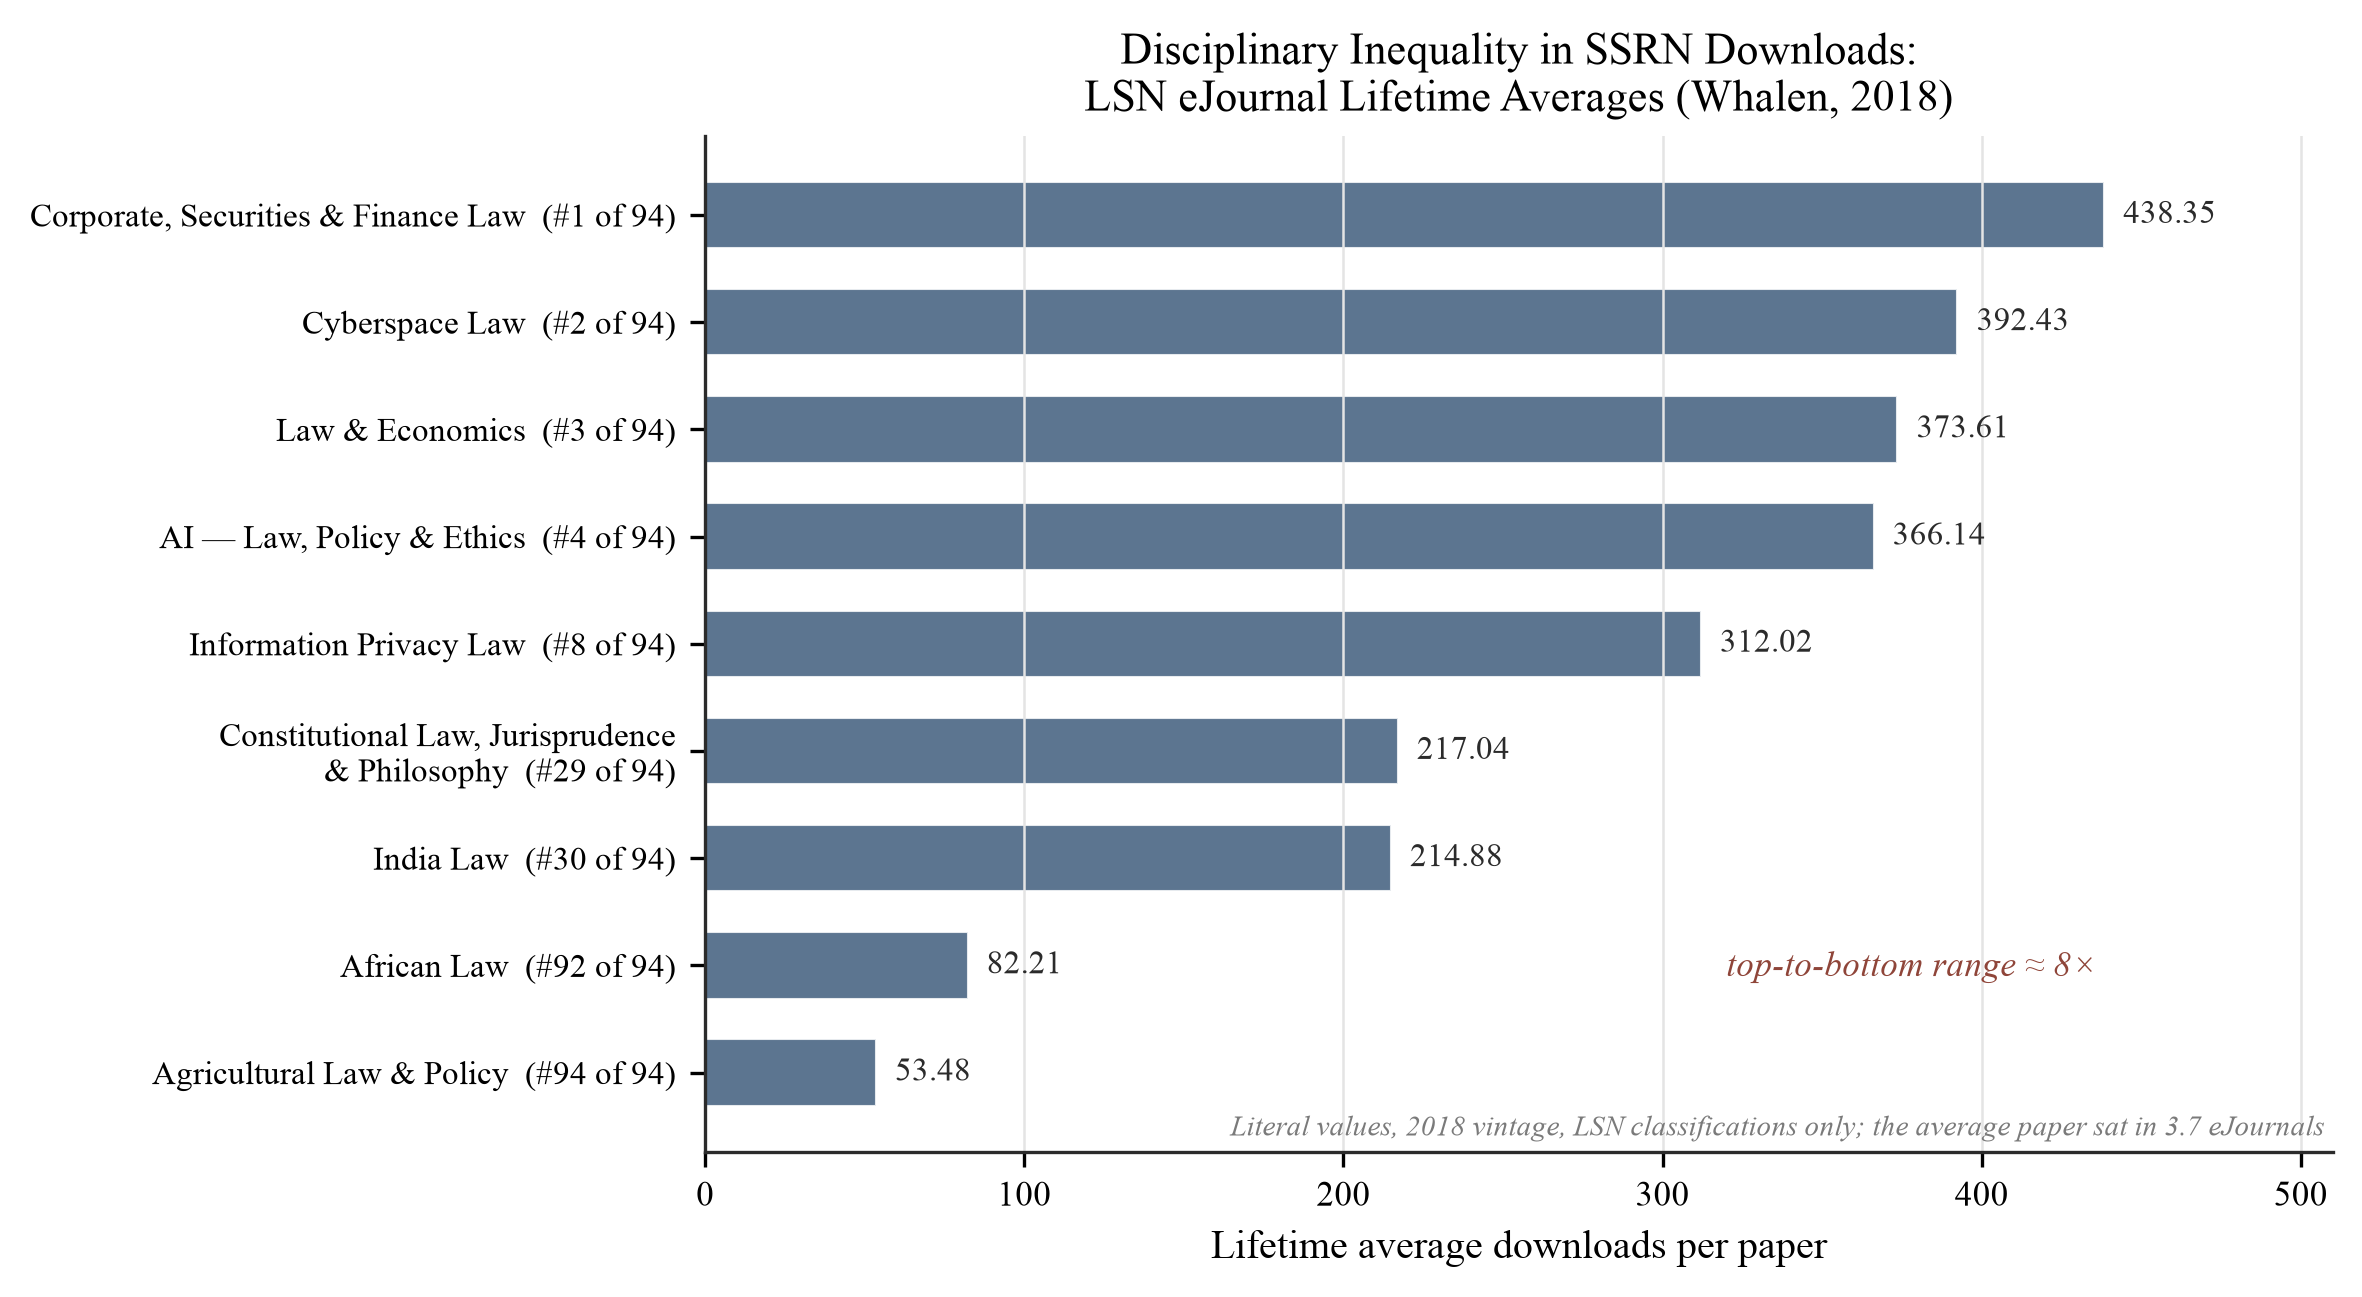
Figure 4. Whalen (2018) [168]의 선택된 LSN eJournal에 대한 논문당 평생 평균 다운로드 수, 리터럴 값: Corporate, Securities & Finance Law 438.35 (94개 중 순위 1); Cyberspace Law 392.43 (2); Law & Economics 373.61 (3); AI – Law, Policy & Ethics 366.14 (4); Information Privacy Law 312.02 (8); Constitutional Law, Jurisprudence & Philosophy 217.04 (29); India Law 214.88 (30); African Law 82.21 (92); Agricultural Law & Policy 53.48 (94). 상위에서 하위까지의 범위는 대략 8배입니다. 값은 2018년 기준이며 LSN 분류만 포함합니다. 평균 논문은 3.7개 eJournal에 할당되었습니다.
메커니즘은 능력주의적이기보다는 구조적입니다. SSRN의 발견은 분류 기반입니다(eJournal 구독자는 그곳으로 분류된 논문에 대한 알림을 받습니다). 따라서 논문의 주소 가능 청중은 어떤 품질 신호가 작동하기 전에 필드의 구독자 기반에 의해 고정됩니다. Whalen은 추가로 더 많은 분류를 가진 논문이 더 많은 다운로드를 얻고 영다운로드(zero downloads)를 기록할 가능성이 낮다는 것을 발견합니다 [168]. 필드 구조는 인용 문화를 통해 카운터에도 영향을 미칩니다. Black과 Caron은 법학 장학금이 경제학이나 금융보다 선행 작업을 더 완전하게 인용하기 때문에 다운로드 대 인용 비율이 필드 간에 체계적으로 다르다는 것을 관찰했습니다 [18]. 법학 내에서도 관심은 특정 주제와 저자 특성에 집중됩니다. 2012 인구조사 샘플에서 기업 및 국제법 주제, 미국 저자성, 그리고 상위 20개 소속이 모두 유의하게 높은 수를 예측했습니다 [139]. 이러한 결정 요소들은 동시대 법률 도서관 논평에도 반영되었습니다 [175]. 따라서 기업법에서는 평범한 숫자가 법률사 또는 농업법에서는 예외적일 수 있으며, 어떤 벤치마크나 규모(섹션 5에서 구성된 것 포함)도 필드 상대적으로 읽어야 합니다. 인용 측면에서 잘 확립된 선례가 있습니다. Radicchi, Fortunato, Castellano (2008)는 각 논문의 수를 필드의 평균으로 재조정한 후에만 인용 분포가 단일 보편적 곡선으로 축소된다는 것을 보였습니다 [182]. 이는 본 논문이 사용량 수가 동등하게 요구하는 참조 클래스의 유사물입니다.
위의 검증된 앵커에만 기반하여 구성된 세 가지 예시는 문제의 중요성을 구체적으로 보여줍니다. 농업법 저자로서 논문이 60의 평생 다운로드를 유지하는 경우 자신의 eJournal 평균 53.48을 초과합니다 [168]. 그러나 가장 눈에 띄게 유통되는 기업법 수에 대해 보정하면 같은 숫자를 실패로 읽을 수 있습니다. 기업 및 증권법 저자로서 같은 60을 가진 경우 해당 필드의 평균 438.35보다 훨씬 아래에 있습니다 [168]. 그리고 마케팅 논문이 네트워크 중앙값 87에 도달하는 저자는 구성상 전형적인 결과를 과소평가할 수 있습니다 [83]. 규모 누락의 오류는 양방향으로 작동합니다. 부당한 절망을 생성하고 성공을 인식하지 못하게 합니다.
섹션 3.2–3.6은 본 논문의 실증적 핵심을 확립합니다. SSRN 다운로드 분포는 심하게 우측 왜곡되어 있으며 대략 로그정규분포이고, 평균은 중앙값뿐 아니라 75번째 백분위수를 초과합니다. 눈에 띄는 꼬리는 엘리트 중앙값의 500배까지 확장되며 비공식적 보정을 오염시킵니다. 카운터는 내용과 무관하게 독립적으로 작동하는 위신, 지위, 색인화 및 필드 구조 효과를 포함합니다. 그리고 학문적 기준선은 단일 학문 영역 내에서 8배 변합니다. 평균 또는 꼬리에 대해 읽은 원본 다운로드 수는 따라서 구성상 해석 불가능합니다. 방어 가능한 읽기는 참조 클래스가 필요합니다. 필드, 논문 연령 및 코호트에 따라 조건부인 분포. Rankings는 모든 결함에도 불구하고 그러한 참조 클래스를 향한 플랫폼의 유일한 공개적 제스처였습니다. 그리고 그 제거는 외부 구성(섹션 5의 벤치마크 맵 및 해석 규모)이 본 논문의 나머지 중심 과제가 되게 합니다.
4. 카운터의 메커니즘: 규칙 하의 카운터
SSRN 대시보드의 어떤 숫자든 해석되기 전에, 그 숫자가 실제로 무엇을 기록하는지 확립할 필요가 있습니다. SSRN은 인용 통계 및 PlumX 지표와 함께 두 개의 주요 논문 수준 사용량 메트릭(초록 조회 및 다운로드)을 표시합니다 [50]. 2026년 7월 15일에 Rankings이 폐지된 후, 이 카운터들은 계속 유지되었습니다. SSRN은 "다운로드 수 및 인용 통계가 개별 논문 및 저자 프로필에서 계속 기록되고 표시될 것"이라고 명시했습니다 [149]. 비교 규모는 사라졌지만 데이터는 남아있습니다. 그러나 남아있는 카운터는 인간 독자층의 원본 관찰이 아닙니다. 플랫폼 아키텍처, 배포 메커니즘, 비인간 트래픽 및 무결성 필터링의 결합 산물입니다. 이러한 각 계층은 아래에서 분해되며, 섹션 5는 그 위에 해석 프레임워크를 구축합니다.
4.1 조회와 다운로드 기록이 무엇인지, 그리고 무엇이 아닌지
초록 조회는 논문의 랜딩 페이지에 대한 요청을 기록합니다. 다운로드는 전문 PDF의 검색을 기록합니다. 둘 다 참여 이벤트이며, 어느 것도 읽기, 이해, 승인 또는 과학적 승인의 직접적인 증거가 아닙니다. 이 구분이 본 논문의 나머지 부분에서 제시되는 모든 주장의 범위를 규정합니다.
SSRN의 공개 카운터는 단순한 HTTP 요청 로그가 아닙니다. 이 플랫폼은 초기부터 데이터 무결성 필터링을 운영해왔으며 [69] 공개적으로 접근 방식을 설명했습니다: 자동화된 다운로드, 반복적인 자체 다운로드, 카운트 조작 시도는 "비정상 활동의 신호"를 사용하여 선별되고, 의심스러운 다운로드(일부 상황에서는 익명 다운로드 포함)는 저자가 볼 수 있는 합계에서 제외됩니다 [144]. 독립적인 관찰자들은 이전에 동일한 동작을 문서화했습니다: 단일 IP 주소에서의 반복 다운로드는 카운터에 적용되지 않습니다 [66]. 따라서 다운로드 카운터는 정리된 통계로, 원시 서버 로그보다 물질적으로 더 견고합니다. 필터링은 가장 감지 가능한 비인간적 활동과 조작적 활동을 제거할 뿐입니다. 카운터는 항상 규칙 하의 카운터이며 자연적 단위가 아니며, 규칙은 변합니다(4.3절).
4.2 비인간 트래픽과 조회수와 다운로드 간의 비대칭성
자동화된 에이전트는 최근 업계 측정에서 전체 인터넷 트래픽의 절반 이상을 차지합니다 [158]. 이 수치는 SSRN의 카운터에 적용될 수 없습니다. SSRN 초록 조회수나 다운로드에서 봇 점유율의 공표된 측정이 파악되지 않았으며, SSRN에 대해 주장된 어떤 구체적인 백분율도 근거가 없습니다. 확립될 수 있는 것은 문제의 구조이며, 두 가지 방향에서 접근됩니다. 조회수를 그럴듯하게 부풀리는 메커니즘과 인접한 플랫폼의 투명한 필터링 기록입니다.
여러 메커니즘이 비인간 초록 조회수를 그럴듯하게 생성합니다. 검색 엔진 크롤러는 새로 게시된 초록 페이지를 정기적으로 색인합니다. 기관의 이메일 보안 시스템, 특히 Microsoft Defender for Office 365의 Safe Links는 들어오는 메일에 포함된 URL을 스캔하고 사전에 가져오며, 이는 인간 수신자가 메시지를 열기 전에 서버 측 요청을 등록할 수 있습니다 [106]. SSRN의 주요 배포 채널이 이메일이기 때문에 (섹션 4.4), 공지 이메일의 링크 스캔은 구조적으로 허위 조회수의 원인이 될 수 있습니다. 보안 프록시 사전 가져오기가 SSRN의 조회수 카운터에 기여하는 정도를 측정한 공표된 연구는 없으며, SSRN 자체는 메트릭을 감사하고 다운로드 카운트에서 비정상 활동을 제외합니다 [144][66][69]. 따라서 플랫폼은 특히 다운로드 측에서 상당한 비중의 이러한 트래픽을 필터링하고 있을 수 있습니다. "대부분의 SSRN 조회수는 인간이 아닙니다"라는 주장은 비공식적인 논의에 나타나지만 측정된 적이 없습니다.
투명한 사례는 RePEc입니다. 그 로깅 서비스인 LogEc은 필터링 방법론과 필터링 기록을 모두 공개하며, 그 기록은 비인간 오염이 얼마나 심각하고 얼마나 비대칭적인지를 보여줍니다. 2007년 7월 초, 로봇은 모니터링된 RePEc 서비스의 추상 조회수의 약 74%를 차지했지만 다운로드의 약 7%만 차지했습니다 [99]. 필터 기록은 군비 경쟁의 연대기로 읽힙니다. 안티맬웨어 링크 스캐너에 대한 휴리스틱은 2010년 7월에 추가되었습니다. 새로운 유형의 체계적인 대량 다운로드는 2017년 1월에 해결되었습니다. 2022년 1월에 도입된 DDoS 완화 필터는 추상 조회수의 54%를 제거했지만 다운로드의 7%만 제거했습니다 [99]. 2025년 10월부터 RePEc는 인간 사용자로 위장한 AI 기반 봇 트래픽의 급증을 기록했습니다 [129]. 2025년 9월, IDEAS에 대한 원본 트래픽의 99.5% 이상이 비인간으로 폐기되었습니다 [129]. 정제 후, 2026년 6월의 RePEc 보고서는 그 서비스 전반에 걸쳐 약 236만 개의 초록 조회수와 238,000개의 다운로드를 계산했습니다 [129].
RePEc 증거는 SSRN에 대한 두 가지 추론을 지지합니다. 오염은 구조적으로 비대칭입니다. 자동화된 에이전트는 전체 텍스트 PDF 검색을 실행하는 것보다 HTML 초록 페이지를 훨씬 더 공격적으로 크롤링하므로 필터링이 불완전한 곳에서는 조회수 카운터가 다운로드 카운터보다 훨씬 더 부풀려집니다. 2007년 측정에서 로봇이 조회수의 약 74%이지만 다운로드의 약 7%인 그 비대칭성 [99]은 repository 트래픽의 건축적 특성이며 RePEc의 특이성이 아닙니다. 구체적인 비율은 이전 가능하지 않습니다. SSRN의 필터링 규칙, 배포 모델 및 청중이 다르며, SSRN은 동등한 필터링 로그를 공개하지 않습니다. 섹션 5.2는 실용적인 결과를 발전시키며, 이는 조회수를 기반으로 한 비율 (예: 변환율)이 인간 참여 품질의 하한으로 읽혀야 한다는 것입니다. 분모가 더 오염된 수량이기 때문입니다. 이 하한 방향은 법칙이 아닌 빈티지 종속적입니다. 조회수 필터링이 다운로드 필터링에 뒤처지는 동안 성립하며, 이는 역사적으로 기록된 체제입니다 [99]. 하지만 플랫폼의 조회수 필터가 다운로드 필터를 따라잡거나 다운로드 측 오염이 조회수 측보다 더 빠르게 증가하는 경우 약해지거나 반대가 될 수 있습니다 (2025-2026 AI 봇 에피소드는 둘 다 증가시켰습니다 [129]). 플랫폼이 카운팅 규칙을 수정할 때마다 방향을 다시 확인해야 합니다.
이 필터링 체제가 설계된 이후로 추가적인 고려사항이 나타났습니다. 필터는 인간 주의에 프록시하도록 의도된 카운트에서 자동화된 요청을 제거하기 위해 구축되었으며, 그 규칙은 여전히 노이즈를 제거합니다. 더 이상 검사 없이 할 수 없는 것은 나머지를 인간으로 취급하는 것입니다. 왜냐하면 필터가 하나를 본 곳에 자동화된 요청의 세 가지 클래스가 이제 있기 때문입니다. 모델 훈련을 위해 텍스트를 수집하는 크롤, 검색 또는 답변 서비스를 위해 인덱싱하는 크롤러, 그리고 시스템이 뭔가를 요청한 사람을 대신하여 실시간으로 만드는 가져오기입니다. 처음 두 개는 주의 카운트에 대한 노이즈로 남습니다. 세 번째는 인간이 그것을 뒤에 있기 때문에 위임된 행위입니다. 왜냐하면 사용자의 질문에 답하거나 문헌 검색을 지원하기 위해 논문의 전체 텍스트를 검색하는 시스템이 콘텐츠를 제공받았고 사용했기 때문입니다. 비록 어떤 사람도 페이지를 로드한 적이 없더라도 말입니다. 자동화된 요청은 자체적으로 무엇이든 읽혔다는 증거가 아닙니다. 프록시는 약해졌으며 필터가 아닙니다. 인간 대 머신은 더 이상 이 기사가 필요로 하는 구별, 즉 이벤트가 학술적 주의의 증거인지 여부를 확실하게 추적하지 않습니다. 인간이든 위임이든 말입니다.
Project COUNTER는 필터가 아닌 보고 어휘에서 이것을 다루기 시작했습니다. 2026년 4월에 발행되고 Release 5.1.1을 위해 2026년 6월 30일에 업데이트된 AI 사용에 대한 모범 사례 지침은 AI 시스템에 의해 액세스된 콘텐츠 및 메타데이터로 정의된 Agent의 선택적 Access_Method를 제공하며, AI 관련 메트릭 유형과 함께 Release 5.1.1은 여전히 "기존 봇 및 크롤러에 의해 생성된 활동은 모든 COUNTER 보고서에서 제외되어야 합니다" [125]를 요구합니다. 도구에는 여기서 중요한 세 가지 제한이 있습니다. 선택적 확장이며 공급자가 생성하기로 선택한 보고서에만 생성되며 제공자의 자체 플랫폼에 내장된 AI 시스템을 먼저 목표로 하며 인바운드 크롤러를 목표로 하지 않습니다. 그 요소는 "COUNTER 보고서의 표준 조회수에 포함되지 않아야 합니다" [125]. 따라서 표준 조회는 공급자가 지침을 구현하는 경우에도 에이전트 액세스를 구별하지 않습니다. 태그된 에이전트 이벤트가 기본 합계에서 제거되는지 또는 레이블이 없이 수행되는지 여부는 지침이 침묵하는 구현의 문제입니다. 또한 거부된 액세스가 아닌 제공된 액세스를 분류합니다. 지침은 "Agent Access_Method와 구체적으로 관련된 거부 메트릭이 없습니다" [125]라고 명시합니다. 이 중 어느 것도 裸 공개 카운터에 도달하지 않습니다. 왜냐하면 그러한 카운터는 COUNTER 보고서가 아니며 액세스 방법을 전달하지 않기 때문입니다. 표준은 그것을 판단할 수 있는 유사 항목입니다. 설명이 아닙니다.
거부는 가설적이지 않으며, 모든 계산 규칙보다 상위에서 작동하지만, 그 도구들은 본질적으로 다르며 하나처럼 작용하지 않습니다. 플랫폼의 robots.txt는 명명된 에이전트들에게 크롤링하지 말 것을 요청합니다. 텍스트-데이터-마이닝 예약은 법적 입장을 주장합니다. 이용약관은 계약적으로 구속합니다. 챌린지 서비스는 이를 완료할 수 없는 클라이언트들로부터 페이지를 보류합니다. 이 중 마지막만이 집행입니다. 여기서 연구된 플랫폼에서, 2026년 8월 29일에 검색한 바와 같이, robots.txt는 세 개의 에이전트(GPTBot, ChatGPT-User 및 Google-Extended)를 명명했으며 다른 것들에 대해서는 침묵했고, 침묵이 잘 작동하는 크롤러들이 허가로 읽는 Robots 제외 기본값입니다. 응답은 출판자 정책을 가리키는 마이닝 예약을 포함했으며, 이는 EU 디지털 단일 시장 지침 제3조에 해당하는 목적의 마이닝을 허용하고 그 외에는 라이선스를 요구합니다. 이용약관은 저자가 개방 라이선스를 선택한 경우를 제외하고 텍스트, 데이터 마이닝 및 AI 훈련에 대한 권리를 예약하며, 이 옵션은 2026년 7월 20일 이후에만 사용 가능하고 모든 권리 보유로 기본 설정되어 있습니다. JavaScript 엔진 없이 만든 인증되지 않은 단일 요청은 페이지 대신 Cloudflare 관리 챌린지를 받았습니다. 명명된 에이전트 중 하나는 훈련 크롤러가 아닌 사용자가 트리거한 페처입니다. 즉, 앞의 단락의 위임된 클래스입니다. 이 자료들은 공표된 제한사항과 하나의 구성 관찰을 기록합니다. 자동화된 또는 인간의 요청이 얼마나 거부되었는지는 확립하지 않습니다. 지시사항은 불균등하게 준수됩니다. 크롤러 동작의 대규모 측정에서, 일부 에이전트는 전체 사이트 제외를 완전히 존중하면서 경로 수준의 제외는 시간의 3분의 1 미만으로 준수했고, 다른 것들은 파일을 완전히 무시했습니다[87]. 또한 담보는 일방적이지 않으며, 챌린지 배치가 다른 곳의 합법적인 인간 사용자들을 방해했기 때문입니다(한 대학 도서관은 사용의 처음 4개월 동안 두 가지 사건을 기록했습니다[29]).
따라서 역사적 비대칭성을 단순히 앞으로 나아갈 수 없습니다. 2007년 발견의 위안, 대략 초록 조회의 74%이지만 다운로드의 약 7%인 로봇들[99], 랜딩 페이지를 탐색하고 전체 텍스트를 거의 가져오지 않는 크롤러들에 의존했습니다. 답변을 뒷받침하기 위해 문서를 검색하는 시스템은 초록에서 멈출 이유가 없으므로, 다운로드 쪽이 구성상 더 깨끗한 통계로 알려져 있지 않습니다. 원본 학술 트래픽이 2025–26에 측정된 경우, 자동화된 공유는 한계적이지 않았으며, 페이지 보기에만 있지 않고 다운로드 및 방문 수 내에서 발견되었습니다. 한 문화유산 컬렉션은 의심되는 봇 트래픽이 제거된 후 2025년 3월 방문 수를 1,000,000에서 125,000으로 수정했습니다[167]. 한 기관 저장소의 대략 3,000만 개의 접근 요청에 대한 공급업체 분류는 그 중 약 4분의 1만을 인간으로 표시했습니다[98]. 개방 저장소 설문 조사에 응한 저장소는 자신의 봇 다운로드의 최소 4분의 1을 11개의 명명된 AI 에이전트에 귀속시켰으며, 그 중 약 100만 개의 요청입니다[135]. 이 수치 중 어느 것도 여기서 연구된 플랫폼의 측정이 아닙니다. 서로 다른 플랫폼, 여러 경우 부재한 방어책, 그리고 세 가지 중 두 가지가 공개 카운터가 표시하는 다운로드 이벤트가 아닌 방문 또는 요청을 계산하는 서로 다른 플랫폼에서 도출되었습니다. 이들은 크기보다는 사전 조건을 확립합니다. 현재 환경에서 모든 사용량 수의 해석 가능성은 필터 품질의 함수이며, 플랫폼이 필터링을 공표하지 않으면, 그 품질은 감사되지 않습니다.
두 가지 식별 문제가 뒤따르며, 이들은 복합됩니다. 먼저 구성: 공개 수명 카운터만으로는 인간, 기존 자동화 및 에이전트 중재 이벤트의 공유를 추정할 수 없으며, 자동화된 클라이언트가 데스크톱 브라우저로 자신을 제시하는 것으로 관찰되었으므로 플랫폼 자신의 보기가 나을 수 없습니다[167]. 선택에서, 카운터는 시도된 접근의 어느 정도가 제공되었는지, 챌린지되었는지, 또는 계산 규칙이 적용되기 전에 제외되었는지 밝힐 수 없습니다. 공표된 정책은 이러한 메커니즘이 존재함을 공개합니다. 그들이 얼마나 자주 작동하는지, 과거에 어떻게 작동했는지, 또는 포함에 미치는 영향을 공개하지 않습니다. 시도된 요청, 챌린지된 요청, 제공된 전체 텍스트 이벤트, 표시된 다운로드, 및 검색된 논문에서 생성된 답변은 따라서 다섯 가지 다른 모집단이며, 이들을 상호 교환 가능한 것으로 취급해서는 안 됩니다. 라이선스되지 않은 것은 이 플랫폼에 대한 크기 또는 순 부호입니다. 필터링되지 않은 학술 사용량은 이제 자동화된 트래픽, 다운로드 포함에 의해 부풀릴 수 있음이 알려져 있지만, 이 플랫폼의 공표되지 않은 필터, 챌린지 규칙 및 크롤러 정책이 더 인간 가중 나머지를 남기는지, 에이전트 중재 발견의 격차, 둘 다 또는 둘 다 아닌지 여부는 측정되지 않습니다. 또한 혼합은 수명 총계가 차지하는 연도 전체에서 안정적이지 않으며, 2024년 이전의 로봇 체제에서 2025–26의 스크레이프 급증을 거쳐 2026년 7월에 도입된 라이선스 기본값까지 실행됩니다. 질문의 다운스트림 결과는 그들 자체로 문서화되어 있습니다. 주요 AI 크롤러를 차단하는 사이트는 콘텐츠가 여전히 접근 가능한 경우에도 AI 답변 엔진에 의해 유의미하게 덜 자주 검색됩니다[70]. 주요 프리프린트 서버에 대해 에이전트 공유의 공표된 추정치가 존재하지 않으며, 작은 효과의 증거가 아닌 연구 격차이며, 제8절에서 지정된 감사는 이를 측정하도록 설계되었습니다. 공개 수명 합계는 알려지지 않은 혼합에 대한 합계이며, 시도된 접근의 알려지지 않은 공유에서 도출되었으며, 어느 것도 외부 추정기가 없으며 어느 것도 정상으로 취급할 근거가 없습니다.
4.3 감소하는 카운터를 측정 이벤트로서
카운터는 필터링 규칙이 변경될 때 감소하거나 재설정될 수 있으며, 이는 어떤 대시보드도 설명하지 않는 필터링 기록의 추가적인 결과입니다. RePEc의 2022년 1월 필터 개정은 이전에 계산된 초록 조회의 절반을 한 번에 제거했습니다 [99]. 2025–2026년 AI-봇 에피소드는 추가적인 방법론적 변화를 강제했습니다 [129]. 공급업체가 보고한 다운로드 통계는 더 일반적으로 계산 관례에 민감한 것으로 알려져 있습니다. 도서관 측 감사에서는 한 대형 출판사의 다운로드 보고서가 비교 가능한 플랫폼보다 대략 2배 높게 나타났으며, "감소된" 수치는 보고된 수치의 43%였습니다 [176]. 저자의 SSRN 카운터가 갑자기 떨어지는 것은 따라서 독서 이벤트만큼이나 측정 이벤트, 즉 플랫폼 측의 필터링 또는 재설정 변화일 가능성이 높으며, 뒷받침 없이 평판 손실로 읽혀서는 안 됩니다. 같은 논리가 메트릭스의 모든 도서관 사용을 지배하며, 여기서 날짜가 기록된 기록은 보존되어야 합니다(6절에서 개발된 프로토콜). 플랫폼의 숫자는 수정될 수 있지만 저자의 날짜 보관 기록은 수정될 수 없습니다.
4.4 Push versus pull: 아키텍처가 비율을 결정합니다
유통 아키텍처는 마지막 기계적 계층입니다. 주요 저장소들 간에 질적으로 다르며 뷰와 다운로드 간의 관계를 직접 형성합니다. SSRN은 주로 push 모델로 운영됩니다. 제출 시 저자들은 1개에서 7개 사이의 주제 분류를 선택하고(평균 LSN 논문은 3.7개의 eJournal 배정을 가짐 [168]), 이는 연구 네트워크 내 배치와 주제별 eJournal 이메일 알림 자격을 결정합니다. 알림 포함은 "큐레이션되고 표적화되지만 보장되지 않으며," 대량 주제의 배포는 최대 45일이 걸릴 수 있습니다 [53]. 구독자들은 이메일을 통해 초록 수준의 공지를 받습니다 [57]. 명확한 관심이든 약한 호기심이든 공지에서 클릭스루하는 모든 수신자는 초록 뷰를 등록합니다. 반면 arXiv는 주로 pull 플랫폼으로 운영됩니다. 연구자들이 적극적으로 목록과 피드를 방문하는 트래픽 기반의 비영리 저장소 [11][65]이며, 일일 공지 목록 내 위치도 가독성과 인용도에 측정 가능하게 영향을 미칩니다 [72]. RePEc는 분산화된 아카이브에서 메타데이터를 집계하고 위에서 설명한 광범위하게 문서화된 필터링을 적용합니다 [99][129].
표 6은 거버넌스 및 발견 메커니즘의 질적 스키마로 플랫폼 간 비교를 요약합니다. 비교 가능한 플랫폼 간 트래픽 데이터는 발표된 기록에 존재하지 않습니다.
표 6. 플랫폼 아키텍처와 사용 지표에 미치는 기계적 영향(질적 스키마).
| 기능 | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| 거버넌스 | 상업용 (Elsevier, 2016년 5월 이후) [46] | 비영리 (Cornell University) [11] | 분산화된 자원봉사 네트워크 [99] |
| 주요 발견 채널 | Push: 저자 선택 분류(1–7; 대량 주제에서 배포까지 45일)로 구동되는 큐레이션된 eJournal 이메일 알림 [53][57] | Pull: 목록과 피드에 대한 의도 기반 방문; 공지 내 위치 효과 문서화됨 [11][72] | 분산 아카이브의 집계; IDEAS/EconPapers를 통한 발견 [99] |
| 필터링 투명성 | 정책이 질적으로 설명됨; 공개 필터링 로그 없음 [144] | 사용 지표에 대해 중앙에서 발표되지 않음 | 완전히 문서화된 방법론 및 수정 이력 (LogEc) [99][129] |
| 뷰 : 다운로드 비율에 미치는 예상 기계적 영향 | 다운로드에 비해 높은 뷰: 이메일 클릭스루가 낮은 의도 노출에서의 뷰 등록 | 방문을 다운로드로의 더 높은 전환: 트래픽은 의도 기반 | 비율은 광범위한 봇 트리밍 후에만 의미 있음; 발표된 수치는 필터 후 [129] |
아키텍처는 저자 심리에 영향을 미칩니다. SSRN의 높은 뷰-다운로드 비율은 상당 부분 설계 결과이기 때문입니다. push 모델은 광범위하고 낮은 의도의 노출을 생성합니다. 초록 스키밍은 또한 정당한 학술 행동입니다(연구자들은 전체 텍스트를 다운로드하지 않으면서 초록을 통해 정기적으로 분야를 모니터함). 따라서 전환되지 않은 뷰는 초록이 이미 정보 페이로드를 전달했다는 것을 의미할 수 있지, 독자를 격퇴했다는 의미가 아닙니다. SSRN 자신의 역사적 경험법칙은 Black과 Caron이 보고했듯이 대략 "3개의 초록 뷰가 1개의 실제 논문 다운로드를 초래한다"는 것이었습니다 [18]. 같은 저자들은 무결성 필터가 없으면 원본 카운터가 "5배 이상으로 부풀려질 것"이라고 지적했습니다 [18]. 섹션 5.2는 이러한 과거 기준점을 현대적 측정과 함께 배치합니다.
논문이 표현되는 방식의 두 가지 기계적 특성이 독자 관심과 함께 전환을 좌우하므로, 측정된 전환율은 부분적으로 연구의 속성이 아닌 인터페이스의 속성입니다. 하나는 플랫폼의 사용자 인터페이스입니다. 전체 텍스트가 인라인 인 브라우저 HTML 렌더링으로 제공되는지, 아니면 다운로드 가능한 PDF로만 제공되는지는 관심 있는 독자가 다운로드 카운터를 트리거하는지 여부에 상당히 큰 영향을 미칩니다. 브라우저에서 전체 텍스트를 소비하는 독자는 동일한 의도를 충족시키면서 뷰만 증가시키기 때문입니다. 다른 하나는 청중의 기기 구성입니다. 모바일 액세스는 데스크톱에 비해 전체 텍스트 PDF 검색을 억제하므로, 독자가 주로 휴대폰(소셜 미디어 링크 또는 모바일 메일 클라이언트에서)으로 접속하는 논문은 동일한 학술적 관심에도 불구하고 체계적으로 낮은 다운로드와 상대적으로 높은 뷰를 기록할 것입니다. 두 효과 모두 위에서 이미 확립된 분모의 기계적 부풀림과 동일한 방향으로 당겨지며, 둘 다 섹션 5.2의 경험적 범위를 고정된 임계값이 아닌 플랫폼 조건적 범위로 읽어야 하는 추가 이유입니다. 한 플랫폼의 인터페이스 및 기기 믹스에서 추정된 전환 규범은 둘 중 하나가 변경될 때 이식되기보다는 재보정되어야 합니다. 사용 지표 문헌은 플랫폼 간 다운로드 보고서와 카운팅 관례의 비교 가능성에 대해 동일한 신뢰성 주의를 제기합니다 [176].
4.5 예측 가능한 부작용: 유사성 자기대조와 메타데이터 위생
프리프린트 게시의 기계적 결과 중 두 가지는 예측 가능하며, 둘 다 불필요한 경보를 일상적으로 야기하므로, 둘 다 나머지 메커니즘과 함께 다루어야 합니다.
유사성 자기대조. SSRN에 게시된 작업논문이 나중에 저널에 제출될 때, 저널의 유사성 검색은 예상된 경우에 저자 자신의 프리프린트와 거의 완전한 일치를 표시합니다. iThenticate의 문서는 해석의 양쪽 절반을 명시적으로 명시합니다: 소프트웨어는 "표절을 확인하지 않으며, 유사성을 확인"하고, "동일한 저자에 대한 프리프린트 일치를 보면, 이는 표절이 아닙니다" [81]. 메커니즘도 문서화되어 있습니다. Crossref Posted Content로 등록된 프리프린트는 유사성 검사 비교 데이터베이스에 포함되므로, 자신의 보관된 프리프린트와의 일치는 설계대로 작동하는 시스템입니다 [36]. 편집자가 프리프린트 소스를 제외하더라도 저장소 메타데이터를 복제하는 2차 수집기도 수집되므로 일치가 나타날 수 있습니다 [81]. 저자의 대응은 방어적이라기보다 행정적이어야 합니다: 표시된 소스를 담당 편집자에게 저자 자신의 타임스탬프가 있는 프리프린트로 식별합니다. Crossref와 iThenticate 지침은 기계적 유사성 점수 임계값보다 정성적 편집 검토를 권고합니다 [36][81]. 검색 서비스 자체에서 지지하는 임계값이 없으므로 여기에는 숫자 임계값이 지정되지 않습니다. 이 조언이 전제하는 침착함은 출판사 정책에 문서화된 근거가 있습니다: 작업논문을 프리프린트 서버에 게시하는 것은 대부분의 학술 저널의 선행 출판 정책에서 허용되지만, 정책은 다양하며 대상 저널의 현재 정책을 확인해야 합니다; 프리프린트 입장은 Sherpa Romeo와 같은 레지스트리에서 공개적으로 색인됩니다. 현저한 예외는 의학 및 인접 임상 분야에 집중되어 있으며, 일부 저널은 여전히 선행 프리프린트 게시를 제한하거나 권하지 않습니다. 해당 분야의 저자는 제출 후가 아니라 게시 전에 대상 저널의 프리프린트 정책을 확인해야 합니다.
AI 작성 감지: 인접한 거짓 경보 채널. 더 새로운 검색 레이어는 구조적으로 유사한 거짓 경보 위험을 야기합니다. AI 작성 감지기는 문서화된 거짓 양성을 생성하며, 부담은 영어 모국어가 아닌 저자들에게 불균형하게 떨어집니다: 공개적으로 이용 가능한 7개의 GPT 감지기에 대한 Stanford 평가(이 연구는 Turnitin을 포함하지 않았음)에서, 모국어가 아닌 화자가 작성한 TOEFL 에세이의 평균 61.3%가 AI 생성으로 잘못 분류되었습니다 [97]. 기관 관행은 우려를 기록했습니다. 2023년 8월 Vanderbilt University는 신뢰성을 이유로 유사성 검사 소프트웨어의 AI 감지 기능을 공개적으로 비활성화했습니다: 공급업체의 주장된 거짓 양성률, 공개된 감지 방법론의 부재, 그리고 위에서 문서화된 모국어가 아닌 영어 저자들에 대한 동일한 불균형 부담 [163]. 여기서의 방어적 자세는 유사성 자기대조와 평행하며 대립적이라기보다 행정적입니다: 동시적 저자 증거로서 원고의 버전 기록과 초안 기록을 보존하고(아래 버전 위생에 대한 추가 주장), 모든 표시에 경보보다 문서화로 답합니다.
버전 관리 및 메타데이터 위생. 카운터가 논문 페이지당 누적되므로, 개정 관행은 지표 무결성에 직접 영향을 미칩니다. SSRN은 동일한 논문 페이지에 수정된 버전을 게시하여 누적된 카운터와 색인된 URL을 보존하는 것을 지원하는 반면, 논문을 삭제하고 다시 업로드하면 지표가 재설정되고 기존 링크가 끊어집니다(SSRN FAQ; 수정되는 지원 페이지, 2026년 8월 14일 액세스 [B-7]). 분류 선택은 마찬가지로 메타데이터 결과를 가지며, eJournal 라우팅을 결정하므로 논문의 주요 노출 이벤트를 결정합니다 [53]. 외부 색인화는 저자가 예상하는 것보다 더 긴 시간에 실행됩니다: SSRN은 Google Scholar 색인화가 검색 엔진에 의해 제어되며 "6-9개월 이상"이 소요될 수 있음을 명시합니다 [55]. 따라서 논문의 초기 카운터는 거의 전적으로 플랫폼의 내부 배포 메커니즘에 의해 생성되며, 이는 5.6절의 초기 0 해석을 고정합니다.
5. 해석 프레임워크: 누락된 척도 재구축
"이 숫자가 좋은가?"라는 질문은 비교 집단이 지정될 때까지 과학적으로 잘못 제기됩니다. 이 섹션은 공개된 경험적 기록을 누락된 비교 장치에 조립합니다: 명시적 소스 신뢰도가 있는 통합 벤치마크 지도(5.1), 경험적 변환 대역(5.2), 졸업식 해석 척도(5.3), 2차원 도달-변환 진단(5.4), 다차원 벤치마크 사양(5.5), 및 시간적 읽기 프로토콜(5.6). 값은 표본 프레임 및 나이와 함께 전체적으로 명시됩니다. 어느 것도 2026 플랫폼에 대한 보정된 백분위수가 아니며, 모두 5.1절의 인플레이션 경고에 따라 읽어야 합니다.
5.1 통합 벤치마크 지도
표 7은 섹션 2.5 감사에서 식별된 SSRN 사용 지표에 대한 모든 사용 가능한 발표된 벤치마크를 통합하며, 각각은 표본 추출 프레임과 출처 신뢰도의 명시적 진술을 포함합니다. 벤치마크는 자신의 프레임을 벗어나는 순간 오용되므로, 각 항목은 출처가 정당하게 수행할 수 있는 추론 역할과 그것을 제한하는 주요 한계를 명시합니다. 증거는 부족합니다: 이 지도는 서로 다른 프레임을 가진 5개 연구에 기초합니다: 2012년 한 법률 네트워크의 인구조사식 표본 [139], 2015년 플랫폼 자신의 상위 목록 스크래핑 [85], 2025년 단일 네트워크 횡단면 스냅샷 [83], 플랫폼 수준 집계 [1], 그리고 한 개의 세부 분야 분해 [168]입니다. 이러한 프레임들은 서로 교환 가능하지 않습니다: 상위 목록 스크래핑은 엘리트 꼬리를 설명하고, 네트워크 인구조사는 전형적인 논문을 설명하며, 플랫폼 집계는 둘 다를 설명하지 않습니다. 관련된 모든 분포도 강하게 우편향이므로, 평균은 체계적으로 중앙값을 초과하며 비전형적인 논문을 설명합니다.
표 7. SSRN 사용 지표에 대한 통합 벤치마크 지도, 표본 추출 프레임, 출처 신뢰도, 허용된 추론 역할 및 주요 한계.
| 벤치마크 | 값 | 출처 (연도; 표본 추출 프레임) | 출처 신뢰도 | 허용된 추론 역할 | 주요 한계 |
|---|---|---|---|---|---|
| 플랫폼에 게시된 후 약 2년 후 중앙값 논문 다운로드 | 63 (평균 122.55) | Siems 2016 [139]; n = 1,107개 LSN 논문은 두 개의 2012년 기간에 게시되었으며, 카운터는 2년 후에 읽혔습니다 | 중상: 표본 및 다운로드 수치 확인됨; 법학만; 2012년 코호트 | 일반 논문 분포의 역사적 보기 | 2년 법학 네트워크 기준점이지 현재의 플랫폼 전체 규범이 아닙니다 |
| 약 2년 후 중앙값 논문 초록 조회 | 369 (평균 564.62; 조회-다운로드 상관관계 0.852) | Siems 2016 [139] | 중상: 수치가 출처의 표 1에 대해 확인됨; 법학만; 2012년 코호트 | 일반 논문 도달 범위의 역사적 보기 | 같은 시대, 단일 분야 프레임; 조회 카운터는 더 오염된 수량입니다 (섹션 4.2) |
| 단일 네트워크 스냅샷에서 중앙값 논문 다운로드 | 87 (평균 221.3; p25 = 35; p75 = 206; p95 = 726; 중앙값 논문 나이 491일) | Jo & Li 2026 [83]; N = 2,361개 마케팅 연구 네트워크 논문, 2025년 8월 15일 스냅샷 | 높음: 발표된 표에 대해 확인됨; 다양한 종류의 두 가지 이상이 보고되었습니다 "발표된 대로" — 조회 p95 = 966은 의심되는 출처 오타입니다 (≈평균 위 0.32 SD; 행이 재검증을 위해 하향 조정됨), 변환 p95 = 77.7은 분모가 작은 비율 아티팩트입니다 (섹션 5.2); 표 5의 전체 패널 | 최근 횡단면 분포 및 변환 모델 | 한 네트워크, 한 분야, 한 날짜; 성숙한 논문; 궤적 없음 |
| 단일 네트워크 스냅샷에서 중앙값 논문 초록 조회 | 504 (평균 611.973; p5 = 151; p25 = 288; p75 = 833; p95 = 966 "발표된 대로") | Jo & Li 2026 [83]; 위와 동일한 표본 | 높음: 발표된 표에 대해 확인됨; p95 값(966)은 의심되는 출처 오타입니다 — ≈평균 위 0.32 SD — "발표된 대로" 재현되었고 저자 문의 대기 중 재검증으로 하향 조정되었습니다 | 최근 횡단면 도달 범위 분포 | 같은 단일 네트워크, 단일 날짜 프레임 |
| 조회→다운로드 변환, 경험적 대역 | 11–19% (≈ 5.3–9개의 초록 조회당 1개 다운로드) | Siems 2016 [139]; Willey & Knapp 2022/23 [172]; Jo & Li 2026 [83] | 중상: Siems, Willey–Knapp 및 Jo & Li 수치가 출처 표에 대해 확인됨 | 조건부 참여 규범 (변환) | 표본 추출 프레임이 적음; 분모는 봇-팽창 가능하므로 측정된 변환은 하한이고 조회가 더 팽창된 카운터로 남아 있습니다 (섹션 4.2) |
| 역사적 플랫폼 전체 경험 법칙 | ~3개 초록 조회 : 1개 다운로드 (~33%) | Black & Caron 2006 [18], SSRN 자신의 통계 보고 | 중간: 그대로 확인됨; 구식 (2006); 플랫폼 전체 | 지표 해부학 및 무결성 이력 | 초기 플랫폼 시대; 현재의 규범이 아닌 상한 기준점 |
| 진입 기준, 역대 상위 10,000개 논문 | ≥160개 평생 다운로드 (≈ 2016년 7월 플랫폼 전체 텍스트 논문 주식의 상위 1.8%, 571,040개 [1]); 그룹 내 중앙값 805; 평균 1,800; 최대 152,242 | Kakushadze 2016 [85]; 2015년 SSRN 상위 목록 스크래핑; 367,478개 논문 | 높음: 발표된 표에 대해 확인됨; 상위 목록 프레임; 단일 저자 작업 | 분포 형태 및 꼬리 동작 | 상위 목록 선택; 현대 중앙값 논문 추정에 부적합 |
| 진입 기준, 상위 30,000명의 저자 | 129개 총 다운로드 (최소); 그룹 내 중앙값 1,626개 총; 논문당 중앙값 210개 다운로드; 최대 824,762 | Kakushadze 2016 [85]; 그룹 SSRN의 "상위 10%" 저자로 설명된 자신의 편지 [161] | 높음: 발표된 표에 대해 확인됨 | 저자 포트폴리오 수준에서의 꼬리 동작 | 같은 상위 목록 선택; 2015년 버전 |
| 조정되지 않은 플랫폼 전체 평생 평균 | ~논문당 222개 다운로드 (~뒤따르는 12개월에서 35개) | 2023년 12월 현재 플랫폼 합계에서 계산됨: 1,157,048개 전체 텍스트 논문에 걸친 256,678,716개 평생 다운로드; ALL-SIS 2024 [1] | 중간: 파생된 집계; 오래된 논문에 의해 기계적으로 팽창됨; 개인 자 척도가 아닙니다 | 플랫폼 규모의 집계 보정만 | 20년 축적에 대한 평균; 실제 논문의 거의 없는 부분을 설명합니다 (섹션 3.3) |
| 단일 분야 내 세부 분야 확산 | ~논문당 다운로드 평균에서 8배 (438.35 회사/증권/금융법 vs 53.48 농업법) | Whalen 2018 [168]; 94개 LSN 전자저널, ~250,000개 논문 | 중상: 출처에서 확인됨; 2018; 평균, 중앙값 아님 | 분류 및 세부 분야 이질성 | 평균, 나이가 일치하는 중앙값이 아님; 법학만; 2018 |
| 초기 다운로드 → 후속 인용 | r ≈ 처음 180일 동안 0.39–0.43 (≈설명된 분산의 16%) | Brody, Harnad & Carr 2006 [25]; arXiv (HEP), N = 14,442 | 높음: 확인됨; 다른 플랫폼, 전이성이 가정됨 (나타나지 않음) | 다운스트림 예측 검증 | 다른 플랫폼 및 시대; 논문 수준의 상관관계는 적습니다 |
| 접근의 달력 구조; 접근→인용 지연 | 주말에 접근이 약 11% 낮고 여름에 약 50% 낮음; 접근 변화 후 약 9개월 후의 거의 단위탄력적 인용 반응 | Yuret 2026 [178]; 7개 저널에서 약 1년간 추적한 1,500개 이상의 논문 | 높음: DOI, 저널, 제목은 Crossref를 통해 검증됨 (2026년 8월 14일); 네 개의 수치 모두 — 7개 저널에서 1,500개 이상의 논문, 주말에 접근이 약 11% 낮고 여름에 약 50% 낮으며, 약 9개월 후의 거의 단위탄력적 인용 반응 (접근이 10% 증가하면 인용이 약 10% 증가하는 관계) — 출판된 논문 초록에 대해 그대로 검증됨 (Springer, 2026년 8월 15일) | 시간 정규화 및 예측 검증 — CSAB 뒤의 달력 정규화 기준점 | 저널 접근 데이터, SSRN 특정이 아님 |
| 계산 관례에 대한 계수 민감도 | 공급업체 다운로드 보고서는 비교 가능한 플랫폼의 약 2배 수준일 수 있음 (보고된 수치의 43%에서 "축소된" 계수); 논문 수준의 지표는 명시적인 데이터 무결성 선별이 필요함 | Wood-Doughty et al. 2019 [176]; Gordon et al. 2015 [69] | 중상: 두 출처 모두 검증되었으며 이미 4.1–4.3절에서 인용됨 | 무결성 및 비교 가능성 경고 — 모든 플랫폼 간 또는 공급업체 간 비교의 정확도를 제한함 | SSRN의 직접적인 벤치마크가 아님; SSRN 특정 감사는 존재하지 않음 |
지도의 세 가지 구조적 해석이 따릅니다.
평균은 전형적인 논문이 아닙니다. 유일한 최근 발행된 분포에서 평균(221.3)은 중앙값(87)의 2.54배이며 75백분위수(3.3절)를 초과합니다 [83]. Siems의 초기 조사에서 평균은 중앙값의 약 2배였습니다 [139]. 플랫폼 수준의 평균인 약 222개의 생애 다운로드 [1]는 모든 개인 척도 중 가장 부적절합니다. 이는 모든 연령의 논문에 의한 20년간의 축적을 집계합니다.
모든 벤치마크는 빈티지를 가지며, 빈티지 편향의 방향은 비교에 따라 달라집니다. 연간 플랫폼 다운로드는 2000년 약 50만 건과 2005년 300만 건 [18]에서 2016년 1,290만 건과 2023년 4,060만 건 [1]으로 증가했으며, 이는 2016년과 2023년 사이에 3.15배 증가했고, 같은 기간 논문 자산은 약 2.03배 증가했습니다(571,040에서 1,157,048 [1]). 그림 5는 이 궤적을 나타냅니다. 다운로드가 논문 자산보다 빠르게 증가했기 때문에, 논문당 다운로드 흐름은 약 55% 증가했습니다(연간 논문당 약 22.6개에서 약 35.1개 [1]), 따라서 고정된 2015년 임계값은 현재 전형적인 논문이 얻는 것의 더 작은 점유율을 나타냅니다. 2026년의 절대 수준 대역으로 읽으면, 약 160개 다운로드 최상위 목록 항목과 같은 오래된 임계값은 따라서 보수적이 아니라 관대합니다: 이를 통과하는 것은 2015년보다 오늘날 더 엄격하지 않으며 더 많지도 않습니다. 편향은 구성에 따라 다릅니다. 계속되는 우측 왜도에서 백분위수 위치의 경우 오래된 앵커가 여전히 꼬리를 과소평가할 수 있지만, 절대 계수의 경우 다운로드 인플레이션이 이를 약하게 만들므로, 이 한정 없이 오래된 임계값이 "보수적 하한"으로 인용되어서는 안 됩니다. 2015년 임계값을 후속 플랫폼 성장으로 곱하는 것도 마찬가지로 부적절합니다: 저자 구성, 배포 채널, 필터링, 주의력에 대한 경쟁이 모두 다운로드 흐름과 함께 변경되었습니다.
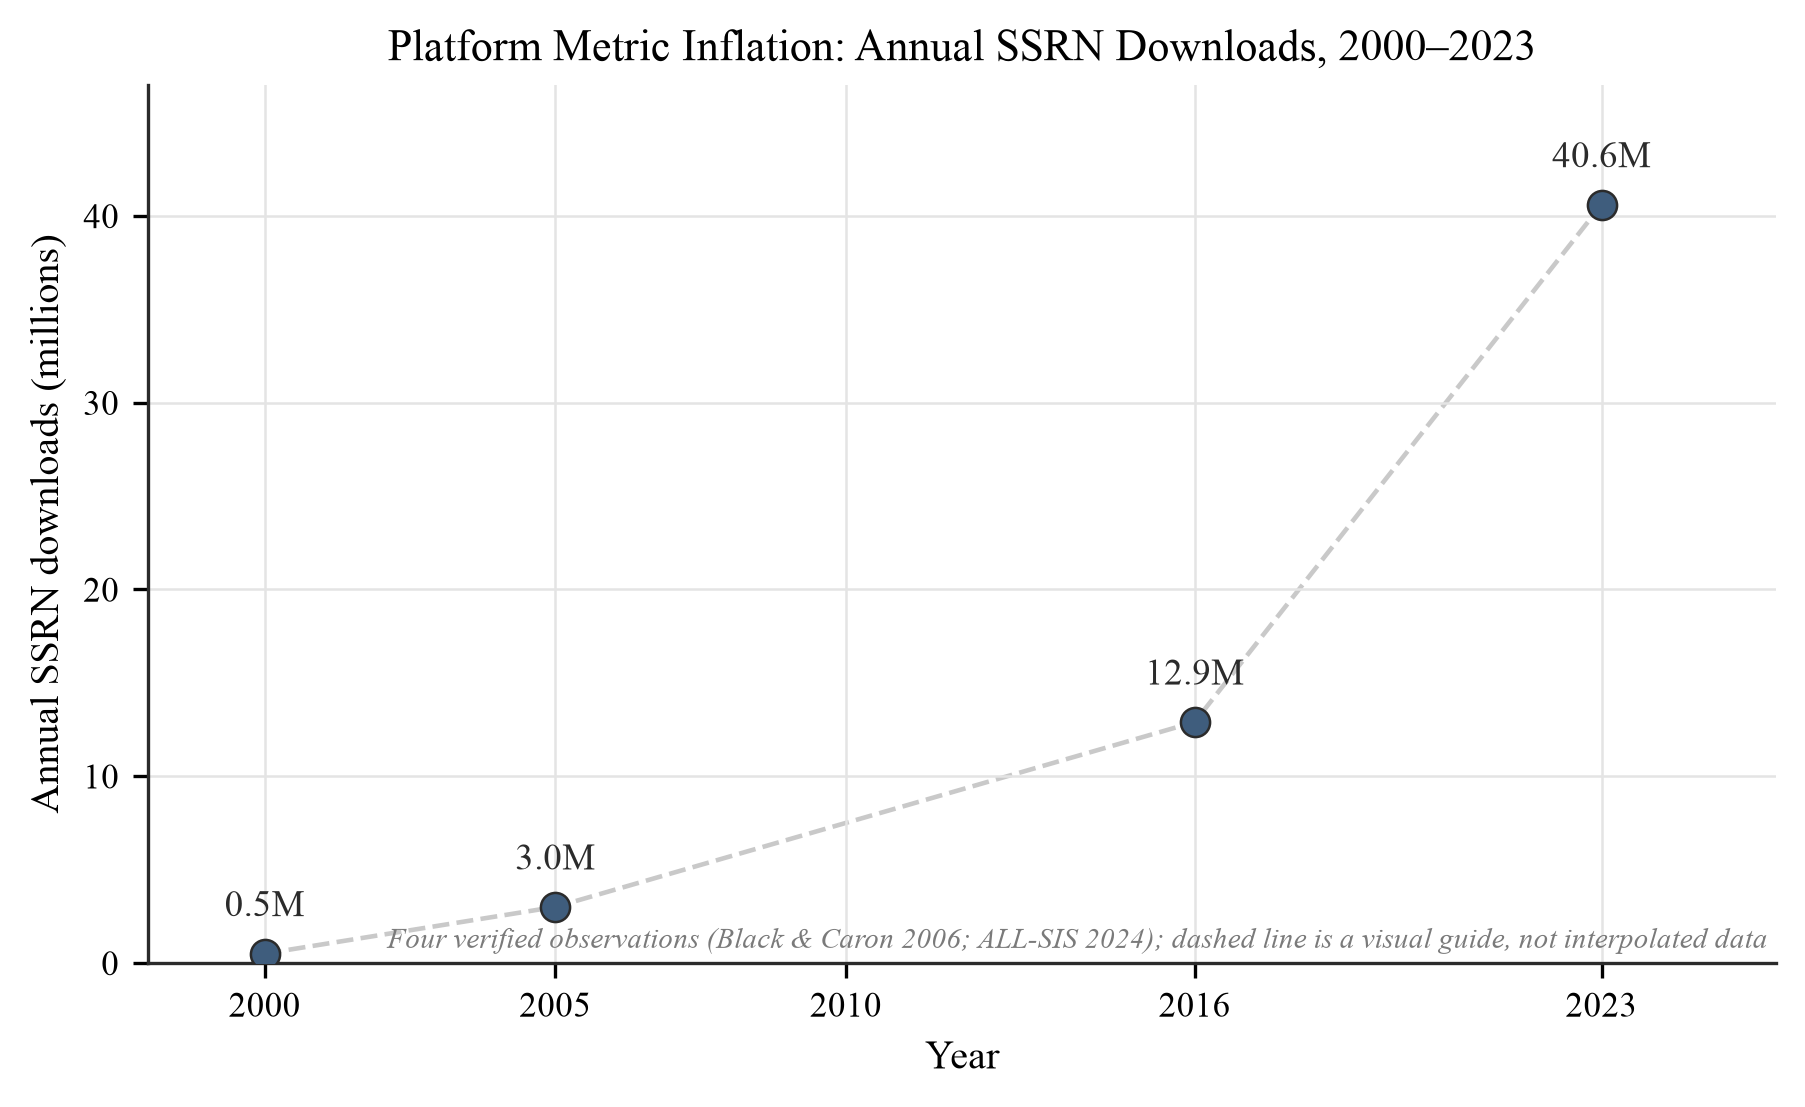
그림 5. 플랫폼 지표 인플레이션, 2000–2023. 연간 SSRN 다운로드: 약 50만 건(2000) 및 약 300만 건(2005) [18]; 1,290만 건(2016) 및 4,060만 건(2023) [1]. 다운로드 흐름이 논문 자산보다 빠르게 증가했기 때문에(2016년에서 2023년 사이 약 3.15배 대 약 2.03배 [1]), 논문당 다운로드 흐름을 약 55% 상승시켜, 2012–2015 샘플에서 추정한 절대 벤치마크는 2026년 수치에 대해 보수적이 아닌 관대한 대역으로 읽힙니다. 여기에 나열된 네 개의 검증된 연도 값만 표시되며, 이들 사이의 보간은 암시되지 않습니다.
현재의 백분위수 출처가 존재하지 않습니다. 2.5절 감사에서 2020년 이후의 플랫폼 전체 분포 연구는 식별되지 않았습니다(2025년 단일 네트워크 스냅샷 [83], 2026년에 발행됨이 유일한 최근 발행된 외부 샘플이며), 2026년 7월 15일 이후 플랫폼은 백분위수를 재구성할 수 있는 비교 데이터를 더 이상 발행하지 않습니다. 격차는 통화 및 플랫폼 특이성의 문제입니다. 사전 인쇄물 주의의 분포와 부등식은 다른 저장소에서 성숙한 연구 영역입니다(bioRxiv 예금의 인용 및 계량 지표 프로필은 전체 서버에 걸쳐 특성화되었습니다 [62]), 그리고 특히 SSRN 다운로드의 준로그정규분포 형태는 이미 2020년 이전에 Kakushadze에 의해 확립되었습니다 [85]. 누락된 것은 현재의, SSRN 특정의, 선셋 이후의 백분위수 분포입니다. 위의 지도는 사용 가능한 프레임으로부터 구성되었으며, 이는 연구 의제에서 제안된 커뮤니티 벤치마크 데이터셋의 주장입니다(8절).
5.2 변환 대역
다운로드와 초록 조회 수의 비율은 합리적으로 안정적인 교차 연구 규범을 가진 유일한 대시보드 수량이며, 저자들은 다른 어떤 것보다 이를 더 일관되게 잘못 읽습니다. 순진하게 읽으면, 변환되지 않는 모든 조회는 거절로 간주되며, 40개의 조회와 7개의 다운로드를 가진 저자는 "82.5% 실패율"을 인식합니다. 이러한 해석은 기계적 근거와 경험적 근거에서 모두 잘못되었습니다.
섹션 4는 메커니즘을 확립했습니다: 분모(조회)는 봇 오염이 더 많고 아키텍처 인플레이션이 더 많은 수량입니다. 왜냐하면 푸시 모델 이메일 클릭스루와 크롤러 트래픽은 독자의 의도를 암시하지 않으면서 조회를 축적하는 반면, 다운로드 카운터는 적극적으로 감사됩니다 [144][99][106]. 자동화된 트래픽이 다운로드보다 조회를 더 많이 인플레이트하는 한, 측정된 변환율은 진정으로 관심 있는 인간 방문자의 변환에 대한 하한입니다. 섹션 4.2는 AI 시스템이 전문을 검색하는 경우 그 비대칭성이 더 이상 가정될 수 없는 이유를 설명하며, 하한은 그에 따라 약해집니다. 경험적으로 발표된 측정은 좁은 대역으로 수렴합니다. Siems는 LSN 조사에서 다운로드당 조회 비율의 중앙값 0.171(평균 0.187)을 측정했습니다 [139]. Willey와 Knapp은 상위 기사 그룹에서 15%의 변환, 단일 인용 기사에서 11%의 변환을 보고합니다 [172]. Jo와 Li의 스냅샷은 초록 조회 100개당 중앙값 18.9개의 다운로드를 산출합니다 [83]. 결과적인 경험적 대역은 11–19%입니다. 즉, 대략 초록 조회 5.3–9개당 다운로드 1개입니다. SSRN의 자체 경험칙 ~3 : 1 (~33%) [18]은 대역 위에 있으며 초기 시대의 플랫폼 전체 상한선으로 읽는 것이 최선이며 현재 규범이 아닙니다. 교차 도메인 예시로서(모집단과 의도는 범주적으로 다릅니다), 이 범위의 브라우즈-커밋 비율은 소비자 소프트웨어에서 높은 것으로 간주될 것이며, 여기서 전형적인 프리미엄 무료-유료 변환 벤치마크는 낮은 한 자리 수에 군집합니다 [10]. 이 비교는 순전히 예시적이며, "7 out of 40"이 관심 부재를 나타낸다는 직관을 재구성합니다. 그림 6은 추정값을 표시합니다.
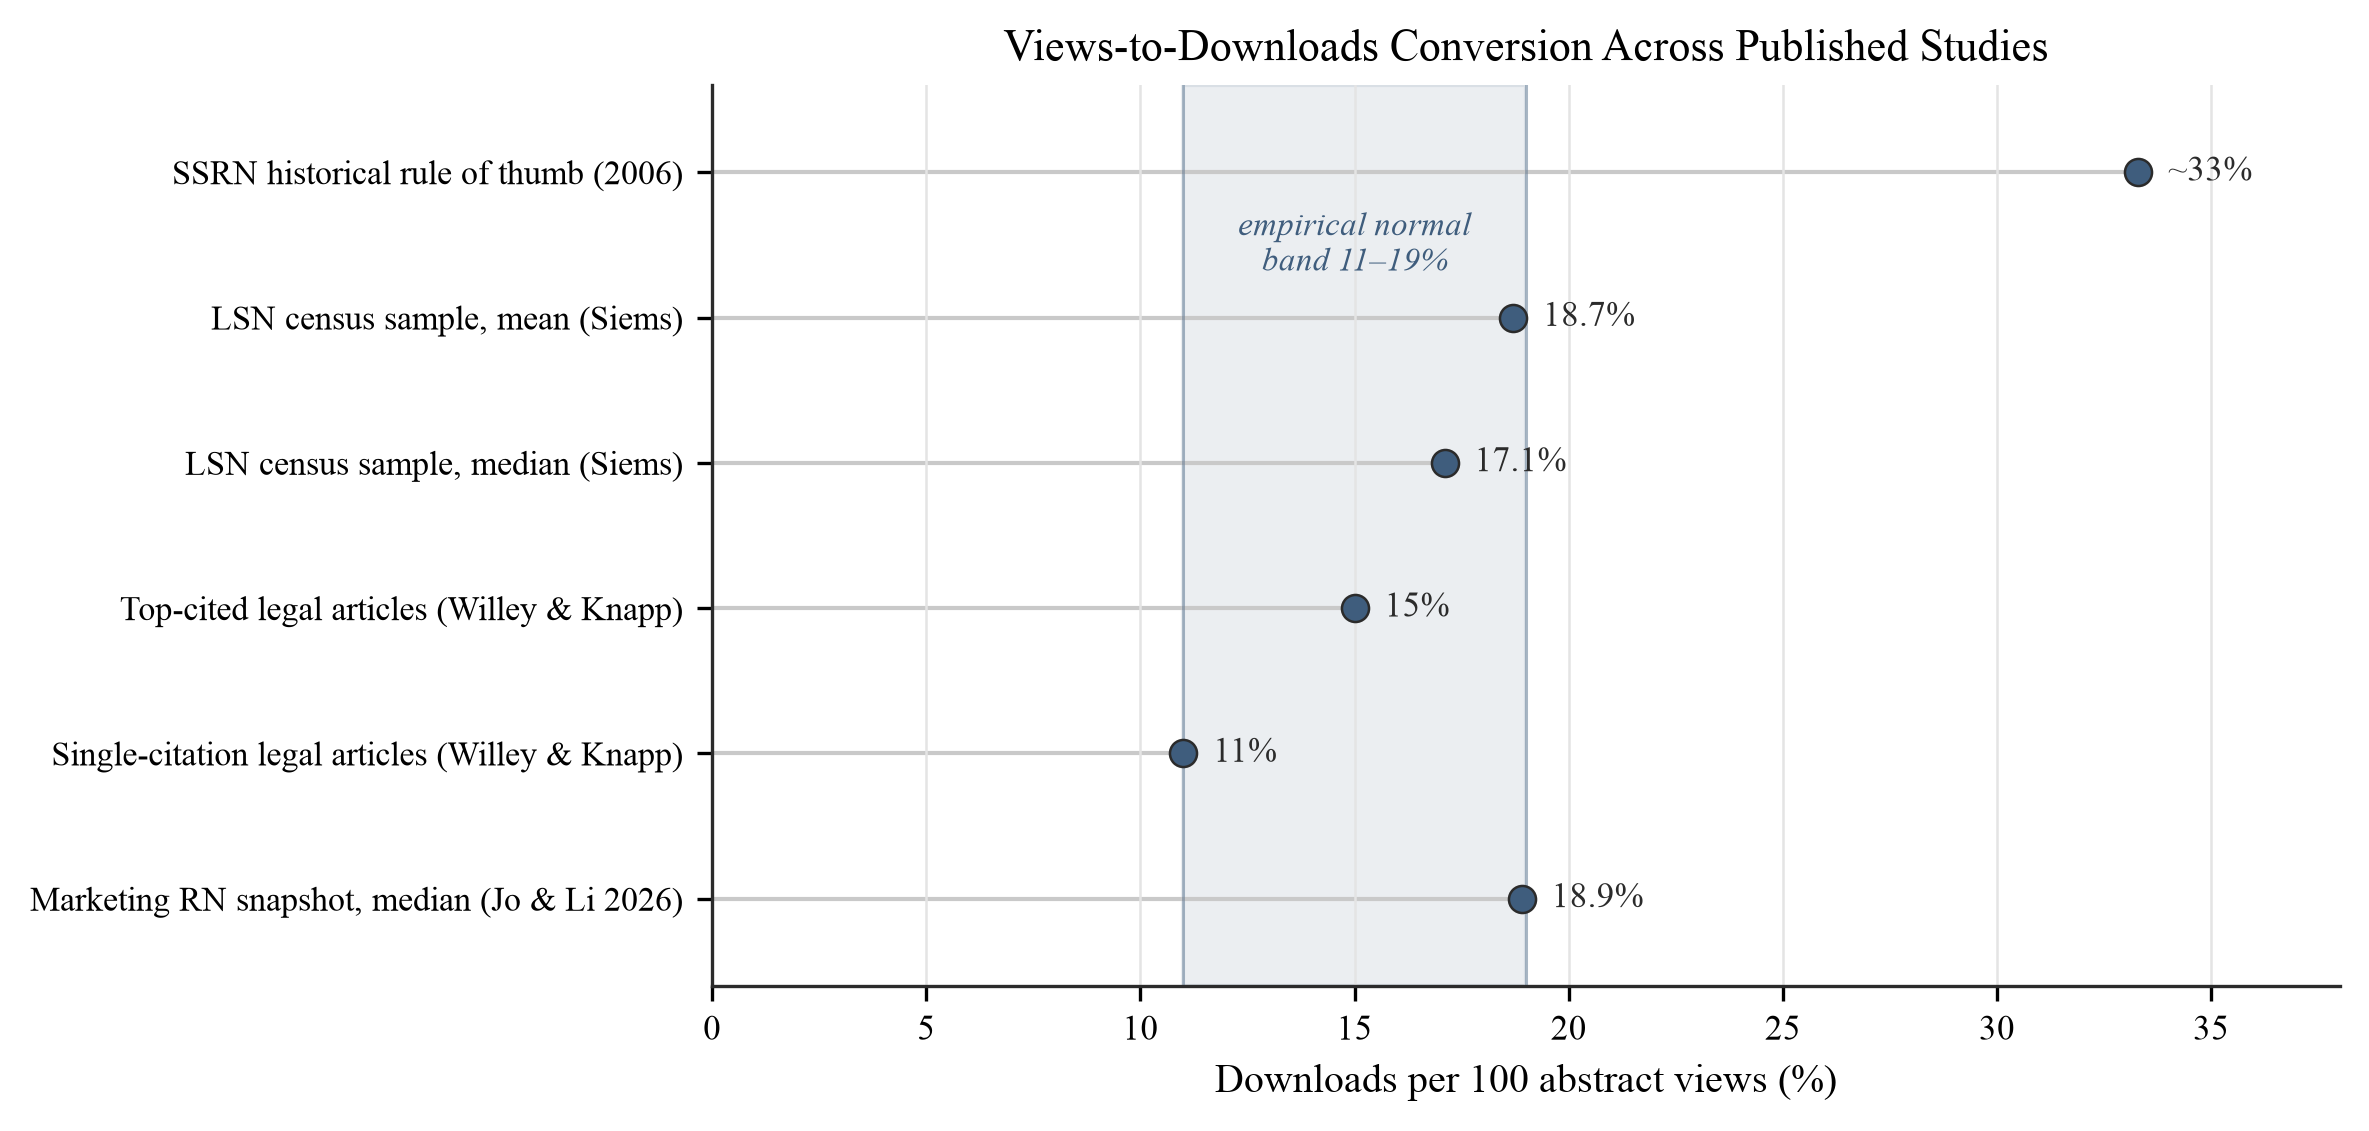
그림 6. 연구 전반에 걸친 조회-다운로드 변환. 발표된 기록 전반에 걸친 변환 추정: SSRN의 역사적 경험칙 ~33% (2006년 보고) [18]; LSN 조사 평균 18.7% 및 중앙값 17.1% [139]; 상위 인용과 단일 인용 법률 기사 중 각각 15% 및 11% [172]; 2025 마케팅 연구 네트워크 스냅샷에서 초록 조회 100개당 중앙값 18.9개 다운로드 [83]. 음영 대역은 11–19%의 경험적 정상 범위를 표시합니다 — 이질적인 추정값의 봉투(전체 네트워크 중앙값 및 출처가 통계 유형을 지정하지 않은 인용 선택 부분표본 수치); Jo와 Li 표본 평균(100당 23.7)은 이를 초과합니다. 모든 값은 인용된 출처에 발표된 대로입니다. 새로운 추정값은 도입되지 않습니다.
대역의 구성원은 서로 다른 표본의 서로 다른 통계이므로, 이는 이질적인 포인트 추정값의 봉투입니다. Siems (17.1%)와 Jo와 Li (18.9%) 수치는 전체 네트워크 표본의 중앙값인 반면, Willey와 Knapp의 15%와 11%는 인용 선택 부분표본(상위 인용 대 단일 인용 법률 기사)에 대해 보고되며, 출처가 통계 유형을 지정하지 않고 해당 선택이 대역의 하한이 있는 위치의 이유입니다. 상한은 훨씬 더 부드럽습니다: Jo와 Li 표본의 평균 변환인 조회 100당 23.7개 다운로드 [83]는 대역 위에 있으며, 해당 표본의 집계 평균의 비율(221.346 ÷ 611.973 = 조회 100당 36.2)과 급격히 다릅니다. 평균의 비율 36.2이 비율의 평균 23.7보다 훨씬 멀리 위에 있다는 것 자체가 진단적입니다. 평균의 비율은 대수적으로 논문당 변환율의 조회 가중 평균이기 때문에, 비율의 가중치 없는 평균을 초과하는 것은 도달과 변환 간의 양의 공분산을 의미합니다: 더 높은 조회 논문은 다소 더 높은 비율로 변환되며, 더 낮은 비율이 아닙니다. 해석은 보수적입니다: 작은 분모 인플레이션은 비율의 가중치 없는 평균을 위로 밀어올리므로 이러한 순서에 대항하여 작용하므로, 이에도 불구하고 평균의 비율을 위에서 관찰하면 양의 의존성 결론이 덜 견고하지 않고 더 견고합니다.
대역은 이 기사의 중앙 작업 예를 제공합니다. 발표된 앵커에서, 40개의 초록 조회를 가진 논문은 대략 4–8개의 다운로드를 산출할 것으로 예상됩니다. 제목의 "7개의 다운로드"는 40개의 조회에서 17.5%의 변환이며, 대역 내에 착지하지만 이 분모에서 넓은 불확실성을 전달하는 포인트 추정값입니다. 7 of 40에 대한 정확한 95% Clopper–Pearson 간격은 약 7.3%에서 약 32.8%까지 실행되며, 양쪽에서 대역을 신뢰합니다: 40개의 조회만으로는 추정값을 대역의 너비로 해결할 수 없으므로, 해석은 분류가 아닌 선별 결과입니다. 두 가지가 예를 추가로 제한합니다. 분모는 작으며(아래에서 언급한 불안정성), 비교는 나이가 맞지 않습니다: 대략 20일째에 40개의 조회는 초기 생활 독서이며, 앵커 중앙값은 성숙한 표본에서 나옵니다(Siems 2년 [139], Jo와 Li 중앙 논문 나이 491일 [83]), 위치 1, 5 및 섹션 5.6은 초기 생활 노출이 다른 체계라고 주장하므로, 나이 축이 정렬되지 않습니다. 따라서 방어 가능한 해석은 17.5%가 선별 결과로 교차 연구 대역과 일치한다는 것이며, 정확한 모집단 백분위수가 아니며 "편안하게 내부"도 아닙니다. 그러한 수치가 유발하는 고통은 독서 부재가 아니라 척도 부재를 반영합니다. 기저 앵커의 빈티지와 범위는 섹션 9에 설정되어 있습니다.
작은 분모는 비율을 불안정하게 만듭니다. 2개의 조회수와 1개의 다운로드를 가진 논문은 명목상 50%의 전환율을 가지지만, 그 추정치는 500개의 조회수를 기반으로 구축한 것보다 더 많은 신뢰를 받을 자격이 없습니다. 모든 공개적인 벤치마킹의 경우, 경험적-베이즈 수축을 참고율을 향해 적용하면 작은 분모가 극단적인 점수를 생성하는 것을 방지할 수 있습니다(섹션 8.3 및 8.8). 이 대역은 양방향 진단으로도 작동합니다. 전환율이 대역보다 훨씬 낮으면 중요한 분모에서 일반적으로 제목–초록–본문 불일치를 나타냅니다. 독자들이 도착해 초록을 읽고 떠나며, 이는 실행 가능한 소통 문제(제목과 초록을 다시 작성)입니다. 연구 품질에 대한 판정이 아닙니다. 전환율이 대역보다 훨씬 높으면 초록 열람으로는 설명할 수 없는 트래픽(언론 보도, 강좌 채택 또는 바이러스 유포)을 신호하며, 조회수의 출처를 확인하도록 촉구합니다. 어느 편차도 그 자체로는 연구 품질에 대해 아무것도 입증하지 않습니다. 추가 한정은 발견이 아닌 가설입니다. 전환율은 개별 논문의 특성이 아닌 독자 열람 스타일의 특성으로서 분야에 따라 체계적으로 달라질 수 있습니다. 큰 분야는 많은 초록 방문과 적은 다운로드를 보이는 "윈도우 쇼핑" 행동을 보일 수 있으며, 소규모의 매우 참여도가 높은 커뮤니티는 더 높은 전환율로 변환합니다. 위의 대역은 너무 적은 프레임에서 추정되어 이를 해결할 수 없으므로, Study 1(섹션 8.6)은 필드별로 층화된 전환을 출력에 포함합니다.
진단, 결코 목표가 아님: 반게임화 제약. 전환 대역이 강력한 이유는 규범으로 읽을 수 있기 때문이며, 그 힘은 위험을 동반합니다. Goodhart의 법칙은 목표로 채택된 측정치가 좋은 측정치가 되기를 멈춘다고 명시합니다[67]. 이는 의사결정에 사용되는 사회 지표의 부패에 관한 Campbell의 법칙과 평행합니다[27]. 11–19% 대역 또는 섹션 5.5의 벤치마크 프레임워크의 어떤 구성 요소라도 승진 임계값("논문은 전환 대역 내에 있어야 계산됨")으로 채택된다면, 그 비율은 즉시 관찰의 대상이 아닌 최적화의 대상이 됩니다. 공격은 구체적이고 저렴합니다. 분모가 더 조작하기 쉬운 양이므로(섹션 4.2), 다운로드에 고정된 비율로 초록 조회수를 조율된 방식으로 증가시키면 비율이 대역 내에 유지되고 공학적 신호가 유기적 전환과 통계적으로 구별되지 않게 됩니다. 프레임워크의 답변은 정의의 문제입니다. 전환 대역, 범위–전환 진단(섹션 5.4) 및 CSAB 구성 요소(섹션 5.5)는 진단 벡터이며, 결코 목표가 아니며, 어떤 구성 요소도 승진 기준으로 읽을 수 없습니다. 게임화에 저항하는 메커니즘은 설계에 내장됩니다. 대역은 하한으로 명시됩니다. 왜냐하면 그 분모는 봇-부풀릴 수 있으므로 읽기는 구성상 팽창에 대해 보수적입니다. 섹션 8.3의 이상 프로토콜은 삭제가 아닌 플래그이므로, 공학적 급증이 보존되고 무음으로 흡수되지 않고 가시화됩니다. 섹션 4.1의 무결성 필터링은 이미 가장 감지 가능한 조율된 활동을 선별합니다. 진단으로 읽으면 대역은 게임화를 대역 외 또는 내부적으로 일관되지 않은 서명으로 노출합니다. 목표로 읽으면 정확히 탐지하려는 조율을 초대할 것입니다. 이 입장은 프레임워크를 확립된 연구 평가 개혁 합의와 일치시킵니다. 단일 숫자와 저널 브랜드 프록시를 거부하고 연구의 자체 내용에 대한 평가를 선호하는 San Francisco Declaration on Research Assessment(DORA)[8], 그리고 전문가 판단을 위한 쉬운 지표의 바로 이 대체를 조심하는 원칙을 가진 Leiden Manifesto[78].
다운로드에는 공개 감시 추적이 없음: 대역을 바닥으로 읽을 추가적인 이유. 인용과 다운로드 사이의 구조적 비대칭은 게임화 우려를 심화시킵니다. 인용은 공개적이고 검사 가능한 흔적을 남깁니다. 인용 문서가 존재하고, 발견 가능하며, 확인할 수 있으므로 인용 조작은 원칙상 제3자가 감사할 수 있습니다. 다운로드 카운터는 그러한 공개 추적을 남기지 않습니다. 이는 플랫폼의 서버에서의 개인 집계이며, 어떤 요청이 계산되었는지, 필터링되었는지 또는 재설명되었는지에 대한 외부 기록이 없으며, 이는 사실 이후에 외부 관찰자가 재구성할 수 없는 은폐된 게임화에 고유하게 노출됩니다. 그 노출은 분모의 봇-오염 이상의 추가적인 이유로, 측정된 전환율을 점 추정치가 아닌 하한으로 취급할 이유입니다(섹션 4.2의 AI 검색에 대한 주의와 함께), 항상 카운터를 이상 프로토콜 및 프레임워크가 의존하는 문서화된 무결성 필터링과 쌍을 이룹니다(섹션 4.1). 감시 추적의 부재는 카운터를 불신할 이유가 아닙니다. 이는 그것을 보수적으로 읽을 이유이며, 조작된 읽기를 탐지 가능하게 유지하는 플래그-삭제 안 함 규칙을 주장할 이유입니다(섹션 8.3).
대역은 보정 목표이며, 상수가 아닙니다. 11–19% 수치와 모든 CSAB 임계값을 어떻게 인용해야 하는지에 대해 한 가지 결과가 따릅니다. 이들은 분야별로, 플랫폼별로 보정할 수량입니다(섹션 4.4, 5.5). 그 보정의 메커니즘은 이미 지정되었습니다. 필드별로 층화된 Study 1(섹션 8.6)은 프레임워크가 필요로 하는 필드별 전환 및 다운로드 분포를 제공하도록 설계되었으며 소비하도록 구축되었습니다. Study 1이 보도될 때까지, 부록 E의 보관 횡단면은 필드 해결 추정치를 제공합니다. 최소 20개 논문을 보유한 14개 분야에 걸쳐 중앙값 전환은 Energy의 0.134에서 Computer Science의 0.195까지 실행되며, 약 1.5배의 확산이 있으며, 논문 나이를 고정하면 0.134에서 0.224까지, 약 1.7배입니다. 다운로드 자체의 3배에서 5배 분야 확산에 대해 설정하면, 전환은 두 수량 중 더 휴대 가능한 것으로, 이는 진단으로 사용 가능하게 만드는 것입니다. 나이는 그것이 생존하지 않는 차원입니다. 테스트할 수 있을 만큼 큰 모든 분야 내에서 전환은 논문이 나이가 들면서 떨어지며, Spearman 계수는 최소 40개 논문을 보유한 8개 분야에 걸쳐 −0.14에서 −0.41까지입니다. 논문 나이 없이 인용된 전환 대역은 나타나는 것보다 적게 작동합니다.
5.3 단계별 해석 척도
Post-Rankings 저자들은 가장 눈에 띄게도 h-지수 해석 가이드의 확립된 형식 [118]에 따른 단계별 척도가 부족합니다. 이 척도는 원시 지표를 평이한 언어의 밴드로 변환합니다. 5.1–5.2절에서 이를 위한 재료를 제공합니다. 표 8은 4가지 수량에 대한 제안된 척도를 제시합니다: 논문 수준의 평생 다운로드, 첫 달 다운로드, 조회-다운로드 전환율, 그리고 저자 수준의 총 다운로드입니다.
표 8. SSRN 지표에 대한 제안된 해석 척도. 밴드는 2012–2015년 증거 [139][85][18][172]를 종합합니다. 논문당 다운로드 흐름이 그 이후로 증가했기 때문에 (5.1절), 절대적 임계값은 2026년에 대해 관대한 밴드로 읽히는 것이 보수적 밴드보다 낫고, 어쨌든 근사치로 읽혀야 합니다. 첫 달 열은 척도의 보정된 단계가 아니라 광범위한 불확실성을 갖는 사전 등록된 예측으로, 연구 1의 예상 패널에서 검증될 예정입니다 (8.6절). 그 셀은 임계값이나 승격 단계로 읽혀서는 안 됩니다 (본문 참고). 강함/예외적 경계의 10,000은 저자의 임시 추정치입니다: 2.5절 감사에서 확인된 공표된 출처 중 10,000 다운로드를 백분위수와 연결한 것이 없습니다. 신생 밴드는 새로운 수치를 도입하지 않습니다: 그 상한은 기존의 2년 중앙값 앵커인 63입니다 [139]. 밴드 경계는 정수로 설정되고 대략 1개 밴드 폭으로 유지됩니다: 무결성 문헌에서 확립된 정밀도 상한 (3.1절, 4.1–4.3절)은 더 세밀한 단계를 거짓 정확성으로 만들므로, 밴드의 대략성은 의도적입니다. 평이한 언어 판정 열은 다운로드 척도만 설명하며 전환율 열로 전이되지 않습니다: 18.9% 중앙값 전환은 "견고함"보다는 보통이고, 27.2% p75는 "강함"이 아닙니다. 평생 다운로드 경계는 구성상 겹치지 않습니다 (신생은 63 미만, 중간은 63–159, 견고함은 160 이상). 표가 상위 행 사이의 공유 끝점을 인쇄하는 곳 — 견고함과 강함 사이의 800, 그리고 해당 전환율 및 저자 수준 절단점 — 구간은 반열림이며, 각 공유 값은 상위 밴드에 속합니다. 두 평생 경계값 자체는 통약 불가능한 참조 클래스에서 도출됩니다: 63은 단일 분야 법학 학문 센서스의 2년 기간 중앙값 [139]인 반면, 160은 전체 플랫폼 상위 목록에 대한 평생, 일생 진입 임계값 [85]입니다. 따라서 이들은 서로 다른 시계 (고정된 2년 논문 연령 대 무한 평생 누적) 위에 있으며 서로 다른 모집단 (한 분야 대 모든 분야)을 설명하므로, 이들을 단일 절대 사다리로 합치는 것은 서로 다른 연령, 분야 및 선택 규칙을 가진 참조 클래스의 조합입니다 — 연구 1의 분야 및 연령 특정 백분위수가 제거하도록 설계된 한계입니다. 이 앵커의 구조적 한계가 강조할 가치가 있습니다: 사용 가능한 참조점이 2년 중앙값 (63 [139]) 및 플랫폼의 상위 꼬리에 집중되어 있기 때문에, 5개 중 4개의 언어 밴드 — 중간, 견고함, 강함, 예외적 — 중앙값 이상의 논문을 설명하므로, 척도는 중앙값 위에 조밀하고 대부분의 논문이 실제로 속하는 광범위한 50번째–98번째 백분위수 범위 전체에 걸쳐 약하게만 구분합니다. 이 압축은 상위 꼬리 증거에 앵커링하는 직접적인 결과입니다. 평범한 것을 단순한 중앙값 위의 것에서 분해하는 것은 연구 1의 분야 및 연령 특정 백분위수를 기다립니다. 척도는 규범적이 아니라 예시적입니다: 연구 1의 예상 패널 (8.6절)이 이러한 오래된 절대 앵커를 대체할 분야 및 연령 특정 백분위수를 보정할 때까지 어떤 밴드 경계도 임용, 채용 또는 승격 결정에 합격/불합격 임계값으로 들어가서는 안 됩니다.
| 밴드 | 논문: 평생 다운로드 | 논문: 첫 달 다운로드 (외삽) | 전환율 (다운로드 / 조회) | 저자: 총 다운로드 | 평이한 언어 판정 |
|---|---|---|---|---|---|
| 신생 | 2년 중앙값 63 미만 [139] | — (별도의 앵커 없음; 본문 참고) | — (분모가 일반적으로 너무 작음; 5.2절) | — | 너무 이른 시기이거나 분야 중앙값 이하 — 젊고 틈새 논문의 통계적 규범. 품질이 아닌 노출을 먼저 진단합니다 (5.4절, 5.6절) |
| 중간 | 63–159 | <15 | <11% | <~130 | 플랫폼의 전형; 중앙값 밴드 |
| 견고함 | 160–800 | 15–50 | 11–19% | ~130–1,600 | 역사적 상위 목록 진입점에서 또는 그 이상 |
| 강함 | 800–10,000 | 50–250 | 19–30% | 1,600–10,000 | 역사적 상위 목록의 전형 |
| 예외적 | >10,000 (저자의 임시 추정치) | >250 | >30% | >10,000 (저자의 임시 추정치) | 문서화된 통상적 학술 유통 범위를 초과 |
각 내부 앵커는 공개된 임계값에 연결되어 있습니다. 신생(Nascent) 밴드는 2년 LSN 중앙값 63 이하의 영역을 다룹니다 [139]. 그 영역은 인구가 많으며 이상하지 않습니다. 사전 지정된 연구 1 밴드(섹션 8.6)는 플랫폼의 논문 중 상당한 비중, 즉 명시된 예측 밴드 아래 15–30% 정도가 평생 다운로드 10회 이하임을 예상하고 있으므로, 최하위 밴드가 중앙값 근처에서 시작하는 척도는 플랫폼에서 가장 많은 수의 논문, 즉 이 글의 주인공도 포함하여 전혀 척도 밖에 놓이게 될 것입니다. 신생 판정은 평가적이지 않습니다. 분야 중앙값 아래, 특히 논문이 최근일 때 카운터는 질의 대한 판단을 내리지 않으며, 첫 번째 진단 단계는 콘텐츠가 아니라 노출입니다(섹션 5.4 및 5.6). 적정(Modest) 밴드는 2년 LSN 중앙값 63에 고정되어 있습니다 [139]. "적정"은 중앙값 밴드입니다. 전형성은 실패가 아닙니다. 적정/견고(Modest/Solid) 경계(평생 다운로드 약 160회)는 모든 시간대 상위 10,000개 논문, 즉 플랫폼의 전체 텍스트 논문 스톡(571,040, 2016년 7월 [1])의 약 상위 1.8%에 대한 Kakushadze 진입점입니다 [85]. 운영상, "견고한(Solid)" 논문은 상위 목록 논문입니다. 견고/강(Solid/Strong) 경계(약 800)는 그 엘리트 그룹 내의 중앙값(805)입니다 [85]. 이는 역사적 엘리트에 진입하는 논문과 이에 전형적인 논문을 분리합니다. 포트폴리오 척도에서 저자 수준 열은 이 논리를 반영합니다. SSRN 자체 알림에서 상위 10% 저자로 설명한 그룹 [161]은 총 다운로드 129회의 진입 최소값과 내부 중앙값 1,626을 가졌습니다 [85]. 모든 저자 수준 앵커는 그 순위 목록에서 도출되므로, 저자 열은 전형적인 저자가 아니라 저자 분포의 상위 꼬리를 설명합니다. 약 130 경계 아래의 저자는 단순히 "적정"이 아닙니다. 그 저자는 역사적으로 순위가 매겨진 그룹 밖에 완전히 떨어져 있으므로, 열의 하위 밴드는 모든 저자 중 보정된 위치가 아니라 "역사적 엘리트 아래"로 읽힙니다. 이는 논문 수준 척도를 압축하는 것과 동일한 상위 꼬리 앵커링입니다. 저자 열의 앵커는 연구 1의 포트폴리오 수준 백분위수를 기다리고 있습니다. 변환 열은 섹션 5.2의 교차 연구 밴드입니다. 강/예외(Strong/Exceptional) 경계 10,000은 공개된 백분위수 앵커를 가지지 않으며 크기 순서 지평으로 유지됩니다.
첫 달 열은 다른 상태를 가집니다. 이는 사전 등록된 예측이며, 연구 1(섹션 8.6)이 검증하도록 설계된 광범위한 불확실성을 가진 거짓으로 증명 가능한 예측이며, 첫 달 셀은 임계값이나 해석적 계단으로 사용될 수 없습니다. 공개된 문헌에 직접적인 첫 달 벤치마크가 존재하지 않으므로, 열은 측정이 아니라 투영이며, 다운로드의 초기 집중(주의 급증은 처음 몇 주에 집중되며, 특히 외부 보도 하에서 [18][116][138])에서 위의 평생 임계값으로 외삽됩니다. 구체적인 경계는 한 가지 공개된 앵커에서 파생됩니다. Kakushadze의 상위 목록 표본에서, 플랫폼의 전체 텍스트 논문 스톡(571,040, 2016년 7월 [1])의 약 상위 1.8%에서 중앙값 12개월 다운로드 수는 247이었습니다 [85]. 따라서 첫 달이 약 250 이상이면 플랫폼의 역사적 엘리트의 연간 기준을 초과하므로 예외 경계이며, 15–50 첫 달 다운로드는 지속되면 약 160 평생 진입 임계값으로 투영되므로 견고합니다. 이 셀들은 단일 역사적 앵커의 투영이며 표의 가장 약한 셀입니다. 인용될 경우 이 파생을 포함합니다.
척도의 사용을 규제하는 두 가지 주의 사항이 있습니다. 학문적 한정자는 선택 사항이 아닙니다. 단일 학문 내에서 논문당 평균 다운로드는 세부 분야 전반에 걸쳐 대략 8배 정도 차이가 나며(기업/증권/금융 법률의 438.35 대 농업 법률의 53.48) [168], 따라서 모든 밴드 진술에는 분야 라벨이 함께해야 합니다. 이는 평생 평균이며 논문 나이에 대해 조정되지 않으며, 부록 E의 보관 횡단면은 그것이 왜 중요한지 보여줍니다. 분야의 명백한 수준은 그것에서 샘플링된 논문의 나이 프로필과 함께 움직이며, 나이를 고정하면 산포를 대략 3배에서 5배로 좁힙니다. 두 번째는 이 공간에서 제안된 대체 단일 숫자 휴리스틱(비율 기반 상대 성능 지수(논문의 다운로드를 일치하는 코호트의 중앙값으로 나눔), ⌊ln D⌋에 기반한 로그 계층 휴리스틱, 언어적 점수카드 판정("빠른 시작/지속적인 관심/느린 시작"))이 여기서 보정되지 않은 저자 휴리스틱으로 포함되어 있으므로, 유효한 숫자 밴드를 가진 것은 없습니다. 로그 직관 자체는 건전하며 말로 유지할 가치가 있습니다. 준 로그 정규 분포 [85] 아래에서, 7에서 20 다운로드로 이동하는 것은 가시성에서 하나의 자연로그 단위의 이동이며, 이를 13 클릭의 추가로 읽는 것은 그것을 놓치는 것입니다.
척도는 또한 저자가 체계적으로 자신의 카운터를 잘못 판단하는 이유를 설명합니다. 마일스톤, 프로필, 발표에서 순환하는 숫자는 섹션 3.5에서 문서화된 대로 중앙값보다 수백 배 이상 높은 보이는 꼬리에서 오며, 분포의 대부분은 LSN 중앙값 63 근처에 앉으며, 준 로그 정규 법칙 아래에서 계단 사이의 거리는 더하기가 아니라 곱하기입니다. 그림 7은 이 값들(일반 논문 중앙값, 진입 임계값, 엘리트 중앙값, 꼬리)을 로그 척도의 벤치마크 사다리로 배열합니다.
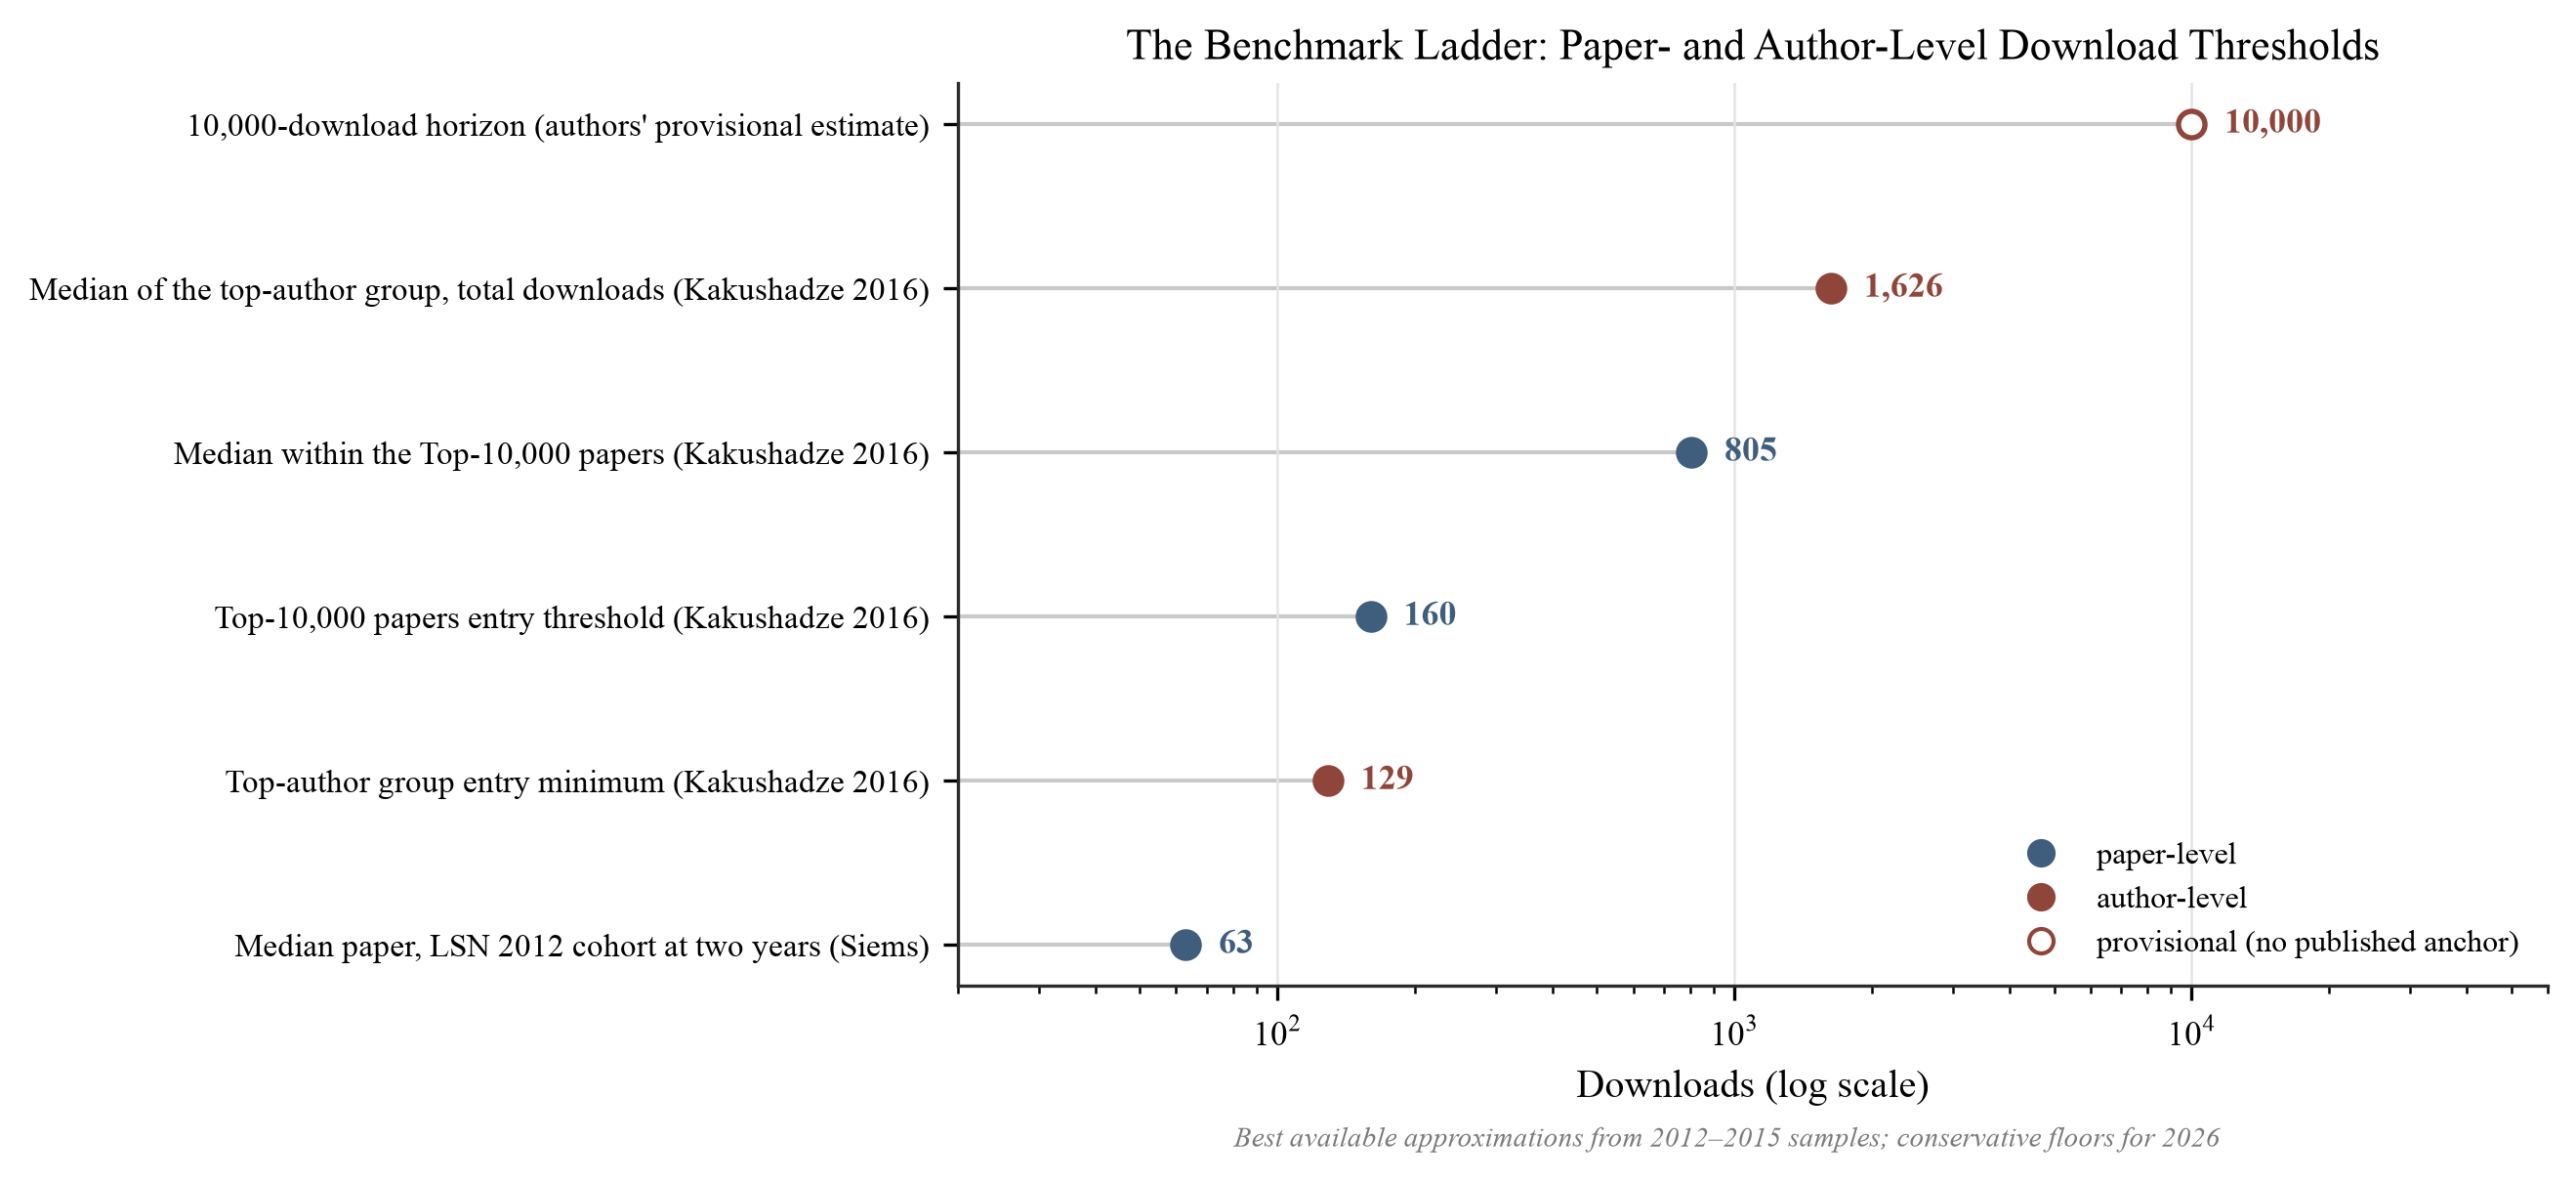
그림 7. 벤치마크 사다리. 로그 척도의 논문 및 저자 수준 다운로드 임계값: LSN 2년 중앙값 63 [139]; 상위 저자 진입 최소값 129 및 상위 논문 진입 약 160 [85]; 상위 10,000개 논문 내 중앙값 805 [85]; 상위 저자 그룹의 중앙값 1,626 [85]; 10,000 다운로드 지평(저자의 임시 추정, 공개된 백분위수 앵커 없음). 2년 중앙값 63 이하의 영역은 표 8의 신생 밴드에 해당합니다. 값은 2012–2015 표본에서 나온 것입니다(이후 인플레이션: 섹션 5.1).
5.4 도달 범위 대 전환율: 2차원 진단
단일 수치, 심지어 대역으로 나뉜 수치도 이를 생성하는 서로 다른 메커니즘을 구별할 수 없습니다. 섹션 4의 메커니즘은 실제로 가장 중요한 하나의 의미를 갖습니다: 가시성 실패와 콘텐츠 무응답은 서로 다른 진단입니다. 논문이 적게 다운로드되는 것은 독자가 거의 만나지 못했거나, 만난 독자들이 전체 텍스트를 거부했기 때문일 수 있습니다. 표 9는 두 개의 정규화된 차원을 교차시킵니다.
표 9. 도달 범위-전환율 진단 매트릭스. 도달 범위와 전환율은 비교 가능한 논문의 참조 클래스(동일 분야, 게시 그룹, 논문 연수, 선행 저자 가시성; 섹션 5.5) 내에서 백분위수로 평가되며, 클래스 중앙값을 경계로 합니다. 현재 증거로는 절대 수치 차단을 정당화할 수 없으며, 주어지지 않습니다. 2×2 표시는 가독성을 위해 각 축을 클래스 중앙값에서 이분화합니다. 기저의 도달 범위와 전환율 백분위수는 연속적이며(섹션 5.4), 3분위 등 더 세밀한 분할이 가능합니다.
| 낮은 전환율 | 높은 전환율 | |
|---|---|---|
| 낮은 도달 범위 | "콜드 스타트"(낮은 도달 범위, 낮은 전환율). 논문이 널리 만나지지 않으며 노출 후 자주 다운로드되지 않습니다. 데이터는 기저의 연구가 약한지 여부를 확립하지 않습니다. 확립되는 것은 확산이 시작되지 않았다는 점뿐입니다. | "숨겨진 관심"(낮은 도달 범위, 높은 전환율). 논문을 접한 독자들은 잘 반응하지만, 접하는 독자가 너무 적습니다. 발견 가능성이 주요 관찰 가능한 병목입니다. 콘텐츠 문제가 아니라 배포 문제입니다. |
| 높은 도달 범위 | "주목 없는 유입"(높은 도달 범위, 낮은 전환율). 제목, 주제 또는 플랫폼 배치가 방문을 끌어들이는 것으로 보이지만, 방문자 중 소수만 전체 텍스트를 얻습니다. 통신 불일치를 진단하기 전에 오염된 분모를 배제합니다: 높은 도달 범위는 진정한 주목이 아니라 유령 조회수일 수 있습니다. 조회수가 두 카운터 중 더 많이 오염되기 때문입니다(섹션 4.2). 투명한 RePEc/LogEc 기록에서 로봇은 대략 74%의 초록 조회수를 차지했지만 다운로드의 약 7%만 차지했습니다[99]. 필터링되지 않은 비인간 트래픽은 정확히 이 높은 도달 범위, 낮은 전환율 특성을 만듭니다. 봇으로 인해 부풀려진 조회수가 제외되었을 때만 잔여 데이터가 청중 적합성과 제목-초록 통신을 조사할 가치가 있습니다. | "강한 초기 확산"(높은 도달 범위, 높은 전환율). 논문이 상대적으로 큰 청중에게 도달하고 노출을 전체 텍스트 관심으로 전환합니다. |
네 개의 사분면은 두 백분위수가 보여주는 확산 패턴에 따라 명명됩니다(콜드 스타트, 숨겨진 관심, 주목 없는 유입, 강한 초기 확산). 라벨은 연구 자체가 아니라 확산의 패턴을 설명하며, 운영상 중요한 것은 메커니즘의 분리입니다. 낮은 도달 범위 사분면은 어느 것도 연구 품질에 대한 추론을 허용하지 않습니다. 이는 이 지표의 평가적 사용과 직접적인 관련이 있습니다. 낮은 확산 사분면은 이 논문의 진단인 콜드 스타트의 이름을 갖습니다. 행렬은 사분면별로 적절한 개입이 다르기 때문에 실질적으로 가치가 있습니다: 숨겨진 관심 후보는 배포(분류 검토, 공지 시점, 외부 가시성)가 필요하고, 주목 없는 유입은 통신 복구(제목 및 초록) 또는 트래픽 감사를 요구합니다. 그림 8은 평면을 템플릿으로 렌더링합니다.
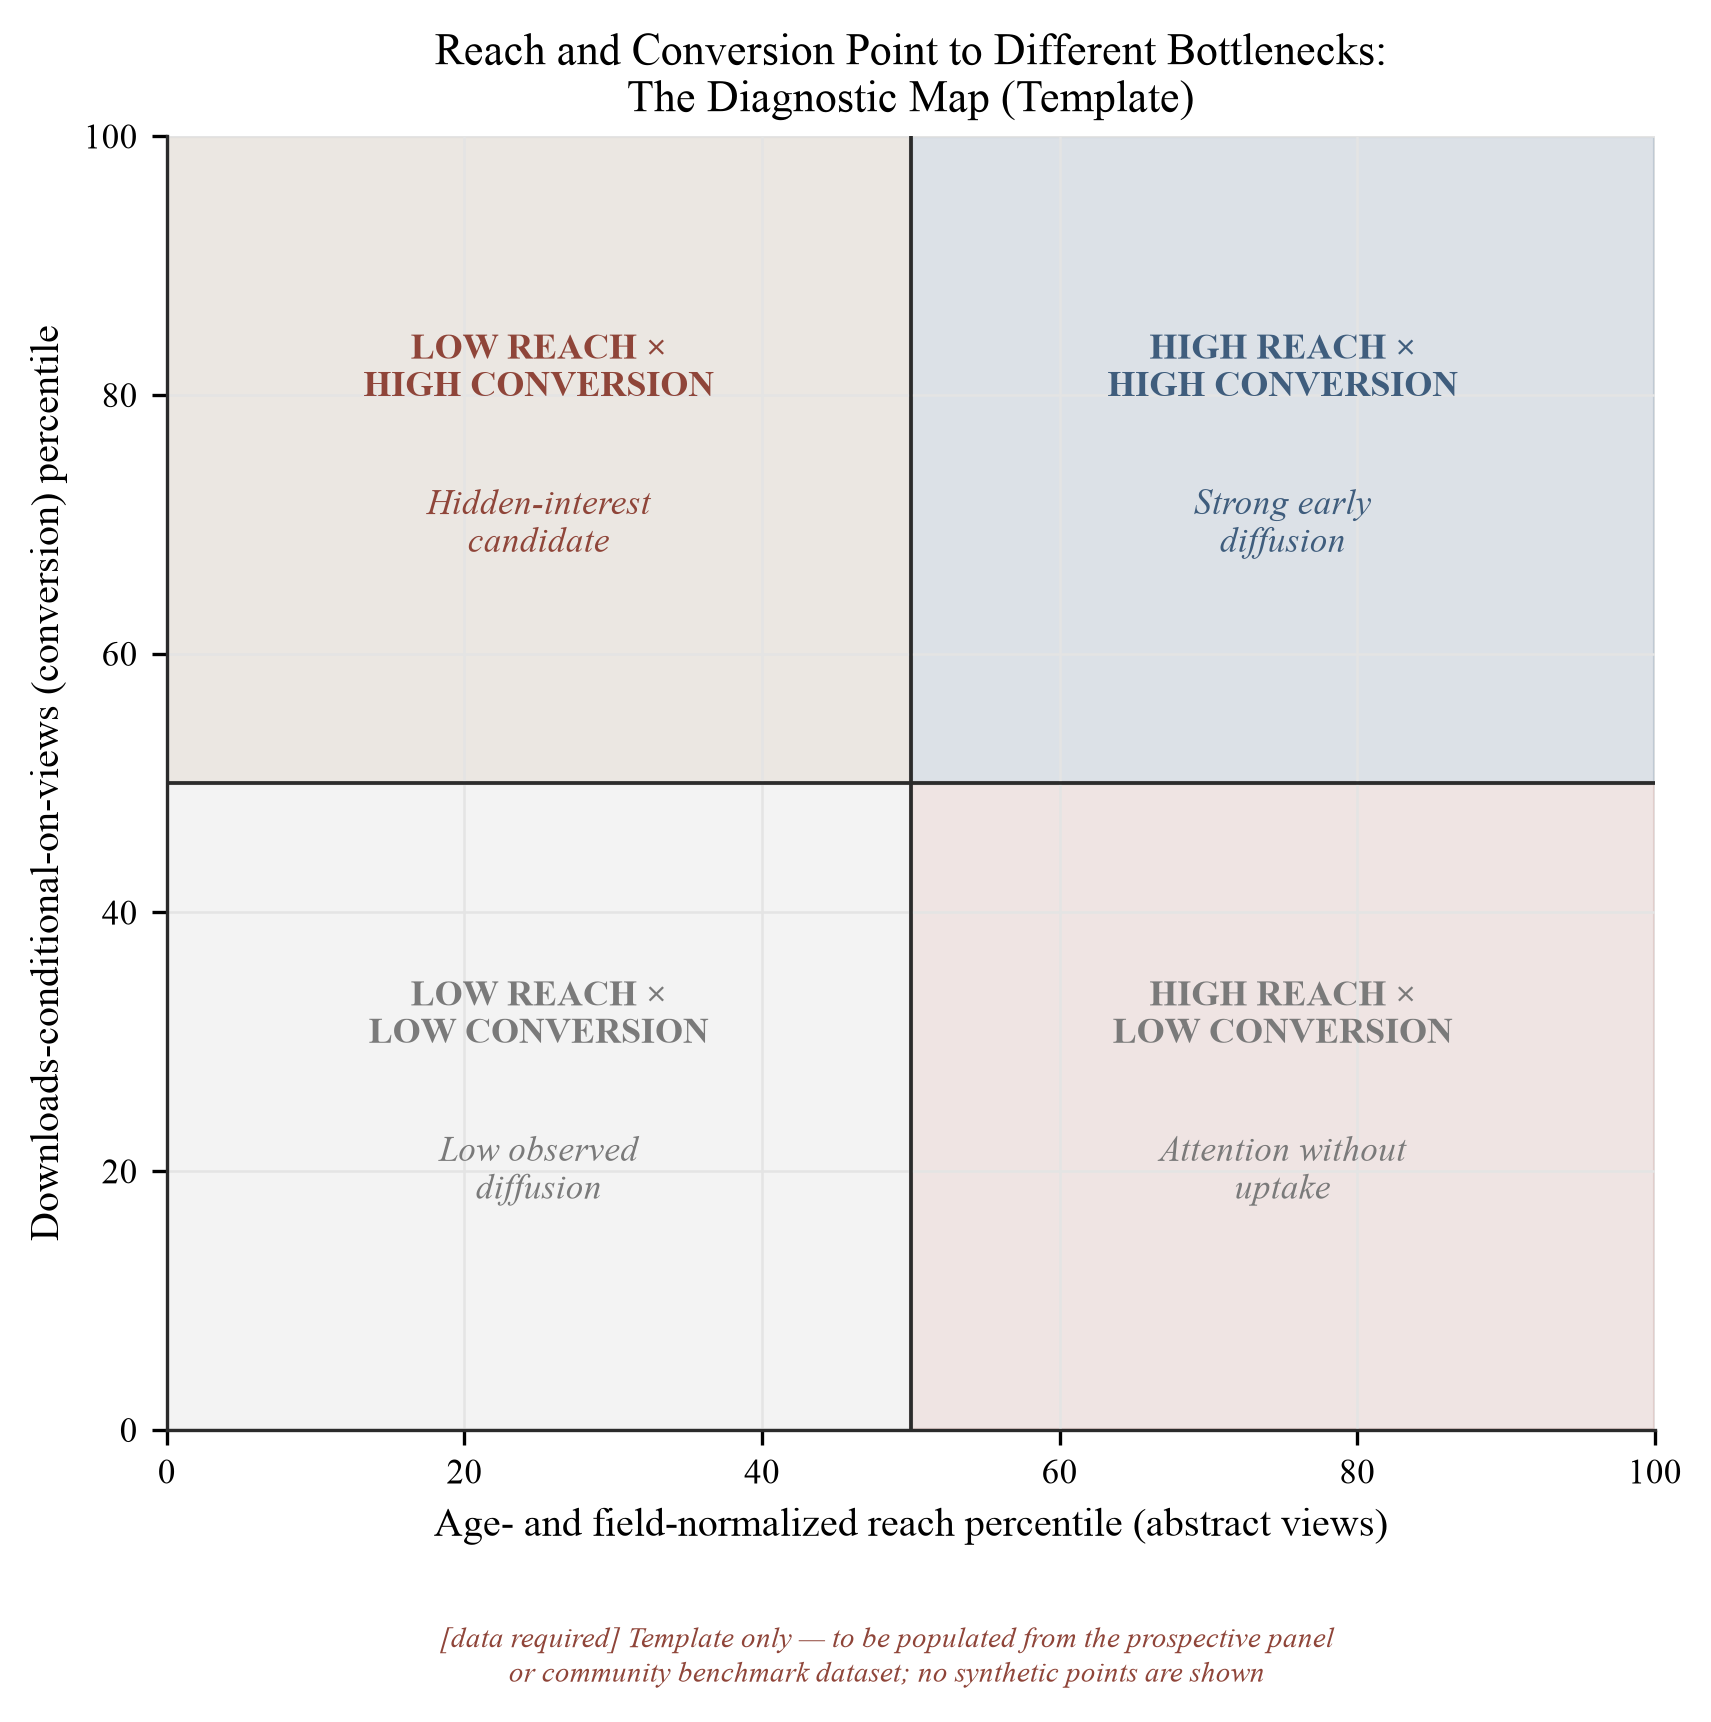
그림 8. 도달 범위-전환율 맵. 논문의 연수, 분야, 그룹 및 가시성 정규화된 조회수 백분위(도달 범위, 가로) 및 조회수-조건-다운로드 백분위(전환율, 세로)로 위치를 파악하기 위한 템플릿. 사분면은 표 9와 같습니다(콜드 스타트, 숨겨진 관심, 주목 없는 유입, 강한 초기 확산). 왼쪽 위 사분면은 낮은 도달 범위에도 불구하고 중앙값 이상의 전환율을 가진 논문을 식별하며, 이는 원시 다운로드 수가 체계적으로 과소평가하는 분류입니다. 경험적 값은 표시되지 않습니다. 맵은 섹션 8의 전망적 패널 또는 커뮤니티 벤치마크 데이터세트로 채워져야 합니다.
5.5 헤드라인 숫자에서 벤치마크까지: CSAB 차원
앞의 각 소절에서는 원시 카운터의 하나의 실패 모드를 수정하며, Cold-Start Scholarly Attention Benchmark(CSAB)는 그 통합입니다: 단일 헤드라인 숫자를 5개의 정규화된 구성요소(표 10)로 대체하는 보고 프레임워크입니다. 정규화 변수들(논문 나이, 분야, 게시 코호트, 이전 저자 가시성)은 각각 경험적으로 동기부여됩니다: 누적 지표는 나이에 따라 기계적으로 증가합니다; 분야 규범은 평균에서 최대 한 자릿수 차이가 납니다[168]; 달력 조건은 주목도를 측정 가능하게 변화시킵니다(기사 접근은 주말에 약 11%, 여름 개월에 약 50% 감소합니다[178]); 그리고 플랫폼 신규 사용자는 확립된 저자와 같은 초기 청중에 직면하지 않습니다[83]. 백분위수가 계산되기 전에 하나의 모집단 관례를 고정해야 합니다. 누적 카운터는 불균질한 생존을 가진 논문 재고 위에서 정의됩니다(논문은 가끔 철회되거나, 병합되거나, 나중 버전으로 대체됩니다). 따라서 모든 CSAB 백분위수는 관찰 날짜의 생존 재고에 대한 진술입니다. 연구 1(섹션 8.6)은 참조 모집단을 암묵적으로 남겨두지 않고 포함 규칙(버전 처리, 철회, 중복 해결)을 사전 지정합니다.
두 개의 중심 구성요소는 간결한 정의를 인정합니다. 나이 τ(게시 이후 일수)의 논문 i에 대해, 분야 f, 게시 코호트 c, 이전 가시성 층 s에서:
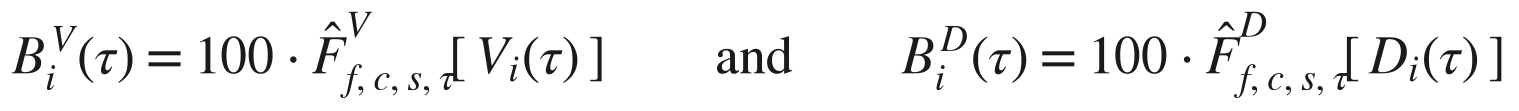
여기서 V_i(τ)와 D_i(τ)는 누적 초록 조회 및 다운로드이고 F̂^V, F̂^D는 f, c, s, 및 τ로 정의된 참조 클래스 내에서 그 개수의 경험적 분포 함수입니다. 정의는 추정량, 명시된 참조 클래스 내의 백분위수를 고정합니다. 참조 분포가 존재하지 않기 때문에 오늘 F̂를 쓸 수 없습니다(섹션 5.1). 공식은 연구 1과 섹션 8의 패널이 추정하도록 설계된 명세이며, 같은 표기법은 섹션 8.9의 예측 검증 설계까지 이어집니다. 백분위수 및 참조 클래스 정규화는 그 자체로 확립된 서지학적 방법입니다: 백분위수는 분야, 문서 유형, 출판 연도에 대해 출판물의 개수를 정규화하는 표준 방법입니다[22]. 0으로 지배되는 지표의 분야 및 시간 정규화를 위한 전담 절차가 있습니다[23]. 다운로드 카운터가 차지하는 정확히 그 체계입니다. 사용 지표를 특히(인용이 아닌 다운로드 및 조회) 참조 클래스에 대해 정규화하는 것은 마찬가지로 성숙한 작업 라인입니다: 사용 서지학 문헌은 오랫동안 다운로드 기반 영향을 사용자 커뮤니티의 특성과 샘플링 프레임을 조건으로 하는 분포로 취급했습니다[92][19]. 그리고 저널 사용 계수 프로그램은 정확히 COUNTER 호환 데이터에서 그러한 정규화된 사용 지표를 구축했습니다[137]. 사용 계산 자체의 표준화는 성숙한 실무자 인프라, COUNTER 실행 규칙의 주제입니다[125]. 분야 정규화 독서력 지표는 altmetrics 문헌에서 비교할 수 있는 확립된 선례를 가집니다[179]. 방법은 따라서 확립되었습니다. 여기의 기여는 SSRN 다운로드에 대한 적용과 사후 순위 환경에서 나이, 분야, 코호트 층화 참조 클래스의 구성입니다.
추정량은 명확하지만, 어떤 F̂가 맞기 전에 세 가지 운영화 질문이 해결되어야 합니다. 첫 번째는 가장 중대합니다. 벤치마크가 무엇을 위한 것인지에 대해 우려하기 때문입니다. 참조 클래스를 이전 저자 가시성(층 s)에 조건을 거는 것은 질문이 진단적일 때 정확합니다: "이 논문은 비교 가능하게 가시적인 저자들의 비교 가능한 논문 중에서 얼마나 잘 수행되고 있습니까?" 질문이 H1–H3의 형평성 질문일 때는 정확히 잘못되었습니다. 왜냐하면 이전 가시성으로 정규화하면 형평성 틀이 측정하기 위해 존재하는 신규 사용자 대 확립된 격차를 빼앗기 때문입니다. s 내 백분위수는 구성에 의해 불이익이 조건을 벗어났기 때문에 냉출발 불이익을 감지할 수 없습니다. 따라서 프레임워크는 하나의 숫자로 절대로 축소되어서는 안 되는 CSAB의 두 가지 뚜렷한 사용을 분리합니다. 설명적 벤치마크로서 완전히 층화된 참조 클래스(s 포함) 내에서 저자의 위치를 보고합니다. 이는 개별 저자가 대시보드에서 원하는 것입니다. H1–H3에 대한 조정된 추정량으로서 조건 집합에서 이전 가시성을 제거하고 대신 관심의 예측변수로 취급하여 기울기를 측정합니다. 불이익을 제거하지 않습니다. 두 답변은 다르며, 다른 질문에 답하며, 가시성 정규화 백분위수를 제시하는 모든 보고서는 둘 중 어느 것인지 명시해야 합니다. 두 번째 질문은 표본 크기입니다. 분야 × 코호트 × 가시성 층 × 8개 나이 포인트로 층화하면 3,000–5,000개의 논문의 확률 표본을 빠르게 소진합니다(섹션 8.6): 완전히 교차된 셀 개수는 수천 개로 실행되므로 대부분의 셀은 작거나 비어 있습니다. 경험적 베이즈 축소는 더 넓은 참조 클래스로 이러한 이유로 명명됩니다(섹션 8.3, 8.8). 하지만 축소는 자신의 명세를 요구합니다: 최소 계층적 구조(광범위한 영역 내 분야, 조악한 나이 띠 내 나이) 및 추정에 대한 사전 지정된 최소 셀 규칙. 셀이 원시 백분위수를 보고하는 대신 부모에서 빌리기 위해 이것 아래. 이 추정측 최소 셀 규칙은 공개 릴리스를 지배하는 개인정보 보호 기반 최소 셀 규칙과 구별되며(부록 D) 더 엄격합니다. 두 가지는 다른 목적을 제공하고 별도로 지정됩니다. 마지막 질문은 모멘텀(표 10)으로, 추정된 정규화된 위치의 변화로 정의됩니다. 추정된 수량의 변화 점수는 평균으로의 회귀를 초대합니다: 날짜 7에서 높게 착륙하는 논문은 부분적으로 추정 잡음에 의해 순전히 통계적 이유로 인해 30일째까지 떨어질 경향이 있습니다. 따라서 모멘텀은 잠재적 위치의 명시적 모델이 필요합니다(예: 측정 오류가 전파된 잠재적 위치의 축소 또는 경험적 베이즈 추정). 두 백분위수 스냅샷의 원시 차이가 아닙니다. 그리고 원시 차이는 모델링된 수량의 설명적 동반자로서만 보고됩니다(만약 보고된다면).
표 10. 콜드 스타트 학술적 관심 벤치마크(CSAB): 하나의 숫자 대신 다섯 가지 차원. 이러한 차원들에 대한 복사 가능한 문장 수준의 보고 템플릿이 부록 B에 제공됩니다.
| 차원 | 지표 | 핵심 질문 | 해석 |
|---|---|---|---|
| 도달 범위 | 연령/분야/코호트/신규 사용자 정규화 조회 백분위수 | 관련 독자들이 논문을 접했습니까? | 발견 가능성 |
| 다운로드 성능 | 정규화된 누적 다운로드 백분위수 | 비교 가능한 논문에 비해 몇 개의 전체 텍스트 획득이 발생했습니까? | 전체 초기 확산 |
| 전환 | 조회 기회에 조건부된 다운로드(섹션 5.2) | 노출된 독자들이 전체 텍스트를 찾았습니까? | 조건부 참여 |
| 모멘텀 | 정규화된 위치의 변화 또는 간격 수준 관심 | 확산이 가속화되고 있습니까, 안정적입니까, 아니면 감소하고 있습니까? | 시간적 궤적 |
| 후속 검증 | 초기 지표에 조건부된 후기 인용 또는 사용 | 초기 관심이 이후 학술적 채택을 예측했습니까? | 예측 타당성 |
이 프레임워크는 "성공"에 대한 보편적 원시 임계값을 거부합니다. 성공은 분석 목적에 상대적으로 정의되어야 합니다: 발견 가능성의 경우, 같은 연령과 분야의 논문들 중에서 높은 도달 범위 백분위수; 독자 채택의 경우, 노출에 조건부된 참조 클래스 이상의 전환; 확산의 경우, 두 가지의 결합 분포; 과학적 영향의 경우, 후속 인용 또는 문서화된 사용. 초기 사용만으로는 마지막 목적에 충분하지 않습니다. 초기 다운로드는 이후 인용 분산의 약 16% 정도만 설명하기 때문입니다 [25]. 이는 제목 예의 해석을 정확하게 만듭니다. 7건의 다운로드는 7건의 다운로드가 생명주기의 같은 단계에 있는 비교 가능한 논문들 중에서 비정상적으로 높게 배치된 범위까지만 "좋은" 것입니다. 7일 값과 180일 값은 동일한 벤치마크로 평가될 수 없습니다.
네 가지 설계 선택은 라이덴 선언문의 8번째 원칙을 따릅니다: 정량적 지표가 그것들 뒤의 가정의 강도를 초과하도록 허용되어서는 안 되며, 거짓 정밀도 자체가 측정의 실패라는 원칙입니다 [78]. 이 프레임워크는 지점 점수가 아닌 대역폭을 보고합니다(표 8); CSAB를 대상이 아닌 진단 벡터로 고정합니다(섹션 5.2); 출력 수치인 도달 범위-전환 지도(그림 8)와 벤치마크 부채(그림 14)를 수치 척도 없이 그려서 모양이 보정된 값으로 잘못 인식되지 않도록 합니다; 그리고 사용하는 모든 숫자에 검증 계층과 레이디를 첨부합니다(표 7). 이들 각각은 증거가 지원할 수 없는 정밀도를 보류합니다. DORA가 논문의 내용의 실질적 평가를 위해 단일 숫자 및 저널 브랜드 대리를 거부할 때 연구 평가에서 요청하는 것처럼 말입니다 [8]. CSAB를 다시 하나의 점수로 축소하면 두 문서 모두가 경고하는 정확히 같은 거짓 정밀도가 다시 도입될 것입니다.
저자에게 CSAB 보고는 단순한 "다운로드: 12," 라인을 다음과 같은 것으로 대체할 것입니다: 14일 후 12건의 다운로드: 비교 가능한 논문들 중 전체 다운로드 백분위수: 67번째; 도달 범위 백분위수: 39번째; 전환 백분위수: 81번째; 해석: 높은 조건부 관심, 평균 미만 노출. 이 모의 설정의 모든 숫자는 예시적입니다. 섹션 8의 참조 분포가 추정될 때까지 그러한 백분위수가 존재하지 않고, 이러한 값들 중 어느 것도 벤치마크로 인용될 수 없기 때문입니다. 하지만 형식은 분해가 무엇을 가져오는지 보여줍니다. 미분화된 실망으로 읽히는 같은 원시 개수는 구체적인 진단으로 해석됩니다: 논문에 접한 독자들은 비정상적으로 잘 반응하지만, 너무 적은 독자가 접하므로, 지시된 개입은 개정이 아니라 배포입니다. 작동된 예는 표 9의 "숨겨진 관심" 사분면의 CSAB 대응물입니다. 부록 B는 이 형식을 백분위수 필드가 섹션 8 분포가 존재할 때까지 공백으로 남는 복사 가능한 보고 템플릿으로 고정합니다.
5.6 읽기 궤적: 노출은 배경 소음이 아니라 처리입니다
프레임워크의 최종 구성 요소는 시간적입니다. 새로 게시된 논문은 동질적인 주의 환경에 진입하지 않습니다. 서로 다른 노출 체계를 거치며(게시 → 내부 발견 → 이메일 배포 → 외부 색인화 → 네트워크 확산), 누적 합계는 이러한 체계들을 하나의 숫자로 축약합니다. 체계 경계는 4절의 메커니즘에 의해 설정됩니다. eJournal 배포는 선별되며 대량 주제에서 최대 45일이 소요될 수 있고[53], 외부 검색 색인화는 6~9개월 이상 걸릴 수 있습니다[55].
불안감을 가장 많이 유발하는 대시보드 상태는 이것에서 직접 비롯됩니다. 첫 주 다운로드 제로는 거절이 아니라 정상적인 배포 전 상태입니다. 공지 주기가 시작되기 전에 논문은 주요 대상 독자에게 아직 노출되지 않았습니다. 초기 제로에 대한 진단 순서는 행정적입니다. 논문이 공개적으로 게시되었는지 확인하고, eJournal 할당을 확인하고, 공지 주기가 지나갈 때까지 기다린 후에야 카운터를 읽습니다. 반대로 배포가 이루어진 후의 첫 달 카운트는 가장 초기이면서 가장 불확실한 선행 지표입니다. 초기 다운로드는 이후 인용과 대략 r ≈ 0.4의 상관관계가 있으며[25], 정보는 있지만 판정과는 거리가 멀고, 초기 급증은 자주 지속적인 관심[116][138]보다는 노출 이벤트(블로그 또는 미디어 보도)입니다.
누적 카운트의 소급적 스크래핑은 논문이 3일차 또는 30일차에 얼마나 많았는지 재구성할 수 없기 때문에, 궤적 기반 해석(및 8절의 패널 연구 의제)은 표준화된 그리드에서 출생부터의 관찰을 필요로 합니다. 표 11은 최소 일정을 규정합니다. 개별 저자의 자기 추적 템플릿으로도 기능합니다. 궤적은 표 11 그리드의 60일 및 90일 읽기에서는 임시적으로만 분류되며, 180일 읽기에서 확신을 가지고 분류되며, 7일차에는 절대 분류되지 않습니다.
표 11. SSRN 논문의 최소 종단 관찰 일정입니다.
| 논문 나이 | 관찰의 핵심 목적 |
|---|---|
| 1일차 | 즉각적인 플랫폼 노출 |
| 3일차 | 매우 초기 발견 |
| 7일차 | 첫 주 벤치마크(대부분 논문의 예상값: 제로에 있거나 제로에 가까움, 배포 전) |
| 14일차 | 초기 안정화 |
| 30일차 | 첫 달 벤치마크 |
| 60일차 | 배포 및 검색 성숙(eJournal 주기 완료[53]) |
| 90일차 | 중기 초기 확산 |
| 180일차 | 하위 영향 측정으로의 전환 |
가능하면 처음 45일 동안 매일 관찰이 선호되는데, 이는 이메일 배포가 해당 기간 내에 다양한 시간에 발생할 수 있기 때문입니다[53]. 이 그리드에 대한 간격별 읽기는 대시보드를 정적 판정에서 궤적으로 변환하며, 이것이 초기 SSRN 메트릭이 방어 가능한 정보를 담을 수 있는 유일한 형식입니다.
4절과 5절은 저자가 답할 수 없는 질문("다운로드 7개가 좋은가?")을 출판된 기록이 뒷받침할 수 있는 네 가지로 대체합니다. 카운트가 벤치마크 지도 및 그 빈티지(5.1, 5.3)를 기준으로 어디에 위치하는가, 경험적 대역 내의 변환은 무엇인가(5.2), 논문이 도달–전환 평면의 어느 사분면을 차지하는가(5.4), 관찰 그리드의 궤적은 무엇을 보여주는가(5.6)? 이 질문 중 어느 것도 폐지된 랭킹을 요구하지 않지만, 이 글의 최종 절들이 제안하는 비교 데이터의 수집을 모두 필요로 합니다.
6. 저자를 위한 실용적인 플레이북
5절의 벤치마크 지도(표 7)는 누락된 척도를 복원하며, 이 절은 2026년 7월 15일 이후 통계 패널을 열고 맥락 없는 카운트를 보는 저자를 위해 이를 적용합니다[148][149]. 순서대로 네 가지 과제가 있습니다. 자신의 카운터를 관찰하는 루틴(6.1–6.2), 랭킹이 과거에 제공했던 비교 프레임에 대한 대체(6.3), 가시성을 합법적으로 개선할 수 있는 레버(6.4), 카운터를 방어 가능한 경력 증거로 변환하는 프로토콜(6.5–6.6). 여기서 사용된 모든 수치적 기준점은 명시적 표본 추출 틀과 시간 창이 있는 출판된 출처로 추적됩니다. 표 7은 이를 통합합니다. 증거 지원이 없는 저자 커뮤니티에서 유통 중인 관행은 나타나는 곳마다 미검증으로 표시되며, 테스트를 위한 후보 가설로서 부록 A의 끝에 수집됩니다.
표 12는 플레이북의 핵심을 순서대로 묻는 일곱 가지 질문 프로토콜로 압축하며, 각 질문은 보존할 가치가 있는 증거 및 답변이 합법적으로 허용할 수 있는 가장 강력한 결론과 쌍을 이룹니다. 6.1–6.2절은 이 프로토콜을 루틴 및 읽기 규칙으로 전개하며, 표 23(부록 A)은 저자가 실제로 마주치는 대시보드 상태로 인덱싱된 상황별 동반자로 남습니다.
표 12. SSRN 카운터를 해석하기 위한 저자 프로토콜: 일곱 가지 질문, 보존할 증거, 및 허용되는 결론입니다. 어떤 단계도 카운터를 품질 점수로 취급하지 않으며, 최종 열은 각 답변이 지원할 수 있는 상한을 명시합니다.
| 단계 | 질문 | 보존할 증거 | 허용되는 결론 |
|---|---|---|---|
| 1 | 카운트를 관찰했을 때 논문의 나이는 몇 살이었습니까? | 날짜가 있는 스크린샷 또는 내보내기, 게시 날짜 포함 | 평생 판정이 아닌 시간 특정 관찰 |
| 2 | 선별 배포 및 외부 색인화가 발생했습니까? | 배포 공지 및 가능한 날짜, 검색 색인 상태 | 배포 전 대 배포 후 체계의 식별(5.6절) |
| 3 | 조회수, 다운로드 및 변환이 함께 무엇입니까? | 두 카운터 및 분모 | 단일 판정이 아닌 도달–조건부 참여 진단(표 9) |
| 4 | 가장 좁은 방어 가능한 참조 클래스는 무엇입니까? | 분야, 동료, 논문 나이, 신규 저자 상태, 분류 이력 | 해당 클래스 내에서만 상대적 위치(5.5절) |
| 5 | 궤적이 변하고 있습니까? | 표 11의 고정된 나이에서 반복된 관찰 | 노출 이벤트의 적용을 받는 모멘텀 또는 정체 — "품질"의 가속이 아님 |
| 6 | 하위 검증이 있습니까? | 인용, 실질적 연락, 출판 또는 문서화된 사용 | 수용의 계층화된 증거, 품질의 증거는 아님 |
| 7 | 주장을 재현할 수 있습니까? | 출처, 날짜, 계산 규칙, 아카이브된 기록 | 근거 없는 이정표가 아닌 감시 가능한 보고서 |
6.1 측정 루틴
해석은 규율 있는 기록으로 시작합니다. SSRN은 현재의 누적 카운트만 표시하고 저자가 제어할 수 있는 이력은 없기 때문입니다. 게시 당일부터 적용하는 6단계는 이후의 모든 추론이 필요로 하는 최소한의 기록을 만듭니다.
1. 카운터와 그 비율을 모두 기록합니다. 초록 조회 수, 다운로드 수, 다운로드-조회 전환 비율을 일정한 간격으로 기록해야 합니다. 표 11의 관찰 격자(1일, 3일, 7일, 14일, 30일, 60일, 90일, 180일)는 일정과 각 측정의 목적을 명시합니다. 각 간격에서의 날짜가 기록된 스크린샷이 저자가 제어할 수 있는 유일한 기록 버전입니다. 플랫폼 카운터는 필터링 규칙이 변경되면 다시 계산될 수 있기 때문입니다 [144][69]. 누적되는 기록은 버전이 있는 증거 패킷입니다. 여기에는 원고 버전, 그 메타데이터와 분류, 날짜가 있는 대시보드 스냅샷, 배포 공지, 저자 본인의 홍보 활동에 대한 날짜가 있는 로그(게시된 스레드, 강연, 메일링 리스트 공지), 그리고 나중의 인용 및 실질적 접촉이 포함됩니다. 홍보 로그가 중요한 이유는 홍보가 노출 처리이기 때문입니다. 본인의 홍보에 대한 날짜가 있는 기록이 없으면, 저자는 유기적 증가와 자발적으로 생성한 증가를 구분할 수 없으며, 주장을 감시하는 사람도 마찬가지입니다 (제8.3절).
2. 게시 이후 경과 시간으로 정규화합니다. 초기 성과를 원시 누적 카운트가 아닌 처음 3~6개월 동안의 월별 다운로드로 표현해야 합니다. 3개월 된 논문을 더 오래된 작업의 역대 총계와 비교하면 체계적으로 오도된 결론이 나옵니다. 카운터는 논문이 플랫폼에 있는 동안 누적되고, 플랫폼의 연간 다운로드 량은 2016년 약 1,290만 건에서 2023년 4,060만 건으로 증가했기 때문입니다 [1].
3. 관찰 기간을 절대 혼합하지 않습니다. 주간 카운트를 12개월 평균과 비교할 수 없으며, 90일 카운트를 역대 총계와 비교할 수 없습니다. 이 가이드북의 모든 비교는 같은 기간과 같은 기간을 짝짓습니다. 이 규칙의 위반은 순위 통계의 사전 폐지 사용에서 가장 흔한 해석 오류였습니다 [161].
4. 논문을 플랫폼이 아닌 학문적 이웃에 위치시킵니다. 논문당 평균 다운로드 수는 Legal Scholarship Network eJournals만 해도 대략 8배 정도 차이가 났습니다 (2018년 데이터에서 기업/증권/금융 438.35 대 농업법 53.48) [168]. 한 분야에서 평범한 카운트는 다른 분야에서는 예외적일 수 있습니다. 관련된 참조 집단은 논문 자신의 eJournal 또는 주제 네트워크이며, 같은 논문 나이에서 검토해야 합니다.
5. 작은 카운트 하나를 과해석하지 않습니다. 무결성 문헌은 사용 카운터의 정밀도에 상한선을 설정합니다. 출판사가 보고한 다운로드는 비교 가능한 플랫폼보다 2배나 높을 수 있습니다 [176], 플랫폼 필터는 원시 트래픽의 큰 부분을 버립니다 [99][129][144], 그러한 필터 없이는 SSRN 자신의 카운터가 "5배 이상" 부풀려집니다 [18]. 따라서 비교 가능한 숫자들 사이의 작은 차이는 정보를 전달하지 않습니다.
6. 초기 수치에 반응하기보다는 장기 누적을 모니터링합니다. 워킹 페이퍼 플랫폼에서 관심은 초기에 집중됩니다 [116][28] (후자의 발견은 SSRN이 아닌 NBER 데이터에서 나옴), 하지만 발견 계층은 천천히 성숙됩니다. SSRN은 Google Scholar 색인화가 "6~9개월 이상" 걸린다고 보고합니다 [55]. 또한 독서는 여러 시간대에 걸쳐 감소하고, 읽기와 인용이 같은 시간 과정을 따를 필요는 없습니다 [91]. 따라서 자신의 곡선을 읽는 하나의 "반감기"도 안전하지 않습니다. 궤적은 표 11 격자의 60~90일 측정에서 임시로 분류될 수 있으며, 180일에는 더욱 확실하게 분류될 수 있지만, 절대 7일 측정에서는 그렇지 않습니다.
6.2 대시보드를 읽기 위한 다섯 가지 규칙
이 기록을 바탕으로, 섹션 5의 분포 증거는 매일 대시보드를 읽기 위한 다섯 가지 경험칙으로 귀결됩니다.
(i) 평균이나 눈에 띄는 별이 아닌 중앙값과 비교합니다. 일반 논문의 유일한 인구조사식 표본은 2년 후 중앙값 63회 다운로드와 369회 초록 조회를 보여줍니다(LSN, 2012년 게시 논문) [139]. 최근 발표된 유일한 표본에서 중앙값은 87회 다운로드이며, 75백분위수(섹션 3.3)를 넘는 221.3의 평균값입니다 [83]. 유통되는 마일스톤 숫자는 2015년 최대값이 수십만 회의 다운로드에 달하는 눈에 띄는 꼬리에서 나옵니다(섹션 3.5) [85]. 저자가 이에 대해 보정하면 준로그정규분포의 꼬리에 대해 보정하는 것이며, 이는 오보정을 보장합니다. 2023년 12월 집계에서 계산한 플랫폼 전체 평균 약 222회의 논문당 평생 다운로드 [1]는 개인적인 척도로 사용하기에 마찬가지로 사용할 수 없습니다.
(ii) 개수뿐만 아니라 전환율을 확인합니다. 독립적인 측정은 대략 11–19%의 초록 조회당 다운로드의 정상 범위에 수렴합니다. LSN 표본의 18.7% 평균값 및 17.1% 중앙값 [139], 그리고 법학 인용 연구의 15%(상위 인용 논문) 및 11%(단일 인용 논문) 수치 [172]입니다. SSRN의 오래된 다운로드당 3회 조회라는 경험칙 [18]은 그 범위 내가 아닌 그 범위를 초과합니다. 최근 마케팅 네트워크 표본은 평균 100회 조회당 23.7회 다운로드로 그 범위를 약간 초과합니다 [83]. 그림 6은 추정값들을 함께 표시합니다. 섹션 5.2의 중심 작업 사례를 규칙으로 실행합니다. 제목의 40회 초록 조회와 7회 다운로드는 17.5%로 변환되며, 점 추정값으로 범위 내이지만 95% Clopper–Pearson 구간이 넓습니다(≈7.3–32.8%). n = 40일 때 읽기는 실패도 아니고 정확한 백분위수도 아닙니다. 일반적인 전환과 일치하는 선별 결과입니다. 범위를 훨씬 아래의 전환은 초록과 논문 간의 불일치와 일치하며, 독자가 도착해 초록을 읽고 떠나는 경우입니다. 이는 실행 가능하며, 조치는 제목과 초록을 수정하는 것입니다. 범위를 훨씬 위의 전환은 초록 탐색으로 설명할 수 없는 트래픽을 신호하며, 미디어 또는 수집기 보도의 직접 링크 같은 경우이며, 조회의 출처를 확인하라는 신호입니다. 두 읽기 모두 선별 진단입니다. 낮은 전환에서 초록 품질로의 추론을 인과적으로 검증한 연구는 없으며, 진단은 자신의 논문에 대한 가설로 기록되어야 합니다.
(iii) 첫 달 다운로드를 가장 이르고 가장 시끄러운 인용 신호로 취급합니다. arXiv 데이터에서 초기 다운로드는 나중 인용과 대략 r ≈ 0.4로 상관관계가 있으며, 원래 저자들 자신은 이를 설명된 분산의 약 16%로만 해석합니다 [25]. 기록된 가장 이른 신호는 생의학 분야입니다. BMJ의 발행 후 첫 주의 온라인 조회수는 그 뒤의 해에 걸쳐 누적된 인용과 대략 0.50으로 상관관계가 있습니다 [119]. 법학에서 Black과 Caron은 논문 수준의 다운로드–인용 상관관계를 약 0.50의 순서로 보고했으며, 100명의 초급 법학 교수 표본에서 약 0.55로 상승합니다 [18]. 분야 및 기간 전반에 걸쳐 논문 수준의 상관관계는 대략 0.1에서 0.6입니다 [80][25], 그리고 arXiv 다운로드 수는 동시대 Twitter 관심을 통제하면 통계적으로 유의미한 예측인자로서의 중요성을 잃습니다 [138]. 집계 수준에서는 협회가 강화됩니다. 100개 법학 대학의 다운로드 기반 및 인용 기반 순위 간 0.84 [77], 그리고 한 저널의 자체 분석에서 6개월 PDF 다운로드와 나중 인용 간 R = 0.724입니다 [114]. 이러한 집계 수치는 개별 논문이 어디에 도달할지를 결정하지 않으며, 첫 달의 다운로드는 나중 인용에 대한 이른 신호입니다.
(iv) 1주일 내 0회 다운로드는 정상적인 배포 전, 거부가 아닙니다. 새로 게시된 논문은 검수를 통과하고, 주제 eJournal로 분류되며, 공지 주기에 진입한 후에만 관심을 얻습니다. SSRN의 자체 문서는 분류를 보장되지 않은 큐레이션으로 설명하며, 부하가 높은 주제의 경우 최대 45일의 지연이 있습니다 [53], 그리고 eJournal 배포 및 이메일 경고는 일몰 후에도 명시적으로 계속되도록 확인되었습니다 [147][57]. 진단 순서는 다음과 같이 진행됩니다. 논문이 공개적으로 게시되었음을 확인하고, eJournal 분류를 확인하고, 공지 주기를 기다리고, 그 이후에만 카운터를 읽습니다. 검색 엔진을 통한 발견은 나중에 도착합니다 [55].
(v) 감소하거나 평탄한 카운터는 독자 손실이 아닌 필터링을 반영할 수 있습니다. SSRN은 명백한 반복 다운로드, 로봇 다운로드 및 기타 불규칙한 활동을 폐기한다고 공개적으로 문서화합니다 [144][66][69]. RePEc/LogEc 경험은 그러한 수정이 얼마나 클 수 있는지 보여줍니다. 2007년 7월 로봇은 초록 조회의 약 74%를 차지했지만 다운로드의 약 7%만 차지했습니다 [99], 그리고 2025년 9월 원본 IDEAS 트래픽의 99.5% 이상이 AI 봇 간섭 중에 폐기되었습니다 [129]. 따라서 갑작스러운 하락 또는 재설명은 독자 행사만큼 측정 행사일 가능성이 높으며, 이는 확증 없이 평판 손실로 읽혀서는 안 됩니다.
6.3 순위 없는 벤치마킹
순위는 비교 기준을 제공했습니다. 오늘날 저자는 이를 대체할 수 있는 방법이 세 가지 있으며, 작업량이 적은 순서대로 정렬되어 있습니다.
마이크로 벤치마크. 가장 직접적인 대체 방법은 자신이 직접 구축하는 참조 그룹입니다. 비교 가능한 기관의 동료가 작성한 방법론적으로 유사한 논문 3~5개를 식별하고, 같은 달에 게시된 논문들을 추적한 후 표 11 일정과 동일하게 공개 카운터를 추적합니다. 그 결과는 정확히 올바른 참조 클래스에 대한 지역화된 백분위수 기준선이며, 필드, 논문 나이, 플랫폼 시대에 따라 구성으로 일치합니다. 폐기된 순위는 모든 나이와 필드의 논문을 단일 리그에서 비교했던 것과 다릅니다. 이는 공개 논문당 카운트만 사용하는 제안된 절차이며, 모든 도움말 사용에서 이렇게 기록되어야 합니다. 또한 가장 고립된 신규 이용자, 즉 콜드 스타트 조건이 가장 영향을 미치는 저자들이 가지지 않을 수 있는 동료 문헌에 어느 정도 익숙함을 전제합니다. 이들을 위해 섹션 10.4(익명 백분위수 대역)의 플랫폼 측 해결책이 구조적 수정입니다. 이는 자체 조립 네트워크를 사용할 필요가 없기 때문입니다.
상대 성능 비율. 동일한 논리를 단일 숫자로 표현할 수 있습니다. 주어진 나이의 논문 다운로드 수와 일치하는 코호트의 중앙값 다운로드 수의 비율입니다. 일치하는 코호트는 같은 분야, 같은 논문 나이, 가능하면 같은 논문 유형을 의미합니다. 1.0의 비율은 코호트의 정확히 중앙값 가시성을 의미하며, 1.0보다 크거나 작은 값은 그에 따라 읽힙니다. 지수는 일치하는 코호트 내에서 논문을 순서 지으며, 백분위수 대역은 참조 분포를 기다립니다. 코호트 기준선을 구축할 수 있는 공개 중앙값은 오래되고 범위가 좁습니다(2012년에 게시된 법률 학문의 2년 시점에 63회 다운로드 [139], 2025년에 관찰된 마케팅 논문의 경우 87회 [83]). 비율 값을 백분위수에 매핑하려면 중앙값만이 아닌 전체 분포가 필요합니다. 해당 분포 없이 비율 대역에 백분위수 레이블을 할당하면 거짓 정밀도가 생성됩니다. 섹션 8의 사전 등록된 의제에는 대역의 보정이 포함됩니다. 그때까지 비율은 등급 척도가 아닌 순서 지정 장치입니다. 두 가지 추가 주의 사항이 장치를 제한합니다. 섹션 5.2의 소수 분모 불안정성이 비율의 분자와 얇은 코호트 중앙값 모두에 적용되므로 작은 카운트에서는 계산하면 안 되며, 경험적 베이즈 축소(섹션 8.3, 8.8)는 그러한 비율을 공개적으로 보고하는 어디서든 적절한 수정입니다. 주어진 비율은 고정된 백분위수로 변환되지 않습니다. "코호트 중앙값의 두 배"는 다양한 형태의 분포에서 다양한 백분위수 위치에 해당하므로 비율은 한 코호트 내에서 논문을 순서 지으나 분포 형태가 다른 코호트나 시대를 통해 비교할 수 없습니다.
궤적에 대한 판정 언어. 커뮤니티 대면 도구는 논문의 초기 궤적을 세 가지 정성적 판정(빠른 시작, 지속적 관심, 느린 시작)으로 분류할 것을 제안했으며, 이는 원시 숫자에 대한 인간적 대안입니다. 어휘는 보유할 가치가 있습니다. 개수를 궤적에 대한 설명으로 변환하고, "느린 시작"은 실패의 동의어가 아니기 때문입니다. 이러한 판정을 위해 원래 제안된 임계값은 일치하지 않는 시간 창의 비교와 공개 메트릭으로 존재하지 않는 플랫폼 전체 "네트워크 평균" 통계에 의존했습니다. SSRN은 공개 셀프서비스 API 또는 통계 엔드포인트를 제공하지 않으며 [51], 가장 가까운 역사적 메트릭("논문당 새 다운로드", 저자 수준 순위 통계)은 순위와 함께 폐기되었습니다([B-9], 역사적 순위 페이지가 더 이상 접근할 수 없다는 주의와 함께 인용됨). 그러므로 판정은 일치하는 비교에서만 할당해야 합니다. 위의 마이크로 벤치마크 그룹 또는 코호트 중앙값 비율이며, 60~90일 표시 이전에는 읽지 않아야 합니다.
어떤 대체가 사용되든 외부 삼각 측량이 이를 강화합니다. Crossref 및 OpenAlex의 인용층 데이터 [35][124]와 SSRN 페이지에 표시된 PlumX 지표 [50]는 다양한 질문에 답합니다. 가시성보다는 하위 사용에 대한 것입니다. Overton과 같은 정책 인용 도구는 논문이 정부 및 기관 문서에서 인용되는 위치를 매핑하여 동일한 삼각 측량을 정책 및 관행 범위로 확장합니다 [187]. 이는 SSRN의 법률, 경제 및 정책 기반에 적합합니다. 이러한 계층은 표 10의 CSAB 프레임워크의 카운터 및 표 9의 도달-변환 진단과 함께 공동으로 검토됩니다. Altmetric 지표는 추가 삼각 측량 계층입니다. 처음부터 초기 주의 신호로 구상되었으며 [123][122], 인용과 구별되는 패턴을 따릅니다 [74][20] 그리고 필드 정규화를 허용합니다 [21]. 또한 자동화된 인플레이션에 취약하며 [75] 액면가 읽기가 아닌 이론 기반 해석이 필요합니다 [76].
6.4 정당한 가시성 개선
순위 제도가 폐지되기 전에는 논문의 추가 홍보가 노력할 가치가 있는지 여부에 대한 반복되는 저자의 결정에 대해 대략적이지만 실제적인 피드백을 제공했습니다(1.3절). 순위 제도 폐지 이후, 그 결정은 여기에 정리된 레버와 진단 도구로부터 결정되어야 합니다. 결정 요인 문헌은 저자의 통제 하에 있고 플랫폼 규칙과 일치하는 작은 규모의 레버 세트를 제시합니다. 각 레버는 가시성에 작용하며 품질에는 작용하지 않으며, 어느 것도 논문의 내용을 변경하지 않습니다. 신속한 배포와 조기 피드백은 프리프린트 게시에 대한 인정된 목적 중 하나이며, 프리프린트에 대한 방법론적 문헌에 있습니다[24]. 정당한 가시성을 위한 플레이북은 그 명시된 기능을 사용합니다.
패키징. LSN 표본에서 제목 특성, 초록 길이, 주제의 두드러짐은 주목과 유의미하게 관련이 있었으며, 저자는 그러한 변수가 관찰 불가능한 품질의 대리 변수일 수 있다는 주의를 제시했습니다[139]. 법률 인용 연구에서 상위 10분위 논문은 하위 10분위 논문보다 더 많은 키워드와 더 긴 초록을 포함했습니다[172](구체적인 수치는 원본에 대한 검증을 기다리고 있습니다). 초록 페이지는 규칙(ii)이 작용하는 변환 표면이므로, 변환이 지속적으로 대역 아래에 있을 때 제목과 초록이 개정할 첫 번째 것입니다. 그러한 개정은 약속과 내용 간의 일치를 목표로 하며, 무분별한 트래픽을 목표로 하지 않습니다. 이미 명확한 초록을 클릭을 최대화하기 위해 다시 쓰면 정확성을 손상시킬 수 있으며, 부정확한 방문자를 유인함으로써 변환을 대역에서 더 멀어지게 할 수 있습니다.
분류. 더 많은 eJournal로 분류된 논문은 2018년 LSN 분석에서 평균적으로 더 많은 다운로드와 더 적은 0 다운로드 결과를 보였습니다[168]. SSRN은 논문당 1~7개의 분류를 허용하며 포함을 큐레이션합니다[53]. 인기 있는 커뮤니티 개선 사항은 검증되지 않았습니다. 이는 분류 전략을 비교하는 연구가 없기 때문입니다. 분류를 3개로 제한하는 것이 제안되었으며, 하나의 핵심, 하나의 광범위, 그리고 하나의 학제 간 eJournal로 선택됩니다. 그 조언은 부록 A의 검증 가능한 가설 중 하나입니다.
배포 및 외부 주목. eJournal 이메일 경보는 플랫폼의 주요 푸시 채널로 남아 있으며 폐지 이후에도 계속됩니다[147][57][152]. 플랫폼 외에, 블로그 보도는 이 질문에 대한 한 가지 경험적 테스트에서 급격한 초기 다운로드 급증을 생성했습니다[116]. 가시 목록 위치는 arXiv 위치 연구에서 열람과 인용을 증가시켰습니다[72]. 학술 대회 참여는 취소된 정치학 회의를 중심으로 구축된 준실험 연구에서 논문당 추가 17-26개의 다운로드와 관련이 있었습니다([B-4], APSA 2012 환경이라는 주의로 인용되었으며, SSRN 경제학 표본이 아닙니다). 실무자 지침은 법학 장학금을 위한 추가 배포 도구를 수집합니다[169]. 초기 공개 배포의 경우: 공개 접근에 대한 무작위 시험은 더 많은 다운로드를 발견했지만 단기 인용 이득은 없었습니다[37]. 반면 코호트 및 분야 연구는 대략 10%에서 2배 정도의 인용 이점을 보고합니다[59][86][17][93]. 여기에는 미국 법률 평론의 +53%가 포함됩니다[40]. 법률 인용에 대한 감사는 가장 많이 인용된 논문의 87%가 SSRN에서 이용 가능했으며, 거의 인용되지 않은 논문의 44-46%와 비교하여, 가장 많이 인용된 그룹의 95%가 출판 연도 또는 그 이전에 SSRN에 게시되었음을 발견했습니다[172]. 프리프린트 입금은 arXiv에서 더 높은 인용과 관련이 있으며, 더 낮은 출판사 사이트 다운로드와 관련이 있습니다[38]. bioRxiv 다운로드는 저널 결과와 상관관계가 있습니다[62]. 모든 bioRxiv 프리프린트의 센서스에서 다운로드 수는 프리프린트가 나중에 게시된 저널의 영향 계수와 상관관계가 있습니다(Kendall τb = 0.59). 이 연관의 인과 방향은 알려져 있지 않습니다[2]. 기계 발견 계층(검색 엔진 및 생성 응답 엔진)은 8절의 감사 프레임워크와 표 20의 기능 감사 의제에서 별도로 처리됩니다[5][164].
버전 관리 위생. 동일한 SSRN 페이지에 업로드된 수정사항은 누적된 카운터와 안정적인 URL을 보존합니다. 반면 삭제 및 재게시는 지표를 0으로 재설정합니다([B-7], 지원 페이지 표현이 시간에 따라 변경되며 제출 시 다시 확인해야 한다는 주의로 인용됨). 경미한 수정사항이 3일째에 재발표를 촉발하고 주목의 "두 번째 물결"을 생성한다는 추가 커뮤니티 주장은 문서화되지 않았으며, 부록 A의 검증되지 않은 관행 중 하나입니다. 신원도 같은 주의가 필요합니다. 검증된 ORCID iD를 SSRN 저자 프로필에 연결하면 논문과 해당 카운터가 별명이 아닌 올바른 사람에게 첨부됩니다. 이는 저자 명확화 문제에 대한 저비용 보호이며, 8.3절의 패널 설계는 통계적으로 해결해야 합니다([B-7], 동일한 재검증 주의).
하지 말아야 할 것. 자체 다운로드 및 관련 조작은 SSRN의 자체 서버 로그에 문서화되었으며, 상위 목록 임계값 근처에서 강화되었으며, 사회적 비교에 의해 주도되었습니다[44]. 플랫폼의 사기 필터는 공개되어 있으며[144][69], 이 역사를 알고 있는 평가 위원회는 지원되지 않은 주장을 할인합니다. 따라서 게임 문헌은 무결성 문헌과 함께 실질적인 경고를 제시합니다. 조작된 수는 감지 가능하며 평판상 비용이 많이 듭니다. 그림 9는 시뮬레이션된 데이터의 문제점의 시간적 서명을 보여줍니다. 유기적 주목은 긴 꼬리를 가진 초기 피크로 누적되는 반면, 조작은 무결성 필터가 플래그 지정하도록 설계된 바로 그 종류의 집중된 스파이크를 생성합니다[144][69].
그림 9. 유기적 누적 대 조작 스파이크. 자체 다운로드의 특징적인 갑작스러운 단일 날 스파이크와 대비되는 매끄러운 유기적 다운로드 궤적은 6.4절의 조작 경고와 4절의 무결성 논의에 동기를 부여합니다[44][69][144]. 표시된 모든 데이터는 시뮬레이션된 것입니다. SSRN에 대한 경험적 이상 탐지 데이터 세트는 존재하지 않습니다.
6.5 카운터를 커리어 증거로 전환: 도서 프로토콜
선셋 이전에 순위 기반 SSRN 증거는 표준화된 도서 구성요소였습니다. 저자의 공개 순위는 승진 파일에 직접 들어갔습니다: "총 모든 다운로드 수에서 3,000명의 법학 저자 중 13위로 순위가 매겨졌으며, 법학대학원이 다양한 승진 및 관련 결정에 고려했습니다" [12]. 표지 레터 가이드는 다운로드 수와 상위 10개 목록 등재를 인용할 것을 권고했습니다 [95]. 실무 지도는 동시에 자가 게시 저작물이 "법학대학원 승진 및 종신 고용 목적으로 계산되지 않을 가능성이 높습니다"라고 주의했으며 [33], 플랫폼 자체의 문서는 그 지표를 저자가 "승진 및 종신 고용 목적으로 사용하고 기관이 채용 및 순위 지정 활동에 사용하는" 데이터로 설명했습니다 [52]. 이러한 모든 증거물은 더 이상 존재하지 않는 공개적 비교 프레임을 전제로 했습니다 [149]. 카운터의 평가적 사용은 처음 제안될 때부터 이의를 제기받았습니다: Black과 Caron의 학문적 성과의 "베타" 측정으로서의 다운로드에 대한 2006년 사례 [18]는 같은 심포지엄 권에서 Eisenberg의 SSRN 기반 순위가 유효하게 측정할 수 있는 것에 대한 비판으로 답변받았습니다 [45]. 다운로드를 인용하는 도서는 그 미결된 논쟁을 상속합니다. 표 13은 남아있는 것으로부터 방어 가능한 증거를 재구성하기 위한 7단계 프로토콜을 제시하며, 3번째와 4번째 열에 적용되는 통제 요구 사항은 도서에 인용된 모든 숫자는 그 출처, 시간 범위, 제한 사항과 함께 이동해야 합니다. 출처 없는 정밀도로 경화된 번역된 주장은 어떤 주장도 하지 않는 것보다 더 나쁩니다.
표 13. 종신 고용, 승진, 채용 도서에서 SSRN 지표에 대한 선셋 후 증거 프로토콜. 각 단계는 조치, 시간 범위가 있는 증거 기반, 숫자와 함께 공개해야 할 제한 사항, 피해야 할 안티패턴, 단계가 허락할 수 있는 가장 강력한 결론을 명명합니다.
| 단계 | 조치 | 증거 기반 (출처; 시간 범위) | 공개할 제한 사항 | 피하기 | 허용 가능한 결론 |
|---|---|---|---|---|---|
| 1. 보존 | 각 논문의 통계 패널과 표 11 간격에서의 저자 프로필과 제출 전의 날짜가 있는 스크린샷을 보관합니다. 배포 공지와 저자 자신의 승진 이벤트의 날짜가 있는 로그와 함께 6.1절의 버전이 있는 증거 패킷으로 조합합니다. | 논문별 카운터는 선셋을 초과합니다 ([148][149]; 2026). 필터링 규칙이 변경될 때 카운터를 다시 명시할 수 있습니다 ([144][69]; 2018년 이후 문서화됨). | 날짜가 있는 개인 보관소는 저자의 제어 하의 유일한 기록 버전입니다. 플랫폼 숫자는 수정 가능하며 공개 기록이 존재하지 않습니다. | "논문에는 X 다운로드가 있습니다" — 날짜 또는 분모 없이 인용됨. | 플랫폼이 표시한 날짜가 있는 감시 가능한 기록 — 평생 평결이 아닌 시간 특정 관찰. |
| 2. 번역 | 표 8을 사용하여 카운트를 대역 언어로 변환합니다 (예: "2015년 상위 10,000개 논문 목록의 ~160 진입 임계값 이상의 평생 다운로드, 즉 플랫폼의 전체 텍스트 논문 재고의 약 상위 1.8%, 2016년 7월의 571,040 [1], 그 당시"), 항상 출처, 샘플, 연도를 명명합니다. 부록 B의 CSAB 템플릿은 백분위수 필드가 참조 패널이 존재할 때까지 비워진 문장 수준 형식을 제공합니다. | 논문 수준 임계값: 진입 ≥160, 그룹 내 중앙값 805 (상위 목록 스크레이프; 2015) [85]. 저자 수준: 최소 129개 총 다운로드 진입, 그룹 내 중앙값 1,626 (동일 스크레이프) [85]. 전형적인 논문 앵커: 2년에 중앙값 63 (LSN; 2012→2014) [139]; 중앙값 87 (마케팅 네트워크; 스냅샷 2025) [83]. | 모든 임계값은 2012–2015 샘플에서 파생됨 (이후 인플레이션 [1]: 5.1절); 2015년 프레임은 상위 목록만 포함합니다. 두 중앙값 앵커는 단일 분야입니다. 대역 언어는 보정된 백분위수로 재명시되지 않아야 합니다. | 오래된 원시 임계값에 매달린 "우수한"과 같은 범용 레이블. | 명명된 샘플, 분야, 연도 내의 상대적 지위 — 더 광범위한 것은 없습니다. |
| 3. 삼각측량 | SSRN 카운터를 독립적 인용 증거와 쌍을 이룹니다: Google Scholar, 법학을 위한 HeinOnline, 경제학을 위한 RePEc, 개방형 인용 계층으로서의 Crossref/OpenAlex, SSRN에 표시되는 PlumX. | 학교 수준 SSRN 다운로드 및 HeinOnline 인용 순위는 0.84에서 상관관계가 있습니다 (미국 법학대학원 100개; 2019) [77]. 논문 수준 다운로드–인용 상관관계는 분야 및 기간에 따라 ~0.1–0.6입니다 [80][25]. 개방형 인용 인프라 [35][124]; PlumX [50]. | 0.84 수치는 학교 수준 상관관계이며 개별 논문이나 저자에게 내려가지 않습니다 (생태학적 추론 주의, 6.2(iii)절). 다운로드는 요구를 측정하며 읽기나 동의가 아닙니다. 논문 수준 상관관계는 겸손하며, 높은 다운로드와 높은 인용 세트는 부분적으로만 겹칩니다 [108]. 수렴하는 인용 증거, 카운터 단독이 아니면 영향력 주장을 수행합니다. | 다운로드를 동의나 정확성과 동일시합니다. | 흡수의 계층화된 증거, 품질의 증명이 아닙니다. |
| 4. 분야 정규화 | 학문적 프레임을 명시적으로 명시합니다 (예: "법학 장학금 내에서, eJournal은 법학 하위 분야에서 대략 8배의 인수로 다릅니다"). | 하위 분야 평균 438.35대 53.48 다운로드/논문 (LSN eJournals; 2018) [168]. 다운로드 대 인용 비율은 그 자체로 분야 구조화됩니다 [18]. | 확산 추정치는 법학 전용이며 2018년 날짜입니다. 분야 간 임계값 전이는 주의가 필요하며, 분야 한정자 없는 백분위수 언어는 해석 불가능합니다. | 새 논문을 다년 누적 합계와 비교하거나 임계값을 분야 간에 이식합니다. | 분야 및 연령으로 적격한 비교 — 절대 보편적 등급이 아닙니다. |
| 5. 보완 | SSRN과 함께 기관 저장소 및 기타 배포 채널을 인용합니다. | SSRN 카운터는 다른 서비스에서 동일 논문의 다운로드에 대해 아무것도 말하지 않습니다 [161]. 2026년 개혁은 기관 배포를 위한 마이그레이션 경로로 저장소 기반 시리즈를 만들었습니다 [47][146]. | 어떤 단일 플랫폼의 카운터도 논문의 총 유통량을 측정하지 않습니다. 도서 주장은 한 카운터가 아닌 논문에 관한 것입니다. | 한 플랫폼의 카운터를 논문의 총 유통량으로 제시합니다. | 논문의 유통에 관한 주장으로, 각 채널의 카운터가 별도로 명명됩니다. |
| 6. 무결성 | 플랫폼의 계산 규칙을 인용된 수와 함께 명시하고, 표시된 수를 문서화하는 날짜가 지정된 아카이브를 유지합니다. | 필터링과 재표현은 문서화된 플랫폼 동작입니다([144][69][66]; 진행 중); 공급업체가 보고한 다운로드 통계는 계산 규칙에 따라 달라집니다([69][176]; 2015–2019). | 카운터는 필터링되고 수정 가능한 추정치이며, 공개 재표현 이력이 없으므로 저자의 날짜가 지정된 아카이브가 유일한 안정적 기록입니다. | 카운터를 고유한 인간 독자의 정확한 수로 취급합니다. | 명시된 규칙에서 명시된 날짜의 필터링된 추정치 — 독자의 인구조사가 아닙니다. |
| 7. 전문가 평가 | 모든 메트릭 라인을 작업의 기여도와 엄밀성에 대한 질적 평가의 맥락으로 제시하며, 이를 대체하지 않습니다. | 메트릭은 타당성이 아닌 확산 단계를 측정합니다(섹션 3.1, 5.5); 높은 다운로드 수와 높은 인용 수 집합은 부분적으로만 겹칩니다[108]. | 정규화되거나 원시적인 사용 메트릭은 연구가 올바르거나 중요한지 여부를 평가하지 않습니다. | 동료 판단을 메트릭으로 대체합니다. | 전문가 검토를 동반하는 맥락적 증거 — 품질 주장은 검토와 함께하며, 수치와 함께하지 않습니다. |
회피 열은 프로토콜의 안티패턴을 수집합니다. 두 가지 경고가 프로토콜 전체를 제한합니다. 다운로드는 수동적 수요를 기록하며 읽기, 승인 또는 품질이 아니며, 카운트는 학문만큼 홍보 역학(블로그 보도, 두드러진 제목, 주제적 물결)에 반응합니다[116][139][138]. 조작 기록을 아는 위원회는 지지되지 않은 수를 할인할 것이며, 이러한 할인을 견디는 요소는 정확히 프로토콜이 요구하는 것입니다: 날짜가 지정된 스크린샷, 출처가 첨부된 밴드 언어, 필드 한정자, 그리고 삼각측량입니다.
6.6 권유의 따름정리
게시에는 대시보드가 보고하지 않는 하나의 문서화된 부작용이 있습니다. 즉, 사전인쇄 플랫폼에서 이름, 소속, 논문 제목을 수확하여 생성된 약탈적 저널 및 학회의 비요청 초대입니다 [107][159]. 인접 감사에서 규모는 상당하며, 전문 연구는 학자 당 2주마다 수십 건에서 전문 그룹 당 월 수천 건에 이르는 초대 흐름을 문서화합니다 (섹션 7.2) [9][84][63]. 약탈적 저널과의 첫 번째 접촉은 조사된 사례의 약 41%에서 비요청 이메일입니다 [32]. 섹션 7과 표 14는 이 현상을 분석합니다. 플레이북의 경우 결과는 4가지 지침으로 축소됩니다. 가시성의 기본 결과로 권유를 예상하되, 그 규모를 절대 학문적 인정으로 읽지 마십시오. 발신자는 선택적으로 가치를 평가하지 않고 기계적으로 가시성을 표적으로 삼습니다 [159][63]. 수확이 주요 수신함을 오염시키지 않도록 전용 주소를 통해 대응을 전달하십시오. 널리 반복되는 개선 사항인 게시 후 처음 2주 동안 프로필 이메일 주소를 숨기는 것은 검증되지 않은 관행입니다 (부록 A). 사업 모델이 수수료이고 감사된 약탈적 아울렛의 논문 처리 요금이 $25에서 $1,800까지 범위를 나타내므로 결코 지불하지 마십시오 [136]. 돈은 더 작은 이해관계입니다. 서류를 정밀 조사하는 동일한 평가 위원회 (섹션 6.5)는 또한 참고문헌을 읽으며, 알려진 약탈적 개최지가 출판 목록에 있으면 모든 수수료보다 오래 지속되는 평판 비용을 부과합니다. Cabells Predatory Reports와 같은 유지 관리되는 스크리닝 서비스 ([B-1]; Beall의 목록은 2017년 1월 이후 업데이트되지 않았으며 라이브 소스로 사용되면 안 됨)와 Think. Check. Submit. [159]의 체크리스트에 대해 초대 개최지를 확인하십시오. 수확 메커니즘은 또한 질적 스크린을 제공합니다. 인간의 독서가 그럴듯하게 형성될 수 있기 전에 사전인쇄 게시 후 며칠 내에 초대를 이메일로 보내는 저널은 정당할 가능성이 거의 없습니다. 이것은 휴리스틱입니다. 어떤 연구도 그 발생 빈도를 측정하지 않았습니다 [63].
6.7 플레이북의 범위
플레이북의 기준은 2012년부터 2015년까지의 것이며, 법률 및 마케팅 중심입니다 [139][85][83][1]. 다운로드-논문당 흐름은 그 이후로 증가했습니다 (섹션 5.1). 신선한 필드-계층화된 백분위 데이터는 아직 존재하지 않으며, 플랫폼이나 커뮤니티에 의한 수집은 섹션 8과 10의 주제입니다. 플레이북은 오독을 줄이며, 품질을 측정하지 않습니다. 네 가지 규칙이 그 사용을 기계적으로 만듭니다: 일치하는 사례를 비교하고, 관찰 기간을 일정하게 유지하고, 모든 숫자에 출처를 첨부하고, 가설에 가설이라는 레이블을 붙입니다.
7. 기생 주의력 계층: 가시성 및 약탈적 권유
지금까지 개발된 해석 체계는 주의력을 노출에서 추상적 조회, 다운로드, 다운스트림 사용으로 흐르는 단일 깔때기로 취급합니다. 그러나 전자출판물을 게시하는 실제 경험에는 완전히 다른 채널을 통해 도착하는 "주의력"의 두 번째 흐름이 자주 포함됩니다: 저널, 컨퍼런스, 정당성이 의문스러운 편집 서비스로부터의 원치 않는 이메일 초대장 [14][61][117][142]. 그 두 번째 흐름에 대한 개념적 설명과 함께 그 규모를 문서화한 감시 증거가 뒤따릅니다.
7.1 관심의 이층 모델
포스팅 이후 환경은 여기서 이층 관심 경제(그림 10)로 취급됩니다. 계층 1은 섹션 4와 6에서 설명한 정당한 유입경로입니다: eJournal 배포, 초록 조회, 다운로드, 그리고 궁극적인 학술적 사용. 계층 2는 기생 계층으로, 동일한 공공 인프라(제목, 초록, 저자 이름, 소속)를 활용하며 저자들을 고객으로 전환시키는 것을 목표로 하고 그들의 저작을 읽으려는 의도는 없는 약탈적 출판사와 서비스 제공자의 생태계입니다. 공시-감사 문헌은 생명 주기를 문서화합니다. 공개 프리프린트 메타데이터(SSRN 제목, 초록, 저자 이름, 소속)가 수집되고[107][159], 정당한 논문 모집을 모방한 의뢰장이 발송되며[61][63], 응응한 저자들이 고객으로 전환됩니다. 경제 엔진도 문서화되어 있습니다: 추정 약탈적 저널의 논문 처리 비용은 평균 약 $178이며, 보고된 범위는 $25–$1,800입니다[136].
두 계층 간의 비대칭성은 해석에 중요합니다. 계층 1은 인간 독자가 논문을 발견하고, 열고, 가치를 부여하기를 요구하는 반면, 계층 2는 논문의 메타데이터가 기계 판독 가능하기만 하면 됩니다. 따라서 프리프린트는 원칙적으로 정당한 계층에서 효과적으로 읽히지 않으면서도 기생 계층에 의해 완전히 처리될 수 있습니다. 이것이 플랫폼의 거의 영 다운로드 논문들, 즉 "유령 논문들"의 상황이며, 기계는 처리하지만 인간은 효과적으로 읽지 않습니다.
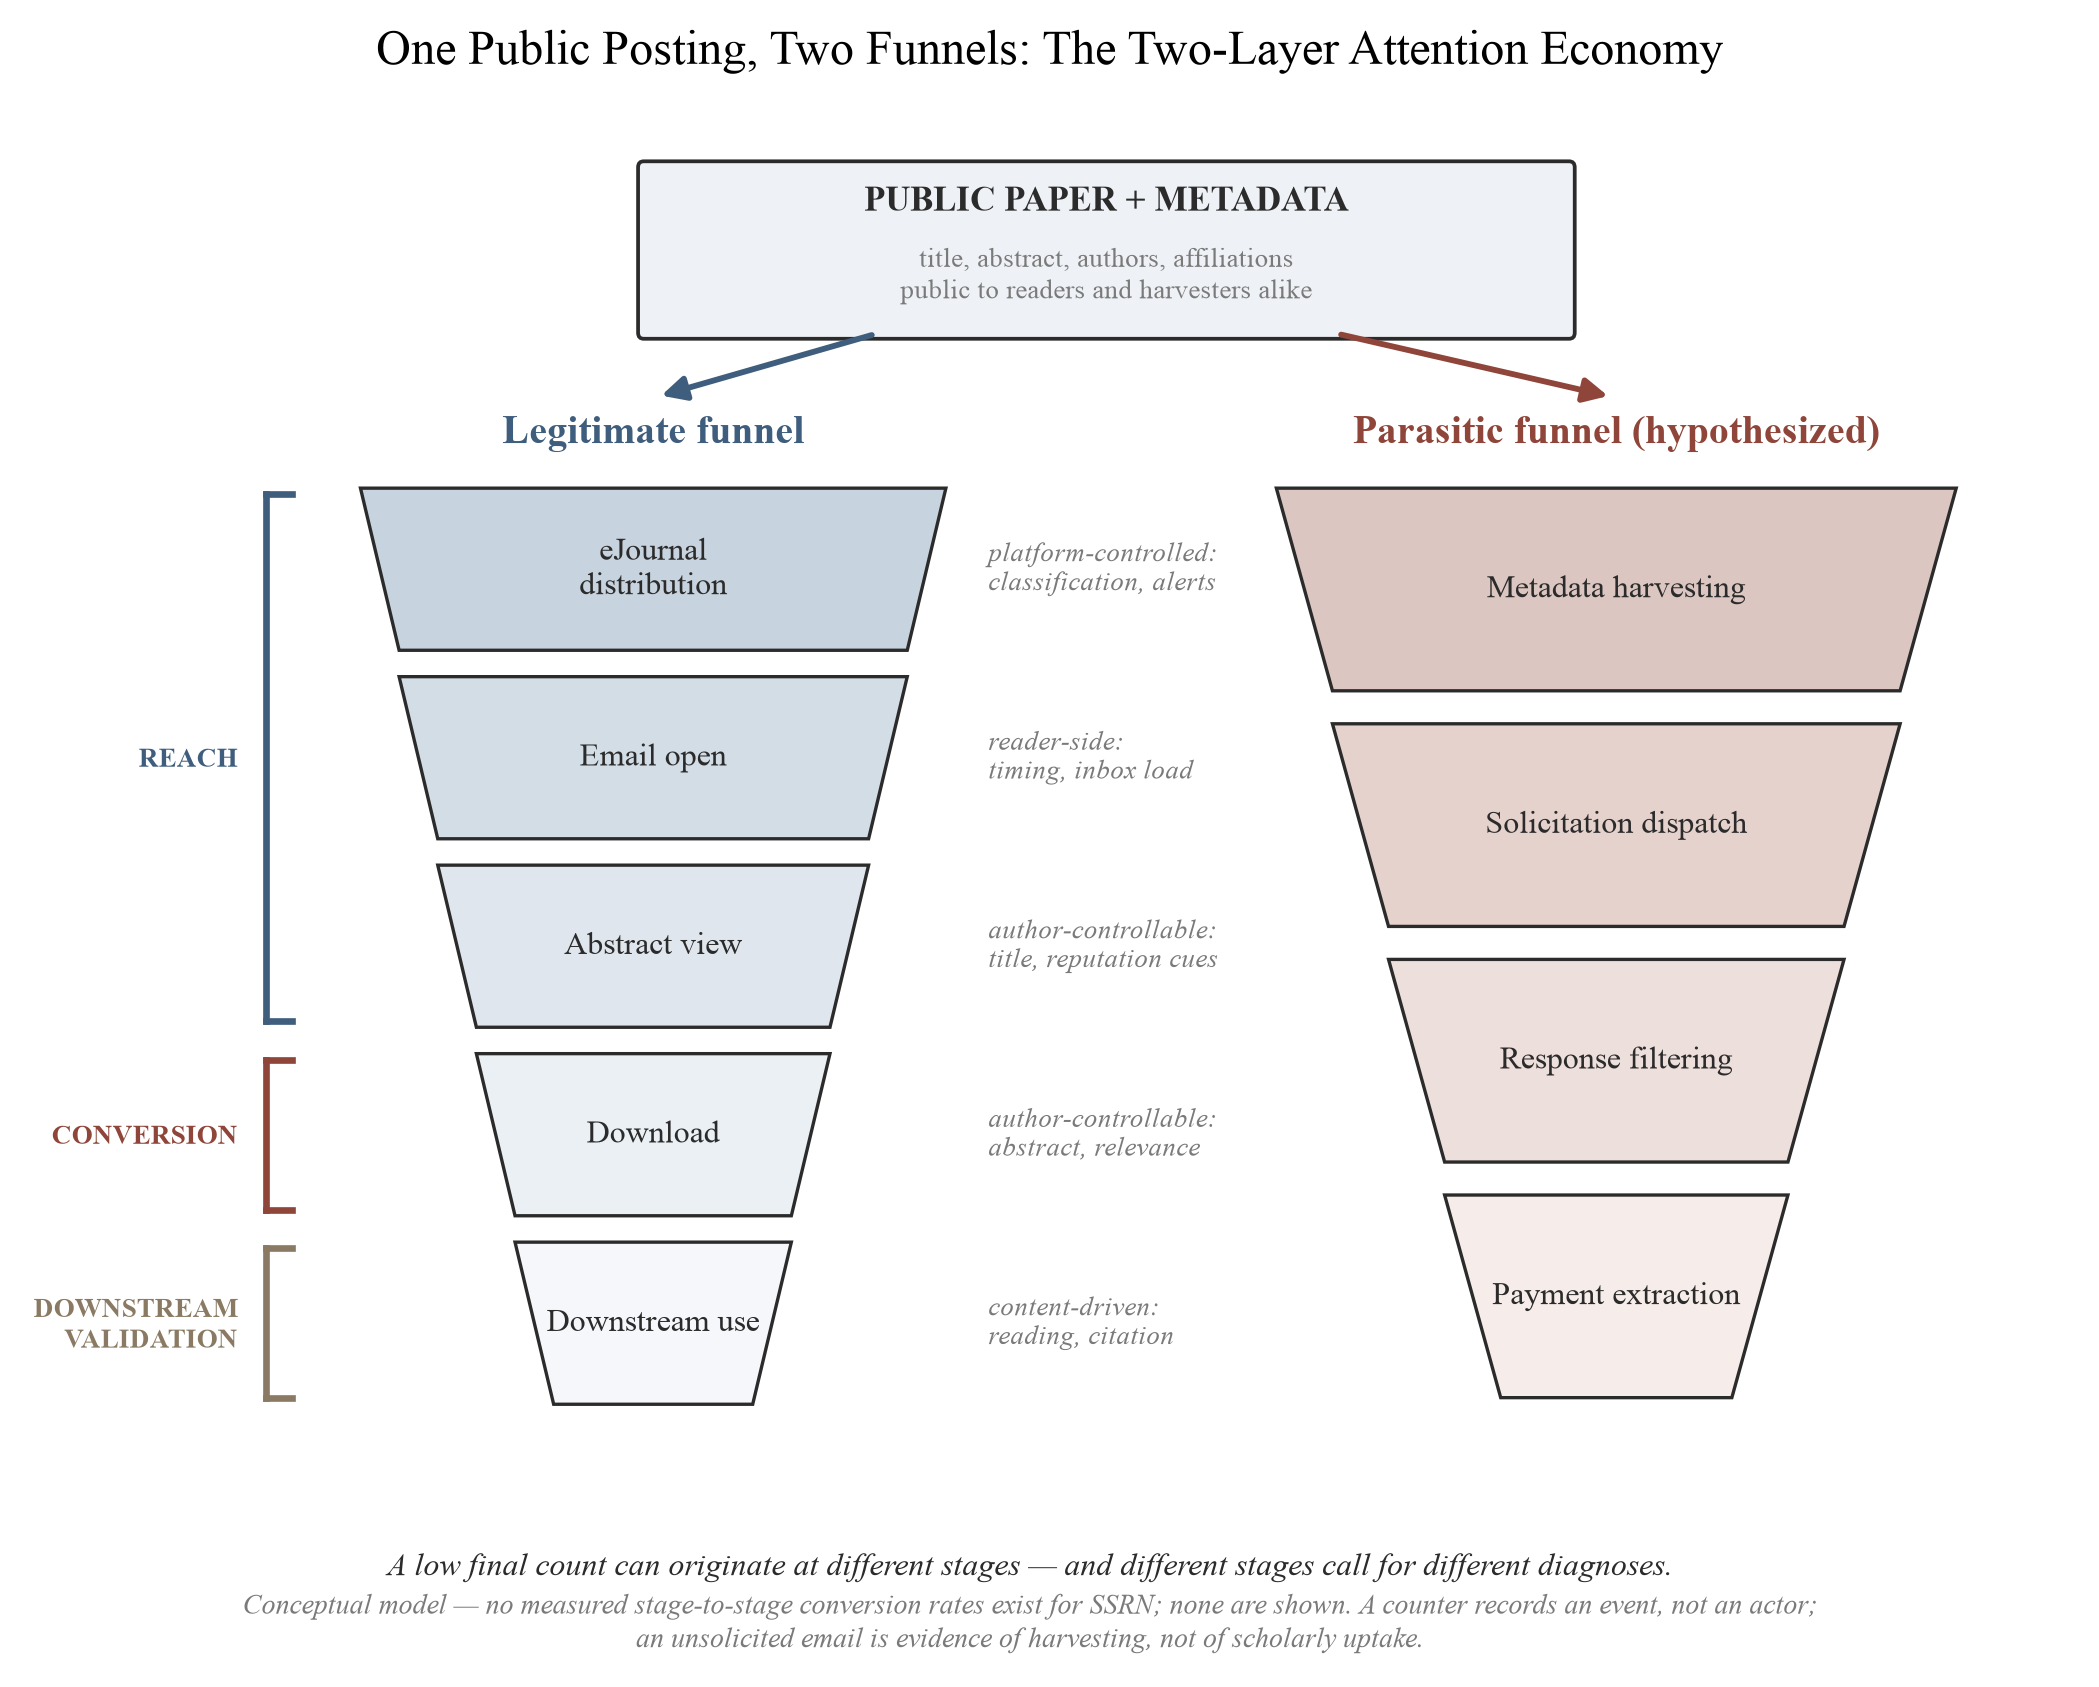
그림 10. 이층 관심 경제의 개념 모델. 두 유입경로 모두 질적 단계 수열로 표시됩니다. SSRN에 대해 측정된 그러한 비율이 없기 때문에 단계 간 전환율은 표시되지 않습니다. 기생 유입경로는 공시-감사 문헌[61][63][107][159]을 바탕으로 한 가설적 재구성입니다(섹션 7.3).
7.2 약탈적 권유의 기록된 규모
약탈적 권유가 대규모 현상이라는 점은 의심의 여지가 없습니다. 2026년의 한 리뷰에서는 학술 스팸에 대한 29개의 경험적 연구를 식별했으며, 이들은 다음과 같은 전술 목록으로 수렴합니다: 부당한 권유, 거짓된 편집 주장, 그리고 의심스러운 지표 및 인덱싱 주장 [61]. 측정된 규모는 상당합니다. 14명의 학술 안과의사가 단일 30일 기간 내에 383개의 고유 출판사로부터 696개의 고유 저널을 아우르는 1,813개의 권유 이메일을 받았습니다 [84]. 학술 방사선과의사들은 2주 기간에 평균 20.7개의 원고 초대와 4.1개의 발표자 초대를 받았습니다 [9]. 한 탐색적 감사는 2023-24년에 단일 비뇨기과의사가 받은 422개의 권유 이메일을 목록화했고 [63], 학술 출판에 대한 사례 연구는 391일에 걸쳐 저널로부터 1,024개의 스팸 이메일을 기록했습니다 [89]. 프리프린트 게시 이후를 추적하는 1년간의 단일 연구자 관찰에서는 256개의 저널로부터 875개의 초대를 기록했으며, 이 중 76%는 선별된 차단 목록에 나타났습니다. 여기서 게시 이후의 도착 지연이 측정되지 않았다는 주의 사항과 함께 인용되는 조건부 출처입니다 [B-10]. 권유는 또한 명백히 전환됩니다. 약탈적 저널에 게시한 저자들 중 41%는 저널과의 첫 접촉이 요청받지 않은 이메일 초대였다고 보고했으며 [32], 권유 말뭉치에 대한 내용 분석은 부당한 언어, 위조된 마감일, 그리고 모호한 주제 범위를 반복적인 설득 장치로 문서화합니다 [96].
증거가 의학에만 국한되지는 않습니다. SSRN 자신의 기반에 훨씬 더 가까운 분야인 사회과학에서, 교육과학 분야의 세 명의 연구자는 3개월 내에 210개의 요청받지 않은 저널 초대를 받았으며, 이는 139개의 저널과 37개의 출판사로 추적되었고, 대부분이 약탈적인 것으로 분류될 수 있습니다; 초대의 대략 절반은 수령인의 전문 분야 밖에 있었으며, 이는 열독 기반이 아닌 메타데이터 기반 타겟팅의 특징입니다 [155]. 부담은 이 글의 주인공인 초기 경력 저자에게 가장 먼저 떨어집니다. 초기 경력 학자의 한 종단 자체 감사는 약 8년에 걸쳐 1,280개의 약탈적 권유(저널로부터 990개, 컨퍼런스로부터 220개, 기타 종류 70개)를 기록했으며, 구독 해제 시도의 기록과 대부분 성공하지 못한 시도를 포함합니다 [160].
이 증거 기반의 두 가지 특징을 명심해야 합니다. 가장 큰 감사는 의학에서 나오고, 위의 사회과학 감사는 분야상 SSRN에 더 가깝지만 더 작으며, 어느 문헌의 규모도 SSRN 저자에게 이전될 수 없습니다. 이 글에 결정적인 것은, 이 연구들 중 어느 것도 프리프린트 게시 이벤트와 관련된 권유의 타이밍을 측정하지 않았다는 것입니다. 예를 들어 [63]의 감사는 내용과 출처를 목록화했지만 도착 시간을 SSRN 활동과 연결하지 않았습니다. 기생 계층을 게시 행위와 연결하는 모든 주장은 따라서 발견이 아닌 메커니즘 가설입니다.
7.3 가설적 타겟팅 메커니즘
새로 게시된 사전인쇄본에 도달하려면 기생적 층이 먼저 이를 찾아야 합니다. 아래의 메커니즘들은 문헌에서 부분적 지지를 받는 가설입니다. 요청을 SSRN 게시와 연결하는 코퍼스는 없습니다.
H-S1 (메타데이터 수집). 약탈적 운영은 제목, 저자명, 소속기관에 대한 공개 초록 페이지와 신규 논문 목록을 긁어냅니다. 실무자 및 자문 출처는 이러한 행동을 설명합니다. 약탈적 저널은 사전인쇄본 서버를 스캔하고 논문의 제목을 언급하는 요청되지 않은 초대를 발송하는 것으로 보고됩니다 [159]. 법학 관련 해설은 요청자가 "기존 학술지, 예를 들어 SSRN에 게시된 논문들을 뒤져 이메일, 이름, 소속 등을 수집한다"고 명시합니다 [107]. 법률 도서관 안내서는 사전인쇄본 게시를 "저자에게 수수료를 받고 자신의 논문을 재게시하도록 요청하는 약탈적 출판사의 스팸 증가"와 연결합니다 [117]. 측정된 규칙성 하나가 이 메커니즘과 맞습니다. 방사선학 감시에서 전문성 감시는 활발히 출판하는 저자들 사이에서 높은 요청 볼륨을 보고합니다 [9]. 이는 단일 게시 사건이 아닌 저자의 누적 서지적 표면으로부터의 수집과 일치합니다. 연구 3 (섹션 8.6)은 따라서 초점 게시와 함께 저자 수준의 노출 통제를 기록합니다.
H-S2 (연락처 획득). 요청에는 이메일 주소가 필요합니다. SSRN 초록 페이지는 역사적으로 저자 연락처 정보를 포함했습니다 [151]. 주소는 또한 논문 자체, 기관 페이지 및 이전 출판물을 통해 순환합니다. SSRN이 현재 저자 이메일을 수집 가능한 형태로 노출하는지는 검증되지 않았습니다. 계측된 요청 로깅 연구는 이를 측정하도록 명시되어 있습니다. 주어진 요청에 대한 획득 채널은 관찰되지 않습니다.
H-S3 (배포 편승). eJournal 다이제스트 및 RSS 유형 피드는 새로운 논문 메타데이터를 구독자에게 재배포합니다 [57][51]. 이러한 채널을 구독하는 기생적 행위자는 스크래핑 없이 구조화된 리드를 수신할 것입니다. 이 경로를 검증한 감시는 없습니다.
게시에서 타겟팅되기까지의 인과 관계는 경험적으로 확립되지 않았습니다. 섹션 8은 이러한 메커니즘의 사전 등록된 검증을 명시합니다. 새로 게시된 논문의 알려진 게시 타임스탬프에 대한 요청 도착을 기록합니다.
7.4 권유 신호의 가설적 유형론
7.3절의 타겟팅 메커니즘이 작동한다면, 다양한 권유 유형은 논문의 기계적 가시성에 대해 서로 다른 정보를 전달해야 합니다. 표 14는 이를 가설적 유형론으로 제시하며, 그 전략 범주는 문서화된 설득 전술에 근거합니다: 자격 불일치 및 부정확한 개인화 [9][63], 위조된 마감일과 아부 [96], 거짓 지표 및 색인화 주장 [61], 그리고 문서화된 APC 시장에 대한 숨겨진 수수료 [136]. 마지막 열은 추론적이며 검증되지 않았습니다. 표는 유행 비율이나 도착 시간 추정을 제공하지 않습니다.
표 14. 프리프린트 공개 후 포식적 권유 신호의 가설적 유형론. 예시 표현은 권유 감시 [9][61][96]에서 문서화된 패턴의 일반화된 다시 쓴 것이며, 특정 메시지의 직접 인용이 아닙니다.
| 권유 패턴 | 설명 | 예시 표현 | 가시성에 대한 가설적 정보 |
|---|---|---|---|
| 일반적인 호칭, 논문 참고 없음 | 특정 논문이나 분야에 대한 언급이 없는 자동화된 초대 | "존경하는 연구자님께, 귀중한 논문을 제출하세요…" | 낮음: 호칭은 어떤 출처에서든 파생될 수 있으며, 논문 자체가 검토되었다는 증거가 없음 |
| 자격 불일치 | 논문과 무관한 분야의 전문성을 인용하는 초대 [9] | "양자물리학의 전문가 역량을 고려하면…" (법률 논문에 대해) | 낮음~없음: 메타데이터 파싱 없는 대량 수집을 나타냄 |
| 타겟팅된, 제목 참고 | 특정 프리프린트와 주제 인접 학술지를 명시하는 초대 [159] | "최근 '[정확한 제목]' 논문이 우리 저널에 적합할 것 같습니다…" | 더 높음 (가설적): 논문의 메타데이터가 발신자에게 도달했으며, 성공적인 색인화 및 스크래퍼 접근을 시사함 |
| 아부성 개인화 | 특정 업무를 "획기적" 또는 "존경받는" 것으로 칭찬 [96] | "귀하의 획기적인 기여…" | 제목 접근 이상 없음: 칭찬은 템플릿화되어 있으며, 실제 읽음이 아님 |
| 위조된 긴급성 및 지표 | 가짜 마감일, 별표 표시된 "영향지수", 색인화 주장 [61][96] | "영향지수 4.2*; 7일 내에 제출하세요" | 없음: 설득 장치는 대상 논문과 무관함 |
| 숨겨진 수수료 | APC가 늦게 또는 첨부 파일에만 공개됨; 시장 범위 $25–$1,800 [136] | 초대 본문에서 수수료 부재 | 없음: 가격 책정 전략이지, 가시성 신호가 아님 |
| 회의 초대, 논문 참고 | 의심스러운 회의에서 발표 또는 제출 초대, 특정 논문을 명시하는 경우가 많으며, 발표자 초대는 학술 스팸의 측정 가능한 구성 요소 [61][9] | "귀하의 논문 '[정확한 제목]'을 …의 기조연설로 발표해 주실 것을 초대합니다" | 타겟팅된 권유와 같음 (가설적): 논문의 메타데이터가 발신자에게 도달했으며, 실질적인 읽음의 증거는 없음 |
| 유료 저자 서비스 | 신청한 지 얼마 되지 않은 프리프린트에 대한 신속한 동료 검토, 번역 또는 편집 서비스 제안 [61][84] | "새로운 프리프린트에 대한 빠른 심사 및 전문적 언어 수정…" | 확립됨: 서비스 스팸은 논문 콘텐츠가 아닌 새 게시 메타데이터를 추적함 |
아부성 행들은 기계적 읽음이 불분명하게 하는 심리적 차원을 담고 있습니다. 템플릿화된 칭찬은 정체된 조회 수를 바라보고 있는 저자에게 닿으며, 그들에게 권유는 아직까지 게시물이 낳은 유일한 "검증"입니다. 따라서 이층 모델은 새 프리프린트에 대한 첫 응답자가 독자가 아닌 포식자일 가능성이 높다는 냉혹한 역설을 예측합니다 (7.5절), 그리고 초보자는 아직 정당한 신호가 도달하지 않았기 때문에 스팸을 관심으로 오독할 수 있습니다. 함정을 예상하는 저자는 이를 할인할 수 있습니다.
표 14는 수신 메시지를 논문의 가시성에 대해 드러낼 수 있는 것을 읽습니다. 그것들을 어떻게 코딩할 것인지가 상호 보완적인 질문이며, 정당한 학술 접촉과 고위험 권유 사이의 구분에 달려 있습니다. 표 15는 그 구분을 최종 열이 코딩 주의사항을 전달하는 여섯 신호의 유형론으로 제시합니다: 모든 신호는 확률적이며 어느 것도 그 자체로는 증명이 아닙니다. 유형론은 또한 연구 3 코드북의 골격입니다 (8.6절), 정당한 접촉의 긍정 클래스 없는 권유 연구는 7.5절이 가설하는 비대칭을 측정할 수 없기 때문입니다.
표 15. 정당한 학술 접촉과 고위험 권유를 분리하기: 코딩 주의사항이 있는 여섯 신호. 검증된 분류기가 아닌 가설적 코딩 체계입니다. 표 14의 가시성 열은 다른 질문을 묻고 영향을 받지 않습니다: 같은 메시지를 두 그리드 모두에서 코딩할 수 있습니다.
| 신호 | 정당한 학술 접촉 | 고위험 권유 | 코딩 주의사항 |
|---|---|---|---|
| 구체성 | 구체적인 논증, 방법 또는 결과에 참여 | 제목이나 키워드가 삽입된 일반적인 칭찬 | 구체성은 모방될 수 있습니다 |
| 학술지 정체성 | 검증 가능한 저널, 편집자, 기관 또는 회의 이력 | 불명확한 소유권, 복사된 브랜딩, 검증 불가능한 이사회 | 새로운 학술지가 자동으로 포식적인 것은 아닙니다 |
| 요청 | 실질적인 질문, 협력 또는 투명한 초대 | 업무와 무관한 긴급 제출 또는 지불 요청 | 수수료만으로는 결정적이지 않으며, 투명성이 중요합니다 |
| 시기 | 어떤 시기든; 종종 실제 읽음 후에 따릅니다 | 공개 게시 직후 신속한 템플릿화된 접촉 | 시간적 근접성이 수확 출처를 증명하지는 않습니다 |
| 언어 | 주제별 및 전문적으로 책임 있음 | 아부, 거짓 친숙성, 인위적 긴급성, 모호한 범위 | 언어 특징은 확률적이며, 증명이 아닙니다 |
| 검증 | 독립적으로 검증 가능한 접촉 세부 정보 및 정책 | 손상된 식별자, 거짓 지표, 오도하는 색인화 주장 | 문서화된 기준에 따른 인간 검토가 필요합니다 |
실제로 이 유형론은 진단보다는 스크리닝 휴리스틱을 제공합니다. 게시 후 처음 며칠 이내에 합법적인 배포 채널이 합리적으로 작동하기 전에 도착하는 학술지 권유는 약탈적일 가능성이 매우 높습니다. 높은 영향력을 가진 합법적인 학술지들은 방금 게시된 원고의 저자들에게 콜드콜을 하는 것으로 보고되지 않으며 [174], 반면 조기의 비청청 초대는 약탈적 학술지들의 문서화된 첫 접촉 방식입니다 [32][174]. 우리는 실무자 논의에서 때때로 제안되는 구체적인 기준값(대략 처음 96시간 이내의 모든 학술지 이메일을 추정상 약탈적인 것으로 취급)을 검증 대기 중인 저자 휴리스틱으로 제안합니다. 이러한 기준값을 보정할 시간 지연 분포를 측정한 연구는 없습니다. 표 15의 타이밍 주의사항은 휴리스틱 자체에 적용됩니다. 시간적 근접성은 의심을 불러일으키지만 발신자가 이 특정 게시물을 수집했다는 것을 증명하지는 않으며, 주소가 프리프린트 전체보다 먼저 존재할 수 있으므로 96시간 스크린은 증거보다는 수신함을 정렬합니다.
7.5 스팸 역설과 속도 비대칭성
2층 모델에서 기생 계층에 관한 두 가지 명제가 따라옵니다.
스팸 역설. 표적화된 권유가 성공적인 메타데이터 수확을 요구한다면, Rankings 이후 환경에서 포식성 스팸의 부재는 그 존재가 다른 것을 나타내는 것보다 플랫폼 비가시성의 더 강한 지표일 수 있습니다. 기생 계층조차 작동시키지 않은 논문은 기계가 읽을 수 있는 배포의 최소 기준을 충족하지 못했을 수 있습니다. 스팸을 불의의 독성 프록시로서 인덱싱으로 변환하는 이 역전의 분석적 매력은 피할 수 없는 성가심을 자유로운 관찰 기구로 바꾼다는 것입니다. 그 진단적 힘은 현재로서는 가설일 뿐입니다. 권유 수신과 어떤 가시성 메트릭 간의 상관관계는 측정된 적이 없으며, Table 14의 일반 권유 행은 원시 스팸 양이 원칙적으로도 노이즈가 많은 신호인 이유를 보여줍니다.
포식자는 독자보다 먼저 도착합니다. 정당한 유입로는 제도적 지체에서 작동합니다. eJournal 포함은 보장되지 않으며 큐레이션되며, 대용량 분류의 경우 45일까지의 지연이 보고되었습니다 [53]. Google Scholar 인덱싱은 6개월 이상 걸립니다 [55]. 첫 주에 거의 영다운로드는 거부가 아닌 정상적인 배포 전 상태와 일치합니다 (섹션 6). 기생 계층이 메타데이터를 프로그래밍 방식으로 수확한다면 이러한 지체가 없습니다. 따라서 연락처 정보를 얻을 수 있는 저자의 경우, 게시물로 인한 첫 포식성 권유까지의 예상 시간이 첫 진정한 학술 연락까지의 예상 시간보다 짧으므로, 미확인 저자는 정당한 계층 전에 기생 계층을 만날 것으로 가설합니다. 반박은 직접적입니다: 진정한 연락이 항상 권유보다 먼저 있습니다.
일과 주로 측정된 문서화된 권유 양 [9][84]은 주와 달로 측정된 배포 메커니즘 [55][53]에 대해 설정되어 가설을 타당하게 만듭니다. 섹션 8에 명시된 로깅 연구만이 이를 테스트할 수 있습니다. 기존 코퍼스가 게시 이벤트에 시간 잠금되지 않았기 때문입니다 [63].
7.6 기생층이 저자에게 알려주지 않는 것
세 가지 경계 진술이 이 섹션의 결론을 제한합니다.
첫째, 권유 이메일은 플랫폼의 카운터를 움직이지 않습니다. 저자에게 보낸 초대는 초록 조회와 논문 다운로드를 생성하지 않습니다. 웹 크롤러가 초록 페이지를 방문하는 범위에서 SSRN은 다운로드 수에서 불규칙하고 자동화된 활동을 필터링한다고 밝힙니다 [66][69][144]. 따라서 스팸 량은 결코 독자층의 증거가 아니며, 권유로 가득 찬 받은편지함이 한 자리 다운로드와 공존하는 것은 모순을 포함하지 않습니다: 두 층은 다른 것들을 계산합니다.
둘째, 기생층은 또한 그 비용을 흡수할 준비가 가장 덜 되어 있는 저자들에게 가장 심하게 영향을 미칩니다: 초기 경력 및 영어를 모국어로 하지 않는 연구자들은 권유에 특히 취약한 것으로 지적됩니다 [142]. 따라서 제6절의 실제 프로토콜은 받은편지함 위생(권유하는 모든 학술지 차단 목록 스크리닝, 비요청 초대에 대한 무응답, 폐지된 목록이 아닌 큐레이션된 서비스를 통한 검증)을 별도의 우려가 아닌 지표 해석의 일부로 취급합니다. 약탈적 학술지의 자동 스크리닝 자체는 활발한 연구 방향입니다 [157].
셋째, 초기 가시성에는 또 다른 부작용이 있으며, 이는 저자들이 명백한 고발로 경험합니다: 나중의 저널 제출 시, 유사성 검사 소프트웨어는 원고와 자신의 SSRN 선행 출판 사이의 거의 완벽한 일치를 플래그합니다. 선행 인쇄본이 iThenticate에서 사용하는 Crossref Posted Content 말뭉치에 인덱싱되기 때문입니다 [36]. 공급업체의 설명서는 동일 저자 선행 인쇄본 일치가 예상된 결과이지 표절이 아니라는 것을 명시합니다 [81]. 적절한 대응은 선행 인쇄본을 편집자에게 공개하는 것이지, 이를 철회하는 것이 아닙니다.
기생층은 이 논문의 핵심 주장이 가장 쉽게 보이는 곳입니다: Rankings 폐지 이후, 원신호(다운로드, 조회, 그리고 지금은 스팸까지)는 그들을 생성한 메커니즘이 명시될 때만 해석 가능한 의미를 갖습니다. 그 명시는 합법적인 층에 대해서는 부분적으로 이용 가능하며, 기생층에 대해서는 여전히 연구 프로그램입니다.
8. 사전등록 준비가 된 연구 의제: 누락된 참조 범주 재구축
앞의 섹션들은 SSRN 주의 지표에 대한 검증 가능한 증거를 종합하고 Rankings 이후 환경에 대한 해석 프레임워크를 제안했습니다. 이 섹션은 프레임워크의 미해결 질문에 경험적으로 답하기 위한 사전등록 준비가 된 의제입니다. 설계상 결과를 보고하지 않습니다: 발견이 아닌 사전 지정된 거짓으로 판정할 수 있는 범주. 아래의 모든 설계, 가설 및 예측 범주는 데이터 수집 전에 공개 과학 프레임워크에 등록될 준비가 되어 있으며, 분석 코드는 함께 공개됩니다. 2026년 7월 15일의 SSRN Rankings 폐지 [149], 2026년 6월 12일 더 이른 목표 날짜 [148]로 공시되었으며 더 광범위한 플랫폼 재초점 [146]에 포함되어 있으므로, 이 의제는 특별히 시간에 민감합니다: 아래의 설계 중 일부는 선행 기간이 매달 후퇴하는 불연속성을 활용하며, 그중 하나인 제8.8절의 백분위 레지스트리는 폐지 자체가 외부 관찰자에게 영구적으로 만든 측정 격차를 다룹니다.
8.1 설계 원칙
네 가지 원칙이 의제를 지배합니다.
출생부터의 관찰. 누적 카운터의 소급적 수집으로는 논문이 3일차, 7일차, 또는 30일차에 어떤 상태였는지를 재구성할 수 없습니다. 따라서 신뢰할 수 있는 벤치마크 패널은 반드시 논문을 게시 시점에 등록하고 표준화된 시점(1일, 3일, 7일, 14일, 30일, 60일, 90일, 180일)(표 11)에 카운터를 기록해야 하며, SSRN이 구독이 많은 주제에서 알림 배포가 최대 45일까지 걸릴 수 있다고 명시하고 있으므로 처음 45일 동안은 일일 관찰이 바람직합니다[53]. 이 원칙은 또한 유출을 방지합니다: 선행 저자의 평판 측도는 초점 게시 날짜에 동결되어야 하므로 향후 성공이 기준 공변량을 오염시킬 수 없습니다. 5.6절에서 이어진 동반 원칙은 배포, 색인 작성, 홍보 이벤트가 아래 설계에 명시된 처리로 진입하고 모델링되지 않은 맥락으로 절대 진입하지 않는다는 것입니다.
도달과 전환의 분리. 5절의 진단 논리를 따르면(표 9), 아래의 모든 설계는 초록 조회수와 다운로드를 별개의 결과로 기록하고 조회수를 조건으로 하여 다운로드를 모델링합니다. 낮은 도달과 낮은 전환은 서로 다른 진단입니다: 독자의 고려 집합에 진입하지 못한 것 대 노출 후 획득 실패. 이들을 단일 카운트로 통합하면 저자가 필요로 하는 정보를 버립니다.
분포 결과, 평균만이 아닌. 플랫폼 주목이 무거운 꼬리 분포를 보이므로[83][85][180], 개입과 플랫폼 변화는 분포의 형태를 변경할 수 있으며 평균은 거의 변하지 않은 채로 둘 수 있습니다. 따라서 결과는 주목의 지니 계수, 상위 1% 및 상위 10% 다운로드 점유율, 0 또는 거의 0에 있는 논문의 비중, 그리고 신규자-확립된 주목 비율을 포함하며, 이는 다른 매체의 주목 불평등 측정 전통을 따릅니다[180].
검증 가능성. 각 가설은 식별 전략 및 실패 조건과 함께 제시됩니다. 프레임워크 자체는 거부에 노출됩니다: 연령 및 분야 정규화된 초기 지표가 표본 외에서 원시 카운트보다 성능이 우수하지 않으면(아래 RQ3), 정규화의 측정 장점에 대한 주장은 거부되거나 축소되어야 합니다. 검증 가능성은 또한 정량적입니다: 의제 전체의 표본 크기는 관심의 가장 작은 효과 크기에 대한 검정력 시뮬레이션으로 확정되어야 합니다. 5개 가설, 3개 연구 질문, 5개 명제의 프로그램에 대한 다중성 전략은 사전 등록에서 커밋되며, 확인적 및 탐색적 분석은 사전에 이러한 방식으로 표시됩니다. 탈락(철회, 병합, 또는 실질적으로 수정된 논문)은 조용히 제외되지 않고 추적 및 보고되며, 프로그램의 모든 실증 보고서에서 코호트 흐름도가 포함됩니다(섹션 8.8).
8.2 가설 및 제안
본 프레임워크는 초기 주의 배분에 관한 5가지 가설과 3가지 연구 질문, 그리고 그 구조에 관한 5가지 제안을 제시합니다. 표 16은 이 가설, 연구 질문, 제안을 전용 설계(P2, P3b, P4)와 결과, 대비, 선호 설계로 연결합니다. P1과 P3은 표 17의 연구 1과 2에서 다룹니다.
H1 (냉시작 불이익). 분야, 게시 코호트, 관찰 가능한 주제, 문서 특성, 달력 조건을 조건부로 할 때, 플랫폼 신규 사용자만으로 구성된 저자의 논문은 적어도 한 명의 이전에 보이는 SSRN 저자가 있는 논문보다 초기 초록 페이지 조회수가 적습니다. H1이 청중 형성이 아닌 변환에 관한 것이므로, 중심 결과는 조회당 다운로드가 아닌 조회입니다.
H2 (명성과 노출). 기관 및 저자 명성은 사전 플랫폼 활동과 관찰 가능한 논문 특성을 통제한 후 초기 초록 페이지 도달을 긍정적으로 예측하며, 지위-주의 문헌[104][105][111][140][60]을 사전인쇄물 확산의 첫 단계로 확장합니다.
H3 (명성과 조건부 전환). 기관 명성은 초록 페이지 노출을 조건부로 전체 텍스트 다운로드를 긍정적으로 예측합니다. Jo와 Li는 마케팅에서 이 패턴과 일치하는 최근 분야별 증거를 제시하며, 상위 50 저자 한 명이 있는 3저자 논문의 다운로드율에서 약 +6.6%의 명성 프리미엄을 보여주지만[83], 더 광범위한 종단 검증이 필요합니다. H2와 H3을 함께 보면, 본 패널의 주요 추정값을 정의합니다. 즉, 명성 기울기의 도달 대 전환 분해를 의미하며, 다운로드의 관찰된 명성 관련 불평등 중 초록 페이지 방문 이전(노출)에 발생하는 분수 대 이후(조건부 전환)입니다. 대부분의 기울기가 독자가 초록을 본 후에 형성된다는 발견은 불평등을 직접 측정 가능한 형태로 내용 평가보다는 발견 메커니즘에 위치시킬 것입니다.
H4 (소통의 균등화자). 더 큰 초록 명확성과 정보 효율성은 이미 보이는 저자보다 낮은 사전 가시성 저자 간에 조건부 전환 개선과 더 큰 연관성을 보입니다. H4는 처치가 저자의 통제 범위 내에 있는 유일한 가설입니다. 사전 지정된 텍스트 측정 및 별도로 온라인 현장 실험 기준에 따라 설계된 무작위 초록 실험으로 검증되어야 합니다[30]. 자체 측정 불확실성을 도입하는 자동화된 "AI 기반" 분류기에만 의존해서는 안 됩니다.
H5 (노출 충격의 지속성). 외생적 또는 준외생적 초기 노출 충격은 즉각적인 노출 창을 넘어 후속 주의를 예측합니다. 이는 다른 곳에서 실험적으로 문서화된 성공이 성공을 낳는 역학[112][131][162]의 학문 플랫폼 유사점이며, arXiv의 위치 노출 효과입니다[72][73].
RQ1. 2026년 7월 15일 Rankings 폐지가 주목의 집중도, 분포 또는 위신 기울기를 변화시켰는가? 상반되는 두 예측 모두 그럴듯하며, 질문은 양측으로 남겨진다: 순위 제거는 인기-피드백 루프를 약화시킬 수 있으며[112][131], 또는 미지의 논문이 주목을 받기 시작하면 가시화될 수 있었던 발견 표면을 제거함으로써 기존 저자 네트워크에 대한 의존성을 증가시킬 수 있다.
RQ2. 큐레이션된 이메일 경보 배포는 신규 진입자인지 기존 저자인지 누구에게 더 큰 비례적 주목 상승을 생성하는가?
RQ3. 7일 및 30일에 관찰된 정규화된 초기 지표가 원본 누적 다운로드보다 나중의 학술 인용 또는 출판 결과를 더 잘 예측하는가?
명제들은 프레임워크의 구조적 주장을 반증 가능한 형태로 재진술한다:
P1 (편향과 보이지 않는 대다수). SSRN 논문의 무작위 층화 표본에 대해, 생애 다운로드의 분포는 중앙값이 평균의 절반 미만이고 상당한 비율의 논문이 생애 다운로드 10회 이하가 되도록 헤비테일이며 우편향이다. 반증: 중앙값 ≥ 0.5 × 평균, 또는 무시할 수 있는 ≤10-다운로드 비율. 발행된 Marketing-network 평균 대 중앙값의 비율(약 2.54)[83] 및 2015년 상위 목록 데이터의 준-로그정규 적합[85]은 플랫폼 전체에 대한 P1을 동기화하지만 확립하지 않는다.
P2 (분류가 서피싱을 지배한다). 저장소 계층 내에서, eJournal 분류의 수는 다운로드와 양의 연관성을 가지며 연령 및 네트워크를 통제할 때 거의 제로에 가까운 다운로드의 확률과 음의 연관성을 가지며, Whalen의 2018년 횡단면 패턴[168]의 복제 및 업데이트이고 플랫폼의 큐레이션된 배포 메커니즘에서의 것이다[53][57]. 반증: 통제 후 유의미한 연관성 없음. 분류 수 자체는 잠재적으로 내생적이다: 더 광범위한 관련성을 가진 논문은 더 많은 분류를 받을 수 있고 더 많은 독자를 끌 수 있으므로, 횡단면 연관성은 어떤 서피싱 효과를 과대평가한다. 따라서 선호되는 식별은 사용 가능한 경우 논문 내 분류 변화이며, 횡단면 추정치는 명시적으로 상한선으로 보고된다.
P3 (기계 가시성은 낮으며 기능-종속적이다). 특정 SSRN 프리프린트가 최고의 사용 가능한 출처가 되도록 구성된 쿼리에 대해, 소비자 AI 답변 엔진은 소수의 경우에만 프리프린트 자체를 인용하며, 기계 가시성은 기록된 생성-엔진-최적화 요소와 유사한 기능으로 증가한다[5][164]. 반증: 프리프린트가 기능과 무관하게 대부분의 경우에 인용되거나, 어떤 기능도 가시성을 예측하지 않음.
P3b (기계-계층 마태 효과). 전문가-검증된 쿼리 관련성을 조건으로, 이전의 웹 및 학술 가시성이 더 큰 논문은 그렇지 않으면 비교 가능한 콜드-스타트 논문보다 AI 답변 시스템에 의해 더 자주 인용된다. 형평성 대안 아래에서, 생성 엔진은 이전 가시성에 대한 프리미엄 없이 관련성에 대해 검색하며 P3b는 거부된다. 이는 기계 계층이 H1–H3의 인간 발견 계층보다 덜 egalitarian이 아니라 더 egalitarian이 될 결과이다. 반증: 일치된 쿼리 관련성에서 가시성 기울기 없음. P3b는 H1–H3의 누적-이점 라인을 발견 스택의 상단으로 확장한다. 이를 테스트하려면 Study 2(섹션 8.6)에서 지정된 이전-가시성 공변수 및 쿼리 층화가 필요하다.
P4 (약탈자가 독자보다 먼저 도착). 게시된 문서나 관련 공개 페이지에서 서지 메타데이터와 연락 경로를 수집할 수 있는 새로 게시된 프리프린트의 경우, 게시 귀인할 수 있는 첫 번째 약탈적 권유까지의 예상 시간이 첫 번째 진정한 학술적 접촉까지의 예상 시간보다 짧습니다. 반박자: 진정한 접촉은 약탈적 권유보다 안정적으로 먼저 일어난다. P4는 현재 플랫폼 인터페이스에서 저자 연락처 세부정보의 공개 가시성이 확립되지 않았기 때문에 수집 가능성을 조건으로 언급됩니다. 수집 메커니즘 자체는 일반적으로 프리프린트 저장소에 대해 문서화되어 있으며 [107][159][151], 미청유 이메일은 권유받은 저자의 상당한 비율에 대해 약탈 저널과의 첫 접촉입니다 [32]. 따라서 귀인을 위해서는 받은 편지함 시간만으로부터의 추론이 아니라 연구 3의 계획된 설계가 필요합니다.
표 16. 가설, 연구 질문 및 식별 전략.
| 질문 | 주요 결과 | 주요 대비 | 선호 설계 |
|---|---|---|---|
| H1: 신참자 불리 | 증분 조회 | 신참자 대 기존 | 계층적 종단 계수 모델 |
| H2: 명성과 도달 범위 | 증분 조회 | 높은 대 낮은 이전 명성 | 공변량 조정 패널 + 일치된 민감도 분석 |
| H3: 명성과 전환 | 조회를 조건으로 한 다운로드 | 높은 대 낮은 명성 | 음이항/포아송 노출 모델 |
| H4: 통신 균등화기 | 조건부 다운로드 확률/비율 | 명확성 × 이전 가시성 | 관찰 텍스트 모델 + 무작위화 재현 |
| H5: 누적 관심 | 충격 후 조회/다운로드 | 노출 충격 대 충격 전 궤적 | 논문 내 사건 연구 |
| RQ1: 순위 폐지 | 일일 관심; 지니 지수; 상위 점유율; 분야별 신규 게시 볼륨 | 이전 순위 노출 분야 대 비교 분야 | 중단/사건 연구 설계 |
| RQ2: 이메일 배포 | 일일 조회/다운로드 | 배포 전 대 배포 후 | 논문 내 사건 연구 (배포 × 신참자) |
| RQ3: 예측 타당성 | 6/12/18개월 인용 | 정규화 대 원본 초기 지표 | 표본 외 예측 비교 |
| P2: 분류가 표면화를 관장 | 다운로드; 거의 0에 가까운 다운로드의 확률 | 분류 수; 사용 가능한 논문 내 분류 변경 | 패널 회귀 + 논문 내 변경 설계 |
| P3b: 기계층 마태 효과 | 답변 시스템에 의한 직접 인용 | 일치된 쿼리 관련성에서 높은 대 낮은 이전 가시성 | 반복 다층 검색 감사 (연구 2) |
| P4: 약탈자가 독자보다 먼저 | 첫 번째까지의 시간 및 코딩된 인바운드 메시지의 속도 | 게시 전 대 게시 후 기간; 약탈적 대 진정한 접촉 | 계획된 전향적 코호트 + 사건-역사 모델 (연구 3) |
주석. 모든 행은 전향적 설계입니다. 어느 것도 실행되지 않았습니다. 결과, 대비, 제외 규칙 및 참조 클래스는 데이터 수집 전에 사전 등록되어야 합니다.
8.3 핵심 패널
참조 설계는 게시 후 최소 12개월 동안 추적되는 새로 게시된 SSRN 논문의 다학제 코호트이며, 표 11의 일정에 따라 관찰됩니다. 논문 수준에서 데이터세트는 제목, 초록, 저자 이름 및 순서, 소속, 게시 날짜, 분류, 키워드, 페이지 수, 사용 가능한 경우 DOI, 개정 이력, 공개 초록 조회수, 공개 다운로드 수, 그리고 후속 인용 지표의 가장 초기 버전을 보존하며, 저자 신원 일치는 공개 참고문헌 인프라[35][124]와 대조하여 무작위 부표본에서 수동으로 검증된 후 추론된 평판이 규모에 따라 사용됩니다. 신규 진입자 상태는 초점 논문의 어떤 저자도 초점 게시 이전 날짜의 SSRN 논문을 갖지 않는 것으로 정의되며, 민감도 정의는 선행 논문 수와 게시 전 인용 스톡을 기반으로 합니다. 기관 명성은 이 정의의 일부가 아닙니다. 명성 자체가 H2 및 H3의 설명 변수이기 때문에 명성을 신규 진입자 상태에 포함시키면 기계적으로 플랫폼 참신성을 선행 저자 가시성과 혼동하며 설계가 분리하려는 가설들을 붕괴시킵니다. 따라서 명성은 모델에 개별 공변량으로만 들어갑니다. 선행 가시성에 의한 정규화는 공정성 근거에서 상응하는 주의로 처리되어야 합니다. 선행 가시성 기준선을 너무 적극적으로 빼는 것은 초급 저자의 진정한 초기 성공에 불이익을 주고 한계화되고 글로벌 남반부 저자의 체계적 노출 부족을 통계적으로 지우고 노출하지 않을 것입니다. 프레임워크의 답은 불평등이 형성되는 곳을 측정하는 것입니다. 이를 순제거하는 것이 아닙니다. 도달-대-전환 분해는 가시성 격차가 노출 또는 전환에서 발생하는지를 지역화하고, 명성은 침묵하게 차이를 내는 잡음이 아닌 이해할 공변량으로 들어갑니다. 명성의 주의력에 대한 분배 효과는 준실험(섹션 8.4–8.5)의 주요 결과입니다. 달력 제어에는 요일, 연중 주, 학년도 및 날짜 고정 효과가 포함됩니다. 기사 접근의 기록된 주말 및 계절 변화(최근 7개 저널 패널에서 주말에 약 11% 낮고 여름에 50% 낮은 활동[178])는 고주파 사용 연구에서 생략을 정당화하기 어렵게 합니다. 완전한 패널 변수 사전(누적 수만이 아닌 간격 증분, 동의한 경우 배포 날짜, 6, 12, 18개월의 인용 스톡, 개정 번호를 포함하여 약 24개 필드 규모)은 부록 C(표 C1)에 명시되어 있으며, 동일한 스키마 파일은 사전 등록 자료(섹션 8.8; 선언문)와 함께 보관됩니다.
도달은 증분 조회수에 대한 계층적 음이항 과정으로 모델링되며, 필드별 나이 효과, 달력 효과, 논문 수준 이질성을 포함합니다. 조건부 전환은 노출로서의 로그 증분 조회수를 포함하는 증분 다운로드로 모델링되므로, 랜딩 페이지 방문을 획득하고 그 방문을 전환하는 것이 통계적으로 분리됩니다. 간단한 형태로, 간격 t에서 논문 i에 대해:
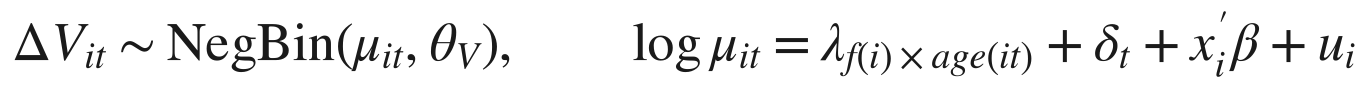

여기서 λ_{f×age}는 필드별 나이 효과, δ_t 달력 날짜 효과, u_i 및 w_i 논문 수준 이질성이고, 두 번째 방정식의 로그 조회 오프셋은 랜딩 페이지 노출에 조건부 다운로드를 만듭니다. 신규 진입자 × 명확성 상호작용 γ_3은 H4 검정입니다. 이 방정식들은 사전 지정된 추정량과 도달에서 전환의 분리를 고정하며, 계층적 구조는 섹션 5.2 및 8.8이 희소 셀의 백분위수가 발표되기 전에 요구하는 정확한 경험적 베이즈 부분 풀링을 수행합니다. x_i의 주제 제어는 결과가 관찰되기 전에 사전 등록에서 동결되고 클러스터된 제목-초록 임베딩에서 구성되므로, 주제 구성을 결과에 맞게 조정할 수 없습니다. 논문이 동시에 최대 7개의 분류를 차지하기 때문에, 분류 효과는 각 논문을 단일 필드로 강제하는 대신 다중 멤버십 계층적 구조로 추정됩니다. 논문 고정 효과가 시간 불변 상태 측정을 흡수하기 때문에, 기준 신규 진입자 및 명성 효과는 논문 간에 추정되고, 논문 고정 효과는 배포 이벤트와 같은 논문 내 처리를 위해 예약됩니다. 과분산 및 과잉 영점이 형식적으로 검정되고, 정당화되는 경우 허들 및 영점 팽창 대안이 보고되며, 성공한 논문을 삭제하지 않고 분위수 및 견고한 추정으로 무거운 꼬리가 처리됩니다. 데이터 정리 규칙 자체가 임의적이 아닌 사전 지정되며, 이상 프로토콜은 삭제하지 않고 표시합니다. 사전 지정된 신호 목록은 다음을 포함합니다: 논문 자신의 이력에 대한 간격 극값, 다운로드 움직임 없는 조회 스파이크, 전환의 불연속, 반복되는 동일한 타임스탬프, 플랫폼 측 재명시. 표시된 간격은 아카이브에서 절대 제거되지 않습니다. 이유 코드와 함께 보존되며, 모든 주요 결과는 4계층 민감도 사다리에서 보고됩니다: (i) 수정되지 않은 카운터; (ii) 플랫폼 확인 무효 활동만 제외; (iii) 견고하거나 윈저화된 추정; (iv) 모든 표시된 간격 제외, 따라서 오직 한 계층에서만 생존하는 모든 결론은 취약한 것으로 보입니다. 임계값은 사전에 설정되지 않고 관찰된 분포에 대해 보정됩니다. 파트너 로그를 사용할 수 있는 경우, 참조자, 사용자 에이전트, 지리 필드는 뉴스레터, 블로그, 프리페치, 크롤러 트래픽을 구별합니다. SSRN의 기록된 블로그 기반 다운로드 스파이크[116]는 극값이 종종 오염이 아닌 유기적 성공임을 보여줍니다. 이상 탐지는 측정 도구입니다. 그것은 불편한 성공을 버릴 허가를 주지 않습니다.
동일한 규율이 시간적 구조에 적용됩니다. 패널은 주변적 주의와 누적적 주의를 구분합니다: 구간 다운로드 ΔD의 코호트 곡선과 각 나이별로 누적된 논문의 180일 다운로드 점유율로, 평생 총량만 읽는 것이 아닙니다. 독서가 동시에 여러 시간 척도에서 감소하므로 [91], 단일 지수 반감기를 감소에 부과하지 않습니다. 따라서 나이 곡선은 기본적으로 스플라인이나 비모수적 추정자로 적합되며, 로그 변환은 구조를 연구하는 데 사용되고 원본 개수는 벤치마크 보고를 위해 유지됩니다. 견고성은 동일한 방식으로 처리됩니다: 명성은 단일 순위 임계값이 아닌 여러 대안적 측정을 통해 조작화되고, 신규 상태는 점진적으로 더 엄격한 정의 하에서 재검증되며, 결과는 윈저화 민감도 검사 및 분위수 추정치와 함께 전체 분포 플롯으로 보고됩니다.
공개 SSRN API가 없으므로 [134][51], 데이터 수집은 선호도 순서대로 세 가지 경로를 통해 진행됩니다: SSRN/Elsevier에 대한 정식 데이터 요청 또는 파트너십; 저자 동의 대시보드 내보내기로, 참여 저자가 정보 제공 동의 하에 자신의 통계 패널 데이터를 기여하며, 섹션 8.8의 레지스트리가 이미 의존하는 중간 계층; 그리고 robots.txt를 존중하는 속도 제한 논문별 공개 페이지 샘플링으로, 기술적 가능성은 기존 오픈소스 수집 도구로 확립됩니다 [134]. 설계는 서비스 약관을 위반하는 대량 스크래핑을 제외하며, 문서화되지 않은 엔드포인트를 안정적인 API로 나타내지 않습니다. 접근 제약은 섹션 9에서 제한 사항으로 논의됩니다.
8.4 준실험 I: 이메일 알림 배포를 주의력 충격으로
섹션 8.4와 8.5는 하나의 분석 모듈을 구성하며, 동일한 패널 코호트에 대한 두 가지 플랫폼 측 개입을 상호보완적 처리로 연구합니다. 알림 배포는 노출 표면을 추가하고, 랭킹 폐지는 하나를 제거했으며, 둘 다 공통의 분포 결과 집합(신규자 점유율, 명성 기울기, 주의력 지니 지수, 상위 점유율)에 비추어 해석됩니다. SSRN의 알림 메커니즘은 게시와 배포가 일치할 필요가 없기 때문에 분석적으로 가치 있습니다. 논문은 먼저 공개적으로 이용 가능해지며, 적격 작업은 나중에 시기가 다양하고 보장되지 않는 큐레이션된 eJournal 알림을 통해 배포됩니다 [53][57]. 배포 상태 날짜를 제공하기로 동의한 저자들의 경우, 논문 내 이벤트 연구는 배포 날짜 주변의 주의력 경로를 추정할 수 있으며, 각 논문이 자신의 대조군 역할을 하므로 주제 매력, 저자 신원, 기관의 안정적 차이가 흡수됩니다. 명세는 표준 이벤트 연구 형태입니다: 결과 Y_it (간격 조회 또는 다운로드)에 대해,
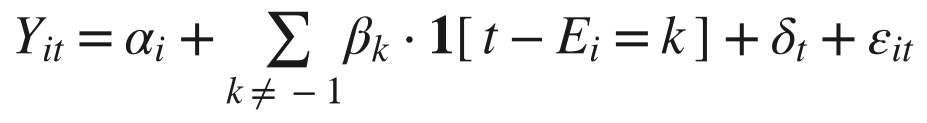
여기서 E_i는 논문 i의 배포 날짜, α_i는 논문 고정효과, δ_t는 달력 날짜 효과, β_k는 k = −1 사전 배포 기준 기간으로 정규화되어 이벤트 주변의 주의력 경로를 추적합니다. 이 방정식은 사전 등록의 추정량을 명시합니다. 주요 이질적 효과는 Distribution × Newcomer 상호작용이며, β_k를 신규자 상태와 상호작용시켜 추정됩니다. 알림이 신규자의 도달력을 불균형적으로 개선한다면, 큐레이션된 배포는 플랫폼 수준의 균등화 장치로 기능합니다. 이득이 저명한 저자들에게 불균형적으로 누적된다면, 배포는 기존의 명성 이점을 증폭합니다 (RQ2). 이산 노출 이벤트(arXiv의 전면 위치 나열 [72][73], SSRN 논문의 블로그 보도 [116])가 초기 주의력의 급격한 증가를 생성한다는 선행 증거는 이 설계가 감지 가능한 1단계를 가지고 있음을 나타냅니다. 사전 명시된 명세는 배포 날짜 주변의 대체 이벤트 창과 빠르게 배포된 논문 대 긴 분류 대기열 후 배포된 논문에 대한 별도 보고도 포함합니다. 최대 45일 지연 [53]이 이질적 노출 이력을 단일 이벤트 시간으로 섞기 때문입니다. 논문 고정효과는 시간 불변 매력만을 흡수하므로, 세 가지 설계 조건은 하중을 지고 있습니다. 배포 시기는 큐레이션되며, 무작위가 아닙니다: 플랫폼은 어떤 적격 논문을 배포할지, 언제 배포할지를 선택합니다 [53][57]. 따라서 이벤트 날짜는 주제성에 대한 시간 변동 선택을 지니고 있습니다 (주제가 현저해지는 주에 배포된 논문은 조용한 주에 배포된 동일한 논문과 다릅니다), 이 선택은 논문 고정효과를 초과하며, 이것이 명세가 배포 지연을 조건화하고 배포 시기 계층을 별도로 보고하는 이유입니다. 배포 상태 날짜는 또한 동의하는 저자들에 대해서만 관찰되므로, 추정 샘플은 패널의 자기 선택 부분 집합입니다. 동의 상태가 기록되고, 이벤트 연구 샘플은 관찰 가능한 공변량에서 전체 코호트와 비교됩니다. 선택은 외적 타당성을 제한합니다. 그리고 저자는 자신의 홍보를 알림에 맞출 수 있습니다: 조율된 자기 홍보 급증은 배포 효과로 가장할 것입니다. 따라서 날짜가 지정된 저자 홍보 로그 (섹션 6.1의 버전 관리된 증거 패킷)는 이 설계의 요구사항입니다: 그것이 없으면 유기적 배포 급증을 자가 생성 급증과 분리할 수 없으며, 섹션 8.3의 이상 사다리는 로그된 자기 홍보와 일치하는 급증을 삭제하지 않고 플래그를 지정합니다.
8.5 준실험 II: 순위 제도 폐지를 자연실험으로
2026년 7월 15일 일몰[149]은 보관된 순위 페이지에서 역사적 순위 노출을 재구성할 수 있다면 두 번째 분석을 허용합니다. 설계의 두 가지 특징이 명확한 단일 날짜 이벤트 연구를 약화시킵니다. 처리는 한 날짜에 도착하지 않았습니다: eJournal별 순위 페이지는 2025년 12월 11일부터 업데이트를 중단했으며(섹션 2.2 [B-2]), 2026년 7월 15일 제거로부터 약 7개월 전이므로, 순위 발견 표면의 철수는 단일 공통 이벤트 날짜보다는 엇갈린 프로세스(라이브 페이지의 첫 번째 단계 동결 후 최종 제거)로 더 잘 모델링됩니다. 따라서 명세에는 최소한 두 개의 이벤트 시간(12월 동결 및 7월 제거)이 포함되며, 엇갈린 형태가 기본 모델이고 단일 날짜 적합이 그에 대해 테스트됩니다. 플랫폼의 구조에서 "이전에 순위에 노출된" 학문 분야를 가정할 수 없습니다: 순위는 플랫폼 전체였으므로, 차등 노출은 내생적이며 "순위가 매겨진 것으로 느껴지는" 필드의 이름을 지정함으로써 운영화되지 않습니다. 노출은 측정되어야 하며, 할당되지 않습니다: 예를 들어, 인터넷 아카이브를 통해 복구된 보관된 순위 페이지에서 필드의 논문 중 공개 상위 목록에 진입한 비율 또는 eJournal별 페이지에서 필드의 존재 밀도로부터입니다. 아카이브가 사용 가능한 노출 측정을 산출하기에 충분하게 각 필드의 순위 페이지를 다루는지 여부는 아직 확립되지 않았습니다; 설계는 노출 측정과 함께 그 밀도를 보고합니다. 그렇게 측정된 노출을 사용하여, 논문 수준의 이벤트 연구 명세는 동결 및 제거 날짜 주변의 높은 노출 및 낮은 노출 필드의 주의 궤적을 비교합니다: 섹션 8.4의 방정식에서 이벤트 시간 항 단독보다는 Exposure_f × EventTime_k 상호작용에 대한 관심 계수를 사용합니다. 가장 유익한 결과는 분포적입니다(섹션 8.1). 순위 메커니즘은 평균을 거의 그대로 두면서 주의의 집중도를 변경할 수 있으며, 모든 효과가 목록을 채운 이미 가시적인 꼬리 논문에 집중될 것으로 예상되므로, 필드 평균 결과는 구성상 저전력입니다. Gini 계수, 상위 점유율 측정, 신규 진입자/기존 비율, 그리고 위신 기울기가 따라서 기본 결과이며, RQ1의 양측 예측, 그리고 섹션 8.1의 전력 시뮬레이션은 평균 주의가 아닌 이러한 분포 통계를 대상으로 해야 하거나, 연구가 잘못된 추정량에 대한 전력 부족으로 인해 무효로 선언될 위험이 있습니다.
두 개의 명명된 방향성 예측은 RQ1을 대체하지 않으면서 명확히 하며, 둘 다 사전에 지정된 이질성 테스트입니다. 가시성 절벽 가설은 일몰 후 이전에 순위에 노출된 필드의 게시 코호트가 알려진 날짜에 발견 표면이 제거되었기 때문에 일치하는 일몰 전 코호트와 비교하여 초기 도달 범위에서 불연속적 감소를 경험한다고 주장합니다. 보상 가설에서, 순위가 약한 발견 생태계를 가진 필드에 대한 보상 가시성 메커니즘으로 기능했다면, 그것의 제거 효과는 Whalen 기울기[168]의 하단인 작은 eJournal 구독 기반을 가진 필드에서 가장 커야 합니다.
저비용 2차 결과는 설계를 주의의 할당에서 플랫폼 자체의 건강으로 확대합니다: 2026년 7월 15일 전후의 필드별 신규 게시물 량입니다. 순위가 게시 인센티브의 일부를 공급했다면, 그것의 폐지는 신규 제출을 억제할 수 있습니다. 이는 위의 주의 결과와 구별되는 행동 결과이며, 공개 신규 논문 목록에서 플랫폼 자체의 2025년 250,000개 이상의 신규 논문 기준선[145]에 대해 관찰 가능하며, 섹션 2.2 [12][B-11]에 기록된 동시대 "상어를 뛰어넘었다"는 논쟁에 대한 직접적인 경험적 답변입니다. 예측은 RQ1과 같이 양측으로 남겨지며, 게시 량 결과는 연구 4 설문의 항목 (3) ("새 업로드 피하기")과 연결됩니다.
분석은 준실험적입니다. 다섯 가지 위협은 중대합니다. 하나는 발표 및 예상 효과입니다: 폐지는 2026년 6월 12일에 발표되었으며 초기 목표는 7월 1일이었고 7월 15일에 실행되었으므로, 진정한 예상 기간이 존재했으며 이동했습니다[148][149]. 2026년 동시 플랫폼 변화의 묶음이 일몰의 달력을 공유하며 단일 이벤트 날짜로 분리할 수 없습니다: 2026년 4월 13일에 발표된 전략적 재집중, 12월 말을 통해 진행되는 상업 Research Paper Series의 폐지, 그리고 제거로부터 5일 후인 2026년 7월 20일의 저자 라이선스 변경[146][150]. 이러한 개입이 7월 창을 겹치므로, 단일 공통 이벤트 날짜는 그들의 결합된 효과를 일몰 단독에 귀속시킬 것입니다. 식별은 따라서 위의 엇갈린 시간(12월 동결은 모든 것을 선행함), 위약 날짜, 그리고 순위 철수에 특이한 분포 서명에 기울며, 설계는 어떤 공동 시간 변화가 분리되지 않은 상태로 남아 있는지 보고합니다. 그 다음은 여름 주의 저하입니다: 7월 중순은 학술 접근의 문서화된 계절 감소와 일치하며, 접근이 여름 개월에 약 50% 떨어집니다[178], 따라서 제거 날짜 전체에 걸친 교차 필드 대조는 일몰을 학문 분야에 따라 다른 필드의 자체 여름 계절성과 혼동시킵니다. 달력 날짜 고정 효과는 공통 계절 성분만 흡수합니다. 따라서 설계는 필드별 계절 기준선(필드별 사전 연도 동일 기간 비교)이 필요합니다. 높은 노출 및 낮은 노출 필드 간의 비무작위 차이는 추가 위협이며, 위의 측정된 노출 운영화 및 일치하는 비교 그룹으로 해결됩니다. 남은 위협은 미래지향적입니다: SSRN은 순위를 다시 검토할 수 있다고 명시했으므로, 관찰 기간 중 부분적 복원은 두 번째 이벤트를 도입할 것입니다. 설계는 그러한 복원을 사후 기간에 대한 검열 지점으로 처리하고 그것을 일몰 대조에 폴딩하지 않고 별개의 처리로 모델링하는 것을 사전 등록합니다. 모든 보고에서 이벤트 시간은 발표(2026년 6월 12일부터), 전환, 그리고 폐지(2026년 7월 15일부터)의 세 개의 명명된 기간으로 분할되므로 예상 효과가 추정됩니다. 사전에 지정된 설계는 따라서 이벤트 시간 사전 추세 테스트, 대체 대역폭, 위약 날짜, 필드별 시간 추세 및 필드별 계절 기준선, 그리고 발표-폐지 전환 기간을 제외한 민감도 분석을 포함합니다. 그림 11은 두 이벤트 연구의 의도한 산출물을 설계 템플릿으로 제시합니다.
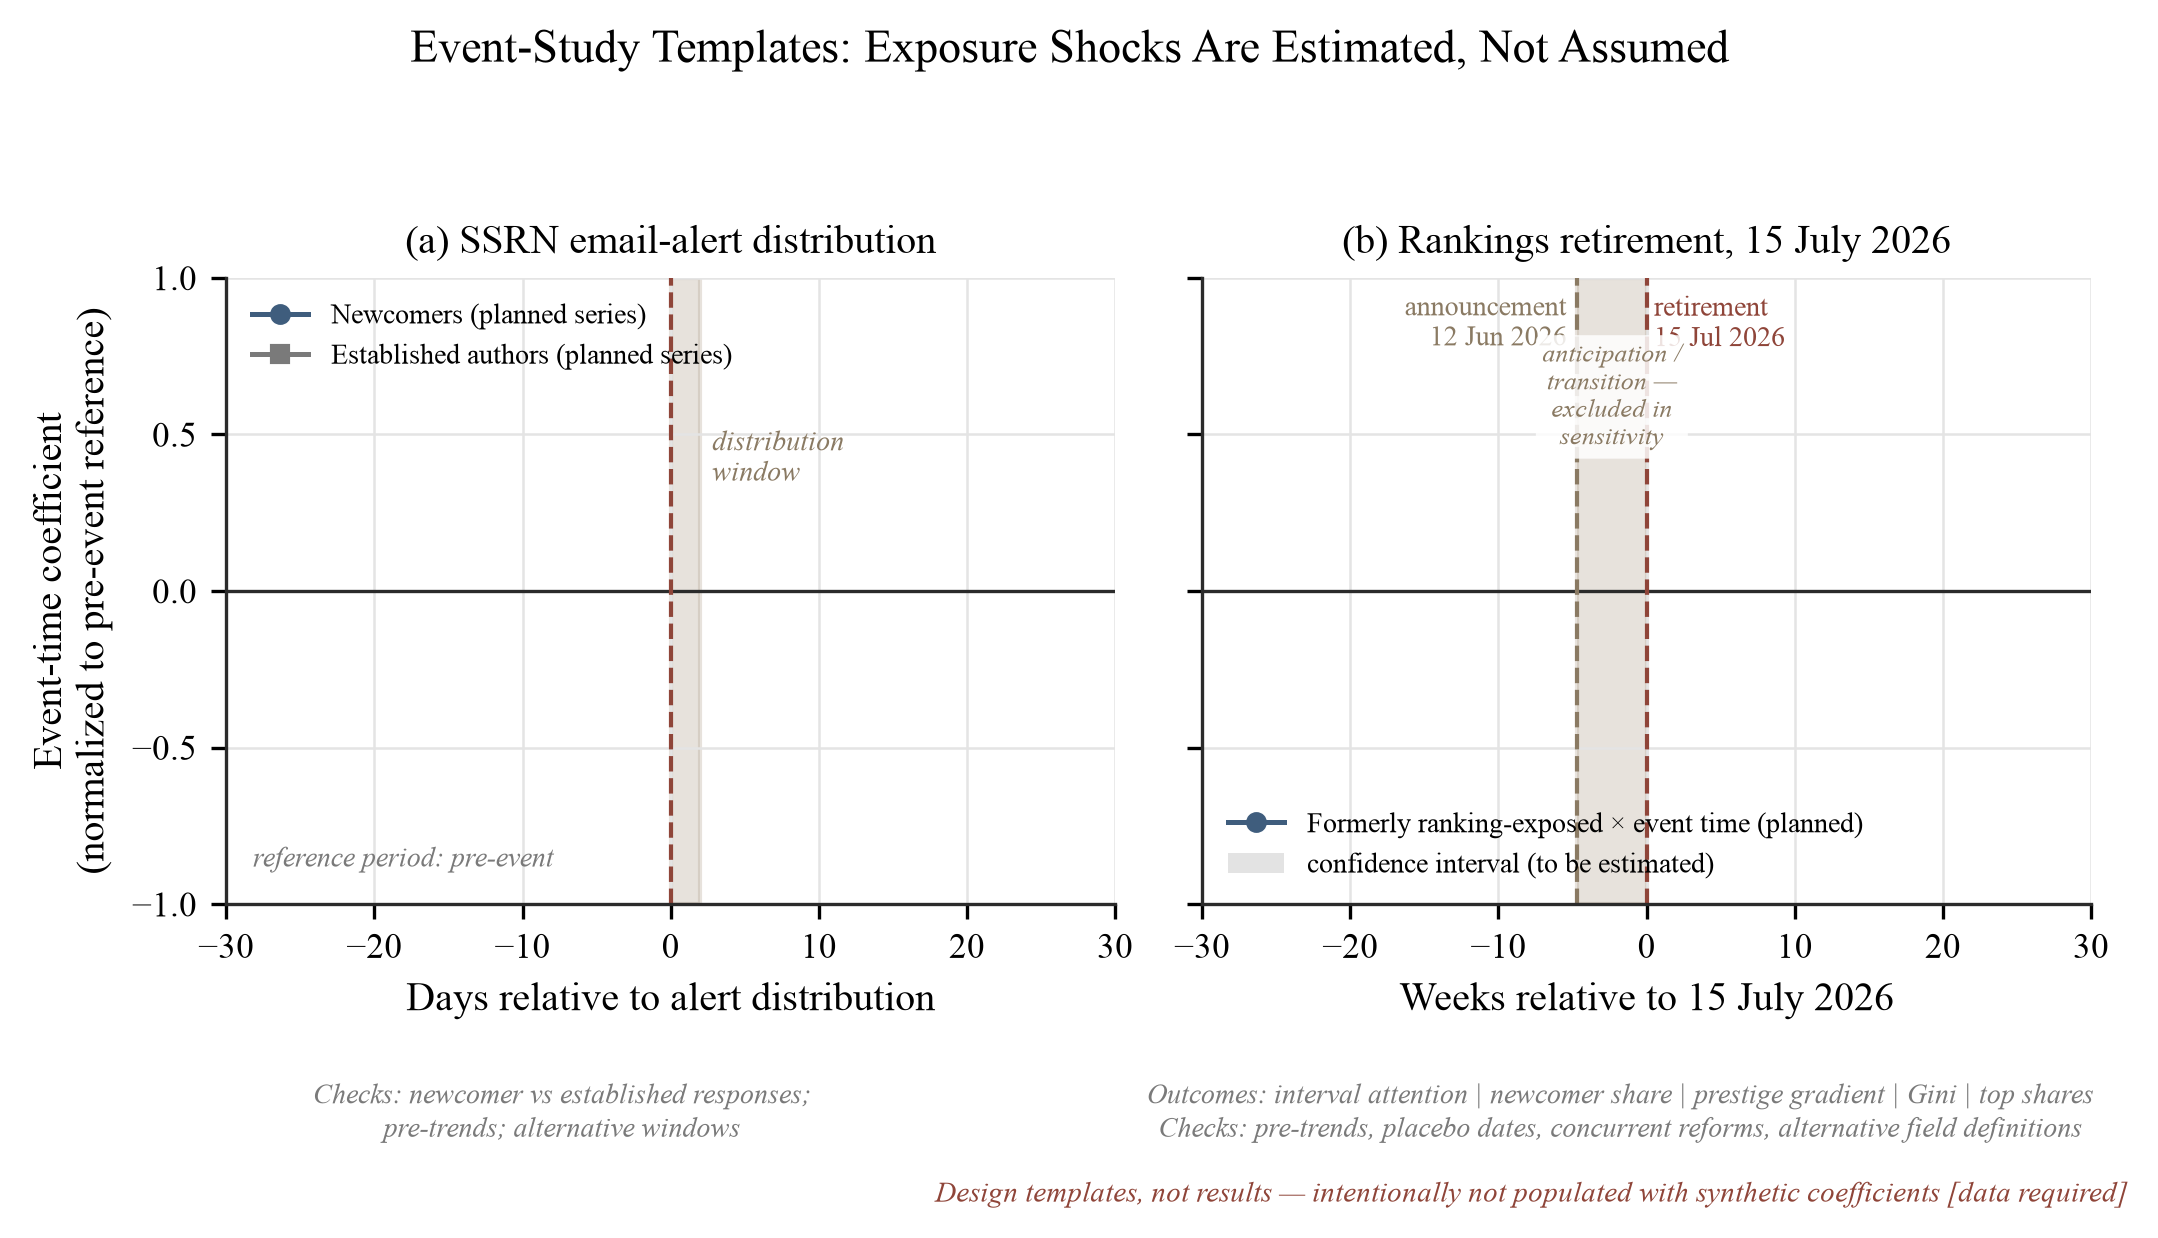
그림 11. 두 플랫폼 준실험을 위한 사건 연구 설계 템플릿. 섹션 8.4–8.5의 설계에 대한 사전 지정된 사건 연구 산출물: (a) 이메일 알림 배포 주변의 주의, 신규 저자 대 기존 저자, 알림이 순간이 아닌 창으로 도착하기 때문에 배포 창이 음영처리됨; (b) 순위 폐기 주변의 주의 및 불평등 결과, 발표(2026년 6월 12일) 및 폐기(2026년 7월 15일) 날짜가 표시되어 있고 예상/전환 기간이 음영처리됨 — 사전 지정된 민감도 분석에서 제외된 창. 분포 결과(구간 주의, 신규 저자 점유율, 명성 기울기, 지니, 상위 점유율) 및 필수 검사가 그림 자체에 표시됩니다. 계수는 사전 기간 참조 기간으로 정규화됩니다. 음영 처리된 회색 영역은 신뢰 구간을 나타냅니다. 이 패널들은 설계 템플릿이며 경험적 값은 표시되지 않으며 생성 코드는 사전 등록 자료와 함께 공개될 예정입니다.
8.6 네 개의 사전지정 연구
핵심 패널과 함께 네 개의 연구가 지정되고 표 17에 요약되어 있습니다. 두 개의 공개 데이터 연구(1과 2)는 제한된 액세스 권한 없이 모든 연구자가 제9절에서 언급한 액세스 제한(플랫폼의 서비스 약관에 따른 속도 제한 수집) 내에서 시도할 수 있습니다. 두 개의 인간 피험자 연구(3과 4)는 참여자가 필요하며 선언문에 명시된 윤리 승인 하에 진행됩니다. 네 가지 모두 다년간의 패널이 성숙해진 이후가 아니라 즉시 벤치마크 공백을 채우기 위해 존재합니다.
표 17. 네 개의 사전지정 연구.
| 연구 1 | 연구 2 | 연구 3 | 연구 4 | |
|---|---|---|---|---|
| 연구 질문 | 중앙값/백분위수 다운로드 분포는 어떻게 되는가? | AI 답변 엔진이 프리프린트 자체를 인용하는가? | 독자가 먼저인가, 약탈자가 먼저인가? | 저자들은 자신의 카운터를 어떻게 읽는가? |
| 데이터 | 3,000–5,000개의 층화된 SSRN 논문 ID | 100–200개의 틈새 질문 × ~5개 엔진 | 2개의 계측된 게시물, 90일 인바운드 로그 | 사전등록된 저자 설문조사, 4개 고정 표현 항목 |
| 방법 | 중앙값, 지니 계수, 감소 곡선, 분류-계수 회귀분석 | 검색 코딩 + 로지스틱 회귀분석 | 채널별 별칭 추적 + 메시지 코딩 | 폐형 설문지 + 기술 통계 |
| 주요 결과 | 중앙값; ≤10-다운로드 비율; 주목도 지니 계수 | 기계 가시성 V | t_독자 vs. t_약탈자 | 어떤 벤치마크와도 비교하지 않는 비율; "7 다운로드"에 대한 첫 열람 분포 |
| 위조 가능한 예측 | 중앙값 < 0.5 × 평균; 지니 0.75–0.90 | 시행의 10–35%에서 프리프린트 인용 | t_약탈자 < t_독자 | 대다수가 어떤 벤치마크와도 비교하지 않은 적이 있다고 보고 |
| 주요 산출물 | 공개, 기계 가독성의 나이, 분야, 코호트 층화된 백분위수 벤치마크 표 | 타임스탬프된 스냅샷과 함께 재현 가능한 검색 및 속성 감사 프로토콜 | 게시 전 기준선 및 코딩 코드북이 포함된 공개 계측 게시 프로토콜 | 저자 해석의 문서화된 분포 및 보고된 행동 변화 |
| 설계가 실패하는 경우 | 정규화가 원시 카운트에 비해 안정성 또는 샘플 외 예측을 개선하지 않는 경우 | 특성이 질의 관련성, 엔진, 날짜를 넘어 아무것도 예측하지 않는 경우 | 기준선 및 노출 제어 후 게시 후 불연속성이 없거나 코딩이 신뢰할 수 없는 경우 | 모집 또는 자기선택이 기술 통계도 해석 불가능하게 남기는 경우 |
| 리소스 프로필 | 공개 데이터; 표준 스크래핑 및 통계 | 공개 AI 엔진 쿼리; 수동 코딩 | 2개의 계측된 게시물; 수신함 로깅(IRB) | 익명 저자 설문조사(IRB) |
주. 각 연구는 데이터 수집 전에 OSF에 등록하고 코드를 공개해야 합니다.
연구 1: "중앙값의 해부학." 이 연구는 3,000–5,000개의 SSRN 초록 ID의 무작위 층화 표본을 추출하는데, 이는 계획 범위이며, 최종 N은 사전지정된 예측 대역과 가장 작은 관심 효과(제8.1절)에 대한 통계력 시뮬레이션으로 설정됩니다. 층화는 게시 연도 및 네트워크별로 진행되며, 논문당 평생 다운로드, 초록 조회, 게시 날짜, 분류 수는 제8.3절의 액세스 경로를 통해 수집됩니다. 추정값: 평생 다운로드 중앙값; 영다운로드 및 10개 이하 다운로드 논문의 비율; 부트스트랩 신뢰 구간이 포함된 주목도 지니 계수; 조회-다운로드 전환율(전체 및 네트워크별로 추정, 제5.2절의 대상-읽기-스타일 가설 검증); 다운로드 감소 곡선; 및 연도 및 네트워크 고정 효과가 있는 분류 수에 대한 로그 다운로드의 회귀분석(P2의 직접 검증 [168]). 사전지정된 예측 대역(평생 다운로드 대략 30–80, ≤10-다운로드 비율 15–30%, 지니 0.75–0.90)은 제5절의 기한 닻값 [83][85][139] 및 인접 매체의 주목도-지니 크기 [180]에서의 외삽값이며, 연구가 이들을 위조할 수 있도록 미리 명시됩니다. 연구 1은 제8.8절에서 논의한 백분위수 벤치마크의 경험적 씨앗입니다.
연구 2: "기계가 당신을 읽는가?" 정보 추구의 증가하는 비율이 이제 생성형 인터페이스에서 시작됩니다: 미국 성인의 약 절반이 AI 챗봇을 사용한다고 보고하며, 약 4분의 1은 매일 사용하고 [121], 편의 표본에서 이미 상당한 소수가 챗봇을 첫 검색 엔진으로 취급하고 있습니다 [4]. 도입부(제1.6절)는 이를 발견 게이트키퍼의 상향 이동으로 개념화했습니다(저널 브랜드 → 저장소 → 검색 엔진 → AI 답변 계층). 각 단계는 제어를 저자에게서 더 멀리, 공개 벤치마크에서 더 멀리 재배치합니다(그림 12). 상단 계층이 프리프린트를 전혀 검색하는지는 알 수 없습니다: 생성형-엔진-최적화 문헌은 지금까지 브랜드 및 상거래에 집중했습니다 [5][100][164], AI 검색 감사는 학술 출처가 아닌 뉴스 속성에 관련되어 있습니다 [82]. 그러한 감사는 새로운 게이트키퍼의 신뢰성에 대한 회의를 권장합니다: Tow 센터 감사(8개 엔진 전체 1,600개 쿼리)에서 엔진들은 시행의 60% 이상에서 올바른 정보를 검색하지 못했고, 최고 성능자(Perplexity)는 37% 시간에 잘못 답변하고 최악의 성능자(Grok-3)는 94%이며, 그들은 일반적으로 부주의한 신뢰로 오류를 범했으며 답변을 거부하지 않았습니다 [82]. 뉴스 속성 검증이 아닌 학술 검색에서의 수치. 2026년 8월 현재 AI 답변 엔진에서 학술 프리프린트 가시성의 통제된 연구는 존재하지 않았습니다 [100]. 기여는 인접한 두 가지 연구 라인에 대항하여 위치합니다. 이 기사가 기반한 생성형-엔진-최적화 연구는 브랜드 및 상업 페이지의 가시성을 측정하고 조작하지만 [5][164] 학술 아티팩트의 검색이 아닙니다. 별도의 부분은 언어 모델이 참고문헌을 생성할 때 인간의 이미 높이 인용된 작품을 인용하는 경향을 재현하고 증폭시킨다는 것을 보여줍니다. 마태 효과를 기계 계층으로 확장합니다 [7]. 이것이 P3b(제8.2절)가 검증하는 메커니즘입니다. 어느 부분도 통제된 질의 관련성 하에서 과학 프리프린트의 발견성을 검토하지 않았고, 특히 플랫폼 순위 표면이 제거된 후 그들의 검색성을 검토하지 않았습니다. 이는 연구 2가 분리하는 대상입니다.
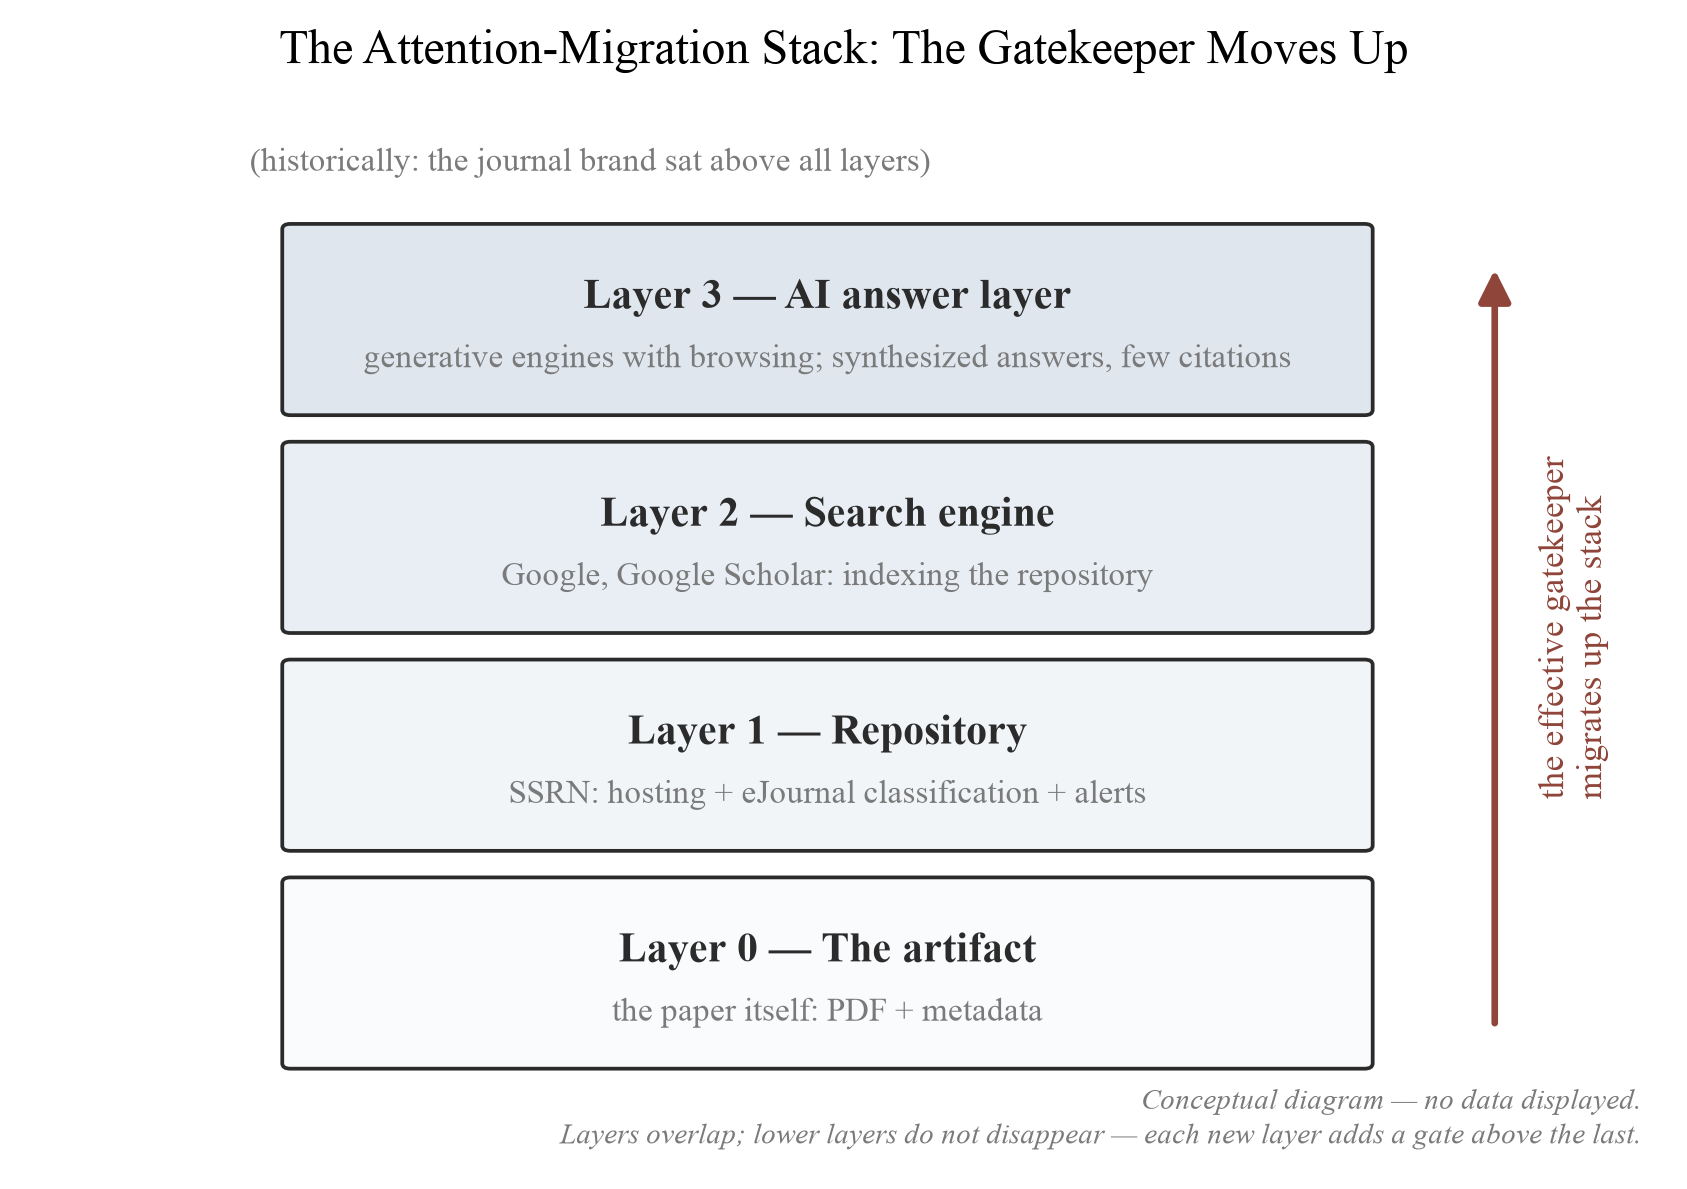
그림 12. 주의 이동 스택. 완성된 원고에서 독자의 주의까지의 계층화된 경로입니다. 이동 논제는 어떤 산출물이 주의를 받을지 결정하는 계층인 효과적인 게이트키퍼가 시간 경과에 따라 위쪽으로 이동했다고 주장합니다. 저널 브랜드에서 저장소 및 검색 엔진을 거쳐 AI 답변 계층까지 이동하며, 각각의 위쪽 이동은 저자로부터 그리고 공개 벤치마크로부터 통제를 더욱 멀리 이동시킵니다. 스택은 개념적 모델입니다.
연구 2는 100-200개의 틈새 질문을 구성하며, 각 질문은 특정 SSRN 사전 출판본이 최고의 이용 가능한 출처가 되도록 설계되었으며, 이 관련성 주장은 질문 저자가 자체 인증한 것이 아니라 맹검된 전문가 평가자에 의해 검증되었습니다. 열람 기능이 활성화된 주요 소비자 AI 시스템을 조회하고 결과를 6가지 상호 배타적 범주로 코딩합니다: (1) 초점 사전 출판본 자체가 인용됨; (2) 동일한 논문의 출판된 버전 또는 미러가 인용되며, 더 광범위한 방식에서는 부재로 오분류될 수 있는 경우; (3) 논문 없이 2차 보도가 인용됨; (4) 다른 하지만 방어 가능한 출처가 인용됨; (5) 추적 가능한 출처 없음; (6) 엔진 거부(그림 13). 초점 논문이나 그 버전을 인용하는 모든 답변에 대해 이진 속성 충실도 플래그는 답변의 주장이 실제로 인용된 출처에 의해 지지되는지 여부를 추가로 기록합니다. 가시성과 충실도는 별도로 보고되며 단일 점수로 병합되지 않습니다. 왜냐하면 엔진이 논문을 눈에 띄게 인용하면서 잘못 표현할 수 있기 때문입니다(인용 표백) 또는 인용 없이 그 내용을 재현할 수 있기 때문입니다(속성 없는 영향). 확인적 회귀는 로지스틱이며, "초점 논문 또는 그 버전이 인용됨" 대 다른 모든 결과의 대조에 대해, 표준 오차는 클러스터되거나 더 나은 교차 무작위 효과 구조를 갖추어 엔진, 질문, 또는 초점 논문을 공유하는 관측값의 비독립성을 존중하도록 적합하게 됩니다. 엔진 전체에서 조회된 동일한 논문과 논문 전체에서 조회된 동일한 엔진은 각각 순진한 독립 시행 오차가 과소평가할 상관된 결과를 유발하기 때문입니다. 공식적으로, 감사의 추정량은 M_pqe입니다: 질문 q에 대한 응답으로 엔진 e에 의해 논문 p가 인용될 확률입니다. M_pqe는 질문, 엔진, 날짜, 모델 버전에 따라 변하기 때문에 논문만의 속성이 아니며, 표기법은 추정량을 정의하고 각 타임스탬프된 실행은 해당 날짜에서 M_pqe의 추정치로 읽혀집니다. 엔진 샘플은 소비자 챗봇을 넘어 신흥 학술 검색 계층(Consensus, Elicit, Scite, Semantic Scholar와 같은 학술 코퍼스에 근거하고 실제 논문을 인용하는 도구)으로 확장되어야 합니다. 사전 출판본이 소비자 엔진에 보이지 않을 수 있지만 학문 분야별 엔진에는 표시될 수 있으며, 두 계층 간의 발산 자체가 관심 있는 결과이기 때문입니다. 기계 가시성은 표 18에서 조작된 논문 특성에 대해 회귀됩니다. 여기에는 P3b가 요구하는 사전 가시성 공변량이 포함됩니다: 각 논문의 감사 전 웹 및 학술 발자국(질문 구성 시점에 고정됨). 질문 샘플은 사전 가시성에 따라 계층화되어 콜드 스타트 논문이 설계상 대표됩니다. 생성 엔진이 비정상이므로, 설계는 타임스탬프된 기본 스냅샷을 다른 사람이 반복할 수 있는 스크립팅된 재실행 프로토콜과 쌍으로 만듭니다. 3가지 추가 감사 위생 요건이 사전 지정됩니다: 부정 대조군(명망 있지만 관련 없는 논문, 제목 변형, 초점 작업을 검색하지 않아야 하는 프롬프트)은 무분별한 인용을 탐지 가능하게 만듭니다. 각 질문은 기록된 세션 상태(깨끗한 대 로그인된 세션, 엔진, 모델 버전, 날짜, 지리)에서 동등한 프롬프트 변형으로 실행되므로 프롬프트 및 세션 특정 인공물을 안정적인 검색 행동으로부터 분리할 수 있습니다. 그리고 결과의 무작위 부분표본이 이중 코딩되며, 평가자 간 동의가 보고됩니다. 단계별 감사 체크리스트 전체가 사전 등록 자료와 함께 저장됩니다. 연구의 주요 입력은 연구자 시간(100-200개 질문의 맹검된 관련성 검증 및 이중 코딩)이며, 제한된 접근 데이터나 특수 인프라가 아닙니다. 전문가 평가자 시간에 대해 시장 요율로 비용을 지불해야 하는 연구는 해당 노동에 대해 명시적으로 예산을 책정해야 합니다. 사전 지정된 예측은 사전 출판본 자체가 시행의 소수에서 인용되며(10-35% 대역), 구조화된 초록 및 출판된 버전 특성이 가시성을 높입니다(P3). 연구 2는 5개의 의제 항목 중 하나의 프로토콜입니다. 교차 엔진 및 교차 저장소 비교를 포함한 학술 기계 가시성의 완전한 감사는 계획된 동료 논문의 주제입니다.
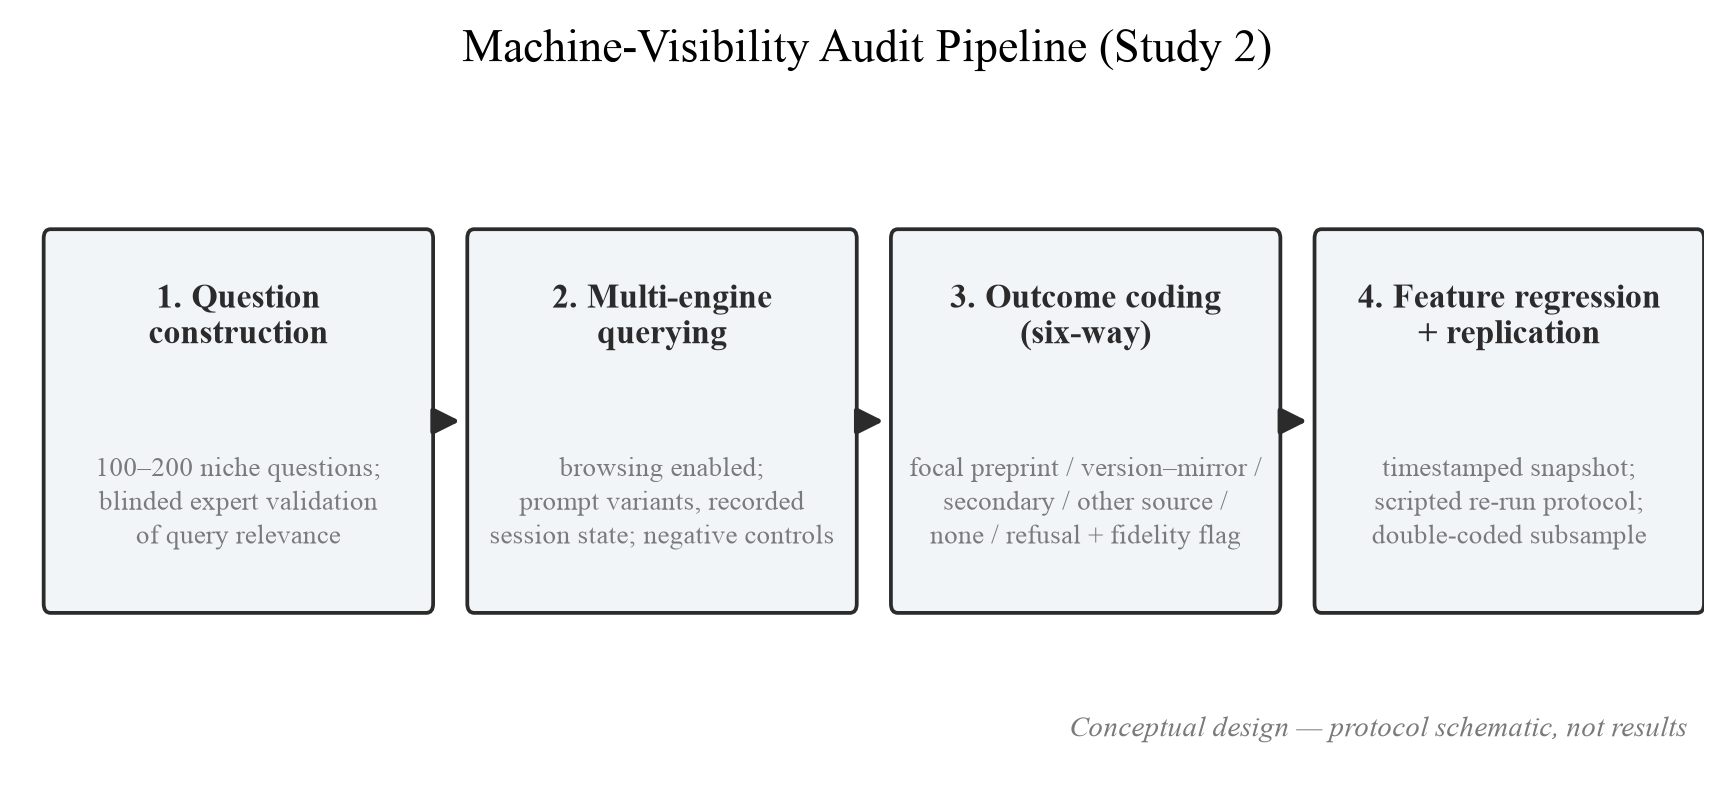
그림 13. 기계 가시성 감사 파이프라인(연구 2). 4단계 연구 2 파이프라인입니다. 6가지 코딩은 초점 사전 출판본의 인용을 출판된 버전이나 미러의 인용으로부터 분리합니다. 부재의 오분류를 방지하며, 속성 충실도 플래그는 "인용되었는가"를 "정직하게 인용되었는가"와 구별하게 합니다. 스냅샷 플러스 복제 구조는 모델 비정상성을 해결합니다: 기본 스냅샷은 날짜가 지정되며, 재실행 프로토콜은 모든 연구자가 나중에 감사를 재현할 수 있게 합니다.
표 18. 기계 가시성 특성의 조작(연구 2).
| 변수 | 정의 | 코딩 |
|---|---|---|
| DOI 존재 | 논문 페이지가 등록된 DOI를 노출합니다 | 1/0 |
| 제목 유형 | 설명적 vs. 암시적 제목 | descriptive = 1 |
| 초록 구조 | 구조화된/통계 풍부 vs. 서사형 | structured = 1 |
| 나이 | 첫 게시 이후 개월 수 | integer |
| 분류 개수 | 할당된 eJournals의 수 | integer |
| 2차 언급 | ≥1개의 인덱싱된 블로그/뉴스 언급 존재 | 1/0 |
| 출판된 버전 | 저널 기록 버전이 존재함 | 1/0 |
| 사전 가시성 | 논문과 저자의 사전 감시 웹 및 학술 활동 기록, 쿼리 구성 시점에 고정됨 (P3b) | 계층화된 순서형 |
| 결과 V | 초점 논문에 대한 검색 결과 | 6가지 범주: 초점 프리프린트 / 출판 버전 또는 미러 / 2차만 / 기타 정당한 출처 / 추적 불가능 / 거부; 인용된 경우에 대한 이진 속성-충실도 플래그 포함 |
주석. 기능 선택은 문서화된 생성 엔진 최적화 요소 [5][164]를 학술 자료에 맞게 조정합니다. 6개의 LLM 기반 엔진에서 약 252,000회의 시행에 걸친 가장 큰 감시 결과, 주제적 관련성과 검색된 맥락 내 목록 위치가 먼저 인용되는 주요 요인으로 파악되었습니다 [164]. 따라서 목록 위치는 연구 2에서 별도의 양도 가능한 가설이며, 관찰 가능한 모든 곳에서 결과 목록 위치를 기록해야 합니다.
표 19는 다른 수준의 설명에서 표 18을 보완합니다. 표 18은 연구 2가 효과를 추정하는 논문 수준 기능을 구체화하는 반면, 표 19는 감시의 측정 구성체를 명시합니다: 무엇을 측정하는지, 어떤 통제 하에서, 그리고 어떤 주요 타당성 위협에 대해 측정합니다. 모든 구성체는 기계 계층에 대한 명확한 주장이며, 각 위협은 순진한 감시가 실패하는 구체적인 방식을 명명합니다.
표 19. 기계 가시성 감시의 측정 구성체 (연구 2).
| 구성체 | 작동 측정 | 필수 통제 | 주요 위협 |
|---|---|---|---|
| 직접 기계 가시성 | 답변에서 인용되거나 링크된 초점 프리프린트 | 쿼리 관련성, 엔진, 날짜, 세션 상태 | 모델 및 색인 표류 |
| 출처 대체 | 프리프린트 대신 인용된 출판 버전, 미러, 또는 2차 보도 | 버전 일치, DOI, 제목 변형 | 부재로의 거짓 분류 |
| 인용 위치 | 답변 내 초점 인용의 순위 및 중요도 | 답변 길이 및 인용 수 | 인터페이스별 표시 |
| 속성 충실도 | 답변의 주장이 인용된 논문으로 정확히 뒷받침됨 | 맹검 주장-출처 검증 | 인용 세탁 또는 환각 |
| 쿼리 민감성 | 동등한 쿼리 표현 전반의 결과 변동 | 무작위화된 프롬프트 변형 | 프롬프트별 아티팩트 |
| 재현성 | 나중 날짜 또는 깨끗한 재실행에서 동일한 결과 | 보관된 프로토콜 및 시스템 메타데이터 | 엔진 비정상성 |
상업 GEO 문헌에서 가장 정당한 양도는 홍보 레시피가 아닌 기능 감시 의제입니다: 표 20은 연구 2가 기계 가시성과의 관련성을 확인하거나 반박하도록 설계된 후보 기능들을 나열합니다. 각 행은 확립된 전술이 아닌 가설이며, 검색과 관련된 기능은 여전히 논문 성숙도, 주제 인기도, 또는 지렛대 대신 사전 가시성에 대한 대리인일 수 있습니다.
표 20. 기계 가시성을 위한 기능 감시 의제 (연구 2의 가설, 권장 사항 아님).
| 후보 기능 | 가설화된 메커니즘 | 지원 증거 |
|---|---|---|
| DOI 등록 | 안정적 식별자가 검색 및 인용 일치를 지원함 | [164] |
| 구조화되고 통계가 풍부한 초록 | 통계 추가가 상업 벤치마크에서 생성 가시성을 최대 ~40% 높임 | [5] |
| 설명적이고 관련성이 높은 제목 | 주제적 관련성은 AI 답변의 상위 인용 요인 | [164] |
| 정확한 eJournal 분류 최대화 | 더 많은 분류가 더 많은 다운로드, 더 적은 0과 관련됨 | [168] |
| ≥1개 항목의 2차 보도 확보 | 엔진은 종종 1차 출처보다 2차 보도를 인용함 | [82] |
연구 3: "누가 먼저 도착하나?" 기기를 갖춘 게시 프로토콜은 P4를 직접 검증합니다. 두 개의 실제 진행 중인 논문이 노출 채널당 고유한 플러스 주소 이메일 별칭을 사용하여 게시되며, 같은 별칭에 대한 2~4주의 사전 게시 기준선 기간이 선행된 90일 인바운드 로그를 포함합니다. 기준선이 없으면 학술 스팸이 높은 배경률을 상대로 계속 도착하기 때문에 게시로 인한 요청 량의 증가를 전혀 속성으로 나눌 수 없습니다. 각 메시지는 게시된 요청 서명[96]과 선별된 차단 목록식 기준을 사용하여 진정한 학술 연락 또는 약탈적 요청으로 코딩되며, 섹션 7.2에서 검토한 특수 감사에서 문서화된 높은 배경률에 대응합니다[9][84][63][61]. 결과는 게시에 속성으로 나뉜 첫 진정한 연락까지의 시간과 첫 약탈적 요청까지의 시간의 비교입니다. P4에 따른 사전 지정된 예측은 요청이 진정한 연락에 선행한다는 것입니다. 두 가지 측정 규칙은 출시 전에 고정됩니다. 기준선과 사후 게시 기간은 길이가 다릅니다(대략 2~4주 대 90일). 따라서 비교는 도착 률(별칭-일당 사건)과 생존 함수의 비교이며, 창 비대칭이 달리 왜곡할 원시 사건 수의 비교는 절대 아닙니다. 그리고 첫 연락까지의 시간은 구조상 우측 검열됩니다. 두 개의 논문이 있으므로 90일 기간 내에 진정한 연락을 받지 않는 별칭은 0이 아닌 검열된 관찰을 생성하므로, 검열 규칙은 사전 지정됩니다. 관찰은 90일에 우측 검열되며, 사건이 없는 별칭은 삭제되거나 즉시로 코딩되지 않고 검열된 시간을 생존 추정에 기여하며, N = 2일 때 결과 곡선은 점 추정이 아닌 정확한 소표본 불확실성과 함께 보고됩니다. 분산 복제 설계의 인과 추정량은 게시 후 요청의 위험 변화(다운로더의 신원이 아님)이며, 일치하는 사전 및 사후 게시 기간에 대해 생존/사건-역사 방법으로 추정됩니다. 저자의 가시적 생산성이 단일 게시와 무관하게 요청 량을 그럴듯하게 예측하기 때문입니다(요청은 저자의 누적된 공개 출력에서 수확되므로 섹션 7.2의 특수 감사에서 문서화된 높은 배경률이 그 출력에 따라 조정됨). 분산 복제는 초점 사건과 함께 저자 수준 노출 제어(이전 게시, 출판 량 및 공개 연락 표면)를 기록해야 합니다. 이는 N = 2 기기를 갖춘 사례 연구이자 메커니즘의 증거이며 분산 복제를 초대하는 공개 프로토콜이며, 이는 총체적으로 전력 추정을 생성할 것입니다. N = 2는 기기 설치의 타당성을 보여주지만 유행도와 인과 규모는 아닙니다. 사전 지정된 효과 크기에 대해 전력 있는 연구 1, 2 및 4와 달리 연구 3은 타당성 파일럿 및 공개 복제 프로토콜입니다.
코딩 프레임은 출시 전에 고정됩니다. 인바운드 메시지는 7가지 유형으로 코딩됩니다: 저널 요청, 회의 초대, 동료 검토 요청, 편집위원회 초대, 책 장 초대, 상업 서비스 제안 및 진정한 학술 통신이며, 이진 약탈적/진정한 분할보다 더 넓은 프레임입니다. 각 기록은 최소 필드 세트를 포함합니다: 타임스탬프, 수신 별칭(채널), 장소 이름, 수수료 공시, 초점 논문에 대한 특이성, 긴급 언어, 유지 관리되는 선별 서비스에 대한 검증 결과 및 코더 신뢰도입니다. 경계선 사례와 합법적 저명도 낮은 장소는 임의 판단이 아닌 사전 지정된 규칙에 의해 관리됩니다. 새롭거나 모호한 장소가 자동으로 약탈적인 것은 아닙니다. 무작위 부분표본은 쌍으로 코딩되며 평가자 간 일치도가 보고됩니다. 집계 수만 공개됩니다(섹션 9; 선언). 전체 코드북은 사전 등록과 함께 보관됩니다. 요청 량은 독서의 증거가 아니며, 요청은 공개 카운터를 이동하지 않습니다. SSRN의 무결성 시스템은 공식 수에서 비정상적인 자동화된 활동을 제외합니다[144]. 그리고 인박스에서 대시보드로의 추론은 어느 쪽 방향으로도 허용되지 않습니다.
연구 4: "저자들이 자신의 카운터를 어떻게 읽는가." 사전에 명시된 저자 설문조사는 표 1에 기록된 포럼 증거의 수요를 직접 측정으로 전환합니다. 이 도구는 4개의 고정된 표현의 항목으로 구성됩니다: (1) "SSRN 다운로드를 벤치마크나 규범과 비교한 적이 있습니까?"이며, 응답 옵션은 특정 발표된 수치, 학문 분야별 표, 비공식적 동료 비교, 그리고 없음을 구분합니다; (2) "대시보드에서 '7 다운로드'를 볼 때 가장 먼저 떠오르는 생각은 무엇입니까?"이며, 옵션은 추론된 실패, 판단하기에는 너무 이르다, 정상이 무엇인지 모르겠다, 그리고 예상되거나 괜찮다를 포함합니다; (3) "2026년 7월 순위 선셋 변경이 귀하의 프리프린트 행동을 변경했습니까?"이며, 옵션은 통계 확인 중단, 새로운 업로드 회피, 업로드하지만 덜 자주 확인, 그리고 영향 없음입니다; 그리고 (4) "채용 및 임용 위원회가 SSRN 지표를 이해한다고 생각하십니까?". 사전에 명시된 예측은 응답자의 대다수가 자신의 카운터를 벤치마크와 비교한 적이 없다고 보고하며, 낮은 수치를 처음 읽을 때 5.6절에서 보여주는 일반적으로 올바른 기본값인 너무 이르다는 읽음보다는 추론된 실패로 치우친다는 것입니다. 표본 크기 목표, 모집 채널 및 분석 코드는 등록 시 고정됩니다. 참여도가 높은 저자, 그리고 아마도 더 불안한 저자들을 향한 자기선택은 8.8절 레지스트리가 하는 것처럼 표본을 제한합니다. 고정선택 형식은 또한 정성적 동반 부분을 허용합니다: 공개 저자 질문의 사전에 명시된 주제별 코딩(명시적 포함 기준 및 9절에 명시된 인용 윤리 아래에서의 코더 간 신뢰도 포함)과 저자들이 자신의 카운터를 어떻게 읽는지, 그리고 어떻게 느끼는지에 대한 반구조화된 인터뷰는 폐쇄형 항목이 할 수 없는 지표 제시의 인간적 결과에 도달합니다. 중앙 구성요소와 관련된 설계 제한이 있습니다. SSRN 저자들에게만 관리되는 4개의 고정 항목은 벤치마크 자유 읽음의 수준을 측정하며, 대조가 아니며, 수준은 그 자체로 벤치마크 불투명성에서 지표 맹성으로의 이 기사의 주장된 경로를 식별할 수 없습니다. SSRN에서의 높은 비교하지 않음 공유는 플랫폼 불투명성과 무관한 카운터에 대한 일반적인 무관심과 동일하게 일치합니다. 판별 및 인과 견인력은 따라서 비교 조건이 필요합니다: 다양한 벤치마크 노출을 가진 플랫폼인 arXiv(승인 및 나열 기반, 자체 가시성 표면 포함) 및 OSF Preprints의 저자들에게 관리되는 동일한 도구는 "SSRN 저자들이 자신의 카운터를 어떻게 읽는가"를 "더 많고 덜 불투명한 플랫폼의 저자들이 자신의 카운터를 다르게 읽는지 여부"로 전환하며, 이는 불투명성-맹성 주장이 실제로 예측하는 대조입니다. 크로스 플랫폼 팔은 연구 4의 일부로 사전에 명시됩니다; 없으면 단일 플랫폼 결과는 메커니즘 테스트가 아니라 SSRN의 설명으로 남을 것입니다. 그러면 연구 4는 1절과 5절의 해석적 주장을 직접 테스트하며, 저자들이 자신의 카운터가 의미한다고 믿는 것을 측정하지만 카운터가 무엇인지는 아닙니다.
8.7 기사 자체를 실험으로 활용
이 기사의 다운로드 궤적도 미리 정해져 있습니다. 게시 후 30일, 90일, 180일 시점에 조회 수를 기록하고 그 중앙값이 확정되면 연구 1의 중앙값과 비교하여 보고합니다. 이 기록은 기술적이며 해석 규칙을 포함하지 않습니다. 두 방향의 해석 모두 논문의 주장에 유리하기 때문이며, 모든 결과가 논증을 확인하는 장치는 아무것도 검증하지 않기 때문입니다. 숫자는 나타나는 그대로 공개됩니다. 한 가지 해석이 기사의 프레임과 배치될 수 있습니다. 즉, 분야 및 연령 중앙값에 위치하는 궤적으로서, 상승도 억제도 아닌 경우인데, 이는 자기참조적 설계가 이 사례에서 측정 가능한 발견 가능성 이점을 제공하지 않음을 나타냅니다. 이 논문이 자신이 축적할 지표를 연구하기 때문에 반사성을 피할 수 없습니다. 목록화된 수단은 이 기록이 아니라 섹션 8의 직접 검증으로 평가됩니다.
8.8 백분위수 벤치마크를 공공재로
이 의제가 생산할 수 있는 가장 유용한 산출물은 프리프린트 다운로드에 대한 백분위수 표입니다. 모든 저자가 찾아보지만 찾을 수 없는 수치입니다. 플랫폼은 역사적으로 평균값과 상위 N개 목록을 공개했지만 중앙값이나 백분위수는 공개하지 않았으며, 2026년 7월 15일 이후로는 논문별 및 저자별 집계만 표시하고 비교 맥락은 전혀 제공하지 않습니다 [149]. h-지수 및 유사 지표의 경우 대중 대상 "X는 좋은가?"라는 안내서의 장르가 존재합니다 [118][128]. 섹션 2.5 감사에서는 SSRN 다운로드에 대한 동등한 자료를 찾을 수 없었습니다. 이러한 표의 원자재는 수년간 인쇄본으로 존재해왔으며 [18][83][85][139][168], 부족한 것은 그 분포를 저자 대면 규모로 변환하는 것입니다.
서비스 종료 후 전체 플랫폼 백분위수의 외부 수집은 더 이상 불가능합니다. 유출된 분포 임계값을 담은 상위 목록이 분포 꼬리에 대한 유일한 공개 창이었으며, 그것들은 사라졌습니다 [149]. 두 가지 상호 보완적 경로가 남아 있습니다. 하나는 연구 1의 층화 표본으로, 논문 수준에서 플랫폼 백분위수를 생성합니다. 다른 경로는 자체 보고된 집계의 크라우드소싱 레지스트리입니다. 저자들이 날짜가 있는 대시보드 스냅샷(논문 나이, 분야, 초록 조회, 다운로드)을 제공하는 자발적 커뮤니티 데이터셋으로, 서비스 종료 이전 분포에 대한 기관 기억이 더 이상 감퇴하기 전에 조립합니다. 표 13의 도서 프로토콜의 보존 단계(표 13)는 채택 규모에서 정확히 이러한 레지스트리의 씨앗입니다. 발명하기보다 확장할 작동 선례도 있습니다. IRUS(Jisc)는 이미 참여 기관 리포지토리 전체에서 표준화된 COUNTER 준수 항목 수준 사용 통계, Total_Item_Requests를 집계합니다 [185]. 이는 다중 기관 사용 집계가 운영상 가능함을 보여줍니다. 프리프린트 레지스트리는 여기서 중요한 참조 클래스 변수(분야, 게시 코호트, 경력 단계)를 포함하도록 확대된 확립된 모델입니다. 북미 대응책인 CC-PLUS는 오픈소스 인프라로 동일한 기능을 제공하며, 컨소시엄 전체에 걸친 COUNTER 5 사용의 자동화된 SUSHI 수확을 합니다 [188]. 따라서 레지스트리는 처음부터 위임받는 대신 작동하는 플랫폼을 확장할 수 있습니다. 이러한 종류의 레지스트리는 2010년대 중반 표본 이후 첫 번째 신선한 다학제 다운로드 분포를 구성할 것입니다 [85][139]. 알려진 약점은 참여하고 있으며 아마도 중앙값 이상의 저자에 대한 자기선택, 날짜가 있는 스크린샷이 필요하지 않으면 검증 불가능한 자체 보고, 그리고 소규모 분야의 범위 격차입니다. 여기서 파생된 백분위수는 따라서 명시적 선택 주의 사항과 함께 공개되어야 하며, 가능한 경우 연구 1 확률 표본에 대해 보정되어야 합니다. 희소 분야별 연령 셀은 불안정한 원시 백분위수가 아니라 더 넓은 참조 클래스를 향한 경험적-베이즈 축소 하에서 보고되어야 합니다(섹션 5.2, 8.3). 레지스트리 프로토콜 및 검증 규칙은 사전등록 자료와 함께 공개될 것이며, 기여 형식은 여기서 고정됩니다. 레지스트리 기록은 부록 C의 패널 스키마의 정의된 부분집합(정체성, 타이밍, 사용, 노출, 감사 도메인)이므로 자체 보고된 기록은 연구 1 패널과 합병 가능하게 유지되며 호환되지 않는 두 번째 데이터셋으로 축적되지 않습니다.
레지스트리의 출력 형식은 해당 프로토콜과 함께 사전 지정되며, 두 가지 산출물이 약속됩니다. 하나는 단일 숫자(예: 10, 40 또는 100 다운로드)를 취하여 각 범위 분야에 대해 해당 백분위수 위치와 표 8의 순 언어 대역을 반환하는 변환 표입니다. 이를 통해 "7 다운로드가 좋은가?"라는 질문의 답변을 추측하는 것이 아니라 조회할 수 있습니다. 다른 하나는 백분위수 "부채꼴" 그림으로, 25번째, 50번째, 75번째, 95번째 백분위수 다운로드 곡선을 분야 및 신입자 계층별로 논문 나이의 함수로 플롯합니다. 이것이 벤치마크가 "날 X에 정상은 얼마나 되는가"라는 질문에 답하는 형식입니다(그림 14; [필요한 데이터]: 어느 산출물도 합성 값으로 채워질 수 없습니다). 두 경로(확률 표본 또는 레지스트리)에서 나온 모든 백분위수 릴리스는 부록 D의 투명성 사양에 따라 공개되며, 최소 셀 개인정보보호 규칙을 포함하므로 이 의제가 제안하는 벤치마크는 치유하기 위해 설계된 불투명성을 재현하지 않습니다. 데이터 위에는 얇은 셀프서비스 계층, 즉 저자가 분야, 논문 나이, 집계를 입력하고 백분위수 대역 및 구두 판정을 받는 공개 온라인 계산기가 있습니다. 이것은 섹션 6.3의 보정되지 않은 점수카드 스타일 휴리스틱을 보정된 도구로 변환할 것입니다. 참조 분포가 존재할 때만 가능합니다. 섹션 8.10은 이러한 서비스를 운영하고 최신 상태로 유지할 수 있는 다중 모델 아키텍처를 제안합니다. 동일한 셀프서비스 계층은 보고 프로토콜이 고용 및 임용 위원회에 새로운 작업 부담을 부과하지 않도록 유지합니다. 도서 형식(표 13)이 요구하는 숫자별 정규화는 계산기(이 섹션)에 의해, 그리고 규모에서 오케스트레이션 계층(섹션 8.10)에 의해 수행되기 때문입니다. 현실적인 배포 경로는 기존 연구정보 인프라, 즉 현재 연구정보 시스템(CRIS) 및 ORCID 연계 프로필을 통해 진행되므로 논문의 식별자에서 벤치마크된 읽기를 생성할 수 있으며 손으로 조립할 필요가 없습니다. 자연스러운 교차 플랫폼 확장은 SSRN, arXiv(분야에 적합한 경우), OSF Preprints에서 동일한 논문의 궤적을 비교하는 병렬 증착 프로토콜로, 표 8의 대역이 푸시 및 풀 아키텍처 간에 전달되는지 여부를 직접 테스트합니다(표 6).
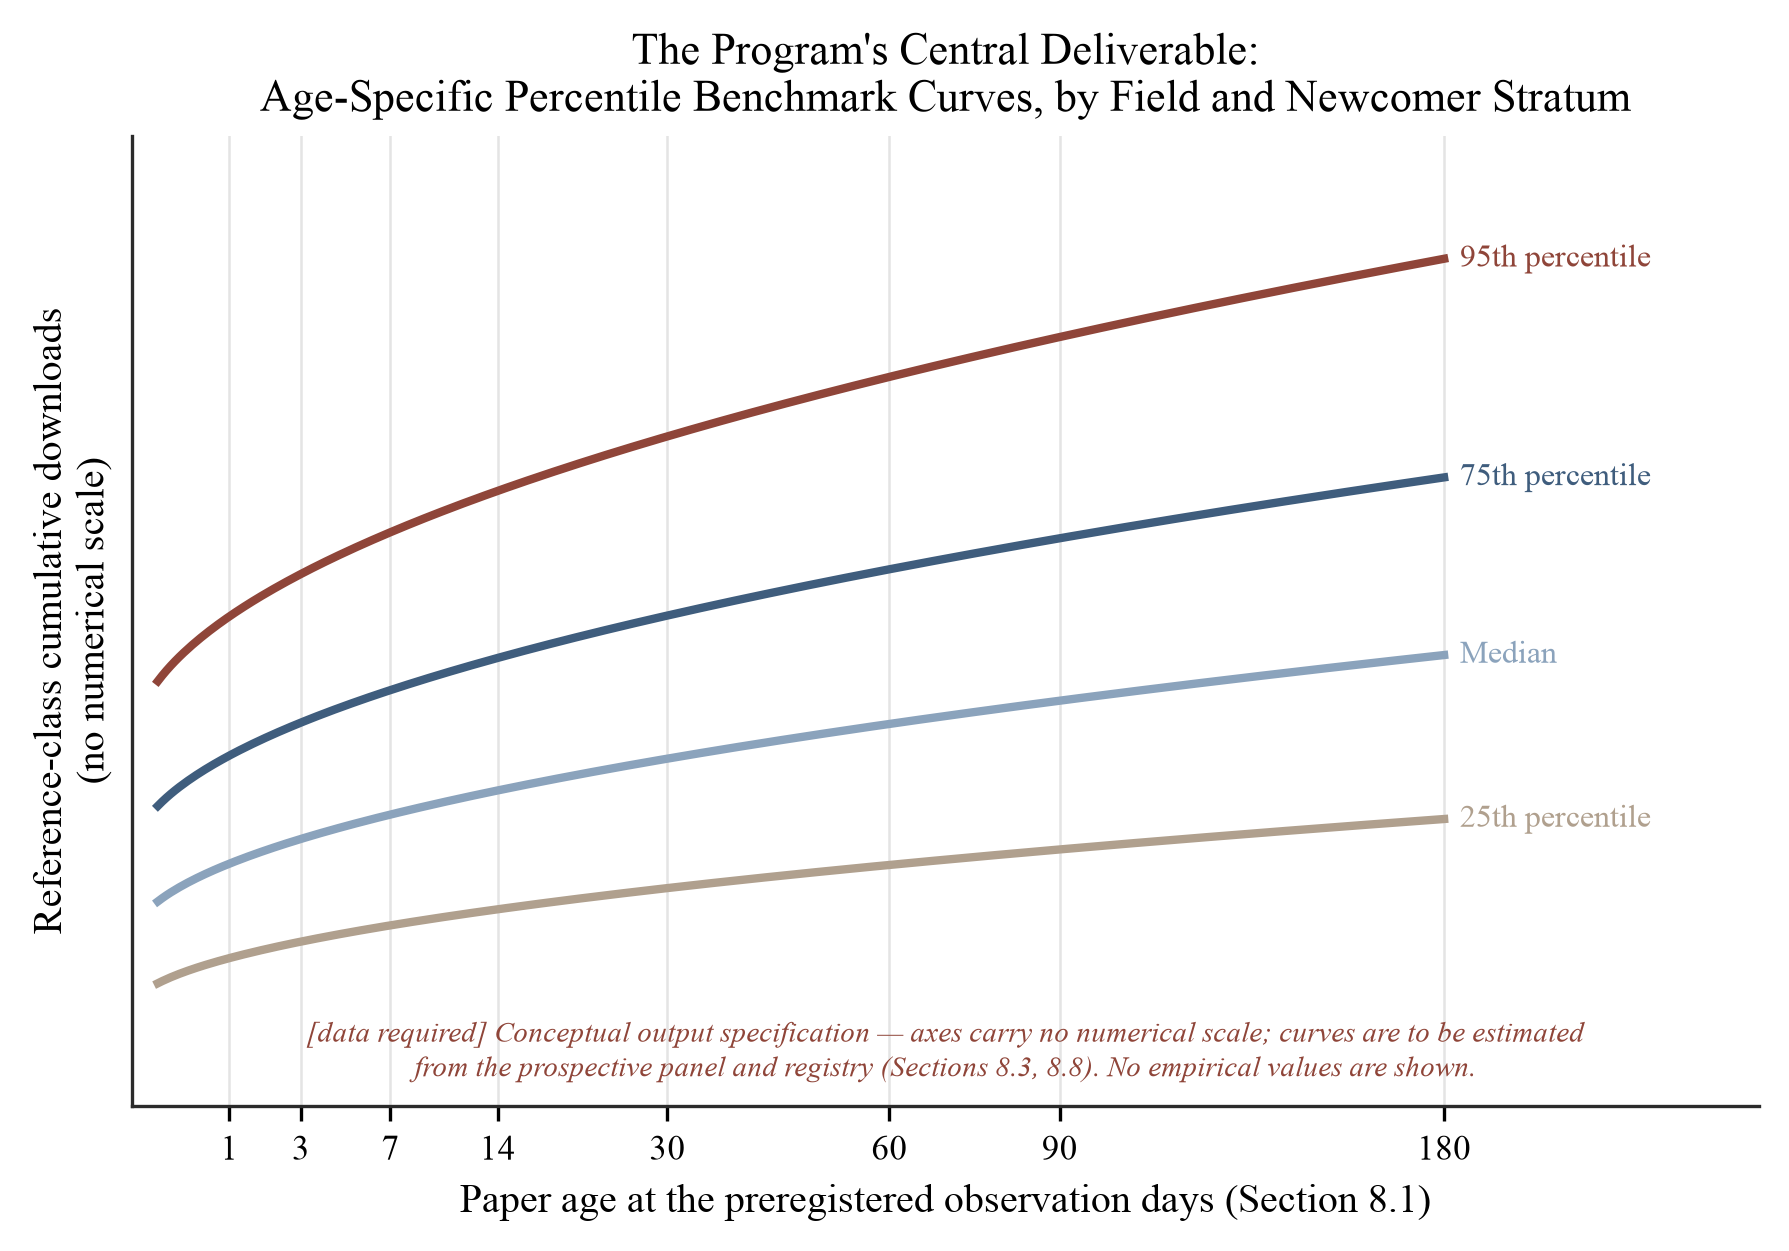
그림 14. 연령별 벤치마크 부채꼴: 프로그램의 중심 산출물. 백분위수 다운로드 곡선(25번째, 50번째, 75번째, 95번째)을 섹션 8.1의 사전 지정된 관찰일에서 평가된 논문 나이의 함수로, 연구 1 표본 및 커뮤니티 레지스트리의 분야 및 신입자 계층별로 추정됩니다. 축은 수치 규모를 포함하지 않습니다. 그림은 개념적 출력 사양이며, 섹션 10.4의 플랫폼 권장 사항과 위에서 설명한 공개 계산기 뒤의 표시 형식입니다.
프로그램의 모든 실증 논문은 최소 보고 패키지에 대해 약속합니다: 코호트 흐름도; 원본 및 정규화된 분포를 나란히 제시; 도달률과 전환율을 별도로 보고; 노출 이력; Section 8.3의 4계층 사다리에 대한 이상 민감도 결과; 확인 결과와 동일한 비중으로 보고된 무의미한 결과 및 반대 결과; 그리고 기계 판독 가능한 벤치마크 표, Study 1의 출력이 위에서 설명한 공개 계산기에 실제로 입력될 수 있는 조건. 프로그램 논문의 초록은 검증된 추정치를 사전 지정된 기대치와 구별합니다.
8.9 예측 타당성
의제의 총괄적 검사(RQ3)는 정규화가 그 복잡성을 정당화하는지 묻습니다. 초기 사용과 이후 인용은 여러 설정에서 긍정적이지만 불완전하게 연관되어 있습니다. 저널 수준의 Granger 분석에서 0.11–0.35 범위의 상관계수[80], 초기 arXiv 코호트에서 약 0.4 (r ≈ 0.4는 분산의 약 16%만 설명함)[25], 20년 전 화학 사전출판물에서 보고된 비교 가능한 연관성[26], 저널 및 논문 수준의 다운로드[71], RePEc 사용 데이터[31], bioRxiv 코호트[62], 메가 저널 사용의 중간 정도 순위 상관[102]이 있습니다. 높은 다운로드 수를 기록한 것과 높은 인용도를 기록한 것의 집합은 부분적으로만 겹칩니다[108][39]. 최근 패널 데이터는 지연을 두고 접근과 인용을 연결합니다. 7개 저널 패널에서 연관성은 약 단위-탄력적이었으며, 접근 10% 증가는 약 9개월 후 인용 약 10% 증가와 관련이 있었습니다[178]. 5.5절의 표기법에서 총괄적 비교는 다음을 추정합니다
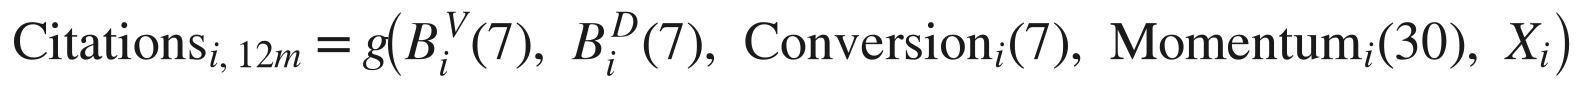
g는 유연하게 적합되고 표본 외에서만 평가됩니다. 방정식은 어떤 정규화된 입력이 원시 개수와 경쟁하는지 고정합니다. 나이, 분야 및 코호트 정규화된 7일 및 30일 메트릭으로부터 6개월, 12개월 및 18개월 인용을 예측하는 모델은 교차 검증 우도, 보정, 순위 상관 및 예측 오차로 표본 외에서 원시 누적 다운로드만 사용하는 모델과 비교되어야 합니다. 이는 Kleinberg 외[88]의 의미에서 예측 정책 문제입니다. 특히 정보 제공적인 결과는 원시 개수가 기성 저자를 선호하는 한편 정규화된 콜드스타트 측정이 이후 인용 수용을 더 잘 예측하는 것입니다. 이 패턴은 원시 초기 카운터가 측정하는 것의 일부가 그 이후의 지적 수요보다는 초기 기회라는 것을 의미합니다. 정규화가 예측 정보를 추가하지 못하면 프레임워크의 측정 주장은 그에 따라 거부되거나 축소됩니다.
Figure 15는 의제를 종합합니다. 하나의 전향적 코호트가 4개 연구와 2개 플랫폼 준실험에 병렬로 공급되며, 모든 모듈은 동일한 버전 관리된 공개 출력 집합에 제출됩니다. 이 공유 구조가 의제를 연구 프로그램으로 만듭니다.
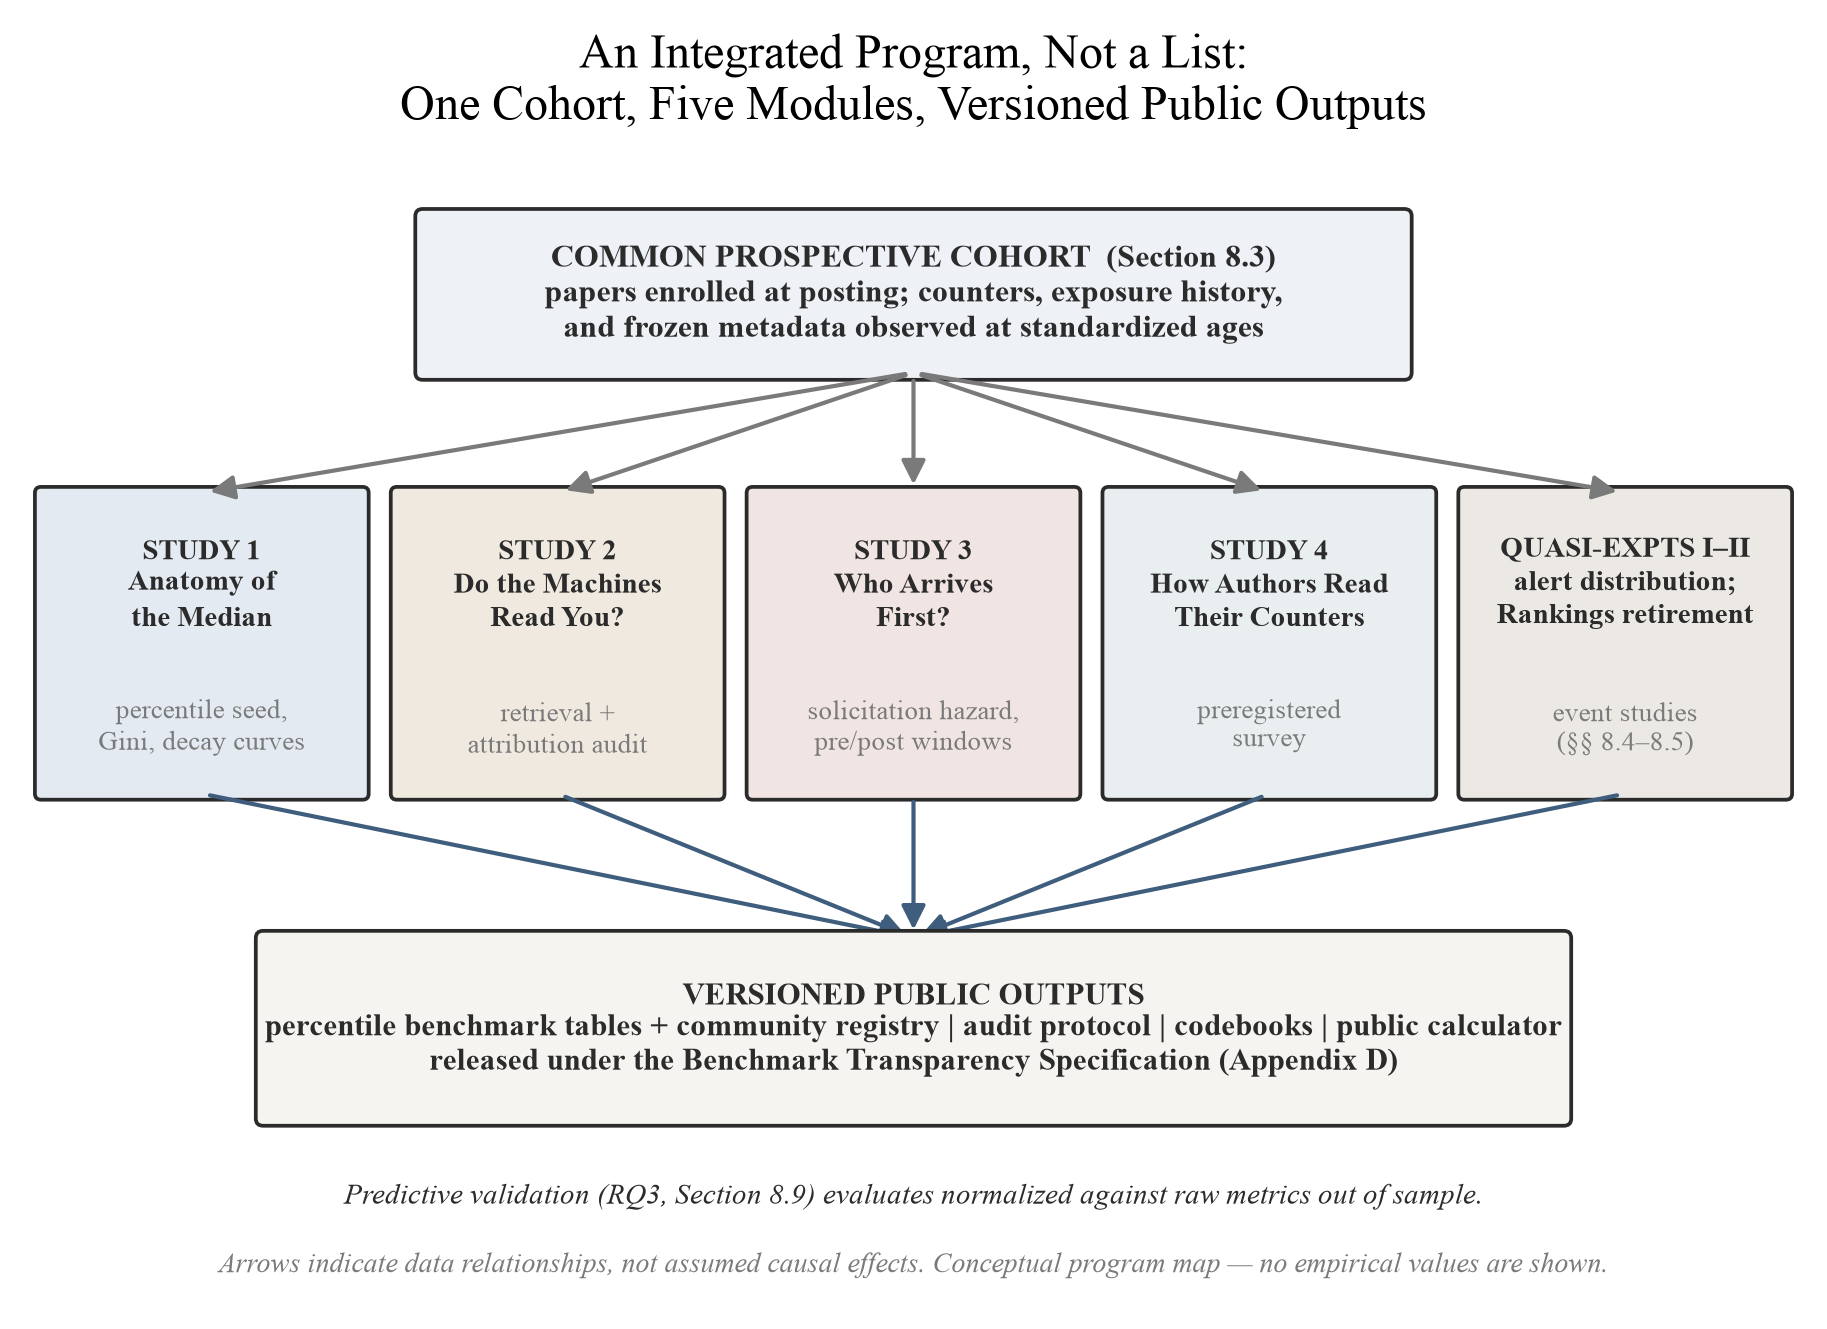
Figure 15. 통합 연구 프로그램입니다. 하나의 전향적 코호트(8.3절)가 4개 연구(8.6절)와 2개 플랫폼 준실험(8.4–8.5절)에 공급되며, 모든 모듈은 버전 관리된 공개 출력으로 제출됩니다 — 백분위수 벤치마크 테이블 및 커뮤니티 레지스트리(8.8절), 감사 프로토콜, 코딩 코드북 및 공개 계산기 — Appendix D의 Benchmark Transparency Specification에 따라 공개되며, 예측 타당성(8.9절)은 결과 벤치마크를 표본 외에서 평가합니다. 화살표는 데이터 관계를 나타내며, 가정된 인과 효과는 아닙니다.
8.10 설계 제안: 벤치마크 전달 계층으로서의 조율된 프론티어 모델
일회성 출판으로는 의제의 산출물이 요구하는 것을 전달할 수 없습니다. 백분위 표, 커뮤니티 레지스트리, CSAB 보고 형식(5.5절; 부록 B), 공개 계산기(8.8절)는 모두 산재된 쇠퇴하는 출처에서 수집되어야 하며, 주장별로 검증되어야 하고, 계산 규칙과 플랫폼 기능이 변함에 따라 최신으로 유지되어야 하며, 개별 저자에게 조정된 언어로 전달되어야 합니다. 그러한 전달 및 유지보수 계층을 위한 후보 아키텍처는 특화된 프론티어 AI 모델의 조율된 파이프라인입니다(저자가 개발하는 시스템 클래스; 이해 관계 참조). 본 소절의 모든 내용은 설계 제안입니다. 구현이 존재하지 않으며, 실증적 성능이 주장되지 않으며, 아래의 어느 곳에서도 정확성, 비용 또는 절감 시간에 대한 수치가 명시되지 않습니다.
조율된 시스템의 한 가지 대안은 단일 범용 모델입니다. "7 다운로드가 좋나요?"라고 소비자 챗봇에 묻는 저자는 유창하지만 검증할 수 없는 주장을 받으며, 이는 답변 엔진 감사 문서가 기록하는 실패 모드이며, 여기서 시스템은 응답을 거부하는 대신 부당한 확신으로 실패합니다[82]. 그 아래에는 구조적 문제가 있습니다. 메트릭 해석은 다양하고 부분적으로 대립하는 목표를 가진 부작업으로 분해됩니다. 증거를 획득하고 날짜를 정하고, 비인간적이거나 이상한 트래픽에 대해 카운터를 검사하고, 나이, 분야, 코호트 및 이전 가시성의 참조 클래스에 대해 검사된 개수를 정규화하고, 정규화된 위치를 대역화된 언어로 번역하고, 릴리스 전에 그 번역에 도전하는 것은 동일한 작업이 아니며, 하나에 대해 최적화된 구성 요소는 다른 것의 판사로서 형편이 없습니다. 확신 있는 읽기를 작성하는 모델이 기본 숫자가 오염되었는지 여부에 대한 유일한 권한자가 되어서는 안 되며, 도슷 언어를 작성하는 모델이 그 언어가 과장을 피하는지 인증해서는 안 됩니다. 조직 원리는 따라서 인식론적 노동의 분할입니다: 생성과 검증은 독립적인 목표를 가진 별도의 구성 요소에 할당되며, 불일치는 평균화되지 않고 보존되고 보고됩니다. 독립적으로 프롬프트되거나 아키텍처적으로 구별되는 평가자의 수렴은 진실이 아니지만, 단일 모델의 유창성보다는 읽기를 위한 더 강한 근거이며, 이는 언어 모델 인스턴스 간의 다중 에이전트 논쟁이 단일 모델만이 혼자 답하는 것에 비해 측정 가능하게 사실적 타당성을 개선하고 환각을 감소시킨다는 실험 증거와 일치하는 설계 직관입니다[43]. 평가자가 다를 경우, 그 다양성 자체가 진단 정보이며, 이는 이 기사 자신의 종합 규칙(범위 및 증거 규율)에서 상충하는 출처가 잡음이 아닌 신호로 취급되었던 것과 같습니다. 두 가지 설계 주의사항이 그 직관을 완화합니다. 구성 요소 간의 합의는 그 자체로 증거가 아닙니다: 공유된 훈련 데이터, 공유된 검색 결과, 공통 프롬프트 가정 또는 조율자 자체를 통한 오염으로부터 발생할 수 있습니다. 다양한 공급업체에서 나온 모델 패밀리는 과학적으로 독립적이지 않으며, 독립성은 별도의 명령, 구성 요소 간의 제한된 정보 흐름, 보존된 중간 출력, 생성 구성 요소가 편집할 수 없도록 하는 증거에 대한 평가를 통해 엔지니어링되어야 합니다. 검증 또한 단순히 두 번째 모델이 수행한다고 해서 신뢰할 수 없게 됩니다: 분쟁이 있거나 결과가 중대한 주장에는 인간 사용자에 의한 기본 출처 검사가 필요합니다.
그림 16은 제안된 파이프라인을 보여주며, 표 21은 기능별로 분해합니다. 처리는 자유 형식 프롬프트가 아닌 동결된 사건 파일에서 시작합니다: 관찰 날짜가 있는 카운터, 논문 나이, 선언된 분야 및 후보 참조 코호트, 노출 이력 및 저자의 실제 질문입니다. 누락된 입력은 누락된 상태로 유지되며, 시스템은 부재한 백분위 분포를 제조하거나, 분모를 대입하거나, 모델 생성 숫자를 관찰된 숫자 대신에 수용할 수 없습니다. 정보 흐름은 기사가 전체적으로 방어하는 해석적 수열을 재현합니다: 원본 카운터 → 무결성 검사 → 참조 클래스 정규화 → 제약 하에서의 해석. 모니터링 구성 요소는 날짜가 있는 출처를 가진 카운터, 플랫폼 문서 및 레지스트리 기록을 검색하므로 모든 하위 값이 보관된 출처로 추적 가능합니다. 모든 사실적 출력은 주장 원장의 항목으로 구성 요소 간에 이동합니다. 각 항목은 주장, 그 지원 출처 또는 데이터 필드, 안정적인 로케이터, 검색 시간, 적용된 변환, 그 참조 클래스 및 검증 상태를 기록하므로 지원되지 않는 출력이 조용히 나중 단계의 전제가 될 수 없습니다. 무결성 검사는 문서화된 봇 필터링 및 AI 크롤러 오염의 배경에 대해[129][144] 기존 시계열 이상 탐지(자유 텍스트 생성을 위한 작업이 아닌 통계 방법의 작업)를 적용합니다. 노출 기록이 허용하는 경우 궤적 중단을 날짜가 있는 노출 이벤트에 귀속시킵니다(5.6절). 정규화는 도구로 호출되는 결정론적 통계 코드에 의해 수행됩니다: 백분위 위치는 버전이 지정된 연구 1 및 레지스트리 표에 대해 8.3절의 축약 규칙에 따라 계산됩니다. 백분위 산술은 자유 텍스트 생성에 위임되지 않습니다. 그 다음에만 해석기 모델이 저자 대면 읽기를 작성하며, 표 8의 대역 언어, 표 9의 도달 대 변환 진단, 부록 B의 CSAB 템플릿에 제한되며, 모든 숫자에 출처, 버전 및 신뢰도 계층이 첨부됩니다. 별도의 검증자 및 비평가가 릴리스 전에 각 주장을 기록된 증거에 대해 확인하며, 각각을 검증됨, 분쟁 중, 지원되지 않음 또는 평가 불가능으로 보고하며, 이 네 가지 서로 다른 상태는 단일 합성 신뢰도 점수로 압축되지 않습니다. 두 가지 제약은 프레임워크에서 변경되지 않은 채로 적용됩니다. 모든 권장사항은 진단된 병목에 따라 조건부이므로, 도달 제한 및 변환 제한 논문은 다른 조치를 보증합니다(표 9), 그리고 이를 구분할 수 없는 시스템은 일반적인 조언을 내보내는 대신 아무것도 말하지 않아야 합니다. 다른 제약은 릴리스된 권장사항이 가설이라는 것입니다: 진단이 올바르면 어떤 메커니즘이 움직여야 하는지 예측하며, 후속 관찰이 그 예측을 테스트합니다. 시스템의 목적 함수는 따라서 좁습니다: 논문과 그 적절한 참조 클래스 사이의 식별 가능한 해석적 마찰을 제거하고, 어떤 카운터의 최대화도 아니며, 이 경계는 플랫폼의 무결성 및 생성형 AI 정책[54][144]과 3절의 게이밍 이력[44]에 의해 고정됩니다.
표 21. 제안된 오케스트레이션 계층의 기능 분해: 기능, 구성 요소 유형, 주요 실패 모드 및 이를 독립적으로 검증하는 메커니즘. 각 행은 작동 가능한 역할 분담에 관한 가설입니다.
| 기능 | 모델 또는 구성 요소 유형 | 주요 실패 모드 | 독립적 검증 메커니즘 |
|---|---|---|---|
| 오케스트레이션 및 출처 추적 | 동결된 사건 파일 및 청구 원장을 유지하는 작업 라우터 | 초기의 미검증 가정이 이후의 모든 단계의 전제로 전파됨 | 검증되지 않은 출력이 신뢰할 수 있는 전제가 되지 않아야 함; 모든 인수인계 시점에 출처, 변환, 검색 시간 및 불확실성이 보존됨 |
| 증거 수집 및 모니터링 | 재실행 일정에 따른 도구 활용 검색 모델; 개방 인용 인프라에 대한 서지 대조 [35][124] | 위조되거나 부정확하게 일치하거나 선별적으로 검색된 출처 | 날짜가 지정된 출처 추적 로그; 모든 값은 보관된 스냅샷까지 추적 가능; 무작위 부분 샘플은 두 번째 구성 요소에 의해 독립적으로 다시 검색됨; 실패한 검색 및 반대 결과는 기록되며 폐기되지 않음 |
| 무결성 검사 | 비생성형 시계열 이상 탐지 [129][144] | 스파이크가 어느 정체성에 대한 증거 없이 "봇" 또는 "리더"로 표시됨 | 이상 플래그는 집계와 함께 게시됨 (8.8절); 8.3절의 4계층 견고성 사다리에 민감도 보고됨; 이상은 플래그로 취급되며 정체성 주장으로 취급되지 않음 |
| 참고 범주 정규화 | 도구로 호출되는 결정론적 통계 코드 | 편의상의 동료들이 유효한 비교 모집단으로 오인됨 | 버전 관리되는 공개 벤치마크 표에 대해 재계산 (부록 D); 분야, 나이, 코호트, 이전 가시성 및 출처 빈티지가 명시되거나 모듈이 기권함; 자유 텍스트 산술은 기록에 수용되지 않음 |
| 해석 초안 작성 | 표 8 대역 언어 및 CSAB 템플릿(부록 B)으로 제한된 일반주의 언어 모델 (부록 B) | 유창한 과장 — 증거가 허용하는 범위를 넘어선 확실성, 범위 또는 인과 상태 | 별도의 검증자에 의한 기록된 증거에 대한 청구 수준 검사; 각 청구는 검증됨, 이의 제기됨, 미지원 또는 평가 불가능으로 보고됨; 미지원 문장은 거부되며 완화되지 않음 |
| 적대적 검토 | 초안자에게 적대적인 목표를 가진 비평가 모델 | 의례적 비평, 또는 중대한 불일치를 숨기는 합성 합의 | 구조화된 의견 불일치 보고 — 증거 상태, 평가자 패턴, 결정 민감도 (분쟁이 진단을 변경하거나 단지 표현만 변경함), 잔존 불확실성 — 병합되지 않은 상태로 제공되며 하나의 신뢰도 숫자로 붕괴되지 않음 |
| 요청 트리아주 | 표 14–15의 코딩 프레임에 대한 전문 분류기 | 증거를 초과하고 평판 해를 위험에 빠뜨리는 범주형 "포식적" 판정 | 플래그 및 검토만, 자동 삭제 안 함, 공개된 고발도 안 함; 레이블이 지정된 세트에 대해 오류율 보고됨; AI 텍스트 분류의 문서화된 한계 및 편향이 인정됨 [157][97] |
| 벤치마크 유지 관리 | 모든 구성 요소의 예약된 오케스트레이션 | 무음 드리프트: 오래된 출처 또는 흔적 없이 덮어써진 릴리스 | 부록 D의 버전 관리되고 날짜가 지정된 릴리스; 개정 사항이 로깅되며 무음으로 덮어써지지 않음 — 정적 스냅샷이 아닌 살아있는 벤치마크 맵 |
| 최종 해석 및 모든 경력 사용 | 인간 저자 | 자동화 편향 및 책임 확산 | 외부 사용 전에 의무적 인간 승인; 도시에어 언어는 표 13 프로토콜을 따르며, 출처, 시간 범위 및 제한 사항이 첨부됨 |
두 경계가 사양을 완성합니다. 하나는 권한 경계입니다: 읽기 전용 액세스가 기본값이며, 계층은 초안을 작성하지만 실행하지 않습니다. 자동으로 원고를 편집하거나, 플랫폼 메타데이터를 변경하거나, 학자 또는 심사 장소에 연락하거나, 공개적으로 게시하거나, 요청 메시지를 삭제할 수 없으며, 구현된 모든 워크플로는 해당 플랫폼 및 제출 정책의 인간 책임 및 공개 의무를 보존해야 합니다 [54][56][144]. 다른 하나는 기권 경계입니다: 널 출력은 정당한 (종종 올바른) 결과이며, 모든 단계는 결함이 있는 입력을 앞으로 전달하는 대신 중단할 수 있습니다. 필수 기권 트리거에는 누락되었거나 방어할 수 없는 참고 범주; 해석에 중요한 검증 불가능한 출처; 제안된 표현이 논문의 청구를 보존하는지 여부에 대한 미해결 불일치; 순수하게 기술적인 패턴으로부터의 인과 결론에 대한 모든 요청 또는 검증된 예측 데이터 세트 없이 인용 또는 경력 결과의 예측 (8.9절); 주의력을 조작, 구매, 시뮬레이션 또는 기타 방식으로 부풀릴 수 있는 모든 요청이 포함됩니다. 마지막 트리거는 계층이 3절이 문서화하는 역사를 가진 메트릭 게이밍 도구가 되지 않도록 합니다 [44][69][144]. 마지막 분리는 의제의 두 증거 흐름을 관리합니다. 8.6절 및 8.8절의 버전 관리되는 백분위수 표는 계층의 유일한 허용 정규화 출처이며, 연구 2의 머신 가시성 감사는 별개의 검색 및 속성 검사에 피드합니다. 머신 검색은 인간 주의의 백분위수가 아니며, 계층은 둘을 혼합할 수 없습니다.
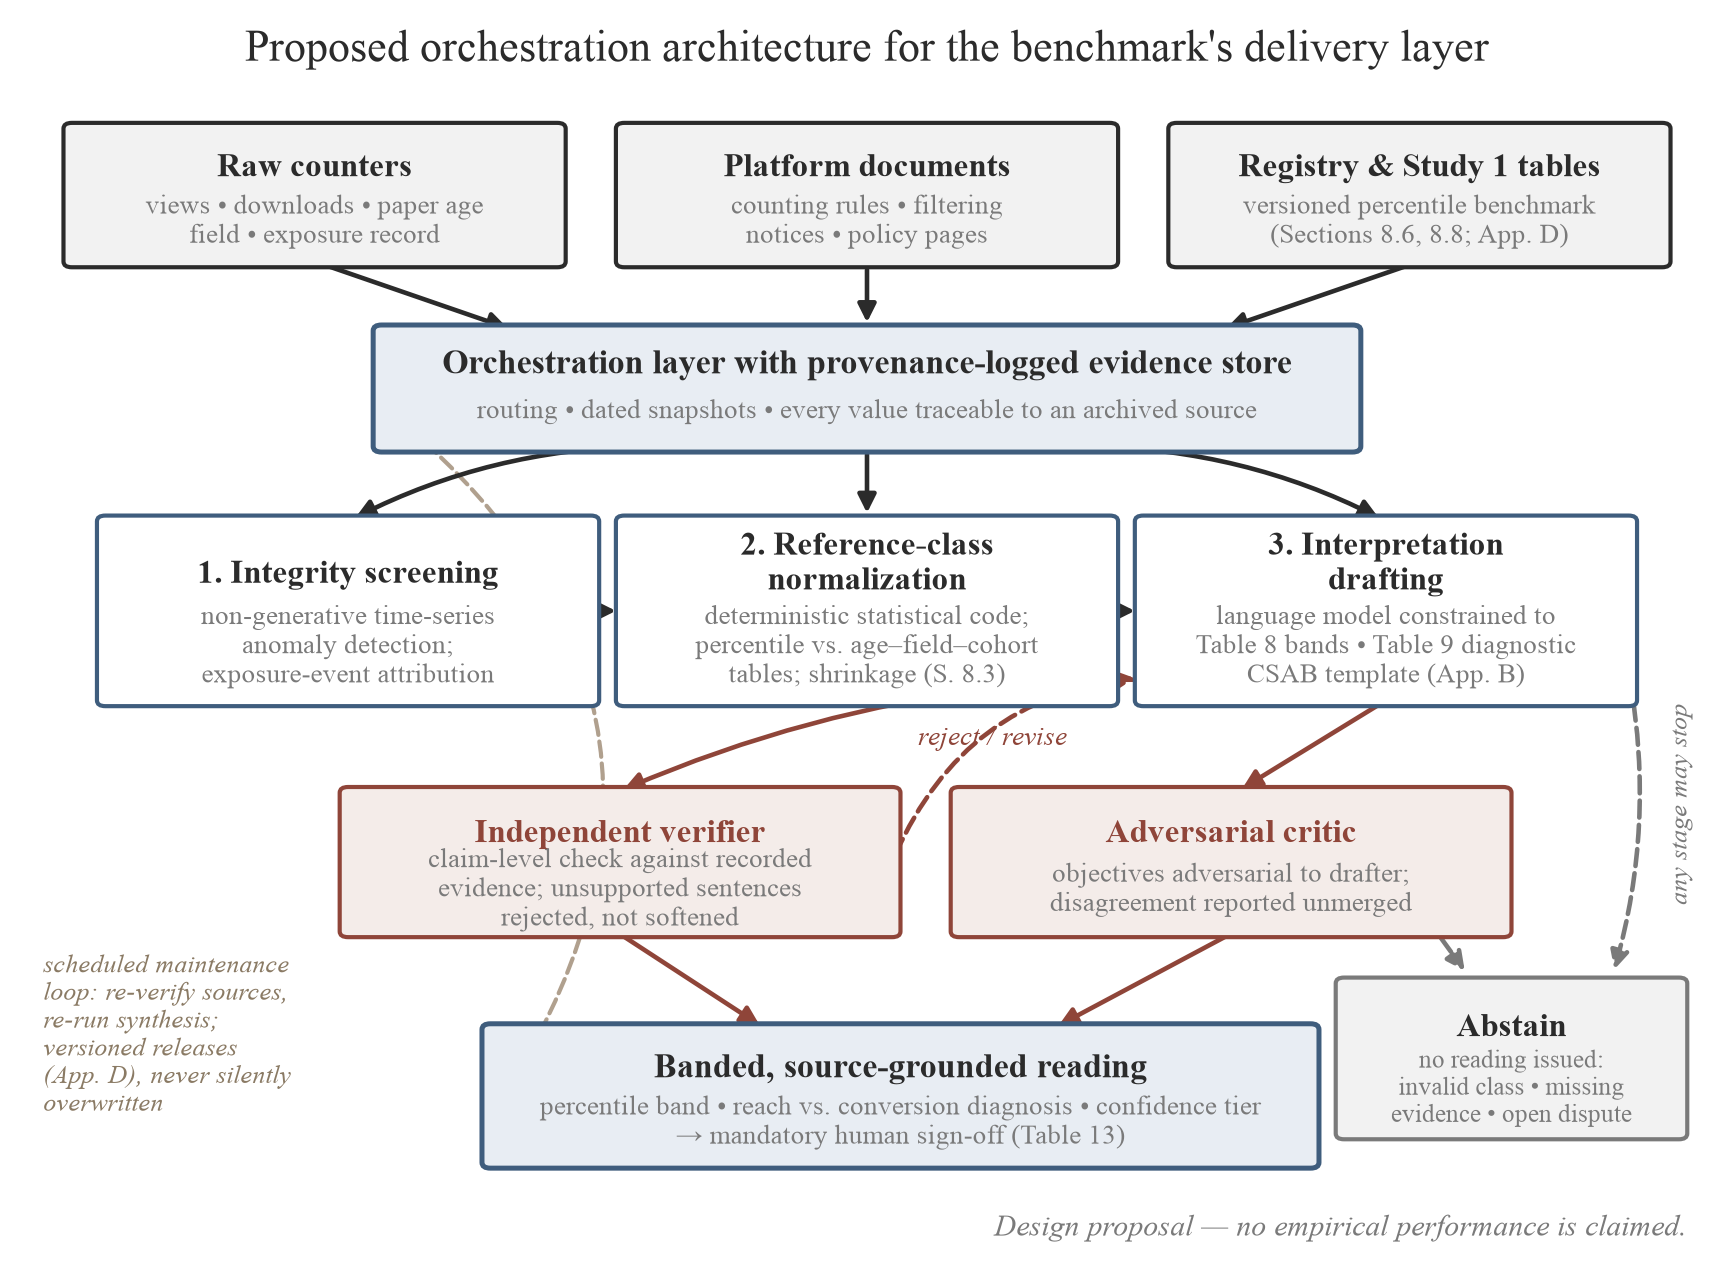
그림 16. 벤치마크의 전달 계층을 위한 제안된 오케스트레이션 아키텍처 (8.10절; 표 21). 특화된 구성 요소는 증거 수집, 무결성 검사, 정규화 및 해석을 분리하며, 생성과 릴리스 사이에 독립적 검증이 삽입되고, 모든 단계에서 기권 경로를 사용할 수 있으며, 예약된 루프가 8.8절의 버전 관리되는 벤치마크를 유지합니다.
같은 학문 분야가 진단을 받은 후 계층이 할 수 있는 일을 제한합니다. 표 22는 행동 정책을 정합니다: 각 관찰된 패턴(도달과 전환을 모멘텀과 함께 읽음, 표 9–10의 어휘로)은 잠정적 진단, 허용 가능한 지원의 제한된 형태, 진단을 뒷받침하거나 약화시킬 수 있는 메커니즘 검사, 그리고 금지된 추론 또는 행동으로 매핑됩니다. 메커니즘 검사 열은 위에서 언급한 규칙을 구체화합니다. 즉, 공개된 권장사항은 가설입니다. 분류 수정이 도달 병목을 제거하려는 것이라면, 계산되는 결과는 나이 조정 도달이며, 총 다운로드에 대한 회고적 설명이 이를 대체할 수 없습니다. 실패한 예측은 실패한 개입으로 기록되어 진단으로 반환되며, 더 유리한 성공 측도에 대해 재점수되지 않습니다. 전체 시퀀스는 따라서 루프로 닫힙니다: 측정 → 검증 → 정규화 → 진단 → 제안 → 비판 및 검증 → 결정 → 관찰 → 업데이트 또는 중단 (그림 17). 그 루프 내에서 인간의 결정은 검증과 모든 행동 사이에 있고, 사후 결정 관찰은 사건 파일로 반환되며, 증거가 부족할 때마다 기권 경로가 주기를 종료합니다. 루프는 복잡성도 제어합니다: 증거가 보존과 모니터링만 지원할 때, 또는 저자 플레이북(섹션 6)의 결정론적 규칙이 이미 질문에 답할 때, 오케스트레이션은 아무것도 추가하지 않으며 실행되지 않아야 합니다.
표 22. 제안된 오케스트레이션 계층의 진단-행동 정책. 패턴은 표 9의 백분위수 규칙에 따라 방어 가능한 참고 클래스 내에서 읽혀집니다; 모든 행은 정책 가설이며, 어떤 셀도 경험적 빈도를 주장하지 않습니다.
| 관찰된 패턴(도달, 전환, 모멘텀) | 잠정적 진단 | 허용 가능한 지원 | 메커니즘 검사 | 금지된 추론 또는 행동 |
|---|---|---|---|---|
| 낮은 도달, 높은 전환, 안정적 또는 상승 | 발견 가능성 병목은 원고 채택 병목보다 패턴과 더 일치합니다("숨겨진 관심", 표 9) | 식별자, 분류, 메타데이터, 인덱싱 및 제목 발견 가능성을 감사; 제한적이고 진정으로 관련된 배포 | 메타데이터 또는 분류 변경 후, 도달이 상승하고 전환이 유지됩니까? | 잘 전환되는 초록을 단순히 더 홍보적으로 만들기 위해 다시 쓰기 |
| 높은 도달, 낮은 전환, 안정적 또는 하락 | 소통 불일치, 청중 불일치, 저의도 노출이 경합하는 설명입니다("주의 없는 채택") | 제목–초록 정렬, 범위 명확성 및 청중 적합성을 검사; 주장 보존 대안만 | 비교 가능한 노출 하에서 전환이 변하고, 모든 수정에 충실도 검사가 있습니까? | 무분별한 홍보 증가; 독자들이 과학을 거부했다고 결론짓기 |
| 낮은 도달, 낮은 전환 | 미식별: 약한 노출, 잘못된 참고 클래스, 메타데이터 실패, 소통 마찰, 또는 틈새 수요 모두 적합합니다("콜드 스타트") | 먼저 참고 클래스와 노출 기록을 검증; 그런 다음 메타데이터와 소통을 별도로 감사 | 한 번에 하나의 측정 가능한 메커니즘만 변경; 영가설 결과 보존 | 낮은 사용량에서 낮은 품질 추론; 단일 원인 판정 반환 |
| 높은 도달, 높은 전환, 상승 | 명시된 클래스에 대한 강한 초기 확산 | 출처 보존; 고정된 나이에서 모니터링; 원인 없이는 아무것도 변경하지 않음 | 패턴이 노출 이벤트 후 및 이상 민감도 하에서 지속됩니까? | 추가 증폭 제조; 주의를 품질 증거로 취급 |
| 높은 도달, 높은 전환, 급격한 증분 하락 | 이벤트 구동 주의, 일반적 감소, 또는 포화(섹션 5.6) | 노출 이벤트 식별; 누적 총계가 아닌 구간 증분 비교 | 감소가 이벤트를 조건으로 나이 매칭된 궤적과 다릅니까? | 감소하는 증분을 과학적 실패라고 부르기 — 누적 개수는 비율 용어로 거의 항상 평탄화 |
| 낮은 도달, 높은 전환, 감소하는 증분 | 조건부 관심이 실제일 수 있는 반면 계속되는 노출은 약합니다 | 배포 또는 인덱싱이 종료되었는지 감사; 제한적이고 관련된 채널 식별 | 복원된 노출이 전환을 저하시키지 않으면서 도달을 높입니까? | 더 넓은 청중을 쫓기 위해 주장을 확대하거나 기술적 세부 사항 제거 |
| 높은 도달, 낮은 전환, 상승하는 노출 | 도착이 증가하지만 전체 텍스트 채택이 비례적으로 증가하지 않습니다 | 저의도 트래픽(섹션 4.2), 청중 불일치 및 표현 명확성 검사 | 비교 가능한 노출에서 주장 충실 표현 변경에 전환이 응하합니까? | 깔때기 상단만 최적화; 모든 조회를 인간 읽기로 계산 |
| 재작성된 카운터, 설명되지 않은 스파이크, 유효하지 않은 코호트 또는 누락된 분모가 있는 모든 패턴 | 메트릭은 현재 원하는 수준에서 해석 가능하지 않습니다 | 스냅샷 보존; 민감도 분석 실행; 주장 축소; 기권 | 이의가 제기된 구간 제외 또는 더 나은 참고 클래스의 읽기가 생존합니까? | 증거 없이 트래픽을 인간 또는 자동화로 표시; 제조된 분모에서 백분위수 방출 |
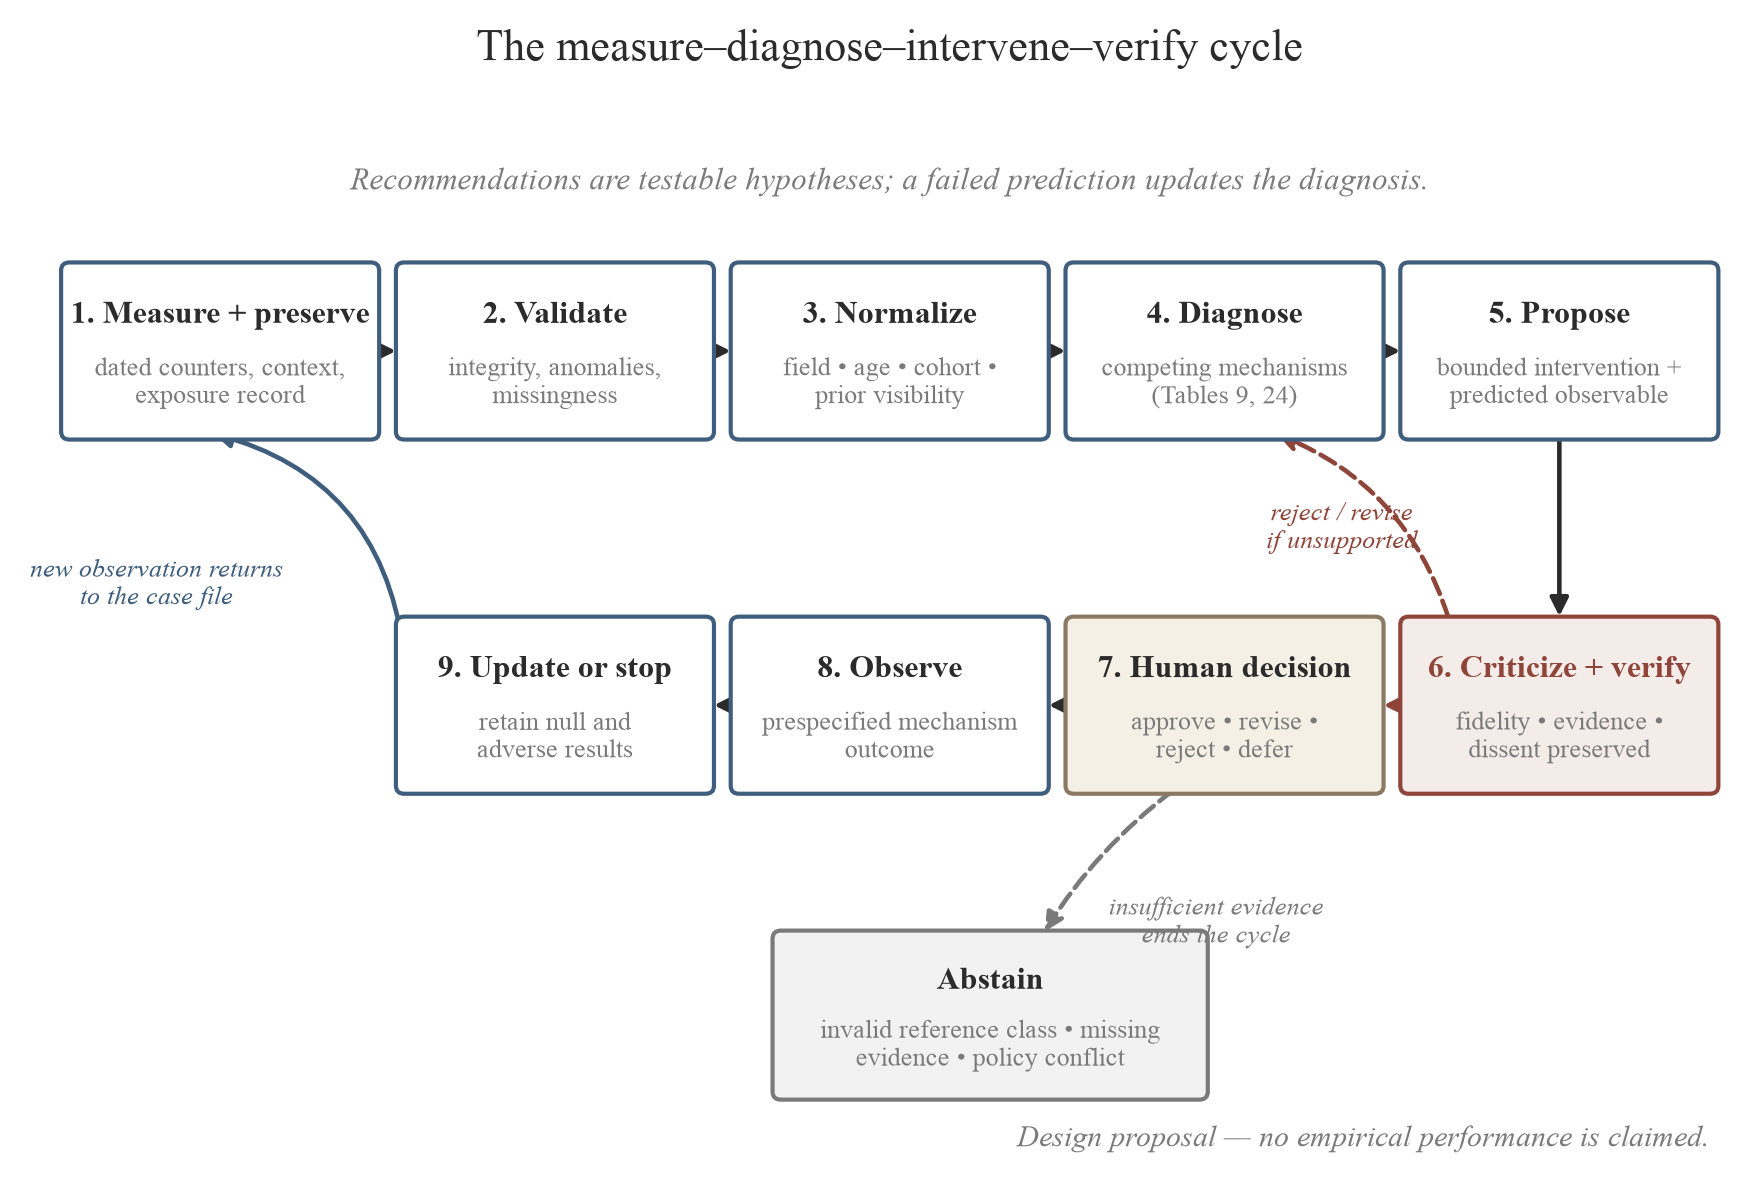
그림 17. 측정–진단–개입–검증 주기(섹션 8.10; 표 22). 권장사항은 검증 가능한 가설로만 루프를 떠납니다: 각각은 이동하려는 메커니즘과 진단을 뒷받침하거나 약화시킬 수 있는 후속 관찰을 명명합니다. 실패한 예측은 진단으로 반환되어 감사 기록에 남고; 인간의 결정은 검증과 모든 행동 사이에 있으며; 기권 경로는 방어 가능한 참고 클래스나 충분한 증거가 존재하지 않을 때마다 주기를 종료합니다. 주기는 원시 주의가 아닌 증거 보존 해석을 최적화합니다.
네 가지 제한이 제안을 제약합니다. 생성은 복구가 아닙니다. 아무리 조율된 모델이라도, 상위 목록이 제거되었을 때 관찰 불가능하게 된 백분위수 분포를 재생성할 수 없으며[149], 계층은 제5절의 보수적 하한 주의사항을 유지하면서 근사치만 유지할 수 있습니다. 또한 조율이 다운로더를 식별하거나, 카운터만으로 자동화된 트래픽에서 인간 트래픽을 구별하거나(제4.2절), 청탁 규모를 읽음성의 증거로 전환하거나(제7.6절), 상관관계 있는 모델 출력을 "에이전트"로 재명명하여 독립적으로 만들거나, 동료 판단을 대체하거나, 연구자로부터 워크플로우로 책임을 이전할 수 없습니다. 조율기 자체도 감시자가 필요합니다. 배포된 해석 계층은 본 논문이 지도한 스택에서 새로운 게이트키퍼가 되며(그림 12), 자신을 수리하기 위해 구축된 불투명성을 상속받아서는 안 됩니다: 추론 흔적과 출처 로그는 검사에 개방되어야 하며, 계층의 자체 검색 및 해석 동작은 모델 비정상성이 모든 출력을 지속적 값이 아닌 시간적 추정치로 만들기 때문에 제2 연구의 규율(타임스탬프 스냅샷 및 스크립트된 복제 프로토콜)로 감시되어야 합니다. 비용과 형평성. 이러한 파이프라인을 운영하는 것은 무료가 아니며, 유료 해석 계층은 본 틀이 중심으로 하는 저자원 및 비제휴 저자들을 배제할 것입니다. AI 텍스트 분류기의 비모국어 영어 사용자에 대한 알려진 편향[97]은 완화되지 않으면 동일하게 할 것입니다. 거짓 정확도가 잔존 위험입니다. 신뢰 계층 없이 띠형 평결을 내보내는 계층은 제3절에서 진단한 정확히 그 오보정을 자동화할 것입니다: 비교 척도 없는 계수가 불확실성이 붙지 않은 평결로 대체됩니다. 아키텍처 자체는 거짓 가능한 객체이며 그 조건에서 의제에 속하며, 더 단순한 지원에 대항하여 평가되고 도표의 정교함에서 추론되지 않습니다. 적절한 설계는 등급이 지정됩니다. 심어진 모호성(무효 인용, 반박 재진술, 방어 불가능한 집단, 진정한 경계선 청탁)이 있는 현실적 사례 패킷은 한 번에 하나씩 성분을 추가하는 조건에 걸쳐 무작위화됩니다: 본 논문의 표의 수동 프로토콜(비AI 방법이 이미 존재하므로 올바른 기준선), 단일 일반주의 모델, 동일 모델과 검색 및 결정론적 계산, 생성 더하기 독립적 비평, 및 완전히 관리된 파이프라인. 검증자, 결정론적 계산기, 불일치 가시성, 또는 인간 게이트를 제거하는 제거는 어느 관리 성분이 비용을 정당화하는지를 격리합니다. 결과는 따로따로 채점되며, 결코 하나의 복합으로 아닙니다: 주장 및 인용 신뢰성; 참조 등급 타당성; 저자 신념의 보정(제4 연구의 도구) 및 모호한 경우에 적절한 기권; 연구자 시간 및 감시 부담; 관리 실패(자율적 외부 조치, 메트릭 게이밍 조언, 범주적 장소 고발); 및 본 논문의 냉출발 논증에 중심적으로, 이전 저자 가시성 및 신참 지위에 따른 편익의 이질성, 계층이 주로 이미 가시적인 저자를 도와준다면 자신을 감소시키기 위해 설계된 부등식을 재현할 것이기 때문입니다. 무효 및 역효과 형평성 결과는 보고 가능한 발견입니다. 모델 버전, 프롬프트, 도구 권한, 및 원본 스냅샷은 보관됩니다, 비정상성 시스템에서 모든 결과는 시간적 추정치이기 때문입니다. 두 추정량은 전체적으로 별도로 유지됩니다: 해석 품질에 대한 효과 및 후속 확산에 대한 효과. 진단을 개선하면서 다운로드를 이동하지 않는 계층은 성공이며, 다운로드를 증가시키면서 주장을 왜곡하는 것은 관리 실패입니다. 관리된 파이프라인이 증거 정확도 및 보정에서 강력한 단일 모델을 능가하지 않으면 설계는 실패합니다: "여러 모델"은 기여가 아니며, 검증되는 가설은 인식론적 노동의 분할입니다. 제안은 AI 보조 해석에 대한 검증 가능한 역할을 명시합니다. AI는 저자가 숫자에 대해 더 나은 질문을 하도록 도울 수 있습니다; 검증된 증거만이 이를 답할 수 있습니다.
9. 제한사항
본 논문의 주장은 아래의 제한사항으로 제한되며, 각각은 자신을 제약하는 산물에 연결됩니다.
증거 기반의 노화 및 구성. 벤치마크 지도의 더 오래된 분포 앵커(표 7)는 2012년에서 2015년 사이에 수집된 표본에 기초하며 법률 학문이 지배적입니다[85][139]; 유일한 최근 항목은 아래에서 논의된 단일 네트워크 스냅샷입니다[83]. 해석 척도의 띠(표 8)는 2026년의 엄격한보다는 관대한 절대 띠로 최상으로 읽혀야 합니다(제5.1절). 플랫폼 전체 연간 다운로드 규모는 중반 2010년대와 2020년대 사이에 몇 배 증가했습니다[1][143], 다운로드당 페이퍼 흐름을 증가시키고 고정된 오래된 임계값을 추정될 때보다 오늘날 더 부드러운 바로 만듭니다. 성장이 분자, 분모, 및 구성을 동시에 변경하기 때문에 어떤 곱셈 교정도 이를 수리할 수 없습니다(제3.2절). 표 8의 띠는 재정규화된 규범보다는 집계 산술에서 파생된 근사치입니다. 2020년 이후 SSRN 다운로드의 플랫폼 전체 분포 연구가 식별되지 않았습니다.
단일 출처 현대 증거. 여기서 사용된 유일한 최근 분포 증거는 한 분야 네트워크의 단일 발표 스냅샷입니다: 2025년 8월 15일에 관찰된 2,361개 마케팅 논문[83]. 이는 왜곡 및 조건부 명성 프리미엄을 입증하지만, 플랫폼 전체 벤치마크를 확립하지는 않으며, 발행된 표의 두 내부 값은 주의 사항 노트와 함께 "발표된 대로" 재현됩니다. 이 출처로부터 다른 SSRN 네트워크로의 일반화는 추외삽입입니다. 부록 E는 독립적인 전 분야 기록 횡단면(n = 1,360)을 추가함으로써 이 의존성을 감소시키며, 왜곡, 평균-중앙값 격차, 변환 띠, 분야 승수, 및 관찰된 본체에서 로그정상성을 재현합니다. 자체 상향 선택 편향을 수행하며 분야 전체에 걸쳐 분포 형태를 확인합니다. 제8절의 의제는 여전히 플랫폼 대표 벤치마크를 목표로 합니다.
상위 목록 편향. 2015년 대표본 적합은 상위 목록(대략 저자와 그들의 논문의 상위 십분위[85])만을 포함하므로, 정예 목록 아래의 분포 본체는 관찰된 것이 아닌 적합된 로그정상분포에서 추론됩니다. 그 적합에서 파생된 백분위수 진술은 모델 기반입니다.
카운터 의미론이 불안정합니다. 조회 및 다운로드 기록이 시간에 따라 변했으며 인터페이스 재설계와 진화하는 봇 필터링으로 계속 변할 것입니다. 플랫폼의 무결성 시스템은 일부 의심스러운 활동을 공식 집계에서 제외하며 [144][66][69], 인접한 RePEc/LogEc 인프라는 로봇 트래픽의 역사적 규모와 압도적 다수의 원본 트래픽을 폐기하도록 요구한 최근 AI 크롤러 파동을 모두 문서화합니다 [99][129]. 따라서 5절에 인용된 변환 규범은 빈티지별 수량이며, 연간 카운터 비교는 행동 및 필터링 변화를 혼동합니다. 일반 웹봇 통계 [158]는 어느 방향으로든 SSRN의 필터링된 카운터로 외삽할 수 없습니다.
플랫폼 변동성과 출처 이동. Rankings 폐기는 더 넓은 2026년 제품 구조 조정에 내장되어 있으므로 [146][149][150], 어떤 분석도 2026년 7월 15일을 독립적인 개입으로 취급해서는 안 됩니다. 이 위협은 8.5절의 설계에 내장되어 있지만 완전히 제거할 수는 없습니다. 플랫폼 지원 페이지는 공지 없이 수정되며, 이러한 모든 페이지는 여기에 접근 날짜와 함께 인용되며, 공식 제출 전에 인용된 플랫폼 언어는 보관된 사본에 대해 재검증해야 합니다.
백분위수 데이터 없음. 완전한 플랫폼 백분위수 데이터는 존재한 적이 없으며, 2026년 7월 15일 이후 이전에 상위 목록 임계값을 공개한 순위가 제거되었으므로 [149], 플랫폼 대표적인 백분위수 프레임을 외부에서 수집할 수 없습니다. 표본 기반 참조 분포는 여전히 보관된 캡처로 조립할 수 있으며, 부록 E는 하나를 보고합니다. 분포의 형태를 고정하며 플랫폼 백분위수를 제공하지 않습니다. 관심 있는 일부 수량(예를 들어, "상위 10%" 저자 알림 이메일의 운명 [161])은 공식적으로 미문서화되어 있으며, 우리는 공식 프레임에서의 소실을 주목하되 종료를 단언하지 않습니다.
사용은 독서가 아니며, 둘 다 품질이 아닙니다. 다운로드는 신중한 독서, 표면적 검토, 보관 저장소, 또는 전혀 사용하지 않을 수 있습니다. 다운로드는 연구 품질의 직접적인 지표가 아니며 인용의 보장된 인과 출처가 아닙니다. 다운로드-인용 연관성은 긍정적이지만 이질적입니다(분야, 집계 수준, 시간 범위에 따라 대략 0.1~0.6) [18][25][39][80][102][108] 그리고 높은 다운로드와 높은 인용 모집단은 부분적으로만 겹칩니다 [108]. 인용 자체는 긍정적, 부정적, 형식적, 또는 전략적일 수 있으며, 인용 과정은 신규 작업에 대해 체계적으로 편향되어 있습니다 [166]. 이 기사의 어떤 내용도 전문가 판단의 메트릭 대체를 허용하지 않습니다. 프레임워크의 방어 가능한 사용은 진단적이고 설명적입니다.
관찰 불가능한 노출 및 무작위가 아닌 명성. 모든 노출이 관찰 가능한 것은 아닙니다. 독자들은 이메일, 소셜 미디어, 검색 결과, 서신에서 제목을 접하기 전에 추상 페이지 조회가 기록됩니다. 네트워크가 잘 연결된 저자는 명성 및 품질 모두와 상관관계가 있는 플랫폼 외 노출을 생성합니다. 따라서 관찰 명성 계수는 상태 기반 주의와 리소스, 주제 및 네트워크의 진정한 차이를 혼합합니다 [111][140]. 저자 정체성 신호의 실험적 조작 [154][64]은 플랫폼 관찰을 보완하지만 대체하지 않습니다. 분야 분류는 부분적으로 저자가 선택하며, 논문은 여러 범주에 속하여 단일 분야 할당을 복잡하게 합니다.
의제 자체의 한계. 8.4–8.5절의 준실험 설계는 발표 효과, 동시 플랫폼 변화, 무작위가 아닌 분야 차이에 직면합니다. 플랫폼 전체 이벤트가 처리되지 않은 대조군을 제공하지 않기 때문에 준실험으로 표시됩니다. 연구 2의 스냅샷은 감사하는 엔진으로 나이가 들 것이며, 복제 프로토콜은 비정상성을 완화하지만 제거하지는 않습니다. 연구 3은 값이 메커니즘과 프로토콜이지 모집단 추정이 아닌 N = 2 사례 연구이며, 그 귀인 논리는 공개 이메일 가시성에 대한 어떤 주장이 아니라 채널별 별칭에 따라 달라집니다. 크라우드소싱 레지스트리는 8.8절에 명시된 자체 선택 및 검증 문제를 상속합니다. 모든 설계에 대한 데이터 액세스는 플랫폼 협력 또는 서비스 약관 범위 내의 속도 제한 수집에 달려 있습니다 [134][51]. 둘 다 보장되지 않습니다.
참고문헌의 폭. 이 기사가 종합이기 때문에 참고문헌이 광범위합니다. 인용된 많은 연구는 프레임, 분야 및 설계 한계를 공유하며, 커뮤니티 게시물은 모집단 매개변수를 설정하지 않고 경험을 문서화합니다. 주장의 증거는 그 뒤의 참고문헌 수가 아니라 검증 계층과 표본 프레임입니다.
대역은 보정 목표이지, 상수가 아닙니다. 11–19% 변환 대역과 CSAB 임계값은 학문적 행동의 보편적 상수가 아니라 분야 및 플랫폼별로 보정되어야 하는 수량입니다(4.4절, 5.2절). 현재 형태는 단일 교차 분야 대역이며, 분야 계층화 연구 1(8.6절)이 보고할 때 프레임워크가 요구하는 분야별 분포로 대체됩니다.
SSRN을 넘어 일반화하려면 이식이 아니라 재보정이 필요합니다. 여기에서 진단된 해석 가능성 문제(공개 비교 척도 없이 표시된 사용 카운터)와 이를 수리하는 도달 대 변환 논리는 SSRN에만 국한되지 않으며, bioRxiv, medRxiv, arXiv, OSF Preprints 등 사용 카운트를 표시하는 모든 사전 인쇄 서버에 적용됩니다 [11][62][2][24]. 이전하지 않는 것은 특정 11–19% 대역 또는 CSAB 임계값입니다. 선정, 배포 아키텍처, 인터페이스는 서버 전체에서 다릅니다. arXiv의 의도 기반 풀 트래픽과 이메일 공지 목록 대 SSRN의 선정된 푸시 경고(표 6). 따라서 해당 플랫폼에서 인용되기 전에 숫자 앵커를 각 플랫폼에서 재추정해야 합니다. 프레임워크는 이식 가능합니다. 보정은 지역적입니다. 8.8절의 평행 입금 프로토콜은 SSRN 대역이 얼마나 멀리 이동하는지에 대한 직접 경험적 검사입니다. 해당 재보정의 규모는 과소평가하기 쉽습니다. bioRxiv의 전체 말뭉치 중앙값 다운로드(약 279이며, 게노믹스에서 대략 496 [2])는 부록 E의 보관 교차 섹션 중앙값인 60의 여러 배입니다. 대략 전체적으로 5배, 게노믹스에서 약 8배입니다. 비교는 지시적입니다. bioRxiv 수치는 전체 말뭉치 조사에서 나오는 반면, 60은 캡처된 페이지를 과대 대표하고, 나이와 구성이 나이에 따라 이동하는 분야를 혼합하고, 나이를 전체 년도로 해결하는 보관 표본에서 나옵니다. 갭의 방향은 안전하게 읽을 수 있습니다. 크기는 아닙니다.
윤리. 본 논문의 커뮤니티-담론 가닥은 수요의 증거로만 사용되며 대표적 감정으로는 절대 사용하지 않는 자발적으로 선택된 공개 게시물로 구성되어 있으며, 실시간으로 검증 가능한 출처가 존재하는 경우에만 인용됩니다. 사용자 게시물은 반공개 포럼 콘텐츠 인용의 윤리에 주의를 기울여 인용되며, 저자가 예상치 못한 상황에서 식별될 수 있는 경우 축어적 인용 대신 의역을 포함하고, 질적 증거에 대한 투명성 규범과 일치합니다 [6]. 연구 3은 계측된 저자에게 자발적이지 않게 전송된 메시지만 기록하며 발신자가 자발적으로 제공한 정보 외에 제3자 개인 데이터를 수집하지 않습니다. 연구 4는 정보 동의 하에서만 자발적인 익명 설문지 응답을 수집합니다. 패널 설계는 공개적으로 표시된 카운터와 서지 메타데이터를 사용하며, 비공개 대시보드 정보(예: 배포 상태 날짜)의 수집은 정보에 입각한 저자 동의가 필요하고, 해당하는 경우 기관 검토가 필요합니다. 인간 참여자와 참여자 생성 데이터를 포함하는 두 가지 연구는 연구 4(저자 설문조사)와 연구 3(수신함 기록과 함께 계측된 게시)입니다. 둘 다 인간 피험자 연구이므로, 둘 다 관련 기관 검토 위원회 또는 연구 윤리 위원회의 승인을 위해 제출되어야 하며 데이터 수집이 시작되기 전에 참여자의 정보에 입각한 동의 하에서 수행되어야 하며, 수신함 로그에 포함된 개인 데이터는 분석 또는 보고 전에 집계 및 익명 처리됩니다. 본 프로토콜은 실행의 전제 조건이며 선언문에 재현되어 있습니다.
10. 결론 및 정책 제안
10.1 분석이 확립한 내용
2026년 7월 15일 SSRN 순위의 폐지로 유일한 공개 비교 척도 [149]가 제거되었습니다. 카운터는 모든 논문과 프로필에 남았으며, 이는 의미 없는 것이 아니라 읽을 수 없는 지표를 남겼습니다. 이러한 손실에 대응하여 본 논문은 명시적인 년도와 신뢰도 주의사항이 포함된 벤치마크 맵 (표 7)으로 검증 가능한 모든 경험적 근거를 종합하고, 해석 프레임워크, 5개 등급 척도, 도달-전환 분해, 그리고 도서목록 프로토콜 (표 8, 9, 13)을 구축합니다. 이는 카운터를 진단으로 변환하고, 누락된 분포를 재구축하는 방법을 명시하는 제8절의 사전등록 준비 완료 의제를 제시합니다.
논증의 핵심에 있는 메커니즘은 다음과 같습니다:
아무도 7번의 다운로드가 의미하는 바를 알 수 없습니다. 7번의 다운로드와 무엇을 비교하는지 모르고, 2026년 7월 15일 이후 플랫폼은 더 이상 "무엇과 비교"하는지에 답하지 않기 때문입니다.
기여도는 성질이 다릅니다. 참조 등급 문제를 명명하는 것이 진단적 기여입니다: 원시 수치는 나이, 분야, 코호트, 노출이 비교 집단을 정의할 때까지 어떤 질문에도 답하지 않습니다. 도구적 기여는 벤치마크 맵과 CSAB로, 감정적으로 두드러지지만 과학적으로 모호한 수를 해석 가능한 진단으로 정규화합니다. 플레이북과 도서목록 프로토콜은 실질적 기여로, 저자와 위원회가 오늘날 카운터에 기초하여 행동할 수 있게 하며 이를 잘못 읽지 않도록 합니다. 정책 측면에서 기여는 익명화된 백분위수 등급입니다: 아무도 식별하지 않으면서 비교 맥락이 복원되고 순위표가 부활합니다.
축적된 증거를 바탕으로, 본 논문의 제목의 질문은 참조 등급이 명시될 때까지 잘못 제시된 것입니다. 모든 이용 가능한 근거에 비추어 보면, 낮은 수는 이 작업에 대한 판결이 아니라 플랫폼의 통계적 규범입니다. 초록 조회 수 40회와 다운로드 7회를 기록한 논문은 제5절의 경험적 전환 대역 [139][172][83]에 따른 스크리닝 결과와 일치하며, 더 오래된 다운로드당 3회 조회의 경험칙 [18]은 그 대역 내가 아니라 위에 있습니다. 유일한 센서스식 표본의 중앙값 논문은 2년 동안 63번의 다운로드를 축적했습니다 [139]. 대략 플랫폼의 전체 텍스트 논문 재고의 상위 1.8% (571,040, 2016년 7월 [1])인 2015년 상위 10,000 목록 진입에는 160회의 평생 다운로드가 필요했습니다 [85]. 준대수정규 주의 체제 하에서 대부분의 저자는 구조상 사다리의 낮은 단계에 서 있습니다. 중앙값 사전인쇄본은 그 저자가 볼 수 없는 로그정규 분포의 긴 꼬리에 살고 있으며, 계열화를 선호하는 분류 메커니즘에 의해 표면화됩니다. 그것은 동료에게 읽히기 전에 포식자에 의해 권유되고, 한때 그것을 위치시킨 순위를 잃었습니다. 척도는 논문을 그 사다리 어딘가에 위치시키며, 질문이 담은 고통은 수가 아니라 누락된 척도에 의해 생성됩니다.
이것은 한 플랫폼에만 특수한 것이 없으며, 이 사건은 전례가 없는 것이 아닙니다. ResearchGate는 지속된 방법론적 비판 [90] 이후 2022년 8월 비판이 많은 복합 RG 점수를 폐지했습니다 [130]. 2022-2023년에 Yale과 Harvard가 주도한 수십 개의 미국 법학교는 미국 뉴스 법학교 순위에서 철수했습니다 [13]. 논쟁적인 척도를 폐지하는 것은 장식적인 행위가 아닙니다. 왜냐하면 척도는 결코 수동적인 설명이 아니었기 때문입니다: 법학교 순위에서 비롯된 반응성 문헌은 공개 순위가 순위가 매겨진 사람들의 행동을 재형성함을 보여줍니다 [58][132]. 따라서 그 부과와 폐지 모두 단지 보고되는 내용이 변경되는 것이 아니라 행동을 변경합니다. 카운터와 그 비교 틀은 함께 지표이며, 카운터를 유지하면서 틀을 폐지하면 모든 사용자가 그것을 읽을 것이 없는 수를 들고 있게 됩니다. 해석 가능성, 공개 카운터에 대한 공개 분포의 이용 가능성은 타당성 및 신뢰도와 함께 모든 지표의 1급 품질 차원으로 취급되어야 합니다. 지표는 해석적 기반을 능가하며, 맥락 없는 지표는 소음이며, 맥락에서 벗어난 수의 회의적 읽기의 일반 규율의 사례입니다 [15]. 같은 지표 맥락과 함께는 저자에게 권한을 부여하고, 학술 소통을 개선하며, 그것을 표시하는 저장소에 대한 신뢰를 유지하는 교정입니다.
프레임워크는 사용자에게 몇 가지 평범한 습관을 요구합니다. 유사한 것과 비교하고, 도달을 전환과 분리하십시오. 궤적을 읽고 총합이 아니라, 모든 수를 날짜가 있는 것으로 취급하고, 카운트가 그 출처, 기간 및 제한 없이 이동하지 않도록 하십시오.
10.2 저자를 위한 권장사항
저자는 새로운 데이터를 기다리지 않고 지금 바로 조치를 취할 수 있습니다. 논문 수준의 카운터에 대한 날짜가 있는 스크린샷을 촬영하여 맥락을 보존하십시오. 일몰 이후에는 저자의 통제 하에 남아 있는 유일한 기록이며, Section 8.8의 커뮤니티 레지스트리를 제공합니다. Table 13의 파일 프로토콜을 따르면서 모든 숫자가 그 출처, 시간 창, 제한사항을 포함하도록 하여 프레임(나이, 분야, 코호트, 출처)과 함께 카운트만 보고하십시오. 대시보드를 감정적이 아닌 진단적으로 읽으십시오. 도달률과 전환을 분리하고(Table 9), 첫 주의 영다운로드를 정상적인 배포 전 행동으로 취급하며[53], 보이는 꼬리가 아닌 같은 달에 게시된 동료의 논문 3~5개를 기준으로 벤치마크하십시오. 보이는 꼬리의 순환 마일스톤 숫자는 heavy-tailed regime에서 보정 오류를 보장합니다[85][180]. 청탁 이메일을 인정이나 카운터에 대한 증거가 아닌 스크래핑 현상으로 취급하십시오[61][107][144].
10.3 평가자를 위한 권장사항
SSRN 다운로드를 평가 지표로 도입한 기관들[12][18][161][52]은 이 지표의 공개 규모가 사라진 현재 거버넌스 문제에 직면해 있습니다. 원시 다운로드 수는 채용, 승진, 재임용 파일에 포함되어서는 안 됩니다. 이는 정확히 중요한 임계값에서 조작되고[44], 단일 네트워크 내 분야별로 최대 8배까지 변동하며[168], 현재는 벤치마크가 불투명합니다. 최소한 방어 가능한 단위는 정의된 집단(같은 분야, 같은 연령대, 같은 게시 기간) 내에서의 백분위수이며, 출처와 시점을 동반해야 하고, 사용 증거는 인용, 동료 평가, 실질적 판단을 보완해야 하지 결코 대체해서는 안 됩니다[108][109][110]. 확립된 연구 평가 개혁 합의는 이 원칙에 기초합니다. DORA의 핵심 지침은 연구 자체를 평가하는 대신 단일 숫자나 학술지 프록시를 사용하지 말 것이며[8], Leiden Manifesto는 정량적 평가가 정성적 전문가 판단을 보완할 뿐 대체하지 않아야 한다고 주장합니다[78]. Metric Tide 검토는 이 주장을 강화하며, 지표가 견고하고, 겸손하고, 투명하고, 다양하고, 성찰적이어야 하며 전문가 평가를 보완하지 결코 대체하지 않는 형태로 사용되어야 함을 요구합니다[173]. 보다 최근의 CoARA 연구 평가 개혁 협약도 마찬가지이며, 수백 개의 서명 기관들은 책임 있는 정량적 사용에 의해 보완되지만 결코 대체되지 않는 정성적 평가에 헌신합니다[183]. 공개 규모가 제거된 다운로드 카운터에는 이 전체 합의가 완전한 힘으로 적용됩니다. Metric Tide의 5가지 차원 중 2가지가 여기서 제안된 방법과 직접적으로 관련이 있습니다. 다양성은 이 논문이 주장하는 분야 정규화이고, 성찰성은 논문이 자신의 관심을 측정하는 섹션 8.7의 입장입니다. 검토의 REF를 고려한 후속 작업은 같은 5가지 원칙을 현재 영국 관행에 적용합니다[184]. 이 합의 자체는 제도적 삶에서의 광범위한 메트릭 과용에 대한 비판의 한 표현입니다[113]. 평가 위원회는 폐지된 "상위 10%" 순위 언어 대신 표 13의 프로토콜 형식(영국의 연구혁신이력서(R4RI) 같은 새로운 평가 형식이 전달하도록 설계된 맥락화된 서술형 증거)을 예상하고 수용해야 합니다[186]. 미국에서는 같은 서류 언어 활용 수단이 고등교육 개방장학금 지도력 이니셔티브(HELIOS Open)의 초점이며, 이는 대학과 함께 승진 및 재임용 기준을 다시 작성합니다[189]. 여기서 명시된 맥락화된 사용 라인은 정확히 그러한 개혁이 종종 결여한 구체적인 평가 기준입니다.
10.4 플랫폼을 위한 권장사항
순위를 대체 맥락 없이 폐지하는 것은 결함 있는 신호 하나를 신호 없음으로 맞바꾸는 것입니다. 그 결과는 저자의 편안함을 넘어 뻗어 있습니다. 일몰이 새로운 투고를 위축시키는지 여부, 즉 8.5절에서 명시한 게시 량 결과는 플랫폼 자체의 건강성에 관한 미해결의 실증적 질문입니다. 이 프레임워크는 SSRN이 폐지하기로 선택한 리그 테이블 장치를 재현하지 않는 구체적인 제품 방향을 암시합니다 [149]:
1. 학문 분야 및 논문 연식별 익명화된 백분위 대역. 각 논문의 다운로드 및 조회 순위를 학문 분야별-연식별 코호트 내 대략적인 백분위 대역으로 표시합니다. 모든 저자가 필요로 하는 정보를, 누구도 식별하지 않고 리더보드를 만들지 않으며 상위 N개 목록의 우승자독식 역학을 줄이는 형태로 게시합니다. 백분위 맥락은 프라이버시를 보호하면서 가독성을 복원합니다. 목표 표시 형식은 정확히 그림 14의 연식별 벤치마크 팬입니다.
2. 시간 정규화된 표시. 생애 누적 수치만이 아니라 연식 일치 비교를 보여주므로, 14일된 논문이 수년간 주목을 축적한 저작과 절대 암묵적으로 비교되지 않습니다.
3. 도달범위를 전환과 분리합니다. 초록 조회와 다운로드를 별개의 신호로 비율과 함께 보고하며, 가시성 부재를 거부와 뒤섞는 단일 수치 해석을 초대하지 않습니다.
4. 투명한 참조 집단. 모든 비교 지표는 그것이 비교하는 모집단, 분야, 기간 및 연령 대역을 명시해야 하며, 레이블이 없는 "상위 X%"는 과학적으로 정보를 주지 못합니다. 부록 D는 모집단 및 코호트 정의에서 최소-셀 프라이버시 규칙 및 인용 가능한 버전 이력까지, 버전 관리된 백분위 릴리스가 가져야 할 10개의 공시 필드를 명시합니다.
5. 누적적 이점에 대한 감시 설계. 분류, 알림 배포, 검색 순위 지정 및 가시 인기도 신호는 희소한 주목을 할당하며 그들의 분배 효과에 대해 평가되어야 합니다. 8.4–8.5절의 실증적 설계는 그러한 감시에 직접 사용 가능합니다.
6. 기능 폐지 시 해석적 잔류에 대해 계획합니다. 비교 기능이 제거될 때, 해석적 손실은 데이터 마이그레이션과 같은 정도의 세심함으로 평가되고 완화되어야 하며, 이는 보관된 분포, 게시된 요약 백분위 또는 지역사회에 대한 명시적 인계를 통해 이루어져야 합니다. 읽을 수 없는 지표는 정보를 주지 못하기 때문입니다.
7. 수확 저항형 접촉 기법, 7절에 문서화된 가시성의 청탁 외부성을 줄입니다 [107][159]. 한 가지 구체적인 후보: 게시 후 대략 처음 48–72시간 동안 저자 접촉 경로의 공개 노출을 지연하거나 난독화하며, 이는 합법적인 배포가 아직 시작되지 않았지만 프로그래매틱 수확이 가장 가능성이 높은 창입니다. 그러한 어떤 조치의 효과도 가정하지 말고 실증적으로 평가되어야 합니다. 접촉 정보를 숨기는 것이 또한 직접 피드백에 의존하는 정확히 신입들을 불리하게 할 수 있으므로 상충이 실제입니다.
8. 공개 필터링 로그 및 문서화된 배포 역학. LogEc 스타일 기록을 게시하여 무결성 필터가 무엇을 폐기하는지 기록하고, eJournal 배포 및 다이제스트 선택이 어떻게 작동하는지 문서화합니다. 인접한 RePEc/LogEc 인프라는 그러한 투명성이 규모 있게 가능함을 보여주는 반면 [99][129], SSRN은 현재 그 필터의 이력을 게시하지 않고서 설명합니다 [144] (표 6). 필터링이 문서화될 때, 카운터 재계산은 평판적 사건이 아니라 측정 이벤트로 읽혀질 수 있습니다.
9. 노출 이력을 명확하게 만듭니다. 논문 페이지 또는 저자 대시보드는 공개 게시, 분류 할당, 큐레이션된 배포, 색인화 확인 및 주요 카운터 재계산을 구별하여 저자가 "아직 노출되지 않음"을 "노출되었지만 전환되지 않음"으로부터 분리할 수 있게 합니다. 이는 5.6절의 노출 체제 읽기의 플랫폼 측 대응이며, 가장 불안감을 야기하는 대시보드 상태인 초기 영(zero)에 대한 가장 저렴한 치료입니다.
10.5 연구 커뮤니티를 위한 권장사항
커뮤니티는 플랫폼을 기다릴 필요가 없습니다. 섹션 8.8의 레지스트리(공개 프로토콜에 따라 기여된 날짜별, 자체 보고된 대시보드 스냅샷)는 10년 만에 첫 번째 신규 다운로드 분포를 생성할 수 있습니다. 표 17의 두 가지 공공 데이터 연구(1과 2)는 섹션 9에 명시된 접근 제한 범위 내에서 모든 연구자가 실행할 수 있으며, 두 가지 참여자 연구(3과 4)는 자원자와 선언문에 명시된 윤리 승인이 필요합니다. 과학계량학은 메트릭 해석 가능성을 자신의 주제로 취급해야 합니다. 10년간의 카운터가 유일한 공개 척도를 능가한 현재의 사례는 마지막이 될 가능성이 낮습니다. 기구화된 게시 프로토콜의 분산형 복제, 백분위수 표의 커뮤니티 유지(및 이를 기반으로 구축된 공개 저자용 계산기, 섹션 8.8 및 8.10), 그리고 플랫폼 변경의 해석적 영향 평가는 모두 그 자체로 연구 기여이며, 이들 각각은 이 문서의 수리 작업을 예방으로 전환합니다.
10.6 마감
"내 일곱 건의 다운로드는 무엇을 의미하는가?"라는 질문이 이 글을 통해 일관되게 제기되었는데, 이는 플랫폼의 거의 200만 명의 저자들이 2026년 7월 15일에 남겨진 질문이기 때문입니다 [49][149]. 여기서 조립된 답변은 안심도 경고도 아니라 보정입니다. 이 수치는 이용 가능한 전환 증거와 일관성이 있지만 여전히 선별 결과이며, 불안감은 없는 척도에 의해 만들어집니다. 척도는 부분적으로는 문헌에서(섹션 3-6이 한 것처럼), 부분적으로는 새로운 데이터에서(섹션 8이 명시하는 것처럼) 다시 구축할 수 있습니다.
이 글은 모든 저자가 남겨진 질문으로 시작했습니다:
"내 7건의 다운로드는 무엇을 의미하는가?"
이 틀은 그것을 다음과 같이 대체합니다:
"이 논문은 같은 나이, 분야, 코호트, 배포 이력을 가진 비교 가능한 논문들 중에서 어디에 위치하는가? 그 제약은 도달인가, 아니면 전환인가? 그리고 독자들이 현재 연구를 발견하는 시스템을 통해 검색되고 인용되고 있는가?"
이것은 계량정보학이 답할 수 있는 질문이며, 이 글은 그 방법을 명시했습니다.
계수기가 기록하는 것은 사건이며, 오직 사건뿐입니다. 조회는 다운로드가 아니며; 다운로드는 읽기가 아니며; 평균은 규범이 아니며; 계수기는 판단이 아니며; 권유는 인정이 아니며; AI 검색은 충실한 저자 표시가 아니며; 척도 없는 수는 정보가 아닙니다.
플랫폼이 계수기를 그 맥락과 분리하여 표시하는 한, 저자, 평가자, 플랫폼은 계속해서 분포적 사실을 개인적 판단으로 읽을 것입니다. 개방 접근은 자신이 싸운 전투(가격 장벽 없이 게시하고 다운로드할 수 있는 권리)를 이겼고, 그렇게 함으로써 자신이 결코 싸우지 않은 전투를 노출했습니다: 주의 할당. 저자는 분야, 나이, 전환을 가지고 계수기를 읽을 수 있습니다. SSRN의 지표는 여전히 가치가 있지만, 그 의미를 이해하는 저자에게만 해당합니다.
부록 A. 상황 → 행동 가이드
표 23은 섹션 4-6을 저자들이 가장 자주 보고하는 상황으로 압축합니다 [161][127][139]. 그 중간 열은 조립된 증거가 라이선스하는 것만 기재하며, 출처와 기간을 포함합니다. 주의 사항 열은 각 읽기에 동반해야 하는 제한을 나타냅니다. 여기에 나타나는 수는 본문의 표 6-7과 그림 6의 수입니다.
표 23. 상황 → 증거가 말하는 것 → 할 일.
| # | 당신의 상황 | 증거가 말하는 것 | 할 일 | 출처 및 주의 사항 |
|---|---|---|---|---|
| 1 | "첫 달에 7건의 다운로드와 40건의 초록 조회." | 전환은 17.5%이며, 점 추정값으로 11-19%의 교차 연구 대역 내에 있습니다. 다만 7/40에 대한 95% Clopper-Pearson 구간(≈7.3-32.8%)은 넓고 대역을 포함합니다. 중앙값 LSN 논문은 2년 후에야 63건의 다운로드에 도달했으며, 중앙값 마케팅 논문은 16개월의 중앙값 나이에 87건에 머물렀습니다. 이는 성숙 표본 앵커이지, 20일 읽기에 나이별로 일치하지 않습니다. 실패의 증거가 아닌, 넓은 구간을 가진 선별 결과입니다. | 표 11 관찰 일정을 계속 진행합니다. 60-90일 이전에는 궤적을 분류하지 마세요. | 대역: [18][139][172]; 중앙값: [139](2012 LSN), [83](2025 마케팅). 모든 앵커는 단일 분야이고 오래되었습니다. 7/40 전환은 성숙 앵커에 나이별로 일치하지 않는 넓은 구간 선별 추정값입니다. |
| 2 | "1주일 동안 다운로드 없음." | 정상 배포 전 상태입니다. 분류는 큐레이팅되며 로드된 주제의 경우 최대 45일이 걸릴 수 있습니다. eJournal 알림은 초기 조회를 유도하고 일몰 후에도 계속됩니다. Google Scholar 색인화는 6-9개월 이상 걸립니다. | 공개 게시를 확인합니다. eJournal 분류를 확인합니다. 논문이 정확한 제목 아래 색인되어 있는지 확인합니다(가장 저렴한 색인 테스트). 공지 사항 주기를 기다립니다. 그 후에만 계수기를 읽습니다. | [53][147][57][55]. 지원 페이지 표현 변경; 액세스 날짜로 다시 확인합니다. |
| 3 | "많은 조회, 적은 다운로드 - 11% 이하의 전환." | 초록-본문 불일치와 일관성이 있습니다: 독자는 초록에서 도착하고 떠납니다. 패키징 변수(제목, 초록, 키워드)는 계수기와 가장 견고하게 연관된 주의 레버입니다. | 제목과 초록을 수정합니다. 추가 변경 전에 다음 기간 동안 전환을 다시 관찰합니다. | [139][168][172]. "낮은 전환 = 약한 초록"의 인과 읽기는 선별 가설이지, 검증된 진단이 아닙니다. |
| 4 | "대역을 훨씬 초과하는 전환, 또는 갑작스러운 조회 급증." | 초록 검색으로 설명할 수 없는 트래픽입니다. 미디어 또는 집계자 링크, 또는 필터가 아직 제거하지 않은 비인간 트래픽입니다. | 외부 소스를 식별합니다(보도, 메일링 리스트). 외부 검증 없이 급증을 독자층으로 인용하지 마세요. | [116][138][144][102 - Safe Links 사전 가져오기 메커니즘, SSRN 자체 필터가 이미 이러한 트래픽을 제외할 수 있다는 주의 사항 포함]. |
| 5 | "내 계수기가 떨어졌거나 수가 수정되었습니다." | 플랫폼은 필터링 규칙이 변경될 때 계수기를 수정합니다. RePEc는 문서화된 에피소드에서 원본 트래픽의 대다수를 버렸습니다(2007년 로봇 ≈74%의 조회; 2025년 9월 IDEAS 트래픽 >99.5%). | 이를 측정 이벤트로 취급합니다. 날짜 지정된 스크린샷을 확인합니다. 외부 검증 없이는 잃어버린 독자층으로 보고하지 마세요. | [144][69][99][129][66]. |
| 6 | "순위가 사라졌고 내가 어디에 위치하는지 모릅니다." | 공개 백분위 프레임이 남아 있지 않으며, 플랫폼 대표적인 프레임도 외부에서 수집할 수 없습니다. 부록 E의 보관 교차 섹션은 표본 기반 참조 분포를 제공하며, 일치하는 비교는 플랫폼 백분위의 대체물입니다. | 같은 달에 게시된 3-5개의 동료 논문의 마이크로 벤치마크를 구축하고 자체 일정에 따라 추적합니다. 선택적으로 당신의 다운로드와 일치하는 코호트 중앙값의 비율을 계산합니다. | [149][51]; 앵커 [139][83][85]. 비율에는 보정된 해석 대역이 없습니다(섹션 6.3). |
| 7 | "위원회가 내 계수를 볼 것입니다." | 조서의 순위 라인은 문서화된 관행이며, 그 비교 프레임은 사라졌습니다. 출처, 분야 한정자, 인용 삼각측량이 있는 대역 언어는 원본 계수가 하지 못하는 정밀도를 견딜 수 있습니다. | 표 13의 7단계 프로토콜을 적용합니다: 보존, 번역, 삼각측량, 분야 정규화, 보완, 무결성, 전문가 평가. | [12][95][33][52][77][108]. 다운로드는 수요를 측정하며, 품질을 측정하지 않습니다. 조작 이력 [44]은 평가자에게 알려져 있습니다. |
| 8 | "포스팅 며칠 후부터 약탈적 초대장이 도착하기 시작했습니다." | 프리프린트 플랫폼에서의 수집의 문서화된 부산물입니다. 인접한 감사에서는 학자당 2주마다 수십 개의 초대장을 보고합니다. 볼륨은 독자들의 인정이 아닌 스크래이퍼에 대한 가시성을 신호합니다. | 절대 결제하지 마세요. Cabells 및 Think. Check. Submit.를 통해 장소를 확인하세요. 전용 주소를 통해 서신을 라우팅하세요. 유형론은 표 14를 참조하세요. | [107][159][9][84][63][32][136]; [B-1] (Beall의 목록은 2017년 이후 폐지됨). 타이밍 규칙성은 측정되지 않았습니다. "포스팅 후 며칠" 화면은 정성적입니다. |
| 9 | "저널의 유사성 확인에서 제 제출 내용이 제 SSRN 프리프린트와 일치하는 것으로 표시되었습니다." | 스크리닝 시스템은 설계대로 작동하고 있습니다. Crossref Posted Content로 등록된 프리프린트는 비교 코퍼스의 일부이며, iThenticate의 지침에 따르면 동일 저자 프리프린트 일치는 표절이 아닙니다. 대부분의 저널의 사전 출판 정책에서는 워킹 페이퍼 포스팅이 허용되지만, 정책은 다양하며 대상 저널을 확인해야 합니다. 주요 예외는 의학 및 임상 분야에 있습니다. | 플래그된 출처를 담당 편집자에게 시간 기록이 있는 프리프린트로 식별하세요. 프리프린트를 철회하지 마세요. 의료 및 임상 장소의 경우, 제출 전에 대상 저널의 프리프린트 정책을 확인하세요(예: Sherpa Romeo 레지스트리를 통해). | [81][36]; 섹션 4.5. 저널 정책은 다양하며 변합니다. 일반 규칙에 의존하기보다는 대상 저널의 현재 정책을 확인하세요. |
| 10 | "랭킹이 없어졌습니다. 논문을 ResearchGate나 Academia.edu로 옮겨야 할까요?" | 서비스 종료 후 저자 마이그레이션은 문서화되지 않았습니다. 다운로드 카운터는 플랫폼 간에 이전 불가능합니다. 비교 플랫폼은 동일한 해석 가능성 문제를 가지고 있습니다. ResearchGate는 방법론적 비판 이후 2022년 8월에 자체 복합 RG 스코어를 폐지했습니다. | SSRN 기록을 유지하고 재배치보다는 보완하세요. 동일한 논문을 기관 또는 주제 저장소에 저장하세요(표 13, 5단계). 날짜가 지정된 카운터 스냅샷을 보존하세요. 축적된 카운터를 잃게 되므로 다른 곳으로 삭제했다가 다시 포스팅하지 마세요. | [130][90][149]; [47][146] (저장소 보완); [161] (한 플랫폼의 카운터는 다른 채널에 대해 아무 말도 하지 않음); [B-7] (삭제 및 재포스팅은 메트릭을 재설정함). 문서화된 마이그레이션이 없다는 것은 증거의 부재이지, 안정성의 증거가 아닙니다. |
검증되지 않은 커뮤니티 관행(섹션 8 의제의 후보 가설). 다음 권장 사항은 저자 커뮤니티에서 순환되며 실용 가이드의 이전 초안에 나타납니다. 어떤 연구도 이를 뒷받침하지 않으며, 여기에 테스트 가능한 가설로 기록됩니다. 결과로 인용되어서는 안 됩니다. (a) eJournal 분류를 3개(하나의 핵심, 하나의 광범위, 하나의 학제 간)로 제한하는 것. 허용되는 7개 중 더 많이 사용하기보다는 [53][168]; (b) SSRN 워킹 페이퍼를 인용하여 해당 저자가 Google Scholar 알림을 통해 알림을 받고 관심으로 상호작용하도록 함 [53][168]; (c) 포스팅 후 처음 14일 동안 프로필 이메일 주소를 숨겨 수집을 줄임; (d) 3일차에 경미한 수정본을 업로드하여 재공지 트리거(SSRN은 제자리 수정본이 카운터 및 URL 보존함을 문서화함 [B-7]); (e) "96시간 내 초대장은 약탈적"이라는 화면에 부착된 수치 발생률; (f) 논문에서 인용한 저자 3~5명에게 직접 연락(해당 SSRN 작업의 인용을 언급하는 짧은 메시지). 이는 홍보보다는 일반적인 학문적 소통으로 프레임되며, 첫 번째 정당한 청중에 대한 채널입니다. 각각은 섹션 8의 관찰 설계로 검증 가능합니다. 테스트될 때까지 적절한 인용 형태는 "커뮤니티 관행, 검증되지 않음"입니다.
표 24는 플레이북을 연대순으로 다시 정렬합니다. 모든 셀은 섹션과 출처로 다시 지적합니다. 타임라인 보기는 저자들이 실제로 묻는 질문("지금 뭘 해야 하나요?")에 상황이 발생하는 순서대로 답변하며, 상황 색인이 있는 표 23을 보완합니다.
표 24. 플레이북을 타임라인으로: 3개 단계 × 3개 축. 모든 셀은 섹션 4–7에 이미 명시된 증거 및 지침을 요약합니다. 검증되지 않은 커뮤니티 관행은 제외됩니다(위의 목록 참조).
| 단계 | 플랫폼 역학 및 측정 | 대상 및 배포 | 권유 방어 |
|---|---|---|---|
| 포스팅 전 | 제목과 초록을 전환 표면으로 취급하고 그에 따라 초안을 작성하세요(§6.4; [139][172]). eJournal 분류를 계획하세요. 최대 7개가 허용되며, 더 많은 분류는 더 많은 다운로드 및 더 적은 영(零)과 관련이 있습니다[53][168] | 3–5개 논문 마이크로벤치마크 코호트를 식별하여 자신의 논문과 함께 추적하세요(§6.3) | 메타데이터가 공개되기 전에 전용 주소를 통해 서신을 라우팅하세요(§6.6) |
| 포스팅 시 | 공개 포스팅 및 eJournal 분류를 확인하세요. 표 11 그리드의 1일차 기준선을 기록하세요(§6.1) | eJournal 이메일 알림은 플랫폼의 주요 푸시 채널이며 서비스 종료 후에도 계속됩니다[147][57] | 권유장을 기대하세요. 이는 기여도의 신호가 아닌 가시성의 기본 결과입니다(§6.6; [159][63]) |
| 처음 주(1–45일) | 초기 영(零)을 거부가 아닌 사전 배포로 읽으세요(§6.2 규칙 iv; [53]). 표 11 일정에 따라 카운터를 기록하세요. 60–90일 이전에는 궤적을 분류하지 마세요(§6.3) | 적절한 곳에서 정당한 외부 지렛값을 적용하세요. 블로그 및 목록 보도는 측정 가능한 초기 급증을 생성했습니다(§6.4; [116][72]) | 절대 결제하지 마세요. 초대하는 장소를 스크린하세요([B-1]; Think. Check. Submit. [159]). 초대장을 표 14 유형론과 비교하여 확인하세요. 스팸 볼륨을 독자 수로 읽지 마세요(§7.6) |
부록 B. CSAB 보고 템플릿
최소한의 저자 또는 평가자 대면 CSAB 명령문(섹션 5.5; 표 10)은 다음을 보고합니다:
논문의 나이가 [X일]일 때, 논문은 [V]건의 초록 조회 수와 [D]건의 검증된 다운로드를 기록했습니다. [정의된 분야 / 집단 / 신규 진입자 참고 집단]과 비교했을 때, 도달 백분위수는 [RV], 다운로드 백분위수는 [RD], 축소 조정 전환 백분위수는 [RC]였습니다. 해당 관찰까지 논문은 문서화된 선별 배포를 [받았 / 받지 못했]습니다. [나이 1]과 [나이 2] 사이에 정규화된 순위는 [상승했 / 안정적이었 / 하락했]습니다. 이러한 지표는 확산을 설명하며 연구 품질 또는 정확성을 확립하지 않습니다.
현대 참고 패널이 추정될 때까지(섹션 5.5, 8.3), 백분위수 필드는 반드시 공백으로 유지되어야 합니다: 직관에서, 플랫폼 전체 평균에서, 또는 오래된 샘플에서 값을 입력할 수 없습니다. 역사적 기준점은 템플릿과 함께 보고될 수 있습니다: 2012 LSN 2년 시점 중앙값 63회 다운로드 [139] 및 2025 마케팅 네트워크 중앙값 87 [83]이며, 각각 샘플, 분야, 나이가 명시되어야 하지만, 누락된 참고 집단을 대체할 수 없습니다. 이 템플릿은 도서관 프로토콜의 번역 단계(표 13, 단계 2)의 문장 수준 대응물입니다.
부록 C. 패널 변수 사전
표 C1은 섹션 8.3의 핵심 패널에 대한 최소 논문-구간 레코드를 나타냅니다: 섹션 5.5의 CSAB 추정치와 섹션 8.4–8.5의 플랫폼 이벤트 분석을 재현하기 위한 가장 작은 스키마입니다. 공개 릴리스는 직접 식별자를 안정적인 연구 키로 교체합니다(분석에 필수적이지 않은 경우). 레지스트리 기여(섹션 8.8)는 그곳에 표시된 이 스키마의 부분집합을 사용합니다.
표 C1. 핵심 패널을 위한 최소 논문-구간 데이터 스키마.
| 도메인 | 변수 | 정의 또는 형식 |
|---|---|---|
| 식별 | paper_id | 안정적인 연구 식별자 |
| 식별 | ssrn_abstract_id | 플랫폼 식별자; 공개 릴리스에서 해시되거나 제한됨 |
| 시간 | posted_at | 최초 공개 게시 날짜 |
| 시간 | observed_at | 메트릭 관찰 타임스탬프(표 11 그리드) |
| 시간 | paper_age_days | 최초 게시 이후 경과 일수 |
| 사용 | abstract_views_cum | 공개 누적 초록 페이지 조회 수 |
| 사용 | downloads_cum | 공개 누적 검증된 다운로드 |
| 사용 | views_interval, downloads_interval | 이전 유효 관찰에서의 증분 |
| 노출 | classification_ids | 관찰 시점에 활성화된 모든 eJournal 분류 |
| 노출 | distributed_status, distributed_at | 선별 배포 지표 및 날짜(동의한 경우) |
| 노출 | search_indexed | 프로토콜 정의 외부 인덱스 상태(정확한 제목 테스트) |
| 논문 | title_frozen, abstract_frozen, keywords, page_count, doi | 최초 관찰 시 가장 먼저 관찰된 원고 메타데이터, 첫 관찰에서 동결됨 |
| 논문 | authors_frozen, affiliations_frozen | 최초 관찰 시점의 저자 이름, 순서 및 소속 |
| 버전 관리 | revision_id, revision_at, material_change_flag | 중요 변경 지표가 있는 버전 이력 |
| 저자 | author_count, platform_newcomer, prior_ssrn_papers | 팀 구조 및 게시 전 플랫폼 이력(섹션 8.3 정의) |
| 평판 | prior_citations, prior_works, institution_measure | 초점 게시 전에 동결되었으며 분야 정규화됨 |
| 달력 | day_of_week, week, season, holiday_flag | 사전 정의된 시간 통제 [178] |
| 하위 항목 | citations_6m, citations_12m, citations_18m, publication_status | 이후 검증 결과(출처 및 날짜, 섹션 8.9 범위) |
| 감사 | collection_method, source_url, quality_flag | 출처, 접근 경로 및 이상 문서화(삭제가 아닌 플래그; 섹션 8.3) |
부록 D. 벤치마크 투명성 명세서
섹션 8.8의 백분위수 벤치마크와 플랫폼 또는 커뮤니티에서 유지하는 후속 벤치마크(섹션 10.4, 권장사항 1 및 4)가 이 논문이 비판하는 벤치마크 불투명성을 재현하지 않도록 유지하기 위해, 모든 백분위수 릴리스는 다음을 명시하는 버전이 지정된 동반 문서와 함께 공표됩니다:
1. 적격 논문 모집단, 네트워크, 문서 유형 및 제외 사항;
2. 게시 집단 날짜 및 관찰 나이;
3. 분야 할당 규칙(여러 분류의 처리 포함);
4. 릴리스 시 효력이 있는 조회 수, 다운로드, 고유 행위자, 반복 및 검증된 트래픽의 정의;
5. 중앙값, 사분위수 범위, P10/P25/P75/P90/P95, 0 점유율, 지니 계수 및 상위 점유율;
6. 보고된 모든 참고 집단에 대한 표본 크기 및 불확실성 구간;
7. 부재, 철회, 개정, 병합 및 반박 재진술의 처리;
8. 조정에 포함된 배포 및 외부 홍보 변수;
9. 개인정보 보호 및 최소 셀 규칙: 섹션 8.8의 크라우드소싱 레지스트리의 경우, 작은 분야-나이 셀이 개별 기여자를 식별할 수 있으므로, 이 항목은 데이터 보호법(영국의 경우 UK GDPR 및 2018년 데이터 보호법)에 의해 관리되는 구속력 있는 제약이며, 형식적인 것이 아닙니다. 공개 제어는 단순 익명화를 넘어 k-익명성 또는 소수 셀에 대한 노이즈 추가(차등 프라이빗) 집계를 포함해야 하며, 허용된 사용 규칙은 레지스트리를 해석이 아닌 평가로 바인딩해야 하며, 고용, 승진, 자원 배분 또는 공개 순위표로의 재조립에 사용을 금지합니다;
10. 버전 이력 및 릴리스에 대한 영구적이고 인용 가능한 참고자료.
어떤 복합 점수도 이러한 구성 요소를 대체할 수 없습니다. 집단 중앙값에 대한 간단한 비율(섹션 6.3의 보정되지 않은 대안)은 분모 셀이 작을 때 불안정할 수 있으며 "중앙값의 2배"가 다르게 형성된 분야 간에 고정 백분위수에 매핑되는 것처럼 거짓으로 제시할 수 있습니다. 저자 대면 보고는 따라서 섹션 8.3에서 희소 셀에 대해 이미 지정된 경험적-베이즈 축소 하에서 백분위수 추정치를 사용하며, 원시 분포는 감사를 위해 사용 가능하게 유지됩니다.
부록 E. 다운로드 분포의 독립적 아카이브 단면
최근 전체 분포 증거의 경우 섹션 3과 5의 종합은 단일 발행된 스냅샷[83]에 의존합니다. 이 부록은 이 논문을 위해 조립된 독립적이고 재현 가능한 단면을 보고하며, 플랫폼 특수 접근권 없이 공개 데이터만 사용하여 여러 분야에 걸쳐 분포 구조를 입증합니다. 이는 알려진 상향 편향을 가진 일회성 아카이브 재구성으로, 게시에서 논문을 전향적으로 관찰하는 섹션 8.6의 사전등록 패널과는 별개로 형태의 입증으로 제시됩니다.
방법. SSRN 논문의 무작위 표본은 23개의 독립적인 무작위 시드에 걸쳐 OpenAlex(소스 S4210172589, "SSRN Electronic Journal")에서 추출했습니다. 각 표본 논문의 사전 폐기 다운로드 및 초록 조회 카운터는 라이브 사이트에서가 아니라 웨이백 머신의 공개 가용성 엔드포인트를 통해 위치한 인터넷 아카이브의 가장 최근 캡처에서 읽었으며, 라이브 사이트는 접근 제어(섹션 4)되고 더 이상 비교 프레임을 게시하지 않습니다. 플랫폼을 쿼리하지 않고 아카이브 사본에서 카운터를 읽으면 절차는 속도 제한 상태로 유지되고 플랫폼을 존중하며 공개된 식별자에서 재현 가능합니다. 논문별 카운터가 순위 종료 후에도 변경되지 않고 비교 순위만 철회했으므로, 2026년 7월 15일 이후의 캡처는 논문의 누적 계수의 유효한 읽기로 남아 있습니다. 따라서 스냅샷은 종료 전 기간으로 제한되지 않았으며, 캡처 날짜는 논문 나이를 계산하기 위해서만 유지됩니다. 페이지 내용이 아닌 중개 봇 챌린지를 반환한 캡처는 삭제했습니다. 표본 추출된 2,600개 논문 중 64%가 사용 가능한 아카이브 캡처를 가졌으며 52%가 기계 판독 가능한 다운로드 카운트를 산출했으며, 25개 분야에 걸친 n = 1,360개 논문(14개는 최소 20개 논문 포함)과 게시 연도에서 2십 년 이상의 논문 나이를 제공합니다. 데이터셋은 appendixE-wayback-downloads.csv로 공개되며 https://doi.org/10.5281/zenodo.22285871에 보관되며, 동일한 파일은 study1-wayback-downloads.csv라는 이름을 가집니다. 표본에서 읽을 수 있는 내용을 제약하는 두 가지 속성이 있습니다. 게시 날짜는 연도만 있고 월은 없습니다: 1,360개 레코드 중 1,358개는 OpenAlex가 SSRN 게시를 연도 해상도로 보고하기 때문에 1월 1일로 표시됩니다. 따라서 나이는 캡처 연도에서 게시 연도를 뺀 것으로 계산되며, 전체 연도로 보고되고 더 짧은 대역은 방어할 수 없습니다. 캡처도 시간 내에 집중됩니다: 688개(표본의 절반)는 2025년 4월 25일에서 5월 7일 사이의 단일 크롤에서 발생하고, 81.5%는 2025년에 발생하므로 논문의 나이는 게시 연도의 재진술에 가깝고 둘을 분리할 수 없습니다. 이 중 첫 번째는 제거 가능합니다. 게시 행 "Posted: DD Mon YYYY"는 동일한 아카이브 캡처에 나타나므로 전체 날짜는 다시 구문 분석하여 복구할 수 있으며, 라이브 사이트의 접근 게이트는 이를 방지하지 않습니다. 표 E1은 이 손실을 명시적으로 만듭니다.
표 E1. 아카이브 단면의 구성 및 각 단계에서의 손실.
| 단계 | 논문 | 초기의 % | 이전의 % |
|---|---|---|---|
| 무작위 표본 추출된 OpenAlex 레코드(SSRN Electronic Journal) | 2,600 | 100.0 | — |
| 사용 가능한 인터넷 아카이브 캡처 위치 | ≈1,660 | 63.8 | 63.8 |
| 캡처에 기계 판독 가능한 다운로드 카운트 포함 | 1,360 | 52.3 | 81.9 |
| 최종 분석 표본 | 1,360 | 52.3 | 100.0 |
결과. 횡단면은 공표된 앵커가 주장하는 모든 정성적 특징을 재현합니다(표 E4). 다운로드는 심하게 우측 편향되어 있습니다: 평균 219, 중앙값 60(95% 부트스트랩 CI 55–69), 평균 대 중앙값 비율 3.65이며, 평균이 75번째 백분위수(158)를 초과합니다. 또한 무거운 상단 꼬리를 가지고 있습니다(95번째 백분위수 816, 중앙값의 13배 이상; 지니 계수 0.75, 95% CI 0.71–0.78). 로그 척도에서 분포는 거의 대칭입니다(ln 다운로드의 왜도 ≈ 0.18). 이는 관찰된 분포 본체에 대한 근사 로그정규성과 일치하며, Kakushadze가 맞출 수 있었던 특성입니다(섹션 3.4에서 상위 목록에만 해당). 다운로드-조회 변환의 중앙값은 16.2%이고 평균은 17.3%로, 11–19% 교차 연구 범위 내에 있습니다(섹션 5.2). 중앙값 다운로드는 동일한 논문 연령에서 분야별로 다릅니다. 연령 대역을 고정하면, 최고 분야 중앙값과 최저 분야 중앙값 간의 차이는 약 3배에서 약 5배까지이며, 정확한 수치는 대역과 표본 부족 분야의 처리 방식에 따라 달라집니다. 모든 연령에 걸쳐 집계하면 차이가 약 12배에 이르며, 이 더 큰 수치는 표본의 변화하는 구성을 반영합니다: 공학은 3년 이하의 논문의 21–27%를 제공하고 9년 이상의 논문의 최대 5%를 제공하는 반면, 경제학은 9–12%와 동일 그룹의 37–54%를 제공하고, 여기서 경제학 논문의 중앙값 연령은 9년인 반면 공학은 1년입니다. 방향은 섹션 3.6의 분야 승수와 일치합니다. 크기는 비교 불가능합니다. 그 승수는 단일 분야의 94개 소분야에 걸친 평생 평균에 기초하고 이 차이는 25개 분야에 걸친 중앙값에 기초하며, 둘 다 연령에 대해 조정되지 않았기 때문입니다. 중앙값 다운로드는 더 오래된 연령 대역에서 더 높으며, 인접한 대부분의 대역 간에 겹치지 않는 95% 부트스트랩 신뢰구간이 있습니다(게시 연도에 중앙값 12, 10년 초과에서 172). 이것이 참조류 논증을 동기화하는 연령 종속성입니다. 단일 분야 내에서 차이는 처음 3~4년에 집중됩니다: 5~10년 대역과 10년 초과 대역 사이에는 통계적 유의성에 도달하지 않습니다(경제학의 Mann-Whitney p = 0.57, 사회과학 0.82, 경영학 0.23). 집계된 기울기의 약 1/4는 연령이 아닌 분야 구성입니다. 이 표본에서 연령도 게시 연도의 재진술에 가깝게 운영됩니다. 캡처의 절반이 2025년 4월 25일과 5월 7일 사이의 한 번의 크롤링에서 취해졌고 81.5%가 2025년에 해당하므로, 연령과 코호트를 여기서 분리할 수 없으며 대역은 단일 논문의 경로가 아닌 수준을 보고합니다. 표본 평균(219)은 공표된 마케팅 네트워크 평균(221)과 일치합니다[83]. 표본 중앙값(60)은 인구조사식 법적 중앙값(63) 수준에 있습니다[139]. 표 E2는 논문 연령별 다운로드 분포를 제공하고 표 E3은 분야별로 제공하며, 둘 다 95% 부트스트랩 신뢰구간과 표본 크기를 포함합니다. 신뢰구간은 가장 작은 분야에서 가장 넓으며, 이것이 분야 차이가 단일 정확한 배수가 아닌 대략 한 자리수 크기의 차이로 설명되는 이유입니다. 기사의 도입 사례는 표본에 대해 직접 읽을 수 있습니다. 2년 미만의 논문 중 30~50개의 초록 조회를 기록한 경우, 해당 사례가 해당하는 대역에서 중앙값 다운로드 수는 7이고, 사분위수 범위는 4~11입니다(n = 42). 제목의 사례는 해당 조회 대역 및 연령에 대한 전형적인 사례입니다. 게시 연도에 표본의 35%가 7번 이하의 다운로드를 기록하고, 중앙값 초록 조회 수는 66이며, 사례 자체의 17.5% 변환은 표본의 57번째 백분위수에 있습니다. 섹션 5.2의 11–19% 변환 대역은 논문의 대역이 아닌 중앙값의 대역입니다: 표본의 41%가 그 안에 속하고, 23%는 아래, 36%는 위입니다. 표본의 절반, 51%가 인구조사식 법적 중앙값 63 아래에 있습니다[139]. 이는 새로운 범위를 분포의 유입된 부분에 배치합니다.
표 E2. 기록 횡단면에서 논문 연령별 다운로드 분포.
| 논문 연령 | n | 중앙값 [95% CI] | 평균 | 사분위수 범위 (P25–P75) |
|---|---|---|---|---|
| 게시 연도 | 203 | 12 [11–14] | 33 | 5–21 |
| 1년 | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4년 | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9년 | 188 | 130 [110–151] | 384 | 72–374 |
| 10년 이상 | 341 | 172 [157–189] | 453 | 96–336 |
| 모든 논문 | 1,360 | 60 [55–69] | 219 | 23–158 |
표 E3. 기록 횡단면에서 분야별 다운로드 분포(n ≥ 20인 분야).
| 분야 (n ≥ 20) | n | 중앙값 [95% CI] | 평균 | 사분위수 범위 |
|---|---|---|---|---|
| 경제학 | 285 | 150 [134–169] | 443 | 76–302 |
| 경영학 | 161 | 150 [126–188] | 335 | 72–330 |
| 심리학 | 24 | 107 [35–192] | 179 | 32–229 |
| 사회과학 | 241 | 85 [78–117] | 219 | 45–189 |
| 의사결정학 | 32 | 74 [56–158] | 615 | 49–260 |
| 컴퓨터과학 | 63 | 42 [36–73] | 167 | 26–104 |
| 의학 | 40 | 42 [24–59] | 81 | 22–66 |
| 농업 & 생명과학 | 36 | 31 [24–57] | 65 | 23–67 |
| 생화학 | 21 | 30 [23–37] | 38 | 20–38 |
| 환경과학 | 72 | 26 [18–32] | 44 | 14–50 |
| 공학 | 196 | 24 [20–26] | 46 | 13–46 |
| 물리학 & 천문학 | 21 | 23 [15–38] | 112 | 13–45 |
| 재료과학 | 55 | 18 [15–25] | 26 | 11–36 |
| 에너지 | 21 | 12 [11–22] | 25 | 11–22 |
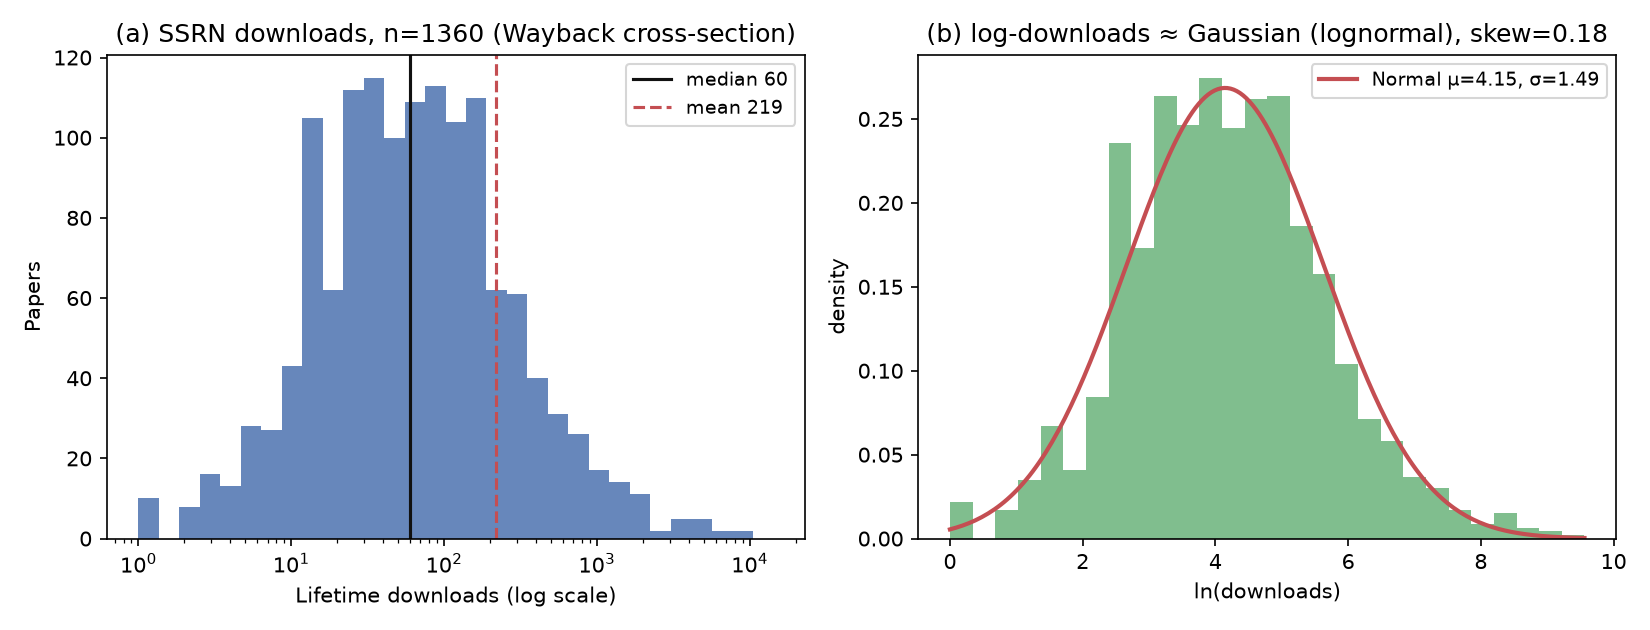
그림 E1. (a) 평균과 중앙값이 표시된 로그 척도의 다운로드 분포; (b) 적합된 정규 밀도를 가진 ln(다운로드)의 히스토그램. 로그-다운로드의 왜도 ≈ 0.18. n = 1,360.
표 E4. 출판된 앵커 대 독립적인 보관 횡단면 (n = 1,360).
| 특성 | 출판된 앵커 | 보관 횡단면 |
|---|---|---|
| 평균 다운로드 | 221 (마케팅) [83] | 219 |
| 중앙값 다운로드 | 87 (마케팅) [83]; 63 (법률) [139] | 60 |
| 평균 / 중앙값 | 2.54 [83] | 3.65 |
| 95번째 백분위수 / 중앙값 | > 8 [83] | 13.6 |
| 다운로드-조회 전환 | 11–19% 대역 (§5.2) | 16.2% 중앙값 |
| 분야 확산 (중앙값) | ≈ 8배 분야 평균, 연령 미조정 [168] | ≈ 동등 연령에서 3–5배; 12.5배 통합 |
| 분포 형태 | 로그-정규, 꼬리만 [85] | 로그-왜도 0.18 (관측된 본체) |
횡단면이 수립하는 것. 횡단면은 분포의 형태와 중심 및 상위 구조를 학문 분야 전반에 걸쳐 확인해주며, 모든 출판된 SSRN 스냅샷의 단일 제공보다 훨씬 광범위한 분야 범위를 가진 독립적인 전 분야 표본이 해줍니다. 이는 플랫폼 대표 백분위수를 추정하지 않으며, 구성의 두 가지 특성으로 인해 상향 편향됩니다. 보관된 캡처는 가시적인 페이지를 과대 표현하므로, 다운로드가 많은 논문이 캡처될 가능성이 더 높습니다. 논문이 표본에 진입하려면 읽을 수 있는 카운터를 포함한 보관 페이지가 있어야 하므로, 극단적인 낮은 꼬리를 제외시킵니다. 따라서 표본의 10회 이하 다운로드가 있는 논문의 비율 (약 10%)은 3.4절과 8.6절이 편견 없는 전체 플랫폼 표본에 예상하는 15–30%보다 훨씬 낮으며, 그 비율의 추정치로 읽으면 안 됩니다. 표본 중앙값(60)이 게다가 출판된 법률(63) 및 마케팅(87) 중앙값에 있거나 그 아래에 있다는 사실은 상향 편향이 중심 질량의 경우 적당하다는 것을 나타내며, 왜도 및 무거운-꼬리 결론은 보수적이라는 것입니다. 보정된 벤치마크의 경우, 적절한 도구는 10절에서 권장하는 플랫폼 대표 백분위수 대역과 8.6절의 사전 등록된 패널입니다. 이 횡단면은 이들이 측정할 구조가 본 논문이 설명하는 구조라는 것을 확인해줍니다. 연구 1이 사전에 고정하는 예측 대역 중 3개(8.6절)는 이 표본에 대해 읽을 수 있으며, 그 상향 편향을 염두에 두고 있습니다. 60 다운로드의 표본 중앙값은 예측된 30~80 범위 내에 있습니다. 0.75의 주의 지니 계수는 예측된 0.75~0.90의 낮은 가장자리에 있으며, 이는 표본 편향이 예측하는 방향이므로, 제외된 낮은 꼬리가 측정된 불평등을 압축합니다. 0.27의 중앙값 대 평균 비율은 예측된 0.5 한계 아래입니다. 이것도 예측 설계를 검증하지 않으며, 그 가치는 확률 표본에서 게시를 관찰하는 논문을 관찰한다는 것입니다. 대역이 부당하게 설정되지 않았다는 것을 기록합니다.
선언
데이터 가용성. 여기서 재현된 모든 종합 앵커는 텍스트 및 표에서 인용된 출판된 출처로 추적되며, 샘플링 프레임 및 검증 상태는 사용 시점에 명시되고, 본 논문의 벤치마크 주장을 기반하는 새로운 모집단 대표 데이터세트가 없습니다. 본 논문을 위해 생성된 유일한 원본 데이터세트는 부록 E의 독립적인 보관 횡단면이며, 공개 아카이브에서 복구된 퇴직 전 카운터를 가진 1,360개 논문의 무작위 전 분야 표본이며, appendixE-wayback-downloads.csv로 출시됩니다 (사전 Study 1이 아닌 부록 E 데이터세트)와 분석 코드를 포함하므로, 절차를 다시 실행하고 확장할 수 있습니다. 이는 분포의 형태를 확인해주며 플랫폼 대표 벤치마크가 아닙니다. 데이터세트는 CC BY 4.0에 따라 https://doi.org/10.5281/zenodo.22285871에 보관되며, 여기서 동일한 파일은 study1-wayback-downloads.csv라는 이름으로 제공되고, 논문 연령 및 분야 모두에서 조정하면서 다운로드 카운트를 참조 클래스에 대해 읽는 개방형 도구와 함께 제공되며, https://github.com/vadimchernets/ssrn-benchmark (MIT 라이선스, Python 표준 라이브러리만 사용)입니다. 자신의 카운터를 이 참조 클래스에 배치하려는 독자는 분석을 재구성하기보다는 해당 도구를 실행할 수 있습니다. 8절의 사전 등록 준비 의제를 위한 자료 (부록 C, 표 C1의 패널 변수 사전 및 검색 감사 쿼리 인벤토리)는 사전 등록 시 보관을 위해 준비됩니다 (8.8절). 레지스트리 기여는 8.8절에서 정의한 스키마 부분 집합을 따르며, 벤치마크 프로그램의 모든 백분위수 출시는 부록 D의 투명성 사양에 따라 출판됩니다. 부록 B의 CSAB 보고 서식을 자유롭게 재사용할 수 있으며, 그 빈 백분위수 규칙에 따릅니다. 2026년 8월 24일, SSRN 지원(티켓 260824-003051)에 정식 요청이 제출되었으며, 은퇴 순위가 암시한 집계 참조 클래스-중앙값, 사분위간 범위, 분야 및 논문 연령으로 계층화된 다운로드 십분위수 대역, 논문 단위 식별자 없음. 그 결과 (승인, 거부 또는 응답 없음)은 후속 개정에서 보고됩니다.
본 논문에 대한 공개 접근. 본 원고의 개방형 라이선스 사본은 https://doi.org/10.5281/zenodo.22166896에 보관됩니다 (CC BY 4.0). 여기서 전체 텍스트는 직접적으로 접근 문제 없이 검색할 수 있습니다. 보관은 SSRN의 정식 기록이 JavaScript 엔진이 없는 클라이언트를 거부하는 봇 완화 뒤에서 제공되기 때문에 제공됩니다. 이는 4.2절에서 문서화된 조건입니다. 정식 사본에 도달할 수 없는 독자, 참고 관리자 및 자동 클라이언트는 보관에서 동일한 텍스트를 얻을 수 있습니다. 동반 논문은 https://doi.org/10.5281/zenodo.22166995 및 https://doi.org/10.5281/zenodo.22168724에서 동일한 조건으로 보관됩니다.
코드 가용성. 부록 E의 독립적 아카이빙 교차 부분에 대한 수확 및 분석 코드는 https://github.com/vadimchernets/ssrn-benchmark에서 데이터셋과 함께 공개되므로 절차를 재현하고 원본 카운터에서 참조 클래스를 다시 도출할 수 있습니다. 본 논문은 분석 코드가 필요한 다른 결과는 보고하지 않습니다. 제8절의 실증 설계에 대한 도형 생성 템플릿은 사전 등록 자료와 함께 온라인 부록으로 공개될 예정입니다.
윤리. 제8절의 실증 설계는 공개적으로 표시된 논문 수준의 카운터 및 서지 메타데이터에 의존합니다. 공개되지 않은 대시보드 정보, 배포 상태 날짜 또는 이메일 메시지의 수집은 정보 제공 동의가 필요하며, 해당하는 경우 기관 검토가 필요합니다(제9절 참조). 인간 피험자 연구를 구성하는 두 가지 설계, 즉 연구 4(저자 설문)와 연구 3(받은편지함 로깅을 통한 기악화된 게시)은 기관 검토 위원회 또는 연구 윤리 위원회 승인을 위해 제출되며, 데이터 수집이 시작되기 전에 참여자의 정보 제공 동의 하에 수행됩니다. 메시지 데이터셋은 모든 보고 전에 집계되고 익명화되며, 커뮤니티 게시물은 생생하고 검증 가능한 출처가 있는 경우에만 인용되며, 저자가 예상과 다르게 식별될 수 있는 경우 의역으로 처리합니다. 데이터 수집은 플랫폼의 서비스 약관에서 허용하는 수단으로 제한됩니다. 설계는 공개적으로 표시된 카운터와 서지 메타데이터를 사용하며 플랫폼의 약관을 위반하는 스크래핑은 사용하지 않습니다. 벌크 또는 공개되지 않은 데이터가 필요한 설계는 자동화된 추출이 아닌 공식 데이터 요청 및 법적 검토를 통해 진행됩니다. 반공개 포럼 콘텐츠의 인용은 기여자 동의 및 재식별 위험에 주의를 기울이며, 이것이 저자가 예상과 다르게 식별될 수 있는 경우 해당 자료를 의역하지 않고 그대로 재현하지 않는 이유입니다. 데이터 수집은 플랫폼의 서비스 약관에서 허용하는 수단으로 제한됩니다. 본 논문은 특정 저널이나 출판사를 "약탈적"으로 표시하지 않습니다. 장소 선별은 검증되고 투명한 기준을 적용하므로 모든 분류를 방어할 수 있으며 명예훼손을 피합니다.
감사의 말. 저자는 2026년 8월에 이메일로 보낸 중요한 의견을 주신 Stefanie Haustein에게 감사합니다. 그 의견은 제4.2절의 수정으로 이어졌습니다. 또한 서신에서 저자가 어떤 단일 정규화를 먼저 주장해야 하는지 질문하고 논증이 아닌 데이터를 보려는 고집을 보인 Vincent Larivière에게 감사합니다. 이는 부록 E에서 보고된 아카이빙 교차 부분을 촉발했습니다.
이해 상충. 저자는 제8.10절에서 논의된 다중 모델 오케스트레이션 방법의 개발자이며, 이는 공개적이고 재현 가능합니다. 독자들은 이 이해를 고려해야 합니다. 저자는 그 절에서 논의된 종류의 AI 오케스트레이션 및 다중 모델 검증 시스템을 다루는 계류 중인 특허 출원(이미 부여된 특허가 아님)의 명시된 신청인입니다. 제8.10절에서 제안된 오케스트레이션 계층 전달 설계는 본 논문의 어떤 결과도 의존하지 않는 개념적 사양입니다. 제8.10절을 완전히 삭제해도 본 논문의 다른 곳에서 어떤 진단, 결과 또는 권고도 변경되지 않습니다.
도구 및 검증. AI 어시스턴트는 저자의 지시에 따라 도구로 사용되었습니다. 아이디어, 연구 및 결론은 저자의 것입니다. 모든 정량적 주장과 인용은 저자가 1차 출처 또는 아카이브된 사본에 대해 검증했습니다. 저자는 콘텐츠에 대해 전적인 책임을 집니다.
참고문헌
본문에서 [B-n]으로 인용된 출처(플랫폼 페이지, 포럼 스레드, 블로그 게시물 및 기타 지원 자료)는 아래 "추가 출처"에 별도로 나열되어 있습니다. 접근 날짜가 표시된 플랫폼 페이지는 불안정하므로 아카이브된 사본에 대해 다시 검증해야 합니다.
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). 약탈적 출판사들이 오픈 액세스를 훼손하고 있습니다. Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). Calling Bullshit: The Art of Skepticism in a Data-Driven World. Random House.
[16] Bessembinder, H. (2018). 주식이 재무부 채권보다 성과가 좋은가? Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). 오픈 액세스 저널 대 구독 저널: 과학적 영향력 비교. BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). 로스쿨 순위 매기기: SSRN을 이용한 학술 성과 측정. Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). 사용 임팩트 팩터: 표본 특성이 사용 기반 임팩트 지표에 미치는 영향. Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). 알트메트릭스가 연구의 더 광범위한 영향을 나타내는가? Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). 트위터 수를 정규화하는 방법? Twitter Index의 저널을 기반으로 한 첫 번째 시도. Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). 백분위수와 백분위 등급 클래스를 이용한 문헌계량 데이터 분석: 기회와 한계. Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). 0이 많은 데이터의 정규화: 새로운 지표 계열의 실증 분석 및 알트메트릭스 데이터와의 사용. Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). 프리프린트 제출과 관련하여 고려할 10가지 간단한 규칙. PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). 초기 웹 사용 통계를 이후 인용 영향의 예측 지표로. JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). 화학 커뮤니케이션에서 전자 프리프린트의 역할: 저널 문헌에서의 인용, 사용 및 수용 분석. JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). 계획된 사회 변화의 영향 평가. Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). 정보 고속도로의 혼잡: 경제학 워킹페이퍼의 비효율성. Journal of Public Economics, 225, 104978 (또한 NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). 생성 AI 시대의 공격적인 크롤러 트래픽 완화: 노스캐롤라이나 대학교 채플힐 도서관의 협력적 접근. The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). 온라인 현장 실험. Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). 경제학의 다운로드 대 인용: 관계, 기여 요인 및 그 이상. In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). 의심되는 약탈적 저널에 발표하는 연구자들의 지식과 동기. BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). "학술 저작물을 선보이세요, 3부: 자체 출판". https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). "사회과학 연구 네트워크(SSRN) 상용 제품 종료". https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. REST API 설명서. https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. 유사성 검사 설명서. https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). 오픈 액세스 출판, 아티클 다운로드 및 인용: 무작위 대조 시험. BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). arXiv가 수학 아티클의 인용을 증가시키고 출판사 다운로드를 감소시키는가? Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). 다운로드와 인용 간의 관계 재검토: Lancet의 경우에서 서로 다른 인용 패턴을 가진 논문의 관점. Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). 미국 법률 평론을 위한 오픈 액세스 이점. SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). 인용 및 사회적 관심에 대한 자금 조달의 영향: 유엔 지속 가능 개발 목표(SDGs)를 사례로. Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). "일반적인 학술 아티클은 몇 번 읽혀지는가?" https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). 다중 에이전트 토론을 통한 언어 모델의 사실성과 추론 개선. arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). 직장 계층 구조에 걸친 사회 비교 및 기만: 현장 및 실험적 증거. Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (2009년부터 유통)
[45] Eisenberg, T. (2006). SSRN 기반 법학대학원 순위 평가. Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). "Elsevier가 사회과학 연구 네트워크(SSRN)를 인수합니다…". PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (또한 LSE Impact Blog, 2016년 5월 18일)
[47] Elsevier Digital Commons. "SSRN Research Paper Series Sunset — DC Options". https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. "SSRN First Look" (제품 페이지). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. "SSRN for Authors and Researchers" (제품 페이지). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. "연구자들은 논문의 영향력을 어떻게 측정할 수 있습니까?" https://www.elsevier.support/ssrn/answer/gauge-impact (2026년 8월 14일 접속)
[51] Elsevier/SSRN Support. "SSRN의 RSS 및 데이터 피드란 무엇입니까". https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. "SSRN이란 무엇입니까?" https://www.elsevier.support/ssrn/answer/what-is-ssrn (2026년 8월 14일 접속)
[53] Elsevier/SSRN Support. 분류 및 배포. https://www.elsevier.support/ssrn/answer/classification-distribution (2026년 8월 14일 접속)
[54] Elsevier/SSRN Support. 생성형 AI 정책. https://www.elsevier.support/ssrn/answer/AI (2026년 8월 14일 접속)
[55] Elsevier/SSRN Support. Google / Google Scholar 색인. https://www.elsevier.support/ssrn/answer/google-scholar (2026년 8월 14일 접속)
[56] Elsevier/SSRN Support. 제출 지침 / 시작하기. https://www.elsevier.support/ssrn/answer/get-started (2026년 8월 14일 접속)
[57] Elsevier/SSRN Support. 구독 (eJournal 메일링). https://www.elsevier.support/ssrn/answer/subscriptions ; https://www.ssrn.com/index.cfm/en/subscribe/도 참조
[58] Espeland, W. N., & Sauder, M. (2007). 순위 및 반응성: 공개 지표가 사회 세계를 재창조하는 방식. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). 공개 접근 논문의 인용 이점. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). 과학 분야의 매튜 효과 및 아이디어의 연쇄 확산. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). 학술 스팸 식별 및 대처 방안: 문헌 검토. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (2026년 5월 8일 발행)
[62] Fraser, N., et al. (2020). bioRxiv 프리프린트, 인용 및 알트메트릭스 간의 관계. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). 신뢰하되 검증하십시오: 약탈적 저널 및 출판사 권유에 대한 탐색적 감시. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). 저자 특성이 단일 블라인드 대 이중 블라인드 동료 검토 결과에 미치는 영향: 과학 초록 및 발행물의 비교 연구에 대한 체계적 검토. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv 20주년. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. "SSRN and Download Statistics" (2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; "Update on SSRN", https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). 통화 관리의 문제: 영국의 경험. Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan에 재인쇄됨. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). 학술 연구에서 디지털 변호사의 진화하는 교육. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). 논문 수준 지표의 데이터 무결성 문제. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). 생성형 AI가 검색을 어떻게 방해하는가: Google 검색, Gemini 및 AI 개요에 대한 실증 연구. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). 저널 및 논문 수준에서 다운로드와 인용 간의 관계 및 언어의 영향. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). arXiv에서 인용 및 열람에 미치는 위치적 효과. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). 마지막이지만 최소한: arXiv에서 인용 및 열람에 미치는 추가 위치적 효과. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). 학술 논문의 소셜 미디어 지표 특성 분석. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). 영향 지표로서의 트윗: Twitter의 자동화된 "봇" 계정의 영향 검토. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). "알트메트릭스" 해석: 인용 및 사회 이론의 관점에서 소셜 미디어 보기. Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). 100개 미국 법학대학원의 학술 영향력 순위. Jurimetrics, 60(1), 1–39 (2019년 가을). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). 서지학: 연구 지표를 위한 라이덴 선언. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). 개인의 과학 연구 성과를 정량화하는 지수. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). 다운로드와 인용 건수 간의 관계에 대하여: Granger 인과관계 추론의 소개. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. 가이드: "유사성 보고서 이해하기"; "프리프린트". https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025년 3월 6일). AI 검색의 인용 문제. Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). AI가 지식 확산에서 평판 프리미엄을 줄일 수 있을까? SSRN 마케팅 워킹페이퍼의 증거. Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). 안과학에서의 약탈적 저널 권유 분석. American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — "1813개 이메일" 수치의 출처
[85] Kakushadze, Z. (2016). SSRN 다운로드를 위한 지수. Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). 오픈 액세스의 효과 (AEA Conference 2014). https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). 스크래퍼는 선택적으로 robots.txt 지시사항을 존중합니다: 대규모 실증 연구의 증거. Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). 예측 정책 문제. American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). 학술 출판에서의 스팸: 사례 연구. JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). ResearchGate 점수를 과학적 평판의 척도로서 비판적으로 살펴봄. Presented at ASCW'15 (Quantifying and Analysing Scholarly Communication on the Web), Web Science Conference 2015, Oxford. http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (대중 버전: "The ResearchGate Score: a good example of a bad metric," LSE Impact Blog, 2015년 12월 9일)
[91] Kurtz, M. J., et al. (2005). 기사 열람 정보의 문헌계량학적 특성. JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). 사용 문헌계량학. Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). 오픈 액세스 인용 장점이 실제로 있을까? 오픈 액세스 및 구독 기반 기사의 인용에 관한 체계적 검토. PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). 디지털 시대의 학술 출판사 과점. PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. "출판 팁" (PDF). https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). 약탈적 간호 저널 및 출판사의 이메일 권유 특성. The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT 탐지기는 비모국어 영어 사용자에게 편향되어 있습니다. Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). 게스트 포스트 — 사랑, 죽음 & 로봇: 학술 판. The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. LogEc 정보 (트래픽 필터링 방법론). https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). 생성 엔진에서의 가시성 최적화: 생성 엔진 최적화의 비판적 검토 (2023–2026). arXiv:2607.14035 (2026년 7월 15일 제출). https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). "메이누스 대학교 법학 및 범죄학 학부가 첫 번째 순위를 차지합니다...". https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). 오픈 액세스 메가 저널에서의 사용과 인용 간의 관계. Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). 하버드 및 시카고 매튜 효과의 증거. Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). 과학에서의 매튜 효과. Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). 과학에서의 매튜 효과, II: 누적 이점과 지적 재산의 상징성. Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. "Microsoft Defender for Office 365의 안전 링크". https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ UrlClickEvents의 클릭에 관한 Microsoft Q&A; + 거짓 열림에 관한 Suped)
[107] Milanovic, M. EJIL:Talk! "학술 스팸 [업데이트됨]". https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). 과학-학술 저널의 전체 텍스트 다운로드 및 인용 분포에 관하여. JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). 적용 평가 정보계량학. Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). 채용, 승진 및 임기 심사를 위한 과학자 평가. PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). 평판이 과학 아이디어 확산에서 인식론적 불평등을 주도합니다. EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). 사회적 영향 편향: 무작위 실험. Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). 메트릭의 폭정. Princeton, NJ: Princeton University Press. ISBN 978-0-691-17495-2.
[114] Nature Neuroscience, Editorial (2008). https://www.nature.com/articles/nn0608-619
[115] Northwestern University LibGuides (연구 평가/메트릭). https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). 블로그가 SSRN 다운로드에 영향을 미칠까? Volokh와 Slashdot 효과를 실증적으로 검증합니다. U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. "출판하기 — 법학 리뷰 회원을 위한 가이드". https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. "좋은 h-지수란 무엇일까요?" https://paperpile.com/g/what-is-a-good-h-index/ (유사 가이드: Elsevier, Researcher.Life, Academia Insider)
[119] Perneger, T. V. (2004). 온라인 "히트 수"와 후속 인용 간의 관계: BMJ의 연구 논문에 관한 전향적 연구. BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). 학술 경력에서의 평판과 영향. PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (archived copy at web.archive.org)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. Published 30 June 2026 (Release 5.1 published 5 May 2023). https://www.countermetrics.org/ ; "Best Practice on AI Usage" (guidance for R5.1.1, updated 30 June 2026), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). Thread 15newc2 "Endless spam since I published a paper a few months ago". https://www.reddit.com/r/AskAcademia/comments/15newc2/ (confirmed via the pullpush.io archive)
[128] Remler, D. (2014, April 23). Are 90% of academic papers really never cited? Reviewing the literature on academic citations. LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: "How RePEc counts views and downloads" (06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; "AI issues in RePEc" (10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; "RePEc in June 2026" (13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). "Removing the RG Score". https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). Experimental study of inequality and unpredictability in an artificial cultural market. Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). The discipline of rankings: Tight coupling and organizational change. American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). Methods and metrics for cold-start recommendations. In Proceedings of the 25th Annual International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '02), 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN R package. https://github.com/enricoschumann/SSRN (also scrapers github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). The impact of AI bots and crawlers on open repositories: Results of a COAR survey, April 2025. Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 'Predatory' open access: a longitudinal study of article volumes and market characteristics. BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). The feasibility of developing and implementing journal usage factors: a research project sponsored by UKSG. Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). How the scientific community reacts to newly submitted preprints. PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). Legal Research in Search of Attention: A Quantitative Assessment. King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. Working-paper version: "What Determines SSRN Downloads", SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). Status, Quality, and Attention: What's in a (Missing) Name? Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). Designing organizations for an information-rich world. In M. Greenberger (Ed.), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). Unexpected Emails to Submit Your Work: Spam or Legitimate Offers? Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary Stats announcement. https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). What SSRN Means When We Talk About Data Integrity. https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). 2025 Year in Review: How SSRN Enhanced Access to Preprints and Early-Stage Research. https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN Strategic Update: Renewed Focus on Core Research Sharing Mission (post author: S. Decker-Lucke). https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). SSRN's Ongoing Commitment to Legal Scholarship. https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRN to Sunset Rankings from July 1st 2026. https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). SSRN Ranking has sunsetted as of 15 July 2026. https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRN will now allow you to choose the licence that's right for your work. https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. Historical FAQ (PDF copy, Scuola Superiore Sant'Anna). https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. Subscription page. https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). Measuring Research: What Everyone Needs to Know. Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). 동료 검토 과정에서 이중맹검이 편향을 감소시키는가? 상위 컴퓨터과학 학술지의 증거. JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (두 번째 저자 성씨 Crossref 기준: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). 약탈적 학술지 및 출판사: 교육과학 분야 연구자를 대상으로 한 학술 스팸의 특성 및 영향. Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): "SSRN 전자저널 순위 평균 다운로드 건수별" (2018, May), https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; "SSRN의 쇠퇴는 없었다" (07.06.2026), https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). AI가 약탈적 학술지를 탐지할 수 있는가? FT50 학술지의 사례. SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). 2025 Imperva 악성 봇 보고서. https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022, February 4). "학술지가 당신의 프리프린트에 관심이 있는가? 학술지 투고 권유에서 알곡과 쭉정이 구분하기". https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). 초기 경력 연구자의 약탈적 이메일 분석 및 예방 시도. Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide "SSRN 지표" (updated 29 Sep 2025). https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ 전자저널 페이지 p=9061269)
[162] van de Rijt, A., et al. (2014). 성공이 성공을 부르는 현상의 현장 실험. PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Center for Teaching / Office of Innovative Technologies) (2023). AI 탐지에 관한 지침 및 Turnitin의 AI 탐지기를 비활성화하는 이유. Published 16 August 2023. https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (accessed 15 August 2026).
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). 인용되는 것: AI 답변 엔진의 경쟁적 지리정보. SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). Drake 농업법 저널 확대: 녹색 이슈. Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). 과학에서의 참신함에 대한 편향. Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025, June). AI 봇이 문화유산을 오프라인 상태로 만들고 있는가? GLAM-E Lab (NYU Engelberg Center / University of Exeter). https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018, May 3). SSRN 전자저널 및 다운로드. https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). 배포, 토론 및 다운로드 개선을 위한 도구… SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (U. Detroit Mercy Law Review에 게재됨)
[170] Wikipedia: "사회과학 연구 네트워크"; "학술 학술지 프리프린트 정책 목록"; "프리프린트". https://en.wikipedia.org/wiki/Social_Science_Research_Network 및 관련 페이지.
[171] Willey, R., & Knapp, M. (2021). 법학 학술지의 인용 증가 방법. Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). 법학 학술지 인용에 대한 SSRN의 영향 및 이를 극대화하는 방법. University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). 지표의 파도: 연구 평가 및 관리에서 지표의 역할에 관한 독립 검토 보고서. HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). 요청하지 않은 제안: 잠재적 약탈적 학술지의 요청하지 않은 이메일의 특징 파악 및 사서의 역할. Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016, September 21). "SSRN에서 가장 많은 관심을 받는 법학 논문". https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). 다운로드 보고서가 학술지 이용을 신뢰성 있게 측정하는가? College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). 사용자, 자기중심성 및 통제 - 21세기의 학술 출판물 영향 추적. SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). 논문 접근: 인용으로의 연결, 주말 효과 및 계절성. Scientometrics (published 23.07.2026). DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). 높은 인용도 간행물을 식별하기 위한 필터링 도구로서의 Mendeley 열독. Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). 소셜 미디어에서의 관심 불평등. arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). 개별 과학적 영향의 진화 정량화. Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). 인용 분포의 보편성: 과학적 영향의 객관적 측도를 향하여. PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). 연구 평가 개혁에 관한 협약. Coalition for Advancing Research Assessment. https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). 지표의 파도 활용: 영국의 책임 있는 연구 평가를 위한 지표, 기반 시설 및 우선순위. Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). 저장소를 위한 표준화되고 COUNTER 준수 사용 통계. https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). 연구 및 혁신 요약 (R4RI): 지침. https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. 정책 인텔리전스 도구. https://www.overton.io
[188] CC-PLUS. 도서관 사용 통계 플랫폼 협력 컨소시아 (오픈 소스 SUSHI/COUNTER-5 수확; IMLS 지원, PALCI 등). https://www.cc-plus.org/
[189] HELIOS Open. 개방 학술 고등 교육 리더십 이니셔티브. https://www.heliosopen.org/
추가 출처
텍스트에 [B-n]으로 인용된 추가 출처: 플랫폼 페이지, 포럼 스레드, 블로그 게시물, 그리고 텍스트 내의 특정 지점을 뒷받침하는 기타 자료. 플랫폼 페이지는 불안정하므로 보관된 사본과 비교하여 다시 확인해야 합니다.
[B-1] Cabells Predatory Reports (활성 약탈적 저널 검사 서비스); Beall's List (보관 전용; 2017년 1월 이후 업데이트되지 않음).
[B-2] Caron, P. TaxProf Blog (2026, January 25). "The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors (EJMR), SSRN 다운로드 및 저자 순위에 대한 토론 스레드 (예: /topic/ssrn-downloads-and-views; /topic/top-10-of-authors-on-ssrn-by-downloads). 익명 포럼; 그러한 토론이 존재한다는 증거로서만 인용됩니다.
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, 스레드 1seeyq3 (2026년 4월 6일, "I've uploaded a working paper to SSRN… honest advice"); Reddit r/academia, 스레드 13w6zjw (2023년 5월 31일, "SSRN Approval Time is Absurd"). 제3자 Reddit 보관소를 통해 존재 확인됨.
[B-6] SSRN — 공지사항의 통계적 보일러플레이트 (예: https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/) 및 2018년 4월 공지사항 (04132018ann002). 플랫폼 페이지; 보관된 사본과 비교하여 확인하십시오. 보관된 사본: https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/ (스냅샷 2025년 12월 29일; 2026년 8월 15일 접속).
[B-7] SSRN FAQ — 버전 관리 및 ORCID. https://www.ssrn.com/index.cfm/en/faq/ (2026년 접속; 보관된 사본과 비교하여 확인하십시오).
[B-8] SSRN — "SSRN has Sunset Rankings" 랜딩 페이지. https://www.ssrn.com/ssrn/rankings-sunset. 보관된 사본: https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset (스냅샷 2026년 7월 19일; 2026년 8월 15일 접속).
[B-9] SSRN — hq.ssrn.com / papers.ssrn.com/topten의 과거 순위 페이지: 상위 10,000 논문 (TRN_gID=10), 상위 30,000 저자 (TRN_gID=7), 상위 3,000 법학 저자, 상위 350 미국 법학 대학, 상위 500 국제 법학 대학, Eigenfactor, 최근 상위 논문 (60일), "Ranking Data Explained" (ranking_data_explain.cfm?id=6 / id=10). 과거 페이지; 2026년 7월 15일 이후 이 URL들은 403/자리 표시자 응답을 반환합니다 — 보관된 사본을 통해 인용하십시오. 상위 10,000 논문 페이지의 보관된 사본: https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10 (스냅샷 2026년 7월 14일, 일몰 전날; 2026년 8월 15일 접속).
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (year-long observation: 875 invitations from 256 journals, 76% from blocklists). DOI 10.1080/10875301.2025.2550600; ResearchGate publication 384286174.
[B-11] Caron, P. TaxProf Blog (2026, June 7). "SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/ (Bainbridge [12]에 대한 답변; 2026년 9월 접속).
대응: [email protected].↩︎
인용 방법
Chernets, V. (2026). 7개의 다운로드가 의미하는 바는 무엇인가? 지표 맹목성과 SSRN 랭킹 종료 후 학술적 주목의 냉각 시작 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}