7ダウンロードは何を意味するのか?メトリック盲目性とSSRNランキング終了後の学術的注目の冷たいスタート
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7296358 · DOI 10.2139/ssrn.7296358 · Zenodo 10.5281/zenodo.22166896 · GitHub
- 正式版:SSRN 7296358 · DOI 10.2139/ssrn.7296358
- アーカイブ済みコピー、引用可能でダウンロード可能:10.5281/zenodo.22166896 — コンセプト DOI、常に最新版に解決される
- マークダウンと PDF の全文:GitHub
- 読みやすい HTML:https://polyhelper.ai/research/download-metrics/
同じテキストが 4 つのサーフェスにあるので、そのうちの 1 つが提供できない場合にも到達できます。SSRN が正式版を保持しているため、それを引用してください。
7ダウンロードは何を意味するのか?
メトリック盲と SSRN ランキング廃止後の学術的注目のコールドスタート
原稿種:批判的合成、方法論的フレームワーク、および事前登録対応の実証的アジェンダ
バージョン:2026年9月
著者:Vadym Chernets, PhD1
所属:AI systems architect
要旨
2026年7月15日、社会科学研究ネットワーク(SSRN)は、長年にわたってプラットフォームの唯一広くアクセス可能な比較フレームを提供していた論文、著者、および機関のリーグテーブルであるパブリックランキングを廃止しました。一方、ダウンロード数と引用統計は個々の論文と著者プロフィールに残りました(SSRN Blog、2026年7月15日)。その結果は非対称の測定イベントでした:著者は数字を保持し、規範を失いました。SSRN のカウンターは意味がなくなったのではなく、読めなくなったのです。すべてのダウンロード数は、スケールのない数字になりました。
本稿は、「7ダウンロードは何を意味するのか?」という問題は、論文の参照クラスが指定されるまでは科学的に不正な問いであると主張しています。生の累積利用数は、論文の年齢、分野、投稿コホート、配布露出、および前任著者の可視性なしには解釈することはできません。この問題は、初期の注目が学術的関心よりも、プラットフォームアーキテクチャ、電子メールアラート配布、検索インデックス作成、著者の威望、および注目の重み付けた動的によって形作られる新しい論文と低可視性の著者にとって最も深刻です。この状態を学術的注目のコールドスタートと名付けます。この要件は新しいものではありません:引用文献計量学における分野、年齢および文書型の数を正規化することは長く確立された慣行であり、使用量データの並列の問題は約15年前にすでに提起されていました(Kurtz & Bollen, 2010)。そのような種類の文献計量指標は、分野、年齢および型が既知で、指標は読み手に代わって計算されるデータベースを想定しています。一方、プリプリントプラットフォームは、著者に参照クラスなし、ツールなし、および(2026年7月以降)比較フレームなしの裸の整数を手渡しています。欠落しているのは方法ではなく、その実装です:SSRN は著者向けにそれを適用する楽器を提供していません。
利用可能な証拠は、単純平均がいかに誤解を招くかを示しています。SSRNネットワークの唯一の最近公表された大サンプル外部研究(マーケティング作業論文2,361件)では、平均ダウンロード数は221.3であるのに対し、中央値は87であり、平均は第75パーセンタイル(206)さえ上回っていました(Jo & Li, 2026)。ダウンロード分布は準対数正規分布であり極端な上側裾を持ち、単一の学問領域ネットワーク内でも平均ダウンロード数は各サブフィールド間でおよそ8倍異なります(Whalen, 2018)。したがって、プラットフォーム全体の平均はいかなる論文をも特に説明するものではなく、新しい論文をそれに対して比較検討することは、集約の虚構に対して較正することです。利用可能な転換証拠では、40の要旨閲覧から7ダウンロードといった数値は失敗を示してはいません。それは広い信頼区間を持つスクリーニング結果であり、リーチ、転換率、経過年数、および分野を通じて解釈されなければなりません。
その証拠から、本論文はランキング後のSSRNメトリクス解釈フレームワークを構築し、露出、要旨閲覧、全文ダウンロード、および下流利用を分離し、リーチ・転換率診断を加えて非可視性と却下を区別しています。単一の虚栄心メトリクスの代わりに、Cold-Start Scholarly Attention Benchmark(CSAB)という多次元的な代替案を提案しています。それに付随するドシエプロトコルでは、報告されるすべてのメトリクスがその出所、時間窓、参照クラス、および限界を伴っています。本論文は次に、欠落している尺度を再構築するための事前登録対応アジェンダを提示しており、それは新しいSSRN論文の第1日目から第180日目まで観察される将来のパネル、キュレートされたメール警告配信とランキング廃止自体を利用した準実験、コミュニティが構築したパーセンタイルベンチマーク、およびAI回答エンジンにおけるプレプリント可視性の監査を含みます。証拠基盤は引用された研究と付録Eの非代表的な文書横断面を統合しており、本論文は欠落しているベンチマークをいかに再構築できるか、およびなぜいかなるダウンロード数もそのプラットフォーム上のコンテキストなしに流通すべきでないのかを明示しています。
キーワード:ダウンロード数; 利用指標; 分野正規化; 研究評価; プレプリント; scientometrics; 昇進と終身雇用; 法学奨学金; altmetrics; マタイ効果; 累積的優位; 注意経済; 要旨閲覧; 捕食的ジャーナル; 生成エンジン最適化。
JEL分類: A14; D83; I23; O33; L86
ハイライト
生のSSRNダウンロード数は、論文の経過年数、分野、投稿コホート、流通露出、および先行する著者可視性なしに安定した解釈を持ちません。
2026年7月15日のランキング廃止はプラットフォームの唯一の公開比較枠組みを除去しましたが、すべてのカウンターは生き残りました:著者は数値を保持し、ノルムを失いました。
唯一の最近公表された大サンプル分布では、ダウンロードは強い右歪みを示し、平均221.3対中央値87です:「平均的な」論文は構造上非典型的です。
リーチ(要旨閲覧)を転換率(閲覧あたりのダウンロード)から分離することは、非可視性と却下を区別します:異なる診断であり異なる対応が必要です。
公表されている閲覧からダウンロードへの転換アンカーは約11~19%の帯域に集中しており、40の要旨閲覧から7ダウンロードはスクリーニング結果として範囲と一致しています:利用可能な証拠に基づけば失敗の兆候ではありません。
Cold-Start Scholarly Attention Benchmark(CSAB)は単一の虚栄心メトリクスの代わりに、正規化されたリーチ、ダウンロード性能、転換率、モーメンタム、および下流検証を報告しています。
事前指定された事前登録対応アジェンダ(将来のパネル、プラットフォーム自体の改革によって作られた2つの異例のタイムリーな準実験、コミュニティパーセンタイルベンチマーク、および生成エンジン最適化が証拠ベースとして扱われる前に必要なAI回答エンジン監査)は、欠落している尺度を再構築する方法を明示しています。
範囲と証拠規律
本論文は批判的総合であり、方法論的フレームワークと事前登録対応経験的アジェンダを伴い、報告される唯一の新しいデータは付録Eの非代表的な文書横断面です。3つの証拠クラスは全体を通じて分離されたままであり、本論文内のすべての数値はそのクラスを伴います:
1. 検証済み推定値:公表された数値は一次出典に対して検証され、そのサンプリングフレームとビンテージとともに引用されるか、検証が部分的である場合は明示された留保条件とともに検証されています。
2. 歴史的アンカー:より早いサンプルと廃止されたプラットフォーム機能。分布構造を明らかにするために保持されており、2026年のための較正されたノルムのままであるからではありません。
3. 概念的および提案された産出:事前指定された予測、ベンチマークテンプレート、および研究設計。明示的にそのようなものとしてラベル付けされており、合成的な知見は含まれていません。
解釈可能性問題、参照クラス議論、およびリーチ–転換率分解は、上記の証拠に基づいて弁護されている分析的主張です。本論文が提案するインフラストラクチャは、解決済みの規範ではなく、コミュニティが構築および評価するための設計として提供されています:コミュニティパーセンタイルレジストリ(セクション8.8)、著者向けカリキュレータ、およびセクション8.10の調整アーキテクチャ。本論文の診断的主張は、そのいずれかが採用されることに依存していません。
最も使用されている公開ベンチマークを失いたての分野では、乏しい公共の利益は、いかなる著者であれ、どこでも実行できる複製可能なプロトコル、ならびに既存の数値の由来と経過年数を述べる総合です。
40の要旨閲覧と7ダウンロードの事例はこの方法論的総合全体を通じて再発生しており、それは表1に記載されている疑問を説明しているためです;結論は引用された証拠に基づいており、いかなる単一ダッシュボードにも依存していません。
3つのルールが総合自体を統治しています。単位は2つの共通分母、論文あたりの生涯ダウンロード数と論文あたりの12ヶ月ダウンロード数に正規化されています。ブリッジングは出典自体が必要な比率を報告している場合のみ実行され、その場合、ネイティブ単位は出典が支持しない仮定を変換に要求する際に保持されています。すべての事実上の主張は検証層を伴い(一次出典に対して検証、明示された留保条件とともに検証、または検証待ち)、表の出典信頼度列に記録されています。出典が競合する場合、最も顕著には有効な廃止日を巡って、競合は後の公式出典を支持することで解決され、フラグが付けられています。各推定値はそのティア、ビンテージ、および経過年数注釈をそれが再利用される場所で保持しています。
ソース選択を支配する単一のルールがあります。参照は、異なるメカニズム、結果、プラットフォーム上の事実、測定上の警告、または設計の先例に貢献する場合に保持されます。引用の数量は目標ではありません。投稿することと読まれることは異なる成果です。この記事は後者についてであり、それを測定するための手段の崩壊についてです。もっともらしく見えるテーブルは証拠ではなく、文脈自由な数字についての記事では、このルールはまず記事自体を拘束します。
1. 序論
1.1 40ビュー、7ダウンロード
研究者(初期段階のキャリア、所属機関がないか、あるいは単にプラットフォームが初めての人)がSSRNに注意深く準備した作業論文をアップロードし、数週間後の2026年8月にそのペーパーの統計パネルを開いたとします。ダッシュボードは「40件の要旨表示」と「7ダウンロード」を報告しています。この時点で、学術的注目の統計についての実務的な知識がなければ、著者はこれらの数字が同僚による壊滅的な拒否、専門分野の専門的なテキストの標準的な統計基準線、または異常に強い軌跡の始まりを意味するのかを判断できません。著者は同僚に尋ねます。「それはひどいですか?」誰も答えられません。ダッシュボードも、学術文献も、プラットフォーム自体も答えを提供しておらず、この数はどのような基準に対して読むべき尺度を持ちません。この状況はメトリック盲目性、すなわち自分自身のカウンターの前に立ちながら、失敗と通常のパフォーマンスと成功を区別できない無能さです。用語はここで理論的構成として導入されており、測定された量ではありません。研究4(セクション8.6)は具体的な指標(ベンチマークに対して自分のカウントを位置づけたことがないと報告する著者の割合、および低いカウントが引き出す最初の読書分布の分布)を提供するため、「メトリック盲目性」は事前登録調査が推定できるものを指します。
コミュニティフォーラムで著者によって語られ、ここで説明的な逸話として提供される関連シーンは、より明白です。研究者が最初のプレプリントをアップロードし、ダッシュボードがゼロビューとゼロダウンロードのままである一方で、数日以内にインボックスが原稿を勧誘するジャーナルから5通のメールを配信します。それらはすべて捕食的なものです。新しい参入者が受け取る唯一の返信は捕食的なジャーナルからのものです。セクション7はこの非対称性を明示的な仮説のセットとして展開し、研究3(セクション8.6)はそれをどのようにタイミングを計るかを指定しています。このシーンは情報空白の現実的対応です。正当な注目経済はこの著者にそれに対して読むべきものがない数を与える一方で、寄生的な経済は阿諛追従を供給し、読者はいません。
2026年の夏まで、おおよその答えが存在しました。SSRNの公開ランキング(トップペーパー、トップ著者、機関別リーグテーブル)により、著者は見える分布内でカウントを位置づけることができました。2026年7月15日、それらのランキングは廃止されました[149]。廃止は、「研究はそれ自体を語るべき」という声明でこの決定を枠づけた2026年6月12日の発表[148]と、2026年4月13日に発表されたプラットフォームのコアな研究共有ミッションへのリソースの戦略的な焦点の変更[146]に続きました。削除は非対称でした。ペーパーごとのダウンロードカウントと引用統計は「個別のペーパーと著者プロファイルで記録され表示され続けます」[149]一方で、それらのカウントに尺度を与えていた分布は消えました。ダッシュボードの研究者の状況はプラットフォーム全体のユーザーベースに一般化されました。190万人以上の著者と150万のペーパー[49]です。
この論文はその状況についてのもので、その論文は2つの部分を持っています。ランキングのシャットダウンはコンテキストを削除し、データではありません。ペーパーごとのカウンターはサンセットを生き残り、まだ表示されます。それらのカウンターを読むことができた比較スケールは消えました。それはメトリクスが読めず、意味がないわけではないのはなぜです。
2つ目は、「7ダウンロードは何を意味しますか?」という質問は、正しい分母と比較グループが指定されるまで、科学的に不適切です。その分母を提供し、それを使用するための機器を提供することが、この論文のタスクです。
1.2 スケールのない数字
解釈上の問題は見た目ほど単純ではありません。7日後の10ダウンロードと90日後の10ダウンロードは同じカウント数ですが、その意味はほぼ確実に異なります。また、一方の論文が国際的に認識されている教授で高い知名度を持つ機関の名前を持ち、もう一方が初めての著者のデビュー作である場合、さらに異なります。学術的な利用指標は、このような文脈を考慮しない形式でまさにこのように提示されているため、すべての数字は必然的にロールシャッハテストになります。同じ「40ビュー」が、ある著者にはパニックを、別の著者には無関心を引き起こすのは、共有されたリファレンスポイントがないからです。
生のダウンロード数の期待値は、カウンターが示さないすべてのものとともに変わります。論文の年数、その分野、投稿の同期グループとカレンダー環境、実際の配信露出、および著者の過去の知名度です。これらの依存関係はすべて実験的に文書化されています。平均生涯ダウンロード数は単一の規律ネットワークのeジャーナル全体で約8倍異なり、企業法および証券法では約438から農業法では約53までです[168]。アクセス活動はカレンダー自体と変わり、ジャーナルアクセスデータで週末は約11%低下し、夏月は約50%低下します[178]。位置と露出はコンテンツとは無関係に重要です。arXiv告知リストの最も見えやすい位置に表示される論文は、その後著しく高い読者数と引用を獲得し、天体物理学では中央値の引用増加が約83%です[72]。名門機関から発信されたアイデアは、知名度の低い機関からの同等のアイデアよりも迅速かつ広く拡散します[111]。これはステータスと注意に関する長年の証拠と一致するパターンです[104][105][140][103]。SSRN上では、増分トップ50共著者は測定可能なダウンロード率の優位性と関連しています[83]。プラットフォーム自体の配信メカニズムもカウンターを形作ります。著者は最大7つの分類を選択でき、キュレートされたトピックベースのメールアラートへの含有は保証されず、高いボリュームのトピックは最大45日の遅延に直面する可能性があります[53][57]。論文の初期カウンターは、関連する配信が既に発生したかどうかだけを反映するかもしれません。
プラットフォームのカウント規則は、著者がめったに見ない第2の層を追加します。SSRNはカウンターをフィルタリングし、明らかなロボット活動と同じ人による繰り返しダウンロードを破棄します[144][66][69]。そのようなフィルターがなければ、カウントは「5倍以上」だけ膨らまされるでしょう[18]。ビューとダウンロードは約安定した変換でリンクされており、BlackとCaronは2006年に「一般に、SSRNウェブサイト上の3つの抽象ビューは1つの実際のペーパーダウンロードをもたらします」と報告しました[18]。後のサンプルでは、変換は抽象ビューの約11%から19%の間に位置します[139][172]。最近のマーケティングサンプルは平均して100ビューあたり約24ダウンロードです[83]。このような解剖学を知っている著者は、すでにタイトルの40ビューと7ダウンロードをチェックできます(セクション5.2は計算を実行します。報告されたバンド内に着地します。広いインターバルスクリーニング結果として)が、プラットフォーム上のものはそれを通信しません。
外部スケールがギャップを埋めません。これは不便ではなく、測定の失敗です。h指数[79]の場合、「良いXとは何か」ガイドの全体的なジャンルが存在します[118][128]。SSRNダウンロードの場合、セクション2.5監査は2026年8月現在、公開ソースにこれに類するものが見つかりませんでした。文献は配布を報告します[85][139][168][83]。しかし、著者に直面しているノルムに変換するものはありません。個々の学者は自分のポートフォリオから台所のベンチマークを即興で作成しました[42]。図書館ガイドは、カウンターが何であるかを説明しますが、それが何を意味するかは説明しません[161][50]。すべての著者がグーグルで検索する数字は見つかりません。
1.3 利害関係:キャリア、不安、そして誇大表現のインセンティブ
格差が重要なのは、その数字が実質的な影響を持つからです。SSRNの公式ドキュメントは、その指標を「著者が昇進・終身雇用の目的で使用し、機関が採用および格付け活動で使用する」ものと説明しています[52]。使用は具体的で実証されています。著名な法律学者は「法律著者全体3,000人のうち総ダウンロード数で13位にランクされており、法学部がさまざまな昇進関連の決定を行う際にこれを考慮に入れている」と報告しており[12]。法律雑誌の投稿ガイドは、推薦状に「SSRNのダウンロード数(多い場合)」およびトップテンリストへの掲載について言及することをお勧めしています[95]。機関はサンセット前までの数週間、SSRNの成績についてプレスリリースを発表していました[101]。集計レベルでは、SSRNのダウンロード数は100の法学部の引用ベースのランキングと0.84で相関しており[77]、これは個別の論文または著者には降りてこない学校レベルの関連性であり、セクション6.2(iii)の生態学的推論の警告です。機関がそのような指標に作用すること自体が、よく文書化された動的特性の例です。公開ランキングは反応的であり、それらが説明すると主張するまさにその行為者の行動を再構成しています。その仕組みは法学部ランキングで詳細に確立されており、同等化と自己成就予言により学校は指標の周りに再編成されました[58][132]。SSRNは、上位30,000人の著者(約360,000人のリストされた著者の約8%)に周期的にメールを送信して、彼らが「トップ10%に入っている」ことを知らせることで、通貨を直接強化しました[161]。「10%」はリストされた著者のシェア(30,000/360,000 ≈ 8.3%)であり、100万人以上の登録著者ベース全体[49]に対して、同じ30,000はより近くトップ2%であるため、表現はランキングされた著者ではなく登録者全員を説明しています。一方、キャリアアドバイスは、自己公開の指標だけでは「おそらく法学部の昇進・終身雇用目的ではカウントされない」と警告しており[33]。より広い評価文献は、指標ベースの評価が採用と終身雇用にどの程度深く浸透し、また設計がどの程度不十分であるかを文書化しています[110][115][153]。ダウンロード自体は品質の直接的な測定ではなく、注意の測定です。初期の使用は後の引用のみを控えめに予測し(相関は約0.4で、初期の作品では分散の約16%を説明し[25]、後の推定では0.11-0.35[80])。高ダウンロード数と高被引用数の論文セットは大幅に異なります[108]。機関は、これらの数字に尺度がなく、学術的影響への結びつきが緩いにもかかわらず、キャリアの証拠としてこれらの数字を扱っており、これは2つの対称的な方向での誤読への立場的な招待です。尺度がなければ、著者は誤読されたカウンターの強さで仕事の線を時期尚早に放棄したり、数字が異常でなかった論文を宣伝することに貴重な時間と社会資本を費やしたりする可能性があります。ランキングは、その欠陥がどうであれ、論文のさらなる宣伝が保証されたかどうかについての、まさにその反復的な決定に対応していました。その削除により、その選択がデータなしで行われました(これはセクション6.4で扱われたポイントです)。
利害関係は感情的でもあります。著者がダッシュボードで経験するものは、指標不安の独特な形式であり、ダウンロード数は強迫的に監視されています。科学計量学の観察者は、自動追跡の可視性ツールのジャンルを2012年の時点で「ナルシシズムの技術」と説明していました[177]。著名な法律学者の1人の自分のカウント監視は「私にはクラックのようだ」という認め(Bainbridge、2007、SSRNゲーミング行動に関する文献で引用)は象徴的になりました[44]。同じ研究プログラムは、不安が生成するものを実験的に確立しました。著者は自分の論文を自己ダウンロードしてカウントを膨らませており、トップテンリストの可視性閾値の近くと同僚との不利な社会的比較の下で最も激しく行っています[44]。このような社会的フィードバックループは、注意市場の一般的な特性です。初期の社会的信号は文化市場の不平等と予測不可能性を増幅し[131]、最初の肯定的な信号はその後の評価に偏見を持たせ[112]、フィールド実験で成功は成功を生みます[162]。ソーシャルメディアで自己報告されたマイルストーン、高いパフォーマーに偏り、ダッシュボードが7を読む人全員の比較を鮮明にします。公開ベンチマークの欠如は、不安を生み出し、誤釈を燃料とし、すべての人にとってメトリクスを弱体化させる人工的な膨張を促します。問題はパフォーマンスの前に測定の問題です。可視的で、感情的に帯電し、キャリアに関連し、解釈不可能である同時にあるメトリクスは、ダッシュボードを見つめている人の個人的な欠陥ではなく、測定インフラストラクチャの本物の失敗です。
1.4 誰が最も傷つくのか:衡平性の側面
読みにくいメトリクスのコストは均等に分配されていません。密集した専門家ネットワークを持つ著者は非公式にベンチマークできます。確立された著者は論文から論文へ以前の可視性を保持しています。公開的な規範の欠如は、初期段階の研究者、独立した未所属の学者、狭い専門分野の著者、プラットフォーム上で歴史的に支配的だった学問分野の外の著者、エリート機関の外の著者に最も重くのしかかります。この不利は構造的であり、単なる情報的なものではありません。SSRNの発見メカニズムは機関のワーキングペーパーシリーズと購読電子ジャーナルアラートを通じて注目をルーティングします[57]。未所属の研究者は投稿することはできますが、高トラフィックの機関シリーズに論文をシード(seed)することはできず、可視性のために完全に主題分類に依存しています[168][53]。そのような著者にとって、機関の露出チャネルは事実上閉ざされており、発見の重みは検索とAIレイヤーに不均衡に落ちます。第8章で検討する機械の可視性は、したがって単なる技術的な問題ではなく、衡平性の問題です。分野メンバーシップだけでも、メリットの判断が入る前に、予想ダウンロード数を数倍シフトさせます[168]。プレスティッジ効果は最初の露出の瞬間に動作します。公開SSRNページはタイトルと要約と並んで著者名と所属を表示するためです。二重盲検査読は別の方法で機能します。著者のアイデンティティを削除すると、査読者スコアを著名な著者に対して測定可能に低下させます(5,027件のICLR投稿の1つの研究では、受理決定に対する影響ははるかに不確定です)[154]、そして評価は実験的にアイデンティティシグナルに反応します[64]。注目度分布の底部では、現象は不平等ではなく不在です。アルトメトリクスデータでは、大規模なSDG焦点サンプルで研究されているすべての分野にわたって、資金なし研究の中央値社会的注目はゼロです[41]。隣接するオープンプラットフォームでの注目は、先進経済のいかなる不平等よりも不平等であり、ジニ係数が0.9を超えています[180]。中央値著者にとって、「7ダウンロードは悪いのか?」という質問は、虚栄心の表示というより、系統的に不均衡なゲームの唯一のシグナルを読もうとする試みです。この非対称性を無視する解釈フレームワークは、不可視性を拒否と読むことで、不利な立場の人々を系統的に誤診します。この非対称性はまた前方へ投影されます。新興のAI答えレイヤーが商業生成エンジン最適化に対して文書化されたブランドと位置バイアスを継承した場合、それはこの不平等を是正するのではなく再現するでしょう[5][164]。その見通しは未所属の研究者と地球規模南部(Global South)の著者に最も重くのしかかります。そしてそれは、第8.6章の機械可視性監査が機関プラットフォームの不思議というよりむしろ衡平性アジェンダに属している理由の1つです。
1.5 解釈に対する文書化された需要
スケールへの需要は仮説的なものではありません。これは学術コミュニティの言説における最も持続的なパターンの一つであり、サンセットの少なくとも10年前にさかのぼります。表1は、著者の質問と懸念の反復的なクラスタ、各クラスタの最も強く文書化された証拠、各クラスタが招く危険なショートカット(役に立つように見えるが間違っている短答)、およびこれに対応する本記事のセクションをまとめています。
表1. 解釈に対する需要:文書化されたコミュニティの苦痛クラスタ(2005–2026)
| # | クラスタ | 著者が質問または報告する内容 | 文書化された証拠(信頼度) | 危険なショートカット | 対応箇所 |
|---|---|---|---|---|---|
| 1 | 「私の数字は正常ですか?」—欠けているベンチマーク | 与えられたダウンロード数が比較可能な論文にとって良いか、悪いか、または典型的かどうか | 公開質問「論文ダウンロード統計の重要性」、Academia StackExchange、2016年(タイトルと日付は公式APIで検証済み)[3];SSRNへの投稿とその価値に関するユーザー質問[126];ダウンロード数がいくつ「良い」と見なされるかについての反復的なフォーラムスレッド(スレッドの存在は確認済み;個別の返信は独立して検証可能ではなく、フォーラム資料は全体を通じて需要の弱い証拠として扱われており、データとしてではない)[B-3];新規投稿の作業論文に関する初心者の著者による「正直なアドバイス」の要求(Reddit、2026年4月;第三者のアーカイブで存在確認済み)[B-5] | 普遍的な生データ数しきい値(「Nダウンロード=良い」) | セクション3、5–6 |
| 2 | メカニクスの混乱—ビュー対ダウンロード | ビューがダウンロードを超える理由;低い比率は抄録が弱いことを意味するかどうか | 歴史的3:1経験則[18];報告された変換帯域11–19%[139][172];最近のサンプル平均≈24%[83];ライブラリガイドは著者がカウンターに何が含まれるかについての不確実性を文書化[161] | 低い比率は抄録が悪いことを意味するという自動的な主張 | セクション4–5 |
| 3 | 感情と社会的比較 | 強迫的なチェック;低い数字と高い数字の両方での恥ずかしさ | 「私にとってクラックのような」(Bainbridge、2007年、[44]で引用);社会的比較下でトップリストしきい値付近での自動ダウンロードの実験的証拠[44] | プラットフォーム全体の平均または目に見える星に対して自分自身をベンチマーク化する | セクション1、5 |
| 4 | キャリア証拠—サンセット後にドシエの順位行を置き換えるもの | サンセット後の終身在職権、昇進、および採用資料で引用すべき内容 | ダウンロードランク「様々な昇進および関連決定で考慮に入れられた」[12];トップ10%通知メール[161];カバーレターアドバイス[95];機関のプレスリリース[101];プラットフォームの評価的使用の説明[52] | 日付、ソース、または分母なしの生累積数の引用 | セクション6(表13) |
| 5 | 投稿後の勧誘スパム | 投稿直後に到着する未承諾のジャーナル招待 | 「毎日、これらのメールを少なくとも2つ受け取ります」(Reddit r/AskAcademia、2023年;アーカイブで検証済み;著者はSSRNではなくMDPIジャーナルで発表していた)[127];「例えばSSRNで投稿されたもの」などの論文からのアドレス収集[107];勧誘量の監査[9][84][63];学術スパムの29の実証研究を特定する体系的レビュー[61] | 集計カウンターから読者の身元または意図を推測する | セクション7 |
| 6 | カウンターの信頼—ボット、ゲーミング、急激な低下 | 数字が本物であるかどうか;カウンターが低下する理由 | 「SSRNは精度の検証を絶対にしない」(Goldman、2005年、現在のフィルタの前;後の更新はSSRNが繰り返された同じソースのダウンロードを割引することを記録)[66];SSRNの公開データ整合性フィルタリング[144][66][69];初期のREPeC データではロボットトラフィックが抄録ビューの約74%を占めるが、ダウンロードのわずか約7%[99];2025–2026年を通じたREPeC上の大規模ボットフィルタリングエピソード[129] | 表示された数を独自の人間の読者の正確なカウントとして扱う | セクション4、9 |
| 7 | 診断—「なぜゼロダウンロード?」 | 最初の数週間でのゼロまたは停滞の意味 | サンセット後の著者の不確実性がコミュニティスレッドで文書化(第三者のアーカイブで存在確認済み)[B-5];プラットフォームサポートページはメトリクスについて説明していますが、2026年8月の時点で解釈ガイダンスを提供していません[52][50](検索監査、セクション2.5) | 配布前のゼロを拒否として扱う | セクション4–6 |
注記。生のまたはアーカイブされたソースに対して独立して検証されたのみ引用符で再現され;その他すべてのコミュニティ資料は言い換えられ、その信頼度ステータスでマークされています。ユーザー投稿の引用の倫理、匿名化と削除されたコンテンツの処理、はセクション9で対応されています。
表1の最も強いクラスタは、慢性的な質問「私の数字は正常ですか?」です。これは年、プラットフォーム、および分野全体で反復します。プラットフォームのインサイダーでさえ返答としてベンチマークを提供せず、コミュニティフォーラムでしばしばこれに答えられる皮肉は、経験豊かなユーザーを含め誰もが欠けているスケールを所有していないことを示唆しています[B-3]。クラスタはまた因果的に接続されています:欠けているベンチマーク(クラスタ1)は感情的負荷(クラスタ3)を生じさせ、これはクラスタ6で検討された信頼を侵食する[44]で文書化されているゲーミング インセンティブを生じさせます。解釈可能性を復元することはチェーンをそのルートで対応させます。このフレームワークはダウンロードを増やすことではなく、意味を復元することを目的とします。
1.6 本論文の主張:8つの立場
本論文が支持する立場であり、それぞれ記載されたセクションで論じられています。
1. 生カウントは参照クラスがなければ解釈不可能である。累積ダウンロード数は、論文の年齢、分野、投稿コーホート、配布チャネル、著者の事前の可視性を条件としなければ、安定した意味を持ちません[83][168][178][53]。これはセクション5の参照クラス問題であり、「7ダウンロードは良いのか?」という問いを問われたままでは不適切にします。
2. 低いリーチと低い転換率は異なる診断である。少数の人しか遭遇しない論文と、多くの人が閲覧するが少数がダウンロードする論文は異なる問題を提起し、異なるアクションを正当化します。認識されない状態はコンテンツの拒否ではありません。セクション4~5は、この区別をリーチバイ転換診断(表9)に発展させ、強い転換が弱いリーチと共存する「隠れた関心」の設定を含みます。
3. カウンターは存続したが、比較スケールは存続しなかった。夕焼けの非対称性(数字は保持、規範は削除[149])はRankings後の状況を正確に記述し、長期潜在的な解釈可能性問題を緊急で普遍的な問題に変換します(セクション2)。
4. パーセンタイルベンチマークは公共財である。あらゆる著者が検索しても見つからないという数字は、分野と論文年齢別のパーセンタイル表です。セクション5と8は、プラットフォームから読み取ることができなくなった今、コミュニティがどのようにしてそれを構築・維持できるかを指定します。
5. 較正された規範には投稿から観察されたパネルが必要である。発表された証拠は加齢する横断面と単一のスナップショットで構成されています[139][85][168][83]。1つの最近の大規模研究は、パネルデータを必要な次のステップとして明示的に特定しています[83]。ゼロの日から観察することなしに、初週および初月の「規範」は外挿法であり、そのようにラベル付けする必要があります(セクション8)。
6. 多次元ベンチマークは単一の虚栄スコアに勝る。正規化されたリーチ、ダウンロードパフォーマンス、転換率、モメンタム、および下流検証を別々に報告する(CSAB、表10)ことで、複合インデックスが破壊する診断情報を保持します(セクション5)。
7. AI回答層は注意の新しい門番になりつつある。ディスカバリーはスタックをシフトアップしており、ジャーナルブランドからリポジトリへ、検索エンジンへ、単一の応答を統合し少数のソースを引用するAI回答エンジンへ[5][164]。米国の成人の4分の1がすでにAIチャットボットを毎日使用していますが[121]、引用チャネルとしてのこれらのエンジンの信頼性は引き続き争点となっており[82]、学術プレプリントの可視性に関する制御された研究はまだ存在しません[100]。セクション8はコンパクト監査プロトコルを述べています。完全な監査は付随作業のために予約されています。
8. ダッシュボードとドシエプロトコルが今必要である。著者と委員会は新しいデータインフラストラクチャを待つことができません。セクション6は、ダッシュボード解釈のための暫定的ルールとドシエ用の7段階証拠プロトコル(表13)を提供します。その統治要件は、報告されたすべての数字がそのソース、時間ウィンドウ、および限界を表示することです。
1.7 貢献
以下のリストは、本論文が既存の文献に加える内容を、各セクションが展開する順序で示しています。
1. 診断。プラットフォーム使用指標における参照クラス問題を特定し、根底にある現象に名前を付けます:学術的関心の冷え始まり。この用語は推薦システムの文献から適用されたもので、冷え始まり項目は、それを配置するために必要な相互作用履歴を欠いています [133]。この冷え始まりにおいて、新しい論文と新しい著者は、初期の関心が実質的な品質が完全な影響を及ぼす前にプラットフォームアーキテクチャ、配布、および事前の評判に大きく依存する拡散システムに入ります [72][111][140][83]。中心的な主張は、第1.1節の不適切設定論文です:見出しの質問は、その分母と比較グループが提供されるまで答えがありません。
2. 統合ベンチマークマップ。廃止以来初めて (第2.5節監査、2026年8月)、SSRN ダウンロードと要約ビューのすべての検証済み経験的ベンチマークを単一の表 (表7) に集約します。明示的なサンプリング枠、ビンテージ、加齢の注意事項、および各行のソース信頼度評価が含まれます。ベンチマークは、大標本分布証拠 [83]、準対数正規トップリストスクレイプ [85]、法律学奨学金サンプル [139][168][171][172]、およびプラットフォーム集計 [1][49] です。
3. 診断を伴う注目ファネルフレームワーク。拡散を露出、要約ビュー、全文ダウンロード、および下流の使用に分解します。その後、リーチ別変換マトリックス (表9) を導出します。これは不可視性を拒否から分離し、生数が体系的に隠す隠れた関心構成を含みます。
4. 解釈器具。ベンチマークマップを段階的解釈スケール (初期段階/控え目/堅実/強力/例外的; 表8)、実例を伴う変換帯、および冷え始まり学術的関心ベンチマーク (CSAB; 表10) に変換します。これは分野、年齢、コーホート、および以前の著者の可視性によって正規化された多次元報告形式です。フィールドメンバーシップのみで予想ダウンロード数が数倍変動し、すべての境界はソース化されているか明示的に著者の推定として示されているため、スケールのバンドは同じフィールドと論文年齢内でのみ比較されます。
5. 実行レイヤー。自分のダッシュボードを読むためのルール、ゼロダウンロードの場合の診断、状況ベースのアクション表 (表23)、捕食勧誘信号の仮説的分類法 (表14)、および7段階ファイルプロトコル (表13) を提供します。勧誘スパムがカウンターを移動させず、読みやすさを示していないという警告があります。
6. 事前登録対応研究アジェンダ。投稿から1、3、7、14、30、60、90、および180日での観察を伴う見通しパネルと、2つの準実験的設計を指定します:キュレートされたメールアラート配布を紙内の関心ショックとして、およびランキング廃止をメトリック解釈における自然実験として。さらに、新しいパーセンタイルへの唯一の残りルートとしてのコミュニティ構築パーセンタイルデータセット、AI応答エンジンのコンパクトな機械可視性監査プロトコル、および本論文自体のダウンロード軌跡の事前指定された純粋に記述的なレコードを指定します。各研究は低コストで実行可能であり、第9節のアクセスと倫理制限内にあり、数値予測は調査結果ではなく事前指定されたバンドとして述べられています。
1.8 記事の構成
本稿の残りは、さらに9つのセクションと5つの付録で構成されています。セクション2では、イベントとその背景を再構成します。2026年改革パッケージの完全な年表、何が残り何が削除されたか(表2、図1)、およびプラットフォームが述べたリソース再配分と焦点の再調整の根拠です。セクション3では、検証済みの分配証拠を提示し、平均値がいかに誤解を招くかを示します。平均値–中央値ギャップ[83]、準対数正規分布の裾部分[85]、および学問分野間の異質性[168](図2–4、表3–5)を扱い、マタイ効果と累積的優位性[104][105][131][162]の理論的背景(縦断的キャリアと引用軌跡で直接定量化されたダイナミクス[120])に対置し、注目度測度と質的測度の区別[25][80][108][178]を行います。セクション4では、カウンターの仕組みを検討します。フィルタリングとデータ整合性[144][66]、必要な反論を伴うロボットとファントムトラフィック[99][106][129]、プラットフォームアーキテクチャ(表6)、およびメタデータとバージョン管理の衛生管理です。セクション5では、解釈コアを展開します。参照クラス議論、統合ベンチマークマップ(表7)、解釈スケール(表8)、変換帯、到達度–変換マトリックス(表9)、およびCSAB(表10)です。セクション6では、フレームワークを著者および評価委員会の実践に活かします。ドシエプロトコル(表13)を含め、付録Aでは状況ベースのガイダンス(表23)を示します。セクション7では、注目経済の寄生層を分析します。捕食的な勧誘を仮説化された可視性シグナルとして扱い、すべてのタイミングおよび蔓延に関する主張を仮説として述べます[9][61][63][84][107]。セクション8では、プリレジストレーション対応の実証的課題を示します。スタック上部のAI回答層への注目の移行とプレプリント検出可能性への影響に関する簡潔な扱いを含めます[5][100][82][121][164]。セクション9では、最良で入手可能な分配証拠の単一ソース特性[83]、2012–2015年のサンプルの経年変化、およびプラットフォーム文書の不安定性を含む制限事項について詳述します。セクション10は、SSRN向けの政策提言をもって結論づけます(最重要として、リーグテーブル競争を復活させることなくコンテキストを回復する代替案として、学問分野と論文年代別の匿名パーセンタイル帯)、および研究コミュニティ向けです。
2. イベント:ランキング廃止およびその背景
2.1 ランキングの内容
SSRNの歴史のほとんどの期間において、その使用カウンターは密集した比較装置の内部にありました。論文レベルでは、プラットフォームは12ヶ月間およびすべての期間のダウンロード数による上位10,000リストを、ローリング60日間のウィンドウで計算された各電子ジャーナルの「最近の上位論文」リストとともに維持していました。著者レベルでは、すべての分野および法律著者の上位3,000名のような分野別リーグを含む全分野にわたる上位30,000リストを、新規ダウンロード数、総ダウンロード数、論文あたりのダウンロード数、および引用数でソート可能な形で維持していました。機関レベルでは、上位350米国法科大学院および上位500国際法科大学院を含む月刊リーグテーブルを維持していました[B-9、過去のランキングページ; 2026年7月15日以降、すべてのそのようなURLはエラーまたはプレースホルダーページを返しており、アーカイブされたコピーからのみ引用できます]。プラットフォームはまた、順位を直接的なパーセンタイル反応に変換しました。ワシントン大学ギャラガー法律図書館のSSRN指標ガイドが記録しているように、「SSRNは定期的に新規ダウンロード数およびすべての期間のダウンロード数で上位30,000著者にメッセージを送信し、彼らが上位10%であることを知らせています」。ガイド自体の「360,000人以上の著者」という図に対して、そのしきい値は記載されている著者のおよそ上位8%(約360,000人のうち30,000人)に相当しました[161、2026年8月14日にアクセス]。狭いエリートではなく、広い上層部です。セクション1.3では、完全に登録されたベースに対して、同じ30,000は上位2%に近いことに言及しています。これらのリストとメッセージは、事実上、SSRNダウンロードに関するプラットフォーム提供の著者向けパーセンタイル情報で、公開されたことがある唯一のものでした。
比較装置は装飾的ではありませんでした。BlackとCaronは2006年に、SSRNダウンロードは法学部の学術的パフォーマンスの「ベータ」測定として機能し、評判調査と引用数を補足することができると提案しました[18]。同じシンポジウム巻には、この提案の批判的な検討が含まれています[45]。制度的には、提案は成功しました。ダウンロードランクは採用資料、昇進ファイル、および機関の宣伝に入りました。SSRN自体のサポートドキュメンテーションは、その指標を著者が昇進とテニュアの目的で使用する図、および機関が採用およびランキング活動で使用する図として説明しています[52、2026年8月14日にアクセス]。法律執筆協会の出版ガイダンスは、著者に法律評論への送付状で「SSRNダウンロード(多い場合)、SSRNの上位10ダウンロードリストへの掲載」に言及することを勧めました[95]。2026年6月、Stephen Bainbridgeはキャリア機能を記録に置きました。彼は「すべての期間のダウンロード数の総数で3,000法律著者のうち13位にランク付けされており、法科大学院はさまざまな昇進および関連する決定でこれを考慮に入れています」[12]。SSRN自体のリーダーシップは、その当時のCEOによるプリプリントで法的学術コミュニケーションのプラットフォームの変換を文書化しました[68]。機関もリーグをマーケティングしました。2026年1月と同じくらい遅く、Maynooth Universityは、その法律およびクリミノロジー学部がSSRNの上位500国際法科大学院でアイルランドの部門の中で最初にランク付けされたことを発表し、143,500を超えるダウンロードを引用しました[101]。装置の行動への影響はEdelmanとLarkinのSSRNサーバーログの分析に文書化されています。この研究では、欺瞞的な自己ダウンロードがトップテンリストの境界に論文が接近したまさにその瞬間に激化し、社会的比較をキャリアの賭け金だけでなく、操作の主要な原動力として特定しました[44]。同じ研究は、2007年にBainbridgeに属するとされた発言を流布させました。ダウンロード数の監視は「私にとってクラックのようなもの」でした[44]。
装置には、より少ない注意を引き付けた2番目の機能がありました。引用と評判調査は複数年のクロックで動きます。ランキングはほぼリアルタイムでフィードバックを返し、初期キャリアの学者と有名な機関の外の著者が、より遅く、より保守的なゲートキーピング機器を待つことなく、目に見える影響を直接実証することができました。それらの欠陥が何であれ、リーグテーブルはプラットフォーム上のすべての著者に同等に見える唯一の比較装置でした。これは、セクション1.4が主張するように、彼らの除去がもっとも重く重くのしかかる理由の一部です。非公式な代替手段が最も少ない著者です。サンセットの影響に関する直接的な分布証拠はまだ存在しないため、これはRQ1(セクション8.5)がテストする方向性の期待です。2側面として、削除が注意を集中させたか分散させたかを問い、符号を前提としていません。
2.2 2026年リトリートの年表
2026年7月15日のランキングの削除は、2025年後期に始まるプラットフォーム上の決定の連鎖の頂点でした。図1に要約されています。
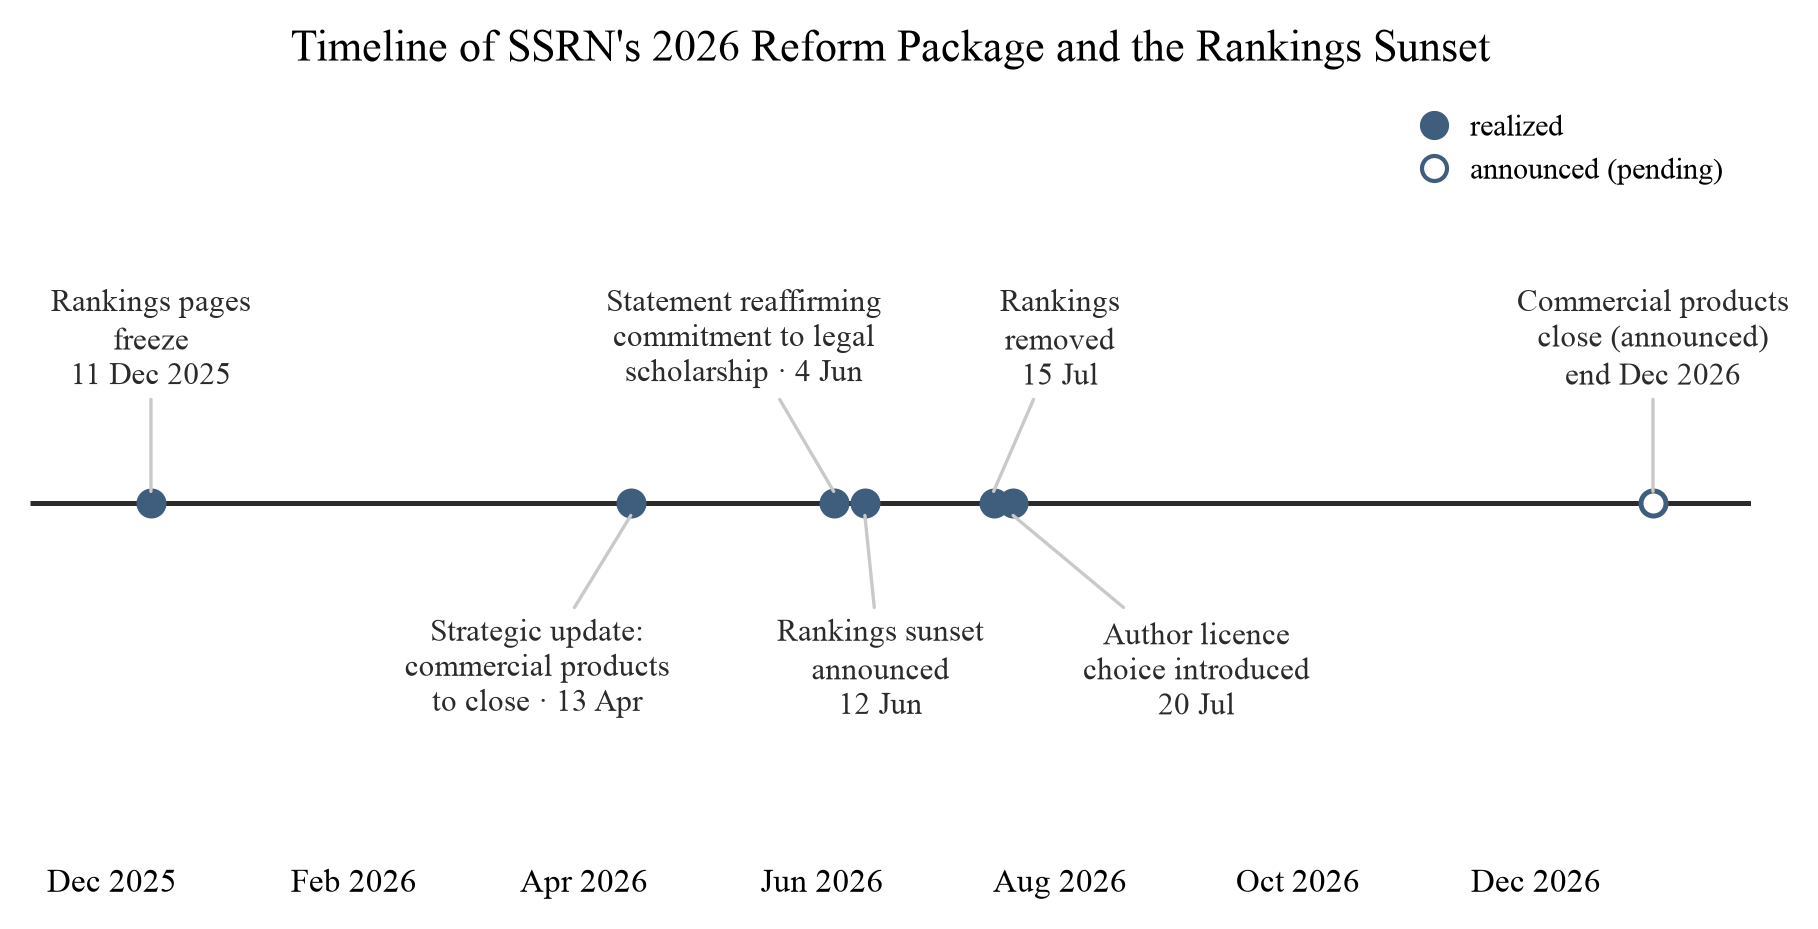
図1. SSRNの2026年改革パッケージのタイムライン。イベント: eジャーナルダウンロードランキングページの凍結(2025年12月11日から、2026年1月25日のTaxProf Blogの投稿で記録 [B-2]); すべての商用製品を2026年末までに閉鎖すると発表する戦略的アップデート(2026年4月13日) [146]; SSRNの法学奨学金へのコミットメントを再確認する公開声明(2026年6月4日) [147]; ランキングを「2026年7月1日から」サンセットすると発表(2026年6月12日) [148]; ランキングの実際の削除(2026年7月15日) [149]; 著者ライセンス選択の導入(2026年7月20日) [150]; 残りの商用製品の閉鎖を発表(2026年12月末) [146]。出典: [146][147][148][149][150][B-2]。
劣化は正式な発表の前に始まりました。2025年12月11日、eジャーナルごとのダウンロードランキングページは更新を停止しました。Paul Caronは、これらのランキングに基づいた「Top Five New Tax Papers」という週刊の特集を20年以上にわたって実行していました。2026年1月25日の投稿で、彼は税務ランキングが「2025年10月12日~2025年12月11日」の期間で凍結されたことを記録し、「これはSSRNのTop Five New Tax Papersの終わりかもしれない」と書きました [B-2、SSRN発表ではなく2026年1月25日の投稿の言い換えとして引用]。
2026年4月13日、SSRNは「戦略的アップデート」を公表し、「中核的な研究共有ミッション」への焦点を改めて、すべての商用製品(Research Paper Series、Sponsored Networks、サイト購読、有料会議議事録、分析ダッシュボード、職位・告知、データフィード)を2026年12月末までに閉鎖することを発表しました [146]。図書館の観察者はこの変化を数日以内に認識し [34]、ElsevierのDigital Commons部門は、Research Paper Seriesコレクションが廃止される機関に向けて移行ガイダンスを公表しました [47]。
この発表は法学界で公開論争を引き起こしました。法学界はランキングインフラストラクチャに最も投資していたコミュニティでした。2026年6月3日~4日、Bainbridgeは「The Social Science Research Network Has Jumped the Shark」というタイトルで広く読まれている批評を公表し、その後、SSRNが論文シリーズの閉鎖のタイミングと主題別eジャーナルの保護についての説明で彼の苦情に対応したことを記録する投稿を公表しました [12]。2026年6月4日、SSRNは法学奨学金への「継続的なコミットメント」に関する声明を発表し、eジャーナル配信とメールアラートが「変わらず継続される」と約束しました [147]。2026年6月7日、CaronはTaxProf Blogでのリプライで「SSRN Has Not Jumped the Shark」というタイトルでBainbridgeに応答しました [B-11]。この交換は、削除の前夜にコミュニティがプラットフォームの比較機能の価値を何と見ていたかの簡潔な公開記録です。
2026年6月12日、SSRNはランキングを「2026年7月1日からサンセット」すると発表し、「SSRNでは、研究は自らを語るべきだといつも考えてきました」と述べました [148]。シャットダウンは最初に発表された日付より2週間遅れて実行されました。2026年7月15日、論文、著者、および機関のランキングが削除されました [149]。5日後の2026年7月20日、さらなる改革により著者ライセンス選択が導入されました [150]。発表された日付と実際の日付の間の2週間のギャップ、および発表と実行の間の1か月の期間は、それ自体が分析的に関連があります。それらは、著者と機関が来たる変化を観察できる予測期間を作成しました。これは第8章の準実験デザインで取り上げられる論点です。
2.3 公式な根拠とその進化
サンセットの公式な正当化は、リソース配分とプラットフォームの焦点転換でした。7月の発表では、ランキングが「かなりの製品開発リソース」を必要とすることを説明し、この決定をより迅速な投稿、より良い発見可能性、研究の完全性への焦点転換の中に位置付けました。また、「ダウンロード数と引用統計は引き続き記録され、個別の論文と著者プロフィールに表示される」と述べました[149]。発表では、比較機能の復帰の可能性が開かれています。SSRNは「様々なランキングのアイデアを再検討する可能性がある」と述べたため[149]、削除は永続的なものとして説明されるべきではありません。記録における沈黙も同様に重要です。発表は、メトリックゲーミング、操作、またはランキングの競争的悪用に帰因する決定の理由を述べておらず、そのような動機を提供する説明は公開されたテキストを超えています[148][149]。
公式な説明のトーンは、発表とランキングURLを置き換えたランディングページの間で進化しました。6月の投稿がリソース配分について述べた場合、置換ページはSSRNの「新しい方向性が個々の著者とその業績を全ての中心に置く」と述べており、「機関と部門の集計されたリーグテーブルはもはやその状況に適合しない」としています[B-8;このページはアクセス制限の背後で提供されており、これらの表現は検索インデックスコピーから引用されているため、引用に伴うアーカイブ済みスナップショットがあるべきです]。6月の投稿はサンセットをコスト決定として提示し、置換ページは機関比較から全体的に遠ざかる原則的な再方向付けとして提示します。
SSRNは著者を完全に公式な文脈への指針なしに放置しませんでした。論文の影響度を判断するためのサポートドキュメンテーションでは、論文レベルのカウンター(要約表示とダウンロード)をPlumX Metrics(引用、使用、およびソーシャルメディアシグナルを集計するElsevierアルトメトリクス製品)で補完することが著者に指示されています[50、2026年8月14日アクセス]。したがって、PlumXはプラットフォームの解釈的文脈に対する事実上の代替として機能します。これは部分的な代替です。個別の論文に対して追加のシグナルを集計しますが、分布、パーセンタイル、またはコホート比較を提供しません。これらはランキングがいかに不完全であれ提供していた要素です。廃止はSSRNのジャーナルワークフローとの統合には及びません。First Lookプログラムはプラットフォームを1,200を超えるElsevierジャーナルに接続し続けています[48][145]。プラットフォームの商業ガバナンスはまた、これらの製品決定を非常に集中した学術出版市場の中に位置付けます[94]。
2.4 残されたもの、削除されたもの
表2は、2026年7月15日のランキング終了後のプラットフォームの状態をマッピングし、各要素の測定上の含意を示しています。つまり、残存、消滅、または報告されない各機能が、カウント数を読み取ろうとする人にとって何を意味するかを示します。削除は非対称でした。すべてのペーパーごと、プロフィールごとのカウンターは残存しています。これらのカウンターの上に構築された比較装置は完全に廃止されました。
表2. 2026年7月15日のランキング終了後に残されたもの、削除されたもの、および測定上の含意。 出典: [147][149][161][B-8][B-9]; 露出メカニズム行: [53][57][55][144][66][69]。
| 機能 | 2026年7月15日後の状態 | 出典の根拠 | 測定上の含意 |
|---|---|---|---|
| ペーパーごとのダウンロード数 | 残存; ペーパーページに表示 | 終了告知で字義通り確認 [149] | 生の使用状況は観察可能なままですが、独自の参照クラスはありません |
| ペーパーごとのアブストラクト閲覧数 | 残存(終了告知で字義通り名付けられていませんが、「ダウンロード数と引用統計」を列挙; 閲覧は引き続き表示されています) | [149], プラットフォーム観察, 2026年8月14日アクセス | リーチは観察可能なままなので、ペーパーごとのリーチ-コンバージョン診断(表9)は計算可能なままです |
| 引用統計(ペーパーと著者プロフィール) | 残存 | 字義通り確認 [149] | 下流での使用は早期注目指標を補完することができます |
| 著者プロフィール(ペーパー、所属機関) | 残存 | プラットフォーム観察, 2026年8月14日アクセス | ポートフォリオレベルの集計は可能なままですが、欠落した分母は同じです |
| eジャーナル購読とメールアラート | 残存 | 「変わらず継続」, 2026年6月4日声明 [147] | プッシュ露出チャネルは存続するため、早期カウンターはアーキテクチャに依存したままです(セクション4.4) |
| トピック分類(1-7, 著者選択) | 残存; eジャーナルルーティングを駆動 | プラットフォーム文書 [53] | 分類は潜在的に重要な露出変数です |
| キュレーションされたeジャーナル配信 | 継続; 掲載は「キュレーション済みかつ標的化、保証されていない」 | [53][57][147] | 配信状況と日付は背景ではなく処置としてモデル化されるべきです |
| 大量トピック内の配信遅延 | 継続; 最大45日 | [53] | 初月のカウントは配信前後のレジームが混在することがあります |
| 外部インデックス作成(Google, Google Scholar) | 継続, 検索エンジン制御のタイミング(「6~9ヶ月以上」) | [55] | 区間打ち切りされた露出プロセス: 露出日付は観察されず、境界が設定されます |
| 疑わしいアクティビティフィルタリング | 継続 | [144][66][69] | カウントはフィルタリングされたイベントであり、確認された読取や支持ではありません |
| AI回答によるペーパー検索 | SSRNからは報告されていません | プラットフォーム報告は存在しません; セクション8.6 | 機械の可視性は独立した反復監査を必要とします(研究2) |
| ペーパーページ上のPlumX Metrics | 残存; インパクト評価の公式ポインター | サポート文書 [50] | 追加のペーパーごとシグナルですが、分布、パーセンタイル、またはコホート比較なし(セクション2.3) |
| トップペーパーリスト(トップ10,000; eジャーナルごとの最近/全期間) | 削除; URLはエラーまたは終了ランディングページを返す | [149][B-8][B-9] | 主要な比較フレーム—および可能な発見サーフェス—が消滅しました |
| トップ著者リスト(トップ30,000; 学問領域別リーグ) | 削除 | [149][B-9] | 著者レベルのパーセンタイル順位はもはや公開観察できません |
| 機関レベルのリーグ(トップ350米国法学部/トップ500国際法学部など) | 削除 | [149][B-8][B-9] | 機関間比較はプラットフォームデータから計算できなくなりました |
| パブリックパーセンタイルフレーミング(著者順位, 「トップ10%」ポジショニング) | ランキングインフラの削除により削除 | [149][161] | 参照クラスは現在、外部で再構築する必要があります(セクション5, 8) |
| 「著者のトップ10%」通知メール | 公式コミュニケーションでは対応されていません; メールはランキングインフラに関連付けられていました | [161][149] | 履歴書で使用可能なパーセンタイルシグナルはもはや到着すると仮定できません |
表2に残っている行は、正確には生のカウンターと、それらを供給する曝露メカニズムです。プラットフォームは以前と同じ速度で数値を生成し続けています。削除された行は、正確には比較フレームのセットです。分布、閾値、ランク、パーセンタイルメッセージです。したがって、このイベントは正確な情報構造を持っています(データは保持され、参照クラスは取り消されました)。その構造は、長年潜在していた問題、つまりSSRN番号の読み方を、急性で普遍的な問題に変えます。プラットフォームが変わったプロパティをベンチマーク不透明性と呼びます。個別カウントを位置付けるのに必要な分布統計(パーセンタイル、中央値、コーホート分布)を公開するか、または生のカウンター、平均、トップNリストのみを公開するかを説明するプラットフォームの段階的プロパティです。2026年7月15日、SSRNは部分的な透明性から完全に近いベンチマーク不透明性に一段階で移動し、この記事の残りの部分は、そのプロパティがユーザーにコストがかかるものの研究として読むことができます。このように定義された不透明性には、少なくとも4つの次元があります。人口カバレッジ(公開統計が説明する対象者)、参照クラス粒度(フィールド、年齢、コーホートで条件付けするかどうか)、時間的安定性(定義とウィンドウが時間とともに比較可能なままであるかどうか)、および監査可能性(カウントルールが確認するのに十分な公開性があるかどうか)です。4つは部分的に独立して実行されます。分母と選択ルールが不明確である場合、ランキングは1つの不透明性の形式を減らしながら別の形式を悪化させる可能性があります。その部分的な独立性は、セクション10.4の推奨事項(項目4と8)が比較数値の戻りだけではなく、開示自体に対処する理由です。プロパティを測定可能にするために、各次元は、プラットフォームの公開インターフェースとドキュメントに適用される明示的な順序チェックリストでスコア付けされます。人口カバレッジ(0 = 生のカウントのみ、1 = プラットフォーム全体の要約統計が公開されている、2 = 定義された人口の分布統計)、参照クラス粒度(0 = なし、1 = フィールドなどの1つの軸、2 = 結合フィールド×年齢×コーホート条件付け)、時間的安定性(0 = カウント定義とウィンドウが文書化されていないか、またはサイレントに改訂されている、1 = 文書化されている、2 = 文書化され、バージョン化されている)、および監査可能性(0 = カウントルールが未公開、1 = 散文で説明、2 = チェック可能な詳細で公開)です。プラットフォームの不透明性プロファイルは、単一のラベルではなく、スコアの4タプルです。同じ機器はサンセット前後のSSRNをスコア付けし(カバレッジ、粒度、および廃止されたリストについては参照クラス粒度で下に移動)、表6のクロスプラットフォーム比較を印象ではなくスコアとして述べることができます。プラットフォームは多くの数値を表示でき、ほぼ完全に不透明なままです。ルーブリックは、精緻化され、評価者間テストされる最初の操作化であり、完成されたインデックスではありません。
2.5 解釈への需要
夕焼けが緊急の問題として提起した質問は、それより前からずっと問い続けられていました。表1(第1.5節)は、検証済みの出典に限定した著者による解釈需要の記録されたクラスターを集約しています。フォーラム資料はそこで需要の証拠として引用されており、分布の証拠ではなく、ユーザー投稿からの引用は投稿自体が特定された場所にのみ再掲されています(半公開的なフォーラム投稿の引用倫理は第9節で扱われています)。
以下の否定的主張は、無造作な検索ではなく構造化された検索監査に基づいており、第1.2節、第1.5節(表1)、および第8.8節の並行的記述も同様です。プロトコルはここで一度述べられます。英語で25以上のクエリ定式化のインベントリを構築し、6つの意図クラスターに組織化しました:規範的(「SSRNダウンロード数はいくつが良いのか」)、定義的(「SSRNダウンロード数に何が含まれるのか」)、サンセット後のナビゲーション的(「SSRNランキングが消えた—どこで比較するか」)、評価的(「テニュア証拠としてのSSRNダウンロード数」)、診断的(「SSRNペーパーゼロダウンロード理由」)、および実用的(「SSRNダウンロード数を増やす方法」)。各クエリについて、現在誰がそれに答えどの程度よく答えるかを記録しました。基準は、返されたソースのいずれかがメトリックスの説明や逸話ではなく段階化された、分野に条件付けられたベンチマーク値を提供するかどうかです。正のコントロールとして、h指数、ResearchGateスコア、および引用数の類似クエリを実行しました。これらは[118][128]に記録された閾値ガイドジャンルを確実に表面化させます。SSRNダウンロード数に対する同じ意図定式化は、サンセット前後を通じて同等のものを表面化させませんでした。このギャップは最も広く相談されるコミュニティ参照にまで及びます:プラットフォームの百科事典風概要はカウンターが何であるかを説明していますが、それらに対する解釈的規範を提供していません[170]。監査は2026年7月~8月を使用して、一般的な目的のウェブ検索エンジンとコンシューマAI回答エンジンに及ぶカスタムパイプラインを使用して実施され、クエリ実行と回答品質スコアリングを自動化しました。完全なクエリリストは著者から入手可能です。結果は否定的な知見であり、そのようなものとしてのみ主張されています:監査期間における証拠の欠落、対象言語とエンジン、そのようなリソースが存在できないことの証明ではなく。
隣接するメトリックスについて、表1(第1.5節)に記録された解釈需要は長い間、大衆向けジャンルによって満たされてきました:「良いh指数とは何か」は数十の段階化された、分野に条件付けられた閾値ガイドで提供されており[118]、規律レベルの引用規範は広く読まれている説明の主題です[128]。SSRNダウンロード数については、そのようなジャンルは存在しません。さらに悪いことに、存在していた最良の構造化ガイドであるワシントン大学法律図書館ページは、2026年7月15日以降、トップ著者とトップペーパーランキングを現在形で説明し続けており、需要がピークに達したちょうどその時点でそれを部分的に誤解釈させるものにしています[156、2026年8月14日アクセス]。サンセットは解釈問題を作成しませんでした;それはエコシステムが持っていた唯一の部分的な回答を、分布の機関的記憶が衰退し始めたちょうどその時点で削除しました。
3. データが示すもの:平均がなぜ嘘をつくのか
3.1 カウンターが測定するもの、および測定しないもの
既存のカウンターの使用はすべて、それらが何を測定するかについての説明を前提としている。表3は各メトリクスの測定内容、その主要な交絡因子、およびそれが正当に果たすことができる診断的役割をまとめたものである。
表3. SSRNメトリクスが測定するもの、および測定しないもの。
| メトリクス | 最も適切な実質的解釈 | 主要な交絡因子 | 適切な診断的役割 |
|---|---|---|---|
| 抄録ページビュー | 論文のランディングページへのリーチ | 検索露出、プラットフォーム配置、著者の評判、外部プロモーション、タイトル、分野の規模、オンライン期間 | 露出/リーチ |
| 全文ダウンロード | 完全な論文を検査または使用する意図 | ビューに影響するすべてのもの、加えて抄録の品質と関連性、およびダウンロード摩擦 | エンゲージメント |
| 抄録ページビューあたりのダウンロード | ランディングページ露出から全文取得への条件付き転換 | 小さい分母、繰り返し行動、異質なトラフィック源 | コンバージョン |
| 被引用数 | 後続の学術文書への観察可能な組み込み | 分野の引用規範、出版遅延、データベースカバレッジ、自己引用、ステータス効果 | 下流の学術的利用 |
| Altmetric/PlumXシグナル | より広いオンラインエンゲージメント | プラットフォーム構成とユーザー行動 | 補足的な拡散証拠 |
表の内容は2つの式の対比に要約できる。ダッシュボードが静かに招待する読み方はダウンロード数=科学的品質である。正当な表現は
観察されたダウンロード数 = f(Q, E, R, C, T, P, ε),
ここでQは研究品質または関連性に関連する特性を表し、Eは露出、Rは評判、Cは通信特性、Tは時間と年齢、Pはプラットフォーム機構、εは観察されない影響を表す。この式は交絡因子を分類するもので、関数形式や係数は指定されていない。この分類は実際の困難さを正確に述べている。研究者は通常、左辺のみを観察している。
表に2つの境界条件が適用される。カウンターは生のトラフィックログではない。SSRNは少なくとも2000年代からカウント数をフィルタリングしている。プラットフォームは「不規則な活動の手がかり」を使用して同じ人物による明らかな重複ダウンロードと明らかなロボットダウンロードを除外し、疑わしい匿名ダウンロードを著者の合計から除外していると述べている[144]。BlackとCaronは、そのようなフィルタリングがなければカウンターは「5倍以上」に膨らむと推定した[18]。カウントされたダウンロードはエンゲージメントイベントを記録するものであり、支持を示すものではない。カウンターは注意プロセスの段階を測定する。それらのどれも科学的価値を測定しておらず、それぞれが読み手がコンテンツを評価する前に作用する可視性因子によって交絡している[44][72][144]。これらの制限は読者データの最初の書誌計量分析から認識されている[91]。段階は2つの仮説的メカニズムを通じて互いに分離することもできる。政策関連のトピックに関する論文は実践家によって大量にダウンロードされ、引用されない一方で、専門的な論文は数少ないダウンロードを得るが、それを必要とする小さな専門家コミュニティによって継続的に引用されるかもしれない。いずれのパターンも可視性と下流での使用を分離し、これが高ダウンロード論文と高被引用論文のセットが部分的にのみ重なる理由の1つである[108]。
3.2 プラットフォーム集計と平均という虚構
SSRNが公開している流通関連の数値は、プラットフォーム全体の集計値のみであり、このデータで最初に注目すべき点は、これらの集計値を平均したときに何が起こるかということです。表4は、検証済みのプラットフォーム統計値とその時点の日付をまとめたものです。
表4. 検証済みSSRNプラットフォーム統計、時点の日付と検証ステータス
| 項目 | 値 | 時点 | 出典 | 検証ステータス |
|---|---|---|---|---|
| フルテキスト論文 | 1,157,048 | 2023年12月18日 | ALL-SIS Citation Methods White Paper [1] | 公開PDF に照らし合わせて検証済み |
| アブストラクト | 1,309,385 | 2023年12月18日 | [1] | 検証済み |
| 著者 | 1,479,875 | 2023年12月18日 | [1] | 検証済み |
| 累積ダウンロード数 | 256,678,716 | 2023年12月18日 | [1] | 検証済み |
| ダウンロード数、直近12ヶ月 | 40,642,329 | 2023年12月18日 | [1] | 検証済み |
| フルテキスト論文(過去の参照時点) | 571,040 | 2016年7月6日 | [1] | 検証済み |
| ダウンロード数、直近12ヶ月(過去の時点) | 12,897,685 | 2016年7月6日 | [1] | 検証済み |
| プレプリント/論文;著者 | 「150万以上」;「190万以上」 | 2026年製品ページ | Elsevier SSRNの製品ドキュメント [49](2026年8月14日アクセス) | 検証済み(丸められたマーケティング数値) |
| 論文;著者;ダウンロード総数;ダウンロード12ヶ月 | >170万;>240万;>3億4400万;>5400万 | 2025年11月1日 | SSRNアナウンスメントボイラープレート [B-6] | 桁数は確認済み;正確な小数点以下(3億4480万/5470万)には引用前の公告のアーカイブ版が必要 |
| 導出値:フルテキスト論文1件あたりの平均累積ダウンロード数 | ≈222 | 2023年12月時点 | 著者による計算:256,678,716÷1,157,048 [1] | 検証済み数値に基づく算術演算 |
| 導出値:論文1件あたり年間平均ダウンロード数 | ≈35 | 2023年12月時点 | 著者による計算:40,642,329÷1,157,048 [1] | 検証済み数値に基づく算術演算 |
最後の2行は著者による計算であり、その旨が明記されています。SSRNは論文あたりの平均値を公表していません。プラットフォーム全体の集計値は出典、日付、定義(フルテキスト対総論文数)により異なるため、論文あたりの導出値は2023年12月のフルテキスト数値の調整版から取得されています [1];2025年11月の生の公告ボイラープレート [B-6] は上記データのみとして保持され、アーカイブ版(例えばweb.archive.org経由)と一緒にのみ使用可能です。元の公告ページは直接入手できなくなっているためです。
2023年12月の調整済み数値によれば、「平均的な」SSRN論文は生涯を通じておよそ222ダウンロードを獲得し、過去1年間ではおよそ35ダウンロードを獲得しています [1]。この導出値は、著者が計算できるプラットフォーム全体の規範に最も近いものですが、集計の虚構のため、体系的に誤解を招くものです。SSRNダウンロード分布に関する実証的研究はすべて強い右裾引きを見出しており、平均は長い上側の裾により中央値ははるか上に引き上げられているため、「平均的な論文」はほぼ実際の論文を説明していません。このセクションの残りの部分は、そのギャップの大きさと結果を明確にします。キャリブレーションのために重要なもう1つの集計があります。年間プラットフォームダウンロード数は、2000年のおよそ50万件から2005年のおよそ300万件に [18]、2016年には1290万件に、2023年までに4064万件に成長しました [1]。論文あたりのダウンロード流も上昇しました。年間ダウンロード数は2016年から2023年にかけて約3.15倍に成長し、論文ストックは約2.03倍に成長しました [1]。論文あたりの流を約55%引き上げました。したがって、より古い研究は、今日、同等の論文が獲得するであろう絶対数を過小評価しています。この偏りが指す方向は比較によって異なります。固定された古いしきい値は今日の数の下限であり、それを絶対的な2026年レベルバンドとして読むとき、それは保守的ではなく、寛容なバーを作ります。逆の操作も同様に認められていません。古いしきい値はプラットフォーム成長を掛けることで2026年の規範に「時代化」することはできません。より大きなリポジトリは同時に分子、分母、著者の構成、流通チャネル、ボットフィルタリング、そして注意の競争を変えるからです。全体を通じて使用される年代別偏読は、古いしきい値の再スケーリングではなく、上記の集計フロー・ストック算術に基づいています。プラットフォーム自体の年次レビューは継続的な成長を確認しています。2025年には25万件以上の新しい論文が投稿され(2024年比20%増)、その年間のダウンロード数は5300万件以上でした [145]。
3.3 平均値は典型的な論文ではない:直接的な証拠
SSRNの最も最近の公開された分布的証拠はJoとLiからもたらされており、彼らは2025年8月15日に収集された単一の横断的スナップショットにおいてSSRNのMarketing Research Networkから2,361本の論文を分析しています[83]。以下のTable 5は彼らの記述統計を完全に再現しており、Section 5の統合ベンチマークマップはそれらを折り込んでいます。平均ダウンロード数は221.346で中央値は87でした:平均値は中央値の約2.54倍です。95パーセンタイル726は中央値の8倍以上です。平均値は75パーセンタイル(206)さえ超えており、これはサンプル内の論文の4分の3以上が「平均的な論文」より下にあることを意味します。このネットワークにおける平均的な論文は約221ダウンロードを有していると言われた研究者は、100ダウンロード数の論文が標準的な値よりかなり下にあると結論付けるでしょう、ただし100は公開された中央値を大幅に上回っています。Figure 2はこの構造を直接表示しています。
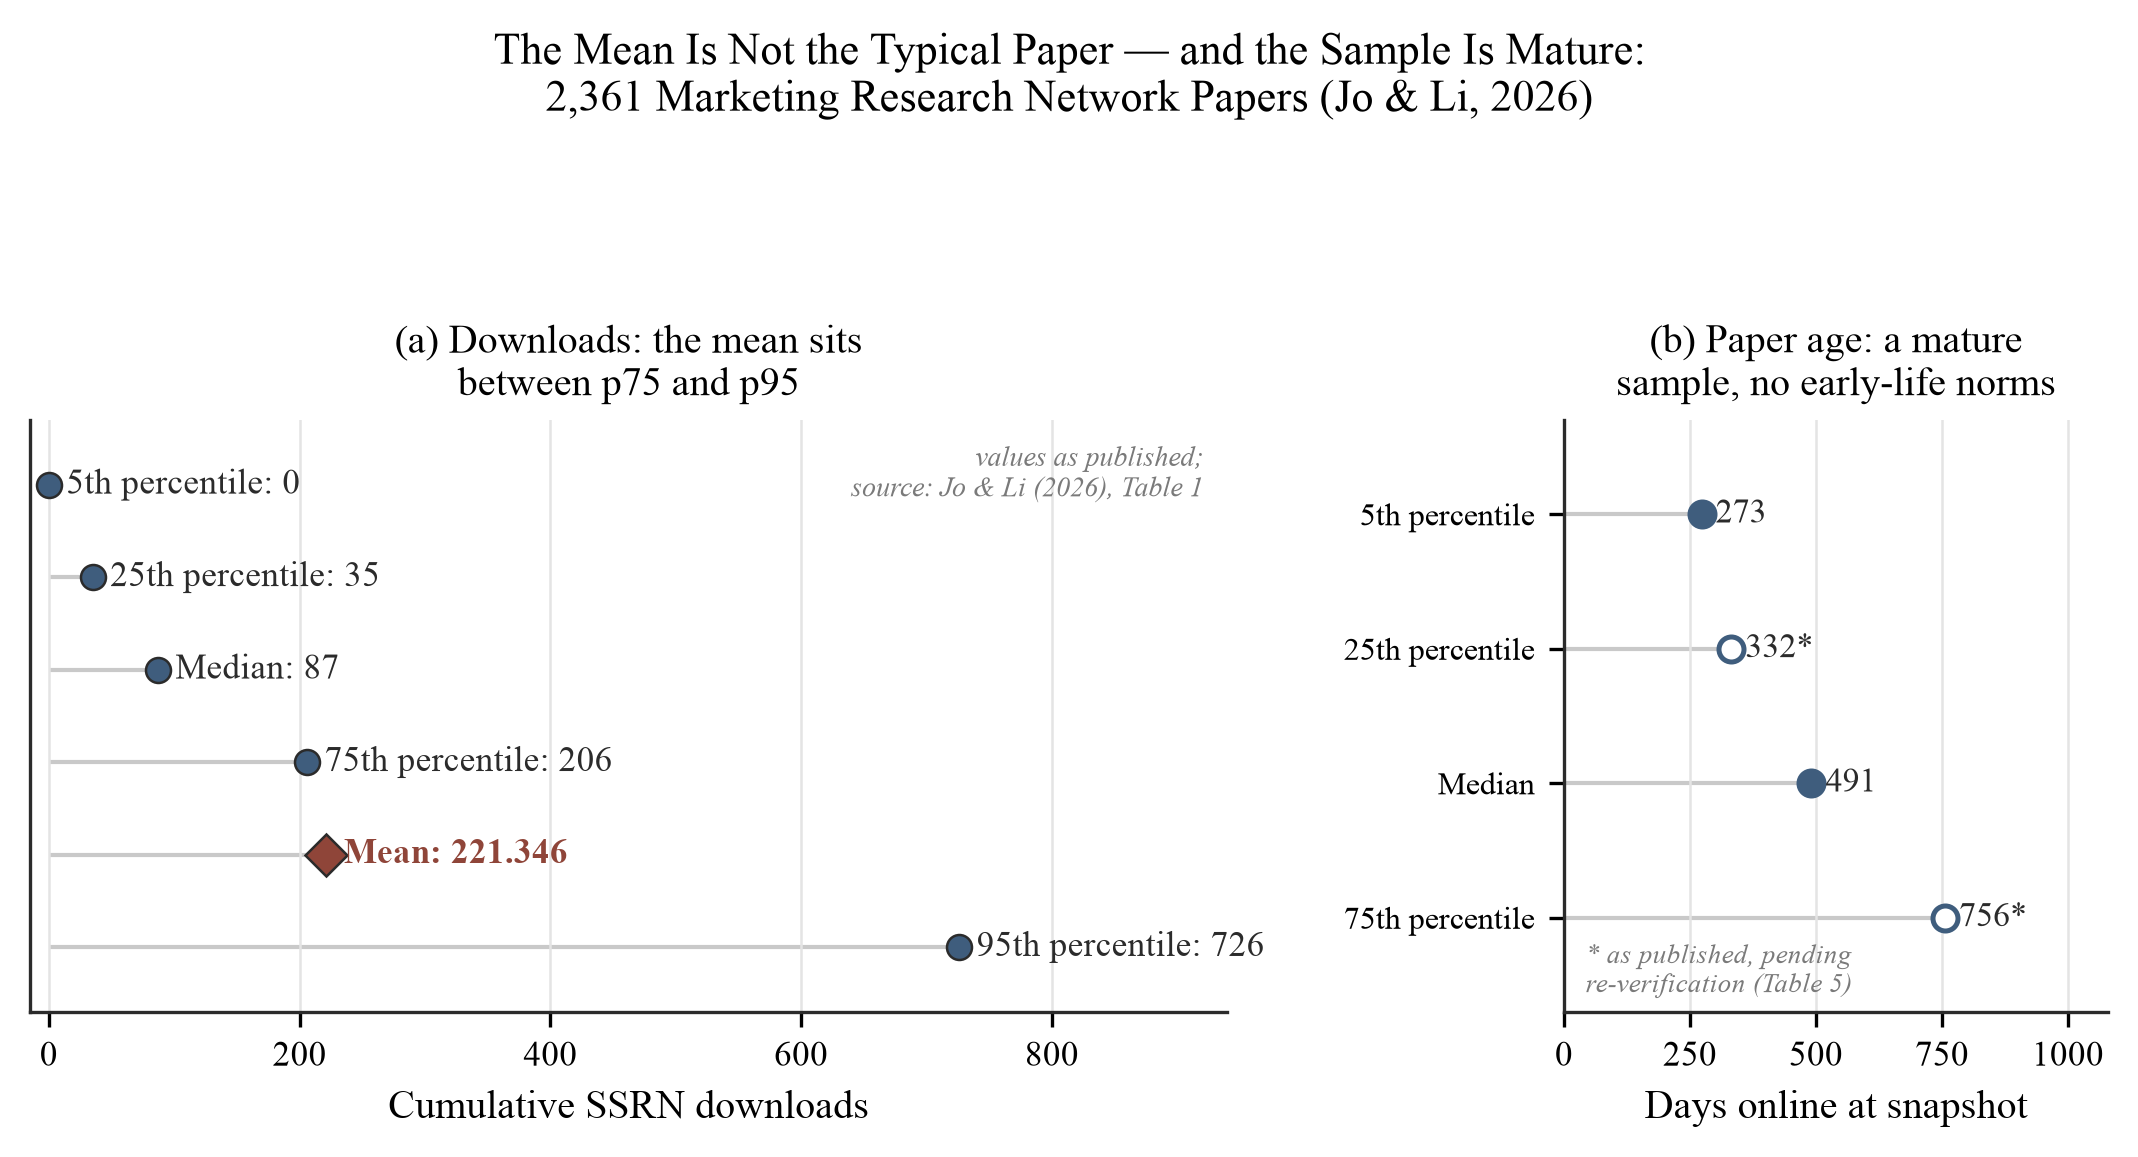
Figure 2. 2,361本のMarketing Research Network論文の公開記述統計。パネル(a):ダウンロード数—p5 = 0、p25 = 35、中央値 = 87、p75 = 206、平均 = 221.346、p95 = 726、値の順序でプロット(平均値がp75とp95の間に位置することに注意)。パネル(b):同じサンプルにおける論文の年齢—5パーセンタイル273日および中央値491日はソースに対して検証済み;25パーセンタイル(332日)および75パーセンタイル(756日)は「公開されたとおり」に再現(Table 5)。ソースのTable 1における2つの値はフラグが立てられ、「公開されたとおり」に再現されていますが、それらは異なる種類の異常です。abstract-views 95パーセンタイル(966)は平均値(611.973;SD 1,100.5)からわずか約0.32 SD上に位置しています—p75がすでに833である右側に歪んだカウントではほぼ不可能です—したがってこれは疑わしい出所エラーであり、最もおそらくは誤字ですが転記またはrounding errorは除外できず、abstract-viewsの行の他のセルは同じ相関エラーの影響を受ける可能性があるものとして扱われます(JoとLiへの著者照会用にフラグが立てられており、その回答はまだ利用可能ではありません)。conversion 95パーセンタイル(77.7、p75の27.2に対して)は異なる現象です:Section 5.2が予測する正確に同じ種類の分母が小さい比率アーティファクトであり、統計的不可能ではありません。年齢パネルは解釈上の限界を可視化します:これらは成熟論文の統計であり、サンプルは初期段階の規範を提供することができません。ソース:Jo and Li (2026)、Table 1 [83]。
Table 5は研究の完全な記述統計、その伴随変数およびダウンロード分布を再現しています、なぜならこれが完全なパーセンタイルパネルを有する唯一の公開されたSSRNサンプルだからです;その複数のセルはこの記事の他の場所で解釈的な役割を果たします。標準偏差は重い尾部を単一の数字として示しています:ダウンロードの平均221.3に対するSD 940.9。ダウンロードの5パーセンタイルはちょうどゼロです、したがってゼロカウンターは成熟サンプルの通常の範囲内にも存在します。conversion パーセンタイルはSection 5.2の横断研究バンドを両側から括弧で囲みます(p25 = 12.1、中央値 = 18.9、p75 = 27.2 per 100ビュー)。年齢パーセンタイル(四分位範囲332–756日)はサンプルの成熟性を固定し、著者性とパッケージング行はSection 6.4および8.3で引き出された共変数規範を提供します。
Table 5. Jo and Li (2026)サンプルの完全な公開記述統計、「公開されたとおり」(N = 2,361 Marketing Research Network論文;2025年8月15日のスナップショット)。 すべての値はソースのTable 1から再現されています[83]。分布的コア—ダウンロードおよびビュー平均値、中央値、および四分位数;conversion平均値および中央値;年齢中央値および5パーセンタイル—は公開されたテーブルに対して検証されています(Table 7を参照)。残りのセル(標準偏差;コアを超えるconversionおよび年齢パーセンタイル;著者、ページ、およびabstract-length行)は「公開されたとおり」に再現されており、ここで独立して再導出されていません;ソースの存在、掲載地、および著者性はCrossrefを介して2026年8月14日に確認されました。2つの内部異常は「公開されたとおり」に保持されフラグが立てられており、それらは同じ種類の問題ではありません。abstract-views 95パーセンタイル(966)は報告された平均値(611.973;SD 1,100.5)から約0.32 SD上に位置しています—これほど歪んだカウントでは統計的にほぼ不可能であり、行自体の75パーセンタイル833と矛盛しています—したがってこれはソース内の疑わしい誤字です;abstract-viewsの残りのセルは相関エラーの影響を受ける可能性があるものとしてフラグが立てられ、JoとLiへの著者照会待ちの再検証にダウングレードされています。conversion 95パーセンタイル(77.704、p75の27.187に対して)は代わりにSection 5.2によって予測される分母が小さい比率アーティファクトであり、同じ種類の分布的異常ではありません。
| 変数 | 平均値 | SD | p5 | p25 | 中央値 | p75 | p95 |
|---|---|---|---|---|---|---|---|
| ダウンロード数 | 221.346 | 940.855 | 0 | 35 | 87 | 206 | 726 |
| Abstract閲覧数 | 611.973 | 1,100.536 | 151 | 288 | 504 | 833 | 966(「公開されたとおり」) |
| 100 abstract閲覧あたりのダウンロード数 | 23.699 | 20.118 | 0 | 12.105 | 18.944 | 27.187 | 77.704(「公開されたとおり」) |
| SSRN上での利用可能性、日数 | 550.210 | 230.557 | 273 | 332 | 491 | 756 | 955 |
| 著者数 | 2.578 | 1.705 | 1 | 1 | 2 | 3 | 5 |
| ページ数 | 32.734 | 29.186 | 1 | 13 | 27 | 46 | 75 |
| Abstract長、単語数 | 182.274 | 71.641 | 87 | 137 | 178 | 217 | 295 |
研究の解釈にとって重要な3つの追加的特性がある。抽象的ビューは、より高いレベルで同じ非対称性を示す:平均ビューは611.973であり、中央値は504であった(p5 = 151、p25 = 288、p75 = 833;p95の966は「公開通りに」再現されているが、疑わしい出所の誤字であり、平均から僅か約0.32 SD上であり、p75が833で示唆される尾より下であり、下流の計算には入らない;図2の注記を参照)。100ビューあたり23.699ダウンロードの公表される変換値がある[83]。また、この研究は到達度と変換を分離している:著者らのポアソン暴露モデルでは、機関的名声は抽象的ビューを条件とした下でダウンロードを予測し(係数0.192、3著者論文の場合、著者の所属が上位50大学である場合、抽象的ビューあたりの推定ダウンロード率は6.6%高かった)、この名声プレミアムは抽象内のAI援助が増加するにつれて減弱した(交互作用−0.627、p < .01)[83]。SSRN自体は現在、投稿時に実質的な生成AIの使用の開示を要求している[54][56]。したがって、注目は、読者が抽象的ページに到達した後でさえも、ステータスシグナルを追跡しており、これはダウンロード数が内容評価だけではなく、可視性と評判効果を含んでいることの直接的証拠である。著者ら自身が述べている制限が議論の方向性を設定する:単一の学問ネットワークの単一のスナップショットは、注目の時間経路を明かすことはできず、彼らはパネルデータが必要な次のステップであることを明確に特定している[83]。このステップはセクション8で取り上げられている。
標本は1つの分野の1つのネットワークであり、1つの日付で観察される:これらの数字は普遍的なSSRN基準ではなく、その価値は構造にある。平均/中央値比2.54およびp95/中央値比8以上は、重い右側スキューのシグナチャであり、SSRN証拠の他のあらゆる本体で繰り返され、異なる分野と十年からのサンプルを含む:法学奨学金の唯一の国勢調査形式のサンプルで、2012年に法学奨学ネットワークに投稿された論文が2年後に測定された場合(n = 1,107)、中央値は63ダウンロード、平均は122.55で、2年の暴露後でも近似的に2倍のギャップがあった[139]。
3.4 分布の形状:準対数正規分布とロングテール
分布の大規模な構造はKakushadzeによって確立されました。彼はSSRNの公開トップリストを分析し、トップ30,000リストの29,985人の著者と、それらに関連する367,478本の論文を調査しました(2015年版ランキングのスクレイピング)[85]。中心的な発見は、ダウンロード数が準対数正規分布に従い、レベルでは大きく偏った長い上側テールを持ち、対数ではおおよそガウス分布に従うということです(論文あたりのln ダウンロード数のフィッティングパラメータ:平均5.406、標準偏差1.016)[85]。Kakushadzeは対数正規性の実用的な帰結を明確に述べています。線形算術はそのようなデータには失敗します。ダウンロード数への h-指数の直接的な適用は情報が不足しています。ダウンロード数は引用数よりも桁違いに大きいため、指数は論文の数に縮小します。代わりに、彼はダウンロード数の対数の整数部に基づいて構築された指数を提案しています(k = ⌊ln D⌋)[85]。解釈の観点から、これはダウンロード数における意味のある違いが加算的ではなく乗算的であることを意味します。この形状はダウンロード数に特有のものではありません。個々の科学的影響の分布自体がおおよそ対数正規分布に従っており、Sinatra、Wang、Deville、Song、およびBarabási(2016)のQ-モデルが科学的キャリア全体で確立しました[181]。したがって、カウンターが要求する乗算的な読み取りは、SSRNのアーティファクトではなく、学術的注目の規範です。
同じデータセットは、上側分布の唯一の公開された閾値アンカーを提供します。トップ10,000論文リストへの登録(プラットフォームの全文論文ストック571,040の約1.8%、2016年7月[1]、時折引用される「トップ1~2%」の数字と矛盾しない)には、最小160ダウンロード、中央値805、平均1,800、最大152,242が必要でした[85]。トップ30,000著者の中で、ダウンロード数の最小合計は129、中央値著者の合計は1,626、論文あたりの中央値ダウンロード数は210、最大値はMichael C. Jensenで824,762でした[85]。紙質のレベルでも、このエリートサンプル内では希少性が続いています。分析された367,478論文のうち、112,793論文(約30.7%)のみが著者の対数指数に寄与するのに十分なダウンロード数を持っていました[85]。プラットフォームの最もダウンロードされた著者による個々の論文のほとんどは控えめな注目を集めており、トップリストの外では、その割合はさらに低くなります。図3は、公開された閾値がマークされたフィッティング分布を視覚化します。
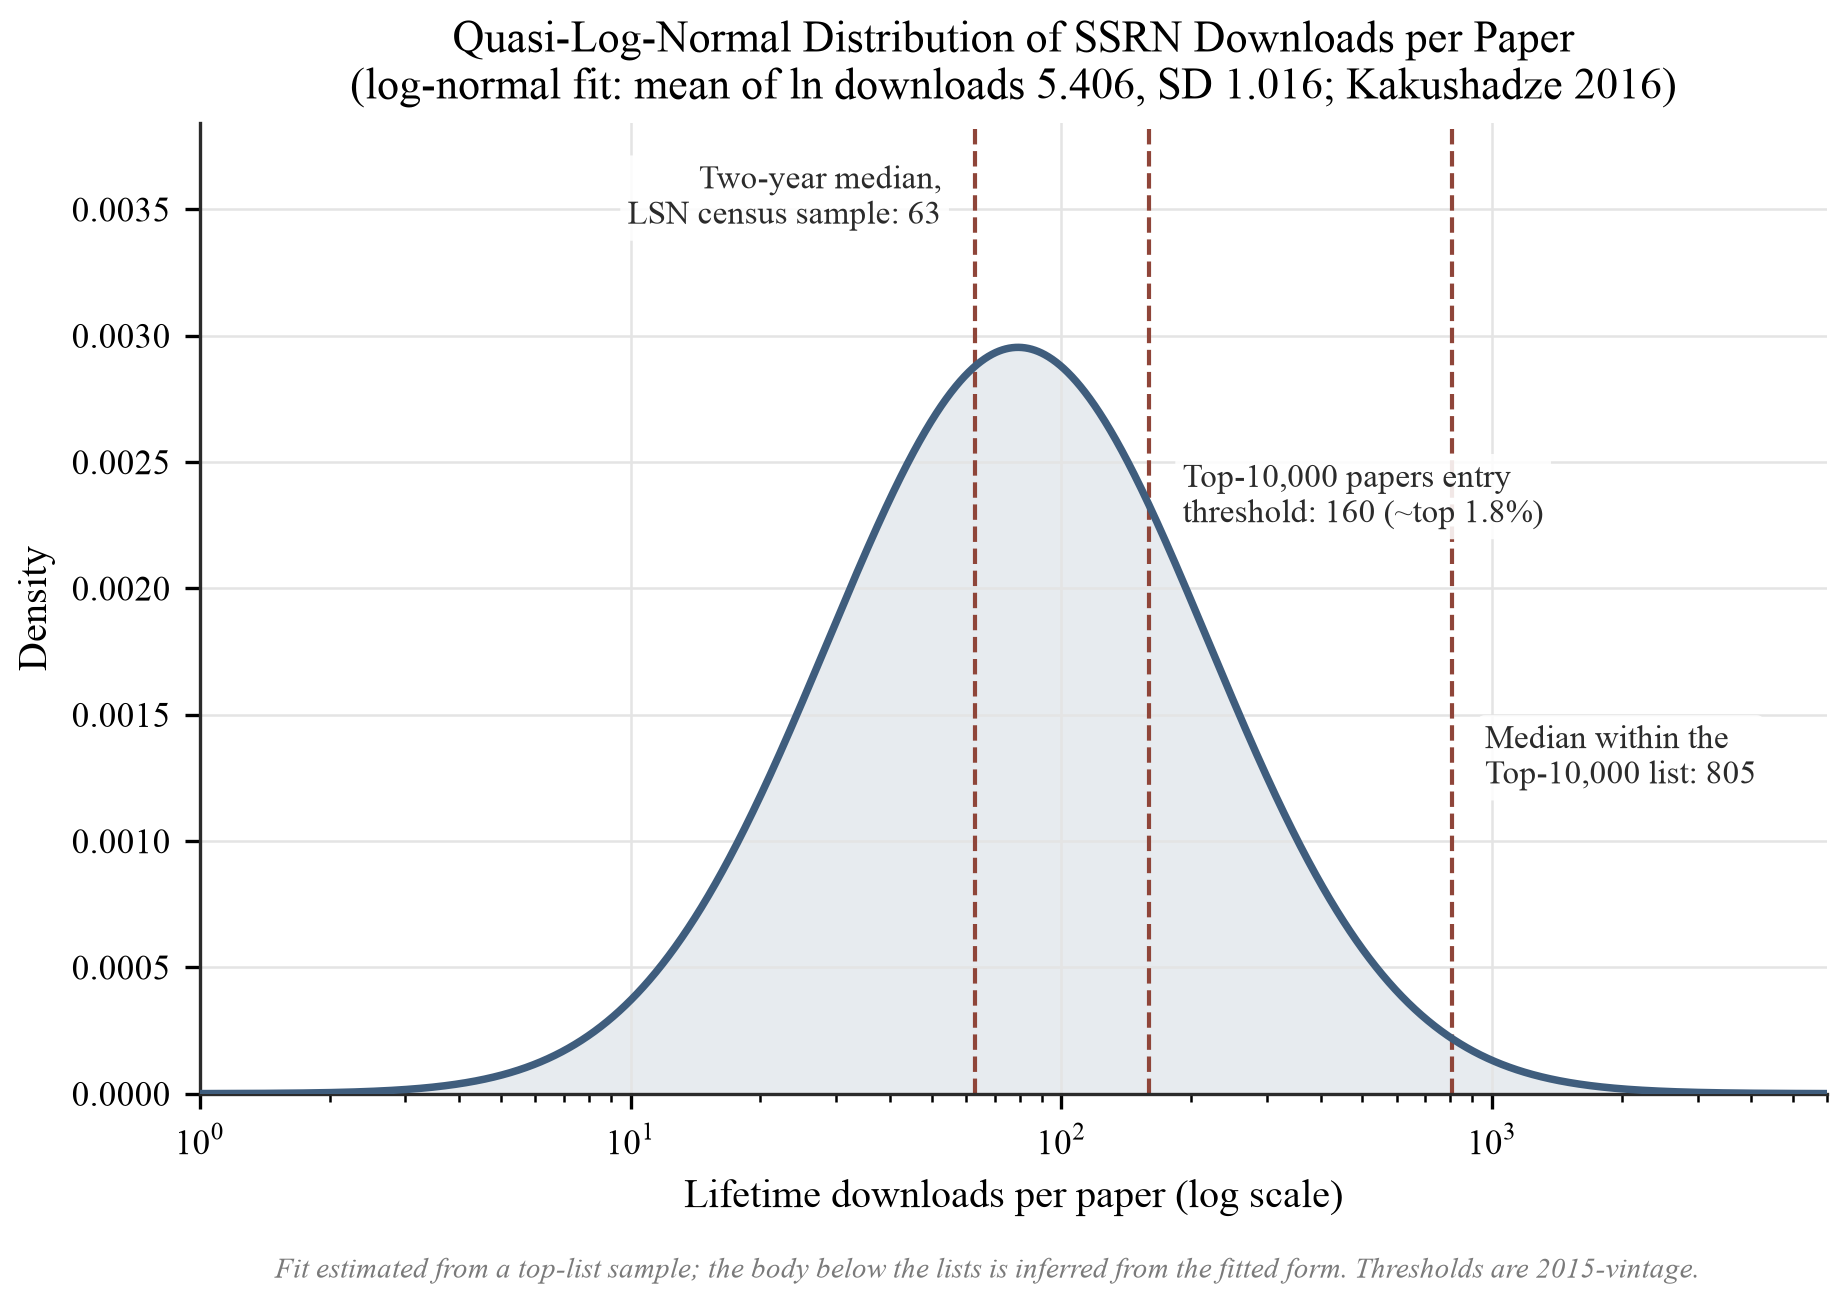
図3. Kakushadzeが報告したパラメータでフィッティングされた対数正規密度(ln ダウンロード数の平均5.406、SD 1.016)[85]。フィッティングされた中央値、exp(5.406) ≈ 223は、報告されたグループ内論文ごとの中央値210より約6%上に位置し、トップリストの分布への適切だが不完全なフィット。破線は、国勢調査スタイルの法律学奨学金サンプルからの2年間の中央値63ダウンロード[139]、トップ10,000論文エントリー閾値160(プラットフォームの全文論文ストック571,040の約1.8%、2016年7月[1])、およびトップ10,000リスト内の中央値(805)[85]をマークしています。フィットはトップリストサンプル(おおよそプラットフォームの上位著者十分位数)から推定されているため、リストより下の分布の主体はフィッティング形式から推定されており、観察されていません。閾値は2015年版です(それ以来のインフレーション:セクション5.1)。この図には定量的な注意が伴っています。曲線はその下側テールを読むよう招待するため、このフィッティング密度の下で暗示される下側テール質量はP(X ≤ 63) ≈ 10.7%およびP(X ≤ 10) ≈ 0.1%です。これは、研究1(セクション8.6)が全プラットフォーム確率サンプルに対して予測する15~30% ≤10ダウンロード シェアより2~3桁小さいです。この乖離は矛盾ではなく、フィットの領域の直接的な尺度です。上位著者十分位数で推定された密度は、観察されなかった下側テールを説明することはできません。したがって、国勢調査スタイルのマーカー([139]の2年間の中央値63、トップ10,000エントリー160およびその中央値805)は、フィッティング曲線に重ねられた外部参照ポイントとしてプロットされており、フィットがそれらを再現することの主張ではありません。マーカーとフィッティング曲線が同じ値をどこに配置するかの距離は、それ自体がリストの下の主体が観察されていないことの視覚的証拠であり、このプロットからは全プラットフォーム下側テール シェアは読み込まれるべきではありません。
これらのアンカーには2つの注意が必要です。サンプリングフレームは分布の上位であるため、Kakushadzeの統計はテールを説明しており、リスト以下の通常の論文の質量はフィッティングされた対数正規形式を通じてのみ特徴付けられています。帰属は単一の著者によるものです。研究はKakushadze(2016)、Journal of Informetrics [85]です。繰り返される誤った引用は2番目の著者を追加し、避けるべきです。
付録Eで報告された独立したアーカイブ横断面は、公開アーカイブから回収された退職前カウンターを持つ1,360論文のランダム全分野サンプルで、分布の主体を直接観察しています。観察された分布がおおよそ対数正規分布(ログダウンロード数の歪度≈ 0.18)であることが判明し、Kakushadzeがテールにのみフィッティングできた形状を主体で裏付け、独立して平均対中央値ギャップ、変換バンド、および分野乗数を再現しています。それ自身の上向き選択バイアスは極端な下側テールを過小観察のままにしています。それでもなお、統合がそれ以外に依存する唯一の最新の全分布アンカーを再現しています。再構成の平均(219)は公開されたマーケティングネットワーク平均221と一致しており、ヘッドライン形状は完全に別のデータソースによっても確認されています。(インターネットアーカイブから検証されたソーシャルサイエンス法として歴史的なウェブデータを回復することについて、およびそのカバレッジと抽出頻度バイアスについては、Arora、Li、Youtie & Shapira、2016、Journal of the Association for Information Science and Technology、67(8)、1904–1915、doi:10.1002/asi.23503を参照してください。)
3.5 可視テールによる較正の誤り
セクション3.2~3.4の結合構造は、体系的な心理的誤りを説明する。2015年のスクレイピングにおいて最もダウンロード数の多かった著者は824,762ダウンロードであり、これはトップ著者グループ自体の中央値(1,626)のおよそ500倍であり、典型的な論文[85]をはるかに上回っている。準対数正規分布則の下では、重要な距離は乗法的である。つまり、通常の論文の中央値(数十ダウンロード)からトップリスト掲載基準(160)への段階は、その基準からトップリストの中央値(805)への段階より小さく、テール最大値[85][139]への距離はさらに劇的である。しかし公開で流通する数字(マイルストーン告知、「トップ著者」プロフィール、機関のプレスリリース[101])は、ほぼ独占的に可視テールから引き出されている。したがって著者は「良い」を中央値より数百倍上に位置する参照クラスに対して較正するのに対し、分布の大部分は中央値の近くに位置している。7ダウンロードのダッシュボード表示は、論文の年代と分野にとって異常でない場合でも失敗として経験される。平均値も同じ誤りに、ただしより軽微な形で参加している。セクション3.3が示したように、平均値は75パーセンタイルより上に位置するため、公式的に聞こえる「平均」でさえも、テール汚染ベンチマークである。そのような意味で平均値は嘘をつく。つまり、それは正しく計算されてから、典型的な値を持たない分布における典型的な値と誤認されるのである。
複数の追加的な証拠が、生の計数器がコンテンツと同じくらい可視構造を反映していることの結論を強化する。注意は位置に反応する。arXiv告知リストでは、位置1に現れた論文はastro-phで約83%高い中央値引用を獲得し、著者らはこの効果を自己選別だけでなく可視性にも実質的に起因するものと考えている[72]。インデックス化ラグにも反応する。SSRN自体は、Google Scholarによるそのコンテンツの外部インデックス化が検索エンジンによって管理され、「6~9ヶ月以上」かかる可能性があることを注記している[54、2026年8月14日にアクセス]。したがって若い論文の計数器は、主要な発見チャネルが動作を開始する前に生成される。注意は引用からダウンロードへと逆方向に流れる。引用されることで読者(引用著者とその著者ネットワーク自身を含む)を引用論文に導き、グレンジャー因果分析はこの引用からダウンロードへのパスが記事のかなりの割合で活動していることを見出す[80][39]。したがって計数器の一部は、読者のコンテンツ品質に関する判断というより、論文の引用および協調ネットワークにおける位置をインデックス化している。これらの機構は各々、品質に関する読者の判断というより可視構造(位置、発見ラグ、ネットワーク位置)を通して計数器を形成する。そしてダッシュボード番号にはこのいずれも見えない。より広い注意経済は同じ集中を極端な形で示す。ソーシャルメディアでは、注意ジニ係数は0.90~0.94に達し、上位1%のアカウントは下位99%を合わせたより多くの注意を受け取る[180]。これはシモンの「情報の豊かさは注意の貧困を生み出す」との命題の現代的な反響である[141]。SSRN上の学術的注意は、より軽微な形で、同じ歪んだ拡散過程の家族に属する。SSRN上で最も落ち着いている聴衆は経済学者および法律学者であり、金融からその構造を認識するだろう。Bessembinderの1926~2016年のCRSPデータ分析は、およそ34.8兆ドルの純株式市場資産創造が上場企業の4%未満に起因し、大多数の株式がその生涯を通じて国債を上回るのに失敗していることを見出した[16]。この平行関係は証拠としてではなく説明として提示されている。富において注意においてと同様に、集計合計は薄い極端なテールによって生成され、巨人に支配された平均に対して自分自身を測定することはカテゴリー誤りである。希少性は使用計数器に限定されない。法律学奨学金全般において、2007年のある調査の法律評論論文の43%は全く引用されず、2015~2019年コホートのわずか18%のみが5年以内に1つの引用を獲得した[171]。
3.6 フィールド乗数:規範の学問的構造
分布は単一の分布ではなく、分野によって異なります。Whalenによる法律学奨学金ネットワークの94の電子ジャーナルに分類された約25万本の論文の分析では、単一の傘下の学問分野内でも、学問的ベースラインはおよそ8倍の因子で変動することが示されています。論文1本あたりの生涯ダウンロード数は、企業・証券・金融法の438.35から農業法・政策の53.48の範囲に及びます[168]。図4がこの勾配を示しています。
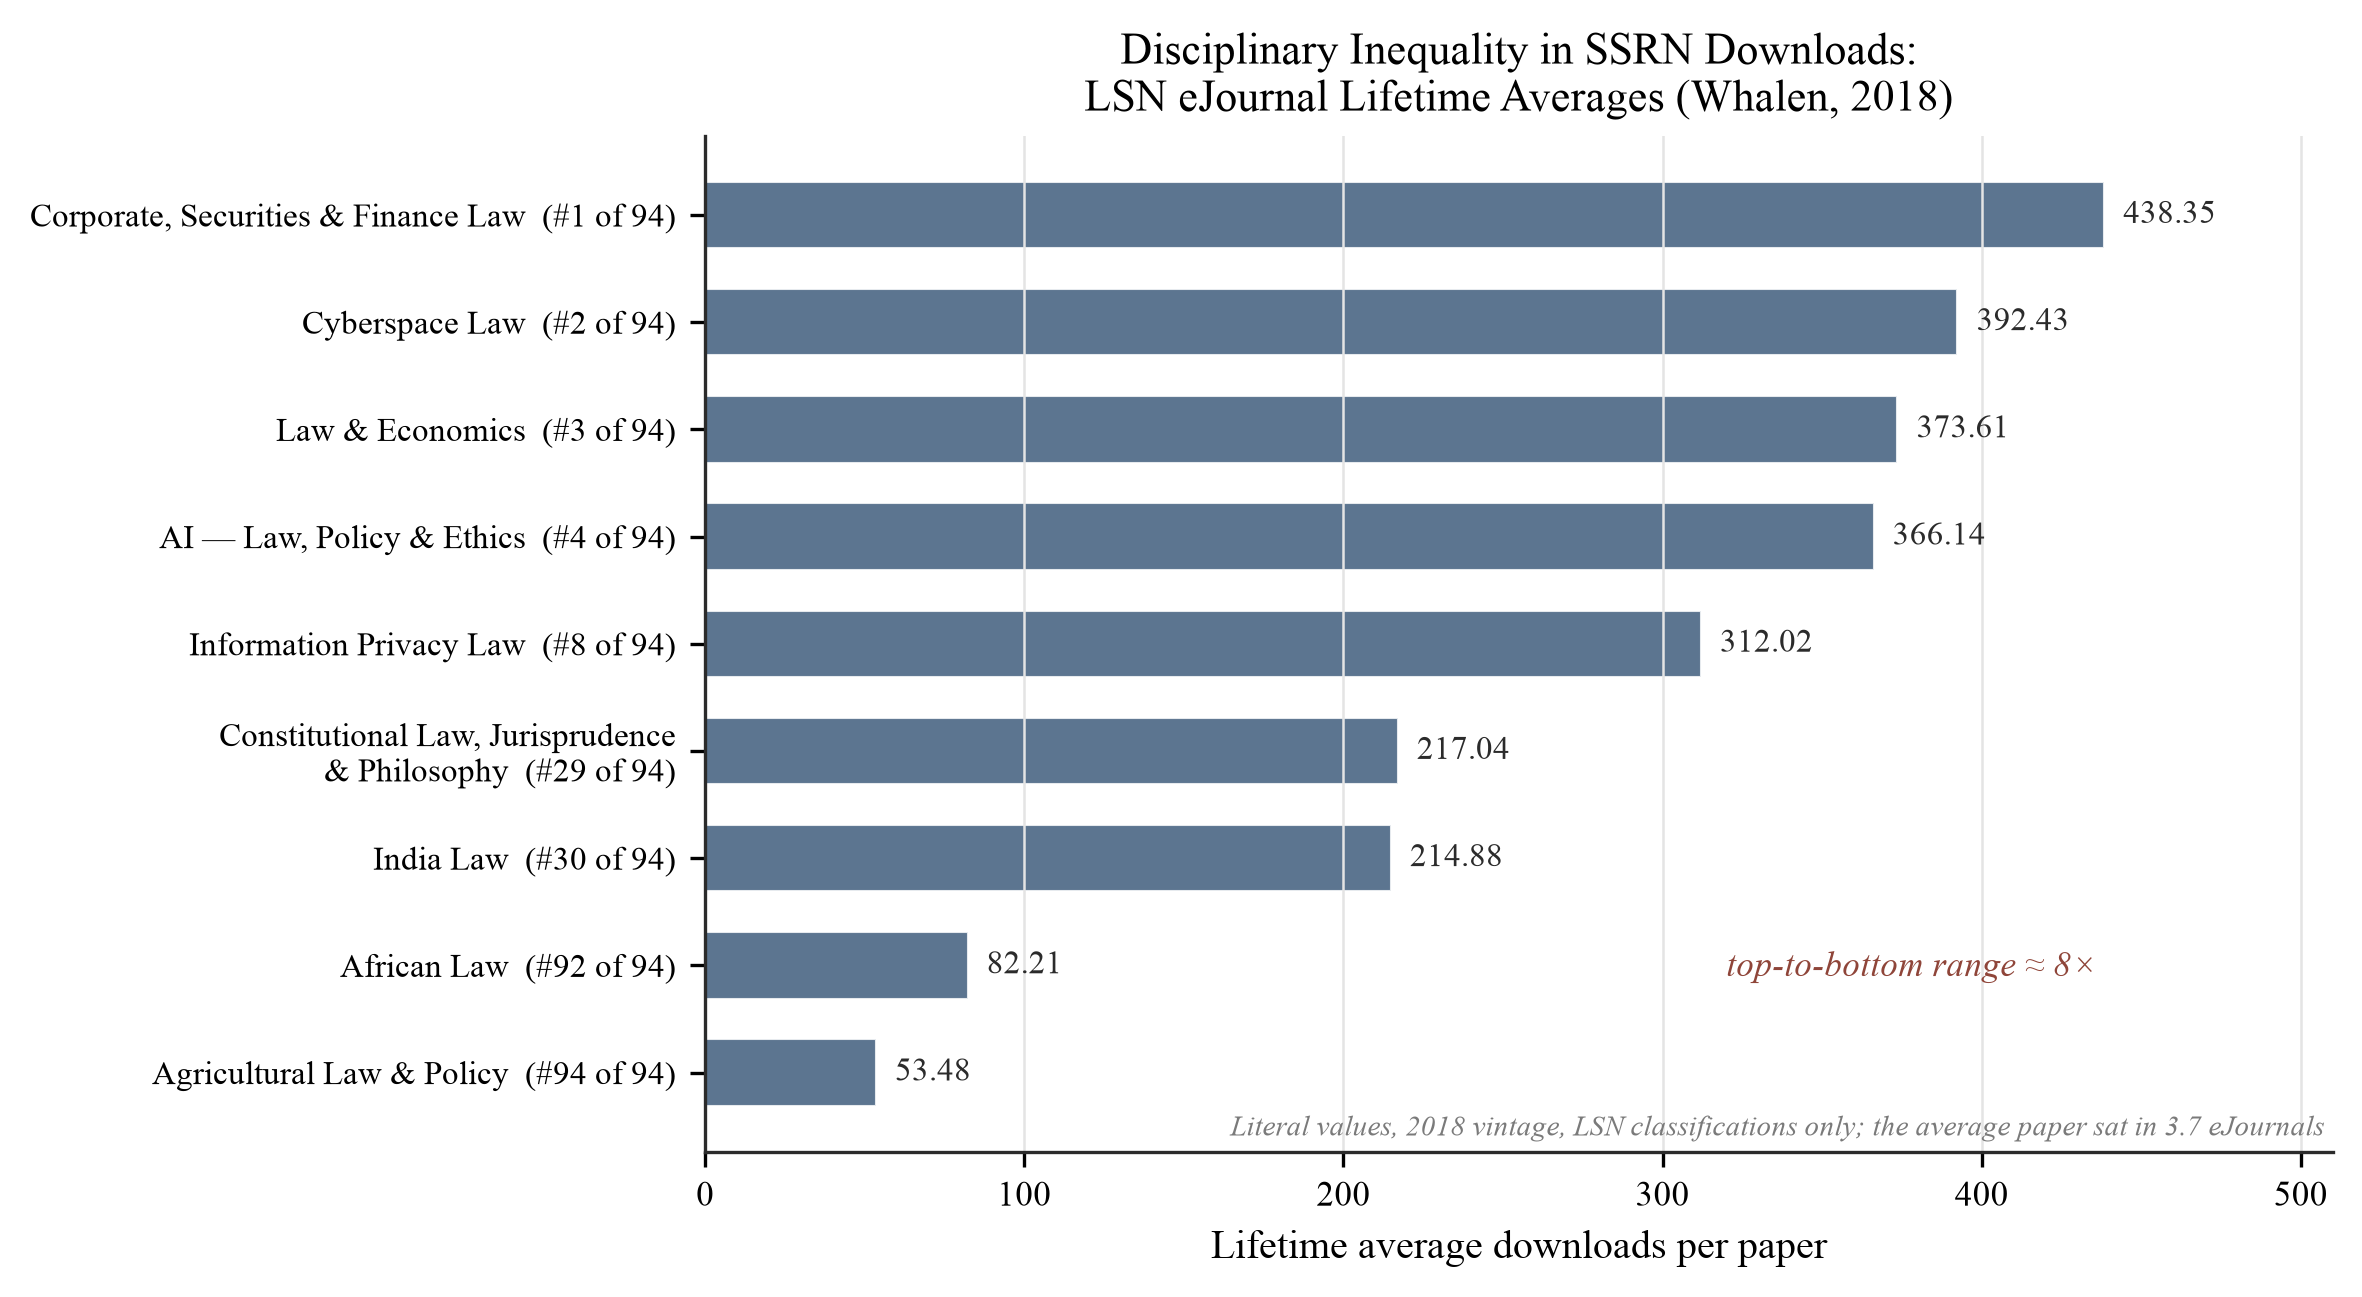
図4。選定されたLSN電子ジャーナルの論文1本あたりの生涯平均ダウンロード数。Whalen (2018) [168]からの文字通りの値:企業・証券・金融法438.35(94中ランク1);サイバースペース法392.43(2);法律・経済学373.61(3);AI – 法律・政策・倫理366.14(4);情報プライバシー法312.02(8);憲法・法学哲学217.04(29);インド法214.88(30);アフリカ法82.21(92);農業法・政策53.48(94)。上下の範囲はおよそ8倍です。値は2018年のもので、LSN分類のみをカバーしています。平均的な論文は3.7の電子ジャーナルに割り当てられました。
メカニズムはメリトクラシーではなく、構造的なものです。SSRNの発見は分類ベースです(電子ジャーナルの購読者は、その電子ジャーナルに分類された論文について通知を受け取ります)。したがって、論文の到達可能なオーディエンスは、品質信号が作動する前に、その分野の購読者ベースによって固定されます。Whalenはさらに、より多くの分類を持つ論文がより多くのダウンロードを獲得し、ゼロのダウンロード記録となる可能性が低いことを発見しています[168]。フィールド構造はまた、引用文化を通じてカウンターを形作ります。BlackとCaronは、ダウンロード対引用の比率が分野全体で体系的に異なることを観察しました。法律学は経済学や金融よりも先行研究をより完全に引用するためです[18]。法律分野内では、注目は特定のトピックと著者の特性に集中します。2012年の国勢調査サンプルでは、企業法と国際法のトピック、米国著者身分、およびトップ20の所属は、すべて有意に高いカウント[139]を予測し、同時期の法律図書館のコメント[175]に反映される決定要因です。したがって、企業法では目立たない数字は、法律史または農業法では例外的かもしれません。また、ベンチマークまたはスケール(第5部で構築されたものを含む)は、フィールド相対的として読む必要があります。引用側にはこれについてよく確立された前例があります。Radicchi、Fortunato、およびCastellano(2008)は、各論文のカウントをその分野の平均によって再スケーリングした後にのみ、引用分布が単一の普遍曲線に崩壊することを示しました[182]。これは、この記事が使用カウントも等しく必要とすると主張する参照クラスの類似物です。
上記の検証されたアンカーのみに基づいて構築された3つの例は、利害を具体的に示します。農業法の著者の論文が60の生涯ダウンロード数を保有している場合、その電子ジャーナルの平均53.48[168]を上回っていますが、最も目立つように流通している企業法のカウントに対してキャリブレートすると、同じ数字を失敗として読むかもしれません。企業・証券法の著者が同じ60を有する場合、その分野の平均438.35[168]をはるかに下回っています。またマーケティングペーパーがネットワーク中央値の87[83]に達する著者は、構造的に典型的な結果を過小評価するかもしれません。欠落したスケールの誤りは両方向に走ります。それは不当な絶望を生み出し、成功を認識されないままにしておきます。
第3.2~3.6部は、この記事の経験的コアを確立しています。SSRNダウンロード分布は大きく右に歪んでおり、およそ対数正規であり、平均は中央値だけでなく75パーセンタイルを超えています。見える裾は精英の中央値の500倍まで延び、非公式なキャリブレーションを汚染します。カウンターは、コンテンツとは独立に機能するプレステージ、位置、インデックス、および場の構造の影響を埋め込みます。また、学問的領域内では学問的ベースラインは8倍変動します。平均値に対して、または裾に対して読まれた生のダウンロードカウントは、したがって構造的に解釈不可能です。防御可能な読取には参照クラスが必要です。フィールド、論文年齢、およびコホートで条件付けされた分布です。ランキングは、すべての欠陥にもかかわらず、そのような参照クラスへのプラットフォームの唯一の公開的なジェスチャーでした。それらの削除により、外部的なジェスチャーの構築(第5部のベンチマークマップと解釈スケール)がこの記事の残りの中央のタスクになります。
4. カウンターのメカニクス:ルール下のカウンター
SSRNダッシュボード上の任意の数字を解釈する前に、その数字が実際に何を記録しているかを確立することが必要です。SSRNは、抽象的ビューとダウンロードという2つの主要な論文レベルの使用指標を、引用統計およびPlumXインジケータ[50]とともに表示します。2026年7月15日のランキングの廃止後、これらのカウンターは継続していました。SSRNは「ダウンロードカウントと引用統計は、個々の論文と著者プロフィール上で記録および表示され続ける」と述べました[149]。比較スケールは消えましたが、データは残りました。残存するカウンターは、しかし、人間の読者シップの生の観察ではありません。それらはプラットフォームアーキテクチャ、配布機械、非人間トラフィック、および完全性フィルタリングの共同製品です。以下で、これらのレイヤーのそれぞれが分解されています。第5部は次に、それらの上に解釈フレームワークを構築します。
4.1 ビューおよびダウンロードレコードとは何か、そしてそうではないもの
抽象ビューは論文のランディングページへのリクエストを記録します。ダウンロードはフルテキストPDFの取得を記録します。両者はエンゲージメントイベントです。いずれも読了、理解、支持、または科学的承認の直接的な証拠ではありません。この区別が、本論文の残り全体で述べられるあらゆる主張を限定しています。
SSRNの公開カウンターは単純なHTTPリクエストログではありません。このプラットフォームは初期段階からデータ整合性フィルタリングを実施してきており[69]、そのアプローチを公開説明しています。自動ダウンロード、繰り返される自己ダウンロード、およびカウント操作の試みは「不規則な活動の兆候」を使用してスクリーニングされ、疑わしいダウンロード(場合によっては匿名ダウンロードを含む)は著者向け集計から除外されます[144]。独立した観察者は同じ動作を以前に記録しました。単一のIPアドレスからの繰り返されたダウンロードはカウンターに加算されません[66]。したがって、ダウンロードカウンターはキュレーションされた統計であり、生のサーバーログよりも実質的により堅牢です。フィルタリングは検出可能な非人間的活動および操作的活動を削除し、それ以上ではありません。カウンターは常にルール下のカウンターであり、自然な単位ではなく、ルールは変わります(セクション4.3)。
4.2 非人間的トラフィックとビューとダウンロード間の非対称性
自動化エージェントは、最近の業界測定においてインターネット全体トラフィックの半分以上を占めています[158]。この数字はSSRNのカウンターに転用することはできません。SSRNの抽象ビューまたはダウンロードにおけるボット比率の公表測定は確認されず、SSRNについて主張される特定のパーセンテージは根拠がありません。確立できるのは問題の構造であり、2つの方向からアプローチされています。ビューを妥当に増加させるメカニズム、および隣接プラットフォームの透明なフィルタリング記録です。
非人間的な抽象ビューを妥当に生成するメカニズムは複数あります。検索エンジンクローラーは新しく投稿された抽象ページを日常的にインデックスします。機関メールセキュリティシステム、特にMicrosoft Defender for Office 365のSafe Linksは、受信メール内に含まれるURLをスキャンし、人間の受信者がメッセージを開く前にサーバー側リクエストを登録することができます[106]。SSRNの主要配信チャネルがメール(セクション4.4)であるため、案内メールのリンクスキャンは、構造的に妥当なファントムビューの源です。セキュリティプロキシプリフェッチングがSSRNのビューカウンターに寄与する程度を測定した公表研究はなく、SSRN自体はそのメトリクスを監査し、ダウンロードカウントから不規則なアクティビティを除外しています[144][66][69]。そのため、プラットフォームはそのようなトラフィックの相当な割合をフィルタリングしている可能性があり、特にダウンロード側ではそうです。「ほとんどのSSRNビューは人間ではない」という主張は非公式な議論に現れていますが、測定されたことはありません。
透明な事例はRepEcです。そのロギングサービスであるLogEcは、そのフィルタリング方法論とフィルタリング履歴の両方を公表しており、記録は非人間的汚染がいかに深刻で、いかに非対称であるかを実証しています。2007年7月の時点で、監視対象のRepEcサービスに対するロボットアクセスは抽象ビューの約74%を占めていましたが、ダウンロードは約7%でした[99]。フィルター履歴は軍拡競争の年表として読まれます。アンチマルウェアリンクスキャナーに対するヒューリスティックスは2010年7月に追加されました。新しい形態の体系的大量ダウンロードは2017年1月に対処されました。2022年1月に導入されたDDoS軽減フィルターは抽象ビューの54%を削除しましたが、ダウンロードはわずか7%でした[99]。2025年10月から、RepEcは人間ユーザーになりすましているAI駆動型ボットトラフィックの急増を記録しました[129]。2025年9月には、IDEASへの生トラフィックの99.5%以上が非人間的として廃棄されました[129]。清掃後、2026年6月のRepEcレポートはそのサービス全体で約236万の抽象ビューと238,000ダウンロードを計上しました[129]。
RepEcの証拠はSSRNについて2つの推論をサポートします。汚染は構造上非対称です。自動化エージェントは完全テキストPDF取得よりもはるかに積極的にHTML抽象ページをクロールするため、フィルタリングが不完全な場所ではビューカウンターがダウンロードカウンターよりも大幅に増加します。その非対称性、2007年測定でのビューでのロボット約74%、ダウンロード約7%[99]は、リポジトリトラフィックのアーキテクチャ特性であり、RepEcの特異なものではありません。特定の比率は転用不可です。SSRNのフィルタリングルール、配信モデル、オーディエンスは異なり、SSRNは同等のフィルタリングログを公表していません。セクション5.2は実用的な結果を展開します。これは、ビュー上に構築されたレート(変換レートなど)は、分母がより汚染された数量であるため、人間エンゲージメント品質の下限として読まれる必要があるということです。この下限方向はビンテージ依存であり、法則ではありません。ビュー側フィルタリングがダウンロード側フィルタリングに遅れている間は成立します。これは歴史的に記録されたレジームです[99]。しかし、プラットフォームのビューフィルターがそのダウンロードフィルターに追いつくか、ダウンロード側汚染がビュー側よりも速く上昇する場合は弱まるか反転する可能性があります。2025-2026年AIボットエピソードは両方を上昇させました[129]。方向は、プラットフォームがカウント規則を修正するたびに再確認されるべきです。
これらのフィルタリングレジームが設計されて以来、さらなる考慮が浮上しています。フィルターは、人間の注意をプロキシすることを意図したカウントから自動化されたリクエストを削除するために構築されており、その規則は依然としてノイズを除去します。それがもはや未検査で実行できないことは、残りを人間として扱うことです。3つのクラスの自動化されたリクエストが、フィルターが1つを見た場所にいるためです。モデルトレーニングのためにテキストを収穫するクロール、検索またはアンサーサービスのインデックスを作成するクローラー、および人がそれに何かを尋ねたことを代理でシステムが行うフェッチです。最初の2つは注意カウントのためにノイズのままです。3つ目は人間がそれの背後にいるため、委任された行為です。システムがユーザーの質問に答えるか文献検索をサポートするために論文の完全テキストを取得するため、コンテンツが提供され、使用されています。ただし、誰も決してページを読み込みました。自動化されたリクエストはそれ自体、何かが読まれたという証拠ではありません。プロキシが弱まりました。フィルターではありません。人間と機械は、この記事が必要とする区別、つまりイベントが学術的注意の証拠であるかどうか、人間または委任された注意を確実に追跡しなくなりました。
Project COUNTERはフィルターではなく、レポート用語にこれに対処し始めました。2026年4月に発行され、2026年6月30日にRelease 5.1.1の更新されたAI使用のベストプラクティスガイダンスは、AIシステムによってアクセスされたコンテンツとメタデータとして定義されるAgent のオプションのAccess_Method、およびAI固有のメトリックタイプを提供しますが、Release 5.1.1は「従来のボットとクローラーによって生成されたアクティビティはすべてのCOUNTERレポートから除外される必要があります」[125]を引き続き要求しています。楽器には、ここで問題になる3つの制限があります。それはオプションの拡張であり、プロバイダーが生成することを選択したレポートのみで作成され、最初はプロバイダー自身のプラットフォームに組み込まれたAIシステムではなく、インバウンドクローラーを対象としています。その要素は「COUNTERレポートの標準ビューに含まれてはいけません」[125]。そのため、標準ビューはプロバイダーがガイダンスを実装する場所でもエージェントアクセスを区別しません。その後、タグ付けされたエージェントイベントがデフォルト合計から削除されるか、ラベルなしで実行されるかは、ガイダンスが沈黙している実装の問題です。また、拒否されるアクセスではなく、提供されたアクセスを分類します。ガイダンスは、「Access_Method Agentに特に関連する拒否メトリクスはありません」[125]と述べています。どのような場合でも、ベアパブリックカウンターに到達することはありません。そのようなカウンターはCOUNTERレポートではなく、アクセス方法を運びません。標準は、それに対して判定できるアナログであり、その説明ではありません。
拒否は仮説的ではなく、いかなるカウントルールより上流で機能しますが、その手段は種類が異なり、単一として機能しません。プラットフォームのrobots.txtは指定されたエージェントにクロールしないよう求めます。テキストおよびデータマイニング予約は法的立場を主張します。利用規約は契約上拘束力を持ちます。チャレンジサービスはそれを完了できないクライアントからページを保留します。これらのうち最後のものだけが強制です。ここで研究されたプラットフォームでは、2026年8月29日に取得された状態では、robots.txtは3つのエージェント(GPTBot、ChatGPT-User、Google-Extended)を指定し、その他については沈黙していました。沈黙はRobots Exclusionのデフォルトであり、よく動作するクローラーは許可と読みます。レスポンスはEUデジタル単一市場指令第3条に該当する目的でのマイニングを許可し、その他は別途ライセンスが必要であることを示すマイニング予約を含んでいました。利用規約はテキストおよびデータマイニングとAI学習に関する権利を留保していますが、著者がオープンライセンスを選択した場合を除きます。このオプションは2026年7月20日以降にのみ利用可能であり、デフォルトではすべての権利が留保されています。JavaScriptエンジンなしで行われた単一の認証なしリクエストは、ページではなくCloudflareが管理するチャレンジを受け取りました。指定されたエージェントの1つは学習クローラーではなく、ユーザーがトリガーしたフェッチャーです。これは前の段落の委任されたクラスです。これらの資料は公開されている制限と1つの構成観察を記録しています。拒否されたリクエストの数(自動化されたものまたは人間のもの)がいくつであるかは確立していません。指令は不均等に遵守されています。クローラー動作の大規模測定では、一部のエージェントはサイト全体の拒否を完全に尊重していますが、パスレベルの拒否は3分の1未満の時間で尊重しており、他のものはファイルを完全に無視しています[87]。副作用は一方向ではありません。チャレンジの展開は他の場所での正当な人間ユーザーに支障をきたしています(1つの大学図書館は最初の4か月間に2つのそのような事件を記録しました[29])。
したがって、歴史的非対称性を単に先に進めることはできません。2007年の調査結果の快適さ、抽象的なビューの約74%ですが、ダウンロードの約7%のロボット[99]は、ランディングページをブラウズし、フルテキストをめったに取得しないクローラーに基づいていました。答えを根拠付けるためにドキュメントを取得するシステムには、抽象的で停止する理由がないため、ダウンロード側はもはや構成上よりクリーンな集計であることが知られていません。生のスカラー交通が2025~26年に測定された場合、自動化された共有は限界的ではなく、ページビューにのみではなく、ダウンロードおよび訪問数の内側で検出されています。1つの文化遺産コレクションは、疑いのあるボット交通が削除された後、2025年3月の訪問カウントを1,000,000から125,000に修正しました[167]。1つの制度リポジトリでの約3,000万アクセスリクエストのベンダー分類は、そのうち約4分の1のみを人間とラベル付けしました[98]。オープンリポジトリの調査に応答するリポジトリは、自体のボットダウンロードの少なくとも4分の1を、11の指定されたAIエージェント[135]に対する約50万リクエストの一部として属性付けしました。これらの数字のいずれも、ここで研究されたプラットフォームの測定ではありません。それらはさまざまなプラットフォーム、異なる防御(いくつかの場合は不在)から取得され、3つのうち2つは公開カウンターが表示するダウンロードイベントではなく訪問またはリクエストをカウントしています。それらは大きさではなく、事前条件を確立しています。現在の環境では、任意の使用状況カウントの解釈可能性はフィルタ品質の関数であり、プラットフォームがそのフィルタリングを公開しない場合、その品質は監査されていません。
2つの識別の問題に続き、それらは複合します。構成:公開ライフタイムカウンターのみから、人間、従来の自動化、およびエージェント仲介イベントのシェアは推定できず、自動化されたクライアントがデスクトップブラウザとして表示されているため、プラットフォームの独自のビューは良くない場合があります[167]。選択では、カウンターはカウントルールが適用される前に、試行されたアクセス、チャレンジされたリクエスト、提供されたフルテキストイベント、または除外されたアクセスのどのシェアが表示されているかを明らかにすることはできません。公開ポリシーは、そのようなメカニズムが存在することを開示しています。それらが機能する頻度、過去に動作した方法、または包含への影響を開示していません。試行されたリクエスト、チャレンジされたリクエスト、提供されたフルテキストイベント、表示されたダウンロード、および取得したペーパーから生成された回答は、したがって5つの異なるポピュレーションであり、それらは相互交換可能なものとして扱われてはいけません。このプラットフォームについて許可されていないのは、大きさまたはネットサインです。未フィルタされたスカラーの使用は、自動化されたトラフィック、ダウンロードを含めて、膨張可能であることが知られていますが、このプラットフォームの非公開フィルター、チャレンジルール、およびクローラーポリシーが、より人間加重された残り、エージェント仲介発見のギャップ、両方、または前者も測定されていません。また、混合は、ライフタイム合計が最大4年にわたって安定していません。これは、2024年前のロボットレジームを通じて、2025~26年の浚渫サージを通じて、2026年7月に導入されたライセンスデフォルトを通じて実行されます。質問の下流の結果は、それ自体が文書化されています。主要なAIクローラーをブロックするサイトは、コンテンツが引き続きアクセス可能な場合でも、AI回答エンジンによって大幅に少ない頻度で取得されます[70]。主要なプリプリントサーバーのエージェント共有の公開推定値は存在しません。これは小さな効果の証拠ではなく、研究ギャップです。第8章で指定された監査は、それを測定するために設計されています。公開ライフタイム合計は、不明な試みたアクセスの不明な共有から取得された不明な混合物の合計であり、どちらの外部推定値もなく、どちらも定常として扱う根拠もありません。
4.3 計数の低下を測定イベントとして
フィルタリングルールの変更により、計数が低下したり再計算されたりすることもあります。これはダッシュボードでは説明されていないフィルタリング記録のさらなる結果です。RePEc の 2022 年 1 月のフィルター改訂では、以前にカウントされた抄録ビューの半分が一度に削除されました [99]。その 2025~2026 年の AI ボット事件はさらなる方法論的変更を強制しました [129]。ベンダーが報告するダウンロード統計は、より一般的には、カウント規約に敏感であることが知られています。図書館側の監査では、ある主要な出版社からのダウンロード報告が比較可能なプラットフォームのおよそ 2 倍高く、「デフレ」されたカウントが報告数字の 43% でした [176]。したがって、著者の SSRN 計数の急激な低下は、読者層のイベントと同じくらいの可能性で測定イベント、つまりプラットフォーム側のフィルタリングまたは再計算の変更である可能性があり、確認なしに評判の喪失として解釈されるべきではありません。同じ推論がメトリクスのいかなるファイル使用にも適用されます。この場合、日付入りの記録は保存されるべきです (第 6 項で開発されたプロトコル)。プラットフォームの数字は改訂される可能性がありますが、著者の日付入りアーカイブは改訂されることはできません。
4.4 プッシュ対プル:アーキテクチャが比率を形作る
配信アーキテクチャは最後の機械的レイヤーです。主要なリポジトリ間で質的に異なり、ビューとダウンロード間の関係を直接形作ります。SSRNは主にプッシュモデルで機能しています。投稿時に著者は1~7つの主題分類から選択し(平均的なLSN論文は3.7個のeJournalアサインメントを持っていました[168])、これらは研究ネットワーク内の配置と主題固有のeJournalメールアラート適格性を決定します。アラートに含まれることは「キュレーションされた対象のある配信であり、保証されるものではなく」[53]、大量トラフィックトピックでの配信には最大45日かかることがあります[53]。購読者はメールで抽象レベルのお知らせを受け取ります[57]。集中した興味からでも軽い興味からでも、お知らせからクリックスルーしたすべての受信者は抽象ビューを登録します。対照的に、arXivは主にプルプラットフォームとして機能しています。研究者が積極的にリストとフィードにアクセスすることで動くトラフィックを持つ非営利リポジトリ[11][65]であり、日次発表リスト内の位置でさえ測定可能に読者数と引用数に影響を与えます[72]。RePEcは分散アーカイブからメタデータを集約し、上記で説明した重い文書化されたフィルタリングを適用します[99][129]。
表6はプラットフォーム間の比較を統治と発見メカニクスの定性的スキーマとしてまとめています。プラットフォーム間で比較可能なトラフィックデータは公開された記録に存在しません。
表6. プラットフォームアーキテクチャとその使用指標への機械的効果(定性的スキーマ)。
| 特性 | SSRN | arXiv | RePEc / IDEAS |
|---|---|---|---|
| 統治 | 商用(Elsevier、2016年5月以降)[46] | 非営利(コーネル大学)[11] | 分散ボランティアネットワーク[99] |
| 主要な発見チャネル | プッシュ:著者が選択した分類(1~7)で駆動されるキュレーション済みeJournalメールアラート(大量トラフィックトピックでの配信は最大45日)[53][57] | プル:リストとフィードへの意図駆動型の訪問。発表内での位置的効果が文書化されている[11][72] | 分散アーカイブの集約。IDEAS/EconPapersを通じた発見[99] |
| フィルタリング透明性 | ポリシーは定性的に説明。公開フィルタリングログなし[144] | 使用指標については一元的に公開されていない | 完全に文書化された方法論と改訂履歴(LogEc)[99][129] |
| ビュー:ダウンロード比率に対する予期された機械的効果 | ダウンロードに対して高いビュー:メールクリックスルーは低い意図の露出からビューを登録 | 訪問のダウンロードへのより高い変換:トラフィックは意図駆動型 | 比率は重いボット除去後のみ意味がある。公開カウントはフィルタ後[129] |
このアーキテクチャは著者の心理に関連しています。SSRNでの高いビュー対ダウンロード比は大部分が設計成果です。プッシュモデルは幅広く低い意図の露出を生成します。抽象的なスキミングはまた正当な学術的行動です(研究者は通常、フルテキストをダウンロードすることなく抽象を通じてフィールドをモニタリングします)。したがって、変換しないビューは、抽象がすでに情報ペイロードを配信したことを意味する可能性があり、読者を排斥したことではありません。SSRNの独自の歴史的経験則は、BlackとCaronによって報告されており、大体「3つの抽象ビュー…1つの実際の論文ダウンロードをもたらす」[18]でした。同じ著者は、整合性フィルタがないと、生カウントが「5倍以上」[18]だけ過度に計算されることに注意しました。セクション5.2は、これらの古い基準点を最新の測定値と並べて配置します。
論文が提示される方法の2つの機械的特性は、読者の興味とともに変換を統治しており、測定された変換率は部分的に研究のプロパティではなくインターフェースのプロパティです。1つはプラットフォームのユーザーインターフェースです。フルテキストがインラインで、ブラウザ内HTML表示として提供されるか、またはダウンロード可能なPDFとしてのみ提供されるかは、興味のある読者が実際にダウンロードカウンターをトリガーするかどうかに重大な影響を与えます。ブラウザでフルテキストを使用する読者は、同じ意図を満たし、ビューのみをインクリメントするためです。もう1つはオーディエンスのデバイス構成です。モバイルアクセスはデスクトップに対してフルテキストPDF取得を抑制するため、読者が主にスマートフォン(ソーシャルメディアリンクまたはモバイルメールクライアントから)で到着する論文は、同じ学術的関心のために、体系的に低いダウンロードとより高い相対的なビューを記録します。どちらの効果も、すでに上で確立された分母の機械的インフレーションと同じ方向に引っ張られ、セクション5.2の実証的バンドを固定閾値ではなくプラットフォーム条件範囲として読む理由がさらにあります。1つのプラットフォームのインターフェースとデバイスミックスで推定される変換規範は、どちらかが変わるときに移植される代わりに再度調整される必要があります。使用指標文献は、プラットフォーム間のダウンロードレポートの比較可能性と計数慣例について同じ信頼性警告を提起しています[176]。
4.5 予測可能な副作用:類似性自己マッチとメタデータ衛生
プレプリント投稿の2つのさらなる機械的結果は予測可能であり、どちらも日常的に不必要な懸念を引き起こすため、両者とも残りの機構とともにここに属します。
類似性自己マッチ。 SSRNに投稿された作業論文が後に学術誌に投稿される場合、学術誌の類似性スクリーニングは、予想される場合に、著者自身のプレプリントとの近ほぼ完全な一致にフラグを立てます。iThentificateのドキュメントは解釈の両方の側面を明示的に述べています。ソフトウェアは「盗用をチェックするのではなく、類似性をチェック」し、「同じ著者のプレプリント一致を見る場合、これは盗用ではありません」[81]。メカニズムも文書化されています。Crossrefで登録されたプレプリントはコンテンツとして類似性チェック比較データベースに含まれるため、自分のデポジットされたプレプリントとの一致は、設計通りにシステムが動作していることです[36]。エディターがプレプリント源を除外している場合でも、リポジトリメタデータを複製するセカンダリアグリゲーターもクロールされるため、一致が浮上することがあります[81]。著者の対応は防御的ではなく管理的である必要があります。フラグが立てられた源を処理エディターに著者自身の時刻刻印付きプレプリントとして識別します。CrossrefおよびiThenticate のガイダンスは、機械的な類似性スコアの閾値ではなく、定性的な編集レビューを勧めています[36][81]。スクリーニングサービス自体によって承認されていないため、ここでは数値の閾値は指定されていません。このアドバイスが前提とする冷静さは、発行者方針に文書化された根拠を持っています。作業論文をプレプリントサーバーに投稿することは、ほとんどの学術誌の先行公開方針では許可されていますが、方針は異なり、ターゲット学術誌の現在の方針を確認する必要があります。プレプリント方針はSherpa Romeoなどのレジストリで公開インデックスされています。顕著な例外は医学および隣接する臨床分野に集中し、一部の学術誌はそれでも先行するプレプリント投稿を制限または抑止しています。それらのフィールドの著者は、投稿後ではなく投稿前にターゲット学術誌のプレプリント方針を確認する必要があります。
AI執筆検出:隣接する誤警報チャネル。 より新しいスクリーニング層は、構造的に類似した誤警報のリスクを伴います。AI執筆検出器は文書化された誤検知を発生させ、負担は非ネイティブ英語ライターに不均衡に落ちます。スタンフォードによる7つの公開GPT検出器の評価では(この研究はTurnitinを含みませんでした)、非ネイティブスピーカーによって書かれたTOEFL エッセイの平均61.3%がAI生成として誤分類されました[97]。機関慣行は懸念を記録しています。2023年8月、ヴァンダービルト大学は公開されていない類似性チェックソフトウェアのAI検出機能を公開で無効にし、その信頼性を理由に挙げています。ベンダー自身の主張された誤検知率、公開されている検出方法論の欠如、および上記で文書化された非ネイティブ英語ライターへの同じ不均衡な負担[163]。ここでの防御的な姿勢は類似性自己マッチと並行していて、対立的ではなく管理的です。原稿のバージョン履歴とドラフト記録を著作権の同時証拠として保存し(以下のバージョン衛生へのさらなる議論)、ドキュメンテーションでアラームではなく任意のフラグに答えます。
バージョン管理とメタデータ衛生。 カウンターは論文ページごとに累積するため、改訂慣行はメトリック完全性に直接影響します。SSRNは、同じ論文ページに改訂版を投稿して、累積カウンターとインデックス付きURLを保持することをサポートしていますが、論文を削除して再アップロードするとメトリックがリセットされ、既存のリンクが壊れます(SSRN FAQ。アクセス日2026年8月14日[B-7]のサポートページ)。分類の選択はメトリックの結果を同様に持っています。これらはeJournalルーティングを決定し、したがって論文の主要な露出イベント[53]を決定するため。外部インデックスは著者が期待するよりも長いクロックで実行されます。SSRNは、Google Scholar インデックスは検索エンジンによって制御され、「6~9か月以上」かかる可能性があることを述べています[55]。したがって、論文の初期カウンターはほぼ完全にプラットフォームの内部配布機械によって生成されており、セクション5.6の初期ゼロの解釈を固定しています。
5. 解釈フレームワーク:欠落していたスケールの再構築
「この数字は良いのか」という質問は、比較グループが指定されるまで科学的に適切ではありません。このセクションは、公開された経験的記録を欠落している比較装置に組み立てます。明示的なソース確信度の統合ベンチマークマップ(5.1)、経験的変換バンド(5.2)、段階的解釈スケール(5.3)、2次元リーチ変換診断(5.4)、多次元ベンチマーク指定(5.5)、および時間的読取プロトコル(5.6)。値は、サンプリングフレームと年齢全体で述べられています。どれも2026年プラットフォームの校正されたパーセンタイルではなく、すべてセクション5.1のインフレーション警告の対象として読む必要があります。
5.1 統合ベンチマークマップ
表7は、セクション2.5の監査で特定されたSSRN使用指標に関するすべての利用可能な公開ベンチマークを統合したもので、各ベンチマークには抽出枠と情報源信頼度の明確な記述が付けられています。ベンチマークはその枠を超えて拡張された瞬間に誤用されるため、各項目には情報源が正当に果たせる推論上の役割と、それを制限する主要な限界も記載されています。証拠は限定的です。このマップは、異なる枠を持つ5つの研究に基づいています。2012年の1つの法律ネットワークの国勢調査型サンプル[139]、2015年のプラットフォーム自体のトップリストのスクレイプ[85]、2025年の単一ネットワーク横断的スナップショット[83]、プラットフォームレベルの集計[1]、および1つのサブフィールド分解[168]です。これらの枠は互換性がありません。トップリストスクレイプはエリートテールを説明し、ネットワーク国勢調査は典型的な論文を説明し、プラットフォーム集計はどちらも説明しません。関係するすべての分布も強く右スキューしているため、平均値は中央値を体系的に超え、非典型的な論文を説明しています。
表7 SSRN使用指標の統合ベンチマークマップ、抽出枠、情報源信頼度、許可される推論上の役割、および主要な限界を示す。
| ベンチマーク | 値 | 情報源(年;抽出枠) | 情報源信頼度 | 許可される推論上の役割 | 主要な限界 |
|---|---|---|---|---|---|
| プラットフォーム上での約2年後の中央値論文ダウンロード | 63(平均122.55) | Siems 2016 [139];n = 2012年の2つのウィンドウに投稿されたLSN論文1,107件、2年後にカウンターを読み取り | 中~高:サンプルとダウンロード数を検証;法律のみ;2012年コホート | 通常論文分布の歴史的見方 | 現在のプラットフォーム全体の規範ではなく、2年間の法律ネットワークアンカー |
| 約2年後の中央値論文抄録ビュー | 369(平均564.62;ビュー・ダウンロード相関0.852) | Siems 2016 [139] | 中~高:情報源の表1に対して数字を検証;法律のみ;2012年コホート | 通常論文到達度の歴史的見方 | 同じく古い単一分野枠;ビューカウンターはより汚染された量です(セクション4.2) |
| 単一ネットワークスナップショットの中央値論文ダウンロード | 87(平均221.3;p25 = 35;p75 = 206;p95 = 726;中央論文年齢491日) | Jo & Li 2026 [83];N = 2,361マーケティング研究ネットワーク論文、2025年8月15日のスナップショット | 高:公開表に対して検証;異なる種類の2つの異常が「公開時点のまま」報告されたことに注記——ビュー p95 = 966は疑わしい情報源タイプミス(平均から約0.32 SD;行は再検証のためダウングレード)、転換 p95 = 77.7は小分母比率アーティファクト(セクション5.2);表5の完全パネル | 最近の横断的分布と転換モデル | 1つのネットワーク、1つのフィールド、1つの日付;成熟した論文;軌道なし |
| 単一ネットワークスナップショットの中央値論文抄録ビュー | 504(平均611.973;p5 = 151;p25 = 288;p75 = 833;p95 = 966「公開時点のまま」) | Jo & Li 2026 [83];上記と同じサンプル | 高:公開表に対して検証;p95値(966)は疑わしい情報源タイプミス——平均から約0.32 SD——「公開時点のまま」再現され、著者への問い合わせ待機中の再検証にダウングレード | 最近の横断的到達度分布 | 同じ単一ネットワーク、単一日付枠 |
| ビュー→ダウンロード転換、経験的バンド | 11~19%(≈抄録ビュー5.3~9件につき約1ダウンロード) | Siems 2016 [139];Willey & Knapp 2022/23 [172];Jo & Li 2026 [83] | 中~高:Siems、Willey–Knapp、およびJo & Liの数字を情報源表に対して検証 | 条件付き参加規範(転換) | 抽出枠が少数;分母はボット膨張可能であるため、測定された転換は下限ですが、ビューは引き続きより膨張したカウンターです(セクション4.2) |
| 歴史的プラットフォーム全体の経験則 | ~3抄録ビュー:1ダウンロード(~33%) | Black & Caron 2006 [18]、SSRNの独自統計を報告 | 中:逐語的に検証;時代遅れ(2006);プラットフォーム全体 | メトリック構造と整合性の歴史 | プラットフォーム初期段階;現在の規範ではなく、上限アンカー |
| エントリー閾値、歴史的トップ10,000論文 | ≥160生涯ダウンロード(≈プラットフォーム全体のフルテキスト論文在庫の上位1.8%、2016年7月[1]の571,040);グループ内中央値805;平均1,800;最大152,242 | Kakushadze 2016 [85];SSRN トップリストのスクレイプ、2015年;367,478論文 | 高:公開表に対して検証;トップリスト枠;単一著者作品 | 分布形状と裾行動 | トップリスト選択;現代の中央値論文の推定に不適切 |
| エントリー閾値、トップ30,000著者 | 129ダウンロード(最小);グループ内中央値1,626ダウンロード合計;論文あたり中央値210ダウンロード;最大824,762 | Kakushadze 2016 [85];グループSSRNの独自の手紙で「著者の上位10%」[161]と説明 | 高:公開表に対して検証 | 著者ポートフォリオレベルの裾行動 | 同じトップリスト選択;2015年版 |
| 調整されていないプラットフォーム全体の生涯平均 | ~222ダウンロード/論文(直近12か月で~35) | 2023年12月時点のプラットフォーム合計から計算:1,157,048フルテキスト論文全体で256,678,716生涯ダウンロード;ALL-SIS 2024 [1] | 中:派生集計;古い論文による機械的膨張;個人的な基準ではない | プラットフォーム規模の集計キャリブレーションのみ | 20年の蓄積にわたる平均;実際の論文をほぼ説明しません(セクション3.3) |
| 単一分野内のサブフィールド拡がり | 論文当たり平均ダウンロードで~8倍(法人/有価証券/金融法438.35 対 農業法53.48) | Whalen 2018 [168];94 LSN eジャーナル、~250,000論文 | 中~高:情報源から検証;2018;平均値、中央値ではない | 分類とサブフィールド異質性 | 平均値、年齢一致中央値ではない;法律のみ;2018 |
| 初期ダウンロード→後の引用 | r ≈ 0.39~0.43(最初の180日以上)(≈分散の16%を説明) | Brody、Harnad & Carr 2006 [25];arXiv(HEP)、N = 14,442 | 高:検証済み;異なるプラットフォーム、転移可能性は示されるのではなく想定 | 下流予測検証 | 異なるプラットフォームと時代;論文レベル相関は控えめ |
| アクセスのカレンダー構造;アクセス→引用ラグ | 週末のアクセスは約11%低く、夏は約50%低い;アクセス変化後約9ヶ月で≈単位弾性の引用応答 | Yuret 2026 [178];7つのジャーナルから約1,500本の論文を約1年間追跡 | 高:DOI、掲載誌、タイトルはCrossrefで検証済み(2026年8月14日);4つの図全て—7つのジャーナルから1,500本以上の論文、週末のアクセスが約11%低く夏が約50%低いこと、およびアクセス量が10%上昇すると約10%の引用上昇に相当する約単位弾性の引用応答が約9ヶ月後に生じること—が公開論文の要旨と照らし合わせて逐語的に検証済み(Springer、2026年8月15日) | 時間的正規化と予測的検証—CSABの背景にあるカレンダー正規化アンカー | ジャーナルアクセスデータ;SSRN固有ではない |
| 計数規約に対する計数の感度 | ベンダーのダウンロードレポートは比較可能なプラットフォームのそれの約2倍に達することができる(報告値の43%で「インフレ化した」計数);論文レベルのメトリクスは明示的なデータ整合性スクリーニングを必要とする | Wood-Doughty et al. 2019 [176];Gordon et al. 2015 [69] | 中程度から高:両方の情報源は検証済みで、セクション4.1–4.3で既に引用されている | 整合性と比較性の警告—プラットフォーム間またはベンダー間の比較の精度を制限する | SSRN直接ベンチマークではない;SSRN固有の監査は存在しない |
マップの3つの構造的解釈が続く。
平均は典型的な論文ではない。 唯一の最近の公開分布では、平均(221.3)は中央値(87)の2.54倍であり、第75百分位数(セクション3.3)[83]をも超えている。Siems の初期の国勢調査では、平均はおよそ中央値の2倍であった[139]。プラットフォームレベルの平均である約222のライフタイムダウンロード[1]は、すべての中で最も適さない個人的なものさしである:すべての年齢の論文による20年間の蓄積を集約している。
すべてのベンチマークはビンテージを持ち、ビンテージバイアスの方向は比較に依存する。 プラットフォームの年間ダウンロードは2000年の約0.5百万から2005年の3百万[18]、2016年の12.9百万から2023年の40.6百万[1]へと成長し、2016年から2023年の間に3.15倍の上昇となった一方、論文在庫は同じ期間にほぼ2.03倍成長した(571,040から1,157,048[1])。図5はこの軌跡をプロットしている。ダウンロードが論文在庫より速く成長したため、論文あたりのダウンロードフローはおよそ55%上昇した(年間論文あたり約22.6から約35.1へ[1])。したがって、固定された2015年のしきい値は現在、典型的な論文が得られる額のより小さいシェアを表している。2026年の絶対レベルバンドとして読むと、~160ダウンロードのトップリストエントリのような古いしきい値は、したがって保守的でなく、むしろ寛容である:それをクリアすることは、2015年より今日がより選別的であり、そうではない。バイアスは構成に依存している。継続的な右スキューの下での百分位位置では、古いアンカーはまだテールを過小評価する可能性があるが、絶対計数ではダウンロードインフレーションはそれらを柔らかくするため、古いしきい値は「保守的な下限」として引用されるべきではなく、この適格性なしに引用されるべきではない。2015年のしきい値にその後のプラットフォーム成長を掛けることも同様に認可されていない:著者構成、流通チャネル、フィルタリング、および注意への競争はすべてダウンロードフローとともに変わった。
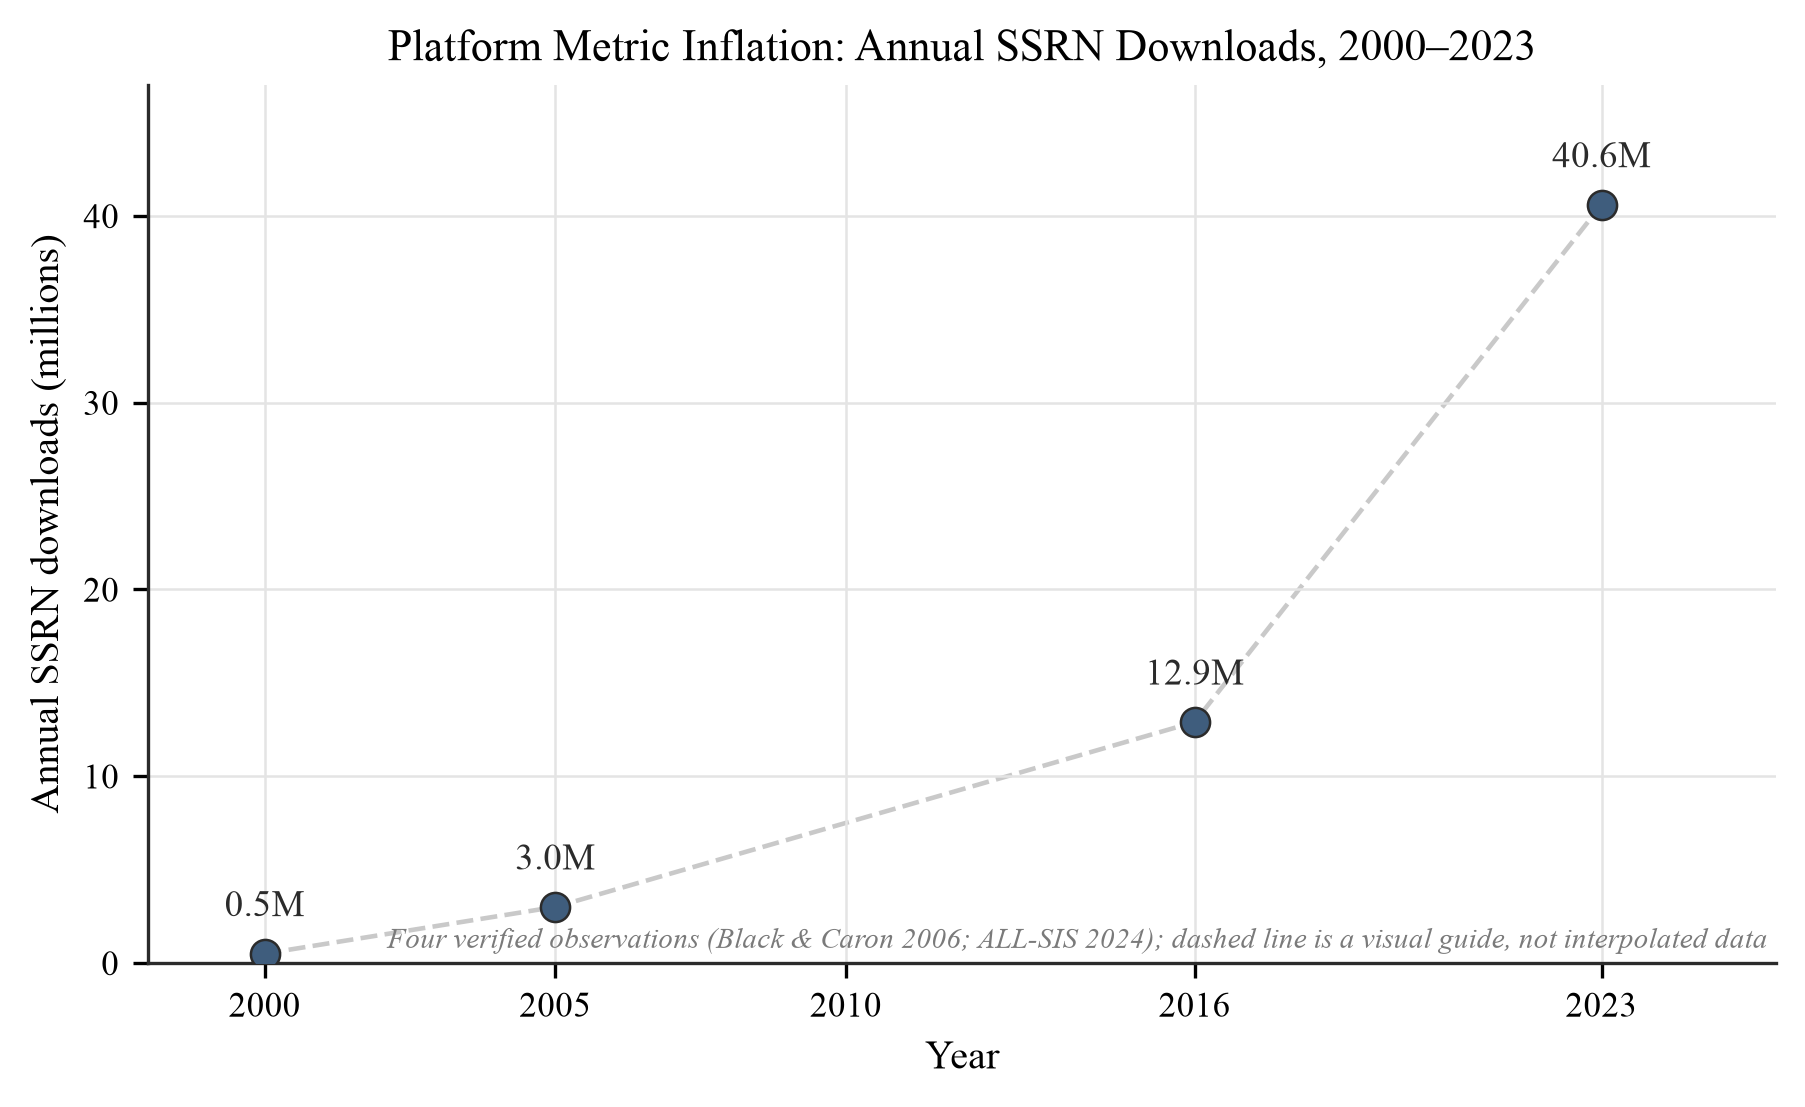
図5. プラットフォームメトリクスインフレーション、2000–2023。年間SSRNダウンロード:~0.5百万(2000)と~3百万(2005)[18];12.9百万(2016)と40.6百万(2023)[1]。ダウンロードフローが論文在庫より速く成長したため(2016年から2023年で≈3.15× 対 ≈2.03×[1])、論文あたりのダウンロードフローをおよそ55%上昇させ、2012–2015年のサンプルで推定された絶対ベンチマークは2026年の読み取り値に対して寛容なバンドではなく保守的に読まれている。ここにリストされている4つの検証済みの年の値のみがプロットされ、それらの間の補間は暗示されていない。
現在のパーセンタイルソースは存在しない。 セクション2.5の監査では2020年以降のプラットフォーム全体の分布研究は特定されず(2025年の単一ネットワークスナップショット[83]は2026年に公開され、最近の公開外部サンプルのみ)、2026年7月15日以降、プラットフォーム自体はパーセンタイルを再構成できるような比較データを公開していない。ギャップは現在性とプラットフォーム固有性の問題である。プリプリント注目度の分布と不平等は他のリポジトリでの成熟した研究分野である(bioRxiv預金の引用とアルトメトリクスプロファイルはサーバー全体で特性化されている[62])、およびSSRNダウンロードの準対数正規形状は既に2020年以前にKakushadze[85]によって確立されていた。欠けているのは現在の、SSRN固有の、サンセット後のパーセンタイル分布である。上記のマップは利用可能なフレームから組み立てられており、これが研究アジェンダ(セクション8)で提案されているコミュニティベンチマークデータセットの議論である。
5.2 コンバージョン帯
ダウンロード数と抄録閲覧数の比率は、比較的安定した研究間標準を持つダッシュボード指標の中では唯一のものであり、著者たちはこれ以上に一貫して誤読する指標はありません。素朴に読むと、コンバートしないすべての閲覧は拒否として計上され、40回の閲覧と7ダウンロードを持つ著者は「82.5%の失敗率」を認識します。この読み方は機械的にも実証的にも間違っています。
セクション4は機構を確立しました。分母(閲覧数)はボット汚染が多く、アーキテクチャインフレーションも多い指標です。プッシュモデルのメールクリックスルーとクローラートラフィックは読者の意図を示さずに閲覧を蓄積し、ダウンロードカウンターは積極的に監査されているからです[144][99][106]。自動トラフィックが閲覧をダウンロード以上に拡大する限り、測定されたコンバージョン率は、本当に関心のある人間の訪問者のコンバージョンの下限です。セクション4.2は、AIシステムがフルテキストを取得する場合、その非対称性がもはや仮定できない理由を説明しており、その限界はそれに応じて弱まります。実証的には、公開された測定値は狭い帯に収束します。Siemsはロジスティック回帰国勢調査でダウンロード当たり平均0.171(平均0.187)の中央値を測定しました[139]。WilleyとKnappは上位記事グループで15%、単一引用記事で11%のコンバージョンを報告しています[172]。JoとLiのスナップショットは、100抄録閲覧当たり中央値18.9ダウンロードを生成しています[83]。結果としての実証的帯は11–19%、つまり、およそ5.3–9抄録閲覧1ダウンロードです。SSRNの古い経験則である約3:1(約33%)[18]は帯上に位置し、現在の標準ではなく初期時代のプラットフォーム全体の上限アンカーとして最も良く読みます。クロスドメイン例として(母集団と意図は範疇的に異なります)、このレンジのブラウズからコミットへのレートは、典型的なフリーミアムの無料から有料へのコンバージョンベンチマークが一桁台の低い数字で集まるコンシューマソフトウェアでは高いと見なされるでしょう[10]。この比較は例示的なだけで、「40分の7」が無関心を示すという直感を再構成します。図6は推定値をプロットします。
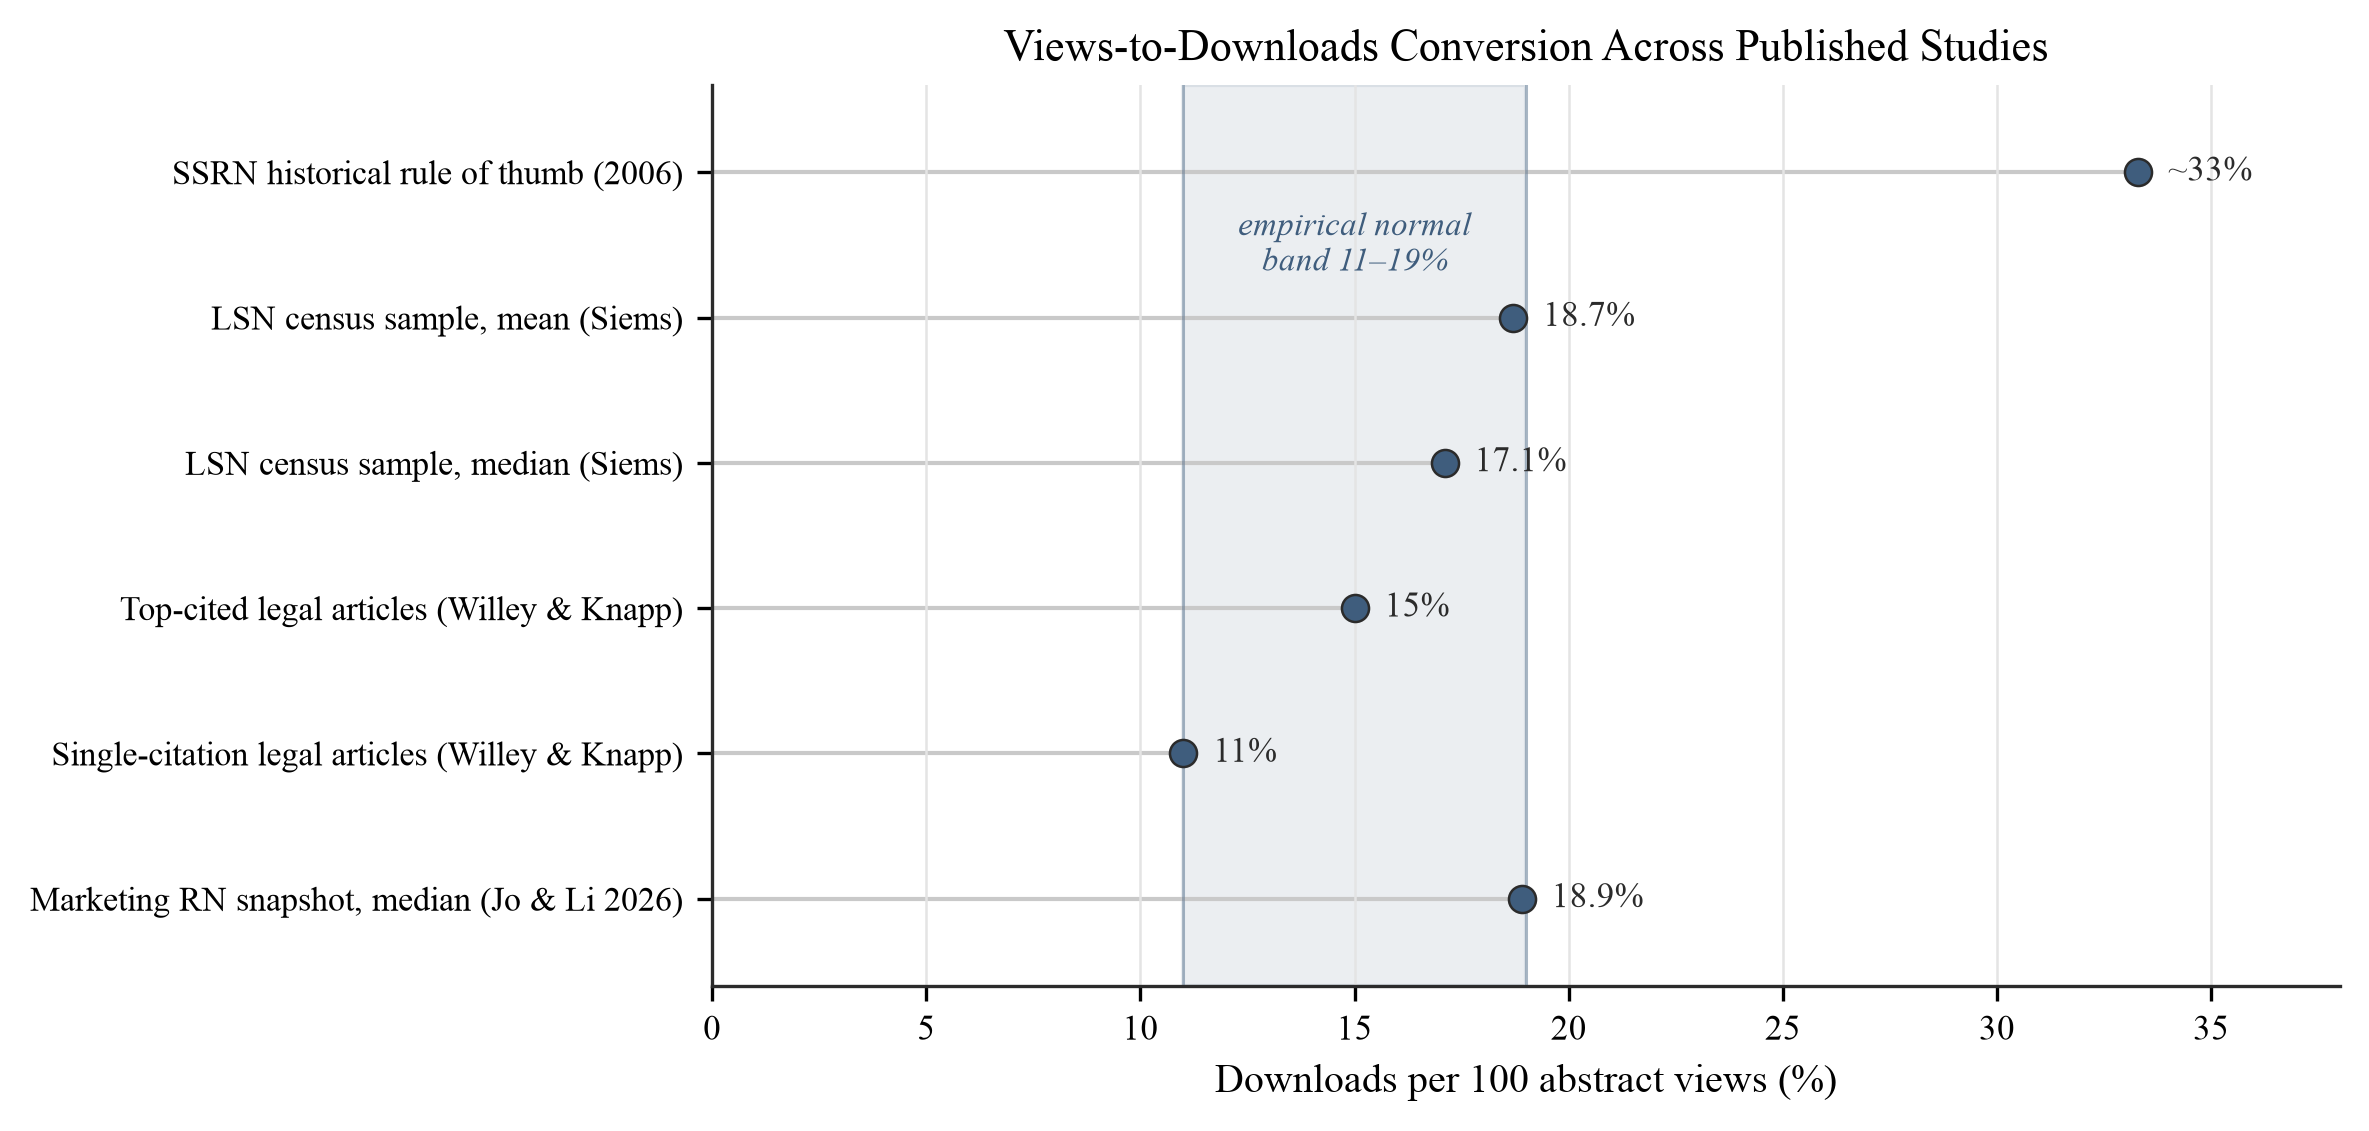
図6. 研究全体でのビューからダウンロードへのコンバージョン。公開記録全体でのコンバージョン推定値:SSRNの歴史的経験則約33%(2006年報告)[18];LSN国勢調査平均18.7%、中央値17.1%[139];引用された上位の法的記事では15%、単一引用法的記事では11%[172];2025年マーケティング研究ネットワークスナップショットでの中央値100抄録ビューあたり18.9ダウンロード[83]。網掛けされた帯は11–19%の実証的正常範囲を示す異質な推定値のエンベロープ(ネットワーク全体の中央値と引用選別サブサンプル数字で、統計タイプはソースが未指定)。JoとLiのサンプル平均(100あたり23.7)はそれを上回ります。すべての値は引用されたソースで発行されているとおりです。新しい推定値は導入されていません。
帯のメンバーは異なるサンプルの異なる統計であるため、これは異質なポイント推定値のエンベロープです。Siems(17.1%)とJoおよびLi(18.9%)の数字はネットワーク全体のサンプルの中央値ですが、WilleyとKnappの15%と11%は引用選別サブサンプル(上位引用対単一引用法的記事)について報告され、統計タイプはソースで指定されていない選択が帯の下端がある理由です。上端はさらに柔軟です。JoとLiサンプル23.7ダウンロード100ビューあたりの平均コンバージョン[83]は帯の上にあり、そのサンプルの集計平均の比率(221.346÷611.973 = 100あたり36.2)と急激に異なります。100あたり36.2の平均比率が100あたり23.7の平均比率をはるかに上回ることは、それ自体が診断的です。平均比率はリーチとコンバージョン間の正の共分散を意味し、論文あたりのコンバージョン率のビュー加重平均であるため、加重されていない平均比率の平均を超過することは、より低いレート、より高いレートでコンバートします。読み方は保守的です。小さい分母インフレーションは加重されていない平均比率を上向きに押し、この順序に対して働きますので、平均比率がとにかくそれを上回っているのを観測すること、正の依存結論がより堅牢であることを示します。
帯はこの記事の中央の実装例を供給します。公開されたアンカーに基づいて、40の抄録ビューを持つ論文は大体4–8ダウンロードを生成することが予想されます。タイトルの「7ダウンロード」、40ビューで、17.5%のコンバージョンで、帯の内側に着地するポイント推定値ですが、この分母で広い不確実性を伝えます。40のうち7の正確な95% Clopper–Pearson間隔は約7.3%から約32.8%までで、両側で帯をまたいでいます。40ビューだけの場合、推定値を帯の幅に解決することはできません。したがって、読み方はスクリーニング結果であり、分類ではない。さらに2つのことが例を制限します。分母は小さいです(以下に記載された不安定性)、比較は年齢一致されていません。40ビュー、大体20日目は初期人生読みですが、アンカー中央値は成熟サンプルから来ます(Siems 2年[139]、JoおよびLi中央値491日の論文年齢[83])。ポジション1および5およびセクション5.6は、初期人生露出は異なるレジームであると主張しており、年齢軸は揃えられていません。防御可能な読み方は、17.5%は正確な人口パーセンタイルではなく、「快適に内側」ではなく、スクリーニング結果として研究間帯と一貫していることです。そのような数字が引き起こす苦痛は、読者数の欠如ではなく、スケールの欠如を反映しています。基本となるアンカーのビンテージと範囲はセクション9で設定されています。
小さい分母は比率を不安定にします。2つのビューと1つのダウンロードを持つ論文は名目上50%のコンバージョン率を示しますが、その推定値は500ビューに基づいて構築されたものより信頼に値しません。公開ベンチマークのために、経験的ベイズ縮小を参照クラス率に向けて適用することで、小さい分母が極端なスコアを生じるのを防ぐべきです(セクション8.3および8.8)。このバンドはまた両方向の診断として機能します。自明でない分母において、バンドをはるかに下回るコンバージョンは通常、タイトル・アブストラクト・本文の不一致を示唆しています:読者は到着し、アブストラクトを読んで去ります。これは実行可能なコミュニケーション問題(タイトルとアブストラクトの書き直し)であり、研究の評価ではありません。バンドをはるかに上回るコンバージョンは、アブストラクト閲覧では説明されないトラフィック(メディア報道、コース採択、またはバイラル流通)を示唆し、ビューの出所を確認することを促すべきです。どちらの逸脱も、それ自体では研究品質について何も確立しません。さらなる適格性は知見ではなく仮説です。コンバージョンは個別論文の性質というより聴衆の読読スタイルの性質として分野全体で体系的に異なる可能性があります:大きな分野は多くのアブストラクト訪問と少数のダウンロードを伴う「ウィンドウショッピング」行動を示す場合があり、一方、小さく高度にエンゲージした共同体はより高いレートでコンバージョンします。上記のバンドはこれを解決するには少なすぎるフレームから推定されているため、Study 1(セクション8.6)はその出力の中に分野階層化されたコンバージョンを含みます。
診断であり決して目標ではない:ゲーム対策制約。 コンバージョンバンドが強力なのは、それが規範として読むことができるからであり、その力は危険をもたらします。グッドハートの法則は、目標として採用された尺度は良い尺度であることをやめると述べており[67]、これはキャンベルの法則による意思決定のために使用される社会指標の腐敗に並行しています[27]。11~19%のバンド、またはセクション5.5のベンチマークフレームワークのいかなる要素も、プロモーション閾値(「論文がコンバージョンバンドの内側に座っていることをカウントすべき」)として採用された場合、その比率は即座に観察の対象ではなく最適化の対象となります。この攻撃は具体的で安価です:分母は、より操作可能な量であるため(セクション4.2)、ダウンロードに対する固定比率でのアブストラクトビューの組織的な膨張は、バンドの内側に比率を保ち、エンジニアリングされた信号を有機的なコンバージョンから統計的に区別不可能にします。フレームワークの答えは定義の問題です。コンバージョンバンド、リーチ・コンバージョン診断(セクション5.4)、およびCSAB構成要素(セクション5.5)は診断ベクトルであり、決して目標ではなく、どの構成要素もプロモーション基準として読まれてはいけません。ゲーミングに対抗する仕組みは設計に組み込まれています:バンドは下限として述べられています。その分母はボット膨張可能であるため、読み取りは構造的に膨張に対して保守的です。セクション8.3の異常プロトコルは削除ではなくフラグです。エンジニアリングされたスパイクは保持され、可視化されるのではなく、静かに吸収されます。セクション4.1の完全性フィルタリングはすでに最も検出可能な組織的活動をふるいにかけます。診断として読むと、バンドはゲーミングを帯域外またはシステム内で一貫性のない署名として公開します。目標として読むと、それが検出することを意図した正確な調整を招待します。この立場はフレームワークを確立された研究評価改革コンセンサスと整列させます:サンフランシスコ研究評価宣言(DORA)は、単一数値とジャーナルブランドプロキシを拒否し、研究自体の内容での評価を支持しており[8]、ライデン宣言は、その原則はまさにこの専門家の判断の簡単な指標への代替に対して注意喚起しています[78]。
ダウンロードに公開監査証跡がない:バンドを下限として読む別の理由。 引用とダウンロード間の構造的非対称性はゲーム懸念を鋭くします。引用は公開的で検査可能な痕跡を残します:引用文書は存在し、発見可能であり、確認できるため、引用操作は原則として第三者によって監査可能です。ダウンロードカウンターはそのような公開証跡を残しません。これはプラットフォームのサーバー上の個人的な集計であり、どのリクエストが数えられたか、フィルタリングされたか、再述されたかについての外部記録がなく、これは事後的に第三者が再構築できない隠れたゲーミングに独自に公開されています。この公開は、分母のボット汚染を超えて、測定されたコンバージョン率を点推定ではなく下限として扱う独立した理由です(セクション4.2のAI検索に関する注釈を受ける)。常にカウンターを異常プロトコルと組み合わせ、フレームワークが依存する文書化された完全性フィルタリング(セクション4.1)が必要です。監査証跡の欠如はカウンターを不信するべき理由ではありません。それは、それを保守的に読み、操作された読み取りを検出可能に保つフラグなし削除規則を主張する理由です(セクション8.3)。
バンドは定数ではなく較正目標です。 11~19%の数字、およびすべてのCSAB閾値がどのように引用されるべきかについて、その結果が続きます:それらは分野によって、およびプラットフォームによって較正される量です(セクション4.4、5.5)。その較正のメカニズムはすでに指定されています:分野階層化Study 1(セクション8.6)はフレームワークが必要とする分野ごとのコンバージョンとダウンロード分布を提供し、消費するために構築されています。Study 1が報告されるまで、付録Eのアーカイブ横断面は分野解決推定値を供給します。少なくとも20の論文を保有する14の分野全体において、中央値コンバージョンはエネルギーの0.134からコンピュータサイエンスの0.195まで実行され、約1.5倍の分散です。論文年齢を固定して保つと、それは0.134から0.224まで実行され、約1.7倍です。ダウンロード自体の3倍から5倍の分野分散に対して、コンバージョンはより移植可能な量です。これが診断として使用可能な理由です。年齢は生き残らない次元です:テストするのに十分な大きさのすべての分野内で、論文が古くなるにつれてコンバージョンは低下します。少なくとも40の論文を保有する8つの分野全体でスピアマン係数は−0.14から−0.41までです。論文年齢なしで引用されたコンバージョンバンドは、それが見た目ほどの作業をしていません。
5.3 段階的解釈スケール
Post-Rankings の著者たちは最も顕著には、h-index 解釈ガイドの確立された形式 [118] に従った段階的スケールを欠いており、これは生のカウンターを平易な言語のバンドに変換するものです。セクション 5.1~5.2 がその材料を提供します。表 8 は 4 つの数量に対する提案されたスケールを示しています:論文レベルの生涯ダウンロード数、初月ダウンロード数、閲覧数からダウンロード数への変換、および著者レベルの総ダウンロード数です。
表 8. SSRN メトリクスの提案された解釈スケール。 バンドは 2012~2015 年の証拠 [139][85][18][172] を統合しています;その後ダウンロード・パー・ペーパーの流量が増加しているため(セクション 5.1)、それらの絶対的な閾値は 2026 年については 寛容な むしろ保守的ではないバンドとして読むのが最善であり、いずれにしても近似値としてです。初月列は校正された段階ではなく、事前登録された広い不確実性を伴う予測であり、研究 1 の見込みパネル(セクション 8.6)によってテストされるべきものです;そのセルは閾値または昇進の段階として読まれてはいけません(テキストを参照)。強力/例外的な境界の 10,000 は著者の暫定的な推定値です:セクション 2.5 の監査で特定された公開されたソースはなく、10,000 ダウンロードをパーセンタイルに結びつけるものはありません。Nascent バンドは新しい数字を導入しません:その上限は既存の 2 年間の中央値アンカー 63 です [139]。バンド境界は丸い数字に設定され、おおよそ 1 つの完全なバンド幅に保たれています:完全性文献によって確立された精密さの天井(セクション 3.1、4.1~4.3)は、より細かい段階を見かけ上正確にするため、バンドの粗さは意図的です。平易な言語の評決列は ダウンロード スケールのみを説明し、変換列に転送されません:18.9% の中央値変換は「Solid」ではなく普通であり、27.2% の p75 は「Strong」ではありません。生涯ダウンロード境界は構成上重複しません(Nascent は 63 未満、Modest 63~159、Solid 160 以上);表がより高い行間の共有エンドポイントを出力する場合―Solid と Strong の間の 800、および対応する変換と著者レベルのカットオフ―区間は半開で、各共有値がより高いバンドに属します。2 つの生涯境界値そのものは比較できない参照クラスから引き出されています:63 は単一分野の法学奨学金国勢調査 [139] の 2 年間のウィンドウ中央値であるのに対し、160 は全プラットフォーム トップリスト [85] の全時間、生涯エントリ閾値です。したがって、それらは異なるクロック(固定された 2 年間のペーパー年齢対無制限の生涯蓄積)上にあり、異なる母集団(1 つのフィールド対すべてのフィールド)を説明しているため、それらを単一の絶対的なはしごにプールすることは、異なる年齢、フィールド、および選択ルールを持つ参照クラスの組み合わせです―研究 1 の分野およびエイジスペシフィックパーセンタイルはこの制限を削除するために設計されています。これらのアンカーの構造的な制限は強調する価値があります:利用可能な参照点は 2 年間の中央値(63 [139])とプラットフォームの上部テール で集中しているため、5 つの言語バンドのうち 4 つ―Modest、Solid、Strong、および Exceptional―は中央値以上のペーパーを説明しており、スケールは中央値上で密集しており、実際にほとんどのペーパーが該当する広い 50 番目~98 番目パーセンタイル範囲にわたって識別が弱いです。この圧縮はトップテール証拠に固定することの直接的な結果です;普通を単なる中央値上からの区別することは、研究 1 の分野およびエイジスペシフィックパーセンタイル(セクション 8.6)を待ちます。スケールは説明的であり、規範的ではありません:研究 1 の見込みパネル(セクション 8.6)がこれらの古い絶対的なアンカーを置き換えるために分野およびエイジスペシフィックパーセンタイルを校正するまで、バンド境界が在職権、採用、または昇進の決定にパス/フェイル閾値として入ってはいけません。
| バンド | 論文:生涯ダウンロード数 | 論文:初月ダウンロード数(推定) | 変換(ダウンロード数 / 閲覧数) | 著者:総ダウンロード数 | 平易な言語の評決 |
|---|---|---|---|---|---|
| Nascent | 2 年間の中央値 63 未満 [139] | — (個別のアンカーなし;テキストを参照) | — (分母は通常は小さすぎる;セクション 5.2) | — | まだ早いか、分野の中央値未満―若く、ニッチなペーパーの統計的規範;品質ではなく、露出を最初に診断してください(セクション 5.4、5.6) |
| Modest | 63~159 | <15 | <11% | <~130 | プラットフォームに典型的;中央値バンド |
| Solid | 160~800 | 15~50 | 11~19% | ~130~1,600 | 歴史的なトップリスト エントリ以上 |
| Strong | 800~10,000 | 50~250 | 19~30% | 1,600~10,000 | 歴史的なトップリストに典型的 |
| Exceptional | >10,000(著者の暫定的な推定値) | >250 | >30% | >10,000(著者の暫定的な推定値) | 通常の学術流通の記録された範囲を超える |
各内部アンカーは公開されたしきい値に結びついている。Nascent帯は、2年LSN中央値63 [139]以下の領域をカバーしている。その領域は多くの論文を含んでおり、異常ではない。事前指定されたStudy 1帯(セクション8.6)は、プラットフォームの論文の相当な割合(予測帯下の約15~30%の範囲)が10以下のライフタイムダウンロード数を有することを予測しているため、最低帯が中央値付近から始まるスケールは、プラットフォームで最も数の多い論文(この論文を含む)をスケール外に完全に置き去りにするだろう。Nascent判定は評価的ではない。フィールド中央値以下、特に論文が若い場合、このカウンターは品質について何の判断も下さず、最初の診断ステップは内容ではなく露出(セクション5.4および5.6)である。Modest帯は2年LSN中央値63 [139]に固定されている。「Modest」は中央値帯である。典型性は失敗ではない。Modest/Solid境界(約160ライフタイムダウンロード)はKakushadzeの全時代トップ10,000論文への入口であり、プラットフォームの全文論文在庫(571,040、2016年7月[1])の約上位1.8% [85]である。運用上、「Solid」論文はトップリスト論文である。Solid/Strong境界(約800)はそのエリート集団内の中央値(805)[85]である。これは歴史的エリートに単に入った論文と、それに典型的な論文を区別する。ポートフォリオスケール上で、著者レベルの列はこのロジックを反映している。SSRNが上位10%の著者として説明した通知[161]を受けたグループは、総ダウンロード数の最小エントリが129で、内部中央値が1,626 [85]であった。すべての著者レベルアンカーがそのランク付きリストから抽出されているため、著者列は典型的な著者ではなく、著者分布の上位テール(うち)を説明している。約130境界以下の著者は単なる「Modest」ではない。その著者は歴史的にランク付けされたグループの外側に完全に外れているため、列の下位帯は、すべての著者の中の校正された位置ではなく「歴史的エリート以下」として読まれる。これは論文レベルスケールを圧縮する同じトップテール固定である。著者列のアンカーはStudy 1のポートフォリオレベルパーセンタイルを待つ。変換列はセクション5.2のクロススタディ帯である。Strong/Exceptional境界の10,000は公開されたパーセンタイルアンカーを持たず、けた違いの視点として保持されている。
最初の月の列は異なるステータスを持っている。これは事前登録された予測であり、Study 1(セクション8.6)がテストするよう設計された広い不確実性を伴う反証可能な予測であり、どの最初の月のセルもしきい値または解釈的な段数として使用されない。公開文献に直接の最初の月ベンチマークが存在しないため、列は測定ではなく投影であり、ダウンロードの記録された初期集中(注意スパイクは特に外部報道下[18][116][138]で最初の週にクラスタ化される)から上記のライフタイム閾値に外挿された。特定の境界は1つの公開されたアンカーから導出される。Kakushadzeのトップリストサンプル、プラットフォームの全文論文在庫(571,040、2016年7月[1])の約上位1.8%では、中央値12ヶ月ダウンロード数は247 [85]であった。したがって最初の月の約250を超えるダウンロード数はプラットフォームの歴史的エリートの年間規範を超えるだろう。それゆえExceptional境界であり、一方15~50の最初の月ダウンロード数は、持続されれば、約160のライフタイム入口しきい値に投影される。それゆえSolidである。これらのセルは単一の歴史的アンカーからの投影であり、表の最も弱いセルである。引用される場合、それらはこの導出を伴う。
スケール使用を管理する2つの注意がある。分野別修飾子は必須ではない。単一の分野内では、論文あたりの平均ダウンロード数は小分野間で約8倍異なる(企業/証券/金融法では438.35、農業法では53.48)[168]。そのためすべての帯ステートメントはフィールドラベルを伴うべきである。それらはライフタイム平均であり、論文の年齢に調整されていない。付録Eの保存クロスセクションはなぜそれが重要かを示している。フィールドの見かけレベルはそれからサンプルされた論文の年齢プロファイルで移動し、年齢を固定に保つことはスプレッドを約3~5倍に狭める。2番目は、このスペースで提案された代替シングルナンバーヒューリスティック(比率ベースの相対パフォーマンス指数(論文のダウンロード数をマッチしたコホートの中央値で除したもの)、⌊ln D⌋に基づく対数階層ヒューリスティック、および言語スコアカード判定(「fast start / steady interest / slow start」))は、検証されたnumeric帯がないため、ここで未校正著者ヒューリスティックとして包含されている。対数直感自体は健全であり、言葉で保つ価値がある。準対数正規分布[85]下で、7から20ダウンロードへの移動は可視性の自然ログユニットの1シフトであり、13クリックの追加として読むことはそれを見逃す。
この尺度は、著者が自分自身のカウンターを体系的に誤判断する理由を説明しています。セクション3.5で文書化されているように、マイルストーン、プロファイル、および告知で流通する数字は、中央値をはるかに上回る数百倍の可視テール由来であり、分布の大部分はLSN中央値の63の近くに位置し、準対数正規則の下では段間の距離は加法的ではなく乗法的です。図7はこれらの値(通常紙の中央値、エントリー閾値、エリート中央値、テール)を対数尺度のベンチマークラダーとして配置しています。
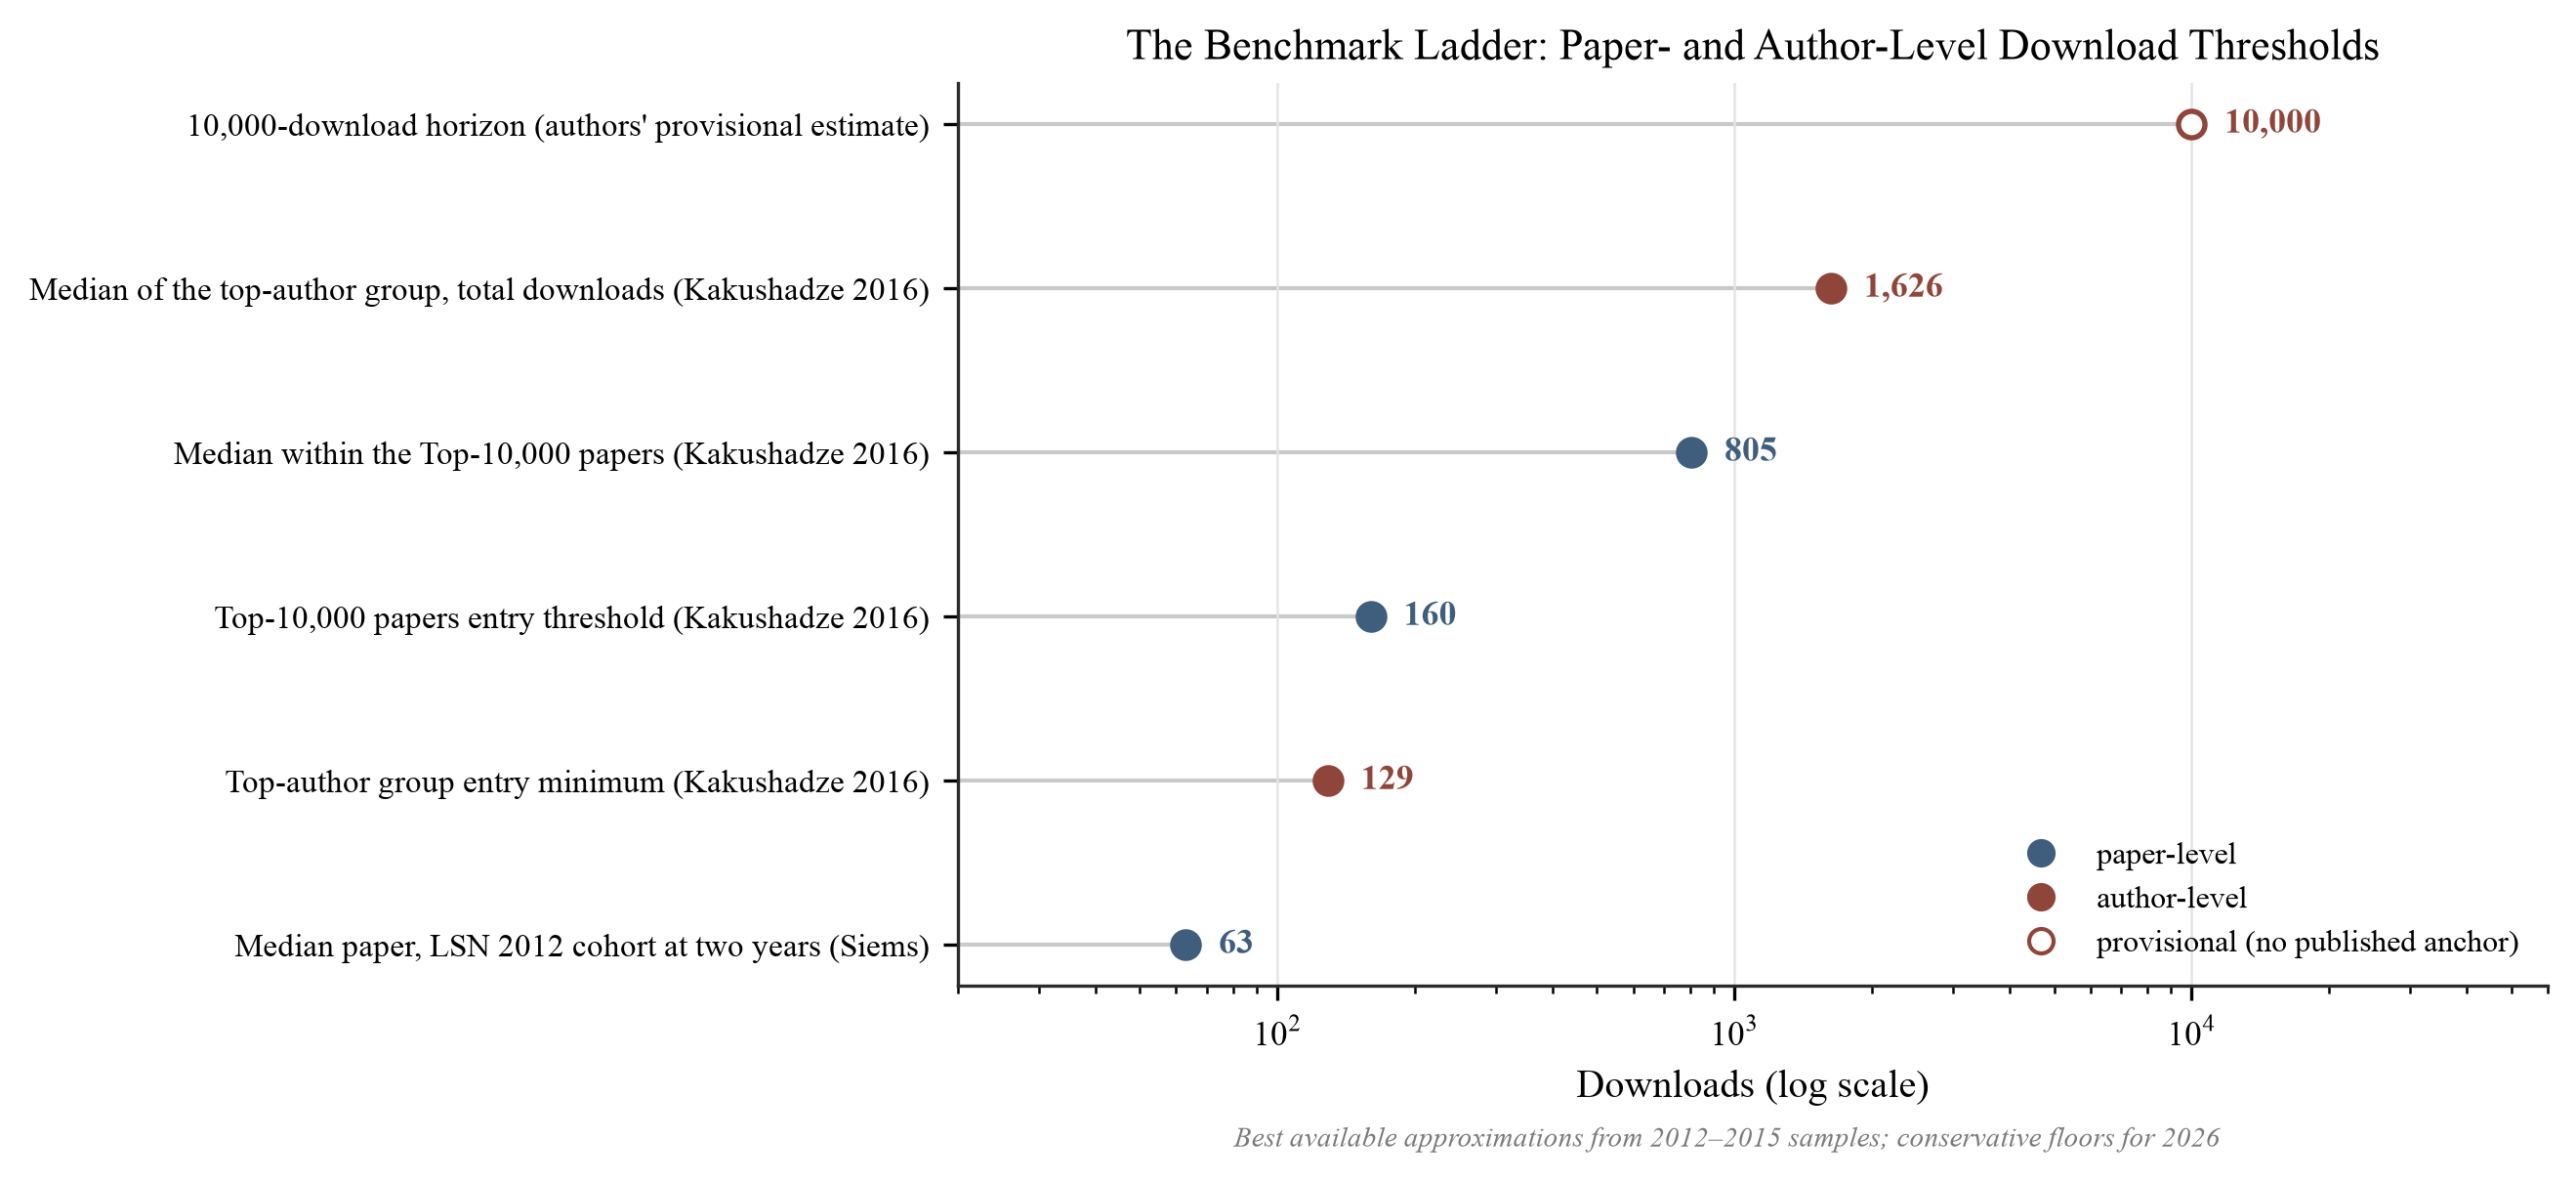
図7。ベンチマークラダー。対数尺度上のペーパーおよび著者レベルのダウンロード閾値:LSN2年中央値63 [139];トップ著者エントリー最小値129およびトップペーパーエントリー~160 [85];トップ10,000ペーパー内の中央値805 [85];トップ著者グループの中央値1,626 [85];10,000ダウンロード地平線(著者の暫定的推定値、公開されたパーセンタイルアンカーなし)。2年中央値63以下の領域は表8のNascent bandに対応しています。値は2012~2015年のサンプルからのものです(以降のインフレーション:セクション5.1)。
5.4 リーチ対コンバージョン:2次元診断
単一のカウント、たとえバンド分けされたものでも、それを生み出す異なるメカニズムを区別することはできません。セクション4の機構には、実務上最も重要な1つの含意があります:可視性の失敗とコンテンツ無応答は異なる診断です:論文がダウンロード数が少ないのは、読者が少数であったためか、または遭遇した読者が全文を拒否したためかのいずれかです。表9は2つの正規化された次元を交差させています。
表9. リーチ–コンバージョン診断マトリクス。 リーチとコンバージョンは、参照クラス内のパーセンタイル(同じ分野、投稿コホート、論文の年齢、および事前著者可視性;セクション5.5)として評価され、クラス中央値を境界として使用します。現在の証拠に基づいて防御可能な絶対値の数値カットオフはなく、与えられていません。2×2表示は読みやすさのためにクラス中央値で各軸を2分化していますが、基礎となるリーチとコンバージョンのパーセンタイルは連続的(セクション5.4)であり、三分位などの細かい区分が利用可能です。
| 低いコンバージョン | 高いコンバージョン | |
|---|---|---|
| 低いリーチ | 「コールドスタート」(低いリーチ、低いコンバージョン)。 論文は広く遭遇することも、露出後に頻繁にダウンロードされることもありません。データは基礎となる研究が弱いかどうかを確立していません。それらは拡散が始まっていないことだけを確立しています。 | 「隠れた関心」(低いリーチ、高いコンバージョン)。 論文に遭遇した読者は良く応答しますが、遭遇した読者が少なすぎます。発見可能性が主な観察可能なボトルネックです—コンテンツの問題ではなく、配布の問題です。 |
| 高いリーチ | 「注目なしのアクセス」(高いリーチ、低いコンバージョン)。 タイトル、トピック、またはプラットフォーム配置がアクセスを引き付けるように見えますが、少数の訪問者が全文を取得します。通信の不一致を診断する前に、汚染された分母を除外してください: 高いリーチは、本当の注目ではなくファントムビューである可能性があります。なぜなら、ビューは2つのカウンターの中でより汚れやすいためです(セクション4.2)—透明なRepEcおよびLogEcレコードでは、ロボットは抄録ビューの約74%を占めていましたが、ダウンロードの約7%のみです[99]。したがって、フィルタリングされていない非人間トラフィックはまさこのような高いリーチ、低いコンバージョンの特徴を生み出します。ボットで膨らまされたビューが除外されたら、残りのデータは視聴者の適合性とタイトル–抄録通信を調査する価値があります。 | 「初期段階の強い拡散」(高いリーチ、高いコンバージョン)。 論文は比較的大きな視聴者に到達し、露出を全文への関心に変換します。 |
4つの象限は、2つのパーセンタイルが示す拡散パターンでラベル付けされています(コールドスタート、隠れた関心、注目なしのアクセス、初期段階の強い拡散)。ラベルは研究自体ではなく拡散のパターンを説明し、運用上重要なのはメカニズムの分離です。どちらの低リーチ象限も研究の質に関する推論を認めておらず、これはこれらのメトリクスの評価的使用に直接関係する点です。低拡散象限は、この記事の独自の診断の名前、コールドスタートを取ります。マトリクスは実際的に価値があります。なぜなら、適切な介入は象限によって異なるためです:隠れた関心の候補は配布が必要です(分類レビュー、告知タイミング、外部可視性)。一方、注目なしのアクセスは通信修復(タイトルと抄録)またはトラフィック監査が必要です。図8は平面をテンプレートとしてレンダリングしています。
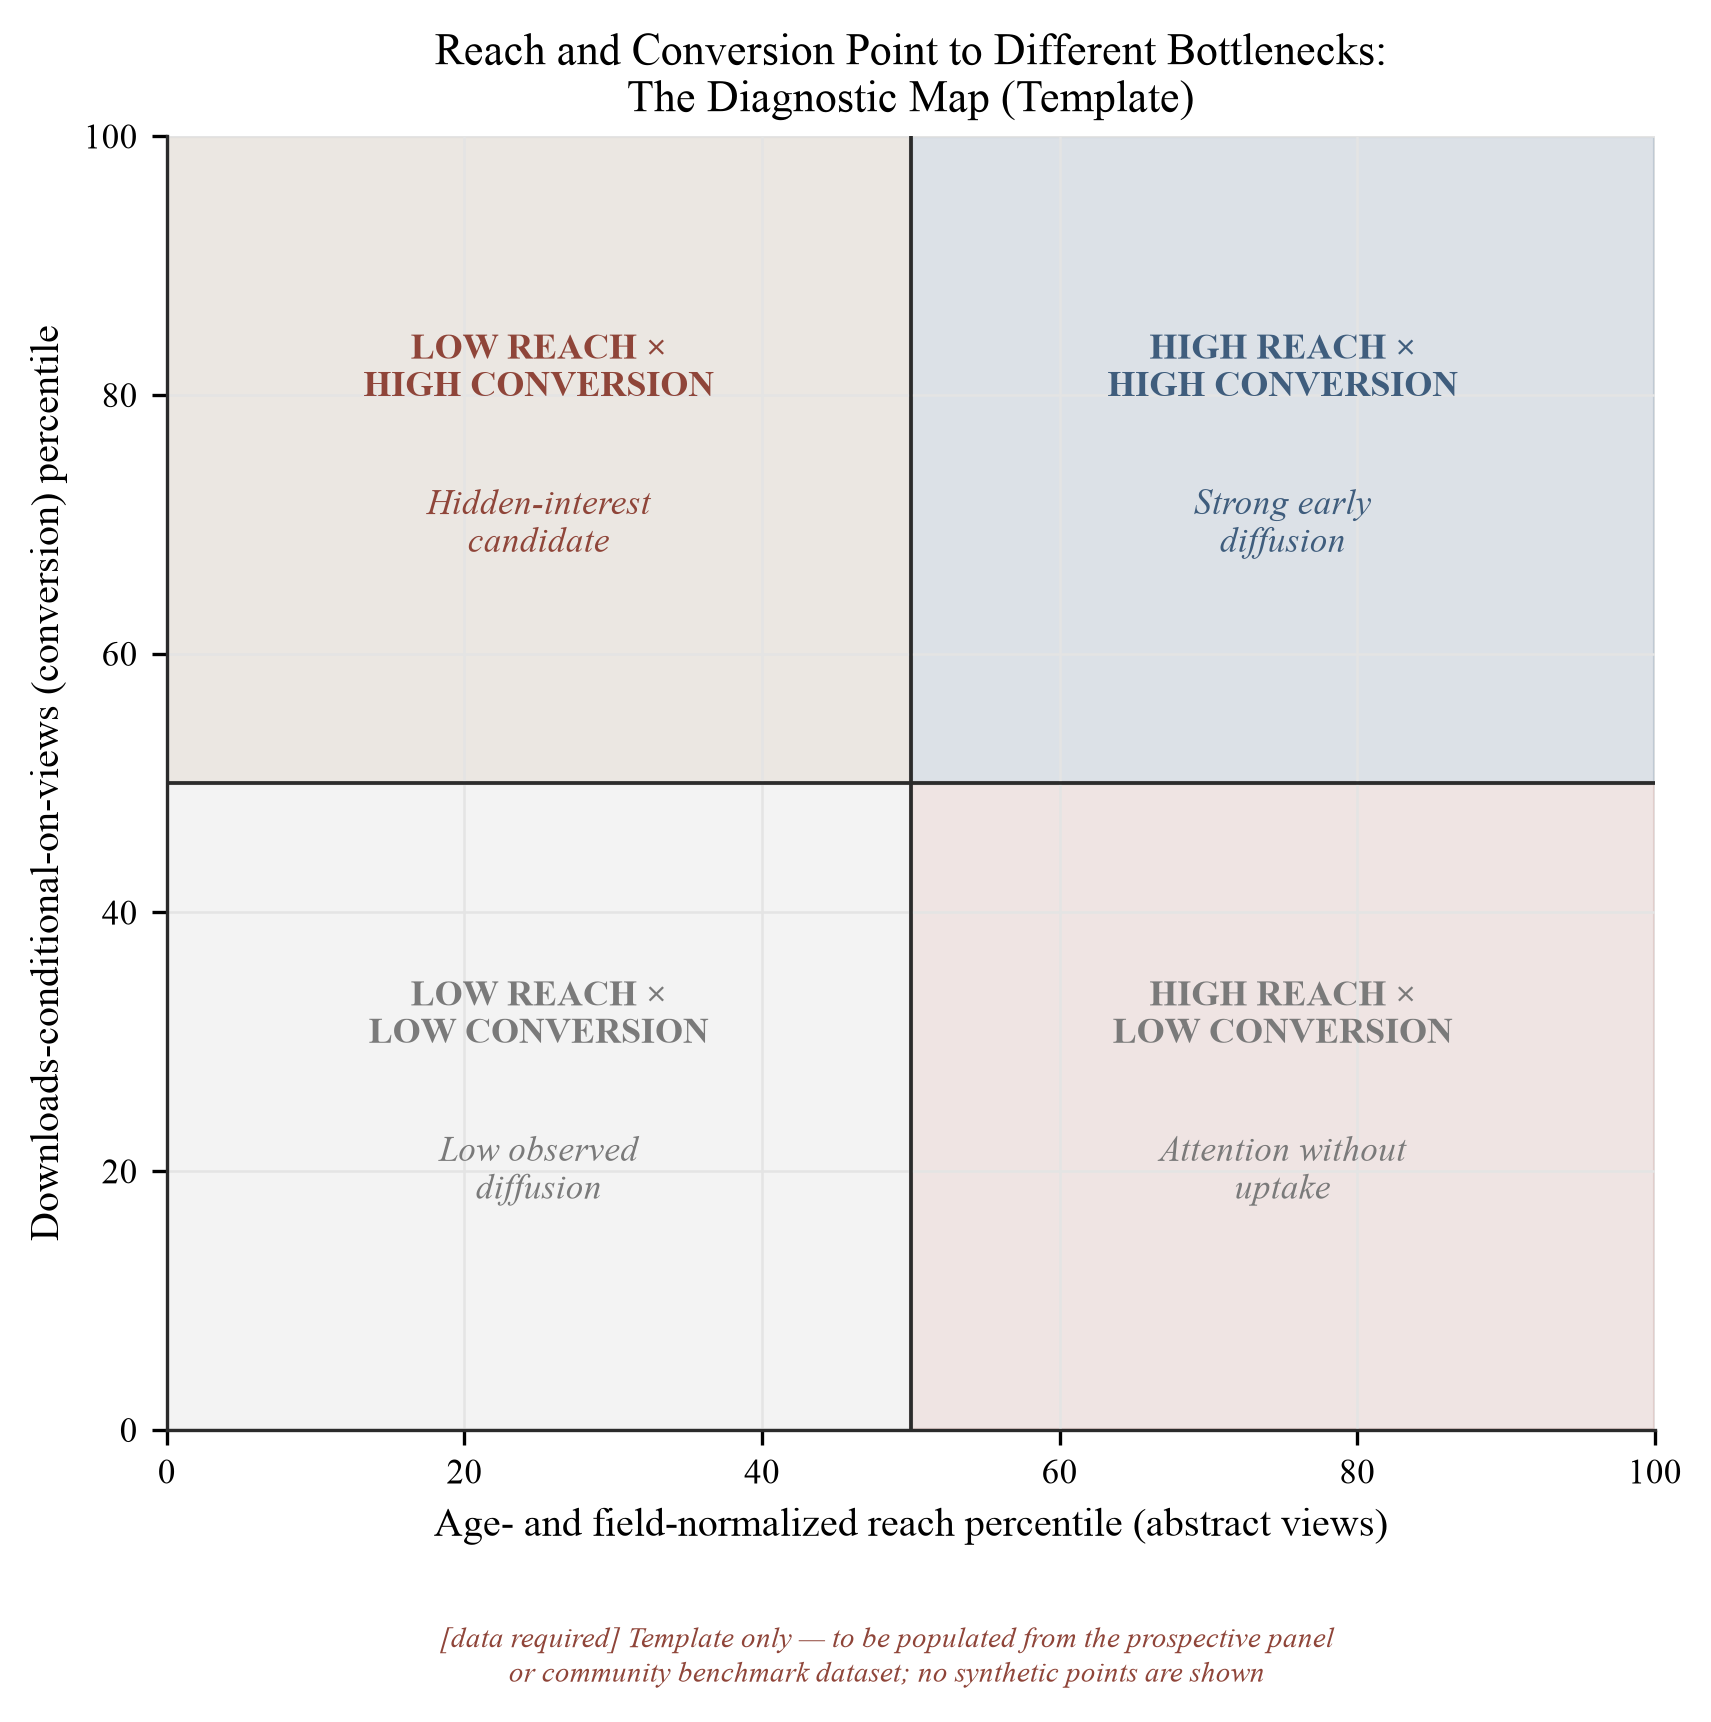
図8. リーチ–コンバージョンマップ。年齢、分野、コホート、および可視性正規化ビュー パーセンタイル(リーチ、水平)およびダウンロード–ビュー条件付きパーセンタイル(コンバージョン、垂直)による論文の配置テンプレート。象限は表9と同じ(コールドスタート、隠れた関心、注目なしのアクセス、初期段階の強い拡散)です。左上象限は、中央値以下のリーチにもかかわらず中央値以上のコンバージョンを持つ論文を識別します。これは生のダウンロード数が体系的に過小評価するクラスです。実証的値は表示されていません。マップはセクション8の見込みパネルまたはコミュニティベンチマークデータセットから入力されることになっています。
5.5 ヘッドライン数値からベンチマークへ:CSAB次元
前のすべての小節は生のカウンターの1つの失敗モードを修正し、Cold-Start Scholarly Attention Benchmark(CSAB)はその統合です:単一のヘッドライン数値を5つの正規化された成分に置き換えるレポートフレームワークです(表10)。正規化変数(論文の経過時間、分野、投稿コホート、および先行著者の可視性)は、それぞれ経験的に動機付けられています:累積メトリクスは機械的に経過時間とともに増加します;分野の規範は平均で1桁異なります[168];暦条件は注目を測定可能にシフトさせます(論文アクセスは週末に約11%低下し、夏月に約50%低下します[178]);プラットフォームの新規参入者は確立された著者と同じ初期オーディエンスに直面しません[83]。パーセンタイルを計算する前に、1つの母集団慣例を固定する必要があります。累積カウンターは異種の生存を持つ論文ストックに対して定義されます(論文は時々撤回、統合、またはより後のバージョンによって取って代わられます)ため、すべてのCSABパーセンタイルは観測日時点での生存ストックに関する声明です。研究1(セクション8.6)は、参照母集団を暗黙的なままにするのではなく、包含ルール(バージョン処理、撤回、および重複排除)を事前に指定します。
2つの中央の成分はコンパクトな定義を認めます。論文 i を経過時間τ(投稿以来の日数)、分野 f、投稿コホート c、および先行可視性階層 s で考えると:
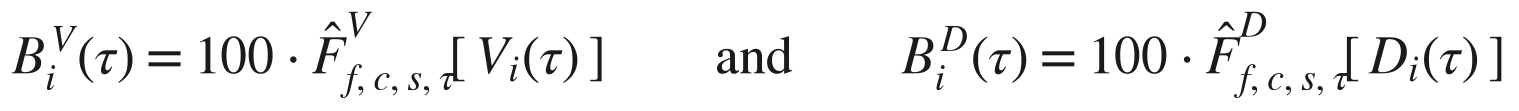
ここで、V_i(τ)とD_i(τ)は累積的な抽象ビューとダウンロードであり、F̂^VとF̂^Dはf、c、s、およびτで定義された参照クラス内のこれらのカウントの経験分布関数です。この定義は推定量(述べられた参照クラス内のパーセンタイル)を固定します。参照分布が存在しない(セクション5.1)ため、今日はどのF̂も書き下すことができません。この式は、研究1とセクション8のパネルが推定するために設計された仕様であり、同じ表記法はセクション8.9の予測検証設計を通じて継続されます。パーセンタイルと参照クラスの正規化は、それ自体が確立された文献計量学的方法です。パーセンタイルは、分野、文書タイプ、および出版年についての出版物のカウントを正規化するための標準的な方法であり[22]、ゼロが支配的な指標の分野および時間正規化のための専用手続き[23]があり、ダウンロードカウンターが占める領域とまさに同じです。特に利用メトリクス(引用ではなくダウンロードとビュー)を参照クラスに対して正規化することは、同様に成熟した研究分野です。利用文献計量学の文献は長い間、ダウンロードベースの影響を、ユーザーコミュニティの特性とサンプリングフレームに条件付けされるべき分布として扱ってきました[92][19]。また、ジャーナル利用係数プログラムはCOUNTER準拠のデータからまさにそのような正規化された利用指標を構築しました[137]。利用カウント自体の標準化は、成熟した実務家インフラストラクチャ、COUNTER行動規範の対象です[125]。フィールド正規化された読者指標は、altmetrics文献における同等の確立された先例があります[179]。したがって、この方法は確立されています。ここでの貢献は、SSRNダウンロードへのその適用、および後ランキング環境のための年齢、分野、およびコホート階層化された参照クラスの構築です。
推定量は明確ですが、任意のF̂が適合される前に、3つの運用化の質問を解決する必要があります。最初の質問は最も結果に大きな影響を及ぼします。なぜなら、ベンチマークが何のためのものであるかに関わるためです。参照クラスの条件付けを先行する著者の可視性(層s)に対して行うことは、質問が診断的である場合に正しいです。「この論文は、同等の可視性を持つ同等の著者による同等の論文の中でどのようにしているのか?」それは、H1~H3の公平性質問である場合、全く間違っています。なぜなら、先行する可視性によって正規化することで、公平性フレームが測定するために存在する新規参入者対確立著者のギャップを差し引くからです。s内のパーセンタイルは、その不利益が構築上条件付けられているため、コールドスタートの不利益を検出できません。したがって、フレームワークは、決して1つの数値に折りたたまれてはならない、CSABの2つの異なる使用方法を分離します。記述的ベンチマークとして、完全に階層化された参照クラス(sを含む)内での著者の位置を報告します。これは個々の著者がダッシュボードで望むものです。H1~H3の調整推定量として、それは条件付けセットから先行する可視性を削除し、代わりに関心の予測変数として扱い、勾配を測定して削除しません。2つの答えは異なり、異なる質問に答え、可視性正規化パーセンタイルを提示するレポートは、2つのどちらであるかを述べなければなりません。2番目の質問はサンプルサイズです。分野×コホート×可視性層×8つの年齢ポイントで階層化することは、3,000~5,000の論文の確率標本をすぐに枯渇させます(セクション8.6)。完全に交差したセル数は数千に達するため、ほとんどのセルは小さいまたは空です。経験ベイズの広い参照クラスへの縮小はこの理由で名付けられました(セクション8.3、8.8)。しかし、縮小にはそれ自体の仕様が必要です。最小限の階層構造(広い領域内の分野、粗い年齢バンド内の年齢)と、推定のための事前指定された最小セルルール。このルール以下では、セルは生のパーセンタイルを報告するのではなく、その親から借ります。この推定側の最小セルルールは、付録Dで公開リリースを統治するプライバシー駆動の最小セルルールと異なり、より厳密に理由付けします。この2つは異なる目的を果たし、別々に指定されます。最後の質問は勢い(表10)であり、推定された正規化位置の変化として定義されます。推定量の変化スコアは平均への回帰を招きます。7日目で高く着地する論文は、推定ノイズによって部分的に、純粋に統計的な理由により30日までに低下する傾向があります。したがって、勢いには基礎となる軌跡の明示的なモデル(例えば、測定誤差が伝播された潜在位置の縮小または経験ベイズ推定)が必要であり、生の差分は、もしあれば、モデル化された量への記述的伴侶としてのみ報告されます。
表10. Cold-Start Scholarly Attention Benchmark (CSAB): 1つの数字ではなく5つの次元。 これらの次元に対応可能な文レベルのレポートテンプレートは付録Bに提供されています。
| 次元 | 指標 | 主要な質問 | 解釈 |
|---|---|---|---|
| リーチ | 年齢/分野/コホート/新規参入者正規化ビューパーセンタイル | 関連する読者層は論文に遭遇しましたか? | 発見可能性 |
| ダウンロード性能 | 正規化累積ダウンロードパーセンタイル | 比較可能な論文に対して、何件のフルテキスト取得が発生しましたか? | 全体的な初期拡散 |
| コンバージョン | ビュー機会に条件付けされたダウンロード(セクション5.2) | 露出した読者はフルテキストを求めましたか? | 条件付きエンゲージメント |
| モメンタム | 正規化位置または区間レベル注意の変化 | 拡散は加速、安定、または減少していますか? | 時間的軌跡 |
| ダウンストリーム検証 | 初期指標に条件付けされた後続の引用または使用 | 初期の注目がその後の学術的受け入れを予測しましたか? | 予測妥当性 |
このフレームワークは「成功」の普遍的な生の閾値を拒否します。成功は分析目的に対して相対的に定義される必要があります: 発見可能性については、同じ年齢と分野の論文の中で高いリーチパーセンタイル; 読者の受け入れについては、露出に条件付けされた参照クラスを上回るコンバージョン; 拡散については、両者の結合分布; 科学的影響については、後続の引用または文書化された使用。最後の目的については、初期使用だけでは不十分です。初期ダウンロードは後続の引用分散のわずか16%程度しか説明できないためです[25]。これにより、表題例の解釈を正確にします。7件のダウンロードは、7件のダウンロードが他の点で比較可能な論文の中でも異常に高い位置にあり、かつそれらのライフサイクルの同じ段階にある場合にのみ「良い」です。day-7値とday-180値は同じベンチマークで評価することはできません。
4つの設計上の選択は、Leiden Manifestoの第8原則に従います: 定量的指標は、その背後にある仮定の強さを超えて実行されてはならず、誤った精度はそれ自体測定の失敗であるということです[78]。このフレームワークは帯域を報告し、ポイントスコアではありません(表8); CSABをターゲットではなく診断ベクトルとして固定します(セクション5.2); その出力図、リーチ-コンバージョンマップ(図8)とベンチマークファン(図14)を数値スケールなしで描画するため、形状はキャリブレーション値と間違われることはできません; それは使用するすべての数値に検証階層と日付を付けます(表7)。これらのそれぞれは、証拠がサポートできない精度を保留しています。DORAが論文の内容の実質的評価のために単一数字とジャーナルブランドプロキシを拒否する際に要求していることです[8]。CSABを1つのスコアに折りたたむことは、両方のドキュメントが警告している誤った精度をまさに再導入することになります。
著者にとって、CSABレポートは単純な行「ダウンロード: 12」を次のようなもので置き換えるでしょう: 14日後の12ダウンロード: 比較可能な論文の全体的なダウンロードパーセンタイル: 67番目; リーチパーセンタイル: 39番目; コンバージョンパーセンタイル: 81番目; 解釈: 高い条件付き関心、中央値以下の露出。 このモックアップのすべての数値は例示的です。セクション8の参照分布が推定されるまでそのようなパーセンタイルは存在せず、これらの値のいずれもベンチマークとして引用されない場合があるためですが、フォーマットはその分解が何をもたらすかを示しています。差別化されていない失望として読まれる同じ生のカウントは、特定の診断に解決されます: 論文に遭遇した読者は異常に良く反応しますが、遭遇する人が少なすぎるため、示唆される介入は修正ではなく配布です。作業例はCSABの表9の「隠された関心」象限の対応物です。付録Bはこのフォーマットをコピー可能なレポートテンプレートとして固定し、そのパーセンタイルフィールドはセクション8の分布が存在するまで空白のままです。
5.6 読書軌跡:エクスポージャーは背景ノイズではなく処置である
フレームワークの最終的な構成要素は時間的なものです。新たに投稿された論文は均質な注意環境に入るのではなく、異なるエクスポージャーレジーム(投稿→内部発見→メール配信→外部インデックス化→ネットワーク拡散)を通過し、累積合計がこれらのレジームを1つの数値に圧縮します。レジーム境界はセクション4の仕組みで設定されます。eJournal配信はキュレーションされており、高容量トピックでは最大45日かかる可能性があり[53]、外部検索インデックス化は6~9か月以上かかることがあります[55]。
最も不安を生じさせるダッシュボード状態は、これから直接生じます:第1週にダウンロード数がゼロなのは、拒否ではなく、分布前の正常な状態です。告知サイクルが実行される前に、論文はまだ主な読者にエクスポーズされていません。初期ゼロの診断シーケンスは管理的なものです。論文が公開されていることを確認し、eJournal割り当てを確認し、告知サイクルを待ち、その後でカウンターを読みます。逆に、分布が発生した後の初月のカウントは、最も早く、最もノイズが多い先行指標です。初期ダウンロードは後の引用と大体r≈0.4で相関し[25]、有益ですが判定には程遠く、初期のスパイクは耐久的な関心ではなく、ブログやメディアカバレッジなどのエクスポージャーイベントであることがよくあります[116][138]。
累積カウントの遡及的スクレイピングは、論文が3日目または30日目に何を持っていたかを再構成できないため、軌跡ベースの解釈(およびセクション8のパネル研究アジェンダ)には、標準化されたグリッド上での誕生からの観察が必要です。表11は最小スケジュールを指定します。これは個々の著者向けの自己追跡テンプレートとしても機能します。軌跡は表11グリッドの60日および90日の読み取りでのみ暫定的に分類され、180日の読み取りで確信を持って分類され、決して7日目ではありません。
表11。SSRN論文の最小縦断観察スケジュール。
| 論文の年齢 | 観察の中核的な目的 |
|---|---|
| 1日目 | 即座のプラットフォームエクスポージャー |
| 3日目 | 非常に初期の発見 |
| 7日目 | 第1週ベンチマーク(ほとんどの論文の期待値:ゼロ付近または正確にゼロ、分布前) |
| 14日目 | 初期の安定化 |
| 30日目 | 初月ベンチマーク |
| 60日目 | 分布と検索成熟(eJournalサイクル完了[53]) |
| 90日目 | 中期初期拡散 |
| 180日目 | 下流への影響測定への移行 |
可能な場合、最初の45日間の毎日観察が好ましいです。メール配信がその期間内の変数時間で発生する可能性があるためです[53]。このグリッド上の区間レベルの読み取りは、ダッシュボードを静的な判定から軌跡に変換し、これが初期SSRNメトリクスが防衛可能な情報を持つ唯一の形式です。
セクション4および5は、著者が答えられない質問(「7ダウンロードは良いですか?」)を、発表されたレコードがサポートできる4つの質問に置き換えます。カウントはベンチマークマップとそのビンテージに対してどこに位置するか(5.1、5.3)。変換は経験的バンド内にあるか(5.2)。論文がリーチ~変換平面のどの象限を占めているか(5.4)。観察グリッド上の軌跡は何を示しているか(5.6)?これらの質問のいずれも廃止されたランキングを必要としませんが、すべてはこの記事の最終セクションが提案する比較データの収集を必要とします。
6. 著者向けの実用的なプレイブック
セクション5のベンチマークマップ(表7)は欠落したスケールを復元し、このセクションはそれを2026年7月15日以降に統計パネルを開いてコンテキストなしでカウントを見る著者に対して実行に移します[148][149]。順番に4つのタスクがあります。独自のカウンターを観察するルーチン(6.1~6.2)、ランキングが提供していた比較フレームの代替(6.3)、表示を正当に改善できるレバー(6.4)、カウンターを防衛可能なキャリア証拠に変換するためのプロトコル(6.5~6.6)。ここで使用されているすべての数値アンカーは、明示的なサンプリングフレームと時間ウィンドウを持つ発表されたソースまで追跡されます。表7がそれらを統合します。明示的な支援がない著者コミュニティで流通しているプラクティスは、それらが現れる場所では未検証としてマークされ、テスト候補仮説として付録Aの最後に収集されます。
表12はプレイブックのコアを、7つの質問のプロトコルに圧縮し、順番に尋ねられ、それぞれが保存する価値のある証拠と答えが正当にライセンスできる最強の結論と対になっています。セクション6.1~6.2はこのプロトコルをルーチンと読書規則に展開し、表23(付録A)はその状況付きのコンパニオンのままであり、著者が実際に遭遇するダッシュボード状態によってインデックス付けされます。
表12。SSRN カウンターを解釈するための著者プロトコル:7つの質問、保存する証拠、および許容できる結論。ステップは、カウンターを品質スコアとして扱うことはなく、最終列は各回答がサポートできる上限を述べています。
| ステップ | 質問 | 保存する証拠 | 許容できる結論 |
|---|---|---|---|
| 1 | カウントが観察されたとき、論文の年齢はどのくらいでしたか? | 日付の入ったスクリーンショットまたはエクスポート、投稿日付を加えたもの | 生涯判定ではなく、時間固有の観察 |
| 2 | キュレーションされた配信と外部インデックス化は発生していましたか? | 利用可能な場合の配信通知と日付、検索インデックスステータス | エクスポーズ前対ポストエクスポーズレジームの識別(セクション5.6) |
| 3 | ビュー、ダウンロード、および変換が一緒に何ですか? | カウンターと分母の両方 | 単一判定ではなく、リーチ対条件付きエンゲージメント診断(表9) |
| 4 | 最も狭い防衛可能な参照クラスは何ですか? | 分野、コーホート、論文の年齢、新規参入者ステータス、分類履歴 | そのクラス内でのみ相対的な位置づけ(セクション5.5) |
| 5 | 軌跡は変化していますか? | 表11の固定年齢での繰り返し観察 | エクスポーズイベントを条件とした勢いまたはプラトー~「品質」の加速ではない |
| 6 | 下流での裏付けはありますか? | 引用、実質的な接触、出版または文書化された使用 | 採用の層状証拠であり、質の証明ではない |
| 7 | 主張は再現可能か? | 出典、日付、計数ルール、アーカイブされた記録 | 裏付けのないマイルストーンではなく、監査可能なレポート |
6.1 測定ルーチン
解釈は規律ある記録から始まります。SSRNは現在の累積カウントのみを表示し、著者の管理下では履歴を保存していないためです。投稿日から適用される6つのステップにより、その後のあらゆる推論に必要な最小限の記録が生成されます。
1. カウンターとその比率の両方を記録してください。 一定の間隔で抽象ビュー、ダウンロード数、ダウンロード・ビュー変換比を記録してください。表11の観察グリッド(1日目、3日目、7日目、14日目、30日目、60日目、90日目、180日目)が観測スケジュールと目的を指定しています。各間隔でのスクリーンショットは、プラットフォームのカウンターがフィルタリングルール変更時に修正される可能性があるため[144][69]、著者が管理できる唯一の記録です。累積記録はバージョン管理された証拠パッケージです。原稿バージョン、そのメタデータと分類、日付付きダッシュボードスナップショット、配布通知、著者自身の推進活動の日付付きログ(投稿スレッド、講演、メーリングリストのお知らせ)、および後の引用と実質的な連絡が含まれます。推進ログは重要です。推進は露出処理だからです。自分自身の広報の日付付き記録がなければ、著者は有機的なスパイクと自己生成的なスパイクを区別することはできません。クレームを監査する誰もができません(第8.3項)。
2. 投稿からの時間で正規化してください。 初期パフォーマンスを生の累積カウントではなく、最初の3~6ヶ月間のダウンロード数/月として表現してください。3ヶ月前の論文を古い作品の全期間の合計と比較すると、体系的に誤解を招く結論が得られます。カウンターはプラットフォーム上で論文の寿命にわたって蓄積され、プラットフォームの年間ダウンロード数は2016年の約1,290万から2023年の4,060万に増加しているためです[1]。
3. 観察ウィンドウを決して混ぜてはいけません。 週次カウントを12ヶ月平均と比較することはできず、90日カウントを全期間合計と比較することはできません。このプレイブックのすべての比較は、同じウィンドウを同じものと対にしています。このルールの違反は、ランキング統計の日没前の使用における最も一般的な解釈エラーの中にありました[161]。
4. 論文をプラットフォーム全体ではなく、その学問的領域に位置付けてください。 論文当たりの平均ダウンロード数は、Legal Scholarship Network eJournalsだけで約8倍異なりました(2018年データで企業/証券/金融では438.35対農業法では53.48)[168]。1つの専門分野で異常でない数は別の分野では例外的です。関連する参照クラスは、論文の所属eJournalまたは主題ネットワークであり、同じ論文年齢で検査されます。
5. 単一の小さなカウントを過度に解釈しないでください。 整合性文献は使用カウンターの精度に上限を設定します。出版社報告のダウンロード数は比較可能なプラットフォームの2倍になる可能性があります[176]。プラットフォームフィルターは生トラフィックの大部分を破棄します[99][129][144]。そのようなフィルターがなければSSRN自体のカウンターは「5倍以上」膨張してしまいます[18]。したがって、比較可能な数値間の小さな差は情報を持ちません。
6. 初期の数字に反応するのではなく、長期的な蓄積を監視してください。 ワーキングペーパープラットフォーム上での注意は早期に集中します[116][28](後者の知見はSSRNではなくNBERデータから派生しています)。しかし発見層は遅くまで成熟します。SSRNはGoogle Scholar インデックスに「6~9ヶ月以上」かかると報告しています[55]。さらに、読書はいくつかの時間スケール同時に減衰し、読書と引用は同じ時系列プロセスに従う必要はありません[91]。したがって、自分のカーブの単一の「半減期」解釈は安全ではありません。軌跡は表11グリッドの60~90日読取値で暫定的に分類でき、180日でより信頼をもって分類でき、7日読取値では決してできません。
6.2 ダッシュボードを読むための5つのルール
このレコードを手に、セクション5の分布的証拠は、日常的にダッシュボードを読むための5つの経験則に集約されます。
(i) 平均値や可視化された星ではなく、中央値と比較する。 通常の論文の唯一の国勢調査的サンプルでは、2年後の中央値を63ダウンロード、369の抄録ビューに置いています(LSN、2012年投稿論文)[139]。最近発表されたサンプルでは、中央値は87ダウンロード、平均値は221.3で、75パーセンタイルより上に位置しています(セクション3.3)[83]。流通している重要な数字は可視テールから来ており、その2015年の最大値は数十万ダウンロードに達しています(セクション3.5)[85]。可視テールに対して校正する著者は、準対数正規分布のテールに対して校正しており、これは必然的に校正を誤ります。2023年12月の集計から計算されたプラットフォーム全体の平均的な論文あたりの生涯ダウンロード数約222は、個人的な基準としても同様に使用できません[1]。
(ii) カウント数だけでなく、変換率をチェックする。 独立した測定値は、抄録ビューあたりダウンロード数の通常の帯域約11~19%に収束しています。LSNサンプルの平均18.7%と中央値17.1%[139]、および法律引用研究の15%(最高被引用記事)と11%(単一引用記事)の数字[172]です。SSRNの長年の「3ビューあたり1ダウンロード」という経験則[18]はその帯域の中ではなく、上に位置しています。最近のマーケティングネットワークサンプルは、100ビューあたり平均23.7ダウンロードで、帯域をやや上回っています[83]。図6は推定値をまとめてプロットしています。セクション5.2の中心的な実例をこのルール経由で実行します。タイトルの40の抄録ビューと7ダウンロードは17.5%に変換され、点推定値として帯域内ですが、幅広い95% Clopper-Pearson区間(≈7.3~32.8%)です。n = 40では、この読みは失敗ではなく、正確なパーセンタイルでもありません。通常の変換と一致するスクリーニング結果です。帯域よりはるかに低い変換は、抄録と論文の間のミスマッチと一致しており、読者は到着して抄録を読んで去ります。これは実行可能であり、タイトルと抄録を修正するというアクションです。帯域よりはるかに高い変換は、抄録ブラウジングでは説明できないトラフィック、例えばメディアまたはアグリゲーターカバレッジからの直接リンクを示唆しており、ビューの起源をチェックするよう促すべきです。両方の読みはスクリーニング診断です。低変換から抄録品質への推論を因果的に検証した研究はなく、診断は自分の論文についての仮説として記録されるべきです。
(iii) 最初の月のダウンロードを最初の、そして最もノイズの多い引用信号として扱う。 arXivデータでは、早期ダウンロードは後の引用と約r ≈ 0.4で相関し、元の著者たち自身がこれを説明分散の約16%にしか翻訳していません[25]。記録上最も初期のそのような信号はバイオメディカルです。BMJでの公開後の最初の週のオンラインヒット数は、その後の年間で蓄積された引用と約0.50で相関しています[119]。法律学では、BlackとCaronは論文レベルのダウンロード-引用相関を約0.50の程度で報告し、100人の若手法学教授のサンプルで約0.55に上昇しています[18]。分野と期間全体では、論文レベルの相関は約0.1~0.6の範囲です[80][25]、そしてarXivダウンロード数は同時期のTwitterの注目が制御されると予測指標として統計的有意性を失います[138]。集計レベルでは、この関連性は緊密になります。100の法律学校のダウンロードベースと引用ベースのランキング間で0.84[77]、および1つのジャーナルの独自分析における6ヶ月のPDFダウンロード数と後の引用間でR = 0.724[114]。これらの集計数値は、個々の論文がどこに終わるかを決めません。最初の月のダウンロードは後の引用についての早期信号です。
(iv) 第1週のゼロダウンロードは正常な配布前の状態であり、拒否ではありません。 新しく投稿された論文は、モデレーションをクリアし、主題eジャーナルに分類され、お知らせサイクルに入った後にのみ注目を集めます。SSRNの独自ドキュメントは、分類を保証されるのではなく、キュレーションとして説明し、大量に読み込まれたトピックの場合は最大45日の遅延があります[53]。eジャーナル配布とメールアラートは、サンセット後も変わらないように明確に確認されました[147][57]。診断シーケンスは次のとおりです。論文が公開されていることを確認し、eジャーナル分類を確認し、お知らせサイクルを待機してから、カウンターを読みます。検索エンジンを通じた発見はさらに後に到着します[55]。
(v) 低下または平坦なカウンターは、読者喪失ではなく、フィルタリングを反映できます。 SSRNは公開的に、見かけの繰り返しダウンロード、ロボットダウンロード、およびその他の不規則なアクティビティを破棄することを記録しています[144][66][69]。RePEc/LogEcの経験は、そのような補正がどの程度大きいかを示しています。2007年7月、ロボットは抄録ビューの約74%を占めていましたが、ダウンロードの約7%にすぎません[99]。2025年9月、AI-ボット干渉の中で生のIDEASトラフィックの99.5%以上が破棄されました[129]。急激な低下またはステートメントは、読者事象と同じくらい測定事象である可能性があり、裏付けなしに評判喪失として読まれるべきではありません。
6.3 ランキングなしのベンチマーキング
ランキングは比較の枠組みを提供していました。今日の著者にはそれに代わる3つの選択肢があり、必要な作業量の少ない順に並べられています。
マイクロベンチマーク。最も直接的な代替案は、自分で構築する参照グループです。方法論的に比較可能な論文を同等の機関にいるピアから3~5本選び、同じ月に投稿されたものを特定し、自分の論文と同じTable 11スケジュールで公開カウンターを追跡します。その結果は、正確に適切な参照クラスに対するローカライズされたパーセンタイル基準となり、分野、論文の年齢、プラットフォーム時代によって構成により一致していることが保証されます。一方、廃止されたランキングではすべての年齢と分野の論文を単一の順位表で比較していました。これは公開されている論文ごとのカウントのみを使用する提案された手続きであり、いかなるドシエ使用においてもそのように記録されるべきです。また、最も孤立した新参者、つまりコールドスタート条件が最も影響する著者たちが持たないかもしれない、ピアの文献についてのある程度の知識を前提としています。彼らにとっては、第10.4節(匿名パーセンタイルバンド)のプラットフォーム側の救済が構造的な解決策であり、それを使用するために自己組織化されたネットワークを必要としないからです。
相対パフォーマンス比。同じロジックは単一の数値として表現することができます。すなわち、特定の年齢での論文のダウンロード数と、マッチした同期群の中央値ダウンロード数の比です。つまり、同じ分野、同じ論文の年齢、および可能な限り同じ論文タイプです。比率1.0は同期群にとって正確に中央値の可視性を意味し、1.0より上または下の値はそれに応じて読まれます。このインデックスはマッチした同期群内で論文を順序付けます。パーセンタイルバンドは参照分布の到来を待っています。同期群のベースラインを構築できる公開中央値は古く、狭いもの(2012年に投稿された法学論文では2年で63ダウンロード[139]、2025年に観察されたマーケティング論文では87[83])であり、比率値をパーセンタイルにマッピングするには中央値だけでなく完全な分布が必要です。その分布なしで比率バンドにパーセンタイルラベルを割り当てると、偽の精度が生じます。第8節の事前登録されたアジェンダにはバンドの較正が含まれます。それまでは、比率は順序付けデバイスであり、採点スケールではありません。デバイスを制限するさらに2つの注意があります。第5.2節の小分母不安定性が比率の分子と薄い同期群中央値の両方に適用され、経験的ベイズ縮小(第8.3節、8.8節)が公開されている比率が報告される場合の適切な修復であるため、小さいカウントでは計算すべきではありません。与えられた比率は固定パーセンタイルに変換されません。「同期群中央値の2倍」は異なる形状の分布においては異なるパーセンタイル位置に対応するため、比率は1つの同期群内で論文を順序付けますが、分布形状が異なる同期群または時代間で比較することはできません。
軌跡についての判定言語。コミュニティ向けツールは、論文の初期軌跡を3つの質的判定(早期の開始、継続的な関心、遅い開始)に分類することを提案しており、生の数字に対する人道的な代替案です。語彙はカウントを軌跡についての記述に変換するため保持する価値があり、「遅い開始」は明示的に失敗の同義語ではありません。これらの判定について当初提案されたしきい値は、合致していない時間枠の比較と、公開メトリクスとして存在しないプラットフォーム全体の「ネットワーク平均」統計に依存していました。SSRNは公開セルフサービスAPIまたは統計エンドポイントを提供していない[51]、最も近い歴史的メトリクス(「新規ダウンロード/論文」、著者レベルのランキング統計)はランキングとともに廃止されました([B-9]、歴史的ランキングページはもはやアクセス可能でないという注意とともに引用)。判定を割り当てるなら、マッチした比較からのみ割り当ててください。上記のマイクロベンチマークグループまたは同期群中央値比率で、60~90日のマーク以降で読まれるのを見ません。
どの代替案を使用する場合でも、外部の三角測量がそれを強化します。Crossrefおよび OpenAlex[35][124]からの引用層データおよびSSRNページに表示されるPlumXインジケータ[50]は異なる質問に答えます。可視性ではなく下流の使用についてです。Overtonなどのポリシー引用ツールは、論文が政府および機関文書にどこで引用されているかをマッピングすることで、同じ三角測量をポリシーと実践のリーチに拡張します[187]。これはSSRNの法学、経済学、およびポリシー基盤に適しています。これらのレイヤーはTable 10のCSABフレームワークのカウンターおよびTable 9のリーチ-変換診断と共に検討されます。Altmetricインジケータはさらなる三角測量レイヤーです。当初から初期の注意信号として考案され[123][122]、引用[74][20]と異なるパターンに従い、分野の正規化[21]を認めます。これらはまた自動化されたインフレーション[75]に対して脆弱であり、額面通りの読み取りではなく、理論主導の解釈[76]が必要です。
6.4 正当な可視性の向上
サンセット前は、ランキングは1つの反復的な著者の決定に対して、粗いながらも実在するフィードバックを提供していました。それは、論文のさらなる推進が努力に値するかどうかという決定です(第1.3節)。サンセット後、その決定はここで集約されたレバーと診断ツールから下される必要があります。決定要因の文献は、著者の管理下にあり、プラットフォームのルールと矛盾しないレバーの小さなセットを特定しています。それぞれは可視性に作用し、品質には作用せず、いずれも論文の内容を変えません。迅速な普及と早期フィードバックはプレプリント投稿の認識された目的であり、プレプリントに関する方法論文献に記載されています[24]。正当な可視性のためのプレイブックはその述べられた機能を使用しています。
パッケージング。 LSNサンプルでは、タイトルの特性、要約の長さ、およびトピックの顕著性は注目と有意に関連していました。著者自身は、そのような変数は観測不可能な品質の代理変数である可能性があるという注意を促しています[139]。法律引用研究では、トップ十分位の論文は、ボトム十分位の論文よりも多くのキーワードと長い要約を含んでいました[172](具体的な数値は元のものに対する検証を待っています)。要約ページはルール(ii)が動作する変換サーフェースであるため、変換がバンドの下に継続的に留まる場合、タイトルと要約は修正する最初の項目です。このような修正は、無分別なトラフィックではなく、約束と内容の間の調整を目的としています。すでに明確な要約をクリック数を最大化するために書き直すと、その精密さを損なう可能性があり、一致しない訪問者を引き付けることで、変換をバンドからさらに遠ざける可能性があります。
分類。 より多くのeジャーナルに分類された論文は、2018年のLSN分析でより多くのダウンロードとより少ないゼロダウンロード結果を平均していました[168]。SSRNは論文ごとに1〜7つの分類を許可しており、包含をキュレーションしています[53]。一般的なコミュニティの改善として、検証されていないために分類戦略を比較する研究がないため、分類を3つに制限し、1つのコア、1つの広い、1つの学際的なeジャーナルとして選択されます。そのアドバイスは、付録Aの検証可能な仮説の中にあります。
配信と外部の注目。 eジャーナルのメールアラートはプラットフォームの主要なプッシュチャネルのままであり、サンセット後も継続しています[147][57][152]。プラットフォーム外では、ブログカバレッジは問題の1つの実証的テストで鋭い初期ダウンロードスパイクを生み出し[116]、目に見えるリスト位置はarXivの位置研究で読者数と引用を増加させ[72]、会議参加は中止された政治学会議を中心に構築された準実験研究で論文ごとに追加の17〜26ダウンロードと関連していました([B-4]、APSA 2012の設定であり、SSRN経済学サンプルではないという注意とともに引用)。実務家ガイドは法律奨学金のさらなる配布ツールを収集しています[169]。早期の公開普及の場合は独立して確立されています。オープンアクセスのランダム化試験ではより多くのダウンロードが見つかりましたが、短期的な引用獲得はありません[37]。一方、コホートおよびフィールド研究は、おおよそ10%から2倍の引用利点を報告しており[59][86][17][93]、アメリカの法学誌では+53%を含み[40]、法律引用の監査では、最も引用されている記事の87%がSSRNで利用可能であるのに対し、ほとんど引用されていない記事の44〜46%であり、最も引用されたグループの95%はSSRNに投稿されていました。発行年内またはそれ以前[172]。プレプリント寄託はarXivでより高い引用と関連していますが、パブリッシャーサイトのダウンロードは少ないです[38]。bioRxivダウンロードはジャーナル結果と相関しています[62]。すべてのbioRxivプレプリントの国勢調査では、ダウンロード数は、プレプリントが後で発表されるジャーナルのインパクトファクターと相関しています(Kendall τb = 0.59)。この関連性の因果関係の方向は不明です[2]。機械発見レイヤー(検索エンジンと生成的回答エンジン)は、第8節の監査フレームワークと表20の機能監査アジェンダで別々に扱われています[5][164]。
バージョン管理のハイジーン。 同じSSRNページにアップロードされた改訂は、累積カウンターと安定したURLを保持しますが、削除と再投稿ではメトリクスをゼロにリセットします([B-7]、サポートページの文言は時間とともに変わるため、投稿時に再検証すべきであるという注意とともに引用)。マイナー改訂が3日目に再発表と「第2波」の注目をトリガーするというさらなるコミュニティの主張は文書化されておらず、付録Aの未検証の実践の中に位置しています。IDは同じケアが必要です。検証されたORCID iDをSSRN著者プロフィールにリンクすると、論文とそのカウンターが同名人ではなく正しい人に添付されたままになります。これは、第8.3節のパネル設計が統計的に解決しなければならない著者の曖昧性問題に対する低コストの保護です([B-7]、同じ再検証の注意)。
何をすべきでないか。 自己ダウンロードおよび関連する操作はSSRN独自のサーバーログに文書化されており、トップリストの閾値の近くで強化され、社会的比較によって駆動されました[44]。プラットフォームの詐欺フィルターは公開されており[144][69]、この履歴を認識している評価委員会は支持されていない主張を割引します。したがって、ゲーミング文献は、整合性の警告とともに実践的な警告をもたらします。操作されたカウントは検出可能で、評判上高くつきます。図9は、シミュレートされたデータの問題のある時間的シグネチャを示しています。有機的な注目は長い尾を持つ初期のピークとして蓄積されますが、操作は整合性フィルターが検出するように設計されているまさにその種の集中したスパイクを生成します[144][69]。
図9. 有機的蓄積対操作スパイク。滑らかな有機ダウンロード軌跡と、自己ダウンロードの特性である急激な単一日のスパイク。第6.4節の操作警告と第4節の整合性議論を動機づけます[44][69][144]。表示されているすべてのデータはシミュレートされています。SSRNには経験的な異常検知データセットは存在しません。
6.5 カウンターを職業経歴証拠に変換する:ドシエプロトコル
サンセット前は、ランク基盤SSRNエビデンスは標準化されたドシエ構成要素でした。著者の公開ランクは昇進ファイルに直接入力されました:「法的著者全体のすべての時間ダウンロード総数において、3,000人中13位にランク付けされており、法学部はこれを様々な昇進および関連する決定で考慮に入れている」[12]。カバーレターガイドはダウンロード数とトップテンリスト掲載を引用することを勧めていました[95]。実務ガイダンスは同時に、自己掲載作品は「おそらく法学部の昇進およびテニュアの目的にはカウントされない」[33]と注意を促し、プラットフォーム自身のドキュメンテーションは、そのメトリクスを「著者が昇進とテニュアの目的で使用し、機関が採用とランク付け活動で使用するデータ」[52]として説明していました。これらすべての成果物は、もはや存在しない公開比較フレームを前提としていました[149]。また、カウンターの評価的使用は最初の提案から異議を唱えられていました:BlackとCaron の2006年のダウンロードを学術的パフォーマンスの「ベータ」測定として支持する主張[18]は、同じシンポジウム巻でSSRNベースのランク付けが有効に測定できるもの批判するEisenbergの反論[45]で答えられました。ダウンロードを引用するドシエは、その未解決の議論を引き継ぎます。表13は、残されたものから防衛可能なエビデンスを再構築するための7ステップのプロトコルを示しており、その支配的な要件は、第3列と第4列に適用され、ドシエで引用されるすべての数値は、そのソース、時間ウィンドウ、および制限事項を伴わなければならないということです。硬い非根拠精度に翻訳された主張は、主張がないよりも悪いです。
表13. テニュア、昇進、および採用ドシエにおけるSSRNメトリクスのサンセット後エビデンスプロトコル。各ステップは、アクション、時間ウィンドウ付きのエビデンシャル基盤、数値と共に開示する必要がある制限事項、回避するアンチパターン、およびステップがライセンスできる最も強い結論の名前を付けます。
| ステップ | アクション | エビデンシャル基盤(ソース;時間ウィンドウ) | 開示する制限事項 | 回避する | 許容される結論 |
|---|---|---|---|---|---|
| 1. 保存する | 表11の間隔で、提出前に各論文の統計パネルと著者プロフィールの日付付きスクリーンショットをアーカイブします。配布通知と著者自身の昇進イベントの日付付きログとともに、セクション6.1のバージョン管理されたエビデンスパケットに組み立てます。 | 論文ごとのカウンターはサンセットを乗り越えます([148][149];2026年)。フィルタリングルールが変更された場合、カウンターを再表示できます([144][69];2018年以降ドキュメント化)。 | 日付付きの個人アーカイブは、著者の制御下にある唯一の記録バージョンです。プラットフォーム番号は改訂可能であり、公開履歴は存在しません。 | 「論文はXダウンロード数である」—日付または分母なしで引用。 | プラットフォームが表示した内容の日付付き、監査可能な記録—生涯の評決ではなく、時間固有の観察。 |
| 2. 翻訳する | 表8を使用してカウントをバンド言語に変換します(例:「2015年トップ10,000論文リストの~160エントリスレッシュホールドを超えるライフタイムダウンロード、つまり、プラットフォームの全文論文ストック571,040の約1.8%、2016年7月[1]、その時点で」)。常にソース、サンプル、および年を命名します。付録Bの CSABテンプレートは文レベルの形式を提供し、そのパーセンタイルフィールドは参照パネルが存在するまで空白のままです。 | 論文レベルのしきい値:エントリ≥160、グループ内中央値805(トップリストスクレイプ;2015年)[85]。著者レベル:エントリ最小129総ダウンロード数、グループ内中央値1,626(同じスクレイプ)[85]。典型的な論文アンカー:2年で中央値63(LSN;2012→2014年)[139];中央値87(マーケティングネットワーク;スナップショット2025年)[83]。 | すべてのしきい値は2012~2015年のサンプルから派生します(以降のインフレーション[1]:セクション5.1)。2015年フレームはトップリストのみをカバーします。2つの中央値アンカーは単一分野です。バンド言語を調整されたパーセンタイルとして再表示してはいけません。 | 「優秀」などの普遍的ラベルを古い生のしきい値に掛けます。 | 名前付きサンプル、フィールド、および年内での相対的な立場—それ以上は何もありません。 |
| 3. 三角測量する | SSRNカウンターを独立した引用エビデンスと組み合わせます:Google Scholar、法学用HeinOnline、経済学用RePEc、オープン引用層としてのCrossref/OpenAlex、SSRNに表示されるPlumX。 | 学校レベルのSSRNダウンロードとHeinOnline引用ランキングは0.84で相関します(100米国法学部;2019年)[77];論文レベルのダウンロード引用相関は、フィールドと時間軸に応じて~0.1~0.6の範囲です[80][25];オープン引用インフラストラクチャ[35][124];PlumX [50]。 | 0.84の数値は学校レベルの相関であり、個別の論文や著者には低下しません(生態学的推論の注意、セクション6.2(iii))。ダウンロードは需要を測定し、読書または承認ではありません。論文レベルの相関は控えめであり、高度にダウンロードされたセットと高度に引用されたセットは部分的にのみ重なります[108]。カウンターだけではなく、収束した引用エビデンスが影響の主張を引き継ぎます。 | ダウンロードを承認または正確性と同等にすること。 | 品質の証拠ではなく、取り上げられたレイヤー化されたエビデンス。 |
| 4. フィールド正規化する | 規律フレームを明示的に述べます(例:「企業法学奨学金内で、eJournalは法的サブフィールド全体で約8倍の係数によって異なります」)。 | サブフィールド平均438.35対53.48ダウンロード/論文(LSN eJournals;2018年)[168];ダウンロード対引用比は、それ自体がフィールド構造化されています[18]。 | スプレッド推定値は法律のみで、2018年にさかのぼります。フィールド間の任意のしきい値の転送には注意が必要であり、フィールド修飾子なしのパーセンタイル言語は解釈不可能です。 | 新しい論文を複数年の累積合計と比較すること、またはしきい値をフィールド全体に移植すること。 | フィールド および年齢修飾された比較—普遍的なグレードではなく。 |
| 5. 補完する | SSRNと並行して機関リポジトリおよび他の配布チャネルを引用します。 | SSRNカウンターは、他のサービスから同じ論文のダウンロードについて何も述べていません[161]。2026年の改革は、機関配布の移行パスとしてリポジトリベースシリーズを作成しました[47][146]。 | 単一プラットフォームのカウンターは、論文の総流通を測定しません。ドシエの主張は、1つのカウンターではなく、論文についてです。 | 1つのプラットフォームのカウンターを論文の総流通として提示すること。 | 各チャネルのカウンタが個別に命名されたペーパーの流通に関する主張。 |
| 6. 完全性 | プラットフォームのカウントルールを引用されたカウントと共に述べ、表示される数値を記録する日付付きアーカイブを保持する。 | フィルタリングと言い換えはドキュメント化されたプラットフォーム動作である([144][69][66]; 進行中)。ベンダー報告のダウンロード統計はカウント規則に依存する([69][176]; 2015–2019)。 | カウンタはフィルタリングされた、改訂可能な推定値である。公開された言い直し履歴は存在しないため、著者の日付付きアーカイブが唯一の安定した記録である。 | カウンタを一意の人間読者の正確な数として扱うこと。 | 述べられたルール下での述べられた日付での、フィルタリングされた推定値 — 読者の国勢調査ではない。 |
| 7. 専門家評価 | すべてのメトリクス行を、その代替物としてではなく、仕事の貢献と厳密性の定性的評価の文脈として提示する。 | メトリクスは有効性ではなく拡散の段階を測定する(セクション 3.1、5.5)。高ダウンロードセットと高引用セットは部分的にしか重複しない[108]。 | 使用メトリクス、正規化または生の形式でも、研究が正しいまたは重要であるかどうかを評価しない。 | ピア判断のメトリクス代替。 | 専門家レビューに付随する文脈的証拠 — 品質主張はレビューに基づくもので、数字に基づくものではない。 |
「回避」列はプロトコルのアンチパターンを収集する。2つの警告がプロトコル全体を境界付ける。ダウンロードは受動的な需要を記録するものであり、読取、承認、または品質ではなく、カウントは学術研究と同程度に宣伝ダイナミクス(ブログカバレッジ、顕著なタイトル、トピック的波)に応答する[116][139][138]。操作記録を知っている委員会は根拠のない数字を割り引くであろう[44]、そのような割引を生き残った成分はまさにプロトコルが要求するもの—日付付きスクリーンショット、ソースが添付されたバンド言語、フィールド修飾子、および三角測量である。
6.6 勧誘の系推論
投稿には、ダッシュボードが報告しない文書化された副作用が1つあります。プレプリントプラットフォームから名前、所属機関、論文タイトルを収集することによって生成される、捕食的ジャーナルと会議からの未請求の招待です[107][159]。隣接する監査では、専門分野の研究が学術者ごとに数十件から月単位で数千件の招待ストリームを文書化している場合、その量は実質的です(セクション7.2)[9][84][63]。捕食的ジャーナルとの最初の接触は、調査事例の約41%で未請求のメールです[32]。セクション7および表14は現象を分析しています。プレイブックについては、結果は4つの指示に還元されます。可視性のデフォルトの結果として勧誘を予想し、その量を学術的認識として読まないでください。送信者は機械的に可視性をターゲットにしており、選択的にメリットをターゲットにしていません[159][63]。対応を専用アドレスを通じてルーティングして、収集が主要なインボックスを汚染しないようにします。広く繰り返されている改善(投稿後最初の2週間プロフィールメールアドレスを隠すこと)は未検証の慣行です(付録A)。支払わないでください。ビジネスモデルが料金だからです。監査済みの捕食的なアウトレットの記事処理料金は$25から$1,800の範囲です[136]。お金はより小さなリスクです。ドッシェ(セクション6.5)を精査する同じ評価委員会はまた参考文献を読み、出版物リストで既知の捕食的な会場は、支払うよりも長く続く評判コストを課しています。Cabells Predatory Reports ([B-1]などの維持されたスクリーニングサービスに対して招待会場を確認してください。Beallのリストは2017年1月以来更新されていないため、ライブソースとして使用してはなりません)、およびThink. Check. Submit.のチェックリストに対して[159]。収集メカニズムは定性的スクリーンも提供します。プレプリントの投稿から数日以内に、人間の読者が妥当に形成される可能性があった前に、招待メールを送るジャーナルは、合法的である可能性が圧倒的に低いです。これはヒューリスティックです。研究がその発生率を測定していません[63]。
6.7 プレイブックの範囲
プレイブックの基準は2012年から2015年にかけてのもので、法律と マーケティングに大きく偏っています[139][85][83][1]。その後、論文ごとのダウンロード フローは増加しています(セクション5.1)。分野別に層化された新しい百分位データはまだ存在しません。そのデータの収集は、プラットフォームまたはコミュニティによるもので、セクション8および10の主題です。プレイブックは誤読を減らしますが、品質は測定しません。4つのルールにより、その使用は機械的です。対照症例を比較し、観測期間を一定に保ち、すべての数値にソースを添付し、仮説に仮説というラベルを付けます。
7. 寄生的注目層:可視性と略奪的勧誘
これまで開発してきた解釈的枠組みは、注目を露出から抽象的な閲覧、ダウンロード、その後の使用へと続く単一のファネルとして扱っています。しかし、プレプリントを投稿した実際の経験には、頻繁に、まったく異なるチャネルを通じて到達する「注目」の第二の流れが含まれます。すなわち、疑わしい正当性を持つジャーナル、会議、編集サービスからの未請求メール招待状です[14][61][117][142]。その第二の流れの概念的説明と、その記録された規模の監査証拠が続きます。
7.1 注意の二層モデル
ポスト投稿環境は、ここでは二層注意経済(図10)として扱われます。第1層は第4節と第6節で説明した正当な流入経路です:eJournal流通、抄録閲覧、ダウンロード、および最終的な学術利用です。第2層は寄生層であり、捕食的出版社およびサービスプロバイダのエコシステムで、同じ公開インフラ(タイトル、抄録、著者名、および所属)を食い物にし、著者の仕事を読むのではなく著者を有料顧客に変換することを目指しています。勧誘監査文献はライフサイクルを記録しています。公開プレプリントメタデータ(SSRNのタイトル、抄録、著者名、および所属)は収集され[107][159]、正当な論文募集を模倣した模倣的招待が送信され[61][63]、関与した著者は有料顧客に変換されます。経済メカニズムも記録されています:推定される捕食的ジャーナルの論文処理料は平均して約$178で、報告された範囲は$25~$1,800です[136]。
二層間の非対称性は解釈にとって重要です。第1層は人間の読者が論文に気付き、開き、価値を認めることを必要としていますが、第2層は論文のメタデータが機械可読になることのみを必要としています。したがって原則として、プレプリントは寄生層によって完全に処理される一方で、正当な層では事実上未読のままである可能性があります。それが、プラットフォームのほぼゼロダウンロード論文、つまり「ゴーストペーパー」の状況であり、機械は処理しますが人間は事実上読みません。
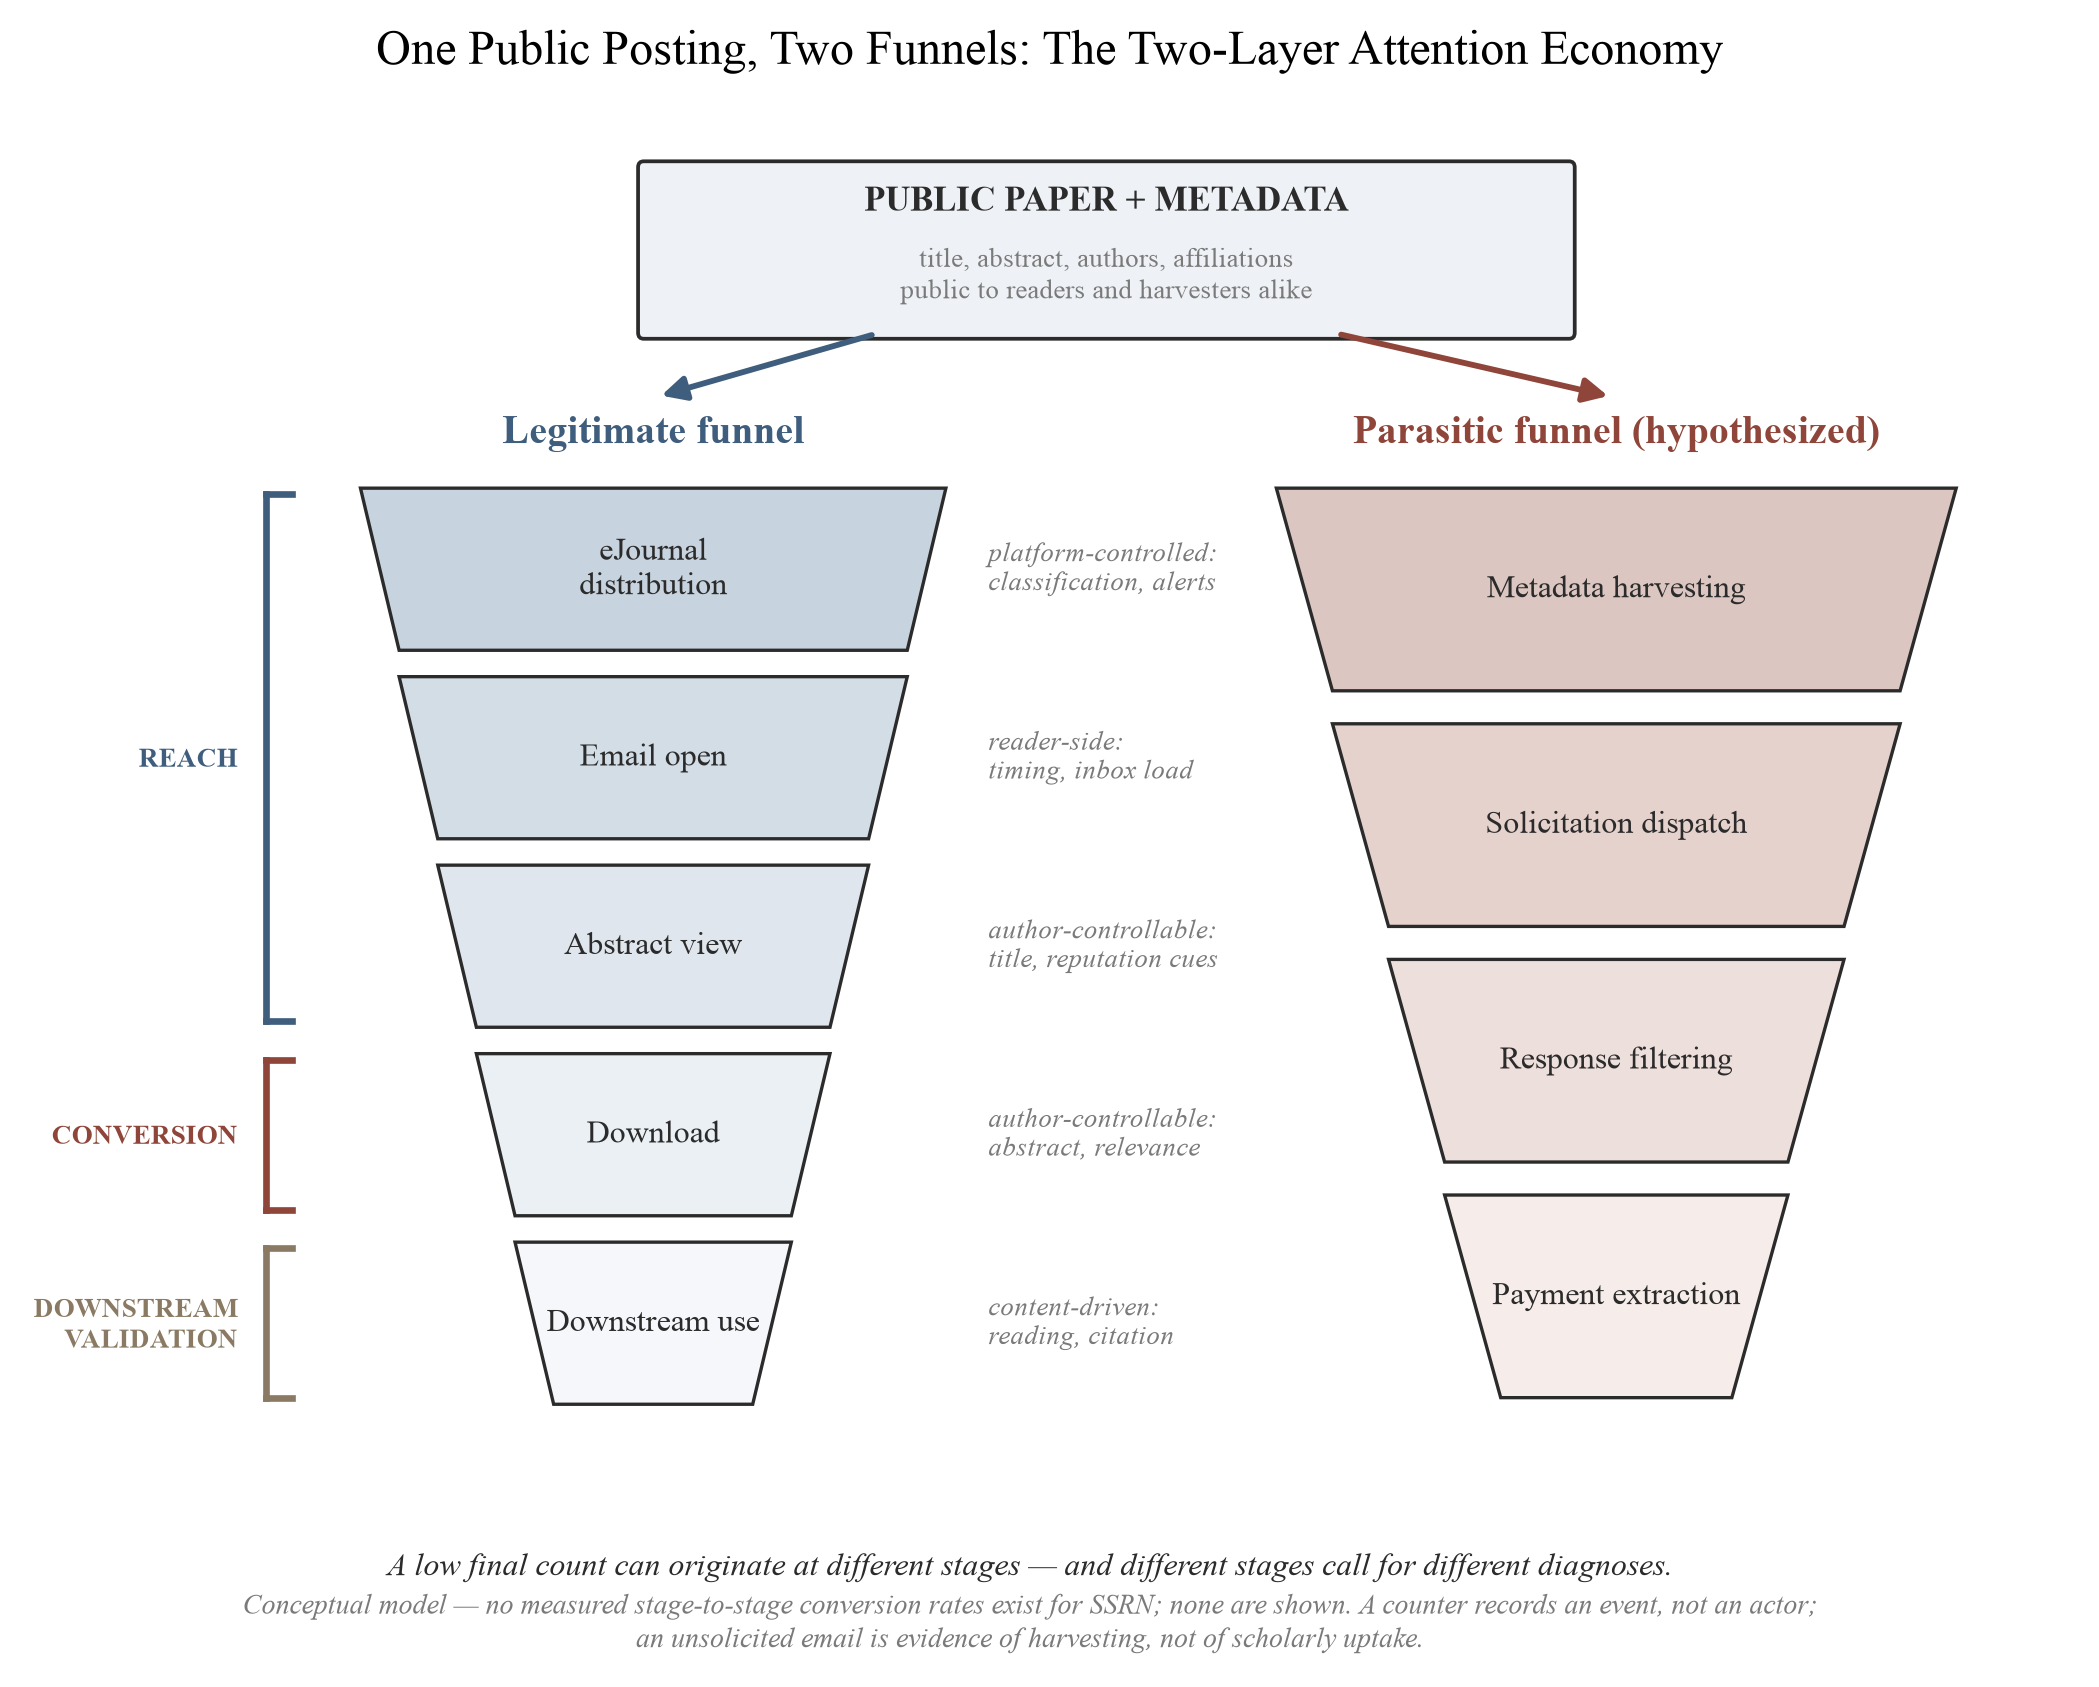
図10 二層注意経済の概念モデル。両方の流入経路は定性的段階シーケンスとして示されています。段階間転換率は表示されていません。SSRNではそのような率は測定されていないためです。寄生流入経路は勧誘監査文献に基づいた仮説的再構成です[61][63][107][159](第7.3節)。
7.2 捕食的勧誘の記録された規模
捕食的勧誘が大規模現象であることに疑いの余地はありません。2026年のレビューは学術スパムに関する29の実証的研究を特定し、戦術のレパートリーに収斂しています。すなわち、お世辞の勧誘、虚偽の編集上の主張、および疑わしい指標とインデックス作成の主張です[61]。測定されたボリュームは相当なものです。14人の学術眼科医が、単一の30日間のウィンドウ内で、383の一意なパブリッシャーから1,813件の勧誘メール、696の一意なジャーナルにまたがるメールを受け取りました[84]。学術放射線科医は、2週間にわたり平均20.7件の原稿招待と4.1件のスピーカー招待を受け取りました[9]。探索的監査は、2023年から24年にかけて単一の泌尿器科医が受け取った422件の勧誘メールをカタログ化し[63]、学術出版のケーススタディは391日間で391日間のジャーナルからの1,024件のスパムメールを記録しました[89]。プリプリント投稿後の1年間の単一研究者の観察は256のジャーナルからの875件の招待を記録し、そのうち76%がキュレートされたブロックリストに表示されたようです。ただし、投稿後の到着ラグは測定されなかったという注意書き付きで、ここで引用されている条件付きのソースです[B-10]。勧誘も実証的に変換されます。推定捕食的ジャーナルで出版した著者の中で、41%がジャーナルとの最初の接触が迷惑メールの招待であったと報告し[32]、勧誘コーパスのコンテンツ分析は、お世辞の言語、捏造された期限、および曖昧なトピック範囲が繰り返される説得デバイスであることを文書化しています[96]。
証拠は医学に限定されません。社会科学では、SSRNの独自の基盤にはるかに近い学問分野で、教育科学の3人の研究者が3ヶ月以内に210件の迷惑メールジャーナル招待を受け取り、139のジャーナルと37のパブリッシャーに追跡されました。その多くは捕食的と分類可能です。招待のおよそ半分は受信者の専門分野外でした。これはメタデータ駆動型ではなく読者層駆動型のターゲティングの署名です[155]。負担は最初に、この記事の主人公である初期段階の著者にかかります。初期段階の学者の1つの縦断的な自己監査は、1,280件の捕食的勧誘(ジャーナルからの990件、会議からの220件、その他の種類の70件)を約8年にわたって記録し、購読解除の実施されたおおむね失敗した試みと共に[160]。
このエビデンスベースの2つの特徴は、視点に保つ必要があります。最大の監査は医学からのもので、上記の社会科学の監査は学問分野で近いですが、より小さいです。どちらの文献からのボリュームもSSRN著者に移植することはできません。この記事にとって決定的なのは、これらの研究のいずれも、プリプリント投稿イベント相対的な勧誘のタイミングを測定していないということです。たとえば、[63]の監査はコンテンツと出所をカタログ化しましたが、到着時間をSSRN活動にリンクしませんでした。寄生層を投稿行為に結びつけるすべての主張は、したがって、発見ではなく、メカニズム仮説です。
7.3 仮説的なターゲティング機構
新たに投稿されたプレプリントに到達するため、寄生層はまずそれを特定する必要があります。以下の機構は文献に部分的な裏付けがある仮説です。統計資料によって勧誘がSSRN投稿に結びついていることは示されていません。
H-S1(メタデータハーベスティング)。 略奪的事業体は公開アブストラクトページと新規論文リストから標題、著者名、および所属機関をスクレイプします。実務家およびアドバイザリー源はこの行動を説明しています。略奪的ジャーナルはプレプリントサーバーをスキャンし、論文の標題を参照した未承諾招待状を送信することが報告されています[159]。法学奨学金解説では、勧誘者は「SSRNに投稿されたものなど既存の学術論文をトロールすることでメールアドレス、名前、所属機関などを収集する」と述べられています[107]。法律図書館ガイドはプレプリント投稿を「著者に論文を再発行するための手数料を支払うよう勧誘する略奪的出版社からのスパム増加」に関連付けています[117]。測定された規則性が機構に適合しています。放射線科監査では、専門分野監査は活発に論文を発表している著者の間で高い勧誘量を報告しており[9]、単一の投稿イベントからではなく著者の累積書誌的表面からのハーベスティングと矛盾しません。研究3(セクション8.6)は焦点投稿と併行して著者レベルの曝露制御を記録します。
H-S2(連絡先取得)。 勧誘はメールアドレスを必要とします。SSRNアブストラクトページは歴史的に著者の連絡先情報を含んでいました[151]。アドレスは論文そのもの、機関ページ、および以前の出版物を通じても流通しています。SSRNが現在著者メールアドレスをハーベスト可能な形式で公開しているかどうかはテストされていません。機器を備えた勧誘ログ記録研究はそれを測定するよう指定されています。特定の勧誘の取得チャネルは観測されていません。
H-S3(配信ピギーバック)。 eジャーナルダイジェストおよびRSSタイプのフィードは新規論文メタデータを加入者に再配信します[57][51]。これらのチャネルに登録された寄生的行為体は、スクレイピングなしで構造化されたリードを受け取ります。この経路は監査で確認されていません。
投稿からターゲットにされることへの因果連鎖は経験的に確立されていません。セクション8は既知の投稿タイムスタンプに対して新たに投稿された論文の勧誘到着をログに記録するこれらの機構の事前登録済みテストを指定しています。
7.4 勧誘シグナルの仮説的分類
セクション7.3のターゲティング機構が機能する場合、異なる勧誘クラスは論文の機械的可視性について異なる情報を持つべきです。表14は仮説的分類として設定されており、その戦略カテゴリは文書化された説得戦術に基づいています:認定情報の不一致とオフターゲットのパーソナライゼーション[9][63]、捏造された期限とお世辞[96]、偽のメトリクスとインデックスクレーム[61]、および文書化されたAPC市場に対する隠蔽された手数料[136]。最後の列は推論的であり、未検証です。表は流行率の割合と到着時間の推定を示していません。
表14. プレプリント投稿後の略奪的勧誘シグナルの仮説的分類。 例のフレーズは勧誘監査[9][61][96]で文書化されたパターンの説明的で創作されたパラフレーズであり、特定のメッセージからの逐語的引用ではありません。
| 勧誘パターン | 説明 | 説明的なフレーズ | 可視性についての仮説的情報 |
|---|---|---|---|
| 一般的な宛先、論文参照なし | 特定の論文または分野への言及がない自動招待 | 「尊敬される研究者の皆様、あなたの貴重な仕事を投稿してください…」 | 低:宛先はいかなるソースからも導出される可能性があります。論文自体が見られたという証拠はありません |
| 認定情報の不一致 | 論文と関係のない分野の専門知識を引用した招待[9] | 「量子物理学の専門知識があることから…」(法律論文への) | 低~なし:メタデータの解析なしのバルク収集を示します |
| 対象型、タイトル参照型 | 特定のプレプリントとトピック的に隣接する会場を命名する招待[159] | 「あなたの最近の論文「[正確なタイトル]」は私たちのジャーナルに適しています…」 | より高い(仮説的):論文のメタデータが送信者に到達したことを意味し、インデックス作成の成功とスクレーパーアクセスを示唆しています |
| お世辞のパーソナライゼーション | 特定の仕事を「革新的」または「尊敬される」として賞賛[96] | 「あなたの革新的な貢献…」 | タイトルアクセス以外なし:賞賛はテンプレート化されており、読まれていません |
| 捏造された緊急性とメトリクス | 作られた期限、アスタリスク付き「インパクトファクター」、インデックスクレーム[61][96] | 「インパクトファクター4.2*;7日以内に投稿してください」 | なし:説得装置はターゲット論文から独立しています |
| 隠蔽された手数料 | APC が遅く開示されるか、添付ファイルにのみ開示される;市場範囲$25–$1,800[136] | 招待本文から手数料が省略されている | なし:価格戦略であり、可視性シグナルではありません |
| 会議招待、論文参照型 | 疑わしい会議での発表またはプレゼンテーション、多くの場合特定の論文を命名する招待;スピーカー招待は学術スパムの測定された構成要素です[61][9] | 「あなたの論文「[正確なタイトル]」をキーノートとして…で発表するようご招待します」 | 対象型勧誘の場合と同様(仮説的):論文のメタデータが送信者に到達しました;実質的な読解の証拠はありません |
| 有料の著者サービス | 新しく投稿されたプレプリントに対して投球される迅速なピアレビュー、翻訳、または編集サービスの提供[61][84] | 「あなたの新しいプレプリントの高速トラックレビューと専門的な言語ポーランド…」 | 確立されていません:サービススパムは新規投稿メタデータを追跡し、論文の内容ではありません |
お世辞の行には、機械的な読解が不明瞭にする心理的な次元があります。テンプレート化された賞賛は、停滞中のカウンターを見つめている著者に届きます。投稿がまだ生産されていない唯一の「検証」となっています。2層モデルは、新しいプレプリントへの最初の応答者が読者ではなく頻繁に捕食者である(セクション7.5)という残酷な反転を予測し、初心者は正当なシグナルがまだ到達していないため、スパムを関心として誤読することができます。フックを予想する著者はそれを割引することができます。
表14は、論文の可視性について何を明かす可能性があるかについて受信メッセージを読みます。それらのメッセージを最初にコード化する方法は補完的な質問であり、これまでのところ暗黙的に残されている正当な学術的接触とより高いリスクの勧誘の区別に基づいています。表15は、最後の列が符号化上の注意事項を含む6つのシグナル分類としてその区別を設定しています:すべてのシグナルは確率的であり、どれも単独では証拠ではありません。分類法はまた、研究3のコードブック(セクション8.6)のスケルトンです。正当な接触の正のクラスがない勧誘研究は、セクション7.5が仮説するジメントリーを測定することができないからです。
表15. 正当な学術的接触とより高いリスクの勧誘の分離:符号化上の注意事項を伴う6つのシグナル。 仮説的な符号化スキーム、検証されたクラシファイアではありません。表14の可視性の列は異なる質問を尋ねており、影響を受けていません:同じメッセージは両方のグリッドで符号化できます。
| シグナル | 正当な学術的接触 | より高いリスクの勧誘 | 符号化上の注意事項 |
|---|---|---|---|
| 特異性 | 具体的な議論、方法、または結果に従事します | タイトルまたはキーワードが挿入された一般的な賞賛 | 特異性は模倣できます |
| 会場の身元 | 検証可能なジャーナル、編集者、機関、または会議の履歴 | 不明な所有権、コピーされたブランディング、検証不可能なボード | 新しい会場は自動的に略奪的ではありません |
| リクエスト | 実質的な質問、協力、または透明な招待 | 仕事に関連しない緊急の投稿または支払いリクエスト | 手数料だけでは決定的ではありません;透明性が重要です |
| タイミング | 任意のタイミング;多くの場合、実際の読解に従います | 公開投稿後まもなくの迅速なテンプレート化された連絡 | 時間的近接性は収集ソースを証明しません |
| 言語 | トピック固有で専門的に責任があります | お世辞、偽りの親密さ、人工的な緊急性、あいまいな範囲 | 言語機能は確率的であり、証拠ではありません |
| 検証 | 独立して検証可能な連絡先の詳細とポリシー | 壊れた識別子、偽のメトリクス、誤解を招くインデックスクレーム | 文書化された基準に基づく人間のレビューが必要です |
実践では、この類型論は診断的ツールというより、むしろスクリーニングのヒューリスティック的なものをもたらしている。投稿後の最初の数日以内に到着した雑誌の勧誘は、正当な流通チャネルが妥当に機能する前のものであり、捕食的である可能性が非常に高い。高インパクト雑誌は、投稿されたばかりの原稿の著者に対して営業電話をかけることは報告されていない[174]が、一方、早期の未請求招待状は、捕食的なベニューの文書化された初接触モードである[32][174]。われわれは、実務家の議論の中で時々提案される特定のカットオフ値(ほぼ最初の96時間以内のジャーナルメールを推定上捕食的なものとして扱う)を、検証待ちの著者ヒューリスティックとして提案する。このような閾値を較正するであろう遅延分布を測定した研究は存在しない。表15のタイミングに関する注意は、ヒューリスティック自体に適用される。時間的近接性は疑惑を生じさせるが、送信者がこの特定の投稿をハーベストしたことを証明するものではない。なぜなら、そのアドレスはプレプリント全体よりも前のものである可能性があるため、96時間スクリーンは証拠ではなく、受信トレイを分類するものだからである。
7.5 スパム・パラドックスと速度の非対称性
二層モデルから、寄生層に関するさらに二つの命題が導き出される。
スパム・パラドックス。的を絞った勧誘がメタデータ収集の成功を必要とするならば、ランキング後の環境においては、掠奪的スパムの不在が、その存在がその他の何ものかを示すよりも強く、プラットフォーム上の目立たなさを示す指標となりうる。寄生層すら発動させないペーパーは、機械可読な配布の最低限の基準をクリアできなかった可能性がある。この反転の分析的な魅力は、スパムを不本意で有毒なインデックス作成のプロキシとして扱うことで、避けられない厄介事が無料の観察機器に変わることである。その診断力は現在のところ仮説に過ぎない。勧誘受信と可視性メトリクスとの相関はこれまで測定されたことがなく、表14の汎用勧誘行は、生のスパムボリュームが原理的にもノイズの多い信号となる理由を示している。
掠奪者は読者より先に現れる。正当なファネルは制度的遅延に基づいて機能する。eジャーナル収録は保証されるのではなく厳選され、大量分類では最大45日の遅延が報告されており[53]、Google Scholar インデックスには6~9カ月以上かかる[55]。初週のダウンロード数がほぼゼロであるのは、却下ではなく通常の配布前の段階と一致している(セクション6)。寄生層がプログラムでメタデータを収集する場合、これらの遅延は全く発生しない。したがって、連絡先情報が入手可能な著者については、投稿に起因する初回の掠奪的勧誘までの予想時間が、初回の本当の学術的な接触までの予想時間より短いと仮説を立てる。そのため、無名の著者は正当な層より先に寄生層に出会うことになる。反証者は直接的である。本当の接触は常に勧誘より先行する。
数日~数週間で測定された文書化された勧誘ボリューム[9][84]は、数週間~数カ月で測定される配布メカニクス[55][53]に対して設定されており、仮説は妥当性がある。セクション8で指定されたログ記録研究だけがそれをテストできる。既存のコーパスは投稿イベントに時間的にロックされなかったため[63]である。
7.6 寄生層が著者に伝えないこと
3つの限定的陳述がこのセクションの結論を制限しています。
第1に、勧誘メールはプラットフォームのカウンターを動かしません。著者宛に送られた招待は、アブストラクトビューもペーパーのダウンロードも生成しません。スクレーパーがアブストラクトページを訪問する範囲で、SSRNは不規則で自動化されたアクティビティをダウンロードカウントから除外すると述べています[66][69][144]。したがって、スパム量は読者層の証拠になることはなく、勧誘メールで満杯のインボックスと1桁のダウンロードが共存することは矛盾を含みません。2つのレイヤーは異なるものを数えています。
第2に、寄生層はまた、その費用を吸収する最も準備ができていない著者に最も大きな影響を与えます。キャリア初期の研究者と英語が非母語の研究者は、勧誘に特に脆弱であると指摘されています[142]。したがって、第6章の実用的なプロトコルはインボックス衛生(勧誘ベニューのブロックリストスクリーニング、未承諾招待への非対応、廃止されたリストではなくキュレーションされたサービスを介した確認)をメトリック解釈の一部として扱い、別の懸念事項として扱いません。捕食的ベニューの自動スクリーニングそのものは、活発な研究方向です[157]。
第3に、早期の可視性にはさらに別の副作用があり、著者は明らかな非難として経験します。その後のジャーナル投稿時に、類似性チェックソフトウェアは、プレプリントがiThenticateで使用されるCrossref Posted Contentコーパスにインデックスされているため、原稿とそれ自身のSSRNプレカーサー間の近完全一致にフラグを立てます[36]。ベンダーのドキュメントは、同じ著者のプレプリント一致が予想される結果であり、剽窃ではないことを明示しています[81]。適切な対応は、プレプリントを編集者に開示することであり、それを取り下げることではありません。
寄生層は、この記事の中心的主張を最も見やすいところです。Rankingsのサンセット後、生の信号(ダウンロード、ビュー、そして今ではスパムさえ)は、それらを生成した仕組みが指定されたときにのみ解釈可能な意味を持ちます。その指定は正当なレイヤーについては部分的に利用可能であり、寄生層についてはそれはまだ研究プログラムです。
8. 事前登録対応研究アジェンダ:欠落した参照クラスの再構築
前のセクションはSSRN注意メトリクスの検証可能な証拠を統合し、ポストRankings環境の解釈フレームワークを提案しました。このセクションは、フレームワークの未解決の質問に経験的に答えるための事前登録対応アジェンダです。デザインでは結果を報告していません。事前指定された、偽造可能なバンドは発見ではなく、以下のすべてのデザイン、仮説、および予測バンドは、データ収集前にオープン科学フレームワークに登録されるための準備ができており、分析コードは並行してリリースされます。2026年7月15日のSSRN Rankingsの廃止[149]は、2026年6月12日に発表され、最初はより早いターゲット日付[148]を持ち、より広いプラットフォーム再焦点化に組み込まれている[146]、このアジェンダを異常に時間に敏感にします。以下の設計の一部は、事前期間が毎月後退する不連続性を活用し、そのうちの1つである第8.8章のパーセンタイルレジストリは、サンセット自体が外部オブザーバーにとって永続的にした測定ギャップに対処しています。
8.1 設計原則
4つの原則が議論の方針を支配しています。
発表時からの観測。 累積カウンターの遡及的なスクレイピングでは、論文が3日目、7日目、または30日目にどのような状態であったかを再構成することはできません。したがって、信頼できるベンチマークパネルは、論文の発表時にそれらを登録し、標準化された年齢、すなわち1日目、3日目、7日目、14日目、30日目、60日目、90日目、および180日目におけるカウンターを記録する必要があります(表11)。SSRNが購読の多いトピックではアラート配布に最大45日かかる可能性があることを述べているため [53]、最初の45日間の日次観測がより好ましいです。この原則はまた、リークに対する保護機構として機能します。著者の事前の評判尺度は、焦点となる発表日に凍結されなければならず、将来の成功がベースラインの共変量を汚染できないようにする必要があります。セクション5.6から引き継がれた補助的な規律は、分配、インデックス付け、および昇格イベントが下記の設計において日付付き処置として現れ、モデル化されないコンテキストとしては決して現れないということです。
リーチとコンバージョンの分離。 セクション5の診断的論理(表9)に従い、下記のあらゆる設計は、抽象ビューとダウンロードを異なる成果として記録し、ビューを条件とした場合のダウンロードをモデル化します。リーチの低さとコンバージョンの低さは異なる診断です。読者の検討対象集合に入らないことと、露出後に獲得されないことの違いです。それらを単一のカウントに統合すると、著者が必要とする情報が失われます。
平均だけでなく分布的な成果。 プラットフォームの注目は厚い裾分布を示すため [83][85][180]、介入とプラットフォームの変化は、その平均値をほぼ変わらないままにしながら、分布の形状を変えることができます。したがって、成果には、注目度のジニ係数、トップ1%およびトップ10%ダウンロード シェア、ゼロにあるか近いペーパーのシェア、および新人から確立された注目度への比率が含まれます。これは他のメディアにおける注目度不平等測定の伝統に従ったものです [180]。
反証可能性。 各仮説は同定戦略とそれが失敗する述べられた条件とペアになっています。枠組み自体が棄却にさらされています。年齢および分野で正規化された初期メトリクスが、サンプル外で生カウントを上回らない場合(以下のRQ3)、正規化の測定上の利点の主張は棄却されるか狭められるべきです。反証可能性は定量的でもあります。議論全体を通じたサンプルサイズは、関心のある最小効果サイズに対するパワーシミュレーションによって最終化されることになっています。5つの仮説、3つの研究質問、および5つの命題の計画に対する多重性戦略は事前登録で確定され、確認的分析と探索的分析は事前に明確に記される。脱落(撤回、統合、または本質的に改訂されたペーパー)は追跡され、報告されます。静かに削除されるのではなく、プログラムの各実証的報告にコホートフロー図が含まれます(セクション8.8)。
8.2 仮説と命題
本フレームワークは、初期的注意の配分に関する5つの仮説と3つの研究質問、およびその構造に関する5つの命題を生成します。表16は、仮説、研究質問、および命題を専用設計(P2、P3b、P4)と結果、対比、優先設計に結び付けており、P1とP3は表17の研究1と研究2によって支持されています。
H1(コールドスタート不利性)。 分野、投稿コーホート、観察可能なトピック、文書特性、および暦的条件を条件として、プラットフォーム新規ユーザーのみで執筆された論文は、少なくとも1人の以前に目視可能なSSRN著者を有する論文よりも少ない初期アブストラクトページビューを受け取ります。中心的な結果はページあたりのダウンロード数ではなくビュー数です。なぜなら、H1は観客形成に関わり、コンバージョンには関わらないからです。
H2(プレスティージと露出)。 機関著者プレスティージと著者プレスティージは、先行するプラットフォーム活動と観察可能な論文特性を制御した後、初期アブストラクトページリーチをポジティブに予測し、ステータス注意文献[104][105][111][140][60]をプレプリント拡散の最初の段階に拡張します。
H3(プレスティージと条件付きコンバージョン)。 機関プレスティージは、アブストラクトページ露出を条件として全文ダウンロードをポジティブに予測します。JoとLiは、マーケティングにおけるこのパターンと一致する最近の分野固有の証拠を提供しており、トップ50著者を1人含む3著者論文のダウンロード率におけるプレスティージプレミアムは約+6.6%ですが、より広範な縦断的検査が必要です。H2とH3を合わせて、パネルの主要推定値を定義します。すなわち、プレスティージ勾配のリーチ対コンバージョン分解であり、ダウンロードにおいて観察されるプレスティージ関連不平等の、アブストラクトページ訪問(露出)前の対その後の(条件付きコンバージョン)分の割合を意味します。勾配の大部分がいずれかの読者がアブストラクトを見る前に形成されるという知見は、不平等を直接測定可能な形で発見メカニクスに位置付け、コンテンツ評価ではなく配置させます。
H4(コミュニケーションを平等化装置として)。 より大きなアブストラクト明確性および情報効率性は、すでに目視可能な著者よりも低い事前可視性著者の間でのコンバージョン改善と関連しています。H4は、治療が著者の制御下に完全に存在する唯一の仮説です。これは事前指定されたテキスト測定および個別にオンラインフィールド実験標準に設計されたランダム化アブストラクト実験でテストされるべきです[30]。自動化された「AI作成」分類器に依存すべきではなく、これは独自の測定不確実性をもたらします。
H5(露出ショックの永続性)。 外生的またはほぼ外生的な初期露出ショックは、即座の露出ウィンドウを超えた昇格された後続の注意を予測します。すなわち、他の場所で実験的に文書化された成功による成功ダイナミクス[112][131][162]および arXiv での位置的露出効果[72][73]の学術プラットフォーム類似です。
RQ1。 2026年7月15日のランキング廃止は、注意の集中度、分布、またはプレスティージ勾配を変更しましたか。反対の予測は両方とも妥当であり、質問は両側として残されています。ランキングを削除すると、人気フィードバックループ[112][131]を減弱させるか、あるいは代わりに事前既存著者ネットワークへの依存を増加させ、未知の論文が注目を集め始めたら可視化される可能性のある発見表面を削除する可能性があります。
RQ2。 キュレートされたメールアラート配信は、新規参入者または確立された著者に対して、より大きな比例注意ゲインを生み出しますか。
RQ3。 7日および30日で観察された正規化された初期メトリクスは、生の累積ダウンロードよりも後続の学術引用または出版成果をより良く予測しますか。
命題は、フレームワークの構造的主張を反証可能な形で再述します:
P1(歪度と不可視の多数派)。 SSRN論文のランダム層化標本全体にわたって、生涯ダウンロード数の分布は重い尾を持ち、右に歪んでおり、中央値は平均値の半分未満であり、論文の相当な割合が10以下の生涯ダウンロード数を持っています。反証者:中央値≥0.5×平均、または無視できる≤10ダウンロード割合。マーケティング・ネットワークの公表された平均対中央値比(約2.54)[83]および2015年トップリストデータの準対数正規適合[85]はP1をプラットフォーム全体に対して動機付けますが、確立しません。
P2(分類が表面化を統治する)。 リポジトリ層内では、eジャーナル分類の数はダウンロードと正の関連があり、年齢とネットワークを制御してほぼゼロダウンロードの確率と負の関連があり、Whalen の2018年横断的パターン[168]のプラットフォームのキュレート配信メカニクス[53][57]下での複製および更新です。反証者:制御後の有意な関連なし。分類数自体が潜在的に内生的である可能性があります。より広い関連性を持つ論文は、より多くの分類を受け取り、より多くの読者を引き付ける可能性があるため、横断的関連は表面化効果を過度に述べます。したがって、優先される識別は、利用可能な論文内分類変更であり、横断的推定値は明示的に上限として報告されます。
P3(マシン可視性は低く、機能依存的です)。 特定のSSRNプレプリントが利用可能な最良のソースとなるように構築されたクエリに対して、消費者AI回答エンジンはプレプリント自体を少数例で引用し、マシン可視性は文書化された生成エンジン最適化要因に類似した機能で上昇します[5][164]。反証者:プレプリントは機能に関係なく大多数の時間で引用される、または機能は可視性を予測しない。
P3b(マシン層マシューエフェクト)。 専門家検証済みクエリ関連性を条件として、より大きな事前ウェブおよび学術可視性を持つ論文は、その他の比較可能なコールドスタート論文よりもAI回答システムによってより頻繁に引用されます。公平性の代替案では、生成エンジンは事前可視性にプレミアムなしで関連性で取得し、P3bは拒否されます。これは機械層がH1-H3の人間発見層よりもより平等主義的である、より少ないものではない結果です。反証者:マッチされたクエリ関連性での可視性勾配なし。P3bは、H1-H3の累積的優位性の線を発見スタックの最上部に拡張します。これをテストするには、研究2(セクション8.6)で指定された事前可視性共変量およびクエリ階層化が必要です。
P4(読者に先立って捕食者が到着する)。 公開されたプリプリントの書誌メタデータと連絡先が公開文書または関連する公開ページから収集可能な新たに投稿されたプリプリントについて、投稿に起因する最初の捕食的勧誘までの予想時間は、最初の真正な学術的接触までの予想時間より短い。反証:真正な接触が確実に捕食的勧誘より先行する。P4は収集可能性を条件として述べられているのは、現在のプラットフォームインターフェース上での著者連絡先の公開可視性が確立されていないためである。収集メカニズム自体は、プリプリントリポジトリ全般について文献化されており[107][159][151]、迷惑メールは多くの勧誘された著者にとって捕食的ジャーナルとの最初の接触である[32]。したがって、帰属にはインボックスのタイミングのみからの推論ではなく、研究3の計測設計が必要である。
表16 仮説、研究質問、および識別戦略。
| 質問 | 主要成果 | 主要な対比 | 推奨される設計 |
|---|---|---|---|
| H1:新参者の不利益 | 段階的ビュー | 新参者対確立者 | 階層的縦断計数モデル |
| H2:威信と到達 | 段階的ビュー | 高い威信対低い事前威信 | 共変量調整パネル+マッチング感度分析 |
| H3:威信と転換 | ビューを条件とするダウンロード | 高い威信対低い威信 | 負二項/ポアソン曝露モデル |
| H4:コミュニケーション平坦化装置 | 条件付きダウンロード確率/レート | 明確性×事前可視性 | 観察テキストモデル+ランダム化複製 |
| H5:累積的注目 | ショック後ビュー/ダウンロード | 曝露ショック対ショック前の軌跡 | 論文内イベントスタディ |
| RQ1:ランキング廃止 | 日次注目;ジニ係数;上位シェア;分野別新規投稿量 | 以前のランキング曝露対比較分野 | 中断/イベントスタディ設計 |
| RQ2:メール配布 | 日次ビュー/ダウンロード | 配布前対配布後 | 論文内イベントスタディ(配布×新参者) |
| RQ3:予測的妥当性 | 6/12/18ヶ月引用数 | 正規化対未処理の初期メトリクス | 外側サンプル予測比較 |
| P2:分類が出現を支配する | ダウンロード;ほぼゼロダウンロードの確率 | 分類カウント;利用可能な論文内分類変更 | パネル回帰+論文内変更設計 |
| P3b:機械層マタイ効果 | 回答システムによる直接引用 | マッチングされたクエリ関連性で高い対低い事前可視性 | 繰り返し多層検索監査(研究2) |
| P4:読者に先立つ捕食者 | 最初のコード化インバウンドメッセージまでの時間と率 | 投稿前対投稿後ウィンドウ;捕食的対真正な接触 | 計測された見通し的コホート+イベント履歴モデル(研究3) |
注記。 すべての行は見通し的設計である。いずれも実行されていない。成果、対比、除外ルール、および参照クラスはデータ収集前に事前登録される予定である。
8.3 コアパネル
参照設計は、新たに投稿されたSSRN論文の学際的なコホートであり、投稿後少なくとも12ヶ月間追跡され、表11のスケジュールで観察されます。論文レベルでは、データセットは、タイトル、要約、著者名と著者順、所属機関、投稿日、分類、キーワード、ページ数、利用可能な場合はDOI、改訂履歴、公開要約閲覧数、公開ダウンロード数、およびその後の引用指標の最も早く利用可能なバージョンを保存しており、著者識別マッチングはオープン書誌インフラストラクチャ[35][124]に対して手動で検証され、その後、推定レピュテーションは規模で使用されます。新規参入者ステータスは、焦点となった論文のいかなる著者も焦点となった投稿前にSSRN論文を持っていないものとして定義され、感度定義は以前の論文数と投稿前引用ストックに基づいています。機関的威信はこの定義の一部ではありません。威信そのものがH2とH3の説明変数であるため、威信を新規参入者ステータスに組み込むと、機械的にプラットフォーム新規性と以前の著者の可視性を混同し、設計が分離することを意図した仮説を崩してしまうためです。したがって、威信はモデルに別の共変量としてのみ入ります。以前の可視性による正規化は、公平性の理由から対応する注意を払う必要があります。以前の可視性ベースラインを過度に積極的に減算すると、ジュニア著者の真正な初期成功にペナルティを与え、統計的に、周辺化され、グローバルサウスの著者の全身的な過小露出を暴露するのではなく消し去ってしまうでしょう。フレームワークの答えは、それを差し引くのではなく、不平等がどこで形成されるかを測定することです。リーチ対転換分解は、可視性ギャップが露出で生じるのか転換で生じるのかを特定し、威信は静かに差し引かれるノイズとしてではなく、理解されるべき共変量として入ります。注目に対する威信の分布効果は、準実験(セクション8.4–8.5)の主要な成果です。カレンダーコントロールには曜日、年の週、学年、および日付固定効果が含まれます。記事アクセスの文書化された週末および季節的な変動(最近の7ジャーナルパネルでは活動は週末でおよそ11%低く、夏で50%低い[178])は、高頻度使用研究でそれらの省略を正当化することを困難にします。完全なパネル変数辞書(約2ダース程度のフィールド、累積カウントのみではなく間隔増分、同意された配布日、6、12、および18ヶ月での引用ストック、および改訂番号を含む)は付録C(表C1)で指定され、同じスキーマファイルは事前登録資料に預託されます(セクション8.8; 宣言)。
リーチは増分ビューの階層的負の二項分布過程としてモデル化され、分野別年齢効果、カレンダー効果、および論文レベルの不均一性があります。条件付転換は、ログ増分ビューを露出として増分ダウンロードでモデル化されるため、ランディングページ訪問の獲得とその訪問の転換が統計的に分離されます。コンパクト形式では、区間tにおける論文iについて:
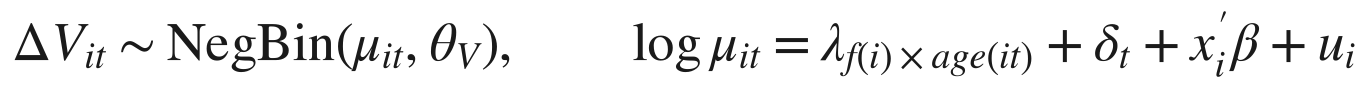

ここで、λ_{f×age}は分野別年齢効果、δ_tはカレンダー日付効果、u_iおよびw_iは論文レベルの不均一性であり、第2の方程式のログビューオフセットはダウンロードをランディングページ露出に条件付けます。新規参入者×明確性相互作用γ_3はH4テストです。これらの方程式は事前指定推定量を固定し、リーチから転換を分離し、階層構造は、セクション5.2および8.8が必要とする正確な経験的ベイズ部分プーリングを実行してから、スパースセルのパーセンタイルが公開されます。x_iのトピックコントロールは、タイトル要約埋め込みから構築され、事前登録で凍結およびクラスター化されており、いかなる結果も観察される前に、トピック構成が結果に合わせて調整されないようにします。論文は最大7つの分類を同時に占めるため、分類効果は各論文を単一のフィールドに強制するのではなく、複数メンバーシップ階層構造で推定されます。論文固定効果が時間不変ステータス測定を吸収するため、基本新規参入者および威信効果は論文間で推定され、論文固定効果は配布イベントなどの紙内治療のために予約されます。過剰分散および過剰ゼロは正式にテストされ、ハードルおよびゼロ膨張代替案は正当化される場合に報告され、重い尾部は成功した論文を削除するのではなく、分位数および堅牢推定で処理されます。データクリーニングルール自体は裁量的ではなく事前指定されており、異常プロトコルはフラグを立てることであり、削除ではありません。事前指定シグナルリストは以下をカバーしています。論文独自の履歴に対する間隔極値、ダウンロード移動なしのビュースパイク、転換の不連続性、同一タイムスタンプの繰り返し、およびプラットフォーム側の再計算。フラグの立った間隔はアーカイブから削除されることはありません。理由コードとともに保持され、すべての見出し結果は4層感度ラダーで報告されます。(i)未変更カウンター; (ii)プラットフォーム確認済み無効アクティビティのみを除外; (iii)堅牢またはウィンザー化推定; (iv)すべてのフラグ付き間隔を除外しており、結論が1つのレイヤーでのみ残る場合、脆弱として見えます。閾値は事前に設定されるのではなく観測分布に対して調整されます。パートナーログが利用可能な場合、リファラー、ユーザーエージェント、および地理フィールドはニュースレター、ブログ、プリフェッチ、およびクローラートラフィックを区別します。SSRNでの文書化されたブログ駆動ダウンロードスパイク[116]は、極値がしばしば汚染ではなく有機的成功である理由を示しています。異常検出は測定ツールです。不都合な成功を破棄することをライセンスしません。
時間的構造にも同じ規律が適用されます。このパネルは限界的注意と累積的注意を区別します。すなわち、論文のダウンロード間隔ΔDのコーホート曲線と、生涯総ダウンロード数ではなく、各年齢までに蓄積された論文の180日ダウンロード数の割合です。単一の指数関数的半減期を減衰に課しません。読者層は複数の時間スケールで同時に減衰するためです[91]。したがって、年齢曲線はデフォルトではスプラインまたはノンパラメトリック推定量で適合させられ、対数変換は構造の研究に使用され、生カウントはベンチマーク報告に保持されます。堅牢性は同じ方法で処理されます。すなわち、声望は単一のランキング閾値ではなく複数の代替測度を通じて操作化され、新参者の状態はより厳格な定義の下で再テストされ、結果はwinsorized感度チェックおよび完全分布プロットとともに分位数推定値と並べて報告されます。
公開されたSSRN APIが存在しないため[134][51]、データ収集は優先順位順に3つのルートで進められます。SSRN/Elsevier への正式なデータリクエストまたはパートナーシップ。著者の同意を得たダッシュボードエクスポート。参加著者が情報提供に基づく同意の下で独自の統計パネルデータを提供する中間層であり、セクション8.8のレジストリが既に依存しているもの。そして、robots.txtを尊重するレート制限付きの論文ごとのサンプリング。既存のオープンソース収集ツール[134]によって技術的実現可能性が確立されている公開ページです。この設計は、利用規約に違反する一括スクレイピングを除外し、安定したAPIとして文書化されていないエンドポイントを表していません。アクセス制約はセクション9で制限事項として論じられています。
8.4 準実験I:メール警告配布は注意喚起ショックとして機能する
8.4節と8.5節は1つの分析モジュールを構成し、同一のパネルコホートに対する補完的な処置として2つのプラットフォーム側介入を研究します。警告配布は曝露サーフェスを追加し、ランキング廃止はそれを除去し、両者は共通の分布結果セット(新規参入者シェア、威信勾配、注意ジニ係数、トップシェア)に対して解釈されます。SSRNの警告メカニズムは分析的価値があります。投稿と配布は一致する必要がなく、論文はまず公開され、その後適格な著作物が配布タイミングが変動し保証されないキュレーティングされた電子ジャーナル警告を通じて配布されるためです[53][57]。配布ステータス日を提供することに同意した著者のため、論文内イベント研究では配布日周辺の注意パスを推定でき、各論文は自らの対照として機能するため、主題の訴求力、著者アイデンティティ、機関の安定した違いは吸収されます。仕様は標準的なイベント研究形式です:結果Y_it(区間ビューまたはダウンロード)の場合、
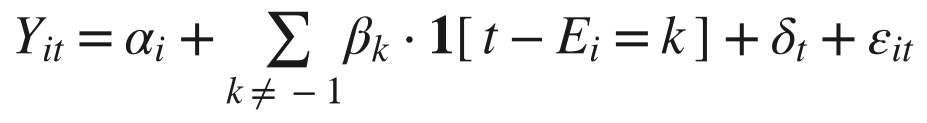
ここでE_iは論文iの配布日、α_iは論文固定効果、δ_tは暦日効果、β_kはk = −1の配布前参照期間に正規化され、イベント周辺の注意パスを追跡します。方程式は事前登録のための推定量を指定します。主要な不均一効果は相互作用Distribution × Newcomerであり、β_kを新規参入者ステータスと相互作用させて推定されます。警告が新規参入者のリーチを不均衡に改善する場合、キュレーティングされた配布はプラットフォームレベルの均等化機能として機能します。利益が名高い著者に不均衡に蓄積する場合、配布は既存の評判優位性を増幅します(RQ2)。離散的な曝露イベント(arXiv上の最前部リスティング[72][73]、SSRNペーパーのブログ報道[116])は急激な初期注意スパイクを生成することを示す先行証拠は、設計が検出可能な第一段階を有することを示唆します。事前指定された仕様には配布日周辺の代替イベントウィンドウも含まれ、および迅速に配布されたペーパーと長い分類キューの後に配布されたペーパーの別々の報告も含まれます。最大45日の遅延[53]はそうでなければ不均一な曝露履歴を単一のイベント時刻に混合するためです。論文固定効果は時間不変の訴求力のみを吸収するため、3つの設計条件は負荷がかかっています。配布タイミングはキュレーティングされており、ランダムではありません:プラットフォームは適格なペーパーのうちどれを配布するか、いつ配布するかを選択します[53][57]。したがってイベント日は主題性の時間変動選択を伴います(トピックが顕著になった週に配布されたペーパーは静かな週に配布されたのと同じペーパーと異なります)。この選択は論文固定効果を乗り越えて生き残ります。これが仕様が配布潜伏期間に条件を付け、配布タイミング層を別々に報告する理由です。配布ステータス日も同意した著者についてのみ観測されるため、推定サンプルはパネルの自己選択サブセットです。同意ステータスしたがって記録され、イベント研究サンプルは完全なコホートと観測可能な共変数と比較されます。選択は外部妥当性を制限します。そして著者は自らの宣伝を警告にタイミングすることができます:調整された自己プロモーションスパイクは配布効果に見えるでしょう。したがって日付のある著者プロモーションログ(6.1節の版管理証拠パケット)はこの設計の要件です:それなしに有機配布スパイクは自己生成スパイクから分離することができず、8.3節の異常ラダーはログされた自己プロモーションに一致するスパイクを削除するのではなく非難します。
8.5 準実験II: ランキング廃止を自然実験とする
2026年7月15日のサンセット[149]により、アーカイブされたランキングページから過去のランキング露出を復元できれば、第二の分析が可能になります。設計の2つの特性が、明確な単一日付のイベント研究を弱めています。処置は1つの日付で到来しませんでした: eジャーナルごとのランキングページは2025年12月11日から更新を停止しました(セクション2.2 [B-2])。これは2026年7月15日の削除のおよそ7ヶ月前であり、ランキング発見サーフェスの撤回は、単一の共通イベント日付としてというより、ライブページの凍結に続いて最終的な削除に至る段階的なプロセスとしてより良くモデル化されます。したがって、仕様は最低でも2つのイベント時間(12月の凍結と7月の削除)を含み、段階的な形式を主要モデルとし、単一日付フィットをそれに対して検証します。「かつてランキング露出していた」分野はプラットフォームの構造から仮定することはできません: ランキングはプラットフォーム全体でしたので、差分露出は内生的であり、「ランク付けされた」と「感じた」分野の名前付けによって操作化されません。露出は測定されなければならず、割り当てられてはいけません: 例えば、インターネットアーカイブを通じて回復されたアーカイブされたランキングページから、分野の論文がパブリックトップリストに入った割合、またはeジャーナルごとのページ上での分野のプレゼンスの密度として。アーカイブが各分野のランキングページを十分に密に網羅して使用可能な露出測定をもたらすかどうかはまだ確立されていません; 設計は露出測定と共に密度を報告します。このように測定された露出により、論文レベルのイベント研究仕様は、凍結日と削除日の周辺で高露出分野と低露出分野の注目軌跡を比較します: セクション8.4の方程式に、イベント時間項だけではなく、Exposure_f × EventTime_k相互作用に関する関心係数を持つものです。最も有益な結果は分布的です(セクション8.1)。ランキング機構は注目の集中度を変える可能性がありますが、平均をほぼ保つ形で、あらゆる効果はすでに可視のテール論文(リストに含まれていた)に集中すると予想されるため、分野平均結果は構造上、低電力です。したがってGini係数、トップシェア測定、新規参入者/確立された比率、およびプレスティージュ勾配が主要な結果であり、RQ1の双方向予測、およびセクション8.1の電力シミュレーションは、平均注目ではなく、これらの分布統計に標的化される必要があります。そうしないと、研究は誤った推定量の電力不足のため無効と宣言されるリスクがあります。
2つの名付けられた方向性予測が、双方向のRQ1を研究されたなしで鋭くします。どちらも事前に指定された不均一性検証です。可視性の断崖仮説は、かつてランキング露出していた分野の退職後の投稿コホートが、既知の日付に発見サーフェスが削除されたため、マッチした退職前コホートと比較して初期リーチで離散的な低下を経験することを主張します。補償仮説の下では、ランキングが弱い発見エコシステムを持つ分野の補償的可視性機構として機能した場合、それらの削除の効果は小さいeジャーナルサブスクリプションベースを持つ分野(Whalen勾配[168]の下限)で最も大きいはずです。
設計を拡張する安価な二次結果は、注目の配分からプラットフォーム自体の健全性まで: 2026年7月15日の前後のウィンドウにおける分野別の新規投稿の量。ランキングが投稿インセンティブの一部を提供した場合、その廃止は新しい提出を冷え込ませるかもしれません。これは上記の注目結果とは異なる行動結果であり、プラットフォーム自体の2025年250,000以上の新規論文のベースラインに対する公開新規論文一覧から観察可能であり[145]、セクション2.2[12][B-11]に記録された同時期の「鮫を飛び越えた」論争への直接的な経験的回答です。予測はRQ1のように双方向のままであり、投稿量結果は調査4のアイテム(3)(「新しいアップロードを避ける」)に接続します。
分析は準実験的です。5つの脅威が実質的です。1つは発表と予期効果です: 廃止は2026年6月12日に発表され、初期目標は7月1日であり、7月15日に実行されたため、本物の予期ウィンドウが存在し、シフトしました[148][149]。同時実行の2026年プラットフォーム変更群はサンセットのカレンダーを共有し、単一のイベント日付では分離できません: 2026年4月13日に発表された戦略的焦点の絞り直し、2026年末を通じて実行される商用研究論文シリーズの廃止、および2026年7月20日の著者ライセンス変更、削除から5日後[146][150]。これらの介入は7月のウィンドウで重複するため、単一の共通イベント日付はそれらの合算効果をサンセット単独に帰属させるでしょう。識別は上記の段階的なタイミング(12月の凍結はそれらすべてに先行)、プラセボ日付、およびランキング撤回に固有の分布シグネチャに依存し、設計はどの共時間変更が未分離のままかを報告します。次に夏の注目の谷があります: 7月中旬は学術的アクセスの文書化された季節的低下と一致し、夏の月にはアクセスが約50%落ちるため[178]、削除日を横切る野外対照対比はサンセットと分野独自の夏季季節性を混同し、これは分野によって異なります。カレンダー日付固定効果は共通の季節成分のみを吸収します。設計はしたがって分野固有の季節基準を必要とします(分野ごとの前年同期間比較)。高露出分野と低露出分野間の非ランダムな違いはさらなる脅威であり、上記の測定露出操作化および対応グループとの比較によって対処されます。残る脅威は前向きです: SSRNはランキングを再検討する可能性があると述べているため、観察ウィンドウ中の部分的な再開は第二のイベントを導入するでしょう。設計は再開をサンセット対比に折り畳まずに後期の検閲ポイントとして扱い、別個の処置としてモデル化することを事前登録します。すべての報告において、イベント時間は3つの名付けられた期間に分割されます: 発表(2026年6月12日から)、移行、および廃止(2026年7月15日から)。したがって予期効果が推定されます。事前に指定された設計はしたがって、イベント時間事前トレンド検証、代替帯域幅、プラセボ日付、分野固有の時間トレンド、および分野固有の季節基準、および発表から廃止への移行期間を除く感度分析を含みます。図11は両方のイベント研究の意図された出力を設計テンプレートとして提示します。
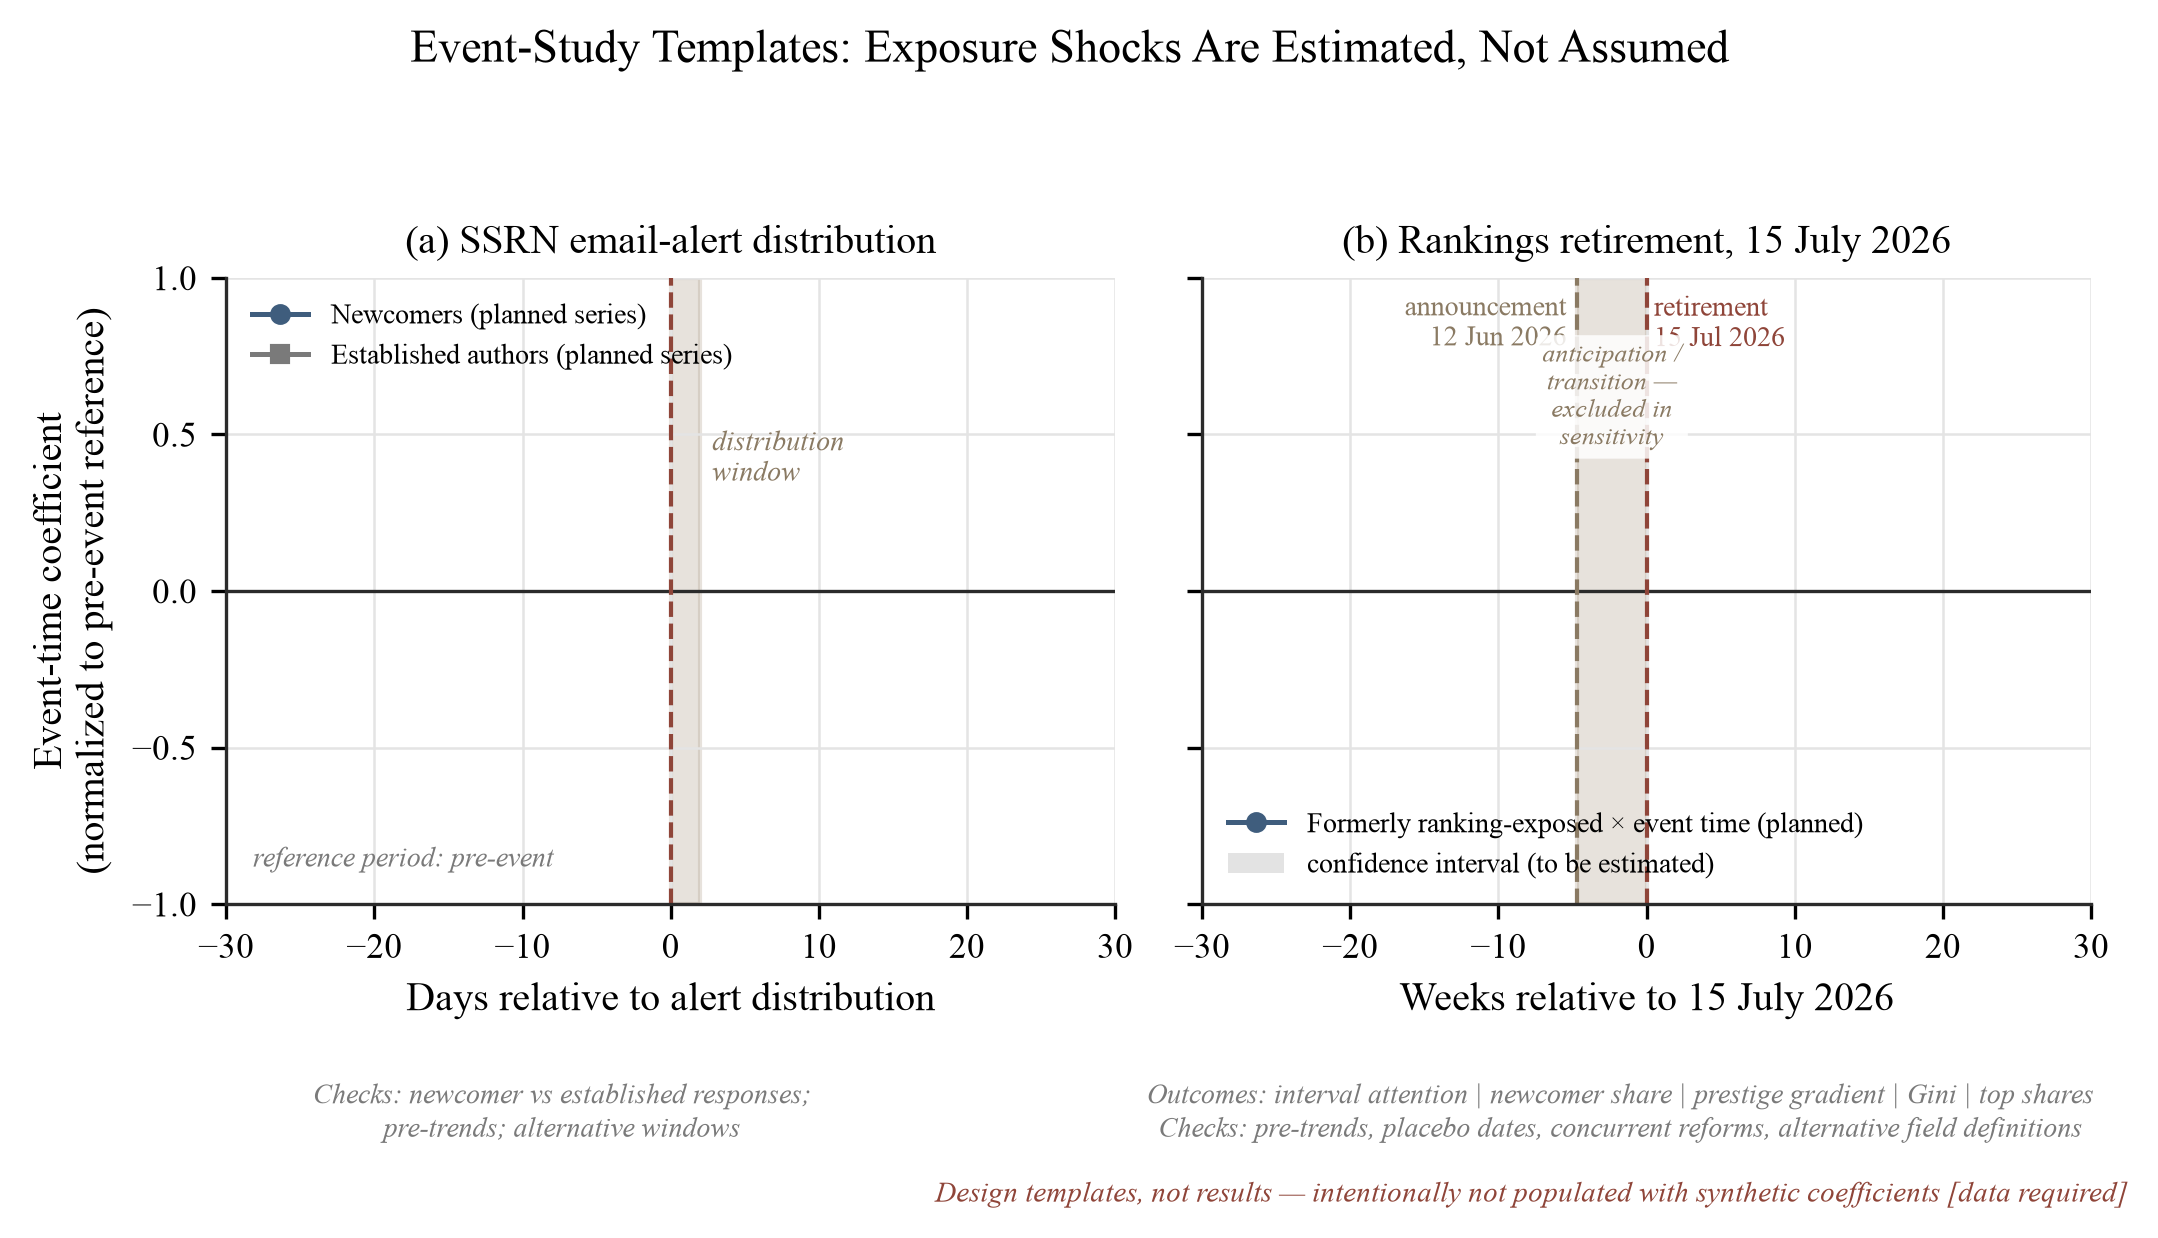
図11. 2つのプラットフォーム準実験のイベント・スタディ設計テンプレート。セクション8.4~8.5の設計のための事前指定イベント・スタディ出力:(a) メールアラート配信周辺の注目度、新規著者対既存著者、配信ウィンドウは網かけ、アラートが瞬間的ではなくウィンドウとして到着するため;(b) ランキング廃止周辺の注目度と不平等アウトカム、発表日(2026年6月12日)と廃止日(2026年7月15日)の両日付が示され、予想・転換期間が網かけされた――事前指定感度分析で除外されるウィンドウ。分布アウトカム(区間注目度、新規利用者シェア、声望勾配、ジニ係数、上位シェア)と必須チェックは図自体に記載されている。係数は事前期間基準に正規化されている;網かけされた灰色領域は信頼区間を示す。これらのパネルは設計テンプレートであり、経験値は示されていない。生成コードはプレレジストレーション資料とともに公開される予定である。
8.6 4つの事前指定研究
コアパネルと並行して、4つの研究が表17に指定・要約されています。2つの公開データ研究(1と2)は、制限されたアクセス権限を持たない研究者であれば誰でも実施でき、セクション9に記載されたアクセス制限の範囲内(プラットフォーム利用規約に基づくレート制限付きの収集)です。2つのヒト対象研究(3と4)は参加者を必要とし、宣言セクションに記載された倫理承認の下で進行します。4つすべてが、複数年のパネル成熟を待つのではなく、ベンチマークの空白を直ちに埋め始めるために存在します。
表17. 4つの事前指定研究。
| 研究1 | 研究2 | 研究3 | 研究4 | |
|---|---|---|---|---|
| 研究課題 | ダウンロード分布の中央値/パーセンタイルは何か? | AIの回答エンジンはプレプリント自体を引用しているか? | 読者か捕食者か、どちらが先か? | 著者は自分のカウンターをどのように読むか? |
| データ | 3,000~5,000のSSRN論文IDを層別化 | 100~200のニッチな質問 × 約5つのエンジン | 2つのインストルメント化された投稿、90日間のインバウンドログ | 事前登録された著者調査、4つの固定文言項目 |
| 方法 | 中央値、ジニ係数、減衰曲線、分類カウント回帰 | 検索コーディング + ロジスティック回帰 | チャネル別エイリアス追跡 + メッセージコーディング | 閉形式質問票 + 記述的割合 |
| 主要成果 | 中央値; ≤10ダウンロードシェア; 注意Gini | 機械可視性V | t_reader対t_predator | 任意のベンチマークとカウンターを比較しないシェア; 「7ダウンロード」の初読分布 |
| 反証可能な予測 | 中央値 < 0.5 × 平均; Gini 0.75–0.90 | プレプリントが試行の10–35%で引用される | t_predator < t_reader | 大多数がいかなるベンチマークとも比較しないことを報告する |
| 主要な成果物 | 公開、機械可読の年齢、分野、およびコホート層別化されたパーセンタイルベンチマークテーブル | タイムスタンプ付きスナップショットを伴う再現可能な取得・帰属監査プロトコル | 事前投稿ベースラインおよびコーディングコードブックを備えたオープンな計器化投稿プロトコル | 著者解釈の文書化された分布と報告された行動変化 |
| 設計が失敗する場合 | 正規化が生データよりも安定性またはサンプル外予測を改善しない | 機能がクエリ関連性、エンジン、および日付を超えて何も予測しない | ベースライン曝露コントロール後の不連続性がない、またはコーディングが信頼できない | 採用または自己選択により、記述的シェアさえも解釈不可能になる |
| リソースプロフィール | 公開データ;標準的なスクレイピングと統計 | 公開AIエンジンクエリ;手動コーディング | 2つの計測されたポスティング;インボックスロギング(IRB) | 匿名著者調査(IRB) |
注記。 各研究は、データ収集前にOSFに登録され、コードが公開されます。
研究1:「中央値の解剖学」。 本研究は、3,000~5,000のSSRN抄録IDのランダムな層化サンプルを実施し、計画範囲であり、最終Nは事前指定された予測帯と最小関心効果に対する検力シミュレーションにより設定されます(セクション8.1)。層化はポスティング年とネットワーク、および論文ごとの生涯ダウンロード数、抄録ビュー、ポスティング日、および分類数は、セクション8.3のアクセス経路を通じて収集されます。推定値:生涯ダウンロードの中央値;ダウンロード数ゼロおよび10以下のダウンロード数を持つ論文のシェア;ブートストラップ信頼区間付きの注目度ジニ係数;ビューからダウンロードへの変換率、全体およびネットワーク層化により推定(セクション5.2の対象者読書様式仮説のテスト);ダウンロード減衰曲線;および分類数に対する対数ダウンロードの回帰、年およびネットワーク固定効果あり(P2の直接テスト[168])。事前指定された予測帯(生涯ダウンロードの中央値はおよそ30~80、≤10ダウンロードシェアは15~30%、ジニ係数0.75~0.90)は、セクション5の日付付きアンカー[83][85][139]および隣接メディアの注目度ジニ係数の大きさ[180]からの外挿であり、研究が仮説を反証できるように事前に述べられています。研究1は、セクション8.8で議論されるパーセンタイルベンチマークの経験的種です。
研究2:「機械はあなたを読みますか?」 情報探索の増加するシェアは現在、生成インターフェイスで開始されています:米国成人の約半数はAIチャットボットを使用していると報告されており、約4分の1が毎日使用しており[121]、便宜サンプルの実質的少数派は既にチャットボットを彼らの最初の検索エンジンとして扱っています[4]。序論(セクション1.6)はこれを発見ゲートキーパーの上昇的移行(ジャーナルブランド→リポジトリ→検索エンジン→AI回答層)として概念化しており、各ステップはコントロールを著者からさらに遠く、公開ベンチマークから更に遠くに再配置しています(図12)。トップレイヤーが事前印刷物を全く取得するかどうかは不明です:生成エンジン最適化文献はこれまでのところブランドと商取引に集中しており[5][100][164]、AIサーチの監査は学術情報源ではなくニュース帰属に関係しました[82]。これらの監査は新しいゲートキーパーの信頼性についての懐疑を助言します:Tow Center監査(8つのエンジン全体で1,600クエリ)では、エンジンは60%以上の試験で正しい情報を取得するのに失敗し、最高成績者(Perplexity)は37%の時間で誤って回答し、最悪者(Grok-3)は94%であり、回答を控えるのではなく根拠のない自信を持って誤りました[82]、ニュース帰属テストからの数値であり、学術サーチからではありません。2026年8月現在、AIアンサーエンジンにおける学術的プレプリント可視性の対照研究は存在しませんでした[100]。本貢献は、隣接する2つの仕事のラインに対して位置しています。生成エンジン最適化研究は本記事が構築するブランドと商業ページの可視性を測定および操作しますが[5][164]、学術成果物の取得ではありません。別の流れは、言語モデルが参考文献を全く生成する場合、すでに高度に引用された仕事を引用する人間の傾向を再現および増幅し、マシューン効果をマシンレイヤーに拡張することを示しています[7]、これはメカニズムP3b(セクション8.2)が検定するものです。どちらの流れも、制御されたクエリ関連性下での科学的プレプリントの発見可能性を調べておらず、具体的には、プラットフォームランキング表面が削除された後のそれらの検索可能性を検査していません。これは研究2が分離するオブジェクトです。
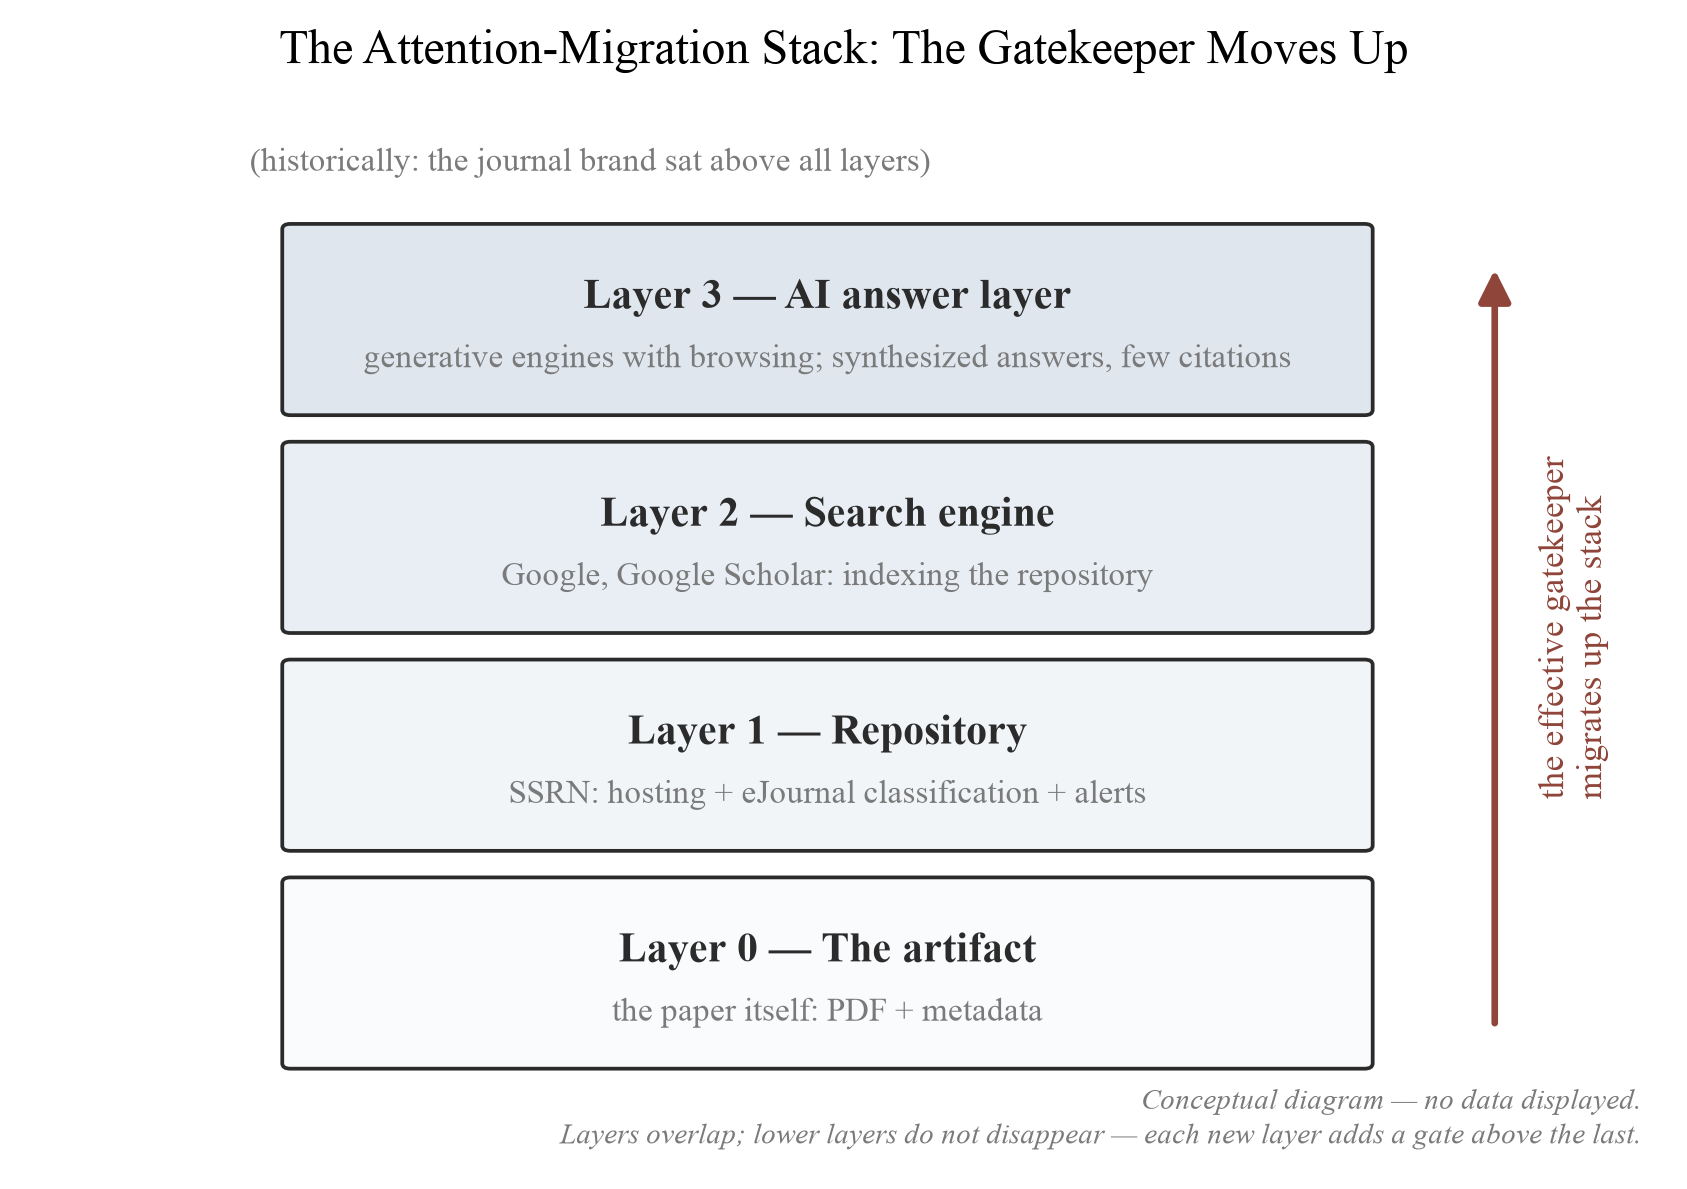
図12. 注意力移動スタック。完成した原稿から読者の注意へと至る層状経路。移動論文は、実効的なゲートキーパー——どの成果物が注意を受けるかを決定する層——が時間とともに上方に移動したと主張する。具体的には、ジャーナルブランドから、リポジトリ、検索エンジンを経由して、AI解答層へと移動する。各々の上方への移動は、著者からの距離をさらに遠くへ、また公開ベンチマークからの距離もさらに遠くへと制御を移転させる。スタックは概念的モデルです。
研究2は100~200個のニッチな質問を構築し、各々が特定のSSRNプレプリントが最も利用可能な情報源となるように設計されている。その妥当性は、クエリ著者による自己認定ではなく、盲検専門家評価者によって検証されている。ブラウジング機能を有効にした主要な消費者向けAIシステムにクエリを提出し、結果を6つの相互排他的カテゴリにコード化する:(1)対象プレプリント自体が引用された、(2)公開版または同じ論文のミラーが引用された(より粗いスキームでは不在として誤分類されるケース)、(3)論文なしで二次情報源が引用された、(4)異なるが正当な情報源が引用された、(5)追跡可能な情報源がない、(6)エンジンの拒否(図13)。対象論文またはその版を引用する回答ごとに、二値の属性忠実度フラグが、その回答の主張が実際に引用された情報源によって支持されているかどうかを追加で記録する。可視性と忠実度は個別に報告され、単一スコアに統合されることはない。エンジンは論文を顕著に引用しながら誤って述べている場合(引用の濫用)もあれば、引用なしでその内容を再現している場合(帰属のない影響)もあり得るためです。確認的回帰は「対象論文またはその版が引用された」対「その他すべての結果」という対比について、ロジスティック分析のままであり、標準誤差はクラスタ化されているか、または好ましくは交差ランダム効果構造に適合させられ、エンジン、クエリ、または対象論文を共有する観測値の非独立性を尊重する。同じ論文が複数のエンジンで、同じエンジンが複数の論文でクエリされる場合、それぞれ相関した結果を誘起するためで、素朴な独立試行誤差ではそれを過小評価するでしょう。形式的には、監査の推定対象はM_pqe:エンジンeがクエリqに応答して論文pを引用する確率です。M_pqeは論文単独の性質ではなく、クエリ、エンジン、日付、およびモデルバージョンで変動するため、表記法は推定対象を定義し、タイムスタンプ付きの各実行はその日付でのM_pqeの推定値として読まれます。エンジンサンプルは消費者チャットボットを超えて、新興の学術検索層(Consensus、Elicit、Scite、Semantic Scholarなどの学術コーパスに基づき実論文を引用するツール)に拡張すべきです。プレプリントが消費者向けエンジンに見えない場合でも、分野固有のエンジンで表出される可能性があり、2つの層間の相違それ自体が関心のある結果だからです。機械可視性は、表18で操作化されたペーパー特性に対して回帰させられます。これには、P3bが要求する事前可視性共変量が含まれます。つまり、各論文のクエリ構築時に凍結された事前監査ウェブおよび学術フットプリントです。クエリサンプルは事前可視性で階層化されており、コールドスタート論文は設計により代表されています。生成エンジンは非定常性を有するため、設計はタイムスタンプ付きの主スナップショットと、他の研究者が繰り返すことができるスクリプト化された再実行プロトコルをペアにします。さらに3つの監査衛生要件が事前指定されています。ネガティブコントロール(著名だが無関係な論文、タイトルバリアント、対象著作物を検索すべきではないプロンプト)は無差別引用を検出可能にする。各クエリは、記録されたセッション状態(クリーンセッション対ログインセッション、エンジン、モデルバージョン、日付、地理情報)下で同等のプロンプトバリアント内で実行されるため、プロンプトおよびセッション固有の人為産物を安定した検索動作から分離できます。結果のランダム部分標本は二重コード化され、評価者間信頼性が報告されます。完全なステップバイステップ監査チェックリストは事前登録資料とともに保管されています。研究の主な入力はリサーチャーの時間です(100~200の質問の盲検妥当性検証と二重コード化)。制限アクセスデータまたは専門インフラストラクチャではありません。専門家評価者時間を市場価格で支払う必要がある研究は、その労働を明示的に予算化すべきです。事前指定された予測は、プレプリント自体が試行の少数派で引用される(範囲10~35%)というもので、構造化抄録および公開版機能が可視性を向上させます(P3)。研究2は5つのアジェンダ項目の中の1つのプロトコルです。学術的な機械可視性の完全な監査(エンジン間および リポジトリ間の比較を含む)は、計画されている関連論文の対象です。
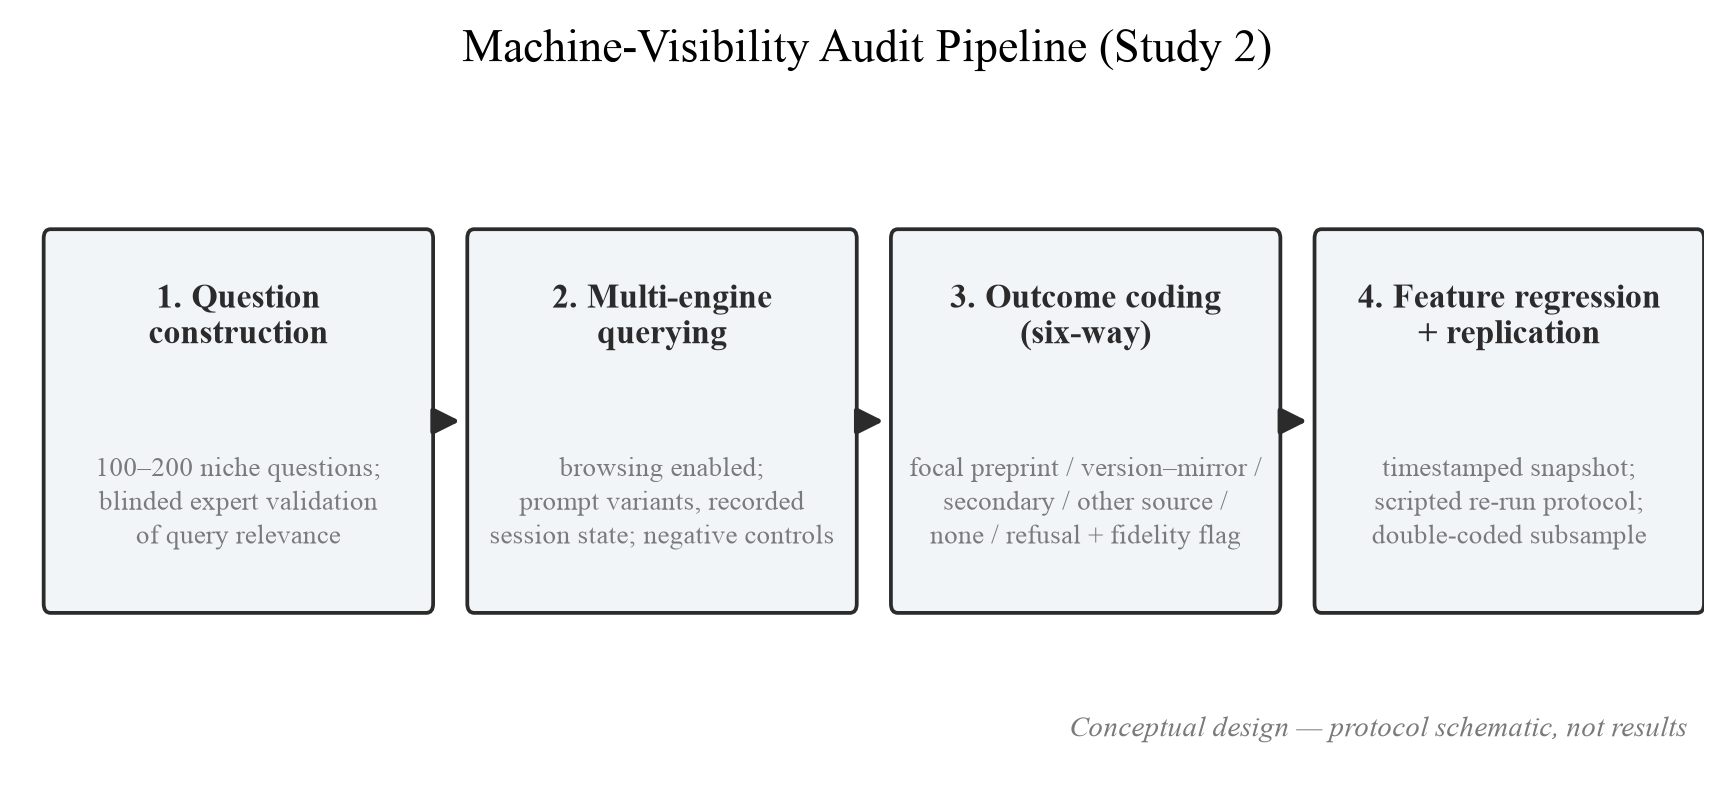
図13. 機械可視性監査パイプライン(研究2)。4ステップの研究2パイプライン。6方向コード化は、対象プレプリントの引用を、その公開版またはミラーの引用から分離し——不在の誤分類を防止し——属性忠実度フラグは「引用されたか」を「忠実に引用されたか」と明確に区別します。スナップショット・プラス・レプリケーション構造はモデル非定常性に対応します。主スナップショットは日付が記載され、再実行プロトコルはあらゆる研究者が後の日付で監査を再現することを可能にします。
表18. 機械可視性特性の操作化(研究2)。
| 変数 | 定義 | コード化 |
|---|---|---|
| DOI存在 | 論文ページが登録DOIを公開している | 1/0 |
| タイトル種別 | 説明的対暗示的タイトル | 説明的 = 1 |
| 抄録構造 | 構造化/統計豊富対叙述的 | 構造化 = 1 |
| 年齢 | 初回投稿以来の月数 | 整数 |
| 分類カウント | 割り当てられたeジャーナル数 | 整数 |
| 二次情報源 | ≥1の索引付きブログ/ニュース言及が存在 | 1/0 |
| 公開版 | 査読済み学術雑誌版が存在する | 1/0 |
| 事前可視性 | 論文および著者の査定前ウェブ・学術的足跡、クエリ構築時点で凍結(P3b) | 層化順序変数 |
| 成果V | 焦点論文の検索結果 | 6つのカテゴリー:焦点プレプリント/発表版またはミラー/セカンダリーのみ/その他の妥当な情報源/追跡可能なものなし/拒否、ならびに引用事例に対する二値帰属忠実度フラグ |
注記。特性の選択は、文献化された生成エンジン最適化要因[5][164]を学術的成果物に適応させたものである。このような最大規模の監査は、6つのLLMベースエンジンにわたる約252,000件の試験の規模で、主題的関連性と検索コンテキスト内のリスト位置が最初に引用されることの主要な推進要因であることを特定した[164]。したがって、リスト位置は研究2の個別の転移可能な仮説であり、結果リスト位置は観察可能な場所ならばどこでも記録すべきである。
表19は異なる記述レベルで表18を補完する。表18は研究2が効果を推定する論文レベルの特性を操作化し、一方表19は監査の測定構成概念を指定する:何が測定されるのか、どのコントロール下で、そしてどの妥当性への主要な脅威に対してである。すべての構成概念は機械層についての個別の主張であり、各脅威は単純な監査がどのように失敗するかの具体的な方法を名付けている。
表19。機械可視性監査の測定構成概念(研究2)。
| 構成概念 | 操作的測定 | 必須コントロール | 主要な脅威 |
|---|---|---|---|
| 直接的機械可視性 | 焦点プレプリントが回答で引用または連結されている | クエリ関連性、エンジン、日付、セッション状態 | モデルおよびインデックスドリフト |
| 情報源置換 | 発表版、ミラー、またはセカンダリーカバレッジがプレプリントの代わりに引用されている | 版照合、DOI、表題変種 | 不在としての誤分類 |
| 引用位置 | 焦点引用の回答内でのランクおよび顕著性 | 回答長および引用数 | インターフェース固有の提示 |
| 帰属忠実度 | 回答内の主張が引用論文により正確に支持されている | 盲検主張–情報源検証 | 引用ロンダリングまたは幻覚 |
| クエリ感度 | 等価なクエリ表現全体での成果の変動 | ランダム化プロンプト変種 | プロンプト固有の成果物 |
| 再現性 | 後日またはクリーン再実行での同一成果 | アーカイブされたプロトコルおよびシステムメタデータ | エンジン非定常性 |
商用GEO文献からの最も妥当な転移は、宣伝レシピではなく特性監査アジェンダである:表20は研究2が確認または反論することが設計される機械可視性との関連を有する候補特性を列挙する。各行は確立されたタクティックではなく仮説であり、検索と関連付けられた特性は依然として論文の成熟性、話題の人気度、または事前可視性のプロキシであるか、支点である可能性がある。
表20。機械可視性の特性監査アジェンダ(研究2の仮説、推奨ではない)。
| 候補特性 | 仮説メカニズム | 支持証拠 |
|---|---|---|
| DOIを登録する | 安定識別子は検索と引用照合を援助する | [164] |
| 構造化された統計豊富な要約 | 統計追加は商用ベンチマークで生成可視性を最大~40%上昇させた | [5] |
| 記述的で関連性密度の高い表題 | 主題関連性はAI回答での引用の上位推進要因である | [164] |
| 正確な電子ジャーナル分類を最大化する | より多くの分類はより多くのダウンロード、ゼロの減少と関連付けられている | [168] |
| セカンダリーカバレッジの≥1項目を確保する | エンジンはしばしば一次情報源よりセカンダリーカバレッジを引用する | [82] |
研究3:「誰が最初に到達するか」計器付き投稿プロトコルはP4を直接検証します。2つの実際に機能している作業論文が、露出チャネルごとに一意のプラスアドレス指定されたメールエイリアスを使用して投稿され、同じエイリアスに対して2~4週間の投稿前ベースラインウィンドウが先行する90日間のインバウンドログが記録されます。ベースラインがなければ、勧誘量の増加は投稿に起因するものとは言えません。学術的スパムは高い背景レート に対して継続的に到着するためです。各メッセージは、公開された勧誘シグネチャ[96]およびキュレーションされたブロックリスト型基準を使用して、セクション7.2で検討された特別監査で文書化された高い背景レート[9][84][63][61]に対して、本物の学術的接触または略奪的勧誘として分類されます。結果は、投稿に起因する初回本物接触までの時間と初回略奪的勧誘までの時間の比較です。P4に従った事前指定予測は、勧誘が本物の接触に先行するというものです。2つの測定ルールは発動前に固定されます。ベースラインと投稿後ウィンドウは長さが不均等です(大よそ2~4週間対90日間)ため、比較は到着レート(エイリアス日ごとのイベント数)と生存関数の比較であり、ウィンドウの非対称性が歪める可能性があるため生イベント数の比較ではありません。初回接触までの時間は構造上右側打ち切りです。2つの論文で、90日間のウィンドウ内で本物の接触を受け取らないエイリアスは、打ち切られた観察であり、ゼロではないので、打ち切りルールは事前指定されます。観察は90日で右側打ち切りされ、イベントなしのエイリアスは生存推定値に打ち切り時間を寄与させ、削除されたり即座とコード化されたりはせず、N = 2では結果の曲線は点推定値ではなく、正確な小サンプル不確実性とともに報告されます。分散複製設計の因果推定値は、投稿後の勧誘のハザード変化(いかなるダウンローダーの識別ではなく)であり、マッチングされた投稿前および投稿後ウィンドウ上で生存/イベント履歴方法で推定されます。著者の可視的な生産性は、単一の投稿とは無関係に勧誘量をもっともらしく予測するため(勧誘は著者の蓄積された公開出力から収集されるため、セクション7.2の特別監査で文書化された高い背景レートはその出力でスケーリングされます)、分散複製は焦点イベント と並行して著者レベルの露出制御(以前の投稿、公開ボリューム、公開接触表面)を記録する必要があります。これはN = 2の計器付きケーススタディであり、メカニズムの証明とパワード推定値をもたらす分散複製を招くオープンプロトコルです。N = 2は計器化の実行可能性を示しており、有病率とも因果的大きさとも異なります。パワード効果サイズに対して事前指定された研究1、2、および4とは異なり、研究3は実行可能性パイロットおよびオープン複製プロトコルです。
コーディングフレームは発動前に固定されます。インバウンドメッセージは7種類にコード化されます。ジャーナル勧誘、会議招待、ピアレビュー要求、編集委員会招待、書籍章招待、商業サービス提供、および本物の学術的通信であり、二項的な略奪的/本物の分割よりも広いフレームです。各レコードには、最小フィールドセットが含まれます。タイムスタンプ、受信エイリアス(チャネル)、会場名、手数料開示、焦点論文への特異性、緊急性言語、維持されたスクリーニングサービスに対する検証結果、およびコーダー信頼度です。境界事例と正当な低評価会場は、アドホック判断ではなく事前指定ルールによって管理されます。新しいまたは曖昧な会場は自動的に略奪的ではありません。ランダムサブサンプルは二重コード化され、評者間一致が報告されます。集計数のみがリリースされ(セクション9;宣言)、完全なコードブックは事前登録と一緒に保管されます。勧誘量は読者数の証拠ではなく、勧誘は公開カウンターを動かしません。SSRNの整合性システムは公式カウント[144]から異常な自動化活動を除外し、どちらの方向でもインボックスからダッシュボードへの推論は許可されません。
研究4: 「著者がカウンターをどのように読むか」 あらかじめ指定された著者アンケート調査により、表1に記録されたフォーラム証拠の需要を直接測定に変換する。本調査票は4つの固定文言項目から構成される: (1) 「SSRNのダウンロード数を何らかのベンチマークまたは基準と比較したことはありますか?」であり、回答選択肢は具体的な公表数値、学科固有の表、非公式なピアとの比較、および比較したことがない、を区別している; (2) 「ダッシュボードに『ダウンロード数7』と表示されているのを見たとき、最初に何を思いますか?」であり、選択肢は推測される失敗、判断するには時期尚早、何が通常なのか検討もつかない、および予想通りまたは問題ない、に及ぶ; (3) 「2026年7月のランキング終了はあなたのプレプリント行動を変えましたか?」であり、統計確認の中止、新規アップロード回避、アップロード後の確認頻度低下、および影響なし、の選択肢がある; および(4) 「採用・終身雇用委員会はSSRNメトリクスを理解していると思いますか?」である。あらかじめ指定された予測は、回答者の多数派がカウンターをいかなるベンチマークにも比較したことがない、と報告すること、および低いカウント値の初期読み取りが、第5.6節で通常は正しいデフォルト判断であることが示される「判断するには時期尚早」という読み取りではなく、推測される失敗へと偏る、ことである。標本サイズの目標、募集経路、および分析コードは登録時に固定される。従事度の高い、そしておそらくより不安な傾向にある著者への自己選択は、本サンプルを制限し、第8.8節のレジストリもそうする。また固定選択肢方式は定性的な補助的展開を認める: 公開された著者提起の質問の事前指定された主題コーディング(明確な包含基準と第9節に述べられた引用倫理の下での符号化者間信頼性を備えた)および著者がどのようにカウンターを読み、またそれについてどう感じるかに関する半構造化インタビューであり、閉形式項目では捉えられないメトリック提示の人的帰結に到達する。1つの設計限界が中心的な構成要素に関わる。SSRNの著者のみを対象とした4つの固定項目は、ベンチマーク無し読み取りの水準を測定するが、対比ではなく、水準単独ではベンチマーク非透明性からメトリック盲目性への本論文が主張する経路を同定することができない。SSRNにおける比較未実施の高い割合は、プラットフォーム非透明性とは何の関係もないカウンターへの一般的な無関心と同じくらい矛盾なく一致している。したがって、判別的および因果的説得力は比較条件を必要とする: ベンチマーク露出が異なるプラットフォーム上に投稿する著者、すなわちarXiv(支持と掲載ベース、それ自身の可視化表面を持つ)およびOSF Preprintsを対象に同じ調査票を実施することにより、「SSRN著者がカウンターをどのように読むか」は「より透明度の高い・低いプラットフォーム上の著者がカウンターをどのように読むか異なるか」に転換し、これが非透明性から盲目性への主張が実際に予測する対比である。クロスプラットフォームアームは研究4の一部として事前指定される; これがないと単一プラットフォーム結果はSSRNを記述的なままにとどまり、メカニズムのテストにはならない。研究4はその後、第1節および第5節の解釈的主張を直接テストし、カウンターが何であるか、ではなく著者がカウンターが何を意味すると信じているかを測定する。
8.7 論文自体が実験となる
この論文自体のダウンロード軌跡もあらかじめ指定されています。投稿後30日、90日、180日時点でカウンターが記録され、その中央値が判明した後、Study 1の中央値と比較して報告されます。記録は記述的であり、解釈規則を含みません。なぜなら、どちらの方向性の読み方でも論文の主張に有利に働き、あらゆる結果が議論を確認するような装置は何も検証せず、数字はそのまま発表されるからです。一つの読み方は論文の枠組みに反します。つまり、分野と年齢の中央値に位置し、上昇も抑制もされていない軌跡は、自己参照的な設計がこの単一のケースにおいて測定可能な発見性の利点をもたらさないことを示唆しています。この論文は自らが蓄積するメトリクスを研究しているため、再帰性を回避することはできません。カタログ化されたレバーはこの記録ではなく、Section 8の直接検定によって評価されます。
8.8 パーセンタイル・ベンチマークとしての公共財
このアジェンダが生み出せる最も有用な成果物は、プレプリント・ダウンロード数のパーセンタイル表であり、これはあらゆる著者が探し求めているにもかかわらず見つけられない数値である。このプラットフォームは歴史的に平均値とトップNのリストを公開してきたが、中央値やパーセンタイルは公開していない。2026年7月15日以降は、論文ごと、著者ごとのカウント数のみを表示し、比較のための文脈をまったく提供していない[149]。h指数および類似の指標については、一般向けの「Xは良好か?」というガイドの充実したジャンルが存在する[118][128]が、Section 2.5の監査ではSSRNダウンロード数について同等の情報源は見つからなかった。そのようなテーブルの生データは数年前から印刷物で存在してきた[18][83][85][139][168]が、不足しているのはそれらの分布を著者向けスケールに変換することである。
サンセット後、プラットフォーム全体のパーセンタイルの外部収集はもはや不可能である。分布の閾値を漏らしたトップ・リストが、裾野への唯一の公開窓口であったが、それは消えた[149]。2つの補完的ルートが残されている。1つはStudy 1の層別サンプルであり、これは論文レベルのプラットフォーム・パーセンタイルを生み出す。もう1つのルートは自己報告カウンタのクラウドソース・レジストリである。つまり、著者が日付付きダッシュボード・スナップショット(論文年齢、分野、アブストラクト・ビュー数、ダウンロード数)を提供する任意参加のコミュニティ・データセットであり、これはサンセット前の分布に関する制度的記憶がさらに減衰する前に組み立てられる。dossierプロトコル(Table 13)の保存ステップは、規模で採択された場合、正確にそのようなレジストリの種子となる。拡張するのではなく発明する必要がない実例も存在する。IRUS (Jisc)は既に、参加する機関リポジトリ全体で、Total_Item_Requestsを含む標準化されたCOUNTER準拠の項目レベル使用統計を集約している[185]。これは、複数機関の使用統計の集約が運用上実行可能であることを示している。プレプリント・レジストリは、ここで重要な参照クラス変数(分野、投稿コホート、キャリアステージ)を保持するように拡大したその確立されたモデルである。北米の同等物であるCC-PLUSは、オープンソース・インフラストラクチャとして同じ機能を提供し、コンソーシアム全体にわたってCOUNTER 5使用統計を自動的にSUSHI収穫している[188]。したがってレジストリは、ゼロから委託される代わりに、実行中のプラットフォームを拡張できる。このような種類のレジストリは、2010年代半ばのサンプル以来、初めて新鮮な、複数分野にわたるダウンロード分布を構成するだろう[85][139]。既知の弱点は、従事し、おそらく中央値以上の著者へのセルフセレクション・バイアス、日付付きスクリーンショットが必要でない限り検証不可能な自己報告、および小規模分野のカバレッジ・ギャップである。したがって、そこから導出されたパーセンタイルは、明示的な選別上の注意条件付きで公開され、可能な限りStudy 1確率サンプルに対して較正されなければならない。また、スパースな分野別年齢別セルは、不安定な生のパーセンタイルとしてではなく、より広い参照クラスに向けての経験的ベイズ縮小の下で報告されなければならない(Sections 5.2, 8.3)。レジストリプロトコルと検証ルールは、事前登録資料とともに公開され、貢献フォーマットは以下のように固定される。レジストリレコードはAppendix Cのパネルスキーマの定義されたサブセット(同一性、タイミング、使用法、露出、監査ドメイン)であり、自己報告レコードはStudy 1パネルとマージ可能なままで、互換性のない第2データセットとして蓄積されない。
レジストリの出力フォーマットはそのプロトコルとともに事前に指定されており、2つの成果物にコミットされている。1つは変換テーブルであり、単一の数値(例えば10、40、または100ダウンロード)を取り、対象とする各分野について、その百分位置とTable 8の平易言語バンドを返す。これにより、「7ダウンロードは良好か?」という質問への答えは、ついに推測ではなく調べることができるようになる。もう1つは、25パーセンタイル、50パーセンタイル、75パーセンタイル、および95パーセンタイルのダウンロード曲線を論文年齢の関数として、分野と新人階層別にプロットするパーセンタイル「扇」図である。これは、ベンチマークが「日X時点で通常はどの程度か」に答える形式である(Figure 14; [必要なデータ]: いずれの成果物も合成値で埋められてはならない)。いずれのルート(確率サンプルまたはレジストリ)からのすべてのパーセンタイル・リリースは、Appendix Dの透明性仕様の下で公開される。これには最小セル・プライバシー・ルールが含まれるため、このアジェンダが提案するベンチマークは、それが改善するために設計された不透明性を再現しない。データの上には薄い自助レイヤーがあり、公開オンライン計算機である。ここに著者が分野、論文年齢、カウンタを入力し、パーセンタイル・バンドと言語的判定を受け取る。これはSection 6.3のキャリブレーションされていないスコアカード・スタイルのヒューリスティックスを、参照分布が存在すれば、一度だけ、キャリブレーションされた測器に変える。Section 8.10は、そのようなサービスがどのように運用され、最新の状態に保たれるかについて、マルチモデル・アーキテクチャを提案している。同じ自助レイヤーは、レポート・プロトコルが採用及び任期委員会に新しい作業負荷を課すことを防ぐ。というのも、dossier形式(Table 13)が要求する数値ごとの正規化は計算機(このセクション)によって、また規模では調整層(Section 8.10)によって行われるからである。その現実的な配置パスは既存の研究情報配管、すなわち現在の研究情報システム(CRIS)およびORCID関連プロファイルを通じて実行されるため、ベンチマーク化された読み取りは、手で組み立てられるのではなく、論文の識別子から生成できる。自然なクロスプラットフォーム拡張は、同じ論文のSSRN、arXiv(分野に応じて)、OSF Preprints上の軌跡を比較する並列デポジット・プロトコルであり、Table 8のバンドがプッシュ・アーキテクチャとプル・アーキテクチャの間で転送されるかどうかの直接テストである(Table 6)。
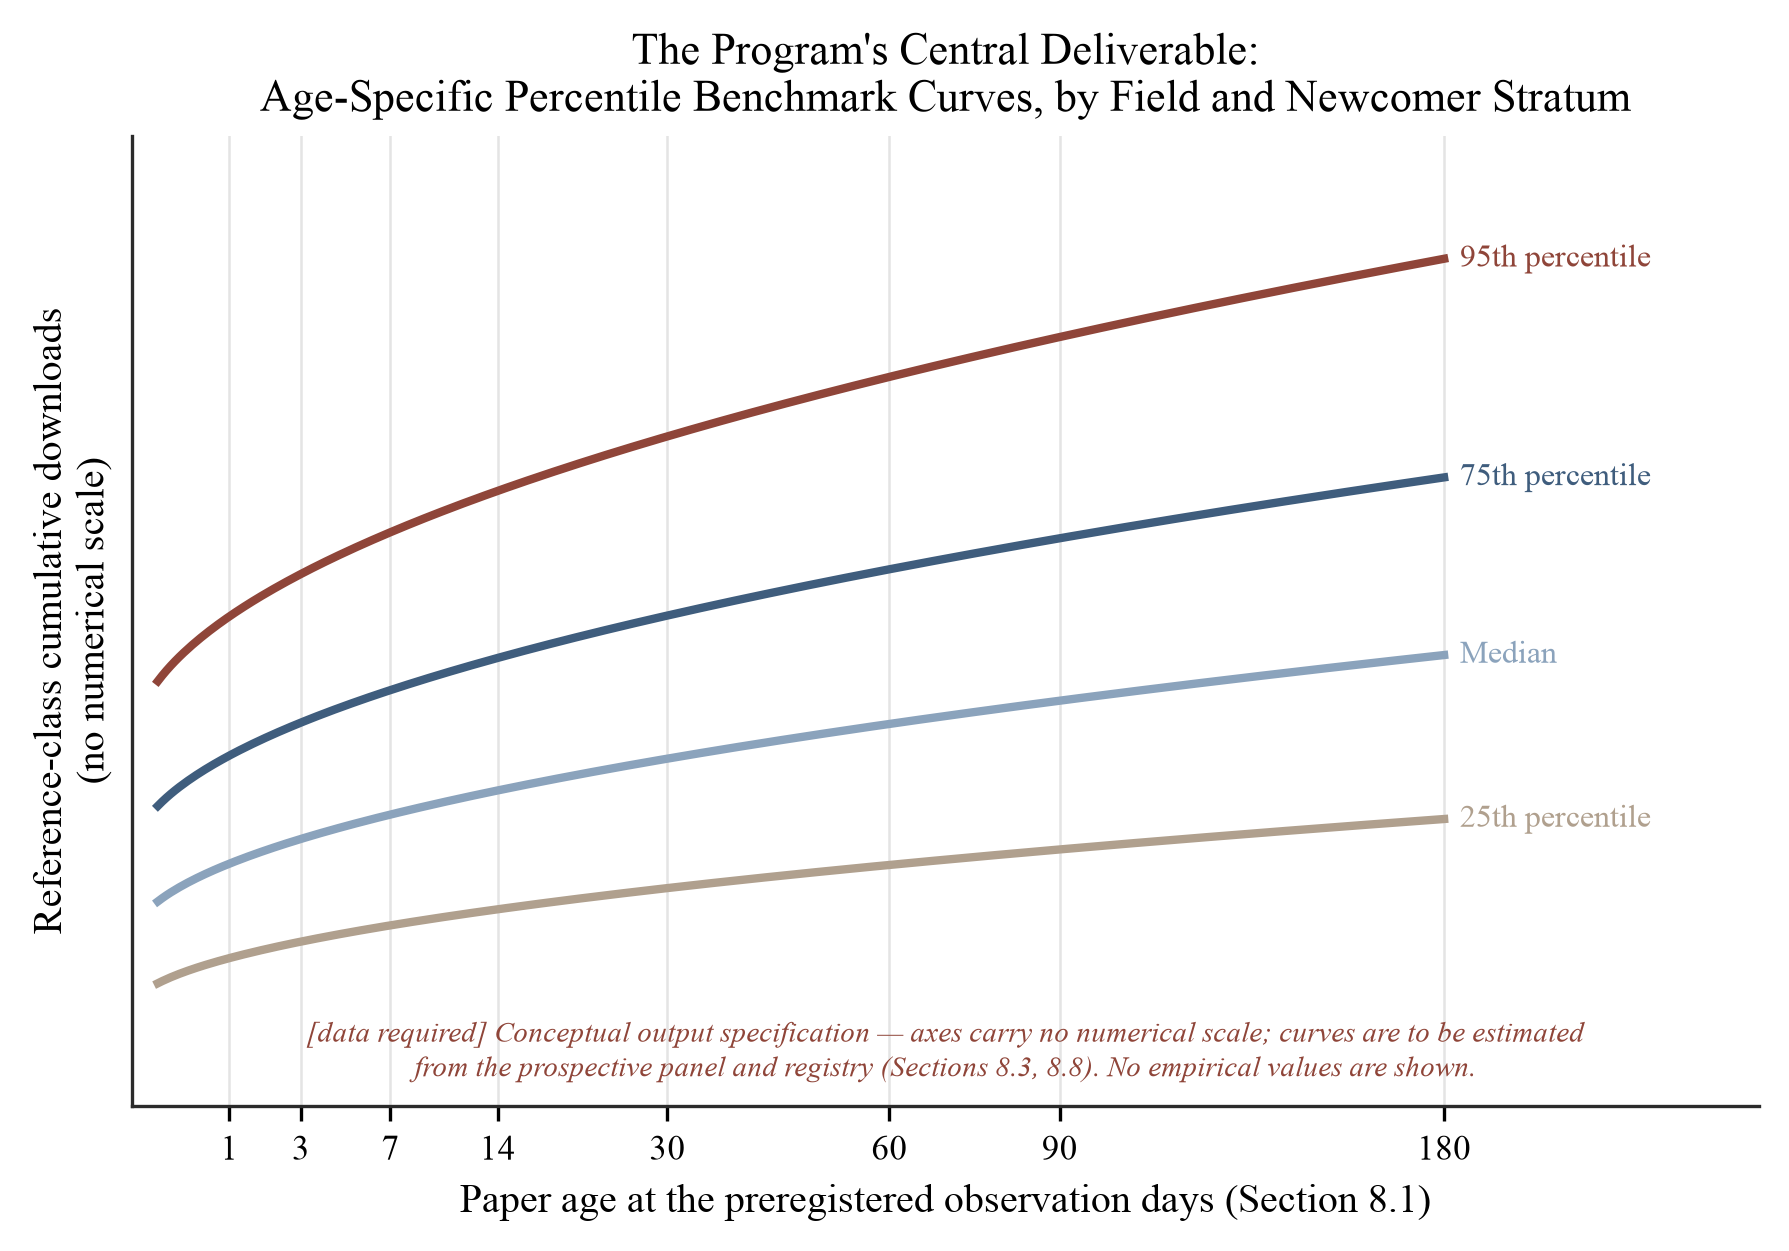
Figure 14. 年齢特異的ベンチマーク扇: プログラムの中心的成果物。パーセンタイル・ダウンロード曲線(25パーセンタイル、50パーセンタイル、75パーセンタイル、95パーセンタイル)は論文年齢の関数として、Section 8.1の事前指定された観測日で評価され、Study 1サンプルおよびコミュニティ・レジストリから分野および新人階層別に推定される。軸に数値スケールはない。この図は概念的出力仕様であり、Section 10.4のプラットフォーム推奨と上記で説明した公開計算機の両方の背後にあるディスプレイ形式である。
本プログラムの実証的論文はすべて、最小報告パッケージにコミットしています。すなわち、コホート流れ図、生データと正規化分布の並べ表示、リーチとコンバージョンの個別報告、曝露歴、第8.3節の4層ラダーに関する異常感度結果、帰無結果と反対の結果は確認結果と同等の顕著性をもって報告、および機械可読ベンチマークテーブル(第1研究の出力が上述の公開計算機に実際に供給できる条件)です。本プログラムの論文の要約では、検証済み推定値と事前指定された期待値を区別しています。
8.9 予測的妥当性
アジェンダの総括的検証(RQ3)は、正規化がその複雑性に見合う価値があるかを問う。早期の利用と後の引用は、設定全体で正の関連性を示すが不完全である。ジャーナルレベルのグレンジャー分析では0.11~0.35程度の相関[80]、初期arXivコホートでは約0.4の相関(r ≈ 0.4は分散の約16%のみを説明する)[25]、20年前に報告された化学プレプリント[26]、ジャーナルおよび論文レベルでのダウンロード[71]、RePEc使用データ[31]、bioRxIVコホート[62]で同等の関連性が報告されており、メガジャーナル利用では中程度の順位相関が見られる[102]。ダウンロード数の多い論文と引用数の多い論文は部分的にしか重ならない[108][39]。最近のパネル証拠は、アクセスと引用のラグを伴う関連性を示している。7つのジャーナルのパネルでは、関連性はおよそ単位弾力性で、アクセス数の10%増加は約9か月後の引用数の約10%増加と関連していた[178]。第5.5節の記号法では、総括的比較の推定値は
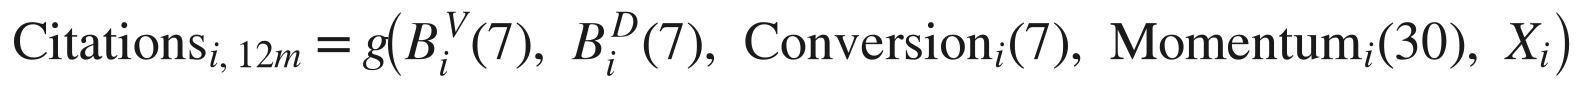
gは柔軟に適合され、サンプル外でのみ評価される。方程式は、どの正規化入力が生のカウントと競合するかを固定する。年齢、分野、コホート正規化された7日目および30日目メトリクスから6か月、12か月、および18か月の引用を予測するモデルは、生の累積ダウンロードのみを使用するモデルと、サンプル外で比較されるべきである(交差検証尤度、校正、順位相関、および予測誤差で)。これはKleinbergら[88]の意味での予測ポリシー問題である。特に有意な結果は、生のカウントが確立されたオーサーを有利にする一方で、正規化されたコールドスタート対策が後の引用採用をより良く予測する場合である。そのパターンは、生の早期カウンターが測定するもののうちの一部が、その後の知的需要ではなく初期の機会であることを示唆している。正規化が予測情報を追加しない場合、フレームワークの測定主張は相応に棄却または縮小される。
図15はアジェンダをまとめている。1つの前向きコホートが4つの研究と2つのプラットフォーム準実験を平行で供給し、すべてのモジュールが同じバージョン管理された公開出力セットに預ける。この共有構造がアジェンダを研究プログラムにする。
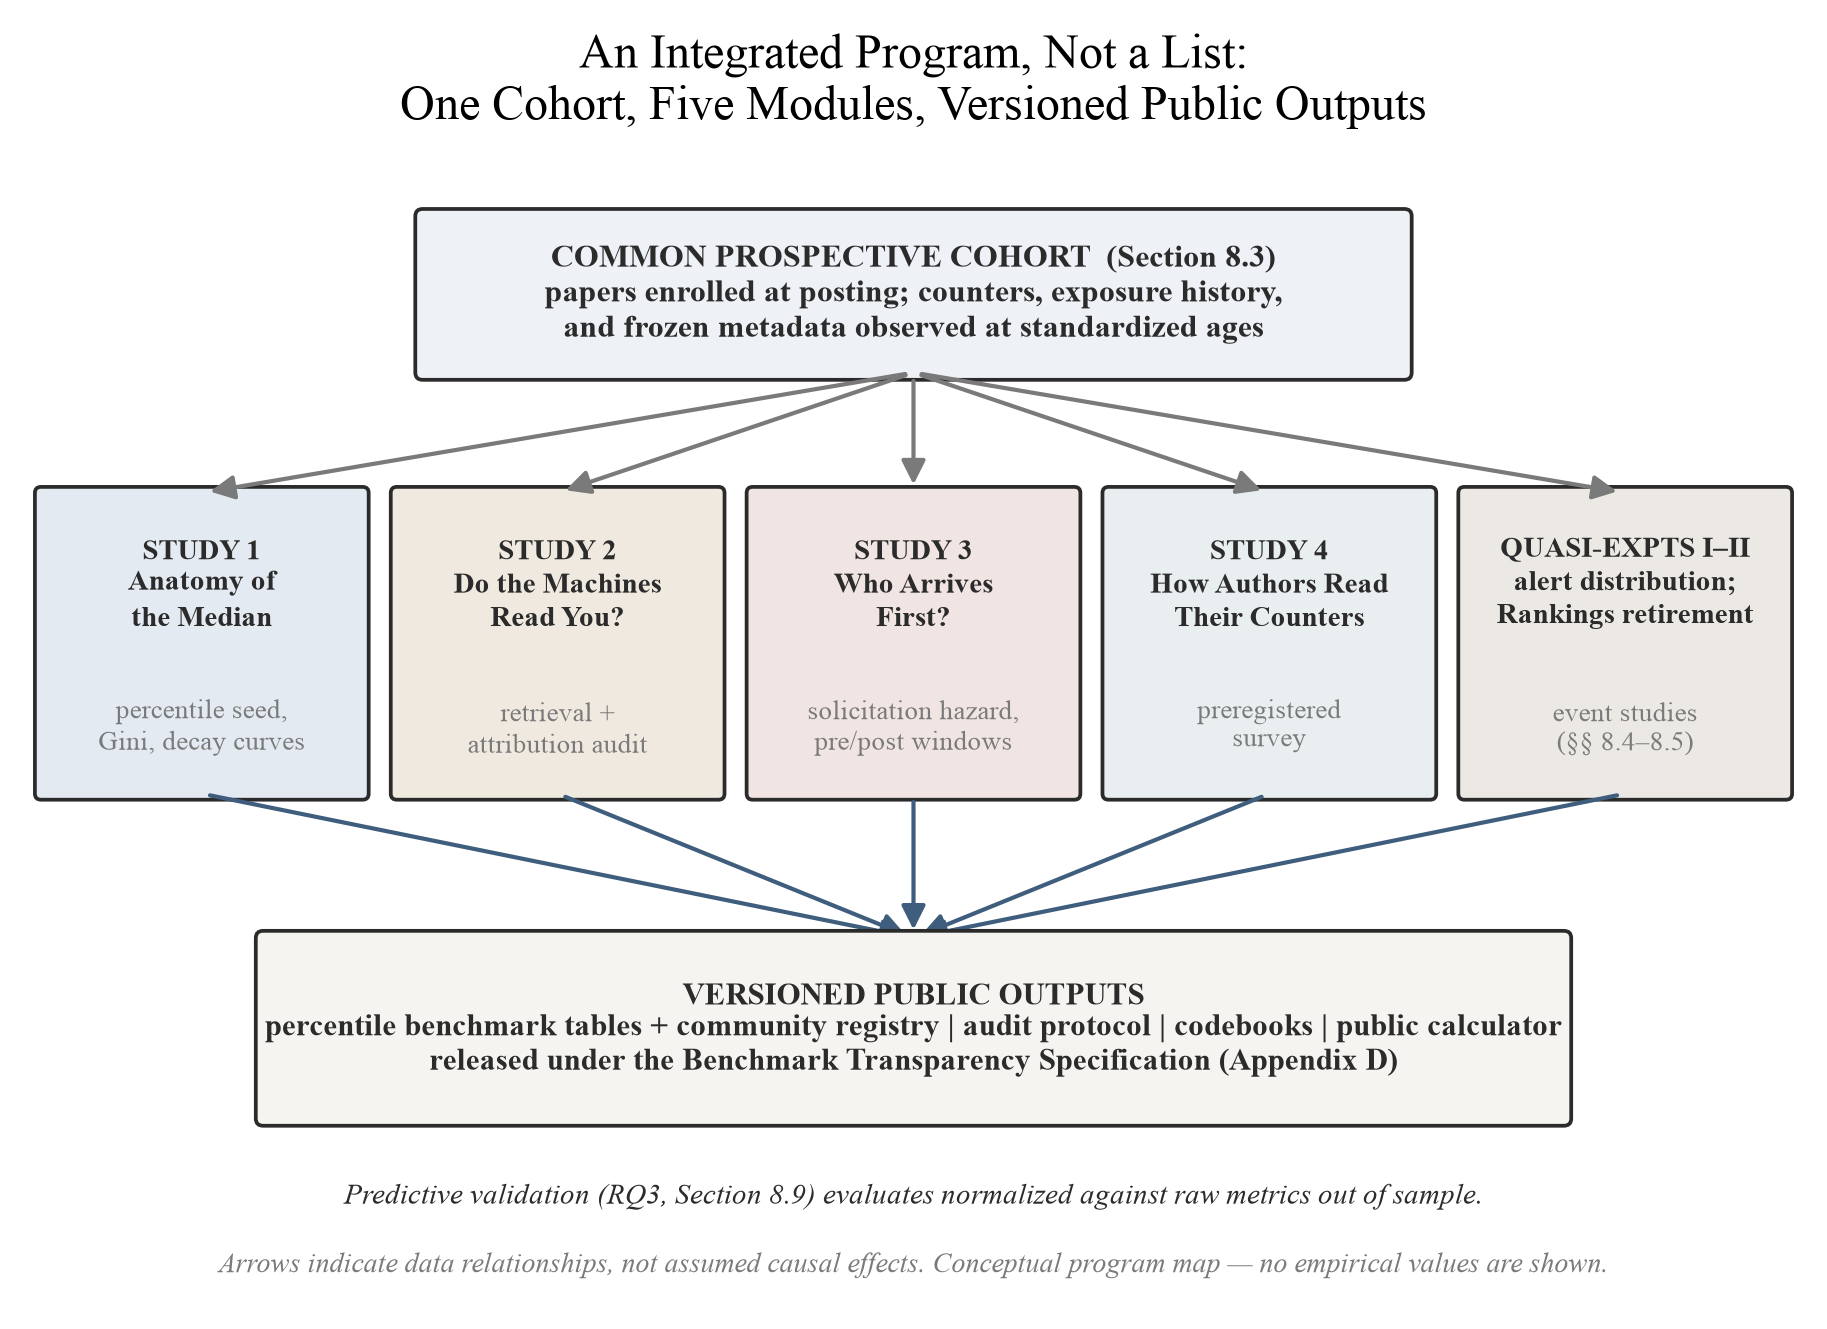
図15。統合された研究プログラム。1つの前向きコホート(第8.3節)が4つの研究(第8.6節)と2つのプラットフォーム準実験(第8.4~8.5節)を供給し、すべてのモジュールがバージョン管理された公開出力(パーセンタイルベンチマークテーブルと第8.8節のコミュニティレジストリ、監査プロトコル、コーディングコードブック、公開計算機)に預ける。これらは附録Dのベンチマーク透明性仕様の下でリリースされており、予測的妥当性(第8.9節)は結果のベンチマークをサンプル外で評価する。矢印はデータ関係を示し、仮定された因果効果は示さない。
8.10 設計提案:オーケストレーションされたフロンティアモデルをベンチマーク配信層として
一回限りの出版では、アジェンダの成果物が要求するものを提供することはできません。パーセンタイル表、コミュニティレジストリ、CSAB報告形式(セクション5.5、付録B)、および公開計算機(セクション8.8)は、すべて散在し劣化する情報源から組み立てられ、クレームごとに検証され、計数規則とプラットフォーム機能の変更に応じて現在の状態に保たれ、個別の著者に調整された言語で配信されなければなりません。その配信・保守層の候補となるアーキテクチャは、特化したフロンティアAIモデルのオーケストレーション化されたパイプラインです(著者が開発するシステムのクラス;利益相反を参照)。このサブセクション内のすべてが設計提案です。実装は存在せず、経験的性能は主張されず、以下のいかなる箇所でも精度、コスト、または節約時間の数値は表明されていません。
オーケストレーション化されたシステムの代替案は、単一の汎用モデルです。消費者チャットボットに「7ダウンロードは良いですか?」と質問する著者は、流暢で検証不可能な主張を受け取ります。これは、回答エンジン監査ドキュメントが記録する失敗モードであり、システムが回答を控える代わりに根拠のない自信を持って誤るというものです[82]。その下には構造的な問題があります。メトリック解釈は、部分的に対立する異なった目的を持つサブタスクに分解されます。証拠の取得と日付付け、カウンターの非人間的またはアノマラスなトラフィックのスクリーニング、スクリーンされたカウントを年齢、分野、コーホート、および事前の可視性の参照クラスに対して正規化すること、正規化された位置をバンド言語に翻訳すること、およびリリース前にその翻訳に異議を唱えることは同じタスクではなく、一方のために最適化されたコンポーネントは別の方の貧弱な判定者です。安心できる読み取りを作成するモデルが、基礎となる数値が汚染されているかどうかについての唯一の権威であるべきではなく、ドッシエ言語を作成するモデルが、言語が過大表現を回避しているかどうかを認定すべきではありません。組織化の原則は、したがって認識論的労働の分割です。生成と検証は、独立した目的を持つ別個のコンポーネントに割り当てられ、不一致は平均化されるのではなく、保持され報告されます。独立的にプロンプトされた、または建築的に異なる評価者の収束は真実ではありませんが、単一モデルの流暢さより強い読み取りの根拠であり、言語モデルインスタンス間のマルチエージェント議論が事実的有効性を測定可能に改善し、単一モデルが単独で答える場合と比較して幻覚を減らすという実験的証拠と一致する設計直感です[43]。評価者が分かれた場合、その分岐自体が診断情報です。ちょうど矛盾した情報源がこの記事自身の総合規則(スコープおよび証拠規律)でシグナルではなくノイズとして扱われたように。その直感を緩和する2つの設計上の注意があります。コンポーネント間の合意はそれ自体が証拠ではありません。共有トレーニングデータ、共有検索結果、共通プロンプト仮定、またはオーケストレーター自体を通じた汚染から生じる可能性があります。異なるベンダーから引き出されたモデルファミリーは科学的に独立していないため、独立性は、別個の命令、コンポーネント間の制限された情報フロー、保持された中間出力、および生成コンポーネントが編集を許可されていない証拠に対する評価を通じて、エンジニアリングされなければなりません。検証もまた、第2のモデルがそれを実行するだけで信頼性が高くなるわけではありません。異議のある、または結果的な請求は、人間ユーザーによる根拠となる情報源の検査を必要とします。
図16は提案されたパイプラインを示し、表21はそれを機能によって分解しています。処理は自由形式のプロンプトではなく、凍結されたケースファイルから始まります。観察日付を持つカウンター、論文の年齢、宣言された分野および候補参照コーホート、露出履歴、および著者の実際の質問です。欠落した入力は欠落したままであり、システムは不在のパーセンタイル分布を製造したり、分母を推計したり、観察されたものの代わりにモデル生成の数値を受け入れたりできません。情報フローは、記事が全体を通じて擁護する解釈シーケンスを再現します。生カウンター→完全性スクリーニング→参照クラス正規化→制約下での解釈。監視コンポーネントは、日付が付いた出所を持つカウンター、プラットフォーム文書、およびレジストリ記録を取得するため、すべての下流値がアーカイブされた情報源に遡及できます。すべての事実上の出力は、請求台帳内のエントリとしてコンポーネント間を移動します。各エントリは、請求、その支持する情報源またはデータフィールド、安定なロケーター、取得時間、適用された変換、その参照クラス、および検証状態を記録し、サポートされていない出力が後の段階の前提として静かに成り立つことができないようにします。完全性スクリーニングは、ボット濾過およびAIクローラー汚染の記録された背景に対して(セクション5.6)、従来の時系列異常検出(自由テキスト生成のためのタスクではなく、統計的方法のためのタスク)を適用します[129][144]。露出記録が許可する場合、著期された露出イベントに軌跡の破裂を属します。正規化は、ツールとして呼び出されるベースの決定論的統計コードによって実行されます。パーセンタイル位置は、セクション8.3の縮小規則の下で、バージョン管理されたスタディ1およびレジストリテーブルに対して計算されます。パーセンタイル演算は、自由テキスト生成に委任されることはありません。その後初めて、インタープリターモデルは著者対面の読み取りを作成し、表8のバンド言語、表9のリーチ対コンバージョン診断、および付録BのCSabテンプレートに限定され、すべての数値に添付されたソース、ビンテージ、および信頼層があります。別個の検証者および批評家は、リリース前に各クレームをその記録された証拠に対してチェックし、各を検証、争点、サポートされていない、または評価不可能として報告し、単一の合成信頼スコアに圧縮されることのない4つの異なった状態があります。2つの制約はフレームワークから変わらずに引き継がれます。任意の推奨は、診断されたボトルネックの条件であり、リーチが制限された論文とコンバージョン制限された論文が異なるアクション(表9)を保証し、それらを区別できないシステムは汎用的なアドバイスを発行する代わりに何も言うべきではありません。他の制約は、リリースされた推奨が仮説であることです。診断が正しい場合、移動すべきメカニズムを予測し、その後の観察がその予測をテストします。したがって、システムの目的関数は狭いです。紙とその適切な参照クラス間の識別可能な解釈摩擦を削除し、プラットフォームの完全性と生成AI政策[54][144]およびセクション3のゲーム履歴[44]によって固定される境界により、カウンターの最大化を決して行いません。
表21.提案されたオーケストレーション層の機能分解:機能、コンポーネントタイプ、主要な失敗モード、およびそれを独立して検証するメカニズム。各行は実現可能な分業に関する仮説です。
| 機能 | モデルまたはコンポーネントタイプ | 主要な失敗モード | 独立検証メカニズム |
|---|---|---|---|
| オーケストレーションおよび出所 | 凍結されたケースファイルとクレーム台帳を維持するタスクルーター | 初期の未サポート仮定が後のすべてのステージの前提として伝播する | 未検証の出力が信頼できる前提になってはいけません。すべての引き渡しで、出所、変換、検索時刻、および不確実性が保存されます |
| エビデンス獲得および監視 | 再実行スケジュールのツール使用検索モデル。公開引用インフラ[35][124]に対する文献マッチング | 捏造、不正確、または選別して検索されたソース | 日付付き出所ログ。すべての値がアーカイブされたスナップショットまでトレース可能。ランダムサンプルが第2コンポーネントによって独立して再取得。失敗した検索と反対の結果は破棄されず記録されます |
| 整合性スクリーニング | 非生成時系列異常検出[129][144] | スパイクが「ボット」または「リーダー」としてラベル付けされるが、どちらかのアイデンティティについての根拠がない | 異常フラグが集約と共に公開される(セクション8.8)。セクション8.3の4層ロバストネスラダーで感度が報告される。異常はアイデンティティクレームではなく、フラグとして扱われます |
| 参照クラス正規化 | ツールとして呼び出される決定論的統計コード | 便宜的なピアが有効な比較母集団と間違えられる | バージョン化された公開ベンチマークテーブル(付録D)に対する再計算。フィールド、年齢、コホート、事前可視性、およびソースの年代が明記されるか、またはモジュールが控えめになります。フリーテキスト算術は記録に受け入れられません |
| 解釈ドラフト | 表8バンド言語およびCSABテンプレート(付録B)に制約された一般主義言語モデル | 流暢な過大表現—エビデンスがライセンスする以上の確実性、スコープ、または因果的地位 | 別の検証者による記録されたエビデンスに対するクレームレベルのチェック。各クレームは検証済み、争点、未サポート、または評価不可能として報告。サポートされていない文は柔らかくされるのではなく拒否されます |
| 敵対的レビュー | ドラフターに敵対する目的を持つ批評モデル | 儀式的な批評、または実質的な異議を隠す合成的な合意 | 構造化された不同意報告—エビデンス状態、評価者パターン、決定感度(異議は診断を変えるか、それとも単に言い回しを変えるか)、残存不確実性—統合されずに配信され、決して1つの信頼数に折りたたまれません |
| 勧誘トリアージ | 表14~15のコーディングフレーム上の専門分類器 | エビデンスを超えた「略奪的」という分類的な判断であり、評判の危害のリスクがある | フラグとレビューのみ、自動削除ではなく、公開された告発ではありません。ラベル付きセットでエラー率が報告されます。AI テキスト分類の文書化された限界およびバイアスが認識されます[157][97] |
| ベンチマーク保守 | すべてのコンポーネントのスケジュール済みオーケストレーション | サイレントドリフト:古いソース、またはトレースなしで上書きされたリリース | 付録Dに基づくバージョン化され日付付けされたリリース。リビジョンはログされ、サイレントに上書きされることはありません—静的スナップショットではなく、生きているベンチマークマップ |
| 最終解釈およびキャリア使用 | 著者 | オートメーションバイアスおよび責任の拡散 | 外部使用前の必須人間による承認。ドシエ言語は表13プロトコルに従い、ソース、時間窓、および制限が添付されます |
2つの境界が仕様を完成させます。1つはパーミッション境界です。読み取り専用アクセスはデフォルトであり、レイヤーはドラフトしますが実行しません。原稿を自律的に編集したり、プラットフォームメタデータを変更したり、学者または会場に連絡したり、公開投稿したり、勧誘メッセージを削除したりすることはできません。実装されたワークフローは、適用可能なプラットフォームおよび投稿ポリシーの人間の責任および開示義務を保持する必要があります[54][56][144]。もう1つは棄権境界です。ヌル出力は正当な(しばしば正しい)結果であり、すべてのステージは不完全な入力を前方に渡す代わりに停止することができます。必須棄権トリガーには、欠落または擁護できない参照クラス、読むことの中心となる検証不可能なソース、提案された定式化がペーパーのクレームを保存するかどうかについての未解決の不同意が含まれます。純粋に記述的なパターンからの因果関係の結論のリクエスト、または検証済み予測データセットなしでの引用またはキャリア成果の予測のリクエスト(セクション8.9)。および注意を操作、購入、シミュレート、またはその他の方法でインフレする要求。最後のトリガーは、レイヤーがセクション3が文書化している履歴のメトリックゲーミング機器になることを防ぎます[44][69][144]。最後の分離は、アジェンダの2つのエビデンスストリームを管理します。セクション8.6および8.8のバージョン化された百分位テーブルはレイヤーの唯一の許容正規化ソースですが、研究2の機械可視性監査は個別の検索および属性チェックをフィードします。機械検索は人間の注意の百分位ではなく、レイヤーは2つをブレンドすることはできません。
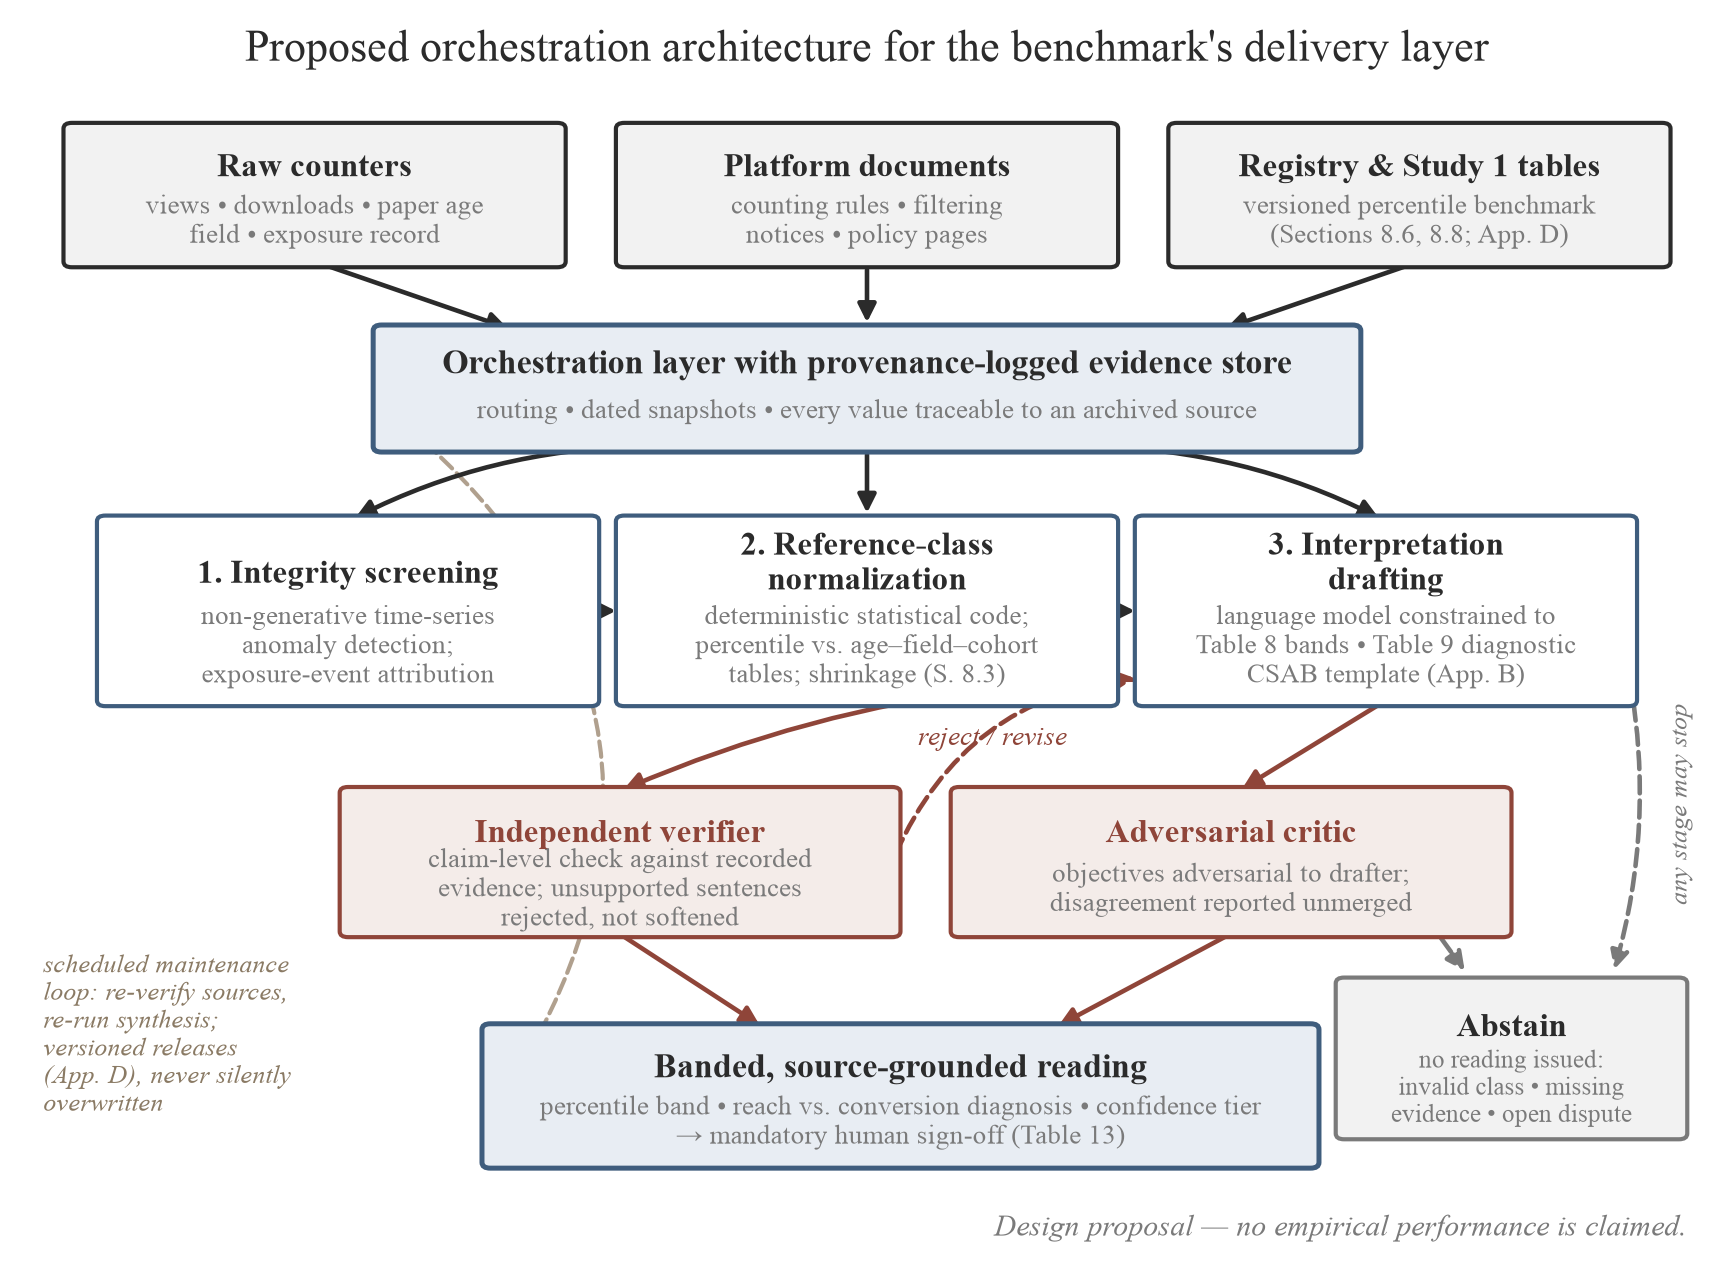
図16.ベンチマークの配信レイヤーの提案されたオーケストレーションアーキテクチャ(セクション8.10、表21)。専門コンポーネントはエビデンス獲得、整合性スクリーニング、正規化、および解釈を分離し、生成とリリース間に独立検証が挿入され、すべてのステージで棄権パスが利用可能になり、セクション8.8のバージョン化されたベンチマークを維持するスケジュール済みループがあります。
同じ規律が、層が診断を得た後にその層が何をすることができるかを制限する。表22は行動方針を定める。各観測パターン(リーチと転換を、表9~10の語彙でモメンタムと共に読む)は、暫定診断、許可された支援の限定的形式、診断を裏付けるか弱める可能性のあるメカニズム検査、および禁止されたままの推論または行動にマップされる。メカニズム検査列は、上で述べた、放出された推奨は仮説であるという規則を実装する。分類修正がリーチボトルネックを除去することになっている場合、カウントされる結果は年齢調整リーチであり、総ダウンロードについての事後的叙述がそれに代わることはない。失敗した予測は失敗した介入として記録され、診断に戻され、より都合の良い成功指標に対して再スコアされることはない。完全なシーケンスはこうしてループに閉じる。測定→検証→正規化→診断→提案→批判と確認→決定→観測→更新または停止(図17)。そのループ内で、人間の決定は検証と任意の行動の間に立ち、決定後の観測はケースファイルに戻り、証拠が不十分な場合はいつでも棄権経路がサイクルを終了させる。ループは複雑さも制御する。証拠が保存と監視のみをサポートする場合、または著者プレイブックの決定論的規則(第6節)がすでに質問に答えている場合、オーケストレーションは何も追加せず、実行されるべきではない。
表22. 提案されたオーケストレーション層の診断から行動への方針。 パターンは表9のパーセンタイル規則の下で防御可能な参照クラス内で読まれる。すべての行は方針仮説であり、どのセルも経験的頻度を主張しない。
| 観測パターン(リーチ、転換、モメンタム) | 暫定診断 | 許可された支援 | メカニズム検査 | 禁止された推論または行動 |
|---|---|---|---|---|
| 低リーチ、高転換、安定または上昇 | 発見可能性ボトルネックは、原稿採択ボトルネック(「隠れた関心」、表9)よりもパターンと一貫性がある | 識別子、分類、メタデータ、インデックス作成、およびタイトル発見可能性を監査する。限定的で、実際に関連性のある配布 | メタデータまたは分類変更後、リーチは上昇し、転換は維持されるか。 | よく転換する要旨をより宣伝的にするためだけに書き直すこと |
| 高リーチ、低転換、安定または低下 | コミュニケーション不一致、オーディエンス不一致、および低意図露出は競合する説明である(「採択のない注目」) | タイトル-要旨の整合性、範囲の明確性、およびオーディエンス適合性をテストする。請求を保存する代替案のみ | 比較可能な露出下で、すべての改訂について忠実性チェックを伴って、転換は変わるか。 | 無分別な宣伝を増加させること。読者が科学を拒否したと結論付けること |
| 低リーチ、低転換 | 不十分に特定されている。弱い露出、誤った参照クラス、メタデータ故障、コミュニケーション摩擦、またはニッチ需要がすべて当てはまる(「コールドスタート」) | 参照クラスと露出記録を最初に検証する。その後、メタデータとコミュニケーションを別々に監査する | 一度に1つの測定可能なメカニズムを変更する。ヌル結果を保存する | 低使用率から低品質を推測すること。単一原因の判定を返すこと |
| 高リーチ、高転換、上昇 | 述べられたクラスに対する強い初期拡散 | 由来を保存する。固定年齢で監視する。原因なく何も変更しない | パターンは露出イベント後に、および異常感度下で持続するか。 | さらなる増幅を製造すること。注目を品質の証拠として扱うこと |
| 高リーチ、高転換、増分が急激に低下 | イベント駆動型注目、通常の減衰、または飽和(第5.6節) | 露出イベントを特定する。累積合計ではなく区間増分を比較する | 減衰はイベントを条件とした年齢一致の軌跡と異なるか。 | 増分の低下を科学的失敗と呼ぶこと。累積カウントはレート観点からほぼ常に平坦化する |
| 低リーチ、高転換、増分が低下 | 条件付き関心は現実的であるかもしれないが、継続的な露出は弱い | 配布またはインデックス作成が終了したかどうかを監査する。限定的で、関連性のあるチャネルを特定する | 復元された露出がリーチを上昇させ、転換を低下させないか。 | 主張を広げたり、技術的特異性を削除してより広いオーディエンスを追求すること |
| 高リーチ、低転換、露出上昇 | 到着は比例する全文採択なく増加している | 低意図トラフィック(第4.2節)、オーディエンス不一致、およびプレゼンテーション明確性をテストする | 比較可能な露出下で、請求忠実なプレゼンテーション変更に転換は応答するか。 | ファネルの上部のみを最適化すること。すべてのビューを人間の読者としてカウントすること |
| 再述された反論、説明されないスパイク、無効なコホート、または欠落した分母を伴う任意のパターン | メトリクスは現在、希望するレベルで解釈可能ではない | スナップショットを保存する。感度分析を実行する。請求を狭める。棄権する | 読みは論争の区間を除外しても、またはより良い参照クラスでも存続するか。 | トラフィックを証拠なしに人間または自動化とラベル付けすること。捏造された分母からパーセンタイルを発行すること |
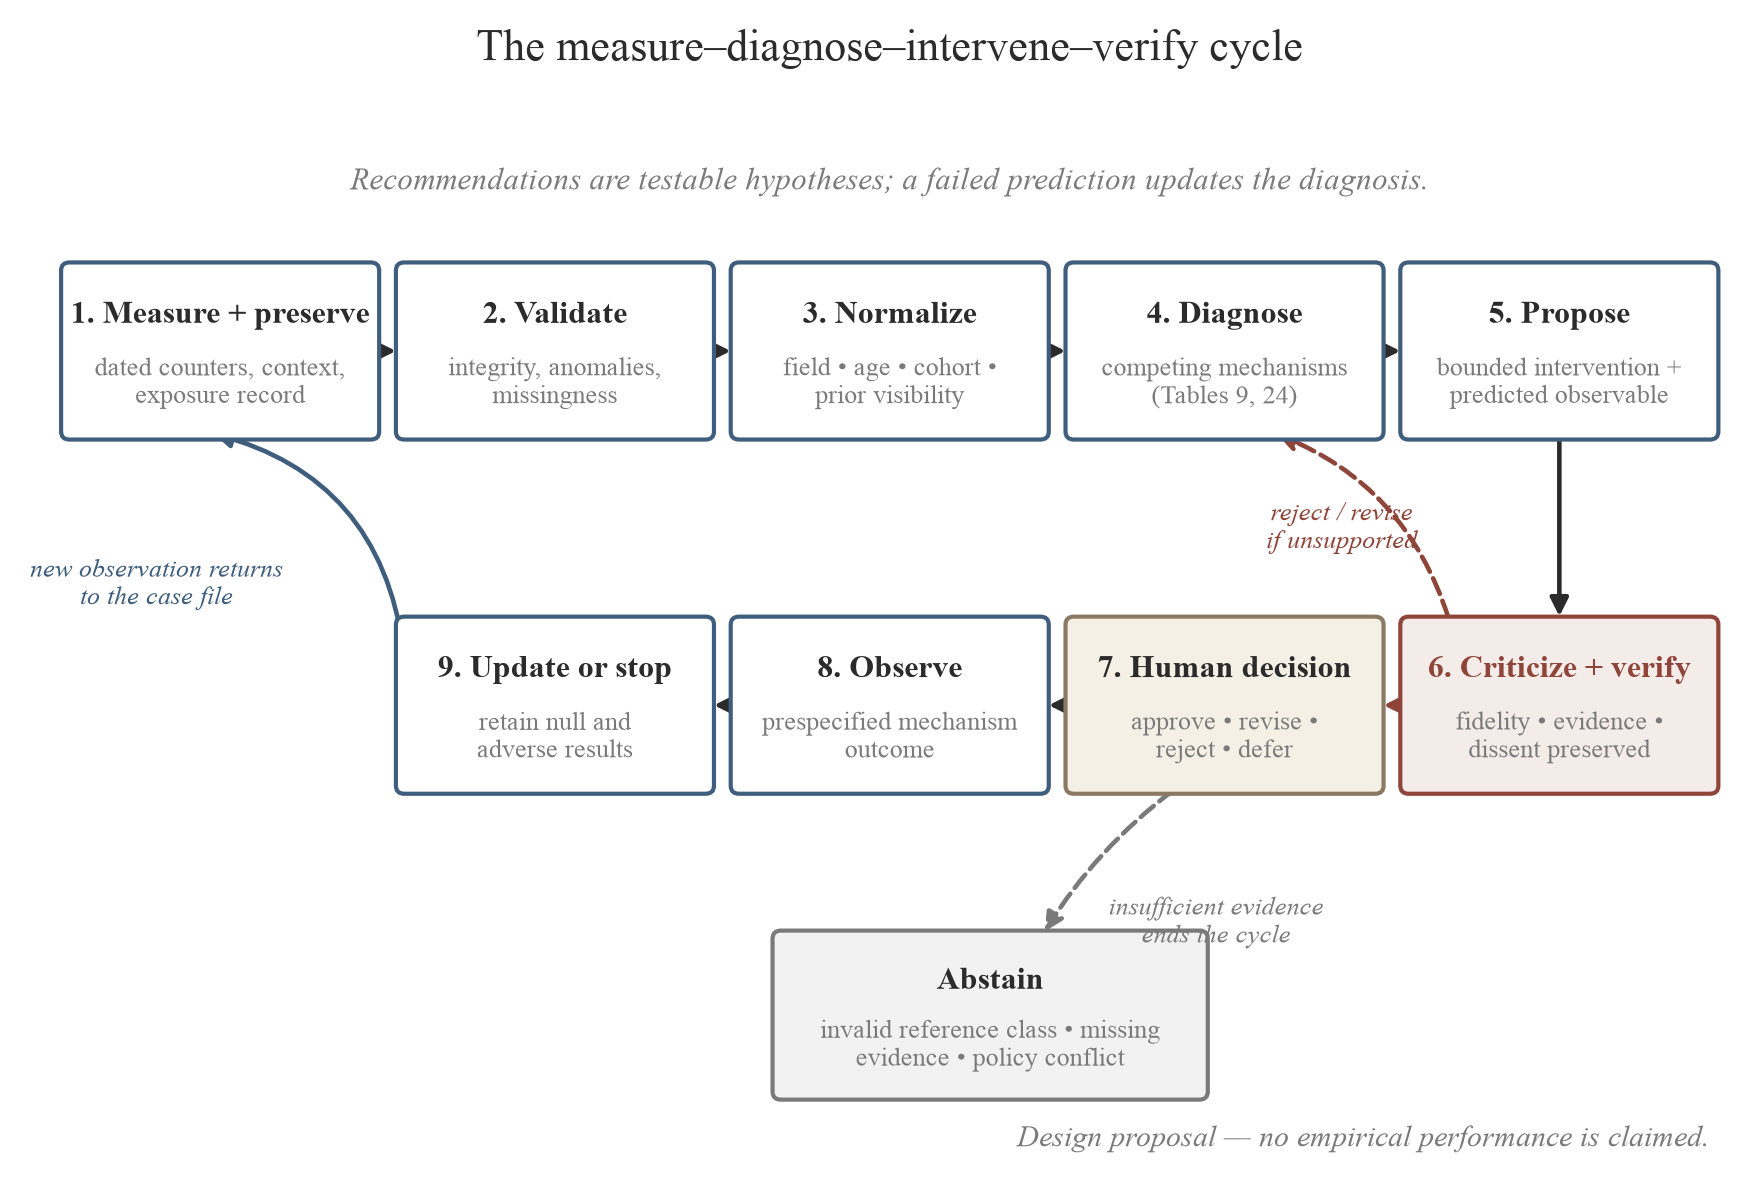
図17. 測定–診断–介入–検証サイクル(第8.10節、表22)。推奨はテスト可能な仮説としてのみループを離れる。それぞれが移動することを意図するメカニズムと、診断を裏付けるか弱める可能性のある後続の観測に名前を付ける。失敗した予測は診断に戻り、監査記録に残る。人間の決定は検証と任意の行動の間に立つ。防御可能な参照クラスまたは十分な証拠が存在しない場合はいつでも棄権経路がサイクルを終了させる。サイクルは生の注目ではなく、証拠保存解釈を最適化する。
4つの限定条件がこの提案を制約します。生成は回復ではありません。どのようにオーケストレーションされたモデルであっても、トップリストが削除されたときに観察不可能になった百分位分布を再生することはできません[149]。また、レイヤーは第5節の保守的床値の注釈が付いた近似値のみを維持できます。オーケストレーションが、ダウンローダーを特定したり、カウンターだけから人間のトラフィックと自動化されたトラフィックを区別したり(第4.2節)、勧誘ボリュームを読者数の証拠に変換したり(第7.6節)、相関のあるモデル出力を「エージェント」と名前を変更することで独立させたり、ピアレビューを置き換えたり、研究者から導く責任をワークフローに移したりすることはできません。オーケストレーター自体が監査人を必要とします。デプロイされた解釈レイヤーは、この記事がマッピングするスタック内の新しいゲートキーパー(図12)となり、それを修復するために構築された不透明性を継承してはなりません。推論トレースと由来ログは検査に開かれていなければならず、レイヤー自身の取得と解釈行動は、研究2の規律(タイムスタンプ付きスナップショットとスクリプト化された複製プロトコル)で監査されるべきです。モデルの非定常性により、すべての出力は日付付きの推定値であり、永続的な値ではありません。コストと公平性。このようなパイプラインを運用することは無料ではなく、有料の解釈レイヤーはこのフレームワークが中心とする低リソース著者と所属のない著者を排除するでしょう。AI テキスト分類器の既知のバイアス[97]は非ネイティブ英語ライターに対する同じことを、緩和されないままにしておくと、行うでしょう。偽りの精度は残留リスクです。信頼階層なしでバンド化された判定を発行するレイヤーは、第3節で診断された正確に同じ不較正を自動化するでしょう。比較スケールのない計数が、不確実性が付加されない判定に置き換わります。アーキテクチャ自体は反証可能なオブジェクトであり、その条件でアジェンダに属しており、より簡単なアシスタンスと比較して評価され、図の洗練さから推測されるべきではありません。適切な設計は段階的です。植え付けられた曖昧性(無効な引用、反論の再説明、防御不可能なコホート、真正に境界線上の勧誘)を含む現実的なケースパケットは、一度に1つの成分を追加する条件全体にランダム化されます。この記事の表の手動プロトコル(既存の非AI方法なので正しいベースライン)、単一の汎用モデル、検索と決定論的計算を伴う同じモデル、生成とそれに続く独立した批評、および完全に統治されたパイプラインです。検証者、決定論的計算機、不同意の可視性、または人間のゲートを削除する削除は、どのガバナンス成分がそのコストに値するかを分離します。結果は別々にスコア付けされ、決して1つの複合として評価されません。主張と引用の忠実性。参考階級の有効性。著者の信念のキャリブレーション(研究4の道具)および曖昧なケースでの適切な棄却。研究者の時間と監督の負担。ガバナンス障害(自律的な外部アクション、指標ゲームアドバイス、範疇的に違反する主張)。および、記事の冷スタート議論に中心的に、事前著者の可視性と新参者ステータスによる利益の異質性。レイヤーが主に既に見える著者を助けるだけの場合、それが削減するように設計された不平等を再現するでしょう。ヌルおよび不利な公平性の結果は報告可能な知見です。モデルバージョン、プロンプト、ツールの許可、およびソーススナップショットはアーカイブされます。非定常システムではすべての結果が日付付きの推定値であるため。2つの推定値は全体を通して分離したままです。解釈品質への影響と後続の拡散への影響。診断を改善しながらダウンロードを移動しないレイヤーは成功であり、ダウンロードを増やしながら主張をゆがめるものはガバナンス障害です。統治されたパイプラインが、証拠の精度とキャリブレーションで強力な単一モデルを上回らない場合、設計は失敗します。「複数のモデル」は貢献ではなく、テスト中の仮説は認識論的労働の分割です。提案は、AIの支援による解釈のためのテスト可能な役割を指定します。AI は著者が数値についてより良い質問をするのに役立つことができます。検証された証拠だけがそれに答えることができます。
9. 限定条件
この記事の主張は、以下の限定条件によって制約されています。各条件はそれが制約するアーティファクトに添付されています。
証拠ベースの経年化と構成。ベンチマークマップの古い分布アンカー(表7)は、2012年から2015年の間に収集されたサンプルに基づいており、法的奨学金が支配的です[85][139]。唯一の最近のエントリは、以下で説明する単一ネットワークのスナップショットです[83]。解釈スケールのバンド(表8)は、2026年の保守的絶対バンドではなく寛容に読まれる方が良いです(第5.1節)。プラットフォーム全体の年間ダウンロード量は、2010年代中盤から2020年代の間に数倍成長しました[1][143]。ダウンロード単位あたりのフローを上昇させ、固定された古いしきい値を今日の場合は見積もられたときよりも柔らかいバーにします。乗数補正はこれを修復することはできません。成長は分子、分母、および構成を同時に変更するため(第3.2節)。表8のバンドは、再スケーリングされたノルムではなく、集計演算から導出される近似値です。2020年以降のプラットフォーム全体の分布研究は特定されていません。
単一ソースの現代的証拠。ここで使用される唯一の最近の分布証拠は、1つの学術ネットワークの単一発表スナップショットです。2,361のマーケティング論文は、2025年8月15日に観察されました[83]。スキューと条件付きプレステージプレミアムを示していますが、プラットフォーム全体のベンチマークを確立しておらず、その発表テーブルの2つの内部値は「発表済み」として再現されており、注意の注釈が付いています。このソースから他のSSRNネットワークへの一般化は、外挿です。付録Eは、この依存性を、独立したすべてのフィールドアーカイブ横断面(n = 1,360)を追加することで軽減します。これにより、スキュー、平均と中央値のギャップ、変換バンド、フィールド乗数、および観察されたボディのログ正規性が再現されます。それは独自の上向き選択バイアスを含み、分野全体の分布の形を確証します。第8節のアジェンダは依然としてプラットフォーム代表的なベンチマークをターゲットにしています。
トップリストバイアス。2015年の大規模サンプル適合は、トップリスト(著者とその論文の上位約10パーセンタイル[85])のみをカバーするため、エリートリスト以下の分布のボディは、観察されたものではなく、適合したログ正規から推測されます。そのフィットから導出されたパーセンタイル陳述はモデルベースです。
カウンター意味論は不安定である。ビューとダウンロードの記録は時間とともに変化してきており、インターフェース再設計とボット濾過の進化に伴って今後も変化し続けるだろう。プラットフォームの完全性システムは公式カウントから疑わしい活動の一部を除外しており[144][66][69]、隣接するRepec/LogEc インフラは、ロボットトラフィックの歴史的規模と、生トラフィックの圧倒的多数を破棄する必要があった最近のAIクローラー波を文書化している[99][129]。したがって、セクション5で引用される変換規範は、ビンテージ固有の量であり、複数年にわたるカウンターの比較は、行動と濾過の変化を混在させている。一般的なウェブボット統計[158]は、どちらの方向でも、SSRNの濾過されたカウンターに外挿することはできない。
プラットフォーム変動とソースドリフト。ランキング廃止は、より広い2026年製品再構成に組み込まれている[146][149][150]ため、分析は2026年7月15日を単独の介入として扱うべきではない。この脅威はセクション8.5の設計に組み込まれているが、完全には排除できない。プラットフォームサポートページは予告なく改訂される。すべてのそのようなページはここにアクセス日付付きで引用されており、引用されたプラットフォーム言語は、正式な提出の前にアーカイブされたコピーに対して再検証されるべきである。
パーセンタイルデータなし。公開の全プラットフォームパーセンタイルデータは存在せず、2026年7月15日以降、以前の上位リストのしきい値をリークしていたランキングが削除されているため[149]、プラットフォーム代表的なパーセンタイルフレームを外部で収集することはできない。サンプルベースの参照分布は、アーカイブされたキャプチャから組み立てることができ、付録Eはそれを報告している。それは分布の形を固定しており、プラットフォームパーセンタイルを提供しない。関心のある量の一部(たとえば、「トップ10%」著者通知メール[161]の運命)は公式には文書化されておらず、私たちはそれらが公開フレームから消えたことに言及しており、その終了を主張していない。
利用は読書ではなく、どちらも品質ではない。ダウンロードは、綿密な読書、表面的な検査、アーカイブ保存、またはまったく使用されない前兆かもしれない。ダウンロードは研究品質の直接的な指標ではなく、引用の保証された因果源ではない。ダウンロード–引用の関連は正だが異質である(大まかに0.1から0.6で、分野、集計レベル、およびホライズンに応じて[18][25][39][80][102][108])、高ダウンロード母集団と高引用母集団は部分的にのみ重複している[108]。引用自体は正、負、定型的、または戦略的であり得、引用プロセスは新規な仕事に対して体系的に偏っている[166]。この記事のなにもが、メトリクス置換を専門家判断に許可しない。フレームワークの防御可能な使用は診断的および記述的である。
観察不可能な暴露と非ランダムな威信。すべての暴露が観察可能なわけではない。読者は、抽象ページビューが記録される前に、メール、ソーシャルメディア、検索結果、および通信でタイトルに遭遇し、ネットワークの多い著者は威信と品質の両方と相関したオフプラットフォーム暴露を生成する。したがって、観察的威信係数は、ステータスベースの注目を、リソース、トピック、およびネットワークの本当の違いと混ぜている[111][140]。著者識別信号の実験的操作[154][64]は、プラットフォーム観察を補完するが、置き換えない。分野の分類は部分的に著者が選択し、論文は複数のカテゴリを占め、単一フィールド割り当てを複雑にする。
議題そのものの制限。セクション8.4–8.5の準実験設計は、発表効果、並行プラットフォーム変更、および非ランダムな分野の違いに直面している。プラットフォーム全体イベントが未処理の対照群を提供しないため、準実験的とラベル付けされている。研究2のスナップショットは、監査する検索エンジンとともに経年し、その複製プロトコルは、非定常性を軽減するが排除しない。研究3は、価値がメカニズムとプロトコルであり、人口推定ではなく、N = 2ケーススタディであり、その帰属ロジックは、公開メール可視性についての主張ではなく、チャネルごとのエイリアスに依存している。クラウドソースレジストリは、セクション8.8で述べられた自己選択および検証問題を継承する。すべての設計のデータアクセスは、プラットフォームの協力またはサービス条件内でのレート制限付き収集[134][51]のいずれかに依存する。どちらも保証されていない。
参考文献の幅。参考文献は記事が総合であるため、幅広い。引用された研究の多くは、フレーム、フィールド、および設計の制限を共有し、コミュニティの投稿は、人口パラメータを確立することなく経験を文書化する。主張の証拠は、その検証階層とサンプリングフレームであり、その背後にある参照の数ではない。
バンドは定数ではなく、キャリブレーション目標である。11~19%の変換バンドとCSABしきい値は、学術行動の普遍的定数ではなく、分野およびプラットフォームによってキャリブレーションされる量である(セクション4.4、5.2)。それらの現在の形式は、単一のクロスフィールドバンドであり、フレームワークが分野層別研究1(セクション8.6)が報告するときに必要とする分野ごとの分布に置き換えられる。
SSRN を超えた一般化には、移植ではなく、再キャリブレーションが必要である。ここで診断された解釈可能性の問題(公開比較スケールなしで表示されるカウンター)および、それを修復するリーチ対変換ロジックはSSRNに固有ではない。これは、bioRxiv、medRxiv、arXiv、およびOSF Preprints[11][62][2][24]を含む、使用カウントを示すプレプリントサーバーに適用される。移転しないのは、特定の11~19%バンドまたはCSABしきい値である。キュレーション、配信アーキテクチャ、およびインターフェースはサーバー間で異なる。arXivの意図駆動型プルトラフィックおよびそのメール発表リストvs. SSRNのキュレーション済みプッシュアラート(表6)。したがって、数値アンカーは、そこで引用される前に、各プラットフォームで再推定されなければならない。フレームワークは移植可能である。そのキャリブレーションはローカルである。セクション8.8の並列デポジットプロトコルは、SSRN バンドがどこまで移動するかの直接的な経験的テストである。その再キャリブレーションのスケールは過小評価しやすい。bioRxivの全コーパス中央値ダウンロード(約279、ゲノミクスでは約496[2])は、付録Eのアーカイブクロスセクションの中央値60の数倍である。全体で約5倍、ゲノミクスで約8倍。比較は指示的のみである。bioRxiv図は全コーパス国勢調査から来ており、60はキャプチャされたページを過度に表し、年齢とフィールドを混ぜ、その構成は年齢とともに移動し、年を全体に解決するアーカイブサンプルから来ている。ギャップの方向は安全に読むことができる。そのサイズはない。
倫理。 本論文のコミュニティ・ディスコース部分は、需要の証拠としてのみ使用される自己選択的な公開投稿で構成されており、代表的な見解としては決して用いられず、生きた検証可能なソースが存在する場合にのみ引用されます。ユーザー投稿は、半公開フォーラムコンテンツの引用倫理に注意を払って引用され、著者が期待に反して識別される可能性がある場合は逐語的引用の代わりに言い換えを行い、定性的証拠の透明性基準と一致しています[6]。研究3は、計測対象著者に一方的に送信されたメッセージのみをログに記録し、送信者が自発的に提供する情報以外の第三者個人データは収集しません。研究4は、インフォームド・コンセントの下で自発的かつ匿名化されたアンケート回答のみを収集します。パネル設計は公開表示されたカウンターと書誌メタデータを使用し、非公開ダッシュボード情報(配布ステータス日付など)の収集には情報提供を受けた著者の同意が必要であり、該当する場合は機関審査が必要です。人間の参加者と参加者生成データに関わる2つの研究は、研究4(著者調査)と研究3(受信トレイログを伴う計測投稿)です。どちらも人間を対象とした研究であるため、データ収集が開始される前に、関連する機関審査委員会または研究倫理委員会による承認を申請し、参加者のインフォームド・コンセントの下で実施され、受信トレイログに含まれる個人データは分析または報告の前に集約され、識別除去されます。本プロトコルは実施の前提条件であり、「宣言」に再現されています。
10. 結論と政策提言
10.1 分析が確立したもの
2026年7月15日のSSRN Rankings廃止により、唯一の公開比較スケールが削除されました[149]。カウンターはすべての論文とプロフィールに残されたままでしたが、これにより指標が意味のないものではなく、読むことができないものになってしまいました。この喪失に対抗するため、本論文は検証可能なすべての経験的根拠を明示的なヴィンテージと信頼度の注釈とともにベンチマークマップ(表7)に集約し、解釈枠組み(5段階スケール、到達度-転換分解、ドシエプロトコル(表8、9、13))を構築し、カウンターを診断に翻訳し、第8章のプリレジストレーション対応の議題を提示しています。これにより、欠落した分布を再構築する方法を具体的に示します。
論証の中核にあるメカニズムは次のようになります:
7回のダウンロードが何を意味するのかは、7回のダウンロードを何と比較するのかを知らなければ誰も知ることができず、2026年7月15日以降、プラットフォームはもはや「何と比較するのか」に答えません。
貢献の種類は異なります。参照クラス問題の命名は診断的な貢献です。年齢、分野、世代、および露出がその比較グループを定義するまで、生のカウントはいかなる質問にも答えません。道具的な貢献はベンチマークマップとCSABであり、感情的に顕著ですが科学的には曖昧な数字を解釈可能な診断に正規化します。プレイブックとドシエプロトコルは実践的な貢献であり、著者と委員会が今日カウンターに基づいて行動することを可能にし、それらを誤読することなくしています。政策的な観点からすると、匿名の百分位数帯の貢献です。誰も特定せず、リーグテーブルも復活させない形で、比較文脈が復元されます。
組み立てられた証拠に基づくと、この論文のタイトルの質問は、参照クラスが指定されるまで、不十分に提示されています。利用可能なすべての根拠に対して、小さいカウントはプラットフォームの統計的規範であり、その仕事の判定ではありません。40の要旨閲覧と7回のダウンロードを持つ論文は、スクリーニング結果として、第5章の経験的転換帯[139][172][83]と一致していますが、より古い1ダウンロード当たり3閲覧という経験則[18]はその帯の中ではなく、その帯の上に位置しています。唯一のセンサススタイルサンプルの中央値の論文は2年間で63回のダウンロードを蓄積しました[139]。2015年トップ10,000リストへの参入(プラットフォーム全体の全文論文の約上位1.8%、571,040件、2016年7月[1])には、生涯ダウンロード160回が必要でした[85]。準対数正規注意体制下では、ほとんどの著者は構造的に階段の下の段に立っています。中央値のプレプリントはその著者が見ることができない対数正規分布の長い尾の中に存在し、分類メカニズムによって関係者が優遇される形で表示されます。ピアによって読まれる前に捕食者によって勧誘され、現在ではそれをかつて位置付けたランキングを失っています。スケールは論文をその階段のどこかに位置付け、質問が持つ苦悩は数字によってではなく、欠落したスケールによって生じています。
このすべてはプラットフォーム固有のものではなく、このイベントは前例がありません。ResearchGateは2022年8月に厳しく批判された複合RGスコアを廃止しました[130]。その後、持続的な方法論的批判[90]を受けました。また、2022年から2023年にかけて、YaleとHarvardが主導するアメリカの数十の法科大学院は、アメリカニュース法科大学院ランキング[13]から撤退しました。論争のある指標を撤退させることは外見的な行為ではありません。なぜなら、その指標は受動的な記述ではなく、法科大学院ランキングから生まれた反応性文献は、公開ランキングがそれをランク付けされた者の行動を変形させることを示すからです[58][132]。したがって、その導入と廃止の両方が、報告されている内容を単に変更するのではなく、行動を変更します。カウンターとその比較枠組みは共同で指標であり、枠組みを廃止してカウンターを保持することは、すべてのユーザーにそれを読む何もない状態でカウントを保有させたままにします。解釈可能性、すなわち公開カウンターのための公開分布の可用性は、妥当性と信頼性とともに、あらゆる指標の第一級の品質次元として扱われるべきです。指標はその解釈インフラを超えて存続し、コンテキストのない指標はノイズであり、文脈から切り離された数字の懐疑的な読み方の一般的な規律の事例です[15]。同じ指標はコンテキストとともに、著者を支援し、学術的コミュニケーションを改善し、それを表示するリポジトリへの信頼を維持するキャリブレーションです。
このフレームワークはそのユーザーにいくつかの通常の習慣を求めています。同じものを同じものと比較し、到達度と転換を分離して保つ。軌跡を読む、すべての数字を日付のあるものとして扱い、その情報源、期間、および制限なしでカウントを移動させないでください。
10.2 著者への推奨事項
著者は新しいデータを待たずに、今すぐ行動することができます。論文レベルのカウンターのスクリーンショットを日付付きで撮取してください。これはコンテキストを保持しており、サンセット後は著者の管理下に残る唯一の記録となり、セクション8.8のコミュニティレジストリのシードとなります。表13の資料作成プロトコルに従い、フレーム(年代、分野、世代、出典)とともにのみカウント数を報告してください。このプロトコルでは、すべての数値がその出典、時間窓、および制限事項を含んでいます。ダッシュボードを診断的に読み、感情的にではなく読んでください。リーチと変換を分離し(表9)、初週のゼロダウンロードを正常な配布前の行動として扱ってください[53]。同じ月に投稿された同僚による3~5編の論文に対してベンチマークを取ってください。見える範囲の末端に対してではなく、その流通マイルストーン数は重尾レジームの下では誤った校正を保証しています[85][180]。勧誘メールをスクレイピング現象として扱ってください。認識としてではなく、カウンターに関する証拠としてではなく[61][107][144]。
10.3 評価者向けの推奨事項
SSRN のダウンロード数を評価通貨として輸入していた機関 [12][18][161][52] は、その通貨の公開スケールが消失した今、ガバナンス上の問題に直面しています。生のダウンロード数を採用、昇進、または任期ファイルに含めるべきではありません。それは重要な閾値でちょうどゲーム化され [44]、単一のネットワーク内の下位分野間で最大8倍の変動があり [168]、今やベンチマークに対して不透明です。最低限防御可能な単位は、定義されたコホート内(同じ分野、同じ年齢帯、同じ掲載期間)のパーセンタイルであり、その出典と年代を伴い、使用実績は引用、ピア評価、および実質的判断を補完すべきであり、代替してはいけません [108][109][110]。確立された研究評価改革コンセンサスはその原則に基づいています。DORA の中核的指示は、単一の数字や会場プロキシを研究自体の評価の代替として使用しないことであり [8]、Leiden Manifesto は定量的評価が定性的専門家判断を支援するべきであり、補足してはいけないと主張しています [78]。Metric Tide レビューはその主張を強化し、堅牢で、謙虚で、透明で、多様で、反射的な指標を求め、それらが専門家評価を支援するためではなく、その代替として使用されるべきではないと述べています [173]。より最近の CoARA Research Assessment 改革契約も同様に、数百の署名組織が定性的評価を支持し、責任ある定量的使用によって補足されてはいけない、としています [183]。公開スケールが削除されたダウンロードカウンターに対して、このコンセンサス全体が完全に適用されます。Metric Tide の5つの次元のうち2つは、ここで提案されている方法に直接関係しています。多様性は、この記事が主張する分野の正規化であり、反射性は第8.7節の姿勢であり、その中で記事は独自の注意を測定しています。レビューの REF に対応する後続版は、現在の英国の実践に同じ5つの原則を取り入れています [184]。このコンセンサス自体は、機関生活における指標の過度な到達に対するより広い批評の1つの表現です [113]。評価委員会は、表13 のプロトコル形式(英国の研究およびイノベーション用レジメ(R4RI)などの新興評価形式が実行するように構築されている文脈化された物語的証拠の形式 [186])を、廃止された「上位10%」ランキング言語の代わりに、期待し受け入れるべきです。米国では、同じ書類言語レバーは、高等教育リーダーシップイニシアティブオープン奨学金(HELIOS Open)の焦点であり、大学と協力して昇進と任期基準を書き直しています [189]。ここで指定されている文脈化された使用行は、そのような改革がしばしば欠けている具体的なルーブリックです。
10.4 プラットフォームに対する推奨事項
ランキングを代替コンテキストなしで廃止することは、1つの欠陥のあるシグナルを信号なしと交換することになります。その結果は著者の快適さを超えています。サンセットが新規投稿を冷え込ませるかどうか、セクション8.5で指定された投稿量の結果は、プラットフォーム自体の健全性に関する公開された経験的問題です。このフレームワークは、SSRNが廃止することを選択したリーグテーブル装置を再作成しない具体的な製品方向を示唆しています[149]:
1. 分野と論文の年齢別の匿名パーセンタイルバンド。各論文のダウンロードとビューのスタンディングを、その分野別年齢別コホート内のおおよそのパーセンタイルバンドとして表示します。すべての著者が必要とする情報を、誰も特定できない、リーダーボードを作成しない、トップNリストの勝者総取り動学を軽減する形式で公開します。パーセンタイルコンテキストはプライバシーを保存しながら読みやすさを復元します。目標表示形式は、図14の年齢固有のベンチマークファンと正確に同じです。
2. 時間正規化表示。生涯カウントだけでなく年齢マッチ比較を表示し、14日齢の論文が数年間にわたって注目を集めた作品と暗黙的に比較されることはありません。
3. 到達と変換を分離。要約の閲覧とダウンロードを個別のシグナルとして報告し、それらの比率を使用して、不可視性を拒否と混同する単一数値の読取りを招待しないようにします。
4. 透明な参照クラス。比較指標は、比較する対象の母集団、フィールド、期間、年齢バンドを述べるべきです。ラベルなしの「トップX%」は科学的に情報がありません。付録Dは、バージョン付きパーセンタイルリリースが提供すべき10の開示フィールドを指定します。母集団とコホート定義から最小セルプライバシールールと引用可能なバージョン履歴まで。
5. 累積的利点について監査設計を行います。分類、アラート配布、検索ランキング、および目に見える人気シグナルは、希少な注意を配分し、分配効果について評価する必要があります。セクション8.4~8.5の経験的設計は、そのような監査に直接使用できます。
6. 機能を廃止する際に解釈的残差について計画を立てます。比較機能を削除する場合、解釈の損失は、データマイグレーションと同じ程度の配慮で評価および軽減する必要があります。アーカイブされた分布、公開された要約パーセンタイル、またはコミュニティへの明示的な引き継ぎを通じて、読み取ることができないメトリクスは情報を提供できません。
7. 収穫耐性のある接触メカニクス、セクション7で文書化された可視性の勧誘外部性を軽減します[107][159]。1つの具体的な候補: 投稿後の最初の約48~72時間の公開露出を遅延または難読化します。これは正規の配布がまだ始まっていなくてもプログラム的な収穫が最も可能性の高いウィンドウです。そのような対策の効果は、経験的に評価される必要があり、想定されるべきではありません。トレードオフは実在しており、連絡先情報を隠すことは正確に直接フィードバックに依存する新参者を不利にしてしまう可能性があります。
8. 公開フィルタリングログとドキュメント化された配布メカニクス。完全性フィルタが廃止する内容のLogEcスタイルレコードを公開し、eJournal配布とダイジェスト選択がどのように動作するかを文書化します。隣接するRepec/LogEcインフラストラクチャは、そのような透明性が規模で実行可能であることを示しています[99][129]、一方SSRNは現在、フィルタの履歴を公開しないでフィルタを説明しています[144](表6)。フィルタリングが文書化されると、カウンターの再声明は評判のイベントではなく測定イベントとして読むことができます。
9. 露出履歴を読みやすくします。論文ページまたは著者ダッシュボードは、公開投稿、分類割り当て、キュレーション配布、インデックス確認、および主なカウンター再声明を区別し、著者が「まだ露出していない」を「露出しているが変換されていない」から分離できるようにします。これはセクション5.6の露出体制の読みのプラットフォーム側の対応であり、最も不安を生み出すダッシュボード状態、早期ゼロの最も安価な治療です。
10.5 研究コミュニティへの提言
コミュニティはプラットフォームの完成を待つ必要はありません。セクション8.8のレジストリ(日付付きの自己報告ダッシュボードスナップショット、オープンプロトコルの下で提供)は、10年ぶりに最初の新しいダウンロード分布を生成できます。表17の2つの公開データ研究(1と2)は、セクション9で述べたアクセス制限の範囲内で、任意の研究者によって実行可能です。一方、2つの参加者研究(3と4)はボランティアと宣言で述べられている倫理承認が必要です。科学計量学は、メトリクスの解釈可能性をその対象領域の一部として扱うべきです。10年間のカウンターがそれらの唯一の公開スケールより長生きしたという現在のケースは、最後のものである可能性は低いです。計測型ポストプロトコルの分散複製、パーセンタイルテーブルのコミュニティメンテナンス(およびそれらの上に構築された公開著者向けカリキュレーター、セクション8.8および8.10)、およびプラットフォーム変更の解釈的インパクト評価は、すべてそれ自体が研究貢献であり、それぞれがこの論文の修復作業を予防に変換します。
10.6 終わりに
「私の7つのダウンロードは何を意味するのか」という質問は、2026年7月15日にプラットフォームのほぼ200万人の著者が抱えることになったその質問であるため、この記事全体を貫いています[49][149]。ここで組み立てられた答えは、安心でも警告でもなく、キャリブレーションです。その数値は利用可能な転換証拠と一致していますが、スクリーニング結果のままです。不安は欠落したスケールによって製造されており、これは文献から部分的に第3~6節のように、また新しいデータから部分的に第8節の指定のように、再構築することができます。
この記事は、すべての著者が抱える質問で始まりました:
「私の7つのダウンロードは何を意味するのか」
このフレームワークはそれを次のように置き換えます:
「この論文は、同じ年齢、分野、コホート、配布履歴の比較可能な論文の中でどこに位置しているのか。その制約は到達範囲か転換か。そして、読者が現在研究を発見するシステムを通じて取得され、引用されているのか」
これは科学計量学が答えることができる質問であり、この記事はその方法を指定しています。
カウンターが記録するのはイベントのみです。ビューはダウンロードではありません。ダウンロードは読書ではありません。平均は規範ではありません。カウンターは判定ではありません。勧誘は認識ではありません。AI検索は忠実な帰属ではありません。そしてスケールのない数値は情報ではありません。
プラットフォームがカウンターをその文脈とは別に表示する限り、著者、評価者、プラットフォームは分布のファクトを個人的な判定として読み続けるでしょう。オープンアクセスが戦ったバトルに勝利しました(価格障壁なしに投稿およびダウンロードする権利)。そしてそれに勝つことで、戦ったことのないバトルを露呈させました。注意の配分です。著者は分野、年齢、転換を備えたカウンターを読むことができます。SSRNのメトリクスは依然として価値を保持していますが、それが何を意味するかを理解する著者にとってのみです。
付録A. 状況→アクションガイド
表23は、著者が最も頻繁に報告する状況に第4~6節を凝縮しています[161][127][139]。その中央列は、集められた証拠が認可するもののみを述べており、ソースとウィンドウがあります。注意事項列は、各読値に伴わなければならない制限を担当します。ここに表示される数字は、本文の表6~7と図6のものです。
表23. 状況→証拠が何を言うか→何をするか。
| # | あなたの状況 | 証拠が何を言うか | 何をするか | ソースと注意事項 |
|---|---|---|---|---|
| 1 | 「最初の月に7つのダウンロードと40の概要表示」 | 転換率は17.5%で、ポイント推定値として11~19%のクロススタディ帯域内ですが、7/40に対する95% Clopper–Pearson区間(≈7.3~32.8%)は広く、帯域をまたいでいます。中央LSN論文は2年後にのみ63ダウンロードに達し、中央マーケティング論文は16か月の中央年齢で87に達しました。成熟したサンプルアンカー、日数20の読値と年齢マッチしていません。広い間隔を持つスクリーニング結果、失敗の証拠ではありません。 | 表11の観察スケジュールを続行します。日数60~90より早くない軌跡を分類します。 | 帯域:[18][139][172]。中央値:[139](2012 LSN)、[83](2025マーケティング)。すべてのアンカーは単一規律で且つ経年劣化しています。7/40転換は広い間隔のスクリーニング推定値で、成熟したアンカーと年齢マッチしていません。 |
| 2 | 「第1週でダウンロードなし」 | 通常の配前分布:分類はキュレーションされており、ロードされたトピックの場合最大45日かかります。eJournalアラートは初期ビューを駆動し、サンセット後も継続します。Google Scholarインデックスには6~9か月以上かかります。 | 公開投稿を確認します。eJournal分類を確認します。論文が正確なタイトルでインデックスされているかどうかを確認します。利用可能な最も安いインデックステストです。発表サイクルを待ちます。それだけカウンターを読みます。 | [53][147][57][55]。サポートページの文言変更。アクセス日付で再検証します。 |
| 3 | 「多くのビュー、少数ダウンロード。転換は11%をはるかに下回る」 | 概要–テキスト不一致と一致しています。読者は概要に到着して去ります。パッケージング変数(タイトル、概要、キーワード)は、カウンターに最も堅牢に関連付けられた注意レバーです。 | タイトルと概要を修正します。次のウィンドウでの転換を再観察してから、さらなる変更を行います。 | [139][168][172]。因果的読み「低転換=弱い概要」はスクリーニング仮説であり、検証済みの診断ではありません。 |
| 4 | 「転換は帯域をはるかに上回る、またはビュー突然スパイク」 | 概要ブラウジングが説明しないトラフィック。メディアまたはアグリゲータリンク、またはフィルターがまだ削除していない非人間トラフィック。 | 外部ソース(カバレッジ、メーリングリスト)を識別します。相関がない限り、スパイクを読者数として引用しないでください。 | [116][138][144][102 — Safe Linksプリフェッチメカニズム。SSRNの独自フィルターがそのようなトラフィックを既に除外している可能性があるという注意事項]。 |
| 5 | 「私のカウンターが低下した、または数字が再計算された」 | フィルタリングルールが変更されると、プラットフォームはカウンターを修正します。RePEc は大規模なraw トラフィックの大部分を文書化されたエピソードで破棄しました(2007年のロボット≈74%ビュー。2025年9月のIDEASトラフィック>99.5%)。 | これを測定イベントとして扱います。日付付きスクリーンショットを確認します。相関がない限り、失われた読者数として報告しないでください。 | [144][69][99][129][66]。 |
| 6 | 「ランキングはなくなり、私がどこに立っているかわかりません」 | パブリックパーセンタイルフレームは残っておらず、プラットフォーム代表のものは外部で収集できません。付録Eの記録クロスセクションは、サンプルベースの参照分布を提供し、マッチした比較はプラットフォームパーセンタイルの代替物です。 | 同じ月に投稿された3~5つのピアペーパーのマイクロベンチマークを作成し、独自のスケジュールで追跡します。オプションで、あなたのダウンロードのマッチしたコホート中央値への比率を計算します。 | [149][51]。アンカー[139][83][85]。比率には較正済みの解釈帯域がありません(セクション6.3)。 |
| 7 | 「委員会が私のカウントを見るでしょう」 | ドシェファイルのランクラインは文書化された慣行であり、それらの比較フレームは去ります。ソース、分野修飾子、引用三角測量を備えた帯域言語は、生カウントが行わない精査を生き残ります。 | 表13の7段階プロトコルを適用します。保存、翻訳、三角測量、フィールド正規化、補完、完全性、専門家評価。 | [12][95][33][52][77][108]。ダウンロード数は需要を測定するもので品質ではなく、操作履歴[44]は評価者に周知されている。 |
| 8 | 「投稿から数日後に捕食的招待が届き始めた。」 | プレプリントプラットフォームからの収集の文書化された副産物であり、隣接する監査では1学者あたり隔週に数十件の招待を報告している。量が多いことはスクレイパーへの可視性を示しており、読者による認識ではない。 | 決して支払わないでください。CabellsおよびThink. Check. Submit.経由で会場を確認してください。対応は専用アドレスを経由してルーティングしてください。分類については表14を参照してください。 | [107][159][9][84][63][32][136];[B-1](Beallリストは2017年から廃止)。タイミング規則性は測定されていなく、「投稿から数日後」スクリーンは定性的です。 |
| 9 | 「ジャーナルの類似度チェックが自分の投稿を自分のSSRNプレプリントと一致するとフラグを立てた。」 | スクリーニングシステムは設計どおりに動作しています。Crossrefに登録されたプレプリント(Posted Content)は比較コーパスの一部であり、iThenticateのガイダンスは同一著者のプレプリント一致は盗用ではないと述べています。ワーキングペーパーを投稿することはほとんどのジャーナルの事前公開ポリシーで許可されていますが、ポリシーは異なり、対象ジャーナルを確認する必要があります。主な例外は医学および臨床分野です。 | フラグが立てられたソースを処理エディタに自分のタイムスタンプ付きプレプリントとして特定してください。プレプリントを撤回しないでください。医学および臨床会場の場合は、投稿前に対象ジャーナルのプレプリントポリシー(例えばSherpa Romeoレジストリ経由)を確認してください。 | [81][36];セクション4.5。ジャーナルポリシーは異なり、変更されます。一般的な規則に頼るのではなく、対象ジャーナルの現在のポリシーを確認してください。 |
| 10 | 「ランキングは消えました。論文をResearchGateやAcademia.eduに移動させるべきでしょうか?」 | サンセット後の著者マイグレーションは文書化されていなく、ダウンロード数カウンターはプラットフォーム間で転送できず、比較対象プラットフォームも同じ解釈可能性の問題を持っています。ResearchGateは2022年8月に方法論的批判の後、独自のRGスコアを廃止しました。 | SSRNレコードを保持し、再配置するのではなく補完してください。機関または主題リポジトリに同じ論文を堆積させ(表13、ステップ5)、日付付きカウンタースナップショットを保存し、他の場所で削除して再投稿しないでください。これは累積されたカウンターを失います。 | [130][90][149];[47][146](リポジトリ補完);[161](1つのプラットフォームのカウンターは他のチャネルについて何も言わない);[B-7](削除と再投稿はメトリクスをリセット)。文書化されたマイグレーションの欠如は、証拠の欠如であり、安定性の証拠ではありません。 |
未検証のコミュニティ慣行(セクション8アジェンダの候補仮説)。以下の推奨事項は著者コミュニティで流通しており、実践的なガイドの初期ドラフトに表示されます。どの研究もそれらをサポートしておらず、ここではテスト可能な仮説として記録され、調査結果として引用されてはいけません。(a) eジャーナル分類を3つ(1つはコア、1つは広い、1つは学際的)に制限すること。許可された7つよりも[53][168];(b) SSRNワーキングペーパーを引用して、著者にGoogleスカラーアラートを通じて通知し、注意をもって返礼する;(c) 投稿後最初の14日間プロフィールメールアドレスを隠して収集を減らす;(d) 3日目にマイナーリビジョンをアップロードして再発表をトリガーする(SSRNは所内リビジョンがカウンターとURLを保持することのみを文書化[B-7]);(e)「96時間以内の招待は捕食的である」スクリーンに付加された数値発生;(f) 論文で引用された著者3~5人への直接的アウトリーチ(SSRN作業の引用を述べた短いメッセージ)。最初の正当な対象者へのチャネルとして、プロモーションではなく通常の学術的コミュニケーションとして構成されます。各々はセクション8の観察設計でテスト可能です。テストされるまで、適切な引用形式は「コミュニティ慣行、未検証」です。
表24はプレイブックを時系列で再度ソートします。すべてのセルはセクションとそのソースに戻ります。タイムラインビューは著者が実際に尋ねる質問(「私は今何をすべきか?」)に発生する順序で回答し、状況をインデックス化した表23を補完します。
表24。プレイブックをタイムラインとして:3つのフェーズ×3つの軸。すべてのセルはセクション4~7で既に述べられている証拠と指示を要約します。未検証のコミュニティ慣行は除外されます(上記のリストを参照)。
| 段階 | プラットフォームの仕組みと測定 | オーディエンスと配信 | 勧誘防止 |
|---|---|---|---|
| 投稿前 | タイトルと要旨をコンバージョン面として扱い、それに応じて草案を作成する(§6.4; [139][172]);eJournal分類を計画する—最大7つが許可され、より多くの分類がより多くのダウンロードと少ないゼロに関連している [53][168] | 自分の論文と一緒に追跡する3~5論文のマイクロベンチマークコホートを特定する(§6.3) | メタデータが公開になる前に、専用アドレスを通じて対応をルーティングする(§6.6) |
| 投稿時 | 公開投稿とeJournal分類を確認し、表11グリッドの1日目ベースラインを記録する(§6.1) | eJournalメールアラートはプラットフォームの主要なプッシュチャネルであり、サンセット後も継続する [147][57] | 勧誘は価値の信号ではなく、可視性のデフォルト結果として期待する(§6.6; [159][63]) |
| 最初の数週間(1~45日目) | 早期のゼロを却下ではなく前分布として読む(§6.2 rule iv; [53]);表11スケジュールでカウンターをログに記録する;60~90日目より前に軌跡を分類しない(§6.3) | 適切な場合は正当な外部レバーを適用する—ブログとリスト提供は測定可能な初期スパイクを生成した(§6.4; [116][72]) | 決して支払わない;招待の会場をスクリーニングする([B-1];Think. Check. Submit. [159]);表14の類型に対して招待をチェックする;スパムボリュームを読者数として読まない(§7.6) |
付録B. CSABレポートテンプレート
最小限の著者または評価者向けCSAB声明(セクション5.5;表10)は以下を報告する:
論文の年齢が[X日]の時点で、その論文は[V]件の要約ビュー数と[D]件の検証済みダウンロード数を記録していました。[定義されたフィールド/コホート/新規参入者参照クラス]と比較すると、そのリーチパーセンタイルは[RV]、ダウンロードパーセンタイルは[RD]、縮小調整済み転換パーセンタイルは[RC]でした。その論文は、その観察時点までに、[文書化されたキュレーション配布を受けた/受けなかった]。年齢[年齢1]から年齢[年齢2]の間に、その正規化ポジションは[上昇した/安定していた/低下した]。これらの指標は普及を説明するものであり、研究品質または正確性を確立するものではありません。
現代的な参照パネルが推定されるまで(セクション5.5、8.3)、パーセンタイルフィールドは空白のままにしておかなければなりません:直観から、プラットフォーム全体の平均から、または経時的なサンプルから値を入力することはできません。歴史的アンカーはテンプレートと並行して報告される場合がある:2012年LSNの2年時点での63ダウンロードの中央値[139]と2025年マーケティングネットワークの87の中央値[83]、それぞれそのサンプル、フィールド、および年齢を示す、しかし欠落している参照クラスの代わりに決して代用されません。このテンプレートは、ドシエプロトコルの翻訳ステップ(表13、ステップ2)の文レベルの対応物です。
附録C. パネル変数辞書
表C1は、セクション8.3のコアパネルの最小限の論文間隔レコードを示します:セクション5.5のCSAB推定値とセクション8.4–8.5のプラットフォームイベント分析を再現するのに十分な最小スキーマです。公開リリースは、分析的に必要でない場合、直接識別子を安定的な研究キーで置き換え、レジストリ寄付(セクション8.8)はこのスキーマの部分集合をそこで示されているとおりに使用します。
表C1. コアパネルの最小論文間隔データスキーマ。
| ドメイン | 変数 | 定義またはフォーマット |
|---|---|---|
| ID | paper_id | 安定的な研究識別子 |
| ID | ssrn_abstract_id | プラットフォーム識別子;公開リリースではハッシュまたは制限 |
| タイミング | posted_at | 最初の公開投稿日 |
| タイミング | observed_at | メトリクス観察タイムスタンプ(表11グリッド) |
| タイミング | paper_age_days | 最初の投稿以降の日数 |
| 使用 | abstract_views_cum | 公開累積要約ページビュー |
| 使用 | downloads_cum | 公開累積検証済みダウンロード |
| 使用 | views_interval、downloads_interval | 前の有効な観察からの増分 |
| エクスポーズア | classification_ids | 観察時点で有効なすべてのeJournal分類 |
| エクスポーズア | distributed_status、distributed_at | キュレーション配布インジケータと日付(同意がある場合) |
| エクスポーズア | search_indexed | プロトコル定義の外部インデックスステータス(完全一致タイトルテスト) |
| 論文 | title_frozen、abstract_frozen、keywords、page_count、doi | 最初に観察された原稿メタデータ、最初の観察時点で固定 |
| 論文 | authors_frozen、affiliations_frozen | 最初の観察時点での著者名、順序、および所属 |
| バージョニング | revision_id、revision_at、material_change_flag | 実質的変更インジケータ付きバージョン履歴 |
| 著者 | author_count、platform_newcomer、prior_ssrn_papers | チーム構成と投稿前プラットフォーム履歴(セクション8.3の定義) |
| レピュテーション | prior_citations、prior_works、institution_measure | 焦点となる投稿の前に固定され、フィールド正規化 |
| カレンダー | day_of_week、week、season、holiday_flag | 事前定義時間制御[178] |
| ダウンストリーム | citations_6m、citations_12m、citations_18m、publication_status | 後の検証成果とソースおよび日付(セクション8.9の対象期間) |
| 監査 | collection_method、source_url、quality_flag | 出所、アクセス経路、および異常ドキュメンテーション(削除ではなくフラグ;セクション8.3) |
附録D. ベンチマーク透明性仕様
セクション8.8のパーセンタイルベンチマーク、およびプラットフォームまたはコミュニティによって維持される後継(セクション10.4、推奨事項1および4)が、この記事が批判するベンチマーク不透明性を再現することを回避するために、すべてのパーセンタイルリリースは以下を指定するバージョン化された付随仕様とともに公開されます:
1. 適格論文の母集団、ネットワーク、文書タイプ、および除外;
2. 投稿コホート日付と観察年齢;
3. フィールド割り当てルール(複数の分類の扱いを含む);
4. リリース時に有効なビュー、ダウンロード、ユニークアクター、リピート、および検証トラフィックの定義;
5. 中央値、四分位範囲、P10/P25/P75/P90/P95、ゼロシェア、ジニ係数、および上位シェア;
6. 報告されたすべての参照クラスのサンプルサイズと不確実性区間;
7. 欠落値、撤回、改訂、マージ、およびカウンター再計算の処理;
8. 調整に含まれる配布および外部プロモーション変数;
9. プライバシーおよび最小セルルール:セクション8.8のクラウドソーシングレジストリの場合、小さいフィールド別年齢セルが個々の寄付者を特定する可能性がある場合、このアイテムは形式ではなくデータ保護法(英国ではUK GDPRおよび2018年データ保護法)によって管理される拘束力のある制約です。開示制御は単純な匿名化を超えて、薄いセルのk-匿名性またはノイズ追加(差分プライバシー)集計まで拡張するべきであり、許可された使用ルールはレジストリを解釈に結びつけ、採用、昇進、リソース配分、または任意の公開リーダーボードへの再組立に使用することを禁止するべきです;
10. バージョン履歴とリリースの永続的で引用可能な参照。
複合スコアはこれらのコンポーネントを置き換えることはできません。コホート中央値への単純な比率(セクション6.3の未調整フォールバック)は、分母セルが小さい場合は不安定になる可能性があり、「中央値の2倍」が異なる形をしたフィールド間の固定パーセンタイルにマップされることを偽って示唆することができます。したがって、著者向けレポートでは、セクション8.3ですでに指定されている経験的ベイズ縮小の下でのパーセンタイル推定値を使用し、一方、生の分布は監査のために利用可能です。
付録E. ダウンロード分布の独立した保存的横断面
最近の全体分布の証拠について、第3節と第5節の総合は単一の公表済みスナップショット[83]に依拠しています。本付録は、本論文のために組み立てられた独立した再現可能な横断面を報告します。これはプラットフォームへの特別なアクセスなしに公開データのみを使用して、分野を通じた分布構造を裏付けるものです。既知の上方バイアスを伴う一度限りの保存的再構成であり、投稿から見通しとして論文を観察する第8.6節の事前登録済みパネルとは異なり、形状の裏付けとして提供されます。
方法論。OpenAlex(ソースS4210172589「SSRN Electronic Journal」)からSSRN論文のランダムサンプルを23の独立したランダムシードを通じて抽出しました。サンプルに含まれた各論文について、退役前のダウンロードおよび抄録閲覧カウンターを、Wayback Machineの公開可用性エンドポイントを通じてInternet Archiveの論文の最新キャプチャから読み取りました。これはライブサイトからではなく、ライブサイトはアクセスゲートされており(第4節)、比較フレームを公開していません。保存されたコピーからカウンターを読み取ることで、プラットフォームをクエリすることなく、手順をレート制限され、プラットフォームに配慮し、リリースされた識別子から再現可能に保つことができます。ペーパーごとのカウンターはランキング廃止時に変わらず生き残り、比較ランキングのみが撤回されたため、2026年7月15日以降の日付付きキャプチャは論文の累積カウントの有効な読み取りのままです。したがってスナップショットは廃止前のウィンドウに限定されず、キャプチャ日付は論文の年齢を計算するためにのみ保持されます。段間的なボット・チャレンジではなくページ内容を返すキャプチャが破棄されました。サンプリングされた2,600論文のうち、64%が使用可能な保存されたキャプチャを持ち、52%が機械可読なダウンロードカウントを生成し、n = 1,360論文、25分野、14分野は少なくとも20論文を有し、論文年齢は投稿年から20年以上におよびます。データセットはappendixE-wayback-downloads.csvとしてリリースされ、https://doi.org/10.5281/zenodo.22285871に預けられており、同じファイルはそこでstudy1-wayback-downloads.csvという名前を持ちます。サンプルの2つの特性がそれから読み取ることができる内容を制限しています。投稿日付は年のみを含みます:1,360レコードのうち1,358件は1月1日のスタンプが付けられています。OpenAlexはSSRN投稿を年の解像度で報告するためです。年齢は投稿年からのキャプチャ年として計算され、完全な年で報告され、短い帯域も防衛できません。キャプチャもまた時間に集中しています:サンプルの半分の688、2025年4月25日から5月7日の単一クロール内にあり、81.5%は2025年内にあります。したがって論文の年齢はここで投稿年の再陳述に近く、両者は分離できません。これらの最初のものは削除可能です。投稿行「Posted: DD Mon YYYY」は同じ保存されたキャプチャに表示されるため、完全な日付は再解析することによって復元でき、ライブサイトのアクセスゲートはこれを防止しません。表E1はこの減少を明示的にしています。
表E1. 保存的横断面の構成および各段階での減少。
| 段階 | 論文 | 初期の% | 前段階の% |
|---|---|---|---|
| ランダムサンプリングされたOpenAlexレコード(SSRN Electronic Journal) | 2,600 | 100.0 | — |
| 使用可能なInternet Archiveキャプチャが見つかった | ≈1,660 | 63.8 | 63.8 |
| キャプチャが機械可読なダウンロードカウントを持っていた | 1,360 | 52.3 | 81.9 |
| 最終的な分析サンプル | 1,360 | 52.3 | 100.0 |
結果。クロスセクションは、公開されたアンカーが主張するすべての定性的特徴を再現しています(表E4)。ダウンロードは強く右に歪んでいます。平均219、中央値60(95%ブートストラップCI 55–69)、平均対中央値比3.65で、平均は75パーセンタイル(158)を超えています。また、重い上側テール(95パーセンタイル816、中央値の13倍以上;ジニ係数0.75、95% CI 0.71–0.78)を持っています。対数では、分布はほぼ対称的です(lnダウンロードの歪度≈0.18)。これは観測された分布の本体での近似的な対数正規性と一致しており、Kakushadzeが上位リストのみで適合できた特性です(セクション3.4)。ダウンロード対ビュー変換の中央値は16.2%、平均は17.3%で、11–19%の研究間帯域内です(セクション5.2)。中央値ダウンロードは同じ論文年齢の分野によって異なります。年齢帯を固定して保つと、最高と最低の分野中央値の間の広がりは約3倍から約5倍の範囲で、正確な数値は帯域と薄くサンプリングされた分野の処理によって異なります。すべての年齢にわたってプールすると、広がりは約12倍に達し、その大きい数値はサンプルの変化する構成を反映しています。エンジニアリングは3年以下の論文の21~27%を供給し、9年以上の論文の最大5%しか供給しませんが、経済学は9~12%と同じグループの37~54%を供給し、ここでの経済学論文の中央年齢は9年で、エンジニアリングは1年です。方向はセクション3.6の分野乗数と一致しています。大きさは比較できません。その乗数は単一の規律の94の小分野全体の生涯平均に基づいており、この広がりは25の規律全体の中央値に基づいており、どちらも年齢について調整されていないためです。中央値ダウンロードはより古い年齢帯で高く、隣接する帯域のほとんどの間で重複しない95%ブートストラップ信頼区間があります(投稿年で中央値12、10年以上で172)。これは参考クラス議論を動機付ける年齢依存性です。単一の分野内では、差異は最初の3年または4年に集中しています。5~10年帯と10年超帯の間では、有意性に達しません(経済学ではMann-Whitney p = 0.57、社会科学では0.82、経営学では0.23)。プールされた勾配の約4分の1は、年齢ではなく分野構成です。このサンプルの年齢は投稿年の言い換えに近く実行されます。なぜなら、キャプチャの半分は2025年4月25日から5月7日の間の1つのクロール中に取得され、81.5%が2025年に該当するため、ここでは年齢とコホートを分離することができず、帯域は任意の単一論文のパスではなくレベルを報告します。サンプル平均(219)は公開されたマーケティングネットワーク平均(221)と一致し[83]、サンプル中央値(60)は国勢調査式法律中央値(63)のレベルに位置します[139]。表E2は論文年齢別のダウンロード分布を示し、表E3は分野別に示しており、どちらも95%ブートストラップ信頼区間とサンプルサイズがあります。信頼区間は最小の分野で最も広いため、分野広がりは単一の正確な倍数ではなく、ほぼ1桁の大きさとして説明されています。記事の冒頭のケースはサンプルに対して直接読むことができます。2年未満で30~50の抄録ビューを持つ論文の中で、そのケースが該当する帯域では、中央値ダウンロード数は7で、四分位範囲は4~11です(n = 42)。タイトルのケースは、そのビュー帯域と年齢の典型的なケースです。投稿年では、サンプルの35%が7ダウンロード以下を記録し、中央値抄録ビュー数は66で、ケースの独自の17.5%の変換はサンプルの57パーセンタイルに位置します。セクション5.2の11–19%変換帯域は、論文ではなく中央値の帯域です。サンプルの41%がそれ内に該当し、23%が下回り、36%が上回ります。サンプルの半分、51%が国勢調査式法律中央値63[139]を下回り、これは新興の範囲を分布の生成された部分に配置します。
表E2。アーカイブクロスセクションの論文年齢別ダウンロード分布。
| 論文年齢 | n | 中央値 [95% CI] | 平均 | IQR (P25–P75) |
|---|---|---|---|---|
| 投稿年 | 203 | 12 [11–14] | 33 | 5–21 |
| 1年 | 253 | 25 [23–29] | 94 | 15–44 |
| 2–4年 | 375 | 52 [47–57] | 110 | 28–100 |
| 5–9年 | 188 | 130 [110–151] | 384 | 72–374 |
| 10年以上 | 341 | 172 [157–189] | 453 | 96–336 |
| 全論文 | 1,360 | 60 [55–69] | 219 | 23–158 |
表E3。アーカイブクロスセクションの分野別ダウンロード分布(n ≥ 20の分野)。
| 分野 (n ≥ 20) | n | 中央値 [95% CI] | 平均 | IQR |
|---|---|---|---|---|
| 経済学 | 285 | 150 [134–169] | 443 | 76–302 |
| 経営学 | 161 | 150 [126–188] | 335 | 72–330 |
| 心理学 | 24 | 107 [35–192] | 179 | 32–229 |
| 社会科学 | 241 | 85 [78–117] | 219 | 45–189 |
| 意思決定科学 | 32 | 74 [56–158] | 615 | 49–260 |
| コンピュータサイエンス | 63 | 42 [36–73] | 167 | 26–104 |
| 医学 | 40 | 42 [24–59] | 81 | 22–66 |
| 農業・生物科学 | 36 | 31 [24–57] | 65 | 23–67 |
| 生化学 | 21 | 30 [23–37] | 38 | 20–38 |
| 環境科学 | 72 | 26 [18–32] | 44 | 14–50 |
| 工学 | 196 | 24 [20–26] | 46 | 13–46 |
| 物理・天文学 | 21 | 23 [15–38] | 112 | 13–45 |
| 材料科学 | 55 | 18 [15–25] | 26 | 11–36 |
| エネルギー | 21 | 12 [11–22] | 25 | 11–22 |
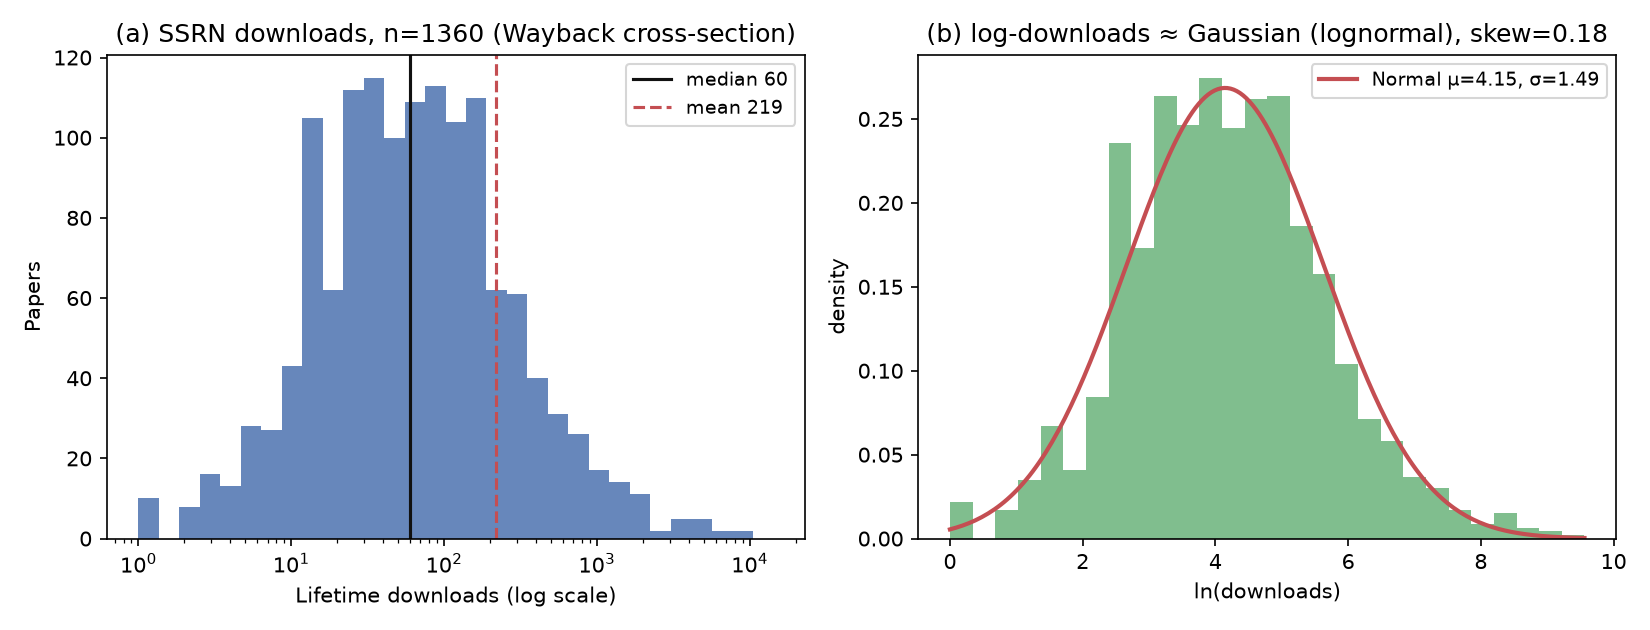
図E1。(a)平均値と中央値をマークした対数スケールのダウンロード分布;(b)適合正規密度を持つln(downloads)のヒストグラム。ログダウンロードの歪度≈0.18。n = 1,360。
表E4。公表されたアンカーと独立したアーカイブクロスセクション(n = 1,360)。
| 特性 | 公表されたアンカー | アーカイブクロスセクション |
|---|---|---|
| 平均ダウンロード数 | 221(マーケティング)[83] | 219 |
| 中央値ダウンロード数 | 87(マーケティング)[83];63(法律)[139] | 60 |
| 平均値/中央値 | 2.54 [83] | 3.65 |
| 95パーセンタイル/中央値 | > 8 [83] | 13.6 |
| ダウンロード・ビュー変換 | 11–19%帯(§5.2) | 16.2%中央値 |
| 分野の広がり(中央値) | ≈分野平均の8倍、年齢調整なし[168] | ≈同一年齢では3–5倍;プール時12.5倍 |
| 分布形状 | 対数正規、テール部分のみ[85] | 対数歪度0.18(観測された本体) |
クロスセクションが確立するもの。このクロスセクションは、分布の形状と、中央部および上部構造を分野全体で裏付けており、公表されたSSRNスナップショットのいずれよりも分野カバレッジが広い独立したすべての分野サンプル上でのものである。プラットフォーム代表的なパーセンタイルを推定するものではなく、その構成の2つの特性により上方にバイアスされている。アーカイブされたキャプチャは目に見えるページを過度に代表しているため、ダウンロード数が多い論文がキャプチャされる可能性が高い。また、論文は読み取り可能なカウンターを備えたアーカイブされたページを持つ場合にのみサンプルに入り、極端な下限を打ち切る:サンプルの10以下のダウンロード数を持つ論文の共有(約10%)は、セクション3.4および8.6が不偏の全プラットフォームサンプルで予想する15–30%をはるかに下回り、その共有の推定値として読むべきではない。それでもサンプル中央値(60)が公表された法律(63)およびマーケティング(87)の中央値と同じか下にあるという事実は、上方バイアスが中央質量では控えめであり、歪度および重いテール結論は、もしそうなら保守的であることを示している。調整されたベンチマークについては、適切な手段はセクション10で推奨されるプラットフォーム代表的なパーセンタイル帯およびセクション8.6の事前登録パネルのままであり、このクロスセクションは、それらが測定する構造がこの記事が説明するものであることを裏付けている。研究1がセクション8.6で事前に固定する予測帯のうち3つは、このサンプルに対して読むことができ、その上方バイアスを念頭に置いている。サンプル中央値60ダウンロードは、予測された30から80の範囲内にある。注意ジニ係数0.75は、予測された0.75から0.90の下限に位置し、これはサンプリングバイアスが予測する方向であり、打ち切られた下限が測定不等式を圧縮するため。中央値と平均値の比0.27は、予測された上限0.5より低い。これはどれも事前設計を検証していないが、その価値は確率サンプルからの投稿以来の論文を観察することであり、帯域が無理のない範囲内で設定されたことは記録する。
宣言
データの利用可能性。ここで再現されたすべての合成アンカーは、テキストと表で引用された公表された情報源までトレース可能であり、サンプリングフレームと検証状態は使用時に述べられており、記事のベンチマーク主張の基礎にある新しい母集団代表的なデータセットはない。この記事のために生成された唯一のオリジナルデータセットは、付録Eの独立したアーカイブクロスセクション、公開アーカイブから回復された退職前カウンターを持つ1,360の論文のランダムすべての分野サンプル、appendixE-wayback-downloads.csv(付録Eデータセット、予想研究1ではない)として分析コードとともにリリースされ、手順を再実行および拡張できます。分布の形状を裏付けており、プラットフォーム代表的なベンチマークではない。データセットはhttps://doi.org/10.5281/zenodo.22285871にCC BY 4.0の下で預金され、同じファイルはstudy1-wayback-downloads.csvという名前を持ち、ダウンロード数をそれに対して読みながら論文の年齢と分野の両方を調整するオープンツールでhttps://github.com/vadimchernets/ssrn-benchmarkで提供される(MITライセンス、Pythonスタンダードライブラリのみ)。独自のカウンターをこの参照クラスに配置したいと考えている読者は、分析を再構築するのではなくそのツールを実行できます。セクション8の事前登録対応アジェンダの資料、パネル変数辞書(付録C、表C1)および検索監査クエリインベントリを含む、事前登録時に預金するために準備されています(セクション8.8);レジストリ貢献はセクション8.8で定義されたスキーマサブセットに従い、ベンチマークプログラムからのパーセンタイルリリースは付録Dの透明性仕様の下で公開されます。付録Bの CSAB報告テンプレートは、その空白パーセンタイルルールを条件に、自由に再利用できます。2026年8月24日、SSRN Support(チケット260824-003051)に対して、廃止されたランキングが暗示する集計参照クラス、中央値、四分位範囲、および分野と論文年齢で層化されたダウンロードの十分位帯、個別論文識別子なし、の正式な要請が提出されました;その結果(付与、拒否、または無応答)は後続の修正で報告されます。
この記事へのオープンアクセス。このマニュスクリプトのオープンライセンスコピーはhttps://doi.org/10.5281/zenodo.22166896(CC BY 4.0)に預金され、フルテキストは直接かつアクセスの課題なく取得可能です。この預金は、SSRNの正規記録がJavaScriptエンジンのないクライアントを拒否するボット軽減の背後で提供されるためであり、セクション4.2に記載されている条件です。正規コピーに到達できない読者、参考文献マネージャー、および自動化されたクライアントは、預金から同じテキストを取得できます。関連論文は同じ条件の下でhttps://doi.org/10.5281/zenodo.22166995およびhttps://doi.org/10.5281/zenodo.22168724に預金されます。
コード提供性。 付録 E の独立アーカイブ横断面の収集・分析コードは、そのデータセットと共に https://github.com/vadimchernets/ssrn-benchmark でリリースされているため、手順は再現可能であり、参照クラスは未処理カウンターから再導出できます。本論文は分析コードを必要とする結果については報告していません。第 8 章の経験的設計の図生成テンプレートは、事前登録資料に添付されるオンライン付録としてリリースされます。
倫理。 第 8 章の経験的設計は、公開されている論文レベルのカウンターと参考文献メタデータに依存しています。非公開ダッシュボード情報、配布ステータス日、またはメールメッセージの収集には、インフォームド・コンセントが必要であり、該当する場合は機関審査が必要です(第 9 章を参照)。人間の対象者に対する研究を構成する 2 つの設計、すなわち研究 4(著者調査)および研究 3(受信トレイログを使用した計器配置)は、機関審査委員会または研究倫理委員会の承認を求めて提出され、データ収集が開始される前に参加者のインフォームド・コンセントの下で実施されます。メッセージデータセットは報告前に集計および脱識別化され、コミュニティ投稿は生きた検証可能なソースが存在する場合にのみ引用され、著者が期待に反して識別される可能性がある場合は言い換えられます。データ収集はプラットフォームの利用規約で許可されている手段に限定されています。設計は公開されているカウンターと参考文献メタデータを使用し、プラットフォームの利用規約を侵害するスクレイピングを採用していません。大量またはプライベート データを必要とする設計は、自動抽出ではなく、正式なデータ要求と法的審査を通じて進めます。半公開フォーラム コンテンツの引用は、寄稿者のコンセントと再識別リスクに配慮しており、著者が期待に反して識別される可能性がある場合は、そのような資料を逐語的に再現するのではなく言い換えるのはこのためです。本論文は特定のジャーナルまたは出版社に「悪質」とラベル付けしていません。会場スクリーニングは検証済みの透明な基準を適用しており、分類を防御可能に保ち、誹謗中傷を回避します。
謝辞。 著者は、2026 年 8 月にメールで送信された批判的コメントについて Stefanie Haustein に感謝しており、これらは第 4.2 章の修正につながりました。また、Vincent Larivière に感謝します。彼の質問—著者が最初に主張すべき単一の正規化は何か、およびデータではなく議論を見たいという彼の主張—は、付録 E で報告されたアーカイブ横断面を促しました。
利益相反。 著者は、第 8.10 章で述べられている多モデル オーケストレーション方法の開発者であり、これらはオープンで再現可能です。読者はこれを考慮すべき利益です。著者は、その章で述べられている種類の AI オーケストレーションおよびマルチモデル検証システムをカバーする保留中の特許出願の指定申請人ですが、付与されていない特許です。第 8.10 章で提案されているオーケストレーション層配信設計は、本論文の調査結果がいずれにも基づいていない概念仕様です。第 8.10 章は完全に削除できますが、本論文の他の箇所の診断、結果、または推奨事項は変わりません。
ツールと検証。 AI アシスタントは著者の指揮下での手段として使用されました。考え、研究、結論は著者のものです。すべての定量的主張と引用は、著者によって主要な情報源またはアーカイブコピーに照らして検証されました。著者は内容に対して単独の責任を負います。
参考文献
テキスト内で [B-n] として引用されたソース(プラットフォーム ページ、フォーラム スレッド、ブログ投稿、およびその他の関連資料)は、以下の「追加ソース」の下に個別にリストされています。アクセス日付付きのプラットフォーム ページは不安定であり、アーカイブされたコピーに対して再検証される必要があります。
[1] AALL / ALL-SIS (2024, June 14). Citation Methods White Paper. https://www.aallnet.org/allsis/wp-content/uploads/sites/4/2024/07/ALL-SIS_CitationMethodsWhitePaper_6_14_24_final.pdf
[2] Abdill, R. J., & Blekhman, R. (2019). Tracking the popularity and outcomes of all bioRxiv preprints. eLife, 8, e45133. DOI 10.7554/eLife.45133
[3] Academia StackExchange (2016, May 28). "Importance of paper download statistics". https://academia.stackexchange.com/questions/69421/
[4] Adobe / Adobe Express Blog (2025; survey fielded May 2025). "Using ChatGPT as a search engine". https://www.adobe.com/express/learn/blog/chatgpt-as-a-search-engine
[5] Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative Engine Optimization. KDD '24. DOI 10.1145/3637528.3671900; arXiv:2311.09735
[6] Aguinis, H., & Solarino, A. M. (2019). Transparency and replicability in qualitative research. Strategic Management Journal, 40(8), 1291–1315. DOI 10.1002/smj.3015
[7] Algaba, A., Mazijn, C., Holst, V., Tori, F., Wenmackers, S., & Ginis, V. (2025). Large Language Models Reflect Human Citation Patterns with a Heightened Citation Bias. Findings of the Association for Computational Linguistics: NAACL 2025, 6844–6879. DOI 10.18653/v1/2025.findings-naacl.381; arXiv:2405.15739
[8] American Society for Cell Biology and co-signing organizations and individuals (2012/2013). San Francisco Declaration on Research Assessment (DORA). Drafted 16 December 2012 at the ASCB Annual Meeting, San Francisco; released 2013. https://sfdora.org/read/
[9] Ansari, S., Khan, M., Weinstein, D., Conant, E. F., Mirza-Aghazadeh-Attari, M., & Yousem, D. M. (2023). Pervasiveness of open journal invitations across radiology specialties. Current Problems in Diagnostic Radiology, 52(6), 534–539. DOI 10.1067/j.cpradiol.2023.04.002; PubMed 37150715
[10] Artisan Growth Strategies; Lenny's Newsletter; First Page Sage — freemium-conversion benchmarks. https://www.artisangrowthstrategies.com/blog/freemium-conversion-rate-benchmarks ; https://www.lennysnewsletter.com/p/what-is-a-good-free-to-paid-conversion
[11] arXiv (Cornell University). Help pages on submission formats. https://info.arxiv.org/help/submit_pdf.html ; https://info.arxiv.org/help/policies/format_requirements.html
[12] Bainbridge, S. (2026). "The Social Science Research Network Has Jumped the Shark" (03.06.2026), https://www.stephenbainbridge.com/p/the-social-science-research-network ; "SSRN Responds to My Complaints With Changes and/or Clarifications" (04.06.2026), https://www.stephenbainbridge.com/p/ssrn-responds-to-my-complaints-with
[13] Bauer-Wolf, J. (2022, November 16). Yale, Harvard law schools drop out of U.S. News rankings, saying they undermine legal profession's tenets. Higher Ed Dive. https://www.highereddive.com/news/yale-harvard-law-schools-drop-out-of-us-news-rankings-saying-they-under/636742/
[14] Beall, J. (2012). 捕食者出版社はオープンアクセスを破壊している。Nature, 489, 179. DOI 10.1038/489179a
[15] Bergstrom, C. T., & West, J. D. (2020). ナンセンスを見破る:データ駆動型の世界における懐疑論の技法。Random House.
[16] Bessembinder, H. (2018). 株式は短期国債を上回るのか?Journal of Financial Economics, 129(3), 440–457. DOI 10.1016/j.jfineco.2018.06.004; SSRN 2900447
[17] Björk, B.-C., & Solomon, D. (2012). オープンアクセス対購読ジャーナル:科学的影響の比較。BMC Medicine, 10:73. DOI 10.1186/1741-7015-10-73
[18] Black, B. S., & Caron, P. L. (2006). ロースクールのランキング:SSRNを使用した学術的業績の測定。Indiana Law Journal, 81(1), 83 ff. SSRN abstract_id=784764; https://www.repository.law.indiana.edu/ilj/vol81/iss1/7/ ; PDF: https://ilj.law.indiana.edu/articles/81/81_1_Black.pdf
[19] Bollen, J., & Van de Sompel, H. (2008). 利用インパクト係数:サンプル特性が利用ベースのインパクト指標に与える影響。Journal of the American Society for Information Science and Technology, 59(1), 136–149. DOI 10.1002/asi.20746
[20] Bornmann, L. (2014). アルトメトリクスは研究のより広範な影響を示しているのか?Journal of Informetrics, 8(4), 895–903. DOI 10.1016/j.joi.2014.09.005; arXiv:1406.7091
[21] Bornmann, L., & Haunschild, R. (2016). Twitterカウントを正規化する方法?Twitter Indexのジャーナルに基づく最初の試み。Scientometrics, 107(3), 1405–1422. DOI 10.1007/s11192-016-1893-6
[22] Bornmann, L., Leydesdorff, L., & Mutz, R. (2013). 書誌計量データの分析におけるパーセンタイルとパーセンタイルランククラスの使用:機会と限界。Journal of Informetrics, 7(1), 158–165. DOI 10.1016/j.joi.2012.10.001; arXiv:1211.0381
[23] Bornmann, L., & Haunschild, R. (2018). ゼロ・インフレーテッドデータの正規化:新しい指標ファミリーとそのアルトメトリクスデータへの適用に関する実証分析。Journal of Informetrics, 12(3), 998–1011. DOI 10.1016/j.joi.2018.01.010
[24] Bourne, P. E., Polka, J. K., Vale, R. D., & Kiley, R. (2017). プレプリント投稿に関して検討すべき10の簡単なルール。PLOS Computational Biology, 13(5), e1005473. DOI 10.1371/journal.pcbi.1005473
[25] Brody, T., Harnad, S., & Carr, L. (2006). 初期のWeb利用統計は後の被引用数に影響するのか。JASIST, 57(8), 1060–1072. DOI 10.1002/asi.20373; arXiv cs/0503020
[26] Brown, C. (2003). 化学通信における電子プレプリントの役割:ジャーナル文献における引用、利用、受け入れの分析。JASIST, 54(5), 362–371. DOI 10.1002/asi.10223
[27] Campbell, D. T. (1979). 計画的社会変化の影響を評価する。Evaluation and Program Planning, 2(1), 67–90. DOI 10.1016/0149-7189(79)90048-X
[28] Carrell, S., Figlio, D., & Lusher, L. (2023). 情報スーパーハイウェイの混雑:経済学ワーキングペーパーの非効率性。Journal of Public Economics, 225, 104978 (also NBER WP 29153)
[29] Casden, J., Romani, D., Shearer, T., & Campbell, J. (2025). 生成AI時代における攻撃的なクローラートラフィックの軽減:ノースカロライナ大学チャペルヒル図書館からのコラボレーティブアプローチ。The Code4Lib Journal, 61. https://journal.code4lib.org/articles/18489
[30] Chen, Y., & Konstan, J. A. (2015). オンラインフィールド実験。Journal of the Economic Science Association, 1(1), 29–42. DOI 10.1007/s40881-015-0005-3
[31] Chu, H., & Krichel, T. (2007). 経済学におけるダウンロード対被引用数:関係性、寄与要因およびそれ以上。In Proceedings of ISSI 2007 (11th International Conference of the International Society for Scientometrics and Informetrics), Madrid.
[32] Cobey, K. D., et al. (2019). 疑わしい捕食者ジャーナルに出版する研究者の知識と動機。BMJ Open, 9(3), e026516. DOI 10.1136/bmjopen-2018-026516
[33] Cooley Law School Blog (2021, December 7). 「あなたの学術研究を紹介する、第3部:自費出版」。https://cooley.edu/blog/showcase-your-scholarship-part-three-self-publishing
[34] CRIV Connection / CRIV Blog (2026, April 20). 「社会科学研究ネットワーク(SSRN)が商用製品を終了」。https://crivblog.com/2026/04/20/social-science-research-network-ssrn-ending-commercial-products/
[35] Crossref. REST APIドキュメント。https://www.crossref.org/documentation/retrieve-metadata/rest-api/
[36] Crossref. Similarity Checkドキュメント。https://www.crossref.org/documentation/similarity-check/similarity-report-understand/
[37] Davis, P. M., et al. (2008). オープンアクセス出版、論文ダウンロード、被引用数:ランダム化比較試験。BMJ, 337, a568. DOI 10.1136/bmj.a568
[38] Davis, P. M., & Fromerth, M. J. (2007). arXivは数学の論文の被引用数を増加させ、出版社のダウンロードを減少させるのか?Scientometrics, 71(2), 203–215. DOI 10.1007/s11192-007-1661-8
[39] Ding, Y., Dong, X., Bu, Y., Zhang, B., Lin, K., & Hu, B. (2021). ダウンロードと被引用数の関係を再考する:Lancetの場合における異なる引用パターンを持つ論文の視点から。Scientometrics, 126(9), 7609–7621. DOI 10.1007/s11192-021-04099-3
[40] Donovan, J. M., Watson, C. A., & Osborne, C. (2014). アメリカのロー・レビューにおけるオープンアクセスの利点。SSRN abstract_id=2506913. https://papers.ssrn.com/sol3/papers.cfm?abstract_id=2506913
[41] Dorta-González, P., & Dorta-González, M. I. (2023). 被引用数と社会的注目に対する資金提供の効果:国連の持続可能な開発目標(SDGs)をケーススタディとして。Online Information Review, 47(7), 1358–1376. DOI 10.1108/OIR-05-2022-0300; arXiv:2304.00862
[42] Douma, M. J. (2021, January 12). 「典型的な学術論文は何回読まれるのか?」https://michaeljdouma.com/2021/01/12/how-many-reads-does-a-typical-academic-article-get/
[43] Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). マルチエージェント議論を通じた言語モデルの事実性と推論の改善。arXiv:2305.14325. https://arxiv.org/abs/2305.14325
[44] Edelman, B., & Larkin, I. (2015). 職場階層全体における社会的比較と欺瞞:フィールドおよび実験的証拠。Organization Science, 26(1), 78–98. DOI 10.1287/orsc.2014.0938; SSRN abstract_id=1346397; HBS WP 09-096 (2009年以来流通)
[45] Eisenberg, T. (2006). SSRNベースのロースクール・ランキング評価。Indiana Law Journal, 81(1), 285–291. https://www.repository.law.indiana.edu/ilj/vol81/iss1/13/
[46] Elsevier (2016, May). 「エルゼビア社会科学研究ネットワーク(SSRN)を買収」。PR Newswire. https://www.prnewswire.com/news-releases/elsevier-acquires-the-social-science-research-network-ssrn-the-leading-social-science-and-humanities-repository-and-online-community-579752311.html (also LSE Impact Blog, 18 May 2016)
[47] Elsevier Digital Commons. 「SSRN Research Paper Series Sunset — DC Options」https://digitalcommons.elsevier.com/en_US/integration-preservation/ssrn-research-paper-series-sunset-dc-options
[48] Elsevier. 「SSRN First Look」(product page). https://www.elsevier.com/products/ssrn-preprint-services/first-look
[49] Elsevier. 「SSRN for Authors and Researchers」(product page). https://www.elsevier.com/products/ssrn-preprint-services/author-researchers
[50] Elsevier/SSRN Support. 「研究者が論文の影響を測定するにはどうすればよいか?」https://www.elsevier.support/ssrn/answer/gauge-impact (2026年8月14日にアクセス)
[51] Elsevier/SSRN Support. 「SSRNのRSSおよびデータフィードとは」https://www.elsevier.support/ssrn/answer/what-are-rss-and-data-feeds-on-ssrn
[52] Elsevier/SSRN Support. 「SSRNとは?」https://www.elsevier.support/ssrn/answer/what-is-ssrn (2026年8月14日にアクセス)
[53] Elsevier/SSRN Support. 分類と配布. https://www.elsevier.support/ssrn/answer/classification-distribution (2026年8月14日にアクセス)
[54] Elsevier/SSRN Support. 生成AI政策. https://www.elsevier.support/ssrn/answer/AI (2026年8月14日にアクセス)
[55] Elsevier/SSRN Support. Google / Google Scholarインデックス. https://www.elsevier.support/ssrn/answer/google-scholar (2026年8月14日にアクセス)
[56] Elsevier/SSRN Support. 投稿ガイドライン/開始方法. https://www.elsevier.support/ssrn/answer/get-started (2026年8月14日にアクセス)
[57] Elsevier/SSRN Support. サブスクリプション (eJournalメーリング). https://www.elsevier.support/ssrn/answer/subscriptions ; また https://www.ssrn.com/index.cfm/en/subscribe/
[58] Espeland, W. N., & Sauder, M. (2007). Rankings and reactivity: How public measures recreate social worlds. American Journal of Sociology, 113(1), 1–40. DOI 10.1086/517897
[59] Eysenbach, G. (2006). Citation Advantage of Open Access Articles. PLoS Biology, 4(5), e157. DOI 10.1371/journal.pbio.0040157
[60] Farys, R., & Wolbring, T. (2021). Matthew effects in science and the serial diffusion of ideas. Quantitative Science Studies, 2(2), 505–526. DOI 10.1162/qss_a_00129
[61] Fernández-Ramos, A., Comas-Forgas, R., & Rodríguez-Bravo, B. (2026). Identifying academic spam and recommendations for dealing with it: a literature review. European Science Editing, 52, e174423. DOI 10.3897/ese.2026.e174423 (2026年5月8日に公表)
[62] Fraser, N., et al. (2020). The relationship between bioRxiv preprints, citations and altmetrics. Quantitative Science Studies, 1(2), 618–638. DOI 10.1162/qss_a_00043
[63] Fung, A., Razi, B., Basto, C., Bariol, S., Hossack, T., Baskaranathan, S., Ende, D., & Woo, H. (2026). Trust, but Verify: An Exploratory Audit of Predatory Journal and Publisher Solicitations. ANZ Journal of Surgery. DOI 10.1111/ans.70568
[64] Giannakakos, V., et al. (2025). Impact of author characteristics on outcomes of single- versus double-blind peer review: a systematic review of comparative studies in scientific abstracts and publications. Scientometrics, 130, 399–421. DOI 10.1007/s11192-024-05213-x
[65] Ginsparg, P. (2011). ArXiv at 20. Nature, 476(7359), 145–147. https://www.nature.com/articles/476145a
[66] Goldman, E. 「SSRN Download Statistics」(2005), https://personal.ericgoldman.org/ssrn_and_downlo/ ; 「SSRN更新情報」https://personal.ericgoldman.org/update_on_ssrn/
[67] Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. In Papers in Monetary Economics, Vol. I. Sydney: Reserve Bank of Australia. Reprinted in C. A. E. Goodhart (1984), Monetary Theory and Practice: The U.K. Experience (ch. 4). London: Macmillan. DOI 10.1007/978-1-349-17295-5_4
[68] Gordon, G. J. (2016). The Digital Lawyer's Evolving Education in Scholarly Research. SSRN abstract_id=2754647
[69] Gordon, G., Lin, J., Cave, R., & Dandrea, R. (2015). The Question of Data Integrity in Article-Level Metrics. PLOS Biology. https://pmc.ncbi.nlm.nih.gov/articles/PMC4546647/
[70] Grossman, R., Liu, S., Chen, M. K., Smith, M., Borcea, C., & Chen, Y. (2026). How Generative AI Disrupts Search: An Empirical Study of Google Search, Gemini, and AI Overviews. arXiv:2604.27790. https://arxiv.org/abs/2604.27790
[71] Guerrero-Bote, V. P., & Moya-Anegón, F. (2014). Relationship between downloads and citations at journal and paper levels, and the influence of language. Scientometrics. DOI 10.1007/s11192-014-1243-5
[72] Haque, A., & Ginsparg, P. (2009). Positional effects on citation and readership in arXiv. JASIST, 60(11), 2203–2218. DOI 10.1002/asi.21166
[73] Haque, A., & Ginsparg, P. (2010). Last but not least: Additional positional effects on citation and readership in arXiv. JASIST, 61(12), 2381–2388. DOI 10.1002/asi.21428; arXiv:1010.2757
[74] Haustein, S., Costas, R., & Larivière, V. (2015). Characterizing social media metrics of scholarly papers. PLOS ONE, 10(3), e0120495. DOI 10.1371/journal.pone.0120495
[75] Haustein, S., Bowman, T. D., Holmberg, K., Tsou, A., Sugimoto, C. R., & Larivière, V. (2016). Tweets as impact indicators: Examining the implications of automated "bot" accounts on Twitter. JASIST, 67(1), 232–238. DOI 10.1002/asi.23456
[76] Haustein, S., Bowman, T. D., & Costas, R. (2016). Interpreting "altmetrics": viewing acts on social media through the lens of citation and social theories. In: Theories of Informetrics and Scholarly Communication (De Gruyter Mouton), 372–405; arXiv:1502.05701
[77] Heald, P. J., & Sichelman, T. (2019). Ranking the Academic Impact of 100 American Law Schools. Jurimetrics, 60(1), 1–39 (Fall 2019). SSRN abstract_id=3483325
[78] Hicks, D., Wouters, P., Waltman, L., de Rijcke, S., & Rafols, I. (2015). Bibliometrics: The Leiden Manifesto for research metrics. Nature, 520(7548), 429–431. DOI 10.1038/520429a. https://www.nature.com/articles/520429a
[79] Hirsch, J. E. (2005). An index to quantify an individual's scientific research output. PNAS, 102(46), 16569–16572.
[80] Hu, B., et al. (2021). On the relationship between download and citation counts: An introduction of Granger-causality inference. Journal of Informetrics, 15(2), 101125. DOI 10.1016/j.joi.2020.101125
[81] iThenticate/Turnitin. ガイド: 「類似性レポートを理解する」; 「プレプリント」。 https://guides.ithenticate.com/hc/en-us/articles/27842305774605 ; https://guides.ithenticate.com/hc/en-us/articles/27848481223693-Preprints
[82] Jaźwińska, K., & Chandrasekar, A. (2025, March 6). AI検索には引用の問題があります。 Columbia Journalism Review / Tow Center. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[83] Jo, W., & Li, J. (2026). AIは知識拡散における評判プレミアムを削減できるか?SSRNマーケティング作業論文からの証拠。Marketing Letters, 37, Article 32. DOI 10.1007/s11002-026-09827-4
[84] Justin, G. A., et al. (2024). 眼科学における略奪的ジャーナルからの勧誘分析。American Journal of Ophthalmology. PMC11257792; https://www.ajo.com/article/S0002-9394(24)00087-4/abstract — 「1813通のメール」という数字の出所
[85] Kakushadze, Z. (2016). SSRNダウンロードのインデックス。Journal of Informetrics, 10(1), 9–28. DOI 10.1016/j.joi.2015.11.005; arXiv:1511.04275; SSRN 2656600
[86] Kim, Heekyung Hellen (2014). オープンアクセスの効果(AEA会議2014)。https://www.aeaweb.org/conference/2014/retrieve.php?pdfid=58
[87] Kim, T., Bock, K., Luo, C., Liswood, A., Poroslay, C., & Wenger, E. (2025). スクレーパーはrobots.txtディレクティブを選別的に尊重します:大規模実証研究からの証拠。Proceedings of the ACM Internet Measurement Conference (IMC '25). DOI 10.1145/3730567.3764471
[88] Kleinberg, J., Ludwig, J., Mullainathan, S., & Obermeyer, Z. (2015). 予測政策問題。American Economic Review, 105(5), 491–495. DOI 10.1257/aer.p20151023
[89] Kozak, M., Iefremova, O., & Hartley, J. (2016). 学術出版におけるスパム:ケーススタディ。JASIST, 67(8), 2009–2015. DOI 10.1002/asi.23521
[90] Kraker, P., & Lex, E. (2015). 科学的評判の指標としてのResearchGateスコアに対する批判的考察。ASCW'15(ウェブ上の学術コミュニケーションの定量化と分析)で発表、Web Science Conference 2015、オックスフォード。http://ascw.know-center.tugraz.at/2015/05/26/kraker-lex-a-critical-look-at-the-researchgate-score/ (一般向けバージョン:「ResearchGateスコア:悪いメトリクスの好例」、LSE Impact Blog、2015年12月9日)
[91] Kurtz, M. J., et al. (2005). 論文閲覧情報の書誌メトリクス特性。JASIST, 56(2), 111–128. DOI 10.1002/asi.20096
[92] Kurtz, M. J., & Bollen, J. (2010). 利用書誌計量学。Annual Review of Information Science and Technology, 44(1), 3–64. DOI 10.1002/aris.2010.1440440108
[93] Langham-Putrow, A., et al. (2021). オープンアクセス引用優位は実在するのか?オープンアクセスと購読ベース論文の引用に関する体系的レビュー。PLOS ONE, 16(6), e0253129. DOI 10.1371/journal.pone.0253129
[94] Larivière, V., Haustein, S., & Mongeon, P. (2015). デジタル時代における学術出版の寡占。PLOS ONE, 10(6), e0127502. DOI 10.1371/journal.pone.0127502
[95] Legal Writing Institute. 「出版のヒント」(PDF)。https://www.lwionline.org/sites/default/files/Publishing-Tips.pdf
[96] Lewinski, A. A., & Oermann, M. H. (2018). 略奪的看護ジャーナルおよび出版社からのメール勧誘の特性。The Journal of Continuing Education in Nursing, 49(4), 171–177. DOI 10.3928/00220124-20180320-07
[97] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT検出器は非ネイティブ英語話者に対して偏りがあります。Patterns, 4(7), 100779. DOI 10.1016/j.patter.2023.100779
[98] Lloyd, T. (2026, May 7). ゲストポスト — 愛、死、ロボット:学術版。The Scholarly Kitchen. https://scholarlykitchen.sspnet.org/2026/05/07/guest-post-love-death-robots-scholarly-edition/
[99] LogEc / RePEc. LogEcについて(トラフィックフィルタリング方法論)。https://logec.repec.org/about.htm ; https://logec.repec.org/
[100] Martinez, O. (2026). 生成エンジンでの可視性の最適化:生成エンジン最適化の批判的調査(2023–2026)。arXiv:2607.14035 (2026年7月15日提出)。https://arxiv.org/abs/2607.14035
[101] Maynooth University News (2026, January). 「Maynooth大学法律・犯罪学部が社会科学研究ネットワークで第一位…」。https://www.maynoothuniversity.ie/news-events/maynooth-university-s-school-law-and-criminology-ranks-first-social-science-research-networks-2
[102] McGillivray, B., & Astell, M. (2019). オープンアクセスメガジャーナルの利用と引用の関係。Scientometrics, 121, 817–838. DOI 10.1007/s11192-019-03228-3
[103] Medoff, M. H. (2006). ハーバードとシカゴのマティー効果の証拠。Journal of Economic Methodology, 13(4), 485–506. DOI 10.1080/13501780601049079
[104] Merton, R. K. (1968). 科学におけるマティー効果。Science, 159(3810), 56–63. DOI 10.1126/science.159.3810.56
[105] Merton, R. K. (1988). 科学におけるマティー効果、II:累積的優位と知的財産権の象徴主義。Isis, 79(4), 606–623. DOI 10.1086/354848
[106] Microsoft Learn. 「Microsoft Defender for Office 365のセーフリンク」。https://learn.microsoft.com/en-us/defender-office-365/safe-links-about (+ UrlClickEventsのクリックに関するMicrosoft Q&A; + 誤ったオープンに関するSuped)
[107] Milanovic, M. EJIL:Talk! 「学術スパム[更新版]」。https://www.ejiltalk.org/academic-spam/
[108] Moed, H. F., & Halevi, G. (2016). 学術雑誌の全文ダウンロードと引用分布について。JASIST, 67(2), 412–431. DOI 10.1002/asi.23405
[109] Moed, H. F. (2017). 応用評価インフォメトリクス。Springer. DOI 10.1007/978-3-319-60522-7
[110] Moher, D., et al. (2018). 採用、昇進、終身在職権のための科学者の評価。PLoS Biology, 16(3), e2004089. DOI 10.1371/journal.pbio.2004089
[111] Morgan, A. C., et al. (2018). 声望は科学的思想の拡散における認識不等式を駆り立てます。EPJ Data Science, 7:40. DOI 10.1140/epjds/s13688-018-0166-4
[112] Muchnik, L., Aral, S., & Taylor, S. J. (2013). 社会的影響バイアス:ランダム化実験。Science, 341(6146), 647–651. DOI 10.1126/science.1240466
[113] Muller, J. Z. (2018). メトリクスの専制。プリンストン、NJ:プリンストン大学出版局。ISBN 978-0-691-17495-2.
[114] Nature Neuroscience、編集(2008)。https://www.nature.com/articles/nn0608-619
[115] Northwestern大学LibGuides(研究評価/メトリクス)。https://libguides.northwestern.edu/c.php?g=1372178&p=10205721
[116] Ohm, P. (2007). ブログはSSRNダウンロードに影響を与えるか?VolokhおよびSlashdot効果の実証的検証。U. Colorado Law Legal Studies Research Paper No. 07-15. https://ssrn.com/abstract=980484
[117] Pace Law Library. 「出版を取得 — 法律評論編集委員向けガイド」。https://libraryguides.law.pace.edu/lawreviews/publishing
[118] Paperpile. 「良いh指数とは何か?」https://paperpile.com/g/what-is-a-good-h-index/ (同様のガイド:Elsevier、Researcher.Life、Academia Insider)
[119] Perneger, T. V. (2004). オンライン「ヒット数」と後続引用の関係:BMJの研究論文の前向き研究。BMJ, 329(7465), 546–547. DOI 10.1136/bmj.329.7465.546
[120] Petersen, A. M., et al. (2014). 学術キャリアにおける評判と影響。PNAS, 111(43), 15316–15321. DOI 10.1073/pnas.1323111111
[121] Pew Research Center (2026, June 17). Americans and AI 2026: Chatbots, Smart Devices and AI's Impact. https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
[122] Piwowar, H. (2013). Altmetrics: Value all research products. Nature, 493(7431), 159. https://www.nature.com/articles/493159a
[123] Priem, J., Taraborelli, D., Groth, P., & Neylon, C. (2010). Altmetrics: A manifesto. http://altmetrics.org/manifesto/ (アーカイブコピーはweb.archive.orgにあります)
[124] Priem, J., Piwowar, H., & Orr, R. (2022). OpenAlex: A fully-open index of scholarly works, authors, venues, institutions, and concepts. arXiv:2205.01833. DOI 10.48550/arXiv.2205.01833
[125] Project COUNTER (2026). COUNTER Code of Practice, Release 5.1.1. 2026年6月30日に公開されました(Release 5.1は2023年5月5日に公開)。https://www.countermetrics.org/ ; "Best Practice on AI Usage" (R5.1.1のガイダンス、2026年6月30日更新), https://www.countermetrics.org/code-of-practice/best-practice/bp-ai/
[126] Quora. "To what extent would you recommend or discourage publishing an academic working paper on SSRN…". https://www.quora.com/To-what-extent-would-you-recommend-or-discourage-publishing-an-academic-working-paper-on-SSRN-to-claim-and-put-a-stake-in-the-ground-e-g-before-any-journal-submission
[127] Reddit r/AskAcademia (2023, August 10). スレッド15newc2「数ヶ月前に論文を公開して以来、終わりのないスパムが続いている」。https://www.reddit.com/r/AskAcademia/comments/15newc2/ (pullpush.ioアーカイブで確認)
[128] Remler, D. (2014, April 23). 学術論文の90%は本当に引用されないのか?学術引用に関する文献のレビュー。LSE Impact Blog. https://blogs.lse.ac.uk/impactofsocialsciences/2014/04/23/academic-papers-citation-rates-remler/
[129] RePEc Blog: 「RecePがビューとダウンロードをカウントする方法」(06.11.2021), https://blog.repec.org/2021/11/06/how-repec-counts-views-and-downloads/ ; 「RePerのAIの問題」(10.11.2025), https://blog.repec.org/2025/11/10/ai-issues-in-repec/ ; 「2026年6月のRecePec」(13.07.2026), https://blog.repec.org/2026/07/13/repec-in-june-2026/
[130] ResearchGate (2022, August). 「RG スコアを削除する」。https://www.researchgate.net/researchgate-updates/removing-the-rg-score
[131] Salganik, M. J., Dodds, P. S., & Watts, D. J. (2006). 人工文化市場における不平等と予測不可能性の実験的研究。Science, 311, 854–856. DOI 10.1126/science.1121066
[132] Sauder, M., & Espeland, W. N. (2009). ランキングの規律:密接な結合と組織変化。American Sociological Review, 74(1), 63–82. DOI 10.1177/000312240907400104
[133] Schein, A. I., Popescul, A., Ungar, L. H., & Pennock, D. M. (2002). コールドスタート推奨のメソッドとメトリクス。第25回 ACM SIGIR国際情報検索研究開発会議(SIGIR '02)の議事録, 253–260. DOI 10.1145/564376.564421
[134] Schumann, E. SSRN Rパッケージ。https://github.com/enricoschumann/SSRN (他のスクレーパー github.com/talsan/ssrn, github.com/karthiktadepalli1/ssrn-scraper)
[135] Shearer, K., & Walk, P. (2025, June 3). AIボットとクローラーがオープンリポジトリに及ぼす影響:COAR調査の結果、2025年4月。Confederation of Open Access Repositories. https://coar-repositories.org/wp-content/uploads/2025/06/Report-of-the-COAR-Survey-on-AI-Bots-June-2025-1.pdf
[136] Shen, C., & Björk, B.-C. (2015). 「掠奪的」オープンアクセス:記事数と市場特性の縦断研究。BMC Medicine, 13, 230. DOI 10.1186/s12916-015-0469-2
[137] Shepherd, P. T. (2007). ジャーナル利用要因の開発と実装の実現可能性:UKSGが支援する研究プロジェクト。Serials: The Journal for the Serials Community, 20(2), 117–123. DOI 10.1629/20117
[138] Shuai, X., Pepe, A., & Bollen, J. (2012). 科学コミュニティが新たに投稿されたプレプリントにどのように反応するか。PLOS ONE, 7(11), e47523. DOI 10.1371/journal.pone.0047523
[139] Siems, M. M. (2016). 注目を求める法学研究:定量的評価。King's Law Journal, 27(2), 170–187. DOI 10.1080/09615768.2015.1105560. ワーキングペーパー版:「SSRNダウンロード数を決定するもの」、SSRN abstract_id=2836950; Durham: https://durham-repository.worktribe.com/OutputFile/1387250
[140] Simcoe, T. S., & Waguespack, D. M. (2011). ステータス、品質、注目:(欠落している)名前に何が含まれているか?Management Science, 57(2), 274–290. DOI 10.1287/mnsc.1100.1270
[141] Simon, H. A. (1971). 情報に満ちた世界のための組織の設計。M. Greenberger (編), Computers, Communications, and the Public Interest (pp. 37–72). Johns Hopkins Press.
[142] Soler, J., & Cooper, A. (2019). 仕事を提出するための予期しないメール:スパムか正当なオファーか?Publications, 7(1), 7. DOI 10.3390/publications7010007
[143] SSRN (2018, April 13). eLibrary統計の発表。https://www.ssrn.com/index.cfm/en/fen/ads/04132018ann014/
[144] SSRN Blog (2018, June 5). データインテグリティについてSSRNが話すときの意味。https://blog.ssrn.com/2018/06/05/what-ssrn-means-when-we-talk-about-data-integrity/
[145] SSRN Blog (2025, December 16). 2025年の年間総括:SSRNがプレプリントと初期段階の研究へのアクセスをどのように改善したか。https://blog.ssrn.com/2025/12/16/2025-year-in-review-how-ssrn-enhanced-access-to-preprints-and-early-stage-research/
[146] SSRN Blog (2026, April 13). SSRN戦略アップデート:コア研究共有ミッションへの焦点の更新(投稿者:S. Decker-Lucke)。https://blog.ssrn.com/2026/04/13/ssrn-strategic-update-renewed-focus-on-core-research-sharing-mission/
[147] SSRN Blog (2026, June 4). 法学奨学金に対するSSRNの継続的なコミットメント。https://blog.ssrn.com/2026/06/04/ssrns-ongoing-commitment-to-legal-scholarship/
[148] SSRN Blog (2026, June 12). SSRNは2026年7月1日からランキングを廃止します。https://blog.ssrn.com/2026/06/12/ssrn-to-sunset-rankings-from-july-1st-2026/
[149] SSRN Blog (2026, July 15). SSRNランキングは2026年7月15日をもって廃止されました。https://blog.ssrn.com/2026/07/15/ssrn-to-sunset-rankings-from-15th-july-2026/
[150] SSRN Blog (2026, July 20). SSRNは現在、あなたの作品に適切なライセンスを選択できるようにしています。https://blog.ssrn.com/2026/07/20/ssrn-will-now-allow-you-to-choose-the-licence-thats-right-for-your-work/
[151] SSRN. 歴史的FAQ(PDFコピー、Scuola Superiore Sant'Anna)。https://www.sssup.it/UploadDocs/4461_SSRN_FAQ.pdf
[152] SSRN. サブスクリプションページ。https://www.ssrn.com/index.cfm/en/subscribe/
[153] Sugimoto, C. R., & Larivière, V. (2018). 研究の測定:誰もが知る必要があること。Oxford University Press. ISBN 9780190640118
[154] Sun, M., Barry Danfa, J., & Teplitskiy, M. (2022). ダブルブラインド査読はバイアスを減らすか?トップコンピュータサイエンス会議からの証拠。JASIST, 73(6), 811–819. DOI 10.1002/asi.24582 (Crossrefによる第2著者の姓: "Barry Danfa")
[155] Sureda-Negre, J., Calvo-Sastre, A., & Comas-Forgas, R. (2022). 掠奪的ジャーナルと出版社:教育科学の研究者に対するアカデミックスパムの特性と影響。Learned Publishing, 35(4), 441–447. DOI 10.1002/leap.1450
[156] TaxProf Blog (Caron, P.): 「SSRNのeジャーナルランキング(論文あたりの平均ダウンロード数)」(2018年5月)、https://taxprof.typepad.com/taxprof_blog/2018/05/ssrn-e-journal-rankings-by-average-downloads-per-paper.html ; 「SSRNは評判を失っていない」(07.06.2026)、https://taxprofblog.aals.org/2026/06/07/
[157] Teixeira da Silva, J. A., Tsigaris, P., & Moussa, S. (2023). AIは掠奪的ジャーナルを検出できるか?FT50ジャーナルの場合。SSRN abstract_id=4391108. DOI 10.2139/ssrn.4391108
[158] Thales / Imperva (2025). 2025年Imperva不正ボットレポート。https://cpl.thalesgroup.com/about-us/newsroom/2025-imperva-bad-bot-report-ai-internet-traffic
[159] Think. Check. Submit. (2022年2月4日)。「ジャーナルはあなたのプレプリントに関心がありますか?ジャーナルの投稿勧誘で質の高い論文を選別する」。https://thinkchecksubmit.org/2022/02/04/is-a-journal-interested-in-your-preprint-separating-the-wheat-from-the-chaff-in-journal-solicitations-to-submit/
[160] Tomlinson, O. W. (2023). キャリア初期の研究者への掠奪的メール分析と予防の試み。Learned Publishing, 36(2), 156–163. DOI 10.1002/leap.1500
[161] University of Washington Gallagher Law Library. LibGuide「SSRNメトリクス」(2025年9月29日更新)。https://lib.law.uw.edu/c.php?g=1238218&p=9061272 (+ eジャーナルについてはp=9061269ページ)
[162] van de Rijt, A., et al. (2014). 成功が成功をもたらす動学の現地実験。PNAS, 111(19), 6934–6939. DOI 10.1073/pnas.1316836111
[163] Vanderbilt University, Brightspace (Teaching Center / Office of Innovative Technologies) (2023). AI検出に関するガイダンスおよびTurnitinのAI検出器を無効にしている理由。2023年8月16日公開。https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/ (2026年8月15日アクセス)。
[164] Vishwakarma, R., Kumar, A., & Jamidar, S. (2026). 引用されるもの:AI回答エンジンにおける競争的GEO。SIGIR '26, 4950–4954. DOI 10.1145/3805712.3808445; arXiv:2605.25517
[165] Wallace, K. L., Hartley, M., & Lepird, C. (2023). ドレーク農業法ジャーナルの拡大:グリーン号。Drake Journal of Agricultural Law, 28, 114–127. https://aglawjournal.wp.drake.edu/wp-content/uploads/sites/66/2023/07/Wallace-Ready-for-PRODUCTION.pdf
[166] Wang, J., Veugelers, R., & Stephan, P. (2017). 科学における新規性への偏見。Research Policy, 46(8), 1416–1436. DOI 10.1016/j.respol.2017.06.006
[167] Weinberg, M. (2025年6月)。AIボットが文化遺産をオフラインにしているのか?GLAM-E Lab (NYU Engelberg Center / University of Exeter)。https://www.glamelab.org/files/Are_AI_Bots_Knocking_Cultural_Heritage_Offline.pdf
[168] Whalen, R. (2018年5月3日)。SSRNのeジャーナルとダウンロード数。https://ryanwhalen.com/2018/05/03/ssrn-e-journals-and-downloads/
[169] Wherry, J. L. (2022). 配布、議論、ダウンロードの改善ツール…SSRN abstract_id=4191909. DOI 10.2139/ssrn.4191909 (U. Detroit Mercy Law Reviewに掲載)
[170] Wikipedia:「Social Science Research Network」;「学術ジャーナルのプレプリント方針一覧」;「プレプリント」。https://en.wikipedia.org/wiki/Social_Science_Research_Network および関連ページ。
[171] Willey, R., & Knapp, M. (2021). 法律学奨学金への引用を増やす方法。Ohio State Technology Law Journal, 18. SSRN 3801190; PDF: https://moritzlaw.osu.edu/sites/default/files/2022-01/HOW%20TO%20INCREASE%20CITATIONS%20TO%20LEGAL.pdf
[172] Willey, R., & Knapp, M. (2022/2023). SSRNが法律学奨学金への引用に与える影響とそれを最大化する方法。University of Arkansas at Little Rock Law Review, 45(3), 475–507. SSRN abstract_id=4037744; https://research.ualr.edu/bowen_lawreview/vol45/iss3/2/
[173] Wilsdon, J., et al. (2015). メトリクスの潮流:研究評価および管理におけるメトリクスの役割に関する独立レビュー報告書。HEFCE. DOI 10.13140/RG.2.1.4929.1363. https://doi.org/10.13140/RG.2.1.4929.1363
[174] Wilson, P. (2022). 勧誘されていない勧誘:潜在的に掠奪的ジャーナルからの勧誘メールの特性の特定と図書館司書の役割。Journal of the Medical Library Association, 110(4), 520–524. DOI 10.5195/jmla.2022.1554; PMC10124592. https://pmc.ncbi.nlm.nih.gov/articles/PMC10124592/
[175] WisBlawg, UW–Madison Law Library (2016年9月21日)。「どの法律論文がSSRN上で最も注目を集めるか」。https://wisblawg.law.wisc.edu/2016/09/21/which-legal-articles-generate-the-most-attention-on-ssrn
[176] Wood-Doughty, A., Bergstrom, T., & Steigerwald, D. G. (2019). ダウンロードレポートはジャーナル利用状況を確実に測定するか?College & Research Libraries, 80(5). https://crl.acrl.org/index.php/crl/article/view/17824/19653
[177] Wouters, P., & Costas, R. (2012). ユーザー、ナルシシズム、統制―21世紀の学術出版の影響を追跡する。SURF Foundation, Utrecht. https://www.cni.org/news/surf-report-users-narcissism-and-control
[178] Yuret, T. (2026). 論文アクセス:引用へのリンク、週末効果、季節性。Scientometrics (2026年7月23日公開)。DOI 10.1007/s11192-026-05710-1
[179] Zahedi, Z., Costas, R., & Wouters, P. (2017). 高引用論文を識別するためのフィルタリングツールとしてのMendeley読者数。Journal of the Association for Information Science and Technology, 68(10), 2511–2521. DOI 10.1002/asi.23883
[180] Zhu, L., & Lerman, K. (2016). ソーシャルメディアにおける注目の不平等。arXiv:1601.07200
[181] Sinatra, R., Wang, D., Deville, P., Song, C., & Barabási, A.-L. (2016). 個別科学的影響の進化を定量化する。Science, 354(6312), aaf5239. DOI 10.1126/science.aaf5239
[182] Radicchi, F., Fortunato, S., & Castellano, C. (2008). 引用分布の普遍性:科学的影響の客観的測定に向けて。PNAS, 105(45), 17268–17272. DOI 10.1073/pnas.0806977105
[183] CoARA (2022). 研究評価改革協定。Coalition for Advancing Research Assessment。https://coara.eu/agreement/the-agreement-full-text/
[184] Curry, S., Gadd, E., & Wilsdon, J. (2022). メトリクスの潮流の活用:英国の責任ある研究評価のためのインディケータ、インフラストラクチャ、優先事項。Research on Research Institute. https://doi.org/10.6084/m9.figshare.21701624
[185] IRUS (Jisc). リポジトリの標準化された COUNTER 準拠の利用統計。https://irus.jisc.ac.uk
[186] UK Research and Innovation (2024). 研究イノベーション概要 (R4RI): ガイダンス。https://www.ukri.org/apply-for-funding/develop-your-application/resume-for-research-and-innovation-r4ri-guidance/
[187] Overton. 政策インテリジェンスツール。https://www.overton.io
[188] CC-PLUS. ライブラリ利用統計プラットフォームで協力するコンソーシア (オープンソース SUSHI/COUNTER-5 収集; IMLS 資金、PALCI など)。https://www.cc-plus.org/
[189] HELIOS Open. 高等教育オープン奨学リーダーシップイニシアティブ。https://www.heliosopen.org/
追加の資料
テキスト内で[B-n]として引用されている追加資料:プラットフォームページ、フォーラムスレッド、ブログ投稿、およびテキスト内の特定のポイントを支持するその他の資料。プラットフォームページは不安定であり、アーカイブされたコピーに対して再確認する必要があります。
[B-1] Cabells Predatory Reports(能動的な略奪的ジャーナルスクリーニングサービス);Beall's List(アーカイブのみ;2017年1月以降更新されていません)。
[B-2] Caron, P. TaxProf Blog (2026, January 25). "The SSRN Top Five New Tax Papers Ranking Is Broken". https://taxprofblog.aals.org/2026/01/25/the-ssrn-top-five-new-tax-papers-ranking-is-broken/
[B-3] EconJobRumors(EJMR)、SSRNダウンロードと著者ランキングに関するディスカッションスレッド(例:/topic/ssrn-downloads-and-views;/topic/top-10-of-authors-on-ssrn-by-downloads)。匿名フォーラム;そのような議論が存在することの証拠としてのみ引用。
[B-4] de Leon, F. L. L., & McQuillin, B. (2020). The Role of Conferences on the Pathway to Academic Impact. Journal of Human Resources, 55(1), 164. https://jhr.uwpress.org/content/55/1/164
[B-5] Reddit r/AskAcademia, thread 1seeyq3 (6 Apr 2026, "I've uploaded a working paper to SSRN… honest advice");Reddit r/academia, thread 13w6zjw (31 May 2023, "SSRN Approval Time is Absurd")。存在はサードパーティのRedditアーカイブで確認されました。
[B-6] SSRN—アナウンスメントの統計的ボイラープレート(例:https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/)および2018年4月のアナウンスメント(04132018ann002)。プラットフォームページ;アーカイブされたコピーに対して確認してください。アーカイブされたコピー:https://web.archive.org/web/20251229194317/https://www.ssrn.com/index.cfm/en/ern/ads/06042025ann001/(スナップショット2025年12月29日;2026年8月15日アクセス)。
[B-7] SSRN FAQ—バージョニングおよびORCID。https://www.ssrn.com/index.cfm/en/faq/(2026年アクセス;アーカイブされたコピーに対して確認してください)。
[B-8] SSRN—「SSRN has Sunset Rankings」ランディングページ。https://www.ssrn.com/ssrn/rankings-sunset。アーカイブされたコピー:https://web.archive.org/web/20260719233259/https://www.ssrn.com/ssrn/rankings-sunset(スナップショット2026年7月19日;2026年8月15日アクセス)。
[B-9] SSRN—hq.ssrn.com / papers.ssrn.com/toptenの履歴ランキングページ:Top 10,000 Papers (TRN_gID=10)、Top 30,000 Authors (TRN_gID=7)、Top 3,000 Law Authors、Top 350 U.S. Law Schools、Top 500 International Law Schools、Eigenfactor、Recent Top Papers (60 days)、「Ranking Data Explained」(ranking_data_explain.cfm?id=6 / id=10)。履歴ページ;2026年7月15日以降、これらのURLは403/プレースホルダーレスポンスを返します—アーカイブされたコピーを介して引用してください。Top 10,000 Papersページのアーカイブされたコピー:https://web.archive.org/web/20260714112806/https://hq.ssrn.com/rankings/Ranking_display.cfm?TRN_gID=10(スナップショット2026年7月14日、サンセットの前日;2026年8月15日アクセス)。
[B-10] Teixeira da Silva, J. A. (2024/2025). Spam, unwanted or unsolicited emails following the publication of preprints (year-long observation: 875 invitations from 256 journals, 76% from blocklists). DOI 10.1080/10875301.2025.2550600; ResearchGate publication 384286174.
[B-11] Caron, P. TaxProf Blog (2026, June 7). "SSRN Has Not Jumped the Shark". https://taxprofblog.aals.org/2026/06/07/ssrn-has-not-jumped-the-shark/(Bainbridge [12]への返信;2026年9月アクセス)。
引用方法
Chernets, V. (2026). 7ダウンロードは何を意味するのか?メトリック盲目性とSSRNランキング終了後の学術的注目の冷たいスタート [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7296358
@misc{chernets2026downloadmetrics,
  author       = {Chernets, Vadym},
  title        = {{What Does 7 Downloads Mean? Metric Blindness and the Cold Start of Scholarly Attention After the SSRN Rankings Sunset}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7296358},
  url          = {https://doi.org/10.2139/ssrn.7296358}
}