여러 AI에게 동시에 질문하고 의견이 다른 부분 확인하기 — 도구
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
AI 한 개에 질문하면 자신감 있는 답변 하나를 얻지만 그것이 맞는지 알 수 있는 쉬운 방법이 없습니다. 두 번째, 세 번째 AI에 묻는 것이 도움이 되지만, 답변이 어디서 다른지 볼 수 있을 때만, 그리고 그들의 의견의 합의가 실제로 어느 정도 가치가 있는지 알 때만 도움이 됩니다. After Chat은 한 가지 질문을 여러 AI에 동시에 던지고 둘 다 수행하는 작은 무료 오픈소스 Python 스크립트 세트입니다. 누가 무엇을 말했는지 보여주고, 그들의 의견의 합의가 어느 정도 가치가 있는지 계산합니다. 이것은 당신의 컴퓨터에서 실행되며, 이미 로그인한 AI 도구를 통해 작동하고, API 키나 추가 구독이 필요 없으며, 스크립트 자체는 Python만 필요합니다.
하나의 AI로는 부족하고, 네 개의 AI가 네 개가 아닙니다
다양한 회사의 AI 모델들은 서로 다르게 학습되기 때문에 항상 같은 실수를 하지는 않습니다. 그래서 사람들은 하나의 질문을 ChatGPT, Claude, Gemini, Grok에 복사해서 답변을 손으로 비교합니다. 그들의 실수들은 보기보다 더 겹치곤 합니다. 350개 이상의 언어 모델을 조사한 2025년 연구에서 두 모델이 모두 틀렸을 때 같은 잘못된 답변을 주는 경우가 많다는 것을 발견했습니다: 한 리더보드 데이터셋에서는 60%의 경우였습니다. 따라서 네 개의 AI가 동의할 때 당신은 네 개 미만의 독립적인 확인을 가지게 됩니다. 여러 개를 묻는 것의 진정한 가치는 불일치입니다: 하나의 AI만 제기한 지점, 또는 다른 수치가 들어간 같은 주장입니다.
실제 사례
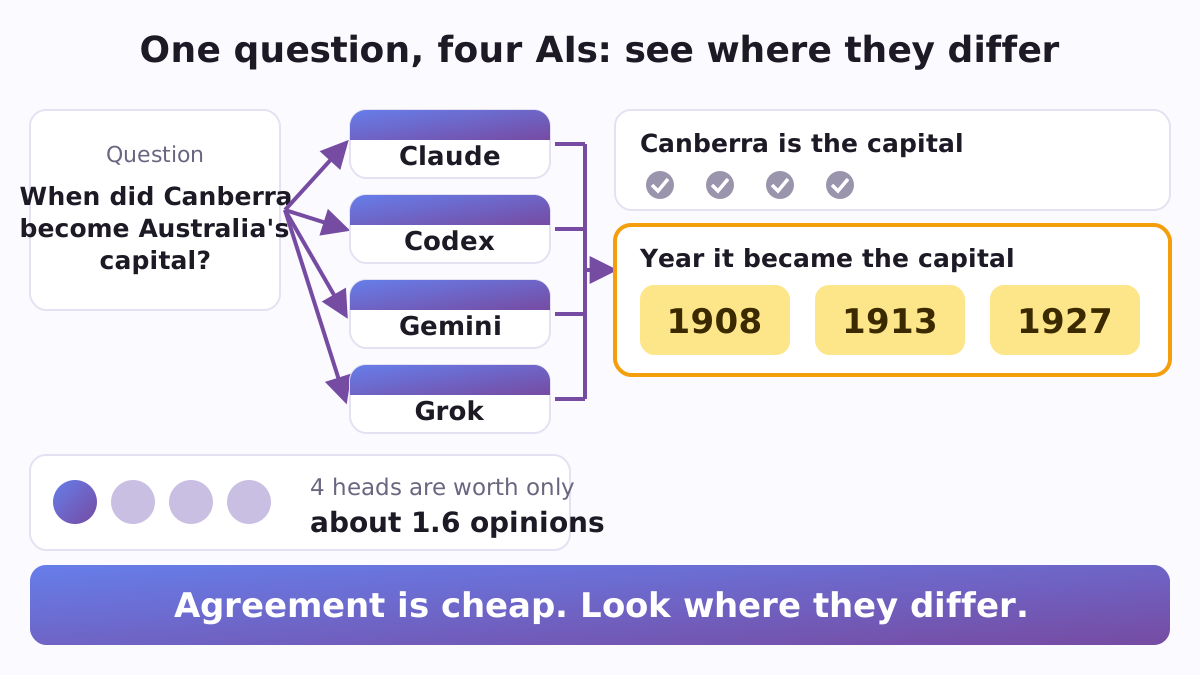
2026년 9월 21일에 저자는 네 개의 AI 명령줄 도구에 한 가지 질문을 제시했습니다: "한 문장으로: 호주의 수도는 무엇이며, 언제 수도가 되었습니까?" 네 도구 모두 25초 이내에 응답했으며, 모두 캔버라라고 답했습니다. 연도에 대해서는 세 가지로 나뉩니다: 1908년, 1913년, 1927년입니다. 각 연도는 방어할 수 있습니다: 부지는 1908년에 선택되었고, 도시는 1913년에 명명되었으며, 의회는 1927년에 그곳으로 이전했습니다. 단독으로 물어봤다면 Codex는 1927년을, Grok은 1913년을 각각 평범한 사실로 제시했을 것입니다. 나란히 놓으면, 그 답변들은 이 질문이 세 가지의 정당한 답변을 가지고 있음을 즉시 보여주었으며, 사람이 확인해야 할 정확한 지점을 가리켜 줍니다.
내부에 포함된 것
- 모두 한 번에 물어보기 (
fanout.py). 목록에 있는 각 AI 도구에 빠른 테스트 질문을 먼저 보내고 설치되지 않았거나 답변하지 않는 도구는 건너뜁니다. 그 다음 당신의 질문을 모든 작동 중인 도구에 동시에 보내며, 당신이 선택한 시간 제한 하에서 각 답변을 자체 파일로 스트리밍합니다. 시간이 끝났을 때 도구가 여전히 작성 중이면 지금까지 작성한 내용은 보관되고 불완전한 것으로 표시되며 버려지지 않습니다. 각 AI는 실행한 폴더가 아닌 자체의 빈 폴더에서 시작하므로 질문만으로 작동합니다. 모든 도구가 확인해야 할 텍스트 페이지 같은 긴 질문은--question-file을 사용하는 파일에 넣습니다. - 누가 무엇을 말했는지 보기 (
provenance.py). 모든 답변을 짧은 주장으로 나누고, 유사하게 표현된 주장들을 그룹화한 다음 하나의 표를 출력합니다: 각 주장과 그것을 만든 AI입니다. 표 아래에는 가장 중요한 두 목록이 옵니다: 오직 하나의 AI만 한 주장(다른 것들이 놓친 것, 또는 그것의 실수)과 AI들이 다른 숫자, 백분율 또는 날짜를 제시하는 주장들입니다. 텍스트 파일의 모든 폴더를 읽으므로 채팅 웹사이트의 답변을 파일에 붙여넣을 수도 있으며, AI당 하나씩, 비교할 수 있습니다. - 합의의 가치 알기 (
neff.py). 알려진 답변이 있는 몇 가지 질문을 제공하고, 각 AI에 대해 맞거나 틀린 것으로 표시하면, AI들이 함께 틀릴 빈도를 측정합니다. 이를 통해 실제로 얼마나 많은 독립적인 의견이 그 가치가 있는지 알아냅니다. 내장된 예제에서 실수가 겹치는 4개의 AI는 약 1.6개의 독립적인 의견의 가치가 있으며, 어떤 수의 그러한 AI도 2.1 이상이 될 수 없습니다. - Claude Code 내의 두 번째 의견 (
second-opinion/SKILL.md). 준비된 스킬: 폴더를~/.claude/skills/에 복사하면, Claude Code가 다른 회사의 AI에게 같은 질문을 하고, 그 답변을 정확히 그대로 보여주며, 두 의견이 일치하는 곳, 다른 곳, 그리고 오직 하나만 언급하는 곳의 짧은 표를 추가할 수 있습니다. 두 개를 하나의 확신 있는 텍스트로 혼합하지 않으며, 다른 AI의 답변을 비교할 자료로 취급하고 따를 지시사항으로 취급하지 않습니다. - AI 에이전트를 위한 안전한 설정 (
safety/). Claude Code의 권한 설정(settings.json)의 준비된 예제로, 모든 세션을 계획 모드에서 시작하고,rm -rf,sudo,curl,git push같은 명령어는 거부하며,.env파일과secrets폴더를 읽을 수 없게 유지하고,rm,mv, 웹 페칭 전에 묻습니다. Codex 설정은 작업 폴더 내에서만, 네트워크 없이 쓸 수 있도록 하고, 그 범위를 넘어가기 전에 묻도록 합니다. 14개 항목의 체크리스트는 이들을 둘러싼 습관을 다룹니다: 사본에서 작업하기, 먼저 계획 요청하기, 실행 취소 유지하기, 오래된 작업을 중지하는 방법 알기. - 연구자를 위한 도구 (
crossings.py,crossings.schema.json,jsonl_log.py). 사람들이 AI와의 채팅에서 AI 에이전트가 실제 작업을 하도록 하기까지의 이동 방식에 대한 연구를 위한 기록 형식이며, 엄격한 검사기가 포함되어 있습니다. 앱 설치는 사용으로 계산되지 않으며, 완료된 단계에는 에이전트가 실제로 만든 것이 필요하며, 누군가 멈출 때 기록은 그들의 자체 말을 유지합니다. 작은 로거는 거부된 계획이나 택한 두 번째 의견 같은 각 결정을 하나의 타임스탬프가 지정된 JSON 줄로 작성합니다.
왜 이렇게 구축되었는가
많은 "LLM 위원회" 도구들은 하나의 병합된 답변으로 끝납니다. 예를 들어, Andrej Karpathy의 인기 있는 llm-council은 OpenRouter라는 API 서비스를 통해 당신의 질문을 모델들에게 전송하며, 이 서비스에 대한 크레딧을 구매해야 하고, "의장" 모델이 최종 답변을 작성하게 합니다. After Chat은 당신이 이미 자신의 계정으로 사용하는 명령행 도구들을 거쳐 진행되며, 의도적으로 병합 전에 중단됩니다: 누가 무엇을 말했는지에 대한 표를 얻게 되고, 판단은 당신에게 남습니다. 모든 스크립트는 Python의 표준 라이브러리만 사용하며 하나의 짧은 파일에 맞습니다(가장 긴 파일은 200줄 미만이므로), 정확히 어떤 작업을 하는지 읽을 수 있고 이를 변경할 수 있습니다.
시작하는 방법
스크립트는 Python 3이 실행되는 모든 곳에서 실행됩니다. Windows에서는 WSL 내에서 fanout.py를 실행합니다. 실시간 비교에는 자신의 계정으로 로그인한 두 개 이상의 AI 명령줄 도구가 필요합니다. 기본 제공 목록에는 Claude Code(claude), OpenAI Codex(codex), Google의 Antigravity CLI(agy, 2026년 6월 18일에 개인 Google 계정에 대해 Gemini CLI에서 인수했음) 및 xAI의 Grok Build(grok)가 포함됩니다. 각 도구의 명령은 --tools와 함께 전달되는 작은 JSON 파일의 한 줄이므로 다른 도구를 추가하거나 새로운 버전에서 변경된 플래그를 따르는 것은 1분이면 됩니다. 명령줄 도구가 없으신가요? 모든 AI 채팅 웹사이트의 답변을 .txt 파일에 붙여넣고(AI마다 하나씩), 해당 폴더에서 provenance.py를 실행하면 각 파일의 이름이 표의 한 열이 됩니다.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
28개의 테스트는 python3 -m unittest tests/test_patterns.py로 실행됩니다. 코드, 테스트 및 안전 설정은 모두 github.com/vadimchernets/after-chat에 있습니다.
어디서 나왔는가
After Chat는 Vadym Chernets의 논문 After Chat: Non-Programmers와 Agentic AI 사이의 세 가지 전환(2026년 9월, SSRN 7520019, DOI 10.2139/ssrn.7520019)의 부수 코드입니다. 이 논문은 AI와의 대화에서 AI 에이전트가 일하도록 하는 단계로 옮겨간 사람들이 왜 이렇게 적은지, 그리고 그 이동을 어떻게 측정할 것인지를 묻습니다. 이 코드는 MIT 라이선스 아래에 있으며 Zenodo에 아카이브되어 있습니다(DOI 10.5281/zenodo.22944451). 동일한 패턴에서 나온 두 가지 즉시 사용 가능한 Claude Code 플러그인이 있습니다: Sidecall은 컴퓨터의 AI 명령줄 도구에 묻고, Roundcall은 자신의 브라우저를 통해 AI 채팅 사이트에 묻습니다.
Vadym Chernets는 또한 Poly A1을 개발합니다. 이것은 서로 다른 회사의 AI들이 서로의 작업을 검증하는 앱입니다.