Verification Theater: AI Verifier Panels의 측정된 실패 모드
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
NeurIPS 2026 워크숍 "누가 에이전트를 검증하는가? 신뢰할 수 있는 에이전트 개발을 향하여"에 포스터로 수락됨 (비보존). 아카이브 사본: 10.5281/zenodo.23197641. PDF: verification-theater.pdf. 아래 그림 및 표는 LaTeX 소스에서 변환되었습니다. PDF가 권위 있는 버전입니다.
초록
다중 에이전트 검증이 기본 신뢰 메커니즘이 되고 있습니다: 독립적인 모델들이 동의했기 때문에 답변이 신뢰됩니다. 사전 등록되고 블라인드 처리된, 온도 영도의 수집에서 16개 모델(9개 최전선 벤더, 7개 로컬 오픈 웨이트)이 동일한 1,500개 사실 질문(및 750개 객관식 팔과 탐색적 대화 팔)에 답변한 결과를 통해, 우리는 패널 검증이 작동하지 않으면서 계속 작동하는 것처럼 보이는 시점을 측정합니다. 이 상태를 우리는 검증 연극이라고 부릅니다. 우리는 4가지 실패 체계를 보고합니다. 첫째, 어려움 반전입니다: 독립적 동의의 인증 향상—2.7–4.6 더 쉬운 3개 오분위수의 질문에—두 번째로 어려운 오분위수에서 0.82로 떨어지고 가장 어려운 질문에서는 0으로 떨어지며, 복제된 답변이 342개 중 0개 경우에서 올바랐습니다(독립 가정 하에 예상 13개). 패널 제외 재층화(비패널 13개 모델로 순위 매긴 어려움)는 풀링된 반전을 제거합니다(78/354 정답, 향상 2.36) 반면 영(0)은 블록 간 패널에서 지속됩니다(0/116); 우리는 전체에 걸쳐 두 가지 코딩을 함께 보고합니다: 배포된 모집단이 가장 어려워하는 질문에서 동의는 오류 인증으로 기능합니다. 둘째, 제한된 답변 공간입니다: 객관식 하에서(로컬 계층), 패널이 38.5%—질문의 4.0–7.9%에서 잘못된 답변을 만장일치로 인증했습니다. 동일 계층의 개방형 답변에서 1.5–4.6% 및 0.3–4.9% 최전선 개방형과 비교합니다. 셋째, 독립성의 프록시로 사용된 레이블이 실증적으로 실패합니다: 지정학적 블록이 오류 상관관계를 예측하지 않습니다(평균 블록 내 0.285 대 블록 간 0.274, 차이 ), 동일한 기반에서 증류된 추론 모델이 패널 동료와 측정된 최소 상관 쌍 중 하나였습니다(; 미국/중국 블록 로컬 쌍 15개 중 14번째, 모든 21개 로컬 쌍 중 20번째). 넷째, 순응입니다: 답변에 동의하지 않았던 검증자가 동료의 것으로 표시되었을 때 동일한 답변을 맹목적으로 동의한 경우는 38.5%입니다; 역방향 프롬프트 대조는 이러한 변화가 자신감 있는 제안의 존재를 추적함을 보여줍니다. 그 진실이 아니라(38.9% 잘못된 것으로 대 34.7% 올바른 것으로; McNemar 정확 ). 우리는 이러한 체계들이 경제적 근원을 공유하며 검증을 그 연극으로부터 분리하는 측정 훈련을 도출합니다.
소개: 극장 문제
AI 모델 패널이 서로를 검증하는 방식이 신뢰 인프라로 배포되고 있으며, 이들 간의 합의는 점점 더 증거로 가격이 책정되고 있습니다. 보안 연구는 오랫동안 실질 없이 보호의 외형만 제공하는 메커니즘에 대한 이름을 가지고 있습니다(Schneier, 2003). 우리는 은유가 아닌 측정을 통해 패널 검증이 그 이름을 얻을 때를 묻습니다. 핵심 발견은 역전입니다: 합의의 인증 가치는 쉬운 문제에 집중되어 있으며 검증이 가장 중요한 바로 그 지점에서 사라지거나—또는 역전됩니다. 우리는 이것을 단일 이상 현상이 아닌 검증자 패널이 실질을 잃으면서 검증의 외형만 유지하는 네 가지 서로 다른 체제 중 하나로 취급하며, 이 네 가지를 공통의 경제적 원인과 공통의 해결책으로 연결합니다.
구체적으로, 이 논문은 다음을 기여합니다: (C1) 독립적인 합의의 인증 가치가 쉬운 문제에 집중되고 모집단 난이도 측정에서 가장 어려운 5분위수에서 역전되는 것(342개 복제 답변 중 0개 정답; 패널 독립 난이도에서는 풀링된 역전이 사라지고 교차-진영 패널의 경우 0/116이 지속됨)을 보여주는 난이도별 인증 상승도 측정—두 코딩은 전체에 걸쳐 함께 보고됨; (C2) 제한된(객관식) 답변 공간이 만장일치 인증 오류를 4.0–7.9%로 밀어올리는 증거로, 개방형 범위인 0.3–4.9%보다 훨씬 높음; (C3) 독립성 프록시로 일상적으로 사용되는 라벨—지정학적 진영 및 모델 계통—이 오류 상관관계를 예측하지 않음을 보여주는 사전 등록된 귀무가설 결과 두 개, 따라서 독립성은 브랜드나 계통도에서 가정하기보다는 행렬로 쌍별 측정되어야 함; 그리고 (C4) 대화형 검증자가 진실보다는 자신 있는 제안의 존재를 추적함을 보여주는 역-프롬프트 대조를 포함한 적합성 측정. 맹검 수집 프로토콜과 신뢰 구성은 동반 논문에서 완전히 설명되어 있으며 여기서는 측정이 요구하는 범위 내에서만 요약됩니다. 이 논문에서 결과로 보고되는 모든 것(C1–C4)은 여기서 측정되며 동반 논문에서 다시 서술되지 않습니다. 이로부터 우리는 (C5) 측정 규율—작업별 클래스별로 발표된 행렬, 난이도별 인증 주장, 맹검 우선 도출, 그리고 어려운 체제 상향 조정—을 도출합니다. 이는 검증을 극장에서 운영상 분리합니다.
선행 연구 및 문제 설정
결함 허용 합의(BFT)는 독립적인 장애를 가정하는데, 이는 우리가 검증하고 근거 없음을 발견하는 가정입니다. 합의-역설 문헌은 이미 균질 군집의 합의-안정화 오류를 명명했습니다(Shehata and Li, 2026). zkML은 계산이 실행되었음을 검증하지만, 그 답이 참임을 검증하지 않습니다—경쟁하지 않고 보완적입니다. Verifier의 딜레마는 인센티브 분석을 제공하고, (Raji et al., 2022)는 감시자 선택 문제를 제공하며, (Du et al., 2024), (Farquhar et al., 2024), (Ding, 2026)은 본 논문이 스트레스 테스트하는 합의-신호 문헌을 제공합니다. 신뢰 구조 자체는 동반 논문(Chernets, 2026)에서 소개되었으며, 본 논문은 이 구조의 검증 엔진이 실행 중인 것처럼 보이면서 실패하는 지점을 매핑합니다. 테스트-시간-계산 연구는 구성적 측면에서 보완적인 결론에 도달합니다: 다양한 측면 검증자들의 앙상블이 단일 검증자를 능가하며(Lifshitz et al., 2025), 분리된 계열에서 추출된 작은 판사들의 패널이 분수의 비용으로 단일 대규모 판사를 능가하며(Verga et al., 2024), 다중 에이전트 토론의 체계적 재평가는 모델 이질성을 유일한 신뢰할 수 있는 개선자로 식별합니다(Zhang et al., 2025); 토론 라인은 구조화된 적대적 논증이 약한 판사들이 더 참된 답에 도달하도록 돕는 것을 보여줍니다(Khan et al., 2024). 동료 검토된 증거는 이미 실질적인 공급자 간 오류 상관관계를 문서화하고 있습니다—정확히 가장 정확한 모델들 사이, 심지어 별개의 아키텍처와 공급자들 간에도 가장 큼(Kim et al., 2025)—이는 라벨에서 추론하기보다는 의존성을 측정하도록 독립적으로 동기를 부여합니다. 그 문헌은 다양성을 위해 패널을 선택합니다; 본 논문은 선택되어진 속성이 검증에서 얼마나 가치가 있는지—그리고 그 부재가 침묵 속에서 얼마나 비용이 드는지—를 측정합니다.
데이터 및 측정
사전 등록된 맹검 수집 하나 (확정적 데이터 수집 전에 프로토콜을 공개적으로 동결; https://osf.io/4y9dv에서 공개 등록): 16개 모델 SimpleQA의 4,326개 항목 중 사전 등록된 무작위 부분표본 1,500개 (고정 시드, 수집 전에 추출; SHA-256이 첨부된 부분표본 CSV를 동결된 등록에 포함) 온도 영도에서 명시된 0–100 신뢰도 (13,446개의 정제된 최전선 답변; 8,802개의 로컬 계층 답변); 공식 저장소 파일의 동결된 사본 (790개 항목, 정규 CSV와 바이트 동일)에서 각 항목마다 최소 2개의 서로 다른 오답 옵션을 요구하는 사전 등록된 구성자에 의해 도출된 로컬 계층 상의 750개 항목 TruthfulQA MC1 암 (고정 셔플 시드; 695개 항목이 7개 모델 모두에서 완전히 답변됨); 탐색적 능동 대 맹검 대화 암. SimpleQA는 최전선 모델을 상대로 적대적으로 수집되었으며, 질문당 하나의 명백한 정답을 가짐 (Wei et al., 2024): 따라서 어려운 계층은 진정한 모수 지식 경계를 탐사하며, 등급 매기기는 금표준과의 동등성으로 축소됩니다. TruthfulQA는 제한된 답변 공간 암을 제공합니다 (Lin et al., 2022). 패널은 단일 맹검 수집의 분석 조합입니다; 모든 재분석은 결정론적입니다 (거부 및 영점 중복을 비동의로 계산하는 문자열 동등성 코딩; 미결정 쌍은 괄호로 보고됨). 어려움은 관찰적으로 질문당 평균 16개 모델 정확도로 조작화되며, 300개 질문의 순위 5분위수로 분할됩니다. 동일한 원본 수집은 동반 논문 (Chernets, 2026)의 기반이 되며, 이는 풀링된 인증 비율 및 여기에 상세히 설명된 분석의 간략한 요약을 보고합니다; 어려움별 계층화된 향상 사다리, 견고성 제품군, -행렬, 합치성 분해는 이 논문에만 나타나며, 남은 모든 중복은 텍스트에서 교차 표시됩니다.
개방형 등급 매기기는 2단계입니다: 결정론적 문자열 동등성 통과 (최전선 등급의 26.8%) 더하기 거부 감지 (6.6%), 남은 66.5%는 LLM 등급자에 의해 등급이 매겨집니다; 인간 표본 검사는 무작위 표본에서 등급자와 98%의 의견 일치를 보였습니다 (). 등급의 3분의 2가 모델이 생성하므로, 모든 주요 결과에는 등급자 오류 민감도 재표본화가 동반됩니다 (모델 등급 판정의 10% 반전, 200개 시드 재표본; 섹션 4 및 부록 A).
실패 체제 I: 난이도 역전
세 개의 사전 지정된 프론티어 패널은 단일 맹검 수집의 분석적 3-모델 조합입니다: US-블록(Anthropic, OpenAI, Google), CN-블록(DeepSeek, Alibaba, Moonshot), 및 크로스-블록(Anthropic, DeepSeek, Mistral); 답변은 3절의 동결된 결정론적 코딩 하에서 주모델의 두 패널-메이트 중 적어도 하나가 독립적으로 동등한 답변을 생성했을 때 복제된 것으로 계산되며, 리프트는 입니다. 세 패널 전체에 걸쳐 복제된 답변이 정답일 확률은 가장 어려운 5분위에서 0.0%(0/342, CI 0.0–1.1)에서 12.8%, 57.5%, 81.0%을 거쳐 가장 쉬운 조건에서 95.1%로 상승합니다; 복제되지 않은 답변에 대한 해당 리프트는 0.00 / 0.82 / 2.68 / 3.09 / 4.56입니다. 가장 어려운 20%의 질문에서 관찰된 모든 동의는 잘못된 답변을 인증했으며, 다음 5분위에서 점 추정치는 동의를 불일치와의 동등성 아래로 배치합니다(0.82, CI [0.51, 1.21]); 가장 어려운 5분위의 영 복제는 각 패널에서 별도로 나타납니다(US 0.00–4.25, CN 0.00–9.76, 크로스-블록 0.00–4.04); Q2 부동등성은 CN 및 크로스-블록 패널에서 유지되며, US 패널의 Q2 리프트는 1.20입니다. 풀링된 인증 리프트의 대부분은 쉬운 질문으로 인해 발생하므로, 계층화되지 않은 리프트 주장은 검증이 필요한 곳에서 제공하는 것을 과장합니다. Q1 영은 하한이 아닌 라이브 기본율에 대해 측정됩니다: 복제되지 않은 Q1 답변은 3.9% 시간에 정답입니다(89/2286), 따라서 독립성은 정답 복제 답변을 예측합니다—관찰된 0(상한 1.1%)은 계층의 자체 기본율보다 유의미하게 아래에 있습니다. 독립성 벤치마크는 여기서 보수적이지, 자유로운 것이 아닙니다: 측정된 전체 모델 간 상관 구조를 보존하는 영값—계층의 질문 전체에 걸친 정확도 레이블의 한 가지 공통 순열, 복제 구조는 동결됨(2,000 순열)—은 11.7–12.4 정답 복제 답변을 예상하며 관찰된 0을 절대 생성하지 않습니다(; 최소 3); 측정된 쌍별 를 분석 이변량 영값에 접으면 기댓값이 더 올라갑니다. 양의 상관관계가 있는 오류는 양의 상관관계가 있는 정답을 의미하기 때문입니다. 계층을 채우는 것은 그 자체로 정보를 제공합니다: 342개의 셀은 106개의 질문에 걸쳐 있습니다—모호한 표현이 아닌 일반적인 좁은 사실(중앙값 17단어), 모델은 이들에 대해 거의 기권하지 않습니다(질문당 9개 답변 중 0.5). 이들의 잘못된 답변은 군집됩니다: 이 106개 질문의 70.8%에서 9개의 프론티어 모델 중 적어도 3개는 동일한 잘못된 답변을 생성했으며, 둘 이상의 패널에 의해 복제된 106개 질문의 67.4%에서 독립적으로 구성된 패널은 동일한 잘못된 합의를 인증했습니다—일반적으로 정답이지만 덜 두드러진 항목을 대체하는 유명 이웃 답변입니다. 모든 106개 금 레이블에 대한 수동 주제 전문가 판정은 2개의 이의 가능하고 0개의 명백히 잘못된 것으로 밝혀졌습니다; 명확하게 방어 가능한 패널 답변 하나와 부분적으로 방어 가능한 것 두 개를 인정하면 가장 어려운 5분위 개수를 0/342에서 최대 13/342(3.8%)로 이동시키므로, 거의 0의 결론은 문자 그대로의 영에서 완화되는 동안 유지됩니다(한 개의 플래그된 레이블: 2010 Royal Academy election은 아카데미가 부여하지 않는 영예 제목에 대해 채점됨). 주장은 직접 검증 가능합니다: 배포된 모집단의 자체 정확도로 계층화된 Q1 리프트 를 모든 복제에서 예측합니다(패널 독립 계층화 하에서 예측은 풀링된 리프트가 아닌 크로스-블록 영입니다). 또한 영은 채점자 가공물이 아닙니다: 모든 패널과 원래 채점자(온도 영, 동일한 동결된 금과의 동등성 프롬프트) 외부의 공급업체 계열의 독립적인 두 번째 채점자가 모든 342개의 Q1 복제 평결을 다시 채점했으며 342/342에 동의했습니다(정답으로 전환 0/342, 상한 1.1%); 모델 채점 레이블의 10% 합성 전환은 모든 리샘플에서 인증된 오류 비율을 86.5% 이상으로 유지합니다(부록).
패널 제외 재층화.
패널 멤버들이 인구 난이도 지수에 기여하기 때문에, 가장 어려운 5분위수는 부분적으로 패널 자체의 실패에 조건부이다. 13개의 비패널 모델만으로 재층화할 때, 가장 어려운 5분위수에서 복제된 답변이 78/354경우(22.0%, 풀링된 리프트 2.36, 독립성 하에서 예상되는 33/354 이상)에서 정확하며, 영값은 교차 집단 패널에서만 지속된다(0/116; 13개 비패널 모델 모두 실패하는 층에서 0/88). 생존하는 영값 자체가 특성화된다: 그 층의 기본율은 31/778 = 3.98%(윌슨 2.8–5.6%)이고, 독립성 기댓값은 116 중 4.6 정답이다; 상관관계 보존 순열 무귀가설(2,000개 순열)은 , 95% 범위 , 그리고 를 산출한다—무귀가설보다 유의하게 낮지만, 그 아래에서 도달 불가능하지 않다. 따라서 위의 반전은 배포된 인구가 어려운 것에 상대적으로이 아니라 패널 독립적 난이도에 상대적으로 검증이 실패하는 위치에 대한 주장이다. 두 번째 민감도 검사로, 완전히 레이블 없는 복제 코딩(맹검된 답변의 결정론적 문자열 비교만, 절대 정확성 레이블을 참고하지 않음) 하에서 사다리를 재도출했다: Q1 결과는 본질적으로 변하지 않았다(344개 복제된 답변 중 2개 정답, 0.6% [0.2–2.1]; 리프트 0.15) 그리고 두 개의 가장 어려운 5분위수의 1 이하 리프트는 지속되는 반면, 상위 5분위수 리프트는 감소한다(4.56에서 2.33) 순수 문자열 매칭이 동일한 정답의 표면적 변형을 놓치기 때문에; 다지선다형 결과는 영향을 받지 않으며, 거기서의 동의는 응답 문자로 코딩되고 구성상 레이블 없다.
세 가지 견고성 검사가 반전을 지지한다. (i) 질문 수준 부트스트랩(5분위 내 2,000개 시드 재표본)은 5개 리프트에 대해 95% CI를 제공한다: [0.00, 0.00], [0.51, 1.21], [2.32, 3.09], [2.84, 3.35], 그리고 [4.16, 5.03]: 어려운 영역 구간은 쉬운 영역 구간을 완전히 배제한다. (ii) 채점자 오류 민감도: 모델 채점된 판정의 10%를 뒤집기(200개 시드 재표본; 342개 가장 어려운 5분위 복제된 답변의 97.1%은 모델 채점되었고 따라서 뒤집을 수 있다) 가장 어려운 5분위의 검증된 오류 비율을 모든 재표본에서 86.5% 이상으로 유지하고, Q1 리프트를 재표본의 92%에서 1 이하로 유지한다(중앙값 0.82), 그리고 Q1–Q2 리프트를 Q3–Q5 리프트 근처에 데려오지 않으며, 이는 모든 200개 재표본에서 2 이상이다. (iii) 7개 모델 로컬 층은 독립적 모델과 패널로 하드–이지 대조를 복제하며, 비단조롭게(Q3 ) 진행된다: 리프트 0.00 / 0.94 / 0.00 / 1.89 / 4.37 동일한 5분위 전체에 걸쳐, 가장 어려운 5분위에서 166개 복제된 답변 중 0개가 정답이다; 이 층은 94.8% LLM 채점되며 (ii)와 동일한 채점자 민감도 재표본으로 다루어진다.
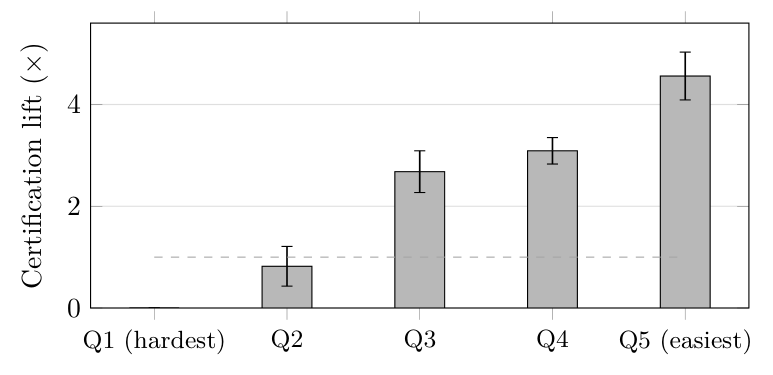 어려움 5분위 전체에 걸친 인증 리프트, 3개 프론티어 패널에 풀링됨, 질문 수준 부트스트랩 95% 구간 포함(2,000개 시드 재표본; 부록 A.1). 점선은 리프트 = 1, 복제되지 않은 답변과의 동등성을 표시한다: 2개의 가장 어려운 5분위수는 점 추정에 의해 그것에서 또는 그 아래 위치한다(Q1 0.00×—측정된 영값, 누락된 데이터가 아님; Q2 0.82×, 그 CI가 동등성을 지나감), 3개의 가장 쉬운 것은 그것보다 훨씬 위에.
실패 양식 II: 제한된 답변 공간
객관식에서 4개의 사전 지정된 로컬 계층 패널이 695개의 완전히 답변된 질문 중 4.0–7.9%(패널당: 4.0, 5.9, 6.6, 7.9)에서 만장일치로 잘못된 선택지에 수렴했으며, 이는 프론티어 계층의 신뢰할 수 있는 만장일치 오류 개방형의 결정론적 범위 0.3–4.9%와 대조됩니다. 로컬 계층의 자체 개방형 답변(8,802개의 등급 매겨진 SimpleQA 응답)에 대해 동일한 인증 지표를 다시 계산하면 계층-형식 혼동을 제거합니다: 동일한 로컬 패널은 엄격한 결정론적 코딩에서 개방형 항목의 1.5–4.6%에만 만장일치 신뢰할 수 있는 오류를 인증합니다(결정되지 않은 범위 포함 최대 9.8%), 프론티어 개방형 범위와 일치합니다—이는 모델 계층보다 제한된 답변 공간이 오류 인증을 주도한다는 패턴과 일치합니다. 그러나 하나의 혼동이 남아 있습니다: 객관식 팔과 개방형 팔은 서로 다른 질문 집합입니다(TruthfulQA MC1 대 SimpleQA). 따라서 형식과 질문 집합이 여기에서 분리되지 않으며, 주장의 인과 형태는 동일한 질문 형식 교환으로만 확정되는데, 이는 실행하지 않았습니다.1 패널별 부트스트랩은 전력이 있는 간격에 구간을 배치합니다: MC 빼기 개방형 인증된 합의 오류는 pp [2.9, 6.8] (파일럿), pp [3.9, 8.1] (US-로컬), pp [2.6, 6.3] (교차-블록)이며, 각각 0을 제외합니다; 개방형 셀이 각주의 87개 항목 집합에 기반한 CN-로컬 패널은 이를 해결하지 않습니다. 메뉴는 산재된 오류를 공유 오류로 변환합니다: 답변 공간이 작을 때, 유사한 모델은 동일한 방해꾼에 착륙하고 패널의 만장일치는 오류 증폭기가 됩니다. 비율은 독립적인 오류로 설명할 수 없습니다: 각 구성원이 주변 비율에서 독립적으로 오류를 범하고 오류가 잘못된 선택지()에 걸쳐 분산되면, 예상되는 만장일치로-동일-잘못된-선택지 비율은 4개 패널 전체에서 0.49–0.92%입니다—관측된 4.0–7.9%는 독립성 기준선보다 4.9–13.5 초과입니다. 설계 결과, 검증 가능한 규칙으로 명시됨: 에이전트에게 고정 선택지 집합을 제공하는 모든 인터페이스는 동일한 콘텐츠에 대한 개방형 추출보다 물질적으로 더 높은 인증된 합의 오류를 예상해야 합니다.
3명의 패널리스트 모두로부터 명시된 신뢰도 를 요구해도 효과를 거의 줄이지 못합니다: 인증된 합의 오류 범위는 4.0–7.9%에서 4.0–7.2%로 이동합니다(패널당 4.0, 5.2, 6.0, 7.2), 즉 거의 모든 만장일치 오류도 신뢰할 수 있는 것입니다. 실패는 또한 특정 주제 영역에 국한되지 않습니다: 최소 20개 항목이 있는 10개의 TruthfulQA 범주 전체에서 병렬 인증된 합의 오류는 1.0%(음모론)에서 8.6%(경제학)까지 이르며, 법률, 건강, 사회학이 중간에 있습니다(부록 A).
실패 체계 III: 독립성 라벨이 독립성을 예측하지 못함
36개의 프론티어 벤더 쌍(1,448개의 공유 질문)에서 쌍별 오류 상관은 0.123–0.395에 걸쳐 있으며, 범위는 사람들이 찾는 라벨로 조직되지 않습니다: 가장 상관성이 높은 쌍과 가장 낮은 쌍 모두 블록 내 쌍입니다(googlexai 0.395 대 googleopenai 0.123), 평균 블록 내 대 블록 간 는 만큼 다르며, 동일 기반 계보 쌍은 695개의 완전히 답변된 객관식 항목에서 6개의 미국/중국 블록 지역 모델로 형성된 15개 쌍 중 14위입니다(; 일곱 번째 지역 모델은 EU 블록이며 사전 등록된 블록/계보 설계 외에 있습니다—이를 포함하면 21개 쌍이 생기며, 계보 쌍은 20위입니다). 두 가지 사전 등록된 귀무 가설(블록, 계보) 모두 재분석에서 유지되며, 남은 것은 측정된 상관 자체입니다. 실용적인 규칙: 독립성은 측정해야 할 쌍별, 작업 클래스별 수량(-행렬)이지, 브랜드, 국기, 또는 족보로부터 유추된 것이 아닙니다—라벨로 패널을 구성하는 것은 캐스팅이지 검증이 아닙니다. 쌍별 는 완전한 통계적 독립성이 아닌 경험적 오류 의존성을 측정합니다: 낮은 는 3개 이상 패널에서의 고차 의존성을 배제하지 않으며, 이는 독립성을 가정된 특성이 아닌 측정되고 작업 조건부인 수량으로 취급해야 하는 또 다른 이유입니다.
블록 라벨의 9개 벤더에 대한 모든 630개 할당에 대한 정확한 순열 검사는 블록 효과의 증거를 찾지 못합니다: 관찰된 블록 내 빼기 블록 간 차이 는 630개 재라벨링 중 132개에 의해 초과되거나 일치합니다(편측 ; 차이에 대한 클러스터링 부트스트랩 95% CI ). 검사는 주장을 제한합니다—작은 블록 효과는 배제되지 않습니다—그리고 운영적 결론은 유지됩니다: 라벨은 쌍별 측정 대신 사용할 수 있는 신호를 전달하지 않습니다. 는 쌍의 기본 오류율이 다를 때 상한이 있기 때문에, 우리는 변장표준화 비율 에 대한 분석을 다시 실행했습니다: 두 가지 사전 등록된 귀무 가설 모두 유지됩니다(블록 차이 , 순열 ; 계보 쌍은 15개 중 14위로 유지됨), 확산은 지속되며(프론티어 쌍에서 0.278–0.821), 극값은 두 개의 블록 간 쌍으로 이동합니다(anthropicmoonshot 0.821, mistralopenai 0.278)—두 지표 모두에서 라벨은 확산을 조직하지 않습니다. 행렬을 16개 모델로 확장하면: 모든 모델에 의해 답변된 81개 질문에서 쌍별 는 에서 (120개 쌍; 블록 평균: 프론티어–프론티어 0.320, 지역–지역 0.350, 프론티어–지역 0.210)에 걸쳐 있습니다—우리 데이터의 어떤 라벨 분류도 예측하지 못하는 크기 차수의 확산입니다(그림 2). 81개의 공통 항목으로 개별 셀 추정치는 넓은 구간을 포함합니다; 결과는 확산 자체이지 어떤 단일 셀이 아닙니다.
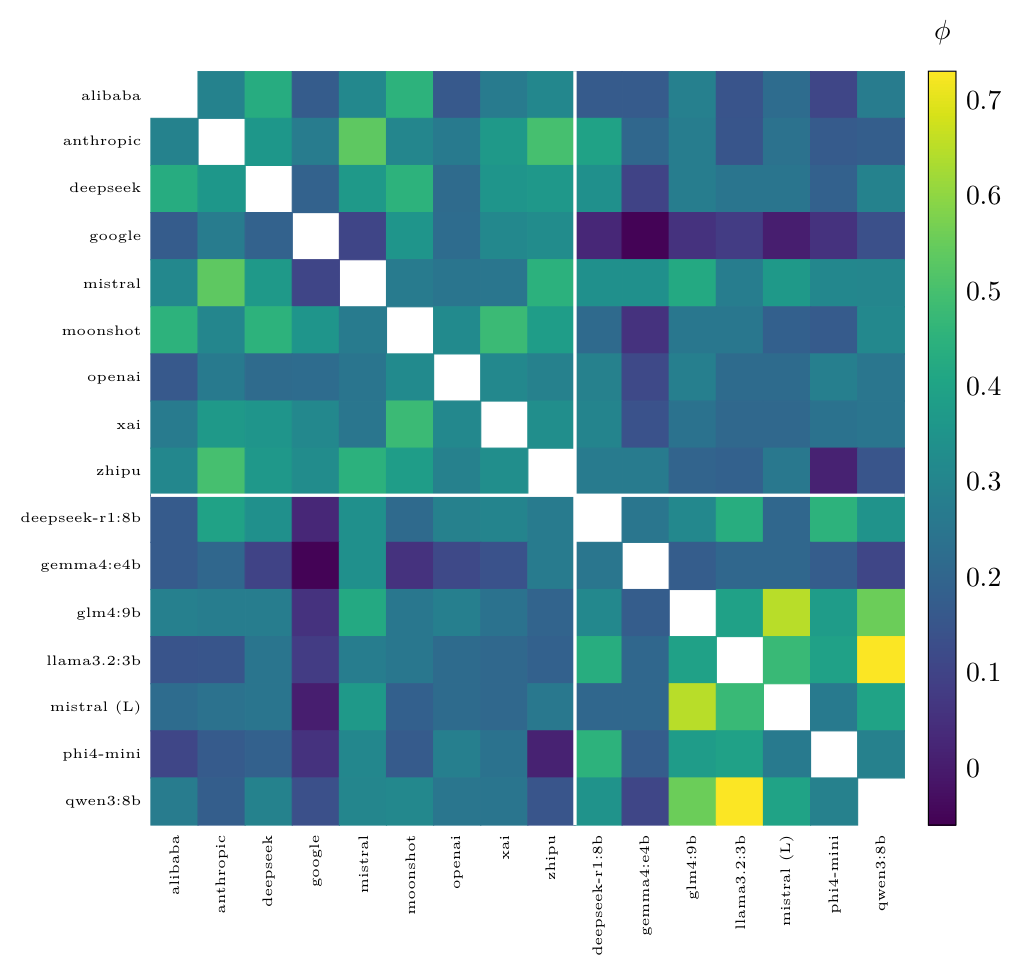 모든 모델이 답변한 81개 질문에 대한 16개 모델 모두의 쌍별 오류 상관관계(ϕ) (9개 프론티어 벤더, 이후 7개의 로컬 오픈 웨이트; 프론티어/로컬 분할은 흰색 규칙으로 표시됨). 각 비대각 셀은 120개의 고유한 쌍 중 하나이며, 대각선(자기상관 = 1.0)은 색상 척도를 압축하지 않도록 의도적으로 공백으로 남겨져 있습니다. ϕ는 −0.05에서 0.73까지의 범위(평균 0.27)로, 두 검증자의 오류가 얼마나 상관되는지에 대한 크기가 한 자리 수 정도 차이나며, 우리 데이터의 어떤 블록이나 계통 레이블도 이를 예측하지 못합니다. 값은 emit_phi_matrix.py(analysis_week1.py 섹션 W5 재사용)에 의해 결정적으로 생성되며, 손으로 입력된 것은 없습니다.
실패 양식 IV: 항복하는 검증 (탐색적)
처음에는 불일치했던 검증자가 동료의 제안과 동일한 답안을 보여받았을 때, 38.5%(168/436)의 경우에 항복했습니다. 처음에는 올바른 답안을 제시했던 검증자가 이를 포기하고 잘못된 답으로 바꾼 경우는 30.9%(46/149)였으며, 업체별 항복률은 13.1%에서 51.6%까지 다양했습니다(처음에 불일치한 전체 부분집합에 대한 업체별 항복률은 20.4%–58.1% 범위).
이러한 뒤집기가 합리적인 신념 업데이트일 수 있을까요? 역방향 프롬프트 통제가 이에 반대합니다. 6개 모델의 로컬 패널에서 우리는 노출 방향을 뒤집은 쌍 절차를 다시 실행했습니다. 처음에 불일치했던 검증자는 동일한 질문 세트에 대해 자신감 있는 잘못된 답안(직접 팔)이나 정답(역방향 팔) 중 하나를 보여받았습니다. 두 팔은 프롬프트 동일—하나의 공유 템플릿("제시된 답안: …"), 표시된 답안은 내용만 다르며, 신뢰도 값이나 출처 귀속이 표시되지 않음—따라서 대조는 표시된 답안의 진실값을 분리합니다. 만약 검증자가 증거를 바탕으로 업데이트한다면, 정답 노출이 더 많이 움직여야 합니다. 대신 두 팔은 거의 동일한 뒤집기율을 보였습니다—잘못된 답으로 향하는 38.9%, 정답으로 향하는 34.7%—그리고 쌍별 비교는 업데이트 이야기를 위해 잘못된 방향으로 진행됩니다. 174개의 불일치 쌍 중 검증자가 처음 입장을 포기하고 잘못된 답으로 간 경우는 104개, 정답으로 간 경우는 70개였습니다(McNemar 정확 ). 모델 수준에서 두 팔은 구별할 수 없었습니다(가장 유순한 검증자의 경우 뒤집기 성향 89.9% vs. 89.9%, 가장 완고한 검증자의 경우 1.5% vs. 1.5%): 동의를 유발하는 것은 자신감 있는 제안이 존재한다는 것이지, 그것이 참이라는 것이 아닙니다—선호도 훈련된 아첨의 패널 검증 측면입니다(Sharma et al., 2024). 또한 비대칭성은 가장 유순한 검증자에 달려 있지 않습니다. 이를 제외하면 835개의 쌍 항목에 불일치 개수 94 vs. 60이 남습니다(정확 ). 두 가지 추가 분해가 이러한 해석을 강화합니다(부록 A): 어느 팔에서든 기록된 모든 뒤집기는 노출 후 신뢰도 와 함께 제시되었습니다(해당 임계값 아래 0개 뒤집기, ), 그리고 직접 팔에서 처음에 올바른 답안을 제시했던 검증자가 40.8%의 경우(20/49)에 정답을 포기했으며, 이는 경계선 발견을 반영합니다. 통제는 로컬 계층에서 실행되었습니다(제한사항). 이 통제의 산문 요약은 동반 논문에도 나타나 있습니다(Chernets, 2026). 모델별 분해, 신뢰도-게이트 분할, 그리고 정답-처음 항복 분석은 여기서만 보고됩니다.
이는 설계 주장을 제한합니다: 목표가 독립적 불일치를 측정하는 것일 때, 추출은 처음-먼저-맹목적이어야 합니다—입장을 정하기 전에 숙의하는 패널은 불일치를 측정하지 않으며, 이를 지워버립니다.
토론: 극장의 경제학 (추측, 증거 아님)
이 섹션은 증거가 아닌 토론입니다. 새로운 측정을 보고하지 않으며, 여기의 어떤 내용도 위의 네 가지 측정된 체제와 동등한 것으로 읽혀서는 안 됩니다. 그렇게 명시된 가운데, 네 가지 체제는 어떤 당사자도 그것들을 알아채도록 보수를 받지 않기 때문에 지속될 수 있습니다. 소비자는 검증 품질의 가격을 매길 수 없고, 플랫폼은 의심보다는 신뢰에 대해 보수를 받으며, 각 검증자의 가장 저렴한 전략은 동의하는 것입니다. 감시자 선택 문제(독립성은 검사자를 선택하는 사람의 속성)와 링크팜 선례(상업적 무게를 지닌 동의 신호는 모두 팜을 초대함)를 더하면, 극장은 사고가 아니라 균형입니다—측정은 동기를 부여하지만 테스트하지는 않는 추측입니다. 인센티브 계정은 공학적 관성과 측정 표준의 부재를 배제하기보다는 보완합니다. 이것은 거짓가능한 성분이기 때문에 강조되었습니다. 이 섹션은 규범적 주장보다는 거짓가능한 시장 예측을 합니다. 예를 들어, 감시되지 않은 패널은 상관된 패널이 더 저렴하고 더 많이 동의하기 때문에 시간이 지남에 따라 최소 다양성 구성으로 수렴해야 합니다.
극장에서 측정으로
해결책은 구성 요소가 아니라 학문적 규칙입니다: (1) 패널의 측정된 -행렬을 작업 클래스별로 공개하되, 브랜드 목록으로는 하지 않습니다(작업 클래스당 맹검 수집 하나로 충분합니다—이 논문의 16개 모델 행렬은 단일 1,500개 항목 통과에서 나왔습니다); (2) 모든 인증 주장을 난이도별로 층화하고 어려운 체제의 상승을 별도로 보고합니다(난이도는 항목별 추론이 아니라 작업 클래스당 캘리브레이션 수집에서 운영화됩니다); (3) 맹검-먼저를 항상 도출합니다—패널 검증의 약속-공개 방식은 계산을 추가하는 것이 아니라 도출 순서를 바꾸므로, 맹검 답변은 병렬화 가능합니다; (4) 가장 어려운 체제를 확대 트리거로 취급합니다—패널의 측정된 상승이 인 질문에서는 합의가 인간이나 기권으로 라우팅되어야 하며, 인증으로는 절대 안 됩니다. 각 규칙은 배포된 시스템을 그에 대해 감시할 수 있도록 명시됩니다.
작동 예시로서, 이 논문의 자체 최전선 패널에 처방을 적용합니다. 규칙 (1): 그 독립성은 제6절의 측정된 -행렬(범위 0.123–0.395)로 보고되며, 공급업체 명단으로는 하지 않습니다—이는 가장 상관관계가 높은 쌍이 블록 내부(googlexai)임을 숨겼을 것입니다. 규칙 (2): 그 인증 상승은 층화되어 보고되며(표 1), 어려운 체제의 상승( Q1에서, Q2에서)이 단일 통합 제목으로 접히지 않고 별도로 명시됩니다. 규칙 (3): 여기의 모든 답변은 어떤 패널도 구성되기 전에 맹검으로 도출되었으며, 이것이 바로 적합성 팔(제7절)이 혼동되지 않고 측정 가능하게 만드는 것입니다. 규칙 (4): 패널의 측정된 상승이 두 개의 가장 어려운 오분위수에서 이므로, 같은 패널의 감시된 배포는 이들 질문을 기권이나 인간 검토로 라우팅했을 것이며, 합의 인증으로는 절대 하지 않았을 것입니다. 따라서 학문적 규칙은 가설적이지 않습니다: 이는 논문의 자체 수치가 생성된 프로토콜입니다.
제한 사항
계층별 단일 벤치마크 제품군(SimpleQA 개방형 프론티어; TruthfulQA MC 로컬)이므로 체제 경계는 벤치마크-상대적이며, 각 프론티어 벤더는 하나의 예산/중급 모델로 표현되므로 벤더 능력 주장은 하지 않습니다. 난이도 계층화는 관찰적(사전 등록된 수집에 대한 사후)이며 5분위수 할당은 평가된 모델과 데이터를 공유합니다. 적합성 팔은 탐색적이며 에서 제한적입니다. 그 역프롬프트 제어는 로컬 모델을 사용했으므로 프론티어 패널로의 전이는 측정이 아닌 유추에 의합니다. 개방형 등급의 약 3분의 2는 LLM 채점자에서 나오며(인간 표본 확인 98% 합의; 모든 342개 최상위 5분위수의 교차 제품군 재채점이 342/342로 일치했으며, 부록의 민감도 재샘플링). 두 벤치마크 모두 공개되어 있으므로 훈련 세트 누출을 배제할 수 없습니다. SimpleQA에서 그 방향은 기억된 정답을 선호하여 어려운 계층을 축소하고 어려운 체제 결과를 보수적으로 만듭니다. TruthfulQA에서는 공개 말뭉치가 오개념 자체를 포함하므로 그 방향은 명확하지 않습니다. 대체 읽기는 섹션 5의 형식-내용 주의사항으로 이미 제한됩니다. 어려운 질문에서 합의가 실패하는 이유에 대한 인과 주장은 하지 않습니다. 메커니즘 후보(공유된 선험, 공유된 맹점, 공유된 훈련 데이터)는 명명되지만 분리되지 않습니다.
결론
합의는 독립성과 역량이 측정된 후에만 증거가 되며, 이 측정은 저렴합니다. 여기서 수행한 전체 재분석은 공개 원시 파일에서 상용 하드웨어로 몇 초 안에 실행됩니다. 패널이 -행렬과 계층화된 리프트를 갖춘 상태로 배송될 때까지, "합의로 검증됨"은 보안 엔지니어들이 가방 검색을 읽는 방식으로 읽어야 합니다.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
재현성 부록
모든 재분석은 원본 등급 JSONL 파일과 두 개의 고정 시드 스크립트(모든 주요 수치를 재현하는 기선 스크립트와 아래의 부트스트랩, 민감도 및 분해 테이블을 생성하는 1주차 추가 기능)가 주어질 때 결정론적입니다. 전체 재계산은 GPU, 네트워크 또는 모델 호출 없이 일반 하드웨어에서 15초 이내에 완료됩니다. 고정된 사전 등록 및 복제 패키지(공개 OSF 등록): https://osf.io/4y9dv.
리프트 래더에 대한 부트스트랩 신뢰 구간
5분위수 내 질문 수준 재샘플링, 2,000개 시드 추첨, 세 프론티어 패널 전체에서 풀링됨.
| 5분위수 | Wilson 95% | Boot 95% | 리프트 | 리프트 boot 95% | |
|---|---|---|---|---|---|
| Q1 (가장 어려움) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5 (가장 쉬움) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
어려움 5분위수별 인증 리프트와 Wilson 및 부트스트랩 95% 신뢰 구간(는 백분율, 리프트는 비율). 리브 패널 아웃 어려움(13개 비패널 모델로 순위 매김) 하에서 풀링된 Q1 셀은 78/354(22.0%, 리프트 2.36)이고, 교차 블록 패널의 경우 0이 지속됩니다(0/116). 섹션 4. 기저율 5분위수별: 3.9 / 15.6 / 21.5 / 26.2 / 20.8%( = 2286 / 2308 / 2209 / 1778 / 912).
채점자 오류 민감도
8,948개 모델 등급 프론티어 판정의 10% 뒤집기(200개 시드 재샘플; 합의 코딩 및 5분위수 할당은 원본 결정론적 프로토콜 코딩에서 고정되고 정확성 레이블만 이동): 가장 어려운 5분위수 "인증된 정답" 셀은 0/342에서 33/342의 중앙값(9.6%; 95% 범위 23–46)으로 상승하므로 Q1 합의의 인증된 오류 비율은 모든 재샘플에서 86.5% 이상으로 유지됩니다. Q1 리프트는 92%의 재샘플에서 1 미만으로 유지되고(중앙값 0.82, 95% 범위 0.56–1.08), Q3–Q5 리프트는 절대 2 미만으로 떨어지지 않습니다(중앙값 2.17 / 2.51 / 3.42). 342개의 Q1 복제 답 중 332개(97.1%)는 모델 등급이며 따라서 이 연습에서 뒤집을 수 있습니다. 합성 뒤집기를 넘어 교차 제품군 감사는 독립적인 두 번째 채점자(모든 패널 외부 및 원본 채점자의 제품군 외부 공급업체 제품군, 온도 0, 바이트 동일한 고정 프롬프트)를 사용하여 모든 342개의 Q1 복제 판정을 재등급했습니다: 합의 342/342(정답으로 뒤집기 0/342, Wilson 상한 1.1%), 모델 등급(332) 및 문자열/거절 코딩(10) 셀 전체에서 균일합니다. 342개 셀이 106개의 고유 질문을 포함하기 때문에 클러스터 보수적 해석은 질문을 단위로 취급합니다: 0/106은 Wilson 상한 3.4%를 제공합니다. 섹션 4의 질문 수준 순열 널은 이미 클러스터 수준에서 작동합니다.
역방향 프롬프트 제어: 모델별 분해
6개의 로컬 모델, 2,399개의 유효한 쌍을 이룬 관찰; flip = 검증자가 맹검 답변을 표시된 답변으로 바꿈.
| 검증자 | 직접 (오답으로) | 역방향 (정답으로) | 차이 |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| 합계 | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
검증자 및 조건별 flip 비율. 어떤 모델도 정답으로 flip할 확률이 확신 있는 오답으로 flip할 확률보다 더 높지 않습니다. 쌍을 이룬 재계산: 두 조건에 모두 포함된 1,028개 항목 (296개는 두 조건 모두에서 flip, 558개는 둘 다에서 flip 안 함); 불일치 쌍 104개 (오답만) vs. 70개 (정답만), 정확한 이항 McNemar (점근 ). 기록된 모든 884개의 flip은 명시된 노출 후 신뢰도 를 동반합니다. 해당 임계값 아래의 flip 비율은 0/547입니다.
TruthfulQA 범주별 MC 인증 합의 오류
4개의 사전 지정된 로컬 패널에서 합산 (항목-패널당 이벤트; 최소 20개 항목을 포함하는 범주): 경제학 8.6%, 소설 6.2%, 초자연적 6.0%, 법률 5.9%, 미신 5.7%, 고정관념 5.4%, 사회학 4.9%, 건강 4.9%, 오개념 2.6%, 음모론 1.0%. 3명 모두 신뢰도 인 패널별 비율: 4.0% (CN-로컬), 5.2% (교차-블록), 6.0% (파일럿), 7.2% (US-로컬).
4.6% 상한선은 추론 모델의 98개 등급 매겨진 답변 중 87개의 항목만 공유하는 1개의 로컬 패널에 기반합니다. 이를 제외하면 엄격한 로컬 개방형 범위는 1.5–1.8%입니다.↩︎
인용 방법
Chernets, V. (2026). Verification Theater: AI Verifier Panels의 측정된 실패 모드 [Paper presentation]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}