약하게 판별적이고, 프로필 주입으로 수정되지 않으며, 조작 가능한 것: LLM 평가에서의 자기 신뢰도
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, 독립 연구자 · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
NeurIPS 2026 워크숍 "TAE (Trust-AI-Eval): AI 평가를 신뢰할 수 있을까?" (비보존)에 포스터로 채택됨. 보관본: 10.5281/zenodo.23197651. PDF: self-confidence-evaluation.pdf. 아래 그림과 표는 LaTeX 소스에서 변환되었으며, PDF가 정본입니다.
초록
평가 파이프라인은 점점 더 모델 자신의 진술된 신뢰도를 신뢰 신호로 소비하고 있습니다—판정자 신뢰성 가중치, 기권 트리거 또는 자가 보고 역량 프로필로서 말입니다. 우리는 사전 등록된 프로토콜 동결 수집을 사용하여 그 신호가 그 가중치를 받을 자격이 있는지 테스트합니다(16개 모델—9개 제공자 각각에서 한 개의 예산/중급 API 모델, 플러스 7개의 로컬 오픈 웨이트; 온도 0에서 진술된 0–100 신뢰도를 가진 22,248개의 등급이 매겨진 답변). 네 가지 발견. (1) 과신뢰는 평가된 16개 모델 모두에서 일관됩니다: 전형적인 진술된 신뢰도는 9개 API 모델 중 7개에서 85–95에 위치하는 반면 정확도는 16.5–66.5%에 걸쳐 있고, 신뢰도 80으로 진술된 최첨단 답변의 60.1%가 틀렸습니다. (2) 자가 신뢰도는 약하게 판별적입니다: 모델 자신의 정확성을 예측하기 위한 AUROC는 0.532–0.788에 걸쳐 있고 9개 모델 중 6개에서 0.62 아래에 위치합니다. (3) 독립적 모델 패널은 자가 평가가 0.545를 주는 곳에서 AUROC 0.832에 도달합니다( , 95% CI ); 패널 합의의 더 엄격한 레이블 없는 재코딩 하에서도 패널이 계속 선도합니다(0.775 vs. 0.545). (4) 모델 자신의 측정된 도메인별 정확도 프로필을 주입하는 것은 위약 대조 단일 공급업체 사다리의 한 확인 단계에서 판별을 실증적으로 개선하지 않았습니다(AUROC , Holm 조정 ), 반면 동일한 주입 채널은 인과적으로 조작 가능합니다: 거짓 프로필은 탐색적 단계의 자가 평가 AUROC를 우연 수준(0.474)으로 몰아냈고, 항목에 주제 레이블이 지정되면 5개 로컬 모델 중 4개에서 보정을 저하시켰습니다. 우리는 현재 개방형 사실적 회상에서 언어화된 정수 신뢰도로 여기에서 도출하고 측정된 자가 평가 신뢰도가 신뢰에 대한 입력이 아니라 측정의 대상이라는 결론을 내립니다: 자가 보고 역량을 섭취하는 하네스는 인증되지 않은 입력 채널을 상속합니다. 제목의 세 절은 서로 다른 증거에 기초하고 있으며 우리는 그것들을 전체적으로 그렇게 표시합니다: 약하게 판별적은 16개 모델에서 확인적입니다; 프로필 주입으로 복구되지 않음은 한 공급업체 제품군의 한 확인 단계이며, 관찰된 효과에 대해 검정력이 부족합니다; 조작 가능은 탐색적이며, 인과 방향은 일치하는 항목에서 표시되지만 배포된 하네스에 대해 테스트된 공격은 없습니다. 판정자 스타일 자가 평가는 모델이 다른 모델의 답변을 평가하는 곳이며 다른 작업이고 여기에서는 테스트되지 않습니다.
서론
현대의 평가 관행은 모델의 진술된 확신을 조용히 측정 도구로 취급합니다: LLM 판사는 확실성 점수를 보고하고, 에이전트 프레임워크는 자체 평가된 역량으로 라우팅하며, 기권 정책은 언어화된 불확실성으로 트리거되고, 보정 벤치마크는 자기 보고 채널이 적어도 정직하다고 가정합니다. 이 가정은 편리합니다—자기 보고는 무료이고 항상 이용 가능하며 답변과 같은 패스에서 생성됩니다—그리고 소비 지점에서 거의 감시되지 않습니다. 우리는 선행 질문을 제기합니다: 자기 평가 신호는 얼마나 판별적입니까, 모델의 자체 측정된 프로필로 복구할 수 있습니까, 그리고 조작될 수 있습니까?
우리는 하나의 사전 등록되고 프로토콜이 고정되며 맹검 수집으로 답변합니다: 16개 모델(9개 제공자 각각에서 하나의 예산/중간 계층 API 모델과 7개 로컬 오픈 가중치), 각각 1,500개의 2023년 이후 사실 질문, 온도 0, 진술된 0–100 신뢰도가 수반된 모든 답변—22,248개 채점된 답변, 모든 분석은 원본에서 결정론적입니다. 이 측정 표준에 대해, 자기 보고 채널은 세 가지 점진적으로 더 자비로운 테스트에서 실패합니다.
C1(약하게 판별적). 진술된 신뢰도는 포화되고 역량과 분리됩니다: 모형별 중앙값은 9개 API 모델 중 7개에서 85–95에 있고 정확도는 16.5–66.5%에 걸쳐 있으며, 신뢰도 80으로 진술된 최첨단 답변의 60.1%가 틀렸습니다. 모델 자체의 항목별 정확성의 예측자로서, 자기 신뢰도는 모델에 따라 AUROC 0.532–0.788에만 도달합니다—모든 부트스트랩 CI는 우연을 제외하지만 9개 모델 중 6개는 0.62 아래에 있으며, 최고의 모델에서도 선택적 예측은 실질적인 잔존 오류를 남깁니다(섹션 4). 독립적 모델 패널은 자기 평가가 0.545를 제공하는 곳에서 0.832에 도달합니다—더 엄격한 라벨 없는 패널 합의 재코딩을 견디는 이점—반면 다른 패널의 명백한 반례는 항목별 자기 지식보다는 주로 모델 간 정체성을 반영합니다(섹션 4의 분해); 자기 보고가 잘 판별되는 한 모델을 식별하려면 자기 보고가 대체하려던 독립적 측정이 필요합니다.
C2(프로필 주입으로부터의 확인적 복구 없음). 가장 직접적인 복구—답변 시간에 모델에 자신의 측정된 도메인별 정확도 프로필을 제공—는 동결되고 플라시보 제어된 사다리 실험의 확인적 단계에서 플라시보 프로필을 크게 이기지 못했습니다(AUROC , 원본 , Holm 조정됨 ; 확인적 끝점이 통과되지 않았습니다). 우리는 이것을 추세가 아닌 영값으로 보고합니다(섹션 5).
C3(조작 가능). 복구가 사용할 주입 채널은 위조를 수용합니다: 셔플된(거짓) 프로필은 탐색적 최첨단 단계의 자기 평가 AUROC를 우연 수준으로 몰아갔습니다(0.474 대 0.710; 감소 ), 단일 위조된 "95% 정확도" 주장은 로컬 모델의 진술된 신뢰도를 50에서 95로 움직였습니다, 그리고 항목이 주제별로 라벨링되면, 5개 중 4개의 로컬 모델은 거짓 프로필을 자신의 손해로 소비합니다(Brier 에서 ; 섹션 6).
이러한 결과들은 함께 역할의 변화를 주장합니다: 자기 평가 신뢰도는 측정되지 않은 입력이 아니라 평가의 측정된 대상이어야 합니다. 섹션 7은 판사 파이프라인, 에이전트 라우팅, 및 조직 설계에 대한 결과를 설명합니다; 동반 논문(Chernets, 2026)은 패널 기반 대안의 실패 모드를 검토하며, 여기에 인용되지만 재진술되지 않습니다.
관련 연구
언어화된 확신과 보정. 현대 신경망의 보정 부족은 오래된 발견입니다(Guo et al., 2017). QA 조정 언어 모델의 경우 현재 모델 세대가 나타나기 훨씬 전부터 보정이 부족했습니다(Jiang et al., 2021). 모델은 불확실성을 말로 표현하도록 학습될 수 있으며(Lin et al., 2022b) 더 큰 모델은 자가 평가 프로브에서 부분적으로 "자신이 아는 것을 압니다"(Kadavath et al., 2022). 그러나 자신이 알지 못하는 것을 인식하지 못합니다(Yin et al., 2023). 도출된 확신의 경험적 감시는 모든 도출 형식에서 지속적인 과신을 발견합니다(Xiong et al., 2024). 언어화된 점수는 토큰 확률보다 더 잘 보정되기도 하지만 여전히 부풀려 있습니다(Tian et al., 2023). 내부 상태 프로빙은 프레임을 선명하게 합니다. 은닉층 활성화에 대한 단순 분류기는 71–83%의 진실성을 복구합니다(Azaria and Mitchell, 2023). 실패는 내부 표현이 아니라 언어화된 출력 채널에 있습니다. 우리의 기여는 규모와 설계입니다. 사전 등록된 고정된 16개 모델의 맹검 수집으로 동일한 도출을 지상 진실과 동일 항목에 대한 독립 패널 합의와 비교 평가합니다. 그리고 이 문헌이 거의 묻지 않는 두 가지 질문입니다. 신호를 모델의 자체 측정 프로필로 복구할 수 있으며, 복구 채널을 공격할 수 있습니까?
다운스트림에서 자가 보고 소비. LLM 심판 파이프라인은 심판 편향과 신뢰성 제한을 상속받습니다(Zheng et al., 2023). 합의 기반 확신 신호는 자체적으로 감시 중입니다(Ding, 2026). 의미론적 엔트로피 탐지기는 자가 보고를 우회하고 답변 분포를 대신 측정합니다(Farquhar et al., 2024). 제3자 평가 프레임워크는 독립적 측정에 대한 거버넌스 사례를 제시합니다(Raji et al., 2022). 우리는 정량적 하한선을 제공합니다. 9개 API 모델 중 6개의 경우 파이프라인이 소비할 자가 보고는 0.62 이하의 AUROC를 가집니다.
신뢰할 수 없는 입력. 간접 프롬프트 주입은 LLM이 수집하는 모든 텍스트 채널이 공격 표면임을 보여줍니다(Greshake et al., 2023). 섹션 6은 특정하면서도 지금까지 명명되지 않은 인스턴스를 찾습니다. 보정 복구가 사용할 자가 능력 프로필 슬롯은 인증되지 않은 입력 채널이며, 이를 위조하면 판별이 우연 수준으로 저하됩니다.
패널과 자체 실패. 다양한 모델의 패널은 점점 더 표준적인 평가 도구입니다(Verga et al., 2024). 비교 대상으로 사용하는 패널 신호는 무료 점심이 아닙니다. 그 실패 체계(난이도 반전, 제약된 답변 공간, 레이블 기반 독립성 가정, 순응성)는 동일한 원시 수집에 대한 동반 제출(Chernets, 2026)에서 측정됩니다. 이 논문은 자가 평가 이야기를 다루고, 동반 논문은 패널 이야기를 다루며, 어떤 표도 이들 사이에서 중복되지 않습니다.
벤치마크. 우리는 2023년 이후 SimpleQA 부분집합(Wei et al., 2024)에서 도출합니다. 정확히 우리가 2021년식 TruthfulQA(Lin et al., 2022a)와 비교해 측정하는 벤치마크 나이 격차 때문입니다(섹션 3).
사전등록 실험: 설계 및 데이터
사전등록되고 맹검된 수집, 확인적 데이터 이전에 공개적으로 동결된 프로토콜: 16개 모델(9개 공급자 각각의 예산/중급 API 모델 1개와 7개의 로컬 오픈웨이트)이 동일한 1,500개의 2023년 이후 팩트 질문(SimpleQA 부분집합)에 온도 0에서 답변했으며, 각 답변에는 0–100 신뢰도가 함께 제시됨; 총 22,248개의 채점된 답변(13,446개 최첨단, 8,802개 로컬).
사전등록 및 동결.
수집 프로토콜은 확인적 데이터가 존재하기 이전에 공개 등록에서 동결되었습니다(재현성 부록의 접근 경로). 사전등록은 벤치마크 및 부분집합(무작위 , 고정 시드, 부분집합 파일의 SHA-256 기록), 모델 명단, 추출 형식, 채점 절차, 분석 계획—섹션 4에서 사용된 패널 합의 대 자신의 신뢰도의 AUROC 비교 포함, 사전지정된 2차 메트릭(등록의 주요 종료점, 패널 불일치의 확실한 오류 플래그율은 동반 제출의 패널측 수량)—및 사후 임시 메트릭 선택에 대한 의사결정 규칙을 사전지정합니다. 작은 탐색적 파일럿(95개 TruthfulQA 항목, 3개 로컬 모델)이 파이프라인을 검증하기 위해 동결 전에 실행되었습니다. 그 숫자는 확인적 데이터와 섞이지 않습니다.
모델 및 추출.
API를 통한 9개 최첨단 공급자—공급자당 예산/중급 모델 1개이므로 아래 공급자 이름은 단일 모델을 나타내며, 제품군이 아님(정확한 모델 ID 및 수집 날짜는 재현성 부록에 있음)—및 7개의 로컬 오픈웨이트 모델. 모든 모델이 모든 항목에 독립적으로 온도 0에서 답변하고 동일한 응답에서 정수 신뢰도 0–100을 제시합니다. 패널은 이 단일 맹검 수집의 분석적 조합입니다—어떤 모델도 다른 모델의 출력을 보지 못합니다.
채점.
정규화된 문자열 동등성을 금표준으로, 거부 탐지 우선; 미해결 개방형 사례는 동등성 대 금표준으로만 제한된 로컬 오픈웨이트 LLM 채점자로 이동합니다(qwen3:8b, 로컬). 50개 항목의 인간 현지조사에서 98% 합의를 발견했습니다(보수적 오류 1개); 342개 가장 어려운 계층 합의 판정의 교차 계열 감사는 342/342에 동의했습니다(제한사항). 구문 분석 실패를 제외하고는 제외 사항이 없습니다(보고됨); 이들은 1개의 로컬 추론 모델에 집중되어 있으며, 1,500개 중 98개의 채점 가능한 답변만 유지합니다—모든 로컬 계층 청구는 모델당 를 수행합니다. 모든 확인적 분석은 원본 JSONL에서 결정론적입니다.
벤치마크 선택, 측정됨.
2023년 이후 주요 벤치마크는 가정이 아닌 측정으로 정당화되는 설계 결정입니다: 탐색적 벤치마크 연령 비교에서 동일한 모델은 2021년식 TruthfulQA MC에서 2023년 이후 SimpleQA보다 에서 의 백분율 포인트 높게 점수를 매겼습니다(deepseek pp, 95% CI ; mistral ; zhipu ; 예: 89.2% 대 28.4%)—벤치마크 연령 및 노출 효과와 일치하는 격차이지만, 이 설계는 오염을 난이도 및 구성 차이와 분리할 수 없습니다. 어떤 주요 수치도 이전 벤치마크에 의존하지 않습니다. 로컬 계층의 750개 항목 TruthfulQA MC1 팔은 그렇게 표시된 경우에만 사용됩니다.
사전등록 대 탐색적.
사전등록되고 확인적: 위의 수집 및 패널 대 자신의 AUROC 비교(섹션 4). 탐색적이며 사용된 모든 곳에 그렇게 표시됨: 벤치마크 연령 비교 팔, 섹션 6의 최첨단 프로필 주입 단계 및 로컬 마이크로프로브. 섹션 5의 프로필 주입 계단은 별개의 동결된 위약 대조 프로토콜입니다(팔, 종료점 및 Holm 계열이 확인적 단계 이전에 고정됨).
결과 1: 자기 신뢰는 보정되지 않았으며 판별력이 약함
"보정(calibration)"이라는 용어가 종종 혼동하는 두 가지 성질을 구분합니다: 대규모 보정(신뢰도 수준이 정확도 수준과 일치하는가?)과 판별(신뢰도가 모델의 정답을 오답보다 높게 순위 매기는가?)입니다.
보정. 표명된 신뢰도는 포화되어 있으며 능력과 단절되어 있습니다: 9개 API 모델 전반에서 표명된 신뢰도는 7개 모델에서 85–95(모델별 중앙값)에 있는 반면 정확도는 16.5–66.5%입니다; 2개는 다릅니다—거부가 많은 모델(10.3% 정확도에서 중앙값 42)과 신뢰도가 분산된 모델 1개(중앙값 60). 모든 모델은 대규모에서 과신합니다: 신뢰도-정확도 격차(CITL, 표 1)는 에서 퍼센트 포인트까지입니다. ECE 열은 거의 CITL과 같습니다: 신뢰도-정확도 격차는 9개 모델 중 7개에서 모든 점유 구간에서 양수입니다(다른 2개의 경우 1개 제외), 따라서 구간별 및 전역 보정 오류가 일치합니다. 거부가 많은 모델도 pp(ECE 0.310)를 유지합니다—낮은 대역은 보정된 자기 인식이 아니라 거부 행동을 반영합니다. 판별력 이점의 일부는 역학적일 수 있습니다—낮은 표명 신뢰도에서 부정확한 것으로 등급이 매겨진 거부는 AUROC를 높입니다(거부 행을 제외하면 0.660, )—따라서 우리는 그 0.788을 보정 순위가 아니라 유도된 자기 인식의 상한으로 읽습니다. 9개 API 모델 전반에 걸쳐 풀링하면 신뢰도 80으로 표명된 답변 중 60.1%(9,310개 중 5,598개)이 틀렸습니다; 모델당 비율은 29.0–83.2%(매크로 평균 57.6%)입니다. 높은 표명 신뢰도를 신뢰하는 소비자는 대다수의 오류를 수용합니다. 판별. 모델 자체의 정확성을 예측하는 것으로서 자기 신뢰는 모델에 따라 AUROC 0.532–0.788을 달성합니다. 부트스트랩 95% CI(표 1)는 모든 모델에서 0.5을 제외하므로 신호는 문자 그대로 무작위가 아닙니다—하지만 9개 모델 중 6개는 0.62 아래에 있습니다. 결과는 운영상입니다: 20% 적용 범위(최고 신뢰도 다섯 분위에 해당하는 항목만 답변)에서 가장 강한 자기 AUROC 3개 모델의 오류율은 여전히 75.3%, 33.3%, 및 15.1%(표 2)입니다—세 번째의 경우만 의미 있는 감소이며 다른 2개의 경우 신뢰 게이트에서 멀리 떨어져 있습니다.
독립적인 모델의 동의를 세는 아키텍처 대안은 패널에서 AUROC 0.832 (95% CI )에 도달하는데, 이는 자체 평가가 0.545 ()일 때입니다. 항목 클러스터링 차이인 는 넓은 폭으로 영점을 제외합니다. 세 가지 사전 지정된 패널은 다음과 같습니다: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), 교차 진영 (Anthropic, DeepSeek, Mistral). 주요 비교는 CN 패널입니다. 다른 사전 지정된 패널에서 풀링된 비교는 역전되는 것으로 보입니다: 패널 인구 전체에서 풀링된 자체 평가 0.842 대 패널 0.697; . 분해에 따르면 이 명백한 역전은 항목당 자체 지식보다는 모델 간 정체성을 주로 반영합니다: 풀링된 0.842는 모델 내 자체-AUROC이 0.596–0.784인 세 모델을 혼합하며 (매크로 평균 0.709; 패널 인구 값—표 1은 전체 등급 집합을 보고합니다), 모델 내 순위 정규화 후 (모델 간 수준 차이를 제거하면서 각 모델 자신의 순위를 유지) 풀링된 값은 0.672로 떨어집니다—모델 간 정체성 기여도 입니다. 0.545 패널은 동일한 확인을 통과합니다 (0.545 풀링 대 0.582 순위 정규화): 그 자체 평가 실패는 진정으로 항목당입니다. 역전의 생존 부분은 더 좁은 진술입니다: 가장 강한 자체 신뢰 판별력을 가진 거부 집약적 모델 (전체 등급 집합에서 0.788)은 이 패널의 동의 신호를 능가합니다—그리고 어떤 모델인지 식별하는 것은 정확히 자체 보고가 대체하려던 독립적 측정이 필요합니다. 세 번째 사전 지정된 패널 (교차 진영)은 둘 사이에 위치합니다: 패널 0.722 대 자신의 0.659 , .
패널 신호의 레이블 없는 재코딩에 대한 민감도.
패널 신호 뒤의 표준 동등성 코딩은 기본 모델의 자체 정확성 레이블을 참조합니다 (두 답변이 모두 정확하다고 등급이 매겨지면 동의로 계산됨). 따라서 패널 동의는 대상 레이블의 결정론적 함수의 일부입니다—레이블 중개 의존성이지만 자체 투표 누수가 아닙니다: 구성상 모델의 자체 기록은 자체 패널 신호에 절대 포함되지 않습니다. 레이블 없는 재코딩 (문자열 동의만; 기본 모델 또는 패널 참여자의 정확성 플래그는 상담하지 않음)은 자체 평가가 0.545를 제공하는 패널에서 패널 AUROC을 0.832에서 0.775로 낮추고, 다른 패널에서는 0.697에서 0.628로 낮춥니다. 주요 패널 이점은 더 엄격한 코딩을 견디어냅니다 (0.775 대 0.545).
표 1은 모델당 그림을 제시합니다. 그림 1은 모든 16개 모델에서 동일한 분리를 보여줍니다: 모든 모델은 보정 대각선 위에 위치하고, 지역 계층은 9.2% 정확도에서 85–100 진술 신뢰도의 대역으로 붕괴합니다.
| 모델 | 정확도 (%) | 평균 신뢰도 | CITL (pp) | Brier | ECE | 자체-AUROC | 95% CI | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
확인 SimpleQA 컬렉션에 대한 모델별 보정(최전선 계층, 전체 등급 집합; 제공업체 이름은 제공업체당 수집된 한 가지 예산/중간 계층 모델을 표시합니다). CITL: 대규모 보정, 평균 명시된 신뢰도에서 정확도를 뺀 값(백분율 포인트). ECE: 10-bin 예상 보정 오차. Self-AUROC: 모델 자신의 항목별 정확성 예측변수로서의 명시된 신뢰도(동점 수정 Mann–Whitney), 부트스트랩 95% CI(행 수준 모델 내 리샘플링, 2,000회 추출, 고정 시드). 모든 값은 원시 등급 JSONL에서의 결정론적 재계산입니다. 모든 CI는 0.5를 제외합니다. CITL은 반올림되지 않은 평균을 사용합니다. 표시된 값은 소수점 첫 자리로 반올림됩니다. {#tab:vendor}
| 커버리지에서의 오류율 | |||||
|---|---|---|---|---|---|
| 2-6 모델 | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
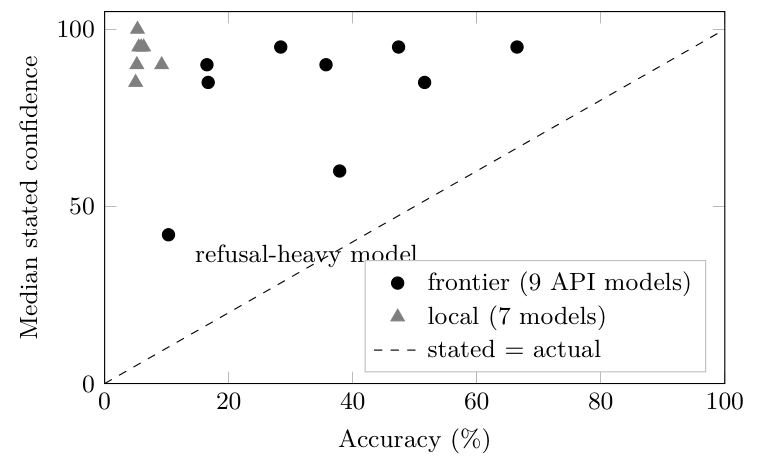 모든 16개 평가 모델에서 일관된 과신뢰: 모델별 중앙값 표시 신뢰도(평균은 표 1에 나타남) 대 동일한 1,500개 맹검 SimpleQA 항목에서 16개 모델 모두의 실제 정확도. 모든 모델이 보정 대각선 위에 있습니다. 거부가 많은 모델(중앙값 표시 신뢰도 42, 10.3% 정확도, CITL +31.0 pp)이 최고의 자가 AUROC 0.788을 가지지만 여전히 과신뢰합니다. 가장 작은 보정 간격은 분산된 신뢰도 모델(+11.1 pp)에 속합니다. 모델별 최전선 중앙값: 표 1의 행 순서로 95/85/95/60/90/95/85/90/42입니다. 일곱 모델 지역 계층은 정확도 5.0–9.2%, 중앙값 신뢰도 85–100 범위에 있습니다(구문 분석 실패 제외 후 지역 모델당 n 등급 98–1,498; 지역 계층은 조작 탐사 및 이 그림에 사용되며, 판별 주장에는 사용되지 않습니다).
결과 2: 측정된 프로필 주입으로부터 판별의 확인 가능한 개선 없음
자연스러운 수정은 모델에 자신의 측정된 역량 프로필—보류된 데이터에서의 도메인별 정확도—을 답변 시점에 제공하는 것입니다. 위약 대조 사다리 실험(팔: 프로필 없음, 전체 수준에 맞춘 위약 프로필, 자신의 측정된 프로필, 섞인 프로필)에서 자신의 프로필 팔은 확인 끝점에서 위약을 유의미하게 이기지 못했습니다: AUROC , 95% CI , 원본 , Holm-조정 ; 확인 끝점을 통과하지 못했습니다. 우리는 이를 명시적으로 좁은 범위의 귀무가설로 보고합니다: 하나의 확인 단계에서 판별은 측정된 프로필 주입으로 수정되지 않았습니다. 점 추정값은 양수이지만 사전 등록된 수정 아래에서 이 수정은 입증되지 않았습니다; 설계는 중간 크기의 효과에만 통계력이 있었습니다(CI로부터의 표준 오류 : AUROC 에 대해서만 80% 통계력, 관찰된 보다 큼—따라서 데이터는 참된 귀무가설과 작은 참 효과 모두와 양립합니다). 설계의 상한선이 제한 요소가 아닙니다. 각 항목의 자신의 빈 정확도—계산 방식은 한 개를 제외한 방식이므로 항목이 자신의 예측자에 기여하지 않음—를 그 항목의 정확성의 유일한 예측자로 취하면 확인 피험자에 대해 0.758의 오라클 AUROC을 산출합니다(네 개의 사다리 피험자 전반에 걸쳐 0.716–0.789). 빈별 정확도 분산 표준 편차 0.195, 21개 빈에 걸친 범위 0.15–1.00입니다. 따라서 빈들은 진정한 프로필이 상당한 정보를 전달할 만큼 충분히 다릅니다: 귀무가설은 주입 채널에 관한 것이지 신호를 등록할 수 없을 만큼 약한 배터리에 관한 것이 아닙니다.1 탐색적 패턴(기준선 보정이 가장 약한 곳에서의 더 큰 이득)은 가설 생성만 합니다.
사다리 설계 및 위약 검증.
네 개의 고정된 단계(피험자: Claude Haiku 4.5, Sonnet 5, Opus 4.8, Fable 5; 정확한 ID claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), 각각 동일한 프롬프트의 보정 슬롯을 차지하는 네 개의 맹검 팔: off (프로필 형태의 구조적 공백), placebo (보정 무관 프로필은 전체 수준에 맞춤; 각 단계별로 참 프로필에 대해 에서 검증됨—측정된 , , , ), core (모델의 자신의 측정된 도메인별 프로필), shuffled (빈-순열화 거짓 프로필; 실패한 조작 검사가 이를 확인 상태에서 탐색적으로 강등한 후). 315개 항목 배터리는 함정 항목과 명시적 기권 토큰이 있는 21개 도메인 빈을 포함합니다; 항목-팔 할당은 확인 단계 전에 고정되었으며, 항목별 무작위 팔 순서 및 피험자 가시 텍스트에 팔 이름이 없습니다. 사전 등록된 퇴화 한계(off 정확도 )는 4개 단계 중 3개를 모든 확인 계산에서 강등했습니다; 표 3는 적격 단계 1개를 보고합니다. 생존한 단계의 off-팔 정확도는 0.85 임계값에 대해 0.847인 반면 강등된 단계는 0.855, 0.888, 0.900에 있습니다—off-팔 답변만 AUROC은 0.575, 0.628, 0.500입니다(기술적으로, 거의 천장 정확도는 수정할 보정 신호를 거의 남기지 않습니다). 네 피험자 모두 단일 공급업체 계열에서 도출됩니다; 제한 사항을 참조하십시오.
| 팔 | 정확도 (모든 항목) | AUROC | Brier | ECE | 쌍대 AUROC (core팔) |
|---|---|---|---|---|---|
| off (프로필 없음) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| core (자신의 프로필) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| shuffled (거짓) | 0.842 | 0.589 | 0.140 | 0.113 | 계산되지 않음 (탐색적) |
프로필 주입 사다리, 확인 대상 단계 (대상: Claude Sonnet 5; : 294개 비함정 항목 2개 사전 등록된 신규 과정 반복—장치는 온도나 시드를 노출하지 않음; AUROC 응답 전용). 확인 대비 (항목 클러스터링 부트스트랩): coreplacebo AUROC , 95% CI , 원본 ; coreoff , CI , 원본 ; 둘 다 홀름 보정에 실패합니다 () 그리고 2원 항목배치 게이트 (항목과 수집 배치 모두에 의해 클러스터링하는 사전 등록된 견고성 요구사항). 쌍을 이룬- 열은 고정된 분석의 항목 클러스터링 쌍 대비를 core에 대해 반복합니다; 이는 팔당 AUROC 열의 산술 차이가 아니며, shuffled에 대해 확인 쌍 대비는 계산되지 않았습니다 (확인 단계 이전에 탐색적으로 강등됨). 우리는 우리 자신의 가설에 반하여 core가 보정에서 우월하지 않음을 지적합니다: 그 ECE (0.099)는 placebo의 (0.090)보다 나쁘며, 이는 확인 영가설을 영가설로 읽을 또 다른 이유입니다. {#tab:ladder}
결과 3: 자아 이미지 채널은 조작 가능합니다
평가 하네스가 자아 역량 프로필을 소비한다면, 그 슬롯은 입력 채널이며, 입력은 위조될 수 있습니다. 증거력이 감소하는 순서로 세 가지 주장을 구분하고 각 결과가 어떤 것을 지지하는지 명시합니다. (i) 인과적 조작 가능성—아래에서 입증: 거짓 프로필을 치환하면 명시된 신뢰도를 인과적으로 변화시키고 통제된 실행에서 보정을 저하시킵니다. (ii) 무결성 취약성—조건부: 공격자가 영향을 미칠 수 있는 출처에서 역량 프로필을 실제로 주입하는 하네스에만 문제가 됩니다. (iii) 배포된 평가 파이프라인의 실질적 공격 표면—본 논문이 동기를 부여하지만 검증하지 않는 가설입니다. 진정한 프로필을 섞인 (거짓) 프로필로 교체하면 탐험적 경계 단계의 자아 평가 AUROC이 우연 수준으로 떨어졌습니다: 진정한 프로필일 때 0.710 대비 0.474 (상한선 강등된 탐험적 단계; 항목 클러스터 부트스트랩: 0.710 [0.586, 0.820] 대비 0.474 [0.349, 0.599], 차이 [, ]). 대조적으로, 확증 적격 단계에서 섞인 것은 위약과 핵심 사이에 위치했습니다 (0.589 대비 0.578 및 0.625; 항목 클러스터 쌍대 대조, 탐험적: ). 해당 단계는 구성상 약한 조작 증거입니다: 거짓 프로필은 사전 등록된 점검을 두 번 통과하지 못했습니다 (외부 판사 0.99/0.94 대비 제한); 동결된 규칙은 확증 데이터가 존재하기 전에 팔을 강등했고, 피험자는 감지 가능하게 그럴듯하지 않은 프로필을 할인할 수 있으며, 소비 점검이 존재하지 않습니다. 독립적 발견: 경계 판사는 그럴듯성만으로 위조를 감지합니다. 무비용 지역 스탠드에서 단일 위조 주장 ("이 영역에서 95% 정확도")은 같은 항목에 대한 모델의 명시된 신뢰도를 50에서 95로 상향시켰습니다; 효과는 잃을 선언적 보정이 있는 모델에 집중됩니다; 이 탐사에서 가장 큰 변화 ( 포인트)는 가장 많이 잃을 수 있는 모델 (glm4:9b)에서 발생했습니다. 두 경계 조건은 효과를 제한합니다: 모델이 현재 항목을 프로필 빈과 연결할 수 있어야 합니다 (레이블이 없는 항목에서 작은 지역 모델은 프로필을 무시합니다; 델타 , 결과 2의 동결된 귀무가설과 일치), 그리고 상한선이 고정된 모델 (신뢰도 상관없이)은 공격할 것이 없습니다.
조작 증거—하나의 탐험적 경계 단계, 지역 마이크로탐사, 주제 레이블된 지역 통과—는 인과적 조작 가능성, 주장 (i)을 확립합니다. 표 4는 마이크로탐사를 보여줍니다: 같은 항목, 같은 모델, 그리고 주입된 자아 프로필에서의 한 줄 변경이 명시된 신뢰도를 최대 포인트까지 이동시킵니다.
탐험적 주제 레이블 통과: 경계의 양쪽, 실시간.
위의 첫 번째 경계 조건 (모델이 항목을 프로필 빈과 연결할 수 있어야 함)은 그 자체로 검증 가능합니다: 각 탐사에 주제를 레이블 지정하면—동결된 프로토콜에서의 공개 편차—연결 장애를 제거합니다. 전체 지역 통과에서 (5개 모델, 팔당 16개 보류 탐사, 온도 0, 고정 시드), 레이블이 없는 항목에서 비활성이었던 거짓 프로필은 항목이 레이블되면 5개 중 4개 모델에 의해 소비됩니다: Brier는 (glm4:9b), (llama3.2:3b, 정확도가 37.5%25.0%로 감소), (mistral:7b), 그리고 (phi4-mini)로 저하됩니다; 에서의 탐사별 부트스트랩 CI는 각 모델에 대해 0을 포함하므로, 마이크로탐사는 모델별 효과 크기보다는 방향과 메커니즘을 확립합니다;
다섯 번째(qwen3:8b)는 배터리를 천장에서 답합니다(100% 정확도, 양쪽 팔 모두에서 신뢰도 100, ), "공격할 것이 없는" 경계를 재현합니다. 메커니즘은 방향성이며 대칭적입니다: 거짓 높음 주장은 가장 약한 빈에서 신뢰도를 정확히 부풀립니다(llama3.2 물리학: 명시된 신뢰도 025% 보유 정확도인 빈에서 100; phi4-mini 논리 1365), 그리고 거짓 낮음 주장은 올바른 답변에서 신뢰도를 낮춥니다(llama3.2 역사 10075% 보유 정확도에서 0), 모델이 다른 방식으로 답하는 항목들에 대해 기권을 유도하기까지 합니다. 경계의 양쪽 모두 실행 결과로 표시됩니다: 레이블이 없는 항목, 프로필 불활성(고정된 널); 레이블이 있는 항목, 위조된 자아상이 명시된 신뢰도로 직접 전파되어 처음부터 끝까지 보정을 저하시킵니다.
| 모델 | 신뢰도 @ "0%" | 신뢰도 @ "95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
로컬 미세탐침(탐색적): 주입된 프로필 슬롯이 항목의 도메인에서 "0% 정확도" 대 "95% 정확도"를 주장할 때 동일한(잘못 답변한) 항목에 대한 명시된 신뢰도; 다섯 개의 로컬 오픈 가중치 모델, 온도 0. 천장-고정 모델(아래 행)은 공격할 선언적 보정이 없습니다. {#tab:microprobe}
평가 실무에 대한 함의
우리의 결과는 하나의 작업 계열(2023년 이후 개방형 사실 기반 QA)과 하나의 유도 형식으로 측정되었으며, 아래의 함의는 그러한 측정으로부터 추외삽합니다.
(1) 진술된 신뢰도의 역할을 역전시킵니다. 자기보고 신뢰도는 현재의 유도 하에서 평가의 입력이 아닌 측정된 목표여야 합니다. 뒷받침하는 수치: 높은 신뢰도의 최첨단 답변 중 60.1%가 틀렸으며, 최고의 자기 AUROC(0.788)는 정확도 리더보드가 마지막으로 순위를 매길 모델에 속합니다. 어느 순위도 자기보고가 판별하는지 예측하지 못합니다.
(2) 판단 파이프라인은 약한 판별력 있는 가중치를 상속합니다. 자기보고 확실성으로 투표를 가중치하는 LLM 판사 또는 앙상블 체계는 여기의 9개 모델 중 6개에 대해 AUROC가 0.62 이하인 신호를 가져옵니다. 포화된 85–95 밴드가 로그에서 안심할 만해 보이기 때문에 조용히 진행됩니다. 확실성 가중치가 사용된다면, 가중치는 보고 자체에서 나온 것이 아니라 측정된 모델별 보정에서 나와야 합니다.
(3) 프로필 슬롯을 인증합니다. 섹션 6의 3단계 위협 모델은 우려를 정렬합니다: 인과적 조작 가능성이 입증되었고, 무결성 취약성은 하네스가 실제로 영향을 받을 수 있는 출처에서 프로필을 주입하는 것에 조건부이며, 배포된 파이프라인의 실질적 공격 표면은 가설로 남아 있습니다. 조건부 클래스의 하네스의 경우, 복구 채널은 노출입니다: 보정을 수정하기로 되어 있던 동일한 주입된 프로필이 판별을 우연 수준(0.474)으로 밀어붙이고 항목이 연관될 수 있게 되면 브라이어 점수를 끝에서 끝까지 저하시키는 위조를 받아들입니다. 그러한 하네스는 무결성 게이트가 필요합니다. 서명된 프로필, 출처 확인 또는 최소한 프로필을 측정하는 사람과 추론 시간에 제공하는 사람을 분리합니다. 인증되지 않은 자기 이미지 슬롯은 보정 페이로드가 있는 열린 프롬프트 주입 포트입니다.
(4) 외부 측정은 자체 감사를 포함한 대안입니다. 독립 패널 합의는 자기평가가 최악인 경우를 지배합니다(AUROC ), 하지만 패널은 동료 논문(Chernets, 2026)에서 검토된 자신의 측정된 실패 체계를 가지고 있습니다. 그 감사 없이 패널 신호를 채택하는 것은 한 단계 위에서 같은 실수를 반복할 것입니다. 탐색적으로 사전 등록된 확장은 세 번째 각도를 추가합니다: 12개의 방향성 프로필 교환 쌍(3,780개 호출)에 걸쳐 다른 모델의 측정된 프로필을 대체하면 AUROC가 최대 만큼 변이했습니다. 때때로 도움이 되기도 했으며, 전이 손실의 유사성 순위 예측은 실패했습니다(스피어만 ): 측정된 프로필은 특권이 있는 자기 접근이 아닌 휴대용 악기입니다. 실용적인 자기평가 진단 배터리는 부록에 설명되어 있습니다.
제한 사항
헤드라인용 단일 벤치마크 패밀리(2023년 이후 개방형 사실 기반 QA); 각 공급자는 하나의 예산/중급 모델로 대표되므로 공급자 수준의 일반화는 주장하지 않습니다; 진술된 신뢰도 추출은 헤드라인 수치를 위한 하나의 프롬프트 형식입니다—다만 탐색적 2단계 팔(150개 항목 5개 로컬 모델)은 형식이 원인이 아님을 시사합니다: 상태 비저장 사후 신뢰도 쿼리는 진술된 신뢰도와 신뢰도 오류율은 낮추었지만 판별력은 낮추지 않았습니다(자체-AUROC 두 형식 모두 0.43–0.61; 풀링된 쌍별 부트스트랩 AUROC 쌍, 모델당 142–150행에 대한 결정적 비-LLM 라벨—문자열 전용 등급 매기기자의 표기된 편차, 그 아래에서 90%의 경우가 해결 불가능함); 주입 무효값은 하나의 사다리의 하나의 확인 단계(315개 항목, 21개 구간), 단일 공급자 패밀리의 모든 4명의 피험자, 더 나은 수리 설계를 배제하지 않습니다; 조작 증거는 하나의 탐색적 경계 단계, 로컬 미세탐침, 그리고 주제 표시된 로컬 통과(공개된 편차)를 결합합니다—확인적 공격 연구가 아닙니다; 등급 매기기는 부분적으로 LLM 기반이며 인간 검증은 50개 항목 표본 조사입니다(98% 일치, 하나의 보수적 오류). 등급 매기기자의 공급자 패밀리는 CN 패널 멤버 하나를 필드하므로 등급 매기기자 독립성 자체가 측정됩니다: 모든 패널 외 패밀리의 두 번째 등급 매기기자와 등급 매기기자 자신이 가장 어려운 5분위 합의 평결 342개를 모두 재평가했고 342/342에 동의했습니다. 등급 매기기자 자신이 로컬 등급 피험자입니다; 모든 1,441개 자체 평가 행의 교차 패밀리 재등급은 98.3%에 동의했고, 불일치는 자체 관대함 방향으로 실행되었습니다(24개 하향 뒤집기 대 1개 상향; 정확도 5.94.4%)—과신감 그림을 강화합니다; 더 완전한 계층화된 재감시는 향후 작업으로 남아 있습니다. 패널 대 자체 비교는 동반 제출과 데이터를 공유합니다; 테이블은 중복되지 않으며, 경계는 섹션 1–2에 명시되며, 이 논문의 범위는 자체 평가만 유지됩니다.
결론
현재 도출되는 자기 평가는 평가 신호가 통과해야 하는 세 가지 테스트에 실패합니다: 정확성을 너무 약하게 추적하여 의사 결정을 제어하지 못하면서도 심각하게 과신하고, 가장 직접적인 자기 지식 개입은 위약 통제 하에서 입증 가능한 개선을 생성하지 못했으며, 입력 채널은 판별을 우연 수준으로 푸시하는 위조품을 수용합니다. 모델이 측정된 증거를 바탕으로 보정을 달성할 때까지, 제시된 신뢰도는 소비할 신호가 아니라 연구할 현상입니다.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
실용 도구: 자기평가 진단
본 연구의 부산물로서, 우리는 간결한 자기평가 진단을 개발했습니다. 이는 연구의 영역 범주(수치, 논리, 물리, 역사, 코드, 확률 및 기타)에 걸친 짧은 결정론적 채점 가능 탐침의 고정된 배터리와, 명시적 기권 토큰을 가진 함정 항목들로 구성됩니다. 각 답변에는 0–100 신뢰도가 명시되어 있으며, 이 도구는 Brier 점수, 과신뢰 격차(평균 신뢰도 빼기 정확도), 신뢰도 판별력(정답에 대한 평균 신뢰도 빼기 오답에 대한 평균 신뢰도), 그리고 함정-기권 비율의 합성으로 채점하여, 그 결과를 잘 보정됨에서 자신감 있게 맹목적인 단계로 매핑합니다. 이는 본 논문의 핵심—보정은 모델의 자기보고에서 읽을 수 있는 것이 아니라 모델에 대해 측정해야 하는 것—을 구현하며, 재현 패키지와 함께 도구로서 발표됩니다. 결과가 아니라 도구로서, 이는 고정된 배터리가 아니라 의역된 탐침을 사용하며, 판별력 점수는 래더의 AUROC 끝점이 아니라 대리변수입니다.
재현 가능성 부록
본 논문의 모든 주요 수치는 공개된 원본 JSONL의 결정론적 함수이며, 어떤 단계도 무작위성, 네트워크 접근, GPU 계산 또는 모델 재쿼리를 포함하지 않습니다.
데이터 가용성.
동결된 사전등록 및 복제 패키지(공개 OSF 등록): https://osf.io/4y9dv. 오라클 상한 스크립트 oracle_auroc.py는 본 논문과 함께 https://doi.org/10.5281/zenodo.23197651에 저장되어 있습니다.
유도 프롬프트(원문).
시스템: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. 사용자 턴은 순수한 질문을 포함하며, 거부는 채점 스크립트의 동결된 거부 사전에 의해 답변 필드에서 감지합니다.
모델 식별자 및 실행 날짜.
제공자당 하나의 예산/중급 API 모델로, 2026-07-24에 라이브로 스모크 검증되었으며 2026년 7월 말에 수집됨(복제 패키지와 함께 공개된 실행 매니페스트의 호출별 타임스탬프): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (공개된 수집 편차: 첫 당사자 계정의 1,500개 항목 중 670개, 나머지는 추론이 비활성화된 동일한 첫 당사자 인프라에서 제공되는 애그리게이터 경로를 통해 served_by는 호출별로 기록됨, 첫 당사자만의 민감도 분할이 사전에 약속됨); zhipu glm-4.5; mistral mistral-small-latest. 로컬 계층(Ollama, 온도 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
동료 논문(Chernets, 2026)은 동일한 동결된 등록 및 원본 수집을 공유합니다. 복제 패키지에는 다음이 포함됩니다: 동결된 등록 텍스트 및 프로토콜, 정확한 모델 식별자가 있는 실행 매니페스트, 원본 등급이 매겨진 수집(최첨단 및 로컬 계층, 탐색 벤치마크 연령 비교 팔 포함), 그리고 세 가지 의존성이 없는 CPU 스크립트입니다. 첫 번째(compute_panel_vs_own_auroc.py)는 패널 동의 대 자체 신뢰도 AUROC 비교(섹션 4)의 정규 정의이며, 정규 값과 함께 모든 비정규 대안 해석(이진 패널 신호, 불확실성 코딩, 동점 처리, 풀링 변형)을 인쇄하여 해석의 선택을 감시할 수 있게 합니다. 두 번째(analysis_tae_week1.py)는 표 1, 그림 1 좌표, 섹션 3의 벤치마크 연령 간격을 다시 인쇄하며, 표 3에 보고된 동결된 사다리 값에 대한 사다리의 동결된 분석 파일의 읽기 전용 검사를 수행합니다. 세 번째(analysis_tae_decomposition.py)는 섹션 4의 풀링된 AUROC 분해 및 순위 정규화, 패널 신호의 라벨 없는 재코딩, 모델별 높은 신뢰도 오류율, 표 1의 CITL/Brier/ECE 열, 표 2의 위험 가용 범위 값, 그리고 섹션 5의 강등된 계단 기술 통계를 다시 인쇄합니다. 각 스크립트는 Python 표준 라이브러리만으로 노트북 CPU에서 몇 초 안에 실행됩니다. 프로필 주입 사다리는 자체 동결된 번들(프로토콜, 배터리, 팔별 채점된 행, 분석 JSON)로 제공되며, 패키지에서 가리킵니다.
동결된 항목별 팔 점수(
scored-arms-*.jsonl; 비함정, 상태ok; 확인 대상)에서oracle_auroc.py로 계산됨(본 논문과 함께 공개됨); 항목의 모든 팔과 복제는 함께 제외됩니다.↩︎
인용 방법
Chernets, V. (2026). 약하게 판별적이고, 프로필 주입으로 복구되지 않으며, 조작 가능함: LLM 평가의 자체 신뢰도 [학술 발표]. NeurIPS 2026 워크숍: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}